
搜索到
240
篇与
人工智能炼丹君
的结果
-
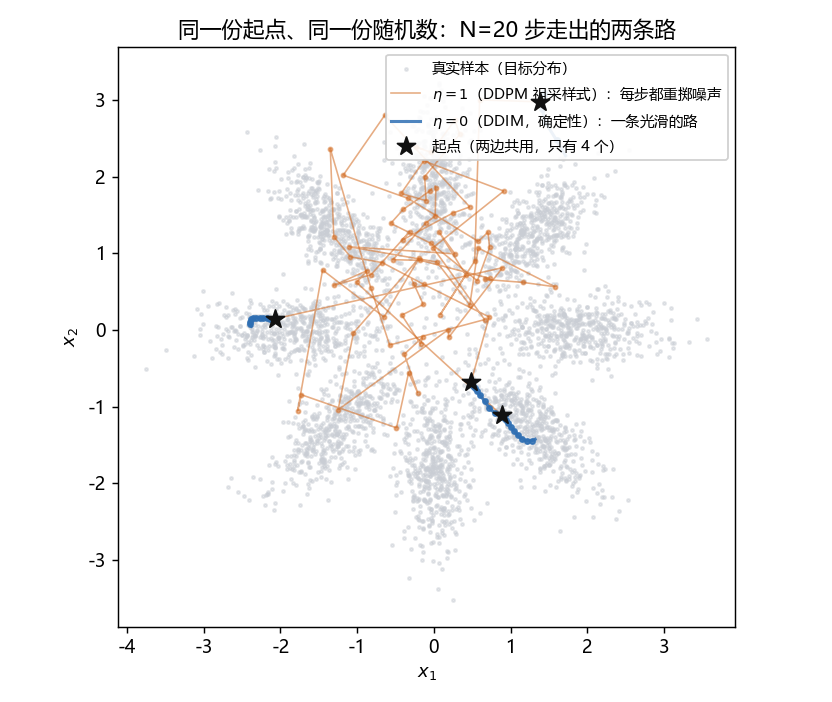
 AIGC 基本功|从 DDIM 到高阶采样器-DDIM AIGC 基本功|从 DDIM 到高阶采样器-DDIM 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、扩散过程的前向与反向推导(diffusion_math) 关键词:DDIM、DPM-Solver、确定性采样、二阶采样、步数、NFE 01. 为什么需要它 先给两个数字,都来自文末附录里能直接跑的脚本。 数字一:本例达到相同终点 RMS 阈值,扫描得到的评估预算相差 12.8 倍。 在二维八分量高斯混合上,score 有闭式解;配对相同初始噪声,比较同一有限区间概率流 ODE 的数值终点,并使用相同的末端 $\hat x_0$ 投影。这里的“精度”是到参考轨迹终点的距离,不能直接换算成图像质量、FID 或运行时间。 采样器 压到 1e-2 需要的模型评估次数 压到 1e-3 DDIM(时间步等间隔) 256 > 384 数据预测指数中点法(教学单步二阶) 63 255 DPM-Solver++ 2M(多步二阶) 40 128 3M(固定 v0.35.1 多步系数) 20 64 3M(二次插值指数积分对照) 20 48 DDIM 首次在扫描点 256 次评估达标,v0.35.1 系数版本在 20 次达标;比例为 12.8。扫描只检查指定预算,不证明整数 NFE 的全局最小值。中点法有限步每步两次评估、收尾一次,所以预算是 $2S-1$。少一次模型调用也不等于少同样比例的墙钟时间;真实网络还要计入算子、调度与引导的成本。 数字二:换采样器后,应重新核验缓存配置。 跨步复用特征依赖相邻去噪计算的冗余,但并非都通过输入位移阈值决定。DeepCache 的官方示例 使用更新间隔,TeaCache 则以时间嵌入相关变化估计模型输出差异。这里先固定同一模型、50 步网格与配对起点,分别跑 η=0/0.5/1,量最后十步“模型输入相对变化”: 采样器 最后 10 步输入相对变化 DDIM(η=0) 0.0197 η=0.5 0.0667 跳步 DDIM 家族祖采样(η=1) 0.1294 η=1 的最后十步平均输入位移代理是 η=0 的 6.6 倍。这提示换采样器后应重新校准缓存判据,但均值不能推出逐步命中率。例如十个变化量中九个为 0.01、一个为 1.21,均值是 0.13,2% 阈值仍会接受九步。实际复用间隔或变化判据也不等于此处的输入位移;本文没有实现特征缓存,没有测缓存命中率、缓存加速或画质退化。 所以这篇文章沿着“更新式 → 概率流 ODE → 指数积分 → 实际评估预算”来解释采样器。η=0 的 DDIM 对应一阶确定性格式,η>0 的同族更新带随机项;随机采样不能全部归为 ODE 积分。比较时要分别报告阶数、时间网格、终端处理和 NFE(number of function evaluations),再用适合任务的质量指标验收。 02. 最小可用理解 三句话讲完: DDIM 给出了可复用同一噪声预测模型的采样族。 它用非马尔可夫联合前向过程保持条件边缘 $q(x_t\mid x_0)$,对应回归项仍在同一加噪边缘上计算。改变联合过程并不等于所有 ELBO 权重都不变;实践复用的是 DDPM 常用的共享简化噪声目标。η 控制随机项,η=0 是确定性的特殊情形。参见 DDIM 第 3–4 节。 η=0 的更新可以放进概率流 ODE 的数值积分框架。 对精确 score、正确初始边缘和精确连续求解,SDE 与概率流 ODE 共享边缘分布;给定一个初值,ODE 轨迹确定。有限步误差、模型误差和起始先验误差仍会改变生成分布。下面用配对初值观察两类离散路径。 这张图要看的是:蓝色的 η=0 轨迹是一条平滑曲线,橙色 η=1 轨迹在同一份随机数下走成了折线——每一步都被注入的方向改变。"同一个采样器家族"的两种极端,轨迹的几何性质完全不同,缓存类加速盯的正是这个几何性质。 选择确定性 ODE 后,可以讨论积分阶数。 用 $\lambda=\log(\alpha/\sigma)$(半 log-SNR)分离可精确积分的线性部分,在光滑性、稳定性、启动及终端误差满足条件时,一、二、三阶的全局误差分别按最大步长的一、二、三次方收敛。指数积分提供了高效格式,但高阶方法能省多少评估,仍需测量。 03. 数学推导 3.1 把 DDIM 的一步拆开 DDPM 的 fixed-small 祖先采样先估干净图,再缩放,再加后验噪声。这里用 $a_t=1-\beta_t$ 表示离散单步信号方差系数,$\bar\alpha_t=\prod_{i=1}^{t}a_i$ 表示累积系数,$\tilde\beta_t$ 是给定 $x_0,x_t$ 的后验方差,$z\sim\mathcal N(0,I)$ 是独立标准高斯噪声;终步不加噪声。后文连续振幅 $\alpha(t)=\sqrt{\bar\alpha(t)}$ 与 $a_t$ 区分。 $$x_{t-1} = \frac{1}{\sqrt{a_t}}\Big(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\Big) + \sqrt{\tilde\beta_t}z$$ DDIM 论文式 (12) 换了一个组织方式。令 $\hat x_0$ 是这一时刻对干净图的估计、$\epsilon_\theta$ 是模型输出的噪声预测,两者由 $\hat x_0 = (x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta)/\sqrt{\bar\alpha_t}$ 相互确定,则一步写成三项: $$x_{t-1} = \underbrace{\sqrt{\bar\alpha_{t-1}}\hat x_0}_{\text{回数据的方向}} + \underbrace{\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}\epsilon_\theta}_{\text{沿当前噪声方向}} + \underbrace{\tilde\sigma_t z}_{\text{新掷的噪声}}$$ 这里第二项必须使用目标时刻的总噪声方差 $1-\bar\alpha_{t-1}$,新注入噪声为 $$\tilde\sigma_t = \eta\sqrt{\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}}\sqrt{1-\frac{\bar\alpha_t}{\bar\alpha_{t-1}}}$$ 每一项在干什么。 第一项是"这一时刻认为的干净图"乘上新时刻的 $\sqrt{\bar\alpha}$,也就是把估计值放到目标噪声水平上。第二项补偿两者的差额:前向过程是 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon$,要从 $x_t$ 走到 $x_{t-1}$,得把噪声幅度从 $\sqrt{1-\bar\alpha_t}$ 缩到 $\sqrt{1-\bar\alpha_{t-1}}$,这个缩放只能沿着"当前噪声方向"做——$\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}$ 正好是这两者的勾股差。第三项才是唯一带随机性的部分。 $\eta$ 是那个旋钮。 $\eta=0$ 时第三项消失,$\tilde\sigma_t=0$,迭代完全确定;$\eta=1$ 时 $\tilde\sigma_t$ 恰好等于 DDPM 的后验标准差,第二、三项合起来正好还原 DDPM 的加噪——在相同的完整时间表、fixed-small 方差、预测器及随机数下,$\eta=1$ 与该 DDPM 更新代数等价;跳步时应比较对应重排时间表的祖先采样,而不是原始 1000 步链。04 节会把这两条都量到浮点误差量级。 为什么可以有这个旋钮。 DDIM 从 $q_\eta(x_{t-1}\mid x_t,x_0)$ 与终点边缘构造非马尔可夫联合过程,保留每个条件边缘 $q(x_t\mid x_0)$。噪声回归仍使用这些边缘,所以同一简化目标训练出的模型能用于不同 η;不要把它说成任意联合过程的完整变分目标、最优解及训练权重都完全相同。η=0 的退化过程还应理解为确定性极限。 3.2 换成 ODE 视角 $\eta=0$ 时迭代没有随机项,它可以被看成一条 ODE 的离散格式。连续时间下,前向过程是 $dx = -\frac{1}{2}\beta(t)x\mathrm{d}t + \sqrt{\beta(t)}\mathrm{d}w$(第一项把 $x$ 往 0 拉,第二项持续注入白噪声),对应的概率流 ODE(与 SDE 共享所有边缘分布的那个确定性方程)是 $$\frac{dx}{dt} = -\frac{1}{2}\beta(t)\Big(x + \nabla_x\log p_t(x)\Big)$$ 这个 score 漂移不是“噪声均值”(布朗增量的均值为零)。设前向漂移 $f=-\beta(t)x/2$、扩散强度平方 $g^2=\beta(t)$,其 Fokker–Planck 方程为 $\partial_t p=-\nabla\cdot(fp)+g^2\Delta p/2$。利用 $\Delta p=\nabla\cdot(p\nabla\log p)$,可改写为 $\partial_t p=-\nabla\cdot[(f-g^2\nabla\log p/2)p]$,正是上述 ODE 的连续性方程。该等价要求足够正则的密度、精确 score 与匹配初始分布;网络近似和有限步求解不自动保留精确边缘。原始 SDE 论文第 4.3 节 给出了这一概率流解释。 对平方损失的最优噪声预测,score 满足 $\nabla_x\log p_t(x)=-\epsilon_*(x,t)/\sigma(t)$;训练网络 $\epsilon_\theta$ 只是其近似。这里 $\alpha(t)=\sqrt{\bar\alpha(t)}$、$\sigma(t)=\sqrt{1-\bar\alpha(t)}$,两者是振幅,且 $\alpha^2+\sigma^2=1$。换坐标令 $\lambda=\log(\alpha/\sigma)=\tfrac12\log[\bar\alpha/(1-\bar\alpha)]$,后文记 $\alpha_s,\sigma_s$ 为当前噪声水平的振幅,$\alpha_t,\sigma_t$ 为目标的振幅;从噪声到数据时 $h=\lambda_t-\lambda_s>0$。 “半”来自 $\mathrm{SNR}=\alpha^2/\sigma^2$,所以 $\lambda=\tfrac12\log\mathrm{SNR}$。本线性 1000 步调度在最吵端 $\bar\alpha_T\approx4.036\times10^{-5}$、$\lambda_T\approx-5.06$,最早训练噪声端 $\bar\alpha_1=0.9999$、$\lambda_1\approx4.61$。两个坐标跨度的数字受单位选择影响,不能用“10 对 1000”直接证明哪一段更难。真正有用的是 $\lambda$ 能让线性部分被解析处理,并显式显示噪声尺度变化。 沿概率流解令 $m(\lambda)=\hat x_0(x(\lambda),\lambda)$。由 $d\lambda/dt=-\beta(t)/(2\sigma^2)$ 和 score 关系,得到 $dx/d\lambda=-\alpha^2x+\alpha m$。又有 $d\log\sigma/d\lambda=-\alpha^2$,故乘积分因子后 $d(x/\sigma)/d\lambda=(\alpha/\sigma)m=e^\lambda m$。把它从 $\lambda_s$ 积到 $\lambda_t$,利用 $\sigma_t e^{\lambda_t}=\alpha_t$,便得到下面的精确积分式。这里的“精确”指该 ODE 的积分恒等式;数值方法还要近似沿未知轨迹的 $m$。参见 DPM-Solver 的指数积分推导 与 DPM-Solver++ 的数据预测形式。 $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\int_{0}^{h} e^{-(h-u)}\hat x_0(\lambda_s+u)du$$ 这个式子值得停一下:它说明整步的解由"$\hat x_0$ 沿着 $\lambda$ 的变化曲线"加权积分决定,权重是 $e^{-(h-u)}$——越靠近区间右端(越干净的那端)权重越大。验证一下:如果 $\hat x_0$ 是常数,积分给出 $\alpha_t(1-e^{-h})\hat x_0$,加上第一项正好是 $\alpha_t \hat x_0+\sigma_t \epsilon$,也就是"一步跳到位"的精确解。所以步法阶数的本质,就是用多少个点上的 $\hat x_0$ 去逼近这条曲线。 3.3 阶数从哪来:泰勒展开 把沿解轨迹的 $m(\lambda_s+u)$ 在 $u=0$ 展开;下式 $\hat x_0,\hat x_0',\hat x_0''$ 分别指当前 $m,m',m''$。导数是总导数,例如 $m'=\partial_\lambda\hat x_0+(\nabla_x\hat x_0)(dx/d\lambda)$,包含输入状态随轨迹变化,不能只对时间标签求偏导。泰勒展开需相应光滑性;逐项积分给出: $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\Big[J_0\hat x_0 + J_1\hat x_0' + J_2\hat x_0'' + \cdots\Big]$$ $$J_0 = 1-e^{-h},\qquad J_1 = e^{-h}-1+h,\qquad J_2 = \frac{h^2-2h+2-2e^{-h}}{2}$$ 小 $h$ 展开看数量级:$J_0\approx h$、$J_1\approx h^2/2$、$J_2\approx h^3/6$。所以导数项每高一阶,整步误差就多一个 $h$。 一阶格式:只留 $J_0$,把 $\hat x_0$ 当成整步不变。局部误差 $O(h^2)$,全局 $O(h)$。 二阶格式:再加 $J_1\hat x_0'$,系数 $\varphi_2 = J_1/h$,用一次评估估出 $\hat x_0'$ 就行。 三阶格式:再加 $J_2\hat x_0''$,系数 $\varphi_3 = J_2/h^2$。 多步法用历史模型输出估计这些总导数。当前点为 $\lambda_0$,两个历史点满足 $\lambda_2\lt\lambda_1\lt\lambda_0$,目标点为 $\lambda_t=\lambda_0+h$。令 $m_j=\hat x_0(x(\lambda_j),\lambda_j)$,$h_0=\lambda_0-\lambda_1$、$h_1=\lambda_1-\lambda_2$,归一化步长比 $r_0=h_0/h$、$r_1=h_1/h$。这样全部差商都有明确单位: $$D_{1,0}=(m_0-m_1)/r_0,\qquad D_{1,1}=(m_1-m_2)/r_1$$ $$D_1=D_{1,0}+\frac{r_0}{r_0+r_1}(D_{1,0}-D_{1,1}),\qquad D_2=\frac{D_{1,0}-D_{1,1}}{r_0+r_1}$$ 在步长同比缩小、$r_0,r_1$ 为正且有界的条件下,在当前点展开,$D_{1,0}=hm'-hh_0m''/2+O(h^3)$,$D_{1,1}=hm'-h(h_0+h_1/2)m''+O(h^3)$;两者相减为 $h(h_0+h_1)m''/2+O(h^3)$。代回可见 $D_1=hm'+O(h^3)$、$D_2=h^2m''/2+O(h^3)$。因此用三点二次插值并精确做上述指数积分时,导数项为 $(J_1/h)D_1+(2J_2/h^2)D_2$。这个 2 来自二次项的归一化,而非随意调参。 这里必须区分两种实现:本地 d2_scale=1.0 复刻固定 diffusers v0.35.1 的多步数据预测更新;d2_scale=2.0 是二次插值指数积分对照版本。05 节直接执行原始上游方法并做外部二次函数检验,报告这两个具体公式的差异,不据此断言整个框架、其他分支或所有名义三阶方法都相同。一般三阶 ODE 求解器也不必对这种强迫函数一步精确。 3.4 DDIM 就是一阶格式 把 03.1 的 DDIM 迭代($\eta=0$)和"只留 $J_0$"的一阶格式对照:$\eta=0$ 时第二项系数为 $\sqrt{1-\bar\alpha_{t-1}}$,第三项为 0,代入 $\hat x_0$ 的定义整理,得到 $$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t(1-e^{-h})\hat x_0(\lambda_s)$$ 与一阶格式逐项相同。所以"DDIM 是一阶方法"不是比喻,是恒等式——04 节用两套独立实现的代码把它验到约 $1.4\times10^{-14}$。 04. 代码实现 全部代码在文末附录,五个脚本:数值实验依赖 NumPy 2.x,配图另需 matplotlib:oracle_gmm.py(实验台与尺子)、ddim_family.py(η 家族)、dpm_solver_lab.py(λ 坐标与高阶格式)、spacing_lab.py(步数摆法)、make_figures.py(配图)。下面的数字是它们的真实输出。 4.1 先造一把可靠的尺子 要在二维上分离模型误差与数值误差,用八个各向异性高斯分量摆成环。权重 $w_k=1/8$、中心 $\mu_k$ 半径 1.8、局部径向/切向方差分别为 0.30/0.05(不是标准差)。加噪后中心变成 $\alpha\mu_k$、协方差变成 $\alpha^2\Sigma_k+\sigma^2I$;令 $\pi_k(x)$ 为观察到 $x$ 后的分量后验权重,则 score 为 $-\sum_k\pi_k(x)(\alpha^2\Sigma_k+\sigma^2I)^{-1}(x-\alpha\mu_k)$。附录按稳定 log-sum-exp 计算权重,并用有限差分验证。解析 score 消除了网络拟合误差,仍保留离散化、终端先验、收尾投影和浮点误差。 A. Oracle 自检:解析 score vs 有限差分 t= 1 abar=0.999900 max|解析 - 差分| = 1.57e-08 t= 200 abar=0.659039 max|解析 - 差分| = 4.99e-11 t= 1000 abar=0.000040 max|解析 - 差分| = 3.10e-11 B. 端点检查:t=T 时协方差与 I 的最大差 = 3.834e-05 C. 尺子的噪声地板:SW1 真vs真 ×8 = 0.03055 ± 0.00452 D. 天花板:真样本当生成样本送进去 SW1 = 0.000000 有限差分只是自检解析公式与代码的一致性。第二项量的是每个分量协方差与 $I$ 的差,不是整个混合分布到标准高斯的完整距离;分量均值仍约有 0.0114 的模长。第三项是当前 4000 样本、512 个固定投影方向下的真对真抽样基线;基线大小不等于方法比较的显著性阈值。第四项为同一经验样本对自身的恒等零值,不能证明分布距离估计无偏。 4.2 最小实现:DDIM 的一步 ddim_family.py 的核心就是下面这个函数,变量名与 3.1 节一一对应: def ddim_step(x, abar_cur, abar_tgt, eps, z, eta): """从 abar_cur 走到 abar_tgt(噪声变小)。返回 (x_tgt, x0_hat)。""" a_c, s_c = alpha_sigma(abar_cur) # 当前时刻的 alpha_t / sigma_t a_t, s_t = alpha_sigma(abar_tgt) # 目标时刻的 alpha_t / sigma_t x0 = (x - s_c * eps) / a_c # 第一项用的 x0_hat var = (1 - abar_tgt) / (1 - abar_cur) * (1 - abar_cur / abar_tgt) sig_tilde = eta * np.sqrt(max(var, 0.0)) # 第三项:新掷噪声的幅度 direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0)) # 第二项:勾股差 return a_t * x0 + direc * eps + sig_tilde * z, x0 最后一行就是 3.1 节那三项,一次加法写完,没有任何按时刻分支的特判。跑个小验证,看 $\tilde\sigma_t$ 在轨迹两端各占多少: _, ABAR = linear_schedule() ts, grid = uniform_t_grid(50) # 51 个 abar,grid[0] 最吵、grid[-1] = 1.0 x, zs = paired_noise(50, n=4, seed=4321) # 起点 + 每一步要用的随机数 print("x.shape =", x.shape, "| grid 长度 =", len(grid)) for i in (0, 25, 48): for eta in (0.0, 1.0): a_c, s_c = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) var = (1 - grid[i+1]) / (1 - grid[i]) * (1 - grid[i] / grid[i+1]) sig_tilde = eta * np.sqrt(var) print(f"step {i:2d} eta={eta:.1f} sigma_tilde = {sig_tilde:.6f}" f" (该步总噪声幅度 {s_t:.4f})") 真实输出: x.shape = (4, 2) | grid 长度 = 51 step 0 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 1.0000) step 0 eta=1.0 sigma_tilde = 0.574284 (该步总噪声幅度 1.0000) step 25 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 0.9509) step 25 eta=1.0 sigma_tilde = 0.419845 (该步总噪声幅度 0.9509) step 48 eta=0.0 sigma_tilde = 0.000000 (该步总噪声幅度 0.0760) step 48 eta=1.0 sigma_tilde = 0.063819 (该步总噪声幅度 0.0760) η=1 时,注入标准差占目标总噪声幅度的比例在示例起点约为 57%,第 48 步约为 84%。这描述三项分解中随机项的比例;它不能单独解释哪种采样器更好,因为漂移、方差、离散化和模型误差都会影响终点分布。 再看 η=1 的第 25 步:ddim_family.py D 节使用 4000 个配对起点、seed=1234,打印每项的 Euclidean RMS,即先求二维平方范数再对样本平均开根号: eta=1 第 25 步三项 RMS: 回数据 0.2119 | 沿噪声方向 1.1114 | 新掷噪声 0.5924 三个向量项的 RMS 描述该批样本的更新组成,既不能推出网络算力花在哪里,也不能单独证明加噪声有害。积分阶数衡量的是确定性更新对连续轨迹的逼近能力,分布质量要另测。 4.3 两次交叉验证 ddim_family.py 里故意写了两套互不相干的代码:一套照 DDPM Algorithm 2 的原式走 1000 步(一步不能跳),一套照 DDIM 式 (12) 走。喂同样的随机数: A. 终点逐元素最大差 = 3.203e-14 终点 RMS = 1.3520 3.2e-14 是本次浮点累加误差的量级。这验证同一完整时间表、fixed-small 方差、同一噪声预测、没有额外裁剪及配对随机数下的代数等价;不涵盖 learned variance、不同终步处理或任意跳步实现。 dpm_solver_lab.py 里同样对待 DDIM 与一阶指数积分器: A. max|DDIM(eta=0) - DPM-Solver-1| S= 20 uniform-t 1.399e-14 uniform-lambda 6.439e-15 S= 50 uniform-t 1.144e-14 uniform-lambda 1.110e-14 两套记号、两套时间网格,输出差在 1e-14。DDIM 是一阶指数积分器,这句到这里可以当结论用了。 4.4 量阶数:误差 vs NFE 4000 次评估的二次插值版本与 2000 次版本在 1000 个配对初值上相差 1.162×10⁻⁸;这是参考解的自检尺度,不是严格误差上界。独立 RK4 直接积分 $dx/d\lambda=\sigma^2(x+\mathrm{score})$,在 128 个另取初值上,2000 与 4000 步相差 1.71×10⁻¹²,4000 步 RK4 与指数积分参考的 RMS 差为 1.11×10⁻⁹;两者使用同一有限端点和最后的 $\hat x_0$ 投影。横轴逐方法由 Counter 实计,包含额外启动评估,不能把各方法 NFE 平均后共用。 这张图要看的是斜率:DDIM 的误差衰减阶约 1,二阶方法约 2,二次插值系数对照接近 3;误差更小的曲线位于图的下方。纵轴量同一 ODE 路径的终点误差,不量模型学到的分布是否正确。 拟合出来: 采样器 实测拟合斜率 p 备注 DDIM(时间步等间隔) 0.98 一阶格式,整数网格与收尾策略同时变化 DDIM(λ 等间隔) 1.01 一阶格式 数据预测指数中点法(单步) 1.91 连续中点,有限步两次、收尾一次 DPM-Solver++ 2M(多步) 2.01 每步一次评估 3M(v0.35.1 多步系数) 2.10 本实验区间呈二阶趋势 3M(二次插值指数积分版本) 2.89 本实验接近三阶趋势 拟合只取真实 NFE≥24、误差大于参考自检尺度三倍的点,中点法为六点、其他方法七点。有限区间斜率不是普适阶数证明;网格量化、启动和末端投影都会影响它。图和正文重用相同随机数消耗顺序与初值,05 节补充系数的独立验证。 4.5 步数与质量的实测表 路径 RMS 与分布距离回答不同问题。SW1 在 512 个固定单位方向投影后计算等样本数的一维经验 Wasserstein-1,再对方向平均;4000 个生成样本与固定的 4000 个参考真样本比较。下表为更换生成起点的五次均值±总体标准差(NumPy std(ddof=0)),不是置信区间;参考样本与投影方向没更换。中点法的真实 NFE 分别是 9、19、49,其余方法为列中预算。 方法 / 名义预算 10 20 50 DDIM(t) 0.1292±0.006 0.0741±0.004 0.0420±0.007 DDIM(λ) 0.2180±0.006 0.1122±0.004 0.0516±0.007 指数中点法 0.1910±0.007 0.0569±0.004 0.0335±0.006 2M 0.0731±0.006 0.0317±0.006 0.0328±0.005 3M 0.0680±0.006 0.0277±0.005 0.0327±0.005 二次插值对照 0.0428±0.005 0.0279±0.004 0.0327±0.005 这里 3M 使用固定 v0.35.1 系数;中点法真实 NFE 为预算减一。 真对真八次基线是 0.0301±0.0026。20 次预算下 DDIM 与多步方法的差距明显,而 2M 与两种 3M 的近邻差别远小于该批重复的波动。50 次下 2M/3M/中点法的估计接近基线;DDIM(λ) 的 0.0516 不能被笼统说成与 0.033 完全一样。更多样本、投影和独立重复能提高分辨能力。RMS 可揭示路径误差,但两条不同耦合路径也可能产生相同边缘分布,所以它不能替代分布质量指标。 4.6 η 到底该调多大 ddim_family.py 在 oracle 下扫一遍 η,再在欠拟合模型下扫一遍。所谓欠拟合是让模型以为数据是单个高斯(用真均值真协方差拟合),它在高噪声区几乎是对的、在低噪声区错得离谱——这是人为选择的一种误差结构,并不代表所有真实网络(也正好对应"训练时看到的是加噪数据分布"这件事)。 图中固定种子下多数格子 η=0 的 SW1 较低,但并不单调或全部最优。oracle 的 N=20 时 η=0.25 得 0.0719,低于 η=0 的 0.0746;单高斯近似在 N=20 也有 0.2124 对 0.2152,在 N=100 时 η=0.75 得 0.1828,低于 η=0 的 0.1845。这些小差别没有独立多种子置信区间,不能据此排名。这个例子能反驳“少步必然应调大 η”,也不能建立“确定性采样必胜”的新定律。 4.7 输入位移能提示什么缓存风险 图量的是 $r_i=\sqrt{\mathbb E\|x_{i+1}-x_i\|^2}/\sqrt{\mathbb E\|x_i\|^2}$ 的逐步值,以及最后十步的均值;它不是逐样本相对误差的平均,也不是特征变化。有限网格最后一步直接投影,不能由图说步长趋于零。最后十步输入代理均值相差 6.6 倍;$\hat x_0$ 位移的平均绝对 RMS 为 0.0371 对 0.2407,约 6.5 倍,单位与数据相同。缓存判据若使用相应代理,应检查整条序列的分布与失败步,真实特征缓存则需另测。 4.8 评估预算 图中柱子为已扫描预算中首次达到指定路径 RMS 阈值的真实 NFE。solve_dpm2s 这个历史函数名保留,但它实现的是数据预测指数中点教学方法,不能写成对原始噪声预测 DPM-Solver-2 的逐项复现。有限步两次评估,$\sigma=0$ 的投影一步一次,故 $S$ 步实际为 $2S-1$ 次。未达标表示扫描到最大预算仍未达到,不是完整最优预算搜索。 4.9 步数该摆在哪:收尾步不是免费的 阶数回答的是"步数变多时误差掉多快",没回答"步数摆在哪"。spacing_lab.py 固定 NFE=20、只改摆法,终点误差如下: 摆法 DDIM(一阶) 2M(二阶) 在 $t$ 上等间隔(本文的时间网格) 1.107e-01 5.285e-02 在 $\lambda$ 上等间隔 1.713e-01 2.897e-02 在 $\lambda$ 上等间隔、落回整数 $t$ 1.712e-01 2.894e-02 Karras / EDM($\rho=7$) 1.873e-01 7.038e-02 Karras($\rho=3$) 2.655e-01 3.397e-01 本例的阶数、网格和收尾点要一起看。 固定 NFE=20,一阶方法在所测 $t$ 网格中的路径误差最低,2M 在所测 λ 网格中最低。Karras 网格这里也使用完全相同的 VP 振幅比 $\sigma/\alpha$ 端点约 158→0.01,并没有直接照搬 EDM 的 80→0.002;差别是内点密度。ρ=7 的最大有限 λ 间隔 1.019,ρ=3 为 2.455,λ 均匀网格为 0.509。ρ=7 也并非表里最差(ρ=3 更差);它在此误差指标上表现较差,不能解释成 EDM 的通用失败或只归因于单段步长。EDM 还包含预条件、Heun 更新、噪声注入等设计,本例只比较网格。EDM 原文。 uniform-t 为什么赢,值得追问一层。 它把 $\lambda$ 的上界截在了 +1.76(NFE=20 时),剩下的干净端交给最后那一步"直接输出 $\hat x_0$"。这条捷径是不是免费的?不是。沿高精度参考轨迹量"在 $\lambda$ 处直接输出 $\hat x_0$ 会偏多少": $\lambda$ −0.23 +0.74 +1.71 +2.67 +3.64 提前收尾的偏差 5.234e-01 1.400e-01 4.398e-02 9.416e-03 1.280e-03 截得越早白送的偏差越大,而且这份偏差不随步数下降——它只取决于截在哪个 $\lambda$。在本例的候选截断点中,可观察到较低的总误差(2M,NFE=20,只改截断点): $\lambda_{max}$ 1.0 2.0 2.5 3.0 4.61(走到底) 终点误差 9.82e-02 2.80e-02 1.71e-02 1.81e-02 2.90e-02 这五个候选呈 U 形,最低点在 2.5,比"走到底"低约 1.7 倍;未证明连续截断范围的全局最优。这条也解释了 uniform-t 的行为为什么还不错:它的截断点随步数自动往右挪(NFE=20 时 1.76、50 时 2.55、100 时 3.1),等于一个廉价的自适应策略——但它是巧合,不是设计。 局部难度代理也有边界。 把一阶缺失项写成 $\delta_i\approx\alpha_{t_i}h^2m'/2$,可观察 $\alpha\|m'\|$ 的变化。本例在 λ<0 与 λ≥0 区间的平均分别约 0.1024、0.1000,峰值约 0.4417,出现在 λ≈−0.19 的中间段;两个区间均值接近不等于全区间难度均匀。该代理没有包含误差传播矩阵、末端投影或实际模型扰动,不能单独算出最优步数排布。 05. 工业级实现对照 本节固定在 diffusers v0.35.1 的 DPMSolverMultistepScheduler,也回查 v0.30.0 多步源文件。结论限定到所读版本与分支;不能把浮动 main 链接当版本证据。 第一处:训练输出、积分参数化与随机过程是三个开关。 prediction_type 指网络输出的 ε / sample / v 等,convert_model_output 再转换成更新需要的数据或噪声预测;algorithm_type="dpmsolver++" 用数据预测积分,dpmsolver 用噪声预测。sde-dpmsolver 与 sde-dpmsolver++ 还改变漂移和随机项,不能说只是往同一条 ODE 原封不动加回噪声。某些新分支处理 flow sigmas,本例不覆盖它们。数据预测能改善某些引导问题,不能由参数化名称推断所有预测曲线都更光滑。 第二处:启动与终端需要单独处理。 历史不足时调度器按 lower_order_nums 降阶;lower_order_final 在低步数等条件下控制最后几步降阶,final_sigmas_type="zero" 让最后目标 σ=0。我们的循环明确在最后一步输出当前 $\hat x_0$;这是收尾近似,并非把高阶项带到 $h=\infty$ 就能无误差地处理整个剩余区间。以固定系数版本测试 warm2s=True,额外一次启动评估后拟合斜率为 2.13,默认为 2.10;影响不大,不能证明启动误差在其他配置中永远无关。 第三处:网格不是坐标变换本身。 源码提供 leading、trailing、默认 linspace 和其他 sigma 排布选项。本文 uniform_t_grid 先取 T→0 的整数节点,而 uniform_lambda_grid 保留 S 个有限模型评估点再附加完全干净目标,两者末端的有限评估位置不同。不能称为“只换内点、其他都一样”的比较。NFE=192 时,DDIM(t) RMS 为 1.245e−02,DDIM(λ) 为 1.775e−02;在扫描预算中分别于 256 和 384 次达到 1e−2。λ 坐标方便指数积分,并不自动证明 λ 均匀网格对所有方法最佳。离散训练时间标签是否可插值也要按网络核对,本文 oracle 接受任意累积系数。 第四处:把三阶系数差异验证到具体公式。 03.3 的 $D_2$ 表示 $h^2m''/2$;二次插值指数积分的末项需要 $2J_2D_2/h^2$。固定 v0.35.1 多步 dpmsolver++ 分支的代码则使用: D2 = (D1_0 - D1_1) / (r0 + r1) x_t = ((sigma_t / sigma_s0) * sample - alpha_t * (exp(-h) - 1) * D0 + alpha_t * ((exp(-h) - 1) / h + 1) * D1 - alpha_t * ((exp(-h) - 1 + h) / h**2 - 0.5) * D2) 上式与附录都采用括号组织赋值。最后一个系数正好为 $J_2/h^2$。另一方面,同版本单步源码 的三阶 heun 数据预测分支写的是 D2 = 2.0 * (D1_1 - D1_0) / (r0 - r1);它的节点及差商方向不同,所以不能只看一个 2 就断定两种算法完全等价。 本轮提取原始文件中的一、二、三阶方法及 _sigma_to_alpha_sigma_t,保持函数 AST 不变,以 PyTorch CPU float64 真执行。均匀和非均匀有限步、12 组噪声/步长组合的上游更新与本地 d2_scale=1.0 对照,最大差 1.24×10⁻¹⁴。调用不走弃用位置参数,使用 algorithm_type="dpmsolver++"、use_flow_sigmas=False;二阶设 midpoint。这验证实际更新分支,不是完整 diffusers 包、生产 scheduler 的所有配置或 GPU 图像生成复现。 再用外部指定的二次函数 $m(\lambda)=A+B\lambda+C\lambda^2/2$,切断模型输出对状态的依赖。指数积分的原函数为 $e^\lambda[A+B(\lambda-1)+C(\lambda^2-2\lambda+2)/2]$,所以不需要高分辨率梯形积分当“真值”。在 λ=0.3 起步、h 从 0.4 缩到 0.025,真实最大绝对误差为: 一阶: 4.17e-02 1.04e-02 2.57e-03 6.39e-04 1.59e-04 二阶midpoint: 8.16e-03 1.05e-03 1.32e-04 1.65e-05 2.07e-06 v0.35.1多步系数: 1.96e-03 2.46e-04 3.06e-05 3.81e-06 4.75e-07 二次插值版本: 6.66e-16 7.77e-16 7.77e-16 4.44e-16 6.11e-16 这里一阶局部误差按 h²、midpoint 按 h³,固定多步系数在该受控函数上也留下 h³ 项;二次插值版本到浮点量级。非均匀历史点同样核对。对二次插值做精确指数积分应具备这一精确性,一般名义三阶 ODE 方法却不必如此。结论是这两个具体指数更新在该归一化下不同,以及本地 GMM 的拟合趋势为 2.10 与 2.89;不把自行修改的系数称为经过真实图像验证的生产补丁,也不推断上游作者意图。 06. 代价与边界 省了什么。 η=0 省掉每步随机噪声生成,固定初始状态时更新确定;本例轨迹位移较平滑,提供了校准缓存判据的动机。主要大幅减少神经网络调用的机制是重新选择过程、网格与更新格式,而不是高维采样中噪声生成本身必然很贵。本例路径误差的预算表不能直接当成生产提速或图像质量证明。 赔了什么。 少了路径噪声这个自由度。 更换初始噪声仍可产生多样性;确定性不等于没有分布覆盖。精确 score 和正确初始分布下,概率流 ODE 本来就能匹配对应 SDE 的边缘,所以不能说它先天必然过平滑。真实模型中的误差与有限步积分可能让随机/确定性方法各有优势,需在同一质量和成本口径下比较。 高阶方法需要历史、稳定性和启动精度。 多步法低预算时历史不够,差商在极短或重复时间点还会失稳。显式高阶不自动比低阶稳;强 CFG、阈值化或不光滑网络输出可能放大局部误差。midpoint / heun 是所读多步实现的二阶选项,不能与作者其他 API 的 solver 选项混用。默认低步数降阶是一种实际稳定化处理,不是自动的最优方案。 理论阶数包含正则性条件。 本例 oracle 是平滑解析函数,仍要考虑网格、启动和末端投影。对真实网络,不应先断言阶数一定打折;应固定连续区间与端点,测多个渐近预算,并检查是否被模型误差或离散标签量化限制。高阶曲线偏离理论时,先分开这些来源。 最后一次投影有代价。 $\sigma=0$ 是 λ=∞,有限训练端点直接输出 $\hat x_0$ 的偏差与求解器阶数不同。4.9 的截断点扫描展示二者的权衡;固定收尾噪声会限制误差继续下降,不能把更多步数误当成能修复所有误差。 什么时候保留随机过程。 如果任务定义本身要求随机转移、训练/蒸馏的路径分布或噪声注入,应先保证过程匹配。若目的是提高真实图像的覆盖与质量,则同时实测 ODE/SDE、η、引导强度和预算,而非套用此二维例子。本文的单高斯近似只代表一种人为误差结构。 什么时候值得上高阶。 本例约 20 次预算时多步方法已显著降低路径误差;预算极低时二次插值版本也可能不稳定(NFE=6 时误差约 0.8445,而 2M 约 0.1460)。这是高阶并非总优的具体反例。预算几百次时高阶仍可能更省达到同一路径阈值的评估次数,不能改口断言一阶必然更好;生产选择还要测单步成本、质量和可靠性。 07. 经典论文脉络 Denoising Diffusion Implicit Models(2020,DDIM):重构非马尔可夫联合前向过程、保持条件边缘,复用简化噪声预测目标,并给出包括确定性极限的采样族。它的反向生成链仍按条件转移逐步执行,不应被称为“非马尔可夫反向”。 Score-Based Generative Modeling through Stochastic Differential Equations(2020):统一 score 与反向 SDE,并给出共享边缘的概率流 ODE,是解释随机过程与确定性流关系的基础。 DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps(2022):解析处理线性部分,并在半 log-SNR 坐标构造指数积分高阶格式。标题中的 Around 10 Steps 是论文所测任务的结果,不是每个模型的预算保证。 DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models(2022):用数据预测及多步变体改善引导采样中的数值稳定性,算法、阈值化和适用空间要分别核对。 Elucidating the Design Space of Diffusion-Based Generative Models(2022,EDM):把噪声调度、求解器、预条件等设计拆开比较,提供 Heun 与噪声水平排布等方案。把其网格搬到 VP oracle 上并不等于复现整套 EDM。 Consistency Models 与 Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference(2023):学习沿概率流轨迹的一致映射,支持一/少步生成;多步推理仍可带重新加噪与调度,不能简单说“从此不需要采样器”。 这条脉络区分过程、数值更新和学习映射:它们可以组合,但对训练目标、初始分布与成本的要求不同。 08. 常见误解 误解一:DDIM 只是把 DDPM 步幅放大。 非马尔可夫前向族与可选随机项给出了额外自由度;η=0 也能走 1000 步,仍然是确定性更新。η=1 只有在完整时间表、fixed-small 方差、相同预测与终步处理时才有前文的 DDPM 等价关系。 误解二:少步必调大 η,或 η=0 必胜。 两个绝对判断都不成立。本例 N=10 的 η=0 比 η=1 的 SW1 低,但 N=20 的 η=0.25 又略低于 η=0;这些单次小差别不能外推。随机标准差占比或平均轨迹位移也不能单独推导质量排序。 误解三:名义阶数越高,任何预算都更省。 NFE=6 的二次插值版本比 2M 更差,启动和稳定性不可省。名义三阶与本文 2.10 的拟合斜率也不矛盾:应检查具体系数、网格、终端及渐近区,而非只读选项名字。03.3 的差商推导与 05 的原始方法实跑给出了可查的局部证据。 误解四:SW1 贴近真对真基线就失效了。 同一分布的两个经验样本仍有非零距离,它是有限样本效应;近邻差别需要更高分辨率的实验。对自身为零不证明估计无偏。配对路径 RMS 可以暴露求解误差,却不能给不同随机耦合的边缘分布作通用质量排名。 误解五:半 log-SNR 坐标、λ 均匀网格、Karras 网格是一件事。 第一项是推导坐标,后两项是评估点排布。本文同端点 Karras 只改内点密度,而 $t$ 网格还改变最后有限评估点;比较要写全这些条件。 误解六:平均输入变化大于阈值,缓存就零命中。 平均数不约束每一步,输入变化又不等于中间特征或残差变化。要证明缓存收益,必须真的实现缓存并量命中率、误差、速度和验收质量,本篇只提供输入位移代理。 09. 动手验证 在 Python 3.11、NumPy 2.4.6、matplotlib 3.10.7 的 Windows CPU 环境下,五个完整脚本全部 exit 0、stderr 为空。图示依赖 matplotlib;数值脚本依赖 NumPy 2.x。NumPy 的随机种子固定,主要实验种子 20260927,η 对照使用 paired_noise 的 1234,投影方向 7。实跑证据另用 PyTorch 2.10.0+cpu 核验原始更新方法;没有 GPU、训练权重或图像质量测试。安装依赖后按以下顺序运行;输出时间随 CPU 与线程设置变化。 cd outputs/fundamentals_files/ddim_samplers/code python oracle_gmm.py # ① 标定尺子(先量地板) python ddim_family.py # ② η 旋钮与缓存抖动 python dpm_solver_lab.py # ③ 阶数、预算、三阶项的受控检验 python spacing_lab.py # ④ 步数摆法与收尾点 python make_figures.py # ⑤ 画图 四个具体的改动实验: 改 ddim_family.py η 扫描点,先看固定种子表,再更换多组种子。本例最后十步输入代理均值为 0.0197、0.0667、0.1294(η=0/0.5/1);记录逐步曲线,不用均值替代缓存命中率。 比较 dpm_solver_lab.py 已列出的 d2_scale=1.0 和 2.0 两种版本。真实 NFE 拟合为 2.10 与 2.89;二次强迫函数最后一个 h 的误差为 4.75e−07 与 6.11e−16。保留上游系数对照,别把教学版本直接当生产补丁。 比较 uniform_t_grid 与 uniform_lambda_grid:DDIM 拟合约 0.98/1.01,扫描到 1e−2 的 NFE 为 256/384。打印最后一个有限 λ,就会看到这不是只有内点密度不同的实验。量化网格可能因重复整数节点而缩短,预算必须读 Counter。 在 spacing_lab.py 里比较 NFE=20、λ 上界 4.61 与 2.5。2M 路径 RMS 为 2.90e−02 与 1.71e−02;沿同一参考路径的提前投影误差也要一起记录。这展示固定预算内截断与积分误差的权衡,不保证 λ=2.5 对其他数据最优。 10. 延伸阅读 DDPM 的训练目标与采样流程:本篇必要先修,定义噪声回归、后验方差与累计调度。 扩散过程的前向与反向推导:补读 SDE/ODE 与参数化;即使只学过 DDPM,03.2 已补充读懂本文所需的连续性方程背景。 变分下界与重参数化:理解条件边缘、联合分布与训练权重的区分。 分类器无关引导:引导改变向量场与数值稳定性,要和求解预算一起测。 流匹配与 Rectified Flow:学习速度场的另一条路径,勿把所有流直接套成 VP 噪声调度。 附录:完整代码 09 节用到的脚本全文如下(oracle_gmm.py、ddim_family.py、dpm_solver_lab.py、spacing_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 oracle_gmm.py # -*- coding: utf-8 -*- """采样器实验的地基:一个 score 有闭式解的二维高斯混合 + 一把「尺子」。 为什么必须先把这两件事钉死: 1. 比较采样器时,最大的干扰项是**模型误差**。同一个噪声网络,在 t=1 和 t=1000 上的误差可以差两个数量级,你根本分不清「这个采样器好」和「这个时间步好学」。 用闭式 score(oracle),模型误差恒为 0,仍有终端先验偏差、收尾投影、离散化和浮点误差。 2. 比较采样器时,第二大的干扰项是**尺子本身的噪声**。切片 Wasserstein 距离 是用有限样本估的,两个「都对」的分布之间也能量出一个正数。这个正数就是 抽样基线;近邻差别需增加样本和重复,而非一律判成运气。 所以这个脚本干三件事:给出 oracle、给出尺子、量出地板。后面三个脚本全部 import 它,保证四处用到的目标分布、指标、随机数是同一套。 python oracle_gmm.py 依赖:numpy, matplotlib(画图时才需要) """ import numpy as np T = 1000 # 训练时的扩散步数 D = 2 # 数据维度(二维才画得出轨迹,也才跑得起闭式 score) N_EVAL = 4000 # 评价用的样本数 N_DIRS = 512 # 切片 Wasserstein 的投影方向数 # ══════════════════════════════════════════════════════════════════ # 1. 噪声调度 # ══════════════════════════════════════════════════════════════════ def linear_schedule(T: int = T, b0: float = 1e-4, b1: float = 0.02): """DDPM / diffusers 默认的线性 beta 调度。 返回 abar 的长度是 T+1:abar[t] = prod_{s<=t} (1 - beta_s), abar[0] = 1 表示「完全干净」。这样下标和论文里的 t 直接对齐, 不用在 0-based / 1-based 之间来回换算。 """ betas = np.linspace(b0, b1, T) abar = np.concatenate([[1.0], np.cumprod(1.0 - betas)]) return betas, abar def alpha_sigma(abar_t: float): """给定 abar_t,返回 (alpha_t, sigma_t) = (sqrt(abar), sqrt(1-abar))。 这是全文唯一的「坐标」:x_t = alpha_t * x_0 + sigma_t * eps。 注意 alpha 是**信号尺度**,不是 DDPM 论文里的 alpha_t = 1 - beta_t。 """ return np.sqrt(abar_t), np.sqrt(1.0 - abar_t) # ══════════════════════════════════════════════════════════════════ # 2. 目标分布:8 个切向拉长的高斯,摆成一个环 # ══════════════════════════════════════════════════════════════════ def make_target(K: int = 8, radius: float = 1.8, radial_var: float = 0.30, tangential_var: float = 0.05): """K 个分量均匀摆在一个半径 radius 的环上,每个分量沿径向拉长。 为什么不用各向同性:各向同性的高斯混合,加噪之后很快变成一个圆球, 各向同性混合的score仍可非线性;这里选各向异性来构造具体实验。 径向拉长之后,环上的 score 场有明显曲率,离散化误差才显出来。 """ ang = np.linspace(0.0, 2.0 * np.pi, K, endpoint=False) mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1) Sig = np.zeros((K, D, D)) for k, a in enumerate(ang): R = np.array([[np.cos(a), -np.sin(a)], [np.sin(a), np.cos(a)]]) Sig[k] = R @ np.diag([radial_var, tangential_var]) @ R.T w = np.ones(K) / K return w, mu, Sig def sample_true(n: int, w, mu, Sig, rng): """从目标分布抽样。""" k = rng.choice(len(w), size=n, p=w) L = np.linalg.cholesky(Sig[k]) # (n, D, D) z = rng.standard_normal((n, D)) return mu[k] + np.einsum("nij,nj->ni", L, z) # ══════════════════════════════════════════════════════════════════ # 3. Oracle:加噪后分布的闭式 score,以及最优的 eps 预测 # ══════════════════════════════════════════════════════════════════ def _cov_at(abar_t: float, Sig): """q(x_t) 的第 k 个分量协方差:C_k = abar * Sig_k + (1 - abar) * I。""" return abar_t * Sig + (1.0 - abar_t) * np.eye(D) def logp_and_score(x, abar_t: float, w, mu, Sig): """返回 (log q_t(x), score_t(x)),x 形状 (n, D)。 q_t 是 K 个高斯的混合:第 k 个分量的均值是 sqrt(abar) * mu_k, 协方差是 abar * Sig_k + (1 - abar) * I。score 是这个混合分布的 对数梯度 = 各分量 score 的后验加权平均。 """ C = _cov_at(abar_t, Sig) # (K, D, D) inv = np.linalg.inv(C) ld = np.log(np.linalg.det(C)) r = x[:, None, :] - np.sqrt(abar_t) * mu[None] # (n, K, D) quad = np.einsum("nki,kij,nkj->nk", r, inv, r) lg = np.log(w)[None, :] - 0.5 * quad - 0.5 * ld[None, :] m = lg.max(axis=1, keepdims=True) p = np.exp(lg - m) Z = p.sum(axis=1, keepdims=True) logp = (m[:, 0] + np.log(Z[:, 0])) pi = p / Z # 后验分量权重 comp = -np.einsum("kij,nkj->nki", inv, r) # 每个分量的 score score = np.einsum("nk,nki->ni", pi, comp) return logp, score def eps_star(x, abar_t: float, w, mu, Sig): """MMSE 意义下最优的 eps 预测:eps* = -sigma_t * score_t(x)。 因为 x_t = alpha x_0 + sigma * eps,对 x_t 求 log 梯度会得到 grad log q_t = -E[eps | x_t] / sigma,所以最优的噪声预测就是 score 乘一个 -sigma。后面所有采样器都拿它当「模型」。 """ _, s = logp_and_score(x, abar_t, w, mu, Sig) return -np.sqrt(1.0 - abar_t) * s def x0_from_eps(x, abar_t: float, eps): """由 x_t 和 eps 反解 x_0:x_0 = (x_t - sigma_t * eps) / alpha_t。""" a, sg = alpha_sigma(abar_t) return (x - sg * eps) / a # ══════════════════════════════════════════════════════════════════ # 4. 尺子:切片 Wasserstein-1 + 平均对数密度 # ══════════════════════════════════════════════════════════════════ def make_dirs(n_dirs: int = N_DIRS, seed: int = 7): """预先抽好投影方向,全篇共用同一组。 这一条很重要:每次评价都重新抽方向的话,两组「同样好」的样本也会因为 方向不同量出不同的数,这部分方差完全是无谓的。方向固定之后, A 和 B 的差别就只来自样本本身。 """ th = np.random.default_rng(seed).standard_normal((n_dirs, D)) th /= np.linalg.norm(th, axis=1, keepdims=True) return th def sliced_w1(X, Y, TH=None, n_dirs: int = N_DIRS, rng=None): """切片 W1:在 n_dirs 个随机方向上算一维 W1,再取平均。 一维 W1 有闭式解:把两个样本集投影后排序,逐位相减取绝对值平均。 单位和数据同单位(这里是「平均要挪多远」),比 MMD^2 好解释。 """ if TH is None: TH = make_dirs(n_dirs) if rng is None else None if TH is None: th = rng.standard_normal((n_dirs, X.shape[1])) th /= np.linalg.norm(th, axis=1, keepdims=True) else: th = TH a = np.sort(X @ th.T, axis=0) b = np.sort(Y @ th.T, axis=0) return float(np.abs(a - b).mean()) def mean_logp(X, w, mu, Sig): """生成样本在真实分布下的平均对数密度。""" lp, _ = logp_and_score(X, 1.0, w, mu, Sig) return float(lp.mean()) def evaluate(X, Xref, w, mu, Sig, lp_ref, TH): """一次评价,返回 (SW1, dlogp)。 dlogp = 生成样本的平均 log 密度 − 真实样本的平均 log 密度。 0仅表示平均log密度相同,不证明分布相同;正数也不等于质量更好。 """ return sliced_w1(X, Xref, TH=TH), mean_logp(X, w, mu, Sig) - lp_ref # ══════════════════════════════════════════════════════════════════ # 5. 主流程:验 oracle、量尺子的噪声地板 # ══════════════════════════════════════════════════════════════════ def main(): rng = np.random.default_rng(20260927) betas, abar = linear_schedule() w, mu, Sig = make_target() print("=" * 68) print("A. Oracle 自检:解析 score vs 有限差分") print("=" * 68) for t in (1, 50, 200, 500, 1000): x = sample_true(8, w, mu, Sig, rng) _, s = logp_and_score(x, abar[t], w, mu, Sig) h = 1e-5 fd = np.zeros_like(s) for i in range(D): e = np.zeros(D) e[i] = h lp_p, _ = logp_and_score(x + e, abar[t], w, mu, Sig) lp_m, _ = logp_and_score(x - e, abar[t], w, mu, Sig) fd[:, i] = (lp_p - lp_m) / (2 * h) err = np.abs(fd - s).max() print(f" t={t:5d} abar={abar[t]:.6f} max|解析 - 差分| = {err:.2e}") print(" 有限差分与解析 score 数值一致;该自检不证明整体生成误差为零") # 顺便看一眼:oracle eps 在 t=1000 处还剩多少信息 print() print("=" * 68) print("B. 端点检查:t=T 时分布离标准正态有多远") print("=" * 68) for t in (200, 500, 800, 1000): C = _cov_at(abar[t], Sig) dev = np.abs(C - np.eye(D)).max() print(f" t={t:5d} abar={abar[t]:.3e} " f"各分量协方差与 I 的最大差 = {dev:.3e}") print(" 越接近 t=T,加噪后的混合越接近一个标准正态球") # ── 尺子的噪声地板 ── print() print("=" * 68) print("C. 尺子的噪声地板:两批「都对」的样本之间也能量出距离") print("=" * 68) Xref = sample_true(N_EVAL, w, mu, Sig, rng) lp_ref = mean_logp(Xref, w, mu, Sig) print(f" 参考样本: {Xref.shape}, 真实样本自己的平均 logp = {lp_ref:.4f}") TH = make_dirs() sw_floor, lp_floor = [], [] for r in range(8): Y = sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(1000 + r)) sw_floor.append(sliced_w1(Y, Xref, TH=TH)) lp_floor.append(mean_logp(Y, w, mu, Sig)) print(f" SW1 真vs真 ×8: 均值 {np.mean(sw_floor):.5f} " f"标准差 {np.std(sw_floor):.5f} 最大 {np.max(sw_floor):.5f}") print(f" dlogp 真vs真 ×8: 均值 {np.mean(lp_floor) - lp_ref:+.4f} " f"标准差 {np.std(lp_floor):.4f}") print(" → 当前抽样基线不能直接当作显著性阈值;近邻差别需更多重复") # ── 一个有参照的好答案长什么样 ── print() print("=" * 68) print("D. 天花板:把真样本直接当生成样本送进去") print("=" * 68) print(f" SW1 = {sliced_w1(Xref, Xref, TH=TH):.6f}" f" dlogp = {mean_logp(Xref, w, mu, Sig) - lp_ref:+.4f}") print(" (同一经验样本对自身为0;不说明有限样本分布估计无偏)") if __name__ == "__main__": main() ddim_family.py # -*- coding: utf-8 -*- """DDIM 家族:一个 eta 旋钮,把 DDPM 祖采样和 DDIM 串成一条线。 这个脚本回答三个问题: 1. **eta=1 的 DDIM 是不是就是 DDPM 祖采样?** 用两套独立的代码(一套写 DDPM Algorithm 2 的原式,一套写 DDIM 论文式 (12)),喂同样的随机数和 同样的起点,看输出能不能对到最后一位。能,那这条家族关系就不是传说。 2. **eta 到底该调多大?** 在 oracle score 下扫一遍:步数少的时候是不是 「加噪声更好」?在欠拟合模型下再扫一遍,看结论翻不翻。 3. **换采样器为什么缓存策略得重调?** 量每步「模型输入变了多少」: 确定性采样器的轨迹是光滑的,随机采样器每一步都往里砸一份新噪声。 python ddim_family.py 依赖:numpy(+ 同目录的 oracle_gmm.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, eps_star, x0_from_eps, alpha_sigma, sliced_w1, mean_logp, make_dirs, N_EVAL, N_DIRS) # ══════════════════════════════════════════════════════════════════ # 0. 时间步网格与模型 # ══════════════════════════════════════════════════════════════════ def uniform_t_grid(S: int, T: int = T): """本文在 t 上取整数等间隔节点;不宣称复刻 diffusers leading 端点。 返回 S+1 个 abar:起点 abar[T],终点 1.0(完全干净)。 """ ts = np.round(np.linspace(0.0, T, S + 1)).astype(int)[::-1] grid = np.array([1.0 if t == 0 else _ABAR[t] for t in ts], dtype=float) return ts, grid def paired_noise(S: int, n: int, seed: int = 1234): """给所有采样器**同一份**起点和同一批随机数。 这是整套实验最要紧的一条:如果每个配置各抽各的起点,配置之间就多了一份 抽样方差,量出来的差别里有多少是采样器的功劳根本说不清。配对之后, eta=0 和 eta=1 的终点之差只能来自算法本身。 """ r = np.random.default_rng(seed + S) x_init = r.standard_normal((n, 2)) zs = [r.standard_normal((n, 2)) for _ in range(S)] return x_init, zs def make_model(kind: str, w, mu, Sig): """两种「模型」,用来分离离散化误差和模型误差。 oracle : 用的就是真 score,没有网络拟合误差;仍有离散化、终端先验、收尾与浮点误差。 gauss : 模型以为数据是一个单高斯(用真均值真协方差拟合), 也就是「容量不足以表达多峰」。高噪声区它几乎是对的, 低噪声区偏差较大;这只是一种人工误差结构,不代表所有网络。 """ if kind == "oracle": return lambda x, abar: eps_star(x, abar, w, mu, Sig) if kind == "gauss": m = (w[:, None] * mu).sum(axis=0) S = ((w[:, None, None] * (Sig + np.einsum("ki,kj->kij", mu, mu))).sum(axis=0) - np.outer(m, m)) w1, mu1, S1 = np.array([1.0]), m[None, :], S[None, :, :] return lambda x, abar: eps_star(x, abar, w1, mu1, S1) raise ValueError(kind) # ══════════════════════════════════════════════════════════════════ # 1. DDIM 的一步(论文式 12,与 diffusers DDIMScheduler.step 逐项对齐) # ══════════════════════════════════════════════════════════════════ def ddim_step(x, abar_cur, abar_tgt, eps, z, eta): """从 abar_cur 走到 abar_tgt(abar_tgt > abar_cur,噪声变小)。 x_tgt = sqrt(abar_tgt) * x0_hat + sqrt(sigma_tgt^2 - sigma_tilde^2) * eps ← 指向 x_t 的方向项 + sigma_tilde * z ← 随机项 sigma_tilde = eta * sqrt( (1-abar_tgt)/(1-abar_cur) * (1 - abar_cur/abar_tgt) ) eta = 0 → 完全没有随机项,DDIM; eta = 1 → 完整时间表时等于 fixed-small DDPM 后验标准差。 """ if not (0 < abar_cur < abar_tgt <= 1 and 0 <= eta <= 1): raise ValueError("要求0<abar_cur<abar_tgt<=1且0<=eta<=1") a_c, s_c = alpha_sigma(abar_cur) a_t, s_t = alpha_sigma(abar_tgt) x0 = (x - s_c * eps) / a_c var = (1.0 - abar_tgt) / (1.0 - abar_cur) * (1.0 - abar_cur / abar_tgt) sig_tilde = eta * np.sqrt(max(var, 0.0)) direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0)) return a_t * x0 + direc * eps + sig_tilde * z, x0 def ddpm_step(x, abar_cur, abar_tgt, eps, z, betas): """DDPM Algorithm 2 的原式,故意写成「另一套代码」用来交叉验证。 x_{t-1} = (x_t - beta_t / sqrt(1 - abar_t) * eps) / sqrt(alpha_t) + sqrt(beta_tilde_t) * z 只在相邻步(stride = 1)上成立,不能跳步。 """ abar_prev = abar_tgt beta_t = 1.0 - abar_cur / max(abar_prev, 1e-12) # = 1 - alpha_t beta_tilde = (1.0 - abar_prev) / (1.0 - abar_cur) * beta_t a_t = np.sqrt(max(abar_cur / max(abar_prev, 1e-12), 1e-12)) mean = (x - beta_t / np.sqrt(1.0 - abar_cur) * eps) / a_t return mean + np.sqrt(max(beta_tilde, 0.0)) * z def run_ddim(x, grid, model, eta, zs, track=False): """沿 grid 走一遍。grid[0] 最吵,grid[-1] = 1.0。 track=True 时额外返回每一步的 (x, x0_hat),D 节量「轨迹抖动」要用。 """ xs, x0s = [x.copy()], [] for i in range(len(grid) - 1): eps = model(x, grid[i]) z = zs[i] if zs is not None else 0.0 x, x0 = ddim_step(x, grid[i], grid[i + 1], eps, z, eta) if track: xs.append(x.copy()) x0s.append(x0.copy()) return x, (xs, x0s) if track else x0s # ══════════════════════════════════════════════════════════════════ # 2. 主流程 # ══════════════════════════════════════════════════════════════════ _BETAS, _ABAR = linear_schedule() def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() Xref = sample_true(N_EVAL, w, mu, Sig, rng) lp_ref = mean_logp(Xref, w, mu, Sig) ev_rng = np.random.default_rng(7) model = make_model("oracle", w, mu, Sig) # ── A. eta=1 的 DDIM 是不是 DDPM 祖采样 ── print("=" * 70) print("A. 交叉验证:DDIM(eta=1, stride=1) 是否等于 DDPM Algorithm 2") print("=" * 70) S = 1000 ts, grid = uniform_t_grid(S) n = 400 x_init = rng.standard_normal((n, 2)) zs = [rng.standard_normal((n, 2)) for _ in range(S)] x_ddpm = x_init.copy() for i in range(S): # 原式,一步步走完 1000 步 t = ts[i] x_ddpm = ddpm_step(x_ddpm, grid[i], grid[i + 1], model(x_ddpm, grid[i]), zs[i], _BETAS) x_ddim, _ = run_ddim(x_init.copy(), grid, model, eta=1.0, zs=zs) d = np.abs(x_ddpm - x_ddim).max() print(f" 两条独立实现,喂同样的 {S} 份随机数") print(f" 终点逐元素最大差 = {d:.3e} 终点 RMS = {np.sqrt((x_ddim**2).mean()):.4f}") print(f" → 差 {d:.1e},是浮点累加误差量级:eta=1 就是 DDPM 祖采样,不是「近似」") # ── B. eta 扫描(oracle score)── print() print("=" * 70) print("B. eta 扫描:步数越少,是不是越该加噪声?(oracle score,配对起点)") print("=" * 70) TH = make_dirs() floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(1000 + r)), Xref, TH=TH) for r in range(6)] print(f" 噪声地板 SW1 = {np.mean(floors):.4f} ± {np.std(floors):.4f}" f"(真实样本对真实样本),仅作当前估计量的抽样基线") NS = (10, 20, 50, 100) print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS)) for eta in (0.0, 0.25, 0.5, 0.75, 1.0): row = [] for S in NS: ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) x, _ = run_ddim(x_init, grid, model, eta, zs) row.append(sliced_w1(x, Xref, TH=TH)) print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row)) # ── C. 换个欠拟合的模型,结论翻不翻 ── print() print("=" * 70) print("C. 同样的扫描,但把模型换成「以为数据是单高斯」") print("=" * 70) gm = make_model("gauss", w, mu, Sig) print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS)) for eta in (0.0, 0.25, 0.5, 0.75, 1.0): row = [] for S in NS: ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) x, _ = run_ddim(x_init, grid, gm, eta, zs) row.append(sliced_w1(x, Xref, TH=TH)) print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row)) # ── D. 每步「模型输入变了多少」:缓存友好度 ── print() print("=" * 70) print("D. 轨迹抖动:每步「模型输入」变了百分之几(缓存相关的一个输入代理量)") print("=" * 70) print(" 缓存类加速(按『这一步的输入和上一步差不多就复用上一步的特征』决策)") print(" 这里只量输入位移代理;没有特征缓存/命中率/画质实测。") print(f" {'eta':>5} {'最后10步 输入相对变化':>22} {'最后10步 x0_hat位移':>22}") S = 50 ts, grid = uniform_t_grid(S) x_init, zs = paired_noise(S, N_EVAL) out = {} for eta in (0.0, 0.5, 1.0): _, (xs, x0s) = run_ddim(x_init.copy(), grid, model, eta, zs, track=True) rel_x = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean()) / np.sqrt(((xs[i] ** 2).sum(1)).mean())) for i in range(len(xs) - 1)] d_x0 = [float(np.sqrt((((x0s[i] - x0s[i - 1]) ** 2).sum(1)).mean())) for i in range(1, len(x0s))] out[eta] = (rel_x, d_x0) print(f" {eta:5.1f} {np.mean(rel_x[-10:]):22.4f} {np.mean(d_x0[-10:]):22.4f}") i = 25 _, (xs, _) = run_ddim(x_init.copy(), grid, model, 1.0, zs, track=True) xcur = xs[i] ac, sc = alpha_sigma(grid[i]); at, st = alpha_sigma(grid[i + 1]) eps = model(xcur, grid[i]); m = (xcur - sc * eps) / ac var = (1 - grid[i + 1]) / (1 - grid[i]) * (1 - grid[i] / grid[i + 1]) rms = lambda v: float(np.sqrt(np.sum(v * v, axis=1).mean())) print(" eta=1 第25步三项 Euclidean RMS:", f"回数据={rms(at*m):.4f} 沿噪声方向={rms(np.sqrt(st*st-var)*eps):.4f}", f"新掷噪声={rms(np.sqrt(var)*zs[i]):.4f}") r0, r1 = out[0.0][0][-10:], out[1.0][0][-10:] print(f" → eta=1 的输入抖动是 eta=0 的 {np.mean(r1) / np.mean(r0):.1f} 倍;" f"按 eta=0 调出来的缓存阈值,换个采样器就完全不是一回事") if __name__ == "__main__": main() dpm_solver_lab.py # -*- coding: utf-8 -*- """从 DDIM 走到高阶:把时间轴换成 lambda,阶数就变成可以直接量出来的东西。 这个脚本做四件事: 1. **验证 DDIM 就是一阶 DPM-Solver。** 两套完全不同的代码(一套写 DDIM 论文式 12,一套写 lambda 空间的一阶指数积分器),同样的时间网格、 同样的模型,看输出是不是同一个数。是,那「DDIM 是一阶方法」就不是比喻。 2. **把阶数量出来。** 拿一条超高精度的参考解当真值,量各采样器终点到它的 距离。这个距离没有抽样噪声(起点配对、采样器确定),能干净地跨几个数量级, 于是「误差 ~ NFE^(-p)」里的 p 可以直接拟合出来。 3. **给出实用的步数-质量表。** 阶数是数值分析的语言,产品要的是 「20 步够不够」,所以再给一张 SW1 表(含抽样基线)。 4. **看高阶方法省下的评估次数到底落在哪。** python dpm_solver_lab.py 依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, eps_star, alpha_sigma, sliced_w1, make_dirs, N_EVAL) from ddim_family import uniform_t_grid, make_model, ddim_step _BETAS, _ABAR = linear_schedule() _LAM = 0.5 * np.log(np.maximum(_ABAR, 1e-300) / np.maximum(1.0 - _ABAR, 1e-300)) # ══════════════════════════════════════════════════════════════════ # 0. lambda 坐标与网格 # ══════════════════════════════════════════════════════════════════ def lam_of_abar(abar): """half log-SNR:lambda = log(alpha) - log(sigma) = 0.5 * log(abar/(1-abar))。""" return 0.5 * np.log(np.maximum(abar, 1e-300) / np.maximum(1.0 - abar, 1e-300)) def abar_of_lam(lam): """lambda 的反函数:abar = e^(2 lam) / (1 + e^(2 lam))。""" e = np.exp(2.0 * lam) return e / (1.0 + e) def nearest_t(abar): """把连续的 abar 落到最近的训练时间步上(离散训练网络需按具体实现处理时间标签)。 注意 abar 是**递减**的,不能用 searchsorted(它只认递增数组), 老老实实找绝对值最小的那个下标。 """ return int(np.clip(int(np.argmin(np.abs(_ABAR - abar))), 1, T)) def uniform_lambda_grid(S: int, quantize: bool = False): """在 lambda 上等间隔取 S 个点,再落回训练网格。 返回 S+1 个 abar:前 S 个是「要评估模型」的位置,最后一个是 1.0 (完全干净,sigma = 0,对应 lambda = +inf,只能用一阶收尾)。 quantize=True 会把每个 lambda 落回整数时间步。落回去之后可能撞车 (两个 lambda 落到同一个 t),撞车会让多步法的差商分母变成 0, 所以强制 t 严格递减。参考解要更细的分辨率,用 quantize=False 直接 吃连续的 abar —— oracle 认得任意 abar;真实模型的时间插值/标签须查训练约定。 """ l0, l1 = _LAM[T], _LAM[1] # 从最吵到最干净 lams = np.linspace(l0, l1, S) if not quantize: return None, np.concatenate([abar_of_lam(lams), [1.0]]) ts = [] for l in lams: t = nearest_t(abar_of_lam(l)) if ts and t >= ts[-1]: t = ts[-1] - 1 # 强制严格递减,避免差商分母为 0 if t < 1: break # 干净端训练网格已无分辨率,到此为止 ts.append(t) ts = np.array(ts, dtype=int) return ts, np.concatenate([_ABAR[ts], [1.0]]) class Counter: """包一层模型,数一下到底调了几次。NFE 不能靠嘴算。""" def __init__(self, model): self.m = model self.n = 0 def __call__(self, x, abar): self.n += 1 return self.m(x, abar) # ══════════════════════════════════════════════════════════════════ # 1. 一阶指数积分器(DPM-Solver-1 / dpmsolver++ 的一阶更新) # ══════════════════════════════════════════════════════════════════ def dpm_pp_first(x, m0, a_s, s_s, a_t, s_t): """x_t = (sigma_t/sigma_s) * x_s - alpha_t * (e^{-h} - 1) * x0_hat h = lambda_t - lambda_s。sigma_t = 0 时 lambda_t = +inf,e^{-h} = 0, 整条式子退化成 x_t = x0_hat —— 最后一步自动正确,不用特判。 """ if s_t <= 0.0: return m0 h = (np.log(a_t) - np.log(s_t)) - (np.log(a_s) - np.log(s_s)) return (s_t / s_s) * x - a_t * (np.exp(-h) - 1.0) * m0 def dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type="midpoint"): """diffusers multistep_dpm_solver_second_order_update 的逐项复刻。 D1 是用上一步的 x0_hat 做差商估出来的导数:D1 ~ h * dx0/dlambda。 midpoint 和 heun 的区别只在 D1 前面的系数,两者都是二阶。 """ lam_t = np.log(a_t) - np.log(s_t) lam_s0, m0 = hist[-1] lam_s1, m1 = hist[-2] h = lam_t - lam_s0 h0 = lam_s0 - lam_s1 r0 = h0 / h D0, D1 = m0, (m0 - m1) / r0 emh = np.exp(-h) if solver_type == "midpoint": return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 - 0.5 * a_t * (emh - 1.0) * D1) return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 + a_t * ((emh - 1.0) / h + 1.0) * D1) def dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0): """三阶多步更新。 d2_scale=1.0 是 diffusers v0.35.1 的 dpmsolver++ 分支(也核对 v0.30.0)`multistep_dpm_solver_third_order_update` 的逐项复刻;d2_scale=2.0 是本文的二次插值指数积分对照版本。 两者的差别见 F 节的受控检验 —— 差的就是这一个 2。 """ lam_t = np.log(a_t) - np.log(s_t) lam_s0, m0 = hist[-1] lam_s1, m1 = hist[-2] lam_s2, m2 = hist[-3] h = lam_t - lam_s0 h0, h1 = lam_s0 - lam_s1, lam_s1 - lam_s2 r0, r1 = h0 / h, h1 / h D0 = m0 D1_0, D1_1 = (m0 - m1) / r0, (m1 - m2) / r1 D1 = D1_0 + (r0 / (r0 + r1)) * (D1_0 - D1_1) D2 = d2_scale * (D1_0 - D1_1) / (r0 + r1) emh = np.exp(-h) return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0 + a_t * ((emh - 1.0) / h + 1.0) * D1 - a_t * ((emh - 1.0 + h) / h ** 2 - 0.5) * D2) # ══════════════════════════════════════════════════════════════════ # 2. 五个采样器 # ══════════════════════════════════════════════════════════════════ def solve_ddim(grid, model, x): """DDIM(eta=0):论文式 12,完全不碰 lambda。""" for i in range(len(grid) - 1): eps = model(x, grid[i]) x, _ = ddim_step(x, grid[i], grid[i + 1], eps, 0.0, 0.0) return x def solve_dpm1(grid, model, x): """一阶指数积分器。理论上应该和 DDIM 逐位相同 —— A 节去验。""" for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) return x def solve_dpm2s(grid, model, x): """数据预测指数中点法:每步先在 lambda 中点落一脚,用中点的 x0 走完。 有限目标一步两次评估,sigma=0 收尾仅一次。中点的 x0 对积分的「加权平均」是二阶准确的, 所以整步的局部误差是 O(h^3),全局 O(h^2)。 """ for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s lam_s, lam_t = np.log(a_s) - np.log(s_s), None if s_t <= 0.0: # 收尾:lambda_t = +inf,中点无从谈起 x = m0 continue lam_t = np.log(a_t) - np.log(s_t) lam_m = 0.5 * (lam_s + lam_t) abar_m = abar_of_lam(lam_m) # oracle 用连续中点;整数标签版本需独立分析 a_m, s_m = alpha_sigma(abar_m) x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m) # 先跳到中点 eps_m = model(x_m, abar_m) m_m = (x_m - s_m * eps_m) / a_m # 中点处的 x0 x = dpm_pp_first(x, m_m, a_s, s_s, a_t, s_t) # 用中点 x0 走完整步 return x def _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model): """在 lambda 的中点补一次评估,拿中点的 x0 走完整步(局部二阶)。 多步法开头那一步没有历史可用,只能降成一阶,而一阶在长度为 h 的区间上 局部误差是 O(h^2),这个误差会一路传到终点 —— 这可能影响全局阶数 的潜在来源之一。给第一步多花一次评估可对照,但不证明其他误差项不存在。 """ lam_s, lam_t = np.log(a_s) - np.log(s_s), np.log(a_t) - np.log(s_t) abar_m = abar_of_lam(0.5 * (lam_s + lam_t)) a_m, s_m = alpha_sigma(abar_m) x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m) eps_m = model(x_m, abar_m) return (x_m - s_m * eps_m) / a_m def solve_multistep(grid, model, x, order=2, solver_type="midpoint", warm2s=False, d2_scale=2.0): """多步法(DPM-Solver++ 2M / 3M):一步一次评估,导数是拿历史 x0 做差商。 开头几步历史不够,自动降阶(和 diffusers 的 lower_order_nums 一样); 最后一步 sigma=0 强制降成一阶(和 final_sigmas_type="zero" 一样)。 warm2s=True 时,第一步改用中点法(多花一次评估)把局部精度提到二阶。 """ hist = [] for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s hist.append((np.log(a_s) - np.log(s_s), m0)) last = (i == len(grid) - 2) if i == 0 and warm2s and s_t > 0.0: x = dpm_pp_first(x, _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model), a_s, s_s, a_t, s_t) elif s_t <= 0.0 or len(hist) < 2 or last: x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) elif order >= 3 and len(hist) >= 3: x = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=d2_scale) else: x = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type) return x # ══════════════════════════════════════════════════════════════════ # 3. 主流程 # ══════════════════════════════════════════════════════════════════ def rms_err(x, xref): return float(np.sqrt(((x - xref) ** 2).sum(1).mean())) def fit_slope(ns, errs, res, nfe_min=24): """在双对数上拟合 err ~ N^(-p),返回 p。 只取渐近段:NFE 太小的时候高阶方法还在「攒历史」(前几步被迫降阶), 这一段量出来的斜率既不是 1 也不是 3,什么都不说明;误差接近参考解 自检差值的点可能受参考误差影响,同样不能要。 """ xs, ys = [], [] for n, e in zip(ns, errs): if n >= nfe_min and e > 3.0 * res and np.isfinite(e) and e > 0: xs.append(np.log(n)) ys.append(np.log(e)) if len(xs) < 3: return float("nan"), 0 p = -np.polyfit(xs, ys, 1)[0] return float(p), len(xs) def local_err_test(): """受控检验:规定 x0_hat(lambda) 是二次多项式,看各阶更新的局部误差阶。 本文要检验的是对二次插值函数做精确指数积分的系数归一化。 这类构造应对外部指定的二次函数精确;一般三阶ODE求解器不必有此性质。 这个检验把「公式对不对」和「轨迹好不好」彻底分开,谁也赖不着谁。 """ rng = np.random.default_rng(3) A, Bc, Cc = rng.standard_normal(2), rng.standard_normal(2), rng.standard_normal(2) g = lambda lam: A + Bc * lam + 0.5 * Cc * lam ** 2 def exact_inc(lam_s, lam_t): def primitive(lam): return np.exp(lam) * (A + Bc * (lam - 1) + 0.5 * Cc * (lam * lam - 2 * lam + 2)) return primitive(lam_t) - primitive(lam_s) hs = [0.4, 0.2, 0.1, 0.05, 0.025] lam_s = 0.3 out = {} for name in ("一阶", "二阶", "三阶-D2原式", "三阶-D2乘2"): errs = [] for h in hs: lam_t = lam_s + h a_s, s_s = alpha_sigma(abar_of_lam(lam_s)) a_t, s_t = alpha_sigma(abar_of_lam(lam_t)) x = np.array([0.7, -0.4]) hist = [(lam_s - j * h, g(lam_s - j * h)) for j in (2, 1, 0)] # 老→新 if name == "一阶": got = dpm_pp_first(x, g(lam_s), a_s, s_s, a_t, s_t) elif name == "二阶": got = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t) elif name == "三阶-D2原式": got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=1.0) else: got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0) want = (s_t / s_s) * x + s_t * exact_inc(lam_s, lam_t) errs.append(float(np.abs(got - want).max())) out[name] = errs print(f" {name:>12}: " + " ".join(f"{e:.2e}" for e in errs)) print(" (h 从 0.4 缩到 0.025)") print(" → 一阶 h^2、二阶 h^3 都对;三阶原式只有 h^3(等于二阶),") print(" D2 乘 2 之后直接掉到 1e-14 —— 二次 x0_hat 下它一步就算准了") def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() TH = make_dirs() Xref = sample_true(N_EVAL, w, mu, Sig, rng) model = make_model("oracle", w, mu, Sig) # ── A. DDIM == 一阶 DPM-Solver ? ── print("=" * 72) print("A. 交叉验证:DDIM(eta=0) 与 lambda 空间一阶指数积分器是不是同一个东西") print("=" * 72) n = 500 for S in (20, 50): _, grid_l = uniform_lambda_grid(S) _, grid_t = uniform_t_grid(S) for name, grid in (("uniform-t", grid_t), ("uniform-lambda", grid_l)): x0 = rng.standard_normal((n, 2)) xa = solve_ddim(grid, model, x0.copy()) xb = solve_dpm1(grid, model, x0.copy()) print(f" S={S:3d} {name:>14} max|DDIM - DPM-Solver-1| = " f"{np.abs(xa - xb).max():.3e}") print(" → 两套代码、两套记号,输出差在浮点误差量级:DDIM 就是一阶方法") # ── B. 参考解 ── print() print("=" * 72) print("B. 参考解:3M 跑 4000 步当真值,再自查一下它自己收敛到哪") print("=" * 72) n_ref = 1000 x_init = rng.standard_normal((n_ref, 2)) _, g_fine = uniform_lambda_grid(4000, quantize=False) _, g_mid = uniform_lambda_grid(2000, quantize=False) xref = solve_multistep(g_fine, model, x_init.copy(), order=3) xchk = solve_multistep(g_mid, model, x_init.copy(), order=3) res = rms_err(xref, xchk) print(f" 4000 步 vs 2000 步参考解的差 = {res:.3e}") print(f" → 这个差值是当前参考解的自检尺度,比它小的差别不可信") # ── C. 阶数 ── print() print("=" * 72) print("C. 把阶数量出来:终点到参考解的 RMS 距离 vs 真实 NFE") print("=" * 72) NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192] solvers = { "DDIM (uniform-t)": lambda S: (uniform_t_grid(S)[1], solve_ddim, {}), "DDIM (=DPM-1, lambda)": lambda S: (uniform_lambda_grid(S)[1], solve_ddim, {}), "数据预测中点(单步)": lambda S: (uniform_lambda_grid(max(S // 2, 2))[1], solve_dpm2s, {}), "DPM-Solver++ 2M": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 2}), "3M(v0.35.1系数)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 3, "d2_scale": 1.0}), "3M(二次插值版本)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep, {"order": 3, "d2_scale": 2.0}), } print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers)) table = {k: [] for k in solvers} nfes = {k: [] for k in solvers} for S in NS: row, real_n = [], [] for k, build in solvers.items(): grid, fn, kw = build(S) c = Counter(model) x = fn(grid, c, x_init.copy(), **kw) row.append(rms_err(x, xref)) real_n.append(c.n) for k, n in zip(solvers, real_n): nfes[k].append(n) table_k = list(solvers) for k, v in zip(table_k, row): table[k].append(v) print(f" nominal={S:3d} " + " ".join(f"{n:3d}:{v:.3e}" for n,v in zip(real_n,row))) print() print(f" 拟合误差 ~ NFE^(-p)(只取 NFE>=24 且误差高于分辨率 {res:.1e}×3 的渐近段):") for k in solvers: p, m = fit_slope(nfes[k], table[k], res) print(f" {k:>24} p = {p:.2f} (用了 {m} 个点)") # ── D. SW1 走到哪一步就分不出高下了 ── print() print("=" * 72) print("D. 分布层面SW1:换起点估计均值和标准差,参考样本固定") print("=" * 72) floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(2000 + r)), Xref, TH=TH) for r in range(8)] print(f" 真样本 vs 真样本(8 次):{np.mean(floors):.4f} ± {np.std(floors):.4f}" f" ← 当前样本量/投影/固定参考样本的抽样基线") PS = [10, 20, 50] print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers)) for S in PS: row = [] for k, build in solvers.items(): grid, fn, kw = build(S) vs = [] for r in range(5): # 换几份起点,量出估计量的抖动 c = Counter(model) x = fn(grid, c, np.random.default_rng(900 + S * 100 + r) .standard_normal((N_EVAL, 2)), **kw) vs.append(sliced_w1(x, Xref, TH=TH)) row.append((c.n, np.mean(vs), np.std(vs))) print(f" nominal={S:3d} " + " ".join(f"{v[0]}:{v[1]:.4f}±{v[2]:.3f}" for v in row)) print(" → 20 步时各采样器的差别还大于抖动;到 50 步大家都贴着地板,") print(" SW1的近邻差别需更多样本/重复;C节RMS量的是同一路径误差,不能代替分布质量") # ── E. 同一个精度,省多少次评估 ── print() print("=" * 72) print("E. 把终点误差压到 1e-2 / 1e-3,最少要几次模型评估(实测扫描)") print("=" * 72) scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160, 192, 256, 384] for k, build in solvers.items(): got = {} for S in scan: if len(got) == 2: break grid, fn, kw = build(S) c = Counter(model) e = rms_err(fn(grid, c, x_init.copy(), **kw), xref) for tol in (1e-2, 1e-3): if tol not in got and e <= tol: got[tol] = c.n s1 = got.get(1e-2, None) s2 = got.get(1e-3, None) f1 = f"NFE={s1:3d}" if s1 else f"未达标(max NFE={c.n})" f2 = f"NFE={s2:3d}" if s2 else f"未达标(max NFE={c.n})" print(f" {k:>24} 1e-2: {f1} 1e-3: {f2}") # ── F. 受控检验:三阶更新到底几阶 ── print() print("=" * 72) print("F. 受控检验:规定一条解析的 x0_hat(lambda),直接量局部误差") print("=" * 72) print(" 做法:不让 x0_hat 由 x 决定,而是规定它是 lambda 的二次多项式") print(" g(lambda)。此时精确解就是 (sigma_t/sigma_s) x + sigma_t * 积分 e^lambda g。") print(" 对二次插值做精确指数积分的版本应一步算准;一般三阶方法不要求这一性质。") local_err_test() # ── G. 卡住 3M 的不是开头那一步 ── print() print("=" * 72) print("G. 是不是「第一步被迫降阶」拖累的?给第一步多花一次评估试试") print("=" * 72) for tag, kw in (("第一步一阶(默认)", {}), ("第一步改中点法(多 1 次评估)", {"warm2s": True})): ns, es = [], [] for S in (24, 32, 48, 64, 96, 128, 192): grid = uniform_lambda_grid(S)[1] c = Counter(model) got = solve_multistep(grid, c, x_init.copy(), order=3, d2_scale=1.0, **kw) ns.append(c.n) es.append(rms_err(got, xref)) p, _ = fit_slope(ns, es, res, nfe_min=24) print(f" 3M(D2 原式)+ {tag:<22} 实测阶数 p = {p:.2f}") print(" → 此对照只量起步处理对本组斜率的影响;系数检验见F节。") if __name__ == "__main__": main() spacing_lab.py # -*- coding: utf-8 -*- """步数该往哪放:同样 20 次评估,换个摆法能差出一个数量级。 阶数(dpm_solver_lab.py 里量出来的 p)说的是「步数变多时误差掉多快」, 但没说「步数摆在哪」。这一篇的主角是**时间步的摆法**: - 在 t 上等间隔(本文取 T 到 0 的整数节点) - 在 lambda 上等间隔(DPM-Solver 的建议) - 在 lambda 上等间隔但落回整数 t(整数标签需按实际网络处理) - 在 log sigma 上等间隔 - Karras / EDM 的 rho=7 摆法(只移植网格,不复现整套 EDM) 判断标准是两条:确定性误差(终点到参考解的距离)和「难度曲线」—— 沿着一条高精度参考轨迹量 |dx0_hat / d lambda|,看哪一段 lambda 上 x0_hat 变得最快;这是局部代理,不单独决定最优网格。 python spacing_lab.py 依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py / dpm_solver_lab.py) """ import numpy as np from oracle_gmm import (T, linear_schedule, make_target, sample_true, alpha_sigma, sliced_w1, make_dirs, N_EVAL) from ddim_family import uniform_t_grid, make_model, ddim_step from dpm_solver_lab import (uniform_lambda_grid, solve_ddim, solve_multistep, solve_dpm2s, lam_of_abar, abar_of_lam, nearest_t, Counter, rms_err, dpm_pp_first, dpm_pp_second, dpm_pp_third) _BETAS, _ABAR = linear_schedule() _LAM = lam_of_abar(_ABAR) # ══════════════════════════════════════════════════════════════════ # 1. 五种摆法 # ══════════════════════════════════════════════════════════════════ def grid_uniform_t(S: int): """本文在 t 上取整数等间隔节点,端点与 leading 选项需分别核对。""" return uniform_t_grid(S)[1] def grid_uniform_lambda(S: int): """在 lambda 上等间隔,连续 abar(DPM-Solver 理论里的标准摆法)。""" return uniform_lambda_grid(S, quantize=False)[1] def grid_uniform_lambda_q(S: int): """在 lambda 上等间隔,但落回整数时间步(标签量化需按具体网络核对)。""" return uniform_lambda_grid(S, quantize=True)[1] def _ratio(abar): """EDM / diffusers 语境里的 sigma:sigma_t / alpha_t = e^{-lambda}。 注意这不是 sqrt(1-abar)。VP 调度下 lambda 就是 -log 这个量, 所以「在 log sigma 上等间隔」等于「在 lambda 上等间隔」——两者是同一个东西, 表里因此只留一种。 """ return np.sqrt(np.maximum(1.0 - abar, 1e-300) / np.maximum(abar, 1e-300)) def grid_uniform_lambda_capped(S: int, lam_max: float): """在 lambda 上等间隔,但只走到 lam_max 就收尾。 为什么要这个变体:uniform-t 天然把 lambda 的上界截在某个值(NFE=20 时 是 +1.76),剩下的干净端交给最后那个「直接输出 x0_hat」的一阶收尾步。 如果 uniform-t 赢的原因是「截得早」而不是「t 本身特别」,那么把 uniform-lambda 截到同一个上界,两者就该差不多。 """ l0 = _LAM[T] lams = np.linspace(l0, lam_max, S) return np.concatenate([abar_of_lam(lams), [1.0]]) def grid_karras(S: int, rho: float = 7.0): """Karras / EDM 的摆法:在 sigma^(1/rho) 上等间隔,EDM 原文取 rho=7。 sigma 用的是 EDM 的那个 sigma(= sigma_t/alpha_t),VP 下等于 e^{-lambda}, 区间是 [_ratio(abar_T), _ratio(abar_1)] ≈ [158, 0.01]。 """ r_hi, r_lo = _ratio(_ABAR[T]), _ratio(_ABAR[1]) r = (r_hi ** (1.0 / rho) + np.arange(S) / (S - 1) * (r_lo ** (1.0 / rho) - r_hi ** (1.0 / rho))) ** rho return np.concatenate([1.0 / (1.0 + r ** 2), [1.0]]) GRIDS = { "uniform-t": grid_uniform_t, "uniform-lambda": grid_uniform_lambda, "uniform-lambda(整数t)": grid_uniform_lambda_q, "lambda截到1.8": lambda S: grid_uniform_lambda_capped(S, 1.8), "lambda截到3.0": lambda S: grid_uniform_lambda_capped(S, 3.0), "karras(rho=7)": grid_karras, "karras(rho=3)": lambda S: grid_karras(S, rho=3.0), } # ══════════════════════════════════════════════════════════════════ # 2. 难度曲线:沿着参考轨迹看 x0_hat 在哪一段变得最快 # ══════════════════════════════════════════════════════════════════ def difficulty_profile(model, n=400, steps=1500, seed=5): """返回 (lam_mid, weight):一阶方法每一步的误差贡献权重。 推导:第 i 步的局部误差(在 x 的单位里)是 delta_i = sigma_{t_i} * ∫ e^lambda [x0(lam) - x0(lam_i)] d lambda ≈ sigma_{t_i} * e^{lam_i} * (h^2/2) * x0'(lam_i) = alpha_{t_i} * e^{-h} * (h^2/2) * x0'(lam_i) 局部代理带 alpha_t 因子,还要同时观察沿轨迹的 x0 导数。 不能只由 alpha 小推出轨迹不动或误差无害;这也未计入传播与末端投影。 返回 alpha(lambda) * |dx0_hat / d lambda|,不是完整误差界。 """ x = np.random.default_rng(seed).standard_normal((n, 2)) grid = uniform_lambda_grid(steps, quantize=False)[1] lams, x0s, alphas = [], [], [] for i in range(len(grid) - 1): a_s, s_s = alpha_sigma(grid[i]) a_t, s_t = alpha_sigma(grid[i + 1]) eps = model(x, grid[i]) m0 = (x - s_s * eps) / a_s lams.append(lam_of_abar(grid[i])) alphas.append(a_s) x0s.append(m0.copy()) x = (s_t / s_s) * x - a_t * (np.exp(-(lam_of_abar(grid[i + 1]) - lam_of_abar(grid[i]))) - 1.0) * m0 if s_t <= 0: break lams = np.array(lams) alphas = np.array(alphas) x0s = np.array(x0s) # (steps, n, 2) dx = np.sqrt(((np.diff(x0s, axis=0)) ** 2).sum(-1).mean(-1)) speed = dx / np.abs(np.diff(lams)) lam_mid = 0.5 * (lams[1:] + lams[:-1]) a_mid = 0.5 * (alphas[1:] + alphas[:-1]) return lam_mid, a_mid * speed, speed # ══════════════════════════════════════════════════════════════════ # 3. 主流程 # ══════════════════════════════════════════════════════════════════ def main(): rng = np.random.default_rng(20260927) w, mu, Sig = make_target() model = make_model("oracle", w, mu, Sig) TH = make_dirs() Xref = sample_true(N_EVAL, w, mu, Sig, rng) n_ref = 1000 x_init = rng.standard_normal((n_ref, 2)) g_ref = uniform_lambda_grid(3000, quantize=False)[1] xref = solve_multistep(g_ref, model, x_init.copy(), order=3) g_chk = uniform_lambda_grid(1500, quantize=False)[1] res = rms_err(xref, solve_multistep(g_chk, model, x_init.copy(), order=3)) print("=" * 72) print("A. 参考解分辨率") print("=" * 72) print(f" 3000 步 vs 1500 步 = {res:.2e}(误差表只能信到这个量级)") # ── B. 摆法对比(确定性误差)── print() print("=" * 72) print("B. 同样 NFE,步数摆在哪:终点到参考解的 RMS 距离") print("=" * 72) print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50)) + " | " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50))) print(f" {'':>22} " + " ".join(f"{'DDIM':>9}" for _ in range(3)) + " | " + " ".join(f"{'2M':>9}" for _ in range(3))) for name, build in GRIDS.items(): row_a, row_b = [], [] for S in (10, 20, 50): grid = build(S) row_a.append(rms_err(solve_ddim(grid, model, x_init.copy()), xref)) row_b.append(rms_err(solve_multistep(grid, model, x_init.copy(), order=2), xref)) print(f" {name:>22} " + " ".join(f"{v:9.3e}" for v in row_a) + " | " + " ".join(f"{v:9.3e}" for v in row_b)) # ── C. 摆法对比(分布层面)── print() print("=" * 72) print("C. 同样的比较,换成 SW1(地板约 0.030,重复换起点看抖动)") print("=" * 72) print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>16}" for s in (10, 20))) for name, build in GRIDS.items(): row = [] for S in (10, 20): grid = build(S) vs = [] for r in range(5): x0 = np.random.default_rng(700 + S * 10 + r).standard_normal( (N_EVAL, 2)) vs.append(sliced_w1(solve_multistep(grid, model, x0, order=2), Xref, TH=TH)) row.append((np.mean(vs), np.std(vs))) print(f" {name:>22} " + " ".join(f"{v[0]:.4f}±{v[1]:.3f}" for v in row)) # ── D. 难度曲线 ── print() print("=" * 72) print("D. 难度曲线:x0_hat 在哪一段 lambda 上变化最快") print("=" * 72) lams, weight, raw = difficulty_profile(model) lo = lams < 0 print(f" 只看 |dx0/dlambda|(不带 alpha 因子):" f"噪声端 {raw[lo].mean():.3e} vs 干净端 {raw[~lo].mean():.3e}") print(f" 乘上 alpha_t 之后的**误差权重**: " f"噪声端 {weight[lo].mean():.3e} vs 干净端 {weight[~lo].mean():.3e}" f" ← 干净端重 {weight[~lo].mean() / weight[lo].mean():.1f} 倍") top = np.argsort(weight)[-5:][::-1] print(" 权重最大的 5 段:") for i in top: print(f" lambda = {lams[i]:+6.2f} 权重 = {weight[i]:.3e}") print(" → 本例噪声端/干净端平均局部代理权重接近,中段峰值更高。") print(" 这是局部估计,未包含误差传播,不能单独证明最优网格。") # ── E2. 收尾步不是免费的 ── print() print("=" * 72) print("E2. 收尾步的代价:在 lambda_max 处直接输出 x0_hat,到底偏了多少") print("=" * 72) print(" 沿高精度参考轨迹取快照,对每个 lambda 量") print(" || x0_hat(x_lambda, lambda) - 轨迹终点 || —— 这就是提前收尾的偏差。") g_fine = uniform_lambda_grid(3000, quantize=False)[1] x = x_init.copy() snaps = [] history = [] for i in range(len(g_fine) - 1): a_s, s_s = alpha_sigma(g_fine[i]) a_t, s_t = alpha_sigma(g_fine[i + 1]) eps = model(x, g_fine[i]) m0 = (x - s_s * eps) / a_s if i % 60 == 0: snaps.append((lam_of_abar(g_fine[i]), float(np.sqrt(((m0 - xref[:n_ref]) ** 2).sum(1).mean())))) history.append((lam_of_abar(g_fine[i]), m0)) if s_t <= 0 or len(history) < 2: x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t) elif len(history) < 3: x = dpm_pp_second(x, history, a_s, s_s, a_t, s_t) else: x = dpm_pp_third(x, history, a_s, s_s, a_t, s_t, d2_scale=2.0) if s_t <= 0: break for lam, d in snaps[::5]: print(f" lambda = {lam:+6.2f} 提前收尾的偏差 = {d:.3e}") print(" → 偏差随 lambda 单调下降:截得越早,这一步白送的误差越大,") print(" 而且它**不随步数下降**(只取决于截在哪个 lambda)") print() print(" 于是 lambda_max 有个最优值(2M, N=20,只改截断点):") for cap in (1.0, 1.5, 2.0, 2.5, 3.0, 3.5, 4.0, 4.61): grid = grid_uniform_lambda_capped(20, cap) e = rms_err(solve_multistep(grid, model, x_init.copy(), order=2), xref) print(f" lambda_max = {cap:4.2f} 终点误差 = {e:.3e}") print(" → 两头都变差:截太早是收尾偏差,截太晚是每步的 h 变大") # ── E. 20 步时各摆法的落脚点 ── print() print("=" * 72) print("E. NFE=20 时各摆法把步子落在 lambda 的哪几个位置") print("=" * 72) for name, build in GRIDS.items(): grid = build(20) lam = np.array([lam_of_abar(g) if g < 1.0 else np.inf for g in grid]) lam_f = lam[np.isfinite(lam)] print(f" {name:>22}: lambda 从 {lam_f[0]:+.2f} 到 {lam_f[-1]:+.2f}," f"相邻间隔 min {np.diff(lam_f).min():.3f} / max {np.diff(lam_f).max():.3f}") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """给「从 DDIM 到高阶采样器」画五张图。 所有数字都是现场重算的:这里 import ddim_family / dpm_solver_lab 里的 采样器,重新跑一遍实验再画,不抄任何手打的表格。改了那边的实现,重跑 这个脚本图就会跟着变,不会出现「图上是旧数字、正文是新数字」。 五张图分别回答: 1. eta=0 和 eta=1 走的是两条什么样的路(同一份随机数,二维真轨迹) 2. eta 该调多大?oracle 模型下扫一遍,欠拟合模型下再扫一遍 3. 为什么换采样器缓存就得重调:模型输入每步变多少 4. 阶数:误差 vs NFE 的双对数斜率 5. 达到 1e-2 / 1e-3 到底要花几次模型评估 只依赖 numpy + matplotlib。跑法:python make_figures.py """ from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import oracle_gmm as OG import ddim_family as DF import dpm_solver_lab as DL ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 RNG_SEED = 20260927 # ══════════════════════════════════════════════════════════════════ # 公共:目标分布、参考解、评估尺子 # ═════════════════════════════════════════════════════════════════= def build_world(): rng = np.random.default_rng(RNG_SEED) w, mu, Sig = OG.make_target() Xref = OG.sample_true(OG.N_EVAL, w, mu, Sig, rng) TH = OG.make_dirs() return w, mu, Sig, Xref, TH def floors(TH, Xref, w, mu, Sig, n=8, base=2000): """尺子的分辨率:真样本对真样本,量 n 次。""" v = [OG.sliced_w1(OG.sample_true(OG.N_EVAL, w, mu, Sig, np.random.default_rng(base + r)), Xref, TH=TH) for r in range(n)] return float(np.mean(v)), float(np.std(v)) # ══════════════════════════════════════════════════════════════════ # 图 1:两条轨迹 # ═════════════════════════════════════════════════════════════════= def fig_traj(w, mu, Sig, Xref): model = DF.make_model("oracle", w, mu, Sig) S = 20 ts, grid = DF.uniform_t_grid(S) n_show = 4 x_init, zs = DF.paired_noise(S, n_show, seed=4321) fig, ax = plt.subplots(figsize=(6.4, 5.4)) ax.scatter(Xref[:, 0], Xref[:, 1], s=3, c="#C9CDD4", alpha=0.45, label="真实样本(目标分布)") styles = {1.0: ("#D2691E", 0.9, 5, r"$\eta=1$(DDPM 祖采样式):每步都重掷噪声"), 0.0: ("#2F6FB3", 1.7, 8, r"$\eta=0$(DDIM,确定性):一条光滑的路")} for eta, (c, lw, ms, lab) in styles.items(): _, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True) P = np.stack(xs, axis=1) # (n, S+1, 2) for k in range(n_show): ax.plot(P[k, :, 0], P[k, :, 1], "-", color=c, lw=lw, alpha=0.85 if eta == 0.0 else 0.55, zorder=4 if eta == 0.0 else 3, label=lab if k == 0 else None) ax.scatter(P[k, 1:-1, 0], P[k, 1:-1, 1], s=ms, color=c, alpha=0.85 if eta == 0.0 else 0.5, zorder=4) ax.scatter(x_init[:, 0], x_init[:, 1], s=110, marker="*", c="#111111", zorder=6, label="起点(两边共用,只有 4 个)") ax.set_xlabel(r"$x_1$") ax.set_ylabel(r"$x_2$") ax.set_title("同一份起点、同一份随机数:N=20 步走出的两条路") ax.legend(loc="upper right", fontsize=8, framealpha=0.9) ax.set_aspect("equal", adjustable="box") fig.tight_layout() p = OUT / "traj_eta.png" fig.savefig(p) plt.close(fig) print(f" [1] {p.name} 轨迹 {n_show} 条 × 2 种 eta") # ══════════════════════════════════════════════════════════════════ # 图 2:eta 扫描(oracle + 欠拟合) # ═════════════════════════════════════════════════════════════════= def fig_eta_sweep(w, mu, Sig, Xref, TH): NS = (10, 20, 50, 100) etas = (0.0, 0.25, 0.5, 0.75, 1.0) flo, flo_sd = floors(TH, Xref, w, mu, Sig) panels = {} for tag, kind in (("oracle(真 score,模型误差=0)", "oracle"), ("欠拟合(模型以为数据是单高斯)", "gauss")): model = DF.make_model(kind, w, mu, Sig) panels[tag] = {e: [] for e in etas} for e in etas: for S in NS: _, grid = DF.uniform_t_grid(S) xi, zs = DF.paired_noise(S, OG.N_EVAL) x, _ = DF.run_ddim(xi, grid, model, e, zs) panels[tag][e].append(OG.sliced_w1(x, Xref, TH=TH)) fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.4), sharey=True) cmap = plt.get_cmap("viridis") for ax, (tag, tab) in zip(axes, panels.items()): for i, e in enumerate(etas): ax.plot(NS, tab[e], "o-", color=cmap(0.15 + 0.7 * i / (len(etas) - 1)), lw=1.6, ms=5, label=r"$\eta=" + f"{e:g}" + r"$") ax.axhline(flo, ls="--", c="#999999", lw=1.2, label=f"噪声地板 {flo:.4f}") ax.set_xscale("log") ax.set_xticks(list(NS)) ax.set_xticklabels([str(s) for s in NS]) ax.set_xlabel("采样步数 N") ax.set_title(tag) ax.grid(alpha=0.25) axes[0].set_ylabel("SW1(越小越好)") axes[0].legend(fontsize=8) axes[1].legend(fontsize=8) fig.suptitle("固定玩具模型的 eta 扫描(不代表所有网络)", fontsize=12) fig.tight_layout() p = OUT / "eta_sweep.png" fig.savefig(p) plt.close(fig) print(f" [2] {p.name} 地板 {flo:.4f}±{flo_sd:.4f};" f"oracle N=10: eta0={panels['oracle(真 score,模型误差=0)'][0.0][0]:.4f}" f" eta1={panels['oracle(真 score,模型误差=0)'][1.0][0]:.4f}") # ══════════════════════════════════════════════════════════════════ # 图 3:每步「模型输入变了多少」 # ═════════════════════════════════════════════════════════════════= def fig_cache_jitter(w, mu, Sig): model = DF.make_model("oracle", w, mu, Sig) S = 50 _, grid = DF.uniform_t_grid(S) x_init, zs = DF.paired_noise(S, OG.N_EVAL) fig, ax = plt.subplots(figsize=(6.6, 4.4)) cols = {0.0: "#2F6FB3", 0.5: "#7A7A7A", 1.0: "#D2691E"} last10 = {} for eta, c in cols.items(): _, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True) rel = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean()) / np.sqrt(((xs[i] ** 2).sum(1)).mean())) for i in range(len(xs) - 1)] last10[eta] = float(np.mean(rel[-10:])) ax.plot(range(1, len(rel) + 1), rel, "-", color=c, lw=1.6, label=r"$\eta=" + f"{eta:g}" + r"$") ax.plot([len(rel) - 9, len(rel)], [last10[eta], last10[eta]], lw=3.2, color=c, alpha=0.35) ax.set_xlabel("步序号(越往右越接近干净端)") ax.set_ylabel(r"模型输入相对变化 $\Delta x_i / x_i$(长度之比,无量纲)") ax.set_title("输入位移代理:本例 eta 改变轨迹变化量") ax.legend(fontsize=9) ax.grid(alpha=0.25) ratio = last10[1.0] / last10[0.0] ax.annotate(f"最后 10 步:eta=1 是 eta=0 的 {ratio:.1f} 倍", xy=(0.42, 0.86), xycoords="axes fraction", fontsize=9, bbox=dict(boxstyle="round,pad=0.35", fc="#FFF6E5", ec="#D2691E")) fig.tight_layout() p = OUT / "cache_jitter.png" fig.savefig(p) plt.close(fig) print(f" [3] {p.name} 最后10步 eta0={last10[0.0]:.4f} " f"eta0.5={last10[0.5]:.4f} eta1={last10[1.0]:.4f} 倍数 {ratio:.1f}") # ══════════════════════════════════════════════════════════════════ # 图 4 + 图 5:阶数与评估预算 # ═════════════════════════════════════════════════════════════════= def build_reference(w, mu, Sig): """超高分辨率参考解;顺手用 2000 步自查它的收敛精度。 随机数的取法与 dpm_solver_lab.py 的 B 节一模一样(同一个种子、同样的 消耗顺序:先抽一批真样本、再抽初始噪声),所以这里打印的分辨率和那边 是同一个数,图上和正文不会对不上。 """ model = DF.make_model("oracle", w, mu, Sig) rng = np.random.default_rng(RNG_SEED) OG.sample_true(OG.N_EVAL, w, mu, Sig, rng) for _ in range(4): rng.standard_normal((500, 2)) # 与 dpm_solver_lab A节消耗一致 x_init = rng.standard_normal((1000, 2)) _, gf = DL.uniform_lambda_grid(4000, quantize=False) _, gm = DL.uniform_lambda_grid(2000, quantize=False) xref = DL.solve_multistep(gf, model, x_init.copy(), order=3, d2_scale=2.0) xchk = DL.solve_multistep(gm, model, x_init.copy(), order=3, d2_scale=2.0) return model, x_init, xref, DL.rms_err(xref, xchk) def fig_order_and_budget(w, mu, Sig): model, x_init, xref, res = build_reference(w, mu, Sig) NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192] solvers = { "DDIM(uniform-t)": lambda S: (DF.uniform_t_grid(S)[1], DL.solve_ddim, {}), "DDIM(=DPM-1, lambda)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_ddim, {}), "数据预测中点(单步)": lambda S: (DL.uniform_lambda_grid(max(S // 2, 2))[1], DL.solve_dpm2s, {}), "DPM-Solver++ 2M": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 2}), "3M(v0.35.1系数)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 3, "d2_scale": 1.0}), "3M(二次插值版本)": lambda S: (DL.uniform_lambda_grid(S)[1], DL.solve_multistep, {"order": 3, "d2_scale": 2.0}), } cols = ["#2F6FB3", "#6FA8DC", "#7A7A7A", "#3E8E41", "#D2691E", "#B03060"] tab = {k: [] for k in solvers} nfes = {k: [] for k in solvers} for S in NS: cn = [] for k, build in solvers.items(): grid, fn, kw = build(S) c = DL.Counter(model) tab[k].append(DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref)) cn.append(c.n) for k, n in zip(solvers, cn): nfes[k].append(n) # ── 图 4:阶数 ── fig, ax = plt.subplots(figsize=(7.0, 5.0)) for (k, errs), c in zip(tab.items(), cols): p, _ = DL.fit_slope(nfes[k], errs, res) ax.plot(nfes[k], errs, "o-", color=c, lw=1.5, ms=4.5, label=f"{k} " + r"$p=" + f"{p:.2f}" + r"$") ax.axhline(res, ls="--", c="#BBBBBB", lw=1.2) ax.text(max(n[-1] for n in nfes.values()), res * 1.15, f"参考解分辨率 {res:.1e}", fontsize=8, color="#888888", ha="right") ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel("NFE(真实模型评估次数,数出来的)") ax.set_ylabel("终点到参考解的 RMS 距离") ax.set_title("本例误差对各方法实际 NFE 的拟合斜率") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=8, loc="lower left") fig.tight_layout() p4 = OUT / "order_nfe.png" fig.savefig(p4) plt.close(fig) # ── 图 5:评估预算 ── scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160, 192, 256, 384] got = {} for k, build in solvers.items(): row = {} for S in scan: grid, fn, kw = build(S) c = DL.Counter(model) e = DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref) for tol in (1e-2, 1e-3): if tol not in row and e <= tol: row[tol] = c.n got[k] = row fig, ax = plt.subplots(figsize=(7.4, 4.6)) names = list(solvers) xs = np.arange(len(names)) for j, (tol, lab) in enumerate(((1e-2, r"压到 $10^{-2}$ 所需 NFE"), (1e-3, r"压到 $10^{-3}$ 所需 NFE"))): vals, txt = [], [] for k in names: v = got[k].get(tol) vals.append(v if v else 0) txt.append(str(v) if v else "未达扫描阈值") bars = ax.bar(xs + (j - 0.5) * 0.38, vals, width=0.36, color=["#8FB8DE", "#1F4E79"][j], label=lab) for b, t in zip(bars, txt): ax.text(b.get_x() + b.get_width() / 2, b.get_height() + 4, t, ha="center", fontsize=8) ax.set_xticks(xs) ax.set_xticklabels(names, rotation=18, ha="right", fontsize=8) ax.set_ylabel("NFE") ax.set_title("同一个精度,高阶方法省下的评估次数(柱子顶上标的是实测值)") ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") fig.tight_layout() p5 = OUT / "nfe_budget.png" fig.savefig(p5) plt.close(fig) print(f" [4] {p4.name} 参考解分辨率 {res:.3e}") print(f" [5] {p5.name} 1e-2 所需 NFE: " + " ".join(f"{k}={got[k].get(1e-2, '>384')}" for k in names)) print(f" 1e-3 所需 NFE: " + " ".join(f"{k}={got[k].get(1e-3, '>384')}" for k in names)) def main(): print("生成配图(数值全部现场重算)") w, mu, Sig, Xref, TH = build_world() fig_traj(w, mu, Sig, Xref) fig_eta_sweep(w, mu, Sig, Xref, TH) fig_cache_jitter(w, mu, Sig) fig_order_and_budget(w, mu, Sig) print("完成,输出目录:", OUT) if __name__ == "__main__": main()
-
AIGC 基本功|DDPM 训练目标与采样流程-DDPM AIGC 基本功|DDPM 训练目标与采样流程-DDPM 所属方向:生成范式 | 难度:进阶 | 前置知识:扩散过程的前向与反向推导(前向闭式解、反向后验、以及 ELBO 化简到「预测噪声」的那一步都在那篇推过,这里直接用结论) 关键词:DDPM、L_simple、ELBO 每步权重、采样方差、Algorithm 1/2、fixed_small / fixed_large 01. 为什么需要它 我第一次照着 DDPM 论文的公式老老实实实现训练目标,结果比「偷懒版」更差。 实验是这样的:数据是二维高斯,调度用原文的线性 $T=1000$,模型是一个跨时间步共享参数的仿射预测器(18 个可学参数),三种目标各拟合一份,然后算生成分布的精确负对数似然。结果是: 训练目标 期望 NLL(nats,越小越好) 等权 $L_{\text{simple}}$ 1.898760 真 ELBO 每步权重 1.922295 差了 0.0235 nats。而 Ho 等人在原文里就明说了:他们把 ELBO 里那一串只跟 $t$ 有关的系数扔掉,直接等权,反而「sample quality 更好」。我当时以为这只是工程上的凑巧,这组玩具实验给出的线索是:权重与有限模型容量共同影响各时段的拟合误差。把同一个仿射预测器的时间基从 3 项加到 5 项(30 个参数),结论立刻反过来:真 ELBO 权重 1.880952,等权 1.881758,真 ELBO 反超。 第二个坑是采样方差。我一直把 $\tilde\beta_t$ 当成「真实后验方差」。实测把方差换成真正的后验协方差之后,生成分布的期望 NLL 从 1.881015 降到 1.880914,差的 0.000101 nats 全部来自把方差钉死成 $\tilde\beta_t$;生成协方差与真值的比值从 $[0.98946,\ 0.98713]$ 变成 $[1.0,\ 1.0]$。准确地说:$\tilde\beta_t I$ 是已知 $x_0$ 的条件后验协方差;对边缘反向 $q(x_{t-1}\mid x_t)$,它是全协方差分解中的下界。本例用它生成的分布偏窄,不能把数值幅度推广到所有数据。 第三个观察是权重分配。$t\ge2$ 的 ELBO KL 权重跨 120.4 倍,而低噪声端的噪声预测有很高的不可约误差。不可约误差不产生期望梯度;真正被权重重新分配的是可学习的超额误差及随机梯度噪声。后文的容量对照说明“加权在哪种模型上更合适”需要实测,不能把某个时间段断言成无用功。 这里的 NLL 是二维连续高斯数据上的交叉熵,不是图像 FID,也不是论文表格的复现。数据固定为 $\mu_0=(1,-0.5)$、$S_0=\begin{pmatrix}0.60&0.25\\0.25&0.35\end{pmatrix}$,种子为 20260927;时间基、拟合样本数和终步方差约定见第 04 节。这样限定后,数字才能比较。 这三个坑合起来就是这一篇要讲的事:DDPM 的训练目标和采样循环是两件独立的东西,前者管误差权重,后者管转移;在 $L_{simple}$ 下可以分别选择,但 ELBO 权重显式依赖反向方差,并非完全独立。把这两件事分开看,后面所有改进(DDIM、CFG、flow matching)才读得懂。 02. 最小可用理解 先统一符号:$x_0\in\mathbb{R}^{D}$ 是数据,$x_t$ 是第 $t$ 个噪声档,$T$ 是总档数;$\beta_t$ 是前向增量噪声方差,$\alpha_t=1-\beta_t$,$\bar\alpha_t=\prod_{s=1}^{t}\alpha_s$,$\bar\alpha_0=1$。$\varepsilon\sim\mathcal{N}(0,I)$ 与 $x_0$ 独立,$\varepsilon_\theta$ 是预测器,$\sigma_t^2$ 是反向模型方差。$q$ 表示数据与固定前向过程,$p_\theta$ 表示生成链;$I$ 是 $D$ 维单位矩阵。只需先修篇的这一条闭式式子: $$x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon$$ 三句话: 训练:每一步都是一个「从 $x_t$ 猜刚才加了什么噪声 $\varepsilon$」的回归问题。DDPM 把它做成等权均方误差 $L_{\text{simple}}$,故意不理 ELBO 给每步分配的系数。 权重:本例 KL 权重 $w_t$ 跨 120 倍。等权是改写目标;是否改善生成质量取决于误差分布、优化、容量和评测目标。 采样:反向一步的均值由 $\varepsilon$ 预测器决定,方差可取固定 $\tilde\beta_t$、$\beta_t$ 或学习值;固定方差不进入 $L_{simple}$,却进入 ELBO,学习方差还需要相应训练项。 这张图要看什么:左轴的两条线是真 ELBO 权重(蓝实线 $\sigma^2=\tilde\beta_t$,红虚线 $\sigma^2=\beta_t$),灰色点线是「等权」压平到 1 的位置。右轴绿线是这一时刻噪声里能学出来的比例 $R^2$。两条曲线正好反向:权重在 $t$ 很小的地方冲到 0.6,而那里的 $R^2$ 几乎是 0;权重最低的 $t\approx350$,反而是 $R^2$ 爬到一半的地方。低噪声端权重大、可预测噪声占比小;右端并不遵循这个反向关系。这提示检查容量分配,不足以单独证明等权必然更优。 03. 数学推导 3.1 ELBO 拆成每步的 KL 下面的 $L$ 是负 ELBO,即期望负对数似然的上界:$\mathbb{E}_{q(x_0)}[-\log p_\theta(x_0)]\le L$。最大化 ELBO 等价于最小化 $L$,符号方向不要混淆。按 DDPM 原文 Eq.5 展开为 $$L = \mathbb{E}_q\Big[-\log p_\theta(x_0|x_1) + \sum_{t=2}^{T} D_{\mathrm{KL}}\big(q(x_{t-1}|x_t,x_0)\,\|\,p_\theta(x_{t-1}|x_t)\big) + D_{\mathrm{KL}}\big(q(x_T|x_0)\,\|\,p(x_T)\big)\Big]$$ 最后一项在固定前向过程与先验时没有可学参数;$L_0=-\log p_\theta(x_0|x_1)$ 也是训练目标的一部分。DDPM 为离散像素采用离散化高斯解码似然,连续数据可选连续密度;中间那一长串是下面推导的 KL 项。把它记为 $L_{t-1}$(下标是 $t-1$ 因为它监督的是「从 $t$ 走到 $t-1$」这一步)。 为什么这一项好算?因为 $q$ 和 $p_\theta$ 都是高斯,两个高斯的 KL 有闭式解。而 $q(x_{t-1}|x_t,x_0)$ 在后验那篇已经推过:$q=\mathcal{N}(\tilde\mu_t,\ \tilde\beta_t I)$,其中 $\tilde\beta_t$ 是一个不依赖 $x_t$ 的常数,$\tilde\mu_t$ 是 $x_t$ 与 $x_0$ 的线性组合。在反向方差固定、不由模型学习的前提下,KL 里唯一依赖模型的部分是均值之差: $$L_{t-1} = \mathbb{E}_q\Big[\tfrac{1}{2\sigma_t^{2}}\big\|\tilde\mu_t(x_t,x_0)-\mu_\theta(x_t,t)\big\|^{2}\Big] + C$$ $C$ 是与参数无关的常数,$\sigma_t^2$ 是反向链在这一步选的方差。 3.2 把均值之差换成噪声之差 $\tilde\mu_t$ 和 $\mu_\theta$ 用同一组系数线性组合,前者组合的是真 $x_0$,后者组合的是模型猜的 $\hat x_0$。把 $x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon)$ 和 $\hat x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon_\theta)$ 代进去,$x_t$ 那一项整整齐齐地消掉,剩下 $$\tilde\mu_t-\mu_\theta = -\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\big(\varepsilon-\varepsilon_\theta\big)$$ 注意这里出现的 $\sqrt{\bar\alpha_{t-1}}/\sqrt{\bar\alpha_t}=1/\sqrt{\alpha_t}$——这是整个化简能成立的关键一步,两个系数只差一个 $\sqrt{\alpha_t}$,所以差值是干净的单项。 平方之后: $$L_{t-1} = \mathbb{E}\Big[w_t\big\|\varepsilon-\varepsilon_\theta\big\|^{2}\Big] + C,\qquad w_t=\frac{\beta_t^{2}}{2\sigma_t^{2}\alpha_t(1-\bar\alpha_t)}$$ 这就是那个「只跟 $t$ 有关的系数」。固定方差时由调度和方差选择决定;若学习方差,就不能把相关项都视为与参数无关的常数。 代入两种方差选择,还能再化简一层: $$w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_{t-1})}\ \ (\sigma_t^{2}=\tilde\beta_t),\qquad w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_t)}\ \ (\sigma_t^{2}=\beta_t)$$ 两条式子的分母只差一个下标。附录 ddpm_lab.py 里解析式和化简式两条都算了,最大相对差 3.93×10⁻¹⁶($\tilde\beta$)和 4.13×10⁻¹⁶($\beta$),就是浮点误差级别。 $t=1$ 时 $\tilde\beta_1=0$,上述固定小方差高斯 KL 权重分母为零、分子非零,不能使用。它不是 $0/0$。ELBO 此时对应重建似然 $L_0$,需另行定义;不是“所有最后一步都不准有高斯密度”。本实验用 $\beta_1>0$ 的连续高斯重建权重补这一点,因此表中的 elbo_tilde 是这一连续数据约定,不是逐字复现离散像素 ELBO。 3.3 $w_t$ 长什么样 线性调度 $T=1000$、$\beta$ 从 $10^{-4}$ 到 $0.02$(原文 CIFAR-10 的配置),$\bar\alpha_T=4.0358\times10^{-5}$。实跑出来: $t$ $\bar\alpha_t$ $\beta_t$ $w_t$($\sigma^2=\tilde\beta_t$) $w_t$($\sigma^2=\beta_t$) 相对 $t=500$ 2 9.998e-01 0.00012 5.9967e-01 2.7269e-01 108.87 10 9.981e-01 0.00028 8.6437e-02 7.3717e-02 15.69 50 9.710e-01 0.00108 1.9279e-02 1.8583e-02 3.50 100 8.970e-01 0.00207 1.0267e-02 1.0081e-02 1.86 250 5.241e-01 0.00506 5.3733e-03 5.3432e-03 0.98 500 7.859e-02 0.01004 5.5082e-03 5.5034e-03 1.00 750 3.351e-03 0.01502 7.6506e-03 7.6502e-03 1.39 900 2.752e-04 0.01801 9.1717e-03 9.1716e-03 1.67 1000 4.036e-05 0.02000 1.0205e-02 1.0204e-02 1.85 最后一列是「相对 $t=500$ 的倍数」,等权相当于把这一列全压成 1.00。 形状是两端高、中间平的一个碗。$\tilde\beta$ 版本的最大值是最小值的 120.4 倍;$\beta$ 版本因为分母用的是 $1-\bar\alpha_t$ 而不是 $1-\bar\alpha_{t-1}$,在 $t$ 很小的地方发散得温和些,动态范围小很多。 左端 $1-\bar\alpha_{t-1}$ 很小,使权重大;中段分母增长与线性增大的 $\beta_t$ 互相抵消;右端 $1-\bar\alpha_t$ 趋近 1 后,$w_t\approx\beta_t/(2\alpha_t)$ 随 $\beta_t$ 上升。不能说 $t=250$ 时分母已饱和:表中此时 $1-\bar\alpha_t\approx0.476$。 这个式子不是我拍脑袋的,脚本里用两个高斯的 KL 数值核了一遍:随机取 $x_0$ 和 $\varepsilon$,令 $\varepsilon_\theta=\varepsilon+\delta$($\delta$ 是一个固定的小扰动),比较「数值算的 KL」与「$w_t\|\delta\|^2$」: t KL(数值) w_t*||delta||^2 相对差 2 1.416848e-02 1.416848e-02 2.89e-13 100 1.612712e-03 1.612712e-03 4.17e-14 500 5.035556e-04 5.035556e-04 1.72e-15 1000 2.188401e-03 2.188401e-03 1.61e-14 相对差在 $10^{-13}$ 量级,推导和代码对上了。 3.4 先分清不可约地板和可学习误差 $w_t$ 只说明「这一步的误差在 ELBO 里值多少钱」,没说明这一步的误差能不能被压下去。真正该看的是贝叶斯地板:给定 $x_t$ 后 $\varepsilon$ 还剩多少不确定性。 数据是 $\mathcal{N}(\mu_0,S_0)$ 时,$x_t$ 的协方差是 $\bar\alpha_t S_0+(1-\bar\alpha_t)I$,条件方差有闭式解,地板就是 $$\mathrm{floor}(t)=\frac{1}{D}\,\mathrm{tr}\Big[\mathrm{Var}(\varepsilon\,|\,x_t)\Big]=\frac{D-(1-\bar\alpha_t)\,\mathrm{tr}\big[(\bar\alpha_tS_0+(1-\bar\alpha_t)I)^{-1}\big]}{D}$$ 定义可学占比 $R^2(t)=1-\mathrm{floor}(t)$($\varepsilon$ 每维先验方差是 1)。实测:$t=1$ 时 $R^2=3.22\times10^{-4}$,$t=500$ 时 0.9616,$t=1000$ 时 1.0000。 在 $t=1$,噪声系数是 $\sqrt{1-\bar\alpha_1}=0.01$,$R^2=3.22\times10^{-4}$ 即约 0.0322%。这说明噪声有很大的条件方差,不说明最优预测毫无用途:生成所需 score 正由小的条件均值决定。$t=2$ 的 108.87 倍权重与 $t=1$ 的 $R^2$ 不能混为同一个时间步。 为什么地板不能用来判断某一步“没用”?记最优预测器 $\varepsilon^{\star}(x_t,t)=\mathbb{E}[\varepsilon\mid x_t]$。把 $\varepsilon-\varepsilon_\theta=(\varepsilon-\varepsilon^{\star})+(\varepsilon^{\star}-\varepsilon_\theta)$ 平方展开;交叉项的条件期望为零,因为 $\mathbb{E}[\varepsilon-\varepsilon^{\star}\mid x_t]=0$,所以 $$\frac{1}{D}\mathbb{E}\|\varepsilon-\varepsilon_\theta\|^2=\frac{1}{D}\mathbb{E}\,\mathrm{tr}\,\mathrm{Var}(\varepsilon\mid x_t)+\frac{1}{D}\mathbb{E}\|\varepsilon^{\star}-\varepsilon_\theta\|^2$$ 第一项是地板,第二项才是超额误差。给它乘 $w_t$ 后,地板依然不产生参数的期望梯度;它会参与有限样本损失和梯度噪声的统计,却不能证明低噪声拟合不重要。高斯加噪还给出 $\nabla_{x_t}\log q_t(x_t)=-\varepsilon^{\star}(x_t,t)/\sqrt{1-\bar\alpha_t}$,其中 $q_t$ 是 $x_t$ 的边缘密度:小的噪声均值经小分母缩放后,仍可对应有限且重要的 score。 因此,有限容量如何分配超额误差、优化噪声多大,以及误差如何沿采样链传播,需要分别验证。不能只凭 $R^2$ 或权重曲线推出生成质量。 3.5 采样方差不是后验方差 $\tilde\beta_t$ 是 $q(x_{t-1}|x_t,x_0)$ 的方差,条件是「已知 $x_0$」。边缘反向 $q(x_{t-1}\mid x_t)$ 要对未知的 $x_0$ 积分。令 $c_0=\sqrt{\bar\alpha_{t-1}}\beta_t/(1-\bar\alpha_t)$、$c_t=\sqrt{\alpha_t}(1-\bar\alpha_{t-1})/(1-\bar\alpha_t)$。对 $q(x_{t-1}\mid x_t,x_0)$ 使用全协方差公式,第一项是条件协方差的期望,第二项是条件均值的协方差: $$\Sigma_t(x_t)=\mathrm{Cov}(x_{t-1}\mid x_t)=\tilde\beta_t I+c_0^2\mathrm{Cov}(x_0\mid x_t)$$ 这是数据的条件不确定性,即使模型恰好输出最优条件均值,也仍然存在;它不等于模型的均值预测偏差。$\hat x_0$ 若是 $x_t$ 的确定函数,$\mathrm{Cov}(x_0-\hat x_0\mid x_t)=\mathrm{Cov}(x_0\mid x_t)$,但误差的二阶矩还会包含偏差项,不能混称。第二项半正定,因此 $\tilde\beta_t I$ 是协方差意义的下界。一般数据的边缘反向分布是高斯的混合,协方差可以依赖 $x_t$;即使匹配其均值与协方差,也不保证高斯转移等于该分布。本节只有在高斯数据下,边缘反向本身才是高斯且协方差与 $x_t$ 无关。实测:用最优 $\varepsilon$ 预测器配 $\tilde\beta_t$,生成协方差只有真值的 $[0.98946,\ 0.98713]$;换成真实后验协方差,比值精确回到 $[1.0,\ 1.0]$,NLL 差 $3.56\times10^{-10}$ nats——在本例中极接近数据分布;仍有有限终点先验与数值误差。 这一节的结论对后面很重要:反向链的均值和方差是两件事。均值决定你往哪走,方差决定你抖多厉害;在这个高斯实验中,固定 $\tilde\beta_t$ 使协方差特征值约偏小 1.1%~1.3%;该数值不是通用结论。 04. 代码实现 4.1 调度、$\tilde\beta_t$、$w_t$(20 行) def linear_beta(T=1000, b1=1e-4, bT=0.02): """DDPM 原文 CIFAR-10 用的线性调度。""" return np.linspace(b1, bT, T) class Sched: """下标约定:abar[t]、bt[t] 的 t 取 0..T;beta[t-1]、alpha[t-1] 对应数学时间步 t。""" def __init__(self, beta): self.T = len(beta) self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) # 长度 T+1 self.bt = np.empty(self.T + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": # t=1 时 tilde_beta_1=0,分母为零。DDPM 把这一步交给 L_0 单独处理, # 这里退化地用 fixed_large 的权重顶上,只为让训练能跑。 w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w np.errstate 那一行不是装饰:\tilde\beta_1=0 会触发除零,不包起来的话 w/w.mean() 之后整条权重变成 nan,训练静悄悄地训出一个废模型。 4.2 三种目标:共享参数的带权最小二乘 要让「权重决定容量往哪搬」这件事看得见,模型必须跨时间步共享参数——否则每一步各自拟合,权重只影响每一步自己的收敛速度,看不出搬移效果。所以用一个仿射 $\varepsilon$ 预测器加固定时间基: $$\varepsilon_\theta(x_t,t)=W\,\big[x_t\otimes\psi(t),\;\psi(t)\big],\qquad \psi(t)=\big[1,\ (t/T)^{0.5},\ t/T\big]$$ (指数取 $[0,0.5,1]$ 而不是 $[0,1,2]$:因为 $\sqrt{1-\bar\alpha_t}$ 在 $t$ 小的时候像 $\sqrt{t}$,纯整数次幂的多项式基在这一段拟合不出来,曲线会剧烈振荡。这是踩过的坑。) 训练集 $M=120000$ 条 $(x_0,t,\varepsilon)$,特征维度 9,可学参数 18 个。三种权重都归一化到均值 1(无正则时整体缩放不改变解;这里另有 $\lambda=10^{-6}$ 的岭项,归一化使正则强度口径一致)。用带权岭回归一步算出闭式解,不做迭代。 4.3 高斯生成链的精确 NLL 一开始我用采样算 NLL,三种目标差 0.002~0.005 nats,而 2 万样本的蒙特卡洛误差就有 ±0.007——结论完全淹没在噪声里。改走闭式解:仿射模型下 $p_\theta(x_0)$ 仍是高斯,把密度沿反向链往前传,最后 $$\mathbb{E}\big[-\log p_\theta(x_0)\big]=H\big[\mathcal{N}(\mu_0,S_0)\big]+D_{\mathrm{KL}}\big(\mathcal{N}(\mu_0,S_0)\,\|\,\mathcal{N}(m,S)\big)$$ 这里 $m,S$ 是生成链终点的均值和协方差,$H$ 是数据分布微分熵。注意两份代码的终步约定:ddpm_lab.py 的 large 与线性插值在 $t=1$ 仍加入相应高斯方差;tilde 的终步方差为零,exact 保留高斯数据的真实条件协方差。ddpm_train.py 则遵循 Algorithm 2,所有固定方差分支的 $t=1$ 都不加噪声。因此下面是各自明确约定下的实验,不能当作同一个终步采样器的横向排名。 用 40 万样本复核,闭式解 1.880914 对蒙特卡洛 1.880890,差 $2.38\times10^{-5}$。两种独立实现(密度前向传播 / 线性映射复合)的均值差 $8.88\times10^{-16}$、协方差差 $5.00\times10^{-16}$。 三种目标 × 两种采样方差: 训练目标 $\sigma^2=\tilde\beta_t$ $\sigma^2=\beta_t$ 差 生成 std / 真 std uniform(等权) 1.898760 1.895815 −0.002945 0.9659 elbo_tilde 1.922295 1.924692 +0.002396 1.0392 elbo_large 1.914947 1.917129 +0.002181 1.0322 (最后一列是生成分布标准差与真分布标准差的比值,1 表示胖瘦刚好对上。等权明显偏窄,真 ELBO 权重的两个版本反而偏宽。) 4.4 权重把超额误差搬到了哪 「超额」= 实际 MSE − 贝叶斯地板,包括容量、有限样本、正则化与优化误差: $t$ 可学占比 $R^2$ 地板 等权超额 真 ELBO 超额 1 0.0003 0.9997 1.516e-01 1.017e-02 5 0.0022 0.9978 1.120e-01 6.824e-03 20 0.0182 0.9818 5.295e-02 3.897e-03 50 0.0853 0.9147 9.778e-03 7.323e-03 100 0.2510 0.7490 4.271e-03 2.560e-02 200 0.5663 0.4337 1.324e-02 2.820e-02 400 0.9000 0.1000 1.067e-03 4.463e-03 600 0.9876 0.0124 5.375e-03 1.349e-02 800 0.9993 0.0007 3.118e-04 1.082e-03 1000 1.0000 0.0000 1.337e-02 2.345e-02 分档汇总:低噪声档 $t\le50$,等权超额 5.140e-02,真 ELBO 5.137e-03(比值 0.10,好 10 倍);高噪声档 $t\ge400$,等权 3.459e-03,真 ELBO 8.060e-03(比值 2.33,差一倍多)。 这张图要看什么:(a) 两条曲线的交叉点大约在 $t=70$——交叉点左边真 ELBO 权重更准,右边等权更准;(b) 取比值后看得更清楚,灰色填充区(比值 <1)是真 ELBO 占优的低噪声段,红色填充区(比值 >1)是等权占优的中高噪声段。这个容量档的加权结果是一部分时段变好、另一部分变差。表格支持这一观察,却不能凭“超额误差相对地板很小”解释哪一段赔得起:地板不参与最优均值的期望梯度,且各时段预测误差对终点分布的影响不同。本例等权 NLL 更低,是反向链传播后由 4.3 实际算出的结果;4.5 的容量反例说明它不是普遍规律。 4.5 换个容量档,结论反过来 时间基从 3 项加到 5 项($[0,0.5,1,1.5,2]$,30 个参数),其他完全不动: 容量档 时间基项数 可学参数 NLL(等权) NLL(真 ELBO) 谁更好 低噪声档超额比 高噪声档超额比 loose 5 30 1.881758 1.880952 真 ELBO 0.71 3.91 tight 3 18 1.898760 1.922295 等权 0.10 2.33 这张表说明两档容量的排序不同,不能推出“容量足够时 ELBO 自然赢”。ELBO、生成 NLL 和感知质量也不是同一个目标;EDM、Min-SNR 同时涉及预条件、噪声分布或多任务梯度冲突,不应仅归因为模型变大。 4.6 真网络版:Algorithm 1 与 Algorithm 2 闭式解毕竟是玩具。附录 ddpm_train.py 给了一份 numpy 手写版:两个隐藏层、三个线性层的 MLP($10\to64\to64\to2$,输入为二维 $x_t$ 加八维时间嵌入,共 4994 个参数),手写反向传播 + Adam,batch 256,20000 步,数据是 7 个高斯的混合(一个中心 + 六个环)。 梯度先对:手写反向传播 vs 有限差分,最大相对差 4.42×10⁻⁹。Algorithm 1(训练) 保留原文的均匀抽 $t$、一步加噪、预测噪声流程;网络、优化器与玩具数据是教学选择,加权分支额外乘 $w_t$。等权目标显式为 $$L_{\mathrm{simple}}=\mathbb{E}_{t\sim U\{1,\ldots,T\},\,x_0\sim q,\,\varepsilon\sim\mathcal{N}(0,I)}\|\varepsilon-\varepsilon_\theta(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon,t)\|^2$$ 只关心相对训练权重时可省整体常数;若要无偏估计 ELBO 的逐步求和,则均匀采样还需乘相应项数,并单独处理 $L_0$。代码是: def train(sc, w_full, steps, batch, rng, lr=1e-3): p = init_params(rng) opt = Adam(p, lr=lr) for _ in range(steps): # 1: t ~ Uniform({1, ..., T}) 2: x_0 ~ q(x_0) 3: eps ~ N(0, I) t_idx = rng.integers(1, T + 1, size=batch) # (256,) x0 = sample_mix(batch, rng) # (256, 2) eps = rng.standard_normal((batch, D)) # (256, 2) # 4: 一步加噪(闭式解,不需要真的走 t 步) a = sc.abar[t_idx] # (256,) xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps # 5: 梯度下降一步 Z = np.concatenate([xt, time_embed(t_idx)], axis=1) # (256, 10) h1, h2, out = forward(p, Z) # (256,64) (256,64) (256,2) opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1])) return p 三个 shape 值得停下来看一眼。第一,t_idx 是一个长度为 batch 的随机整数向量,不是标量——每个样本走不同的时间步,这是 $L_{\text{simple}}$ 里那个 $\mathbb{E}_t$ 的实现方式,也是「等权」的字面含义:每个 $t$ 被抽中的概率相同。第二,Z 的第二维是 $10 = 2 + 8$,其中 8 维来自 TIME_FREQ = (1,2,4,8) 的 cos/sin 时间嵌入;不把 $t$ 喂进去的话,网络不知道当前噪声档位,$L_{\text{simple}}$ 根本学不动。第三,w_full[t_idx - 1] 这个减一是全文最容易写错的地方:时间步 $t$ 从 1 数到 $T$,而数组下标从 0 开始。写反了整条权重会整体错位一步,$t$ 很小的地方拿到的是 $t+1$ 的权重——在动态范围 120 倍的曲线上,错位一步就能让训练目标面目全非。 Algorithm 2(采样) 是完整 1000 步链: def sample_chain(sc, p, n, which="tilde", rng=None): x = rng.standard_normal((n, D)) # x_T ~ N(0, I) for t in range(T, 0, -1): eps_hat = predict_eps(p, x, t) a, a_prev = sc.abar[t], sc.abar[t - 1] alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1] mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t) sigma = np.sqrt(sc.bt[t]) if which == "tilde" else np.sqrt(beta_t) z = rng.standard_normal((n, D)) x = mu + (sigma * z if t > 1 else 0.0) # t == 1 时不加噪声 return x 最后那行 if t > 1 else 0.0 就是 diffusers 里 if t > 0 的同一个判断(下标约定差 1):最后一步不加噪声。均值那一行是 $\tilde\mu_t$ 的另一种写法——把 $x_0$ 用 Tweedie 公式替掉之后 $\tilde\mu_t=\frac{1}{\sqrt{\alpha_t}}\big(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon_\theta\big)$,比 3.2 节那个两项组合的形式更紧凑,也是 diffusers 之外大多数实现采用的写法。 采样之后用三个教学指标打分,先明确它们不是 4.3 的生成模型 NLL。这里的 $\Delta\log p_0=\mathbb{E}_{p_\theta}[\log p_{\mathrm{data}}]-\mathbb{E}_{p_{\mathrm{data}}}[\log p_{\mathrm{data}}]$ 把生成样本代入已知数据密度,积分分布和打分密度都与 NLL 不同。 采样之后用三个指标打分:$\log p_0$ 相对真样本、到最近模式中心的距离比、模式覆盖数(某个分量占比超过 2% 才算被覆盖)。这三个指标是互补的——$\log p_0$ 只衡量落在高密度区,模式覆盖才告诉你有没有整个丢掉某个模式;这次两个网络都是 7/7,但仅靠覆盖数与平均中心距离,不能断言模式内的分布已拟合正确。一个反例是按真实分量权重只输出七个中心:它没有分量内方差,却能获得很高密度评分和 7/7 覆盖。完整脚本新增这一反例供实跑:密度评分 +0.9580、中心距离比 0、覆盖 7/7,尽管分量内方差为零。 训练目标 $\log p_0$ 相对真样本 到最近中心距离 / 真样本 模式覆盖 uniform −0.2208 ± 0.0195 1.0857 7/7 elbo_tilde −0.4212 ± 0.0062 1.1997 7/7 在这次固定训练种子的运行中,等权分支在上述两个评分上更接近真样本基线。表内 ± 是同一个已训练模型的三个采样种子间标准差,不是重复训练标准差或置信区间;两个分支用了不同初始化与训练随机序列,故不能把差距全归因于权重,也不能和高斯 NLL 的差值比较。每步 MSE 剖面中,$t=1$ 两个网络都约 1.0,说明低噪声档的噪声条件方差大;$t=1000$ 为 0.0016 与 0.0026。这不意味着低噪声 score 无需精确学习。 只换采样方差、不动网络: 方差选择 $\log p_0$ 相对真样本 到最近中心距离 / 真样本 $\tilde\beta_t$(fixed_small) −0.2363 ± 0.0123 1.0968 $\beta_t$(fixed_large) −0.2640 ± 0.0129 1.1099 这里和 4.3 的高斯实验结论相反:高斯闭式解里 $\beta_t$ 把偏窄补回来了(std 比 0.9659 → 0.9720),多峰数据上 $\tilde\beta_t$ 反而更好。两个方差在低噪声段的相对差较大,高噪声段很接近;本次 large 分支的平均中心距离更大。这是可观察结果,尚未隔离方差、预测误差与多步传播各自的贡献。方差选择取决于数据、预测误差、调度与评价指标,不能只按是否多峰判断,别把一维高斯的结论直接搬。 05. 工业级实现对照 对照 huggingface/diffusers v0.35.1 的固定版本源码:DDPMScheduler.step、_get_variance 和 previous_timestep,于 2026-10-09 逐项核对。本文讨论默认完整训练时间网格;推理若跳步,应使用当前与目标步的累计 $\bar\alpha$ 重新组合转移系数。这一份源码就是知识树里给这个节点配的 code_refs。 第一处差异:方差有六个分支,不是一个数。 我 4.1 节只写了 $\tilde\beta_t$ 和 $\beta_t$ 两种,框架里是 _get_variance() 的六个 variance_type: if variance_type == "fixed_small": # 默认:后验方差的下界 variance = variance elif variance_type == "fixed_small_log": # 取 log 再 exp(0.5*log),代数上等价 variance = torch.log(variance); variance = torch.exp(0.5 * variance) elif variance_type == "fixed_large": # 直接上 beta_t variance = current_beta_t elif variance_type == "fixed_large_log": variance = torch.log(current_beta_t) elif variance_type == "learned": # 网络自己输出 return predicted_variance elif variance_type == "learned_range": # 在 [tilde_beta, beta] 之间插值 min_log = torch.log(variance); max_log = torch.log(current_beta_t) frac = (predicted_variance + 1) / 2 variance = frac * max_log + (1 - frac) * min_log 值得注意的是 learned_range:两个端点是固定小方差与大方差的对数,与 4.3/第 06 节线性方差扫描采用相同端点,但插值空间不同。公式 $f=(v+1)/2$ 只有在网络输出 $v\in[-1,1]$ 时才把结果限制于端点之间;这个版本的 scheduler 不 clamp $v$,越界时是外插。学习方差还需要配套的训练损失,不能只把输出通道翻倍。 第二处差异:最后一步不加噪声。 源码里 variance = 0; if t > 0: ...,t=0 对应本文的 $t=1$。这是 Algorithm 2 和该 scheduler 的终步约定;即使选 fixed_large 也跳过终步噪声,不能仅由 $\tilde\beta_1=0$ 推出所有方差分支都必须如此。连续密度模型可另定义有非零方差的终步分布,如本篇高斯账本;须明确自己评估的是哪条链。 第三处差异:累计噪声表预先计算,转移系数在 step 内由当前与目标时间步组合。 step() 里那两行: pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample 展开就是 3.2 节的 $\tilde\mu_t$,$c_0=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}$、$c_x=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$,一字不差。 这张图要看什么:三条线是反向一步的三个配料随 $t$ 的变化——蓝线是「拉向 $\hat x_0$ 的系数」$c_0$,灰虚线是「保留 $x_t$ 的系数」$c_x$,红线是注入噪声的标准差 $\sqrt{\tilde\beta_t}$。较多时间步的 $c_0$ 在 1e-4 ~ 1e-2 量级,低噪声端会增大。系数大小不是实际位移大小:$\mu_\theta-x_t=c_0\hat x_0+(c_t-1)x_t$ 还取决于两个向量,且 $c_0+c_t$ 一般不等于 1;因此不能把 $c_0=0.003$ 直接解释成“挪了千分之三”,也不能据此断言图像在哪些步才成形。这是完整 1000 步离散表下的系数,不意味着采样必须走满 1000 步。重排噪声表或换求解器后,模型可用更少的评估次数采样。 第四处差异:prediction_type 有三个选项。 epsilon(默认)、sample(直接预测 $x_0$)、v_prediction(预测 $v$)。源码把三者统一先转成 pred_original_sample,再走同一套系数——参数化只是换了个入口,反向一步的代数完全一样。参数化之间的权重差异在那篇《扩散过程的前向与反向推导》里算过(本线性调度下,以等权噪声误差换算:$v$ 的系数是 $\bar\alpha_t$,$x_0$ 的系数是 $\bar\alpha_t/(1-\bar\alpha_t)$;系数动态范围分别约 2.5×10⁴ 与 2.5×10⁸)。 第五处:clip_sample=True 是默认开的。 默认 clip_sample_range=1.0,把 pred_original_sample 夹到 $[-1,1]$。这适合相应归一化像素设定,不能直接套给任意潜空间——潜变量即使经过模型约定的尺度归一化,也不因此具有 $[-1,1]$ 的有界支撑。因此不能照搬像素裁剪,是否关闭或采用其他限幅应遵循具体模型配置。 06. 代价与边界 等权省了什么:不用管 $\tilde\beta_1=0$ 的退化,不用管 $L_0$ 的离散解码器,没有显式时间权重,但不保证每步的梯度范数一致(这点很重要——那篇前向反向推导里算过,$x_0$ 参数化跨 2.5×10⁸ 倍,不同时间档的梯度大小可能差异很大,实际范数还受网络雅可比和数据影响)。 等权赔了什么:三档实测摆在一起看—— 场景 等权 真 ELBO 权重 谁赢 容量宽裕(30 参数,高斯) 1.881758 1.880952 真 ELBO 容量吃紧(18 参数,高斯) 1.898760 1.922295 等权 容量吃紧(MLP,7 峰混合) −0.2208 −0.4212 等权 怎么选择权重:若关注低噪声重建精度,应在任务数据上测量各时段超额误差与最终质量,比较等权与加权;本例的 10 倍误差比不能直接推出超分、修复都不该用等权。 采样方差的边界:高斯数据上 $\beta_t$ 把偏窄从 3.4% 补到 2.8%(补回 0.6 个百分点,还没补满);多峰数据上 $\beta_t$ 反而更差。所以别把「fixed_large 更大更对」当成通例——应按相同终步约定,控制训练随机性,再比较目标任务的质量、覆盖和方差指标。是否多峰只是数据特征之一。 这张图要看什么:(a) 三条线是本高斯实验每步的方差——$\tilde\beta_t$(蓝)、$\beta_t$(红虚)、真实后验方差(绿)。绿线与蓝线的差异取决于时间步,较低噪声端尤其需关注,这个差值是 3.5 节的条件不确定性项。最优高斯预测器下,加入真实条件协方差后,NLL 缺口从约 0.000101 降到 3.56e-10 nats;仍保留有限终点先验与数值误差,不宣称精确等于零。(b) 在 $\tilde\beta_t$ 与 $\beta_t$ 之间插值扫一遍:蓝线(左轴)是生成分布标准差与真分布之比,从 0.9659 单调爬到 0.9720;红线(右轴)是期望 NLL,几乎是一条平线。标准差之比是敏感指标,NLL 对这件事几乎不动——想判断方差选得对不对,同时检查 NLL 与协方差,不要只看一个指标。 采样成本要按同一口径计数:4000 样本 × 1000 步是 $4\times10^6$ 次样本级前向;训练 20000 步 × batch 256 是 $5.12\times10^6$ 次样本级前向,另有反向计算。不能拿样本级采样前向数除以训练优化器步数,声称采样贵 200 倍。批量大小与硬件利用率还会改变墙钟时间。 最后一个容易搞混的地方:训练目标(等权还是加权)和采样器(DDPM 随机链还是 DDIM 确定链)在等权噪声回归设定下可以分别比较。本篇始终使用逐步高斯反向转移,但既比较训练权重,也比较固定/真实协方差和终步约定。等权噪声回归可以配合 DDIM 等其他采样构造;完整 ELBO 的具体形式仍与所定义的生成链有关。换了训练目标不影响你能不能换采样器,反过来也一样——DDIM 那篇最关键的观察就是:DDPM 的训练目标根本没有约束反向链必须是一阶 Markov 的。把这两件事当成一件事,是读扩散模型文献时最普遍的混线。 07. 经典论文脉络 arXiv:1503.03585(Sohl-Dickstein et al., 2015)——扩散的雏形。 定义了前向 Markov 链和反向链,用前向扩散与变分目标训练反向过程,样本质量也远不够看。贡献是「这个方向存在」。 Denoising Diffusion Probabilistic Models(Ho et al., 2020)——DDPM,本篇的锚点。 三件事:把 $\tilde\mu_t$ 参数化成预测 $\varepsilon$;指出 ELBO 里那串只跟 $t$ 有关的系数可以扔掉、等权反而更好;给出 $\tilde\beta_t/\tilde\mu_t$ 的闭式解并配上线性调度。上述参数化与简化目标是该论文实验选择的一部分,采样质量改善还依赖网络、调度和训练配置。 Improved Denoising Diffusion Probabilistic Models(Nichol & Dhariwal, 2021)。 两件事直接对着本篇的洞:一是学方差(对应 learned_range,在 $\tilde\beta_t$ 与 $\beta_t$ 之间让网络选位置,且在 log 空间插值);二是余弦调度,改善低分辨率设置下线性噪声调度过快破坏信号、后段接近纯噪声的问题。 Denoising Diffusion Implicit Models(Song et al., 2020)——DDIM。 指出 DDPM 的训练目标其实没有约束反向链必须是 Markov 的,于是可以推一个非 Markov 的确定性问题,一步跨很多步。训练和采样在这里正式解耦。 Elucidating the Design Space of Diffusion-Based Generative Models(Karras et al., 2022)——EDM。 从「每步该加权多少」重新出发,把加权、预处理、调度统一成一套设计空间,并用二阶求解器把步数压到几十步。它分析采样器、噪声分布与预条件等独立设计因素,不能称为本文“容量排序翻转”的真实模型复现。 08. 常见误解 ①「$L_{\text{simple}}$ 就是 ELBO。」 不是。它丢掉了两样东西:每步的 $w_t$,以及 $L_0$ 那一项的离散解码器。它是一个设计选择,不是近似——丢掉的部分在数学上并不小($w_t$ 跨 120 倍),本文的一个小容量档出现等权优势,另一个容量档相反;这些实验不能给所有容量受限模型下结论。 ②「$\tilde\beta_t$ 是真实后验方差。」 不是,它是已知 $x_0$ 时的后验方差。边缘反向还要计入 $x_0\mid x_t$ 的条件不确定性;即使预测均值完全正确,该项也不消失。本高斯例的协方差两个对角元分别约偏低 1.1% 和 1.3%;这是方差口径,不能写成标准差也下降相同比例,更不能推广到所有时间步或数据。 ③「权重大意味着更容易学。」 权重衡量误差在目标中的代价,条件方差衡量不可约误差;两者不是同一个量。低噪声端 $R^2$ 小不意味着该步 score 不重要。 ④「采样方差是训出来的。」 默认不是。fixed_small 是硬编码的 $\tilde\beta_t$,跟训练毫无关系;只有 learned / learned_range 才让网络参与,而且此时模型输出通道要翻倍(step() 里 model_output.shape[1] == sample.shape[1] * 2 那个判断就是干这个的)。 ⑤「换方差只影响采样,不影响训练。」 一半对。方差确实不参与 $L_{\text{simple}}$ 的计算,但 $w_t$ 的公式里有 $\sigma_t^2$——所以用真 ELBO 权重训练时,你选的方差会通过 $w_t$ 反过来改变训练目标(表 3 里 elbo_tilde 和 elbo_large 是两种不同的训练目标,不只是两种采样方式)。 ⑥「等权赢,所以加权分析没用了。」 本文两个容量档已经出现排序翻转;权重还与噪声调度、预条件、数据与优化相互作用。应在同一评测口径下选择,不能把一次玩具胜负当成普遍结论。 ⑦「$T=1000$ 是个需要调的超参。」 不完全是。$T$ 决定了 $w_t$ 的动态范围,也决定了每步要挪多远;但它同时被 $\beta$ 调度绑住——改 $T$ 不改 $\beta$ 的端点,等于改了整条噪声表的形状。Improved DDPM 同时研究余弦调度,并将默认训练扩散步数由 1000 增至 4000;它也研究减少推理步数。训练噪声网格与推理评估次数是不同的超参数,比较前要一起交代。 09. 动手验证 两个数值实验脚本都在附录,只依赖 NumPy;配图脚本另需 matplotlib。原种子下的数值表保留,本轮在 Windows/CPU 上完整复跑并核对,训练与采样种子的统计限制见 4.6: python ddpm_lab.py # 闭式解实验室,几秒跑完 python ddpm_train.py --steps 20000 --n-gen 4000 # 真网络版,几分钟 ddpm_lab.py 会依次打印六段(真实输出摘要,不是预期值): A 段:两种方差下的 $w_t$ 表格,解析式与化简式的最大相对差 3.93e-16;用两个高斯的 KL 数值核对,相对差 2.89e-13;并明确打印 t=1 的 tilde_beta_1 = 0.000e+00。 B 段:训练集规模(120000 条、时间基 3 项、18 个参数)与权重动态范围 120.4。 C 段:真分布熵 1.880914 nats;「最优 $\varepsilon$ 预测器 + $\tilde\beta_t$」1.881015(差 +0.000101);「最优 $\varepsilon$ 预测器 + 真实后验方差」1.880914(差 +3.56e-10)。三种目标 × 两种方差的 NLL 表。 D 段:每步超额误差剖面,低噪声档比值 0.10、高噪声档比值 2.33。 E 段:$\lambda$ 插值扫描,NLL 1.898760 → 1.895815,生成 std 比 0.9659 → 0.9720。 F 段:两档容量对照,loose 真 ELBO 赢(1.880952 vs 1.881758)、tight 等权赢(1.898760 vs 1.922295)。 ddpm_train.py 的 A 段是梯度检查(有限差分相对差 4.42e-09),C 段是三种指标打分(uniform −0.2208±0.0195 / elbo_tilde −0.4212±0.0062),D 段只换采样方差($\tilde\beta_t$ −0.2363±0.0123 / $\beta_t$ −0.2640±0.0129)。 想自己动手改的话,三个地方最值得试:把 BASIS 从 3 项换成 5 项看结论翻转(F 段已经在做);把 T 从 1000 降到 100 看 $w_t$ 的动态范围怎么变;把数据从高斯换成 ddpm_train.py 的 7 峰混合,看方差选择的结论会不会反过来。 10. 延伸阅读 前置:扩散过程的前向与反向推导(前向闭式解、反向后验、ELBO→$\varepsilon$ 的化简)、变分下界与重参数化(ELBO 这个工具本身从哪来)。 已发布后继:DDIM 与高阶采样器、CFG、潜空间扩散、流匹配。 往上一层:把 RL 用到扩散模型上(训练目标被换成奖励之后,$w_t$ 这套分析还成不成立)。 附录:完整代码 09 节用到的脚本全文如下(ddpm_lab.py、ddpm_train.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ddpm_lab.py # -*- coding: utf-8 -*- """DDPM 训练目标的最小实验室(闭式解版,只依赖 numpy,无 torch)。 这个脚本回答四个只能用数字回答的问题: A. ELBO 里那一串「只跟 t 有关的系数」到底是什么形状。 解析式 w_t = beta_t^2 / (2 sigma_t^2 alpha_t (1 - abar_t)), 用两个高斯的 KL 数值核一遍,确认没推导错。 B. 用带权最小二乘训练一个**跨时间步共享参数**的 epsilon 网络 (仿射 + 固定时间基),比较三种目标: uniform —— DDPM 的 L_simple,等权 elbo_tilde —— 真 ELBO 权重,sigma^2 = tilde_beta_t(diffusers 的 fixed_small) elbo_large —— 真 ELBO 权重,sigma^2 = beta_t(diffusers 的 fixed_large) 模型容量故意给小(3 个时间基、9 维特征、18 个参数),所以权重真的会决定容量往哪搬。 C. 仿射模型下 p_theta(x_0) 是一个高斯,可以算出**精确 NLL**。 用「密度沿链前向传播」算,再用「线性映射复合」交叉验证一遍。 D. 反向链的方差 sigma^2 到底该取 tilde_beta_t 还是 beta_t。 在 beta_tilde 与 beta 之间插值扫一遍,看 NLL 与生成分布的胖瘦怎么变。 运行: /usr/local/bin/python3 ddpm_lab.py 依赖: numpy(无 GPU、无 torch) """ import os import numpy as np RNG_SEED = 20260927 T = 1000 D = 2 # ══════════════════════════════════════════════════════════════════ # 0. 噪声调度与前向过程的闭式量 # ══════════════════════════════════════════════════════════════════ def linear_beta(T=1000, b1=1e-4, bT=0.02): """DDPM 原文 CIFAR-10 用的线性调度。""" return np.linspace(b1, bT, T) def cosine_beta(T=1000, s=0.008, clip=0.999): """Improved DDPM 的余弦调度:先定 abar(t) 再反解 beta。""" u = np.arange(1, T + 1) / T f = np.cos(((u + s) / (1 + s)) * np.pi / 2) ** 2 f0 = np.cos((s / (1 + s)) * np.pi / 2) ** 2 abar = f / f0 beta = 1.0 - abar / np.concatenate([[1.0], abar[:-1]]) return np.clip(beta, 1e-8, clip) class Sched: """下标约定:abar[t]、bt[t] 的 t 取 0..T;beta[t-1]、alpha[t-1] 对应数学时间步 t。""" def __init__(self, beta): self.T = len(beta) self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) # 长度 T+1 # tilde_beta_t = (1 - abar_{t-1}) / (1 - abar_t) * beta_t self.bt = np.empty(self.T + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): """ELBO 第 t 项里 ||eps - eps_theta||^2 前面的系数(长度 T,下标 0 对应 t=1)。 which="tilde" -> sigma^2 = tilde_beta_t (fixed_small) which="large" -> sigma^2 = beta_t (fixed_large) t=1 时 tilde_beta_1 = 0,权重分母为零(分子非零)。DDPM 把这一项交给 L_0(离散解码器) 单独处理;这里为了让训练能跑,退化地用 fixed_large 的权重顶上。 """ s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w def weight_simplified(self, which="tilde"): """上面那条式子化简之后的样子,用来核对代数没推错。""" denom = 1.0 - (self.abar[:-1] if which == "tilde" else self.abar[1:]) with np.errstate(divide="ignore", invalid="ignore"): return self.beta / (2.0 * self.alpha * denom) def q_sample(x0, t_idx, abar, rng): """x_t = sqrt(abar_t) x_0 + sqrt(1 - abar_t) eps,一步到位。""" a = abar[t_idx] if np.isscalar(a): a = np.full(len(x0), a) eps = rng.standard_normal(x0.shape) return np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps, eps # ══════════════════════════════════════════════════════════════════ # 1. 数据:一个二维高斯(NLL 能算到机器精度) # ══════════════════════════════════════════════════════════════════ MU0 = np.array([1.0, -0.5]) S0 = np.array([[0.60, 0.25], [0.25, 0.35]]) def sample_gauss(n, rng): L = np.linalg.cholesky(S0) return MU0 + rng.standard_normal((n, D)) @ L.T def entropy_gauss(S): """高斯熵(nats)。""" _, ld = np.linalg.slogdet(S) return 0.5 * (D * np.log(2 * np.pi * np.e) + ld) def kl_gauss(m0, S0_, m1, S1_): """KL( N(m0, S0_) || N(m1, S1_) ),闭式解。""" L = np.linalg.cholesky(S1_) y = np.linalg.solve(L, m1 - m0) Sinv_S0 = np.linalg.solve(S1_, S0_) _, ld1 = np.linalg.slogdet(S1_) _, ld0 = np.linalg.slogdet(S0_) return 0.5 * (np.trace(Sinv_S0) + y @ y - D + ld1 - ld0) def expected_nll(m, S): """E_{x ~ p_data}[-log p_theta(x)] 的**精确值**。 = 数据分布的熵 + KL(p_data || p_theta),两个高斯之间全是闭式解, 没有蒙特卡洛噪声——用固定测试集估 NLL 时,2 万样本的波动有 ±0.007 nats, 比我们要比的 0.002~0.004 nats 还大,所以这里必须用闭式解。 """ return entropy_gauss(S0) + kl_gauss(MU0, S0, m, S) def gauss_nll(X, m, S): """多元高斯负对数似然(nats)。协方差病态时加抖动兜底。""" jitter = 0.0 for _ in range(8): try: L = np.linalg.cholesky(S + jitter * np.eye(D)) y = np.linalg.solve(L, (X - m).T) return 0.5 * (np.sum(y * y, axis=0) + 2 * np.sum(np.log(np.diag(L))) + D * np.log(2 * np.pi)) except np.linalg.LinAlgError: jitter = 1e-12 if jitter == 0.0 else jitter * 100.0 raise RuntimeError("协方差矩阵无法正定化,说明反向链已经数值发散") # ══════════════════════════════════════════════════════════════════ # 2. 模型:eps_theta(x, t) = B(psi_t) x + c(psi_t),参数跨 t 共享 # psi 是固定的幂函数时间基,只有 B、c 的系数是可学的 # ══════════════════════════════════════════════════════════════════ # 时间基故意取得很小:让「容量」成为真正的约束,权重才会决定容量往哪搬。 # 指数里出现 0.5,是因为最优的 B_t 与 sqrt(1 - abar_t) 成正比, # 在 t 很小时它按 sqrt(t) 走 —— 用纯多项式去拟合会在开头剧烈震荡。 BASIS = { "loose": [0.0, 0.5, 1.0, 1.5, 2.0], # 5 项:较高容量档,不代表一般容量充分 "tight": [0.0, 0.5, 1.0], # 3 项:容量真的成了瓶颈 } BASIS_EXP = BASIS["tight"] # 默认用容量吃紧那一档,机制看得最清楚 K = len(BASIS_EXP) def set_basis(name): global BASIS_EXP, K BASIS_EXP = BASIS[name] K = len(BASIS_EXP) return K def psi_basis(t_arr): """t (1..T) -> (n, K) 的固定时间基,u = t / T in (0, 1]。""" u = np.asarray(t_arr, dtype=float) / T return np.stack([u ** e for e in BASIS_EXP], axis=-1) def feats(x, psi): """拼特征:[x ⊗ psi, psi],最后一维长度 D*K + K。""" px = x[:, :, None] * psi[:, None, :] # (n, D, K) return np.concatenate([px.reshape(len(x), -1), psi], axis=1) def fit_weighted_ridge(Phi, E, w, lam): """最小化 sum_i w_i ||W phi_i - eps_i||^2 + lam ||W||^2。""" P = Phi.shape[1] A = np.einsum("n,np,nq->pq", w, Phi, Phi) + lam * np.eye(P) Bmat = np.einsum("n,np,nd->pd", w, Phi, E) return np.linalg.solve(A, Bmat) def model_Bc(W, psi_t): """把共享权重在某个时刻 t 上展开成 eps = B x + c。""" Wx = W[: D * K, :].reshape(D, K, D) # Wx[i, k, j] Bmat = np.einsum("ikj,k->ji", Wx, psi_t) cvec = psi_t @ W[D * K:, :] return Bmat, cvec def optimal_Bc(sc, t): """高斯数据下 eps 的最优预测器(后验均值),用来做参考与验算。""" a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) Bmat = np.sqrt(1.0 - a) * np.linalg.inv(C) cvec = -np.sqrt(a) * (Bmat @ MU0) return Bmat, cvec def mse_analytic(Bmat, cvec, sc, t): """E||B x_t + c - eps||^2 的闭式解(对 D 维取了平均)。 (x_t, eps) 是联合高斯:Var(x_t) = C_t = abar_t S0 + (1-abar_t) I, Cov(x_t, eps) = sqrt(1-abar_t) I,E[x_t] = sqrt(abar_t) mu0,E[eps] = 0。 展开 ||B x_t + c - eps||^2 的期望即得下式,不用蒙特卡洛,没有抽样噪声。 """ a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) m = np.sqrt(a) * MU0 quad = np.trace(Bmat @ C @ Bmat.T) # Var(B x_t) bias = np.sum((Bmat @ m + cvec) ** 2) # 均值没对上的部分 cross = 2.0 * np.sqrt(1.0 - a) * np.trace(Bmat) # -2 Cov(B x_t, eps) return float((quad + bias - cross + D) / D) def mse_floor(sc, t): """贝叶斯最优的 MSE 地板:Var(eps | x_t) 的迹除以 D。""" a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) return float((D - (1.0 - a) * np.trace(np.linalg.inv(C))) / D) def learnability(sc, t): """这一时刻的 eps 里,有多大比例是能从 x_t 里看出来的。 R^2 = 1 - 地板 / Var(eps),Var(eps) 的每维是 1。 """ return 1.0 - mse_floor(sc, t) # ══════════════════════════════════════════════════════════════════ # 3. 精确 NLL:把高斯密度沿反向链往前传 # ══════════════════════════════════════════════════════════════════ def _s2_mat(sigma2, t): """每步注入的噪声协方差:既接受标量(各向同性),也接受 (T+1, D, D)。""" if sigma2.ndim == 1: return sigma2[t] * np.eye(D) return sigma2[t] def chain_moments_prop(sc, Bcfun, sigma2): """写法一:密度传播。x_{t-1} = M_t x_t + v_t + noise。""" m = np.zeros(D) S = np.eye(D) sig = np.atleast_1d(sigma2) for t in range(T, 0, -1): Bmat, cvec = Bcfun(t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1]) v = -kk * cvec / np.sqrt(sc.alpha[t - 1]) m = M @ m + v S = M @ S @ M.T + _s2_mat(sig, t) return m, S def chain_moments_comp(sc, Bcfun, sigma2): """写法二:把整条链复合成一个仿射映射,再累加各步噪声。独立实现,用于交叉验证。""" m = np.zeros(D) S = np.zeros((D, D)) Pprev = np.eye(D) for t in range(1, T + 1): Bmat, cvec = Bcfun(t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1]) v = -kk * cvec / np.sqrt(sc.alpha[t - 1]) m = m + Pprev @ v S = S + Pprev @ _s2_mat(sigma2, t) @ Pprev.T Pprev = Pprev @ M S = S + Pprev @ Pprev.T # x_T ~ N(0, I) 的那一坨 return m, S def sigma2_exact_posterior(sc): """真实后验 q(x_{t-1}|x_t) 的协方差(高斯数据下可算)。 = tilde_beta_t I + Var(mu_t | x_t) = tilde_beta_t I + (beta_t^2 / (alpha_t (1 - abar_t))) Var(eps | x_t) 第二项就是 DDPM 反向链扔掉的那部分:真实后验比 beta_tilde 更胖。 """ out = np.zeros((T + 1, D, D)) for t in range(1, T + 1): a = sc.abar[t] C = a * S0 + (1.0 - a) * np.eye(D) var_eps = np.eye(D) - (1.0 - a) * np.linalg.inv(C) kk2 = sc.beta[t - 1] ** 2 / (sc.alpha[t - 1] * (1.0 - a)) out[t] = sc.bt[t] * np.eye(D) + kk2 * var_eps return out def sigma2_from_choice(sc, which="tilde", lam_mix=0.0): """反向链每步注入的方差。lam_mix 在 tilde_beta 与 beta 之间插值。""" if which == "tilde": base = sc.bt.copy() other = np.concatenate([[0.0], sc.beta]) else: base = np.concatenate([[0.0], sc.beta]) other = sc.bt.copy() return (1.0 - lam_mix) * base + lam_mix * other # ══════════════════════════════════════════════════════════════════ # 4. 主流程 # ══════════════════════════════════════════════════════════════════ def section_A(sc): print("=" * 74) print("A. ELBO 每步权重:解析式 vs 两个高斯的 KL") print("=" * 74) w_tilde = sc.weight("tilde") w_large = sc.weight("large") ws_tilde = sc.weight_simplified("tilde") ws_large = sc.weight_simplified("large") ok = np.isfinite(ws_tilde) & (ws_tilde > 0) rel = np.max(np.abs(w_tilde[ok] - ws_tilde[ok]) / ws_tilde[ok]) print(f" 化简式与原始式的最大相对差(tilde):{rel:.3e}") rel2 = np.max(np.abs(w_large - ws_large) / ws_large) print(f" 化简式与原始式的最大相对差(large):{rel2:.3e}") print(f" t=1 的 tilde_beta_1 = {sc.bt[1]:.3e}(后验方差为 0 => 权重发散," f"这就是 DDPM 要把 L_0 单独拿出来的原因)") print() print(" t abar_t beta_t w_t(sigma^2=bt) w_t(sigma^2=beta) 相对等权") for t in [2, 10, 50, 100, 250, 500, 750, 900, 1000]: print(f" {t:<6d}{sc.abar[t]:<12.3e}{sc.beta[t-1]:<10.5f}" f"{w_tilde[t-1]:<18.4e}{w_large[t-1]:<20.4e}" f"{w_tilde[t-1] / w_tilde[499]:<10.2f}") print() span = w_tilde[1] / w_tilde.min() print(f" sigma^2=tilde_beta 时,权重最大值(t=2)是最小值(t={int(np.argmin(w_tilde))+1})的 " f"{span:.1f} 倍") print(f" 等权 L_simple 相当于把这条曲线整体压平到 1") print() # 数值核对:KL( q(x_{t-1}|x_t,x_0) || p_theta(x_{t-1}|x_t) ) == w_t * ||delta_eps||^2 rng = np.random.default_rng(RNG_SEED) print(" —— KL 数值核对(随机取 x_0, eps,令 eps_theta = eps + delta)——") print(" t KL(数值) w_t*||delta||^2 相对差") for t in [2, 100, 500, 1000]: x0 = sample_gauss(1, rng)[0] a = sc.abar[t] eps = rng.standard_normal(D) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps delta = rng.standard_normal(D) * 0.3 eps_hat = eps + delta kk = sc.beta[t - 1] / np.sqrt(1 - a) mu_tilde = (xt - kk * eps) / np.sqrt(sc.alpha[t - 1]) mu_theta = (xt - kk * eps_hat) / np.sqrt(sc.alpha[t - 1]) s2 = sc.bt[t] kl = np.sum((mu_tilde - mu_theta) ** 2) / (2 * s2) pred = w_tilde[t - 1] * np.sum(delta ** 2) print(f" {t:<7d}{kl:<18.6e}{pred:<20.6e}{abs(kl-pred)/kl:<12.2e}") print() return w_tilde, w_large def fit_three(sc, w_tilde, w_large, lam=1e-6): """三种权重各解一遍带权最小二乘。不打印任何东西,供 section_B / section_F 共用。""" rng = np.random.default_rng(RNG_SEED + 1) M = 120_000 t_idx = rng.integers(1, T + 1, size=M) x0 = sample_gauss(M, rng) a = sc.abar[t_idx] eps = rng.standard_normal((M, D)) xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps psi = psi_basis(t_idx) Phi = feats(xt, psi) # 三种权重都归一化到均值 1(整体缩放不改变无正则时的解, # 归一化只是为了让正则强度在三种目标下可比) schemes = { "uniform": np.ones(T), "elbo_tilde": w_tilde / w_tilde.mean(), "elbo_large": w_large / w_large.mean(), } W = {} for name, w_full in schemes.items(): w = w_full[t_idx - 1] W[name] = fit_weighted_ridge(Phi, eps, w, lam) return W, schemes def section_B(sc, w_tilde, w_large): print("=" * 74) print("B. 带权最小二乘训练:三种目标,共享参数,容量有限") print("=" * 74) W, schemes = fit_three(sc, w_tilde, w_large) print(f" 训练集:M=120000 条 (x_0, t, eps),时间基 {K} 项,特征维度 {K * (D + 1)}," f"可学参数 {K * (D + 1) * D} 个") print(f" 三种权重都归一化到均值 1(无正则时整体缩放不改变解;归一化使正则强度口径一致)") print(f" 权重动态范围:elbo_tilde 的 max/min = {w_tilde.max()/w_tilde.min():.1f}") print() return W, schemes def model_moments(sc, Wm, which="tilde"): """把训练好的共享权重展开成整条反向链→生成分布的均值与协方差。""" s2 = sigma2_from_choice(sc, which) return chain_moments_prop( sc, lambda t: model_Bc(Wm, psi_basis(np.array([t]))[0]), s2) def excess_bands(sc, W): """低噪声档 / 高噪声档的超额误差均值,以及 elbo 相对 uniform 的比值。""" lo = np.arange(1, 51) hi = np.arange(400, 1001) out = {} for band, idx in [("lo", lo), ("hi", hi)]: e = {} for name in ["uniform", "elbo_tilde"]: e[name] = float(np.mean([ mse_analytic(*model_Bc(W[name], psi_basis(np.array([t]))[0]), sc, t) - mse_floor(sc, t) for t in idx])) out[band] = (e["uniform"], e["elbo_tilde"], e["elbo_tilde"] / e["uniform"]) return out def section_C(sc, W, schemes): print("=" * 74) print("C. 仿射模型下的精确 NLL(密度前向传播)") print("=" * 74) rng = np.random.default_rng(RNG_SEED + 2) Xtest = sample_gauss(400_000, rng) nll_true = expected_nll(MU0, S0) print(f" 参考:真分布 N(mu_0, S_0) 的熵 = {nll_true:.6f} nats" f"({nll_true / np.log(2) / D:.4f} bits/dim)") print(f" 蒙特卡洛复核(40 万样本):{gauss_nll(Xtest, MU0, S0).mean():.6f} nats" f",与闭式解差 {abs(gauss_nll(Xtest, MU0, S0).mean()-nll_true):.2e}") # 交叉验证两种写法 m1, S1 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde")) m2, S2 = chain_moments_comp(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde")) print(f" 两种写法的差异:均值 {np.max(np.abs(m1-m2)):.2e},协方差 {np.max(np.abs(S1-S2)):.2e}") # 蒙特卡洛复核:真跑 20 万条链,比对经验均值/协方差 rng3 = np.random.default_rng(RNG_SEED + 3) xs = rng3.standard_normal((200_000, D)) for t in range(T, 0, -1): Bmat, cvec = optimal_Bc(sc, t) kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t]) mu = (xs - kk * (xs @ Bmat.T + cvec)) / np.sqrt(sc.alpha[t - 1]) xs = mu + np.sqrt(sc.bt[t]) * rng3.standard_normal((200_000, D)) print(f" 蒙特卡洛复核:均值差 {np.max(np.abs(xs.mean(0)-m1)):.2e}," f"协方差差 {np.max(np.abs(np.cov(xs.T)-S1)):.2e}") nll_opt = expected_nll(m1, S1) print(f" 「最优 eps 预测器 + sigma^2=tilde_beta」的期望 NLL = {nll_opt:.6f} nats," f"比真分布差 {nll_opt - nll_true:+.6f} nats") print(f" 蒙特卡洛复核(同上 40 万样本):{gauss_nll(Xtest, m1, S1).mean():.6f} nats," f"差 {abs(gauss_nll(Xtest, m1, S1).mean()-nll_opt):.2e}") print(f" 生成分布的协方差 diag = {np.diag(S1)},真值 diag = {np.diag(S0)} " f"=> 比值 {np.diag(S1)/np.diag(S0)}") # 把真实后验方差(而不是 tilde_beta)灌回反向链:在本高斯实验中接近数据分布,仍有有限终点先验误差 s2_exact = sigma2_exact_posterior(sc) m3, S3 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), s2_exact) nll_exact = expected_nll(m3, S3) print(f" 「最优 eps 预测器 + 真实后验方差」的期望 NLL = {nll_exact:.6f} nats," f"比真分布差 {nll_exact - nll_true:+.2e} nats") print(f" 此时生成协方差 diag / 真值 = {np.diag(S3)/np.diag(S0)}," f"均值差 {np.max(np.abs(m3 - MU0)):.2e}") print(" => reverse 链的均值用最优 eps 预测器、方差用真实后验方差," "在本高斯实验中极接近数据分布;仍有有限终点先验与数值误差;") print(" 约 0.0001 nats 的缺口主要来自固定 tilde_beta;对照的残差如上,不视为严格零。") print() print(" 三种训练目标 × 两种采样方差的期望 NLL(nats,越小越好):") print(" 训练目标 sigma^2=tilde_beta sigma^2=beta 差 生成std/真std") rows = {} for name in ["uniform", "elbo_tilde", "elbo_large"]: Wm = W[name] out = {} for which in ["tilde", "large"]: m, S = model_moments(sc, Wm, which) out[which] = expected_nll(m, S) out[which + "_std"] = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0)))) rows[name] = out print(f" {name:<16}{out['tilde']:<22.6f}{out['large']:<18.6f}" f"{out['large']-out['tilde']:<+12.6f}{out['tilde_std']:.4f}") print() return rows, nll_true, nll_opt def section_D(sc, W): print("=" * 74) print("D. 每步误差剖面:权重把「超额误差」搬到了哪") print("=" * 74) grid = list(range(1, 1001)) floor = np.array([mse_floor(sc, t) for t in grid]) learn = np.array([learnability(sc, t) for t in grid]) prof = {} for name, Wm in W.items(): mse = [] for t in grid: Bmat, cvec = model_Bc(Wm, psi_basis(np.array([t]))[0]) mse.append(mse_analytic(Bmat, cvec, sc, t)) prof[name] = np.array(mse) print(" 闭式解算的,没有蒙特卡洛噪声。『超额』= MSE − 贝叶斯地板。") print(" t 可学占比R^2 地板 uniform超额 elbo_tilde超额 elbo_large超额") for t in [1, 5, 20, 50, 100, 200, 400, 600, 800, 950, 1000]: i = t - 1 print(f" {t:<6d}{learn[i]:<12.4f}{floor[i]:<9.4f}" f"{prof['uniform'][i]-floor[i]:<14.3e}{prof['elbo_tilde'][i]-floor[i]:<16.3e}" f"{prof['elbo_large'][i]-floor[i]:.3e}") print() lo = slice(0, 50) # t = 1..50 hi = slice(399, 1000) # t = 400..1000 eu_u, eu_e = prof["uniform"] - floor, prof["elbo_tilde"] - floor print(f" 低噪声档 t<=50 :uniform 超额均值 {eu_u[lo].mean():.3e}," f"elbo_tilde {eu_e[lo].mean():.3e}(比值 {eu_e[lo].mean()/eu_u[lo].mean():.2f})") print(f" 高噪声档 t>=400 :uniform 超额均值 {eu_u[hi].mean():.3e}," f"elbo_tilde {eu_e[hi].mean():.3e}(比值 {eu_e[hi].mean()/eu_u[hi].mean():.2f})") print() print(f" 可学占比 R^2:t=1 时 {learn[0]:.2e},t=500 时 {learn[499]:.4f}," f"t=1000 时 {learn[999]:.4f}") print() return grid, prof, floor, learn def section_E(sc, W): print("=" * 74) print("E. 采样方差该取 tilde_beta 还是 beta:在两者之间插值扫一遍") print("=" * 74) nll_true = expected_nll(MU0, S0) print(" lam 是插值系数:sigma^2 = (1-lam)*tilde_beta + lam*beta") print(" lam NLL(uniform训练) NLL(elbo_tilde训练) 生成 std / 真 std") out = {"lam": [], "nll_uniform": [], "nll_elbo": [], "std_ratio": []} for lam in [0.0, 0.25, 0.5, 0.75, 1.0]: s2 = sigma2_from_choice(sc, "tilde", lam_mix=lam) row, sr = [], 0.0 for name in ["uniform", "elbo_tilde"]: m, S = chain_moments_prop( sc, lambda t: model_Bc(W[name], psi_basis(np.array([t]))[0]), s2) row.append(expected_nll(m, S)) if name == "uniform": sr = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0)))) out["lam"].append(lam) out["nll_uniform"].append(row[0]) out["nll_elbo"].append(row[1]) out["std_ratio"].append(sr) print(f" {lam:<7.2f}{row[0]:<19.6f}{row[1]:<22.6f}{sr:.4f}") best = out["lam"][int(np.argmin(np.abs(np.array(out["std_ratio"]) - 1.0)))] print(f" 扫描范围内标准差比最接近 1 的 lam ≈ {best:.2f}(这一列是最敏感的指标," f"NLL 对 lam 几乎不动)") print(f" 参考:真分布熵 = {nll_true:.6f}") print() return out def section_F(sc, w_tilde, w_large): """容量充足 vs 容量吃紧:『该不该扔掉系数』的答案会不会反过来。""" print("=" * 74) print("F. 同样两个目标,换一档模型容量:结论会反过来") print("=" * 74) print(" 两档时间基都只动特征个数,训练数据、种子、正则强度完全一样。") print() print(" 容量档 时间基项数 可学参数 NLL(等权) NLL(真ELBO) 谁更好 低噪声档超额比 高噪声档超额比") out = {} for regime in ["loose", "tight"]: k = set_basis(regime) Wf, _ = fit_three(sc, w_tilde, w_large) n_u = expected_nll(*model_moments(sc, Wf["uniform"])) n_e = expected_nll(*model_moments(sc, Wf["elbo_tilde"])) bands = excess_bands(sc, Wf) better = "等权" if n_u < n_e else "真ELBO" n_par = k * (D + 1) * D out[regime] = dict(K=k, nll_uniform=n_u, nll_elbo=n_e, bands=bands, W=Wf) print(f" {regime:<8}{k:<12}{n_par:<11}{n_u:<12.6f}{n_e:<14.6f}" f"{better:<9}{bands['lo'][2]:<16.2f}{bands['hi'][2]:.2f}") set_basis("tight") print() print(" 列『超额比』= 真 ELBO 权重的超额误差 / 等权的超额误差,小于 1 表示更好。") print(" => 本实验较高容量档 ELBO 权重略胜,较低容量档等权胜;不推广到任意容量或模型。") print() return out def main(): sc = Sched(linear_beta(T)) print(f"调度:线性 T={T},beta 从 {sc.beta[0]:.1e} 到 {sc.beta[-1]:.3f}," f"abar_T = {sc.abar[T]:.4e}") print() w_tilde, w_large = section_A(sc) W, schemes = section_B(sc, w_tilde, w_large) print() rows, nll_true, nll_opt = section_C(sc, W, schemes) print() grid, prof, floor, learn = section_D(sc, W) print() mix = section_E(sc, W) print() regimes = section_F(sc, w_tilde, w_large) return dict(sched=sc, w_tilde=w_tilde, w_large=w_large, W=W, nll_rows=rows, nll_true=nll_true, nll_opt=nll_opt, grid=grid, prof=prof, floor=floor, learn=learn, mix=mix, regimes=regimes) if __name__ == "__main__": main() ddpm_train.py # -*- coding: utf-8 -*- """照着 DDPM 原文 Algorithm 1 / Algorithm 2 写的最小实现(纯 numpy,无 torch)。 为什么还要写一遍神经网络版:ddpm_lab.py 用带权最小二乘的闭式解把「优化算法」 这个变量消掉了,代价是模型只能仿射。这里补上手写反向传播的两层 MLP, 在**多模态**的目标分布上跑完整的一千步采样,看训练目标的权重到底怎么影响 最后生成出来的东西。 A. 梯度核对:手写反向传播 vs 有限差分 B. Algorithm 1:按两种权重(等权 / ELBO-tilde)各训练一个网络 C. Algorithm 2:一千步采样,三种指标打分 D. 反向链方差 sigma^2 = tilde_beta 还是 beta 运行: /usr/local/bin/python3 ddpm_train.py # 默认 20000 步 /usr/local/bin/python3 ddpm_train.py --steps 40000 依赖: numpy """ import argparse import os import numpy as np RNG_SEED = 20260927 T = 1000 D = 2 # ══════════════════════════════════════════════════════════════════ # 0. 调度(与 ddpm_lab.py 同一套,下标约定:t 取 1..T) # ══════════════════════════════════════════════════════════════════ def linear_beta(T=1000, b1=1e-4, bT=0.02): return np.linspace(b1, bT, T) class Sched: def __init__(self, beta): self.beta = beta self.alpha = 1.0 - beta self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)]) self.bt = np.empty(len(beta) + 1) self.bt[0] = 0.0 self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta def weight(self, which="tilde"): """ELBO 第 t 项里 ||eps - eps_theta||^2 的系数。""" s2 = self.bt[1:] if which == "tilde" else self.beta with np.errstate(divide="ignore", invalid="ignore"): w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:])) if which == "tilde": # t=1 分母为零、分子非零;用连续重建方差 beta_1 的权重 w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1])) return w # ══════════════════════════════════════════════════════════════════ # 1. 目标分布:7 个分量的二维高斯混合(环状 + 一个中心) # ══════════════════════════════════════════════════════════════════ RING_R = 1.15 N_RING = 6 CENTERS = np.array( [[RING_R * np.cos(2 * np.pi * k / N_RING), RING_R * np.sin(2 * np.pi * k / N_RING)] for k in range(N_RING)] + [[0.0, 0.0]] ) SCALES = np.array([0.17, 0.20, 0.16, 0.22, 0.18, 0.19, 0.28]) WEIGHTS = SCALES ** 2 # 分量越大越容易被采到,制造不均匀 WEIGHTS = WEIGHTS / WEIGHTS.sum() def sample_mix(n, rng): kk = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS) return CENTERS[kk] + SCALES[kk][:, None] * rng.standard_normal((n, D)) def logp_mix(X): """混合分布在 X 处的对数密度(各分量都是各向同性高斯)。""" d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1) # (n, K) comp = np.log(WEIGHTS)[None, :] - 0.5 * d2 / SCALES[None, :] ** 2 \ - D * np.log(SCALES[None, :]) - 0.5 * D * np.log(2 * np.pi) m = comp.max(axis=1, keepdims=True) return (m[:, 0] + np.log(np.exp(comp - m).sum(axis=1))) def nearest_center_dist(X): d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1) return np.sqrt(d2.min(axis=1)) # ══════════════════════════════════════════════════════════════════ # 2. 时间嵌入 + 两层 MLP + 手写 Adam # ══════════════════════════════════════════════════════════════════ TIME_FREQ = (1, 2, 4, 8) # 8 维时间基 def time_embed(t_arr): u = np.asarray(t_arr, dtype=float) / T cols = [] for w in TIME_FREQ: cols.append(np.cos(w * np.pi * u)) cols.append(np.sin(w * np.pi * u)) return np.stack(cols, axis=-1) N_IN = D + 2 * len(TIME_FREQ) H = 64 def init_params(rng): def he(fan_in, fan_out): return rng.standard_normal((fan_in, fan_out)) * np.sqrt(2.0 / fan_in) return { "W1": he(N_IN, H), "b1": np.zeros(H), "W2": he(H, H), "b2": np.zeros(H), "W3": he(H, D), "b3": np.zeros(D), } def forward(p, Z): h1 = np.maximum(Z @ p["W1"] + p["b1"], 0.0) h2 = np.maximum(h1 @ p["W2"] + p["b2"], 0.0) return h1, h2, h2 @ p["W3"] + p["b3"] def backward(p, Z, h1, h2, out, eps, w): """d/d(theta) of mean_i w_i ||out_i - eps_i||^2。""" n = len(Z) dout = 2.0 * (w[:, None] * (out - eps)) / n g = {} g["W3"] = h2.T @ dout g["b3"] = dout.sum(0) dh2 = dout @ p["W3"].T dh2[h2 <= 0] = 0.0 g["W2"] = h1.T @ dh2 g["b2"] = dh2.sum(0) dh1 = dh2 @ p["W2"].T dh1[h1 <= 0] = 0.0 g["W1"] = Z.T @ dh1 g["b1"] = dh1.sum(0) return g class Adam: def __init__(self, p, lr=1e-3, b1=0.9, b2=0.999, eps=1e-8): self.m = {k: np.zeros_like(v) for k, v in p.items()} self.v = {k: np.zeros_like(v) for k, v in p.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.i = 0 def step(self, p, g): self.i += 1 for k in p: self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g[k] self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * g[k] ** 2 mh = self.m[k] / (1 - self.b1 ** self.i) vh = self.v[k] / (1 - self.b2 ** self.i) p[k] -= self.lr * mh / (np.sqrt(vh) + self.eps) def predict_eps(p, x, t_idx): Z = np.concatenate([x, time_embed(np.full(len(x), t_idx))], axis=1) _, _, out = forward(p, Z) return out # ══════════════════════════════════════════════════════════════════ # 3. Algorithm 1(训练)与 Algorithm 2(采样) # ══════════════════════════════════════════════════════════════════ def train(sc, w_full, steps, batch, rng, lr=1e-3): """保留 DDPM Algorithm 1 的抽样与加噪流程,另允许教学用时间权重。""" p = init_params(rng) opt = Adam(p, lr=lr) for _ in range(steps): # 1: t ~ Uniform({1, ..., T}) 2: x_0 ~ q(x_0) 3: eps ~ N(0, I) t_idx = rng.integers(1, T + 1, size=batch) x0 = sample_mix(batch, rng) eps = rng.standard_normal((batch, D)) # 4: 一步加噪(闭式解,不需要真的走 t 步) a = sc.abar[t_idx] xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps # 5: 梯度下降一步 Z = np.concatenate([xt, time_embed(t_idx)], axis=1) h1, h2, out = forward(p, Z) opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1])) return p def sample_chain(sc, p, n, which="tilde", rng=None): """DDPM 原文 Algorithm 2。which 决定 sigma^2 取 tilde_beta 还是 beta。""" x = rng.standard_normal((n, D)) # x_T ~ N(0, I) for t in range(T, 0, -1): eps_hat = predict_eps(p, x, t) a, a_prev = sc.abar[t], sc.abar[t - 1] alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1] # mu_tilde = (x_t - beta_t/sqrt(1-abar_t) * eps_hat) / sqrt(alpha_t) mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t) if which == "tilde": sigma = np.sqrt(sc.bt[t]) else: sigma = np.sqrt(beta_t) z = rng.standard_normal((n, D)) x = mu + (sigma * z if t > 1 else 0.0) # t == 1 时不加噪声 return x # ══════════════════════════════════════════════════════════════════ # 4. 主流程 # ══════════════════════════════════════════════════════════════════ def section_A(): print("=" * 74) print("A. 手写反向传播 vs 有限差分") print("=" * 74) rng = np.random.default_rng(RNG_SEED) sc = Sched(linear_beta(T)) p = init_params(rng) n = 32 t_idx = rng.integers(1, T + 1, size=n) x0 = sample_mix(n, rng) eps = rng.standard_normal((n, D)) a = sc.abar[t_idx] xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps Z = np.concatenate([xt, time_embed(t_idx)], axis=1) w = np.ones(n) h1, h2, out = forward(p, Z) g = backward(p, Z, h1, h2, out, eps, w) def loss(): _, _, o = forward(p, Z) return float(np.mean(np.sum((o - eps) ** 2, axis=1))) print(" 参数 解析梯度 有限差分 相对差") worst = 0.0 for key in ["W1", "b1", "W2", "b2", "W3", "b3"]: idx = tuple(0 for _ in p[key].shape) h = 1e-6 orig = p[key][idx] p[key][idx] = orig + h lp = loss() p[key][idx] = orig - h lm = loss() p[key][idx] = orig num = (lp - lm) / (2 * h) ana = g[key][idx] rel = abs(num - ana) / max(abs(num), 1e-12) worst = max(worst, rel) print(f" {key:<8}{ana:<16.8e}{num:<16.8e}{rel:.2e}") print(f" => 最大相对差 {worst:.2e}(有限差分自己的精度极限在 1e-6 量级)") print() return sc def section_B(sc, steps): print("=" * 74) print("B. Algorithm 1:两种权重各训一个网络") print("=" * 74) w_tilde, w_large = sc.weight("tilde"), sc.weight("large") schemes = { "uniform": np.ones(T), "elbo_tilde": w_tilde / w_tilde.mean(), } print(f" 步数 {steps},batch 256,两层 MLP({N_IN} -> {H} -> {H} -> {D}),Adam lr=1e-3") print(f" elbo 权重的动态范围:max/min = {w_tilde.max()/w_tilde.min():.1f}") models = {} # 注意:不能用 hash(name)——Python 的字符串 hash 每次进程都变,结果会不可复现。 seed_of = {"uniform": 11, "elbo_tilde": 22, "elbo_large": 33} for name, w in schemes.items(): rng = np.random.default_rng(RNG_SEED + seed_of.get(name, 44)) models[name] = train(sc, w, steps, 256, rng) print(f" [{name}] 训练完成") print() return models def _score(X, base_logp, base_dist): """三个指标:log p0 相对真样本、到最近模式中心的距离比、模式覆盖数。""" dlogp = logp_mix(X).mean() - base_logp dratio = nearest_center_dist(X).mean() / base_dist assign = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1).argmin(1) frac = np.bincount(assign, minlength=len(CENTERS)) / len(X) return dlogp, dratio, int((frac > 0.02).sum()) def section_C(sc, models, n_gen, n_seed=3): print("=" * 74) print("C. Algorithm 2:一千步采样,三个指标打分") print("=" * 74) rng0 = np.random.default_rng(RNG_SEED + 77) Xtrue = sample_mix(20_000, rng0) base_logp = logp_mix(Xtrue).mean() base_dist = nearest_center_dist(Xtrue).mean() print(f" 基线(2 万真样本):log p0 均值 {base_logp:.4f}," f"到最近模式中心距离均值 {base_dist:.4f}") print(f" 每组用 {n_seed} 个不同的采样种子重复,报告采样间均值 ± 标准差;训练每分支仅一个独立固定种子") print() print(" 训练目标 log p0 相对真样本 到最近中心距离/真样本 模式覆盖") res = {} for name, p in models.items(): dl, dr, cov = [], [], [] for s in range(n_seed): rng = np.random.default_rng(RNG_SEED + 88 + s) a, b, c = _score(sample_chain(sc, p, n_gen, "tilde", rng), base_logp, base_dist) dl.append(a) dr.append(b) cov.append(c) res[name] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)), dratio=float(np.mean(dr)), frac=cov[0]) print(f" {name:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}" f"{np.mean(dr):<22.4f}{cov[0]}/7") print() return res, base_logp, base_dist def section_D(sc, models, n_gen, n_seed=3): print("=" * 74) print("D. 反向链方差:tilde_beta(fixed_small)还是 beta(fixed_large)") print("=" * 74) rng0 = np.random.default_rng(RNG_SEED + 77) Xtrue = sample_mix(20_000, rng0) base_logp = logp_mix(Xtrue).mean() base_dist = nearest_center_dist(Xtrue).mean() p = models["uniform"] print(" 用 uniform(L_simple)训出来的那个网络,只换每步注入的方差:") print(" 方差选择 log p0 相对真样本 到最近中心距离/真样本") out = {} for which in ["tilde", "large"]: dl, dr = [], [] for s in range(n_seed): rng = np.random.default_rng(RNG_SEED + 99 + s) a, b, _ = _score(sample_chain(sc, p, n_gen, which, rng), base_logp, base_dist) dl.append(a) dr.append(b) out[which] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)), dratio=float(np.mean(dr))) print(f" {which:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}{np.mean(dr):.4f}") print() return out def mse_profile(sc, models, rng_seed=RNG_SEED + 123): """每个时刻的 eps 预测误差(蒙特卡洛,用来画图)。""" rng = np.random.default_rng(rng_seed) grid = np.array([1, 2, 5, 10, 20, 50, 100, 200, 400, 600, 800, 950, 1000]) n = 6000 prof = {} for name, p in models.items(): vals = [] for t in grid: x0 = sample_mix(n, rng) a = sc.abar[t] eps = rng.standard_normal((n, D)) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps vals.append(float(np.mean((predict_eps(p, xt, t) - eps) ** 2))) prof[name] = np.array(vals) return grid, prof def score_counterexample(): """七个中心按真实分量权重重复输出;覆盖完整,但分量内方差为零。""" rng = np.random.default_rng(RNG_SEED + 777) true = sample_mix(20_000, rng) idx = rng.choice(len(WEIGHTS), size=20_000, p=WEIGHTS) centers_only = CENTERS[idx] result = _score(centers_only, logp_mix(true).mean(), nearest_center_dist(true).mean()) print("F. 密度评分反例:只输出七个模式中心(分量内方差为零)") print(f" delta_logp={result[0]:+.4f}, center_distance_ratio={result[1]:.4f}, coverage={result[2]}/7") print(" 高密度与全覆盖仍不能证明分量内分布正确;这不是模型NLL。") return result def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=20000) ap.add_argument("--n-gen", type=int, default=4000) args = ap.parse_args() sc = section_A() models = section_B(sc, args.steps) res, base_logp, base_dist = section_C(sc, models, args.n_gen) dres = section_D(sc, models, args.n_gen) grid, prof = mse_profile(sc, models) print("=" * 74) print("E. 每步预测误差(MSE,真 eps 的每维方差是 1)") print("=" * 74) print(" t uniform elbo_tilde") for i, t in enumerate(grid): print(f" {t:<7d}{prof['uniform'][i]:<12.4f}{prof['elbo_tilde'][i]:.4f}") counterexample = score_counterexample() return dict(sched=sc, models=models, res=res, dres=dres, grid=grid, prof=prof, counterexample=counterexample) if __name__ == "__main__": main() make_figures.py # -*- coding: utf-8 -*- """画本文的四张图。数据源全部来自 ddpm_lab.py 的真实输出,不另造数。 weight_profile.png ELBO 每步权重 vs 这个时刻真正可学的信号占比 excess_error.png 两种训练目标把「超额误差」搬到了哪 variance_ledger.png 反向链每步注入的噪声:beta_tilde / beta / 真实后验 step_anatomy.png 反向一步的三个配料怎么随 t 变 运行: /usr/local/bin/python3 make_figures.py 依赖: numpy, matplotlib(字体 PingFang SC) 注意:matplotlib 的 mathtext 标签一律用 raw 字符串,且反斜杠后面只能跟字母 ——源码会被 sync-code 原样搬进文章附录,反斜杠后面跟非字母会被体检器判成转义污染。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import ddpm_lab as LAB plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "PingFang SC", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C_MAIN, C_ALT, C_GREEN, C_GRAY = "#2563eb", "#dc2626", "#059669", "#6b7280" T = LAB.T D = LAB.D # ─────────────────────────── 图 1:权重 vs 可学占比 ─────────────────────────── def fig_weight_profile(sc, w_tilde, w_large, learn): fig, ax = plt.subplots(figsize=(9.2, 5.4)) tt = np.arange(1, T + 1) ax.semilogy(tt, w_tilde, color=C_MAIN, lw=2.0, label=r"真 ELBO 权重 $w_t$($\sigma^2=\tilde\beta_t$)") ax.semilogy(tt, w_large, color=C_ALT, lw=1.6, ls="--", label=r"真 ELBO 权重 $w_t$($\sigma^2=\beta_t$)") ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.text(620, 1.15, "等权 $L_{\mathrm{simple}}$ 就压在这条 1 上", color=C_GRAY, fontsize=9) ax.set_xlabel(r"时间步 $t$") ax.set_ylabel(r"预测误差平方前面的系数 $w_t$") ax.set_ylim(3e-3, 3.0) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9, loc="lower left") ax2 = ax.twinx() ax2.plot(tt, learn, color=C_GREEN, lw=2.0) ax2.set_ylabel(r"这一时刻能学出来的噪声占比 $R^2$", color=C_GREEN) ax2.set_ylim(-0.05, 1.05) ax2.tick_params(axis="y", labelcolor=C_GREEN) ax2.set_title("(a) 权重与可预测比例:低噪声地板大,不代表 score 无用", fontsize=11) span = w_tilde.max() / w_tilde.min() ax.annotate(rf"权重跨 {span:.0f} 倍", xy=(2, w_tilde[0]), xytext=(70, 0.35), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax.annotate(rf"$t=1$ 时 $R^2$只有 {learn[0]:.1e}", xy=(1, 0.02), xytext=(120, 0.012), fontsize=9, color=C_GREEN, arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2)) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "weight_profile.png"), dpi=130) plt.close(fig) # ──────────────────────── 图 2:超额误差被搬到哪 ──────────────────────── def fig_excess(sc, grid, prof, floor, learn): fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0)) tt = np.asarray(grid) ax = axes[0] ax.semilogy(tt, prof["uniform"] - floor, color=C_MAIN, lw=2.0, label=r"等权($L_{\mathrm{simple}}$)") ax.semilogy(tt, prof["elbo_tilde"] - floor, color=C_ALT, lw=2.0, label="真 ELBO 权重") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel(r"超额误差 MSE $-$ 贝叶斯地板") ax.set_title("(a) 本容量档:低噪声超额误差改善,部分后段变差") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.set_xlim(0, 1000) ax = axes[1] ratio = (prof["elbo_tilde"] - floor) / (prof["uniform"] - floor) ax.semilogy(tt, ratio, color=C_GREEN, lw=2.0) ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.fill_between(tt, 1e-3, ratio, where=(ratio < 1.0), color=C_MAIN, alpha=0.13) ax.fill_between(tt, 1.0, ratio, where=(ratio > 1.0), color=C_ALT, alpha=0.13) ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("真 ELBO 权重 / 等权 的超额误差之比") ax.set_title("(b) 同一条曲线取比值:1 以下变好,1 以上变差") ax.grid(alpha=0.25, which="both") ax.set_xlim(0, 1000) ax.set_ylim(1e-2, 1e2) ax.text(60, 0.022, "低噪声档平均:约改善 10 倍", color=C_MAIN, fontsize=9) ax.text(430, 4.5, "中高噪声档:差 2~6 倍", color=C_ALT, fontsize=9) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "excess_error.png"), dpi=130) plt.close(fig) # ───────────────────── 图 3:每步注入的噪声账本 ───────────────────── def fig_variance(sc, mix): s2_exact = LAB.sigma2_exact_posterior(sc) tt = np.arange(1, T + 1) tr_exact = np.array([np.trace(s2_exact[t]) / D for t in range(1, T + 1)]) fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0)) ax = axes[0] ax.semilogy(tt, sc.bt[1:], color=C_MAIN, lw=2.0, label=r"$\tilde\beta_t$(DDPM 反向链用的,fixed_small)") ax.semilogy(tt, sc.beta, color=C_ALT, lw=1.8, ls="--", label=r"$\beta_t$(fixed_large)") ax.semilogy(tt, tr_exact, color=C_GREEN, lw=2.0, label=r"高斯数据的条件方差(含未知数据的条件不确定性)") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("每步注入噪声的方差") ax.set_title(r"(a) 本高斯数据的条件方差不小于 $\tilde\beta_t$") ax.set_ylim(1e-6, 1e0) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax = axes[1] lam = np.asarray(mix["lam"]) sr = np.asarray(mix["std_ratio"]) nn = np.asarray(mix["nll_uniform"]) ax.plot(lam, sr, "o-", color=C_MAIN, lw=2.0, label="生成分布的标准差 / 真分布") ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":") ax.set_xlabel(r"插值系数 $\lambda$:$\sigma^2=(1-\lambda)\tilde\beta_t+\lambda\beta_t$") ax.set_ylabel("标准差之比(1 表示胖瘦刚好对上)") ax.set_ylim(0.960, 0.978) ax2 = ax.twinx() ax2.plot(lam, nn, "s--", color=C_ALT, lw=1.8, label="期望 NLL") ax2.set_ylabel("期望 NLL(nats)", color=C_ALT) ax2.tick_params(axis="y", labelcolor=C_ALT) ax.set_title(r"(b) 换成 $\beta_t$ 把 3.4% 的偏窄补回 0.6 个点(没补满)", fontsize=11) ax.grid(alpha=0.25) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "variance_ledger.png"), dpi=130) plt.close(fig) # ──────────────────── 图 4:反向一步的三个配料 ──────────────────── def fig_step(sc): tt = np.arange(1, T + 1) abar_prev = sc.abar[:-1] abar_cur = sc.abar[1:] beta = sc.beta # x_{t-1} = c_x * x_t + c_0 * x_hat0 + sigma_t * z c_x = np.sqrt(sc.alpha) * (1.0 - abar_prev) / (1.0 - abar_cur) c_0 = np.sqrt(abar_prev) * beta / (1.0 - abar_cur) sigma = np.sqrt(sc.bt[1:]) fig, ax = plt.subplots(figsize=(9.2, 5.4)) ax.semilogy(tt, c_0, color=C_MAIN, lw=2.2, label=r"均值中 $\hat x_0$ 的系数(不是位移比例)") ax.semilogy(tt, c_x, color=C_GRAY, lw=1.8, ls="--", label=r"保留 $x_t$ 的系数") ax.semilogy(tt, sigma, color=C_ALT, lw=2.0, label=r"注入噪声的标准差 $\sqrt{\tilde\beta_t}$") ax.set_xlabel(r"时间步 $t$") ax.set_ylabel("系数 / 标准差(绝对值)") ax.set_title("反向一步的两个均值系数与噪声标准差") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.set_ylim(1e-6, 3.0) ax.annotate(rf"$t=500$:$c_0$={c_0[499]:.2e}", xy=(500, c_0[499]), xytext=(560, 2e-5), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax.annotate(rf"$t=2$:$c_0$={c_0[1]:.2f}", xy=(2, c_0[1]), xytext=(90, 0.9), fontsize=9, color=C_MAIN, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "step_anatomy.png"), dpi=130) plt.close(fig) def main(): sc = LAB.Sched(LAB.linear_beta(T)) w_tilde = sc.weight("tilde") w_large = sc.weight("large") grid = list(range(1, T + 1)) floor = np.array([LAB.mse_floor(sc, t) for t in grid]) learn = np.array([LAB.learnability(sc, t) for t in grid]) print(" 重新训练三份闭式解权重(与 ddpm_lab.py 同一套种子)...") W, _ = LAB.section_B(sc, w_tilde, w_large) prof = {} for name, Wm in W.items(): prof[name] = np.array([ LAB.mse_analytic(*LAB.model_Bc(Wm, LAB.psi_basis(np.array([t]))[0]), sc, t) for t in grid]) mix = LAB.section_E(sc, W) fig_weight_profile(sc, w_tilde, w_large, learn) fig_excess(sc, grid, prof, floor, learn) fig_variance(sc, mix) fig_step(sc) print(" 四张图已写入 figures/") return dict(sc=sc, W=W, prof=prof, floor=floor, learn=learn, mix=mix) if __name__ == "__main__": main()
-
AIGC 基本功|扩散过程的前向与反向推导-SDE AIGC 基本功|扩散过程的前向与反向推导-SDE 所属方向:数学基础 | 难度:入门 | 前置知识:变分下界与重参数化(KL、重参数化技巧、重参数化梯度) 关键词:马尔可夫链、前向扩散、反向去噪、随机微分方程、score matching、DDPM、DDIM、DPM-Solver 01. 为什么需要它 先摆四组数字,全部来自文末附录里六个能直接跑的脚本。 第一组:同一个 score 下比较不同采样器。 在 2D 七分量高斯混合上,score 有闭式解,可以排除神经网络拟合误差。下表记录一次固定种子实验的 dlogp,即生成样本与参考样本的平均 $\log p_0(x)$ 之差。它只是一个分布统计量:0 只说明这一个均值相同,不代表分布完全相同;正值也不是“生成得更好”。 配置 score 评估次数 dlogp DDPM 祖采样 N=1000 1000 −0.032 DDPM 祖采样 N=200 200 +0.089 DDIM(η=0)N=50 50 +0.090 Heun 二阶 N=50 100 +0.019 DDIM@50 与 DDPM@200 在这次运行中的 dlogp 接近,但不能据此得出通用的“4 倍提速”。Heun@50 的 +0.019 与 DDPM@1000 的 −0.032 也不足以证明谁更准确:还需重复随机种子、估计差值的不确定性,并结合模式占比和模式内半径等指标。比较成本时要按 score 调用次数 NFE 计,Heun 每步调用两次。 不把这件事算清楚,调 num_inference_steps 就是盲猜:既不知道收益的量级,也分不清收益里哪部分来自「换了算法的阶数」、哪部分来自「少走了冤枉路」。 第二组:调度改变了各噪声水平上的计算分配。 本实验把线性调度换成余弦,DDIM@50 的单次 dlogp 从 0.090 变到 0.050。线性调度有 74.1% 的离散步处在单位方差参考下 SNR<1 的区域,这描述了噪声水平分配,并不证明这些步骤“没有用”;高噪声阶段也负责形成全局结构。0.040 的差值需要重复实验确认,不能称为已经验证的 1.8 倍质量提升。 这张图要看什么:左图是信号方差系数,右图是在数据方差为 1 的约定下的信噪比。虚线标出 $\bar\alpha=0.5$ 的位置;低于这条线仍可能保留有用语义,不能把阴影区直接标成无效计算。 第三组:换个参数化(ε / v / x₀),等于给每个时间步换了 8 个数量级的权重。 三种参数化描述的是同一个量,但作为最小二乘目标并不等价。把它们的损失都折算回「对 ε 误差的权重」:ε 参数化恒为 1;v 参数化跨 2.5×10⁴ 倍;x₀ 参数化跨 2.5×10⁸ 倍(t=1 时 1.0×10⁻⁴,t=1000 时 2.5×10⁴)。这表明改变参数化会改变隐式时间权重。DDPM 的简化目标是经样本质量实验支持的重新加权,不能仅由此表推出其唯一理由。 第四组:验证手段本身有个坑。 我第一版是用 MMD² 给采样器排序的,跑出来的表看着非常漂亮:Heun 在 N≥10 就顶到「噪声地板」,其余采样器一路降到 0 以下。问题是那个「地板」是单次抽样的运气值——拿真实样本去对真实样本、重复 8 次,MMD² 的标准差是 ±3.6×10⁻⁴,比 N≥100 时各采样器之间的差别还大。发现它的办法很笨:做一次噪声标定。附录里的 mmd_noise_check.py 就是干这个的。分布距离的估计量本身有方差,用它排序前先量一下噪声。 02. 最小可用理解 三句话。 第一句:前向是一串手工设好的加噪,能一步算出来。 它形式上是一条 1000 步的马尔可夫链,但因为每步加的都是高斯,累乘之后仍然是高斯,所以 $q(x_t|x_0)$ 有闭式解,不需要真的跑 1000 次。 第二句:固定前向过程下,反向漂移由边缘 score 决定。 给定 $x_t$ 预测本次噪声,均方误差最优答案是噪声的条件均值,等于 score 的一个时间相关倍率,通常不等于本次实际噪声。精确 score、正确终端分布和连续过程下,生成可归结为数值求解;有限步反向核的近似及模型误差还要分别检查。 第三句:采样器既选择过程,也选择离散化。 DDPM / 反向 SDE、DDIM / 概率流 ODE 的随机性与漂移不同;求解器还要选择参数化、时间网格、阶数、方差和预测后处理,不能只把它们看作同一个更新式改几个系数。 这张图要看什么:左图叠加各时刻独立抽样的边缘快照,展示模式逐渐被噪声混合;它不是同一批样本的连续前向路径。右图记录 40 条初始噪声的 Heun 轨迹,展示本例如何回到模式附近,不能据此推断自然图像的布局、细节或可省步数。 03. 数学推导 3.1 前向链:为什么能一步到位 设原始数据 $x_0 \sim p_0$。前向过程每一步只做一件事:往上加一点高斯噪声。 $$q(x_t|x_{t-1}) = \mathcal{N}(x_t; \sqrt{\alpha_t}\,x_{t-1},\ \beta_t I)$$ 这里 $\alpha_t = 1 - \beta_t$,而 $\beta_t$ 是方差而不是标准差——这个记号是 DDPM 原文定的,容易看错。写成重参数化形式就是 $x_t = \sqrt{\alpha_t}\,x_{t-1} + \sqrt{\beta_t}\,\varepsilon$。 现在把两步接起来看: $$x_t = \sqrt{\alpha_t\alpha_{t-1}}\,x_{t-2} + \sqrt{\alpha_t\beta_{t-1}}\,\varepsilon_1 + \sqrt{\beta_t}\,\varepsilon_2$$ 两个独立高斯的线性组合仍是高斯,噪声方差为 $(\alpha_t\beta_{t-1}+\beta_t)I$。代入 $\beta_{t-1}=1-\alpha_{t-1}$、$\beta_t=1-\alpha_t$,得到 $\alpha_t(1-\alpha_{t-1})+(1-\alpha_t)=1-\alpha_t\alpha_{t-1}$。这才是两步方差的正确化简。 于是归纳下去,任意步数都能一步算出来。记 $\bar\alpha_t = \prod_{s\le t}\alpha_s$: $$q(x_t|x_0) = \mathcal{N}\big(x_t;\ \sqrt{\bar\alpha_t}\,x_0,\ (1-\bar\alpha_t)I\big)$$ 这就是整个扩散模型里唯一一条「白送」的公式,训练时要多少步的加噪样本都能直接算。这里使用独立、零均值、各向同性高斯噪声,因而协方差简化成标量乘 $I$。各向同性不是高斯闭式解的必要条件:若第 $t$ 步噪声协方差为 $Q_t$,则 $\Sigma_t=\alpha_t\Sigma_{t-1}+Q_t$,仍为高斯条件分布;若改用非高斯噪声,本文这条高斯密度式一般不再成立。$p_t(x_t)=\int q(x_t\mid x_0)p_0(x_0)dx_0$ 是边缘密度,未必高斯,须与 $q(x_t\mid x_0)$ 分清。 附录里的 forward_diffusion.py 拿 20 万样本对着验了一遍:用「逐步迭代 1000 次」和「一步闭式」两条路分别算 $x_t$ 的均值与方差,误差量级都在 $10^{-3}$,正好是 20 万样本的蒙特卡洛噪声水平(t=1000 时闭式方差误差 6.20×10⁻³,逐步方差误差 6.19×10⁻³,两者接近是统计核对,不能替代上面的代数证明;两条路径使用独立噪声,不逐样本比对)。 3.2 反向链:条件后验与边缘后验要分开 我们需要 $q(x_{t-1}\mid x_t)$;先求已知 $x_0$ 的条件后验。令 $y=x_{t-1}$,利用前向马尔可夫性: $$q(y\mid x_t,x_0)\propto q(x_t\mid y)q(y\mid x_0)$$ 把两个高斯的指数展开,丢掉与 $y$ 无关的项: $$\log q(y\mid x_t,x_0)= -\frac12 A_t\|y\|^2+b_t^\top y+C$$ $$A_t=\frac{\alpha_t}{\beta_t}+\frac{1}{1-\bar\alpha_{t-1}},\qquad b_t=\frac{\sqrt{\alpha_t}}{\beta_t}x_t+\frac{\sqrt{\bar\alpha_{t-1}}}{1-\bar\alpha_{t-1}}x_0$$ $A_t$ 是标量精度,$b_t$ 是线性项,$C$ 为常数;配方成 $-A_t\|y-A_t^{-1}b_t\|^2/2$。使用 $\bar\alpha_t=\alpha_t\bar\alpha_{t-1}$ 化简,就得到 DDPM 式 (6)、(7): $$q(x_{t-1}\mid x_t,x_0)=\mathcal N(\tilde\mu_t,\tilde\beta_t I)$$ $$\tilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t$$ $$\tilde\mu_t=c_t x_0+d_t x_t,\quad c_t=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t},\quad d_t=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$$ 上面的精度配方用于 $t\ge2$;$t=1$ 时 $x_{t-1}=x_0$ 已知,是点质量,不能在精度表达式里除以零。此时闭式系数的极限给出 $\tilde\beta_1=0$。 采样时 $x_0$ 未知,要对 $q(x_0\mid x_t)$ 积分。全期望与全协方差给出: $$\mathbb E[x_{t-1}\mid x_t]=c_t\mathbb E[x_0\mid x_t]+d_t x_t$$ $$\operatorname{Cov}(x_{t-1}\mid x_t)=\tilde\beta_t I+c_t^2\operatorname{Cov}(x_0\mid x_t)$$ 所以把 $x_0$ 替换为最优均值可得到真实反向均值,却不能同时得到真实反向协方差。一般数据下真实逆核还是混合分布。反例:一维等权双峰 $x_0\sim\tfrac12\mathcal N(-2,0.04)+\tfrac12\mathcal N(2,0.04)$,观测 $x_t=0$、$\bar\alpha_t=0.9$,后验均值为 0,但方差约为 2.19;用零方差均值回到 0 会丢掉两个峰。diffusion_checks.py 独立算出分量均值、分量方差及总方差。有限步 DDPM 高斯核与最后的均值去噪属于近似,不能因 score 精确就宣称逆核精确。 3.3 从 ELBO 到「只预测噪声」 以前向链 $q(x_{1:T}\mid x_0)$ 为变分分布,生成链为 $p_\theta(x_{0:T})$。Jensen 不等式给出 $\mathrm{ELBO}\le\log p_\theta(x_0)$,因此负 ELBO 是负对数似然的上界: $$-\log p_\theta(x_0)\le -\mathrm{ELBO}=L_T+\sum_{t=2}^T\mathbb E_q L_{t-1}+\mathbb E_q L_0$$ $L_T=\mathrm{KL}(q(x_T\mid x_0)\Vert p(x_T))$ 是条件终端先验项。固定调度下不依赖去噪网络;本文数据取期望后,线性调度为 $1.065154\times10^{-4}$ nats,余弦为 $6.410060\times10^{-9}$ nats。它与边缘终端 KL 相差 $I(x_0;x_T)$,不能混用。忽略固定项不改变网络梯度,报告似然界时仍须计入。 去噪匹配项比较条件后验与模型反向核: $$L_{t-1}=\mathrm{KL}(q(x_{t-1}\mid x_t,x_0)\Vert p_\theta(x_{t-1}\mid x_t))$$ $L_0=-\log p_\theta(x_0\mid x_1)$ 是最终解码项。离散像素须用离散化似然,连续数据也不能未经评估便认定它很小。 设模型方差为固定的 $\sigma_t^2 I$。高斯 KL 展开为: $$L_{t-1}=\frac{\|\tilde\mu_t-\mu_\theta\|^2}{2\sigma_t^2}+\frac D2\left(\frac{\tilde\beta_t}{\sigma_t^2}-1+\log\frac{\sigma_t^2}{\tilde\beta_t}\right)$$ $D$ 是数据维数。若方差固定,第二项对均值网络是常数;只有 $\sigma_t^2=\tilde\beta_t$ 时它才为零,不能把“同协方差”当成所有 DDPM 的前提。若方差可学习,这一项参与优化。 由 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon$ 解出 $x_0$ 再代回均值: $$\tilde\mu_t=\frac1{\sqrt{\alpha_t}}\left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon\right)$$ 把实际噪声 $\varepsilon$ 换成网络输出 $\varepsilon_\theta(x_t,t)$ 得到 $\mu_\theta$。两均值之差是一个确定倍率乘噪声残差,所以固定方差下与网络有关的项为: $$w_t\|\varepsilon-\varepsilon_\theta(x_t,t)\|^2,\qquad w_t=\frac{\beta_t^2}{2\sigma_t^2\alpha_t(1-\bar\alpha_t)}$$ DDPM 式 (12)、(14) 改用均匀抽取 $t$ 的简化目标: $$L_{\text{simple}}=\mathbb E_{t,x_0,\varepsilon}\|\varepsilon-\varepsilon_\theta(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon,t)\|^2$$ 这是依据样本质量实验选择的重新加权目标,通常不等于原 ELBO。对每个噪声时刻,理想无限容量的 MSE 最优解是条件均值;有限共享网络的梯度和训练结果仍会随权重变化。06 节将另一类“输出参数化的代数权重”换算到噪声残差空间,它与这里的 ELBO 权重 $w_t$ 是不同概念。 3.4 连续化:分布方程、时间方向和积分变量 离散步号是 $t=0,\ldots,T$,连续时间是 $u=t/T\in[0,1]$,步长 $\Delta u=1/T$。离散 $\beta_t$ 是无量纲方差,连续 $\beta(u)$ 是每单位时间的噪声率。令 $\beta_t\approx\beta(u)\Delta u$ 并展开 $\sqrt{1-\beta_t}\approx1-\beta_t/2$,得到 VP-SDE: $$dx=-\tfrac12\beta(u)x\,du+\sqrt{\beta(u)}\,dw_u$$ $w_u$ 为标准布朗运动,正向增量协方差为 $du\,I$。记 $a(u)=\exp(-\int_0^u\beta(v)dv)$,边缘协方差为 $a(u)\operatorname{Cov}(x_0)+(1-a(u))I$;只有初始单位协方差才严格保持单位协方差。 有限离散表与指定连续率是两个设计。 本实验将线性表端点乘 $T$ 得到连续线性率 0.1 到 20;在 $u=1$,其 $a(u)$ 与离散乘积相差约 7.01%。这个差包含 $\log(1-\beta_t)\ne-\beta_t$ 的有限步效应及率插值/求积约定,不能称为所有连续化不可避免的固定误差。更直接的精确嵌入是每个区间取: $$\beta_{\text{exact}}(u)=-T\log(1-\beta_t),\qquad (t-1)/T\lt u\le t/T$$ 此时区间积分为 $-\log(1-\beta_t)$,边界处 $a(t/T)=\prod_{j=1}^t(1-\beta_j)=\bar\alpha_t$,前向转移也完全对应。附录独立核对该等式。本文采样器使用 $L=\log(a_{\text{prev}}/a_{\text{cur}})$,等于使用累计噪声钟作为积分变量。 为解释 score 系数,写一般标量扩散 $dx=f(x,u)du+g(u)dw_u$ 的 Fokker–Planck 方程: $$\partial_u p=-\nabla\cdot(fp)+\tfrac12 g^2\Delta p$$ 定义边缘 score $s=\nabla\log p$,有 $ps=\nabla p$,从而 $\Delta p=\nabla\cdot(ps)$。代入得连续性方程: $$\partial_u p=-\nabla\cdot\left[(f-\tfrac12 g^2s)p\right]$$ 所以速度 $f-\tfrac12g^2s$ 的确定性 ODE 与正向 SDE 具有同一系列边缘分布。反向 SDE 定理及概率流推导 给出: $$dx=\left[-\tfrac12\beta x-\beta s(x,u)\right]du+\sqrt\beta\,d\bar w_u\quad\text{(反向 SDE)}$$ $$dx=\left[-\tfrac12\beta x-\tfrac12\beta s(x,u)\right]du\quad\text{(概率流 ODE)}$$ 这里反向求解 $du\lt0$;反向布朗增量协方差是 $|du|I$,不是负的 $du I$。为消除实现歧义,可用递增反向时间 $\tau=1-u$:SDE 漂移为 $\beta(x/2+s)$,噪声增量为 $\sqrt{\beta\Delta\tau}z$;ODE 漂移为 $\beta(x+s)/2$。它们从同一正确终端分布出发、使用精确 score 并满足正则性条件时,才有相同目标边缘;路径联合分布不同,有限求解器也不同。 记一次反向区间的积分: $$L=\int_{u_{\text{prev}}}^{u_{\text{cur}}}\beta(u)du=\log\frac{a_{\text{prev}}}{a_{\text{cur}}}>0$$ 在累计噪声钟中冻结当前 $x,s$,Euler 漂移更新为 $x\leftarrow x+L(x/2+c s)$,$c=1$ 对应 SDE,$c=1/2$ 对应 ODE;前者另加 $\sqrt Lz$。不能只删 SDE 的噪声而保留完整 score 系数。反例:稳态 $p=\mathcal N(0,I)$ 的 score 为 $-x$,概率流速度恰为 0;删噪声后的 SDE 漂移却是 $-\beta x/2$,会错误收缩方差。diffusion_checks.py 在 $L=0.1$ 给出删噪声方差 0.9025、Euler–Maruyama 方差 1.0025、精确 ODE 方差 1;EM 的 0.0025 是有限步误差。 3.5 四种参数化:实际 target 与条件均值 令 $a=\bar\alpha_t$、$b=\sqrt{1-a}$。实际训练样本满足 $x_t=\sqrt a x_0+b\varepsilon$。条件高斯的 score 为 $\nabla_{x_t}\log q(x_t\mid x_0)=-\varepsilon/b$。对 $x_0$ 的后验取平均,并把求导移入积分(需可微及可积条件),得到边缘 score 的恒等式: $$s_t(x_t)=\mathbb E\left[\nabla_{x_t}\log q(x_t\mid x_0)\mid x_t\right]=-\frac{\mathbb E[\varepsilon\mid x_t]}{\sqrt{1-a}}$$ 因此应写 $\hat\varepsilon_{\text{MMSE}}=\mathbb E[\varepsilon\mid x_t]=-\sqrt{1-a}s_t(x_t)$。网络只看到 $x_t,t$,不同 $x_0,\varepsilon$ 能形成同一观测,不能恢复每次真实噪声。MSE 的条件分解说明其不可约误差: $$\mathbb E[\|\varepsilon-h(x_t)\|^2\mid x_t]=\operatorname{tr}\operatorname{Cov}(\varepsilon\mid x_t)+\|\mathbb E[\varepsilon\mid x_t]-h(x_t)\|^2$$ 把 $\mathbb E[\varepsilon\mid x_t]$ 代回加噪等式,得 Tweedie 公式: $$\mathbb E[x_0\mid x_t]=\frac{x_t+(1-a)s_t(x_t)}{\sqrt a}$$ 高斯先验反例:$x_0,\varepsilon$ 独立且皆标准正态,此时 $x_t$ 也为标准正态,$\mathbb E[\varepsilon\mid x_t]=\sqrt{1-a}x_t$,但条件噪声协方差为 $aI$。本文 $D=2,a=0.25$ 的最优期望平方误差为 0.5,并非 0。零预测器的向量 RMSE 基线是 $\sqrt D$;只有独立标准高斯“瞎猜”才是 $\sqrt{2D}$。 v 参数化 定义实际 target 为 $v=\sqrt a\varepsilon-\sqrt{1-a}x_0$。联合变换及逆变换是: $$\begin{pmatrix}x_t\\v\end{pmatrix}=\begin{pmatrix}\sqrt a&\sqrt{1-a}\\-\sqrt{1-a}&\sqrt a\end{pmatrix}\begin{pmatrix}x_0\\\varepsilon\end{pmatrix}$$ $$x_0=\sqrt a x_t-\sqrt{1-a}v,\qquad \varepsilon=\sqrt{1-a}x_t+\sqrt a v$$ 矩阵转置乘自身等于单位阵,保持联合向量范数;这一性质不保证所有单输出预测或反解都不会放大误差。固定 $x_t$ 时,$\delta\varepsilon=\sqrt a\delta v$、$\delta x_0=-\sqrt{1-a}\delta v$;反解 $v$ 从噪声残差会除以 $\sqrt a$,高噪声时仍可能放大。对条件均值取同一线性变换也成立,网络的 MSE 最优 $v$ 输出是 $\mathbb E[v\mid x_t]$。 score_bridges.py 保留所有数值核对:Tweedie 对精确混合后验均值最大差约 $10^{-15}\sim10^{-13}$,两种 MMSE 噪声算法差约 $10^{-16}\sim10^{-15}$,实际 $(x_0,\varepsilon)$ 用实际 $v$ 重建差约 $10^{-15}$。100 万样本的自归一化重要性采样提供独立后验均值核对,有限样本有偏且有抽样误差,ESS 仅诊断权重集中程度,不是误差保证。 04. 代码实现 4.1 实验设计:把「模型误差」这个变量消掉 真实扩散模型的采样误差来自两处:score 估计得不准,以及数值积分不准。想把第二处单独看清楚,就得让第一处等于零——用一个 score 有闭式解的目标分布。 办法是选高斯混合:$p_0 = \sum_k w_k\mathcal{N}(\mu_k, s_k^2 I)$。前向加噪之后,第 $k$ 个分量的均值缩到 $\sqrt{\bar\alpha_t}\mu_k$、方差变成 $\bar\alpha_t s_k^2 + (1-\bar\alpha_t)$,仍然是各向同性高斯,所以 $p_t$ 还是高斯混合,且 $$\nabla_x\log p_t(x) = -\sum_k r_k(x)\frac{x - \sqrt{\bar\alpha_t}\mu_k}{\bar\alpha_t s_k^2 + (1-\bar\alpha_t)},\qquad r_k(x) = \frac{w_k\mathcal{N}_k(x)}{\sum_j w_j\mathcal{N}_j(x)}$$ $r_k$ 就是「这个样本属于第 $k$ 个分量」的责任度,是标准的软分配。由此排除 score 拟合误差;剩下的差异还包含有限终端高斯近似、逆核与终步去噪近似、积分误差及样本统计误差。 这里有个调参坑值得记一下:我第一版用了 3 个很宽的分量(标准差 0.45/0.35/0.55),结果五种采样器全部顶到 MMD 噪声地板上,分不出高下。换成 7 个紧分量(标准差 0.16~0.30)之后差距才显出来——目标太光滑,分辨不出采样器的差别。这是本 toy 的分辨力调整;自然图像的误差可能同时影响布局、模式覆盖和细节,不能从低维混合外推唯一成因。 4.2 前向:闭式解核对 核心就几行,除了算 $\bar\alpha$ 之外没有任何魔法: def linear_beta(T=1000, beta_1=1e-4, beta_T=0.02): return np.linspace(beta_1, beta_T, T) def alpha_bar_from_beta(beta): return np.cumprod(1.0 - beta) def q_sample(x0, t_idx, alpha_bar, rng): a = alpha_bar[t_idx] eps = rng.standard_normal(x0.shape) return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps q_sample 就是 3.1 节那个闭式解。余弦调度多两行——按 $\bar\alpha_t$ 定义式算完之后要把 β 截到 0.999 以内,因为 $t=T$ 时 $\cos(\pi/2)=0$ 会让最后一步 $\beta=1$,实操直接炸: def cosine_beta(T=1000, s=0.008, clip=0.999): t = np.arange(1, T + 1) / T f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2 f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2 beta = beta_from_alpha_bar(f / f0) # 反解出每步的 beta return np.clip(beta, None, clip) 4.3 反向:五个采样器 DDPM 祖采样——用高斯核近似反向转移。对一般数据,即使均值来自精确 score,有限步高斯核也不等于真实反向条件分布。把 3.2 节的 $\tilde\mu_t$ 和 $\tilde\beta_t$ 抄进来,再把 $\hat x_0$ 换成 Tweedie 公式: def run_ddpm(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev # 跨 k 步的等效 alpha beta_j = 1.0 - alpha_j s = score_at(x, alpha_bar, t_cur) mean = (x + beta_j * s) / np.sqrt(alpha_j) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) x = mean + np.sqrt(var) * rng.standard_normal(x.shape) return x Euler-Maruyama(反向 SDE)——把 $L$ 和 $c=1$ 代进 3.4 节的结果: def run_em(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s = score_at(x, alpha_bar, taus[j]) x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape) return x 概率流 ODE——唯一的改动是 score 系数减半、噪声项删掉: def run_ode(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s = score_at(x, alpha_bar, taus[j]) x = x + 0.5 * L * (x + s) return x Heun 二阶——Euler 预测一步,再用终点的 score 校正一次。每步两次评估: def run_heun(x, alpha_bar, taus, rng): for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) s0 = score_at(x, alpha_bar, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 # Euler 预测 s1 = score_at(x1, alpha_bar, taus[j + 1]) # 终点再评估一次 d1 = 0.5 * L * (x1 + s1) x = x + 0.5 * (d0 + d1) return x DDIM 单独说,因为它长得不像上面四个。它先把样本一步跳到 $\hat x_0$,再按目标时刻的 $\bar\alpha$ 重新加回噪声: $$x_{t-1} = \sqrt{\bar\alpha_{t-1}}\,\hat x_0 + \sqrt{1-\bar\alpha_{t-1}}\,\hat\varepsilon$$ $\hat x_0$ 用 Tweedie 公式算、$\hat\varepsilon$ 用 $\varepsilon=-\sqrt{1-\bar\alpha_t}s$ 算。η=0 的 DDIM 在小步长极限对应概率流 ODE,其 score 漂移系数为反向 SDE 的一半;DDPM 的均值更新对应后者,两者并不在代数上相同。 4.4 结果 七个分量、每档生成 4000 个样本、参照集 8000 个真实样本。三个统计量扣除参照样本的估计值;0 仅表示该统计量相同,不能保证模式比例、半径或整个分布正确: 采样器 N=10 N=25 N=50 DDPM −0.365 +0.266 +0.249 DDIM −0.248 +0.124 +0.090 EM(SDE) −2.725 −0.756 −0.347 Euler(ODE) −2.340 −0.792 −0.348 Heun +0.546 +0.084 +0.019 采样器 N=100 N=200 N=1000 DDPM +0.174 +0.089 −0.032 DDIM +0.057 +0.032 +0.007 EM(SDE) −0.189 −0.100 −0.081 Euler(ODE) −0.159 −0.074 −0.014 Heun +0.005 +0.002 +0.001 上表是单次实验的 dlogp。两批独立真实样本在这次运行中的差值约 0.053;这不是经重复估计的标准差或置信区间。表格主要帮助识别量级很大的离散化偏差,微小差异不做显著性排序。三点读法: DDPM / DDIM 在 N=10 还能看,Euler 系直接崩(−2.3 ~ −2.7,说明样本散在低密度区根本没收敛)。这里最大单步跨约 1.92 的积分量;网格、非线性 score 与数值方法共同影响结果,不能把所有误差唯一归因到第一步。 误差变号可作为线索。 正的 dlogp 表示生成样本的平均目标密度较高,负的表示较低;本实验结合半径诊断观察到聚拢或散开的倾向。单个密度均值也可能受分量占比变化影响,不能独立确定失败原因。 本次 Heun 在 N≥20 的 dlogp 较小,但差异接近采样波动时不作排名;接近0也不足以证明整个分布正确。 补充两个不同统计量:按模式归属估算的分量占比 TV,以及模式内均方半径的相对误差。在 N=50 的本次运行中,Heun 为 0.011 / 0.066,DDIM 为 0.014 / 0.155,DDPM 为 0.019 / 0.340,Euler-ODE 为 0.017 / 0.358。这里数值分别为占比误差偏移 dTV 与半径误差偏移 dspread,并非未经扣基线的绝对误差;它们分别检查模式比例与分散程度,排序并非处处一致,也要估计采样误差。 这张图要看什么:左图画的是单个诊断统计量的偏差,参考虚线只表示一次真实样本对照差值,不是置信区间。右图比较线性漂移项的指数因子和 Euler 近似,解释大步长为何可能困难;完整 score 场同时参与更新,不能仅用这一项定量归因全部误差。 按相同 NFE 复核。 新增 diffusion_checks.py 每种方法做五个独立种子,每次生成 4000 个、参考 8000 个样本;Heun 用 25 步,其他方法 50 步,实际计数都为 50 次 score 调用。下面报告跨种子的均值和样本标准差(ddof=1),标准差不是置信区间,也不是对单次抽样标准误的替代。 方法 步数 NFE 平均 dlogp 跨种子 SD ddpm 50 50 +0.2751 0.0081 ddim 50 50 +0.0840 0.0129 em 50 50 -0.3231 0.0233 ode 50 50 -0.3707 0.0270 heun 25 50 +0.0775 0.0141 每次独立生成与参考样本的密度均值差,还可估计 iid 标准误 $\sqrt{s_g^2/n_g+s_r^2/n_r}$,两批样本独立时方差相加;完整数值由脚本打印。少量重复只帮助观察稳健性,不代表真实图像模型上的方法排名。 dlogp 等于 0 的反例。 在二维标准高斯目标下,把所有样本放到半径 $\sqrt2$ 的圆上,期望 $\log p$ 与真实高斯完全相同;但半径四次矩是 4,真实高斯为 8,径向分布显然不同。该解析反例说明单个均值相同也可严重失真,不能把密度偏移当作完整分布距离。 固定带宽的 MMD 平方 U 统计量可能为负,而总体 MMD 平方非负;8 次真实样本对照中约 $3.6\times10^{-4}$ 是用 ddof=0 计算的这一组经验散布,既不是通用噪声下界,也不是置信区间。mmd2 默认用待比较样本选带宽,此时数据自适应值不能直接套固定核的无偏性;严谨评测应以独立数据固定带宽。模式归属使用最近均值,重叠分量可能错分;缺少某模式样本时半径误差置 1 是教学约定,不能视作准确总体 TV 或缺失模式的半径估计。MMD 原始论文 给出固定核估计的定义。 4.5 为什么朴素 Euler 在大步长下会崩 把上面第 1 点挖到底。概率流 ODE 里线性部分 $\tfrac12\beta x$ 的精确解是 $e^{L/2}$,而 Euler 用的是它的一阶展开 $1+L/2$。线性子问题的相对误差为 $1-(1+L/2)e^{-L/2}$,随正 $L$ 增大而趋近 1: 采样步数 N 每步最大积分量 $L_{\max}$ $e^{L/2}$ 与 $1+L/2$ 的相对误差 10 1.9197 24.95% 20 0.9852 8.80% 50 0.4002 1.75% 100 0.2011 0.47% 200 0.1008 0.12% 1000 0.0202 0.01% DDPM 与 DDIM 的更新含精确线性指数因子。 从当前到前一时刻,因子为 $\sqrt{a_{\text{prev}}/a_{\text{cur}}}=e^{L/2}$,不是孤立的 $\sqrt{a}$。DDIM 还近似积分剩余噪声预测项;DDPM 仍使用近似高斯逆核。因此该表仅解释线性子项,不能单独证明完整误差大小或工业选择。DPM-Solver 系统利用半线性结构构造积分器,反向 SDE 的 Euler–Maruyama 与 predictor–corrector 也有实际用途。 高阶方法也需要合适的步长。 本次 Heun@10 的 dlogp 为 +0.546,DDIM@10 为 −0.248,说明这个网格上的 Heun 出现明显偏聚拢。原因可能包括稳定域、非线性 score 与步长的相互作用;不能说二阶校正必然放大线性项误差,更不能推广为 DPM-Solver 高阶算法在所有少步数任务上都更差。 05. 工业级实现对照 以下以 diffusers v0.35.1 / scheduling_ddpm.py 的 DDPMScheduler.add_noise、step 和 _get_variance 为准;已获取固定版本原始源码并执行原方法,核验日为 2026-10-15。 add_noise 就是 3.1 节的闭式解,一字不差: sqrt_alpha_prod = alphas_cumprod[timesteps] ** 0.5 sqrt_one_minus_alpha_prod = (1 - alphas_cumprod[timesteps]) ** 0.5 noisy_samples = sqrt_alpha_prod * original_samples + sqrt_one_minus_alpha_prod * noise 第一个值得注意的细节:noise 是从外面传进来的,不是在函数里采的。因为训练时需要知道「这次加的是哪个 ε」才能算损失——如果接口内部采样且不返回噪声,就无法直接取得 target;接口当然也可以选择同时返回噪声。该实现还把累计表移到样本设备,系数转为样本 dtype,先展平 timestep 系数再逐维增加尾轴,支持批量样本广播。整数 timestep 是从 0 开始的数组下标,本文理论 $t=1$ 对应源码 timestep 0。 第二个细节:alphas_cumprod 在 __init__ 里用 torch.cumprod(1 - betas) 一次算好并缓存。1000 个数,每个训练步都要按 timestep 取,重新累乘显然不划算。这就是 3.1 节那条「白送」的公式在工程上的直接体现。 step 的均值在对齐配置时与本文等价。 它写的是 DDPM 原文公式 (7) 的系数形式: current_alpha_t = alpha_prod_t / alpha_prod_t_prev current_beta_t = 1 - current_alpha_t pred_original_sample = (sample - beta_prod_t ** 0.5 * model_output) / alpha_prod_t ** 0.5 # 即 Tweedie pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample 把 pred_original_sample_coeff 和 current_sample_coeff 代进 3.2 节的 $\tilde\mu_t$ 表达式展开,$x_t$ 的系数会化简成 $1/\sqrt{\alpha_j}$、$\varepsilon$ 的系数化简成 $-\beta_j/(\sqrt{\alpha_j}\sqrt{1-\bar\alpha_{\text{cur}}})$,也就是 $\tilde\mu = (x_t + \beta_j s)/\sqrt{\alpha_j}$——和我 4.3 节那个「一行 DDPM」完全一样。current_alpha_t = alpha_prod_t / alpha_prod_t_prev 对应的正是我的 alpha_j,所以 diffusers 支持跳步(strided)采样;这里只在相同 prediction_type、方差与不启用 clipping/thresholding 的条件下和最小实现等价。 三处工程实现要额外核对的差异: 第一,调度不是自由参数,是分类的。beta_schedule 有 linear / scaled_linear / squaredcos_cap_v2 / sigmoid 几个分支;我 4.2 节实现的余弦调度在它这里叫 squaredcos_cap_v2,走的是通用函数 betas_for_alpha_bar——先给定 $\bar\alpha(t)$ 的解析式,再按 $1 - \bar\alpha(t_2)/\bar\alpha(t_1)$ 反解出每步 β,并且硬编码 max_beta=0.999。这正好对上我 cosine_beta 里那句 clip,不是巧合:$t=T$ 时 $\cos(\pi/2)=0$ 会给出 $\beta_T=1$,必须截。 第二,有限终端 SNR 会引入起点分布近似。线性表的 $\bar\alpha_T=4.0358\times10^{-5}$,仍保留少量数据成分;推理却常从标准高斯开始。diffusers 的 rescale_betas_zero_snr 对应 Lin 等,2023 的修正,但要与训练的参数化、时刻采样和起点设置一起核对。对已有 epsilon checkpoint 不能只开一个开关就假定兼容,零 SNR 下若仍用除以 $\sqrt{\bar\alpha_T}$ 的公式还会遇到奇异点。 第三,参数化是可切换的输出头。prediction_type 支持 epsilon / sample / v_prediction 三选一,step 开头那个 if-elif 就干这件事。三种模式对 pred_original_sample 的算法不同,但固定方差的后续均值系数计算共用——这正是 3.5 节「它们描述同一个量」在工程上的样子。也正因如此,采样端转换形式可由配置选择,但 checkpoint 的训练目标必须匹配,不能把 epsilon 权重仅改一行配置就当作 v 预测器,代价藏在 06 节的权重表里。 固定官方方法的真实对照。 将 v0.35.1 中原始 add_noise、get_velocity、step、_get_variance、previous_timestep 的函数体按 AST 原样取出,在 PyTorch 2.10.0+cpu 上执行。对 float32/float64 以及 [2,3]、[2,1,3,4]、[2,1,2,3,4] 六组加噪/速度广播核对,差为 0;自定义 timestep [999,799,399,49,0] 与三个 prediction_type 共 15 组均值/方差对照,最大误差小于 $10^{-10}$。独立后验配方及 KL 权重最大误差约 $9.68\times10^{-14}$。为了单独检查均值,实跑用零噪声适配器替代随机数入口;原函数体未改,这不等于完整 diffusers 包或 GPU 模型复现。 注意默认 clip_sample=True 会裁剪预测的 $x_0$ 到约定范围,教学等价对照关闭它;另有实际裁剪分支对照。fixed_small 方差会被数值下界截到 $10^{-20}$。当源码 timestep 为 0 时不调用随机数;若自定义最后时刻大于 0、previous_timestep 为 −1,它仍会走噪声分支,加一个极小噪声,与本文严格零方差最终均值略有差别。若使用 learned 方差,还要核对双通道输出及 _get_variance 分支,本文的固定方差核不能代表它们。 06. 代价与边界 代价一:换参数化不是改记号,是改损失权重。 把三种参数化都折算回「对 $\varepsilon$ 误差的权重」(推导见 score_bridges.py 的文档串:x₀ 的损失 $\|\delta x_0\|^2$ 折成 $\varepsilon$ 误差要乘倍率,v 的误差因为 $\delta\varepsilon = \sqrt{\bar\alpha_t}\,\delta v$ 也要乘): t $\bar\alpha_t$ ε 参数化的权重 v 参数化的权重 x₀ 参数化的权重 1 9.999×10⁻¹ 1.0000 1.0001 1.0001×10⁻⁴ 100 8.970×10⁻¹ 1.0000 1.1148 1.1480×10⁻¹ 500 7.859×10⁻² 1.0000 1.2725×10¹ 1.1725×10¹ 900 2.752×10⁻⁴ 1.0000 3.6336×10³ 3.6326×10³ 1000 4.036×10⁻⁵ 1.0000 2.4778×10⁴ 2.4777×10⁴ 这张表是等价残差之间的代数权重,不是网络参数梯度的实测值。 ε、v、x₀ 三种目标的输出尺度、网络雅可比以及时间采样方式都会影响梯度。等权 ε 损失在这里对应 ε 残差权重恒为 1;不能据此断言各时刻梯度相同,也不能仅凭该表断言 x₀ 目标一定被高噪声支配或无法训练。 这张图要看什么:把不同输出误差换算到 ε 误差时,各自带上不同时间权重。曲线说明训练目标不等价,不是实测梯度图;实际训练还要连同参数化和时间采样权重一起分析。 代价二:阶数更高也要选择合适的网格。 Heun@10 的表现说明本实验的大步长不合适,不是对所有高阶求解器的否定。DPM-Solver 专门利用扩散 ODE 的半线性结构,不能从朴素 Heun 的结果推导它的少步数表现。 代价三:随机项改变有限步采样的误差与方差。 DDIM 的 η 从 0 到 1,本次 N=50 的 dlogp 为 0.090、0.065、0.092、0.169、0.249。这里 η=1 配上相同时间网格和方差选择可恢复所实现的 DDPM 更新,但不能把单次结果概括为“噪声没有用”。在精确 score、连续时间和正确初始分布下,反向 SDE 与概率流 ODE 都能得到相同边缘分布;有限步误差的优劣取决于具体离散化。 边界:这套实验测不到模型误差。 oracle score 排除了训练误差,却仍有有限终端分布近似、离散化和样本统计误差;它不是现实图像模型误差的严格下界。真实网络的误差还会与采样轨迹交互,必须在目标 checkpoint 上另做实验。 边界:高斯混合不是自然图像。 这里的数据维数、模态结构、score 光滑性和引导强度都很简单。表格适合验证公式与数值方法,不能当作真实模型加速倍率或通用采样器排名。 ODE 也能生成多样样本与估计似然。 确定性只意味着固定初始噪声对应固定轨迹;不同随机初值仍可覆盖整个数据分布。原始 score-SDE 论文 就利用概率流 ODE 计算似然。在向量场满足正则条件时精确流可逆,但有限步 DDIM / ODE 数值求解一般不能无误差反演。 按任务给一张实验决策表(密度偏移绝对值仅衡量一个统计量,须结合覆盖、半径和抽样波动): 步数预算 该选谁 实测依据 8~10 步 在目标模型上比较合适的少步采样器 本 toy 的 Heun@10 偏聚拢,不能推出其他高阶方法的排名 20~50 步 Heun 是本实验可考虑的方案 Heun@50 的 dlogp 为 0.019,需结合其他指标和重复试验 100~200 步 同 NFE 比较,避免只按步数选 N=200:Heun 0.002、DDIM 0.032、DDPM 0.089 要多样性 ODE / SDE 都可,比较分布覆盖 ODE 的多样性来自随机初值;SDE 还增加路径随机性 要反演 / 要编辑 可考虑概率流 ODE / DDIM 理想流可逆;有限步反演仍有数值和模型误差 表格只总结当前教学实验能支持的选择。没有实测的 PNDM / DPM-Solver 不参与排名;真实模型应以同等 NFE、重复种子与多个质量指标比较。 07. 经典论文脉络 ① 1503.03585(Sohl-Dickstein et al., 2015)——把扩散搬进生成模型。 用非平衡热力学里的一个想法:先定义一个把数据逐步破坏成噪声的正向过程,再学它的反向过程。贡献是框架本身,同时研究了高斯与二项扩散等设置,展示了可训练的生成扩散框架;这里不对其所有应用的实用性作统一判断。 ② 2006.11239(Ho et al., 2020)——DDPM,把目标改成「预测噪声」。 三件事:把 $\tilde\mu_t$ 参数化成预测 $\varepsilon$;指出把 ELBO 里那一串只跟 t 有关的系数扔掉、直接用等权的 $L_{\text{simple}}$ 反而效果更好;给出 3.2 节那套 $\tilde\beta_t / \tilde\mu_t$ 的闭式解。该参数化与经验重新加权推动了图像扩散质量;早期工作已有可训练目标,不能把历史概括为此前无法训练。 ③ 2011.13456(Song et al., 2021)——把离散和连续统一起来。 这篇是本节点的锚点。它做了两件大事:把 DDPM(VP-SDE)和它自己那套 score matching(VE-SDE)统一到同一个 SDE 框架下,把它们写成不同漂移与扩散系数下的 SDE,并由相应 Fokker–Planck 方程构造边缘等价的概率流 ODE;以及提出了概率流 ODE——同一个边缘分布、确定性求解、还能用现成的 ODE 求解器(原文使用自适应 RK45 / Dormand–Prince,见附录 D.2、D.4)。3.4 节那两条式子就出自这里。 ④ 2010.02502(Song et al., 2021)——DDIM,确定性采样。 把反向链改成不含随机项的确定性映射:样本轨迹只由 $x_T$ 决定,跳步采样不再需要「一步一小步」的假设。两篇作者不同:DDIM 的第一作者是 Jiaming Song,score-SDE 的第一作者是 Yang Song——DDIM 本质上就是概率流 ODE 的一个(指数积分器风格的)离散化。原文在特定模型与数据上展示少步生成及显著采样加速;具体质量取决于模型、步数与指标,不能称所有任务 50 步等于 1000 步。 ⑤ 2102.09672(Nichol & Dhariwal, 2021)——余弦调度。 指出线性调度把信噪比压得太快(就是 01 节第二组数字里那 74%),改成 $\bar\alpha_t = \cos^2(\cdot)$ 之后低步数下的质量明显更好。这篇的价值在于它把「调度」从工程细节变成了有图像解释的设计问题:$\bar\alpha_t$ 的形状决定了「每个时刻还剩多少信息量」,而余弦的形状让信息量的衰减更均匀。 在这五篇之外还有两条重要支线:v 参数化与渐进蒸馏 探讨不同预测目标和低步数训练;零终端 SNR 分析特定训练/推理噪声设置的不一致。前者不是对所有尺度问题的自动修复,后者也不意味着每个有限时间非零 SNR 过程都定义错误。它们都是在这条主线已经跑通之后,针对具体失效模式的补丁。 08. 常见误解 误解一:「DDPM 和 DDIM 是同一条 ODE 的两种离散化。」 DDPM 是带噪声的高斯反向马尔可夫链,连续极限对应反向 SDE;η=0 的 DDIM 是确定性路径,可联系到概率流 ODE。二者的连续边缘分布可一致,但漂移中的 score 系数不同:SDE 是 1,ODE 是 1/2,不能只把 DDPM 的噪声删除就得到 DDIM。 误解二:「反向过程就是把噪声一步步减掉。」 方向反了。反向 drift 是 $+\tfrac12\beta x + \beta s$,$x$ 那一项是往外推的。前向把分布压向原点,score 与线性项合起来才决定方向;对稳态标准高斯,反向 SDE 的总漂移向内,概率流速度为零,不能把每个样本都理解成向外吹。我按「减掉」实现了三个采样器,全部崩掉(4.3 节那个符号坑),而错误版本跑起来并不报错、只是数值不对——这类 bug 只能靠对着闭式解核对来抓。 误解三:「换个参数化只是记号问题,等价就是等价。」 描述的对象等价,作为训练目标不等价。权重表跨 8 个数量级(06 节),这不是小差异。代数转换对任意兼容输出都成立,不要求网络先收敛;不同的未加权训练目标、共享参数及时间采样通常产生不同优化过程。 误解四:「换成 mean log p 就能可靠排序。」 MMD / FID 需要估计不确定性,mean log p 同样需要,而且单个均值不能刻画完整分布。对两批真实样本只算一次差值,不能据此画置信区间;必须重复抽样或用适当的标准误 / bootstrap 分析。 误解五:「ODE 无随机项,所以没有多样性;SDE 多走几步只会累积坏噪声。」 随机性可以来自初始噪声,也可以来自路径。精确连续过程下两者都可得到正确分布;更多步数通常减少相应数值方法的离散误差,但有限模型、引导、网格与算力约束下仍应实测。 误解六:「$\bar\alpha_t$ 和 $1-\bar\alpha_t$ 加起来是 1,所以信噪比就是 $\bar\alpha_t$。」 信噪比是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$。以单位数据方差为参考,t=500 时线性调度 $\bar\alpha_{500}=7.86\times10^{-2}$,看着还有 7.9% 的信号,但信噪比只有 0.085(−10.7 dB)——信号和噪声的幅度比已经掉到 1:3.4 以下。只看 $\bar\alpha$ 会严重高估「还剩多少信息」。 09. 动手验证 六个脚本都在文末完整附录里,保存到同一目录后用 Python 3 运行。除绘图脚本外只依赖 NumPy,绘图另需 matplotlib。本次实际环境为 Windows、Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7;BLAS 单线程。主实验种子 20260926 保持,新增核对种子见脚本,未测试 GPU 或真实图像吞吐。 python forward_diffusion.py # 前向闭式解核对 + 两种调度对比 + 终端 SNR python reverse_sampling.py # 五种采样器 × 七档步数的主实验 python score_bridges.py # Tweedie / ε / v 四条恒等式核对 + 权重表 python mmd_noise_check.py # 先量一下 MMD² 自己的噪声 python make_figures.py # 生成四张图 python diffusion_checks.py # 条件target/后验/精确嵌入/同NFE五种子反例 值得自己动手改着看的四处: 第一,把 N 设成 10,看 DDIM 和 Euler 谁先崩。 预期:DDIM 的 dlogp 是 −0.248(偏散、没收敛完),Euler 是 −2.340(散得离谱)。对照 4.5 节的最大积分量与线性子项误差,并检查覆盖和半径;它们提供诊断线索,不能独立解释全部误差。 第二,给 run_ode 加一个符号。 把 x + 0.5 * L * (x + s) 改成 x - 0.5 * L * (x + s) 再跑,观察分布是否继续被收缩,并记录实际统计量,勿把旧试跑数字当作本环境必然输出。稳态高斯的解析方差反例可先由 diffusion_checks.py 验证。这就是 3.4 节那个 $du<0$ 的坑。 第三,把目标分布的 SCALES 从 0.16~0.24 改成 0.45 附近。 检查估计噪声是否遮住方法差异;结果依赖分量、种子、带宽与样本量,不预设所有方法必然相同。这是 4.1 节那个「目标太光滑就分不出来」的第二遍确认。 第四,改 forward_diffusion.py 里的 linear_beta,把 beta_T 从 0.02 降到 0.01。 预期:$\bar\alpha_T$ 变大(终端残留信号变多),t=500 的 SNR 也跟着变。可以顺着看 05 节说的那个「非零终端 SNR」到底有多敏感。 10. 延伸阅读 前置:变分下界与重参数化。先掌握 Jensen 不等式、KL 与条件期望;本文补全后验配方、负 ELBO 方向与固定方差权重,不要求预先学会随机微积分。 下一步:DDPM 训练目标与采样流程。把本文数学对象接到训练网络、方差选择和完整采样循环。 下一步:从 DDIM 到高阶采样器。进一步研究累计噪声钟、半线性积分、网格与 NFE。 下一步:流匹配与 Rectified Flow。比较速度场训练与 score 漂移的联系及不同路径选择。 评测:FID / CLIP Score 到底测了什么。延续本文的统计量反例;低维解析分布上的均值匹配不替代图像评测。 原始来源:2015 扩散框架、DDPM、score-SDE、DDIM、Improved DDPM、渐进蒸馏、DPM-Solver、零终端 SNR、MMD 原始论文。工业源码固定到 diffusers v0.35.1。 附录:完整代码 09 节用到的脚本全文如下(mmd_noise_check.py、forward_diffusion.py、diffusion_checks.py、score_bridges.py、reverse_sampling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 mmd_noise_check.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """MMD^2 估计噪声核对:本样本量和带宽下,微小差异不足以可靠排序。 写这篇的时候第一版主指标就是 MMD^2,跑出来的表看着很漂亮(Heun 在 N>=10 就顶到"噪声地板",其余采样器数值一路降到 0 以下)。问题是那个 "噪声地板"是单次抽样的运气值:把真实样本对真实样本重复 8 次,MMD^2 的标准差是 3.6e-4,比 N>=100 时各采样器之间的差别还大。 所以正文改用三个可直接计算但仍有抽样波动的统计量(mean log p_0 / 分量占比 TV / 模式内半径),MMD^2 只留作低步数区间的旁证。 跑法:python mmd_noise_check.py """ import numpy as np from forward_diffusion import sample_data from reverse_sampling import mmd2, run_ddpm, make_stride from forward_diffusion import alpha_bar_from_beta, linear_beta, T, D ab = alpha_bar_from_beta(linear_beta(T)) print("A. 真实样本 vs 真实样本(应当 ~0),重复 8 次,看估计量的散布") for bw in [None, 1.9, 1.0, 0.5]: vals = [] for k in range(8): a = sample_data(2000, np.random.default_rng(1000 + k)) b = sample_data(2000, np.random.default_rng(5000 + k)) v, used = mmd2(a, b, bw=bw) vals.append(v) vals = np.array(vals) print(f" bw={str(bw):>5} (实取{used:.2f}) mean={vals.mean():+.3e} " f"std={vals.std():.3e} min={vals.min():+.3e} max={vals.max():+.3e}") print() print("B. ddpm@1000 换 8 个不同的初始噪声种子") for bw in [None, 1.0, 0.5]: ref = sample_data(4000, np.random.default_rng(7)) vals = [] for k in range(8): rng = np.random.default_rng(3000 + k) x = rng.standard_normal((2000, D)) x = run_ddpm(x, ab, make_stride(1000, T), rng) v, used = mmd2(x, ref, bw=bw) vals.append(v) vals = np.array(vals) print(f" bw={str(bw):>5} (实取{used:.2f}) mean={vals.mean():+.3e} " f"std={vals.std():.3e}") print(f" -> {np.array2string(vals, precision=3, formatter={'float': lambda v: f'{v:+.2e}'})}") print() print("C. 极端对照:把样本整体平移 0.5,看各带宽的分辨力") ref = sample_data(4000, np.random.default_rng(7)) for shift in [0.05, 0.1, 0.2, 0.5]: y = sample_data(2000, np.random.default_rng(11)) + shift row = f" shift={shift:.2f} " for bw in [1.9, 1.0, 0.5, 0.25]: v, _ = mmd2(y, ref, bw=bw) row += f"bw={bw}:{v:+.2e} " print(row) forward_diffusion.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """扩散前向过程:闭式解、噪声调度、信噪比。 只依赖 numpy。正文里出现的每一个数字都由本脚本打印,不手填。 要回答三个问题: 1. q(x_t | x_0) 的闭式解是不是真的成立(蒙特卡洛对着验) 2. 线性调度和余弦调度把"难度"分配得有多不一样(看 alpha_bar / SNR) 3. 前向终点的分布离标准正态到底差多少(决定了 L_T 那一项有多大) 运行: python forward_diffusion.py """ import numpy as np SEED = 20260926 T = 1000 # 总步数,与 DDPM 原文一致 D = 2 # 玩具数据维度 # ── 玩具数据:2D 七分量各向同性高斯混合(环状 + 一个中心分量)────────── # 分量故意取紧(标准差 0.16~0.30):score 场的曲率大,离散化误差才显出来。 # 换成 3 个宽分量(标准差 ~0.5)的话,oracle score 下所有采样器都会直接顶到 # MMD 噪声地板上,分不出高下——这是调这个玩具问题时踩的第一个坑。 WEIGHTS = np.array([0.14, 0.13, 0.15, 0.12, 0.14, 0.13, 0.19]) MEANS = np.array([[-2.6, -1.0], [-1.0, -2.2], [1.4, -2.0], [2.6, -0.4], [1.6, 1.8], [-0.6, 2.4], [0.0, 0.0]]) SCALES = np.array([0.22, 0.18, 0.20, 0.16, 0.24, 0.20, 0.30]) def sample_data(n, rng): """从 p_0 采 n 个样本。""" k = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS) return MEANS[k] + SCALES[k][:, None] * rng.standard_normal((n, D)) # ── 噪声调度 ────────────────────────────────────────────────────────── def linear_beta(T=T, beta_1=1e-4, beta_T=0.02): """DDPM 原文的线性调度,beta 从 1e-4 均匀涨到 0.02。""" return np.linspace(beta_1, beta_T, T) def cosine_beta(T=T, s=0.008, clip=0.999): """Nichol & Dhariwal 的余弦调度,返回 beta_t。 alpha_bar_t = cos^2(((t/T + s)/(1+s)) * pi/2) / cos^2((s/(1+s)) * pi/2) 分母只是为了让 t=0 时 alpha_bar=1。 按 t=T 代入会得到 alpha_bar_T = 0(cos(pi/2)=0),也就是最后一步 beta=1, 实操上会炸。原文和 diffusers 都会把 beta 截到 0.999 以内,这里照做。 """ t = np.arange(1, T + 1) / T f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2 f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2 a_bar = f / f0 beta = beta_from_alpha_bar(a_bar) return np.clip(beta, None, clip) def cosine_alpha_bar(T=T, s=0.008, clip=0.999): """截尾之后的余弦调度的 alpha_bar,与 cosine_beta 一致。""" return alpha_bar_from_beta(cosine_beta(T, s, clip)) def alpha_bar_from_beta(beta): """alpha_bar_t = prod_{s<=t} (1 - beta_s),t = 1..T。""" return np.cumprod(1.0 - beta) def beta_from_alpha_bar(alpha_bar): """反解出每步的 beta_t = 1 - alpha_bar_t / alpha_bar_{t-1}。""" prev = np.concatenate([[1.0], alpha_bar[:-1]]) return 1.0 - alpha_bar / prev def snr_db(alpha_bar): """信噪比 alpha_bar/(1-alpha_bar),取 10*log10。""" return 10.0 * np.log10(alpha_bar / (1.0 - alpha_bar)) def q_sample(x0, t_idx, alpha_bar, rng): """x_t = sqrt(alpha_bar_t) * x_0 + sqrt(1 - alpha_bar_t) * eps。 t_idx 是 0-based 的数组下标,对应 alpha_bar[t_idx]。 """ a = alpha_bar[t_idx] eps = rng.standard_normal(x0.shape) return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps # ── 加噪后分布的解析形式(反向采样要用 oracle score)────────────────── def noised_mixture(alpha_bar_t): """p_t 仍是高斯混合:第 k 个分量的均值缩到 sqrt(a)*mu_k, 协方差变成 a*Sigma_k + (1-a)*I。因为 Sigma_k = s_k^2 I,结果仍是各向同性。 """ a = alpha_bar_t means = np.sqrt(a) * MEANS var = a * SCALES ** 2 + (1.0 - a) # 每个分量的方差(标量) return WEIGHTS, means, var def log_density(x, weights, means, var): """各向同性高斯混合的 log 密度,x: [n, 2]。""" n, d = x.shape # [n, K] sq = ((x[:, None, :] - means[None, :, :]) ** 2).sum(-1) comp = -0.5 * (sq / var[None, :] + d * np.log(2 * np.pi * var)[None, :]) mx = comp.max(axis=1, keepdims=True) e = np.exp(comp - mx) mix = (weights[None, :] * e).sum(1) return (np.log(mix) + mx[:, 0]) def score_fn(x, alpha_bar_t): """nabla_x log p_t(x) 的闭式解。混合权重用 log-sum-exp 稳住数值。""" w, m, v = noised_mixture(alpha_bar_t) n, d = x.shape sq = ((x[:, None, :] - m[None, :, :]) ** 2).sum(-1) comp = -0.5 * (sq / v[None, :] + d * np.log(2 * np.pi * v)[None, :]) mx = comp.max(axis=1, keepdims=True) e = np.exp(comp - mx) resp = w[None, :] * e resp = resp / resp.sum(1, keepdims=True) # [n, K] 责任度 # grad log N(x; m_k, v_k I) = -(x - m_k)/v_k return -(resp[:, :, None] * (x[:, None, :] - m[None, :, :]) / v[None, :, None]).sum(1) # ────────────────────────────────────────────────────────────────────── # A. 闭式解核对 # ────────────────────────────────────────────────────────────────────── def check_closed_form(rng, alpha_bar, n=200_000): """一步一步加噪 1000 次,和闭式解 x_t = sqrt(a) x_0 + sqrt(1-a) eps 对着验。""" x0 = sample_data(n, rng) out = [] for t_idx in [49, 199, 499, 999]: a = alpha_bar[t_idx] # 路径 1:逐步迭代 x = x0.copy() beta = beta_from_alpha_bar(alpha_bar) for i in range(t_idx + 1): x = np.sqrt(1.0 - beta[i]) * x + np.sqrt(beta[i]) * rng.standard_normal(x.shape) # 路径 2:独立噪声闭式抽样;只比较边缘统计量,不逐样本配对 xt_cf, _ = q_sample(x0, t_idx, alpha_bar, rng) # 逐样本比不了(噪声不同),比统计量 out.append({ "t": t_idx + 1, "alpha_bar": a, "mean_step": np.abs(x.mean(0) - np.sqrt(a) * x0.mean(0)).max(), "var_step": np.abs(x.var(0) - (a * x0.var(0) + (1 - a))).max(), "var_cf": np.abs(xt_cf.var(0) - (a * x0.var(0) + (1 - a))).max(), }) return out # ────────────────────────────────────────────────────────────────────── # B. 调度对比 # ────────────────────────────────────────────────────────────────────── def schedule_report(): lin_b = linear_beta(T) lin_a = alpha_bar_from_beta(lin_b) cos_b = cosine_beta(T) cos_a = alpha_bar_from_beta(cos_b) rows = [] for t in [1, 50, 100, 250, 500, 750, 900, 1000]: rows.append({ "t": t, "lin_a": lin_a[t - 1], "cos_a": cos_a[t - 1], "lin_snr": snr_db(lin_a[t - 1]), "cos_snr": snr_db(cos_a[t - 1]), "lin_b": lin_b[t - 1], "cos_b": cos_b[t - 1], }) return lin_b, lin_a, cos_b, cos_a, rows def half_life(alpha_bar): """alpha_bar 掉到 0.5 是第几步——一半的采样步数花在这之后。""" idx = np.argmax(alpha_bar < 0.5) return int(idx) + 1 if alpha_bar[idx] < 0.5 else T # ────────────────────────────────────────────────────────────────────── # C. 区分边缘终端 KL 与 ELBO 的条件终端 KL # ────────────────────────────────────────────────────────────────────── def terminal_kl(alpha_bar_T): """KL( q(x_T) || N(0,I) ),q(x_T) 是七分量高斯混合。 没有闭式解,用蒙特卡洛:E_{q(x_T)}[ log q(x_T) - log N(0,I) ] """ rng = np.random.default_rng(SEED + 7) x = sample_data(400_000, rng) w, m, v = noised_mixture(alpha_bar_T) eps = rng.standard_normal(x.shape) xt = np.sqrt(alpha_bar_T) * x + np.sqrt(1.0 - alpha_bar_T) * eps lq = log_density(xt, w, m, v) ln = -0.5 * ((xt ** 2).sum(1) + D * np.log(2 * np.pi)) return float((lq - ln).mean()), float((lq - ln).std() / np.sqrt(len(xt))) def terminal_elbo_kl(alpha_bar_T): """E_data KL(q(x_T|x_0) || N(0,I)) 的闭式值。""" if not 0 <= alpha_bar_T < 1: raise ValueError("alpha_bar_T must lie in [0,1)") second_moment = np.sum(WEIGHTS * (np.sum(MEANS ** 2, axis=1) + D * SCALES ** 2)) return 0.5 * (alpha_bar_T * second_moment - D * alpha_bar_T - D * np.log1p(-alpha_bar_T)) def main(): rng = np.random.default_rng(SEED) print("=" * 68) print("A. 闭式解核对:逐步迭代 vs 一步闭式(20 万样本,2D)") print("=" * 68) lin_b, lin_a, cos_b, cos_a, _rows = schedule_report() for r in check_closed_form(rng, lin_a): print(f" t={r['t']:>4} alpha_bar={r['alpha_bar']:.6e} " f"|均值差|={r['mean_step']:.2e} 逐步方差误={r['var_step']:.2e} " f"闭式方差误={r['var_cf']:.2e}") print() print("=" * 68) print("B. 两种调度把信息怎么抹掉的") print("=" * 68) print(f" {'t':>5} {'alpha_bar(linear)':>18} {'alpha_bar(cosine)':>18} " f"{'SNR_dB(lin)':>12} {'SNR_dB(cos)':>12}") for r in _rows: print(f" {r['t']:>5} {r['lin_a']:>18.6e} {r['cos_a']:>18.6e} " f"{r['lin_snr']:>12.2f} {r['cos_snr']:>12.2f}") print(f"\n alpha_bar 掉到 0.5 的步数:linear = {half_life(lin_a)}," f"cosine = {half_life(cos_a)}") print(f" 也就是说 linear 调度下,{100 * np.mean(lin_a < 0.5):.1f}% 的步数" f"花在信噪比已经低于 0 dB 的区域") print() print("=" * 68) print("C. 边缘终端 KL 和 ELBO 条件终端 KL(不同对象)") print("=" * 68) for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]: kl, se = terminal_kl(aT) print(f" {name:>7}: E_data KL(q(x_T|x_0)||N(0,I)) = {terminal_elbo_kl(aT):.6e} nats") print(f" {name:>7}: alpha_bar_T={aT:.6e} KL(q(x_T)||N(0,I)) = {kl:.6e} nats" f" (±{se:.1e})") print() print("=" * 68) print("D. 连续时间对账:beta(t) = T * beta_i,积分出来的 alpha_bar 对不对") print("=" * 68) b_min, b_max = T * float(lin_b[0]), T * float(lin_b[-1]) print(f" beta_min = {b_min:.4f}(Song et al. VP-SDE 默认 0.1)" f" beta_max = {b_max:.4f}(默认 20)") for t in [0.25, 0.5, 0.75, 1.0]: i = int(round(t * T)) - 1 a_cont = np.exp(-(b_min * t + 0.5 * (b_max - b_min) * t * t)) print(f" t={t:.2f} 离散 alpha_bar={lin_a[i]:.6e} " f"连续 exp(-int beta)={a_cont:.6e} 相对差={abs(lin_a[i] - a_cont) / lin_a[i]:.2e}") print() print("=" * 68) print("E. 终点还剩多少原始信号(非零终端 SNR 问题)") print("=" * 68) for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]: amp = np.sqrt(aT) snr_T = aT / (1.0 - aT) print(f" {name:>7}: alpha_bar_T={aT:.6e} sqrt(alpha_bar_T)={amp:.6e}" f" => x_T 里原始信号的振幅占比 {amp * 100:.4f}%") print(f" 终端 SNR = {snr_T:.4e}(= {snr_db(aT):.2f} dB)," f"若设计为纯高斯终端则应为 0;有限时间允许非零值") if __name__ == "__main__": main() diffusion_checks.py """NumPy checks for conditional targets, posterior uncertainty and sampling statistics. Run: python diffusion_checks.py. No model weights or GPU are required. """ import json from pathlib import Path import numpy as np import forward_diffusion as fd import reverse_sampling as rs def main(): rng = np.random.default_rng(20261015) ab = fd.alpha_bar_from_beta(fd.linear_beta()) x = rng.normal(size=(30, fd.D)) h = 1e-5 score_errors = [] for t in [1, 50, 500, 1000]: a = ab[t - 1] w, m, v = fd.noised_mixture(a) finite_diff = np.empty_like(x) for d in range(fd.D): step = np.zeros_like(x) step[:, d] = h finite_diff[:, d] = (fd.log_density(x + step, w, m, v) - fd.log_density(x - step, w, m, v)) / (2 * h) score_errors.append(float(np.max(np.abs(finite_diff - fd.score_fn(x, a))))) assert max(score_errors) < 1e-7 # Conditioning a standard Gaussian prior leaves nonzero target uncertainty. a = 0.25 x0 = rng.normal(size=(100000, fd.D)) eps = rng.normal(size=x0.shape) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps eps_mean = np.sqrt(1 - a) * xt # marginal score is -xt mmse = float(np.mean(np.sum((eps - eps_mean) ** 2, axis=1))) assert abs(mmse - fd.D * a) < 0.006 target_example = dict(empirical_mmse=mmse,analytic_mmse=fd.D*a, zero_predictor_rmse=np.sqrt(fd.D), independent_gaussian_predictor_rmse=np.sqrt(2*fd.D)) # q(x0|xt=0) for a symmetric two-mode prior: mean=0 hides both modes. a, s2, mu = 0.9, 0.04, 2.0 vt = a * s2 + 1 - a posterior_component_mean = (1 - a) * mu / vt posterior_component_var = s2 * (1 - a) / vt posterior_var = posterior_component_var + posterior_component_mean ** 2 posterior_example = dict(component_means=[-posterior_component_mean, posterior_component_mean], within_component_variance=posterior_component_var, true_variance=posterior_var, plugin_final_variance=0.0,plugin_final_mean=0.0) assert posterior_var > 2 # Exact finite-interval embedding: exp(-int rate)=prod(1-beta). b = fd.linear_beta() rates = -fd.T * np.log1p(-b) embedded = np.exp(-np.cumsum(rates) / fd.T) embedding_error = float(np.max(np.abs(embedded - ab))) assert embedding_error < 2e-14 # Stationary N(0,I): reverse SDE needs the full score, ODE drift is zero. L = 0.1 correct_em_variance = (1 - L/2)**2 + L deleted_noise_variance = (1 - L/2)**2 ode_variance = 1.0 assert abs(correct_em_variance - 1) < 0.003 assert deleted_noise_variance < 0.91 # A radius-sqrt(D) sphere has the Gaussian's exact expected log-density, # but different radial fourth moment. This is a distribution counterexample. gaussian_logp = -fd.D/2 * (1 + np.log(2*np.pi)) sphere_logp = -0.5 * (fd.D + fd.D*np.log(2*np.pi)) counterexample = dict(dlogp=sphere_logp-gaussian_logp, sphere_radius_fourth_moment=fd.D**2, gaussian_radius_fourth_moment=fd.D*(fd.D+2)) assert abs(counterexample['dlogp']) < 1e-14 # Same NFE=50 for all methods; five independent runs, not a confidence band. configs = [('ddpm',50),('ddim',50),('em',50),('ode',50),('heun',25)] repeated = [] for name, n in configs: vals, ses = [], [] for k in range(5): seed = 70000 + 100*k ref = fd.sample_data(8000,np.random.default_rng(seed)) gen_rng = np.random.default_rng(seed+1) initial = gen_rng.standard_normal((4000,fd.D)) before = rs.SCORE_CALLS generated = rs.SAMPLERS[name][0](initial,ab,rs.make_stride(n),gen_rng) nfe = rs.SCORE_CALLS-before assert nfe == 50 and np.isfinite(generated).all() lg = fd.log_density(generated,fd.WEIGHTS,fd.MEANS,fd.SCALES**2) lr = fd.log_density(ref,fd.WEIGHTS,fd.MEANS,fd.SCALES**2) vals.append(float(lg.mean()-lr.mean())) ses.append(float(np.sqrt(lg.var(ddof=1)/len(lg)+lr.var(ddof=1)/len(lr)))) repeated.append(dict(method=name,steps=n,nfe=nfe,seeds=5,dlogp_runs=vals, dlogp_mean=float(np.mean(vals)), across_seed_sd=float(np.std(vals,ddof=1)), iid_standard_errors=ses)) results = dict(passed=True,score_gradient_max_abs=max(score_errors), conditional_target=target_example,posterior=posterior_example, exact_embedding_max_abs=embedding_error, stationary_gaussian=dict(correct_em_variance=correct_em_variance, delete_noise_variance=deleted_noise_variance, probability_flow_variance=ode_variance), density_counterexample=counterexample,repeated_sampling=repeated, errors=[],warnings=[]) target = Path(__file__).with_name('validation_results.json') target.write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf8') print(json.dumps(results,ensure_ascii=False,indent=2)) if __name__ == '__main__': main() score_bridges.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """把 score / epsilon / x_0 / v 四种参数化钉死在同一组恒等式上。 扩散模型的代码里同一个东西有四种写法,换参数化是家常便饭(SD 2.x 用 v, 不同checkpoint分别采用epsilon、v或x_0,必须检查训练目标配置)。这篇要说的是: 它们描述的是同一个量,但**作为训练目标并不等价**——换参数化等于给每个 时间步偷偷换了一个权重。 跑法:python score_bridges.py """ import numpy as np from forward_diffusion import ( D, SEED, T, MEANS, SCALES, WEIGHTS, alpha_bar_from_beta, linear_beta, noised_mixture, sample_data, score_fn, ) ALPHA_BAR = alpha_bar_from_beta(linear_beta(T)) def abar(t): """t 是 1-based 步号。""" return 1.0 if t == 0 else float(ALPHA_BAR[t - 1]) def score_at(x, t): return score_fn(x, abar(t)) # ────────────────────────────────────────────────────────────────────── # A. 精确后验均值 E[x_0 | x_t] # ────────────────────────────────────────────────────────────────────── def posterior_mean_exact(x, t): """q(x_0 | x_t) 仍是高斯混合,第 k 个分量: 后验权重 r_k = 与 score 里用的是同一份责任度 后验方差 C_k = (1/s_k^2 + alpha_bar/(1-alpha_bar))^{-1} 后验均值 m_k = C_k * (mu_k / s_k^2 + sqrt(alpha_bar) * x_t / (1-alpha_bar)) """ a = abar(t) if a >= 1.0: return x.copy() _, m_t, v_t = noised_mixture(a) # 加噪后各分量的均值 / 方差 n = x.shape[0] sq = ((x[:, None, :] - m_t[None, :, :]) ** 2).sum(-1) logc = -0.5 * (sq / v_t[None, :] + D * np.log(2 * np.pi * v_t)[None, :]) mx = logc.max(1, keepdims=True) resp = WEIGHTS[None, :] * np.exp(logc - mx) resp = resp / resp.sum(1, keepdims=True) # [n, K] s2 = SCALES ** 2 C = 1.0 / (1.0 / s2 + a / (1.0 - a)) # [K] mk = C[None, :, None] * (MEANS[None, :, :] / s2[None, :, None] + np.sqrt(a) * x[:, None, :] / (1.0 - a)) return (resp[:, :, None] * mk).sum(1) def tweedie_mean(x, t): """Tweedie:E[x_0 | x_t] = (x_t + (1 - alpha_bar_t) * score) / sqrt(alpha_bar_t)。""" a = abar(t) if a >= 1.0: return x.copy() return (x + (1.0 - a) * score_at(x, t)) / np.sqrt(a) def eps_from_score(x, t): """E[eps|x_t] = -sqrt(1 - alpha_bar_t) * marginal score。""" a = abar(t) return -np.sqrt(1.0 - a) * score_at(x, t) def eps_from_x0(x, x0_hat, t): """反解:eps = (x_t - sqrt(alpha_bar_t) * x_0) / sqrt(1 - alpha_bar_t)。""" a = abar(t) return (x - np.sqrt(a) * x0_hat) / np.sqrt(1.0 - a) def v_target(x0, eps, t): """v = sqrt(alpha_bar) * eps - sqrt(1 - alpha_bar) * x_0。""" a = abar(t) return np.sqrt(a) * eps - np.sqrt(1.0 - a) * x0 def recover_from_v(x, v, t): """v 和 x_t 之间是一个旋转:x_0 = a*x_t - b*v,eps = b*x_t + a*v。 变换矩阵 [[a, b], [-b, a]] 行列式为 a^2+b^2=1,所以它是正交的—— 这也保证联合向量范数;固定 x_t 时 eps 误差为 sqrt(a)*delta_v,不能推成任意误差无放大。 """ a, b = np.sqrt(abar(t)), np.sqrt(1.0 - abar(t)) return a * x - b * v, b * x + a * v # ────────────────────────────────────────────────────────────────────── # B. 蒙特卡洛交叉验证(不靠闭式解,纯重要性采样) # ────────────────────────────────────────────────────────────────────── def is_posterior_mean(xi, t, n=1_000_000, seed=SEED + 11): """E[x_0 | x_t = xi] 的自归一化重要性采样估计。 x_0^i 就是从 p_0 里采的,所以权重直接取 q(xi | x_0^i) 即可, 不需要知道归一化常数。 """ rng = np.random.default_rng(seed) x0 = sample_data(n, rng) a = abar(t) b2 = 1.0 - a sq = ((xi[None, :] - np.sqrt(a) * x0) ** 2).sum(1) logw = -0.5 * sq / b2 logw -= logw.max() w = np.exp(logw) ess = w.sum() ** 2 / (w ** 2).sum() return (w[:, None] * x0).sum(0) / w.sum(), ess # ────────────────────────────────────────────────────────────────────── # C. 三种参数化在 epsilon 空间下的每步权重 # ────────────────────────────────────────────────────────────────────── def loss_weights(t): """把三种参数化的训练损失都换算回"相当于给 eps 误差加了多大权重"。 - eps 参数化:delta_eps = delta_u -> 权重 1 - x_0 参数化:eps = (x_t - sqrt(a) x_0)/sqrt(1-a) delta_eps = -sqrt(a/(1-a)) * delta_u -> 权重 a/(1-a) = SNR 反过来,x_0 的损失 ||delta_u||^2 折算成 eps 误差是 ||delta_eps||^2 = SNR * ||delta_x0||^2, 即 x_0 损失对 eps 误差的权重是 1/SNR - v 参数化 :eps = sqrt(1-a)*x_t + sqrt(a)*v,delta_eps = sqrt(a) * delta_v -> v 损失折算成 eps 误差的权重是 1/a = 1/alpha_bar 返回 (权重_eps, 权重_v, 权重_x0),都是"乘在 ||delta_eps||^2 上的系数"。 """ a = abar(t) if t > 0 else 1.0 snr = a / (1.0 - a) return 1.0, 1.0 / a, 1.0 / snr def main(): rng = np.random.default_rng(SEED) print("=" * 72) print("A. Tweedie 恒等式核对:闭式后验均值 vs 公式 (x_t + (1-a) s)/sqrt(a)") print("=" * 72) print(f" {'t':>5} {'alpha_bar':>14} {'最大绝对误差':>16} {'x_t 范数均值':>14}") for t in [1, 50, 100, 250, 500, 750, 1000]: x = sample_data(2000, rng) xt, _ = (np.sqrt(abar(t)) * x + np.sqrt(1 - abar(t)) * rng.standard_normal(x.shape), None) e1 = posterior_mean_exact(xt, t) e2 = tweedie_mean(xt, t) err = np.abs(e1 - e2).max() print(f" {t:>5} {abar(t):>14.6e} {err:>16.3e} " f"{np.linalg.norm(xt, axis=1).mean():>14.4f}") print() print("=" * 72) print("B. MMSE eps 与边缘 score 的换算:两条路算条件均值是否一致") print("=" * 72) print(f" {'t':>5} {'|eps(score) - eps(x_0)| 最大':>28}") for t in [50, 250, 500, 1000]: x0 = sample_data(2000, rng) eps_true = rng.standard_normal(x0.shape) a = abar(t) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps_true # 路线 1:从 score e_s = eps_from_score(xt, t) # 路线 2:从 Tweedie 反解出的 x_0 e_x = eps_from_x0(xt, tweedie_mean(xt, t), t) print(f" {t:>5} {np.abs(e_s - e_x).max():>28.3e}") # 顺便看看 MMSE 估计量离真实 eps 有多远(这是"复原不了"的那部分) print(f" (MMSE 估计量与本次真实 eps 的 RMSE = " f"{np.sqrt(((e_s - eps_true) ** 2).sum(1).mean()):.4f}," f"零预测基线 sqrt(D)={np.sqrt(D):.4f};独立标准高斯猜测基线 sqrt(2D)={np.sqrt(2 * D):.4f})") print() print("=" * 72) print("C. v 参数化:它与 (x_t, eps, x_0) 之间是一个旋转") print("=" * 72) for t in [50, 500, 1000]: x0 = sample_data(2000, rng) eps = rng.standard_normal(x0.shape) a = abar(t) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps v = v_target(x0, eps, t) x0_rec, eps_rec = recover_from_v(xt, v, t) print(f" t={t:>5} 重建 x_0 误差={np.abs(x0_rec - x0).max():.3e} " f"重建 eps 误差={np.abs(eps_rec - eps).max():.3e} " f"v 的范数均值={np.linalg.norm(v, axis=1).mean():.4f}") print() print("=" * 72) print("D. 蒙特卡洛交叉验证(100 万样本的重要性采样,不依赖上面的闭式解)") print("=" * 72) print(f" {'t':>5} {'Tweedie':>22} {'重要性采样':>22} {'有效样本数':>12}") for t in [50, 250, 500, 1000]: xi = sample_data(1, rng)[0] xi = np.sqrt(abar(t)) * xi + np.sqrt(1 - abar(t)) * rng.standard_normal(2) tm = tweedie_mean(xi[None, :], t)[0] im, ess = is_posterior_mean(xi, t) print(f" {t:>5} {np.array2string(tm, precision=4):>22} " f"{np.array2string(im, precision=4):>22} {ess:>12.0f}") print() print("=" * 72) print("E. 换参数化 = 给每个时间步换权重(折算回 eps 空间的系数)") print("=" * 72) print(f" {'t':>5} {'alpha_bar':>13} {'w_eps':>12} {'w_v':>14} {'w_x0':>14}") for t in [1, 10, 50, 100, 250, 500, 750, 900, 1000]: we, wv, wx = loss_weights(t) print(f" {t:>5} {abar(t):>13.6e} {we:>12.4f} {wv:>14.4e} {wx:>14.4e}") wes, wvs, wxs = zip(*[loss_weights(t) for t in range(1, T + 1)]) print(f"\n eps 参数化: 权重恒为 1,动态范围 {max(wes) / min(wes):.1f}") print(f" v 参数化: 权重 {min(wvs):.4e} ~ {max(wvs):.4e}," f"动态范围 {max(wvs) / min(wvs):.3e}") print(f" x_0 参数化: 权重 {min(wxs):.4e} ~ {max(wxs):.4e}," f"动态范围 {max(wxs) / min(wxs):.3e}") if __name__ == "__main__": main() reverse_sampling.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """反向采样:五种采样器在"同一个 oracle score"下的正面对比。 这一节要回答的是:反向 SDE 与概率流 ODE 的漂移不同,为什么工业界 能搞出 DDPM / DDIM / DPM-Solver / Euler / Heun 这么多种采样器?差别到底 在哪里? 关键设计:目标分布用 2D 高斯混合,加噪之后仍然是高斯混合,所以 nabla_x log p_t(x) 有闭式解。也就是说这里的 score 是**理论最优**的, 不掺任何网络拟合误差——差异来自离散化、有限终端噪声近似以及蒙特卡洛波动。 五种采样器: ddpm DDPM 祖采样(ancestral),高斯反向核近似,每步注噪声 ddim DDIM,eta=0,确定性 em Euler-Maruyama 解反向 SDE,一阶,注噪声 ode Euler 解概率流 ODE,一阶,确定性 heun Heun 二阶解概率流 ODE,每步两次 score 评估 运行: python reverse_sampling.py """ import numpy as np from forward_diffusion import ( D, SEED, T, MEANS, SCALES, WEIGHTS, alpha_bar_from_beta, cosine_beta, linear_beta, log_density, sample_data, score_fn, ) # ────────────────────────────────────────────────────────────────────── # 时间步工具 # ────────────────────────────────────────────────────────────────────── def make_stride(n_steps, T=T): """把 0..T 均匀切成 n_steps 段,返回 1-based 的 t 序列(含 T 与 0)。 例:n_steps=50, T=1000 -> [1000, 980, 960, ..., 20, 0] """ idx = np.linspace(T, 0, n_steps + 1).astype(int) # 保证严格递减且唯一 idx = np.unique(idx)[::-1] return list(idx) def abar_at(alpha_bar, t): """t 是 1-based 步号;t=0 时 alpha_bar=1(即 x_0 本身)。""" return 1.0 if t == 0 else float(alpha_bar[t - 1]) SCORE_CALLS = 0 def score_at(x, alpha_bar, t): global SCORE_CALLS SCORE_CALLS += 1 return score_fn(x, abar_at(alpha_bar, t)) # ────────────────────────────────────────────────────────────────────── # 五种采样器 # ────────────────────────────────────────────────────────────────────── def _tweedie_x0(x, s, a_cur): """Tweedie 公式:E[x_0 | x_t] = (x_t + (1-a_t) * score) / sqrt(a_t)。""" return (x + (1.0 - a_cur) * s) / np.sqrt(a_cur) def _eps_from_score(s, a_cur): """epsilon 与 score 的换算:E[epsilon | x_t] = -sqrt(1 - a_t) * marginal score。""" return -np.sqrt(1.0 - a_cur) * s def run_ddpm(x, alpha_bar, taus, rng, **kw): """DDPM 祖采样:用精确反向均值配固定高斯方差,有限步并非精确逆核。 x_{t-1} = (x_t + beta_t * s) / sqrt(alpha_t) + sigma_t * z sigma_t^2 = beta_t * (1 - abar_{t-1}) / (1 - abar_t) """ for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev beta_j = 1.0 - alpha_j if beta_j < 1e-12: continue s = score_at(x, alpha_bar, t_cur) mean = (x + beta_j * s) / np.sqrt(alpha_j) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) x = mean + np.sqrt(max(var, 0.0)) * rng.standard_normal(x.shape) return x def run_ddim(x, alpha_bar, taus, rng, **kw): """DDIM,eta=0:先跳到去噪后的 x_0,再重新加回 target 时刻的噪声。 x_{t-1} = sqrt(abar_{t-1}) * xhat_0 + sqrt(1 - abar_{t-1}) * eps_hat """ for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) s = score_at(x, alpha_bar, t_cur) xhat0 = _tweedie_x0(x, s, a_cur) eps_hat = _eps_from_score(s, a_cur) x = np.sqrt(a_prev) * xhat0 + np.sqrt(max(1.0 - a_prev, 0.0)) * eps_hat return x def _log_step(alpha_bar, t_cur, t_prev): """跨一步"累积"起来的积分量 L = int beta du = log(alpha_bar_{prev}/alpha_bar_{cur}) > 0。 这一步很关键:正向 SDE 的时间是 u = t/T,从 0 涨到 1;反向采样是让 u **往回走**,所以 du 是负的。改用递增反向时间后,drift 符号整体翻转; 完整score与线性项共同决定方向,稳态高斯的ODE速度为零。 用 L 记这段区间上 beta 的积分,Euler 步就写成: dx = +L * (0.5 x + c * s) (c=1 是 SDE,c=1/2 是 ODE) """ a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) return float(np.log(a_prev / a_cur)) def run_em(x, alpha_bar, taus, rng, **kw): """Euler-Maruyama 解反向 SDE:全量 score + 注入噪声。 反向 SDE 的 drift 里 score 的系数是 **1 倍**(不是 ODE 的半倍), 另外每步还要加 sqrt(L) 的噪声。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s = score_at(x, alpha_bar, taus[j]) x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape) return x def run_ode(x, alpha_bar, taus, rng, **kw): """Euler 解概率流 ODE:半倍 score,无噪声。 和 EM 只差两处:score 系数从 1 减到 0.5,噪声项整个去掉。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s = score_at(x, alpha_bar, taus[j]) x = x + 0.5 * L * (x + s) return x def run_heun(x, alpha_bar, taus, rng, **kw): """Heun 二阶解概率流 ODE:Euler 预测一步,再用终点的 score 校正一次。 每步两次 score 评估(NFE = 2 * n_steps)。 """ for j in range(len(taus) - 1): L = _log_step(alpha_bar, taus[j], taus[j + 1]) if L < 1e-12: continue s0 = score_at(x, alpha_bar, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 # Euler 预测 s1 = score_at(x1, alpha_bar, taus[j + 1]) # 在目标时刻再评估一次 d1 = 0.5 * L * (x1 + s1) x = x + 0.5 * (d0 + d1) return x SAMPLERS = { "ddpm": (run_ddpm, 1), "ddim": (run_ddim, 1), "em": (run_em, 1), "ode": (run_ode, 1), "heun": (run_heun, 2), } # ────────────────────────────────────────────────────────────────────── # 评价:MMD^2(RBF 核,median heuristic) # ────────────────────────────────────────────────────────────────────── def _rbf_kernels(a, b, bw): sa = (a ** 2).sum(1) sb = (b ** 2).sum(1) d2 = sa[:, None] + sb[None, :] - 2.0 * a @ b.T return np.exp(-d2 / (2.0 * bw ** 2)) def mmd2(x, y, bw=None, n_cap=1500): """固定且独立于待评估样本的带宽下是MMD^2无偏估计;自动带宽为数据自适应诊断。""" rng = np.random.default_rng(0) if len(x) > n_cap: x = x[rng.choice(len(x), n_cap, replace=False)] if len(y) > n_cap: y = y[rng.choice(len(y), n_cap, replace=False)] if bw is None: allp = np.vstack([x[:800], y[:800]]) d2 = ((allp[:, None, :] - allp[None, :, :]) ** 2).sum(-1) bw = float(np.sqrt(np.median(d2) / 2.0)) bw = max(bw, 1e-3) kxx = _rbf_kernels(x, x, bw) kyy = _rbf_kernels(y, y, bw) kxy = _rbf_kernels(x, y, bw) n, m = len(x), len(y) # 去掉对角线才无偏 t1 = (kxx.sum() - np.trace(kxx)) / (n * (n - 1)) t2 = (kyy.sum() - np.trace(kyy)) / (m * (m - 1)) t3 = kxy.mean() return float(t1 + t2 - 2 * t3), bw def mean_logp(x): """生成样本在真实 p_0 下的平均 log 密度。 比 MMD 更能抓一种特定的失败:采样器把样本堆到高密度区(过聚拢), 或者样本飘到分量之间的低密度地带。 """ return float(log_density(x, WEIGHTS, MEANS, SCALES ** 2).mean()) def assign_components(x): """按最近的均值把样本归到混合分量上(分量标准差同量级,够用)。""" d = ((x[:, None, :] - MEANS[None, :, :]) ** 2).sum(-1) return d.argmin(1) def tv_weights(x): """经验分量占比与真实权重之间的全变差距离。 抓的是"各模式的比例对不对"——模式丢了一个、或者某个模式被过度采样, 这个数会涨,而 mean log p 未必涨(甚至可能更漂亮)。 """ idx = assign_components(x) n = len(x) hist = np.bincount(idx, minlength=len(WEIGHTS)) / n return float(0.5 * np.abs(hist - WEIGHTS).sum()) def mode_spread_err(x): """每个分量内部样本的均方半径,与理论值 D*s_k^2 的相对误差(取各分量最大)。 抓的是"样本落在模式的中心但挤成一团"或者"散得太开"。 """ idx = assign_components(x) errs = [] for k in range(len(WEIGHTS)): sel = x[idx == k] if len(sel) < 30: errs.append(1.0) continue r2 = ((sel - MEANS[k]) ** 2).sum(1).mean() errs.append(abs(r2 / (D * SCALES[k] ** 2) - 1.0)) return float(max(errs)) def moment_err(x, y): """均值与协方差的绝对误差(作为 MMD 之外的直观补充)。""" return float(np.abs(x.mean(0) - y.mean(0)).max()), \ float(np.abs(np.cov(x.T) - np.cov(y.T)).max()) # ────────────────────────────────────────────────────────────────────── # 主实验 # ────────────────────────────────────────────────────────────────────── def sweep(n_list=(10, 20, 25, 50, 100, 200, 1000), n_samples=4000, schedule="linear", seed=SEED): """固定一份真实样本做参照,扫采样器 × 步数。""" alpha_bar = (alpha_bar_from_beta(linear_beta(T)) if schedule == "linear" else alpha_bar_from_beta(cosine_beta(T))) ref = sample_data(8000, np.random.default_rng(seed)) # 噪声地板:两份**独立**真实样本之间的 MMD^2。 # 单次值不是置信区间;细微差异需要重复抽样评估。 ref_b = sample_data(4000, np.random.default_rng(seed + 999)) floor, bw = mmd2(ref[:4000], ref_b) # 三个主指标都先在大样本真实数据上算一遍当基线,后面一律报"相对基线的偏移", # 理想期望下匹配的统计量差为0,有限样本仍有波动,0也不保证整个分布匹配。 base = { "logp": mean_logp(ref), "tv": tv_weights(ref), "spread": mode_spread_err(ref), } # 一次对照差值(不是标准误或置信区间) noise = { "logp": mean_logp(ref_b) - base["logp"], "tv": tv_weights(ref_b) - base["tv"], "spread": mode_spread_err(ref_b) - base["spread"], } results = {"_floor": floor, "_bw": bw, "_base": base, "_noise": noise} for name, (fn, mult) in SAMPLERS.items(): for n in n_list: rng = np.random.default_rng(seed + 1) x = rng.standard_normal((n_samples, D)) taus = make_stride(n, T) before_nfe = SCORE_CALLS x = fn(x, alpha_bar, taus, rng) actual_nfe = SCORE_CALLS - before_nfe assert actual_nfe == (len(taus) - 1) * mult m2, _ = mmd2(x, ref, bw=bw) me, ce = moment_err(x, ref) results[(name, n)] = { "mmd2": m2, "nfe": actual_nfe, "mean_err": me, "cov_err": ce, "dlogp": mean_logp(x) - base["logp"], "dtv": tv_weights(x) - base["tv"], "dspread": mode_spread_err(x) - base["spread"], "finite": bool(np.isfinite(x).all()), } return results, bw def stride_stats(n_list=(10, 20, 50, 100, 200, 1000), T=T): """每一步跨过的"积分量" L = int beta du,以及 Euler 近似 e^{L/2} 会错多少。 DDPM / DDIM 的更新里线性部分是**精确**解掉的(直接乘 sqrt(alpha_bar)), Euler 却把它展开成一阶:e^{L/2} ≈ 1 + L/2。步长越大这两个差得越远, 这是一个线性子项的诊断,不能单独归因非线性完整采样误差。 """ alpha_bar = alpha_bar_from_beta(linear_beta(T)) out = [] for n in n_list: taus = make_stride(n, T) Ls = np.array([_log_step(alpha_bar, taus[j], taus[j + 1]) for j in range(len(taus) - 1)]) lm = float(Ls.max()) err = float(np.abs(np.exp(lm / 2) - (1 + lm / 2)) / np.exp(lm / 2)) out.append({"n": n, "L_max": lm, "L_mean": float(Ls.mean()), "euler_err": err}) return out def ablation_noise(n=50, n_samples=4000, seed=SEED): """把 DDIM 的 eta 从 0 拉到 1,看"注入噪声"这一项单独值多少钱。 eta=0 -> DDIM(确定性);eta=1 -> 等价 DDPM 祖采样。 sigma_t = eta * sqrt(beta_t * (1 - abar_{t-1}) / (1 - abar_t)) """ alpha_bar = alpha_bar_from_beta(linear_beta(T)) ref = sample_data(8000, np.random.default_rng(seed)) base_logp, base_tv, bw0 = _ablation_baseline(seed) out = [] taus = make_stride(n, T) for eta in [0.0, 0.25, 0.5, 0.75, 1.0]: rng = np.random.default_rng(seed + 1) x = rng.standard_normal((n_samples, D)) for j in range(len(taus) - 1): t_cur, t_prev = taus[j], taus[j + 1] a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev) alpha_j = a_cur / a_prev beta_j = 1.0 - alpha_j if beta_j < 1e-12: continue s = score_at(x, alpha_bar, t_cur) xhat0 = _tweedie_x0(x, s, a_cur) eps_hat = _eps_from_score(s, a_cur) var = beta_j * (1.0 - a_prev) / (1.0 - a_cur) sig = eta * np.sqrt(max(var, 0.0)) coeff = np.sqrt(max(1.0 - a_prev - sig ** 2, 0.0)) x = np.sqrt(a_prev) * xhat0 + coeff * eps_hat + sig * rng.standard_normal(x.shape) m2, _ = mmd2(x, ref, bw=bw0) out.append({"eta": eta, "mmd2": m2, "dlogp": mean_logp(x) - base_logp, "dtv": tv_weights(x) - base_tv}) return out def _ablation_baseline(seed=SEED): ref = sample_data(8000, np.random.default_rng(seed)) _, bw0 = mmd2(ref[:2000], sample_data(2000, np.random.default_rng(seed + 3))) return mean_logp(ref), tv_weights(ref), bw0 def main(): print("=" * 74) print("主实验:同一个 oracle score,五种采样器 × 七档步数") print(f"目标:2D 七分量高斯混合;参照集 8000 真实样本;每档生成 {4000} 个") print("主指标是 dlogp / dTV / dspread 三个(都扣掉了真实样本自己的基线," "0 = 仅该统计量匹配)") print("MMD^2 只列出来做旁证——它自身的噪声有 ±3.6e-4,见 mmd_noise_check.py") print("=" * 74) res, bw = sweep() floor = res["_floor"] base, noise = res["_base"], res["_noise"] n_list = [10, 20, 25, 50, 100, 200, 1000] print(f" MMD^2(噪声 ±3.6e-4,所以微小差异需重复抽样确认):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['mmd2']:>13.2e}" print(row) print() print(" 主指标 1 —— mean log p_0 相对真实样本的偏移(nats,0 = 仅该统计量匹配):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dlogp']:>13.3f}" print(row) print() print(" 主指标 2 —— 分量占比的全变差距离偏移(0 = 与参照占比误差相同):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dtv']:>13.4f}" print(row) print() print(" 主指标 3 —— 模式内均方半径的相对误差(0 = 与参照半径误差相同):") print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list)) for name in ["ddpm", "ddim", "em", "ode", "heun"]: row = f" {name:<8}" for n in n_list: row += f"{res[(name, n)]['dspread']:>13.4f}" print(row) print() print("=" * 74) print("为什么 DDIM 大步长扛得住、Euler 扛不住:看每步跨过的 L 有多大") print("=" * 74) print(f" {'N':>6} {'L_max':>10} {'L_mean':>10} {'e^(L/2) 与 1+L/2 的相对误差':>30}") for r in stride_stats(): print(f" {r['n']:>6} {r['L_max']:>10.4f} {r['L_mean']:>10.4f} " f"{r['euler_err'] * 100:>27.2f}%") print(f"\n 基线:真实样本 mean log p_0 = {base['logp']:.4f}," f"TV = {base['tv']:.4f},spread err = {base['spread']:.4f}") print(f" 指标自身噪声(另一份独立真实样本对基线的偏移):" f"logp {noise['logp']:+.4f} / TV {noise['tv']:+.4f} / " f"spread {noise['spread']:+.4f}") print() print(" 按 NFE(score 评估次数)对齐再看一遍——Heun 每步算两次:") print(f" {'采样器':<8} {'N':>6} {'NFE':>6} {'dlogp':>11} {'dspread':>11}") for name, n in [("ddpm", 1000), ("ddpm", 200), ("ddim", 50), ("ddim", 100), ("em", 50), ("ode", 50), ("heun", 25), ("heun", 50), ("ode", 200)]: r = res[(name, n)] print(f" {name:<8} {n:>6} {r['nfe']:>6} {r['dlogp']:>11.4f} " f"{r['dspread']:>11.4f}") print() print("=" * 74) print("关键对照:50 步能追上 1000 步吗(主指标看 dlogp,0 = 仅mean log p统计量一致)") print("=" * 74) for name, n in [("ddpm", 1000), ("ddim", 50), ("heun", 50), ("ode", 50), ("em", 50), ("ddpm", 50)]: r = res[(name, n)] print(f" {name:<6} N={n:<5} NFE={r['nfe']:<5} " f"dlogp={r['dlogp']:+.4f} dTV={r['dtv']:+.4f} " f"dspread={r['dspread']:+.4f} MMD^2={r['mmd2']:+.2e}") print() print("=" * 74) print("消融:只改 eta(注入多少噪声),其余完全不动,N=50") print("=" * 74) print(f" {'eta':>6} {'dlogp':>12} {'dTV':>12} {'MMD^2':>13}") for r in ablation_noise(): print(f" {r['eta']:>6.2f} {r['dlogp']:>12.4f} {r['dtv']:>12.4f} " f"{r['mmd2']:>13.2e}") print() print("=" * 74) print("换余弦调度再跑一遍(N=50)") print("=" * 74) res_c, _ = sweep(n_list=(50,), schedule="cosine") print(f" {'采样器':<8} {'dlogp(linear)':>15} {'dlogp(cosine)':>15}") for name in ["ddpm", "ddim", "em", "ode", "heun"]: print(f" {name:<8} {res[(name, 50)]['dlogp']:>15.4f} " f"{res_c[(name, 50)]['dlogp']:>15.4f}") print() print(f" (参照:MMD^2 噪声地板 = {floor:.3e},RBF 带宽 = {bw:.3f};" f"真实样本 mean log p_0 = {base['logp']:.4f})") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「扩散过程的前向与反向推导」的四张解释图。 数值一律从同目录的三个脚本里取(forward_diffusion / reverse_sampling / score_bridges),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。 四张图分别回答: 1. 噪声调度到底把"难度"怎么分配到 1000 步上的 2. 五种采样器的误差随步数怎么降,以及每步跨过的积分量有多大 3. 前向把数据流推成球、反向沿轨迹走回七个模式,长什么样 4. 换参数化等价于给每个时间步换了多大权重(跨 10 个数量级) 只依赖 numpy + matplotlib。跑法:python make_figures.py """ import textwrap from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from matplotlib.collections import LineCollection import forward_diffusion as FD import reverse_sampling as RS import score_bridges as SB ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(parents=True, exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.bbox": "tight", }) INK = "#1f2937" MUTE = "#6b7280" C_LIN = "#d1495b" # 线性调度 / 差的一侧:红 C_COS = "#2f6fb0" # 余弦调度:蓝 C_DDPM = "#e0a03c" C_DDIM = "#2f9e6f" C_EM = "#8b5cf6" C_ODE = "#d1495b" C_HEUN = "#1f6feb" C_OK = "#2f9e6f" C_BAD = "#d1495b" def sci(v): """2.48e+08 -> 2.5e8,读起来省事。""" return f"{v:.1e}".replace("e+0", "e").replace("e+", "e").replace("e-0", "e-") def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left") if xlabel: ax.set_xlabel(xlabel, fontsize=10, color=MUTE) if ylabel: ax.set_ylabel(ylabel, fontsize=10, color=MUTE) ax.tick_params(colors=MUTE, labelsize=9) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#d1d5db") ax.grid(alpha=0.25, linewidth=0.6) ax.set_axisbelow(True) def footer(fig, text, width=72): """把「这张图要看什么」放到坐标轴下方。 必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来, 放在 0~0.05 之间的话会和 x 轴标签叠在一起。 """ wrapped = "\n".join(textwrap.wrap(text, width=width)) fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE, va="top", ha="left", linespacing=1.6) # ────────────────────────────────────────────────────────────────────── # 图 1:噪声调度怎么分配难度 # ────────────────────────────────────────────────────────────────────── def fig_schedule(): lin_b, lin_a, cos_b, cos_a, rows = FD.schedule_report() ts = np.arange(1, FD.T + 1) snr_lin = FD.snr_db(lin_a) snr_cos = FD.snr_db(cos_a) fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.1)) ax = axes[0] ax.plot(ts, lin_a, color=C_LIN, lw=2.0, label=r"linear $\beta$ 调度") ax.plot(ts, cos_a, color=C_COS, lw=2.0, label="余弦调度") ax.set_yscale("log") ax.axhline(0.5, color=MUTE, ls=":", lw=1.0) for x, c, lbl in [(FD.half_life(lin_a), C_LIN, f"linear 跌破 0.5:第 {FD.half_life(lin_a)} 步"), (FD.half_life(cos_a), C_COS, f"余弦跌破 0.5:第 {FD.half_life(cos_a)} 步")]: ax.axvline(x, color=c, ls="--", lw=1.0, alpha=0.8) ax.legend(fontsize=8.5, frameon=False, loc="lower left") style(ax, r"$\bar\alpha_t$:还剩下多少原始信号", "步数 t", r"$\bar\alpha_t$(对数轴)") ax = axes[1] ax.plot(ts, snr_lin, color=C_LIN, lw=2.0, label="linear") ax.plot(ts, snr_cos, color=C_COS, lw=2.0, label="余弦") ax.axhline(0.0, color=INK, lw=1.0) ax.fill_between(ts, snr_lin.min(), 0.0, where=(snr_lin < 0), color=C_LIN, alpha=0.10) i500 = 499 ax.annotate(f"t=500\nlinear {snr_lin[i500]:.1f} dB\n余弦 {snr_cos[i500]:.1f} dB", xy=(500, snr_lin[i500]), xytext=(620, -6), fontsize=8.5, color=INK, arrowprops=dict(arrowstyle="->", color=MUTE, lw=0.9)) ax.legend(fontsize=8.5, frameon=False, loc="upper right") style(ax, "信噪比:低于 0 dB 时信号已经被噪声淹没", "步数 t", "SNR (dB)") fig.suptitle("图 1 线性调度把 74% 的步数花在了信噪比已经低于 0 dB 的区域", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图是「还剩多少信号」,右图是「信噪比」。线性调度第 260 步的单位参照信号方差系数跌破 0.5," "后续处在较低 SNR 区间,但不等于无效计算;图中 SNR 以数据方差为 1 作参考。") fig.savefig(OUT / "schedule_snr.png") plt.close(fig) # ────────────────────────────────────────────────────────────────────── # 图 2:采样器误差随步数怎么降 + 每步跨过的积分量 # ────────────────────────────────────────────────────────────────────── def fig_samplers(res=None): if res is None: res, _ = RS.sweep() n_list = [10, 20, 25, 50, 100, 200, 1000] cols = {"ddpm": C_DDPM, "ddim": C_DDIM, "em": C_EM, "ode": C_ODE, "heun": C_HEUN} names = {"ddpm": "DDPM 祖采样", "ddim": "DDIM (η=0)", "em": "Euler–Maruyama (SDE)", "ode": "Euler (概率流 ODE)", "heun": "Heun 二阶 (ODE)"} fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.3)) ax = axes[0] for name in ["ddpm", "ddim", "em", "ode", "heun"]: y = [abs(res[(name, n)]["dlogp"]) for n in n_list] ax.plot(n_list, y, marker="o", ms=4.5, lw=1.9, color=cols[name], label=names[name]) ax.set_xscale("log") ax.set_yscale("log") ax.axhline(0.0528, color=MUTE, ls="--", lw=1.0) ax.text(11, 0.062, "一次真实样本对照差值 0.053", fontsize=8, color=MUTE) ax.legend(fontsize=8, frameon=False, loc="upper right") style(ax, "单一统计量偏差(不能独立确认分布正确)", "采样步数 N(对数轴)", r"$|$mean log $p_0$ 偏移$|$(nats)") ax = axes[1] st = RS.stride_stats() ns = [r["n"] for r in st] ax.plot(ns, [r["L_max"] for r in st], marker="s", ms=4.5, lw=1.9, color=C_ODE, label=r"每步跨过的积分量 $L=\int\beta(u)du$(最大)") ax.plot(ns, [r["euler_err"] * 100 for r in st], marker="^", ms=4.5, lw=1.9, color=C_HEUN, label=r"Euler 近似 $e^{L/2}\approx 1+L/2$ 的相对误差") ax.set_xscale("log") ax.set_yscale("log") for r in st: if r["n"] in (10, 50): ax.annotate(f"{r['euler_err'] * 100:.1f}%", xy=(r["n"], r["euler_err"] * 100), xytext=(r["n"] * 1.15, r["euler_err"] * 100 * 1.6), fontsize=8.5, color=C_HEUN) ax.legend(fontsize=8, frameon=False, loc="upper right") style(ax, "为什么朴素 Euler 在大步长下会崩", "采样步数 N(对数轴)", "数值(对数轴,% 按数值读)") fig.suptitle("图 2 采样器诊断统计量与线性漂移的离散误差", fontsize=12, color=INK, x=0.012, ha="left", y=1.02) footer(fig, "要看什么:左图为单次实验,近零差异不作显著性排名;右图只比较线性漂移项的数值近似。DDPM/DDIM 把线性部分" "精确解掉了(包含精确线性指数因子),Euler 却把它展开成一阶,N=10 时每步误差就有 25%。") fig.savefig(OUT / "sampler_scaling.png") plt.close(fig) return res # ────────────────────────────────────────────────────────────────────── # 图 3:前向流形被推成球,反向轨迹走回七个模式 # ────────────────────────────────────────────────────────────────────── def fig_trajectories(): rng = np.random.default_rng(FD.SEED) ab = FD.alpha_bar_from_beta(FD.linear_beta(FD.T)) x0 = FD.sample_data(600, rng) snaps = [0, 60, 200, 500, 1000] cols_f = plt.cm.viridis(np.linspace(0.05, 0.85, len(snaps))) # 反向:从同一批噪声出发,用 Heun 走 50 步,记录轨迹 x = rng.standard_normal((40, FD.D)) taus = RS.make_stride(50, FD.T) paths = [x.copy()] for j in range(len(taus) - 1): L = RS._log_step(ab, taus[j], taus[j + 1]) if L < 1e-12: continue s0 = RS.score_at(x, ab, taus[j]) d0 = 0.5 * L * (x + s0) x1 = x + d0 s1 = RS.score_at(x1, ab, taus[j + 1]) x = x + 0.5 * (d0 + 0.5 * L * (x1 + s1)) paths.append(x.copy()) fig, axes = plt.subplots(1, 2, figsize=(11.4, 4.9)) ax = axes[0] for t, c in zip(snaps, cols_f): a = 1.0 if t == 0 else float(ab[t - 1]) xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * rng.standard_normal(x0.shape) ax.scatter(xt[:, 0], xt[:, 1], s=7, color=c, alpha=0.65, label=f"t={t}") ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70, color=INK, linewidths=1.6, label="分量中心") ax.legend(fontsize=8, frameon=False, loc="upper left", ncol=2) style(ax, "前向:七个模式逐步趋近高斯云", r"$x_1$", r"$x_2$") ax.set_aspect("equal") ax = axes[1] # 背景:p_0 的密度等高线 g = np.linspace(-4.6, 4.6, 220) GX, GY = np.meshgrid(g, g) grid = np.stack([GX.ravel(), GY.ravel()], 1) lp = FD.log_density(grid, FD.WEIGHTS, FD.MEANS, FD.SCALES ** 2) dens = np.exp(lp - lp.max()).reshape(GX.shape) ax.contourf(GX, GY, dens, levels=np.linspace(0.02, 1.0, 12), cmap="Blues", alpha=0.9, vmin=0.0, vmax=1.6) ax.contour(GX, GY, dens, levels=[0.05, 0.2, 0.5], colors="#1d4ed8", linewidths=0.7, alpha=0.55) P = np.stack(paths, 1) # [n, steps, 2] for i in range(P.shape[0]): seg = P[i] ax.add_collection(LineCollection( [seg[k:k + 2] for k in range(len(seg) - 1)], colors="#1f6feb", linewidths=0.8, alpha=0.5)) ax.scatter(P[:, 0, 0], P[:, 0, 1], s=14, color=MUTE, label="起点 x_T ~ N(0,I)") ax.scatter(P[:, -1, 0], P[:, -1, 1], s=16, color=C_OK, label="终点 x_0") ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70, color=INK, linewidths=1.6) ax.legend(fontsize=8, frameon=False, loc="upper left") style(ax, "反向:50 步 Heun,40 条轨迹从噪声回到模式", r"$x_1$", r"$x_2$") ax.set_aspect("equal") fig.suptitle("图 3 前向是「加水搅匀」,反向是「沿着 score 场把水滤掉」", fontsize=12, color=INK, x=0.012, ha="left", y=1.0) footer(fig, "要看什么:左图叠加的是各时刻独立边缘快照,不是同一条前向路径;右图是同批初始噪声的Heun轨迹。" "它展示本例分布变化,不证明自然图像的细节成因,也不证明全局步数可省。") fig.savefig(OUT / "trajectories.png") plt.close(fig) # ────────────────────────────────────────────────────────────────────── # 图 4:换参数化 = 换每步权重 # ────────────────────────────────────────────────────────────────────── def fig_param_weights(): ts = np.arange(1, FD.T + 1) w = np.array([SB.loss_weights(t) for t in ts]) # [T, 3] fig, ax = plt.subplots(figsize=(7.6, 4.5)) ax.plot(ts, w[:, 0], color=C_OK, lw=2.4, label=r"$\varepsilon$ 参数化:恒为 1") ax.plot(ts, w[:, 1], color=C_DDPM, lw=2.0, label=r"$v$ 参数化:$1/\bar\alpha_t$") ax.plot(ts, w[:, 2], color=C_BAD, lw=2.0, label=r"$x_0$ 参数化:$1/\mathrm{SNR}_t$") ax.set_yscale("log") ax.axhline(1.0, color=MUTE, ls=":", lw=1.0) ax.annotate(rf"$x_0$ 跨 {sci(w[-1, 2] / w[0, 2])} 倍(1.0e-4 → 2.5e4)", xy=(1000, w[-1, 2]), xytext=(300, 6e2), fontsize=9, color=C_BAD, arrowprops=dict(arrowstyle="->", color=C_BAD, lw=0.9)) ax.annotate(rf"$v$ 跨 {sci(w[-1, 1] / w[0, 1])} 倍(1.0 → 2.5e4)", xy=(1000, w[-1, 1]), xytext=(300, 1.6e0), fontsize=9, color=C_DDPM, arrowprops=dict(arrowstyle="->", color=C_DDPM, lw=0.9)) ax.set_ylim(5e-5, 1e5) ax.legend(fontsize=9, frameon=False, loc="lower right") style(ax, "同一个模型,换参数化等于给每个时间步换权重", "步数 t", r"折算到 $\varepsilon$ 空间后的权重(对数轴)") fig.suptitle(r"图 4 $\varepsilon$ 参数化的权重恒为 1,$x_0$ 参数化跨了 8 个数量级", fontsize=12, color=INK, x=0.012, ha="left", y=1.03) footer(fig, "要看什么:三种参数化描述的是同一个量,但作为训练目标并不等价。$x_0$ 参数化在 t=1 处权重只有" " 1e-4、在 t=1000 处却有 2.5e4。这些是代数残差权重,不是实测参数梯度;不能据此单独判断 " "训练稳定性或最终质量。") fig.savefig(OUT / "param_weights.png") plt.close(fig) def main(): fig_schedule() res = fig_samplers() fig_trajectories() fig_param_weights() print(f"[OK] 四张图已写入 {OUT}") for f in sorted(OUT.glob("*.png")): print(f" {f.name} {f.stat().st_size / 1024:.0f} KB") if __name__ == "__main__": main()
-
AIGC 基本功|VAE 结构与训练目标-VAE AIGC 基本功|VAE 结构与训练目标-VAE 所属方向:表征与压缩 | 难度:进阶 | 前置知识:变分下界与重参数化(本篇是它的直接后继,ELBO 与重参数化在那里推过,这里只用结论) 关键词:VAE、编码器、解码器、潜空间、KL 权重、后验坍缩、scaling factor 01. 为什么需要它 先看一个可复现的尺度错误:预训练扩散模型要求 VAE latent 乘以 vae.config.scaling_factor,却把原始 latent 直接送进去。张量形状仍正确,但它已经偏离训练分布。下面用一维高斯去噪器量化这个误差;这些数字来自教学模型,不是 Stable Diffusion 图像质量实验,不能据此断言真实图像一定发灰或过曝。 这不是玄学,可以精确算出来。设潜空间真实标准差是 $\sigma$,扩散模型的噪声表却是按「数据方差为 1」标定的。在完全干净那一端($\bar{\alpha}\to1$)两种估计相同;噪声增加时它们的均值系数比会偏离 1,但绝对误差差距在两端都趋零。MMSE 指最小均方误差估计。用高斯模型可以算出,单位方差假设的后验均值系数是匹配真实方差系数的 $$r(\bar{\alpha}) = \bar{\alpha} + \frac{1 - \bar{\alpha}}{\sigma^{2}}$$ 倍。$\sigma = 5.49$(这是由 SD1.x 常用配置系数反推的尺度,第 03.4 节会讲为什么)时,$\bar{\alpha} = 0.5$ 处 $r = 0.5166$——幅度只剩一半。实测的均方误差从本该有的 0.9682 涨到 7.8154,恶化 8.07 倍。这是高斯教学模型的估计误差,不是图像实测。 反着错也一样疼。如果你的 VAE 是规规矩矩训的(潜空间方差约等于 1),却照抄 Stable Diffusion 的 0.18215,那么 $\sigma$ 变成 0.18215,同一个 $\bar{\alpha}=0.5$ 处 $r = 15.5699$——幅度被放大 15.6 倍,教学去噪器的后验均值幅度被高估。这仍是一维教学类比,不是换 VAE 后图像表现的预测。 还有第三种错法:训练扩散模型时没有统一 latent 与噪声调度的尺度。LDM 原文 D.1 与附录 G观察到,论文中的 KL 正则自编码器具有较高 latent 方差,这会改变给定噪声调度的信噪比并影响高分辨率卷积采样;作者据此对 latent 做缩放。 这段观察针对 LDM 论文中具体的 KL / VQ 自编码器:KL latent 的高方差改变了给定噪声调度下的信噪比,影响高分辨率卷积采样;论文所用 VQ latent 的方差接近 1。它不表示所有 VQ 码本天然归一化,也不表示尺度错误一定对应某一种视觉伪影。 最后是 KL 权重本身的坑。在我的最小实验里,把 KL 权重 $\beta$ 从 0.1 调到 1,重建 MSE 从 0.2119 跳到 1.0000——1.0000 就是「什么都不学、直接输出均值」的分数(数据逐维方差已被归一化成 1)。八维都低于本文的 KL 诊断阈值,平均 KL 很小但非精确零,提示近似后验坍缩。 这一篇就把这三件事串起来:VAE 的结构决定了潜空间里有什么,KL 权重决定了还剩下什么,而潜变量尺度的使用约定解释为何要遵守 0.18215 这类配置。 02. 最小可用理解 三句话: 结构:编码器把 $x$ 压成 $2d$ 个数($d$ 个均值 $\mu$、$d$ 个对数方差 $\log\sigma^{2}$),重参数化采出一个 $z$,解码器从 $z$ 重建 $x$。训练目标是 ELBO——本质上是「重建质量」减「每个潜变量维度花掉的 KL 预算」。 KL 项既是正则,也可以看作信息预算。一维潜变量要花掉多少 KL,就必须换回足够的重建收益,否则最优解就是关掉这一维。实测里 $\beta = 10^{-3}$ 时模型正好活 4 个维度(合成数据的真实因子数就是 4),$\beta$ 收到 0.3 只剩 3 个,$\beta = 1$ 一个不剩。这里的“活”只是逐维平均 KL 超过 0.05 nat 的诊断计数,不能证明各维是独立开关,也不能直接视为有效因子数。 潜空间的尺度要与扩散模型的训练约定一致。本实验无衰减、$\beta=10^{-3}$ 时跨维边际标准差 RMS 为 1.0067;固定 seed、加 L2 梯度且 $\beta=10^{-6}$ 时为 2.7174。它们描述特定优化结果。LDM 的 KL 自编码器用很弱的正则(附录 G 写约 $10^{-6}$),但不能仅从这个系数推出 SD1.x latent 的实际方差或训练过程。SD1.x 的 0.18215 对应倒数约 5.49 的标定尺度,必须从具体配置读取。 这张图要看什么:四张子图连起来读。(a) 重建 MSE 在 $\beta$ 超过 0.1 后逐渐上升到 1.0 那条虚线,提示本实验的重建已接近均值预测基线;(b) 总 KL 随权重增大趋近零,提示近似后验接近先验;(c) 潜空间边际标准差:蓝线(无权重衰减)在较大 $\beta$ 下接近 1,红线是同 seed 加 L2 梯度的对照;横轴是不同训练任务的超参数,不是同一次训练的时间轨迹,绿虚线是由 SD1.x 系数倒数构造的 5.49 参照;(d) 还活着的维度数从 8 一路掉到 0,中间在 4 这个地方有个明显的台阶——数值上与合成数据的驱动因子数相同,但不能证明解耦。 03. 数学推导 3.1 一次编码到底出了什么 设数据 $x \in \mathbb{R}^{D}$,潜变量 $z \in \mathbb{R}^{d}$。VAE 的编码器不输出一个 $z$,它输出一个分布: $$q_{\phi}(z \mid x) = \mathcal{N}\!\left(z;\ \mu_{\phi}(x),\ \text{diag}\left(\sigma_{\phi}^{2}(x)\right)\right)$$ 网络实际算出来的是 $\mu$ 和对数方差 $\text{logvar}$ 两组数,各 $d$ 个。为什么是 logvar 而不是方差:网络输出可取任意实数,而方差必须为正。在精确算术下,$\sigma^2=\exp(\text{logvar})$ 保证正值;用对数参数表达很小的方差也方便。浮点计算仍可能溢出或下溢,因此要同时核对截断和 dtype,不能说取对数自动解决数值问题。本实验 $\beta=10^{-6}$ 时跨维后验噪声标准差 RMS 约 0.009,描述的是各维方差平均后开方,不是每个样本统一的方差。 如果只调用不记录参数依赖的普通采样接口,自动微分通常无法得到通过该样本的路径梯度;也可使用 score-function 估计。这里采用 AEVB 的重参数化,把参数依赖写成: $$z = \mu + \sigma \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I)$$ $\odot$ 是逐元素乘。随机性全部塞进 $\epsilon$ 里,$\mu$ 和 $\sigma$ 变成普通可导函数。这使本实现可以对固定噪声样本直接反向传播;它不是唯一可用的梯度估计方法。 解码器给的是似然,取对角高斯: $$p_{\theta}(x \mid z) = \mathcal{N}\!\left(x;\ \text{dec}_{\theta}(z),\ \sigma_{\text{dec}}^{2} I\right)$$ 取对数: $$\log p_{\theta}(x \mid z) = -\frac{\lVert x - \text{dec}_{\theta}(z) \rVert^{2}}{2\sigma_{\text{dec}}^{2}} - \frac{D}{2}\log\left(2\pi\sigma_{\text{dec}}^{2}\right)$$ 当 $\sigma_{\text{dec}}>0$ 固定时,第二项与 $z$ 和解码器均值参数无关,是训练中的常数;若学习这个方差,就不能丢掉它。所以重建项就是平方误差之和除以 $2\sigma_{\text{dec}}^{2}$——「重建用 MSE」不是拍脑袋定的,它是高斯似然的必然结果,而 $\sigma_{\text{dec}}$ 就是重建项的隐式权重。日志里那种 recon + beta * kl 的写法,还要明确 reduction:若 recon 是逐元素均值,则标准负 ELBO 按同尺度缩放后的 KL 系数为 $2\sigma_{\text{dec}}^{2}/D$。 把两件事拼起来,ELBO 给出下面的不等式: $$\log p(x) \ge \mathbb{E}_{q}\left[\log p_{\theta}(x|z)\right] - \text{KL}\!\left(q_{\phi}(z|x)\,\Vert\,p(z)\right)$$ 先验取标准正态 $p(z)=\mathcal{N}(0,I)$。加入可调权重后,我们最小化以下目标;$\beta=1$ 时才是上述负 ELBO 去掉固定常数: $$J = \frac{\mathbb{E}_{q}\left[\lVert x - \text{dec}_{\theta}(z) \rVert^{2}\right]}{2\sigma_{\text{dec}}^{2}} + \beta \sum_{j=1}^{d} \text{KL}_{j}, \qquad \text{KL}_{j} = \text{KL}\!\left(\mathcal{N}(\mu_{j}, \sigma_{j}^{2})\,\Vert\,\mathcal{N}(0,1)\right)$$ $\beta$ 是我们插进去的旋钮:$\beta = 1$ 是标准 ELBO,$\beta>1$ 是 $\beta$-VAE 采用的权衡路线,但是否解耦取决于数据、模型和优化,没有普遍保证。本文后面的数值脚本使用逐元素 MSE,因此其 $\beta_{\text{toy}}$ 与本式 $\beta$ 的关系为 $\beta_{\text{toy}}=2\sigma_{\text{dec}}^2\beta/D$;不能把脚本的 1 自动叫作标准 ELBO。注意 KL 是对维度求和而不是求平均,这一点第 05 节还会回来算账。 3.2 KL 的闭式解,逐项推 两个对角高斯之间的 KL 有闭式解。按定义 $\text{KL}(q \Vert p) = \mathbb{E}_{q}[\log q] - \mathbb{E}_{q}[\log p]$ 分头算。因为逐维独立,下面只看第 $j$ 维。 先算 $\mathbb{E}_{q}[\log q]$。$q_{j} = \mathcal{N}(\mu_{j}, \sigma_{j}^{2})$,所以 $$\log q_{j}(z_{j}) = -\frac{1}{2}\log(2\pi\sigma_{j}^{2}) - \frac{(z_{j} - \mu_{j})^{2}}{2\sigma_{j}^{2}}$$ 对 $q_{j}$ 取期望时,右边第二项的期望是 $\sigma_{j}^{2} / (2\sigma_{j}^{2}) = 1/2$,于是 $$\mathbb{E}_{q_{j}}\left[\log q_{j}\right] = -\frac{1}{2}\left(1 + \log 2\pi + \log \sigma_{j}^{2}\right)$$ 只有三项,和 $\mu_{j}$ 无关——这一点值得停一下:在 $\mu_{j}$ 上平移一个高斯分布,它的熵不变。 再算 $\mathbb{E}_{q}[\log p]$。先验 $p_{j} = \mathcal{N}(0,1)$,同样展开 $$\mathbb{E}_{q_{j}}\left[\log p_{j}\right] = -\frac{1}{2}\log 2\pi - \frac{\mathbb{E}_{q_{j}}\left[z_{j}^{2}\right]}{2}$$ 这里用到 $z_{j} = \mu_{j} + \sigma_{j}\epsilon$,所以 $\mathbb{E}_{q_{j}}[z_{j}^{2}] = \mu_{j}^{2} + \sigma_{j}^{2}$——这就是 $z$ 的二阶矩,它才是把 $\mu$ 拉进公式的那一项。 两者相减,$-\frac{1}{2}\log 2\pi$ 正好抵消: $$\text{KL}_{j} = \frac{1}{2}\left(\mu_{j}^{2} + \sigma_{j}^{2} - \log \sigma_{j}^{2} - 1\right)$$ 对 $j$ 求和即得总 KL。这个式子里每一块都有明确的物理含义,逐项读: $\mu_{j}^{2}$ 是均值偏离先验中心的成本。 不同输入的均值发生变化可以传递信息,但这一项不是互信息本身。即使所有输入的均值都是 0,只要方差仍依赖输入,潜变量也可能携带信息;只有整个条件分布都与输入无关时,这一维才不传信息。逐维 KL 同时包含信息代价与聚合后验偏离先验的代价,不能把 8~12 nats 直接叫作有效信息量。 $\sigma_j^2$ 与 $-\log\sigma_j^2$ 共同约束方差:函数 $t-\log t-1$ 对 $t>0$ 非负,唯一最小点在 $t=1$。连同 $\mu_j^2$,单样本 KL 为零恰好要求均值 0、方差 1。 要把 KL 叫作信息预算,还要区分数据分布 $p_{\text{data}}(x)$ 与生成模型 $p_\theta(x)$,并定义联合分布 $q(x,z)=p_{\text{data}}(x)q_\phi(z\mid x)$。在对数中插入聚合后验 $q(z)$: $$\mathbb E_{p_{\text{data}}}\mathrm{KL}(q_\phi(z\mid x)\Vert p(z))=I_q(X;Z)+\mathrm{KL}(q(z)\Vert p(z))$$ 第一项是 $\mathbb E_q\log[q_\phi(z\mid x)/q(z)]$,表示输入与潜变量的互信息;第二项是聚合后验偏离先验的成本。这个恒等式来自把对数比拆成两项并分别积分,不要求神经网络近似。平均 KL 约束两项总和,不能把每个 KL 数值都叫有效信息。 两个反例帮助区分统计对象。若所有输入都得到 $q(z\mid x)=\mathcal N(3,1)$,平均 KL 为 4.5 nats,但 $I_q(X;Z)=0$,没有输入信息。在线性模型未坍缩解中,$m^2v+s^2=1$,所以聚合后验恰好等于先验;取 $\lambda=0.2$ 时互信息为 $-\tfrac12\log0.2\approx0.8047$ nats,仍在传信息。二者分别说明“KL 大”与“边际像先验”都不能单独判断信息或坍缩。 3.3 权重到底在权衡什么:一维线性 VAE 的闭式解 上面的直觉可以算到精确解。把模型简化到最狠:一维数据 $x \sim \mathcal{N}(0, v)$,线性编码器 $q(z|x) = \mathcal{N}(mx, s^{2})$($m$ 是缩放系数,$s^{2}$ 是固定的后验方差),线性解码器 $p(x|z) = \mathcal{N}(wz, \sigma_{\text{dec}}^{2})$。这里要求 $v>0$、$\sigma_{\text{dec}}>0$、$\beta>0$、$s>0$,观测噪声固定。目标函数展开成 $$J(w, m, s) = \frac{v(1 - wm)^{2} + w^{2} s^{2}}{2\sigma_{\text{dec}}^{2}} + \frac{\beta}{2}\left(m^{2} v + s^{2} - \log s^{2} - 1\right)$$ 第一项里的 $v(1-wm)^{2}$ 是「编码-解码这条路的增益偏离 1 有多远」,$w^{2}s^{2}$ 是「采样噪声被放大 $w$ 倍后落在输出上的方差」;第二项就是上一节的 KL。三个未知数各求一次偏导并置零: $$\frac{\partial J}{\partial w} = \frac{-v m(1 - wm) + w s^{2}}{\sigma_{\text{dec}}^{2}} = 0, \qquad \frac{\partial J}{\partial m} = \frac{-v w(1 - wm)}{\sigma_{\text{dec}}^{2}} + \beta m v = 0, \qquad \frac{\partial J}{\partial s} = \frac{w^{2} s}{\sigma_{\text{dec}}^{2}} + \beta\left(s - \frac{1}{s}\right) = 0$$ 记路增益 $u := wm$(它就是「潜变量被真正使用的程度」),把 $\partial_m$ 的式子两边乘 $w$ 换成 $u$,可以整理出 $w^{2}(1-u) = \beta \sigma_{\text{dec}}^{2} u$;再从 $\partial_w$ 得到 $w^{2} s^{2} = v u (1-u)$;从 $\partial_s$ 得到 $s^{2}\left(\beta + w^{2}/\sigma_{\text{dec}}^{2}\right) = \beta$。三式联立,令 $$\lambda := \frac{\beta \sigma_{\text{dec}}^{2}}{v}$$ 解出来是一组非常干净的东西: $$u = 1 - \lambda, \qquad s^{2} = \lambda, \qquad w^{2} = v(1 - \lambda)$$ 代回验一遍:$\partial_m$ 要求 $w(1-u)/\sigma_{\text{dec}}^{2}=\beta m$。乘以 $w$,代入 $w^2=v(1-\lambda)$ 和 $1-u=\lambda$,得到 $v(1-\lambda)\lambda/\sigma_{\text{dec}}^{2}=\beta(1-\lambda)$。在未坍缩区间约去 $1-\lambda$,正好得到 $\lambda=\beta\sigma_{\text{dec}}^{2}/v$。第 04.2 节的数值优化与此吻合。 $\lambda$ 的读法:它是 KL 权重乘观测噪声方差,再除以数据方差的无量纲比值。这个比例决定一切: $u = 1-\lambda$ 随 $\lambda$ 线性下降。$\lambda \to 0$ 时 $u \to 1$、$s^{2} \to 0$,退化成确定性自编码器——潜变量满负荷工作,采样噪声归零。 $s^{2}=\lambda$ 随权重变化;$\beta=1$ 时等于这个线性高斯模型的真实后验方差,其他权重一般对应不同的变分目标。 当 $\lambda>1$ 时上述分支要求 $w^2<0$,不存在实数解;$\lambda=1$ 时它连续接到坍缩点,最优解退化成坍缩点 $(w, m, s) = (0, 0, 1)$。坍缩阈值是 $\beta^{\ast} = v / \sigma_{\text{dec}}^{2}$:数据方差越大、或者解码器的观测噪声越小,需要的 $\beta$ 就越大。这是线性高斯模型的阈值,不是神经 VAE 的通用保证。 附带一个值得记住的事实:$(0,0,1)$ 在任意 $\beta$ 下都是驻点(数值验证梯度恒等于 0)。它只是当 $\lambda < 1$ 时不是最小值。所以「后验坍缩」不是数值 bug、不是训练不充分——在本线性模型的阈值以上,它是该目标的最优解;一般神经模型也可能因局部最优和优化动力学而坍缩。 仅检验驻点不足以证明全局阈值。先固定 $w$,目标对 $m$ 是凸二次、对 $s^2>0$ 严格凸。令 $b=\beta\sigma_{\text{dec}}^2$,分别求极小得 $m=w/(w^2+b)$ 与 $s^2=b/(w^2+b)$。代回后令 $t=b/(w^2+b)\in(0,1]$: $$J(t)=\frac{v}{2\sigma_{\text{dec}}^2}t-\frac{\beta}{2}\log t$$ 其导数在 $t=\lambda$ 为零,二阶导数为 $\beta/(2t^2)>0$,所以全局最小点为 $t=\min(\lambda,1)$。这补足上面阈值的证明。$\beta\to0^+$ 是极限,恰好 $\beta=0$ 时方差可趋零但不满足我们要求的严格正方差,不能直接套用内部驻点。 3.4 潜空间的统计性质,和那个 0.18215 现在把「编码器」反过来看会得到什么分布。训练完之后,把所有 $x$ 编码一遍,潜变量的边际分布是 $$q(z) = \int q_{\phi}(z \mid x)\, p_{\text{data}}(x)\, \mathrm{d}x$$ 这是个混合分布。对每一维分别算方差,用全方差公式: $$\text{Var}(z_{j}) = \underbrace{\text{Var}_{p_{\text{data}}}\!\left[\mu_{j}(x)\right]}_{\text{均值变化}} + \underbrace{\mathbb{E}_{p_{\text{data}}}\!\left[\sigma_{j}^{2}(x)\right]}_{\text{采样噪声}}$$ 左边是 scaling_factor 要归一化的东西,右边两项来源完全不同:前一项是「不同样本被编码到不同位置」,后一项是「每个样本自己抖多少」。下表先对每维方差取平均再开方,不能先平均标准差再平方,也不能把两项标准差直接相加。方差占比不是互信息。实测拆账($\beta$ 从小到大): $\beta$ 均值变化 std RMS 后验噪声 std RMS 边际 std RMS 均值变化方差占比 1e-06 2.060 0.009 2.060 100% 1e-05 1.411 0.014 1.411 100% 0.0001 1.004 0.355 1.065 89% 0.001 0.726 0.697 1.007 52% 0.01 0.705 0.717 1.005 49% 0.1 0.620 0.779 0.995 39% 0.3 0.406 0.914 1.000 16% 1 0.003 1.000 1.000 0% $\beta = 10^{-3}$ 附近有个交叉点:总方差中的均值变化与平均后验方差约各占一半。较小权重处均值变化贡献更大,较大权重处平均后验方差贡献更大——$\beta = 1$ 时 $z$ 就是一坨噪声,$\text{std}_x(\mu)$ 只剩 0.003。 那么 scaling_factor 是什么?在 LDM 的 std-rescaling 分支,它是首个训练 batch 后验样本展平标准差的倒数;使用预训练模型则遵守保存的配置,不能在当前 batch 上重新标定。LDM 的 固定版本原始标定代码 使用 1. / z.flatten().std();diffusers 文档中的标准差描述要结合实际乘法方向理解。本文 toy 的跨维 RMS 也不等于一般的展平标准差:设 $\bar\mu_j=\mathbb E_x\mu_j(x)$,把通道视作均匀随机索引,则展平方差还多出 $\mathrm{Var}_j(\bar\mu_j)$。本次 $\beta=10^{-6}$ 无 L2 的 RMS 为 2.0596,按总体方差估计的展平 std 为 2.0617。LDM 代码 torch.std() 还使用样本方差修正;它是单 batch 后验样本的估计量,不是对整个数据分布的精确标准差。 $$z_{\text{scaled}} = s \cdot z, \qquad s = \frac{1}{\text{std}(z)}$$ SD1.x 的 官方推理配置取 $s=0.18215$;diffusers v0.35.1 的 AutoencoderKL 默认也为此值,具体 checkpoint 可能覆盖默认,倒过来就是 $\text{std}(z) = 5.4900$、$\text{Var}(z) = 30.1399$。为什么需要这一步,LDM D.1 用信噪比的语言回答了:扩散模型的噪声表 $\sigma_t$ 是相对数据尺度标定的,把这个比值写出来 $$\text{SNR} = \frac{\text{Var}(z)\,\bar{\alpha}}{1 - \bar{\alpha}}$$ 单位数据方差假设对应 $\bar{\alpha}/(1-\bar{\alpha})$;本高斯模型的实际 SNR 是它的 30.14 倍,即约 14.79 dB。噪声方差仍为 $1-\bar{\alpha}$,变的是信号方差,不能说实际噪声被缩小了 30 倍。 接下来用一维高斯后验均值说明尺度不匹配怎样造成估计偏差,不能把它翻译成真实图像发灰或过曝。假设扩散模型是在单位方差潜空间上训好的,那它的去噪器就是一个高斯 MMSE 估计:先验 $z_{0} \sim \mathcal{N}(0, \sigma_{p}^{2} I)$,观测 $z_{t} = \sqrt{\bar{\alpha}}\,z_{0} + \sqrt{1-\bar{\alpha}}\,\epsilon$,后验均值是 $$\hat{z}_{0} = \frac{\sigma_{p}^{2}\sqrt{\bar{\alpha}}}{\sigma_{p}^{2}\bar{\alpha} + 1 - \bar{\alpha}}\, z_{t}$$ 代入 $\sigma_{p}^{2} = 1$ 得 $\hat{z}_{0} = \sqrt{\bar{\alpha}}\, z_{t}$;而真实潜空间的标准差是 $\sigma$,正确的 MMSE 估计要用 $\sigma_{p}^{2} = \sigma^{2}$。两者相除就是第 01 节那个 $r(\bar{\alpha}) = \bar{\alpha} + (1-\bar{\alpha})/\sigma^{2}$。$\sigma = 5.49$ 时它在 $\bar{\alpha} \to 0$ 处趋于 $1/\sigma^{2} = 0.033$,这是两个均值系数之比的极限。在 $\bar{\alpha}=0$ 时两种后验均值都为零,输出比本身是 $0/0$,两种 MSE 均为 $\sigma^2$;不能据极限比值认为纯噪声端的绝对误差差距最大。 对同一观察过程还可精确算错假设估计器的 MSE: $$M_{\text{bad}}=(1-\bar{\alpha})^2\sigma^2+\bar{\alpha}(1-\bar{\alpha})$$ 匹配该尺度的理论最小 MSE 为 $M_{\text{good}}=\sigma^2(1-\bar{\alpha})/(\sigma^2\bar{\alpha}+1-\bar{\alpha})$,相减得到: $$M_{\text{bad}}-M_{\text{good}}=\frac{\bar{\alpha}(1-\bar{\alpha})^2(\sigma^2-1)^2}{\sigma^2\bar{\alpha}+1-\bar{\alpha}}$$ 差距非负,在两端都趋零。若先缩放原数据并维持原噪声表,SNR 也随之改变;因此表中的匹配估计器与“正确缩放后同一步”不是同一个观察问题。 04. 代码实现 完整脚本在文末附录(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py),依赖 NumPy 与 matplotlib。2026-10-13 在 Windows CPU 上完整重跑;Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7,BLAS 使用单线程。训练脚本默认优先读同目录缓存,--full 才重新训练;复制附录到空目录时会从头计算。下面是实跑输出,运行时间受机器影响,不能保证两分钟完成。反向传播手写,另以 PyTorch CPU 自动微分与固定噪声中心差分核验。 4.1 最小 VAE 与两轮对照实验 模型就是 3.1 节那套,符号一一对应: def forward(self, x, eps): p = self.p h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0) mu = h1 @ p["Wmu"] + p["bmu"] # 后验均值 lv_raw = h1 @ p["Wlv"] + p["blv"] lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX) # logvar 截断,防 exp 溢出 sig = np.exp(0.5 * lv) # 后验标准差 sigma z = mu + sig * eps # 重参数化 g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0) xhat = g1 @ p["V2"] + p["c2"] return xhat, dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw, sig=sig, z=z, g1=g1, xhat=xhat, eps=eps) @staticmethod def losses(x, xhat, mu, lv, sig): recon = float(np.mean((xhat - x) ** 2)) # 重建:MSE kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0) # 逐维 KL(3.2 节那个式子) return recon, kl_dim, float(np.sum(kl_dim)) # 对维度求和 数据是合成的:64 个观测维度由 4 个高斯因子线性混合而成,再除以训练集逐维标准差使方差为 1,未减样本均值。输出逐维训练均值的 MSE 精确为 1;输出零还会含样本均值平方。潜变量给了 8 维,故意比真实因子数多一倍,看模型怎么选。编码器/解码器各一层 128 宽的隐藏层,Adam,250 epoch,把逐维平均 KL 大于 0.05 nat 计为“超过 KL 阈值”。这不是另一种按后验均值方差定义的 active units 指标,也不是互信息测试。数据/初始化/批次与训练噪声/评估噪声种子分别为 0/1/2/3;4096 个样本训练后仍在同一训练集评估,每样本采 8 次取平均,因此这里展示训练拟合而非测试泛化。 跑两轮:一组不加重衰减,一组给权重加上 $10^{-3}$ 的衰减。结果: weight_decay beta 重建MSE 总KL std(z) 1/std KL阈值计数 ----------------------------------------------------------------------------------- 0 1e-06 0.0030 76.958 2.0596 0.4855 8/8 0 1e-05 0.0031 39.861 1.4107 0.7088 8/8 0 0.0001 0.0038 23.512 1.0651 0.9389 7/8 0 0.001 0.0062 12.454 1.0067 0.9934 4/8 0 0.01 0.0247 7.843 1.0055 0.9946 4/8 0 0.1 0.2119 3.092 0.9952 1.0048 4/8 0 0.3 0.6206 0.884 1.0000 1.0000 3/8 0 1 1.0000 0.000 1.0001 0.9999 0/8 0 3 1.0001 0.000 1.0000 1.0000 0/8 0.001 1e-06 0.0046 55.983 2.7174 0.3680 8/8 0.001 1e-05 0.0046 49.327 2.5978 0.3849 6/8 0.001 0.0001 0.0049 28.672 2.0580 0.4859 5/8 0.001 0.001 0.0075 13.409 1.3082 0.7644 4/8 0.001 0.01 0.0259 7.917 1.0689 0.9355 4/8 0.001 0.1 0.2148 3.107 1.0051 0.9949 4/8 0.001 0.3 0.6302 0.858 1.0017 0.9983 3/8 0.001 1 1.0000 0.000 1.0000 1.0000 0/8 0.001 3 1.0000 0.000 1.0000 1.0000 0/8 三件事一眼可见: 第一,重建误差逐渐上升,而阈值计数呈台阶。 $\beta$ 从 $10^{-2}$ 到 0.1、0.3、1,MSE 是 $0.0247\to0.2119\to0.6206\to1.0000$;超过 KL 阈值的维度数为 $4\to4\to3\to0$。总 KL 打印到三位小数为 0.000 不代表数学上精确为零,应连同逐维均值和方差判断近似坍缩。 第二,计数与因子数相等是一项观察。 $\beta=10^{-3}$ 时逐维 KL 约为 [2.96, 0.002, 3.19, 0.004, 3.12, 3.18, 0.001, 0.001]。超过阈值的四维与合成数据四个驱动因子的数量相同;不能据此证明一维对应一个因子、模型发现了真实因子,或冗余维度一定关闭。 第三,相同训练算法在不同正则下产生不同尺度。 无 L2 时从 1.0067($\beta=10^{-3}$)到 2.0596($\beta=10^{-6}$);L2 系数 $10^{-3}$、$\beta=10^{-6}$ 时为 2.7174,对应 RMS 倒数 0.3680。这是有限训练的配对观察,不能证明 SD 的 5.49 来自同一机制。 代码把 wd * W 加入 Adam 的梯度,作用于五组编码器/解码器矩阵,是耦合 L2 正则,不是 AdamW。单看解码器,放大 latent 可以缩小相应权重;但编码器权重与后验方差也会同时变化,所以完整正则不能只归因为“小解码器偏好”。本实验固定单个 seed,没有跨 seed 统计,不能推出一般尺度漂移机制。 4.2 换条路验一遍:一维闭式解 3.3 节那组闭式解值得单独验,因为「后验坍缩阈值 $\lambda = 1$」这个结论如果错了,整篇文章的框架就错了。做法是直接对 $(w, m, \log s)$ 做梯度下降。 def closed_form(beta, v=V, sigma_x=SIGMA_X): lam = beta * sigma_x ** 2 / v if lam >= 1.0: # lambda >= 1:坍缩 return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True) u = 1.0 - lam return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False) ($v = 1$、$\sigma_{\text{dec}} = 1$,所以 $\lambda = \beta$、坍缩阈值 $\beta^{\ast} = 1$。)对照结果: beta lambda | u=wm 预测 拟合 | s^2 预测 拟合 | w^2 预测 拟合 | 坍缩 0.05 0.050 | 0.9500 0.9500 | 0.0500 0.0500 | 0.9500 0.9500 | 否 0.1 0.100 | 0.9000 0.9000 | 0.1000 0.1000 | 0.9000 0.9000 | 否 0.2 0.200 | 0.8000 0.8000 | 0.2000 0.2000 | 0.8000 0.8000 | 否 0.4 0.400 | 0.6000 0.6000 | 0.4000 0.4000 | 0.6000 0.6000 | 否 0.6 0.600 | 0.4000 0.4000 | 0.6000 0.6000 | 0.4000 0.4000 | 否 0.8 0.800 | 0.2000 0.2000 | 0.8000 0.8000 | 0.2000 0.2000 | 否 0.95 0.950 | 0.0500 0.0500 | 0.9500 0.9500 | 0.0500 0.0500 | 否 1 1.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 1.2 1.200 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 2 2.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 5 5.000 | 0.0000 0.0000 | 1.0000 1.0000 | 0.0000 0.0000 | 是 未坍缩区间内,闭式解与数值拟合的最大偏差:5.91e-06 坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0): beta=0.05 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=0.5 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=1 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 beta=5 dJ/dw=+0.00e+00 dJ/dm=+0.00e+00 dJ/ds=+0.00e+00 坍缩点 vs 解析解的目标函数值(谁小谁是最优): beta=0.05 J(解析解)= 0.09989 J(坍缩点)= 0.50000 beta=0.5 J(解析解)= 0.42329 J(坍缩点)= 0.50000 beta=0.9 J(解析解)= 0.49741 J(坍缩点)= 0.50000 beta=1 J(解析解)= 0.50000 J(坍缩点)= — beta=2 J(解析解)= 0.50000 J(坍缩点)= — 三处细节值得留意。偏差 5.91e-06 是有限步优化与闭式解的一致性检查,全局正确性来自 3.3 节的消元证明。梯度恒等于 0 说明坍缩点在任意 $\beta$ 下都是驻点——它一直「在那儿」,$\lambda \ge 1$ 时它只是终于变成了最小值。$\beta = 0.9$ 时两者的目标值只差 0.0026,只说明本线性目标的最优值接近坍缩值;不是势垒或坍缩速度的测量,不能据此推断真实网络的训练动力学。 4.3 后验坍缩长什么样 这张图要看什么:三张子图是三档 $\beta$ 下逐维 KL 的柱状图,蓝色是超过 0.05 nat 阈值的维度,灰色是低于阈值的维度。注意三张图的纵轴量级完全不同(3.19 / 0.39 / 0.00001 nats,差五个数量级),各图保留至少 0.35 nat 的纵轴范围以显示阈值线,并标注本组 KL 最大值而非纵轴上限——如果共享纵轴,后两张会被压成一条线,看不出结构。$\beta = 10^{-3}$ 时是 4 根高柱加 4 根贴地;$\beta = 0.3$ 时只剩 3 根矮柱,重建 MSE 已经涨到 0.6206;$\beta = 1$ 时一根都没有。 4.4 潜尺度漂移:从 1.0067 到 2.7174 这张图左侧按全方差公式堆叠两项方差:跨样本后验均值方差、平均后验方差;右侧显示第一项占总方差的比例。两项方差相加后开方才得到边际标准差,标准差本身不能直接堆叠。这个分解描述二阶统计,不能等同于信息与噪声的互信息分解。 这张图帮助理解尺度与信息的区别:相同的边际方差可以来自不同的均值/条件方差组合。缩放只调整统计尺度,不保证 latent 的语义分布匹配,也不能单凭 std 判断是否坍缩。 4.5 忘掉 scaling_factor 的代价,量化 这张图要看什么:左图的纵轴是对数的,三条线分别是三种潜空间尺度下的去噪幅度比 $r$。绿线 $\sigma = 1.0$ 平在 $r = 1$ 上(正确);蓝线是按 SD1.x 配置倒数构造的教学情形 $\sigma = 5.49$,$\bar{\alpha}$ 越小掉得越狠,最左端贴在 $1/\sigma^{2} = 0.033$,也就是幅度只剩 3.3%(后验均值幅度偏小);红线是反向错误——潜空间其实是单位方差却照抄了 0.18215,$\sigma$ 变成 0.182,$r$ 冲到 30 倍(后验均值幅度偏大)。右图是同一个前向过程下两种去噪器的均方误差,中段拉开 8 倍,两端收敛($\bar{\alpha} \to 1$ 时都没噪声要除,$\bar{\alpha} \to 0$ 时都没信息可用——误差差距最大的地方在中间,这跟直觉不太一样)。 alpha_bar | 错假设 MSE 正确 MSE 理论后验方差 恶化倍数 0.999 | 0.0010 0.0010 0.0010 1.03x 0.99 | 0.0130 0.0101 0.0101 1.28x 0.9 | 0.3933 0.1106 0.1107 3.55x 0.5 | 7.8154 0.9682 0.9679 8.07x 0.1 | 24.5816 6.9502 6.9305 3.54x 0.01 | 29.6359 23.2187 23.1056 1.28x 「理论后验方差」一列是和蒙特卡洛结果并排校核的:$\bar{\alpha}=0.5$ 处 0.9679 对 0.9682,这一格的差值约 $3\times10^{-4}$;其他格的采样波动会更大,不能把单个差值当作整张表的误差保证。 05. 工业级实现对照 以下核对固定 diffusers v0.35.1 的 AutoencoderKL 与 DiagonalGaussianDistribution,以及 LDM 固定提交 a506df5756472e2ebaf9078affdde2c4f1502cd4 的标定和训练损失。源码版本固定于链接;2026-10-13 执行了原分布类与 retrieve_latents 函数的 CPU 最小对照,未运行预训练权重或整条生成管线。 编码链路(AutoencoderKL._encode / encode):encoder(x) → quant_conv → 把结果塞进 DiagonalGaussianDistribution。和最小实现的差异有四处: 用卷积而不是全连接。最小实现里 x 是一个 64 维向量,一层矩阵乘就够;图像要保留空间结构,所以编码器是卷积堆栈,以 SD1.x 的 $f=8$ 配置为例,输出 [B, 2*z_channels, H/8, W/8],每个 latent 空间位置各出一组 $(\mu, \text{logvar})$。KL 也因此对每个元素都算一次。 *quant_conv 是 1×1 卷积,默认从 `2latent_channels映到同样的通道数**。编码器已经输出均值与 logvar 所需的双倍通道;这里做通道混合,随后torch.chunk(parameters, 2, dim=1)` 分成两组,不是在 quant_conv 这一步翻倍。 logvar 被硬截断到 $[-30, 20]$,这一行是 self.logvar = torch.clamp(self.logvar, -30.0, 20.0)。别小看它:$\exp(20) = 4.85\times10^{8}$,$\exp(-30) = 9.36\times10^{-14}$。我的最小实现里也照抄了这个阈值。不加截断,很大的 logvar 会增大 KL,极小值会压低采样标准差;exp(20) 在 float16 中仍会溢出,截断不能替代 dtype 控制。手写实现对截断外的 logvar 原始输出置零梯度;边界处不可微,验证避开端点。 encode 返回的是后验分布,不乘 scaling factor。这一步由调用方负责——pipeline 里显式写 latents = vae.encode(image).latent_dist.sample() * vae.config.scaling_factor。这个设计是个典型的「容易漏」:它不在 encode 里面,所以复制粘贴半段代码就会丢掉。 推理时用 sample() 还是 mode():两者都合法,必须与具体管线的约定一致。mode() 返回均值,适合需要确定性编码的实验;sample(generator=...) 返回后验样本,固定随机生成器也能复现。diffusers 的 Stable Diffusion img2img 中 retrieve_latents 默认走 sample,所以不能说图生图、修补必须用 mode()。deterministic=True 是把分布对象的方差与标准差置零的特殊模式,不等于重新训练过的普通自编码器。 KL 的实现细节:kl() 里写的是 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3])。跟 3.2 节那个式子逐字对上(var 就是 $\sigma^{2}$,logvar 就是 $\log\sigma^{2}$),只是求和范围从「8 个潜变量维度」变成「$4 \times 64 \times 64 = 16384$ 个元素」,对四维图像 latent 返回每个样本一个标量。此方法默认只求和第 1、2、3 维,把五维视频张量直接传入会留下最后一维;本次 CPU 实跑时参数张量形状如下,分成均值和 logvar 后,KL 返回 [2,4]。参数张量与默认输出的对应关系: parameters: [2, 8, 2, 3, 4] mean/logvar: [2, 4, 2, 3, 4] kl() default: [2, 4] 所以视频模型必须核对专用实现或显式归约全部非 batch 维,不能把图像接口原样套上去。这一点是全文最容易被忽略的工程事实:KL 是逐元素求和的,所以潜变量个数一变,同一个 $\beta$ 数值的含义完全不同。LDM 用 $10^{-6}$、我的实验用 $10^{-3}\sim1$,这两个数不能直接比较。LDM 的 原损失实现把重建/感知项按 batch 平均的元素和计算,KL 也先求元素和再按 batch 平均;本脚本重建却按元素平均。比较 $\beta$ 必须同时记录形状、归约、似然尺度以及感知/对抗项。 视频 VAE 上这条线怎么延伸:时间维一起下采样,例如一种时空压缩约定下为 [B, C, T/4, H/8, W/8];实际首帧/因果边界及倍率依模型而定,KL 求和范围又大了一个量级。KL 虽逐元素求和,但编码器、解码器会耦合各维,不能保证各维独立开关。元素数增大时还要同时看重建项如何归约,不能仅凭维度数断言同一 β 必然关闭更多维度——这也是为什么视频 VAE 的 loss 配比需要单开一篇(见 视频 VAE 的常见 loss 组合)。 带 shift 的 VAE 要区分编码和解码方向:例如 diffusers 的 SD3 管线 在解码前使用 $z_{\text{raw}}=z_{\text{diffusion}}/\text{scale}+\text{shift}$;对应的正向变换才是 $z_{\text{diffusion}}=(z_{\text{raw}}-\text{shift})\cdot\text{scale}$。读取具体 checkpoint 的配置和管线,不把 SD1.x 的常数套到 SD3 / FLUX。 06. 代价与边界 VAE 是有损压缩,需要先量重建误差。 以 $f=8$、4 latent 通道为例,512×512 RGB 图变成 $4\times64\times64=16384$ 个 latent 元素,元素数比为 48。这不是文件字节压缩比,也不是 FLOPs 加速比,后者还取决于 dtype、网络通道和实现。细纹理、文字等是否损失要通过具体 VAE 重建验证;生成先验可以猜出合理细节,却不能保证恢复压缩前同一张图的真实细节。 减小 $\beta$ 可能改善拟合,却不能保证全局性能单调。 本 toy 展示重建与正则的权衡,实际网络还受优化、结构与其他损失影响。更大的平均 KL 既可能承载信息,也可能表示聚合后验偏离先验。换 VAE 时核对语义、通道、尺度、shift 和扩散模型训练约定,一个标量缩放不能保证兼容。 增大 $\beta$ 会提高信息代价,但阈值来自指定模型。 在线性闭式模型中,未坍缩区 MSE 为 $\beta\sigma_{\text{dec}}^2$,到阈值后连续接到 $v$;逐维 KL 连续趋零。本文神经 toy 在脚本 $\beta=1$ 附近拟合接近均值基线,不能把 1 称为所有 VAE 的坍缩阈值。 保真任务要实测而非一律排除 latent。 超分、医学或文档生成需要核对细节保真和任务指标,可比较像素空间、低压缩倍率或多尺度方案。LDM 原文本身也展示了超分模型,所以“超分不能用 latent”不成立。算力收益与压缩误差需要一起评估。 另一条路线:VQ。 用有限码本替换连续高斯,带来量化误差、码本容量与使用率等另一组权衡。LDM 论文观察到它所用的 VQ latent 方差接近 1;这不是离散化的数学保证,码本仍然可以整体缩放,是否需要归一化要看实际训练分布。 07. 经典论文脉络 Kingma & Welling, 2013, Auto-Encoding Variational Bayes(arXiv:1312.6114) — VAE 本体。两个贡献撑起了后面所有工作:重参数化技巧(把采样挪出计算图)和对角高斯近似后验与标准高斯先验的 KL 闭式项(3.2 节那个式子)。 Higgins 等, ICLR 2017, β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework — 把 KL 权重从固定的 1 变成可调旋钮,$\beta>1$ 换解耦表征。作者讨论了增大 $\beta$ 时的重建与解耦权衡;其结果不是所有模型的坍缩保证。原始 OpenReview 入口保留;本次该站返回挑战页,因此定义与权衡另据 同作者后续解释。 van den Oord 等, 2017, Neural Discrete Representation Learning(arXiv:1711.00937) — VQ-VAE。用码本查表替换连续高斯采样,潜空间变成离散索引,训练自编码器时若取均匀离散先验,确定性索引的 KL 是常数,因此可从该阶段的优化目标中省掉;随后仍要学习索引先验。不是概率模型中的 KL 数学上不存在。 Esser 等, CVPR 2021, Taming Transformers for High-Resolution Image Synthesis(arXiv:2012.09841) — VQGAN。给 VQ 自编码器加上感知损失和对抗损失,研究感知压缩与潜空间自回归生成的组合,展示高分辨率合成;本文不据此给出商用质量保证或历史首次判断。 Rombach 等, CVPR 2022, High-Resolution Image Synthesis with Latent Diffusion Models(arXiv:2112.10752) — LDM / Stable Diffusion。它把「KL 权重、潜空间方差、信噪比、scaling factor」这四件事的关系写进了 4.3.2 与 D.1 两节,附录 G 列出标定估计量;0.18215 则是 SD1.x 的具体配置,不能推广到全部后续 VAE。 顺着这条线看,故事其实是「潜空间的统计性质从哪儿来」在被一步步讲清楚:2013 年给了目标函数,2017 年研究权重与表征的权衡,2017—2021 年发展离散化和感知训练路线,2022 年把压缩与 latent 尺度约定纳入扩散模型设计。各路线有不同目标,不能概括为前者被后者彻底替代。 08. 常见误解 误解一:KL 既然是正则项,越大越好。 KL 确实可以看作正则,也可用信息预算解释,但增强它会牺牲重建。第 09 节的密集扫描显示 MSE 从 $0.0650$ 到 $0.8881$ 逐步上升;台阶出现在人为设阈值的存活维度计数,不能把稀疏扫描误读为“中间没有过渡”。 误解二:任意 KL 权重下都在拟合原模型的真实后验。 当 $\beta=1$ 且变分族足够时,最优 $q$ 可以等于该生成模型的真实后验;本文线性高斯模型就是例子。$\beta\ne1$ 则改变权衡,存活区 $s^2=\beta\sigma_{\text{dec}}^2/v$ 同时依赖权重、观测噪声和数据方差 $v$,不能说与数据无关。 误解三:聚合后验等于先验就意味着坍缩。 逐样本 $q(z\mid x)$ 和聚合后验 $q(z)=\int q(z\mid x)p_{\text{data}}(x)\,dx$ 是两个对象。本文未坍缩线性解满足 $m^2v+s^2=(1-\lambda)+\lambda=1$,因而 $q(z)=\mathcal N(0,1)$,但 $m\ne0$,仍然传递信息。真正的完全坍缩要求几乎所有输入的整个 $q(z\mid x)$ 都等于同一个先验。 误解四:scaling factor 是固定的魔法常数。 LDM 的标定实现使用首个训练 batch 的 latent 展平后的标准差,令缩放因子为其倒数;这不是逐通道独立归一化。使用预训练模型时应遵守 checkpoint 保存的系数,不能随手在一张新图上重估并替换。换 VAE 还可能改变 latent 的语义和通道分布,重算一个标量不保证与原扩散模型兼容。 误解五:后验采样只在训练时用。 官方 img2img 管线默认也会采样;固定 generator 可以控制随机性。mode() 是去掉编码采样噪声的一种选择,必须核对训练与推理的分布约定,不能统一替换所有管线。 误解六:截断范围等于所有精度下的安全范围。 [-30,20] 是实现中的防护范围,但 exp(20) 超过 fp16 最大有限值,实际还要看计算 dtype 和 VAE 是否上转 fp32。实验中的 logvar 约 −9.4 离 −30 很远,不能仅凭这个数断言已接近数值崩溃。 09. 动手验证 三个小实验,训练扫描较慢,时间取决于 CPU/BLAS;缓存输出不等于本次训练。建议保存 stdout 并核对种子与配置。 实验一:确认坍缩是「跳」还是「滑」。 一行命令: python vae_minimal.py --betas=0.03,0.05,0.1,0.2,0.5 --wd=0 实测($\text{weight\_decay} = 0$,$250$ epoch,随机种子固定,可复现): $\beta$ $0.03$ $0.05$ $0.1$ $0.2$ $0.5$ 重建 MSE $0.0650$ $0.1057$ $0.2119$ $0.4200$ $0.8881$ 总 KL $5.580$ $4.554$ $3.092$ $1.677$ $0.196$ 存活维度 $4/8$ $4/8$ $4/8$ $4/8$ $1/8$ 结论:重建误差逐渐增加,存活维度的计数呈台阶。 这里把每维 KL 超过 0.05 nat 计为存活,所以计数天然离散。在线性模型中,每维 KL 为 $-\tfrac12\log\lambda$(未坍缩时),连续趋向 0,并不会从 3 直接跳到 0;应同时观察逐维 KL、重建与均值/方差统计。 实验二:比较耦合 L2 系数对固定 seed 的影响。 把权重衰减单独开到 $10^{-2}$: python vae_minimal.py --wd=0.01 三档权重衰减下 $\text{std}(z)$ 的对照(同一批 $\beta$,小权重处的统计尺度变化更明显): $\beta$ $\text{wd} = 0$ $\text{wd} = 10^{-3}$ $\text{wd} = 10^{-2}$ $10^{-6}$ $2.0596$ $2.7174$ $2.6747$ $10^{-5}$ $1.4107$ $2.5978$ $2.6385$ $10^{-4}$ $1.0651$ $2.0580$ $2.5400$ $10^{-3}$ $1.0067$ $1.3082$ $2.0464$ $10^{-2}$ $1.0055$ $1.0689$ $1.3657$ $10^{-1}$ $0.9952$ $1.0051$ $1.0523$ $3\times10^{-1}$ $1.0000$ $1.0018$ $1.0000$ 看这张表的方式是看「回到 1.00 的那个拐点」在往右挪:$\text{wd} = 0$ 时 $\beta \ge 10^{-3}$ 就已经归位;$\text{wd} = 10^{-3}$ 时要到 $\beta \ge 10^{-2}$;$\text{wd} = 10^{-2}$ 时要一路推到 $\beta \ge 0.3$。权重衰减把「潜尺度失控」的区间往大 $\beta$ 方向整整推了两个数量级。一个诚实的补充:$10^{-6}$ 那一档 $10^{-2}$ 的 $2.6747$ 反而略低于 $10^{-3}$ 的 $2.7174$,说明这三个有限训练结果不严格单调;单 seed、三个档位不足以证明饱和或一般因果机制。 实验三:反向验证 scaling factor。 指定另外两个标定系数各跑一次;这个参数通过 $\sigma=1/s$ 构造不同数据方差,不是在同一个 SD latent 上分别应用 0.5 和 2.0(--sf 会把整张表按新系数重算): python latent_scaling.py --sf=0.5 python latent_scaling.py --sf=2.0 实际结果: $\text{scaling factor}$ $\text{std}(z)$ $r$ 在 $\bar{\alpha}=0.999$ $r$ 在 $\bar{\alpha}=0.01$ $\bar{\alpha}=0.5$ 处 MSE 比值 $0.18215$(SD1.x 系数对应 toy) $5.4900$ $0.9990$ $0.0428$ $8.07\times$ $0.5$(另一标定系数) $2.0000$ $0.9992$ $0.2575$ $1.57\times$ $2.0$(另一标定系数) $0.5000$ $1.0030$ $3.9700$ $1.56\times$ $\sigma = 2$ 时 $r$ 全程在 1 以下(最低 $0.2575$,正是 $1/\sigma^{2} = 0.25$ 加上 $\bar{\alpha}$ 那一项),该高斯估计器的幅度偏小;$\sigma = 0.5$ 时 $r$ 全程在 1 以上(最高 $3.97$,趋近 $1/\sigma^{2} = 4$),该高斯估计器的幅度偏大。在这个高斯模型中:$r$ 是大于还是小于 1,只取决于 $\sigma$ 是大于还是小于 1;当 $\bar{\alpha}\to0$ 时系数比趋向 $1/\sigma^2$,但两个后验均值本身趋零、MSE 差也趋零。表中 8.07 倍是 $\bar{\alpha}=0.5$ 的有限 Monte Carlo 误差比,不能与噪声端 0.0428 的系数比混为一项指标。它说明与预训练模型尺度约定一致的重要性,不提供真实图像质量或完整采样链的性能保证。 10. 延伸阅读 前置:变分下界与重参数化 —— ELBO 的完整推导和重参数化为什么可导,本篇只用结论。 同方向:视频 VAE 的常见 loss 组合 —— 真实训练里 $\beta$ 不是单独出现的,它要和 L1、LPIPS、GAN 四项一起配比。 数值细节:混合精度与数值稳定性 —— logvar 截断那类技巧在 fp16 下会变得更关键。 下一步:潜空间扩散与 Stable Diffusion 架构会讲 $\text{Var}(z)$ 和信噪比这条线在 UNet 采样里怎么具体表现出来;离散化表征:VQ-VAE 与 VQGAN讲离散码本与使用率问题;视频 VAE 的时空压缩结构继续核对时间压缩与归约约定。 附录:完整代码 09 节用到的脚本全文如下(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 vae_minimal.py """最小 VAE:numpy 手写反向传播,扫 KL 权重 beta,观察潜空间统计量怎么变。 这篇文章要回答的问题是:KL 权重 beta 调大调小,到底改变了什么? 本脚本做两轮对照实验: 条件 A(无权重衰减):观察不同 beta 下的潜尺度,不能预设所有 beta 都接近 1。 条件 B(权重衰减 1e-3):对五组编码/解码权重同时加入 L2 梯度; 与条件 A 比较固定 seed 的训练结果,不能单独归因解码器。 两轮对照展示本模型在有限优化下的尺度变化。平均 KL 同时惩罚信息与 聚合后验偏离先验,不能保证每个 beta 的边际尺度精确等于 1。 固定 seed 的结果不能反推 Stable Diffusion 的训练轨迹或一般因果机制。 运行: python vae_minimal.py 依赖: numpy """ import os import json import numpy as np # ── 固定随机性,保证正文里贴的每个数字都能复现 ───────────────────────── DATA_SEED = 0 INIT_SEED = 1 BATCH_SEED = 2 EVAL_SEED = 3 N_TRAIN = 4096 # 训练样本数 D_OBS = 64 # 观测维度(类比一张图的像素数) H_HID = 128 # 编码器/解码器隐藏层 D_LAT = 8 # 潜变量维度 K_FAC = 4 # 合成数据的真实因子数(< D_LAT,故意留出冗余维度) EPOCHS = 250 BATCH = 256 LR = 3e-3 LOGVAR_MIN, LOGVAR_MAX = -30.0, 20.0 # 与 diffusers DiagonalGaussianDistribution 一致 BETAS = [1e-6, 1e-5, 1e-4, 1e-3, 1e-2, 1e-1, 3e-1, 1.0, 3.0] WD_LIST = [0.0, 1e-3] # 两轮对照:无权重衰减 / 有权重衰减 # ─────────────────────────── 合成数据 ─────────────────────────── def make_data(n=N_TRAIN, d=D_OBS, k=K_FAC, seed=DATA_SEED): """x = A u + 观测噪声,u 是 k 维高斯因子。 教学数据由 k=4 个高斯因子驱动,并带观测噪声;不宣称真实图像只有四因子。 潜变量维度 D_LAT=8 > 4,留出冗余以便比较逐维 KL;后验坍缩不要求冗余维度。 最后仅除以训练集逐维标准差,不减样本均值。输出逐维训练均值时 MSE 精确为 1; 输出零时会额外含样本均值平方。下文 evaluate 也使用同一训练集,不是泛化测试。 """ rng = np.random.default_rng(seed) A = rng.normal(size=(d, k)) / np.sqrt(k) U = rng.normal(size=(n, k)) X = U @ A.T + 0.05 * rng.normal(size=(n, d)) X = X / X.std(axis=0, keepdims=True) # 逐维方差 = 1 return X # ─────────────────────────── 模型 ─────────────────────────── class VAE: """编码器 x -> h -> (mu, logvar),解码器 z -> g -> x_hat。 符号与正文第 03 节一致: h = relu(x W1 + b1) 编码器隐藏层 mu = h Wmu + bmu 后验均值 logvar = h Wlv + blv 后验对数方差(网络出的是 log sigma^2) z = mu + exp(0.5 logvar) * eps 重参数化 x_hat = relu(z V1 + c1) V2 + c2 解码器 """ def __init__(self, d_obs=D_OBS, h=H_HID, d_lat=D_LAT, seed=INIT_SEED): rng = np.random.default_rng(seed) sc = lambda fan_in, fan_out: rng.normal( scale=np.sqrt(2.0 / (fan_in + fan_out)), size=(fan_in, fan_out) ) self.p = {} self.p["W1"] = sc(d_obs, h) self.p["b1"] = np.zeros(h) self.p["Wmu"] = sc(h, d_lat) self.p["bmu"] = np.zeros(d_lat) self.p["Wlv"] = sc(h, d_lat) self.p["blv"] = np.zeros(d_lat) self.p["V1"] = sc(d_lat, h) self.p["c1"] = np.zeros(h) self.p["V2"] = sc(h, d_obs) self.p["c2"] = np.zeros(d_obs) self.d_obs, self.h, self.d_lat = d_obs, h, d_lat def forward(self, x, eps): p = self.p h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0) mu = h1 @ p["Wmu"] + p["bmu"] lv_raw = h1 @ p["Wlv"] + p["blv"] lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX) # 防 exp 溢出,见第 05 节 sig = np.exp(0.5 * lv) z = mu + sig * eps g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0) xhat = g1 @ p["V2"] + p["c2"] cache = dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw, sig=sig, z=z, g1=g1, xhat=xhat, eps=eps) return xhat, cache @staticmethod def losses(x, xhat, mu, lv, sig): """recon = 逐元素均方误差;kl = 0.5 * sum_d(mu^2 + var - 1 - logvar)。 注意 kl 是对潜变量维度「求和」而不是求平均——这是标准写法, 比较 beta 还需同时记录重建归约和张量形状,不能仅按潜维数推断最优行为。 """ recon = float(np.mean((xhat - x) ** 2)) kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0) # [d] return recon, kl_dim, float(np.sum(kl_dim)) def backward(self, cache, beta): """全部手推。grad 的形状与 self.p 一一对应。""" p = self.p x, h1, mu, lv, lv_raw, sig, z, g1, xhat, eps = ( cache[k] for k in ["x", "h1", "mu", "lv", "lv_raw", "sig", "z", "g1", "xhat", "eps"] ) B, D = x.shape[0], self.d_obs g = {k: np.zeros_like(v) for k, v in p.items()} # 重建项:recon = mean((xhat - x)^2),d/d(xhat) = 2 (xhat - x) / (B*D) dxhat = 2.0 * (xhat - x) / (B * D) g["V2"] += g1.T @ dxhat g["c2"] += dxhat.sum(axis=0) dg1 = (dxhat @ p["V2"].T) * (g1 > 0) # relu g["V1"] += z.T @ dg1 g["c1"] += dg1.sum(axis=0) dz = dg1 @ p["V1"].T # [B, d] # 重参数化:dz 同时流回 mu 与 logvar 两条支路 dmu = dz + beta * mu / B # KL 对 mu 的导数 = beta * mu dlv = dz * (0.5 * sig * eps) + beta * 0.5 * (sig ** 2 - 1.0) / B # 被 clamp 的位置梯度必须截断,否则会用未截断的 logvar 继续更新 dlv = dlv * ((lv_raw > LOGVAR_MIN) & (lv_raw < LOGVAR_MAX)) g["Wmu"] += h1.T @ dmu g["bmu"] += dmu.sum(axis=0) g["Wlv"] += h1.T @ dlv g["blv"] += dlv.sum(axis=0) dh1 = (dmu @ p["Wmu"].T + dlv @ p["Wlv"].T) * (h1 > 0) g["W1"] += x.T @ dh1 g["b1"] += dh1.sum(axis=0) return g # ─────────────────────────── Adam ─────────────────────────── class Adam: def __init__(self, params, lr=LR, b1=0.9, b2=0.999, eps=1e-8): self.m = {k: np.zeros_like(v) for k, v in params.items()} self.v = {k: np.zeros_like(v) for k, v in params.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.t = 0 def step(self, params, grads): self.t += 1 for k in params: self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * grads[k] self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * grads[k] ** 2 mhat = self.m[k] / (1 - self.b1 ** self.t) vhat = self.v[k] / (1 - self.b2 ** self.t) params[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps) def train(beta, X, weight_decay=0.0, epochs=EPOCHS, batch=BATCH, seed=BATCH_SEED): """训练一个 VAE。weight_decay 是本次实验的关键对照变量。""" rng = np.random.default_rng(seed) model = VAE() opt = Adam(model.p) n = X.shape[0] for _ in range(epochs): perm = rng.permutation(n) for s in range(0, n, batch): xb = X[perm[s:s + batch]] eps = rng.normal(size=(xb.shape[0], D_LAT)) xhat, cache = model.forward(xb, eps) model.losses(xb, xhat, cache["mu"], cache["lv"], cache["sig"]) grads = model.backward(cache, beta) if weight_decay > 0: # 只对权重做衰减,偏置不管 for k in ["W1", "Wmu", "Wlv", "V1", "V2"]: grads[k] += weight_decay * model.p[k] opt.step(model.p, grads) return model def evaluate(model, X, beta, weight_decay=0.0, n_repeat=8): """统计潜空间性质,并把边际标准差拆成两半: Var(z_j) = Var_x(mu_j(x)) + E_x[sigma_j(x)^2] 前一半是「不同样本被编码到不同位置」,后一半是「每个样本自己抖多少」。 scaling_factor 要归一化的是两者之和的开方。 """ rng = np.random.default_rng(EVAL_SEED) n, d = X.shape[0], D_LAT mu_all = np.empty((n, d)) var_all = np.empty((n, d)) recon_all = 0.0 kl_dim_all = np.zeros(d) for s in range(0, n, 512): xb = X[s:s + 512] B = xb.shape[0] h1 = np.maximum(xb @ model.p["W1"] + model.p["b1"], 0.0) mu = h1 @ model.p["Wmu"] + model.p["bmu"] lv = np.clip(h1 @ model.p["Wlv"] + model.p["blv"], LOGVAR_MIN, LOGVAR_MAX) var = np.exp(lv) sig = np.sqrt(var) mu_all[s:s + B] = mu var_all[s:s + B] = var # 逐维 KL:先对 batch 求和,最后统一除以总样本数 kl_dim_all += 0.5 * np.sum(mu ** 2 + var - lv - 1.0, axis=0) / n # 用同一个 mu 重复采样 n_repeat 次,估计解码器实际看到的抖动有多大 eps = rng.normal(size=(B, n_repeat, d)) z = mu[:, None, :] + sig[:, None, :] * eps z_flat = z.reshape(-1, d) h1d = np.maximum(z_flat @ model.p["V1"] + model.p["c1"], 0.0) xhat = (h1d @ model.p["V2"] + model.p["c2"]).reshape(B, n_repeat, D_OBS) recon_all += np.sum((xhat - xb[:, None, :]) ** 2) / (n * n_repeat * D_OBS) std_mu = mu_all.std(axis=0) # [d] mean_sig = np.sqrt(var_all.mean(axis=0)) # [d] marginal_std = np.sqrt(std_mu ** 2 + var_all.mean(axis=0)) # [d] overall_std = float(np.sqrt(np.mean(marginal_std ** 2))) return dict( beta=beta, weight_decay=weight_decay, recon=float(recon_all), kl=float(np.sum(kl_dim_all)), kl_dim=kl_dim_all.tolist(), std_mu=std_mu.tolist(), mean_sig=mean_sig.tolist(), marginal_std=marginal_std.tolist(), overall_std=overall_std, scaling_factor=1.0 / overall_std, active_dims=int(np.sum(kl_dim_all > 0.05)), # 仅为本实验 KL 阈值计数,不是互信息/AU mean_mu=mu_all.mean(axis=0).tolist(), flat_std=float(np.sqrt(np.mean(marginal_std ** 2) + np.var(mu_all.mean(axis=0)))), data_mean_mse=float(np.mean((X-X.mean(axis=0)) ** 2)), data_zero_mse=float(np.mean(X ** 2)), ) def sweep(wd_list=None, betas=None, verbose=True): wd_list = WD_LIST if wd_list is None else wd_list betas = BETAS if betas is None else betas X = make_data() out = {} for wd in wd_list: rows = [] for beta in betas: model = train(beta, X, weight_decay=wd) rows.append(evaluate(model, X, beta, weight_decay=wd)) out[f"wd={wd:g}"] = rows if verbose: print(f"--- weight_decay = {wd:g} ---") for m in rows: print(f" beta={m['beta']:<8g} recon={m['recon']:.4f} " f"kl={m['kl']:9.3f} std(z)={m['overall_std']:7.4f} " f"1/std={m['scaling_factor']:7.4f} active={m['active_dims']}/{D_LAT}") return out CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "beta_sweep.json") def load_or_sweep(path=CACHE): """图与正文共用同一份结果,避免图文数字漂移。""" if os.path.exists(path): with open(path) as f: rows=json.load(f) if set(rows) != {f"wd={wd:g}" for wd in WD_LIST}: raise ValueError("Figure cache does not contain the two default paired sweeps") return rows res = sweep() with open(path, "w") as f: json.dump(res, f, indent=2) return res def _parse_cli(argv): """正文 09 节的两个实验就是靠这两个参数复现的: python vae_minimal.py --betas 0.03,0.05,0.1,0.2,0.5 --wd 0 python vae_minimal.py --wd 0.01 """ wd_list, betas, full = None, None, False for a in argv: if a.startswith("--betas="): betas = [float(t) for t in a.split("=", 1)[1].split(",")] elif a.startswith("--wd="): wd_list = [float(t) for t in a.split("=", 1)[1].split(",")] elif a == "--full": full = True return wd_list, betas, full if __name__ == "__main__": import sys wd_list, betas, force = _parse_cli(sys.argv[1:]) custom = wd_list is not None or betas is not None if os.path.exists(CACHE) and not force and not custom: # 扫描要跑 9 x 2 x 250 = 4500 个 epoch,读缓存是为了让「跑一遍就有输出」 # 这句话成立;想从头算就加 --full。指定了自定义参数就不走缓存。 with open(CACHE) as f: res = json.load(f) print(f"[缓存] 读 {os.path.basename(CACHE)};加 --full 可重跑约 5 分钟的完整扫描") else: if custom: print(f"自定义扫描:wd={wd_list or WD_LIST} beta={betas or BETAS}") else: print("开始完整扫描(9 个 beta x 2 组权重衰减 x 250 epoch,约 5 分钟)...") res = sweep(wd_list, betas) if not custom: with open(CACHE, "w") as f: json.dump(res, f, indent=2) print(f"\n{'='*84}") print(f"{'weight_decay':>14} {'beta':>9} {'重建MSE':>10} {'总KL':>10} " f"{'std(z)':>9} {'1/std':>8} {'存活维度':>8}") print(f"{'-'*84}") for key, rows in res.items(): for m in rows: print(f"{key:>14} {m['beta']:>9g} {m['recon']:>10.4f} {m['kl']:>10.3f} " f"{m['overall_std']:>9.4f} {m['scaling_factor']:>8.4f} " f"{m['active_dims']:>5}/{D_LAT}") print("\n潜尺度拆账(std_mu = 跨维均值变化标准差 RMS;mean_sig = 跨维采样噪声标准差 RMS):") for key, rows in res.items(): print(f" {key}") for m in rows: frac = np.mean(np.array(m["std_mu"]) ** 2) / ( np.mean(np.array(m["std_mu"]) ** 2) + np.mean(np.array(m["mean_sig"]) ** 2)) print(f" beta={m['beta']:<8g} std_mu={np.sqrt(np.mean(np.array(m['std_mu']) ** 2)):6.3f} " f"mean_sig={np.sqrt(np.mean(np.array(m['mean_sig']) ** 2)):6.3f} std(z)={m['overall_std']:6.3f} " f"均值变化方差占比={frac:5.1%}") collapse_closed_form.py """一维线性 VAE 的闭式解:后验坍缩的阈值到底在哪。 第 03 节推了这么一个结论: 设 数据 x ~ N(0, v),编码器 q(z|x) = N(m x, s^2), 解码器 p(x|z) = N(w z, sigma_x^2)(sigma_x 固定,等价于重建项的权重), 目标 J = [v(1-wm)^2 + w^2 s^2] / (2 sigma_x^2) + beta * 0.5 * (m^2 v + s^2 - log s^2 - 1) 令 lambda = beta * sigma_x^2 / v,则驻点为 u := w m = 1 - lambda (潜变量被真正使用的程度) s^2 = lambda (后验方差) w^2 = v (1 - lambda) (解码器权重) 当 lambda > 1 时此分支要求 w^2 < 0,不存在实数解;lambda = 1 接到坍缩点,最优解退化为坍缩点 (w, m, s) = (0, 0, 1)。 这个脚本用数值优化去拟合 (w, m, s),逐项对照闭式解, 顺便验证「坍缩点永远是一个驻点」这件事。 运行: python collapse_closed_form.py 依赖: numpy """ import numpy as np V = 1.0 # 数据方差 SIGMA_X = 1.0 # 解码器的观测噪声标准差,固定(它就是重建项的隐式权重) # ─────────────────────────── 目标函数与梯度 ─────────────────────────── def objective(w, m, s, beta, v=V, sigma_x=SIGMA_X): recon = (v * (1.0 - w * m) ** 2 + w ** 2 * s ** 2) / (2.0 * sigma_x ** 2) kl = 0.5 * beta * (m ** 2 * v + s ** 2 - np.log(s ** 2) - 1.0) return recon + kl def grad(w, m, s, beta, v=V, sigma_x=SIGMA_X): dJ_dw = (-v * m * (1.0 - w * m) + w * s ** 2) / sigma_x ** 2 dJ_dm = -v * w * (1.0 - w * m) / sigma_x ** 2 + beta * m * v dJ_ds = w ** 2 * s / sigma_x ** 2 + beta * (s - 1.0 / s) return dJ_dw, dJ_dm, dJ_ds def fit(beta, v=V, sigma_x=SIGMA_X, steps=20000, lr=0.02, seed=0): """对 (w, m, log s) 做梯度下降。用 log s 参数化保证 s > 0。""" rng = np.random.default_rng(seed) w = rng.normal() * 0.5 m = rng.normal() * 0.5 t = rng.normal() * 0.5 # s = exp(t) for i in range(steps): s = np.exp(t) gw, gm, gs = grad(w, m, s, beta, v, sigma_x) # 对 t 的梯度要过一次链式法则 w -= lr * gw m -= lr * gm t -= lr * gs * s return w, m, np.exp(t) def closed_form(beta, v=V, sigma_x=SIGMA_X): if beta <= 0 or v <= 0 or sigma_x <= 0: raise ValueError("beta, v and sigma_x must be positive") lam = beta * sigma_x ** 2 / v if lam >= 1.0: # 坍缩 return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True) u = 1.0 - lam return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False) # ─────────────────────────── 主流程 ─────────────────────────── if __name__ == "__main__": betas = [0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.95, 1.0, 1.2, 2.0, 5.0] print(f"v = {V}, sigma_x = {SIGMA_X}, lambda = beta * sigma_x^2 / v = {SIGMA_X**2/V} * beta") print(f"闭式预测:坍缩阈值 beta* = v / sigma_x^2 = {V / SIGMA_X**2:g}\n") print(f"{'beta':>6} {'lambda':>8} | {'u=wm 预测':>10} {'拟合':>9} " f"| {'s^2 预测':>9} {'拟合':>9} | {'w^2 预测':>9} {'拟合':>9} | 坍缩") max_err = 0.0 for beta in betas: cf = closed_form(beta) w, m, s = fit(beta) u_fit = w * m err = max(abs(u_fit - cf["u"]), abs(s ** 2 - cf["s2"]), abs(w ** 2 - cf["w2"])) max_err = max(max_err, err) if not cf["collapsed"] else max_err print(f"{beta:>6g} {cf['lam']:>8.3f} | {cf['u']:>10.4f} {u_fit:>9.4f} " f"| {cf['s2']:>9.4f} {s**2:>9.4f} | {cf['w2']:>9.4f} {w**2:>9.4f} " f"| {'是' if cf['collapsed'] else '否'}") print(f"\n未坍缩区间内,闭式解与数值拟合的最大偏差:{max_err:.2e}") # 坍缩点是不是永远的驻点? print("\n坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0):") for beta in [0.05, 0.5, 1.0, 5.0]: gw, gm, gs = grad(0.0, 0.0, 1.0, beta) print(f" beta={beta:<6g} dJ/dw={gw:+.2e} dJ/dm={gm:+.2e} dJ/ds={gs:+.2e}") # 坍缩点在不同 beta 下到底是不是最优?比一下目标函数值 print("\n坍缩点 vs 解析解的目标函数值(谁小谁是最优):") for beta in [0.05, 0.5, 0.9, 1.0, 2.0]: cf = closed_form(beta) if cf["collapsed"]: j_star = objective(0.0, 0.0, 1.0, beta) j_alt = None else: w2 = cf["w2"] w = np.sqrt(w2) m = cf["u"] / w j_star = objective(w, m, np.sqrt(cf["s2"]), beta) j_alt = objective(0.0, 0.0, 1.0, beta) alt = " —" if j_alt is None else f"{j_alt:9.5f}" print(f" beta={beta:<6g} J(解析解)={j_star:9.5f} J(坍缩点)={alt}") latent_scaling.py """scaling_factor 到底在补什么:把「潜空间标准差」翻译成「信噪比」。 Stable Diffusion 的 VAE 有个著名常数 0.18215。它是这么用的: 编码: z_scaled = z * 0.18215 (交给扩散模型之前) 解码: z = z_scaled / 0.18215 (交给解码器之前) 核对 checkpoint 配置与实际乘除方向。LDM 原始实现 std-rescaling 分支 用首个 batch 后验样本的展平标准差倒数,并非逐通道独立归一化。 0.18215 是 SD1.x 配置中的缩放系数,1/s 只是它对应的标定尺度, 不表示本脚本实测了该预训练 VAE 的当前输出统计。 本脚本把这段话变成可算的数。核心结论是两条: 1. 若扩散模型是在单位方差潜空间上训练的,它对 z_0 的后验均值估计就是 z_hat_0 = sqrt(alpha_bar) * z_t (高斯先验 N(0, I) 下的 MMSE 估计)。而真实潜空间标准差是 sigma 时, 正确的 MMSE 估计是 z_hat_0 = sigma^2 sqrt(alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar) * z_t 两者之比 r = alpha_bar + (1 - alpha_bar) / sigma^2。 r 是后验均值系数之比;不能由一维高斯结果推断真实图像亮度或伪影。 2. 每一层的真实信噪比是 sigma^2 * alpha_bar / (1 - alpha_bar), 模型以为的是 alpha_bar / (1 - alpha_bar),整整差 sigma^2 倍 (20*log10(sigma) 分贝)。 运行: python latent_scaling.py 依赖: numpy """ import numpy as np SD_SCALING_FACTOR = 0.18215 # diffusers AutoencoderKL 的默认值 ABARS = [0.999, 0.99, 0.9, 0.5, 0.1, 0.01] def latent_std_from_scaling(s): """scaling_factor 是潜空间边际标准差的倒数。""" if not np.isfinite(s) or s <= 0: raise ValueError("scaling factor must be finite and positive") return 1.0 / s def mmse_model(z_t, abar): """在「潜空间方差 = 1」的假设下训练出来的高斯 MMSE 去噪器。""" return np.sqrt(abar) * z_t def mmse_true(z_t, abar, sigma): """潜空间真实标准差为 sigma 时的高斯 MMSE 去噪器。""" return sigma ** 2 * np.sqrt(abar) / (sigma ** 2 * abar + 1.0 - abar) * z_t def amplitude_ratio(abar, sigma): """模型输出 / 正确输出 = alpha_bar + (1 - alpha_bar) / sigma^2。""" return abar + (1.0 - abar) / sigma ** 2 def snr(abar, sigma): """真实信噪比 Var(z_0 的信号成分) / Var(噪声成分) = sigma^2 * abar / (1 - abar)。""" return sigma ** 2 * abar / (1.0 - abar) def mmse_mse(abar, sigma): """高斯 MMSE 估计的理论误差,就是后验方差。""" return sigma ** 2 * (1.0 - abar) / (sigma ** 2 * abar + 1.0 - abar) def demo_step(abar, sigma, n=400000, seed=0): """蒙特卡洛:固定同一个前向过程,比较两个去噪器。 est_model:按「潜空间方差 = 1」训练出来的理想去噪器,用在方差为 sigma^2 的 潜空间上,是忘缩放的一种教学类比。 est_true :同一前向过程就该 sigma 匹配的理想估计器。对原始 z0 缩放但保持 原噪声表,会改变观察到的 SNR;所以它不等价于正确缩放的同一步 MSE。 """ rng = np.random.default_rng(seed) z0 = sigma * rng.normal(size=n) eps = rng.normal(size=n) z_t = np.sqrt(abar) * z0 + np.sqrt(1.0 - abar) * eps est_model = mmse_model(z_t, abar) est_true = mmse_true(z_t, abar, sigma) return (float(np.mean((est_model - z0) ** 2)), float(np.mean((est_true - z0) ** 2))) if __name__ == "__main__": import sys # 正文 09 节实验三:换一个反事实的 scaling_factor 重算整张表 # python latent_scaling.py --sf=0.5 # python latent_scaling.py --sf=2.0 for a in sys.argv[1:]: if a.startswith("--sf="): SD_SCALING_FACTOR = float(a.split("=", 1)[1]) sigma_sd = latent_std_from_scaling(SD_SCALING_FACTOR) print("=" * 72) print("一、0.18215 意味着什么") print("=" * 72) print(f" scaling_factor = {SD_SCALING_FACTOR}") print(f" 潜空间边际标准差 sigma = 1 / {SD_SCALING_FACTOR} = {sigma_sd:.4f}") print(f" 潜空间边际方差 Var(z) = {sigma_sd**2:.4f}") print(f" 信噪比偏移 = {20*np.log10(sigma_sd):.2f} dB") print() print(" 对照:若某个 VAE 的潜空间方差真的接近 1(LDM 说 VQ 版就是如此),") print(" scaling_factor 就应当接近 1,完全不需要 rescale。") print() print("=" * 72) print("二、忘掉 scaling factor,去噪幅度错多少") print("=" * 72) print(" r = 模型输出 / 正确输出;r=1 才是正确的") print(f" {'alpha_bar':>10} | " + " | ".join(f"sigma={s:<7.4g}" for s in [sigma_sd, 1.0, SD_SCALING_FACTOR])) for abar in ABARS: rs = [amplitude_ratio(abar, s) for s in [sigma_sd, 1.0, SD_SCALING_FACTOR]] print(f" {abar:>10g} | " + " | ".join(f"{r:>13.4f}" for r in rs)) print() print("=" * 72) print("三、蒙特卡洛实测:单步去噪的均方误差(n=400000)") print("=" * 72) print(f" {'alpha_bar':>10} | {'错假设 MSE':>12} {'正确 MSE':>12} {'理论后验方差':>14} {'恶化倍数':>10}") for abar in ABARS: m_bad, m_good = demo_step(abar, sigma_sd) print(f" {abar:>10g} | {m_bad:>12.4f} {m_good:>12.4f} {mmse_mse(abar, sigma_sd):>14.4f} " f"{m_bad/m_good:>10.2f}x") print() print(" 读法:固定同一个前向过程 z_t = sqrt(alpha_bar) z_0 + sqrt(1-alpha_bar) eps,") print(" 「错假设」是拿了按单位方差潜空间训好的去噪器却喂未缩放的 latent,") print(" 「正确」是同一观察过程就该 sigma 匹配的估计器;不是正确缩放的同一步实测。") print(f" 「理论后验方差」= sigma^2 (1-alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar),") print(f" 与蒙特卡洛的「正确」一列应当吻合(校核 alpha_bar=0.5:" f"{mmse_mse(0.5, sigma_sd):.4f} vs 实测 {demo_step(0.5, sigma_sd)[1]:.4f})") print() print("=" * 72) print("四、反向的错误:换了个方差接近 1 的 VAE,却照抄 0.18215") print("=" * 72) print(f" {'alpha_bar':>10} | {'r(幅度被放大的倍数)':>24}") for abar in ABARS: print(f" {abar:>10g} | {amplitude_ratio(abar, SD_SCALING_FACTOR):>24.4f}") print() print(" r >> 1:高斯后验均值系数偏大;不能推断生成图过曝或结构模糊。") print() print("=" * 72) print("五、信噪比视角(LDM D.1 的定义 Var(z) / sigma_t^2)") print("=" * 72) print(f" {'alpha_bar':>10} | {'模型以为的 SNR':>16} {'真实 SNR':>16} {'倍数':>10}") for abar in ABARS: a = abar / (1.0 - abar) b = snr(abar, sigma_sd) print(f" {abar:>10g} | {a:>16.4f} {b:>16.4f} {b/a:>10.2f}x") make_figures.py """画本文的四张图。数据源全部来自 vae_minimal.py / latent_scaling.py 的真实输出, 不另造数,避免图文数字漂移。 beta_sweep.png beta 扫描全景:重建 / KL / 潜尺度 / KL 阈值计数 latent_scale_split.png 潜尺度的拆账:编码位置 vs 采样噪声 scaling_snr.png 忘掉 scaling_factor 的后果:幅度比 + 单步去噪 MSE collapse_profile.png 后验坍缩的指纹:逐维 KL 怎么一个个死掉 运行: python make_figures.py 依赖: numpy, matplotlib(Windows 优先 Microsoft YaHei,其他平台需中文字体) """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import vae_minimal as VM import latent_scaling as LS plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.facecolor"] = "white" plt.rcParams["axes.facecolor"] = "white" plt.rcParams["savefig.facecolor"] = "white" plt.rcParams["font.size"] = 11 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) # exist_ok 必须带,否则目录已存在会 PermissionError C_MAIN, C_ALT = "#2563eb", "#dc2626" C_GRAY = "#6b7280" def _b(rows): return np.array([r["beta"] for r in rows]) # ─────────────────────────── 图 1:beta 扫描全景 ─────────────────────────── def fig_beta_sweep(res): rows0 = res["wd=0"] rows1 = res["wd=0.001"] fig, axes = plt.subplots(2, 2, figsize=(13.5, 8.6)) ax = axes[0][0] ax.plot(_b(rows0), [r["recon"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["recon"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.set_xscale("log") ax.set_yscale("log") ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(1.1e-6, 1.05, "重建 MSE = 1:训练均值预测基线", color=C_GRAY, fontsize=9) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("重建 MSE($D$ 维平均)") ax.set_title("(a) 重建误差随 β 变化") ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[0][1] ax.plot(_b(rows0), [r["kl"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["kl"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.set_xscale("log") ax.set_yscale("symlog", linthresh=1e-1) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("总 KL(nats,8 维求和)") ax.set_title("(b) KL:β 越大越贴先验,坍缩时归零") ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[1][0] ax.plot(_b(rows0), [r["overall_std"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["overall_std"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(1.1e-6, 1.03, "std(z) = 1:单位尺度参照", color=C_GRAY, fontsize=9) ax.axhline(LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR), color="#059669", lw=1, ls="--") ax.text(1.1e-6, 5.62, "std(z) = 5.49:由 SD1.x 配置系数反推", color="#059669", fontsize=9) ax.set_xscale("log") ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("潜空间边际标准差 std(z)") ax.set_ylim(0.9, 6.2) ax.set_title("(c) 有限训练后的潜尺度统计") ax.legend(fontsize=9, loc="upper right") ax.grid(alpha=0.25) reciprocal = lambda x: np.divide(1.0, x, out=np.full_like(x, np.inf, dtype=float), where=x != 0) ax2 = ax.secondary_yaxis("right", functions=(reciprocal, reciprocal)) ax2.set_ylabel("对应的 scaling_factor = 1 / std(z)") ax = axes[1][1] ax.plot(_b(rows0), [r["active_dims"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减") ax.plot(_b(rows1), [r["active_dims"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3") ax.axhline(4, color="#059669", lw=1, ls="--") ax.text(1.1e-6, 4.2, "真实因子数 = 4", color="#059669", fontsize=9) ax.set_xscale("log") ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("超过阈值的维度数(逐维 KL > 0.05 nat)") ax.set_ylim(-0.3, 8.6) ax.set_title("(d) 不同权重下的 KL 阈值计数") ax.legend(fontsize=9, loc="lower left") ax.grid(alpha=0.25) fig.suptitle("KL 权重扫描:重建、KL、潜尺度、KL 阈值计数(潜变量 8 维,真实因子 4 个)", fontsize=13, y=0.98) fig.tight_layout(rect=[0, 0, 1, 0.96]) out = os.path.join(FIGDIR, "beta_sweep.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 2:潜尺度拆账 ─────────────────────────── def fig_scale_split(res): rows = res["wd=0"] betas = _b(rows) std_mu = np.array([np.mean(np.array(r["std_mu"]) ** 2) for r in rows]) # 编码位置的跨样本波动 mean_sig = np.array([np.mean(np.array(r["mean_sig"]) ** 2) for r in rows]) # 采样噪声 RMS x = np.arange(len(betas)) fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.6)) ax = axes[0] ax.bar(x, std_mu, 0.62, label=r"后验均值的跨样本方差", color=C_MAIN) ax.bar(x, mean_sig, 0.62, bottom=std_mu, label=r"平均后验方差", color="#f59e0b") ax.set_xticks(x) ax.set_xticklabels([f"{b:g}" for b in betas]) ax.set_xlabel(r"KL 权重 $\beta$(离散档位)") ax.set_ylabel("Var(z) 的构成(各维平均)") ax.set_title("(a) 方差拆账:后验均值变化与后验噪声") ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") ax = axes[1] frac = std_mu / (std_mu + mean_sig) ax.plot(x, frac, "o-", color=C_MAIN, lw=2) ax.axhline(0.5, color=C_GRAY, lw=1, ls=":") ax.set_xticks(x) ax.set_xticklabels([f"{b:g}" for b in betas]) ax.set_xlabel(r"KL 权重 $\beta$") ax.set_ylabel("方差里来自编码位置的比例") ax.set_ylim(-0.03, 1.06) ax.set_title("(b) 总方差中均值变化的占比") ax.grid(alpha=0.25) for i, (xi, fi) in enumerate(zip(x, frac)): ax.annotate(f"{fi:.2f}", (xi, fi), textcoords="offset points", xytext=(0, 8), ha="center", fontsize=9, color=C_MAIN) fig.suptitle("全方差公式:两项方差相加;方差占比不等于互信息", fontsize=12.5, y=1.0) fig.tight_layout(rect=[0, 0, 1, 0.95]) out = os.path.join(FIGDIR, "latent_scale_split.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 3:scaling factor 的后果 ─────────────────────────── def fig_scaling_snr(): sigma_sd = LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR) abar = np.logspace(-3, np.log10(0.9999), 400) fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.8)) ax = axes[0] for sigma, lab, col in [(sigma_sd, rf"$\sigma$={sigma_sd:.2f}(由 SD1.x 配置反推)", C_MAIN), (1.0, r"$\sigma$=1.0(单位尺度参照)", "#059669"), (LS.SD_SCALING_FACTOR, rf"$\sigma$={LS.SD_SCALING_FACTOR:.3f}(照抄 0.18215 用错 VAE)", C_ALT)]: ax.plot(abar, LS.amplitude_ratio(abar, sigma), "-", color=col, lw=2, label=lab) ax.axhline(1.0, color=C_GRAY, lw=1, ls=":") ax.text(5e-2, 1.35, "$r=1$:单位尺度参照", color=C_GRAY, fontsize=9) ax.text(2e-3, 0.025, r"噪声端系数比极限 $1/\sigma^2=0.033$,两种均值都趋零", color=C_MAIN, fontsize=9) ax.set_xscale("log") ax.set_yscale("log") ax.set_ylim(2e-2, 6e1) ax.set_xlabel(r"$\bar{\alpha}$(1 = 完全干净,0 = 纯噪声)") ax.set_ylabel("去噪幅度比 $r$ = 模型输出 / 正确输出") ax.set_title("(a) 高斯 MMSE 教学模型的后验均值幅度比") ax.legend(fontsize=9, loc="center left") ax.grid(alpha=0.25, which="both") ax = axes[1] abars = np.array(LS.ABARS) bad, good = [], [] for a in abars: b_, g_ = LS.demo_step(a, sigma_sd, n=400000) bad.append(b_) good.append(g_) ax.plot(abars, bad, "o-", color=C_ALT, lw=2, label=r"错假设去噪器(按 $\sigma$=1 训练)") ax.plot(abars, good, "s-", color=C_MAIN, lw=2, label=r"正确去噪器(就该 $\sigma$ 训练)") ax.set_xscale("log") ax.set_yscale("log") ax.set_xlabel(r"$\bar{\alpha}$") ax.set_ylabel("单步去噪均方误差") ax.set_title("(b) 同一个前向过程下的 MSE 差距") ax.legend(fontsize=9) ax.grid(alpha=0.25) i5 = int(np.argmin(np.abs(abars - 0.5))) ax.annotate(f"{bad[i5]/good[i5]:.1f}×", (abars[i5], bad[i5]), textcoords="offset points", xytext=(12, -6), color=C_ALT, fontsize=11) fig.suptitle(r"忘掉 scaling_factor 的代价:实际信噪比高于单位尺度假设 $\sigma^2$ = 30.1 倍(14.8 dB)", fontsize=12.5, y=1.0) fig.tight_layout(rect=[0, 0, 1, 0.94]) out = os.path.join(FIGDIR, "scaling_snr.png") fig.savefig(out, dpi=150) plt.close(fig) return out # ─────────────────────────── 图 4:坍缩指纹 ─────────────────────────── def fig_collapse_profile(res): rows = res["wd=0"] picks = [1e-3, 3e-1, 1.0] # 三档:够用 / 正在坍缩 / 完全坍缩 # 每张子图各自缩放:三档之间差 20 倍,共享 y 轴会把另两张压成一条线 fig, axes = plt.subplots(1, 3, figsize=(13.5, 4.2)) d = len(rows[0]["kl_dim"]) for ax, beta in zip(axes, picks): row = min(rows, key=lambda r: abs(r["beta"] - beta)) kl = np.array(row["kl_dim"]) colors = [C_MAIN if v > 0.05 else "#d1d5db" for v in kl] ax.bar(np.arange(d), kl, 0.68, color=colors) ax.axhline(0.05, color=C_GRAY, lw=1, ls=":") ax.set_xticks(np.arange(d)) ax.set_xticklabels([f"$z_{j+1}$" for j in range(d)], fontsize=9) ax.set_xlabel("潜变量维度") ax.set_ylim(0, max(0.35, kl.max() * 1.18)) ax.set_title(rf"$\beta$={row['beta']:g} 阈值计数 {row['active_dims']}/{d} " f"重建 MSE={row['recon']:.4f}") ax.grid(alpha=0.25, axis="y") ax.text(0.99, 0.92, f"本组 KL 最大 {kl.max():.2g} nats", transform=ax.transAxes, ha="right", fontsize=8.5, color=C_GRAY) axes[0].set_ylabel("逐维 KL(nats)") axes[1].set_ylabel("逐维 KL(nats)") axes[2].set_ylabel("逐维 KL(nats)") fig.suptitle("逐维 KL:阈值计数仅供诊断(注意三张图的纵轴范围不同)", fontsize=12.5, y=0.99) fig.tight_layout(rect=[0, 0, 1, 0.91]) out = os.path.join(FIGDIR, "collapse_profile.png") fig.savefig(out, dpi=150) plt.close(fig) return out if __name__ == "__main__": res = VM.load_or_sweep() for fn in [fig_beta_sweep, fig_scale_split, fig_collapse_profile]: print("写出", fn(res)) print("写出", fig_scaling_snr())
-
AIGC 基本功|变分下界与重参数化-ELBO AIGC 基本功|变分下界与重参数化-ELBO 所属方向:数学基础 | 难度:入门 | 前置知识:无知识树先修节点;需了解条件概率、概率密度、期望、矩阵乘法与链式求导 关键词:变分推断、ELBO、重参数化、KL 散度、后验坍缩、β-VAE、IWAE、得分函数估计量 01. 为什么需要它 先摆三组可复现的数字,全部出自文末四份完整脚本。本轮在 Windows CPU、Python 3.11.9、NumPy 2.4.6 实跑;固定 float64 与随机种子。前三份脚本做数学实验,第四份还依赖 matplotlib 3.10.7 生成三图。表中的“最优”来自第 4.3 节的线性高斯闭式,不是训练真实图像模型得到的性能。 第一组:KL 项掉到 0,潜变量整条死掉。 固定解码器噪声 σ²=0.25,让四个独立数据方向分别具有方差 λ=4.0、1.0、0.25、0.0625,只改 KL 项的权重 β,看看最优解长什么样: 数据方向方差 λ β=0.5 β=1.0 β=2.0 β=4.0 死亡阈值 β* 4.0 MSE 0.125 存活 MSE 0.250 存活 MSE 0.500 存活 MSE 1.000 存活 16.00 1.0 MSE 0.125 存活 MSE 0.250 存活 MSE 0.500 存活 MSE 1.000 死亡 4.00 0.25 MSE 0.125 存活 MSE 0.250 死亡 死亡 死亡 1.00 0.0625 死亡 死亡 死亡 死亡 0.25 死亡那一格的具体解是 a=0、s=1、KL=0:编码器把均值直接输出 0、方差输出 1,等于彻底放弃这个维度。此时重建误差精确等于 λ——也就是把 x 全猜成 0 的水平,这个维度一点信息都没传。问题在于看 loss 曲线你只会看到「KL 顺利降到 0,总损失还在降」,很难意识到这是失败而不是收敛。 第二组:把 ELBO 当成似然来监控,会被方差骗。 在一个 D=6、K=3 的高斯线性模型上,真实 log p(x) = -5.434331,解析 ELBO = -7.419767,两者差 1.985436。但用训练时真正用的那个单样本蒙特卡洛估计量去估 ELBO,重复 4000 次,标准差是 4.308——比它和 log p(x) 之间的差距还大一倍多,结果有 40.7% 的采样值直接越过了 -5.434 这条「上界」。如果把单样本曲线直接当成精确似然或模型排序,可能被波动误导;重复评估与报告不确定性才有助于比较。 第三组:不用重参数化,梯度方差能大到没法训练。 同一个模型上估 ∇ E_q[log p(x|z)],重参数化的梯度方差和是 377.55,得分函数估计量是 3043.11,差 8.1 倍。听起来还能忍?把数据维度 D 从 8 拉到 2048: D 重参数化方差 得分函数方差 比值 8 2.08 2 469 1 188× 64 1.98 104 328 52 630× 512 1.84 7 579 291 4 121 907× 2048 1.84 114 230 222 61 916 893× 重参数化的方差几乎不随 D 动,得分函数估计量按 D² 往上冲,到 D=2048(约 45×45 个标量)比值是 6191 万倍。这是本教学扫描中一个很大的方差差距,足以说明原始得分函数估计量可能难用;它不证明所有高维模型都无法用得分函数训练。这里固定 K=3、归一化 W 的列范数、s=0.6、每个 D 用 4000 次采样,并未训练 2048 维图像模型。2048 只是观测维度,约等于 45×45 个标量的数量。 这三组数字背后是同一件事:我们想最大化的是 log p(x),但它算不动,只能换成它的一个下界 ELBO 来优化;而换成下界之后,「换掉了什么」「这个下界的估计量有多吵」「梯度怎么穿过采样」这三笔账必须自己算清楚。不搞清楚 KL 项的价,你就不知道 β 该往哪调;不搞清楚下界的松紧,你就不知道扩散模型的训练目标从哪来。 02. 最小可用理解 三句话讲完核心: 算不动的边际似然换成一个能算的下界:$p_\theta(x)$ 要对所有 z 积分,算不动,于是引入一个我们自己挑的分布 $q_\phi(z \mid x)$,用 Jensen 不等式把优化目标换成 ELBO,它只需要在 q 下求期望,采样就能算。 下界和真值之间差的那一坨,正好是 q 和真实后验的 KL:固定生成模型时,对数边际密度等于 ELBO 加上后验 KL(完整公式见 3.3)。所以「下界有多松」等价于「q 离真后验有多远」,而不是「q 离先验有多远」——后者的 KL 在 ELBO 中被减去,是另一回事。 要让这个下界能被反向传播,就把随机性从梯度路径上挪走:写成 $z = m_\phi + s_\phi \odot \epsilon$,$\epsilon$ 与参数无关,固定一份噪声后,z 是参数的确定性函数,梯度沿它传回 $m_\phi$ 和 $s_\phi$;在可交换微分与期望等正则条件下,这给出有效的路径梯度估计。 03. 数学推导 先统一符号:$x\in\mathbb R^D$ 是一个观测,$z\in\mathbb R^K$ 是隐变量;$\theta$ 控制生成模型,$\phi$ 控制编码器;$m_\phi(x),s_\phi(x)\in\mathbb R^K$ 分别是均值和逐维标准差,$s_j>0$。$\odot$ 表示逐元素乘,$\ell=\log s$,工业代码的 logvar 则是 $2\ell$。$I_D,I_K$ 是相应单位矩阵,$\mathrm{tr}$ 是迹。本文对数为自然对数,KL 和对数密度的单位是 nats;连续密度可以大于 1,对数密度也可以为正。 3.1 边际似然为什么算不动 生成模型的设定很简单:先从一个固定先验里采隐变量 $z \sim p(z)$(通常是标准正态),再用解码器生成观测 $x \sim p_\theta(x \mid z)$。要拟合数据,目标是对数边际似然: $$\log p_\theta(x) = \log \int p_\theta(x \mid z) \, p(z) \, dz$$ 麻烦全在这个积分上。$p_\theta(x \mid z)$ 是由神经网络给出参数的条件概率分布,一般非线性解码器的边际积分没有可用闭式解;本文第 4 节的线性高斯模型是特意选出的可解特例。用数值积分的话,z 是 K 维,网格点数随 K 指数爆炸,K=32 就已经不可能。而 K 小了模型表达能力又不够——这正是我们不愿意接受的取舍。 3.2 换个能算的目标 既然积分算不动,就绕开它。引入在目标分布支撑上为正、满足相关可积条件的以 x 为条件的分布 $q_\phi(z \mid x)$(后面简称 $q$),把被积函数乘一个 $q/q$: $$\log p_\theta(x) = \log \int q_\phi(z \mid x) \, \frac{p_\theta(x, z)}{q_\phi(z \mid x)} \, dz = \log \mathbb{E}_{q_\phi}\!\left[\frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right]$$ log 是凹函数,Jensen 不等式给出 $\log \mathbb{E}[Y] \ge \mathbb{E}[\log Y]$,于是 $$\log p_\theta(x) \ge \mathbb{E}_{q_\phi}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] \equiv \mathcal{L}(\theta, \phi)$$ 右边就是 ELBO(Evidence Lower Bound)。它好算:$\log p_\theta(x, z) = \log p_\theta(x \mid z) + \log p(z)$ 两项都能直接求值,期望用采样估计就行。代价是我们不再直接优化 log p(x),而是优化它的一个下界。 3.3 差的那一项到底是什么 这是全文最关键的一步,也是最容易被跳过的一步。把 $\log p_\theta(x)$ 写成对 q 的期望(它和 z 无关,所以这么写是恒等的),再硬塞一个 $\log \frac{q}{q}$ 进去: $$\log p_\theta(x) = \mathbb{E}_{q}\!\left[\log p_\theta(x)\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{p_\theta(z \mid x)}\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] + \mathbb{E}_{q}\!\left[\log \frac{q_\phi(z \mid x)}{p_\theta(z \mid x)}\right]$$ 第一项正是 ELBO,第二项按定义就是 KL 散度。合起来: $$\log p_\theta(x) = \mathcal{L}(\theta, \phi) + \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p_\theta(z \mid x)\big)$$ KL 恒非负,所以 $\mathcal{L} \le \log p_\theta(x)$,和 Jensen 的结论一致——但这一版多给了一个信息:等号成立当且仅当 q 等于真实后验。这里固定 x 和生成模型 θ,缝隙才完全等于 q 到该模型真实后验的 KL;联合训练改变 θ 时,后验与 log pθ(x) 本身也会改变。“q 等于后验”指概率分布几乎处处相同,并要求式中的量有定义。 3.4 把 ELBO 拆成两项看 把 $\log p_\theta(x, z)$ 展开,ELBO 可以写成更有物理含义的形式: $$\mathcal{L}(\theta, \phi) = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$ 第一项是重建项:从 q 里采 z,解码器能不能还原出 x。第二项是先验对齐项:q 别离先验太远——因为生成时我们是从先验采 z 的,标准高斯先验具有全空间支撑,“覆盖不到”应理解为采到的概率很小,而非严格为零。这个惩罚逐个 x 约束 q;仅让汇总后验 q(z)=E数据[q(z|x)] 接近先验,不能保证每个条件后验都接近先验。 这里有个必须记住的区分,后面第 08 节还会回到它: $\mathrm{KL}(q \,\|\, p(z))$ —— 出现在 ELBO 里,是要被最小化的一项,物理含义是「编码分布别跑太偏」。 $\mathrm{KL}(q \,\|\, p(z \mid x))$ —— 不出现在 ELBO 里,是下界的缝隙,物理含义是「q 离真后验还差多少」。 在我们那个 D=6 的例子里,这两个数是 3.364364 和 1.985436,不是一回事,也不是简单的包含关系。β-VAE 显式改的是先验 KL 的权重,但重新训练后 q 与生成模型都会变化,所以真实后验差距也会变化,且不保证变小。 顺带一个很容易漏掉的推论:把 KL 乘上 β 之后得到的目标 $$\mathcal{L}_\beta = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \beta \cdot \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$ 当 $\beta\ge1$,仍有 $\mathcal L_\beta=\mathcal L-(\beta-1)\mathrm{KL}(q\Vert p)\le\mathcal L\le\log p_\theta(x)$,所以它仍是下界,只是更松;$0<\beta<1$ 时则不再保证下界。不同 β 的目标包含不同惩罚,不能直接当成同一种似然估计比较。 3.5 梯度怎么穿过采样 ELBO 对解码器参数 $\theta$ 的梯度没问题,重建项直接可导。麻烦在对 $\phi$ 的梯度:期望的分布本身依赖于 $\phi$,而采样操作不可导。设 $f(z) = \log p_\theta(x \mid z)$,要估的是 $\nabla_\phi \mathbb{E}_{q_\phi}[f(z)]$。 方法一:得分函数估计量(REINFORCE)。 直接把导数挪进期望: $$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{q_\phi}\!\left[f(z) \, \nabla_\phi \log q_\phi(z \mid x)\right]$$ 在可交换微分与积分、分布支持集不随参数变化等常见正则条件下,这个式子成立;它不要求 f 对 z 可导,也可用于离散 z;方差可能较大,因为整个 f 都被乘进梯度里。此处 f 不显含 φ;若 f 也依赖 φ,另需加上 E_q[∇φ f]。下面两种估计量只比较重建项梯度,先验 KL 的解析梯度另算。对高斯先验,KL 对 m 的梯度是 m,对 ℓ 的梯度是 s²−1;最大化 ELBO 时从重建梯度里减去它们。 方法二:重参数化。 把 z 写成参数的确定性函数外加一个与参数无关的噪声: $$z = m_\phi(x) + s_\phi(x) \odot \epsilon, \quad \epsilon \sim \mathcal{N}(0, I)$$ 于是期望可以改写成对 $\epsilon$ 的期望,导数直接进去: $$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{\epsilon}\!\left[\nabla_\phi f\big(m_\phi(x) + s_\phi(x) \odot \epsilon\big)\right] = \mathbb{E}_{\epsilon}\!\left[\nabla_z f(z) \cdot \nabla_\phi z\right]$$ 关键在于 $\nabla_z f$ 用到了 f 对 z 的局部形状,相当于「知道往哪个方向挪 z 会让 f 变大」,这是方法一完全没有利用的信息。 方差为什么差这么多——把与 z 无关的部分拆开。 高斯解码器 $p(x|z)=\mathcal N(Wz+b,\sigma^2 I_D)$ 中,$W\in\mathbb R^{D\times K}$、$b\in\mathbb R^D$、$\sigma^2>0$ 固定。令 $d=x-b$: $$f(z)=-\frac D2\log(2\pi\sigma^2)-\frac{\|d-Wz\|^2}{2\sigma^2}=c_0+\frac{d^\top Wz}{\sigma^2}-\frac{z^\top W^\top Wz}{2\sigma^2},\quad c_0=-\frac D2\log(2\pi\sigma^2)-\frac{d^\top d}{2\sigma^2}$$ 路径梯度对 $c_0$ 求导为零;得分函数把它乘上 $S(z)=\nabla_\phi\log q(z|x)$,虽然 E_q[S]=0,不改变梯度期望,却可能造成很大的方差。归一化常数和固定观测残差都在 c₀ 中,仅凭 D 扫描不能把全部差距归因于前者。本实验同时把 W 列范数固定,避免梯度尺度随 D 自然增长,故 D² 趋势是这组设置的观测,不是普适定律。 用与当前采样 z 无关的 baseline c,E_q[(f-c)S]=E_q[fS]。脚本用解析 E_q[f] 作预言机 baseline,D=2048 的方差比从 61 916 893× 降至约 5.3×;它不是通用最优 baseline。若按梯度各分量的总方差选一个标量,最优常数为 E[f‖S‖²]/E[‖S‖²],通常并非 E[f]。实际可用历史批次或独立样本估计 c,并在这个梯度估计里停止对 c 求导;直接减去同批样本均值会引入相关性,在独立同分布 n 个样本的简单情形把期望缩成 (1−1/n) 倍。 一个反例说明边界。 固定 q=N(m,1),在 m=0 估计 f(z)=sin(10z) 的均值梯度,pathwise 是 10cos(10z),score 是 z sin(10z)。200000 个共同噪声样本实跑,方差分别 50.062 与 0.499,后者更低。两者理论均值均为 10exp(−50)。因此重参数化在本文高斯重建中明显有利,并不保证任何可微 f 上都方差更小。反例与推导核验见第 09 节。 3.6 下界能有多紧:IWAE 单样本 ELBO 的缝是 $\mathrm{KL}(q \,\|\, p(z \mid x))$。要缩缝有两条路:把 q 变强(换更灵活的后验族),或者换一个更紧的界。后者的经典做法是 IWAE 的 k 样本界: $$L_k = \mathbb{E}_{z_1 \dots z_k \sim q_\phi}\!\left[\log \frac{1}{k} \sum_{l=1}^{k} \frac{p_\theta(x, z_l)}{q_\phi(z_l \mid x)}\right]$$ 注意顺序:先对 k 个重要性权重取平均,再取 log。单样本 ELBO 是「log 再取平均」(每个样本的 log 比值取期望),IWAE 是「平均再 log」,Jensen 保证后者更紧。可以证明 $\log p_\theta(x) \ge L_{k+1} \ge L_k \ge L_1 = \mathcal{L}$,收敛还需要更强的尾部与可积条件,具体充分条件见下文。 这里 $\widehat L_k=\log(k^{-1}\sum_l w_l)$ 是随机结果,而 $L_k=\mathbb E[\widehat L_k]$ 才是下界,$w_l=p(x,z_l)/q(z_l|x)>0$。支持覆盖使 E_q[w]=p(x),Jensen 给出 Lk≤log p(x)。单调性也能一步看清:k+1 个权重的均值等于所有“删去一个权重”的 k 样本均值的平均;先应用 log 的凹性,再取期望,就得到 L{k+1}≥L_k。这个论证针对同一固定模型与 q 下的独立同分布采样,并要求相应期望存在。 IWAE 原文定理 1 给出重要性权重有界时趋近真值的充分条件。一般讨论极限还须保证期望可随极限交换,例如相关 log 估计量的均匀可积性;只有支持覆盖和 E[w] 有限不足以直接交换 log 与期望。即便界更紧,单次结果以及有限重复的均值仍可越过 log p(x),也不保证逐次单调。 明确反例:离散真实后验为 (0.5,0.5),q=(0.9,0.1),设 p(x)=1,则权重为 (5/9,5)。一条先采到 5、再采到两次 5/9 的路径,其 log 平均权重依次为 1.6094、1.0217、0.7115,全高于真实 log p(x)=0 且连续下降;对全部路径取期望得到的 L₁、L₂、L₃ 则是 −0.3681、−0.2761、−0.2200,保持下界与单调性。多采样平均 log 权重只降低同一 ELBO 估计的方差;改成 log 平均权重才改变期望目标及其偏差。 代价是:梯度不再是对单个样本的简单求和,k 个权重互相耦合(每个权重的梯度都带上了其他权重的归一化因子),总计算量随 k 线性上涨;编码器梯度的信噪比还可能随 k 增大而下降(见 Rainforth 等,2018),这反而不利于训练编码器——工程上这是个明确的取舍,不是免费的午餐。 这张图要看什么:左图四根柱子——ELBO(-7.420)加 KL(q‖p(z|x))(1.985)正好等于 log p(x)(-5.434),而 KL(q‖p(z))(3.364)是另一根完全不同的柱子,别混。中图是单样本蒙特卡洛 ELBO 的 4000 次采样分布,标准差 4.31,虚线是真实上界 -5.434,40.7% 的样本落在它右边。右图是 IWAE 的 k 扫描,k 从 1 涨到 500,6000 次重复的平均缝隙从 2.049 缩到 0.00262,标准误分别为 0.04643 和 0.00080;这是有限重复的估计,不能当成解析界。k=1、5、50、500 时单次越过 log p(x) 的比例分别为 34.7%、43.5%、47.7%、48.2%。标准误描述均值的不确定性,不是严格置信界。 04. 代码实现 4.1 恒等式核对:先造一个能算到机器精度的模型 要验证「差的那一项到底是什么」,必须三样东西都有解析解:边际似然、真实后验、ELBO。高斯线性模型满足这一点。将联合 log 密度中的 z 项配方: $$\log p(x,z)=\text{const}-\frac12z^\top Pz+h^\top z=\text{const}-\frac12(z-\mu)^\top P(z-\mu),\quad P=I_K+\frac{W^\top W}{\sigma^2},\quad h=\frac{W^\top(x-b)}{\sigma^2},\quad\mu=P^{-1}h$$ 所以后验 p(z|x)=N(μ,P⁻¹),边际 p(x)=N(b,WWᵀ+σ²I_D)。P 正定,实际计算可用 solve/Cholesky;这里 K=3,为便于展示保留显式逆。我们的模型为:$z \sim \mathcal{N}(0, I_K)$,$x \mid z \sim \mathcal{N}(Wz + b, \sigma^2 I_D)$。边际仍是高斯,后验是共轭高斯,ELBO 也能闭式算。 import numpy as np D, K, SIGMA2 = 6, 3, 0.35 ** 2 rng_model = np.random.default_rng(20260925) W = rng_model.normal(0, 1, size=(D, K)) * 0.9 b = rng_model.normal(0, 0.3, size=(D,)) def true_posterior(x): """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。""" prec = np.eye(K) + W.T @ W / SIGMA2 cov = np.linalg.inv(prec) return cov @ (W.T @ (x - b) / SIGMA2), cov def elbo_analytic(x, m, s): """ELBO 的解析值。注意 ||x - Wz - b||^2 对 q 求期望会多出一项 trace。""" var = s ** 2 resid = x - (W @ m + b) recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2) kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(recon - kl), float(recon), float(kl) def kl_gauss_gauss(m, s, mean2, cov2): """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。""" var, diff = s ** 2, mean2 - m cov2_inv = np.linalg.inv(cov2) _, logdet2 = np.linalg.slogdet(cov2) return 0.5 * (np.trace(cov2_inv @ np.diag(var)) + diff @ cov2_inv @ diff - K + logdet2 - np.sum(np.log(var))) 重建项里那个 np.trace(W.T @ W @ np.diag(var)) 是最容易漏掉的一项:对 $z$ 求期望时,$\|x - Wz - b\|^2$ 里的 $Wz$ 项会因为 z 的随机性多出一份方差贡献。漏了它,ELBO 就不是下界了。 关键一步是故意把 q 指定错:取真实后验的均值再加扰动,协方差只留对角线,再乘 0.8 并加 0.05。在固定状态下,真实边际方差为 [0.21735,0.04503,0.04927],q 方差为 [0.22388,0.08602,0.08942],三个都更大,不能称为“更自信”。这份 q 同时有均值偏移、方差失配和缺失相关性。这样 KL(q‖p(z|x)) 严格大于 0,缝才看得见。跑起来: [1] 解析三项 E_q[log p(x|z)] = -4.055403 KL(q || p(z)) = 3.364364 ELBO = -7.419767 KL(q || p(z|x)) = 1.985436 ELBO + KL(q||p(z|x)) = -5.434331 log p(x) = -5.434331 |误差| = 1.776e-15 恒等式对到 2e-15 以内。同时注意:KL(q‖p(z))=3.364 比 KL(q‖p(z|x))=1.985 还大——这两个量的大小关系没有必然规律,别用其中一个去猜另一个。 均值正确时,“把协方差的非对角项丢掉”仍不是 reverse KL 意义下的最优对角近似。设 q=N(m,diag(v)),真实后验精度为 P,KL 中依赖 v_j 的项为 (P_jj v_j−log v_j)/2,对它求导得到 v_j=1/P_jj,均值最优为 m=μ。于是: $$\min_{m,v}\mathrm{KL}(q\Vert p(z|x))=\frac12\log\frac{\prod_j P_{jj}}{\det P}$$ 本例直接使用真实边际方差 diag(P⁻¹) 时,残留缝隙为 0.79398;使用 1/diag(P) 时为 0.40038。这才是在固定生成模型下该对角族的近似误差;原来 1.98544 还包含人为指定 q 的额外误差。满协方差 q 等于后验时,缝才为零。 4.2 两种梯度估计量,方差实测 同一个模型上,$\nabla_m$ 和 $\nabla_\ell$($\ell = \log s$)的解析梯度都能写出来,所以「谁对谁错」有标准答案,剩下的差别纯粹是方差: def sample_reparam(x, m, s, W, b, sigma2, rng, n): """重参数化:z = m + s ⊙ ε,梯度经 z 反传。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps score_z = (x - (z @ W.T + b)) @ W / sigma2 # ∇_z log p(x|z) return score_z, score_z * s * eps # ∂z/∂m = 1, ∂z/∂ℓ = s ⊙ ε def sample_score(x, m, s, W, b, D, sigma2, rng, n, baseline=None): """得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps r = x - (z @ W.T + b) f = -0.5 * (D * np.log(2 * np.pi * sigma2) + np.einsum("nd,nd->n", r, r) / sigma2) if baseline is not None: f = f - baseline return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0) 两行代码的差别就是全部:重参数化用的是 $\nabla_z f$,得分函数用的是 $f$ 本身。跑 40000 次独立采样: 真实梯度(解析) ∇_m = [ 0.4228 4.9273 -0.6448] ∇_ℓ = [-1.9319 -2.4426 -3.8296] 估计量对比(40000 次独立采样,方差 = 6 个参数分量方差之和) 重参数化 方差和= 377.55 均值相对误差= 0.41% 5%相对RMS需 n≈3068 得分函数(无 baseline) 方差和= 3043.11 均值相对误差= 3.95% 5%相对RMS需 n≈24722 得分函数(预言机 baseline) 方差和= 1586.45 均值相对误差= 3.09% 5%相对RMS需 n≈12889 方差比:得分函数 / 重参数化 = 8.1× 加 baseline 之后 = 4.2× 在上述正则条件与独立 baseline 下,三个估计量理论上无偏;有限样本均值仍有误差。表中的样本数是按相对均方根误差计算的估计:设单样本梯度协方差为 V、真实梯度为 g,则 n 个独立样本均值满足 E‖ĝ−g‖²=tr(V)/n,所以 n≈tr(V)/(0.05²‖g‖²)。3068 与 24722 不是“95% 概率落在 5% 内”的保证。方差和是 6 个参数分量方差之和,正文表取总体式 ddof=0 的样本估计。 这张图要看什么:左图是 $\nabla_m$ 第 0 个分量(真值 0.4228)在三种估计量下的分布——均值都压在真值附近,标准差分别是 5.7、16.9、12.0,尾巴长度差一个量级。右图的双对数坐标里,重参数化那条线几乎是平的(方差 2.08 → 1.84),得分函数曲线在本设置中近似呈 D² 增长;而把蓝色点(加了 baseline)和橙色点对比,比值从 1188× 一路到 6191 万×,加完 baseline 却稳定在 5~7×——说明减去完整均值能显著降低本组 score 方差;归一化常数与固定残差都参与,不能由此隔离各自的贡献。 4.3 β 加权:把维度死掉的过程解出来 这一节的目标是要一个能解到全局最优的玩具模型,这样「维度死了」是解析结论而不是训练运气。构造:每个坐标独立,$x_j \sim \mathcal{N}(0, \lambda_j)$,$q(z_j \mid x_j) = \mathcal{N}(a_j x_j, s_j^2)$,$p(x_j \mid z_j) = \mathcal{N}(b_j z_j, \sigma^2)$。每个维度就是一份独立副本,逐个维度单独求最优即可: SIGMA2 = 0.25 # 解码器观测噪声方差 def kl_of(a, lam, s): return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2)) def recon_mse(a, b, lam, s): """E_{x,z}[(x - b z)^2],重建误差的期望。""" return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2 def objective(p, lam, beta): a, b, ell = p s = np.exp(ell) return -recon_mse(a, b, lam, s) / (2 * SIGMA2) - beta * kl_of(a, lam, s) 目标对 $(a, b, \ell)$ 的梯度全部解析,脚本里再用中心差分核对一遍(实测最大偏差 5.5e-10),避免推错。数值梯度上升保留多起点作对照:a=b=0 是一个驻点,单起点可能停住;它不构成全局最优证明。下面直接把三变量问题降成一变量,给出全局解。 先固定 a,s 对 b 求导,得到 b*=aλ/(a²λ+s²)。令 r=a²λ+s²>0、t=s²/r∈(0,1],代回重建 MSE=λt,数据平均 KL=(r−1−log r−log t)/2。r−1−log r≥0,在 r=1 取到最小;其余目标为: $$J(t)=-\frac{\lambda t}{2\sigma^2}+\frac\beta2\log t,\quad J'(t)=-\frac\lambda{2\sigma^2}+\frac\beta{2t},\quad J''(t)=-\frac\beta{2t^2}<0$$ 因此 β>0、λ>0 时唯一最优 t=min(βσ²/λ,1)。选正号的一组解为 s²=t、a=√((1−t)/λ)、b=√(λ(1−t));a,b 同时取负也是同一重建解。t=1 时 a=b=0、s=1,MSE=λ;否则 MSE=βσ²、平均 KL=−log(t)/2。阈值 β*=λ/σ² 与连续的 MSE=min(βσ²,λ) 就这样推出来,等号处也关闭。λ 是数据方差,不是以 nats 衡量的信息量。 本轮扫描和配图采用这份闭式。独立多起点优化在 (λ,β)=(4,0.25) 仍有目标差 1.51×10⁻⁵,MSE 0.0627248 对闭式 0.0625,说明有限迭代会留下误差;原文 5.53×10⁻³ 的偏差也不应当作精确最优证明。闭式内部一致性误差 8.88×10⁻¹⁶;另以原三变量目标的随机扰动与一变量网格核对,均未发现更优值。 跑完 β 扫描,把最优解和闭式预测放在一起对: λ β s²闭式 βσ²/λ a²λ闭式 1-s² MSE闭式 βσ² 1.0000 1.00 0.25000 0.25000 0.75000 0.75000 0.25000 0.25000 1.0000 2.00 0.50000 0.50000 0.50000 0.50000 0.50000 0.50000 1.0000 3.00 0.75000 0.75000 0.25000 0.25000 0.75000 0.75000 0.2500 0.50 0.50000 0.50000 0.50000 0.50000 0.12500 0.12500 最大内部一致性偏差 = 8.88e-16;独立数值优化误差另列 λ=4.0000 理论死亡阈值 β* = λ/σ² = 16.00 λ=1.0000 理论死亡阈值 β* = λ/σ² = 4.00 λ=0.2500 理论死亡阈值 β* = λ/σ² = 1.00 λ=0.0625 理论死亡阈值 β* = λ/σ² = 0.25 存活时最优解落在闭式 $s^2 = \beta\sigma^2/\lambda$、$a^2\lambda = 1 - s^2$、$\mathrm{MSE} = \beta\sigma^2$ 上。这个闭式有个反直觉的推论:存活时的重建误差只由 β 和解码器噪声决定,跟这个维度携带多少信息 λ 无关——λ 只决定「这个维度值不值得用」。 05. 工业级实现对照 最小实现里 KL 是两个高斯的闭式,官方示例也是闭式,但分布、归约和 dtype 必须对齐。本节固定 diffusers v0.35.1 与 pytorch/examples 提交 acc295dc7b90,以 2026-10-12 的核对为准;主分支后续可变化。已从原始源码 AST 原样提取相关方法,在 PyTorch 2.10.0+cpu 上真实执行;没有下载权重、MNIST 或运行整个生成管线。 1. 官方最小实现:pytorch/examples。 pytorch/examples 的 vae/main.py 里,loss_function 就是标准的 BCE 重建加闭式 KL,没有任何 β(以本轮核对的固定源码为准): def loss_function(recon_x, x, mu, logvar): BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum') # 0.5 * sum(1 + log(sigma^2) - mu^2 - sigma^2) KLD = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp()) return BCE + KLD 和本文 3.4 节那一项完全对得上:$\mathrm{KL} = \frac{1}{2}\sum(\mu^2 + s^2 - 1 - \log s^2)$,代码里写成 -0.5 * sum(1 + logvar - mu^2 - exp(logvar)),logvar 就是 $\log s^2$。要加 β 得自己动手,官方示例没有。 2. 为什么参数化 logvar 而不是 s。 方差必须为正,直接学 s 要加约束;学 $\log s^2$ 则值域是全体实数,网络怎么输出都合法。diffusers 的 DiagonalGaussianDistribution 还额外做了截断(以本轮核对的固定源码为准): self.mean, self.logvar = torch.chunk(parameters, 2, dim=1) self.logvar = torch.clamp(self.logvar, -30.0, 20.0) self.std = torch.exp(0.5 * self.logvar) self.var = torch.exp(self.logvar) clamp 到 [-30, 20] 限制指数输入,但不等于所有精度安全:$\exp(20)$ 约为 4.85 亿,fp32 可表示但 fp16 已无法表示;下界 -30 避免过小方差与过大负 logvar。还需核对计算 dtype,截断本身不是所有精度下的安全保证。 3. 采样就是重参数化,一行代码。 同一个类里: def sample(self, generator=None): sample = randn_tensor(self.mean.shape, generator=generator, device=self.parameters.device, dtype=self.parameters.dtype) x = self.mean + self.std * sample return x 就是本文 3.5 的 $z = m + s \odot \epsilon$。mode() 直接返回均值——一些确定性编码场景使用 mode(),但 diffusers img2img 默认使用后验 sample(generator=...),训练和推理均可采样。 4. KL 的求和维度与归一化。 diffusers 里 kl() 写成(以本轮核对的固定源码为准): return 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3]) 对通道、高、宽三个维度求和,得到的是每个样本一个标量,得到 [B] 后,训练侧可按其目标再取 batch 平均。这里源码固定求和 dim=[1,2,3],该结论只适用于 [B,C,H,W];若直接输入五维 [B,C,T,H,W],返回 [B,W],本轮实跑形状为 [2,4],不能据类名假定它已归约全部视频维度。应核对具体视频 VAE 类与外部 loss,不能直接复用此四维示例。这个区别很实际:若重建归约保持不变,却仅把每样本的 KL 再除以 $C \times H \times W$,其相对权重就会相应变小;若两个 loss 一同同比缩放,其相对权重则不变。单独把 KL 改成逐元素平均时,潜变量维度越多,其相对权重越小,可能使先验对齐变弱、尺度漂移;过强 KL 才更直接推动后验坍缩。 5. 训练时 KL 根本不在模型里。 值得注意的是 AutoencoderKL 的模型文件里没有 kl_loss 这个东西,它只通过 encode() 返回 DiagonalGaussianDistribution 后验,KL 由外部训练脚本算。这是工程上的职责划分:模型只负责给出分布,损失函数怎么组合(KL 权重、perceptual loss、对抗损失)交给训练配置。 6. 潜空间的缩放。 SD1.x 常见 scaling_factor=0.18215 是乘到原始 latent 上的系数,按缩放后目标标准差为 1 的约定,对应原始标准差约 $1/0.18215\approx5.49$,缩放后才接近 1,不能把 0.18 当成原始潜空间尺度。它来自特定 VAE 与扩散训练的尺度约定,不由 ELBO 唯一决定。 7. 最小实现和工业实现的差异。 工业代码增加 logvar 截断、dtype 控制、分布采样接口及 latent 尺度约定。KL 逐维求和来自概率定义,batch 平均来自训练目标;它们不是任意工程细节。sample() 与 mode() 都有推理用途,要依具体管线选择。 06. 代价与边界 省了什么。 把一个对 K 维积分的不可解问题,变成了「采样 + 两个可导项」,梯度能用标准反向传播算。这是 VAE、扩散模型、以及一大票潜变量模型能训练起来的全部前提。 赔了什么,四条。 一是下界不是似然。 优化 ELBO 不等于优化 log p(x),中间隔着 KL(q‖p(z|x))。在固定生成模型下,这个缝受 q 族表达能力与实际优化结果共同影响:均值场对角高斯拟合不了有相关性的真实后验,缝就永远在。本例里缝是 1.985 nats,在一个 log p(x) 只有 -5.43 的小模型上,数值上差约 36%,但连续对数密度受坐标单位影响,不宜把这个比例当作通用误差尺度。 二是 KL 的方向有偏好。 $\mathrm{KL}(q\Vert p(z\mid x))$ 是 reverse KL:当 $q$ 把概率放到真实后验很低的地方,代价很大,因此在受限的单峰近似族下常表现为 mode-seeking,可能只覆盖一个峰;反向的 $\mathrm{KL}(p\Vert q)$ 则倾向覆盖目标的质量,即 mass-covering。VAE 的模糊不能单归因于这个方向,逐像素重建目标、解码器分布与压缩瓶颈都有关。 三是推断被参数化摊平(amortized)之后又多了一层误差。 经典变分推断对每个 x 单独优化一组变分参数;VAE 用一个共享的编码器网络去输出所有 x 的 $m_\phi(x)$ 和 $s_\phi(x)$。这一步是为了快——测试时一次前向就得到近似后验参数,不用重新迭代——但共享映射还增加了约束。即便每个 x 单独看,最优的对角高斯后验就在那儿,共享编码器也可能一辈子到不了。Cremer 等的分析 区分近似差距与摊销差距。若再把实际优化单独列账,固定 θ 与 x,可写成 log p(x)−L实际=(log p(x)−L族最优)+(L族最优−L共享最优)+(L共享最优−L实际),分别对应近似、共享约束、优化差距。在 L实际属于该共享模型族等前提下各项非负。当前实验直接指定一份 x 的 q,没有训练共享编码器,不能测出摊销差距。这也解释了为什么给编码器加容量在有些任务上能明显提 ELBO——在固定生成模型时,这改善的是近似推断。 四是加权 KL 会直接杀死维度。 这是第 4.3 节那张表的完整结论: λ=4.0000 在 β≤12.0 内都存活 λ=1.0000 从 β=4.0 起死亡(β=1 时 KL=0.6931) λ=0.2500 从 β=1.0 起死亡 λ=0.0625 从 β=0.25 起死亡 死亡阈值是 $\beta^\ast = \lambda / \sigma^2$。读出这个式子的含义:一个维度要活下来,数据方差 λ 必须盖过「KL 的价」β 乘上「解码器噪声」σ²。β 翻倍,能活下来的维度门槛就翻倍;解码器越准(σ² 越小),越多的维度能活。这仅解释线性高斯模型的阈值。强大的自回归解码器可通过其他条件预测数据而忽略 z,不能简单等同于把固定高斯观测方差 σ² 调小。 这张图要看什么:左图四条曲线是不同 λ 下重建 MSE 随 β 的变化,实心点表示维度存活、空心方块表示已死——注意存活段的 MSE 就是 $\beta\sigma^2$ 这条直线,跟 λ 无关;而死掉的段 MSE 平在 λ 上不再变化。右图是 $(\lambda, \beta)$ 平面上的相图,斜线是 $\beta = \lambda/\sigma^2$,横轴是 λ/σ²、纵轴是 β,线的上方关闭、下方存活。调 β 之前先看一眼这个平面:你真正要判断的是「在当前 β 下,哪些数据方向位于存活区域」。 缓解手段:free bits。 归约顺序对应 IAF 原文附录 C.8、公式 15 的分组平均后截断;本文另加 β 作教学对照。 在本脚本中,先对数据取每维平均 KL,再换成 $\max(\mathbb E_{\mathrm{data}}[\mathrm{KL}],C)$,是在 KL 小于 C 时去掉进一步压低它的梯度,给重建项使用这部分容量的机会;这不是保证至少传 C nats 的硬约束。下面的线性实验确实在边界附近找到更好的重建,但一般神经网络不保证被救活。这个“先平均再截断”的目标与“每个样本先截断再平均”通常不同,数值和全局解也不同。本模型 r=1 时记 R=−log(t)/2≥0,MSE=λexp(−2R),目标为 −λexp(−2R)/(2σ²)−βmax(R,C),所以 R*=max(C,0.5log(λ/(βσ²)),0)。这个特例确实用到 C 附近,但普遍神经网络无此保证。闭式结果(β=4): λ C=0(纯 β) C=0.05 C=0.2 1.0000 a=0.000 KL=0.000 MSE=1.000 a=0.308 KL=0.050 MSE=0.905 a=0.574 KL=0.200 MSE=0.670 0.2500 a=0.000 KL=0.000 MSE=0.250 a=0.617 KL=0.050 MSE=0.226 a=1.148 KL=0.200 MSE=0.168 λ=1.0 的维度被救回来了(MSE 1.000 → 0.670),λ=0.25 的也从 0.250 降到 0.168。代价是放松了对先验 KL 的惩罚;是否改善或损害解耦需要独立评估——这是一笔明码标价的交易。 什么时候不该用。 归一化流和自回归模型在相应建模假设下可计算精确似然,不一定需要变分下界;VQ 模型可精确计算离散 token 序列的自回归概率,但一般仍不能精确边缘化得到像素似然。ELBO 也不是训练高维生成模型的唯一途径,score matching、流匹配和对抗训练是其他路线。同一数据、同一似然约定下标准 ELBO 可比较为下界,但 q 的质量影响松紧,不能直接据此断言真实似然或感知质量的排序。 07. 经典论文脉络 Kingma & Welling, 1312.6114(2013)——VAE 原文。贡献是把「变分推断 + 重参数化 + 神经网络编码器」拼成一个能用 SGD 训的东西,并给出 SGVB 估计量。它同时确立了沿用至今的 loss 形式:重建项减 KL。本文 3.2~3.5 节基本是这篇的复述。 Rezende, Mohamed & Wierstra, 1401.4082(2014)——几乎同期独立提出的重参数化,论文里叫 stochastic backpropagation。贡献是把这个方法从「VAE 的一个技巧」推广到论文所讨论的可微潜变量模型与分布族,仍需可用的噪声变换和正则条件,并系统讨论了高斯之外的分布族怎么处理。想理解重参数化的适用边界(哪些分布能做、哪些只能退回得分函数),这篇比 VAE 原文讲得更清楚。 Burda, Grosse & Salakhutdinov, 1509.00519(2015)——IWAE。贡献就是本文 3.6 那个 $L_k$:把「log 再平均」换成「平均再 log」,得到一个随 k 单调变紧的界,并证明了收敛性。它澄清了一个当时普遍的误解——「多采几个样本只是降方差」,实际上换的是界本身。 Higgins et al., ICLR 2017——β-VAE。给 KL 项加权重 β > 1,旨在增强因子化与解耦表征,效果须独立评测;目标与重建取舍可对照同组作者的 2018 原论文。本文第 4.3 节给出线性高斯教学特例的代价面:只在存活区域,MSE 随 β 成正比;到阈值后饱和。它不是该论文非线性模型的通用定理,也未在本实验测量解耦指标。 Bowman et al., 1511.06349(2015)——讨论句子 VAE 后验坍缩的代表性工作。用 VAE 做句子生成,强大的自回归解码器会直接忽略潜变量,KL 掉到 0。这篇提出的 KL annealing(训练初期把 β 从 0 慢慢涨到 1)是可尝试的缓解手段之一,效果依赖具体模型和优化过程,并非保证解决坍缩。 补充两篇:Kingma et al. 的 IAF(1606.04934)走的是另一条路——不改界,改 q,用可逆变换把后验族变强来直接缩小那个缝;Kingma & Welling 的综述(1906.02691)适合把上述脉络串起来通读。 08. 常见误解 误解一:「ELBO 里的 KL 就是 q 和真实后验的差距」。 ELBO 里减去的是 $\mathrm{KL}(q\Vert p(z))$;下界的差距是 $\mathrm{KL}(q\Vert p(z\mid x))$。调整 β 会通过训练改变 q 和生成模型,后者也可能变化,只是没有保证随前者一起下降。 误解二:「ELBO 是下界,所以蒙特卡洛估计值不会超过 log p(x)」。 下界性质是对期望成立的,不是对每个样本成立。本例单样本估计的标准差是 4.308,而缝只有 1.985,结果 40.7% 的样本越过了真实上界。若有限样本估计越过 log p(x),采样波动是一种解释;仍应核对归约、似然常数与实现,不能仅凭越界认定程序正确。 误解三:「重参数化是为了让采样可微」。 准确说法是把参数相关的随机变量表示为固定噪声上的可导变换,从而得到路径梯度。采样「不可微」这个表述本身就有问题:得分函数估计量里 $\nabla_\phi \log q_\phi$ 是对参数求导,完全可微,它对 f 连可导性都不要求。路径估计用上了 ∇z f,在本文高斯重建实验中方差较低;第 3.5 节的正弦反例说明排序可反转。其首要机制是把参数相关采样表示成固定噪声的可导映射,方差降低是有条件的好处。 误解四:「KL 掉到 0 说明 KL 项优化到位了」。 这是后验坍缩的典型症状。本例 λ=1.0、β=4 时最优解就是 a=0、s=1、KL=0、MSE=1.000(正好等于 λ),编码器彻底放弃了这个维度。看数据平均 KL 为零可推出几乎所有 x 的 q(z|x)=p(z),说明潜变量不携带 x 信息;非零 KL 也未必等于有用信息。辅助统计量 A=Var数据(E_q[z|x])=a²λ 只检查均值活动度。active_unit() 使用 IWAE 第 5.2 节 的经验阈值 A>0.01;它不等价于理论 a≠0,方差编码的信息也可能被它漏掉。临近阈值时仍存活但 A≤0.01 的方向会被统计判为 inactive。 误解五:「β 越大解耦越好,重建变差只是小代价」。 在线性模型中,最优 MSE 为 $\min(\beta\sigma^2,\lambda)$,连续增加后饱和;每维 KL 也连续趋零。离散的存活计数会出现台阶,但不意味着误差发生跳变。更强的 KL 约束还可能让所有维度关闭,不能只用 β 大小判断解耦质量。 09. 动手验证 前三个实验只依赖 numpy,配图脚本还需 matplotlib;完整四脚本均在附录。把它们保存到同一个目录运行,reparam_gradients.py 和 make_figures.py 会导入相邻脚本: python -B elbo_identity.py python -B reparam_gradients.py python -B beta_kl_weight.py python -B make_figures.py 本轮 CPU 实跑约 1.7、0.7、1.0、6.7 秒,仅供环境对照,不承诺其他机器的耗时。模型生成与状态种子 20260925,MC 种子 7,IWAE 种子 13,梯度小模型种子 11,维度扫描种子 23。matplotlib 字体选 Microsoft YaHei/SimHei/DejaVu Sans;其他平台请换成已安装的中文字体。计算线程在本轮进程中设为 1。 实验一:比较三份 q。 把 make_q 的均值设成真实后验均值,分别用 np.diag(cov) 与 1 / np.diag(np.linalg.solve(cov,np.eye(K))) 作方差。预期 KL 缝隙为 0.79398 与 0.40038;原指定 q 为 1.98544。要到零还需完整协方差,不只是换均值或对角方差。 实验二:换独立 baseline 并查无偏条件。 用独立 pilot 样本或上一批 f 的均值作当前批次 c,比较方差与均值误差。不要直接对当前批次减自身均值后声称严格无偏;可用 leave-one-out 排除当前样本。方差改善依 f、score 与 baseline 的关系决定,不承诺一定到 4.2×。 实验三:比较 free bits 的两种归约顺序。 运行: from beta_kl_weight import closed_form_optimal print(closed_form_optimal(lam=0.25, beta=4.0, free_bits=0.5)) 这里对应数据平均 KL 外取 max,低方差方向在这个解析模型中会使用 latent;若改为逐样本 max 后求期望,须重新计算目标与最优解,不能沿用这里的闭式。 实验四:重现两个反例。 离散 IWAE 权重路径与正弦梯度的最小实验如下;第二个种子固定 73、20 万共同噪声,独立运行的方差应约为 50 与 0.5,具体有限样本数值允许变化。 import numpy as np weights = np.array([5.0, 5.0/9.0, 5.0/9.0]) print(np.log(np.cumsum(weights)/np.arange(1,4))) z = np.random.default_rng(73).normal(size=200000) print(np.var(10*np.cos(10*z)), np.var(z*np.sin(10*z))) 第一行输出 [1.60943791, 1.02165125, 0.71149632];这条可发生的路径同时反驳“单次一定是下界”和“单次随 k 单调”。它不反驳对全部路径取期望的定理。 10. 延伸阅读 按知识树的依赖关系,从这篇出发有三个方向: 往下(直接依赖本文):扩散过程的前向与反向推导——离散潜变量链的变分界与连续 SDE/score 视角怎样联系;SDE 训练并非只有 ELBO 一条路线。另一个直接后继是 VAE 结构与训练目标。 往旁(同一个估计量,另一副马甲):策略梯度与 PPO 基础——本文 3.5 的得分函数估计量在 RL 里叫 REINFORCE,方差问题一模一样,baseline 的作用也一模一样。读过这篇再去看 PPO,会省掉一次重新理解。 已发布的相关篇目:视频 VAE 的常见 loss 组合——KL 之外还有哪些 loss 会加进来,以及它们各自的量级;FlashAttention 为什么不需要存下注意力矩阵 与 性能建模与 Profiling——本文没碰的工程侧。 完整的知识树见博客目录页 AIGC 基本功知识树,按依赖顺序排好了先修课。 附录:完整代码 09 节用到的脚本全文如下(reparam_gradients.py、make_figures.py、elbo_identity.py、beta_kl_weight.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 reparam_gradients.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """重参数化 vs 得分函数(REINFORCE)梯度估计量,方差实测。 要估的量:∇_φ E_{q_φ}[log p(x|z)],φ = (m, ℓ),ℓ = log s。 这一项没法解析求的时候只能采样,两种采样方式的方差差好几个数量级。 真实梯度在这个高斯线性模型里能解析算出来,所以「谁对谁错」有标准答案, 剩下的差别就纯粹是方差。 两部分实验: A. 固定一个小模型(D=6),看三种估计量的分布 B. 扫数据维度 D,看方差比怎么长——这里才是重参数化真正救命的地方 只依赖 numpy,直接 `python reparam_gradients.py` 即可运行。 """ import numpy as np import elbo_identity as EI from elbo_identity import ( D, K, SIGMA2, W, b, elbo_analytic, make_one_x, make_q, ) N_TRIAL = 40000 # ══════════════════════════════════════════════════════════════ # A. 小模型:三种估计量的分布 # ══════════════════════════════════════════════════════════════ def true_grad(x, m, s, Wm, bm, sigma2): """∇_m 与 ∇_ℓ 的解析梯度,ℓ = log s。""" g_m = Wm.T @ (x - (Wm @ m + bm)) / sigma2 g_ell = -(s ** 2) * np.diag(Wm.T @ Wm) / sigma2 return g_m, g_ell def log_lik_rows(x, z, Wm, bm, Dm, sigma2): """批量算 log p(x|z),z: [n, K]。""" r = x - (z @ Wm.T + bm) return -0.5 * (Dm * np.log(2 * np.pi * sigma2) + np.einsum("nd,nd->n", r, r) / sigma2) def sample_reparam(x, m, s, Wm, bm, sigma2, rng, n): """重参数化:z = m + s ⊙ ε,梯度经 z 反传。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps score_z = (x - (z @ Wm.T + bm)) @ Wm / sigma2 # ∇_z log p(x|z) return score_z, score_z * s * eps # ∂z/∂m=1, ∂z/∂ℓ=s⊙ε def sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n, baseline=None): """得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。""" eps = rng.normal(size=(n, m.size)) z = m + s * eps f = log_lik_rows(x, z, Wm, bm, Dm, sigma2) if baseline is not None: f = f - baseline return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0) def summarize(name, gm_hat, ge_hat, g_m, g_ell): var = float(np.var(gm_hat, axis=0).sum() + np.var(ge_hat, axis=0).sum()) gnorm = float(np.linalg.norm(np.concatenate([g_m, g_ell]))) err = float(np.linalg.norm(np.concatenate([gm_hat.mean(0) - g_m, ge_hat.mean(0) - g_ell]))) / gnorm n_needed = int(np.ceil((var ** 0.5 / (0.05 * gnorm)) ** 2)) print(f" {name:<24s} 方差和={var:11.2f} 均值相对误差={err:6.2%} " f"5%相对RMS需 n≈{n_needed}") return var def part_a(): print("=" * 68) print("A. 小模型(D=6, σ=0.35):三种估计量的分布") print("=" * 68) # 与 elbo_identity.state() 同一颗种子 => 同一个 x、同一个 q rng_state = np.random.default_rng(EI.STATE_SEED) x, _ = make_one_x(rng_state) m, s = make_q(x, rng_state) g_m, g_ell = true_grad(x, m, s, W, b, SIGMA2) _, recon, kl = elbo_analytic(x, m, s) print(f"\n真实梯度(解析)") print(f" ∇_m = {np.array2string(g_m, precision=4)}") print(f" ∇_ℓ = {np.array2string(g_ell, precision=4)}") print(f" E_q[log p(x|z)] = {recon:.4f},KL(q||p(z)) = {kl:.4f}") rng = np.random.default_rng(11) n = N_TRIAL print(f"\n估计量对比({n} 次独立采样,方差 = 6 个参数分量方差之和)") gm_r, ge_r = sample_reparam(x, m, s, W, b, SIGMA2, rng, n) gm_s, ge_s = sample_score(x, m, s, W, b, D, SIGMA2, rng, n) gm_sb, ge_sb = sample_score(x, m, s, W, b, D, SIGMA2, rng, n, baseline=recon) v_r = summarize("重参数化", gm_r, ge_r, g_m, g_ell) v_s = summarize("得分函数(无 baseline)", gm_s, ge_s, g_m, g_ell) v_sb = summarize("得分函数(预言机 baseline)", gm_sb, ge_sb, g_m, g_ell) print(f"\n 方差比:得分函数 / 重参数化 = {v_s / v_r:.1f}×") print(f" 加 baseline 之后 = {v_sb / v_r:.1f}×") print(f"\n∇_m 第 0 个分量(真值 {g_m[0]:.4f})的估计分布") for name, g in (("重参数化", gm_r[:, 0]), ("得分函数", gm_s[:, 0]), ("得分函数+baseline", gm_sb[:, 0])): print(f" {name:<20s} mean={g.mean():9.4f} std={g.std():8.3f} " f"min={g.min():9.2f} max={g.max():9.2f}") print(f"\n均值误差随样本数的收敛(∇_m 第 0 个分量)") print(f" {'n':>7s} {'重参数化':>12s} {'得分函数':>12s}") for n2 in (10, 100, 1000, 10000, N_TRIAL): print(f" {n2:7d} {abs(gm_r[:n2, 0].mean() - g_m[0]):12.5f} " f"{abs(gm_s[:n2, 0].mean() - g_m[0]):12.5f}") return dict(g_m0=g_m[0], gm_r=gm_r[:, 0], gm_s=gm_s[:, 0], gm_sb=gm_sb[:, 0], var_r=v_r, var_s=v_s, var_sb=v_sb) # ══════════════════════════════════════════════════════════════ # B. 方差比随数据维度 D 怎么长 # ══════════════════════════════════════════════════════════════ def build_model(Dm, Km, seed): """构造一个 decoder 列范数归一化的线性高斯模型,让梯度尺度不随 D 漂。""" rng = np.random.default_rng(seed) Wm = rng.normal(size=(Dm, Km)) Wm /= np.linalg.norm(Wm, axis=0, keepdims=True) # 每列范数 = 1 bm = rng.normal(0.0, 0.3, size=(Dm,)) return Wm, bm def part_b(): print("\n" + "=" * 68) print("B. 方差比随数据维度 D 的变化(σ²=1,decoder 列范数归一化)") print("=" * 68) rng = np.random.default_rng(23) rows = [] print(f"\n {'D':>6s} {'重参数化':>12s} {'得分函数':>14s} {'比值':>10s} " f"{'+baseline 方差':>14s} {'比值':>10s}") for Dm in (8, 64, 512, 2048): Wm, bm = build_model(Dm, K, seed=1000 + Dm) z_true = rng.normal(size=(K,)) x = Wm @ z_true + bm + rng.normal(size=(Dm,)) # σ² = 1 m = Wm.T @ (x - bm) # 一个合理的变分均值 s = np.full((K,), 0.6) sigma2 = 1.0 n = 4000 gm_r, ge_r = sample_reparam(x, m, s, Wm, bm, sigma2, rng, n) gm_s, ge_s = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n) # 预言机 baseline:E_q[log p(x|z)] 的解析值 resid = x - (Wm @ m + bm) recon = -0.5 * (Dm * np.log(2 * np.pi * sigma2) + (resid @ resid + np.trace(Wm.T @ Wm @ np.diag(s ** 2))) / sigma2) gm_sb, ge_sb = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n, baseline=recon) v_r = float(np.var(gm_r, axis=0).sum() + np.var(ge_r, axis=0).sum()) v_s = float(np.var(gm_s, axis=0).sum() + np.var(ge_s, axis=0).sum()) v_sb = float(np.var(gm_sb, axis=0).sum() + np.var(ge_sb, axis=0).sum()) rows.append((Dm, v_r, v_s, v_sb)) print(f" {Dm:6d} {v_r:12.2f} {v_s:14.2f} {v_s / v_r:9.1f}× " f"{v_sb:14.2f} {v_sb / v_r:9.1f}×") print("\n 为什么长这么快:f = log p(x|z) 的均值里有一大坨与参数无关的") print(" 与 z 无关的归一化常数和残差均值。它们乘到 score 中会增加方差;") print(" 本扫描固定 K=3、归一化 W 列范数、s=0.6,非一般维度定律。") print(" baseline 减去完整 E[f];pathwise 不一定在所有问题上都更低方差。") return rows if __name__ == "__main__": a = part_a() rows = part_b() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「变分下界与重参数化」的三张解释图。 数值全部来自同目录的三个脚本(elbo_identity / reparam_gradients / beta_kl_weight),这里只负责把它们画出来——改了那几个脚本这里要重跑, 避免图与正文数字不一致。 三张图分别回答: 1. ELBO 离真实目标差多少,差的那一项是什么,多采样能不能补上 2. 重参数化到底省了多少方差,以及这个差距随数据维度怎么长 3. KL 项加权的 β 是怎么把潜变量维度一刀一刀切掉的 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import Rectangle import beta_kl_weight as BK import elbo_identity as EI import reparam_gradients as RG ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) INK = "#1f2937" C_ELBO = "#2f6fb0" # ELBO:蓝 C_GAP = "#e0a03c" # 缺口:橙 C_BAD = "#d1495b" # 越界 / 死亡:红 C_OK = "#2f9e6f" # 收紧 / 存活:绿 C_SCORE = "#8b5cf6" # 得分函数:紫 def style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=13.0, weight="bold", color=INK, pad=10) if xlabel: ax.set_xlabel(xlabel, fontsize=11, color="#475569") if ylabel: ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(labelsize=10, colors="#64748b") for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.grid(axis="y", color="#eef2f7", lw=1.0) ax.set_axisbelow(True) # ══════════════════════════════════════════════════════════════ # 图 1:ELBO 离 log p(x) 差多少 # ══════════════════════════════════════════════════════════════ def fig_elbo_gap(): st = EI.state() mc = EI.mc_table(st) iw = EI.iwae_table(st) log_px, elbo, gap, kl_prior = st["log_px"], st["elbo"], st["gap"], st["kl"] fig, axes = plt.subplots(1, 3, figsize=(16.2, 4.9)) fig.patch.set_facecolor("white") # ── (a) 分解:两条横向长条 ── ax = axes[0] style(ax, "(a) log p(x) 拆成两截", "nats(对数似然,0 在右边)") rows = [ ("ELBO(能算,优化它)", elbo, C_ELBO, "white"), ("log p(x)(本例闭式真值)", log_px, C_BAD, "white"), ("KL(q‖p(z)):loss 里那一项", -kl_prior, "#94a3b8", "white"), ("KL(q‖p(z|x)):上面两条的差", -gap, C_GAP, "white"), ] for i, (name, v, color, tc) in enumerate(rows): y = len(rows) - 1 - i ax.barh(y, -v, left=v, height=0.52, color=color) ax.text(v + 0.18, y, f"{v if i < 2 else abs(v):.3f}", ha="left", va="center", fontsize=10, color=INK, weight="bold") ax.axvline(log_px, color=C_BAD, ls="--", lw=1.3) ax.axvline(elbo, color=C_ELBO, ls="--", lw=1.3) ax.annotate("", xy=(elbo, 3.28), xytext=(log_px, 3.28), arrowprops=dict(arrowstyle="<->", color="#a16207", lw=1.8)) ax.text((elbo + log_px) / 2, 3.75, "差 = 1.985", ha="center", va="bottom", fontsize=10.5, color="#a16207", weight="bold", bbox=dict(fc="white", ec="none", alpha=0.9, pad=1.0)) ax.text(-9.35, 0.68, "上面两条之差 = 下面橙色那条,\n不是灰色那条——这两个 KL 常被混为一谈", ha="left", va="center", fontsize=9, color="#64748b", linespacing=1.5) ax.set_yticks(range(len(rows))) ax.set_yticklabels([r[0] for r in rows][::-1], fontsize=9.5) ax.set_xlim(-9.6, 1.5) ax.set_ylim(-0.6, 3.9) ax.grid(axis="x", color="#eef2f7", lw=1.0) ax.grid(axis="y", visible=False) # ── (b) 单样本 MC 会越过上界 ── ax = axes[1] style(ax, f"(b) L=1 的 MC 估计({EI.MC_REP} 次)", "单次估计值", "频数") vals = mc[1]["vals"] ax.hist(vals, bins=70, color="#cbd5e1", edgecolor="white", lw=0.4) over = vals[vals > log_px] ax.hist(over, bins=70, color=C_BAD, alpha=0.85, label=f"{mc[1]['frac']:.1%} 越过了 log p(x)") ax.axvline(elbo, color=C_ELBO, lw=2.0, label=f"ELBO = {elbo:.3f}") ax.axvline(log_px, color=C_BAD, lw=2.0, ls="--", label=f"log p(x) = {log_px:.3f}") ax.set_xlim(-26, 7) ax.legend(fontsize=9, frameon=False, loc="upper left") ax.set_yscale("log") ax.set_ylim(0.7, 900) ax.text(0.03, 0.05, "估计量是无偏的:它在 ELBO 周围晃,\n不是「恒小于 log p(x)」", transform=ax.transAxes, ha="left", va="bottom", fontsize=9.5, color="#64748b", linespacing=1.5) # ── (c) IWAE 收紧 ── ax = axes[2] style(ax, f"(c) 多采样收紧(每项 {EI.IW_REP} 次)", "k(每次采几个 z)", "nats") ks = np.array(EI.IW_KS, dtype=float) means = np.array([iw[k]["mean"] for k in EI.IW_KS]) stds = np.array([iw[k]["std"] for k in EI.IW_KS]) ax.errorbar(ks, means, yerr=stds, fmt="o-", color=C_OK, lw=2.0, capsize=4, markersize=6) ax.axhline(log_px, color=C_BAD, ls="--", lw=1.6, label=f"log p(x) = {log_px:.3f}") ax.axhline(elbo, color=C_ELBO, ls=":", lw=1.6, label=f"ELBO = {elbo:.3f}") ax.set_xscale("log") ax.set_ylim(-9.4, -4.7) ax.set_xlim(0.7, 900) for k, m in zip(ks, means): ax.annotate(f"还差 {log_px - m:.3f}", (k, m), textcoords="offset points", xytext=(8, 12 if k > 1 else -18), fontsize=9, color="#64748b", bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6)) ax.legend(fontsize=9, frameon=False, loc="lower right") ax.text(0.03, 0.06, "期望界更紧;误差棒是单次标准差", transform=ax.transAxes, fontsize=9.5, color="#64748b") fig.suptitle("这张图要看什么:ELBO 与真实目标之间那道缝," "固定 q 的 KL 缝隙与采样波动是两件事", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "elbo_gap.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") # ══════════════════════════════════════════════════════════════ # 图 2:重参数化省了多少方差 # ══════════════════════════════════════════════════════════════ def fig_grad_variance(): a = RG.part_a() rows = RG.part_b() fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0)) fig.patch.set_facecolor("white") # ── (a) 估计分布 ── ax = axes[0] style(ax, "(a) ∂L/∂m 第 0 个分量的估计分布", "估计值", "频数") bins = np.linspace(-70, 70, 90) for vals, color, name in ((a["gm_r"], C_ELBO, "重参数化"), (a["gm_s"], C_SCORE, "得分函数"), (a["gm_sb"], C_GAP, "得分函数+baseline")): ax.hist(vals, bins=bins, histtype="step", lw=1.8, color=color, label=f"{name} std={vals.std():.1f}") ax.axvline(a["g_m0"], color=C_OK, lw=2.2, label=f"真值 = {a['g_m0']:.3f}") ax.set_xlim(-70, 70) ax.set_yscale("log") ax.legend(fontsize=9.5, frameon=False, loc="upper left") ax.text(0.98, 0.05, "理论均值相同,有限样本均值有误差:\n" f"std = {a['gm_r'].std():.1f} / {a['gm_s'].std():.1f} / " f"{a['gm_sb'].std():.1f}", transform=ax.transAxes, ha="right", va="bottom", fontsize=9.5, color="#64748b", linespacing=1.5) # ── (b) 随维度怎么长 ── ax = axes[1] style(ax, "(b) 方差随数据维度 D 怎么长", "D(数据维度)", "梯度方差(6 个分量之和)") Ds = np.array([r[0] for r in rows], dtype=float) vr = np.array([r[1] for r in rows]) vs = np.array([r[2] for r in rows]) vsb = np.array([r[3] for r in rows]) ax.loglog(Ds, vs, "o-", color=C_SCORE, lw=2.0, markersize=7, label="得分函数(无 baseline)") ax.loglog(Ds, vsb, "s--", color=C_GAP, lw=2.0, markersize=6, label="得分函数 + baseline") ax.loglog(Ds, vr, "o-", color=C_ELBO, lw=2.0, markersize=7, label="重参数化") # 斜率 2 的参考线 ref = vs[0] * (Ds / Ds[0]) ** 2 ax.loglog(Ds, ref, ":", color="#cbd5e1", lw=2.0, label="∝ D² 参考线") for d, v, r in zip(Ds, vs, vr): ratio = v / r txt = f"{ratio:,.0f}×" if ratio < 1e4 else f"{ratio:.1e}×" ax.annotate(txt, (d, v), textcoords="offset points", xytext=(8, -14), fontsize=9.5, color=C_SCORE, weight="bold", bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6)) ax.set_ylim(2e-1, 1e10) ax.legend(fontsize=9.5, frameon=False, loc="upper left") ax.text(0.97, 0.03, "本归一化扫描中 pathwise 方差近似稳定", transform=ax.transAxes, fontsize=9.5, color=C_ELBO, ha="right", va="bottom", weight="bold") fig.suptitle("这张图要看什么:重参数化不是「更准」,是「腰围更小」——" "本实验分布更集中;方差排序不是普遍定理", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "grad_variance.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") # ══════════════════════════════════════════════════════════════ # 图 3:β 怎么把潜变量维度切掉 # ══════════════════════════════════════════════════════════════ def fig_beta_tradeoff(): table = BK.sweep(BK.LAMS, BK.BETAS, verbose=False) s2 = BK.SIGMA2 fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0)) fig.patch.set_facecolor("white") # ── (a) 重建误差 vs β ── ax = axes[0] style(ax, "(a) β 越大,重建越差——直到某一维被直接放弃", "β(KL 项的权重)", "该维的重建 MSE") colors = ["#2f6fb0", "#2f9e6f", "#e0a03c", "#d1495b"] bgrid = np.linspace(0.2, 14, 100) ax.plot(bgrid, bgrid * s2, ":", color="#94a3b8", lw=1.8, label="理论:MSE = βσ²(还活着)") for lam, c in zip(BK.LAMS, colors): betas, mses, alive = [], [], [] for beta in BK.BETAS: a, b, s, mse, kl, au = table[(lam, beta)] betas.append(beta) mses.append(mse) alive.append(BK.active_unit(a, lam)) betas = np.array(betas) mses = np.array(mses) alive = np.array(alive) ax.plot(betas[alive], mses[alive], "o-", color=c, lw=2.0, markersize=6, label=f"λ={lam}") if (~alive).any(): ax.plot(betas[~alive], mses[~alive], "s", color=c, markersize=7, mfc="white", mew=1.8) ax.axhline(mses[~alive][0], color=c, ls="--", lw=1.0, alpha=0.45) ax.set_xscale("log") ax.set_yscale("log") ax.set_ylim(0.028, 7.0) ax.legend(fontsize=9, frameon=False, loc="upper left", ncol=2) ax.text(0.5, 0.012, "实心圆 = 该维还活着(MSE 贴着 βσ² 往上走);" "空心方块 = 该维已死,MSE 停在 λ", transform=ax.transAxes, ha="center", va="bottom", fontsize=9.5, color="#64748b") # ── (b) 相图 ── ax = axes[1] style(ax, "(b) 存活 / 死亡的相图", "λ / σ²(该维的信噪比)", "β") snr = np.array(BK.LAMS) / s2 grid = np.logspace(-1, 1.6, 60) ax.loglog(grid, grid, "-", color="#94a3b8", lw=2.2, label="理论分界:β = λ/σ²") ax.fill_between(grid, grid, 1e3, color=C_BAD, alpha=0.06) ax.fill_between(grid, 1e-3, grid, color=C_OK, alpha=0.06) for lam in BK.LAMS: for beta in BK.BETAS: a, b, s, mse, kl, au = table[(lam, beta)] ok = BK.active_unit(a, lam) ax.plot(lam / s2, beta, "o" if ok else "s", color=C_OK if ok else C_BAD, markersize=7, mfc=C_OK if ok else "white", mew=1.6) ax.text(0.05, 0.93, "上方:KL 太贵,维度被关掉", transform=ax.transAxes, fontsize=10, color=C_BAD, weight="bold") ax.text(0.05, 0.06, "下方:数据方差信噪比盖过 KL 的价,维度存活", transform=ax.transAxes, fontsize=10, color=C_OK, weight="bold") ax.set_xlim(0.1, 40) ax.set_ylim(0.15, 20) ax.legend(fontsize=9.5, frameon=False, loc="center right") ax.grid(axis="y", color="#eef2f7", lw=1.0) fig.suptitle("这张图要看什么:线性高斯特例:β 给 KL 加权," "等于给每个潜变量维度标一个价——信噪比不够的维度直接归零", fontsize=11.5, color="#64748b", y=1.02) fig.tight_layout() p = OUT / "beta_tradeoff.png" fig.savefig(p, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" ✓ {p.name}") if __name__ == "__main__": print("生成配图 →", OUT) fig_elbo_gap() fig_grad_variance() fig_beta_tradeoff() print("完成:3 张") elbo_identity.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ELBO 恒等式核对:log p(x) = ELBO + KL(q || p(z|x))。 构造一个「后验有解析解」的模型,这样三样东西都能算到机器精度: * 边际似然 log p(x) —— 高斯线性模型,边际仍是高斯 * 真实后验 p(z|x) —— 共轭高斯,闭式解 * ELBO —— 重建项对 q 可解析求期望,KL 两项都是高斯闭式 有解析解才能验证「差的那一项到底是什么」,靠采样是验不出来的。 只依赖 numpy,直接 `python elbo_identity.py` 即可运行。 """ import numpy as np RNG = np.random.default_rng(20260925) # ── 模型:z ~ N(0, I_K),x|z ~ N(W z + b, sigma^2 I_D) ── D, K = 6, 3 SIGMA = 0.35 # 解码器观测噪声标准差 SIGMA2 = SIGMA ** 2 W = RNG.normal(0.0, 1.0, size=(D, K)) * 0.9 # 解码器权重 b = RNG.normal(0.0, 0.3, size=(D,)) # 解码器偏置 def make_one_x(rng=None): """从真实的边际分布里采一个 x,并返回它的解析 log p(x)。 rng 可显式传入:这样 reparam_gradients / make_figures 拿到的是同一个 x, 不会因为模块级 RNG 被别人消耗过而对不上数字。 """ if rng is None: rng = RNG z = rng.normal(size=(K,)) x = W @ z + b + SIGMA * rng.normal(size=(D,)) cov = W @ W.T + SIGMA2 * np.eye(D) sign, logdet = np.linalg.slogdet(cov) d = x - b quad = d @ np.linalg.solve(cov, d) log_px = -0.5 * (D * np.log(2 * np.pi) + logdet + quad) return x, log_px def true_posterior(x): """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。""" prec = np.eye(K) + W.T @ W / SIGMA2 cov = np.linalg.inv(prec) mean = cov @ (W.T @ (x - b) / SIGMA2) return mean, cov # ── 变分后验 q(z|x) = N(m, diag(s^2)):故意用「对角」错误指定 ── def make_q(x, rng=None): """取真实后验的均值,协方差只留对角线,再乘 0.8 并加 0.05。 真实后验是有相关性的(cov 非对角),q 强行对角 => KL(q||p(z|x)) > 0, 这正是我们要留出来的那条缝。 """ if rng is None: rng = RNG mean, cov = true_posterior(x) m = mean + 0.15 * rng.normal(size=(K,)) # 均值也偏一点 var = np.diag(cov).copy() * 0.8 + 0.05 # 与原方差大小须逐项比较 return m, np.sqrt(var) def log_gauss_diag(z, mean, var, ): """log N(z; mean, diag(var))(省略常数也行,但这里算全)。""" return float(-0.5 * np.sum(np.log(2 * np.pi * var) + (z - mean) ** 2 / var)) def log_joint(x, z): """log p(x, z) = log p(x|z) + log p(z)。""" r = x - (W @ z + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + r @ r / SIGMA2) log_prior = -0.5 * (K * np.log(2 * np.pi) + z @ z) return log_lik + log_prior def elbo_analytic(x, m, s): """ELBO 的解析值。 E_q[log p(x|z)] 里 ||x - Wz - b||^2 对 q 求期望: ||x - Wm - b||^2 + tr(W^T W diag(s^2)) 第二项是采样噪声经过解码器放大出来的那部分,容易被漏掉。 """ var = s ** 2 resid = x - (W @ m + b) recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2) kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(recon - kl), float(recon), float(kl) def kl_gauss_gauss(m, s, mean2, cov2): """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。""" var = s ** 2 diff = mean2 - m cov2_inv = np.linalg.inv(cov2) trace = float(np.trace(cov2_inv @ np.diag(var))) quad = float(diff @ cov2_inv @ diff) _, logdet2 = np.linalg.slogdet(cov2) return 0.5 * (trace + quad - K + logdet2 - np.sum(np.log(var))) def mc_elbo(x, m, s, L, rng): """蒙特卡洛 ELBO:L 个样本取平均(L=1 就是训练时实际用的那个)。""" eps = rng.normal(size=(L, K)) z = m + s * eps residual = x - (z @ W.T + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + np.sum(residual ** 2, axis=1) / SIGMA2) var = s ** 2 kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var)) return float(log_lik.mean() - kl) def iwae_log_bound(x, m, s, k, rng): """IWAE 的 k 样本界:log (1/k) sum_l p(x,z_l)/q(z_l),用 logsumexp 稳算。""" eps = rng.normal(size=(k, K)) z = m + s * eps var = s ** 2 residual = x - (z @ W.T + b) log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + np.sum(residual ** 2, axis=1) / SIGMA2) log_prior = -0.5 * (K * np.log(2 * np.pi) + np.sum(z ** 2, axis=1)) log_q = -0.5 * np.sum(np.log(2 * np.pi * var) + (z - m) ** 2 / var, axis=1) logw = log_lik + log_prior - log_q mx = logw.max() return float(mx + np.log(np.mean(np.exp(logw - mx)))) # ── 下面两个表被 main 与 make_figures 共用,种子固定 => 数字永远一致 ── MC_LS = (1, 4, 16, 64) MC_REP = 4000 IW_KS = (1, 5, 50, 500) IW_REP = 6000 STATE_SEED = 20260925 def state(): """文章与配图共用的那一份状态:同一个 x、同一个 q。 用固定种子重放,保证单独跑本脚本与跑 make_figures 拿到同一组数字。 """ rng = np.random.default_rng(STATE_SEED) x, log_px = make_one_x(rng) m, s = make_q(x, rng) post_mean, post_cov = true_posterior(x) elbo, recon, kl = elbo_analytic(x, m, s) gap = kl_gauss_gauss(m, s, post_mean, post_cov) return dict(x=x, log_px=log_px, m=m, s=s, elbo=elbo, recon=recon, kl=kl, gap=gap) def mc_table(st): """蒙特卡洛 ELBO 的均值 / 标准差 / 越过 log p(x) 的比例。""" rng = np.random.default_rng(7) out = {} for L in MC_LS: vals = np.array([mc_elbo(st["x"], st["m"], st["s"], L, rng) for _ in range(MC_REP)]) out[L] = dict(mean=float(vals.mean()), std=float(vals.std()), frac=float(np.mean(vals > st["log_px"])), vals=vals) return out def iwae_table(st): """IWAE 的 k 样本界。""" rng = np.random.default_rng(13) out = {} for k in IW_KS: vals = np.array([iwae_log_bound(st["x"], st["m"], st["s"], k, rng) for _ in range(IW_REP)]) out[k] = dict(mean=float(vals.mean()), std=float(vals.std()), gap=float(st["log_px"] - vals.mean()), se=float(vals.std(ddof=1) / np.sqrt(IW_REP)), frac=float(np.mean(vals > st["log_px"])), vals=vals) return out def main(): print("=" * 68) print("ELBO 恒等式核对 log p(x) = ELBO + KL(q || p(z|x))") print("=" * 68) print(f"模型: D={D}, K={K}, sigma={SIGMA}") st = state() x, log_px, m, s = st["x"], st["log_px"], st["m"], st["s"] elbo, recon, kl, gap = st["elbo"], st["recon"], st["kl"], st["gap"] print(f"\n[1] 解析三项") print(f" E_q[log p(x|z)] = {recon: .6f}") print(f" KL(q || p(z)) = {kl: .6f}") print(f" ELBO = {elbo: .6f}") print(f" KL(q || p(z|x)) = {gap: .6f}") print(f" ELBO + KL(q||p(z|x)) = {elbo + gap: .6f}") print(f" log p(x) = {log_px: .6f}") print(f" |误差| = {abs(elbo + gap - log_px): .3e}") # ── 蒙特卡洛波动:ELBO 的估计量是无偏的,不是恒小于 log p(x) ── print(f"\n[2] 蒙特卡洛估计的波动(每项 {MC_REP} 次重复)") print(f" {'L':>5s} {'mean':>12s} {'std':>10s} {'超过 log p(x) 的比例':>22s}") mc = mc_table(st) for L in MC_LS: r = mc[L] print(f" {L:5d} {r['mean']:12.5f} {r['std']:10.5f} {r['frac']:21.1%}") print(f" log p(x) = {log_px:.5f}(上界本身),ELBO(解析) = {elbo:.5f}") # ── IWAE:k 越大越紧 ── print(f"\n[3] IWAE 的 k 样本界(每项 {IW_REP} 次重复)") print(f" {'k':>5s} {'mean L_k':>12s} {'std':>9s} {'log p(x) - L_k':>16s}") iw = iwae_table(st) for k in IW_KS: r = iw[k] print(f" {k:5d} {r['mean']:12.5f} {r['std']:9.5f} {r['gap']:16.5f} SE={r['se']:.5f} 越界={r['frac']:.1%}") print(f" 参考:单样本 MC ELBO 的均值 = {elbo:.5f}(= ELBO 解析值,不随 k 变)") print("\n结论:期望下界 L_k 随 k 单调;单次结果和有限重复均值可以越界或不单调;" "而「取平均再 log」和「log 再取平均」是两件事。") if __name__ == "__main__": main() beta_kl_weight.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """β-VAE 的 KL 加权:一个能解到最优的玩具模型,看潜变量维度怎么死掉。 构造:数据每个坐标独立,x_j ~ N(0, λ_j),潜变量每个坐标也独立, q(z_j | x_j) = N(a_j x_j, s_j²),p(x_j | z_j) = N(b_j z_j, σ²) 这样每个维度就是一份独立副本,最优解可由闭式得到;保留多起点梯度上升用于独立数值对照。 单维目标(要最大化),把 λ 与 σ² 都当作常数: L(a, b, ℓ) = -[λ(1 - b a)² + b² s²] / (2σ²) - β · KL KL = 0.5 · (a² λ + s² - 1 - log s²), s = exp(ℓ) 梯度全部解析,脚本里再用有限差分核对一遍,避免推错。 只依赖 numpy,直接 `python beta_kl_weight.py` 即可运行。 """ import numpy as np SIGMA2 = 0.25 # 解码器观测噪声方差 def kl_of(a, lam, s): """KL(N(a x, s²) || N(0, 1)),对 x ~ N(0, λ) 取期望后的形式。""" return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2)) def recon_mse(a, b, lam, s): """E_{x,z}[(x - b z)²],重建误差的期望。""" return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2 def objective(p, lam, beta, free_bits=None): """目标函数值(越大越好)。free_bits=C 时 KL 项取 max(KL, C)。""" a, b, ell = p s = np.exp(ell) kl = kl_of(a, lam, s) kl_eff = max(kl, free_bits) if free_bits is not None else kl return -(recon_mse(a, b, lam, s)) / (2 * SIGMA2) - beta * kl_eff def grad(p, lam, beta, free_bits=None): """解析梯度 ∇(∂L/∂a, ∂L/∂b, ∂L/∂ℓ)。""" a, b, ell = p s2 = np.exp(2 * ell) g = np.zeros(3) g[0] = lam * b * (1.0 - b * a) / SIGMA2 g[1] = (lam * a * (1.0 - b * a) - b * s2) / SIGMA2 g[2] = -b ** 2 * s2 / SIGMA2 if free_bits is None or kl_of(a, lam, np.exp(ell)) > free_bits: # KL 项对 (a, b, ℓ) 的梯度 g[0] -= beta * a * lam g[2] -= beta * (s2 - 1.0) return g def grad_fd(p, lam, beta, free_bits=None, h=1e-6): """中心差分梯度,用来核对解析梯度有没有推错。""" g = np.zeros(3) for i in range(3): e = np.zeros(3) e[i] = h g[i] = (objective(p + e, lam, beta, free_bits) - objective(p - e, lam, beta, free_bits)) / (2 * h) return g def optimize(lam, beta, free_bits=None, n_init=9, n_iter=12000, seed=0): """多起点梯度上升,返回最好的 (a, b, s)。 必须多起点:(a, b) = (0, 0) 是「维度死亡」解,单起点容易掉进去出不来。 """ rng = np.random.default_rng(seed) best_p, best_v = None, -np.inf for k in range(n_init): if k == 0: p = np.array([0.9, 0.9, np.log(0.6)]) elif k == 1: p = np.array([0.0, 0.0, 0.0]) # 死亡解,也让它试试 else: p = np.array([rng.uniform(-1.5, 1.5), rng.uniform(-1.5, 1.5), rng.uniform(-1.2, 0.5)]) lr = 0.02 for t in range(n_iter): g = grad(p, lam, beta, free_bits) g = np.clip(g, -50.0, 50.0) # 梯度裁剪:b²s²/σ² 那一项能把参数炸飞 p = p + lr * g # 数值保护,别让 exp(ℓ) 或 (a, b) 爆掉 p[0] = float(np.clip(p[0], -8.0, 8.0)) p[1] = float(np.clip(p[1], -8.0, 8.0)) p[2] = float(np.clip(p[2], -4.0, 1.0)) if t % 1000 == 999: lr *= 0.6 # 收尾再磨一遍:β 很小的时候收敛慢,不磨的话 s² 会差到 1e-3 lr = 1e-4 for t in range(6000): g = np.clip(grad(p, lam, beta, free_bits), -50.0, 50.0) p = p + lr * g v = objective(p, lam, beta, free_bits) if v > best_v: best_v, best_p = v, p a, b, ell = best_p return float(a), float(b), float(np.exp(ell)), float(best_v) def closed_form_optimal(lam, beta, free_bits=None): """数据期望 KL 外取 max(KL,C) 的闭式全局最优(省略似然常数)。""" if lam <= 0 or beta <= 0 or (free_bits is not None and free_bits < 0): raise ValueError("lam and beta must be positive; C must be nonnegative") rate = max(0.0, 0.5 * np.log(lam / (beta * SIGMA2))) if free_bits is not None: rate = max(rate, free_bits) t = np.exp(-2 * rate) a, b, s = np.sqrt((1 - t) / lam), np.sqrt(lam * (1 - t)), np.sqrt(t) return float(a), float(b), float(s), float(objective(np.array([a,b,np.log(s)]),lam,beta,free_bits)) def active_unit(a, lam, thr=0.01): """IWAE 5.2 节的 active unit 经验判据:Cov_x(E_q[z]) = a²λ 是否超过阈值。""" return a ** 2 * lam > thr # 文章与配图共用的扫描范围 LAMS = [4.0, 1.0, 0.25, 0.0625] BETAS = [0.25, 0.5, 1.0, 2.0, 3.0, 4.0, 6.0, 8.0, 12.0] def sweep(lams, betas, verbose=True): """扫 (λ, β) 网格,返回 {(λ, β): (a, b, s, MSE, KL, a²λ)}。""" table = {} if verbose: print("\n[1] β 扫描:每个 (λ, β) 的最优解") print(f"\n {'λ':>7s} {'β':>5s} {'a':>8s} {'b':>8s} {'s':>8s} " f"{'重建MSE':>9s} {'KL':>8s} {'a²λ':>8s} {'存活':>5s}") for lam in lams: for beta in betas: a, b, s, _ = closed_form_optimal(lam, beta) kl = kl_of(a, lam, s) mse = recon_mse(a, b, lam, s) au = a ** 2 * lam table[(lam, beta)] = (a, b, s, mse, kl, au) if verbose: print(f" {lam:7.4f} {beta:5.2f} {a:8.4f} {b:8.4f} {s:8.4f} " f"{mse:9.4f} {kl:8.4f} {au:8.4f} " f"{'是' if active_unit(a, lam) else '死':>5s}") return table def main(): print("=" * 72) print("β-VAE 的 KL 加权:潜变量维度怎么死掉") print(f"σ² = {SIGMA2}(解码器噪声),单维独立副本,闭式全局最优;多起点梯度上升独立对照") print("=" * 72) # ── 先核对解析梯度 ── print("\n[0] 解析梯度 vs 有限差分") for lam, beta in ((4.0, 1.0), (0.25, 4.0)): p = np.array([0.7, -0.4, np.log(0.8)]) ga, gf = grad(p, lam, beta), grad_fd(p, lam, beta) print(f" λ={lam:<5} β={beta:<4} 解析={np.array2string(ga, precision=5)} " f"差分={np.array2string(gf, precision=5)} 最大偏差={np.abs(ga - gf).max():.2e}") print("\n[0b] 独立多起点梯度上升 vs 闭式(数值误差,不当成全局证明)") for lam,beta in [(1.0,1.0),(0.25,4.0),(4.0,0.25)]: numeric=optimize(lam,beta,n_init=3,n_iter=3000,seed=17) exact=closed_form_optimal(lam,beta) print(f" lambda={lam} beta={beta} objective_gap={exact[3]-numeric[3]:.6g} " f"MSE_numeric={recon_mse(*numeric[:2],lam,numeric[2]):.6g} MSE_exact={min(beta*SIGMA2,lam):.6g}") table = sweep(LAMS, BETAS) print("\n[2] 每个 λ 的「死亡阈值」:β 到多大时这个维度不再被用") for lam in LAMS: dead = [beta for beta in BETAS if not active_unit(table[(lam, beta)][0], lam)] if dead: print(f" λ={lam:<7.4f} 从 β={min(dead)} 起死亡" f"(β=1 时 KL={table[(lam, 1.0)][4]:.4f})") else: print(f" λ={lam:<7.4f} 在 β≤{max(BETAS)} 内都存活") # ── 闭式解核对:存活时 s² = βσ²/λ,a²λ = 1 - s²,重建 MSE = βσ² ── print("\n[2b] 闭式解核对(存活的格子才成立)") print(f" {'λ':>7s} {'β':>5s} {'s²闭式':>9s} {'βσ²/λ':>9s} " f"{'a²λ闭式':>9s} {'1-s²':>9s} {'MSE闭式':>9s} {'βσ²':>9s}") worst = 0.0 for lam in LAMS: for beta in BETAS: a, b, s, _, kl, au = table[(lam, beta)] if not active_unit(a, lam): continue s2_pred = beta * SIGMA2 / lam rows = (s ** 2, s2_pred, au, 1 - s ** 2, recon_mse(a, b, lam, s), beta * SIGMA2) print(f" {lam:7.4f} {beta:5.2f} " + " ".join(f"{v:9.5f}" for v in rows)) worst = max(worst, abs(s ** 2 - s2_pred), abs(au - (1 - s ** 2)), abs(recon_mse(a, b, lam, s) - beta * SIGMA2)) print(f" 最大偏差 = {worst:.2e} → 存活时闭式内部一致性(不代替独立数值核验)") print(f" 推论:维度存活条件 s² < 1 ⟺ β < λ/σ²,即该维的信噪比要盖过 KL 的价") for lam in LAMS: print(f" λ={lam:<7.4f} 理论死亡阈值 β* = λ/σ² = {lam / SIGMA2:.2f}") # ── free bits:数据期望KL外的截断惩罚;非信息下限保证 ── print("\n[3] free bits 对照(β=4,KL 项取 max(KL, C))") print(f" {'λ':>7s} {'C=0(纯 β)':>22s} {'C=0.05':>22s} {'C=0.2':>22s}") for lam in LAMS: cells = [] for C in (None, 0.05, 0.2): a, b, s, _ = closed_form_optimal(lam, 4.0, free_bits=C) cells.append(f"a={a:5.3f} KL={kl_of(a, lam, s):5.3f} " f"MSE={recon_mse(a, b, lam, s):5.3f}") print(f" {lam:7.4f} " + " ".join(f"{c:>22s}" for c in cells)) print("\n[4] 一个直觉:β 大了以后,模型宁可不要这个维度") print(" λ=0.0625 时这个坐标的数据方差本来就小于解码器噪声 σ²=0.25,") print(" 用它换来的重建收益抵不上 KL 的代价,最优解就是把它整条关掉。") if __name__ == "__main__": main()
-
AIGC 基本功|FlashAttention 为什么不需要存下注意力矩阵-FlashAttn AIGC 基本功|FlashAttention 为什么不需要存下注意力矩阵-FlashAttn 所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本(本篇是它的直接后继) 关键词:FlashAttention、online softmax、tiling、IO感知、显存优化 01. 为什么需要它 上一篇《自注意力机制的计算与显存账本》结尾留了一个没解的结:N=4096 的视频 DiT,按保守教学分配模型计,单层注意力为 2.39 GiB 激活,无重算训练时按同一假设累加 32 层就是 76.5 GiB,尚未包含权重、梯度、优化器与 FFN。推理的临时激活则不能直接乘层数。当时摆出了两条出路:稀疏化(算得少,但要看清赔的是什么质量)和 FlashAttention。这一篇把后者讲透。 先把一个流传很广的说法钉死:FlashAttention 不是近似注意力。它算出来的就是标准的 softmax 注意力,在实数算术下等价,浮点下允许舍入差异(第 04 节有实测:本次 float64 实验最大绝对误差不超过 8.9e-16;这组输入的舍入量级,非通用误差保证)。它快的理由也不神秘——附录 io_ledger.py 给出的同类型元素教学账本,单头 d=64、N=4096 时: 朴素实现要在 HBM(显存)上搬 130 MiB:分数矩阵 S 写一次读一次,softmax 权重 P 写一次读一次,4N² 次元素搬运; FlashAttention 只搬 17.8 MiB,少了 7.3 倍。 两种实现的主导矩阵乘 FLOPs 相同,但重算和归一化开销不同。在这组 A100 参数的 roofline 模型中,朴素实现算术强度为 31.5 FLOP/byte,低于约 200 的平衡点;这支持优先优化 IO 的方向,不证明所有序列、硬件或近似注意力方法都必然更慢。本文 130 MiB、17.8 MiB 是脚本估算值,不是 GPU 访存计数器实测。 另一个结论更值钱:显式保存概率矩阵 P 的朴素实现仍需二次存储,S 本身通常不必一并保留,该显式物化实现的主导存储随 N 二次增长;FlashAttention 把这两个矩阵整个从显存里删掉了,训练激活从 O(N²) 降到 O(N)——在统一采用六份线性张量、忽略小的 LSE 与工作区的教学预算中,上面那个 76.5 GiB 降为 4.5 GiB。N=32768 的长视频任务,本文教学模型的朴素实现要约 4.54 TiB 激活,超过这里对比的单卡教学预算;融合侧同一账本为 36 GiB,仍未计 FFN、权重、优化器和完整工作区。FlashAttention 为长序列精确注意力减少了重要的容量障碍;具体模型能否训练还受其他层、并行策略和硬件影响。 02. 最小可用理解 三句话讲完核心思想: softmax attention 每行需要两个标量和一个 d 维向量:这行的最大值 m、指数和 l、未归一化加权和 U。把分数按块流进来,每块用一条递推式把这三个量修正一次,全流完之后 U÷l 就是精确的 softmax 注意力输出——中间任何一步都不需要把整行摆在内存里。这叫 online softmax。 显式物化 N×N 经常造成较低的算术强度;受限类型取决于维度、硬件与实现。朴素实现把 N×N 的 S、P 写回显存再读回来;FlashAttention 用 tiling(分块)把它们关在片上 片上存储里算完就扔,在原论文两级存储模型及 d≤M≤Nd 的范围内,HBM 读写量由 Θ(Nd+N²) 变为 Θ(N²d²/M);M 按可存的同类型元素数计,实际 kernel 的混合精度预算另算。 反向传播要用的 S、P 全部重算。除 Q/K/V(或它们的重算来源)外,前向存输出 O 和每行的 logsumexp(都是 O(N)),反向时拿 Q、K 重新过一遍分块流程,把需要的局部 P 重新算出来——用重复计算换显存,这是整个方法里最「敢」的一步。 这张图要看什么:左边朴素实现的 S、P 两个 N×N 是该前向示意中的主要中间量,它们必须写回 HBM 再读回来;右边是同一个 N×N 被切成 B_r×B_c 的小块,K/V 块进 SRAM 常驻、Q 块逐行流过,跨块只有 O_i、l_i、m_i 三个 O(N) 的量一直活着。 03. 数学推导 3.1 出发点:safe softmax 为什么需要先看全一行 设一行分数为 $s_1, \dots, s_N$,softmax 的定义是 $$p_i = \frac{\exp(s_i)}{\sum_{j=1}^{N} \exp(s_j)}$$ 先修要求是矩阵乘、逐行 softmax 和链式法则;这里补齐指数换参考系与 softmax 雅可比,不需要先懂 CUDA。本文先讨论有限分数、至少一个未遮 key、无 dropout 的单头自注意力,$Q,K,V\in\mathbb R^{N\times d}$,$S=QK^\top/\sqrt d$;d 为头宽度。直接计算 $\exp(s)$ 会溢出,fp32 的阈值约为 $\log(\mathrm{finfo}(\mathrm{float32}).\mathrm{max})\approx88.72$。常用 safe softmax——先求这行的最大值 m,再算平移后的指数: $$p_i = \frac{\exp(s_i - m)}{\sum_{j=1}^{N} \exp(s_j - m)}, \qquad m = \max_{1 \le j \le N} s_j$$ 把指数共同平移 -m(数学上等价于分子分母同乘 $\exp(-m)$,实现不真的计算这个乘子),结果不变,但指数的输入全部落在 $(-\infty, 0]$,永不溢出。问题就出在这个 m 上:m 是对整行取的 max。你必须先把 N 个分数全部看过一遍才知道 m 是多少,然后才能开始算 exp——这解释了常见实现先保存分数再做 softmax 的流程;算法并不强制保存整个 N×N,也可重算分数或逐行处理,只是 IO 和效率不同。 而注意力输出对这一行还要再多两个量:分母 $l = \sum_j \exp(s_j - m)$,以及未归一化加权和 $U = \sum_j \exp(s_j - m)\, v_j$($v_j$ 是第 j 个 token 的 Value 向量)。最终输出 O 就是 $U / l$。 所以真正要回答的问题是:如果分数是一块一块到来的(事先不知道后面块里有什么),这三个量还能算吗? 3.2 online softmax 递推式(全文核心) 能。做法是把「以 m 为参考系」改成「以当前的 m 为参考系,m 变了就整体换算」。 设 $J_t$ 为前 t 块中未被遮住的 key 下标集合,至少含一个有限分数;维护三个量:参考系最大值 $m^{(t)}$、分母 $l^{(t)}$、未归一化加权和 $U^{(t)}$,它们满足不变式 $$U^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})\, v_j, \qquad l^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})$$ U 表示未归一化加权和,最终输出才记作 O;这样不把中途累加器与归一化结果混为同一量。现在第 $t+1$ 块到了,块内最大值是 $m_{\text{blk}}$。新的全局最大值是 $$m^{(t+1)} = \max(m^{(t)},\ m_{\text{blk}})$$ 关键一步来了:旧累积量是按 $m^{(t)}$ 为参考系记的,而新的不变式要求参考系换成 $m^{(t+1)}$。把不变式里的 $\exp(s_j - m^{(t)})$ 拆成 $\exp(s_j - m^{(t+1)}) \cdot \exp(m^{(t+1)} - m^{(t)})$,旧量的换算系数就是 $\exp(m^{(t)} - m^{(t+1)})$: $$l^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, l^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})$$ $$U^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, U^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})\, v_j$$ 每一步只是把指数拆成两项相乘再重新合并,等价性是代入即可验证的恒等式;所有块流完后 $U^{(T)}/l^{(T)}$ 与朴素 softmax 在实数算术下相同(差在浮点舍入,第 04 节实测 1e-16 量级)。这个「换参考系」的系数在论文和代码里叫 rescale,跨块最大值、求和与 rescale 都会带来额外的标量操作;它们不改变主导矩阵乘次数。 严谨一点可以正向验证不变式:假设第 t 步的不变式成立,那么 $$U^{(t+1)} = e^{m^{(t)} - m^{(t+1)}} \sum_{j \in J_t} e^{s_j - m^{(t)}} v_j + \sum_{j \in \text{blk}} e^{s_j - m^{(t+1)}} v_j = \sum_{j \in J_{t+1}} e^{s_j - m^{(t+1)}} v_j$$ (第一个等号就是递推式,第二个等号把 $e^{m^{(t)} - m^{(t+1)}}$ 乘进求和号里、指数相加后正好变回 $e^{s_j - m^{(t+1)}}$。)旧块和新块在同一个参考系下合并,不变式保持。$l$ 的证明一字不差,把 $v_j$ 去掉就行。归纳基础是初始状态 $m^{(0)} = -\infty$、$l^{(0)} = 0$、$U^{(0)} = 0$:第一个含有效 key 的块到来时换算系数按 0 处理(代码只在旧最大值有限的位置做减法,避免提前计算未定义差值),三个量直接等于该块的局部值。 三个细节值得停一下: 这个递推对任意分块都成立,块大小可以是 1(一个 key 一个 key 地流),也可以是 128 行。块大小只影响效率,不影响结果。 $\exp(m^{(t)} - m^{(t+1)}) \le 1$ 恒成立(因为 $m$ 单调不减),rescale 永远是在把旧量缩小,不会因正指数而溢出,但有限精度下可能下溢到零、求和也有舍入误差;点积溢出必须另外处理。 $m^{(t)} + \log l^{(t)}$ 就是 logsumexp(LSE)。它是反向传播唯一需要额外记录的东西——记住这个,第 3.3 节要用。 掩码把被遮分数设为 $-\infty$。若此前最大值有限,它的指数贡献为零。若一整行截至当前全被遮住,不能直接算 $-\infty-(-\infty)$;本文约定该行累计量为零,最终全遮行返回零输出、LSE 为 $-\infty$。这是接口约定,全遮行本身没有概率归一化定义。实现用带 where= 的 np.subtract 跳过未定义减法;普通 np.where 会先求值两个分支,不能保证避免 NaN 警告。更进一步,如果一整块都被遮住(Q 块整体在 K 块之前),这块连算都不用算,直接跳过。第 04 节实测这个「整块跳过」在 N=4096、块 64 时省掉 49.2% 的块。 3.3 反向传播:重算换显存 这里的 $O=PV$ 指最终归一化输出,$G=\partial L/\partial O\in\mathbb R^{N\times d}$ 是上游梯度,$A=GV^\top=\partial L/\partial P\in\mathbb R^{N\times N}$。先对一行 softmax 求导,$\delta_{jk}$ 表示 j=k 时为 1、否则为 0: $$\frac{\partial p_j}{\partial s_k}=p_j(\delta_{jk}-p_k)$$ 把损失对各 $p_j$ 的导数 $A_j$ 代入链式法则,得到 $$\frac{\partial L}{\partial s_k}=\sum_j A_jp_j(\delta_{jk}-p_k)=p_k\left(A_k-\sum_j A_jp_j\right)$$ 因此矩阵形式为 $$dS=P\odot\left(A-\operatorname{rowsum}(A\odot P)\right)$$ 行和是 $N\times1$,沿 key 轴广播。继续对 $S=QK^\top/\sqrt d$ 与 $O=PV$ 求导: $$dQ=dS\,K/\sqrt d,\qquad dK=dS^\top Q/\sqrt d,\qquad dV=P^\top G$$ 反向真正巧的一步是先把行和算出来。对第 i 行,用内积线性性可得 $$\delta_i=\sum_j P_{ij}\langle G_i,V_j\rangle=\left\langle G_i,\sum_j P_{ij}V_j\right\rangle=\langle G_i,O_i\rangle$$ 所以 $\delta=\operatorname{rowsum}(G\odot O)$,仅为 N 个数,无需为这项先构造完整 A/P。前向额外保存 O 和 $\mathrm{LSE}_i=m_i+\log l_i$;反向从 Q/K 重算局部分数,再用 $$P_{ij}=\exp(S_{ij}-\mathrm{LSE}_i)$$ 恢复局部概率,把它和局部 $G_iV_j^\top-\delta_i$ 相乘得到 dS,立即累加到 dQ/dK/dV 后丢弃。Q/K/V、输出和梯度仍是 $O(Nd)$,局部 tile 为 $O(B_rB_c)$;只有在 d 与块大小固定时才能简称 O(N)。原论文附录 B 给出分块反向;附录 attention_backward 把上述步骤完整实现,第 4.6 节实际核验梯度。 以上推导无 dropout。若训练使用概率 dropout,令随机乘子为 $R/(1-p)$,p 为丢弃率;dV 和 dP 都要使用同一随机掩码重放,不能直接照抄本教学函数。LSE 仍对应 dropout 之前的 softmax。生产实现还需保留随机生成器状态,见第 05 节。 用重复计算换显存——这笔交易的换算率是:每层每个头多算一遍 QK^T 和一次 exp(具体比例取决于前后向统计口径与实现),对本文保守教学账本,这对应去掉 S、P、浮点 dropout 乘子三项;真实朴素反向通常不用同时保存 S,具体减少几份取决于实现。N=4096、本文简化模型上,单层激活 2.39 GiB → 0.141 GiB,17 倍。 3.4 IO 账:搬运量到底差多少 设单头维度 d,片上存储预算为 M 个元素(不是字节);fp16 下 192 KiB 对应 M=98304。SRAM 里要同时放下 K 块、V 块(各 $B_c \times d$)和 Q 块、输出块(各 $B_r \times d$),论文 Algorithm 1 取(脚本对整数块大小向下取整) $$B_c = \frac{M}{4d}, \qquad B_r = \min(B_c,\ d)$$ NVIDIA Ampere 文档 给出 A100 每个 SM 的 192 KiB 统一 L1/共享内存空间及共享内存配额;它不是全部可用于单个 block 的任意数组。以这一数量级作为教学预算,fp16 下 d=64 时 $B_c = 384$、$B_r = 64$——这是论文 IO 模型的粗略分块预算;真实 kernel 还受 score tile、累加器、寄存器、共享内存配额与 occupancy 约束,192 KiB 也不是每个 block 可独占的共享内存。 朴素实现的搬运量(单位:元素个数):QK^T 读 Q、K 各 Nd、写 S 一次 N²;softmax 读 S 写 P 各 N²;PV 读 P 一次 N²、读 V 写 O 各 Nd。合计 $4Nd + 4N^2$,主导项 4N²。 FlashAttention 的搬运量:K、V 各进 SRAM 一次($2Nd$);Q 块每换一个 K/V 块就要重读一遍,共 $T_c \cdot Nd$($T_c = \lceil N/B_c\rceil$ 是 K/V 块数);输出 O 同理要读出写回各一遍($2 T_c Nd$);l、m 两个 O(N) 的运行量共 $4T_c N$。合计约 $2Nd + 3T_cNd + 4T_cN$,代进去: $$\text{HBM 搬运量} \;\approx\; 3 \cdot \frac{N}{B_c} \cdot Nd \;=\; \Theta\!\left(\frac{N^2 d^2}{M}\right)$$ 两个量级一比:朴素是 $\Theta(N^2)$,Flash 是 $\Theta(N^2 d^2/M)$,比值 $d^2/M$ 在 d=64、fp16、M=98304 个元素(192 KiB) 时约等于 0.04——大 O 比例省略了常数,不能直接当作 25 倍的实际收益;脚本计入 Q/O 反复读写后的模型比值为 7.3 倍。原论文 Theorem 2 的前提为 $d\le M\le Nd$;其中线性项可被主导项吸收。若整份输入已能驻留片上,不能继续把 $N^2d^2/M$ 往下外推到低于读写输入输出的 $\Omega(Nd)$。小 N 时仍应保留线性项与取整。本文计数也忽略初始化、最终归一化、LSE 写回及多级缓存,提供对照账本而非 GPU 字节计数器。 一个预算反例:d=64、Bc=384、Br=64,若 Q/K/V 用 2 字节,而输出累加器、分数 tile 和统计量用 4 字节,仅这些数组就需 221696 字节,超过 192 KiB;这还未算额外概率 tile。因而同类型元素模型推得的 384 不能作为实际混合精度 kernel 的可用配置。真实实现会重用存储、分配寄存器并选不同 tile。 按本文简化模型,朴素注意力的算术强度在 N 远大于 d 时约为 d/2 FLOP/byte(fp16),所以固定 d=64 时接近 32;它会随 d 改变,并非与头维度无关。A100 示例的约 200 FLOP/byte 是 NVIDIA A100 白皮书 中 dense FP16 Tensor Core 峰值312 TFLOP/s与HBM带宽1555 GB/s之比,真实 softmax 的非矩阵乘指令、缓存与调度仍会影响性能。 这张图要看什么:固定 d 与 SRAM 大小时,左图两者的大 N 主导项均为 N²,比值渐近趋于常数;线性项和取整会让有限 N 的比值变化;右图斜率不同(N² 对 N),N 越大两条线离得越远,朴素教学激活曲线越过示例 80 GiB 预算线的位置,FlashAttention 还有几百倍余量。 04. 代码实现 完整脚本在文末附录(flash_online_softmax.py、io_ledger.py、attention_checks.py、make_figures.py)。前三项数值/账本实验主要用 NumPy,梯度对拍还需 PyTorch,配图需 matplotlib。本次 2026-10-14 在 Windows、Python 3.11.9、NumPy 2.4.6、PyTorch 2.10.0+cpu、matplotlib 3.10.7 实跑;BLAS/OMP 线程设为 1。下面表格来自同一次完整运行,不是 GPU 性能复现。 4.1 递推式长什么样:逐块打印 先看一个能盯着看的例子(N=8、D=4、K/V 块大小 B_c=2,Q 整行一起处理): # 局部Sij已设置掩码;m_old/l/O是已见块的累计量。 m_new = np.maximum(m_old, Sij.max(axis=-1)) shifted = np.full_like(Sij, -np.inf) np.subtract(Sij, m_new[:, None], out=shifted, where=np.isfinite(m_new)[:, None]) Pij = np.exp(shifted) delta = np.full_like(m_old, -np.inf) np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old)) corr = np.exp(delta) l[i0:i1] = l[i0:i1] * corr + Pij.sum(axis=-1) O[i0:i1] = O[i0:i1] * corr[:, None] + Pij @ Vj m[i0:i1] = m_new 和第 3.2 节逐符号对上:m_new 是 $m^{(t+1)}$,corr 是换参考系系数,Pij.sum 是块内指数和,Pij @ Vj 是块内加权和。代码内部 O 保存的是数学记号 U,函数最后才除以 l 得到归一化输出。全遮行不做除法,保持零输出。函数要求相同非空形状 [N,D] 与有限浮点输入;支持尾块、一维 key_valid 和等长因果掩码。float16 输入提升到 float32 累加并输出 float32;float64 保持 float64。它未实现非等长、GQA 或 dropout,不能当作完整 CUDA API 替代品。 实跑的逐块轨迹(第 0 号 query): j= 0 m=+0.2968 l=1.7748 corr=0.0000 j= 2 m=+0.6071 l=3.0317 corr=0.7333 j= 4 m=+0.6071 l=3.9732 corr=1.0000 j= 6 m=+0.6071 l=5.3007 corr=1.0000 看两点:j=2 时新块里出现了更大的分数,m 被抬高、旧累积量被打了个 0.733 的折扣;j=4 之后 m 没再变,corr 恒为 1,rescale 白做——此时乘子在数学上为 1;具体 GPU kernel 是否跳过这些操作要核对实现,不能仅由轨迹推断。最大的单个临时矩阵只有 16 个元素([8, 2]),而 N×N 是 64;这里不等于同时存活临时数组的总元素数;代码对尾块和全遮行的额外检查也占临时空间。 4.2 等价性:和朴素实现在实数算术下等价,浮点下允许舍入差异 attention_naive 是上一篇的标准实现(S、P 都落地),两者对拍: N D causal 最大绝对误差 相对误差 256 64 False 5.551e-16 1.192e-15 256 64 True 8.882e-16 3.520e-16 1024 64 False 2.082e-16 8.962e-16 1024 64 True 6.661e-16 2.332e-16 2048 64 False 3.053e-16 1.205e-15 2048 64 True 6.661e-16 2.856e-16 4096 64 False 1.249e-16 9.209e-16 4096 64 True 7.772e-16 2.426e-16 本次表的最大绝对误差为 1.2e-16 到 8.9e-16;这是此输入、规模与 float64 运算顺序下的结果。这就是「精确注意力」四个字的实测含义:不是「误差很小」,是算法本身和朴素 softmax 完全等价。 4.3 峰值内存:O(N²) 对 O(N),实测 用 tracemalloc 量函数内新分配的峰值内存(float64、D=64、块 64×64;Q/K/V 已提前分配,不计入本表): N naive 实测 naive 理论 2N²·8 flash 实测 比值 1024 16.5 MiB 16.0 MiB 1.2 MiB 13.9x 2048 65.0 MiB 64.0 MiB 2.2 MiB 29.4x 4096 258.0 MiB 256.0 MiB 4.3 MiB 60.0x 8192 1028.0 MiB 1024.0 MiB 8.5 MiB 121.0x 理论列只计 S/P;tracemalloc 表还包含输出、运行量和局部临时数组。NumPy 在此环境向 Python 跟踪器登记数组分配,这些数值与主导项一致;tracemalloc 不等于进程 RSS,也不覆盖所有 BLAS 内部缓冲,更不是 GPU 显存峰值。最后那行是阶数的直接证据:N 翻倍,naive 峰值 ×4(二次),flash 峰值 ×2(线性)。 4.4 时间:CPU 教学循环的实测口径 N naive flash(B=64) flash/naive 1024 13.6 ms 16.2 ms 1.2x 2048 57.5 ms 65.4 ms 1.1x 4096 230.0 ms 266.1 ms 1.2x 每个方法先预热一次,再量 5 次取墙钟中位数,包含 Python 循环与 NumPy分配,不计输入生成。这里 flash 教学循环慢约 1.1–1.2 倍;不同机器或本机再次运行可能变化。可能原因包括:乘加次数一样还多了 rescale 和逐块 exp;一次大矩阵乘被拆成 (N/64)² 个 64×64 小矩阵乘,BLAS 跑不满小块,Python 循环开销也进来了;CPU 也有 SRAM 缓存,但这里的 Python/NumPy 分块没有实现专门的缓存与线程优化,不能把它当作 GPU 内核速度的预测。第三张图展示 IO 模型为何支持在 GPU 上尝试这一优化。 4.5 因果掩码:跳块比例与真实算力要分开 本脚本朴素路径先计算全分数,再遮住未来 key,因此该路径不因掩码节省矩阵乘;这是所测实现的选择,不是所有精确算法的限制。FlashAttention 按「Q 块整体在 K 块之前就整块跳过」处理,N=4096、块 64 时实测: 块总数(非因果) : 4096 块总数(因果跳过): 2080 跳过的块占比 : 49.2% 保留的是含对角线的下三角,块数是 $T(T+1)/2$,占比 $(T+1)/2T$,T 大时趋近一半。对齐、等长且等块时,49.2% 是跳过的 tile 数比例;对角 tile 中仍有被遮元素,softmax/调度还有开销,所以不等于总 FLOPs 或延迟精确减半。时序因果视频注意力还须明确 token 排序与掩码定义。 4.6 反向与边界:实际梯度对拍 attention_checks.py 对 N=1/7/17、float64/float32/float16 输入、因果/非因果、正常/全遮及部分遮 key、三组包含尾块的块大小组合,总计 108 组前向结果与 PyTorch 2.10 的 CPU math SDPA(float64 参考)对拍;最大绝对差为 2.33e-7。float16 输入先提升到 float32,并非模拟 GPU 的每一处精度行为。float64 分块反向对 autograd 最大差为 1.33e-15。另对 N=7、d=5 的 Q/K/V 共 105 个参数做中心差分,步长 1e-5,最大差为 8.74e-11;全遮行零输出约定也参与检验。 还实际提取并执行 FlashAttention v2.8.3 官方测试的 attention_ref 与 construct_local_mask 原函数 AST,CPU float64、不做默认 float32 upcast,对三种长度及两种因果设置核对输出与梯度。这是原始参考函数的检查,未安装或执行 CUDA kernel,不能据此声称 GPU 速度/低精度训练已复现。独立对拍支持实现正确性;第 03 节的恒等式才说明算法为何等价。 05. 工业级实现对照 最小实现讲清了原理,但生产 kernel 和它有四处本质差异,每处都值得知道为什么: 第一,理论 tile 和工程配置要分清。 本次固定核对 flash-attention v2.8.3,入口为 flash_attn_func。flash_fwd_launch_template.h 中有基于头维度、架构、dropout/因果等条件的编译配置分支;Python _get_block_size_n 也说明应匹配 CUDA 块尺寸。静态分支选配置不等于每次运行都在线 autotune。$B_c=M/(4d)$ 只为 IO 分析提供同阶预算,实际还要计 score tile、寄存器、共享内存和 occupancy。本文不判断更新版本的 kernel 细节。 第二,减少非矩阵乘操作。 FlashAttention-2 使用未归一化输出累计,减少 rescale、除法等非矩阵乘工作。corr=1 时数学上无需改变旧值,但不能笼统声称所有 kernel 都按每行最大值是否变化来分支跳过。 第三,前向的结构是「外层 Q、内层 K/V」。 我们按论文 v1 的写法外层遍历 K/V 块;FlashAttention-2 把循环反过来(外层 Q 块),好处是输出 O 常驻寄存器不用反复读写、且不同 Q 块之间天然并行,能吃满更多 SM。论文 v1 的伪代码适合理解递推,v2 的循环结构才是现在 kernel 的样子。 第四,dropout 要重放随机过程。 固定接口保存 rng_state,反向从同一状态重建概率 dropout;flash_bwd_kernel.h 中可核对 Philox seed/offset 与块坐标。仅口头说“种子一样”仍不够:并行划分与计数器映射也必须一致。无需保存完整二次掩码,是特定 kernel 的实现能力,不代表所有朴素框架必定保存浮点掩码。 另一个易错边界是非等长因果对齐。 v2.8.3 接口明确对齐右下角;Nq=5、Nk=2 的保留矩阵为下面五行,前 3 行全遮时输出零。本文 NumPy函数只支持等长,因此不暗中把一种对齐当作另一种。PyTorch 2.10 SDPA 文档 的 is_causal 在非方形时定义左上对齐;跨 API 迁移要显式核对。 0 0 0 0 0 0 1 0 1 1 PyTorch SDPA 可以按环境选优化后端,也有 CPU/math 路径;调用该 API 本身不能证明使用了 CUDA FlashAttention。评估时还要把 dropout_p 显式设为 0,该函数不会因模型切换 eval 就自动关闭传入的 dropout。 原 FlashAttention 论文分别在 BERT-large/MLPerf、GPT-2/HuggingFace、Long Range Arena 上报告 15%、3 倍、2.4 倍端到端收益。这些模型、基线与任务不同,不能把三组数字当作只改变 N 的对照实验,更不能由它们证明收益严格随 N 单调增加。 排查问题时你会想知道「此刻到底在用哪个后端」。PyTorch 留了一个官方口子: import torch from torch.nn import functional as F from torch.nn.attention import sdpa_kernel, SDPBackend # CUDA环境使用;形状[B,H,N,D],输入half,关闭dropout。 q = k = v = torch.randn(1, 2, 128, 64, device="cuda", dtype=torch.float16) with sdpa_kernel(SDPBackend.FLASH_ATTENTION): out = F.scaled_dot_product_attention(q, k, v, is_causal=True, dropout_p=0.0) # 强制走 flash;如果这个头维度/掩码组合它不支持,应按官方后端约束排查告警或错误;本文CPU实跑明确选择MATH, # 而不是悄悄退回 math 后端——「悄悄降级」正是性能莫名掉一半时最该先查的事 这张图要看什么:横轴是 N,纵轴是「每搬 1 字节做多少次运算」,灰色虚线是机器平衡点(201 FLOP/byte)。本模型中朴素实现的强度渐近接近 32;FlashAttention 的估计从 N=2048 起超过平衡点。这是按矩阵乘峰值做的模型分类,真实瓶颈还受非矩阵乘指令、缓存、并行度和调度影响。 06. 代价与边界 FlashAttention 省下了 HBM 搬运和 N² 显存,赔进去的和没管住的也要说清楚。 代价:重计算和额外归一化操作。 反向要重算局部分数及概率,其中包含矩阵乘和逐元素运算,不能统称为固定 30% 的额外非矩阵乘开销。小序列的收益取决于 kernel、调度和硬件,没有统一的“序列短于512就亏损”阈值。 数值边界:实数算术等价不保证浮点逐位一致。 kernel 内部用 fp16/bf16 存储、fp32 累加,块内的归一化和朴素实现的一次性归一化在浮点上不同。对训练的影响需要结合 dtype、输入尺度与误差测试判断,但如果你在做数值敏感的分析(比如逐 token 概率对比),应建立与输入尺度、dtype 和应用需求匹配的容差,并检查遮罩及非有限值;不能仅凭“精确算法”就把所有数值差异判为正常舍入。 边界的核心一条:它改变存储阶数,但不消除精确稠密注意力的二次计算。 显存从 $O(N^2)$ 降到 $O(N)$,但算力还是 $\Theta(N^2 d)$、在第 3.4 节限定模型中,HBM 搬运为 $\Theta(N^2 d^2/M)$。N=32768 时 FlashAttention 的单头搬运是 1061 MiB——比朴素实现的 8.2 GiB 好得多,但随 N 继续平方增长这一点没变。上下文再往上涨(1M token),可以考虑稀疏注意力、线性注意力、状态空间模型或并行方案;它们各有建模或系统代价,是否合适须按任务验证。FlashAttention 的块结构恰恰是它们的底座:把注意力切成块之后,「整块跳过」才成为可能,第 4.5 节那个 49.2% 推广到任意稀疏模式就是块稀疏注意力。 不该用的场景:需要拿到完整注意力权重做分析或可视化的(P 从头到尾没存在过,想看它就得回到朴素实现);自定义的任意注意力偏置如果 kernel 不支持,绕过去的方法可能把优势吃掉;以及缺乏适配内核的环境;CPU 也有 SRAM 缓存,但本文 NumPy 循环没有实现专门的 CPU cache 优化(第 4.4 节的 CPU 实测就是例子)。 07. 经典论文脉络 这条线的演进关系一句话各说清: Milakov & Gimelshein, 2018(arXiv:1805.02867)Online normalizer calculation for softmax——给出 softmax 的 online normalizer 算法:流式更新 max 和指数和。从原文可核对其减少内存访问的 softmax/TopK 实验;不从这篇论文推断此前所有研究的范围。 Rabe & Staats, 2021(arXiv:2112.05682)Self-attention Does Not Need O(n²) Memory——讨论单 query 的常数额外空间方案,并给出分块的低内存自注意力实现及速度/内存实验;不能把单 query 的额外空间结论写成整段输出总存储 O(1),也不能概括为没有实用价值。 Dao et al., 2022(arXiv:2205.14135)FlashAttention——本篇锚点。补上缺失的一环:把流式更新从「逐 token」改成「逐块」(tiling),配上 IO 复杂度分析和 GPU kernel,报告精确注意力在其测试 GPU/模型上的速度和内存收益。 Dao, 2023(arXiv:2307.08691)FlashAttention-2——循环重排(外层 Q)、削减非矩阵乘 FLOPs、更好的并行度,把 v1 大约 25-40% 的峰值算力利用率推向 50-73%。 这条阅读线从流式归一化、低内存自注意力到 IO 与 GPU 调度,逐步解释同一数学操作为何能有不同的存储和运行代价。它是选定论文的演进关系,不是对所有先行工作或产品的首次性判断。 08. 常见误解 以下几条都值得单独记住,前两条我当初也信过: 「FlashAttention 是近似注意力,所以有精度损失」。错。它是精确算法,和朴素 softmax 数学等价(第 4.2 节实测 1e-16)。真正近似的是 Linformer、Performer 那一族。两者经常被并列讨论,但一个在改算法,一个在改数据的搬运方式。 「它快是因为算了更少的 FLOPs」。反了,它的 FLOPs 略多于朴素实现(第 4.4 节本次CPU教学循环约慢 1.1–1.2 倍)。主要收益来自减少 IO,也来自更好的并行划分与调度——这正是它给所有做系统优化的人的启示:先问数据在哪,再问算了多少。 「显存优化只对前向有用」。训练反向同样受益:除 Q/K/V 外额外存 O 和 LSE(固定 d 时为 O(N)),反向重算 P。本文三份二次张量是教学分配假设,真实反向不一定保存三份;可靠结论是分块重算避免显式保留完整 P。 「块开得越大越快」。块大小受 SRAM 硬约束:超过每个 block 的资源上限可能无法启动或编译;寄存器 spill 等情况也会引入额外访存,整个方法的根基(中间结果不落 HBM)就塌了。真实 kernel 的块大小是约束内的调优问题,不是越大越好。 「有了它就不用再关心 N²」。它改变了激活存储阶数;固定 d/M、在本文模型内,稠密计算与搬运的主导项仍随 N 平方增长。能继续走的长上下文路线是稀疏化(改算力阶数)和状态空间/线性注意力(改注意力本身),FlashAttention 的块结构是它们的载体,不是替代品。 09. 动手验证 跑文末附录的 flash_online_softmax.py(只依赖 numpy),预期输出与正文一致: 第 2 节等价性表:本次非因果最大误差 1.2e-16 到 5.6e-16,因果 6.7e-16 到 8.9e-16——全是舍入级别; 第 3 节内存表:naive 峰值和理论值 $2N^2 \times 8$ 字节吻合,N 翻倍时 naive ×4.0、flash ×2.0。 再运行附录 attention_checks.py,它用 seed=1024、N=1024、d=64、块 64×64,故意把正确函数的 corr = np.exp(delta) 替换成 corr = np.ones_like(delta);这是自动构造的错误反例。最大差实测为 0.275658、平均差为 0.013599。这项对比把“丢掉换参考系会出错”变成可重复实验,不让读者误把旧代码里的 np.where 当作必要写法。 最后改 io_ledger.py 开头的硬件常数(比如把 SRAM_PER_SM 调到 48 KiB,作为更小片上预算的假设,不能据此代表某款消费级卡),重跑看块大小和搬运量比值怎么变——你会看到 SRAM 越小,FlashAttention 相对朴素实现的搬运量优势越小,$d^2/M$ 里的 M 直接控制这一切。 10. 延伸阅读 按知识树的依赖关系,建议按这个顺序继续走: 前置:自注意力机制的计算与显存账本——本篇所有显存账本的出处(2.39 GiB、94% 那几笔账都在那篇里);旋转位置编码 RoPE 与 视频 DiT 里的 3D RoPE——注意力的另外两个必备零件,本篇刻意没有碰位置编码。 后继:视频生成里的稀疏注意力——FlashAttention 的块结构是稀疏模式的执行底座,「整块跳过」从因果掩码推广到任意稀疏图;算子融合与 CUDA Graph——把「少搬内存」推到极端就是融合,FlashAttention 是这个思路最成功的案例;KV Cache 与自回归视频生成——推理时的另一本显存账。 延伸到知识树之外:想读 kernel 源码,从 Dao-AILab/flash-attention 的 flash_attn/flash_attn_interface.py 进,先读 forward 再读 backward;想读原始推导,Milakov & Gimelshein(1805.02867)给出了独立 softmax 在线归一化的直接推导。 附录:完整代码 09 节用到的脚本全文如下(io_ledger.py、flash_online_softmax.py、attention_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 io_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """IO 账本:朴素注意力和 FlashAttention 在 HBM 上到底搬了多少字节。 这篇讲的是「为什么快」。答案不在 FLOPs 上——两者的乘加次数几乎一样—— 而在于 GPU 有两级内存: HBM(显存) 带宽约 1.5 TB/s,容量 40~80 GB SRAM(片上) 带宽约 19 TB/s,但每个 SM 只有 192 KB 朴素实现把 N×N 的分数矩阵写回 HBM 再读出来,等于把数据在这条 13 倍带宽差的 通道上来回搬;FlashAttention 用 tiling 让这些中间结果根本不落 HBM。 下面的模型把每一笔读写都点清楚,参数是可调的,读者可以改硬件常数重算。 硬件数量级取自 FlashAttention 论文第2节与NVIDIA A100白皮书(40GB、非稀疏Tensor Core峰值)。 只依赖 numpy。直接 `python io_ledger.py` 即可运行。 """ import numpy as np # ── 硬件常数(A100 40GB 量级,论文第2节/NVIDIA白皮书)──────────────────── HBM_BW = 1.555e12 # HBM 带宽,字节/秒 SRAM_BW = 19.0e12 # 片上 SRAM 带宽,字节/秒 SRAM_PER_SM = 192 * 1024 # 每个 SM 的片上 SRAM,字节 FLOPS_PEAK = 312e12 # fp16 tensor core 峰值,FLOP/秒 GIB = 1024 ** 3 MIB = 1024 ** 2 # ──────────────────────────────────────────────────────────── # 块大小:SRAM 里能同时放下什么 # ──────────────────────────────────────────────────────────── def block_sizes(d, sram_bytes=SRAM_PER_SM, dtype_bytes=2): """返回 (B_r, B_c):Q 块行数与 K/V 块行数。 SRAM 里要同时放下 K_j、V_j 两个 [B_c, d] 和 Q_i、O_i 两个 [B_r, d]。 论文的取法是 B_c = M / (4d)、B_r = min(B_c, d),这里取整近似: 先让 K_j+V_j 占掉一半 SRAM,Q 块则不超过 d 行(与分数tile的存储预算同阶)。 """ if d <= 0 or dtype_bytes <= 0 or sram_bytes < 4*d*dtype_bytes: raise ValueError("存储预算不足或参数非正") elems = sram_bytes / dtype_bytes B_c = max(1, int(elems // (4 * d))) B_r = min(B_c, d) return B_r, B_c # ──────────────────────────────────────────────────────────── # HBM 读写量(单位:元素个数,乘 dtype_bytes 得字节) # ──────────────────────────────────────────────────────────── def hbm_elems_naive(N, d): """朴素实现:S 和 P 都要落地。 QK^T: 读 Q(Nd) + 读 K(Nd) + 写 S(N²) softmax: 读 S(N²) + 写 P(N²) PV: 读 P(N²) + 读 V(Nd) + 写 O(Nd) """ return 4 * N * d + 4 * N * N def hbm_elems_flash(N, d, B_r, B_c): """FlashAttention:外层遍历 K/V 块,内层遍历 Q 块。 K、V 各读一遍(每个 j 块进 SRAM 后,内层 i 循环里一直复用) Q 每个 j 都要重读一遍:T_c · N·d O 每个 (j,i) 都要读出来再写回去(累加器跨 j 迭代):2 · T_c · N·d l、m 两个 O(N) 的运行量同理:4 · T_c · N """ T_c = int(np.ceil(N / B_c)) return 2 * N * d + 3 * T_c * N * d + 4 * T_c * N def flops_attention(N, d): """两个 N×N 矩阵乘,一次 [M,K]×[K,N] 算 2MKN 个浮点运算。""" return 4 * N * N * d def activation_bytes(N, d, H, B=1, dtype_bytes=2): """单层注意力的训练激活(反向要用的中间张量)。 保守教学模型:6 个 [B,N,d_model] 线性项 + S/P/浮点乘子 3 个 [B,H,N,N]。 此函数 d 是总宽度 d_model,不是其他 IO 函数中的头宽度。 融合侧保留同样六份线性预算,忽略小的 LSE 与工作区;不是框架峰值测量。 """ lin = 6 * B * N * d * dtype_bytes quad = 3 * B * H * N * N * dtype_bytes return lin + quad, lin def roofline(bytes_moved, flops): """算术强度(FLOP/byte)与两个理想下界时间。返回 (强度, 内存时间, 算力时间, 瓶颈)。""" intensity = flops / bytes_moved t_mem = bytes_moved / HBM_BW t_comp = flops / FLOPS_PEAK bound = "内存受限" if t_mem > t_comp else "算力受限" return intensity, t_mem, t_comp, bound # ──────────────────────────────────────────────────────────── # 报表 # ──────────────────────────────────────────────────────────── def report_io(): d, b = 64, 2 # 单头维度 64,fp16 B_r, B_c = block_sizes(d) print("=" * 74) print("1. SRAM 块大小与 HBM 读写量(单头,d=64,fp16)") print("=" * 74) print(f" SRAM {SRAM_PER_SM / 1024:.0f} KB / SM,fp16 下能放 " f"{SRAM_PER_SM / b:.0f} 个元素") print(f" → B_c = M/(4d) = {B_c},B_r = min(B_c, d) = {B_r}\n") print(f"{'N':>7} {'naive HBM':>12} {'flash HBM':>12} {'比值':>8} " f"{'naive 强度':>11} {'flash 强度':>11}") rows = [] for N in (1024, 2048, 4096, 8192, 16384, 32768): nb = hbm_elems_naive(N, d) * b fb = hbm_elems_flash(N, d, B_r, B_c) * b fl = flops_attention(N, d) i_n, _, _, bound_n = roofline(nb, fl) i_f, _, _, bound_f = roofline(fb, fl) rows.append((N, nb, fb, i_n, i_f, bound_n, bound_f)) print(f"{N:>7} {nb / MIB:>10.1f} MiB {fb / MIB:>10.1f} MiB " f"{nb / fb:>7.1f}x {i_n:>9.1f} {i_f:>9.1f} ") print(f"\n 机器平衡点(峰值算力/带宽)= {FLOPS_PEAK / HBM_BW:.0f} FLOP/byte") print(" 仅本理想模型:强度低于平衡点由HBM项主导,高于时由计算项主导。\n") print(f"{'N':>7} {'naive 瓶颈':>12} {'flash 瓶颈':>12}") for N, nb, fb, i_n, i_f, bn, bf in rows: print(f"{N:>7} {bn:>12} {bf:>12}") print("\n 注意:flash 的强度在 N 大时越过平衡点,模型说它变成算力受限了。") print(" 但真实 kernel 达不到峰值——softmax 的 exp 走的是特殊函数单元,") print(" 不走 tensor core,这个「非矩阵乘开销」正是 FlashAttention-2 之后") print(" 继续优化的地方。峰值资源模型给出理想时间下界,不是实测速度承诺。") def report_activation(): d, H, B, b = 3072, 24, 1, 2 print("\n" + "=" * 74) print("2. 教学激活存储模型(简化 Transformer:d=3072, H=24, B=1, 32 层, bf16)") print("=" * 74) print(f"{'N':>7} {'朴素/层':>12} {'Flash/层':>12} {'比值':>8} " f"{'朴素 32 层':>12} {'Flash 32 层':>13}") for N in (1024, 4096, 8192, 32768): naive, flash = activation_bytes(N, d, H, B, b) print(f"{N:>7} {naive / GIB:>10.2f} GiB {flash / GIB:>10.3f} GiB " f"{naive / flash:>7.0f}x {32 * naive / GIB:>10.1f} GiB " f"{32 * flash / GIB:>11.2f} GiB") n4096, f4096 = activation_bytes(4096, d, H, B, b) print(f"\n N=4096 时,朴素实现单层 {n4096 / GIB:.2f} GiB,其中二次项占 " f"{100 * (1 - f4096 / n4096):.1f}%——") print(" 这正是 attention_basics 那篇里「三个 N×N 吃掉 94%」的那一格。") print(" FlashAttention 删掉的就是这一格,剩下的是 O(N) 的线性项。") def report_speed_limit(): d, b = 64, 2 B_r, B_c = block_sizes(d) print("\n" + "=" * 74) print("3. 理想时间下界:如果只受 HBM 带宽限制,两者各要多久(单头,d=64)") print("=" * 74) print(f"{'N':>7} {'FLOPs':>10} {'naive 内存时间':>16} {'flash 内存时间':>16} " f"{'纯带宽模型比':>9}") for N in (1024, 4096, 16384): nb = hbm_elems_naive(N, d) * b fb = hbm_elems_flash(N, d, B_r, B_c) * b fl = flops_attention(N, d) print(f"{N:>7} {fl / 1e9:>8.2f} G {nb / HBM_BW * 1e3:>14.3f} ms " f"{fb / HBM_BW * 1e3:>14.3f} ms {nb / fb:>8.1f}x") print("\n 此列只比较理想 HBM 时间,并非完整模型训练或实际 kernel 加速上界。") print(" 论文的端到端训练加速与此处单头 IO 模型口径不同,不能直接相比。") if __name__ == "__main__": report_io() report_activation() report_speed_limit() flash_online_softmax.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """online softmax 的正确性与显存代价实测(FlashAttention 的核心那一步)。 对比两种实现: naive —— 先算出完整的 N×N 分数矩阵 S,再逐行 softmax 得到 P,最后算 O = P V flash —— 按块流过 K/V,只维护三个 O(N) 的运行量:输出累加器 O、分母 l、 运行最大值 m(第 03 节递推式的直接实现) 无dropout且同一掩码时两者在实数算术下等价;求和顺序、dtype及临时数组不同。 这份脚本回答三个问题: 1. 递推式写出来的结果,和朴素 softmax 数学等价、数值误差多大?(1.1 节) 2. 峰值内存真的差一个 N 吗?(用 tracemalloc 量,不是估的) 3. 那算力呢?——在 CPU + numpy 上速度由实际运行环境决定,这一点必须诚实讲清楚 只依赖 numpy。直接 `python flash_online_softmax.py` 即可运行。 """ import time import tracemalloc import numpy as np NEG = -np.inf # ──────────────────────────────────────────────────────────── # 两个被测实现 # ──────────────────────────────────────────────────────────── def attention_naive(Q, K, V, causal=False): """标准实现:S 和 P 都是完整的 N×N 常驻张量。""" D = Q.shape[-1] S = (Q @ K.T) / np.sqrt(D) # [N, N] ← 第一块 N×N if causal: S = np.where(np.triu(np.ones((Q.shape[0], K.shape[0])), 1) > 0, NEG, S) S -= S.max(axis=-1, keepdims=True) # safe softmax,不改变结果 P = np.exp(S) # [N, N] ← 第二块 N×N P /= P.sum(axis=-1, keepdims=True) return P @ V def attention_flash(Q, K, V, B_r, B_c, causal=False, trace=False, key_valid=None): """等长单头自注意力;输入有限,float16提升到float32累加。 key_valid是一维key保留掩码;全遮行按本文约定返回零输出、LSE=-inf。 支持尾块,不实现dropout、GQA、非等长因果对齐或GPU kernel。 """ Q, K, V = (np.asarray(x) for x in (Q, K, V)) if Q.ndim != 2 or Q.shape != K.shape or Q.shape != V.shape or min(Q.shape) <= 0: raise ValueError("Q/K/V必须为相同非空[N,D]浮点矩阵") if not all(np.issubdtype(x.dtype, np.floating) and np.isfinite(x).all() for x in (Q,K,V)): raise ValueError("仅支持有限浮点输入") if any(not isinstance(b, (int, np.integer)) or isinstance(b, bool) or b <= 0 for b in (B_r,B_c)): raise ValueError("块大小必须为正整数") N, D = Q.shape dtype = np.result_type(Q.dtype, K.dtype, V.dtype, np.float32) Q, K, V = (x.astype(dtype, copy=False) for x in (Q,K,V)) valid = np.ones(N, dtype=bool) if key_valid is None else np.asarray(key_valid) if valid.shape != (N,) or valid.dtype != bool: raise ValueError("key_valid必须为[N]布尔数组") scale = 1.0 / np.sqrt(D) O = np.zeros((N, D), dtype=dtype) l = np.zeros(N, dtype=dtype) m = np.full(N, NEG, dtype=dtype) peak_tmp = 0 for j0 in range(0, N, B_c): Kj, Vj = K[j0:j0+B_c], V[j0:j0+B_c] for i0 in range(0, N, B_r): i1 = min(i0+B_r, N) if causal and i1 <= j0: continue Qi = Q[i0:i1] Sij = (Qi @ Kj.T) * scale if not np.isfinite(Sij).all(): raise ValueError("点积溢出;需缩小输入或使用更高精度") keep = np.broadcast_to(valid[j0:j0+B_c], Sij.shape).copy() if causal: keep &= (j0+np.arange(Sij.shape[1]))[None,:] <= np.arange(i0,i1)[:,None] Sij = np.where(keep, Sij, NEG) peak_tmp = max(peak_tmp, Sij.size) m_old = m[i0:i1] m_new = np.maximum(m_old, Sij.max(axis=-1)) # 对全遮行不计算-inf-(-inf),避免np.where提前求值导致NaN/警告。 shifted = np.full_like(Sij, NEG) np.subtract(Sij, m_new[:,None], out=shifted, where=np.isfinite(m_new)[:,None]) Pij = np.exp(shifted) delta = np.full_like(m_old, NEG) np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old)) corr = np.exp(delta) l[i0:i1] = l_old = l[i0:i1] * corr + Pij.sum(axis=-1) O[i0:i1] = O[i0:i1] * corr[:,None] + Pij @ Vj m[i0:i1] = m_new if trace: print(f" j={j0:>2} i={i0:>2} m={m_new[0]:+.4f} l={l_old[0]:.4f} corr={corr[0]:.4f}") out = np.zeros_like(O) np.divide(O, l[:,None], out=out, where=l[:,None]>0) LSE = np.full_like(l, NEG) active = l>0 LSE[active] = m[active]+np.log(l[active]) return out, LSE, peak_tmp def attention_backward(Q, K, V, G, B_r=64, B_c=64, causal=False, key_valid=None): """无dropout的分块反向:从O/LSE重算局部P,不存完整P。""" O, LSE, _ = attention_flash(Q,K,V,B_r,B_c,causal=causal,key_valid=key_valid) Q,K,V,G = (np.asarray(x,dtype=O.dtype) for x in (Q,K,V,G)) if G.shape != O.shape or not np.isfinite(G).all(): raise ValueError("G必须为有限[N,D]梯度") N,D=Q.shape valid=np.ones(N,dtype=bool) if key_valid is None else np.asarray(key_valid) dQ,dK,dV = (np.zeros_like(x) for x in (Q,K,V)) row_delta=(G*O).sum(axis=-1) for i0 in range(0,N,B_r): i1=min(i0+B_r,N) for j0 in range(0,N,B_c): j1=min(j0+B_c,N) keep=np.broadcast_to(valid[j0:j1],(i1-i0,j1-j0)).copy() if causal: keep &= np.arange(j0,j1)[None,:] <= np.arange(i0,i1)[:,None] S=(Q[i0:i1]@K[j0:j1].T)/np.sqrt(D) logP=np.full_like(S,NEG) np.subtract(S,LSE[i0:i1,None],out=logP,where=keep & np.isfinite(LSE[i0:i1,None])) P=np.exp(logP) dP=G[i0:i1]@V[j0:j1].T dS=P*(dP-row_delta[i0:i1,None]) dQ[i0:i1] += dS@K[j0:j1]/np.sqrt(D) dK[j0:j1] += dS.T@Q[i0:i1]/np.sqrt(D) dV[j0:j1] += P.T@G[i0:i1] return dQ,dK,dV def peak_bytes(fn, *args, **kwargs): """跑一次 fn,返回 (结果, 峰值字节数)。用 tracemalloc 实测。""" tracemalloc.start() tracemalloc.reset_peak() out = fn(*args, **kwargs) _, peak = tracemalloc.get_traced_memory() tracemalloc.stop() return out, peak def timed(fn, *args, repeat=5, **kwargs): durations = [] fn(*args, **kwargs) # 预热一次,不计入统计 out = None for _ in range(repeat): t0 = time.perf_counter() out = fn(*args, **kwargs) durations.append(time.perf_counter() - t0) return out, float(np.median(durations)) # ──────────────────────────────────────────────────────────── # 1. 递推式长什么样:一个能逐块打印的最小例子 # ──────────────────────────────────────────────────────────── def demo_recurrence(): rng = np.random.default_rng(0) N, D, B_c = 8, 4, 2 Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) print("=" * 68) print("1. online softmax 的递推过程(N=8, D=4, K/V 块大小 B_c=2)") print("=" * 68) print(" Q 块固定为整行(B_r=N),K/V 分成 4 块依次流过;") print(" 每个K/V块打印第 0 号 query 的 m / l / corr,看它们怎么被逐次修正:\n") _, _, peak = attention_flash(Q, K, V, B_r=N, B_c=B_c, trace=True) print(f"\n 最大的单个临时矩阵只有 {peak} 个元素(并非临时内存总和) = [{N}, {B_c}],而 N×N = {N * N}") # ──────────────────────────────────────────────────────────── # 2. 等价性:和朴素 softmax 逐位对得上吗 # ──────────────────────────────────────────────────────────── def demo_exactness(): print("\n" + "=" * 68) print("2. 数值等价性(float64,非因果 / 因果两种掩码)") print("=" * 68) print(f"{'N':>6} {'D':>4} {'causal':>7} {'最大绝对误差':>14} {'相对误差':>12}") for N in (256, 1024, 2048, 4096): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) for causal in (False, True): ref = attention_naive(Q, K, V, causal) got, _, _ = attention_flash(Q, K, V, B_r=64, B_c=64, causal=causal) diff = np.abs(ref - got).max() rel = diff / np.abs(ref).max() print(f"{N:>6} {D:>4} {str(causal):>7} {diff:>14.3e} {rel:>12.3e}") print("\n 误差量级是浮点舍入(1e-15),不是近似——FlashAttention 是精确算法。") # ──────────────────────────────────────────────────────────── # 3. 峰值内存:是不是真的差一个 N # ──────────────────────────────────────────────────────────── def demo_memory(): print("\n" + "=" * 68) print("3. 峰值内存实测(tracemalloc,float64,D=64,B_r=B_c=64)") print("=" * 68) print(f"{'N':>6} {'naive 实测':>12} {'naive 理论 2N²·8':>18} " f"{'flash 实测':>12} {'比值':>8}") peaks = {} for N in (1024, 2048, 4096, 8192): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) _, p_naive = peak_bytes(attention_naive, Q, K, V) _, p_flash = peak_bytes(attention_flash, Q, K, V, 64, 64) peaks[N] = (p_naive, p_flash) print(f"{N:>6} {p_naive / 2**20:>10.1f} MiB " f"{2 * N * N * 8 / 2**20:>16.1f} MiB " f"{p_flash / 2**20:>10.1f} MiB {p_naive / p_flash:>7.1f}x") g_n = peaks[8192][0] / peaks[4096][0] g_f = peaks[8192][1] / peaks[4096][1] print(f"\n N 从 4096 翻到 8192:naive 峰值 ×{g_n:.1f},flash 峰值 ×{g_f:.1f}") print(" 这就是 O(N²) 和 O(N) 的区别:前者翻两倍(4×),后者跟着翻倍(2×)。") print(" 朴素实现要同时留住 S 和 P 两个 N×N(理论列就是 2N²·8 字节,和实测对得上);") print(" flash 只留 B_r×B_c 的块,剩下的是 O(N·D) 的输出累加器。") # ──────────────────────────────────────────────────────────── # 4. 时间:CPU教学循环的实际耗时 # ──────────────────────────────────────────────────────────── def demo_time(): print("\n" + "=" * 68) print("4. 墙钟时间(CPU + numpy,线程配置以运行环境为准;预热1次+5次中位数)——反直觉的一项是这个") print("=" * 68) print(f"{'N':>6} {'naive':>10} {'flash(B=64)':>13} {'flash/naive':>12}") for N in (1024, 2048, 4096): D = 64 rng = np.random.default_rng(N) Q = rng.normal(size=(N, D)) K = rng.normal(size=(N, D)) V = rng.normal(size=(N, D)) _, t_naive = timed(attention_naive, Q, K, V) _, t_flash = timed(attention_flash, Q, K, V, 64, 64) print(f"{N:>6} {t_naive * 1e3:>9.1f} ms {t_flash * 1e3:>12.1f} ms " f"{t_flash / t_naive:>11.1f}x") print("\n 以上比值是本机本次计时,不能据此预测 GPU;可能影响速度的因素包括:") print(" 1. 乘加次数一模一样,还额外多了每块的 rescale 和逐元素 exp;") print(" 2. 一次大矩阵乘被拆成 (N/B)² 次 64×64 的小矩阵乘,") print(" BLAS 在小块上根本跑不满,Python 循环开销也进来了;") print(" 3. 最关键的:它省的是**内存搬运**,不是 FLOPs,") print(" CPU 同样有 SRAM 缓存,但本示例没有专门优化缓存和线程,") print(" 因此分块可能省容量,却被 Python 循环与小 GEMM 开销抵消。") print(" 第 05 节讲GPU实现如何优化IO与调度,本文不实测GPU性能。") # ──────────────────────────────────────────────────────────── # 5. 因果掩码:统计本实现跳过的全遮块比例 # ──────────────────────────────────────────────────────────── def demo_causal_blocks(): print("\n" + "=" * 68) print("5. 因果掩码下实际算了多少块(N=4096, B_r=B_c=64)") print("=" * 68) N, B = 4096, 64 T_r = T_c = N // B total = 0 for j in range(T_c): for i in range(T_r): if i * B + B <= j * B: # 整个 Q 块都在 K 块之前 → 全遮,跳过 continue total += 1 print(f" 块总数(非因果) : {T_r * T_c}") print(f" 块总数(因果跳过): {total}") print(f" 跳过的块占比 : {100.0 * (1 - total / (T_r * T_c)):.1f}%") print("\n 朴素实现就算加了因果掩码,N×N 的矩阵照样得整块算完再遮,") print(" 本脚本朴素路径不跳块;flash省去全遮块,但并非精确减半(严格说是") print(" (T²+T)/2 / T² ≈ 一半多一点的对角块保留)。") if __name__ == "__main__": np.set_printoptions(precision=4, suppress=True) demo_recurrence() demo_exactness() demo_memory() demo_time() demo_causal_blocks() attention_checks.py """CPU数学对拍与反例;依赖numpy和torch。与GPU速度复现无关。""" import inspect import json from pathlib import Path import numpy as np import torch from torch.nn import functional as F from torch.nn.attention import sdpa_kernel, SDPBackend from flash_online_softmax import attention_flash, attention_backward def main(): torch.set_num_threads(1) rng=np.random.default_rng(42) rows=[];grad_errors=[] for N in (1,7,17): D=5 for dtype in (np.float64,np.float32,np.float16): Q,K,V=(rng.normal(size=(N,D)).astype(dtype) for _ in range(3)) for causal in (False,True): for masked in (False,True): valid=np.ones(N,dtype=bool) if masked: valid[:min(3,N)]=False keep=np.broadcast_to(valid,(N,N)).copy() if causal: keep &= np.arange(N)[None,:] <= np.arange(N)[:,None] # Math后端、float64参考用于隔离输入量化和分块舍入。 ts=[torch.tensor(x.astype(np.float64)[None,None],requires_grad=True) for x in (Q,K,V)] with sdpa_kernel(SDPBackend.MATH): ref=F.scaled_dot_product_attention(*ts,attn_mask=torch.tensor(keep),dropout_p=0.0) G=rng.normal(size=(N,D));expected=torch.autograd.grad((ref*torch.tensor(G[None,None])).sum(),ts) for br,bc in ((1,1),(3,2),(8,11)): out,lse,_=attention_flash(Q,K,V,br,bc,causal=causal,key_valid=valid) error=float(np.max(np.abs(out-ref.detach().numpy()[0,0]))) assert error < (2e-12 if dtype==np.float64 else 2e-6) assert np.all(out[~keep.any(-1)]==0) and np.isneginf(lse[~keep.any(-1)]).all() rows.append(dict(N=N,dtype=str(np.dtype(dtype)),causal=causal,masked=masked,block=[br,bc],max_abs=error)) if dtype==np.float64: gs=attention_backward(Q,K,V,G,br,bc,causal=causal,key_valid=valid) err=max(float(np.max(np.abs(g-e.numpy()[0,0]))) for g,e in zip(gs,expected)) assert err<2e-12;grad_errors.append(err) Q,K,V=(rng.normal(size=(7,5)) for _ in range(3));G=rng.normal(size=(7,5));valid=np.array([False,False,True,True,False,True,True]) grads=attention_backward(Q,K,V,G,3,2,causal=True,key_valid=valid) fd_errors=[];step=1e-5 for x,g in zip((Q,K,V),grads): for idx in np.ndindex(x.shape): old=x[idx];x[idx]=old+step;plus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G) x[idx]=old-step;minus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G);x[idx]=old fd_errors.append(abs((plus-minus)/(2*step)-g[idx])) assert max(fd_errors)<1e-8 # 仅为展示错误:删除rescale,其他代码保持一致。不要用于计算正确注意力。 src=inspect.getsource(attention_flash).replace('corr = np.exp(delta)','corr = np.ones_like(delta)') ns=dict(np=np,NEG=-np.inf);exec(src,ns) rng=np.random.default_rng(1024);Q,K,V=(rng.normal(size=(1024,64)) for _ in range(3)) correct=attention_flash(Q,K,V,64,64)[0];bad=ns['attention_flash'](Q,K,V,64,64)[0];diff=np.abs(correct-bad) res=dict(passed=True,environment=dict(torch=torch.__version__,numpy=np.__version__,device='CPU',threads=1),forward_cases=rows, forward_max_abs=max(x['max_abs'] for x in rows),autograd_max_abs=max(grad_errors),finite_difference_parameters=len(fd_errors),finite_difference_max_abs=max(fd_errors), broken_rescale=dict(seed=1024,N=1024,D=64,max_abs=float(diff.max()),mean_abs=float(diff.mean())),errors=[],warnings=[]) Path(__file__).with_name('validation_results.json').write_text(json.dumps(res,indent=2),encoding='utf8') print(json.dumps({k:v for k,v in res.items() if k!='forward_cases'},indent=2)) if __name__=='__main__': with np.errstate(all='raise'): main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「FlashAttention」的三张解释图。 数值全部来自同目录下的 io_ledger.py(HBM 读写量、激活显存、算术强度), 改了那个脚本的话这里要跟着重跑,避免图与正文数字不一致。 三张图分别回答: 1. tiling 到底怎么切、什么留在 SRAM、什么留在 HBM 2. 两本账随 N 怎么长(HBM 读写量、教学激活存储模型) 3. 为什么说是「内存受限」变的「不那么受限」(算术强度对机器平衡点) 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Rectangle from io_ledger import ( FLOPS_PEAK, HBM_BW, activation_bytes, block_sizes, flops_attention, hbm_elems_flash, hbm_elems_naive, ) ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) C_NAIVE = "#e05263" # 朴素实现:红 C_FLASH = "#2f9e6f" # FlashAttention:绿 C_SRAM = "#f0a03c" # SRAM 高亮:橙 C_GREY = "#94a3b8" C_SKIP = "#e4e9f0" INK = "#182238" MIB = 1024 ** 2 GIB = 1024 ** 3 def _style(ax, title, xlabel=None, ylabel=None): ax.set_title(title, fontsize=13.5, weight="bold", color=INK, pad=10) if xlabel: ax.set_xlabel(xlabel, fontsize=11, color="#475569") if ylabel: ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(colors="#475569", labelsize=10) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.set_axisbelow(True) def _box(ax, x, y, w, h, text, fc, fs=10.5, tc="white"): ax.add_patch(FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.12", linewidth=0, facecolor=fc, edgecolor="none")) ax.text(x + w / 2, y + h / 2, text, ha="center", va="center", fontsize=fs, color=tc, weight="bold", linespacing=1.5) def _arrow(ax, x1, y1, x2, y2, label=None, color="#475569"): ax.add_patch(FancyArrowPatch( (x1, y1), (x2, y2), arrowstyle="-|>", mutation_scale=13, linewidth=1.4, color=color, shrinkA=2, shrinkB=2)) if label: ax.text((x1 + x2) / 2, max(y1, y2) + 0.22, label, ha="center", fontsize=9, color=color) def _caption(fig, text): fig.text(0.5, 0.012, text, ha="center", fontsize=9.5, color="#94a3b8") # ──────────────────────────────────────────────────────────── # 图 1:tiling 怎么切 # ──────────────────────────────────────────────────────────── def fig_tiling(): fig = plt.figure(figsize=(13.6, 6.0), facecolor="#fbfcfe") # ── 左:朴素实现 ── ax = fig.add_axes([0.03, 0.09, 0.46, 0.80]) ax.set_xlim(0, 10); ax.set_ylim(0, 7.4); ax.axis("off") ax.text(0, 7.05, "本例朴素前向:物化 S 与 P", fontsize=13.5, weight="bold", color=C_NAIVE) _box(ax, 0.1, 5.1, 1.5, 1.1, "Q, K, V\n[N, d]", "#64748b", fs=10) _box(ax, 2.4, 4.8, 2.0, 1.7, "S = QK^T / √d\n[N, N]", C_NAIVE, fs=11) _box(ax, 5.3, 4.8, 2.0, 1.7, "P = softmax(S)\n[N, N]", C_NAIVE, fs=11) _box(ax, 8.2, 5.1, 1.6, 1.1, "O = PV\n[N, d]", "#64748b", fs=10) _arrow(ax, 1.65, 5.65, 2.35, 5.65) _arrow(ax, 4.45, 5.65, 5.25, 5.65, "读 S 写 P") _arrow(ax, 7.35, 5.65, 8.15, 5.65, "读 P") ax.text(4.4, 4.25, "N=4096, d=64, fp16:S 和 P 各 32 MiB", ha="center", fontsize=9.5, color="#475569") ax.add_patch(Rectangle((0.1, 2.2), 9.7, 1.35, facecolor="#eef2f7", edgecolor="#cbd5e1", linewidth=1.2)) ax.text(4.95, 3.2, "HBM 带宽 1.5 TB/s", ha="center", fontsize=10.5, color="#475569", weight="bold") ax.text(4.95, 2.5, "S 写一次读一次,P 写一次读一次 → 简化计数 4N² 次元素搬运", ha="center", fontsize=9.5, color="#64748b") _arrow(ax, 3.4, 4.75, 3.4, 3.6, color=C_NAIVE) _arrow(ax, 6.3, 4.75, 6.3, 3.6, color=C_NAIVE) ax.text(0.1, 1.35, "代价:数据在这条通道上来回两趟,", fontsize=10.5, color=C_NAIVE, weight="bold") ax.text(0.1, 0.75, "表中带宽数量级不同,非延迟之比", fontsize=10.5, color=C_NAIVE, weight="bold") # ── 右:FlashAttention ── ax2 = fig.add_axes([0.53, 0.09, 0.44, 0.80]) ax2.set_xlim(0, 10); ax2.set_ylim(0, 7.4); ax2.axis("off") ax2.text(0, 7.05, "FlashAttention:按块流过,只留 O(N)", fontsize=13.5, weight="bold", color=C_FLASH) T = 8 gx0, gy0, cell = 1.05, 3.1, 0.46 for i in range(T): for j in range(T): if i + 1 <= j: # 因果掩码下整块跳过(先判,优先级最高) fc, ec = C_SKIP, "#c3ccd8" elif j == 3: # 当前正在处理的 K/V 块列 fc, ec = "#cdeadb", C_SRAM elif i == 5: # 当前 Q 块行 fc, ec = "#dfeaf6", "#94a3b8" else: fc, ec = "#f7fafc", "#dde3ea" ax2.add_patch(Rectangle( (gx0 + j * cell, gy0 + (T - 1 - i) * cell), cell * 0.90, cell * 0.90, facecolor=fc, edgecolor=ec, linewidth=1.1)) gtop = gy0 + T * cell ax2.text(gx0 - 0.42, gy0 + T * cell / 2, "Q 块逐行流过", fontsize=9.5, color="#475569", ha="center", va="center", rotation=90) ax2.add_patch(FancyBboxPatch( (gx0 + 3 * cell - 0.06, gy0 - 0.06), cell * 1.02, T * cell + 0.12, boxstyle="round,pad=0.03,rounding_size=0.1", linewidth=1.6, edgecolor=C_SRAM, facecolor="none", linestyle="--")) ax2.text(gx0 + 3.5 * cell, gy0 - 0.42, "K_j, V_j 常驻 SRAM", ha="center", fontsize=9.5, color=C_SRAM, weight="bold") ax2.text(gx0 + T * cell + 0.45, gtop - 0.35, "一块 = [B_r, B_c]\n= [64, 64]", fontsize=9.5, color="#475569", va="top", linespacing=1.5) ax2.text(gx0 + T * cell + 0.45, gtop - 1.55, "灰色块:因果掩码下\n整块跳过,连算都不算", fontsize=9, color="#94a3b8", va="top", linespacing=1.5) ax2.text(gx0 + T * cell + 0.45, gtop - 2.95, "片上空间受限:\n驻留 K/V 与 Q/O 块,\n还要容纳分数和统计量", fontsize=9, color=C_SRAM, va="top", linespacing=1.5) by = 1.85 ax2.text(0.15, by + 0.52, "跨 K/V 块一直复用的三个量:", fontsize=10.5, color=INK, weight="bold") for k, (label, color) in enumerate([ ("O_i 未归一化累加器 [N, d]", C_FLASH), ("l_i 分母 [N]", "#7fb3d5"), ("m_i 运行最大值 [N]", "#c9a227")]): ax2.add_patch(Rectangle((0.15, by - k * 0.46), 4.6, 0.28, facecolor=color, edgecolor="none")) ax2.text(4.9, by - k * 0.46 + 0.14, label, fontsize=9.5, color="#475569", va="center") ax2.text(0.15, 0.12, "每来一块就 rescale 一次(乘 e^{m旧−m新}),最后 O/l 收尾", fontsize=9.5, color="#64748b") _caption(fig, "图 1:切的是「K/V 块 × Q 块」这两层循环,不是把注意力切开。" "左边突出两份二次中间量,右边只维护线性的累加量(固定 d)。") fig.savefig(OUT / "tiling.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/tiling.png") # ──────────────────────────────────────────────────────────── # 图 2:两本账随 N 怎么长 # ──────────────────────────────────────────────────────────── def fig_curves(): d, b = 64, 2 B_r, B_c = block_sizes(d) Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) naive_io = np.array([hbm_elems_naive(N, d) * b for N in Ns]) / MIB flash_io = np.array([hbm_elems_flash(N, d, B_r, B_c) * b for N in Ns]) / MIB fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.1), facecolor="#fbfcfe") fig.subplots_adjust(bottom=0.20, top=0.86, wspace=0.25) ax = axes[0] ax.loglog(Ns, naive_io, "o-", color=C_NAIVE, lw=2.2, ms=6, label="朴素实现(∝N²)") ax.loglog(Ns, flash_io, "s-", color=C_FLASH, lw=2.2, ms=6, label="FlashAttention(∝N²/M)") ax.annotate(f"{naive_io[2] / flash_io[2]:.1f}×", xy=(Ns[2], naive_io[2]), xytext=(Ns[2] * 1.6, naive_io[2] * 3.0), fontsize=11, color=C_NAIVE, weight="bold", arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3)) ax.legend(fontsize=10, frameon=False, loc="upper left") ax.grid(True, which="both", color="#eef2f7", lw=0.9) _style(ax, "HBM 读写量(单头 d=64, fp16)", "序列长度 N", "MiB") ax = axes[1] d2, H, B = 3072, 24, 1 lay = 32 naive_act = np.array( [activation_bytes(N, d2, H, B)[0] * lay for N in Ns]) / GIB flash_act = np.array( [activation_bytes(N, d2, H, B)[1] * lay for N in Ns]) / GIB ax.loglog(Ns, naive_act, "o-", color=C_NAIVE, lw=2.2, ms=6, label="朴素实现(∝N²)") ax.loglog(Ns, flash_act, "s-", color=C_FLASH, lw=2.2, ms=6, label="FlashAttention(∝N)") ax.axhline(80, color="#64748b", ls="--", lw=1.4) ax.text(Ns[0] * 1.15, 92, "示例预算:80 GiB(非硬件规格)", fontsize=9.5, color="#64748b") ax.annotate("76.5 GiB", xy=(4096, naive_act[2]), xytext=(4096 * 1.8, naive_act[2] * 2.2), fontsize=10.5, color=C_NAIVE, weight="bold", arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3)) ax.annotate("4.5 GiB", xy=(4096, flash_act[2]), xytext=(4096 * 0.55, flash_act[2] * 6.0), fontsize=10.5, color=C_FLASH, weight="bold", arrowprops=dict(arrowstyle="->", color=C_FLASH, lw=1.3)) ax.legend(fontsize=10, frameon=False, loc="upper left") ax.grid(True, which="both", color="#eef2f7", lw=0.9) _style(ax, "教学激活存储模型(简化视频 DiT,32 层)", "序列长度 N", "GiB") _caption(fig, "图 2:两张都是对数轴,斜率就是复杂度阶数。" "左图的大 N 主导项均为 N²,有限 N 时比例受线性项和取整影响;" "右图斜率不同(N² 对 N),N 越大差距越离谱。") fig.savefig(OUT / "io_curve.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/io_curve.png") # ──────────────────────────────────────────────────────────── # 图 3:算术强度 vs 机器平衡点 # ──────────────────────────────────────────────────────────── def fig_intensity(): d, b = 64, 2 B_r, B_c = block_sizes(d) Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) naive_i = np.array([flops_attention(N, d) / (hbm_elems_naive(N, d) * b) for N in Ns]) flash_i = np.array([flops_attention(N, d) / (hbm_elems_flash(N, d, B_r, B_c) * b) for N in Ns]) balance = FLOPS_PEAK / HBM_BW fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe") fig.subplots_adjust(bottom=0.22, top=0.86) ax.axhspan(0, balance, color="#fdf1f2", zorder=0) ax.axhline(balance, color="#64748b", ls="--", lw=1.6, zorder=3) ax.text(Ns[-1] * 2.1, balance * 0.70, f"机器平衡点 {balance:.0f} FLOP/byte\n(峰值算力 ÷ HBM 带宽)", fontsize=10, color="#475569", va="center", linespacing=1.5) ax.text(Ns[0] * 1.02, balance * 0.40, "线下:本 roofline 模型由 HBM 项主导(实际瓶颈需测量)", fontsize=10, color=C_NAIVE) ax.text(Ns[0] * 1.02, balance * 1.32, "线上:本模型计算项主导", fontsize=10, color=C_FLASH) ax.semilogx(Ns, naive_i, "o-", color=C_NAIVE, lw=2.4, ms=7, label="朴素实现", zorder=4) ax.semilogx(Ns, flash_i, "s-", color=C_FLASH, lw=2.4, ms=7, label="FlashAttention", zorder=4) for x, v in zip(Ns, naive_i): ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points", xytext=(0, -16), ha="center", fontsize=9, color=C_NAIVE) for x, v in zip(Ns, flash_i): ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points", xytext=(0, 9), ha="center", fontsize=9, color=C_FLASH) ax.set_xticks(Ns) ax.set_xticklabels([f"{n // 1024}K" for n in Ns]) ax.set_xlim(Ns[0] * 0.75, Ns[-1] * 4.5) ax.set_ylim(0, balance * 1.85) ax.legend(fontsize=10.5, frameon=False, loc="center right") ax.grid(axis="y", color="#eef2f7", lw=0.9) _style(ax, "算术强度:每搬 1 字节能做多少次运算(单头 d=64, fp16)", "序列长度 N", "FLOP / byte") _caption(fig, "图 3:朴素实现的强度几乎不随 N 变(一直贴在 32 附近)," "在此模型中由 HBM 项主导;FlashAttention 的估计抬过平衡点," "并不单独证明实际 kernel 已充分利用计算单元。") fig.savefig(OUT / "intensity.png", facecolor="#fbfcfe") plt.close(fig) print(" figures/intensity.png") if __name__ == "__main__": print("生成配图:") fig_tiling() fig_curves() fig_intensity()
-
AIGC 每日速读|2026-09-25|快手开源修图登顶,GEdit仍输GPT 今日 AIGC 论文速览 今日共 10 篇 · 图像编辑与生成安全 2 篇 · 统一预训练与视频运动 2 篇 · 多模态联合生成 2 篇 · 音频生成与后训练 2 篇 · 推理加速与视频评测 2 篇 重点论文标题列表 KwaiMind(快手):180万对数据炼电商修图 UVU(清华大学):视觉监督前移,RefCOCO涨7.7 ⚡ Unite-Audio(东京科学大学):117M音频生成,CLAP登顶 MotionSpec(卡迪夫大学):频谱轨迹约束视频运动 RecCAR(巴伊兰大学):反向注意力补齐,音画更同步 今日论文速览 1. KwaiMind:180万对数据炼电商修图 KwaiMind Technical Report | 快手 | arXiv:2609.26375 关键词:图像编辑,电商,CTR奖励,Ecom-Bench,在线强化学习 ⚠️ 前序问题:电商修图不是通用编辑:商品主体要一模一样、促销文字要渲染准确、图还得有点击欲。通用编辑模型在这三件事上都没专门优化,而电商数据的采集清洗又贵又杂,缺一套能稳定产出高质量配对数据的流水线。 本文贡献:快手发布 KwaiMind:多模态 DiT 底座,Agent 数据引擎维护约 180 万高质量编辑对;继续预训练加 SFT 后走偏好优化与在线 RL,用 VLM 通用裁判加 CTR、文字渲染、商品一致性三类专用奖励训练专精策略,再经 on-policy 蒸馏合并成单一模型;配套发布覆盖 11 类商业编辑任务的 Ecom-Bench。 Overview of the end-to-end data pipeline. Coordinator Agent routes samples through filtering, generation, captioning, and post-filtering with bounded feedback loops and human review. 实验效果:开源编辑器里综合最强:ImgEdit 4.15、GEdit 5.79、REDEdit 英/中 3.75/3.73,Ecom-Bench 视觉质量第一;CTR 引导优化把生成图预测 CTR 超过原图的比例从 12.16% 提到 37.41%,线上 A/B 实际 CTR 相对提升约 2.44%。 Overall comparison on general image editing benchmarks: ImgEdit, GEdit, and the English and Chinese splits of REDEdit. Hatched bars denote closed-source models. 批判点评:最强的限定词是开源:图上闭源模型全面更高——ImgEdit 被 Seedream 4.0 的 4.27 和 GPT-Image-2 的 4.20 压着,GEdit 上 Nano Banana 2 拿 7.02、GPT-Image-2 拿 7.10,比 KwaiMind 的 5.79 高出一大截,REDEdit 两个语种同样如此。真正立住的卖点其实是 CTR 这条商业指标,而不是编辑质量本身。 2. UVU:视觉监督前移,RefCOCO涨7.7 UVU: Improving Multimodal Understanding via Vision-Language Unified Autoregressive Paradigm | 清华大学;腾讯优图实验室;南京大学;格拉斯哥大学 | arXiv:2609.27915 关键词:统一自回归,像素级codebook,连续视觉编码,视觉监督,预训练 ⚠️ 前序问题:多模态大模型的细粒度视觉理解长期靠稀疏文本监督撑着,已有的视觉监督大多加在后训练阶段,那时视觉表征已基本定型,监督信号只能当辅助约束。要重塑感知骨干,得把视觉监督搬进预训练。 本文贡献:提出 UVU 视觉语言统一自回归范式:不用向量量化,SigLIP-2 连续视觉特征直接进 LM 解码器做下一 token 预测;设计大规模迭代层次聚类算法构建 20 万词表的像素级视觉 codebook,让图像 patch 与文本 token 在预训练期共享统一监督,模型由此内化视觉重建能力。 Overview of the UVU vision-language unified autoregressive framework. Continuous visual features from SigLIP-2 are projected and integrated with textual embeddings for autoregressive next-token prediction in an LM decoder, generating pixel-level image tokens. 实验效果:同为 3B/Qwen2.5 底座,RefCOCO 从 84.1 涨到 91.8、LISA 57.4→71.7、CVBench-3D 71.9→76.6、BLINK 46.9→52.8;相对去掉视觉监督的自版 UVU*,RefCOCO +6.2、LISA +12.1。注意力热图显示 UVU 更聚焦目标区域。 Comparison of visual attention heatmaps under three paradigms: from left to right, without visual supervision, AR + VQ, and UVU (Ours). 批判点评:对手没输干净:SEEDB 74.1 仍低于 LLaVA-OV 的 75.4,MMStar 55.0 输给 56.7,ScienceQA 91.3 远低于 GLM-4v 的 96.7;MME 2201.9 对 LLaVA-OV 2146.3 的领先也只有 2.6%。统一目前只覆盖理解侧,生成侧数据还没进训练,作者自己也在文中承认。 3. Unite-Audio:117M音频生成,CLAP登顶 UNITE-AUDIO: Joint Learning of Continuous Tokenization and Latent Flow Matching for Text-to-Audio Generation | 东京科学大学;清华大学;武汉大学;东京大学;蚂蚁集团 | arXiv:2609.28206 关键词:文本生成音频,联合训练,flow matching,Flow-GRPO,连续表征 ⚠️ 前序问题:文本生成音频的主流做法是两阶段:先训重建导向的音频 tokenizer 再冻结,然后在固定隐空间训生成模型。但为重建优化的表征未必适合生成,生成目标无法反过来塑造隐空间。 本文贡献:首个把连续音频表征学习和隐空间 flow matching 联合训练的 TTA 系统:掩码波形过在线编码器,EMA 编码器提供停止梯度的目标特征,重建与自监督生成预测耦合,让生成目标直接塑造隐空间;再用 Flow-GRPO 后训练强化文本条件对齐。 Overview of the proposed framework: (a) the reconstruction path and (b) the generation path. Blue denotes regions with gradient propagation, while gray denotes regions without gradient propagation. 实验效果:117M 隐空间生成模型(不含编解码器)在 AudioCaps-886 上 CLAP 0.534 全表最高(EzAudio 0.496、TangoFlux-RL 0.480),KL 1.057 最低,RTF 0.062;NFE 压到 4 时 RTF 仅 0.009 仍保 CLAP 0.512。 Comparison between conventional separate tokenizer-generator training and our joint single-stage training. 批判点评:分布指标难看:FD_OpenL3 84.76 是 EzAudio 38.26 的两倍多,FD_16k 43.25 也落后 GenAU 的 31.94,IS 11.34 不及 TangoFlux-RL 的 12.20——语义对齐赢了,音频分布保真还差得远;首个联合训练的含金量取决于你更看重 CLAP 还是 FD。 4. MotionSpec:频谱轨迹约束视频运动 MotionSpec: Spectral Trajectory Supervision for Motion-Consistent Video Generation | 卡迪夫大学;中国科大;华东师范大学 | arXiv:2609.28095 关键词:视频生成,运动一致性,傅里叶谱,光流,微调目标 ⚠️ 前序问题:文生视频单帧越来越真,运动却常失真:动作推进不一致、复杂动作下结构崩坏。标准生成目标对运动本身几乎没有专门约束,运动演化处于欠约束状态。 本文贡献:提出 MotionSpec 运动监督:谱轨迹一致性 STC 构造锚点相对的稠密运动轨迹,经时间傅里叶变换成运动谱体积,对齐幅度与相位同时约束运动强度和时序组织;辅以局部光流一致性 LFC 稳定相邻帧过渡,两者随时间步加权加进微调目标。 Overview of the pipeline. At each training step, the video generative model takes the prompt, timestep, noise level, and real data as inputs. 实验效果:在 Wan2.1 上微调,VMBench 均分 61.57→65.07,其中物体完整性 OIS 48.34→56.53、时序一致性 TCS 97.09→98.82;VideoJAM-Bench 运动分 85.3→93.61。定性对比里 Wan2.1 的骑车段后半程自行车几乎消失,MotionSpec 保留完整。 Qualitative Results. On the left are the results of Wan2.1, and on the right are the results of ours. 批判点评:外观分几乎没动:App 仅 81.95→82.20(+0.25);PAS 上单独用 LFC(24.27)反而高于完整版(23.74),说明两个目标存在拉扯。评测全部在 Wan2.1 一个底座上做,换模型的泛化性未知。 5. RecCAR:反向注意力补齐,音画更同步 All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation | 巴伊兰大学;NVIDIA | arXiv:2609.27901 关键词:联合视频生成,跨模态注意力,KL正则,音画同步,人体解剖 ⚠️ 前序问题:联合视频-动作/视频-音频生成的扩散 Transformer 里存在不对称:伴随模态到视频的对应很强,但反过来约束视频生成的对应路始终弱——视频听动作指令的能力远弱于动作看视频的能力,人体解剖崩坏、音画不同步由此而来。 本文贡献:把两个方向的跨模态对应表示成视频 token 上的分布,定义反向对应差距;提出 RecCAR,KL 正则把弱方向对齐到以视频到模态对应为固定参考的强方向,即插即用地微调 EchoMotion 这类联合生成模型。 Illustration of asymmetric reciprocal cross-modal correspondence. For a motion token corresponding to the head, the VM correspondence correctly localizes the head region in the video, while the reciprocal MV correspondence is dispersed. 实验效果:视频-动作联合生成 Human Anatomy 0.69→0.75,VMBench 多数指标超 EchoMotion、CoMoVi、FlowMo;视频-音频生成音画失同步从 0.804 降到 0.752。散点图上每个 prompt 的反向差距在微调后一致下降。 Qualitative comparison of RecCAR against EchoMotion, CoMoVi, and FlowMo across three representative scenes. 批判点评:增益以自家基线为参照:0.75 的解剖分意味着仍有约四分之一样本不达标,音频侧 0.752 的失同步也谈不上小;teaser 里对比的 LTX-2 只做了定性展示,未给出与闭源模型在同一协议下的量化差距。 6. GestureFAR:9.3毫秒每token的流式手势 GestureFAR: Streaming Co-Speech Gesture Generation with Flow Autoregression | 罗切斯特大学;东京大学;加州大学圣克鲁兹分校;加州大学洛杉矶分校;Meta | arXiv:2609.21576 关键词:手势生成,流式,flow自回归,蒸馏,实时交互 ⚠️ 前序问题:流式陪聊手势生成此前靠离散运动 token 自回归,把高维连续运动压进有限 codebook,真实感和多样性都受损;而连续方法又难以保证逐 token 因果,实时交互卡在延迟上。 本文贡献:提出流式手势生成框架 GestureFAR:因果 VAE 把全身动作编码成可流式的连续隐变量,Transformer 对音频-运动上下文自回归,每 token 配 flow-matching 头从连续分布采样下一潜变量;再冻结因果骨干,用一致性加分布匹配目标把多步 flow 头蒸馏成单步前向。 Overview of GestureFAR. GestureFAR generates co-speech gestures from streaming audio by autoregressing over continuous motion latents. 实验效果:BEAT2 流式组 FGD 3.08 全面最佳(LiveGesture 4.57、MIBURI 8.06),BC 0.741 接近离线最优;1 步蒸馏后每 token 9.3ms,是教师 8 步 24.4ms 的 2.6 倍速、MIBURI 62.9ms 的 6.8 倍速。 Qualitative comparison on BEAT2. We visualize generated full-body gestures from different methods under the same speech inputs, with the semantically salient words highlighted in red. 批判点评:BC 0.741 仍低于 MIBURI 的 0.790 和 LiveGesture 的 0.794,多样性 13.24 也略逊离线系;单步蒸馏换速度后 FGD 反而比教师还好(3.08 vs 3.17),这个反常更像评测协议的产物而非能力证明,文中未解释。 7. DeltaS:状态漂移选KV,六个基准+2.1 DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video | Maum AI;首尔大学;延世大学 | arXiv:2609.27470 关键词:KV缓存淘汰,流式视频,线性注意力,混合架构,训练无关 ⚠️ 前序问题:视频语言模型转向线性/全注意力混合架构后,线性注意力状态固定大小,但全注意力 KV 缓存仍随流式视频无限增长;流式场景下问题还没来就得决定淘汰谁,现有基于位置、注意力或 KV 本身的信号都拿不到这个先验。 本文贡献:提出训练无关的 DeltaS:读门控 delta 线性注意力的循环状态,用一块帧内状态的归一化变化量(状态漂移)衡量该块带来多少新信息,漂移大的块对应 KV 留存;信号计算只占前向的 1.9%,无需代理查询。 Overview of DeltaS. Each video chunk updates the recurrent linear-attention states, whose normalized changes yield a shared score for retaining the corresponding KV entries across full-attention layers. 实验效果:预算与留存策略对齐的受控比较里,状态漂移信号全面胜过位置/注意力/KV 三类基线;六个长视频基准平均超最强无查询基线 2.1 分,最长基准 LVBench 超 5.6 分。 Performance margin as a function of KV retention rate. DeltaS generally shows larger margins at lower retention rates. 批判点评:增益随留存率升高而收窄:留存 token 超过约四成后在 EgoS 上反而落后基线 0.7 分,高预算场景收益有限;hybrid 架构前提也把它限死在门控 delta 线性注意力这一类骨干上。 8. DriftAudio:一步生成后训练FAD降34% DriftAudio: Marginal Drifting for Distributional Post-Training of One-Step Text-to-Audio Generators | 悉尼科技大学 | arXiv:2609.27598 关键词:一步生成,分布后训练,文本生成音频,Drifting,FAD ⚠️ 前序问题:一步文本生成音频模型把推理成本打下来之后,生成分布仍欠火候;常规后训练依赖逐条件配对的真实样本,自由文本条件下一个 prompt 往往只有一两条真实参考,逐条件 Drifting 根本做不了。 本文贡献:提出 DriftAudio 边缘分布后训练:把 Drifting 从逐条件搬到边缘音频分布上做,在冻结的 PANNs 特征空间里用重采样真实样本、滚动生成的 FIFO 样本库和当前批次共同估计漂移场,得到 detached 训练目标只更新生成器,一步推理流程原样保留。 Overview of DriftAudio. The one-step generator remains text-conditioned, while Drifting is performed on the marginal audio distribution in feature space. 实验效果:从 MeanAudio 出发 FAD 降 33.9%、FD 降 17.6%,KL 与 CLAP 同步改善;从 FdAudio 出发 FAD 1.22→0.99,一步生成的分布质量明显抬升。 Mean and covariance components of FAD for the four evaluated models. Numbers above the bars denote total FAD. 批判点评:不是白捡的:从 FdAudio 出发时 IS 和 CLAP 出现回退,说明边缘分布对齐和条件保真之间存在交换;方法绑定冻结的 PANNs 特征空间,换更强的音频评价骨干是否还成立未验证。 9. InGuard:嵌入层安检,省一半去噪步 InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation | 阿里巴巴 AAIG | arXiv:2609.27620 关键词:文生图安全,内嵌护栏,嵌入改写,潜空间检测,RevGen ⚠️ 前序问题:T2I 的安全护栏都装在外面:前置 prompt 分类器加后置图像分类器,两者不用模型自身表征——prompt 检查准头有限,图像检查要等全量去噪烧完才跑,而且违规 prompt 只能一刀切拒绝,本可改写成安全输出的也被扔掉。 本文贡献:提出 InGuard 内嵌护栏:文本编码器嵌入上直接做风险三级分类(不安全/风险/良性),SAGE 对风险 prompt 做嵌入空间软门控改写使其输出安全图而非拒答,去噪中途用一步干净潜变量估计做潜空间检测,发现风险即刻提前终止;配套 RevGen Safety 基准,1 万条 prompt 由真实图反生成并注入受控 IP 角色。 Overview of our InGuard framework. Three complementary components work in sequence: prompt embedding risk classification, SAGE embedding-space safety enhancement, and latent detection with early termination. 实验效果:五个开源 T2I 模型上安全率 97.9%-98.8%,追平或超过外置护栏;良性扰动少 57.5%-73.5%,参数少约 3.7 倍,50%-55.6% 的去噪步被跳过;潜空间检测在 44%-50% 计算量处就逼近图像级 F1。 Pretraining effects on Avg F1 across five LDMs; latent detection vs denoising-step fraction used as a compute proxy. 批判点评:SAGE 改写不是万能的:论文自己承认增强失败时只能靠潜空间检测兜底拦截,等于承认存在漏改样本;RevGen 由自家反生成流水线构造,跨基准的代表性有待第三方复检。 10. CineGuard:11种运镜的抄袭检测 Did You Steal My Shot? Pioneering Camera Motion Plagiarism Detection in Generative Videos | 河海大学 | arXiv:2609.22267 关键词:运镜抄袭,生成视频,涡度,基准,版权保护 ⚠️ 前序问题:运镜是影视级 IP,但生成视频用一句 prompt 就能复刻高价值运镜;现有相似度检测都盯着画面内容,训练数据把运镜和内容缠在一起,传统光流又表达不了复杂相机运动——运镜抄袭至今无人管。 本文贡献:构建首个运镜分析基准 CineFlow:11 种运镜风格的模拟数据集把运镜与内容解耦;提出 CineGuard 检测网络,在光流上叠加流体力学涡度作为平移不变线索,3D 卷积提 tubelet 嵌入后过 ViT 主干加全局相机适配器,对比学习聚拢同运镜视频。 Architecture of the motion plagiarism detection network. The input flow is first augmented with vorticity, then a 3D convolution extracts tubelet embeddings. 实验效果:抄袭检测超最强基线 3.02 倍;在 Veo 3.1 与即梦的商业生成视频上,余弦相似度 0.56-0.83,基线全部落在 0.35 以下,Precision@5 最高 0.73 对基线约 0.27。 Performance of plagiarism detection on generative videos. Left: cosine similarity between videos. Right: Precision@5 for retrieving videos with the same motion label. 批判点评:局限写在图里:FPV Drone 这类复合运镜相似度掉到 0.56,是全表最低,混合运镜仍是软肋;基准是简单几何场景模拟出来的,真实影视素材上的迁移只有商业视频小样本佐证。 趋势观察 编辑模型的主战场从通用能力挪向行业指标 KwaiMind 把 CTR 预测直接做成奖励信号训进编辑模型,线上 A/B 实测 +2.44%;InGuard 则把安全检查搬进生成管线内部,省下一半去噪步。两条线指向同一件事:图像生成的竞争正在从「生成质量」转向「商业约束下的生成质量」,奖励函数和护栏的构造方式开始比骨干网络更值钱。 视觉监督正在从后训练前移到预训练 UVU 用像素级 codebook 把视觉监督直接塞进预训练,RefCOCO 一项涨 7.7 分;MotionSpec 则在视频微调里用频谱约束补上运动监督的缺口。共同逻辑:等表征定型再补监督太晚了,感知质量的上限在预训练阶段就被决定。 一步生成与流式生成进入质量补课期 DriftAudio 给一步 TTA 做边缘分布后训练,FAD 降三分之一;GestureFAR 用单步蒸馏把手势生成压到每 token 9.3ms;Unite-Audio 把去噪步数压到 4 还能保住 CLAP。速度战的下一程是质量战——谁能在一步、几步的预算里把分布差距补回来,谁就拿到实时产品化的门票。 混合架构的两组记忆开始学会协作 DeltaS 证明线性注意力的循环状态可以反过来指挥全注意力 KV 缓存的淘汰,六个长视频基准平均 +2.1;Unite-Audio 则让生成目标直接塑造 tokenizer 隐空间,打破「先冻结表征再训生成」的铁律。两篇都在挑战模块化管线里各训各的默认假设。 人工智能炼丹君 整理 | 2026-09-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 基本功|性能建模与 Profiling:算力、带宽与显存账本-Roofline AIGC 基本功|性能建模与 Profiling:算力、带宽与显存账本-Roofline 所属方向:推理加速 | 难度:进阶 | 前置知识:混合精度与数值稳定性、自注意力机制的计算与显存账本 关键词:性能建模、Profiling、Roofline、算术强度、memory bandwidth、FLOPs、MFU、PyTorch Profiler、Nsight 01. 为什么需要它 先看本次 CPU 复核得到的两段计算:GEMM 约 98.57 MFLOP,逐元素 add 约 100 MFLOP;二者运算量相近,最短耗时却分别为 1.029 ms 和 23.623 ms,差 22.9 倍。环境为 Windows / AMD64、NumPy 2.4.6、OpenBLAS,线程请求值为 1。machine_probe.py 会记录实际 NumPy 构建配置和全部计时样本。 这里 add 复用 200 万元素的三份 fp32 数组,工作集 24 MB,重复 50 轮;累计逻辑流量 1200 MB,并不等于实测 DRAM 搬运量。GEMM 通过矩阵复用获得更高逻辑算术强度,但本实验没有硬件计数器,不能把 22.9 倍差距全部归因于 DRAM 带宽。它足以提醒我们:只比较 FLOPs,不能预测耗时。 再看一个优化评审:想把 LayerNorm 换成更快的低精度计算单元。若一行数据确实能驻留片上、只读输入并写输出,本文简化账本的强度约为 1.5 个教学操作/Byte;是否由带宽主导,还要核对标量、归约、平方根的执行资源,不能直接与 BF16 Tensor Core 的 ridge point 比较。只有在已确认流量主导、其他资源不变的模型里,单独提高计算峰值的收益才是 1.00。 小 batch GEMM 的权重量化常能减少字节,但反量化、格式元数据和内核效率也要记账。 这篇的目的就是把这套「先算账再动手」的方法补齐:两个账本——速度账(算力 vs 带宽)和容量账(显存四项)——加上一套实测手段(profiler)。量化、算子融合、KV cache 管理、并行切分,所有推理优化节点的收益判断都站在这篇的地基上。 02. 最小可用理解 阅读前只需会矩阵形状、乘加计数和单位换算;混合精度一篇解释 dtype 与字节数,注意力一篇解释 Q/K/V。本篇会补足异步计时、缓存层级与活跃 token 的必要背景,不要求先懂 CUDA 内核。 三句话讲完核心: 任何算子的耗时有一个下界,由两种资源里更慢的那个决定:$T \ge \max(F/P_{\text{peak}},\ D/\beta)$。$F$ 是算子要做的浮点运算数,$P_{\text{peak}}$ 是硬件与该指令类型匹配的峰值算力;$D$ 是算子要搬运的字节数,$\beta$ 是带宽。算得再快也快不过「数据没到」。 算术强度 $I = F/D$ 决定卡在哪:与 ridge point $I^{\ast} = P_{\text{peak}}/\beta$ 比较,$I \lt I^{\ast}$ 表示该二资源模型的流量项主导,优先检查少搬字节的机会(融合、量化、FlashAttention);$I \gt I^{\ast}$ 表示计算项主导,再检查少算或提高同口径吞吐的机会。两种分类都须用实际流量和热点执行资源核验。 显存容量是另一本独立的账:权重 + KV cache + 激活 + 额外开销四项加总,才决定一张卡能塞多少并发。「权重放得下就能跑」只覆盖了四项里的第一项。 03. 数学推导 3.1 时间下界为什么取 max 一个算子要做 $F$ 个浮点运算(FLOP,口径:一次乘加记 2 个 FLOP),硬件每秒最多做 $P_{\text{peak}}$ 个——就算计算单元一刻不停,也至少要 $F/P_{\text{peak}}$ 秒。同理,算子要把 $D$ 字节的数据在内存和计算单元之间搬个来回,总线每秒最多搬 $\beta$ 字节——至少要 $D/\beta$ 秒。无论计算和搬运是否重叠,总时间都不能短于这两个最低时间,所以可取 max 作为下界。若进一步用等号近似真实时间,才需要充分重叠和接近峰值利用率等假设: $$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{D}{\beta}\right)$$ 注意这是下界:真实 kernel 还有 kernel launch、同步、缓存未命中、TLB miss 等额外开销,只要 $F$、$D$ 和对应物理峰值口径正确,实际耗时不能突破这个下界。后面的实验用经验标定值和逻辑数组流量代入,此时算出的只是参考模型估计;计时波动或缓存会产生超过 100% 的达成率,并不违反物理下界。差距也不能全算成可消除的优化空间。 3.2 算术强度与 ridge point 定义算术强度: $$I = \frac{F}{D}$$ 物理含义:每从内存搬 1 字节数据,能换来多少次浮点运算。它取决于实现与所选存储层级;实际缓存命中和重复加载又与硬件有关,不能视为完全与机器无关。再定义机器的 ridge point: $$I^{\ast} = \frac{P_{\text{peak}}}{\beta}$$ 物理含义:给定指令资源与存储层级下,「算」和「搬」模型时间一样长的分界点,单位都是 FLOP/Byte,所以可以比。把 $I$ 与 $I^{\ast}$ 代回 3.1 的下界: $I \lt I^{\ast}$(模型流量项主导):$D/\beta$ 那一项更大,$T \approx D/\beta$,模型性能上界 $F/T \le I \cdot \beta$——性能与算力峰值无关,只跟 $I$ 成正比,这就是 roofline 图上那条斜线; $I \ge I^{\ast}$(模型计算项主导):$T \approx F/P_{\text{peak}}$,性能封顶在 $P_{\text{peak}}$,这就是平顶。 $P_{\text{peak}}$ 必须匹配运算类型。本文采用 A100 40GB SXM 白皮书 Table 1的 BF16 dense Tensor Core 312 TFLOP/s、HBM2 带宽 1555 GB/s,得到 $I^{\ast}=200.6$;同表 FP32 CUDA core 只有 19.5 TFLOP/s,对应 12.5 FLOP/Byte。A100 的表中没有原生 FP8 Tensor Core。保留这些旧卡作为易复算例子,数字不是对所有算子的统一峰值。 H100 SXM 官方规格给带稀疏脚注的 BF16 1979、FP8 3958 TFLOP/s;除去结构化稀疏的二倍口径后约为 989.5、1979。代码取 BF16 的约数 989、带宽 3.35 TB/s。下面若对 add、LayerNorm、softmax 统一代入 $P=312$ TFLOP/s,只是在演示一个假想统一操作吞吐的教学模型,不能据此诊断 A100 上的标量算子。真实不同资源的写法见 3.6。 3.3 给几类算子记账 GEMM:$A[M,K] \times B[K,N] \to C[M,N]$。每个输出元素要做 $K$ 次乘加,共 $M N K$ 次,乘加各记一次: $$F_{\text{gemm}} = 2MNK,\qquad D_{\text{gemm}} = b\,(MK + KN + MN)$$ $b$ 是每元素字节数(bf16 取 2)。这是每份输入读一次、输出写一次且不读取旧 C 的最低流量示例,未计分块重读、write allocate 与输出累加。固定 K/N 时增大 M 可摊薄权重读取,提高模型 I;大 batch 更可能接近计算侧、小 batch 更可能受流量影响,但缓存命中、矩阵布局和内核调度可能改变实际瓶颈。 逐元素算子:$n$ 个元素各做 1 次运算,读 2 份写 1 份: $$F = n,\qquad D = 3 b n,\qquad I = \frac{1}{3b}$$ $I$ 是常数(fp32 下约 0.083,bf16 下约 0.17),与 $n$ 无关。在固定 dtype 与访存模型下,增大 n 本身不会提高 I,因而不会像增加 GEMM 的复用维度那样跨越 roofline 分界。 简化 LayerNorm:共 n 行、每行 d 个元素(本节不加偏置,只保留 gamma),先求均值、减均值、平方后再求均值,最后除标准差并乘 gamma;忽略每行 eps 加法/平方根等小量,按教学规则每个元素约六次操作。若整行及统计量能复用、gamma 读取等小量忽略,最低流量示例为一次读与一次写: $$F_{\text{ln}}\approx6nd,\qquad D_{\text{ln,min}}\approx2bnd,\qquad I_{\text{ln,min}}\approx\frac{3}{b}$$ bf16 时得到约1.5个教学操作/Byte。本文 NumPy 分步实现会反复读写大数组,共约10遍,fp32 下 $I\approx6/(10\times4)=0.15$;广播 gamma 和行统计量按可复用小数组另计。两种流量口径不同,不应把最低流量模型冒充 NumPy 的物理实测流量。 softmax 的读写口径:本文的三阶段教学实现先读 X 求 max,再读 X、计算并保存指数数组 E(同时归约求和),最后读 E、归一化并写 P。因此是 3 读 2 写,约 $D=5bnd$;这里假设“保存 E 与求和”已融合,并不是第 4.2 节 NumPy 各语句的完整流量。若整行能驻留片上存储,融合实现可约 1 读 1 写,二者的理想流量比为 2.5。 在线归一化原论文 Algorithm 2的 Safe softmax 不保存 E,输出时重新计算 exp,因此是 3 读 1 写;Algorithm 3 的 online 版本先流式求归一化量,再重读输入写概率,为 2 读 1 写,其对照是 4/3 的流量比。它们与本文保存 E 的基线不同,也与 Triton 整行融合示例的驻留前提不同,不能混用这些比值。 本文与 roofline_model.softmax 对保存 E 或整行驻留的模型统一用约 $5nd$ 作为教学操作计数(max、减法、exp、求和、除法各按一次,忽略每行的小量);它不是五类操作都拥有相同吞吐的物理断言。max、exp 与除法并非都能跑在 Tensor Core 上;重新计算 exp 的 Safe 版本、online 递推及实际分块内核都需另数操作。 单头注意力($N$ 是 token 数,$D_{h}$ 是每头维度):两次 $N \times N \times D_{h}$ 的矩阵乘加 softmax: $$F_{\text{attn}} = 4N^{2}D_{h} + 5N^{2}$$ 朴素实现的分数矩阵 $S$ 和概率矩阵 $P$ 都要落显存,二次项访存约 $4N^{2}$;FlashAttention 原论文 Algorithm 1 与 IO 分析只让当前分数/概率瓦片驻留片上,不保存完整 $N^{2}$ 矩阵;若仅统计每份输入读取一次与输出写回一次,可得到不可避免的数据流量下界;真实分块内核会反复读入 K/V 或 Q 等数据: $$D_{\text{朴素}} = b\,(4N^{2} + 4ND_{h}),\qquad D_{\text{flash,min}} = b \cdot 4ND_{h}$$ 代入 $N=4096$、$D_{h}=128$、bf16(脚本 roofline_model.py 实算):朴素 $D = 138.41\ \text{MB}$、$I = 62.7$,落在 A100($I^{\ast} = 200.6$)的带宽受限区;理想最低流量 $D_{\mathrm{flash,min}} = 4.19\ \text{MB}$、$I = 2068$,跳进算力受限区。教学函数令两种路径使用相同操作计数(×1.000),参考模型从 0.089 ms 降到 0.028 ms(×3.2);真实 online softmax 有额外归约/重缩放操作,不能据此说实际 FLOPs 完全不变。这是按最低流量与假想统一吞吐计算的理想示例,33 倍不是实际 FlashAttention 访存或速度的测量;有限片上存储下还需分块 IO 模型。FlashAttention 那篇的完整递推在知识树的下一节点展开,这里先用 roofline 把它的收益定位清楚。 图 1:这张图要看三样——散点的横坐标是各算子的算术强度 $I$,点越靠右越「算得过来」;按 I 与 I 的相对位置给点作模型分类;点到经验参考折线的距离并不能单独证明真实瓶颈;FlashAttention 会改变访存量和横坐标,无法直接把这段垂直差距视为它的加速收益。* 3.4 模型估计随资源改变的比值 把算力翻倍($P_{\text{peak}} \to 2P_{\text{peak}}$),加速比是: $$S_{\text{算力}} = \frac{\max(F/P_{\text{peak}},\ D/\beta)}{\max(F/(2P_{\text{peak}}),\ D/\beta)}$$ 若模型流量项主导,分子分母都是 $D/\beta$,$S_{\text{算力}} = 1$。算力受限时加速至多为 2;当 $1\lt I/I^{\ast}\lt 2$ 时,算力翻倍会遇到带宽上限,加速为 $I/I^{\ast}$。带宽翻倍对称地反一次。roofline_model.py 第四节用统一教学计数代入 $P=312$ TFLOP/s、$\beta=1555$ GB/s,下面是该假想二资源模型的结果;只有 BF16 dense GEMM 的计算峰值与 A100 规格直接匹配,其他行仍需 3.6 的资源区分: 算子 I/I* 算力×2 的加速 带宽×2 的加速 逐元素 add [16M] 0.001 1.00x 2.00x LayerNorm [4096, 3072] 0.007 1.00x 2.00x softmax 朴素三遍 [4096, 4096] 0.002 1.00x 2.00x GEMM 512x4096x4096 2.041 2.00x 1.00x attention 朴素 [N=4096,D=128] 0.312 1.00x 2.00x attention ideal-min [N=4096,D=128] 10.307 2.00x 1.00x 这些是模型估计时间的比值,不是对真实优化加速比的无条件上限。一个实现若同时消除了调度开销、缓存重读或中间分配,实际加速可以大于单独改变 P 或 beta 的模型比值;反过来,开销不降也可能达不到该比值。图 2 用于提出测量假设,不能代替 profile。 图 2:这张图要看什么——横轴 $I/I^{\ast}=1$ 那条竖线就是分界线:线左边算力翻倍的理想收益为 1,带宽翻倍收益在 1 到 2 之间;只有 I/I≤0.5 时完整得到 2 倍。线右边对称,I/I≥2 才完整得到算力翻倍的 2 倍。投入硬件或投入算子融合之前,先看自己在哪一侧。 3.5 显存的容量账 速度账之外另有一本容量账。下面以未分块 prefill、同时处理 BS 个 token 为例,显存分四项: $$M_{\text{total}} = N_{\text{params}} \cdot b_{w} + 2BSLd_{\text{kv}}b_{\text{kv}} + N_{\text{active}}a + \rho M_{\text{sum}}$$ 逐项说物理含义:$N_{\text{params}}$ 是参数量、$b_{w}$ 是每参数字节数(fp16 为 2)——这一项与并发无关,是常数;$B$ 是并发序列数、$S$ 是序列长度、$L$ 是层数、$d_{\text{kv}}$ 是每层 KV 总维度(GQA 模型用实际的 KV head 数乘头维度)——KV cache 每个 token 每层都要存一份 K 和一份 V,所以是 $2BSLd_{\text{kv}}b_{\text{kv}}$ 字节;$b_{\text{kv}}$ 是 KV 的每元素字节数,与权重 dtype 独立;KV 总容量随并发线性增长;$a$ 是每 token 的激活峰值(推理不保留整层中间结果,但当前层十几份临时张量要同时活着,$d_{\text{model}}=4096$、fp16 时假设同时存活 16 份这种张量得到 128 KiB/token;这是容量练习的显式假设,未做模型显存峰值测量,不能视为经验通用常数);$\rho$ 是额外开销率,$M_{\text{sum}}$ 是前三项之和。这里 $N_{\text{active}}$ 是同时处理的活跃 token 数:未分块 prefill 取 BS,逐 token decode 通常取 B,分块 prefill 取本轮实际 chunk token 数。KV cache 仍按已保存上下文 token 数计。变长序列应把 BS 换成各序列实际长度之和;权重 fp16 并不要求 KV 也用 fp16,代码显式支持 kv_b 和 active_tokens。第 04 节把未分块 prefill 的教学账本代进一个 7B 模型。 3.6 同一 kernel 的运算可能不走同一资源 把不同工作量分开:$F_{\text{tc}}$ 为 Tensor Core 的乘加 FLOP,$F_{\text{scalar}}$ 为普通浮点管线 FLOP,$N_{\exp}$ 为指数次数,$D_{\ell}$ 为存储层级 $\ell$ 的实测字节数。分别匹配峰值 $P_{\text{tc}}$、$P_{\text{scalar}}$、指数吞吐 $R_{\exp}$ 和该层带宽 $\beta_{\ell}$,仍可逐项取最大: $$T\ge\max\left(\frac{F_{\text{tc}}}{P_{\text{tc}}},\frac{F_{\text{scalar}}}{P_{\text{scalar}}},\frac{N_{\exp}}{R_{\exp}},\max_{\ell}\frac{D_{\ell}}{\beta_{\ell}}\right)$$ 这是更细的乐观下界;如果操作有依赖或共享执行资源,还可能需要把某些时间相加。没有 $R_{\exp}$ 实测或明确规格时,就不能从 $5nd$ 推出 softmax 的硬件计算时间。Hierarchical Roofline 原文解释为什么每一级存储都需要自己的流量与带宽,不能拿逻辑数组流量直接配 DRAM 带宽。 一个纯算术反例(单位为教学单位,非任何GPU规格):Tensor工作量10、吞吐100,标量工作量90、吞吐10,搬100字节、带宽100。误把100次操作全除以100得到计算时间1;分资源后下界为 max(0.1,9,1)=9。resource_time 实跑验证了这个9倍差距。这说明“运算数少”与“该类资源能做多快”必须一起定义。 04. 代码实现 保留原来的三个数值脚本与四幅图,并增加可独立运行的 profiler_probe.py。数值实验只需 Python 3.10+ 与 NumPy;图表另外需要 matplotlib,Profiler 对照另需 PyTorch(本次 2.10.0+cpu)。依次运行 machine_probe.py、roofline_model.py、memory_ledger.py、profiler_probe.py、make_figures.py,文末附录包含完整代码。 原稿的大工作集默认占用较多内存,尤其十亿元素 add 还曾通过 float64 临时数组初始化。本版默认用有界工作集;machine_probe.py --large 和 memory_ledger.py --large 保留原 32M 向量、4096 方阵与 64 MiB batch 权重实验,运行前需确认资源。默认模式不能证明 DRAM 流量、GPU 内核瓶颈或服务吞吐。 本次快照时间 2026-10-10 09:12:57;Windows / AMD64、NumPy 2.4.6、OpenBLAS、fp32,BLAS/OpenMP线程请求值均为 1(只设置本次进程)。经验参考 $\beta=55.74$ GB/s、$P=151.75$ GFLOP/s、$I^{\ast}=2.72$ FLOP/Byte。它们是所选 shape 的最短样本结果,不是设备峰值。 4.1 标定两个经验参考 add 标定用 200 万个 fp32 元素、三份数组,总工作集 24 MB,累计每轮逻辑读写也是 24 MB;是否触及 DRAM,取决于缓存层级与系统状态。方阵乘用 1024×1024,三份数组工作集 12 MiB,$F=2n^{3}$,不能将这个 shape 的经验参考视作所有矩阵形状的可达峰值。 预热一次后,add 测 8 次,GEMM 测 5 次;代码同时保存全部样本、min、median、max。参考折线采用最短时间,以观察接近最佳状态的实现;端到端延迟应另测典型请求、并发和分位数,不能套用这个 min。 add:最短 0.431 ms,中位数 0.612 ms GEMM:最短 14.152 ms,中位数 14.367 ms 经验 P = 151.75 GFLOP/s,add 逻辑字节率 beta = 55.74 GB/s,I* = 2.72 比值超过 100% 不代表违反物理定律:逻辑 D 未用硬件计数器测量,而基线 P/beta 只来自一个 shape 和访问模式。本机算子若运行得比参考更好,也会超过这条经验折线。 4.2 把真实算子打上 roofline 关键测试对象是 matmul-softmax-matmul 微基准;此处省略 1/√D 缩放,不是完整的生产 attention。下面按 NumPy 语句累计逻辑读写:右侧 1~10 是分数/概率矩阵的累计访问遍数;它不包含 Q/K/V/O 的线性项,也不是十次完整 DRAM 扫描的测量。实际 BLAS 分块、CPU缓存、write allocate 都可能改变物理流量: def attention_naive(): np.matmul(q, kt, out=S) # 写 S 1 遍 np.max(S, axis=-1, keepdims=True, out=rowmax) # 读 S 2 遍 np.subtract(S, rowmax, out=S) # 读写 S 4 遍 np.exp(S, out=S) # 读写 S 6 遍 np.sum(S, axis=-1, keepdims=True, out=rowsum) # 读 S 7 遍 np.divide(S, rowsum, out=S) # 读写 S 9 遍 np.matmul(S, v, out=O) # 读 S 写 O 10 遍 本次默认模式的真实输出(经验 $I^{\ast}=2.72$;“模型位置”只指该参考折线): 算子 | I | 模型位置 | 估计 ms | 最短 ms | 中位 ms | 参考比值 逐元素 add(1 遍) | 0.08 | 带宽 | 0.431 | 0.400 | 0.511 | 108% add+relu 两遍(预分配) | 0.10 | 带宽 | 0.718 | 1.032 | 1.465 | 70% add+relu 写成一行(有中间数组) | 0.10 | 带宽 | 0.718 | 2.530 | 2.970 | 28% LayerNorm [1024,1024] 预分配 | 0.15 | 带宽 | 0.753 | 1.261 | 1.290 | 60% attention 朴素 [N=512,D=128] | 11.75 | 算力 | 0.893 | 1.191 | 1.211 | 75% GEMM 128x1024x1024 | 51.20 | 算力 | 1.769 | 1.978 | 2.116 | 89% GEMM 512x1024x1024 | 128.00 | 算力 | 7.076 | 7.020 | 7.320 | 101% GEMM 1024x1024x1024 | 170.67 | 算力 | 14.152 | 14.017 | 14.306 | 101% 逐元素、LayerNorm 与注意力的 exp/max 被各按一个教学操作计数,因此表中的参考 P 只可作粗略标尺,不能认为这些指令都能达到 GEMM 吞吐。分配与归约是否主导,还需更细的 profile。 本次朴素 attention 的模型位置是“算力”,参考比值 75%;原稿 arm64、大 shape 快照的位置曾是“带宽”。这正好构成反例:同一个算法换 shape、BLAS、线程和经验参考,模型分类便可能改变;仅凭这张总计时表无法确证哪级缓存、哪类指令才是瓶颈。 图 1 画全部 8 行,图文使用同一快照。 4.3 显存账本与 batch 拐点 未分块 prefill 的容量教学账代一个 7B 模型(32 层、$d_{\text{kv}} = 4096$、权重和 KV 都取 fp16): 模型:7B,fp16 权重 = 13.0 GiB,32 层,d_kv = 4096 KV cache 单价:512 KiB / token (一条 4096 长的序列 = 2.00 GiB) batch 权重 KV cache 激活 额外开销 合计 假设 78 GiB 可用预算 1 13.0G 2.00G 0.50G 4.66G 20.20G 装得下 8 13.0G 16.00G 4.00G 9.91G 42.95G 装得下 16 13.0G 32.00G 8.00G 15.91G 68.95G 装得下 24 13.0G 48.00G 12.00G 21.91G 94.95G OOM 32 13.0G 64.00G 16.00G 27.91G 120.95G OOM 两个读数:权重是常数,batch 再大都是 13.0 GiB;KV cache 按 512 KiB/token 线性涨,batch 16 时(32 GiB)已经是权重的 2.5 倍。此处 30% 是人为设定的额外开销/前三项总量比率,不是实测额外开销率;它也不同于 PagedAttention 论文中 KV cache 已分配容量的浪费比例。同一张卡只把本教学模型的额外开销率改成 4%,batch 24 从 94.95 GiB 降到 75.96 GiB,从 OOM 变装得下:不换卡、不改模型,这个假设账本跨过一个 batch 档位;真实分页收益需只对可优化的 KV 分配项建模,并检查实际可用显存。例如 batch=24 若只把“KV 额外开销/有效KV”从 30% 改为 4%,而权重、激活不加该比例,合计从 87.44 GiB 降到 74.96 GiB;这是另一个显式教学账本,仍不是 PagedAttention 实测复现。 容量账决定“能开多大”,速度账用于比较吞吐与延迟。默认 batch 微基准固定 1024×1024 的 fp32 权重,只有 4 MiB;原稿 4096×4096、64 MiB 可通过 --large 恢复。本次每个 B 预热一次后测 15 次,吞吐是 B 除以最短 GEMM 时间,不包含请求排队、前后处理或完整模型: B | F MFLOP | D MB | I | 模型位置 | 最短 ms | 中位 ms | 吞吐 K token/s 1 | 2.097 | 4.202 | 0.50 | 带宽 | 0.059 | 0.065 | 16.9 2 | 4.194 | 4.211 | 1.00 | 带宽 | 0.382 | 0.391 | 5.2 4 | 8.389 | 4.227 | 1.98 | 带宽 | 0.346 | 0.347 | 11.6 8 | 16.777 | 4.260 | 3.94 | 算力 | 0.406 | 0.416 | 19.7 16 | 33.554 | 4.325 | 7.76 | 算力 | 0.502 | 0.512 | 31.9 32 | 67.109 | 4.456 | 15.06 | 算力 | 0.711 | 0.802 | 45.0 64 | 134.218 | 4.719 | 28.44 | 算力 | 1.107 | 1.138 | 57.8 128 | 268.435 | 5.243 | 51.20 | 算力 | 1.939 | 2.043 | 66.0 256 | 536.871 | 6.291 | 85.33 | 算力 | 3.604 | 3.722 | 71.0 B=1 到 256,最短延迟增长 61.0 倍,GEMM-only 吞吐增长 4.2 倍;没有理由预设“batch 越大延迟就一定平坦”。B=1 的参考比值 128% 也证明经验折线不是硬件上界。4 MiB 权重可能被缓存复用,D 表只记逻辑流量,不能直接把 D/时间当成 DRAM 带宽。 另作两个容量反例:在 batch=24、4096上下文下,把 KV 从 2 字节改成 1 字节,KV 项从 48 GiB 降至 24 GiB;仅改变权重 dtype 并不会自动改变 KV dtype。相同 KV 上下文做逐 token decode,激活项若按 128 KiB/活跃token 的假设计数,则从 prefill 的 12 GiB 变为约 0.00293 GiB;实际 attention workspace、分配器和运行库仍要另计。memory_ledger.ledger 支持这两种参数,见 09 节。 图 3:这张图要看什么——左边是实测延迟,右边是实测吞吐,曲线不保证出现理想平坦段;竖虚线是首个跨过经验 ridge point 的采样 B,模型边界在它与前一采样值之间;延迟变化可能有多个原因,不能从该图猜测具体库路径。 图 4:这张图要看什么——左图是显存四项的堆叠:蓝色权重是常数,红色 KV cache 随并发线性涨,越过黑色可用线就是 OOM;右图是只改一个参数(额外开销率 30%→4%)的效果,batch 24 从 OOM 变装得下。 05. 工业级实现对照 PyTorch v2.10.0 torch/profiler/profiler.py#profile是本次核验的固定源码版本。附录 profiler_probe.py 定义了完整 x/w,CPU 也能运行;若 CUDA 可用,才加 CUDA activity 并在独立计时前后同步。预热与延迟测量放在采集区外,减少把初始化和采集成本当作 kernel 时间的风险。它和本文账本的对应关系是: key_averages 聚合算子事件,不等于直接聚合 GPU kernel;嵌套事件的总时间可能重复包含子调用,不能把所有行的 total time 简单相加。CPU 本次按 self_cpu_time_total 排序;CUDA 分支按 self_device_time_total 排序,该分支尚未在本次 CPU 机器实测。 with_flops=True 在该版本只估计支持的矩阵乘与二维卷积等算子;本次 aten::mm 报 524288,与 $2\times16\times128\times128$ 一致,输出 shape 为 [16,128]。它不是全模型完整 FLOPs 计数,也不是实测指令数。 profile_memory=True 跟踪张量分配/释放。本次 mm 的 self CPU memory 为 8192 字节,恰好等于输出大小;这是该事件的分配增量,不是 CPU RSS 或设备显存峰值,也不涵盖预先创建的权重、KV、allocator reserve 与所有 workspace。 record_shapes 等开关会增加开销并保留张量引用,可能影响优化;定位后应关闭采集单独计时。代码导出 Chrome trace,后续才能分析热点、子事件与时间线。 PaLM §4.1 与 Appendix B定义的训练 MFU 排除激活重算 FLOPs,只计模型所需前向与反向运算。使用 MFU(Model FLOPs Utilization)时应先定义模型理论运算量、时间窗口、卡数与匹配硬件峰值,典型形式为 $\mathrm{MFU}=F_{\text{model}}/(T_{\text{wall}}N_{\text{gpu}}P_{\text{peak}})$。本文不从这一次 mm 采集计算模型 MFU;分布式通信、并发重叠和计时范围都可能改变分母。 Nsight 工具的分工:Nsight Systems 官方 User Guide对应 kernel 空隙、同步和通信时间线;Nsight Compute 官方 Profiling Guide给热点 kernel 的指令吞吐、缓存层级、occupancy 与 stall 等指标。Speed Of Light 的两个百分比是利用率摘要,不能只比较它们便确证瓶颈。先用时间线选热点,再用与该 kernel 指令/存储层级相匹配的计数器检验模型。本次没有 NVIDIA GPU,不宣称完成 nsys/ncu 实测。 SDPA 会按输入和硬件选择后端,不能断言所有 diffusers/transformers 默认用某个 FlashAttention 实现。本文 2068 个教学操作/Byte 来自理想一次读写与统一计数,真实 FlashAttention 仍有分块重读、标量归约和有限片上容量约束。 06. 代价与边界 roofline 是模型,模型有假设。四条主要假设和不成立时的样子: 把下界当时间近似时,假设计算与访存充分重叠。真实 kernel 在算和搬之间来回切换,还有 launch 和同步的开销。小工作集与短 kernel 常会受这些开销影响,但总计时不足以定量区分每一项,本次 B=1 结果也不能单独证明 launch 开销主导。 假设峰值算力是一个数。实际有 fp16/bf16/fp8/稀疏好几档,差 6 倍以上;按 BF16 dense 口径,H100 SXM 相比 A100 40GB SXM 的 ridge point 从约 201 升到 295——在同一 GEMM 逻辑流量与指令口径的模型里,更多强度值会落进带宽侧,拿旧卡的直觉做判断会错。 假设 $D$ 与缓存无关。本文数组账本的 $D$ 是逻辑读写,缓存命中会让逻辑 D/时间大于 DRAM 标称带宽;这并不代表物理DRAM超速,必须先测相应层级流量。锚点论文 Hierarchical Roofline(arXiv:2009.05257)就是把单一 roofline 扩展成每级缓存一条,用于定位数据移动发生在哪一层。 假设算子孤立。decode 阶段 GEMM 的「权重」每层都要重新读一遍,全局账(整个模型、整个请求)和单算子账结论可能不同;通信算子(allreduce)的账本里延迟和消息数占大头,照搬本文公式会算错。 什么时候不用它:动态 shape、算子间强耦合(融合边界在变)、通信密集的分布式场景——这些先上 profiler 看时间线,先选热点与明确测量口径,再用 roofline;分层、分资源模型也可以帮助分析这些复杂负载,只是本文简单二资源式不够。坦诚标注:本文当前数值实测来自 Windows CPU 的 NumPy 与一个 PyTorch CPU 小矩阵;原大工作集形状保留为可选模式,数字本身不可迁移,理想分段趋势也可能被缓存、内核选择和调度打破。 07. 经典论文脉络 Roofline: An Insightful Visual Performance Model for Multicore Architectures(Williams et al., CACM 2009;2008 Berkeley 技术报告版本):提出算术强度与 ridge point,一根折线把「算力受限/带宽受限」变成可判定的题。一切性能建模的原点。 Hierarchical Roofline Performance Analysis for Deep Learning Applications(Yang et al., 2020):把 roofline 按缓存层级展开,回答「多搬的字节发生在哪一级存储」,是本文锚点论文,也补了单一 roofline 在深度学习负载上最大的盲区。 FlashAttention(Dao et al., 2022):IO-aware 的代表作——保持精确注意力的数学结果与主导矩阵乘量级,靠 tiling + online softmax 避免完整 N×N 中间量落 HBM;标量重缩放和重复读取仍有代价,是否改变实际瓶颈须看形状与内核。roofline 视角下「优化带宽」的教科书案例。 Mixed Precision Training(Micikevicius et al., 2017):换 dtype 同时改两本账——$b$ 变小省字节,算力单元换挡提峰值。哪半边有收益取决于受限类型(已发长文专门讲数值稳定那半)。 Efficient Memory Management with PagedAttention(Kwon et al., 2023):在论文比较的服务负载中显著减少 KV cache 分配浪费;这些比例不能直接乘到权重、激活和所有显存上,虚拟内存的分页思想搬进显存管理。知识树里 KV cache 一篇的主角。 五篇连起来是一条线:先有判定工具(roofline),再按受限类型各给一把钥匙——算力侧(混合精度)、带宽侧(FlashAttention)、容量侧(PagedAttention)。 08. 常见误解 “FLOPs 少就更快”。本次开头的约100MFLOP实验已给出反例;它支持“只数运算不够”,不能单独证明DRAM带宽造成了全部时间差。 “显存够放权重就能跑”。未分块 prefill 的显式教学参数给 batch=24 的 94.95 GiB,超过假设78 GiB预算;KV、活跃激活与额外分配都需记账。模型没有实际在GPU上运行,OOM是容量模型预测。 “新卡算力翻倍,推理就必定提速”。仅当匹配的计算资源主导且可利用新增吞吐才有希望;量化还会改变字节、反量化成本和数值误差,不能把它等同于只改P。 “MFU低说明实现差”。小batch、长上下文、通信或排队可能限制吞吐;模型理论FLOPs、每步时间和硬件峰值口径不同,也会改变MFU。先拆测量窗口与资源,才能评价实现。 “图上的带宽分类就是硬件瓶颈证明”。经验GEMM P和逻辑D只构成参考模型;本次4MiB权重可被缓存反复用,不能把表里的D直接当HBM/DRAM流量。换工作集大小、读取硬件计数器和时间线后,再检验假设。 “FlashAttention把整个N²放进SRAM”。它保留瓦片和行统计量;有限片上存储导致分块重读,理想4ND字节只是一次读写的下界。 09. 动手验证 依次执行五个完整脚本,比较快照的最短值、中位数和全部样本;不预设某行参考比值必须低于50%或接近100%。改变工作集、shape与线程设置,每次重新标定并重画四图。若观察到分类或延迟变化,先记录变化,再用工具确认原因。 先运行 machine_probe.py,再用 ledger(..., kv_b=1) 对照 kv_b=2;KV项应分别24/48 GiB。再加 active_tokens=24 比较decode激活,注意它没有改变已保存的KV上下文。 memory_ledger.ledger( 7e9, 2, 32, 4096, 24, 4096, 131072, 0.30, kv_b=1) 在 roofline_model.py 中只把例子的P改为1979e12、保留beta和字节数,观察模型边界右移;这是控制变量练习,不能称为真实H100换卡结果。真实换卡需要同时核对带宽、指令类型、dtype、缓存和内核。 运行 profiler_probe.py,核对 [16,128]×[128,128]、524288 FLOP和8192字节输出,打开trace查看算子事件;CPU结果不能用来证明CUDA分支或GPU显存表现。 10. 延伸阅读 按知识树的依赖关系,从这篇出发有三个方向: 往上游:自注意力机制的计算与显存账本——本文 3.3 节那笔注意力账的完整推导;混合精度与数值稳定性——换 dtype 的另一本账(数值范围与累加精度)。 往下游(受限类型各一把钥匙):FlashAttention(带宽侧)、KV Cache 与自回归视频生成(容量侧)、算子融合与 CUDA Graph(launch/中间量侧)、量化(字节/计算侧)。 目录:完整知识树见博客目录页 AIGC 基本功知识树,按依赖顺序排好了先修课。 继续阅读 FlashAttention 为什么不需要存下注意力矩阵:本文 3.3 节的最低流量示例省略了真实分块重读,那篇把 online softmax 的递推式一步步推出来。 附录:完整代码 09 节用到的脚本全文如下(machine_probe.py、roofline_model.py、profiler_probe.py、memory_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 machine_probe.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """在同一台机器上把 roofline 的「峰值」和「落点」都实测出来。 只依赖 numpy。直接 `python machine_probe.py` 即可运行,约 20 秒。 为什么要自己测一遍 ------------------ roofline_model.py 里的 A100/H100 峰值是厂商标称值,读者手边不一定有 GPU。 本脚本统一记录教学操作数和逻辑数组流量;GEMM乘加按2计数,exp/max各按1。 add有效字节率与GEMM经验算力只构成参考折线,不是所有算子的硬件物理下界。 同一台机器、BLAS和线程设置可以比较本次结果,但仍须硬件计数器才能诊断瓶颈。 每个算子的 D 都按实现里实际的读写遍数来数: LayerNorm 预分配版 10 遍(mean / 减均值 / 平方 / 再 mean / 除 / 乘 gamma) attention 朴素预分配 10 遍(写 S / max / 减 / exp / sum / 除 / 读 S 写 O) 遍数不是拍脑袋来的,是照着下面每一行 numpy 数出来的。 输出的每个数字都来自 `time.perf_counter()` 的真实计时。 """ import argparse import io import os import statistics from contextlib import redirect_stdout import json import platform import time from pathlib import Path import numpy as np FP32 = 4 # 本机跑 fp32,BLAS 后端在快照 environment 中实际记录 _LAST_TIMING = {} SNAPSHOT = Path(__file__).resolve().parent / "probe_results.json" def _best(fn, repeat: int): """预热后取repeat次最短值,另存全部样本和中位数;不代表请求延迟分位数。""" fn() # 预热:第一次要分配 / 触发缺页 samples = [] for _ in range(repeat): t = time.perf_counter() fn() samples.append(time.perf_counter() - t) _LAST_TIMING.clear() _LAST_TIMING.update(samples_seconds=samples, median_seconds=statistics.median(samples), min_seconds=min(samples), max_seconds=max(samples), repeats=repeat) return min(samples) # ── 一、标定可达带宽:二元 add 模式(读两份写一份)─────────────────── def measure_bandwidth(n: int = 2_000_000, repeat: int = 8) -> float: """返回实测可达带宽(Byte/s)。 默认每份 fp32 数组 8 MB;large模式128 MB;应核对目标机器缓存大小,这里测量此访问模式的有效带宽。 z = x + y:读 2n、写 n,共 3n 个元素。 """ x = np.ones(n, dtype=np.float32) y = np.ones(n, dtype=np.float32) z = np.empty(n, dtype=np.float32) dt = _best(lambda: np.add(x, y, out=z), repeat) return 3 * n * FP32 / dt # ── 二、标定峰值算力:大矩阵乘 ──────────────────────────────────── def measure_matmul_peak(n: int = 1024, repeat: int = 5) -> float: """返回实测可达算力(FLOP/s)。 大方阵乘能摊薄访存;测得的是此shape/BLAS/线程数的经验参考,非物理峰值。 FLOPs = 2·n³(口径同 roofline_model.py:一次乘加记 2 个浮点运算)。 """ rng = np.random.default_rng(0) a = rng.standard_normal((n, n), dtype=np.float32) b = rng.standard_normal((n, n), dtype=np.float32) c = np.empty((n, n), dtype=np.float32) dt = _best(lambda: np.matmul(a, b, out=c), repeat) return 2 * n ** 3 / dt def calibrate(verbose: bool = True, large: bool = False): n = 32_000_000 if large else 2_000_000 side = 4096 if large else 1024 bw = measure_bandwidth(n=n) bw_timing = dict(_LAST_TIMING) fl = measure_matmul_peak(n=side) peak = dict(peak_flops=fl, peak_bw=bw, vector_elements=n, matrix_side=side, bandwidth_timing=bw_timing, matmul_timing=dict(_LAST_TIMING)) if verbose: print("=" * 80) print(f"本机标定({platform.machine()},numpy {np.__version__},fp32)") print("=" * 80) print(f" 实测可达带宽 beta = {bw / 1e9:8.2f} GB/s") print(f" 实测可达算力 P = {fl / 1e9:8.2f} GFLOP/s") print(f" ridge point I* = {fl / bw:8.1f} FLOP/Byte") print(" 注:这是该shape下的经验参考,不是所有算子的物理上限;") print(" 换 BLAS 后端、换 dtype、换线程数都会变。口径一致才有可比性。") return peak def build_ops(large: bool = False): """构造待实测的算子。每个元素 = (名字, F, D, 函数, repeat)。""" rng = np.random.default_rng(0) ops = [] # ── 逐元素:1 遍 vs 2 遍 vs「看起来融合了」 ── n = 32_000_000 if large else 2_000_000 a = rng.standard_normal(n, dtype=np.float32) b = rng.standard_normal(n, dtype=np.float32) o1 = np.empty(n, dtype=np.float32) tmp = np.empty(n, dtype=np.float32) def add_relu_two_pass(): # 5n 个元素:tmp 读写各一次 np.add(a, b, out=tmp) np.maximum(tmp, 0, out=o1) def add_relu_one_line(): # 写法像融合了,numpy 照样分配中间数组 np.maximum(np.add(a, b), 0, out=o1) ops.append(("逐元素 add(1 遍)", 1.0 * n, FP32 * 3 * n, lambda: np.add(a, b, out=o1), 8)) ops.append(("add+relu 两遍(预分配)", 2.0 * n, FP32 * 5 * n, add_relu_two_pass, 8)) ops.append(("add+relu 写成一行(有中间数组)", 2.0 * n, FP32 * 5 * n, add_relu_one_line, 8)) # ── LayerNorm:预分配的 10 遍版 ── ln_n, ln_d = (8192, 4096) if large else (1024, 1024) x = rng.standard_normal((ln_n, ln_d), dtype=np.float32) g = rng.standard_normal(ln_d, dtype=np.float32) mu = np.empty((ln_n, 1), dtype=np.float32) var = np.empty((ln_n, 1), dtype=np.float32) xc = np.empty_like(x) xc2 = np.empty_like(x) def layernorm_buffered(): np.mean(x, axis=-1, keepdims=True, out=mu) # 读 x 1 遍 np.subtract(x, mu, out=xc) # 读 x 写 xc 3 遍 np.multiply(xc, xc, out=xc2) # 读 xc 写 xc2 5 遍 np.mean(xc2, axis=-1, keepdims=True, out=var) # 读 xc2 6 遍 np.sqrt(var + 1e-5, out=var) # 小量 np.divide(xc, var, out=xc) # 读 xc 写 xc 8 遍 np.multiply(xc, g, out=xc) # 读 xc 写 xc 10 遍 ops.append((f"LayerNorm [{ln_n},{ln_d}] 预分配", 6.0 * ln_n * ln_d, FP32 * 10 * ln_n * ln_d, layernorm_buffered, 5)) # ── 朴素注意力:S 落盘,10 遍 N² 访存 ── N, D = (2048 if large else 512), 128 q = rng.standard_normal((N, D), dtype=np.float32) k = rng.standard_normal((N, D), dtype=np.float32) v = rng.standard_normal((N, D), dtype=np.float32) kt = np.ascontiguousarray(k.T) S = np.empty((N, N), dtype=np.float32) O = np.empty((N, D), dtype=np.float32) rowmax = np.empty((N, 1), dtype=np.float32) rowsum = np.empty((N, 1), dtype=np.float32) def attention_naive(): # 本微基准省略 1/sqrt(D) 缩放,只测 matmul-softmax-matmul 的执行开销。 np.matmul(q, kt, out=S) # 写 S 1 遍 np.max(S, axis=-1, keepdims=True, out=rowmax) # 读 S 2 遍 np.subtract(S, rowmax, out=S) # 读写 S 4 遍 np.exp(S, out=S) # 读写 S 6 遍 np.sum(S, axis=-1, keepdims=True, out=rowsum) # 读 S 7 遍 np.divide(S, rowsum, out=S) # 读写 S 9 遍 np.matmul(S, v, out=O) # 读 S 写 O 10 遍 ops.append((f"attention 朴素 [N={N},D={D}]", 4.0 * N * N * D + 5.0 * N * N, FP32 * (10 * N * N + 4 * N * D), attention_naive, 5)) # ── GEMM 三个规模 ── side = 4096 if large else 1024 for m in ((512, 2048, 4096) if large else (128, 512, 1024)): ma = rng.standard_normal((m, side), dtype=np.float32) mb = rng.standard_normal((side, side), dtype=np.float32) mc = np.empty((m, side), dtype=np.float32) ops.append((f"GEMM {m}x{side}x{side}", 2.0 * m * side * side, FP32 * (m * side + side * side + m * side), lambda ma=ma, mb=mb, mc=mc: np.matmul(ma, mb, out=mc), 5)) return ops def probe(peak: dict, verbose: bool = True, large: bool = False): ops = build_ops(large=large) I_star = peak["peak_flops"] / peak["peak_bw"] if verbose: print("\n" + "=" * 80) print("三、真实算子打到这张 roofline 上:模型估计 vs 实测") print("=" * 80) hdr = (f"{'算子':<32s}{'I':>9s}{'受限':>8s}{'T估计':>10s}{'T实测':>10s}" f"{'达成率':>9s}{'实测算力':>14s}") print(hdr) print("-" * len(hdr)) rows = [] for name, F, D, fn, repeat in ops: dt = _best(fn, repeat) I = F / D bound = "算力" if I >= I_star else "带宽" t_pred = max(F / peak["peak_flops"], D / peak["peak_bw"]) eff = t_pred / dt rows.append(dict(name=name, I=I, bound=bound, t_pred=t_pred, t_real=dt, eff=eff, flops=F, bytes=D, gflops=F / dt / 1e9, timing=dict(_LAST_TIMING))) if verbose: print(f"{name:<32s}{I:>9.2f}{bound:>8s}{t_pred * 1e3:>8.2f}ms" f"{dt * 1e3:>8.2f}ms{eff * 100:>8.0f}%" f"{F / dt / 1e9:>11.1f} GF/s") if verbose: print("\n 参考比值 = 模型估计 / 实测,回答的是「这个实现离 roofline 还有多远」。") print(" 低达成率可能来自指令、缓存、调度或同步;单凭此比值不能诊断额外访存。") return rows def demo_same_flops(): """约100MFLOP,有限工作集重复访问对比,不是DRAM压力测试。""" print("\n" + "=" * 80) print("四、约100MFLOP,两种算子在有限工作集上差多少时间") print("=" * 80) rng = np.random.default_rng(3) target = 1.0e8 # GEMM:2·M·K·N = target,取 K=N=1024 M = int(target / (2 * 1024 * 1024)) ma = rng.standard_normal((M, 1024)).astype(np.float32) mb = rng.standard_normal((1024, 1024)).astype(np.float32) mc = np.empty((M, 1024), dtype=np.float32) t_gemm = _best(lambda: np.matmul(ma, mb, out=mc), 10) f_gemm = 2.0 * M * 1024 * 1024 # 逐元素:n 个元素各算 1 次,F = n # 复用有限工作集,避免十亿元素及float64临时数组造成多GB瞬时分配。 chunk, rounds = 2_000_000, 50 n_elem = chunk * rounds a = rng.standard_normal(chunk, dtype=np.float32) b = rng.standard_normal(chunk, dtype=np.float32) o = np.empty(chunk, dtype=np.float32) def chunked_add(): for _ in range(rounds): np.add(a, b, out=o) t_elem = _best(chunked_add, 5) print(f" GEMM : F = {f_gemm / 1e9:.3f} GFLOP, " f"D = {FP32 * (M * 1024 + 1024 * 1024 + M * 1024) / 1e6:.1f} MB, " f"实测 {t_gemm * 1e3:.3f} ms({f_gemm / t_gemm / 1e9:.0f} GFLOP/s)") print(f" 逐元素 : F = {n_elem / 1e9:.3f} GFLOP, " f"D = {FP32 * 3 * n_elem / 1e6:.1f} MB, " f"实测 {t_elem * 1e3:.3f} ms({n_elem / t_elem / 1e9:.0f} GFLOP/s)") print(f" → FLOPs 基本相同,耗时差 {t_elem / t_gemm:.0f} 倍。") print(" 同样运算量不代表同样时间:这里逐元素算子的运算数并未") print(f" 减少;逻辑 I={1 / (FP32 * 3):.2f} FLOP/Byte,24MB工作集反复访问,不能确证DRAM瓶颈。") return dict(gemm_flops=f_gemm, gemm_seconds=t_gemm, add_flops=n_elem, add_seconds=t_elem, add_working_set_bytes=3 * chunk * FP32, add_logical_bytes=FP32 * 3 * n_elem, chunk=chunk, rounds=rounds, ratio=t_elem / t_gemm) def main(): parser = argparse.ArgumentParser() parser.add_argument("--large", action="store_true", help="恢复原大shape实验;先确认可用内存") args = parser.parse_args() peak = calibrate(large=args.large) rows = probe(peak, large=args.large) demo = demo_same_flops() config = io.StringIO() with redirect_stdout(config): np.show_config() environment = dict(platform=platform.platform(), numpy=np.__version__, thread_settings={k: os.environ.get(k) for k in ("OPENBLAS_NUM_THREADS", "OMP_NUM_THREADS", "MKL_NUM_THREADS")}, numpy_config=config.getvalue(), preset="large" if args.large else "bounded") # 把这次标定存成快照:make_figures / memory_ledger 直接读它, # 保证「图上的数字」和「正文引用的数字」来自同一次运行。 SNAPSHOT.write_text(json.dumps( dict(peak=peak, rows=rows, demo=demo, environment=environment, note=f"{platform.machine()} / numpy {np.__version__} / fp32", timestamp=time.strftime("%Y-%m-%d %H:%M:%S")), ensure_ascii=False, indent=1), encoding="utf-8") print(f"\n标定快照已存到 {SNAPSHOT.name},make_figures / memory_ledger 会复用它。") print(f"这台机器的 roofline:P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, " f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, " f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f} FLOP/Byte") if __name__ == "__main__": main() roofline_model.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """Roofline 模型的最小实现:把「算力账」和「带宽账」合成一条上界曲线。 只依赖 numpy(其实只是用来排版,算法本身是纯标量运算)。 直接 `python roofline_model.py` 即可运行,约 1 秒。 符号与文章第 03 节一一对应 -------------------------- F 浮点运算数(FLOP)。口径:一次乘加(MAC)记 2 FLOP D 教学逻辑流量(Byte):按数组读写计;并非硬件DRAM计数器 I 算术强度 I = F / D,单位 FLOP/Byte P_peak 峰值算力(FLOP/s) beta 峰值带宽(Byte/s) I_star ridge point = P_peak / beta,只判定所给模型的主导资源 关键结论(代码算完会打印): T >= max(F / P_peak, D / beta) 把 F 降为一半或把 D 降为一半时的模型比值,见 optimize_headroom() """ import json from pathlib import Path def _local_spec(): """本机实测峰值:优先读 machine_probe.py 存下的标定快照。 快照不存在时明确要求先运行 machine_probe.py。 这样 SPECS 里的「本机实测」永远是同一次标定,不会和正文引用的数字分叉。 """ snap = Path(__file__).resolve().parent / "probe_results.json" if snap.exists(): p = json.loads(snap.read_text(encoding="utf-8"))["peak"] return dict(peak_flops=p["peak_flops"], peak_bw=p["peak_bw"]) raise FileNotFoundError("请先运行 machine_probe.py 生成本机快照;不能用别人的峰值兜底") # ── BF16/FP8 dense GEMM 厂商峰值;不能视为逐元素/exp吞吐。 # A100 40GB SXM: https://images.nvidia.com/aem-dam/en-zz/Solutions/data-center/nvidia-ampere-architecture-whitepaper.pdf # H100 SXM: https://www.nvidia.com/en-us/data-center/h100/ (带*稀疏值除2) # 注意 H100 BF16 dense 算力增幅大于带宽增幅,ridge point 比 A100 高: # 带宽涨 2.15 倍、bf16 算力涨约 3.17 倍 → 更多 kernel 落在带宽受限区。 SPECS = { "A100-40GB SXM (bf16)": dict(peak_flops=312e12, peak_bw=1555e9), "H100-80GB SXM (bf16)": dict(peak_flops=989e12, peak_bw=3350e9), "H100-80GB SXM (fp8)": dict(peak_flops=1979e12, peak_bw=3350e9), # 下面这一条不是标称值,是 machine_probe.py 在同一台机器上实测出来的 "本机实测(见 machine_probe.py)": _local_spec(), } BF16 = 2 # bytes per element def roofline_time(F: float, D: float, peak_flops: float, peak_bw: float): """roofline 时间下界:算力时间与带宽时间取 max(假设两者完美重叠)。""" t_compute = F / peak_flops t_memory = D / peak_bw return max(t_compute, t_memory), t_compute, t_memory def resource_time(terms, moved_bytes, bandwidth): """按不同资源给下界,terms 为 [(工作量, 同口径峰值), ...]。 例:Tensor Core FLOP、FP32 CUDA-core FLOP、exp次数分别使用对应吞吐。 只取max仍是假定资源可完美重叠的乐观下界,不能冒充实测耗时。 """ if moved_bytes < 0 or bandwidth <= 0: raise ValueError("字节数非负、带宽为正") if any(work < 0 or rate <= 0 for work, rate in terms): raise ValueError("工作量非负、同口径吞吐为正") return max([moved_bytes / bandwidth] + [work / rate for work, rate in terms]) def bound_of(F: float, D: float, peak_flops: float, peak_bw: float) -> str: I = F / D I_star = peak_flops / peak_bw return "算力受限" if I >= I_star else "带宽受限" def optimize_headroom(F: float, D: float, peak_flops: float, peak_bw: float): """把运算量 F 或搬运量 D 减半,理想模型可快多少? 答案与算术强度有关:带宽受限时只减少运算量的模型收益为 0,算力受限时最多 2 倍。 返回 (F 减半的加速比, D 减半的加速比),分别等价于只将峰值算力或带宽翻倍。 """ def speedup(F2, D2): t0, _, _ = roofline_time(F, D, peak_flops, peak_bw) t1, _, _ = roofline_time(F2, D2, peak_flops, peak_bw) return t0 / t1 return speedup(F / 2, D), speedup(F, D / 2) # ── 几类算子的 F / D 账本 ────────────────────────────────────────── def gemm(M: int, K: int, N: int, b: int = BF16): """矩阵乘 [M,K] @ [K,N] -> [M,N]。读 A、读 B、写 C。""" F = 2.0 * M * K * N D = b * (M * K + K * N + M * N) return F, D def elementwise(n: int, b: int = BF16, n_pass: int = 1, n_read: int = 1): """逐元素算子:读 n_read 份、写 1 份;n_pass 表示这样读写几轮。 二元运算(如 add)是 n_read=2:读两份输入、写一份输出。 """ F = 1.0 * n * n_pass # 每个元素算 1 次 D = b * (n_read + 1) * n * n_pass return F, D def layernorm(n: int, d: int, b: int = BF16): """简化 LayerNorm(无 beta):两次归约、减均值、平方、除标准差、乘 gamma,约 6 次/元素。 访存 = 读 x 一遍 + 写 y 一遍(统计量是 O(n) 的小量,忽略)。""" F = 6.0 * n * d D = b * 2 * n * d return F, D def softmax(n: int, d: int, b: int = BF16, fused: bool = True): """softmax:exp / 减最大值 / 归一化,约 5 次运算/元素。 fused=True 假设整行可驻留片上存储,读 1 遍写 1 遍;不是独立 online normalizer 的通用 IO fused=False 保存 E 的三阶段模型:读X求max;读X写E同时归约和;读E写P,共3读2写 不是原论文 Algorithm 2 的重算 exp、3读1写版本;F=5nd不适用于后者或online递推 """ F = 5.0 * n * d D = b * 2 * n * d if fused else b * (3 * n * d + 2 * n * d) return F, D def attention(N: int, D: int, b: int = BF16, flash: bool = False): """单头注意力。N 是 token 数,D 是每头维度。 flash=False(朴素):分数矩阵 S 和权重 P 都要落 HBM S = Q K^T 写 N^2 P = softmax(S) 读 N^2 写 N^2 O = P V 读 N^2 → 二次项访存 ≈ 4 N^2 b flash=True(强缓存假设下的最低流量,不是真实 FlashAttention IO):Q/K/V 读进来、O 写出去,只保留一块分数/概率瓦片,不分配完整 N^2 矩阵 → 访存 ≈ 4 N D b """ F = 4.0 * N * N * D + 5.0 * N * N # 两个 N×N×D 的矩阵乘 + softmax if flash: D_bytes = b * (3 * N * D + N * D) # 读 Q K V,写 O else: D_bytes = b * (4 * N * N + 4 * N * D) # 上面再加 S/P 的读写 return F, D_bytes def fmt(x: float, unit: str = "") -> str: for u, s in (("T", 1e12), ("G", 1e9), ("M", 1e6), ("K", 1e3)): if x >= s: return f"{x / s:.2f} {u}{unit}" return f"{x:.2f} {unit}" def main(): print("=" * 78) print("一、三组 GEMM 规格与本机经验标定(不是所有算子的统一物理峰值)") print("=" * 78) print(f"{'设备':<28s}{'P_peak':>14s}{'beta':>14s}{'I* = P/beta':>16s}") ridges = {} for name, s in SPECS.items(): I_star = s["peak_flops"] / s["peak_bw"] ridges[name] = (s, I_star) print(f"{name:<28s}{fmt(s['peak_flops'], 'FLOP/s'):>16s}" f"{fmt(s['peak_bw'], 'B/s'):>14s}{I_star:>12.1f} FLOP/B") a100 = SPECS["A100-40GB SXM (bf16)"] h100 = SPECS["H100-80GB SXM (bf16)"] print(f"\n A100 -> H100:带宽 ×{h100['peak_bw'] / a100['peak_bw']:.2f}," f"算力 ×{h100['peak_flops'] / a100['peak_flops']:.2f}," f"ridge point {a100['peak_flops'] / a100['peak_bw']:.0f} -> " f"{h100['peak_flops'] / h100['peak_bw']:.0f}(更高 = 更多算子落入带宽受限区)") # ── 二、算子账本 ──────────────────────────────────────────────── N, D = 4096, 128 # 一个典型的 DiT / LLM 单头规模 cases = [ ("逐元素 add [16M]", elementwise(16_000_000, n_read=2)), ("LayerNorm [4096, 3072]", layernorm(4096, 3072)), ("softmax fused [4096, 4096]", softmax(4096, 4096, fused=True)), ("softmax 朴素三遍 [4096, 4096]", softmax(4096, 4096, fused=False)), ("GEMM 512x4096x4096", gemm(512, 4096, 4096)), ("GEMM 4096x4096x4096", gemm(4096, 4096, 4096)), ("attention 朴素 [N=4096,D=128]", attention(N, D, flash=False)), ("attention ideal-min [N=4096,D=128]", attention(N, D, flash=True)), ] print("\n" + "=" * 78) print("二、统一操作计数的教学模型(b=2,P=312T,beta=1555G)") print("=" * 78) hdr = (f"{'算子':<32s}{'F (教学操作)':>14s}{'D (Byte)':>14s}" f"{'I':>10s}{'受限':>10s}{'T_roof':>12s}") print(hdr) print("-" * len(hdr)) for name, (F, Db) in cases: I = F / Db T, tc, tm = roofline_time(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{name:<32s}{fmt(F):>14s}{fmt(Db, 'B'):>14s}" f"{I:>10.2f}{bound_of(F, Db, a100['peak_flops'], a100['peak_bw']):>10s}" f"{T * 1e3:>10.3f} ms") # ── 三、FlashAttention 把算术强度抬了多少 ──────────────────────── print("\n" + "=" * 78) print("三、物化 S/P 与理想最低 IO 对比(单头 N=4096, D=128, bf16)") print("=" * 78) F_naive, D_naive = attention(N, D, flash=False) F_flash, D_flash = attention(N, D, flash=True) T_naive, _, _ = roofline_time(F_naive, D_naive, a100["peak_flops"], a100["peak_bw"]) T_flash, _, _ = roofline_time(F_flash, D_flash, a100["peak_flops"], a100["peak_bw"]) print(f" FLOPs : {fmt(F_naive)} -> {fmt(F_flash)} " f"(×{F_flash / F_naive:.3f},几乎没变)") print(f" 访存 : {fmt(D_naive, 'B')} -> {fmt(D_flash, 'B')} " f"(×{D_flash / D_naive:.4f},省 {D_naive / D_flash:.1f} 倍)") print(f" 算术强度 : {F_naive / D_naive:.1f} -> {F_flash / D_flash:.1f} FLOP/B " f"(×{(F_flash / D_flash) / (F_naive / D_naive):.1f})") print(f" 受限类型 : {bound_of(F_naive, D_naive, **a100)} -> " f"{bound_of(F_flash, D_flash, **a100)}") print(f" roofline : {T_naive * 1e3:.3f} ms -> {T_flash * 1e3:.3f} ms " f"(×{T_naive / T_flash:.2f})") print(f" 注意:模型比值来自「少搬 {D_naive / D_flash:.0f} 倍字节」," "此处给各运算统一计数和统一P,仅为教学模型;真实内核的标量吞吐、exp及重读需另计。") # ── 四、砍算力 vs 砍带宽,谁的收益大 ──────────────────────────── print("\n" + "=" * 78) print("四、教学资源模型中,只翻倍 P 或 beta 的时间估计比值") print("=" * 78) print(f"{'算子':<32s}{'I/I*':>10s}{'算力×2 的加速':>16s}{'带宽×2 的加速':>16s}") I_star = a100["peak_flops"] / a100["peak_bw"] for name, (F, Db) in cases: s_flops, s_bw = optimize_headroom(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{name:<32s}{(F / Db) / I_star:>10.3f}" f"{s_flops:>14.2f}x{s_bw:>14.2f}x") print("\n 读法:带宽受限的行(I/I* < 1)里「算力×2」那一列几乎都是 1.00——" "\n 在只改变计算峰值且访存不变的理想模型里,该列为 1。") # ── 五、GEMM 什么时候从带宽受限翻到算力受限 ───────────────────── print("\n" + "=" * 78) print("五、GEMM [M,4096] x [4096,4096]:M 多大才开始算力受限") print("=" * 78) K = Nout = 4096 print(f"{'M':>8s}{'I (FLOP/B)':>14s}{'受限':>12s}") prev = None for M in (1, 2, 4, 8, 16, 32, 64, 128, 256, 512, 1024, 4096): F, Db = gemm(M, K, Nout) b = bound_of(F, Db, a100["peak_flops"], a100["peak_bw"]) print(f"{M:>8d}{F / Db:>14.2f}{b:>12s}") if prev == "带宽受限" and b == "算力受限": print(f" ↑ 拐点:M 在 ({M // 2}, {M}] 之间," f"I 越过 ridge point {I_star:.0f}") prev = b print("\n 推论:小 batch 推理(M=1~8)里的 GEMM 是带宽受限的," "这时候做 fp8 量化省的是字节、不是算力。") if __name__ == "__main__": main() profiler_probe.py """最小 PyTorch Profiler 对照:无需模型权重;默认CPU,可选CUDA。""" import json import statistics import time from pathlib import Path import torch from torch.profiler import ProfilerActivity, profile, record_function def main(): torch.manual_seed(7) torch.set_num_threads(1) device = torch.device("cuda" if torch.cuda.is_available() else "cpu") x = torch.randn(16, 128, device=device) w = torch.randn(128, 128, device=device) activities = [ProfilerActivity.CPU] if device.type == "cuda": activities.append(ProfilerActivity.CUDA) def synchronize(): if device.type == "cuda": torch.cuda.synchronize() with torch.inference_mode(): for _ in range(5): torch.mm(x, w) synchronize() samples = [] for _ in range(10): synchronize() start = time.perf_counter() torch.mm(x, w) synchronize() samples.append(time.perf_counter() - start) # profiler区域用于观察事件;上面单独计时用于延迟,避免混入采集开销。 with profile(activities=activities, record_shapes=True, profile_memory=True, with_flops=True, acc_events=True) as prof: with record_function("one_matmul"): y = torch.mm(x, w) synchronize() events = prof.key_averages() sort = "self_device_time_total" if device.type == "cuda" else "self_cpu_time_total" print(events.table(sort_by=sort, row_limit=8)) mm = next(event for event in events if event.key == "aten::mm") expected = 2 * 16 * 128 * 128 assert mm.flops == expected assert y.shape == (16, 128) and torch.isfinite(y).all() result = dict(torch_version=torch.__version__, device=str(device), x_shape=list(x.shape), w_shape=list(w.shape), y_shape=list(y.shape), estimated_mm_flops=mm.flops, expected_mm_flops=expected, mm_self_cpu_memory_bytes=mm.self_cpu_memory_usage, y_bytes=y.numel() * y.element_size(), standalone_seconds=samples, median_seconds=statistics.median(samples), event_keys=[event.key for event in events], note="CPU实跑时不宣称CUDA内核验证;算子分配增量不是设备显存总占用") here = Path(__file__).resolve().parent prof.export_chrome_trace(str(here / "profiler_trace.json")) (here / "profiler_results.json").write_text(json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8") print(json.dumps(result, ensure_ascii=False, indent=2)) if __name__ == "__main__": main() memory_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """显存账本 + batch 扫描:容量这本账怎么算,以及它怎么反过来决定速度。 只依赖 numpy(第二部分要真跑计时)。直接 `python memory_ledger.py` 即可运行,约 10 秒。 第一部分是「容量账」:权重 / KV cache / 激活 / 额外开销四项加总,看 假设 78 GiB 可用预算 能塞多少条并发请求。第二部分是「速度账」:batch 变大之后,同一份权重被更多 token 摊薄,算术强度抬上去。I与I*仅标记模型分类交界,计时曲线不一定出现相同拐点。 """ import argparse import statistics import json import time from pathlib import Path import numpy as np GIB = 1024 ** 3 def _load_peak(): """优先读 machine_probe.py 存下的标定快照(保证口径一致); 未运行时明确报错,避免误用另一台机器的峰值。""" snap = Path(__file__).resolve().parent / "probe_results.json" if snap.exists(): peak = json.loads(snap.read_text(encoding="utf-8"))["peak"] return peak["peak_flops"], peak["peak_bw"] raise FileNotFoundError("请先运行 machine_probe.py;不使用其他机器标定兜底") P_PEAK, BETA = _load_peak() I_STAR = P_PEAK / BETA def kv_cache_bytes(n_tokens: int, n_layers: int, d_kv: int, b: int = 2) -> int: """KV cache 字节数:每个 token 每层都要存一份 K 和一份 V。 n_tokens 序列长度(或并发请求的总 token 数) n_layers 层数 L d_kv 每层的 KV 总维度 = n_kv_heads × d_head(GQA 时用实际的 KV head 数) b 每个元素的字节数(fp16/bf16 = 2,fp8 = 1) """ return 2 * n_tokens * n_layers * d_kv * b def ledger(n_params: float, b_w: int, n_layers: int, d_kv: int, batch: int, seq: int, act_per_token: int, overhead_rate: float, kv_b: int = 2, active_tokens: int | None = None): """推理显存账本的四项,单位 GiB。 act_per_token 每个 token 的激活峰值(字节)。推理不保留整层的中间结果, 但当前层的十几份临时张量要同时活着:d_model=4096、fp16 时 一份 [d] 张量 8 KiB,取 16 份 ≈ 128 KiB / token。 这是16份张量的教学假设,不是实测或通用经验值。 overhead_rate 教学额外开销 / (权重 + KV + 激活),不是实测碎片率。 本函数按未分块 prefill 计 batch*seq 个活跃 token; 逐 token decode 的激活应改为 batch*act_per_token,KV 仍取 batch*seq。 """ w = n_params * b_w if min(n_params, b_w, n_layers, d_kv, batch, seq, act_per_token, overhead_rate, kv_b) < 0: raise ValueError("容量输入不得为负") active = batch * seq if active_tokens is None else active_tokens if active < 0: raise ValueError("活跃token数不得为负") kv = kv_cache_bytes(batch * seq, n_layers, d_kv, b=kv_b) act = active * act_per_token frag = (w + kv + act) * overhead_rate return dict(weights=w / GIB, kv=kv / GIB, act=act / GIB, frag=frag / GIB, total=(w + kv + act + frag) / GIB) def part1(): print("=" * 80) print("一、显存账本:一张 假设 78 GiB 可用预算,能塞多少条并发请求") print("=" * 80) # Llama-2-7B 的配置:32 层、32 个 KV head、d_head=128 → d_kv = 4096 N_PARAMS, N_LAYERS, D_KV = 7e9, 32, 4096 SEQ = 4096 per_token = kv_cache_bytes(1, N_LAYERS, D_KV) print(f" 模型:7B,fp16 权重 = {N_PARAMS * 2 / GIB:.1f} GiB," f"{N_LAYERS} 层,d_kv = {D_KV}") print(f" KV cache 单价:{per_token / 1024:.0f} KiB / token " f"(一条 {SEQ} 长的序列 = {per_token * SEQ / GIB:.2f} GiB)") print() hdr = (f"{'batch':>6s}{'权重':>9s}{'KV cache':>10s}{'激活':>9s}" f"{'额外开销':>9s}{'合计':>9s}{'78GiB预算':>10s}") print(hdr) print("-" * len(hdr)) for batch in (1, 4, 8, 16, 24, 32): # 朴素预分配:按最大长度全预留,教学假设:以权重+KV+激活总和的 30% 估计额外开销,不是实测碎片比例 naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, act_per_token=131072, overhead_rate=0.30) ok = "装得下" if naive["total"] < 78 else "OOM" print(f"{batch:>6d}{naive['weights']:>8.1f}G{naive['kv']:>9.2f}G" f"{naive['act']:>8.2f}G{naive['frag']:>8.2f}G" f"{naive['total']:>8.2f}G{ok:>10s}") # 换成低开销假设(教学假设,非 PagedAttention 实测):额外开销率降到 4% print("\n 同一张卡,把额外开销率从 30% 降到 4%(低开销假设):") print(f"{'batch':>6s}{'朴素合计':>11s}{'低开销假设':>11s}{'多出来的并发':>16s}") for batch in (8, 16, 24, 32): naive = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.30) low_overhead = ledger(N_PARAMS, 2, N_LAYERS, D_KV, batch, SEQ, 131072, 0.04) extra = "" if naive["total"] > 78 >= low_overhead["total"]: extra = "从 OOM 变装得下" print(f"{batch:>6d}{naive['total']:>10.2f}G{low_overhead['total']:>10.2f}G" f"{extra:>16s}") print("\n 读法:权重那一项是常数,batch 再大也不变;KV cache 才是随并发") print(" 线性增长的那一项,batch 16 时它已经比权重还大。") print(" 「显存够放权重就能跑」这句话漏掉了后面三项。") # 用 roofline_model 里同款口径:下界 = max(F/P, D/beta)。 # P_PEAK / BETA / I_STAR 已在文件顶部从标定快照读出,这里不再覆盖, # 否则快照刷新后正文引用的数字会和实际跑出来的对不上。 def batch_sweep(repeats: int = 15, d: int = 1024): """固定一份「权重」,扫 batch,返回每一档的实测延迟/吞吐/算术强度。""" rng = np.random.default_rng(0) W = rng.standard_normal((d, d), dtype=np.float32) # 默认4 MiB,large模式64 MiB的权重 W_bytes = W.nbytes FP32 = 4 def run(B): x = rng.standard_normal((B, d), dtype=np.float32) y = np.empty((B, d), dtype=np.float32) np.matmul(x, W, out=y) # 预热 samples = [] for _ in range(repeats): t = time.perf_counter() np.matmul(x, W, out=y) samples.append(time.perf_counter() - t) return min(samples), samples rows = [] for B in (1, 2, 4, 8, 16, 32, 64, 128, 256): F = 2.0 * B * d * d D = W_bytes + 2 * B * d * FP32 I = F / D dt, samples = run(B) rows.append(dict(B=B, F=F, D=D, I=I, lat=dt, thr=B / dt, bound="算力" if I >= I_STAR else "带宽", t_pred=max(F / P_PEAK, D / BETA), eff=max(F / P_PEAK, D / BETA) / dt, matrix_side=d, median_seconds=statistics.median(samples), samples_seconds=samples)) return rows, W_bytes def part2(d=1024): """batch 扫描实测:延迟、吞吐、算术强度,以及拐点在哪。""" print("\n" + "=" * 80) print("二、batch 扫描实测:吞吐什么时候不再涨") print("=" * 80) rows, W_bytes = batch_sweep(d=d) (Path(__file__).resolve().parent / "batch_results.json").write_text( json.dumps(dict(rows=rows, weight_bytes=W_bytes, peak=dict(peak_flops=P_PEAK, peak_bw=BETA), matrix_side=d), indent=2), encoding="utf-8") print(f" 固定「权重」W 形状 [{d}, {d}],fp32 = {W_bytes / 2 ** 20:.0f} MiB;" f"batch B 就是一次喂进去的 token 数") print(f" 经验参考(来自 machine_probe 的标定快照):" f"P = {P_PEAK / 1e9:.0f} GFLOP/s,beta = {BETA / 1e9:.1f} GB/s," f"I* = {I_STAR:.1f}") print() hdr = (f"{'B':>6s}{'F (GFLOP)':>12s}{'D (MB)':>10s}{'I':>9s}{'受限':>8s}" f"{'延迟 ms':>10s}{'吞吐 K/s':>11s}{'估计 ms':>10s}{'达成率':>9s}") print(hdr) print("-" * len(hdr)) prev_bound = None for r in rows: print(f"{r['B']:>6d}{r['F'] / 1e9:>12.3f}{r['D'] / 1e6:>10.2f}" f"{r['I']:>9.2f}{r['bound']:>8s}{r['lat'] * 1e3:>10.3f}" f"{r['thr'] / 1e3:>9.1f}K{r['t_pred'] * 1e3:>10.3f}" f"{r['eff'] * 100:>8.0f}%") if prev_bound == "带宽" and r["bound"] == "算力": print(f" ↑ 拐点:B 从 {r['B'] // 2} 到 {r['B']} 之间" f"越过 ridge point {I_STAR:.1f}") prev_bound = r["bound"] # 只标记延迟变化;不从总计时猜测库实现路径或实际硬件瓶颈。 for r0, r1 in zip(rows, rows[1:]): if r1["B"] == 2 * r0["B"] and r1["lat"] > r0["lat"] * 1.5: print(f" ! 反常:B={r0['B']} 只要 {r0['lat'] * 1e3:.2f} ms," f"B={r1['B']} 却要 {r1['lat'] * 1e3:.2f} ms") base = rows[0] top = rows[-1] print(f"\n 延迟:B=1 时 {base['lat'] * 1e3:.3f} ms,B={top['B']} 时 " f"{top['lat'] * 1e3:.3f} ms(涨 {top['lat'] / base['lat']:.1f} 倍)") print(f" 吞吐:B=1 时 {base['thr'] / 1e3:.1f} K/s,B={top['B']} 时 " f"{top['thr'] / 1e3:.1f} K/s(涨 {top['thr'] / base['thr']:.1f} 倍)") print(f" 单样本成本:B={top['B']} 时把 {W_bytes / 2 ** 20:.0f} MiB 权重的逻辑读取摊薄到 {top['B']} 个样本," f"每个样本只摊 {W_bytes / top['B'] / 2 ** 20:.2f} MiB") print(" → 增大 batch 可摊薄权重访问;延迟是否平坦、吞吐能增加多少仍需实测。") print(" → 上面标 ! 的行是 roofline 看不见的东西:同样的公式、更大的 batch," "可能涉及内核选择、调度或计时波动,单凭本表不能确诊。") if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument("--large", action="store_true", help="batch权重恢复4096x4096") args = parser.parse_args() part1() part2(d=4096 if args.large else 1024) make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「性能建模与 Profiling」一文的四张解释图。 图里的计时优先读取已保存的实测快照,避免重绘时图文使用不同测量: * roofline.png 峰值与落点来自 machine_probe.calibrate() / probe() * batch_scaling.png 来自 memory_ledger.batch_sweep() * memory_ledger.png 来自 memory_ledger.ledger() * opt_gain.png 来自 roofline_model.optimize_headroom() 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行,约 40 秒。 改了另外三个脚本,这里要重跑,避免图与正文数字对不上。 """ import json import sys from pathlib import Path import matplotlib.pyplot as plt import numpy as np HERE = Path(__file__).resolve().parent sys.path.insert(0, str(HERE)) import machine_probe as MP # noqa: E402 import memory_ledger as ML # noqa: E402 import roofline_model as RM # noqa: E402 OUT = HERE.parent / "figures" try: # exist_ok=True 是必须的:目录已存在时 pathlib 会抛 FileExistsError, # 少数沙箱环境连 exist_ok=True 的 mkdir 也一并拦,这里再兜一层。 OUT.mkdir(exist_ok=True) except PermissionError: if not OUT.is_dir(): raise plt.rcParams.update({ "font.sans-serif": ["Microsoft YaHei", "SimHei", "PingFang SC", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, "savefig.dpi": 160, }) C_MEM = "#e05263" # 带宽受限:红 C_CMP = "#3f7fbf" # 算力受限:蓝 C_ACC = "#2f9e6f" # 好结果:绿 C_GREY = "#94a3b8" # ── 图 1:roofline 曲线 + 实测落点 ──────────────────────────────── def fig_roofline(peak, rows): P = peak["peak_flops"] / 1e9 # GFLOP/s beta = peak["peak_bw"] / 1e9 # GB/s I_star = P / beta # 因为两个都除过 1e9,比值不变 I = np.logspace(-2, 4, 400) perf = np.minimum(P, beta * I) fig, ax = plt.subplots(figsize=(8.4, 5.4)) ax.loglog(I, perf, color="k", lw=2.2) ax.axvline(I_star, color=C_GREY, ls="--", lw=1.4) ax.text(I_star * 1.15, 3, f"ridge point I* = {I_star:.0f}\nFLOP/Byte", color="#475569", fontsize=9, va="bottom") ax.text(0.012, 25, f"GEMM经验参考 P = {P:.0f} GFLOP/s", fontsize=9, color="#475569") ax.text(0.012, P * 3, "斜线 = add经验参考,beta = " f"{beta:.0f} GB/s", fontsize=9, color="#475569") # 落点:用实测时间反推实际性能 short = { "逐元素 add(1 遍)": "逐元素 add", "add+relu 两遍(预分配)": "add+relu 两遍", "add+relu 写成一行(有中间数组)": "add+relu 一行写法", "LayerNorm [8192,4096] 预分配": "LayerNorm", "attention 朴素 [N=2048,D=128]": "朴素 attention", "GEMM 512x4096x4096": "GEMM M=512", "GEMM 2048x4096x4096": "GEMM M=2048", "GEMM 4096x4096x4096": "GEMM M=4096", } offsets = { # 手工调过:右边缘和重叠的标签让位 "GEMM M=4096": (-10, 10), "GEMM M=2048": (10, -4), "GEMM M=512": (12, -14), "朴素 attention": (7, -3), } # 左下角四个点挤在一起,用箭头把标签拉到右边的空地上 arrows = { "逐元素 add": (0.42, 9.5), "LayerNorm": (0.42, 5.6), "add+relu 两遍": (0.42, 3.1), "add+relu 一行写法": (0.42, 1.75), } for r in rows: name = short.get(r["name"], r["name"]) if r["name"].startswith("GEMM "): name = "GEMM M=" + r["name"].split()[1].split("x")[0] elif r["name"].startswith("LayerNorm"): name = "LayerNorm" elif r["name"].startswith("attention"): name = "朴素 attention" y = r["gflops"] ax.scatter([r["I"]], [y], s=52, color=C_MEM if r["bound"] == "带宽" else C_CMP, zorder=5, edgecolor="white", linewidth=0.8) if name.startswith("GEMM M="): m = int(name.split("=")[1]) target = {128: (55, P * 1.8), 512: (280, P * 3.3), 1024: (900, P * 1.8)}.get(m) if target: ax.annotate(name, (r["I"], y), xytext=target, fontsize=8.5, color="#334155", arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9)) continue if name in arrows: tx, ty = arrows[name] ax.annotate(name, (r["I"], y), xytext=(tx, ty), fontsize=8.5, color="#334155", arrowprops=dict(arrowstyle="-", color=C_GREY, lw=0.9), va="center") continue dx, dy = offsets.get(name, (7, -3)) ha = "right" if dx < 0 else "left" ax.annotate(name, (r["I"], y), textcoords="offset points", xytext=(dx, dy), fontsize=8.5, color="#334155", ha=ha) ax.set_xlabel("算术强度 I = F / D (FLOP/Byte)") ax.set_ylabel("教学操作计数 / 实测时间 (Gop/s)") ax.set_title("图 1:逻辑流量与经验参考 —— 模型位置不能单独确诊瓶颈", fontsize=11) ax.set_xlim(0.01, 5000) ax.set_ylim(0.3, max(600, P * 6)) ax.grid(alpha=0.25, which="both", ls=":") handles = [plt.Line2D([], [], marker="o", ls="", color=C_MEM, label="模型分类:I < I*"), plt.Line2D([], [], marker="o", ls="", color=C_CMP, label="模型分类:I >= I*")] ax.legend(handles=handles, loc="lower right", fontsize=8.5, framealpha=0.9) fig.tight_layout() fig.savefig(OUT / "roofline.png") plt.close(fig) # ── 图 3:batch 扫描的延迟与吞吐 ────────────────────────────────── def fig_batch(rows): B = [r["B"] for r in rows] lat = [r["lat"] * 1e3 for r in rows] thr = [r["thr"] / 1e3 for r in rows] fig, ax1 = plt.subplots(figsize=(8.4, 5.0)) ax1.plot(B, lat, "o-", color=C_CMP, lw=2, label="延迟(左轴)") ax1.set_xscale("log", base=2) ax1.set_xlabel("batch B(一次喂进去的 token 数)") ax1.set_ylabel("延迟 (ms)", color=C_CMP) ax1.tick_params(axis="y", labelcolor=C_CMP) ax2 = ax1.twinx() ax2.plot(B, thr, "s--", color=C_ACC, lw=2, label="吞吐(右轴)") ax2.set_ylabel("吞吐 (K token/s)", color=C_ACC) ax2.tick_params(axis="y", labelcolor=C_ACC) # 拐点:I 越过 ridge point 的地方 cross = next((r for r in rows if r["bound"] == "算力"), None) if cross: ax1.axvline(cross["B"], color=C_GREY, ls=":", lw=1.5) ax1.text(cross["B"] * 1.05, max(lat) * 0.92, f"越过 ridge point\nB ≈ {cross['B']}", fontsize=9, color="#475569") # 库的反常:延迟不随 batch 单调 b8 = next((r["lat"] for r in rows if r["B"] == 8), None) spike = next((r for r in rows if r["B"] in (2, 4) and b8 is not None and r["lat"] > 1.5 * b8), None) if spike: ax1.annotate(f"B={spike['B']} 延迟为 B=8 的 {spike['lat']/b8:.1f} 倍\n(原因需 profile)", (spike["B"], spike["lat"] * 1e3), textcoords="offset points", xytext=(14, -6), fontsize=8.5, color=C_MEM) ax1.set_title("图 3:batch 扫描 —— 实测延迟、吞吐与 roofline 模型交界", fontsize=11) ax1.grid(alpha=0.25, ls=":") lines1, lab1 = ax1.get_legend_handles_labels() lines2, lab2 = ax2.get_legend_handles_labels() ax1.legend(lines1 + lines2, lab1 + lab2, loc="upper left", fontsize=9) fig.tight_layout() fig.savefig(OUT / "batch_scaling.png") plt.close(fig) # ── 图 4:显存账本 ──────────────────────────────────────────────── def fig_ledger(): batches = [1, 4, 8, 16, 24, 32] naive = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.30) for b in batches] low_overhead = [ML.ledger(7e9, 2, 32, 4096, b, 4096, 131072, 0.04) for b in batches] fig, (ax, ax2) = plt.subplots(1, 2, figsize=(11.2, 4.8), gridspec_kw={"width_ratios": [1.35, 1]}) x = np.arange(len(batches)) keys = [("weights", "权重", "#3f7fbf"), ("kv", "KV cache", "#e05263"), ("act", "激活", "#e8a33d"), ("frag", "额外开销", "#94a3b8")] bottom = np.zeros(len(batches)) for k, label, color in keys: vals = np.array([d[k] for d in naive]) ax.bar(x, vals, bottom=bottom, label=label, color=color, width=0.62, edgecolor="white", linewidth=0.6) bottom += vals ax.axhline(78, color="k", ls="--", lw=1.3) ax.text(len(batches) - 0.4, 79, "教学假设:78 GiB 可用预算", fontsize=8.5, ha="right", color="#334155", bbox=dict(facecolor="white", alpha=0.85, edgecolor="none", pad=1)) for i, d in enumerate(naive): if d["total"] > 78: ax.text(i, d["total"] + 2, "OOM", ha="center", fontsize=9, color=C_MEM, fontweight="bold") ax.set_xticks(x) ax.set_xticklabels(batches) ax.set_xlabel("并发序列数 batch") ax.set_ylabel("显存 (GiB)") ax.set_title("图 4a:未分块 prefill 教学账本(额外开销率 30%)", fontsize=10.5) ax.legend(fontsize=8.5, ncol=2) ax.grid(axis="y", alpha=0.25, ls=":") w_naive = [d["total"] for d in naive] w_low_overhead = [d["total"] for d in low_overhead] ax2.bar(x - 0.2, w_naive, width=0.4, label="额外开销率30%", color="#e05263") ax2.bar(x + 0.2, w_low_overhead, width=0.4, label="低开销假设", color="#2f9e6f") ax2.axhline(78, color="k", ls="--", lw=1.3) ax2.set_xticks(x) ax2.set_xticklabels(batches) ax2.set_xlabel("并发序列数 batch") ax2.set_ylabel("合计显存 (GiB)") ax2.set_title("图 4b:只把额外开销率从 30% 降到 4%", fontsize=10.5) ax2.legend(fontsize=8.5) ax2.grid(axis="y", alpha=0.25, ls=":") fig.suptitle("图 4:显存账本的四项 —— 权重是常数,KV cache 随并发线性增长", fontsize=11) fig.tight_layout() fig.savefig(OUT / "memory_ledger.png") plt.close(fig) # ── 图 2:砍算力 vs 砍带宽,各有多少钱 ──────────────────────────── def fig_opt_gain(): a100 = RM.SPECS["A100-40GB SXM (bf16)"] ratio = np.logspace(-2, 1.2, 300) sp_flops, sp_bw = [], [] for r in ratio: # 造一个算术强度恰好是 r × I* 的算子:固定 D,F 由 r 决定 D = 1e8 F = r * (a100["peak_flops"] / a100["peak_bw"]) * D s_f, s_b = RM.optimize_headroom(F, D, a100["peak_flops"], a100["peak_bw"]) sp_flops.append(s_f) sp_bw.append(s_b) fig, ax = plt.subplots(figsize=(8.4, 4.8)) ax.semilogx(ratio, sp_flops, color=C_CMP, lw=2.2, label="算力翻 2 倍能拿到的加速") ax.semilogx(ratio, sp_bw, color=C_MEM, lw=2.2, label="带宽翻 2 倍能拿到的加速") ax.axvline(1.0, color=C_GREY, ls="--", lw=1.4) ax.text(1.05, 1.02, "I = I*:分界线", fontsize=9, color="#475569") ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) < 1, color=C_MEM, alpha=0.07) ax.fill_between(ratio, 0.98, 2.02, where=np.array(ratio) >= 1, color=C_CMP, alpha=0.07) ax.text(0.05, 1.9, "带宽受限区:\n换更快的算力单元 = 0 收益", fontsize=9, color=C_MEM) ax.text(6, 1.9, "算力受限区:\n加带宽 = 0 收益", fontsize=9, color=C_CMP) ax.set_xlabel("算术强度 / ridge point (I / I*)") ax.set_ylabel("教学模型时间估计比值") ax.set_ylim(0.95, 2.1) ax.set_title("图 2:只改变一个资源的教学模型 —— 实际收益需验证", fontsize=11) ax.grid(alpha=0.25, ls=":") ax.legend(fontsize=9, loc="center right") fig.tight_layout() fig.savefig(OUT / "opt_gain.png") plt.close(fig) def main(): # --only <图名>:只重画指定一张(roofline / batch / ledger / gain), # 避免为了改一张图的标签把所有实测算子重跑一遍、数字跟正文引用分叉。 only = None if "--only" in sys.argv: only = sys.argv[sys.argv.index("--only") + 1] # 优先读 machine_probe.py 存的标定快照,保证图上数字与正文引用同源 if MP.SNAPSHOT.exists(): snap = json.loads(MP.SNAPSHOT.read_text(encoding="utf-8")) peak = snap["peak"] print(f"读取标定快照({snap['timestamp']},{snap['note']}):") else: print("没找到标定快照,现场标定一遍…") peak = MP.calibrate(verbose=False) MP.SNAPSHOT.write_text(json.dumps( dict(peak=peak, rows=MP.probe(peak, verbose=False), note="fresh", timestamp=""))) print(f" P = {peak['peak_flops'] / 1e9:.0f} GFLOP/s, " f"beta = {peak['peak_bw'] / 1e9:.1f} GB/s, " f"I* = {peak['peak_flops'] / peak['peak_bw']:.1f}") if only in (None, "roofline"): rows = snap.get("rows") if MP.SNAPSHOT.exists() and "snap" in locals() else None if not rows: rows = MP.probe(peak, verbose=False) fig_roofline(peak, rows) if only in (None, "batch"): batch_snap = HERE / "batch_results.json" if batch_snap.exists(): sweeps = json.loads(batch_snap.read_text(encoding="utf-8"))["rows"] else: sweeps, weight_bytes = ML.batch_sweep() batch_snap.write_text(json.dumps(dict(rows=sweeps, weight_bytes=weight_bytes, peak=peak), indent=2)) fig_batch(sweeps) if only in (None, "ledger"): fig_ledger() if only in (None, "gain"): fig_opt_gain() if only and only not in ("roofline", "batch", "ledger", "gain"): raise ValueError("unknown figure: " + only) print(f"\n图已写入 {OUT}") if __name__ == "__main__": main()
-
AIGC 基本功|自注意力机制的计算与显存账本-MHA AIGC 基本功|自注意力机制的计算与显存账本-MHA 所属方向:注意力与位置编码 | 难度:入门 | 前置知识:无(这是知识树注意力方向的根节点) 关键词:自注意力、multi-head attention、QKV、复杂度、显存账本、缩放因子 01. 为什么需要它 先看一个真实会撞上的场景:你拿到一个约 3.62B 参数的简化 Transformer(批量 B=1、宽度 d=3072、头数 H=24、层数 L=32,权重和下面的教学张量均按 bf16 两字节),想在 1024×1024 的图生视频任务上训练,并保留各层激活供反向使用。VAE 八倍下采样、patch size 为 2 之后,单帧 latent 是 128×128、patch 网格是 64×64,单帧序列长度 N=4096(视频若联合多个潜帧,N 还要乘潜帧数)。模型权重 bf16 约 6.75 GiB,80 GB 的 A100/H100 看起来还装得下;但若用下面的显式中间量账本、无激活重算地保留 32 层,权重加注意力激活已经超过容量,还没算 FFN、梯度和优化器状态。这里是解释 OOM 风险的教学构造,不是某张 GPU 的峰值测量。 把账摊开看(怎么算出来的见第 03、04 节):一层注意力在 N=4096 时按下述教学账本计为 2.39 GiB 激活,32 层就是 76.5 GiB——是权重的 11 倍;这个乘法还假设这些层的相应中间量同时为反向传播保留。这说明只看权重大小无法判断是否 OOM;在这套训练存储假设下,激活已经超过预算,而且爆的是其中三个特定张量:分数矩阵、softmax 权重、浮点 dropout 乘子,各占 31.4%,三项合计吃掉单层激活的 94%。 按本文简化层结构,N=4096 时两个 N×N 矩阵乘只占整层前向 FLOPs 的 18.2%;它们与线性项之比在 N=18432 达到 1,只看 attention 投影则交叉点为 6144。这是运算量比例,不是运行时间比例;IO、kernel 形状与融合可能让 FLOPs 较少的部分反而更慢。 因此应同时记录 FLOPs、激活存储假设和实际时间线。N=32768 时,本文教学账本的一层存储为 145 GiB,二次项 FLOPs 占 64%;这些值用于理解增长趋势,不能替代实际框架的显存测量。 02. 最小可用理解 三句话讲完核心思想: 每个 token 经三组可学习的线性投影得到 Query、Key、Value;它们不是输入向量的三份原样拷贝。每个 token 再拿自己的 Query 和所有 token(包括自己)的 Key 做内积打分,分数过 softmax 变成权重,再对所有 Value 加权求和,得到这个 token 的新表示。权重由 Q/K、位置编码和掩码共同决定,输出内容还依赖 V。 计算和显存都分两笔:一笔随 N 线性(QKV 投影、输出投影、FFN),一笔随 N 二次(分数矩阵 S、softmax 权重 P、浮点 dropout 乘子各一份 B×H×N×N)。显存爆炸的几乎都是第二笔,这是显式保存中间量的教学实现假设;融合、重算或不使用 dropout 会改变这笔账。 「O(N²) 是瓶颈」有适用条件:二次项与线性项的比值是 N/(6d),占总量的比例是 N/(6d+N),N 小于 2d 时它连 attention 模块内部的一半都不到。在本例朴素存储方案下,N² 项先成为显存大头;实际耗时瓶颈仍需测量。 两 token 先走一遍。 暂取单头 D=1,某个 query 的数值为 1,两枚 key 分别为 1 和 0,两枚 value 分别为 10 和 0。缩放因子 √D=1,分数为 [1, 0],softmax 权重约 [0.731, 0.269],因此输出是 0.731×10+0.269×0≈7.31。若把两枚 key 都改成 1,分数同为 1,权重各 0.5,输出变成 5。这个反例说明:权重由 Q/K 的相对打分决定,而输出还取决于 V;注意力不是「把 Query 复制出来」,也不是看单个分数的绝对大小。 这张图要看什么:多头切的是 d_model 这个维度(H·D 拆成 H 份),不是把注意力复制 H 份;切分本身零算术开销,但分数矩阵从 1 个 N×N 变成 H 个 N×N,显存乘上 H。 03. 数学推导 3.1 单头:打分、归一化、加权求和 设输入序列 $X \in \mathbb{R}^{N \times d}$,N 是 token 数,d 是每个 token 的向量维度(d_model)。三个投影矩阵 $W_q, W_k, W_v \in \mathbb{R}^{d \times d}$ 把每个 token 映射成查询、键、值: $$Q = X W_q, \quad K = X W_k, \quad V = X W_v$$ 每个 token 的 Query 要和所有 token 的 Key 算相似度,写成矩阵形式就是一次 $N \times D$ 对 $D \times N$ 的矩阵乘,得到分数矩阵 $S \in \mathbb{R}^{N \times N}$,其中 $S_{ij}$ 是第 i 个 token 对第 j 个 token 的打分: $$S = \frac{Q K^{\top}}{\sqrt{D}}$$ 本小节是单头,H=1、D=d,所以 Q/K/V 都是 N×D;下一小节切成 H 头后才有 D=d/H。除以 $\sqrt{D}$ 不是装饰,推导一下就知道:为解释尺度,暂假设每个坐标上的 $q_i$ 与 $k_i$ 相互独立、均值为 0、方差为 1,而且不同坐标的乘积不相关,那么点积的方差是 $$\mathrm{Var}(q \cdot k) = \sum_{i=1}^{D} \mathrm{Var}(q_i k_i) = D$$ 点积的标准差随 $\sqrt{D}$ 线性增长。D=128 时分数的摆动幅度是 D=1 的 11 倍,softmax 拿到这么大的输入会直接饱和:最大的那个分数吃掉几乎全部权重,输出逼近 one-hot。接近 one-hot 时,softmax Jacobian 的多数项会很小;有限 logits 的精确 softmax 通常并非严格 one-hot,浮点舍入可能进一步使梯度消失。在这些假设下,除以 $\sqrt{D}$ 把分数方差归一回 1。训练后的 Q/K 未必满足独立与单位方差,同一 token 的 Q 与 K 也可能相关,所以这不是对所有模型 logits 的精确分布定理;它是控制初始化时维度增长效应的动机。第 04 节 D 从 8 扫到 256 的随机实验只检验这个动机。 分数过 softmax 变成权重(每行归一化,行内竞争): $$P_{ij} = \frac{\exp(S_{ij})}{\sum_{j'} \exp(S_{ij'})}$$ 最后对 Value 加权求和得到输出 $O = P V$,形状和输入一样是 $N \times d$。工程实现里 softmax 前要先减去每行最大值再取指数,防止 $\exp$ 上溢——这不改变结果,因为分子分母同乘了一个常数。 3.2 多头:切的是维度,不是份数 把 d 维切成 H 段,每段 D = d/H 维当作一个独立的「头」,各算各的注意力,最后拼回来过一个输出投影: $$\mathrm{MHA}(X) = \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_H)\, W_o, \qquad \mathrm{head}_h = \mathrm{softmax}\!\left(\frac{Q_h K_h^{\top}}{\sqrt{D}}\right) V_h$$ $Q_h$ 是 $Q$ 的第 h 段 D 列。两个常被搞错的点: 固定 d 时,多头不改变两次矩阵乘的主导 FLOPs。H 个头各做 $N^2 D$ 次乘加,总共 $H \cdot N^2 D = N^2 d$,和不切头(一个 D=d 的单头)一样;softmax、调度等开销仍随头数变化。多头改的是「在多少个独立子空间里同时做注意力」,是表达能力的再分配,不是算力的加倍。 多头增加显存。分数矩阵是按头存的:H 个 $N \times N$。显存里 显式分数存储的 N² 项系数是 H 而不是 1。 3.3 算力账:二次项什么时候过半 一层 transformer 的前向 FLOPs(一次 $[M,K] \times [K,N]$ 矩阵乘算 $2MKN$ 个浮点运算): 四个 d×d 投影(Q、K、V 输入投影 + 输出投影):$8 N d^2$ FFN(升维 4d 再降回):$16 N d^2$ 注意力内部两个 N×N 矩阵乘($QK^{\top}$ 与 $PV$):$4 N^2 d$ 线性项合计 $24 N d^2$,二次项是 $4 N^2 d$,比值等于 $N / (6d)$。令比值等于 1: $$4 N^2 d = 24 N d^2 \quad \Longrightarrow \quad N^{\star} = 6d$$ d=3072 时 $N^{\star} = 18432$。如果只看 attention 模块内部(4 个投影对 2 个 N×N 乘),交叉点是 $N^{\star} = 2d = 6144$。你日常跑的 N=4096 在两条线之下——二次项占整层算力 18.2%,占模块内 40.0%。 3.4 显存账:三个 B×H×N×N 下面采用一个刻意显式的教学分配模型:B 是批量、H 是头数、N 是 token 数、d 是总通道宽度;同时计入 X/Q/K/V/ctx/O,以及 S、P 和一份浮点 dropout 乘子,全部按 bf16 两字节估算。它只数某一层注意力中指定张量的字节总和,不是框架峰值,也不是反向传播的最低存储要求;未计权重、梯度、优化器、FFN、临时工作区及分配器开销。bool mask 通常只占一字节,dropout=0 时可省掉该项,S 也通常不必与 P 同时保留。 线性项:X、Q、K、V、加权和、输出,共 6 个 $[B, N, d]$ 张量(不含 FFN 的话); 二次项:分数矩阵 S、softmax 权重 P、浮点 dropout 乘子,各 $[B, H, N, N]$。 $$\text{单层激活} \approx 6 B N d \cdot 2 + 3 B H N^2 \cdot 2 \;\; \text{字节}$$ 两笔相等解得 $N^{\star} = 2d/H$,d=3072、H=24 时 *N=256**——序列长度刚过几百,显存就已经被 N² 项主导了。算力和显存的交叉点差 72 倍(18432 对 256),这就是「算力瓶颈来得晚、显存瓶颈来得早」的定量出处。 这张图要看什么:左边 N=4096 的堆叠条里红色三个格子(S、P、浮点 dropout 乘子)占 94%,线性项挤在边上几乎看不见;右边是对数轴,两条教学模型的比值随 N 近似线性增长,N=32768 时为 129 倍。融合侧统一按六份线性张量 6BNd·bytes 计,忽略小的 LSE 与内核工作区;这不是具体框架的峰值比。 04. 代码实现 完整脚本在文末附录(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py),只依赖 numpy。下面按执行顺序拆核心片段。形状、随机种子下的数值及静态账本已用附录脚本复跑;CPU 耗时随机器和运行条件变化,后面的表保留原稿 Linux 环境的一次样例,并给出本次复跑作对照。 4.1 前向:六行写完 MHA def mha(X, W_q, W_k, W_v, W_o, H, causal=False): B, N, d_model = X.shape D = d_model // H Q = split_heads(X @ W_q, H) # [B, H, N, D] K = split_heads(X @ W_k, H) # [B, H, N, D] V = split_heads(X @ W_v, H) # [B, H, N, D] S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) # [B, H, N, N] if causal: mask = np.triu(np.ones((N, N), dtype=bool), k=1) S = np.where(mask, -np.inf, S) P = softmax(S, axis=-1) # [B, H, N, N] return merge_heads(P @ V) @ W_o, P # [B, N, d_model] 切头函数值得单独看一眼——对这里连续的输入,它是 reshape 加 transpose 的视图变换;非连续输入的 reshape 可能触发拷贝: def split_heads(t, H): B, N, d_model = t.shape D = d_model // H return t.reshape(B, N, H, D).transpose(0, 2, 1, 3) 配置 B=2、N=8、d_model=32、H=4 时各张量的真实形状: [1] 各张量形状 X (2, 8, 32) 输入 Q/K/V (2, 4, 8, 8) 切头后 [B, H, N, D] S (2, 4, 8, 8) 分数矩阵,N×N 是显存爆炸的源头 O (2, 8, 32) 输出,和输入同形 4.2 验证四条性质 脚本跑出来的校验结果: [3] 性质校验 (a) 权重行和为 1 : max|sum(P)-1| = 2.22e-16 (b) 向量化 vs 四重循环 : max|O - O_loop| = 2.22e-16 allclose=True (c) 因果掩码上三角全 0 : max = 0.00e+00 且下三角行和仍为 1 : max|sum-1| = 2.22e-16 (d) 各头权重并不相同 : 头 0 与 H 头平均的平均绝对差 = 0.0223 头之间的平均离散度 : 0.0206(0 表示所有头完全一样) (b) 是最值得做的一次校验:把公式照定义抄成四重循环(一个 token 一个 token 地打分、归一、加权),结果和向量化版本在浮点精度内完全一致。下标搞反、transpose 方向写错这类 bug,靠肉眼很难发现,靠一个慢十倍但显然正确的对照实现能当场抓住。 4.3 缩放因子的实测 D 扫描表(固定 scale=1,看 softmax 最大权重): 固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变: D 分数标准差 最大权重(未缩放) 最大权重(缩放后) 8 2.8587 0.9089 0.2711 16 3.9246 0.9970 0.1718 32 5.6569 1.0000 0.2427 64 8.0203 1.0000 0.1547 128 11.3903 1.0000 0.1322 256 16.0367 1.0000 0.1619 和 3.1 节的推导对上了:分数标准差就是 $\sqrt{D}$(2.8587 ≈ √8,16.0367 ≈ √256)。本次随机样本在 D=16 时最大权重为 0.9970,之后若干行四舍五入显示 1.0000;这说明可能接近饱和,不能证明所有 token 的梯度严格为零。缩放后最大权重回落到 0.13~0.27,分布活着。另外注意主配置(D=8)下的对比:未缩放最大权重 0.5948,缩放后 0.2589——D 小的时候不缩放也能活,缩放用于控制点积随维度增长的方差;这组随机样本不构成某个 D 阈值的通用结论。 4.4 显存账本实跑 attention_memory.py 在 d_model=3072、H=24、B=1、bf16 下逐项清点: [1] 逐项账本 B=1 N=4096 bf16(2 字节) 分数矩阵 S [B, H, N, N] 805,306,368 31.4% softmax 权重 P [B, H, N, N] 805,306,368 31.4% 浮点 dropout 乘子 [B, H, N, N] 805,306,368 31.4% 输入 X / Q / K / V / ctx / O 各 25,165,824 1.0% 合计 2,566,914,048 2.39 GiB → N² 项共 2.25 GiB,线性项共 144.00 MiB,N² 项占 94.1% 随 N 的增长(一层,不含 FFN): [2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子) N 线性项 N² 项 合计 融合侧教学值 倍数 1024 36.00 MiB 144.00 MiB 180.00 MiB 36.00 MiB 5.0x 2048 72.00 MiB 576.00 MiB 648.00 MiB 72.00 MiB 9.0x 4096 144.00 MiB 2.25 GiB 2.39 GiB 144.00 MiB 17.0x 8192 288.00 MiB 9.00 GiB 9.28 GiB 288.00 MiB 33.0x 16384 576.00 MiB 36.00 GiB 36.56 GiB 576.00 MiB 65.0x 32768 1.12 GiB 144.00 GiB 145.12 GiB 1.12 GiB 129.0x 若训练时按同一教学假设保留每层中间量,且不做重算,才可再乘层数:L=32 层时,N=2048 的激活是 20.25 GiB(权重的 3.0 倍),N=8192 是 297 GiB(权重的 44 倍)。推理时不应把当前层临时激活直接乘 L;需要缓存历史的自回归推理另计 KV cache 随 N 和并发数 B 都线性涨:B=32、N=32768、L=80 时光 KV cache 就要 960 GiB,这就是为什么长上下文服务都把 GQA/MLA 当标配。 4.5 算力账本实跑 flops_ledger.py 的占比表(d=3072,含 FFN): N 线性项 二次项 二次项占比 4096 927.71 GFLOPs 206.16 GFLOPs 18.2% 16384 3.71 TFLOPs 3.30 TFLOPs 47.1% 32768 7.42 TFLOPs 13.19 TFLOPs 64.0% 65536 14.84 TFLOPs 52.78 TFLOPs 78.0% 脚本末尾有一段 CPU 微基准。下表是原稿 Linux 环境的一次实测(numpy float32,d_t=1024、16 头);这不是性能保证,也不能和新环境的时延逐项混用: N 投影 (ms) QK^T (ms) 实测比 FLOPs 比 256 1.64 2.36 1.44 0.25 1024 6.64 60.80 9.16 1.00 4096 21.36 1148.15 53.75 4.00 在原稿样例的 N=256 行,QK^T 的算术量只有投影的四分之一,耗时比却是 1.44。2026-10-08 在 Windows 上重跑同一脚本得到投影 3.39 ms、QK^T 12.37 ms,耗时比 3.65;N=4096 则为 27.13 ms 和 1257.98 ms。两组数值不同,恰好说明时延不是 FLOPs 公式能单独预测的。脚本给出的简化算术强度(AI = FLOPs / 估算访存字节)提示了一种原因:投影约 85~228,QK^T 约 21~31,后者还要写出 H·N² 项。但这些是模型估算,不是 CPU 硬件访存计数;一组耗时不足以排除 BLAS 实现、线程数、缓存命中和矩阵布局。应把它当作 profiler 要验证的假说,而不是由时延表证明的因果结论。FlashAttention 原论文则明确以减少 HBM 与片上 SRAM 之间的 IO 为目标,避免把完整 N×N 权重矩阵落到 HBM;它仍需计算全局注意力的二次项。 这张图要看什么:两条曲线是二次项算力占比随 N 的爬升,红蓝两条竖虚线分别是 N=2d=6144(只算 attention 模块)和 N=6d=18432(算上 FFN);你常用的 N=4096 在两条线左边很远的位置。 05. 工业级实现对照 参考实现(以 2026-09 的 main 分支为准,上游重构频繁): huggingface/transformers → modeling_llama.py:LlamaAttention.forward huggingface/transformers → masking_utils.py / integrations/flash_attention.py:attention 实现分发 生产代码和第 04 节的最小实现有五处不一样,每一处都有理由。 5.1 不落地 N×N:eager / sdpa / flash 三条路 HF 的 attention 实现 attn_implementation 有三档: eager:与本文显式计算 S/P 的思路相同;最小代码没有 dropout,也不代表训练账本的全部分配。好处是 P 可访问,代价是二次存储;具体峰值取决于 dtype、存活期与 dropout。 sdpa:调 PyTorch 的 scaled_dot_product_attention,由 PyTorch 按硬件、dtype、mask 等选择 flash、memory-efficient 或 math 后端;不能仅凭 sdpa 名称断言没有 N×N 中间量。 flash_attention_2:在线 softmax + 分块计算,显存 O(N·d),本文统一教学账本在 N=32768 时两者为 129 倍,真实节省比例需实测。 长序列训练通常优先评估可用的融合后端,但要检查硬件、dtype、掩码形式和是否需要显式注意力权重;不能把 sdpa 这个名字等同于必走 Flash kernel。融合实现常不返回完整 P;可视化注意力图或对 P 加自定义正则时,可能需要 eager、专门的导出路径或改变算法,收益与成本都要实测。 5.2 因果掩码不是加 −inf 的稠密矩阵 最小实现里我建了一个 $N \times N$ 的 bool 矩阵,这本身就又是一笔 N² 显存。支持的融合后端可以用 is_causal=True 或滑动窗口等结构化信息在内核内判断位置关系,从而避免显式的 N×N 因果掩码;但 eager、某些 padding/自定义 mask 或后端回退仍可能构造稠密掩码。是否落地要看实际分发路径,不能仅凭 API 名称保证。自己无条件创建 N×N causal mask,会额外消耗显存。 5.3 QKV 合并成一个投影 三个 $d \times d$ 投影合并成一个 $d \times 3d$(或直接 qkv_proj),一次 GEMM 出 Q、K、V。算术量不变,但少起两次 kernel、权重读取更连续。代价是 PyTorch 里要自己 chunk(3, dim=-1) 拆回来——本次核对的 modeling_llama.py 仍保留独立的 q_proj/k_proj/v_proj;融合 QKV 是另一些架构或执行后端的选择。 5.4 KV 头数可以比 Q 头少:GQA 多头切分时 K、V 的头数用 $H_{kv} < H$(比如 8 对 32),多个 Query 头共享一组 KV。公式的改动只是把 $K_h$ 换成 $K_{\lfloor h/(H/H_{kv})\rfloor}$。它不改变 attention 核心两次矩阵乘的主导 FLOPs,但可以减少 K/V 投影的 FLOPs,省的是 KV cache 和 KV 的显存与带宽——推理时 KV cache 缩到 $H_{kv}/H$(LLaMA-3 70B 的 8/64 为 1/8)。这是在固定 Query 宽度时减少 KV 头数、压缩线性 KV 项的优化,而 FlashAttention 优化的是 N² 那一笔,两者正交,经常一起用。 5.5 buffer 化与 position_ids 无位置编码且无位置相关掩码的自注意力对 token 排列是等变的。位置信息可通过正弦表、可学习嵌入、RoPE 或掩码注入,其中 RoPE 的旋转点积体现相对位移,不应统称绝对位置编码。不同实现对 RoPE 的缓存策略并不相同。以 本次核对的 Hugging Face Llama 源码(2026-10-08)为例,LlamaRotaryEmbedding 把逆频率 inv_freq 存为非持久 buffer,而 forward 用 position_ids 计算当次的 cos/sin;不能把它描述成预先缓存整张 cos/sin 表。LlamaModel.forward 在未提供位置时按已缓存 token 数生成 position_ids,外部也能传入位置,例如 packed 序列需要明确处理段内位置。位置如何进入 Q/K,是 RoPE 那一篇的主题。 06. 代价与边界 把 N² 落地换来了什么,又赔了什么。 朴素实现唯一的优点是 S、P 全程可见:可视化注意力图、或使用依赖完整 P 的蒸馏损失,需要访问相应权重。加到 logits 上的结构化 bias 则不必先物化 P;若内核支持其形式,可在分块时应用。导出完整 P 仍需相应的二次输出存储。工程上常见的折中是:训练用 sdpa/flash,分析时用小 N 的 eager 导出注意力图。 二次项的 FLOPs 收益要按序列长度评估。 若各项运行时间恰好与 FLOPs 成正比,N=4096 时消除占比 18.2% 的二次项,整层理想加速约为 1.22 倍;现实中的 IO 和融合会改变时间占比,因此这不是 FlashAttention 的实测加速上限。 多头的账要两头看。 头数 H 越大,每个头的 D = d/H 越小:每头维度 D 改变会影响子空间容量,但不存在这里能够证明的 D<32 通用质量阈值;固定 d=H·D 时,标准 MHA 的 KV cache 与 KV 投影参数量不因增加 H 而线性增长;若固定 D 则另当别论。所以现代模型反而从「H 越多越好」退到「适度头数 + GQA」:LLaMA-3 70B 用 64 个 Query 头配 8 个 KV 头。 什么时候根本不该用全局自注意力。 像素级 self-attention(把 H×W 个像素当 token)在中等分辨率下 N 就上了万,N² 显存直接不可行——这是 latent diffusion 在压缩空间里计算更经济的原因之一;卷积等其他算子的成本也同时下降。高分辨率密集预测里,窗口注意力、局部注意力是常态而不是妥协。 别只优化注意力。 N 小于 2d 时(d=3072 即 N<6144),attention 模块内部的算力大头是投影;FFN 属于整层的另一部分;显存侧倒是早就归 N² 管。所以「 profiling 之前先改结构」是赌博——performance_profiling 那一篇讲的账本方法就是为此准备的。 07. 经典论文脉络 Attention Is All You Need(Vaswani et al., 2017)——本文锚点。把缩放点积注意力 + 多头定型成今天的形态,丢掉循环结构,端到端只靠注意力。 Neural Machine Translation by Jointly Learning to Align and Translate(Bahdanau et al., 2014)——注意力的史前史:注意力最初是翻译里的一组对齐权重,softmax 那一行的「分布」语义就是从这来的。 Generating Long Sequences with Sparse Transformers(Child et al., 2019)——处理长序列 N² 成本的一条代表性稀疏路线:限制每个位置可看的位置集合,减少需要计算和保存的格子;具体节省取决于稀疏模式与实现。 FlashAttention(Dao et al., 2022)——不动公式、只改执行:在线 softmax + 分块,让 N×N 不落地。精确注意力,不是近似——这一点和稀疏/线性路线有本质区别。 GQA: Training Generalized Multi-Query Transformer Models(Ainslie et al., 2023)——把矛头从 N² 转向 KV cache:KV 头数变少、Q 头分组共享,是许多现代模型降低 KV cache 成本的重要设计。 五篇连起来读的线索:注意力先是「一种对齐手段」(2014),再是「唯一的序列算子」(2017),然后 N² 账单到期,在这五篇代表作里,2019 年的路线砍格子,2022 年的路线改执行而保持精确注意力,2023 年的路线则着眼于自回归推理时线性增长的 KV cache。不同成本可以并存,后出现的方案不意味着前一笔账已消失。 08. 常见误解 「注意力是 O(N²),所以序列不长时它也是最慢的部分。」 N=4096、d=3072 时二次项只占本文层结构前向 FLOPs 的 18.2%,但不能据此猜测热点。应结合算术强度、硬件与 profiler 判断。 「多头注意力算 H 遍,所以比单头慢 H 倍。」 H·N²·D = N²·d,多头和全维单头的算术量完全相同;多的是 H 份 N×N 显存和 H 份小矩阵乘的调度开销,不是 H 倍算力。 「显存不够就是模型太大,换个更小的模型。」 d=3072、L=32 的模型权重 6.75 GiB,N=8192 时仅激活就 297 GiB。先算激活账(6B·N·d·bytes + 3B·H·N²·bytes 乘层数),再决定动不动模型。这套无重算训练账本提示应先比较开 gradient checkpointing、换 sdpa/flash、或降分辨率。 「除以 √D 是可要可不要的数值技巧。」 本次样本中未缩放 logits 更容易接近饱和;D=16 的最大权重实际为 0.9970,显示 1.0000 也不等于数学上梯度严格为零。它控制点积方差随维度增长;其他归一化或初始化设计也能缓解饱和,不能据此宣称不缩放就一定无法训练。 「浮点 dropout 乘子不占显存。」 bool mask 通常每元素一字节,而 bf16 为两字节;本文账本计的是两字节的浮点 dropout 乘子,两者不能混称。使用逐元素 dropout 的 eager 训练通常还需保留随机掩码或等价信息;占用取决于表示与实现,不一定恰好是一份 bf16 张量。FlashAttention 可以保存随机数状态并在分块反向时重建掩码。 09. 动手验证 把附录里的 mha_minimal.py 存下来直接跑(python mha_minimal.py),对照三处输出: 形状链:X (2,8,32) → Q/K/V (2,4,8,8) → S (2,4,8,8) → O (2,8,32)。确认分数矩阵是按头存的 4 个 8×8,不是 1 个。 缩放对照:未缩放最大权重 0.5948,缩放后 0.2589;再把 D 扫描表看一遍,本次 D=16 的未缩放值是 0.9970,后续多行显示值接近 1。 等价性:向量化实现与四重循环实现的 max 误差应为 1e-16 量级(你机器上具体数字可能略有不同,但 allclose 一定是 True)。 然后做两个改动观察变化: 把 H 从 4 改成 1 再改成 8,跑性质校验 (d):在 H=1 时头间离散度按定义为 0(没有第二个头);H=8 的数值要以实际重跑为准。这个随机初始化实验只展示不同投影可产生不同权重,不证明训练后各头必然学到互补功能,也不保证头数越多质量越高。 跑 flops_ledger.py 的 CPU 实测段,找到你机器上「实测比」超过「FLOPs 比」的 N 拐点,和理论交叉点 N*=2d 对一下差多少。 预期最容易误判的是第二个:原稿样例在 N=256 的耗时比是 1.44,本次复跑是 3.65,而 FLOPs 比都是 0.25。这只说明两次运行里时延都没有跟着算术量成比例变化;是否由访存、调度或其他因素主导,还需用 profiler 在目标硬件上验证。 10. 延伸阅读 按知识树的依赖顺序,下一步建议这么走: 旋转位置编码 RoPE 的原理与实现——注意力对位置是盲的,RoPE 是视觉/语言模型目前的主流注入方式;本文的 Q、K 在那里会被旋转一次。 视频 DiT 里的 3D RoPE 与分辨率外推——RoPE 在时间/高/宽三组频率上的拆分,视频生成的位置问题。 性能建模与 Profiling:算力、带宽与显存账本——把本文的两本账变成系统方法,roofline 分析。 序列并行——N² 显存装不下时的横向切分方案。 策略梯度与 PPO 基础 等 RL 方向的文章与本篇无直接依赖,可随时穿插。 附录:完整代码 09 节用到的脚本全文如下(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 mha_minimal.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """多头自注意力(MHA)的最小可运行实现:把公式逐行翻译成 numpy。 只依赖 numpy,直接 `python mha_minimal.py` 即可运行。 刻意不用 PyTorch:讲原理时框架的抽象反而是噪声,而且 numpy 谁都能跑。 生产实现见文章第 05 节对 transformers 的引用。 公式符号与代码变量名的对应关系 ------------------------------ X 输入序列 形状 [B, N, d_model] W_q/W_k/W_v 三个输入投影矩阵 形状 [d_model, d_model] W_o 输出投影矩阵 形状 [d_model, d_model] Q, K, V 查询 / 键 / 值 形状 [B, H, N, D] S 缩放后的注意力分数 形状 [B, H, N, N],S = Q K^T / sqrt(D) P softmax 后的权重 形状 [B, H, N, N] O 注意力输出 形状 [B, N, d_model] 运行后你会看到:每一层的真实 shape、注意力权重的数值范围、 以及四条性质校验(行和为 1 / 与循环实现等价 / 缩放系数的影响 / 因果掩码)。 """ import numpy as np rng = np.random.default_rng(0) def split_heads(t: np.ndarray, H: int) -> np.ndarray: """[B, N, H*D] -> [B, H, N, D]。 多头不是「复制 H 份再算」,而是把 d_model 这个维度切成 H 段, 每段独立算一次注意力,最后再拼回去。这一步只是 reshape + transpose, 本身不做任何算术,但它决定了后面所有矩阵乘的形状。 """ B, N, d_model = t.shape D = d_model // H return t.reshape(B, N, H, D).transpose(0, 2, 1, 3) def merge_heads(t: np.ndarray) -> np.ndarray: """[B, H, N, D] -> [B, N, H*D],split_heads 的逆操作。""" B, H, N, D = t.shape return t.transpose(0, 2, 1, 3).reshape(B, N, H * D) def softmax(x: np.ndarray, axis: int = -1) -> np.ndarray: """数值稳定的 softmax:先减去最大值再取指数,避免 exp 溢出。""" x = x - x.max(axis=axis, keepdims=True) e = np.exp(x) return e / e.sum(axis=axis, keepdims=True) def mha(X: np.ndarray, W_q, W_k, W_v, W_o, H: int, causal: bool = False): """完整的多头自注意力前向。返回 (输出, 注意力权重 P)。""" B, N, d_model = X.shape D = d_model // H # ① 三个投影:每个 token 独立地把自己映射成 query / key / value Q = split_heads(X @ W_q, H) # [B, H, N, D] K = split_heads(X @ W_k, H) # [B, H, N, D] V = split_heads(X @ W_v, H) # [B, H, N, D] # ② 打分:每个 query 和所有 key 做内积,得到 N×N 的分数矩阵 S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) # [B, H, N, N] # ③ 因果掩码:第 i 个 query 只能看 0..i 的 key if causal: mask = np.triu(np.ones((N, N), dtype=bool), k=1) S = np.where(mask, -np.inf, S) # ④ 归一化成权重,再对 V 做加权求和 P = softmax(S, axis=-1) # [B, H, N, N] ctx = P @ V # [B, H, N, D] # ⑤ 拼回 d_model,过输出投影 O = merge_heads(ctx) @ W_o # [B, N, d_model] return O, P def mha_naive_loop(X, W_q, W_k, W_v, W_o, H): """完全不用矩阵乘的「照着定义抄」版本:四重循环。 用来验证上面的向量化实现没有把下标搞反。逻辑等价但慢得多(O(B·H·N²·D))。 """ B, N, d_model = X.shape D = d_model // H Q = (X @ W_q).reshape(B, N, H, D).transpose(0, 2, 1, 3) K = (X @ W_k).reshape(B, N, H, D).transpose(0, 2, 1, 3) V = (X @ W_v).reshape(B, N, H, D).transpose(0, 2, 1, 3) out = np.zeros((B, H, N, D)) for b in range(B): for h in range(H): for i in range(N): # 先逐个算出这一行 N 个分数,再 softmax,再加权求和 s = np.array([float(Q[b, h, i] @ K[b, h, j]) / np.sqrt(D) for j in range(N)]) p = softmax(s) out[b, h, i] = p @ V[b, h] return merge_heads(out) @ W_o def main(): B, N, d_model, H = 2, 8, 32, 4 D = d_model // H print(f"配置: B={B} N={N} d_model={d_model} H={H} D={D}") X = rng.normal(size=(B, N, d_model)) * 0.5 W_q, W_k, W_v, W_o = (rng.normal(size=(d_model, d_model)) / np.sqrt(d_model) for _ in range(4)) # ── 1. 每一层的真实形状 ────────────────────────────────── Q = split_heads(X @ W_q, H) K = split_heads(X @ W_k, H) S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D) print("\n[1] 各张量形状") print(f" X {X.shape} 输入") print(f" Q/K/V {Q.shape} 切头后 [B, H, N, D]") print(f" S {S.shape} 分数矩阵,N×N 是显存爆炸的源头") print(f" O {mha(X, W_q, W_k, W_v, W_o, H)[0].shape} 输出,和输入同形") # ── 2. 分数的量级:为什么要除以 sqrt(D) ────────────────── raw = Q @ K.transpose(0, 1, 3, 2) # 不除以 sqrt(D) print("\n[2] 缩放系数 sqrt(D) 的作用") print(f" D = {D}, sqrt(D) = {np.sqrt(D):.4f}") print(f" 未缩放分数的标准差 : {raw.std():.4f} 分布范围 [{raw.min():.2f}, {raw.max():.2f}]") print(f" 缩放后分数的标准差 : {S.std():.4f} 分布范围 [{S.min():.2f}, {S.max():.2f}]") print(f" 未缩放 softmax 的最大权重: {softmax(raw).max():.4f}") print(f" 缩放后 softmax 的最大权重: {softmax(S).max():.4f}") # D 越大,不缩放的分数方差越大,softmax 越容易塌成 one-hot print(" 固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变:") print(" D 分数标准差 最大权重(未缩放) 最大权重(缩放后)") for D_test in (8, 16, 32, 64, 128, 256): q = rng.normal(size=(256, D_test)) k = rng.normal(size=(256, D_test)) s_raw = q @ k.T s_scaled = s_raw / np.sqrt(D_test) print(f" {D_test:4d} {s_raw.std():9.4f} " f"{softmax(s_raw).max():14.4f} {softmax(s_scaled).max():15.4f}") # ── 3. 性质校验 ──────────────────────────────────────── print("\n[3] 性质校验") O, P = mha(X, W_q, W_k, W_v, W_o, H) print(f" (a) 权重行和为 1 : max|sum(P)-1| = " f"{np.abs(P.sum(axis=-1) - 1).max():.2e}") O_loop = mha_naive_loop(X, W_q, W_k, W_v, W_o, H) print(f" (b) 向量化 vs 四重循环 : max|O - O_loop| = " f"{np.abs(O - O_loop).max():.2e} allclose=" f"{np.allclose(O, O_loop)}") _, P_causal = mha(X, W_q, W_k, W_v, W_o, H, causal=True) upper = np.triu(P_causal, k=1) print(f" (c) 因果掩码上三角全 0 : max = {upper.max():.2e}") print(f" 且下三角行和仍为 1 : max|sum-1| = " f"{np.abs(P_causal.sum(axis=-1) - 1).max():.2e}") # 随机初始化的不同投影产生不同权重;这不是训练后头功能分化的证据 P_mean = P.mean(axis=1) # [B, N, N],把 H 个头的权重平均 diff = np.abs(P[0, 0] - P_mean[0]).mean() spread = np.abs(P[0] - P[0].mean(axis=0, keepdims=True)).mean() print(f" (d) 各头权重并不相同 : 头 0 与 H 头平均的平均绝对差 = {diff:.4f}") print(f" 头之间的平均离散度 : {spread:.4f}(0 表示所有头完全一样)") # ── 4. 不看自己的极端情形:注意力塌缩成「复制」 ────────── print("\n[4] 极端情形:把 K 设成和 Q 完全一样(自注意力且 W_q=W_k)") X2 = rng.normal(size=(1, 4, d_model)) Q2 = split_heads(X2 @ W_q, H) S2 = Q2 @ Q2.transpose(0, 1, 3, 2) / np.sqrt(D) P2 = softmax(S2) diag_share = np.trace(P2[0, 0]) / 4 print(f" 对角线权重占比 = {diag_share:.4f}(1.0 表示每个 token 只关注自己)") if __name__ == "__main__": main() attention_memory.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """自注意力的显存账本:把一层 attention 的每一笔开销都算成字节。 只依赖 numpy(其实只用到它做格式化,核心就是整数乘除)。 直接 `python attention_memory.py` 即可运行。 算的是「训练时一层 MHA 需要为反向传播留下来的激活」, 这是显式保留中间量的保守教学模型,并非框架实测或反向所需最小值。默认的模型尺寸 采用简化 Transformer:d_model=3072、H=24、D=128。 """ import numpy as np BYTES = {"fp32": 4, "fp16": 2, "bf16": 2, "fp8": 1} MIB = 1024 ** 2 GIB = 1024 ** 3 def fmt(nbytes: float) -> str: if nbytes >= GIB: return f"{nbytes / GIB:8.2f} GiB" if nbytes >= MIB: return f"{nbytes / MIB:8.2f} MiB" return f"{nbytes / 1024:8.2f} KiB" def ledger(B: int, N: int, d_model: int, H: int, dtype: str = "bf16", dropout: bool = True): """返回一层 MHA 的逐项激活显存(字节)。 N² 项有三个:分数矩阵 S、softmax 后的 P、以及与所选 dtype 同宽的浮点 dropout 乘子(非 bool mask)。 这三项就是 O(N²) 显存的真身——不是「注意力复杂度是 N²」这句话, 而是本教学模型假设同时保存的三个 B×H×N×N 张量;框架可复用或省略它们。 """ b = BYTES[dtype] linear = B * N * d_model * b # 每个 [B, N, d_model] 的张量 square = B * H * N * N * b # 每个 [B, H, N, N] 的张量 return { "输入 X": linear, "Q": linear, "K": linear, "V": linear, "分数矩阵 S": square, "softmax 权重 P": square, "浮点 dropout 乘子": square if dropout else 0, "加权和 ctx": linear, "输出 O": linear, } def main(): d_model, H, D = 3072, 24, 128 print(f"模型尺寸: d_model={d_model} H={H} D={D} (H*D = {H * D})") # ── 1. 单个 N 下的逐项账本 ────────────────────────────── B, N = 1, 4096 items = ledger(B, N, d_model, H, "bf16") total = sum(items.values()) print(f"\n[1] 逐项账本 B={B} N={N} bf16(2 字节)") print(f" {'项目':<16}{'形状':<22}{'字节数':>14} 占比") for name, nb in items.items(): shape = "[B, N, d_model]" if nb == B * N * d_model * 2 else "[B, H, N, N]" print(f" {name:<16}{shape:<22}{nb:>14,} {nb / total:6.1%}") print(f" {'合计':<16}{'':<22}{total:>14,} {fmt(total)}") quad = sum(v for k, v in items.items() if "S" in k or "P" in k or "乘子" in k) lin = total - quad print(f" → N² 项共 {fmt(quad)},线性项共 {fmt(lin)},N² 项占 {quad / total:.1%}") # ── 2. N 增长时账本怎么变 ─────────────────────────────── print("\n[2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子)") print(f" {'N':>7}{'线性项':>12}{'N² 项':>12}{'合计':>12} " f"{'融合侧教学值':>15} 倍数") for N in (1024, 2048, 4096, 8192, 16384, 32768): it = ledger(1, N, d_model, H, "bf16") q = it["分数矩阵 S"] + it["softmax 权重 P"] + it["浮点 dropout 乘子"] l = sum(it.values()) - q # 与 FlashAttention 文统一:六份线性量的教学预算,忽略小的 LSE 与工作区 flash = 6 * 1 * N * d_model * 2 print(f" {N:>7}{fmt(l):>12}{fmt(q):>12}{fmt(l + q):>12} " f"{fmt(flash):>15} {(l + q) / flash:5.1f}x") # ── 3. 交叉点:从哪个 N 开始 N² 项压过线性项 ──────────── # 3·B·H·N² = 6·B·N·d → N* = 2d / H N_star = 2 * d_model / H print("\n[3] 交叉点") print(f" 3·B·H·N²·bytes = 6·B·N·d·bytes 解得 N* = 2d/H = {N_star:.0f}") print(f" 也就是说 N 超过 {N_star:.0f} 之后,一层 attention 的激活显存") print(f" 就由 N² 项主导;N=4096 时已经超出 {(4096 / N_star):.0f} 倍。") # ── 4. 乘上层数:为什么 L 层比 N 更狠 ──────────────────── print("\n[4] 乘上层数 L(无重算训练,按上述教学模型保留各层中间量)") print(f" {'L':>4}{'N=2048':>12}{'N=4096':>12}{'N=8192':>12} 说明") for L in (12, 24, 32, 48): row = [] for N in (2048, 4096, 8192): tot = sum(ledger(1, N, d_model, H, "bf16").values()) row.append(fmt(tot * L)) print(f" {L:>4}{row[0]:>12}{row[1]:>12}{row[2]:>12}") print(" 以上均未计入模型权重与优化器状态;梯度检查点减少内部保存量,但仍需保留边界激活,并非通用的 1/L。") # ── 5. 推理侧的另一种账本:KV cache ───────────────────── print("\n[5] 推理侧:KV cache 的账本(随 N 线性增长,但随并发数 B 线性增长)") print(" 公式: 2 · B · N · L · H · D · bytes") print(f" {'B':>4}{'N':>7}{'L=32':>12}{'L=80':>12}") for B in (1, 8, 32): for N in (4096, 32768): r = [] for L in (32, 80): nb = 2 * B * N * L * H * D * 2 r.append(fmt(nb)) print(f" {B:>4}{N:>7}{r[0]:>12}{r[1]:>12}") # ── 6. 权重和激活谁更大 ──────────────────────────────── print("\n[6] 权重 vs 激活:别只盯着模型大小") L = 32 # 一层 transformer 的权重:4 个 d×d 投影 + 2 个 FFN 的 4d×d w_per_layer = (4 * d_model * d_model + 2 * d_model * 4 * d_model) * 2 print(f" 一层权重(4 个 d×d + FFN 的 2×4d×d,bf16): {fmt(w_per_layer)}") print(f" L={L} 层总权重 : {fmt(w_per_layer * L)}") for N in (2048, 8192): act = sum(ledger(1, N, d_model, H, "bf16").values()) * L print(f" N={N} 时 L={L} 层激活 : {fmt(act)} " f"(是权重的 {act / (w_per_layer * L):.1f} 倍)") if __name__ == "__main__": main() flops_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """自注意力的算力账本:把一层 attention 拆成「线性项」和「二次项」两笔。 只依赖 numpy。直接 `python flops_ledger.py` 即可运行。 最后有一段 CPU 实测,耗时约 10 秒;不同机器数值会不同,看趋势即可。 FLOPs 口径:一次矩阵乘 [M,K] @ [K,N] 需要 M·K·N 次乘加(MAC), 一次乘加算 2 个浮点运算,所以 FLOPs = 2·M·K·N。全文统一用这个口径。 """ import time import numpy as np def layer_flops(N: int, d: int, with_ffn: bool = True): """一层 transformer 的前向 FLOPs,拆成线性项和二次项。""" # 4 个 d×d 投影:Q、K、V 三个输入投影 + 1 个输出投影 proj = 4 * 2 * N * d * d # FFN:升到 4d 再降回来,两个矩阵乘 ffn = 2 * 2 * N * d * 4 * d if with_ffn else 0.0 # 注意力内部两个 N×N 的矩阵乘:QK^T 与 P·V attn = 2 * 2 * N * N * d return proj + ffn, attn def fmt_flops(f: float) -> str: for unit, scale in (("P", 1e15), ("T", 1e12), ("G", 1e9), ("M", 1e6)): if f >= scale: return f"{f / scale:7.2f} {unit}FLOPs" return f"{f:7.2f} FLOPs" def main(): d, H = 3072, 24 print(f"模型尺寸: d_model={d} H={H}") # ── 1. 一层里两笔账各是多少 ───────────────────────────── print("\n[1] 一层 transformer 的前向 FLOPs(N=4096, 含 FFN)") linear, quad = layer_flops(4096, d) print(f" 线性项(QKV 投影 + O 投影 + FFN): {fmt_flops(linear)}") print(f" 二次项(QK^T 与 P·V) : {fmt_flops(quad)}") print(f" 二次项占比 : {quad / (linear + quad):.1%}") # 只看 attention 内部:4 个投影 vs 2 个 N×N 矩阵乘 l_attn_only, q_attn_only = layer_flops(4096, d, with_ffn=False) print(f" 只算 attention 模块本身(去掉 FFN): 二次项占 " f"{q_attn_only / (l_attn_only + q_attn_only):.1%}") # ── 2. 交叉点:二次项什么时候超过线性项 ────────────────── # 4N²d = 24Nd² → N* = 6d print("\n[2] 交叉点") print(f" 含 FFN : 4N²d = 24Nd² → N* = 6d = {6 * d}") print(f" 只含投影: 4N²d = 8Nd² → N* = 2d = {2 * d}") print(f" 结论:N 小于 {2 * d} 时,二次项的 FLOPs 少于 attention 投影,") print(f" 这只比较运算量;是否为耗时瓶颈仍取决于访存、内核与硬件。") # ── 3. 占比怎么随 N 变化 ─────────────────────────────── print("\n[3] 二次项占比随 N 变化(d=3072,含 FFN)") print(f" {'N':>7}{'线性项':>16}{'二次项':>16}{'二次项占比':>10}") for N in (512, 1024, 2048, 4096, 8192, 16384, 32768, 65536): l, q = layer_flops(N, d) print(f" {N:>7}{fmt_flops(l):>16}{fmt_flops(q):>16}{q / (l + q):>10.1%}") # ── 4. 训练总算力:前向的三倍 ─────────────────────────── print("\n[4] 训练一个 token 的 FLOPs(前向 + 反向 ≈ 3 倍前向)") for N in (2048, 4096, 8192): l, q = layer_flops(N, d) print(f" N={N:<6} 每 token 前向 {fmt_flops((l + q) / N)}" f" 训练 {fmt_flops(3 * (l + q) / N)}") # ── 5. CPU 实测:二次项的增长是不是真的更快 ────────────── print("\n[5] CPU 实测(本机一次运行,看趋势不看绝对值;numpy float32)") d_t, H_t = 1024, 16 rng = np.random.default_rng(0) X = rng.normal(size=(4096, d_t)).astype(np.float32) W = rng.normal(size=(d_t, d_t)).astype(np.float32) / np.sqrt(d_t) def bench(fn, repeat=3): best = float("inf") for _ in range(repeat): t0 = time.perf_counter() fn() best = min(best, time.perf_counter() - t0) return best * 1000.0 print(f" {'N':>6}{'投影 (ms)':>12}{'QK^T (ms)':>12}{'实测比':>9}" f"{'FLOPs 比':>10}") measured = {} for N in (256, 512, 1024, 2048, 4096): x = X[:N] t_proj = bench(lambda: x @ W) D_t = d_t // H_t Q = (x @ W)[:, :].reshape(N, H_t, D_t).transpose(1, 0, 2) t_qk = bench(lambda: Q @ Q.transpose(0, 2, 1)) # 理论 FLOPs 比:二次项 / 一个投影 ratio_flops = (2 * N * N * d_t) / (2 * N * d_t * d_t) measured[N] = t_qk / t_proj print(f" {N:>6}{t_proj:>12.2f}{t_qk:>12.2f}" f"{t_qk / t_proj:>9.2f}{ratio_flops:>10.2f}") print(f" 注意看 N=256 那一行:QK^T 的算术量只有投影的 0.25 倍,") print(f" 本次 QK^T / 投影耗时比为 {measured[256]:.2f}。耗时比不必等于 FLOPs 比。") # ── 6. 算术强度:FLOPs 回答不了「为什么慢」 ─────────────── print("\n[6] 算术强度 AI = FLOPs / 访存字节(float32,4 字节/元素)") print(" 估算 AI 较低提示应检查访存;是否实际受限需测硬件计数器。") print(f" {'算子':<22}{'N=256':>12}{'N=1024':>12}{'N=4096':>12}") rows = [] for N in (256, 1024, 4096): # 投影 X[N,d] @ W[d,d]:读 X 与 W,写输出 f_proj = 2 * N * d_t * d_t m_proj = (N * d_t + d_t * d_t + N * d_t) * 4 # QK^T:读 Q 与 K,写 N×N 的分数矩阵(H 份) f_qk = 2 * N * N * d_t m_qk = (2 * N * d_t + H_t * N * N) * 4 rows.append((N, f_proj / m_proj, f_qk / m_qk)) print(f" {'投影 X@W_q':<22}" + "".join(f"{r[1]:>12.1f}" for r in rows)) print(f" {'注意力 QK^T':<22}" + "".join(f"{r[2]:>12.1f}" for r in rows)) print(f" {'(投影 / QK^T)':<22}" + "".join(f"{r[1] / r[2]:>12.1f}" for r in rows)) print(" 投影的 AI 高出 4~7 倍:权重矩阵被整批 token 复用,读一次能做 N 次乘加。") print(" QK^T 的 AI 低:输出是 H·N²,写完就走,数据复用少。") print(" 该估算不能解释本机时延;FlashAttention 原论文通过分块减少 HBM IO,") print(" 避免显式落地完整 N×N 权重矩阵,但算术量仍是二次。") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """生成「自注意力机制的计算与显存账本」的三张解释图。 数值全部来自同目录下的 attention_memory.py 与 flops_ledger.py, 改了那两个脚本的话这里要跟着重跑,避免图与正文数字不一致。 只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。 """ from pathlib import Path import matplotlib.pyplot as plt import numpy as np from matplotlib.patches import FancyBboxPatch ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) plt.rcParams.update({ "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"], "axes.unicode_minus": False, "figure.dpi": 160, }) C_QUAD = "#e05263" # N² 项:红 C_LIN = "#3f7fbf" # 线性项:蓝 C_FLASH = "#2f9e6f" # FlashAttention:绿 C_GREY = "#94a3b8" INK = "#182238" MIB = 1024 ** 2 GIB = 1024 ** 3 def _style(ax, title, xlabel, ylabel): ax.set_title(title, fontsize=14, weight="bold", color=INK, pad=10) ax.set_xlabel(xlabel, fontsize=11, color="#475569") ax.set_ylabel(ylabel, fontsize=11, color="#475569") ax.tick_params(colors="#475569", labelsize=10) for s in ("top", "right"): ax.spines[s].set_visible(False) for s in ("left", "bottom"): ax.spines[s].set_color("#cbd5e1") ax.grid(axis="y", color="#eef2f7", linewidth=1) ax.set_axisbelow(True) # ──────────────────────────────────────────────────────────── # 图 1:显存账本的构成 # ──────────────────────────────────────────────────────────── def fig_memory_ledger(): d_model, H = 3072, 24 b = 2 # bf16 fig, axes = plt.subplots(1, 2, figsize=(13.2, 4.9), facecolor="#fbfcfe") # 左:N=4096 时的逐项占比(一根堆叠条) ax = axes[0] N = 4096 lin_item = 1 * N * d_model * b quad_item = 1 * H * N * N * b labels = ["输入 X", "Q", "K", "V", "分数矩阵 S", "softmax 权重 P", "浮点 dropout 乘子", "加权和 ctx", "输出 O"] sizes = [lin_item, lin_item, lin_item, lin_item, quad_item, quad_item, quad_item, lin_item, lin_item] colors = [C_LIN] * 4 + [C_QUAD] * 3 + [C_LIN] * 2 total = sum(sizes) left = 0.0 for lab, s, c in zip(labels, sizes, colors): ax.barh([0], [s / GIB], left=left / GIB, color=c, edgecolor="white", linewidth=1.2, height=0.55) if s / total > 0.05: ax.text(left / GIB + s / GIB / 2, 0, f"{lab}\n{s / total:.1%}", ha="center", va="center", fontsize=9.5, color="white", weight="bold") left += s ax.set_xlim(0, total / GIB) ax.set_yticks([]) for s in ("left", "top", "right"): ax.spines[s].set_visible(False) ax.set_xlabel("单层 MHA 的教学激活存储(GiB)", fontsize=11, color="#475569") ax.set_title(f"N={N} 时,三个 N² 项吃掉 94%", fontsize=14, weight="bold", color=INK, pad=10) ax.text(0, -0.42, f"合计 {total / GIB:.2f} GiB | 模型 d_model={d_model}, " f"H={H}, bf16", ha="left", fontsize=10, color="#64748b") # 右:随 N 增长,朴素实现 vs FlashAttention ax = axes[1] Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768]) lin = 6 * Ns * d_model * b # 与逐项账本相同:6 个 [B,N,d] 张量 quad = 3 * H * Ns ** 2 * b # 3 个 [B,H,N,N] 张量 naive = (lin + quad) / GIB flash = (6 * Ns * d_model * b) / GIB # 统一教学线性预算,忽略小的 LSE ax.plot(Ns, naive, "o-", color=C_QUAD, linewidth=2.4, markersize=6, label="朴素实现(落 N² 到显存)") ax.plot(Ns, flash, "s-", color=C_FLASH, linewidth=2.4, markersize=6, label="融合侧教学值(6Nd)") ax.fill_between(Ns, flash, naive, color=C_QUAD, alpha=0.10) ax.set_yscale("log") ax.set_xscale("log") ax.set_xticks(Ns) ax.set_xticklabels([f"{n:,}" for n in Ns], fontsize=9) ax.legend(fontsize=10, frameon=False, loc="upper left") _style(ax, "两者比值随 N 近似线性增长", "序列长度 N(token 数)", "单层教学激活存储(GiB,对数轴)") ax.text(0.98, 0.06, f"N=32768 时相差 {naive[-1] / flash[-1]:.0f} 倍", transform=ax.transAxes, ha="right", fontsize=10, color=C_QUAD, weight="bold") fig.suptitle("自注意力的显存账本:钱花在哪一笔", fontsize=17, weight="bold", color="#0f172a", y=1.03) fig.tight_layout() fig.savefig(OUT / "memory_ledger.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) # ──────────────────────────────────────────────────────────── # 图 2:算力账本里二次项的占比 # ──────────────────────────────────────────────────────────── def fig_flops_ratio(): d = 3072 Ns = np.logspace(9, 16.5, 300, base=2) # 512 ~ 92682 quad = 4 * Ns ** 2 * d lin_proj = 8 * Ns * d * d # 只含 4 个投影 lin_all = lin_proj + 16 * Ns * d * d # 再算上 FFN fig, ax = plt.subplots(figsize=(8.6, 5.0), facecolor="#fbfcfe") r_only = quad / (quad + lin_proj) r_all = quad / (quad + lin_all) ax.plot(Ns, r_only, "-", color=C_QUAD, linewidth=2.6, label="只算 attention 模块(4 个投影 vs 2 个 N×N 乘)") ax.plot(Ns, r_all, "-", color=C_LIN, linewidth=2.6, label="算上 FFN(整层的线性项)") ax.axhline(0.5, color=C_GREY, linestyle="--", linewidth=1.2) ax.text(Ns[0], 0.52, "50% 线", fontsize=10, color=C_GREY) for N_star, color, tag in ((2 * d, C_QUAD, "N* = 2d = 6,144"), (6 * d, C_LIN, "N* = 6d = 18,432")): ax.axvline(N_star, color=color, linestyle=":", linewidth=1.6) ax.text(N_star * 1.05, 0.06, tag, fontsize=10.5, color=color, weight="bold", rotation=90, va="bottom") ax.set_xscale("log", base=2) ax.set_xticks([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536]) ax.set_xticklabels(["512", "1K", "2K", "4K", "8K", "16K", "32K", "64K"]) ax.set_ylim(0, 1) ax.legend(fontsize=10.5, frameon=False, loc="upper left") _style(ax, "二次项的 FLOPs 占比随 N 增长(不等于耗时占比)", "序列长度 N(token 数)", "二次项占该层前向 FLOPs 的比例") ax.text(0.98, 0.30, "常用的 N=4096:\n只算 attention 时二次项占 40%,\n算上 FFN 后只占 18%", transform=ax.transAxes, ha="right", fontsize=10, color="#475569", bbox=dict(boxstyle="round,pad=0.4", facecolor="#f1f5f9", edgecolor="#e2e8f0")) fig.suptitle("算力账本:二次项什么时候才是主角", fontsize=16, weight="bold", color="#0f172a", y=1.00) fig.tight_layout() fig.savefig(OUT / "flops_ratio.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) # ──────────────────────────────────────────────────────────── # 图 3:多头到底切了什么 # ──────────────────────────────────────────────────────────── def fig_head_split(): fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe") ax.set_xlim(0, 1) ax.set_ylim(0, 1) ax.axis("off") def block(x, y, w, h, title, lines, color, fs=11): ax.add_patch(FancyBboxPatch( (x, y), w, h, boxstyle="round,pad=0.01,rounding_size=0.02", facecolor=color, edgecolor="white", linewidth=1.6)) ax.text(x + w / 2, y + h * 0.74, title, ha="center", va="center", fontsize=fs + 2, weight="bold", color=INK) ax.text(x + w / 2, y + h * 0.33, "\n".join(lines), ha="center", va="center", fontsize=fs, color="#334155", linespacing=1.5) def arrow(x1, y, x2, label): ax.annotate("", xy=(x2, y), xytext=(x1, y), arrowprops=dict(arrowstyle="-|>", color=C_GREY, linewidth=2.0, mutation_scale=16)) ax.text((x1 + x2) / 2, y + 0.045, label, ha="center", fontsize=11, color="#475569", weight="bold") # X block(0.02, 0.30, 0.16, 0.42, "X", ["[B, N, d_model]", "d_model = H · D"], "#dbeafe") arrow(0.185, 0.51, 0.245, "三个投影") # Q/K/V 未切头 block(0.25, 0.30, 0.17, 0.42, "Q, K, V", ["各 [B, N, H·D]", "仍是完整宽度"], "#e0e7ff") arrow(0.425, 0.51, 0.485, "切头") # 切头后 block(0.49, 0.30, 0.17, 0.42, "切头之后", ["[B, H, N, D]", "reshape + transpose"], "#ede9fe") arrow(0.665, 0.51, 0.725, r"$QK^\top/\sqrt{D}$") # 分数矩阵 block(0.73, 0.22, 0.25, 0.58, "分数矩阵 S", ["[B, H, N, N]", "H 个 N×N,不是 1 个", "← 显存就花在这里"], "#fecaca", fs=11) # 底部说明 ax.text(0.5, 0.10, "每个头只用自己的 D = d_model / H 维去做内积,H 个头各算各的 N×N;\n" "最后把 H 份 D 维结果拼回 d_model,再过一次输出投影 W_o。", ha="center", va="center", fontsize=11.5, color="#475569", linespacing=1.6) ax.text(0.5, 0.02, "关键:分头不改变总算术量(H · N² · D = N² · d_model),它改变的是每个子空间的表达能力。", ha="center", va="center", fontsize=11, color=C_QUAD, weight="bold") fig.suptitle("多头注意力切的是 d_model 这一维,不是复制 H 份", fontsize=16, weight="bold", color="#0f172a", y=0.99) fig.tight_layout() fig.savefig(OUT / "head_split.png", bbox_inches="tight", facecolor=fig.get_facecolor()) plt.close(fig) if __name__ == "__main__": fig_memory_ledger() fig_flops_ratio() fig_head_split() print(f"已生成 3 张图到 {OUT}") for p in sorted(OUT.glob("*.png")): print(f" {p.name} {p.stat().st_size / 1024:.0f} KiB")
-
AIGC 每日速读|2026-09-24|阿里Qwen3.8-Omni发布,视频推理输Gemini 今日 AIGC 论文速览 今日共 10 篇 · 全模态基座与语音智能体 2 篇 · 视频编辑与生成智能体 2 篇 · 生成推理加速与量化 2 篇 · 视觉Tokenizer与音视频生成 2 篇 · 奖励模型与生成安全评测 2 篇 重点论文标题列表 Qwen3.8-Omni(Qwen Team, Alibaba Group):原生全模态智能体,百万上下文 VideoX-Qwen(Nanjing University):120万对指令视频编辑数据 QuantWM(Harbin Institute of Technology (Shenzhen)):2比特KV量化压住时序闪烁 Flash-dLLM(VILA Lab, MBZUAI):扩散LLM提速五倍且不伤精度 VideoGen-Agent(Princeton University):RL教会智能体用工具做视频 今日论文速览 1. Qwen3.8-Omni:原生全模态智能体,百万上下文 Qwen3.8-Omni: Towards Native Omni-Modal Agents | Qwen Team, Alibaba Group | arXiv:2609.25611 关键词:全模态智能体,稀疏MoE,百万上下文,视频剪辑,插件框架 前序问题:全模态模型此前主要强调感知和交互,真正的长程智能体任务——调工具、跑多步、把一段素材剪辑成片——要靠外挂 harness 拼,而现有 agent harness 对音频和视频没有原生支持。缺一个在多模态上原生 co-training、又不丢文本能力的底座。 本文贡献:发布 Qwen3.8-Omni-Flash:Thinker 继承 Qwen3.8-Next 的稀疏 MoE 骨干(GDN 与交错注意力混合),上下文扩到 100 万 token;原生多模态 co-training 把文本侧的智能体能力迁移到音视频任务,再经多教师蒸馏合并领域专精策略;配套开源 Qwen-MM-Plugins 插件框架与 Qwen-Live-Harness 实时交互框架。 Qwen3.8-Omni-Flash is a unified end-to-end model capable of processing multiple modalities 实验效果:WildClawBench-MM 从上代 34.5 涨到 71.0(+36.5)、AgenticVBench 14.5→36.8、OmniGAIA 57.2→74.0;Video-MME-v2 47.9→65.0。开智能体模式后 LVOmniBench 63.3→73.6,OmniVideoBench 单次 query 消耗 token 从 14.6 万降到 7.9 万(约 -45.7%)。 The overview of Qwen3.8-Omni-Flash-Realtime and Qwen-Live-Harness 批判点评:摘要口气很大,但表格里对手没输干净:Gemini 3.8 Flash 在三个视频推理基准的静态设置上全面更高,开智能体后 OmniVideoBench(70.1 vs 67.8)和 Video-MME-v2 仍被压着;teaser 图的 OmniCap-IF 一栏 Flash 拿 20.2,落在上代 Plus 的 28.3 和 Muse Spark 1.2 的 26.8 之后。所谓「领先」主要立在自己参与的新评测上。 2. VideoX-Qwen:120万对指令视频编辑数据 VideoX-Qwen: Data-Centric Instruction-Based Video Editing | Nanjing University;Jiutian Research | arXiv:2609.26015 关键词:指令视频编辑,数据合成,Qwen3-VL,Wan,成对监督 前序问题:通用视频编辑缺的不是模型而是监督:编辑要在执行指令的同时保住无关主体、场景结构和时序连续性,而成对(源视频、指令、目标视频)数据的规模和任务覆盖都远远不够,指令视频编辑长期落后于图像编辑。 本文贡献:一条可扩产的数据流水线:Qwen3-VL-235B 做源视频筛选与目标解析,加/删走 SAM3 加 Minimax-Remover,替换/属性走 Qwen-Image-Edit 首帧编辑加 WanAnimate 传播,自动通过率 89%,产出 120 万条方向性编辑对(每组任务超 40 万条)。模型侧统一 Qwen-Wan 编辑器:多模态语义条件加稠密源视频 latent 引导,图像-视频三阶段渐进训练。 Paired-video construction pipeline 实验效果:100 例对比 UniVideo 和 Kling O1:11 项指标里 9 项均值最优,覆盖指令遵循、编辑质量、内容保持、结构与感知相似度和视频分布质量。 Qualitative comparisons on compound and attribute editing 批判点评:「9/11 最优」的另一面是 11 项里输了 2 项,且对比规模只有 100 例;加/删两条数据路线直接复用 Minimax-Remover 和 WanAnimate,编辑对质量上限被这些现成生成器封顶。论文把「逐条校验富化后的指令」画成 proposed extension(虚线框),等于承认 120 万对里指令与实际编辑的一致性还没有被逐一验证。 3. QuantWM:2比特KV量化压住时序闪烁 QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for World Models and Video Generation | Harbin Institute of Technology (Shenzhen);National University of Singapore | arXiv:2609.26425 关键词:KV cache量化,视频生成加速,世界模型,注意力补偿,训练无关 前序问题:视频生成和世界模型的 KV cache 是部署瓶颈,已有 2-bit 量化方法在 VBench 这类指标上「几乎无损」,但作者实测发现:指标没掉,画面却在闪——逐帧指标天生看不见时序问题。 本文贡献:训练无关、严格因果的 2-bit KV 量化框架。诊断先行:Key 的量化重建误差比 Value 小,输出退化却更大,因为小扰动就能改变 QK^T 注意力 logits、挪走 Query 选中的时序-空间 token。对症两招:QSAC 聚类联合历史 Query 敏感度与残差范围选 INT2 友好的 Key 质心;PSAC 用低秩投影沿 Query 主子空间补偿残余 Key 误差。 Overview of QuantWM's inference system 实验效果:Causal-Forcing、LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 五个底模上,KV cache 最高压缩 6.20×,图像与视频质量指标全面超过现有 2-bit 方法,额外开销有限,且保持严格因果可流式推理。 Visual comparison of BF16, K16V2, K2V16 and K2V2 on world models 批判点评:这篇最值钱的是诊断而不是方法:它解释了为什么「VBench 几乎无损」的结论靠不住——逐帧指标对时序闪烁盲。但时序改善的验收仍以看图为主,论文没给出时序稳定性的量化指标;6.20× 的压缩上限是在 93 帧生成这一档测的,更长序列的收益未报告。 4. Flash-dLLM:扩散LLM提速五倍且不伤精度 Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs | VILA Lab, MBZUAI | arXiv:2609.26796 关键词:扩散语言模型,KV cache,并行解码,Triton,推理加速 前序问题:扩散 LLM 靠并行去噪生成文本,但双向注意力让自回归那套 KV cache 直接失效;已有加速工作把 KV cache 和并行解码分开研究,两者合用时 GPU 显存 I/O 反而成了主要瓶颈。 本文贡献:训练无关两件套。Flash-Cache:把 QKV 投影、RoPE、cache 写入、注意力计算融进一个 I/O 感知的融合 Triton 核,砍掉冗余访存;Flash-Verify:让 dLLM 自己既当 drafter 又当 verifier 做草稿-验证式并行解码,不挂辅助模型。 Overview of Flash-dLLM 实验效果:LLaDA-1.5 上对此前最强的 Elastic-Cache 在 GSM8K/HumanEval 分别提速 5.1 倍和 11.0 倍;Flash-Cache 加 Flash-Verify 达到精度 83.02%、吞吐 210.6 tokens/s(Elastic-Cache 为 82.79%、41.7);batch 16 显存约 26GB,对照 Fast-dLLM 的 50GB 降约 48%,后者在 batch 24 直接 OOM。 Throughput and peak memory versus batch size on GSM8K 批判点评:赢面都在 dLLM 阵营内部:可扩展性图里自回归的 Llama3 在 batch 32 的吞吐仍高于 Flash-dLLM,「扩散 LLM 加速后追平 AR」还没有发生。精度与吞吐是硬权衡(80.2% 到 83.2% 对应 278 降到 186 tokens/s),宣传里 81 倍是对无 cache 基线的倍数,直接引用容易被误读成对 SOTA 的提速。 5. VideoGen-Agent:RL教会智能体用工具做视频 VideoGen-Agent: Reinforcing Video Generation Agents | Princeton University;Stanford University;UC Davis;MMLab, CUHK;BenchFlow;GWU | arXiv:2609.24997 关键词:生成智能体,强化学习,工具调用,视频生成,VABench 前序问题:视频生成模型面对需要专业知识、特定身份、物理一致或时序事件的 prompt 经常直接翻车:太极招式做不对、指定角色画不像、物理参数乱来。单靠扩大底模收益有限,缺一个会检索、仿真、检测来补信息的生成智能体。 本文贡献:六类任务上训一个共享策略:先在教师轨迹上 SFT 建立工具使用习惯(检索文本/图像、仿真、目标检测、深度估计等),再用类别感知混合奖励(工具调用合法性、任务适配度、视频质量)做 RL。配套 VABench:600 条 held-out prompt,覆盖程序知识、单/多实体身份、物理一致、场景合成、多镜头时序。 Overview of VideoGen-Agent 实验效果:VABench 上从底模 56.5 提到 75.6(+19.1 分);把生成工具换成更强的 Seedance 2.0 后,不重训智能体就到 86.1;人评 84.3% 偏好升级配置而非最强独立基线。 Qualitative comparison on Procedural Knowledge generation 批判点评:86.1 这档数字藏着归因问题:从 75.6 到 86.1 的增量完全来自换生成工具,智能体一行代码没动——agent 框架的收益上限被底模和工具质量强绑定,这一段「白捡的分」其实是底模的分。混合奖励里「视频质量」一项依赖 VLM 裁判打分,裁判偏差会直接写进策略,论文未讨论防 reward hacking 的机制。 6. Vorch-Human:一个模型统一说话人与歌声视频 Vorch-Human: Unified Multi-Task Human-Centric Generation via Long-Horizon Continuation | Vorch Team;Harbin Institute of Technology, Shenzhen;Tongji University | arXiv:2609.26117 关键词:音视频统一生成,数字人,扩散transformer,长视频,身份保持 前序问题:以人为核心的音视频生成被拆成好几个模型:语音驱动数字人、参考音色合成说话视频、外观加声音参考生成场景,各自训练各自维护。它们本质上是同一组模态、只是条件不同的任务。 本文贡献:双流音视频扩散 transformer,在传统 noisy 音频/视频接口之外增加 clean 条件 token 组,用 per-token 任务嵌入、时间位置类型、条件掩码和共享多模态 prompt 编码器,把驱动语音、音色样本、首帧、主体图统一进一个模型;两级数据管线做说话人聚类与跨片段身份串联;长视频靠冻结 latent 前缀递归、每段只生成新后缀。 Role-aware unified human-centric architecture 实验效果:5 分钟长生成保持身份一致与音画同步;GSB 人评对 LongCat-Video-Avatar-1.5:动作/姿态/表情净偏好 +46.9%,口型准确度 +47.5%,单人音视频驱动整体净偏好 +27.1%。 Raw GSB breakdown for LongCat-Video-Avatar-1.5 批判点评:同一张 GSB 图的另一半:视觉质量净偏好 -13.1%,多人场景再输 -9.2%——赢的两项全在「跟音频对齐」上,纯画质反而输给 LongCat,摘要里 strong identity preservation 的措辞没覆盖这个短板。署名主体写作「Vorch Team」,机构披露不完整,技术报告性质明显。 7. StableVQ:三招治住VQ码本训练崩溃 StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training | Huazhong University of Science and Technology;KlingAI Research;South China Normal University | arXiv:2609.26774 关键词:VQ tokenizer,码本利用率,训练稳定,自回归生成,ImageNet 前序问题:共享投影 codebook 把 VQ tokenizer 的利用率推上去之后,训练稳定性成了新瓶颈:码本利用长期趴在低位、出现永久死码、甚至在 26 万步附近突然崩到 0。现有方法各打各的补丁,缺少对根因的解释。 本文贡献:把根因归结为 Encoder-Decoder 与 Codebook 的「纠缠训练」:两个子系统各自都无法独立完成任务,只能靠碰巧合作维持。三个零参数改动:Dynamic STE 按量化距离压低不可靠梯度;Region VQ Loss 让激活码向邻近未激活码按比例传播目标;Decoupled Schedule 给两个子系统各配独立学习率调度。 Three characteristic failure modes of VQ training 实验效果:ImageNet 256 重建:262k 码本 120 epoch rFID 0.92(对照 FVQ 1.29、SimVQ 3.16),16k 码本 1.13;鲁棒性指标 UR-AUC 60.59,比 FVQ 的 8.08、SimVQ 的 2.17 高一个量级;只用单个线性投影层就追平需要 ViTBlock 投影器的 FVQ。 Qualitative reconstruction comparison with a 16k codebook 批判点评:主张是「治崩溃」,但主表里 FVQ 和 SimVQ 在各自标准配置下利用率本来就是 100%,差距全在故意制造码本-token 分布错配的鲁棒性测试里拉开——这三招买的更像「最坏情况的保险」,常态训练收益主要是 rFID 那 0.2 到 0.4。下游生成只给「competitive」,FID 全表在附录。 8. Qwen-Audio 3.1:全双工误答率从73%压到13% Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction | Alibaba Token Foundry, Alibaba Group | arXiv:2609.25176 关键词:全双工语音,语音智能体,GRPO,在线蒸馏,工具调用 前序问题:实时语音助手要同时干三件互相打架的事:理解还在演化的请求、执行动作、遵守对话规则(何时说、何时闭嘴、是否插话)。上一代在背景有人说话时 73% 的轮次会错误应答,全双工的「闭嘴」比「会说」更难。 本文贡献:Think/Act/Speak and Coordinate 三层:Core-Cocktail SFT 加 M2-OPD 多教师在线策略蒸馏迁移文本能力;自进化可执行环境加多粒度 rollout 的 GRPO 教工具调用与参数落地;全双工决策模型独立管「说不说」。另给 Voice Harness 前后台原型:对话在前台、任务在后台异步跑。 Qwen-Audio-3.1-Realtime model framework for continuous spoken interaction 实验效果:tau-Voice 半双工改编任务成功 78.4%→82.0%(Airline 64.0%→74.0%);Full-Duplex-Bench v1.5 背景语音应答率 73.0%→13.0%、恢复率 0.26→0.87;FLEURS 宏平均 WER 9.01→3.98;WebSearch1K 检索调用从 4.37 次降到 1.05 次(-76%)。 Qwen-Audio-3.1-Realtime post-training pipeline 批判点评:两个回撤写在正文里:EVA-A 的 Mean 分从 70.50 掉到 66.26,WebSearch1K 的 F1 从 60.87% 降到 58.61%——少说话、少调用是把双刃剑;Daily Chat 和 persona 交互的 Spoken 分也在微跌。摘要只报提升项,回撤要翻到结果表才看得见,读技术报告别只读开头。 9. RULER:六项Rubric奖励治SVG生成 RULER: Instance-aware Rubric Rewards for SVG Generation | Ant Group;The Hong Kong University of Science and Technology (Guangzhou);Independent Researcher;University of Oxford | arXiv:2609.25270 关键词:SVG生成,Rubric奖励,GRPO,reward hacking,视觉裁判 前序问题:自然语言生成 SVG 是没有绝对真值的开放任务:CLIP、Aesthetic 这些在自然图像上标定的标量指标迁到风格化矢量图上会误判,直接拿来当 RL 奖励还会触发 reward hacking——评测和优化同时失去可靠信号。 本文贡献:实例化 rubric 奖励:每条指令由前沿模型生成六项 rubric(语义、视觉、风格三轴),裁判 VLM 逐项给渲染 rollout 打分,加权满意度经 GRPO 优化。rubric 只从文本推导,不需要配对 SVG 真值、也不需要人类偏好标注。训练用 Qwen3-VL-8B 做裁判,与评测用的 GPT-5-mini 分开。 Qualitative comparison of scalable vector graphics generation between RULER and four baselines 实验效果:MMSVG-Illustration/Icon 上 rubric 分从 0.432/0.395 提到 0.693/0.683,超过专用 SVG 模型、追平大得多的 DeepSeek-V3;人评盲测对自家 Qwen3-8B 骨干胜率 89.7%、对 Qwen3-32B 66.1%;消融显示去掉语义轴掉 10.1%、换静态 rubric 掉 22.7%。 Ablation of rubric design on MMSVG-Illustration and MMSVG-Icon 批判点评:「追平 DeepSeek-V3」在可视化图里并非全赢:五个示例里同心圆靶一栏 DeepSeek-V3 的 0.94 高于 Ours 的 0.92;Ours 的 CLIP 分(0.28-0.35)与基线几乎无差,说明传统指标确实分不出好坏,但反过来也意味着 rubric 分数与人类直觉的对应完全押在裁判 VLM 上。人评规模只有 150 条 prompt。 10. Moderation Gap:三成有害视频骗过逐帧审核 The Temporal Moderation Gap: Text-to-Video Safety Filters Are Blind to Harm in Motion | National University of Singapore;University of New South Wales;Fuzhou University | arXiv:2609.26233 关键词:文生视频,安全审核,帧序,红队测试,评测方法 前序问题:T2V 服务的安全栈是从图像生成继承的:关键词过滤加随机抽 8 帧逐帧检查。这套栈对「伤害只存在于帧序」的视频天然失明——闯红灯、往转动的车床里伸手、误服药片,每一帧单看都无害。 本文贡献:理论上证明:任何忽略帧序的审核器只要放行某片段,就必然放行其良性重排。实测未修改的基准 prompt 就能让 32.7% 的 Sequential-Action 目标落入审核盲区,改写、拆场景、反馈式搜索都无显著改善(McNemar p≥0.12)——不需要任何 prompt 技巧就能触发。修复方向是读帧序:时序感知检测器 AUC 0.74,逐帧检查等于抛硬币。 The temporal moderation gap 实验效果:对 97 帧全部打分发现:约三分之一的交付片段只是把不安全帧藏起来,其余按帧序整体看仍有害,尽管每一帧都通过了审核;用户实验确认人能区分片段与其重排的安全性。 Three Sequential-Action gap clips 批判点评:论文顺带揭了一个测量陷阱:在搜索出的 prompt 上用它自己的渲染种子打分,会把 7.5% 的单次生成率虚标成 46.7%——这个坑对所有做安全评测的人都成立。但修复方案的 AUC 0.74 离可用尚远,且全部证据来自 Sequential-Action 一类动作伤害,跨帧累积的暗示性内容等其他类型未覆盖。 趋势观察 全模态模型开始从「能听会说」转向「能干活」 Qwen3.8-Omni 把上下文推到 100 万 token 并配好插件与实时 harness,Qwen-Audio-3.1-Realtime 则把「何时闭嘴」当成一等公民单独训练。两条线指向同一件事:多模态模型的竞争正在从感知指标挪向任务成功率,模型外面的 harness、插件和记忆管理层开始决定产品形态。 视频编辑与视频生成的瓶颈,先卡在数据而不是模型 VideoX-Qwen 用 120 万对合成编辑数据喂出一个统一编辑器,VideoGen-Agent 则用六类任务的教师轨迹加 RL 教模型调用工具。两者都在补同一个洞:指令视频任务缺少可靠的监督与反馈信号,谁的流水线能稳定产出高质量配对数据,谁就拿到上限。 加速这条线在「省显存」和「省访存」上分头推进,且都是训练无关 QuantWM 发现 2-bit KV 量化的真正受害者是时序稳定性而非单帧指标,用注意力补偿把闪烁压回去;Flash-dLLM 则把瓶颈定位到 GPU 显存 I/O,用融合核加自验证并行解码把吞吐推到 210.6 tokens/s。共同点是都不动训练,靠推理系统层的重新安排。 评测开始把「裁判本身」当成被审对象 RULER 证明静态标量指标在 SVG 上失灵,改用逐指令生成的 rubric 当奖励;Moderation Gap 则证明逐帧安全审核对帧序盲。两者都在说同一件事:在开放生成任务里,裁判的构造方式本身就是被评测对象,默认信任任何单一打分器都危险。 人工智能炼丹君 整理 | 2026-09-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-23|NVIDIA像素扩散FID 1.46,仍输latent 今日 AIGC 论文速览 今日共 10 篇 · 图像生成与像素扩散 2 篇 · 视频世界模型与 3D 一致 2 篇 · 视频生成加速与流式编辑 2 篇 · 动作与音频生成 2 篇 · 音视频因果与奖励评测 2 篇 重点论文标题列表 PixelDiT2(NVIDIA):像素扩散 FID 压到 1.46 WorldCrafter(ARC Lab, Tencent IEG):分钟级探索重访 PSNR 18.0 ⚡ GAE(HKUST):相机轨迹误差砍半 FVD 降 23% SparkDiffusion(Peking University, Melon Group):97% 稀疏下 265 倍单卡加速 MixiMotion(PTIT, Hanoi):一步动作对齐 0.835 逼近教师 今日论文速览 1. PixelDiT2:像素扩散 FID 压到 1.46 PixelDiT2: Representation-Grounded Pixel Diffusion Transformers | NVIDIA;University of Rochester | arXiv:2609.24919 关键词:像素空间扩散,表征先验,表示对齐,DINOv3,ImageNet ⚠️ 前序问题:像素空间扩散不用自编码器、直接在 RGB 上去噪,省掉了 latent 重建瓶颈,代价是收敛慢、最终画质长期落后 latent 扩散。作者的判断是缺一个显式表征先验:latent 扩散天然在紧凑结构化的隐空间里去噪,像素扩散却要一边学「好去噪的表征」一边学「怎么生成像素」,两件事挤在同一次训练里互相拖累。 本文贡献:提出 representation grounding:用一个冻结的预训练视觉基座模型在整个去噪过程里持续提供 per-patch 表征监督。带噪图像走像素去噪通路,同时冻结编码器产出 per-patch 特征,一个时间步条件化的 DiT 块 P_g 把它映射成 scaffold,再通过空间 AdaLN 调制扩散 transformer;REPA 只作为训练期辅助目标。另提出延迟 grounding dropout:训练初期保留 grounding,到 epoch 160 再开启 dropout。 PixelDiT2 at ImageNet-512x512: samples, architecture, and convergence. 实验效果:ImageNet-256×256 上 H/16 模型 600 epoch 达 FID 1.46、IS 301.6;512×512 上 680 epoch 达 FID 1.48、IS 295.7,两档都是像素侧最好(同表其余像素方法 1.61–3.94 / 1.78–3.95)。论文强调 epoch 预算:512 档 epoch 200 就超过 PixelDiT 850 epoch 的 FID,预算低 4.25 倍。 PixelDiT2 reaches FID 1.78 at epoch 200 and 1.48 at epoch 680. 批判点评:「补上表征先验」在像素侧成立,但把两张表横着读是另一面:256 上 latent 侧 RAE-XL FID 1.13、REPA-XL 1.29 都优于 1.46,512 上 RAE-XL 1.13 同样压过 1.48,IS 也不及 REPA-XL 306.3 与 JiT-G 306.8。也就是说「追平」只在像素扩散内部成立,跨阵营仍差约 0.3 FID,摘要里 narrowed the gap 的措辞容易被读成已经追平。另外延迟 dropout 的开启时机是在 512 档上调出来的,256 档用的是从头独立 dropout,两档训练协议并不一致,跨分辨率可比性打了折扣。 2. WorldCrafter:分钟级探索重访 PSNR 18.0 WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory | ARC Lab, Tencent IEG;Peking University | arXiv:2609.24984 关键词:视频世界模型,隐式3D记忆,长程一致性,相机可控,流式生成 ⚠️ 前序问题:视频世界模型做交互式探索时,长程一致性一直是硬伤:走出一段距离再回头,场景常常「认不出」是刚才那个地方。难点在于历史观测越来越多,而视频生成器的 token 预算是固定的,怎么把历史压进有限 token、又不依赖显式深度对应,是个两难——显式 3D 重建重且脆,简单堆历史帧则 token 直接爆掉。 本文贡献:核心洞察是「让被请求的视角来决定历史怎么压缩」。一个与视频生成器联合训练的 memory encoder 把历史观测编成紧凑的 3D-aware 表示,再由 pose-conditioned readout 按当前目标相机位姿读出固定数量的、目标视角专属 token,在去噪前注入,全程不需要显式深度对应。配合 max-coverage 历史检索、最近时间上下文和 few-step 蒸馏,实现从单张图或文本出发的流式分钟级探索。 Overview of the WorldCrafter pipeline. 实验效果:VBench 自建输入模式 725 段视频上 Overall 81.910 为全表第一(Alaya-EVOKE 81.406、SANA-WM 80.841、Echo-WM 80.211),主体一致性 82.695、背景一致性 90.589、运动平滑 98.787、整体一致性 26.745 均为第一。长程重访一致性上 MEt3R 0.166、PSNR 18.016、SSIM 0.517,相对次优 Lyra 2.0(0.334 / 14.050 / 0.390)近乎翻倍。 Qualitative long-horizon revisit comparison in a static scene. 批判点评:重访那张表真正的第一不是 WorldCrafter 而是它的加速版 WorldCrafter-fast(MEt3R 0.129、PSNR 20.868、SSIM 0.616)——少步蒸馏的变体反而在一致性上更好,这暗示「更多步数」本身可能带来累积漂移,论文没有就这条给出解释。视觉质量上也不是全胜:美学质量 AQ 61.432 只排第四,不及 SANA-WM 63.467;动态程度 DD 96.893 是全表最低(其余 97.087–100),说明换来的一致性里有一部分是靠画面动得更少买到的。评测均在自建输入模式下完成,未与公开榜单协议对齐。 3. GAE:相机轨迹误差砍半 FVD 降 23% GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation | The Hong Kong University of Science and Technology;ARC Lab, Tencent IEG;The University of Hong Kong;The University of Texas at Austin | arXiv:2609.24981 关键词:几何原生隐空间,3D一致性,自编码器表征,相机轨迹,感知生成统一 ⚠️ 前序问题:视觉生成器能出逼真画面,却保不住一个前后一致的 3D 场景。作者认为这不只是建模问题,更是表征问题:生成器演化的是外观为中心的隐空间,感知模型恢复几何用的是语义丰富、编码跨视角结构的空间,两者不在同一坐标系上。常见补丁是「再输出一个几何头」,等于把几何当副产品,治标不治本。 本文贡献:不把几何当额外输出,而是直接把一个几何基座模型的特征重参数化成紧凑、可扩散的隐空间——几何原生自编码器 GAE,其 latent 同时可解码到外观、深度、相机和点图。训练分两阶段:先训 codec 把冻结的多层几何特征压进 latent,再用条件流只在「待生成视角」的 latent 上做流匹配,参考视角 latent、相机射线和文本作为控制,让感知与生成共用同一个隐空间接口。 Overview of Geometry-Native Autoencoder (GAE). 实验效果:在固定生成器与训练协议的控制对比下:重建侧 GAE-128 用比原始几何特征少 24 倍的通道,PSNR 28.76 / LPIPS 0.036 / rFID 5.4(RealEstate10K)反而略优于原始 L0 特征;生成侧 GAE-64 最优,RealEstate10K FVD 225.7、PSNR 20.02、SSIM 0.711,DL3DV FVD 287.0、PSNR 18.00,相对最好的非 GAE 受控 latent 分别降 FVD 12.7% 与 23.1%;ATE 在 RealEstate10K 降 52.8%、DL3DV 降 23.3%,MEt3R 取到受控组最佳 0.1208 / 0.1347。 Multi-frame RGB, geometry, and camera-pose comparison across RealEstate10K scenes. 批判点评:最有价值的是控制变量设计,但同一张表也留了口子:受控组之外还列了 Gen3R 与 GLD 两个参考方法,其中 Gen3R 在 RealEstate10K 的 MEt3R 是 0.1157,优于 GAE-64 的 0.1208——「最佳」限于受控 latent 这个口径。DL3DV 的重投影误差上 GAE 只有 0.0028–0.0029,反而不如 WAN2.1 VAE 的 0.0019,说明几何原生 latent 在像素级回投影精度上并不占优。另外通道数选择本身就不一致:128 在重建上最好、64 在生成上最好,论文没给选择依据,实际部署还得自己再权衡一次。 4. SparkDiffusion:97% 稀疏下 265 倍单卡加速 SparkDiffusion: Mitigating the High-Sparsity Trap --- A Unified Framework for up to $265\times$ Single-GPU Acceleration of Visual Generation | Peking University, Melon Group;Tsinghua University;Alibaba Group;University of Electronic Science and Technology of China;Harbin Institute of Technology | arXiv:2609.23153 关键词:稀疏注意力,推理加速,少步蒸馏,FP8量化,视频扩散 ⚠️ 前序问题:视频扩散 transformer 贵在注意力要处理超长时空 token 序列,做稀疏注意力是自然的加速思路。但作者发现一个「高稀疏陷阱」:稀疏度推到极致时,逐步训练损失还在稳步下降,最终生成质量却停滞甚至倒退。诊断指出这是监督问题——主要误差来自高噪声的结构生成阶段,逐步局部训练修不动它,只有对齐终态的训练才修得动。 本文贡献:由此给出一条分阶段原则:先把稀疏架构适配成粗粒度先验,再校正终态分布。SparkDiffusion 按此串起三件事——短程稀疏 warm-up、少步 trajectory-mixed 蒸馏、FP8 量化配融合 kernel,并把三者做成可乘的加速因子。覆盖 Wan2.1/Wan2.2 骨干、T2V/I2V 任务、480P/720P 分辨率,以及 H100 与 RTX 5090 两种 GPU。 Overview of the SparkDiffusion framework. 实验效果:3 步无 CFG 推理下,Wan2.1-T2V-14B-720P 在单张 RTX 5090 上端到端 265× 加速(H100 上 220×);Wan2.1-T2V-1.3B-480P 端到端 1.3 秒出片。长序列 720P 上维持 97% 注意力稀疏,1.3B-480P 上 90%。VBench 总分从 dense 的 83.69 到 83.15,掉 0.54 分;同表延迟与显存项均为最好(18.0 / 8.0)。 End-to-end latency and speedup of SparkDiffusion over Full Attention on NVIDIA H100 and RTX 5090 GPUs. 批判点评:265× 是三个因子相乘的结果,其中大部分来自 3 步蒸馏而非稀疏本身,读标题很容易把功劳全记在稀疏上——论文在图表里做了分解,但正文强调的仍是合成后的倍数。质量代价是实打实的:83.15 低于 dense 83.69,且稀疏度从 90% 提到 97% 时分数从 83.42 掉到 83.15,说明高稀疏陷阱只是被缓解、没被消除。另外源码里仍能看到若干未清理的 TODO 占位注释(作者元数据、BF16 两列标注为占位),作为预印本部分数值还需等正式版复核。 5. MixiMotion:一步动作对齐 0.835 逼近教师 MixiMotion: One-Step Text-to-Motion Generation via Asymmetric Set Distillation | Posts and Telecommunications Institute of Technology, Hanoi, Vietnam | arXiv:2609.23010 关键词:文本到动作,一步生成,集合蒸馏,运动学监督,推理延迟 ⚠️ 前序问题:文本到动作生成质量上来了,但迭代采样要几十上百次网络评估,延迟高,交互式动画、游戏这类场景用不了。压缩成严格一步模型有两大障碍:一是文本条件下的动作天然多模态,同一提示对应多个合理动作,固定的教师-学生一一对应会把多种有效模式平均掉;二是只在归一化表征空间里对齐,解码后可能出现明显运动学瑕疵。 本文贡献:MixiMotion 用离线集合蒸馏:对每个提示让冻结的多步教师先生成 K=4 个动作存进离线教师库,学生训练与推理时都不再查教师;学生从独立噪声采样 M=8 个一步样本,用非对称双向集合匹配训练——教师到学生方向鼓励覆盖教师支持的多样动作,学生到教师方向抑制不被支持的生成,两侧权重 α=(1, 0.20) 故意不对称。再叠加解码空间的端点、轨迹与身体分组运动学监督。 MixiMotion: offline asymmetric set distillation for one-step text-to-motion generation. 实验效果:ViMoGen 上语义对齐 0.835,一步方法里第一(MotionLCM-1 0.825、naive 一步教师 0.711),逼近 50 步 HY-Motion-1.0-Lite 教师的 0.858;六个类别中有四类超过 MotionLCM-1。25 人盲评总体 4.33 对教师 4.50,同为一步/少步里最高(MotionHiFlow 4.20、MotionLCM-1 3.98)。单次网络评估延迟从 829.58 ms 降到 9.30 ms。 Qualitative comparisons between HY-Motion-1.0-Lite and MixiMotion. 批判点评:摘要里的 89.2× 是单次网络评估口径,正文自己给出的端到端加速是 6.75×——差了十几倍,文本编码与渲染等开销没算进去,读者很容易把 89.2× 当成真实提速。另外 0.835 其实仍略低于多步的 MLD 0.840(与 MDM 0.833 基本持平),「逼近教师」成立,但严格说还没超过最好的多步基线。消融里非对称权重只带来 0.829→0.835 的 0.006 增益,解码空间监督贡献 0.832→0.835,各组件边际收益都很小;学生从教师热启动、460M 参数与教师同量级,并没有变小。语义分数由 Qwen3-VL-30B 判 yes/no 问题自动给出,非人类标注。 6. SVEET:双向模型改流式 15 FPS Streaming Video Editing with Easy Adaptation | Shanghai Jiao Tong University | arXiv:2609.24788 关键词:流式视频编辑,双向转自回归,特征解耦,正交解耦训练,实时生成 ⚠️ 前序问题:预训练的双向视频扩散模型编辑质量好,但它需要看完整段视频,做不了逐帧自回归的流式编辑。直接改造会撞上两个矛盾:双向骨干的特征在时间上互相依赖,而流式推理要求条件帧彼此独立;可控性与因果性两个优化目标还会互相拉扯,联合训练通常顾此失彼。 本文贡献:先系统复盘已有 video-to-video 扩散方案,归纳出流式适配的两条原则:骨干特征解耦、条件帧独立。据此给预训练双向模型加一条辅助控制分支,用时间独立自注意力编码源视频,中间特征注入对应骨干块;为弥合双向与流式的特征空间差异,再提出解耦训练 ODT,显式约束「视频可控性」与「模型因果性」两个优化方向正交,使二者在推理时兼容,并实现跨异构骨干的零样本迁移。 Our proposed SVEET. 实验效果:视频风格迁移上 VLM 编辑准确率 7.4322 为全表第一(LiveEdit 5.8672、DayDream+CF 5.2321、SDV2 4.2297),CLIP 文本对齐 0.2287、主体一致性 0.9447、背景一致性 0.9298、运动平滑 0.9898、美学质量 0.5550 均为第一。消融中 ODT 把 2D 版从 7.1898 提到 7.4322、3D 版从 7.0653 提到 7.3315,推理期投影(6.4250)与两阶段 teacher forcing(7.0927)都不如它。单张 H100 上 15 FPS,未用任何额外加速手段。 Qualitative comparison results on stylization. 批判点评:唯一没拿第一的一列是整体一致性(0.1123 第二),而拿下这列的 Channel concat 编辑准确率只有 1.8902——几乎没在编辑,说明这个指标在这组对比里更接近「越不改越高分」,拿它当唯一失分项反而暴露了指标本身失效。实验只在风格迁移这一个任务上给了完整数字,其余编辑任务的优势主要靠定性图支撑。15 FPS 是在 H100 上测的,离真正的端侧实时还有距离,且论文没有给出不同分辨率或时长下的 FPS 曲线。 7. COT-TTS:听对话推断语气 MOS 4.15 COT-TTS: Audio Context-Aware Text-to-Speech with Chain-of-Thought Reasoning | The Hong Kong University of Science and Technology;Nanjing University;JIUTIAN Research, China Mobile;Peking University;China Mobile (Hong Kong) Innovation Research Institute | arXiv:2609.22697 关键词:上下文感知语音合成,链式推理,可编辑风格,级联对比,时长一致性 ⚠️ 前序问题:语音合成的说话方式现在基本靠用户显式下指令,但自然对话里该怎么说本应从上下文推断出来。现有系统要么让用户逐句指定,要么把 ASR、LLM、TTS 串成级联——参数动辄 30B 以上,而且级联转换会把原始语音里的副语言信息(非语言发声、节奏、情绪强度)丢掉。 本文贡献:把「上下文感知推理式 TTS」定义成新任务:给定历史对话音频、目标文本和参考语音,先理解上下文,再显式推理出一段中间 CoT,最后按指定音色合成目标语音,且这段 CoT 可被检查与编辑。配套建了大规模双语对话语音数据集(900 万训练样本,含 100 万高质量子集)和 800 条人工核验、源不重叠的评测基准,并给出 0.6B / 1.7B 端到端自回归模型,直接产出带情绪标注的转写、可编辑风格推理和语音 token。 Overview of the end-to-end CoT-guided autoregressive model. 实验效果:英文基准上 COT-TTS-0.6B 拿到 Human MOS 4.150 全表第一(级联 3.050–3.500),情绪一致性 0.954 第一,时长误差 1.155 秒远优于级联的 5.1–12.5 秒;中文基准上 0.6B Human MOS 4.200 同样第一。可编辑 CoT 变体在中文上拿到最高的 LLM 综合分 3.461 与历史理解 4.079。参数量只有级联系统(34–39B)的几十分之一。 Distributions of the normalized audio quality score, naturalness score, target-audio effective-speech ratio, and emotional expression intensity over 50K randomly sampled examples. 批判点评:「参数少几十倍、效果相当」要看是哪一列:UTMOSv2 2.943 低于 two-a3b-fish 的 3.138,DNSMOSPro 3.180 明显不及 two-qwen3omni-seedvc 的 4.240,WER 0.041 也高于 three-dia-a3b-fish 的 0.012;LLM 评测的 CoT 逻辑 4.558 不及 4.836,综合分 2.304 不及 3.601。真正领先的是人类整体评分、情绪一致性和时长误差三项。更值得注意的是两个反常:0.6B 的人类评分(4.150 / 4.200)高于 1.7B(4.050 / 4.150),规模变大反而变差;开启可编辑 CoT 后推理分数上去了,英文 Human MOS 却从 4.150 掉到 3.500——论文把这解释为改动把分布推离训练域,等于承认「可编辑」目前要付音质代价。 8. Common Cause:灰度视频让音频翻车 62% Common Cause, Not Cross-Attention: Blocking Visual Shortcuts in Audio-Video Generation | RIKEN iTHEMS;RIKEN AIP;South China University of Technology;Columbia University | arXiv:2609.22361 关键词:音视频生成,因果推断,反事实不变性,视觉捷径,共享表征失效 ⚠️ 前序问题:音视频联合生成器的训练数据里,「看起来是什么」和「听起来是什么」高度相关——某种材质、纹理或物体外观总与某种声音同时出现。这种相关往往是虚假的:模型可以只从外观预测声音,完全不碰「是什么事件」这个因果变量。一旦测试时外观与事件的关联被打破,模型就会直接合成错误事件的声音。 本文贡献:这是一篇受控的因果研究而非又一个模型。先建音视结构因果模型,让音频在构造上独立于视频的干扰外观,再系统检验流行解法——直接 cross-attention、共享 latent、bottleneck、无监督 shared/private 分解、忠实共享先验,证明这些「走公共因」的做法全都抓不住要害,因为共享 latent 不是干预,模型照样拿得到外观代理变量。真正堵住捷径需要对干扰变量做干预:在 SCM 与干预假设下,论文证明反事实不变性是识别因果预测器的充要条件。 The counterfactual intervention do(v:=v') made concrete (Colored-MNIST). 实验效果:在特征向量 SCM、程序化像素视频、真实图像配频谱音频、移动真实数字、条件生成器五个场景验证。反事实惩罚随因果线索变强从 263× 平滑坍缩到 2.7×,说明捷径只在因果线索难读时才被采用;Moving-MNIST 上直接模型 OOD 准确率 0.21 而本文方法 0.995。对真实预训练视频转音频模型 MMAudio 做输入干预:灰度化让 top-1 声音类别翻转 62%、色彩旋转 54%,最小编辑只翻 22%。 The failure, made audible. 批判点评:最尖锐的一段是「修不好」:作者用重着色一致性项把 MMAudio 的速度网络微调 1500 步,色彩旋转翻转率基本没动(62.5% → 63.9%),真正下降的是通用 OOD 敏感度(高斯噪声 83.3% → 70.8%)——这次微调买到的是整体更鲁棒,而不是论文想修的外观捷径,恰好反证诊断与修复之间还有距离。另外结论高度依赖 SCM 与干预假设成立,真实数据上的干预只能做「改写外观」这类近似;MMAudio 实验只有 24 条真实视频、其中 18 条用于微调,样本量偏小。 9. RewardVerse:先写准则再打分 PLCC 0.52 RewardVerse: Rubric-Guided Policy Optimization for Video Reward Modeling | Institute of Automation, Chinese Academy of Sciences;University of Chinese Academy of Sciences;The Hong Kong University of Science and Technology;Tencent | arXiv:2609.22947 关键词:视频奖励模型,评分准则中介,标量漂移,RGPO,强化学习奖励 ⚠️ 前序问题:用强化学习优化视频生成模型时,奖励模型是地基,但现有视频奖励模型直接把复杂主观质量映射成一个标量,没有显式评分准则,于是出现标量漂移:分数尺度在不同提示之间坍缩或整体平移,RL 拿这种奖励训练并不稳。 本文贡献:借鉴人工标注工程,在「评测请求」和「打分器」之间插入一个动态评分准则 rubric 作为中间表示:先显式生成评测标准,再按准则打分,给标量一个语义锚点。为训练这条协作流水线提出两阶段 RGPO:阶段一用自演化的种子 rubric 预热打分器(偏好奖励 + 格式奖励 + 校准损失),阶段二联合优化 rubric 生成器、产出随请求自适应的准则,同时持续把打分器对齐人类评分。 Overview of RewardVerse and its two-stage RGPO training. 实验效果:16 维 EvalVerse 基准上 Joint(Ours) 在 14 个维度取得最高 PLCC,宏平均 PLCC 0.520、SRCC 0.493 均为第一(次优 Q-Scorer 0.467 / 0.354);Logic 维度 PLCC 0.750 对次优 0.593,Action 0.566 对 0.390。漂移诊断上 RGPO 把均值偏差从 +0.610 降到 +0.164,PLCC/SRCC 从 0.240/0.222 提到 0.505/0.458,预测标准差从 0.457 扩到 1.332,被压缩的分数区间被重新拉开。换到闭源 Gemini-3.1-Pro 上,加 rubric 仍让 PLCC 从 0.490 提到 0.593。 Score distributions of six reward models on the shared 10-dimensional test subset. 批判点评:「14/16 维最高」是真的,但剩下两维恰好是最容易被低层画质解释的:Temporal 那列 Ours 0.538 不及 VideoScore2 的 0.697,SRCC 侧也有两列被 Q-Scorer 与 Raw-rubric 超过。也就是说在偏感知质量而非认知/时序的维度上,rubric 中介的优势会收窄——论文自己也点出 Q-Scorer 在光照、逻辑这类与低层画质相关的维度上仍有竞争力。Gemini 实验只对比了有/无 rubric 两个变体,且受限于 API 只能读自然语言浮点输出,无法与开源模型在同一训练协议下横比。此外 rubric 由模型自生成,其质量评估仍依赖同一套 VLM 裁判,存在自证循环的风险。 10. IMPLICIT-Bench:5493 条中性提示词测隐式偏见 IMPLICIT-Bench: Measuring Implicit Bias in Text-to-Image Models under Neutral Prompts | The University of Melbourne | arXiv:2609.24228 关键词:文生图偏见评测,隐式偏见,知识图谱三元组,中性提示,去偏见权衡 ⚠️ 前序问题:文生图模型的偏见评测大多用「一张 [职业] 的照片」这类槽位模板,只能孤立地探显性人口属性(性别、肤色)。它漏掉了更隐蔽的一类:在自然提示里,当与刻板印象相关的属性没有被指定时,模型仍然默认输出刻板结果——这种隐式偏见现有评测基本看不见。 本文贡献:用结构化知识图谱构造受控提示三元组:中性、刻板、反刻板三个变体只在单一偏见维度上不同,其余场景语义保持一致,从而能把偏见效应精确归因到模板类基准做不到的粒度。最终发布 5,493 条提示、覆盖 11 个偏见类别,并用多模型一致性、CLIP 验证和人工评测三重校验。基于它评测现有去偏见方法,揭示出偏见降低与语义保真之间的基本权衡。 Four-stage KG-grounded benchmark pipeline. 实验效果:过滤后保留的中性图显著偏向刻板端:VLM 均值从 1.75 升到 3.40(Qwen3-VL)、1.26 升到 2.65(Gemma-4),未参与筛选的 CLIP 验证器同向移动。最终基准上 CLIP 判定 67.7% 的 Δx 为正(Cohen's d = +0.39),Qwen3-VL 71.6%(d = +0.85),三个裁判在 Δx 层面正相关(Pearson r = 0.22–0.44)。12 名人工评审在 100 个样例上复现了同样排序:刻板 3.78 > 中性 3.17 > 反刻板 1.60,75.9% 的 KG 被认为确实反映社会刻板印象。 Cross-model qualitative comparison, set 1. 批判点评:三个裁判的一致性是这个方法最脆弱的一环:Gemma-4 的倾向比例只有 48.7%,几乎等于抛硬币,d 也只有 +0.29,与 CLIP 的 67.7%、Qwen3-VL 的 71.6% 不在一个量级;裁判间 Pearson r 仅 0.22–0.44,CLIP 与两个构建裁判的逐图相关性也只有 0.42 / 0.55。人工侧同样不完美:VLM 相对人类均值的 MAE 接近 0.97–0.99,且 12%–16% 的样例把刻板与反刻板的方向判反。样本分布也不均衡——physical-appearance 类只有 14 条,人工研究里 sexual-orientation 一行只落在单个样例上。作者自列的局限同样实在:KG schema 单轴、源数据带 WEIRD 偏斜、去偏见实验只在 Qwen-Image 上做过。 趋势观察 世界模型这一轮在比「记得住」,不是在比「画得好」 WorldCrafter 让目标相机位姿去决定历史怎么压成固定数量的 token,GAE 则干脆把几何基座的特征重参数化成生成用的隐空间。两者承认的是同一件事:分钟级的一致性不是把模型做大就能换来的,而是取决于历史和几何以什么形式存在。有意思的是 WorldCrafter 的加速版在重访一致性上反超了标准版,说明步数与一致性之间未必是正相关。 像素扩散与 latent 扩散的差距,正被「表征」而不是「架构」填平 PixelDiT2 不引入自编码器,而是让一个冻结的视觉编码器在整个去噪过程里持续提供 per-patch 表征,把表征学习和像素生成拆成两件事。不过两张主表横着读会发现,1.46 是像素侧最好、却仍不及 latent 侧 RAE-XL 的 1.13,IS 也不及 REPA-XL 的 306.3——差距在缩小,但没有消失。 加速方案的瓶颈已经从「算力」挪到了「监督」 SparkDiffusion 指出高稀疏下逐步损失在降、终态质量却不涨,根因是监督没有对齐终态;SVEET 则指出双向改流式的瓶颈不在算力而在两个优化方向互相干扰,于是显式约束它们正交。两者都不是靠新算子取胜,而是重新安排了训练时究竟该优化什么。 评测类工作开始把「裁判本身」当成被审对象 IMPLICIT-Bench 的三个裁判一致性只有 Pearson r = 0.22–0.44,其中一个几乎等于抛硬币;RewardVerse 则发现外部打分器在认知类维度上可以是负相关(VideoScore-v1.1 在 Logic 上 PLCC −0.245)。当奖励模型和偏见裁判都开始被自己的盲区反噬,评测可信度就成了需要单独论证的事,而不是默认前提。 人工智能炼丹君 整理 | 2026-09-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-22|阶跃星辰全双工98.9登顶,清华W4A4逼近FP16 今日 AIGC 论文速览 今日共 10 篇 · 语音与音频生成 2 篇 · 视频生成与物理一致 2 篇 · 图像编辑与三维生成 2 篇 · 生成理解一体化 2 篇 · 推理加速与评测 2 篇 重点论文标题列表 StepAudio 3(StepFun-Audio Team):全双工语音模型98.9分登顶 OmniVChat(CUHK):全模态对话视频2800题 ⚡ CompAdapt(HIT):物理视频生成PIS 0.862 KaiNinja(Alaya Lab):3D部件生成免分割器 4DGS-Fixer(Goertek Alpha Labs):稀疏四视角重建4D高斯 今日论文速览 1. StepAudio 3:全双工语音模型98.9分登顶 StepAudio 3 Realtime Technical Report | StepFun-Audio Team | arXiv:2609.14005 关键词:实时语音交互,全双工对话,边想边说,音频语言模型,MTP解码 ⚠️ 前序问题:实时语音交互要同时满足三件互相拉扯的事:听懂语音里丰富的声学线索(意图、情绪、环境),在对方还没说完时就能自然接话(停顿、附和、打断),以及先做足够深的推理再开口。传统做法要么把推理挪到对话之外、延迟跟着涨,要么为了低延迟直接砍掉推理深度——「想得深」和「答得快」长期被当成一对不可兼得的取舍。 本文贡献:StepAudio 3 Realtime 把整套系统组织成一个连续的「听—对话—思考—行动」循环。三个关键部件:Deep Perception 从原始音频里抽取丰富的声学线索来理解意图;Seamless Duplex 对同步的用户/模型双路音频流建模,处理停顿、附和与打断;核心创新是 Think-While-Speaking——让私有推理与语音输出并行执行,并用 Medusa 式的 MTP 解码加速思考,从而把「想」这一步塞进「说」的同一段时间窗里。训练侧配了一个 Adaptive Thinking 路由,先判断当前这一轮是否需要显式推理,若不需要就走 direct route、留一个空的 think block,避免为简单对话付出推理成本。此外集成了Voice Agent,在对话流不中断的前提下异步执行工具调用,把工具返回结果再融回对话。 实验效果:按官方技术报告的自测:推理模式下 StepAudioChat 宏平均 73.0,达到专用推理模型的水平;MMSU 90.6;Artificial Analysis Full-Duplex Bench Overall 98.9;τ-Voice 宏任务成功率 56.0%。同表里 ASR 侧 StepAudio 3 ASR Max 在 LibriSpeech clean 1.18、WenetSpeech meeting 4.35、AISHELL-1 0.49,三项均为全表最低错误率;音频理解侧 MMAR 86.5、AudioMultiChallenge 49.3;通用能力侧 HMMT 86.8、GPQA Diamond 83.0、MultiChallenge 59.7。 批判点评:优势几乎全部集中在「实时语音交互」这一列:Full-Duplex Bench 98.9 领先 Doubao 2.0 Lite 的95.3 与同表 Gemini 系列的 95.1~98.4,ASR 三项也确实拿到最低错误率。但同一张表暴露了明确的短板——AudioMultiChallenge 49.3,比同表最好成绩 67.0 落后近 18 分;GPQA Diamond 83.0 低于同表最高的 90.3;MultiChallenge 59.7 也落后最好成绩 68.1。τ-Voice 上 56.0 与 Doubao 2.0 Lite 的 56.5 基本持平甚至略低,说明「边想边说」这套机制在需要长链条决策的智能体任务上还没转化成稳定优势。此外全部数字均为团队自评、无第三方复现,报告也没有给出 Think-While-Speaking 与串行思考在同等算力预算下的严格对照——增益里究竟有多少来自 MTP 解码加速、多少来自推理与发声的并行重叠,需要拆开才能判断架构本身的净贡献。 2. OmniVChat:全模态对话视频2800题 OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue | The Chinese University of Hong Kong;Alibaba Token Hub;Shanghai Jiao Tong University;Shanghai Innovation Institute;Zhejiang University | arXiv:2609.21465 关键词:音视频对话,全模态模型,合成数据,强化学习奖励,基准评测 ⚠️ 前序问题:让全模态模型像人一样「看着你、听你说话就直接回应」,而不是先把语音转成文字、把视频转成描述再喂给语言模型。直接吃音视频能省掉转写带来的外部延迟与算力,也保住了表情、环境、手边物品这类感知线索。但这条路有两个卡点:一是人们用自己设备录的真实对话数据极其稀缺;二是同一个意图有无数种说法,好的回答往往要结合用户所处的环境与表情,用关键词匹配根本判不出回答质量。 本文贡献:论文把这条路线正式命名为 OmniVChat,并配齐了数据、评测、训练三件套。数据侧 OmniVChat-Studio 是一个多智能体合成引擎,用智能体协作加视频生成造出单轮与多轮的音视频对话;评测侧 OmniVChat-Bench 覆盖 5 大能力类、17 个子类、22 个场景域共 2800 条合成实例,另有人工实录的 OmniVChat-Bench-Human(360 条)作为真实分布对照;训练侧 OmniVChat-RL 给出一套把回答正确性、效率与风格联合起来的 rubric 奖励设计,直接在合成对话上训练 Qwen3-Omni-Instruct,验证奖励设计能否迁移到真实录制的对话上。 实验效果:RL 训练满 1000 步(记录 51 个 checkpoint)后,OmniVChat-Bench 与人工录制的 OmniVChat-Bench-Human 命中率同步上涨,且合成集与实录集的曲线走势一致,论文还逐条给出了 16 个子类的学习曲线,说明在合成数据上得到的增益确实能迁移到真实对话。对比表里 Qwen3-Omni-Instruct 基线的综合命中率 0.186,训练后与 Qwen3.5-Omni-Plus 的 0.361、Doubao Seed 2.0 Lite 的 0.330 进入同一档。 批判点评:最值得警惕的是奖励设计里的「效率」项。训练曲线显示 Reply Efficiency(每千词的 rubric 命中数)从约 5 涨到 20 的同时,平均回复长度从接近 100 词一路掉到 35 词左右——效率提升有相当一部分来自「少说几句」而不是「说得更准」,在固定 rubric 打分下这几乎必然发生,机制上和同期的 reference-free 语音指标那篇讲的 reward hacking 完全一致。第二,OmniVChat-Bench 全部是合成实例,而实录集只有 360 条,并且只覆盖十二个单轮子类中的一部分,所以「迁移到真实对话」的证据强度受限于实录集规模——论文自己也在多个子类上标注 Bench Only,意味着这些能力在真实录制条件下根本没有对照数据。第三,用合成对话同时做训练和评测,存在评测集与训练分布同源的风险,跨数据集的零样本能力没有被检验。 3. CompAdapt:物理视频生成PIS 0.862 CompAdapt: Adaptable Composite Motion Modeling for Physics-Consistent Text-to-Video Generation | Harbin Institute of Technology;Alibaba Taobao | arXiv:2609.21455 关键词:文生视频,物理一致性,复合运动建模,神经动力学,一次性适配 ⚠️ 前序问题:扩散式文生视频能出画质、也能出时序连贯,但常常违反基本物理:物体不受重力、碰撞后穿模、运动类型中途乱切。已有的物理约束方法大多只会处理单一运动类型,还要人工指定物理参数,换一个没见过的物理环境就失灵。问题在于真实场景里的运动几乎都是复合的——耦合、多阶段转换、多物体碰撞,单一类型的动力学先验覆盖不了。 本文贡献:CompAdapt 把神经动力学建模从单一运动类型扩展到复合物理行为。架构上有两个关键模块:Motion Type Composite(MTC)在潜空间里把多个运动类型按时间关系做算子级复合,Multi-Object Interaction(MOT)在检测到物体接触时切到显式的交互动力学。自然语言提示被解析成结构化的物理语义——运动类型、时序关系、初始物理参数——实现端到端指定,不再需要人工调参。跨新物理环境靠 dynamics-aware prior matching 做一次性适配,不必重训核心动力学模块;另有 physics-aware 潜特征融合模块负责高速与复杂运动下的画面保真。 实验效果:消融实验:去掉 MTC 后 PIS 掉到 0.615,去掉时序建模掉到 0.589,去掉双 LLM 语义解析掉到 0.724,完整版 0.862;FID 15.0 / FVD 91.4 / PSNR 17.2 / SSIM 0.61,相比 Wan-Move(16.3 / 93.5 / 16.5 / 0.58)与 Go-with-the-Flow(17.5 / 96.7 / 14.9 / 0.56)在四项上均有改善,生成开销 2.9 与 Wan-Move 持平。定性部分把 NewtonGen、PhysT2V、Wan2.2、CogVideoX-5B、Veo3、Sora 全部拉到同一组提示下逐帧对照,覆盖抛体旋转、阻尼振荡、均匀加速、形变碰撞等组合运动。 批判点评:三处需要打折。第一,主指标 PIS(物理一致性分数)由论文自行定义,没有第三方榜单或社区复现支撑,而它在消融中的跨度(0.589 → 0.862)恰恰是全文最大的增益来源,指标自证的风险较高。第二,所谓「复合运动」实际只覆盖 9 类情形,其中真正涉及物体接触的弹性碰撞仅 2 类,多物体场景仍是最薄的一环,所谓 multi-object collisions 的证据量偏小。第三,「一次性适配」并不等于「免数据」——流程本身仍需要目标环境的一段观测视频(one-shot reference)才能完成 prior matching,因此把它当作通用物理先验来用还有前置成本。论文 comments 自注为 NeurIPS 2026 投稿(23 页、4 图),尚未经同行评审。 4. KaiNinja:3D部件生成免分割器 KaiNinja: Extending Native 3D Generators to the Part Level | Alaya Lab;The University of Tokyo;UC Merced;Institute of Science Tokyo | arXiv:2609.15659 关键词:三维生成,部件级建模,双体积表示,稀疏体素,免分割 ⚠️ 前序问题:TRELLIS.2 这类原生 3D 生成器能把一张图变成高保真、带材质、非水密的网格,但输出是一个融合好的整体;而下游的编辑、绑定骨骼、物理仿真全都按部件操作。最直接的办法是在融合网格上再跑一个 3D 分割网络,可这样既慢、又被分割精度卡死。真正的技术障碍更基础:O-Voxel 网格每个体素只存一片表面,所以单个 volume 在任何分辨率下都无法表示两个部件贴合的那层界面。 本文贡献:论文提出双体积(dual-volume)表示来补上缺失的界面——同一位置存两套体积,让贴合面两侧各自有归属。KaiNinja 建立在 TRELLIS.2 的 O-Voxel 之上,分两阶段生成:Stage 1 的 Layout Flow 把 3D 噪声网格去噪成逐 volume 的 occupancy 布局,两条流各自有自注意力、再用零初始化的全局注意力块跨流通信;Stage 2 的 SLat Flow 复用 TRELLIS.2 权重,只在活跃体素上对稀疏噪声去噪,最后由 FVAE 解码成 O-Voxel 体积并装配成部件分离的网格。整条流水线里没有掩码、也没有分割器。训练数据来源混杂,包含 CAD 模型和由 LLM 驱动的智能体创作的资产,作者称这是首个用智能体创作的部件数据训练的 3D 生成模型。 实验效果:相对不同范式的部件生成流水线,整体 Chamfer distance 降低 40%、严格部件 F-score 提升 16%;在held-out 测试集与训练未出现过的源上,KaiNinja 产出的部件数量都最接近真值,而 TRELLIS.2+X-Part、Hunyuan3D-2.1+X-Part、OmniPart、PartPacker 这几个基线常常把部件融在一起或者碎开。作者还报告一个反直觉现象:同样的骨干、同样的数据,加上部件级监督之后整体几何保真度反而也提升了。 批判点评:「免分割器」是这篇最硬的卖点,而它恰好没有回答分割器方案真正的软肋——精度上限。论文比的是部件数量、Chamfer 距离与 F-score,没有给出「部件语义是否对得上真值」的证据:在训练未出现的源上,KaiNinja 的部件着色与真值明显对不齐(椅子、花瓶、水壶几行都能看出切分位置与真值不同),也就是说「切得开」和「切得对」之间仍有距离,而语义正确性恰恰是分割器方案此前唯一能保证的东西。其次,40% / 16% 相对的是各基线外挂 X-Part 分割器后的组合结果,比的是「你的流水线 vs 别人的流水线」,而不是「dual-volume vs legacy O-Voxel」,无法分离表示本身的净贡献。第三,所谓「首个用智能体创作数据训练」目前只是自述,论文没有给出这类数据在训练集中的占比,也没有做数据来源的消融,因此这个卖点暂时无法验证。 5. 4DGS-Fixer:稀疏四视角重建4D高斯 4DGS-Fixer: Generative Sparse-View 4D Gaussian Splatting with Iterative Refinement Guided by Video Diffusion Priors | Goertek Alpha Labs;Singapore Institute of Technology;The Hong Kong University of Science and Technology | arXiv:2609.21176 关键词:4D高斯泼溅,稀疏视角,视频扩散先验,迭代精修,动态场景重建 ⚠️ 前序问题:用稀疏视角视频重建动态场景是典型的病态问题:观测太少、信息缺失,再多优化技巧也补不出来。更具体的症结在初始化——只有几个输入视角时,COLMAP 只能重建出稀疏残缺的点云,大片区域没有足够的高斯基元支撑,后续优化根本无从下手。也就是说问题出在起点,不在优化器。 本文贡献:论文给出一个两阶段的迭代精修框架。Stage 1 初始化:先对多路同步视频估计多视角深度图,把它们融合成稠密点云,为动态 4DGS 提供更完整的几何起点,替代 COLMAP 的稀疏点云。Stage 2 精修:沿新的相机轨迹渲染出视频,送进一个预训练的视频修复/恢复模型得到「修复后的伪目标视频」,再把它当作伪监督去迭代更新 4DGS 表示,多轮往复。整条链路的思路是用视频扩散先验补足缺失的观测信息,而不是继续在几何约束上加码。 实验效果:在常用的稀疏视角动态基准上,相对此前最好的方法 PSNR 提升接近 2 dB,作者称 substantially outperforms 现有基线。定性对比给出 GT / 4C4D / Ours 三行并排结果,4DGS-Fixer 在人物细节与背景完整度上都比 4C4D 明显更干净、更少孔洞。论文 comments 标注已接收至 SIGGRAPH Asia TC。 批判点评:整条链路的关键一步是「拿视频修复模型的输出当监督」,这带来一个绕不开的疑问:修复模型的幻觉会被原样写进 4DGS。用修复后的序列做伪监督,本质上是把生成先验的偏好当成真值——一旦输入视角极少、修复模型开始「编」,4DGS 就会忠实地记住这些编出来的内容;而 PSNR 的提升恰恰可能来自「补全得更像训练分布」而不是「更接近真实场景」。论文没有做「关掉修复模型、只保留深度稠密初始化」的对照,因此也说不清 2 dB 里有多少来自几何初始化、多少来自扩散先验。其次是部署成本:方法需要四路同步相机加一个预训练视频修复模型,实时性与泛化到非受控场景的能力都未讨论。源码层面还有个小瑕疵——LaTeX 里仍留着旧名「STGFixer pipeline」的残句没清理,说明从 STGFixer 改名到 4DGS-Fixer 之后并未完全同步。 6. RefineEdit:九类编辑背景保持最优 Refinement Is Inherently Editable: Training-Free Prompt-to-Prompt Image Editing with Generative Refinement Network | City University of Hong Kong (Dongguan);City University of Hong Kong;MBZUAI | arXiv:2609.20633 关键词:图像编辑,免训练,生成式精修网络,二值图像码,背景保持 ⚠️ 前序问题:文本引导的图像编辑要在「改对」和「别乱改」之间走钢丝。扩散类编辑器靠空间控制(掩码、注意力图)来圈定改动范围,而掩码一旦不准,结果不是改不彻底就是动到无关区域;因果自回归类编辑器还有一层额外约束——解码顺序固定,前面已经决定的 token 后面没法回头修正,早期的一个坏决策会被一路带下去。 本文贡献:论文换了一个编辑载体:不去控制扩散过程,而是在 Generative Refinement Network 的二值图像码上做全局精修。核心机制是双分支耦合——编辑分支从源轨迹的某个中间状态初始化,复用已经成形的布局;两个分支对同一批源采样 bit 分别给出概率,用它们的带符号差值挑出「该改的位置和 bit」。被选中的 bit 进入编辑精修,其余 bit 复制源分支持续演化的状态,于是「定位」与「生成」被绑在同一个精修过程里,编辑证据可以随图像演化不断被重新评估。为跨精修步稳定,论文加了两道约束:adaptive spatial freezing 抑制掩码无谓扩张,finite bit locking 让最近选中的 bit 保持可编辑。整套方案免训练、不需要外部掩码,也不需要注意力控制。 实验效果:在 PIE-Bench 的九类编辑任务上,RefineEdit 在 PSNR / LPIPS / MSE / SSIM 四项背景保持指标上全部最好,同时整图 CLIP 与被编辑区域 CLIP 也最高——「改得准」与「背景不崩」这次没有被做成取舍。定性部分与 LEDits++、FlowEdit、ChordEdit、MasaCtrl 在替换、添加、擦除、属性/姿态/颜色/材质/背景修改与风格迁移九类上逐一并排对比。 批判点评:最大的边界条件藏在实验设置里:这套流程要求源图来自 GRN 自己的生成轨迹——编辑分支要「继承源状态」,因此它编辑不了任意真实照片。论文在 limitation 里自己承认了这一点,但对普通用户而言,「只能改模型自己生成的图」和「能改我相册里的照片」是两个完全不同的产品。其次是超参:switch step(从第几步开始分叉)以及空间/bit 两个阈值都需要逐类调整,而且最优值是在同一个 PIE-Bench 评测集上选出来的,相当于用测试集选超参;论文的 limitation 也承认这些类别特定设置是在该基准上挑的,跨数据集泛化没有被验证。第三,九类各自用自己那一档配置,但真实用户不会先告诉系统「这次是换材质还是换背景」,多类混合的编辑场景仍未被覆盖。 7. QuAKE:W4A4 文生图量化误差校正 Quantization-Aware Kalman Estimation for Diffusion Sampling | Tsinghua University | arXiv:2609.21407 关键词:扩散模型量化,推理加速,W4A4,卡尔曼滤波,采样校正 ⚠️ 前序问题:量化是扩散模型落地的现实路径,但 W4A4 这种激进压缩会让量化去噪器的输出明显偏离全精度版本,而误差还会沿时间步持续传播、越积越大。已有的采样期校正方法基本只看当前步的局部信息,没有利用整条轨迹的历史——而误差恰恰是跨时间步传播的,用局部信息去修一个全局累积的问题,方向就不对。 本文贡献:论文把「用量化去噪器采样」重新表述成一个在线估计问题:既然真实的全精度输出拿不到,那就用历史量化输出去把它估回来。QuAKE 是为此设计的量化感知 Kalman 估计器,用一个平滑轨迹先验叠加一个条件高斯观测模型,每一步以闭式解递归更新「输出窗口」的后验,再把后验均值喂给采样器。它不改动量化网络、天然支持任意高阶多步 ODE 采样器,是一个即插即用的轻量校正器。论文同时给出了量化噪声的实证统计(边缘分布接近高斯、联合分布呈明显相关结构、条件分布可线性拟合),用来说明为什么 Kalman 这一套假设在这类噪声上站得住。 实验效果:在多个 W4A4 量化的文生图模型上,QuAKE 在「与全精度采样的分布差异」这一指标上持续领先:FLUX.1-dev + MJHQ-30K 上 FID 7.02 / KID 0.158,优于朴素量化的 7.30 / 0.257、TAC-Diffusion 的 7.31 / 0.304、Q-Drift 的 7.16 / 0.209;Sana-0.6B 上 7.90 / 0.289;PixArt-α 上 13.71 / 1.987;PixArt-Σ 上 15.99 / 3.401。开销按论文自己的测量几乎免费:FLUX.1-dev 单步延迟 22.2 ms(BF16)降到 6.2 ms(INT4 与 QuAKE 相同),DiT 体积 160 GiB 降到 102 / 104 GiB,端到端 23.51 s 降到 2.20 / 2.24 s。 批判点评:有一个容易被标题盖住的细节:QuAKE 赢的是分布距离(FID / KID),但在感知质量列上并不总是赢朴素量化。以 FLUX.1-dev + MJHQ-30K 为例,IR 分数 QuAKE 0.8822 低于 Quantized 的 0.8887,CLIP-IQA 0.9042 也低于 0.9057——也就是说 Kalman 校正主要抹平的是低层分布偏差,并没有让图在感知偏好上更讨喜;如果优化目标是下游打分模型或人眼偏好,朴素 INT4 甚至可能更安全。这不是论文的错,但摘要里「持续优于已有方法」的表述容易被读成全面胜出。其次,效率那一组三个数字(6.2 vs 6.2 ms、102 vs 104 GiB、2.20 vs 2.24 s)方向一致地说明校正本身几乎免费,反过来也说明它的收益完全来自「估得更准」而不是「跑得更快」——真正的加速来自量化,QuAKE 只负责把量化弄坏的部分补回来。最后,全部实验集中在文生图,视频扩散这类时间步更多、误差累积更长的场景是否同样成立,尚未给出证据。 8. AURA:对话式音乐编辑只训91M AURA: Unified Multimodal Framework for Conversational Music Editing | Aalto University;Technical University of Denmark;University of South Dakota;OpenRB Lab | arXiv:2609.14344 关键词:音乐编辑,多轮对话,多模态大模型,LoRA,概念token ⚠️ 前序问题:现有的指令式音乐编辑器是「一问一答」的:每条指令独立处理,用户想「先弱化鼓、再压一下高频、最后把情绪调柔和」这种逐步打磨的工作流根本走不通,因为模型记不住上一轮改了什么。此外,要改音乐光靠文字往往不够——用户脑子里想的是「这段场景听起来该是什么样」,而不是一串精确的音频术语。 本文贡献:AURA 把音乐编辑变成多轮对话。用一个多模态大模型读完整的对话历史、可选的一张图以及参考音频,把编辑意图蒸馏成一组紧凑的 concept token;再由 concept-to-audio(C2A)模块把这些 token 与逐帧对齐的参考特征注入冻结的 MusicGen 骨干——内部通过交叉注意力与 BiFAM 做对齐,让编辑既精确又不碰无关内容。训练只更新 91M 参数(LoRA rank-64 / α=128 加两个投影器与 C2A),1.9B 骨干全程冻结;对话数据由 Slakh2100 合成,共 66,539 段多轮对话。 实验效果:在域内 Slakh2100 与域外 MoisesDB 上同时评测:Add 任务的域外 FAD 0.84 对 Instruct-MG 的 3.84,Remove 任务域外 FAD 0.72 对 3.55,均为 4~5 倍降低;Remove 任务域内 SI-SDR +11.32 dB、SDRi +4.89,而 Instruct-MG 是 −2.10 / −8.53。消融显示对话历史确实起作用:只把最后一条指令喂给模型,Remove 的 SI-SDR 会掉到 −5.2 dB,SSIM 从 0.84 掉到 0.54。 批判点评:摘要里「域外 4~5 倍 FAD 降低」是有选择性的——它只覆盖 Add 与 Remove 两个任务;在 Extract 上 AURA 是 4.24 对 Instruct-MG 的 5.20,只有约 1.2 倍,并没有复现那个量级。更要紧的是 Extract 的SI-SDR 虽然比基线好得多(−7.62 对 −15.18),但仍是负值,说明「从混音里把目标音轨抽出来」这个任务本身离可用还有距离。其次,Remove 的域内增益(+11.32 dB)看着最亮眼,但该任务的域内评测集就来自训练数据来源域(Slakh2100 合成),换到域外 MoisesDB 只剩 +2.54 dB,跌幅接近 4 倍,真正的跨域能力比表格第一屏呈现的要弱。第三,91M 可训练参数对 1.9B 冻结骨干确实是漂亮的效率数字,但它同时意味着能力上限被 MusicGen-medium 这个骨干锁死,而论文没有给出换更大骨干的对照。 9. Qwen-Audio-3.0-TTS:四代语音模型瓶颈迁移史 The Evolving Bottleneck in Speech Generation: Interface Co-design and Staged Alignment from CosyVoice to Qwen-Audio-3.0-TTS | Alibaba Token Foundry | arXiv:2609.16514 关键词:语音合成,接口设计,瓶颈迁移,流匹配,阶段性对齐 ⚠️ 前序问题:语音合成的发展通常被叙述成「模型更大、tokenizer 更好、数据更多」,但这类叙事解释不了为什么某些改动立竿见影、某些就收效甚微。真正值得追问的是:每一代系统当下的主导瓶颈在哪里——是表征不够内容对齐?是接口不能因果流式?是覆盖度与可学习性不足?还是模型容量与跨模块协调出了问题? 本文贡献:这是一篇技术回顾(technical retrospective),沿 CosyVoice → CosyVoice 2 → CosyVoice 3 → Qwen-Audio-3.0-TTS 这条线给出另一种解释:进步来自瓶颈的反复迁移。四代之间不变的是一条分解——自回归语言模型负责「规划」,flow-matching 模型负责「渲染」;变的是两者之间的接口契约。作者把契约形式化成四个维度:representation(表征)、ownership(归属)、availability(可用性)、gradient reach(梯度可达性),并明确区分「单篇论文内的证据」与「跨论文比较」。每一代针对一个不同的约束:CosyVoice 立下监督式语义 token 这个内容对齐接口;CosyVoice 2 让接口对因果流式可用、把句级说话人嵌入从语言模型里移出;CosyVoice 3 靠多任务监督、数据与模型扩容、以及可微奖励优化(DiffRO)提升接口的可学习性与覆盖;Qwen-Audio-3.0-TTS 把帧率从 25 Hz 降到 12.5 Hz、渲染器改为条件在连续隐状态而非离散 token 嵌入上,并用五阶段课程做联合分阶段对齐。 实验效果:文中给出的实证来自各代公开系统:语义 token 的引入把中文 CER 从 2.56 降到 1.45、英文 WER 从 3.81 降到 2.57(CosyVoice 2 的模块消融);数据从约 17 万小时扩到 100 万小时、语言模型从 0.5B 扩到 1.5B(CosyVoice 3);Qwen-Audio-3.0-TTS 把帧率减半并保留 K=6561 的码本,五阶段课程依次为独立预训练、联合训练与质量退火、语言模型强化学习、声学鲁棒性、flow-matching 强化学习。 批判点评:这篇最需要标注边界的地方,作者自己写在 Figure 1 的图注里:「箭头编码的是我们的回顾性解释,而非受控的跨版本实验」。也就是说「瓶颈迁移」是一个事后叙事,不是被控制变量检验过的因果结论——拿它指导新系统设计时,风险在于你可能把相关性当成了因果。另一个更具体的问题是证据来源:文中复现的 tokenizer 对比(例如把帧率减半同时保持 K=6561 会一并损伤内容一致性与相似度)引自 Xiang et al. (2026),属于「论文内对比」的二次引用,不是独立复现;Table 1 也是同样的性质。因此这篇更适合当作一份结构清晰的领域地图来读——四维接口那套分析框架确实好用,也确实解释了「为什么改 tokenizer 有效、改渲染器无效」这类问题——但不宜当成可直接复制的工程配方。论文 comments 自注为 technical retrospective(11 页),本身也不以实验贡献为目标。 10. Ref-Free Metrics:13类语音指标在干净音频失效 The Limits of Reference-Free Speech Quality Metrics as Evaluators and Rewards on Modern Text-to-Speech | AGIGO;ETH Zurich;Sapienza University of Rome;University of Zurich | arXiv:2609.13150 关键词:语音质量指标,无参考评测,奖励攻击,成对偏好,评测协议 ⚠️ 前序问题:UTMOS、DNSMOS、SCOREQ 这类无参考质量预测器,今天既是 TTS 的默认自动评测器,又越来越常被拿去做偏好优化的奖励信号。这两个角色都建立在同一个假设上:预测分数能跟上人类偏好。但这个假设在什么条件下成立、什么时候会崩,此前没有被系统检验过。 本文贡献:论文把假设直接摆到台面上测。做法是构造一个成对判定任务——给两个音频片段,问预测器打分更高的那个是不是人更偏好的那个——然后在 6 个人工评分语料上跑,覆盖从「瑕疵明显」到「几近无瑕」的完整质量区间。评测对象包括 13 个无参考预测器家族(33 个分数变体)、13 个 Praat 韵律描述符,以及一批经典信号处理特征,每项都给出相对「随机基线」与「人类天花板」的位置。第二部分把这些指标当奖励用,对比单分数奖励与复合奖励在策略优化下的行为差异,并给出数据效率曲线。 实验效果:结论相当刺。在瑕疵明显的 BVCC 上,各指标准确率能爬到人类天花板附近(天花板 0.887,标定的复合分数到 0.92);但一旦两边音频都干净(TTS-HP),没有任何单个预测器能可靠指认被偏好的样本,好几个的准确率甚至低于「直接挑时长更长的那个」这个傻瓜基线(argmax clip duration 在 BVCC 0.517、SOMOS 0.368、SingMOS 0.456、SpeechJudge 0.370、TTS-Arena 0.523、TTS-HP 0.524),复合分数也才 0.52,而人类天花板是 0.764。奖励侧更严重:优化单一分数会诱发 reward hacking——指标冲上去了,但独立留出评测器和人工听测同时变差;复合奖励能抵抗这个倾向。数据效率曲线还给了个实用兜底:每类只取 min(20%, 1000) 条域内成对数据拟合一个带正则的线性头,就能把准确率相对最好的单指标提升 +1.5%(BVCC)到 +6.6%(SOMOS)。 批判点评:这篇的价值是给出一把尺子,而不是给出一个能用的指标——它自己也承认在干净音频上没有任何固定公式可迁移。要留意三点。第一,复合分数需要通过域内偏好标注拟合(论文用了 min(20%, 1000) 条域内成对数据),相对增益只有 +1.5% 到 +6.6%,也就是说「改用复合分数」这个建议的前提是你已经有该领域的偏好数据,对做通用 Reward Model 的人是不小的门槛。第二,它测的是成对偏好准确率,不是绝对 MOS 拟合度,「指标失效」的结论不能直接推成「MOS 预测不准」——在需要绝对分数的场景里结论需要重新验证。第三,时长基线之所以能赢,是因为评测语料里存在系统性的时长偏差,这提示「最好用的信号」可能来自数据偏置而非感知质量;反过来说,这也意味着任何在干净音频上得到的排行榜,都可能只是某个数据偏置的代理指标。 趋势观察 「边想边说」正在把推理的延迟藏起来 StepAudio 3 让私有推理与语音输出并行执行,用 Medusa 式 MTP 解码把思考压进说话的同一段时间窗;QuAKE 则把量化误差的校正重新表述成一个在线估计问题,用轨迹历史去猜全精度输出本该是什么。两者都在回答同一个问题:当「想清楚」和「立刻给」不能同时满足时,能不能把其中一件事塞进另一件事的时间窗里,而不是二选一。 物理一致性开始从「单类型」走向「复合行为」 CompAdapt 把神经动力学从单一运动类型扩到耦合运动、多阶段转换与多物体碰撞,并用一次性适配去应对没见过的物理律;4DGS-Fixer 干脆不追求几何自洽,改用视频扩散先验把缺失的观测补出来当伪监督。一个在约束上加码,一个在数据上放开,方向相反,但都承认了同一件事:稀疏观测下的物理,靠纯几何推不出来。 「部件」正在成为 3D 生成的新交付单位 KaiNinja 指出 O-Voxel 每个体素只存一片表面、单个 volume 在任何分辨率下都表示不了两个部件贴合的那层界面,于是用双体积表示把界面补上,全程不需要掩码或分割器。下游的编辑、绑骨与仿真要的正是部件而不是一整块表面。这提示 3D 生成的下一步未必是把表面做得更细,而是把语义切分做得更明确。 质量指标同时当评测和奖励,正在被自己的盲区反噬 语音侧,Ref-Free Metrics 那篇的 13 个无参考预测器在干净音频上集体失效,好几个甚至不如「挑最长的那个」,而优化单一分数会直接诱发 reward hacking;对话视频侧,OmniVChat 的效率项让平均回复长度从约 100 词掉到 35 词,效率上涨里混着「少说几句」。当同一个分数既当尺子又当奖励,它没测到的那部分就一定会被优化出来。 人工智能炼丹君 整理 | 2026-09-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注