


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:评测 | 难度:进阶 | 前置知识:无(本篇自洽,只需要你见过「协方差矩阵」和「余弦相似度」这两个词)
关键词:FID、Inception Score、CLIP Score、2-Wasserstein 距离、样本量偏差、指标失效
先给一个我自己跑出来的数字,它比任何论述都更能说明问题。
我从同一个分布里抽两组样本:真实组和生成组来自同一个人工构造的 2048 维多元高斯:协方差特征值按 $1/k$ 衰减,迹归一化为 2048。总体的高斯距离为 0,但两组有限样本的估计值不必为 0。每组 10000 个样本时,实测 FID = 71.20;每组加到 50000 个样本,实测 FID = 14.21。两组的总体分布相同,但具体抽样不同。这里改变样本量并重复抽样取平均;不是对真实 Inception 图像特征的测量。
这不是实现写错了,而是 FID 的固有性质:它是一个自带正偏差的估计量。偏差来自哪里?Inception-v3 的 pool3 特征是 2048 维,一个 2048×2048 的协方差矩阵有 $2048 \times 2049 / 2 \approx 2.10 \times 10^{6}$ 个自由参数,全靠有限样本去填。有限样本让均值与协方差发生波动,经非线性距离公式后产生估计偏差。同分布基线的期望非负,但不能把自由参数数量直接当作最低样本量。我做过分解(附录 fid_bias_lab.py 的 [A2] 段):在 $d=512$、$n=40000$ 时,把均值换成真值只能消掉 1.4% 的偏差,把协方差换成真值能消掉 98.6%——在这组谱和尺度下,偏差主要来自协方差估计。
这些数字展示了样本量可以显著改变同分布基线,但不能把 71 或 57 分推广为所有真实模型的偏差。特征整体乘 $c$,距离就乘 $c^2$;谱结构、参考集是否固定、两个分布的差异也会影响偏差。因此跨论文比较前必须核对特征器、数据集和样本量等协议。Chong 与 Forsyth 的研究 还说明偏差依赖生成器,同样的样本量并不能自动消除排序偏差。
第二个坑在另一头。FID 只比较分布,不比较单张图。例如,若只是把同一组图像与 prompt 重新错配,图像集合不变,FID 就完全不变;但把所有橘猫换成黑猫可能改变图像分布,不能保证 FID 不变。因此文生图评测常配合 CLIP 相似度或其他条件一致性指标——它不需要真实图片做参考(reference-free),能逐样本给分。但 CLIP Score 有自己的洞:它先给每个图文对打分,常见的数据集均值会丢失分布信息,好样本和坏样本可以互相平均掉。在合成共享空间里,可以构造汇总分数近似相同、逐样本分布却不同的两组输出。第 6.3 节列出四组例子;标准差比最大约 17.55 倍对应 $p=0.9$,并非 $p=0.3$ 那一行。分数一样,产品体验完全不同。
所以这篇要讲清楚的是三件事:FID 的闭式解是怎么推出来的、它的偏差有多大且怎么补救、以及 FID 和 CLIP Score 各自测的是哪一半。
三句话:
生成模型的评测有一个结构性困难:无条件生成或自由文生图评测通常没有逐图配对的真值。你拿不到「这张生成图对应的真值图」,因此 MSE、PSNR、SSIM 等有参考指标不能直接用于这种非配对比较——它们要求两张图逐像素对齐。
一个自然的替代是「只给生成图打分」,这就是 Inception Score(IS)的思路:把生成图送进 Inception-v3,看分类分布 $p(y \mid x)$ 是不是既尖锐又有多样性。但它有一个致命缺陷:它根本不看真实图片。记忆训练集也可能得到高 IS,因为 IS 不检查是否抄袭,也不比较目标数据分布。高 IS 还要求预测类别清晰且类别边缘分布有多样性,并非真实图片自动「满分」。FID 同样不直接检验记忆训练集。
FID 的出发点就是要补上这一半:把真实分布也纳入比较,比较两个分布之间的距离,而不是给单张图打分。
图像在 Inception 特征空间(2048 维)里的分布形状未知,而且在这个维度上你没法可靠地估计它的形状。FID 选择用一阶矩和二阶矩近似描述,估计质量仍依赖样本量。
那么问题变成:在只知道均值和协方差的条件下,应该假设什么分布?答案是高斯——它是给定前两阶矩时熵最大的分布,也就是「在已知信息下最不作额外假设」的那个选择。这个选择的物理含义是:FID 只承诺比较前两阶矩,不承诺比较形状。后面 3.5 节会看到,这个妥协是有代价的。
设 $X \sim \mathcal{N}(\mu_1, \Sigma_1)$、$Y \sim \mathcal{N}(\mu_2, \Sigma_2)$。2-Wasserstein 距离的平方定义为所有耦合(joint distribution)中传输代价的最小值:
$$W_2^2 = \min_{\text{coupling}} \mathbb{E} \big[ \| X - Y \|^2 \big]$$
先看任意一个耦合的代价是多少。设交叉协方差 $C = \mathrm{Cov}(X, Y)$,把 $\|X - Y\|^2$ 展开成三项并分别取期望:第一项 $\mathbb{E}\|X\|^2 = \|\mu_1\|^2 + \mathrm{Tr}(\Sigma_1)$(因为 $\mathrm{Tr}(\Sigma_1)$ 就是 $X$ 各维方差之和);第二项同理;第三项交叉项 $\mathbb{E}[X^\top Y] = \mu_1^\top \mu_2 + \mathrm{Tr}(C)$。三项合并,$\|\mu_1\|^2 + \|\mu_2\|^2 - 2\mu_1^\top\mu_2$ 正好凑成 $\|\mu_1 - \mu_2\|^2$,于是
$$\mathbb{E} \big[ \| X - Y \|^2 \big] = \| \mu_1 - \mu_2 \|^2 + \mathrm{Tr}(\Sigma_1) + \mathrm{Tr}(\Sigma_2) - 2\,\mathrm{Tr}(C)$$
前三项由边缘分布决定,动不了。所以要让传输代价最小,等价于让 $\mathrm{Tr}(C)$ 最大。约束是联合协方差矩阵必须半正定:
$$\begin{pmatrix} \Sigma_1 & C \\ C^\top & \Sigma_2 \end{pmatrix} \succeq 0$$
这个半正定约束下的迹最大化有闭式解(协方差补全问题的标准结果)。$\Sigma_1$ 可逆时最优解为
$$C^\star = \Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Sigma_1^{-1/2}$$
代回去,利用迹的循环性质把外面的 $\Sigma_1^{1/2}$ 和 $\Sigma_1^{-1/2}$ 抵消掉,得到
$$\mathrm{Tr}(C^\star) = \mathrm{Tr} \Big( \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Big) = \mathrm{Tr} \Big( \big( \Sigma_1 \Sigma_2 \big)^{1/2} \Big)$$
最后一个等号值得停一下,因为它是实现环节最容易写错的地方。$\Sigma_1 \Sigma_2$ 两个对称矩阵的乘积一般不是对称矩阵,不能直接交给对称特征值求解器。当 $\Sigma_1$ 正定时,$\Sigma_1 \Sigma_2$ 与 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 相似:
$$\Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big) \Sigma_1^{-1/2} = \Sigma_1 \Sigma_2$$
而后者 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 是对称半正定的(对任意 $v$ 有 $v^\top \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} v = (\Sigma_1^{1/2} v)^\top \Sigma_2 (\Sigma_1^{1/2} v) \ge 0$)。相似矩阵特征值相同,而主平方根与相似变换可交换,所以两者的平方根迹相等:
$$\mathrm{Tr} \big( (\Sigma_1 \Sigma_2)^{1/2} \big) = \sum_i \sqrt{\lambda_i}, \quad \lambda_i = \text{eig} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)$$
奇异协方差可由连续性取极限,实际计算仍使用半正定夹心矩阵而无需显式求逆。
把所有项拼起来,就是 FID 的完整定义:
$$\mathrm{FID} = \| \mu_{\text{real}} - \mu_{\text{gen}} \|^2 + \mathrm{Tr}(\Sigma_{\text{real}}) + \mathrm{Tr}(\Sigma_{\text{gen}}) - 2\,\mathrm{Tr} \Big( \big( \Sigma_{\text{real}} \Sigma_{\text{gen}} \big)^{1/2} \Big)$$
三项的物理含义分别是:均值项管「两组图的平均特征偏了多远」(对应内容/风格的整体偏移),两个迹项管「各自铺开得多宽」(对应多样性),交叉项管「两者铺开的形状有多重合」。注意如果两组分布只是整体缩放 $c$ 倍,那么 $\mu$ 变 $c$ 倍、$\Sigma$ 变 $c^2$ 倍,四项一起变 $c^2$ 倍——FID 不是尺度不变的,这一点后面会用到。
上面那个「最后一个等号」在实现里就是一道坎。看看三种写法差多少(附录 fid_core.py 的 [2][3] 段,随机生成的对称正定 $\Sigma_1, \Sigma_2$):
| $d$ | 对称化路线(正确) | eigh(Σ1Σ2)(错误) |
通用特征值参考 |
|---|---|---|---|
| 8 | 11.5957639872 | 10.8132126304 | 11.5957639872 |
| 32 | 41.7985007127 | 40.2403835447 | 41.7985007127 |
| 128 | 173.3801162800 | 165.4519506579 | 173.3801162800 |
本表里错误写法偏小,且绝对误差随所选维度增加;这不是任意矩阵都成立的单调律。原因很具体:np.linalg.eigh 是专供对称矩阵的求解器,它只读矩阵的上三角(或下三角)并假设输入对称。按 NumPy 官方文档,默认 UPLO="L" 只读下三角并按其镜像解释上三角,并不是计算 $(A+A^\top)/2$。它与半正定夹心矩阵不是一回事。
误差会原样传进 FID。同一对 128 维特征($n=4096$),正确路线算出 FID = 45.584468,错误路线算出 50.484178,差 +4.899711。这个量级足以让你以为模型退化了。
3.2 节的高斯假设现在来收账了。构造一个极端例子:
两者的均值都是 0,协方差都是 $I + m m^\top$。前两阶矩完全一样,所以 FID 的真值严格等于 0,不管两个模式离多远。
但人(或者一个简单的分类器)一眼就能看出区别。实测(附录 fid_bias_lab.py 的 [D] 段,$d=32$、$n=40000$;记 $a = \|m\|$,横轴是两个模式中心的间距 $2a$):
| 模式间距 $2a$ | FID(总体真值) | FID(经验估计) | 贝叶斯最优 AUC | 1-NN 双样本检验准确率 | 二次特征 ridge AUC |
|---|---|---|---|---|---|
| 2 | 1.42e-14 | 0.0156 | 0.5365 | 0.4956 | 0.5022 |
| 4 | 2.84e-14 | 0.0162 | 0.6601 | 0.5056 | 0.5003 |
| 8 | −2.84e-14 | 0.0163 | 0.8106 | 0.6204 | 0.4972 |
| 12 | 0.0 | 0.0165 | 0.8739 | 0.7010 | 0.4977 |
| 16 | 8.53e-14 | 0.0239 | 0.9033 | 0.7518 | 0.5042 |
FID 从头到尾是 0(那 0.015~0.024 是前面说的有限样本估计误差,不是信号),而贝叶斯最优判别器的 AUC 已经到了 0.9033,1-NN 双样本检验准确率到了 0.7518(0.5 表示完全无法区分)。两个模式明明越离越远,FID 一动不动。
更值得玩味的是最后两列:二次特征上的 ridge 分类器 AUC 也一直是 0.50。这不是巧合——这里的平方损失 ridge 在类平衡、矩匹配时缺少均值层面的监督信号。不能推广为所有二次判别器都只看前两阶矩:例如对 $x^2$ 设阈值也可以利用平方值分布的尾部差异。为了确认这一点我做了对照实验:固定模式间距,改成把 $Q$ 的协方差整体放大 $s$ 倍(破坏矩匹配),于是 FID 和二次 ridge AUC 一起抬头:
| 协方差放大倍数 $s$ | FID | 二次特征 ridge AUC |
|---|---|---|
| 1.0 | 8.53e-14 | 0.5021 |
| 1.05 | 0.0585 | 0.5022 |
| 1.2 | 0.8745 | 0.5198 |
| 1.5 | 4.8490 | 0.5972 |
| 2.0 | 16.4710 | 0.7806 |
本实验中,矩匹配使总体 FID 为零,二次特征 ridge 的测试 AUC 接近随机水平 0.5;改变协方差后两者均发生变化。 1-NN 那种基于局部密度的判别器则不吃这一套——它看的是密度本身的形状,不是矩。
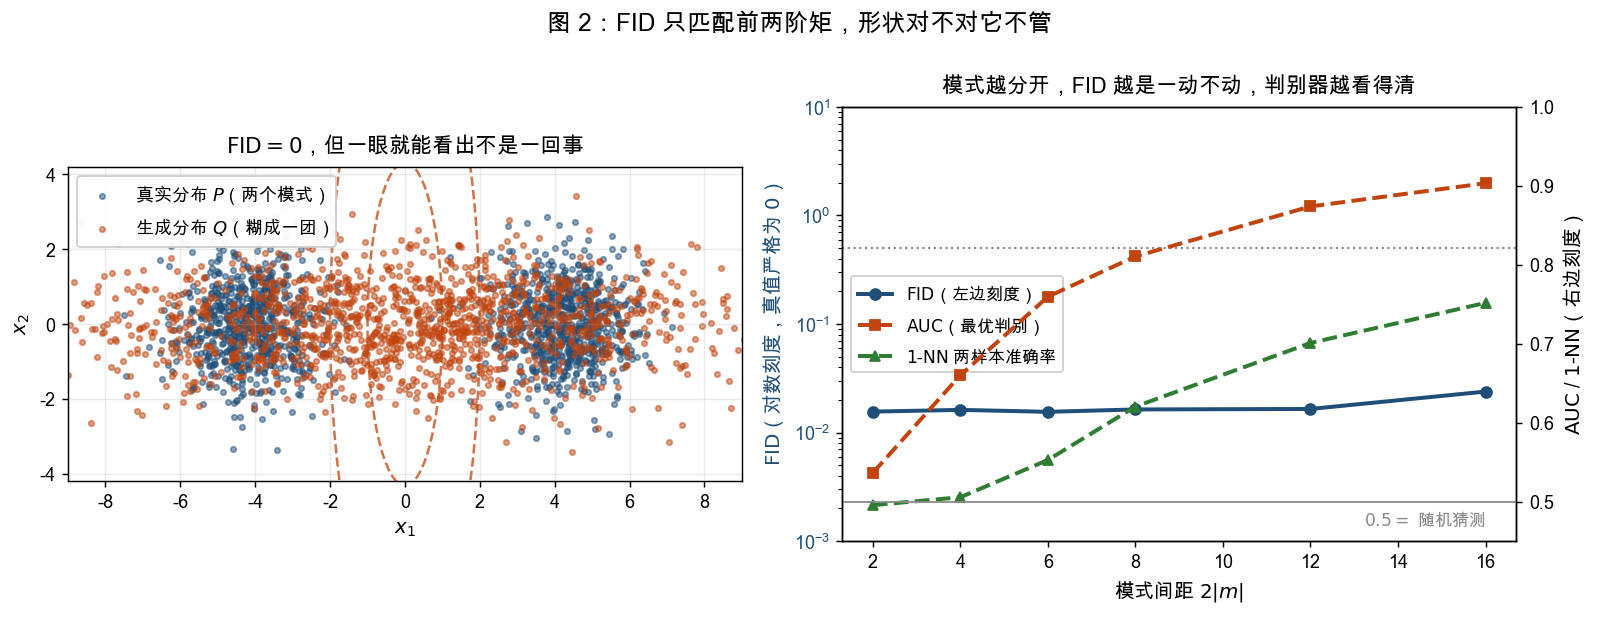
这张图要看什么:左图是 $P$(蓝)和 $Q$(橙)在二维上的真实散点,连同它们各自的 1σ/2σ 椭圆——注意两个椭圆几乎完全重合,这就是「前两阶矩完全一样」的几何含义:二阶统计量把两个分离的团和一个糊在一起的团画成了同一个椭圆。右图是同一个实验扫过模式间距的结果,蓝线(FID,左轴对数刻度)从头到尾贴在 $10^{-14}$ 量级纹丝不动,橙线(贝叶斯最优 AUC)和绿线(1-NN 准确率,右轴)一路爬到 0.90 / 0.75。两条线之间的那片空白,就是 FID 用高斯假设换来的盲区。
核心只有三件事:对称矩阵的平方根、$\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$ 的对称化路线、以及协方差怎么估。下面这段是 fid_core.py 的主干(完整版见附录)。
import numpy as np

def sqrtm_sym(C: np.ndarray, eps: float = 1e-6) -> np.ndarray:
    r"""对称半正定矩阵的平方根。

    对 C = V diag(w) V^T,有 C^{1/2} = V diag(sqrt(w)) V^T。
    eps 是相对谱尺度的负特征值容差,不是给正特征值设置下限。
    明显非半正定输入报错;容差内负值截到 0,保留真正的零特征值。
    """
    C = np.asarray(C, dtype=np.float64)
    if C.ndim != 2 or C.shape[0] != C.shape[1] or not np.isfinite(C).all():
        raise ValueError("C must be a finite square matrix")
    scale = max(np.linalg.norm(C, ord=np.inf), np.finfo(float).tiny)
    if not np.allclose(C, C.T, rtol=0.0, atol=eps * scale):
        raise ValueError("C must be symmetric")
    w, V = np.linalg.eigh((C + C.T) / 2)
    if w.min() < -eps * max(np.abs(w).max(), np.finfo(float).tiny):
        raise ValueError("C must be positive semidefinite")
    w = np.sqrt(np.clip(w, 0.0, None))
    return (V * w) @ V.T

def trace_sqrt_product(sigma1: np.ndarray, sigma2: np.ndarray,
                       eps: float = 1e-6) -> float:
    r"""计算 Tr((Σ1 Σ2)^{1/2}),走对称化路线。

    Σ1 正定时,Σ1 Σ2 与 Σ1^{1/2} Σ2 Σ1^{1/2} 相似:
        Σ1^{1/2} (Σ1^{1/2} Σ2 Σ1^{1/2}) Σ1^{-1/2} = Σ1 Σ2
    二者特征值相同,而后者是**对称半正定**的,可以安全用 eigh。
    主平方根与相似变换可交换,所以迹也相同:
        Tr((Σ1 Σ2)^{1/2}) = Σ_i sqrt(λ_i)
    """
    s1 = sqrtm_sym(sigma1, eps)
    M = s1 @ sigma2 @ s1
    M = 0.5 * (M + M.T)               # 强制对称,压掉浮点不对称
    w = np.linalg.eigvalsh(M)
    return float(np.sqrt(np.clip(w, 0.0, None)).sum())
这里先展示平方根与交叉项;完整均值、协方差与距离实现见附录。
四个符号和 3.3 节的推导一一对应:mu1/mu2 是 $\mu_1/\mu_2$,sigma1/sigma2 是 $\Sigma_1/\Sigma_2$,trace_sqrt_product 就是 $\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$,eps 是判定负特征值是否属于舍入误差的相对容差,不是把所有小特征值抬高的正则项。
跑 python fid_core.py 的自检输出(这些数字全部是实跑结果):
[1] 恒等性:FID(P, P) 必须为 0
    FID(P,P) = -4.263e-14

[2] 对称化路线 vs 错误写法 vs 一般特征值参考实现
         d          sym(正确)        naive(错误)      eigvals(参考)
         8    11.5957639872    10.8132126304    11.5957639872
        32    41.7985007127    40.2403835447    41.7985007127
       128   173.3801162800   165.4519506579   173.3801162800

[3] 这个差异会传进 FID:同一对特征,两种写法差多少
    FID(sym)   = 45.584468
    FID(naive) = 50.484178   (差值 +4.899711)

[4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍
    c=0.5  FID=   11.396117  期望 c^2*base=   11.396117
    c=2.0  FID=  182.337871  期望 c^2*base=  182.337871
    c=4.0  FID=  729.351482  期望 c^2*base=  729.351482

[5] 有偏 vs 无偏协方差(n 越小差得越多)
          n      unbiased        biased           差值
        256     43.932626     43.765931    -0.166696
       1024     10.959338     10.948996    -0.010341
       8192      1.518005      1.517825    -0.000180
逐条对一下这几个数为什么要看:
0.0、极小正值和极小负值都可能正确。明显超出容差才需要排查。附录还验证奇异、小尺度协方差与非 PSD 输入。生产里大家用的是 mseitzer/pytorch-fid(截至 2026-10 的实现为准),核心函数在 src/pytorch_fid/fid_score.py#calculate_frechet_distance。和上面的最小实现有五处差异,每一处都有原因:
1. 矩阵平方根用的是 scipy 而不是 eigh。 官方写的是
covmean, _ = linalg.sqrtm(sigma1.dot(sigma2), disp=False)
if not np.isfinite(covmean).all():
    offset = np.eye(sigma1.shape[0]) * eps
    covmean = linalg.sqrtm((sigma1 + offset).dot(sigma2 + offset))
if np.iscomplexobj(covmean):
    if not np.allclose(np.diagonal(covmean).imag, 0, atol=1e-3):
        raise ValueError("Imaginary component {}".format(np.max(np.abs(covmean.imag))))
    covmean = covmean.real
scipy.linalg.sqrtm 是通用矩阵的主平方根求解器,不假设输入对称,所以直接喂 $\Sigma_1\Sigma_2$ 是对的——这跟我的对称化路线在数学上等价,只是浮点路径不同。代价是结果可能带极小的虚部(数值误差),所以有了那段 .real 兜底:先看对角线虚部是不是都在 $10^{-3}$ 以内,超了就报错而不是默默取实部。我的最小实现用 eigvalsh 绕开了复数问题,代价是必须自己先把矩阵对称化。真正的坑是有人为了去掉 scipy 依赖把它换成 np.linalg.eigh——那就是 3.4 节那个 +4.9 的错误。
2. 数值容差与正则化不同。 本文只截掉容差内的负特征值并保留零值,以便奇异或小尺度协方差仍满足恒等性;不能无条件把所有特征值抬到 eps。pytorch-fid 在 sqrtm 失败时给协方差加 eps*I 重试,这是改变问题的正则化兜底,应记录是否触发。
3. 协方差用 np.cov(act, rowvar=False),默认无偏。 也就是 04 节 [5] 那张表的第一列。这一点在 $n$ 小的时候会造成跨实现的系统差异。
4. 特征提取有一整套约定。 src/pytorch_fid/inception.py 里的 InceptionV3 取的是第 3 个 block(最终平均池化之后)的 2048 维;resize_input=True 会先把输入双线性缩放到 299×299;use_fid_inception=True 用的是与 TensorFlow 版对齐的 FID 专用权重,而不是 torchvision 默认的 ImageNet 权重。命令行还有 --dims,可以选 64 / 192 / 768 / 2048——换了 dims 就是换了另一个指标,数字不可比,这是跨论文比较时最常被忽略的一项。
5. 保留数值诊断。 该实现返回原始结果,不自动截零。生产实现也可以先验证误差在容差内再截零,但不能不加检查地掩盖大负值;正好为 0 并不说明出错。
还有一个官方不管、但你必须自己管的事:预处理的一致性。Parmar 等人在 arXiv:2104.11222 里指出,resize 是否抗锯齿、图片是否被 JPEG 量化,都会显著改变 FID 的数值——大到足以改变两篇论文的排序。所以在比对任何两个 FID 之前,先确认两边的 Inception 权重、dims、resize 方式、量化流程、样本量、协方差是否有偏,这六项是不是一致。六项里任何一项对不上,两个 FID 就不是同一个东西。
把 01 节那个实验做全(附录 fid_bias_lab.py 的 [A] 段,$P$ 和 $Q$ 是同一个分布,所以真值是 0):
| 每组样本量 $n$ | FID($d=512$) | FID($d=2048$) |
|---|---|---|
| 50 | 431.54 | 2131.57 |
| 1000 | 53.85 | 640.65 |
| 10000 | 5.39 | 71.20 |
| 50000 | 1.09 | 14.21 |
两个观察:
| $d$ | 64 | 128 | 256 | 512 | 1024 | 2048 |
|---|---|---|---|---|---|---|
| FID($P$,$P$) | 0.1326 | 0.4517 | 1.5584 | 5.3967 | 19.5333 | 71.1371 |
这里约 $d^{1.8}$ 的拟合只适用于所选的 $1/k$ 协方差谱、迹归一化与扫描范围。真实 Inception 的谱和尺度不同,不能把这个指数当作通用样本量定律。
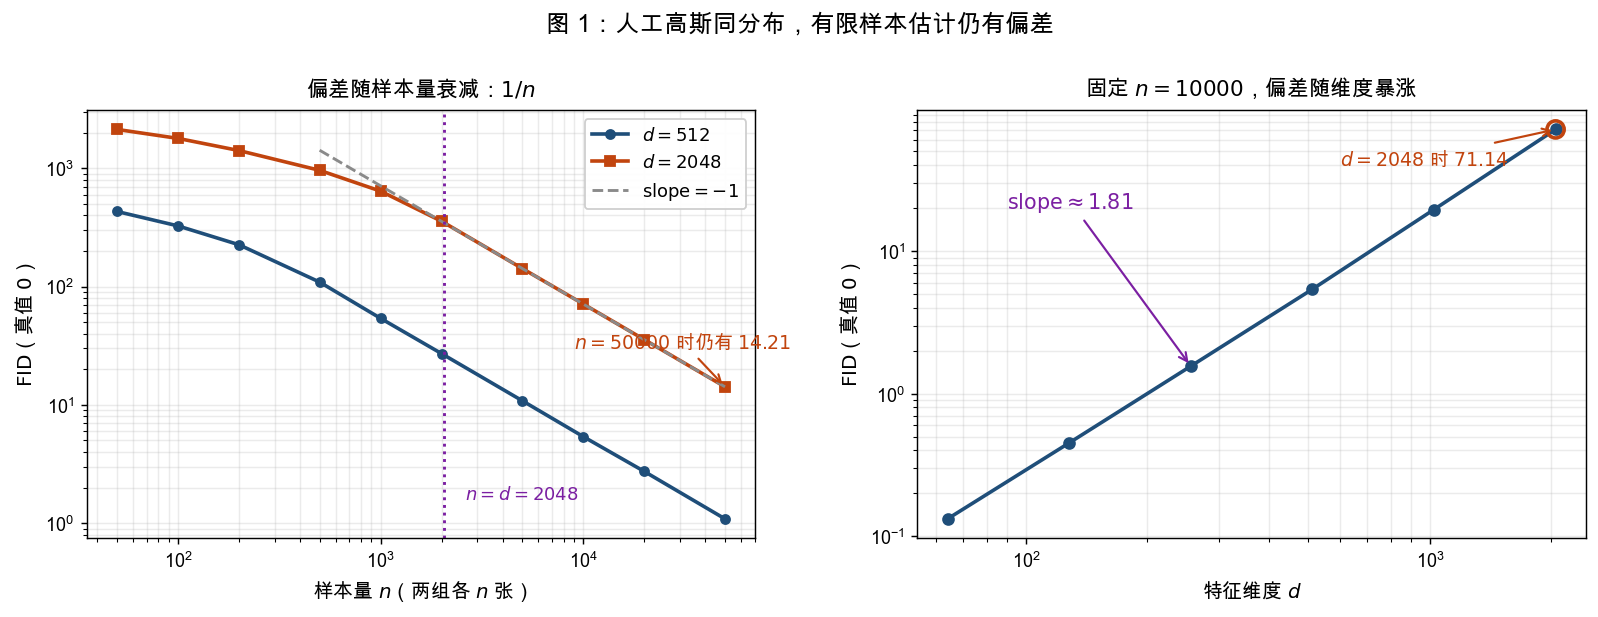
这张图要看什么:左图是 $P=Q$(真值 0)时 FID 随样本量的变化,双对数刻度,蓝线 $d=512$、橙线 $d=2048$,灰色虚线是斜率 $-1$ 的参考——两条实测线几乎与它平行,这就是「偏差按 $1/n$ 衰减」的直接证据;注意橙线在 $n=50000$ 时还有 14.21,远没有收敛到 0。右图固定 $n=10000$ 扫维度,同样是对数刻度,拟合斜率约 1.814,意味着维度翻一倍偏差涨约 3.5 倍;最右端采用了与 Inception pool3 相同的维度,但使用的是合成高斯特征,并非实际图像嵌入。
在偏差近似服从 $1/n$ 展开的样本区间,可以尝试外推;需检验拟合稳定性。Chong & Forsyth(arXiv:1911.07023)的做法是:用 $n = N, N/2, N/4, N/8$ 四个点算四个 FID,对 $1/n$ 做线性拟合 $\mathrm{FID}(n) \approx F_{\infty} + \beta / n$,截距 $F_{\infty}$ 就是外推到无穷样本量的估计。
实测([C] 段,$d=512$):
外推把误差压掉了约 11 倍。代价是要多算三次特征统计量(不过统计量可以复用——从大样本里抽子集就行,不用重新过一遍 Inception)。
报告时同时给参考/生成样本数、原始 FID 和完整协议;使用外推还要报告拟合点、重复采样与不确定性。负截距反映估计误差,不是负的总体距离;外推不保证每个有限样本实验都更准。
CLIP Score 的定义(Hessel 等,arXiv:2104.08718)比 FID 简单得多:
$$\mathrm{CLIP\text{-}S} = w \cdot \max \big( \cos(f_{\text{img}}, f_{\text{txt}}), 0 \big), \quad w = 2.5$$
其中 $f_{\text{img}}$ 和 $f_{\text{txt}}$ 是 CLIP 的图像/文本编码,$w=2.5$ 只是把数值放大到好读的量级。原始 CLIPScore 为图像描述评价提出,reference-free 指不需要人工参考描述;它仍需要待评图像和文本。迁移到文生图时不需要配对真值图。这里按原论文 $w=2.5$,其他实现也会用 100 等缩放,必须注明模型和约定。
下面的人工共享空间反例中,两者最优点不同(附录 clip_alignment_lab.py 的 [A] 段:一个结构化的 CLIP 替身,共享表示空间 $d_s=64$、$K=24$ 个概念,真实数据的多样性固定为 $\sigma_{\text{real}}=0.5$,$n=20000$):
| 生成多样性 $\sigma_g$ | 0.05 | 0.2 | 0.4 | 0.5 | 0.6 | 0.8 | 1.0 |
|---|---|---|---|---|---|---|---|
| FID | 10.97 | 5.24 | 0.63 | 0.029 | 0.65 | 5.65 | 15.61 |
| CLIP Score | 2.323 | 1.323 | 0.744 | 0.607 | 0.515 | 0.399 | 0.335 |
FID 在 $\sigma_g = 0.5$(真实数据的多样性)处取最小 0.029,呈 U 形;CLIP Score 单调递减,在 $\sigma_g = 0.05$(几乎退化成确定性输出)处取最大 2.323。该构造下,相似度奖励靠近概念中心,分布距离奖励匹配设定的方差;不能解释为所有 CLIP 模型都偏好确定性。 顺带一提,真实数据自己的 CLIP Score 是 0.6082,而 $\sigma_g=0.5$ 那个「FID 最优」的模型是 0.6073——跟真实数据几乎一样。也就是说在这个实验里,FID 最优点才对应「和真实数据一致」,CLIP Score 的最优点对应的是「模式收敛」。
而且 CLIP Score 的均值性质会掩盖分布。构造两个模型([B] 段):$M_1$ 以概率 $p$ 输出完美匹配的图、以 $1-p$ 输出纯噪声;$M_2$ 每张图都中等匹配(二分调 $\sigma$ 让它的 CLIP Score 与 $M_1$ 相同):
| $p$ | $M_1$ CLIP Score | $M_1$ 逐样本标准差 | $M_1$ 好图占比 | $M_1$ FID | $M_2$ $\sigma$ | $M_2$ CLIP Score | $M_2$ 逐样本标准差 | $M_2$ FID |
|---|---|---|---|---|---|---|---|---|
| 0.3 | 0.8330 | 0.4695 | 0.2980 | 9.920 | 0.353 | 0.8332 | 0.1078 | 1.323 |
| 0.5 | 1.3039 | 0.5078 | 0.4966 | 10.191 | 0.204 | 1.3016 | 0.0847 | 5.112 |
| 0.7 | 1.7896 | 0.4627 | 0.7012 | 10.677 | 0.122 | 1.7895 | 0.0536 | 8.079 |
| 0.9 | 2.2681 | 0.2992 | 0.9023 | 11.584 | 0.058 | 2.2688 | 0.0171 | 10.663 |
两组 CLIP Score 的最大差距只有 0.0023(按构造应该同分),但 $M_1$ 的逐样本相似度标准差是 $M_2$ 的 17.55 倍($p=0.9$ 时 0.2992 对 0.0171)。同一个分数,一个是「九成图完美、一成完全不沾边」,另一个是相似度更集中的输出($p=0.9$ 时均值也很高,不能称为勉强沾边)。汇总均值看不见这个区别,但逐样本 CLIPScore 的直方图或分位数可以显示它。
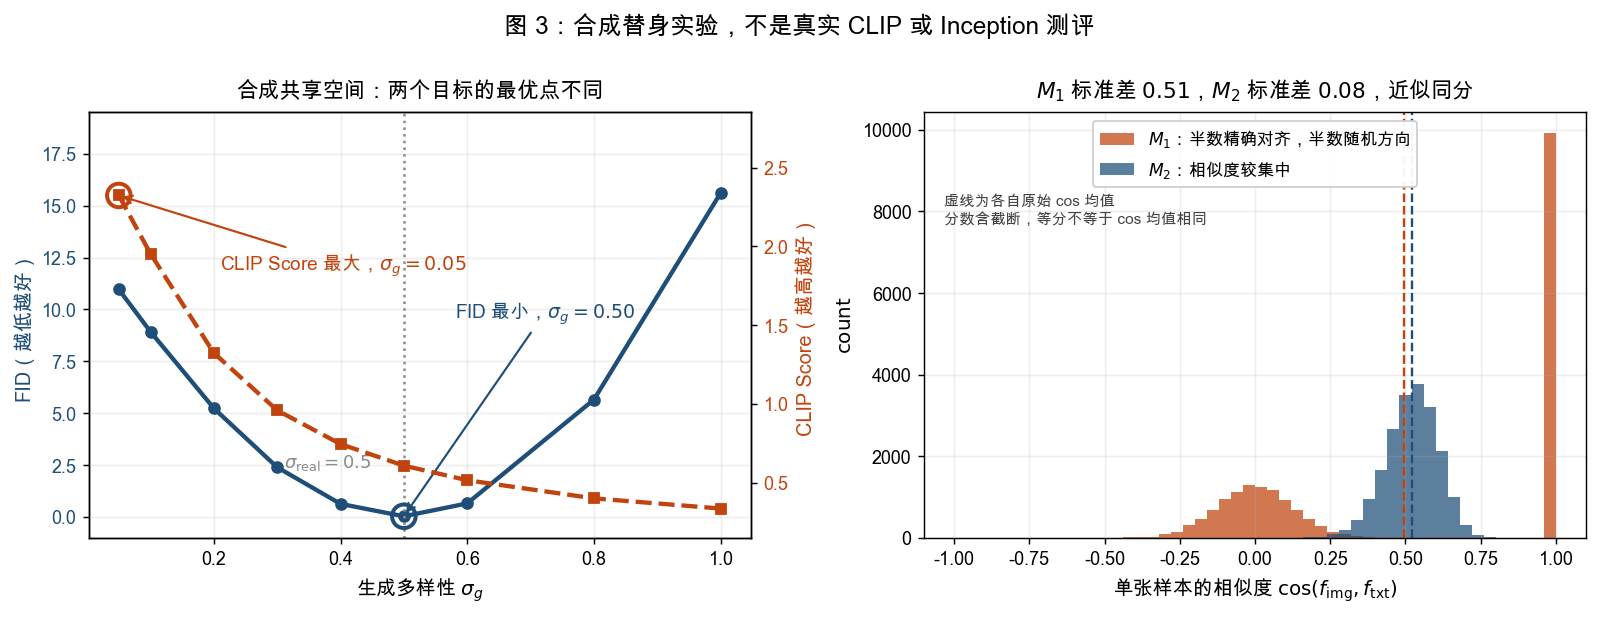
这张图要看什么:左图是同一个 $\sigma_g$ 扫描下两个指标的走向,蓝线(FID,左轴,越低越好)呈 U 形、在 $\sigma_g=0.5$ 处触底,橙线(CLIP Score,右轴,越高越好)单调下降、在最左端 $\sigma_g=0.05$ 处封顶——两条线的最优点不同,说明这组构造下两个目标存在冲突;0.5 并不是横轴右端,也不能据此断言现实模型的普遍走势;灰色竖虚线标出的是真实数据的多样性 $\sigma_{\text{real}}=0.5$。右图是 $p=0.5$ 那一行两个模型的逐样本相似度分布:橙色的 $M_1$ 是明显的双峰(一半堆在接近 1 的位置、一半堆在 0 附近),蓝色的 $M_2$ 是一根集中在 0.5 附近的单峰,图中直方图直接来自附录实际实验数据,橙/蓝虚线分别是原始余弦均值。CLIPScore 先对每个相似度截零,分数接近不保证原始余弦均值相同;汇总分数仍可能掩盖两种很不一样的样本分布。
补充一条横向的:Borji 的 Pros and Cons of GAN Evaluation Measures(arXiv:1802.03446)系统比较了十几种指标的失效模式,结论是没有任何单一指标能在所有场景下胜出——这也是本篇反复强调「两个指标一起看、连同它们的盲区一起看」的依据。
误解 1:「FID 越低,生成的图越好。」 FID 只比较两个分布的前两阶矩,不比较单张图。实测证据:把两个模式越拉越远,FID 一动不动(3.5 节,FID 恒为 0,1-NN 判别率 0.7518)。反过来的方向也成立——FID 很低但每张图都文不对题,是完全可能的。
误解 2:「FID = 0 说明两个分布一样。」 3.5 节整节都在反驳这一点。前两阶矩匹配就够了,形状随便怎么不同都行。高斯假设换来的就是这个。
误解 3:「两篇论文的 FID 可以直接比大小。」 我自己踩过最狠的一个。至少六项要对齐:Inception 权重、特征维度 dims、resize 方式与是否抗锯齿、量化流程、样本量、协方差是否有偏。实测的敏感度:$d=2048$ 时样本量从 10k 到 50k,本文特定人工高斯模型的估计距离从 71.20 变 14.21(差 57);特征整体乘 $c$ 倍,FID 乘 $c^2$ 倍($c=2$ 时 45.58 → 182.34)。这些数字说明 FID 更像一个有单位的物理量,不是一个无量纲分数。
误解 4:「FID 与 CLIP Score 必然反向变化。」 两者测的内容不同,可能同好同坏,也可能冲突。本文合成实验给出冲突的一个例子,不是普遍定律。CFG 的变化也不能精确等同于给合成嵌入加某个固定高斯噪声。
误解 5:「平均 CLIP Score 高,说明每张图都对。」 数据集均值会掩盖尾部。实测两个 CLIP Score 差 0.0023 的模型,逐样本相似度标准差差 17.55 倍(0.2992 对 0.0171)。要看单张图的质量分布,得看直方图或者低分位数,不能只看均值。
误解 6:「FID 非负,所以所有负输出都直接夹为 0。」 应先确认输入和平方根实现,再检查负值是否在尺度相关容差内。小负数可以记录后截零,明显负数必须报错;恰好输出 0 本身既不能证明正确,也不能证明有错。
三个数值脚本在文末附录,依赖 numpy;配图另需 matplotlib,不使用真实 Inception/CLIP 权重:
python fid_core.py            # 约 1 秒:FID 最小实现 + 5 组自检
python fid_bias_lab.py ALL    # 约 1 分钟:样本量偏差 / 维度 / 外推 / 矩盲区
python clip_alignment_lab.py ALL   # 约 10 秒:FID 与 CLIP Score 的相反最优
预期结果(这些数字是实跑输出,可以直接对):
fid_core.py 会按尺度相关容差断言恒等性,包括奇异和小尺度 PSD 输入。数值可以恰好为 0;不要要求固定尾数或符号。明显超出容差时再查矩阵平方根与输入。fid_bias_lab.py 的 [A] 段,$d=2048$ 那一列:n=10000 应约 71.20、n=50000 应约 14.21($P=Q$,真值 0)。[D] 段最后一行的贝叶斯 AUC 应约 0.9033、1-NN 准确率应约 0.7518,而总体 FID 的数值实现应在零附近的浮点容差内。clip_alignment_lab.py 的 [A] 段,最优 $\sigma_g$:FID 是 0.5、CLIP Score 是 0.05。[B] 段最后打印的「CLIP Score 最大差距」应约 0.0023、「标准差比值」应约 17.55 倍。想自己造一个「FID 失效」的例子?改 fid_bias_lab.py 的 [D] 段里那个 a(模式间距的一半)就行:把 $a$ 从 1 扫到 8(中心间距从 2 到 16),总体 FID 保持 0;本例 1-NN 准确率从约 0.50 增至 0.75。
09 节用到的脚本全文如下(fid_bias_lab.py、fid_core.py、clip_alignment_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""
fid_bias_lab.py —— FID 的样本量偏差实验。

回答三个问题:
  [A] 两个分布**完全一样**时,FID 是多少?(答:不是 0,而且 n 越小越离谱)
  [B] 这个偏差随维度 d、样本量 n 怎么变?
  [C] 能不能把它外推掉?(Chong & Forsyth, arXiv:1911.07023 的做法)
  [D] FID 只看前两阶矩,那「前两阶矩完全一样、分布完全不同」能骗过去吗?

运行:
    python fid_bias_lab.py            # 全跑
    python fid_bias_lab.py A          # 只跑 A 段
"""

from __future__ import annotations

import json
import os
import sys

import numpy as np

from fid_core import fid_from_features, frechet_distance, covariance

HERE = os.path.dirname(os.path.abspath(__file__))
OUT_JSON = os.path.join(HERE, "_fid_bias_results.json")


# ──────────────────────────────────────────────────────────────
# 造一个明确指定谱与尺度的合成协方差:特征值按 1/k 衰减,迹归一到 d
# ──────────────────────────────────────────────────────────────
def spectrum_cov(d: int, trace: float | None = None, alpha: float = 1.0) -> np.ndarray:
    r"""对角协方差,特征值 λ_k ∝ k^{-alpha},归一化到 Tr(Σ)=trace。

    这是人为选择的谱衰减模型,并非对 Inception pool3 的实测拟合:
    少数几个方向撑着大部分方差,长尾方向方差很小。
    trace 默认取 d,也就是「每个维度平均方差为 1」。
    """
    k = np.arange(1, d + 1, dtype=np.float64)
    lam = k.astype(np.float64) ** (-alpha)
    if trace is None:
        trace = float(d)
    lam = lam * (trace / lam.sum())
    return np.diag(lam)


def sample_gaussian(mean: np.ndarray, cov_diag: np.ndarray, n: int,
                    rng: np.random.Generator) -> np.ndarray:
    """从对角协方差的高斯里采样(对角阵直接按列缩放,不用 Cholesky)。"""
    d = mean.shape[0]
    lam = np.diag(cov_diag) if cov_diag.ndim == 2 else cov_diag
    z = rng.standard_normal((n, d))
    return mean[None, :] + z * np.sqrt(lam)[None, :]


# ──────────────────────────────────────────────────────────────
# [A] P == Q 时的 FID
# ──────────────────────────────────────────────────────────────
def section_a(d_list=(512, 2048), reps=3, verbose=True):
    print("=" * 74)
    print("[A] 两个分布完全一样时,FID 不是 0")
    print("    真实分布 = 生成分布,理论上 FID = 0。实测:")
    print("=" * 74)

    n_list = [50, 100, 200, 500, 1000, 2000, 5000, 10000, 20000, 50000]
    out = {}
    for d in d_list:
        rng = np.random.default_rng(20261001 + d)
        cov = spectrum_cov(d)
        mu = np.zeros(d)
        rows = []
        for n in n_list:
            vals = []
            for r in range(reps):
                x1 = sample_gaussian(mu, cov, n, rng)
                x2 = sample_gaussian(mu, cov, n, rng)
                vals.append(fid_from_features(x1, x2))
            m = float(np.mean(vals))
            s = float(np.std(vals))
            rows.append((n, m, s))
            if verbose:
                print(f"    d={d:>5}  n={n:>6}  FID = {m:>10.4f}  (std {s:.4f})")
        out[d] = rows
        if verbose:
            print()
    return {"n_list": n_list, "by_d": {str(k): v for k, v in out.items()}}


# ──────────────────────────────────────────────────────────────
# [A2] 偏差到底来自均值还是协方差
# ──────────────────────────────────────────────────────────────
def section_a2(d=512, n=40000, reps=3, verbose=True):
    print("=" * 74)
    print("[A2] 偏差来自哪里:均值还是协方差?(P == Q,真值 0)")
    print("=" * 74)
    rng = np.random.default_rng(556677)
    cov = spectrum_cov(d)
    mu = np.zeros(d)

    full, mean_known, cov_known = [], [], []
    for _ in range(reps):
        x1 = sample_gaussian(mu, cov, n, rng)
        x2 = sample_gaussian(mu, cov, n, rng)
        m1, s1 = x1.mean(0), covariance(x1)
        m2, s2 = x2.mean(0), covariance(x2)
        full.append(frechet_distance(m1, s1, m2, s2))
        # 假设均值已知(用真实 mu=0),只估协方差
        mean_known.append(frechet_distance(mu, s1, mu, s2))
        # 假设协方差已知(用真实 cov),只估均值
        cov_known.append(frechet_distance(m1, cov, m2, cov))

    f, mk, ck = float(np.mean(full)), float(np.mean(mean_known)), float(np.mean(cov_known))
    theory_mean = 2.0 * np.trace(cov) / n
    if verbose:
        print(f"    d={d}  n={n}")
        print(f"    两个都估(正常做法)      FID = {f:>10.4f}")
        print(f"    均值已知、只估协方差      FID = {mk:>10.4f}   "
              f"占全部偏差的 {mk / f * 100:5.1f}%")
        print(f"    协方差已知、只估均值      FID = {ck:>10.4f}   "
              f"占全部偏差的 {ck / f * 100:5.1f}%")
        print(f"    理论值 2*Tr(Sigma)/n = {theory_mean:.6f}(对照上一行)")
        print()
        print("    -> 偏差几乎全部来自**协方差估计**。均值那一项理论上就是")
        print("       2*Tr(Sigma)/n,小到可以忽略;麻烦的是 d x d 个协方差元素。")
    print()
    return {"d": d, "n": n, "full": f, "mean_known": mk, "cov_known": ck,
            "theory_mean": float(theory_mean)}


# ──────────────────────────────────────────────────────────────
# [B] 偏差随 d 与 n 的缩放
# ──────────────────────────────────────────────────────────────
def section_b(verbose=True):
    print("=" * 74)
    print("[B] 偏差随维度 d 怎么长(固定 n=10000)")
    print("=" * 74)
    n = 10000
    rows = []
    for d in (64, 128, 256, 512, 1024, 2048):
        rng = np.random.default_rng(777000 + d)
        cov = spectrum_cov(d)
        mu = np.zeros(d)
        vals = []
        for r in range(3):
            x1 = sample_gaussian(mu, cov, n, rng)
            x2 = sample_gaussian(mu, cov, n, rng)
            vals.append(fid_from_features(x1, x2))
        m = float(np.mean(vals))
        rows.append((d, m, d / n))
        if verbose:
            print(f"    d={d:>5}  n={n}  d/n={d / n:>7.4f}  FID = {m:>10.4f}")
    print()
    return {"n": n, "rows": rows}


# ──────────────────────────────────────────────────────────────
# [C] 外推:FID(n) ≈ F_inf + beta / n
# ──────────────────────────────────────────────────────────────
def section_c(verbose=True):
    print("=" * 74)
    print("[C] 能不能把偏差外推掉?(arXiv:1911.07023 的做法)")
    print("    用 n = N, N/2, N/4, N/8 四个点,对 1/n 做线性拟合,截距即 F_inf")
    print("=" * 74)

    d = 512
    rng = np.random.default_rng(31337)
    cov = spectrum_cov(d)

    # C1: P == Q,真值 0
    N = 40000
    sizes = [N, N // 2, N // 4, N // 8]
    est = []
    for n in sizes:
        v = []
        for r in range(3):
            x1 = sample_gaussian(np.zeros(d), cov, n, rng)
            x2 = sample_gaussian(np.zeros(d), cov, n, rng)
            v.append(fid_from_features(x1, x2))
        est.append(float(np.mean(v)))
    inv_n = np.array([1.0 / n for n in sizes])
    beta, a0 = np.polyfit(inv_n, np.array(est), 1)
    if verbose:
        for n, e in zip(sizes, est):
            print(f"    P==Q  n={n:>6}  FID = {e:>9.4f}")
        print(f"    外推 F_inf = {a0:>9.4f}   (真值 0.0000, 斜率 beta={beta:.2f})")
    c1 = {"sizes": sizes, "est": est, "extrap": float(a0), "slope": float(beta)}

    # C2: P != Q,真值可以直接从矩算出来
    print()
    shift = np.zeros(d)
    shift[0] = 0.5                       # 只在第 0 维上挪一点
    mu_q = shift
    cov_q = cov * 1.03                   # 协方差整体放大 3%
    true_fid = frechet_distance(np.zeros(d), cov, mu_q, cov_q)
    est2 = []
    for n in sizes:
        v = []
        for r in range(3):
            x1 = sample_gaussian(np.zeros(d), cov, n, rng)
            x2 = sample_gaussian(mu_q, cov_q, n, rng)
            v.append(fid_from_features(x1, x2))
        est2.append(float(np.mean(v)))
    beta2, a02 = np.polyfit(inv_n, np.array(est2), 1)
    if verbose:
        for n, e in zip(sizes, est2):
            print(f"    P!=Q  n={n:>6}  FID = {e:>9.4f}")
        print(f"    真值 FID  = {true_fid:>9.4f}")
        print(f"    外推 F_inf = {a02:>9.4f}   (斜率 beta={beta2:.2f})")
        print(f"    直接用 n={N} 的估计误差 = {est2[0] - true_fid:+.4f}")
        print(f"    外推后的误差           = {a02 - true_fid:+.4f}")
    print()
    return {"c1": c1, "c2": {"sizes": sizes, "est": est2, "true": float(true_fid),
                             "extrap": float(a02), "slope": float(beta2)}}


# ──────────────────────────────────────────────────────────────
# [D] 前两阶矩一样、分布完全不同
# ──────────────────────────────────────────────────────────────
def _auc(scores_pos: np.ndarray, scores_neg: np.ndarray) -> float:
    """Mann-Whitney U 形式的 AUC:P(score_pos > score_neg)。"""
    a = np.sort(scores_pos)
    b = np.sort(scores_neg)
    # 对每个 b,统计有多少 a 严格大于它
    cnt = a.size - np.searchsorted(a, b, side="right")
    return float(cnt.sum() / (a.size * b.size))


def _quad_features(X: np.ndarray) -> np.ndarray:
    """二次特征展开:[x_i, x_i x_j (i<=j)]。"""
    n, d = X.shape
    iu = np.triu_indices(d)
    quad = X[:, iu[0]] * X[:, iu[1]]
    return np.concatenate([X, quad], axis=1)


def _gauss_logpdf(X: np.ndarray, mean: np.ndarray, cov: np.ndarray) -> np.ndarray:
    """对角/一般协方差下的高斯 log 密度。"""
    d = X.shape[1]
    Xc = X - mean[None, :]
    if cov.ndim == 2 and cov.shape[0] == cov.shape[1]:
        lam, V = np.linalg.eigh(cov)
        lam = np.clip(lam, 1e-12, None)
        proj = Xc @ V
        quad = (proj ** 2 / lam[None, :]).sum(axis=1)
        logdet = np.log(lam).sum()
    else:
        lam = np.asarray(cov).ravel()
        quad = (Xc ** 2 / lam[None, :]).sum(axis=1)
        logdet = np.log(lam).sum()
    return -0.5 * (quad + logdet + d * np.log(2 * np.pi))


def _nn_two_sample(Xa: np.ndarray, Xb: np.ndarray, m: int = 2500) -> float:
    """1-近邻两样本检验的准确率。

    把两组样本混在一起,对每个点找它的最近邻,看这个邻居是不是同组的。
    P == Q 时这个比例趋近 0.5(纯随机),分布有差别时会明显大于 0.5。
    """
    A, B = Xa[:m], Xb[:m]
    P = np.concatenate([A, B], axis=0)
    D = ((P[:, None, :] - P[None, :, :]) ** 2).sum(-1)
    np.fill_diagonal(D, np.inf)
    idx = np.argmin(D, axis=1)
    lab = np.concatenate([np.zeros(m), np.ones(m)])
    return float((lab[idx] == lab).mean())


def _ridge_auc(Xp: np.ndarray, Xq: np.ndarray, feat, ntr: int, lam: float,
               rng: np.random.Generator) -> float:
    """在给定特征映射上训一个 ridge 二分类器,返回测试集 AUC。"""
    Fp, Fq = feat(Xp), feat(Xq)
    n = Xp.shape[0]
    Xtr = np.concatenate([Fp[:ntr], Fq[:ntr]], axis=0)
    ytr = np.concatenate([np.ones(ntr), -np.ones(ntr)])
    Xte = np.concatenate([Fp[ntr:], Fq[ntr:]], axis=0)
    yte = np.concatenate([np.ones(n - ntr), -np.ones(n - ntr)])
    sd = Xtr.std(axis=0)
    sd[sd < 1e-12] = 1.0
    Xtr, Xte = Xtr / sd, Xte / sd
    Phi = Xtr.T @ Xtr
    w = np.linalg.solve(Phi + lam * np.eye(Phi.shape[0]), Xtr.T @ ytr)
    sc = Xte @ w
    return _auc(sc[yte > 0], sc[yte < 0])


def section_d(verbose=True):
    print("=" * 74)
    print("[D] 前两阶矩完全一样、分布完全不同 —— FID 看得见吗")
    print("    真实 P = 0.5*N(+m, I) + 0.5*N(-m, I)   (两个分离的模式)")
    print("    生成 Q = N(0, I + m m^T)                (一个把两个模式糊在一起的团)")
    print("    两者均值都是 0、协方差都是 I + m m^T  =>  FID 真值严格等于 0")
    print("=" * 74)

    d = 32
    n = 40000
    rng = np.random.default_rng(24680)
    u = rng.standard_normal(d)
    u /= np.linalg.norm(u)

    if verbose:
        print(f"    {'模式间距 2|m|':>12} {'FID(总体)':>12} {'FID(经验)':>10} "
              f"{'最优AUC':>9} {'1NN':>7} {'二次AUC':>8} {'线性AUC':>8}")
    rows = []
    for a in (1, 2, 3, 4, 6, 8):
        m = a * u
        sign = rng.integers(0, 2, size=n) * 2 - 1
        Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :]
        cov_q = np.eye(d) + np.outer(m, m)
        Xq = rng.multivariate_normal(np.zeros(d), cov_q, size=n)

        # 总体 FID:直接用矩算,理论值 0
        cov_p = np.eye(d) + np.outer(m, m)
        fid_pop = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q)
        # 经验 FID
        fid_emp = frechet_distance(Xp.mean(0), covariance(Xp),
                                   Xq.mean(0), covariance(Xq))
        # 最优判别(log 密度比)
        inv_q = np.linalg.inv(cov_q)

        def logp_mix(X):
            return np.logaddexp(-0.5 * ((X - m) ** 2).sum(1),
                                -0.5 * ((X + m) ** 2).sum(1))

        def logq(X):
            return -0.5 * (X @ inv_q * X).sum(1)

        auc_bayes = _auc(logp_mix(Xp) - logq(Xp), logp_mix(Xq) - logq(Xq))
        # 1-NN 两样本检验
        acc_nn = _nn_two_sample(Xp, Xq)
        # 二次特征 / 线性特征的 ridge 分类器
        auc_quad = _ridge_auc(Xp, Xq, _quad_features, 8000, 1.0, rng)
        auc_lin = _ridge_auc(Xp, Xq, lambda X: X, 8000, 1.0, rng)

        rows.append((2 * a, float(fid_pop), float(fid_emp), auc_bayes,
                     acc_nn, auc_quad, auc_lin))
        if verbose:
            print(f"    {2 * a:>12} {fid_pop:>12.2e} {fid_emp:>10.4f} "
                  f"{auc_bayes:>9.4f} {acc_nn:>7.4f} {auc_quad:>8.4f} {auc_lin:>8.4f}")

    # 对照组:把 Q 的协方差整体放大 s 倍(破坏矩匹配),FID 与二次判别一起醒过来
    print()
    print("    对照组(2|m|=8):把 Q 的协方差整体放大 s 倍,破坏矩匹配")
    print(f"    {'s':>6} {'FID':>10} {'二次特征 ridge AUC':>20}")
    m = 8 * u
    sign = rng.integers(0, 2, size=n) * 2 - 1
    Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :]
    cov_p = np.eye(d) + np.outer(m, m)
    ctrl = []
    for s in (1.0, 1.05, 1.2, 1.5, 2.0):
        cov_q_s = cov_p * s
        Xq_s = rng.multivariate_normal(np.zeros(d), cov_q_s, size=n)
        fid_s = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q_s)
        auc_s = _ridge_auc(Xp, Xq_s, _quad_features, 8000, 1.0, rng)
        ctrl.append((s, float(fid_s), auc_s))
        print(f"    {s:>6} {fid_s:>10.4f} {auc_s:>20.4f}")
    print("      -> 本例矩匹配时总体 FID 为 0,平方损失 ridge 的 AUC 近 0.5。")
    print("         这不代表任意二次分类器都无法区分两组分布。")
    print()
    return {"d": d, "n": n, "rows": rows, "control": ctrl}


# ──────────────────────────────────────────────────────────────
def main():
    which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL"
    res = {}
    if which in ("ALL", "A"):
        res["A"] = section_a()
    if which in ("ALL", "A2"):
        res["A2"] = section_a2()
    if which in ("ALL", "B"):
        res["B"] = section_b()
    if which in ("ALL", "C"):
        res["C"] = section_c()
    if which in ("ALL", "D"):
        res["D"] = section_d()
    if which == "ALL":
        with open(OUT_JSON, "w", encoding="utf-8") as f:
            json.dump(res, f, ensure_ascii=False, indent=1)
        print(f"结果已写入 {OUT_JSON}")


if __name__ == "__main__":
main()"""
fid_core.py —— FID(Fréchet Inception Distance)的最小可用实现。
本机没有 torch,也没有 scipy(scipy.linalg.sqrtm 是官方实现的核心依赖),
所以这里的矩阵平方根全部用 numpy 的对称特征分解手算。
好处是每一步都看得见,也正好能把「手写实现最容易踩的那个坑」暴露出来。
运行:
python fid_core.py
"""
from __future__ import annotations
import numpy as np
# ──────────────────────────────────────────────────────────────
# 1. 对称 PSD 矩阵的平方根
# ──────────────────────────────────────────────────────────────
def sqrtm_sym(C: np.ndarray, eps: float = 1e-6) -> np.ndarray:
r"""对称半正定矩阵的平方根。
对 C = V diag(w) V^T,有 C^{1/2} = V diag(sqrt(w)) V^T。
eps 是相对谱尺度的负特征值容差,不是给正特征值设置下限。
明显非半正定输入报错;容差内负值截到 0,保留真正的零特征值。
"""
C = np.asarray(C, dtype=np.float64)
if C.ndim != 2 or C.shape[0] != C.shape[1] or not np.isfinite(C).all():
raise ValueError("C must be a finite square matrix")
scale = max(np.linalg.norm(C, ord=np.inf), np.finfo(float).tiny)
if not np.allclose(C, C.T, rtol=0.0, atol=eps * scale):
raise ValueError("C must be symmetric")
w, V = np.linalg.eigh((C + C.T) / 2)
if w.min() < -eps * max(np.abs(w).max(), np.finfo(float).tiny):
raise ValueError("C must be positive semidefinite")
w = np.sqrt(np.clip(w, 0.0, None))
return (V * w) @ V.T
def sqrtm_naive(A: np.ndarray, eps: float = 1e-6) -> np.ndarray:
"""「把 A 直接当对称矩阵开方」。
np.linalg.eigh 只读矩阵的上/下三角并**假设输入对称**,
默认 UPLO="L",以 A 的下三角及其镜像构造对称矩阵,
并不等于 (A + A^T)/2。
很多手写 FID 就是这么写的,而 A = Σ1 Σ2 恰恰不是对称矩阵。
"""
w, V = np.linalg.eigh(A)
w = np.sqrt(np.clip(w, eps, None))
return (V * w) @ V.T
# ──────────────────────────────────────────────────────────────
# 2. Tr((Σ1 Σ2)^{1/2})
# ──────────────────────────────────────────────────────────────
def trace_sqrt_product(sigma1: np.ndarray, sigma2: np.ndarray,
eps: float = 1e-6) -> float:
r"""计算 Tr((Σ1 Σ2)^{1/2}),走对称化路线。
Σ1 正定时,Σ1 Σ2 与 Σ1^{1/2} Σ2 Σ1^{1/2} 相似:
Σ1^{1/2} (Σ1^{1/2} Σ2 Σ1^{1/2}) Σ1^{-1/2} = Σ1 Σ2
二者特征值相同,而后者是**对称半正定**的,可以安全用 eigh。
主平方根与相似变换可交换,所以迹也相同:
Tr((Σ1 Σ2)^{1/2}) = Σ_i sqrt(λ_i)
"""
s1 = sqrtm_sym(sigma1, eps)
M = s1 @ sigma2 @ s1
M = 0.5 * (M + M.T) # 强制对称,压掉浮点不对称
w = np.linalg.eigvalsh(M)
return float(np.sqrt(np.clip(w, 0.0, None)).sum())
def trace_sqrt_product_naive(sigma1: np.ndarray, sigma2: np.ndarray,
eps: float = 1e-6) -> float:
"""对照用的错误写法:直接对 Σ1 Σ2 调 eigh。"""
return float(np.trace(sqrtm_naive(sigma1 @ sigma2, eps)))
def trace_sqrt_product_ref(sigma1: np.ndarray, sigma2: np.ndarray) -> float:
"""参考实现:用一般矩阵的特征值求解器 eigvals(不假设对称)。"""
ev = np.linalg.eigvals(sigma1 @ sigma2)
return float(np.sqrt(np.clip(ev.real, 0.0, None)).sum())
# ──────────────────────────────────────────────────────────────
# 3. FID 本体
# ──────────────────────────────────────────────────────────────
def frechet_distance(mu1: np.ndarray, sigma1: np.ndarray,
mu2: np.ndarray, sigma2: np.ndarray,
eps: float = 1e-6, mode: str = "sym") -> float:
r"""两个多元高斯之间的 Fréchet 距离(= 2-Wasserstein 距离的平方)。
FID = ||μ1 - μ2||^2 + Tr(Σ1) + Tr(Σ2) - 2 Tr((Σ1 Σ2)^{1/2})
mode="sym" 用对称化路线(正确)
mode="naive" 用 eigh(Σ1 Σ2)(错误,保留它只为对照)
"""
diff = mu1 - mu2
if mode == "sym":
tr = trace_sqrt_product(sigma1, sigma2, eps)
elif mode == "naive":
tr = trace_sqrt_product_naive(sigma1, sigma2, eps)
else:
raise ValueError(f"unknown mode: {mode}")
# 注意:这里**不做** max(val, 0)。浮点误差确实会让 FID(P,P) 变成 -1e-9 量级,
# 但把负数夹成 0 会把真正的实现 bug(比如开方写错)一起藏掉——
# 我自己第一版就是因为夹了 0,测试全绿而结果是错的。
return float(diff @ diff + np.trace(sigma1) + np.trace(sigma2) - 2.0 * tr)
def covariance(X: np.ndarray, unbiased: bool = True) -> np.ndarray:
r"""样本协方差。unbiased=True 用 1/(n-1)(np.cov 默认),
False 用 1/n(高斯最大似然估计的常见约定)。"""
X = np.asarray(X, dtype=np.float64)
if X.ndim != 2 or not np.isfinite(X).all():
raise ValueError("X must be a finite [n, d] array")
n = X.shape[0]
if n < (2 if unbiased else 1):
raise ValueError("not enough samples for covariance")
Xc = X - X.mean(axis=0, keepdims=True)
denom = (n - 1) if unbiased else n
return (Xc.T @ Xc) / denom
def fid_from_features(X1: np.ndarray, X2: np.ndarray,
unbiased: bool = True, eps: float = 1e-6,
mode: str = "sym") -> float:
"""直接从两组特征算 FID。X1: 真实 [n1, d],X2: 生成 [n2, d]。"""
mu1, mu2 = X1.mean(axis=0), X2.mean(axis=0)
sig1 = covariance(X1, unbiased=unbiased)
sig2 = covariance(X2, unbiased=unbiased)
return frechet_distance(mu1, sig1, mu2, sig2, eps=eps, mode=mode)
# ──────────────────────────────────────────────────────────────
# 4. 自检
# ──────────────────────────────────────────────────────────────
def _rand_psd(d: int, rng: np.random.Generator, k: int | None = None) -> np.ndarray:
"""随机对称正定矩阵:A A^T/k + 0.5 I;加单位阵后满秩。"""
k = k or d
A = rng.standard_normal((d, k))
return A @ A.T / k + 0.5 * np.eye(d)
def self_test() -> None:
rng = np.random.default_rng(20261001)
print("=" * 68)
print("[1] 恒等性:FID(P, P) 必须为 0")
d = 32
mu = rng.standard_normal(d)
sig = _rand_psd(d, rng)
identity = frechet_distance(mu, sig, mu, sig)
assert abs(identity) < 1e-10 * np.trace(sig)
print(f" FID(P,P) = {identity:.3e} (按容差判断,不要求固定符号或尾数)")
for scale in (1.0, 1e-12):
singular = np.diag([scale, 0.0, 2 * scale])
z = np.zeros(3)
got = frechet_distance(z, singular, z, singular)
assert abs(got) < 1e-10 * np.trace(singular)
try:
sqrtm_sym(np.diag([1.0, -0.1]))
except ValueError:
pass
else:
raise AssertionError("non-PSD input was accepted")
print(" 奇异/小尺度 PSD 恒等性、非 PSD 拒绝:通过")
print()
print("[2] 对称化路线 vs 错误写法 vs 一般特征值参考实现")
print(f" {'d':>6} {'sym(正确)':>16} {'naive(错误)':>16} {'eigvals(参考)':>16}")
for d in (8, 32, 128):
s1 = _rand_psd(d, rng)
s2 = _rand_psd(d, rng)
a = trace_sqrt_product(s1, s2)
b = trace_sqrt_product_naive(s1, s2)
c = trace_sqrt_product_ref(s1, s2)
assert np.isclose(a, c, rtol=1e-9)
print(f" {d:>6} {a:>16.10f} {b:>16.10f} {c:>16.10f}")
print()
print("[3] 这个差异会传进 FID:同一对特征,两种写法差多少")
d = 128
n = 4096
mu_a = rng.standard_normal(d) * 0.3
sa = _rand_psd(d, rng)
sb = sa + 0.05 * np.eye(d)
xa = rng.multivariate_normal(mu_a, sa, size=n)
xb = rng.multivariate_normal(-mu_a, sb, size=n)
fa = fid_from_features(xa, xb, mode="sym")
fb = fid_from_features(xa, xb, mode="naive")
print(f" FID(sym) = {fa:.6f}")
print(f" FID(naive) = {fb:.6f} (差值 {fb - fa:+.6f})")
print()
print("[4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍")
base = fid_from_features(xa, xb, mode="sym")
for c in (0.5, 2.0, 4.0):
got = fid_from_features(xa * c, xb * c, mode="sym")
assert np.isclose(got, c * c * base, rtol=1e-9)
print(f" c={c:<4} FID={got:>12.6f} 期望 c^2*base={c * c * base:>12.6f}")
print()
print("[5] 有偏 vs 无偏协方差(n 越小差得越多)")
d = 128
truth_a = _rand_psd(d, rng)
truth_b = truth_a + 0.08 * np.eye(d)
print(f" {'n':>7} {'unbiased':>13} {'biased':>13} {'差值':>12}")
for n in (256, 1024, 8192):
pa = rng.multivariate_normal(np.zeros(d), truth_a, size=n)
pb = rng.multivariate_normal(np.zeros(d), truth_b, size=n)
fu = fid_from_features(pa, pb, unbiased=True)
fb2 = fid_from_features(pa, pb, unbiased=False)
print(f" {n:>7} {fu:>13.6f} {fb2:>13.6f} {fb2 - fu:>+12.6f}")
print()
print("=" * 68)
if __name__ == "__main__":
self_test()"""
clip_alignment_lab.py —— CLIP Score 与 FID 到底在给谁打高分。
本机没有 torch,跑不了真的 CLIP。这里搭的是一个**结构替身**:
- 两个编码器把图像和文本投到同一个共享空间(真 CLIP 就是这么干的)
- 打分用余弦相似度,并且照抄 CLIPScore 论文的定义
CLIP-S = w * max(cos(image, text), 0),w = 2.5(arXiv:2104.08718)
- 相似度用归一化向量,FID 用未归一化的原始特征(实际评测也是这么用的)
替身复现不了真 CLIP 的具体数值,但复现了它的**结构**。
下面两个结论都只依赖结构,不依赖具体权重:
[A] CLIP Score 随生成多样性单调下降,FID 是 U 形 —— 两者的最优解不在一个地方
[B] CLIP Score 只用一个均值,好坏样本可以互相平均掉
运行:
python clip_alignment_lab.py
"""
from __future__ import annotations
import json
import os
import sys
import numpy as np
from fid_core import fid_from_features
HERE = os.path.dirname(os.path.abspath(__file__))
OUT_JSON = os.path.join(HERE, "_clip_results.json")
W = 2.5 # CLIPScore 论文的缩放系数
# ──────────────────────────────────────────────────────────────
# 共享空间与两个(替身)编码器
# ──────────────────────────────────────────────────────────────
def build_concepts(K: int, ds: int, rng: np.random.Generator) -> np.ndarray:
"""K 个语义概念的类心,单位范数。ds >> K 时它们近似两两正交。"""
C = rng.standard_normal((K, ds))
C /= np.linalg.norm(C, axis=1, keepdims=True)
return C
def encode_image(C: np.ndarray, idx: np.ndarray, sigma: float,
rng: np.random.Generator) -> np.ndarray:
"""「图像编码器」:类心 + 各向同性噪声。sigma 就是生成多样性。"""
Z = rng.standard_normal((idx.shape[0], C.shape[1]))
return C[idx] + sigma * Z
def encode_text(C: np.ndarray, idx: np.ndarray) -> np.ndarray:
"""「文本编码器」:prompt 直接就是类心本身。"""
return C[idx]
def clip_score(images: np.ndarray, texts: np.ndarray, w: float = W) -> dict:
"""CLIP-S = w * max(cos(image, text), 0),逐样本取均值。"""
a = images / np.linalg.norm(images, axis=1, keepdims=True)
b = texts / np.linalg.norm(texts, axis=1, keepdims=True)
cos = (a * b).sum(axis=1)
return {
"score": float(w * np.maximum(cos, 0.0).mean()),
"cos_mean": float(cos.mean()),
"cos_std": float(cos.std()),
"cos_frac_gt_half": float((cos > 0.5).mean()),
"cos": cos,
}
# ──────────────────────────────────────────────────────────────
# [A] 多样性扫描:FID 与 CLIP Score 的最优解不在一起
# ──────────────────────────────────────────────────────────────
def section_a(K=24, ds=64, n=20000, verbose=True):
print("=" * 76)
print("[A] 生成多样性 sigma_g 扫描:FID 与 CLIP Score 分别给谁打高分")
print(f" 真实数据 sigma_real = 0.5,K={K} 个概念,共享空间维度 ds={ds}")
print("=" * 76)
rng = np.random.default_rng(90210)
C = build_concepts(K, ds, rng)
idx = rng.integers(0, K, size=n)
real_img = encode_image(C, idx, 0.5, rng)
real_txt = encode_text(C, idx)
ref = clip_score(real_img, real_txt)
if verbose:
print(f" 真实数据自己的 CLIP Score = {ref['score']:.4f} "
f"(cos 均值 {ref['cos_mean']:.4f})")
print()
print(f" {'sigma_g':>8} {'FID':>10} {'CLIPScore':>11} "
f"{'cos均值':>9} {'cos标准差':>10}")
rows = []
for sg in (0.05, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0):
idx2 = rng.integers(0, K, size=n)
gen_img = encode_image(C, idx2, sg, rng)
gen_txt = encode_text(C, idx2)
fid = fid_from_features(real_img, gen_img)
cs = clip_score(gen_img, gen_txt)
rows.append((sg, float(fid), cs["score"], cs["cos_mean"], cs["cos_std"]))
if verbose:
mark = " <- 真实值" if abs(sg - 0.5) < 1e-9 else ""
print(f" {sg:>8} {fid:>10.4f} {cs['score']:>11.4f} "
f"{cs['cos_mean']:>9.4f} {cs['cos_std']:>10.4f}{mark}")
fids = [r[1] for r in rows]
scores = [r[2] for r in rows]
best_fid = rows[int(np.argmin(fids))][0]
best_cs = rows[int(np.argmax(scores))][0]
if verbose:
print()
print(f" FID 最小时 sigma_g = {best_fid}")
print(f" CLIP Score 最大时 sigma_g = {best_cs}")
print(" -> 在本合成实验中,FID 偏好的方差与 CLIPScore 不同;")
print(" 不能据此把真实模型中的多样性与文本对齐视为必然冲突。")
print()
return {"K": K, "ds": ds, "n": n, "rows": rows,
"real_score": ref["score"], "best_fid_sigma": best_fid,
"best_clip_sigma": best_cs}
# ──────────────────────────────────────────────────────────────
# [B] 同一个均值,完全不同的现实
# ──────────────────────────────────────────────────────────────
def _score_for_sigma(C, idx, sigma) -> float:
"""用固定种子探一次,避免二分过程本身消耗主随机流。"""
probe = np.random.default_rng(4242)
img = encode_image(C, idx, sigma, probe)
return clip_score(img, encode_text(C, idx))["score"]
def section_b(K=24, ds=64, n=20000, verbose=True):
print("=" * 76)
print("[B] 汇总 CLIP Score 是均值:好样本和坏样本可以互相平均掉")
print(" 模型 M1:p 的概率输出完美匹配,1-p 的概率输出纯噪声")
print(" 模型 M2:各样本相似度较集中(调 sigma 让截断后的 CLIPScore 与 M1 相同)")
print(" 两者的 CLIP Score 一样,现实完全不一样。")
print("=" * 76)
rng = np.random.default_rng(1357)
C = build_concepts(K, ds, rng)
idx = rng.integers(0, K, size=n)
real_img = encode_image(C, idx, 0.5, rng)
if verbose:
print(f" {'p':>6} {'M1 CLIP':>9} {'M1 cos标准差':>13} {'M1 好图占比':>12} "
f"{'M1 FID':>10} | {'M2 sigma':>9} {'M2 CLIP':>9} {'M2 cos标准差':>13} "
f"{'M2 好图占比':>12} {'M2 FID':>10}")
rows = []
for p in (0.3, 0.5, 0.7, 0.9):
# M1: 混合
good = rng.random(n) < p
img1 = np.where(good[:, None], C[idx], 0.0) # 完美命中类心
noise = rng.standard_normal((n, ds))
noise /= np.linalg.norm(noise, axis=1, keepdims=True)
img1 = img1 + np.where(good[:, None], 0.0, noise) # 否则是随机方向
cs1 = clip_score(img1, encode_text(C, idx))
fid1 = fid_from_features(real_img, img1)
# M2: 二分法找 sigma,使 CLIP Score 与 M1 对齐
# 注意要对齐的是 score(含 max(cos, 0) 截断),不是裸的 cos 均值
target = cs1["score"]
lo, hi = 1e-3, 50.0
for _ in range(60):
mid = 0.5 * (lo + hi)
if _score_for_sigma(C, idx, mid) > target:
lo = mid
else:
hi = mid
sg2 = 0.5 * (lo + hi)
img2 = encode_image(C, idx, sg2, rng)
cs2 = clip_score(img2, encode_text(C, idx))
fid2 = fid_from_features(real_img, img2)
rows.append({"p": p, "m1_clip": cs1["score"], "m1_std": cs1["cos_std"],
"m1_good": cs1["cos_frac_gt_half"], "m1_fid": float(fid1),
"m2_sigma": float(sg2), "m2_clip": cs2["score"],
"m2_std": cs2["cos_std"], "m2_good": cs2["cos_frac_gt_half"],
"m2_fid": float(fid2)})
bins = np.linspace(-1.0, 1.0, 51)
rows[-1].update(hist_bins=bins.tolist(),
hist1=np.histogram(np.clip(cs1["cos"], -1, 1), bins)[0].tolist(),
hist2=np.histogram(np.clip(cs2["cos"], -1, 1), bins)[0].tolist(),
m1_cos_mean=cs1["cos_mean"], m2_cos_mean=cs2["cos_mean"])
if verbose:
print(f" {p:>6} {cs1['score']:>9.4f} {cs1['cos_std']:>13.4f} "
f"{cs1['cos_frac_gt_half']:>12.4f} {fid1:>10.3f} | "
f"{sg2:>9.3f} {cs2['score']:>9.4f} {cs2['cos_std']:>13.4f} "
f"{cs2['cos_frac_gt_half']:>12.4f} {fid2:>10.3f}")
if verbose:
print()
d_clip = max(abs(r["m1_clip"] - r["m2_clip"]) for r in rows)
d_std = max(r["m1_std"] / max(r["m2_std"], 1e-9) for r in rows)
print(f" CLIP Score 最大差距 = {d_clip:.4f} (按构造两者应当同分)")
print(f" 逐样本相似度标准差的比值最大 = {d_std:.2f} 倍")
print(" -> 同一个 CLIP Score 背后,可以是「p 的图完美、其余完全不沾边」,")
print(" 也可以是「各样本有相近的相似度」。汇总均值看不见这个区别,逐样本分数分布可以。")
print()
return {"K": K, "ds": ds, "n": n, "rows": rows}
def main():
which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL"
res = {}
if which in ("ALL", "A"):
res["A"] = section_a()
if which in ("ALL", "B"):
res["B"] = section_b()
if which == "ALL":
with open(OUT_JSON, "w", encoding="utf-8") as f:
json.dump(res, f, ensure_ascii=False, indent=1)
print(f"结果已写入 {OUT_JSON}")
if __name__ == "__main__":
main()"""
make_figures.py —— 画本文的配图。
数据来源都是已经跑完的实验(_fid_bias_results.json / _clip_results.json),
不在这里重新算,避免图上的数字和正文漂移。
运行:
python make_figures.py
"""
from __future__ import annotations
import json
import os
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(HERE, "..", "figures")
os.makedirs(FIGDIR, exist_ok=True)
# 配色(正文里写「这张图要看什么」时按这六个名字来描述)
C_MAIN = "#1f4e79" # 深蓝:主曲线
C_ALT = "#c1440e" # 橙红:对照曲线
C_GREEN = "#2e7d32" # 绿:第三组
C_PURPLE = "#7b1fa2" # 紫:标注线
C_GRAY = "#8a8a8a" # 灰:参考线
C_LIGHT = "#bcd7ee" # 浅蓝:填充
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.dpi"] = 130
plt.rcParams["savefig.dpi"] = 130
def _load(name):
p = os.path.join(HERE, name)
if not os.path.exists(p):
return None
with open(p, encoding="utf-8") as f:
return json.load(f)
# ──────────────────────────────────────────────────────────────
# 图 1:FID 的样本量偏差
# ──────────────────────────────────────────────────────────────
def fig_bias(res):
rows512 = res["A"]["by_d"]["512"]
rows2048 = res["A"]["by_d"]["2048"]
rows_b = res["B"]["rows"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7))
# ── 左:偏差 vs n ──
n5 = [r[0] for r in rows512]
f5 = [r[1] for r in rows512]
n2 = [r[0] for r in rows2048]
f2 = [r[1] for r in rows2048]
ax1.loglog(n5, f5, "o-", color=C_MAIN, lw=2, ms=5, label=r"$d=512$")
ax1.loglog(n2, f2, "s-", color=C_ALT, lw=2, ms=5, label=r"$d=2048$")
# 参考斜率 1/n
ref_n = np.array([n2[3], n2[-1]], dtype=float)
ref_y = f2[-1] * (ref_n / n2[-1]) ** (-1.0)
ax1.loglog(ref_n, ref_y, "--", color=C_GRAY, lw=1.6,
label=r"$\mathrm{slope}=-1$")
ax1.axvline(2048, color=C_PURPLE, ls=":", lw=1.6)
ax1.annotate(r"$n=d=2048$", xy=(2048, 1.0), xytext=(2600, 1.6),
color=C_PURPLE, fontsize=10)
ax1.annotate(r"$n=50000$ 时仍有 $14.21$", xy=(n2[-1], f2[-1]),
xytext=(9000, 30), color=C_ALT, fontsize=10.5,
arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2))
ax1.set_xlabel("样本量 $n$(两组各 $n$ 张)", fontsize=11)
ax1.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11)
ax1.set_title("偏差随样本量衰减:$1/n$", fontsize=12, pad=8)
ax1.legend(loc="upper right", fontsize=10, framealpha=0.95)
ax1.grid(True, which="both", alpha=0.25)
# ── 右:偏差 vs d ──
dd = [r[0] for r in rows_b]
bb = [r[1] for r in rows_b]
ax2.loglog(dd, bb, "o-", color=C_MAIN, lw=2, ms=6)
lo, hi = np.log(dd[0]), np.log(dd[-1])
slope = (np.log(bb[-1]) - np.log(bb[0])) / (hi - lo)
ax2.annotate(r"$\mathrm{slope}\approx %.2f$" % slope,
xy=(dd[2], bb[2]), xytext=(90, 20), fontsize=11.5,
color=C_PURPLE,
arrowprops=dict(arrowstyle="->", color=C_PURPLE, lw=1.2))
ax2.scatter([2048], [bb[-1]], s=90, facecolors="none",
edgecolors=C_ALT, lw=2, zorder=5)
ax2.annotate(r"$d=2048$ 时 $71.14$", xy=(2048, bb[-1]),
xytext=(600, 40), color=C_ALT, fontsize=10.5,
arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2))
ax2.set_xlabel("特征维度 $d$", fontsize=11)
ax2.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11)
ax2.set_title(r"固定 $n=10000$,偏差随维度暴涨", fontsize=12, pad=8)
ax2.grid(True, which="both", alpha=0.25)
fig.suptitle("图 1:人工高斯同分布,有限样本估计仍有偏差", fontsize=13.5, y=1.0)
fig.tight_layout()
out = os.path.join(FIGDIR, "fig_fid_bias.png")
fig.savefig(out, bbox_inches="tight", facecolor="white")
plt.close(fig)
print("wrote", out, f"slope={slope:.3f}")
# ──────────────────────────────────────────────────────────────
# 图 2:前两阶矩一样、分布完全不同
# ──────────────────────────────────────────────────────────────
def fig_moment_blind(res):
rows = res["D"]["rows"]
sep = [r[0] for r in rows]
fpop = [abs(r[1]) for r in rows]
femp = [r[2] for r in rows]
aucb = [r[3] for r in rows]
nn = [r[4] for r in rows]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7))
# ── 左:二维示意 ──
rng = np.random.default_rng(20261001)
a = 4.2 # 二维示意里把模式拉开一点,让「两个团」一眼可见
n = 1400
sgn = rng.integers(0, 2, size=n) * 2 - 1
P = rng.standard_normal((n, 2)) + np.stack([sgn * a, np.zeros(n)], axis=1)
covq = np.eye(2) + np.array([[a * a, 0.0], [0.0, 0.0]])
Q = rng.multivariate_normal(np.zeros(2), covq, size=n)
ax1.scatter(P[:, 0], P[:, 1], s=9, alpha=0.5, color=C_MAIN,
label="真实分布 $P$(两个模式)")
ax1.scatter(Q[:, 0], Q[:, 1], s=9, alpha=0.5, color=C_ALT,
label="生成分布 $Q$(糊成一团)")
# 画 Q 的 1 个标准差椭圆
w, V = np.linalg.eigh(covq)
ang = np.degrees(np.arctan2(V[1, -1], V[0, -1]))
from matplotlib.patches import Ellipse
for k, col in ((1, C_ALT), (2, C_ALT)):
e = Ellipse((0, 0), 2 * k * np.sqrt(w[0]), 2 * k * np.sqrt(w[1]),
angle=ang, fill=False, ls="--", lw=1.4,
edgecolor=col, alpha=0.75)
ax1.add_patch(e)
ax1.set_xlim(-9, 9)
ax1.set_ylim(-4.2, 4.2)
ax1.set_aspect("equal", adjustable="box")
ax1.set_xlabel(r"$x_1$", fontsize=11)
ax1.set_ylabel(r"$x_2$", fontsize=11)
ax1.set_title(r"$\mathrm{FID}=0$,但一眼就能看出不是一回事", fontsize=12, pad=8)
ax1.legend(loc="upper left", fontsize=10, framealpha=0.95)
ax1.grid(True, alpha=0.25)
# ── 右:FID 与可区分度 ──
ax2.plot(sep, femp, "o-", color=C_MAIN, lw=2.2, ms=6,
label=r"$\mathrm{FID}$(左边刻度)")
ax2.set_yscale("log")
ax2.set_ylim(1e-3, 1e1)
ax2.axhline(0.5, color=C_GRAY, ls=":", lw=1.2)
ax2.set_xlabel("模式间距 $2|m|$", fontsize=11)
ax2.set_ylabel(r"$\mathrm{FID}$(对数刻度,真值严格为 $0$)", fontsize=11,
color=C_MAIN)
ax2.tick_params(axis="y", labelcolor=C_MAIN)
ax3 = ax2.twinx()
ax3.plot(sep, aucb, "s--", color=C_ALT, lw=2.2, ms=6,
label=r"$\mathrm{AUC}$(最优判别)")
ax3.plot(sep, nn, "^--", color=C_GREEN, lw=2.2, ms=6,
label=r"$1$-$\mathrm{NN}$ 两样本准确率")
ax3.axhline(0.5, color=C_GRAY, ls="-", lw=1.0)
ax3.set_ylim(0.45, 1.0)
ax3.set_ylabel(r"$\mathrm{AUC}$ / $1$-$\mathrm{NN}$(右边刻度)", fontsize=11)
ax3.text(sep[-1], 0.47, r"$0.5=$ 随机猜测", color=C_GRAY, fontsize=9.5,
ha="right")
h1, l1 = ax2.get_legend_handles_labels()
h2, l2 = ax3.get_legend_handles_labels()
ax2.legend(h1 + h2, l1 + l2, loc="center left", fontsize=9.5,
framealpha=0.95)
ax2.set_title("模式越分开,FID 越是一动不动,判别器越看得清",
fontsize=12, pad=8)
fig.suptitle("图 2:FID 只匹配前两阶矩,形状对不对它不管", fontsize=13.5, y=1.0)
fig.tight_layout()
out = os.path.join(FIGDIR, "fig_moment_blind.png")
fig.savefig(out, bbox_inches="tight", facecolor="white")
plt.close(fig)
print("wrote", out)
# ──────────────────────────────────────────────────────────────
# 图 3:FID 与 CLIP Score 的最优解不在一起
# ──────────────────────────────────────────────────────────────
def fig_clip_vs_fid(cres):
rows = cres["A"]["rows"]
sg = [r[0] for r in rows]
fid = [r[1] for r in rows]
cs = [r[2] for r in rows]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7))
# ── 左:sigma 扫描 ──
ax1.plot(sg, fid, "o-", color=C_MAIN, lw=2.4, ms=6)
ax1.set_xlabel(r"生成多样性 $\sigma_g$", fontsize=11)
ax1.set_ylabel("FID(越低越好)", fontsize=11, color=C_MAIN)
ax1.tick_params(axis="y", labelcolor=C_MAIN)
ax1.set_ylim(-1.0, 19.5)
imin = int(np.argmin(fid))
ax1.scatter([sg[imin]], [fid[imin]], s=170, facecolors="none",
edgecolors=C_MAIN, lw=2.2, zorder=5)
ax1.annotate(r"FID 最小,$\sigma_g=%.2f$" % sg[imin],
xy=(sg[imin], fid[imin]), xytext=(0.58, 9.6),
color=C_MAIN, fontsize=10.5,
arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2))
ax3 = ax1.twinx()
ax3.plot(sg, cs, "s--", color=C_ALT, lw=2.4, ms=6)
ax3.set_ylabel("CLIP Score(越高越好)", fontsize=11, color=C_ALT)
ax3.tick_params(axis="y", labelcolor=C_ALT)
ax3.set_ylim(0.15, 2.85)
imax = int(np.argmax(cs))
ax3.scatter([sg[imax]], [cs[imax]], s=170, facecolors="none",
edgecolors=C_ALT, lw=2.2, zorder=5)
ax3.annotate(r"CLIP Score 最大,$\sigma_g=%.2f$" % sg[imax],
xy=(sg[imax], cs[imax]), xytext=(0.21, 1.85),
color=C_ALT, fontsize=10.5,
arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2))
ax1.axvline(0.5, color=C_GRAY, ls=":", lw=1.4)
ax1.text(0.31, 2.4, r"$\sigma_{\mathrm{real}}=0.5$", color=C_GRAY,
fontsize=10)
ax1.set_title("合成共享空间:两个目标的最优点不同", fontsize=12, pad=8)
ax1.grid(True, alpha=0.22)
# ── 右:同一个 CLIP Score 的两种现实 ──
brows = cres["B"]["rows"]
target = [r for r in brows if abs(r["p"] - 0.5) < 1e-9][0]
# 直接读取实验的真实 cos 直方图;不重新捏造近似分布。
bins = np.asarray(target["hist_bins"])
ax2.stairs(target["hist1"], bins, fill=True, alpha=0.72, color=C_ALT,
label=r"$M_1$:半数精确对齐,半数随机方向")
ax2.stairs(target["hist2"], bins, fill=True, alpha=0.72, color=C_MAIN,
label=r"$M_2$:相似度较集中")
for key, color in [("m1_cos_mean", C_ALT), ("m2_cos_mean", C_MAIN)]:
ax2.axvline(target[key], color=color, ls="--", lw=1.3)
ax2.text(0.03, 0.74, "虚线为各自原始 cos 均值\n分数含截断,等分不等于 cos 均值相同",
transform=ax2.transAxes, color="#444444", fontsize=8.5)
ax2.set_xlabel(r"单张样本的相似度 $\cos(f_{\mathrm{img}}, f_{\mathrm{txt}})$", fontsize=11)
ax2.set_ylabel(r"$\mathrm{count}$", fontsize=11)
ax2.set_title(r"$M_1$ 标准差 $%.2f$,$M_2$ 标准差 $%.2f$,近似同分"
% (target["m1_std"], target["m2_std"]), fontsize=12, pad=8)
ax2.legend(loc="upper center", fontsize=9.5, framealpha=0.95)
ax2.grid(True, alpha=0.22)
fig.suptitle("图 3:合成替身实验,不是真实 CLIP 或 Inception 测评",
fontsize=13.5, y=1.0)
fig.tight_layout()
out = os.path.join(FIGDIR, "fig_clip_vs_fid.png")
fig.savefig(out, bbox_inches="tight", facecolor="white")
plt.close(fig)
print("wrote", out)
# ──────────────────────────────────────────────────────────────
def main():
res = _load("_fid_bias_results.json")
cres = _load("_clip_results.json")
made = []
if res:
fig_bias(res)
fig_moment_blind(res)
made += ["fig_fid_bias.png", "fig_moment_blind.png"]
if cres:
fig_clip_vs_fid(cres)
made.append("fig_clip_vs_fid.png")
print("figures:", made)
if __name__ == "__main__":
main()
评论 (0)