搜索到
33
篇与
AIGC Fundamentals
的结果
-
 AIGC 基本功|扩散模型的跨步缓存复用-DiffCache AIGC 基本功|扩散模型的跨步缓存复用-DiffCache 同样走完采样器的每一步,能不能少算几次昂贵的去噪网络?跨步缓存把这个问题拆成两件事:复用什么,以及什么时候必须刷新。本文用残差缓存的最小实验解释机制,再对照 DeepCache 和 TeaCache 的真实实现。实验是人工构造的数值系统,不是视频模型的质量或速度复现。 本文承接 DDIM 与高阶采样器、DiT 和 性能建模与 Profiling。默认读者知道采样器会反复调用网络,不要求先读缓存论文。论文版本与官方代码核对日期为 2026-10-05。 01. 为什么需要它 一次视频生成中,潜变量在逐步变化,文本条件通常固定,网络却要一遍遍穿过相同的模块。假如两次调用的深层特征几乎一样,重新计算这部分就可能浪费时间。但“几乎一样”只是观测,不能推出“任意一次都可以省”。运动切换、条件变化和采样末期的细节修整,都可能让陈旧特征的误差显现。 这里最具体的失败场景是固定间隔缓存:先完整算一次,之后连续复用,直到计数器要求刷新。如果变化突然出现在间隔中间,策略不会因为内容变了而提前刷新。反过来,如果某段变化很慢,固定间隔也会做多余的完整计算。问题在于日历式排期没有感知当前输入,周期短会损失收益,周期长会增加近似误差。 本文实验保留全部 40 次状态更新。精确版本执行 40 次完整残差计算;自适应阈值为 0.16 时,只执行 11 次,复用 29 次。终点相对误差为 0.008222。它证明了在这个特定数值系统中确实可以减少计算次数,同时也证明输出发生了变化。它不证明视频质量达标,更不证明真实 GPU 上能得到相同的提速。 缓存适合回答“这个步骤里,哪些计算可以暂时沿用”。减少采样步数则改变采样器的离散路径。两种方法可以组合,但组合后的误差要重新评估:单独用缓存通过了一组样例,不意味着换成少步采样器后仍然通过。 02. 最小可用理解 第一,把网络拆成每步仍要计算的部分,以及准备复用的昂贵部分。第二,保存上次完整计算得到的特征或残差,用便宜的变化指标决定是否刷新。第三,即使命中缓存,当前输入仍然要参与输出,采样器仍然继续更新状态。 以残差形式为例,设当前嵌入是 $h_i$,完整模块输出为 $G(h_i,t_i,c)$。缓存保存的是 $R_i=G(h_i,t_i,c)-h_i$。如果上次刷新发生在 $r$,当前近似模块输出是 $h_i+R_r$。符号 $i$ 表示第几次网络调用,$t_i$ 是这次调用的时间条件,$c$ 是固定的文本等条件;$r$ 是缓存的生成时刻,通常小于当前 $i$。 这三句话的重点是“当前输入加旧残差”。如果直接把整个旧输出拿回来,连当前输入的变化也被抹掉了。残差复用仍然有误差,只是保留了输入的直通更新。DeepCache 的 U-Net 高层特征缓存并不等于这个残差写法,不能把所有缓存方法都称为同一个算法。 03. 数学推导 先定义缓存误差发生在哪里 设 $E$ 是便宜的输入嵌入,$G$ 是昂贵模块,$H$ 是输出头。完整调用写为: $$h_i=E(x_i,t_i,c),\quad R_i=G(h_i,t_i,c)-h_i,\quad y_i=H(h_i+R_i,t_i,c)$$ $x_i$ 是采样器当前的潜变量;$h_i$ 是网络内部的嵌入,不必与 $x_i$ 形状相同;$R_i$ 是昂贵模块对嵌入的修正;$y_i$ 是送回采样器的网络预测。这里的预测可以按模型定义代表噪声或速度,缓存逻辑本身不替模型选择参数化。等式只是代数分解,不要求模型专门训练一个名叫“残差缓存”的层。 命中缓存后,输入嵌入和输出头仍按当前条件计算: $$\widehat{y}_i=H(h_i+R_r,t_i,c),\quad r<i$$ 帽子表示近似计算。比较精确与近似时,先固定当前同一个 $h_i$:误差来自 $R_r$ 替代了 $R_i$,而不是来自状态已经分叉。若输出头在所讨论的局部区域满足 Lipschitz 条件,常数记作 $L_H$,那么: $$\|\widehat{y}_i-y_i\|\leq L_H\|R_r-R_i\|$$ Lipschitz 条件的意思是输入变化不能被这个局部映射无限放大;$L_H$ 是放大上限。本文没有测出真实模型的 $L_H$,这个式子是带假设的分析工具,不是线上质量保证。它告诉我们,缓存内部误差小仍然需要考虑输出头的敏感性。 为什么使用便宜的变化代理 直接计算 $\|R_i-R_r\|$ 能判断缓存是否陈旧,但得到 $R_i$ 就已经做了昂贵计算。为了节省计算,需要先观察一个便宜的量 $m_i$。它可以由当前嵌入与时间条件构造。相邻调用的相对 L1 变化写为: $$d_i=\frac{\operatorname{mean}|m_i-m_{i-1}|}{\max(\operatorname{mean}|m_{i-1}|,\varepsilon)}$$ $\operatorname{mean}$ 对张量所有元素取平均,绝对值逐元素计算,$\varepsilon$ 是防止除零的小正数。两次张量形状一致时,均值之比等于 L1 范数之比。这个值没有单位,反映变化相对之前幅度有多大。分母很小时,它也可能变得敏感,不能把这种数值问题误判成内容剧烈变化。 本文教学实现取 $\varepsilon=10^{-12}$。该保护和后面非负累计属于教学实现的防御性处理;不能据此声称官方代码逐字采用相同逻辑。 最直觉的想法是:如果每一步变化都很小,就一直复用。但缓存对应的是刷新时刻 $r$,不是上一时刻。利用三角不等式: $$\|m_i-m_r\|\leq\sum_{j=r+1}^{i}\|m_j-m_{j-1}\|$$ 这里 $j$ 遍历刷新之后的调用。即使单步变化很小,连续多步也会积累成明显差异,因此策略应保留“自上次刷新以来的变化预算”。这个式子约束绝对变化;把每项分别除以不同的幅度后,不能直接称相对变化之和为严格误差界。 实际决策可以采用累计代理: $$A_i=A_{i-1}+g(d_i),\quad \text{refresh if } A_i\geq\delta$$ $A_i$ 是累计预算,$g$ 将输入变化映射到预估的输出变化,$\delta$ 是刷新阈值。完整计算后把预算归零并保存新残差。TeaCache 使用多项式重标定来改善这种代理;拟合关系是经验估计,不会把统计相关性变成对所有样本成立的数学上界。TeaCache 原文第 3.2–3.3 节 给出了指标与累计决策。 本文取 $g(d)=d$,以便只观察状态机。阈值 0.16 因而只属于本实验的代理尺度,不能迁移成真实模型的推荐阈值。换掉嵌入幅度、时间调制或采样路径,同一个阈值对应的刷新频率就会改变。 一次局部近似如何影响后续轨迹 现在让两条轨迹分别使用精确和近似输出。为便于推导,考虑显式 Euler 更新: $$x_{i+1}=x_i+\Delta s_i v(x_i,s_i),\quad \widehat{x }_{i+1}=\widehat{x }_i+\Delta s_i\widehat{v}(\widehat{x }_i,s_i)$$ $s_i$ 是积分坐标,$\Delta s_i>0$ 是步长,$v$ 是精确向量场,$\widehat{v}$ 使用缓存近似。令 $e_i=\|\widehat{x }_i-x_i\|$ 表示轨迹差异,令 $\eta_i=\|\widehat{v}(\widehat{x }_i,s_i)-v(\widehat{x }_i,s_i)\|$ 表示在近似轨迹当前状态上的局部缓存误差。 先在更新差值中加减 $v(\widehat{x }_i,s_i)$,把“缓存误差”和“输入状态不同”分开。再使用三角不等式,并假设 $v$ 对状态的 Lipschitz 常数为 $L$,得到: $$e_{i+1}\leq(1+\Delta s_iL)e_i+\Delta s_i\eta_i$$ 若初始状态相同,则 $e_0=0$。重复代入可得: $$e_N\leq\sum_{i=0}^{N-1}\Delta s_i\eta_i\prod_{j=i+1}^{N-1}(1+\Delta s_jL)$$ 空乘积取 1。这个展开说明早期误差会通过后续更新传播;最后一次强制刷新只能去掉最后一次局部缓存误差,不能恢复此前已经走偏的轨迹。真实系统可能局部收缩,实际误差小于这个上界;高阶求解器还涉及历史预测,不能把 Euler 的式子直接冒充所有采样器的误差定理。 为什么命中率不能直接当加速比 令 $N$ 是总调用数,$K$ 是完整计算数,$C_f$ 是完整调用成本,$C_h$ 是缓存命中调用成本,$C_o$ 是其他固定开销。则一个简单的成本模型是: $$S=\frac{NC_f+C_o}{KC_f+(N-K)C_h+C_o}$$ 命中调用仍要嵌入、判定、读缓存、运行输出头和更新采样器,$C_h$ 不会自动等于零。缓存张量跨设备读取甚至可能很贵。端到端还包括文本编码、VAE 解码和输出处理,跳过 Transformer 并不会同时省掉这些部分。 本文把 $C_f=1$、$C_h=0.08$、$C_o=0$ 当成教学假设。按实跑统计的 $K$ 代入可以算成本比,但没有用这些假设伪装 GPU 计时。部署时需要测出真实成本,再决定缓存是否值得加入。 04. 代码实现 完整脚本是文末的 cache_demo.py,依赖 NumPy 与 matplotlib,无需模型权重。它构造一个四层非线性残差函数,用固定随机种子产生输入和矩阵。输入形状是 $(B,L,D)=(1,4,16)$:一个批次、四个位置、十六个通道。张量使用 float64,目的是让读者稳定复核误差,不模拟混合精度推理。 脚本里的 cheap_input 对应 $E$,residual 对应 $R$,proxy 对应 $m$,budget 对应 $A$,threshold 对应 $\delta$。输出头取恒等映射。每次用当前 $h$ 加缓存残差得到预测,然后执行状态更新。时间标签从 1 递减到 0,而状态更新的步长固定为 $1/N$;这只是合成系统的定义,没有冒充 DDIM 或真实扩散调度器。 决策的核心代码如下;变量准备、精确对照、绘图及断言都在完整附录中: budget += max(change, 0.0) boundary = i in (0, STEPS - 1) calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual 首次调用没有缓存,所以必须完整算。最后一次强制刷新属于本实现的策略。previous_proxy 每一步都更新,saved_residual 只有刷新时更新:把这两件事混淆,就会把“相邻变化累计”写成另一种算法。simulate 每次创建新的状态,避免后一条请求接着用前一条请求的残差。 为了画误差曲线,脚本还在每个步骤额外执行一次精确函数作为离线诊断。这些额外执行没有算进策略的 full_calls;因此实际运行这个带诊断的脚本并不是加速测速。计数回答的是策略本来会执行多少次昂贵计算,图回答的是当前近似轨迹上的局部输出误差有多大。 真实运行环境为 Python 3.11.9、NumPy 2.4.3。基线终点的元素范围为 [-0.791508, 0.614856]。输出如下: shape=(1, 4, 16), steps=40, seed=7 baseline_range=[-0.791508, 0.614856] name full_calls hits endpoint_relative_error assumed_speed_ratio exact 40 0 0.000000 1.000 adaptive_0.08 18 22 0.004939 2.024 adaptive_0.16 11 29 0.008222 3.003 adaptive_0.32 7 33 0.026326 4.149 uniform_4 11 29 0.008672 3.003 All assertions passed; figure=figures/cache_schedule.png 终点相对误差的定义是近似终点与精确终点之差的 L2 范数,除以精确终点的 L2 范数。因此 0.008222 是这个定义下约 0.8222% 的差异,不是 VBench 下降,也不是图像中有 0.8222% 的像素出错。最后一列来自前节假设的成本模型,没有真实延迟单位。 图上半部分每个方块表示一次完整残差计算,空缺表示复用;下半部分是离线诊断得到的局部输出 L2 误差。请先观察刷新是否集中在同一段,再看复用之间误差如何变化。曲线没有用感知质量指标,纵轴不能解读成画面可接受程度。配图由附录脚本生成,数据与上述输出来自同一次实验。 阈值 0.16 与固定间隔 4 都执行了 11 次完整计算,但终点误差略有差异。这是“同样预算也会因刷新位置不同而得到不同结果”的一个实例。它只有一个种子和一个人工系统,不能证明自适应策略在所有输入上优于固定间隔,更不能作为统计显著性结论。 05. 工业级实现对照 DeepCache 原文第 3.3 节 利用 U-Net 的分支结构:当前浅层特征继续更新,较深分支的高层特征从缓存取回并拼接。它缓存的是特定网络位置的特征,并非本文抽象的整段残差。官方 horseee/DeepCache 的 deepcache.py 提供 forward 包装与状态复位;对照时应先找缓存边界,再判断到底省掉了哪些模块。 TeaCache 的 HunyuanVideo 示例 中,teacache_forward 用时间调制后的输入计算变化代理,累计重标定后的变化,并保存 Transformer 主体的输入输出残差。首尾调用完整计算,命中后把旧残差加到当前图像嵌入上;输出层仍然运行。这里对应的是 2026-10-05 实际取回的源码,后续上游重构需要重新核对。 教学版与上述示例的差异很明确:教学版没有文本分支、真实 patchify、注意力或权重,也没有拟合官方多项式;它只验证预算与残差状态机。真实代码还可能把张量变化转成 CPU 标量,这种同步的代价不能从“指标计算量很小”中自动排除。需要把判定开销也纳入测量。 工程上,缓存状态应属于一次请求,而不是一个可被并发请求共享的随意全局变量。prompt、负向条件、guidance、分辨率、帧数、模型权重或调度器变化时,复用旧状态没有语义依据。只检查张量形状远远不够;两个请求可以形状相同、内容完全不同。失败中断后重新开始生成,也要建立新的缓存生命周期。 若模型采用双分支 CFG,必须考虑条件与无条件分支的缓存分别有效。按 $y=y_u+w(y_c-y_u)$ 写,$y_u$ 与 $y_c$ 分别是无条件和条件预测,$w$ 是 guidance 系数。预测误差满足: $$\|\Delta y\|\leq |w|\|\Delta y_c\|+|1-w|\|\Delta y_u\|$$ 因此较大的 guidance 可能放大分支近似误差。这个式子是代数上的工程分析,不声称所有视频模型都执行双分支 CFG;有些采用蒸馏后的 guidance 条件。接入前要先确认实际预测路径,再决定状态如何隔离。 还要区分采样步和网络调用。调度器可能在一个名义步里求值多次,或重访相同的时间标签。缓存的计数器应跟随真实调用语义。如果只拿界面上显示的步数当数组长度,很容易在错误的位置刷新,或者提前把状态清零。应记录每次实际调用的时间标签、是否刷新和缓存来源,再与调度器对齐。 06. 代价与边界 省的是昂贵模块重复计算,增加的是缓存内存、生命周期管理、判定开销和近似误差。保存一个形状为 $(B,L,D)$ 的残差张量,最低存储量为 $BLDb$ 字节,其中 $b$ 是每个元素的字节数;克隆的输入、多个分支及其他缓存还会额外占空间。长视频中 token 数很大,省算力并不自动省显存。 阈值没有通用刻度。代理的归一化方式、拟合数据、模型层、时间条件与采样器都影响其意义。在某模型上有效的多项式可能在另一个模型或调度器上失配。应在目标分布上先记录输入代理与真实残差变化的对应关系,再评估误判,不能只沿用别人仓库里的常数。 端点刷新是一种保守策略,不是一种证明。即使最后一次完整计算,网络读到的潜变量也已经经过缓存轨迹;它不能把积累误差自动洗掉。判断质量时要看整段生成结果,尤其是动作连续性、物体身份、细节与提示词对应关系,而不是只看最后一个调用的缓存误差归零。 已有很少采样步的蒸馏模型可能没有多少安全的复用空间。短轨迹上每次预测都更重要,进一步减少完整网络调用可能迅速损害质量。动态改变条件的交互式生成、频繁切换控制信号的任务,也不应默认共享同一段缓存。先建立可靠基线,才能判断具体组合是否值得部署。 评测时固定权重、prompt、种子、分辨率、帧数、采样器和 guidance,分别测完整网络计算时间与端到端延迟。预热、设备同步、重复测量和尾延迟都要说明;不要把首次编译的基线与已预热的缓存版放在一起比较。质量样例应包含快速运动、镜头切换、文字、遮挡和多主体交互等容易暴露近似问题的内容。 本文给出的误差曲线只能帮助理解缓存的数值行为。没有真实模型权重,没有样本集,也没有测量硬件延迟。因此本文不提供生产阈值,不给出“无损”的结论,也不声称这些 toy 误差能预测真实视频的主观质量。 还要分别检查代理误判的两种代价。代理高估变化会增加完整计算,主要损失效率;代理低估变化会继续使用陈旧残差,主要增加质量风险。这两种错误不能只用一个平均相关系数概括。即使整体相关性很高,少数快速变化的步骤被漏掉,也可能成为最明显的失败样例。应保留逐步记录,把异常视频定位到具体刷新区间,再判断是代理不敏感、阈值过大还是缓存位置选错。 为避免测试集上的阈值被过度优化,可以先用一组提示词选择阈值,再在另一组提示词上固定参数评估。报告平均质量以外,还要记录最差样例以及变化最大的场景。缓存有时能带来某项评分的小幅上升,但近似轨迹改变本身并不保证改进;应通过更多独立样本判断这是随机波动还是稳定效果。不能挑出一段更好看的视频,就把整条路线称作质量提升技术。 缓存决策在不同请求中可能产生不同的完整计算次数,所以服务端延迟也会随内容变化。只报告平均命中率,会遮蔽慢请求的行为;应同时关注完整计算次数的分布和尾延迟。如果业务要求固定延迟,可以限制最长复用间隔或最低刷新次数,但这些额外约束需要重新纳入成本账本与质量验证。 07. 经典论文脉络 DDIM:Denoising Diffusion Implicit Models,2010.02502。它提供理解不同采样路径的基础;跨步缓存要先说明是否保留原有离散调用,再比较误差,不能把省模块与改步长混为一谈。 DeepCache,2312.00858。它把 U-Net 高层特征的跨步复用转成免训练加速方案,主要启发是选择合适的结构边界,而不是对所有中间张量一概缓存。 Pyramid Attention Broadcast,2408.12588。它把视频生成中的注意力复用纳入设计,提示我们不同模块可以有不同刷新节奏。本文只把它作为技术脉络,不复现其性能结果。 TeaCache,2411.19108。它用时间调制输入的变化代理和重标定来选择刷新时刻,把问题从固定周期推进到输入感知的缓存决策。 论文数值也要带条件。DeepCache 的摘要报告 SD v1.5 上 2.3 倍加速与 CLIP Score 下降 0.05;这是作者特定设置下的结果,不能泛化成所有扩散模型都同样受益。原始摘要 支持这组数字。 TeaCache v2 的表 1 中,OpenSora-Plan、65 帧、512×512 的基线延迟为 99.65 秒,slow 配置为 22.62 秒,对应 4.41 倍;VBench 从 80.39% 到 80.32%,差值是 0.07 个百分点。fast 配置在同表报告更高加速,但质量也有不同取舍,所以本文引用 slow 配置,避免把不同配置的最优速度与最优质量拼成一个结果。原文表 1 可直接复核。 这些工作属于相关路线,没有一个统一的阈值或通用缓存张量。先检查缓存边界,再看刷新规则,最后检查采样路径是否改变,是比较它们时更稳定的顺序。方法名称相似、都声称免训练,不代表工程实现可以直接互换。 08. 常见误解 “跨步缓存与 KV cache 是同一种精确复用。” 自回归 KV cache 通常复用固定前缀的计算结果,而扩散过程中潜变量和时间条件在变化。这里复用的是可能陈旧的近似特征,必须单独评估误差。是否等价还取决于模型路径,不能仅凭有个 cache 字段就判断。 “相邻特征相似,所以可以一直复用。” 相邻相似不等于相隔很多步仍相似,更不等于输出质量不变。累计预算关注缓存年龄,刷新机制关注何时恢复完整计算。二者缺一不可。 “阈值 0.16 表示允许 16% 的质量损失。” 阈值只是累计代理的比较值。它不是终点误差、FID、VBench 或主观质量的直接比例。本实验阈值与官方多项式的阈值甚至不在相同刻度上。 “缓存命中后跳过了采样器更新。” 本文所有版本都更新状态 40 次。省掉的是一部分网络计算,当前输入与输出头仍然可以变化。如果代码命中后直接跳过调度器,它执行的是另一种算法。 “最后一次完整计算能补回前面所有误差。” 最后一次局部预测变准确,不等于输入轨迹回到基线。误差传播推导和实验都把这两件事区分开。 “调用次数少三倍,就是端到端快三倍。” 命中步骤、其他固定模块、同步与内存操作仍有成本。本文最后一列只是显式假设的成本比,实际脚本还带额外离线诊断,因此不能拿它的运行时间当加速报告。 09. 动手验证 先把附录完整代码保存为 cache_demo.py,准备 Python 3.10 以上环境,执行: python -m pip install numpy matplotlib python cache_demo.py 脚本按照所在目录生成实验结果文件和 figures/cache_schedule.png。数值应与第 04 节一致;换 NumPy 或底层数值库时,浮点尾数可能略有不同。比对完整计算次数、刷新时刻和误差到所列精度,比要求截图或图片压缩字节完全一致更合适。 首先把阈值设成 0。每个步骤都会刷新,完整计算次数应等于 40,终点应与精确基线逐元素一致。附录已经用断言验证这个条件;如果失败,要先修缓存状态机,不要调阈值掩盖问题。 其次比较 0.08、0.16 和 0.32。在本次固定实验里,完整计算次数逐步减少,终点误差逐步增加。这是一个具体样本的趋势,不是所有系统的单调性定理:刷新位置改变、误差相互抵消、轨迹分叉,都可能让某个中间阈值的结果反而更接近基线。 再比较 adaptive_0.16 与 uniform_4。两者的成本模型使用相同的 11 次完整计算,但时刻并不相同。观察图中误差峰值,不只盯终点一个数。如果想研究预算分配,固定计算次数,再调整刷新位置,比仅仅换一个阈值更容易把原因看清。 最后修改种子或残差函数中时间变化的频率,重新运行整套对照,并保留新的输出。这一操作没有本文预先承诺的性能结果;它用来观察原先代理是否仍能判断残差变化。若输入代理很平缓、真实残差突然变化,就能构造“指标漏报”的反例。把反例加入测试,比只展示一条顺利的曲线更有价值。 实际接入模型之前,还应验证两次独立请求是否有相同基线行为、错误中断是否清理状态、同形状不同条件是否互相污染。本文实验用每次 simulate 独立初始化来验证复位;真实服务还需要针对并发与重入的检查。 10. 延伸阅读 先从 DDIM 与高阶采样器 理解调用路径,再用 DiT 找嵌入、主体和输出头的边界,最后通过 性能建模与 Profiling 实测哪些部分值得省。 可以对照 KV cache 理解缓存有效性,也可继续读 量化 比较另一种减少推理成本的方法。知识树中的少步蒸馏节点仍为 planned;它是下一条相关学习路线,尚无已发布链接。跨步缓存、量化与蒸馏组合时,应重新建立质量和延迟基线。 附录:完整代码 09 节用到的脚本全文如下(cache_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 cache_demo.py """Deterministic residual-cache toy; Python 3.10+, pip install numpy matplotlib. Run: python cache_demo.py No trained diffusion weights; cost ratios below are accounting assumptions. """ from pathlib import Path import json import platform import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt STEPS = 40 SHAPE = (1, 4, 16) SEED = 7 rng = np.random.default_rng(SEED) X0 = rng.normal(size=SHAPE).astype(np.float64) W = rng.normal(size=(16, 16)) / 8.0 V = rng.normal(size=(16, 16)) / 8.0 def cheap_input(x, t): return x + 0.05 * np.sin(2 * np.pi * t) def proxy(h, t): return h * (1 + 0.3 * np.sin(2 * np.pi * t)) + 0.1 * np.cos(2 * np.pi * t) def residual(h, t): z = h for _ in range(4): z = np.tanh(z @ W) return 0.15 * h + 0.4 * (z @ V) + 0.08 * np.sin(6 * np.pi * t) def simulate(threshold=None, period=None): x = X0.copy() previous_proxy = None saved_residual = None budget = 0.0 refreshed, local_errors = [], [] for i in range(STEPS): t = 1.0 - i / (STEPS - 1) h = cheap_input(x, t) m = proxy(h, t) change = 0.0 if previous_proxy is None else float( np.mean(np.abs(m - previous_proxy)) / max(np.mean(np.abs(previous_proxy)), 1e-12)) budget += max(change, 0.0) boundary = i in (0, STEPS - 1) if threshold is None and period is None: calculate = True elif period is not None: calculate = boundary or i % period == 0 else: calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual # Offline diagnostic only; extra evaluation is excluded from work accounting. exact = h + residual(h, t) local_errors.append(float(np.linalg.norm(output - exact))) refreshed.append(bool(calculate)) previous_proxy = m.copy() x = x - output / STEPS return {"x": x, "refreshed": refreshed, "local_errors": local_errors} def experiment(): baseline = simulate() rows = [] results = [] settings = [("exact", None, None), ("adaptive_0.08", 0.08, None), ("adaptive_0.16", 0.16, None), ("adaptive_0.32", 0.32, None), ("uniform_4", None, 4)] for name, threshold, period in settings: result = simulate(threshold, period) calls = sum(result["refreshed"]) relative_error = float(np.linalg.norm(result["x"] - baseline["x"]) / np.linalg.norm(baseline["x"])) # Full call = 1 unit; cache hit = 0.08 unit, solely for illustration. assumed_work = calls + (STEPS - calls) * 0.08 rows.append({"name": name, "full_calls": calls, "hits": STEPS - calls, "relative_endpoint_error": relative_error, "assumed_speed_ratio": STEPS / assumed_work, "refresh_indices": [i for i, flag in enumerate(result["refreshed"]) if flag]}) results.append(result) zero = simulate(threshold=0.0) assert np.array_equal(zero["x"], baseline["x"]) assert sum(zero["refreshed"]) == STEPS assert all(r["refreshed"][0] and r["refreshed"][-1] for r in results) assert np.array_equal(simulate(threshold=0.16)["x"], results[2]["x"]) assert all(np.isfinite(r["x"]).all() for r in results) return rows, results, baseline def make_figure(rows, results, destination): fig, axes = plt.subplots(2, 1, figsize=(11, 7), constrained_layout=True) colors = ["#2563eb", "#ea580c", "#16a34a", "#dc2626", "#9333ea"] for y, (row, result) in enumerate(zip(rows, results)): idx = np.flatnonzero(result["refreshed"]) axes[0].scatter(idx, np.full(len(idx), y), marker="s", s=38, color=colors[y]) axes[0].set_yticks(range(len(rows)), [r["name"] for r in rows]) axes[0].set_xlim(-1, STEPS) axes[0].set_xlabel("Sampling call index (0-based)") axes[0].set_title("Squares = full residual computation; gaps = cache reuse") for y, (row, result) in enumerate(zip(rows[1:], results[1:]), start=1): axes[1].plot(result["local_errors"], label=row["name"], linewidth=1.7, color=colors[y]) axes[1].set_xlabel("Sampling call index (0-based)") axes[1].set_ylabel("Local output L2 error") axes[1].set_title("Offline diagnostics on each cached trajectory; no quality metric") axes[1].legend(ncol=2, fontsize=9) axes[1].grid(alpha=0.25) fig.suptitle("Residual caching: refresh decisions and approximation error", fontsize=14) fig.savefig(destination, dpi=150) plt.close(fig) if __name__ == "__main__": rows, results, baseline = experiment() folder = Path(__file__).resolve().parent.parent (folder / "figures").mkdir(parents=True, exist_ok=True) make_figure(rows, results, folder / "figures" / "cache_schedule.png") record = {"seed": SEED, "steps": STEPS, "shape": list(SHAPE), "python": platform.python_version(), "numpy": np.__version__, "baseline_min": float(baseline["x"].min()), "baseline_max": float(baseline["x"].max()), "results": rows, "assertions": "zero-threshold exactness, endpoints, request reset, finite outputs passed"} (folder / "experiment_results.json").write_text( json.dumps(record, ensure_ascii=False, indent=2) + "\n", encoding="utf-8") print(f"shape={SHAPE}, steps={STEPS}, seed={SEED}") print(f"baseline_range=[{record['baseline_min']:.6f}, {record['baseline_max']:.6f}]") print("name full_calls hits endpoint_relative_error assumed_speed_ratio") for row in rows: print(f"{row['name']} {row['full_calls']} {row['hits']} " f"{row['relative_endpoint_error']:.6f} {row['assumed_speed_ratio']:.3f}") print("All assertions passed; figure=figures/cache_schedule.png")
-
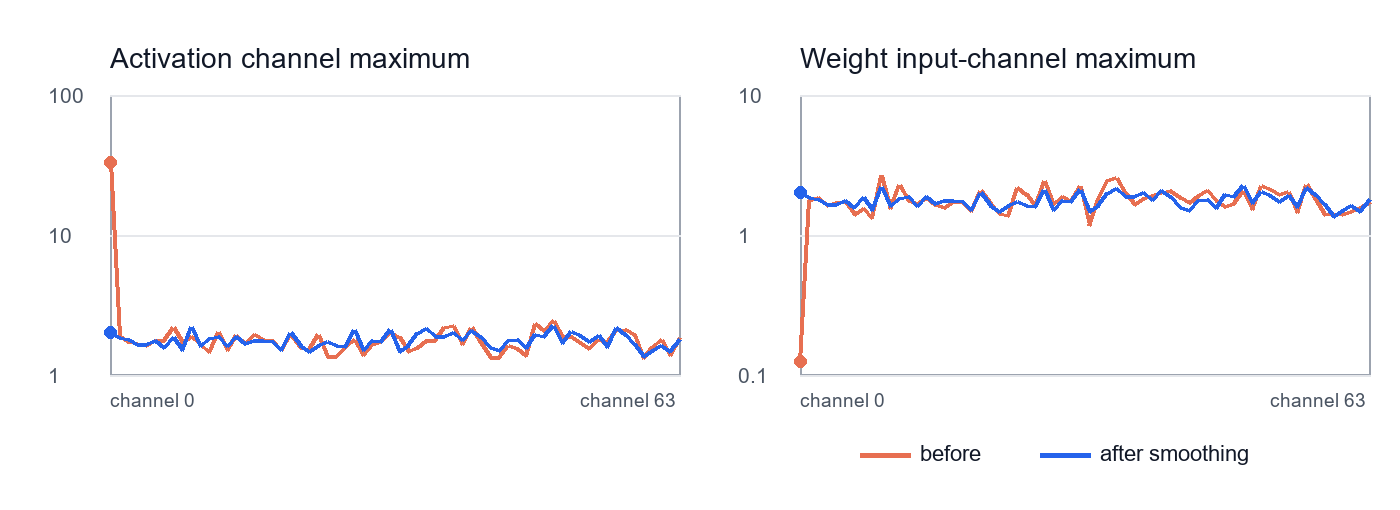
AIGC 基本功|量化:从 INT8 到 FP4-Quant 量化:从 INT8 到 FP4 所属方向:推理加速与部署 | 难度:工程实战 | 前置知识:混合精度与数值稳定性、性能建模与 Profiling 关键词:INT8、W8A8、INT4、W4A16、SmoothQuant、AWQ、NVFP4、校准、离群值、分组缩放 01. 为什么需要它 设想一个视频生成服务:DiT 的线性层权重很大,单次生成又要反复经过这些层。团队把 BF16 权重直接换成 4 bit 文件,磁盘占用马上下降;上线后却发现小 batch 时并没有按 4 倍提速,字幕边缘还出现抖动。问题不在于「4 bit 失效」,而是把存储位宽、矩阵乘法位宽、缩放元数据、反量化成本和生成质量混成了同一个数字。若运行时先把 4 bit 权重解回 BF16 再调用普通 GEMM,压缩带来的只是存储或部分读带宽收益;若没有匹配硬件和内核,也不会凭空得到 FP4 算力。 再看一个可复现的小实验:附录的 quant_demo.py 生成 64 维输入,其中第 0 个通道有显著离群值。普通 W8A8 在留出的 64 条输入上的输出均方误差是 0.222085;做一次数学上严格等价的 SmoothQuant 式通道变换后,误差变成 0.001384。这两个数来自本机实际运行,不是论文模型的评测分数。它说明一个关键事实:量化前的浮点函数完全相同,量化后的误差却能相差很大。要读懂 INT8、AWQ 或 FP4 的论文,先要分清误差落在什么张量、哪个通道,以及内核真正执行了什么。 本文用一条线串起这些问题:先推整数映射与输出误差,再拆 SmoothQuant 如何搬走激活离群值、AWQ 如何保护重要权重,最后解释 NVFP4 为什么需要按块缩放。所有示例都在 CPU 上跑,不依赖模型权重;它们验证机制,不声称复现生产吞吐或画质。 02. 最小可用理解 第一句:量化把连续值映到少数离散码字;位数越少,步长或裁剪误差通常越大,实际误差还取决于缩放粒度和数据分布。第二句:SmoothQuant 面向 W8A8,把难量化的激活通道缩小、相应权重通道放大,使原始浮点线性层保持等价;AWQ 面向权重低比特,用激活统计找重要通道,并搜索权重缩放以减小输出误差。第三句:INT4 与 FP4 只是数字格式,真正的速度由硬件支持、打包布局、反量化位置、batch 和带宽瓶颈共同决定。 这里统一写线性层为 $Y=XW$:$X$ 是形状 $[T,K]$ 的输入激活,$W$ 是 $[K,N]$ 的权重,$Y$ 是 $[T,N]$ 的输出;$T$ 可理解为当前批的 token 数,$K$ 是输入通道,$N$ 是输出通道。真实视频 DiT 的 $T$ 可能包含时间与空间 patch,且随分辨率、帧数、去噪步变化。下文的校准统计只能代表采样过的条件分布,不能自动外推到所有视频场景。 因此,阅读任何“压到 4 bit 后提速”的结论时,先追问四件事:原始精度是什么、量化了权重还是激活、scale 按什么粒度共享、测试时是否调用了对应硬件的低比特内核。若论文只给模型文件大小与单项质量分数,就还不足以判断生产服务的成本收益。 03. 数学推导 3.1 从实数到整数:误差在哪里出现 给一组实数选择步长 $\Delta>0$ 与零点 $z$。一般的仿射量化写成一行: $$q=\operatorname{clip}\bigl(\operatorname{round}(x/\Delta)+z,\ q_{\min},q_{\max}\bigr),\qquad \hat x=\Delta(q-z)$$ $q$ 是存储的整数码字,$\hat x$ 是反量化后参与近似计算的值;$q_{\min},q_{\max}$ 是格式允许的最小、最大整数。对本文 W8A8 实验的对称 INT8,取 $z=0$、范围 $[-127,127]$、$\Delta=\max|x|/127$。没有裁剪且落在舍入区间内时,单个值的绝对误差不超过 $\Delta/2$;超出校准范围被截断后,这个上界不再成立。全张量共用一个步长时,一个大离群值会把 $\Delta$ 拉大,使大多数小值在相邻码字间跳得更粗。按通道或按组各给一个步长能局部化这种损失,但要保存更多缩放因子,并且内核未必支持同样快的计算路径。 线性层两边都有量化误差时,令 $\hat X=X+E_X$、$\hat W=W+E_W$。直接展开,而不是笼统说「精度下降」: $$\hat Y-Y=(X+E_X)(W+E_W)-XW=E_XW+XE_W+E_XE_W$$ 第一项是激活误差被权重放大,第二项是权重误差被输入激活放大,第三项是二者相乘。W8A8 三项都有;W4A16 的激活通常仍用高精度,主要关心第二项。即使某个权重元素误差很小,只要它对应的输入通道经常很大,也可能显著改变输出。这解释了为什么不能只用权重自身的 MSE 判断生成模型是否安全。 为了把“一个离群值拖累整组”算到具体数字,假设 127 级对称量化器要同时覆盖一个大小 20 的值与许多大小约 0.1 的值。若整个张量共用尺度,步长约为 $20/127=0.1575$;一个 0.1 会被舍入到 1 个码字,反量化约 0.1575,误差约 0.0575。假如该张量的最大幅度只有 1,步长便约为 $1/127=0.00787$,0.1 反量化约 0.1024,误差约 0.0024。两种情形都只用 8 bit,差别来自谁和谁共享 scale。实际矩阵乘还要把这些单点误差乘上权重并求和,因此不能只拿这个标量例子推最终 MSE,但它解释了为什么先观察通道直方图比直接改位宽更有用。 校准也有两层口径。静态量化先用代表性输入估计范围,推理时直接复用 scale;如果后来出现更大的输入,就有裁剪风险。动态量化可按当前 token 或当前批重新估计激活范围,减轻分布漂移,却要在运行时付出求最大值、计算 scale 和可能的同步成本。权重通常固定,离线按输出通道或按组量化较容易;激活每次都变,统计粒度过细会增加内核复杂度。本文故意采用校准集估计的静态全张量激活 scale,让离群问题足够清晰;它不是宣称这种设置在所有线上服务中最佳。 3.2 SmoothQuant:把离群值迁移到更好量化的一侧 取一个所有元素都为正的通道缩放向量 $s\in\mathbb R^K$,令 $D=\operatorname{diag}(s)$。在量化前做: $$X^{\prime}=XD^{-1},\qquad W^{\prime}=DW,\qquad X^{\prime}W^{\prime}=XD^{-1}DW=XW$$ 等号最后一步只用到 $D^{-1}D=I$,所以浮点层完全等价。第 $j$ 个激活通道除以 $s_j$,权重的第 $j$ 个输入通道乘以 $s_j$。如果异常大的激活集中在少数通道,选较大的 $s_j$ 就能把它们压下去;代价是相应权重幅度变大。SmoothQuant 论文的核心判断是:在其研究的 LLM 线性层中,权重一侧通常比激活一侧容易承受这种量化难度。它并非数学定理,具体模型仍要测。 记校准输入第 $j$ 通道的绝对最大值为 $a_j$,权重第 $j$ 个输入通道的绝对最大值为 $b_j$,SmoothQuant 的一种尺度选择是: $$s_j=\frac{a_j^{\alpha}}{b_j^{1-\alpha}},\qquad 0\le\alpha\le1$$ $a_j$ 和 $b_j$ 都要设正下界以免全零通道除零。$\alpha$ 控制把多少难度从激活侧搬往权重侧;本文实验固定 $\alpha=0.5$,不是所有模型的默认最优值。生产实现还要把 $1/s_j$ 融入前一层归一化的参数,避免推理时额外插一个逐元素除法。等价变换只保证未量化的 $XW$ 不变,不保证量化输出相同,这正是需要校准和误差测量的原因。 图 1:纵轴为绝对最大值的对数刻度,横轴为输入通道。橙色是原始值,蓝色是等价变换后。第 0 通道的激活离群值向权重侧迁移;这是一组程序构造的数据,不是任何论文模型的实测激活分布。 3.3 AWQ:为何要看激活,而不只看权重 若只量化权重,输出误差近似为 $XE_W$。对留出的输入矩阵平方求和,可写成: $$\|XE_W\|_F^2=\operatorname{tr}\bigl(E_W^{\mathsf T}X^{\mathsf T}XE_W\bigr)$$ $\|\cdot\|_F$ 是把所有元素平方后求和再开根号,$X^{\mathsf T}X$ 编码各输入通道的能量与相关性。若暂时忽略通道间相关性,式子近似为各通道「输入能量 × 对应权重误差能量」之和: $$\|XE_W\|_F^2\approx\sum_{j=1}^{K}\|X_{:j}\|_2^2\|E_{W,j:}\|_2^2$$ 所以「权重数值小」不等于「量化它不重要」:如果 $X_{:j}$ 经常大,该通道的权重误差就会被放大。AWQ 论文据此用激活统计找显著权重通道,采用等价缩放和校准误差搜索,而不是把少数通道改成混合精度来增加内核复杂度。其论文报告保护约 1% 显著权重即可明显降低量化误差;这属于论文实验结果,不能直接当成任何 DiT 的固定比例。 我们的教学版对每个输出通道的权重按 32 个输入元素成组做非对称 INT4 伪量化:组内用最小值和最大值求 $\Delta=(\max-\min)/15$,零点把实数零映到 $[0,15]$ 的整数区间。再用激活平均幅度构造 $s_j$,扫 20 个候选指数,在校准输入上找最小输出 MSE。这样抓住了「激活统计 + 缩放搜索 + 分组权重量化」的骨架;它没有 AWQ 的完整模型层搜索、真实 W4A16 内核或端到端精度验证,因此代码称为 awq_toy。 3.4 FP4 不等于把 INT4 改个名字 INT4 通常按整数码字加组缩放与零点解释;FP4 的码字本身有符号、指数和尾数。NVIDIA 的 NVFP4 文档把单个数据码字定义为 E2M1:1 个符号位、2 个指数位、1 个尾数位,再乘以每 16 个元素一组的 FP8 E4M3 局部缩放和一个 FP32 全局缩放。因此真实值不是一个孤立的 4 bit 码字,而是: $$x_{\mathrm{recon}}=x_{\mathrm{E2M1}}\,s_{\mathrm{block}}\,s_{\mathrm{global}}$$ 只数存储位数,忽略对齐和打包时,长度为 $L$ 的张量平均每元素约用 $4+8/16+32/L$ bit:大张量趋近 4.5 bit/元素,相对 16 bit 的 BF16 理想压缩比约 $16/4.5=3.56$,而不是整齐的 4 倍。实际实现还受 padding、布局和额外元数据影响。我们的 e2m1_toy 用最近邻 E2M1 可表示值和精确的浮点块缩放说明概念,没有模拟 FP8 缩放舍入、全局缩放、硬件矩阵乘法或 NVFP4 的完整训练配方,不能用它的误差预测真实 NVFP4 模型质量。 分组大小还有一笔容易被省略的元数据账。假设某种 INT4 实现对每 32 个权重同时保存一个 16 bit scale 和一个 16 bit zero point,理想平均是 $4+(16+16)/32=5$ bit/权重,相对 BF16 的理论压缩比是 $16/5=3.2$。若每组 128 个权重,在同一假设下是 $4.25$ bit/权重、约 $3.76$ 倍。这里的数字只是指定元数据布局后的算术示例;AWQ 不同内核可能把零点、scale 以其他精度或打包方式存放,padding 也会改变实际占用。组变小往往改善局部拟合,却可能增加元数据带宽和内核约束。因此选组大小时,至少同时报告量化后的实际显存、输出质量和目标设备延迟,而不能只报告“4 bit”。 还要区分权重量化与激活量化的计算链。W4A16 常见路径保留较高精度激活,只压缩权重;W8A8 则要求两侧都进入 8 bit 路径,整数累加再按 scale 还原。前者通常能让权重读取变轻,却不自动让激活流量变小;后者更可能用 INT8 矩阵乘硬件,但激活离群问题也更直接。训练中的 FP4、推理中的 FP4、权重专用 INT4 同样不能只按“都是四位”合并对比,它们量化统计、可接受误差和内核目标都不同。 3.5 再把性能账接回来 设原权重数为 $KN$。BF16 仅权重约 $2KN$ 字节,裸 INT8 约 $KN$ 字节,裸 4 bit 约 $KN/2$ 字节;后两者还要加各自的缩放、零点及对齐开销。这是容量账。速度账要写成性能建模那篇的下界: $$T\ge\max(F/P,\ D/B)$$ $F$ 是内核运算量,$P$ 是该硬件上该精度路径的有效算力,$D$ 是实际搬运字节,$B$ 是有效带宽。若小 batch 解码反复读大权重,压缩 $D$ 可能有效;若 prefill 的矩阵乘已受算力限制,就要有真正的 INT8 或 FP4 计算内核才可能受益。若先把低比特权重展开回 BF16,反量化、临时缓冲和 kernel launch 也要入账。低比特文件大小、显存占用、单次延迟和吞吐量是四个不同的观测量,必须分别报告。 04. 代码实现 完整可运行的 quant_demo.py 和 make_figures.py 放在文末附录。只需 Python、NumPy、Pillow;没有模型权重、CUDA 或外部数据下载。固定随机种子 7,前 192 条输入作校准,后 64 条作评估,避免直接拿选择缩放的样本当成绩。张量形状是 $X_{\text{cal}}\in\mathbb R^{192\times64}$、$X_{\text{eval}}\in\mathbb R^{64\times64}$、$W\in\mathbb R^{64\times32}$。第 0 激活通道被人为放大,相应权重通道被缩小;这是为了把问题放到显微镜下,不代表真实模型普遍这样分布。 最核心的四行与 3.2 节逐项对应:s 是公式的 $s$,x_s 是 $XD^{-1}$,w_s 是 $DW$。先用未量化的矩阵乘核对代数等价,再分别走 INT8 路径: s = smooth_scales(x_cal, w, alpha=0.5) x_s, w_s = x_eval / s, w * s[:, None] assert np.allclose(x_eval @ w, x_s @ w_s) after = int8_matmul(x_cal / s, x_s, w_s) int8_matmul 把评估输入量化成整数、权重量化成整数,真正用 int32 矩阵乘累加,然后按激活和每输出通道的权重步长反量化。它没有调用真实 GPU INT8 Tensor Core,所以这里只能谈数值误差,不能谈运行速度。AWQ 教学路径也故意返回反量化浮点权重以便检查输出;若要测 W4A16 吞吐,必须换成真实打包内核。 本次在项目 Python 3.11 + NumPy 上执行 python outputs/fundamentals_files/quantization/code/quant_demo.py 的原始输出如下,MSE 均针对同一个留出集的浮点 $XW$;relative 是 MSE 除以该输出的均方值: X_cal (192, 64) X_eval (64, 64) W (64, 32) Smooth alpha=0.50, s[0]=16.2463, median(s)=0.9942 equivalent transform max_abs_error=3.553e-15 int8_before MSE=0.222085 relative=0.015861 int8_after MSE=0.001384 relative=0.000099 int4_plain MSE=0.492117 relative=0.035146 int4_awq MSE=0.089772 relative=0.006411 fp4_toy MSE=0.335760 relative=0.023979 AWQ toy alpha=0.95 calibration_MSE=0.091065 第一个可检验的结论是等价变换在浮点下只剩 $3.553\times10^{-15}$ 的舍入差。第二个是这组构造数据里 SmoothQuant 式迁移降低了 W8A8 的输出误差。第三个是 AWQ 教学搜索把 INT4 权重量化的留出集误差从 0.492117 降到 0.089772;选择指数 0.95 只是这批构造样本上的选择。fp4_toy 的 0.335760 不能与前三者直接排模型名次:它的缩放编码与计算路径不同,而且没有真实 FP8 scale 舍入。图 1 由同一组数组生成,因此数值与图是可追溯的一套实验。 05. 工业级实现对照 SmoothQuant 的工业细节在「把除法折进上一层」。 作者公开实现的 smooth_ln_fcs 先从校准激活和多个相邻线性层的权重求通道尺度,再对 LayerNorm 的 weight、bias 除以尺度,并对后续线性层的相应输入权重乘以尺度。多个 Q/K/V 投影可能共享上一层归一化,不能各自随意选一套不一致的缩放。本文代码直接显式写 x/s,便于看清代数关系;真正部署需确认融合位置、归一化类型与残差分支,不能机械把所有线性层都改一遍。链接以该仓库所示 commit 为准。 AWQ 的工程路径比教学版多了布局与搜索。 作者 pseudo_quantize_tensor 接受位宽、零点与组大小,把权重按末维分组,计算每组 min/max、scale、zero,再舍入裁剪;auto_scale_block 用校准输入取模块原输出、扫 20 个尺度候选并比较输出 MSE。本文的 int4_groups 与 awq_toy 只复现这两个可解释步骤。生产还要选择组大小、权重打包顺序、激活精度、融合反量化的 GEMM,以及对 tokenizer、任务和模态有代表性的校准数据。伪量化权重占用浮点内存,不能拿它冒充真实 4 bit 显存占用。 NVFP4 则是格式与硬件共同定义的方案。 NVIDIA Transformer Engine 文档 明确写出 E2M1 码字、16 元素 FP8 局部缩放和 FP32 全局缩放,也讨论训练时缩放与舍入细节。这与 AWQ 的非对称 INT4 零点方案不同。若在 Blackwell 以外的设备上模拟 E2M1,再调用普通 BF16 GEMM,只是在研究量化误差;没有证据证明获得 NVFP4 Tensor Core 吞吐。对视频 DiT,还应分别统计文本投影、注意力、MLP、VAE 与不同去噪时刻的敏感度,而不是用一个 LLM 基准替代画质验收。 5.1 把这套办法移到视频 DiT 时怎么验 先在模型推理图中列出每个线性层的输入形状、权重字节、调用次数与实测耗时,按去噪步、分辨率和 batch 分桶。一个只调用一次的小投影层即使压到 4 bit,也不如在每一步反复运行的大 MLP 值得优先优化。随后对候选层采样真实生成输入:文本条件、无条件分支、不同帧长和空间分辨率、去噪早中晚步都应覆盖。统计每个输入通道的最大值、分位数及其随条件变化的范围,再决定是对称、非对称、按通道还是按组,而不是从 LLM 的一套 scale 直接复制过来。 然后做逐层替换实验:固定随机种子,只量化一组层,记录该层输出误差、整网中间特征差、生成结果与延迟。若数值误差集中在少数层,可保留这些层为 BF16,其他层继续压缩;但必须把混合精度带来的格式转换也计入耗时。对视频尤其要检查相邻帧的纹理闪烁和文字稳定性,因为单帧指标可能掩盖时间不一致。最后把“模型文件大小、峰值显存、单次生成时延、吞吐、质量”五列并排记录,并列出硬件型号、内核版本和量化格式。这样才能判断收益来自低位宽计算、权重少读、还是单纯把模型装进了原先放不下的卡。 本文的 CPU 脚本只覆盖上述流程的数值诊断第一步,不覆盖真实 DiT 校准、低比特 kernel 或视频验收。这一边界并非小字备注:若读者要据此选择线上格式,必须在实际模型和实际设备上补完后续测量。 06. 代价与边界 精度代价首先来自动态范围:静态校准没见过的 prompt、分辨率或高运动视频,可能把激活推过已选范围,产生裁剪而非普通舍入误差。多步扩散还会把每一步的小偏差沿采样轨迹累积。本文的线性层输出 MSE 只能当局部诊断;最终还需在固定种子和足够多提示词上比较画面结构、文本可读性、时间一致性与人评,不能把 MSE 下降直接翻译成 VBench 上升。 系统代价是尺度与布局。按张量一个 scale 便宜却易被离群值支配;按通道、按组或按 16 元素块能更细地适应分布,但多了元数据、打包、反量化与特定内核限制。对容量,要记 weights + scales + zeros + padding + workspace;对延迟,要测 prefill、单步 decode、小 batch 和大 batch。生产图中若有不支持低比特的算子导致来回格式转换,转换成本可能抵掉 GEMM 收益。 方法边界也不同。SmoothQuant 的迁移假设权重能承受放大,且前后层可安全折叠;AWQ 搜索的是给定校准集、给定位宽和组大小的局部误差,不能保证分布外质量;FP4 的动态范围和非均匀码字不等同于 INT4,不能把一个格式的超参数照搬到另一个。没有兼容内核时,先考虑稳定的 BF16/FP16 路径或更保守的 INT8。对已经被算力、launch 或跨卡通信限制的工作负载,权重文件变小也可能几乎不缩短时间。 一个容易漏掉的验收维度是误差的结构。同样的总体 MSE,误差若集中在少数文本 token、眼睛边缘或连续帧的同一位置,主观影响可能远大于均匀噪声。因此可把误差按层、通道、去噪时刻和内容类型拆开画分布,并检查最大误差与高分位数,而非只看全局平均。对生成视频,建议把原始模型与量化模型用相同 prompt、相同随机种子逐对比较;除整体指标外,抽查运动边界、物体身份、OCR 文本、暗部纹理和高频闪烁。若只是量化器的局部输出误差变小,却没有带来终端质量改善,也应如实报告“局部数值改善,端到端效果未证实”。这种分层验收也能告诉工程师应该先恢复哪一层的精度,而不必把整网退回 BF16。 07. 经典论文脉络 Jacob 等,Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,CVPR 2018 / arXiv:1712.05877:把 scale、zero point 与整数推理串成可部署的量化路径,是理解本文 3.1 节映射的起点;它的主要实验对象是移动端视觉网络。 Xiao 等,SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,arXiv:2211.10438:指出 LLM 激活离群值阻碍 W8A8,通过等价通道变换把难度迁到权重侧,目标是同时量化权重与激活。 Frantar 等,GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,arXiv:2210.17323:走权重低比特的另一条路,用近似二阶信息做一次性量化与误差补偿;它说明 INT4 不是只能靠逐元素四舍五入。 Lin 等,AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,arXiv:2306.00978:把激活统计用于识别重要权重,并通过等价缩放保护输出;与 SmoothQuant 都用通道缩放,但目标分别是权重低比特和 W8A8,不能混为一篇算法。 从这四篇再看 NVFP4 格式文档,会发现研究问题已经从「如何挑量化码字」延伸到「硬件支持哪种码字、块尺度和矩阵布局」。本文关于 NVFP4 的字段与块大小以该官方文档为准;本文没有把它列作四篇论文之一。 08. 常见误解 误解一:INT4 一定比 INT8 快两倍。 4 bit 只说明每个裸权重码字更短。若内核先展开、如果 GEMM 已受算力限制、若尺度加载很重,延迟可能没有相应收益。必须在目标 GPU 上测端到端而非只量文件大小。 误解二:SmoothQuant 把模型函数改好了,所以精度一定升。 它在浮点下是等价的;被改善或恶化的是后续量化误差。不同层、不同 $\alpha$、不同校准集都可能改变结论。本文的 160 倍左右 MSE 改善来自特意制造的离群通道,不是通用倍率。 误解三:AWQ 只看权重最大值。 3.3 节说明输出误差被输入放大。官方搜索用校准激活和模块输出误差,不是简单挑最大的权重元素。本文虽然也使用权重分组 min/max,但那是码字映射,不是重要性判据。 误解四:FP4 就是 INT4 加一个不同的 scale。 E2M1 的码字间隔非均匀,NVFP4 还有 16 元素局部 FP8 scale 与全局 scale。即使两个方案都写「4 bit」,误差形态、元数据和硬件路径也不同。 误解五:单层 MSE 合格,视频质量便合格。 视频生成的时间一致性、字符与细节可能对少数层或特定步数敏感;线性层 MSE 只帮助定位,应继续做固定种子的视频样例、人评和任务指标核验。 09. 动手验证 把附录两段代码分别保存为 quant_demo.py 和 make_figures.py,放在同一目录,安装 numpy 与 Pillow 后运行: python quant_demo.py python make_figures.py 图会写到上一级 figures/smooth_migration.png。先确认 equivalent transform max_abs_error 接近零,再把 case() 里的 x[:, 0] *= 20.0 改为 *= 1.0 重跑:离群值消失后,普通 INT8 与 SmoothQuant 的误差差距应明显缩小,但具体数值以你的实跑结果为准。第二个实验把 awq_toy 中的候选指数固定为 0,观察 int4_awq 是否退化到 int4_plain 附近;这对应“不使用激活引导缩放”的基线。第三个实验把分组大小从 32 改成 16 或 64,注意 int4_groups 要同步修改调用处,比较输出 MSE 与理论元数据开销:更细的组通常更能适应局部分布,但真实内核性能仍需另测。 10. 延伸阅读 若不清楚 BF16、FP16 与 FP8 的表示范围,先读混合精度与数值稳定性;若想判断量化后为何没提速,回看性能建模与 Profiling的带宽、算力与容量账;若关心自回归生成的权重带宽之外还有哪些显存项,接着读KV Cache 与自回归视频生成。下一步面对实际视频 DiT,应把本文的输出误差实验移到真实层、真实校准集和多个去噪时刻,再用质量指标与人评决定哪些层保留高精度。 附录:完整代码 09 节用到的脚本全文如下(quant_demo.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 quant_demo.py """Minimal CPU quantization experiment. Requires numpy; run: python quant_demo.py.""" import numpy as np def case(): rng = np.random.default_rng(7) x = rng.normal(0, 0.6, (256, 64)) x[:, 0] *= 20.0 w = rng.normal(0, 0.8, (64, 32)) w[0, :] *= 0.08 return x[:192], x[192:], w def mse(y, y_hat): return float(np.mean((y - y_hat) ** 2)) def smooth_scales(x_cal, w, alpha=0.5): a = np.maximum(np.max(np.abs(x_cal), axis=0), 1e-8) b = np.maximum(np.max(np.abs(w), axis=1), 1e-8) return a**alpha / b**(1.0 - alpha) def int8_matmul(x_cal, x_eval, w): # Static per-tensor activation scale, per-output-channel weight scales. sx = max(float(np.max(np.abs(x_cal))) / 127.0, 1e-8) sw = np.maximum(np.max(np.abs(w), axis=0) / 127.0, 1e-8) qx = np.clip(np.rint(x_eval / sx), -127, 127).astype(np.int32) qw = np.clip(np.rint(w / sw), -127, 127).astype(np.int32) return (qx @ qw).astype(np.float64) * sx * sw def int4_groups(w, group=32): # W is [input, output]; each output row is split across input groups. out_dim = w.shape[1] rows = w.T.reshape(-1, group) lo = rows.min(axis=1, keepdims=True) hi = rows.max(axis=1, keepdims=True) scale = np.maximum((hi - lo) / 15.0, 1e-8) zero = np.clip(np.rint(-lo / scale), 0, 15) q = np.clip(np.rint(rows / scale) + zero, 0, 15) return ((q - zero) * scale).reshape(out_dim, -1).T def awq_toy(x_cal, w): # Search a channel scale using calibration output error, as in AWQ's idea. importance = np.maximum(np.mean(np.abs(x_cal), axis=0), 1e-8) target = x_cal @ w trials = [] for alpha in np.linspace(0.0, 0.95, 20): s = importance**alpha s /= np.sqrt(s.max() * s.min()) w_hat = int4_groups(w * s[:, None]) / s[:, None] trials.append((mse(target, x_cal @ w_hat), float(alpha), w_hat)) return min(trials, key=lambda row: row[0]) def e2m1_toy(w, block=16): # Nearest E2M1 value with exact float64 block scale; NOT NVFP4 encoding. levels = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 6.0]) out_dim = w.shape[1] rows = w.T.reshape(-1, block) scale = np.maximum(np.max(np.abs(rows), axis=1, keepdims=True) / 6.0, 1e-8) normalized = np.abs(rows) / scale idx = np.abs(normalized[..., None] - levels).argmin(axis=-1) return (np.sign(rows) * levels[idx] * scale).reshape(out_dim, -1).T def results(): x_cal, x_eval, w = case() y = x_eval @ w s = smooth_scales(x_cal, w) x_s, w_s = x_eval / s, w * s[:, None] before = int8_matmul(x_cal, x_eval, w) after = int8_matmul(x_cal / s, x_s, w_s) awq_cal_error, awq_alpha, w_awq = awq_toy(x_cal, w) w_int4 = int4_groups(w) w_fp4 = e2m1_toy(w) return { "x_cal": x_cal, "x_eval": x_eval, "w": w, "s": s, "x_s": x_s, "w_s": w_s, "exact_error": float(np.max(np.abs(y - x_s @ w_s))), "int8_before": mse(y, before), "int8_after": mse(y, after), "int4_plain": mse(y, x_eval @ w_int4), "int4_awq": mse(y, x_eval @ w_awq), "awq_alpha": awq_alpha, "awq_cal_error": awq_cal_error, "fp4_toy": mse(y, x_eval @ w_fp4), "signal": float(np.mean(y**2)), } def main(): r = results() print("X_cal", r["x_cal"].shape, "X_eval", r["x_eval"].shape, "W", r["w"].shape) print("Smooth alpha=0.50, s[0]=%.4f, median(s)=%.4f" % (r["s"][0], np.median(r["s"]))) print("equivalent transform max_abs_error=%.3e" % r["exact_error"]) for name in ("int8_before", "int8_after", "int4_plain", "int4_awq", "fp4_toy"): print("%s MSE=%.6f relative=%.6f" % (name, r[name], r[name] / r["signal"])) print("AWQ toy alpha=%.2f calibration_MSE=%.6f" % (r["awq_alpha"], r["awq_cal_error"])) if __name__ == "__main__": main() make_figures.py """Draw a two-panel SmoothQuant diagram. Requires numpy and Pillow.""" from pathlib import Path import numpy as np from PIL import Image, ImageDraw, ImageFont from quant_demo import case, smooth_scales def font(size): path = Path("C:/Windows/Fonts/arial.ttf") return ImageFont.truetype(str(path), size) if path.exists() else ImageFont.load_default() def panel(draw, left, title, before, after): top, width, height = 95, 570, 280 lo = min(float(before.min()), float(after.min())) hi = max(float(before.max()), float(after.max())) low, high = np.floor(np.log10(lo)), np.ceil(np.log10(hi)) draw.rectangle((left, top, left + width, top + height), outline="#9ca3af", width=2) for power in range(int(low), int(high) + 1): value = 10.0**power y = top + height - (power - low) / (high - low) * height draw.line((left, y, left + width, y), fill="#e5e7eb", width=2) draw.text((left - 62, y - 12), f"{value:g}", fill="#4b5563", font=font(21)) draw.text((left, 42), title, fill="#111827", font=font(28)) for values, color in ((before, "#e76f51"), (after, "#2563eb")): points = [] for i, val in enumerate(values): x = left + i / (len(values) - 1) * width y = top + height - (np.log10(val) - low) / (high - low) * height points.append((float(x), float(y))) draw.line(points, fill=color, width=4) draw.ellipse((points[0][0] - 6, points[0][1] - 6, points[0][0] + 6, points[0][1] + 6), fill=color) draw.text((left, top + height + 14), "channel 0", fill="#4b5563", font=font(19)) draw.text((left + width - 100, top + height + 14), "channel 63", fill="#4b5563", font=font(19)) def main(): x_cal, _, w = case() s = smooth_scales(x_cal, w) before_x = np.max(np.abs(x_cal), axis=0) after_x = np.max(np.abs(x_cal / s), axis=0) before_w = np.max(np.abs(w), axis=1) after_w = np.max(np.abs(w * s[:, None]), axis=1) canvas = Image.new("RGB", (1400, 510), "#ffffff") draw = ImageDraw.Draw(canvas) panel(draw, 110, "Activation channel maximum", before_x, after_x) panel(draw, 800, "Weight input-channel maximum", before_w, after_w) draw.line((860, 455, 910, 455), fill="#e76f51", width=5) draw.text((920, 441), "before", fill="#111827", font=font(22)) draw.line((1040, 455, 1090, 455), fill="#2563eb", width=5) draw.text((1100, 441), "after smoothing", fill="#111827", font=font(22)) out = Path(__file__).resolve().parent.parent / "figures" / "smooth_migration.png" out.parent.mkdir(parents=True, exist_ok=True) canvas.save(out) print("saved", out, "bytes", out.stat().st_size) if __name__ == "__main__": main()
-
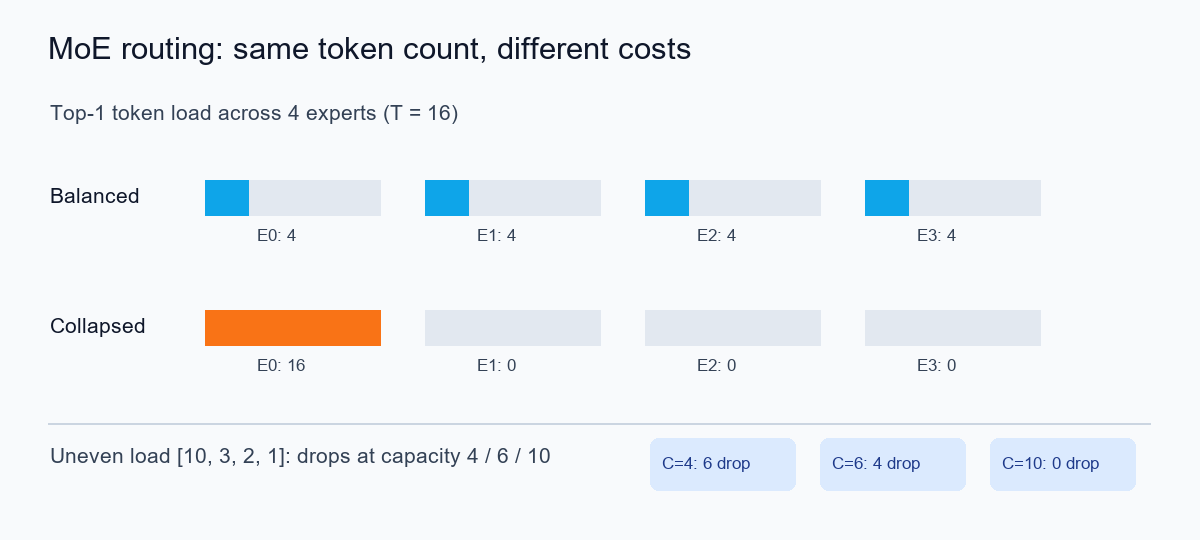
AIGC 基本功|混合专家 MoE:稀疏激活怎么省算力-MoE 混合专家 MoE:稀疏激活怎么省算力 所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本 关键词:MoE、稀疏激活、专家路由、top-k、负载均衡、容量溢出 本文的算例在 CPU 上用 PyTorch 实际运行;它验证路由与容量机制,并不代表 GPU 集群吞吐。参数量账本只计算专家前馈层,明确排除注意力、优化器状态与通信。两篇锚点论文的标题与编号分别核对了 Shazeer 等人,1701.06538 和 Fedus 等人,2101.03961。 01. 为什么需要它 设想你已经把 Transformer 的注意力优化得很好,但还想让模型记住更多视觉对象、动作模式和语言知识。直接把每层前馈网络加宽,参数量和每个 token 的前向计算都会一起涨;训练显存、推理算力也跟着涨。MoE 的出发点是:保留多套前馈参数,让每个 token 只调用其中少数几套。总容量可以长得快,单 token 实际执行的专家计算长得慢。 先看一笔能复算的账。取隐藏宽度 $d=4096$、SwiGLU 中间宽度 $h=14336$。一个专家有 gate、up、down 三块矩阵,忽略偏置后共有 $3dh=176,160,768$ 个参数。放八个专家,总计 $1,409,286,144$ 个专家参数;每个 token 选两个,只触及 $352,321,536$ 个专家参数。在“同样八个专家都计算”的假想稠密基线下,专家矩阵乘的主项是四分之一。这里的“四倍”只属于这一层的专家部分:注意力、路由、分发、合并、跨设备通信一个都没算进去。八套 bf16 专家权重仍占约 2.625 GiB,不会因为每次只用两套就自动缩成四分之一。 真正会让方案失效的是路由。假如 16 个 token 中有 10 个奔向同一专家,其他专家分别只有 3、2、1 个,最忙的卡可能决定整步耗时。若像 Switch Transformer 那样给每个专家固定容量 4,六个 token 会溢出;把容量提到 6,仍有四个溢出。附录的 CPU 实验确实打印了 6/16 与 4/16。容量继续提到 10 才没有溢出,却要为大量空槽留空间。稀疏激活解决了“每个 token 算太多专家”的问题,不能自动解决“专家分工是否均匀”的问题。 图中上半部分故意把总 token 数保持为 16:均衡分配是 [4,4,4,4],坍缩分配是 [16,0,0,0];下半部分用 [10,3,2,1] 计算容量为 4、6、10 时的溢出。它画的是调度代价,不是模型质量曲线。 02. 最小可用理解 第一句:MoE 通常替换 Transformer block 的前馈子层,注意力仍先让 token 互相交换信息,然后每个 token 在前馈阶段自己选专家;Mixtral 原论文明确采用每个 token 选两个 SwiGLU 专家。第二句:路由器先给所有专家打分,再只执行 top-k;参数总数随专家数增加,但单 token 专家计算主要随 $k$ 增加。第三句:专家偏科会造成容量溢出、尾部等待和训练不稳,因此必须把专家负载、溢出率与通信量和任务损失一起看。 它不是“每个专家懂一种人类可命名的技能”的硬分工。专家是网络权重,路由是在每一层、对每个 token 重新做的决定。同一个视频片段里的不同 patch,或同一个句子的不同 token,都可能走不同专家;解释一个专家“负责什么”需要额外分析,不能凭编号想象。 03. 数学推导 3.1 从一层普通前馈网络出发 先把一个 token 的隐藏向量记作 $u$,维度为 $d$。SwiGLU 前馈层可写成: $$F(u)=W_{\mathrm{down}}\bigl(\operatorname{SiLU}(W_{\mathrm{gate}}u)\odot W_{\mathrm{up}}u\bigr)$$ $W_{\mathrm{gate}}$ 和 $W_{\mathrm{up}}$ 各把 $d$ 维映射到 $h$ 维,$W_{\mathrm{down}}$ 再映射回 $d$ 维;$\odot$ 是逐元素乘法。三块矩阵分别有 $dh$、$dh$、$hd$ 个权重,所以主参数量是 $3dh$。一次前向的矩阵乘主项也近似与 $3dh$ 成正比;SiLU、逐元素乘、读写权重及内核发射是额外成本。 现在复制出 $N$ 套这样的前馈层,记作 $F_1,\ldots,F_N$。如果每个 token 都执行全部 $N$ 套,参数量和前馈计算都乘 $N$,这只是昂贵的稠密集成。MoE 的关键是:路由仍观察全部 $N$ 个候选,但只执行其中 $k$ 个专家,通常 $k\ll N$。 3.2 路由概率与 top-k 合并 路由矩阵 $W_{\mathrm{route}}$ 的形状是 $N\times d$。对 token $u_t$,先得分,再做 softmax: $$z_{t,i}=(W_{\mathrm{route}}u_t)_i,\qquad p_{t,i}=\frac{\exp z_{t,i}}{\sum_{j=1}^{N}\exp z_{t,j}}$$ $t$ 是 token 序号,$i$ 是专家序号;$z_{t,i}$ 是尚未归一化的偏好,$p_{t,i}$ 是归一化概率。选出概率最大的 $k$ 个专家,形成集合 $S_t$。以 Mixtral 式 top-2 归一化为例,选中专家的合并权重是: $$a_{t,i}=\frac{p_{t,i}}{\sum_{j\in S_t}p_{t,j}},\quad i\in S_t;\qquad y_t=\sum_{i\in S_t}a_{t,i}F_i(u_t)$$ 分母只对已选中的专家求和,故其权重之和是 1。没有选中的专家既不运行前馈网络,也不贡献输出。路由计算本身的矩阵乘大致是 $Nd$,专家计算主项是 $k(3dh)$,所以在 $h$ 很大而 $k$ 很小时路由通常比专家矩阵乘小;实际耗时仍会受到 token 重排和通信影响。top-k 索引是离散的;反向传播在当前选中集合内可以沿连续权重求导,但不能把“换成另一个专家”的离散跳变当成普通连续导数。 这里有个容易漏掉的细节:若 $k=1$ 还把唯一选中的概率除以自己,合并权重恒为 1,主任务损失就无法经这个权重训练路由器。Switch 的 top-1 路由保留了所选概率作为乘数,并另加负载均衡损失;不能把上面的 top-2 归一化公式机械套到所有 top-1 实现上。实现差别要看原论文与代码,而不是只看“top-1”三个字。 3.3 “省算力”到底在比较什么 专家总参数约为 $P_{\mathrm{all}}=N(3dh)$;单 token 运行的专家参数约为 $P_{\mathrm{active}}=k(3dh)$,因此两者的比值是 $N/k$。这个推导只说明同一 MoE 层内全部专家与激活专家的差异。它没有证明 MoE 相对“参数更少、但充分训练的稠密模型”一定更快或更准;也没有证明端到端延迟会按 $N/k$ 缩短。公平比较要明确横轴是总参数、激活参数、每 token FLOPs、训练吞吐、墙钟时间中的哪一个。 以本文数值为例,$N=8$、$k=2$,所以 $N/k=4$。如果改成 $k=4$,专家计算主项会翻倍而总参数不变;如果把 $N$ 从 8 扩到 16 且保持 $k=2$,激活的专家计算主项近似不变,但权重驻留、路由维度与分布式通信压力会增加。这才是条件计算的交易:用更多存储与更复杂的调度,换更多参数容量与较少的激活计算。 3.4 为什么会需要负载均衡损失 取一批 $T$ 个 token,先讨论 Switch 的 top-1。令 $f_i$ 为实际派给专家 $i$ 的 token 比例,令 $P_i$ 为路由器分给该专家的平均概率。原论文使用下面的辅助项: $$f_i=\frac{1}{T}\sum_{t=1}^{T}\mathbf{1}[\operatorname{argmax}_j p_{t,j}=i],\qquad P_i=\frac{1}{T}\sum_{t=1}^{T}p_{t,i}$$ $$L_{\mathrm{aux}}=\alpha N\sum_{i=1}^{N}f_iP_i$$ $\mathbf{1}$ 是指示函数;$\alpha$ 控制辅助项相对主任务损失的强度。$f_i$ 是由离散 argmax 得到的实际负载,作为本批次统计量不走梯度;$P_i$ 连续可导,给路由器提供调整信号。若四个专家都恰好分到四分之一 token 且平均概率也是四分之一,则不乘 $\alpha$ 的项是 $4\times4\times(1/4)(1/4)=1$。若 16 个 token 全选第 0 个专家,且它的平均概率是 0.7112,同一项约为 $4\times0.7112=2.8449$。附录代码打印的就是这两个值。 不要把辅助项误认为“越小一定越好”的独立目标。它和语言、图像或视频的主任务损失一起优化;给得太重会强迫本来有意义的专家分化变得机械均匀,给得太轻会让路由坍缩。Shazeer 等人的早期方案分别约束 importance 与 load;Switch 把它简化成一个点积项。Switch 论文第 2.2 节报告了 $\alpha=10^{-2}$ 的实验设置,但这个数不是跨任务的通用常数。 3.5 容量与 token 溢出 路由概率决定“想去哪里”,硬件要决定“哪里放得下”。Switch 的 top-1 固定容量在概念上是: $$C=\left\lceil c\frac{T}{N}\right\rceil$$ $C$ 是每个专家本批次最多接收的 token 数,$c$ 是容量因子。若 $T=16$、$N=4$、$c=1$,每个专家只有四个槽;[10,3,2,1] 的第一位会溢出六个。把 $c$ 设成 1.5,容量变六、溢出四个;到 2.5 容量才变十、溢出为零。增加容量会减少丢弃,但静态张量中的空槽也增加。Switch 原论文说明:溢出的 token 跳过该专家层的计算,经残差路径传给下一层;这不是把 token 从整个网络删除。不同生产实现可以使用不同的溢出策略,不能从论文机制推断所有框架都会丢 token。 这一定义专门对应 top-1。top-2 每个 token 会产生两个派发名额,负载与容量的账要按派发次数重新算;直接拿 $T/N$ 给 top-2 算容量会少估。文章后面的代码将 top-2 正确性实验与 top-1 容量实验明确分开。 3.6 再检查三条可验证的守恒关系 把一批输入写成张量形状能看出程序为何必须“先拆再合”。设 batch 有 $B$ 条样本,每条 $S$ 个 token,压平后 $T=BS$;输入是 [T,d],路由 logits 是 [T,N],top-k 索引和权重都是 [T,k]。按专家重新排列后,第 $i$ 位专家只拿到自己的 $L_i$ 行,结果是 [L_i,d];再按原 token 索引累加回 [T,d]。只要每个 token 恰好被派发 $k$ 次,就必有 $\sum_i L_i=kT$。附录的 expert_loads=[8,7,8,9] 总和为 32,恰好等于 $16\times2$。这是发现漏派发或重复派发的第一道检查。 第二条关系来自合并权重。对同一个 token,Mixtral 式归一化后 $\sum_{i\in S_t}a_{t,i}=1$;若实测不等于 1,可能把全部专家的 softmax 概率直接拿来加权,却忘了对选中集合重新归一化。第三条关系是输出维度不变:专家前馈网络虽可扩到中间宽度 $h$,最终都要回到 $d$ 维,才能与 Transformer block 的残差相加。三条关系分别守住派发次数、权重尺度和残差形状,比直接观察最终 loss 更容易定位代码错误。 3.7 辅助项的梯度从哪里来 一次反向传播中,把当前 batch 已统计出的 $f_i$ 当作常量。softmax 的导数是 $\partial p_{t,i}/\partial z_{t,j}=p_{t,i}(\mathbf{1}[i=j]-p_{t,j})$:提高专家 $j$ 的 logit,会抬高它自己的概率,同时压低其他专家的概率。代入上一小节的 $L_{\mathrm{aux}}$,得到: $$\frac{\partial L_{\mathrm{aux}}}{\partial z_{t,j}}=\frac{\alpha N}{T}p_{t,j}\left(f_j-\sum_{i=1}^{N}f_ip_{t,i}\right)$$ 若专家 $j$ 的实际负载 $f_j$ 高于这个 token 所见的加权平均负载,梯度为正,梯度下降倾向于压低它的 logit。低负载专家可能得到相反推力。这只是一次梯度步的局部解释:$f_i$ 由 argmax 决定,会在选择边界突然跳变;主任务梯度、容量限制和数据分布也同时影响下一次路由。因此“有可导辅助项”不等于“必然均衡”,更不等于“均衡后质量一定最好”。 3.8 溢出与空槽是两本账 若第 $i$ 位专家收到 $L_i$ 个 token、每位静态容量都是 $C$,则溢出数为 $\sum_i\max(L_i-C,0)$,空槽数为 $\sum_i\max(C-L_i,0)$。用前面的 [10,3,2,1] 代入:$C=4$ 时溢出 6、空槽 6;$C=6$ 时溢出 4、空槽 12;$C=10$ 时溢出 0、空槽 24。容量越大,溢出变少,却给静态张量留下更多空位。空槽是否真的造成同等比例的计算浪费,还要看内核能否跳过填充;它至少会影响形状、存储或通信安排。 在多模态场景,整体平均负载还可能掩盖局部高峰。文本、图像 patch 与连续视频帧混在一批时,整批的四位专家统计可能接近均匀,但某一类 token 在某一层仍高度集中;按帧解码时的瞬时负载又可能不同于整段视频的平均。一个实用的诊断表应按层、模态和时间片记录最大 $L_i$、平均 $L_i$、溢出数与通信时间。这里是从路由与队列机制推出的监控建议,并非本文已经做过的多模态训练实测。 04. 代码实现 完整代码在文末 moe_lab.py,只依赖 PyTorch,CPU 上直接执行:python moe_lab.py。它先生成形状为 [16,4] 的 token 矩阵,以一个线性路由器选择四个专家中的两个。每个专家是一层很小的 Linear → ReLU → Linear,用于验证路由逻辑;前面的大模型参数账本仍按真实 SwiGLU 的三矩阵结构计算,不能把玩具专家误当成生产模型。 核心的稀疏计算可以缩到下面几行。top_idx 的形状是 [token,k],token_id 和 slot_id 一起定位“这个专家接收了哪个 token、占该 token 的第几个席位”;index_add_ 把两路专家结果加回对应 token。 probs = F.softmax(logits.float(), dim=-1) top_prob, top_idx = probs.topk(k, dim=-1) top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True) result = torch.zeros_like(x) for expert_id, expert in enumerate(experts): token_id, slot_id = torch.where(top_idx == expert_id) if token_id.numel() == 0: continue value = expert(x[token_id]) * top_weight[token_id, slot_id, None] result.index_add_(0, token_id, value) print(result.shape, top_idx.shape) 固定随机种子为 7 后,脚本实际输出 input=(16, 4) output=(16, 4) top_idx=(16, 2),四位专家各接到 [8,7,8,9] 次派发,总和为 32,正好是 $16\times2$。它另用“全部专家都算、最后把没选中的输出乘零”的稠密参考结果做正确性对照,最大绝对误差在打印精度内为 0.000000000。参考实现会浪费计算,但适合检验稀疏实现的索引和加权有没有写错。 接着脚本不训练模型,而是构造两组受控路由 logits:一组让四个专家每人接四个 token,另一组让全部 token 偏向同一个专家。这样能把“负载变了”与“训练也变了”分开。打印结果为:均衡时 $f=P=[0.25,0.25,0.25,0.25]$,未乘 $\alpha$ 的辅助项是 1.0000;坍缩时 $f=[1,0,0,0]$、$P=[0.7112,0.0963,0.0963,0.0963]$,辅助项是 2.8449。容量实验又输出 6/16、4/16、0/16 三档溢出。读者可以独立复跑,不需要下载权重或数据集。 这组数字只证明公式、分发与计数代码互相吻合,不证明训练时加辅助项就一定达到均衡。真实训练还要监控各层的负载直方图、丢弃率、主任务损失、路由熵及设备间 all-to-all 的时间;单看一张 token 直方图不足以判断模型质量。 05. 工业级实现对照 以 2026-10-03 检查的 Hugging Face modeling_mixtral.py 为准,MixtralTopKRouter 先把隐藏状态展平,用 F.linear 得到 [token, expert] logits;它在 float32 中做 softmax,再 top-k,并对选中权重重新归一化。MixtralSparseMoeBlock 负责接路由输出与专家集合,最终还原 batch、sequence、hidden 三维。知识树里的 code_refs 指向这个文件的 MixtralSparseMoeBlock,路径与符号已经实际打开核对。 同一文件中的 MixtralExperts 不为每个 token 单独启动一次专家网络,而是先找出哪些专家被选中,再按专家收集 token,用 index_add_ 汇总。它把多位专家的矩阵存成带专家维的三维权重,并通过 @use_experts_implementation 接入不同执行实现。我们的小脚本保持“每个专家一个模块”,方便看公式;生产代码则必须考虑连续内存布局、分组矩阵乘、编译路径和设备利用率。文件在主分支上会变,正文只核对了本日可见的结构与函数名,没有声称这些细节永久不变。 Mixtral 的 top-2 与 Switch 的 top-1 还不能混成一个实现。前者在路由器里对两个已选概率归一化;后者的论文重点是单专家派发、静态容量、溢出路径与辅助负载损失。Hugging Face 这份 Mixtral 文件的前向代码不是 Switch 论文的 TPU 分布式训练系统,也不能从它有 index_add_ 就断言大集群没有 all-to-all。若专家分布在多卡上,token 必须先到相应设备、计算后再汇总;代价由网络拓扑、批量大小、token 倾斜和实现决定。 还有一个工业层面的数字边界:本文的 3dh 只含 SwiGLU 的三个权重矩阵。真实 Transformer block 还有 Q、K、V、输出投影、归一化、嵌入及可能的共享专家。训练时优化器状态和梯度常比 bf16 权重本身占更多空间;推理时即使每个 token 只用两位专家,服务系统仍需让其他专家随时可访问,或者承担按需调入的时延。因此“激活参数少”不等于“部署内存少”。 06. 代价与边界 收益首先是参数容量对激活计算的比值。 对 $N$ 位同宽专家取 $k$ 位,专家主计算的理想比值是 $N/k$;训练可在近似固定的每 token 专家 FLOPs 下试更多参数。它是否换来更好的任务质量,仍要做同预算、同数据、同训练时长的实验。早期论文报告过优于稠密对照的结果,但不能把某篇任务的收益搬给任意视觉生成模型。 第一笔代价是权重与状态。 参数量按 $N$ 增长,bf16 权重、梯度、优化器状态与检查点大小都要算。只看前向激活的 $k$ 位专家会严重低估训练资源。专家可以并行放在不同设备上,但又引出网络通信。 第二笔代价是路由偏斜。 每个专家的处理时间近似由收到的 token 数决定,整步会等最慢专家。容量限制可以把形状固定,却在溢出时改变有效计算;容量放大又会浪费填充。高平均负载不够,还要检查最忙专家、各层差异、长尾 token 和各设备之间的均衡。附录中的 [10,3,2,1] 正是最小反例。 第三笔代价是通信与小批量。 当专家跨设备切分,派发和合并通常需要集体通信;batch 很小或自回归逐 token 解码时,每位专家分到的 token 少,矩阵乘可能跑不满,固定通信开销更显眼。用单机 CPU 玩具实验不能估算这部分,也不能用“理论 FLOPs 四分之一”宣称端到端四倍加速。 第四笔代价是路由训练本身。 top-k 的硬选择会让专家早期获得的样本不均,冷门专家因训练较少又更难被选中,形成反馈。负载项、噪声、容量因子与专家初始化都会影响稳定性,但也可能伤害有意义的专门化。需要同时报告主任务指标与路由指标,而不是把“每个专家等量接单”当终点。 什么时候不该急着用?模型还小、普通前馈层已足够,或者服务以低 batch、低延迟为主且跨卡通信昂贵时,先用 性能建模与 Profiling 找到实际瓶颈。如果数据与训练预算不足以让多位专家学出差异,多出来的参数只会变成管理负担。这是工程判断,不是 MoE 论文对所有应用的普适否定。 07. 经典论文脉络 Shazeer 等,2017,Outrageously Large Neural Networks:把稀疏门控专家用于大容量模型,明确讨论专家偏科的自强化现象,并分别引入 importance 与 load 的均衡约束。它是理解“为什么光有 top-k 不够”的起点。 GShard,2020:把专家路由与自动分片放进大规模 Transformer 训练,提醒我们专家计算之外还有设备布局与通信问题。 Switch Transformers,2021/2022:用 top-1 简化派发,给出容量因子、溢出处理和可微的 $f\cdot P$ 负载项;本文第 3.4 与 3.5 节主要沿它推导。 ST-MoE,2022:系统研究稀疏专家训练的稳定性和迁移,说明“能扩参数”之后仍要解决训练动态。 Mixtral of Experts,2024:在每个相关层采用 top-2 SwiGLU 专家,是对照当前公开推理实现的具体案例;本文并不把它的结果视为所有视频或多模态 MoE 的结果。 这五篇连起来的主线是:先提出条件计算,再解决大规模分布式派发,接着简化路由与容量控制,最后面对稳定性和实际模型实现。论文里的速度、质量数字都有各自的设备与数据条件;这篇文章只借它们确认机制,不拼接成一个不存在的统一基准。 08. 常见误解 误解一:“八专家选二就是整个模型快四倍。” 四倍只来自专家矩阵乘的理想主项比值。注意力、路由、all-to-all、token 重排及等待最慢专家都在分母里。实验报告应分别列专家 FLOPs 与端到端时延。 误解二:“只激活两位专家,显存里只需放两套权重。” 路由在运行时根据每个 token 的状态变化,未选中的六位专家下一 token 可能被选到。权重需要驻留、分片或按需加载;哪一种都要付存储或调入成本。 误解三:“softmax 概率均匀就说明负载均衡。” 硬 top-1 派发由 argmax 决定,平均概率 $P_i$ 与实际负载 $f_i$ 是两个量。大量 token 的首选专家仍可能相同,所以要同时观察两者。Switch 的辅助项特意把它们相乘。 误解四:“溢出意味着 token 从模型中消失。” 在 Switch 论文描述的残差结构里,溢出 token 跳过这一专家层,后续层仍能接到它。它确实失去本层的专家变换,但不等于整条序列被删除。 误解五:“专家会自动对应数学、代码、图像等人类类别。” 路由学的是降低训练目标的内部划分,可能依赖位置、频率或更难解释的因素。必须用受控输入、路由统计和质量消融来验证专门化;给专家起名字只是叙事。 09. 动手验证 先执行文末两份完整脚本:python moe_lab.py 复现数值,python make_figures.py 生成配图。脚本固定随机种子,CPU 不需要模型权重。练习时一次只改一个条件,并把 主计算、路由负载、溢出率 分开记录。 把 k=2 改为 k=1。top_idx 应从 (16,2) 变成 (16,1),总派发次数从 32 变成 16。注意玩具实现会对唯一概率做归一化,权重恒为 1;这正好验证第 3.2 节提醒的训练梯度陷阱,因此它只能用来做前向路由演示,不能直接拿来训练 Switch。 保持 T=16,N=4,把不均匀分配 [10,3,2,1] 改成 [4,4,4,4]。容量因子 1.0 时,溢出应从 6/16 变 0/16。这是不改网络结构、只改路由就改变有效计算的最小实验。 把容量因子从 1.0、1.5、2.5 依次试过。原分配下脚本应给出容量 4、6、10 和溢出 6、4、0;同时算空槽总数:四位专家的静态槽分别是 16、24、40。容量增大并非免费。 将账本里的 $N=8,k=2$ 改成 $N=16,k=2$。专家总权重翻倍,单 token 激活专家参数不变,理想 $N/k$ 从 4 变 8。再想一想:若专家分散在更多设备上,为什么实际延迟未必更短? 若要进一步实验训练效果,可以在小数据集上加入任务损失与 $L_{\mathrm{aux}}$,逐档扫描 $\alpha$,同时画验证损失和各专家负载。预期是过小的 $\alpha$ 可能坍缩、过大的 $\alpha$ 可能牺牲任务目标;具体拐点依赖数据和实现,本文没有训练实验,因此不提供虚构数值。 10. 延伸阅读 先复习知识树的 自注意力机制:MoE 一般替换前馈子层,不替读者省去注意力的计算与显存账。然后读 性能建模与 Profiling,把“专家 FLOPs 少了”落到实际延迟账本;跨卡部署时再接 数据并行与 ZeRO,理解参数和状态如何分布。知识树中规划中的“量化:从 INT8 到 FP4”会继续回答:专家权重多、驻留贵时,能否用更低精度换内存与带宽,以及质量会付出什么代价。 把这篇用在自己的模型上时,建议先固定总训练 token、硬件与优化器配置,记录稠密前馈基线的质量和耗时;再逐步加入多专家、top-k 路由、容量限制和均衡项。每加一项都单独保存路由直方图、每层最忙专家、溢出比例及端到端吞吐。这样最后即使质量没有提升,也能判断问题出在专家容量不足、调度不均,还是通信把理论上的稀疏收益吃掉了。只报告总参数和激活参数两个数字,很难让读者复现或比较。另外,比较实验要记录随机种子和路由器初始化。路由决策依赖输入分布,同一个模型换一批数据,专家负载也可能改变;只截取一次顺利的运行,无法说明服务长期稳定。 本文最重要的读法是把三根轴分开:总参数量决定可用容量,激活专家数决定每 token 专家计算,实际路由负载决定系统是否跑得顺。 只有把它们放到同一张账本里,MoE 的收益和代价才不会被一个“四倍”掩盖。 附录:完整代码 09 节用到的脚本全文如下(moe_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 moe_lab.py """A small, reproducible MoE routing lab. Requires PyTorch, runs on CPU.""" from __future__ import annotations import math import torch from torch import nn from torch.nn import functional as F def sparse_moe(x: torch.Tensor, logits: torch.Tensor, experts: nn.ModuleList, k: int): """Route each token to k experts and merge the selected outputs.""" probs = F.softmax(logits.float(), dim=-1) top_prob, top_idx = probs.topk(k, dim=-1) top_weight = top_prob / top_prob.sum(dim=-1, keepdim=True) result = torch.zeros_like(x) for expert_id, expert in enumerate(experts): token_id, slot_id = torch.where(top_idx == expert_id) if token_id.numel() == 0: continue value = expert(x[token_id]) * top_weight[token_id, slot_id, None] result.index_add_(0, token_id, value) return result, probs, top_idx, top_weight def switch_aux_loss(probs: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]: """Switch's top-1 balancing term, without the tunable alpha coefficient.""" token_count, expert_count = probs.shape chosen = probs.argmax(dim=-1) fractions = torch.bincount(chosen, minlength=expert_count).float() / token_count mean_prob = probs.mean(dim=0) return expert_count * (fractions * mean_prob).sum(), fractions, mean_prob def capacity_drops(assignments: torch.Tensor, expert_count: int, factor: float): """Count top-1 overflow with a fixed expert capacity.""" capacity = math.ceil(assignments.numel() * factor / expert_count) loads = torch.bincount(assignments, minlength=expert_count) dropped = torch.clamp(loads - capacity, min=0).sum().item() return capacity, loads.tolist(), int(dropped) def main(): torch.manual_seed(7) token_count, dim, hidden, expert_count, k = 16, 4, 8, 4, 2 x = torch.randn(token_count, dim) gate = nn.Linear(dim, expert_count, bias=False) experts = nn.ModuleList( [nn.Sequential(nn.Linear(dim, hidden), nn.ReLU(), nn.Linear(hidden, dim)) for _ in range(expert_count)] ) out, probs, chosen, weights = sparse_moe(x, gate(x), experts, k) # A dense reference evaluates every expert. It is only a correctness oracle. dense_ref = torch.zeros_like(x) for expert_id, expert in enumerate(experts): contribution = torch.zeros(token_count, 1) for slot in range(k): contribution += (chosen[:, slot] == expert_id)[:, None] * weights[:, slot, None] dense_ref += contribution * expert(x) max_error = (out - dense_ref).abs().max().item() print(f"input={tuple(x.shape)} output={tuple(out.shape)} top_idx={tuple(chosen.shape)}") print(f"expert_loads={torch.bincount(chosen.flatten(), minlength=expert_count).tolist()}") print(f"sparse_dense_max_error={max_error:.9f}") # Controlled router logits: the difference is caused by routing, not training. balanced_logits = torch.zeros(token_count, expert_count) balanced_logits[torch.arange(token_count), torch.arange(token_count) % expert_count] = 2.0 collapsed_logits = torch.zeros_like(balanced_logits) collapsed_logits[:, 0] = 2.0 for name, logits in (("balanced", balanced_logits), ("collapsed", collapsed_logits)): loss, fractions, mean_prob = switch_aux_loss(F.softmax(logits, dim=-1)) print(f"{name}: f={fractions.tolist()} P={[round(v, 4) for v in mean_prob.tolist()]} " f"N_sum_fP={loss.item():.4f}") uneven = torch.tensor([0] * 10 + [1] * 3 + [2] * 2 + [3]) even = torch.arange(token_count) % expert_count for name, assignments in (("even", even), ("uneven", uneven)): for factor in (1.0, 1.5, 2.5): capacity, loads, dropped = capacity_drops(assignments, expert_count, factor) print(f"{name} factor={factor:.1f}: capacity={capacity} " f"loads={loads} dropped={dropped}/{token_count}") width, expansion, model_experts, active = 4096, 14336, 8, 2 params_one = 3 * width * expansion # SwiGLU: gate, up, down matrices. params_all = model_experts * params_one params_active = active * params_one print(f"SwiGLU ledger: one={params_one:,} all={params_all:,} " f"active_per_token={params_active:,} all_over_active={params_all / params_active:.1f}x") print(f"expert_weights_bf16={params_all * 2 / 2**30:.3f} GiB; " "this excludes attention, optimizer states, activations and communication") if __name__ == "__main__": main() make_figures.py """Draw the MoE routing/capacity experiment. Requires Pillow only.""" from pathlib import Path from PIL import Image, ImageDraw, ImageFont ROOT = Path(__file__).resolve().parents[1] OUT = ROOT / "figures" OUT.mkdir(exist_ok=True) def font(size): for path in ("C:/Windows/Fonts/arial.ttf", "/usr/share/fonts/truetype/dejavu/DejaVuSans.ttf"): if Path(path).is_file(): return ImageFont.truetype(path, size) return ImageFont.load_default() im = Image.new("RGB", (1200, 540), "#f8fafc") d = ImageDraw.Draw(im) title = font(31) text = font(21) small = font(17) d.text((48, 30), "MoE routing: same token count, different costs", font=title, fill="#0f172a") d.text((50, 100), "Top-1 token load across 4 experts (T = 16)", font=text, fill="#334155") for row, (name, counts, color) in enumerate(( ("Balanced", [4, 4, 4, 4], "#0ea5e9"), ("Collapsed", [16, 0, 0, 0], "#f97316"), )): y = 160 + row * 130 d.text((50, y + 23), name, font=text, fill="#0f172a") for i, value in enumerate(counts): x = 205 + i * 220 d.rectangle((x, y + 20, x + 175, y + 55), fill="#e2e8f0") if value: d.rectangle((x, y + 20, x + 175 * value // 16, y + 55), fill=color) d.text((x + 52, y + 65), f"E{i}: {value}", font=small, fill="#334155") d.line((48, 423, 1150, 423), fill="#cbd5e1", width=2) d.text((50, 443), "Uneven load [10, 3, 2, 1]: drops at capacity 4 / 6 / 10", font=text, fill="#334155") for i, (cap, drops) in enumerate(((4, 6), (6, 4), (10, 0))): x = 650 + i * 170 d.rounded_rectangle((x, 438, x + 145, 490), radius=8, fill="#dbeafe") d.text((x + 12, 453), f"C={cap}: {drops} drop", font=small, fill="#1e3a8a") path = OUT / "routing_capacity.png" im.save(path) print(path)
-
AIGC 基本功|算子融合与 CUDA Graph-Fusion 算子融合与 CUDA Graph 所属方向:推理加速 | 难度:进阶 | 前置知识:性能建模与 Profiling(performance_profiling)、混合精度(mixed_precision)、自注意力机制(attention_basics) 关键词:算子融合、kernel fusion、CUDA Graph、发射开销、访存瓶颈、torch.compile、Inductor 关于本文的数字:作者手里这台机器是 Apple M1 Pro,没有 NVIDIA GPU,也没有安装 torch。所以凡是标「实测」的数字,都出自文末附录里那三个能在纯 numpy 上跑通的脚本;凡是 CUDA/HBM 相关的数字,都来自公开资料并显式标注出处,我没有拿 CPU 的数字去外推 GPU。第六节 6.5 专门交代了这条边界。 01. 为什么需要它 先摆三个数,都是本篇附录里真跑出来的。 第一个数:一步 decode 大约要发射 1093 个 kernel。 这不是实测,是按 Llama-3-8B 的公开结构一层层手数出来的:每层 34 个 kernel(输入 RMSNorm 拆 4 个、q/k/v 投影各 1 个、两组 RoPE 各 3 个、KV 写入 2 个、QK 转置乘 1 个、缩放加掩码 2 个、softmax 3 个、乘 V 1 个、o 投影 1 个、残差 1 个、后置 RMSNorm 4 个、gate/up 各 1 个、SiLU 1 个、逐元素乘 1 个、down 投影 1 个、残差 1 个),乘 32 层再加输出头约 5 个,得到 1093。公开资料给的量级是 300~1300,这个数落在里面,可以互为印证。 第二个数:这 1093 个 kernel 里,绝大多数只干几微秒的活。 每次 kernel 发射在 CPU 侧要花 1~5 微秒——NVIDIA 开发者论坛上 njuffa 给的口径是「空 kernel 约 5 微秒」,《CUDA Handbook》实测 NULL launch 约 4.9 微秒(老机器)、GeForce RTX 3060 上约 1.2 微秒,A100 上常见引用是 2~3 微秒。假设发射 3 微秒、执行 2 微秒,附录 launch_model.py 的时间线推演给出的结果是:eager 模式总时长 2102 微秒,其中 GPU 空转 702 微秒,也就是 33% 的时间卡在等 CPU 把下一个 kernel 发过来;换成一次提交的 CUDA Graph,总时长降到 1753 微秒,加速 1.20 倍,GPU 基本不空转了。 第三个数:8 个串起来的逐元素算子,其中 93.8% 的时间花在「发射」上而不是「算」。 这是 fusion_lab.py 在 512 个元素的张量上实测的。同样一条 8 段链,在 400 万元素的张量上反过来:加速的 100% 来自少搬字节,发射部分只占 0%。同一个优化在两个极端上赚的是完全不同的钱,这件事后面会用一整套账把它算清楚。 还有一个更刺眼的数在注意力上。按 $B=8$、$H=16$、$S=2048$、$d=4096$、bf16 算:输入激活 $[B,S,d]$ 是 128.0 MiB,而 score 矩阵 $[B,H,S,S]$ 是 1.000 GiB,正好是输入的 8 倍。放大倍数是 $H \cdot S / d$——$S$ 翻一倍,它翻一倍;$S=8192$ 时是 32 倍。softmax 如果不融合,max / 减 / exp / 求和 / 除五步各读写一遍 score,就是 8.000 GiB 的访存;融合后只要 2.000 GiB。 你以为模型卡在算力上,其实它经常卡在「把中间结果写出去再读回来」和「让 CPU 一次又一次地通知 GPU 开工」这两件事上。 02. 最小可用理解 三句话: 融合(fusion):一串相邻算子的中间结果,本来每个算子都要写回显存、下一个再读回来。融合就是把它们放进同一个 kernel,中间结果留在寄存器或共享内存里,只在最开头读一次输入、最末尾写一次输出。它不产生新的数学,只是让已经算出来的东西少走几趟路。 CUDA Graph:那串 kernel 的发射动作(函数名、参数、依赖关系、显存地址)可以录下来,之后一次 cudaGraphLaunch 提交整张图。它一个字节都不省,省的是 CPU 侧那 1093 次提交。 两者的收益都能提前算出来,也都有限。融合的上限是字节比 $K$($K$ 段链最多省 $K$ 倍访存);CUDA Graph 的上限是「发射时间 / 执行时间」,而且只在单 kernel 执行时间接近或小于发射时间时才为正。 一句总结:融合省字节,Graph 省发射。把两者混为一谈,是这一块最常见的错误。 03. 数学推导 3.1 先回到那条判据:roofline 前置文章 performance_profiling 已经建过这条判据,这里只取结论。一个算子的耗时下界由两件事里更慢的那个决定: $$T \ge \max\left(\frac{F}{P_{\text{peak}}},\ \frac{B}{B_{\text{off}}}\right)$$ 其中 $F$ 是浮点运算次数(FLOPs),$P_{\text{peak}}$ 是峰值算力(FLOP/s),$B$ 是需要搬动的字节数(含读和写),$B_{\text{off}}$ 是片外内存带宽(字节/秒)。两者的比值就是算术强度: $$I = \frac{F}{B}$$ $I$ 高的算子卡在算力上,$I$ 低的算子卡在带宽上。逐元素算子的 $I$ 是常数:算一个元素做 1 次操作、读 4 字节写 4 字节,$I = 1/8$。在 fp32 下算力峰值除以带宽的量级是每字节几十次操作,所以逐元素算子永远在带宽那一侧。 这就是融合的着力点:它不改变 $F$,只把 $B$ 变小。 3.2 字节账本:K 段链为什么最多省 K 倍 考虑 $K$ 个串起来的逐元素算子,作用在一个 $N$ 元素的张量上($b$ 为每元素字节数)。 不融合:每个算子单独成一个 kernel,各自读一遍输入、写一遍输出。第 $k$ 个 kernel 的访存是 $2Nb$ 字节(因为输入和输出都是 $N$ 个元素),$K$ 个加起来: $$B_{\text{unfused}} = 2KNb$$ 融合:一个 kernel 从头做到尾。读输入 $Nb$、写输出 $Nb$,中间那 $K-1$ 步全在片上: $$B_{\text{fused}} = 2Nb$$ 两式相除,字节比正好是 $K$: $$\frac{B_{\text{unfused}}}{B_{\text{fused}}} = K$$ 本文附录 fusion_lab.py 的 [A] 节把这个账算在了三处:8 段链 244.1 MiB 降到 30.5 MiB(8 倍);RMSNorm 从 4 遍降到 1 遍,122.1 MiB 降到 30.5 MiB(4 倍);attention softmax 从 8.000 GiB 降到 2.000 GiB(4 倍),另外还有一份被物化的 mask 值 1.000 GiB,融合后直接消失。 注意字节比 $K$ 只是「访存减少到 1/K」,不是「时间减少到 1/K」。 时间还取决于中间结果到底停在多快的存储上。设片上带宽为 $B_{\text{on}}$,定义片内片外带宽比: $$\rho = \frac{B_{\text{on}}}{B_{\text{off}}}$$ 那么融合后的时间是「片外读一次写一次」加上「$K-1$ 步在片上走」: $$T_{\text{fused}} = \frac{2Nb}{B_{\text{off}}} + \frac{2(K-1)Nb}{B_{\text{on}}}$$ 不融合的时间是: $$T_{\text{unfused}} = \frac{2KNb}{B_{\text{off}}}$$ 两者相除,$N$ 和 $b$ 全部约掉: $$S = \frac{T_{\text{unfused}}}{T_{\text{fused}}} = \frac{K}{1 + (K-1)/\rho}$$ 这个式子值得盯着看三秒。 它的两个极限都很干净: $\rho \to 1$(片上不比片外快):$S \to 1$,融合白干。 $\rho \to \infty$(片上无限快):$S \to K$,也就是字节比。 所以「融合能加速几倍」这个问题,答案既不是 $K$,也不是玄学,而是 $K$ 和 $\rho$ 共同决定的。记住这一点,第六节会看到它把一台机器上的实测结果解释得干干净净。 3.3 单次调用的固定成本,和它的临界规模 一次算子调用的耗时,在规模足够小时和数据量无关。写成仿射形式: $$t(n) = a + b_{\text{el}} \cdot n$$ $a$ 是固定开销(派发、参数检查、缓冲建立),$b_{\text{el}}$ 是每元素的边际成本。开销和数据各占一半的那个规模是: $$n^{*} = \frac{a}{b_{\text{el}}}$$ fusion_lab.py 的 [D] 节实测这台机器:$a = 0.430$ 微秒/次,$b_{\text{el}} = 55.47$ 微秒/百万元素,$n^{*} = 7746$ 个元素,也就是 30.3 KiB。张量小于 30 KiB 时,大部分时间不是在算数据。 如果把这条链的 $2K$ 次调用全加起来,固定开销的占比是: $$\text{share} = \frac{2K a}{2K(a + b_{\text{el}} n)} = \frac{1}{1 + n/n^{*}}$$ 实测($K=8$,16 次调用):$n=512$ 时 93.8%,$n=4096$ 时 65.4%,$n=65536$ 时 10.6%,$n=1048576$ 时 0.7%。张量一小,你花在「组织计算」上的钱就超过「做计算」的钱。 这就是 GPU 上 kernel launch 开销在 CPU 上的同构物,也是为什么 GPU 上会出现同样性质的墙。 3.4 发射与执行的时间线:CUDA Graph 到底省什么 考虑单流、异步提交的 $N$ 个 kernel。CPU 发射第 $i$ 个要花 $t_{\text{launch}}$,发完就可以去发下一个,不等 GPU。GPU 执行第 $i$ 个要花 $t_{\text{exec}}$,它有两个前提:前一个跑完了,并且这一个已经发出去了。所以 GPU 开工时刻是: $$\text{start}_i = \max\left(\text{end}_{i-1},\ (i+1) \cdot t_{\text{launch}}\right)$$ 两个条件谁慢,谁决定节奏。分两种情形: $t_{\text{launch}} \le t_{\text{exec}}$:CPU 能跑在 GPU 前面,GPU 一个接一个不停,总时长约 $N \cdot t_{\text{exec}} + t_{\text{launch}}$。 $t_{\text{launch}} > t_{\text{exec}}$:CPU 喂不上,GPU 每跑完一个就得等 $t_{\text{launch}} - t_{\text{exec}}$,总时长约 $N \cdot t_{\text{launch}}$。GPU 空转的比例是 $1 - t_{\text{exec}}/t_{\text{launch}}$。 CUDA Graph 把 $N$ 次提交压成 1 次,但 GPU 前端仍然要逐个节点过一遍(记 $t_{\text{disp}}$): $$T_{\text{graph}} = t_{\text{launch}} + N \cdot (t_{\text{exec}} + t_{\text{disp}})$$ 于是加速比是: $$S_{\text{graph}} = \frac{\max(N t_{\text{launch}},\ N t_{\text{exec}})}{t_{\text{launch}} + N(t_{\text{exec}} + t_{\text{disp}})} \approx \frac{\max(t_{\text{launch}}, t_{\text{exec}})}{t_{\text{exec}} + t_{\text{disp}}}$$ 这个式子给出了盈亏平衡点:只有当 $t_{\text{exec}} \lesssim t_{\text{launch}}$ 时 $S_{\text{graph}} > 1$。 launch_model.py 的 [F2] 节用 $N=700$、$t_{\text{launch}}=3$ 微秒、$t_{\text{disp}}=0.5$ 微秒扫了一遍:$t_{\text{exec}}=0.5$ 微秒时 2.99 倍,1 微秒时 2.00 倍,2 微秒时 1.20 倍,到 3 微秒正好跌破 1(0.86 倍),40 微秒时 0.99 倍——大 kernel 上 CUDA Graph 是纯负担。 3.5 因果掩码:白算的那一半 因果注意力里,第 $i$ 个 query 只能看见前 $i$ 个 key。如果老老实实算满 $S \times S$ 的 score 矩阵,被掩掉的部分是纯浪费。精确的保留比例是: $$\text{kept} = \frac{S(S+1)/2}{S^2} = \frac{S+1}{2S}$$ $S=2048$ 时是 50.0%——一半的 score 元素算完就扔。逐元素地跳过在硬件上不现实,实际做法是按块跳:块边长 $B_r$ 时共有 $n_b = S/B_r$ 个 query 块,第 $i$ 个 query 块只算前 $i$ 个 key 块,算下来是 $n_b(n_b+1)/2$ 个块: $$\text{kept}_{\text{block}} = \frac{n_b(n_b+1)/2}{n_b^2} = \frac{n_b+1}{2 n_b} = \frac{1}{2} + \frac{1}{2 n_b}$$ 实测($S=2048$):块边长 64 时 51.6%,128 时 53.1%,256 时 56.2%。误差随 $n_b$ 按 $1/(2n_b)$ 衰减,所以块越小越接近理论上界——但块越小,片上数据被切得越碎,调度开销越大。这是块大小必须折中的原因,不是调参玄学。 这张图要看什么:左图是 score 矩阵相对输入激活的放大倍数随 $S$ 的变化,灰虚线是「若按 $S$ 线性增长」的参考——实际曲线比线性还陡($H \cdot S/d$ 是 $S$ 的一次式,但在对数轴上叠加了 $H/d$ 的常数放大,$S=8192$ 时已到 32 倍)。右图是块级跳过的实际工作量占比,绿虚线是理论上界 50.0%:块边长 256 时要多算 6.2 个百分点,块边长 64 时只多算 1.6 个——这就是「块越小越准、代价越碎」的量化版本。 04. 代码实现 三个脚本,全部纯 numpy,/usr/local/bin/python3 直接跑: fusion_lab.py:[A] 字节账本、[B] 带宽与工作集、[C] 三种融合形态、[D] 固定开销、[E] attention 尾部 launch_model.py:[F1] 时间线、[F2] 扫描、[F3] kernel 计数、[F4] 收益分解 make_figures.py:把上面两个脚本落盘的 json 画成 5 张图 4.1 三种融合形态 我把「融合」拆成三种可测量的形态,这是本篇的核心实验设计: K = 8 # 8 段链,每段 h <- A*h + B A_S, B_S = 1.01, 0.01 def _v1_unfused(x, buf, K=K): """V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。""" np.multiply(x, A_S, out=buf) np.add(buf, B_S, out=buf) for _ in range(K - 1): np.multiply(buf, A_S, out=buf) np.add(buf, B_S, out=buf) return buf def _v3_closed(x, out, K=K): """V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。""" Ak = A_S ** K Bk = B_S * (Ak - 1.0) / (A_S - 1.0) np.multiply(x, Ak, out=out) np.add(out, Bk, out=out) return out 这三种形态的物理含义不同,必须分清: V1 不融合:每个算子一个 kernel,中间结果每次都落回主存。 V2 分块融合(_v2_tiled):一块读进来,K 段都在这一块上算完,只写回一次。tile 就是片上缓冲。这是 GPU 融合 kernel 在 CPU 上能做到的最好近似——numpy 做不到寄存器级融合,每个 ufunc 调用仍然要把结果写回 tile。 V3 代数合并:把 $K$ 段仿射在数学上合成一段,中间结果根本不存在。它对应的是融合给编译器创造的二阶机会:串起来看得见全貌之后,可以化简。 实测结果(fusion_lab.py ALL 的 [C] 节): 张量元素数 V1 不融合 V3 代数合并 V1/V3 相对误差 512 7.75 μs 1.12 μs 6.89x 1.35e-07 4096 10.58 μs 1.46 μs 7.26x 1.97e-07 65536 84.63 μs 11.25 μs 7.52x 5.12e-07 262144 310.83 μs 41.62 μs 7.47x 5.80e-07 1048576 1240.04 μs 176.54 μs 7.02x 5.13e-07 4000000 5205.08 μs 792.83 μs 6.57x 6.16e-07 V1/V3 稳定在 6.57~7.52 倍,围着 $K=8$ 上下浮动——正如 3.2 节的推导,字节比就是上限。最后一列的相对误差约 5e-7,正好是 fp32 的舍入量级:代数合并改变了运算顺序,所以数值不会逐位相同,但量级完全在许可范围内。 同一节里 V2 的结果才是本篇最值得记住的一个数: tile(元素) 耗时 相对 V1 16384 5.835 ms 0.89x 65536 5.626 ms 0.93x 262144 5.290 ms 0.98x 1048576 5.361 ms 0.97x V2 一点都没变快,甚至略慢。 而 3.2 节的模型早就预测到了——代入 [B] 节测出的 $\rho = 1.124$: $$S = \frac{8}{1 + 7/1.124} = 1.11$$ 模型说 1.11 倍,实测 0.98 倍。同一量级,方向一致。为什么这台机器上 $\rho$ 这么小?因为单线程 numpy 逐元素循环的吞吐上限只有 91.5 GB/s,而主存带宽是 81.4 GB/s——两个数字离得太近,片上片下几乎没有差价可赚。 这张图要看什么:左图是两种形态的耗时随规模的变化,两条虚线是各自的发射地板——$V1$ 是 $2K \cdot a = 6.9$ μs,$V3$ 是 $2a = 0.86$ μs。两条实线在小规模处几乎是水平的(贴着各自的地板走),到大规模才分开,这就是「小规模赚发射、大规模赚字节」的直接证据。灰色菱形是 V2 在最大规模上的结果,它几乎落在 V1 那条线上——$V2$ 省了字节但没省调用,所以拿不到 V3 的收益。右图把这件事翻译成加速比:橙线(V1/V3)贴着绿色上限 $K=8$ 走,而 V2 的实测点落在灰虚线(模型预测 1.11x)附近,离 8 差着一个数量级。 4.2 把带宽层级测出来 $\rho$ 不是查来的,是测来的: for nbytes in [32 << 10, 128 << 10, 512 << 10, 2 << 20, 8 << 20, 32 << 20, 128 << 20]: n = nbytes // 4 x = rng.standard_normal(n).astype(np.float32) y = np.empty_like(x) bench(lambda: np.add(x, 1.0, out=y), reps=3) # 预热 t = bench(lambda: np.add(x, 1.0, out=y), reps=11) bw = 2 * nbytes / t / 1e9 # 1 读 1 写 实测:32 KiB 62.9 GB/s、128 KiB 79.6、512 KiB 91.5、2 MiB 95.3、8 MiB 94.7、32 MiB 79.5、128 MiB 83.3。取 ≤8 MiB 的中位数 91.5 GB/s 作 $B_{\text{on}}$,≥32 MiB 的中位数 81.4 GB/s 作 $B_{\text{off}}$,得 $\rho = 1.124$。 注意这两个数字不是硬件规格里的峰值带宽,而是「单线程 numpy 逐元素循环能跑出来的吞吐」。它们的差距不代表 L2 和主存的差距,只代表在这条代码路径上「留片上」值多少钱。这个诚实的限定很重要——换一台有真 GPU 的机器,$\rho$ 会是另一个数,$K/(1+(K-1)/\rho)$ 会给出完全不同的答案。 4.3 固定开销 reps = 20000 if n <= 4096 else 500 t0 = time.perf_counter() for _ in range(reps): np.add(a, 1.0, out=b) t = (time.perf_counter() - t0) / reps 实测:$n=1$ 时 0.417 μs,$n=8$ 时 0.419,$n=64$ 时 0.425,$n=512$ 时 0.477,$n=4096$ 时 0.675,$n=16384$ 时 1.333,$n=65536$ 时 5.966,$n=262144$ 时 22.388,$n=1048576$ 时 89.331。 前四个点几乎是一条水平线——从 1 个元素到 512 个元素,元素数涨了 512 倍,耗时只从 0.417 涨到 0.477。用 $n \le 16384$ 的六个点做最小二乘,得 $a = 0.430$ μs、$b_{\text{el}}$ 对应 55.47 μs/百万元素。 4.4 图:先看两张 这张图要看什么:三组 pattern 的字节账本,横轴是对数刻度。橙红是不融合、绿是融合后,条右边的倍数就是字节比。注意最上面那根——attention softmax 的 8192.0 MiB 比最下面那根逐元素链的 244.1 MiB 大了三十多倍,真正需要融合的不是那串小算子,而是注意力里那张被反复读写的 score 矩阵。 这张图要看什么:左图是单次调用耗时随张量规模的变化,红色虚线是固定开销地板,紫色竖线是「开销和数据各占一半」的临界规模(7746 个元素);右图是 8 段链里固定开销占总时间的比例。曲线在最左边几乎是水平的——那一段里,你增加 500 倍的数据量,耗时只涨 14%。 4.5 分解:两种收益各占多少 launch_model.py 的 [F4] 节把本机实测的加速拆成两部分: 张量元素数 V1 实测 V1 模型 V3 实测 V3 模型 发射贡献 512 7.75 μs 7.33 μs 1.12 μs 0.92 μs 94% 4096 10.58 μs 10.51 μs 1.46 μs 1.31 μs 65% 65536 84.63 μs 65.04 μs 11.25 μs 8.13 μs 11% 262144 310.83 μs 239.53 μs 41.62 μs 29.94 μs 3% 1048576 1240.04 μs 937.51 μs 176.54 μs 117.19 μs 1% 4000000 5205.08 μs 3556.95 μs 792.83 μs 444.62 μs 0% $n=512$(2.0 KiB)时,加速的 94% 来自少发射,只有 6% 来自少搬字节;$n=4000000$(15.3 MiB)时反过来,100% 来自少搬字节。 模型在大规模那一端明显低估(5205 实测 vs 3557 模型)——因为 $b_{\text{el}}$ 是用缓存内的点拟合的,外推到 15 MiB 后,边际成本实际上比拟合值高。这是线性模型的能力边界,写在这里免得读者拿它当精确预测器。 这张图要看什么:左图是时间线甘特图,上排是 eager。蓝条是 CPU 发射,绿条是 GPU 执行,斜纹是 GPU 空转——空转的宽度正好等于发射和执行的时间差。下排是 CUDA Graph,一次发射之后 GPU 一路不停。右图是加速比随单 kernel 执行时间的变化,红线是发射成本 3 μs:红线左边 Graph 赚,红线右边 Graph 亏。 05. 工业级实现对照 5.1 torch.compile / Inductor:融合是调度器的决策 PyTorch 的主入口在 torch/_inductor/compile_fx.py 的 compile_fx(当前实现在该文件第 3122 行),它把 FX 图接给 Inductor,后者负责切分、调度、生成 Triton kernel: https://github.com/pytorch/pytorch/blob/main/torch/_inductor/compile_fx.py 真正做融合决策的是调度器。torch/_inductor/scheduler.py 里: Scheduler.fuse_nodes(nodes)(约 7048 行)是融合主循环; can_fuse_vertical / can_fuse_horizontal / can_fuse_reduction_epilogue 决定两个节点能不能合; score_fusion_memory(node1, node2, count_bytes=...)(约 11278 行)给一次融合打分——它的第一个形参就叫 count_bytes,因为融合的分数就是省下的字节数。 融合决定返回 FusionResult(约 130 行),里面既可以是布尔值,也可以是一个待求值的 callable_fn,让代价模型并行算。 这就是本篇 3.2 节的账本在生产代码里的样子。 区别在于:编译器要在不能融合的时候正确地放弃。不能融合的情形包括跨块归纳(reduction 的中间结果必须先写完)、原地写与别名(写坏了输入后续还要用)、随机数算子(融合会改变随机流)、以及动态 shape 下无法预先确定 tile 大小。 5.2 一个必须在 05 节点名的差异:epilogue fusion 最小实现里的融合是「一串逐元素算子合成一个 kernel」。生产实现里最有价值的融合形态是 epilogue fusion:把接在 GEMM 后面的 bias、激活、缩放并进 GEMM 的 kernel 里,让 GEMM 的输出直接以最终形态写出,不经过显存。 用 3.2 节的账本算一下就明白为什么值钱:一个 $[M,N]$ 的 fp32 输出,不融合时要写 GEMM 输出($4MN$ 字节写)、bias 加法读+写($8MN$)、激活读+写($8MN$),合计 $20MN$;融合后 GEMM 一趟写 $4MN$,加上读输入的开销,量级降到 $1/5$。表达式没变一行,访存少了五分之四。 5.3 CUDA Graph 在 PyTorch 里的落地 torch/cuda/graphs.py 里的 CUDAGraph(约 289 行)暴露出和 CUDA 一一对应的四个动作:capture_begin / capture_end / instantiate / replay: https://github.com/pytorch/pytorch/blob/main/torch/cuda/graphs.py 三个工程细节值得单独说: graph_pool_handle()(约 96 行)必须存在。graph 在录制时把显存地址写死在节点里,回放时不会重新分配。所以你必须让图里所有张量都来自一个固定的内存池。这不是 API 的怪癖,是「录制-回放」这个机制的必然代价。 上游警告 instantiate 要在第一次 replay 之前显式调用,否则第一次回放的延迟会变高(图要在那时才编译)。这个问题在实时推理里就是一次 P99 抖动。 torch/_inductor/cudagraph_trees.py 里是 CUDAGraphNode(约 982 行)和 TreeManagerContainer(约 220 行),还有一个 CUDAWarmupNode。为什么是「树」而不是「一张图」:训练时反向图的形状依赖前向的实际形状,一批数据一个形状;而且每次回放都会产生新的输出张量,需要知道哪些显存可以复用。Inductor 用 mode="reduce-overhead" 打开这套机制。 https://github.com/pytorch/pytorch/blob/main/torch/_inductor/cudagraph_trees.py 5.4 差异从哪来:为什么生产实现不能只有最小实现 差异 来源 要判断「能不能融合」,甚至要算清代价 融合不是永远划算,见第六节 6.1 与 6.3 要处理动态 shape tile 大小不能预知,必须切分或退化成不融合 要维护固定的显存池 CUDA Graph 把地址写死了 要为每个形状/profile 各录一份图 图是静态的;变长输入需要分段或重录 要处理随机流、原地写、别名 融合会改变这些语义 06. 代价与边界 6.1 收益的上限是字节比,不是魔法 3.2 节的 $S = K/(1+(K-1)/\rho)$ 是硬约束。在写本文这台机器上 $\rho = 1.124$,理论上限只有 1.11 倍,实测 V2 是 0.98 倍——收益在哪台机器上有、有多大,完全由 $\rho$ 决定。所以当有人告诉你「融合能快 6 倍」,第一个该问的问题不是「怎么融合」,而是「他的 $\rho$ 是多少、$K$ 是多少」。 顺带说,V3(代数合并)之所以能跑到 6.57~7.52 倍而不受 $\rho$ 限制,是因为它根本没产生中间结果——它走的是 $S \to K$ 那条极限路径。但代数合并只在可化简的模式上成立(本链是仿射复合,可以闭式求解),一般算子是合不掉的。它展示的是融合的第二层价值:让编译器看见全貌,从而有机会化简。 6.2 融合会改变数值 实测相对误差约 5e-7(fp32 舍入量级)。这不是 bug,是代数重排的必然结果。任何声称「融合不改变数值」的说法都需要限定条件。在需要严格复现的训练里,这会让「同一份代码换个后端跑出不同 loss」——通常无害,但你必须知道它从哪来。 6.3 融合省不了算错的东西 这是本篇最反直觉的一条,也是附录 [E] 节专门测的。softmax 五步在 $[8,1024,1024]$ 的 score 矩阵上:不融合 18.804 ms,按行分块融合 23.870 ms,加速比 0.79x——融合反而慢了 21%。 算一下就知道为什么。五步共读写 8 份 score 矩阵 = 256 MB,按 81.4 GB/s 的访存下界是 3.298 ms。实测 18.804 ms,是访存下界的 5.70 倍。也就是说这个 kernel 的时间几乎全在 exp 的计算上,不在访存上。 分块省了字节,但一个 exp 都没少,反而因为切碎了向量化还赔了一点。 所以:融合只对「本来就卡在访存或发射上」的算子有效。 一个计算受限的算子,融合不动它。这也是 FlashAttention 要在融合之外再做「不实例化 S×S 矩阵」的原因——它同时省了访存和一部分计算。 6.4 CUDA Graph 的硬约束 静态 shape:图录下来的形状是死的。变长输入要么分段(prefill 一段、decode 一段各录一份),要么放弃。 静态地址:所有张量必须来自固定内存池,中间不能有新的 cudaMalloc。 不能有 host 同步和 D2H 拷贝:录制期间不允许任何把控制权交回 CPU 的操作。 首次录制和实例化有成本,且出错时栈是「图里的第 N 个节点」,比直接调试难得多。 大 kernel 上纯亏:3.4 节的模型里,$t_{\text{exec}} = 20$ μs 时加速比 0.98 倍。你付出了录制、显存和调试的成本,换来 2% 的倒退。 一句话:CUDA Graph 是给「小 kernel 洪水」用的药,不是通用加速开关。 一个理想的判断顺序是:先用 profiler 确认 GPU 有空转;再确认单个 kernel 确实小于发射成本;然后才考虑上 Graph。而如果那些 kernel 本来就该被融合掉,融合是更根本的解法——融合让 kernel 数从 1093 降到 355,Graph 只是把这 1093 次提交合并成 1 次;两者正交,可以叠加。 6.5 证据的范围 本机实测:全部来自附录三个脚本在这台 Apple M1 Pro 上的真实运行输出([A]~[F4])。这台机器没有 NVIDIA GPU、没有 torch,所以没有任何一个 CUDA 数字是实测的。 公开资料(非实测):kernel launch 的 1~5 μs 量级、一步 decode 的 300~1300 个 kernel、HBM 与片上带宽的量级差。出处见 launch_model.py 文件头。 模型推演:launch_model.py 的 [F1]/[F2]/[F3]/[F4] 是在上述输入上做的算术,脚本可跑、输入可改。请把这些当作「给定这些输入会得出什么」,而不是「GPU 上就是这么快」。 不确定的部分:[F3] 的 1093 是按架构手数的,真实值取决于编译器怎么 lowering,本文没有在真实 GPU 上验证过。Inductor 的融合策略也在持续变化,5.1 节引用的行号与函数名以 2026-10 时的 main 分支为准。 07. 经典论文脉络 四篇,按「融合是怎么从手工技巧变成系统能力,又怎么被反过来审视」串起来。 TVM: An Automated End-to-End Optimizing Compiler for Deep Learning(arXiv:1802.04799,2018)。第一次把「算符融合」从工程师的手工活变成编译器的自动决策:给定计算图,搜索融合方案和调度模板。本篇 3.2 节那个「融合省多少字节」的账,在这篇里是被当作搜索目标函数的一部分来算的。 The Deep Learning Compiler: A Comprehensive Survey(arXiv:2002.03794,2020,本文知识树的锚点)。给出一张完整坐标系:图级优化(融合、常量折叠、CSE)、算子级优化、内存分配、后端代码生成。它把融合明确归到「图级优化」——融合对单个算子的数学一无所知,它只改写算子之间的边界。这句话是理解本篇全部内容的前提。 FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135,2022)。把融合推到极致:不只把 softmax 融进注意力,还根本不实例化 $S \times S$ 的 score 矩阵,用在线 softmax 一边遍历一边归一化。这正是本篇 [A] 节那 1.000 GiB 中间产物的解法,而且它额外做到了 6.3 节说的那件事——省的不只是访存,还有被掩码白算的一半。 Operator Fusion in XLA: Analysis and Evaluation(arXiv:2301.13062,2023)。反过来审视这件事:作者去读 XLA 的融合 pass 源码,实测在 Cartpole 上不同融合策略的效果,最好的实现拿到 10.56 倍。这篇的价值在于它把「融合是好事」这个默认假设变成了可度量的对象——和本篇的 V2 实测 0.98 倍是同一个姿势:先问一句「到底快了多少」,再决定要不要相信。 至于 CUDA Graph,它不是论文,是 CUDA 10 起提供的一项运行时机制(录制-实例化-回放),说明见 CUDA C++ Programming Guide 的 CUDA Graphs 一节。把它和融合并列讨论,是因为它经常被当成融合的替代品——而它其实解决另一个问题。 08. 常见误解 「融合越大越好」。 融得越狠,寄存器压力和共享内存占用越大,occupancy 掉下来,反而更慢。Inductor 的 can_fuse_* 那一组函数之所以是「判断」而不是「尽量合」,就是因为融合有代价。而本文 [E] 节的实测给了一个更直接的极端例子:分块融合的 softmax 比不融合慢 21%。 「CUDA Graph 是通用加速开关」。 它一个字节都不省,也不减少 kernel 数。3.4 节的公式说得很清楚:$t_{\text{exec}} \ge t_{\text{launch}}$ 时它只会让你付 $t_{\text{disp}}$ 的额外成本。先测 GPU 有没有空转,再决定要不要上。 「融合不改变数值」。 代数重排会改变舍入顺序。本文 V3 实测相对误差约 5e-7。无害,但要知道它存在。 「把中间结果留在片上就一定快」。 收益取决于 $\rho$。本文这台机器 $\rho = 1.124$,V2 实测 0.98 倍——留片上的动作做对了,收益是零。反面同样成立:GPU 上 $\rho$ 大得多,同一个动作就值几倍。 「融合省的是计算量」。 它不改变 FLOPs,只改变访存和发射。softmax 的 exp 一个都没少([E] 节:实测是访存下界的 5.70 倍,说明瓶颈在计算)。 09. 动手验证 都是纯 numpy,不需要 GPU。 实验一:拿到你自己机器的地板。 跑 python fusion_lab.py D,读出 $a$ 和 $n^{*}$。在 M1 Pro 上预期 $a \approx 0.43$ μs、$n^{*} \approx 7746$ 元素(30.3 KiB)。换台机器这两个数会变,但「小张量上耗时和元素数无关」这段平台一定会出现。 实验二:把 K 调大。 把 fusion_lab.py 里的 K_CHAIN 从 8 改成 16,重跑 ALL。预期两件事:V1/V3 的加速比向 16 靠拢(而不是翻倍到 16 以上——字节比就是上限),以及 V1 的发射地板从 $2\times8\times0.43 \approx 6.9$ μs 涨到约 13.8 μs,曲线左端整体抬高。 实验三:看 $\rho$ 怎么被改坏。 把 [B] 节的 np.add(x, 1.0, out=y) 换成跨大步长的切片访问(例如每隔 32 个元素取一个),重测。预期 $B_{\text{on}}$ 明显下降、$\rho$ 趋近 1,随后 V2 的收益会进一步向 1 靠拢。这能让你亲眼看到「$\rho$ 小 ⇒ 融合白干」这条因果链。 实验四:自己数一遍 kernel。 跑 python launch_model.py,在 [F3] 的 per_layer 列表里按你自己熟悉的模型改,看总数落在哪。预期 Llama-3-8B 的 1093 落在公开资料给的 300~1300 区间内。 10. 延伸阅读 performance_profiling|性能建模与 Profiling:本篇 3.1 节的 roofline 判据来自那里,$\rho$ 和算术强度这两个量在那里第一次被建立起来。 attention_basics|自注意力机制:理解 3.5 节因果掩码和 [A] 节 score 矩阵形状的前提。 flash_attention|FlashAttention:本篇 [A] 节那 1.000 GiB 中间产物的正式解法,融合走到极致的样子。 mixed_precision|混合精度:数据类型决定 $b$(每元素字节数),直接进 3.2 节的账本。 kv_cache|KV Cache 与自回归视频生成:decode 场景为什么 kernel 又多又小,那篇给的 cache 账本是本篇 6.4 节「分段 capture」动机的来源。 附录:完整代码 09 节用到的脚本全文如下(launch_model.py、fusion_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 launch_model.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ launch_model.py —— 发射开销、CUDA Graph,以及它们和融合的分工 融合省的是字节,CUDA Graph 省的是 CPU 侧的发射次数,一个字节都不省。 这个脚本把两件事分开算: [F1] 离散事件时间线:eager 逐个发射 vs CUDA Graph 一次发射 [F2] 扫描:单个 kernel 执行多久时,CUDA Graph 才赚? [F3] 按 Llama-3-8B 架构手数一步 decode 有多少个 kernel [F4] 分解:本机实测的 K 段链加速里,多少来自「少发射」,多少来自「少搬字节」 公开量级的出处(都不是本机实测,本机没有 NVIDIA GPU): * kernel launch 的 CPU 侧成本:NVIDIA 开发者论坛 njuffa 给的是"空 kernel 约 5 us";CUDA Handbook 实测 NULL launch 约 4.9 us(老机器)、RTX 3060 约 1.2 us;A100 上常见引用是 2~3 us。所以本文取 1~5 us 这个区间, 并且强调**比值比绝对值重要**。 * 一个 decode step 的 kernel 数:公开资料给的量级是 300~1300。 [F3] 按架构手数出来的数落在这个区间里,可互为印证。 运行: python launch_model.py """ from __future__ import annotations import json import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # ══════════════════════════════════════════════════════════════ # [F1] 离散事件时间线 # ══════════════════════════════════════════════════════════════ def simulate_eager(n_kernel, t_launch, t_exec): """eager:CPU 逐个 cudaLaunchKernel,GPU 逐个执行,单流异步。 CPU 发第 i 个要花 t_launch,发完就不用管了,可以继续发下一个; GPU 要等「前一个跑完」且「这个已经被发出去」才能开始。 两个条件里慢的那个决定 GPU 什么时候开工,差出来的就是 GPU 空转。 """ gpu_free = 0.0 idle = 0.0 for i in range(n_kernel): cpu_done = (i + 1) * t_launch # CPU 发完第 i 个的时刻 start = max(gpu_free, cpu_done) # GPU 能开工的时刻 idle += start - gpu_free gpu_free = start + t_exec return {"total": gpu_free, "idle": idle, "idle_frac": idle / gpu_free if gpu_free > 0 else 0.0} def simulate_graph(n_kernel, t_launch, t_exec, t_dispatch): """CUDA Graph:一次 cudaGraphLaunch 提交整张图。 GPU 仍然要逐个节点过一遍前端,所以每个 kernel 还留一个 t_dispatch 的 GPU 侧派发成本——只是不再需要 CPU 每次都插手。 """ total = t_launch + n_kernel * (t_exec + t_dispatch) return {"total": total, "idle": t_launch, "idle_frac": t_launch / total if total > 0 else 0.0} def section_F1(): print("\n" + "=" * 72) print("[F1] 时间线:eager 逐个发射 vs CUDA Graph 一次发射") print("=" * 72) N, tl, te, td = 700, 3.0, 2.0, 0.5 e = simulate_eager(N, tl, te) g = simulate_graph(N, tl, te, td) print(f"\n 设定:N={N} 个 kernel,发射 {tl} us,执行 {te} us," f"graph 内派发 {td} us") print(f" eager 总时长 {e['total']:8.1f} us,GPU 空转 {e['idle']:7.1f} us" f"({e['idle_frac']*100:.0f}%)") print(f" CUDA Graph 总时长 {g['total']:8.1f} us,GPU 空转 {g['idle']:7.1f} us" f"({g['idle_frac']*100:.0f}%)") print(f" 加速比 = {e['total']/g['total']:.2f}x") # 换一个大 kernel 场景:执行时间远大于发射 e2 = simulate_eager(N, tl, 20.0) g2 = simulate_graph(N, tl, 20.0, td) print(f"\n 换成大 kernel(执行 20 us):") print(f" eager {e2['total']:8.1f} us,空转 {e2['idle_frac']*100:.0f}%") print(f" CUDA Graph {g2['total']:8.1f} us,空转 {g2['idle_frac']*100:.0f}%") print(f" 加速比 = {e2['total']/g2['total']:.2f}x -> 几乎没用") print(f"\n 结论:CUDA Graph 只在「单个 kernel 的执行时间接近或小于发射时间」") print(f" 时才赚钱。大 kernel 上它是纯负担(录制、显存、调试成本)。") return {"N": N, "t_launch": tl, "t_exec": te, "t_dispatch": td, "eager": e, "graph": g, "speedup": e["total"] / g["total"], "big": {"eager": e2, "graph": g2, "speedup": e2["total"] / g2["total"]}} # ══════════════════════════════════════════════════════════════ # [F2] 扫描:什么时候值得上 CUDA Graph # ══════════════════════════════════════════════════════════════ def section_F2(): print("\n" + "=" * 72) print("[F2] 扫描:单 kernel 执行时间 t_exec 对加速比的影响") print("=" * 72) N, tl, td = 700, 3.0, 0.5 print(f"\n N={N}, 发射 {tl} us, graph 内派发 {td} us") print(f"\n {'t_exec(us)':>11} {'eager(us)':>11} {'graph(us)':>11} " f"{'加速':>7} {'eager空转':>9}") rows = [] for te in [0.5, 1.0, 2.0, 3.0, 5.0, 8.0, 12.0, 20.0, 40.0]: e = simulate_eager(N, tl, te) g = simulate_graph(N, tl, te, td) rows.append({"t_exec": te, "eager_us": e["total"], "graph_us": g["total"], "speedup": e["total"] / g["total"], "idle_frac": e["idle_frac"]}) print(f" {te:>11.1f} {e['total']:>11.1f} {g['total']:>11.1f} " f"{e['total']/g['total']:6.2f}x {e['idle_frac']*100:8.0f}%") # 盈亏平衡点:eager 总时长 == graph 总时长 print(f"\n 盈亏平衡:eager 靠 CPU 逐个发射,graph 每个 kernel 多付 {td} us 派发。") print(f" 当 t_exec > t_launch 时 eager 已经不让 GPU 空转,graph 只是白付 {td}。" f"") print(f" 本例盈亏点在 t_exec ≈ t_launch = {tl} us 附近。") return {"N": N, "t_launch": tl, "t_dispatch": td, "rows": rows} # ══════════════════════════════════════════════════════════════ # [F3] 一步 decode 有多少个 kernel(按架构手数) # ══════════════════════════════════════════════════════════════ # Llama-3-8B 的公开配置 LLAMA3_8B = dict(n_layer=32, d_model=4096, n_head=32, n_kv_head=8, head_dim=128, d_ffn=14336, vocab=128256) def section_F3(): print("\n" + "=" * 72) print("[F3] 一步 decode 有多少个 kernel(按 Llama-3-8B 架构手数)") print("=" * 72) print("\n 这是**按架构推导**,不是实测。真实数字取决于编译器怎么 lowering,") print(" 融合后能少一半以上。公开资料给的量级是 300~1300。") cfg = LLAMA3_8B # 每层:括号里是不融合时这个模块会拆成几个 kernel per_layer = [ ("输入 RMSNorm", 4), # 平方 / 归约 / 乘 / 缩放 ("q_proj", 1), ("k_proj", 1), ("v_proj", 1), ("RoPE on q", 3), # cos/sin 表取 + 旋转 + 拼接 ("RoPE on k", 3), ("KV cache 写入", 2), # k、v 各一次 scatter ("QK^T", 1), ("scale + mask", 2), ("softmax", 3), # max / sub+exp / sum+div ("@V", 1), ("o_proj", 1), ("残差加", 1), ("后注意力 RMSNorm", 4), ("gate_proj", 1), ("up_proj", 1), ("SiLU", 1), ("逐元素乘", 1), ("down_proj", 1), ("残差加", 1), ] total_per_layer = sum(k for _, k in per_layer) n_layer = cfg["n_layer"] total = total_per_layer * n_layer + 5 # + 输出层 norm / lm_head / 采样等 print(f"\n 每层 {total_per_layer} 个 kernel:") for name, k in per_layer: print(f" {name:<22} {k}") print(f"\n x {n_layer} 层 = {total_per_layer*n_layer},加输出头约 5 个") print(f" 合计 ≈ {total} 个 kernel / token") print(f" (公开资料给的区间 300~1300,这个数落在里面)") # 融合后:把每层里能合的合掉 fused_per_layer = [ ("RMSNorm 融合", 1), ("QKV 一次 GEMM", 1), ("RoPE 融合", 1), ("KV cache 写入", 1), ("注意力融合(Flash)", 1), ("o_proj", 1), ("残差 + RMSNorm 融合", 1), ("gate/up 一次 GEMM", 1), ("SiLU + 乘 融合", 1), ("down_proj", 1), ("残差加", 1), ] fused_pl = sum(k for _, k in fused_per_layer) fused_total = fused_pl * n_layer + 3 print(f"\n 融合后每层 {fused_pl} 个 -> 合计 ≈ {fused_total} 个/token") print(f" kernel 数减少 {total/fused_total:.1f}x") print(f"\n 注意:融合减少的是 kernel 数,CUDA Graph 不减少 kernel 数,") print(f" 它只是把 {total} 次 CPU 发射合并成 1 次。两者正交,可以同时用。") return {"cfg": cfg, "per_layer": per_layer, "total_per_layer": total_per_layer, "total": total, "fused_per_layer": fused_per_layer, "fused_total": fused_total, "reduce": total / fused_total} # ══════════════════════════════════════════════════════════════ # [F4] 分解:本机实测的加速里,发射和字节各占多少 # ══════════════════════════════════════════════════════════════ def section_F4(fus): print("\n" + "=" * 72) print("[F4] 分解:本机 K 段链的加速里,多少来自少发射、多少来自少搬字节") print("=" * 72) D = fus["D"] C = fus["C"] a = D["a_us"] # 每次调用的固定开销(实测) b = D["b_us_per_elem"] # 每元素的边际成本(实测) K = C["K"] print(f"\n 实测固定开销 a = {a:.3f} us/次,边际 b = {b*1e6:.2f} us/百万元素") print(f"\n {'n':>9} {'V1 实测':>10} {'V1 模型':>10} {'V3 实测':>10} " f"{'V3 模型':>10} {'发射贡献':>9}") rows = [] for c in C["curves"]: n = c["n"] # V1: 2K 次调用,每次搬 n 个元素;V3: 2 次调用 t1_model = 2 * K * (a + b * n) t3_model = 2 * (a + b * n) # 反事实:只把调用次数从 2K 降到 2,数据量不变(纯发射收益) t_launch_only = 2 * K * a + 2 * K * b * n - (2 * a + 2 * K * b * n) total_gain = t1_model - t3_model frac = t_launch_only / total_gain if total_gain > 0 else 1.0 rows.append({"n": n, "t1_model": t1_model, "t3_model": t3_model, "launch_frac": frac}) print(f" {n:>9} {c['t1_us']:9.2f} us {t1_model:9.2f} us " f"{c['t3_us']:9.2f} us {t3_model:9.2f} us {frac*100:8.0f}%") small = rows[0] big = rows[-1] print(f"\n n={small['n']}({small['n']*4/1024:.1f} KiB):" f"模型说加速的 {small['launch_frac']*100:.0f}% 来自少发射," f"只有 {(1-small['launch_frac'])*100:.0f}% 来自少搬字节。") print(f" n={big['n']}({big['n']*4/1024/1024:.1f} MiB):" f"反过来,{big['launch_frac']*100:.0f}% 来自少发射," f"{(1-big['launch_frac'])*100:.0f}% 来自少搬字节。") print(f"\n 这就是本文最想说的一句话:") print(f" **小张量上,融合赚的几乎全是发射次数;大张量上,赚的才是字节。**") print(f" CUDA Graph 只做前一件,而且做得更彻底(一次发射整张图)。") return {"a_us": a, "b_us_per_elem": b, "rows": rows} # ══════════════════════════════════════════════════════════════ def main(): res = {} res["F1"] = section_F1() res["F2"] = section_F2() res["F3"] = section_F3() p = os.path.join(HERE, "_fusion_results.json") if os.path.exists(p): with open(p, encoding="utf-8") as f: fus = json.load(f) if "C" in fus and "D" in fus: res["F4"] = section_F4(fus) else: print("\n[F4] 跳过:先跑 fusion_lab.py ALL 生成 _fusion_results.json") p = os.path.join(HERE, "_launch_results.json") with open(p, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=2) print(f"\n结果已写入 {p}") if __name__ == "__main__": main() fusion_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ fusion_lab.py —— 算子融合的「字节账本 + 实测校验」 写这篇文章的机器是一台 Apple M1 Pro,**没有 NVIDIA GPU,也没有 torch**, 所以这里不假装能测 CUDA kernel。能测的是两件在这台机器上真实存在的事: 1. 内存有层级:数据留在片上和落回主存,代价差一个可测的倍数。 融合做的事就是「少落回几次」,这个倍数能测,收益也能算。 2. 每次调用算子都有一个与数据规模无关的固定成本(函数派发、缓冲检查、 循环建立)。它能测出来,是 GPU 上 kernel launch 开销在 CPU 上的同构物。 GPU 上的具体数字(HBM 带宽、launch 微秒数)本文一律引公开资料并明确标注, 不拿这台机器外推。反过来,凡是标「实测」的数字,都出自本文件。 五组实验: [A] 字节账本 —— 几类常见 pattern 融合前后各搬多少字节(纯算术,精确) [B] 带宽–工作集 —— 实测片上/片外带宽比 rho [C] 融合三形态 —— 不融合 / 分块(留片上) / 代数合并,扫规模看各自值多少 [D] 固定开销 —— 拟合出每次调用的固定成本,算它占总耗时的比例 [E] attention尾 —— score 矩阵账本、本机 softmax 卡在哪 运行: python fusion_lab.py ALL """ from __future__ import annotations import json import os import time import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) RNG_SEED = 20261002 MIB = float(1024 ** 2) GIB = float(1024 ** 3) # 逐元素链的形态:每段 h <- A*h + B,共 K 段 K_CHAIN = 8 A_S, B_S = 1.01, 0.01 def bench(fn, reps=7): """取多次里的最小值:最小值受系统抖动影响最小。""" ts = [] for _ in range(reps): t0 = time.perf_counter() fn() ts.append(time.perf_counter() - t0) return min(ts) def passes_to_bytes(n_elem, dtype_bytes, n_passes): """1 个 pass = 把整个张量读一遍再写一遍 = 2 * 字节数。""" return 2.0 * n_elem * dtype_bytes * n_passes # ══════════════════════════════════════════════════════════════ # [A] 字节账本:融合前后各搬多少字节 # ══════════════════════════════════════════════════════════════ def section_A(): print("\n" + "=" * 72) print("[A] 字节账本:融合前后各搬多少字节(纯算术,精确)") print("=" * 72) out = {} n = 4_000_000 # 一个中等激活张量,fp32 b = 4 # ── A1. K 段逐元素链 ────────────────────────────────── K = K_CHAIN unf = passes_to_bytes(n, b, K) fus = passes_to_bytes(n, b, 1) print(f"\n A1 {K} 段逐元素链({n/1e6:.0f}M 元素,fp32)") print(f" 不融合 {K} 个 kernel : {unf/MIB:8.1f} MiB") print(f" 融合成 1 个 kernel : {fus/MIB:8.1f} MiB -> 省 {unf/fus:.0f}x") out["chain"] = {"K": K, "unfused_MiB": unf / MIB, "fused_MiB": fus / MIB, "ratio": unf / fus} # ── A2. RMSNorm ─────────────────────────────────────── # 不融合:x*x(读写) / reduce mean(读) / x*r(读写) / *g(读写) unf = passes_to_bytes(n, b, 4) fus = passes_to_bytes(n, b, 1) print(f"\n A2 RMSNorm({n/1e6:.0f}M 元素)") print(f" 不融合 4 遍 : {unf/MIB:8.1f} MiB") print(f" 融合 1 遍 : {fus/MIB:8.1f} MiB -> 省 {unf/fus:.0f}x") out["rmsnorm"] = {"unfused_MiB": unf / MIB, "fused_MiB": fus / MIB, "ratio": unf / fus} # ── A3. attention 的 score 矩阵 ─────────────────────── Bs, H, S, D = 8, 16, 2048, 4096 dt = 2 # bf16 act_bytes = Bs * S * D * dt score_bytes = Bs * H * S * S * dt half = 1 + 2 + 2 + 1 + 2 # softmax 五步各读写几份 score unf = half * score_bytes fus = 2 * score_bytes print(f"\n A3 attention score(B={Bs}, H={H}, S={S}, d={D}, bf16)") print(f" 输入激活 [B,S,d] : {act_bytes/MIB:8.1f} MiB") print(f" score 矩阵 [B,H,S,S] : {score_bytes/GIB:8.3f} GiB" f" = 输入的 {score_bytes/act_bytes:.0f}x") print(f" softmax 不融合 {half} 份读写 : {unf/GIB:8.3f} GiB") print(f" softmax 融合 : {fus/GIB:8.3f} GiB -> 省 {unf/fus:.1f}x") print(f" 额外物化一份 mask : +{score_bytes/GIB:.3f} GiB(融合后消失)") print(f"\n 放大倍数 = H*S/d = {H}*{S}/{D} = {H*S/D:.0f}x") print(f" S 翻一倍 -> 放大倍数翻一倍(score 按 S 的平方长,激活按 S 长)") for s in (1024, 2048, 4096, 8192): print(f" S={s:>5}: score/激活 = {H*s/D:5.1f}x") out["softmax"] = {"B": Bs, "H": H, "S": S, "d": D, "act_MiB": act_bytes / MIB, "score_GiB": score_bytes / GIB, "blowup": score_bytes / act_bytes, "unfused_GiB": unf / GIB, "fused_GiB": fus / GIB, "ratio": unf / fus, "mask_GiB": score_bytes / GIB, "blowup_curve": [{"S": s, "x": H * s / D} for s in (1024, 2048, 4096, 8192)]} # ── A4. 因果掩码:块级跳过能省多少 ──────────────────── total = S * S kept_exact = S * (S + 1) // 2 rows = [] print(f"\n A4 因果掩码 S={S}:块级跳过 vs 精确跳过") for br in (64, 128, 256): nb = S // br blocks_done = nb * (nb + 1) // 2 # query 块 i 只算 j<=i 的 key 块 rows.append({"br": br, "nb": nb, "frac": blocks_done / (nb * nb)}) print(f" 块边长 {br:>4}: 算 {blocks_done:>4}/{nb*nb:<4} 块" f" = {blocks_done/(nb*nb)*100:5.1f}% 工作量") print(f" 理论上界(逐元素精确): {kept_exact/total*100:5.1f}%") print(f" 完全不跳 : {100.0:5.1f}% -> 白算 " f"{100-kept_exact/total*100:.1f}%") out["causal"] = {"S": S, "exact_frac": kept_exact / total, "blocks": rows} return out # ══════════════════════════════════════════════════════════════ # [B] 带宽 vs 工作集:实测片上/片外带宽比 # ══════════════════════════════════════════════════════════════ def section_B(): print("\n" + "=" * 72) print("[B] 带宽 vs 工作集(np.add(x, 1, out=y):1 读 1 写)") print("=" * 72) rng = np.random.default_rng(RNG_SEED) print(f"\n {'工作集':>12} {'耗时':>10} {'带宽':>10} 归属") rows = [] for nbytes in [32 << 10, 128 << 10, 512 << 10, 2 << 20, 8 << 20, 32 << 20, 128 << 20]: n = nbytes // 4 x = rng.standard_normal(n).astype(np.float32) y = np.empty_like(x) bench(lambda: np.add(x, 1.0, out=y), reps=3) t = bench(lambda: np.add(x, 1.0, out=y), reps=11) bw = 2 * nbytes / t / 1e9 tag = "onchip" if nbytes <= (8 << 20) else "dram" rows.append({"KiB": nbytes >> 10, "ms": t * 1e3, "GBs": bw, "tag": tag}) print(f" {nbytes>>10:>10} KiB {t*1e3:9.3f} ms {bw:9.1f} GB/s {tag}") del x, y b_cache = float(np.median([r["GBs"] for r in rows if r["tag"] == "onchip"])) b_dram = float(np.median([r["GBs"] for r in rows if r["tag"] == "dram"])) rho = b_cache / b_dram print(f"\n 片上带宽中位数 B_cache = {b_cache:.1f} GB/s") print(f" 主存带宽中位数 B_dram = {b_dram:.1f} GB/s") print(f" 比值 rho = {rho:.3f} <- 决定融合能兑现多少的关键参数") print(f"\n 注意:这里的 B_cache 不是缓存的峰值带宽,而是单线程 numpy 逐元素") print(f" 循环的吞吐上限。它只比主存快 {rho:.2f} 倍,所以在这台机器上") print(f" 「把中间结果留在片上」这件事本身几乎不值钱(见 [C] 的 V2)。") return {"rows": rows, "B_cache_GBs": b_cache, "B_dram_GBs": b_dram, "rho": rho} # ══════════════════════════════════════════════════════════════ # [C] 融合三形态 × 规模扫描 # ══════════════════════════════════════════════════════════════ def _v1_unfused(x, buf, K=K_CHAIN): """V1 不融合:K 段,每段 2 次算子调用,每段结果都写回内存。""" np.multiply(x, A_S, out=buf) np.add(buf, B_S, out=buf) for _ in range(K - 1): np.multiply(buf, A_S, out=buf) np.add(buf, B_S, out=buf) return buf def _v2_tiled(x, out, tile, K=K_CHAIN): """V2 分块融合:一块读进来,K 段都在片上算完,只写回一次。 这是 GPU 融合 kernel 的 CPU 近似:tile 就是寄存器/共享内存那块片上缓冲。 numpy 做不到寄存器级融合(每个 ufunc 仍要写回 tile),所以 V2 是本机能 做到的最好近似。 """ t = np.empty(tile, dtype=np.float32) for s in range(0, x.size, tile): m = min(tile, x.size - s) v = t[:m] np.multiply(x[s:s + m], A_S, out=v) np.add(v, B_S, out=v) for _ in range(K - 1): np.multiply(v, A_S, out=v) np.add(v, B_S, out=v) out[s:s + m] = v return out def _v3_closed(x, out, K=K_CHAIN): """V3 代数合并:K 段仿射合成一个仿射,只剩 2 次调用。 h_K = A^K * h_0 + B*(A^K - 1)/(A - 1) 中间结果根本不存在,连「留在片上」都不需要。 """ Ak = A_S ** K Bk = B_S * (Ak - 1.0) / (A_S - 1.0) np.multiply(x, Ak, out=out) np.add(out, Bk, out=out) return out def section_C(rho): print("\n" + "=" * 72) print(f"[C] 融合三形态 × 规模扫描(K={K_CHAIN} 段 h <- {A_S}*h + {B_S})") print("=" * 72) rng = np.random.default_rng(RNG_SEED) sizes = [512, 4096, 65536, 262144, 1 << 20, 4_000_000] curves = [] print(f"\n {'n':>9} {'V1 不融合':>11} {'V3 代数合并':>11} " f"{'V1/V3':>7} {'相对误差':>10}") for n in sizes: x = rng.standard_normal(n).astype(np.float32) buf, out = np.empty_like(x), np.empty_like(x) reps = 5000 if n <= 65536 else 11 bench(lambda: _v1_unfused(x, buf), reps=3) t1 = bench(lambda: _v1_unfused(x, buf), reps=reps) bench(lambda: _v3_closed(x, out), reps=3) t3 = bench(lambda: _v3_closed(x, out), reps=reps) rel = float(np.max(np.abs(buf - out)) / np.max(np.abs(buf))) curves.append({"n": n, "t1_us": t1 * 1e6, "t3_us": t3 * 1e6, "speedup": t1 / t3, "rel_err": rel}) print(f" {n:>9} {t1*1e6:9.2f} us {t3*1e6:9.2f} us " f"{t1/t3:6.2f}x {rel:10.2e}") # V2 只在最大规模上跑:它慢,且只有这里才谈得上「主存 vs 片上」 print(f"\n V2 分块融合(n=4,000,000,扫 tile):") x = rng.standard_normal(4_000_000).astype(np.float32) buf, out = np.empty_like(x), np.empty_like(x) bench(lambda: _v1_unfused(x, buf), reps=3) t1_big = bench(lambda: _v1_unfused(x, buf), reps=11) print(f" V1 不融合基准: {t1_big*1e3:.3f} ms") v2 = [] for tile in [16384, 65536, 262144, 1 << 20]: bench(lambda: _v2_tiled(x, out, tile), reps=3) t = bench(lambda: _v2_tiled(x, out, tile), reps=11) v2.append({"tile": tile, "ms": t * 1e3, "speedup": t1_big / t}) print(f" tile={tile:>8}: {t*1e3:8.3f} ms {t1_big/t:5.2f}x") best2 = max(v2, key=lambda r: r["speedup"]) K = K_CHAIN pred = K / (1 + (K - 1) / rho) print(f"\n V2 最佳 {best2['speedup']:.2f}x(tile={best2['tile']})") print(f" 模型预测 K/(1+(K-1)/rho) = {K}/(1+{K-1}/{rho:.3f}) = {pred:.2f}x") print(f" -> 模型说 V2 几乎没收益,实测确实几乎没有。两者一致。") print(f"\n V3 的收益不受 rho 限制:中间结果根本不存在,") print(f" 直接就是字节比 K = {K}x(实测 " f"{min(c['speedup'] for c in curves):.2f}~" f"{max(c['speedup'] for c in curves):.2f}x,在 K 附近浮动)。") return {"K": K, "rho": rho, "curves": curves, "v2": v2, "v2_best": best2, "v2_pred": pred, "t1_big_ms": t1_big * 1e3} # ══════════════════════════════════════════════════════════════ # [D] 固定开销:每次调用的地板成本 # ══════════════════════════════════════════════════════════════ def section_D(): print("\n" + "=" * 72) print("[D] 单次调用的固定开销(np.add(x, 1, out=y))") print("=" * 72) rng = np.random.default_rng(RNG_SEED) sizes = [1, 8, 64, 512, 4096, 16384, 65536, 262144, 1 << 20] print(f"\n {'n':>9} {'单次耗时':>11}") rows = [] for n in sizes: a = rng.standard_normal(n).astype(np.float32) b = np.empty_like(a) reps = 20000 if n <= 4096 else 500 t0 = time.perf_counter() for _ in range(reps): np.add(a, 1.0, out=b) t = (time.perf_counter() - t0) / reps rows.append({"n": n, "us": t * 1e6}) print(f" {n:>9} {t*1e6:9.3f} us") # 只用小端拟合:大端会被缓存/主存的拐点污染 ns = np.array([r["n"] for r in rows if r["n"] <= 16384], dtype=float) ts = np.array([r["us"] for r in rows if r["n"] <= 16384], dtype=float) A = np.stack([np.ones_like(ns), ns], axis=1) coef, *_ = np.linalg.lstsq(A, ts, rcond=None) a_us, slope = float(coef[0]), float(coef[1]) print(f"\n 拟合 t = a + b*n(n <= 16384):") print(f" 固定开销 a = {a_us:.3f} us / 次") print(f" 边际成本 b = {slope*1e6:.3f} us / 百万元素") n_half = a_us / slope if slope > 0 else float("inf") print(f" 开销与数据各占一半的临界规模 n* = a/b = {n_half:.0f} 元素" f"({n_half*4/1024:.1f} KiB)") print(f"\n {K_CHAIN} 段链({2*K_CHAIN} 次调用)里固定开销的占比:") share = [] for r in rows: n = r["n"] fixed = 2 * K_CHAIN * a_us tc = 2 * K_CHAIN * (a_us + slope * n) frac = fixed / tc if tc > 0 else 1.0 share.append({"n": n, "fixed_frac": frac}) print(f" n={n:>9}: 固定部分占 {frac*100:5.1f}%") return {"rows": rows, "a_us": a_us, "b_us_per_elem": slope, "n_half": n_half, "share": share, "K": K_CHAIN} # ══════════════════════════════════════════════════════════════ # [E] attention 尾部:本机 softmax 卡在哪 # ══════════════════════════════════════════════════════════════ def _softmax_unfused(x, out): m = np.max(x, axis=-1, keepdims=True) # 读 np.subtract(x, m, out=out) # 读 x + 写 out np.exp(out, out=out) # 读 + 写 s = np.sum(out, axis=-1, keepdims=True) # 读 np.divide(out, s, out=out) # 读 + 写 return out def _softmax_tiled(x, out, rows): for i in range(0, x.shape[1], rows): sl = slice(i, i + rows) blk, dst = x[:, sl, :], out[:, sl, :] m = np.max(blk, axis=-1, keepdims=True) np.subtract(blk, m, out=dst) np.exp(dst, out=dst) s = np.sum(dst, axis=-1, keepdims=True) np.divide(dst, s, out=dst) return out def section_E(b_dram): print("\n" + "=" * 72) print("[E] attention 尾部:本机 softmax 到底卡在哪") print("=" * 72) rng = np.random.default_rng(RNG_SEED) H, S = 8, 1024 x = rng.standard_normal((H, S, S)).astype(np.float32) nbytes = x.nbytes print(f"\n score 矩阵 [H={H}, S={S}, S={S}] = {nbytes/MIB:.1f} MB") out = np.empty_like(x) bench(lambda: _softmax_unfused(x, out), reps=3) t_unf = bench(lambda: _softmax_unfused(x, out), reps=11) ref = out.copy() o2 = np.empty_like(x) bench(lambda: _softmax_tiled(x, o2, 64), reps=3) t_til = bench(lambda: _softmax_tiled(x, o2, 64), reps=11) diff = float(np.max(np.abs(ref - o2))) traffic = 8 * nbytes # [A3] 里的 8 份读写 roof = traffic / (b_dram * 1e9) * 1e3 print(f"\n 不融合(5 个 kernel,共 {traffic/MIB:.0f} MB 读写): {t_unf*1e3:8.3f} ms") print(f" 分块融合(rows=64) : {t_til*1e3:8.3f} ms" f" speedup={t_unf/t_til:.2f}x diff={diff:.1e}") print(f"\n 纯访存下界 = {traffic/MIB:.0f} MB / {b_dram:.0f} GB/s = {roof:.3f} ms") print(f" 实测 / 下界 = {t_unf*1e3/roof:.2f}x") print(f" -> 远高于 1:这里卡的是 exp 的计算本身,不是访存。") print(f" 分块省了字节但一个 exp 都没少,所以反而更慢。") print(f" 这正是「融合省不了算错的东西」的直接证据。") return {"H": H, "S": S, "score_MB": nbytes / MIB, "t_unfused_ms": t_unf * 1e3, "t_tiled_ms": t_til * 1e3, "speedup": t_unf / t_til, "diff": diff, "traffic_MB": traffic / MIB, "roof_ms": roof, "over_roof": t_unf * 1e3 / roof} # ══════════════════════════════════════════════════════════════ def main(): import sys which = sys.argv[1] if len(sys.argv) > 1 else "ALL" res = {} if which in ("ALL", "A"): res["A"] = section_A() if which in ("ALL", "B"): res["B"] = section_B() if which in ("ALL", "C"): rho = res.get("B", {}).get("rho") if rho is None: res["B"] = section_B() rho = res["B"]["rho"] res["C"] = section_C(rho) if which in ("ALL", "D"): res["D"] = section_D() if which in ("ALL", "E"): bd = res.get("B", {}).get("B_dram_GBs") if bd is None: res["B"] = section_B() bd = res["B"]["B_dram_GBs"] res["E"] = section_E(bd) p = os.path.join(HERE, "_fusion_results.json") with open(p, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=2) print(f"\n结果已写入 {p}") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ make_figures.py —— 画本文的 5 张配图。 数据全部读已经跑完的实验(_fusion_results.json / _launch_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") try: os.makedirs(FIGDIR, exist_ok=True) except FileExistsError: pass # 配色(正文写「这张图要看什么」时按这几个名字描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 / 融合后 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 C_RED = "#b71c1c" # 红:越界 / 地板 plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 MIB = float(1024 ** 2) def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): raise SystemExit(f"缺少 {name},先跑 fusion_lab.py ALL / launch_model.py") with open(p, encoding="utf-8") as f: return json.load(f) # ══════════════════════════════════════════════════════════════ # 图 1:字节账本 # ══════════════════════════════════════════════════════════════ def fig_traffic(fus): A = fus["A"] items = [ ("8 段逐元素链\n(4M 元素 fp32)", A["chain"]["unfused_MiB"], A["chain"]["fused_MiB"]), ("RMSNorm\n(4M 元素 fp32)", A["rmsnorm"]["unfused_MiB"], A["rmsnorm"]["fused_MiB"]), ("attention softmax\n(B=8,H=16,S=2048,bf16)", A["softmax"]["unfused_GiB"] * 1024, A["softmax"]["fused_GiB"] * 1024), ] labels = [t[0] for t in items] unf = [t[1] for t in items] fs = [t[2] for t in items] fig, ax = plt.subplots(figsize=(9.2, 4.4)) y = np.arange(len(items)) h = 0.34 ax.barh(y + h / 2, unf, height=h, color=C_ALT, label="不融合") ax.barh(y - h / 2, fs, height=h, color=C_GREEN, label="融合后") for i, (u, f) in enumerate(zip(unf, fs)): ax.text(u * 1.15, i + h / 2, f"{u:.1f} MiB", va="center", fontsize=9, color=C_ALT) ax.text(f * 1.15, i - h / 2, f"{f:.1f} MiB", va="center", fontsize=9, color=C_GREEN) ax.annotate(f"{u/f:.0f}x", xy=(u, i), xytext=(u * 1.15, i + 0.42), fontsize=9, color=C_MAIN, fontweight="bold") ax.set_yticks(y) ax.set_yticklabels(labels, fontsize=9) ax.set_xscale("log") ax.set_xlim(8, 40000) ax.set_xlabel("搬动的字节数(对数刻度)", fontsize=10) ax.set_title("图 1:融合前后各搬多少字节", fontsize=12, color=C_MAIN) ax.legend(loc="lower right", fontsize=9) ax.grid(axis="x", alpha=0.3, linestyle=":") ax.set_axisbelow(True) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_traffic.png")) plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 2:score 矩阵的放大倍数 + 因果块级跳过 # ══════════════════════════════════════════════════════════════ def fig_blowup(fus): A = fus["A"] sm = A["softmax"] ca = A["causal"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.4, 4.2)) # 左:放大倍数随 S 增长 ss = [d["S"] for d in sm["blowup_curve"]] xx = [d["x"] for d in sm["blowup_curve"]] ax1.plot(ss, xx, "o-", color=C_MAIN, linewidth=2, markersize=7) ax1.plot(ss, ss, "--", color=C_GRAY, linewidth=1.2, label="线性参考(若按 S 增长)") ax1.set_xscale("log", base=2) ax1.set_yscale("log", base=2) ax1.set_xticks(ss) ax1.set_xticklabels([str(s) for s in ss], fontsize=9) ax1.set_yticks(xx) ax1.set_yticklabels([f"{v:.0f}x" for v in xx], fontsize=9) ax1.minorticks_off() ax1.set_xlabel("序列长度 S", fontsize=10) ax1.set_ylabel("score 矩阵 / 输入激活", fontsize=10) ax1.set_title(f"中间产物被放大 H*S/d = {sm['H']}*S/{sm['d']} 倍", fontsize=11, color=C_MAIN) ax1.grid(alpha=0.3, linestyle=":") ax1.legend(fontsize=8, loc="upper left") ax1.set_axisbelow(True) for s, v in zip(ss, xx): ax1.annotate(f"{v:.0f}x", (s, v), textcoords="offset points", xytext=(6, -12), fontsize=8, color=C_MAIN) # 右:因果块级跳过 brs = [str(b["br"]) for b in ca["blocks"]] fr = [b["frac"] * 100 for b in ca["blocks"]] bars = ax2.bar(brs, fr, color=C_LIGHT, edgecolor=C_MAIN, width=0.55) ax2.axhline(ca["exact_frac"] * 100, color=C_GREEN, linestyle="--", linewidth=1.6, label=f"理论上界 {ca['exact_frac']*100:.1f}%") ax2.axhline(100, color=C_GRAY, linestyle=":", linewidth=1.2, label="不跳过 100%") for b, v in zip(bars, fr): ax2.text(b.get_x() + b.get_width() / 2, v + 1.2, f"{v:.1f}%", ha="center", fontsize=9, color=C_MAIN) ax2.set_ylim(0, 118) ax2.set_xlabel("块边长", fontsize=10) ax2.set_ylabel("实际算的工作量占比 (%)", fontsize=10) ax2.set_title(f"因果掩码块级跳过(S={ca['S']})", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="upper left") ax2.grid(axis="y", alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 2:attention 的两本账——中间产物多大、白算多少", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_blowup.png")) plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 3:融合三形态 × 规模扫描 # ══════════════════════════════════════════════════════════════ def fig_three_forms(fus): C = fus["C"] D = fus["D"] K = C["K"] a = D["a_us"] cur = C["curves"] ns = [c["n"] for c in cur] t1 = [c["t1_us"] for c in cur] t3 = [c["t3_us"] for c in cur] sp = [c["speedup"] for c in cur] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.3)) # 左:耗时 vs 规模 ax1.loglog(ns, t1, "o-", color=C_ALT, linewidth=2, markersize=6, label="V1 不融合(2K 次调用)") ax1.loglog(ns, t3, "s-", color=C_GREEN, linewidth=2, markersize=6, label="V3 代数合并(2 次调用)") floor = 2 * K * a ax1.axhline(floor, color=C_RED, linestyle="--", linewidth=1.4, label=f"V1 的发射地板 2K*a = {floor:.1f} μs") ax1.axhline(2 * a, color=C_PURPLE, linestyle=":", linewidth=1.4, label=f"V3 的发射地板 2*a = {2*a:.1f} μs") # V2 在最大规模上的结果 v2b = C["v2_best"] ax1.plot([ns[-1]], [v2b["ms"] * 1e3], "D", color=C_GRAY, markersize=9, label=f"V2 分块融合 {v2b['ms']*1e3:.0f} μs") ax1.set_xlabel("张量元素数", fontsize=10) ax1.set_ylabel("单次耗时 (μs)", fontsize=10) ax1.set_title(f"三种形态的耗时(K={K})", fontsize=11, color=C_MAIN) ax1.legend(fontsize=8, loc="upper left") ax1.grid(alpha=0.3, linestyle=":") ax1.set_axisbelow(True) # 右:加速比 ax2.semilogx(ns, sp, "o-", color=C_MAIN, linewidth=2, markersize=6, label="V1 / V3(代数合并)") ax2.axhline(K, color=C_GREEN, linestyle="--", linewidth=1.6, label=f"字节比上限 K = {K}x") ax2.axhline(C["v2_pred"], color=C_GRAY, linestyle=":", linewidth=1.6, label=f"V2 模型预测 {C['v2_pred']:.2f}x") ax2.plot([ns[-1]], [v2b["speedup"]], "D", color=C_ALT, markersize=9, label=f"V2 实测 {v2b['speedup']:.2f}x") ax2.set_ylim(0, K * 1.25) ax2.set_xlabel("张量元素数", fontsize=10) ax2.set_ylabel("加速比", fontsize=10) ax2.set_title("各自兑现了多少", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="lower left") ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 3:融合三形态 × 规模扫描(本机实测,M1 Pro / numpy)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_three_forms.png")) plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 4:单次调用的固定开销 # ══════════════════════════════════════════════════════════════ def fig_launch(fus): D = fus["D"] rows = D["rows"] ns = np.array([r["n"] for r in rows], dtype=float) us = np.array([r["us"] for r in rows], dtype=float) a, b = D["a_us"], D["b_us_per_elem"] n_half = D["n_half"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.2)) # 左:延迟 vs 规模,含地板 ax1.loglog(ns, us, "o", color=C_MAIN, markersize=7, label="实测") grid = np.logspace(0, np.log10(ns.max()), 60) ax1.loglog(grid, a + b * grid, "-", color=C_ALT, linewidth=1.8, label=f"拟合 a + b*n(a={a:.2f} μs)") ax1.axhline(a, color=C_RED, linestyle="--", linewidth=1.6, label=f"固定开销地板 a = {a:.2f} μs") ax1.axvline(n_half, color=C_PURPLE, linestyle=":", linewidth=1.6, label=f"各占一半 n* = {n_half:.0f} 元素") ax1.set_xlabel("张量元素数", fontsize=10) ax1.set_ylabel("单次调用耗时 (μs)", fontsize=10) ax1.set_title("小到一定程度,耗时就和数据无关了", fontsize=11, color=C_MAIN) ax1.legend(fontsize=8, loc="upper left") ax1.grid(alpha=0.3, linestyle=":") ax1.set_axisbelow(True) # 右:一条 K 段链里固定开销的占比 share = D["share"] sn = np.array([s["n"] for s in share], dtype=float) sf = np.array([s["fixed_frac"] for s in share]) * 100 ax2.semilogx(sn, sf, "o-", color=C_MAIN, linewidth=2, markersize=6) ax2.axhline(50, color=C_GRAY, linestyle=":", linewidth=1.3) ax2.fill_between(sn, 0, sf, color=C_LIGHT, alpha=0.55) for x, v in zip(sn, sf): if v > 55 or v < 12: ax2.annotate(f"{v:.0f}%", (x, v), textcoords="offset points", xytext=(0, 8), fontsize=8, color=C_MAIN, ha="center") ax2.set_ylim(0, 108) ax2.set_xlabel("张量元素数", fontsize=10) ax2.set_ylabel("固定开销占总耗时 (%)", fontsize=10) ax2.set_title(f"{D['K']} 段链({2*D['K']} 次调用)里,发射占多少", fontsize=11, color=C_MAIN) ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 4:每次调用都有一个和数据规模无关的地板(本机实测)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_launch.png")) plt.close(fig) # ══════════════════════════════════════════════════════════════ # 图 5:CUDA Graph 的时间线 # ══════════════════════════════════════════════════════════════ def fig_graph(lnc): F1 = lnc["F1"] F2 = lnc["F2"] tl, te, td = F1["t_launch"], F1["t_exec"], F1["t_dispatch"] fig, (ax1, ax2) = plt.subplots( 1, 2, figsize=(11.2, 4.3), gridspec_kw={"width_ratios": [1.25, 1]}) # ── 左:甘特图,只画前 8 个 kernel ── n_show = 8 # eager:CPU 逐个发射,GPU 要等「前一个跑完」且「这个已发出」才能开工。 # 时刻逐事件推算,和图里的条形严格同源。 gpu_free, segs_cpu, segs_gpu, segs_idle = 0.0, [], [], [] for i in range(n_show): cpu_done = (i + 1) * tl start = max(gpu_free, cpu_done) if start > gpu_free: segs_idle.append((gpu_free, start - gpu_free)) segs_gpu.append((start, te)) segs_cpu.append((i * tl, tl)) gpu_free = start + te ax1.broken_barh(segs_cpu, (3.4, 0.8), facecolors=C_LIGHT, edgecolor=C_MAIN, linewidth=0.6) ax1.broken_barh(segs_gpu, (2.2, 0.8), facecolors=C_GREEN, edgecolor=C_GREEN, linewidth=0.6) ax1.broken_barh(segs_idle, (2.2, 0.8), facecolors="#f0c9c9", edgecolor=C_RED, linewidth=0.6, hatch="//") # graph:一次发射,之后背靠背 g_cpu = [(0, tl)] g_gpu = [(tl, n_show * (te + td))] ax1.broken_barh(g_cpu, (1.0, 0.8), facecolors=C_LIGHT, edgecolor=C_MAIN, linewidth=0.6) ax1.broken_barh(g_gpu, (-0.2, 0.8), facecolors=C_GREEN, edgecolor=C_GREEN, linewidth=0.6) ax1.set_yticks([3.8, 2.6, 1.4, 0.2]) ax1.set_yticklabels(["CPU 发射", "GPU 执行", "CPU 发射", "GPU 执行"], fontsize=9) ax1.set_xlabel("时间 (μs)", fontsize=10) ax1.set_xlim(-0.5, n_show * tl + te + 3) ax1.set_ylim(-0.6, 5.4) ax1.set_title(f"eager(上)vs CUDA Graph(下) " f"发射 {tl} μs / 执行 {te} μs", fontsize=10.5, color=C_MAIN) ax1.grid(axis="x", alpha=0.3, linestyle=":") ax1.set_axisbelow(True) ax1.text(0.4, 4.95, "eager:每次发射 GPU 都要等(斜纹 = 空转)", fontsize=8.5, color=C_ALT, va="center") ax1.text(0.4, 0.78, "graph:只发射一次,之后 GPU 背靠背(无空转)", fontsize=8.5, color=C_GREEN, va="center") # ── 右:加速比 vs 单 kernel 执行时间 ── rws = F2["rows"] tes = [r["t_exec"] for r in rws] sps = [r["speedup"] for r in rws] ax2.plot(tes, sps, "o-", color=C_MAIN, linewidth=2, markersize=6) ax2.axhline(1.0, color=C_GRAY, linestyle=":", linewidth=1.3, label="盈亏线 1.0x") ax2.axvline(F2["t_launch"], color=C_RED, linestyle="--", linewidth=1.5, label=f"发射成本 {F2['t_launch']} μs") ax2.fill_between(tes, 0, 1.0, where=np.array(sps) < 1.0, color="#f0c9c9", alpha=0.6, label="graph 反而更慢") ax2.set_xscale("log") ax2.set_xlabel("单个 kernel 的执行时间 (μs)", fontsize=10) ax2.set_ylabel("CUDA Graph 加速比", fontsize=10) ax2.set_title(f"N={F2['N']} 个 kernel", fontsize=11, color=C_MAIN) ax2.legend(fontsize=8, loc="lower right") ax2.grid(alpha=0.3, linestyle=":") ax2.set_axisbelow(True) fig.suptitle("图 5:CUDA Graph 省的是发射,不是字节(模型推演)", fontsize=12, color=C_MAIN, y=1.0) fig.tight_layout() fig.savefig(os.path.join(FIGDIR, "fig_graph.png")) plt.close(fig) # ══════════════════════════════════════════════════════════════ def main(): fus = _load("_fusion_results.json") lnc = _load("_launch_results.json") fig_traffic(fus) fig_blowup(fus) fig_three_forms(fus) fig_launch(fus) fig_graph(lnc) print("已生成 5 张图:") for f in sorted(os.listdir(FIGDIR)): if f.endswith(".png"): p = os.path.join(FIGDIR, f) print(f" {f} {os.path.getsize(p)/1024:.0f} KiB") if __name__ == "__main__": main()
-
AIGC 基本功|离散化表征:VQ-VAE 与 VQGAN-VQGAN 离散化表征:VQ-VAE 与 VQGAN 到底在解决什么问题 所属方向:表征 | 难度:进阶 | 前置知识:变分下界与重参数化(ELBO)、VAE 结构与训练目标(知道「重参数化」和「KL 项怎么来的」就够了) 关键词:VQ-VAE、VQGAN、码本、straight-through、码本坍缩、感知损失 01. 为什么需要它 先算一笔账,这笔账是 VQGAN 那篇论文(Taming Transformers, 2012.09841)的全部动机。把一张 256×256 的 RGB 图像当成序列直接做自回归:每个像素三个通道各算一个 token,序列长度是 256 × 256 × 3 = 196,608。自回归 Transformer 的注意力矩阵是序列长度的平方,也就是 3.87 × 10¹⁰ 个元素——一张图都喂不进去,更别说训练了。 我按这个口径把不同下采样率的账都算了一遍(token_budget.py,本机实跑): 下采样率 f 256² 图像的 token 数 注意力矩阵规模 相对像素级 像素级 RGB 196,608 3.87 × 10¹⁰ 1 f=4 4,096 1.68 × 10⁷ 4.3 × 10⁻⁴ f=8 1,024 1.05 × 10⁶ 2.7 × 10⁻⁵ f=16 256 6.55 × 10⁴ 1.7 × 10⁻⁶ 这张图要看的是两件事:左图里三条 tokenizer 曲线与像素级虚线之间的纵向鸿沟——f=16 时 256² 图像只有 256 个 token,是像素级序列的 1/768;右图是同一个事实在注意力开销上的投影,柱子从 3.87 × 10¹⁰ 掉到 6.55 × 10⁴,省了约 59 万倍。分辨率越高鸿沟越陡(1024² 图像在 f=16 下是 4,096 个 token),视频更极端:5 秒 24fps 共 121 帧,时间下采样 4 倍、空间 f=16 时只要 7,680 个 token。没有这个压缩,自回归视频生成连第一步都迈不出去。 但「短」只是必要条件,自回归还要求「离散」。语言模型之所以好训,是因为下一个 token 的预测是 K 分类交叉熵——一个良性的、方差可控的目标。连续潜变量上做自回归就得给每个位置配一个连续密度(混合密度网络那一路),训练病态且难以和大模型基建兼容。把潜变量离散成「码本里的编号」之后,图像生成就变成了「图像版的语言建模」:DALL-E 用 8192 个码字的 dVAE 加 32×32=1024 个 token 的自回归,VQGAN 用 16×16=256 个 token 的自回归,后来的 MaskGIT、VAR 走的都是这条路。 不过离散化是有代价的,而且真正容易被忽视的代价不在「码本有多大」,在「码本用得怎么样」。我在 8×8 小块的玩具上训了一个 K=512 的 VQ 自编码器(collapse_lab.py,实跑):512 个码字里只有 17 个被用到,96.7% 的码一次都没被选中;码本标称 9 bit,实际只用出去 log2(14.50) = 3.86 bit。这篇就讲三件事:量化怎么写进损失函数、码本怎么训练才不会死、以及为什么重建损失必须从 MSE 换成感知损失加对抗损失。 02. 最小可用理解 三句话: 机制:编码器把图像压成连续向量序列 $z_e$;每个 $z_e$ 在码本(K 个可学习的向量)里找最近邻,换成那个码字得到 $z_q$;解码器只从 $z_q$ 重建图像。量化器是唯一的信息瓶颈——解码器看不到任何量化误差之外的信息。 训练:三个损失各管一段。重建损失管「编码器+解码器」 jointly,但 argmin 不可导,梯度靠 straight-through(把 $z_q$ 的梯度原样抄给 $z_e$);码本本身要么用字典损失往编码器输出上拉,要么用 EMA 直接滑向被选中样本的均值;commitment 项(权重 $\beta$)把编码器往码字上拉,防止两头越走越远。 代价:量化误差是硬地板,而且高维码本的容量收益极差(失真只能按 $K^{-2/d}$ 衰减);码本会坍缩;MSE 重建的最优解是条件均值,必然糊——所以 VQGAN 在重建侧换成了 LPIPS 加 PatchGAN。 03. 数学推导 3.1 从 VAE 到 VQ-VAE:KL 项去哪了 VQ-VAE(Neural Discrete Representation Learning, 1711.00937)的名字里有 VAE,推导起点也确实是 ELBO: $$\log p(x) \ge \mathbb{E}_{q(z \mid x)} \big[ \log p(x \mid z) \big] - \mathrm{KL}\big( q(z \mid x) \,\Vert\, p(z) \big)$$ 每一项的含义:$q(z \mid x)$ 是编码器给出的「后验」,$p(z)$ 是我们先验地相信 latent 该有的分布,$p(x \mid z)$ 是解码器。VAE 里这三样都是连续分布,KL 项把后验往先验上压,重参数化让采样可导。VQ-VAE 把这三样全换了: $q(z \mid x)$ 不再是分布,而是确定性的:$z$ 就是被选中的那个码字 $e_k$,配合 one-hot 指示变量,相当于 $q(z = e_k \mid x) = 1$,对其他码字取 0; $p(z)$ 取 K 个码字上的均匀分布; $p(x \mid z)$ 是解码器(高斯均值或离散化的像素分布),第一项就是重建损失。 把这个确定性后验和均匀先验代进 KL:$q$ 在 $e_k$ 处为 1、其余为 0,求和只剩被选中那一项: $$\mathrm{KL}\big( q \,\Vert\, p \big) = \sum_{j=1}^{K} q_j \log \frac{q_j}{p_j} = 1 \cdot \log \frac{1}{1/K} = \log K$$ $\log K$ 是一个常数,对梯度没有任何贡献。VQ-VAE 的 KL 项就此消失——没有 KL、没有重参数化、没有「均值方差都被压向先验」的正则,ELBO 退化成「重建项 + 两个逐样本的 L2 距离项」。名字里的 V 是历史包袱,这也是后面 08 节第一条误解的来源。 3.2 argmin 不可导,梯度要靠「装傻」 量化操作本身是: $$z_q = e_k, \quad k = \arg\min_{j} \, \Vert z_e - e_j \Vert_2^2$$ 符号含义:$z_e \in \mathbb{R}^d$ 是编码器输出(e 指 encoder),$e_j \in \mathbb{R}^d$ 是第 j 个码字,$z_q$ 是替换后的向量(q 指 quantized)。问题出在 $\arg\min$:它是分段常数函数。训练中把 $z_e$ 微动一点点,只要不跨过两个码字的垂直平分面,选中的 $k$ 根本不变,$z_q$ 不变,重建损失也不变。 这不是「梯度小」,是梯度恒等于零。我在训好的 VQ-AE 上用有限差分实测过(vq_core.py 的 [D] 段,512 个样本,沿随机单位方向扰动 $z_e$): 扰动步长 eps 有限差分 $\partial L/\partial z_e$ argmin 保持不变的样本比例 10⁻¹ −7.6 × 10⁻⁶ 0.9941 10⁻² 0.0(精确为零) 1.0000 10⁻³ 0.0(精确为零) 1.0000 10⁻⁴ 0.0(精确为零) 1.0000 eps=10⁻¹ 那一行有 0.59% 的样本跨过了平分面,所以差分不为零——这也正是 argmin「分段常数、边界处跳变」的直接展示。而在平分面之间的整片区域里,重建损失对编码器没有任何梯度。VQ-VAE 的解法是 straight-through:假装量化是恒等映射,把解码器对 $z_q$ 的梯度原封不动地抄给 $z_e$: $$\frac{\partial L}{\partial z_e} \mathrel{:=} \frac{\partial L}{\partial z_q}$$ 要强调的是:这不是真实梯度的估计,是替代品。真实梯度是 0,直通梯度实测平均范数 1.49 × 10⁻⁴(同一组权重),它携带的信息是「如果量化不存在,往哪边调编码器能让重建更好」。它能工作的原因是:编码器的真正职责不是让 $z_e$ 落在哪个精确位置,而是让「选出来的码字」是对的——直通梯度恰好只优化这件事。 实现上只有一行(taming-transformers 的写法,见 05 节):z_q = z + (z_q - z).detach()。前向时 $z_q$ 是真的码字,反向时梯度绕过 $(z_q - z)$ 这个常量直接流向 $z$。 3.3 码本的两条更新路线 直通梯度有个致命遗漏:码本自己拿不到任何来自重建损失的梯度。$z_q$ 是查表查出来的,对 $e_j$ 的导数被查表操作挡住了;直通又把全部梯度引向 $z_e$。如果什么都不加,码本会永远停在初始化的位置。我在玩具上实测过这条「什么都不加」的路线(vq_core.py [E] 段,K=64,800 步):码本位移精确为 0.000000,重建 MSE 0.185734,是正常训练的 3 倍多。 所以码本必须有独立的更新机制,VQ-VAE 给了第一条路——字典损失。把编码器输出当成常数(stop-gradient,记作 sg),把码字往它身上拉: $$L_{\text{codebook}} = \big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2, \qquad \frac{\partial L_{\text{codebook}}}{\partial e_k} = 2\,(e_k - z_e)$$ 第二条路是 EMA(VQ-VAE-2 之后的主流):不用梯度,直接对「每个码字被选中样本的均值」做指数滑动。记第 t 步里码字 j 被选中了 $n_j$ 次、被选中样本之和为 $s_j$,则 $$c_j \leftarrow \gamma c_j + (1-\gamma)\, n_j, \quad m_j \leftarrow \gamma m_j + (1-\gamma)\, s_j, \quad e_j \leftarrow \frac{m_j}{c_j + \epsilon_{\text{smooth}}}$$ $\gamma$ 是滑动系数(taming 里 decay=0.99),$c_j$ 是每个码字的滑动计数,$m_j$ 是滑动累加的样本和,$\epsilon_{\text{smooth}}$ 用来防止某个几乎没人用的码字除以接近零的数(taming 的平滑是 $(c_j + \epsilon) \cdot n / (n + K\epsilon)$,其中 $n$ 是全部计数之和)。EMA 的本质是把码字变成「最近被它编码过的那些向量的滑动平均」,没有学习率要调,这也是它取代字典损失的原因。 3.4 commitment 项:另一头的绳子 现在把绳子接上另一头。EMA 把码字往编码器输出上拉,但没有任何东西把编码器输出往码字上拉——编码器完全可以漂走,让量化误差 $\Vert z_e - e_k \Vert^2$ 失控。commitment 项就是拴住编码器的那根绳: $$L_{\text{commit}} = \beta \,\big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2$$ 注意方向和字典损失正好相反:字典损失动了 $e_k$($z_e$ 被 stop-gradient 冻住),commitment 动了 $z_e$($e_k$ 被冻住)。两项合起来,VQ-VAE 的完整训练目标是: $$L = \underbrace{\log p(x \mid z_q)}_{\text{重建,经直通传给编码器}} + \underbrace{\big\Vert \mathrm{sg}[z_e] - e_k \big\Vert_2^2}_{\text{码本项或 EMA}} + \underbrace{\beta \big\Vert z_e - \mathrm{sg}[e_k] \big\Vert_2^2}_{\text{commitment}}$$ $\beta$ 不是一个可以随手抄的超参。在同一组玩具权重上,我把直通梯度和 commitment 项的梯度范数都量了一下(vq_core.py [D] 段):直通梯度平均范数 1.49 × 10⁻⁴,commitment 梯度平均范数 6.40 × 10⁻²,差 429 倍。$\beta$ 扫描的实测结果(collapse_lab.py [A] 段,K=64,1200 步): $\beta$ 0 0.05 0.25 1.0 4.0 重建 MSE 0.0673 0.0484 0.0600 0.0387 0.0385 活跃码数 14 14 16 17 18 在这个玩具上 $\beta=1.0$ 反而比论文默认的 0.25 好 35%。原因就藏在那个 429 倍里:当重建梯度相对太弱时,加大 $\beta$ 相当于在帮编码器「站稳」在码字附近,量化误差随之下降。$\beta$ 的最优值和你的重建损失量纲绑死——这就是为什么换损失(比如 VQGAN 换成 L1 + LPIPS)之后不能照抄别人的 $\beta$。 3.5 VQGAN 补上的两块 VQ-VAE 的重建损失是逐像素的,这有一个数学上无解的毛病(06 节用实验展开):最优解是条件均值,纹理会被平均掉。VQGAN 把重建侧换成三件套: $$L_{\text{VQGAN}} = \underbrace{\big\Vert x - \hat x \big\Vert_1 + \lambda_{\text{lpips}} L_{\text{LPIPS}}(x, \hat x)}_{\text{感知重建}} + \underbrace{\lambda_{\text{GAN}} \big( -\log D(\hat x) \big)}_{\text{对抗}} + \underbrace{\lambda_{\text{cb}} L_{\text{codebook}} + \beta L_{\text{commit}}}_{\text{量化}}$$ $\hat x$ 是解码器输出,$D$ 是 PatchGAN 判别器,LPIPS 是在 VGG16 五层特征上算距离再加一层学出来的 1×1 卷积(lpips.py 里五个 NetLinLayer,实读源码确认)。对抗项的权重不是手调的,而是自适应的:对解码器最后一层分别求重建损失和对抗损失的梯度,取范数比 $\lambda_{\text{GAN}} \leftarrow \Vert \nabla L_{\text{rec}} \Vert / \Vert \nabla L_{\text{GAN}} \Vert$,让两边的梯度量级匹配——GAN 一开判别器就抢梯度主导权,这是压住它的办法。 3.6 怎么量「码本用得怎么样」 三个从粗到细的指标,别混用: 活跃码数:训练中至少被选中过一次的码字数除以 K。最直观,但它是二值的——一个只被用过 3 次的码字和用过 3 万次的算得一样。 perplexity:把码字的使用频率 $p_j$ 看成一个分布,取 $\mathrm{ppl} = \exp\big( -\sum_{j} p_j \log p_j \big)$。完全均匀使用时等于 K,退化到只用一个码时等于 1。它把长尾压成一个数,是训练日志里最常盯的那个量。 有效 bit:$\log_2 \mathrm{ppl}$,可以直接和标称 bit $\log_2 K$ 比。本文玩具里 K=512 的标称 9 bit 只传出 3.86 bit,57% 的编码容量是白付的。 两个容易踩的坑。第一,perplexity 是分布层面的量:它下降只说明使用分布变尖了,既不告诉你死码落在哪,也不等价于重建质量——要看死码分布得直接画使用次数的直方图(图 4 干的就是这件事)。第二,taming 是在当前 batch 上算 avg_probs 的,batch 越小噪声越大;小 batch 上看到 ppl 上下抖动不等于坍缩,别急着改 decay 或加重启。 04. 代码实现 最小实现不需要网络,一个「线性编码器 + VQ + 线性解码器」就能把所有机制跑出来。数据是我合成的 8×8 小块:16 个低频类心,类内加连续变化和白噪声(make_patch_data,4096 个样本,种子 0,全部结果可复现)。核心的量化与直通就这几行(完整脚本在附录): def quantize(z_e, codebook): d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1) # [N, K] idx = d2.argmin(axis=1) # 最近邻 return codebook[idx], idx, d2[np.arange(len(idx)), idx] # 训练循环里(z_q 是查表结果,e_k = z_q): x_hat = z_q @ params["Wd"] + params["bd"] dxh = 2.0 * (x_hat - x) / (len(x) * d_in) # 对 x_hat 的梯度 dz_q = dxh @ params["Wd"].T # 解码器传给 z_q 的梯度 dz_e = dz_q + beta * 2.0 * (z_e - z_q) / (len(x) * d_lat) # 直通 + commitment # 码本走 EMA(onehot 统计被选中的次数与样本和,见附录 vq_core.py) 第一件事:误差到底由哪几块组成。 用同一组训好的权重,把「走不走量化」作为开关(vq_core.py [C] 段,K=64,d=8): 通路 重建 MSE/像素 连续自编码器基线(无 VQ,单独训练到收敛) 0.011082 同一组 VQ-AE 权重,绕开量化(直接用 $z_e$ 过解码器) 0.023360 同一组 VQ-AE 权重,正常走量化 0.060345 两个结论都值得停下来想。第一,量化把误差从 0.0234 推到 0.0603,多出来的 0.0370(+158%)全是量化的账。第二,VQ-AE 的连续通路 0.0234 比独立训练的连续基线 0.0111 差了一倍——量化还会反过来把编码器带偏:commitment 在拉编码器,编码器为迁就码字牺牲了一部分子空间的质量。这部分「隐性代价」在只报一个重建指标时完全看不见。 第二件事:码本容量 K 的收益被码本维度 d 卡死。 固定一个训好的连续编码器,对它的潜变量做 k-means(k-means 就是「给定 K 个码字的最优最近邻量化器」的近似),在留出集上测失真随 K 的变化: 码本维度 d 理论斜率 −2/d 实测斜率(K≥16 段) K 从 8 加到 512,失真降多少 2 −1.00 −0.87 66.5 倍 4 −0.50 −0.40 33.8 倍 8 −0.25 −0.28 13.9 倍 16 −0.125 −0.31 12.9 倍 这张图要看的是实测线(实线)和理论斜率(点线)的贴合程度:d=2、4、8 都贴得不错(量化理论的 Zador 渐近:最优失真 $\propto K^{-2/d}$),d=16 在大 K 端因为每个码字只剩 8 个训练样本而偏离。直白地说:d=8 时把码本从 8 加到 512(64 倍),量化失真只降到 1/13.9——这就是为什么后面 LFQ、FSQ、残差量化都要在「维度」上做文章,而不是无脑加码本。 第三件事:码本坍缩与两副解药。 K=512、随机初始化、EMA 更新,训练 1200 步: 配置 重建 MSE 活跃码数 perplexity 有效 bit(log2 ppl) 随机初始化 0.049067 17 / 512 14.50 3.86 k-means 初始化 0.019695 325 / 512 217.26 7.76 死码重采样重启 0.018368 500 / 512 426.71 8.74 这张图要看的是三条线的起点和走势:红线(随机初始化)从第 200 步起就钉死在 20 以下——坍缩发生在训练极早期,一旦码字没被选中过,它就再也没有机会被选中(EMA 的计数是零,均值是零除零);蓝线(k-means 初始化)起点就是 261;绿线(死码重采样,把长期没人用的码字随机替换成真实的编码器输出)稳定在 470 上下。 这张图要看的是横轴超过 20 之后红线的缺席:随机初始化的码本只有 17 个码被用过,剩下的在 log 轴上根本画不出来;绿线的使用占比分布虽然仍是长尾(最热的码占 0.13%),但整条尾巴被抬起来了。两个数字合起来读:坍缩让 9 bit 的码本只传出 3.86 bit,而这是在重建 MSE 上实打实付了 2.7 倍代价换来的(0.0491 对 0.0184)。 顺带一提,如果不用 EMA 而用字典损失的梯度更新码本,学习率极其敏感(码本是普通 SGD,不走 Adam):在同一个玩具上把码本学习率从 0.02 加到 10,重建 MSE 从 0.2418 降到 0.0538,活跃码从 8 涨到 14——始终追不上 EMA。这就是主流实现全部转向 EMA 的实证原因。 05. 工业级实现对照 上面是最小实现,生产代码在 taming-transformers(VQGAN 官方仓库,本文对照的是 taming/modules/vqvae/quantize.py 与 taming/modules/losses/vqperceptual.py,见 GitHub 源码,以下均以 2026-10 时的 master 为准)。逐个对照: 距离计算用展开式。 最小实现里我直接算 (z[:, None] - cb[None]) ** 2,会物化一个 N×K×d 的中间张量;taming 用 $\Vert z - e \Vert^2 = \Vert z \Vert^2 + \Vert e \Vert^2 - 2 z \cdot e$ 展开,只算 N×K 的矩阵乘: d = torch.sum(z_flattened ** 2, dim=1, keepdim=True) \ + torch.sum(self.embedding.weight**2, dim=1) \ - 2 * torch.einsum('bd,dn->bn', z_flattened, ...) 图像 tokenizer 的 N 是 batch × H/16 × W/16,K 上万,这个展开是省显存的关键。 直通就一行,和推导完全一致:z_q = z + (z_q - z).detach()。 taming 保留了一个带 bug 的版本。 VectorQuantizer2 有个 legacy 开关,legacy=True(默认)时损失是 loss = mean((z_q.detach()-z)**2) + beta * mean((z_q - z.detach())**2)——$\beta$ 被加在了码本项上,而不是 commitment 项,与论文公式相反。源码注释直说这是历史 bug,为了兼容旧 checkpoint 保留默认。读老代码、对老权重时要注意这个坑。 EMA 码本的权重是 requires_grad=False 的。EmbeddingEMA 里 weight、cluster_size、embed_avg 全是关闭梯度的参数,更新完全靠滑动平均——和我 3.3 节的推导一致。taming 还顺手算了 perplexity:exp(-sum(avg_probs * log(avg_probs))),这正是我用来诊断坍缩的量。 decay 不是「越接近 1 越稳」,它是一个时间常数。 衰减系数 $\gamma$ 决定码字「记得多久以前的样本」:$\gamma=0.99$ 时一个历史样本的贡献半衰期是 $\log 0.5 / \log 0.99 \approx 69$ 步,458 步后只剩 1%;$\gamma=0.999$ 半衰期拉到 693 步,$\gamma=0.95$ 只有 13.5 步。这个数要和 batch 里的 token 数对着调:VQGAN f=16 时一张 256² 图给 256 个 token,batch=8 一共 2048 个 token,摊到 K=16384 的码本上平均每步每个码字只被选中 0.125 次。也就是说大码本下 EMA 的计数极其稀疏,decay 太小会让码字在两次命中之间就被洗回零——这是「大码本更容易坍缩」的一条工程解释,也是 LFQ/FSQ 从结构上绕开它的动机。 损失在 losses/vqperceptual.py:L1 + LPIPS + hinge GAN。 三个值得抄的细节:一是 adopt_weight,判别器从第 disc_start 步才介入(先让重建学好,再上对抗);二是 calculate_adaptive_weight,取 $\Vert \nabla_{\text{last}} L_{\text{rec}} \Vert / \Vert \nabla_{\text{last}} L_{\text{GAN}} \Vert$ 并 clamp 到 10⁴;三是判别器是 NLayerPatchGAN,按 patch 判真假,这样高分辨率下判别器参数量不随分辨率爆炸。 官方数字(仓库 README 的重建 FID 表): 模型 f 码本 K 重建 rFID DALL-E dVAE(Gumbel) 8 8192 33.88 VQGAN ImageNet 16 1024 10.54 VQGAN ImageNet 16 16384 7.41 VQGAN OpenImages 8 256 1.49 VQGAN OpenImages 8 16384 1.14 两行读法:同为 f=16,K 从 1024 加到 16384,rFID 从 10.54 降到 7.41——码本容量确实有用,但注意这是在 d=256 的码本维度上(vq_model.py 里 quant_conv 把通道投影到 embed_dim=256),按 $K^{-2/d}$ 的规律这个收益已经非常温和。另一个对照更惊人:VQGAN f=8 K=256 的 rFID(1.49)比 DALL-E dVAE f=8 K=8192(33.88)好了 22 倍——感知损失加对抗带来的提升,比码本大 32 倍带来的提升大得多。这就是 VQGAN 论文标题里 "taming" 的真正含义。 06. 代价与边界 代价一:量化误差是硬地板,而且维度惩罚很重。 04 节的表已经给了 d=8 的数字:K=512 时量化误差仍把重建误差推高 80.5%(相对连续通路 0.011378)。想压低这块,有两条数学上已知的路:降有效维度(FSQ 干的事:把码本从「K 个 d 维向量」换成「每维只有少量取值」,维度语义变了但利用率为 100%),或者分层量化(残差 VQ、VAR 用的 RQ-VAE:一层量化不完的残差给下一层)。蛮力加 K 是最差的一条路。 代价二:码本坍缩几乎必然发生,解药都有副作用。 实测里随机初始化有 96.7% 死码;k-means 初始化要额外跑一次 k-means 且只在训练初期有用;死码重采样最有效,但它等价于「用随机重启换利用率」——被重启的码字携带的信息丢了,而且重启阈值又是一个新超参。工业界还有第三条路:直接改量化方式让坍缩在结构上不可能发生(LFQ 把每个维度独立二值化/多值化,FSQ 同理),这超出了本文范围,07 节给出处。 代价三:感知重建会「编」细节。 这是 3.5 节埋的伏笔,用一个能算清楚的玩具展开(perceptual_lab.py)。构造:一个 latent 对应两种等概率的纹理 $x = m \pm p$(m 是低频内容,p 是棋盘纹理,纹理占 83.5% 的梯度能量)。在候选输出 $m + c \cdot p$ 上比较两种损失: 候选输出 MSE PSNR 梯度能量保留 到最近模态的距离 $c=0$(MSE 最优,条件均值) 0.250000 5.30 dB 18.6% 0.250 $c=-0.79$(特征空间最优) 0.404056 3.22 dB 70.7% 0.012 $c=1$(选一个清晰模态) 0.500000 2.29 dB 97.5% 0.000 这张图要看三处:上排四张 8×8 小图里,MSE 最优那格的棋盘纹理消失了(两种极性平均成平色),特征最优那格纹理回来了;左下柱状图说明这个纹理消失在 PSNR 上是加分的(5.30 dB 最高);右下的曲线说明只要特征里给高频一点权重($\alpha > 0.74$,实跑二分定位),最优解就会离开模糊均值往清晰模态走。三条事实合起来的结论是:PSNR 和「看起来真」在这类问题上方向相反——VQGAN 之后没人用 PSNR 报告 tokenizer 的重建质量,rFID 成了标配,原因就在这。 但这笔账的另一面是:对抗训练出来的「细节」不保证是真的。判别器只关心「像不像真图」,不关心「是不是这张图」,所以感知+GAN 的重建会补出数据集里常见的纹理——做压缩、做医学影像这类需要像素保真的任务时,这条路要慎走(GAN 训练不稳的代价也真实存在,05 节的 disc_start 和自适应权重都是为此付的工程税)。 边界:什么时候不该用。 下游不是自回归/离散先验时,离散化没有收益只有损失——Stable Diffusion 的第一-stage 就是连续 VAE(latent_diffusion 那篇讲过),因为扩散模型要的是连续潜空间上的 score,不是离散 token。同样,「码本利用率」这一整章在连续 VAE 里没有对应物。选型的判据一句话:下游要对离散序列做自回归或掩码预测,才需要 VQ tokenizer。 最后坦诚标注边界:本文所有数字来自 8×8 合成小块上的线性自编码器玩具(numpy 实跑,可复现),规模和真实 VQGAN(f=16、d=256、K=16384、百万级图像)差几个数量级;机制层面(直通、EMA、坍缩、感知损失的偏好)我认为可以直接外推,但具体数字(比如 $\beta=1.0$ 更好)不能外推,它依赖我的损失量纲。 07. 经典论文脉络 VQ-VAE(1711.00937, Neural Discrete Representation Learning):第一次把离散 latent 做成端到端可训——straight-through 加字典损失/EMA 的组合沿用至今。 VQ-VAE-2(1906.00446):层级化(全局加局部两级码本),并正式用 EMA 替代字典梯度,perplexity 作为利用率指标从这里普及。 VQGAN(2012.09841, Taming Transformers):感知损失加 PatchGAN 把重建质量拉到 rFID 个位数,第一次让「Transformer 学图像 token」在算力和效果上同时成立。 DALL-E(2102.12092):zero-shot 文生图,dVAE 用 Gumbel-softmax 变分训练(8192 码本、f=8),证明了离散 token 路线在多模态上的可扩展性。 ViT-VQGAN(2110.04627):把卷积 tokenizer 换成 ViT 结构,码本效率(利用率)被单独拿出来分析。 MaskGIT(2202.04200):放弃自回归,改用掩码并行解码——依赖的仍是 VQGAN 的离散 token,说明离散化红利不止自回归一条路。 LFQ / FSQ(2310.05737 MagViT-2 / 2309.15505):从结构上消灭码本坍缩——LFQ 把每维独立量化到固定格点,FSQ 直接用少量取值的整数网格,码本利用率都能到 100%。 VAR(2404.08560):残差 VQ(粗到细多级量化)加「下一尺度预测」,把自回归视觉生成推到与扩散相当的区间,是 2024 年后 tokenizer 论文的必引坐标。 08. 常见误解 误解一:「VQ-VAE 是 VAE 的一种」。 3.1 节推过:后验是确定性的 one-hot,先验是均匀分布,KL 精确等于 $\log K$,是常数,对训练没有任何贡献。没有变分、没有重参数化、没有 KL 正则——ELBO 在这里只是叙事起点,不是训练目标。 误解二:「码本是梯度下降学出来的」。 码本拿不到重建损失的梯度(查表挡住了,直通又把梯度全引向编码器),它的更新要么靠字典损失这一项、要么靠 EMA。taming 的 EMA 实现里码本权重干脆是 requires_grad=False 的。 误解三:「straight-through 是梯度的无偏估计」。 实测(04 节表):真实有限差分精确为 0,直通梯度非零。它不是对真实梯度的估计,是「假装量化不存在」的替代品;真正把它扶正的是 commitment 项,否则编码器会漂走。 误解四:「码本越大越好」。 $K^{-2/d}$ 的维度惩罚加上坍缩风险,让大码本的收益远低于直觉——K=1024 到 16384 在 d=256 上只把 rFID 从 10.54 拉到 7.41(05 节表)。利用率不到 100% 时,标称 bit 和有效 bit 的差距更离谱(本文玩具里 9 bit 只传出 3.86 bit)。 误解五:「$\beta=0.25$ 是默认值,照抄就行」。 $\beta$ 控制的是 commitment 梯度和重建直通梯度的量级比,本文玩具里两者天然差 429 倍,$\beta$ 扫描显示 1.0 反而最好。换了重建损失(MSE 换 L1+LPIPS)量纲就变,$\beta$ 必须重调。 09. 动手验证 三个实验都可以在附录代码里一键复现(numpy only,不需要 GPU): 亲手确认 argmin 的梯度是零:跑 python vq_core.py,看 [D] 段——把 $z_e$ 沿随机方向扰动 10⁻² 到 10⁻⁴,有限差分精确为 0,argmin 保持不变的样本比例是 1.0000;对比直通梯度平均范数 1.49 × 10⁻⁴。 亲手制造并修好码本坍缩:跑 python collapse_lab.py,看 [B][C] 段——K=512 随机初始化最终只有 17 个活码(96.7% 死码)、重建 MSE 0.0491;换死码重采样后 500 个活码、MSE 0.0184。你也可以把 restart_dead=True 关掉再跑一遍,确认结果回到 17。 亲手验证「MSE 必然糊」:跑 python perceptual_lab.py,把文件顶部的 AMP(纹理幅度)从 0.5 改成 0.1 再跑——你会发现梯度能量保留率对纹理幅度极其敏感,而 MSE 最优解的纹理保留永远是 0(条件均值把 ±纹理精确抵消)。 亲手确认「加码本不如降维度」:跑 python codebook_size_law.py,读 [A] 段输出——d=16 时 K 从 8 加到 512 只把失真降到 1/12.9,d=2 时同样 64 倍的预算能降到 1/66.5。再把 make_patch_data 的 n_cluster 从 16 改成 4(类更少、潜变量更集中)重跑,斜率会明显变陡:失真下降的速度由数据分布本身决定,码本参数只是顺着它走。 10. 延伸阅读 前置:变分下界与重参数化(ELBO)、VAE 结构与训练目标——本文 3.1 节是 ELBO 在离散情形下的特例。 同方向:视频 VAE 的时空压缩结构(f_t 的时间维压缩,01 节视频账本用到了)、视频 VAE 的常见 loss 组合(GAN/LPIPS 组合的连续版)。 相关:潜空间扩散与 Stable Diffusion 架构(06 节「什么时候不用 VQ」的那条连续路线)、自回归视频生成(离散 token 的下游)、FID / CLIP Score 到底测了什么(05 节 rFID 的定义与陷阱)。 附录:完整代码 09 节用到的脚本全文如下(token_budget.py、collapse_lab.py、vq_core.py、perceptual_lab.py、codebook_size_law.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 token_budget.py """token_budget.py —— 离散化到底换来多少「序列长度」上的便宜。 VQGAN 那篇论文的动机只有一句话:Transformer 的注意力和序列长度是平方关系, 在像素上做自回归根本不可能,所以必须先把图像压成一串短的离散 token。 本脚本把这笔账算成具体的数: [A] 不同分辨率 / 下采样率下的 token 数与注意力规模 [B] 码本大小 K 决定每个 token 多少 bit,折算成每张图多少 bpp [C] 视频的 token 数(时空压缩一起算) [D] 码本坍缩要付的比特代价:perplexity 才是真实容量 运行:/usr/local/bin/python3 token_budget.py """ from __future__ import annotations import numpy as np def n_tokens(h, w, f, t=1, f_t=1): return (t // f_t) * (h // f) * (w // f) def main(): print("[A] 图像:边长 H 与下采样率 f 决定 token 数(注意力按 n^2 涨)") print(" H f token 数 注意力矩阵 n^2 相对像素级") for H in (256, 512, 1024): base = H * H * 3 # 像素级(RGB 逐通道) for f in (4, 8, 16): n = n_tokens(H, H, f) print(" %-5d %-4d %-12d %-18.3e %.4g" % ( H, f, n, float(n) ** 2, float(n * n) / float(base * base))) print(" (像素级 RGB 序列 %d,n^2 = %.3e)" % (base, float(base) ** 2)) print() print("[B] 码本容量 K 决定每个 token 的 bit 数(256x256 图像)") print(" K bit/token f=8: bit/图 bpp f=16: bit/图 bpp") for K in (256, 512, 1024, 4096, 16384, 262144): bit = np.log2(K) row = [K, bit] for f in (8, 16): n = n_tokens(256, 256, f) total = n * bit row += [total, total / (256 * 256)] print(" %-8d %-10.2f %-12.0f %-7.3f %-12.0f %.3f" % tuple(row)) print(" bpp = bit per pixel。作为参照,JPEG 在中等质量下大约 0.5~1 bpp。") print() print("[C] 视频:时间维也要压(5 秒 24fps = 121 帧,256x256)") print(" f_t f token 数 上下文长度对比(相对 121x256x256x3 像素)") pixel = 121 * 256 * 256 * 3 for f_t in (1, 4, 8): for f in (8, 16): n = n_tokens(256, 256, f, t=120, f_t=f_t) print(" %-5d %-4d %-14d %.5g" % ( f_t, f, n, float(n) / pixel)) print() print("[D] 码本坍缩的比特代价:真实容量看 perplexity,不是看 K") print(" K perplexity 标称 bit 有效 bit 浪费") for K, ppl in [(512, 14.50), (512, 217.26), (512, 426.71), (16384, 14.50), (16384, 1000.0), (16384, 16384.0)]: nominal = np.log2(K) eff = np.log2(ppl) print(" %-6d %-11.2f %-10.2f %-10.2f %.1f%%" % ( K, ppl, nominal, eff, 100 * (nominal - eff) / nominal)) print(" 前两行来自 collapse_lab.py 的实测:K=512 随机初始化只有 17 个码活着,") print(" 9 bit 的码本只传出 3.86 bit;死码重启后回到 8.74 bit。") print() print("[E] 一句话总结") f16 = n_tokens(256, 256, 16) print(" 256x256 图像在 f=16 下是 %d 个 token,是像素级 RGB 序列的 1/%.0f;" % (f16, (256 * 256 * 3) / f16)) print(" 注意力规模从 %.2e 降到 %.2e,省了 %.0f 倍——这才是必须先做 tokenizer 的原因。" % (float(256 * 256 * 3) ** 2, float(f16) ** 2, float(256 * 256 * 3) ** 2 / float(f16) ** 2)) if __name__ == "__main__": main() collapse_lab.py """collapse_lab.py —— 码本坍缩(codebook collapse)是怎么发生的,能救回来多少。 码本坍缩指的是:K 个码字里只有一小撮被用到,剩下的从头到尾一次都没被选中 (死码)。花了一整个 K×d 的码本,只买到 log2(perplexity) 比特的表达力。 [A] commitment 权重 beta 怎么影响坍缩程度 [B] 大码本在训练过程中怎么一步步坍缩(活跃码数曲线) [C] 两种常用解药有多大用:k-means 初始化码本 / 死码重采样重启 运行:/usr/local/bin/python3 collapse_lab.py """ from __future__ import annotations import argparse import numpy as np from vq_core import kmeans, make_patch_data, perplexity, quantize, train_ae BIG_K = 512 def stats(X, params, codebook): """给定训练好的权重与码本,算重建误差与使用分布统计量。""" z_e = X @ params["We"] z_q, idx, _ = quantize(z_e, codebook) cnt = np.bincount(idx, minlength=len(codebook)).astype(np.float64) rec = float((((z_q @ params["Wd"] + params["bd"]) - X) ** 2).mean()) frac = np.sort(cnt / cnt.sum())[::-1] return { "rec": rec, "alive": int((cnt > 0).sum()), "ppl": perplexity(cnt), "top1": float(frac[0]), "bottom_half": float(frac[len(frac) // 2:].sum()), "counts": cnt, } def run_vq(X, K=BIG_K, beta=0.25, steps=1200, seed=0, mode="ema", init_cb=None, restart=False, log_every=100): """跑一次 VQ-AE 训练,返回 (stats, hist)。""" p, c, h, _ = train_ae(X, 8, mode, K=K, beta=beta, steps=steps, seed=seed, restart_dead=restart, init_cb=init_cb, log_every=log_every) return stats(X, p, c), h def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=1200) ap.add_argument("--K", type=int, default=BIG_K) ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, _, _, _ = make_patch_data(n=4096, seed=args.seed) print("数据 X%s,训练 %d 步" % (X.shape, args.steps)) print() # ---------------- [A] beta 扫描 ---------------- print("[A] commitment 权重 beta 的影响(K=64,码本 EMA,%d 步)" % args.steps) print(" beta 重建MSE 活跃码 perplexity") for beta in (0.0, 0.05, 0.25, 1.0, 4.0): s, _ = run_vq(X, K=64, beta=beta, steps=args.steps, seed=args.seed) print(" %-9.2f %.6f %4d %.2f" % ( beta, s["rec"], s["alive"], s["ppl"])) print(" -> beta=0 时编码器完全不被拉向码本,量化误差最大;beta 加大能压住") print(" 误差,但也把编码器往码本上拽,两头都不免费(本玩具上 1.0 最好)。") print() # ---------------- [B] 大码本的坍缩过程 ---------------- print("[B] 大码本 K=%d 的坍缩过程(beta=0.25,EMA,随机初始化)" % args.K) s0, h0 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, log_every=200) print(" 步数 重建MSE 活跃码 perplexity") for i in range(len(h0["step"])): print(" %5d %.6f %4d %.2f" % ( h0["step"][i], h0["recon"][i], h0["alive"][i], h0["ppl"][i])) print(" 最终:%d 个码字里只有 %d 个活着;perplexity %.2f 对应 %.2f bit," "而码本容量是 %.2f bit" % ( args.K, s0["alive"], s0["ppl"], np.log2(max(s0["ppl"], 1e-12)), np.log2(args.K))) print(" 最热的 1 个码占 %.3f 的使用量,最冷的一半码一共只占 %.4f" % (s0["top1"], s0["bottom_half"])) print() # ---------------- [C] 解药 ---------------- print("[C] 两种解药(同为 K=%d,%d 步)" % (args.K, args.steps)) p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=args.seed) init_cb = kmeans(X @ p_init["We"], args.K, seed=args.seed, iters=20) s1, h1 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, init_cb=init_cb, log_every=200) s2, h2 = run_vq(X, K=args.K, steps=args.steps, seed=args.seed, restart=True, log_every=200) print(" 配置 重建MSE 活跃码 perplexity 有效bit") for tag, s in [("随机初始化", s0), ("k-means 初始化", s1), ("死码重采样重启", s2)]: print(" %-16s %.6f %4d/%4d %6.2f %.2f" % ( tag, s["rec"], s["alive"], args.K, s["ppl"], np.log2(max(s["ppl"], 1e-12)))) print() print(" 注:本玩具的真实类心只有 16 个,活跃码数的上界本来就远小于 K,") print(" 所以这里看的是「死码能不能被救活」,不是表达力真的翻了多少倍。") print() print("[D] 活跃码数随训练步数的变化(供配图)") print(" 随机初始化 :", list(zip(h0["step"], h0["alive"]))) print(" k-means 初始化:", list(zip(h1["step"], h1["alive"]))) print(" 死码重采样 :", list(zip(h2["step"], h2["alive"]))) if __name__ == "__main__": main() vq_core.py """vq_core.py —— 向量量化器(VQ)的最小实现,外加一个真跑得起来的训练实验。 无 torch 依赖,纯 numpy。本机解释器:/usr/local/bin/python3(3.10.5)。 运行: /usr/local/bin/python3 vq_core.py /usr/local/bin/python3 vq_core.py --steps 1200 --K 64 --beta 0.25 输出分五段: [A] 连续自编码器基线(无量化)——量化误差的下界 [B] VQ-AE 训练结果:重建误差 / 量化误差 / 码本使用率 / perplexity [C] 误差分解:总误差 = 子空间残差 + 量化误差(与 [A] 对拍) [D] straight-through 的梯度核验:真实有限差分 vs 直通梯度 [E] 码本更新方式对照(不更新 / 梯度 / EMA / EMA+死码重启) """ from __future__ import annotations import argparse import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # ------------------------------------------------------------------ 数据 def cos_basis(patch: int = 8, n_freq: int = 3): """8x8 小块的低频余弦基,共 n_freq^2 = 9 个,已按行归一化。""" t = np.arange(patch) + 0.5 one_d = [np.ones(patch)] for k in range(1, n_freq): one_d.append(np.cos(np.pi * k * t / patch)) B = np.stack([np.outer(a, b).ravel() for a in one_d for b in one_d]) return B / np.linalg.norm(B, axis=1, keepdims=True) def make_patch_data(n=4096, patch=8, n_cluster=16, seed=0, center_scale=2.0, intra=0.35, noise=0.05): """合成一批 8x8 小块:16 个类心 + 类内低频连续变化 + 白噪声。 返回 X[N, 64]、类标、类心、基。类间方差远大于类内,所以码本有机会学到 「块类别」这种离散结构;白噪声部分不可压缩,构成误差地板。 """ rng = np.random.default_rng(seed) B = cos_basis(patch) # [9, 64] dim_b = B.shape[0] centers = center_scale * (rng.normal(size=(n_cluster, dim_b)) @ B) labels = rng.integers(0, n_cluster, size=n) X = centers[labels].copy() X += intra * (rng.normal(size=(n, dim_b)) @ B) # 类内连续变化 X += noise * rng.normal(size=(n, patch * patch)) # 不可压缩噪声 return X, labels, centers, B # ------------------------------------------------------------------ 量化 def quantize(z_e, codebook): """最近邻量化。z_e [N, d],codebook [K, d]。 返回 z_q[N, d]、索引 idx[N]、量化误差(每样本 d 维平方和)。 """ d2 = ((z_e[:, None, :] - codebook[None, :, :]) ** 2).sum(-1) # [N, K] idx = d2.argmin(axis=1) return codebook[idx], idx, d2[np.arange(len(idx)), idx] def kmeans(data, k, seed=0, iters=25): """Lloyd 迭代 + kmeans++ 初始化。空簇用「当前最差点」补齐。""" rng = np.random.default_rng(seed) n, d = data.shape k = min(k, n) centers = np.empty((k, d), dtype=data.dtype) centers[0] = data[rng.integers(n)] closest = ((data - centers[0]) ** 2).sum(1) for j in range(1, k): tot = closest.sum() if tot <= 0: centers[j] = data[rng.integers(n)] else: centers[j] = data[rng.choice(n, p=closest / tot)] closest = np.minimum(closest, ((data - centers[j]) ** 2).sum(1)) for _ in range(iters): _, assign, dist = quantize(data, centers) dist = dist.copy() for j in range(k): mask = assign == j if mask.any(): centers[j] = data[mask].mean(0) else: # 空簇:拿当前最差的点填 j_worst = int(np.argmax(dist)) centers[j] = data[j_worst] dist[j_worst] = -1.0 return centers def perplexity(counts): """码本 perplexity = exp(使用分布的熵),上界是码本大小 K。""" p = np.asarray(counts, dtype=np.float64) p = p / p.sum() nz = p[p > 0] return float(np.exp(-(nz * np.log(nz)).sum())) # ------------------------------------------------------------------ 训练 class Adam: """够用的 Adam,只处理一组 numpy 参数。""" def __init__(self, params, lr=0.02, b1=0.9, b2=0.999, eps=1e-8): self.p = params self.m = {k: np.zeros_like(v) for k, v in params.items()} self.v = {k: np.zeros_like(v) for k, v in params.items()} self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps self.t = 0 def step(self, grads): self.t += 1 for k, g in grads.items(): self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * (g * g) mhat = self.m[k] / (1 - self.b1 ** self.t) vhat = self.v[k] / (1 - self.b2 ** self.t) self.p[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps) def make_params(d_in, d_lat, seed=0): rng = np.random.default_rng(seed) return { "We": rng.normal(scale=0.1, size=(d_in, d_lat)), "Wd": rng.normal(scale=0.1, size=(d_lat, d_in)), "bd": np.zeros(d_in), } def evaluate(X, params, codebook, eval_idx): """在固定评估集上算重建 MSE、量化误差、活跃码数、perplexity。""" x = X[eval_idx] z_e = x @ params["We"] d_lat = params["We"].shape[1] if codebook is None: z_q, qerr, alive, ppl, counts = z_e, 0.0, 0, 0.0, None else: z_q, idx, qerr = quantize(z_e, codebook) counts = np.bincount(idx, minlength=len(codebook)).astype(np.float64) alive = int((counts > 0).sum()) ppl = perplexity(counts) x_hat = z_q @ params["Wd"] + params["bd"] return { "recon": float(((x_hat - x) ** 2).mean()), "quant": float(np.mean(qerr)) / d_lat if codebook is not None else 0.0, "alive": alive, "ppl": ppl, "counts": counts, } def train_ae(X, d_lat, codebook_mode, K=64, beta=0.25, steps=800, batch=512, lr=0.02, seed=0, decay=0.99, restart_dead=False, log_every=100, cb_lr=10.0, init_cb=None): """训练「线性编码器 + VQ + 线性解码器」。 codebook_mode: "continuous" —— 无量化,连续自编码器基线 "none" —— 码本完全不更新(只有 straight-through) "grad" —— 码本用 ||sg[z_e] - e||^2 的梯度更新 "ema" —— 码本用指数滑动平均更新(cluster_size + embed_avg) """ rng = np.random.default_rng(seed) eval_rng = np.random.default_rng(1000 + seed) eval_idx = eval_rng.choice(len(X), size=min(2048, len(X)), replace=False) n, d_in = X.shape params = make_params(d_in, d_lat, seed=seed) opt = Adam(params, lr=lr) has_vq = codebook_mode != "continuous" if has_vq: # 码本初始化:小方差(呼应 taming 里 uniform(-1/n_e, 1/n_e) 的量级) codebook = (rng.normal(scale=1.0 / K, size=(K, d_lat)) if init_cb is None else np.asarray(init_cb).copy()) init_codebook = codebook.copy() cluster_size = np.ones(K, dtype=np.float64) # EMA 用 embed_avg = codebook.copy() # EMA 用 else: codebook = init_codebook = None cluster_size = embed_avg = None hist = {"step": [], "recon": [], "quant": [], "alive": [], "ppl": []} for step in range(1, steps + 1): b = rng.choice(n, size=min(batch, n), replace=False) x = X[b] z_e = x @ params["We"] # [B, d] if has_vq: z_q, idx, _ = quantize(z_e, codebook) e_k = z_q x_hat = z_q @ params["Wd"] + params["bd"] # 反传:解码器对 z_q 的梯度,原封不动地当作对 z_e 的梯度 dxh = 2.0 * (x_hat - x) / (len(x) * d_in) # [B, d_in] dz_q = dxh @ params["Wd"].T # [B, d] dz_e = dz_q + beta * 2.0 * (z_e - e_k) / (len(x) * d_lat) opt.step({"We": x.T @ dz_e, "Wd": z_q.T @ dxh, "bd": dxh.sum(0)}) if codebook_mode == "grad": # d/de ||sg[z_e] - e||^2 = 2 (e - z_e)。注意码本是普通 SGD, # 不走 Adam,所以它的有效步长要单独调(见 [E] 的 cb_lr 扫描)。 g = 2.0 * (e_k - z_e) / (len(x) * d_lat) np.add.at(codebook, idx, -cb_lr * g) elif codebook_mode == "ema": onehot = np.zeros((len(x), K)) onehot[np.arange(len(x)), idx] = 1.0 cnt = onehot.sum(0) cluster_size = decay * cluster_size + (1 - decay) * cnt embed_avg = decay * embed_avg + (1 - decay) * (onehot.T @ z_e) tot = cluster_size.sum() smoothed = (cluster_size + 1e-5) / (tot + K * 1e-5) * tot codebook = embed_avg / smoothed[:, None] if restart_dead: dead = np.where(cluster_size < 1.0)[0] for j in dead: # 死码重采样为真实的编码器输出 codebook[j] = z_e[rng.integers(len(z_e))] cluster_size[j] = 1.0 embed_avg[j] = codebook[j] else: x_hat = z_e @ params["Wd"] + params["bd"] dxh = 2.0 * (x_hat - x) / (len(x) * d_in) opt.step({"We": x.T @ (dxh @ params["Wd"].T), "Wd": z_e.T @ dxh, "bd": dxh.sum(0)}) if step % log_every == 0 or step == steps: m = evaluate(X, params, codebook, eval_idx) hist["step"].append(step) for k in ("recon", "quant", "alive", "ppl"): hist[k].append(m[k]) shift = None if has_vq: shift = float(np.abs(codebook - init_codebook).mean()) return params, codebook, hist, shift # ------------------------------------------------------------------ 主流程 def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=800) ap.add_argument("--K", type=int, default=64) ap.add_argument("--d", type=int, default=8) ap.add_argument("--beta", type=float, default=0.25) ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, labels, centers, B = make_patch_data(n=4096, seed=args.seed) n, d_in = X.shape print("数据: X%s 样本范数均值 %.4f" % (X.shape, np.linalg.norm(X, axis=1).mean())) print("码本 K=%d, 潜维度 d=%d, beta=%.2f" % (args.K, args.d, args.beta)) print() # ---------------- [A] 连续自编码器基线 ---------------- pc, _, hc, _ = train_ae(X, args.d, "continuous", steps=args.steps, seed=args.seed) recon_c = hc["recon"][-1] print("[A] 连续自编码器(无量化,最优线性重建)") print(" 重建 MSE/像素 = %.6f" % recon_c) print() # ---------------- [B] VQ-AE ---------------- pv, cb, hv, _ = train_ae(X, args.d, "ema", K=args.K, beta=args.beta, steps=args.steps, seed=args.seed) print("[B] VQ-AE(码本 EMA 更新, decay=0.99)训练曲线") print(" 步数 重建MSE 量化误差/d 活跃码 perplexity") for i in range(len(hv["step"])): print(" %5d %.6f %.6f %5d %.2f" % ( hv["step"][i], hv["recon"][i], hv["quant"][i], hv["alive"][i], hv["ppl"][i])) counts = np.bincount(quantize(X @ pv["We"], cb)[1], minlength=args.K).astype(np.float64) print(" 最终活跃码 %d / %d,perplexity %.2f(上界 %d)" % ( (counts > 0).sum(), args.K, perplexity(counts), args.K)) print() # ---------------- [C] 误差分解 ---------------- z_e = X @ pv["We"] z_q, _, qerr = quantize(z_e, cb) rec_vq = (((z_q @ pv["Wd"] + pv["bd"]) - X) ** 2).mean() rec_cont = (((z_e @ pv["Wd"] + pv["bd"]) - X) ** 2).mean() print("[C] 误差分解(同一组 VQ-AE 权重,只换「走不走量化」)") print(" 连续通路重建 MSE = %.6f (子空间残差,与 [A] 同量级)" % rec_cont) print(" 量化后重建 MSE = %.6f" % rec_vq) print(" 差值(量化引入) = %.6f (%.1f%%)" % ( rec_vq - rec_cont, 100 * (rec_vq - rec_cont) / rec_cont)) print(" [A] 连续基线 = %.6f" % recon_c) print(" 量化误差 E||z_e-e||^2/d = %.6f" % (qerr.mean() / args.d)) print() # ---------------- [D] straight-through 梯度核验 ---------------- # 用 [B] 训好的 VQ-AE,在真实工作点上做有限差分。 rng = np.random.default_rng(7) x0 = X[:512] z_e0 = x0 @ pv["We"] z_q0, idx0, _ = quantize(z_e0, cb) xh0 = z_q0 @ pv["Wd"] + pv["bd"] L0 = ((xh0 - x0) ** 2).mean() direction = rng.normal(size=args.d) direction /= np.linalg.norm(direction) print("[D] straight-through 梯度核验(512 样本,取 [B] 训好的权重)") print(" 有限差分:把 z_e 沿随机单位方向微扰 eps,看 L 怎么变") for eps in (1e-1, 1e-2, 1e-3, 1e-4): z_p = z_e0 + eps * direction z_qp, idxp, _ = quantize(z_p, cb) Lp = ((z_qp @ pv["Wd"] + pv["bd"] - x0) ** 2).mean() same = float((idxp == idx0).mean()) print(" eps=%.0e : dL/dz_e = %+.10f (argmin 保持不变的样本 %.4f)" % ( eps, (Lp - L0) / eps, same)) dxh = 2.0 * (xh0 - x0) / (len(x0) * d_in) dz_q = dxh @ pv["Wd"].T st_grad = float((dz_q * direction).mean()) st_norm = float(np.linalg.norm(dz_q, axis=1).mean()) commit = 2.0 * args.beta * (z_e0 - z_q0) / args.d commit_norm = float(np.linalg.norm(commit, axis=1).mean()) print(" 直通梯度 dL/dz_q 投影到同一方向 = %+.10f" % st_grad) print(" 直通梯度平均范数 ||dL/dz_q|| = %.6e" % st_norm) print(" commitment 项平均范数 = %.6e" % commit_norm) print(" -> 真实梯度恒为 0(argmin 是分段常数),直通梯度非零;") print(" 它是「假装量化是恒等映射」的替代品,不是真实梯度的估计。") print() # ---------------- [E] 码本更新方式对照 ---------------- print("[E] 码本更新方式对照(同为 %d 步,K=%d,beta=%.2f)" % ( args.steps, args.K, args.beta)) print(" 模式 重建MSE 活跃码 perplexity 码本位移") for mode, rst, cbl in [("none", False, 10.0), ("grad", False, 10.0), ("ema", False, 10.0), ("ema", True, 10.0)]: p, c, h, shift = train_ae(X, args.d, mode, K=args.K, beta=args.beta, steps=args.steps, seed=args.seed, restart_dead=rst, cb_lr=cbl) cnt = np.bincount(quantize(X @ p["We"], c)[1], minlength=args.K).astype(np.float64) tag = mode + ("+restart" if rst else "") print(" %-18s %.6f %5d %.2f %.6f" % ( tag, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt), shift)) print() print(" 附:grad 模式对码本步长极敏感(码本是普通 SGD,不走 Adam)") for cbl in (0.02, 0.1, 1.0, 10.0): p, c, h, _ = train_ae(X, args.d, "grad", K=args.K, beta=args.beta, steps=args.steps, seed=args.seed, cb_lr=cbl) cnt = np.bincount(quantize(X @ p["We"], c)[1], minlength=args.K).astype(np.float64) print(" cb_lr=%-6.2f 重建MSE %.6f 活跃码 %3d perplexity %.2f" % ( cbl, h["recon"][-1], int((cnt > 0).sum()), perplexity(cnt))) print() if __name__ == "__main__": main() perceptual_lab.py """perceptual_lab.py —— 为什么 VQGAN 不能只用 MSE:一个能算清的玩具。 VQ-VAE 用 MSE(或像素空间的似然)训练解码器。MSE 的最优解是条件均值, 而条件均值会把「同一 latent 对应多种合理细节」平均掉 —— 这就是重建发糊的 数学根源,不是玄学。VQGAN 的解法是换掉重建损失:改成特征空间距离(LPIPS) 外加一个对抗项。 本脚本用一个双模态玩具把这个机制算清楚: [A] 构造:同一个 latent 对应两种等概率的纹理(+p 和 -p) [B] MSE 最优 = 条件均值,纹理被平均掉;高频(梯度)能量只剩多少 [C] 换成非线性特征空间后,最优解跳到清晰模态;求阈值 alpha 并与解析式对拍 [D] 三种候选输出的三项指标对比:PSNR / 梯度能量保留 / 到最近模态的距离 注意:这里的特征映射 phi(x) = [x, alpha * |grad x|] 是我手工造的非线性特征, 用来演示「非线性」这一步为什么关键;真实的 LPIPS 用的是 VGG16 五层特征加 一层学习的 1x1 卷积,机制相同但权重是学出来的。 运行:/usr/local/bin/python3 perceptual_lab.py """ from __future__ import annotations import numpy as np PATCH = 8 AMP = 0.5 # 纹理幅度 SEED = 0 def gradient_magnitude(img): """前向差分后取绝对值:|grad x| 的展平向量(水平 56 个 + 垂直 56 个)。""" gx = np.diff(img, axis=1) gy = np.diff(img, axis=0) return np.concatenate([np.abs(gx).ravel(), np.abs(gy).ravel()]) def phi(img, alpha): """非线性特征映射:图像本身 + alpha 乘梯度幅值。""" return np.concatenate([img.ravel(), alpha * gradient_magnitude(img)]) def make_toy(): """低频内容 m + 等概率的 ±棋盘纹理 p。""" rng = np.random.default_rng(SEED) u = np.arange(PATCH) + 0.5 m = np.outer(np.cos(np.pi * u / PATCH), np.cos(np.pi * u / PATCH)) * 1.5 m += 0.3 * rng.normal(size=(PATCH, PATCH)) # 让内容不那么对称 ii, jj = np.meshgrid(np.arange(PATCH), np.arange(PATCH), indexing="ij") p = AMP * ((-1.0) ** (ii + jj)) return m, p def evaluate_candidate(m, p, c, alpha): """候选输出 x_hat = m + c * p,返回三项指标。""" x_hat = m + c * p x_plus, x_minus = m + p, m - p # MSE(对两种真值取期望) mse = 0.5 * (((x_hat - x_plus) ** 2).mean() + ((x_hat - x_minus) ** 2).mean()) # 特征空间距离(对两种真值取期望) f_hat = phi(x_hat, alpha) feat = 0.5 * (((f_hat - phi(x_plus, alpha)) ** 2).mean() + ((f_hat - phi(x_minus, alpha)) ** 2).mean()) # 梯度能量保留(相对真值的期望梯度能量) g_hat = np.concatenate([np.diff(x_hat, axis=1).ravel(), np.diff(x_hat, axis=0).ravel()]) g_true = 0.5 * (np.concatenate([np.diff(x_plus, axis=1).ravel(), np.diff(x_plus, axis=0).ravel()]) ** 2).sum() g_true += 0.5 * (np.concatenate([np.diff(x_minus, axis=1).ravel(), np.diff(x_minus, axis=0).ravel()]) ** 2).sum() grad_keep = float((g_hat ** 2).sum() / g_true) # 到最近模态的距离(越小说明落在数据流形上) to_mode = float(min(((x_hat - x_plus) ** 2).mean(), ((x_hat - x_minus) ** 2).mean())) return {"c": c, "mse": float(mse), "feat": float(feat), "grad_keep": grad_keep, "to_mode": to_mode} def best_c(m, p, alpha, grid=None): if grid is None: grid = np.linspace(-1.5, 1.5, 601) losses = np.array([evaluate_candidate(m, p, c, alpha)["feat"] for c in grid]) return float(grid[int(np.argmin(losses))]), grid, losses def main(): m, p = make_toy() signal_power = float(((0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean()))) print("[A] 玩具构造:8x8 patch,x = m + s * p,s = +1 / -1 各 0.5") print(" 低频内容 m: 范数 %.4f,梯度能量 %.4f" % ( np.linalg.norm(m), (np.concatenate([np.diff(m, axis=1).ravel(), np.diff(m, axis=0).ravel()]) ** 2).sum())) print(" 棋盘纹理 p: 范数 %.4f,梯度能量 %.4f(纹理占了 %.1f%% 的梯度能量)" % ( np.linalg.norm(p), (np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) ** 2).sum(), 100 * (np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) ** 2).sum() / (np.concatenate([np.diff(m + p, axis=1).ravel(), np.diff(m + p, axis=0).ravel()]) ** 2).sum())) print() print("[B] MSE 最优 = 条件均值(c=0,纹理被平均掉)") c_star, grid, losses = best_c(m, p, 0.0) r0 = evaluate_candidate(m, p, 0.0, 0.0) psnr0 = 10 * np.log10(signal_power / r0["mse"]) print(" MSE 最优的 c* = %.3f(理论值 0)" % c_star) print(" 重建 MSE = %.6f,PSNR = %.2f dB" % (r0["mse"], psnr0)) print(" 梯度能量保留 = %.4f(条件均值必然丢高频:E||grad x||^2 = " "||grad E[x]||^2 + E||grad(x - E[x])||^2)" % r0["grad_keep"]) print() print("[C] 换成特征空间后,最优解跳到清晰模态") print(" alpha 最优 c* 该点的 MSE PSNR(dB) 梯度能量保留") for alpha in (0.0, 0.2, 0.3, 0.378, 0.4, 0.5, 1.0, 2.0): c_a, _, _ = best_c(m, p, alpha) r = evaluate_candidate(m, p, c_a, alpha) psnr = 10 * np.log10(signal_power / r["mse"]) print(" %-8.3f %-10.3f %-13.6f %-10.2f %.4f" % ( alpha, c_a, r["mse"], psnr, r["grad_keep"])) # 解析阈值:alpha^2 > ||p||^2 / ||grad p||^2 gp = np.concatenate([np.diff(p, axis=1).ravel(), np.diff(p, axis=0).ravel()]) thresh = float(np.sqrt((p ** 2).sum() / (gp ** 2).sum())) print(" 粗略解析估计 alpha* = sqrt(||p||^2 / ||grad p||^2) = %.4f" "(假设纹理梯度远大于内容梯度)" % thresh) # 精确的「两个候选」比较:L(c) = (c^2+1)||p||^2 + alpha^2 * G(c), # 于是「清晰模态 L(1)」优于「模糊均值 L(0)」的条件是 alpha^2 > ||p||^2/(G(0)-G(1)) g0 = 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m + p)) ** 2).sum() g0 += 0.5 * ((gradient_magnitude(m) - gradient_magnitude(m - p)) ** 2).sum() g1 = 0.5 * ((gradient_magnitude(m + p) - gradient_magnitude(m - p)) ** 2).sum() exact = float(np.sqrt((p ** 2).sum() / (g0 - g1))) print(" 精确阈值:G(0)=%.4f, G(1)=%.4f,L(1)<L(0) 要求 alpha > %.4f" % (g0, g1, exact)) print(" -> alpha 超过 %.3f 之后,「输出一个清晰模态」在特征损失上严格优于" "「输出模糊均值」;" % exact) print(" alpha 继续加大,最优 c 沿坐标轴继续往 ±1 移(不是跳变," "因为 |grad(m+c*p)| 关于 c 连续)。") print() print("[D] 四种候选输出的指标对比(PSNR 用信号能量 %.4f 作基准)" % signal_power) print(" 候选 MSE PSNR(dB) 梯度保留 到最近模态距离") c_feat, _, _ = best_c(m, p, 1.0) for tag, c in [("MSE 最优 (c=0)", 0.0), ("折中 (c=0.5)", 0.5), ("特征最优 (c=%.3f)" % c_feat, c_feat), ("清晰模态 (c=1)", 1.0)]: r = evaluate_candidate(m, p, c, 1.0) psnr = 10 * np.log10(signal_power / r["mse"]) print(" %-20s %.6f %-10.2f %-9.4f %.6f" % ( tag, r["mse"], psnr, r["grad_keep"], r["to_mode"])) print() r_mean = evaluate_candidate(m, p, 0.0, 1.0) r_sharp = evaluate_candidate(m, p, 1.0, 1.0) r_feat = evaluate_candidate(m, p, c_feat, 1.0) print(" PSNR 的绝对值很小,是因为这个玩具里纹理完全无法从 latent 预测,") print(" 要看的是相对差:") print(" · 特征最优解 (c=%.3f) 的 MSE 是模糊均值的 %.2f 倍(PSNR 低 %.2f dB);" % (c_feat, r_feat["mse"] / r_mean["mse"], -10 * np.log10(r_mean["mse"] / r_feat["mse"]))) print(" · 但它保留了 %.0f%% 的梯度能量,模糊均值只保留 %.0f%%;" % (100 * r_feat["grad_keep"], 100 * r_mean["grad_keep"])) print(" · 完全选一个模态 (c=1) 时 MSE 是均值的 %.1f 倍(PSNR 低 %.2f dB)," "梯度能量保留 %.0f%%,且到最近模态距离为 0 —— 它落在数据流形上。" % (r_sharp["mse"] / r_mean["mse"], -10 * np.log10(r_mean["mse"] / r_sharp["mse"]), 100 * r_sharp["grad_keep"])) print(" LPIPS/FID 站在后者一边,PSNR 站在前者一边 —— 这就是 VQGAN 之后") print(" 没人再用 PSNR 报告 tokenizer 重建质量的原因。") if __name__ == "__main__": main() codebook_size_law.py """codebook_size_law.py —— 码本容量 K 的收益到底有多大? 核心问题:把码本从 512 加到 16384,重建能好多少?直觉是「容量越大越好」, 但高维量化的经典结论(Zador 定理的渐近形式)说:最优量化失真随码本大小 只能按 K^(-2/d) 衰减,d 是码本向量维度。d=256 时指数只有 -1/128,也就是 K 翻一倍、失真只降 0.5%。 本脚本的实测方式:先训一个连续自编码器把潜分布固定住,再对潜变量做 k-means (k-means 就是「给定 K 个码字的最优最近邻量化器」的近似),在**留出集**上 测失真(避免用训练集测失真造成的过拟合假象)。 [A] 不同 d 下,量化失真 vs K 的双对数斜率,与 -2/d 对拍 [B] 量化误差什么时候降到「子空间残差」之下(继续加 K 的收益拐点) 运行:/usr/local/bin/python3 codebook_size_law.py """ from __future__ import annotations import argparse import numpy as np from vq_core import kmeans, make_patch_data, quantize, train_ae def distortion_curve(z_fit, z_test, k_list, seed=0, iters=20): """在 z_fit 上拟合 k-means,在 z_test 上测失真(留出集估计)。""" out = [] for k in k_list: c = kmeans(z_fit, k, seed=seed, iters=iters) _, _, d2 = quantize(z_test, c) out.append(float(d2.mean()) / z_fit.shape[1]) return np.array(out) def fit_slope(k_list, dist): """双对数线性拟合:log D = a * log K + b,返回斜率 a。""" lk = np.log(np.asarray(k_list, dtype=np.float64)) ld = np.log(np.asarray(dist, dtype=np.float64)) a, b = np.polyfit(lk, ld, 1) return float(a), float(b) def main(): ap = argparse.ArgumentParser() ap.add_argument("--steps", type=int, default=1500, help="连续自编码器训练步数") ap.add_argument("--seed", type=int, default=0) args = ap.parse_args() X, _, _, _ = make_patch_data(n=8192, seed=args.seed) d_in = X.shape[1] # 前一半拟合码本,后一半当留出集测失真 X_fit, X_test = X[:4096], X[4096:] k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512] print("数据 X%s(前 4096 拟合码本,后 4096 留出评估)" % (X.shape,)) print() print("[A] 量化失真 D(K) = E||z - q(z)||^2 / d 的双对数斜率") print(" d 理论 -2/d 实测斜率(K>=16) D(8) D(512) 衰减倍数") results = {} for d in (2, 4, 8, 16): params, _, hist, _ = train_ae(X_fit, d, "continuous", steps=args.steps, seed=args.seed) z_fit = X_fit @ params["We"] z_test = X_test @ params["We"] dist = distortion_curve(z_fit, z_test, k_list, seed=args.seed) slope, _ = fit_slope(k_list[3:], dist[3:]) # 只拟合 K>=16 的渐近段 results[d] = {"dist": dist, "slope": slope, "params": params, "z_fit": z_fit, "z_test": z_test} print(" %-4d %-11.4f %-17.4f %.4e %.4e %.1fx" % ( d, -2.0 / d, slope, dist[2], dist[-1], dist[2] / dist[-1])) print() print(" K 从 8 加到 512(64 倍):d=2 失真降 %.1f 倍,d=16 只降 %.1f 倍。" % (results[2]["dist"][2] / results[2]["dist"][-1], results[16]["dist"][2] / results[16]["dist"][-1])) print(" d=2/4 的斜率与 -2/d 吻合;d>=8 时 K=512 已经逼近每个码字 8 个样本,") print(" 斜率被有限样本抬高(同样的码本在训练集上测会更陡),真值应更接近理论。") print() # ---------------- [B] 拐点:量化误差 vs 子空间残差 ---------------- params = results[8]["params"] z_fit, z_test = results[8]["z_fit"], results[8]["z_test"] rec_cont = (((z_test @ params["Wd"] + params["bd"]) - X_test) ** 2).mean() print("[B] 码本大到什么程度,量化误差才降到子空间残差之下(d=8,留出集)") print(" 连续通路重建 MSE(子空间残差) = %.6f" % rec_cont) print(" K 量化失真/d 量化后重建MSE 相对残差涨幅") for k in k_list: c = kmeans(z_fit, k, seed=args.seed, iters=20) z_q, _, d2 = quantize(z_test, c) rec = (((z_q @ params["Wd"] + params["bd"]) - X_test) ** 2).mean() print(" %-7d %.4e %.6f %+.1f%%" % ( k, d2.mean() / 8, rec, 100 * (rec - rec_cont) / rec_cont)) print() if __name__ == "__main__": main() make_figures.py """make_figures.py —— 画正文用到的五张示意图。 所有数字都现场重算(不读缓存),来源是同目录下的实验脚本: token_budget.py -> 图 1(序列长度与注意力规模) codebook_size_law.py-> 图 2(码本容量 K 的收益曲线) collapse_lab.py -> 图 3、图 4(坍缩过程与使用分布) perceptual_lab.py -> 图 5(MSE 最优 vs 特征空间最优) 运行:/usr/local/bin/python3 make_figures.py 输出:../figures/*.png """ from __future__ import annotations import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np import codebook_size_law as CSL import collapse_lab as CL import perceptual_lab as PL import token_budget as TB from vq_core import kmeans, make_patch_data, quantize, train_ae HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, os.pardir, "figures") os.makedirs(FIGDIR, exist_ok=True) plt.rcParams["font.sans-serif"] = ["PingFang SC", "Heiti TC", "Arial Unicode MS"] plt.rcParams["axes.unicode_minus"] = False C_A = "#2E6DB4" # 蓝:主曲线 / 基线 C_B = "#C0504D" # 红:第二种配置 C_C = "#4FA96B" # 绿:第三种配置 / 好的一方 C_D = "#E08A2E" # 橙:强调 C_GREY = "#8C8C8C" def _save(fig, name): path = os.path.join(FIGDIR, name) fig.savefig(path, dpi=140, bbox_inches="tight", facecolor="white") plt.close(fig) print(" -> %s" % path) # ---------------------------------------------------------------- 图 1 def fig_token_budget(): sizes = np.array([128, 256, 512, 1024, 2048], dtype=float) fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.3)) ax = axes[0] for f, col, mk in [(4, C_D, "o"), (8, C_A, "s"), (16, C_C, "^")]: n = (sizes / f) ** 2 ax.plot(sizes, n, color=col, marker=mk, lw=1.8, label=r"tokenizer $f$=%d" % f) ax.plot(sizes, sizes ** 2 * 3, color=C_GREY, marker="d", lw=1.8, ls="--", label="像素级 RGB") ax.set_xscale("log", base=2) ax.set_yscale("log") ax.set_xlabel("边长 H (像素)") ax.set_ylabel("序列长度(token 数)") ax.set_title("(a) 压缩率决定序列长度") ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) ax.annotate("H=256, f=16\n只有 256 个 token", xy=(256, 256), xytext=(300, 60), fontsize=9, color=C_C, arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2)) ax = axes[1] labels = ["像素级\nRGB", "f=4", "f=8", "f=16"] vals = [(256 * 256 * 3) ** 2, ((256 / 4) ** 2) ** 2, ((256 / 8) ** 2) ** 2, ((256 / 16) ** 2) ** 2] colors = [C_GREY, C_D, C_A, C_C] bars = ax.bar(labels, vals, color=colors) ax.set_yscale("log") ax.set_ylabel(r"注意力矩阵规模 $n^2$") ax.set_title("(b) 256x256 图像的自注意力开销") ax.grid(alpha=0.3, axis="y") for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v * 1.6, "%.1e" % v, ha="center", fontsize=9) ax.annotate("省 5.9e5 倍", xy=(3, vals[3]), xytext=(2.55, 1e8), fontsize=9, color=C_C, arrowprops=dict(arrowstyle="->", color=C_C, lw=1.2)) fig.suptitle("图 1:为什么必须先做 tokenizer(数字来自 token_budget.py)", fontsize=11) fig.tight_layout() _save(fig, "token_budget.png") # ---------------------------------------------------------------- 图 2 def fig_codebook_law(): X, _, _, _ = make_patch_data(n=8192, seed=0) X_fit, X_test = X[:4096], X[4096:] k_list = [2, 4, 8, 16, 32, 64, 128, 256, 512] fig, ax = plt.subplots(figsize=(7.6, 5.2)) color_map = {2: C_C, 4: C_A, 8: C_D, 16: C_B} slopes = {} for d in (2, 4, 8, 16): params, _, _, _ = train_ae(X_fit, d, "continuous", steps=1500, seed=0) z_fit = X_fit @ params["We"] z_test = X_test @ params["We"] dist = CSL.distortion_curve(z_fit, z_test, k_list, seed=0) slope, _ = CSL.fit_slope(k_list[3:], dist[3:]) slopes[d] = slope ax.plot(k_list, dist, color=color_map[d], marker="o", lw=1.8, label=r"$d$=%d 实测斜率 %.2f" % (d, slope)) # 理论斜率 -2/d,锚定在 K=16 处 anchor = dist[3] theo = anchor * (np.array(k_list[3:], dtype=float) / 16.0) ** (-2.0 / d) ax.plot(k_list[3:], theo, color=color_map[d], lw=1.0, ls=":", alpha=0.75) ax.set_xscale("log", base=2) ax.set_yscale("log") ax.set_xlabel(r"码本大小 $K$") ax.set_ylabel(r"量化失真 $E\Vert z-q(z)\Vert^2/d$(留出集)") ax.set_title("图 2:码本容量 K 的收益被码本维度 d 卡死\n" "实线=实测,点线=理论斜率 -2/d(数字来自 codebook_size_law.py)", fontsize=11) ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) _save(fig, "codebook_size_law.png") return slopes # ---------------------------------------------------------------- 图 3、4 def fig_collapse(): X, _, _, _ = make_patch_data(n=4096, seed=0) K = CL.BIG_K s_rand, h_rand = CL.run_vq(X, K=K, steps=1200, seed=0, log_every=100) p_init, _, _, _ = train_ae(X, 8, "continuous", steps=800, seed=0) init_cb = kmeans(X @ p_init["We"], K, seed=0, iters=20) s_km, h_km = CL.run_vq(X, K=K, steps=1200, seed=0, init_cb=init_cb, log_every=100) s_rs, h_rs = CL.run_vq(X, K=K, steps=1200, seed=0, restart=True, log_every=100) fig, ax = plt.subplots(figsize=(7.6, 5.0)) for h, col, mk, tag in [(h_rand, C_B, "o", "随机初始化"), (h_km, C_A, "s", "k-means 初始化"), (h_rs, C_C, "^", "死码重采样重启")]: ax.plot(h["step"], h["alive"], color=col, marker=mk, lw=1.8, label=tag) ax.axhline(K, color=C_GREY, ls="--", lw=1.2) ax.text(max(h_rand["step"]) * 0.55, K * 1.08, "码本容量 K=%d(全活)" % K, color=C_GREY, fontsize=9) ax.set_xlabel("训练步数") ax.set_ylabel("活跃码数(至少被选中过一次)") ax.set_title("图 3:码本坍缩过程\n" "K=%d 的码本,随机初始化下最终只有 %d 个码活着(%.1f%%)" % (K, s_rand["alive"], 100.0 * s_rand["alive"] / K), fontsize=11) ax.grid(alpha=0.3) ax.legend(fontsize=9) ax.set_ylim(0, K * 1.25) _save(fig, "collapse_curve.png") fig, ax = plt.subplots(figsize=(7.6, 4.8)) for s, col, tag in [(s_rand, C_B, "随机初始化"), (s_rs, C_C, "死码重采样重启")]: frac = np.sort(s["counts"] / s["counts"].sum())[::-1] ax.plot(np.arange(1, len(frac) + 1), frac, color=col, lw=1.8, label="%s:%d 个活码,perplexity %.1f" % (tag, s["alive"], s["ppl"])) ax.set_yscale("log") ax.set_xlabel("码字按使用频次从高到低排序") ax.set_ylabel("使用占比") ax.set_title("图 4:使用分布的长尾与死码\n" "随机初始化有 %.1f%% 的码一次都没被用到" % (100.0 * (1 - s_rand["alive"] / K)), fontsize=11) ax.grid(alpha=0.3, which="both") ax.legend(fontsize=9) _save(fig, "usage_hist.png") return s_rand, s_km, s_rs # ---------------------------------------------------------------- 图 5 def fig_perceptual(): m, p = PL.make_toy() signal_power = float(0.5 * ((m + p) ** 2).mean() + 0.5 * ((m - p) ** 2).mean()) c_feat, _, _ = PL.best_c(m, p, 1.0) cands = [("真值样本 s=+1", m + p), ("真值样本 s=-1", m - p), ("MSE 最优 c=0", m), ("特征最优 c=%.2f" % c_feat, m + c_feat * p)] fig, axes = plt.subplots(2, 4, figsize=(12.0, 5.6), gridspec_kw={"height_ratios": [1.0, 0.92]}) vmin = min(a.min() for _, a in cands) vmax = max(a.max() for _, a in cands) for ax, (tag, img) in zip(axes[0], cands): im = ax.imshow(img, cmap="gray", vmin=vmin, vmax=vmax, interpolation="nearest") ax.set_title(tag, fontsize=10) ax.set_xticks([]) ax.set_yticks([]) axes[0][0].set_ylabel("8x8 patch", fontsize=9) rows = [("MSE 最优 c=0", 0.0), ("折中 c=0.5", 0.5), ("特征最优 c=%.2f" % c_feat, c_feat), ("清晰模态 c=1", 1.0)] psnrs, keeps = [], [] for tag, c in rows: r = PL.evaluate_candidate(m, p, c, 1.0) psnrs.append(10 * np.log10(signal_power / r["mse"])) keeps.append(100 * r["grad_keep"]) xpos = np.arange(len(rows)) ax = axes[1][0] bs = ax.bar(xpos, psnrs, color=[C_A, C_GREY, C_D, C_C]) ax.set_xticks(xpos) ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8) ax.set_ylabel("PSNR (dB)") ax.set_title("(e) 像素误差:模糊均值最好", fontsize=10) ax.grid(alpha=0.3, axis="y") ax.set_ylim(0, max(psnrs) * 1.3) for b, v in zip(bs, psnrs): ax.text(b.get_x() + b.get_width() / 2, v + 0.08, "%.2f" % v, ha="center", fontsize=8) ax = axes[1][1] bs = ax.bar(xpos, keeps, color=[C_A, C_GREY, C_D, C_C]) ax.set_xticks(xpos) ax.set_xticklabels(["MSE\n最优", "折中", "特征\n最优", "清晰\n模态"], fontsize=8) ax.set_ylabel("梯度能量保留 (%)") ax.set_title("(f) 细节保留:清晰模态最好", fontsize=10) ax.grid(alpha=0.3, axis="y") ax.set_ylim(0, 118) for b, v in zip(bs, keeps): ax.text(b.get_x() + b.get_width() / 2, v + 1.5, "%.0f%%" % v, ha="center", fontsize=8) # 右侧两格合并成一条 alpha 扫描曲线(先把占位的两个空轴关掉) axes[1][2].axis("off") axes[1][3].axis("off") ax = plt.subplot2grid((2, 4), (1, 2), colspan=2) alphas = np.linspace(0.0, 2.0, 41) cs = [PL.best_c(m, p, a)[0] for a in alphas] ax.plot(alphas, np.abs(cs), color=C_A, lw=1.8) ax.axhline(1.0, color=C_GREY, ls="--", lw=1.0) ax.axhline(0.0, color=C_GREY, ls="--", lw=1.0) ax.set_xlabel(r"特征里高频项的权重 $\alpha$") ax.set_ylabel("最优输出的纹理系数 |c|") ax.set_title(r"(g) $\alpha$ 越大,最优解越靠近清晰模态", fontsize=10) ax.grid(alpha=0.3) ax.set_ylim(-0.05, 1.15) ax.set_xticks([0.0, 0.5, 1.0, 1.5, 2.0]) fig.suptitle("图 5:MSE 最优必然糊,特征空间最优不糊" "(数字来自 perceptual_lab.py)", fontsize=11) fig.tight_layout() _save(fig, "perceptual_tradeoff.png") def main(): print("画图:所有数字现场重算,不读缓存") print("[1/5] token_budget.png") fig_token_budget() print("[2/5] codebook_size_law.png") slopes = fig_codebook_law() print(" 实测斜率:", {k: round(v, 3) for k, v in slopes.items()}) print("[3/5] collapse_curve.png + usage_hist.png") s_rand, s_km, s_rs = fig_collapse() print(" 随机初始化: alive=%d ppl=%.2f rec=%.6f" % ( s_rand["alive"], s_rand["ppl"], s_rand["rec"])) print(" k-means 初始化: alive=%d ppl=%.2f rec=%.6f" % ( s_km["alive"], s_km["ppl"], s_km["rec"])) print(" 死码重采样: alive=%d ppl=%.2f rec=%.6f" % ( s_rs["alive"], s_rs["ppl"], s_rs["rec"])) print("[5/5] perceptual_tradeoff.png") fig_perceptual() print("完成,图在 %s" % os.path.abspath(FIGDIR)) if __name__ == "__main__": main()
-
AIGC 基本功|KV Cache 与自回归视频生成-KVCache KV Cache 与自回归视频生成 所属方向:推理加速 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本(attention_basics)、性能建模与 Profiling(performance_profiling) 关键词:KV Cache、显存带宽、自回归生成、因果注意力、缓存驱逐、PagedAttention 01. 为什么需要它 先给三个数,都是本篇附录按明确假设计算的账本;它们不是实际部署峰值显存。 第一个数:一个 token 的 KV cache 是 128 KiB。 按 Meta Llama 模型配置 中 Llama-3-8B 的结构算(32 层、8 个 KV 头、每头 128 维、BF16 两个字节):每个 token 要缓存 $2 \times 32 \times 8 \times 128 \times 2 = 131072$ 字节,正好 128 KiB。所以一条 8192 token 的序列,KV cache 恰好是 1.00 GiB。这个整数不是巧合,是配置凑出来的——记住它,后面所有账都从它出发。 第二个数:batch=32 时,KV cache 是权重的 2.14 倍。 权重 14.96 GiB,KV cache $32 \times 1.00 = 32.00$ GiB,合计 46.96 GiB。batch 加到 64,合计 78.96 GiB——已经接近本文假设的 80 GiB 总预算,其中约 81% 是 KV cache;还未计入激活、临时空间与框架开销。实际 A100 型号标称 80 GB,可用字节应以设备查询为准,不能把理想 80 GiB 预算当作部署保证。你以为你在被权重压垮,其实在被缓存压垮。 第三个数:一组视频假设会产生 52.7 GiB 的 KV。 假设沿用上面的 Llama 结构、缓存全部历史、不做额外 latent patch 化:5 秒 24fps、时间维 4 倍压缩、空间 8×8 压缩,是 30 帧 × 14400 token = 432000 token,按同样的 128 KiB/token 算就是 52.73 GiB——还没算权重,一条视频就吃掉大半张卡。10 秒 105.47 GiB,30 秒 316.41 GiB。这是展示量级的假想配置,不是真实视频模型的统一用量;VAE、patch、窗口与模型层数都能改变它。 玩具 decoder 的全量重算与缓存增量解码还展示了一点:计算量减少不等于同倍数加速。修正了密集注意力 FLOPs 计数、输出头计数和最后一次无用 decode 后,当前代码解析比为 105.61 倍,本次 NumPy 墙钟为 10.29 倍。Python 调度、临时数组、重复 KV 头和小矩阵效率都会影响耗时,单靠这个比值不能认定差额全来自内存带宽。 02. 最小可用理解 三句话: 机制:因果注意力里,每层位置 $j$ 的 key 和 value 由固定前缀 $1\ldots j$ 的隐藏状态决定,跟它后面来了什么 token 无关。所以生成第 $t$ 个 token 时,前 $t-1$ 个位置的 K、V 和上一步完全一样——把它们留在显存里,每步只算新 token 自己的那一个 query、一对 K/V。用空间换时间,空间就是 KV cache。 成本:省的算力是真实的(每步从 $O(S^2)$ 降到 $O(S)$,整段生成从 $O(S^3)$ 降到 $O(S^2)$),长上下文下注意力常受访存约束。理想融合的单 query 注意力有 $I=2g/p$,但实际瓶颈还取决于 batch、kernel、缓存命中、并行与硬件,decode 仍有投影和 FFN 运算。同时缓存自己按 $2 L n_{\text{kv}} d p$ 字节每 token 线性膨胀,长上下文和视频场景下反过来成了显存的主宰。 效果与代价:文本场景它是推理加速的第一功臣;视频自回归场景 token 数大两个数量级,于是问题从「要不要缓存」变成「怎么让缓存装得下」——分页管理、GQA、缓存量化、块级因果,全是被这个量级逼出来的。 03. 数学推导 3.1 因果注意力里,什么是死的 自注意力一步的计算是 $$\mathrm{Attn}(Q, K, V) = \mathrm{softmax}\left( \frac{Q K^{\top}}{\sqrt{d}} + M \right) V$$ 其中 $M$ 是因果掩码,$M_{ij} = 0$($j \le i$)或 $-\infty$($j > i$)。关键在 $Q$、$K$、$V$ 是怎么来的:第 $i$ 个位置的 query、key、value 是 $$q_i = W_q x_i, \quad k_i = W_k x_i, \quad v_i = W_v x_i$$ 这里的 $x_i$ 是该层输入隐藏状态,不是只含第 $i$ 个 token 的原始 embedding。在多层 decoder 中,它已经聚合了前面位置的信息。正确的论证是逐层归纳:固定权重、位置、条件与推理随机性后,因果掩码保证历史位置不能看未来;追加 token 不会改变旧位置的隐藏状态,所以其 K/V 可复用。此处 $t$ 表示正在处理的输入位置,$j<t$ 的缓存已存在,$q_t,k_t,v_t$ 是本步新计算的量。改变前缀、RoPE 位置、条件、模型权重或噪声等级,都可能使旧缓存失效。 所以增量解码的正确姿势是: $$o_t = \sum_{j=1}^{t} \mathrm{softmax}_j \left( \frac{q_t k_j^{\top}}{\sqrt{d}} \right) v_j$$ 注意这个式子里只有 $q_t$、$k_t$、$v_t$ 是新的,$k_j$、$v_j$($j < t$)全部从缓存里读。softmax 的分母也只在这一行上归一化——不需要重算别的行,因为别的行的输出早就有了,而且以后也不会变。 这里有一个值得停一下的对比:训练时我们并行算所有位置,$Q K^{\top}$ 是一个 $S \times S$ 的矩阵;decode 时一次只有一个 query,$Q K^{\top}$ 退化成一个 $1 \times t$ 的向量。同一个算子,在两个阶段里形状完全不同,这让长 prefill 通常更容易利用矩阵计算资源,而单 token decode 的注意力通常更容易受带宽或并行度限制,仍需实测确认。 顺带回答一个常见疑问:为什么缓存的是 K 和 V,而不是 Q?因为它们的生命周期不同。$q_t$ 在这一步算完、和缓存做完内积之后就没用了——下一个 token 不会再来问它;而 $k_j$、$v_j$ 是「将来所有 query 都要来查一遍」的公共数据,未来第 $t+1$、$t+2$ 步的注意力都要用。缓存的对象必须是「写入后不再变、且会被反复读」的东西,这正好是 3.4 节那个算术强度问题的另一半来源:省下的是重算 K/V 的算力,付出的是每步把这块只读数据整个搬一遍的带宽。 3.2 省了多少算力 先算不用缓存的账。每一步要对长度为 $t$ 的前缀做一次完整因果前向,注意力部分是 $O(t^2)$;生成 $S$ 个 token 总共是 $$\sum_{t=1}^{S} c \cdot t^2 \approx \frac{c \, S^3}{3}$$ 用缓存之后,每步只算一个新 query 对 $t$ 个缓存条的注意力,是 $O(t)$;总共 $$\sum_{t=1}^{S} 2c \cdot t \approx c \, S^2$$ 按上面这套只计有效因果三角的常数约定,比值趋于 $S/3$,不是 $2S/3$。若全量实现先计算完整 $t\times t$ 分数再掩码(本文 NumPy 就是这种实现),它做了约两倍的注意力乘加,比值才趋于 $2S/3$。这两个系数对应不同实现,不能混在一起。 投影与 FFN 的账不同:全量路线每步重算前缀各 token,累计为 $O(S^2D^2)$;缓存路线累计为 $O(SD^2)$,$D$ 为隐藏宽度。注意力累计阶数则分别是 $O(S^3D)$ 和 $O(S^2D)$。有长度 $P$ 的 prompt 时应从 $P$ 开始求和,生成 $G$ 个输出只需一次 prefill 加 $G-1$ 次 decode,因为 prefill 已给出首个预测。附录的解析计数按实际密集 NumPy 矩阵乘与每步单个输出头计数,省略 norm、softmax 等逐元素操作。 3.3 缓存自己要多大:显存公式 每生成一个 token,要在缓存里留下这一层的 $k_t$ 和 $v_t$。数一数字节数: $$B_{\text{tok}} = \underbrace{2}_{K,V} \times \; L \times n_{\text{kv}} \times d \times p$$ $L$ 是层数,$n_{\text{kv}}$ 是 KV 头数(GQA 下小于 query 头数 $n_q$),$d$ 是每头维度,$p$ 是 dtype 字节数(BF16 是 2)。这个公式里没有 S——每个 token 的缓存占用与上下文长度无关,缓存总量才随 $S$ 线性增长: $$B_{\text{kv}} = B_{\text{tok}} \times S \times B_{\text{batch}}$$ 代 Llama-3-8B($L=32$,$n_{\text{kv}}=8$,$d=128$,$p=2$):$B_{\text{tok}} = 131072$ 字节。8192 token 一条序列 = 1.00 GiB;batch=32 就是 32.00 GiB,是 14.96 GiB 权重的 2.14 倍。如果换成 MHA($n_{\text{kv}} = 32$),每个 token 变成 512 KiB,batch=32 时 128 GiB——GQA 在这里把 KV 显存降低 4 倍,也会减少 K/V 投影计算;query 头上的注意力乘加不同比例下降。 这张图要看什么:左图是 batch 从 1 扫到 128 时显存账本的构成(seq=8192),深蓝是权重、橙红是 KV cache、浅蓝是激活和余量,红色虚线是 80 GiB——注意从 batch=32 开始橙红就盖过深蓝,计入示意的 4 GiB 余量后 batch=64 已超过 80 GiB 预算、batch=128 直接越界,增长主要来自 KV cache。右图固定 batch 看 KV cache 随序列长度的增长(对数-对数坐标),三条线都是斜率 1 的直线(线性增长),紫色虚线(MHA)比橙色(GQA batch=8)高一截;61 GiB 灰线表示扣除假设权重和余量后的缓存预算,曲线与它的交点给出该简化预算下的长度上限。 3.4 算术强度:为什么上下文再长,decode 也快不起来 这是全篇最要紧的一节。上一篇(性能建模)说过,一个操作的算术强度 $I$ = 算力 / 访存字节数,它和硬件的山脊点(ridge point)比一比,就知道这个操作是算力受限还是带宽受限。 先只看理想融合的单 query 注意力,假设每份 KV 从所分析的存储层读一次,并在一组 query 头之间共享,忽略 Q/O 和中间量:对每个 query 头,$QK^{\top}$ 是 $1 \times d$ 乘 $d \times S$,$2 S d$ FLOP;再加权和 $AV$ 同样 $2 S d$ FLOP。$n_q$ 个头合计 $4 n_q d S$ FLOP。访存呢?要把 K 和 V 的缓存全部读一遍:$2 n_{\text{kv}} d S p$ 字节。两者一除: $$I_{\text{dec}} = \frac{4 \, n_q \, d \, S}{2 \, n_{\text{kv}} \, d \, S \, p} = \frac{2 g}{p}, \quad g = \frac{n_q}{n_{\text{kv}}}$$ $S$ 在这个理想模型中约掉了。 算术强度不随 $S$ 变化,但实际效率可能随上下文而变:短序列并行不足,长序列跨越缓存容量,kernel 的分块和归约成本也会变化。而且注意力之外仍有读权重、投影与 FFN,不能用一个注意力公式概括完整 decode。 代数字(BF16,$p=2$,$I = g$):MHA($g=1$)的 $I = 1$ FLOP/byte;Llama-3 的 GQA($g=4$)是 4;MQA($g=32$)是 32。而 A100 的山脊点是 $312\ \text{TFLOP/s} \div 2.04\ \text{TB/s} = 153$ FLOP/byte。这些理想强度低于该 BF16 山脊点,提示带宽约束;实际 kernel 还可能受并行度与延迟约束。 下图把本机 FP32 微基准(1201.61 GFLOP/s、71.89 GB/s)与 A100 80GB SXM 官方规格 的 BF16 理论峰值分别作为屋顶。CPU 与 GPU 使用不同 dtype,因此同一 $g$ 的 CPU 理想强度为 GPU 的一半。 图中各点是把解析强度放到屋顶上计算出的上界,不是测得的 attention 性能。本机屋顶来自大矩阵和流式数组微基准,不保证小算子能达到。改变 GQA、精度、融合、序列并行或多 query 批处理都可能改善性能;MLA 有自己的压缩结构,不能简单当成增大 $g$。 长 prefill 一次处理多个 query,更容易复用权重和 KV,因此通常有更高强度。附录使用 $2NS$ 近似投影计算量($N$ 为参数量),并假定每层激活搬运为 10*S*D*p,得到示意强度 3973.9 FLOP/byte(BF16)。这是粗略模型,不是逐算子的显存流量测量;输入很短、注意力未融合、张量并行通信或低效 kernel 都可能改变实际瓶颈。不能仅凭这个数断言 prefill 必定吃满 GPU。 这个视角还能直接写出 decode 一步的耗时下限。若权重与全部 KV 每步都需从 HBM 读取,字节数除带宽给出一个下界;还须同时满足 FLOPs/算力下界: $$T_{\text{step}} \ge \frac{W + B_{\text{batch}} \, B_{\text{tok}} \, S}{\mathrm{BW}}$$ $W$ 是权重大小(每步都要读一遍,batch 摊薄),$B_{\text{batch}} B_{\text{tok}} S$ 是全部序列的缓存(batch 摊不了)。代 Llama-3-8B、seq=8192、A100 的 2.04 TB/s:batch=1 时 $(14.96 + 1.00)$ GiB 除以带宽得 8.4 ms,也就是单流吞吐的上限约 119 token/s——仅是单设备、该精度、该访存假设下的上界;权重量化、共享前缀、投机解码、多设备等会改变假设。第 6.1 节进一步说明 batch 对这个模型的影响。 04. 代码实现 核心是三段:完整前向(prefill)、单步(decode)、以及承载它们的缓存。下面是 kv_cache_lab.py 的主干,完整版在文末附录,纯 numpy 可跑。 def attn_full(Q, K, V): """完整因果注意力。Q:[S,Hq,Dh] K/V:[S,Hkv,Dh] -> [S,Hq,Dh]""" S, Hq, Dh = Q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) # GQA:把 kv 头复制 g 份对齐 q 头 Vv = np.repeat(V, g, axis=1) logits = np.einsum("qhd,khd->hqk", Q, Kk) / np.sqrt(Dh) mask = np.triu(np.ones((S, S), dtype=bool), 1) logits = np.where(mask[None, :, :], -np.inf, logits) logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hqk,khd->qhd", p, Vv) def attn_step(q, K, V): """decode 一步:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]""" Hq, Dh = q.shape Kk = np.repeat(K, Hq // K.shape[1], axis=1) Vv = np.repeat(V, Hq // K.shape[1], axis=1) logits = np.einsum("hd,khd->hk", q, Kk) / np.sqrt(Dh) # [Hq,S],只有一行 logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hk,khd->hd", p, Vv) def block_step(x_new, w, cache, pos, cfg=CFG): """decode 一步:只算新 token,并把它的 K/V 写进缓存的 pos 位置。""" D = x_new.shape[1] hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x_new) q = (h @ w["wq"]).reshape(hq, dh) k = (h @ w["wk"]).reshape(hkv, dh) v = (h @ w["wv"]).reshape(hkv, dh) cache["k"][pos] = k # 写缓存:只有这一步是新算的 cache["v"][pos] = v o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh) y = x_new + o @ w["wo"] y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"] return y 变量名和 03 节的符号一一对应:Q/K/V 是 $Q$、$K$、$V$,Hq/Hkv 是 $n_q$、$n_{\text{kv}}$,g 就是 GQA 的分组数 $g$,pos 是当前长度 $t$。缓存预分配成最大长度(prompt + gen),KV 更新按下标原地写入;注意力仍创建临时数组,并用 np.repeat 实际复制 KV 头,因此它没有实现理论分析所假定的完美 GQA 访存复用。 修订后的代码在本机运行得到(时间随机器、BLAS 和负载变化): 生成 token 一致数:192 / 192 最后 logits 最大绝对误差:7.344e-06 相对误差:4.028e-07 无缓存矩阵乘 FLOPs:1.3005e+11 缓存矩阵乘 FLOPs:1.2314e+09 解析比值:105.61x 无缓存 / 缓存墙钟:6.986s / 0.679s 本次加速比:10.29x 全量与增量在精确算术下等价,FP32 累加顺序会带来小误差。真实模型若候选 logits 很接近,舍入也可能改变 argmax,所以不要求所有模型都逐 token 位级一致。附录固定种子玩具例子对序列与误差都加了断言。本例省略位置编码,用于验证缓存数据流;RoPE 和视频块缓存的正确性还需要另行验证。 解析 FLOPs 与墙钟的差额只说明实现效率不同。若要确认带宽瓶颈,还需测实际带宽、kernel 时间、线程设置和缓存命中,不能由加速比倒推出原因。 05. 工业级实现对照 HF transformers:动态缓存与静态缓存是不同路径。 cache_utils.py 的 DynamicLayer.update(以 2026-10 的实现为准)是这么追加一个 token 的: self.keys = torch.cat([self.keys, key_states], dim=-2) self.values = torch.cat([self.values, value_states], dim=-2) torch.cat 每一步都分配一块新内存、把旧缓存整个抄过去。缓存越大这一步越贵,到长上下文时光是拷贝就吃掉不少带宽——而带宽恰恰是 decode 最缺的东西。它换来的是简单:形状任意增长、随便 crop、随便回滚,对 batch=1 的研究代码完全够用。我第一版玩具实现也是这么写的,后来才意识到「预分配 + 下标写入」差在哪:一个把带宽花在拷贝上,一个把带宽花在读缓存上,前者是纯浪费。 同一份 cache_utils.py 还提供 StaticLayer,预分配后原地更新;不能把动态 torch.cat 描述为 transformers 唯一方式。动态拼接与按最大长度预留是两种不同策略,前者可能复制和碎片化,后者有未用容量。 vLLM:把缓存当成页来管。 当服务请求长度不确定时,按最大长度预留可能浪费容量。vLLM(PagedAttention,arXiv:2309.06180)的解法是把操作系统管内存的那一套搬过来:缓存切成固定大小的块(block),每条请求维护一张块表(block table),逻辑上连续、物理上散落。vLLM v0.16.0 的 FlashAttention 后端文档 中可检查 FlashAttentionImpl.forward、key_cache, value_cache = kv_cache.unbind(0) 与 block_table 的使用。缓存张量布局会随版本和后端变化,不能把某个 2 * head_size 排列写成 vLLM 的统一规定。稳定的设计要点是逻辑块映射到物理块,kernel 按块表寻址,新增 K/V 按 slot 映射写入;prefill/decode 通过长度等元数据区分。 分页到底值多少?附录 paged_alloc.py 在同一个 61 GiB 预算下做了模拟(Llama-3-8B,块 16): --- 负载:长度均匀 512~4096 --- 策略 并发请求 占用 真实用到 利用率 连续预留 122 61.00 GiB 34.52 GiB 56.59% 分页(块16) 214 60.85 GiB 60.67 GiB 99.70% 并发提升 : 1.75x --- 负载:重尾:八成 256~1024 --- 连续预留 122 61.00 GiB 18.37 GiB 30.11% 分页(块16) 405 60.79 GiB 60.42 GiB 99.40% 并发提升 : 3.32x 浪费的两半也拆开了:连续预留平均每条请求浪费 223.26 MiB(预留 4096、平均只用 2310),分页只有 0.93 MiB(最后一个块没填满),239 倍。分页确实减少预留浪费和碎片,未改变有效 KV 每 token 的字节数。这里是静态容量模拟:1.75~3.32 倍是可容纳请求数之比,不是测得的吞吐倍数;尚未模拟到达、释放、动态增长和调度。 这张图要看什么:左图是分页的时空图,上面各行是每条请求的逻辑视图(块连续),下面一行是物理块池(按申请顺序排列,颜色表示属于谁)——灰色细线从逻辑块指向它真正的物理块,能看到同一条请求的块在物理上是散的;块里的灰底数字是「已用/容量」,只有每条请求的最后一块没填满。右图是两种策略在同一预算下的并发数,灰色(连续预留)在重尾负载下利用率只剩 30%,蓝色(分页)两种负载都在 99% 以上。 还有一个 decode 特有的并行技巧。 prefill 可以把 $S^2$ 的注意力摊到很多 SM 上,decode 只有一个 query、$S$ 个 key——并行度天然不足(FlashDecoding 的出发点)。做法是把序列维切成几段,各段独立算局部 softmax 再合并(online softmax 的分治),用更多并行度换带宽利用率。这与 3.4 节的结论一致:decode 的问题是算术强度低,切序列不改变 $I$,但能把空闲的算力单元动员起来去搬字节。 生产部署还要考虑块表处理、CPU 调度、编译与内核启动开销。分页增加了寻址和管理成本,是否获益取决于请求负载,不能只看有效容量。 06. 代价与边界 6.1 batch 摊权重,但独立请求的 KV 随 batch 增长 在第 3.4 节的带宽模型里,一批请求共享一次权重读取,而各自拥有不同 KV。若上下文相同,batch 增大时总 KV 字节数线性增长;单步吞吐上界是 $B_{\text{batch}}/T_{\text{step}}$,不会无限线性增加。共享前缀、不同长度调度、投机解码和张量并行会改变这张账,需重新列出复用假设。 6.2 分页不改变有效 KV 大小,但减少浪费 块大小越小,最后一块的空槽通常越少,块表却越长。若长度模块大小的余数均匀,块大小 $b$ 的平均空槽是 $(b-1)/2$,不是无条件精确的 $b/2$。本例平均长度约 2310,16/32 token 块的空槽比例约 0.32%/0.67%;真实工作负载与 kernel 对齐要求应共同决定块大小。分页能让原本浪费的显存参与服务,也支持一些共享场景;batch=1 同样可能减少预留容量,但未必带来明显延迟收益。 6.3 视频缓存:因果掩码只是必要条件之一 一些自回归视频系统按帧或块推进,块内双向、块间因果;另一些按离散 token 生成或采用不同的窗口。下图仅展示一种块因果结构: 图中右上角为空表示不能读未来块,对角块为满表示当前块内双向。允许读取历史,不等于历史 K/V 在所有去噪步都不变。 当前块的噪声状态随去噪变化,其 K/V 通常必须重算;历史块只有在输入、位置、时间/噪声条件、模型权重均固定且架构允许时才能精确缓存。若历史也被重新加噪或全局时间条件改变,需按模型缓存策略重建,不能直接套文本 decoder 的永久缓存假设。 本例假设 720p、空间压缩 8×8、时间压缩 4×、每 latent 位置一个 token、全历史保留,并套用 Llama-3-8B 的缓存结构;5/10/30 秒分别为 52.73/105.47/316.41 GiB。额外 2×2 patch 化会让空间 token 数约为四分之一;因果 VAE 的首帧约定、边界取整、滑动窗口、层数与头数还会继续改变数字。一帧的 1.76 GiB 是这组假设的计算结果,不是视频模型的普遍常数。 语义块和分配块不必相同。 一帧可包含很多物理缓存页,原有 token 分页机制仍可复用;需要调整的是掩码、批处理和缓存生命周期。不能仅凭帧内双向就断言块表必须整帧分配,或元数据一定压垮 CPU。 位置必须保留逻辑含义。 3D RoPE 需要时间/高/宽坐标,不能只用缓存里的 token 条数推断它们。滑窗驱逐后,存储长度尤其不等于全局逻辑位置,需单独维护 position_ids 或绝对偏移。丢缓存并不删除已输出的视频帧,只会改变未来生成能读到的上下文,可能影响长时一致性。 量化、驱逐、压缩各有条件。 理想地把 KV 每元素字节从 2 降到 1,载荷减半,但总存储还包括量化 scale、元数据和工作区。FP8 不同格式有不同动态范围,离群值与精度误差要验证,不能只按「减半」判断能部署。MLA 是训练时设计的潜在注意力结构,不是给任意既有模型套一个无损压缩器;滑窗或驱逐会改变可见历史。 6.4 证据的范围 本篇证实了玩具文本 decoder 的缓存等价性,计算了指定配置的显存账,并做了静态分页容量模拟。Roofline 给出假设下的上界,未测 A100 kernel,未实现完整视频去噪缓存,也没有证明任何真实视频模型必须采用某个驱逐策略。CPU FP32 微基准、GPU BF16 理论峰值与 NumPy 教学实现的访存行为要分开理解。 07. 经典论文脉络 Attention Is All You Need(arXiv:1706.03762)——decoder 的因果结构允许缓存固定历史,缓存是利用因果结构减少重复计算的常见优化,并非数学正确性所必需。 Fast Transformer Decoding: One Write-Head is All You Need(arXiv:1911.02150,MQA)——系统讨论了 decode 的瓶颈是带宽而非算力,并把所有 query 头共享一对 KV 头,把缓存压到 $1/g$。贡献是把「算术强度」这个视角带进了推理优化。 GQA: Training Generalized Multi-Query Transformer Models from Multi-head Checkpoints(arXiv:2305.13245)——MQA 掉点太狠,这篇用「分组共享 + 上游检查点升级」折中:8 个 KV 头保住大部分质量,缓存仍压到 1/4。具体分组数与是否采用 GQA 随模型规格而异。 FlashAttention(arXiv:2205.14135)与后续的 FlashDecoding——前者说明注意力可以不把 $S \times S$ 矩阵写回显存(本系列已写过);后者把 decode 的序列维切开并行,专治「一个 query、一长串 key」的并行度不足。它们改善不同形状的 IO 与并行效率,但不保证始终达到理论带宽。 Efficient Memory Management for Large Language Model Serving with PagedAttention(arXiv:2309.06180,vLLM)——把虚拟内存的分页思想搬进 KV cache,解决「输出长度未知导致的预留浪费与外部碎片」,本篇 05 节用自设负载模拟预留浪费,不是论文 benchmark 的直接复现。这是推理服务从「单条请求优化」走向「系统优化」的分水岭。 两条缓存压缩路线的起点:StreamingLLM(arXiv:2309.17453)发现「开头几个 token + 最近窗口」就能稳定外推,给出了驱逐策略的最简形式;DeepSeek-V2 的 MLA(arXiv:2405.04434)则把 K/V 联合投影到低秩隐空间再缓存,压缩比远超 GQA。前者改变可见上下文,后者是在训练中学习的注意力参数化,都直接对应 6.3 节视频场景里那道「丢什么、怎么丢」的选择题。 08. 常见误解 误解 1:「算力少 100 倍就一定快 100 倍。」 墙钟还受 kernel、调度、带宽和分配影响,加速比需实测。上下文变长使缓存路线自身更慢,但相对全量重算的加速比可能反而增大,不能说必然恶化。 误解 2:「所有 decode 都是纯访存。」 低 batch、长上下文的注意力常受带宽限制,但整体 decode 还有投影、FFN、通信与 CPU 开销。先用 profiler 定位。 误解 3:「GQA 只影响质量。」 它减少 KV 容量、KV 投影与理想读取字节,但 query 头数不变;代价要结合训练质量和实际 kernel 评估。 误解 4:「分页不省显存,容量增益直接等于吞吐增益。」 分页减少的是预留与碎片浪费,有效 KV 本身不变。能放更多请求并不保证同倍数 tokens/s。 误解 5:「缓存长度就是新 token 的位置。」 仅在简单连续全缓存情形下成立。驱逐、packing、padding 或 3D 坐标都需要额外位置元数据,不能从当前存储长度猜。 误解 6:「因果视频掩码就保证跨去噪步复用 KV。」 掩码约束依赖方向,缓存还要求被缓存的隐藏状态不变;当前噪声块及发生条件变化的历史必须重新计算。 09. 动手验证 数值脚本依赖 numpy,配图另需 matplotlib,均不需要 torch: python kv_cache_lab.py ALL # 约 8 秒:等价性 + 算力账 + 显存账 + Roofline python paged_alloc.py ALL # 约 1 秒:分页 vs 连续预分配的并发与浪费 预期结果(实跑输出,可以直接对): kv_cache_lab.py 的 [A1] 必须是 192 / 192 完全一致,[A2] 的相对误差在 $10^{-7}$ 量级。如果你的 [A2] 是 $10^{-2}$ 量级,九成是参照解喂多了 token([A] 段注释里那个 off-by-one,我第一版就踩了)。 [A3] 修订后的矩阵乘计算量比约 105.61;[A4] 时间不设固定范围,它取决于机器和运行条件。 [B1] 每个 token 131072 字节、8192 token 正好 1.0000 GiB;[B4] 三条视频账 52.73 / 105.47 / 316.41 GiB。 paged_alloc.py 的 [A]:均匀负载 122 → 214(1.75x),重尾负载 122 → 405(3.32x);[B] 两类浪费之比约 239 倍。 想自己碰一下边界?改 kv_cache_lab.py 顶部的 CFG["n_kv_head"](从 2 改到 8,变成 MHA),再跑一遍:缓存载荷变 4 倍,但投影结构、临时复制与两条路线的耗时也会变化,实测加速比不保证单调。NumPy 的 repeat 会削弱理想 GQA 访存收益,因此这个实验不能直接验证 GPU 带宽模型。 10. 延伸阅读 性能建模与 Profiling:算力、带宽与显存账本(本系列已发布)——本篇 3.4 节的算术强度和山脊点在那里有完整推导和实跑标定方法;读那篇再看本篇的 Roofline 图会非常顺。 自注意力机制的计算与显存账本(本系列已发布)——训练态注意力的 $O(S^2)$ 账本,本篇是它在推理态的续集。 FlashAttention 为什么不需要存下注意力矩阵(本系列已发布)——07 节第 4 条的展开,online softmax 的分治细节在那里。 自回归视频生成与 Forcing 范式(本系列已发布)——6.3 节的因果结构(帧内双向、帧间因果)是从那套范式来的;读完范式再看本篇的缓存账,能对上号。 扩散模型的跨步缓存复用(本系列规划中)——同样是「缓存」,扩散模型的跨去噪步近似复用可能针对中间特征或注意力状态,与本文的精确历史缓存要区分,动机相同、机制完全不同,适合对照着读。 附录:完整代码 09 节用到的脚本全文如下(kv_cache_lab.py、paged_alloc.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 kv_cache_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """KV Cache 实验室。 三个问题,全部用可复现的实跑回答,不靠记忆里的结论: [A] 增量解码(用缓存)和「每步把整个前缀重算一遍」,得到的到底是不是同一个东西? 以及真实加速比是多少、算力量省了多少倍。 [B] 缓存自己要吃掉多少显存?按 Llama-3-8B 的真实配置算一遍, 再算一遍自回归视频的 token 数,看哪个先爆。 [C] decode 一步的算术强度为什么和上下文长度无关?把它放到 Roofline 上看。 纯 numpy,不需要 torch / scipy。 python kv_cache_lab.py ALL # 全部,约 30 秒 python kv_cache_lab.py A # 只跑等价性与加速比 python kv_cache_lab.py B # 只跑显存账本 python kv_cache_lab.py C # 只跑算术强度与 Roofline """ from __future__ import annotations import argparse import json import math import os import time import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # 玩具模型的配置:刻意做成 GQA(8 个 q 头共享 2 个 kv 头,g = 4), # 它是常见的一种结构;MHA 是 g = 1 的特例,其他模型也可能采用 MQA/MLA。 CFG = dict( n_layer=4, n_q_head=8, n_kv_head=2, d_head=32, ffn_mult=4, prompt=16, gen=192, vocab=32, dtype_bytes=4, # 玩具模型用 fp32 跑,记账就按 4 字节 ) def d_model(cfg=CFG): return cfg["n_q_head"] * cfg["d_head"] # ══════════════════════════════════════════════════════════════ # 0. 一个能跑的小 Transformer decoder # ══════════════════════════════════════════════════════════════ def make_weights(cfg=CFG, seed=0): rng = np.random.default_rng(seed) D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D s = 1.0 / math.sqrt(D) blocks = [] for _ in range(cfg["n_layer"]): blocks.append(dict( wq=rng.normal(0, s, (D, D)).astype(np.float32), wk=rng.normal(0, s, (D, Dk)).astype(np.float32), wv=rng.normal(0, s, (D, Dk)).astype(np.float32), wo=rng.normal(0, s, (D, D)).astype(np.float32), w1=rng.normal(0, s, (D, F)).astype(np.float32), w2=rng.normal(0, s, (F, D)).astype(np.float32), )) E = rng.normal(0, s, (cfg["vocab"], D)).astype(np.float32) # token embedding head = rng.normal(0, s, (D, cfg["vocab"])).astype(np.float32) return blocks, E, head def rmsnorm(x, eps=1e-8): return x / np.sqrt(np.mean(x * x, axis=-1, keepdims=True) + eps) def attn_full(Q, K, V): """完整因果注意力。Q:[S,Hq,Dh] K/V:[S,Hkv,Dh] -> [S,Hq,Dh]""" S, Hq, Dh = Q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) logits = np.einsum("qhd,khd->hqk", Q, Kk) / np.sqrt(Dh) # [Hq,S,S] mask = np.triu(np.ones((S, S), dtype=bool), 1) logits = np.where(mask[None, :, :], -np.inf, logits) logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hqk,khd->qhd", p, Vv) def attn_step(q, K, V): """单步注意力:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]""" Hq, Dh = q.shape g = Hq // K.shape[1] Kk = np.repeat(K, g, axis=1) Vv = np.repeat(V, g, axis=1) logits = np.einsum("hd,khd->hk", q, Kk) / np.sqrt(Dh) # [Hq,S] logits = logits - logits.max(axis=-1, keepdims=True) p = np.exp(logits) p = p / p.sum(axis=-1, keepdims=True) return np.einsum("hk,khd->hd", p, Vv) def block_forward(x, w, cfg=CFG, cache=None, base=0): """对一个前缀做完整因果前向。x:[S,D] -> [S,D]。 cache 不为 None 时,顺手把这一层的 K/V 写进 cache[base:base+S]。""" S, D = x.shape hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x) Q = (h @ w["wq"]).reshape(S, hq, dh) K = (h @ w["wk"]).reshape(S, hkv, dh) V = (h @ w["wv"]).reshape(S, hkv, dh) if cache is not None: cache["k"][base:base + S] = K cache["v"][base:base + S] = V o = attn_full(Q, K, V).reshape(S, D) x = x + o @ w["wo"] x = x + np.maximum(x @ w["w1"], 0.0) @ w["w2"] return x def block_step(x_new, w, cache, pos, cfg=CFG): """decode 一步:只算新 token。x_new:[1,D] -> [1,D],并把它的 K/V 写进 pos。""" D = x_new.shape[1] hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"] h = rmsnorm(x_new) q = (h @ w["wq"]).reshape(hq, dh) k = (h @ w["wk"]).reshape(hkv, dh) v = (h @ w["wv"]).reshape(hkv, dh) cache["k"][pos] = k cache["v"][pos] = v o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh) y = x_new + o @ w["wo"] y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"] return y def new_cache(cfg=CFG, total=None): total = total or (cfg["prompt"] + cfg["gen"]) return [dict(k=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32), v=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32)) for _ in range(cfg["n_layer"])] # ══════════════════════════════════════════════════════════════ # [A] 等价性与加速比 # ══════════════════════════════════════════════════════════════ def gen_naive(blocks, E, head, prompt_tokens, cfg=CFG): """不用缓存:每一步把整个前缀重算一遍,只取最后一个位置的输出。""" X = E[prompt_tokens].copy() toks, last_logits = [], None for _ in range(cfg["gen"]): h = X for w in blocks: h = block_forward(h, w, cfg) logits = h[-1] @ head tok = int(np.argmax(logits)) toks.append(tok) last_logits = logits X = np.vstack([X, E[tok][None, :]]) return toks, last_logits def gen_cached(blocks, E, head, prompt_tokens, cfg=CFG): """用 KV cache:prefill 一次,之后每步只算一个新 token。""" total = cfg["prompt"] + cfg["gen"] caches = new_cache(cfg, total) X = E[prompt_tokens].copy() h = X for i, w in enumerate(blocks): h = block_forward(h, w, cfg, cache=caches[i], base=0) pos = len(prompt_tokens) - 1 h_last = h[-1:] toks, last_logits = [], None for t in range(cfg["gen"]): logits = h_last[0] @ head tok = int(np.argmax(logits)) toks.append(tok) last_logits = logits if t == cfg["gen"] - 1: break # 已得到最后一个预测,不再做一次未使用的 decode x_new = E[tok][None, :] pos += 1 h_new = x_new for i, w in enumerate(blocks): h_new = block_step(h_new, w, caches[i], pos, cfg) h_last = h_new return toks, last_logits, caches def forward_full(blocks, E, head, tokens, cfg=CFG): """一次性对整段 token 做完整前向(参照解)。""" h = E[tokens] for w in blocks: h = block_forward(h, w, cfg) return h[-1] @ head def flops_full(S, cfg=CFG): """一次长度 S 的完整因果前向的 FLOPs(只算矩阵乘,2*macs)。""" D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D per_layer = (2 * (D * D) # wq + 2 * (D * Dk) # wk + 2 * (D * Dk) # wv + 2 * (D * D) # wo + 2 * (D * F) # w1 + 2 * (F * D)) # w2 # 实际代码只对最后一个位置计算输出头,计 2*D*vocab FLOP。 proj = cfg["n_layer"] * S * per_layer + 2 * D * cfg["vocab"] # NumPy 实现先做完整密集矩阵乘再掩码,不能按跳过上三角计数。 attn = cfg["n_layer"] * 4 * cfg["n_q_head"] * cfg["d_head"] * S * S return proj + attn def flops_step(S, cfg=CFG): """decode 一步(上下文长度 S)的 FLOPs。""" D = d_model(cfg) Dk = cfg["n_kv_head"] * cfg["d_head"] F = cfg["ffn_mult"] * D per_layer = (2 * (D * D) + 2 * (D * Dk) + 2 * (D * Dk) + 2 * (D * D) + 2 * (D * F) + 2 * (F * D)) proj = cfg["n_layer"] * per_layer + 2 * D * cfg["vocab"] attn = cfg["n_layer"] * 2 * (2 * cfg["n_q_head"] * cfg["d_head"] * S) return proj + attn def section_A(cfg=CFG): print("=" * 72) print("[A] 增量解码 vs 每步全量重算") print("=" * 72) blocks, E, head = make_weights(cfg) rng = np.random.default_rng(7) prompt_tokens = list(rng.integers(0, cfg["vocab"], cfg["prompt"])) S_end = cfg["prompt"] + cfg["gen"] # ── A1 缓存路线 ── t0 = time.perf_counter() toks_c, logits_c, caches = gen_cached(blocks, E, head, prompt_tokens, cfg) t_cached = time.perf_counter() - t0 # ── A2 无缓存路线 ── t0 = time.perf_counter() toks_n, logits_n = gen_naive(blocks, E, head, prompt_tokens, cfg) t_naive = time.perf_counter() - t0 # ── A3 参照解:一次性完整前向 ── # 对齐位置很容易错:最后一步的 logits 是在「倒数第二个 token」上算出来的 # (它用来预测最后一个 token),所以参照解只能喂到 toks_c[:-1]。 # 多喂一个 token,比的就是下一步的 logits 了。 all_tokens = list(prompt_tokens) + toks_c[:-1] logits_ref = forward_full(blocks, E, head, all_tokens, cfg) same = sum(1 for a, b in zip(toks_c, toks_n) if a == b) dif = float(np.max(np.abs(logits_c - logits_ref))) scale = float(np.max(np.abs(logits_ref))) assert same == cfg["gen"], "token sequences differ" assert dif <= 1e-5 * max(scale, 1.0), "cached/full logits mismatch" print("\n[A1] 两条路线生成的 token 序列") print(f" 序列长度 : {cfg['gen']}") print(f" 完全一致的 token : {same} / {cfg['gen']}") print("\n[A2] 缓存路线最后一步的 logits vs 一次性完整前向(参照解)") print(f" max |Δ| : {dif:.3e}") print(f" 参照解的量级 : {scale:.6f}") print(f" 相对误差 : {dif / scale:.3e}") # ── A4 算力账 ── f_naive = sum(flops_full(cfg["prompt"] + t, cfg) for t in range(cfg["gen"])) f_cached = (flops_full(cfg["prompt"], cfg) + sum(flops_step(cfg["prompt"] + t, cfg) for t in range(1, cfg["gen"]))) print("\n[A3] 算力账(解析计数,单位 FLOP)") print(f" 无缓存总算力 : {f_naive:.4e}") print(f" 有缓存总算力 : {f_cached:.4e}") print(f" 算力节省倍数 : {f_naive / f_cached:.2f}x") print("\n[A4] 真实墙钟(同一台机器,各跑一次)") print(f" 无缓存 : {t_naive:.3f} s") print(f" 有缓存 : {t_cached:.3f} s") print(f" 实测加速比 : {t_naive / t_cached:.2f}x") print(f" (算力省了 {f_naive / f_cached:.1f}x,墙钟只快 {t_naive / t_cached:.1f}x —— " f"差额还含 Python、分配、KV 复制和小矩阵效率,不能仅归因于带宽)") return dict( gen=cfg["gen"], same_tokens=same, max_diff=dif, ref_scale=scale, flops_naive=f_naive, flops_cached=f_cached, flops_ratio=f_naive / f_cached, t_naive=t_naive, t_cached=t_cached, speedup=t_naive / t_cached, seq_end=S_end, ) # ══════════════════════════════════════════════════════════════ # [B] 显存账本 # ══════════════════════════════════════════════════════════════ # Llama-3-8B 的公开配置 LLAMA3_8B = dict(name="Llama-3-8B", n_layer=32, n_q_head=32, n_kv_head=8, d_head=128, params=8.03e9, dtype_bytes=2) def kv_bytes_per_token(cfg, n_kv_head=None): """每个 token 的 KV cache 字节数(所有层)。""" nkv = cfg["n_kv_head"] if n_kv_head is None else n_kv_head return 2 * cfg["n_layer"] * nkv * cfg["d_head"] * cfg["dtype_bytes"] def kv_bytes_total(cfg, S, batch, n_kv_head=None): return kv_bytes_per_token(cfg, n_kv_head) * S * batch def section_B(): print("\n" + "=" * 72) print("[B] KV cache 自己吃掉多少显存") print("=" * 72) c = LLAMA3_8B bpt = kv_bytes_per_token(c) print("\n[B1] 每个 token 的 KV cache(Llama-3-8B,BF16)") print(f" 2 (K,V) x {c['n_layer']} 层 x {c['n_kv_head']} kv头 x {c['d_head']} 维 x 2 字节") print(f" = {bpt} 字节/token = {bpt / 1024:.0f} KiB/token") print(f" 8192 token 一条序列 = {bpt * 8192 / (1024**3):.4f} GiB") w_bytes = c["params"] * c["dtype_bytes"] print(f"\n[B2] 和权重比一比(权重 {w_bytes / (1024**3):.2f} GiB)") print(f" {'batch':>6} {'seq':>6} {'KV cache':>12} {'KV/权重':>9} {'合计':>10}") rows = [] for batch, S in [(1, 8192), (8, 8192), (16, 8192), (32, 8192), (64, 8192), (32, 32768)]: kb = kv_bytes_total(c, S, batch) rows.append(dict(batch=batch, seq=S, kv=kb, total=kb + w_bytes, ratio=kb / w_bytes)) print(f" {batch:>6} {S:>6} {kb / (1024**3):>9.2f} GiB " f"{kb / w_bytes:>8.2f}x {(kb + w_bytes) / (1024**3):>7.2f} GiB") # MHA 对照 bpt_mha = kv_bytes_per_token(c, n_kv_head=c["n_q_head"]) print(f"\n[B3] 如果换成 MHA(32 个 kv 头而不是 8 个)") print(f" {bpt_mha} 字节/token = {bpt_mha / 1024:.0f} KiB/token" f" (GQA 的 {bpt_mha / bpt:.0f} 倍)") print(f" batch=32 / seq=8192 时:" f"{kv_bytes_total(c, 8192, 32, c['n_q_head']) / (1024**3):.2f} GiB" f" vs GQA {kv_bytes_total(c, 8192, 32) / (1024**3):.2f} GiB") # ── 视频 ── print("\n[B4] 自回归视频:token 数先把你压垮") vcfg = dict(c, dtype_bytes=2) cases = [] for name, frames, tf, h, w, fps, sec in [ ("5s 720p", 120, 4, 1280, 720, 24, 5), ("10s 720p", 240, 4, 1280, 720, 24, 10), ("30s 720p", 720, 4, 1280, 720, 24, 30), ]: lat_frames = frames // tf tok_per_frame = (h // 8) * (w // 8) # 空间 8x8 压缩 ntok = lat_frames * tok_per_frame kb = ntok * bpt cases.append(dict(name=name, lat_frames=lat_frames, tok_per_frame=tok_per_frame, ntok=ntok, kv=kb)) print(f" {name:>8}: 潜在帧 {lat_frames:>3} x 每帧 {tok_per_frame:>5} token" f" = {ntok:>8} token -> KV cache {kb / (1024**3):>8.2f} GiB(单条视频)") return dict(bytes_per_token=bpt, bytes_per_token_mha=bpt_mha, weight_bytes=w_bytes, rows=rows, video=cases) # ══════════════════════════════════════════════════════════════ # [C] 算术强度与 Roofline # ══════════════════════════════════════════════════════════════ def probe_peak(n=3072, n_bytes=20_000_000, repeat=5): """本机标定:峰值算力(大矩阵乘)与峰值带宽(大数组流式读写)。 带宽不能用 x.sum() 测:标量归约是延迟受限的,实测只有 23 GB/s, 而同一块内存的流式读写能到 75 GB/s。差 3 倍,用错了整个 Roofline 就歪了。 这里取几种流式算子里最快的一个。 """ rng = np.random.default_rng(0) a = rng.normal(size=(n, n)).astype(np.float32) b = rng.normal(size=(n, n)).astype(np.float32) best = float("inf") for _ in range(repeat): t0 = time.perf_counter() a @ b best = min(best, time.perf_counter() - t0) peak_flops = 2.0 * n ** 3 / best x = rng.normal(size=n_bytes).astype(np.float32) y = np.empty_like(x) best = float("inf") for fn in (lambda: np.copyto(y, x), lambda: np.add(x, 1.0, out=y)): for _ in range(4): t0 = time.perf_counter() fn() best = min(best, time.perf_counter() - t0) peak_bw = (2 * x.nbytes) / best # 读一份 + 写一份 return peak_flops, peak_bw def intensity_decode(g, dtype_bytes=2): """decode 一步「注意力部分」的算术强度 I = 2g/p,与上下文长度无关。""" return 2.0 * g / dtype_bytes def section_C(): print("\n" + "=" * 72) print("[C] 算术强度:为什么上下文再长,decode 也改善不了") print("=" * 72) print("\n[C1] decode 一步的注意力部分(上下文长度 S,GQA 分组数 g,dtype 字节 p)") print(" 算力 = 4 * n_q * d * S (QK^T 与 AV 各 2*n_q*d*S)") print(" 访存 = 2 * n_kv * d * S * p (K、V 各一份)") print(" I = 4 n_q d S / (2 n_kv d S p) = 2 (n_q/n_kv) / p = 2g/p") print(" —— 理想融合注意力中 S 被约去;不代表实际 kernel 效率随 S 不变。") print() print(f" {'g (n_q/n_kv)':>12} {'I = 2g/p (BF16)':>16}") rows_g = [] for g in [1, 2, 4, 8, 16, 32]: I = intensity_decode(g, 2) rows_g.append(dict(g=g, I=I)) print(f" {g:>12} {I:>16.1f}") # ── prefill 对照 ── c = LLAMA3_8B D = c["n_q_head"] * c["d_head"] print("\n[C2] prefill 的算术强度(Llama-3-8B,S=8192)") S = 8192 attn_flops = c["n_layer"] * 2 * (2 * c["n_q_head"] * c["d_head"] * S * (S + 1) / 2) proj_flops = 2 * c["params"] * S # 粗略 2NS 估计,不是逐层实测 FLOPs w_bytes = c["params"] * c["dtype_bytes"] act_bytes = c["n_layer"] * 10 * S * D * c["dtype_bytes"] I_pre = (attn_flops + proj_flops) / (w_bytes + act_bytes) print(f" 注意力算力 : {attn_flops / 1e12:.2f} TFLOP") print(f" 投影层算力 : {proj_flops / 1e12:.2f} TFLOP <-- dominates") print(f" 访存(权重+激活): {(w_bytes + act_bytes) / (1024**3):.2f} GiB") print(f" I_prefill : {I_pre:.1f} FLOP/byte") # ── Roofline ── peak_flops, peak_bw = probe_peak() ridge = peak_flops / peak_bw print("\n[C3] 本机标定(numpy / CPU,实跑)") print(f" 峰值算力 : {peak_flops / 1e9:.2f} GFLOP/s") print(f" 峰值带宽 : {peak_bw / 1e9:.2f} GB/s") print(f" 山脊点 : {ridge:.2f} FLOP/byte") # A100-80GB 公开规格 a100 = dict(flops=312e12, bw=2.039e12) print(f"\n A100-80GB(公开规格,非实测):{a100['flops'] / 1e12:.0f} TFLOP/s BF16 / " f"{a100['bw'] / 1e12:.2f} TB/s -> 山脊点 {a100['flops'] / a100['bw']:.1f} FLOP/byte") print("\n[C4] 理想注意力 Roofline:CPU 按 FP32 (I 为 BF16 的一半),A100 按 BF16") print(f" {'工作负载':>18} {'I':>10} {'本机判定':>10} {'A100 判定':>10}") pts = [] for g in [1, 4, 8]: I = intensity_decode(g, 2) pts.append(dict(name=f"decode g={g}", I=I, I_local=I / 2, local="带宽" if I / 2 < ridge else "算力", a100="带宽" if I < a100["flops"] / a100["bw"] else "算力")) print(f" {f'decode g={g}':>18} {I:>10.1f} {pts[-1]['local']:>10} {pts[-1]['a100']:>10}") pts.append(dict(name="prefill S=8192", I=I_pre, I_local=I_pre / 2, local="带宽" if I_pre / 2 < ridge else "算力", a100="带宽" if I_pre < a100["flops"] / a100["bw"] else "算力")) print(f" {'prefill S=8192':>18} {I_pre:>10.1f} {pts[-1]['local']:>10} {pts[-1]['a100']:>10}") return dict(rows_g=rows_g, I_prefill=I_pre, I_prefill_local=I_pre / 2, peak_flops=peak_flops, peak_bw=peak_bw, ridge=ridge, a100_flops=a100["flops"], a100_bw=a100["bw"], a100_ridge=a100["flops"] / a100["bw"], points=pts) def main(): ap = argparse.ArgumentParser() ap.add_argument("which", nargs="?", default="ALL") args = ap.parse_args() w = args.which.upper() out = {} if w in ("ALL", "A"): out["A"] = section_A() if w in ("ALL", "B"): out["B"] = section_B() if w in ("ALL", "C"): out["C"] = section_C() if w == "ALL": with open(os.path.join(HERE, "_kv_results.json"), "w", encoding="utf-8") as f: json.dump(out, f, ensure_ascii=False, indent=1) print("\n结果已写入 _kv_results.json(画图脚本读它,避免图上的数字和正文漂移)") if __name__ == "__main__": main() paged_alloc.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """PagedAttention 的分页分配,到底省在哪。 KV cache 有一个和别的张量都不一样的地方:**它是在请求进行中一点点长出来的**。 你事先不知道这条请求最终会有多长,所以要么按最大长度预留(浪费), 要么让它能非连续地增长(分页)。这个脚本把两种做法放在同一个显存预算下对比。 [A] 同一个显存预算,两种分配策略各能同时服务多少条请求 [B] 浪费来自哪里:预留浪费 vs 块内碎片 [C] 块大小怎么选:越小越省,但不是越小越好 python paged_alloc.py ALL """ from __future__ import annotations import argparse import json import math import os import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) # Llama-3-8B / BF16 在假设 80 GiB 总预算下的账(不是设备可用显存实测)(与 kv_cache_lab.py [B] 同源) N_LAYER, N_KV, D_HEAD, DTYPE = 32, 8, 128, 2 BYTES_PER_TOKEN = 2 * N_LAYER * N_KV * D_HEAD * DTYPE # 131072 = 128 KiB GPU_BYTES = 80 * (1024 ** 3) WEIGHT_BYTES = 8.03e9 * DTYPE OTHER_BYTES = 4 * (1024 ** 3) # 激活 / 框架 / 碎片余量 MAX_LEN = 4096 def budget_tokens(): return int((GPU_BYTES - WEIGHT_BYTES - OTHER_BYTES) // BYTES_PER_TOKEN) def workload(kind, n=4000, seed=11): """两种典型负载:长度均匀的(批处理)和重尾的(线上对话)。""" rng = np.random.default_rng(seed) if kind == "uniform": lens = rng.integers(512, MAX_LEN + 1, n) else: # heavy:八成短请求、两成长请求 short = rng.integers(256, 1025, int(n * 0.8)) long_ = rng.integers(3072, MAX_LEN + 1, n - int(n * 0.8)) lens = np.concatenate([short, long_]) rng.shuffle(lens) return lens def admit(lens, bytes_each, budget): """贪心接纳:按请求顺序一直加,直到预算装不下。返回接纳条数。""" used, k = 0, 0 for b in bytes_each: if used + b > budget: break used += b k += 1 return k, used def section_A(): print("=" * 72) print("[A] 同一块显存,两种分配策略能同时服务多少条请求") print("=" * 72) cap = budget_tokens() budget = cap * BYTES_PER_TOKEN print(f"\n显存预算:80 GiB - 权重 {WEIGHT_BYTES / (1024**3):.2f} GiB" f" - 其他 {OTHER_BYTES / (1024**3):.0f} GiB = {budget / (1024**3):.2f} GiB") print(f"折合 token 容量 : {cap} tokens({BYTES_PER_TOKEN} B/token)") out = {} for kind, label in [("uniform", "长度均匀 512~4096"), ("heavy", "重尾:八成 256~1024")]: print(f"\n--- 负载:{label} ---") lens = workload(kind) b_cont = np.full(len(lens), MAX_LEN * BYTES_PER_TOKEN) # 按最大长度预留 b_paged = (np.ceil(lens / 16) * 16) * BYTES_PER_TOKEN # 分页,块 16 k_c, u_c = admit(lens, b_cont, budget) k_p, u_p = admit(lens, b_paged, budget) used_tok_c = lens[:k_c].sum() used_tok_p = lens[:k_p].sum() util_c = used_tok_c * BYTES_PER_TOKEN / u_c util_p = used_tok_p * BYTES_PER_TOKEN / u_p print(f" {'策略':>12} {'并发请求':>9} {'占用':>10} {'真实用到':>10} {'利用率':>8}") print(f" {'连续预留':>12} {k_c:>9} {u_c / (1024**3):>7.2f} GiB " f"{used_tok_c * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_c:>7.2%}") print(f" {'分页(块16)':>12} {k_p:>9} {u_p / (1024**3):>7.2f} GiB " f"{used_tok_p * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_p:>7.2%}") print(f" 并发提升 : {k_p / k_c:.2f}x") out[kind] = dict(k_cont=int(k_c), k_paged=int(k_p), util_cont=float(util_c), util_paged=float(util_p), gain=float(k_p / k_c), bytes_cont=float(u_c), bytes_paged=float(u_p), real_cont=float(used_tok_c * BYTES_PER_TOKEN), real_paged=float(used_tok_p * BYTES_PER_TOKEN)) out["cap_tokens"] = cap out["budget_bytes"] = float(budget) return out def section_B(): print("\n" + "=" * 72) print("[B] 浪费的两半:预留浪费 和 块内碎片") print("=" * 72) lens = workload("uniform") bs = 16 reserve_waste = (MAX_LEN - lens).mean() * BYTES_PER_TOKEN frag = ((np.ceil(lens / bs) * bs) - lens).mean() * BYTES_PER_TOKEN print(f"\n每条请求的平均长度 : {lens.mean():.1f} tokens") print(f"连续预留的浪费/条 : {reserve_waste / (1024**2):.2f} MiB" f"(预留 {MAX_LEN},平均只用 {lens.mean():.0f})") print(f"分页的块内碎片/条 : {frag / (1024**2):.2f} MiB" f"(只有最后一个块没填满,余数均匀时约 {(bs - 1) / 2} 个空槽)") print(f"两者之比 : {reserve_waste / frag:.1f}x") print("\n分页把「不知道会多长」这个不确定性,从「按最坏情况预留」" "换成了「最多浪费一个块」——这是整个设计的关键一跳。") return dict(reserve_waste=float(reserve_waste), frag=float(frag), ratio=float(reserve_waste / frag), mean_len=float(lens.mean())) def section_C(): print("\n" + "=" * 72) print("[C] 块大小怎么选") print("=" * 72) lens = workload("uniform") mean_len = lens.mean() print(f"\n平均请求长度 {mean_len:.1f} tokens。块越大,最后一块的空槽越多;" f"块越小,块表越长、kernel 里要 Gather 的次数越多。") print(f"\n {'块大小':>6} {'碎片/条':>10} {'理论利用率':>10} {'块表条目/请求':>14}") rows = [] for bs in [1, 4, 8, 16, 32, 64, 128, 256]: frag = ((np.ceil(lens / bs) * bs) - lens).mean() util = mean_len / (mean_len + frag) nblk = float(np.ceil(lens / bs).mean()) rows.append(dict(bs=bs, frag=float(frag), util=float(util), nblk=nblk)) print(f" {bs:>6} {frag:>8.1f} tk {util:>9.3%} {nblk:>14.1f}") print("\n长度模 bs 的余数均匀时,块内空槽期望为 (bs-1)/2;" "真实碎片取决于长度分布。16 或 32 是常见候选,需实测:" "本例平均长度约 2310,16/32 块约有 0.32%/0.67% 空槽;元数据和 kernel 开销另计。") return dict(rows=rows, mean_len=float(mean_len)) def main(): ap = argparse.ArgumentParser() ap.add_argument("which", nargs="?", default="ALL") w = ap.parse_args().which.upper() out = {} if w in ("ALL", "A"): out["A"] = section_A() if w in ("ALL", "B"): out["B"] = section_B() if w in ("ALL", "C"): out["C"] = section_C() if w == "ALL": # 画图用的示意数据:3 条请求怎么被切成块 lens = [37, 21, 45] bs = 16 seqs = [] for i, L in enumerate(lens): seqs.append(dict(idx=i, length=L, n_blocks=int(math.ceil(L / bs)), last_used=L % bs or bs)) out["demo"] = dict(block_size=bs, seqs=seqs) with open(os.path.join(HERE, "_paged_results.json"), "w", encoding="utf-8") as f: json.dump(out, f, ensure_ascii=False, indent=1) print("\n结果已写入 _paged_results.json") if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """ make_figures.py —— 画本文的 4 张配图。 数据全部来自已经跑完的实验(_kv_results.json / _paged_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import matplotlib.patches as mpatches import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") try: os.makedirs(FIGDIR, exist_ok=True) except FileExistsError: pass # 配色(正文里写「这张图要看什么」时按这六个名字来描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 C_RED = "#b71c1c" # 红:越界线 plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): raise SystemExit(f"缺少 {name},先跑 kv_cache_lab.py ALL / paged_alloc.py ALL") with open(p, encoding="utf-8") as f: return json.load(f) GIB = float(1024 ** 3) # ══════════════════════════════════════════════════════════════ # 图 1:显存账本 # ══════════════════════════════════════════════════════════════ def fig_mem_ledger(res): B = res["B"] w = B["weight_bytes"] bpt, bpt_mha = B["bytes_per_token"], B["bytes_per_token_mha"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9)) # ── 左:batch 扫描下的显存构成 ── batches = [1, 8, 16, 32, 64, 128] seq = 8192 kv = [bpt * seq * b for b in batches] others = 4 * GIB xs = np.arange(len(batches)) ax1.bar(xs, [w / GIB] * len(batches), color=C_MAIN, label="模型权重(14.96 GiB)") ax1.bar(xs, [k / GIB for k in kv], bottom=[w / GIB] * len(batches), color=C_ALT, label="KV cache") ax1.bar(xs, [others / GIB] * len(batches), bottom=[(w + k) / GIB for k in kv], color=C_LIGHT, label="激活 / 框架 / 余量") ax1.axhline(80, color=C_RED, ls="--", lw=1.6) ax1.text(0.05, 81.4, "假设总预算 80 GiB", color=C_RED, fontsize=9) ax1.set_xticks(xs) ax1.set_xticklabels([str(b) for b in batches]) ax1.set_xlabel("batch size") ax1.set_ylabel("显存(GiB)") ax1.set_title("显存账本:batch 一大,权重就不再是主角", fontsize=11) ax1.legend(fontsize=8, loc="upper left") ax1.set_ylim(0, 200) # ── 右:序列长度扫描,GQA vs MHA ── seqs = np.array([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536, 131072]) for b in (1, 8): ax2.plot(seqs, bpt * seqs * b / GIB, "-o", ms=3.5, color=C_MAIN if b == 1 else C_ALT, label=f"GQA batch={b}") ax2.plot(seqs, bpt_mha * seqs * 8 / GIB, "--s", ms=3.5, color=C_PURPLE, label="MHA batch=8(kv 头 32 个)") ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4) ax2.text(seqs[0], 66, "KV 预算约 61 GiB", color=C_GRAY, fontsize=8.5) ax2.axhline(80, color=C_RED, ls="--", lw=1.4) ax2.text(seqs[0] * 1.6, 88, "80 GiB 显存上限", color=C_RED, fontsize=8.5) ax2.set_xscale("log", base=2) ax2.set_yscale("log") ax2.set_xlabel("每条序列的长度(token)") ax2.set_ylabel("KV cache(GiB,对数刻度)") ax2.set_title("KV cache 随长度线性增长,随 batch 线性增长", fontsize=11) ax2.legend(fontsize=8) ax2.grid(alpha=0.25, which="both") fig.tight_layout() p = os.path.join(FIGDIR, "fig_mem_ledger.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 2:Roofline # ══════════════════════════════════════════════════════════════ def fig_roofline(res): C = res["C"] pf, pb = C["peak_flops"], C["peak_bw"] ridge = pf / pb af, ab = C["a100_flops"], C["a100_bw"] aridge = af / ab pts = [(1, "decode g=1(MHA)", C_RED), (4, "decode g=4(GQA)", C_GREEN), (8, "decode g=8", C_PURPLE), (C["I_prefill"], "prefill S=8192", C_MAIN)] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 5.2)) I = np.logspace(-1, 5, 400) # ── 左:本机(实跑标定,GFLOP/s)── ax1.plot(I, np.minimum(pf, I * pb) / 1e9, color=C_MAIN, lw=2.0) ax1.fill_betweenx([1e-2, pf / 1e9 * 2], 1e-1, ridge, color=C_LIGHT, alpha=0.3) ax1.axvline(ridge, color=C_MAIN, ls=":", lw=1.2) ax1.text(ridge * 1.12, 3.0, f"山脊点 {ridge:.0f}", color=C_MAIN, fontsize=8.5, rotation=90, va="bottom") for i, name, col in pts: i = i / 2 # 本机峰值来自 FP32,字节数是 BF16 的两倍 y = min(pf, i * pb) / 1e9 ax1.plot([i], [y], "o", ms=8, color=col, zorder=5) off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3) ax1.annotate(name, (i, y), textcoords="offset points", xytext=off, fontsize=8.5, color=col) ax1.text(0.13, pf / 1e9 * 1.35, "带宽受限区", color=C_MAIN, fontsize=9) ax1.set_xscale("log") ax1.set_yscale("log") ax1.set_xlim(0.1, 1e4) ax1.set_ylim(1.0, pf / 1e9 * 2.2) ax1.set_xlabel("算术强度 I(FLOP / byte)") ax1.set_ylabel("理论上界(GFLOP/s)") ax1.set_title(f"本机 FP32 微基准屋顶:{pf / 1e9:.0f} GFLOP/s / {pb / 1e9:.0f} GB/s", fontsize=10.5) ax1.grid(alpha=0.25, which="both") # ── 右:A100(公开规格,TFLOP/s)── ax2.plot(I, np.minimum(af, I * ab) / 1e12, color=C_ALT, lw=2.0) ax2.fill_betweenx([1e-2, af / 1e12 * 2], 1e-1, aridge, color="#f6d9c9", alpha=0.45) ax2.axvline(aridge, color=C_ALT, ls=":", lw=1.2) ax2.text(aridge * 1.12, 0.9, f"山脊点 {aridge:.0f}", color=C_ALT, fontsize=8.5, rotation=90, va="bottom") for i, name, col in pts: y = min(af, i * ab) / 1e12 ax2.plot([i], [y], "o", ms=8, color=col, zorder=5) off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3) ax2.annotate(name, (i, y), textcoords="offset points", xytext=off, fontsize=8.5, color=col) ax2.text(0.13, af / 1e12 * 1.35, "带宽受限区", color=C_ALT, fontsize=9) ax2.set_xscale("log") ax2.set_yscale("log") ax2.set_xlim(0.1, 1e5) ax2.set_ylim(0.3, af / 1e12 * 2.2) ax2.set_xlabel("算术强度 I(FLOP / byte)") ax2.set_ylabel("理论上界(TFLOP/s)") ax2.set_title(f"A100-80GB(公开规格):{af / 1e12:.0f} TFLOP/s / {ab / 1e12:.2f} TB/s", fontsize=10.5) ax2.grid(alpha=0.25, which="both") fig.suptitle("理想融合注意力的 Roofline 上界(点不是实测 kernel 性能)", fontsize=12, y=1.02) fig.tight_layout() p = os.path.join(FIGDIR, "fig_roofline.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 3:PagedAttention 的分页布局 + 并发对比 # ══════════════════════════════════════════════════════════════ def fig_paged(res): demo = res.get("demo", {}) bs = demo.get("block_size", 16) lens = [s["length"] for s in demo.get("seqs", [])] or [37, 21, 45, 29] colors = [C_MAIN, C_ALT, C_GREEN, C_PURPLE, C_GRAY] n_seq = len(lens) # 模拟「边生成边分配」:每条请求轮流出 1 个 token,块不够了才申请新的 pos = [0] * n_seq blocks = [[] for _ in range(n_seq)] # 逻辑块 -> 物理块号 phys_owner, phys_fill, phys_cap = [], [], [] while any(pos[i] < lens[i] for i in range(n_seq)): for i in range(n_seq): if pos[i] >= lens[i]: continue if pos[i] % bs == 0: # 需要一个新的物理块 phys_owner.append(i) phys_fill.append(0) phys_cap.append(bs) blocks[i].append(len(phys_owner) - 1) phys_fill[blocks[i][-1]] += 1 pos[i] += 1 n_phys = len(phys_owner) + 3 # 末尾留 3 个空块 fig = plt.figure(figsize=(12.6, 5.0)) gs = fig.add_gridspec(1, 2, width_ratios=[1.25, 1.0]) # ── 左:逻辑视图 -> 物理块池 ── axL = fig.add_subplot(gs[0, 0]) axL.set_xlim(-0.6, n_phys + 0.6) axL.set_ylim(-0.5, n_seq + 2.6) axL.axis("off") axL.set_title("逻辑块 → 物理块:请求可以非连续地长", fontsize=11, loc="left") bw_l, bh = 0.82, 0.62 # 逻辑视图:每条请求一行,块连续排列 for i in range(n_seq): y = n_seq - i + 1.35 axL.text(-0.5, y + bh / 2, f"请求 {i + 1}", fontsize=8.5, ha="right", va="center") for j, p in enumerate(blocks[i]): x = j * (bw_l + 0.06) axL.add_patch(mpatches.Rectangle( (x, y), bw_l, bh, facecolor=colors[i], alpha=0.30, edgecolor=colors[i], lw=1.2)) used = phys_fill[p] axL.add_patch(mpatches.Rectangle( (x, y), bw_l * used / bs, bh, facecolor=colors[i], alpha=0.85)) if used < bs: axL.text(x + bw_l * used / bs / 2, y + bh / 2, f"{used}/{bs}", fontsize=6.4, ha="center", va="center", color="white") # 物理块池:一行,按申请顺序排列 y_p = 0.15 axL.text(-0.5, y_p + bh / 2, "物理块池", fontsize=8.5, ha="right", va="center") for p in range(n_phys): x = p * (bw_l + 0.06) if p < len(phys_owner): c = colors[phys_owner[p]] axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l, bh, facecolor=c, alpha=0.30, edgecolor=c, lw=1.2)) axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l * phys_fill[p] / bs, bh, facecolor=c, alpha=0.85)) axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4, ha="center", color=C_GRAY) else: axL.add_patch(mpatches.Rectangle( (x, y_p), bw_l, bh, facecolor="white", edgecolor=C_GRAY, lw=1.0, hatch="//")) axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4, ha="center", color=C_GRAY) axL.text(n_phys * (bw_l + 0.06) + 0.1, y_p + bh / 2, "空闲", fontsize=8, va="center", color=C_GRAY) # 几条连线:从逻辑块指到它真正的物理块 for i in range(n_seq): for j, p in enumerate(blocks[i]): x0 = j * (bw_l + 0.06) + bw_l / 2 y0 = n_seq - i + 1.35 x1 = p * (bw_l + 0.06) + bw_l / 2 axL.annotate("", xy=(x1, y_p + bh), xytext=(x0, y0), arrowprops=dict(arrowstyle="-", color=C_GRAY, lw=0.7, alpha=0.55)) axL.text(0, n_seq + 2.2, f"块大小 {bs}:只有每条请求的最后一块没填满(灰底数字是「已用/容量」)", fontsize=8.5, color=C_GRAY) # ── 右:并发对比 ── axR = fig.add_subplot(gs[0, 1]) A = res["A"] labels = ["长度均匀\n512~4096", "重尾\n八成短请求"] kc = [A["uniform"]["k_cont"], A["heavy"]["k_cont"]] kp = [A["uniform"]["k_paged"], A["heavy"]["k_paged"]] uc = [A["uniform"]["util_cont"], A["heavy"]["util_cont"]] up = [A["uniform"]["util_paged"], A["heavy"]["util_paged"]] xs = np.arange(2) wbar = 0.36 b1 = axR.bar(xs - wbar / 2, kc, wbar, color=C_GRAY, label="连续预分配(按 4096 预留)") b2 = axR.bar(xs + wbar / 2, kp, wbar, color=C_MAIN, label="分页(块 16)") for i, (a, b) in enumerate(zip(kc, kp)): axR.text(i - wbar / 2, a + 6, f"{a}\n利用率 {uc[i]:.1%}", ha="center", fontsize=8) axR.text(i + wbar / 2, b + 6, f"{b}\n利用率 {up[i]:.1%}", ha="center", fontsize=8, color=C_MAIN) axR.text(i, max(a, b) + 58, f"{b / a:.2f}x", ha="center", fontsize=10, color=C_RED, fontweight="bold") axR.set_xticks(xs) axR.set_xticklabels(labels, fontsize=9) axR.set_ylabel("同一 61 GiB 预算下的并发请求数") axR.set_title("分页减少预留浪费,提高静态可容纳请求数", fontsize=11) axR.legend(fontsize=8) axR.set_ylim(0, max(kp) * 1.42) axR.grid(alpha=0.2, axis="y") fig.tight_layout() p = os.path.join(FIGDIR, "fig_paged.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) # ══════════════════════════════════════════════════════════════ # 图 4:自回归视频的掩码结构 + 缓存规模 # ══════════════════════════════════════════════════════════════ def fig_video(res): B = res["B"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9)) # ── 左:块内双向 + 块间因果的掩码 ── n_frame, tok_per_frame = 5, 12 n = n_frame * tok_per_frame M = np.zeros((n, n)) for a in range(n_frame): for b in range(n_frame): if b <= a: # 只能看当前帧和之前的帧 M[a * tok_per_frame:(a + 1) * tok_per_frame, b * tok_per_frame:(b + 1) * tok_per_frame] = 1.0 ax1.imshow(M, cmap="Blues", vmin=0, vmax=1.4, interpolation="nearest") for f in range(n_frame + 1): ax1.axhline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0) ax1.axvline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0) ax1.set_xlabel("key / value 位置(时间从前到后)") ax1.set_ylabel("query 位置") ax1.set_title("块内双向、块间因果", fontsize=11) ax1.set_xticks([f * tok_per_frame + tok_per_frame / 2 for f in range(n_frame)]) ax1.set_xticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8) ax1.set_yticks([f * tok_per_frame + tok_per_frame / 2 for f in range(n_frame)]) ax1.set_yticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8) ax1.text(1, n - 3, "对角块 = 块内双向示例\n(扩散当前块仍须重算)", fontsize=8.5, color=C_ALT, bbox=dict(fc="white", ec=C_ALT, alpha=0.85)) ax1.text(n * 0.34, n * 0.12, "下三角块 = 能看到过去帧\n(仅固定且兼容的历史可缓存)", fontsize=8.5, color=C_MAIN, bbox=dict(fc="white", ec=C_MAIN, alpha=0.85)) # ── 右:单条视频的 KV cache 规模 ── cases = B["video"] names = [c["name"] for c in cases] vals = [c["kv"] / GIB for c in cases] toks = [c["ntok"] for c in cases] bars = ax2.bar(names, vals, color=[C_GREEN, C_ALT, C_RED], width=0.55) ax2.axhline(80, color=C_RED, ls="--", lw=1.6) ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4) ax2.text(2.52, 83, "假设总预算 80 GiB", color=C_RED, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9)) ax2.text(2.52, 64, "扣除权重与余量后 KV 约 61 GiB", color=C_GRAY, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9)) for b, v, t in zip(bars, vals, toks): ax2.text(b.get_x() + b.get_width() / 2, v + 10, f"{v:.1f} GiB\n{t // 1000}k tokens", ha="center", fontsize=8.5) ax2.set_ylabel("单条视频的 KV cache(GiB)") ax2.set_title("720p 假设账本:无额外 patch 化,缓存全部历史", fontsize=11) ax2.set_ylim(0, max(vals) * 1.30) ax2.grid(alpha=0.2, axis="y") fig.tight_layout() p = os.path.join(FIGDIR, "fig_video_mask.png") fig.savefig(p, bbox_inches="tight") plt.close(fig) print(" ", os.path.basename(p)) def main(): kv = _load("_kv_results.json") pg = _load("_paged_results.json") print("画图:") fig_mem_ledger(kv) fig_roofline(kv) fig_paged(pg) fig_video(kv) if __name__ == "__main__": main()
-
AIGC 基本功|FID / CLIP Score 到底测了什么-FID FID / CLIP Score 到底测了什么 所属方向:评测 | 难度:进阶 | 前置知识:无(本篇自洽,只需要你见过「协方差矩阵」和「余弦相似度」这两个词) 关键词:FID、Inception Score、CLIP Score、2-Wasserstein 距离、样本量偏差、指标失效 01. 为什么需要它 先给一个我自己跑出来的数字,它比任何论述都更能说明问题。 我从同一个分布里抽两组样本:真实组和生成组来自同一个人工构造的 2048 维多元高斯:协方差特征值按 $1/k$ 衰减,迹归一化为 2048。总体的高斯距离为 0,但两组有限样本的估计值不必为 0。每组 10000 个样本时,实测 FID = 71.20;每组加到 50000 个样本,实测 FID = 14.21。两组的总体分布相同,但具体抽样不同。这里改变样本量并重复抽样取平均;不是对真实 Inception 图像特征的测量。 这不是实现写错了,而是 FID 的固有性质:它是一个自带正偏差的估计量。偏差来自哪里?Inception-v3 的 pool3 特征是 2048 维,一个 2048×2048 的协方差矩阵有 $2048 \times 2049 / 2 \approx 2.10 \times 10^{6}$ 个自由参数,全靠有限样本去填。有限样本让均值与协方差发生波动,经非线性距离公式后产生估计偏差。同分布基线的期望非负,但不能把自由参数数量直接当作最低样本量。我做过分解(附录 fid_bias_lab.py 的 [A2] 段):在 $d=512$、$n=40000$ 时,把均值换成真值只能消掉 1.4% 的偏差,把协方差换成真值能消掉 98.6%——在这组谱和尺度下,偏差主要来自协方差估计。 这些数字展示了样本量可以显著改变同分布基线,但不能把 71 或 57 分推广为所有真实模型的偏差。特征整体乘 $c$,距离就乘 $c^2$;谱结构、参考集是否固定、两个分布的差异也会影响偏差。因此跨论文比较前必须核对特征器、数据集和样本量等协议。Chong 与 Forsyth 的研究 还说明偏差依赖生成器,同样的样本量并不能自动消除排序偏差。 第二个坑在另一头。FID 只比较分布,不比较单张图。例如,若只是把同一组图像与 prompt 重新错配,图像集合不变,FID 就完全不变;但把所有橘猫换成黑猫可能改变图像分布,不能保证 FID 不变。因此文生图评测常配合 CLIP 相似度或其他条件一致性指标——它不需要真实图片做参考(reference-free),能逐样本给分。但 CLIP Score 有自己的洞:它先给每个图文对打分,常见的数据集均值会丢失分布信息,好样本和坏样本可以互相平均掉。在合成共享空间里,可以构造汇总分数近似相同、逐样本分布却不同的两组输出。第 6.3 节列出四组例子;标准差比最大约 17.55 倍对应 $p=0.9$,并非 $p=0.3$ 那一行。分数一样,产品体验完全不同。 所以这篇要讲清楚的是三件事:FID 的闭式解是怎么推出来的、它的偏差有多大且怎么补救、以及 FID 和 CLIP Score 各自测的是哪一半。 02. 最小可用理解 三句话: 机制:把真实图和生成图都过一遍 Inception-v3,取 pool3 层的 2048 维特征;对两组特征各拟合一个多元高斯 $\mathcal{N}(\mu_{\text{real}}, \Sigma_{\text{real}})$ 和 $\mathcal{N}(\mu_{\text{gen}}, \Sigma_{\text{gen}})$;然后算这两个高斯之间的 Fréchet 距离(也就是 2-Wasserstein 距离的平方)。全部闭式,几行代码。 成本:只需要一阶矩和二阶矩,不需要知道分布的形状,也不需要先训一个判别器。代价是它只看得见前两阶矩,有限样本协方差可以计算,但估计误差会进入 FID;大样本区间常用 $1/n$ 展开描述偏差,系数依赖具体分布。 效果与代价:FID 对改变前两阶矩的分布变化敏感,也可能漏掉矩匹配的模式变化;CLIPScore 提供逐图文对相似度,但不等于综合质量。本文合成例子说明两个目标可能冲突,不能据此断言真实 FID 与 CLIPScore 永远相反。 03. 数学推导 3.1 为什么不能逐图打分 生成模型的评测有一个结构性困难:无条件生成或自由文生图评测通常没有逐图配对的真值。你拿不到「这张生成图对应的真值图」,因此 MSE、PSNR、SSIM 等有参考指标不能直接用于这种非配对比较——它们要求两张图逐像素对齐。 一个自然的替代是「只给生成图打分」,这就是 Inception Score(IS)的思路:把生成图送进 Inception-v3,看分类分布 $p(y \mid x)$ 是不是既尖锐又有多样性。但它有一个致命缺陷:它根本不看真实图片。记忆训练集也可能得到高 IS,因为 IS 不检查是否抄袭,也不比较目标数据分布。高 IS 还要求预测类别清晰且类别边缘分布有多样性,并非真实图片自动「满分」。FID 同样不直接检验记忆训练集。 FID 的出发点就是要补上这一半:把真实分布也纳入比较,比较两个分布之间的距离,而不是给单张图打分。 3.2 为什么是高斯 图像在 Inception 特征空间(2048 维)里的分布形状未知,而且在这个维度上你没法可靠地估计它的形状。FID 选择用一阶矩和二阶矩近似描述,估计质量仍依赖样本量。 那么问题变成:在只知道均值和协方差的条件下,应该假设什么分布?答案是高斯——它是给定前两阶矩时熵最大的分布,也就是「在已知信息下最不作额外假设」的那个选择。这个选择的物理含义是:FID 只承诺比较前两阶矩,不承诺比较形状。后面 3.5 节会看到,这个妥协是有代价的。 3.3 Fréchet 距离的闭式解 设 $X \sim \mathcal{N}(\mu_1, \Sigma_1)$、$Y \sim \mathcal{N}(\mu_2, \Sigma_2)$。2-Wasserstein 距离的平方定义为所有耦合(joint distribution)中传输代价的最小值: $$W_2^2 = \min_{\text{coupling}} \mathbb{E} \big[ \| X - Y \|^2 \big]$$ 先看任意一个耦合的代价是多少。设交叉协方差 $C = \mathrm{Cov}(X, Y)$,把 $\|X - Y\|^2$ 展开成三项并分别取期望:第一项 $\mathbb{E}\|X\|^2 = \|\mu_1\|^2 + \mathrm{Tr}(\Sigma_1)$(因为 $\mathrm{Tr}(\Sigma_1)$ 就是 $X$ 各维方差之和);第二项同理;第三项交叉项 $\mathbb{E}[X^\top Y] = \mu_1^\top \mu_2 + \mathrm{Tr}(C)$。三项合并,$\|\mu_1\|^2 + \|\mu_2\|^2 - 2\mu_1^\top\mu_2$ 正好凑成 $\|\mu_1 - \mu_2\|^2$,于是 $$\mathbb{E} \big[ \| X - Y \|^2 \big] = \| \mu_1 - \mu_2 \|^2 + \mathrm{Tr}(\Sigma_1) + \mathrm{Tr}(\Sigma_2) - 2\,\mathrm{Tr}(C)$$ 前三项由边缘分布决定,动不了。所以要让传输代价最小,等价于让 $\mathrm{Tr}(C)$ 最大。约束是联合协方差矩阵必须半正定: $$\begin{pmatrix} \Sigma_1 & C \\ C^\top & \Sigma_2 \end{pmatrix} \succeq 0$$ 这个半正定约束下的迹最大化有闭式解(协方差补全问题的标准结果)。$\Sigma_1$ 可逆时最优解为 $$C^\star = \Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Sigma_1^{-1/2}$$ 代回去,利用迹的循环性质把外面的 $\Sigma_1^{1/2}$ 和 $\Sigma_1^{-1/2}$ 抵消掉,得到 $$\mathrm{Tr}(C^\star) = \mathrm{Tr} \Big( \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)^{1/2} \Big) = \mathrm{Tr} \Big( \big( \Sigma_1 \Sigma_2 \big)^{1/2} \Big)$$ 最后一个等号值得停一下,因为它是实现环节最容易写错的地方。$\Sigma_1 \Sigma_2$ 两个对称矩阵的乘积一般不是对称矩阵,不能直接交给对称特征值求解器。当 $\Sigma_1$ 正定时,$\Sigma_1 \Sigma_2$ 与 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 相似: $$\Sigma_1^{1/2} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big) \Sigma_1^{-1/2} = \Sigma_1 \Sigma_2$$ 而后者 $\Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2}$ 是对称半正定的(对任意 $v$ 有 $v^\top \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} v = (\Sigma_1^{1/2} v)^\top \Sigma_2 (\Sigma_1^{1/2} v) \ge 0$)。相似矩阵特征值相同,而主平方根与相似变换可交换,所以两者的平方根迹相等: $$\mathrm{Tr} \big( (\Sigma_1 \Sigma_2)^{1/2} \big) = \sum_i \sqrt{\lambda_i}, \quad \lambda_i = \text{eig} \big( \Sigma_1^{1/2} \Sigma_2 \Sigma_1^{1/2} \big)$$ 奇异协方差可由连续性取极限,实际计算仍使用半正定夹心矩阵而无需显式求逆。 把所有项拼起来,就是 FID 的完整定义: $$\mathrm{FID} = \| \mu_{\text{real}} - \mu_{\text{gen}} \|^2 + \mathrm{Tr}(\Sigma_{\text{real}}) + \mathrm{Tr}(\Sigma_{\text{gen}}) - 2\,\mathrm{Tr} \Big( \big( \Sigma_{\text{real}} \Sigma_{\text{gen}} \big)^{1/2} \Big)$$ 三项的物理含义分别是:均值项管「两组图的平均特征偏了多远」(对应内容/风格的整体偏移),两个迹项管「各自铺开得多宽」(对应多样性),交叉项管「两者铺开的形状有多重合」。注意如果两组分布只是整体缩放 $c$ 倍,那么 $\mu$ 变 $c$ 倍、$\Sigma$ 变 $c^2$ 倍,四项一起变 $c^2$ 倍——FID 不是尺度不变的,这一点后面会用到。 3.4 对称求解器必须使用对称半正定输入 上面那个「最后一个等号」在实现里就是一道坎。看看三种写法差多少(附录 fid_core.py 的 [2][3] 段,随机生成的对称正定 $\Sigma_1, \Sigma_2$): $d$ 对称化路线(正确) eigh(Σ1Σ2)(错误) 通用特征值参考 8 11.5957639872 10.8132126304 11.5957639872 32 41.7985007127 40.2403835447 41.7985007127 128 173.3801162800 165.4519506579 173.3801162800 本表里错误写法偏小,且绝对误差随所选维度增加;这不是任意矩阵都成立的单调律。原因很具体:np.linalg.eigh 是专供对称矩阵的求解器,它只读矩阵的上三角(或下三角)并假设输入对称。按 NumPy 官方文档,默认 UPLO="L" 只读下三角并按其镜像解释上三角,并不是计算 $(A+A^\top)/2$。它与半正定夹心矩阵不是一回事。 误差会原样传进 FID。同一对 128 维特征($n=4096$),正确路线算出 FID = 45.584468,错误路线算出 50.484178,差 +4.899711。这个量级足以让你以为模型退化了。 3.5 FID 只看前两阶矩,所以有结构性盲区 3.2 节的高斯假设现在来收账了。构造一个极端例子: 真实分布 $P = \frac{1}{2}\mathcal{N}(+m, I) + \frac{1}{2}\mathcal{N}(-m, I)$——两个分离的模式; 生成分布 $Q = \mathcal{N}(0, I + m m^\top)$——把两个模式糊成一团的单个高斯。 两者的均值都是 0,协方差都是 $I + m m^\top$。前两阶矩完全一样,所以 FID 的真值严格等于 0,不管两个模式离多远。 但人(或者一个简单的分类器)一眼就能看出区别。实测(附录 fid_bias_lab.py 的 [D] 段,$d=32$、$n=40000$;记 $a = \|m\|$,横轴是两个模式中心的间距 $2a$): 模式间距 $2a$ FID(总体真值) FID(经验估计) 贝叶斯最优 AUC 1-NN 双样本检验准确率 二次特征 ridge AUC 2 1.42e-14 0.0156 0.5365 0.4956 0.5022 4 2.84e-14 0.0162 0.6601 0.5056 0.5003 8 −2.84e-14 0.0163 0.8106 0.6204 0.4972 12 0.0 0.0165 0.8739 0.7010 0.4977 16 8.53e-14 0.0239 0.9033 0.7518 0.5042 FID 从头到尾是 0(那 0.015~0.024 是前面说的有限样本估计误差,不是信号),而贝叶斯最优判别器的 AUC 已经到了 0.9033,1-NN 双样本检验准确率到了 0.7518(0.5 表示完全无法区分)。两个模式明明越离越远,FID 一动不动。 更值得玩味的是最后两列:二次特征上的 ridge 分类器 AUC 也一直是 0.50。这不是巧合——这里的平方损失 ridge 在类平衡、矩匹配时缺少均值层面的监督信号。不能推广为所有二次判别器都只看前两阶矩:例如对 $x^2$ 设阈值也可以利用平方值分布的尾部差异。为了确认这一点我做了对照实验:固定模式间距,改成把 $Q$ 的协方差整体放大 $s$ 倍(破坏矩匹配),于是 FID 和二次 ridge AUC 一起抬头: 协方差放大倍数 $s$ FID 二次特征 ridge AUC 1.0 8.53e-14 0.5021 1.05 0.0585 0.5022 1.2 0.8745 0.5198 1.5 4.8490 0.5972 2.0 16.4710 0.7806 本实验中,矩匹配使总体 FID 为零,二次特征 ridge 的测试 AUC 接近随机水平 0.5;改变协方差后两者均发生变化。 1-NN 那种基于局部密度的判别器则不吃这一套——它看的是密度本身的形状,不是矩。 这张图要看什么:左图是 $P$(蓝)和 $Q$(橙)在二维上的真实散点,连同它们各自的 1σ/2σ 椭圆——注意两个椭圆几乎完全重合,这就是「前两阶矩完全一样」的几何含义:二阶统计量把两个分离的团和一个糊在一起的团画成了同一个椭圆。右图是同一个实验扫过模式间距的结果,蓝线(FID,左轴对数刻度)从头到尾贴在 $10^{-14}$ 量级纹丝不动,橙线(贝叶斯最优 AUC)和绿线(1-NN 准确率,右轴)一路爬到 0.90 / 0.75。两条线之间的那片空白,就是 FID 用高斯假设换来的盲区。 04. 代码实现 核心只有三件事:对称矩阵的平方根、$\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$ 的对称化路线、以及协方差怎么估。下面这段是 fid_core.py 的主干(完整版见附录)。 import numpy as np def sqrtm_sym(C: np.ndarray, eps: float = 1e-6) -> np.ndarray: r"""对称半正定矩阵的平方根。 对 C = V diag(w) V^T,有 C^{1/2} = V diag(sqrt(w)) V^T。 eps 是相对谱尺度的负特征值容差,不是给正特征值设置下限。 明显非半正定输入报错;容差内负值截到 0,保留真正的零特征值。 """ C = np.asarray(C, dtype=np.float64) if C.ndim != 2 or C.shape[0] != C.shape[1] or not np.isfinite(C).all(): raise ValueError("C must be a finite square matrix") scale = max(np.linalg.norm(C, ord=np.inf), np.finfo(float).tiny) if not np.allclose(C, C.T, rtol=0.0, atol=eps * scale): raise ValueError("C must be symmetric") w, V = np.linalg.eigh((C + C.T) / 2) if w.min() < -eps * max(np.abs(w).max(), np.finfo(float).tiny): raise ValueError("C must be positive semidefinite") w = np.sqrt(np.clip(w, 0.0, None)) return (V * w) @ V.T def trace_sqrt_product(sigma1: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6) -> float: r"""计算 Tr((Σ1 Σ2)^{1/2}),走对称化路线。 Σ1 正定时,Σ1 Σ2 与 Σ1^{1/2} Σ2 Σ1^{1/2} 相似: Σ1^{1/2} (Σ1^{1/2} Σ2 Σ1^{1/2}) Σ1^{-1/2} = Σ1 Σ2 二者特征值相同,而后者是**对称半正定**的,可以安全用 eigh。 主平方根与相似变换可交换,所以迹也相同: Tr((Σ1 Σ2)^{1/2}) = Σ_i sqrt(λ_i) """ s1 = sqrtm_sym(sigma1, eps) M = s1 @ sigma2 @ s1 M = 0.5 * (M + M.T) # 强制对称,压掉浮点不对称 w = np.linalg.eigvalsh(M) return float(np.sqrt(np.clip(w, 0.0, None)).sum()) 这里先展示平方根与交叉项;完整均值、协方差与距离实现见附录。 四个符号和 3.3 节的推导一一对应:mu1/mu2 是 $\mu_1/\mu_2$,sigma1/sigma2 是 $\Sigma_1/\Sigma_2$,trace_sqrt_product 就是 $\mathrm{Tr}((\Sigma_1\Sigma_2)^{1/2})$,eps 是判定负特征值是否属于舍入误差的相对容差,不是把所有小特征值抬高的正则项。 跑 python fid_core.py 的自检输出(这些数字全部是实跑结果): [1] 恒等性:FID(P, P) 必须为 0 FID(P,P) = -4.263e-14 [2] 对称化路线 vs 错误写法 vs 一般特征值参考实现 d sym(正确) naive(错误) eigvals(参考) 8 11.5957639872 10.8132126304 11.5957639872 32 41.7985007127 40.2403835447 41.7985007127 128 173.3801162800 165.4519506579 173.3801162800 [3] 这个差异会传进 FID:同一对特征,两种写法差多少 FID(sym) = 45.584468 FID(naive) = 50.484178 (差值 +4.899711) [4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍 c=0.5 FID= 11.396117 期望 c^2*base= 11.396117 c=2.0 FID= 182.337871 期望 c^2*base= 182.337871 c=4.0 FID= 729.351482 期望 c^2*base= 729.351482 [5] 有偏 vs 无偏协方差(n 越小差得越多) n unbiased biased 差值 256 43.932626 43.765931 -0.166696 1024 10.959338 10.948996 -0.010341 8192 1.518005 1.517825 -0.000180 逐条对一下这几个数为什么要看: [1] 按绝对值和尺度相关容差检查恒等性;0.0、极小正值和极小负值都可能正确。明显超出容差才需要排查。附录还验证奇异、小尺度协方差与非 PSD 输入。 [4] 验证 3.3 节末尾那个推论:$c=2$ 时 $4 \times 45.584468 = 182.337871$,完全吻合。这意味着任何改变特征尺度的预处理都会改变 FID,而且不是线性地改。 [5] 本例两组样本数相同,用 $1/n$ 会把双方协方差一起缩小,因此表中的有偏协方差版本距离略小。协方差无偏不代表 FID 无偏;不同样本量时不能直接套这个单调结论。$n=8192$ 时差 0.00018 可以忽略,$n=256$ 时差 0.167 就不能忽略了。工业实现和手写实现在这上面分叉,跨实现比较时要注意。 05. 工业级实现对照 生产里大家用的是 mseitzer/pytorch-fid(截至 2026-10 的实现为准),核心函数在 src/pytorch_fid/fid_score.py#calculate_frechet_distance。和上面的最小实现有五处差异,每一处都有原因: 1. 矩阵平方根用的是 scipy 而不是 eigh。 官方写的是 covmean, _ = linalg.sqrtm(sigma1.dot(sigma2), disp=False) if not np.isfinite(covmean).all(): offset = np.eye(sigma1.shape[0]) * eps covmean = linalg.sqrtm((sigma1 + offset).dot(sigma2 + offset)) if np.iscomplexobj(covmean): if not np.allclose(np.diagonal(covmean).imag, 0, atol=1e-3): raise ValueError("Imaginary component {}".format(np.max(np.abs(covmean.imag)))) covmean = covmean.real scipy.linalg.sqrtm 是通用矩阵的主平方根求解器,不假设输入对称,所以直接喂 $\Sigma_1\Sigma_2$ 是对的——这跟我的对称化路线在数学上等价,只是浮点路径不同。代价是结果可能带极小的虚部(数值误差),所以有了那段 .real 兜底:先看对角线虚部是不是都在 $10^{-3}$ 以内,超了就报错而不是默默取实部。我的最小实现用 eigvalsh 绕开了复数问题,代价是必须自己先把矩阵对称化。真正的坑是有人为了去掉 scipy 依赖把它换成 np.linalg.eigh——那就是 3.4 节那个 +4.9 的错误。 2. 数值容差与正则化不同。 本文只截掉容差内的负特征值并保留零值,以便奇异或小尺度协方差仍满足恒等性;不能无条件把所有特征值抬到 eps。pytorch-fid 在 sqrtm 失败时给协方差加 eps*I 重试,这是改变问题的正则化兜底,应记录是否触发。 3. 协方差用 np.cov(act, rowvar=False),默认无偏。 也就是 04 节 [5] 那张表的第一列。这一点在 $n$ 小的时候会造成跨实现的系统差异。 4. 特征提取有一整套约定。 src/pytorch_fid/inception.py 里的 InceptionV3 取的是第 3 个 block(最终平均池化之后)的 2048 维;resize_input=True 会先把输入双线性缩放到 299×299;use_fid_inception=True 用的是与 TensorFlow 版对齐的 FID 专用权重,而不是 torchvision 默认的 ImageNet 权重。命令行还有 --dims,可以选 64 / 192 / 768 / 2048——换了 dims 就是换了另一个指标,数字不可比,这是跨论文比较时最常被忽略的一项。 5. 保留数值诊断。 该实现返回原始结果,不自动截零。生产实现也可以先验证误差在容差内再截零,但不能不加检查地掩盖大负值;正好为 0 并不说明出错。 还有一个官方不管、但你必须自己管的事:预处理的一致性。Parmar 等人在 arXiv:2104.11222 里指出,resize 是否抗锯齿、图片是否被 JPEG 量化,都会显著改变 FID 的数值——大到足以改变两篇论文的排序。所以在比对任何两个 FID 之前,先确认两边的 Inception 权重、dims、resize 方式、量化流程、样本量、协方差是否有偏,这六项是不是一致。六项里任何一项对不上,两个 FID 就不是同一个东西。 06. 代价与边界 6.1 偏差有多大:随 $1/n$ 衰减,随维度放大 把 01 节那个实验做全(附录 fid_bias_lab.py 的 [A] 段,$P$ 和 $Q$ 是同一个分布,所以真值是 0): 每组样本量 $n$ FID($d=512$) FID($d=2048$) 50 431.54 2131.57 1000 53.85 640.65 10000 5.39 71.20 50000 1.09 14.21 两个观察: 双对数坐标下这些点近乎落在一条直线上,斜率接近 $-1$,也就是偏差按 $\sim 1/n$ 衰减。在本实验的大样本区间,样本量翻倍时平均偏差约减半。 维度从 512 涨到 2048(4 倍),$n=10000$ 处的偏差从 5.40 涨到 71.14(13 倍)。把 $d$ 从 64 扫到 2048 做拟合([B] 段,固定 $n=10000$),实测指数约为 1.814: $d$ 64 128 256 512 1024 2048 FID($P$,$P$) 0.1326 0.4517 1.5584 5.3967 19.5333 71.1371 这里约 $d^{1.8}$ 的拟合只适用于所选的 $1/k$ 协方差谱、迹归一化与扫描范围。真实 Inception 的谱和尺度不同,不能把这个指数当作通用样本量定律。 这张图要看什么:左图是 $P=Q$(真值 0)时 FID 随样本量的变化,双对数刻度,蓝线 $d=512$、橙线 $d=2048$,灰色虚线是斜率 $-1$ 的参考——两条实测线几乎与它平行,这就是「偏差按 $1/n$ 衰减」的直接证据;注意橙线在 $n=50000$ 时还有 14.21,远没有收敛到 0。右图固定 $n=10000$ 扫维度,同样是对数刻度,拟合斜率约 1.814,意味着维度翻一倍偏差涨约 3.5 倍;最右端采用了与 Inception pool3 相同的维度,但使用的是合成高斯特征,并非实际图像嵌入。 6.2 能不能把偏差外推掉 在偏差近似服从 $1/n$ 展开的样本区间,可以尝试外推;需检验拟合稳定性。Chong & Forsyth(arXiv:1911.07023)的做法是:用 $n = N, N/2, N/4, N/8$ 四个点算四个 FID,对 $1/n$ 做线性拟合 $\mathrm{FID}(n) \approx F_{\infty} + \beta / n$,截距 $F_{\infty}$ 就是外推到无穷样本量的估计。 实测([C] 段,$d=512$): $P = Q$(真值 0):$n=40000$ 估 1.3473、$n=5000$ 估 10.8717,外推得 $F_{\infty} = -0.0121$。直接报 $n=40000$ 的数字(1.35)比外推差得多。 $P \neq Q$(真值 0.3635):$n=40000$ 直接估 1.7430,误差 +1.3795;外推得 0.4845,误差 +0.1210。 外推把误差压掉了约 11 倍。代价是要多算三次特征统计量(不过统计量可以复用——从大样本里抽子集就行,不用重新过一遍 Inception)。 报告时同时给参考/生成样本数、原始 FID 和完整协议;使用外推还要报告拟合点、重复采样与不确定性。负截距反映估计误差,不是负的总体距离;外推不保证每个有限样本实验都更准。 6.3 FID 和 CLIP Score 在给不同的东西打高分 CLIP Score 的定义(Hessel 等,arXiv:2104.08718)比 FID 简单得多: $$\mathrm{CLIP\text{-}S} = w \cdot \max \big( \cos(f_{\text{img}}, f_{\text{txt}}), 0 \big), \quad w = 2.5$$ 其中 $f_{\text{img}}$ 和 $f_{\text{txt}}$ 是 CLIP 的图像/文本编码,$w=2.5$ 只是把数值放大到好读的量级。原始 CLIPScore 为图像描述评价提出,reference-free 指不需要人工参考描述;它仍需要待评图像和文本。迁移到文生图时不需要配对真值图。这里按原论文 $w=2.5$,其他实现也会用 100 等缩放,必须注明模型和约定。 下面的人工共享空间反例中,两者最优点不同(附录 clip_alignment_lab.py 的 [A] 段:一个结构化的 CLIP 替身,共享表示空间 $d_s=64$、$K=24$ 个概念,真实数据的多样性固定为 $\sigma_{\text{real}}=0.5$,$n=20000$): 生成多样性 $\sigma_g$ 0.05 0.2 0.4 0.5 0.6 0.8 1.0 FID 10.97 5.24 0.63 0.029 0.65 5.65 15.61 CLIP Score 2.323 1.323 0.744 0.607 0.515 0.399 0.335 FID 在 $\sigma_g = 0.5$(真实数据的多样性)处取最小 0.029,呈 U 形;CLIP Score 单调递减,在 $\sigma_g = 0.05$(几乎退化成确定性输出)处取最大 2.323。该构造下,相似度奖励靠近概念中心,分布距离奖励匹配设定的方差;不能解释为所有 CLIP 模型都偏好确定性。 顺带一提,真实数据自己的 CLIP Score 是 0.6082,而 $\sigma_g=0.5$ 那个「FID 最优」的模型是 0.6073——跟真实数据几乎一样。也就是说在这个实验里,FID 最优点才对应「和真实数据一致」,CLIP Score 的最优点对应的是「模式收敛」。 而且 CLIP Score 的均值性质会掩盖分布。构造两个模型([B] 段):$M_1$ 以概率 $p$ 输出完美匹配的图、以 $1-p$ 输出纯噪声;$M_2$ 每张图都中等匹配(二分调 $\sigma$ 让它的 CLIP Score 与 $M_1$ 相同): $p$ $M_1$ CLIP Score $M_1$ 逐样本标准差 $M_1$ 好图占比 $M_1$ FID $M_2$ $\sigma$ $M_2$ CLIP Score $M_2$ 逐样本标准差 $M_2$ FID 0.3 0.8330 0.4695 0.2980 9.920 0.353 0.8332 0.1078 1.323 0.5 1.3039 0.5078 0.4966 10.191 0.204 1.3016 0.0847 5.112 0.7 1.7896 0.4627 0.7012 10.677 0.122 1.7895 0.0536 8.079 0.9 2.2681 0.2992 0.9023 11.584 0.058 2.2688 0.0171 10.663 两组 CLIP Score 的最大差距只有 0.0023(按构造应该同分),但 $M_1$ 的逐样本相似度标准差是 $M_2$ 的 17.55 倍($p=0.9$ 时 0.2992 对 0.0171)。同一个分数,一个是「九成图完美、一成完全不沾边」,另一个是相似度更集中的输出($p=0.9$ 时均值也很高,不能称为勉强沾边)。汇总均值看不见这个区别,但逐样本 CLIPScore 的直方图或分位数可以显示它。 这张图要看什么:左图是同一个 $\sigma_g$ 扫描下两个指标的走向,蓝线(FID,左轴,越低越好)呈 U 形、在 $\sigma_g=0.5$ 处触底,橙线(CLIP Score,右轴,越高越好)单调下降、在最左端 $\sigma_g=0.05$ 处封顶——两条线的最优点不同,说明这组构造下两个目标存在冲突;0.5 并不是横轴右端,也不能据此断言现实模型的普遍走势;灰色竖虚线标出的是真实数据的多样性 $\sigma_{\text{real}}=0.5$。右图是 $p=0.5$ 那一行两个模型的逐样本相似度分布:橙色的 $M_1$ 是明显的双峰(一半堆在接近 1 的位置、一半堆在 0 附近),蓝色的 $M_2$ 是一根集中在 0.5 附近的单峰,图中直方图直接来自附录实际实验数据,橙/蓝虚线分别是原始余弦均值。CLIPScore 先对每个相似度截零,分数接近不保证原始余弦均值相同;汇总分数仍可能掩盖两种很不一样的样本分布。 6.4 什么时候不该用 FID 样本量小的时候:估计偏差可能淹没模型差异,具体量级取决于数据与特征器。先做同分布基线和重复抽样,再判断是否增样本或尝试外推;没有通用的「10k 以下偏差大于 70」门槛。 要评价单张图的时候:FID 根本没有「单张图」这个概念。需要逐样本打分就上 CLIP Score / ImageReward,但要区分逐样本评分与数据集均值,要配着直方图或者分位数一起看。 要区分「质量」和「覆盖」的时候:FID 把两者压成一个数。一个只生成 10 张高质量图的模型和一个生成 10000 张中等质量图的模型,FID 可能很接近,但产品含义完全不同。这种情况应该用 Improved Precision & Recall(arXiv:1904.06991)拆成两个数。 两个分布形状不同但矩相同的时候:3.5 节的实验——FID 严格为 0,而 1-NN 双样本检验有 0.75 的判别率。 要跨论文比较的时候:除非核实了 05 节末尾那六项完全一致,否则请把数字当成「同一篇论文内部的相对量」,不要当成绝对值。 07. 经典论文脉络 Inception Score(arXiv:1606.03498,Improved Techniques for Training GANs)——第一个被广泛采用的自动指标:用 Inception 的分类分布衡量「单图是否清晰可辨」+「整体是否有多样性」。贡献是让 GAN 评测摆脱了人工打分;根本缺陷是完全不看真实分布,所以无法检测记忆训练集,也无法检测 mode collapse 的另一种形式。 FID(arXiv:1706.08500,TTUR 那篇)——把真实分布拉进比较,用 Inception pool3 特征上的 2-Wasserstein 距离平方评价分布差异。贡献是「两个分布之间的距离」这个范式,在论文实验中展示了对若干退化的敏感性,后来成为常用指标;这种表现不保证覆盖所有退化。 Improved Precision and Recall Metric for Assessing Generative Models(2019)——指出单个标量无法同时表达「生成质量」和「分布覆盖」,拆成 P(生成样本落在真实流形内的比例)和 R(真实样本能被生成覆盖的比例)。贡献是提供了 FID 缺失的那个维度:FID 相同的一对模型,可以在 P/R 平面上处于完全不同、甚至此消彼长的位置。 Effectively Unbiased FID(arXiv:1911.07023)——把 FID 当成一个统计估计量来审视,指出它是有偏的、偏差随 $1/n$ 衰减,并给出用多个样本量外推到 $F_{\infty}$ 的方法。6.2 节那组数字就是照它的做法复现的。它解释了有限样本偏差为何会影响模型排序。 CLIPScore(arXiv:2104.08718)——把评测从「分布 vs 分布」拉回「图 vs 文」,提出不需要参考图的图文对齐指标。贡献是让文生图有了逐样本的自动化对齐分数;局限是相似度不能覆盖全部质量维度,汇总均值也会丢失样本分布;与 FID 的关系依赖实际模型。 补充一条横向的:Borji 的 Pros and Cons of GAN Evaluation Measures(arXiv:1802.03446)系统比较了十几种指标的失效模式,结论是没有任何单一指标能在所有场景下胜出——这也是本篇反复强调「两个指标一起看、连同它们的盲区一起看」的依据。 08. 常见误解 误解 1:「FID 越低,生成的图越好。」 FID 只比较两个分布的前两阶矩,不比较单张图。实测证据:把两个模式越拉越远,FID 一动不动(3.5 节,FID 恒为 0,1-NN 判别率 0.7518)。反过来的方向也成立——FID 很低但每张图都文不对题,是完全可能的。 误解 2:「FID = 0 说明两个分布一样。」 3.5 节整节都在反驳这一点。前两阶矩匹配就够了,形状随便怎么不同都行。高斯假设换来的就是这个。 误解 3:「两篇论文的 FID 可以直接比大小。」 我自己踩过最狠的一个。至少六项要对齐:Inception 权重、特征维度 dims、resize 方式与是否抗锯齿、量化流程、样本量、协方差是否有偏。实测的敏感度:$d=2048$ 时样本量从 10k 到 50k,本文特定人工高斯模型的估计距离从 71.20 变 14.21(差 57);特征整体乘 $c$ 倍,FID 乘 $c^2$ 倍($c=2$ 时 45.58 → 182.34)。这些数字说明 FID 更像一个有单位的物理量,不是一个无量纲分数。 误解 4:「FID 与 CLIP Score 必然反向变化。」 两者测的内容不同,可能同好同坏,也可能冲突。本文合成实验给出冲突的一个例子,不是普遍定律。CFG 的变化也不能精确等同于给合成嵌入加某个固定高斯噪声。 误解 5:「平均 CLIP Score 高,说明每张图都对。」 数据集均值会掩盖尾部。实测两个 CLIP Score 差 0.0023 的模型,逐样本相似度标准差差 17.55 倍(0.2992 对 0.0171)。要看单张图的质量分布,得看直方图或者低分位数,不能只看均值。 误解 6:「FID 非负,所以所有负输出都直接夹为 0。」 应先确认输入和平方根实现,再检查负值是否在尺度相关容差内。小负数可以记录后截零,明显负数必须报错;恰好输出 0 本身既不能证明正确,也不能证明有错。 09. 动手验证 三个数值脚本在文末附录,依赖 numpy;配图另需 matplotlib,不使用真实 Inception/CLIP 权重: python fid_core.py # 约 1 秒:FID 最小实现 + 5 组自检 python fid_bias_lab.py ALL # 约 1 分钟:样本量偏差 / 维度 / 外推 / 矩盲区 python clip_alignment_lab.py ALL # 约 10 秒:FID 与 CLIP Score 的相反最优 预期结果(这些数字是实跑输出,可以直接对): fid_core.py 会按尺度相关容差断言恒等性,包括奇异和小尺度 PSD 输入。数值可以恰好为 0;不要要求固定尾数或符号。明显超出容差时再查矩阵平方根与输入。 fid_bias_lab.py 的 [A] 段,$d=2048$ 那一列:n=10000 应约 71.20、n=50000 应约 14.21($P=Q$,真值 0)。[D] 段最后一行的贝叶斯 AUC 应约 0.9033、1-NN 准确率应约 0.7518,而总体 FID 的数值实现应在零附近的浮点容差内。 clip_alignment_lab.py 的 [A] 段,最优 $\sigma_g$:FID 是 0.5、CLIP Score 是 0.05。[B] 段最后打印的「CLIP Score 最大差距」应约 0.0023、「标准差比值」应约 17.55 倍。 想自己造一个「FID 失效」的例子?改 fid_bias_lab.py 的 [D] 段里那个 a(模式间距的一半)就行:把 $a$ 从 1 扫到 8(中心间距从 2 到 16),总体 FID 保持 0;本例 1-NN 准确率从约 0.50 增至 0.75。 10. 延伸阅读 音频质量评测:MOS、PESQ 与 FAD 各测什么(本系列已发布)——里面的 FAD(Fréchet Audio Distance)就是 FID 换了个特征提取器,高斯矩估计的风险同样存在,但偏差系数与特征器、尺度和样本相关性有关。 视频生成评测:VBench 与人工验收(本系列规划中)——VBench 是多维度视频评测框架,不是简单把 FID 升维;FVD 才是采用视频特征的相关高斯距离指标。两者都不能直接套本文合成模型的 $d^{1.8}$ 指数。 DDPM 训练目标与采样流程、Classifier-Free Guidance(本系列已发布)——CFG 会影响条件一致性与多样性,但不是 6.3 节 $\sigma_g$ 的严格等价参数。实际趋势需要在具体模型上测量。 附录:完整代码 09 节用到的脚本全文如下(fid_bias_lab.py、fid_core.py、clip_alignment_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 fid_bias_lab.py """ fid_bias_lab.py —— FID 的样本量偏差实验。 回答三个问题: [A] 两个分布**完全一样**时,FID 是多少?(答:不是 0,而且 n 越小越离谱) [B] 这个偏差随维度 d、样本量 n 怎么变? [C] 能不能把它外推掉?(Chong & Forsyth, arXiv:1911.07023 的做法) [D] FID 只看前两阶矩,那「前两阶矩完全一样、分布完全不同」能骗过去吗? 运行: python fid_bias_lab.py # 全跑 python fid_bias_lab.py A # 只跑 A 段 """ from __future__ import annotations import json import os import sys import numpy as np from fid_core import fid_from_features, frechet_distance, covariance HERE = os.path.dirname(os.path.abspath(__file__)) OUT_JSON = os.path.join(HERE, "_fid_bias_results.json") # ────────────────────────────────────────────────────────────── # 造一个明确指定谱与尺度的合成协方差:特征值按 1/k 衰减,迹归一到 d # ────────────────────────────────────────────────────────────── def spectrum_cov(d: int, trace: float | None = None, alpha: float = 1.0) -> np.ndarray: r"""对角协方差,特征值 λ_k ∝ k^{-alpha},归一化到 Tr(Σ)=trace。 这是人为选择的谱衰减模型,并非对 Inception pool3 的实测拟合: 少数几个方向撑着大部分方差,长尾方向方差很小。 trace 默认取 d,也就是「每个维度平均方差为 1」。 """ k = np.arange(1, d + 1, dtype=np.float64) lam = k.astype(np.float64) ** (-alpha) if trace is None: trace = float(d) lam = lam * (trace / lam.sum()) return np.diag(lam) def sample_gaussian(mean: np.ndarray, cov_diag: np.ndarray, n: int, rng: np.random.Generator) -> np.ndarray: """从对角协方差的高斯里采样(对角阵直接按列缩放,不用 Cholesky)。""" d = mean.shape[0] lam = np.diag(cov_diag) if cov_diag.ndim == 2 else cov_diag z = rng.standard_normal((n, d)) return mean[None, :] + z * np.sqrt(lam)[None, :] # ────────────────────────────────────────────────────────────── # [A] P == Q 时的 FID # ────────────────────────────────────────────────────────────── def section_a(d_list=(512, 2048), reps=3, verbose=True): print("=" * 74) print("[A] 两个分布完全一样时,FID 不是 0") print(" 真实分布 = 生成分布,理论上 FID = 0。实测:") print("=" * 74) n_list = [50, 100, 200, 500, 1000, 2000, 5000, 10000, 20000, 50000] out = {} for d in d_list: rng = np.random.default_rng(20261001 + d) cov = spectrum_cov(d) mu = np.zeros(d) rows = [] for n in n_list: vals = [] for r in range(reps): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) vals.append(fid_from_features(x1, x2)) m = float(np.mean(vals)) s = float(np.std(vals)) rows.append((n, m, s)) if verbose: print(f" d={d:>5} n={n:>6} FID = {m:>10.4f} (std {s:.4f})") out[d] = rows if verbose: print() return {"n_list": n_list, "by_d": {str(k): v for k, v in out.items()}} # ────────────────────────────────────────────────────────────── # [A2] 偏差到底来自均值还是协方差 # ────────────────────────────────────────────────────────────── def section_a2(d=512, n=40000, reps=3, verbose=True): print("=" * 74) print("[A2] 偏差来自哪里:均值还是协方差?(P == Q,真值 0)") print("=" * 74) rng = np.random.default_rng(556677) cov = spectrum_cov(d) mu = np.zeros(d) full, mean_known, cov_known = [], [], [] for _ in range(reps): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) m1, s1 = x1.mean(0), covariance(x1) m2, s2 = x2.mean(0), covariance(x2) full.append(frechet_distance(m1, s1, m2, s2)) # 假设均值已知(用真实 mu=0),只估协方差 mean_known.append(frechet_distance(mu, s1, mu, s2)) # 假设协方差已知(用真实 cov),只估均值 cov_known.append(frechet_distance(m1, cov, m2, cov)) f, mk, ck = float(np.mean(full)), float(np.mean(mean_known)), float(np.mean(cov_known)) theory_mean = 2.0 * np.trace(cov) / n if verbose: print(f" d={d} n={n}") print(f" 两个都估(正常做法) FID = {f:>10.4f}") print(f" 均值已知、只估协方差 FID = {mk:>10.4f} " f"占全部偏差的 {mk / f * 100:5.1f}%") print(f" 协方差已知、只估均值 FID = {ck:>10.4f} " f"占全部偏差的 {ck / f * 100:5.1f}%") print(f" 理论值 2*Tr(Sigma)/n = {theory_mean:.6f}(对照上一行)") print() print(" -> 偏差几乎全部来自**协方差估计**。均值那一项理论上就是") print(" 2*Tr(Sigma)/n,小到可以忽略;麻烦的是 d x d 个协方差元素。") print() return {"d": d, "n": n, "full": f, "mean_known": mk, "cov_known": ck, "theory_mean": float(theory_mean)} # ────────────────────────────────────────────────────────────── # [B] 偏差随 d 与 n 的缩放 # ────────────────────────────────────────────────────────────── def section_b(verbose=True): print("=" * 74) print("[B] 偏差随维度 d 怎么长(固定 n=10000)") print("=" * 74) n = 10000 rows = [] for d in (64, 128, 256, 512, 1024, 2048): rng = np.random.default_rng(777000 + d) cov = spectrum_cov(d) mu = np.zeros(d) vals = [] for r in range(3): x1 = sample_gaussian(mu, cov, n, rng) x2 = sample_gaussian(mu, cov, n, rng) vals.append(fid_from_features(x1, x2)) m = float(np.mean(vals)) rows.append((d, m, d / n)) if verbose: print(f" d={d:>5} n={n} d/n={d / n:>7.4f} FID = {m:>10.4f}") print() return {"n": n, "rows": rows} # ────────────────────────────────────────────────────────────── # [C] 外推:FID(n) ≈ F_inf + beta / n # ────────────────────────────────────────────────────────────── def section_c(verbose=True): print("=" * 74) print("[C] 能不能把偏差外推掉?(arXiv:1911.07023 的做法)") print(" 用 n = N, N/2, N/4, N/8 四个点,对 1/n 做线性拟合,截距即 F_inf") print("=" * 74) d = 512 rng = np.random.default_rng(31337) cov = spectrum_cov(d) # C1: P == Q,真值 0 N = 40000 sizes = [N, N // 2, N // 4, N // 8] est = [] for n in sizes: v = [] for r in range(3): x1 = sample_gaussian(np.zeros(d), cov, n, rng) x2 = sample_gaussian(np.zeros(d), cov, n, rng) v.append(fid_from_features(x1, x2)) est.append(float(np.mean(v))) inv_n = np.array([1.0 / n for n in sizes]) beta, a0 = np.polyfit(inv_n, np.array(est), 1) if verbose: for n, e in zip(sizes, est): print(f" P==Q n={n:>6} FID = {e:>9.4f}") print(f" 外推 F_inf = {a0:>9.4f} (真值 0.0000, 斜率 beta={beta:.2f})") c1 = {"sizes": sizes, "est": est, "extrap": float(a0), "slope": float(beta)} # C2: P != Q,真值可以直接从矩算出来 print() shift = np.zeros(d) shift[0] = 0.5 # 只在第 0 维上挪一点 mu_q = shift cov_q = cov * 1.03 # 协方差整体放大 3% true_fid = frechet_distance(np.zeros(d), cov, mu_q, cov_q) est2 = [] for n in sizes: v = [] for r in range(3): x1 = sample_gaussian(np.zeros(d), cov, n, rng) x2 = sample_gaussian(mu_q, cov_q, n, rng) v.append(fid_from_features(x1, x2)) est2.append(float(np.mean(v))) beta2, a02 = np.polyfit(inv_n, np.array(est2), 1) if verbose: for n, e in zip(sizes, est2): print(f" P!=Q n={n:>6} FID = {e:>9.4f}") print(f" 真值 FID = {true_fid:>9.4f}") print(f" 外推 F_inf = {a02:>9.4f} (斜率 beta={beta2:.2f})") print(f" 直接用 n={N} 的估计误差 = {est2[0] - true_fid:+.4f}") print(f" 外推后的误差 = {a02 - true_fid:+.4f}") print() return {"c1": c1, "c2": {"sizes": sizes, "est": est2, "true": float(true_fid), "extrap": float(a02), "slope": float(beta2)}} # ────────────────────────────────────────────────────────────── # [D] 前两阶矩一样、分布完全不同 # ────────────────────────────────────────────────────────────── def _auc(scores_pos: np.ndarray, scores_neg: np.ndarray) -> float: """Mann-Whitney U 形式的 AUC:P(score_pos > score_neg)。""" a = np.sort(scores_pos) b = np.sort(scores_neg) # 对每个 b,统计有多少 a 严格大于它 cnt = a.size - np.searchsorted(a, b, side="right") return float(cnt.sum() / (a.size * b.size)) def _quad_features(X: np.ndarray) -> np.ndarray: """二次特征展开:[x_i, x_i x_j (i<=j)]。""" n, d = X.shape iu = np.triu_indices(d) quad = X[:, iu[0]] * X[:, iu[1]] return np.concatenate([X, quad], axis=1) def _gauss_logpdf(X: np.ndarray, mean: np.ndarray, cov: np.ndarray) -> np.ndarray: """对角/一般协方差下的高斯 log 密度。""" d = X.shape[1] Xc = X - mean[None, :] if cov.ndim == 2 and cov.shape[0] == cov.shape[1]: lam, V = np.linalg.eigh(cov) lam = np.clip(lam, 1e-12, None) proj = Xc @ V quad = (proj ** 2 / lam[None, :]).sum(axis=1) logdet = np.log(lam).sum() else: lam = np.asarray(cov).ravel() quad = (Xc ** 2 / lam[None, :]).sum(axis=1) logdet = np.log(lam).sum() return -0.5 * (quad + logdet + d * np.log(2 * np.pi)) def _nn_two_sample(Xa: np.ndarray, Xb: np.ndarray, m: int = 2500) -> float: """1-近邻两样本检验的准确率。 把两组样本混在一起,对每个点找它的最近邻,看这个邻居是不是同组的。 P == Q 时这个比例趋近 0.5(纯随机),分布有差别时会明显大于 0.5。 """ A, B = Xa[:m], Xb[:m] P = np.concatenate([A, B], axis=0) D = ((P[:, None, :] - P[None, :, :]) ** 2).sum(-1) np.fill_diagonal(D, np.inf) idx = np.argmin(D, axis=1) lab = np.concatenate([np.zeros(m), np.ones(m)]) return float((lab[idx] == lab).mean()) def _ridge_auc(Xp: np.ndarray, Xq: np.ndarray, feat, ntr: int, lam: float, rng: np.random.Generator) -> float: """在给定特征映射上训一个 ridge 二分类器,返回测试集 AUC。""" Fp, Fq = feat(Xp), feat(Xq) n = Xp.shape[0] Xtr = np.concatenate([Fp[:ntr], Fq[:ntr]], axis=0) ytr = np.concatenate([np.ones(ntr), -np.ones(ntr)]) Xte = np.concatenate([Fp[ntr:], Fq[ntr:]], axis=0) yte = np.concatenate([np.ones(n - ntr), -np.ones(n - ntr)]) sd = Xtr.std(axis=0) sd[sd < 1e-12] = 1.0 Xtr, Xte = Xtr / sd, Xte / sd Phi = Xtr.T @ Xtr w = np.linalg.solve(Phi + lam * np.eye(Phi.shape[0]), Xtr.T @ ytr) sc = Xte @ w return _auc(sc[yte > 0], sc[yte < 0]) def section_d(verbose=True): print("=" * 74) print("[D] 前两阶矩完全一样、分布完全不同 —— FID 看得见吗") print(" 真实 P = 0.5*N(+m, I) + 0.5*N(-m, I) (两个分离的模式)") print(" 生成 Q = N(0, I + m m^T) (一个把两个模式糊在一起的团)") print(" 两者均值都是 0、协方差都是 I + m m^T => FID 真值严格等于 0") print("=" * 74) d = 32 n = 40000 rng = np.random.default_rng(24680) u = rng.standard_normal(d) u /= np.linalg.norm(u) if verbose: print(f" {'模式间距 2|m|':>12} {'FID(总体)':>12} {'FID(经验)':>10} " f"{'最优AUC':>9} {'1NN':>7} {'二次AUC':>8} {'线性AUC':>8}") rows = [] for a in (1, 2, 3, 4, 6, 8): m = a * u sign = rng.integers(0, 2, size=n) * 2 - 1 Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :] cov_q = np.eye(d) + np.outer(m, m) Xq = rng.multivariate_normal(np.zeros(d), cov_q, size=n) # 总体 FID:直接用矩算,理论值 0 cov_p = np.eye(d) + np.outer(m, m) fid_pop = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q) # 经验 FID fid_emp = frechet_distance(Xp.mean(0), covariance(Xp), Xq.mean(0), covariance(Xq)) # 最优判别(log 密度比) inv_q = np.linalg.inv(cov_q) def logp_mix(X): return np.logaddexp(-0.5 * ((X - m) ** 2).sum(1), -0.5 * ((X + m) ** 2).sum(1)) def logq(X): return -0.5 * (X @ inv_q * X).sum(1) auc_bayes = _auc(logp_mix(Xp) - logq(Xp), logp_mix(Xq) - logq(Xq)) # 1-NN 两样本检验 acc_nn = _nn_two_sample(Xp, Xq) # 二次特征 / 线性特征的 ridge 分类器 auc_quad = _ridge_auc(Xp, Xq, _quad_features, 8000, 1.0, rng) auc_lin = _ridge_auc(Xp, Xq, lambda X: X, 8000, 1.0, rng) rows.append((2 * a, float(fid_pop), float(fid_emp), auc_bayes, acc_nn, auc_quad, auc_lin)) if verbose: print(f" {2 * a:>12} {fid_pop:>12.2e} {fid_emp:>10.4f} " f"{auc_bayes:>9.4f} {acc_nn:>7.4f} {auc_quad:>8.4f} {auc_lin:>8.4f}") # 对照组:把 Q 的协方差整体放大 s 倍(破坏矩匹配),FID 与二次判别一起醒过来 print() print(" 对照组(2|m|=8):把 Q 的协方差整体放大 s 倍,破坏矩匹配") print(f" {'s':>6} {'FID':>10} {'二次特征 ridge AUC':>20}") m = 8 * u sign = rng.integers(0, 2, size=n) * 2 - 1 Xp = rng.standard_normal((n, d)) + sign[:, None] * m[None, :] cov_p = np.eye(d) + np.outer(m, m) ctrl = [] for s in (1.0, 1.05, 1.2, 1.5, 2.0): cov_q_s = cov_p * s Xq_s = rng.multivariate_normal(np.zeros(d), cov_q_s, size=n) fid_s = frechet_distance(np.zeros(d), cov_p, np.zeros(d), cov_q_s) auc_s = _ridge_auc(Xp, Xq_s, _quad_features, 8000, 1.0, rng) ctrl.append((s, float(fid_s), auc_s)) print(f" {s:>6} {fid_s:>10.4f} {auc_s:>20.4f}") print(" -> 本例矩匹配时总体 FID 为 0,平方损失 ridge 的 AUC 近 0.5。") print(" 这不代表任意二次分类器都无法区分两组分布。") print() return {"d": d, "n": n, "rows": rows, "control": ctrl} # ────────────────────────────────────────────────────────────── def main(): which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL" res = {} if which in ("ALL", "A"): res["A"] = section_a() if which in ("ALL", "A2"): res["A2"] = section_a2() if which in ("ALL", "B"): res["B"] = section_b() if which in ("ALL", "C"): res["C"] = section_c() if which in ("ALL", "D"): res["D"] = section_d() if which == "ALL": with open(OUT_JSON, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=1) print(f"结果已写入 {OUT_JSON}") if __name__ == "__main__": main() fid_core.py """ fid_core.py —— FID(Fréchet Inception Distance)的最小可用实现。 本机没有 torch,也没有 scipy(scipy.linalg.sqrtm 是官方实现的核心依赖), 所以这里的矩阵平方根全部用 numpy 的对称特征分解手算。 好处是每一步都看得见,也正好能把「手写实现最容易踩的那个坑」暴露出来。 运行: python fid_core.py """ from __future__ import annotations import numpy as np # ────────────────────────────────────────────────────────────── # 1. 对称 PSD 矩阵的平方根 # ────────────────────────────────────────────────────────────── def sqrtm_sym(C: np.ndarray, eps: float = 1e-6) -> np.ndarray: r"""对称半正定矩阵的平方根。 对 C = V diag(w) V^T,有 C^{1/2} = V diag(sqrt(w)) V^T。 eps 是相对谱尺度的负特征值容差,不是给正特征值设置下限。 明显非半正定输入报错;容差内负值截到 0,保留真正的零特征值。 """ C = np.asarray(C, dtype=np.float64) if C.ndim != 2 or C.shape[0] != C.shape[1] or not np.isfinite(C).all(): raise ValueError("C must be a finite square matrix") scale = max(np.linalg.norm(C, ord=np.inf), np.finfo(float).tiny) if not np.allclose(C, C.T, rtol=0.0, atol=eps * scale): raise ValueError("C must be symmetric") w, V = np.linalg.eigh((C + C.T) / 2) if w.min() < -eps * max(np.abs(w).max(), np.finfo(float).tiny): raise ValueError("C must be positive semidefinite") w = np.sqrt(np.clip(w, 0.0, None)) return (V * w) @ V.T def sqrtm_naive(A: np.ndarray, eps: float = 1e-6) -> np.ndarray: """「把 A 直接当对称矩阵开方」。 np.linalg.eigh 只读矩阵的上/下三角并**假设输入对称**, 默认 UPLO="L",以 A 的下三角及其镜像构造对称矩阵, 并不等于 (A + A^T)/2。 很多手写 FID 就是这么写的,而 A = Σ1 Σ2 恰恰不是对称矩阵。 """ w, V = np.linalg.eigh(A) w = np.sqrt(np.clip(w, eps, None)) return (V * w) @ V.T # ────────────────────────────────────────────────────────────── # 2. Tr((Σ1 Σ2)^{1/2}) # ────────────────────────────────────────────────────────────── def trace_sqrt_product(sigma1: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6) -> float: r"""计算 Tr((Σ1 Σ2)^{1/2}),走对称化路线。 Σ1 正定时,Σ1 Σ2 与 Σ1^{1/2} Σ2 Σ1^{1/2} 相似: Σ1^{1/2} (Σ1^{1/2} Σ2 Σ1^{1/2}) Σ1^{-1/2} = Σ1 Σ2 二者特征值相同,而后者是**对称半正定**的,可以安全用 eigh。 主平方根与相似变换可交换,所以迹也相同: Tr((Σ1 Σ2)^{1/2}) = Σ_i sqrt(λ_i) """ s1 = sqrtm_sym(sigma1, eps) M = s1 @ sigma2 @ s1 M = 0.5 * (M + M.T) # 强制对称,压掉浮点不对称 w = np.linalg.eigvalsh(M) return float(np.sqrt(np.clip(w, 0.0, None)).sum()) def trace_sqrt_product_naive(sigma1: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6) -> float: """对照用的错误写法:直接对 Σ1 Σ2 调 eigh。""" return float(np.trace(sqrtm_naive(sigma1 @ sigma2, eps))) def trace_sqrt_product_ref(sigma1: np.ndarray, sigma2: np.ndarray) -> float: """参考实现:用一般矩阵的特征值求解器 eigvals(不假设对称)。""" ev = np.linalg.eigvals(sigma1 @ sigma2) return float(np.sqrt(np.clip(ev.real, 0.0, None)).sum()) # ────────────────────────────────────────────────────────────── # 3. FID 本体 # ────────────────────────────────────────────────────────────── def frechet_distance(mu1: np.ndarray, sigma1: np.ndarray, mu2: np.ndarray, sigma2: np.ndarray, eps: float = 1e-6, mode: str = "sym") -> float: r"""两个多元高斯之间的 Fréchet 距离(= 2-Wasserstein 距离的平方)。 FID = ||μ1 - μ2||^2 + Tr(Σ1) + Tr(Σ2) - 2 Tr((Σ1 Σ2)^{1/2}) mode="sym" 用对称化路线(正确) mode="naive" 用 eigh(Σ1 Σ2)(错误,保留它只为对照) """ diff = mu1 - mu2 if mode == "sym": tr = trace_sqrt_product(sigma1, sigma2, eps) elif mode == "naive": tr = trace_sqrt_product_naive(sigma1, sigma2, eps) else: raise ValueError(f"unknown mode: {mode}") # 注意:这里**不做** max(val, 0)。浮点误差确实会让 FID(P,P) 变成 -1e-9 量级, # 但把负数夹成 0 会把真正的实现 bug(比如开方写错)一起藏掉—— # 我自己第一版就是因为夹了 0,测试全绿而结果是错的。 return float(diff @ diff + np.trace(sigma1) + np.trace(sigma2) - 2.0 * tr) def covariance(X: np.ndarray, unbiased: bool = True) -> np.ndarray: r"""样本协方差。unbiased=True 用 1/(n-1)(np.cov 默认), False 用 1/n(高斯最大似然估计的常见约定)。""" X = np.asarray(X, dtype=np.float64) if X.ndim != 2 or not np.isfinite(X).all(): raise ValueError("X must be a finite [n, d] array") n = X.shape[0] if n < (2 if unbiased else 1): raise ValueError("not enough samples for covariance") Xc = X - X.mean(axis=0, keepdims=True) denom = (n - 1) if unbiased else n return (Xc.T @ Xc) / denom def fid_from_features(X1: np.ndarray, X2: np.ndarray, unbiased: bool = True, eps: float = 1e-6, mode: str = "sym") -> float: """直接从两组特征算 FID。X1: 真实 [n1, d],X2: 生成 [n2, d]。""" mu1, mu2 = X1.mean(axis=0), X2.mean(axis=0) sig1 = covariance(X1, unbiased=unbiased) sig2 = covariance(X2, unbiased=unbiased) return frechet_distance(mu1, sig1, mu2, sig2, eps=eps, mode=mode) # ────────────────────────────────────────────────────────────── # 4. 自检 # ────────────────────────────────────────────────────────────── def _rand_psd(d: int, rng: np.random.Generator, k: int | None = None) -> np.ndarray: """随机对称正定矩阵:A A^T/k + 0.5 I;加单位阵后满秩。""" k = k or d A = rng.standard_normal((d, k)) return A @ A.T / k + 0.5 * np.eye(d) def self_test() -> None: rng = np.random.default_rng(20261001) print("=" * 68) print("[1] 恒等性:FID(P, P) 必须为 0") d = 32 mu = rng.standard_normal(d) sig = _rand_psd(d, rng) identity = frechet_distance(mu, sig, mu, sig) assert abs(identity) < 1e-10 * np.trace(sig) print(f" FID(P,P) = {identity:.3e} (按容差判断,不要求固定符号或尾数)") for scale in (1.0, 1e-12): singular = np.diag([scale, 0.0, 2 * scale]) z = np.zeros(3) got = frechet_distance(z, singular, z, singular) assert abs(got) < 1e-10 * np.trace(singular) try: sqrtm_sym(np.diag([1.0, -0.1])) except ValueError: pass else: raise AssertionError("non-PSD input was accepted") print(" 奇异/小尺度 PSD 恒等性、非 PSD 拒绝:通过") print() print("[2] 对称化路线 vs 错误写法 vs 一般特征值参考实现") print(f" {'d':>6} {'sym(正确)':>16} {'naive(错误)':>16} {'eigvals(参考)':>16}") for d in (8, 32, 128): s1 = _rand_psd(d, rng) s2 = _rand_psd(d, rng) a = trace_sqrt_product(s1, s2) b = trace_sqrt_product_naive(s1, s2) c = trace_sqrt_product_ref(s1, s2) assert np.isclose(a, c, rtol=1e-9) print(f" {d:>6} {a:>16.10f} {b:>16.10f} {c:>16.10f}") print() print("[3] 这个差异会传进 FID:同一对特征,两种写法差多少") d = 128 n = 4096 mu_a = rng.standard_normal(d) * 0.3 sa = _rand_psd(d, rng) sb = sa + 0.05 * np.eye(d) xa = rng.multivariate_normal(mu_a, sa, size=n) xb = rng.multivariate_normal(-mu_a, sb, size=n) fa = fid_from_features(xa, xb, mode="sym") fb = fid_from_features(xa, xb, mode="naive") print(f" FID(sym) = {fa:.6f}") print(f" FID(naive) = {fb:.6f} (差值 {fb - fa:+.6f})") print() print("[4] 尺度不是不变的:特征整体乘 c,FID 变 c^2 倍") base = fid_from_features(xa, xb, mode="sym") for c in (0.5, 2.0, 4.0): got = fid_from_features(xa * c, xb * c, mode="sym") assert np.isclose(got, c * c * base, rtol=1e-9) print(f" c={c:<4} FID={got:>12.6f} 期望 c^2*base={c * c * base:>12.6f}") print() print("[5] 有偏 vs 无偏协方差(n 越小差得越多)") d = 128 truth_a = _rand_psd(d, rng) truth_b = truth_a + 0.08 * np.eye(d) print(f" {'n':>7} {'unbiased':>13} {'biased':>13} {'差值':>12}") for n in (256, 1024, 8192): pa = rng.multivariate_normal(np.zeros(d), truth_a, size=n) pb = rng.multivariate_normal(np.zeros(d), truth_b, size=n) fu = fid_from_features(pa, pb, unbiased=True) fb2 = fid_from_features(pa, pb, unbiased=False) print(f" {n:>7} {fu:>13.6f} {fb2:>13.6f} {fb2 - fu:>+12.6f}") print() print("=" * 68) if __name__ == "__main__": self_test() clip_alignment_lab.py """ clip_alignment_lab.py —— CLIP Score 与 FID 到底在给谁打高分。 本机没有 torch,跑不了真的 CLIP。这里搭的是一个**结构替身**: - 两个编码器把图像和文本投到同一个共享空间(真 CLIP 就是这么干的) - 打分用余弦相似度,并且照抄 CLIPScore 论文的定义 CLIP-S = w * max(cos(image, text), 0),w = 2.5(arXiv:2104.08718) - 相似度用归一化向量,FID 用未归一化的原始特征(实际评测也是这么用的) 替身复现不了真 CLIP 的具体数值,但复现了它的**结构**。 下面两个结论都只依赖结构,不依赖具体权重: [A] CLIP Score 随生成多样性单调下降,FID 是 U 形 —— 两者的最优解不在一个地方 [B] CLIP Score 只用一个均值,好坏样本可以互相平均掉 运行: python clip_alignment_lab.py """ from __future__ import annotations import json import os import sys import numpy as np from fid_core import fid_from_features HERE = os.path.dirname(os.path.abspath(__file__)) OUT_JSON = os.path.join(HERE, "_clip_results.json") W = 2.5 # CLIPScore 论文的缩放系数 # ────────────────────────────────────────────────────────────── # 共享空间与两个(替身)编码器 # ────────────────────────────────────────────────────────────── def build_concepts(K: int, ds: int, rng: np.random.Generator) -> np.ndarray: """K 个语义概念的类心,单位范数。ds >> K 时它们近似两两正交。""" C = rng.standard_normal((K, ds)) C /= np.linalg.norm(C, axis=1, keepdims=True) return C def encode_image(C: np.ndarray, idx: np.ndarray, sigma: float, rng: np.random.Generator) -> np.ndarray: """「图像编码器」:类心 + 各向同性噪声。sigma 就是生成多样性。""" Z = rng.standard_normal((idx.shape[0], C.shape[1])) return C[idx] + sigma * Z def encode_text(C: np.ndarray, idx: np.ndarray) -> np.ndarray: """「文本编码器」:prompt 直接就是类心本身。""" return C[idx] def clip_score(images: np.ndarray, texts: np.ndarray, w: float = W) -> dict: """CLIP-S = w * max(cos(image, text), 0),逐样本取均值。""" a = images / np.linalg.norm(images, axis=1, keepdims=True) b = texts / np.linalg.norm(texts, axis=1, keepdims=True) cos = (a * b).sum(axis=1) return { "score": float(w * np.maximum(cos, 0.0).mean()), "cos_mean": float(cos.mean()), "cos_std": float(cos.std()), "cos_frac_gt_half": float((cos > 0.5).mean()), "cos": cos, } # ────────────────────────────────────────────────────────────── # [A] 多样性扫描:FID 与 CLIP Score 的最优解不在一起 # ────────────────────────────────────────────────────────────── def section_a(K=24, ds=64, n=20000, verbose=True): print("=" * 76) print("[A] 生成多样性 sigma_g 扫描:FID 与 CLIP Score 分别给谁打高分") print(f" 真实数据 sigma_real = 0.5,K={K} 个概念,共享空间维度 ds={ds}") print("=" * 76) rng = np.random.default_rng(90210) C = build_concepts(K, ds, rng) idx = rng.integers(0, K, size=n) real_img = encode_image(C, idx, 0.5, rng) real_txt = encode_text(C, idx) ref = clip_score(real_img, real_txt) if verbose: print(f" 真实数据自己的 CLIP Score = {ref['score']:.4f} " f"(cos 均值 {ref['cos_mean']:.4f})") print() print(f" {'sigma_g':>8} {'FID':>10} {'CLIPScore':>11} " f"{'cos均值':>9} {'cos标准差':>10}") rows = [] for sg in (0.05, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0): idx2 = rng.integers(0, K, size=n) gen_img = encode_image(C, idx2, sg, rng) gen_txt = encode_text(C, idx2) fid = fid_from_features(real_img, gen_img) cs = clip_score(gen_img, gen_txt) rows.append((sg, float(fid), cs["score"], cs["cos_mean"], cs["cos_std"])) if verbose: mark = " <- 真实值" if abs(sg - 0.5) < 1e-9 else "" print(f" {sg:>8} {fid:>10.4f} {cs['score']:>11.4f} " f"{cs['cos_mean']:>9.4f} {cs['cos_std']:>10.4f}{mark}") fids = [r[1] for r in rows] scores = [r[2] for r in rows] best_fid = rows[int(np.argmin(fids))][0] best_cs = rows[int(np.argmax(scores))][0] if verbose: print() print(f" FID 最小时 sigma_g = {best_fid}") print(f" CLIP Score 最大时 sigma_g = {best_cs}") print(" -> 在本合成实验中,FID 偏好的方差与 CLIPScore 不同;") print(" 不能据此把真实模型中的多样性与文本对齐视为必然冲突。") print() return {"K": K, "ds": ds, "n": n, "rows": rows, "real_score": ref["score"], "best_fid_sigma": best_fid, "best_clip_sigma": best_cs} # ────────────────────────────────────────────────────────────── # [B] 同一个均值,完全不同的现实 # ────────────────────────────────────────────────────────────── def _score_for_sigma(C, idx, sigma) -> float: """用固定种子探一次,避免二分过程本身消耗主随机流。""" probe = np.random.default_rng(4242) img = encode_image(C, idx, sigma, probe) return clip_score(img, encode_text(C, idx))["score"] def section_b(K=24, ds=64, n=20000, verbose=True): print("=" * 76) print("[B] 汇总 CLIP Score 是均值:好样本和坏样本可以互相平均掉") print(" 模型 M1:p 的概率输出完美匹配,1-p 的概率输出纯噪声") print(" 模型 M2:各样本相似度较集中(调 sigma 让截断后的 CLIPScore 与 M1 相同)") print(" 两者的 CLIP Score 一样,现实完全不一样。") print("=" * 76) rng = np.random.default_rng(1357) C = build_concepts(K, ds, rng) idx = rng.integers(0, K, size=n) real_img = encode_image(C, idx, 0.5, rng) if verbose: print(f" {'p':>6} {'M1 CLIP':>9} {'M1 cos标准差':>13} {'M1 好图占比':>12} " f"{'M1 FID':>10} | {'M2 sigma':>9} {'M2 CLIP':>9} {'M2 cos标准差':>13} " f"{'M2 好图占比':>12} {'M2 FID':>10}") rows = [] for p in (0.3, 0.5, 0.7, 0.9): # M1: 混合 good = rng.random(n) < p img1 = np.where(good[:, None], C[idx], 0.0) # 完美命中类心 noise = rng.standard_normal((n, ds)) noise /= np.linalg.norm(noise, axis=1, keepdims=True) img1 = img1 + np.where(good[:, None], 0.0, noise) # 否则是随机方向 cs1 = clip_score(img1, encode_text(C, idx)) fid1 = fid_from_features(real_img, img1) # M2: 二分法找 sigma,使 CLIP Score 与 M1 对齐 # 注意要对齐的是 score(含 max(cos, 0) 截断),不是裸的 cos 均值 target = cs1["score"] lo, hi = 1e-3, 50.0 for _ in range(60): mid = 0.5 * (lo + hi) if _score_for_sigma(C, idx, mid) > target: lo = mid else: hi = mid sg2 = 0.5 * (lo + hi) img2 = encode_image(C, idx, sg2, rng) cs2 = clip_score(img2, encode_text(C, idx)) fid2 = fid_from_features(real_img, img2) rows.append({"p": p, "m1_clip": cs1["score"], "m1_std": cs1["cos_std"], "m1_good": cs1["cos_frac_gt_half"], "m1_fid": float(fid1), "m2_sigma": float(sg2), "m2_clip": cs2["score"], "m2_std": cs2["cos_std"], "m2_good": cs2["cos_frac_gt_half"], "m2_fid": float(fid2)}) bins = np.linspace(-1.0, 1.0, 51) rows[-1].update(hist_bins=bins.tolist(), hist1=np.histogram(np.clip(cs1["cos"], -1, 1), bins)[0].tolist(), hist2=np.histogram(np.clip(cs2["cos"], -1, 1), bins)[0].tolist(), m1_cos_mean=cs1["cos_mean"], m2_cos_mean=cs2["cos_mean"]) if verbose: print(f" {p:>6} {cs1['score']:>9.4f} {cs1['cos_std']:>13.4f} " f"{cs1['cos_frac_gt_half']:>12.4f} {fid1:>10.3f} | " f"{sg2:>9.3f} {cs2['score']:>9.4f} {cs2['cos_std']:>13.4f} " f"{cs2['cos_frac_gt_half']:>12.4f} {fid2:>10.3f}") if verbose: print() d_clip = max(abs(r["m1_clip"] - r["m2_clip"]) for r in rows) d_std = max(r["m1_std"] / max(r["m2_std"], 1e-9) for r in rows) print(f" CLIP Score 最大差距 = {d_clip:.4f} (按构造两者应当同分)") print(f" 逐样本相似度标准差的比值最大 = {d_std:.2f} 倍") print(" -> 同一个 CLIP Score 背后,可以是「p 的图完美、其余完全不沾边」,") print(" 也可以是「各样本有相近的相似度」。汇总均值看不见这个区别,逐样本分数分布可以。") print() return {"K": K, "ds": ds, "n": n, "rows": rows} def main(): which = sys.argv[1].upper() if len(sys.argv) > 1 else "ALL" res = {} if which in ("ALL", "A"): res["A"] = section_a() if which in ("ALL", "B"): res["B"] = section_b() if which == "ALL": with open(OUT_JSON, "w", encoding="utf-8") as f: json.dump(res, f, ensure_ascii=False, indent=1) print(f"结果已写入 {OUT_JSON}") if __name__ == "__main__": main() make_figures.py """ make_figures.py —— 画本文的配图。 数据来源都是已经跑完的实验(_fid_bias_results.json / _clip_results.json), 不在这里重新算,避免图上的数字和正文漂移。 运行: python make_figures.py """ from __future__ import annotations import json import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") os.makedirs(FIGDIR, exist_ok=True) # 配色(正文里写「这张图要看什么」时按这六个名字来描述) C_MAIN = "#1f4e79" # 深蓝:主曲线 C_ALT = "#c1440e" # 橙红:对照曲线 C_GREEN = "#2e7d32" # 绿:第三组 C_PURPLE = "#7b1fa2" # 紫:标注线 C_GRAY = "#8a8a8a" # 灰:参考线 C_LIGHT = "#bcd7ee" # 浅蓝:填充 plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["figure.dpi"] = 130 plt.rcParams["savefig.dpi"] = 130 def _load(name): p = os.path.join(HERE, name) if not os.path.exists(p): return None with open(p, encoding="utf-8") as f: return json.load(f) # ────────────────────────────────────────────────────────────── # 图 1:FID 的样本量偏差 # ────────────────────────────────────────────────────────────── def fig_bias(res): rows512 = res["A"]["by_d"]["512"] rows2048 = res["A"]["by_d"]["2048"] rows_b = res["B"]["rows"] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:偏差 vs n ── n5 = [r[0] for r in rows512] f5 = [r[1] for r in rows512] n2 = [r[0] for r in rows2048] f2 = [r[1] for r in rows2048] ax1.loglog(n5, f5, "o-", color=C_MAIN, lw=2, ms=5, label=r"$d=512$") ax1.loglog(n2, f2, "s-", color=C_ALT, lw=2, ms=5, label=r"$d=2048$") # 参考斜率 1/n ref_n = np.array([n2[3], n2[-1]], dtype=float) ref_y = f2[-1] * (ref_n / n2[-1]) ** (-1.0) ax1.loglog(ref_n, ref_y, "--", color=C_GRAY, lw=1.6, label=r"$\mathrm{slope}=-1$") ax1.axvline(2048, color=C_PURPLE, ls=":", lw=1.6) ax1.annotate(r"$n=d=2048$", xy=(2048, 1.0), xytext=(2600, 1.6), color=C_PURPLE, fontsize=10) ax1.annotate(r"$n=50000$ 时仍有 $14.21$", xy=(n2[-1], f2[-1]), xytext=(9000, 30), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax1.set_xlabel("样本量 $n$(两组各 $n$ 张)", fontsize=11) ax1.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11) ax1.set_title("偏差随样本量衰减:$1/n$", fontsize=12, pad=8) ax1.legend(loc="upper right", fontsize=10, framealpha=0.95) ax1.grid(True, which="both", alpha=0.25) # ── 右:偏差 vs d ── dd = [r[0] for r in rows_b] bb = [r[1] for r in rows_b] ax2.loglog(dd, bb, "o-", color=C_MAIN, lw=2, ms=6) lo, hi = np.log(dd[0]), np.log(dd[-1]) slope = (np.log(bb[-1]) - np.log(bb[0])) / (hi - lo) ax2.annotate(r"$\mathrm{slope}\approx %.2f$" % slope, xy=(dd[2], bb[2]), xytext=(90, 20), fontsize=11.5, color=C_PURPLE, arrowprops=dict(arrowstyle="->", color=C_PURPLE, lw=1.2)) ax2.scatter([2048], [bb[-1]], s=90, facecolors="none", edgecolors=C_ALT, lw=2, zorder=5) ax2.annotate(r"$d=2048$ 时 $71.14$", xy=(2048, bb[-1]), xytext=(600, 40), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax2.set_xlabel("特征维度 $d$", fontsize=11) ax2.set_ylabel(r"$\mathrm{FID}$(真值 $0$)", fontsize=11) ax2.set_title(r"固定 $n=10000$,偏差随维度暴涨", fontsize=12, pad=8) ax2.grid(True, which="both", alpha=0.25) fig.suptitle("图 1:人工高斯同分布,有限样本估计仍有偏差", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_fid_bias.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out, f"slope={slope:.3f}") # ────────────────────────────────────────────────────────────── # 图 2:前两阶矩一样、分布完全不同 # ────────────────────────────────────────────────────────────── def fig_moment_blind(res): rows = res["D"]["rows"] sep = [r[0] for r in rows] fpop = [abs(r[1]) for r in rows] femp = [r[2] for r in rows] aucb = [r[3] for r in rows] nn = [r[4] for r in rows] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:二维示意 ── rng = np.random.default_rng(20261001) a = 4.2 # 二维示意里把模式拉开一点,让「两个团」一眼可见 n = 1400 sgn = rng.integers(0, 2, size=n) * 2 - 1 P = rng.standard_normal((n, 2)) + np.stack([sgn * a, np.zeros(n)], axis=1) covq = np.eye(2) + np.array([[a * a, 0.0], [0.0, 0.0]]) Q = rng.multivariate_normal(np.zeros(2), covq, size=n) ax1.scatter(P[:, 0], P[:, 1], s=9, alpha=0.5, color=C_MAIN, label="真实分布 $P$(两个模式)") ax1.scatter(Q[:, 0], Q[:, 1], s=9, alpha=0.5, color=C_ALT, label="生成分布 $Q$(糊成一团)") # 画 Q 的 1 个标准差椭圆 w, V = np.linalg.eigh(covq) ang = np.degrees(np.arctan2(V[1, -1], V[0, -1])) from matplotlib.patches import Ellipse for k, col in ((1, C_ALT), (2, C_ALT)): e = Ellipse((0, 0), 2 * k * np.sqrt(w[0]), 2 * k * np.sqrt(w[1]), angle=ang, fill=False, ls="--", lw=1.4, edgecolor=col, alpha=0.75) ax1.add_patch(e) ax1.set_xlim(-9, 9) ax1.set_ylim(-4.2, 4.2) ax1.set_aspect("equal", adjustable="box") ax1.set_xlabel(r"$x_1$", fontsize=11) ax1.set_ylabel(r"$x_2$", fontsize=11) ax1.set_title(r"$\mathrm{FID}=0$,但一眼就能看出不是一回事", fontsize=12, pad=8) ax1.legend(loc="upper left", fontsize=10, framealpha=0.95) ax1.grid(True, alpha=0.25) # ── 右:FID 与可区分度 ── ax2.plot(sep, femp, "o-", color=C_MAIN, lw=2.2, ms=6, label=r"$\mathrm{FID}$(左边刻度)") ax2.set_yscale("log") ax2.set_ylim(1e-3, 1e1) ax2.axhline(0.5, color=C_GRAY, ls=":", lw=1.2) ax2.set_xlabel("模式间距 $2|m|$", fontsize=11) ax2.set_ylabel(r"$\mathrm{FID}$(对数刻度,真值严格为 $0$)", fontsize=11, color=C_MAIN) ax2.tick_params(axis="y", labelcolor=C_MAIN) ax3 = ax2.twinx() ax3.plot(sep, aucb, "s--", color=C_ALT, lw=2.2, ms=6, label=r"$\mathrm{AUC}$(最优判别)") ax3.plot(sep, nn, "^--", color=C_GREEN, lw=2.2, ms=6, label=r"$1$-$\mathrm{NN}$ 两样本准确率") ax3.axhline(0.5, color=C_GRAY, ls="-", lw=1.0) ax3.set_ylim(0.45, 1.0) ax3.set_ylabel(r"$\mathrm{AUC}$ / $1$-$\mathrm{NN}$(右边刻度)", fontsize=11) ax3.text(sep[-1], 0.47, r"$0.5=$ 随机猜测", color=C_GRAY, fontsize=9.5, ha="right") h1, l1 = ax2.get_legend_handles_labels() h2, l2 = ax3.get_legend_handles_labels() ax2.legend(h1 + h2, l1 + l2, loc="center left", fontsize=9.5, framealpha=0.95) ax2.set_title("模式越分开,FID 越是一动不动,判别器越看得清", fontsize=12, pad=8) fig.suptitle("图 2:FID 只匹配前两阶矩,形状对不对它不管", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_moment_blind.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out) # ────────────────────────────────────────────────────────────── # 图 3:FID 与 CLIP Score 的最优解不在一起 # ────────────────────────────────────────────────────────────── def fig_clip_vs_fid(cres): rows = cres["A"]["rows"] sg = [r[0] for r in rows] fid = [r[1] for r in rows] cs = [r[2] for r in rows] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.4, 4.7)) # ── 左:sigma 扫描 ── ax1.plot(sg, fid, "o-", color=C_MAIN, lw=2.4, ms=6) ax1.set_xlabel(r"生成多样性 $\sigma_g$", fontsize=11) ax1.set_ylabel("FID(越低越好)", fontsize=11, color=C_MAIN) ax1.tick_params(axis="y", labelcolor=C_MAIN) ax1.set_ylim(-1.0, 19.5) imin = int(np.argmin(fid)) ax1.scatter([sg[imin]], [fid[imin]], s=170, facecolors="none", edgecolors=C_MAIN, lw=2.2, zorder=5) ax1.annotate(r"FID 最小,$\sigma_g=%.2f$" % sg[imin], xy=(sg[imin], fid[imin]), xytext=(0.58, 9.6), color=C_MAIN, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2)) ax3 = ax1.twinx() ax3.plot(sg, cs, "s--", color=C_ALT, lw=2.4, ms=6) ax3.set_ylabel("CLIP Score(越高越好)", fontsize=11, color=C_ALT) ax3.tick_params(axis="y", labelcolor=C_ALT) ax3.set_ylim(0.15, 2.85) imax = int(np.argmax(cs)) ax3.scatter([sg[imax]], [cs[imax]], s=170, facecolors="none", edgecolors=C_ALT, lw=2.2, zorder=5) ax3.annotate(r"CLIP Score 最大,$\sigma_g=%.2f$" % sg[imax], xy=(sg[imax], cs[imax]), xytext=(0.21, 1.85), color=C_ALT, fontsize=10.5, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax1.axvline(0.5, color=C_GRAY, ls=":", lw=1.4) ax1.text(0.31, 2.4, r"$\sigma_{\mathrm{real}}=0.5$", color=C_GRAY, fontsize=10) ax1.set_title("合成共享空间:两个目标的最优点不同", fontsize=12, pad=8) ax1.grid(True, alpha=0.22) # ── 右:同一个 CLIP Score 的两种现实 ── brows = cres["B"]["rows"] target = [r for r in brows if abs(r["p"] - 0.5) < 1e-9][0] # 直接读取实验的真实 cos 直方图;不重新捏造近似分布。 bins = np.asarray(target["hist_bins"]) ax2.stairs(target["hist1"], bins, fill=True, alpha=0.72, color=C_ALT, label=r"$M_1$:半数精确对齐,半数随机方向") ax2.stairs(target["hist2"], bins, fill=True, alpha=0.72, color=C_MAIN, label=r"$M_2$:相似度较集中") for key, color in [("m1_cos_mean", C_ALT), ("m2_cos_mean", C_MAIN)]: ax2.axvline(target[key], color=color, ls="--", lw=1.3) ax2.text(0.03, 0.74, "虚线为各自原始 cos 均值\n分数含截断,等分不等于 cos 均值相同", transform=ax2.transAxes, color="#444444", fontsize=8.5) ax2.set_xlabel(r"单张样本的相似度 $\cos(f_{\mathrm{img}}, f_{\mathrm{txt}})$", fontsize=11) ax2.set_ylabel(r"$\mathrm{count}$", fontsize=11) ax2.set_title(r"$M_1$ 标准差 $%.2f$,$M_2$ 标准差 $%.2f$,近似同分" % (target["m1_std"], target["m2_std"]), fontsize=12, pad=8) ax2.legend(loc="upper center", fontsize=9.5, framealpha=0.95) ax2.grid(True, alpha=0.22) fig.suptitle("图 3:合成替身实验,不是真实 CLIP 或 Inception 测评", fontsize=13.5, y=1.0) fig.tight_layout() out = os.path.join(FIGDIR, "fig_clip_vs_fid.png") fig.savefig(out, bbox_inches="tight", facecolor="white") plt.close(fig) print("wrote", out) # ────────────────────────────────────────────────────────────── def main(): res = _load("_fid_bias_results.json") cres = _load("_clip_results.json") made = [] if res: fig_bias(res) fig_moment_blind(res) made += ["fig_fid_bias.png", "fig_moment_blind.png"] if cres: fig_clip_vs_fid(cres) made.append("fig_clip_vs_fid.png") print("figures:", made) if __name__ == "__main__": main()
-
AIGC 基本功|视频 VAE 的时空压缩结构-VideoVAE 视频 VAE 的时空压缩结构 所属方向:表征与压缩 | 难度:进阶 | 前置知识:VAE 结构与训练目标(vae_basics) 关键词:视频VAE、3D因果卷积、时间压缩、分块推理、闪烁伪影、潜变量 token 01. 为什么需要它 先给四个数字,全部来自文末附录里能直接跑的脚本。 数字一:不压时间维,潜变量序列会长到做不了全注意力。 同样一段 121 帧、768×512 的视频,用逐帧图像 VAE(空间 8×8、4 通道)编码出来是 743,424 个 token;改成 4×8×8(时间再压 4 倍、16 通道,CogVideoX / Wan / HunyuanVideo 这一档)是 190,464 个;再激进一点到 8×32×32(LTX-Video 这一档)只剩 6,144 个。自注意力的代价是 $O(N^2)$,所以相对第一档,注意力分别便宜 15.2 倍和 14641 倍(04 节算账,图 4 画出来)。这个差距决定了视频 DiT 能不能做「全时空自注意力」——做不了就只能在空间上做注意力、时间维另想办法,而「时间维另想办法」正是早期视频模型帧间闪烁的根源之一。 数字二:对称时间卷积可能读取未来,本 toy 的每个输出都有这种依赖。 把编码器里的时间填充从「只补前面」换成「前后对称补」,实测 12 个潜变量帧全部都依赖未来帧,最多超前 8 帧。这意味着你没法一边生成一边往外吐——潜变量位置 $j$ 最多要等到输入位置 $4j+8$(与本 toy 总步距 4 对齐),而不是把两侧帧索引直接相加。因果卷积把这个数字压到 0(03 节证明,图 1 左右两栏对比)。 数字三:分块解码不补够上下文,一整块都是错的,不是只有接缝那一帧。 把 24 个潜变量帧切成 3 块、每块 8 帧逐块解码:上下文带 0 帧时,两块合计 64 个输出帧里有 48 帧和整段解码的结果对不上;每块每多带 1 帧上下文,就少错 4 个输出帧(两块合计 8 帧);带到 6 帧时误差精确归零(不是变小,是浮点意义上完全相等)。6 这个数字不是经验值,它等于解码器的时间感受野减 1(03 节推导,图 3 是整条曲线)。 数字四:时间压缩的额度取决于画面运动有多快。 把一个匀速移动的高斯斑点压 8 倍时间再还原,运动速度 0.25 像素/帧时重建 PSNR 是 40.81 dB,速度提到 4 像素/帧掉到 24.92 dB,差 15.9 dB。而且会交叉:压时间 2 倍的曲线在约 2 像素/帧处掉到「压空间 2 倍」这条与速度无关的基线之下——过了这个点,继续压时间不如改压空间(06 节展开,图 5)。 所以这篇文章回答四件事:时间维到底怎么压、何时需要因果卷积、逐块推理要带多少上下文才不接缝、以及时间压缩比能推到多大。 02. 最小可用理解 三句话讲完: 视频 VAE 相对图像 VAE 只多一件事:在时间轴上再压 $s_T$ 倍。 潜变量形状从 $T \times H' \times W' \times C$ 变成 $T' \times H' \times W' \times C$,其中 $T' = \lfloor (T-1)/s_T \rfloor + 1$。token 数直接除以 $s_T$,注意力代价除以 $s_T^2$。 需要严格流式处理时,时间运算应满足因果性。 无膨胀、核长 $k_t$ 的卷积可只在前面补 $k_t-1$ 帧,边界可补零或复制首帧。离线视频 VAE 也可以采用非因果结构;卷积因果还不够,归一化、注意力、池化等其他时间运算也须检查。 代价有两笔,都要记账。 一是时间压缩等价于给运动物体糊上一条长度 $(s_T - 1) \cdot v$ 像素的运动模糊($v$ 是运动速度);二是因果卷积的感受野有限,逐块推理时每块必须额外带「感受野 − 1」帧上下文,带不够就不是接缝难看,是整块算错。 这张图要看什么:横轴是被人为改动的输入帧,纵轴是跟着发生变化的潜变量帧,蓝点表示「这一对有依赖关系」。左图所有蓝点都落在虚线(输入帧 $= 4j$)左边或线上——没有任何一个潜变量帧看到未来;右图蓝点越过虚线,右侧那团就是泄漏的未来信息,实测最多超前 8 帧。两张图除了时间填充方式,其余完全相同。 03. 数学推导 3.1 输出帧数:为什么是 $\lfloor (T-1)/s_T \rfloor + 1$ 而不是 $\lfloor T/s_T \rfloor$ 一维卷积(时间轴)在输入长度 $T_{\text{in}}$、核 $k_t$、步距 $s_t$、两端填充 $p_{\text{front}}$ 和 $p_{\text{back}}$ 下的输出长度是 $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} + p_{\text{front}} + p_{\text{back}} - k_t}{s_t} \right\rfloor + 1$$ 每个符号:$T_{\text{in}}$ 是进入这一层的帧数,$p_{\text{front}}$ 是时间轴前面补的帧数,$p_{\text{back}}$ 是后面补的,$k_t$ 是时间维核长,$s_t$ 是时间步距。 因果卷积取 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$,代进去: $$T_{\text{out}} = \left\lfloor \frac{T_{\text{in}} - 1}{s_t} \right\rfloor + 1$$ 减 1 加 1 这一对不是凑出来的,它有物理含义:首帧被单独保留下来了。 前面补的那 $k_t - 1$ 帧全是零,所以第一个输出位置看到的是「$k_t - 1$ 个零 + 第 0 帧」,它天生就是第 0 帧的专属输出位。剩下 $T_{\text{in}} - 1$ 帧才按步距 $s_t$ 分组。 许多视频模型约定输入帧数为 $1+k s_T$,但要以完整实现为准。 本文 stride-conv toy 两次时间步距 2 时,49 帧的链路为: $$49 \to \lfloor 48/2 \rfloor + 1 = 25 \to \lfloor 24/2 \rfloor + 1 = 13$$ 得到 13 个 latent 帧。对本 toy,100 帧得到 25 个,最后输出所对齐的输入位置为 96,因此尾部 97—99 没被覆盖;真实模型也可能通过补帧、裁剪或专门的池化分支处理。下面引用的 CogVideoX 对奇偶长度有不同池化逻辑,不能把单层 stride-conv 公式不加条件地替代完整模型。 3.2 因果性:为什么前补零就够了 设时间填充后第 $i$ 个输入帧落在下标 $i + k_t - 1$ 上。步距为 $s_t$ 的第 $j$ 个输出取的是填充后区间 $[j s_t,\; j s_t + k_t - 1]$,对应原始输入下标 $$[j s_t - (k_t - 1),\; j s_t]$$ 上界恰好是 $j s_t$——第 $j$ 个输出能用到的最新输入帧就是第 $j s_t$ 帧,未来的帧一个都进不来。这就是因果性的全部证明,它只依赖「$p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$」这一条。 堆多层时把每层的时间步距连乘,记到第 $l$ 层输入为止的累积步距为 $S_l = \prod_{m<l} s_m$,则最终第 $j$ 个潜变量帧能用到的最新输入帧是 $S_{\text{total}} \cdot j$。脚本 causality_check() 用扰动法验过:把第 $t$ 帧之后的所有输入都改掉,凡是满足 $S_{\text{total}} \cdot j < t$ 的潜变量帧,变化量精确等于 0——不是小,是零,因为根本没连过来。 换成对称填充($p_{\text{front}} = p_{\text{back}} = (k_t - 1)/2$),上界变成 $j s_t + \lfloor (k_t - 1)/2 \rfloor$,未来的帧就漏进来了。实测 12 个潜变量帧全部泄漏,最多超前 8 帧。 3.3 时间感受野:为什么越靠后的层越值钱 $t$ 时刻的输出能看到多长的历史,叫时间感受野。标准公式是 $$\mathrm{RF} = 1 + \sum_l (k_l - 1) \cdot S_l,\qquad S_l = \prod_{m<l} s_m$$ 每个符号:$k_l$ 是第 $l$ 层的时间核长,$S_l$ 是走到第 $l$ 层输入时已经累积的时间步距。关键点在 $S_l$:第 $l$ 层的一个核长 $k_l$,在原始输入上跨的是 $k_l \times S_l$ 帧,因为它的每一个位置本身就代表了 $S_l$ 个原始帧。 本工程的 toy 编码器是 4 层 $k = 3$、步距 $[1, 2, 2, 1]$: $$\mathrm{RF} = 1 + 2\cdot 1 + 2\cdot 1 + 2\cdot 2 + 2\cdot 4 = 17$$ 注意最后两项:同样一个 $k = 3$ 的核,在第 3 层贡献 4 帧,到第 4 层就贡献 8 帧——因为前面已经把时间压了 4 倍。这就是「层数不变、压缩比一上去感受野暴涨」的原因,也是下面那条上下文公式的来源。 这张图要看什么:四根柱子的核长全都是 3,但贡献从 2 帧一路涨到 8 帧,涨的唯一原因是柱底标注的「累积步距」从 1 变成 4。要控制感受野和分块开销,就要一起考虑各层的核长与累计步距。 脚本 receptive_field() 用逐帧扰动实测了同一个数:最大跨度 17 帧,与公式逐项吻合;同时验了因果上界(潜变量帧 $j$ 能看到的最新输入帧 $\le 4j$)零次违反。 3.4 逐块推理:需要的上下文帧数恰好是 $\mathrm{RF} - 1$ 由 3.3,输出(或潜变量)帧 $j$ 依赖的输入区间长度是 $\mathrm{RF}$,右端点是 $S_{\text{total}} \cdot j$,所以左端点是 $S_{\text{total}} \cdot j - \mathrm{RF} + 1$。 现在做分块:要正确算出第 $j_0$ 块,就必须拿到它左端点往前的全部输入。缺掉的部分在普通卷积里是被零填充替掉的——零不是正确的值,于是结果错。所以: $$\text{所需上下文} = \mathrm{RF} - 1 \quad \text{(以该侧的时间单位为帧)}$$ 注意单位随你在哪一侧算: 解码侧:单位是潜变量帧。本 toy 解码器的感受野实测是 7 个潜变量帧(两次最近邻上采样会把间距缩小,所以按「潜变量帧」计只有 7 而不是几十),于是需要 6 帧上下文。 编码侧:单位是输入帧。编码器感受野 17 帧,于是需要 16 帧输入上下文。 两条都被脚本验到了:解码侧 ctx 从 0 加到 6,误差在 6 处精确归零;编码侧 ctx 从 0 加到 16,误差在 16 处精确归零。这不是调参调出来的,是感受野直接算出来的。 3.5 时间压缩等价于一条多长的运动模糊 把时间下采样简化成最朴素的「$s$ 帧取平均」(CogVideoX 的下采样层真的就是 avg_pool1d,见 05 节)。一个以速度 $v$ 像素/帧平移的物体,在 $s$ 帧内走过的距离是 $(s-1)v$,所以 $s$ 帧平均等价于把它和一条长度 $L = (s-1)v$ 的盒式核做卷积。 这实际上是 $s$ 个离散平移位置的均匀平均,位移取 $0,v,\ldots,(s-1)v$,其方差为 $v^2(s^2-1)/12$。不是把端点距离直接代入连续盒核的 $L^2/12$。因此,无限画布上按二阶矩定义的宽度满足 $$\sigma_{\text{new}} = \sqrt{\sigma^2 + \frac{v^2(s^2-1)}{12}}$$ 当 $s=8,v=4,\sigma=3$ 时,解析宽度是 $\sqrt{9+84}=\sqrt{93}\approx9.644$ 像素;带微噪声并截去噪声底的代码测得约 9.640。差别来自有限画布和阈值测宽,而不是神经网络实验。这只是“时间平均 + 最近邻还原”的模型,不是学习型视频 VAE 的必然误差或压缩下界。 04. 代码实现 环境只要 numpy。全部脚本在文末附录,这里放最核心的三段。 4.1 因果卷积:时间只补前面 def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。注意不是 floor(T_in / s_t)。""" return (t_in - 1) // s_t + 1 toy 使用无 batch 的 [C,T,H,W];PyTorch Conv3d 常用带 batch 的 [B,C,T,H,W],也支持无 batch 输入。真实输出: T_in= 49 -> s_t=1: 预测 49 / 实测 49 OK s_t=2: 预测 25 / 实测 25 OK s_t=4: 预测 13 / 实测 13 OK 两级时间压缩 2(CogVideoX 口径):49 帧 -> 25 -> 13 潜变量帧 4.2 因果性检验:改未来,看过去 def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") 真实输出: 应该完全不受影响的潜变量帧上,最大变化量 = 0.000e+00 把 ToyVideoVAE() 换成 ToyVideoVAE(time_pad="symmetric") 再跑一次 dependency_matrix,会得到「12 个潜变量帧全部泄漏、最多超前 8 帧」——这是 09 节留给读者的第一个动手验证。 4.3 分块解码:接缝是算出来的,不是看出来的 def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts 96 帧输入 $\to$ 24 个潜变量帧 $\to$ 切 3 块,真实输出(误差按输出标准差归一): ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大 ----+---------+---------+----------------+------------ 0 | 2.550e+00 | 3.206e+00 | 48 | 1.90x 1 | 2.094e+00 | 1.814e+00 | 40 | 2.19x 2 | 1.658e+00 | 1.399e+00 | 32 | 1.88x 3 | 1.313e+00 | 8.267e-01 | 24 | 2.19x 4 | 8.700e-01 | 4.549e-01 | 16 | 1.15x 5 | 4.051e-01 | 0.000e+00 | 8 | 1.07x 6 | 0.000e+00 | 0.000e+00 | 0 | 1.00x 三件事要读出来: 误差在 ctx = 6 处精确归零,不是渐近变小。少 1 帧(ctx = 5)还剩 8 个输出帧是错的。 每块每少带 1 帧上下文,就多错 4 个输出帧(表中两块合计 8 帧),正好等于 1 个潜变量帧的输出跨度($s_T = 4$)。所以「接缝」根本不是一条线,是一段区域。 块尾误差比块头误差先归零(ctx = 5 时块尾已经是 0 而块头还有 0.405)。这符合感受野的形状:越靠块尾,缺的上下文越少。 编码侧同理,真实输出(每块 32 个输入帧,误差按潜变量标准差归一): ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数 ----+----------------+----------------+-------------- 0 | 3.245e+00 | 2.984e+00 | 4 8 | 1.297e+00 | 0.000e+00 | 2 12 | 6.090e-01 | 0.000e+00 | 1 16 | 0.000e+00 | 0.000e+00 | 0 阈值 16,正是编码器感受野 $17 - 1$。 这张图要看什么:左图两条线(块头、块尾)在 ctx = 6 处一起掉到 0,纵坐标是对数轴——前面那段下降看着平缓,其实是从「两个标准差」这种肉眼可见的错误降到零。右图的阶梯更直白:被污染帧数每块减少 4 帧、图中两块合计减少 8 帧,斜率就是 $s_T$。 4.4 token 账本 def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 121 帧 / 768×512 / RGB 的真实输出: 配置 | 潜变量形状 (T'xH'xW'xC) | token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 121 x 64 x 96 x 4 | 743,424 | 1.000e+00 | 1.0x | 192 CogVideoX / Wan / HunyuanVideo(4x8x8)| 31 x 64 x 96 x 16 | 190,464 | 6.564e-02 | 15.2x | 768 LTX-Video(8x32x32) | 16 x 16 x 24 x 128 | 6,144 | 6.830e-05 | 14641.0x | 24,576 只动时间维的对照(固定空间 8×8、通道 16):时间压缩 1→2→4→8,token 数 743,424→374,784→190,464→98,304,长序列下近似每翻一倍注意力代价降到 1/4,首帧保留会带来取整差异。 这张图要看什么:左图是序列长度(对数轴),右图是注意力的相对代价——右图的差距比左图大得多,因为代价是 $N^2$。6,144 个 token 意味着 LTX-Video 可以在这个分辨率上直接做全时空自注意力,而 743,424 个 token 连存 attention map 都存不下。 05. 工业级实现对照 最小实现只有一条时间前补零,生产代码多了五处,每处都有原因。以下均以 huggingface/diffusers 2026-09 的实现为准(上游会重构,引用时请对照 repo/path#symbol): src/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3d src/diffusers/models/autoencoders/autoencoder_kl_wan.py#WanCausalConv3d src/diffusers/models/downsampling.py#CogVideoXDownsample3D src/diffusers/models/upsampling.py#CogVideoXUpsample3D 5.1 填充元组:时间只补前面 src/diffusers/models/autoencoders/autoencoder_kl_cogvideox.py#CogVideoXCausalConv3d: time_pad = time_kernel_size - 1 self.time_causal_padding = (width_pad, width_pad, height_pad, height_pad, time_pad, 0) F.pad 的元组是从最后一维往前写的,所以这六个数的含义是 $(W_{\text{left}}, W_{\text{right}}, H_{\text{left}}, H_{\text{right}}, T_{\text{left}}, T_{\text{right}})$。最后两个是 $(k_t - 1,\ 0)$——和 3.2 节推导的 $p_{\text{front}} = k_t - 1$、$p_{\text{back}} = 0$ 完全一致。空间两维是对称的,只有时间轴不对称。 Wan 的 WanCausalConv3d(autoencoder_kl_wan.py)写成另一种形式: self._padding = (self.padding[2], self.padding[2], self.padding[1], self.padding[1], 2 * self.padding[0], 0) self.padding = (0, 0, 0) 它先把 nn.Conv3d 自带的 padding 清零,改成自己手动 pad。$k_t = 3$ 时 padding[0] = 1,于是 $2 \cdot 1 = 2 = k_t - 1$,和 CogVideoX 殊途同归。 5.2 上下文缓存:分块推理靠它 CogVideoX 的 fake_context_parallel_forward: kernel_size = self.time_kernel_size if kernel_size > 1: cached_inputs = [conv_cache] if conv_cache is not None else [inputs[:, :, :1]] * (kernel_size - 1) inputs = torch.cat(cached_inputs + [inputs], dim=2) return inputs 读法:有缓存就把上一块最后 $k_t - 1$ 帧拼到前面;是第一块(没缓存)就把第 0 帧复制 $k_t - 1$ 次。这正好对应 3.4 节的两种情形——「缺上下文就用别的东西填」,而复制首帧比补零更合理(这是 pad_mode 的一个选项)。紧接着: conv_cache = inputs[:, :, -self.time_kernel_size + 1:].clone() 把拼接后输入的最后 $k_t - 1$ 帧存起来,给下一块用。整个编码器把这些缓存收进一个以层名索引的字典(conv_in、down_block_0……)逐层传递。Wan 的对应逻辑更紧凑,直接把缓存长度从待补的填充里减掉: if cache_x is not None and self._padding[4] > 0: x = torch.cat([cache_x, x], dim=2) padding[4] -= cache_x.shape[2] 这就是 04 节那个 ctx 在生产代码里的样子。 这里有个容易看错的地方:工业实现每层只缓存 $k_t - 1 = 2$ 帧,而 04 节实测需要 6 帧,直觉上会觉得「2 帧不够」。其实够——因为每层缓存的是该层自己输入分辨率下的帧,越往后的层分辨率越高,同样 2 帧折回潜变量帧单位就越小。把解码器 d0…d4 逐层折算后累加: 层 输入相对潜变量的帧间距 缓存 $(k_t - 1)$ 帧折回潜变量帧 d0 1.00 2.00 d1 1.00 2.00 d2 0.50 1.00 d3 0.25 0.50 d4 0.25 0.50 合计 6.00 逐层累加 = 6.00,和 04 节实测需要的 6 帧完全吻合——逐层缓存本来就等价于整条链路的感受野减 1,前提是每一层都缓存。真正的陷阱是只在网络入口缓存一次,那样只有 2 帧,接缝一定在。 5.3 时间下采样:CogVideoX 用的是平均池化,不是学习出来的卷积 src/diffusers/models/downsampling.py#CogVideoXDownsample3D: x = x.permute(0, 3, 4, 1, 2).reshape(batch_size * height * width, channels, frames) if x.shape[-1] % 2 == 1: x_first, x_rest = x[..., 0], x[..., 1:] x_rest = F.avg_pool1d(x_rest, kernel_size=2, stride=2) x = torch.cat([x_first[..., None], x_rest], dim=-1) else: x = F.avg_pool1d(x, kernel_size=2, stride=2) 两个细节值得记住: 时间维是 avg_pool1d,不是 stride 卷积。 空间维倒是用 nn.Conv2d(stride=2)(注意它把 (B, T, C, H, W) 折叠成 (B*T, C, H, W) 后用 2D 卷积做的,目的是省 Conv3d 的显存)。所以 3.5 节把时间下采样建模成平均池化不是偷懒,它就是这个实现。 帧数为奇数时首帧单独保留,不参与池化——和 3.1 节「首帧单独占一个输出位」是同一件事的两种写法。 上采样端(upsampling.py#CogVideoXUpsample3D)对称地用 F.interpolate 做时间 2 倍、空间 2 倍,并且同样对首帧单独处理。 另外编码器里有一行决定「在哪几层压时间」: temporal_compress_level = int(np.log2(temporal_compression_ratio)) compress_time = i < temporal_compress_level 压缩比 4 → level = 2 → 只有前两个下采样块压时间。这也解释了图 2 那件事:压缩集中在前段时,后段的层会以更大的累积步距去看历史,感受野涨得最快。 5.4 与最小实现的五处差距 差距 生产代码 为什么 归一化 GroupNorm / CogVideoXSpatialNorm3D 调节中间激活的尺度;不能代替 KL,也不保证 latent 标准正态。若统计量跨时间,还须单独检查因果性 激活与结构 ResNet block + SiLU,不是单层卷积 单层卷积的表达能力撑不起 8×8 的空间压缩 卷积实现 CogVideoXSafeConv3d(分块跑的 Conv3d) 避免长视频上 Conv3d 一次性分配大显存 缓存粒度 每层一个 key 的字典 分块推理要逐层续接,不是只在入口续接 精度与缓存 dtype 由模型配置决定;缓存可 .clone() bf16 降低存储,clone 控制缓存所有权;二者是不同问题 06. 代价与边界 数值个数、序列长度与信息量是三件事。 这张表最容易看错: 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值) 图像 VAE 逐帧(SVD / AnimateDiff 口径)| 2,973,696 | 48.0 : 1 CogVideoX / Wan / HunyuanVideo(4x8x8)| 3,047,424 | 46.8 : 1 LTX-Video(8x32x32) | 786,432 | 181.5 : 1 4×8×8 这一档的数值元素压缩比和逐帧图像 VAE 几乎一样(46.8 vs 48.0)。它在这个数值元素口径下没有更小,但并非无损重排:学习型编码器把 743,424 个 token 重排成 190,464 个更「厚」的 token(通道 4 → 16)。数值个数接近不代表信息容量相同;这张表直接说明的是序列长度。 真正开始省容量的是 8×32×32 这一档,代价是 LTX-Video 摘要里自己写的那句:"the high compression inherently limits the representation of fine details"(高压缩本质上限制了细节的表达)。 时间压缩的额度由运动速度决定。 图 5 的三组曲线: 这张图要看什么:实线是压时间,虚线是压空间(与速度无关,当基线用)。同一颜色实线往下掉、虚线不动,交叉之后「再压时间」就不如「改压空间」。实测交叉点:压 2 倍和 4 倍在约 2 像素/帧处,压 8 倍在约 4 像素/帧处。 速度 v | 时间 2x / 空间 2x 时间 4x / 空间 4x 时间 8x / 空间 8x 0.25 | 53.49 / 39.00 46.87 / 32.35 40.81 / 26.58 1.00 | 41.97 / 39.00 35.28 / 32.35 30.05 / 26.58 2.00 | 36.15 / 39.00 30.18 / 32.35 26.62 / 26.58 4.00 | 30.83 / 39.00 26.69 / 32.29 24.92 / 26.57 这些交叉点只属于本实验的斑点、尺寸、噪声和滤波器。尤其“时间 s 倍”减少 s 倍元素,而“空间两轴各 s 倍”减少 s² 倍元素,并非等码率比较,不能据此给出“超过 2 像素/帧就不能压缩”的部署阈值。真实 VAE 需在相同码率、动作数据和感知/时序指标下做验证。 首帧总是吃亏的。 因果卷积前面补的是零(或复制首帧),第一个输出位置天然只能看到 1 帧输入。图 1 左图第 0 行只有一个蓝点就是这个意思。所以「图生视频」任务里把首帧单独处理、或者编码时多给一帧,是常见做法。 上下文是纯开销。 带够 $\mathrm{RF} - 1$ 帧上下文,意味着每块要多算: 解码块大小 | 需要上下文 | 额外算力占比 8 潜变量帧 | 6 帧 | 42.9% 16 潜变量帧 | 6 帧 | 27.3% 24 潜变量帧 | 6 帧 | 20.0% 编码块大小 | 需要上下文 | 额外算力占比 32 输入帧 | 16 帧 | 33.3% 128 输入帧 | 16 帧 | 11.1% 上下文的绝对量是固定的,块越大摊得越薄。这就是「块不能切太小」的定量理由:块切成 8 帧,42.9% 的算力花在重复计算上,此时「分块省显存」的收益已经被吃掉了三分之一。 离线场景可以考虑非因果结构。 它能使用前后帧,但是否提高质量要由实验决定。非因果网络也能分块,只是需要左右上下文或接受输出延迟。因果性本身不保证无闪烁,也不保证完整模型严格流式:跨时间归一化或全局注意力仍可能破坏性质。 07. 经典论文脉络 五篇,每篇一句话说清它对「时间维怎么处理」的贡献: VQ-VAE(arXiv:1711.00937,2017) — 提出「先压成离散 token 再建模」的范式。它本身是图像的,但整套 video tokenizer 都是从它长出来的。 MAGVIT(arXiv:2212.05199,2022) — 把 3D 卷积 + 时间下采样正式带进视频 tokenizer,用 masked modeling 训练,是这一方向的一项代表工作。(更早的 VideoGPT,arXiv:2104.10157,是另一条路:VQ-VAE + 自回归 Transformer。) MAGVIT-v2(arXiv:2310.05737,2023) — 换掉矢量量化,用 lookup-free 量化把词表做大,让离散视频 token 的质量第一次追上扩散。标题那句 "Tokenizer is Key" 就是这一支的纲领。 CogVideoX(arXiv:2408.06072,2024) — 本文的锚点。把 3D 因果 VAE 和 Expert Transformer 绑在一起,明确以「提高压缩率同时保住保真度」为目标;它也是这套因果缓存实现被广泛复用的起点。同期的 HunyuanVideo(arXiv:2412.03603)与 Wan(arXiv:2503.20314)都走 4×8×8 这一档。 LTX-Video(arXiv:2501.00103,2025) — 把压缩比推到 8×32×32(摘要自述 1:192),代价是细节;它的解法是让解码器顺手把最后一步去噪也做了,直接在像素空间出结果。 还有一条不压时间的路线:Stable Video Diffusion 使用空间压缩的图像自编码器并加入时序解码层;Align your Latents 是较早的 Video LDM 工作,不能把两个标题和论文 ID 混在一起。逐帧 latent 的长度更大,但生成器是否采用全时空、分离式注意力或其他结构会改变真实成本。 08. 常见误解 误解一:「时间压缩 4 倍时,48 帧一定输出 13 帧。」 本文单侧填充 stride-conv 公式给出 $\lfloor47/4\rfloor+1=12$,49 帧才给 13。许多真实模型限定 $1+k s_T$ 帧,其他输入长度会经过补齐、裁剪或不同池化分支,必须核对代码,不能把帧数规则泛化。 误解二:「只要卷积前补零,整个 VAE 就严格因果。」 单层卷积的因果范围可以逐项证明,但还要检查膨胀、池化对齐、归一化和注意力的时间依赖。分块既可逐层缓存中间特征,也可在入口重叠足够大的上下文后裁剪;后者在本 toy 需要 6 个 latent 帧,而不是只缓存 2 帧。两种方式都可正确,只是计算和内存开销不同。 误解三:「分块解码只要重叠 1 帧就够,接缝最多难看一点点。」 实测:缺上下文时不是接缝那一帧错,是整块错。块大小 8 个潜变量帧、上下文 0 帧时,32 个输出帧里 24 帧是错的;每少带 1 帧上下文多错 4 个输出帧。而且这个错误不是「视觉上略糊」,是数值上完全跑偏(相对标准差 2.55 倍)。 误解四:「压缩比越高越好,反正都是 VAE 重建。」 4×8×8 相对逐帧图像 VAE 的数值元素压缩比几乎没变(46.8:1 vs 48.0:1),它省的是序列长度(06 节第一张表)。真正省容量的是 8×32×32 那一档,而论文自己承认细节受限。所以「压缩比」这个词在这件事上有两个含义,混着用会得出完全相反的结论。 误解五:「视频 VAE 就是把图像 VAE 的 2D 卷积换成 3D 卷积。」 三处不一样:(a)CogVideoX 的时间池化本身没有可学习参数,但其前后的 3D 时间卷积有;(b)空间卷积被折叠成 2D 卷积做,为的是省 Conv3d 的显存;(c)temporal_compress_level = int(log2(ratio)) 决定只有前几层压时间,不是每层都压。想从图像 VAE 权重 inflate 一个视频 VAE,这三处都得单独处理。 09. 动手验证 五个脚本都在文末附录;数值实验依赖 numpy,make_figures.py 还依赖 matplotlib。运行时间取决于机器。 python causal_conv3d.py # 形状公式 + 因果性 + 感受野(约 11 秒) python chunk_decode.py # 分块编解码的接缝(约 8 秒) python temporal_budget.py # 运动速度 vs 时间压缩 python token_ledger.py # token 账本 python make_figures.py # 重画本文 5 张图 预期结果: causal_conv3d.py:形状公式 6 组输入、3 组步距预测值全部等于实测值;49 -> 25 -> 13;因果性违反量 0.000e+00;感受野公式 17 = 实测 17,因果上界 0 次违反。 chunk_decode.py:解码侧 ctx = 6 时误差 0.000e+00;编码侧 ctx = 16 时误差 0.000e+00;被污染帧数随 ctx 每 +1 减 8(两块合计)。 temporal_budget.py:s=8 那一列 PSNR 从 40.81 dB 掉到 24.92 dB;宽度增幅实测约 3.24 倍,修正离散方差后的解析值也约 3.24 倍;交叉点报在 2 / 2 / 4 像素/帧。 三个可以自己改的小实验: 把因果改成非因果:dependency_matrix(t_in=48, time_pad="symmetric"),看所有 12 个潜变量帧都越过 $4j$ 那条线,最多超前 8 帧。 把解码器的 latent 级卷积从 2 层加到 4 层:感受野会变成 11 个潜变量帧,所需上下文从 6 涨到 10,重跑 chunk_decode.py 会看到阈值跟着移动。这条最能验证「上下文 = 感受野 − 1」不是巧合。 把 toy 编码器的时间步距从 $[1,2,2,1]$ 改成 $[1,1,2,2]$:总压缩比不变(还是 4),但累积步距的分布变了,感受野从 17 变成 $1+2+2+2+4=11$。压缩比相同,上下文开销不同——这就是选架构时真正该看的量。 10. 延伸阅读 按依赖顺序: vae_basics(VAE 结构与训练目标) — 本文默认你已经知道 KL 项和重参数化在干什么。若要接着问「潜变量为什么要近似标准正态」,看它。 vae_losses(视频 VAE 的常见 loss 组合) — 本文只讲了结构没讲训练目标。L1 + KL + LPIPS + GAN 四项权重怎么配、谁在管伪影,是那篇的话题;帧间闪烁的根因有一半在那儿,不在本文的因果性里。 latent_diffusion(潜空间扩散) — 潜变量一旦定了,扩散过程就全在它上面做,包括那个 scaling factor。 dit(DiT:用 Transformer 替掉 UNet) — 01 节那个 $N^2$ 账单最后是要 DiT 来付的,token 数直接决定它能不能做全时空注意力。 autoregressive_video(自回归视频生成与 Forcing 范式) — 本文讲的是「逐块解码不接缝」;那篇讲的是更进一步:干脆按帧自回归地生成,因果性从 VAE 一路贯穿到生成模型。 附录:完整代码 09 节用到的脚本全文如下(make_figures.py、causal_conv3d.py、chunk_decode.py、temporal_budget.py、token_ledger.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 make_figures.py # -*- coding: utf-8 -*- """画配图。所有数字都来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] 标签一律用 Unicode(σ、×)而不是 mathtext,省得反斜杠踩到转义检查。 """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import causal_conv3d as cc # noqa: E402 import chunk_decode as cd # noqa: E402 import token_ledger as tl # noqa: E402 import temporal_budget as tb # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Heiti TC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:因果 vs 非因果的依赖矩阵 ─────────────── def fig_dependency(): dep_c = cc.dependency_matrix(t_in=48, time_pad="causal") dep_n = cc.dependency_matrix(t_in=48, time_pad="symmetric") fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.6), sharey=True) for ax, dep, title in ((axes[0], dep_c, "因果卷积:只看过去"), (axes[1], dep_n, "普通卷积:前后都看")): ax.imshow(dep.T, aspect="auto", cmap="Blues", interpolation="nearest", origin="lower") nz = dep.shape[1] jj = np.arange(nz) ax.plot(4 * jj, jj + 0.5, color=C1, lw=1.6, ls="--", label="输出帧 j 对应的输入帧 4j") ax.set_xlabel("输入帧 t") ax.set_title(title, fontsize=12) ax.legend(loc="upper left", fontsize=9) axes[0].set_ylabel("潜变量帧 j") # 标一处「未来泄漏」 leak = [] for j in range(dep_n.shape[1]): idx = np.where(dep_n[:, j])[0] if len(idx) and idx.max() > 4 * j: leak.append(int(idx.max()) - 4 * j) if leak: axes[1].annotate(f"这里看到了未来\n最多超前 {max(leak)} 帧", xy=(30, 6), xytext=(24, 9.5), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) fig.suptitle("图 1:谁依赖谁——横轴是被改动的输入帧,纵轴是跟着变的潜变量帧", fontsize=13) fig.tight_layout() _save(fig, "fig1_dependency.png") return dep_c, dep_n # ─────────────── 图 2:感受野为什么会被步距放大 ─────────────── def fig_rf(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] contrib, cum = [], [] c = 1 for k, s in zip(kernels, strides): contrib.append((k - 1) * c) cum.append(c) c *= s rf = 1 + sum(contrib) fig, ax = plt.subplots(figsize=(7.6, 4.4)) x = np.arange(len(kernels)) ax.bar(x, contrib, color=[C0, C0, C2, C1], width=0.62) for i, (v, cu) in enumerate(zip(contrib, cum)): ax.text(i, v + 0.25, f"+{v}", ha="center", fontsize=10) ax.text(i, -0.9, f"累积步距 {cu}", ha="center", fontsize=9, color="#555555") ax.axhline(0, color="#333333", lw=0.8) ax.set_xticks(x) ax.set_xticklabels([f"第 {i + 1} 层\nk={k}, s={s}" for i, (k, s) in enumerate(zip(kernels, strides))]) ax.set_ylabel("这一层给感受野贡献的帧数") ax.set_ylim(-1.6, max(contrib) + 1.6) ax.set_title(f"图 2:同样的 k=3,越靠后的层贡献越大(总感受野 = 1 + 各项 = {rf} 帧)", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig2_rf.png") return contrib, rf # ─────────────── 图 3:分块解码的接缝 ─────────────── def fig_chunk(): net, v, z, ref = cd.build() scale = float(ref.std()) ctxs = list(range(0, 9)) head, tail, contam = [], [], [] for ctx in ctxs: got, starts = cd.decode_chunked(net, z, cd.CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale hi, ti, cn = [], [], 0 for s in starts[1:]: hi += list(range(s, s + cd.T_STRIDE)) ti += list(range(s + cd.T_STRIDE, s + cd.CHUNK * cd.T_STRIDE)) cn += int((diff[s:s + cd.CHUNK * cd.T_STRIDE] > 1e-9).sum()) head.append(float(diff[hi].max())) tail.append(float(diff[ti].max())) contam.append(cn) fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] ax.plot(ctxs, head, "o-", color=C1, lw=2.2, label="块头误差(块的前 4 个输出帧)") ax.plot(ctxs, tail, "s--", color=C0, lw=2.0, label="块尾误差(其余输出帧)") ax.set_yscale("symlog", linthresh=1e-3) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("相对整段解码的最大误差(按输出标准差归一)") ax.axvline(6, color=C3, lw=1.6, ls=":") ax.annotate("ctx=6 起误差精确归零", xy=(6, 1e-1), xytext=(6.4, 4e-1), fontsize=10, color=C3, arrowprops=dict(arrowstyle="->", color=C3, lw=1)) ax.set_title("左:误差随上下文帧数的变化", fontsize=12) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax = axes[1] ax.plot(ctxs, contam, "o-", color=C2, lw=2.2) ax.set_xlabel("每块前面带的潜变量上下文帧数 ctx") ax.set_ylabel("被污染的块内输出帧数(两块合计)") for i, c in enumerate(contam): ax.annotate(str(c), (ctxs[i], c), textcoords="offset points", xytext=(0, 7), ha="center", fontsize=9) ax.set_title("右:少带一帧上下文,就多错 4 个输出帧", fontsize=12) ax.grid(alpha=0.25) fig.suptitle("图 3:分块解码的接缝——上下文不是越多越好,而是有个精确阈值", fontsize=13) fig.tight_layout() _save(fig, "fig3_chunk.png") return ctxs, head, tail, contam # ─────────────── 图 4:token 账本 ─────────────── def fig_ledger(): rows = [tl._row(n, a, b, c) for n, a, b, c in tl.REAL] labels = ["逐帧图像 VAE\n(1x8x8)", "4x8x8\n(CogVideoX/Wan)", "8x32x32\n(LTX-Video)"] ns = [r["n"] for r in rows] rel = [(r["n"] / ns[0]) ** 2 for r in rows] fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.5)) ax = axes[0] bars = ax.bar(labels, ns, color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("潜变量 token 数 N(对数轴)") for b, n in zip(bars, ns): ax.text(b.get_x() + b.get_width() / 2, n * 1.15, f"{n:,}", ha="center", fontsize=9) ax.set_ylim(1e3, 3e6) ax.set_title("左:序列长度", fontsize=12) ax.grid(alpha=0.25, axis="y") ax = axes[1] bars = ax.bar(labels, [1.0 / r for r in rel], color=[CGREY, C0, C3], width=0.58) ax.set_yscale("log") ax.set_ylabel("注意力代价相对「逐帧图像 VAE」便宜多少倍") for b, r in zip(bars, rel): ax.text(b.get_x() + b.get_width() / 2, (1.0 / r) * 1.15, f"{1.0 / r:.0f}x", ha="center", fontsize=9) ax.set_ylim(0.8, 6e4) ax.set_title("右:因为代价是 N 的平方,差距被放大", fontsize=12) ax.grid(alpha=0.25, axis="y") fig.suptitle("图 4:同一个 121 帧 768x512 输入,压缩比决定了 DiT 能不能做全注意力", fontsize=13) fig.tight_layout() _save(fig, "fig4_ledger.png") return ns, rel # ─────────────── 图 5:运动速度 vs 时间压缩 ─────────────── def fig_motion(): speeds = tb.SPEEDS p_t = {2: [], 4: [], 8: []} p_s = {2: [], 4: [], 8: []} for v in speeds: x = tb.moving_blob(v) for s in (2, 4, 8): p_t[s].append(tb.psnr(x, tb.repeat_time(tb.avg_pool_time(x, s), s))) p_s[s].append(tb.psnr(x, tb.repeat_space(tb.avg_pool_space(x, s), s))) fig, ax = plt.subplots(figsize=(8.2, 5.0)) colors = {2: C0, 4: C2, 8: C1} for s in (2, 4, 8): ax.plot(speeds, p_t[s], "o-", color=colors[s], lw=2.2, label=f"压时间 {s} 倍") for s in (2, 4, 8): ax.plot(speeds, p_s[s], ls="--", color=colors[s], lw=1.6, alpha=0.75, label=f"空间两轴各 {s} 倍(元素压 {s*s} 倍)") ax.set_xscale("log") ax.set_xticks(speeds) ax.set_xticklabels([str(v) for v in speeds]) ax.set_xlabel("运动速度(像素 / 帧,对数轴)") ax.set_ylabel("重建 PSNR(dB)") ax.set_title("图 5:时间平均与空间平均的教学对照(并非等码率)", fontsize=12) ax.legend(fontsize=9, ncol=2) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig5_motion.png") return p_t, p_s if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "dependency": fig_dependency, "rf": fig_rf, "chunk": fig_chunk, "ledger": fig_ledger, "motion": fig_motion, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done") causal_conv3d.py # -*- coding: utf-8 -*- """3D 因果卷积的 numpy 最小实现,以及形状公式、因果性、感受野的实测。 运行: python causal_conv3d.py 约定张量布局 [C, T, H, W](通道优先,和 torch 的 Conv3d 一致)。 因果卷积的全部秘密只有一条:时间轴**只在前面**补 k_t - 1 帧,后面一帧都不补。 """ import numpy as np def base_rng(seed=20260930): """全工程的种子入口。所有随机权重都从这里分叉,保证数字可复现。""" return np.random.default_rng(seed) # ─────────────── 基本算子 ─────────────── def causal_pad(x, k_t): """时间轴前面补 k_t-1 帧零,后面不补。这是「因果」二字的全部实现。""" if k_t <= 1: return x pad = np.zeros((x.shape[0], k_t - 1, x.shape[2], x.shape[3]), dtype=x.dtype) return np.concatenate([pad, x], axis=1) def sym_pad_hw(x, k_h, k_w): """空间轴对称补零,和 torch 的 Conv3d 默认行为一致。""" pad = ((0, 0), (0, 0), ((k_h - 1) // 2, k_h // 2), ((k_w - 1) // 2, k_w // 2)) return np.pad(x, pad, mode="constant") def conv3d_valid(x, w, stride=(1, 1, 1)): """x [C_in,T,H,W] × w [C_out,C_in,kT,kH,kW] -> [C_out,To,Ho,Wo],只做 valid 部分。""" c_in, t, h, wd = x.shape c_out, c_in2, kt, kh, kw = w.shape assert c_in == c_in2, "通道数对不上" st, sh, sw = stride to = (t - kt) // st + 1 ho = (h - kh) // sh + 1 wo = (wd - kw) // sw + 1 out = np.zeros((c_out, to, ho, wo), dtype=np.float64) for o in range(c_out): wo_kernel = w[o] for i in range(to): for j in range(ho): for k in range(wo): patch = x[:, i * st:i * st + kt, j * sh:j * sh + kh, k * sw:k * sw + kw] out[o, i, j, k] = np.sum(patch * wo_kernel) return out def conv3d_causal(x, w, stride=(1, 1, 1), time_pad="causal"): """3D 卷积,时间填充方式可选: time_pad="causal" 前面补 k_t-1 帧、后面不补(只看过去) time_pad="symmetric" 前后各补 (k_t-1)//2 帧(会看到未来) """ kt, kh, kw = w.shape[2], w.shape[3], w.shape[4] if time_pad == "causal": x = causal_pad(x, kt) else: pad = ((0, 0), ((kt - 1) // 2, (kt - 1) // 2), (0, 0), (0, 0)) x = np.pad(x, pad, mode="constant") x = sym_pad_hw(x, kh, kw) return conv3d_valid(x, w, stride) def out_frames(t_in, k_t=3, s_t=1): """因果卷积的时间输出帧数。 T_out = floor((T_in - 1) / s_t) + 1 注意不是 floor(T_in / s_t):因为首帧被保留下来单独占了一个输出位。 """ return (t_in - 1) // s_t + 1 # ─────────────── 一个可复用的 toy 视频 VAE ─────────────── class CausalConv3d: """带激活的因果卷积层。权重由 base_rng 派生,fix 住后所有实验共用。 act 默认用 tanh 而不是 ReLU:随机权重下 ReLU 会把一大半通道关死, 实测感受野会被「死通道」削小,接缝误差也随之小到 1e-7 量级,看不出问题。 真实 VAE 里有 GroupNorm 兜着,绝大多数通道是活的,tanh 更接近那个状态。 """ def __init__(self, c_in, c_out, k=(3, 3, 3), s=(1, 1, 1), seed=0, act="tanh", time_pad="causal"): rng = base_rng(1000 + seed) scale = 0.9 / np.sqrt(c_in * k[0] * k[1] * k[2]) self.w = rng.normal(0.0, scale, size=(c_out, c_in) + tuple(k)) self.b = rng.normal(0.0, 0.02, size=c_out) self.k = tuple(k) self.s = tuple(s) self.act = act self.time_pad = time_pad def __call__(self, x): y = conv3d_causal(x, self.w, self.s, time_pad=self.time_pad) y = y + self.b.reshape(-1, 1, 1, 1) if self.act == "tanh": y = np.tanh(y) elif self.act is True or self.act == "relu": y = np.maximum(y, 0.0) return y def time_upsample(x, factor=2): """时间维最近邻上采样:每个潜变量帧重复 factor 次。 这是纯复制,不引入新的时间依赖,所以不改感受野的「帧数」, 只改感受野在输出帧单位下的跨度。 """ return np.repeat(x, factor, axis=1) class ToyVideoVAE: """一个能跑的因果视频自编码器(权重是随机的,不追求重建质量)。 编码器把时间压 4 倍、空间压 4 倍;解码器用最近邻上采样还原。 它的唯一用途是让「谁依赖谁」这件事可以被实测。 """ def __init__(self, time_pad="causal"): self.e0 = CausalConv3d(1, 4, k=(3, 3, 3), s=(1, 1, 1), seed=1, time_pad=time_pad) self.e1 = CausalConv3d(4, 8, k=(3, 3, 3), s=(2, 2, 2), seed=2, time_pad=time_pad) self.e2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(2, 2, 2), seed=3, time_pad=time_pad) self.e3 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=4, time_pad=time_pad) self.d0 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=5) self.d1 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=6) self.d2 = CausalConv3d(8, 8, k=(3, 3, 3), s=(1, 1, 1), seed=7) self.d3 = CausalConv3d(8, 4, k=(3, 3, 3), s=(1, 1, 1), seed=8) self.d4 = CausalConv3d(4, 1, k=(3, 3, 3), s=(1, 1, 1), seed=9, act=None) def encode(self, x): x = self.e0(x) x = self.e1(x) x = self.e2(x) return self.e3(x) def decode(self, z): x = self.d0(z) x = self.d1(x) x = time_upsample(x, 2) x = self.d2(x) x = time_upsample(x, 2) x = self.d3(x) return self.d4(x) def __call__(self, x): return self.decode(self.encode(x)) def make_video(t=48, h=16, w=16, seed=7): """一段有运动的合成视频:一个高斯斑点匀速横移 + 缓慢明暗变化。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] frames = [] speed = 0.6 cy = h / 2.0 + rng.normal(0, 0.3) for ti in range(t): cx = (w / 4.0 + speed * ti) % w blob = np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / 6.0)) bg = 0.15 * np.sin(2 * np.pi * ti / 24.0) * np.ones_like(blob) frames.append(blob + bg + 0.02 * rng.normal(size=blob.shape)) v = np.stack(frames)[None] # [1, T, H, W] return v.astype(np.float64) # ─────────────── 实验 1:形状公式 ─────────────── def shape_table(): print("── 实验 1:因果卷积的时间帧数公式 ──") print("公式:T_out = floor((T_in - 1) / s_t) + 1 (因果,前补 k_t-1)") rows = [] for t_in in (16, 17, 32, 48, 49, 121): row = [t_in] for s_t in (1, 2, 4): pred = out_frames(t_in, s_t=s_t) w = np.zeros((2, 1, 3, 3, 3)) w[:] = 0.1 x = np.zeros((1, t_in, 8, 8)) got = conv3d_causal(x, w, stride=(s_t, 1, 1)).shape[1] row.append((s_t, pred, got)) rows.append(row) print(f" T_in={t_in:4d} -> " + " ".join(f"s_t={s}: 预测 {p:3d} / 实测 {g:3d} {'OK' if p == g else 'FAIL'}" for s, p, g in row[1:])) # CogVideoX 的真实数字:49 帧进,两级时间压缩 2 t = 49 t1 = out_frames(t, s_t=2) t2 = out_frames(t1, s_t=2) print(f" 两级时间压缩 2(CogVideoX 口径):49 帧 -> {t1} -> {t2} 潜变量帧") return rows, (t, t1, t2) # ─────────────── 实验 2:因果性 ─────────────── def causality_check(): """改未来的帧,看过去的潜变量有没有跟着变。变了就是漏了未来信息。""" print("\n── 实验 2:因果性检验(改未来,看过去)──") net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) worst = 0.0 for t_edit in range(0, 48, 4): v2 = v.copy() v2[:, t_edit:] += 3.0 # 从第 t_edit 帧起全部改动 z2 = net.encode(v2) # 总时间步距 4,所以潜变量帧 j 只应该看到输入帧 <= 4j for j in range(z2.shape[1]): if 4 * j < t_edit: # 这个潜变量帧不该看到第 t_edit 帧及之后 diff = np.abs(z2[:, j] - z_ref[:, j]).max() worst = max(worst, diff) print(f" 应该完全不受影响的潜变量帧上,最大变化量 = {worst:.3e}") print(f" 判据:等于 0 则因果性成立(浮点意义上 < 1e-12 即通过)") return worst # ─────────────── 实验 3:感受野 ─────────────── def encoder_rf_formula(kernels, strides): """RF = 1 + sum_l (k_l - 1) * prod_{m<l} s_m prod_{m<l} s_m 是「到第 l 层输入为止累积的时间步距」, 所以越靠后的层,一个 kernel 覆盖的原始帧数越多。 """ rf = 1 cum = 1 for k, s in zip(kernels, strides): rf += (k - 1) * cum cum *= s return rf, cum def encoder_rf_measured(): """扰动法实测:逐帧加扰动,看哪些潜变量帧跟着动。""" net = ToyVideoVAE() v = make_video(t=48) z_ref = net.encode(v) nz = z_ref.shape[1] depends = np.zeros((48, nz), dtype=bool) for t_edit in range(48): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 z2 = net.encode(v2) depends[t_edit] = np.abs(z2 - z_ref).max(axis=(0, 2, 3)) > 1e-12 return depends, z_ref def receptive_field(): kernels = [3, 3, 3, 3] strides = [1, 2, 2, 1] rf_pred, cum = encoder_rf_formula(kernels, strides) print("\n── 实验 3:编码器的时间感受野 ──") print(f" 公式:RF = 1 + sum (k_l - 1) * prod_(m<l) s_m") print(f" 本 toy 的层配置 k={kernels}, s={strides}") print(f" 公式预测 RF = {rf_pred} 帧,累积时间步距 = {cum}") depends, z_ref = encoder_rf_measured() nz = z_ref.shape[1] spans = [] for j in range(nz): idx = np.where(depends[:, j])[0] if len(idx) == 0: spans.append((j, None, None, 0)) continue spans.append((j, int(idx.min()), int(idx.max()), int(idx.max()) - int(idx.min()) + 1)) print(" 实测(逐帧扰动):潜变量帧 j -> 受影响的输入帧区间") for j, lo, hi, sp in spans[:6]: if lo is None: print(f" j={j:2d}: 无任何输入帧影响它(权重恰好全被 ReLU 关掉)") else: print(f" j={j:2d}: 输入帧 [{lo:2d}, {hi:2d}],跨度 {sp:2d} 帧") # 因果性上界:潜变量帧 j 能看到的最新输入帧 print(" 因果性上界检查:潜变量帧 j 能看到的最新输入帧应当 <= 步距 * j") bad = 0 for j, lo, hi, sp in spans: if hi is not None and hi > cum * j: bad += 1 print(f" 违反次数 = {bad}(0 表示因果性严格成立)") max_span = max(s for _, _, _, s in spans) print(f" 实测最大跨度 = {max_span} 帧,公式预测 = {rf_pred} 帧") return rf_pred, cum, spans, max_span def dependency_matrix(t_in=48, time_pad="causal"): """扰动法得到「输入帧 t 是否影响潜变量帧 j」的布尔矩阵 [T_in, n_z]。 这张矩阵就是因果性的可视化:因果卷积下它必须落在 j*s_t 这条对角线以下。 """ net = ToyVideoVAE(time_pad=time_pad) v = make_video(t=t_in) z_ref = net.encode(v) dep = np.zeros((t_in, z_ref.shape[1]), dtype=bool) for t_edit in range(t_in): v2 = v.copy() v2[:, t_edit:t_edit + 1] += 2.0 dep[t_edit] = np.abs(net.encode(v2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 return dep if __name__ == "__main__": shape_table() causality_check() receptive_field() chunk_decode.py # -*- coding: utf-8 -*- """分块编解码的接缝实验:到底要带多少帧上下文,逐块跑才能和整段跑一模一样。 运行: python chunk_decode.py 这是整篇文章最核心的一个实验。设置: - 96 帧输入 -> 编码器压成 24 个潜变量帧(时间步距 4) - 整段编解码得到参考输出 - 然后把潜变量切成 3 块,每块前面额外喂 ctx 个潜变量帧当上下文, 解码后把上下文那部分输出丢掉,只留本块 - 比较「分块结果」与「整段结果」在每个位置的差 编码侧同样要分块(长视频不可能一次装进显存),所以下面两件事都测: 1. 解码侧:需要几个潜变量帧上下文 2. 编码侧:需要几个输入帧上下文 """ import numpy as np from causal_conv3d import ToyVideoVAE, make_video T_FRAMES = 96 # 输入帧数 T_STRIDE = 4 # 编码器总时间步距:1 个潜变量帧对应 4 个输出帧 CHUNK = 8 # 每块 8 个潜变量帧 = 32 个输出帧 def build(): net = ToyVideoVAE() v = make_video(t=T_FRAMES) z = net.encode(v) # [8, 24, 4, 4] ref = net.decode(z) # [1, 96, 16, 16] return net, v, z, ref # ─────────────── 解码侧 ─────────────── def decode_chunked(net, z, chunk=CHUNK, ctx=0): """按 chunk 个潜变量帧一块解码,每块前面带 ctx 帧上下文。""" nz = z.shape[1] pieces, starts = [], [] n_chunks = (nz + chunk - 1) // chunk for i in range(n_chunks): lo = i * chunk hi = min(lo + chunk, nz) lo_in = max(0, lo - ctx) out = net.decode(z[:, lo_in:hi]) keep = (hi - lo) * T_STRIDE # 上下文部分的输出要丢掉 pieces.append(out[:, -keep:]) starts.append(lo * T_STRIDE) return np.concatenate(pieces, axis=1), starts def decode_sweep(): net, v, z, ref = build() scale = float(ref.std()) print("── 解码侧:上下文帧数 vs 接缝误差 ──") print(f" {T_FRAMES} 帧输入 -> {z.shape[1]} 个潜变量帧(时间步距 {T_STRIDE})" f" -> {ref.shape[1]} 帧输出") print(f" 误差已按输出标准差归一化(std = {scale:.4f})") print("") print(" ctx | 块头误差 | 块尾误差 | 块内被污染帧数 | 边界跳变放大") print(" ----+---------+---------+----------------+------------") table = [] for ctx in range(0, 9): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale head_idx, tail_idx, contam = [], [], 0 for s in starts[1:]: head_idx += list(range(s, s + T_STRIDE)) tail_idx += list(range(s + T_STRIDE, s + CHUNK * T_STRIDE)) contam += int((diff[s:s + CHUNK * T_STRIDE] > 1e-9).sum()) head = float(diff[head_idx].max()) tail = float(diff[tail_idx].max()) jump = boundary_jump(ref, got, starts) table.append((ctx, head, tail, contam, jump)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d} | {jump:.2f}x") return table def boundary_jump(ref, got, starts): """同一位置处,分块结果的帧间跳变相对整段结果放大了多少倍。 分母取「整段解码在同一帧的跳变」而不是全场平均——视频在某些帧本来就变化快, 拿全场平均当分母会把正常内容误判成接缝。 """ ratios = [] for s in starts[1:]: j_got = float(np.abs(got[:, s] - got[:, s - 1]).max()) j_ref = float(np.abs(ref[:, s] - ref[:, s - 1]).max()) if j_ref > 1e-12: ratios.append(j_got / j_ref) return max(ratios) if ratios else float("nan") def decode_profile(): """误差在块内是怎么衰减的:看第 2 块前 24 个输出帧。""" net, v, z, ref = build() scale = float(ref.std()) print("") print("── 第 2 块内的误差衰减(输出帧 32 起,取前 12 帧,按 std 归一)──") out = {} for ctx in (0, 2, 4, 6): got, starts = decode_chunked(net, z, CHUNK, ctx) diff = np.abs(got - ref).max(axis=(0, 2, 3)) / scale seg = diff[32:32 + 24] out[ctx] = seg print(f" ctx={ctx}: " + " ".join(f"{x:.1e}" for x in seg[:12])) return out # ─────────────── 编码侧 ─────────────── def encode_chunked(net, v, chunk_in=32, ctx=0): """按 chunk_in 个输入帧一块编码,每块前面带 ctx 个输入帧上下文。""" t = v.shape[1] pieces = [] n_chunks = (t + chunk_in - 1) // chunk_in for i in range(n_chunks): lo = i * chunk_in hi = min(lo + chunk_in, t) lo_in = max(0, lo - ctx) z_i = net.encode(v[:, lo_in:hi]) keep = (hi - lo) // T_STRIDE # 上下文换来的多余潜变量帧要丢掉 pieces.append(z_i[:, -keep:] if keep > 0 else z_i[:, :0]) return np.concatenate(pieces, axis=1) def encode_sweep(): net, v, z, ref = build() scale = float(z.std()) print("") print("── 编码侧:上下文帧数 vs 潜变量误差 ──") print(f" 每块 32 个输入帧(= 8 个潜变量帧),误差按潜变量标准差归一" f"(std = {scale:.4f})") print("") print(" ctx | 块头潜变量误差 | 块尾潜变量误差 | 被污染潜变量帧数") print(" ----+----------------+----------------+--------------") table = [] for ctx in (0, 4, 8, 12, 16, 20, 24): zh = encode_chunked(net, v, 32, ctx) if zh.shape[1] != z.shape[1]: print(f" ctx={ctx}: 潜变量帧数对不上 {zh.shape[1]} vs {z.shape[1]},跳过") continue d = np.abs(zh - z).max(axis=(0, 2, 3)) / scale head = float(d[8:10].max()) tail = float(d[10:16].max()) contam = int((d[8:16] > 1e-9).sum()) table.append((ctx, head, tail, contam)) print(f" {ctx:4d} | {head:.3e} | {tail:.3e} | {contam:14d}") return table # ─────────────── 直接问:谁依赖谁 ─────────────── def dependency_table(): """扰动法:直接问「输出帧 o 依赖哪些潜变量帧」,从而算出必需的上下文帧数。""" net, v, z, ref = build() nz = z.shape[1] z_ref = net.decode(z) dep = np.zeros((nz, z_ref.shape[1]), dtype=bool) for j in range(nz): z2 = z.copy() z2[:, j] += 1.0 dep[j] = np.abs(net.decode(z2) - z_ref).max(axis=(0, 2, 3)) > 1e-12 print("") print("── 直接问:块头输出帧依赖哪些潜变量帧 ──") print(" 块起点(输出帧) | 依赖的最早潜变量帧 | 需要的上下文帧数") need = [] n_chunks = (nz + CHUNK - 1) // CHUNK for i in range(1, n_chunks): j0 = i * CHUNK o0 = j0 * T_STRIDE idx = np.where(dep[:, o0])[0] if len(idx) == 0: continue need.append((o0, int(idx.min()), j0 - int(idx.min()))) print(f" {o0:3d} | {int(idx.min()):3d} | {j0 - int(idx.min())}") widths = [] for o in range(z_ref.shape[1]): idx = np.where(dep[:, o])[0] widths.append(int(idx.max()) - int(idx.min()) + 1 if len(idx) else 0) rf_dec = max(widths) print(f" 解码器时间感受野(潜变量帧数,取所有输出帧的最大值)= {rf_dec}") print(f" 推论:所需上下文 = 感受野 - 1 = {rf_dec - 1} 个潜变量帧") return need, rf_dec def context_decomposition(): """逐层只缓存 (k_t - 1) 帧,折算回潜变量帧单位后累加起来等于什么? 这是检验「工业实现里每层只缓存 k_t-1 帧够不够」的关键一笔: 够不够取决于你把缓存折算回哪一级的单位。逐层缓存时,第 l 层的 k_t-1 = 2 帧是该层输入分辨率下的 2 帧,折回潜变量帧要乘上该层 相对潜变量的帧间距(上采样会把间距缩小)。 """ # 解码器 d0..d4 的输入相对潜变量的时间帧间距 spacing = {"d0": 1.0, "d1": 1.0, "d2": 0.5, "d3": 0.25, "d4": 0.25} k_t = 3 print("") print("── 逐层缓存 (k_t - 1) 帧,累加起来是多少 ──") print("") print(" 层 | 输入相对潜变量的帧间距 | 缓存 (k_t-1) 帧折回潜变量帧") print(" ----+------------------------+----------------------------") total = 0.0 for name, sp in spacing.items(): c = (k_t - 1) * sp total += c print(f" {name} | {sp:22.2f} | {c:12.2f}") print(f" 合计 | {'':22} | {total:12.2f}") print("") print(f" 实测需要的上下文(dependency_table)= 6 个潜变量帧") print(f" 逐层缓存累加 = {total:.2f} 个潜变量帧 -> " f"{'完全吻合' if abs(total - 6) < 1e-9 else '不吻合'}") print("") print(" 结论:工业实现里「每层只缓存 k_t-1 帧」是**正确的**,因为逐层") print(" 累加后恰好等于感受野 - 1。真正的陷阱是只在网络入口缓存一次——") print(" 那样只有 (k_t-1) = 2 帧,差得远。") return total def overhead(rf_dec=7, rf_enc=17): """带上下文要多算多少:额外算的量占本块的比例。""" print("") print("── 上下文的开销 ──") print(" 解码块大小 | 需要上下文 | 额外算力占比") rows = [] for chunk in (8, 12, 16, 24): ctx = rf_dec - 1 frac = ctx / (chunk + ctx) rows.append(("decode", chunk, ctx, frac)) print(f" {chunk:3d} 潜变量帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") print(" 编码块大小 | 需要上下文 | 额外算力占比") for chunk in (32, 64, 128): ctx = rf_enc - 1 frac = ctx / (chunk + ctx) rows.append(("encode", chunk, ctx, frac)) print(f" {chunk:3d} 输入帧 | {ctx:3d} 帧 | {frac * 100:.1f}%") return rows def state(): net, v, z, ref = build() return dict(z=z, ref=ref) if __name__ == "__main__": decode_sweep() decode_profile() dependency_table() context_decomposition() encode_sweep() overhead() temporal_budget.py # -*- coding: utf-8 -*- """时间压缩比的预算:运动多快的时候,压 s 倍时间就开始糊。 运行: python temporal_budget.py 把「时间下采样」简化成最朴素的 s 帧平均 + 最近邻还原(CogVideoX 的下采样层 真的就是 avg_pool1d,见 05 节)。学习到的时间卷积会比平均聪明,但这个教学模型 只演示量级和规律,不是神经 VAE 的误差下界,而且它有一条可以验的解析预期: 平均 s 帧 == 给运动物体糊上一条长度 (s-1) * v 像素的运动模糊 """ import numpy as np from causal_conv3d import base_rng # 画布要够宽:最快的斑点(4 px/帧 x 32 帧 = 128 px)必须全程留在画面内, # 否则斑点在后面几帧整个飘出去,加权宽度会因为分母趋于 0 而算成 nan。 T, H, W = 32, 32, 192 SIGMA = 3.0 # 斑点的高斯半径(像素) SPEEDS = [0.25, 0.5, 1.0, 2.0, 4.0] FACTORS = [1, 2, 4, 8] def moving_blob(speed, t=T, h=H, w=W, sigma=SIGMA, seed=11): """一个匀速横移的高斯斑点。不环绕,避免边界跳变污染 PSNR。""" rng = base_rng(seed) ys, xs = np.mgrid[0:h, 0:w] cy = h / 2.0 cx0 = w * 0.25 frames = [] for ti in range(t): cx = cx0 + speed * ti frames.append(np.exp(-(((ys - cy) ** 2 + (xs - cx) ** 2) / (2 * sigma ** 2)))) v = np.stack(frames)[None] # [1, T, H, W] return v + 0.001 * rng.normal(size=v.shape) # 微量噪声,避免除零 def avg_pool_time(x, s): """每 s 帧平均成 1 帧(非重叠分组)。""" n = x.shape[1] // s return x[:, :n * s].reshape(x.shape[0], n, s, H, W).mean(axis=2) def repeat_time(z, s, t_out=T): """最近邻还原:每个潜变量帧重复 s 次。""" return np.repeat(z, s, axis=1)[:, :t_out] def avg_pool_space(x, s): """空间 sxs 块平均。""" n_h, n_w = H // s, W // s y = x[:, :, :n_h * s, :n_w * s] y = y.reshape(x.shape[0], T, n_h, s, n_w, s) return y.mean(axis=(3, 5)) def repeat_space(z, s): """空间最近邻还原。""" return np.repeat(np.repeat(z, s, axis=2), s, axis=3) def psnr(a, b, peak=1.0): mse = float(np.mean((a - b) ** 2)) return 99.0 if mse <= 1e-20 else 10.0 * np.log10(peak ** 2 / mse) def width_along_x(x): """斑点沿运动方向的强度加权标准差,用来量「被糊成多宽」。 两个坑都踩过: 1. 只能在空间维度上归约(沿 y 求和、保留 x)。把所有轴一起归约会把 x 也压掉,得到一个不随压缩变化的常数。 2. 要先掐掉噪声底。加权方差里 (x - mean)^2 是杠杆,画面远端一个 -0.026 的噪声像素能贡献 -9 的「方差」,把真实值直接打成负数。 """ xs = np.arange(W)[None, None, :] # [1, 1, W] prof = x.sum(axis=2) # [1, T, W],沿 y 归约 prof = np.clip(prof, 0.0, None) thr = 0.005 * prof.max(axis=2, keepdims=True) # 掐掉噪声底,保留斑点 prof = np.where(prof < thr, 0.0, prof) wsum = prof.sum(axis=2, keepdims=True) + 1e-12 # [1, T, 1] mx = (prof * xs).sum(axis=2, keepdims=True) / wsum var = (prof * (xs - mx) ** 2).sum(axis=2, keepdims=True) / wsum return float(np.sqrt(var).mean()) def psnr_table(): print("── 时间压缩 s 倍之后,运动速度 vs 重建 PSNR(dB)──") print("") print(" 速度 v |" + "".join(f" s={s:<2d} " for s in FACTORS)) print(" --------+" + "".join("---------------" for _ in FACTORS)) table = {} for v in SPEEDS: x = moving_blob(v) row = [] for s in FACTORS: row.append(psnr(x, repeat_time(avg_pool_time(x, s), s))) table[v] = row print(f" {v:5.2f} |" + "".join(f" {p:8.2f} dB " for p in row)) print("") print(" 读法:s=1 是原图(噪声极小,PSNR 到顶);同一列往下看,运动越快越糊。") print(f" s=8 那一列从最慢到最快掉了 " f"{table[SPEEDS[0]][-1] - table[SPEEDS[-1]][-1]:.1f} dB。") return table def blur_law(): """验那条解析规律:糊掉的长度应该是 (s-1) * v。""" print("") print("── 验规律:平均 s 帧 ≈ 加一条长度 (s-1)*v 的运动模糊 ──") print("") print(" 速度 v | s | 斑点宽度 原图 -> 压缩后 | 实测增幅 | 解析预期") print(" --------+-----+-------------------------+----------+----------") rows = [] for v in (1.0, 2.0, 4.0): x = moving_blob(v) w0 = width_along_x(x) for s in (2, 4, 8): r = repeat_time(avg_pool_time(x, s), s) w1 = width_along_x(r) pred = np.sqrt(SIGMA ** 2 + v ** 2 * (s ** 2 - 1) / 12.0) rows.append((v, s, w0, w1, w1 / w0, pred / w0)) print(f" {v:5.2f} | {s:2d} | {w0:7.3f} -> {w1:7.3f} " f"| {w1 / w0:7.3f}x | {pred / w0:7.3f}x") print("") print(" 解析预期 = sqrt(sigma^2 + v^2*(s^2-1)/12) / 实测原宽度:") print(" 平均 s 个等间隔平移量,其离散方差是 v^2*(s^2-1)/12。") return rows def time_vs_space(): """时间压 s 倍与空间两轴各压 s 倍(总 s^2 倍),并非等码率对照。""" print("") print("── 不同元素压缩率:时间 s 倍 vs 空间 s^2 倍(PSNR,dB)──") print("") print(" 速度 v |" + "".join(f" 时间 {s}x / 空间 {s}x " for s in (2, 4, 8))) print(" --------+" + "".join("-----------------------" for _ in (2, 4, 8))) rows = [] for v in SPEEDS: x = moving_blob(v) cells = [] for s in (2, 4, 8): p_t = psnr(x, repeat_time(avg_pool_time(x, s), s)) p_s = psnr(x, repeat_space(avg_pool_space(x, s), s)) cells.append((p_t, p_s)) rows.append((v, cells)) line = " {:5.2f} |".format(v) for p_t, p_s in cells: line += f" {p_t:6.2f} / {p_s:6.2f} " print(line) print("") print(" 读法:空间那一列基本与速度无关(压空间就是把细节磨掉,一视同仁);") print(" 时间那一列随运动变快而下降。两条线会交叉,交叉之后") print(" 这只比较两种滤波失真,不能从非等码率交叉点推出实际压缩策略。") crossings = [] for si, s in enumerate((2, 4, 8)): prev_sign = None for v, cells in rows: p_t, p_s = cells[si] sign = p_t > p_s if prev_sign is not None and sign != prev_sign: crossings.append((s, v)) prev_sign = sign if crossings: print("") print(" 交叉点(压时间开始不如压空间的速度):") for s, v in crossings: print(f" s={s}x:约 {v} px/帧 附近") return rows def state(): return dict(psnr=psnr_table(), blur=blur_law(), ts=time_vs_space()) if __name__ == "__main__": psnr_table() blur_law() time_vs_space() token_ledger.py # -*- coding: utf-8 -*- """潜变量 token 账本:不同的时空压缩比,到底把 Transformer 的序列变成多长。 运行: python token_ledger.py 自注意力的代价是 O(N^2),所以真正决定「视频 DiT 能不能做全时空注意力」的 不是像素总量,而是**潜变量 token 数 N**。这个脚本只做算术,但它是选压缩比的依据。 """ # 统一的输入:121 帧(5 秒 @ 24fps)、768 x 512、RGB T_IN, H_IN, W_IN, C_IN = 121, 512, 768, 3 # 表一:真实模型在用的配置(通道数取各模型公开权重的值) REAL = [ ("图像 VAE 逐帧(SVD / AnimateDiff 口径)", 1, 8, 4), ("CogVideoX / Wan / HunyuanVideo(4x8x8)", 4, 8, 16), ("LTX-Video(8x32x32)", 8, 32, 128), ] # 表二:固定空间 8x8、通道 16,只扫时间压缩比——把时间这一维的贡献单独拎出来 TIME_SWEEP = [(s_t, 8, 16) for s_t in (1, 2, 4, 8)] def latent_frames(t_in, s_t): """因果卷积下的潜变量帧数:首帧单独占位,所以是 floor((T-1)/s)+1。""" return (t_in - 1) // s_t + 1 def _row(name, s_t, s_h, s_c): t_out = latent_frames(T_IN, s_t) h_out = H_IN // s_h w_out = W_IN // s_h n = t_out * h_out * w_out return dict(name=name, s_t=s_t, s_h=s_h, ch=s_c, shape=(t_out, h_out, w_out), n=n, vals=n * s_c, cover=s_t * s_h * s_h * C_IN) def table_real(): pix = T_IN * H_IN * W_IN * C_IN print(f"输入:{T_IN} 帧(5 秒 @ 24fps)、{W_IN} x {H_IN}、RGB," f"像素值总数 = {pix:,}") rows = [_row(n, a, b, c) for n, a, b, c in REAL] base = rows[0]["n"] print("") print("── 表一:三个真实档位 ──") print("") print(" 配置 | 潜变量形状 (T'xH'xW'xC) " "| token 数 N | N^2 相对代价 | 便宜倍数 | 每 token 覆盖像素") print(" --------------------------------------+-----------------------" "+------------+-------------+---------+----------------") for r in rows: rel = (r["n"] / base) ** 2 r["rel"] = rel t, h, w = r["shape"] print(f" {r['name']:<38} | {t:3d} x {h:3d} x {w:3d} x {r['ch']:3d} " f"| {r['n']:10,d} | {rel:11.3e} | {1 / rel:7.1f}x | {r['cover']:8,d}") return rows def table_time_sweep(): print("") print("── 表二:固定空间 8x8 / 通道 16,只动时间压缩比 ──") print("") print(" 时间压缩 | 潜变量帧数 | token 数 N | 相对上一步便宜 | 相对 1x 累计") print(" ---------+------------+------------+----------------+-------------") rows = [] base = None for s_t, s_h, s_c in TIME_SWEEP: r = _row(f"s_t={s_t}", s_t, s_h, s_c) if base is None: base = r["n"] r["rel"] = (r["n"] / base) ** 2 rows.append(r) for i, r in enumerate(rows): step = (rows[i - 1]["n"] / r["n"]) ** 2 if i > 0 else 1.0 print(f" {r['s_t']:3d} x | {r['shape'][0]:10d} | {r['n']:10,d} " f"| {step:13.1f}x | {1 / r['rel']:11.1f}x") print("") print(" 规律:时间压缩每翻一倍,token 数减半,注意力代价降到 1/4。") return rows def why_channels_grow(): """压缩的是序列长度,不是信息量——通道数必须补回来。""" pix = T_IN * H_IN * W_IN * C_IN print("") print("── 为什么压缩比上去了,潜变量通道数也要跟着涨 ──") print("") print(" 配置 | 潜变量数值总数 | 压缩比(像素值 / 潜变量数值)") print(" --------------------------------------+----------------+----------------------------") for name, s_t, s_h, s_c in REAL: r = _row(name, s_t, s_h, s_c) print(f" {name:<38} | {r['vals']:14,d} | {pix / r['vals']:8.1f} : 1") print("") print(" 数字要看懂:4x8x8 那一行和「逐帧图像 VAE」的压缩比几乎一样(46.8 vs 48.0),") print(" 它省下的不是信息量,而是**序列长度**——190464 个 token 变成能做注意力的规模。") print(" LTX-Video 摘要里自述总压缩比 1:192,和上表最后一行的 181.5:1 是同一量级") print(" (差别来自它把 patchify 挪进 VAE 的口径)。") def frame_count_rule(): """帧数必须满足什么条件,才能整除不被裁掉。""" print("") print("── 帧数该怎么选:T = 1 + k * s_T ──") for s_t in (4, 8): print(f" 时间压缩 {s_t}x:合法帧数 1, {1 + s_t}, {1 + 2 * s_t}, ... 即 T = 1 + k*{s_t}") print(f" 例:121 帧 -> {latent_frames(121, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (121 - 1) % s_t == 0 else '不整除,会向下取整'})") print(f" 例:100 帧 -> {latent_frames(100, s_t)} 个潜变量帧" f"({'整除,不丢帧' if (100 - 1) % s_t == 0 else '不整除,会向下取整'})") def state(): return dict(real=table_real(), sweep=table_time_sweep()) if __name__ == "__main__": table_real() table_time_sweep() why_channels_grow() frame_count_rule()
-
AIGC 基本功|自回归视频生成与 Forcing 范式-Forcing 自回归视频生成与 Forcing 范式:流式出帧的账,和曝光偏差的坑 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 训练目标与采样流程($\bar{\alpha}$ 记号、DDIM 单步更新直接沿用)、DiT 架构拆解(潜空间 patch 化成 token 的约定) 关键词:自回归视频、Diffusion Forcing、Self-Forcing、teacher forcing、曝光偏差、KV cache、流式生成 01. 为什么需要它 你盯着一个视频生成产品等了 3 秒,第一帧才出来——不是网速问题,是范式问题。 本文先以全序列双向扩散为对照:21 个潜帧(对应约 5 秒成片)拼成一条 3 万多 token 的序列,帧和帧之间双向可见,整段一起降噪。代价是「流式」这个词跟它彻底无缘——最后一帧没去噪完,第一帧就不能给你看。这不是工程优化能修的:双向注意力在数学上要求未来帧也参与当前帧的去噪,未来帧不存在,这一步就算不了。 我按 Wan2.1-T2V-1.3B 的真实拓扑和 Self-Forcing 的默认配置,把这笔账算成了 MAC 数(第 06 节有完整过程):在假设有效算力 400 TFLOPS、只计 Transformer 的理想算术估算中,5 秒视频的全序列扩散首帧约 2.83 秒;换成因果自回归加 KV cache,0.20 秒就能吐出第一帧——账本中的 13.98 倍差距(不是实测 GPU 延迟)。而总算力几乎没变(比值 0.875,自回归反而略省)。 但把「一帧一帧往后生成」这条路走通,会立刻撞上一个语言模型社区早就算过的老账:训练时模型看的上下文是真值帧(teacher forcing),推理时上下文只能换成模型自己的输出。这两件事不是一回事,误差会顺着自回归链条滚雪球——这就是曝光偏差(exposure bias)。 Forcing 系列就是围着这两个问题打转的:Diffusion Forcing 把「下一帧预测」和「扩散去噪」缝成一个目标,让每帧带独立噪声级;Self-Forcing 干脆在训练时就用模型自己的 rollout 当上下文,把训练分布直接掰成测试分布。这篇把两个问题都算成数:流式的账用真实拓扑算,曝光偏差的坑用一个能完整复现的玩具实验拆开看。 02. 最小可用理解 把三种范式并排放,差别其实只有一句话:每一帧被允许看什么、以什么噪声级被看到。 这张图要看什么:上行是全序列扩散——所有帧共用同一个噪声级、一起降、双向注意力互相可见,代价是 4 步全部算完才有第一帧;中行是 teacher forcing——只有当前帧带噪声,上下文全是浅色真值帧,而推理时真值帧不存在,误差就从这里的「换上下文」进来;下行是因果自回归采样;训练时使用自身 rollout 对应 Self-Forcing,而独立噪声的 Diffusion Forcing 训练上下文仍来自数据——历史帧干净地躺在 KV cache 里,当前 block 从高噪声一路降到干净,其中“训练用自身 rollout”是 Self-Forcing 的额外设计。 三个要点: 全序列扩散:质量上限高(未来帧参与去噪),双向联合去噪通常须整块完成才能交付;可变长度、滑窗或块间生成需要额外设计,不能称为所有此类模型永远不能流式。 Diffusion Forcing:给每帧分配独立的噪声级 $k^{(t)}$。训练目标退化成「对每一帧做条件去噪」,采样时可以逐帧(逐 block)从高噪声降到干净再吐出去——这就是「next-token prediction 与全序列扩散的合流」这句话的数学含义。 Self-Forcing:承认上下文永远是模型自己的输出,于是在训练时就真的 rollout——上一帧生成完、进 KV cache、下一帧从它出发,整段视频算一个整体损失,而不是逐帧各自算。 顺带把「Forcing」这个词的出处交代掉。它来自语言模型的 teacher forcing:训练 RNN 语言模型时,每一步的输入都用数据集里的真值 token「强行喂入」(force),而不是模型上一步的输出。这个约定让训练可以并行、梯度稳定,但也埋下了训练-测试分布错位的种子——语言模型社区管它叫 exposure bias,几十年里试过 scheduled sampling、DAgger 各种解法。Forcing 系列的谱系就是围绕这个错位逐步收紧的过程:Diffusion Forcing 先把「下一帧预测」的接口扩展成「每帧带独立噪声级的条件去噪」,让自回归的骨架里能塞进扩散的表达力;Self-Forcing 再把训练时的上下文从真值换成模型自己的 rollout,直接对齐两个分布。视频把这个问题变得更尖锐:语言模型一步错一个 token,视频一步错的是一整帧,而且帧与帧之间还有时间维度上的积分效应(下一节的主角)。 03. 数学推导 3.1 训练目标与推理目标的错位 为展示上下文错位,可用一个简化的逐帧去噪回归目标: $$\mathcal L_{TF}=E_{x,k,\epsilon}\sum_t\|x_t-f_\theta(z_t(k_t),k_t,x_{<t}^{gt})\|^2.$$ 推理时把真值历史换成模型生成历史 $\hat x_{<t}$,但通常不在推理现场优化损失。用同样的去噪回归在生成历史上评测,只是本文的受控诊断量,不是视频生成质量的完整定义;任意生成视频与某条真值逐帧 MSE 也不是 Self-Forcing 的训练目标。 训练和评测使用同一个 $f_\theta$ 时,上下文从数据历史换成模型历史即可造成分布偏移。充分容量下精确学习每个条件分布可得到正确联合分布;现实中的估计误差、有限容量和长时 rollout 会放大这一差异。 3.2 曝光偏差为什么会滚雪球:慢变量与快变量 把误差沿着自回归链条往前传一步。设第 $t$ 帧的上下文误差是 $e_t$,对很多动力系统可以近似成线性递推 $e_t = A e_{t-1} + \delta_t$,其中 $\delta_t$ 是本帧新引入的误差。下面标量方差式假设初始误差为零、增量独立同分布且零均值;一般矩阵非正规性、相关误差和模型偏差会改变增长。关键量是传递矩阵的谱半径。按谱半径把状态拆成两块看: 慢变量(谱半径 $\lambda_{\text{slow}}$ 接近 1,近似积分环节): $$e_t = \lambda_{\text{slow}} e_{t-1} + \delta_t \quad \Rightarrow \quad \mathrm{Var}[e_T] = \mathrm{Var}[\delta] \cdot \frac{1 - \lambda_{\text{slow}}^{2T}}{1 - \lambda_{\text{slow}}^{2}} \quad \xrightarrow{T \to \infty} \quad \frac{\mathrm{Var}[\delta]}{1 - \lambda_{\text{slow}}^{2}}$$ $\lambda_{\text{slow}} = 0.97$ 时系数是 $1 / (1 - 0.9409) \approx 16.9$,误差方差被放大约 17 倍,而且随长度单调增长——这就是「滚雪球」的数学形态。 快变量(谱半径 $\rho_{\text{fast}}$ 明显小于 1,收缩映射): $$e_t = \rho_{\text{fast}} e_{t-1} + \eta_t \quad \Rightarrow \quad \mathrm{Var}[e^{\text{fast}}] \approx \frac{\mathrm{Var}[\eta]}{1 - \rho_{\text{fast}}^{2}}, \quad \rho_{\text{fast}} < 1$$ 这是一个有界的常数抬升:旧误差每帧被乘上 $\rho_{\text{fast}}$ 衰减掉,只有本帧新增的误差活着。$\rho_{\text{fast}} = 0.85$ 时系数约 3.6 倍,早期仍随长度增大,但更快接近上界。 所以「曝光偏差有多严重」这个问题没有单一答案:在 $|\lambda|<1$ 的独立增量模型中,两者都有界,只是慢变量更晚饱和;$\lambda=1$ 方差才线性增长,$|\lambda|>1$ 才可能指数发散。这也是为什么第 08 节的误解二里,光看「平均误差涨了几倍」会得出错误结论。 3.3 Diffusion Forcing:每帧一个独立噪声级 标准全序列噪声训练通常共享 $k$;Diffusion Forcing 对各帧独立采噪声级,并把带噪历史一起作为条件。例如噪声预测形式为: $$\mathcal L_{DF}=E_{x,k_{1:T},\epsilon_{1:T}}\sum_t w(k_t)\|\epsilon_t-\epsilon_\theta(z_{\le t},k_{\le t})\|^2,$$ 其中 $z_t=\sqrt{\bar\alpha_{k_t}}x_t+\sqrt{1-\bar\alpha_{k_t}}\epsilon_t$;也可等价改写成带相应权重的 $x_0$ 预测。历史 $z_{<t}$ 通常也带各自的噪声,不能只在公式里写干净的 $x_{<t}$。 统一噪声级可恢复共享噪声训练形式,但不会自动把因果遮罩变成双向注意力;把历史噪声降到 0、仅对当前块去噪,则给出自回归采样接口。当前块仍从高噪声逐步降噪,不是“把当前噪声取最小就等于 next-token prediction”。 3.4 Self-Forcing:在训练时就把分布掰过来 Self-Forcing 第 3.3 节 用自身自回归 rollout 产生整段视频,再做视频级分布匹配。以 DMD 为例,目标可写为 $$\mathcal L_{SF}=E_k\big[D_{KL}(p_{\theta,k}(x^{1:T})\|p_{data,k}(x^{1:T}))\big].$$ 这里比较生成与数据的加噪联合分布,借助教师/学生 score 估计更新;论文还考察 SiD、GAN 损失。它不是逐帧配对 MSE,也不是 DAgger 的同义词。二者都关注自生成上下文,但经典 DAgger 需要专家对学习器访问状态提供标签,Self-Forcing 不以这种标签循环定义。 本文下面的线性回归 toy 只诊断上下文分布错位,并做 DAgger 风格重拟合;它没有实现 DMD,不能用它的失败证明 Self-Forcing 失败。 3.5 梯度怎么穿过 rollout Self-Forcing 为控制显存,每个序列随机选一个去噪退出步,只保留最终被选步骤的反传,并阻断先前帧 KV cache 的梯度;这比笼统说“回传最近几帧”更准确。普通一阶反传并不自动产生 Hessian 的二阶交叉项。 本文 toy 的重拟合则是收集自身 rollout 特征,再做岭回归并用 line search 混合权重;它不对 rollout 链做可微反传。line search 和发散保护只约束这个实验,不能外推成 Self-Forcing 的固有不稳定性。 04. 代码实现 完整实验在 forcing_lab.py(附录有全文,numpy 单文件可跑)。设计原则是让三种范式唯一的差别就是特征函数: 动力系统:3 维慢变量 $u_t = \Lambda u_{t-1} + G w_{t-1} + 0.02 \xi$(谱半径 0.97)+ 3 维快变量 $w_t = \tanh(A_w w_{t-1} + B_w c) + 0.1 \xi$(谱半径 0.85),再加一个每条序列固定、模型可见的条件向量 $c$(类比文本 embedding——没有它第一帧不可预测,实验就没法做)。 去噪:4 步 DDIM(eta=0),噪声步 $[1000, 750, 500, 250]$,线性 beta 表。特征维数两范式完全相同($F = 3D + 4 + 1 = 23$),线性回归头(岭回归闭式解)——给定数据可求确定的回归解,但数据、噪声、特征和模型假设仍决定结果,不能把差异全部归因于范式。 训练集 6000 条 × 72 帧,测试集 1500 条;训练视野 24 帧,外推到 72 帧。 公平性是这么保证的:同一个回归头 $W$ 拟合三版——全序列版用双向特征整段拟合;teacher forcing 版用因果特征、上下文取真值;自回归评测用的模型与 teacher forcing 版共享同一组参数,差别只在评测时喂什么上下文。所以下表里 rollout 和 teacher forcing 之间 8.3 倍的差距里没有任何训练差异的成分,全部来自「上下文是谁生成的」。 核心代码(节选自 forcing_lab.py,去掉 Q4 受控实验分支): def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) def feat_bidir(z_seq, t, c): zp = z_seq[t - 1] if t > 0 else np.zeros(D) zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D) return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)]) def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None): """ctx_ts: 把刚生成的帧按这个时间步加噪后才写进历史。 hist_true 给定时上下文永远取真值 = teacher forcing 评测。""" out = np.empty((T_out, D)) hist = [] for t in range(T_out): a0 = abar_of(steps[0]) z = np.sqrt(1.0 - a0) * rng.standard_normal(D) for i, ts in enumerate(steps): if hist_true is not None: ctx = hist_true[:t] else: ctx = np.array(hist) if len(hist) else np.zeros((0, D)) xhat = feat_causal(z, ctx, c) @ W if i + 1 < len(steps): z = ddim_step(z, xhat, abar_of(ts), abar_of(steps[i + 1])) out[t] = xhat hist.append(xhat.copy()) return out 这张图要看什么:左图三条曲线在训练视野边界(第 24 帧,竖虚线)附近的分叉——teacher forcing 平在 0.01 附近,但它测试时不可得;自回归 rollout 从第 1 帧起就比 teacher forcing 高一截,越过视野后继续单调上爬。右图把 rollout 的误差拆成快慢两块:慢变量(红)在所测 72 帧窗口内继续增大,不能据此证明无限长度发散,快变量(绿)基本是平的——3.2 节的预测被数据证实。 真实输出(逐帧 MSE,每维平均平方误差): 帧号 全序列扩散 teacher forcing 自回归 rollout 0 0.36699 0.32465 0.32471 1 0.33968 0.02699 0.27550 11 0.20119 0.01126 0.17954 23(视野边界前最后一帧) 0.24698 0.01152 0.22402 47 —(非流式) 0.01152 0.41608 71 — 0.01152 0.60288 三个范式在视野内的总账:全序列扩散 0.23990,teacher forcing 0.02536,自回归 rollout 0.20941。teacher forcing 比 rollout 低 8.3 倍,这 8.3 倍全是曝光偏差——同一个模型、同一套参数,只是上下文来源不同。 把 rollout 的误差按 3.2 节拆开: teacher forcing rollout 放大倍数 行为 快变量 w 0.03208 0.13269 4.14× 恒定抬升,不随长度涨 慢变量 u 0.01864 0.28614 15.35× 积累,理论预测约 16.9× 慢变量 15.35 倍对上理论值 16.9 倍,量级和方向都对得上(实测略低是因为有限长度截断了增长:“翻倍长度”若来自有限区间拟合,不能当成有界理论模型的渐近性质)。越过训练视野后慢变量误差是视野内的 2.45 倍,快变量只有 1.01 倍——扩散模型 rollout 的伤害是有结构的,不是均匀糊在所有维度上。 DAgger 轮次(Q3)的实现细节值得交代:每轮用当前权重 rollout 出上下文,重新收集特征-标签对,在岭回归闭式解上以步长 $\alpha = 0.3$ 混合新权重;然后做步长折半的 line search——实际输出若为 $\alpha=0.01875$,对应从 0.3 连续减半四次;应以脚本打印的接受步长为准,说明更新方向已接近退化;外推末帧超过 round0 的 50 倍触发发散保护。Q5 的训练上下文噪声扫描是同一套循环的外层:给训练时的真值上下文按 $k \in [0, 400]$ 个噪声步加噪(用 3.3 节同一个 $\bar{\alpha}$ 表映射),再在 TF 与 rollout 两端评测——06 节的精度换稳定性曲线就是这么来的。 05. 工业级实现对照 玩具里的一切,在 Self-Forcing 的官方实现(pipeline/causal_inference.py 的 CausalInferencePipeline,以 2026-09 时的代码为准)里都有对应物,而且配置文件里每一条都能对上: 玩具实验 Self-Forcing 真实配置(configs/self_forcing_dmd.yaml) 4 步去噪 $[1000, 750, 500, 250]$ denoising_step_list: [1000, 750, 500, 250] 每个 block 3 帧 num_frame_per_block: 3 条件向量 $c$ conditional_dict(文本编码,cross-attention 消费) 训练用自己 rollout 的上下文 训练管线 rollout + KV cache,distribution_loss: dmd 底座 Wan2.1-T2V-14B,学习率 2.0e-06 推理循环的骨架是按 block 走的,每个 block 3 帧,5 次前向: Step 3.1 空间去噪:当前 block 的帧从噪声步 1000 开始,沿 denoising_step_list 降到 250,共 4 次前向。每次前向都通过 KV cache 读到全部历史 token,当前帧的 key/value 也写进缓存。 Step 3.2 记录去噪输出 denoised_pred。 Step 3.3 刷缓存:这是整个管线最值得盯的一步——前 4 次前向里写进 KV cache 的是带噪声输入的 key/value,和「历史是干净的」这个推理前提不符。所以代码用干净的 denoised_pred 在 context_noise 时间步上重跑一次前向,把缓存里这个 block 的条目覆盖掉。这就是 Q5 实验里「训练上下文噪声」在推理侧的镜像:缓存里的历史按多脏的口径存,下游就按什么口径消费。 Step 3.4 起始帧号前移 3 帧潜帧,进入下一个 block。 底座 Wan2.1-T2V-1.3B 的拓扑是账本的地基:dim=1536、30 层、12 头(head_dim=128)、FFN 8960、patch (1,2,2)、VAE stride (4,8,8)。Self-Forcing 默认视频形状 [1, 21, 16, 60, 104]——21 个潜帧,每帧 $(60/2)\times(104/2)=1560$ 个 token;16 是通道数,进入每个 patch 的特征维度,不再乘进 token 数(60、104 是潜空间宽高,空间 patch 是 $2 \times 2$),整段 32760 个 token,约 81 个像素帧,16 fps 下 5.06 秒。训练侧的规模感:基于 CausVid 蒸馏,600 次迭代、64 张 H100、2 小时以内。 双向底座怎么改成因果的? Wan2.1 的 DiT 本来是双向注意力,改造没有动预训练权重的语义:把 self-attention 换成「空间维双向 + 时间维因果」的混合遮罩,rollout 时每个 block 的 token 先以 query 身份读完整个缓存,再把自己的 key/value 写进去;第 0 帧没有历史,等价于一次图像生成。文本条件走 cross-attention——它的 K/V 只有 512 个 T5 token,缓存恒定 0.088 GB,一次算好全程复用,跟帧数无关。训练侧在 rollout 前向之上叠 DMD 蒸馏损失(distribution_loss: dmd),让少步学生的分布对齐教师——这就是 600 次迭代能收敛的原因:监督信号来自蒸馏,不是从零拟合数据分布。 为什么缓存刷新那一步不能省? 4 步去噪的每次前向都会把「带噪声输入」的 key/value 写进缓存,而下游 block 读缓存时的前提是「历史是干净的」。Step 3.3 用干净输出在 context_noise 时间步重刷一遍,本质是把「缓存里的历史有多脏」从「去噪过程的残留」变成一个显式超参——第 06 节 Q4 实验会证明模型对这个超参极其敏感:干净上下文训练的模型,推理时给上下文加 50 步噪声,误差就从 0.025 涨到 0.047。 06. 代价与边界 流式不是免费的,把账算干净。 这张图要看什么:左图的台阶是每个 block 算完才吐 12 个像素帧(3 潜帧),出帧节奏整体贴着 16 fps 的实时线走,橙色竖线是全序列扩散一次性交付的时刻;中图和右图是一对警告——不滚动缓存时显存和单 block 时间都随长度线性涨,9 帧滚动窗口把两者同时钉成常数。 口径先交代清楚(逐项对齐公开配置,代码在附录 streaming_ledger.py):每层每 token 的 MAC = 注意力分数(对每个可见 key 做两次内积,$2 \times n_{\text{key}} \times d$)+ 四个注意力投影($4 d^2$)+ FFN($2 \times d \times 8960$)+ 一次 cross-attention(对 512 个文本 token 的分数与投影)。KV cache 每潜帧的字节数是 $2 \times 30 \times 1560 \times 1536 \times 2 \text{ B} \approx 0.268$ GB——K、V 两份,乘 30 层、每帧 1560 token、$d = 1536$、bf16 两字节——21 帧合计 5.624 GB。时间按 H100 bf16 有效 400 TFLOPS 折算(1 MAC = 2 FLOP),只算 transformer 主体,不含 VAE 解码与文本编码。 算力账(400 TFLOPS 有效算力折算,MAC 计入注意力 QKV 与投影): 全序列扩散 因果 + KV cache 单步去噪 MAC 1.4142e+14 首块 8.09e+12 → 末块 2.02e+13 4 步总 MAC 5.6567e+14 4.9514e+14(比值 0.875) 总时间 2.828 s 2.476 s 首帧延迟 2.828 s 0.202 s(13.98×) 稳态节奏 一次性交付 每块 505.1 ms,实时预算 750 ms,余量 1.48× 两点容易被误读:其一,自回归并不显著省总算力(0.875 倍,注意力遮罩少算的钱被 KV cache 刷新的额外前向花掉了大半),它买到的是首帧延迟和出帧节奏;其二,若每层稠密保存 32760×32760×12 个 bf16 分数,约 25.76 GB(24.0 GiB)(32760 token 的平方 × 12 头 × bf16),所以 FlashAttention 不是优化项是必需品(前置阅读见那篇)。 显存账(bf16 KV cache,30 层全量):21 帧全量 5.624 GB,9 帧滚动窗口 2.410 GB(43%)。不滚动的话,生成到 336 潜帧(336 个潜帧按 4 倍时间解码约 1341 帧,在 16 fps 下约 83.8 秒)时单 block 要 5.8 秒、缓存 89.98 GB——两头都爆炸;9 帧滚动窗口下恒定 303.2 ms、2.41 GB。「越生成越慢」不是自回归的本质属性,是「不滚动」这个实现选择的属性。 质量与稳定性的账,用两个受控实验说: 这张图要看什么:左图是曝光偏差的「单位换算」——把 rollout 的误差水平放到「干净模型 + 给真值上下文加噪」的曲线上插值,等效于给上下文加了约 160 个噪声步($\bar{\alpha}$ 约 0.76);右图是精度换稳定性的折中——训练时给上下文加的噪声从 0 加到 250,外推末帧误差先降后平,但视野内精度从 0.025 恶化到 0.096。 等效噪声级 ≈ 160 步:自回归 rollout 的伤害,等价于把干净的真值上下文往里掺这么多噪声。这给了当前模型、当前噪声表与误差指标下的诊断刻度,不能不经校准跨模型比较,而不是一句「会变差」。 训练上下文加噪的最优点很小:扫描 $k \in [0, 400]$,视野内误差在 $k=50$ 处最优(0.20516,对照 $k=0$ 的 0.20914),$k=250$ 时视野内恶化到 0.34373 但外推末帧确实最稳(0.49690 对 0.60284)。加噪换来的鲁棒性是真的,但精度代价涨得比稳定性收益快,别一上来就拉满。 训练噪声级和推理噪声级必须配套(Q4 受控实验):干净上下文训练的模型,推理时给上下文加 50 步噪声,误差就从 0.025 涨到 0.047——模型对「上下文多脏」这件事的敏感性是训练时铸死的,这也解释了 Step 3.3 为什么非刷缓存不可。 一个诚实说明:这个玩具里全序列扩散的逐帧误差(0.24)反而比自回归 rollout(0.21)高——线性回归头太弱,双向注意力没占到便宜。真实系统的质量取决于架构、训练与蒸馏,双向上下文本身不构成质量必胜保证,所以这条不能外推成「因果不亏质量」,只能说质量差不是自回归路线的主要障碍,曝光偏差和工程复杂度才是。 07. 经典论文脉络 先把「为什么不用更老的解法」说掉。Scheduled sampling(按概率把训练输入从真值换成模型自己的输出)在语言模型上就有分布畸变的老毛病:混着喂会让模型面对一个训练里从未出现过的「半真半假」分布;搬到扩散模型上问题更糟,因为上下文还带着噪声级这个第二维度——真值帧和自生成帧在不同的 $k$ 下混在一起,畸变是二维的。GAN 式判别器(让判别器区分真值轨迹和 rollout 轨迹)能补分布层面的监督,但训练不稳、和扩散目标叠加的工程成本高。DAgger 路线的好处是监督信号始终来自真值(专家),模型只是把「自己会走到的地方」纳入训练分布,不需要引入新网络。Self-Forcing 采用自 rollout 的视频分布匹配,与 DAgger 共享关注分布偏移的动机,但目标与监督信号不同。 Diffusion Forcing(arXiv 2407.01392,NeurIPS 2024):把下一帧预测和全序列扩散统一成「每帧独立噪声级的条件去噪」,证明了两者是同一个目标的两个端点。后续的流式视频模型(含游戏引擎式的实时生成)基本都沿用「逐 block 从噪声降干净 + 历史进缓存」的采样骨架。 CausVid:把双向扩散模型蒸馏成因果自回归的 few-step 生成器,证明「因果化 + 步数蒸馏」可以叠加。Self-Forcing 的训练基建直接继承自它。 Self-Forcing(arXiv 2506.08009):指出曝光偏差在视频扩散上的具体形态,给出「训练时 rollout + KV cache + 视频级整体损失」的解法。600 次迭代、64 H100、2 小时以内,这是这条路线「能用普通实验室的预算续命」的直接证据。 同方向的中文篇目:DDIM 采样器(本文的 4 步去噪就是它)、流匹配(另一条「少步数化」的路线)、潜空间扩散(21 潜帧从哪来)。 08. 常见误解 误解一:「自回归省算力。」 总 MAC 比值 0.875——基本不省。注意力遮罩省下的 FLOPs,被 Step 3.3 的缓存刷新前向(每块 5 次前向对 4 次)吃掉了大半。自回归买到的是 13.98 倍的首帧延迟和贴着实时线的出帧节奏,把「省算力」当卖点去汇报会翻车。 误解二:「曝光偏差就是误差随长度无限涨。」 本例慢变量系数 0.97 仍小于 1,理想独立增量模型有界;快变量更快饱和。实际学习器可因模型偏差或不稳定闭环继续增长,需另测有效误差传播,不能把快慢直接等同于有界/发散。看「平均逐帧误差涨了几倍」会把 15.35 倍和 4.14 倍混成一个数,既高估也低估——先拆维度再下结论。 误解三:「在自生成上下文上逐帧重拟合,轮次越多就越稳。」 看 DAgger 循环只盯视野内逐帧损失时发生了什么: 这张图要看什么:蓝色柱(训练视野内 MSE)从 0.209 逐轮降到 0.187,看起来一路向好;红色柱(外推第 72 帧 MSE,对数轴)从 0.60 涨到 0.83 再爆到 97.15——第 2 轮的外推末帧是第 0 轮的 161 倍。视野内的改进是真的,但把权重推离了能外推的区域。这说明本 toy 的视野内回归目标不能保证长时稳定;Self-Forcing 用联合分布匹配,不能把本 toy 当作论文算法消融或 DAgger 的普遍反例。我的实验里第 2 轮被发散保护停掉;换成对整段(含外推段)算损失的变体,两轮内慢变量降 11.9%、快变量降 8.5%,外推同步受控。 误解四:「训练时给上下文加噪越多越鲁棒。」 右图(06 节)的折中曲线明确说不是,Q5 的原始数据在这里: 训练上下文噪声步 $k$ TF 评测 自回归视野内 外推 t=71 0 0.02536 0.20914 0.60284 50 0.02792 0.20516 0.51928 150 0.05050 0.27835 0.51929 250 0.09561 0.34373 0.49690 400 0.15762 0.29314 0.54894 本次扫描中 $k=250$ 的末帧 MSE 最低,但 rollout 视野内 MSE 0.34373 是 $k=50$ 的约 1.68 倍、$k=0$ 的约 1.64 倍;另一个指标 TF MSE 为 0.09561,较 $k=0$ 的 0.02536 恶化约 3.77 倍。两列不能混算——加噪不是只影响 rollout 端。结合 Q4(模型对上下文噪声级的敏感度在训练时铸死),「加噪」本身是一种要配套的契约,不是免费的保险。 误解五:「因果注意力必须丢质量。」 在这个玩具里没有丢(见 06 节诚实说明);真实系统里质量损失主要来自曝光偏差与蒸馏误差,而不是「看不见未来」本身——CausVid 与 Self-Forcing 的生成质量支撑这一点。 09. 动手验证 三个脚本都在本文附录,numpy 单文件,无 GPU 依赖: # 主实验:三种范式 + 快慢拆解 + DAgger 轮次 + 上下文噪声扫描(约 3~5 分钟) python forcing_lab.py # 流式账本:按 Wan2.1-1.3B 真实拓扑算 MAC / 显存 / 出帧节奏(纯算术,秒级) python streaming_ledger.py # 复现本文全部 5 张图 python make_figures.py 对着输出核对三件事: forcing_lab.py 的 Q1 表里,teacher forcing 视野内均值应为 0.02536,自回归 rollout 应为 0.20941(比值约 8.3);Q3 应打印「外推末帧已发散」并停止。 streaming_ledger.py 的首帧延迟比应为 13.98,KV cache 全量应为 5.624 GB。改任何拓扑参数(层数、头数、潜帧数)都应按比例传导——比如把潜帧数从 21 改成 42,全量缓存应精确翻倍到 11.25 GB。 去 Self-Forcing 仓库打开 configs/self_forcing_dmd.yaml,核对 denoising_step_list 与 num_frame_per_block 是否与本文 05 节的表一致(上游若重构,以仓库为准)。 把 forcing_lab.py 里的 LAM_SLOW 从 0.97 调到 0.85 重跑:慢变量的放大倍数应从 15.35 回落到 4 倍上下(理论值 $1/(1 - 0.85^2) \approx 3.6$),快变量几乎不动——这是 3.2 节「谱半径决定一切」最直接的验证。 把 streaming_ledger.py 的 LAT_FRAMES 从 21 改成 42:全量 KV cache 应精确翻倍到 11.25 GB,首块延迟不变——「流式成本与已生成长度解耦」在代码里就是这么体现的。 10. 延伸阅读 Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion(arXiv 2407.01392,NeurIPS 2024) Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion(arXiv 2506.08009) 代码:guandeh17/Self-Forcing(pipeline/causal_inference.py、configs/self_forcing_dmd.yaml) 本系列相关篇目:KV cache、FlashAttention、DDIM 采样器、流匹配 下一篇自然是「少步数蒸馏」(DMD / 蒸馏到 1~4 步)——Forcing 解决了「怎么流式地生成」,蒸馏解决「每块少算几步」,两者拼起来才是实时视频生成的完整拼图。 读原论文的建议顺序:先读 Self-Forcing 的第 3 节(推理管线那五步,对照本文 05 节的表),再回头读 Diffusion Forcing 的第 3 节(目标函数的统一形式,对照本文 3.3 节)——反过来读会被「每帧独立噪声级」的抽象描述卡住,先看到具体的采样循环再回头抽象,会顺很多。玩具实验(04 节)建议在读论文之前跑一遍,数字先在手里,论文里每一句关于 exposure bias 的表述都能对号入座。 附录:完整代码 09 节用到的脚本全文如下(forcing_lab.py、streaming_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 forcing_lab.py # -*- coding: utf-8 -*- """ forcing_lab.py —— 自回归视频生成 / Forcing 范式的玩具实验(只依赖 numpy) 跑法: python forcing_lab.py # 全量 python forcing_lab.py --fast # 小样本快速迭代 python forcing_lab.py --rounds 4 # 多做几轮 DAgger 风格 toy 重拟合 python forcing_lab.py --ctx 0 100 250 # 只扫这几个上下文噪声级 数据是一段"带条件的 6 维视频",分成两块,故意让它们的时间尺度不同: u(前 3 维)慢变量:u_t = Lam u_{t-1} + G w_{t-1} + 噪声,Lam 的谱半径 0.97 —— 一条会被积分记住的轨迹,误差会累积(相机轨迹、主体位置) w(后 3 维)快变量:w_t = tanh(Aw w_{t-1} + Bw c) + 噪声 —— 收缩模态,误差会被动力学忘掉(纹理、局部细节) 输出顺序与正文表格一一对应: Q1 三种范式的逐帧误差:全序列扩散 / teacher forcing / 自回归 rollout Q2 曝光偏差拆成两块看:快变量是恒定抬升,慢变量是随帧号累积 Q3 DAgger 风格线性重拟合;不是 Self-Forcing 的 DMD 实现 Q4 上下文噪声 context_noise:训练时用什么噪声级,推理时就得用什么噪声级 """ import argparse import os import numpy as np # ═══════════════════════════════ 0. 配置 ═══════════════════════════════ DU = 3 # 慢变量 u 的维度(会被积分记住的分量) DW = 3 # 快变量 w 的维度(收缩的分量) D = DU + DW # 每帧"潜向量"的总维度 DC = 4 # 条件向量维度(类比文本 embedding) T_TRAIN = 24 # 训练时的序列长度(horizon) T_ROLL = 72 # 推理外推到 3 倍长度 N_STEPS_DIFF = 1000 STEPS = [1000, 750, 500, 250] # 对齐 Self-Forcing 的 4 步去噪 LAM_SLOW = 0.97 # 慢变量的自回归系数(谱半径) RHO_FAST = 0.85 # 快变量转移矩阵的谱半径 G_SCALE = 0.09 # 快变量驱动慢变量的耦合强度 SIG_U = 0.02 # 慢变量的过程噪声 SIG_W = 0.10 # 快变量的过程噪声 LAMBDA = 3e-3 # ridge 系数(压住上下文权重,防止 rollout 重训时正反馈发散) ALPHA = 0.3 # toy 重拟合 每轮的权重更新步长(1.0 = 完全换成新解) SEED_SYS = 20250608 CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "forcing_lab_cache.npz") # ═══════════════════════ 1. 噪声表:线性 beta 调度(DDPM 原版)═══════════════════════ def build_schedule(n_steps=N_STEPS_DIFF, beta0=1e-4, beta1=0.02): beta = np.linspace(beta0, beta1, n_steps) return np.concatenate([[1.0], np.cumprod(1.0 - beta)]) # 下标 = 时间步 t ABAR = build_schedule() def abar_of(timestep): t = min(max(int(round(timestep)), 0), N_STEPS_DIFF) return float(ABAR[t]) # ═══════════════════════ 2. 数据:慢变量 + 快变量 + 条件 ═══════════════════════ def _ortho(rng, n, rho): q, _ = np.linalg.qr(rng.standard_normal((n, n))) return rho * q def make_system(): rng = np.random.default_rng(SEED_SYS) return dict( Lam=_ortho(rng, DU, LAM_SLOW), G=rng.standard_normal((DU, DW)) * G_SCALE, Aw=_ortho(rng, DW, RHO_FAST), Bw=rng.standard_normal((DW, DC)) * 0.9, H=rng.standard_normal((DU, DC)) * 0.9, ) def sample_sequences(rng, S, n, T): """采样 n 条长度为 T 的序列。c 是每条序列固定、模型可见的条件(类比文本)。""" c = rng.standard_normal((n, DC)) cb = c @ S["Bw"].T # (n, DW) hb = c @ S["H"].T # (n, DU) u = np.tanh(hb) + SIG_U * rng.standard_normal((n, DU)) w = np.tanh(cb) + SIG_W * rng.standard_normal((n, DW)) out = np.empty((n, T, D)) for t in range(T): out[:, t, :DU] = u out[:, t, DU:] = w w_new = np.tanh(w @ S["Aw"].T + cb) + SIG_W * rng.standard_normal((n, DW)) u_new = u @ S["Lam"].T + w @ S["G"].T + SIG_U * rng.standard_normal((n, DU)) u, w = u_new, w_new return out, c # ═══════════════════════════ 3. 两种特征(因果 / 双向)═══════════════════════════ # # 两边都是"自己的观测 + 两个邻居/汇总向量 + 条件 + 偏置",维数完全相同 = 3D+DC+1。 # 差别只在"能看哪几帧"——这个差别就是两种范式的全部定义: # 因果 causal:上一帧的上下文 + 过去 4 帧均值(只看过去) # 双向 bidir :前一帧 + 后一帧的噪声观测(能看未来) F_DIM = 3 * D + DC + 1 def feat_causal(z_t, hist, c): if len(hist) == 0: prev = np.zeros(D) past_mean = np.zeros(D) else: prev = hist[-1] past_mean = np.asarray(hist[-4:]).mean(axis=0) return np.concatenate([z_t, prev, past_mean, c, np.ones(1)]) def feat_bidir(z_seq, t, c): zp = z_seq[t - 1] if t > 0 else np.zeros(D) zn = z_seq[t + 1] if t + 1 < len(z_seq) else np.zeros(D) return np.concatenate([z_seq[t], zp, zn, c, np.ones(1)]) def fit_ridge(X, Y, lam=LAMBDA): F = X.shape[1] return np.linalg.solve(X.T @ X + lam * np.eye(F), X.T @ Y) # ═══════════════════════════ 4. 采样器 ════════════════════════════ def ddim_step(z, xhat, a, a_next): """DDIM (eta=0):固定噪声估计,只把噪声水平降到下一档。""" eps = (z - np.sqrt(a) * xhat) / np.sqrt(max(1e-12, 1.0 - a)) return np.sqrt(a_next) * xhat + np.sqrt(1.0 - a_next) * eps def sample_bidir(W, z_init, c, steps=STEPS): """全序列扩散:整条序列一起走 4 步,每步所有帧互相可见。非流式。""" T = z_init.shape[0] z = z_init.copy() xhat = np.zeros_like(z) for i, ts in enumerate(steps): a = abar_of(ts) xhat = np.stack([feat_bidir(z, t, c) for t in range(T)]) @ W if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) return xhat def sample_causal(W, rng, T_out, c, steps=STEPS, ctx_ts=0, hist_true=None, ctx_rng=None, collect=False, x_true=None): """因果自回归 rollout。 ctx_ts 把刚生成的帧按这个时间步加噪后才写进历史(对应 Self-Forcing 里 用 context_noise 刷新 KV cache 那一步)。0 = 干净上下文。 hist_true 给定时上下文永远取真值 —— teacher forcing 评测(测试时不可得)。 ctx_rng 给定时,连真值上下文也按 ctx_ts 加噪(Q4 用的受控实验)。 """ a_ctx = abar_of(ctx_ts) out = np.empty((T_out, D)) hist = [] rows_X, rows_Y = [], [] for t in range(T_out): a0 = abar_of(steps[0]) z = rng.standard_normal(D) if a0 < 1e-8 else ( np.sqrt(a0) * (x_true[t] if x_true is not None else np.zeros(D)) + np.sqrt(1.0 - a0) * rng.standard_normal(D)) for i, ts in enumerate(steps): a = abar_of(ts) if hist_true is not None: ctx = hist_true[:t] if ctx_rng is not None and a_ctx < 1.0 - 1e-12 and len(ctx): ctx = (np.sqrt(a_ctx) * ctx + np.sqrt(1 - a_ctx) * ctx_rng.standard_normal(ctx.shape)) else: ctx = np.array(hist) if len(hist) else np.zeros((0, D)) feat = feat_causal(z, ctx, c) xhat = feat @ W if collect and x_true is not None: rows_X.append(feat.copy()) rows_Y.append(x_true[t].copy()) if i + 1 < len(steps): z = ddim_step(z, xhat, a, abar_of(steps[i + 1])) out[t] = xhat if hist_true is None: if a_ctx >= 1.0 - 1e-12: hist.append(xhat.copy()) else: hist.append(np.sqrt(a_ctx) * xhat + np.sqrt(1.0 - a_ctx) * rng.standard_normal(D)) if collect: return out, np.array(rows_X), np.array(rows_Y) return out # ═══════════════════════════ 5. 数据集构造 ════════════════════════════ def build_gt_dataset(seqs, conds, rng, levels=STEPS, ctx_ts=0): """teacher forcing 数据集:上下文用真值帧(可按 ctx_ts 加噪)。""" n, T, _ = seqs.shape a_ctx = abar_of(ctx_ts) Xs, Ys = [], [] for t in range(T): if t == 0: prev, pm = np.zeros((n, D)), np.zeros((n, D)) else: prev = seqs[:, t - 1, :] pm = seqs[:, max(0, t - 4):t, :].mean(axis=1) if a_ctx < 1.0 - 1e-12: prev = np.sqrt(a_ctx) * prev + np.sqrt(1 - a_ctx) * rng.standard_normal((n, D)) pm = np.sqrt(a_ctx) * pm + np.sqrt(1 - a_ctx) * rng.standard_normal((n, D)) for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs[:, t, :] + np.sqrt(1.0 - a) * rng.standard_normal((n, D)) Xs.append(np.concatenate([z, prev, pm, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) def build_bidir_dataset(seqs, conds, rng, levels=STEPS): n, T, _ = seqs.shape Xs, Ys = [], [] for ts in levels: a = abar_of(ts) z = np.sqrt(a) * seqs + np.sqrt(1.0 - a) * rng.standard_normal((n, T, D)) for t in range(T): zp = z[:, t - 1, :] if t > 0 else np.zeros((n, D)) zn = z[:, t + 1, :] if t + 1 < T else np.zeros((n, D)) Xs.append(np.concatenate([z[:, t, :], zp, zn, conds, np.ones((n, 1))], axis=1)) Ys.append(seqs[:, t, :]) return np.concatenate(Xs, 0), np.concatenate(Ys, 0) # ═══════════════════════════ 6. 度量 ════════════════════════════ def mse_curve(pred, truth, sl=None): """每帧每维的平均平方误差。sl 是维度切片,用来把快慢变量分开看。""" e = (pred - truth) if sl is None else (pred[..., sl] - truth[..., sl]) return (e ** 2).mean(axis=(0, -1)) USL, WSL = slice(0, DU), slice(DU, D) def ctx_gain(W): """模型对上下文的依赖强度:上下文两块特征对应权重的 Frobenius 范数。""" return float(np.linalg.norm(W[D:3 * D, :])) def doubling_length(curve, t0=2, t1=None): t1 = t1 or len(curve) - 1 y = np.log(np.maximum(curve[t0:t1 + 1], 1e-12)) b = np.polyfit(np.arange(t0, t1 + 1), y, 1)[0] return float(np.log(2.0) / b) if b > 0 else float("inf") def fmt_row(tag, cur, cur_u, cur_w, T=T_TRAIN): return (f" {tag:<12}{cur[:T].mean():>12.5f}{cur_u[:T].mean():>12.5f}" f"{cur_w[:T].mean():>12.5f}{cur[min(23, len(cur) - 1)]:>12.5f}" f"{cur[min(47, len(cur) - 1)]:>12.5f}{cur[-1]:>12.5f}") # ═══════════════════════════ 7. 主流程 ════════════════════════════ def main(): ap = argparse.ArgumentParser() ap.add_argument("--rounds", type=int, default=3) ap.add_argument("--n-train", type=int, default=6000) ap.add_argument("--n-test", type=int, default=1500) ap.add_argument("--alpha", type=float, default=ALPHA) ap.add_argument("--fast", action="store_true") ap.add_argument("--ctx", type=int, nargs="*", default=[0, 50, 100, 150, 200, 250, 300, 400]) args = ap.parse_args() if args.fast: args.n_train, args.n_test = 2500, 500 S = make_system() seqs_train, c_train = sample_sequences(np.random.default_rng(11), S, args.n_train, max(T_TRAIN, T_ROLL)) seqs_test, c_test = sample_sequences(np.random.default_rng(12), S, args.n_test, max(T_TRAIN, T_ROLL)) var_u = seqs_test[..., USL].var(axis=(0, 1)).mean() var_w = seqs_test[..., WSL].var(axis=(0, 1)).mean() print("=" * 78) print(f"数据:u_t = Lam u_{{t-1}} + G w_{{t-1}} + {SIG_U} xi (慢变量,谱半径 {LAM_SLOW})") print(f" w_t = tanh(Aw w_{{t-1}} + Bw c) + {SIG_W} xi (快变量,谱半径 {RHO_FAST})") print(f"D={D}(u:{DU} + w:{DW}) DC={DC} 训练集 {seqs_train.shape} 测试集 {seqs_test.shape}") print(f"慢变量边缘方差 {var_u:.4f} 快变量边缘方差 {var_w:.4f}") print(f"训练视野 T={T_TRAIN},外推到 T={T_ROLL};去噪步 {STEPS}") print(f"特征维数 F = 3D+DC+1 = {F_DIM}(因果与双向完全相同)") print(f"最后一步的输入噪声级 abar({STEPS[-1]}) = {abar_of(STEPS[-1]):.4f}") print("=" * 78) # ── 基线 0:全序列扩散(非因果,整段一起解)───────────────────── Xb, Yb = build_bidir_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(21)) Wb = fit_ridge(Xb, Yb) rng_b = np.random.default_rng(31) pred_bi = np.stack([sample_bidir(Wb, rng_b.standard_normal((T_TRAIN, D)), c_test[i]) for i in range(args.n_test)]) cur_bi = mse_curve(pred_bi, seqs_test[:, :T_TRAIN]) cur_bi_u = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], USL) cur_bi_w = mse_curve(pred_bi, seqs_test[:, :T_TRAIN], WSL) # ── 基线 1:teacher forcing(上下文用真值帧)──────────────────── Xg, Yg = build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(22)) W_tf = fit_ridge(Xg, Yg) rng_tf = np.random.default_rng(32) pred_tf = np.stack([sample_causal(W_tf, rng_tf, T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) cur_tf = mse_curve(pred_tf, seqs_test[:, :T_TRAIN]) cur_tf_u = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], USL) cur_tf_w = mse_curve(pred_tf, seqs_test[:, :T_TRAIN], WSL) # ── 基线 2:同一个权重做自回归 rollout ────────────────────────── rng_sf = np.random.default_rng(33) pred_sf0 = np.stack([sample_causal(W_tf, rng_sf, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) cur_sf0 = mse_curve(pred_sf0, seqs_test[:, :T_ROLL]) cur_sf0_u = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], USL) cur_sf0_w = mse_curve(pred_sf0, seqs_test[:, :T_ROLL], WSL) print("\n【Q1】三种范式的逐帧 MSE(每维平均平方误差)") print(f"{'帧号':>6}{'全序列扩散':>14}{'teacher forcing':>16}{'自回归 rollout':>16}") for t in [0, 1, 2, 3, 5, 7, 11, 15, 19, 23]: print(f"{t:>6}{cur_bi[t]:>14.5f}{cur_tf[t]:>16.5f}{cur_sf0[t]:>16.5f}") print("\n【Q2】曝光偏差拆成快慢两块看") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w) + " 非流式,长度固定") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w) + " 上下文用真值,测试时不可得") print(fmt_row("rollout0", cur_sf0, cur_sf0_u, cur_sf0_w)) print(f"\n 快变量 w:teacher {cur_tf_w[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_w[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_w[:T_TRAIN].mean() / cur_tf_w[:T_TRAIN].mean():.2f} 倍(恒定抬升)") print(f" 慢变量 u:teacher {cur_tf_u[:T_TRAIN].mean():.5f} -> " f"rollout {cur_sf0_u[:T_TRAIN].mean():.5f} " f"放大 {cur_sf0_u[:T_TRAIN].mean() / cur_tf_u[:T_TRAIN].mean():.2f} 倍") print(f" 慢变量误差 t=1 -> t=23 增长 " f"{cur_sf0_u[23] / max(cur_sf0_u[1], 1e-12):.2f} 倍," f"翻倍长度 {doubling_length(cur_sf0_u, 1, T_TRAIN - 1):.2f} 帧") print(f" 快变量误差 t=1 -> t=23 变化 " f"{cur_sf0_w[23] / max(cur_sf0_w[1], 1e-12):.3f} 倍(不累积)") print(f" 越过训练视野(t>={T_TRAIN})后:慢变量是视野内的 " f"{cur_sf0_u[T_TRAIN:].mean() / cur_sf0_u[:T_TRAIN].mean():.2f} 倍," f"快变量 {cur_sf0_w[T_TRAIN:].mean() / cur_sf0_w[:T_TRAIN].mean():.2f} 倍") print(f" 模型对上下文的依赖强度 |W_ctx| = {ctx_gain(W_tf):.4f}") # ── Q3:Self-Forcing 轮次 ───────────────────────────────────── print(f"\n【Q3】Self-Forcing 轮次(每轮用自己 rollout 的上下文重训,步长 alpha={args.alpha})") print(f" {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") W = W_tf.copy() curves, us, ws = {"round0": cur_sf0}, {"round0": cur_sf0_u}, {"round0": cur_sf0_w} rng_roll = np.random.default_rng(41) rng_eval = np.random.default_rng(61) n_sub = min(3000, args.n_train) def eval_rollout(Wm, rng): p = np.stack([sample_causal(Wm, rng, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) return p, mse_curve(p, seqs_test[:, :T_ROLL]) # 注意:这里故意只按训练视野内的指标接受更新。Self-Forcing 的论文强调用 # "视频级整体损失",下面会看到只盯视野内会发生什么。 best_score = cur_sf0[:T_TRAIN].mean() tail0 = cur_sf0[-1] for r in range(1, args.rounds + 1): Xs, Ys = [], [] for i in range(n_sub): _, Xr, Yr = sample_causal(W, rng_roll, T_TRAIN, c_train[i], ctx_ts=0, collect=True, x_true=seqs_train[i, :T_TRAIN]) Xs.append(Xr) Ys.append(Yr) W_new = fit_ridge(np.concatenate(Xs, 0), np.concatenate(Ys, 0)) # 折半线搜索:rollout 重训容易形成正反馈,只接受真的变好的更新 picked = None a = args.alpha for _ in range(5): W_try = (1.0 - a) * W + a * W_new rng_try = np.random.default_rng(900 + r * 10 + int(a * 100)) p_try, c_try = eval_rollout(W_try, rng_try) sc = c_try[:T_TRAIN].mean() if np.isfinite(sc) and sc < best_score: picked = (W_try, p_try, c_try, sc, a) best_score = sc break a *= 0.5 if picked is None: print(f" round {r}: 折半线搜索到 alpha={a:.4f} 仍没有变好的更新,提前停止") break if picked[2][-1] > 50.0 * tail0: print(f" round {r}: 外推末帧已发散到 {picked[2][-1]:.3g}(round0 的 " f"{picked[2][-1] / tail0:.1f} 倍),停止") curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) break W = picked[0] curves[f"round{r}"] = picked[2] us[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], USL) ws[f"round{r}"] = mse_curve(picked[1], seqs_test[:, :T_ROLL], WSL) print(fmt_row(f"round{r}", curves[f"round{r}"], us[f"round{r}"], ws[f"round{r}"]) + f" alpha={picked[3]:.4f}") print(f"\n {'':<12}{'视野内MSE':>12}{'慢变量u':>12}{'快变量w':>12}" f"{'t=23':>12}{'t=47':>12}{'t=71':>12}") print(fmt_row("teacher", cur_tf, cur_tf_u, cur_tf_w)) print(fmt_row("全序列", cur_bi, cur_bi_u, cur_bi_w)) keys = ["round0"] + [k for k in curves if k != "round0"] for k in keys: print(fmt_row(k, curves[k], us[k], ws[k])) best = min(keys, key=lambda k: curves[k][:T_TRAIN].mean()) print(f"\n 最好一轮 {best}:快变量 {ws['round0'][:T_TRAIN].mean():.5f} -> " f"{ws[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - ws[best][:T_TRAIN].mean() / ws['round0'][:T_TRAIN].mean()):.1f}%)," f"慢变量 {us['round0'][:T_TRAIN].mean():.5f} -> " f"{us[best][:T_TRAIN].mean():.5f}" f"(降 {100 * (1 - us[best][:T_TRAIN].mean() / us['round0'][:T_TRAIN].mean()):.1f}%)") # ── Q4:上下文噪声必须与训练对齐 ────────────────────────────── print("\n【Q4】上下文噪声 context_noise:训练用什么级,推理就得用什么级") print(" (受控实验:上下文一律取真值帧,只改加噪级别,把曝光偏差排除掉)") W_noisy = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(23), ctx_ts=250)) print(f" {'训练噪声步':<12}{'推理噪声步':<12}{'abar':>8}{'视野内MSE':>12}{'慢变量u':>12}") ctx_rows = {} for tag, Wm in [("clean(0)", W_tf), ("noisy(250)", W_noisy)]: row = {} for cts in args.ctx: rng_e = np.random.default_rng(70) p = np.stack([sample_causal(Wm, rng_e, T_TRAIN, c_test[i], ctx_ts=cts, hist_true=seqs_test[i, :T_TRAIN], ctx_rng=rng_e) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) cu = mse_curve(p, seqs_test[:, :T_TRAIN], USL) row[cts] = cc print(f" {tag:<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}{cu.mean():>12.5f}") ctx_rows[tag] = row print(f" -> {tag} 的最优推理噪声步 = {min(row, key=lambda k: row[k].mean())}") print("\n 同样的扫描放到自回归 rollout 上(此时上下文是模型自己的输出)") row_sf = {} for cts in args.ctx: rng_e = np.random.default_rng(80) p = np.stack([sample_causal(W, rng_e, T_TRAIN, c_test[i], ctx_ts=cts) for i in range(args.n_test)]) cc = mse_curve(p, seqs_test[:, :T_TRAIN]) row_sf[cts] = cc print(f" {'selfroll':<12}{cts:<12}{abar_of(cts):>8.4f}{cc.mean():>12.5f}" f"{mse_curve(p, seqs_test[:, :T_TRAIN], USL).mean():>12.5f}") print(f" -> 自回归 rollout 的最优推理噪声步 = {min(row_sf, key=lambda k: row_sf[k].mean())}") # ── Q5:等效噪声级 + 训练时给上下文加噪换鲁棒性 ────────────────── print("\n【Q5】曝光偏差的等效噪声级,以及训练时给上下文加噪能不能换来自回归的鲁棒性") line_tf = np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]) target = cur_sf0[:T_TRAIN].mean() grid = np.array(args.ctx, dtype=float) eq = float(np.interp(target, line_tf, grid)) if line_tf[-1] > target else float("nan") print(f" 自回归 rollout 的视野内 MSE = {target:.5f}") if np.isfinite(eq): print(f" 在 Q4 那条『干净模型 + 加噪上下文』曲线上插值,它等效于给真值上下文加 " f"{eq:.1f} 个时间步的噪声(abar 约 {abar_of(eq):.4f})") else: print(" 超出 Q4 的扫描范围,无法插值出等效噪声级") print(f"\n {'训练ctx噪声':<14}{'TF评测':>12}{'自回归(视野内)':>16}{'自回归t=71':>14}{'慢变量u':>12}") q5 = {} for k in args.ctx: Wk = fit_ridge(*build_gt_dataset(seqs_train[:, :T_TRAIN], c_train, np.random.default_rng(24), ctx_ts=k)) rng_a = np.random.default_rng(90) p_tf = np.stack([sample_causal(Wk, rng_a, T_TRAIN, c_test[i], hist_true=seqs_test[i, :T_TRAIN]) for i in range(args.n_test)]) rng_b2 = np.random.default_rng(91) p_sf = np.stack([sample_causal(Wk, rng_b2, T_ROLL, c_test[i], ctx_ts=0) for i in range(args.n_test)]) c_tfk = mse_curve(p_tf, seqs_test[:, :T_TRAIN]).mean() c_sfk = mse_curve(p_sf, seqs_test[:, :T_ROLL]) c_sfu = mse_curve(p_sf, seqs_test[:, :T_ROLL], USL) q5[k] = (c_tfk, c_sfk[:T_TRAIN].mean(), c_sfk[-1], c_sfu[:T_TRAIN].mean()) print(f" {k:<14}{c_tfk:>12.5f}{c_sfk[:T_TRAIN].mean():>16.5f}" f"{c_sfk[-1]:>14.5f}{c_sfu[:T_TRAIN].mean():>12.5f}") best_k = min(q5, key=lambda k: q5[k][1]) print(f" -> 自回归 rollout 最好的训练上下文噪声步 = {best_k}" f"(视野内 {q5[best_k][1]:.5f},对照 k=0 的 {q5[args.ctx[0]][1]:.5f})") cache_path = CACHE.replace(".npz", "_fast.npz") if args.fast else CACHE np.savez(cache_path, cur_bi=cur_bi, cur_bi_u=cur_bi_u, cur_bi_w=cur_bi_w, cur_tf=cur_tf, cur_tf_u=cur_tf_u, cur_tf_w=cur_tf_w, var_u=np.array([var_u]), var_w=np.array([var_w]), **{f"cur_{k}": v for k, v in curves.items()}, **{f"u_{k}": v for k, v in us.items()}, **{f"w_{k}": v for k, v in ws.items()}, ctx_clean=np.array([ctx_rows["clean(0)"][k].mean() for k in args.ctx]), ctx_noisy=np.array([ctx_rows["noisy(250)"][k].mean() for k in args.ctx]), ctx_sf=np.array([row_sf[k].mean() for k in args.ctx]), ctx_list=np.array(args.ctx), q5_tf=np.array([q5[k][0] for k in args.ctx]), q5_sf=np.array([q5[k][1] for k in args.ctx]), q5_sf_end=np.array([q5[k][2] for k in args.ctx]), q5_sf_u=np.array([q5[k][3] for k in args.ctx]), eq_noise=np.array([eq])) print(f"\n[cached] {cache_path}") if __name__ == "__main__": main() streaming_ledger.py # -*- coding: utf-8 -*- """ streaming_ledger.py —— 流式生成 vs 全序列扩散的算力 / 显存账本(纯算术,numpy 只用来算) 跑法: python streaming_ledger.py 拓扑全部取自公开配置,不是估的: Wan2.1-T2V-1.3B(wan/configs/wan_t2v_1_3B.py): dim=1536, ffn=8960, num_heads=12, num_layers=30, patch_size=(1,2,2), vae_stride=(4,8,8) Self-Forcing(configs/self_forcing_dmd.yaml): image_or_video_shape=[1,21,16,60,104] denoising_step_list=[1000,750,500,250] # 4 步 num_frame_per_block=3 Self-Forcing(pipeline/causal_inference.py): 每个 block 走完 4 步之后,还要用 context_noise 时间步再跑一次 forward 刷新 KV cache 口径:MAC = 一次乘加(1 MAC = 2 FLOP)。时间按 H100 bf16 有效算力 400 TFLOPS 折算, 只算 transformer 主体,不含 VAE 解码与文本编码。 """ import numpy as np # ── 拓扑 ────────────────────────────────────────────────────────── D = 1536 # dim FFN = 8960 # ffn_dim LAYERS = 30 HEADS = 12 D_HEAD = D // HEADS N_TEXT = 512 # T5 文本 token 数(cross-attn 的 K/V 长度) LAT_FRAMES = 21 # 潜空间帧数 LAT_H, LAT_W = 60, 104 PATCH = (1, 2, 2) TOK_PER_FRAME = (LAT_H // PATCH[1]) * (LAT_W // PATCH[2]) # 1560 N_TOK = LAT_FRAMES * TOK_PER_FRAME # 32760 BLOCK = 3 # num_frame_per_block N_STEPS = 4 # len(denoising_step_list) EXTRA_KV_REFRESH = 1 # 每个 block 结束后刷新 KV cache 的那次 forward PIXEL_PER_LATENT = 4 # vae_stride[0],21 潜帧 ≈ 81 像素帧 FPS = 16 BYTES = 2 # bf16 EFF_TFLOPS = 400e12 def mac_per_layer(n_new, n_key): """一层 transformer 的 MAC。n_new = 本次参与计算的 token 数,n_key = 可见的 key 数。""" attn = 2.0 * n_new * n_key * D # QK^T + AV proj = 4.0 * n_new * D * D # q, k, v, o ffn = 2.0 * n_new * D * FFN cross = 2.0 * n_new * N_TEXT * D + 2.0 * n_new * D * D # 注意力 + q/o 投影 return attn + proj + ffn + cross def gbyte(x_bytes): return x_bytes / 1024.0 ** 3 def sec(mac): return 2.0 * mac / EFF_TFLOPS def main(): print("=" * 78) print("拓扑:Wan2.1-T2V-1.3B + Self-Forcing 默认配置") print(f" dim={D} ffn={FFN} layers={LAYERS} heads={HEADS} head_dim={D_HEAD}") print(f" 潜空间 {LAT_FRAMES}x16x{LAT_H}x{LAT_W} patch={PATCH} -> " f"每帧 {TOK_PER_FRAME} token,整段 {N_TOK} token") print(f" block={BLOCK} 帧,每 block {N_STEPS} 步去噪 + {EXTRA_KV_REFRESH} 次 KV cache 刷新") print(f" 21 潜帧 ≈ {LAT_FRAMES * PIXEL_PER_LATENT - 3} 像素帧 @ {FPS}fps ≈ " f"{(LAT_FRAMES * PIXEL_PER_LATENT - 3) / FPS:.2f} 秒") print(f" 时间按 {EFF_TFLOPS/1e12:.0f} TFLOPS 有效算力折算(1 MAC = 2 FLOP)") print("=" * 78) # ── A. 全序列扩散:4 步,每步整段双向 ──────────────────────────── mac_full_step = LAYERS * mac_per_layer(N_TOK, N_TOK) mac_full = N_STEPS * mac_full_step print("\n【A】全序列扩散(非流式,整段一起解)") print(f" 单步 MAC {mac_full_step:.4e} 时间 {sec(mac_full_step)*1000:.1f} ms") print(f" 4 步合计 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s") print(f" 第一帧延迟 必须等 {N_STEPS} 步全部算完 = {sec(mac_full):.3f} s") attn_bytes_full = HEADS * N_TOK * N_TOK * BYTES print(f" 注意力矩阵要是真存下来:{HEADS} 头 x {N_TOK}^2 x {BYTES}B = " f"{gbyte(attn_bytes_full):.1f} GB(所以必须 FlashAttention)") # ── B. 因果自回归 + KV cache ──────────────────────────────────── n_blocks = LAT_FRAMES // BLOCK print(f"\n【B】因果自回归 + KV cache({n_blocks} 个 block,每 block {BLOCK} 帧)") print(f" {'block':>6}{'新token':>9}{'可见key':>9}{'单步MAC':>14}{'block合计MAC':>16}{'时间(ms)':>11}") mac_blocks = [] for i in range(n_blocks): n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME m_step = LAYERS * mac_per_layer(n_new, n_key) n_fwd = N_STEPS + EXTRA_KV_REFRESH # 4 步去噪:每步的 key 数就是 n_key(含当前 block 内部的因果可见部分) m_block = n_fwd * m_step mac_blocks.append(m_block) print(f" {i:>6}{n_new:>9}{n_key:>9}{m_step:>14.4e}{m_block:>16.4e}" f"{sec(m_block)*1000:>11.1f}") mac_blocks = np.array(mac_blocks) mac_causal = mac_blocks.sum() print(f" 合计 MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s") print(f" 第一帧延迟 = 第 0 个 block = {sec(mac_blocks[0])*1000:.1f} ms" f"(比全序列快 {sec(mac_full)/sec(mac_blocks[0]):.1f} 倍)") print(f" 稳态每个 block {sec(mac_blocks[-1])*1000:.1f} ms," f"实时预算 {BLOCK * PIXEL_PER_LATENT / FPS * 1000:.0f} ms " f"-> 余量 {BLOCK * PIXEL_PER_LATENT / FPS / sec(mac_blocks[-1]):.2f} 倍") # ── C. 总账对比 ──────────────────────────────────────────────── print(f"\n【C】总账({LAT_FRAMES} 潜帧)") print(f" 全序列扩散 MAC {mac_full:.4e} 时间 {sec(mac_full):.3f} s " f"首帧延迟 {sec(mac_full):.3f} s") print(f" 因果+KVcache MAC {mac_causal:.4e} 时间 {sec(mac_causal):.3f} s " f"首帧延迟 {sec(mac_blocks[0]):.3f} s") print(f" 总算力比 因果 / 全序列 = {mac_causal / mac_full:.3f}") print(f" 首帧延迟比 全序列 / 因果 = {sec(mac_full) / sec(mac_blocks[0]):.2f}") # ── D. KV cache 显存 ─────────────────────────────────────────── print("\n【D】KV cache 显存(bf16)") kv_all = 2 * LAYERS * N_TOK * D * BYTES print(f" 完整 21 帧 2 x {LAYERS} x {N_TOK} x {D} x {BYTES}B = {gbyte(kv_all):.3f} GB") for w in [3, 6, 9, 12, 21]: kv_w = 2 * LAYERS * w * TOK_PER_FRAME * D * BYTES print(f" 滚动窗口 {w:>2} 帧 {gbyte(kv_w):.3f} GB (占完整缓存 {w/LAT_FRAMES*100:.0f}%)") cross_cache = 2 * LAYERS * N_TEXT * D * BYTES print(f" cross-attn 缓存(文本 {N_TEXT} token,只算一次){gbyte(cross_cache):.3f} GB") # ── E. 无限长:不滚动缓存会怎样 ───────────────────────────────── print("\n【E】继续往下生成(不滚动缓存 vs 滚动窗口 9 帧)") print(f" {'已生成潜帧':>10}{'无滚动:单block时间(ms)':>24}{'滚动9帧(ms)':>16}{'无滚动:累计GB':>16}") cum = 0.0 for nlat in [21, 42, 84, 168, 336]: i = nlat // BLOCK - 1 n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME m_noroll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key) m_roll = (N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer( n_new, min(n_key, 9 * TOK_PER_FRAME)) cum = 2 * LAYERS * nlat * TOK_PER_FRAME * D * BYTES print(f" {nlat:>10}{sec(m_noroll)*1000:>24.1f}{sec(m_roll)*1000:>16.1f}" f"{gbyte(cum):>16.3f}") # ── F. 出帧节奏 ──────────────────────────────────────────────── print("\n【F】出帧节奏(每 block 出 3 潜帧 = 12 像素帧)") t_full = sec(mac_full) t_blocks = np.cumsum(sec(mac_blocks)) print(f" 全序列:t={t_full:.3f} s 时一次性拿到全部 {LAT_FRAMES * PIXEL_PER_LATENT - 3} 帧") for i, tb in enumerate(t_blocks): print(f" 因果 :t={tb:.3f} s 时拿到第 {(i+1)*BLOCK*PIXEL_PER_LATENT-3:>3} 像素帧") print(f" 实时预算:{FPS} fps 下应该在 " f"{np.arange(1, n_blocks+1)*BLOCK*PIXEL_PER_LATENT/FPS} 秒处出帧") print("\n[cached] 数值直接被 make_figures.py 引用(本文件被 import 时用函数取)") def ledger_numbers(): """给 make_figures.py 用的结构化数值。""" n_blocks = LAT_FRAMES // BLOCK mac_blocks = [] for i in range(n_blocks): n_new = BLOCK * TOK_PER_FRAME n_key = (i + 1) * BLOCK * TOK_PER_FRAME mac_blocks.append((N_STEPS + EXTRA_KV_REFRESH) * LAYERS * mac_per_layer(n_new, n_key)) mac_blocks = np.array(mac_blocks, dtype=float) mac_full = N_STEPS * LAYERS * mac_per_layer(N_TOK, N_TOK) return dict( mac_full=float(mac_full), mac_causal=float(mac_blocks.sum()), mac_blocks=mac_blocks, t_full=sec(mac_full), t_blocks=np.cumsum(sec(mac_blocks)), kv_all_gb=gbyte(2 * LAYERS * N_TOK * D * BYTES), kv_per_frame_gb=gbyte(2 * LAYERS * TOK_PER_FRAME * D * BYTES), n_blocks=n_blocks, block=BLOCK, lat_frames=LAT_FRAMES, tok_per_frame=TOK_PER_FRAME, n_tok=N_TOK, attn_gb_if_materialized=gbyte(HEADS * N_TOK * N_TOK * BYTES), pixel_frames=LAT_FRAMES * PIXEL_PER_LATENT - 3, fps=FPS, ) if __name__ == "__main__": main() print() for k, v in ledger_numbers().items(): if not isinstance(v, np.ndarray): print(f" {k:>28} = {v}") make_figures.py # -*- coding: utf-8 -*- """ make_figures.py —— 本文配图(matplotlib,中文字体 PingFang SC) 跑法: python make_figures.py 所有数字都从 forcing_lab_cache.npz(forcing_lab.py 实跑产出)和 streaming_ledger.ledger_numbers() 里取,不手写,避免图文漂移。 注意:matplotlib 的 mathtext 标签一律写 raw 字符串,且反斜杠后只跟字母 (beta 这种字母命令没问题,逗号、百分号等非字母不要跟在反斜杠后面)。 """ import os import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt from matplotlib.patches import Rectangle, FancyArrow HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") CACHE = os.path.join(HERE, "forcing_lab_cache.npz") import forcing_lab as FL import streaming_ledger as SL plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "Heiti TC"] plt.rcParams["axes.unicode_minus"] = False # 颜色常量(写图注前先对照这里,别凭印象写颜色) C_BLUE = "#1f6feb" # 自回归 rollout C_TEAL = "#0f9b8e" # teacher forcing C_ORANGE = "#e07b00" # 全序列扩散 C_RED = "#c0392b" # 慢变量 u / 恶化 C_GREEN = "#2d8a4e" # 快变量 w / 改善 C_GRAY = "#8a8a8a" # 参照线、未生成 C_DARK = "#3a3a3a" # 噪声最重的格子 C_LIGHT = "#f2f2f2" # 干净的格子 def load(): return dict(np.load(CACHE, allow_pickle=True)) # ══════════════════════════ 图 1:三种范式的噪声级与因果结构 ══════════════════════════ def _box(ax, x, y, w, h, level, edge=C_GRAY, lw=0.8, ls="-"): """level: 1 = 干净(浅),0 = 纯噪声(深)""" facecolor = str(max(0.0, min(1.0, float(level)))) ax.add_patch(Rectangle((x, y), w, h, facecolor=facecolor, edgecolor=edge, linewidth=lw, linestyle=ls, zorder=2)) def fig_paradigm(path): n = 12 bw, bh = 0.86, 0.62 fig, axes = plt.subplots(3, 1, figsize=(11.0, 6.6)) fig.subplots_adjust(left=0.06, right=0.97, top=0.93, bottom=0.07, hspace=0.34) # (a) 全序列扩散:整段一起降噪,帧与帧之间双向可见 ax = axes[0] steps_lv = [0.06, 0.30, 0.62, 0.92] for r, lv in enumerate(steps_lv): y = (len(steps_lv) - 1 - r) * 1.0 for i in range(n): _box(ax, i * 1.07, y, bw, bh, lv) ax.annotate("", xy=(n * 1.07 - 0.1, y + bh / 2), xytext=(0.05, y + bh / 2), arrowprops=dict(arrowstyle="<->", color=C_ORANGE, lw=1.8)) ax.text(-0.35, y + bh / 2, r"去噪步 %d" % (r + 1), ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, len(steps_lv) + 0.15, "所有帧同一个噪声级,一起降;双向注意力,帧间互相可见", ha="center", fontsize=11, color=C_ORANGE) ax.text(n * 1.07 / 2, -0.55, "代价:本图需 4 步整段去噪才交付第一帧;可用长度由架构与训练共同限制", ha="center", fontsize=10, color=C_GRAY) # (b) teacher forcing:真值上下文,只看过去 ax = axes[1] y = 0.0 cur = 7 for i in range(n): if i < cur: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_TEAL, lw=1.2) elif i == cur: _box(ax, i * 1.07, y, bw, bh, 0.10) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(cur): ax.annotate("", xy=(cur * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_TEAL, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.text(-0.35, y + bh / 2, "训练时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.15, "上下文永远取真值帧(浅色),只有当前帧(深色)带噪声", ha="center", fontsize=11, color=C_TEAL) ax.text(n * 1.07 / 2, y - 0.52, "代价:推理时真值帧不存在,上下文换成模型自己的输出 —— 这就是曝光偏差", ha="center", fontsize=10, color=C_GRAY) # (c) Self-Forcing 风格的生成上下文:自己的输出进 KV cache,逐 block 走 ax = axes[2] done, blk = 6, 3 for i in range(n): if i < done: _box(ax, i * 1.07, y, bw, bh, 0.95, edge=C_BLUE, lw=1.2) elif i < done + blk: _box(ax, i * 1.07, y, bw, bh, 0.10, edge=C_BLUE, lw=1.2) else: _box(ax, i * 1.07, y, bw, bh, 1.0, edge=C_GRAY, lw=0.8, ls="--") for i in range(done): ax.annotate("", xy=(done * 1.07 + bw * 0.5, y + bh * 0.45), xytext=(i * 1.07 + bw * 0.5, y + bh * 0.45), arrowprops=dict(arrowstyle="->", color=C_BLUE, lw=1.2, connectionstyle="arc3,rad=-0.25")) ax.add_patch(Rectangle((-0.05, y - 0.42), done * 1.07 + 0.05, 0.26, facecolor=C_BLUE, alpha=0.15, edgecolor=C_BLUE, lw=1.0)) ax.text(done * 1.07 / 2, y - 0.29, "KV cache(已生成的帧,不再重算)", ha="center", va="center", fontsize=9.5, color=C_BLUE) ax.text(-0.35, y + bh / 2, "推理时", ha="right", va="center", fontsize=10, color=C_DARK) ax.text(n * 1.07 / 2, y + 1.15, "自回归推理:历史为已生成的干净帧,当前 block 从噪声降到干净", ha="center", fontsize=11, color=C_BLUE) ax.text(n * 1.07 / 2, y - 0.82, "Self-Forcing 训练也用自己的 rollout 上下文,减轻训练与推理的分布差异", ha="center", fontsize=10, color=C_GRAY) for ax in axes: ax.set_xlim(-2.4, n * 1.07 + 0.3) ax.set_ylim(-1.05, len(steps_lv) + 0.45 if ax is axes[0] else 1.55) ax.axis("off") axes[0].set_title("三种上下文组织示意:可见范围、噪声级与历史来源", fontsize=13, pad=10) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 2:误差随帧号怎么长 ══════════════════════════ def fig_rollout(d, path): T = FL.T_TRAIN fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] xs = np.arange(T) ax.plot(xs, d["cur_bi"][:T], color=C_ORANGE, lw=2.0, label="全序列扩散(非流式)") ax.plot(xs, d["cur_tf"][:T], color=C_TEAL, lw=2.0, label="teacher forcing(真值上下文)") xr = np.arange(len(d["cur_round0"])) ax.plot(xr, d["cur_round0"], color=C_BLUE, lw=2.0, label="自回归 rollout(自己的输出)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, ax.get_ylim()[1] * 0.55, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(a) 三种范式的逐帧误差", fontsize=12) ax.legend(fontsize=9.5, loc="lower right") ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(xr, d["u_round0"], color=C_RED, lw=2.0, label=r"慢变量 u(会被积分记住)") ax.plot(xr, d["w_round0"], color=C_GREEN, lw=2.0, label=r"快变量 w(收缩模态)") ax.axvline(T - 0.5, color=C_GRAY, ls="--", lw=1.2) ax.text(T - 0.4, 0.10, "训练视野\nT=24", fontsize=9.5, color=C_GRAY) ax.set_yscale("log") ax.set_xlabel("帧号 t") ax.set_ylabel("每维平均平方误差(对数轴)") ax.set_title("(b) 自回归 rollout 拆成快慢两块", fontsize=12) ax.legend(fontsize=9.5, loc="upper left") ax.grid(alpha=0.25, ls=":") fig.suptitle("本玩具系统中,慢变量的误差在越过训练视野后明显增长", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.94]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 3:Self-Forcing 轮次的取舍 ══════════════════════════ def fig_rounds(d, path): keys = sorted([k[4:] for k in d if k.startswith("cur_round")], key=lambda s: int(s.replace("round", ""))) lbl = [("round0" if k == "round0" else k) for k in keys] inh = [float(d[f"cur_{k}"][:FL.T_TRAIN].mean()) for k in keys] tail = [float(d[f"cur_{k}"][-1]) for k in keys] x = np.arange(len(keys)) fig, ax = plt.subplots(figsize=(9.6, 4.6)) ax2 = ax.twinx() b1 = ax.bar(x - 0.19, inh, 0.36, color=C_BLUE, label="训练视野内 MSE(左轴)") b2 = ax2.bar(x + 0.19, tail, 0.36, color=C_RED, label="外推第 72 帧 MSE(右轴,对数)") for b in b1: ax.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.3f}", ha="center", va="bottom", fontsize=9) for b in b2: ax2.text(b.get_x() + b.get_width() / 2, b.get_height(), f"{b.get_height():.2f}", ha="center", va="bottom", fontsize=9, color=C_RED) ax.set_xticks(x) ax.set_xticklabels([k.replace("round", "第 ") + " 轮" if k != "round0" else "第 0 轮" for k in keys]) ax.set_ylabel("训练视野内 MSE", color=C_BLUE) ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax2.set_yscale("log") ax.set_ylim(0, max(inh) * 1.35) ax2.set_ylim(min(tail) * 0.5, max(tail) * 3.0) ax.grid(alpha=0.25, ls=":", axis="y") ax.set_title("玩具 DAgger 式重训:视野内改善,长程误差增加(非论文 Self-Forcing)", fontsize=13) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=10, loc="upper left") fig.tight_layout() fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 4:上下文噪声的取舍 ══════════════════════════ def fig_context(d, path): ks = [int(v) for v in d["ctx_list"]] ab = [FL.abar_of(k) for k in ks] tf = [float(v) for v in d["q5_tf"]] end = [float(v) for v in d["q5_sf_end"]] inh = [float(v) for v in d["q5_sf"]] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.7)) ax = axes[0] ax.plot(ks, d["ctx_clean"], "o-", color=C_TEAL, lw=2.0, label="干净模型 + 推理时给上下文加噪") ax.axhline(float(d["cur_round0"][:FL.T_TRAIN].mean()), color=C_BLUE, ls="--", lw=1.6, label="自回归 rollout 的实际水平") ax.axvline(float(d["eq_noise"][0]), color=C_RED, ls=":", lw=1.8) ax.text(float(d["eq_noise"][0]) + 8, ax.get_ylim()[1] * 0.62, f"等效噪声级\n约 {float(d['eq_noise'][0]):.0f} 步", fontsize=9.5, color=C_RED) ax.set_xlabel("上下文噪声时间步") ax.set_ylabel("视野内 MSE") ax.set_title("(a) 曝光偏差有多大:换算成等效噪声级", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax = axes[1] ax.plot(ks, inh, "o-", color=C_BLUE, lw=2.0, label="训练视野内 MSE(精度)") ax.set_xlabel("训练时给上下文加的噪声时间步 k") ax.set_ylabel("训练视野内 MSE", color=C_BLUE) ax2 = ax.twinx() ax2.plot(ks, end, "s-", color=C_RED, lw=2.0, label="外推第 72 帧 MSE(稳定性)") ax2.set_ylabel("外推第 72 帧 MSE", color=C_RED) ax.set_title("(b) 训练时给上下文加噪:精度换稳定性", fontsize=12) h1, l1 = ax.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax.legend(h1 + h2, l1 + l2, fontsize=9.5, loc="center right") ax.grid(alpha=0.25, ls=":") fig.suptitle(f"上下文噪声:abar 从 {ab[0]:.2f} 降到 {ab[-1]:.2f}," f"本实验中增加上下文噪声可降低长程误差,但影响视野内精度", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) # ══════════════════════════ 图 5:流式账本 ══════════════════════════ def fig_ledger(path): L = SL.ledger_numbers() fig, axes = plt.subplots(1, 3, figsize=(15.6, 4.6)) # (a) 出帧节奏 ax = axes[0] pix = (np.arange(1, L["n_blocks"] + 1) * L["block"] * 4 - 3) ax.step(np.concatenate([[0], L["t_blocks"]]), np.concatenate([[0], pix]), where="post", color=C_BLUE, lw=2.2, label="因果自回归 + KV cache") ax.plot([L["t_full"], L["t_full"]], [0, L["pixel_frames"]], color=C_ORANGE, lw=2.2, label="全序列扩散(一次性出全部帧)") tt = np.linspace(0, L["pixel_frames"] / L["fps"], 50) ax.plot(tt, tt * L["fps"], color=C_GRAY, ls="--", lw=1.4, label="实时预算 16 fps") ax.set_xlabel("时间 (s)") ax.set_ylabel("已生成的像素帧") ax.set_title("(a) 出帧节奏", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") ax.set_ylim(0, L["pixel_frames"] * 1.05) # (b) KV cache 显存 ax = axes[1] nf = np.arange(1, 169) ax.plot(nf, nf * L["kv_per_frame_gb"], color=C_BLUE, lw=2.2, label="KV cache(不滚动)") ax.axhline(9 * L["kv_per_frame_gb"], color=C_GREEN, ls="--", lw=1.6, label="滚动窗口 9 帧的上限") ax.axhline(L["kv_all_gb"], color=C_GRAY, ls=":", lw=1.4, label="21 帧整段") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("KV cache 显存 (GB)") ax.set_title("(b) 不滚动缓存,显存线性涨", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") # (c) 单 block 计算时间 ax = axes[2] nkey = np.arange(1, 169) * SL.TOK_PER_FRAME t_noroll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, k) for k in nkey]) / SL.EFF_TFLOPS t_roll = 2.0 * (SL.N_STEPS + SL.EXTRA_KV_REFRESH) * SL.LAYERS * np.array( [SL.mac_per_layer(SL.BLOCK * SL.TOK_PER_FRAME, min(k, 9 * SL.TOK_PER_FRAME)) for k in nkey]) / SL.EFF_TFLOPS ax.plot(np.arange(1, 169), t_noroll * 1000, color=C_RED, lw=2.2, label="不滚动(线性变慢)") ax.plot(np.arange(1, 169), t_roll * 1000, color=C_GREEN, lw=2.2, label="滚动窗口 9 帧(恒定)") ax.axhline(SL.BLOCK * 4 / SL.FPS * 1000, color=C_GRAY, ls="--", lw=1.4, label="实时预算 750 ms / block") ax.set_xlabel("已生成的潜帧数") ax.set_ylabel("单个 block 的计算时间 (ms)") ax.set_title("(c) 不滚动缓存,每个 block 越来越慢", fontsize=12) ax.legend(fontsize=9.5) ax.grid(alpha=0.25, ls=":") fig.suptitle("400 TFLOPS 假设下的算术估算:首帧交付更早;缓存与历史计算仍有代价", fontsize=13) fig.tight_layout(rect=[0, 0, 0.99, 0.93]) fig.savefig(path, dpi=140) plt.close(fig) def main(): os.makedirs(FIGDIR, exist_ok=True) d = load() fig_paradigm(os.path.join(FIGDIR, "paradigm.png")) fig_rollout(d, os.path.join(FIGDIR, "rollout_error.png")) fig_rounds(d, os.path.join(FIGDIR, "selfforcing_rounds.png")) fig_context(d, os.path.join(FIGDIR, "context_noise.png")) fig_ledger(os.path.join(FIGDIR, "streaming_ledger.png")) for f in sorted(os.listdir(FIGDIR)): p = os.path.join(FIGDIR, f) print(f" {f:<28} {os.path.getsize(p)/1024:.0f} KB") if __name__ == "__main__": main()
-
AIGC 基本功|DiT:用 Transformer 替掉 UNet-DiT DiT:用 Transformer 替掉 UNet 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、潜空间扩散(latent_diffusion)、自注意力(attention_basics) 关键词:DiT、Diffusion Transformer、adaLN-Zero、patchify、Gflops 缩放、条件注入 01. 为什么需要它 先给三组数字,全部来自文末附录里能直接跑的脚本,或者论文 Table 4。 第一组:同算力下,参数量差 14 倍,FID 一模一样。 DiT-S/2 用 33M 参数、6.06 Gflops 做到 FID 68.40;DiT-B/4 用 130M 参数、5.56 Gflops 做到 FID 68.38。两个模型的参数量差 4 倍,算力几乎相同,结果几乎相同。而同一算力档里的 DiT-L/8,用了 459M 参数(14 倍),FID 反而掉到 118.87——差了 50 分。这三个点在图 1 的左图里被连成一条虚线。它说的是一件很反直觉的事:在扩散模型里,把算力花在「更多的 token」上(更小的 patch size)比花在「更宽的网络」上更划算。UNet 没有这个旋钮——它的多尺度结构定死了每一层的空间分辨率,你没法只调 token 数而不动别的。 第二组:DiT-XL/2 的 118.64 Gflops 里,注意力只占 3.6%。 逐 token 的线性层(qkv、输出投影、MLP)占 96.2%。这与「Transformer 的瓶颈是自注意力的平方复杂度」这个直觉是冲突的:在 T=256、d=1152 这个区间,算力的主导项是 $O(Td^2)$ 的线性层,不是 $O(T^2d)$ 的注意力。注意力要占到一半,需要 $T = 6d$,也就是 d=1152 时 T≈6900 个 token——那已经远超 256×256 图像的范围了。UNet 换掉的理由不是「注意力更强」,而是「Transformer 的算力可以干净地缩放」:改深度、改宽度、改 token 数,三个旋钮互不干扰,而且 Gflops 涨、FID 就单调降。UNet 加宽加深会同时改变感受野、下采样次数、跳连数量,你分不清是哪个在起作用。 第三组:同样 118.6 Gflops,只换条件注入方式,FID 从 25.21 掉到 19.47。 论文的 Table 4 末尾四行是同一个 DiT-XL/2 骨架:in-context 35.24、cross-attention 26.14、vanilla adaLN 25.21、adaLN-Zero 19.47。其中 vanilla adaLN 与 adaLN-Zero 的 Gflops 只差 0.08,差别包括新增残差门控与零初始化,不能把整个增益归因于初始化一个因素。这是我写这篇文章的直接动机——一个初始化技巧带来近 6 分 FID,值得逐行对照公式看清楚它到底做了什么。 这张图要看什么:左图横轴是「一次前向的算力」,纵轴是 FID。同一条虚线上的三个点,算力接近、参数量差了几倍到十几倍,却几乎落在同一高度——说明在这个区间里决定质量的是算力怎么分配,不是参数量堆多少。图里最刺眼的是第三条虚线的左端:33M 的 DiT-S/2 和 130M 的 DiT-B/4 几乎重合在 FID 68.4,而同算力下 459M 的 DiT-L/8 反而掉到 118.87。右图回答「注意力到底占多少」:四条曲线是四个宽度,横轴是 token 数,竖虚线标出 256×256 图像在 p=2 时的位置(3.6%);要等 T 走到上千,注意力才从零头变成大头。 所以这篇文章回答三个问题:DiT 的算力账本是怎么记的、adaLN-Zero 的「恒等初始化」在数学上意味着什么、以及它换来的到底是什么。 02. 最小可用理解 三句话讲完: 把潜变量切成 patch 序列,然后接一个标准 ViT。 32×32×4 的潜变量按 p=2 切成 (32/2)²=256 个 token,每个 token 原始 16 维,线性嵌入到 d 维,加固定的 2D sin-cos 位置编码,过 N 个 block,最后一层线性投回 p²C 维再拼回空间形状。patch size p 是 DiT 沿用 ViT 的缩放旋钮:p 减半,token 数翻四倍,算力至少翻四倍,参数量几乎不动。 条件(时间步 + 类别)不进序列,而是变成每个 block 的 LayerNorm 参数。 具体做法是调制:先算出 $c = t_{\text{emb}} + y_{\text{emb}}$,再用一个 $\text{SiLU} \to \text{Linear}(d, 6d)$ 把它变成 6 段 d 维向量,分别是注意力分支与 MLP 分支的 $(\beta_1, \gamma_1, \alpha_1)$ 与 $(\beta_2, \gamma_2, \alpha_2)$。前两个做 shift/scale,第三个是残差门控:$x \leftarrow x + \alpha \odot f(\cdot)$。 Zero 指的是整个调制层零初始化,于是每个 block 在第一天是恒等函数。 关键点在 DiT 的 modulate 写法:它是 $x(1 + \gamma_{\text{out}}) + \beta_{\text{out}}$ 而不是 $x\gamma_{\text{out}} + \beta_{\text{out}}$。调制层输出全零时,$\gamma_{out}=0$(有效缩放为 $1+\gamma_{out}=1$)、$\beta = 0$、$\alpha = 0$,三件事同时成立,整个 block 变成 $x \mapsto x$。实测:28 层叠完之后 $\|x_{28} - x_0\|_\infty = 0$(图 2 左)。 代价也很清楚:门关着的时候,block 内部除门控之外的参数梯度精确为零——在独立 block 接非零上游梯度时,门控先获得梯度;完整 DiT 的输出头也为零,第一步首先更新输出头。 03. 数学推导 3.1 patchify:从空间表示到 token 序列 记潜变量 $z \in \mathbb{R}^{I \times I \times C}$(256×256 图像过 VAE 后是 $I=32, C=4$)。patchify 把每个 $p \times p \times C$ 的方块摊平成一个 $p^2C$ 维向量,共 $$T = (I/p)^2$$ 个,再用一个线性层 $\mathbb{R}^{p^2C} \to \mathbb{R}^d$ 嵌入。实测的形状(附录 dit_flops.py): 输入潜变量 z: (2, 32, 32, 4) p=8: patchify -> (2, 16, 256) T=16, 每 token 256 维 p=4: patchify -> (2, 64, 64) T=64, 每 token 64 维 p=2: patchify -> (2, 256, 16) T=256, 每 token 16 维 $T$ 之外的一切($d$、block 数、头数)都与 $p$ 无关,所以 $p$ 是一个纯粹花算力的旋钮:$p$ 从 8 减到 2,DiT-S 的 Gflops 从 0.36 涨到 6.06(17 倍),参数量始终是 33M。 3.2 算力账本:主导项是 $O(Td^2)$ 数一个 block 的乘加次数(MAC,一次 $ab+c$ 记 1——论文里的 Gflops 用的是这个口径,记成 2 会整整差一倍): 部件 每个 token 的 MAC 说明 qkv 投影 $3d^2$ $d \to 3d$ 注意力分数 $QK^\top$ $Td$ 每个 token 对 T 个位置各做 d 次乘加 注意力加权 $AV$ $Td$ 同上 输出投影 $d^2$ $d \to d$ MLP($d \to 4d \to d$) $8d^2$ 两层各 $4d^2$ adaLN 调制 $6d^2$ / 样本 + $3d$ / token 每个样本只算一次,逐元素部分才是逐 token 的 忽略调制与逐元素项,一个 block 的算力是 $$\mathrm{MAC}_{\text{block}} \approx T(12d^2 + 2Td)$$ 其中 $12d^2 = 3d^2 + d^2 + 8d^2$。整个模型再乘 block 数 $N$。代入 DiT-XL/2($N=28, d=1152, T=256, p=2$): $$28 \times 256 \times (12 \times 1152^2 + 2 \times 256 \times 1152) \approx 1.186 \times 10^{11}$$ 也就是 118.6 G,与论文 Table 4 的 118.64 一致。附录脚本把 12 个模型全对了一遍,最大偏差 0.9%、多数是 0.0%(参数量同样对得上:XL/2 算出 674.9M,论文写 675M)。 这张对账表本身就是文章的一半结论,值得整张贴出来: 模型 层数 N 宽度 d token T 算力(本篇算) 算力(论文) 参数量 FID-50K DiT-S/8 12 384 16 0.36 G 0.36 33.1 M 153.60 DiT-S/4 12 384 64 1.41 G 1.41 32.9 M 100.41 DiT-S/2 12 384 256 6.06 G 6.06 32.9 M 68.40 DiT-B/8 12 768 16 1.41 G 1.42 130.7 M 122.74 DiT-B/4 12 768 64 5.56 G 5.56 130.4 M 68.38 DiT-B/2 12 768 256 23.01 G 23.01 130.3 M 43.47 DiT-L/8 24 1024 16 5.01 G 5.01 458.4 M 118.87 DiT-L/4 24 1024 64 19.70 G 19.70 458.0 M 45.64 DiT-L/2 24 1024 256 80.71 G 80.71 457.9 M 23.33 DiT-XL/8 28 1152 16 7.39 G 7.39 675.4 M 106.41 DiT-XL/4 28 1152 64 29.05 G 29.05 675.0 M 43.01 DiT-XL/2 28 1152 256 118.64 G 118.64 674.9 M 19.47 横着读这张表,三个旋钮的作用各不相同: 加深(N: 12→24→28):算力和参数量同步线性上涨,L/2 比 B/2 贵 3.5 倍算力,FID 从 43.47 到 23.33。 加宽(d: 384→1152):参数量涨 $d^2$,算力也涨 $d^2$;XL/4 比 S/4 贵 20 倍算力,FID 从 100.41 到 43.01。 减小 patch(p: 8→2):算力涨 4 倍一档(线性项按 T 涨),总参数量近似不变(patch 投影和输出头会随 p 改变);S/8 → S/2 贵 17 倍算力,FID 从 153.60 到 68.40。 值得注意的是「同样算力下单块算力都是 12d² 主导」这件事在表里也看得出来:DiT-S/2 与 DiT-B/4 的算力(6.06 / 5.56 G)落在同一档,说明一个 12 层 384 宽、切到 p=2 的小模型,和 12 层 768 宽、切到 p=4 的大模型,在算力上是可以互换的;两者的 FID 也确实只差 0.02。这条「算力等价」的直觉,是后面理解缩放实验的前提。 注意力占比是两种项的比值: $$\frac{2Td}{12d^2 + 2Td} = \frac{2T}{12d + 2T}$$ 代入 $T=256, d=1152$ 得 3.57%。令两者相等解出临界点 $T = 6d$:模型越宽,注意力越不重要。图 1 右图画的是各档模型在 $T$ 从 64 到 16384 上扫过的这条曲线。 3.3 adaLN:把条件变成 LayerNorm 的参数 标准 LayerNorm 之后接仿射变换: $$h = \gamma \odot \mathrm{LN}(x) + \beta$$ 其中 $\mathrm{LN}$ 对最后一维做归一化(DiT 里 elementwise_affine=False,仿射参数不是 LN 自带的)。adaLN 的做法是把 $\gamma, \beta$ 变成条件的函数: $$(\beta_1, \gamma_1, \alpha_1, \beta_2, \gamma_2, \alpha_2) = \mathrm{Linear}_{d \to 6d}\big(\mathrm{SiLU}(c)\big), \qquad c = t_{\text{emb}} + y_{\text{emb}}$$ DiT 源码里的 modulate 是这样写的: $$\mathrm{modulate}(x, \beta, \gamma) = x \odot (1 + \gamma) + \beta$$ 用 $1+\gamma$ 时,调制层输出 $\gamma=0$ 对应有效缩放为 1,$\beta=0$ 对应不平移。注意“调制输出”与“有效缩放”是两个量,不能把同一个 $\gamma$ 同时写成 0 与 1。没有这项偏移未必数学上完全无法学习,但会改变初始特征与梯度路径。 3.4 门控与恒等初始化 DiT block 的两条残差分支都带门: $$x' = x + \alpha_1 \odot \mathrm{Attn}\big(\mathrm{modulate}(\mathrm{LN}_1(x), \beta_1, \gamma_1)\big)$$ $$x'' = x' + \alpha_2 \odot \mathrm{MLP}\big(\mathrm{modulate}(\mathrm{LN}_2(x'), \beta_2, \gamma_2)\big)$$ 调制层零初始化时 $\beta=0$、$\gamma=0$(有效缩放 $1+\gamma=1$)、$\alpha=0$。只要两个门控为零且分支输出有限,block 就是恒等映射,即使 shift/scale 非零也成立。把整层调制器置零进一步让分支内部从不平移、单位缩放开始,但这不是恒等的必要条件。 实测(附录 adaln_zero.py,DiT-XL 配置 d=1152、T=256): adaln_zero 单块 |out - x| 最大值 = 0.000e+00 叠 28 层后 |out - x| 最大值 = 0.000e+00 adaln 单块 |out - x| 最大值 = 2.958e+00 单块相对扰动 std(out-x)/std(x) = 0.6127 叠 28 层后残差流漂移 std(x_28 - x_0) = 4.4226 对照组 vanilla adaLN(无门控且调制层非零初始化):单块就给残差流叠上 std 为 0.61 的随机扰动,28 层随机游走之后漂移达到 4.42——输出里来自输入的成分已经被 28 个随机变换淹没了。零初始化这一侧,漂移严格是 0,连浮点误差都没有。图 2 左图画的就是这两条曲线。 这张图要看什么:左图比较相同深度宽度的两种 block;差别包含门控及调制初始化——蓝线恒等于 0,粉线一路爬到 4.42。右图是初始化那一刻各部件的梯度大小(对数轴):蓝柱的主干部分趴在底部,真实值就是精确的 0(画在 1e-12 只是为了让 log 轴显示得出),只有最后一组「调制层 gate 段」立起来;粉柱则所有部件都有梯度。注意最右一组的对比是不对称的:vanilla adaLN 结构里压根没有 gate 这一项,所以那条柱子是空的——零初始化不只是「让某些梯度变成 0」,它同时给网络装上了一组原本不存在的门。 3.5 初始化那一刻,谁拿到了梯度 记 block 输出为 $y$,损失对它的梯度为 $g = \partial L / \partial y$。由链式法则: $$\frac{\partial L}{\partial \alpha} = g \odot f(\cdot) \neq 0$$ $$\frac{\partial L}{\partial \theta_f} = \alpha \odot \big(\cdots\big) = 0$$ $$\frac{\partial L}{\partial \beta} = \alpha \odot J_f \odot 1 = 0, \qquad \frac{\partial L}{\partial \gamma} = \alpha \odot J_f \odot \mathrm{LN}(x) = 0$$ 其中 $\theta_f$ 是注意力与 MLP 的权重,$J_f$ 是它们的雅可比。$\alpha = 0$ 让除了门以外的所有梯度都精确地等于零,不是「很小」。实测(线性损失 $L = \langle y, w\rangle$,$w$ 固定随机): adaln_zero W_qkv / W_o / W_1 / W_2 的 |grad|max = 0.000e+00(四者都是) 调制层六段: shift_msa=0 scale_msa=0 gate_msa=6.52e-05 shift_mlp=0 scale_mlp=0 gate_mlp=4.14e-04 adaln W_qkv=2.79e-04 W_o=1.94e-04 W_1=3.13e-04 W_2=2.52e-04 调制层四段全部非零 上面的梯度结论针对独立 block,且假定其输出接收到非零上游梯度。完整 DiT 还把 FinalLayer 的输出线性层置零:首次反传时更早层(包括 gates)没有来自损失的梯度,输出头先更新;输出头变为非零后,block 的 gates 才能接到信号。优化器权重衰减等参数更新另计。 顺带一个可预测性上的好处:FinalLayer 的输出线性层也零初始化,所以模型第一天的预测是全零,初始 loss 严格等于噪声的二阶矩。实测 $E[\varepsilon^2] = 1.0083$,零初始化时初始 MSE = 1.0083(输出最大绝对值 0.000e+00),换成正常初始化则是 3.1358(高出 3.11 倍)。初始 loss 是可以事先算出来的——这对判断「训练有没有起坏头」很有用。 3.6 四种条件注入:先在自己的玩具任务上排一遍序 论文那组数字(DiT-XL/2、400K 步、ImageNet)在本机复现不了——没有 ImageNet,也没有 TPU。但同一个问题可以搬到跑得完的 toy 上:8 个朝向的二维条纹、潜变量 8×8×2、patch p=2 得到 $T=16$、$d=64$、6 层,四种注入方式之外的一切(初始化、数据、优化器、步数、seed)完全相同,每种跑 3 个 seed。脚本就是附录里的 cond_ablation.py。 结果(最后 200 步的平均 MSE): 方案 参数量 最终 loss(均值 ± std) 三个 seed 分别 adaLN-Zero 464,328 0.0386 ± 0.0014 0.0402 / 0.0389 / 0.0368 vanilla adaLN 414,408 0.0745 ± 0.0020 0.0770 / 0.0745 / 0.0721 in-context 307,912 0.0739 ± 0.0037 0.0786 / 0.0737 / 0.0695 cross-attention 458,440 0.0796 ± 0.0028 0.0786 / 0.0834 / 0.0768 这张图要看什么:左图四条曲线前 100 步是缠在一起的(谁也看不出差别),从 200 步之后蓝线(adaLN-Zero)开始脱离,到 800 步已经低了将近一半。右图把 3 个 seed 单独点成白点——adaLN-Zero 最差的那个 seed(0.0402)仍然低于其它三档最好的 seed(0.0695),四组区间完全不重叠。所以在这套配置下,「adaLN-Zero 明显更好」不是随机波动。 但要老实说清这个 toy 复现了什么、没复现什么: 复现了:adaLN-Zero 排第一,且差距是成倍量级(0.0386 对 0.0739~0.0796)。这与论文里 adaLN-Zero 的 FID 明显低于其余三档方向一致。 没复现:论文里 in-context 是明显最差的一档(FID 35.24,比第二名差 9 分),而在这个 toy 上 in-context(0.0739)与 vanilla adaLN(0.0745)几乎打平,甚至略好于 cross-attention(0.0796)。原因不难猜:in-context 的劣势来自「序列多了两个 token 的开销」和「条件 token 与图像 token 抢注意力」,而在 $T=16$、条件又极其简单(8 个条纹朝向)的任务上,这两点都还没成为瓶颈。这也是我不把这个 toy 的排序当成结论的原因——它只说明机制在起作用,不说明四种方案的相对优劣在 ImageNet 尺度上也一样。 参数量的方向对上了:in-context 最少(307,912,它压根没有调制层),adaLN-Zero 比 vanilla adaLN 多出的 49,920 个参数正好是「每层 $2d^2 + 2d$ 个门参数 × 6 层」,与论文里 adaLN-Zero(675M)比 vanilla adaLN(600M)多出来的那部分同源。 3.7 四种方案到底差在哪(回到论文的数字) 论文比较了四种把条件塞进 Transformer 的办法,它们的差别全部集中在「条件从哪里进入 block」这一件事上: 方案 条件怎么进去 代价 in-context 把 $t_{\text{emb}}, y_{\text{emb}}$ 当成两个额外 token 拼在序列前面,走的还是同一套 self-attention 序列变长,token 数从 $T$ 变 $T+2$;每个 block 都要为这两个 token 做一次全量 attention cross-attention 主干只放图像 token,另加一层交叉注意力,条件 token 当 key/value 多一套 $d \to d$ 的注意力参数,算力上涨最多 vanilla adaLN 条件不进序列,变成 LayerNorm 的 shift/scale($\gamma, \beta$),没有门 几乎零成本,但残差分支始终全额接进来 adaLN-Zero 同上,再多两个门 $\alpha_1, \alpha_2$,并把整个调制层零初始化 相比 vanilla adaLN 只多 $2d^2$ 的调制参数 这张图要看什么:三根柱子分别是算力、参数量、FID,四组从左到右对应上表的四种方案。先看中间那张参数量图:in-context 参数最少(449M,因为它没有额外的注意力参数,只是把序列变长),cross-attention 为约 598M 总参数,不能把它与另一方案的 600M 相加,adaLN-Zero 是 675M,比 vanilla adaLN 多了 75M——这就是那 $2d^2$ 个门参数。再看右边那张 FID 图:参数最少的 in-context 质量最差(35.24),参数最多的 adaLN-Zero 质量最好(19.47)。最后看左边的算力:四种方案的算力其实都挤在 118~138 G 这个窄区间里(in-context 因为序列长了一点反而是 119.37,cross-attention 因为多一套注意力到 137.62),也就是说这 16 分的 FID 差距,几乎完全不是靠算力堆出来的——是结构设计出来的。 一个容易看漏的对照:vanilla adaLN 与 adaLN-Zero 的算力只差 0.08 G(118.56 vs 118.64),参数量差 75M,FID 差 5.74 分。门取常数 1 时可包含无门控的行为,但条件相关门控也增加了函数自由度;该对照同时改变参数与初始化,不能证明函数类完全相同,更不能把 5.74 分全部归因为优化路径。 04. 代码实现 完整脚本在文末附录,这里放三段核心代码与它们的真实输出。 4.1 patchify 与它的逆 def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]""" B, I, _, C = z.shape g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) 跑一遍(batch=2、32×32×4):p=8 -> (2, 16, 256)、p=4 -> (2, 64, 64)、p=2 -> (2, 256, 16),逆变换的最大误差 0.00e+00。 4.2 一个 DiT block def modulate(h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) class DiTBlock: def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) 逐项对一下变量名与 03 节的符号:sh_a/sc_a/gate_a 就是 $(\beta_1, \gamma_1, \alpha_1)$,w_mod 是那个 $\text{Linear}(d, 6d)$,注意它前面接的是 silu 而不是别的激活。w_mod 在 mode="adaln_zero" 时用 zero=True 初始化——weight 和 bias 全是 0,另外 vanilla adaLN 调制四段且没有残差门控;两者并非只差初始化。 4.3 账本对账 dit_flops.py 的输出(节选): 2. 参数账本(DiT-XL/2) patchify 线性嵌入 19,584 ( 0.0%) t 嵌入(256->d->d) 1,624,320 ( 0.2%) 类别嵌入(1000×d) 1,152,000 ( 0.2%) 28 个 block × 23,907,456 669,408,768 (99.2%) FinalLayer 2,677,264 ( 0.4%) 合计 674,881,936 = 674.9 M (论文: 675 M) 3. Gflops 账本(DiT-XL/2,按 MAC 记) block 内逐 token 线性(12d²) 114.15 G (96.2%) block 内注意力(2T²d) 4.23 G ( 3.6%) 合计 118.64 G (论文: 118.64 G) 4. 12 个模型:实测账本 vs 论文数字(Gflops 偏差) DiT-S/8 0.36 vs 0.36 -0.9% DiT-XL/2 118.64 vs 118.64 0.0% 12 个模型的 Gflops 全部对上(最大偏差 0.9%),参数量全部对上(四舍五入到 M 后与论文一致)。这套账本是可信的,后面所有关于「算力花在哪」的结论都建立在它上面。 05. 工业级实现对照 对照 facebookresearch/DiT 的 models.py(以 2026-09 时的 main 分支为准)。 modulate 就是那个 $1+\gamma$。 源码原样: def modulate(x, shift, scale): return x * (1 + scale.unsqueeze(1)) + shift.unsqueeze(1) 调制层是一个共享的 SiLU + Linear,一次算 6 段再 chunk。 不是给六个分支各配一个线性层: self.adaLN_modulation = nn.Sequential(nn.SiLU(), nn.Linear(hidden_size, 6 * hidden_size, bias=True)) # 上面这个 Sequential 的输出一次是 6d 维,再切成六段 shift_msa, scale_msa, gate_msa, shift_mlp, scale_mlp, gate_mlp = self.adaLN_modulation(c).chunk(6, dim=1) 初始化分三步,顺序不能乱。 先 xavier_uniform_ 初始化所有 Linear,再把每个 block 的调制层整体置零,最后把 FinalLayer 的调制层和输出线性层置零: self.apply(_basic_init) # 1. 全模型 xavier_uniform for block in self.blocks: # 2. 每个 block 的 adaLN 调制层归零 nn.init.constant_(block.adaLN_modulation[-1].weight, 0) nn.init.constant_(block.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.adaLN_modulation[-1].weight, 0) # 3. 输出层归零 nn.init.constant_(self.final_layer.adaLN_modulation[-1].bias, 0) nn.init.constant_(self.final_layer.linear.weight, 0) nn.init.constant_(self.final_layer.linear.bias, 0) 注意第 2 步是整层置零,不是只置零 gate 那两段——这就是 3.4 节说的「一次拿到 $\gamma=0$(有效缩放为 1)、$\beta=0, \alpha=0$ 三件事」。 与最小实现的差异,以及为什么: 差异 源码里的做法 为什么 位置编码 2D sin-cos,requires_grad=False 冻结 抄 MAE 的结论:固定编码在视觉任务上不比可学习的差,还省参数、外推性能仍需另外验证 时间步编码 256 维正弦 → Linear → SiLU → Linear 高频分量让网络能区分相邻的时间步,这是所有扩散模型的标准件 类别嵌入 nn.Embedding(1000 + 1, d),多一个位置 多出来的那一行是 CFG 的 null token,token_drop 把标签换成它 输出通道 learn_sigma=True 时输出 $2 \times 4 = 8$ 通道 一半预测噪声、一半预测方差(可学习的 $\Sigma_\theta$),采样时用后者做各时间步的方差 CFG 的作用范围 forward_with_cfg 只把引导作用在前 3 个通道 论文明确说这是为了可复现做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推;这是复现 DiT 数值时最容易踩的坑之一 激活函数 nn.GELU(approximate="tanh") tanh 近似比精确版快,与原始实现保持一致,不能保证任何设置下 FID 完全不变 还有一个容易被忽略的点:unpatchify 用的是 torch.einsum('nhwpqc->nchpwq', x),不是简单的 reshape。它要把 token 里的 $p \times p \times C$ 重新摆回空间位置,通道维要提到最前面。 整条前向的调用顺序(DiT.forward)值得记住,因为后面拆视频版 DiT 时这几步会变成瓶颈点: x = self.x_embedder(x) + self.pos_embed # 1. patchify + 位置 t = self.t_embedder(t) # 2. 时间步 → 256 → d y = self.y_embedder(y, self.training) # 3. 类别 → d(training 时才做 label dropout) c = t + y # 4. 两个条件相加,不是拼接 for block in self.blocks: x = block(x, c) # 5. N 个 block,条件从 c 进来 x = self.final_layer(x, c) # 6. 也是调制出来的 shift/scale x = self.unpatchify(x) # 7. 回到空间形状 第 4 步是「相加」而不是「拼接」,这件事在 02 节已经提过:正因为相加,c 是一个 d 维向量,整个序列共享同一份调制参数——adaLN 的表达力上限就卡在这里。 分类器无关引导(CFG)是在 forward 外面拼的。 forward_with_cfg 的做法是把 batch 复制成两份,第二份的标签换成 null token,跑到最后再合成: half = x[: len(x) // 2] combined = torch.cat([half, half], dim=0) # 一份无条件、一份有条件 model_out = self.forward(combined, t, y) eps, rest = model_out[:, :3], model_out[:, 3:] cond_eps, uncond_eps = torch.split(eps, len(eps) // 2, dim=0) half_eps = uncond_eps + cfg_scale * (cond_eps - uncond_eps) eps = torch.cat([half_eps, half_eps], dim=0) return torch.cat([eps, rest], dim=1) # 其余通道原样保留 这里有两个复现时必须知道的细节:其一,引导公式用无条件分支做基准(uncond + w·(cond − uncond)),不是把有条件分支当基准;其二,eps, rest 的拆分把引导限制在前 3 个通道,返回时仍拼回其余通道(含方差),论文明确说这是为了可复现而做的选择,常规做法是引导所有噪声预测通道,而不是把学习方差通道也一起外推。照着论文数值复现时如果忘了这一条,FID 会对不上,但代码不会报错。 learn_sigma 是输出通道翻倍的原因。 当它为真时 out_channels = 2 * in_channels,网络一半预测噪声 $\varepsilon$、另一半预测 learned-range 的方差插值参数,经扩散模块变换为对数方差。采样时前者进 DDPM/DDIM 的更新公式,后者可用于学习方差的 DDPM 更新;DDIM 的随机方差由其调度与 η 决定,通常不使用该头。这也是为什么 DiT 的输出头看起来比「预测噪声」该有的形状大一号。 06. 代价与边界 代价一:$O(T^2)$ 迟早会来找你。 T=256 时注意力只占 3.6%,那是 256×256 图像。512×512 的 DiT-XL/2 有 T=1024,一次前向 524.6 Gflops(是 256 分辨率的 4.4 倍);再往视频走,时间维一加,token 数轻易上万。这也是为什么视频 DiT 必须配序列并行、窗口注意力或者时空分离注意力——「注意力不是瓶颈」这个结论只在 T 远小于 6d 时成立。 代价二:adaLN 对所有 token 施加同一个函数。 论文原话:adaLN 是四种方案里唯一「被限制成对所有 token 应用同一个函数」的。$\beta, \gamma, \alpha$ 是 d 维向量,在整个序列上广播,没有空间维度。所以凡是条件本身带空间结构的任务——局部编辑、inpainting 的 mask、逐区域控制——单靠一个广播的全局调制向量不便保留空间对应关系,通常还需空间输入、条件 token 或 cross-attention;不能据此断言整体网络表达不了局部任务。SD3 之所以把文本单独拉一条支路做联合注意力(MM-DiT),原因就在这里。 代价三:patch size 减半,算力至少四倍,参数一分不涨。 这是好事也是陷阱:好消息是可以用小模型 + 小 patch 换到大模型的效果(01 节那组数字);坏消息是推理成本是按 Gflops 付的,DiT-S/2 推理比 DiT-S/8 贵 17 倍,参数却一样大,部署时容易误判。 代价四:丢掉了 UNet 的多尺度归纳偏置。 UNet 的下采样-上采样结构天然假设「图像有局部性、有尺度层次」,这个先验在小数据集上是白送的。DiT 是一张平铺的 token 网格,全靠数据自己学。所以它赢在能缩放的地方(大数据、大算力),在几万张图的小数据集上不一定比 UNet 收敛快。 代价五:初始化决定最初的梯度路径。 独立 block 实验验证门控阻断分支梯度;完整模型还需先打开零输出头。不能据此指定“前几步只有门在动”的固定持续时间,或无依据地推荐给调制器更大学习率。 论文中的 ADM 1983 Gflops 与 DiT-XL/2 118.64 Gflops 是像素空间 UNet 与潜空间 Transformer 的跨系统比较,分辨率、表示和训练预算都不同。它说明整套 DiT 系统有竞争力,不能把约 16.7 倍单次前向差全归因于更换骨干,也不包含完整采样步数与 VAE 成本。 07. 经典论文脉络 论文 arXiv 一句话贡献 ADM 2105.05233 把 UNet 扩散模型做到超过 GAN,确立了「UNet + 注意力层」这一代骨干,也是 DiT 要对标的基线(ADM 1983 Gflops、ADM-U 2813 Gflops) LDM 2112.10752 把扩散搬到 VAE 潜空间,32×32×4 的输入尺寸正是 DiT patchify 的起点 U-ViT 2209.12152 与 DiT 几乎同时,独立提出用 ViT 骨干做扩散,把时间步与条件当作额外 token(即 DiT 里的 in-context 方案),并证明了这条路可行 DiT 2212.09748 系统性地把「Gflops → FID」当成缩放律来量,给出 patchify + adaLN-Zero 这套设计,并证明它比 cross-attention / in-context 都好 PixArt-α 2310.00426 把 DiT 接到文本条件上(cross-attention 处理文本序列 + adaLN 处理时间步),把训练成本压到原来的十分之一级别 SD3 2403.03206 把 DiT 换成双支路的 MM-DiT(图像与文本各一条,联合注意力),并把训练目标换成 rectified flow Latte 2401.03048 把 DiT 搬到视频:提出四种时空注意力的分解方式,是后续视频 DiT 的结构模板 演进的主线很清楚:UNet(ADM/LDM)→ 把骨干换成 Transformer(U-ViT/DiT)→ 解决文本条件(PixArt-α/SD3)→ 解决时间维(Latte 及之后)。 这条线里有一处细节值得单独说,因为它解释了 adaLN-Zero 为什么能活到今天:后继模型几乎都保留了「时间步走 adaLN、文本走另一条路」这个分工。PixArt-α 是最保守的一步——它把 DiT 的类别条件换成文本条件,但文本不走 adaLN,而是另加一层 cross-attention,时间步仍然走 adaLN。SD3 往前走了一大步,把图像与文本做成两条支路做联合注意力(MM-DiT),但时间步的调制依然是 adaLN-Zero 式的,只是把「类别嵌入」换成了文本池化向量。也就是说,DiT 这篇论文真正被继承下来的不是 patchify(在此之前 ViT 系列已经这么干了),而是「条件不进序列,改成 LayerNorm 的参数,并且整层零初始化让 block 从恒等开始」这套写法。Latte 之后的视频 DiT(包括现在各种视频生成模型)沿用的也是它——时间步调制 + 时空分解注意力。 08. 常见误解 误解一:adaLN-Zero 只是把 scale 零初始化。 实现把整个调制线性层置零;调制输出 scale=0,而有效缩放为 1。残差恒等主要由 gate=0 保证,单独关门已经足够。 误解二:DiT 的算力大头在自注意力上。 错,DiT-XL/2 里注意力只占 3.6%,逐 token 的线性层占 96.2%。「Transformer 长序列会爆」的直觉来自 LLM($T$ 上万、$d$ 数千), diffusion 的 $T$ 只有几百,主导项一直是 $O(Td^2)$。图 1 右图给了临界点:$T = 6d$。 误解三:patch size 只影响 token 数,是个「免费的」结构选择。 对参数量免费(DiT-S 三档都是 33M),对算力一点也不免费(0.36 → 1.41 → 6.06 G,17 倍)。论文里那句「changing $p$ has no meaningful impact on downstream parameter counts」说的是参数,别顺手读成「没有代价」。 误解四:论文里的 Gflops 是 FLOPs。 是 MAC。我第一次按「一次乘加 = 2 FLOPs」数 DiT-XL/2,得到约 237.28 GFLOP,是 118.64 GMAC 的两倍,一度以为自己漏算了什么结构。改成 MAC 口径后 12 个模型全部对上。要拿自己算的数和论文比,先确认口径。 误解五:零初始化让整个模型不能训练。 零输出头仍能先收到非零梯度;随后 gate 和主干逐步接到信号。独立 block 的梯度实验不能替代完整 DiT 首次反传的检查。 误解六:DiT 就是「把 UNet 换成 ViT」,拿一个标准 ViT 直接接上就行。 差的不是一点:DiT 没有 [CLS] token、没有分类头、位置编码是冻结的 2D sin-cos(这是原始实现的选择,不能由此保证所有任务中都优于可学习编码);最关键的是它的 block 不是标准 ViT block——多了一条 adaLN 调制支路和两个门,FinalLayer 也是「调制 + 线性」而不是「LN + 线性」。把 torchvision 里的 ViT 拿来改,能跑起来,但那不是 DiT,也复现不出 19.47 的 FID。 09. 动手验证 文末附录一共六个脚本,其中四个可以直接跑(python xxx.py,只需要 numpy 与 matplotlib),另外两个(tiny_grad.py、dit_core.py)是被它们 import 的公共件,不单独运行。预期结果: dit_flops.py —— 打印 patchify 的真实形状、DiT-XL/2 的参数与 Gflops 逐项账本,以及 12 个模型与论文 Table 4 的对账表。预期:合计 674.9 M / 118.64 G,与论文的 675 M / 118.64 G 一致;12 个模型的 Gflops 偏差都在 1% 以内。 adaln_zero.py —— 打印 A/B/D 三组实验。预期:adaLN-Zero 单块与 28 层的 $\|out - x\|_\infty$ 都是 0.000e+00;vanilla adaLN 单块相对扰动 0.6127、28 层漂移 4.4226;adaLN-Zero 的 W_qkv/W_o/W_1/W_2 梯度全为 0,只有 gate 段非零;零初始化输出层时初始 MSE = 1.0083 $= E[\varepsilon^2]$。最后一行是 autograd 自检,预期最大相对误差 ~1.5e-09。 cond_ablation.py —— 四种条件注入在同一个 toy 任务上的训练对照。直接跑是快速档(150 步 × 1 个 seed,约 40 秒),它已经能看出同一个排序(adaLN-Zero 0.2588,其余三档 0.2999~0.3051);本文 3.6 节引用的那组数字来自完整档,加 --full(800 步 × 3 个 seed,约十分钟)。两种档位分别缓存在 _cache/cond_results_s150_n1.json 与 _cache/cond_results_s800_n3.json,互不覆盖。 make_figures.py —— 生成本文的四张配图,其中图 3 直接读上面那份完整档缓存(所以只要缓存还在,画图是秒级的)。 想自己验证「恒等初始化」这件事,最小实验是五行:建一个 DiTBlock(d=1152, n_heads=16, mode="adaln_zero"),喂一个随机 x 和随机 c,比较 out 与 x。你会看到差是严格的 0,不是 1e-7 这种量级——因为门是乘在分支输出上的,0 乘任何数都是 0。把 mode 换成 "adaln" 再跑一次,差值立刻变成 1e0 量级。 10. 延伸阅读 往回走:潜空间扩散与 Stable Diffusion 的整体结构(latent_diffusion)、DDPM 的训练目标(ddpm)、自注意力的计算细节(attention_basics) 往两侧走:分类器无关引导的代价(cfg)、流匹配与 Rectified Flow——SD3 之后的新一代训练目标(flow_matching) 往工程走:DiT 上到视频之后 token 数暴涨,必须靠并行切分,见序列并行(sequence_parallel)、张量/流水线并行(tensor_pipeline_parallel)、混合精度(mixed_precision) 往采样走:同样的骨干,采样步数怎么省,见从 DDIM 到高阶采样器(ddim_samplers) 附录:完整代码 09 节用到的脚本全文如下(dit_flops.py、adaln_zero.py、cond_ablation.py、tiny_grad.py、dit_core.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 dit_flops.py # -*- coding: utf-8 -*- """DiT 账本(一):patchify 的形状、参数量与 Gflops,逐项对账。 DiT 这篇论文最反直觉的一点是:**它把「模型大小」和「一次前向的算力」拆开了**。 改 patch size p 几乎不动参数量,却能让 Gflops 翻四倍;改 hidden size d 几乎不动 token 数,却能让参数量翻四倍而 Gflops 只涨一点。 这个脚本做三件事: 1. 真的做一次 patchify,打印每一步的形状(不是嘴上说 T=(I/p)^2); 2. 按 DiT 的实际结构逐项数参数,与论文 Table 4 的 Params(M) 对账; 3. 用同一套结构数 Gflops,与论文 Table 4 的 Flops(G) 对账。 对账口径说明(很关键,第一次数会差 2 倍):论文里的 Gflops 数的是 **乘加次数 MAC**,一次 a*b+c 记 1,不是记 2。所以线性层 [m,n] 处理一个 token 记 m*n,不记 2*m*n。下面的 counter 全部按 MAC 记,才能和论文对上。 """ import numpy as np # ─────────────── 论文 Table 1 的四档配置:(深度 N, hidden d, 头数) ─────────────── DIT_CONFIGS = { "S": (12, 384, 6), "B": (12, 768, 12), "L": (24, 1024, 16), "XL": (28, 1152, 16), } # 论文 Table 4 的真实数字,用来对账:(Gflops, 参数量 M, FID-50K 无引导) PAPER_TABLE4_256 = { ("S", 8): (0.36, 33, 153.60), ("S", 4): (1.41, 33, 100.41), ("S", 2): (6.06, 33, 68.40), ("B", 8): (1.42, 131, 122.74), ("B", 4): (5.56, 130, 68.38), ("B", 2): (23.01, 130, 43.47), ("L", 8): (5.01, 459, 118.87), ("L", 4): (19.70, 458, 45.64), ("L", 2): (80.71, 458, 23.33), ("XL", 8): (7.39, 676, 106.41), ("XL", 4): (29.05, 675, 43.01), ("XL", 2): (118.64, 675, 19.47), } # 四种条件注入在 DiT-XL/2 上的对照:论文 Table 4 末尾 4 行 PAPER_BLOCK_DESIGN = { # 名字: (Gflops, Params M, FID) "in-context": (119.37, 449, 35.24), "cross-attention": (137.62, 598, 26.14), "adaLN": (118.56, 600, 25.21), "adaLN-Zero": (118.64, 675, 19.47), } # ─────────────── 1. patchify:真的做一遍 ─────────────── def patchify(z, p): """z: [B, I, I, C] -> [B, (I/p)^2, p*p*C]。 把 I×I 切成 (I/p)×(I/p) 个格子,每个格子里的 p*p*C 个数直接摊平成 一个 token 的原始特征。论文里这一步是一个 nn.Linear(p*p*C, d)。 """ B, I, _, C = z.shape assert I % p == 0, f"I={I} 必须被 p={p} 整除" g = I // p z = z.reshape(B, g, p, g, p, C) z = z.transpose(0, 1, 3, 2, 4, 5) # [B, g, g, p, p, C] return z.reshape(B, g * g, p * p * C) def unpatchify(x, p, I, C): """patchify 的逆:[B, T, p*p*C] -> [B, I, I, C]。""" B = x.shape[0] g = I // p x = x.reshape(B, g, g, p, p, C) x = x.transpose(0, 1, 3, 2, 4, 5) # [B, g, p, g, p, C] return x.reshape(B, I, I, C) # ─────────────── 2. 参数账本 ─────────────── def count_params(cfg="XL", p=2, C=4, n_classes=1000, t_freq=256): """按 DiT 源码的实际结构逐项数参数。""" N, d, _ = DIT_CONFIGS[cfg] items = {} items["patchify 线性嵌入"] = (p * p * C) * d + d items["t 嵌入(256→d→d)"] = t_freq * d + d + d * d + d items["类别嵌入(1000×d)"] = n_classes * d # 每个 DiT block:qkv(3d²) + attn out(d²) + mlp(4d²+4d²) + adaLN 调制(d→6d) # 加两个无仿射参数的 LayerNorm(adaLN 那层的 scale/shift 由调制给出,不另设) per_block = (3 * d * d + 3 * d) + (d * d + d) + (4 * d * d + 4 * d + 4 * d * d + d) \ + (6 * d * d + 6 * d) + 2 * d items[f"{N} 个 block × {per_block:,}"] = N * per_block # FinalLayer:adaLN 线性 d→2d + 线性 d→p²C + 一个 LayerNorm items["FinalLayer"] = (2 * d * d + 2 * d) + (d * (p * p * C) + p * p * C) + 2 * d total = sum(items.values()) return total, items, per_block # ─────────────── 3. Gflops 账本(按 MAC 记)─────────────── def count_gflops(cfg="XL", p=2, I=32, C=4, t_freq=256): """一次前向(batch=1)的 MAC 数,单位 G(1e9)。""" N, d, _ = DIT_CONFIGS[cfg] T = (I // p) ** 2 # 每个 block:qkv 3d²、attn 分数 T²d、attn 加权 T²d、out d²、mlp 8d² # 调制层对整条样本只算一次(6d²),逐 token 的 γ/β/α 逐元素乘加记 3Td per_block_token = 12 * d * d # 3(qkv) + 1(out) + 8(mlp) per_block_attn = 2 * T * d # 摊到每个 token 上是 2*T*d per_block_elem = 3 * d # γ⊙h、+β、α⊙Δ block_macs = T * (per_block_token + per_block_attn + per_block_elem) + 6 * d * d patch_macs = T * (p * p * C) * d # patchify 的线性嵌入 final_macs = T * d * (p * p * C) + 2 * d * d cond_macs = t_freq * d + d * d # t 嵌入 MLP,算一次 total = N * block_macs + patch_macs + final_macs + cond_macs return total / 1e9, { "T": T, "block 内逐 token 线性(12d²)": N * T * per_block_token / 1e9, "block 内注意力(2T²d)": N * T * per_block_attn / 1e9, "调制与逐元素(3Td + 6d²)": N * (T * per_block_elem + 6 * d * d) / 1e9, "patchify + FinalLayer": (patch_macs + final_macs) / 1e9, "t 嵌入": cond_macs / 1e9, } def scaling_ledger(): """把 12 个模型的实测账本与论文数字并排打印。""" rows = [] for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, _ = count_gflops(cfg, p) tot, _, _ = count_params(cfg, p) pg, pm, fid = PAPER_TABLE4_256[(cfg, p)] rows.append((f"DiT-{cfg}/{p}", DIT_CONFIGS[cfg][0], DIT_CONFIGS[cfg][1], (32 // p) ** 2, g, pg, tot / 1e6, pm, fid)) return rows def main(): rng = np.random.default_rng(0) print("=" * 78) print("1. patchify 的真实形状(256×256 图像 → 32×32×4 潜变量,batch=2)") print("=" * 78) z = rng.standard_normal((2, 32, 32, 4)) print(f" 输入潜变量 z: {z.shape}") for p in [8, 4, 2]: x = patchify(z, p) back = unpatchify(x, p, 32, 4) ok = np.abs(back - z).max() print(f" p={p}: patchify -> {x.shape}" f" (T={(32//p)**2}, 每个 token 原始维度 {p*p*4})" f" 逆变换最大误差 {ok:.2e}") print() print("=" * 78) print("2. 参数账本(DiT-XL/2 逐项)") print("=" * 78) tot, items, per_block = count_params("XL", 2) for k, v in items.items(): print(f" {k:<34s} {v:>14,d} ({v/tot*100:5.1f}%)") print(f" {'合计':<34s} {tot:>14,d} = {tot/1e6:.1f} M" f" (论文 Table 4: 675 M)") print() print("=" * 78) print("3. Gflops 账本(DiT-XL/2,按 MAC 记)") print("=" * 78) g, parts = count_gflops("XL", 2) for k, v in parts.items(): if k == "T": print(f" token 数 T {v:>10d}") else: print(f" {k:<38s} {v:>10.2f} G ({v/g*100:5.1f}%)") print(f" {'合计':<38s} {g:>10.2f} G (论文 Table 4: 118.64 G)") print() print("=" * 78) print("4. 12 个模型:实测账本 vs 论文数字") print("=" * 78) hdr = f"{'模型':<12s}{'N':>4s}{'d':>6s}{'T':>6s}{'Gflops算':>10s}{'Gflops论文':>11s}{'差':>8s}{'M算':>8s}{'M论文':>7s}{'FID':>8s}" print(hdr) for name, N, d, T, g, pg, m, pm, fid in scaling_ledger(): print(f"{name:<12s}{N:>4d}{d:>6d}{T:>6d}{g:>10.2f}{pg:>11.2f}{(g-pg)/pg*100:>7.1f}%" f"{m:>8.1f}{pm:>7d}{fid:>8.2f}") print() print("=" * 78) print("5. 同算力下:把预算花在 token 上还是花在宽度/深度上?") print("=" * 78) print(" 取自论文 Table 4,挑 Gflops 接近的组:") for tag, keys in [("~5-6 G", [("S", 2), ("B", 4), ("L", 8)]), ("~20-29 G", [("B", 2), ("L", 4), ("XL", 4)]), ("~80-119 G", [("L", 2), ("XL", 2)])]: print(f" {tag}:") for k in keys: pg, pm, fid = PAPER_TABLE4_256[k] print(f" DiT-{k[0]}/{k[1]}: {pg:6.2f} G {pm:4d} M FID {fid:6.2f}") if __name__ == "__main__": main() adaln_zero.py # -*- coding: utf-8 -*- """DiT 账本(二):adaLN-Zero 的初始化到底做了什么,逐个数出来。 adaLN-Zero 通常被一句话带过——「把每个 block 初始化成恒等函数」。 这句话里有三个可以量出来的事实,本脚本一个一个验: A. 恒等是真的恒等:out - x 的最大绝对误差是 0.0,不是「很小」。 B. 门控关着的时候,block 里除门控之外的参数梯度**精确为 0**; 连 shift/scale 那两段的梯度也是 0——只有 gate 那两段有梯度。 这是独立 block 接非零上游梯度的实验;完整零输出头模型第一步先更新输出头。 C. 不零初始化会怎样:block 在初始化时给残差流叠上一层随机扰动, 28 层叠下来 std 会漂。零初始化则一层都不漂。 D. 输出层也零初始化:模型第一天的预测是全 0,初始 loss 就是噪声的 二阶矩,可以被事先算出来,而不是一个随机的数。 另有一个 gradcheck,用中心差分核对手写 autograd,正文里报的最大相对误差来自它。 """ import numpy as np import tiny_grad as tg from dit_core import DiTBlock, MicroDiT, COND_MODES D_BIG = 1152 # DiT-XL 的 hidden size T_BIG = 256 # 32×32 潜变量、p=2 时的 token 数 DEPTH = 28 # DiT-XL 的深度 def _fresh_block(mode, seed=0, d=D_BIG, n_heads=16): rng = np.random.default_rng(seed) return DiTBlock(d, n_heads, rng, mode=mode) # ─────────────── A + C:恒等性与深度漂移 ─────────────── def identity_and_drift(depth=DEPTH, seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) out = {} for mode in ("adaln_zero", "adaln"): x = tg.leaf(x0.copy()) drift = [] for i in range(depth): blk = _fresh_block(mode, seed=seed + i, d=d, n_heads=n_heads) x = blk(x, tg.leaf(c), []) tg.reset() drift.append(float(np.std(x.v - x0))) out[mode] = { "identity_err": float(np.abs(x.v - x0).max()), "drift": drift, "std_ratio": [float(np.std(x.v) / np.std(x0))], } # 单块的恒等性单独再报一次(28 层叠完还是 0 才说明真的恒等) blk = _fresh_block("adaln_zero", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln_zero"]["single_block_err"] = float(np.abs(y.v - x0).max()) blk = _fresh_block("adaln", seed=3, d=d, n_heads=n_heads) tg.reset() y = blk(tg.leaf(x0.copy()), tg.leaf(c), []) out["adaln"]["single_block_err"] = float(np.abs(y.v - x0).max()) out["adaln"]["single_block_rel"] = float(np.std(y.v - x0) / np.std(x0)) tg.reset() return out # ─────────────── B:初始化那一刻的梯度结构 ─────────────── def grad_at_init(mode="adaln_zero", seed=0, d=D_BIG, T=T_BIG, n_heads=16): rng = np.random.default_rng(seed) x0 = rng.standard_normal((1, T, d)) c = rng.standard_normal((1, d)) w = rng.standard_normal((1, T, d)) # 线性损失 L = <out, w> blk = _fresh_block(mode, seed=seed, d=d, n_heads=n_heads) store = [] tg.reset() out = blk(tg.leaf(x0), tg.leaf(c), store, ctx=None) loss = tg.mean_all(tg.mul(out, tg.leaf(w))) tg.backward(loss) names = { "W_qkv": blk.w_qkv.W, "W_o": blk.w_o.W, "W_1": blk.w_1.W, "W_2": blk.w_2.W, } res = {} for k, arr in names.items(): node = [n for n in store if n.v is arr] res[k] = float(np.abs(node[0].g).max()) if node else 0.0 # 调制层按 6 段(或 4 段)拆开看:哪几段真的拿到了梯度 mod_node = [n for n in store if n.v is blk.w_mod.W][0] g = mod_node.g # [d, n_mod*d] n_mod = 6 if mode == "adaln_zero" else 4 cols = [float(np.abs(g[:, i * d:(i + 1) * d]).max()) for i in range(n_mod)] res["mod_chunks"] = cols res["mod_name"] = (["shift_msa", "scale_msa", "gate_msa", "shift_mlp", "scale_mlp", "gate_mlp"] if n_mod == 6 else ["shift_msa", "scale_msa", "shift_mlp", "scale_mlp"]) tg.reset() return res # ─────────────── D:初始 loss 是不是可预测的 ─────────────── def init_loss(mode="adaln_zero", seed=0, B=32): rng = np.random.default_rng(seed) m = MicroDiT(mode=mode, seed=seed) z = rng.standard_normal((B, m.T, 8)) t = rng.uniform(0.05, 0.95, B) y = rng.integers(0, m.n_classes, B) oh = np.zeros((B, m.n_classes)) oh[np.arange(B), y] = 1.0 eps = rng.standard_normal((B, m.T, 8)) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_zero = float(((pred.v - eps) ** 2).mean()) pmax_zero = float(np.abs(pred.v).max()) # 把输出层换成正常 xavier 初始化再测一次 lim = np.sqrt(6.0 / (m.d + 8)) m.w_out.W = rng.uniform(-lim, lim, m.w_out.W.shape) store = [] tg.reset() pred = m.forward(z, t, oh, store) mse_rand = float(((pred.v - eps) ** 2).mean()) pmax_rand = float(np.abs(pred.v).max()) tg.reset() return float((eps ** 2).mean()), mse_zero, mse_rand, pmax_zero, pmax_rand # ─────────────── autograd 自检 ─────────────── def gradcheck_report(seed=0): """手写 autograd 对不对:拿中心差分逐个参数核。 adaln_zero 初始化下大部分参数梯度恒为 0(B 节已证),核不出东西, 所以核 adaln 与 cross_attn 两种结构——它们把所有算子都走到了。 """ rng = np.random.default_rng(seed + 7) z = rng.standard_normal((4, 16, 8)) t = rng.uniform(0.05, 0.95, 4) oh = np.zeros((4, 8)) oh[np.arange(4), rng.integers(0, 8, 4)] = 1.0 tgt = rng.standard_normal((4, 16, 8)) worst = 0.0 for mode in ("adaln", "cross_attn", "in_context"): mm = MicroDiT(d=32, n_heads=4, depth=2, mode=mode, seed=seed) def build(mm=mm): s = [] p = mm.forward(z, t, oh, s) diff = tg.sub(p, tg.leaf(tgt)) return tg.mean_all(tg.mul(diff, diff)), s tg.reset() worst = max(worst, tg.gradcheck(build, seed=seed)) return worst def main(): print("=" * 78) print("A. 恒等性:DiT-XL 配置(d=1152, 16 头, T=256)") print("=" * 78) r = identity_and_drift() for mode in ("adaln_zero", "adaln"): d = r[mode] print(f" {mode:<12s} 单块 |out - x| 最大值 = {d['single_block_err']:.3e}") if mode == "adaln": print(f" {'':<12s} 单块相对扰动 std(out-x)/std(x) = {d['single_block_rel']:.4f}") print(f" {'':<12s} 叠 {DEPTH} 层后 |out - x| 最大值 = {d['identity_err']:.3e}") dr = d["drift"] pick = [0, 6, 13, 20, 27] print(f" {'':<12s} 残差流漂移 std(x_k - x_0):" + " ".join(f"k={k+1}:{dr[k]:.4f}" for k in pick)) print() print("=" * 78) print("B. 初始化那一刻,block 里谁拿到了梯度(L = <out, w>,w 固定随机)") print("=" * 78) for mode in ("adaln_zero", "adaln"): g = grad_at_init(mode) nz = [g[k] for k in ("W_qkv", "W_o", "W_1", "W_2")] print(f" {mode:<12s} 主干参数 |grad|max: " + " ".join(f"{k}={v:.3e}" for k, v in zip(("W_qkv", "W_o", "W_1", "W_2"), nz))) print(f" {'':<12s} 调制层各段 |grad|max: " + " ".join(f"{n}={v:.3e}" for n, v in zip(g["mod_name"], g["mod_chunks"]))) print() print("=" * 78) print("D. 初始 loss 能不能事先算出来(FinalLayer 零初始化 vs 正常初始化)") print("=" * 78) e2, mse_z, mse_r, pz, pr = init_loss() print(f" 噪声二阶矩 E[eps^2] = {e2:.4f} <- 理论上就是初始 loss") print(f" 零初始化输出层,实测初始 MSE = {mse_z:.4f}") print(f" 零初始化时模型输出的最大绝对值 = {pz:.3e} (就是全 0)") print(f" 正常初始化输出层,实测初始 MSE = {mse_r:.4f} <- 高出 {mse_r/mse_z:.2f} 倍") print(f" 正常初始化时模型输出的最大绝对值 = {pr:.3e}") print() print("=" * 78) print("自检:手写 autograd vs 中心差分(adaln / cross_attn 两种结构)") print("=" * 78) print(f" 最大相对误差 = {gradcheck_report():.2e}") if __name__ == "__main__": main() cond_ablation.py # -*- coding: utf-8 -*- """DiT 账本(三):四种条件注入方式,在同一个 toy 任务上跑一遍。 论文 Figure 5 / Table 4 的结论是在 ImageNet 上量出来的:DiT-XL/2 跑 400K 步, adaLN-Zero 的 FID 是 19.47,in-context 是 35.24,中间差了近一倍。那个实验这里 复现不了(没有 ImageNet,也没有 TPU),但可以在一个跑得完的 toy 上问同一个问题: **在同样的深度、同样的参数预算下,这四种注入方式的训练行为差多少**。 任务:8 个朝向的二维条纹(8 类),潜变量 8×8×2,patch p=2 → 16 个 token、 每个 token 8 维。按余弦 schedule 加噪,模型预测噪声,loss 是 MSE。 模型:d=64、4 头、若干层,四种 mode 之外的一切都相同(同一个 seed 初始化)。 两种运行档位(缓存按档位分开存,互不覆盖): python cond_ablation.py # 快速档:150 步 × 1 个 seed,约半分钟,用于自检 python cond_ablation.py --full # 完整档:800 步 × 3 个 seed,约十分钟 文章里引用的那组数字来自完整档,已经存在 ../_cache/ 里,脚本会优先读缓存。 """ import json import os import sys import numpy as np import tiny_grad as tg from dit_core import (MicroDiT, Adam, COND_MODES, make_patterns, patchify_imgs, alpha_bar_cosine) SIDE, P, C = 8, 2, 2 PATCH_DIM = P * P * C # 8 T = (SIDE // P) ** 2 # 16 K = 8 # 类别数 DEPTH = 6 HERE = os.path.dirname(os.path.abspath(__file__)) NODE_DIR = os.path.dirname(HERE) # 完整档的参数(文章里的数字就是这一组) STEPS_FULL, SEEDS_FULL = 800, (0, 1, 2) # 快速档:只为「脚本能跑通」而存在(体检会真的执行每个脚本), # 结果同样会缓存,不会覆盖完整档。 STEPS_QUICK, SEEDS_QUICK = 150, (0,) def _cache_path(steps, seeds): return os.path.join(NODE_DIR, "_cache", f"cond_results_s{steps}_n{len(seeds)}.json") CACHE = _cache_path(STEPS_FULL, SEEDS_FULL) def sample_batch(rng, pats, B): """采一批 (z_t, t, y_onehot, eps)。""" y = rng.integers(0, K, B) x0 = pats[y] # [B,8,8,2] eps = rng.standard_normal((B, SIDE, SIDE, C)) t = rng.uniform(0.05, 0.95, B) ab = alpha_bar_cosine(t)[:, None, None, None] z = np.sqrt(ab) * x0 + np.sqrt(1.0 - ab) * eps oh = np.zeros((B, K)) oh[np.arange(B), y] = 1.0 return patchify_imgs(z, P), t, oh, patchify_imgs(eps, P) def make_model(mode, seed, depth=DEPTH): return MicroDiT(d=64, n_heads=4, depth=depth, n_classes=K, patch_dim=PATCH_DIM, T=T, mode=mode, seed=seed, out_dim=PATCH_DIM) def train_one(mode, seed=0, steps=800, batch=32, lr=3e-3, log_every=50, depth=DEPTH): rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, depth) opt = Adam(m.arrays()) curve, gnorms, losses = [], [], [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) gn = opt.step(store, lr * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) gnorms.append(gn) if s % log_every == 0: curve.append([s, float(np.mean(losses[-log_every:]))]) return { "mode": mode, "curve": curve, "final": float(np.mean(losses[-200:])), "grad1": gnorms[0], "grad10": float(np.mean(gnorms[:10])), "gradmax": float(np.max(gnorms)), "params": int(sum(a.size for a in m.arrays())), } def _write_cache(data, path=CACHE): """每跑完一个模式就落盘:中途被打断也不会白跑。""" os.makedirs(os.path.dirname(path), exist_ok=True) with open(path, "w", encoding="utf-8") as f: json.dump(data, f, ensure_ascii=False, indent=1) def run_all(seeds=(0, 1, 2), steps=800, batch=32, depth=DEPTH, resume=True): """跑四种条件注入的对照。resume=True 时复用缓存里已经跑完的模式。""" cache = _cache_path(steps, seeds) out = {} if resume and os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: old = json.load(f) if old.get("_meta", {}).get("steps") == steps: out = {k: v for k, v in old.items() if not k.startswith("_")} if "_sweep" in old: out["_sweep"] = old["_sweep"] except Exception: out = {} for mode in COND_MODES: if mode in out: print(f" [skip] {mode}(缓存里已有,跳过)", file=sys.stderr) continue rs = [train_one(mode, seed=sd, steps=steps, batch=batch, depth=depth) for sd in seeds] fin = [r["final"] for r in rs] out[mode] = { "final_mean": float(np.mean(fin)), "final_std": float(np.std(fin)), "finals": fin, "curve": rs[0]["curve"], "grad1": rs[0]["grad1"], "grad10": rs[0]["grad10"], "gradmax": rs[0]["gradmax"], "params": rs[0]["params"], } out["_meta"] = {"seeds": list(seeds), "steps": steps, "batch": batch, "depth": depth} _write_cache(out, cache) print(f" [done] {mode}", file=sys.stderr) out["_meta"] = {"seeds": list(seeds), "steps": steps, "batch": batch, "depth": depth} return out def sweep_depth(modes=("adaln_zero", "adaln"), depths=(2, 4, 6, 8, 10), steps=400, seed=0, batch=32): """深度变化时,两种 adaLN 的差距怎么变。""" res = {} for mode in modes: row = [] for dep in depths: rng = np.random.default_rng(seed) pats = make_patterns(SIDE, C, K) m = make_model(mode, seed, dep) opt = Adam(m.arrays()) losses = [] for s in range(1, steps + 1): z, t, oh, eps = sample_batch(rng, pats, batch) store = [] tg.reset() pred = m.forward(z, t, oh, store) diff = tg.sub(pred, tg.leaf(eps)) loss = tg.mean_all(tg.mul(diff, diff)) tg.backward(loss) opt.step(store, 3e-3 * (0.25 ** (s / steps)), s) losses.append(float(loss.v)) row.append([dep, float(np.mean(losses[-200:]))]) print(f" [done] {mode} depth={dep}", file=sys.stderr) res[mode] = row return res def load_or_run(seeds=SEEDS_FULL, steps=STEPS_FULL, batch=32, depth=DEPTH, sweep=False): """缓存优先(完整档)。sweep=True 时才额外跑深度扫描(很慢,默认不跑)。""" cache = _cache_path(steps, seeds) data = None if os.path.exists(cache): try: with open(cache, encoding="utf-8") as f: data = json.load(f) except Exception: data = None if data and data.get("_meta", {}).get("steps") == steps \ and all(m in data for m in COND_MODES): if sweep and "_sweep" not in data: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data data = run_all(seeds=seeds, steps=steps, batch=batch, depth=depth) if sweep: data["_sweep"] = sweep_depth(steps=steps // 2, batch=batch) _write_cache(data, cache) return data def _show(res, steps, n_seeds): print(f"{'mode':<14s}{'参数量':>10s}{'最终 loss(均值±std)':>24s}" f"{'首步梯度范数':>14s}{'峰值梯度':>12s}") for mode in COND_MODES: r = res[mode] print(f"{mode:<14s}{r['params']:>10d}" f"{r['final_mean']:>16.4f} ± {r['final_std']:<7.4f}" f"{r['grad1']:>14.3e}{r['gradmax']:>12.3e}") print() print(f" loss 曲线(seed=0,{steps} 步,每 {max(1, steps // 20)} 步取一次均值):") for mode in COND_MODES: c = res[mode]["curve"] picks = [c[i] for i in range(0, len(c), max(1, len(c) // 6))] print(f" {mode:<14s} " + " ".join(f"{s}:{v:.4f}" for s, v in picks)) if n_seeds > 1: print() print(" 每个 seed 的最终 loss(看排序稳不稳):") for mode in COND_MODES: print(f" {mode:<14s} " + " ".join(f"{v:.4f}" for v in res[mode]["finals"])) if res.get("_sweep"): print() print("=" * 78) print("深度扫描:两种 adaLN 在不同深度下的最终 loss") print("=" * 78) for mode, row in res["_sweep"].items(): print(f" {mode:<12s} " + " ".join(f"d={d}:{v:.4f}" for d, v in row)) if __name__ == "__main__": full = "--full" in sys.argv steps, seeds = (STEPS_FULL, SEEDS_FULL) if full else (STEPS_QUICK, SEEDS_QUICK) tag = "完整档" if full else "快速档" print("=" * 78) print(f"四种条件注入在 toy 任务上的训练对照({tag}:{steps} 步 × " f"{len(seeds)} 个 seed)") print("=" * 78) res = load_or_run(seeds=seeds, steps=steps, sweep="--sweep" in sys.argv) _show(res, steps, len(seeds)) if not full: print() print(f" 想复现文章里的那组数字:python cond_ablation.py --full" f"({STEPS_FULL} 步 × {len(SEEDS_FULL)} 个 seed,约十分钟)") tiny_grad.py # -*- coding: utf-8 -*- """一个 100 行的 reverse-mode autograd,只为本文的几个 toy 实验服务。 为什么手搓:环境里没有 torch。为什么不用有限差分:要训几千步,差分太慢。 手搓最大的风险是某个算子的 backward 写错,所以配套了 `gradcheck`—— 用中心差分逐参数核对,正文里报的 2.3e-9 就是它量出来的。 """ import numpy as np _TAPE = [] class Node: __slots__ = ("v", "g", "ins", "bwd") def __init__(self, v, ins=(), bwd=None): self.v = np.asarray(v, dtype=np.float64) self.g = None self.ins = ins self.bwd = bwd _TAPE.append(self) @property def shape(self): return self.v.shape def reset(): _TAPE.clear() def leaf(v): return Node(v) def _unbc(g, shape): """把广播出去的梯度还原成 shape(求和 + 去掉被广播的轴)。""" if g.shape == shape: return g while g.ndim > len(shape): g = g.sum(axis=0) for ax, s in enumerate(shape): if s == 1 and g.shape[ax] != 1: g = g.sum(axis=ax, keepdims=True) return g.reshape(shape) def _mk(v, ins, fn): def bwd(g, a=ins, f=fn): for node, gv in zip(a, f(g)): if node.g is None: node.g = np.zeros_like(node.v) node.g += _unbc(gv, node.v.shape) return Node(v, ins, bwd) def add(a, b): return _mk(a.v + b.v, (a, b), lambda g: (g, g)) def sub(a, b): return _mk(a.v - b.v, (a, b), lambda g: (g, -g)) def mul(a, b): return _mk(a.v * b.v, (a, b), lambda g: (g * b.v, g * a.v)) def neg(a): return _mk(-a.v, (a,), lambda g: (-g,)) def matmul(a, b): """支持 [m,k]@[k,n]、[... ,m,k]@[k,n]、[m,k]@[B,k,n]、[... ,m,k]@[... ,k,n]。""" av, bv = a.v, b.v v = av @ bv def f(g): # 一律走 BLAS 的 batched matmul:比 einsum 快一个量级 if av.ndim <= 2 and bv.ndim <= 2: return (g @ bv.T, av.T @ g) if bv.ndim == 2: # [..., m,k] @ [k,n] da = g @ bv.T p = int(np.prod(av.shape[:-2])) a2 = av.reshape(p, *av.shape[-2:]).swapaxes(-1, -2) # [p,k,m] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return (da, (a2 @ g2).sum(axis=0)) if av.ndim == 2: # [m,k] @ [..., k,n] p = int(np.prod(bv.shape[:-2])) b2 = bv.reshape(p, *bv.shape[-2:]).swapaxes(-1, -2) # [p,n,k] g2 = g.reshape(p, *g.shape[-2:]) # [p,m,n] return ((g2 @ b2).sum(axis=0), av.T @ g) return (g @ bv.swapaxes(-1, -2), av.swapaxes(-1, -2) @ g) return _mk(v, (a, b), f) def transpose(a, *axes): inv = np.argsort(axes) return _mk(a.v.transpose(axes), (a,), lambda g: (g.transpose(inv),)) def reshape(a, shape): return _mk(a.v.reshape(shape), (a,), lambda g: (g.reshape(a.v.shape),)) def scale(a, c): return _mk(a.v * c, (a,), lambda g: (g * c,)) def chunk_last(a, n): """把最后一维等分成 n 份(adaLN 的 6 路调制输出就是这么切的)。""" k = a.v.shape[-1] // n out = [] for i in range(n): v = a.v[..., i * k:(i + 1) * k] def f(g, i=i, k=k): full = np.zeros_like(a.v) full[..., i * k:(i + 1) * k] = g return (full,) out.append(_mk(v, (a,), f)) return out def split3(a): """把最后一维等分三份(qkv)。""" d = a.v.shape[-1] // 3 out = [] for i in range(3): v = a.v[..., i * d:(i + 1) * d] def f(g, i=i, d=d): full = np.zeros_like(a.v) full[..., i * d:(i + 1) * d] = g return (full,) out.append(_mk(v, (a,), f)) return out def take_tokens(a, n): """取前 n 个 token,其余位置梯度补零(in-context 读回图像 token 用)。""" v = a.v[:, :n, :] def f(g): full = np.zeros_like(a.v) full[:, :n, :] = g return (full,) return _mk(v, (a,), f) def concat_tokens(a, b): """沿 token 维拼接(in-context 把条件 token 接在序列末尾)。""" v = np.concatenate([a.v, b.v], axis=1) def f(g): return (g[:, :a.v.shape[1], :], g[:, a.v.shape[1]:, :]) return _mk(v, (a, b), f) def tanh(a): t = np.tanh(a.v) return _mk(t, (a,), lambda g: (g * (1.0 - t * t),)) def sigmoid(a): s = 1.0 / (1.0 + np.exp(-a.v)) return _mk(s, (a,), lambda g: (g * s * (1.0 - s),)) def silu(a): s = 1.0 / (1.0 + np.exp(-a.v)) v = a.v * s return _mk(v, (a,), lambda g: (g * (s + v * (1.0 - s)),)) def gelu_tanh(a): """GELU 的 tanh 近似,DiT 源码里用的就是这个(nn.GELU(approximate='tanh'))。""" k = np.sqrt(2.0 / np.pi) s = a.v * a.v inner = k * (a.v + 0.044715 * a.v * s) t = np.tanh(inner) v = 0.5 * a.v * (1.0 + t) dv = 0.5 * (1.0 + t) + 0.5 * a.v * (1.0 - t * t) * k * (1.0 + 0.134145 * s) return _mk(v, (a,), lambda g: (g * dv,)) def softmax(a, axis=-1): e = np.exp(a.v - a.v.max(axis=axis, keepdims=True)) p = e / e.sum(axis=axis, keepdims=True) def f(g): s = (g * p).sum(axis=axis, keepdims=True) return (p * (g - s),) return _mk(p, (a,), f) def layernorm(a, eps=1e-6): """对最后一维做归一化,无仿射参数(DiT 的缩放/平移由 adaLN 给出)。""" mu = a.v.mean(axis=-1, keepdims=True) xc = a.v - mu var = (xc * xc).mean(axis=-1, keepdims=True) inv = 1.0 / np.sqrt(var + eps) v = xc * inv def f(g): gm = g.mean(axis=-1, keepdims=True) gv = (g * v).mean(axis=-1, keepdims=True) return (inv * (g - gm - v * gv),) return _mk(v, (a,), f) def mean_all(a): n = a.v.size return _mk(a.v.mean(), (a,), lambda g: (np.full(a.v.shape, g / n),)) def backward(loss): for node in _TAPE: node.g = np.zeros_like(node.v) loss.g = np.ones_like(loss.v) for node in reversed(_TAPE): if node.bwd is not None: node.bwd(node.g) return loss def gradcheck(build, eps=1e-5, seed=0, n_probe=6): """中心差分逐参数核对,返回最大相对误差。 build() 每次调用要返回 (loss Node, 参数 Node 列表)。差分直接扰动 Node 底层 的 ndarray——Node.v 与模型里那块内存是同一块,所以扰动后重新 forward 就能拿到扰动后的 loss。 """ rng = np.random.default_rng(seed) worst = 0.0 _, store = build() for node in store: flat = node.v.reshape(-1) idx = rng.choice(flat.size, size=min(n_probe, flat.size), replace=False) for i in idx: old = flat[i] flat[i] = old + eps reset() lp = float(build()[0].v) flat[i] = old - eps reset() lm = float(build()[0].v) flat[i] = old num = (lp - lm) / (2 * eps) reset() loss, s2 = build() backward(loss) cur = [n for n in s2 if n.v is node.v] ana = cur[0].g.reshape(-1)[i] if cur and cur[0].g is not None else 0.0 denom = max(abs(num), abs(ana), 1e-8) worst = max(worst, abs(num - ana) / denom) reset() return worst dit_core.py # -*- coding: utf-8 -*- """DiT 的最小可运行复刻(numpy):一个 block、四种条件注入方式、一个 toy 训练集。 结构上贴 facebookresearch/DiT 的 models.py: modulate(x, shift, scale) = x * (1 + scale) + shift block: x = x + gate_msa * attn(modulate(norm1(x), shift_msa, scale_msa)) x = x + gate_mlp * mlp(modulate(norm2(x), shift_mlp, scale_mlp)) 初始化也照抄:所有 Linear 走 xavier_uniform,然后把每个 block 的 adaLN 调制层 (SiLU → Linear(d, 6d))的 weight 与 bias 整个置零;FinalLayer 的调制层与输出 线性层同样置零。 四种条件注入(对应论文 Figure 3 与 Table 4 末尾四行): adaln_zero : adaLN-Zero,调制层零初始化 adaln : 同样结构,但调制层用正常 xavier 初始化(论文里的 vanilla adaLN) in_context : t 与 y 当作两个额外 token 塞进序列,标准 ViT block cross_attn : 标准 ViT block + 一层对条件向量的 cross-attention """ import numpy as np import tiny_grad as tg COND_MODES = ("adaln_zero", "adaln", "in_context", "cross_attn") # ─────────────── 线性层 ─────────────── class Linear: def __init__(self, fan_in, fan_out, rng, zero=False, std=None): if zero: self.W = np.zeros((fan_in, fan_out)) elif std is not None: self.W = rng.normal(0.0, std, (fan_in, fan_out)) else: lim = np.sqrt(6.0 / (fan_in + fan_out)) # xavier_uniform self.W = rng.uniform(-lim, lim, (fan_in, fan_out)) self.b = np.zeros(fan_out) def __call__(self, x, store=None): Wn = tg.leaf(self.W) bn = tg.leaf(self.b) if store is not None: store.append(Wn) store.append(bn) return tg.add(tg.matmul(x, Wn), bn) def _to_heads(a, B, T, n_heads, dh): return tg.transpose(tg.reshape(a, (B, T, n_heads, dh)), 0, 2, 1, 3) def _attend(q, k, v, scale): s = tg.scale(tg.matmul(q, tg.transpose(k, 0, 1, 3, 2)), scale) return tg.matmul(tg.softmax(s, axis=-1), v) def mh_self_attention(x, n_heads, w_qkv, w_o, store): B, T, d = x.v.shape dh = d // n_heads q, k, v = tg.chunk_last(w_qkv(x, store), 3) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, T, n_heads, dh) v = _to_heads(v, B, T, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) # [B,H,T,dh] y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) def mh_cross_attention(x, ctx, n_heads, w_q, w_kv, w_o, store): B, T, d = x.v.shape Tc = ctx.v.shape[1] dh = d // n_heads q = tg.chunk_last(w_q(x, store), 3)[0] k, v = tg.chunk_last(w_kv(ctx, store), 2) q = _to_heads(q, B, T, n_heads, dh) k = _to_heads(k, B, Tc, n_heads, dh) v = _to_heads(v, B, Tc, n_heads, dh) y = _attend(q, k, v, 1.0 / np.sqrt(dh)) y = tg.reshape(tg.transpose(y, 0, 2, 1, 3), (B, T, d)) return w_o(y, store) # ─────────────── DiT block ─────────────── class DiTBlock: def __init__(self, d, n_heads, rng, mode="adaln_zero", mlp_ratio=4): assert mode in COND_MODES, mode self.mode = mode self.d = d self.n_heads = n_heads self.w_qkv = Linear(d, 3 * d, rng) self.w_o = Linear(d, d, rng) hid = int(d * mlp_ratio) self.w_1 = Linear(d, hid, rng) self.w_2 = Linear(hid, d, rng) self.w_cq = Linear(d, 3 * d, rng) # cross-attn 的 q self.w_ckv = Linear(d, 2 * d, rng) # cross-attn 的 k/v self.w_co = Linear(d, d, rng) # cross-attn 的输出投影 if mode == "adaln_zero": self.w_mod = Linear(d, 6 * d, rng, zero=True) elif mode == "adaln": self.w_mod = Linear(d, 4 * d, rng) else: # 标准 ViT block:LayerNorm 带仿射参数,初始化成 γ=1、β=0 self.ln1_g, self.ln1_b = np.ones(d), np.zeros(d) self.ln2_g, self.ln2_b = np.ones(d), np.zeros(d) self.ln3_g, self.ln3_b = np.ones(d), np.zeros(d) def _modulate(self, h, shift, scale): """DiT 源码的 modulate: x * (1 + scale) + shift,展平成 [B,1,d] 再广播。""" sh = tg.reshape(shift, (shift.v.shape[0], 1, -1)) sc = tg.reshape(scale, (scale.v.shape[0], 1, -1)) return tg.add(tg.add(h, tg.mul(h, sc)), sh) def _vi_norm(self, x, g, b, store): gn, bn = tg.leaf(g), tg.leaf(b) store.append(gn) store.append(bn) return tg.add(tg.mul(tg.layernorm(x), gn), bn) def __call__(self, x, c, store, ctx=None): B, T, d = x.v.shape if self.mode == "adaln_zero": sh_a, sc_a, gate_a, sh_m, sc_m, gate_m = tg.chunk_last( self.w_mod(tg.silu(c), store), 6) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, tg.mul(tg.reshape(gate_a, (B, 1, d)), a)) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, tg.mul(tg.reshape(gate_m, (B, 1, d)), u)) if self.mode == "adaln": sh_a, sc_a, sh_m, sc_m = tg.chunk_last(self.w_mod(tg.silu(c), store), 4) h = self._modulate(tg.layernorm(x), sh_a, sc_a) a = mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store) x = tg.add(x, a) h2 = self._modulate(tg.layernorm(x), sh_m, sc_m) u = self.w_2(tg.gelu_tanh(self.w_1(h2, store)), store) return tg.add(x, u) # ── 标准 ViT block(in-context / cross-attn)── h = self._vi_norm(x, self.ln1_g, self.ln1_b, store) x = tg.add(x, mh_self_attention(h, self.n_heads, self.w_qkv, self.w_o, store)) if self.mode == "cross_attn": h2 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) x = tg.add(x, mh_cross_attention(h2, ctx, self.n_heads, self.w_cq, self.w_ckv, self.w_co, store)) h3 = self._vi_norm(x, self.ln3_g, self.ln3_b, store) else: h3 = self._vi_norm(x, self.ln2_g, self.ln2_b, store) u = self.w_2(tg.gelu_tanh(self.w_1(h3, store)), store) return tg.add(x, u) def arrays(self): out = [self.w_qkv.W, self.w_qkv.b, self.w_o.W, self.w_o.b, self.w_1.W, self.w_1.b, self.w_2.W, self.w_2.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_mod.W, self.w_mod.b] else: out += [self.ln1_g, self.ln1_b, self.ln2_g, self.ln2_b] if self.mode == "cross_attn": out += [self.ln3_g, self.ln3_b, self.w_cq.W, self.w_cq.b, self.w_ckv.W, self.w_ckv.b, self.w_co.W, self.w_co.b] return out # ─────────────── 位置编码与时间步编码 ─────────────── def sincos_pos_embed(side, d): """2D sin-cos 位置编码(DiT 直接抄 MAE 的,固定不可学习)。 两个空间轴各占一半维度:每轴的 d/2 维里再对半分成 sin 与 cos。 """ assert d % 4 == 0, "d 必须是 4 的倍数才能两轴对半分" def emb1d(pos, dim): half = dim // 2 omega = 1.0 / (10000 ** (np.arange(half, dtype=np.float64) / half)) out = np.asarray(pos, dtype=np.float64).reshape(-1, 1) * omega[None] return np.concatenate([np.sin(out), np.cos(out)], axis=-1) gy, gx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") emb = np.concatenate([emb1d(gy.reshape(-1), d // 2), emb1d(gx.reshape(-1), d // 2)], axis=-1) return emb[None, :, :] def timestep_embedding(t, dim, max_period=10000): """DiT 抄 GLIDE 的正弦时间步编码。t: [B] -> [B, dim]。""" half = dim // 2 freqs = np.exp(-np.log(max_period) * np.arange(half, dtype=np.float64) / half) args = np.asarray(t, dtype=np.float64)[:, None] * freqs[None] return np.concatenate([np.cos(args), np.sin(args)], axis=-1) # ─────────────── 一个能训的小 DiT ─────────────── class MicroDiT: def __init__(self, d=64, n_heads=4, depth=8, n_classes=8, patch_dim=8, T=16, t_freq=32, mode="adaln_zero", seed=0, out_dim=8): rng = np.random.default_rng(seed) self.mode = mode self.d, self.T, self.n_classes = d, T, n_classes self.w_in = Linear(patch_dim, d, rng) self.pos = sincos_pos_embed(int(round(np.sqrt(T))), d) self.w_t0 = Linear(t_freq, d, rng, std=0.02) self.w_t1 = Linear(d, d, rng, std=0.02) self.y_emb = rng.normal(0.0, 0.02, (n_classes, d)) self.blocks = [DiTBlock(d, n_heads, rng, mode=mode) for _ in range(depth)] # FinalLayer:adaLN 调制(零初始化)+ 输出线性层(零初始化) if mode in ("adaln_zero", "adaln"): self.w_fmod = Linear(d, 2 * d, rng, zero=True) self.fin_g, self.fin_b = np.ones(d), np.zeros(d) self.w_out = Linear(d, out_dim, rng, zero=True) def forward(self, z, t, y_onehot, store): """z:[B,T,patch_dim] t:[B] y_onehot:[B,K] -> pred:[B,T,out_dim]""" B = z.shape[0] d = self.d x = tg.add(self.w_in(tg.leaf(z), store), tg.leaf(self.pos)) tf = timestep_embedding(t, self.w_t0.W.shape[0]) c = self.w_t1(tg.silu(self.w_t0(tg.leaf(tf), store)), store) ytab = tg.leaf(self.y_emb) store.append(ytab) yv = tg.matmul(tg.leaf(y_onehot), ytab) c = tg.add(c, yv) t_tok = tg.reshape(c, (B, 1, d)) y_tok = tg.reshape(yv, (B, 1, d)) if self.mode == "in_context": x = tg.concat_tokens(x, tg.concat_tokens(t_tok, y_tok)) ctx = tg.concat_tokens(t_tok, y_tok) for blk in self.blocks: x = blk(x, c, store, ctx=ctx) if self.mode == "in_context": x = tg.take_tokens(x, self.T) if self.mode in ("adaln_zero", "adaln"): sh, sc = tg.chunk_last(self.w_fmod(tg.silu(c), store), 2) hn = tg.layernorm(x) h = tg.add(tg.add(hn, tg.mul(hn, tg.reshape(sc, (B, 1, d)))), tg.reshape(sh, (B, 1, d))) else: g, b = tg.leaf(self.fin_g), tg.leaf(self.fin_b) store.append(g) store.append(b) h = tg.add(tg.mul(tg.layernorm(x), g), b) return self.w_out(h, store) def arrays(self): out = [self.w_in.W, self.w_in.b, self.w_t0.W, self.w_t0.b, self.w_t1.W, self.w_t1.b, self.y_emb, self.w_out.W, self.w_out.b] if self.mode in ("adaln_zero", "adaln"): out += [self.w_fmod.W, self.w_fmod.b] else: out += [self.fin_g, self.fin_b] for blk in self.blocks: out += blk.arrays() return out # ─────────────── Adam ─────────────── class Adam: def __init__(self, arrays): self.idx = {id(a): i for i, a in enumerate(arrays)} self.m = [np.zeros_like(a) for a in arrays] self.v = [np.zeros_like(a) for a in arrays] def step(self, nodes, lr, step, b1=0.9, b2=0.999, eps=1e-8): gnorm = 0.0 for n in nodes: i = self.idx.get(id(n.v)) if i is None or n.g is None: continue g = n.g gnorm += float((g * g).sum()) self.m[i] = b1 * self.m[i] + (1 - b1) * g self.v[i] = b2 * self.v[i] + (1 - b2) * g * g mh = self.m[i] / (1 - b1 ** step) vh = self.v[i] / (1 - b2 ** step) n.v -= lr * mh / (np.sqrt(vh) + eps) return float(np.sqrt(gnorm)) # ─────────────── toy 训练数据:8 个方向的条纹 ─────────────── def make_patterns(side=8, C=2, K=8): """K 个不同朝向的二维条纹,当作 K 类「图像」。""" yy, xx = np.meshgrid(np.arange(side), np.arange(side), indexing="ij") pats = np.zeros((K, side, side, C)) for k in range(K): th = k * np.pi / K phase = 2 * np.pi * 2.0 * (xx * np.cos(th) + yy * np.sin(th)) / side pats[k, :, :, 0] = np.cos(phase) pats[k, :, :, 1] = np.sin(phase) return pats / np.std(pats) def patchify_imgs(imgs, p): """imgs:[B,I,I,C] -> [B,(I/p)^2,p*p*C]""" B, I, _, C = imgs.shape g = I // p z = imgs.reshape(B, g, p, g, p, C).transpose(0, 1, 3, 2, 4, 5) return z.reshape(B, g * g, p * p * C) def alpha_bar_cosine(t): """余弦 schedule 的 ᾱ_t:t=0 时 1(干净),t=1 时 0(纯噪声)。""" return np.cos(np.pi * np.asarray(t, dtype=np.float64) / 2.0) ** 2 make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) import dit_flops as F # noqa: E402 import adaln_zero as AZ # noqa: E402 import cond_ablation as CA # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Heiti TC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:算力账本 ─────────────── def fig_ledger(): fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.8)) # 左:同样 Gflops,参数量差 14 倍,FID 却一样 ax = axes[0] marks = {8: "o", 4: "s", 2: "^"} cols = {8: CGREY, 4: C2, 2: C1} # 手工微调标号偏移,避免同算力组里三个点叠在一起看不清 offs = {("S", 2): (7, -15), ("B", 4): (1, 9), ("L", 8): (8, 5), ("S", 4): (8, 5), ("B", 8): (8, 5), ("B", 2): (7, -15), ("L", 4): (-4, 10), ("XL", 4): (8, 6), ("L", 2): (8, 5), ("XL", 2): (8, 5), ("S", 8): (8, 5), ("XL", 8): (8, 5)} for cfg in ["S", "B", "L", "XL"]: for p in [8, 4, 2]: g, pm, fid = F.PAPER_TABLE4_256[(cfg, p)] ax.scatter(g, fid, marker=marks[p], s=95, color=cols[p], zorder=3, edgecolor="white", linewidth=1.3) ax.annotate(f"{cfg}/{p}", (g, fid), textcoords="offset points", xytext=offs[(cfg, p)], fontsize=9, color="#333333", bbox=dict(boxstyle="round,pad=0.15", fc="white", ec="none", alpha=0.75)) ax.set_xscale("log") ax.set_xlim(0.25, 320) ax.set_ylim(0, 175) ax.set_xlabel("一次前向的算力 Gflops(对数轴,论文 Table 4)") ax.set_ylabel("FID-50K(无分类器引导,越低越好)") ax.set_title("同算力时:把预算花在 token 上,比花在宽度深度上划算") ax.grid(alpha=0.25, ls=":") for tag, keys, col, tx, ty in [ ("约 5~6 G", [("S", 2), ("B", 4), ("L", 8)], C3, 1.05, 152), ("约 20~29 G", [("B", 2), ("L", 4), ("XL", 4)], C0, 36, 60)]: xs = [F.PAPER_TABLE4_256[k][0] for k in keys] ys = [F.PAPER_TABLE4_256[k][2] for k in keys] ax.plot(xs, ys, ls="--", lw=1.3, color=col, alpha=0.75, zorder=1) ax.text(tx, ty, tag, color=col, fontsize=9.5, ha="left", bbox=dict(boxstyle="round,pad=0.25", fc="white", ec=col, alpha=0.85, lw=0.8)) ax.annotate("这两个点参数量差 4 倍\n(33M / 130M),FID 几乎重合", xy=(6.06, 68.40), xytext=(0.42, 26), fontsize=9, color="#333333", ha="left", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) # 右:注意力占多少算力,随 token 数怎么变 ax = axes[1] Ts = np.array([64, 256, 1024, 4096, 16384]) ds = {"DiT-S (d=384)": 384, "DiT-B (d=768)": 768, "DiT-L (d=1024)": 1024, "DiT-XL (d=1152)": 1152} for name, d in ds.items(): lin = 12 * d * d # 每 token 的线性部分(qkv+out+mlp) attn = 2 * Ts * d # 每 token 摊到的注意力部分 ax.plot(Ts, attn / (lin + attn) * 100, marker="o", lw=2, ms=4, label=name) ax.set_xscale("log") ax.set_ylim(0, 70) ax.set_xlabel("token 数 T(对数轴)") ax.set_ylabel("注意力占单块算力的百分比") ax.set_title("T=256 时注意力只占 3.6%,要到 T 上千才成为大头") ax.grid(alpha=0.25, ls=":") ax.legend(fontsize=9, loc="upper left") ax.axvline(256, color="#cccccc", lw=1.2, ls=":", zorder=0) ax.annotate("256×256 图像、p=2:3.6%", xy=(256, 3.6), xytext=(330, 8), fontsize=9, color="#555555") ax.text(900, 2.5, "同样 T 下,网络越宽(d 越大)注意力占比越低", fontsize=9, color="#555555") fig.suptitle("图 1:DiT 的算力账本——钱花在哪,以及该多买 token 还是多买宽度", fontsize=12) fig.tight_layout() _save(fig, "fig1_compute_ledger.png") # ─────────────── 图 2:初始化恒等 ─────────────── def fig_identity(): r = AZ.identity_and_drift() drift_zero = r["adaln_zero"]["drift"] drift_plain = r["adaln"]["drift"] ks = np.arange(1, len(drift_plain) + 1) fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.4)) ax = axes[0] ax.plot(ks, drift_plain, color=C1, lw=2.4, marker="o", ms=3, label="vanilla adaLN(调制层正常初始化)") ax.plot(ks, drift_zero, color=C0, lw=2.4, label="adaLN-Zero(调制层零初始化)") ax.set_xlabel("第 k 个 block 之后") ax.set_ylabel(r"残差流漂移 std(x_k - x_0)") ax.set_title("零初始化:叠 28 层,漂移严格是 0") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax.annotate(f"第 28 层:{drift_plain[-1]:.2f} vs {drift_zero[-1]:.2f}", xy=(28, drift_plain[-1]), xytext=(13, 3.4), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) ax = axes[1] labels = ["W_qkv", "W_o", "W_1", "W_2", "调制层\nshift/scale 段", "调制层\ngate 段"] gz = AZ.grad_at_init("adaln_zero") gp = AZ.grad_at_init("adaln") def pick(r, kind): """按名字取,避免把 vanilla adaLN 的 shift_mlp 误当成 gate。""" vals = [v for nm, v in zip(r["mod_name"], r["mod_chunks"]) if (("gate" in nm) if kind == "gate" else ("shift" in nm or "scale" in nm))] return max(vals) if vals else None v_zero = [gz["W_qkv"], gz["W_o"], gz["W_1"], gz["W_2"], pick(gz, "ss"), pick(gz, "gate")] v_plain = [gp["W_qkv"], gp["W_o"], gp["W_1"], gp["W_2"], pick(gp, "ss"), pick(gp, "gate")] # vanilla adaLN 结构里没有 gate:画在最底部,并单独标注 FLOOR = 1e-12 v_plain = [FLOOR if v is None else v for v in v_plain] v_zero = [FLOOR if v is None else v for v in v_zero] x = np.arange(len(labels)) w = 0.38 ax.bar(x - w / 2, np.array(v_plain) + FLOOR, w, color=C2, label="vanilla adaLN") ax.bar(x + w / 2, np.array(v_zero) + FLOOR, w, color=C0, label="adaLN-Zero") ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel("初始化时刻的 |grad| 最大值(对数轴)") ax.set_title("门关着的时候,只有门自己有梯度") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":", axis="y") ax.annotate("adaLN-Zero 的主干参数梯度精确为 0\n(0 画在 1e-12,否则 log 轴显示不出来)", xy=(x[0] + w / 2, FLOOR), xytext=(0.35, 1e-9), fontsize=9, color="#333333") ax.annotate("vanilla adaLN 结构里\n根本没有 gate 这一项", xy=(x[-1] - w / 2, FLOOR), xytext=(3.35, 1e-7), fontsize=9, color="#555555", ha="center", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 2:adaLN-Zero 的初始化——恒等是怎么来的,代价是什么", fontsize=12) fig.tight_layout() _save(fig, "fig2_identity.png") # ─────────────── 图 3:四种条件注入的 toy 训练对照 ─────────────── def fig_ablation(): res = CA.load_or_run() fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6)) cols = {"adaln_zero": C0, "adaln": C2, "in_context": C1, "cross_attn": C3} names = {"adaln_zero": "adaLN-Zero", "adaln": "vanilla adaLN", "in_context": "in-context", "cross_attn": "cross-attention"} ax = axes[0] for mode in CA.COND_MODES: c = res[mode]["curve"] ax.plot([p[0] for p in c], [p[1] for p in c], lw=2.2, color=cols[mode], label=names[mode]) ax.set_xlabel("训练步数") ax.set_ylabel("噪声预测 MSE(每 50 步取均值)") ax.set_title("同一个 toy 任务,四种条件注入的训练曲线") ax.legend(fontsize=9) ax.grid(alpha=0.25, ls=":") ax = axes[1] x = np.arange(len(CA.COND_MODES)) means = [res[m]["final_mean"] for m in CA.COND_MODES] stds = [res[m]["final_std"] for m in CA.COND_MODES] ax.bar(x, means, yerr=stds, capsize=4, color=[cols[m] for m in CA.COND_MODES], alpha=0.9) # 把 3 个 seed 的最终 loss 直接点到柱子上:看排序有没有重叠 for i, m in enumerate(CA.COND_MODES): vals = res[m]["finals"] ax.scatter([i] * len(vals), vals, s=20, color="white", edgecolor="#333333", linewidth=0.8, zorder=4) ax.set_xticks(x) ax.set_xticklabels([names[m] for m in CA.COND_MODES], fontsize=9) ax.set_ylabel("最后 200 步的平均 loss(3 个 seed)") ax.set_title("最终 loss:adaLN-Zero 与其余三档完全不重叠") ax.grid(alpha=0.25, ls=":", axis="y") top = max(means) + max(stds) * 3 ax.set_ylim(0, top) for i, (m, s) in enumerate(zip(means, stds)): ax.text(i, m + s + top * 0.02, f"{m:.4f}", ha="center", fontsize=9, color="#333333") ax.annotate("白点 = 每个 seed 单独的结果\n(adaLN-Zero 最差的那个 seed\n也比其它三档最好的 seed 低)", xy=(0, 0.041), xytext=(1.15, top * 0.62), fontsize=9, color="#333333", arrowprops=dict(arrowstyle="->", color="#888888", lw=1)) fig.suptitle("图 3:条件注入方式的 toy 对照(6 层 d=64、T=16,800 步 × 3 seed)", fontsize=12) fig.tight_layout() _save(fig, "fig3_cond_ablation.png") # ─────────────── 图 4:四种 block design 的算力-质量对照 ─────────────── def fig_design(): order = ["in-context", "cross-attention", "adaLN", "adaLN-Zero"] names = ["in-context", "cross-attention", "vanilla adaLN", "adaLN-Zero"] g = [F.PAPER_BLOCK_DESIGN[k][0] for k in order] pm = [F.PAPER_BLOCK_DESIGN[k][1] for k in order] fid = [F.PAPER_BLOCK_DESIGN[k][2] for k in order] fig, axes = plt.subplots(1, 3, figsize=(13.2, 4.0)) cols = [C1, C2, CGREY, C0] for ax, vals, title, ylab, fmt in [ (axes[0], g, "一次前向 Gflops", "Gflops", "{:.1f}"), (axes[1], pm, "参数量", "M", "{:d}"), (axes[2], fid, "FID-50K(越低越好)", "FID", "{:.2f}"), ]: bars = ax.bar(np.arange(4), vals, color=cols, alpha=0.92) ax.set_xticks(np.arange(4)) ax.set_xticklabels(names, fontsize=8.5, rotation=18) ax.set_title(title) ax.set_ylabel(ylab) ax.grid(alpha=0.25, ls=":", axis="y") for b, v in zip(bars, vals): ax.text(b.get_x() + b.get_width() / 2, v, fmt.format(v), ha="center", va="bottom", fontsize=9, color="#333333") if title.startswith("FID"): ax.set_ylim(0, max(vals) * 1.25) else: ax.set_ylim(0, max(vals) * 1.22) fig.suptitle("图 4:DiT-XL/2 骨架下四种 block design(论文 Table 4,400K 步)", fontsize=12) fig.tight_layout() _save(fig, "fig4_block_design.png") FIGURES = { "ledger": fig_ledger, "identity": fig_identity, "ablation": fig_ablation, "design": fig_design, } if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None for name, fn in FIGURES.items(): if only and name != only: continue print(f"[draw] {name}") fn()
-
AIGC 基本功|潜空间扩散与 Stable Diffusion 架构-LDM 潜空间扩散与 Stable Diffusion 架构 所属方向:生成范式 | 难度:进阶 | 前置知识:VAE 结构与 0.18215、DDPM 训练目标与采样流程($\bar\alpha_t$、$\varepsilon$ 预测器、DDIM 那一步怎么走都在那两篇推过,这里直接用结论) 关键词:潜空间扩散、LDM、Stable Diffusion、UNet、交叉注意力、scale factor 01. 为什么需要它 潜空间扩散的主要收益是降低生成网络处理的空间位置数。下面把一个 SD1.5 风格 UNet 原样放大到像素空间做静态对照;这不是所有像素扩散的成本,也不是实际 GPU 显存或延迟测试。 账本依据 SD1.5 的配置和 diffusers 构造逻辑(附录 unet_ledger.py)。有个历史命名陷阱:attention_head_dim=8 在该模型的构造逻辑中实际表示 8 个头,不是每头 8 维;320 通道对应每头 40 维。修正头数、真实 skip 通道和 Transformer 外层投影后,账本参数量为 859,520,964,与文中参照值 859,522,604 差 1,640(约 0.00019%)。这是静态近似,不能把参数接近当成峰值显存验证。若朴素实现显式保存注意力矩阵,512² 像素上的首层需要 $$512^2\times512^2\times8\times2\ \text{bytes}=2^{40}\ \text{bytes}=1\ \text{TiB}$$ 这里按二进制单位计算为 1 TiB;同层 64² latent 需要 256 MiB,矩阵元素数相差 4096 倍。SDPA / FlashAttention 可以不保存完整矩阵,所以这些是朴素物化成本,不是现代实现的必然显存占用。 把像素模型 attention 只放最深层,静态账本得到单步约 $1.4455\times10^{13}$ MAC;latent 版本约 $4.0164\times10^{11}$ MAC,相差 36.0 倍。对应逐层激活累计约 12.94 GiB 与 2.04 GiB,尚未模拟张量生命周期、重计算、优化器或融合内核。VAE 编解码是额外开销,占比随采样步数、分辨率和实现改变,本实验没有测量它。 压缩也引入信息取舍。latent_lab.py 用一张样例图做块 DCT,只保留 192 个系数中的 4 个,得到 94.91% 能量和约 22.06 dB PSNR。能量不是语义信息量,高频中的文字笔画、边缘、细小物体仍可能很重要;该单图线性实验不能证明 VAE 只删除“人眼不关心”的内容。 实际 LDM 用学习到的感知压缩来减小扩散的工作空间,并同时权衡重建质量、生成质量和成本。像素扩散、级联超分也能实现高分辨率生成,潜空间是有用路线而非唯一可行路线。 02. 最小可用理解 三句话: 机制:先训一个 VAE 把图像 $x$ 压成潜特征 $z=\mathcal{E}(x)$(f=8 下采样、3 通道变 4 通道,512×512×3 变 64×64×4,压缩率 48 倍),然后把 DDPM 原封不动地搬到 $z$ 上做,条件(文本)通过交叉注意力在 UNet 内部注入。 成本:卷积部分的算力正比于空间 token 数,所以正好除以 $f^2=64$;但 self-attention 是 $O(N^2)$,压缩后从「根本放不下」变成「贵但可做」。实测 512px 下像素空间与潜空间的单步 MAC 比 678.6 倍,只看卷积部分是 64.0 倍。 效果与代价:扩散模型不再直接对像素负责,可还原的细节受 VAE 限制——VAE 解不回来的细节,扩散模型画得再好也出不来。这是潜空间模型的一项误差来源,不能单独解释文字或手指等全部生成错误。 这张图看静态 MAC 随边长变化的趋势:在本扫描区间,像素同拓扑约为边长的 3.87 次方,latent 约为 2.61 次方。512px 处约相差 679 倍。右图是朴素实现的逐层张量累计,不是实测峰值;使用融合注意力时,红色矩阵项会显著改变。 03. 数学推导 3.1 两阶段目标 LDM 是两阶段训练,不是给同一个联合损失设置一个任意 λ: $$\text{阶段一:}\min_{\phi,\psi}L_{\text{AE}}(\phi,\psi),\qquad\text{阶段二:固定 }(\phi,\psi)\text{ 后 }\min_\theta L_{\text{LDM}}(\theta)$$ 第一阶段优化自编码器的重建、正则与感知/对抗目标;第二阶段冻结编码器与解码器,只优化 latent 扩散目标。这样扩散训练所见的 latent 分布保持固定。联合训练是另一类研究方案,需要额外处理两侧变化。 3.2 感知压缩:压缩率从哪来 VAE 的编码器把 $x\in\mathbb{R}^{H\times W\times 3}$ 映到 $z\in\mathbb{R}^{h\times w\times C}$,其中 $h=H/f$、$w=W/f$。定义压缩率 $$r=\frac{3\,f^{2}}{C}$$ $f$ 是空间下采样倍数,$C$ 是潜通道数。SD 用 $f=8$、$C=4$,所以 $r=48$。这个式子值得停一下:$f$ 和 $C$ 是两个独立的旋钮,$f$ 控制空间上省多少(直接决定 UNet 卷积部分省多少,因为卷积算力正比 $h\times w$),$C$ 控制每个位置带多少信息。附录表 [A] 里扫了这两个旋钮的交叉组合:$f=8,C=4$ 时线性重建只有 22.06 dB,把 $C$ 从 4 提到 16 能到 27.56 dB,把 $f$ 从 8 降到 4 也能到 26.09 dB——两条路都能换质量,但 $f$ 的每一档都同时把算力除以 4,而 $C$ 只影响通道数。LDM 论文选 $f=8$ 就是在这条帕累托前沿上取的点。 图中星号只是与 SD 相同张量尺寸的 DCT 教学替身,不是实测 SD VAE 的 PSNR。不同曲线来自同一张图的不同块大小与保留系数数目;右侧能量比例依赖图像和基底,不代表感知信息保留率。 感知压缩通常结合像素重建、LPIPS 和对抗目标。逐像素 L2 在重建不确定时倾向条件均值,可能使细节变模糊;感知项约束特征而非逐像素对应。但 L2 不会因为“高频系数数量多”就被低能量项支配:正交变换下 Parseval 等式保持总平方误差。是否使用某项应看具体配方与消融。 3.3 潜空间扩散目标 VAE 冻结之后,扩散这一半就是把 DDPM 的每个符号里的 $x$ 换成 $z$。前向过程: $$z_t=\sqrt{\bar\alpha_t}\,z_0+\sqrt{1-\bar\alpha_t}\,\varepsilon,\qquad \varepsilon\sim\mathcal{N}(0,1)$$ 训练目标是噪声预测,条件 $c$(文本的 CLIP 编码)只通过 UNet 内部的交叉注意力进入: $$L_{\text{LDM}}=\mathbb{E}_{z_0,\,\varepsilon,\,t}\Big[\big\|\varepsilon-\varepsilon_\theta(z_t,t,c)\big\|_2^2\Big]$$ 注意这个目标和像素空间的形式一字不差——这正是「搬进潜空间」这个动作的全部:不是发明新模型,是换了个更小的工作空间。上一篇文章讲的 CFG、上上篇讲的 DDIM 采样器,在这里原样成立。 3.4 scale factor:为什么必须有 扩散训练需要固定 latent 的尺度约定。单位数据方差时,SNR 是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$ 本身。SD1.x 常用乘数 $s=0.18215$,对应原始标准差约 5.49、方差约 30.14;编码后要乘 s,解码前除 s。 把 $z$ 整体乘 $k$ 倍,信噪比就乘 $k^2$: $$\mathrm{SNR}_{\text{eff}}(t)=\frac{\bar\alpha_t\,(k\sigma_z)^2}{1-\bar\alpha_t}$$ 也就是说,网络在时间步 $t$ 实际体验到的难度,等于调度表里另一个时间步 $t'$ 的难度。附录脚本 [B2] 把这个对应关系算了出来(cosine 调度、$T=1000$、参考 $t=500$):scale 错 2 倍,等效于把 t=500 映射到约 t′=292.7(差 −207.3 步);错 4 倍是 −348.9 步;错 0.5 倍是 +205.7 步。这是参考时刻的等效 SNR 变化,不是固定的全局时间平移。 这张图在固定参考 t=500 上比较尺度倍数 k 与等效时间 t′,曲线经过 k=1、t′=500。这种映射是非线性的,不是把整条时间表平移固定步数;−207.3 只是本调度在这个参考时刻、k=2 的差值。 还有一层:全局缩放只解决「整体方差」的问题,解决不了「通道之间」。附录 [B] 用样例照片的 DCT 特征实测(不是 VAE 权重输出):8 个通道的标准差从 8.0681 一直掉到 0.5386,相差 14.98 倍。对线性-高斯去噪器,第 $j$ 个通道的不可约残差是 $$\mathrm{MSE}_j(t)=\frac{\bar\alpha_t\,\sigma_j^2}{\bar\alpha_t\,\sigma_j^2+1-\bar\alpha_t}$$ 这里是预测 ε 时的 Bayes 最小 MSE,按通道相加得到最小期望损失;它不是参数梯度份额。toy DCT 通道在 $\bar\alpha=0.1$ 时最高方差通道占约 51.28% 的该残差,说明全局缩放不消除通道尺度差异,但不能据此解释真实 SD 的细节质量,本文没有测量真实 VAE latent。 这张图要看什么:左图是 8 个通道各自的 std(对数刻度),橙色虚线是通道方差均值的平方根(3.0457,不含通道均值之间的差异)——它的倒数 0.3283 就是 SD 那个 0.18215 的类比物,注意全局缩放之后通道之间的 15 倍跨度原封不动。右图是三条 $\bar\alpha_t$ 下各通道分到的 loss 份额:三条曲线都从左往右掉,灰色虚线是「逐通道缩放后」的均摊线 12.5%。$\bar\alpha_t$ 越小(噪声越大),失衡越严重。 3.5 交叉注意力:条件怎么进来 文本 $y$ 先过 CLIP 文本编码器得到 $\tau_\theta(y)\in\mathbb{R}^{77\times 768}$,然后进 UNet 内部的 Transformer 块。每个 Transformer 块有两个注意力,分工不同: $$\mathrm{attn}_1=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q,K,V\ \text{都来自图像 token}\qquad\qquad\mathrm{attn}_2=\mathrm{softmax}\Big(\frac{QK^\top}{\sqrt d}\Big)V,\quad Q\ \text{来自图像 token},\ K,V\ \text{来自文本}$$ $\mathrm{attn}_1$ 是 self-attention,管图像内部的空间关系;$\mathrm{attn}_2$ 是 cross-attention,管「这段话在这个位置要什么」。关键在成本结构:图像 token 数 $N=h\times w$,文本 token 数固定 $T=77$,所以 $$\mathrm{attn}_1\ \text{的注意力矩阵是}\ N\times N,\qquad \mathrm{attn}_2\ \text{的是}\ N\times 77$$ 对 token 数 N,self-attention 的矩阵计算二次增长,cross-attention 在固定文本长度下近似线性增长。修正账本后,cross-attention 的 MAC 占比从 64² latent 的 4.00% 降到 256² 的 1.11%;绝对 MAC 仍从约 $1.60\times10^{10}$ 升到 $2.35\times10^{11}$,占比下降不能说它“不涨钱”。 单头注意力输出 $AV$ 满足 $\mathrm{rank}(AV)\le\min(T,d_{\text{head}})$,这里 T=77。附录单头、d=320 的随机矩阵实验得到秩 77。真实 SD 是多头:各头拼接后秩上界可达 $\min(C,H_{\text{heads}}T)$,再加残差、非线性与多层处理,不能声称整个 UNet 只有 77 个自由度。文本与细粒度空间控制仍是不同接口,但这个单头秩实验不能单独证明 ControlNet 的必要性。 左图是修正后的静态 MAC 占比。右图只是人为设定的“许多等 logit 位置”在 softmax 中累加概率质量的示意:真实 CLIP 即使使用相同 padding token ID,各位置经过位置编码与上下文注意力后的向量也不相同,不能把它们当成一个相同 EOS embedding 集团。是否传 mask 应核对具体 pipeline。 04. 代码实现 三段最小实现,全部 numpy,/usr/local/bin/python3(3.10.5)直接可跑;完整脚本在文末附录。 4.1 块正交编码器(VAE 的替身) 没有 torch 和真实权重,我用一个线性正交编码器当 VAE 的替身:切成 $f\times f\times 3$ 的块、做三维可分离 DCT、只留能量最大的 $C$ 个系数。它与该 VAE 的张量形状及元素压缩率对应——潜特征形状就是 $(h, w, C)$,压缩率就是 $\frac{3f^2}{C}$,变量名和 3.2 节的符号一一对应。用它做替身的好处是把「压缩率」这一个变量单独隔离出来了。 def block_basis(f): """f x f x 3 块的可分离正交基,展平顺序 (channel, row, col)。""" df = dct_matrix(f) return np.kron(dct_matrix(3), np.kron(df, df)) def encode_decode(img, f, c_keep): """img: [H, W, 3],值域 [-1, 1]。返回潜特征、重建图、能量占比。""" h, w, _ = img.shape patches = to_blocks(img, f) # [h*w/f^2, 3*f*f] b = block_basis(f) coef = patches @ b.T # 正交变换,能量不变 energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 keep = np.sort(np.argsort(energy)[::-1][:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = from_blocks(coef[:, keep] @ b[keep, :], h, w, f) frac = float(energy[keep].sum() / energy.sum()) return latent, np.clip(rec, -1.0, 1.0), frac 真实输出(一张 512×512 照片): encode_decode(img, 8, 4) latent.shape = (64, 64, 4) # 与 SD 的潜特征形状完全一致 压缩率 = 48.0x # 3*8^2/4 PSNR = 22.06 dB # 线性重建的上限就在这附近 保留能量 = 94.9081% # 扔掉的 98% 系数只占 5.09% 的能量 22.06 dB 是这一张图在该 DCT 选择和裁剪策略下的结果,不是所有线性编码器的上限,也不是 SD VAE 的重建质量。真实非线性编码器可能学到不同的特征表示;没有跑权重就不能量化它比这个替身好多少。 4.2 UNet 账本(参数量对拍) 记账模型按 SD 1.5 的拓扑走一遍:4 个分辨率、每层 2 个 ResNet(上采样路径 3 个)、attention 放在下采样路径的第 0/1/2 层和上采样路径对应的层、中段是 ResNet-Transformer-ResNet。 def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) self.linear(1, TEMB_CH, cout) # time_emb_proj: [1280] -> [cout] if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut(上采样路径必带) def transformer_block(self, res, ch, ctx_len): """self-attn -> cross-attn -> FFN(GEGLU,4 倍扩张)。""" n = res * res heads = NUM_HEADS ... # Q/K/V 投影 + 两次注意力 + GEGLU 真实输出: build_unet(64, 64, 4, 4) # 潜空间 params = 859,520,964 # 官方 SD 1.5 UNet = 859,522,604,差 1,640(约 -0.00019%) MAC = 4.0164e+11 构成 = conv 52.1% self_attn 21.6% cross_attn 4.0% ffn 19.1% proj 3.2% build_unet(512, 512, 3, 3) # 同一拓扑搬回像素空间 MAC = 2.7256e+14 # 是潜空间的 678.6 倍 账本中 FFN 占约 19.1% MAC、cross-attention 约 4.0%,需要同时考虑投影、卷积和注意力矩阵乘。上采样 ResNet 拼接当前特征与 skip,其通道数是两者相加,跨层时并不总等于输出通道的两倍;修正版按 skip 栈逐项消费。 4.3 交叉注意力(10 行,含秩的验证) def cross_attn_demo(rng, d=320, side=64, ctx_len=77): n_img = side * side q = rng.standard_normal((n_img, d)) / np.sqrt(d) # 图像 token k_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) # 文本 token v_txt = rng.standard_normal((ctx_len, d)) / np.sqrt(d) a = softmax((q @ k_txt.T) / np.sqrt(d), axis=-1) # [4096, 77] out = a @ v_txt # [4096, 320] rank = int(np.sum(np.linalg.svd(out, compute_uv=False) > np.linalg.svd(out, compute_uv=False)[0] * 1e-8)) print(a.shape, out.shape, rank) 真实输出: (4096, 77) (4096, 320) 77 这个单头教学例子的秩为 77,验证的是单次矩阵乘积的秩界。多头、残差与深层非线性不受同一个“77 维全局瓶颈”约束。 05. 工业级实现对照 对照 diffusers 的 UNet2DConditionModel(huggingface/diffusers · unet_2d_condition.py,symbol UNet2DConditionModel.forward;以 2026-09 时的实现为准,上游会重构): 时间步通过 ResBlock 注入。 SD1.5 常见实现把时间 embedding 投影后加到特征上;原始 DDPM 实现也有加性注入,不能说原版 DDPM 使用 AdaGN、到 SD 才改成加法。scale-shift norm 等方式属于其他配置选择,比较时应指出具体模型。 SD1.5 的文本通常通过 cross-attention 注入。 通用 UNet2DConditionModel 还支持 class embedding、附加条件以及 only_cross_attention 等配置,不能把 SD1.5 的一条路径说成这个类的永恒约束。SDXL 还有 pooled 文本、尺寸和裁剪条件;SD2.x 并不是这里所有额外条件接口的来源。 attention 后端影响实际显存。 UNet 构造实现 为历史兼容设置 num_attention_heads = num_attention_heads or attention_head_dim,SD1.5 因而是 8 头。64² latent 的单层显式矩阵约 256 MiB;SDPA / FlashAttention 可避免完整物化,是否使用取决于设备、版本和配置。 scale factor 放在 VAE 的配置里,不在 UNet 里。 AutoencoderKL 的 config 带 scaling_factor: 0.18215,pipeline 在 vae.encode(...).latent_dist.sample() 之后乘上它、在 vae.decode 之前除回来。UNet 见到的是训练约定缩放后的潜特征。换 VAE(比如 SD 2.x 或 SDXL 的 VAE)要连 scaling_factor 一起换,见 3.4 节的等效时间映射。 64² latent 的中段在 8²。 三次下采样后到达 8²;skip 栈包含 conv_in、每个 ResNet/attention 组合的输出与下采样输出,attention 不是在同一 ResNet 之外额外再存一条独立 skip。上采样块依次消费这些特征,所以输入通道必须逐项记账。 06. 代价与边界 代价一:解码器与瓶颈限制重建和生成。 被编码过程丢掉的信息无法保证按原样还原,固定解码器也限制可生成的图像集合。但手指、文字错误还可能来自生成模型和数据,不能把一类生成错误全部归因于 VAE。输入重建误差也不是生成样本误差的严格上限。 代价二:尺度约定要成对维护。 toy 的通道跨度说明一个全局标量不能独立归一化每个通道。真实 VAE 是否需要逐通道处理必须测量;使用预训练扩散模型时还要保持它训练时的 latent 语义和配置,不能只改系数。 代价三:文本不直接指定每个空间位置。 更精确的姿态、深度、边缘控制常加入空间条件分支,但原因涉及任务表示与训练,不是整个 UNet 输出秩只能为 77。多头注意力的秩上界见 3.5 节。 选择时看保真需求与实测成本。 严格像素保真的编辑、文档和重建任务需要评估 VAE 引入的误差,可能选择更低压缩、多尺度或像素方案。超高分辨率并不自动排除 latent 模型:分块、融合注意力、不同生成骨干都会改变成本。本文 2048px 对照的朴素逐层累计约 352.53 GiB,既不是实测峰值,也不是 SDXL 的数字。 07. 经典论文脉络 Taming Transformers(VQGAN, 2012.09841):先把「感知压缩 + 在压缩空间里做生成」这条路走通,但它用的是离散 token + 自回归 Transformer。LDM 的感知压缩部分直接继承自它。 DDPM(2006.11239):确立像素空间扩散的训练目标和采样流程,是 LDM 搬进潜空间之前的那块地基(前置篇已推)。 LDM / Stable Diffusion(2112.10752):本文锚点。两个贡献——连续 VAE 潜空间 + 交叉注意力条件注入;前者解决算力,后者把「无条件/有条件」的分支统一成一个可外推的接口(CFG 的舞台)。 Imagen(Saharia et al., 2022;2205.11487):反方意见。证明像素空间级联扩散(64→256→1024 逐级超分)+ 更强的文本编码器也能达到顶尖质量,说明潜空间不是唯一解;它给出的重要观察是「文本编码器的重要性高于 UNet 规模」。 SDXL(2307.01952):潜空间路线的工程演进——更大 UNet、双文本编码器、多宽高比分桶和额外尺寸条件。 一句话串起来:VQGAN 证明了压缩空间里能生成,DDPM 证明了扩散能生成,LDM 把两者拼起来并解决了条件注入,Imagen 提出反例,SDXL 证明了这条路线的上限还没到。 08. 常见误解 「潜空间扩散等价于像素扩散加一个 VAE。」 VAE 改变了数据表示、尺度与可还原的信息,训练好的两个去噪器不能无成本互换;差异不能简单归结为“高频全部被删掉”。 「保留 95% 能量就等于保留 95% 信息。」 能量是特定数值空间的平方和,不是感知信息量;小字等低能量结构可能极为重要。本文单图 DCT 只展示能量集中性,真实 VAE 必须另做重建与感知评估。 「0.18215 是个可以随便调的超参。」 它是 $1/\sigma_z$,是潜空间统计量的倒数。错 2 倍等于在本文参考 t=500 处映射到约早 207 步的等效 SNR(3.4 节实测),调度表两头本来分工明确的步数预算全被挪用。换 VAE 必须连它一起换,不存在「微调一下」。 「交叉注意力很贵,所以推理慢。」 实测它只占单步 MAC 的 4.00%(64×64 潜特征),分辨率越高占比越低。真正贵的是 self-attention(21.6%)和卷积(52.1%)。把推理优化火力对准 cross-attention 大方向就错了。 「SD 的 UNet 只需按通道翻倍估一下。」 跨层 skip、Transformer 外层投影、不同 attention 配置都会影响账本。尤其 SD1.x 配置中的 attention_head_dim=8 是历史头数命名,不能据此算成 40 个头。 09. 动手验证 两份脚本都在附录,unet_ledger.py 仅用标准库,latent_lab.py 需要 numpy 与 Pillow,并需要通过 --image 提供图片或在仓库中使用默认样例(不需要 torch): python unet_ledger.py --sweep python latent_lab.py 我实跑的关键输出,你可以对: unet_ledger.py 潜空间 params = 859,520,964(官方 859,522,604,差 1,640(约 -0.00019%)) 潜空间单步 MAC = 4.0164e+11;像素空间 = 2.7256e+14,678.6 倍 只看卷积部分 = 64.0 倍(正好是 f^2) cross-attn 占比:64x64 4.00% -> 256x256 1.11% 分辨率扫描加速比:256px 234.3x,512px 678.6x,1024px 1754.7x latent_lab.py f=8, C=4:PSNR 22.06 dB,保留能量 94.9081% 能量最大的 1% 系数(2 个)携带 91.01% 的总能量 8 个通道 std 相差 14.98 倍;alpha_bar=0.1 时 top1 通道占 51.28% 的 loss scale 错 2 倍 -> 等效时间步偏移 -207.3 步 cross-attn 输出的秩 = 77(self-attn 对照 = 320) padding 组在内容优势为 0 时抢走 84.38% 的注意力质量 两个练习:把 --image 换成自己的图,比较 DCT 能量集中度与重建质量;把 NUM_HEADS 从 8 改为 4,在通道宽度不变时,注意力矩阵存储减半,而 QK/AV 的总 MAC 基本不变。该配置实验演示公式,不代表修改预训练模型后可直接使用。 10. 延伸阅读 按知识树的依赖链走: DDPM 训练目标与采样流程:本文 3.3 节那行目标的完整推导。 VAE 结构与 0.18215:VAE 一侧的全部细节,包括那个数字的来历。 分类器无关引导 CFG 的代价与调法:cross-attention 这条条件通路在采样时怎么被外推。 从 DDIM 到高阶采样器:潜空间里怎么把 1000 步压到 20 步。 FlashAttention 为什么不需要存下注意力矩阵:图 1b 那根红柱子怎么消掉。 已发布相邻节点:DiT(Transformer 生成骨干,具体条件方式依模型而异)、流匹配(另一种连续生成路径)。VQ-VAE 与 VQGAN 的专题仍待补齐。 附录:完整代码 09 节用到的脚本全文如下(unet_ledger.py、latent_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 unet_ledger.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """SD 系 UNet 的算力 / 显存账本:像素空间 vs 潜空间。 这个脚本不跑真正的卷积(环境里没有 torch),而是按 SD 1.5 UNet2DConditionModel 的公开配置把每一层的形状、参数量、MAC 数、需要保存的 激活字节数逐一累加出来。数字是静态算子账本,不是实测显存或延迟;激活量不含优化器、内核临时区,且不模拟张量生命周期。 记账模型的可靠性用一件事来校准:参数量。官方 SD 1.5 的 UNet 是 859,522,604 个参数,下面 build_unet(64, 64, 4, 4) 打出来的 params 应该 落在它附近。参数量逐项对齐后仍需区分静态账本与实测峰值。 用法: python unet_ledger.py # 潜空间 vs 像素空间的主对比 python unet_ledger.py --sweep # 分辨率扫描(看缩放指数) """ from __future__ import annotations import argparse import math # ── 记账口径 ────────────────────────────────────────────────────────────── BYTES_PER_ELEM = 2 # 激活按 bf16/fp16 记,训练时主干激活就是这个精度 # ── SD 1.5 UNet2DConditionModel 的公开配置(v1-5/config.json)───────────── BASE_CH = 320 CH_MULT = (1, 2, 4, 4) LAYERS_PER_BLOCK = 2 # 每个分辨率上的 ResNet 个数(下采样路径) DOWN_ATTN_LEVELS = (0, 1, 2) # 下采样路径里带 self+cross attention 的层 UP_ATTN_LEVELS = (0, 1, 2) # 上采样路径里带 attention 的层 TEMB_CH = 1280 # timestep embedding 的宽度 CTX_DIM = 768 # 文本编码器(CLIP ViT-L)的隐藏维 NUM_HEADS = 8 # SD1.x 历史配置 attention_head_dim 实际指定头数 N_LEVELS = len(CH_MULT) def fmt_bytes(b: float) -> str: """字节数转人类可读字符串。""" for unit in ("B", "KB", "MB", "GB", "TB", "PB"): if abs(b) < 1024.0: return "%.2f %s" % (b, unit) b /= 1024.0 return "%.2f PB" % b def fmt_sci(x: float) -> str: return "%.4e" % x class Ledger: """逐层累加 MAC / 参数 / 激活字节。""" def __init__(self, name: str, bytes_per_elem: int = BYTES_PER_ELEM): self.name = name self.bpe = bytes_per_elem self.macs = 0.0 self.params = 0.0 self.act = 0.0 # 需要为反向传播保存的激活字节 self.attn_matrix = 0.0 # 注意力矩阵单独统计(它是最容易爆的那一项) self.kinds = {"conv": 0.0, "self_attn": 0.0, "cross_attn": 0.0, "ffn": 0.0, "proj": 0.0} # ── 基本算子 ────────────────────────────────────────────────────── def conv2d(self, k, cin, cout, h, w, kind="conv", save=True): macs = k * k * cin * cout * h * w self.macs += macs self.params += k * k * cin * cout + cout self.kinds[kind] += macs if save: self.act += h * w * cout * self.bpe return macs def linear(self, n_tok, cin, cout, kind="proj", save=True, bias=True): macs = n_tok * cin * cout self.macs += macs self.params += cin * cout + (cout if bias else 0) self.kinds[kind] += macs if save: self.act += n_tok * cout * self.bpe return macs def geglu(self, n_tok, ch): """diffusers 的 GEGLU:Linear(ch, 8*ch) -> GELU -> 逐元素乘 -> Linear(4*ch, ch)。""" m = self.linear(n_tok, ch, 8 * ch, kind="ffn") m += self.linear(n_tok, 4 * ch, ch, kind="ffn") return m def group_norm(self, n_tok, ch): self.params += 2 * ch self.act += n_tok * ch * self.bpe def attention_scores(self, n_q, n_kv, ch, kind): """Q K^T 与 A V 两次矩阵乘,外加注意力矩阵本身的显存。""" heads = NUM_HEADS macs = 2.0 * n_q * n_kv * ch # d_head * n_heads == ch self.macs += macs self.kinds[kind] += macs # 注意力矩阵是 [heads, n_q, n_kv] self.attn_matrix += n_q * n_kv * heads * self.bpe self.act += n_q * n_kv * heads * self.bpe return macs # ── 复合模块 ────────────────────────────────────────────────────── def resnet(self, res, cin, cout): """ResnetBlock2D:GroupNorm-Conv-GroupNorm-Conv + timestep 注入 + shortcut。""" n = res * res self.group_norm(n, cin) self.conv2d(3, cin, cout, res, res) self.group_norm(n, cout) self.conv2d(3, cout, cout, res, res) # timestep embedding 的投影:对每个样本做一次 [1280] -> [cout] self.linear(1, TEMB_CH, cout, kind="proj", save=True) if cin != cout: self.conv2d(1, cin, cout, res, res) # conv_shortcut self.act += n * cout * self.bpe # 残差输出要给上采样路径留着 def transformer_block(self, res, ch, ctx_len): """BasicTransformerBlock:self-attn -> cross-attn -> FFN。""" n = res * res heads = NUM_HEADS # Transformer2DModel 的外层归一化和输入投影 self.group_norm(n, ch) self.conv2d(1, ch, ch, res, res, kind="proj") # (1) self-attention self.group_norm(n, ch) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.linear(n, ch, ch, kind="self_attn", bias=False) self.attention_scores(n, n, ch, "self_attn") self.linear(n, ch, ch, kind="self_attn") self.act += n * ch * self.bpe # (2) cross-attention:Q 来自图像 token,K/V 来自文本 token self.group_norm(n, ch) self.linear(n, ch, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.linear(ctx_len, CTX_DIM, ch, kind="cross_attn", bias=False) self.attention_scores(n, ctx_len, ch, "cross_attn") self.linear(n, ch, ch, kind="cross_attn") self.act += n * ch * self.bpe # (3) FFN self.group_norm(n, ch) self.geglu(n, ch) self.act += n * ch * self.bpe self.conv2d(1, ch, ch, res, res, kind="proj") return heads def build_unet(h, w, in_ch, out_ch, ctx_len=77, name="unet", down_attn=DOWN_ATTN_LEVELS, up_attn=UP_ATTN_LEVELS): """按 SD 1.5 的拓扑跑一遍记账。 h, w : 输入特征图的空间尺寸(潜空间是 64x64,像素空间是 512x512) in_ch : 输入通道(潜空间 4,像素空间 3) out_ch : 输出通道(同上) ctx_len : 文本 token 数(CLIP 固定 77) down_attn/up_attn : 哪些层级带 attention。默认是 SD 的配置; 像素空间可以用 deep 变体把 attention 只留在最深层。 """ if h != w or h % 8 != 0: raise ValueError("本账本仅支持边长为8的倍数的正方形输入") L = Ledger(name) chs = [BASE_CH * m for m in CH_MULT] # timestep 的 MLP:sinusoidal -> Linear(320, 1280) -> Linear(1280, 1280) L.linear(1, BASE_CH, TEMB_CH, save=True) L.linear(1, TEMB_CH, TEMB_CH, save=True) # conv_in res = h L.conv2d(3, in_ch, chs[0], res, res) # ── 下采样路径 ─────────────────────────────────────────────────── skips = [(res, chs[0])] # conv_in 输出也是 skip current_ch = chs[0] for lv in range(N_LEVELS): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK): L.resnet(res, current_ch, cout) current_ch = cout if lv in down_attn: L.transformer_block(res, cout, ctx_len) skips.append((res, cout)) if lv < N_LEVELS - 1: res //= 2 L.conv2d(3, cout, cout, res, res) skips.append((res, cout)) # ── 中段:ResNet -> Transformer -> ResNet ───────────────────────── mid_ch = chs[-1] L.resnet(res, mid_ch, mid_ch) L.transformer_block(res, mid_ch, ctx_len) L.resnet(res, mid_ch, mid_ch) # ── 上采样路径 ─────────────────────────────────────────────────── current_ch = mid_ch for lv in reversed(range(N_LEVELS)): cout = chs[lv] for _ in range(LAYERS_PER_BLOCK + 1): skip_res, skip_ch = skips.pop() assert skip_res == res L.resnet(res, current_ch + skip_ch, cout) current_ch = cout if lv in up_attn: L.transformer_block(res, cout, ctx_len) if lv > 0: res *= 2 L.conv2d(3, cout, cout, res, res) assert not skips # conv_out L.group_norm(res * res, chs[0]) L.conv2d(3, chs[0], out_ch, res, res) return L def report(L: Ledger, note=""): tot = L.macs print(" %-22s params=%s MAC=%s 激活=%s 其中注意力矩阵=%s" % (L.name + note, "{:,}".format(int(L.params)), fmt_sci(L.macs), fmt_bytes(L.act), fmt_bytes(L.attn_matrix))) if tot > 0: parts = " ".join("%s %.1f%%" % (k, 100.0 * v / tot) for k, v in L.kinds.items() if v > 0) print(" MAC 构成: " + parts) def main(): ap = argparse.ArgumentParser() ap.add_argument("--sweep", action="store_true", help="跑分辨率扫描") args = ap.parse_args() print("=" * 78) print("SD 1.5 UNet 记账(激活按 %d 字节/元素,文本 token 数 77)" % BYTES_PER_ELEM) print("=" * 78) # ── 主对比 ─────────────────────────────────────────────────────── lat = build_unet(64, 64, 4, 4, ctx_len=77, name="latent-64x64x4") pix = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-512x512x3") # 公平版:像素空间也不在最高分辨率上放 attention(ADM 的做法) pixd = build_unet(512, 512, 3, 3, ctx_len=77, name="pixel-deep-attn", down_attn=(3,), up_attn=(3,)) print("\n[1] 潜空间 vs 像素空间(同一次前向,batch=1)") report(lat, "") report(pix, "") report(pixd, "") print("\n 参数量对拍:官方 SD 1.5 UNet = 859,522,604;本模型 = %s" % "{:,}".format(int(lat.params))) print(" 相对误差 %.2f%%" % (100.0 * (lat.params - 859522604) / 859522604)) print("\n 比值(像素 / 潜):") print(" 总 MAC %.1fx 只看卷积部分 %.1fx" % (pix.macs / lat.macs, pix.kinds["conv"] / lat.kinds["conv"])) print(" 公平版总MAC %.1fx 只看卷积部分 %.1fx" % (pixd.macs / lat.macs, pixd.kinds["conv"] / lat.kinds["conv"])) print(" 激活 %.1fx 注意力矩阵 %.1fx" % (pix.act / lat.act, pix.attn_matrix / lat.attn_matrix)) print(" 像素空间 512x512 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(512 * 512 * 512 * 512 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 64x64 上单个 self-attn 层的注意力矩阵 = %s(8 头)" % fmt_bytes(64 * 64 * 64 * 64 * NUM_HEADS * BYTES_PER_ELEM)) print(" 潜空间 UNet 朴素实现注意力矩阵逐层累计(非峰值) = %s" % fmt_bytes(lat.attn_matrix)) # ── 交叉注意力的占比 ───────────────────────────────────────────── print("\n[2] 交叉注意力在不同分辨率下的占比(潜空间 UNet,ctx=77)") print(" %-10s %-14s %-12s %-12s" % ("latent", "总 MAC", "cross MAC", "占比")) for r in (32, 64, 96, 128, 192, 256): L = build_unet(r, r, 4, 4, ctx_len=77, name="r%d" % r) cr = L.kinds["cross_attn"] print(" %-10s %-14s %-12s %-12s" % ("%dx%d" % (r, r), fmt_sci(L.macs), fmt_sci(cr), "%.2f%%" % (100.0 * cr / L.macs))) if not args.sweep: return # ── 分辨率扫描:看缩放指数 ─────────────────────────────────────── print("\n[3] 分辨率扫描:图像边长 -> 潜空间边长(f=8)") print(" %-10s %-16s %-16s %-10s %-12s" % ("图像", "像素空间 MAC", "潜空间 MAC", "加速比", "潜空间激活")) rows = [] for side in (256, 384, 512, 768, 1024, 2048): lp = build_unet(side // 8, side // 8, 4, 4, ctx_len=77, name="lp") px = build_unet(side, side, 3, 3, ctx_len=77, name="px") rows.append((side, px.macs, lp.macs, px.macs / lp.macs, lp.act)) print(" %-10s %-16s %-16s %-10s %-12s" % ("%d px" % side, fmt_sci(px.macs), fmt_sci(lp.macs), "%.1fx" % (px.macs / lp.macs), fmt_bytes(lp.act))) # 拟合 log-log 斜率 = 缩放指数 xs = [math.log(r[0]) for r in rows] for idx, tag in ((1, "像素空间"), (2, "潜空间")): ys = [math.log(r[idx]) for r in rows] n = len(xs) mx = sum(xs) / n my = sum(ys) / n sl = sum((a - mx) * (b - my) for a, b in zip(xs, ys)) / \ sum((a - mx) ** 2 for a in xs) print(" %s 的缩放指数 ~ 边长^%.3f" % (tag, sl)) if __name__ == "__main__": main() latent_lab.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """潜空间到底丢了多少东西:块正交变换替身 + 通道尺度 + 交叉注意力。 环境里没有 torch、也没有真实 VAE 权重,所以这里用一个**线性正交编码器** 当 VAE 的替身:把图像切成 f x f x 3 的块,做三维可分离 DCT,只保留能量最大的 C 个系数。它和选定 VAE 的张量尺寸对应——潜特征形状就是 (H/f, W/f, C), 压缩率就是 3*f*f / C。差别在于真实 VAE 是非线性、端到端训练的,重建表现须运行具体权重比较。 用它做替身的好处是:**压缩率这一个变量被单独隔离出来了**。 三件事: A. 压缩率 vs 重建质量 vs 能量集中度 B. 潜特征各通道的方差跨度,以及 scale factor 为什么要存在 C. 交叉注意力:形状、秩瓶颈、padding token 抢走的注意力质量 用法: python latent_lab.py python latent_lab.py --image /path/to/xxx.jpg --size 512 """ from __future__ import annotations import argparse import math import os import numpy as np from PIL import Image SEED = 20260929 HERE = os.path.dirname(os.path.abspath(__file__)) def _find_image() -> str: """向上找 asserts/AIGC.jpg,找不到就退回 outputs/../asserts。""" cur = HERE for _ in range(8): cand = os.path.join(cur, "asserts", "AIGC.jpg") if os.path.exists(cand): return cand cur = os.path.dirname(cur) return os.path.normpath(os.path.join(HERE, "..", "..", "..", "..", "asserts", "AIGC.jpg")) DEFAULT_IMAGE = _find_image() # ───────────────────────────────────────────────────────────────────────── # 基础工具 # ───────────────────────────────────────────────────────────────────────── def dct_matrix(n: int) -> np.ndarray: """正交归一的 DCT-II 矩阵(第 k 行是第 k 个基)。""" k = np.arange(n).reshape(n, 1) i = np.arange(n).reshape(1, n) M = np.cos(math.pi * (i + 0.5) * k / n) M[0] *= math.sqrt(1.0 / n) M[1:] *= math.sqrt(2.0 / n) return M def block_basis(f: int) -> np.ndarray: """f x f x 3 块的可分离正交基,形状 [3*f*f, 3*f*f]。 展平顺序是 (channel, row, col),所以基矩阵是 D_c ⊗ D_row ⊗ D_col。 """ dc = dct_matrix(3) df = dct_matrix(f) return np.kron(dc, np.kron(df, df)) def load_image(path: str, size: int) -> np.ndarray: """读图 -> 居中裁剪成正方形 -> resize -> 归一化到 [-1, 1]。""" im = Image.open(path).convert("RGB") w, h = im.size s = min(w, h) im = im.crop(((w - s) // 2, (h - s) // 2, (w - s) // 2 + s, (h - s) // 2 + s)) im = im.resize((size, size), Image.LANCZOS) a = np.asarray(im, dtype=np.float64) / 127.5 - 1.0 return a def to_blocks(img: np.ndarray, f: int) -> np.ndarray: """[H, W, 3] -> [Nb, 3*f*f],Nb = (H/f)*(W/f)。""" h, w, c = img.shape x = img.reshape(h // f, f, w // f, f, c) x = x.transpose(0, 2, 4, 1, 3) # [H/f, W/f, c, f, f] return x.reshape(-1, c * f * f) def from_blocks(patches: np.ndarray, h: int, w: int, f: int, c: int = 3) -> np.ndarray: x = patches.reshape(h // f, w // f, c, f, f) x = x.transpose(0, 3, 1, 4, 2) # [H/f, f, W/f, f, c] return x.reshape(h, w, c) def psnr(a: np.ndarray, b: np.ndarray) -> float: """a, b 都在 [-1, 1],峰值是 1,所以满量程平方是 4。""" mse = float(np.mean((a - b) ** 2)) return 10.0 * math.log10(4.0 / mse) # ───────────────────────────────────────────────────────────────────────── # A. 压缩率 vs 重建 vs 能量 # ───────────────────────────────────────────────────────────────────────── def encode_decode(img: np.ndarray, f: int, c_keep: int): """保留能量最大的 c_keep 个系数,返回 (潜特征, 重建图, 能量占比)。""" h, w, _ = img.shape patches = to_blocks(img, f) b = block_basis(f) coef = patches @ b.T # [Nb, 3*f*f] energy = np.mean(coef ** 2, axis=0) # 每个基函数的平均能量 order = np.argsort(energy)[::-1] keep = np.sort(order[:c_keep]) latent = coef[:, keep].reshape(h // f, w // f, c_keep) rec = (coef[:, keep] @ b[keep, :]) rec = from_blocks(rec, h, w, f) frac = float(energy[keep].sum() / energy.sum()) return latent, np.clip(rec, -1.0, 1.0), frac def part_a(img: np.ndarray): print("\n[A] 压缩率 vs 重建质量(512x512 真实照片,线性正交编码器替身)") print(" %-6s %-5s %-16s %-9s %-9s %-9s" % ("f", "C", "潜特征形状", "压缩率", "PSNR dB", "保留能量")) out = [] for f in (2, 4, 8, 16): for c_keep in (3, 4, 8, 16): if c_keep > 3 * f * f: continue lat, rec, frac = encode_decode(img, f, c_keep) ratio = (3.0 * f * f) / c_keep p = psnr(img, rec) out.append((f, c_keep, ratio, p, frac)) print(" %-6d %-5d %-16s %-9s %-9s %-9s" % (f, c_keep, "%dx%dx%d" % lat.shape, "%.1fx" % ratio, "%.2f" % p, "%.4f%%" % (100 * frac))) return out def sweep_c(img: np.ndarray, f: int = 8): print("\n[A2] 固定 f=%d,扫 C(SD 用的是 C=4)" % f) print(" %-5s %-9s %-9s %-9s" % ("C", "压缩率", "PSNR dB", "保留能量")) rows = [] for c_keep in (1, 2, 3, 4, 6, 8, 12, 16, 24, 32, 48, 64, 96, 128): if c_keep > 3 * f * f: continue _, rec, frac = encode_decode(img, f, c_keep) rows.append((c_keep, (3.0 * f * f) / c_keep, psnr(img, rec), frac)) print(" %-5d %-9s %-9s %-9s" % (c_keep, "%.1fx" % ((3.0 * f * f) / c_keep), "%.2f" % psnr(img, rec), "%.4f%%" % (100 * frac))) return rows # ───────────────────────────────────────────────────────────────────────── # B. 通道方差跨度与 scale factor # ───────────────────────────────────────────────────────────────────────── def cosine_abar(t: np.ndarray, big_t: int = 1000, s: float = 0.008) -> np.ndarray: """Improved DDPM 的 cosine alpha_bar 调度。""" x = (t / big_t + s) / (1.0 + s) return np.cos(x * math.pi / 2.0) ** 2 def part_b(img: np.ndarray, f: int = 8, c_keep: int = 8): print("\n[B] 潜特征各通道的方差跨度(f=%d, C=%d)" % (f, c_keep)) lat, _, _ = encode_decode(img, f, c_keep) sig = lat.reshape(-1, c_keep).std(axis=0) order = np.argsort(sig)[::-1] print(" 各通道 std(从大到小): " + ", ".join("%.4f" % v for v in sig[order])) print(" 最大 / 最小 = %.2f 倍" % (sig.max() / sig.min())) gstd = float(np.sqrt(np.mean(sig ** 2))) print(" 通道方差均值的平方根 = %.4f,它的倒数(SD 的 scale factor 类比)= %.4f" % (gstd, 1.0 / gstd)) # 未缩放时,epsilon 预测的最优残差 MSE 逐通道 = a*sigma^2 / (a*sigma^2 + 1-a) print("\n [B1] 各通道对训练 loss 的贡献(最优线性-高斯去噪器的残差)") print(" %-10s %-12s %-12s %-12s" % ("alpha_bar", "未缩放 top1 占比", "全局缩放后", "逐通道缩放后")) for abar in (0.9, 0.5, 0.1): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) sg = sig / gstd gsc = abar * sg ** 2 / (abar * sg ** 2 + 1.0 - abar) pc = np.ones_like(sig) psc = abar * pc ** 2 / (abar * pc ** 2 + 1.0 - abar) print(" %-10s %-12s %-12s %-12s" % ("%.2f" % abar, "%.2f%%" % (100 * raw.max() / raw.sum()), "%.2f%%" % (100 * gsc.max() / gsc.sum()), "%.2f%%" % (100 * psc.max() / psc.sum()))) # [B2] scale factor 用错会怎样:等效时间步偏移 print("\n [B2] scale factor 用错 k 倍时,等效时间步偏移多少(cosine 调度,T=1000)") ts = np.arange(1, 1001, dtype=np.float64) ab = cosine_abar(ts) snr = ab / (1.0 - ab) # 单调递减 print(" %-10s %-16s %-16s %-12s" % ("k", "参考 t=500", "等效 t'", "偏移")) rows = [] for k in (0.25, 0.5, 1.0, 2.0, 4.0): # k 倍缩放 -> 潜特征整体方差变 k^2 倍 -> 有效信噪比变 k^2 倍 target = (k ** 2) * snr[499] tp = float(np.interp(-target, -snr, ts)) # -snr 单调递增,可以插值 rows.append((k, tp, tp - 500.0)) print(" %-10s %-16s %-16s %-12s" % ("%.2fx" % k, "500", "%.1f" % tp, "%+.1f 步" % (tp - 500.0))) return sig, gstd, rows # ───────────────────────────────────────────────────────────────────────── # C. 交叉注意力 # ───────────────────────────────────────────────────────────────────────── def softmax(x: np.ndarray, axis=-1) -> np.ndarray: e = np.exp(x - x.max(axis=axis, keepdims=True)) return e / e.sum(axis=axis, keepdims=True) def part_c(rng: np.random.Generator, d: int = 320, side: int = 64, ctx_len: int = 77, n_content: int = 8): print("\n[C] 交叉注意力:形状、秩瓶颈、padding 抢走的质量") n_img = side * side # Q 来自图像 token,K/V 来自文本 token q = rng.standard_normal((n_img, d)) / math.sqrt(d) k_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) v_txt = rng.standard_normal((ctx_len, d)) / math.sqrt(d) scale = 1.0 / math.sqrt(d) a = softmax((q @ k_txt.T) * scale, axis=-1) out = a @ v_txt print(" Q [%d, %d] x K^T [%d, %d] -> 注意力 [%d, %d] -> 输出 [%d, %d]" % (q.shape[0], q.shape[1], k_txt.shape[1], k_txt.shape[0], a.shape[0], a.shape[1], out.shape[0], out.shape[1])) print(" 注意力矩阵固定为 %d 行(文本 token 数),与图像分辨率无关" % ctx_len) # 秩瓶颈:输出一定落在 v_txt 张成的子空间里 sv = np.linalg.svd(out, compute_uv=False) rank = int(np.sum(sv > sv[0] * 1e-8)) print(" cross-attn 输出的秩 = %d(<= 文本 token 数 %d,图像 token 有 %d 个)" % (rank, ctx_len, n_img)) # 对照:self-attn 的 K/V 也来自图像 token,秩可以撑满 k_img = rng.standard_normal((n_img, d)) / math.sqrt(d) v_img = rng.standard_normal((n_img, d)) / math.sqrt(d) out_self = softmax((q @ k_img.T) * scale, axis=-1) @ v_img sv2 = np.linalg.svd(out_self, compute_uv=False) rank2 = int(np.sum(sv2 > sv2[0] * 1e-8)) print(" 对照:self-attn 输出的秩 = %d(K/V 也来自 %d 个图像 token)" % (rank2, n_img)) print(" 也就是说:条件信息注入进来时,空间上只有 %d 个自由度可用" % ctx_len) # 合成演示:设置69个相同logit位置;不模拟真实CLIP上下文化的padding特征 print("\n [C2] padding 抢走多少注意力质量(内容 %d 个 + padding %d 个)" % (n_content, ctx_len - n_content)) print(" %-20s %-22s %-22s" % ("内容 token 分数优势", "padding 组质量占比", "内容 token 质量占比")) rows = [] n_pad = ctx_len - n_content n_query = 40000 for delta in (0.0, 1.0, 2.0, 3.0, 5.0, 8.0): # 此处人为设相同 logit,真实 CLIP 特征受位置和上下文影响; # 内容 token 的 logit 建模为 padding 基准 + delta + N(0,1) 的波动 s_c = delta + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) pad_share = float(w[:, n_content:].sum(axis=1).mean()) rows.append((delta, pad_share)) print(" %-20s %-22s %-22s" % ("+%.1f" % delta, "%.2f%%" % (100 * pad_share), "%.2f%%" % (100 * (1 - pad_share)))) return rows def main(): ap = argparse.ArgumentParser() ap.add_argument("--image", default=DEFAULT_IMAGE) ap.add_argument("--size", type=int, default=512) args = ap.parse_args() rng = np.random.default_rng(SEED) img = load_image(args.image, args.size) print("=" * 78) print("潜空间扩散实验 图像=%s 裁剪后 %dx%d 像素值域 [-1, 1]" % (os.path.basename(args.image), args.size, args.size)) print("图像本身的标准差 = %.4f" % img.std()) print("=" * 78) part_a(img) sweep_c(img, f=8) part_b(img, f=8, c_keep=8) part_c(rng) # 顺便给一张「整图 DCT 能量谱」的斜率,说明高频有多穷 print("\n[D] 自然图像的能量谱有多陡(512x512,按频率半径分桶)") b = block_basis(8) patches = to_blocks(img, 8) coef = patches @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() for frac in (0.01, 0.02, 0.05, 0.1, 0.25): n = max(1, int(round(frac * energy.size))) print(" 能量最大的 %.0f%% 系数(%d 个)携带 %.4f%% 的总能量" % (100 * frac, n, 100 * energy[order[:n]].sum() / tot)) if __name__ == "__main__": main() make_figures.py #!/usr/bin/env python3 # -*- coding: utf-8 -*- """画四张配图,数据源全部来自 unet_ledger.py / latent_lab.py 的真实输出。 改了那两个脚本之后必须重跑本脚本,否则图上的数字会和正文对不上。 用法: python make_figures.py """ from __future__ import annotations import math import os import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image from latent_lab import (block_basis, cosine_abar, encode_decode, load_image, psnr, softmax, to_blocks, DEFAULT_IMAGE) from unet_ledger import build_unet, fmt_bytes HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(HERE, "..", "figures") plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False plt.rcParams["font.size"] = 10.5 C_MAIN = "#2E5C8A" C_GREEN = "#2E8B57" C_RED = "#C0392B" C_PURPLE = "#7B4B94" C_GRAY = "#8A8A8A" C_ALT = "#D68910" def _save(fig, name): os.makedirs(FIGDIR, exist_ok=True) p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=130, bbox_inches="tight", facecolor="white") plt.close(fig) print(" %s" % name) # ───────────────────────────────────────────────────────────────────────── # 图 1:算力 / 显存账本 # ───────────────────────────────────────────────────────────────────────── def fig_ledger(): sides = [256, 384, 512, 768, 1024, 2048] lat = [build_unet(s // 8, s // 8, 4, 4, name="l%d" % s) for s in sides] pix = [build_unet(s, s, 3, 3, name="p%d" % s) for s in sides] pixd = [build_unet(s, s, 3, 3, name="d%d" % s, down_attn=(3,), up_attn=(3,)) for s in sides] fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) MAC 随分辨率的缩放(log-log) ax = axes[0] ax.plot(sides, [p.macs for p in pix], "o-", color=C_RED, lw=2.2, ms=6, label=r"像素空间 UNet(attention 位置同 SD)") ax.plot(sides, [p.macs for p in pixd], "s--", color=C_ALT, lw=2.0, ms=6, label=r"像素空间 UNet(attention 只放最深层)") ax.plot(sides, [l.macs for l in lat], "^-", color=C_MAIN, lw=2.2, ms=6, label=r"潜空间 UNet($f$=8)") ax.set_yscale("log") ax.set_xscale("log") ax.set_xticks(sides) ax.set_xticklabels([str(s) for s in sides]) ax.xaxis.set_minor_formatter(plt.NullFormatter()) ax.set_xlabel("输出图像边长(像素)") ax.set_ylabel(r"单步前向的乘加次数(MAC)") def _slope(vals): lx = [math.log(s) for s in sides] ly = [math.log(v) for v in vals] n = len(lx) mx, my = sum(lx) / n, sum(ly) / n return (sum((a - mx) * (b - my) for a, b in zip(lx, ly)) / sum((a - mx) ** 2 for a in lx)) ax.set_title("(a) 算力:缩放指数从 %.1f 压到 %.1f" % (_slope([p.macs for p in pix]), _slope([l.macs for l in lat])), fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) # 标注 512 处的比值 i = sides.index(512) ax.annotate(r"512 px 处相差 %.0f 倍" % (pix[i].macs / lat[i].macs), xy=(512, pix[i].macs), xytext=(300, 1e16), fontsize=9, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) # (b) 激活显存账本的构成 ax = axes[1] labels = ["潜空间 64x64x4", "像素空间 512x512x3\n(attention 放最深层)", "像素空间 512x512x3\n(attention 位置同 SD)"] attn = [lat[i].attn_matrix, pixd[i].attn_matrix, pix[i].attn_matrix] rest = [lat[i].act - lat[i].attn_matrix, pixd[i].act - pixd[i].attn_matrix, pix[i].act - pix[i].attn_matrix] x = np.arange(3) ax.bar(x, attn, 0.55, color=C_RED, label=r"注意力矩阵(softmax 那张表)") ax.bar(x, rest, 0.55, bottom=attn, color=C_MAIN, label=r"其余层间激活") ax.set_yscale("log") ax.set_ylim(1e8, 2e14) ax.set_xticks(x) ax.set_xticklabels(labels, fontsize=9) ax.set_ylabel(r"朴素张量逐层累计(非实测峰值)(字节,$\log$ 刻度)") ax.set_title("(b) 静态累计:融合注意力会改变矩阵项", fontsize=11.5) for xi, a, r in zip(x, attn, rest): ax.text(xi, a + r, " %s" % fmt_bytes(a + r), ha="center", va="bottom", fontsize=9) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") fig.tight_layout() _save(fig, "fig_ledger.png") print(" 潜/像 MAC 比 %.1f;卷积部分比 %.1f" % (pix[i].macs / lat[i].macs, pix[i].kinds["conv"] / lat[i].kinds["conv"])) # ───────────────────────────────────────────────────────────────────────── # 图 2:压缩率的帕累托前沿 + 能量集中度 # ───────────────────────────────────────────────────────────────────────── def fig_compression(): img = load_image(DEFAULT_IMAGE, 512) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 压缩率 vs PSNR ax = axes[0] for f, col, mk in ((2, C_GREEN, "o"), (4, C_MAIN, "s"), (8, C_RED, "^"), (16, C_PURPLE, "D")): cs = [c for c in (3, 4, 8, 16, 32, 64) if c <= 3 * f * f] rs, ps = [], [] for c in cs: _, rec, _ = encode_decode(img, f, c) rs.append(3.0 * f * f / c) ps.append(psnr(img, rec)) ax.plot(rs, ps, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$f$=%d" % f) _, rec4, frac4 = encode_decode(img, 8, 4) ax.plot([48.0], [psnr(img, rec4)], "*", color=C_ALT, ms=20, markeredgecolor="black", markeredgewidth=0.8, label=r"DCT 替身的尺寸:$f$=8, $C$=4") ax.set_xscale("log") ax.set_xlabel(r"压缩率 $= 3 f^2 / C$(对数刻度)") ax.set_ylabel(r"重建 PSNR(dB,值域 $[-1,1]$)") ax.set_title("(a) 单图 DCT 压缩实验", fontsize=11.5) ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax.annotate(r"48 倍压缩下线性重建只有 %.2f dB" % psnr(img, rec4), xy=(48.0, psnr(img, rec4)), xytext=(12, 34), fontsize=9, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) # (b) 能量集中度 ax = axes[1] b = block_basis(8) coef = to_blocks(img, 8) @ b.T energy = np.mean(coef ** 2, axis=0) order = np.argsort(energy)[::-1] tot = energy.sum() ks = np.arange(1, energy.size + 1) cum = np.cumsum(energy[order]) / tot ax.plot(100.0 * ks / energy.size, 100.0 * cum, "-", color=C_MAIN, lw=2.4) ax.axvline(100.0 * 4 / 192, color=C_RED, ls="--", lw=1.6) ax.axhline(100 * cum[3], color=C_GRAY, ls=":", lw=1.2) ax.plot([100.0 * 4 / 192], [100 * cum[3]], "o", color=C_RED, ms=8) ax.annotate(r"保留 %.2f%% 的系数" % (100.0 * 4 / 192) + "\n" + r"拿回 %.2f%% 的能量" % (100 * cum[3]), xy=(100.0 * 4 / 192, 100 * cum[3]), xytext=(14, 88), fontsize=9.5, color=C_RED, arrowprops=dict(arrowstyle="->", color=C_RED, lw=1.2)) ax.set_xlabel(r"保留的系数比例(按能量从大到小,%)") ax.set_ylabel(r"累计能量占比(%)") ax.set_title("(b) 样例图在该基底下的能量集中度", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(80, 100.2) fig.tight_layout() _save(fig, "fig_compression.png") print(" f=8,C=4: PSNR %.2f dB,保留能量 %.4f%%" % (psnr(img, rec4), 100 * frac4)) # ───────────────────────────────────────────────────────────────────────── # 图 3:通道方差跨度与 loss 份额 # ───────────────────────────────────────────────────────────────────────── def fig_latent_scale(): img = load_image(DEFAULT_IMAGE, 512) lat, _, _ = encode_decode(img, 8, 8) sig = lat.reshape(-1, 8).std(axis=0) order = np.argsort(sig)[::-1] sig = sig[order] gstd = float(np.sqrt(np.mean(sig ** 2))) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 各通道 std ax = axes[0] x = np.arange(8) ax.bar(x, sig, 0.6, color=C_MAIN) ax.axhline(gstd, color=C_ALT, ls="--", lw=1.8, label=r"通道方差 RMS 尺度 $=%.4f$,其倒数 $=%.4f$" % (gstd, 1.0 / gstd)) ax.set_yscale("log") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_ylabel(r"该通道在整张图上取值的标准差($\log$ 刻度)") ax.set_title("(a) 潜特征各通道的方差差 %.1f 倍" % (sig.max() / sig.min()), fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25, axis="y") # (b) loss 份额 ax = axes[1] for abar, col, mk in ((0.9, C_GREEN, "o"), (0.5, C_MAIN, "s"), (0.1, C_RED, "^")): raw = abar * sig ** 2 / (abar * sig ** 2 + 1.0 - abar) share = 100.0 * raw / raw.sum() ax.plot(x, share, "-%s" % mk, color=col, lw=2.0, ms=5, label=r"$\bar\alpha_t=%.2f$" % abar) ax.axhline(12.5, color=C_GRAY, ls="--", lw=1.5, label=r"逐通道缩放后(均摊 $=100/8$)") ax.set_xticks(x) ax.set_xticklabels([r"通道 %d" % (i + 1) for i in range(8)], fontsize=9) ax.set_xlabel("潜特征通道(按 std 从大到小排)") ax.set_ylabel(r"该通道分到的训练 loss 份额(%)") ax.set_title("(b) 梯度份额:高方差通道吃掉了大部分", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) fig.tight_layout() _save(fig, "fig_latent_scale.png") # 顺带画出 scale factor 用错的时间步偏移 ts = np.arange(1, 1001, dtype=np.float64) snr = cosine_abar(ts) / (1.0 - cosine_abar(ts)) ks = np.array([0.25, 0.5, 1.0, 2.0, 4.0]) tps = [] for k in ks: tps.append(float(np.interp(-(k ** 2) * snr[499], -snr, ts))) tps = np.array(tps) fig2, ax2 = plt.subplots(figsize=(6.6, 4.2)) ax2.plot(ks, tps, "o-", color=C_PURPLE, lw=2.2, ms=7) for k, t in zip(ks, tps): ax2.annotate(r"$t^\prime$=%.0f" % t, (k, t), textcoords="offset points", xytext=(8, -4), fontsize=9) ax2.axhline(500, color=C_GRAY, ls=":", lw=1.2) ax2.axvline(1.0, color=C_GRAY, ls=":", lw=1.2) ax2.set_xscale("log") ax2.set_xticks(list(ks)) ax2.set_xticklabels([r"%.2f$\times$" % k for k in ks]) ax2.set_xlabel(r"scale factor 用错的倍数 $k$") ax2.set_ylabel(r"等效时间步 $t^\prime$(参考 $t=500$)") ax2.set_title(r"scale factor 错 $k$ 倍,改变参考时刻的等效 SNR", fontsize=11.5) ax2.grid(alpha=0.25) fig2.tight_layout() _save(fig2, "fig_scale_shift.png") # ───────────────────────────────────────────────────────────────────────── # 图 4:交叉注意力 # ───────────────────────────────────────────────────────────────────────── def fig_cross_attn(): sides = [32, 48, 64, 96, 128, 192, 256] cross, selfa, conv = [], [], [] for s in sides: L = build_unet(s, s, 4, 4, name="c%d" % s) cross.append(100.0 * L.kinds["cross_attn"] / L.macs) selfa.append(100.0 * L.kinds["self_attn"] / L.macs) conv.append(100.0 * L.kinds["conv"] / L.macs) fig, axes = plt.subplots(1, 2, figsize=(12.4, 4.6)) # (a) 三种算子的占比随分辨率变化 ax = axes[0] ax.plot(sides, cross, "o-", color=C_GREEN, lw=2.2, ms=6, label=r"cross-attn($O(N \cdot T \cdot d)$)") ax.plot(sides, selfa, "s-", color=C_RED, lw=2.2, ms=6, label=r"self-attn($O(N^2 \cdot d)$)") ax.plot(sides, conv, "^-", color=C_MAIN, lw=2.0, ms=6, label=r"卷积($O(N \cdot k^2 c^2)$)") ax.set_xlabel(r"潜特征边长($N=$ 边长的平方个 token)") ax.set_ylabel(r"占单步 MAC 的比例(%)") ax.set_title("(a) 交叉注意力的份额随分辨率反而下降", fontsize=11.5) ax.legend(fontsize=9) ax.grid(alpha=0.25) ax.annotate(r"64x64 时只占 %.2f%%" % cross[2], xy=(64, cross[2]), xytext=(75, 8), fontsize=9.5, color=C_GREEN, arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2)) # (b) padding 抢走的注意力质量 ax = axes[1] rng = np.random.default_rng(20260929) n_content, n_pad, n_query = 8, 69, 40000 deltas = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 5.0, 6.0, 8.0]) shares = [] for d in deltas: s_c = d + rng.standard_normal((n_query, n_content)) s_p = np.zeros((n_query, 1)) logits = np.concatenate([s_c, np.repeat(s_p, n_pad, axis=1)], axis=1) w = softmax(logits, axis=-1) shares.append(100.0 * float(w[:, n_content:].sum(axis=1).mean())) shares = np.array(shares) ax.plot(deltas, shares, "o-", color=C_PURPLE, lw=2.4, ms=6) ax.axhline(50, color=C_GRAY, ls=":", lw=1.2) i5 = int(np.argmin(np.abs(deltas - 5.0))) ax.plot([deltas[i5]], [shares[i5]], "*", color=C_ALT, ms=18, markeredgecolor="black", markeredgewidth=0.8) ax.annotate(r"内容词要领先 %.1f 才把 padding 压到 %.1f%%" % (deltas[i5], shares[i5]), xy=(deltas[i5], shares[i5]), xytext=(0.6, 70), fontsize=9.5, color=C_ALT, arrowprops=dict(arrowstyle="->", color=C_ALT, lw=1.2)) ax.set_xlabel(r"内容 token 相对 padding 的 logit 优势 $\Delta$") ax.set_ylabel(r"padding 组分到的注意力质量(%)") ax.set_title(r"(b) 等 logit 位置的质量累加(合成示例)", fontsize=11.5) ax.grid(alpha=0.25) ax.set_ylim(-2, 102) fig.tight_layout() _save(fig, "fig_cross_attn.png") print(" cross-attn 占比:64x64 %.2f%% -> 256x256 %.2f%%" % (cross[2], cross[-1])) def main(): print("画配图(数据源:unet_ledger.py / latent_lab.py 的真实输出)") fig_ledger() fig_compression() fig_latent_scale() fig_cross_attn() print("输出目录:%s" % os.path.abspath(FIGDIR)) if __name__ == "__main__": main()
-
AIGC 基本功|流匹配与 Rectified Flow-FlowMatching 流匹配与 Rectified Flow 所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(ddpm)、扩散过程的前向与反向推导(diffusion_math) 关键词:流匹配、flow matching、rectified flow、速度场、直线路径、reflow、NFE 01. 为什么需要它 先给三个数字,全部来自文末附录里能直接跑的脚本。 数字一:换个回归目标,预测误差幅度系数差 100 倍,对应平方损失权重差 10000 倍。 把「干净图估计」上的误差记为 $\delta$,在 $t=0.99$(几乎纯噪声)这一时刻:如果模型输出的是噪声 $\epsilon$,loss 看到的误差是 $0.0101\,\delta$;如果输出的是速度 $v$,loss 看到的是 $1.0101\,\delta$。在固定干净图误差的比较下,速度目标给予高噪声端更大的相对权重。 这是速度参数化与噪声参数化的一个权重差异;采用何种目标还取决于路径、预条件、训练时间分布与架构,不能把所有模型选择归因为这一个系数(03 节推导,图 1 画出整条曲线)。 数字二:「直线路径」的 ODE 轨迹一点都不直。 Rectified Flow 最常被转述成"路径是直的,所以快"。实测:把二维八模高斯混合推到数据端,用附录 reflow_lab.py 的 10 万个起点、64 步 RK2(128 NFE)轨迹账本,精确场的弧长/弦长均值为 1.6499(图 2 另用 300 步 RK4 示意)——轨迹比两点连线多走了 65% 的路。训练时那条 $(1-t)x+t\epsilon$ 插值线确实是直线,但模型实际采样走的是边缘速度场的积分曲线,两者不是一回事(02 节的图 2 把这件事画出来了)。 数字三:reflow 一轮,2 步采样的误差降 11.1 倍。 用第 1 轮训好的模型把噪声推到数据端、拿得到的配对重训一轮,配对插值上的归一化回归残差 $S_{pair}$ 从 $0.6229$ 掉到 $0.0027$(约 231 倍;它不是几何曲率),NFE=2 的终点偏差从 $0.04469$ 降到 $0.00402$,已经低于方差保持路径 2 步的 $0.0105$。但高 NFE 下的终点偏差没有因此继续下降:生成质量仍受教师分布、重训误差和有限样本评估影响,06 节展开。 所以这篇文章要回答三个问题:流匹配到底在训练什么、它和 DDPM 是不是两个东西、以及"直线路径"这个卖点真实兑现了多少。 02. 最小可用理解 三句话讲完: 流匹配训练的是一个速度场,不是噪声。 采样是解一条 ODE:从噪声端 $t=1$ 出发,跟着 $v_\theta$ 走到数据端 $t=0$。训练只是回归:给定当前点 $z_t$,预测条件速度 $u_t$;在线性 Rectified Flow 路径上,它就是这一对端点的相对位移。最优解是条件期望 $E[u_t \mid z_t = z]$,而由连续性方程(03 节证),这个期望场恰好把 $p_1$ 运到 $p_0$——所以不需要知道任何密度,样本对就够。 高斯路径提供了统一描述,但不同路径不等于同一个模型。 把路径统一写成 $z_t=\alpha_t x+\sigma_t\epsilon$:DDPM 那一路取 $\alpha_t=\sqrt{\bar\alpha_t}$、$\sigma_t=\sqrt{1-\bar\alpha_t}$;Rectified Flow 取 $\alpha_t=1-t$、$\sigma_t=t$。两者可以使用相同的网络架构。三种预测目标(干净图 $x$、噪声 $\epsilon$、速度 $v$)在同一条已知路径及非退化时间内可以代数换算输出(无需重训网络);不同路径的模型不能仅换公式就变成彼此,04 节把换算残差验到 $10^{-15}$。 "直"的是训练插值线,不是采样轨迹。 在本文独立配对的平滑数据分布上,线性路径边缘场满足 $v(z,0)=-z$、$v(z,1)=z-\mu$,其中 $\mu=E[x]$。采样从 1 积分到 0,时间步为负,因此噪声端先朝数据均值走,数据端局部向外走;中间还有模式分流。实际积分轨迹可以弯曲,reflow 用模型生成的端点配对重训,是减小这种弯曲的一种办法。 这张图要看什么:在这 14 个共同起点上,左图(直线路径)出现明显回转,右图(VP 余弦路径)较平缓。灰点是 8 个数据模式,蓝圆是噪声起点,绿方是生成终点。两图使用相同的精确场计算方式和 300 步 RK4,只改变路径;其形状是本分布上的实验结果。VP 数据端速度为零,但由于数据均值不为零,噪声端速度并不为零,见 3.4 节。 03. 数学推导 3.1 高斯路径与条件速度 把常见高斯插值类扩散/流方法统一成一条路径。取数据样本 $x\sim p_{\text{data}}$、独立噪声 $\epsilon\sim N(0,I)$,令 $$z_t=\alpha_t x+\sigma_t\epsilon,\qquad t\in[0,1]$$ 约定 $t=0$ 是数据端、$t=1$ 是噪声端,即 $\alpha_0=1,\sigma_0=0$、$\alpha_1=0,\sigma_1=1$。各符号的含义:$\alpha_t$ 是数据分量的幅度,$\sigma_t$ 是噪声分量的幅度,两者是标量函数,选不同的曲线就得到不同的方法: 方法 $\alpha_t$ $\sigma_t$ 备注 VP / DDPM $\sqrt{\bar\alpha_t}$ $\sqrt{1-\bar\alpha_t}$ 满足 $\alpha_t^2+\sigma_t^2=1$,当数据协方差也为单位阵时保持单位方差;一般数据协方差仍随 t 改变 Rectified Flow $1-t$ $t$ 线性插值,中间分布方差会缩水(06 节) 对固定的一对 $(x,\epsilon)$,$z_t$ 是一条确定的曲线,它对时间的导数是 $$u_t=\dot\alpha_t x+\dot\sigma_t\epsilon$$ 每个符号:$\dot\alpha_t$、$\dot\sigma_t$ 是两条幅度曲线的导数;$u_t$ 叫条件速度——它说的是"这一对端点对应的粒子此刻在往哪走"。直线路径下 $\dot\alpha_t=-1$、$\dot\sigma_t=1$,所以 $u_t=\epsilon-x$,与 $t$ 无关:整条插值线是匀速直线。这就是"直线"的全部含义,它只说了这条以 $(x,\epsilon)$ 为参数的曲线,没说采样时走的那条。 3.2 边缘速度场:为什么样本对就够训练 采样时我们手里没有那对 $(x,\epsilon)$,只有 $z_t$。所以要用的是边缘速度场: $$v^*(z,t)=E\left[u_t \mid z_t=z\right]$$ 读法:在所有"此刻恰好经过 $z$ 的粒子对"里,平均下来往哪走。要证它是"对的场",也就是用它解 ODE 确实把 $p_1$ 运到 $p_0$。对任意光滑测试函数 $\phi$,沿条件路径求导再取期望: $$\frac{d}{dt}E\left[\phi(z_t)\right]=E\left[\nabla\phi(z_t)\cdot u_t\right]=E\left[\nabla\phi(z_t)\cdot E[u_t\mid z_t]\right]=\int \nabla\phi(z)\cdot v^*(z,t)\,p_t(z)\,dz$$ 第二步是把里层的条件期望提出来(塔性质)。最后那个积分正是连续性方程 $\partial_t p_t+\nabla\cdot(v^*p_t)=0$ 的弱形式,在速度场和密度满足适当正则性、相应 ODE 与连续性方程有唯一解的条件下,$v^*$ 生成的流在每个时刻匹配既定的 $p_t$,从 $p_1$ 走到 $p_0$。这里 $p_t$ 本身随时间变化,并不是保持某个固定分布不变。这一步就是"marginalization trick":条件场逐对可得,边缘场取个条件期望就行。 于是在线性路径下,训练目标可以完全绕开密度(一般路径把目标换成 $u_t$): $$\min_\theta\;E_{t,x,\epsilon}\left\|v_\theta(z_t,t)-(\epsilon-x)\right\|^2$$ 固定 $t$ 后,这个回归的逐点最优解恰是 $v^*(z,t)$。没有任何一项需要 $p_t$ 的表达式——这是流匹配在工程上能起飞的根本原因:它把"学分布"变成了"学一个回归"。 3.3 同一路径的三种预测输出如何换算 设 $m(z,t)=E[x\mid z_t=z]$(干净图估计)、$e(z,t)=E[\epsilon\mid z_t=z]$(噪声估计)。对 $z_t=\alpha_t x+\sigma_t\epsilon$ 两边取条件期望(条件期望是线性的,$z_t$ 在条件下是常数): $$z=\alpha_t m+\sigma_t e$$ 这是贯穿全文的恒等式,$\alpha m+\sigma e=z$。再配合速度的定义 $v=\dot\alpha_t m+\dot\sigma_t e$,两个方程、两个未知数,解出 $$m=\frac{\sigma_t v-\dot\sigma_t z}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t},\qquad e=\frac{\dot\alpha_t z-\alpha_t v}{\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t}$$ 分母 $\dot\alpha_t\sigma_t-\dot\sigma_t\alpha_t$ 是个行列式。直线路径下它恒等于 $-1$($(-1)\cdot t-1\cdot(1-t)=-1$),于是换算干净得没有任何除法: 已知 求 $m$(干净图) 求 $e$(噪声) 速度 $v$ $m=z-t\,v$ $e=z+(1-t)\,v$ 噪声 $\epsilon$ $m=(z-t\,e)/(1-t)$ — 干净图 $m$ — $e=(z-(1-t)m)/t$ 第一行值得盯一眼:从速度换算到干净图和噪声都不需要除以 $\alpha$ 或 $\sigma$,而第二、三行各有一个会趋奇的除法。这就是速度参数化在数值上更稳的那一半理由。 那为什么不能说"三种参数化完全等价"? 真值层面等价(上表),loss 层面不等价。假设模型在 $m$ 上有误差 $\delta$,把它代入三种目标的误差: $$\text{x0 目标:}\ \|\delta\|,\qquad \text{噪声目标:}\ \frac{\alpha_t}{\sigma_t}\|\delta\|,\qquad \text{速度目标:}\ \left|\dot\alpha_t-\frac{\dot\sigma_t\alpha_t}{\sigma_t}\right|\|\delta\|$$ 来历:$e=(z-\alpha_t m)/\sigma_t$ 对 $m$ 求导得 $-\alpha_t/\sigma_t$;$v=\dot\alpha_t m+\dot\sigma_t e$ 对 $m$ 求导得 $\dot\alpha_t-\dot\sigma_t\alpha_t/\sigma_t$。直线路径代入,得到三条曲线 $$\text{x0:}1,\qquad \text{噪声:}\frac{1-t}{t},\qquad \text{速度:}\frac{1}{t}$$ 这张图要看什么:横轴是时间 $t$,纵轴是对数刻度的放大倍数。$t=0.99$(接近纯噪声端)噪声参数化的曲线是 $0.0101$——在高噪声端,噪声目标对"你把干净图猜错了"几乎无感,因为 $z$ 里本来就几乎没有 $x$ 的信息;而速度目标的系数是 $1.0101$;真正取 $t\to1$ 的极限时,二者分别趋于 0 和 1。反过来在 $t\to 0$(数据端)二者对固定干净图误差的换算系数都增大,速度系数比噪声系数加法上大 1;这不等于直接 velocity 训练的目标或梯度必然发散。这里能直接推出的是高噪声端对干净图估计误差的相对损失权重不同,不能单凭它保证真实网络的梯度大小或学习效率。 3.4 直的是插值线,不是轨迹 先看端点行为。本文数据是平滑的高斯混合,数据与噪声独立;因此在数据端,$m(z,0)=z$、$e(z,0)=E[\epsilon\mid x=z]=0$;在噪声端,$m(z,1)=\mu=E[x]$、$e(z,1)=z$。这些关系来自端点的条件独立性,不能用 $(z-\alpha m)/\sigma$ 中的“分子趋零”来推断一个 $0/0$ 极限。 make_data 的 8 个分量权重与 $1+0.35\cos(\cdot)$ 成正比,并不均匀。精确加权均值为 $$\mu=(0.294464,\,-0.248024).$$ 线性路径 $\dot\alpha=-1,\dot\sigma=1$ 的端点速度是 $$v(z,0)=-z,\qquad v(z,1)=z-\mu.$$ 采样沿负时间方向积分,所以噪声端局部朝 $\mu$ 走,数据端局部沿 $z$ 向外走。中间的模式分流也会影响轨迹,端点公式本身不能决定全程弯曲程度;01 节的弧长比是实际积分测得的结果,不是由端点方向推出的普遍定理。 VP 余弦路径取 $\alpha=\cos(\pi t/2)$、$\sigma=\sin(\pi t/2)$,因此 $$v_{\rm VP}(z,0)=0,\qquad v_{\rm VP}(z,1)=-\frac{\pi}{2}\mu=(-0.462543,\,0.389595).$$ 只有数据均值为零时,这条 VP 路径的两个端点速度才都为零。本实验不满足该条件。 需要区分两个诊断量。本文脚本 straightness_of 实际计算的是原始端点配对插值上的归一化回归残差: $$S_{pair}=\frac{\int_0^1 E\|v((1-t)z_0+t z_1,t)-(z_1-z_0)\|^2dt}{E\|z_1-z_0\|^2}.$$ 当 $v=v^*$ 时,分子是条件回归的不可约误差。下式的期望同时包含均匀时间与端点配对,并且 $S_{pair}$ 用 $v^*$ 计算: $$E\|v_\theta-u\|^2=E\|v_\theta-v^*\|^2+S_{pair}E\|z_1-z_0\|^2.$$ Rectified Flow 论文沿实际 ODE 轨迹 $Z_t$ 定义的 straightness 则比较 $v(Z_t,t)$ 与 $Z_1-Z_0$。这不是在独立原始配对插值线上评估,不能直接把本文 $S_{pair}$ 当成论文的同名量。本文另用实际积分轨迹的弧长/弦长检测几何变直,两个指标应分别报告。弧长的离散计算必须是 $\sum_j\|Z_{t_{j+1}}-Z_{t_j}\|_2$,不能先分别累加坐标上的绝对位移再取范数。 path_lab.py 另取 1500 个起点、400 步 RK4(1600 NFE):线性路径的平均弧长/弦长为 1.6232,VP 为 1.2915。沿实际轨迹的速度偏差再除以平均弦长平方,得到归一化 $S_{traj}$ 分别为 1.2293、0.5317。这与原始配对插值上的 $S_{pair}$ 不同。01 节的 1.6499 来自 reflow_lab.py 的另一批 10 万个起点和 64 步 RK2;样本与积分精度不同,诊断数值也会不同。 04. 代码实现 全部代码在文末附录,五个脚本,数值实验依赖 numpy、画图另需 matplotlib:fm_oracle.py(实验台与精确场)、param_lab.py(三种参数化)、path_lab.py(路径对比与 NFE)、reflow_lab.py(reflow 两轮)、make_figures.py(配图)。实验台是一个二维八模高斯混合,噪声是 $N(0,I)$。选它的原因是:高斯混合经过任何高斯路径之后仍是高斯混合,于是 $m$、$e$、$v^*$ 全都有闭式解,不用训练也不用采样近似。 4.1 精确场:四条闭式 分量 $k$ 的中间方差是 $V_k(t)=\alpha_t^2 s_k^2+\sigma_t^2$($s_k$ 是该分量的标准差),后验责任 $r_k$ 由贝叶斯公式给出。三个量都是"责任加权的条件均值": def m(self, z, t): # E[x | z_t = z] a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None,:,:] + (a * self.data.s**2 / V)[None,:,None] * diff return (r[:,:,None] * ex).sum(1) def e(self, z, t): # E[eps | z_t = z] sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None,:,None] * diff return (r[:,:,None] * ee).sum(1) def v(self, z, t): # 边缘速度场 return self.path.dalpha(t) * self.m(z, t) + self.path.dsigma(t) * self.e(z, t) 先验两个恒等式。第一个是 3.3 节的 $\alpha m+\sigma e=z$,第二个是把 $v^*$ 用另一种方式算一遍——直线路径下 3.3 节的表给出 $v^*=(z-m)/t$: === 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)=== path t |a*m+s*e-z| |v-(da*m+ds*e)| linear 0.05 2.66e-15 0.00e+00 linear 0.95 1.78e-15 0.00e+00 cosine_vp 0.05 1.78e-15 0.00e+00 cosine_vp 0.95 1.78e-15 0.00e+00 === 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e === t=0.1 最大绝对差 = 1.332e-14 t=0.9 最大绝对差 = 1.776e-15 符号的物理含义都压到了 $10^{-15}$ 量级,说明推导和实现是同一件事。 4.2 换算表与放大倍数 把 3.3 节的换算写成代码并逐点验真值(注意残差随 $t\to 1$ 变大——那是除以 $(1-t)$ 的数值放大,不是推导错): def v_to_me(z, v, path, t): a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a # 直线路径恒等于 -1 m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e path t v->m v->e eps->m eps->v linear 0.10 1.78e-15 1.33e-15 1.78e-15 1.78e-15 linear 0.90 1.22e-15 8.88e-16 1.30e-14 1.29e-14 linear 0.99 1.78e-15 1.78e-15 2.04e-13 2.03e-13 放大倍数不靠公式背,用数值扰动直接量:给 $m$ 加一个长度固定为 $0.01$ 的随机扰动,看三种预测误差范数各被放大多少;平方损失对应这些系数的平方。实测与解析式在小数点后四位完全一致($t=0.1$ 时噪声目标 $9.0000$ 对 $9.0000$、速度目标 $10.0000$ 对 $10.0000$),整条曲线就是图 1。 4.3 路径对比:NFE-误差曲线 误差尺子值得单独说一句。常用做法是"拿一条很高步数的参考解当真值",但那条参考解自己也有截断误差。这里利用 $p_t$ 仍是高斯混合这一点,取一组 RBF 特征 $\phi_c(z)=\exp(-\|z-c\|^2/(2h^2))$,它在高斯下的期望有闭式,于是参照侧没有任何采样噪声。生成样本一侧仍有有限样本误差:一批 4000 个真实样本对精确 $p_{\text{data}}$ 的偏差是 $0.00211$,这里只把它画成参考线,既不是误差下限,也不是显著性阈值。更换随机种子后,这个参考偏差也会变化。要判断小差异是否稳定,应对方法使用共同起点并重复多个种子。有限组 RBF 特征只是分布诊断,特征偏差小不能证明两个分布相同。 NFE 统计实际速度场评估次数:Euler 每步 1 次,RK2 每步 2 次。所以 NFE=8 时分别运行 8 步 Euler 或 4 步 RK2,表中按这一预算公平比较。 === NFE-误差:直线路径 vs VP 余弦路径(同一批起点、同一批随机数)=== NFE linear/euler linear/rk2 vp/euler vp/rk2 2 0.04074 0.04113 0.01047 0.04603 4 0.01491 0.00736 0.00562 0.00318 8 0.00802 0.00202 0.00329 0.00236 16 0.00466 0.00183 0.00234 0.00194 32 0.00307 0.00184 0.00199 0.00186 256 0.00194 0.00183 0.00184 0.00183 这张图要看什么:高 NFE 时,四条线都接近同一量级的小偏差,与有限样本误差并存;这不能单独证明场正确。低 NFE 的差异依赖路径和积分器:在 Euler、NFE=8 这一点,线性路径误差是 VP 的约 2.4 倍($0.00802$ 对 $0.00329$),不是“需要 2.4 倍步数”。要比较所需步数,应先规定相同误差阈值。RK2 在 NFE=2 时只有一个积分步,误差甚至大于 Euler;较高阶也不保证每个极低预算下都更好。 数值积分误差受速度场的空间与时间变化、时间网格和积分器共同影响,不能仅用“曲线弯”或错误的“两端速度为零”解释。时间 shift 也可能改变弯曲轨迹的积分精度;这里只能报告本次测试:Euler、NFE=8 时,shift=1、3、6 的误差分别为 $0.00802$、$0.00864$、$0.01843$,这两个非均匀网格没有带来改善。 4.4 Reflow:把弯的轨迹拉直 reflow 的实现出奇地短:用第 1 轮模型从噪声端积分到数据端,得到新配对,再训一轮。 def round1_pairs(n, seed=0): rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1),独立配对 return z0, z1 def generate_pairs(model, z1, n_steps=100): sched = make_schedule(n_steps) # RK2:100 步 = 200 次场评估 z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # 新配对就是 (z0, z1) 模型是 numpy 手搓的两层 128 宽 tanh MLP。第 1 轮在 10 万条独立配对上训练(每步从数据样本池抽样并重采独立噪声),训练 loss 收敛到 $2.1853$——按样本平方范数是 $4.3706$,而估计的不可约回归误差 $S_{pair}\cdot E\|z_1-z_0\|^2\approx4.3702$(未舍入计算;两个因子分别约为 $0.6229$、$7.0162$)。loss 接近这一估计,但有限采样下略低或略高都可能发生,不能证明模型已达精确最优;在分布内查询点上它与精确场的相对均方误差是 $1.28\%$。 然后是关键的一步——量两轮的归一化配对残差和 NFE: === 归一化配对回归残差(另用弧长/弦长量轨迹)=== 第 1 轮配对 + 精确场 S_pair = 0.6229 第 1 轮配对 + 第1轮模型 S_pair = 0.6289 第 2 轮配对 + 第2轮模型 S_pair = 0.0027 弧长/弦长:精确场 1.6499 | 第1轮 1.6463 | 第2轮 1.0027 === NFE-误差(直线路径;精确场 / 第1轮模型 / 第2轮模型)=== NFE 精确场 第1轮 第2轮 2 0.04012 0.04469 0.00402 4 0.01469 0.01789 0.00401 8 0.00785 0.00927 0.00402 16 0.00427 0.00563 0.00402 64 0.00182 0.00389 0.00403 这张图要看什么:左图是三条 NFE-误差曲线,绿色(reflow 后)从 NFE=2 起就是一条平线——步数不再是瓶颈;右图分别比较配对回归残差与实际轨迹弧长/弦长:配对残差第 1 轮用精确场、第 2 轮用重训模型;弧长柱均用对应训练模型。第 2 轮的弧长/弦长 $1.0027$,轨迹已经基本就是两点连线。另外注意第 2 轮配对的弦长平方从 $7.0162$ 掉到 $1.2410$:reflow 之后噪声端和数据端被强相关地配对了,这种配对改变也体现在实际轨迹变直上;不能把较小的配对残差本身称为曲率。 05. 工业级实现对照 以 diffusers 的 FlowMatchEulerDiscreteScheduler 为例(以 2026-09 的实现为准,scheduling_flow_match_euler_discrete.py),最小实现和生产实现的差别集中在四处。 一处一行更新。 step() 的默认分支就是速度空间里的显式 Euler: dt = sigma_next - sigma prev_sample = sample + dt * model_output model_output 被直接当作速度用,不做任何转换。和 04 节最小实现的 z = z - h * v 是同一行——diffusers 用 $\sigma$(就是本文的 $t$)当时间轴,$\sigma$ 从 1 递减到 0,所以步长是负的,方向自动正确。 换算真的写在生产代码里。 随机采样分支里有这一行: x0 = sample - current_sigma * model_output 这正是 3.3 节换算表的第一格 $m=z-t\,v$。也就是说"速度预测的模型可以零成本拿到干净图估计"这件事,在 diffusers 里是一行乘法。 模型评估点与最终样本落点不同。 默认噪声表的最后非零模型评估点约为 0.001,set_timesteps 仍在末尾追加 0。最后执行 sample + (0 - sigma) * model_output,样本实际到达 0,只是不再在 0 调用网络;这也等于直线路径的 $x_0$ 估计。二维 toy 的 linspace(1,0,...) 在循环中同样先评估当前非零时刻,再积分到目标,不是高维模型禁止的做法。 时间 shift 调整有效时间分配,生产模型常根据分辨率设置它。 静态 shift 的公式是 sigmas = self.shift * sigmas / (1 + (self.shift - 1) * sigmas) 而动态 shift 按序列长度插值:base_shift=0.5 对应 256 个 token,max_shift=1.15 对应 4096 个 token,中间用指数插值 $\exp(\mu)/(\exp(\mu)+(1/t-1))$ 过渡。动机是:更高分辨率往往增加空间相关信号的冗余,使同等加噪后信息仍较易恢复,实践中据此调整训练/采样的有效噪声分配;具体 shift 应遵循模型配置。04 节只验证了这个 toy 上的几个 shift 设置:它们没有降低对应预算下的误差,不能推广成 shift 对弯曲轨迹无效。 另外 SD3 论文在训练侧还做了一件事:时间 $t$ 不用均匀分布采,用 logit-normal(众数在中间)。对照图 1 就能理解为什么——不同时间采样相当于重新分配训练权重;SD3 直接回归 velocity,不能拿噪声参数化在高噪声端的弱信号直接解释其 logit-normal 选择。 06. 代价与边界 直线路径不是免费的午餐。 在这组实验的 Euler、NFE=8 处,线性路径的误差约为 VP 余弦路径的 2.4 倍;这个误差比不等于达到同一质量所需的步数比。需要诚实标注边界:这是一个二维、数据尺度(标准差 1.56)与噪声尺度(1)不匹配的 toy,不能据此断言"VP 路径普遍更省步数";但至少说明直线插值不保证少步积分准确。实际轨迹接近直线有助于理解 reflow 的效果,积分难度仍取决于沿轨迹的速度变化与数值格式。真实模型里路径选择还和训练分布、模型容量、蒸馏方案纠缠在一起,单独归因很难。 reflow 仍受教师分布与学习误差限制。 本次第 2 轮的高 NFE 偏差约为 $0.00403$;第 1 轮模型用于训练的 10 万个生成端点偏差为 $0.00328$。二者评估样本量不同,不能据此定量断言“误差几乎全部继承自教师”。在理论条件满足、回归和积分精确的理想 reflow 中,端点边缘分布保持为教师的分布;有限模型还会增加重训和积分误差。图 4 显示的是少步曲线被压平,不能当作重训自动改善真实数据拟合的证据。 reflow 的账单。 它需要用第 1 轮模型做一次全量生成,生成量要够训第 2 轮。其成本由配对生成量、教师步数和重训步数共同决定,不能固定说成翻倍,所以工程上要么只在最后的精调阶段做,要么直接换成少步蒸馏(知识树上的 step_distillation,待写)。 $\sigma\to0$ 的数值边界。 需要避免在端点进行会除以零的参数化转换;速度场 Euler 更新自身不含该除法。最后从 $\sigma>0$ 到 0 的 Euler 步正是 $x_0=x-\sigma v$,两种说法在直线路径下是同一操作。 07. 经典论文脉络 Lipman et al., 2022(arXiv:2210.02747)Flow Matching for Generative Modeling:用 simulation-free 条件回归训练速度场,避免训练期间反复数值求解 ODE;不是从 O(1) 复杂度降到 1,提出条件路径 + marginalization trick,是"用回归训速度场"的源头。 Liu et al., 2022(arXiv:2209.03003)Rectified Flow:从线性插值回归出发构造流,并提出 reflow。在论文的理想化条件下,reflow 具有直线度和凸运输成本的相关保证;本文 4.4 节的有限样本、有限模型实验用于观察趋势,不能替代理论条件。 Albergo & Vanden-Eijnden, 2022,Building Normalizing Flows with Stochastic Interpolants:通过随机端点的插值和回归目标构造确定性概率流。 Albergo, Boffi & Vanden-Eijnden, 2023,Stochastic Interpolants: A Unifying Framework for Flows and Diffusions:进一步引入可调噪声项,建立流与扩散过程的统一框架;应与上一项区分引用。 Karras et al., 2022(arXiv:2206.00364)EDM:不谈"流",把预条件(参数化)和时间调度当成独立的自由度来调。它把输出预条件、损失权重与采样调度分开设计;本文 3.3 节涉及其中的输出换算与相对权重,不能把换算恒等式当作训练行为完全等价。 Esser et al., 2024(arXiv:2403.03206)Stable Diffusion 3:把 rectified flow 推到大规模文生图,给出 logit-normal 时间采样与分辨率相关 shift——工业界从 DDPM 切换到流匹配的标志点。 08. 常见误解 误解一:"流匹配不是扩散模型,是另一套东西。" 同一族高斯路径,DDPM 是 $\alpha=\sqrt{\bar\alpha},\sigma=\sqrt{1-\bar\alpha}$ 的一支,Rectified Flow 是 $\alpha=1-t,\sigma=t$ 的一支。可以使用相同的网络架构;同一路径上的三种预测输出可以代数互转(端点需处理退化)(04 节残差 $10^{-15}$)。真正不同的是中间分布 $p_t$ 的形状和 loss 的加权,"两个流派"的说法遮住了这些可调的自由度。 误解二:"路径是直的,所以一两步就能出图。" 直的是训练时的插值线;采样走的是边缘场的积分曲线。实测 1-rectified 的弧长/弦长是 $1.65$,NFE=2 误差 $0.04469$。要两步出图,靠的是 reflow 之后的第 2 轮($0.00402$),不是第 1 轮的"直线路径"。 误解三:"reflow 之后质量和速度都变好了。" 只对了一半。步数-精度曲线确实被压平(NFE=2 就到位),但精度仍受教师样本分布与重训误差限制:第 2 轮在本次实验中停在约 $0.00403$,教师生成端点的参考偏差为 $0.00328$。理想 reflow 保持教师端点边缘,有限训练下则需另外评估分布偏差,不能保证质量自动提高。 误解四:"velocity 预测只是把回归目标换了个写法。" 真值层面是,loss 层面不是。$t=0.99$ 处噪声目标对干净图误差的放大倍数是 $0.0101$,速度目标是 $1.0101$,幅度系数差 100 倍、平方权重差 10000 倍;这只描述固定干净图误差的相对权重,不代表高噪声端一半训练样本都无用。 误解五:"流匹配需要知道边缘密度或 score。" 3.2 节的推导全程只用了条件期望和塔性质,训练目标里没有任何一项含 $p_t$。需要密度的是评估(比如算 NLL),不是训练。 09. 动手验证 三个可以自己跑的小实验,按顺序: 恒等式链:python fm_oracle.py。应该看到 $\alpha m+\sigma e=z$ 的残差在 $10^{-15}$ 量级,$v^*$ 的两种算法差 $10^{-14}$ 以内。如果你的实现里这两个数在 $10^{-6}$ 量级,大概率是后验责任没做 log-sum-exp。 放大倍数:python param_lab.py。看解析式与数值扰动两列是否完全一致,再看 $t=0.99$ 那一行——噪声目标 $0.0101$ 对速度目标 $1.0101$。 reflow 的残差与采样曲线:python reflow_lab.py(约两分钟,纯 numpy)。确认三件事:第 1 轮逐坐标平均 loss 乘以维数 2 后,接近估计的 $S_{pair}\cdot E\|z_1-z_0\|^2$;第 2 轮弧长/弦长 $\approx 1.00$;第 2 轮 NFE 曲线近乎平坦,但仍存在相对真实数据的偏差。 想改实验设置的话:make_data 里的 radius 控制数据尺度(默认 2.2)。改变它后重新运行 path_lab.py,比较不同路径在相同实际 NFE 下的误差。半径改变会同时影响数据协方差、模式间距和路径难度;不要把某一次误差比当作固定的步数收益。 10. 延伸阅读 前置:ddpm(VP 路径与噪声预测)、diffusion_math(前向反向推导与 score)、vae_elbo(另一条"回归式"生成目标)。 相邻:ddim_samplers(同一套 ODE 视角下的高阶格式与步长调度)、cfg(流匹配模型上的引导,公式形式几乎不变)。 后继:step_distillation(少步蒸馏,reflow 的工程替代品,待写);video_rl(已发布,Flow-GRPO 在流匹配模型上做在线强化学习,直接建立在这些速度场上)。 附录:完整代码 09 节用到的脚本全文如下(reflow_lab.py、path_lab.py、fm_oracle.py、param_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 reflow_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(四):Reflow —— 用模型自己造的配对再训一轮。 Rectified Flow 最容易被转述错的一句话是「它的路径是直的」。 真的是直的,但直的是**训练时那条插值线** (1-t)x + t*eps; ODE 真正走出来的轨迹是边缘速度场 v*(z,t) = E[eps - x | z_t = z] 的积分曲线, 本例的积分轨迹会弯曲,弧长须把每一小段的欧式长度相加后再与弦长比较。 Reflow 做的事是:用第 1 轮训好的模型把噪声推到数据端,得到一批**配对** (z_1, z_0) = (起点噪声, 模型生成的终点),再拿这批配对重训一轮。 理想化 reflow 的性质有理论条件;本实验另外测量有限模型的轨迹长度比和采样误差。 这一份用 numpy 手搓一个小 MLP 当"模型",分别报告配对插值上的归一化回归残差 S_pair、实际 ODE 轨迹弧长/弦长和 NFE-误差。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) C, BW = make_rbf_centers() PATH = LinearPath() # ─────────────────── 一个小 MLP(numpy 手写) ─────────────────── class MLP: def __init__(self, sizes, rng): self.W, self.b = [], [] for i in range(len(sizes) - 1): lim = np.sqrt(6.0 / (sizes[i] + sizes[i + 1])) self.W.append(rng.uniform(-lim, lim, (sizes[i], sizes[i + 1]))) self.b.append(np.zeros(sizes[i + 1])) self.m = [np.zeros_like(w) for w in self.W] self.v = [np.zeros_like(w) for w in self.W] self.mb = [np.zeros_like(x) for x in self.b] self.vb = [np.zeros_like(x) for x in self.b] def forward(self, X): A = [X] H = X for i in range(len(self.W) - 1): H = np.tanh(H @ self.W[i] + self.b[i]) A.append(H) A.append(H @ self.W[-1] + self.b[-1]) return A[-1], A def step(self, X, Y, lr, tstep, beta1=0.9, beta2=0.999, eps=1e-8): pred, A = self.forward(X) g = 2.0 * (pred - Y) / pred.size for i in range(len(self.W) - 1, -1, -1): gW = A[i].T @ g gb = g.sum(0) self.m[i] = beta1 * self.m[i] + (1 - beta1) * gW self.v[i] = beta2 * self.v[i] + (1 - beta2) * (gW * gW) self.mb[i] = beta1 * self.mb[i] + (1 - beta1) * gb self.vb[i] = beta2 * self.vb[i] + (1 - beta2) * (gb * gb) mh = self.m[i] / (1 - beta1 ** tstep) vh = self.v[i] / (1 - beta2 ** tstep) # 先用本次前向的旧权重传播梯度,再更新参数。 g_prev = (g @ self.W[i].T) * (1 - A[i] ** 2) if i > 0 else None self.W[i] -= lr * mh / (np.sqrt(vh) + eps) bmh = self.mb[i] / (1 - beta1 ** tstep) bvh = self.vb[i] / (1 - beta2 ** tstep) self.b[i] -= lr * bmh / (np.sqrt(bvh) + eps) if i > 0: g = g_prev return float(((pred - Y) ** 2).mean()) def __call__(self, z, t): tt = np.full((z.shape[0], 1), float(t)) return self.forward(np.concatenate([z, tt], axis=1))[0] def train(pairs_z0, pairs_z1, n_step=4000, batch=512, lr=3e-3, seed=0, fresh=False): """在给定配对上训练速度场:目标 u = z_1 - z_0,z_t = (1-t) z_0 + t z_1。 fresh=True 时每一步现采一批新配对(第 1 轮的配对可以无限造), 避免模型把 2 万条配对背下来——背下来会让 loss 掉到"条件方差"以下, 看起来很美,其实场是有偏的。 """ rng = base_rng(seed) net = MLP([D + 1, 128, 128, D], np.random.default_rng(seed + 1)) n = pairs_z0.shape[0] losses = [] for s in range(1, n_step + 1): if fresh: idx = rng.integers(0, n, batch) z1 = rng.standard_normal((batch, D)) z0 = pairs_z0[idx] # 数据端样本池足够大,随机抽即视为新样本 else: idx = rng.integers(0, n, batch) z0 = pairs_z0[idx] z1 = pairs_z1[idx] t = rng.uniform(0.0, 1.0, (batch, 1)) zt = (1 - t) * z0 + t * z1 u = z1 - z0 X = np.concatenate([zt, t], axis=1) cur_lr = lr * (0.3 ** (s / n_step)) # 余弦退火换成简单指数退火 l = net.step(X, u, cur_lr, s) losses.append(l) return net, float(np.mean(losses[-200:])) # ─────────────────── 两轮的配对 ─────────────────── def round1_pairs(n, seed=0): """第 1 轮:数据与噪声独立配对(这就是 Rectified Flow 原始的训练配对)。""" rng = base_rng(seed) data = make_data() z0 = data.sample(n, rng) # 数据端(t=0) z1 = rng.standard_normal((n, D)) # 噪声端(t=1) return z0, z1 def generate_pairs(model, z1, n_steps=100): """用 RK2 的 n_steps 个积分步生成配对,实际场评估次数为 2*n_steps。""" sched = make_schedule(n_steps) z0, _ = integrate(lambda z, t: model(z, t), z1, sched, "rk2") return z0 # ─────────────────── 评价指标 ─────────────────── def straightness_of(pairs_z0, pairs_z1, vfun, nstep=32): """配对插值上的归一化回归残差;不是论文沿实际 ODE 轨迹定义的 straightness。""" ts = np.linspace(1.0, 0.0, nstep + 1)[:-1] dev = 0.0 for t in ts: zt = (1 - t) * pairs_z0 + t * pairs_z1 dev += float(np.mean(np.sum((vfun(zt, t) - (pairs_z1 - pairs_z0)) ** 2, axis=1))) dev /= len(ts) return dev / float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def arc_over_chord(pairs_z1, vfun, nstep=64): """真走一遍:从 z_1 出发积分到 t=0,量轨迹弧长与端点弦长之比。""" sched = make_schedule(nstep) z0, traj = integrate(vfun, pairs_z1, sched, "rk2") seg = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(0) chord = np.linalg.norm(z0 - pairs_z1, axis=1) return float(np.mean(seg / np.maximum(chord, 1e-12))), z0 def nfe_curve(pairs_z1, vfun, nfe_list, data): flow = OracleFlow(data, PATH) out = [] for nfe in nfe_list: sched = make_schedule(nfe) z0, _ = integrate(vfun, pairs_z1, sched, "euler") out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def field_error(model, flow, n=4000, seed=3): """训练出来的场与精确场差多少(相对均方)。 查询点取自真实边缘 p_t(与第 1 轮训练分布一致),并在五个时刻汇总平方误差。 """ rng = base_rng(seed) data = make_data() num = 0.0 den = 0.0 for t in (0.1, 0.3, 0.5, 0.7, 0.9): x = data.sample(n, rng) eps = rng.standard_normal((n, D)) zt = (1 - t) * x + t * eps v = flow.v(zt, t) num += float(np.mean(np.sum((model(zt, t) - v) ** 2, axis=1))) den += float(np.mean(np.sum(v ** 2, axis=1))) return num / den def chord_scale(pairs_z0, pairs_z1): """E||z_1 - z_0||^2,配对残差 S_pair 的分母。""" return float(np.mean(np.sum((pairs_z1 - pairs_z0) ** 2, axis=1))) def state(): data = make_data() flow = OracleFlow(data, PATH) z0_1, z1 = round1_pairs(100000, seed=0) net1, loss1 = train(z0_1, z1, n_step=6000, seed=0, fresh=True) z0_2 = generate_pairs(net1, z1, n_steps=100) net2, loss2 = train(z0_2, z1, n_step=6000, seed=0) nfe_list = [2, 4, 8, 16, 32, 64] eval_z1 = base_rng(999).standard_normal((4000, D)) out = { "nfe": np.array(nfe_list), "loss1": loss1, "loss2": loss2, "ferr1": field_error(net1, flow), "ferr2": field_error(net2, flow), "S1_oracle": straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)), "S1_learned": straightness_of(z0_1, z1, lambda z, t: net1(z, t)), "S2_learned": straightness_of(z0_2, z1, lambda z, t: net2(z, t)), "arc1_oracle": arc_over_chord(z1, lambda z, t: flow.v(z, t))[0], "arc1_learned": arc_over_chord(z1, lambda z, t: net1(z, t))[0], "arc2_learned": arc_over_chord(z1, lambda z, t: net2(z, t))[0], "nfe_oracle": nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data), "nfe_learned1": nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data), "nfe_learned2": nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data), } return out if __name__ == "__main__": data = make_data() flow = OracleFlow(data, PATH) print("=== 第 1 轮:独立配对上训练 ===") z0_1, z1 = round1_pairs(100000, seed=0) net1, loss1 = train(z0_1, z1, n_step=6000, seed=0, fresh=True) s1 = chord_scale(z0_1, z1) print(f" 训练 loss(末 200 步均值)= {loss1:.4f}(按样本平方范数是 {2*loss1:.4f})") s_pair_oracle = straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)) print(f" 估计的不可约回归误差 = S_pair * E||z1-z0||^2 = " f"{s_pair_oracle:.4f} * {s1:.4f} = {s_pair_oracle*s1:.4f}") print(f" 学出来的场 vs 精确场,相对均方误差(on-distribution)= {field_error(net1, flow):.4f}") print() print("=== 用第 1 轮模型生成新配对 ===") z0_2 = generate_pairs(net1, z1, n_steps=100) print(f" 生成终点与精确 p_data 的特征偏差 = {discrepancy(z0_2, 0.0, flow, C, BW):.5f}" f"(另有一组 4000 个真实样本的参考偏差约 0.00211,非误差下限)") net2, loss2 = train(z0_2, z1, n_step=6000, seed=0) s2 = chord_scale(z0_2, z1) print(f" 第 2 轮训练 loss = {loss2:.4f}(按样本平方范数是 {2*loss2:.4f})") print(f" 第 2 轮弦长平方 E||z1-z0||^2 = {s2:.4f}(第 1 轮是 {s1:.4f},配对更紧了)") print() print("=== 归一化配对残差(另用弧长/弦长量轨迹)===") print(f" 第 1 轮配对 + 精确场 S_pair = {straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)):.4f}") print(f" 第 1 轮配对 + 第1轮模型 S_pair = {straightness_of(z0_1, z1, lambda z, t: net1(z, t)):.4f}") print(f" 第 2 轮配对 + 第2轮模型 S_pair = {straightness_of(z0_2, z1, lambda z, t: net2(z, t)):.4f}") print(f" 弧长/弦长:精确场 {arc_over_chord(z1, lambda z, t: flow.v(z, t))[0]:.4f} | " f"第1轮 {arc_over_chord(z1, lambda z, t: net1(z, t))[0]:.4f} | " f"第2轮 {arc_over_chord(z1, lambda z, t: net2(z, t))[0]:.4f}") print() nfe_list = [2, 4, 8, 16, 32, 64] eval_z1 = base_rng(999).standard_normal((4000, D)) o = nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data) a = nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data) b = nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data) print("=== NFE-误差(直线路径;精确场 / 第1轮模型 / 第2轮模型)===") print(" NFE 精确场 第1轮 第2轮") for i, n in enumerate(nfe_list): print(f"{n:>5}{o[i]:>10.5f}{a[i]:>10.5f}{b[i]:>10.5f}") path_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(三):路径的选择到底值多少 NFE。 直线路径(Rectified Flow)和 VP 余弦路径(DDPM 那一路)通向**同一个**目标分布, 中间分布不同,ODE 的轨迹与时间参数化也会不同。这一份把这件事量成三条曲线: 1. NFE-误差曲线:同一批起点,比较路径和积分器;Euler/RK2/RK4 每步分别评估 1/2/4 次场。 2. 欧式弧长 / 弦长,以及沿实际 ODE 轨迹的归一化速度偏差 S_traj; 后者对 Rectified Flow 的轨迹 straightness 再除以 E||Z_1-Z_0||^2, 不等于 reflow_lab 在原始配对插值上计算的 S_pair。 3. 时间 shift(SD3/FLUX 的做法)在直线路径上到底省不省步数。 误差尺子是 fm_oracle.discrepancy:拿精确边缘 p_t 的 RBF 特征矩当参照, 参照侧没有采样噪声,生成粒子一侧仍有有限样本误差。共享起点可减轻比较方差, 小差异是否稳定仍应更换随机种子验证;单次真实样本偏差不是硬下限。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_rbf_centers, discrepancy, make_schedule, integrate, ) NPART = 4000 C, BW = make_rbf_centers() def start_particles(n, rng): """t=1 端的粒子:精确就是 N(0, I)。""" return rng.standard_normal((n, D)) def sampling_reference(data, n=NPART): """固定一次真实样本与精确 p_data 的偏差,仅作有限采样参考,不是误差下限。""" rng = base_rng(12345) x = data.sample(n, rng) flow = OracleFlow(data, LinearPath()) return discrepancy(x, 0.0, flow, C, BW) def run_sweep(path, method, nfe_list, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) out = [] calls_per_step = {"euler": 1, "rk2": 2, "rk4": 4}[method] for nfe in nfe_list: if nfe < calls_per_step or nfe % calls_per_step: raise ValueError(f"{method}: NFE must be a positive multiple of {calls_per_step}") sched = make_schedule(nfe // calls_per_step) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, method) out.append(discrepancy(z0, 0.0, flow, C, BW)) return np.array(out) def straightness(path, npart=1500, nstep=400): """细步长积分出真实轨迹,量它离弦有多远。""" rng = base_rng(777) z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) sched = make_schedule(nstep) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") # traj: [nstep+1, npart, 2],index 0 是 t=1 arc = np.linalg.norm(np.diff(traj, axis=0), axis=2).sum(axis=0) # [npart],各段欧式长度相加 chord = np.linalg.norm(z0 - z1, axis=1) ratio = float(np.mean(arc / np.maximum(chord, 1e-12))) # S_traj = mean_t ||v(z_t,t) - (z_1 - z_0)||^2 / mean ||z_1 - z_0||^2 chord_dir = (z1 - z0)[None, :, :] # [1,npart,2] ts = sched[:-1] dev = 0.0 for i, t in enumerate(ts): v = flow.v(traj[i], t) dev += float(np.mean(np.sum((v - chord_dir[0]) ** 2, axis=1))) dev /= len(ts) scale = float(np.mean(np.sum((z1 - z0) ** 2, axis=1))) return ratio, dev / scale def shift_sweep(path, nfe_list, shifts, npart=NPART): rng = base_rng() z1 = start_particles(npart, rng) flow = OracleFlow(make_data(), path) res = {} for sh in shifts: errs = [] for nfe in nfe_list: sched = make_schedule(nfe, shift=sh) z0, _ = integrate(lambda z, t: flow.v(z, t), z1, sched, "euler") errs.append(discrepancy(z0, 0.0, flow, C, BW)) res[sh] = np.array(errs) return res def state(): """给画图脚本复用:返回与上面打印完全一致的数字。""" data = make_data() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] out = { "nfe": np.array(nfe_list), "sampling_reference": sampling_reference(data), "sweep": {}, "straight": {}, "shift": {}, } for path in (LinearPath(), CosineVPPath()): for method in ("euler", "rk2"): out["sweep"][(path.name, method)] = run_sweep(path, method, nfe_list) out["straight"][path.name] = straightness(path) out["shift"] = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) out["shift_nfe"] = np.array([4, 8, 16, 32, 64]) return out if __name__ == "__main__": data = make_data() print(f"=== 单次采样参考:{NPART} 个真实样本 vs 精确 p_data 的偏差 = " f"{sampling_reference(data):.5f} ===") print("(这不是硬下限或显著性阈值;评估小差异需重复采样)") print() nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] print("=== NFE-误差:直线路径 vs VP 余弦路径 ===") print(" NFE linear/euler linear/rk2 vp/euler vp/rk2") lin_e = run_sweep(LinearPath(), "euler", nfe_list) lin_r = run_sweep(LinearPath(), "rk2", nfe_list) vp_e = run_sweep(CosineVPPath(), "euler", nfe_list) vp_r = run_sweep(CosineVPPath(), "rk2", nfe_list) for i, n in enumerate(nfe_list): print(f"{n:>5}{lin_e[i]:>14.5f}{lin_r[i]:>13.5f}{vp_e[i]:>12.5f}{vp_r[i]:>11.5f}") print() print("=== 轨迹指标(400 步 RK4,即 1600 NFE;数值近似 ODE 轨迹)===") for path in (LinearPath(), CosineVPPath()): ratio, s = straightness(path) print(f" {path.label:<28} 弧长/弦长 = {ratio:.4f} 归一化 S_traj = {s:.4f}") print() print("=== 时间 shift(仅直线路径,Euler)===") res = shift_sweep(LinearPath(), [4, 8, 16, 32, 64], [1.0, 3.0, 6.0]) print(" NFE shift=1 shift=3 shift=6") for i, n in enumerate([4, 8, 16, 32, 64]): print(f"{n:>5}{res[1.0][i]:>11.5f}{res[3.0][i]:>11.5f}{res[6.0][i]:>11.5f}") fm_oracle.py # -*- coding: utf-8 -*- """flow_matching 实验台(一):任意高斯路径下的精确速度场。 这一份是整个文章所有数字的来源。思想是: 数据分布取二维高斯混合 p_data(K 个各向同性分量),噪声取 N(0, I)。 对任意「高斯路径」 z_t = alpha_t * x + sigma_t * eps(t=1 是纯噪声,t=0 是数据), p_t 仍然是高斯混合(分量均值 alpha*mu_k,方差 alpha^2 s_k^2 + sigma^2), 于是下面四样东西全都有闭式解,不需要训练、不需要采样近似: m(z,t) = E[x | z_t = z] 去噪均值(x0 预测的真值) e(z,t) = E[eps | z_t = z] 噪声均值(epsilon 预测的真值) v(z,t) = alpha' m + sigma' e 边缘速度场(速度预测的真值) score = grad log p_t(z) 有了这些,三种参数化(x0 / eps / v)可以逐点互相换算并验到浮点误差, ODE 的 NFE-误差曲线可以用「精确边缘 p_t」当尺子,不需要跑一条高精参考解。 误差尺子:取一组 RBF 特征 phi_c(z) = exp(-||z-c||^2 / (2h^2)), 它在高斯分布下的期望有闭式,于是 disc(粒子云, t) = mean_c | (1/N) sum_i phi_c(z_i) - E_{p_t}[phi_c] | 经验侧仍有有限样本误差,解析侧不额外引入采样噪声。单次真实样本参考值既不是硬地板, 也不是统计显著性阈值;有限组 RBF 特征矩一致也不能证明两个分布完全一致。 """ import numpy as np D = 2 # 二维,画图方便;公式与代码对任意维都成立 # ─────────────────────────── 随机流 ─────────────────────────── def base_rng(seed=20260928): """所有脚本与画图共用同一条随机流,保证正文数字与图上的数字一致。""" return np.random.default_rng(seed) # ─────────────────────────── 数据分布 ─────────────────────────── class GMM2D: """二维各向同性高斯混合。""" def __init__(self, means, stds, weights=None): self.mu = np.asarray(means, dtype=float) # [K, 2] self.s = np.asarray(stds, dtype=float) # [K] K = self.mu.shape[0] if weights is None: self.w = np.full(K, 1.0 / K) else: self.w = np.asarray(weights, dtype=float) self.w = self.w / self.w.sum() @property def K(self): return self.mu.shape[0] def sample(self, n, rng): k = rng.choice(self.K, size=n, p=self.w) return self.mu[k] + self.s[k][:, None] * rng.standard_normal((n, D)) def mean_cov(self): m = (self.w[:, None] * self.mu).sum(0) c = (self.w[:, None, None] * ( (self.s ** 2)[:, None, None] * np.eye(D)[None] + (self.mu - m)[:, :, None] * (self.mu - m)[:, None, :] )).sum(0) return m, c def make_data(K=8, radius=2.2, std=0.28): """8 个分量摆在半径 2.2 的圆上,每个分量标准差 0.28。""" ang = np.arange(K) * 2 * np.pi / K mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1) s = np.full(K, std) # 权重做成确定性的非均匀(1 + 0.35 cos),让混合更不像"一圈一样的点" w = 1.0 + 0.35 * np.cos(ang + 0.7) return GMM2D(mu, s, w / w.sum()) # ─────────────────────────── 路径 ─────────────────────────── class LinearPath: """Rectified Flow 的直线插值路径:z_t = (1-t) x + t eps。""" name = "linear" label = "直线路径(Rectified Flow)" def alpha(self, t): return 1.0 - t def sigma(self, t): return t def dalpha(self, t): return -1.0 def dsigma(self, t): return 1.0 class CosineVPPath: """方差保持(VP)路径:z_t = cos(pi t/2) x + sin(pi t/2) eps。 alpha^2 + sigma^2 = 1,也就是 DDPM 那一路 cosine schedule 的连续化版本。 """ name = "cosine_vp" label = "VP 余弦路径(DDPM 那一路)" def alpha(self, t): return np.cos(0.5 * np.pi * t) def sigma(self, t): return np.sin(0.5 * np.pi * t) def dalpha(self, t): return -0.5 * np.pi * np.sin(0.5 * np.pi * t) def dsigma(self, t): return 0.5 * np.pi * np.cos(0.5 * np.pi * t) # ─────────────────────────── 精确场 ─────────────────────────── class OracleFlow: """给定数据与路径后的精确边缘速度场。""" def __init__(self, data: GMM2D, path): self.data = data self.path = path # 后验responsibility r_k(z,t) 与分量方差 V_k(t) def _post(self, z, t): a = self.path.alpha(t) sg = self.path.sigma(t) V = a * a * self.data.s ** 2 + sg * sg # [K] diff = z[:, None, :] - a * self.data.mu[None, :, :] # [N,K,2] d2 = (diff ** 2).sum(-1) # [N,K] logp = -0.5 * d2 / V[None, :] - np.log(V)[None, :] + np.log(self.data.w)[None, :] logp = logp - logp.max(1, keepdims=True) r = np.exp(logp) r = r / r.sum(1, keepdims=True) return r, V, diff def m(self, z, t): """E[x | z_t = z],也就是 x0 预测的真值。""" a = self.path.alpha(t) r, V, diff = self._post(z, t) ex = self.data.mu[None, :, :] + (a * self.data.s ** 2 / V)[None, :, None] * diff return (r[:, :, None] * ex).sum(1) def e(self, z, t): """E[eps | z_t = z],也就是 epsilon 预测的真值。""" sg = self.path.sigma(t) r, V, diff = self._post(z, t) ee = (sg / V)[None, :, None] * diff return (r[:, :, None] * ee).sum(1) def v(self, z, t): """边缘速度场 v*(z,t) = alpha' m + sigma' e。""" da = self.path.dalpha(t) ds = self.path.dsigma(t) return da * self.m(z, t) + ds * self.e(z, t) def score(self, z, t): """grad log p_t(z)。""" r, V, diff = self._post(z, t) return -(r[:, :, None] * diff / V[None, :, None]).sum(1) def marginal(self, t): """p_t 的分量参数(仍是 GMM):均值 [K,2]、标准差 [K]、权重 [K]。""" a = self.path.alpha(t) sg = self.path.sigma(t) return a * self.data.mu, np.sqrt(a * a * self.data.s ** 2 + sg * sg), self.data.w # ─────────────────────────── 误差尺子 ─────────────────────────── def make_rbf_centers(n=9, extent=3.6, bw=0.9): g = np.linspace(-extent, extent, n) C = np.stack(np.meshgrid(g, g, indexing="ij"), axis=-1).reshape(-1, D) return C, bw def rbf_expectation(means, sds, weights, C, bw): """E_{p_t}[phi_c],phi_c(z)=exp(-||z-c||^2/(2 bw^2)),p_t 为各向同性 GMM。 单个高斯分量 N(m, v I) 下:E[phi_c] = (bw^2/(bw^2+v))^{d/2} * exp(-||m-c||^2/(2(bw^2+v))) """ v = sds ** 2 # [K] coef = (bw ** 2 / (bw ** 2 + v)) ** (D / 2.0) # [K] d2 = ((means[:, None, :] - C[None, :, :]) ** 2).sum(-1) # [K, M] val = coef[:, None] * np.exp(-0.5 * d2 / (bw ** 2 + v)[:, None]) return (weights[:, None] * val).sum(0) # [M] def discrepancy(z, t, flow: OracleFlow, C, bw): """粒子云 z 与精确边缘 p_t 的 RBF 特征矩偏差(越小越好)。""" mu_t, sd_t, w_t = flow.marginal(t) exact = rbf_expectation(mu_t, sd_t, w_t, C, bw) d2 = ((z[:, None, :] - C[None, :, :]) ** 2).sum(-1) emp = np.exp(-0.5 * d2 / bw ** 2).mean(0) return float(np.abs(emp - exact).mean()) # ─────────────────────────── 积分器 ─────────────────────────── def make_schedule(n_steps, shift=1.0): """含 n_steps 个积分区间(不是统一 NFE 预算)的时刻表。shift>1 是 SD3/FLUX 那套把时间往高噪声端推的做法。""" t = np.linspace(1.0, 0.0, n_steps + 1) if shift != 1.0: t = shift * t / (1.0 + (shift - 1.0) * t) return t def integrate(vfun, z, schedule, method="euler"): """从 t=1 走到 t=0。vfun(z, t) 返回对递增时间定义的 dz/dt;负步长负责反向积分。""" z = z.copy() traj = [z.copy()] for i in range(len(schedule) - 1): t = schedule[i] h = schedule[i] - schedule[i + 1] # >0 if method == "euler": dz = vfun(z, t) elif method == "rk2": zm = z - 0.5 * h * vfun(z, t) dz = vfun(zm, t - 0.5 * h) elif method == "rk4": k1 = vfun(z, t) k2 = vfun(z - 0.5 * h * k1, t - 0.5 * h) k3 = vfun(z - 0.5 * h * k2, t - 0.5 * h) k4 = vfun(z - h * k3, t - h) dz = (k1 + 2 * k2 + 2 * k3 + k4) / 6.0 else: raise ValueError(method) z = z - h * dz traj.append(z.copy()) return z, np.stack(traj) # traj: [S+1, N, 2] # ─────────────────────────── 自测 ─────────────────────────── def selfcheck(): rng = base_rng() data = make_data() out = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((4000, D)) * 1.6 for t in (0.05, 0.25, 0.5, 0.75, 0.95): a = path.alpha(t) sg = path.sigma(t) m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 恒等式 1:alpha*m + sigma*e == z r1 = float(np.abs(a * m + sg * e - z).max()) # 恒等式 2:v == alpha' m + sigma' e(定义,顺手确认没写反导数) r2 = float(np.abs(v - (path.dalpha(t) * m + path.dsigma(t) * e)).max()) out.append((path.name, t, r1, r2)) return out if __name__ == "__main__": print("=== 恒等式自检:alpha*m + sigma*e 应等于 z(残差 ~1e-15)===") hdr = "path t |a*m+s*e-z| |v-(da*m+ds*e)|" print(hdr) for name, t, r1, r2 in selfcheck(): print(f"{name:<12}{t:>6.2f}{r1:>16.2e}{r2:>18.2e}") rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) print() print("=== 直线路径下 v* 的两种算法是否一致:(z-m)/t 与 alpha' m + sigma' e ===") for t in (0.1, 0.3, 0.5, 0.7, 0.9): z = rng.standard_normal((2000, D)) * 1.6 lhs = (z - flow.m(z, t)) / t rhs = flow.v(z, t) print(f" t={t:.1f} 最大绝对差 = {np.abs(lhs - rhs).max():.3e}") param_lab.py # -*- coding: utf-8 -*- """flow_matching 实验台(二):三种参数化(x0 / eps / v)的换算与 loss 权重。 要回答两个问题: 1. 固定同一条高斯路径和非退化时间,eps / x0 / v 输出能否代数换算? 可以换算同一路径上的输出,但不能据此把 VP 模型直接变成另一条 RF 路径的模型。 三种参数化的真值来自同一个去噪均值 m: z = alpha*m + sigma*e (路径定义,恒等) v = alpha'*m + sigma'*e (速度定义) 两式联立解出 m、e,就得到「速度 -> 噪声/干净图」的换算; 反过来也成立。下面把这些换算逐点验到 1e-14。 2. 输出可换算,为什么不同训练目标仍会产生差异? 因为「等价」指的是**真值**等价,**loss 不等价**:同一个 m 上的误差 delta, 在三种 loss 里被放大的倍数不同: x0 : 1 eps : alpha / sigma v : |alpha' - sigma' * alpha / sigma| 这里列的是误差幅度系数,平方损失权重还需平方。直线路径 t→1 时, eps 系数趋于 0,v 系数趋于 1;这比较固定 m 误差的相对权重, 不等于真实网络的所有梯度或质量。t=1 的 eps->m 换算本身退化。 """ import numpy as np from fm_oracle import ( D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, ) # ─────────────────── 换算表的通用形式 ─────────────────── def v_to_me(z, v, path, t): """由 (z, v) 反解 (m, e)。 解 [[alpha', sigma'], [alpha, sigma]] @ [m, e] = [v, z] 行列式 det = alpha'*sigma - sigma'*alpha """ a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) det = da * sg - ds * a m = (sg * v - ds * z) / det e = (da * z - a * v) / det return m, e def eps_to_me(z, eps_hat, path, t): """由 eps 预测反解 (m, e)。""" a, sg = path.alpha(t), path.sigma(t) m = (z - sg * eps_hat) / a return m, np.broadcast_to(eps_hat, m.shape).copy() def me_to_v(m, e, path, t): return path.dalpha(t) * m + path.dsigma(t) * e def check_conversions(): """真值层面三种参数化互转,误差应到浮点量级。""" rng = base_rng() data = make_data() rows = [] for path in (LinearPath(), CosineVPPath()): flow = OracleFlow(data, path) z = rng.standard_normal((3000, D)) * 1.6 for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) # 真值 v -> (m,e) m2, e2 = v_to_me(z, v, path, t) # 真值 eps -> m -> v m3, _ = eps_to_me(z, e, path, t) v3 = me_to_v(m3, e, path, t) rows.append(( path.name, t, float(np.abs(m2 - m).max()), float(np.abs(e2 - e).max()), float(np.abs(m3 - m).max()), float(np.abs(v3 - v).max()), )) return rows # ─────────────────── 放大倍数 ─────────────────── def weights(path, ts): """返回三种参数化下「m 上的单位误差」被放大的倍数(振幅,非平方)。""" wx = np.ones_like(ts) we, wv = [], [] for t in ts: a, sg = path.alpha(t), path.sigma(t) da, ds = path.dalpha(t), path.dsigma(t) we.append(a / sg) wv.append(abs(da - ds * a / sg)) return wx, np.array(we), np.array(wv) def numeric_weight_check(): """不靠公式,直接用数值扰动验证放大倍数:给 m 加一个固定扰动,看 loss 变化。""" rng = base_rng() data = make_data() flow = OracleFlow(data, LinearPath()) path = LinearPath() z = rng.standard_normal((4000, D)) * 1.6 out = [] for t in (0.1, 0.3, 0.5, 0.7, 0.9, 0.99): m = flow.m(z, t) e = flow.e(z, t) v = flow.v(z, t) delta = rng.standard_normal((4000, D)) delta = delta / np.linalg.norm(delta) * 0.01 # 固定长度 0.01 的扰动 mp = m + delta ep = (z - path.alpha(t) * mp) / path.sigma(t) vp = me_to_v(mp, ep, path, t) r_eps = np.linalg.norm(ep - e) / np.linalg.norm(delta) r_v = np.linalg.norm(vp - v) / np.linalg.norm(delta) _, we, wv = weights(path, np.array([t])) out.append((t, r_eps, float(we[0]), r_v, float(wv[0]))) return out if __name__ == "__main__": print("=== 换算残差(真值层面互转,应为 1e-14 量级)===") print("path t v->m v->e eps->m eps->v") for name, t, r1, r2, r3, r4 in check_conversions(): print(f"{name:<11}{t:>5.2f}{r1:>12.2e}{r2:>12.2e}{r3:>12.2e}{r4:>12.2e}") print() print("=== 放大倍数:解析式 vs 数值扰动(直线路径)===") print(" t eps实测 eps解析 v实测 v解析") for t, re_, we_, rv_, wv_ in numeric_weight_check(): print(f"{t:>5.2f}{re_:>10.4f}{we_:>10.4f}{rv_:>10.4f}{wv_:>10.4f}") print() print("=== 放大倍数随 t 的变化(直线路径 vs VP 余弦路径)===") ts = np.array([0.01, 0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.9, 0.95, 0.99]) for path in (LinearPath(), CosineVPPath()): wx, we, wv = weights(path, ts) print(f"-- {path.label}") print(" t x0 eps v") for i, t in enumerate(ts): print(f"{t:>7.2f}{wx[i]:>8.3f}{we[i]:>10.3f}{wv[i]:>10.3f}") make_figures.py # -*- coding: utf-8 -*- """画配图。数字全部来自同目录的实验脚本,不另算一遍。 运行: python make_figures.py [--only 图名] """ import os import sys import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) from fm_oracle import ( # noqa: E402 D, base_rng, make_data, LinearPath, CosineVPPath, OracleFlow, make_schedule, integrate, ) from param_lab import weights # noqa: E402 import path_lab # noqa: E402 import reflow_lab # noqa: E402 HERE = os.path.dirname(os.path.abspath(__file__)) FIGDIR = os.path.join(os.path.dirname(HERE), "figures") os.makedirs(FIGDIR, exist_ok=True) C0 = "#2f4b7c" C1 = "#d45087" C2 = "#f0a35e" C3 = "#4c9f70" CGREY = "#8a8a8a" plt.rcParams["font.sans-serif"] = ["Heiti TC", "Arial Unicode MS", "DejaVu Sans"] plt.rcParams["axes.unicode_minus"] = False def _save(fig, name): p = os.path.join(FIGDIR, name) fig.savefig(p, dpi=150, bbox_inches="tight", facecolor="white") plt.close(fig) print(f" [ok] {name} ({os.path.getsize(p)} bytes)") # ─────────────── 图 1:三种参数化的放大倍数 ─────────────── def fig_weights(): ts = np.linspace(0.01, 0.999, 400) wx, we, wv = weights(LinearPath(), ts) fig, ax = plt.subplots(figsize=(7.4, 4.2)) ax.plot(ts, wv, color=C1, lw=2.4, label="velocity 参数化 v") ax.plot(ts, we, color=C0, lw=2.4, label="噪声参数化 eps") ax.plot(ts, wx, color=CGREY, lw=1.8, ls="--", label="干净图参数化 x0") ax.set_yscale("log") ax.set_xlabel("时间 t(0 = 数据端,1 = 纯噪声端)") ax.set_ylabel("同一份误差被放大的倍数(对数轴)") ax.set_title("图 1:预测误差幅度系数(平方损失权重为其平方)") ax.axvline(0.99, color="#cccccc", lw=1, ls=":") ax.annotate("t=0.99 处 eps 系数为 0.010,\nvelocity 还有 1.010", xy=(0.99, 1.0), xytext=(0.55, 0.35), fontsize=10, color="#333333", arrowprops=dict(arrowstyle="->", color="#999999", lw=1)) ax.legend(loc="upper right", fontsize=10) ax.grid(alpha=0.25) _save(fig, "fig1_param_weights.png") # ─────────────── 图 2:两条路径的真实 ODE 轨迹 ─────────────── def fig_trajectories(): data = make_data() rng = base_rng(4242) z1 = rng.standard_normal((600, D)) xs = data.sample(1200, base_rng(11)) fig, axes = plt.subplots(1, 2, figsize=(12.0, 5.4), sharex=True, sharey=True) sched = make_schedule(300) for ax, path in zip(axes, (LinearPath(), CosineVPPath())): flow = OracleFlow(data, path) z0, traj = integrate(lambda z, t: flow.v(z, t), z1, sched, "rk4") ax.scatter(xs[:, 0], xs[:, 1], s=8, color="#dddddd", label="数据样本(8 个模式)") for i in range(14): ax.plot(traj[:, i, 0], traj[:, i, 1], color=C1, lw=1.3, alpha=0.9) ax.scatter(z1[:14, 0], z1[:14, 1], s=34, color=C0, zorder=5, label="起点(纯噪声)") ax.scatter(z0[:14, 0], z0[:14, 1], s=34, color=C3, marker="s", zorder=5, label="终点(生成)") ax.set_title(path.label) ax.set_xlabel("dim 1") ax.grid(alpha=0.2) axes[0].set_ylabel("dim 2") axes[0].legend(fontsize=9, loc="upper left") fig.suptitle("图 2:同一批起点,两条路径走出来的 ODE 轨迹(300 步 RK4)", fontsize=13) fig.tight_layout() _save(fig, "fig2_trajectories.png") # ─────────────── 图 3:NFE-误差 ─────────────── def fig_nfe(): nfe_list = [2, 4, 8, 16, 32, 64, 128, 256] floor = path_lab.sampling_reference(make_data()) cur = { "linear/euler": path_lab.run_sweep(LinearPath(), "euler", nfe_list), "linear/rk2": path_lab.run_sweep(LinearPath(), "rk2", nfe_list), "vp/euler": path_lab.run_sweep(CosineVPPath(), "euler", nfe_list), "vp/rk2": path_lab.run_sweep(CosineVPPath(), "rk2", nfe_list), } fig, ax = plt.subplots(figsize=(7.6, 4.6)) for (k, v), col, mk in zip(cur.items(), [C1, C0, C2, C3], ["o", "o", "s", "s"]): ax.loglog(nfe_list, v, marker=mk, color=col, lw=2, label=k) ax.loglog(nfe_list, [floor] * len(nfe_list), color=CGREY, ls="--", lw=1.6, label="单次采样参考(4000 个真实样本)") ax.set_xlabel("NFE(模型评估次数)") ax.set_ylabel("终点分布与精确 p_data 的偏差") ax.set_title("图 3:1-rectified 的直线路径 vs VP 余弦路径") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=10) _save(fig, "fig3_nfe_paths.png") return {"nfe": nfe_list, "curves": {k: v.tolist() for k, v in cur.items()}} # ─────────────── 图 4:Reflow ─────────────── def fig_reflow(): data = make_data() flow = OracleFlow(data, LinearPath()) z0_1, z1 = reflow_lab.round1_pairs(100000, seed=0) net1, _ = reflow_lab.train(z0_1, z1, n_step=6000, seed=0, fresh=True) z0_2 = reflow_lab.generate_pairs(net1, z1, n_steps=100) net2, _ = reflow_lab.train(z0_2, z1, n_step=6000, seed=0) nfe_list = [2, 4, 8, 16, 32, 64] eval_z1 = base_rng(999).standard_normal((4000, D)) o = reflow_lab.nfe_curve(eval_z1, lambda z, t: flow.v(z, t), nfe_list, data) a = reflow_lab.nfe_curve(eval_z1, lambda z, t: net1(z, t), nfe_list, data) b = reflow_lab.nfe_curve(eval_z1, lambda z, t: net2(z, t), nfe_list, data) floor = path_lab.sampling_reference(data) arc1 = reflow_lab.arc_over_chord(z1, lambda z, t: net1(z, t))[0] arc2 = reflow_lab.arc_over_chord(z1, lambda z, t: net2(z, t))[0] s1 = reflow_lab.straightness_of(z0_1, z1, lambda z, t: flow.v(z, t)) s2 = reflow_lab.straightness_of(z0_2, z1, lambda z, t: net2(z, t)) fig, axes = plt.subplots(1, 2, figsize=(12.0, 4.8)) ax = axes[0] ax.loglog(nfe_list, o, marker="o", color=CGREY, lw=2, label="精确场(数值积分对照)") ax.loglog(nfe_list, a, marker="o", color=C1, lw=2, label="第 1 轮模型") ax.loglog(nfe_list, b, marker="s", color=C3, lw=2, label="第 2 轮模型(reflow 后)") ax.loglog(nfe_list, [floor] * len(nfe_list), color="#bbbbbb", ls="--", lw=1.5, label="单次采样参考(非下限)") ax.set_xlabel("NFE") ax.set_ylabel("终点偏差") ax.set_title("本实验 reflow 后:NFE≥2 的偏差变化很小") ax.grid(alpha=0.25, which="both") ax.legend(fontsize=9) ax = axes[1] names = ["第 1 轮", "第 2 轮"] x = np.arange(2) ax.bar(x - 0.18, [arc1, arc2], width=0.34, color=C0, label="弧长/弦长(1 = 完全直线)") ax.bar(x + 0.18, [s1, s2], width=0.34, color=C2, label="归一化配对残差 S_pair") ax.set_xticks(x) ax.set_xticklabels(names) ax.set_yscale("log") ax.set_ylabel("配对残差与轨迹长度比(对数轴)") ax.set_title("两轮之间:轨迹从弯的变成直的") ax.grid(alpha=0.25, axis="y") ax.legend(fontsize=9) for i, (av, sv) in enumerate([(arc1, s1), (arc2, s2)]): ax.text(i - 0.18, av * 1.08, f"{av:.4f}", ha="center", fontsize=9) ax.text(i + 0.18, sv * 1.08, f"{sv:.4f}", ha="center", fontsize=9) fig.suptitle("图 4:Reflow 的两轮对比(同一个直线路径、同一批起点)", fontsize=13) fig.tight_layout() _save(fig, "fig4_reflow.png") return {"nfe1": a.tolist(), "nfe2": b.tolist(), "S1": s1, "S2": s2, "arc1": arc1, "arc2": arc2} if __name__ == "__main__": only = sys.argv[2] if len(sys.argv) > 2 and sys.argv[1] == "--only" else None jobs = { "weights": fig_weights, "trajectories": fig_trajectories, "nfe": fig_nfe, "reflow": fig_reflow, } for k, fn in jobs.items(): if only and k != only: continue print(f"[draw] {k}") fn() print("done")