


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:推理加速与部署 | 难度:工程实战 | 前置知识:混合精度与数值稳定性、性能建模与 Profiling
关键词:INT8、W8A8、INT4、W4A16、SmoothQuant、AWQ、NVFP4、校准、离群值、分组缩放
设想一个视频生成服务:DiT 的线性层权重很大,单次生成又要反复经过这些层。团队把 BF16 权重直接换成 4 bit 文件,磁盘占用马上下降;上线后却发现小 batch 时并没有按 4 倍提速,字幕边缘还出现抖动。问题不在于「4 bit 失效」,而是把存储位宽、矩阵乘法位宽、缩放元数据、反量化成本和生成质量混成了同一个数字。若运行时先把 4 bit 权重解回 BF16 再调用普通 GEMM,压缩带来的只是存储或部分读带宽收益;若没有匹配硬件和内核,也不会凭空得到 FP4 算力。
再看一个可复现的小实验:附录的 quant_demo.py 生成 64 维输入,其中第 0 个通道有显著离群值。普通 W8A8 在留出的 64 条输入上的输出均方误差是 0.222085;做一次数学上严格等价的 SmoothQuant 式通道变换后,误差变成 0.001384。这两个数来自本机实际运行,不是论文模型的评测分数。它说明一个关键事实:量化前的浮点函数完全相同,量化后的误差却能相差很大。要读懂 INT8、AWQ 或 FP4 的论文,先要分清误差落在什么张量、哪个通道,以及内核真正执行了什么。
本文用一条线串起这些问题:先推整数映射与输出误差,再拆 SmoothQuant 如何搬走激活离群值、AWQ 如何保护重要权重,最后解释 NVFP4 为什么需要按块缩放。所有示例都在 CPU 上跑,不依赖模型权重;它们验证机制,不声称复现生产吞吐或画质。
第一句:量化把连续值映到少数离散码字;位数越少,步长或裁剪误差通常越大,实际误差还取决于缩放粒度和数据分布。第二句:SmoothQuant 面向 W8A8,把难量化的激活通道缩小、相应权重通道放大,使原始浮点线性层保持等价;AWQ 面向权重低比特,用激活统计找重要通道,并搜索权重缩放以减小输出误差。第三句:INT4 与 FP4 只是数字格式,真正的速度由硬件支持、打包布局、反量化位置、batch 和带宽瓶颈共同决定。
这里统一写线性层为 $Y=XW$:$X$ 是形状 $[T,K]$ 的输入激活,$W$ 是 $[K,N]$ 的权重,$Y$ 是 $[T,N]$ 的输出;$T$ 可理解为当前批的 token 数,$K$ 是输入通道,$N$ 是输出通道。真实视频 DiT 的 $T$ 可能包含时间与空间 patch,且随分辨率、帧数、去噪步变化。下文的校准统计只能代表采样过的条件分布,不能自动外推到所有视频场景。
因此,阅读任何“压到 4 bit 后提速”的结论时,先追问四件事:原始精度是什么、量化了权重还是激活、scale 按什么粒度共享、测试时是否调用了对应硬件的低比特内核。若论文只给模型文件大小与单项质量分数,就还不足以判断生产服务的成本收益。
给一组实数选择步长 $\Delta>0$ 与零点 $z$。一般的仿射量化写成一行:
$$q=\operatorname{clip}\bigl(\operatorname{round}(x/\Delta)+z,\ q_{\min},q_{\max}\bigr),\qquad \hat x=\Delta(q-z)$$
$q$ 是存储的整数码字,$\hat x$ 是反量化后参与近似计算的值;$q_{\min},q_{\max}$ 是格式允许的最小、最大整数。对本文 W8A8 实验的对称 INT8,取 $z=0$、范围 $[-127,127]$、$\Delta=\max|x|/127$。没有裁剪且落在舍入区间内时,单个值的绝对误差不超过 $\Delta/2$;超出校准范围被截断后,这个上界不再成立。全张量共用一个步长时,一个大离群值会把 $\Delta$ 拉大,使大多数小值在相邻码字间跳得更粗。按通道或按组各给一个步长能局部化这种损失,但要保存更多缩放因子,并且内核未必支持同样快的计算路径。
线性层两边都有量化误差时,令 $\hat X=X+E_X$、$\hat W=W+E_W$。直接展开,而不是笼统说「精度下降」:
$$\hat Y-Y=(X+E_X)(W+E_W)-XW=E_XW+XE_W+E_XE_W$$
第一项是激活误差被权重放大,第二项是权重误差被输入激活放大,第三项是二者相乘。W8A8 三项都有;W4A16 的激活通常仍用高精度,主要关心第二项。即使某个权重元素误差很小,只要它对应的输入通道经常很大,也可能显著改变输出。这解释了为什么不能只用权重自身的 MSE 判断生成模型是否安全。
为了把“一个离群值拖累整组”算到具体数字,假设 127 级对称量化器要同时覆盖一个大小 20 的值与许多大小约 0.1 的值。若整个张量共用尺度,步长约为 $20/127=0.1575$;一个 0.1 会被舍入到 1 个码字,反量化约 0.1575,误差约 0.0575。假如该张量的最大幅度只有 1,步长便约为 $1/127=0.00787$,0.1 反量化约 0.1024,误差约 0.0024。两种情形都只用 8 bit,差别来自谁和谁共享 scale。实际矩阵乘还要把这些单点误差乘上权重并求和,因此不能只拿这个标量例子推最终 MSE,但它解释了为什么先观察通道直方图比直接改位宽更有用。
校准也有两层口径。静态量化先用代表性输入估计范围,推理时直接复用 scale;如果后来出现更大的输入,就有裁剪风险。动态量化可按当前 token 或当前批重新估计激活范围,减轻分布漂移,却要在运行时付出求最大值、计算 scale 和可能的同步成本。权重通常固定,离线按输出通道或按组量化较容易;激活每次都变,统计粒度过细会增加内核复杂度。本文故意采用校准集估计的静态全张量激活 scale,让离群问题足够清晰;它不是宣称这种设置在所有线上服务中最佳。
取一个所有元素都为正的通道缩放向量 $s\in\mathbb R^K$,令 $D=\operatorname{diag}(s)$。在量化前做:
$$X^{\prime}=XD^{-1},\qquad W^{\prime}=DW,\qquad X^{\prime}W^{\prime}=XD^{-1}DW=XW$$
等号最后一步只用到 $D^{-1}D=I$,所以浮点层完全等价。第 $j$ 个激活通道除以 $s_j$,权重的第 $j$ 个输入通道乘以 $s_j$。如果异常大的激活集中在少数通道,选较大的 $s_j$ 就能把它们压下去;代价是相应权重幅度变大。SmoothQuant 论文的核心判断是:在其研究的 LLM 线性层中,权重一侧通常比激活一侧容易承受这种量化难度。它并非数学定理,具体模型仍要测。
记校准输入第 $j$ 通道的绝对最大值为 $a_j$,权重第 $j$ 个输入通道的绝对最大值为 $b_j$,SmoothQuant 的一种尺度选择是:
$$s_j=\frac{a_j^{\alpha}}{b_j^{1-\alpha}},\qquad 0\le\alpha\le1$$
$a_j$ 和 $b_j$ 都要设正下界以免全零通道除零。$\alpha$ 控制把多少难度从激活侧搬往权重侧;本文实验固定 $\alpha=0.5$,不是所有模型的默认最优值。生产实现还要把 $1/s_j$ 融入前一层归一化的参数,避免推理时额外插一个逐元素除法。等价变换只保证未量化的 $XW$ 不变,不保证量化输出相同,这正是需要校准和误差测量的原因。
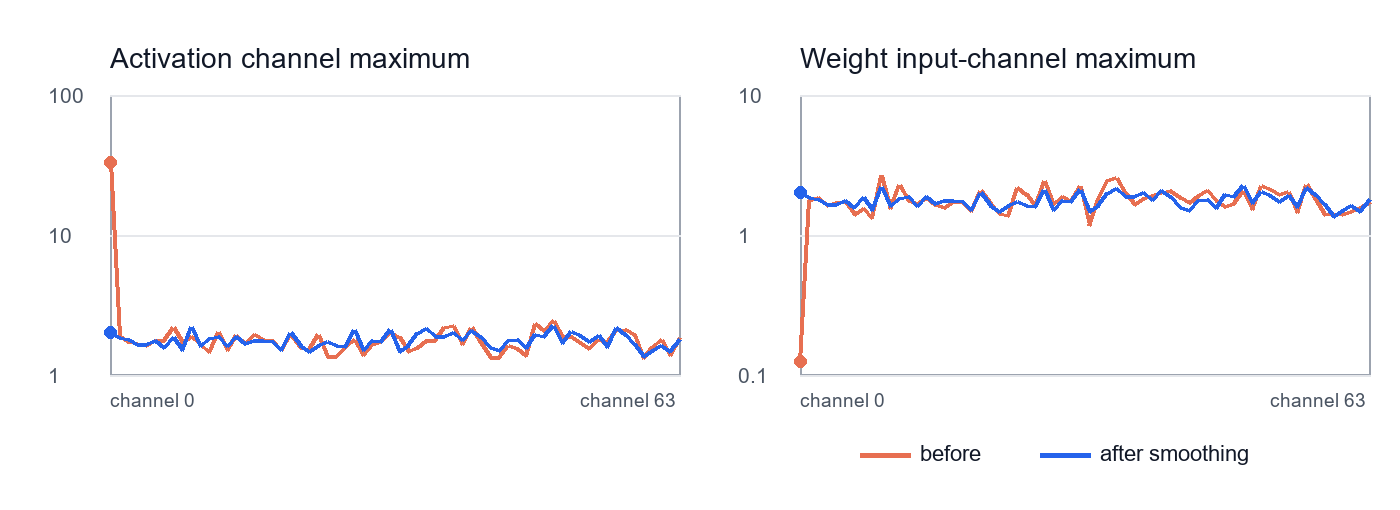
图 1:纵轴为绝对最大值的对数刻度,横轴为输入通道。橙色是原始值,蓝色是等价变换后。第 0 通道的激活离群值向权重侧迁移;这是一组程序构造的数据,不是任何论文模型的实测激活分布。
若只量化权重,输出误差近似为 $XE_W$。对留出的输入矩阵平方求和,可写成:
$$\|XE_W\|_F^2=\operatorname{tr}\bigl(E_W^{\mathsf T}X^{\mathsf T}XE_W\bigr)$$
$\|\cdot\|_F$ 是把所有元素平方后求和再开根号,$X^{\mathsf T}X$ 编码各输入通道的能量与相关性。若暂时忽略通道间相关性,式子近似为各通道「输入能量 × 对应权重误差能量」之和:
$$\|XE_W\|_F^2\approx\sum_{j=1}^{K}\|X_{:j}\|_2^2\|E_{W,j:}\|_2^2$$
所以「权重数值小」不等于「量化它不重要」:如果 $X_{:j}$ 经常大,该通道的权重误差就会被放大。AWQ 论文据此用激活统计找显著权重通道,采用等价缩放和校准误差搜索,而不是把少数通道改成混合精度来增加内核复杂度。其论文报告保护约 1% 显著权重即可明显降低量化误差;这属于论文实验结果,不能直接当成任何 DiT 的固定比例。
我们的教学版对每个输出通道的权重按 32 个输入元素成组做非对称 INT4 伪量化:组内用最小值和最大值求 $\Delta=(\max-\min)/15$,零点把实数零映到 $[0,15]$ 的整数区间。再用激活平均幅度构造 $s_j$,扫 20 个候选指数,在校准输入上找最小输出 MSE。这样抓住了「激活统计 + 缩放搜索 + 分组权重量化」的骨架;它没有 AWQ 的完整模型层搜索、真实 W4A16 内核或端到端精度验证,因此代码称为 awq_toy。
INT4 通常按整数码字加组缩放与零点解释;FP4 的码字本身有符号、指数和尾数。NVIDIA 的 NVFP4 文档把单个数据码字定义为 E2M1:1 个符号位、2 个指数位、1 个尾数位,再乘以每 16 个元素一组的 FP8 E4M3 局部缩放和一个 FP32 全局缩放。因此真实值不是一个孤立的 4 bit 码字,而是:
$$x_{\mathrm{recon}}=x_{\mathrm{E2M1}}\,s_{\mathrm{block}}\,s_{\mathrm{global}}$$
只数存储位数,忽略对齐和打包时,长度为 $L$ 的张量平均每元素约用 $4+8/16+32/L$ bit:大张量趋近 4.5 bit/元素,相对 16 bit 的 BF16 理想压缩比约 $16/4.5=3.56$,而不是整齐的 4 倍。实际实现还受 padding、布局和额外元数据影响。我们的 e2m1_toy 用最近邻 E2M1 可表示值和精确的浮点块缩放说明概念,没有模拟 FP8 缩放舍入、全局缩放、硬件矩阵乘法或 NVFP4 的完整训练配方,不能用它的误差预测真实 NVFP4 模型质量。
分组大小还有一笔容易被省略的元数据账。假设某种 INT4 实现对每 32 个权重同时保存一个 16 bit scale 和一个 16 bit zero point,理想平均是 $4+(16+16)/32=5$ bit/权重,相对 BF16 的理论压缩比是 $16/5=3.2$。若每组 128 个权重,在同一假设下是 $4.25$ bit/权重、约 $3.76$ 倍。这里的数字只是指定元数据布局后的算术示例;AWQ 不同内核可能把零点、scale 以其他精度或打包方式存放,padding 也会改变实际占用。组变小往往改善局部拟合,却可能增加元数据带宽和内核约束。因此选组大小时,至少同时报告量化后的实际显存、输出质量和目标设备延迟,而不能只报告“4 bit”。
还要区分权重量化与激活量化的计算链。W4A16 常见路径保留较高精度激活,只压缩权重;W8A8 则要求两侧都进入 8 bit 路径,整数累加再按 scale 还原。前者通常能让权重读取变轻,却不自动让激活流量变小;后者更可能用 INT8 矩阵乘硬件,但激活离群问题也更直接。训练中的 FP4、推理中的 FP4、权重专用 INT4 同样不能只按“都是四位”合并对比,它们量化统计、可接受误差和内核目标都不同。
设原权重数为 $KN$。BF16 仅权重约 $2KN$ 字节,裸 INT8 约 $KN$ 字节,裸 4 bit 约 $KN/2$ 字节;后两者还要加各自的缩放、零点及对齐开销。这是容量账。速度账要写成性能建模那篇的下界:
$$T\ge\max(F/P,\ D/B)$$
$F$ 是内核运算量,$P$ 是该硬件上该精度路径的有效算力,$D$ 是实际搬运字节,$B$ 是有效带宽。若小 batch 解码反复读大权重,压缩 $D$ 可能有效;若 prefill 的矩阵乘已受算力限制,就要有真正的 INT8 或 FP4 计算内核才可能受益。若先把低比特权重展开回 BF16,反量化、临时缓冲和 kernel launch 也要入账。低比特文件大小、显存占用、单次延迟和吞吐量是四个不同的观测量,必须分别报告。
完整可运行的 quant_demo.py 和 make_figures.py 放在文末附录。只需 Python、NumPy、Pillow;没有模型权重、CUDA 或外部数据下载。固定随机种子 7,前 192 条输入作校准,后 64 条作评估,避免直接拿选择缩放的样本当成绩。张量形状是 $X_{\text{cal}}\in\mathbb R^{192\times64}$、$X_{\text{eval}}\in\mathbb R^{64\times64}$、$W\in\mathbb R^{64\times32}$。第 0 激活通道被人为放大,相应权重通道被缩小;这是为了把问题放到显微镜下,不代表真实模型普遍这样分布。
最核心的四行与 3.2 节逐项对应:s 是公式的 $s$,x_s 是 $XD^{-1}$,w_s 是 $DW$。先用未量化的矩阵乘核对代数等价,再分别走 INT8 路径:
s = smooth_scales(x_cal, w, alpha=0.5)
x_s, w_s = x_eval / s, w * s[:, None]
assert np.allclose(x_eval @ w, x_s @ w_s)
after = int8_matmul(x_cal / s, x_s, w_s)
int8_matmul 把评估输入量化成整数、权重量化成整数,真正用 int32 矩阵乘累加,然后按激活和每输出通道的权重步长反量化。它没有调用真实 GPU INT8 Tensor Core,所以这里只能谈数值误差,不能谈运行速度。AWQ 教学路径也故意返回反量化浮点权重以便检查输出;若要测 W4A16 吞吐,必须换成真实打包内核。
本次在项目 Python 3.11 + NumPy 上执行 python outputs/fundamentals_files/quantization/code/quant_demo.py 的原始输出如下,MSE 均针对同一个留出集的浮点 $XW$;relative 是 MSE 除以该输出的均方值:
X_cal (192, 64) X_eval (64, 64) W (64, 32)
Smooth alpha=0.50, s[0]=16.2463, median(s)=0.9942
equivalent transform max_abs_error=3.553e-15
int8_before MSE=0.222085 relative=0.015861
int8_after MSE=0.001384 relative=0.000099
int4_plain MSE=0.492117 relative=0.035146
int4_awq MSE=0.089772 relative=0.006411
fp4_toy MSE=0.335760 relative=0.023979
AWQ toy alpha=0.95 calibration_MSE=0.091065
第一个可检验的结论是等价变换在浮点下只剩 $3.553\times10^{-15}$ 的舍入差。第二个是这组构造数据里 SmoothQuant 式迁移降低了 W8A8 的输出误差。第三个是 AWQ 教学搜索把 INT4 权重量化的留出集误差从 0.492117 降到 0.089772;选择指数 0.95 只是这批构造样本上的选择。fp4_toy 的 0.335760 不能与前三者直接排模型名次:它的缩放编码与计算路径不同,而且没有真实 FP8 scale 舍入。图 1 由同一组数组生成,因此数值与图是可追溯的一套实验。
SmoothQuant 的工业细节在「把除法折进上一层」。 作者公开实现的 smooth_ln_fcs 先从校准激活和多个相邻线性层的权重求通道尺度,再对 LayerNorm 的 weight、bias 除以尺度,并对后续线性层的相应输入权重乘以尺度。多个 Q/K/V 投影可能共享上一层归一化,不能各自随意选一套不一致的缩放。本文代码直接显式写 x/s,便于看清代数关系;真正部署需确认融合位置、归一化类型与残差分支,不能机械把所有线性层都改一遍。链接以该仓库所示 commit 为准。
AWQ 的工程路径比教学版多了布局与搜索。 作者 pseudo_quantize_tensor 接受位宽、零点与组大小,把权重按末维分组,计算每组 min/max、scale、zero,再舍入裁剪;auto_scale_block 用校准输入取模块原输出、扫 20 个尺度候选并比较输出 MSE。本文的 int4_groups 与 awq_toy 只复现这两个可解释步骤。生产还要选择组大小、权重打包顺序、激活精度、融合反量化的 GEMM,以及对 tokenizer、任务和模态有代表性的校准数据。伪量化权重占用浮点内存,不能拿它冒充真实 4 bit 显存占用。
NVFP4 则是格式与硬件共同定义的方案。 NVIDIA Transformer Engine 文档 明确写出 E2M1 码字、16 元素 FP8 局部缩放和 FP32 全局缩放,也讨论训练时缩放与舍入细节。这与 AWQ 的非对称 INT4 零点方案不同。若在 Blackwell 以外的设备上模拟 E2M1,再调用普通 BF16 GEMM,只是在研究量化误差;没有证据证明获得 NVFP4 Tensor Core 吞吐。对视频 DiT,还应分别统计文本投影、注意力、MLP、VAE 与不同去噪时刻的敏感度,而不是用一个 LLM 基准替代画质验收。
先在模型推理图中列出每个线性层的输入形状、权重字节、调用次数与实测耗时,按去噪步、分辨率和 batch 分桶。一个只调用一次的小投影层即使压到 4 bit,也不如在每一步反复运行的大 MLP 值得优先优化。随后对候选层采样真实生成输入:文本条件、无条件分支、不同帧长和空间分辨率、去噪早中晚步都应覆盖。统计每个输入通道的最大值、分位数及其随条件变化的范围,再决定是对称、非对称、按通道还是按组,而不是从 LLM 的一套 scale 直接复制过来。
然后做逐层替换实验:固定随机种子,只量化一组层,记录该层输出误差、整网中间特征差、生成结果与延迟。若数值误差集中在少数层,可保留这些层为 BF16,其他层继续压缩;但必须把混合精度带来的格式转换也计入耗时。对视频尤其要检查相邻帧的纹理闪烁和文字稳定性,因为单帧指标可能掩盖时间不一致。最后把“模型文件大小、峰值显存、单次生成时延、吞吐、质量”五列并排记录,并列出硬件型号、内核版本和量化格式。这样才能判断收益来自低位宽计算、权重少读、还是单纯把模型装进了原先放不下的卡。
本文的 CPU 脚本只覆盖上述流程的数值诊断第一步,不覆盖真实 DiT 校准、低比特 kernel 或视频验收。这一边界并非小字备注:若读者要据此选择线上格式,必须在实际模型和实际设备上补完后续测量。
精度代价首先来自动态范围:静态校准没见过的 prompt、分辨率或高运动视频,可能把激活推过已选范围,产生裁剪而非普通舍入误差。多步扩散还会把每一步的小偏差沿采样轨迹累积。本文的线性层输出 MSE 只能当局部诊断;最终还需在固定种子和足够多提示词上比较画面结构、文本可读性、时间一致性与人评,不能把 MSE 下降直接翻译成 VBench 上升。
系统代价是尺度与布局。按张量一个 scale 便宜却易被离群值支配;按通道、按组或按 16 元素块能更细地适应分布,但多了元数据、打包、反量化与特定内核限制。对容量,要记 weights + scales + zeros + padding + workspace;对延迟,要测 prefill、单步 decode、小 batch 和大 batch。生产图中若有不支持低比特的算子导致来回格式转换,转换成本可能抵掉 GEMM 收益。
方法边界也不同。SmoothQuant 的迁移假设权重能承受放大,且前后层可安全折叠;AWQ 搜索的是给定校准集、给定位宽和组大小的局部误差,不能保证分布外质量;FP4 的动态范围和非均匀码字不等同于 INT4,不能把一个格式的超参数照搬到另一个。没有兼容内核时,先考虑稳定的 BF16/FP16 路径或更保守的 INT8。对已经被算力、launch 或跨卡通信限制的工作负载,权重文件变小也可能几乎不缩短时间。
一个容易漏掉的验收维度是误差的结构。同样的总体 MSE,误差若集中在少数文本 token、眼睛边缘或连续帧的同一位置,主观影响可能远大于均匀噪声。因此可把误差按层、通道、去噪时刻和内容类型拆开画分布,并检查最大误差与高分位数,而非只看全局平均。对生成视频,建议把原始模型与量化模型用相同 prompt、相同随机种子逐对比较;除整体指标外,抽查运动边界、物体身份、OCR 文本、暗部纹理和高频闪烁。若只是量化器的局部输出误差变小,却没有带来终端质量改善,也应如实报告“局部数值改善,端到端效果未证实”。这种分层验收也能告诉工程师应该先恢复哪一层的精度,而不必把整网退回 BF16。
从这四篇再看 NVFP4 格式文档,会发现研究问题已经从「如何挑量化码字」延伸到「硬件支持哪种码字、块尺度和矩阵布局」。本文关于 NVFP4 的字段与块大小以该官方文档为准;本文没有把它列作四篇论文之一。
误解一:INT4 一定比 INT8 快两倍。 4 bit 只说明每个裸权重码字更短。若内核先展开、如果 GEMM 已受算力限制、若尺度加载很重,延迟可能没有相应收益。必须在目标 GPU 上测端到端而非只量文件大小。
误解二:SmoothQuant 把模型函数改好了,所以精度一定升。 它在浮点下是等价的;被改善或恶化的是后续量化误差。不同层、不同 $\alpha$、不同校准集都可能改变结论。本文的 160 倍左右 MSE 改善来自特意制造的离群通道,不是通用倍率。
误解三:AWQ 只看权重最大值。 3.3 节说明输出误差被输入放大。官方搜索用校准激活和模块输出误差,不是简单挑最大的权重元素。本文虽然也使用权重分组 min/max,但那是码字映射,不是重要性判据。
误解四:FP4 就是 INT4 加一个不同的 scale。 E2M1 的码字间隔非均匀,NVFP4 还有 16 元素局部 FP8 scale 与全局 scale。即使两个方案都写「4 bit」,误差形态、元数据和硬件路径也不同。
误解五:单层 MSE 合格,视频质量便合格。 视频生成的时间一致性、字符与细节可能对少数层或特定步数敏感;线性层 MSE 只帮助定位,应继续做固定种子的视频样例、人评和任务指标核验。
把附录两段代码分别保存为 quant_demo.py 和 make_figures.py,放在同一目录,安装 numpy 与 Pillow 后运行:
python quant_demo.py
python make_figures.py
图会写到上一级 figures/smooth_migration.png。先确认 equivalent transform max_abs_error 接近零,再把 case() 里的 x[:, 0] *= 20.0 改为 *= 1.0 重跑:离群值消失后,普通 INT8 与 SmoothQuant 的误差差距应明显缩小,但具体数值以你的实跑结果为准。第二个实验把 awq_toy 中的候选指数固定为 0,观察 int4_awq 是否退化到 int4_plain 附近;这对应“不使用激活引导缩放”的基线。第三个实验把分组大小从 32 改成 16 或 64,注意 int4_groups 要同步修改调用处,比较输出 MSE 与理论元数据开销:更细的组通常更能适应局部分布,但真实内核性能仍需另测。
若不清楚 BF16、FP16 与 FP8 的表示范围,先读混合精度与数值稳定性;若想判断量化后为何没提速,回看性能建模与 Profiling的带宽、算力与容量账;若关心自回归生成的权重带宽之外还有哪些显存项,接着读KV Cache 与自回归视频生成。下一步面对实际视频 DiT,应把本文的输出误差实验移到真实层、真实校准集和多个去噪时刻,再用质量指标与人评决定哪些层保留高精度。
09 节用到的脚本全文如下(quant_demo.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""Minimal CPU quantization experiment. Requires numpy; run: python quant_demo.py."""
import numpy as np


def case():
    rng = np.random.default_rng(7)
    x = rng.normal(0, 0.6, (256, 64))
    x[:, 0] *= 20.0
    w = rng.normal(0, 0.8, (64, 32))
    w[0, :] *= 0.08
    return x[:192], x[192:], w


def mse(y, y_hat):
    return float(np.mean((y - y_hat) ** 2))


def smooth_scales(x_cal, w, alpha=0.5):
    a = np.maximum(np.max(np.abs(x_cal), axis=0), 1e-8)
    b = np.maximum(np.max(np.abs(w), axis=1), 1e-8)
    return a**alpha / b**(1.0 - alpha)


def int8_matmul(x_cal, x_eval, w):
    # Static per-tensor activation scale, per-output-channel weight scales.
    sx = max(float(np.max(np.abs(x_cal))) / 127.0, 1e-8)
    sw = np.maximum(np.max(np.abs(w), axis=0) / 127.0, 1e-8)
    qx = np.clip(np.rint(x_eval / sx), -127, 127).astype(np.int32)
    qw = np.clip(np.rint(w / sw), -127, 127).astype(np.int32)
    return (qx @ qw).astype(np.float64) * sx * sw


def int4_groups(w, group=32):
    # W is [input, output]; each output row is split across input groups.
    out_dim = w.shape[1]
    rows = w.T.reshape(-1, group)
    lo = rows.min(axis=1, keepdims=True)
    hi = rows.max(axis=1, keepdims=True)
    scale = np.maximum((hi - lo) / 15.0, 1e-8)
    zero = np.clip(np.rint(-lo / scale), 0, 15)
    q = np.clip(np.rint(rows / scale) + zero, 0, 15)
    return ((q - zero) * scale).reshape(out_dim, -1).T


def awq_toy(x_cal, w):
    # Search a channel scale using calibration output error, as in AWQ's idea.
    importance = np.maximum(np.mean(np.abs(x_cal), axis=0), 1e-8)
    target = x_cal @ w
    trials = []
    for alpha in np.linspace(0.0, 0.95, 20):
        s = importance**alpha
        s /= np.sqrt(s.max() * s.min())
        w_hat = int4_groups(w * s[:, None]) / s[:, None]
        trials.append((mse(target, x_cal @ w_hat), float(alpha), w_hat))
    return min(trials, key=lambda row: row[0])


def e2m1_toy(w, block=16):
    # Nearest E2M1 value with exact float64 block scale; NOT NVFP4 encoding.
    levels = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 3.0, 4.0, 6.0])
    out_dim = w.shape[1]
    rows = w.T.reshape(-1, block)
    scale = np.maximum(np.max(np.abs(rows), axis=1, keepdims=True) / 6.0, 1e-8)
    normalized = np.abs(rows) / scale
    idx = np.abs(normalized[..., None] - levels).argmin(axis=-1)
    return (np.sign(rows) * levels[idx] * scale).reshape(out_dim, -1).T


def results():
    x_cal, x_eval, w = case()
    y = x_eval @ w
    s = smooth_scales(x_cal, w)
    x_s, w_s = x_eval / s, w * s[:, None]
    before = int8_matmul(x_cal, x_eval, w)
    after = int8_matmul(x_cal / s, x_s, w_s)
    awq_cal_error, awq_alpha, w_awq = awq_toy(x_cal, w)
    w_int4 = int4_groups(w)
    w_fp4 = e2m1_toy(w)
    return {
        "x_cal": x_cal, "x_eval": x_eval, "w": w, "s": s,
        "x_s": x_s, "w_s": w_s,
        "exact_error": float(np.max(np.abs(y - x_s @ w_s))),
        "int8_before": mse(y, before), "int8_after": mse(y, after),
        "int4_plain": mse(y, x_eval @ w_int4),
        "int4_awq": mse(y, x_eval @ w_awq),
        "awq_alpha": awq_alpha, "awq_cal_error": awq_cal_error,
        "fp4_toy": mse(y, x_eval @ w_fp4),
        "signal": float(np.mean(y**2)),
    }


def main():
    r = results()
    print("X_cal", r["x_cal"].shape, "X_eval", r["x_eval"].shape,
          "W", r["w"].shape)
    print("Smooth alpha=0.50, s[0]=%.4f, median(s)=%.4f" %
          (r["s"][0], np.median(r["s"])))
    print("equivalent transform max_abs_error=%.3e" % r["exact_error"])
    for name in ("int8_before", "int8_after", "int4_plain",
                 "int4_awq", "fp4_toy"):
        print("%s MSE=%.6f relative=%.6f" %
              (name, r[name], r[name] / r["signal"]))
    print("AWQ toy alpha=%.2f calibration_MSE=%.6f" %
          (r["awq_alpha"], r["awq_cal_error"]))


if __name__ == "__main__":
main()"""Draw a two-panel SmoothQuant diagram. Requires numpy and Pillow."""
from pathlib import Path
import numpy as np
from PIL import Image, ImageDraw, ImageFont
from quant_demo import case, smooth_scales
def font(size):
path = Path("C:/Windows/Fonts/arial.ttf")
return ImageFont.truetype(str(path), size) if path.exists() else ImageFont.load_default()
def panel(draw, left, title, before, after):
top, width, height = 95, 570, 280
lo = min(float(before.min()), float(after.min()))
hi = max(float(before.max()), float(after.max()))
low, high = np.floor(np.log10(lo)), np.ceil(np.log10(hi))
draw.rectangle((left, top, left + width, top + height), outline="#9ca3af", width=2)
for power in range(int(low), int(high) + 1):
value = 10.0**power
y = top + height - (power - low) / (high - low) * height
draw.line((left, y, left + width, y), fill="#e5e7eb", width=2)
draw.text((left - 62, y - 12), f"{value:g}", fill="#4b5563", font=font(21))
draw.text((left, 42), title, fill="#111827", font=font(28))
for values, color in ((before, "#e76f51"), (after, "#2563eb")):
points = []
for i, val in enumerate(values):
x = left + i / (len(values) - 1) * width
y = top + height - (np.log10(val) - low) / (high - low) * height
points.append((float(x), float(y)))
draw.line(points, fill=color, width=4)
draw.ellipse((points[0][0] - 6, points[0][1] - 6,
points[0][0] + 6, points[0][1] + 6), fill=color)
draw.text((left, top + height + 14), "channel 0", fill="#4b5563", font=font(19))
draw.text((left + width - 100, top + height + 14), "channel 63",
fill="#4b5563", font=font(19))
def main():
x_cal, _, w = case()
s = smooth_scales(x_cal, w)
before_x = np.max(np.abs(x_cal), axis=0)
after_x = np.max(np.abs(x_cal / s), axis=0)
before_w = np.max(np.abs(w), axis=1)
after_w = np.max(np.abs(w * s[:, None]), axis=1)
canvas = Image.new("RGB", (1400, 510), "#ffffff")
draw = ImageDraw.Draw(canvas)
panel(draw, 110, "Activation channel maximum", before_x, after_x)
panel(draw, 800, "Weight input-channel maximum", before_w, after_w)
draw.line((860, 455, 910, 455), fill="#e76f51", width=5)
draw.text((920, 441), "before", fill="#111827", font=font(22))
draw.line((1040, 455, 1090, 455), fill="#2563eb", width=5)
draw.text((1100, 441), "after smoothing", fill="#111827", font=font(22))
out = Path(__file__).resolve().parent.parent / "figures" / "smooth_migration.png"
out.parent.mkdir(parents=True, exist_ok=True)
canvas.save(out)
print("saved", out, "bytes", out.stat().st_size)
if __name__ == "__main__":
main()
评论 (0)