


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:推理加速 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本(attention_basics)、性能建模与 Profiling(performance_profiling)
关键词:KV Cache、显存带宽、自回归生成、因果注意力、缓存驱逐、PagedAttention
先给三个数,都是本篇附录按明确假设计算的账本;它们不是实际部署峰值显存。
第一个数:一个 token 的 KV cache 是 128 KiB。 按 Meta Llama 模型配置 中 Llama-3-8B 的结构算(32 层、8 个 KV 头、每头 128 维、BF16 两个字节):每个 token 要缓存 $2 \times 32 \times 8 \times 128 \times 2 = 131072$ 字节,正好 128 KiB。所以一条 8192 token 的序列,KV cache 恰好是 1.00 GiB。这个整数不是巧合,是配置凑出来的——记住它,后面所有账都从它出发。
第二个数:batch=32 时,KV cache 是权重的 2.14 倍。 权重 14.96 GiB,KV cache $32 \times 1.00 = 32.00$ GiB,合计 46.96 GiB。batch 加到 64,合计 78.96 GiB——已经接近本文假设的 80 GiB 总预算,其中约 81% 是 KV cache;还未计入激活、临时空间与框架开销。实际 A100 型号标称 80 GB,可用字节应以设备查询为准,不能把理想 80 GiB 预算当作部署保证。你以为你在被权重压垮,其实在被缓存压垮。
第三个数:一组视频假设会产生 52.7 GiB 的 KV。 假设沿用上面的 Llama 结构、缓存全部历史、不做额外 latent patch 化:5 秒 24fps、时间维 4 倍压缩、空间 8×8 压缩,是 30 帧 × 14400 token = 432000 token,按同样的 128 KiB/token 算就是 52.73 GiB——还没算权重,一条视频就吃掉大半张卡。10 秒 105.47 GiB,30 秒 316.41 GiB。这是展示量级的假想配置,不是真实视频模型的统一用量;VAE、patch、窗口与模型层数都能改变它。
玩具 decoder 的全量重算与缓存增量解码还展示了一点:计算量减少不等于同倍数加速。修正了密集注意力 FLOPs 计数、输出头计数和最后一次无用 decode 后,当前代码解析比为 105.61 倍,本次 NumPy 墙钟为 10.29 倍。Python 调度、临时数组、重复 KV 头和小矩阵效率都会影响耗时,单靠这个比值不能认定差额全来自内存带宽。
三句话:
自注意力一步的计算是
$$\mathrm{Attn}(Q, K, V) = \mathrm{softmax}\left( \frac{Q K^{\top}}{\sqrt{d}} + M \right) V$$
其中 $M$ 是因果掩码,$M_{ij} = 0$($j \le i$)或 $-\infty$($j > i$)。关键在 $Q$、$K$、$V$ 是怎么来的:第 $i$ 个位置的 query、key、value 是
$$q_i = W_q x_i, \quad k_i = W_k x_i, \quad v_i = W_v x_i$$
这里的 $x_i$ 是该层输入隐藏状态,不是只含第 $i$ 个 token 的原始 embedding。在多层 decoder 中,它已经聚合了前面位置的信息。正确的论证是逐层归纳:固定权重、位置、条件与推理随机性后,因果掩码保证历史位置不能看未来;追加 token 不会改变旧位置的隐藏状态,所以其 K/V 可复用。此处 $t$ 表示正在处理的输入位置,$j<t$ 的缓存已存在,$q_t,k_t,v_t$ 是本步新计算的量。改变前缀、RoPE 位置、条件、模型权重或噪声等级,都可能使旧缓存失效。
所以增量解码的正确姿势是:
$$o_t = \sum_{j=1}^{t} \mathrm{softmax}_j \left( \frac{q_t k_j^{\top}}{\sqrt{d}} \right) v_j$$
注意这个式子里只有 $q_t$、$k_t$、$v_t$ 是新的,$k_j$、$v_j$($j < t$)全部从缓存里读。softmax 的分母也只在这一行上归一化——不需要重算别的行,因为别的行的输出早就有了,而且以后也不会变。
这里有一个值得停一下的对比:训练时我们并行算所有位置,$Q K^{\top}$ 是一个 $S \times S$ 的矩阵;decode 时一次只有一个 query,$Q K^{\top}$ 退化成一个 $1 \times t$ 的向量。同一个算子,在两个阶段里形状完全不同,这让长 prefill 通常更容易利用矩阵计算资源,而单 token decode 的注意力通常更容易受带宽或并行度限制,仍需实测确认。
顺带回答一个常见疑问:为什么缓存的是 K 和 V,而不是 Q?因为它们的生命周期不同。$q_t$ 在这一步算完、和缓存做完内积之后就没用了——下一个 token 不会再来问它;而 $k_j$、$v_j$ 是「将来所有 query 都要来查一遍」的公共数据,未来第 $t+1$、$t+2$ 步的注意力都要用。缓存的对象必须是「写入后不再变、且会被反复读」的东西,这正好是 3.4 节那个算术强度问题的另一半来源:省下的是重算 K/V 的算力,付出的是每步把这块只读数据整个搬一遍的带宽。
先算不用缓存的账。每一步要对长度为 $t$ 的前缀做一次完整因果前向,注意力部分是 $O(t^2)$;生成 $S$ 个 token 总共是
$$\sum_{t=1}^{S} c \cdot t^2 \approx \frac{c \, S^3}{3}$$
用缓存之后,每步只算一个新 query 对 $t$ 个缓存条的注意力,是 $O(t)$;总共
$$\sum_{t=1}^{S} 2c \cdot t \approx c \, S^2$$
按上面这套只计有效因果三角的常数约定,比值趋于 $S/3$,不是 $2S/3$。若全量实现先计算完整 $t\times t$ 分数再掩码(本文 NumPy 就是这种实现),它做了约两倍的注意力乘加,比值才趋于 $2S/3$。这两个系数对应不同实现,不能混在一起。
投影与 FFN 的账不同:全量路线每步重算前缀各 token,累计为 $O(S^2D^2)$;缓存路线累计为 $O(SD^2)$,$D$ 为隐藏宽度。注意力累计阶数则分别是 $O(S^3D)$ 和 $O(S^2D)$。有长度 $P$ 的 prompt 时应从 $P$ 开始求和,生成 $G$ 个输出只需一次 prefill 加 $G-1$ 次 decode,因为 prefill 已给出首个预测。附录的解析计数按实际密集 NumPy 矩阵乘与每步单个输出头计数,省略 norm、softmax 等逐元素操作。
每生成一个 token,要在缓存里留下这一层的 $k_t$ 和 $v_t$。数一数字节数:
$$B_{\text{tok}} = \underbrace{2}_{K,V} \times \; L \times n_{\text{kv}} \times d \times p$$
$L$ 是层数,$n_{\text{kv}}$ 是 KV 头数(GQA 下小于 query 头数 $n_q$),$d$ 是每头维度,$p$ 是 dtype 字节数(BF16 是 2)。这个公式里没有 S——每个 token 的缓存占用与上下文长度无关,缓存总量才随 $S$ 线性增长:
$$B_{\text{kv}} = B_{\text{tok}} \times S \times B_{\text{batch}}$$
代 Llama-3-8B($L=32$,$n_{\text{kv}}=8$,$d=128$,$p=2$):$B_{\text{tok}} = 131072$ 字节。8192 token 一条序列 = 1.00 GiB;batch=32 就是 32.00 GiB,是 14.96 GiB 权重的 2.14 倍。如果换成 MHA($n_{\text{kv}} = 32$),每个 token 变成 512 KiB,batch=32 时 128 GiB——GQA 在这里把 KV 显存降低 4 倍,也会减少 K/V 投影计算;query 头上的注意力乘加不同比例下降。
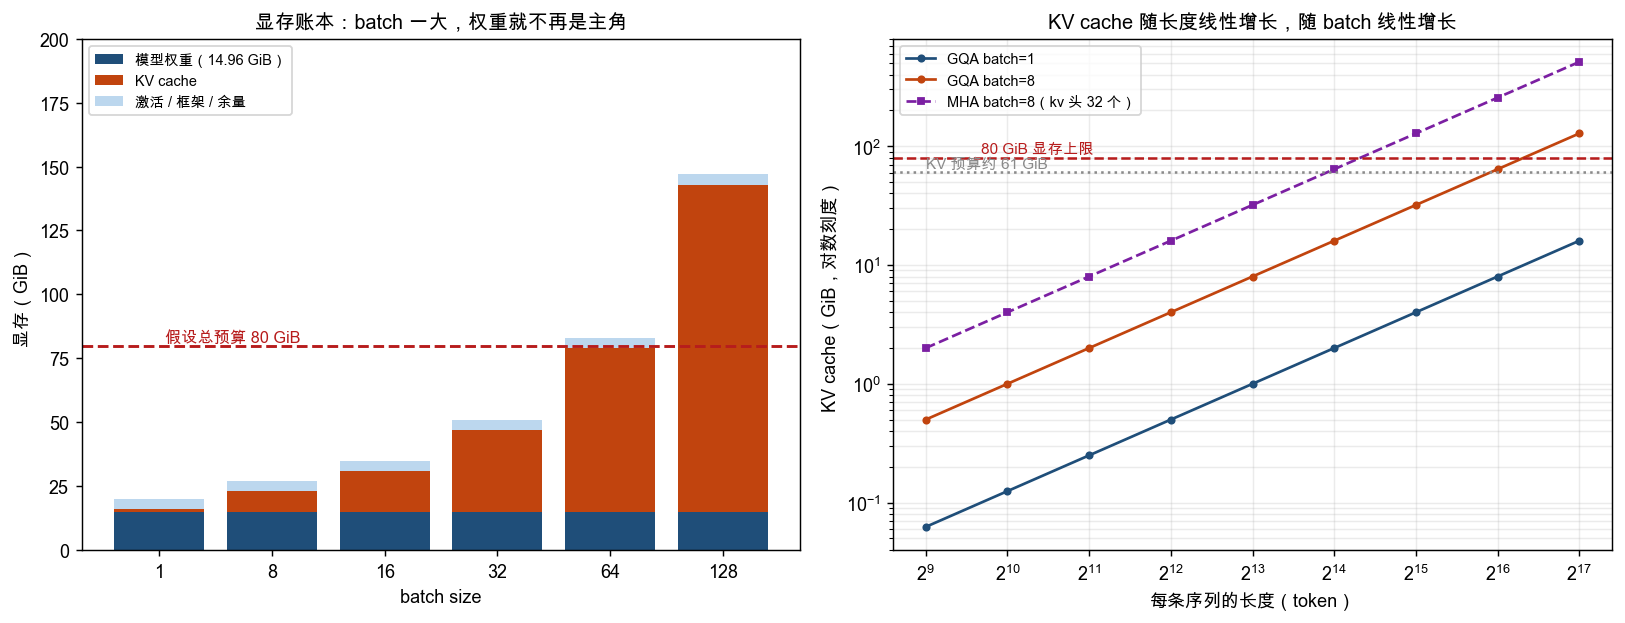
这张图要看什么:左图是 batch 从 1 扫到 128 时显存账本的构成(seq=8192),深蓝是权重、橙红是 KV cache、浅蓝是激活和余量,红色虚线是 80 GiB——注意从 batch=32 开始橙红就盖过深蓝,计入示意的 4 GiB 余量后 batch=64 已超过 80 GiB 预算、batch=128 直接越界,增长主要来自 KV cache。右图固定 batch 看 KV cache 随序列长度的增长(对数-对数坐标),三条线都是斜率 1 的直线(线性增长),紫色虚线(MHA)比橙色(GQA batch=8)高一截;61 GiB 灰线表示扣除假设权重和余量后的缓存预算,曲线与它的交点给出该简化预算下的长度上限。
这是全篇最要紧的一节。上一篇(性能建模)说过,一个操作的算术强度 $I$ = 算力 / 访存字节数,它和硬件的山脊点(ridge point)比一比,就知道这个操作是算力受限还是带宽受限。
先只看理想融合的单 query 注意力,假设每份 KV 从所分析的存储层读一次,并在一组 query 头之间共享,忽略 Q/O 和中间量:对每个 query 头,$QK^{\top}$ 是 $1 \times d$ 乘 $d \times S$,$2 S d$ FLOP;再加权和 $AV$ 同样 $2 S d$ FLOP。$n_q$ 个头合计 $4 n_q d S$ FLOP。访存呢?要把 K 和 V 的缓存全部读一遍:$2 n_{\text{kv}} d S p$ 字节。两者一除:
$$I_{\text{dec}} = \frac{4 \, n_q \, d \, S}{2 \, n_{\text{kv}} \, d \, S \, p} = \frac{2 g}{p}, \quad g = \frac{n_q}{n_{\text{kv}}}$$
$S$ 在这个理想模型中约掉了。 算术强度不随 $S$ 变化,但实际效率可能随上下文而变:短序列并行不足,长序列跨越缓存容量,kernel 的分块和归约成本也会变化。而且注意力之外仍有读权重、投影与 FFN,不能用一个注意力公式概括完整 decode。
代数字(BF16,$p=2$,$I = g$):MHA($g=1$)的 $I = 1$ FLOP/byte;Llama-3 的 GQA($g=4$)是 4;MQA($g=32$)是 32。而 A100 的山脊点是 $312\ \text{TFLOP/s} \div 2.04\ \text{TB/s} = 153$ FLOP/byte。这些理想强度低于该 BF16 山脊点,提示带宽约束;实际 kernel 还可能受并行度与延迟约束。 下图把本机 FP32 微基准(1201.61 GFLOP/s、71.89 GB/s)与 A100 80GB SXM 官方规格 的 BF16 理论峰值分别作为屋顶。CPU 与 GPU 使用不同 dtype,因此同一 $g$ 的 CPU 理想强度为 GPU 的一半。
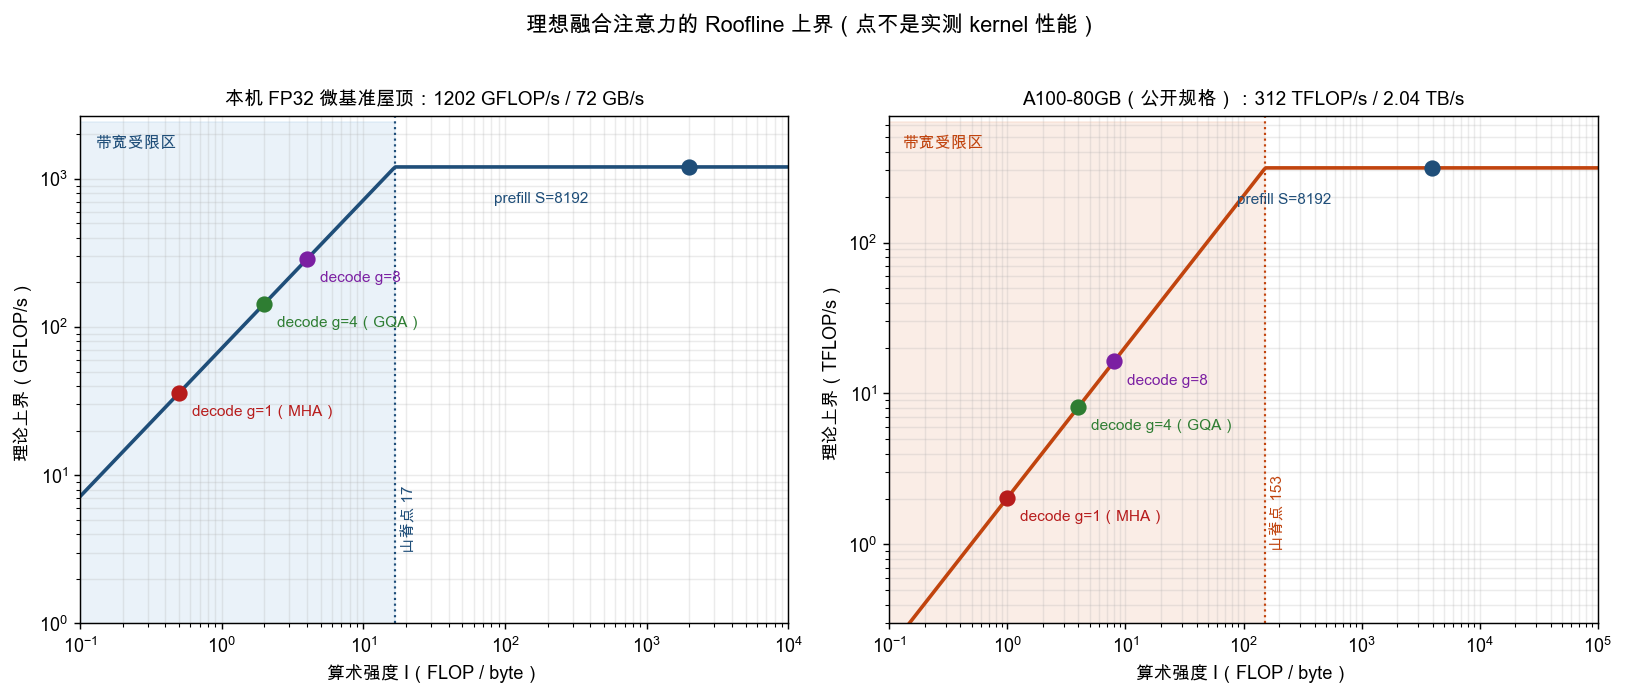
图中各点是把解析强度放到屋顶上计算出的上界,不是测得的 attention 性能。本机屋顶来自大矩阵和流式数组微基准,不保证小算子能达到。改变 GQA、精度、融合、序列并行或多 query 批处理都可能改善性能;MLA 有自己的压缩结构,不能简单当成增大 $g$。
长 prefill 一次处理多个 query,更容易复用权重和 KV,因此通常有更高强度。附录使用 $2NS$ 近似投影计算量($N$ 为参数量),并假定每层激活搬运为 10*S*D*p,得到示意强度 3973.9 FLOP/byte(BF16)。这是粗略模型,不是逐算子的显存流量测量;输入很短、注意力未融合、张量并行通信或低效 kernel 都可能改变实际瓶颈。不能仅凭这个数断言 prefill 必定吃满 GPU。
这个视角还能直接写出 decode 一步的耗时下限。若权重与全部 KV 每步都需从 HBM 读取,字节数除带宽给出一个下界;还须同时满足 FLOPs/算力下界:
$$T_{\text{step}} \ge \frac{W + B_{\text{batch}} \, B_{\text{tok}} \, S}{\mathrm{BW}}$$
$W$ 是权重大小(每步都要读一遍,batch 摊薄),$B_{\text{batch}} B_{\text{tok}} S$ 是全部序列的缓存(batch 摊不了)。代 Llama-3-8B、seq=8192、A100 的 2.04 TB/s:batch=1 时 $(14.96 + 1.00)$ GiB 除以带宽得 8.4 ms,也就是单流吞吐的上限约 119 token/s——仅是单设备、该精度、该访存假设下的上界;权重量化、共享前缀、投机解码、多设备等会改变假设。第 6.1 节进一步说明 batch 对这个模型的影响。
核心是三段:完整前向(prefill)、单步(decode)、以及承载它们的缓存。下面是 kv_cache_lab.py 的主干,完整版在文末附录,纯 numpy 可跑。
def attn_full(Q, K, V):
    """完整因果注意力。Q:[S,Hq,Dh]  K/V:[S,Hkv,Dh]  ->  [S,Hq,Dh]"""
    S, Hq, Dh = Q.shape
    g = Hq // K.shape[1]
    Kk = np.repeat(K, g, axis=1)          # GQA:把 kv 头复制 g 份对齐 q 头
    Vv = np.repeat(V, g, axis=1)
    logits = np.einsum("qhd,khd->hqk", Q, Kk) / np.sqrt(Dh)
    mask = np.triu(np.ones((S, S), dtype=bool), 1)
    logits = np.where(mask[None, :, :], -np.inf, logits)
    logits = logits - logits.max(axis=-1, keepdims=True)
    p = np.exp(logits)
    p = p / p.sum(axis=-1, keepdims=True)
    return np.einsum("hqk,khd->qhd", p, Vv)


def attn_step(q, K, V):
    """decode 一步:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]"""
    Hq, Dh = q.shape
    Kk = np.repeat(K, Hq // K.shape[1], axis=1)
    Vv = np.repeat(V, Hq // K.shape[1], axis=1)
    logits = np.einsum("hd,khd->hk", q, Kk) / np.sqrt(Dh)   # [Hq,S],只有一行
    logits = logits - logits.max(axis=-1, keepdims=True)
    p = np.exp(logits)
    p = p / p.sum(axis=-1, keepdims=True)
    return np.einsum("hk,khd->hd", p, Vv)


def block_step(x_new, w, cache, pos, cfg=CFG):
    """decode 一步:只算新 token,并把它的 K/V 写进缓存的 pos 位置。"""
    D = x_new.shape[1]
    hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"]
    h = rmsnorm(x_new)
    q = (h @ w["wq"]).reshape(hq, dh)
    k = (h @ w["wk"]).reshape(hkv, dh)
    v = (h @ w["wv"]).reshape(hkv, dh)
    cache["k"][pos] = k                    # 写缓存:只有这一步是新算的
    cache["v"][pos] = v
    o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh)
    y = x_new + o @ w["wo"]
    y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"]
    return y
变量名和 03 节的符号一一对应:Q/K/V 是 $Q$、$K$、$V$,Hq/Hkv 是 $n_q$、$n_{\text{kv}}$,g 就是 GQA 的分组数 $g$,pos 是当前长度 $t$。缓存预分配成最大长度(prompt + gen),KV 更新按下标原地写入;注意力仍创建临时数组,并用 np.repeat 实际复制 KV 头,因此它没有实现理论分析所假定的完美 GQA 访存复用。
修订后的代码在本机运行得到(时间随机器、BLAS 和负载变化):
生成 token 一致数:192 / 192
最后 logits 最大绝对误差:7.344e-06
相对误差:4.028e-07
无缓存矩阵乘 FLOPs:1.3005e+11
缓存矩阵乘 FLOPs:1.2314e+09
解析比值:105.61x
无缓存 / 缓存墙钟:6.986s / 0.679s
本次加速比:10.29x
全量与增量在精确算术下等价,FP32 累加顺序会带来小误差。真实模型若候选 logits 很接近,舍入也可能改变 argmax,所以不要求所有模型都逐 token 位级一致。附录固定种子玩具例子对序列与误差都加了断言。本例省略位置编码,用于验证缓存数据流;RoPE 和视频块缓存的正确性还需要另行验证。
解析 FLOPs 与墙钟的差额只说明实现效率不同。若要确认带宽瓶颈,还需测实际带宽、kernel 时间、线程设置和缓存命中,不能由加速比倒推出原因。
HF transformers:动态缓存与静态缓存是不同路径。 cache_utils.py 的 DynamicLayer.update(以 2026-10 的实现为准)是这么追加一个 token 的:
self.keys = torch.cat([self.keys, key_states], dim=-2)
self.values = torch.cat([self.values, value_states], dim=-2)
torch.cat 每一步都分配一块新内存、把旧缓存整个抄过去。缓存越大这一步越贵,到长上下文时光是拷贝就吃掉不少带宽——而带宽恰恰是 decode 最缺的东西。它换来的是简单:形状任意增长、随便 crop、随便回滚,对 batch=1 的研究代码完全够用。我第一版玩具实现也是这么写的,后来才意识到「预分配 + 下标写入」差在哪:一个把带宽花在拷贝上,一个把带宽花在读缓存上,前者是纯浪费。
同一份 cache_utils.py 还提供 StaticLayer,预分配后原地更新;不能把动态 torch.cat 描述为 transformers 唯一方式。动态拼接与按最大长度预留是两种不同策略,前者可能复制和碎片化,后者有未用容量。
vLLM:把缓存当成页来管。 当服务请求长度不确定时,按最大长度预留可能浪费容量。vLLM(PagedAttention,arXiv:2309.06180)的解法是把操作系统管内存的那一套搬过来:缓存切成固定大小的块(block),每条请求维护一张块表(block table),逻辑上连续、物理上散落。vLLM v0.16.0 的 FlashAttention 后端文档 中可检查 FlashAttentionImpl.forward、key_cache, value_cache = kv_cache.unbind(0) 与 block_table 的使用。缓存张量布局会随版本和后端变化,不能把某个 2 * head_size 排列写成 vLLM 的统一规定。稳定的设计要点是逻辑块映射到物理块,kernel 按块表寻址,新增 K/V 按 slot 映射写入;prefill/decode 通过长度等元数据区分。
分页到底值多少?附录 paged_alloc.py 在同一个 61 GiB 预算下做了模拟(Llama-3-8B,块 16):
--- 负载:长度均匀 512~4096 ---
              策略       并发请求          占用        真实用到       利用率
            连续预留        122    61.00 GiB    34.52 GiB   56.59%
         分页(块16)        214    60.85 GiB    60.67 GiB   99.70%
    并发提升        : 1.75x

--- 负载:重尾:八成 256~1024 ---
            连续预留        122    61.00 GiB    18.37 GiB   30.11%
         分页(块16)        405    60.79 GiB    60.42 GiB   99.40%
    并发提升        : 3.32x
浪费的两半也拆开了:连续预留平均每条请求浪费 223.26 MiB(预留 4096、平均只用 2310),分页只有 0.93 MiB(最后一个块没填满),239 倍。分页确实减少预留浪费和碎片,未改变有效 KV 每 token 的字节数。这里是静态容量模拟:1.75~3.32 倍是可容纳请求数之比,不是测得的吞吐倍数;尚未模拟到达、释放、动态增长和调度。
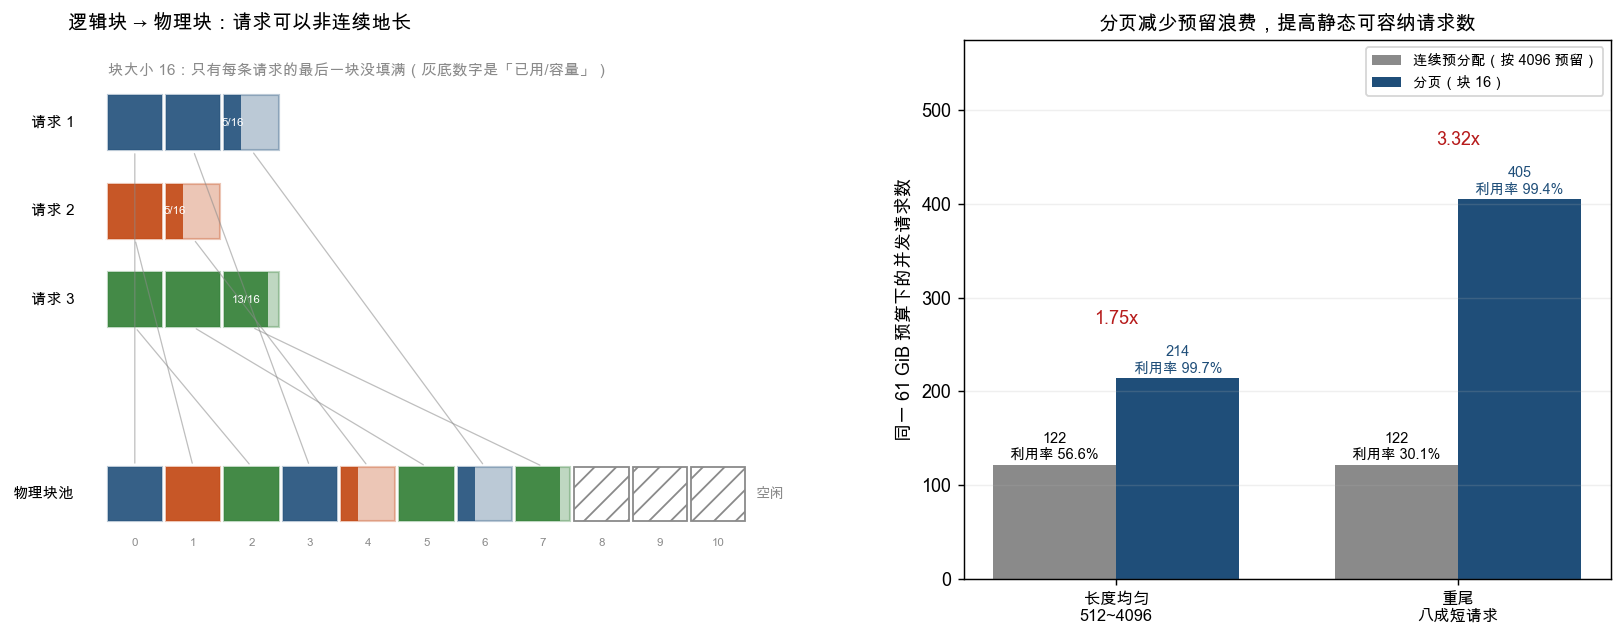
这张图要看什么:左图是分页的时空图,上面各行是每条请求的逻辑视图(块连续),下面一行是物理块池(按申请顺序排列,颜色表示属于谁)——灰色细线从逻辑块指向它真正的物理块,能看到同一条请求的块在物理上是散的;块里的灰底数字是「已用/容量」,只有每条请求的最后一块没填满。右图是两种策略在同一预算下的并发数,灰色(连续预留)在重尾负载下利用率只剩 30%,蓝色(分页)两种负载都在 99% 以上。
还有一个 decode 特有的并行技巧。 prefill 可以把 $S^2$ 的注意力摊到很多 SM 上,decode 只有一个 query、$S$ 个 key——并行度天然不足(FlashDecoding 的出发点)。做法是把序列维切成几段,各段独立算局部 softmax 再合并(online softmax 的分治),用更多并行度换带宽利用率。这与 3.4 节的结论一致:decode 的问题是算术强度低,切序列不改变 $I$,但能把空闲的算力单元动员起来去搬字节。
生产部署还要考虑块表处理、CPU 调度、编译与内核启动开销。分页增加了寻址和管理成本,是否获益取决于请求负载,不能只看有效容量。
在第 3.4 节的带宽模型里,一批请求共享一次权重读取,而各自拥有不同 KV。若上下文相同,batch 增大时总 KV 字节数线性增长;单步吞吐上界是 $B_{\text{batch}}/T_{\text{step}}$,不会无限线性增加。共享前缀、不同长度调度、投机解码和张量并行会改变这张账,需重新列出复用假设。
块大小越小,最后一块的空槽通常越少,块表却越长。若长度模块大小的余数均匀,块大小 $b$ 的平均空槽是 $(b-1)/2$,不是无条件精确的 $b/2$。本例平均长度约 2310,16/32 token 块的空槽比例约 0.32%/0.67%;真实工作负载与 kernel 对齐要求应共同决定块大小。分页能让原本浪费的显存参与服务,也支持一些共享场景;batch=1 同样可能减少预留容量,但未必带来明显延迟收益。
一些自回归视频系统按帧或块推进,块内双向、块间因果;另一些按离散 token 生成或采用不同的窗口。下图仅展示一种块因果结构:
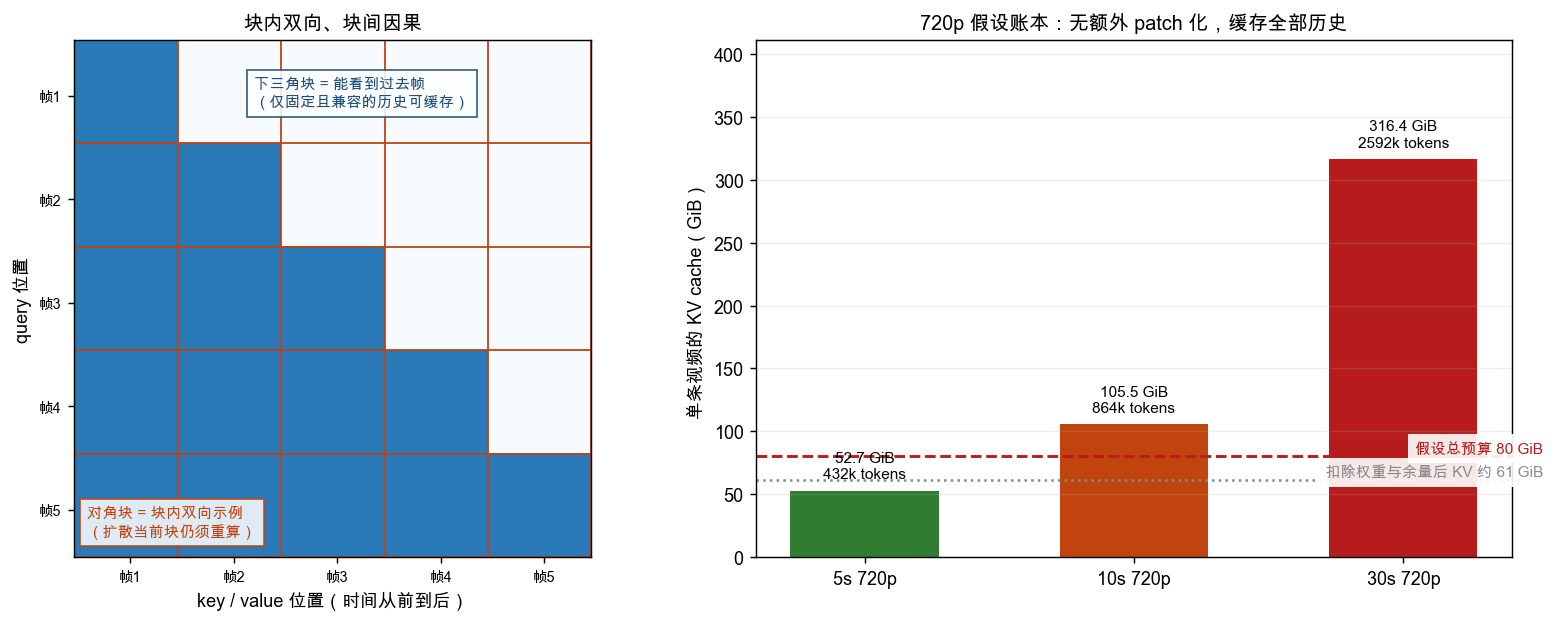
图中右上角为空表示不能读未来块,对角块为满表示当前块内双向。允许读取历史,不等于历史 K/V 在所有去噪步都不变。 当前块的噪声状态随去噪变化,其 K/V 通常必须重算;历史块只有在输入、位置、时间/噪声条件、模型权重均固定且架构允许时才能精确缓存。若历史也被重新加噪或全局时间条件改变,需按模型缓存策略重建,不能直接套文本 decoder 的永久缓存假设。
本例假设 720p、空间压缩 8×8、时间压缩 4×、每 latent 位置一个 token、全历史保留,并套用 Llama-3-8B 的缓存结构;5/10/30 秒分别为 52.73/105.47/316.41 GiB。额外 2×2 patch 化会让空间 token 数约为四分之一;因果 VAE 的首帧约定、边界取整、滑动窗口、层数与头数还会继续改变数字。一帧的 1.76 GiB 是这组假设的计算结果,不是视频模型的普遍常数。
语义块和分配块不必相同。 一帧可包含很多物理缓存页,原有 token 分页机制仍可复用;需要调整的是掩码、批处理和缓存生命周期。不能仅凭帧内双向就断言块表必须整帧分配,或元数据一定压垮 CPU。
位置必须保留逻辑含义。 3D RoPE 需要时间/高/宽坐标,不能只用缓存里的 token 条数推断它们。滑窗驱逐后,存储长度尤其不等于全局逻辑位置,需单独维护 position_ids 或绝对偏移。丢缓存并不删除已输出的视频帧,只会改变未来生成能读到的上下文,可能影响长时一致性。
量化、驱逐、压缩各有条件。 理想地把 KV 每元素字节从 2 降到 1,载荷减半,但总存储还包括量化 scale、元数据和工作区。FP8 不同格式有不同动态范围,离群值与精度误差要验证,不能只按「减半」判断能部署。MLA 是训练时设计的潜在注意力结构,不是给任意既有模型套一个无损压缩器;滑窗或驱逐会改变可见历史。
本篇证实了玩具文本 decoder 的缓存等价性,计算了指定配置的显存账,并做了静态分页容量模拟。Roofline 给出假设下的上界,未测 A100 kernel,未实现完整视频去噪缓存,也没有证明任何真实视频模型必须采用某个驱逐策略。CPU FP32 微基准、GPU BF16 理论峰值与 NumPy 教学实现的访存行为要分开理解。
误解 1:「算力少 100 倍就一定快 100 倍。」 墙钟还受 kernel、调度、带宽和分配影响,加速比需实测。上下文变长使缓存路线自身更慢,但相对全量重算的加速比可能反而增大,不能说必然恶化。
误解 2:「所有 decode 都是纯访存。」 低 batch、长上下文的注意力常受带宽限制,但整体 decode 还有投影、FFN、通信与 CPU 开销。先用 profiler 定位。
误解 3:「GQA 只影响质量。」 它减少 KV 容量、KV 投影与理想读取字节,但 query 头数不变;代价要结合训练质量和实际 kernel 评估。
误解 4:「分页不省显存,容量增益直接等于吞吐增益。」 分页减少的是预留与碎片浪费,有效 KV 本身不变。能放更多请求并不保证同倍数 tokens/s。
误解 5:「缓存长度就是新 token 的位置。」 仅在简单连续全缓存情形下成立。驱逐、packing、padding 或 3D 坐标都需要额外位置元数据,不能从当前存储长度猜。
误解 6:「因果视频掩码就保证跨去噪步复用 KV。」 掩码约束依赖方向,缓存还要求被缓存的隐藏状态不变;当前噪声块及发生条件变化的历史必须重新计算。
数值脚本依赖 numpy,配图另需 matplotlib,均不需要 torch:
python kv_cache_lab.py ALL     # 约 8 秒:等价性 + 算力账 + 显存账 + Roofline
python paged_alloc.py ALL      # 约 1 秒:分页 vs 连续预分配的并发与浪费
预期结果(实跑输出,可以直接对):
kv_cache_lab.py 的 [A1] 必须是 192 / 192 完全一致,[A2] 的相对误差在 $10^{-7}$ 量级。如果你的 [A2] 是 $10^{-2}$ 量级,九成是参照解喂多了 token([A] 段注释里那个 off-by-one,我第一版就踩了)。paged_alloc.py 的 [A]:均匀负载 122 → 214(1.75x),重尾负载 122 → 405(3.32x);[B] 两类浪费之比约 239 倍。想自己碰一下边界?改 kv_cache_lab.py 顶部的 CFG["n_kv_head"](从 2 改到 8,变成 MHA),再跑一遍:缓存载荷变 4 倍,但投影结构、临时复制与两条路线的耗时也会变化,实测加速比不保证单调。NumPy 的 repeat 会削弱理想 GQA 访存收益,因此这个实验不能直接验证 GPU 带宽模型。
09 节用到的脚本全文如下(kv_cache_lab.py、paged_alloc.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""KV Cache 实验室。

三个问题,全部用可复现的实跑回答,不靠记忆里的结论:

  [A] 增量解码(用缓存)和「每步把整个前缀重算一遍」,得到的到底是不是同一个东西?
      以及真实加速比是多少、算力量省了多少倍。
  [B] 缓存自己要吃掉多少显存?按 Llama-3-8B 的真实配置算一遍,
      再算一遍自回归视频的 token 数,看哪个先爆。
  [C] decode 一步的算术强度为什么和上下文长度无关?把它放到 Roofline 上看。

纯 numpy,不需要 torch / scipy。

    python kv_cache_lab.py ALL     # 全部,约 30 秒
    python kv_cache_lab.py A       # 只跑等价性与加速比
    python kv_cache_lab.py B       # 只跑显存账本
    python kv_cache_lab.py C       # 只跑算术强度与 Roofline
"""

from __future__ import annotations

import argparse
import json
import math
import os
import time

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))

# 玩具模型的配置:刻意做成 GQA(8 个 q 头共享 2 个 kv 头,g = 4),
# 它是常见的一种结构;MHA 是 g = 1 的特例,其他模型也可能采用 MQA/MLA。
CFG = dict(
    n_layer=4,
    n_q_head=8,
    n_kv_head=2,
    d_head=32,
    ffn_mult=4,
    prompt=16,
    gen=192,
    vocab=32,
    dtype_bytes=4,      # 玩具模型用 fp32 跑,记账就按 4 字节
)


def d_model(cfg=CFG):
    return cfg["n_q_head"] * cfg["d_head"]


# ══════════════════════════════════════════════════════════════
# 0. 一个能跑的小 Transformer decoder
# ══════════════════════════════════════════════════════════════

def make_weights(cfg=CFG, seed=0):
    rng = np.random.default_rng(seed)
    D = d_model(cfg)
    Dk = cfg["n_kv_head"] * cfg["d_head"]
    F = cfg["ffn_mult"] * D
    s = 1.0 / math.sqrt(D)
    blocks = []
    for _ in range(cfg["n_layer"]):
        blocks.append(dict(
            wq=rng.normal(0, s, (D, D)).astype(np.float32),
            wk=rng.normal(0, s, (D, Dk)).astype(np.float32),
            wv=rng.normal(0, s, (D, Dk)).astype(np.float32),
            wo=rng.normal(0, s, (D, D)).astype(np.float32),
            w1=rng.normal(0, s, (D, F)).astype(np.float32),
            w2=rng.normal(0, s, (F, D)).astype(np.float32),
        ))
    E = rng.normal(0, s, (cfg["vocab"], D)).astype(np.float32)   # token embedding
    head = rng.normal(0, s, (D, cfg["vocab"])).astype(np.float32)
    return blocks, E, head


def rmsnorm(x, eps=1e-8):
    return x / np.sqrt(np.mean(x * x, axis=-1, keepdims=True) + eps)


def attn_full(Q, K, V):
    """完整因果注意力。Q:[S,Hq,Dh]  K/V:[S,Hkv,Dh]  ->  [S,Hq,Dh]"""
    S, Hq, Dh = Q.shape
    g = Hq // K.shape[1]
    Kk = np.repeat(K, g, axis=1)
    Vv = np.repeat(V, g, axis=1)
    logits = np.einsum("qhd,khd->hqk", Q, Kk) / np.sqrt(Dh)      # [Hq,S,S]
    mask = np.triu(np.ones((S, S), dtype=bool), 1)
    logits = np.where(mask[None, :, :], -np.inf, logits)
    logits = logits - logits.max(axis=-1, keepdims=True)
    p = np.exp(logits)
    p = p / p.sum(axis=-1, keepdims=True)
    return np.einsum("hqk,khd->qhd", p, Vv)


def attn_step(q, K, V):
    """单步注意力:一个 query 对长度 S 的缓存。q:[Hq,Dh] K/V:[S,Hkv,Dh] -> [Hq,Dh]"""
    Hq, Dh = q.shape
    g = Hq // K.shape[1]
    Kk = np.repeat(K, g, axis=1)
    Vv = np.repeat(V, g, axis=1)
    logits = np.einsum("hd,khd->hk", q, Kk) / np.sqrt(Dh)        # [Hq,S]
    logits = logits - logits.max(axis=-1, keepdims=True)
    p = np.exp(logits)
    p = p / p.sum(axis=-1, keepdims=True)
    return np.einsum("hk,khd->hd", p, Vv)


def block_forward(x, w, cfg=CFG, cache=None, base=0):
    """对一个前缀做完整因果前向。x:[S,D] -> [S,D]。
    cache 不为 None 时,顺手把这一层的 K/V 写进 cache[base:base+S]。"""
    S, D = x.shape
    hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"]
    h = rmsnorm(x)
    Q = (h @ w["wq"]).reshape(S, hq, dh)
    K = (h @ w["wk"]).reshape(S, hkv, dh)
    V = (h @ w["wv"]).reshape(S, hkv, dh)
    if cache is not None:
        cache["k"][base:base + S] = K
        cache["v"][base:base + S] = V
    o = attn_full(Q, K, V).reshape(S, D)
    x = x + o @ w["wo"]
    x = x + np.maximum(x @ w["w1"], 0.0) @ w["w2"]
    return x


def block_step(x_new, w, cache, pos, cfg=CFG):
    """decode 一步:只算新 token。x_new:[1,D] -> [1,D],并把它的 K/V 写进 pos。"""
    D = x_new.shape[1]
    hq, hkv, dh = cfg["n_q_head"], cfg["n_kv_head"], cfg["d_head"]
    h = rmsnorm(x_new)
    q = (h @ w["wq"]).reshape(hq, dh)
    k = (h @ w["wk"]).reshape(hkv, dh)
    v = (h @ w["wv"]).reshape(hkv, dh)
    cache["k"][pos] = k
    cache["v"][pos] = v
    o = attn_step(q, cache["k"][:pos + 1], cache["v"][:pos + 1]).reshape(1, hq * dh)
    y = x_new + o @ w["wo"]
    y = y + np.maximum(y @ w["w1"], 0.0) @ w["w2"]
    return y


def new_cache(cfg=CFG, total=None):
    total = total or (cfg["prompt"] + cfg["gen"])
    return [dict(k=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32),
                 v=np.zeros((total, cfg["n_kv_head"], cfg["d_head"]), np.float32))
            for _ in range(cfg["n_layer"])]


# ══════════════════════════════════════════════════════════════
# [A] 等价性与加速比
# ══════════════════════════════════════════════════════════════

def gen_naive(blocks, E, head, prompt_tokens, cfg=CFG):
    """不用缓存:每一步把整个前缀重算一遍,只取最后一个位置的输出。"""
    X = E[prompt_tokens].copy()
    toks, last_logits = [], None
    for _ in range(cfg["gen"]):
        h = X
        for w in blocks:
            h = block_forward(h, w, cfg)
        logits = h[-1] @ head
        tok = int(np.argmax(logits))
        toks.append(tok)
        last_logits = logits
        X = np.vstack([X, E[tok][None, :]])
    return toks, last_logits


def gen_cached(blocks, E, head, prompt_tokens, cfg=CFG):
    """用 KV cache:prefill 一次,之后每步只算一个新 token。"""
    total = cfg["prompt"] + cfg["gen"]
    caches = new_cache(cfg, total)
    X = E[prompt_tokens].copy()
    h = X
    for i, w in enumerate(blocks):
        h = block_forward(h, w, cfg, cache=caches[i], base=0)
    pos = len(prompt_tokens) - 1
    h_last = h[-1:]
    toks, last_logits = [], None
    for t in range(cfg["gen"]):
        logits = h_last[0] @ head
        tok = int(np.argmax(logits))
        toks.append(tok)
        last_logits = logits
        if t == cfg["gen"] - 1:
            break  # 已得到最后一个预测,不再做一次未使用的 decode
        x_new = E[tok][None, :]
        pos += 1
        h_new = x_new
        for i, w in enumerate(blocks):
            h_new = block_step(h_new, w, caches[i], pos, cfg)
        h_last = h_new
    return toks, last_logits, caches


def forward_full(blocks, E, head, tokens, cfg=CFG):
    """一次性对整段 token 做完整前向(参照解)。"""
    h = E[tokens]
    for w in blocks:
        h = block_forward(h, w, cfg)
    return h[-1] @ head


def flops_full(S, cfg=CFG):
    """一次长度 S 的完整因果前向的 FLOPs(只算矩阵乘,2*macs)。"""
    D = d_model(cfg)
    Dk = cfg["n_kv_head"] * cfg["d_head"]
    F = cfg["ffn_mult"] * D
    per_layer = (2 * (D * D)        # wq
                 + 2 * (D * Dk)     # wk
                 + 2 * (D * Dk)     # wv
                 + 2 * (D * D)      # wo
                 + 2 * (D * F)      # w1
                 + 2 * (F * D))     # w2
    # 实际代码只对最后一个位置计算输出头,计 2*D*vocab FLOP。
    proj = cfg["n_layer"] * S * per_layer + 2 * D * cfg["vocab"]
    # NumPy 实现先做完整密集矩阵乘再掩码,不能按跳过上三角计数。
    attn = cfg["n_layer"] * 4 * cfg["n_q_head"] * cfg["d_head"] * S * S
    return proj + attn


def flops_step(S, cfg=CFG):
    """decode 一步(上下文长度 S)的 FLOPs。"""
    D = d_model(cfg)
    Dk = cfg["n_kv_head"] * cfg["d_head"]
    F = cfg["ffn_mult"] * D
    per_layer = (2 * (D * D) + 2 * (D * Dk) + 2 * (D * Dk)
                 + 2 * (D * D) + 2 * (D * F) + 2 * (F * D))
    proj = cfg["n_layer"] * per_layer + 2 * D * cfg["vocab"]
    attn = cfg["n_layer"] * 2 * (2 * cfg["n_q_head"] * cfg["d_head"] * S)
    return proj + attn


def section_A(cfg=CFG):
    print("=" * 72)
    print("[A] 增量解码 vs 每步全量重算")
    print("=" * 72)
    blocks, E, head = make_weights(cfg)
    rng = np.random.default_rng(7)
    prompt_tokens = list(rng.integers(0, cfg["vocab"], cfg["prompt"]))

    S_end = cfg["prompt"] + cfg["gen"]

    # ── A1 缓存路线 ──
    t0 = time.perf_counter()
    toks_c, logits_c, caches = gen_cached(blocks, E, head, prompt_tokens, cfg)
    t_cached = time.perf_counter() - t0

    # ── A2 无缓存路线 ──
    t0 = time.perf_counter()
    toks_n, logits_n = gen_naive(blocks, E, head, prompt_tokens, cfg)
    t_naive = time.perf_counter() - t0

    # ── A3 参照解:一次性完整前向 ──
    # 对齐位置很容易错:最后一步的 logits 是在「倒数第二个 token」上算出来的
    # (它用来预测最后一个 token),所以参照解只能喂到 toks_c[:-1]。
    # 多喂一个 token,比的就是下一步的 logits 了。
    all_tokens = list(prompt_tokens) + toks_c[:-1]
    logits_ref = forward_full(blocks, E, head, all_tokens, cfg)

    same = sum(1 for a, b in zip(toks_c, toks_n) if a == b)
    dif = float(np.max(np.abs(logits_c - logits_ref)))
    scale = float(np.max(np.abs(logits_ref)))
    assert same == cfg["gen"], "token sequences differ"
    assert dif <= 1e-5 * max(scale, 1.0), "cached/full logits mismatch"

    print("\n[A1] 两条路线生成的 token 序列")
    print(f"    序列长度          : {cfg['gen']}")
    print(f"    完全一致的 token  : {same} / {cfg['gen']}")

    print("\n[A2] 缓存路线最后一步的 logits vs 一次性完整前向(参照解)")
    print(f"    max |Δ|           : {dif:.3e}")
    print(f"    参照解的量级      : {scale:.6f}")
    print(f"    相对误差          : {dif / scale:.3e}")

    # ── A4 算力账 ──
    f_naive = sum(flops_full(cfg["prompt"] + t, cfg) for t in range(cfg["gen"]))
    f_cached = (flops_full(cfg["prompt"], cfg)
                + sum(flops_step(cfg["prompt"] + t, cfg) for t in range(1, cfg["gen"])))

    print("\n[A3] 算力账(解析计数,单位 FLOP)")
    print(f"    无缓存总算力      : {f_naive:.4e}")
    print(f"    有缓存总算力      : {f_cached:.4e}")
    print(f"    算力节省倍数      : {f_naive / f_cached:.2f}x")

    print("\n[A4] 真实墙钟(同一台机器,各跑一次)")
    print(f"    无缓存            : {t_naive:.3f} s")
    print(f"    有缓存            : {t_cached:.3f} s")
    print(f"    实测加速比        : {t_naive / t_cached:.2f}x")
    print(f"    (算力省了 {f_naive / f_cached:.1f}x,墙钟只快 {t_naive / t_cached:.1f}x —— "
          f"差额还含 Python、分配、KV 复制和小矩阵效率,不能仅归因于带宽)")

    return dict(
        gen=cfg["gen"], same_tokens=same, max_diff=dif, ref_scale=scale,
        flops_naive=f_naive, flops_cached=f_cached,
        flops_ratio=f_naive / f_cached,
        t_naive=t_naive, t_cached=t_cached, speedup=t_naive / t_cached,
        seq_end=S_end,
    )


# ══════════════════════════════════════════════════════════════
# [B] 显存账本
# ══════════════════════════════════════════════════════════════

# Llama-3-8B 的公开配置
LLAMA3_8B = dict(name="Llama-3-8B", n_layer=32, n_q_head=32, n_kv_head=8,
                 d_head=128, params=8.03e9, dtype_bytes=2)


def kv_bytes_per_token(cfg, n_kv_head=None):
    """每个 token 的 KV cache 字节数(所有层)。"""
    nkv = cfg["n_kv_head"] if n_kv_head is None else n_kv_head
    return 2 * cfg["n_layer"] * nkv * cfg["d_head"] * cfg["dtype_bytes"]


def kv_bytes_total(cfg, S, batch, n_kv_head=None):
    return kv_bytes_per_token(cfg, n_kv_head) * S * batch


def section_B():
    print("\n" + "=" * 72)
    print("[B] KV cache 自己吃掉多少显存")
    print("=" * 72)

    c = LLAMA3_8B
    bpt = kv_bytes_per_token(c)
    print("\n[B1] 每个 token 的 KV cache(Llama-3-8B,BF16)")
    print(f"    2 (K,V) x {c['n_layer']} 层 x {c['n_kv_head']} kv头 x {c['d_head']} 维 x 2 字节")
    print(f"    = {bpt} 字节/token = {bpt / 1024:.0f} KiB/token")
    print(f"    8192 token 一条序列 = {bpt * 8192 / (1024**3):.4f} GiB")

    w_bytes = c["params"] * c["dtype_bytes"]
    print(f"\n[B2] 和权重比一比(权重 {w_bytes / (1024**3):.2f} GiB)")
    print(f"    {'batch':>6}  {'seq':>6}  {'KV cache':>12}  {'KV/权重':>9}  {'合计':>10}")
    rows = []
    for batch, S in [(1, 8192), (8, 8192), (16, 8192), (32, 8192), (64, 8192), (32, 32768)]:
        kb = kv_bytes_total(c, S, batch)
        rows.append(dict(batch=batch, seq=S, kv=kb,
                         total=kb + w_bytes, ratio=kb / w_bytes))
        print(f"    {batch:>6}  {S:>6}  {kb / (1024**3):>9.2f} GiB  "
              f"{kb / w_bytes:>8.2f}x  {(kb + w_bytes) / (1024**3):>7.2f} GiB")

    # MHA 对照
    bpt_mha = kv_bytes_per_token(c, n_kv_head=c["n_q_head"])
    print(f"\n[B3] 如果换成 MHA(32 个 kv 头而不是 8 个)")
    print(f"    {bpt_mha} 字节/token = {bpt_mha / 1024:.0f} KiB/token"
          f"  (GQA 的 {bpt_mha / bpt:.0f} 倍)")
    print(f"    batch=32 / seq=8192 时:"
          f"{kv_bytes_total(c, 8192, 32, c['n_q_head']) / (1024**3):.2f} GiB"
          f"  vs  GQA {kv_bytes_total(c, 8192, 32) / (1024**3):.2f} GiB")

    # ── 视频 ──
    print("\n[B4] 自回归视频:token 数先把你压垮")
    vcfg = dict(c, dtype_bytes=2)
    cases = []
    for name, frames, tf, h, w, fps, sec in [
        ("5s 720p", 120, 4, 1280, 720, 24, 5),
        ("10s 720p", 240, 4, 1280, 720, 24, 10),
        ("30s 720p", 720, 4, 1280, 720, 24, 30),
    ]:
        lat_frames = frames // tf
        tok_per_frame = (h // 8) * (w // 8)          # 空间 8x8 压缩
        ntok = lat_frames * tok_per_frame
        kb = ntok * bpt
        cases.append(dict(name=name, lat_frames=lat_frames,
                          tok_per_frame=tok_per_frame, ntok=ntok, kv=kb))
        print(f"    {name:>8}: 潜在帧 {lat_frames:>3} x 每帧 {tok_per_frame:>5} token"
              f" = {ntok:>8} token  ->  KV cache {kb / (1024**3):>8.2f} GiB(单条视频)")

    return dict(bytes_per_token=bpt, bytes_per_token_mha=bpt_mha,
                weight_bytes=w_bytes, rows=rows, video=cases)


# ══════════════════════════════════════════════════════════════
# [C] 算术强度与 Roofline
# ══════════════════════════════════════════════════════════════

def probe_peak(n=3072, n_bytes=20_000_000, repeat=5):
    """本机标定:峰值算力(大矩阵乘)与峰值带宽(大数组流式读写)。

    带宽不能用 x.sum() 测:标量归约是延迟受限的,实测只有 23 GB/s,
    而同一块内存的流式读写能到 75 GB/s。差 3 倍,用错了整个 Roofline 就歪了。
    这里取几种流式算子里最快的一个。
    """
    rng = np.random.default_rng(0)
    a = rng.normal(size=(n, n)).astype(np.float32)
    b = rng.normal(size=(n, n)).astype(np.float32)
    best = float("inf")
    for _ in range(repeat):
        t0 = time.perf_counter()
        a @ b
        best = min(best, time.perf_counter() - t0)
    peak_flops = 2.0 * n ** 3 / best

    x = rng.normal(size=n_bytes).astype(np.float32)
    y = np.empty_like(x)
    best = float("inf")
    for fn in (lambda: np.copyto(y, x), lambda: np.add(x, 1.0, out=y)):
        for _ in range(4):
            t0 = time.perf_counter()
            fn()
            best = min(best, time.perf_counter() - t0)
    peak_bw = (2 * x.nbytes) / best      # 读一份 + 写一份
    return peak_flops, peak_bw


def intensity_decode(g, dtype_bytes=2):
    """decode 一步「注意力部分」的算术强度 I = 2g/p,与上下文长度无关。"""
    return 2.0 * g / dtype_bytes


def section_C():
    print("\n" + "=" * 72)
    print("[C] 算术强度:为什么上下文再长,decode 也改善不了")
    print("=" * 72)

    print("\n[C1] decode 一步的注意力部分(上下文长度 S,GQA 分组数 g,dtype 字节 p)")
    print("    算力 = 4 * n_q * d * S           (QK^T 与 AV 各 2*n_q*d*S)")
    print("    访存 = 2 * n_kv * d * S * p      (K、V 各一份)")
    print("    I    = 4 n_q d S / (2 n_kv d S p) = 2 (n_q/n_kv) / p = 2g/p")
    print("    —— 理想融合注意力中 S 被约去;不代表实际 kernel 效率随 S 不变。")
    print()
    print(f"    {'g (n_q/n_kv)':>12}  {'I = 2g/p (BF16)':>16}")
    rows_g = []
    for g in [1, 2, 4, 8, 16, 32]:
        I = intensity_decode(g, 2)
        rows_g.append(dict(g=g, I=I))
        print(f"    {g:>12}  {I:>16.1f}")

    # ── prefill 对照 ──
    c = LLAMA3_8B
    D = c["n_q_head"] * c["d_head"]
    print("\n[C2] prefill 的算术强度(Llama-3-8B,S=8192)")
    S = 8192
    attn_flops = c["n_layer"] * 2 * (2 * c["n_q_head"] * c["d_head"] * S * (S + 1) / 2)
    proj_flops = 2 * c["params"] * S  # 粗略 2NS 估计,不是逐层实测 FLOPs
    w_bytes = c["params"] * c["dtype_bytes"]
    act_bytes = c["n_layer"] * 10 * S * D * c["dtype_bytes"]
    I_pre = (attn_flops + proj_flops) / (w_bytes + act_bytes)
    print(f"    注意力算力        : {attn_flops / 1e12:.2f} TFLOP")
    print(f"    投影层算力        : {proj_flops / 1e12:.2f} TFLOP   <--  dominates")
    print(f"    访存(权重+激活): {(w_bytes + act_bytes) / (1024**3):.2f} GiB")
    print(f"    I_prefill         : {I_pre:.1f} FLOP/byte")

    # ── Roofline ──
    peak_flops, peak_bw = probe_peak()
    ridge = peak_flops / peak_bw
    print("\n[C3] 本机标定(numpy / CPU,实跑)")
    print(f"    峰值算力  : {peak_flops / 1e9:.2f} GFLOP/s")
    print(f"    峰值带宽  : {peak_bw / 1e9:.2f} GB/s")
    print(f"    山脊点    : {ridge:.2f} FLOP/byte")

    # A100-80GB 公开规格
    a100 = dict(flops=312e12, bw=2.039e12)
    print(f"\n    A100-80GB(公开规格,非实测):{a100['flops'] / 1e12:.0f} TFLOP/s BF16 / "
          f"{a100['bw'] / 1e12:.2f} TB/s  ->  山脊点 {a100['flops'] / a100['bw']:.1f} FLOP/byte")

    print("\n[C4] 理想注意力 Roofline:CPU 按 FP32 (I 为 BF16 的一半),A100 按 BF16")
    print(f"    {'工作负载':>18}  {'I':>10}  {'本机判定':>10}  {'A100 判定':>10}")
    pts = []
    for g in [1, 4, 8]:
        I = intensity_decode(g, 2)
        pts.append(dict(name=f"decode g={g}", I=I,
                        I_local=I / 2, local="带宽" if I / 2 < ridge else "算力",
                        a100="带宽" if I < a100["flops"] / a100["bw"] else "算力"))
        print(f"    {f'decode g={g}':>18}  {I:>10.1f}  {pts[-1]['local']:>10}  {pts[-1]['a100']:>10}")
    pts.append(dict(name="prefill S=8192", I=I_pre,
                    I_local=I_pre / 2, local="带宽" if I_pre / 2 < ridge else "算力",
                    a100="带宽" if I_pre < a100["flops"] / a100["bw"] else "算力"))
    print(f"    {'prefill S=8192':>18}  {I_pre:>10.1f}  {pts[-1]['local']:>10}  {pts[-1]['a100']:>10}")

    return dict(rows_g=rows_g, I_prefill=I_pre, I_prefill_local=I_pre / 2,
                peak_flops=peak_flops, peak_bw=peak_bw, ridge=ridge,
                a100_flops=a100["flops"], a100_bw=a100["bw"],
                a100_ridge=a100["flops"] / a100["bw"], points=pts)


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("which", nargs="?", default="ALL")
    args = ap.parse_args()
    w = args.which.upper()
    out = {}
    if w in ("ALL", "A"):
        out["A"] = section_A()
    if w in ("ALL", "B"):
        out["B"] = section_B()
    if w in ("ALL", "C"):
        out["C"] = section_C()
    if w == "ALL":
        with open(os.path.join(HERE, "_kv_results.json"), "w", encoding="utf-8") as f:
            json.dump(out, f, ensure_ascii=False, indent=1)
        print("\n结果已写入 _kv_results.json(画图脚本读它,避免图上的数字和正文漂移)")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""PagedAttention 的分页分配,到底省在哪。
KV cache 有一个和别的张量都不一样的地方:**它是在请求进行中一点点长出来的**。
你事先不知道这条请求最终会有多长,所以要么按最大长度预留(浪费),
要么让它能非连续地增长(分页)。这个脚本把两种做法放在同一个显存预算下对比。
[A] 同一个显存预算,两种分配策略各能同时服务多少条请求
[B] 浪费来自哪里:预留浪费 vs 块内碎片
[C] 块大小怎么选:越小越省,但不是越小越好
python paged_alloc.py ALL
"""
from __future__ import annotations
import argparse
import json
import math
import os
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
# Llama-3-8B / BF16 在假设 80 GiB 总预算下的账(不是设备可用显存实测)(与 kv_cache_lab.py [B] 同源)
N_LAYER, N_KV, D_HEAD, DTYPE = 32, 8, 128, 2
BYTES_PER_TOKEN = 2 * N_LAYER * N_KV * D_HEAD * DTYPE # 131072 = 128 KiB
GPU_BYTES = 80 * (1024 ** 3)
WEIGHT_BYTES = 8.03e9 * DTYPE
OTHER_BYTES = 4 * (1024 ** 3) # 激活 / 框架 / 碎片余量
MAX_LEN = 4096
def budget_tokens():
return int((GPU_BYTES - WEIGHT_BYTES - OTHER_BYTES) // BYTES_PER_TOKEN)
def workload(kind, n=4000, seed=11):
"""两种典型负载:长度均匀的(批处理)和重尾的(线上对话)。"""
rng = np.random.default_rng(seed)
if kind == "uniform":
lens = rng.integers(512, MAX_LEN + 1, n)
else: # heavy:八成短请求、两成长请求
short = rng.integers(256, 1025, int(n * 0.8))
long_ = rng.integers(3072, MAX_LEN + 1, n - int(n * 0.8))
lens = np.concatenate([short, long_])
rng.shuffle(lens)
return lens
def admit(lens, bytes_each, budget):
"""贪心接纳:按请求顺序一直加,直到预算装不下。返回接纳条数。"""
used, k = 0, 0
for b in bytes_each:
if used + b > budget:
break
used += b
k += 1
return k, used
def section_A():
print("=" * 72)
print("[A] 同一块显存,两种分配策略能同时服务多少条请求")
print("=" * 72)
cap = budget_tokens()
budget = cap * BYTES_PER_TOKEN
print(f"\n显存预算:80 GiB - 权重 {WEIGHT_BYTES / (1024**3):.2f} GiB"
f" - 其他 {OTHER_BYTES / (1024**3):.0f} GiB = {budget / (1024**3):.2f} GiB")
print(f"折合 token 容量 : {cap} tokens({BYTES_PER_TOKEN} B/token)")
out = {}
for kind, label in [("uniform", "长度均匀 512~4096"), ("heavy", "重尾:八成 256~1024")]:
print(f"\n--- 负载:{label} ---")
lens = workload(kind)
b_cont = np.full(len(lens), MAX_LEN * BYTES_PER_TOKEN) # 按最大长度预留
b_paged = (np.ceil(lens / 16) * 16) * BYTES_PER_TOKEN # 分页,块 16
k_c, u_c = admit(lens, b_cont, budget)
k_p, u_p = admit(lens, b_paged, budget)
used_tok_c = lens[:k_c].sum()
used_tok_p = lens[:k_p].sum()
util_c = used_tok_c * BYTES_PER_TOKEN / u_c
util_p = used_tok_p * BYTES_PER_TOKEN / u_p
print(f" {'策略':>12} {'并发请求':>9} {'占用':>10} {'真实用到':>10} {'利用率':>8}")
print(f" {'连续预留':>12} {k_c:>9} {u_c / (1024**3):>7.2f} GiB "
f"{used_tok_c * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_c:>7.2%}")
print(f" {'分页(块16)':>12} {k_p:>9} {u_p / (1024**3):>7.2f} GiB "
f"{used_tok_p * BYTES_PER_TOKEN / (1024**3):>7.2f} GiB {util_p:>7.2%}")
print(f" 并发提升 : {k_p / k_c:.2f}x")
out[kind] = dict(k_cont=int(k_c), k_paged=int(k_p),
util_cont=float(util_c), util_paged=float(util_p),
gain=float(k_p / k_c),
bytes_cont=float(u_c), bytes_paged=float(u_p),
real_cont=float(used_tok_c * BYTES_PER_TOKEN),
real_paged=float(used_tok_p * BYTES_PER_TOKEN))
out["cap_tokens"] = cap
out["budget_bytes"] = float(budget)
return out
def section_B():
print("\n" + "=" * 72)
print("[B] 浪费的两半:预留浪费 和 块内碎片")
print("=" * 72)
lens = workload("uniform")
bs = 16
reserve_waste = (MAX_LEN - lens).mean() * BYTES_PER_TOKEN
frag = ((np.ceil(lens / bs) * bs) - lens).mean() * BYTES_PER_TOKEN
print(f"\n每条请求的平均长度 : {lens.mean():.1f} tokens")
print(f"连续预留的浪费/条 : {reserve_waste / (1024**2):.2f} MiB"
f"(预留 {MAX_LEN},平均只用 {lens.mean():.0f})")
print(f"分页的块内碎片/条 : {frag / (1024**2):.2f} MiB"
f"(只有最后一个块没填满,余数均匀时约 {(bs - 1) / 2} 个空槽)")
print(f"两者之比 : {reserve_waste / frag:.1f}x")
print("\n分页把「不知道会多长」这个不确定性,从「按最坏情况预留」"
"换成了「最多浪费一个块」——这是整个设计的关键一跳。")
return dict(reserve_waste=float(reserve_waste), frag=float(frag),
ratio=float(reserve_waste / frag), mean_len=float(lens.mean()))
def section_C():
print("\n" + "=" * 72)
print("[C] 块大小怎么选")
print("=" * 72)
lens = workload("uniform")
mean_len = lens.mean()
print(f"\n平均请求长度 {mean_len:.1f} tokens。块越大,最后一块的空槽越多;"
f"块越小,块表越长、kernel 里要 Gather 的次数越多。")
print(f"\n {'块大小':>6} {'碎片/条':>10} {'理论利用率':>10} {'块表条目/请求':>14}")
rows = []
for bs in [1, 4, 8, 16, 32, 64, 128, 256]:
frag = ((np.ceil(lens / bs) * bs) - lens).mean()
util = mean_len / (mean_len + frag)
nblk = float(np.ceil(lens / bs).mean())
rows.append(dict(bs=bs, frag=float(frag), util=float(util), nblk=nblk))
print(f" {bs:>6} {frag:>8.1f} tk {util:>9.3%} {nblk:>14.1f}")
print("\n长度模 bs 的余数均匀时,块内空槽期望为 (bs-1)/2;"
"真实碎片取决于长度分布。16 或 32 是常见候选,需实测:"
"本例平均长度约 2310,16/32 块约有 0.32%/0.67% 空槽;元数据和 kernel 开销另计。")
return dict(rows=rows, mean_len=float(mean_len))
def main():
ap = argparse.ArgumentParser()
ap.add_argument("which", nargs="?", default="ALL")
w = ap.parse_args().which.upper()
out = {}
if w in ("ALL", "A"):
out["A"] = section_A()
if w in ("ALL", "B"):
out["B"] = section_B()
if w in ("ALL", "C"):
out["C"] = section_C()
if w == "ALL":
# 画图用的示意数据:3 条请求怎么被切成块
lens = [37, 21, 45]
bs = 16
seqs = []
for i, L in enumerate(lens):
seqs.append(dict(idx=i, length=L,
n_blocks=int(math.ceil(L / bs)),
last_used=L % bs or bs))
out["demo"] = dict(block_size=bs, seqs=seqs)
with open(os.path.join(HERE, "_paged_results.json"), "w", encoding="utf-8") as f:
json.dump(out, f, ensure_ascii=False, indent=1)
print("\n结果已写入 _paged_results.json")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
make_figures.py —— 画本文的 4 张配图。
数据全部来自已经跑完的实验(_kv_results.json / _paged_results.json),
不在这里重新算,避免图上的数字和正文漂移。
运行:
python make_figures.py
"""
from __future__ import annotations
import json
import os
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
import numpy as np
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(HERE, "..", "figures")
try:
os.makedirs(FIGDIR, exist_ok=True)
except FileExistsError:
pass
# 配色(正文里写「这张图要看什么」时按这六个名字来描述)
C_MAIN = "#1f4e79" # 深蓝:主曲线
C_ALT = "#c1440e" # 橙红:对照曲线
C_GREEN = "#2e7d32" # 绿:第三组
C_PURPLE = "#7b1fa2" # 紫:标注线
C_GRAY = "#8a8a8a" # 灰:参考线
C_LIGHT = "#bcd7ee" # 浅蓝:填充
C_RED = "#b71c1c" # 红:越界线
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.dpi"] = 130
plt.rcParams["savefig.dpi"] = 130
def _load(name):
p = os.path.join(HERE, name)
if not os.path.exists(p):
raise SystemExit(f"缺少 {name},先跑 kv_cache_lab.py ALL / paged_alloc.py ALL")
with open(p, encoding="utf-8") as f:
return json.load(f)
GIB = float(1024 ** 3)
# ══════════════════════════════════════════════════════════════
# 图 1:显存账本
# ══════════════════════════════════════════════════════════════
def fig_mem_ledger(res):
B = res["B"]
w = B["weight_bytes"]
bpt, bpt_mha = B["bytes_per_token"], B["bytes_per_token_mha"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9))
# ── 左:batch 扫描下的显存构成 ──
batches = [1, 8, 16, 32, 64, 128]
seq = 8192
kv = [bpt * seq * b for b in batches]
others = 4 * GIB
xs = np.arange(len(batches))
ax1.bar(xs, [w / GIB] * len(batches), color=C_MAIN, label="模型权重(14.96 GiB)")
ax1.bar(xs, [k / GIB for k in kv], bottom=[w / GIB] * len(batches),
color=C_ALT, label="KV cache")
ax1.bar(xs, [others / GIB] * len(batches),
bottom=[(w + k) / GIB for k in kv], color=C_LIGHT, label="激活 / 框架 / 余量")
ax1.axhline(80, color=C_RED, ls="--", lw=1.6)
ax1.text(0.05, 81.4, "假设总预算 80 GiB", color=C_RED, fontsize=9)
ax1.set_xticks(xs)
ax1.set_xticklabels([str(b) for b in batches])
ax1.set_xlabel("batch size")
ax1.set_ylabel("显存(GiB)")
ax1.set_title("显存账本:batch 一大,权重就不再是主角", fontsize=11)
ax1.legend(fontsize=8, loc="upper left")
ax1.set_ylim(0, 200)
# ── 右:序列长度扫描,GQA vs MHA ──
seqs = np.array([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536, 131072])
for b in (1, 8):
ax2.plot(seqs, bpt * seqs * b / GIB, "-o", ms=3.5,
color=C_MAIN if b == 1 else C_ALT,
label=f"GQA batch={b}")
ax2.plot(seqs, bpt_mha * seqs * 8 / GIB, "--s", ms=3.5, color=C_PURPLE,
label="MHA batch=8(kv 头 32 个)")
ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4)
ax2.text(seqs[0], 66, "KV 预算约 61 GiB", color=C_GRAY, fontsize=8.5)
ax2.axhline(80, color=C_RED, ls="--", lw=1.4)
ax2.text(seqs[0] * 1.6, 88, "80 GiB 显存上限", color=C_RED, fontsize=8.5)
ax2.set_xscale("log", base=2)
ax2.set_yscale("log")
ax2.set_xlabel("每条序列的长度(token)")
ax2.set_ylabel("KV cache(GiB,对数刻度)")
ax2.set_title("KV cache 随长度线性增长,随 batch 线性增长", fontsize=11)
ax2.legend(fontsize=8)
ax2.grid(alpha=0.25, which="both")
fig.tight_layout()
p = os.path.join(FIGDIR, "fig_mem_ledger.png")
fig.savefig(p, bbox_inches="tight")
plt.close(fig)
print(" ", os.path.basename(p))
# ══════════════════════════════════════════════════════════════
# 图 2:Roofline
# ══════════════════════════════════════════════════════════════
def fig_roofline(res):
C = res["C"]
pf, pb = C["peak_flops"], C["peak_bw"]
ridge = pf / pb
af, ab = C["a100_flops"], C["a100_bw"]
aridge = af / ab
pts = [(1, "decode g=1(MHA)", C_RED), (4, "decode g=4(GQA)", C_GREEN),
(8, "decode g=8", C_PURPLE), (C["I_prefill"], "prefill S=8192", C_MAIN)]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 5.2))
I = np.logspace(-1, 5, 400)
# ── 左:本机(实跑标定,GFLOP/s)──
ax1.plot(I, np.minimum(pf, I * pb) / 1e9, color=C_MAIN, lw=2.0)
ax1.fill_betweenx([1e-2, pf / 1e9 * 2], 1e-1, ridge, color=C_LIGHT, alpha=0.3)
ax1.axvline(ridge, color=C_MAIN, ls=":", lw=1.2)
ax1.text(ridge * 1.12, 3.0, f"山脊点 {ridge:.0f}", color=C_MAIN, fontsize=8.5,
rotation=90, va="bottom")
for i, name, col in pts:
i = i / 2 # 本机峰值来自 FP32,字节数是 BF16 的两倍
y = min(pf, i * pb) / 1e9
ax1.plot([i], [y], "o", ms=8, color=col, zorder=5)
off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3)
ax1.annotate(name, (i, y), textcoords="offset points",
xytext=off, fontsize=8.5, color=col)
ax1.text(0.13, pf / 1e9 * 1.35, "带宽受限区", color=C_MAIN, fontsize=9)
ax1.set_xscale("log")
ax1.set_yscale("log")
ax1.set_xlim(0.1, 1e4)
ax1.set_ylim(1.0, pf / 1e9 * 2.2)
ax1.set_xlabel("算术强度 I(FLOP / byte)")
ax1.set_ylabel("理论上界(GFLOP/s)")
ax1.set_title(f"本机 FP32 微基准屋顶:{pf / 1e9:.0f} GFLOP/s / {pb / 1e9:.0f} GB/s",
fontsize=10.5)
ax1.grid(alpha=0.25, which="both")
# ── 右:A100(公开规格,TFLOP/s)──
ax2.plot(I, np.minimum(af, I * ab) / 1e12, color=C_ALT, lw=2.0)
ax2.fill_betweenx([1e-2, af / 1e12 * 2], 1e-1, aridge, color="#f6d9c9", alpha=0.45)
ax2.axvline(aridge, color=C_ALT, ls=":", lw=1.2)
ax2.text(aridge * 1.12, 0.9, f"山脊点 {aridge:.0f}", color=C_ALT, fontsize=8.5,
rotation=90, va="bottom")
for i, name, col in pts:
y = min(af, i * ab) / 1e12
ax2.plot([i], [y], "o", ms=8, color=col, zorder=5)
off = (-108, -20) if i >= 100 else (7, -13 if i < 100 else -3)
ax2.annotate(name, (i, y), textcoords="offset points",
xytext=off, fontsize=8.5, color=col)
ax2.text(0.13, af / 1e12 * 1.35, "带宽受限区", color=C_ALT, fontsize=9)
ax2.set_xscale("log")
ax2.set_yscale("log")
ax2.set_xlim(0.1, 1e5)
ax2.set_ylim(0.3, af / 1e12 * 2.2)
ax2.set_xlabel("算术强度 I(FLOP / byte)")
ax2.set_ylabel("理论上界(TFLOP/s)")
ax2.set_title(f"A100-80GB(公开规格):{af / 1e12:.0f} TFLOP/s / {ab / 1e12:.2f} TB/s",
fontsize=10.5)
ax2.grid(alpha=0.25, which="both")
fig.suptitle("理想融合注意力的 Roofline 上界(点不是实测 kernel 性能)", fontsize=12, y=1.02)
fig.tight_layout()
p = os.path.join(FIGDIR, "fig_roofline.png")
fig.savefig(p, bbox_inches="tight")
plt.close(fig)
print(" ", os.path.basename(p))
# ══════════════════════════════════════════════════════════════
# 图 3:PagedAttention 的分页布局 + 并发对比
# ══════════════════════════════════════════════════════════════
def fig_paged(res):
demo = res.get("demo", {})
bs = demo.get("block_size", 16)
lens = [s["length"] for s in demo.get("seqs", [])] or [37, 21, 45, 29]
colors = [C_MAIN, C_ALT, C_GREEN, C_PURPLE, C_GRAY]
n_seq = len(lens)
# 模拟「边生成边分配」:每条请求轮流出 1 个 token,块不够了才申请新的
pos = [0] * n_seq
blocks = [[] for _ in range(n_seq)] # 逻辑块 -> 物理块号
phys_owner, phys_fill, phys_cap = [], [], []
while any(pos[i] < lens[i] for i in range(n_seq)):
for i in range(n_seq):
if pos[i] >= lens[i]:
continue
if pos[i] % bs == 0: # 需要一个新的物理块
phys_owner.append(i)
phys_fill.append(0)
phys_cap.append(bs)
blocks[i].append(len(phys_owner) - 1)
phys_fill[blocks[i][-1]] += 1
pos[i] += 1
n_phys = len(phys_owner) + 3 # 末尾留 3 个空块
fig = plt.figure(figsize=(12.6, 5.0))
gs = fig.add_gridspec(1, 2, width_ratios=[1.25, 1.0])
# ── 左:逻辑视图 -> 物理块池 ──
axL = fig.add_subplot(gs[0, 0])
axL.set_xlim(-0.6, n_phys + 0.6)
axL.set_ylim(-0.5, n_seq + 2.6)
axL.axis("off")
axL.set_title("逻辑块 → 物理块:请求可以非连续地长", fontsize=11, loc="left")
bw_l, bh = 0.82, 0.62
# 逻辑视图:每条请求一行,块连续排列
for i in range(n_seq):
y = n_seq - i + 1.35
axL.text(-0.5, y + bh / 2, f"请求 {i + 1}", fontsize=8.5, ha="right", va="center")
for j, p in enumerate(blocks[i]):
x = j * (bw_l + 0.06)
axL.add_patch(mpatches.Rectangle(
(x, y), bw_l, bh, facecolor=colors[i], alpha=0.30,
edgecolor=colors[i], lw=1.2))
used = phys_fill[p]
axL.add_patch(mpatches.Rectangle(
(x, y), bw_l * used / bs, bh, facecolor=colors[i], alpha=0.85))
if used < bs:
axL.text(x + bw_l * used / bs / 2, y + bh / 2, f"{used}/{bs}",
fontsize=6.4, ha="center", va="center", color="white")
# 物理块池:一行,按申请顺序排列
y_p = 0.15
axL.text(-0.5, y_p + bh / 2, "物理块池", fontsize=8.5, ha="right", va="center")
for p in range(n_phys):
x = p * (bw_l + 0.06)
if p < len(phys_owner):
c = colors[phys_owner[p]]
axL.add_patch(mpatches.Rectangle(
(x, y_p), bw_l, bh, facecolor=c, alpha=0.30, edgecolor=c, lw=1.2))
axL.add_patch(mpatches.Rectangle(
(x, y_p), bw_l * phys_fill[p] / bs, bh, facecolor=c, alpha=0.85))
axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4,
ha="center", color=C_GRAY)
else:
axL.add_patch(mpatches.Rectangle(
(x, y_p), bw_l, bh, facecolor="white",
edgecolor=C_GRAY, lw=1.0, hatch="//"))
axL.text(x + bw_l / 2, y_p - 0.28, str(p), fontsize=6.4,
ha="center", color=C_GRAY)
axL.text(n_phys * (bw_l + 0.06) + 0.1, y_p + bh / 2, "空闲",
fontsize=8, va="center", color=C_GRAY)
# 几条连线:从逻辑块指到它真正的物理块
for i in range(n_seq):
for j, p in enumerate(blocks[i]):
x0 = j * (bw_l + 0.06) + bw_l / 2
y0 = n_seq - i + 1.35
x1 = p * (bw_l + 0.06) + bw_l / 2
axL.annotate("", xy=(x1, y_p + bh), xytext=(x0, y0),
arrowprops=dict(arrowstyle="-", color=C_GRAY,
lw=0.7, alpha=0.55))
axL.text(0, n_seq + 2.2,
f"块大小 {bs}:只有每条请求的最后一块没填满(灰底数字是「已用/容量」)",
fontsize=8.5, color=C_GRAY)
# ── 右:并发对比 ──
axR = fig.add_subplot(gs[0, 1])
A = res["A"]
labels = ["长度均匀\n512~4096", "重尾\n八成短请求"]
kc = [A["uniform"]["k_cont"], A["heavy"]["k_cont"]]
kp = [A["uniform"]["k_paged"], A["heavy"]["k_paged"]]
uc = [A["uniform"]["util_cont"], A["heavy"]["util_cont"]]
up = [A["uniform"]["util_paged"], A["heavy"]["util_paged"]]
xs = np.arange(2)
wbar = 0.36
b1 = axR.bar(xs - wbar / 2, kc, wbar, color=C_GRAY, label="连续预分配(按 4096 预留)")
b2 = axR.bar(xs + wbar / 2, kp, wbar, color=C_MAIN, label="分页(块 16)")
for i, (a, b) in enumerate(zip(kc, kp)):
axR.text(i - wbar / 2, a + 6, f"{a}\n利用率 {uc[i]:.1%}", ha="center", fontsize=8)
axR.text(i + wbar / 2, b + 6, f"{b}\n利用率 {up[i]:.1%}", ha="center", fontsize=8,
color=C_MAIN)
axR.text(i, max(a, b) + 58, f"{b / a:.2f}x", ha="center", fontsize=10,
color=C_RED, fontweight="bold")
axR.set_xticks(xs)
axR.set_xticklabels(labels, fontsize=9)
axR.set_ylabel("同一 61 GiB 预算下的并发请求数")
axR.set_title("分页减少预留浪费,提高静态可容纳请求数", fontsize=11)
axR.legend(fontsize=8)
axR.set_ylim(0, max(kp) * 1.42)
axR.grid(alpha=0.2, axis="y")
fig.tight_layout()
p = os.path.join(FIGDIR, "fig_paged.png")
fig.savefig(p, bbox_inches="tight")
plt.close(fig)
print(" ", os.path.basename(p))
# ══════════════════════════════════════════════════════════════
# 图 4:自回归视频的掩码结构 + 缓存规模
# ══════════════════════════════════════════════════════════════
def fig_video(res):
B = res["B"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12.6, 4.9))
# ── 左:块内双向 + 块间因果的掩码 ──
n_frame, tok_per_frame = 5, 12
n = n_frame * tok_per_frame
M = np.zeros((n, n))
for a in range(n_frame):
for b in range(n_frame):
if b <= a: # 只能看当前帧和之前的帧
M[a * tok_per_frame:(a + 1) * tok_per_frame,
b * tok_per_frame:(b + 1) * tok_per_frame] = 1.0
ax1.imshow(M, cmap="Blues", vmin=0, vmax=1.4, interpolation="nearest")
for f in range(n_frame + 1):
ax1.axhline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0)
ax1.axvline(f * tok_per_frame - 0.5, color=C_ALT, lw=1.0)
ax1.set_xlabel("key / value 位置(时间从前到后)")
ax1.set_ylabel("query 位置")
ax1.set_title("块内双向、块间因果", fontsize=11)
ax1.set_xticks([f * tok_per_frame + tok_per_frame / 2 for f in range(n_frame)])
ax1.set_xticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8)
ax1.set_yticks([f * tok_per_frame + tok_per_frame / 2 for f in range(n_frame)])
ax1.set_yticklabels([f"帧{f + 1}" for f in range(n_frame)], fontsize=8)
ax1.text(1, n - 3, "对角块 = 块内双向示例\n(扩散当前块仍须重算)",
fontsize=8.5, color=C_ALT,
bbox=dict(fc="white", ec=C_ALT, alpha=0.85))
ax1.text(n * 0.34, n * 0.12, "下三角块 = 能看到过去帧\n(仅固定且兼容的历史可缓存)",
fontsize=8.5, color=C_MAIN,
bbox=dict(fc="white", ec=C_MAIN, alpha=0.85))
# ── 右:单条视频的 KV cache 规模 ──
cases = B["video"]
names = [c["name"] for c in cases]
vals = [c["kv"] / GIB for c in cases]
toks = [c["ntok"] for c in cases]
bars = ax2.bar(names, vals, color=[C_GREEN, C_ALT, C_RED], width=0.55)
ax2.axhline(80, color=C_RED, ls="--", lw=1.6)
ax2.axhline(61, color=C_GRAY, ls=":", lw=1.4)
ax2.text(2.52, 83, "假设总预算 80 GiB", color=C_RED, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9))
ax2.text(2.52, 64, "扣除权重与余量后 KV 约 61 GiB", color=C_GRAY, fontsize=8.5, ha="right", bbox=dict(fc="white", ec="none", alpha=0.9))
for b, v, t in zip(bars, vals, toks):
ax2.text(b.get_x() + b.get_width() / 2, v + 10, f"{v:.1f} GiB\n{t // 1000}k tokens",
ha="center", fontsize=8.5)
ax2.set_ylabel("单条视频的 KV cache(GiB)")
ax2.set_title("720p 假设账本:无额外 patch 化,缓存全部历史", fontsize=11)
ax2.set_ylim(0, max(vals) * 1.30)
ax2.grid(alpha=0.2, axis="y")
fig.tight_layout()
p = os.path.join(FIGDIR, "fig_video_mask.png")
fig.savefig(p, bbox_inches="tight")
plt.close(fig)
print(" ", os.path.basename(p))
def main():
kv = _load("_kv_results.json")
pg = _load("_paged_results.json")
print("画图:")
fig_mem_ledger(kv)
fig_roofline(kv)
fig_paged(pg)
fig_video(kv)
if __name__ == "__main__":
main()
评论 (0)