搜索到
54
篇与
DiT
的结果
-
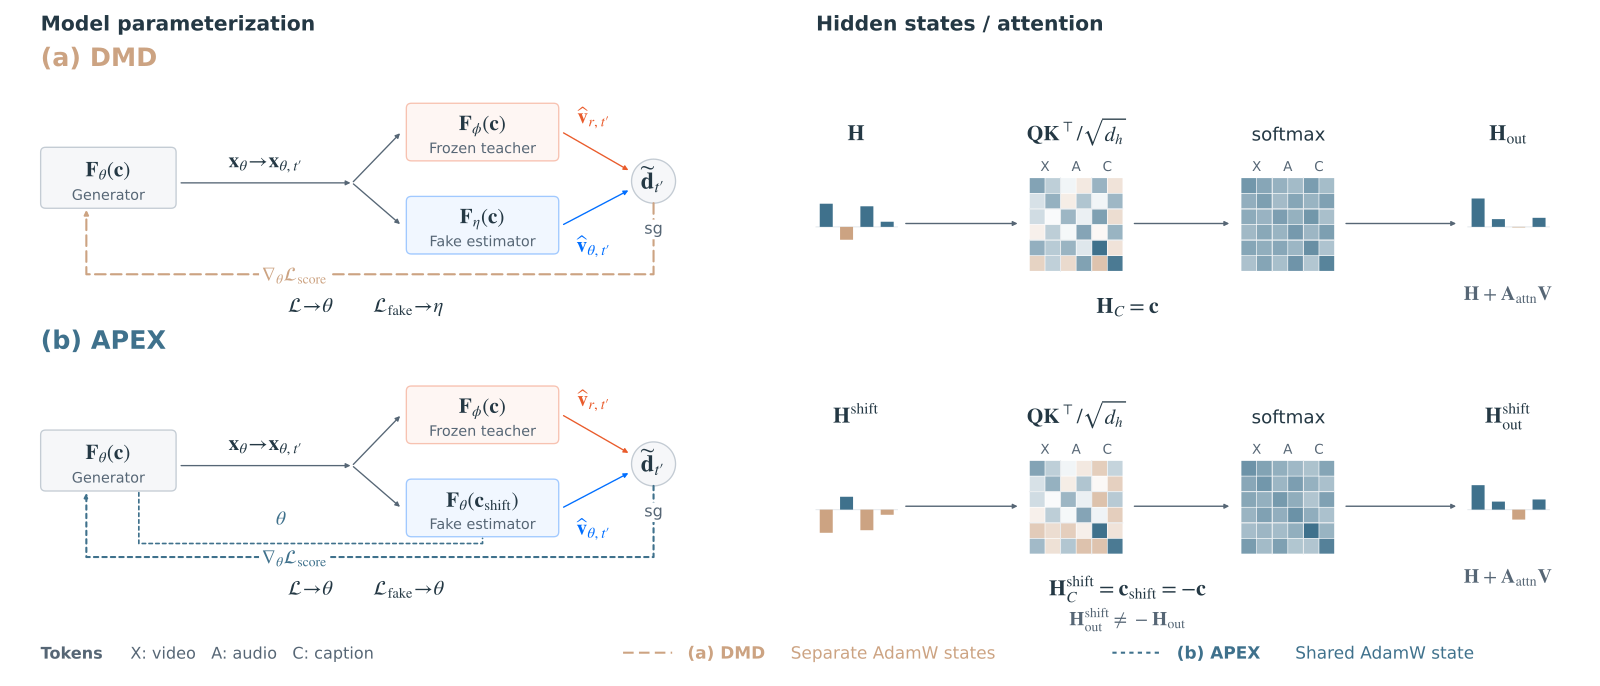
 AIGC 每日速读|2026-11-13|清华流式视频指令偏好净胜30%-APEX 今日 AIGC 论文速览 今日共 10 篇 · 流式视频与偏好对齐 2 篇 · 生成加速 3 篇 · 几何视频与压缩重建 2 篇 · 图文生成 1 篇 · 语音与三维头像生成 2 篇 概览导读:三分钟流式视频中途改指令,人物仍要按要求行动。首篇 APEX 用同一网络兼做生成和假分数估计,70 例成对人工评测的指令遵循净偏好比 S2-Avatar 高 30 个百分点。接着看图像编辑与视频扩散缓存、稀疏注意力和语义 KV 压缩如何省计算;后半篇讨论视频偏好奖励、相机控制与压缩重建,再到文字图像、局部语音编辑和双人 3D 头像。不同论文的速度、质量和偏好口径不直接横比。 重点论文标题列表 APEX(清华):长视频指令偏好净胜30% IdealCache(电子科大):图像编辑缓存提速5.84倍 ESTRA(悉尼大学):视频注意力稀疏到5%仍清晰 SemanticKV(厦大):按指令保留视频记忆 GenRM-Flow(浙大):让视频生成器自己打偏好分 选读入口:想做会随指令变化的三分钟流式视频,先读 APEX;要给 Qwen-Image-Edit 或 HunyuanVideo 省推理时间,读 IdealCache;低密度注意力和长视频缓存预算分别看 ESTRA、SemanticKV。给视频生成器做偏好奖励读 GenRM-Flow;相机轨迹控制新画面看 UGG,极低码率重建看 ADE-GVC。海报中文字总拼错读 Four-Step DiT;多轮只改语音局部风格读 DialInstruct-TTS;双人虚拟头像的互动读 DiaHeads。 今日论文速览 1. APEX:长视频指令偏好净胜30% Few-Step Streaming Video Generation via Condition Shifting | 清华大学;生数科技;西湖大学 | arXiv:2611.14033 关键词:流式视频生成, 少步蒸馏, 条件偏移, 长视频, 指令遵循 前序问题:连续生成三分钟视频时,每个片段都要反复调用生成主干;常见分布匹配蒸馏另养一张“假分数”网络,增加训练显存和迭代时间。 方法直觉:同一生成器换一套文本条件,就让它在生成和估计自身分布之间切换;省掉独立假分数网络,仍保留冻结教师和生成历史回放。 本文贡献:把 APEX 的 condition shifting 扩展到流式视频:原文本条件负责出片,偏移后的条件负责估计生成分布的速度场;训练沿用 Self-Replay Forcing 和感知正则。这里的 NFE 是每片段对视频主干的调用次数,实验用 3 次,再接一次空间 Refiner。 Figure 2 : DMD and APEX in Self-Replay Forcing. DMD uses independent fake parameters η \eta ; APEX shares generator and fake parameters θ \theta and, by default, AdamW states. Teacher parameters ϕ \phi are frozen. Left: θ \mathbf{x}_{\theta} is the rollout/replay output, t ′ t^{\prime} the scoring time, ~ t ′ \widetilde{\mathbf{d}}_{t^{\prime}} the normalized correction, and sg \mathop{{\color[rgb]{1,0,0}\operatorname{sg}}}\nolimits stop-gradient. The correction contributes ∇ θ ℒ score \nabla_{\theta}\mathcal{L}_{\mathrm{score}} ; ℒ \mathcal{L} is the full generator objective. The fake-velocity subscript θ \theta identifies the generated distribution. Right: \mathbf{H} and out \mathbf{H}_{\mathrm{out}} denote input and output hidden states; C \mathbf{H}_{C} contains projected text tokens \mathbf{c} . Within each row, , , \mathbf{Q},\mathbf{K},\mathbf{V} are queries, keys, and values, and attn = softmax ( ⊤ / d h ) \mathbf{A}_{\mathrm{attn}}=\operatorname{softmax}(\mathbf{Q}\mathbf{K}^{\top}/\sqrt{d_{h}}) , with head dimension d h d_{h} . Superscript shift \mathrm{shift} marks states under shift = − \mathbf{c}_{\mathrm{shift}}=-\mathbf{c} . The single-head example uses fixed weights and omits the causal mask and other transformer operations; values are schematic. 实验效果:70 例、每例 180 秒的成对人工评测中,APEX 相对 S2-Avatar 的“指令遵循”净偏好为 +30.0%(胜率减败率),一致性和整体画质各 +4.3%;320 例 StreamAV-Bench 的 Progressive 指令分从 3.831 到 3.856。匹配训练设置下,峰值单卡分配显存低 4.4%,平均迭代时间短 9.2%,这是训练成本而非推理速度。 Figure 3 : Paired examples at 3 backbone NFE. (a) APEX retains both bags late in the sequence, while S2-Avatar shows one. (b) APEX brings the tube to the other hand for the applying instruction; S2-Avatar continues holding it at its side. Each pair uses the same reference and timestamps, with a common one-step 2 × 2\times Refiner. 批判点评:人工评测里运动质量偏向 S2-Avatar,音画同步多为平局;70 例三分钟长流和 3 NFE 加共同 Refiner 的结论不能外推到任意主干或时长。论文没有把少步采样写成相对 S2-Avatar 的端到端推理倍数。 2. IdealCache:图像编辑缓存提速5.84倍 IdealCache: Rethinking Cache Scheduling in Diffusion Transformers via Ideal Trajectories | 电子科技大学;独立研究者 | arXiv:2611.10340 关键词:图像编辑, 视频生成, 扩散加速, 特征缓存, 最短路径 前序问题:扩散 Transformer(DiT)的缓存通常模仿原始逐步去噪轨迹;但中间状态接近原轨迹,不保证最终编辑结果最好,还会把原轨迹当成隐形质量上限。 方法直觉:先定义希望到达的理想输出,再衡量跳过若干完整计算后偏离理想轨迹多少;把“在哪些步更新缓存”变成受计算预算约束的最短路径。 本文贡献:IdealCache 为每个输入构造候选目标形成理想轨迹集合,以缓存偏差作为图边权,离线搜索非均匀更新日程;推理时直接复用日程,不重训 DiT。ℬ 表示保留完整更新的预算,不是生成步数。原文覆盖 Qwen-Image、Qwen-Image-Edit 和 HunyuanVideo。 Figure 2: Cache deviation as edge weight. Starting from x t ∗ x_{t}^{*} on the ideal trajectory, a single full pass populates the cache with residuals Δ t , Δ t \Delta\mathbf{h}_{t},\Delta\mathbf{e}_{t} . We then take t − k t{-}k Euler updates that all reuse those residuals (red dashed), arriving at x ^ k \hat{x}_{k} . The squared distance to the ideal endpoint x k ∗ x_{k}^{*} is the cache-deviation edge weight w ( k → t ) w(k\to t) used in our graph. 实验效果:Qwen-Image-Edit 的 GEdit-Bench 上,ℬ=7 时批量为 1 的端到端墙钟速度为原 50 步的 5.84 倍,整体分 7.59;FlowEdit 上 ℬ=25 的背景保留 SSIM 从原流程 0.665 到 0.687,SSIM 越高表示与输入背景越相似。HunyuanVideo 在表内 ℬ=10 时为 4.32 倍。 Figure 3: Qualitative editing results on Qwen-Image-Edit. Our method achieves better background preservation in some cases while maintaining comparable editing quality. IdealCache with ℬ = 10 \mathcal{B}{=}10 ( ∼ \sim 4.2 × 4.2\times speedup) achieves visual quality comparable to the vanilla 50-step baseline. 批判点评:速度含文本编码、VAE 图像解码等固定开销,不等于单个 DiT 内核提速。FlowEdit 的 ℬ=10 背景 SSIM 0.679 仍较高,但 ImageReward 由原流程 1.054 降到 0.991;不同预算须在编辑保真和速度间取舍,离线理想轨迹构造也有成本。 3. ESTRA:视频注意力稀疏到5%仍清晰 ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration | 悉尼大学;澳大利亚联邦科学与工业研究组织 | arXiv:2611.10448 关键词:视频扩散, 稀疏注意力, 无训练加速, H20, 画质保真 前序问题:视频扩散 Transformer(DiT) 的长时空 token 让注意力昂贵;现有免训练稀疏法在密度很低时,近似误差会迅速破坏生成画面。 方法直觉:把计算预算留给真正重要的单个 key-value token;其余 token 由聚类代表近似,并根据组内离散程度修正代表权重。 本文贡献:ESTRA 先聚合相似 query 给单个 key 打分,再在 5% 或 1% 的精确交互预算内挑选 token;余下 key 用均值和方差校正模块(VCM) 表示。这里“密度”是精确计算的视频 query-key 交互占比,稀疏阶段之外还存在固定处理成本。 Figure 2: ESTRA overview. (a) Independent query and key clusters provide query centroids and K/V means. (b) Each centroid scores individual keys for selection shared by its query cluster. (c) VCM uses remaining-key spread and query norms to calibrate representative weights. (d) Original queries attend jointly to selected tokens and fixed cluster means, with log-count and VCM biases on representative logits. Colors identify clusters. Attention scaling is omitted. 实验效果:原文在 NVIDIA H20、720p、无密集预热的 Wan2.1-14B(81 帧)上,5% 密度端到端从 6838 秒到 2097 秒,即 3.26 倍;HunyuanVideo-13B(129 帧)从 6490 到 1378 秒,即 4.71 倍。其与密集输出的 Wan 画面 SSIM 为 0.489,高于 Sol-Attn 12.8% 密度时的 0.283;SSIM 越高表示结构越接近密集参考。 Figure 1: High-quality video generation at up to 99% attention sparsity. At 5% exact-interaction density, ESTRA more closely preserves the composition and appearance of the dense references than the baselines shown, while using higher sparsity and achieving greater end-to-end speedups. At 1%, the videos remain visually coherent, with particularly small changes in the HunyuanVideo example. Density denotes the fraction of video query–key interactions evaluated exactly; speedups are end to end on an NVIDIA H20. Additional examples are provided in Appendix D . 批判点评:把 5% 密度误读成整体计算量仅 5% 会夸大收益;在 1% 密度,Wan 的 VBench 动态程度从密集参考 66.98 降到 61.87。该时间受 H20、帧数、分辨率和具体内核影响,跨机器不可直接照搬。 4. SemanticKV:按指令保留视频记忆 Semantically Aligned KV Cache Compression for Efficient Agentic Autoregressive Video Generation | 厦门大学 | arXiv:2611.11452 关键词:自回归视频生成, KV 缓存, 语义约束, 长视频, 显存 前序问题:自回归视频越生成越长,历史帧的 键值(KV)缓存占满显存;普通压缩只看注意力热度,可能删掉对提示词中人物、动作和物件仍重要的状态。 方法直觉:先从计划中抽取必须遵循的语义约束,再找各约束关注的历史位置;每组都能为某个缓存 token 投票,避免少数约束被平均淹没。 本文贡献:SemanticKV 不重训生成器:文本交叉注意力定位语义相关视频位置,收集其自注意力 query;组内平均、组间取最大后做一次 top-k 保留,并维持剩余键值与位置不变。这里保留预算按字节约束,0.7 压缩率指约删去 70% KV。 Figure 2: Overview of SemanticKV . Semantic constraints ℛ \mathcal{R} are matched to prompt tokens. Text cross-attention identifies related video positions, from which we collect the generator’s self-attention queries. Their attention to each KV entry is averaged within groups and maximized across groups. A single top- k k selection retains high-scoring entries within the byte budget, together with states required by the backbone. Retained keys, values, and positions remain unchanged. 实验效果:Causal Forcing 的 5 秒视频综合评测 VBench、0.7 压缩率下,综合分 Total Score 为 84.10,对比最强压缩基线 84.05 和 Full KV 83.99;DiT-only FPS 提升 1.22 倍,KV 从 6.04 GB 到 1.81 GB。LongLive 2.0 的 60 秒实验中,KV 从 20.76 GB 到 6.23 GB,但 VBenchLong 总分从 80.12 降到 78.84。 Figure 4: Paired semantic fidelity on matched prompt–seed tuples. (a) Tie-aware superiority rates. (b) Mean paired differences with prompt-clustered bootstrap 95% confidence intervals. Positive differences favor SemanticKV ; Full KV is the uncompressed reference. 批判点评:方法依赖规划器提出的约束,漏掉的细节未必获保留;5 秒的分数优势很小,也不能等同于所有长视频质量提升。速度数字是 DiT-only,未含规划、筛选和验证全链路。 5. GenRM-Flow:让视频生成器自己打偏好分 GenRM-Flow: Generators are Process-aware Reward Models in Flow Matching | 浙江大学;Joy Future Academy;厦门大学;清华大学 | arXiv:2611.11421 关键词:视频生成, 偏好对齐, 流匹配, 奖励模型, FlowAWR 前序问题:视频偏好对齐常靠外部视觉语言模型或附加判别头评分;评分器没有直接使用视频生成器在噪声潜空间里的预测能力。 方法直觉:偏好微调后的生成器与冻结原模型,对同一视频的速度预测误差差值,本身可读成逐时刻奖励;用这份奖励替代外部判官指导再训练。 本文贡献:GenRM-Flow 从离线偏好目标推导隐式过程奖励:在流匹配噪声状态上比较当前策略与参考策略的速度预测误差,不新增打分头;将它接入按奖励加权微调视频生成器的 FlowAWR。文中不同偏好训练目标都是到目标策略的路径,不是附加奖励网络。 Figure 2: The pipeline of GenRM-Flow . (Panel A) Traditional paradigms rely on representational capacity , utilizing a frozen backbone (e.g., a VLM or base generator) as a feature extractor coupled with an auxiliary discriminative head. (Panel B) The proposed framework sources the reward directly from generative capacity . Following preference optimization, the implicit reward R D ( , c ) R^{D}(\mathbf{x},c) is algebraically extracted from the velocity-prediction errors. The scalar score is computed natively by contrasting the active policy (flame, θ ⋆ \theta^{\star} ) against a frozen reference (snowflake, θ ref \theta_{\mathrm{ref}} ), requiring no architectural modifications or auxiliary heads. 实验效果:原文留出偏好对比集上,Wan2.1-T2V-1.3B 的平均成对预测准确率为 86.79%,PAVRM 为 76.06%;同主干接入 FlowAWR 后,VBench 的动态程度从 PAVRM 的 67.83 到 73.46。14B 主干对应动态程度为 71.82 到 74.87;这些是作者协议内结果。 Figure 4: Qualitative comparison between PAVRM and GenRM-Flow as the per-step reward signal in FlowAWR with a 1.3B backbone. Both runs use FlowAWR with the same configuration, differing only in the reward signal. Red boxes mark localized structural deformations, spatial inconsistencies, and temporal artifacts produced by PAVRM. Across scenes, our reward yields visibly fewer geometric defects and better spatial and temporal continuity. 批判点评:奖励要运行当前与参考生成器的速度预测,不能把“无附加头”误写成零额外计算;奖励依赖已微调策略及参考策略。论文的原始奖励不做组内归一化时约 250 步出现策略坍塌,训练稳定性需要单独处理。 6. UGG:相机轨迹控制视频也补几何 UGG: Unified Generative Geometry Model | 麻省理工学院;加州大学圣迭戈分校;剑桥大学 | arXiv:2611.14440 关键词:相机控制视频, 4D 场景生成, 深度预测, 相机姿态, 条件补全 前序问题:给视频第一帧和相机轨迹,要补出连贯的中间画面;单独训练视频生成与几何预测模型,常让画面、深度和相机姿态彼此不一致。 方法直觉:把已看到的 RGB、深度和相机射线设为干净 token,缺失部分设为带噪 token;同一模型以“补空缺”完成视频生成或几何预测。 本文贡献:UGG(Unified Generative Geometry Model)将 RGB、深度及用密集射线图表示的相机姿态放进统一 transformer;各模态有专属投影和前馈层,共享多模态自注意力。还可采样多个可能场景并用可观测图像的几何证据选择。原文已接收 NeurIPS 2026。 Figure 2: Generative-predictive transformer. We model RGB, depth, and camera pose as spatially aligned tokens, with camera pose represented as dense ray maps. Partial observations are zero-noise context tokens, while missing modalities are noisy tokens to be denoised. A unified transformer processes all tokens with modality-specific projections and feed-forward layers together with shared multimodal self-attention, enabling information exchange across modalities. The decoded RGB, depth, and ray maps form a complete 4D scene representation for cross-modal generation, geometric prediction, and inference-time consistency search. 实验效果:RealEstate10K 双端点帧加目标相机轨迹的视频补全中,UGG 的 峰值信噪比 PSNR 为 25.73 dB、感知距离 LPIPS 为 0.061,对照 SEVA 为 25.25 dB、0.081;PSNR 越高、LPIPS 越低通常表示与真值更接近。但 DL3DV 同设定中,UGG 的 PSNR 16.61 dB 低于 SEVA 的 17.61 dB。 Figure 4: Qualitative comparison of camera-controlled generation. Given the first and last RGB frames and a target camera trajectory, we compare generated intermediate frames against ground truth and baseline video generation methods. UGG better preserves scene identity and dynamic content compared with the generic video completion baselines. 批判点评:“统一”不意味着每个数据集都最好;DL3DV 是明确反例。画面指标依赖真值和给定相机轨迹,也不直接证明开放世界长视频的物理一致性;测试时多样本搜索会增加推理成本。 7. Four-Step DiT:四步画海报字更准 Four-Step Text-Bearing Image Generation via Distillation with Local Response Regularization and Teacher-Guided Training | 清华大学 | arXiv:2611.12042 关键词:图文生成, 扩散蒸馏, 文字渲染, GLM-Image, 四步采样 前序问题:文字海报要同时画好场景和拼对字;把 50 步图像模型压成四步后,字符细节往往先坏掉。 方法直觉:让学生模型的局部去噪响应更平稳,同时用教师图像和合成字符串分阶段喂给它,使少数几步既管布局又管字形。 本文贡献:研究在 GLM-Image 的扩散 Transformer(DiT) 的分布匹配蒸馏中加入局部响应路径长度正则,并保留冻结的自回归视觉先验、字形编码器与 VAE;文字训练从短字符串逐步走到密集布局。四步是学生去噪转移次数,教师是 50 步,不能直接当成端到端 12.5 倍。 Figure 2: Four-step distillation with complementary response and data supervision. Frozen autoregressive and glyph encoders retain semantic and character conditions. Distribution matching transfers teacher synthesis behavior, while the path-length term regularizes the student’s local response. Teacher-guided progressive training combines explicit text examples with visually integrated typography; the VAE remains fixed. 实验效果:原文 1024×1024、NVIDIA A100 的单图推理从教师 5.818 秒到学生 1.742 秒,端到端快 3.34 倍,两者仍需 40 GB GPU 内存。CVTG-2K 单词准确率为 0.5045,四步 TDM 为 0.1690;图像组合生成评测 GenEval Overall 为 0.84 对 0.81。单词准确率是所生成文字与目标文本匹配的比例。 Figure 6: Qualitative comparison of four-step GLM-Image students. Within each three-column group, outputs are ordered as the student without text training, TDM, and our complete framework. Cases cover (a) an English poster, (b) a Chinese poster, (c) a bilingual sign, (d) product packaging, (e) multiline text, (f) a bilingual display, (g) object counting, and (h) spatial relations. The examples illustrate differences in literal text preservation, object counts, and spatial arrangement while retaining coherent scene appearance. 批判点评:加速来自蒸馏与专门文字训练,付出教师生成数据和训练成本;推理显存没有下降。数值只覆盖文中主干、A100 和评测集,不能据此保证任意长文本都不拼错。 8. ADE-GVC:按画面失真选视频去噪起点 When to Start Denoising? Adaptive Denoising Entry for Generative Video Compression | 北京航空航天大学;阿里巴巴集团;香港科技大学 | arXiv:2611.13620 关键词:生成式视频压缩, 扩散重建, 自适应去噪, 视频保真, 码率 前序问题:超低码率视频压缩会丢掉细节;扩散模型从固定噪声时刻开始重建,对失真轻重不同的片段常在保真与真实感之间失衡。 方法直觉:让轻度和重度压缩失真走不同的去噪起点,再把压缩痕迹作为时序条件输入视频扩散 Transformer(DiT);这样重建力度可随内容调整。 本文贡献:ADE-GVC 由潜变量压缩网络、时间适配器、起点预测器和视频扩散模型组成;预测器从压缩潜变量估计起始时刻 τ,适配器提供压缩感知条件。它输出的是原视频的压缩重建,不是从文本自由生成新视频。 Figure 3 : The overall architecture of ADE-GVC consists of a latent compression network (LCN), temporal adaptor (TA), timestep predictor (TP), and video diffusion model. The input video g \bm{V}_{g} is encoded into the clean latent 1 \bm{x}_{1} , which is compressed by the LCN into c \bm{x}_{c} and a compression-aware feature t \bm{f}_{t} . The TP predicts the denoising entry τ \tau from c \bm{x}_{c} , while the TA converts t \bm{f}_{t} into the visual context v \bm{c}_{v} . Conditioned on v \bm{c}_{v} , the VideoDiT denoises τ c \bm{x}^{c}_{\tau} , into ^ 1 \hat{\bm{x}}_{1} , which is decoded to reconstruct ^ 1 \hat{\bm{V}}_{1} . 实验效果:以 S²VC 为 BD-Rate 零点,HEVC-B 的感知距离 DISTS 口径 BD-Rate(等质量平均码率差) 为 −56.4%,GLC-Video 为 −13.4%;负值表示在相同感知失真水平下平均所需码率更低。论文另对 1920×1080、96 帧平均解码计时:优化后的 0.831 秒对原始 4.341 秒,约 5.11 倍,但这是其自身实现优化对照。 Figure 7 : Qualitative comparisons on a single frame in terms of representative VVC, PLVC, GLC-Video and our ADE-GVC methods. We also report the Bpp/DISTS metrics to quantify compression efficiency. 批判点评:不同指标口径会得出不同节省值,不能把 DISTS 与 PSNR 下的百分比混成一个总收益。起点预测和时间适配器需要训练;表中解码加速是并行化、编译和 bf16 累积作用,不是仅由自适应去噪带来。 9. DialInstruct-TTS:多轮只改一句话的语气 DialInstruct-TTS: Interactive Expressive Speech Generation via Multi-Turn Dialogue with Fine-Grained Temporal Control | 奈良先端科学技术大学院大学 | arXiv:2611.13875 关键词:语音生成, 多轮语音编辑, 局部风格控制, TTS, 内容保留 前序问题:一次性文本转语音(TTS)指令往往给整句话同一种语气;想只把中间一段改成低声说,通常要重写指令并重生成全句,已满意部分也会变化。 方法直觉:对话规划器每轮汇总最新要求和历史,形成按时间定位的风格计划;只修订目标潜变量,锁定其余片段。 本文贡献:DialInstruct-TTS 用 Qwen 系列规划器形成标出时间段与风格的 TemporalPlan,再由时序声学控制模块调整情绪、语速、音量和发声方式;reference-latent revision 负责保留非目标区域。它是生成语音的交互式局部编辑,不是通用对话代理。 Figure 2: Architecture of DialInstruct-TTS 实验效果:原文全局风格主观评测中,指令匹配均分为 4.283,对照 Qwen3-TTS 为 3.077;五轮语速修改中,“目标控制与内容都成功”为 15/20,有无非目标锁定的对照为 6/20。30 次最终偏好比较,多轮修订获 29 票,完整重述获 1 票;都是论文的指定主观协议。 Figure 4: Mean subjective ratings and final preference for full-restatement and multi-turn revision. Final preference is 1/30 versus 29/30, with no ties. Means are shown without error bars; numerical results are in Appendix E.4 . 批判点评:局部控制并不各项都稳:同一消融里音量修改成功仅 4/20。多轮流程引入规划和反复合成开销,论文偏好票数不能换算为统一的端到端编辑成功率。 10. DiaHeads:双人对话头像一起动 DiaHeads: Jointly Generating Coordinated 3D Dialogue Heads with Non-verbal Cues from Dual Audio | 中国科学技术大学 | arXiv:2611.06970 关键词:3D 头像生成, 音频驱动, 双人对话, 非语言动作, 注视 前序问题:各自按音频生成说话头像,容易得到两张嘴都动却没有互相看、点头或等待反馈的双人画面。 方法直觉:把两人的音轨放进同一条件,再让注视、摇头、点头、微笑四类离散提示和连续头部动作共享潜空间;模型一次生成两个人的动作。 本文贡献:DiaHeads 冻结双路 HuBERT 编码音频,用变分编码器融合连续 FLAME 头部参数与四类非语言 cue;时间相关的 flow prior 替代独立高斯先验,共享解码器同时输出两位参与者。FLAME 是 3D 人头参数模型。 Fig. 2: Overview of the proposed DiaHeads. The audio streams of both interlocutors are encoded by two frozen HuBERT backbones and fused into a conditioning vector c c by a transformer. A dual-branch variational encoder processes the continuous parameters ( F , G ) (F,G) and the discrete cues N N in separate branches, each conditioned on c c through FiLM modulation, and the two branches are combined through a product-of-experts posterior z ∼ ( μ , e σ / 2 ) z\sim\mathcal{N}(\mu,e^{\sigma/2}) , shown as the “Low-level Motion Encoder” and “High-level Cue Encoder”. A flow-based prior built from five residual coupling blocks, each consisting of a flip operation and a Conv1D coupling layer, replaces the standard Gaussian prior, and a shared VAE decoder, conditioned on c c through FiLM, jointly reconstructs the head parameters Y ^ \hat{Y} and the discrete cues of both interlocutors. The units at the bottom right detail the two SyncNet encoders, which are built from 1D convolution, batch normalization, and ReLU. 实验效果:CANDOR-FG 双人数据上,交互 DTW(两人动作时序不匹配程度,越低越好)为 0.3171,对照双人基线 DIM 为 0.7526;盲选中 DiaHeads 获 58 票,SadTalker 33 票、DIM 17 票。但单人头部 FLAME MSE 为 0.6662,高于 SadTalker 的 0.5523,精细动作保真并非全胜。 Fig. 5: Qualitative comparison of generated 3D head animations over a 30 s dialogue clip. Participant A is shown in blue and participant B in orange. Each method occupies two rows labeled A and B, sampled every 2.5 s. Our method produces appropriate mouth movements during overlapping speech at 8 s, marked by the purple box, and responsive nodding with mutual gaze at 20–23 s, marked by the yellow box, while the baselines show incorrect lip-sync and lack interactive behaviors. 批判点评:论文展示的是 3D 头像动画参数,不是直接输出真人视频;双人数据和四种 cue 限制了外推范围。交互协调改善与单人几何误差存在取舍;原文仅称准备投稿 IEEE Transactions on Multimedia,未写成已接收。 趋势观察 视频生成的计算预算不再只数采样步 APEX 省掉训练时的独立假分数网络;ESTRA 压低注意力精确交互,SemanticKV 精简历史缓存。三者改变的是不同成本,不能把倍数直接相加。 编辑和生成更看最终条件满足 IdealCache 用理想输出搜索缓存日程,UGG 用相机轨迹和几何共同约束中间帧,DialInstruct-TTS 则锁住语音中不需修改的区间。 评测必须保留反例和口径 APEX 的运动质量并非胜出;UGG 在 DL3DV 双端点帧设置的 PSNR 落后 SEVA;SemanticKV 的 60 秒总分低于 Full KV。 今日讨论 APEX 在 70 例三分钟视频中得到指令遵循 +30.0% 净偏好,但运动质量偏向 S2-Avatar。若为一条中途多次换商品动作的直播片段选生成器,你会怎样同时检验指令执行、人物连续性和动作自然度,何时不应为了指令偏好牺牲运动质量? 人工智能炼丹君 整理 | 2026-11-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
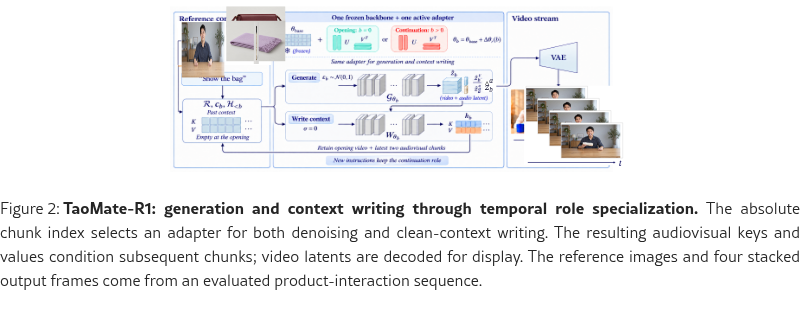
AIGC 每日速读|2026-11-12|阿里多参考长视频换指令不断档-TaoMate-R1 今日 AIGC 论文速览 今日共 10 篇 · 多参考与广告视频审修 2 篇 · 多场景视频与生成加速 3 篇 · 几何控制与图文生成 2 篇 · 三维动作生成 1 篇 · 生成结果评测 2 篇 重点论文标题列表 TaoMate-R1(阿里):多参考长视频换指令不断档 Review-and-Edit(Anoki):广告视频问题一键找到修复入口 OneReel(伊利诺伊大学香槟分校):多场景视频只共享少量关键帧 MG-Cache(北京邮电大学):视频去噪按时间层级双重缓存 FADE(四川大学):预测弯曲去噪轨迹少算视频 选读入口:要用多张参考图连续拍人和商品,先读 TaoMate-R1;要从广告成片定位错误并派给修复工具,读 Review-and-Edit。想控制跨场景一致性读 OneReel;要在既有 DiT 上提速,对照 MG-Cache 的缓存内存和 FADE 的离线校准。要画准钟表与披萨比例读 Angular Control;要让图文长文配图对位读 UniWeaver;做长序列 3D 动作看 FlashMotion。评估改图判官和视频物理常识,分别读 EditJudge-Bench 与 PhyRubric。 今日论文速览 1. TaoMate-R1:多参考长视频换指令不断档 TaoMate-R1: Temporal Role Specialization for Streaming Multi-Reference Video Generation | 阿里巴巴集团 | arXiv:2611.14307 关键词:视频生成, 多参考生成, 流式生成, LoRA, 场景连续性 前序问题:指定人物和商品后连续拍两分钟,提示词中途换动作或物品;按片段生成常在接缝处换掉人物、房间或亮度。 方法直觉:把“开场建景”和“后续延续”当成两种时间职责,各自用一套低秩适配器;同一职责既生成当前片段,也写入下一段要看的历史。 本文贡献:TaoMate-R1 在冻结的 MiniMax H3 主干上配两组 LoRA,而非按去噪与写历史两种操作分组。Self Gradient Forcing 让开场和延续适配器沿自己生成的历史联合训练。32 个多参考案例采用相同两适配器预算比较。 Figure 2: TaoMate-R1: generation and context writing through temporal role specialization. The absolute chunk index selects an adapter for both denoising and clean-context writing. The resulting audiovisual keys and values condition subsequent chunks; video latents are decoded for display. The reference images and four stacked output frames come from an evaluated product-interaction sequence. 实验效果:在 10 条约两分钟、指令会变化且共用教师音频条件的长流上,相对按操作分组,接缝平均亮度跳变从 1.96 降至 0.613;接缝 DINO 特征相似度从 0.973 到 0.990。DINO 是图像特征相似度,数值越高通常表示相邻帧外观更接近。该比较没有统一报告端到端推理延迟。 Figure 6: Scene continuity over a two-minute interaction. Each row combines the first frame’s left half, centre columns sampled every 0.5 s, and the last frame’s right half (case 006, 119 s). Grey ticks mark instruction changes; endpoints retain native aspect ratios. The bands contrast composition changes in clip-wise generation with stable presenter and table geometry in the TaoMate-R1 stream. 批判点评:这是按参考生成新音视频,不是对现成视频直接编辑。接缝更平稳不等于所有指令都执行成功:长流的问答遵循分为 0.980,按操作分组为 1.00;结论依赖这套主干、两适配器预算和共享音频条件。 2. Review-and-Edit:广告视频问题一键找到修复入口 Multimodal Judges Flag, Humans Decide: A Review-and-Edit Framework for AI-Generated Product Video Ads | Anoki 公司 | arXiv:2611.13178 关键词:生成视频审阅, 视频编辑, 商品一致性, 多模态评测, 人工复核 前序问题:电商商品页自动变成短广告后,镜头里商品形状、文案、旁白或字幕可能错;只给整条广告打一个好坏分,编辑者不知道该修哪一幕。 方法直觉:把广告按场景和六类问题拆开,让多模态 judge 先指出时间点与依据,再由人确认;每条确认的问题直达对应编辑工具。 本文贡献:系统检查商品、场景质量、发音、脚本、声音和字幕。门户把模型发现与商品照片、事实资料并列给审阅者;确认后可借别条广告的镜头、重生镜头、做视频到视频编辑或局部高分辨率修复。这里的核心是审修流程,视频生成与修复工具作为可替换后端。 Figure 3 : The production portal. Panels (a) to (c) show the review and panel (d) the edit page. (a) The review page for one ad: 1 the ad and its scenes, 2 the six questions, collapsed, each tagged when a judge flagged it, and 3 the evidence: the catalog photos, product facts, brand kit and script. (b) 4 A judge’s finding sits inside the question with its scene, kind and evidence; the reviewer accepts or rejects each with a thumbs up or down and 5 answers below, where “Product wrong” then asks which scenes are at fault. (c) 6 The scene judges’ finding above 7 the per-scene grid, with keep, swap out or no opinion for each scene, and 8 the secondary options for the kind of problem. (d) On the edit page: 9 the scenes with confirmed issues; 10 a confirmed issue opens the scene tool on its scene, with 11 the scene’s versions and 12 ways to change it: another ad’s scene of the same product, a new scene, or Repair, which fixes the scene in place, today by regenerating its clip at higher resolution. 实验效果:在自家流水线的 120 条广告、562 个场景中,辅助审阅标记约 60% 的场景有商品问题。对其中 60 条广告,辅助审阅的多数标记率为 58%,隐藏 judge 后两名审阅者为 26%;两组不能直接视作随机对照。另在盲标的 120 个场景上,商品 judge 的 AUC 为 0.84;它召回 29 个缺陷中的 26 个,但 56 个告警中仅 26 个是真缺陷。 Figure 2 : One generated 15 s ad ( video in our release) as judges and reviewers reviewed it, one row per question. Reviewers accepted the judges’ product findings and rejected nearly all of their pronunciation findings. They also marked the S3 and S4 captions and added two problems the judges missed in S2: an impossible motion in the scene and an unsupported claim in its line. 批判点评:高召回带来较多误报,必须保留人工决定;实验证据来自单一市场、英语旁白和一条内部生成流水线。研究没有证明全自动编辑或审核耗时一定缩短。 3. OneReel:多场景视频只共享少量关键帧 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学香槟分校;得州大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 稀疏注意力, 共享记忆, 多GPU 前序问题:多场景视频若所有帧彼此全连接,注意力成本随场景数迅速膨胀;分场景单独生成又容易让人物和物体跨场景变样。 方法直觉:场景内部保持完整注意力,跨场景只交换被挑出的代表帧;提示词和时长先划定每个场景的作用范围。 本文贡献:OneReel 无需再训练生成主干:对每个场景保留本地注意力,把聚类选出的潜变量代表帧放进有界共享记忆;再把本地及共享 K/V 打包为连续的可变长注意力输入,并按通信成本选择多 GPU 分工。理论上的跨场景注意力随场景数由平方变线性。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种生成模型的实验相对稠密注意力报告端到端 1.7–4.9 倍加速。40 个多场景请求中,HunyuanVideo-1.5 480p 的文本遵循分从稠密的 27.7 提至 61.9;同表的动作分从 34.5 到 64.1。分数只在论文这套多场景提示与评测协议下可比,性能还依赖共享记忆和多 GPU 打包实现。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:需事先给出场景提示及持续时间;代表帧太少会漏掉跨场景细节,太多则削弱加速。作者对一分钟长视频另加场景局部 RoPE,说明注意力作用域之外的时间位置编码同样影响效果。 4. MG-Cache:视频去噪按时间层级双重缓存 MG-Cache: Multi-Granularity Caching for Accelerating Diffusion Transformer Inference | 北京邮电大学 | arXiv:2611.11365 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 多粒度缓存 前序问题:扩散 Transformer 要重复计算几十次;各时间步和各层变化程度不同,统一跳过容易积累误差,高清长视频尤其耗时。 方法直觉:先用小批校准样本找出可跳过的去噪时间步,在线再按各层输入变化和重要性决定是否复用注意力或 MLP 的中间特征。 本文贡献:MG-Cache 的第一阶段离线分析时间步冗余,第二阶段对层内模块按稳定度与敏感度动态缓存;无需重新训练生成模型。论文在 HunyuanVideo 与 FLUX.1-dev 上同时测速度、画质和相对未缓存输出的保真度。 Figure 2 : Overview of the Multi-Granularity Cache (MG-Cache). We design a two-stage strategy to exploit computational redundancy during inference. Stage 1 performs a static offline analysis to identify and preserve critical timesteps based on a timestep feature table [ M ^ t ] [\hat{M}_{t}] constructed from a small batch of calibration dataset. Stage 2 introduces a dynamic layer-wise caching mechanism that computes layer importance scores and input stability to adaptively determine whether to reuse cached features. 实验效果:HunyuanVideo 文生视频、544×960、129 帧、原始 50 步条件下,慢档由 982.03 秒降至 358.86 秒,即 2.74 倍;VBench 从 75.45% 到 75.14%,PSNR 27.44 dB 是相对原始输出的像素保真度。bf16 层缓存对该分辨率需 49.8 GB,论文使用内存卸载;因此速度收益不能脱离缓存容量与数据搬运谈。 Figure 1 : Visual quality comparison. While achieving a higher speedup than baselines, our method also maintains superior fidelity to the original output. For instance, in the first row (Prompt 1), other methods exhibit blurring on the text "stop," whereas our method preserves text sharpness. 批判点评:离线校准和高分辨率层缓存是额外成本。快档可进一步提速,但同表 VBench 降到 74.13%;部署需按显存、内存和质量目标调阈值。 5. FADE:预测弯曲去噪轨迹少算视频 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 特征预测 前序问题:缓存法在跳过多个去噪步时通常按直线或整数阶变化外推特征;遇到弯曲且随时间变化的轨迹,误差会累积。 方法直觉:用分数阶动力学描述特征轨迹的弯曲程度;先离线测好各阶段和层的参数,在线按查表结果在完整计算和预测步之间交替。 本文贡献:FADE 用 Mittag–Leffler 分数阶算子外推 DiT 中间特征,离线校准最合适的阶数并存入多维查找表;推理时按时空位置取参数,减少被跳过步骤的计算且不微调主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频的同表条件下,原始 50 步耗时 190.2 秒、VBench 80.68%;FADE 在 N=6、m=1 设置下耗时 37.9 秒、VBench 80.12%。按列出的延迟相除,墙钟加速约 5.02 倍;表中 Spd. 列的 5.56 倍与 FLOPs 比 29,773/5,359 一致,两个口径不应混写。同预算 HiCache 为 37.8 秒和 79.93%,FADE 主要改善该表的质量而非进一步缩短时延。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:收益依赖离线校准的查找表及具体主干;换架构或采样预算需重新标定。VBench 相对原始生成仍下降 0.56 个百分点,不能把“保真”写成无损。 6. Angular Control:让画出来的时钟真指向指定时刻 Continuous Angular Control in Text-to-Image Generation via Geometric Token Encoding | 毕尔肯特大学;CISPA 亥姆霍兹信息安全中心;弗赖堡大学 | arXiv:2611.13172 关键词:图像生成, 几何控制, 扩散模型, 角度编码 前序问题:让文生图模型画 10:10 很容易,要求 1:45 时两根针常常还是落回惯见姿势;要求披萨只剩指定圆弧比例也有类似问题。 方法直觉:把时针、分针或扇区边界的角度编码成周期性的正弦和余弦 token,直接放进提示词;训练时由局部约束逐步放松到整物体约束,让数字位置落到正确部件。 本文贡献:该法在冻结文本编码器前插入角色专属几何 token,并用 LoRA 调整 SD 2.1 去噪器。Stochastic Localization Relaxation(SLR)混合部件框、物体框和无定位三种训练监督;推理无需输入框。另用指针互换偏好损失防止时针和分针角度对调。 Figure 2 : Left: Overview of our geometric token encoding framework, illustrated for clock-time control. The target clock time ( h , m ) (h,m) or fraction-sector boundaries are encoded as sinusoidal pairs and mapped through the projection network P P to produce role-specific geometric tokens h , m \mathbf{e}_{h},\mathbf{e}_{m} (or s , e \mathbf{e}_{s},\mathbf{e}_{e} ) injected into the prompt before the frozen text encoder. Both tasks share the same MLP architecture and condition a LoRA-adapted SD 2.1 denoising U-Net. Right: Stochastic Localization Relaxation (SLR). Training samples one of three localization regimes (55/30/15%): component-level CALL using component boxes, object-level CALL using a shared object box, and unconstrained standard cross-attention. No localization input is required at inference. 实验效果:时钟 Acc@6° 指两针都在目标角度 6° 内;四种未微调基线均低于 1%,本法在不同读图器下约 63–78%。圆形物体比例误差不超过 0.10 的 Acc@0.10,训练类为 89.5%,未见过的物体类为 88.8%,未见过的比例为 84.9%;基线约 20%。这些数字来自带精确角度标注的任务数据。 Figure 8 : Qualitative comparison of the original periodic encoding and the augmented encoding with the scalar fraction f f near the angular boundaries. The periodic encoding produces small sectors near 0 ∘ 0^{\circ} but may generate narrow slices even for complete-sector targets ( 360 ∘ 360^{\circ} ), reflecting its endpoint ambiguity. Adding f f distinguishes the endpoints and enables complete-object generation, but can produce oversized sectors for small target angles ( 1 ∘ 1^{\circ} – 5 ∘ 5^{\circ} ). Results are shown for pizza, pie, and cake. 批判点评:必须有任务专用的几何标注与训练;复杂场景或部件不清时精度会下降。0° 与 360° 的周期编码端点相同,附录增加比例标量虽能区分整圆,却可能放大小角度扇区。 7. UniWeaver:把文字和配图按任务一起编排 UniWeaver: Harnessing Unified Multimodal Models for Interleaved Text-Image Generation | 俄亥俄州立大学;伦敦大学学院;香港中文大学;香港科技大学(广州);香港大学 | arXiv:2611.13530 关键词:图文交错生成, 多模态生成, 规划, 视觉反馈 前序问题:用户只说“做一份操作指南”,统一多模态模型常先写完一段再补图,图与步骤错位,关键步骤也可能没有画面。 方法直觉:先确定每一段要讲什么、配什么图和共享风格,生成后再按可观察清单检查图片是否支持文字;失败时修正局部。 本文贡献:UniWeaver 是模型无关的图文交错生成工作流,包含任务范围、文字与图片规划、参考图分配和视觉复核。作者用该流程构造覆盖 20 类任务的 1 万条训练轨迹,并建立 120 条留出任务的 UniWeaver-Bench,从文字覆盖、写作质量、视觉覆盖与图文对齐评估终稿。 Figure 3: Overview of UniWeaver. ① UniWeaver introduces a structured workflow for interleaved text-image generation, with execution trajectories providing supervision for fine-tuning (Section 3.1 ). ② UniWeaver-10K Dataset provides 10,000 goal-only tasks paired with structured planning trajectories across 20 task families (Section 3.2 ). ③ UniWeaver-Bench systematically evaluates final interleaved outputs on 120 held-out tasks (Section 3.3 ). 实验效果:在同一 120 任务消融协议中,基于 BAGEL 的完整方法综合分 58.89;去掉共享视觉风格为 48.21,去掉任务目标为 53.01。分数按任务门禁通过率加权,只对过门任务计算;不能直接解读为每张图片质量提高 10.68 分。论文未给统一的额外模型调用成本与端到端耗时。 Figure 5: Qualitative comparison on two representative tasks. UniWeaver produces more coherent, actionable instructions with task-relevant visuals, while baselines exhibit repetitive content, missing details, or ineffective visual support. Zoom in for better view. 批判点评:这一流程依赖规划与视觉 judge,长文可能增加调用与返工成本;评测本身也依赖模型判分。图文能力提升并不自动代表单张图的生成模型更强。 8. FlashMotion:一万帧动作也能快生成 FlashMotion: Ultra-Fast Long-Term 3D Motion Generation | 腾讯 IEG Motus Group;中国人民大学;清华大学;得州大学达拉斯分校;武汉大学;南开大学;香港大学 | arXiv:2611.13626 关键词:3D动作生成, 文生动作, 音乐舞蹈, 语音手势, 少步采样 前序问题:游戏和虚拟人的长动作既要跟文本、音乐或语音走,又要少采样、少显存;长序列常出现脚滑、抖动或推理跟不上交互。 方法直觉:同时缩短“要采几步”和“每步有多贵”:用少步平均速度预测完整动作,再用轻量双向时序模块看前后动作与条件。 本文贡献:FlashMotion 将带运动学和动力学约束的 3D motion-space MeanFlow 与约 6000 万参数的 BiMamba/CoBiMamba 组合,支持文生动作、音乐生舞蹈和语音生手势;Adaptive Soft mask 用于动作中间段编辑。这里生成的是 3D 运动表示,后续骨骼绑定与渲染另算。 Fig. 2: Overview of FlashMotion . (a) Inference flow with clean-motion prediction and MeanFlow updates. (b) Training model inputs and output: noisy motion, conditions, and timesteps are mapped to the clean-motion target. (c) Shared BiMamba/CoBiMamba block. Dashed purple paths denote optional conditioning, omitted in BiMamba and used in CoBiMamba for condition-guided state selection. 实验效果:BABEL 长序列文生动作实验中,四步版 R@1 为 29.134%,对 DART 的 26.105%;R@1 是文本查询时正确动作排在第一的比例。RTX 3090、batch=1 的一万帧动作输出,论文报 46,303 FPS,对 DART 的 75 FPS;这是运动序列吞吐,不是最终视频渲染帧率。一阶段更快但 FID 更差,反映速度与分布质量取舍。 Fig. 3: Text-to-motion comparison under a shared sequence of 3 prompts. 批判点评:仿真中的动作可用于角色动画,但机器人执行和真实人体安全性不能由这些分数推导。速度比较受动作长度、硬件和只计模型生成的口径影响。 9. EditJudge-Bench:先测判官会不会看错改图 EditJudge-Bench: Auditing VLM Image-Edit Judges with Synthetic Ground Truth | 丹麦技术大学;Pioneer Centre for AI | arXiv:2611.12524 关键词:图像编辑评测, VLM判官, 合成真值, 反事实 前序问题:图像编辑榜常请视觉语言模型判断“改对了吗”,但真实改图既有意外副作用又没有精确真值,判官判错时很难归因。 方法直觉:用 Blender 场景参数生成编辑前后对,哪一物体、位置、材质或形状被改过都有确定答案;再让 VLM 判断编辑指令是否真的执行。 本文贡献:EditJudge-Bench 有 1,382 对合成图,覆盖九类编辑并配错误方向、错对象、无编辑等反事实指令;以 25 种判官配置检验指令核验可靠性,并比较不同提示模板和图文顺序。它评测的是编辑判官,不是推出新的图像编辑模型。 Figure 2: Overview of the nine edit types in EditJudge-Bench . The central inset shows the underlying Blender scene parameter modified by each edit: object position \mathbf{x} , rotation \mathbf{r} , scale \mathbf{s} , shape parameter θ \mathbf{\theta} , articulation joint ψ \mathbf{\psi} , material \mathbf{m} , visibility \mathbf{v} , lighting state \mathbf{l} , and camera state \mathbf{c} . Surrounding images show one rendered edit from the source image per category. Because each edit is a deterministic parameter change, magnitude and direction are known exactly. 实验效果:论文报告 GPT-4o 使用常见 VIEScore 模板的整体 AUROC 为 69.0%;AUROC 是随机抽一正一负时把正确编辑排得更高的概率。若干微调判官为 51.7–66.3%,图文顺序等提示格式可改变结果最多 14.1 个百分点。尽管测试图是合成的,判官排名与两项真人偏好榜的 Spearman 相关分别为 0.95 和 0.71。 Figure 3: Example image pairs in EditJudge-Bench . For each edit type, we show three original/edited image pairs from our benchmark. 批判点评:Blender 场景与真实照片仍有域差;排名相关高不表示任何单一判官在真实编辑上都可靠。旋转、形状等空间编辑尤其难判,应逐类审计。 10. PhyRubric:逐条指出生成视频违反哪条物理 PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation | 伊利诺伊大学芝加哥分校 | arXiv:2611.13576 关键词:视频生成评测, 物理常识, 细项量表, 时间戳诊断 前序问题:文生视频若小勺瞬间跳位、按钮还没按灯就亮,单个“物理分”说不清问题发生在哪一秒,也不利于修提示词。 方法直觉:在看到生成视频前,先把每条提示词拆成语义与物理预期;播放后逐项给出是否达成及对应时间戳。 本文贡献:PhyRubric 包含五个物理领域、34 类情境;PhyRubric-Bench 对十种文生视频模型做细项诊断,另用 3,788 条视频训练开源 PhyRubric-Judge。判官分别报语义遵循 SA、物理是否可评、物理分 PC,并给违反预期的证据。 Figure 2 : Overview of PhyRubric. (1) Rubric formulation : each caption is paired with a rubric covering semantic adherence (SA) and physical commonsense (PC), constructed before any video is seen and reused to score videos from all models. (2) PhyRubric-Bench : captions spanning five physical domains and their rubrics are drafted by LLMs and reviewed by humans. Videos from 10 T2V models are pre-annotated by an agent and verified by humans. (3) Train & Judge : an agentic annotator labels training videos to build PhyRubric-Train, on which we train PhyRubric-Judge. Given a video and its caption, the judge outputs an SA score, whether PC is assessable, a PC score, and a diagnosis of the violated expectation with timestamped evidence. 实验效果:在该榜单,JP 是全部视频中 SA 与 PC 都至少 4/5 的比例;Seedance 2.5 平均 JP 44.20%,Veo 3.1 为 36.20%,但并非跨数据集总排名。判官相对真人物理分的 Pearson r 为 0.32,Gemini 4 Argon 为 0.31;两者物理通过判别 AUC 均 0.68,说明自动诊断仍有明显误差。 Figure 7 : Two failure cases from PhyRubric-Bench. (a) A small squirt of ketchup becomes a full bowl and the spoon jumps between 1.50 s and 1.62 s. (b) The roof light is lit from the first frame, before the finger reaches the button at 2.30 s. 批判点评:PC 只对“物理可评”的视频平均,单看它会漏掉根本没生成目标事件的失败;JP 更适合合看。细项量表和时间戳需人审,诊断改写提示词的示例不能直接当作普遍修复率。 趋势观察 把长视频的共同信息压到必要位置 TaoMate-R1 按时间职责训练适配器,OneReel 只交换场景代表帧;一个处理生成历史角色,一个处理跨场景注意力。 加速仍要算额外状态成本 MG-Cache 在高分辨率视频需要大型层缓存;FADE 需要离线校准分数阶。两者速度数字均不可脱离各自硬件和采样设置。 可控生成与评测都转向可定位证据 Angular Control 把角度直接编码进 prompt,Review-and-Edit 按场景定位问题,EditJudge-Bench 与 PhyRubric 追问判官和物理诊断的可靠性。 今日讨论 TaoMate-R1 在十条两分钟长流上把接缝亮度跳变从 1.96 降到 0.613,但长流问答遵循分略低于按操作分组。若按开场与延续分组拍一条中途连续换五次商品指令的广告,哪些指标能同时验证接缝、人物身份和指令执行,何时该放弃这套分组? 人工智能炼丹君 整理 | 2026-11-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
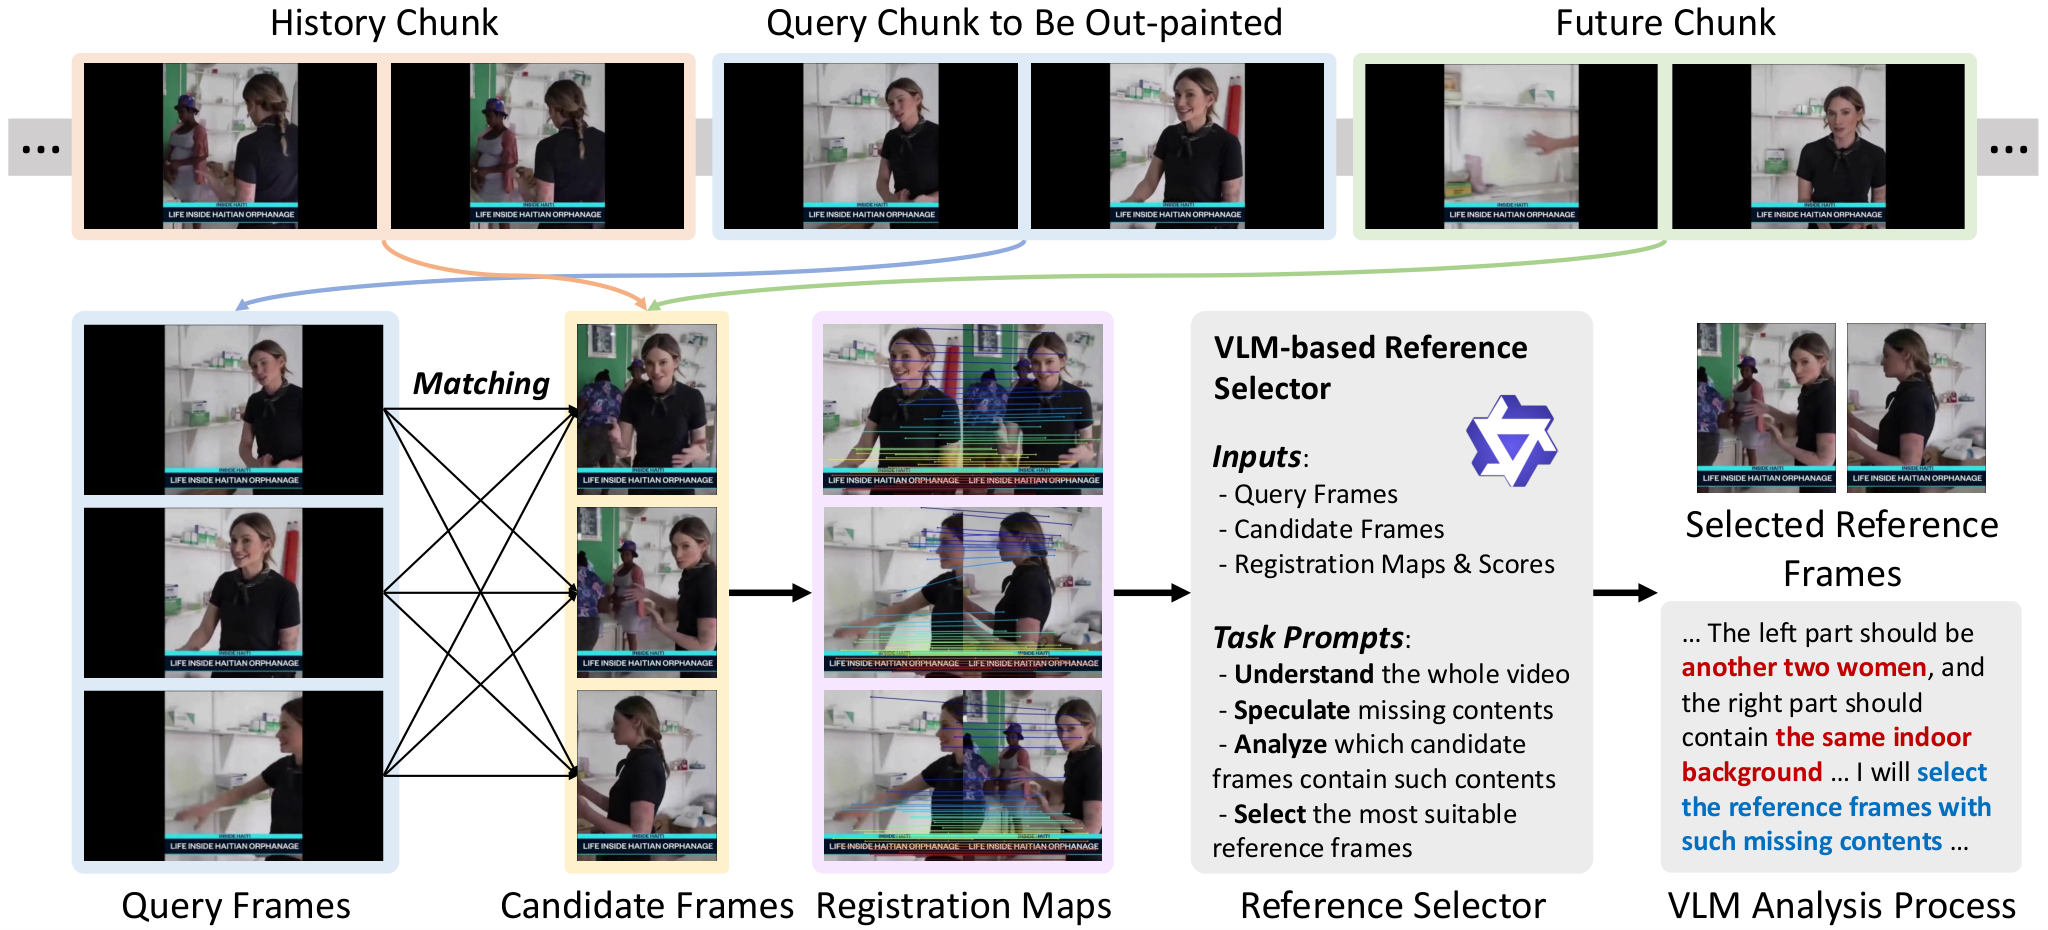
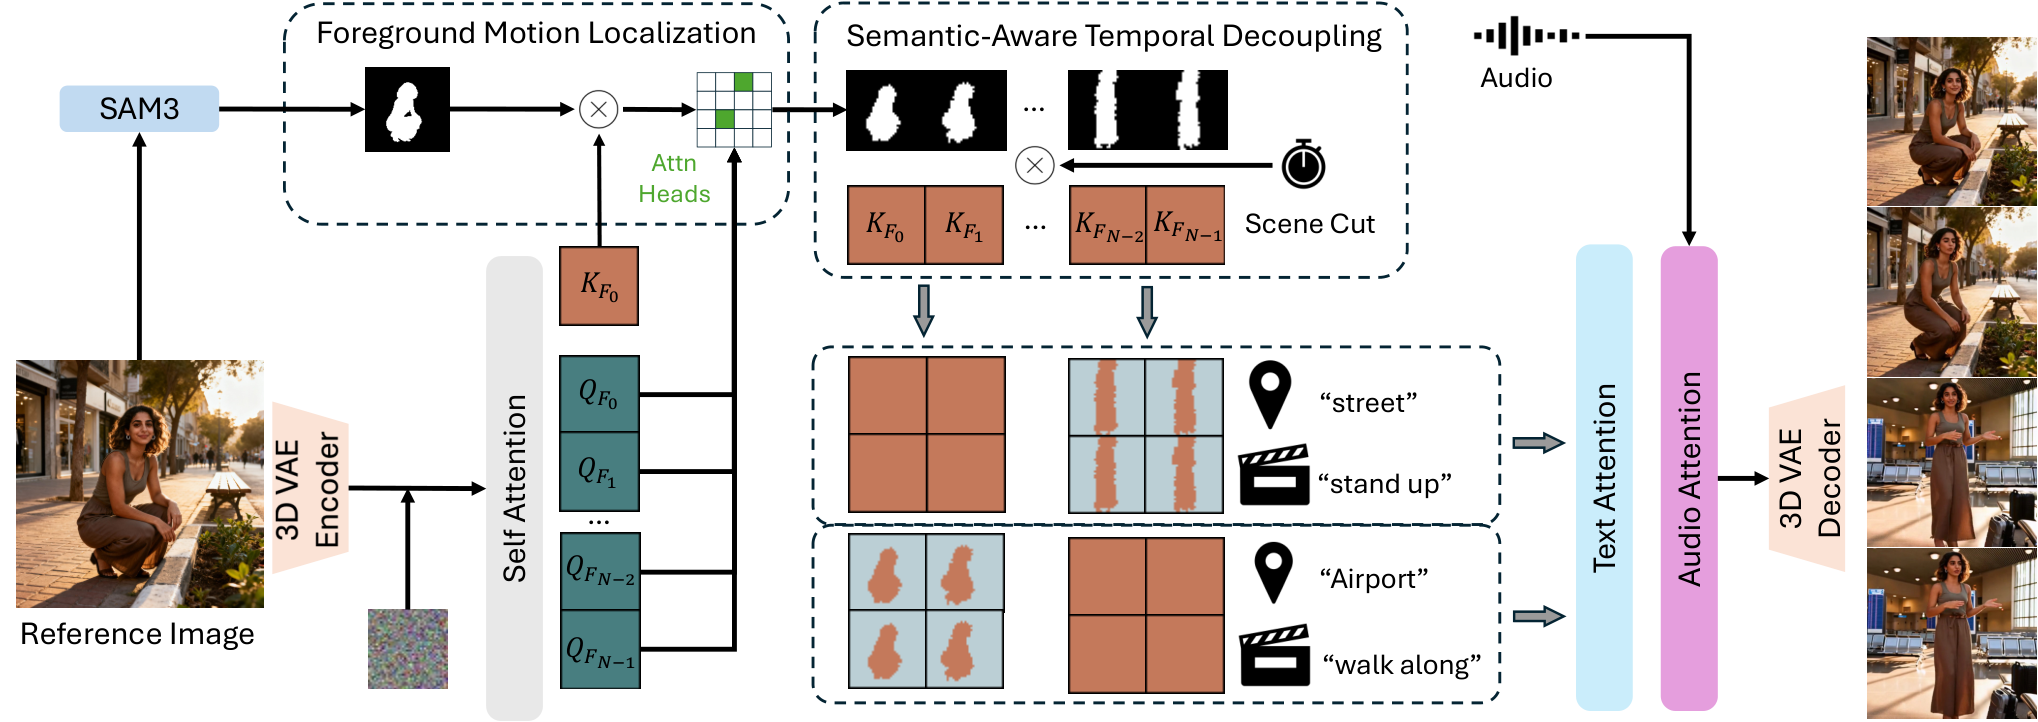
AIGC 每日速读|2026-11-11|南京大学给长视频扩画找回旧镜头-LongSCOP 今日 AIGC 论文速览 今日共 10 篇 · 视频扩画与分场景控制 3 篇 · 视频生成与推理系统 4 篇 · 图像与音频编辑 2 篇 · 物理三维场景 1 篇 重点论文标题列表 LongSCOP(南京大学):给长视频扩画找回旧镜头 SceneShifter(悉尼大学):换场景却不换人 ⚡ OneReel(伊利诺伊大学):多镜头共用四帧记忆 MPEG-Diffusion(Roblox):三成全分辨率 token 生成视频 V2C-Edit(台湾大学):图像改动由 VLM 逐步导航 选读入口:要给长片补画左右画面,先读 LongSCOP 的参考帧条件与时间代价;要按音频和台词切换人物所在场景,读 SceneShifter;多分镜同人并想缩短生成时间,读 OneReel。只想降低高清视频去噪成本,读 MPEG-Diffusion;图像指令常被忽略,读 V2C-Edit;物理运动失真,读 PhysOPSD。多轮续写与回退读 ReelCache;混音里只改一个声源读 STEER;去噪特征缓存读 FADE;布料家具三维场景读 SoftPAT3D。 今日论文速览 1. LongSCOP:给长视频扩画找回旧镜头 LongSCOP: Semantically Consistent Long Video Outpainting | 南京大学;香港大学;中国科学院深圳先进技术研究院;香港中文大学;深圳理工大学;索非亚大学 INSAIT | arXiv:2611.12445 关键词:视频扩画, 长视频编辑, 参考帧检索, 自强制训练 ⚠️ 前序问题:给长视频向画面外扩出内容时,按块生成容易在块与块之间闪烁、坍塌,人物和背景也会逐渐变样。只看当前几帧,可能错过前后已经露出的缺失区域。 方法直觉:若待补的画面区域在别的时刻出现过,就把那个时刻作为参照;训练时让模型接触自己的前一块预测,减少训练时用真帧、推理时用生成帧造成的误差积累。 本文贡献:LongSCOP 联合 self-forcing(自强制:以前一步生成帧作为训练条件)、潜变量校准和未来参考帧稳定逐块扩画;用配准分数筛候选,再由 Qwen3.5-VL-27B 推断缺失内容、选关键参考帧。作者还构建 6.2 万段训练视频和长视频扩画基准 LVO-Bench。 Figure 4: Illustration of key reference frame retrieval framework. Given query frames from current query chunk to be out-painted and candidate frames from both history chunk and future chunk, we aim to find the most suitable reference frames to out-paint current chunk. Specifically, we calculate the registration maps and scores for all query-candidate pairs, and then input them into a VLM, Qwen3.5-VL-27B [ 32 ] . The VLM is requested to understand the whole video, speculate the missing contents ( i.e. , contents to out-paint like the two women and the indoor background), analyze which candidate frames may contain such missing contents, finally select the most suitable reference frames. 实验效果:在 LVO-Bench 上,对照 VACE,结构相似度 SSIM 由 0.725 升至 0.749,峰值信噪比 PSNR 由 18.59 升至 19.87 dB,生成视频分布距离 FVD 由 225.5 降至 197.3(越低越好)。但以 Mast3R 检索处理 15 秒视频时,9B 版本由 VACE 的 13.5 分钟增至 16.5 分钟;27B 版本为 20.1 分钟。 Figure 5: Qualitative comparison. Our LongSCOP could achieve stable video out-painting results and maintain the semantic consistency over a long time horizon. The region circled by the yellow box indicates the original input region. Zoom in for better views. 批判点评:收益依赖长视频里确实有可借的参考帧;遮挡区域从未露出时,检索无法提供缺失外观。短片 DAVIS 上 LongSCOP 的 PSNR 20.04 dB 低于 Infinite-Canvas 的 20.80 dB,不能把长视频优势泛化为所有扩画。 2. SceneShifter:换场景却不换人 SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960 关键词:音驱人物动画, 多场景控制, 前景一致性, 稀疏注意力 ⚠️ 前序问题:一张人物参考图配一段音频,想让背景按指定时间从街道切到车站,人物却常跟着变脸、变衣服,或背景根本不切。 方法直觉:把同一场景内部的背景联系保留,切断不同场景背景之间的注意力;让前景人物跨场景继续互相看见,并从能追踪主体运动的注意力头提取动态前景掩码。 本文贡献:SceneShifter 无需重训,在时空自注意力中抑制跨场景背景 token 互看,保留跨场景人物联系;动态前景定位和转场上下文窗口分别处理大动作与切换边界,并建立 SceneShifterBench 测试切场时间、人物保持和画质。 Figure 3 : Pipeline of the proposed SceneShifter framework. 实验效果:在 MultiTalk 主干的 SceneShifterBench 上,场景切换成功率由基础模型 38.7% 升至 99.3%,切换时点准确率由 17.5% 升至 98.1%;对照 DiTCtrl 的时点准确率为 96.6%,但其衣着保持只有 31.7%,SceneShifter 为 100.0%。14 人、每准则 140 次盲评中,人物一致性获得 65.7% 偏好票。 Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone. 批判点评:方法无法让基础模型生成本来不会的大幅姿态动作;短于主干训练片长的场景,背景画质会下降。多主体互相遮挡时掩码可能合并,人物离开再进入后外观漂移。 3. OneReel:多镜头共用四帧记忆 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学厄巴纳-香槟分校;得克萨斯大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 场景结构注意力, 共享帧记忆, 推理加速 ⚠️ 前序问题:把多个分镜一起生成能让角色连续,却让所有镜头互相注意,成本随总长度快速增长;分镜各自生成又容易换人。 方法直觉:一个镜头保留内部完整注意力,只从其他镜头读少量代表帧。分镜提示和时长已给出边界,无须在去噪早期再猜哪里该跨镜头连接。 本文贡献:OneReel 用场景范围限定注意力,每步按潜帧聚类更新有界共享记忆;把本场景及共享 K/V(注意力键和值)打包成可高效执行的变长密集运算,并在多 GPU 上均衡分镜负载。固定共享帧数时,跨场景注意力成本随镜头数近似线性增长。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种视频生成模型上的端到端加速相对密集注意力为 1.7–4.9 倍,相对已有稀疏方法为 1.2–2.2 倍。40 条多场景请求、HunyuanVideo-1.5 480p 下,CLIP 文本跟随分(自动图文匹配,越高越好)由密集方案 27.7% 升至 61.9%。默认四帧共享记忆相对不共享把 Text+ID(文本与人物身份联合分)由 17.0% 升至 24.3%,同时延迟增加 19%。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:收益以明确分镜提示和时长为前提;四帧共享是质量与延迟的折中,继续加至八帧只多 2.3 个百分点的 Text+ID,却再添 15% 延迟。跨场景一致性不能只凭文本跟随分推断,需看同一角色在镜头间是否稳定。 4. MPEG-Diffusion:三成全分辨率 token 生成视频 MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069 关键词:视频生成, 混合分辨率, 扩散 Transformer, 推理加速 ⚠️ 前序问题:视频扩散模型全画面高分辨率去噪昂贵;把主体裁为高清、背景低清,容易在交界处出现鬼影,还得事先知道主体在哪里。 方法直觉:让高清查询读高清键值、低清查询读低清键值,避免一个低清 token 强行代替多个高清 token;在解码前先把两种潜变量融合,让边界邻域一起解码。 本文贡献:MPEG-Diffusion 先以低分辨率跑前 k 步,再用冻结主干特征训练的线性头选高清区域;双分辨率注意力填补缺失键值,混合分辨率解码器合并潜变量。k 是开始分辨率分叉的去噪步,不是生成帧数。 Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts. 实验效果:Wan2.1 14B、720p、k=40 且总 token 预算相当于全高清的 30% 时,去噪阶段相对全高清加速 4.8 倍;同预算 Foveated Diffusion 为 5.2 倍,但 DOVER 自动质量分(越高越好)为 0.743,本文 0.794。k=25 的 38% token 设置下,本文为 3.3 倍、DOVER 0.803;750 次左右双视频投票中,对 Foveated Diffusion 的平局折半胜率为 90.1%。 Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ). 批判点评:4.8 倍指去噪时间,不是包含编码、解码的整条视频产线。质量未完全回到全高清:k=40 时 Wan2.1 14B 的 VBench 视频生成质量分为 83.9,高清基线 85.3;选高清区域的线性头也需要训练。 5. V2C-Edit:图像改动由 VLM 逐步导航 VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;台湾中央研究院 | arXiv:2611.10066 关键词:图像编辑, 流匹配, VLM 引导, 无反演编辑 ⚠️ 前序问题:用 FlowEdit 改图时,源图约束过紧会出现零编辑:背景保住了,请求的变化却没有发生。固定的源图耦合时序无法适应不同改动。 方法直觉:每个去噪时间步备好不同强度的编辑速度,让视觉语言模型比较候选结果是否真正执行指令;指令已基本实现时,再用空间掩码保护无需改动的区域。 本文贡献:V2C-Edit 是免训练的流式编辑控制:构造四种源图耦合速度,用 ILS(Instruction-Level Similarity,指令级相似度)逐步选方向,采用两阶段自适应掩码;ILS 评估改动本身,而非只比目标文案与整图的 CLIP 相似度。 Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F . 实验效果:FLUX 上的 MagicBrush 数据集,对照 FlowEdit,GPT 指令对齐分 5.56→6.07,Gemini 分 4.76→5.36;未编辑区域的 PSNR(峰值信噪比,越高越接近源图)为 17.48→17.44 dB,略降。H100 80GB 上 50 张图平均每张 26.44 秒、峰值 53GB;基础 FlowEdit 为 4.00 秒、36GB。 Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image. 批判点评:更强的指令完成度换来约 6.6 倍单图耗时和 17GB 额外峰值显存,非实时编辑方案;PSNR 也显示背景保留并未同步改善。ILS 依赖 VLM 逐步评估,在不同编辑指令和 VLM 上的稳定性要另验。 6. PhysOPSD:物理代码教视频动起来 PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴 Token Hub | arXiv:2611.12411 关键词:视频生成, 物理一致性, 自蒸馏, 可执行模拟 ⚠️ 前序问题:视频模型能画出逼真画面,仍会把摆锤、接触或流体运动画错。单靠文字很难给出可控制的物理过程,离线视频示例又把物理规律与外观混在一起。 方法直觉:用可执行模拟程序生成可调物理过程,作为训练期特权信息;对同一场景只改变一个物理参数,并保持生成噪声一致,让模型看到动态变化的原因。 本文贡献:PhysOPSD 用 PhysOPSD-Engine 把真实物理情境转成可验证模拟,构造密集与抽象两级物理草稿;在 on-policy self-distillation(模型用自己生成的样本接受教师纠正)中提供配对物理变体。代码是训练用物理条件,最终目标是生成视频。 Figure 3: Overview of our proposed PhysOPSD . 实验效果:用 3K 物理样本后,8.3B 主干在 PhyGround 的 Overall 从原 HunyuanVideo-1.5 的 66.3 升至 68.3;同规模 80K 样本 SFT 为 66.1,21K 样本 PhysHPO 为 67.0。VideoPhy-2 的 All 指标为 67.0,对照 PhysHPO 为 66.0。这里 K 表示千条训练实例。 Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 . 批判点评:改善仍依赖模拟程序覆盖目标物理现象,镜头外观与真实互动的泛化要单独测。表中 3K 只表示训练实例数;建立可执行模拟程序的成本、推理耗时与真实世界失败率仍需另验。 7. ReelCache:续写视频压住历史缓存 ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973 关键词:视频续写, KV 缓存压缩, 分块生成, 推理系统 ⚠️ 前序问题:逐块续写视频要保存旧块的注意力 K/V 缓存;用户回退、分叉时保留所有版本耗显存,删掉后重算又拖慢下一块。 方法直觉:同一块的缓存既有通道冗余,也有时空相关性;相邻块还共享部分基向量。先低秩分解,再像编码视频那样压系数,并把分叉历史组织成树。 本文贡献:ReelCache 在每层预测满足保留能量目标的秩,再压缩注意力缓存;跨块共享低秩基,树形管理恢复、回退和分叉。KV 是注意力的键和值,压缩的是生成过程的历史状态,不是最终视频文件。 Figure 9: Overview of ReelCache . 实验效果:五种视频模型上,对照文中缓存基线,KV 存储缩小 14.46–21.13 倍,下一块生成加快 1.25–3.36 倍,六项代表性 VBench 视频生成指标下降小于 1%。CausVid 上额外压缩开销约 0.2%,解压开销 3.2%;RAVEN 分别 0.8% 和 4.2%。 Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads. 批判点评:这项收益集中在长历史、多轮恢复和分叉;短片一次生成时,树形缓存管理的收益较小。VBench 的六项平均跌幅低于 1% 不代表每条视频完全无可见变化,仍需对关键主体做逐帧检查。 8. STEER:音频编辑先找对声源 Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630 关键词:音频编辑, 声源选择, 去噪轨迹, 后训练 ⚠️ 前序问题:混合音里说“只删掉狗叫”,统一音频编辑器可能误删说话声,或把所有声音一起变了。错误声源往往在早期去噪就选定,后续难纠正。 方法直觉:训练时多看决定声源的早期状态;再让模型从自身跑偏的中间状态继续去噪,学会把选错的声源拉回来。 本文贡献:STEER(Source-selection Training via Early-trajectory Emphasis and Recovery)分两阶段后训练:Emphasis 强化早期关键状态,Recovery 用自生成轨迹学习纠错;得到 SteerSound,并建立同时检查目标改到位和非目标保留的 Selective Audio Editing Benchmark。 Figure 1: Strengthening selective audio editing with STEER. Left: Existing editors may leave the target unchanged or modify non-target content. Middle: Early states shape final source selection, while later denoising tends to follow the established editing direction rather than revise it. Right: STEER addresses these failures through early-trajectory emphasis (Emphasis) and recovery training (Recovery), yielding SteerSound with more reliable selective editing. 实验效果:在自建选择性音频编辑基准上,原始基础编辑器的整体成功率 70.42%、选择性错误率 28.48%;两阶段后为 85.78% 和 8.45%。但在复杂音频编辑测试集,SteerSound 的生成 CLAP 音文匹配分(越高越好)从基础模型 0.223 略降到 0.220,KL 分布距离(越低越好)由 1.915 升到 2.133;选择性提升不等于所有生成指标齐升。 Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement. 批判点评:结果依赖作者构造的编辑任务与基准;不同声源重叠、指令模糊时仍需人工听感。两阶段后训练有额外数据和训练成本,论文摘要未给可直接推广的推理加速结论。 9. FADE:分数阶预测少算视频去噪 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:扩散加速, 视频生成, 特征缓存, 分数阶动力学 ⚠️ 前序问题:扩散 Transformer 的中间特征随去噪步非线性变化,简单缓存或线性外推在弯曲轨迹处会积累误差,导致生成细节和运动失真。 方法直觉:先离线测不同层、步和位置适合的分数阶变化率,推理时按查找表选阶数,在完整计算步之间预测特征;分数阶算子允许比整数阶外推更灵活地贴近弯曲轨迹。 本文贡献:FADE(Fractional Anomalous Dynamics Extrapolation)离线建立多维阶数 LUT(查找表),在线交替执行完整计算与 Mittag–Leffler 分数阶特征预测;无需重新训练生成主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频、原始 50 步设置,完整推理为 190.2 秒、VBench 视频生成分 80.68%;同为 5359T FLOPs(T 为万亿次浮点运算估计)预算下,FADE 为 37.9 秒、80.12%,HiCache 为 37.8 秒、79.93%。表中 5.56 倍是 FLOPs 口径,按实际秒数约 5.0 倍。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:离线 profile 与查找表构建有前置成本,跨模型或分辨率可能需重做;输出 VBench 仍比完整 50 步低 0.56 分,且表中同预算延迟几乎与 HiCache 持平,优势主要是质量。 10. SoftPAT3D:让布料玩具稳稳落座 SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087 关键词:文本到3D, 可变形物体, 物理仿真, 场景生成 ⚠️ 前序问题:文本生成的三维房间里,布料可能穿过椅面、玩具悬空;把软物体当刚体摆放,无法给后续仿真一个有效的静止初态。 方法直觉:先为布料、绳索等构造制造过程对应的自然形状和材料,再让它们与家具一起在统一接触求解器里落到平衡;失败时优化摆放位置。 本文贡献:SoftPAT3D 在文本到三维场景流程中,补全遮住的承托表面并建碰撞网格,为软体指定 rest shape(无外力自然形状)和材料,统一仿真接触、检查几何与提示符合度,再用可微仿真调整初始摆放。 Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ). 实验效果:主实验表的 34 个场景里,SoftPAT3D 生成 43 个软体,接触穿越为每千条边 0、穿透 0 mm,完成 21 个场景;对照刚体流程完成 2/32。共同的 13 个可渲染场景上,GPT-5.4 物理合理性评分从刚体流程 43 升至 90(0–100),CLIP 图文匹配分由 23.9 升至 28.2。 Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them. 批判点评:这些几何与评分结果依赖作者的场景集、碰撞建模和求解预算;34 个场景仍有 13 个未达到完整通过。模型处理的是静态平衡,不能直接推断复杂布料动态也正确。 趋势观察 长视频更需要选对历史 LongSCOP 检索前后帧补画缺失区域;OneReel 跨镜头只分享代表帧;ReelCache 压缩并恢复分叉历史。三者操作对象不同,分别是像素参考、注意力范围和缓存状态。 速度收益要看时间口径 MPEG-Diffusion 的 4.8 倍是去噪阶段;OneReel 报端到端 1.7–4.9 倍;FADE 表中 5.56 倍是 FLOPs,实际秒数约五倍。不同指标不可横比。 控制精度有代价 V2C-Edit 提高指令对齐却使单图耗时从 4.00 增至 26.44 秒;LongSCOP 的 VLM 参考帧检索也将 15 秒片处理从 13.5 增至 16.5 分钟。 今日讨论 LongSCOP 在 LVO-Bench 把 FVD 从 VACE 的 225.5 降到 197.3,却使 15 秒视频处理由 13.5 分钟增至 16.5 分钟。如何验证参考帧检索在遮挡区域从未露出的长视频上是否仍有收益,并用同一组输入比较扩画稳定性与时间成本? 人工智能炼丹君 整理 | 2026-11-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-11-11|悉尼大学让人物跨场景不丢-SceneShifter 今日 AIGC 论文速览 今日共 10 篇 · 视频场景控制与素材编排 2 篇 · 图像编辑与协同生成 2 篇 · 视频生成及缓存 3 篇 · 音频编辑 1 篇 · 工业缺陷图像与三维场景生成 2 篇 重点论文标题列表 SceneShifter(悉尼大学):说换场景就换且人物不丢 Clips2Story(纽约大学):散片按关键词剪成故事 ⚡ V2C-Edit(台湾大学):每一步都判断有没有改到位 MPEG-Diffusion(得州大学奥斯汀分校):只把主角用高清算 PhysOPSD(港科大):让可运行物理规则教视频 选读入口:想让人物视频按时换背景,先读 SceneShifter;素材库需要自动剪成主题故事,看 Clips2Story。要改一张图却常“没改到”,看 V2C-Edit;要给长视频降算力或支持回退分叉,分别看 MPEG-Diffusion 与 ReelCache。关心物理运动、选错音频声源、图像与掩码协同、工业缺陷造数、布料三维接触,则依次读 PhysOPSD、STEER、SnB、REDiff-AD、SoftPAT3D。 今日论文速览 1. SceneShifter:说换场景就换且人物不丢 SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960 关键词:视频生成, 多场景控制, 音频驱动动画, 注意力 ⚠️ 前序问题:一段音频驱动的人物视频要在指定帧从露台切到地铁。普通生成容易晚换背景,也可能在换景时把人脸或衣服一起改掉。 方法直觉:把背景和人物在时空注意力中分开:跨场景的背景不要互相引用,人物则仍可借前后场景维持身份。人物移动时,固定区域掩码会失效,需要随动作追踪。 本文贡献:SceneShifter 无需再训练生成主干。它在跨场景背景 token 间抑制自注意力,保留前景 token 的跨场景联系;从能追踪主体轨迹的注意力层和头提取动态前景掩码,再按提示时间切换场景。作者另建 SceneShifterBench,测场景切换时点、人物保留及视觉质量。 Figure 3 : Pipeline of the proposed SceneShifter framework. 实验效果:SceneShifterBench 的 MultiTalk 主干上,场景切换成功率从原模型的 38.7% 到 99.3%;场景时间准确率从 17.5% 到 98.1%。同表中 DiTCtrl 的成功率为 98.7%,但人物空间分为 0.847,对本法 0.943。数据是指定多场景提示下的生成对照;原文没有统一的端到端延迟数字,额外的掩码提取也需计入实际部署。 Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone. 批判点评:这是音频驱动的人物视频生成控制,不是把一段现成视频任意换景。大幅动作或人暂时消失后重入仍可能失去身份;附录给出该失败例。主干本身不会的动作,注意力控制也不能补出来。 2. Clips2Story:散片按关键词剪成故事 Clips2Story: Training-Free Video Storyboarding and Editing Using Multimodal Retrieval-Embedded Generation | 纽约大学;华盛顿大学;密歇根大学 | arXiv:2611.05992 关键词:视频编辑, 素材编排, 故事板, 多模态检索 ⚠️ 前序问题:素材库里只有打乱顺序的零散片段,编辑者想按“毕业”之类关键词拼成短片;按原片时间轴摘要会把无关镜头和旧叙事一并带入。 方法直觉:先找与主题相关的镜头,再让语言模型安排叙事顺序和衔接旁白,最后组装输出;素材选择与叙事组织是两个不同步骤。 本文贡献:Clips2Story-ND 为片段提取视觉与语音文字描述,检索候选,再把描述交给 LLM 生成可改的故事板和过渡旁白;系统拼接已选镜头,并检索旁白所需画面。作者从五类共 100 部长视频切片、打乱时间顺序,分别测试片段级和场景级素材池。 Figure 1: Overview of the proposed Clips2Story-ND pipeline. Given a pool of raw video footage and a user-specified keyword, we first extract textual descriptors from the video clips and retrieve those most relevant to the keyword. We then use an LLM to generate an editable storyboard with connective narration. Finally, we compose the output video by assembling the selected clips and retrieving accompanying visuals for the narration. 实验效果:15 人用五分量表评价三类视频各六段短片;Clips2Story-ND 相对 REGen 的叙事连贯性为 4.43±0.14 对 3.17±0.11,关键词对齐为 4.42±0.13 对 3.11±0.16。它依赖逐片描述、检索和 LLM 规划,原文未给可与扩散生成时延直接比较的统一耗时。 Figure 5: Genre-wise comparison of CLIPScore, VTGHLS, OPC, KR-Narration, KR-Frame, and KR-Caption under the scene-level setting. Error bars indicate 95% confidence intervals. Specific numbers can be found in Table 6 . 批判点评:这项工作主要是检索、剪辑和生成旁白,不合成全新视频镜头。100 部原片切碎再打乱是可控测试,开放素材库的版权、镜头语义偏差与叙事可编辑性仍需单测。 3. V2C-Edit:每一步都判断有没有改到位 VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;中央研究院 | arXiv:2611.10066 关键词:图像编辑, 流匹配, VLM 反馈, 区域保持 ⚠️ 前序问题:让图里钟面的数字换语言,同时保住背景。FlowEdit 的源图耦合太强时会出现 zero-edit:输出几乎和原图一样,目标变化没有发生。 方法直觉:不要把“贴近原图”的力度固定到所有去噪步;每一步比较几种编辑速度,并请视觉语言模型按指令判断哪种更像完成了编辑。 本文贡献:V2C-Edit 在不训练生成主干的条件下构造四种源图耦合程度的速度场。ILS(Instruction-Level Similarity,指令级相似度)比较预估改动与用户指令,选择该步速度;当语义改动足够且局部掩码不损伤 ILS 时,再限制无关区域的更新。实验用 FLUX 与 Stable Diffusion 3。 Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F . 实验效果:MagicBrush 的 FLUX 设置下,相对 FlowEdit,GPT-4.1 代评的指令对齐分(0–10,越高越按指令改)由 5.56 到 6.07,未编辑区域的 PSNR(像素保真度,越高越接近源图)为 17.48 对 17.44 dB;PIE-Bench 对应指令分 5.32 到 5.85、PSNR 21.82 到 21.84 dB。逐步 VLM 评估增加推理调用,论文未给统一端到端秒数。 Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image. 批判点评:同表在 Stable Diffusion 3 上,部分 CLIP 分和背景保真并非全胜;依赖 VLM 判断的指令质量也会影响速度选择。 4. MPEG-Diffusion:只把主角用高清算 MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069 关键词:视频生成, 混合分辨率, 扩散加速, 自选主体 ⚠️ 前序问题:视频扩散全画面用高清 token 去噪很贵;直接让背景低清,清晰区与模糊区的边界又容易出现重影,还常需要人预先圈主角。 方法直觉:让同一分辨率的查询读同分辨率的键和值,再在解码前融合两套潜变量;主角区域交给模型的早期特征来选。 本文贡献:MPEG-Diffusion 先在低分辨率运行前 k 个去噪步,随后线性头从冻结 DiT 特征预测高清区域;双分辨率注意力用线性映射补齐缺少的键值,混合分辨率解码器先融合高低清潜变量,再生成整帧。线性映射、区域头与解码器需训练,不能当作纯免训练加速。 Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts. 实验效果:仅处理约 30% 全分辨率 token 时,Wan2.1 14B 的去噪加速 4.8 倍,1.3B 为 3.8 倍,均相对全高清去噪;用户两两比较对既有混合分辨率方法的偏好超过 90%。14B 表中 VBench 质量分 82.9,对全高清 85.3;组件另有约 3% 运行开销的 1.3B 分解统计。加速数字不等于整条出片链路的同倍加速。 Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ). 批判点评:高清区域外仍以低分辨率生成,背景细节有明确预算代价;主角区域选择也依赖早期特征和训练标注。若目标是全景细节,需与全高清结果逐帧比较,而不能只看主角。 5. PhysOPSD:让可运行物理规则教视频 PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴集团 | arXiv:2611.12411 关键词:视频生成, 物理一致性, 在策略蒸馏, 可执行模拟 ⚠️ 前序问题:球碰撞、摆动和液体运动的视频看起来像真的,却常违反物理规律。离线监督训练跟不上模型自己生成的错误状态,物理奖励又稀疏。 方法直觉:把可执行模拟当作教师可见的额外条件:相同噪声下只改物理参数,学生就能看见运动因果变化,而不仅是另一段外观不同的参考视频。 本文贡献:PhysOPSD-Engine 将物理场景写成可验证的模拟程序,形成密集与抽象两级草稿。PhysOPSD 用 OPSD(在策略自蒸馏:在学生自身生成轨迹上获得密集教师纠正)训练视频模型;共享 rollout 噪声配对不同物理参数,使教师的纠正聚焦动力学变化。代码是训练期特权条件,目标仍是视频生成。 Figure 3: Overview of our proposed PhysOPSD . 实验效果:使用 3000 条后训练样本时,13B 主干在 PhyGround 总体物理分为 66.5,对 8 万条样本的 SFT 为 64.8、2.1 万条的 PhysHPO 为 65.8;同表 VBench 总质量 84.0 对 SFT 83.9。数字限于该评测与主干,训练还需编写、运行模拟并完成在策略采样,不能只按 3K 比较总成本。 Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 . 批判点评:模拟可参数化的摆、碰撞等场景是优势,也限制了覆盖面;难建模的开放世界动作未获同等保证。论文自身将模拟可落地动力学列为适用边界。 6. ReelCache:续写分叉少存历史缓存 ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973 关键词:长视频生成, KV 缓存, 分支续写, 低秩压缩 ⚠️ 前序问题:长视频按块生成并允许回退或分叉时,历史注意力 KV(键和值)缓存越存越大;丢掉旧缓存又要重算,下一块等待更久。 方法直觉:相邻块的通道基方向相似,保留少量方向和编码后的系数;编辑分支只复制必要的历史状态,让共同前缀复用。 本文贡献:ReelCache 在块内对 KV 做跨通道低秩分解,再视频编码系数;每层在线预测达到指定保留能量所需的秩。块间管理器复用、增补或重拟合基方向,把块状态组织为树,使 resume、rewind、fork 共用前缀。该方法处理缓存与下一块推理,不重新训练视频生成模型。 Figure 9: Overview of ReelCache . 实验效果:论文在五种视频生成模型的多轮长视频工作负载上,相对基线将 KV 存储降低 14.46–21.13 倍,下一块生成提速 1.25–3.36 倍;六个代表性 VBench 指标下降均小于 1%。这些是缓存场景的下一块延迟,不等于首段生成提速;压缩和解压也有额外计算,表中 CausVid 的解压令下一块生成慢约 3.2%。 Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads. 批判点评:收益取决于历史长度、分叉次数与缓存驻留策略。原文 HTML 标题区有模板警告,但 arXiv 论文题名与摘要可核;不能据模板文字推断会议接收。 7. STEER:改声音时先选对声源 Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630 关键词:音频编辑, 声源选择, 早期去噪, 在轨恢复 ⚠️ 前序问题:一句“只移除左边说话者”交给统一音频编辑器,模型可能把另一人删掉;早期去噪一旦选错,后面往往救不回来。 方法直觉:编辑目标是在去噪轨迹开头定下来的,因此训练应多看早期关键状态;再让模型从自己生成的偏离状态学会纠错。 本文贡献:STEER 是 Source-selection Training via Early-trajectory Emphasis and Recovery:第一阶段强调早期轨迹上的声源选择,第二阶段用模型自己生成的 rollout 状态训练恢复。作者训练基础多任务编辑器并得到 SteerSound,还建 Selective Audio Editing Benchmark,分别衡量目标声源改到位与非目标保留。 Figure 6 : Architecture of our base editor. 实验效果:在作者基础编辑器的选择性编辑基准上,整体任务成功率从 70.42% 到完整 STEER 的 85.78%,选错声源比例从 28.48% 降至 8.45%;只做早期强调则为 84.02% 和 9.99%。这是额外后训练所得,不是免训练插件;作者还在 UNISON 与 SAM Audio 上报告迁移效果。 Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement. 批判点评:选择性测试依赖作者构造的任务和自动评判规则,复杂重叠声源与极短目标音仍需试听验证。额外训练两阶段和自生成轨迹会增加训练成本,原文没有统一的单条推理时延对照。 8. SnB:两套生成器半路接上 Split and Bridge: Multimodal Generation via Diffusion Bridging | 佛蒙特大学;脑科学与智能技术卓越创新中心 | arXiv:2611.10441 关键词:多模态生成, 图像编辑, 扩散桥接, 图像与掩码 ⚠️ 前序问题:要同时生成图像和对应分割掩码,常见做法是重新训练一个共同潜空间;现有高质量单模态生成器难直接复用。 方法直觉:先让两条反向扩散轨迹共享一段路,再在分叉点用桥接模块把它们连起来;共享程度控制结构一致性与各自画质的取舍。 本文贡献:Split and Bridge(SnB)在采样时耦合预训练单模态扩散模型;从共同先验出发,t_split 处经 bridge 修改条件、模型或中间层,再走各自的去噪轨迹。可学习 bridge 增强跨模态映射,不需从头联合训练整套生成器。论文测图像与语义掩码配对,也展示图像编辑和交错协同生成。 Figure 1: SnB leverages pretrained diffusion models by coupling reverse trajectories during sampling. We start from a common state sampled from a prior, then at t s p l i t t_{split} , a bridge module is used to implement a score intervention on the reverse process. This intervention can be through modifying conditioning signals (e.g., prompts), changing diffusion models that estimate the score functions, or changing certain layers in the diffusion models. This flexibility applies SnB in various tasks, like interleaved co-generation (top left pair) and multimodal generation (top right pair). Learnable bridges allows stronger trajectory manipulation in mapping one modality to another. 实验效果:CelebAMask-HQ 的图像—掩码联合生成表中,t_split=50% 时 SnB 一致性 0.73、FID 60.84;MLD 对照为 0.68、121.69。FID 是生成图像与参考分布的距离,越低越好;分叉点改到 80% 时一致性升至 0.79,条件生成 FID 却恶化,说明不能只追一致性。bridge 需训练,额外模型和同步采样也有成本。 Figure 3: Qualitative comparison of SnB and previous top-down multimodal approaches on CelebAMask-HQ. SnB balances between coherence and quality of generated modality pairs. 批判点评:图像和掩码等可对齐模态更适合这套桥接;跨模态关联弱时共享噪声未必足够。论文所报是特定数据集与分叉比例,不代表任意两个预训练模型都能直接拼接。 9. REDiff-AD:借一张缺陷图造新缺陷 REDiff-AD: No Training and No Target Masks for Industrial Anomaly Image Generation via Diversity-Driven In-Context MMDiT | 台湾大学 | arXiv:2611.10875 关键词:缺陷图像生成, 少样本条件, 伪掩码, 整流流 ⚠️ 前序问题:工厂缺陷样本少,且换一种产品就重训生成器或画目标掩码很费事。目标是产生更多有变化的缺陷图及可用伪掩码。 方法直觉:把一张有掩码的参考缺陷和正常目标图放进同一个生成上下文,模型学到缺陷外观后迁移到目标;生成时的注意力还能反推缺陷出现在哪。 本文贡献:REDiff-AD 用冻结的整流流 MMDiT(多模态扩散 Transformer)做上下文缺陷迁移,不要求目标掩码。语义定位先给目标可编辑区域;AAM 加强弱缺陷参考,DOK 减少照搬参考形状;聚合目标到参考的注意力,再结合边缘和颜色得到像素级伪掩码。输入仍需一张带掩码的参考异常图。 Figure 3 : Overview of the proposed REDiff-AD model. Semantic localization first determines a loose editable region on the target. A frozen in-context MMDiT transfers the masked reference, with AAM strengthening weak anomalies and DOK reducing reference-shape copying. Aggregated target-to-reference attention is then refined into the output pseudo-mask. 实验效果:MVTec-AD 表中各类平均 KID(核 Inception 距离,越低表示生成分布越接近参考)为 31.09,对 O2MAG 的 47.63。RTX 5090 上,30 步设置每图耗时 16 秒、显存 9 GB,对 O2MAG 的 20 秒、16 GB;但合成图训练的平均异常分类准确率为 70.77%,低于 O2MAG 的 73.51%,生成指标优势不能直接当成判别收益。 Figure 4 : Qualitative illustration of the effects of DOK and AAM. DOK diversifies the geometry of the defect, while AAM improves the robustness of in-context defect generation. 批判点评:需要带掩码的参考缺陷,不能称为完全无标注。工业异常边界和实际缺陷多样性不同,伪掩码噪声可能影响下游定位;跨产品泛化要用新产品验证。 10. SoftPAT3D:布料玩偶生成后不穿模 SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087 关键词:文本生成3D, 可变形物体, 物理仿真, 场景编辑 ⚠️ 前序问题:文本生成的沙发和毯子看似搭在一起,三维网格里却可能相互穿透或漂浮;没有材料、自然形状和接触初态,也无法直接进仿真。 方法直觉:按布料或玩偶的制造方式恢复自然形状,补出被遮挡的支撑家具,再把整场景放进同一接触仿真里落到稳定状态。 本文贡献:SoftPAT3D 沿用文本到图像再到三维资产的前段流程,为可变形物体构造静止形状、材料参数和初始放置;重建支撑物的碰撞网格后统一求静态平衡。几何和视觉语言检查失败的场景可通过放置网格搜索与可微仿真梯度优化。生成结果可继续做物体移动、拉扯等三维编辑。 Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ). 实验效果:作者的 65 条提示上,本法结果均无不期望的物体互穿,而所比较系统各有互穿;这是论文的几何检查口径。代价是额外的资产补全、碰撞网格、材料赋值、仿真与可能的优化,原文没有与纯生成器统一计时的端到端速度对照。 Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them. 批判点评:仿真稳定与画面完全符合提示仍是两回事:论文展示了物体最终聚成一团等失败例。场景质量依赖碰撞网格和材料库,复杂软体或未知材质需另验。 趋势观察 把编辑作用点放到过程里 SceneShifter 改时空注意力里的背景连接,V2C-Edit 每步按指令选速度;STEER 则把声源选择放在去噪早段训练。 生成预算从平均分配转向按需分配 MPEG-Diffusion 只让关键区域保持高清;ReelCache 压缩并共享历史块 KV,二者分别针对空间 token 和长视频历史。 可执行结构给生成增加约束 PhysOPSD 用可编辑物理模拟作训练条件,SoftPAT3D 在三维场景完成后再用接触仿真消除互穿。 综合指标不能盖过任务失败 REDiff-AD 的生成 KID 较优,但平均下游分类准确率低于 O2MAG;Clips2Story 的叙事分须放回打乱素材的实验设定。 今日讨论 SceneShifter 在 MultiTalk 上将换景成功率从 38.7% 提到 99.3%,但附录也出现人物消失再入镜后身份改变的失败例。若连续换五个场景并有人物出入画,哪些指标能验证动态前景掩码是否同时保住切换帧精度、重入身份和推理时延? 人工智能炼丹君 整理 | 2026-11-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
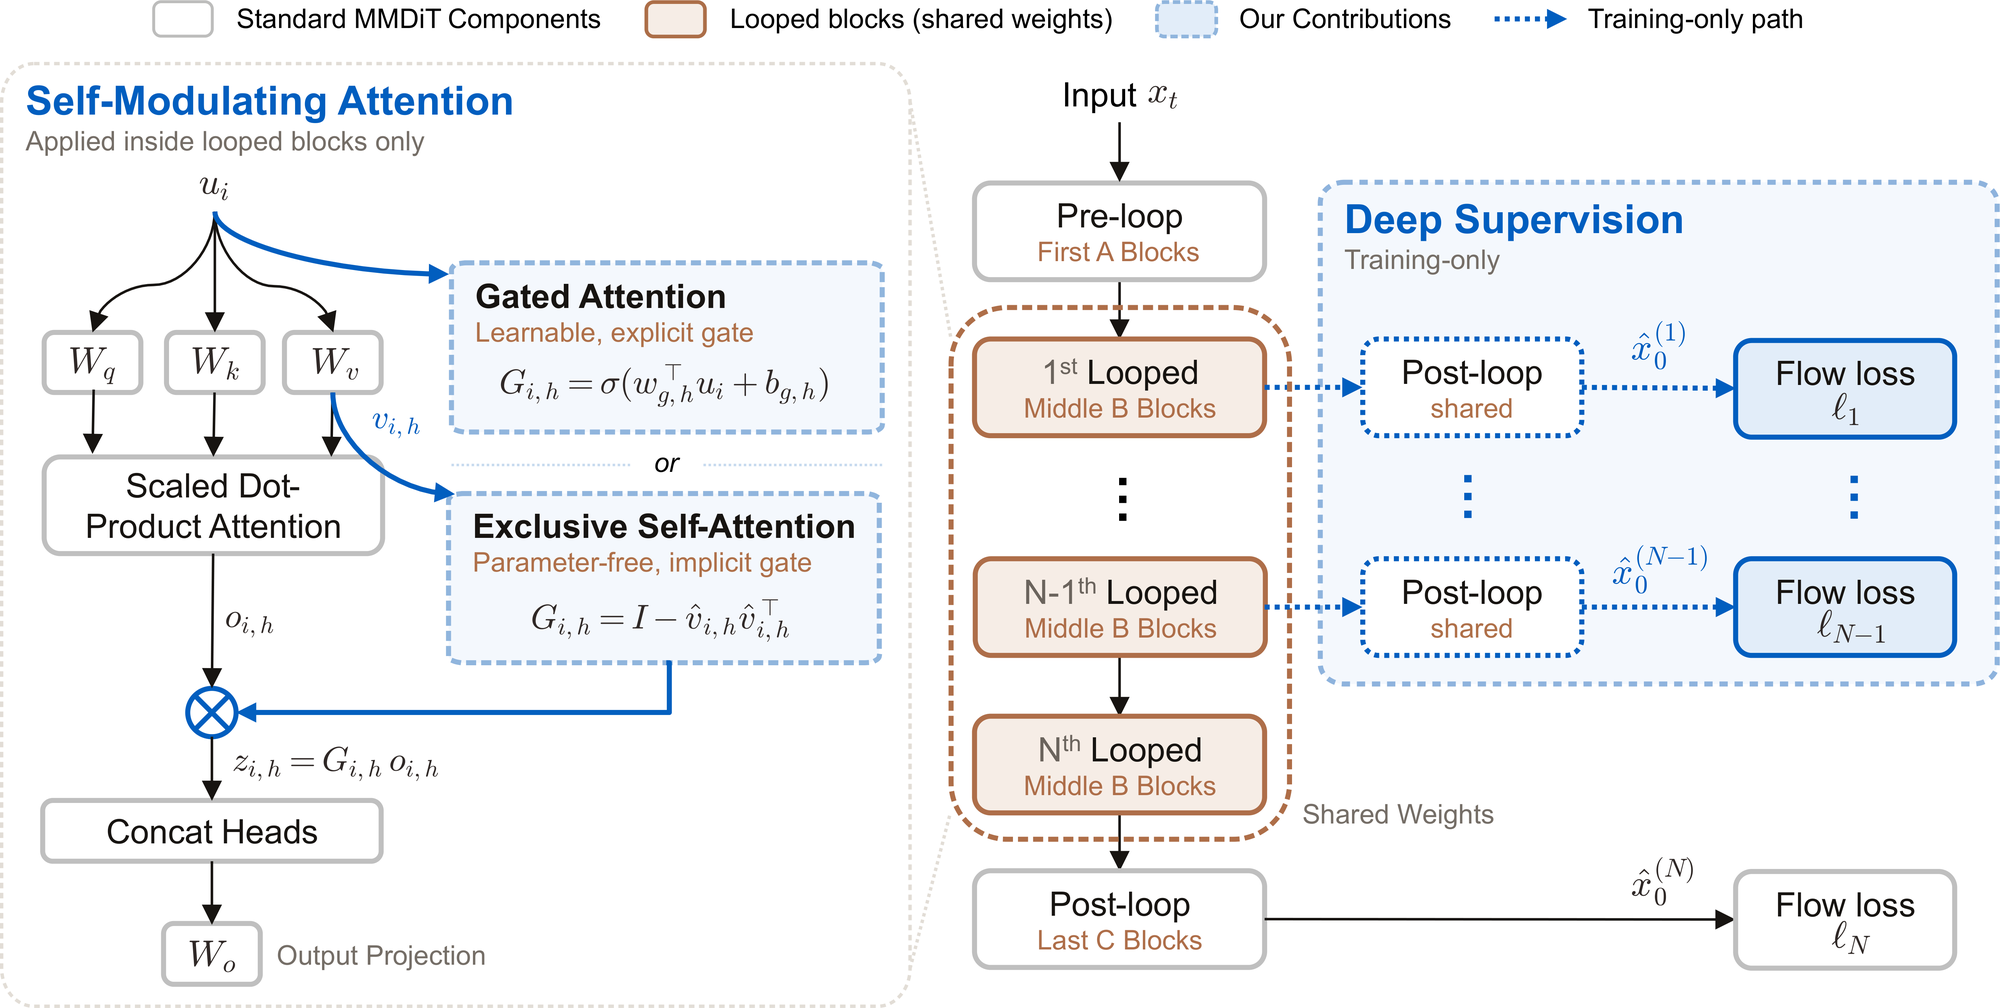
AIGC 每日速读|2026-10-04|商汤小模型绕圈反超6.5倍大模型,Looped-DiT 今日 AIGC 论文速览 今日共 10 篇 · 高效文生图架构 3 篇 · 统一多模态 1 篇 · 长视频与音视频生成 2 篇 · 生成推理加速 2 篇 · 视频强化学习与图像评测 2 篇 重点论文标题列表 Looped-DiT(商汤):260M循环4圈赢6.5倍大模型 Multimodal Flow(华科):图文全连续流建模,仅用150B词元 NEPA-DiT(密歇根大学):预测嵌入当条件,FID 1.32 MosaiChunk(康奈尔大学):只训13.6M路由,长视频回访不失忆 Soundwich(西蒙弗雷泽大学):冻结LTX-2.5免训练拆分音轨 今日论文速览 1. Looped-DiT:260M循环4圈赢6.5倍大模型 Looped Diffusion Transformer | 商汤科技;清华大学;南洋理工大学 | arXiv:2609.40305 关键词:文生图, 循环计算, 参数共享, 深度监督, 潜在推理 前序问题:文生图模型提质通常只有两条路:加参数或加去噪步数。语言模型里已验证的「循环复用同一组层」能在不增参数的前提下加深计算,但直接搬进 MMDiT 并不稳定:推理圈数超过训练值后性能先涨后跌,中间表示里可线性解码的空间位置信息逐圈流失。 本文贡献:Looped-DiT 把网络切成前段 6 块、循环段 5 块、后段 6 块,每个去噪步内让循环段共享权重重复 N 次(训练取 4 圈)。两项稳定手段:深度监督,每圈输出都经共享后段解码并计入 flow loss;自调制注意力,用门控或无参的 Exclusive Self-Attention 抑制注意力对局部信息的过度改写。 实验效果:260M 的 B/16 在 GenEval、DPG、PRISM、CoRe、Spatial、TIIF 六项均值 71.5,六项全部高于 1.7B 的 InternVL-U(均值 69.0),也高于 6.6B 的 Uni-CoT(66.8),单图推理算力约为 InternVL-U 的 1/4.9。参数对齐对照里,B/32 均值从 55.2 提到 59.1;同等推理预算下,加圈比加去噪步更划算。 批判点评:「参数不变」不等于「算力不变」:循环版每步推理 267 GFLOPs,是同参数基线的 1.83 倍,训练 1246 GFLOPs 更是 2.83 倍。按推理算力对齐时,加宽版 MiniT2I 已到 58.6,与 Looped-DiT 的 59.1 只差 0.5。分项看,循环擅长约束求解,需要常识推断的 CoRe/Generalization 只 +7.5,远不如文本 CoT 的 +22.2。 2. Multimodal Flow:图文全连续流建模,仅用150B词元 Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces | 华中科技大学;北京交通大学;地平线 | arXiv:2609.40362 关键词:统一多模态, 连续流匹配, 文生图, 视觉理解, 多模态预训练 前序问题:统一理解生成模型多走两条路:文本和图像都离散化,图像要过量化瓶颈;或文本离散、图像连续,两种目标与采样流程各写一套。全连续建模能让两种模态共用一个生成过程,但在多模态预训练规模上很少被系统验证。 本文贡献:MF-1 用冻结的 T5-small 与 SigLIP2 把文本块(每 8 个词元一块)和图像编码成连续表示,按顺序组织成 hyperchunk,交给一个 chunk-causal 的 flow 主干学习单一速度场;注意力投影共享、FFN 按模态分开。训练时并行预测多个目标块,推理时逐块生成,再由预训练图像解码器与单独训练的文本解码器还原。 实验效果:1.6B 版本只用 150B 预训练词元,GenEval 0.82、DPG 83.44,理解侧 POPE 86.1、MMBench 67.2。数据、优化与参数完全对齐时,全连续版 GenEval 0.713、MMBench 46.7,高于 Transfusion 式混合(0.669 / 33.7)与 Chameleon 式全离散(0.374 / 38.4)。 批判点评:生成强、理解弱:MMBench 67.2 落后同量级的 Janus-Pro(75.5)与 JanusFlow(74.9),VQAv2 72.6 也低于 JanusFlow 的 79.8(对方有预训练 LLM 初始化);DPG 83.44 还没追上纯生成的 SD3 Medium(84.08)。scaling 曲线上 1.6B 预训练阶段 GenEval 只到约 0.32,表中 0.82 是再经 5B 词元微调后的结果;「全连续」也依赖冻结编码器与外部解码器,图像输入仅 224 分辨率。 3. NEPA-DiT:预测嵌入当条件,FID 1.32 Embedding Prediction Helps Image Generation | 密歇根大学;卡内基梅隆大学 | arXiv:2610.02203 关键词:类别条件生成, 嵌入预测, 扩散 Transformer, 表征对齐, ImageNet 前序问题:DiT 里类别或文本只嵌入一次,每个去噪步复用同一个条件,「这个条件对眼前这张噪声图意味着什么」全留给生成器自己推断。NEPA(下一嵌入预测自回归)已能在连续嵌入上做自回归预测,作者想知道:能否用预测出的干净图嵌入替代固定条件。 本文贡献:把生成写成「条件 → 噪声图 → 干净图」的嵌入序列,干净图的 patch 嵌入正是条件与噪声图之后的「下一组嵌入」。作者训练 NEPA 模型用多嵌入预测(MEP)一次性预测全部干净嵌入;生成时 DiT 以这些预测为条件,并在每个去噪步按当前噪声状态重新计算,条件随采样进程自适应。 实验效果:ImageNet 256×256 上,NEPA-DiT-XL 结合 REPA,SDE-250 采样 FID 1.32、IS 311.0,ODE-96 采样 FID 1.57;训练为 NEPA 240 + 生成器 80 epoch,约为 REPA(800 epoch)训练算力的三分之一。九组规模交叉实验中,生成器或 NEPA 模型变大,FID 都单调下降。 批判点评:训练省了,推理贵了:多挂一个 711M 的 NEPA 网络,总参数约 1.39B,是 SiT-XL/2+REPA(675M)的两倍;同为 SDE-250,单图 160 TFLOPs,比对方的 91 TFLOPs 多 76%。换成更省的 ODE-96,FID 1.57 反而不如 REPA 原版的 1.42。若放开 tokenizer,表中 SFD、RAEv2 已做到 1.06。 4. MosaiChunk:只训13.6M路由,长视频回访不失忆 MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation | 康奈尔大学;加州大学伯克利分校;哈佛大学;Impossible Inc. | arXiv:2610.02153 关键词:自回归视频生成, 长时记忆, KV 缓存, 记忆路由, 场景回访 前序问题:自回归长视频受限于上下文窗口:物体或场景移出窗口后细节丢失,镜头转回来时往往「重新编」一个。整块检索历史 chunk 能补记忆,但固定显存预算下塞不了几块;滑动窗口则干脆遗忘。 本文贡献:作者先验证冻结的视频生成器能直接消费非连续拼接的历史 KV 并还原对应内容。MosaiChunk 据此把每个历史 chunk 聚成若干 section 并编码描述子,由轻量路由器全局挑出 top-N,在固定活跃显存预算内拼成一块跨时空的 KV 马赛克;生成器全程冻结,只自蒸馏训练路由器。同时发布 RememBench 回访基准,含 T2V 与 I2V 两个子集。 实验效果:在 MiniMax-H3 改造的自回归版 H3-AR(T2V)上,两块远程记忆预算下回访 CLIP 从滑窗基线 0.751 升到 0.936,LPIPS 从 0.652 降到 0.500,优于整块检索 MoC(0.841);LingBot-World-Infinity(I2V)180° 旋转回访 CLIP 0.793→0.863。路由器只有 13.65M 参数。 批判点评:自建基准涨幅大,公开基准涨幅小:WBench 的 Subject 一致性仅 88.10→88.38,两块预算下 Segment 一致性反从 97.47 掉到 94.94;T2V 的 Drift 也略升(0.050→0.055)。论文还写明评测用的是早期 checkpoint:T2V 计划训 4000 步、实取第 416 步,I2V 计划 4768 步、实取第 500 步,未解释为何不用训完的权重。 5. Soundwich:冻结LTX-2.5免训练拆分音轨 Soundwich: Video Generation with Layered and Controllable Audio | 西蒙弗雷泽大学;塞浦路斯大学;CYENS 卓越中心;特拉维夫大学 | arXiv:2610.00691 关键词:音视频联合生成, 音轨分离, 免训练, 时间控制, 可编辑音频 前序问题:联合音视频模型已能生成带同步声音的视频,但音频是一条混好的总轨:谁在何时说话、配乐和环境声都没法单独改。实际制作中,对白、音乐、音效、环境声都是分轨编辑的。 本文贡献:Soundwich 不做训练,直接改造冻结的 LTX-2.5:先把音频轨迹扩成 N 条可编辑分轨加一条内部场景轨,用缓存的「出声 / 静音」特征(timing carrier)在指定时间窗内回放或压制;再用 gather–broadcast 注意力让各分轨共享全局声学语境,并用实体掩码把每条分轨的跨模态注意力路由到画面中对应的发声者。 实验效果:15 个多声源场景上,时间窗成功率 93.1%、窗外误发声 1.7%、声源归属 90.0%,窗内 WER 0.060;同场景原版 LTX-2.5 窗成功率仅 20.4%,MiniMax H3 为 27.0%,Gemini Omni 为 85.0%。去掉 timing carrier,窗成功率从 93.3% 跌到 15.6%。 批判点评:评测规模很小:主表只有 15 个场景、每场景 3 个固定种子,场景广播模块的人评只收回 15 份问卷。真正接近的对手是闭源 Gemini Omni,WER 0.072 对 0.060、窗成功率 85.0% 对 93.1%,且它只有 14 个场景可计 WER。声源归属 90.0% 比朴素批量扩展的 82.2% 只高 7.8 个点。 6. DMAD:判别器替掉辅助分数网络,4步出片 DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation | 得州农工大学;字节跳动智能创作 | arXiv:2610.02188 关键词:少步蒸馏, 分布匹配, 对抗蒸馏, 视频生成, 音视频生成 前序问题:DMD 系列少步蒸馏要从「目标分数 − 学生分数」的差里取梯度,因此必须额外维护一个持续拟合学生分布的辅助扩散模型,显存与算力开销都大,在 14B、33B 级视频模型上尤其吃紧。 本文贡献:DMAD 把分布匹配改写成分类:共享主干上挂两个判别头,分别区分「真实数据 vs 学生」与「教师样本 vs 学生」,用 logit 直接学习对数密度比,学生只用作用在 logit 上的线性损失训练,无需拟合辅助分数。作者证明判别器最优时该损失恰好还原 DMD 的梯度,并用真实头在真实与教师样本间的 logit 差,自适应调节各噪声级上教师监督的权重。 实验效果:ImageNet-64 一步 FID 1.04(加投影判别器),SDXL 四步 COCO-10K FID 14.47,Wan2.1-14B 四步 VBench 85.15,均优于所比少步方法与多步教师。在 MiniMax-H3-33B 联合音视频生成上,四步学生人评总体偏好 79.1% 胜 DMD2、84.6% 胜 rCM;每次生成器更新耗时从 818.1s 降到 233.3s。 批判点评:人评高分主要来自画质与音质(对 DMD2 胜率 84.2% / 87.9%),提示词对齐只有 54.3% 对 45.7%,接近打平。AVGen-Bench 上音画同步 AV 分 49.1,低于 DMD2 的 56.7;唇形同步 30.6,离教师的 39.0 也远。SDXL 一步时 Patch FID 32.42,反而比 DMD2 的 26.98 差,细节保真不如整体 FID 好看。 7. FlashForward:复用在途KV,4卡流水线生成长视频 In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion | Meta;南洋理工大学 | arXiv:2609.32540 关键词:自回归视频扩散, KV 缓存, 流水线并行, 长视频生成, 推理加速 前序问题:少步自回归视频扩散按 chunk 逐段生成。为记住已生成内容,Self-Forcing、HiAR 等方法要额外跑「只更新缓存、不推进输出」的前向来重建干净或低噪 KV。可每次去噪前向本来就算出了当前 chunk 的 KV,这部分被白白浪费。 本文贡献:FlashForward 直接复用每个去噪阶段算出的「在途」KV:当前 chunk 完成一个阶段后,该阶段的缓存即可供下一个 chunk 使用,于是每张 GPU 负责一个去噪阶段,不同 chunk 在卡间流水并行。为弥补噪声历史带来的外观与运动漂移,再由 planner 预先生成稀疏的干净锚点 latent,从前后两侧约束 renderer 的轨迹。 实验效果:4 卡下,16 FPS、20 秒以上视频比 HiAR 快 1.16–1.69 倍、比 Self-Forcing 快 1.42–2.92 倍(1.3B 与 14B,480p / 720p)。1.3B 480p 生成 65 秒视频去噪耗时 21.3s(HiAR 24.7s、Self-Forcing 65.1s);VBench 总分 0.838,65 秒 VBench-Long 0.8395,高于 Self-Forcing 的 0.7806。 批判点评:提速依赖多卡流水:单卡 480p 下它比 Self-Forcing 还慢(20 秒视频 17.77s 对 17.44s,65 秒 59.64s 对 57.89s)。生成 5 秒短片时 4 卡耗时 2.21s,慢于 HiAR 的 2.06s,更慢于双向模型的 1.13s。14B 720p 峰值显存 112.8 GiB/卡,比 Self-Forcing 多约 20 GiB;20 秒视频语义分 0.748 也略低于 HiAR 的 0.757。 8. TVRL:用VLM梯度给视频token分功劳 Token-Level Video Reinforcement Learning | 美国东北大学 | arXiv:2610.01973 关键词:视频生成, 强化学习, GRPO, 信用分配, VLM 奖励 前序问题:视频生成的 RL 后训练通常给整段视频一个标量奖励。可视频的缺陷是局部的:有的 token 已满足提示词,有的才需要修。标量奖励定位不了错误,优化时既会扰动本来正确的区域,又对真正出错的区域用力不足。 本文贡献:TVRL 让奖励自己给出 token 级功劳:冻结 VLM 对提示词拆出的若干是非题给出答案似然,平均后作为视频级奖励;同一 VLM 对视频输入的梯度幅值,则标出哪些生成 token 最影响该得分。在 GRPO 中,组相对优势决定更新方向与强度,经 3×3 平滑、按问题条件化的 credit 图在裁剪策略比内重加权各去噪步的转移对数概率。 实验效果:以 HunyuanVideo-1.5 为底座、Qwen3.5-9B 作奖励,VBench-2.0 Overall 从 54.09 升到 57.69(+3.60),同设置 GRPO 仅 54.54。换 SAGE、Flow、Dance 三种 SDE 采样器,比匹配 GRPO 高 2.68–3.15;换 VideoAlign 等四种奖励模型,高 1.33–3.15。 批判点评:增益并不均匀:常识维度上 TVRL 常不如 GRPO(Qwen3.5-9B 奖励下 64.31 对 64.88,VideoScore2 下 64.60 对 64.89),VideoScore2 下 Human 维度也从 91.52 降到 90.79。评论家规模很关键:换成 Qwen3.5-0.8B 时 Overall 仅 51.85,比未训练的底座 54.09 还低。所有结果都只训 100 步(64 张 A100),单步耗时比 GRPO 多 18%。 9. PixelDense:4个冻结老师分两路对齐像素扩散 PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion | 弗吉尼亚大学;密歇根州立大学;Adobe;Arcade AI | arXiv:2610.00483 关键词:像素扩散, 表征对齐, 稠密预测, 文生图, 几何先验 前序问题:REPA 通过对齐预训练编码器特征来加速 DiT 训练,但对齐目标几乎都是 DINOv2、CLIP 这类语义编码器。已有分析指出起作用的是空间结构而非全局语义,那么专门预测结构的稠密预测模型(分割、深度)为何没人拿来当对齐老师? 本文贡献:在像素空间扩散上,作者先验证 SAM2、Depth Anything v2、Metric3D v2 单独加入都优于只用 DINOv2,但四个老师直接相加反而不如最好的单个几何老师,语义与几何梯度在同一投影上互相争抢。PixelDense 因此让 DINOv2+SAM2 走语义投影流、两个深度模型走几何投影流,再加权重空间正交惩罚让两流处在不相交子空间;老师全部冻结、推理时丢弃。 实验效果:在 PixelGen-XXL(512×512)上,GenEval Overall 0.7927→0.8093,DPG 78.7→78.9,HPS 0.280→0.282;同一配方不调参迁移到 DeCo,GenEval 0.8620→0.8690。部分加噪重建中,τ=0.5 时 COCO 全景 PQ 23.23→31.43;PIE-Bench 上 SDEdit 背景 PSNR 最多高 2.2 dB。论文已接收 NeurIPS 2026。 批判点评:几何探针涨得多,生成指标涨得少:GenEval 只 +0.017、DPG +0.2、HPS +0.002,DeCo 上 +0.007,计数项 58.75 仍低于 PixelGen 原版的 59。消融里单独的几何流(DA2+M3D)只有 0.7960,还不如 DINOv2+DA2 单老师的 0.8069。主实验只是在已发布权重上用 2 张 H200 微调 1 万步,从头训练仅给出「1.23 倍更快达到基线峰值」一项。 10. VIEScore2:16×16网格同时打分并圈出缺陷 VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations | 滑铁卢大学;NVIDIA;台湾大学(中国台湾);南洋理工大学 | arXiv:2610.00994 关键词:图像评测, 缺陷定位, 生成与编辑, GRPO, VLM 评估器 前序问题:现有合成图评估器大多只给一个标量分数,不说明依据在图上哪里;能定位缺陷的模型又通常不打分、也不支持编辑任务的条件图输入。生成与编辑的评测和奖励信号,缺一个「既能打分也能指位置」的统一接口。 本文贡献:VIEScore2 把图像表示为 N×N(默认 16×16)文本网格,单次前向同时输出感知质量、语义一致性分数与缺陷格子位置,支持可选条件图,覆盖文生图、编辑、参考图生成等任务。它基于 Qwen3-VL-8B 在 38K 条混合监督上先 SFT,再以 Dice 重叠、分数准确度与格式奖励做 GRPO,最后用无参数解析器把网格结果转成可读解释。 实验效果:主测试集整体分数 SRCC 0.601,高于同输入下最强的零样本通用 VLM Gemini-3-Flash(0.491)与 GPT-5.6-sol(0.437);联合评测网格 IoU 0.324,Qwen3-VL-8B 原版仅 0.070。缺陷定位在 6 个基准中 3 个第一、5 个进前三。 批判点评:整体领先主要来自训练同源数据:RichHF(0.692)与 EvalMuse(0.803)拉高均值,编辑类子集反被零样本 API 压过,TIE 0.429 对 Gemini-3-Flash 的 0.686,MRIE 0.417 对 GPT-5.6-sol 的 0.684。定位上,轻量的 SegFormer-b0 在主测试集 F1 拿到 0.493,与它的 0.506 相差无几;GRPO 之后 PQ 的 SRCC 还从 0.580 降到 0.558。 趋势观察 「加算力不加参数」成了今天的共同母题 Looped-DiT 让同一组块在每个去噪步里绕 4 圈,NEPA-DiT 每步重算一次预测嵌入当条件,两者都用额外推理算力换质量而不是加参数;但细看算力表,前者每步 1.83 倍 GFLOPs,后者单图多 76% TFLOPs,「小模型赢大模型」的账要连推理成本一起算。另一头,DMAD 与 FlashForward 继续在蒸馏和 KV 复用上压缩视频生成的步数与等待时间,TVRL 与 VIEScore2 则把奖励和评测从一个标量推进到 token 与网格级定位。 人工智能炼丹君 整理 | 2026-10-04 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-10-02|NVIDIA砍掉视觉编码器,PixelUMM图像视频同模 今日 AIGC 论文速览 今日共 10 篇 · 统一理解生成与三维细节 2 篇 · 推理式与可控视频生成 2 篇 · 音视频联合生成 1 篇 · 视频推理加速 4 篇 · 视频文字编辑评测 1 篇 重点论文标题列表 PixelUMM(NVIDIA):像素直进图像视频同模型 BTC3D(香港城市大学(东莞)):分块条件补3D细节 ThinkV2V(港中大):先推理再改视频 LIFT(加州大学圣迭戈分校):只画终帧也能控未来 StereoBind(西电):声源移动立体声跟着走 今日论文速览 1. PixelUMM:像素直进图像视频同模型 PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation | NVIDIA;滑铁卢大学 | arXiv:2609.38597 关键词:统一多模态, 像素空间, 图像生成, 视频生成, 视觉理解 前序问题:统一理解与生成模型通常给同一张图准备两套表示:ViT 特征服务理解,VAE latent 服务生成。这不只让视觉上下文变长,也把成熟的视觉语言预训练与生成接口绑在两条管线上。图像还能直接切 patch,视频却要同时兼容理解侧的采样帧与生成侧的连续时空块,统一接口更难。 本文贡献:PixelUMM 取消预训练视觉编码器和 VAE,把图像变成空间 patch、视频变成时空 tubelet,都只用一层线性投影接入 8B Mixture-of-Transformers。理解走自回归文本预测,生成在原始像素上做 flow matching;共享 attention 让干净条件与带噪目标直接交互。论文还系统比较 patch/tubelet 大小、线性头与卷积解码头,发现卷积头能压掉格子伪影。 实验效果:不使用视觉 encoder/tokenizer 时,PixelUMM 在图像理解 MMMU 得 41.67、视频理解 MVBench 得 70.53;图像生成 GenEval 原始 prompt 为 0.77,用 BAGEL-long 重写后为 0.83,DPG-Bench 为 85.74。视频生成 VBench 总分 83.24,处于统一模型可比区间,但不是各榜第一。 批判点评:“统一”仍有边界:理解与生成使用两套 Transformer expert,只共享 attention,并非一组参数同时做两件事。原始像素 token 让更小 patch 和 tubelet 虽然降低 loss,却直接抬高序列长度与训练成本。作者也提醒各模型训练数据不同,当前表格不能证明 encoder-free 架构本身更优;MMMU 41.67 与主流 8B VLM 仍有明显差距。 2. BTC3D:分块条件补3D细节 BTC3D: Blended Tile Conditioning for Detail-Enhancing Image-to-3D Generation | 香港城市大学(东莞);SB Intuitions;巴塞罗那自治大学 | arXiv:2609.39709 关键词:图像生成3D, 免训练, 分块条件, 细节保真, 流匹配 前序问题:扩散式 image-to-3D 已经能出像样模型,可一旦输入图细节丰富,纹理就糊成一团。主流做法把整张图压成一个全局条件特征,空间信息在这一步被压掉,作者称之为 detail attenuation;而想补细节通常要重训或微调大模型,对 3D 管线代价过高。 本文贡献:BTC3D 是推理时即插即用的免训练框架。它先验证 image-to-3D 模型存在「图像特征可加性」:把局部图块的特征相加,仍能得到语义一致且保留局部细节的 3D 输出。据此把输入图切成若干 tile,各自提取局部条件并按前景权重聚合成 blended tile embedding;再配一个 dynamic conditioning 调度,在扩散后期低噪声阶段逐步加大 tile 条件的权重,早期仍交给全局条件主导结构。 实验效果:在 3D-Arena 与 Toys4K 上,把 BTC3D 接到 TRELLIS、TRELLIS.2、Hunyuan3D-v2.1 上都提升了纹理与视觉保真,且保持全局结构一致。20 名参与者、400 次两两偏好测试中,接入 BTC3D 的 TRELLIS.2 拿到 67.25% 选票(269 票),基线只有 32.75%(131 票),纹理密集的样本优势最明显。 批判点评:收益主要靠人眼偏好而非几何或纹理指标说话,67.25% 也是相对自家基线的增幅,缺少跨方法横评;论文同时承认纹理稀疏的样本上两者偏好接近持平,说明方法吃的是「有没有细节可补」。另外 tile 切分与融合系数 α、β 都是人工超参,动态调度只按扩散时间步推进,不看当前生成内容。 3. ThinkV2V:先推理再改视频 ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing | 香港中文大学;字节跳动;浙江大学;俄亥俄州立大学 | arXiv:2609.38541 关键词:视频编辑, 多模态大模型, 显式推理, DiT, 指令跟随 前序问题:现有指令视频编辑器多把 MLLM 当语义编码器,直接把 prompt 压成条件。碰到“把会被雨淋湿的东西收起来”这类不直接点名目标的指令,模型必须先理解因果与对象关系,再决定改哪里;只抓关键词往往画面能改,却改错对象或违背真实意图。 本文贡献:ThinkV2V 让 MLLM 先显式分析源视频和指令,再通过 learnable-query connector 把推理结果送给多条件 DiT。训练采用从直接编辑到推理密集样本的 progressive curriculum;推理时生成多份候选编辑 prompt,迭代反思并选择最可靠的一份。团队同时整理 ThinkV2V-150K 与专门考隐式意图、因果编辑的 ThinkV2V-Bench。 实验效果:5B 编辑器在 ThinkV2V-Bench 上由 Seed-1.6-VL 评测的 Overall 为 2.72,高于 OpenVE-Edit 的 2.09 和 14B DITTO 的 2.02;Gemini-2.5-Pro 评测下为 2.61,也高于 ICVE 的 2.52。模型在 32 卡上分三阶段训练,最终 720p 推理,以小于多条 10B–14B 基线的规模拿到最佳综合分。 批判点评:核心结论依赖 Seed-1.6-VL 与 Gemini-2.5-Pro 充当裁判,复杂编辑的自动分数仍可能偏向更会“讲意图”的输出。Inference-Time Thinking Scaling 需要多候选生成、反思和筛选,论文没有把新增延迟与算力单独量化。150K 数据由既有模型与筛选流程构建,推理能力有多少来自 MLLM、多少来自数据课程,还缺更严格的因果拆分。 4. LIFT:只画终帧也能控未来 LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation | 加州大学圣迭戈分校;弗吉尼亚大学;Meta;Amazon;Lambda | arXiv:2609.38146 关键词:视频生成, 相机控制, 未来布局, on-policy self-distillation, 图生视频 前序问题:相机大幅移动时,首帧之外会露出全新区域。只给相机轨迹能控制“镜头往哪走”,却不能指定新区域里出现什么;逐帧框轨迹虽然能控布局,标注和交互成本又太高。真正实用的接口应允许用户只在未来关键帧画几个框,同时让中间过程自然长出来。 本文贡献:LIFT 把最后一帧的 bounding box 与局部 prompt 编成稀疏 layout latent,与首帧和噪声视频一起送入 DiT,相机 token 另行注入。训练时用拥有逐帧 dense layout 的冻结教师,在学生自己访问的 ODE 状态上做 on-policy self-distillation,把 dense 轨迹知识蒸馏给只看终帧布局的学生;同一个学生交替学习有布局与仅相机两种模式。 实验效果:LIFT 1.3B 在终帧布局控制上 mIoU 0.51,高于需要逐帧框的 MagicMotion 0.41;同时相机 RotErr 2.97、TransErr 0.59,视频 FVD 99.35。OPSD 只用 500×16=8000 次样本更新,直接或 dense-to-sparse SFT 都要 4000×32=12.8 万次,训练样本量缩到 1/16。 批判点评:布局接口仍只是 2D 框加局部文字,没有深度、朝向、遮挡和实例关系;相机一转,两个框在 3D 中究竟谁挡谁并未显式建模。所谓 1/16 训练量比较的是作者设定的更新预算,并不等于端到端数据与教师成本也缩到 1/16;OPSD 还依赖一个先用 dense layout 训练好的教师。 5. StereoBind:声源移动立体声跟着走 Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation | 西安电子科技大学;vivo 蓝图影像实验室 | arXiv:2609.38748 关键词:音视频联合生成, 立体声, 空间音频, 运动轨迹, 跨模态对应 前序问题:联合音视频模型已经能做到“画面里有什么就听到什么”和大致同步,却很少管声音来自哪里。AR/VR 中声源从左往右移动时,左右声道也应连续变化;只用文本或整段视频条件生成声音,往往知道是汽车声,却无法让声像跟随汽车轨迹。 本文贡献:StereoBind 把可见声源的 motion track 作为共同坐标系:Visual Motion Binding 绑定视觉运动与音频 token,Spatial Track Encoder 提供绝对位置,Residual Track RoPE 编码相对位移。团队用真实视频定位跟踪加合成立体声、再配合可控合成场景,构建 StereoWorld-29K,并用 StereoWorldBench 单独评测动态空间对应。 实验效果:在 StereoWorldBench 上,StereoBind 的 ILD-W 为 2.754、SELD-Acc 0.757、SMR-Err 14.86、AST-Ang 0.465、AST-Cal 0.314,五项空间指标都优于表中 Ovi、MiniMax-H3、LTX-2.5/2.3 及两条 video-to-spatial-audio 基线;视觉 Subject Consistency 0.955、Motion Smoothness 0.996,整体画面质量没有明显牺牲。 批判点评:当前条件是一条主要声源轨迹,训练和评测强调水平声像移动;多声源竞争、声源与听者同时运动、遮挡和完整 3D 声场仍被列为未来工作。空间指标全面领先不代表总体音质全面领先,Subject Consistency 0.955 低于 MiniMax-H3 的 0.968,Audio PQ 6.86 也只是略高于 6.81。 6. ReCaVSR:1080p单卡跑21.2FPS ReCaVSR: One-Step Streaming Diffusion Video Super-Resolution with Recycled Latents and Learned Cache Routing | 中国科学技术大学 | arXiv:2609.37831 关键词:视频超分辨率, 流式扩散, KV Cache, 一步生成, 实时推理 前序问题:扩散式视频超分画质好,却很难满足直播级延迟。现有流式方案要么多步去噪,要么每层都保留完整历史 KV;但视频超分当前帧已有低清观测,上一块超分 latent 也带着局部时序信息,继续为所有层保存同样长的历史既占显存又拖慢注意力。 本文贡献:ReCaVSR 基于 Wan2.2 做一步流式超分,把上一块生成的 SR latent 直接回收为下一块条件,再为每个 DiT 层学习不同的历史缓存范围,训练完导出固定路由。生成器用 sequential self-rollout 对齐真实因果推理;Multi-Scope Query 判别器同时看全局、空间窗口和时间 tube;LR-conditioned FlashDecoder 在解码时再次利用低清观测。 实验效果:单张 A100-80GB 输出 1080×1920 时达到 21.20 FPS、峰值显存 15.16GB,相对 FlashVSR Tiny 快 2.72 倍、少用 38.0% 显存,首个完整 RGB 输出的模型时间为 0.982 秒。LongVSR60 上 MUSIQ 57.89、CLIP-IQA 0.4932、DOVER 0.6075,后三项都高于列出的流式基线。 批判点评:它并非所有重建指标都第一:REDS30 的 PSNR 21.67 明显低于 RealViformer 23.32,说明生成式纹理仍会牺牲逐像素保真。缓存路由在训练后固定,遇到运动强度突变或硬切镜不能自适应;论文的长视频测试还是单段连续镜头,跨场景时旧 latent 和 KV 会不会污染新镜头尚未验证。 7. PARK:稀疏注意力快1.76倍 PARK: Accurate Block Retrieval for Sparse Attention in Video Diffusion Transformers | 华南理工大学 | arXiv:2609.38978 关键词:视频生成, 稀疏注意力, DiT, block retrieval, 免训练加速 前序问题:视频 DiT 的稀疏注意力通常先把 query 与 key 分块求均值,再按块检索。这个近似有两重错位:Softmax 前把多个 query 平均会抹掉各自偏好的 key;在原始 key 空间做欧氏聚类,也不保证同一簇的 key 在当前 query 下拥有相似 QK 分数。检索一旦选错块,要么掉画质,要么为了兜底算太多。 本文贡献:PARK 保留块内每一个原始 query,分别对 key block 做归一化后再平均分布,避免 query-centroid 代替整块偏好;key 侧则从当前 query 推导度量,先变换 key 再做 K-means,让欧氏距离对应 QK-score 误差。方法完全免训练,并把 PAMA 检索写成融合 GPU kernel,把准确率收益留住而不让检索开销反噬。 实验效果:在 Wan2.1-1.3B 上,PARK 将单次测试从 745 秒降到 423 秒,端到端 1.76 倍加速,同时 PSNR 27.52、SSIM 0.908、LPIPS 0.177,优于同表其他稀疏基线。跨 Wan2.2-14B、Wan2.1-14B、Wan2.1-1.3B 和 HunyuanVideo 四个模型,相对 dense 的加速范围为 1.53–1.76 倍。 批判点评:收益建立在四个视频扩散模型和固定检索配置上,作者明确没有验证 LLM 或其他多模态任务。主表中 Wan2.2 的 Aesthetic Quality 65.29% 仍低于 dense 的 65.56%,Wan2.1-1.3B 的 Background Consistency 96.87% 也低于 dense 的 96.99%;它更像高质量近似,而不是无损替换。 8. UnStep:免训练把视频推到50FPS UnStep: Training-Free Acceleration of Causal Video Diffusion with Fewer Steps Than Distillation | Meta 超级智能实验室 | arXiv:2609.32518 关键词:视频生成, 因果扩散, 免训练加速, KV Cache, 推理优化 前序问题:四步因果蒸馏已经比 50 步双向教师快,但 Self Forcing 在 H100 上仍只有 17 FPS。步数继续砍到一两步会掉质量,历史 KV 随视频变长继续膨胀;同时当 DiT 已经很少步,RoPE、cache 索引、attention 调度和 VAE 解码这些过去被遮住的系统开销反而成了瓶颈。 本文贡献:UnStep 是不改权重的推理 wrapper:后续块从四步减到两步,只保留 sink 加最近窗口;把已生成 latent 重新加到近干净噪声,再复用原有 clean-cache pass 做一次修正,并对 attention 的 V/O 投影做截断 SVD 抵消少步误差。系统侧再融合 RoPE、缓存系数、固定长度 attention,并把 VAE 改成 FP16 与 channels-last 卷积。 实验效果:同一 Self Forcing checkpoint 在 H100 上从 17.0 FPS 提到 49.8 FPS,VBench Total 反而从 84.31 到 84.56;相同 wrapper 套在 Causal Forcing 和 LongLive 1.0 上也都约 49.8 FPS。若推理时改成一步,H100 达 59.6 FPS;GB200 最快报告 77 FPS,全程没有重训。 批判点评:所有超参数只在 Self Forcing、5 秒 T2V、单张 H100 这一套设置上调过,迁移结果证明“能用”,不代表每个 checkpoint、GPU、任务和长度都最优。50 FPS 的成绩同时叠加算法减步与大量 H100 专用 kernel 优化,不能全部归功于新的生成算法;而训练自由的约束也限制了更激进稀疏或量化后的质量恢复。 9. DeCoPrune:剪85%缓存仍保上下文 DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency | 南洋理工大学;清华大学;普林斯顿大学 | arXiv:2609.39096 关键词:自回归视频, KV Cache, 训练自由剪枝, 长上下文, 一致性 前序问题:自回归视频扩散把每段历史都塞进 KV Cache,时间越长,显存和 attention 成本越大。固定滑窗只看远近,attention 权重或相似度剪枝又不直接回答“这个历史块是否提供了不可替代的信息”,所以容易把稍后 prompt 才会重新提到的物体细节一起删掉。 本文贡献:DeCoPrune 用同一条去噪轨迹里的中间 probe 与最终预测做差:没有历史支持时难以稳定去噪、step-to-final discrepancy 较大的 token 被判为更需要上下文,因此保留高差异 token,再物理压紧历史 KV。论文同时构建 CMBench,用一分钟上下文中的物体取放、场景恢复等续写任务专测“前文记没记住”,并提供按 attention head 类型分组的 HS 版本。 实验效果:主设置剪掉 85.43% 历史 KV,续写 FPS 从 FullKV 的 1.568 提到 6.489,快 4.14 倍;CMBench DINO 从 0.6803 只降到 0.6701。head-specialized 版本在 86.19% 剪枝率下 DINO 为 0.6783,几乎追平 FullKV,且 VBench 的图像质量项没有出现系统性崩塌。 批判点评:“剪掉 85%”并不等于显存有硬上限,作者明确承认剩余缓存仍随视频长度线性增长。Denoising consistency 是 future-agnostic 的:某个细节此刻很好去噪、因此被删掉,但未来指令恰好再次询问它时仍可能失忆。主干又集中在 LingBot World v2,其他开源模型的分钟级 FullKV 本身就不稳定,方法与 backbone 上限难完全拆开。 10. ViTeX-Bench:387段视频检验动态改字 ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing | 得州农工大学 | arXiv:2609.40356 关键词:视频编辑, 场景文字, 评测基准, 时序一致性, 编辑局部性 前序问题:视频里的招牌、球衣或屏幕改字,要同时满足字符串正确、跨帧不漂、背景不被改。通用视频编辑指标可能把“画面很稳但根本没改字”的结果评得很高,静态 OCR 又看不见闪烁与字符漂移,现有公开数据也缺少真实视频的成对编辑参考。 本文贡献:ViTeX-Bench 收集 387 段 720p、120 帧、24 FPS 真实视频,其中 230 段提供人工复核的成对训练编辑,157 段冻结测试。评测拆成文字正确性、视觉/时序质量、编辑局部性三轴共 13 个指标,并用 OCR 校准、人评相关性与 Pareto 前沿解释取舍;配套的 ViTeX-Edit-14B 用随运动对齐的 glyph-video 条件微调 VACE。 实验效果:八条基线中,ViTeX-Edit-14B 在 video-native 编辑器里 CharAcc 最高,为 0.688,text-crop Warp 1.53 也最低;相较 VideoPainter 的 CharAcc 0.619 提升 0.069。但逐帧 FLUX-Text 的 CharAcc 仍达 0.737,代价是 Warpc 13.01、字符跨帧严重漂。人评与 OCR 方法排名的 Spearman 相关系数为 0.95。 批判点评:这个基准把“漂亮、正确、稳定、局部”拆开是优点,也暴露了参考模型并非全面第一:ViTeX-Edit 的 SeqAcc 0.341 低于 FLUX-Text 0.528。数据以清晰、局部、拉丁文字为主;非拉丁切片里除 AnyText2 外其余编辑器 CharAcc 都低于 0.19,严重运动、曲面文字、密集排版的覆盖仍不足。 趋势观察 加速的战场从「少走几步」挪到了「每层只记该记的」 ReCaVSR 给每个 DiT 层学一个缓存跨度,PARK 修正稀疏注意力的块检索误差,UnStep 把两步采样、限窗 KV 与 kernel 优化叠进同一个免训练 wrapper,DeCoPrune 则用去噪一致性挑出真正依赖历史的 token,四篇都指向同一件事:视频模型已进入少步时代,下一轮效率竞争发生在缓存、检索与运行时细节。另一头,PixelUMM 去掉视觉编码器让像素直进统一模型,说明「统一」正在从拼模块转向砍模块。 人工智能炼丹君 整理 | 2026-10-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-10-01|一次蒸馏插遍54个模型,LongLive-Plug 今日 AIGC 论文速览 今日共 10 篇 · 视频与图像生成模型 5 篇 · 世界模型与音视频联合生成 1 篇 · 推理加速与模型压缩 2 篇 · 生成理解一体化与奖励模型 2 篇 重点论文标题列表 LongLive-Plug(NVIDIA):蒸馏一次,插遍54个模型 SplitMoE(国科大):专家拆两拨,人像涨9分 HelixWorld(港科大):24帧实时出声的世界 LDM-is-AE(港理工):不用分词器,FID 1.80 NesTok(华北电力大学):变长 token,gFID 1.46 今日论文速览 1. LongLive-Plug:蒸馏一次,插遍54个模型 LongLive-Plug: Once-for-All Distillation for Video Generation | NVIDIA | arXiv:2609.38154 关键词:视频生成, 扩散蒸馏, LoRA 复用, 少步采样, 免训练部署 前序问题:视频扩散模型每做一次下游特化就要重跑一遍蒸馏:要么为少步采样,要么为长视频补误差修正。论文在 Wan2.2-TI2V-5B 上算了账——四个任务各自的专用蒸馏再花 83.9、150.0、86.8、56.1 H100 卡时,合计 376.8,加上一次性底座蒸馏约 80 卡时,总共 456.8 卡时。能力是通用的,钱被重复付了四遍。 本文贡献:把「单遍 CFG」「少步采样」「自回归长时误差修正」各蒸馏成一个 LoRA 挂在底座上,之后插到任何结构兼容的下游模型即可用,下游不再重训。CFG LoRA 只在 w=5 的固定引导强度下训练,推理时靠调 LoRA 权重换引导强度;与少步 LoRA 叠加,下游同时保住少步生成和 CFG 可控。作者称下游新增条件分支、扩展输出通道后适配器仍可复用。 Once-for-all distillation: reusable LoRAs plug into compatible downstream models. 实验效果:在 Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3 三个底座家族、八个任务类别共 54 个下游模型上验证免训练部署。世界模型 SCOPE 上把朴素四步的 FVD 从 805.5 拉回 478.7,优于专用蒸馏的 502.1;ControlNet 上六项全优于朴素四步,深度 si-RMSE 从 2.135 降到 1.641、DOVER 从 8.90 升到 10.11;原生 20–50 步调度降到 1/5–1/12.5。 Downstream distillation cost: task-specific distillation accumulates while LongLive-Plug stays flat. 批判点评:省的是专用蒸馏的钱,80 卡时的一次性底座蒸馏照付,且只对同一底座家族有效。更关键的取舍藏在正文一句「相对任务专用蒸馏存在按指标而异的取舍」——插拔版不是全面反超,而是用 80 卡时换一个接近 456.8 卡时的结果。CFG LoRA 的引导控制是推理权重外推出来的,训练只见过 w=5 这一个点。 2. SplitMoE:专家拆两拨,人像涨9分 Breaking the Uniformity Trap: Scaling Video Diffusion Model via SplitMoE | 中国科学院大学;字节跳动;Canva Research;北京科技大学 | arXiv:2609.38140 关键词:视频生成, 混合专家, 稀疏路由, DiT 规模化, 负载均衡 前序问题:MoE 从 LLM 搬到视频生成上一直水土不服:token 级路由各自为政,再用负载均衡损失把使用率往均匀方向压,结果语义连贯的一块画面被拆到互不相关的专家里,作者称之为「均匀性陷阱」。视频数据时空冗余、语义长尾,本来就不该被均匀分配。 本文贡献:把专家池显式劈成两拨:语义专家抓高层语义抽象,通用专家兜住残差视觉信息和生成自由度。路由用原型引导,配合 pull-push 正则——pull 把原型锚在有意义的视觉语义上,push 防止原型塌缩冗余。两条 sigmoid 独立打分,一个 token 可以同时选中一个语义专家和一个通用专家,不必在所有专家间做全局 softmax 竞争。 Pipeline of SplitMoE: each Video MoE layer splits into Semantic and Generic branches with VAE-prototype induced semantic routing. 实验效果:在同等激活参数预算(A14B)下对比 Wan2.2 系列:Creativity 58.46%、Human Fidelity 84.47%、T2V-CompBench 属性一致性 84.63% 三项拿到全场第一,人像保真比 Wan2.2 的 75.33% 高出 9 个多点。对比同数据微调的密集 Wan2.2-FT 全维领先,且收敛更快——约 70% 训练步数就达到可比的验证扩散损失。 Qualitative comparison with baseline methods. 批判点评:「打破均匀性陷阱」的措辞比结果激进。它自己的表里 Physics 69.41% 输给 LTX-2 的 76.71%,Interaction 69.98% 输给 Wan2.2 的 73.29% 和 OmniWeaving 的 73.94%,Commonsense 64.89% 离 LongCat-Video 的 70.94% 差 6 个点。消融也显示去掉原型引导的 w/o PG 版本在 Commonsense 上 63.22% 与完整版 64.89% 差距很小,语义路由的主要收益其实集中在物理和人像两项。 3. HelixWorld:24帧实时出声的世界 HelixWorld: A Real-time Interactive Audio-Visual World Model | 香港科技大学;Noiz AI | arXiv:2609.38123 关键词:世界模型, 音视频生成, 实时交互, 空间音频, 因果蒸馏 前序问题:主流交互式世界模型全是哑巴:只管画面渲染和操控,声音这一维整个缺失。级联的视频转音频模型拿不到相机轨迹和用户动作,声场对不上自运动,串行延迟也谈不上实时;而把它们硬改成因果自回归,历史误差会迅速累积成灾难性多模态漂移。训练数据同样缺——现有世界模型数据集基本无声,视频语料里的音轨又常被后期配乐和旁白污染。 本文贡献:先用一个双向教师模型在自建的高保真空间音视频数据(真立体声 + 度量级相机位姿)上学 6-DoF 轨迹与动作条件,再用在线轨迹蒸馏把它压成少步因果学生,配合长程流式微调压掉曝光偏差。块内注意力保持双向以维持音视频交互,跨块注意力严格因果并配滑动 KV 缓存。同时提出 HelixBench,首次把空间声学一致性纳入世界模型评测。 Causal distillation pipeline: self-forcing rollout, online trajectory distillation, DMD, and long-horizon tuning. 实验效果:单张 NVIDIA H800 上稳态 RTF 0.77,768×512、24 FPS,含视频与音频解码。HelixBench 上因果学生 KL 1.3934、FAD 2.3872、IB 0.2987、Spatial 41.7583 全部第一;级联配音路线(HelixWorld+AudioX / ThinkSound / PrismAudio)的空间分甚至是负的,说明分离式生成根本抓不住声源位置。 Visual comparison under interactive control. 批判点评:WBench 导航榜上它平均 79.9 只排第 4,落后 Alaya-EVOKE-Turbo 82.0、EchoWM 81.0、Zing-0.5 81.0——「比肩 SOTA 无声世界模型」是有选择的比法。更反直觉的是音画同步:学生的 DeSync 0.5867 秒反而差于 LTX-2.3 base 的 0.4042 秒,CLAP 0.3016 也略低于级联的 HelixWorld+AudioX 0.3094,联合生成在语义对齐上没打赢「先出画面再配音」。 4. LDM-is-AE:不用分词器,FID 1.80 LDM-is-AE: Latent Diffusion Model is an Auto-Encoder for End-to-End Image Generation | 香港理工大学;OPPO 研究院 | arXiv:2609.37080 关键词:图像生成, 潜在扩散, 自编码器, 一阶段训练, 表示学习 前序问题:LDM 的两段式流程先训一个自编码器定住 latent 空间,再在里面训扩散。问题在于这个空间是为重建优化的,训练扩散时它是冻住的,天然与去噪动力学不匹配。而两阶段里最强的那批又几乎都挂着 DINOv2 这类外部视觉基础模型做监督,等于把表示学习的成本挪到表外。 本文贡献:核心观察是:LDM 骨干每一步去噪其实都在做 latent→feature→latent 的变换,这本身就是一次内部「解码—编码」。于是把 DiT 劈成互逆的两半 DiT-D 与 DiT-E,在中间特征上加一个轻量 MLP 头对齐到像素空间并施加图像域监督,把这条 latent→image→latent 路径显式化;零噪声时它自然等价于一次自编码。另配时间感知的辅助特征混合,避免对齐吃掉去噪容量。 Architecture and training design of LDM-is-AE: (a) network architecture and training pipeline; (b) time-aware auxiliary feature mixing. 实验效果:ImageNet 256×256 上 FID 1.80、IS 314,512×512 上 FID 1.90、IS 320——512 这一档超过了 JiT-H/32 的 1.94、REPA-SiT-XL/2 的 2.08。生成器训练 FLOPs 7.02,低于 JiT-H/16 的 14.0。自编码路径上 PSNR 27.57 高于 VAVAE 的 26.59 和 SDVAE 的 25.94。 Class-conditional ImageNet samples generated by LDM-is-AE at 256x256 resolution. 批判点评:FID 1.80 这个数得放在「不用 VFM 的一阶段方法」这个限定里看:两阶段挂 DINOv2 的 LightningDiT、REPA-SiT 仍然更好。更值得玩味的是它自己的重建口径——rFID 0.7879 明显差于 VAVAE 的 0.2650 和 REPA-E 的 0.4980,PSNR 最高却 rFID 最差,说明这个 latent 是奔着自然图像分布去的,压根不为「还原输入」负责,论文把这叫 diffusion-native,换个说法就是不忠于输入。 5. NesTok:变长 token,gFID 1.46 NesTok: Nested Self-Aligned 1D Tokenizer for Autoregressive Image Generation | 华北电力大学;中国科学技术大学;斯坦福大学 | arXiv:2609.36756 关键词:图像生成, 视觉分词器, 变长 token, 自回归生成, 嵌套对齐 前序问题:变长 1D 分词器想用一个 tokenizer 覆盖不同算力预算,主流做法是嵌套 dropout——随机截断 latent 序列并保留前缀,逼着前面的 token 装下最重要的信息。但「长度灵活」不等于「token 用得好」:已有工作发现序列加长后下游 AR 生成质量收益递减甚至倒退,尾部 token 基本成了摆设。 本文贡献:提出嵌套自对齐:跨长度联合优化重建,同时用全长序列去指导短序列,让短前缀逼近全长的重建质量,而不是只让前缀独立地「更重要」。配套的动机实验很直白——嵌套 dropout 训出来的码本在靠后位置归一化熵很低,码本多样性塌了,gFID 只有 2.46。 Overview of the nested self-aligned training pipeline. 实验效果:ImageNet 上 rFID 0.98,下游 AR 生成 gFID 1.46(带引导)、IS 295.9,在变长自回归图像生成这一档里是当前最好,优于 ReTok 的 2.27、One-D-Piece 的 2.35、DetailFlow-32 的 2.75,也远好于嵌套 dropout 基线的 2.46。 gFID with and without classifier-free guidance across different methods, model sizes, and token lengths. 批判点评:1.46 这个 SOTA 是「变长自回归」这个小池子里的 SOTA:同一张表上扩散路线的 Lightning-DiT-XL 带引导 gFID 1.35、REPA-XL/2 1.42 都更好。而重建口径更尴尬——rFID 0.98 远差于 LightningDiT 用的 KL tokenizer 0.28 和 SD-VAE 的 0.62,等于用重建质量换了生成质量。另外它仍是 VQ 分词器,390M 参数不算轻。 6. PixelDiff-GAN:加判别器,FID 降到28.6 Adversarial Training for Pixel Diffusion | Adobe Research;加州大学圣地亚哥分校;加州大学默塞德分校 | arXiv:2609.38170 关键词:图像生成, 像素扩散, 对抗训练, 后训练, 频谱分析 前序问题:像素扩散直接在 RGB 上出图,绕开了自编码器这个瓶颈,但产出的图像在细尺度自然图像统计上系统性偏低——说白了就是高频细节不够。这是个老问题,却一直没人系统性地验证对抗训练能不能补。 本文贡献:保留预训练模型原来的扩散/流匹配目标不动,只在非高噪声时间步上对预测输出额外加一个对抗损失,架构和采样流程一行不改。作者还做了归因:频带与幂律分析显示原模型系统性地欠产高频,对抗后训练正好把这部分谱功率补回来。 Noise-gate rationale: structure settles early, detail settles late. 实验效果:两个像素骨干上同时改善分布保真、覆盖率、提示对齐和感知质量。DeCo 上 FID 从 33.27 降到 28.59、pFID 27.9→24.4、CMMD 0.836→0.736、recall 0.361→0.406、DPG 81.6→83.3、TOPIQ 0.71→0.77、MANIQA 0.64→0.71;PixelGen 上 DPG 从 78.4 提到 80.8。1065 组配对样本的胜率也明显高于 latent 扩散的同类做法。 Pixel radial-profile band share over 30,000 images per model; gray = no-GAN, green = +GAN. 批判点评:FID 28.59 的绝对值放在今天并不好看,它赢的是「相对自己」这一档。真正有价值的是边界实验:同样的流程搬到 latent 扩散(PixArt / SANA)上没有可比增益,也几乎没加回解码后的高频功率——作者据此认为「能否直接触达被修正的图像统计」才是对抗后训练成不成立的关键。另外论文自己提到真实照片在 TOPIQ 上只拿 0.57,比生成的还低,等于承认无参考指标不足以单独作证。 7. DIET:砍半专家,57GB 变 30GB DIET: Deletion-response Expert Trimming for Video Diffusion Transformers | 西安交通大学;上海交通大学;阿里巴巴 Token Hub;阿里云 | arXiv:2609.37829 关键词:视频生成, MoE 剪枝, 专家裁剪, 免微调压缩, 推理加速 前序问题:MoE 的稀疏激活只省算力不省显存——所有专家的参数一个不少地躺在 checkpoint 里。整块删掉专家是最直接的瘦身办法,但现有一次性剪枝判据靠静态激活或路由频率打分,看不见「删掉某个专家、token 重新路由之后」这一层到底发生什么。而在这个规模上穷举多种删除组合,代价根本付不起。 本文贡献:用一次 all-expert 标定把条件/无条件 token 下所有专家输出和 router 状态全部录下来,之后重放任何单专家删除及其成组重路由,退化成对缓存状态的张量运算,零额外前向。在此基础上把「保留哪些专家」写成整体多样性损失:每个被删专家匹配到最近的保留专家,求和最近邻余弦距离作集合级覆盖损失。求解分两层——层内贪心+单交换+模拟退火,层间用回归指导的预算分配。 DIET overview: grouped MoE capture, replay-to-signature, intra-layer ODL, and inter-layer budget search. 实验效果:在 LingBot-Video 30B-A3B 上免微调剪掉 50% 专家(6144→3072),checkpoint 从 57GB 降到 30GB,48GB 单卡可部署;284 条固定用例上 VBench Total 反而从 0.7941 升到 0.8115。层间非均匀预算分配比均匀分配多拿 1.2 个点。所有保留预算下都优于从 LLM 移植过来的剪枝基线。 Primary evaluation and routing dynamics across candidate retention budgets. 批判点评:VBench 从 0.7941 涨到 0.8115 是这条工作最抓眼的数字,但幅度只有 1.7 个百分点,且出自自家固定的 284 条协议,更像「没掉点」而不是「变好了」。省下的是 27GB 存储,激活算力并没少——稀疏激活本来就只算一部分。另外这套标定缓存的前提是条件/无条件 token 可配对,CFG 之外的采样路径能否同样成立没有验证。 8. SoL-Refiner:一步上 4K,快 8.91 倍 SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video | NVIDIA | arXiv:2609.37969 关键词:视频生成, 超分辨率精修, 一步蒸馏, 强化学习后训练, 推理加速 前序问题:高分辨率视频生成的代价随时空 token 数暴涨。实用做法是先在低分辨率出片再用 refiner 精修,但常规 refiner 本身要跑好几个目标分辨率的去噪步,等于引入第二个采样瓶颈。而且多数 refiner 只针对自家基模型开发,换一个生成器还灵不灵几乎没人测。 本文贡献:从 LTX-2.3 出发走三步:高分辨率续训学精修映射、帧级奖励模型做 RL 后训练提升感知质量、最后一步蒸馏压成单步。推理侧配 TAE 小自编码器降低编解码开销,用 latent 上采样初始化,再由 Sol Video Inference Engine 执行单次 NFE。同时建了 Refiner-Bench——150 条对齐视频、统一输入协议,专门横向比 refiner。 Training and inference pipeline of SoL-Refiner. 实验效果:一步版在 Refiner-Bench 上 VBench 均值 0.81048、UniPercept 均值 60.4150,超过同为一档步数的 SEEDVR2 和三步的 LTX-2.3 Refiner。4K 上相对三步 LTX-2.3 Refiner,VBench 与 UniPercept 均值分别提升 3.86% 和 22.79%。叠满加速栈后 2K 延迟档精修提速 8.91 倍;配四步 MiniMax H3 基模型,整条两级流水线比直接全分辨率生成快 27 倍。 Performance across output resolutions: three-step LTX-2.3 Refiner vs one-step SoL-Refiner. 批判点评:一步版输给自家多步版——0.81048 对 23 步的 0.81691,主体一致性 0.92191、动态度 0.71333 都被多步版和 LTX-2.0 Refiner 压过。8.91 倍是「精修阶段」的加速,不是端到端;27 倍那个数则是把基模型也换成低分辨率四步 H3 之后的联合结果。另外 Refiner-Bench 是自建集,起点又是 LTX-2.3,公平性靠 shared-input 协议兜着。 9. OmniTaskonomy:19个生成任务换25项能力 OmniTaskonomy: When Does Visual Generation Improve Visual Understanding? | 加州大学伯克利分校;杜克大学;卡内基梅隆大学;华盛顿大学;Elorian;Impossible Research | arXiv:2609.38079 关键词:统一多模态, 生成理解一体化, 任务迁移, 梯度对齐, 训练课程 前序问题:生成能给理解带来多少好处,一直是笔糊涂账:已有工作普遍认为理解反哺生成容易,反过来收益微弱。但这在直觉上说不通——生成提供的是像素级稠密监督,覆盖外观、空间关系、几何,而这些恰恰也是识别、计数、空间推理、3D 感知需要的。 本文贡献:用「同一个底层视觉问题、两种输出模态」的受控配对来做因果分离:I2I 生成任务和 I2T 理解任务表达同一个问题,只换监督形式。再搭一个覆盖 19 个 I2I 生成任务与 25 项 I2T 理解能力的统一分类法 OmniTaskonomy(按识别、重建、重组三个基础问题组织),画出完整的迁移图谱。机制上用梯度对齐解释:生成与理解在理解分支 pre-attention RMSNorm 参数上的梯度对齐越强,迁移增益越大。 OmniTaskonomy: a unified taxonomy of I2I tasks and understanding capabilities under the three Rs. 实验效果:先做 I2I 再做 I2T 的课程能稳定提升理解表现,且增益随 I2I 数据量单调增长;混合训练则没有一致的规模收益。I2I 训练还能减少达到同一理解水平所需的 I2T 监督量,在 I2T 数据稀缺时收益最大。迁移图谱里既有直觉对应的组合(深度预测→度量 3D 推理、物体指向→计数、拼图重建→2D 排序),也有反直觉的(2.5D 分割→类别识别、Z-depth 预测→定位)。 Generation-to-understanding transfer across visual capabilities. 批判点评:结论的成立高度依赖课程顺序——先 I2I 后 I2T 才有效,混合训练就没有一致的规模收益,这更像是「课程设计」而非「生成天然有益」。迁移图谱是选择性的:作者自己也说收益 task-dependent,图里有多少格子是负增益论文没有全列。梯度对齐目前只是相关性分析,拿它做任务选择的先验还缺因果验证。 10. ThinkRM:先定评分表,9B 超 GPT-4.1 Think Before You Score: Thinking Reward Model for Visual Generation | 杭州电子科技大学;中国科学院自动化研究所;北京大学;商汤科技;复旦大学;西北工业大学;南洋理工大学;清华大学 | arXiv:2609.37372 关键词:奖励模型, 视觉生成评测, 评分细则, 偏好优化, 强化学习 前序问题:视觉奖励模型通常把任务条件和候选输出直接映射成一个标量分数,至于「这个 case 到底该评什么」完全隐在黑箱里。图像生成和图像编辑的评判标准差异极大,用一套固定标准硬套,细粒度区分能力必然上不去。 本文贡献:提出「先想清楚再打分」:为每个 case 先自适应地生成评分细则(rubric),再按细则做逐条评估,最后产出细粒度 pointwise 分数。训练上先做结构化 SFT 冷启动,再用成对偏好优化;作者发现常规成对偏好优化会引起分数极化,于是提出 Pairwise Dual-Group Relative Policy Optimization,在保留细粒度打分能力的同时提升判别力。 Thinking Reward Model (TRM) follows the Think-Before-You-Score paradigm, with RM and RL performance. 实验效果:9B 模型在 GenAI-T2I 上从基线的 58.9% 提到 71.2%、MMRB2-T2I 从 59.4% 提到 67.9%,两个榜上都超过 GPT-4.1;编辑侧 EditScore-ERB 0.750/0.639/0.743、EditReward-ERB 67.8%、MMRB2 从 53.0% 提到 58.2%。用它做奖励去优化 BAGEL、FLUX.1-dev、SD3.5-M 等多个生成模型,跨架构跨规模一致有提升。 Qualitative comparison of SenseNova-U1.5 before and after RL fine-tuning with TRM. 批判点评:「超过 GPT-4.1」是在特定榜单和特定打分协议下的结果,且作者明说 pointwise 模型只统计非平局预测的准确率,平局样本另算——这个口径会显著抬高数字。冷启动 SFT 已经把 58.9% 拉到 70.1%,后面的成对优化只再加 1.1 个点,说明真正吃重的是 rubric 监督数据本身。另外 8 家单位联合、训练只用约 4000 条偏好对,规模偏小。 趋势观察 蒸馏的计价单位从「每个模型」变成「每个底座家族」 LongLive-Plug 把少步采样、单遍 CFG、长时误差修正各做成一只 LoRA,一次 80 卡时的底座蒸馏换掉四个任务 376.8 卡时的专用蒸馏;SoL-Refiner 把多步精修压成一步再叠 TAE 与推理引擎拿到 8.91 倍;DIET 直接免微调砍掉一半专家把 57GB 压到 30GB。三篇下手的地方完全不同——一只 LoRA、一次 NFE、一半专家——但都在问同一个问题:这份能力到底要不要为每个落点重付一遍钱。 生成与理解之间的账开始被逐项结算 OmniTaskonomy 用 19 个生成任务对 25 项理解能力画出迁移图谱,结论是收益 selective 且强依赖「先 I2I 后 I2T」的课程;Think Before You Score 则反过来问评估侧——给每个 case 先拟一份评分细则再打分,9B 模型在两个榜上压过 GPT-4.1。前者说明「生成有益理解」不能当口号用,后者说明奖励模型缺的不是参数量而是「该评什么」这一步显式化。 人工智能炼丹君 整理 | 2026-10-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
深度解读|字节Seed×UCSD VSA2|砍掉95%注意力计算 720p端到端快4.62倍 VSA2 深度解读:字节 Seed 与 UCSD 把视频稀疏注意力推到 95%,720p 端到端快 4.62 倍 论文:Improving Video Sparse Attention with Fine-grained Router and Sparse Rebasing 机构:UC San Diego · 字节跳动 Seed · UC Berkeley · Georgia Tech 作者:Peiyuan Zhang、Guoqiang Wei、Yilong Zhao、Zixiang Zhang、Wei Zhou、Will Lin、Heng Zhang、Xiaonan Nie、Yan Zeng、Hao Zhang(Peiyuan Zhang 与 Yilong Zhao 的工作完成于字节 Seed 实习期间) 日期:2026-09-26(arXiv 2609.32882) 代码:截至发稿未见 VSA2 的代码与权重;前代 VSA、STA 的 kernel 在 FastVideo 仓库(hao-ai-lab/FastVideo)开源 论文状态:arXiv 预印本,comment 字段为空,暂无接收信息 01 先说说这东西是干嘛用的 视频 DiT 越做越长、越做越清晰,最先扛不住的是注意力。 论文开头给了一个量级:一段 5 秒的高清视频,展开成 token 就超过 10 万个。3D 全注意力的计算量随序列长度平方增长,训练和推理的大头都落在注意力上。作者后面测速用的 720p、10 秒视频,是 22 万 token。 UCSD 这个组在更早的 STA 论文里给过一个更直观的数:HunyuanVideo 生成一段 5 秒 720P 视频总共要 945 秒,其中注意力就占了 800 秒。 大家早就知道注意力矩阵里大部分元素贡献很小,于是有了一大批稀疏注意力方法。但这里有一道分水岭: 只在推理时稀疏(Sparse VideoGen、SpargeAttn 这一类):模型还是用全注意力训出来的,最贵的预训练阶段一点没省; 训练时就稀疏(VSA、SLA、SLA2 这一类):理论上预训练也能省。但按作者的说法,这类方法在 post-training 阶段大约能稀疏掉 80%,再往上就碰到天花板;真正拿去做预训练的工作规模都偏小,评价主要只看 loss。 VSA2 想做的是后一类的"完整版":一个能从预训练中途接入、一路用到 RL 和推理的可训练稀疏注意力。它在前代 VSA 的基础上改了两处结构,外加一套训练配方: 细粒度 router:选块时的池化粒度不再和 GPU 友好的块大小绑定,而是先用小得多的池化算注意力分数,softmax 之后再合并成块级分数; per-sequence TopK:总计算预算固定,但不再要求每个 query 分到一样多的 KV 块,难的 query 可以多拿; Sparse Rebasing:低分辨率阶段照旧用全注意力 checkpoint,到 480p/720p 这种最烧算力的阶段才切换成 VSA2;配合 Hard-to-Easy Curriculum,训练时稀疏度高、推理时放宽。 结果是这样的(论文 Table 2 与 Figure 8): 设置 注意力稀疏度 加速 质量 480p 预训练,训练/推理都用 top64 90% 端到端 2.09× 人评与全注意力互有胜负 720p 预训练,训练/推理都用 top64 95% 端到端 4.62× 人评与全注意力基本持平 注意力算子,22 万 token(单卡 H800,对比 FlashAttention-3) top64 注意力 8.9× — 作者团队也值得一提。UCSD 这边是 Hao Zhang 组,STA、VSA 和 FastVideo 都出自这里,一作 Peiyuan Zhang 同时是 STA 和 VSA 的一作;另一半作者来自字节 Seed。所以这篇可以看成 VSA 这条路线第一次在完整的视频 DiT 训练流程里走通——从预训练、RL 到推理。 (图片来源:论文 Figure 3。样本来自 Table 2 中 Exp 6 的 checkpoint,每组上行是全注意力、下行是 VSA2;第一组和第三组是图生视频,中间一组是文生视频) 02 主要亮点,以及需要冷静看的地方 值得关注的地方: 全流程验证。480p 预训练、720p 预训练、RL、推理四个环节都换成了稀疏注意力,并且和同数据、同超参、同步数训出来的全注意力模型逐项对比。按作者的说法,这是第一个在视频 DiT 开发各阶段都端到端验证过的可训练稀疏注意力; "router 不需要学"有实验支撑。几组对照实验显示,让 router 接收梯度(不管是 NSA 式借道 coarse branch,还是 MoE 式直接反传),都不如完全不给梯度(Figure 7(c)(d)),结构因此更简单; 选块粒度和硬件块大小解耦。细粒度 router 配 top64,loss 比粗粒度 router 配 top128 还低(Figure 7(e)),fine branch 的计算量直接砍半; 稀疏预算按整条序列分配。per-sequence TopK 让每个 query block 拿到的 KV 块数可变,loss 比传统的 per-token TopK 低(Figure 7(f)); 不用从头训。Sparse Rebasing 只在高分辨率阶段切换,新增参数只有一个零初始化的门控投影; "训难测易"换来更好的运动。用 top64 训、top128 推,文生视频运动质量的人评净胜率达到 22.1%(Table 2 Exp 2); kernel 是认真做过的。router 的 GEMM、softmax、池化融合成一个 CuTe DSL kernel,fine branch 用 ThunderKittens 实现 block-sparse attention,22 万 token 下注意力比 FlashAttention-3 快 8.9 倍。 需要冷静看的地方: 人评的分辨率很粗。分数是(更好 − 更差)/ 149,每 0.67% 就是一条 prompt。720p 那一行"运动 +6.71%、指令跟随 −2.01%",换算过来是净多赢 10 条、净少 3 条,多数格子都在统计噪声范围内(详见第 09 段); "计算量减半"只算了 fine branch。把 router 自身的开销算进去,720p 下相对 VSA 的 top128,实际省下的注意力时间大约是三分之一(我按论文给的 router 耗时占比粗算,见第 10 段); 没有外部 baseline。没有和 SLA、SLA2、VMoBA、Sparse VideoGen 在同一个模型上比,也没有 VBench 这类公开 benchmark,对比对象只有全注意力和 VSA/NSA 的设计变体; 模型、数据、代码都不公开。参数量、数据集、VAE 配置论文都没写,外部无法复现; 训练省了多少没给数。论文动机是降低预训练成本,但给出的加速全在推理侧,没有训练吞吐或 GPU 小时的对比; Hard-to-Easy 有代价。运动变好了,指令跟随和美学却下降(Exp 3 的文生视频指令跟随净输 15.4%),需要再做一轮更高 top-K 的 RL 才能拉回来; 30 秒长视频只有抽帧展示,没有全注意力对照,也没有量化指标; 扩展性有两个已知隐患:router 的相对开销固定在全注意力的 $1/R^2$ 左右,序列更长时会变成瓶颈;动态稀疏模式和 Ring-Attention 序列并行不好配合。这两点作者在附录里自己承认了。 03 视频稀疏注意力这条赛道现在什么样 先把 VSA2 放回坐标系里。视频 DiT 的稀疏注意力大致分三拨。 第一拨:免训练,只管推理。 拿一个用全注意力训好的模型,推理时找出不重要的注意力块跳过。代表是 Sparse VideoGen(在线判断每个头是"空间头"还是"时间头",在 CogVideoX-v1.5 和 HunyuanVideo 上端到端最高 2.28 倍和 2.33 倍),以及 SpargeAttn、XAttention、Radial Attention 等。STA 算半只脚在这里:它用固定的 3D 滑动 tile 窗口,免训练时 HunyuanVideo 从 945 秒降到 685 秒,允许微调后降到 268 秒。 这一拨的共同问题是模型没见过稀疏,稀疏度一高就容易掉质量,而且预训练成本一分没省。 第二拨:微调之后稀疏。 在已有模型上用少量步数把稀疏注意力"训进去"。清华的 SLA 把注意力权重分成关键、边缘、可忽略三类,关键部分走稀疏注意力、边缘部分走线性注意力,在 Wan2.1-1.3B 上注意力计算省 95%,端到端 2.2 倍;后续的 SLA2 加上可学习 router 和量化感知训练,把稀疏度推到 97%。VSA 也做过类似的改造:把 Wan-2.1 换成稀疏注意力后,注意力提速 6 倍,端到端从 31 秒降到 18 秒。 第三拨:预训练就稀疏。 DSV、VSA 都尝试过从预训练阶段就用稀疏注意力。VSA 当时从 6000 万参数一路做到 14 亿参数的 scaling 实验,找到一个训练 FLOPs 降 2.53 倍、diffusion loss 不掉的点。但正如 VSA2 自己指出的,这些实验规模偏小,评价主要看 loss,没有人评和视觉对比。 LLM 那边的两条线也是 VSA2 的直接参照: DeepSeek 的 NSA:压缩、选择、滑窗三路注意力,同一 GQA 组内的 query 头共享稀疏模式,选块分数借用压缩分支; Moonshot 的 MoBA:对 key 块做均值池化当门控,不带可训练参数。 VSA2 的不少消融实验,就是在回答"LLM 这套设计搬到视频上还成不成立"。 所以 VSA2 的位置很清楚:沿着 VSA 的 coarse-to-fine 框架,把"预训练就稀疏"推进到完整的视频 DiT 训练流程里,并重新设计了 router。 04 旧 router 卡在哪:两个结构性天花板 先把 coarse-to-fine 框架讲清楚,VSA2 的改动都在它上面动刀。 以 VSA 为例,一层稀疏注意力分两步: coarse branch(粗粒度支路):把相邻的 B 个 token(在视频里是一个 $B_t\times B_h\times B_w$ 的小立方体,下面叫 cube)的 Q、K、V 各求平均,得到长度为 $L/B$ 的短序列,在上面做一次全注意力。这一步既产出一份粗粒度的注意力输出,又得到一张 cube 与 cube 之间的亲和度分数图; 选块 + fine branch(细粒度支路):每个 query cube 在分数图里挑 TopK 个最相关的 key cube,然后只在这些 cube 对里做逐 token 的 block-sparse attention。 为了让 GPU 算得快,block-sparse attention 的块大小 B 通常取 64 或 128,这是硬件决定的。问题在于,以往的 router 顺手把池化步长也设成了 B——一个 cube 的 128 个 token 被压成一个向量去算分数。 作者认为这带来两个结构性天花板。 天花板一:池化太粗,看不清关键 token。 128 个 token 的平均值会把 $\mathbf{QK}^\top$ 里的细节抹平。长视频、高分辨率下,这种"混叠"要么让真正关键的 token 漏选、质量下降,要么逼着你多选块、稀疏度上不去。 天花板二:每个 query 分到的预算一样多。 标准的 per-token TopK 要求每个 query 看同样数量的 KV。简单的 query 浪费算力,难的 query 又吃不饱。稀疏度一往上推,最先饿着的恰恰是最需要上下文的那些 query。 从公式上看更清楚。假如算力无限,最理想的选块分数应该是先算完整的 token 级注意力 $\mathbf{A}$,再按块求平均: $$\mathbf{A}=\mathrm{Softmax}\big(\mathbf{Q}\mathbf{K}^\top/\sqrt{D}\big)$$ $$\mathbf{P}_{oracle}=\mathrm{MeanPool}_{B\times B}(\mathbf{A})$$ VSA 的 coarse branch 则是把池化挪到了 softmax 前面,先按整个 cube 池化出 $\mathbf{Q}_c=\mathrm{MeanPool}_B(\mathbf{Q})$、$\mathbf{K}_c=\mathrm{MeanPool}_B(\mathbf{K})$,再算注意力: $$\mathbf{P}_c=\mathrm{Softmax}\big(\mathbf{Q}_c\mathbf{K}_c^\top/\sqrt{D}\big)$$ 如果注意力是线性的,两者相等;但 softmax 是非线性的,所以这只是近似,精度取决于"cube 内部的 token 足够相似"这个局部性假设。cube 越大,这个假设越站不住。 VSA2 的解法,一句话就是:只在 router 里把 cube 切得更细。下图左边是以往的 router,右边是 VSA2 的细粒度 router,细节放到第 07 段讲。 (图片来源:论文 Figure 1。左:VSA 等方法使用的常规 router,Q、K 都按整个 cube 池化,softmax 之后直接 TopK;右:VSA2 的细粒度 router,先按小得多的尺寸 R 池化 Q、K,softmax 之后再按 G×G 做分数池化,最后 TopK) 05 router 要不要学?作者先做了一组拆解实验 (05~07 三段偏技术,只想看结果的可以直接跳到 08。) 改 router 之前,作者先回答了一个更根本的问题:router 的选块能力到底从哪来? 这件事在 MoE 里很明确:router 的打分会乘到专家输出上,梯度能流回来,router 是学出来的。但在稀疏注意力里,TopK 选出的是一张布尔 mask,fine branch 的梯度流不回 router。VSA 的 coarse branch 虽然有梯度(来自它自己的输出 $\mathbf{O}_c$),但这份梯度并不来自选块结果。 于是有两种假说: 局部性启发:相邻 token 本来就相似,均值池化出来的 cube 特征已经够用,router 根本不需要参数和梯度。MoBA、Quest 是这个思路; 辅助监督:router 和 coarse branch 共享参数,coarse branch 的梯度虽然不直接针对选块,但顺带把 router 也练好了。NSA 属于这种。 作者设计了几组参数量对齐的消融: (图片来源:论文 Figure 7。(a) 全注意力设置下 GQA(4 组)与 MHA 的训练 loss;(b) "按头分组 + 按邻域分组"的混合方案与纯"按邻域分组"对比;(c) router 的 QKV 绑定 coarse branch 还是 fine branch;(d) MoE 式可反传 router 与 VSA 对比;(e) 有无细粒度 router、top64 与 top128 对比;(f) per-token 与 per-sequence TopK 对比。除 (f) 从 256p 视频 checkpoint 初始化外,其余都从头训练;(b)(e)(f) 的放大插图是训练末段) 先看 router 相关的两组: (c) router 绑谁:把 coarse branch 和 fine branch 的 QKV 投影拆开,让 router 跟 coarse branch 共用 QKV(能收到 $\mathbf{O}_c$ 的梯度),或者跟 fine branch 共用(相当于 MoBA 式的无梯度 router)。结果后者 loss 更低; (d) 直接给 router 梯度:仿照 FFN 里的 MoE,coarse、router、fine 各用一套独立的 QKV,fine branch 的输出再乘上 router 的打分,让 router 直接拿到梯度。结果这种 MoE 式反传并不比原版 VSA 好。 结论是:在视频扩散模型里,复杂的可学习 router 没必要,无梯度 router 就够了,效果还更好。 既然 router 不学,能改进的就只剩"无梯度 router 本身的精度",这就引出了细粒度 router。 同一张图里还有两组是针对 NSA 设计的: (a) GQA vs MHA:全注意力下,MHA 的训练 loss 明显低于 4 组的 GQA。LLM 用 GQA 主要是为了解码时省 KV cache,视频 DiT 是双向、整段去噪,没有这个约束; (b) 按头分组 vs 按邻域分组:NSA 让同一 GQA 组内的 query 头共享稀疏模式(group head);VSA2 让时空上相邻的 query token 共享(group neighbour)。有效组大小相同时,纯 group neighbour 更好。 我的看法:这组实验的结论很干脆,但有两点要留个心眼。一是 (a)~(d) 和 (f) 都只训了 1 万步,(e) 也只有 3 万步,全是单次运行,没给多随机种子的方差;二是 (e)(f) 两组的差距要靠放大插图才分得清,曲线大部分时候是重叠的。结论的方向我倾向于相信,但"显著更低"的说法要打个折。 另一个有意思的对照是 SLA2。SLA2 的核心卖点恰恰是可学习 router,VSA2 却说 router 不用学,两篇结论看似相反。不过场景不同:SLA2 是在训好的 Wan2.1 上做短程微调,router 要在很少的步数里适配一个现成的全注意力模型;VSA2 是数万步的预训练,网络的其他部分有足够时间去适应一个固定的 router。我的理解是,在预训练尺度上,与其让 router 学会挑块,不如让模型学会适应 router。 06 VSA2 的整体结构:两条支路、一个 router、一扇门 (图片来源:论文 Figure 2。左侧 coarse branch 把 Q、K、V 按 cube 池化后做 cube 级全注意力,再 Repeat 回原分辨率,乘上由 Gate 投影经 Tanh 得到的门控值;右侧细粒度 router 产出块级 mask M,交给 BlockSparseAttn 计算 fine branch;两路输出相加得到最终结果) 按数据流走一遍。 第 0 步:重排。 把 token 从逐行扫描的顺序重排成逐 cube 的顺序,让同一个 cube 里的 token 在内存里挨着。注意力是整个 Transformer 里唯一依赖 token 顺序的算子,所以这个重排只需在网络开头做一次,RoPE 位置编码跟着一起重排即可。 coarse branch:和 VSA 一样。 按 cube 做均值池化,在 $L/B$ 长度的序列上做全注意力,再把输出复制回每个 token。作者也试过 NSA 式的池化和基于注意力的池化,都没比简单的均值池化更好。 fine branch:只算选中的块。 用 router 给出的 mask 做 block-sparse attention。文本条件部分照 MMDiT 的做法处理:视频到文本、文本到视频的注意力保持完整,不做稀疏。 门控合并: $$\mathbf{O}=\tanh(\mathbf{X}\mathbf{W}_g)\odot\mathbf{O}_c+\mathbf{O}_f$$ $\mathbf{X}$ 是这一层的隐状态,$\mathbf{W}_g$ 是一个单通道投影,每个 token、每个头算出一个门控值,用来调节 coarse branch 的贡献;fine branch 的输出直接加上去。 这扇门的初始化很关键,第 08 段会讲到:$\mathbf{W}_g$ 是 VSA2 唯一新增的参数,初始化为零。 router 是 VSA2 相对 VSA 真正动刀的地方,单独拿出来讲。 07 细粒度 router:先小池化,softmax 之后再合并 VSA2 把 router 从 coarse branch 里拆了出来,单独用一个小得多的池化尺寸 R(见第 04 段的 Figure 1 右图)。记 $\mathbf{Q}_r=\mathrm{MeanPool}_R(\mathbf{Q})$、$\mathbf{K}_r=\mathrm{MeanPool}_R(\mathbf{K})$,router 的块级分数是: $$\hat{\mathbf{P}}=\mathrm{Softmax}\big(\mathbf{Q}_r\mathbf{K}_r^\top/\sqrt{D}\big)$$ $$\mathbf{P}_r=\mathrm{MeanPool}_{G\times G}(\hat{\mathbf{P}})$$ 拆开是三步,作者叫它 pool-softmax-pool: 小池化:每 R 个相邻 token 求平均(R 远小于 B),序列长度从 L 缩到 L/R; softmax:在这个"半粗粒度"的序列上算注意力分数; 再池化:把一对 cube 之间的 G×G 个分数求平均(G = B/R),得到 N×N 的块级分数。 它夹在两个极端之间:比 oracle 便宜得多(序列只有 L/R 长),又比 VSA 的 coarse branch 保留了更多 cube 内部的差异。换个说法,池化有一部分挪到了 softmax 之后,非线性造成的失真就小一部分。 论文没给具体的 B 和 R,但可以反推。 附录给了稀疏度的估算公式: $$\text{Sparsity}\approx 1-\Big(\frac{1}{R^2}+\frac{KB}{L}\Big)$$ 其中 $1/R^2$ 是 router 的开销(相对全注意力),$KB/L$ 是 fine branch 的开销(平均每个 query block 看 K 个 KV block),coarse branch 的 $1/B^2$ 小到可以忽略。 把 Table 2 的三组数代进去:480p(约 9.9 万 token)top64 时稀疏度 0.90、top128 时 0.82,720p(约 22 万 token)top64 时 0.95。两个 480p 的数一减,$64B/99\text{K}\approx0.08$,B 应该是 128;再代回去,R 取 8 时三个数都能对上(算出来是 0.902、0.819、0.947),取 4 或 16 都对不上。所以我推断 VSA2 用的是 B = 128、R = 8、G = 16——这是我的推算,论文正文没有写。 这组参数能说明几件事: router 的开销恒定在全注意力的 1/64,约 1.6%,跟序列长度无关; 720p 下约有 1719 个块,每个 query block 平均只看其中 64 个,也就是 3.7%; fine branch 的相对开销随序列变长而下降,所以同样的 top64,分辨率越高稀疏度越高。这正是作者强调的"从 480p 到 720p 不需要调大 top-K"。 per-sequence TopK:预算按整条序列分。 传统做法是每个 query block 各挑 K 个;VSA2 把 N×N 的分数矩阵拉平,在整条序列上一次挑出 N×K 个块对,各个头的预算相同。总计算量不变,但每个 query block 分到的 KV 块数可以差很多。Figure 7(f) 显示这样做的 loss 比 per-token 低一点;作者也试过按累计概率截断的 top-p 类方法,没有正向结果。 下面是按论文公式写的示意代码,方便对照理解(不是官方实现,真实 kernel 不会物化中间的注意力矩阵): import torch @torch.no_grad() # router 不接收梯度 def fine_grained_router(q, k, R, topk): # q, k: [H, N, B, D],已按 cube-major 重排; # 假设每个 block 内按 G 个大小为 R 的子立方体连续存放 H, N, B, D = q.shape G = B // R # MeanPool_R -> [H, L/R, D] qr = q.reshape(H, N * G, R, D).mean(dim=2) kr = k.reshape(H, N * G, R, D).mean(dim=2) # softmax -> [H, L/R, L/R] scores = qr @ kr.transpose(-1, -2) / D ** 0.5 p_hat = scores.softmax(dim=-1) # MeanPool_{GxG} -> [H, N, N] p = p_hat.reshape(H, N, G, N, G).mean(dim=(2, 4)) # per-sequence TopK:整条序列一起挑 N * topk 个块对 idx = p.reshape(H, N * N).topk(N * topk, dim=-1).indices mask = torch.zeros(H, N * N, dtype=torch.bool, device=q.device) mask.scatter_(1, idx, True) # 每行(query block)选中的块数可以不同 return mask.reshape(H, N, N) 融合 kernel:中间矩阵不能写出来。 上面代码里的 p_hat 是 (L/R)×(L/R) 大小。按我反推的 R = 8,22 万 token 时每个头约有 7.6 亿个元素,BF16 下约 1.5 GB,20 个头就是约 30 GB,物化出来显存和带宽都扛不住。 所以作者用 CuTe DSL 写了一个融合 kernel,把 GEMM、softmax 和 G×G 池化合在一起: (图片来源:论文 Figure 5。Q、K 先按 R 池化成 Qr、Kr;第一遍在 SRAM 上逐块计算 softmax 之前的注意力分数并累积 log-sum-exp;第二遍重新计算注意力块、做 softmax,并直接在 SRAM 上完成 G×G 池化,只把 L/B × L/B 的块级分数写回 HBM) $\mathbf{Q}_r\mathbf{K}_r^\top$ 要算两遍,多了一次计算,但换来 I/O 大幅减少。作者称比不融合的版本明显更快,但没给具体倍数。这是典型的用计算换访存,和 FlashAttention 的思路一脉相承。 08 训练配方:Sparse Rebasing 与 Hard-to-Easy 结构讲完,再看怎么训。对想在自家训练流程里用的人来说,这部分可能比结构本身更有参考价值。 先交代训练设置。 模型结构大体沿用 MMDiT,目标是 flow matching(预测速度),文生视频和图生视频联合训练;时间步采样用 logit-normal 分布,并按分辨率做偏移;工程上用了 FSDP、序列并行、激活重计算和 torch.compile。训练分三段:480p 预训练、720p 预训练,以及从 480p checkpoint 出发的 RL。所有阶段的训练片段都是 5~12 秒、多种长宽比。参数量、数据集、VAE 配置,论文都没有写。 Sparse Rebasing:只在最贵的阶段切换。 现在的视频 DiT 普遍走渐进式训练:先图像,再低分辨率短视频,最后高分辨率长视频。VSA2 从一个用全注意力训到 256p 的视频 checkpoint 出发,到 480p、720p 预训练和 RL 阶段才换成 VSA2。 切换之所以平滑,靠的是那扇门:$\mathbf{W}_g$ 零初始化,刚切换时 $\mathbf{O}=\mathbf{O}_f$,输出只来自 fine branch,也就是用同一套 Q、K、V 做的稀疏注意力,对原模型的扰动最小。coarse branch 的贡献之后再慢慢学出来。 这个思路和 MoE 从稠密模型 upcycling 很像(这是我的类比)。好处有两个:一是可以直接复用全注意力训好的文生图、低分辨率视频 checkpoint;二是低分辨率阶段序列本来就短,稀疏注意力省不了多少,没必要在那里折腾。 Hard-to-Easy Curriculum:训得难,测得松。 训练时用更激进的稀疏度(top-K 小),推理时放宽(top-K 大)。Table 2 的 Exp 1~4 对比了 top32/top64 训练与 top64/top128 推理的几种组合,规律很一致:推理时的 top-K 比训练时大,运动质量就更好。 最突出的是 Exp 2(top64 训、top128 推),文生视频运动质量人评净胜 22.1%。 但代价也很一致:指令跟随和美学变差。 Exp 3(top32 训、top128 推)的文生视频指令跟随净输 15.4%。 作者对这两个现象的解释是: 运动变好,是类似结构化 dropout 的正则效果; 指令跟随变差,是训练与推理不一致造成的。MMDiT 里视频和文本 token 共用一个注意力空间,推理时多看了视频 token,分给文本 token 的注意力就被稀释了。 对应的补救办法是:拿 top64 预训练好的 checkpoint,在 RL 阶段改用 top128 再训一轮(Exp 6)。结果文生视频的指令跟随和美学基本拉回持平(−2.01%、0.00%),运动质量仍然保持优势(文生 +7.38%、图生 +8.05%)。 RL 用的是 reward feedback learning,不是 GRPO 或 DPO。 模型直接预测干净视频 $x_0$,由一个基于 VLM 的奖励模型和一个基于 CLIP 的奖励模型打分,梯度直接穿过奖励模型回传给 DiT。一个值得肯定的细节:奖励权重是在全注意力 checkpoint 上调的,VSA2 直接沿用、不做任何调整。这对 VSA2 来说是偏保守的比较方式。 (图片来源:论文 Figure 4。(a) 480p 预训练和 (b) 720p 预训练的训练 loss,VSA2(蓝)整体略低于全注意力(绿),放大插图里才看得清差距;(c) 480p RL 阶段的美学 reward 与运动 reward,两种注意力的曲线基本重合) 90%~95% 稀疏度下 loss 反而略低于全注意力,这一点值得多想一下。我的一个猜测是:VSA2 并不是全注意力的"子集",coarse branch 额外提供了一条带门控的全局汇总通路,相当于多了一点结构上的归纳偏置。论文没有做去掉 coarse branch 的消融,这个问题目前没有答案。 09 人评表怎么读:每 0.67% 就是一条 prompt VSA2 的质量评估主要靠两样:训练 loss(作者引用 Movie Gen 的结论,认为它和人类偏好相关性好),以及 149 条人工挑选的高难度 prompt 上的成对人评。 人评规则是:同一条 prompt 下 VSA2 和全注意力各生成一个 10 秒视频,评分员判"更好、一样、更差",最后报告(更好 − 更差)/ 149。评测分辨率是 480×864(约 9.9 万 token)和 720×1280(约 22 万 token),用的是 EMA checkpoint。 这意味着表里的每个百分比都能换算回"净多赢了几条":1/149 ≈ 0.67%。先看七组实验的配置: Exp 阶段 训练 / 推理 top-K 注意力稀疏度 端到端加速 1 480p 64 / 64 0.90 2.09× 2 480p 64 / 128 0.82 1.92× 3 480p 32 / 128 0.82 1.92× 4 480p 32 / 64 0.90 2.09× 5 480p RL 64 / 64 0.90 2.09× 6 480p RL 64+128 / 128 0.82 1.92× 7 720p 64 / 64 0.95 4.62× 再看人评结果,括号里是我按 ×149 换算的净条数: Exp 文生·运动 文生·指令跟随 文生·美学 图生·运动 图生·指令跟随 1 −1.34%(−2) +1.34%(+2) −0.67%(−1) +8.72%(+13) +1.34%(+2) 2 +22.1%(+33) −3.36%(−5) −4.7%(−7) +6.71%(+10) −8.72%(−13) 3 +7.38%(+11) −15.4%(−23) −4.7%(−7) +11.4%(+17) −9.4%(−14) 4 +12.1%(+18) −10.1%(−15) −7.38%(−11) +4.03%(+6) −4.03%(−6) 5 −4.03%(−6) +1.34%(+2) −2.01%(−3) +8.05%(+12) −4.7%(−7) 6 +7.38%(+11) −2.01%(−3) 0.00%(0) +8.05%(+12) −2.69%(−4) 7 +6.71%(+10) −2.01%(−3) +1.34%(+2) +0.67%(+1) −1.34%(−2) (数据来源:论文 Table 2,正数表示 VSA2 优于同阶段的全注意力模型;括号内的净条数是我的换算) 几个读法: 第一,720p 那一行才是标题数字对应的质量。 95% 稀疏、端到端 4.62 倍的情况下,五项指标里净差最大的是文生视频运动 +10 条,其余都在 3 条以内。说"与全注意力基本持平"是站得住的。 第二,多数格子在噪声范围内。 论文没报告平票比例。我粗算了一下:假如 VSA2 和全注意力其实一样好,且有一半是平票,那么净胜条数的标准差约为 8.6 条,也就是 ±5.8%。按这把尺子量,超出两个标准差的只有 Exp 2 的文生运动(+22.1%)和 Exp 3 的文生指令跟随(−15.4%),Exp 4 的文生运动(+12.1%)刚好擦线。也就是说,Hard-to-Easy 对运动的提升和对指令跟随的损害是可信的信号,其余的正负差别大多分辨不出来。 第三,正文有一处表述不严谨。 论文说 Exp 2 中"评分员认为 22.1% 的 VSA2 文生视频样本运动更好",但按它自己的计分规则,22.1% 是净胜率(更好减更差),不是"更好"的比例。实际被判为更好的比例只会更高。 第四,图生视频的运动几乎全线为正。 7 组实验里只有 Exp 7 接近 0,其余都在 +4%~+11.4%。单看每格都不算显著,但方向一致,值得后续验证。 作者还做了一个挺有说服力的分析:把 Exp 1 里两个分别训练的 checkpoint(一个 VSA2、一个全注意力)的注意力图并排对比,训练 6 万步之后两者的注意力模式仍然高度相似(论文 Figure 6)。以往的分析一般是拿全注意力模型推理时的注意力图做 profiling,这里是两个独立训练的模型直接对比,更能说明稀疏训练没有把模型带偏。 10 速度到底从哪来 (图片来源:论文 Figure 8。单张 H800、batch 1、20 个头、head dim 128、top64;统计的是 Figure 2 中除 QKV 投影之外所有算子的总耗时。橙线是 FlashAttention-3,蓝线是 VSA2,虚线是 VSA2 的 router、fine branch、coarse branch 分项耗时) 算子层面:22 万 token(对应 720p、10 秒)时,VSA2 的注意力比 FlashAttention-3 快 8.9 倍。序列越长差距越大,图里 43.6 万 token 处 FA3 已经超过 3000 毫秒,VSA2 仍在几百毫秒以内。 router 的开销不小:22 万 token 时占注意力总耗时的 22%,43.6 万 token 时升到 30%。 理想与实测之间还有空间。 95% 稀疏意味着计算量只剩约 5%,按 FLOPs 算理想加速接近 20 倍,实测是 8.9 倍。差出来的部分,一块是 router 自己(22%),另一块我推测来自 block-sparse 的访存开销,以及每个 query block 选中块数不等带来的负载不均。论文没有给 fine branch 单独的 MFU,没法细拆。 端到端层面:720p 端到端 4.62 倍,比注意力的 8.9 倍低一截,因为 DiT 里还有线性层、归一化,以及文本编码、VAE 解码等开销。论文没有说明端到端计时具体包含哪些环节、用了几张卡、多少步。 用 Amdahl 定律倒推一下(我的粗算,假设 8.9 倍对端到端里的所有注意力都成立):全注意力时,注意力约占 720p 端到端时间的 88%;换成 VSA2 之后,注意力只剩端到端时间的 46% 左右,非注意力部分反而占了一半以上。 这有一个直接推论:在 720p 这个量级,继续压注意力的边际收益已经在变小,下一步的大头在步数蒸馏、特征缓存、量化这些手段上。论文也提到,稀疏注意力和这些方法基本正交。 "计算量减半"要打个折。 摘要说 VSA2 比 VSA "注意力计算减半、loss 还更低",依据是 Figure 7(e):细粒度 router 配 top64 优于粗粒度 router 配 top128,fine branch 的计算量确实减半。但 router 本身不是免费的。 按论文给的 22% router 耗时占比粗算:VSA2 的注意力耗时里,fine branch(连同很小的 coarse branch)约占 78%;换成 VSA 的 top128,这部分翻倍,总耗时约为 VSA2 的 1.56 倍。也就是说,VSA2 相对 VSA 实际省下的注意力时间约 36%,大约三分之一。如果改按附录的 FLOPs 公式和我反推的参数算,720p 省 29%、480p 省 41%。数字依然可观,但不是一半。 router 的开销会越来越显眼。 按稀疏度公式,router 的相对开销固定在 $1/R^2$,fine branch 的相对开销 $KB/L$ 随序列变长而下降。按我反推的 B = 128、R = 8、K = 64,两者在 $L=KBR^2\approx52$ 万 token 时持平。作为参照,1080p、10 秒视频按 720p 的 22 万 token 等比例换算约 49.5 万 token,已经贴着这个拐点,而 1080p 正是作者在附录里写的下一步。到那时,要么把 R 调大(router 更便宜,但也更粗),要么就得换一种分层的 router。 11 30 秒长视频:是个信号,还不是结论 (图片来源:论文 Figure 11,附录。样本来自 Exp 6 的 checkpoint,四组 30 秒视频的抽帧:雪山滑雪、水中追球的小狗、乡间土路上开旧卡车的男人、客厅里弹钢琴的男人) 论文附录展示了一组 30 秒视频:训练数据最长只有 12 秒,模型直接生成了 30 秒,作者称"没有明显退化",并把它当作 VSA2 能往分钟级视频扩展的早期证据。 这组结果值得看,但证据力度有限: 没有全注意力对照。30 秒这组只有 VSA2 自己的样本,分不清长度泛化能力来自稀疏注意力还是模型本身; 没有量化指标,也没说明生成分辨率和 token 数; 抽帧看不出时序问题。比如第二行最后一帧,小狗和水花已经糊成一团,是剧烈运动的正常模糊还是长时退化,单凭抽帧判断不了。作者提到补充材料里附了视频文件。 不过有一点是确定的:30 秒视频的 token 数是 10 秒的三倍左右,全注意力的计算量就是九倍。越是这种长度,稀疏注意力的收益越大。 作者在附录里写了两个后续方向:一是做 1080p,二是和 Self-Forcing 这类自回归视频生成方法结合。后者逐块生成视频,天然需要高效的长上下文注意力。 12 想自己用要注意什么 现状:截至发稿,VSA2 的代码和权重都没有公开。前代 VSA、STA 的 kernel 在 FastVideo 仓库里开源,VSA2 的 fine branch 和 VSA 一样用 ThunderKittens 实现 block-sparse attention,复现有现成的起点;需要自己补的是细粒度 router 的融合 kernel,以及支持每个 query block 选中块数不等的调度。 如果想照着复现,关键配置是这些(B、R 为我的反推): 块大小 B = 128(cube 的三维切法论文没给),router 池化尺寸 R = 8,G = B/R = 16; 平均每个 query block 选 64 个 KV block,用 per-sequence TopK,各个头预算相同; router 不接收梯度,Q、K 直接用 fine branch 的投影结果; 门控 $\mathbf{W}_g$ 零初始化,coarse branch 的输出乘 tanh 门控后与 fine branch 相加; 与文本相关的注意力保持完整。 训练配方上的建议: 不要从头训。低分辨率阶段保留全注意力,到 480p 以上再切换; 如果想用 Hard-to-Easy 换运动质量,最后记得用推理时的 top-K 再做一轮 RL 或微调,否则指令跟随会掉; 序列并行优先用 Ulysses(按头切分)。VSA2 每个头的计算量相同,Ulysses 下负载天然均衡;Ring-Attention 按序列切分,而 per-sequence TopK 选中的 KV 块可能集中在少数分片上,GPU 之间会负载不均。这是作者在附录里承认的限制。 如果你手上是开源模型、只想加速推理:VSA2 需要训练,不是即插即用的方案。在 Wan2.1 这类开源模型上,SLA、VSA 这类微调方案,或者 Sparse VideoGen 这类免训练方案,代码都已经开源,现在就能用。 硬件:测速只在 H800 上做过,kernel 依赖 ThunderKittens 和 CuTe DSL,换到其他架构的卡上需要重新评估。 13 需要留意的限制 前面零散提过,这里集中说。 1. 人评样本少、粒度粗。 149 条 prompt,每格的分辨率是 0.67%。论文没报告评分员人数、是否盲评、平票比例和评分一致性。除了 Hard-to-Easy 带来的运动提升和指令跟随下降,其余多数差异都在统计噪声以内。"与全注意力持平"的结论站得住,"部分场景超过全注意力"需要更大的评测集来确认。 2. 没有外部 baseline,没有公开 benchmark。 对比对象只有同条件训练的全注意力,以及 VSA/NSA 的设计变体。没有在同一个模型上比 SLA、SLA2、VMoBA、Sparse VideoGen,也没有 VBench 之类的公开指标。 3. 无法复现。 模型参数量、数据集、VAE、训练算力都没公开,代码和权重也没放出,外部读者只能相信内部实验。 4. 训练加速没有量化。 论文的出发点是预训练成本,但所有加速数字都来自推理。Sparse Rebasing 到底省了多少 GPU 小时、训练吞吐提升多少,没有给。 5. "计算量减半"没算 router。 算上 router,720p 下相对 VSA 实际省下约三分之一(见第 10 段)。 6. 消融的统计强度一般。 Figure 7 的消融是 1 万到 3 万步的单次运行,(e)(f) 的差距要靠放大插图才看得见,没有多随机种子。 7. Hard-to-Easy 的代价要靠额外训练来补。 运动质量的提升伴随着指令跟随和美学的下降,要再做一轮更高 top-K 的 RL 才能恢复。工程上意味着训练和推理要维护两套 top-K 配置。 8. 扩展性隐患。 router 的相对开销固定在 $1/R^2$,按反推参数在约 52 万 token(接近 1080p、10 秒)时会追平 fine branch;动态稀疏和 Ring-Attention 不好配合。这两点作者都在附录里承认了。 9. 长视频证据薄弱。 30 秒生成只有抽帧展示,没有全注意力对照和量化指标。 10. 端到端测速条件不透明。 端到端加速用的硬件、GPU 数、采样步数、是否包含文本编码与 VAE 解码,论文都没交代。 14 横向对比表格 下面这张表是我按各论文公开信息整理的,不是论文原表。各方法的模型、硬件、分辨率、baseline 都不同,加速倍率跨行不能直接比较。 方案 何时引入稀疏 怎么选块 选块器是否学习 报告的稀疏度 论文报告的加速 VSA2(2026.09) 预训练中途接入,覆盖 RL 与推理 细粒度 pool-softmax-pool,per-sequence TopK 否,无梯度 90%~95% 注意力 8.9×(H800,对比 FA3);720p 端到端 4.62× VSA(2025.05,NeurIPS 2025) 从头预训练,或改造已有模型 cube 级 coarse attention 的分数,逐 query block TopK 与 coarse branch 共享参数 — 训练 FLOPs 降 2.53×;Wan-2.1 注意力 6×,端到端 31 秒→18 秒 SLA(2025.09) 微调 按注意力权重分关键、边缘、可忽略,边缘部分走线性注意力 启发式划分 注意力计算省 95% 注意力 13.7×;Wan2.1-1.3B 端到端 2.2× SLA2(2026.02) 微调 + 量化感知训练 可学习 router 决定走稀疏还是线性 是 97% 注意力约 18.6×;Wan2.1-14B-720P 端到端 4.35×(RTX 5090,排除 CPU offload 开销) STA(2025.02,ICML 2025) 免训练或微调 固定的 3D 滑动 tile 窗口 无选块器 — HunyuanVideo 端到端 945 秒→685 秒(免训练)、268 秒(微调) Sparse VideoGen(2025.02) 仅推理 在线 profiling,把头分成空间头和时间头 不需要训练 — 端到端最高 2.28×(CogVideoX-v1.5)、2.33×(HunyuanVideo) NSA / MoBA(2025.02,LLM) 预训练 NSA:压缩分支打分,GQA 组内共享;MoBA:key 块均值池化做门控 NSA 借道压缩分支获得梯度;MoBA 无参数 — 语言模型,不直接可比 几点解读: VSA2 真正的差异化不在倍率,而在"何时引入稀疏"那一列。 表里其他视频方法要么只管推理,要么在现成模型上微调,VSA2 是唯一在完整的视频 DiT 训练流程里(预训练 + RL + 推理)端到端验证过的; "router 要不要学",各家答案不同。 SLA2 押注可学习 router,VSA2 的消融说不用学。两者一个是微调、一个是预训练,场景不同,目前还谈不上谁对谁错; 单看倍率,SLA2 在 Wan2.1-14B-720P 上的 4.35 倍和 VSA2 的 4.62 倍量级相当,但模型、硬件、测速条件都不同,不能据此排高下。更实际的差别是门槛:SLA2 可以拿开源模型直接微调,VSA2 得从预训练阶段就改,对大多数团队来说前者容易得多。 15 总结感受 我觉得这篇论文最大的价值,是把"可训练稀疏注意力"从一个小规模、只看 loss 的研究结论,变成了一个在完整视频 DiT 训练流程里走通的工程方案。预训练、RL、推理都换成 90%~95% 稀疏的注意力,人评还能和全注意力打平,这件事本身就是一个很强的信号。 具体的技术结论里,有三条我认为会被后续工作反复引用: router 不需要学,但需要比硬件块更细的粒度。 选块能力来自数据本身的局部性,而不是梯度;真正限制精度的,是把 128 个 token 压成一个向量的那一步; 稀疏预算应该按序列分,而不是按 query 均分。 固定总预算、让难的 query 多拿,是一种简单有效的自适应计算; 稀疏注意力可以在训练中途接入。 "要不要用稀疏注意力"从一个预训练开始前就得拍板的架构决策,变成了一个可以到高分辨率阶段再做的工程决策,采用门槛低了很多。 但也要清醒地看到,这篇论文的证据几乎全是内部的:内部模型、内部数据、149 条 prompt 的人评、没有外部 baseline,也没有代码。它更像一份高质量的工业实践报告,而不是一篇可以被独立验证的方法论文。 给不同读者的建议: 如果你在训练自己的视频 DiT:这篇是目前最值得参考的稀疏注意力训练配方。Sparse Rebasing 和"高分辨率阶段才切换"的思路可以直接借鉴;Hard-to-Easy 能换来运动质量,但要为指令跟随留一轮 RL。 如果你做推理部署、用的是开源模型:VSA2 暂时用不上,SLA、VSA 改造版或 Sparse VideoGen 这些有代码的方案更现实。另外记住,在 720p 量级上注意力被砍掉之后,非注意力部分就成了大头,步数蒸馏和缓存可能比继续压注意力更划算。 如果你是研究者:有几个问题这篇论文没有回答。稀疏训练为什么能让 loss 低于全注意力,是 coarse branch 带来的额外通路,还是正则效应?router 在 1080p 以上怎么扩展?每个 query 选中的块数不等时,序列并行的负载怎么均衡? VSA2 把视频稀疏注意力的讨论,从"推理时怎么少算"推进到了"训练时就不算"。它能不能撑到 1080p 和分钟级视频,取决于 router 开销和序列并行这两个问题怎么解决,这也是这条路线接下来最值得期待的地方。 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-29|阿里双Agent语音涨10.4分,Qwen-Audio 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 图像生成与编辑 3 篇 · 语音与动作生成 2 篇 · 数据集与评测 1 篇 重点论文标题列表 Qwen-Audio-Agent(阿里巴巴 Token Foundry):双Agent并行,座舱91.04% DyMD(北航):14B 压成 1.3B 四步 HetA-DiT(高通 AI 研究院):两成 token 走全注意力 Routed Forcing(清华大学):动力学+45%,嘴部不动 RWTD(字节跳动 Seed):一步模型 GenEval 0.80 今日论文速览 1. Qwen-Audio-Agent:双Agent并行,座舱91.04% Qwen-Audio-Agent Technical Report | 阿里巴巴 Token Foundry | arXiv:2609.25195 关键词:全双工语音, 智能体架构, 任务委派, 语音助手, 异步执行 前序问题:全双工语音助手要一边聊天一边干活,但一段对话里既混着「马上能答」的即时操作,也混着「要跑好几步」的长任务。现有做法要么让前台模型自己把工具全调完(长任务把对话卡死),要么整段委托给后台(用户干等,中途插一句还会把任务一起取消)。语音打断与任务取消、执行完成与结果回传被绑成一根绳,是这套系统要解决的核心矛盾。 本文贡献:提出前后台双 Agent 架构:Frontend Agent 只负责对话,并判断这一步是直接调工具还是委派出去;Backend Agent 在独立上下文里跑被委派的任务;Orchestration Runtime 负责维护任务状态、协调向用户要授权,并把结果排回对话。关键设计是把「语音打断」和「任务取消」解耦,把「执行完成」和「结果投递」解耦,所以后台在跑的时候对话还能继续往下聊。独立适配器让前台模型、后台 Agent、客户端可以分别替换,已在桌面助手、智能座舱、语音客服三类场景落地。 Foreground-background architecture of Qwen-Audio-Agent. 实验效果:内部座舱基准 134 个用例上,混合执行的任务成功率 91.04%,直接执行 72.39%、全部委派 80.60%。另在「三种配置都成功」的同一批轮次上做延迟评测,混合执行的平均任务执行延迟比这两个基线分别低 26.73% 和 30.91%。 Illustrative timeline of a delegated task. 批判点评:两个数字其实来自两个不同的评测集合:成功率是 134 个座舱用例,延迟只统计三种配置都跑成功的轮次——也就是说最难的那批(只有混合执行成功、基线直接失败)根本没进延迟统计,26.73% 的降幅是在对自己有利的子集上算出来的。另外 91.04% 比的是同一套系统的两种退化配置,没有跟任何外部语音智能体对照,报告也没给后台任务的绝对耗时。 2. DyMD:14B 压成 1.3B 四步 DyMD: Preserving Interaction Dynamics through Distribution Matching Distillation in Few-Step Video World Models | 北京航空航天大学;京东未来学院 | arXiv:2609.31349 关键词:视频世界模型, 分布匹配蒸馏, 少步生成, 具身智能, 交互动力学 前序问题:大视频扩散模型是很强的具身预测先验,但多步采样对交互式下游太贵。DMD 能把采样压到几步,代价却是机器人与物体之间的交互运动被抹掉:画面看着没问题,机械臂却基本不动,生成出来的世界对规划毫无用处。 本文贡献:从 teacher 信号和 fake-score 信号两头定位问题:弱重加噪让 teacher 后验一直集中在「没动作」的 rollout 附近,而动作更强的 rollout 又带来更大的 fake-score 拟合误差,反过来拖住生成器学动力学。DyMD 给两个自适应机制——temporal affinity 条件下的重加噪采样,按每条 rollout 当前交互保真度混合基础时间步表与 teacher 先验;dynamics-guided fake-score tracking,用噪声条件预测器估计每条 rollout 的拟合难度并上调其 critic 权重。14B teacher 蒸成 4 步 1.3B 学生,推理时不加任何辅助模块。 Overview of DyMD. 实验效果:具身视频基准上,相对 Base DMD 把 R-Bench 任务遵循度提 9.6 个百分点、PAI-Bench-G 的 Domain 分提 5.1 分,视觉质量基本持平。作为下游动作规划骨干,在两个 WorldArena 任务上平均成功率 34%,Base DMD 为 16%。 Visual comparison of interaction dynamics between Base DMD and DyMD at four NFE. 批判点评:34% 对 16% 看着翻倍,但绝对值仍只有三分之一,而且只在两个任务上测;全文反复验证的其实是主表那两个更朴素的数(9.6 / 5.1)。另外整套收益建立在「先用 V-JEPA 类特征算 temporal affinity」之上,这个额外前向的开销并没有计进推理成本。 3. HetA-DiT:两成 token 走全注意力 Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion | 高通 AI 研究院;波恩大学 | arXiv:2609.31050 关键词:视频扩散, 稀疏注意力, 推理加速, token 路由, DMD 前序问题:视频扩散的自注意力在长时空 token 序列上是二次开销。现有高效注意力基本对所有 token 一视同仁,但去噪难度在不同视频区域、不同时间步上差异极大,均匀省算力必然在最难的地方翻车。 本文贡献:提出 HetA-DiT:一个轻量不确定度分支预测每个 token 的去噪难度,据此把不确定的 token 送进稠密全局注意力、把更可信的 token 交给便宜的局部注意力。路由同时随内容和时间步自适应,并保留全局上下文,还留了一个参数控制质量-效率权衡。关键工程点是推理时不新增 Transformer 前向——不确定度估计直接复用上一个去噪步的结果,也因此能和少步 DMD 蒸馏兼容。 HetA-DiT. Heterogeneous self-attention computation assigned to tokens with different denoising complexities. 实验效果:在 DMD 蒸馏后的 Wan2.2-5B 与 Wan2.1-1.3B 上评测,VBench、VBench-2.0 和人工偏好上质量与基线可比,但只有约 20% 的 token 走稠密注意力。 Qualitative comparison of HetA-DiT to baseline DMD. 批判点评:摘要只说「维持可比质量」,没给 VBench 总分的具体差值;而「约 20% 走稠密」是路由比例、不是端到端加速比,局部注意力在真实硬件上能兑现多少要看实现,论文里也没有 wall-clock 延迟表。此外不确定度复用上一步估计,意味着第一个去噪步的路由其实是盲的。 4. Routed Forcing:动力学+45%,嘴部不动 Where and When to Force: Routed Forcing for Streaming Avatars | 清华大学;京东未来学院;东南大学 | arXiv:2609.30963 关键词:流式数字人, 蒸馏, DMD, 多样性塌缩, 区域路由 前序问题:Self Forcing 用 DMD 把双向视频扩散模型蒸成因果、少步的流式生成器,但 DMD 最小化的是 reverse KL,本质是 mode-seeking:学生会丢掉高动态模态、塌到静止输出上,把生成视频的动态和多样性一起压扁。 本文贡献:先把这种塌缩量化成一张区域异质图:人物区域(姿态、手势)多样性损失最大,音频驱动的嘴部损失很小,背景几乎不变。据此提出两维路由——Where:人物区域改用 Data-Forcing Distillation(拿真实视频当监督),嘴部与背景保留 DMD 以保口型和场景稳定;When:高噪声阶段开 DFD 注入真实动态,低噪声阶段切回 DMD 修细节,避免真实视频与学生 rollout 的空间差异带来模糊与伪影。 Routed Forcing routes distillation by semantic region and noise stage. 实验效果:相对 Self Forcing,动态最高提升 45%,多样性提升 7–25%,视频质量与口型同步基本保持。 Qualitative comparison of different training strategies. 批判点评:45% 是「最高」值,7–25% 的多样性区间跨了不同指标,主表里并不是每项都赢。更重要的是整套方法依赖先用分割模型对学生 rollout 抽人物 mask、用面部关键点抽嘴部 mask,这些前处理在流式实时场景里的开销没有被计入收益。 5. RWTD:一步模型 GenEval 0.80 Aligning One-Step Generative Models with Reward-Weighted Transport Distillation | 字节跳动 Seed;加州大学伯克利分校 | arXiv:2609.30840 关键词:一步生成, 奖励对齐, 最优传输, 蒸馏, 后训练 前序问题:一步生成器推理便宜,但后训练极难:通用隐式生成器既没有可算的似然,也没有去噪轨迹可借,而 GenEval、HPSv2 这类奖励往往根本不可导,梯度类方法又容易把图改得过度风格化。 本文贡献:提出 Reward-Weighted Transport Distillation,只要采样和标量奖励分数。它没有直接对齐常规的 reward-tilted 参考分布,而是构造自适应目标:把「当前分布」与「参考分布」分别倾斜后再混合——当前项吸收训练中已发现的改进,参考项把目标锚回预训练生成器。实现上用特征空间最优传输加不动点回归完成对齐。理论分析表明其不动点分布在 off-policy 倾斜参考与 on-policy 倾斜当前模型之间插值,给出了「适应奖励」与「保留先验」的权衡解释。 SANA Sprint 1.6B comparisons. RWTD improves alignment on difficult position prompts. 实验效果:把一步模型 SANA Sprint 1.6B 的 GenEval 从 0.73 提到 0.80;单独的偏好对齐实验显示跨奖励泛化良好,HPSv2 后训练在涨分的同时基本保住了组合能力与真实感。 Effect of mixed reward tilting on GenEval and held-out PickScore / diversity. 批判点评:0.73→0.80 是 GenEval 单项,摘要没说明其他指标是否同步变好。论文自己指出梯度类基线 FAV、DRaFT 在 HPSv2 上出现明显风格化、属于奖励过优化,而 RWTD 只是「大体保留真实感」——这说明 RWTD 同样在往奖励方向偏,只是偏得慢。另外最优传输做在特征空间,编码器选谁会直接影响结论。 6. SAP-DMD:两步采样救回高频细节 Spectral Amplitude Purification in Distribution Matching for Diffusion Distillation | 浙江大学;加州大学伯克利分校 | arXiv:2609.29116 关键词:扩散蒸馏, DMD, 频域分析, 一步生成, 细节恢复 前序问题:DMD 能让扩散模型几步出图,但优化动态长期被低频信号主导:方向误差的幅度谱高度集中在低频,弱的中高频信号被压住,细结构和纹理迟迟回不来。 本文贡献:提出 SAP-DMD,一个即插即用模块:自适应地调制 DMD 方向场的幅度谱,压掉幅度谱的支配性长尾,削弱低频主导,让中高频结构更快恢复。改动只在方向场上做,不替换骨干、不加参数。 2-step performance evolution during training on SD3.5 Medium. 实验效果:在 PixArt-α、SD3、SD3.5 上,2 步与 4 步采样下都更快收敛、生成质量更好。 Qualitative comparison of 4-step (top) and 2-step (bottom) generation. 批判点评:摘要通篇是定性表述——「更快收敛」「质量更好」,没有给任何一个具体数字,FID/CLIP 的实际对比全在正文表里。所谓「即插即用」也只在这三个文生图模型上验过,视频与编辑类任务没测。另外压低频本身是经验操作,压到什么程度靠阈值超参,论文没有给出选参依据。 7. FuseReg:换解码器 gFID 降 27% FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders | 布朗大学;南加州大学;莱斯大学;阿伯丁大学;圣母大学;马里兰大学;宾夕法尼亚大学 | arXiv:2609.31620 关键词:表征自编码器, 层融合, 正则化, 图像生成, 重建生成鸿沟 前序问题:表征自编码器(RAE)直接把预训练视觉编码器的特征当重建与扩散潜变量用。但要选哪些编码器层组成这个共享潜空间是个两难:浅层保像素细节更好,深层生成指标更好。固定启发式的层融合把两个本该分开优化的目标硬绑在了一起。 本文贡献:提出 FuseReg:不挑层,改为在随机采样的编码器层子集上训练。理论分析给出机制解释——子集采样显式惩罚了对跨层不一致的敏感性。结果是同一个解码器可以不重训地同时处理完整、稀疏、单层三种融合方式。 Cosine-similarity maps of decoder intermediate-block features under different layer fusions. 实验效果:ImageNet-256 + DINOv3-L 上,单个 FuseReg 解码器在三种融合下的 PSNR 都高于为固定融合专门训的解码器;只换解码器、生成器完全不动,RAEv2 DiT-XL 的无引导 gFID 降 27%;生成与扩散两阶段一起正则化,DiT-Base 的 gFID 降 29%。 One FuseReg decoder supports both sparse and single-layer fusions. 批判点评:27% 和 29% 都是相对自身基线的相对降幅,不是 gFID 绝对值,也没跟非 RAE 路线(如 SD-VAE)的潜空间横向比。另外随机子集训练要求训练时多跑几种融合,成本靠「一次训练多处可用」摊平——这个账只在论文自己的设定下成立。 8. Timo:40K 动作片段六维评测 Timo: $\textbf{T}$aming Mult$\textbf{i}$modal Diffusion Transformer for Human $\textbf{Mo}$tion Generation | 逐际动力 | arXiv:2609.30761 关键词:人体动作生成, MMDiT, flow matching, 运动学监督, 评测基准 前序问题:现有人体动作生成大多用 cross-attention 注入文本语义,忽略了动作与文本 token 之间的双向建模。直接把视觉生成里好用的 MMDiT 搬过来也不行:关节运动时间上连贯、跨关节相关性却很弱,MMDiT 配 flow matching 直接上会产出不协调、抖动严重的动作。 本文贡献:提出 kinematics-aware 的 MMDiT 框架 Timo:用全共享的多模态注意力做文本-动作双向建模,配合 flow matching、几何与旋转运动学监督(直接比较真实旋转及其随时间的变化),以及从「广泛动作学习」到「细节字幕对齐」的两阶段课程。同时构建了 6 个公开数据集、40,025 条留出片段的基准,在同一评测器与评分协议下测六个互补维度。 Kinematics-aware multimodal generation with a shared 24-block stack. 实验效果:定量与定性均明显超过现有方法,在六个维度中的五个上超过 Kimodo,基准平均分相对提升 40.8%。并在 LimX Luna、LimX Oli 两台实体人形机器人上完成重定向与跟踪执行。 Qualitative comparison across models and prompts. 批判点评:40.8% 是「基准平均分」的相对提升,而这个基准的作者就是本论文自己:六个维度、统一评测器都是他们定的,被比较的四个系统是「重新评测而非引用原文数字」,训练数据与表示各不相同,文中也承认自家数据含内部采集。机器人演示只做到重定向跟踪,没有闭环控制指标。 9. HyperErase:超网络一次前向出 LoRA HyperErase: Scale-Calibrated Hypernetwork for Multi-Concept Erasure in Text-to-Image Models | 哈尔滨工业大学(深圳);清华大学深圳国际研究生院;吉林大学;鹏城实验室;华南理工大学 | arXiv:2609.31154 关键词:概念擦除, 超网络, LoRA, 文生图, 模型安全 前序问题:概念擦除的主流做法是静态权重:训一个冻结的 adapter,遇到不同 prompt 变体就不好使,多概念叠加时还会发生参数互相干扰。 本文贡献:把概念擦除重构成「prompt 条件的参数摊销」:训一个超网络,把文本描述直接映射为该 prompt 专属的 LoRA 更新,不需要逐 prompt 做梯度优化,也免去手工合并 LoRA。为了让合成出的 adapter 稳且准,又提出 decoupled rectification——把 LoRA token 拆成 pattern 与 scale 两个子空间,对 scale 用平方根变换抑制乘性过缩放,并在推理时用教师给出的规范先验做校正。 Overview of HyperErase: hypernetwork-driven prompt-conditioned parameter synthesis. 实验效果:在主要概念类别上,擦除有效性、图像质量、语义对齐三者的权衡全面改善,性能接近「金标准」的单概念基线;一次前向就能为每个 prompt 变体产出专属 LoRA,推理期无需梯度更新。 Visual results of artist style erasure. 批判点评:摘要里「接近金标准单概念基线」是自我定位,实际是在 I2P / NudeNet 这类检测指标上逼近,而 FID、CLIP 的对比分散在不同概念类别的表里,没有一张表把三个维度同时摆在一起。另外超网络本身要先跑完 gold baseline 的擦除流程、收集 checkpoint-prompt 对,这个前置成本并没有被算进「免优化」的收益里。 10. TrafficImag:31K 样本的反事实路口 TrafficImag: A Benchmark for Counterfactual Roadside Traffic Video Generation | 德克萨斯大学奥斯汀分校;杜克大学 | arXiv:2609.30722 关键词:反事实生成, 路侧交通, 视频生成, 评测基准, 世界模型 前序问题:现成路侧交通数据集支持感知、预测和视觉问答,但不评「反事实视频生成」:改掉某一个交通参与者的行为之后,生成的未来既要符合道路拓扑,又不能扰动其余交通参与者。 本文贡献:TrafficImag 把大规模路侧数据(9,022 张标注图、7,043 段去重视频、31,145 条以参与者为中心的历史-未来样本)和一套可执行协议绑在一起,覆盖行为推理、干预感知的图像编辑、条件视频生成三类任务。每次干预都用「参与者级程序」来描述:目标参与者、意图行为、合法路线、交互顺序、时间约束,从而给异构基础模型提供统一评测接口。评测四个互补的有效性维度,端到端反事实只有四项全过才算成功。 Overview of the TrafficImag benchmark. 实验效果:在多个 SOTA 基础模型上,最强推理器的 macro F1 为 80.4%;完整条件接口把最好生成器的端到端成功率从 23.3% 拉到 55.0%。Oracle 研究显示条件视频执行仍是剩余的主要瓶颈。 Matched 8-second rollouts for a programmed left-turn counterfactual. 批判点评:55.0% 已经是最好的数,意味着接口给全后仍有近一半反事实做不成;而 20 个场景 × 3 次重复对百分比类指标来说置信区间很宽。论文自己也承认瓶颈在视频执行,也就是说这个基准当下更多是在给生成器记分,还没真正定位到路侧场景的语义难题。 趋势观察 少步蒸馏开始为「丢掉的东西」买单 今天十篇里有四篇在修蒸馏的副作用:DyMD 修的是机器人不再和物体交互,Routed Forcing 修的是数字人塌成静态,SAP-DMD 修的是低频把高频细节吃掉,RWTD 则换了个方向——先承认一步生成器的后训练很难做,再用最优传输把奖励塞进去。共同点是 NFE 已经不是瓶颈,蒸馏完之后「还剩什么」才是。 「对所有东西一视同仁」正在被放弃 HetA-DiT 只让约两成 token 走稠密注意力,Routed Forcing 按人物、嘴部、背景分区域换监督信号,FuseReg 干脆不挑层而是在随机层子集上训练。三篇方法毫不相干,但都在拒绝均匀处理——按 token、按区域、按层做差异化分配,成了这一批论文共享的默认动作。 人工智能炼丹君 整理 | 2026-09-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-28|阿里 397B 只改提示词就涨 50 分,WanPE 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与编辑 5 篇 · 音视频与语音生成 2 篇 · 图像与 3D 生成 2 篇 · 多模态理解与评测 1 篇 重点论文标题列表 WanPE(南大):397B 分镜规划提示词 AV-GRPO(上海人工智能实验室):音视频联合生成的模态解耦 RL ⚡ TRACK(NVIDIA):免训练大小模型按步换班 ViRDM(美国东北大学):砍掉教师与批评家做因果后训练 EditVoice(厦门大学):变长非自回归零样本语音编辑 今日论文速览 1. WanPE:397B 分镜规划提示词 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation | 南京大学;Wan 团队(阿里巴巴集团);中国科学技术大学;复旦大学;清华大学 | arXiv:2609.30221 关键词:文生视频, 提示词增强, GRPO, 电影分镜, 评测基准 ⚠️ 前序问题:现代视频生成器已能生成 30 秒、并忠实遵循复杂条件,文本提示几乎直接决定多镜头序列里动作、机位轨迹、光效和声音如何展开。但现有的提示增强大多还停留在「可选扩写」层面,面对导演级的镜头级规划(分镜如何组织、跨镜头语义如何不漂)能力明显不足。 本文贡献:提出 WanPE——397B 参数的提示增强模型,在 105 万条真实视频上训练。核心有两块:一是 video-grounded 逆向构建(reverse SFT),从真实视频反推出镜头级电影分镜规划,让模型学到的是「怎么组织分镜」而不是「怎么把句子写长」;二是 Semantic-Consistency GRPO(SC-GRPO),用语义一致性奖励把用户意图在跨镜头、跨时间维度上保住。配套还建了 WanPEval:249 条人工标注请求,覆盖 5–30 秒时长与不同意图粒度,约 1.1 万次盲评 pairwise 比较。 WanPE training pipeline. Video-grounded reverse SFT and semantic-consistency GRPO. 实验效果:驱动 Wan3.0 生成器时,相对原始用户提示,5–15 秒人类偏好提升 10.66–18.84 分,30 秒竞技场提升 50.86 分。5–15 秒子集上专家偏好 S / Bradley–Terry 分数为 50.61 / 61.85,超过 Seedance 2.0(43.42 / 54.70)、MiniMax-H3(36.40 / 49.27)、Kling 3.0(20.80 / 37.40)与 HappyHorse 1.1(24.89 / 40.46)。消融显示逆向构建明显优于正向改写,SC-GRPO 在各模型规模上都能稳住语义保真。 Fine-grained expert evaluation on the 5-15 seconds subset of WanPEval. Left: Preference scores across generation durations and request-granularity levels. Right: Preference scores S across seven content categories. 批判点评:397B 这个体量本身就是最大的成本项,而表里的规模曲线并不支持它:4B 是 43.60 / 56.21,9B 是 46.00 / 58.01,397B 才 50.61 / 61.85——为了最后 5 分,参数量涨了两个数量级。更值得注意的是 30 秒子集:+WanPE-397B 的 Overall 60.24 只是险胜 Seedance 2.5 的 59.76,而且拆开看,动作类 50.00 被 Seedance 2.5 的 68.18 甩开一大截,知识类、演讲类也不占优。换句话说,WanPE 真正补齐的是「镜头语言」,动作生成本身的短板它一个字都没碰。 2. AV-GRPO:音视频联合生成的模态解耦 RL AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation | 上海人工智能实验室;香港理工大学;新加坡国立大学;南洋理工大学;浙江大学 | arXiv:2609.29816 关键词:音视频联合生成, 强化学习后训练, GRPO, 跨模态同步, 扩散模型 ⚠️ 前序问题:音视频联合生成里,异质多模态奖励互相纠缠导致信用分配困难,两个模态塔动力学差异大、联合优化极贵,而同步性评测又依赖成对样本、奖励没法公平比较——直接把 RL 后训练搬过来几乎处处碰壁。 本文贡献:提出 AV-GRPO 这一模态锚定的在线扩散 RL 框架,三个模块:模态锚定 rollout 解耦学习信号并稳定难度;轨迹锁定的冻结塔优化降低成本、重新分配信用;针对模态各自动力学的自适应目标与扰动强度。由此把耦合的多模态偏好学习拆成单模态子问题,实现精确奖励归因。同时构建了 5DAV 数据集,在五个维度上解耦样本、难度可控。基于 LTX-2.3 22B,8 卡 A800 上跑 LoRA 与全参两档。 Overview of the AV-GRPO training pipeline. 实验效果:JavisBench 上 AV-IB 从 0.224 提到 0.247,JavisScore 0.202 → 0.222,DeSync 0.708 → 0.607;VABench 上 Lip Sync 1.439 → 1.646、DeSync 0.726 → 0.542。在生成质量、语义对齐与跨模态同步三项上均超过 LTX-2.3,LoRA 与全参微调两档都成立。 Left: Radar chart comparing performance on the 5DAV and VGGSound datasets. Middle: Metrics are reported as relative percentage changes with respect to the baseline. Right: Comparison of model performance with different alternating step intervals. 批判点评:表里藏着一个不太好看的反差:LTX-2.3+AV-GRPO(lora) 在 Alignment(4.512 对 4.510)、Expressiveness(4.450 对 4.434)、Visual Realism(4.402 对 4.395)三项主观指标上,全都高于全参版。花了全参训练的成本,主观质量却没赢过 LoRA,说明这套「冻结塔 + 分塔信用分配」的收益主要落在同步类客观指标上,主观提升更接近采样噪声。而且这三项差距都在小数点后第三位,论文也没给方差或多次运行,显著性无从判断。 3. TRACK:免训练大小模型按步换班 Accelerating Video Diffusion via Training-Free Trajectory Routing | NVIDIA | arXiv:2609.30096 关键词:视频扩散加速, 免训练, 模型路由, 步级调度, 能耗优化 ⚠️ 前序问题:视频扩散推理昂贵:要把大模型跑很多个去噪步。即便做了步数蒸馏,剩下每一个蒸馏步依然要付一次完整的大模型前向,推理成本还是下不来。 本文贡献:TRACK(TRajectory-Aware Capacity routing via top-K selection)是一种异构去噪策略:离线校准阶段先跑一遍全大模型的参考轨迹,每一步同时收集小模型的预测,与大模型预测比较得到相对分歧分数(两边共享同一 latent、timestep、条件与 guidance),再把该信号跨校准集聚合成分步分歧分数图,据此决定切换策略——质量敏感步留给大模型(如 Wan 2.1 14B),低分歧步路由给小模型(1.3B)。推理时每步只执行被选中的那一个模型,不重训练、不改架构与调度器、也不需要在线双模型评估。 Training-Free Trajectory-Aware Capacity routing. Top: Offline calibration rolls out the all-large-model reference trajectory and, at every step, evaluates the large and small checkpoints using the same latent, timestep, conditioning, and guidance inputs. Bottom: Online inference applies that policy while preserving the shared latent representation and scheduler update. 实验效果:在 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo 四条管线上分别取得 1.95×、2.04×–2.73×、2.69×、2.17× 加速,聚合质量相当、DreamSim 多样性保留 >95%。在 A100 上用 NVML 实测,去噪能耗降低约 45%–60%:Wan 2.1 每视频省 194.57 kJ,折合每千条视频省 54.05 kWh(降 49.3%);Cosmos 3(Super/Edge)能耗降近 60%。 Speed--quality tradeoffs across video pipelines. Each panel compares the all-large model (baseline) and TRACK (ours) switching policy. All models retain comparable aggregate quality at the selected operating points in most quality dimensions. 批判点评:「质量相当」这个结论要挑一下口径:它取的是 VBench 的时间闪烁、运动平滑、主体一致性、背景一致性四个维度的均值——恰好是「换小模型不太容易崩」的那四个。真正的代价作者写在 Limitations 里:部署时必须同时驻留大小两个模型,显存占用反而高于单模型管线。另外对已经把步数压到 3–4 步的蒸馏管线(FastVideo 只有 2.17×),可换的步数本就只剩个位数,收益上限天然受限。 4. ViRDM:砍掉教师与批评家做因果后训练 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation | 美国东北大学;Adobe Research | arXiv:2609.28923 关键词:因果视频生成, 分布匹配, 后训练, 显存优化, VBench ⚠️ 前序问题:少步自回归视频扩散能实现低延迟流式生成,但现有后训练方法几乎都依赖 DMD:需要一个庞大的预训练教师和一个在线 critic,靠 diffusion score 估计分布差异。三套网络同时在线,资源开销成了主要门槛。 本文贡献:ViRDM 把教师与 critic 整个去掉,只让生成器对齐一份离线预计算的目标表征分布。三个障碍逐个击破:用一致性式采样 + 随机截断 clean-exit 监督(S 从 U{1..K} 采样,选中的那次评估才吃梯度)把梯度路径变得可行;用轻量 VAE 解码器压显存;用分阶段 vector–Jacobian product 拆解反传。此外还给出了视频 RDM 的生成种群规模与初始化策略(因果 ODE 初始化最优),并加了 flow 动力学正则来补表征分布对时间变化约束不足的问题。 Consistency-style sampling with stochastic exits for few-step video RDM. 实验效果:同样 8 卡 A100 的设置下,峰值显存从 77.1 GB/卡降到 48.3 GB/卡,后训练时间从 22 小时压到 2 小时,VBench Total 从 84.51 提到 84.87。只需 20 次生成器更新、16 A100 GPU-小时,比此前最佳少步因果基线高 0.36 分。用户研究中文本-视频对齐 40.4%、视觉质量 43.0% 均为四步因果方法里最高(Self Forcing 两项均为 32.6%)。 Replacing the resource-intensive teacher-critic stack with direct representation distribution matching for few-step causal video post-training. In the same 8-A100 parallelized training setting, this reduces peak memory from 77.1 to 48.3 GB per GPU and post-training time from 22 to 2 hours, while improving the VBench Total from 84.51 to 84.87. 批判点评:84.87 对 84.51 只涨了 0.36 分,而论文自己的消融表把原因说得很直白:要把 Dynamic Degree 维度单独剔掉再比,ViRDM 才更好看——说明动力学恰恰是 RDM 的软肋(表征分布对时间演化约束不足),得额外加 flow 正则才勉强补回来,等于承认「省掉教师 critic」的代价是引入了新的手工正则。另外 84.87 是在 Wan2.1-1.3B 这个 1.3B 小骨架上拿的,跟动辄 14B 的双向模型不在一个量级,跨量级横向对比要打折扣。 5. EditVoice:变长非自回归零样本语音编辑 EditVoice: Variable-Length Non-Autoregressive Zero-Shot TTS and Speech Editing with Edit Flows | 厦门大学 | arXiv:2609.29889 关键词:零样本 TTS, 语音编辑, 非自回归生成, Edit Flows, 变长序列建模 ⚠️ 前序问题:现有非自回归零样本 TTS 虽然能并行生成,但几乎都要在生成前先指定目标序列长度——长度得靠另一个模块预估,一旦估错就直接影响韵律与内容。 本文贡献:EditVoice 是首个变长 NAR 零样本 TTS:用 Edit Flows 通过插入、删除、替换三类编辑操作同时更新语音内容和序列长度。训练上采用 speech-infilling,把零样本 TTS 与文本驱动语音编辑统一到同一目标下,推理时前缀提示和后缀提示两种摆位都能用;提出 Complementary Prompt Sampling(CPS),按每类操作取两种摆位里速率更大的那个,利用互补的 Edit Flow 预测。还发现模型能编辑训练来源之外的语音(包括它自己生成的),据此做端到端编辑与免训练的后生成精炼。 Overview of the EditVoice zero-shot TTS inference pipeline. Stage one generates semantic speech tokens using CPS, and stage two applies post-generation refinement to the generated sequence before speech detokenization. 实验效果:在 10K 小时 GigaSpeech 上训练 Edit Flow 模型,在 Seed-TTS Eval EN、LibriSpeech-PC 上零样本 TTS 表现具竞争力,在 RealEdit 上语音编辑表现具竞争力。后生成精炼把 WER 从 2.66% 降到 1.55%,且 8 步生成 + 2 步精炼已经超过不做精炼的 16 步生成。 Post-generation refinement on Seed-TTS Eval EN. Starting from the same 8-step CPS output, WER and edits to generated tokens are measured over 8 refinement steps. The dashed line denotes 16-step CPS generation without refinement. 批判点评:全文只有 5 页 3 张图,实验规模偏薄:10K 小时训练的对比对象里有 CosyVoice 2 这类数据量级高一个档的系统,「competitive」具体竞争到什么程度得回表里逐项看。后精炼这个卖点本质是拿推理时算力换质量——8+2 步打败 16 步听起来漂亮,但总步数只少了 6 步,换成真实延迟并不划算。另外「能编辑非训练来源的语音」是意外发现而不是设计,作者没给系统的泛化边界评估,这条能力在多说话人、跨语种上会不会退化是未知数。 6. OREO:用 2D 编辑反馈对齐 3D 保真 OREO: Fidelity Alignment in 3D Generation via On-the-fly Rendering-Editing Optimization | 香港理工大学;腾讯 ARC Lab | arXiv:2609.29788 关键词:3D 生成, 保真对齐, 2D 扩散先验, 强化编辑, ECCV 2026 ⚠️ 前序问题:3D 生成模型进步很快,但产出的资产视觉保真度往往不够——几何、布局对得上,质感与细节就是差一口气,和 2D 扩散模型能达到的写实程度有明显落差。 本文贡献:OREO 是一个对齐框架,核心是不依赖静态数据集,而是建立动态优化闭环:把 3D 输出渲染出的视图交给 2D 模型做 Reinforced Editing,在保持几何、视角和内容不变的前提下提升视觉保真;这些被实时编辑过的渲染图反过来作为高质量 2D 伪目标,监督 3D 生成器从自己的样本里学习、逐步提升画质。 Overview of OREO. 实验效果:以 Trellis 为底座,对参考图 $x^{ref}$ 的 CLIP / DINO 相似度在 Conceptual Design 上从 0.7613 / 0.7916 提到 0.7834 / 0.8065,在 GSO 上从 0.7722 / 0.7022 提到 0.7764 / 0.7069;对比 Photo3D(0.7380 / 0.7837、0.7512 / 0.7034)同样领先。论文已被 ECCV 2026 接收。 Qualitative comparison of 2D feedback sources (Reinforced Editing / NanoBanana Pro / Qwen-Image-Edit). 批判点评:消融表里最刺眼的一行:去掉 Source Branch 后 ΔCLIP / ΔDINO 从 +0.0379 / +0.0298 直接翻成 −0.0523 / −0.0497——比不做对齐还差。整套方法对「保留源分支」这一条设计极其敏感,稳健性存疑。变体对比里把分布匹配换成 DMD,分数掉到 0.5393 / 0.5486,说明这条路和当前主流的 3D 蒸馏范式并不兼容。另外绝对增益全部停在小数点后第二位,而「视觉保真」这件事到头来还是用 CLIP / DINO 相似度做 proxy,离人眼判断有多远没人说得清。 7. ComplexSync:复杂场景 70FPS 实时唇形同步 ComplexSync: High-Fidelity and Real-Time Lip Sync in Complex Scenarios | 广州趣丸网络科技 | arXiv:2609.29225 关键词:唇形同步, 扩散蒸馏, 实时推理, 视觉基础模型, 基准评测 ⚠️ 前序问题:唇形同步要让口型动态与语音精确对齐。扩散模型生成质量高,但在遮挡、侧脸、复杂光照等复杂场景下容易失稳,而且推理延迟高到没法实际部署。 本文贡献:ComplexSync 是一套统一的扩散框架,三块设计:一是双流联合训练策略,抑制参考帧的信息泄漏同时保留自然动态;二是基于蒸馏的单步去噪加速方案,做到 70+ FPS 吞吐;三是关系对齐损失,借助视觉基础模型(VFM)的结构先验提升复杂场景因素下的同步精度与鲁棒性。此外还给出首个专门面向复杂唇形同步的 benchmark,含 200+ 条挑战视频序列与专门指标。 Overview of ComplexSync. (a) Dual-stream joint training strategy designed to suppress spatial information leakage and ensure high-fidelity synthesis. (b) Distillation-based acceleration scheme that facilitates single-step denoising for real-time inference. (c) Relational alignment loss leveraging VFMs to enhance synchronization precision and robustness under unconstrained conditions. 实验效果:在标准场景与复杂场景上均达到 SOTA,同时支持实时推理,吞吐超过 70 FPS。训练分三阶段:第一阶段 8 卡 A100 训 200K 步,第二阶段 4 卡 A100 训 50K 步,第三阶段再训 10K 步,分辨率 512×512。 Qualitative comparison with existing methods. Given that static images cannot fully capture critical temporal attributes such as synchronization, naturalness, and stability, we provide comprehensive video comparisons in the supplementary materials. 批判点评:三阶段累计 260K 步、起步就是 8 张 A100,这个训练预算对一家业务公司来说更像工程投入而非可复现的研究。全文只在 512×512 分辨率验证,而真实配音、数字人场景常见的是 1080p 以上——放大后的口型稳定性没有数据。定性对比仍然用静态帧,同步、自然度、稳定性这些纯时间属性都推给了补充视频,而这恰是唇形同步最容易「单帧好看、连起来崩」的地方。 8. AdaPilot:一套策略零样本迁移各生成器 AdaPilot: Towards Scene-Adaptive Policy Learning for Cross-Generator Text-to-Image Quality Optimization | 南洋理工大学;同花顺研究院 | arXiv:2609.29517 关键词:文生图, 强化学习, 跨生成器迁移, 多轮视觉反馈, 奖励设计 ⚠️ 前序问题:提升文生图质量的路线已经从生成器微调、提示优化走到了带多轮视觉反馈的强化学习,但现有策略都与特定生成器、特定任务深度耦合,学到的能力很难泛化成一套通用的质量优化策略——换个生成器就得重训。 本文贡献:AdaPilot 把多轮图像生成建模成马尔可夫决策过程,用端到端 RL 学一个场景自适应、可跨生成器迁移的质量优化策略。三点关键:策略与生成器内部解耦(只通过 prompt 和编码后的视觉观测交互,不碰梯度与内部状态),因此能跨生成器复用;场景感知奖励(AdaReward)把质量评估维度与任务语义自适应对齐;过程级奖励建模图像质量在多轮里的演化轨迹。实现上用 Qwen2.5-VL-7B-Instruct 作 agent,Qwen-Image-2512 作冻结生成器。 An illustration of the proposed AdaPilot. 实验效果:在 7 个指标(CLIP-T、HPS、GDino、Aesthetic、OCR 用于奖励,Realism、Physics 为留出维度)上超过 Flow-GRPO、T2I-R1、T2I-Copilot 等基线。跨生成器评测中,单一策略零样本迁移到未见过生成器(Qwen-Image、GPT-Image-1、Gemini-3-pro-Image-Preview 等)时,在所有被评生成器上仍保持正平均增益,OOD 数据集上每个维度都领先。 Averages over applicable evaluation metrics for four unseen image generators on four out-of-distribution datasets and overall, comparing results with and without AdaPilot to evaluate zero-shot cross-generator transfer. 批判点评:论文自己给的失败案例很说明问题:一张要求对比八位利物浦前锋的密集信息图,多轮迭代确实把版面理清了,但文字仍基本不可读、球员身份与属性不一致、图表数值不可验证,agent 明知有残缺陷还是终止了。这暴露了「策略只改 prompt」的天花板——当缺陷出在生成器自身的文字渲染与数值编码能力时,再聪明的提示改写也救不回来。另外训练时要同时部署 CLIP ViT-L/14、HPS v2.1、Grounding DINO、GLM-OCR 和 Qwen2.5-VL-72B 五个评估器算奖励,这套推理栈的成本并没有被算进收益里。 9. ZoomDiff:双摄平滑变焦的高保真插值 ZoomDiff: A High-Fidelity Diffusion Model for Dual-Camera Smooth Zooming | 哈尔滨工业大学;淘宝(阿里巴巴集团) | arXiv:2609.28083 关键词:双摄变焦, 帧插值, 扩散模型, 高频重建, 时间一致性 ⚠️ 前序问题:双摄像头之间的数字变焦切换,几何结构和色彩一致性上会出现肉眼可见的跳变。现有双摄平滑变焦(DCSZ)方法多在帧插值模型上微调,扛不住大视差与复杂几何变换;直接套扩散式帧插值模型,又因为条件引导不足、VAE 编码丢高频、时间一致性不够,保真度还是上不去。 本文贡献:ZoomDiff 在潜空间与像素空间同时吃透双摄输入:一是多步去噪过程中强化双图条件引导,提升几何一致性;二是把 VAE 编码器的 flow 对齐多尺度特征注回解码器(ref injector),把 VAE 编码时丢掉的高频细节补回来;三是引入 flow 引导的时间一致性监督($\mathcal{L}_{ftc}$)让转场更顺。并给出把步数从 25 压到 8 / 4 的适配方案。 The dual-camera images ($\mathbf{X}_0$ and $\mathbf{X}_F$) are fed into the VAE encoder and the semantic encoder. 实验效果:合成与真实数据集上全面领先:PSNR 23.80、SSIM 0.761、LPIPS 0.253、PSNR-div 23.01、FVD 131.332,真实集 MUSIQ 73.634、LIQE 4.874、DBCNN 0.692、DOVER 0.665,均为最优。步数压缩上,25 步 45.89s(FLOPs 743T)可压到 8 步 21.28s(2.16×)与 4 步 15.71s(2.92×)。 Visual comparisons on the synthetic dataset and the real-world dataset. Our method still produces more consistent results. 批判点评:两个反差值得记。其一,扩散类基线整体拉胯:Wan2.1 只有 17.71 PSNR、TRF 14.15、Framer 的 DOVER 只有 0.335,全都输给光流法(UPRNet 22.58、RIFE LPIPS 0.261)——说明「生成式先验」在这个任务上并非天然优势,ZoomDiff 的赢面来自双图条件引导与高频注入这两个工程补丁,而非换 backbone。其二,步数压缩后质量反而上升:8 步版 PSNR 24.08 高于 25 步版的 23.80,而去掉步数适配的 8 步版只有 22.32。也就是说 25 步其实是过采样,指标对步数并不单调,任何「步数越少越差」的外推在这里都不成立。 10. ODU-Bench:14 个全模态模型的需求理解评测 Omni Demand Understanding: A Benchmark for Contextual User-Intent Inference in Multimodal Interaction | 上海交通大学;上海创智学院;阿里巴巴;香港中文大学;清华大学;香港理工大学;南开大学;约翰斯·霍普金斯大学 | arXiv:2609.21392 关键词:多模态交互, 需求理解, 评测基准, 误触发, MLLM ⚠️ 前序问题:音视频自然交互正成为 AI 助手的重要入口,但现有交互能力基准主要评「回复质量」,漏掉了更基础的一问:模型能不能从复杂的多模态交互里正确推断用户的真实需求?现实中的需求在口语里往往是欠规格的,得靠视觉线索、声学线索和对话历史补;含糊表达、噪声环境进一步加剧难度。反过来,听起来像请求的 utterance 也可能根本不是给助手的需求,导致误触发。 本文贡献:把 Omni Demand Understanding(ODU)定义成一个独立的多模态上下文推断问题:给定交互流,模型必须判断是否存在需求,并从多模态与对话上下文推断意图,评测覆盖五个维度(M1 需求存在性、M2 关键点命中率、M3 时间跨度 IoU、M4 转录、M5 用户画像),同时覆盖单轮与多轮。ODU-Bench 用挑战驱动的 taxonomy、taxonomy 引导的 agentic 视频生成加真人录制交互来构建,标注从互补媒体证据重建并经人工校验。 Overview of the ODU-Bench construction pipeline. Challenge-driven targets are expanded into coarse-to-fine scripts, screened for plausibility and challenge validity, and realized as synthesized or human-recorded interactions. 实验效果:评测 14 个原生 MLLM:最强者 Gemini 3.1 Pro 也只能恢复 44.7% 必须从视觉、声学或对话上下文推断的关键信息;14 个模型里有 11 个在非需求场景上的误触发率(FTR)超过 50%。 Qualitative error analysis on English generated audio-visual scenes. (a)--(b) Demand-present cases; M2 reports covered/reference key points. (c)--(d) No-demand cases. 批判点评:44.7% 和「11/14 误触发率 >50%」这两个数字,真正打脸的是当前「先响应、后理解」的范式——模型宁可硬猜一个需求,也不愿意说「这不是需求」。可惜基准本身大量依赖 agentic 生成的交互与 LLM judge,虽然论文做了 judge 稳定性检验和真人录制对照(Δ = Rec − Syn),合成数据与真人数据之间的分布差仍是这套结论最大的外推风险:如果 agentic 生成场景的「挑战性」分布和真实用户偏得比较多,44.7% 这个数就未必能平移到线上。 趋势观察 生成的瓶颈正在往「输入端」和「调度端」挪 今天这十篇里有三篇在动生成流程的两端而不是中间:WanPE 用 397B 模型重写提示词,把导演级分镜规划搬到文本空间完成;TRACK 不改模型、不重训练,只决定每一步该派大模型还是小模型上场;AdaPilot 则干脆只通过 prompt 和视觉观测跟生成器打交道。共同点是:底座模型被当成黑箱,可优化的空间被挪到了它前面和外面——这对没算力训底座的团队是好事,对卖底座的团队不是。 「砍掉教师与 critic」成为后训练的新共识 ViRDM 把 DMD 的教师+critic+生成器三件套砍成只训生成器,8 卡 A100 下显存 77.1→48.3 GB、时间 22h→2h,VBench 还涨了 0.36;OREO 同样放弃静态数据与蒸馏范式,改用 2D 编辑实时产出伪目标做自我监督;AV-GRPO 冻结一塔训另一塔来降低 RL 成本。三条独立工作指向同一判断:昂贵的在线监督预算正在被更便宜的离线/自产目标替换,代价往往是引入新的手工正则(ViRDM 的 flow 正则就是这么来的)。 评测基准开始盯「理解」而不是「生成」 ODU-Bench 评测 14 个原生 MLLM 后发现,最强的 Gemini 3.1 Pro 也只能恢复 44.7% 必须靠上下文推断的关键信息,而且 11/14 的模型在非需求场景上误触发率超过 50%。这个数字比任何生成质量榜单都更能说明当前语音/视觉助手的实际状态:问题不在答得好不好,而在该不该答都还没判断对。ComplexSync 也顺手补了首个复杂场景唇形同步 benchmark,200+ 条挑战序列把遮挡、侧脸这些长期被平均掉的case单独拎出来。 人工智能炼丹君 整理 | 2026-09-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-25|快手开源修图登顶,GEdit仍输GPT 今日 AIGC 论文速览 今日共 10 篇 · 图像编辑与生成安全 2 篇 · 统一预训练与视频运动 2 篇 · 多模态联合生成 2 篇 · 音频生成与后训练 2 篇 · 推理加速与视频评测 2 篇 重点论文标题列表 KwaiMind(快手):180万对数据炼电商修图 UVU(清华大学):视觉监督前移,RefCOCO涨7.7 ⚡ Unite-Audio(东京科学大学):117M音频生成,CLAP登顶 MotionSpec(卡迪夫大学):频谱轨迹约束视频运动 RecCAR(巴伊兰大学):反向注意力补齐,音画更同步 今日论文速览 1. KwaiMind:180万对数据炼电商修图 KwaiMind Technical Report | 快手 | arXiv:2609.26375 关键词:图像编辑,电商,CTR奖励,Ecom-Bench,在线强化学习 ⚠️ 前序问题:电商修图不是通用编辑:商品主体要一模一样、促销文字要渲染准确、图还得有点击欲。通用编辑模型在这三件事上都没专门优化,而电商数据的采集清洗又贵又杂,缺一套能稳定产出高质量配对数据的流水线。 本文贡献:快手发布 KwaiMind:多模态 DiT 底座,Agent 数据引擎维护约 180 万高质量编辑对;继续预训练加 SFT 后走偏好优化与在线 RL,用 VLM 通用裁判加 CTR、文字渲染、商品一致性三类专用奖励训练专精策略,再经 on-policy 蒸馏合并成单一模型;配套发布覆盖 11 类商业编辑任务的 Ecom-Bench。 Overview of the end-to-end data pipeline. Coordinator Agent routes samples through filtering, generation, captioning, and post-filtering with bounded feedback loops and human review. 实验效果:开源编辑器里综合最强:ImgEdit 4.15、GEdit 5.79、REDEdit 英/中 3.75/3.73,Ecom-Bench 视觉质量第一;CTR 引导优化把生成图预测 CTR 超过原图的比例从 12.16% 提到 37.41%,线上 A/B 实际 CTR 相对提升约 2.44%。 Overall comparison on general image editing benchmarks: ImgEdit, GEdit, and the English and Chinese splits of REDEdit. Hatched bars denote closed-source models. 批判点评:最强的限定词是开源:图上闭源模型全面更高——ImgEdit 被 Seedream 4.0 的 4.27 和 GPT-Image-2 的 4.20 压着,GEdit 上 Nano Banana 2 拿 7.02、GPT-Image-2 拿 7.10,比 KwaiMind 的 5.79 高出一大截,REDEdit 两个语种同样如此。真正立住的卖点其实是 CTR 这条商业指标,而不是编辑质量本身。 2. UVU:视觉监督前移,RefCOCO涨7.7 UVU: Improving Multimodal Understanding via Vision-Language Unified Autoregressive Paradigm | 清华大学;腾讯优图实验室;南京大学;格拉斯哥大学 | arXiv:2609.27915 关键词:统一自回归,像素级codebook,连续视觉编码,视觉监督,预训练 ⚠️ 前序问题:多模态大模型的细粒度视觉理解长期靠稀疏文本监督撑着,已有的视觉监督大多加在后训练阶段,那时视觉表征已基本定型,监督信号只能当辅助约束。要重塑感知骨干,得把视觉监督搬进预训练。 本文贡献:提出 UVU 视觉语言统一自回归范式:不用向量量化,SigLIP-2 连续视觉特征直接进 LM 解码器做下一 token 预测;设计大规模迭代层次聚类算法构建 20 万词表的像素级视觉 codebook,让图像 patch 与文本 token 在预训练期共享统一监督,模型由此内化视觉重建能力。 Overview of the UVU vision-language unified autoregressive framework. Continuous visual features from SigLIP-2 are projected and integrated with textual embeddings for autoregressive next-token prediction in an LM decoder, generating pixel-level image tokens. 实验效果:同为 3B/Qwen2.5 底座,RefCOCO 从 84.1 涨到 91.8、LISA 57.4→71.7、CVBench-3D 71.9→76.6、BLINK 46.9→52.8;相对去掉视觉监督的自版 UVU*,RefCOCO +6.2、LISA +12.1。注意力热图显示 UVU 更聚焦目标区域。 Comparison of visual attention heatmaps under three paradigms: from left to right, without visual supervision, AR + VQ, and UVU (Ours). 批判点评:对手没输干净:SEEDB 74.1 仍低于 LLaVA-OV 的 75.4,MMStar 55.0 输给 56.7,ScienceQA 91.3 远低于 GLM-4v 的 96.7;MME 2201.9 对 LLaVA-OV 2146.3 的领先也只有 2.6%。统一目前只覆盖理解侧,生成侧数据还没进训练,作者自己也在文中承认。 3. Unite-Audio:117M音频生成,CLAP登顶 UNITE-AUDIO: Joint Learning of Continuous Tokenization and Latent Flow Matching for Text-to-Audio Generation | 东京科学大学;清华大学;武汉大学;东京大学;蚂蚁集团 | arXiv:2609.28206 关键词:文本生成音频,联合训练,flow matching,Flow-GRPO,连续表征 ⚠️ 前序问题:文本生成音频的主流做法是两阶段:先训重建导向的音频 tokenizer 再冻结,然后在固定隐空间训生成模型。但为重建优化的表征未必适合生成,生成目标无法反过来塑造隐空间。 本文贡献:首个把连续音频表征学习和隐空间 flow matching 联合训练的 TTA 系统:掩码波形过在线编码器,EMA 编码器提供停止梯度的目标特征,重建与自监督生成预测耦合,让生成目标直接塑造隐空间;再用 Flow-GRPO 后训练强化文本条件对齐。 Overview of the proposed framework: (a) the reconstruction path and (b) the generation path. Blue denotes regions with gradient propagation, while gray denotes regions without gradient propagation. 实验效果:117M 隐空间生成模型(不含编解码器)在 AudioCaps-886 上 CLAP 0.534 全表最高(EzAudio 0.496、TangoFlux-RL 0.480),KL 1.057 最低,RTF 0.062;NFE 压到 4 时 RTF 仅 0.009 仍保 CLAP 0.512。 Comparison between conventional separate tokenizer-generator training and our joint single-stage training. 批判点评:分布指标难看:FD_OpenL3 84.76 是 EzAudio 38.26 的两倍多,FD_16k 43.25 也落后 GenAU 的 31.94,IS 11.34 不及 TangoFlux-RL 的 12.20——语义对齐赢了,音频分布保真还差得远;首个联合训练的含金量取决于你更看重 CLAP 还是 FD。 4. MotionSpec:频谱轨迹约束视频运动 MotionSpec: Spectral Trajectory Supervision for Motion-Consistent Video Generation | 卡迪夫大学;中国科大;华东师范大学 | arXiv:2609.28095 关键词:视频生成,运动一致性,傅里叶谱,光流,微调目标 ⚠️ 前序问题:文生视频单帧越来越真,运动却常失真:动作推进不一致、复杂动作下结构崩坏。标准生成目标对运动本身几乎没有专门约束,运动演化处于欠约束状态。 本文贡献:提出 MotionSpec 运动监督:谱轨迹一致性 STC 构造锚点相对的稠密运动轨迹,经时间傅里叶变换成运动谱体积,对齐幅度与相位同时约束运动强度和时序组织;辅以局部光流一致性 LFC 稳定相邻帧过渡,两者随时间步加权加进微调目标。 Overview of the pipeline. At each training step, the video generative model takes the prompt, timestep, noise level, and real data as inputs. 实验效果:在 Wan2.1 上微调,VMBench 均分 61.57→65.07,其中物体完整性 OIS 48.34→56.53、时序一致性 TCS 97.09→98.82;VideoJAM-Bench 运动分 85.3→93.61。定性对比里 Wan2.1 的骑车段后半程自行车几乎消失,MotionSpec 保留完整。 Qualitative Results. On the left are the results of Wan2.1, and on the right are the results of ours. 批判点评:外观分几乎没动:App 仅 81.95→82.20(+0.25);PAS 上单独用 LFC(24.27)反而高于完整版(23.74),说明两个目标存在拉扯。评测全部在 Wan2.1 一个底座上做,换模型的泛化性未知。 5. RecCAR:反向注意力补齐,音画更同步 All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation | 巴伊兰大学;NVIDIA | arXiv:2609.27901 关键词:联合视频生成,跨模态注意力,KL正则,音画同步,人体解剖 ⚠️ 前序问题:联合视频-动作/视频-音频生成的扩散 Transformer 里存在不对称:伴随模态到视频的对应很强,但反过来约束视频生成的对应路始终弱——视频听动作指令的能力远弱于动作看视频的能力,人体解剖崩坏、音画不同步由此而来。 本文贡献:把两个方向的跨模态对应表示成视频 token 上的分布,定义反向对应差距;提出 RecCAR,KL 正则把弱方向对齐到以视频到模态对应为固定参考的强方向,即插即用地微调 EchoMotion 这类联合生成模型。 Illustration of asymmetric reciprocal cross-modal correspondence. For a motion token corresponding to the head, the VM correspondence correctly localizes the head region in the video, while the reciprocal MV correspondence is dispersed. 实验效果:视频-动作联合生成 Human Anatomy 0.69→0.75,VMBench 多数指标超 EchoMotion、CoMoVi、FlowMo;视频-音频生成音画失同步从 0.804 降到 0.752。散点图上每个 prompt 的反向差距在微调后一致下降。 Qualitative comparison of RecCAR against EchoMotion, CoMoVi, and FlowMo across three representative scenes. 批判点评:增益以自家基线为参照:0.75 的解剖分意味着仍有约四分之一样本不达标,音频侧 0.752 的失同步也谈不上小;teaser 里对比的 LTX-2 只做了定性展示,未给出与闭源模型在同一协议下的量化差距。 6. GestureFAR:9.3毫秒每token的流式手势 GestureFAR: Streaming Co-Speech Gesture Generation with Flow Autoregression | 罗切斯特大学;东京大学;加州大学圣克鲁兹分校;加州大学洛杉矶分校;Meta | arXiv:2609.21576 关键词:手势生成,流式,flow自回归,蒸馏,实时交互 ⚠️ 前序问题:流式陪聊手势生成此前靠离散运动 token 自回归,把高维连续运动压进有限 codebook,真实感和多样性都受损;而连续方法又难以保证逐 token 因果,实时交互卡在延迟上。 本文贡献:提出流式手势生成框架 GestureFAR:因果 VAE 把全身动作编码成可流式的连续隐变量,Transformer 对音频-运动上下文自回归,每 token 配 flow-matching 头从连续分布采样下一潜变量;再冻结因果骨干,用一致性加分布匹配目标把多步 flow 头蒸馏成单步前向。 Overview of GestureFAR. GestureFAR generates co-speech gestures from streaming audio by autoregressing over continuous motion latents. 实验效果:BEAT2 流式组 FGD 3.08 全面最佳(LiveGesture 4.57、MIBURI 8.06),BC 0.741 接近离线最优;1 步蒸馏后每 token 9.3ms,是教师 8 步 24.4ms 的 2.6 倍速、MIBURI 62.9ms 的 6.8 倍速。 Qualitative comparison on BEAT2. We visualize generated full-body gestures from different methods under the same speech inputs, with the semantically salient words highlighted in red. 批判点评:BC 0.741 仍低于 MIBURI 的 0.790 和 LiveGesture 的 0.794,多样性 13.24 也略逊离线系;单步蒸馏换速度后 FGD 反而比教师还好(3.08 vs 3.17),这个反常更像评测协议的产物而非能力证明,文中未解释。 7. DeltaS:状态漂移选KV,六个基准+2.1 DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video | Maum AI;首尔大学;延世大学 | arXiv:2609.27470 关键词:KV缓存淘汰,流式视频,线性注意力,混合架构,训练无关 ⚠️ 前序问题:视频语言模型转向线性/全注意力混合架构后,线性注意力状态固定大小,但全注意力 KV 缓存仍随流式视频无限增长;流式场景下问题还没来就得决定淘汰谁,现有基于位置、注意力或 KV 本身的信号都拿不到这个先验。 本文贡献:提出训练无关的 DeltaS:读门控 delta 线性注意力的循环状态,用一块帧内状态的归一化变化量(状态漂移)衡量该块带来多少新信息,漂移大的块对应 KV 留存;信号计算只占前向的 1.9%,无需代理查询。 Overview of DeltaS. Each video chunk updates the recurrent linear-attention states, whose normalized changes yield a shared score for retaining the corresponding KV entries across full-attention layers. 实验效果:预算与留存策略对齐的受控比较里,状态漂移信号全面胜过位置/注意力/KV 三类基线;六个长视频基准平均超最强无查询基线 2.1 分,最长基准 LVBench 超 5.6 分。 Performance margin as a function of KV retention rate. DeltaS generally shows larger margins at lower retention rates. 批判点评:增益随留存率升高而收窄:留存 token 超过约四成后在 EgoS 上反而落后基线 0.7 分,高预算场景收益有限;hybrid 架构前提也把它限死在门控 delta 线性注意力这一类骨干上。 8. DriftAudio:一步生成后训练FAD降34% DriftAudio: Marginal Drifting for Distributional Post-Training of One-Step Text-to-Audio Generators | 悉尼科技大学 | arXiv:2609.27598 关键词:一步生成,分布后训练,文本生成音频,Drifting,FAD ⚠️ 前序问题:一步文本生成音频模型把推理成本打下来之后,生成分布仍欠火候;常规后训练依赖逐条件配对的真实样本,自由文本条件下一个 prompt 往往只有一两条真实参考,逐条件 Drifting 根本做不了。 本文贡献:提出 DriftAudio 边缘分布后训练:把 Drifting 从逐条件搬到边缘音频分布上做,在冻结的 PANNs 特征空间里用重采样真实样本、滚动生成的 FIFO 样本库和当前批次共同估计漂移场,得到 detached 训练目标只更新生成器,一步推理流程原样保留。 Overview of DriftAudio. The one-step generator remains text-conditioned, while Drifting is performed on the marginal audio distribution in feature space. 实验效果:从 MeanAudio 出发 FAD 降 33.9%、FD 降 17.6%,KL 与 CLAP 同步改善;从 FdAudio 出发 FAD 1.22→0.99,一步生成的分布质量明显抬升。 Mean and covariance components of FAD for the four evaluated models. Numbers above the bars denote total FAD. 批判点评:不是白捡的:从 FdAudio 出发时 IS 和 CLAP 出现回退,说明边缘分布对齐和条件保真之间存在交换;方法绑定冻结的 PANNs 特征空间,换更强的音频评价骨干是否还成立未验证。 9. InGuard:嵌入层安检,省一半去噪步 InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation | 阿里巴巴 AAIG | arXiv:2609.27620 关键词:文生图安全,内嵌护栏,嵌入改写,潜空间检测,RevGen ⚠️ 前序问题:T2I 的安全护栏都装在外面:前置 prompt 分类器加后置图像分类器,两者不用模型自身表征——prompt 检查准头有限,图像检查要等全量去噪烧完才跑,而且违规 prompt 只能一刀切拒绝,本可改写成安全输出的也被扔掉。 本文贡献:提出 InGuard 内嵌护栏:文本编码器嵌入上直接做风险三级分类(不安全/风险/良性),SAGE 对风险 prompt 做嵌入空间软门控改写使其输出安全图而非拒答,去噪中途用一步干净潜变量估计做潜空间检测,发现风险即刻提前终止;配套 RevGen Safety 基准,1 万条 prompt 由真实图反生成并注入受控 IP 角色。 Overview of our InGuard framework. Three complementary components work in sequence: prompt embedding risk classification, SAGE embedding-space safety enhancement, and latent detection with early termination. 实验效果:五个开源 T2I 模型上安全率 97.9%-98.8%,追平或超过外置护栏;良性扰动少 57.5%-73.5%,参数少约 3.7 倍,50%-55.6% 的去噪步被跳过;潜空间检测在 44%-50% 计算量处就逼近图像级 F1。 Pretraining effects on Avg F1 across five LDMs; latent detection vs denoising-step fraction used as a compute proxy. 批判点评:SAGE 改写不是万能的:论文自己承认增强失败时只能靠潜空间检测兜底拦截,等于承认存在漏改样本;RevGen 由自家反生成流水线构造,跨基准的代表性有待第三方复检。 10. CineGuard:11种运镜的抄袭检测 Did You Steal My Shot? Pioneering Camera Motion Plagiarism Detection in Generative Videos | 河海大学 | arXiv:2609.22267 关键词:运镜抄袭,生成视频,涡度,基准,版权保护 ⚠️ 前序问题:运镜是影视级 IP,但生成视频用一句 prompt 就能复刻高价值运镜;现有相似度检测都盯着画面内容,训练数据把运镜和内容缠在一起,传统光流又表达不了复杂相机运动——运镜抄袭至今无人管。 本文贡献:构建首个运镜分析基准 CineFlow:11 种运镜风格的模拟数据集把运镜与内容解耦;提出 CineGuard 检测网络,在光流上叠加流体力学涡度作为平移不变线索,3D 卷积提 tubelet 嵌入后过 ViT 主干加全局相机适配器,对比学习聚拢同运镜视频。 Architecture of the motion plagiarism detection network. The input flow is first augmented with vorticity, then a 3D convolution extracts tubelet embeddings. 实验效果:抄袭检测超最强基线 3.02 倍;在 Veo 3.1 与即梦的商业生成视频上,余弦相似度 0.56-0.83,基线全部落在 0.35 以下,Precision@5 最高 0.73 对基线约 0.27。 Performance of plagiarism detection on generative videos. Left: cosine similarity between videos. Right: Precision@5 for retrieving videos with the same motion label. 批判点评:局限写在图里:FPV Drone 这类复合运镜相似度掉到 0.56,是全表最低,混合运镜仍是软肋;基准是简单几何场景模拟出来的,真实影视素材上的迁移只有商业视频小样本佐证。 趋势观察 编辑模型的主战场从通用能力挪向行业指标 KwaiMind 把 CTR 预测直接做成奖励信号训进编辑模型,线上 A/B 实测 +2.44%;InGuard 则把安全检查搬进生成管线内部,省下一半去噪步。两条线指向同一件事:图像生成的竞争正在从「生成质量」转向「商业约束下的生成质量」,奖励函数和护栏的构造方式开始比骨干网络更值钱。 视觉监督正在从后训练前移到预训练 UVU 用像素级 codebook 把视觉监督直接塞进预训练,RefCOCO 一项涨 7.7 分;MotionSpec 则在视频微调里用频谱约束补上运动监督的缺口。共同逻辑:等表征定型再补监督太晚了,感知质量的上限在预训练阶段就被决定。 一步生成与流式生成进入质量补课期 DriftAudio 给一步 TTA 做边缘分布后训练,FAD 降三分之一;GestureFAR 用单步蒸馏把手势生成压到每 token 9.3ms;Unite-Audio 把去噪步数压到 4 还能保住 CLAP。速度战的下一程是质量战——谁能在一步、几步的预算里把分布差距补回来,谁就拿到实时产品化的门票。 混合架构的两组记忆开始学会协作 DeltaS 证明线性注意力的循环状态可以反过来指挥全注意力 KV 缓存的淘汰,六个长视频基准平均 +2.1;Unite-Audio 则让生成目标直接塑造 tokenizer 隐空间,打破「先冻结表征再训生成」的铁律。两篇都在挑战模块化管线里各训各的默认假设。 人工智能炼丹君 整理 | 2026-09-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-23|NVIDIA像素扩散FID 1.46,仍输latent 今日 AIGC 论文速览 今日共 10 篇 · 图像生成与像素扩散 2 篇 · 视频世界模型与 3D 一致 2 篇 · 视频生成加速与流式编辑 2 篇 · 动作与音频生成 2 篇 · 音视频因果与奖励评测 2 篇 重点论文标题列表 PixelDiT2(NVIDIA):像素扩散 FID 压到 1.46 WorldCrafter(ARC Lab, Tencent IEG):分钟级探索重访 PSNR 18.0 ⚡ GAE(HKUST):相机轨迹误差砍半 FVD 降 23% SparkDiffusion(Peking University, Melon Group):97% 稀疏下 265 倍单卡加速 MixiMotion(PTIT, Hanoi):一步动作对齐 0.835 逼近教师 今日论文速览 1. PixelDiT2:像素扩散 FID 压到 1.46 PixelDiT2: Representation-Grounded Pixel Diffusion Transformers | NVIDIA;University of Rochester | arXiv:2609.24919 关键词:像素空间扩散,表征先验,表示对齐,DINOv3,ImageNet ⚠️ 前序问题:像素空间扩散不用自编码器、直接在 RGB 上去噪,省掉了 latent 重建瓶颈,代价是收敛慢、最终画质长期落后 latent 扩散。作者的判断是缺一个显式表征先验:latent 扩散天然在紧凑结构化的隐空间里去噪,像素扩散却要一边学「好去噪的表征」一边学「怎么生成像素」,两件事挤在同一次训练里互相拖累。 本文贡献:提出 representation grounding:用一个冻结的预训练视觉基座模型在整个去噪过程里持续提供 per-patch 表征监督。带噪图像走像素去噪通路,同时冻结编码器产出 per-patch 特征,一个时间步条件化的 DiT 块 P_g 把它映射成 scaffold,再通过空间 AdaLN 调制扩散 transformer;REPA 只作为训练期辅助目标。另提出延迟 grounding dropout:训练初期保留 grounding,到 epoch 160 再开启 dropout。 PixelDiT2 at ImageNet-512x512: samples, architecture, and convergence. 实验效果:ImageNet-256×256 上 H/16 模型 600 epoch 达 FID 1.46、IS 301.6;512×512 上 680 epoch 达 FID 1.48、IS 295.7,两档都是像素侧最好(同表其余像素方法 1.61–3.94 / 1.78–3.95)。论文强调 epoch 预算:512 档 epoch 200 就超过 PixelDiT 850 epoch 的 FID,预算低 4.25 倍。 PixelDiT2 reaches FID 1.78 at epoch 200 and 1.48 at epoch 680. 批判点评:「补上表征先验」在像素侧成立,但把两张表横着读是另一面:256 上 latent 侧 RAE-XL FID 1.13、REPA-XL 1.29 都优于 1.46,512 上 RAE-XL 1.13 同样压过 1.48,IS 也不及 REPA-XL 306.3 与 JiT-G 306.8。也就是说「追平」只在像素扩散内部成立,跨阵营仍差约 0.3 FID,摘要里 narrowed the gap 的措辞容易被读成已经追平。另外延迟 dropout 的开启时机是在 512 档上调出来的,256 档用的是从头独立 dropout,两档训练协议并不一致,跨分辨率可比性打了折扣。 2. WorldCrafter:分钟级探索重访 PSNR 18.0 WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory | ARC Lab, Tencent IEG;Peking University | arXiv:2609.24984 关键词:视频世界模型,隐式3D记忆,长程一致性,相机可控,流式生成 ⚠️ 前序问题:视频世界模型做交互式探索时,长程一致性一直是硬伤:走出一段距离再回头,场景常常「认不出」是刚才那个地方。难点在于历史观测越来越多,而视频生成器的 token 预算是固定的,怎么把历史压进有限 token、又不依赖显式深度对应,是个两难——显式 3D 重建重且脆,简单堆历史帧则 token 直接爆掉。 本文贡献:核心洞察是「让被请求的视角来决定历史怎么压缩」。一个与视频生成器联合训练的 memory encoder 把历史观测编成紧凑的 3D-aware 表示,再由 pose-conditioned readout 按当前目标相机位姿读出固定数量的、目标视角专属 token,在去噪前注入,全程不需要显式深度对应。配合 max-coverage 历史检索、最近时间上下文和 few-step 蒸馏,实现从单张图或文本出发的流式分钟级探索。 Overview of the WorldCrafter pipeline. 实验效果:VBench 自建输入模式 725 段视频上 Overall 81.910 为全表第一(Alaya-EVOKE 81.406、SANA-WM 80.841、Echo-WM 80.211),主体一致性 82.695、背景一致性 90.589、运动平滑 98.787、整体一致性 26.745 均为第一。长程重访一致性上 MEt3R 0.166、PSNR 18.016、SSIM 0.517,相对次优 Lyra 2.0(0.334 / 14.050 / 0.390)近乎翻倍。 Qualitative long-horizon revisit comparison in a static scene. 批判点评:重访那张表真正的第一不是 WorldCrafter 而是它的加速版 WorldCrafter-fast(MEt3R 0.129、PSNR 20.868、SSIM 0.616)——少步蒸馏的变体反而在一致性上更好,这暗示「更多步数」本身可能带来累积漂移,论文没有就这条给出解释。视觉质量上也不是全胜:美学质量 AQ 61.432 只排第四,不及 SANA-WM 63.467;动态程度 DD 96.893 是全表最低(其余 97.087–100),说明换来的一致性里有一部分是靠画面动得更少买到的。评测均在自建输入模式下完成,未与公开榜单协议对齐。 3. GAE:相机轨迹误差砍半 FVD 降 23% GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation | The Hong Kong University of Science and Technology;ARC Lab, Tencent IEG;The University of Hong Kong;The University of Texas at Austin | arXiv:2609.24981 关键词:几何原生隐空间,3D一致性,自编码器表征,相机轨迹,感知生成统一 ⚠️ 前序问题:视觉生成器能出逼真画面,却保不住一个前后一致的 3D 场景。作者认为这不只是建模问题,更是表征问题:生成器演化的是外观为中心的隐空间,感知模型恢复几何用的是语义丰富、编码跨视角结构的空间,两者不在同一坐标系上。常见补丁是「再输出一个几何头」,等于把几何当副产品,治标不治本。 本文贡献:不把几何当额外输出,而是直接把一个几何基座模型的特征重参数化成紧凑、可扩散的隐空间——几何原生自编码器 GAE,其 latent 同时可解码到外观、深度、相机和点图。训练分两阶段:先训 codec 把冻结的多层几何特征压进 latent,再用条件流只在「待生成视角」的 latent 上做流匹配,参考视角 latent、相机射线和文本作为控制,让感知与生成共用同一个隐空间接口。 Overview of Geometry-Native Autoencoder (GAE). 实验效果:在固定生成器与训练协议的控制对比下:重建侧 GAE-128 用比原始几何特征少 24 倍的通道,PSNR 28.76 / LPIPS 0.036 / rFID 5.4(RealEstate10K)反而略优于原始 L0 特征;生成侧 GAE-64 最优,RealEstate10K FVD 225.7、PSNR 20.02、SSIM 0.711,DL3DV FVD 287.0、PSNR 18.00,相对最好的非 GAE 受控 latent 分别降 FVD 12.7% 与 23.1%;ATE 在 RealEstate10K 降 52.8%、DL3DV 降 23.3%,MEt3R 取到受控组最佳 0.1208 / 0.1347。 Multi-frame RGB, geometry, and camera-pose comparison across RealEstate10K scenes. 批判点评:最有价值的是控制变量设计,但同一张表也留了口子:受控组之外还列了 Gen3R 与 GLD 两个参考方法,其中 Gen3R 在 RealEstate10K 的 MEt3R 是 0.1157,优于 GAE-64 的 0.1208——「最佳」限于受控 latent 这个口径。DL3DV 的重投影误差上 GAE 只有 0.0028–0.0029,反而不如 WAN2.1 VAE 的 0.0019,说明几何原生 latent 在像素级回投影精度上并不占优。另外通道数选择本身就不一致:128 在重建上最好、64 在生成上最好,论文没给选择依据,实际部署还得自己再权衡一次。 4. SparkDiffusion:97% 稀疏下 265 倍单卡加速 SparkDiffusion: Mitigating the High-Sparsity Trap --- A Unified Framework for up to $265\times$ Single-GPU Acceleration of Visual Generation | Peking University, Melon Group;Tsinghua University;Alibaba Group;University of Electronic Science and Technology of China;Harbin Institute of Technology | arXiv:2609.23153 关键词:稀疏注意力,推理加速,少步蒸馏,FP8量化,视频扩散 ⚠️ 前序问题:视频扩散 transformer 贵在注意力要处理超长时空 token 序列,做稀疏注意力是自然的加速思路。但作者发现一个「高稀疏陷阱」:稀疏度推到极致时,逐步训练损失还在稳步下降,最终生成质量却停滞甚至倒退。诊断指出这是监督问题——主要误差来自高噪声的结构生成阶段,逐步局部训练修不动它,只有对齐终态的训练才修得动。 本文贡献:由此给出一条分阶段原则:先把稀疏架构适配成粗粒度先验,再校正终态分布。SparkDiffusion 按此串起三件事——短程稀疏 warm-up、少步 trajectory-mixed 蒸馏、FP8 量化配融合 kernel,并把三者做成可乘的加速因子。覆盖 Wan2.1/Wan2.2 骨干、T2V/I2V 任务、480P/720P 分辨率,以及 H100 与 RTX 5090 两种 GPU。 Overview of the SparkDiffusion framework. 实验效果:3 步无 CFG 推理下,Wan2.1-T2V-14B-720P 在单张 RTX 5090 上端到端 265× 加速(H100 上 220×);Wan2.1-T2V-1.3B-480P 端到端 1.3 秒出片。长序列 720P 上维持 97% 注意力稀疏,1.3B-480P 上 90%。VBench 总分从 dense 的 83.69 到 83.15,掉 0.54 分;同表延迟与显存项均为最好(18.0 / 8.0)。 End-to-end latency and speedup of SparkDiffusion over Full Attention on NVIDIA H100 and RTX 5090 GPUs. 批判点评:265× 是三个因子相乘的结果,其中大部分来自 3 步蒸馏而非稀疏本身,读标题很容易把功劳全记在稀疏上——论文在图表里做了分解,但正文强调的仍是合成后的倍数。质量代价是实打实的:83.15 低于 dense 83.69,且稀疏度从 90% 提到 97% 时分数从 83.42 掉到 83.15,说明高稀疏陷阱只是被缓解、没被消除。另外源码里仍能看到若干未清理的 TODO 占位注释(作者元数据、BF16 两列标注为占位),作为预印本部分数值还需等正式版复核。 5. MixiMotion:一步动作对齐 0.835 逼近教师 MixiMotion: One-Step Text-to-Motion Generation via Asymmetric Set Distillation | Posts and Telecommunications Institute of Technology, Hanoi, Vietnam | arXiv:2609.23010 关键词:文本到动作,一步生成,集合蒸馏,运动学监督,推理延迟 ⚠️ 前序问题:文本到动作生成质量上来了,但迭代采样要几十上百次网络评估,延迟高,交互式动画、游戏这类场景用不了。压缩成严格一步模型有两大障碍:一是文本条件下的动作天然多模态,同一提示对应多个合理动作,固定的教师-学生一一对应会把多种有效模式平均掉;二是只在归一化表征空间里对齐,解码后可能出现明显运动学瑕疵。 本文贡献:MixiMotion 用离线集合蒸馏:对每个提示让冻结的多步教师先生成 K=4 个动作存进离线教师库,学生训练与推理时都不再查教师;学生从独立噪声采样 M=8 个一步样本,用非对称双向集合匹配训练——教师到学生方向鼓励覆盖教师支持的多样动作,学生到教师方向抑制不被支持的生成,两侧权重 α=(1, 0.20) 故意不对称。再叠加解码空间的端点、轨迹与身体分组运动学监督。 MixiMotion: offline asymmetric set distillation for one-step text-to-motion generation. 实验效果:ViMoGen 上语义对齐 0.835,一步方法里第一(MotionLCM-1 0.825、naive 一步教师 0.711),逼近 50 步 HY-Motion-1.0-Lite 教师的 0.858;六个类别中有四类超过 MotionLCM-1。25 人盲评总体 4.33 对教师 4.50,同为一步/少步里最高(MotionHiFlow 4.20、MotionLCM-1 3.98)。单次网络评估延迟从 829.58 ms 降到 9.30 ms。 Qualitative comparisons between HY-Motion-1.0-Lite and MixiMotion. 批判点评:摘要里的 89.2× 是单次网络评估口径,正文自己给出的端到端加速是 6.75×——差了十几倍,文本编码与渲染等开销没算进去,读者很容易把 89.2× 当成真实提速。另外 0.835 其实仍略低于多步的 MLD 0.840(与 MDM 0.833 基本持平),「逼近教师」成立,但严格说还没超过最好的多步基线。消融里非对称权重只带来 0.829→0.835 的 0.006 增益,解码空间监督贡献 0.832→0.835,各组件边际收益都很小;学生从教师热启动、460M 参数与教师同量级,并没有变小。语义分数由 Qwen3-VL-30B 判 yes/no 问题自动给出,非人类标注。 6. SVEET:双向模型改流式 15 FPS Streaming Video Editing with Easy Adaptation | Shanghai Jiao Tong University | arXiv:2609.24788 关键词:流式视频编辑,双向转自回归,特征解耦,正交解耦训练,实时生成 ⚠️ 前序问题:预训练的双向视频扩散模型编辑质量好,但它需要看完整段视频,做不了逐帧自回归的流式编辑。直接改造会撞上两个矛盾:双向骨干的特征在时间上互相依赖,而流式推理要求条件帧彼此独立;可控性与因果性两个优化目标还会互相拉扯,联合训练通常顾此失彼。 本文贡献:先系统复盘已有 video-to-video 扩散方案,归纳出流式适配的两条原则:骨干特征解耦、条件帧独立。据此给预训练双向模型加一条辅助控制分支,用时间独立自注意力编码源视频,中间特征注入对应骨干块;为弥合双向与流式的特征空间差异,再提出解耦训练 ODT,显式约束「视频可控性」与「模型因果性」两个优化方向正交,使二者在推理时兼容,并实现跨异构骨干的零样本迁移。 Our proposed SVEET. 实验效果:视频风格迁移上 VLM 编辑准确率 7.4322 为全表第一(LiveEdit 5.8672、DayDream+CF 5.2321、SDV2 4.2297),CLIP 文本对齐 0.2287、主体一致性 0.9447、背景一致性 0.9298、运动平滑 0.9898、美学质量 0.5550 均为第一。消融中 ODT 把 2D 版从 7.1898 提到 7.4322、3D 版从 7.0653 提到 7.3315,推理期投影(6.4250)与两阶段 teacher forcing(7.0927)都不如它。单张 H100 上 15 FPS,未用任何额外加速手段。 Qualitative comparison results on stylization. 批判点评:唯一没拿第一的一列是整体一致性(0.1123 第二),而拿下这列的 Channel concat 编辑准确率只有 1.8902——几乎没在编辑,说明这个指标在这组对比里更接近「越不改越高分」,拿它当唯一失分项反而暴露了指标本身失效。实验只在风格迁移这一个任务上给了完整数字,其余编辑任务的优势主要靠定性图支撑。15 FPS 是在 H100 上测的,离真正的端侧实时还有距离,且论文没有给出不同分辨率或时长下的 FPS 曲线。 7. COT-TTS:听对话推断语气 MOS 4.15 COT-TTS: Audio Context-Aware Text-to-Speech with Chain-of-Thought Reasoning | The Hong Kong University of Science and Technology;Nanjing University;JIUTIAN Research, China Mobile;Peking University;China Mobile (Hong Kong) Innovation Research Institute | arXiv:2609.22697 关键词:上下文感知语音合成,链式推理,可编辑风格,级联对比,时长一致性 ⚠️ 前序问题:语音合成的说话方式现在基本靠用户显式下指令,但自然对话里该怎么说本应从上下文推断出来。现有系统要么让用户逐句指定,要么把 ASR、LLM、TTS 串成级联——参数动辄 30B 以上,而且级联转换会把原始语音里的副语言信息(非语言发声、节奏、情绪强度)丢掉。 本文贡献:把「上下文感知推理式 TTS」定义成新任务:给定历史对话音频、目标文本和参考语音,先理解上下文,再显式推理出一段中间 CoT,最后按指定音色合成目标语音,且这段 CoT 可被检查与编辑。配套建了大规模双语对话语音数据集(900 万训练样本,含 100 万高质量子集)和 800 条人工核验、源不重叠的评测基准,并给出 0.6B / 1.7B 端到端自回归模型,直接产出带情绪标注的转写、可编辑风格推理和语音 token。 Overview of the end-to-end CoT-guided autoregressive model. 实验效果:英文基准上 COT-TTS-0.6B 拿到 Human MOS 4.150 全表第一(级联 3.050–3.500),情绪一致性 0.954 第一,时长误差 1.155 秒远优于级联的 5.1–12.5 秒;中文基准上 0.6B Human MOS 4.200 同样第一。可编辑 CoT 变体在中文上拿到最高的 LLM 综合分 3.461 与历史理解 4.079。参数量只有级联系统(34–39B)的几十分之一。 Distributions of the normalized audio quality score, naturalness score, target-audio effective-speech ratio, and emotional expression intensity over 50K randomly sampled examples. 批判点评:「参数少几十倍、效果相当」要看是哪一列:UTMOSv2 2.943 低于 two-a3b-fish 的 3.138,DNSMOSPro 3.180 明显不及 two-qwen3omni-seedvc 的 4.240,WER 0.041 也高于 three-dia-a3b-fish 的 0.012;LLM 评测的 CoT 逻辑 4.558 不及 4.836,综合分 2.304 不及 3.601。真正领先的是人类整体评分、情绪一致性和时长误差三项。更值得注意的是两个反常:0.6B 的人类评分(4.150 / 4.200)高于 1.7B(4.050 / 4.150),规模变大反而变差;开启可编辑 CoT 后推理分数上去了,英文 Human MOS 却从 4.150 掉到 3.500——论文把这解释为改动把分布推离训练域,等于承认「可编辑」目前要付音质代价。 8. Common Cause:灰度视频让音频翻车 62% Common Cause, Not Cross-Attention: Blocking Visual Shortcuts in Audio-Video Generation | RIKEN iTHEMS;RIKEN AIP;South China University of Technology;Columbia University | arXiv:2609.22361 关键词:音视频生成,因果推断,反事实不变性,视觉捷径,共享表征失效 ⚠️ 前序问题:音视频联合生成器的训练数据里,「看起来是什么」和「听起来是什么」高度相关——某种材质、纹理或物体外观总与某种声音同时出现。这种相关往往是虚假的:模型可以只从外观预测声音,完全不碰「是什么事件」这个因果变量。一旦测试时外观与事件的关联被打破,模型就会直接合成错误事件的声音。 本文贡献:这是一篇受控的因果研究而非又一个模型。先建音视结构因果模型,让音频在构造上独立于视频的干扰外观,再系统检验流行解法——直接 cross-attention、共享 latent、bottleneck、无监督 shared/private 分解、忠实共享先验,证明这些「走公共因」的做法全都抓不住要害,因为共享 latent 不是干预,模型照样拿得到外观代理变量。真正堵住捷径需要对干扰变量做干预:在 SCM 与干预假设下,论文证明反事实不变性是识别因果预测器的充要条件。 The counterfactual intervention do(v:=v') made concrete (Colored-MNIST). 实验效果:在特征向量 SCM、程序化像素视频、真实图像配频谱音频、移动真实数字、条件生成器五个场景验证。反事实惩罚随因果线索变强从 263× 平滑坍缩到 2.7×,说明捷径只在因果线索难读时才被采用;Moving-MNIST 上直接模型 OOD 准确率 0.21 而本文方法 0.995。对真实预训练视频转音频模型 MMAudio 做输入干预:灰度化让 top-1 声音类别翻转 62%、色彩旋转 54%,最小编辑只翻 22%。 The failure, made audible. 批判点评:最尖锐的一段是「修不好」:作者用重着色一致性项把 MMAudio 的速度网络微调 1500 步,色彩旋转翻转率基本没动(62.5% → 63.9%),真正下降的是通用 OOD 敏感度(高斯噪声 83.3% → 70.8%)——这次微调买到的是整体更鲁棒,而不是论文想修的外观捷径,恰好反证诊断与修复之间还有距离。另外结论高度依赖 SCM 与干预假设成立,真实数据上的干预只能做「改写外观」这类近似;MMAudio 实验只有 24 条真实视频、其中 18 条用于微调,样本量偏小。 9. RewardVerse:先写准则再打分 PLCC 0.52 RewardVerse: Rubric-Guided Policy Optimization for Video Reward Modeling | Institute of Automation, Chinese Academy of Sciences;University of Chinese Academy of Sciences;The Hong Kong University of Science and Technology;Tencent | arXiv:2609.22947 关键词:视频奖励模型,评分准则中介,标量漂移,RGPO,强化学习奖励 ⚠️ 前序问题:用强化学习优化视频生成模型时,奖励模型是地基,但现有视频奖励模型直接把复杂主观质量映射成一个标量,没有显式评分准则,于是出现标量漂移:分数尺度在不同提示之间坍缩或整体平移,RL 拿这种奖励训练并不稳。 本文贡献:借鉴人工标注工程,在「评测请求」和「打分器」之间插入一个动态评分准则 rubric 作为中间表示:先显式生成评测标准,再按准则打分,给标量一个语义锚点。为训练这条协作流水线提出两阶段 RGPO:阶段一用自演化的种子 rubric 预热打分器(偏好奖励 + 格式奖励 + 校准损失),阶段二联合优化 rubric 生成器、产出随请求自适应的准则,同时持续把打分器对齐人类评分。 Overview of RewardVerse and its two-stage RGPO training. 实验效果:16 维 EvalVerse 基准上 Joint(Ours) 在 14 个维度取得最高 PLCC,宏平均 PLCC 0.520、SRCC 0.493 均为第一(次优 Q-Scorer 0.467 / 0.354);Logic 维度 PLCC 0.750 对次优 0.593,Action 0.566 对 0.390。漂移诊断上 RGPO 把均值偏差从 +0.610 降到 +0.164,PLCC/SRCC 从 0.240/0.222 提到 0.505/0.458,预测标准差从 0.457 扩到 1.332,被压缩的分数区间被重新拉开。换到闭源 Gemini-3.1-Pro 上,加 rubric 仍让 PLCC 从 0.490 提到 0.593。 Score distributions of six reward models on the shared 10-dimensional test subset. 批判点评:「14/16 维最高」是真的,但剩下两维恰好是最容易被低层画质解释的:Temporal 那列 Ours 0.538 不及 VideoScore2 的 0.697,SRCC 侧也有两列被 Q-Scorer 与 Raw-rubric 超过。也就是说在偏感知质量而非认知/时序的维度上,rubric 中介的优势会收窄——论文自己也点出 Q-Scorer 在光照、逻辑这类与低层画质相关的维度上仍有竞争力。Gemini 实验只对比了有/无 rubric 两个变体,且受限于 API 只能读自然语言浮点输出,无法与开源模型在同一训练协议下横比。此外 rubric 由模型自生成,其质量评估仍依赖同一套 VLM 裁判,存在自证循环的风险。 10. IMPLICIT-Bench:5493 条中性提示词测隐式偏见 IMPLICIT-Bench: Measuring Implicit Bias in Text-to-Image Models under Neutral Prompts | The University of Melbourne | arXiv:2609.24228 关键词:文生图偏见评测,隐式偏见,知识图谱三元组,中性提示,去偏见权衡 ⚠️ 前序问题:文生图模型的偏见评测大多用「一张 [职业] 的照片」这类槽位模板,只能孤立地探显性人口属性(性别、肤色)。它漏掉了更隐蔽的一类:在自然提示里,当与刻板印象相关的属性没有被指定时,模型仍然默认输出刻板结果——这种隐式偏见现有评测基本看不见。 本文贡献:用结构化知识图谱构造受控提示三元组:中性、刻板、反刻板三个变体只在单一偏见维度上不同,其余场景语义保持一致,从而能把偏见效应精确归因到模板类基准做不到的粒度。最终发布 5,493 条提示、覆盖 11 个偏见类别,并用多模型一致性、CLIP 验证和人工评测三重校验。基于它评测现有去偏见方法,揭示出偏见降低与语义保真之间的基本权衡。 Four-stage KG-grounded benchmark pipeline. 实验效果:过滤后保留的中性图显著偏向刻板端:VLM 均值从 1.75 升到 3.40(Qwen3-VL)、1.26 升到 2.65(Gemma-4),未参与筛选的 CLIP 验证器同向移动。最终基准上 CLIP 判定 67.7% 的 Δx 为正(Cohen's d = +0.39),Qwen3-VL 71.6%(d = +0.85),三个裁判在 Δx 层面正相关(Pearson r = 0.22–0.44)。12 名人工评审在 100 个样例上复现了同样排序:刻板 3.78 > 中性 3.17 > 反刻板 1.60,75.9% 的 KG 被认为确实反映社会刻板印象。 Cross-model qualitative comparison, set 1. 批判点评:三个裁判的一致性是这个方法最脆弱的一环:Gemma-4 的倾向比例只有 48.7%,几乎等于抛硬币,d 也只有 +0.29,与 CLIP 的 67.7%、Qwen3-VL 的 71.6% 不在一个量级;裁判间 Pearson r 仅 0.22–0.44,CLIP 与两个构建裁判的逐图相关性也只有 0.42 / 0.55。人工侧同样不完美:VLM 相对人类均值的 MAE 接近 0.97–0.99,且 12%–16% 的样例把刻板与反刻板的方向判反。样本分布也不均衡——physical-appearance 类只有 14 条,人工研究里 sexual-orientation 一行只落在单个样例上。作者自列的局限同样实在:KG schema 单轴、源数据带 WEIRD 偏斜、去偏见实验只在 Qwen-Image 上做过。 趋势观察 世界模型这一轮在比「记得住」,不是在比「画得好」 WorldCrafter 让目标相机位姿去决定历史怎么压成固定数量的 token,GAE 则干脆把几何基座的特征重参数化成生成用的隐空间。两者承认的是同一件事:分钟级的一致性不是把模型做大就能换来的,而是取决于历史和几何以什么形式存在。有意思的是 WorldCrafter 的加速版在重访一致性上反超了标准版,说明步数与一致性之间未必是正相关。 像素扩散与 latent 扩散的差距,正被「表征」而不是「架构」填平 PixelDiT2 不引入自编码器,而是让一个冻结的视觉编码器在整个去噪过程里持续提供 per-patch 表征,把表征学习和像素生成拆成两件事。不过两张主表横着读会发现,1.46 是像素侧最好、却仍不及 latent 侧 RAE-XL 的 1.13,IS 也不及 REPA-XL 的 306.3——差距在缩小,但没有消失。 加速方案的瓶颈已经从「算力」挪到了「监督」 SparkDiffusion 指出高稀疏下逐步损失在降、终态质量却不涨,根因是监督没有对齐终态;SVEET 则指出双向改流式的瓶颈不在算力而在两个优化方向互相干扰,于是显式约束它们正交。两者都不是靠新算子取胜,而是重新安排了训练时究竟该优化什么。 评测类工作开始把「裁判本身」当成被审对象 IMPLICIT-Bench 的三个裁判一致性只有 Pearson r = 0.22–0.44,其中一个几乎等于抛硬币;RewardVerse 则发现外部打分器在认知类维度上可以是负相关(VideoScore-v1.1 在 Logic 上 PLCC −0.245)。当奖励模型和偏见裁判都开始被自己的盲区反噬,评测可信度就成了需要单独论证的事,而不是默认前提。 人工智能炼丹君 整理 | 2026-09-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注