搜索到
19
篇与
扩散模型
的结果
-
 AIGC 基本功|扩散模型的跨步缓存复用-DiffCache AIGC 基本功|扩散模型的跨步缓存复用-DiffCache 同样走完采样器的每一步,能不能少算几次昂贵的去噪网络?跨步缓存把这个问题拆成两件事:复用什么,以及什么时候必须刷新。本文用残差缓存的最小实验解释机制,再对照 DeepCache 和 TeaCache 的真实实现。实验是人工构造的数值系统,不是视频模型的质量或速度复现。 本文承接 DDIM 与高阶采样器、DiT 和 性能建模与 Profiling。默认读者知道采样器会反复调用网络,不要求先读缓存论文。论文版本与官方代码核对日期为 2026-10-05。 01. 为什么需要它 一次视频生成中,潜变量在逐步变化,文本条件通常固定,网络却要一遍遍穿过相同的模块。假如两次调用的深层特征几乎一样,重新计算这部分就可能浪费时间。但“几乎一样”只是观测,不能推出“任意一次都可以省”。运动切换、条件变化和采样末期的细节修整,都可能让陈旧特征的误差显现。 这里最具体的失败场景是固定间隔缓存:先完整算一次,之后连续复用,直到计数器要求刷新。如果变化突然出现在间隔中间,策略不会因为内容变了而提前刷新。反过来,如果某段变化很慢,固定间隔也会做多余的完整计算。问题在于日历式排期没有感知当前输入,周期短会损失收益,周期长会增加近似误差。 本文实验保留全部 40 次状态更新。精确版本执行 40 次完整残差计算;自适应阈值为 0.16 时,只执行 11 次,复用 29 次。终点相对误差为 0.008222。它证明了在这个特定数值系统中确实可以减少计算次数,同时也证明输出发生了变化。它不证明视频质量达标,更不证明真实 GPU 上能得到相同的提速。 缓存适合回答“这个步骤里,哪些计算可以暂时沿用”。减少采样步数则改变采样器的离散路径。两种方法可以组合,但组合后的误差要重新评估:单独用缓存通过了一组样例,不意味着换成少步采样器后仍然通过。 02. 最小可用理解 第一,把网络拆成每步仍要计算的部分,以及准备复用的昂贵部分。第二,保存上次完整计算得到的特征或残差,用便宜的变化指标决定是否刷新。第三,即使命中缓存,当前输入仍然要参与输出,采样器仍然继续更新状态。 以残差形式为例,设当前嵌入是 $h_i$,完整模块输出为 $G(h_i,t_i,c)$。缓存保存的是 $R_i=G(h_i,t_i,c)-h_i$。如果上次刷新发生在 $r$,当前近似模块输出是 $h_i+R_r$。符号 $i$ 表示第几次网络调用,$t_i$ 是这次调用的时间条件,$c$ 是固定的文本等条件;$r$ 是缓存的生成时刻,通常小于当前 $i$。 这三句话的重点是“当前输入加旧残差”。如果直接把整个旧输出拿回来,连当前输入的变化也被抹掉了。残差复用仍然有误差,只是保留了输入的直通更新。DeepCache 的 U-Net 高层特征缓存并不等于这个残差写法,不能把所有缓存方法都称为同一个算法。 03. 数学推导 先定义缓存误差发生在哪里 设 $E$ 是便宜的输入嵌入,$G$ 是昂贵模块,$H$ 是输出头。完整调用写为: $$h_i=E(x_i,t_i,c),\quad R_i=G(h_i,t_i,c)-h_i,\quad y_i=H(h_i+R_i,t_i,c)$$ $x_i$ 是采样器当前的潜变量;$h_i$ 是网络内部的嵌入,不必与 $x_i$ 形状相同;$R_i$ 是昂贵模块对嵌入的修正;$y_i$ 是送回采样器的网络预测。这里的预测可以按模型定义代表噪声或速度,缓存逻辑本身不替模型选择参数化。等式只是代数分解,不要求模型专门训练一个名叫“残差缓存”的层。 命中缓存后,输入嵌入和输出头仍按当前条件计算: $$\widehat{y}_i=H(h_i+R_r,t_i,c),\quad r<i$$ 帽子表示近似计算。比较精确与近似时,先固定当前同一个 $h_i$:误差来自 $R_r$ 替代了 $R_i$,而不是来自状态已经分叉。若输出头在所讨论的局部区域满足 Lipschitz 条件,常数记作 $L_H$,那么: $$\|\widehat{y}_i-y_i\|\leq L_H\|R_r-R_i\|$$ Lipschitz 条件的意思是输入变化不能被这个局部映射无限放大;$L_H$ 是放大上限。本文没有测出真实模型的 $L_H$,这个式子是带假设的分析工具,不是线上质量保证。它告诉我们,缓存内部误差小仍然需要考虑输出头的敏感性。 为什么使用便宜的变化代理 直接计算 $\|R_i-R_r\|$ 能判断缓存是否陈旧,但得到 $R_i$ 就已经做了昂贵计算。为了节省计算,需要先观察一个便宜的量 $m_i$。它可以由当前嵌入与时间条件构造。相邻调用的相对 L1 变化写为: $$d_i=\frac{\operatorname{mean}|m_i-m_{i-1}|}{\max(\operatorname{mean}|m_{i-1}|,\varepsilon)}$$ $\operatorname{mean}$ 对张量所有元素取平均,绝对值逐元素计算,$\varepsilon$ 是防止除零的小正数。两次张量形状一致时,均值之比等于 L1 范数之比。这个值没有单位,反映变化相对之前幅度有多大。分母很小时,它也可能变得敏感,不能把这种数值问题误判成内容剧烈变化。 本文教学实现取 $\varepsilon=10^{-12}$。该保护和后面非负累计属于教学实现的防御性处理;不能据此声称官方代码逐字采用相同逻辑。 最直觉的想法是:如果每一步变化都很小,就一直复用。但缓存对应的是刷新时刻 $r$,不是上一时刻。利用三角不等式: $$\|m_i-m_r\|\leq\sum_{j=r+1}^{i}\|m_j-m_{j-1}\|$$ 这里 $j$ 遍历刷新之后的调用。即使单步变化很小,连续多步也会积累成明显差异,因此策略应保留“自上次刷新以来的变化预算”。这个式子约束绝对变化;把每项分别除以不同的幅度后,不能直接称相对变化之和为严格误差界。 实际决策可以采用累计代理: $$A_i=A_{i-1}+g(d_i),\quad \text{refresh if } A_i\geq\delta$$ $A_i$ 是累计预算,$g$ 将输入变化映射到预估的输出变化,$\delta$ 是刷新阈值。完整计算后把预算归零并保存新残差。TeaCache 使用多项式重标定来改善这种代理;拟合关系是经验估计,不会把统计相关性变成对所有样本成立的数学上界。TeaCache 原文第 3.2–3.3 节 给出了指标与累计决策。 本文取 $g(d)=d$,以便只观察状态机。阈值 0.16 因而只属于本实验的代理尺度,不能迁移成真实模型的推荐阈值。换掉嵌入幅度、时间调制或采样路径,同一个阈值对应的刷新频率就会改变。 一次局部近似如何影响后续轨迹 现在让两条轨迹分别使用精确和近似输出。为便于推导,考虑显式 Euler 更新: $$x_{i+1}=x_i+\Delta s_i v(x_i,s_i),\quad \widehat{x }_{i+1}=\widehat{x }_i+\Delta s_i\widehat{v}(\widehat{x }_i,s_i)$$ $s_i$ 是积分坐标,$\Delta s_i>0$ 是步长,$v$ 是精确向量场,$\widehat{v}$ 使用缓存近似。令 $e_i=\|\widehat{x }_i-x_i\|$ 表示轨迹差异,令 $\eta_i=\|\widehat{v}(\widehat{x }_i,s_i)-v(\widehat{x }_i,s_i)\|$ 表示在近似轨迹当前状态上的局部缓存误差。 先在更新差值中加减 $v(\widehat{x }_i,s_i)$,把“缓存误差”和“输入状态不同”分开。再使用三角不等式,并假设 $v$ 对状态的 Lipschitz 常数为 $L$,得到: $$e_{i+1}\leq(1+\Delta s_iL)e_i+\Delta s_i\eta_i$$ 若初始状态相同,则 $e_0=0$。重复代入可得: $$e_N\leq\sum_{i=0}^{N-1}\Delta s_i\eta_i\prod_{j=i+1}^{N-1}(1+\Delta s_jL)$$ 空乘积取 1。这个展开说明早期误差会通过后续更新传播;最后一次强制刷新只能去掉最后一次局部缓存误差,不能恢复此前已经走偏的轨迹。真实系统可能局部收缩,实际误差小于这个上界;高阶求解器还涉及历史预测,不能把 Euler 的式子直接冒充所有采样器的误差定理。 为什么命中率不能直接当加速比 令 $N$ 是总调用数,$K$ 是完整计算数,$C_f$ 是完整调用成本,$C_h$ 是缓存命中调用成本,$C_o$ 是其他固定开销。则一个简单的成本模型是: $$S=\frac{NC_f+C_o}{KC_f+(N-K)C_h+C_o}$$ 命中调用仍要嵌入、判定、读缓存、运行输出头和更新采样器,$C_h$ 不会自动等于零。缓存张量跨设备读取甚至可能很贵。端到端还包括文本编码、VAE 解码和输出处理,跳过 Transformer 并不会同时省掉这些部分。 本文把 $C_f=1$、$C_h=0.08$、$C_o=0$ 当成教学假设。按实跑统计的 $K$ 代入可以算成本比,但没有用这些假设伪装 GPU 计时。部署时需要测出真实成本,再决定缓存是否值得加入。 04. 代码实现 完整脚本是文末的 cache_demo.py,依赖 NumPy 与 matplotlib,无需模型权重。它构造一个四层非线性残差函数,用固定随机种子产生输入和矩阵。输入形状是 $(B,L,D)=(1,4,16)$:一个批次、四个位置、十六个通道。张量使用 float64,目的是让读者稳定复核误差,不模拟混合精度推理。 脚本里的 cheap_input 对应 $E$,residual 对应 $R$,proxy 对应 $m$,budget 对应 $A$,threshold 对应 $\delta$。输出头取恒等映射。每次用当前 $h$ 加缓存残差得到预测,然后执行状态更新。时间标签从 1 递减到 0,而状态更新的步长固定为 $1/N$;这只是合成系统的定义,没有冒充 DDIM 或真实扩散调度器。 决策的核心代码如下;变量准备、精确对照、绘图及断言都在完整附录中: budget += max(change, 0.0) boundary = i in (0, STEPS - 1) calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual 首次调用没有缓存,所以必须完整算。最后一次强制刷新属于本实现的策略。previous_proxy 每一步都更新,saved_residual 只有刷新时更新:把这两件事混淆,就会把“相邻变化累计”写成另一种算法。simulate 每次创建新的状态,避免后一条请求接着用前一条请求的残差。 为了画误差曲线,脚本还在每个步骤额外执行一次精确函数作为离线诊断。这些额外执行没有算进策略的 full_calls;因此实际运行这个带诊断的脚本并不是加速测速。计数回答的是策略本来会执行多少次昂贵计算,图回答的是当前近似轨迹上的局部输出误差有多大。 真实运行环境为 Python 3.11.9、NumPy 2.4.3。基线终点的元素范围为 [-0.791508, 0.614856]。输出如下: shape=(1, 4, 16), steps=40, seed=7 baseline_range=[-0.791508, 0.614856] name full_calls hits endpoint_relative_error assumed_speed_ratio exact 40 0 0.000000 1.000 adaptive_0.08 18 22 0.004939 2.024 adaptive_0.16 11 29 0.008222 3.003 adaptive_0.32 7 33 0.026326 4.149 uniform_4 11 29 0.008672 3.003 All assertions passed; figure=figures/cache_schedule.png 终点相对误差的定义是近似终点与精确终点之差的 L2 范数,除以精确终点的 L2 范数。因此 0.008222 是这个定义下约 0.8222% 的差异,不是 VBench 下降,也不是图像中有 0.8222% 的像素出错。最后一列来自前节假设的成本模型,没有真实延迟单位。 图上半部分每个方块表示一次完整残差计算,空缺表示复用;下半部分是离线诊断得到的局部输出 L2 误差。请先观察刷新是否集中在同一段,再看复用之间误差如何变化。曲线没有用感知质量指标,纵轴不能解读成画面可接受程度。配图由附录脚本生成,数据与上述输出来自同一次实验。 阈值 0.16 与固定间隔 4 都执行了 11 次完整计算,但终点误差略有差异。这是“同样预算也会因刷新位置不同而得到不同结果”的一个实例。它只有一个种子和一个人工系统,不能证明自适应策略在所有输入上优于固定间隔,更不能作为统计显著性结论。 05. 工业级实现对照 DeepCache 原文第 3.3 节 利用 U-Net 的分支结构:当前浅层特征继续更新,较深分支的高层特征从缓存取回并拼接。它缓存的是特定网络位置的特征,并非本文抽象的整段残差。官方 horseee/DeepCache 的 deepcache.py 提供 forward 包装与状态复位;对照时应先找缓存边界,再判断到底省掉了哪些模块。 TeaCache 的 HunyuanVideo 示例 中,teacache_forward 用时间调制后的输入计算变化代理,累计重标定后的变化,并保存 Transformer 主体的输入输出残差。首尾调用完整计算,命中后把旧残差加到当前图像嵌入上;输出层仍然运行。这里对应的是 2026-10-05 实际取回的源码,后续上游重构需要重新核对。 教学版与上述示例的差异很明确:教学版没有文本分支、真实 patchify、注意力或权重,也没有拟合官方多项式;它只验证预算与残差状态机。真实代码还可能把张量变化转成 CPU 标量,这种同步的代价不能从“指标计算量很小”中自动排除。需要把判定开销也纳入测量。 工程上,缓存状态应属于一次请求,而不是一个可被并发请求共享的随意全局变量。prompt、负向条件、guidance、分辨率、帧数、模型权重或调度器变化时,复用旧状态没有语义依据。只检查张量形状远远不够;两个请求可以形状相同、内容完全不同。失败中断后重新开始生成,也要建立新的缓存生命周期。 若模型采用双分支 CFG,必须考虑条件与无条件分支的缓存分别有效。按 $y=y_u+w(y_c-y_u)$ 写,$y_u$ 与 $y_c$ 分别是无条件和条件预测,$w$ 是 guidance 系数。预测误差满足: $$\|\Delta y\|\leq |w|\|\Delta y_c\|+|1-w|\|\Delta y_u\|$$ 因此较大的 guidance 可能放大分支近似误差。这个式子是代数上的工程分析,不声称所有视频模型都执行双分支 CFG;有些采用蒸馏后的 guidance 条件。接入前要先确认实际预测路径,再决定状态如何隔离。 还要区分采样步和网络调用。调度器可能在一个名义步里求值多次,或重访相同的时间标签。缓存的计数器应跟随真实调用语义。如果只拿界面上显示的步数当数组长度,很容易在错误的位置刷新,或者提前把状态清零。应记录每次实际调用的时间标签、是否刷新和缓存来源,再与调度器对齐。 06. 代价与边界 省的是昂贵模块重复计算,增加的是缓存内存、生命周期管理、判定开销和近似误差。保存一个形状为 $(B,L,D)$ 的残差张量,最低存储量为 $BLDb$ 字节,其中 $b$ 是每个元素的字节数;克隆的输入、多个分支及其他缓存还会额外占空间。长视频中 token 数很大,省算力并不自动省显存。 阈值没有通用刻度。代理的归一化方式、拟合数据、模型层、时间条件与采样器都影响其意义。在某模型上有效的多项式可能在另一个模型或调度器上失配。应在目标分布上先记录输入代理与真实残差变化的对应关系,再评估误判,不能只沿用别人仓库里的常数。 端点刷新是一种保守策略,不是一种证明。即使最后一次完整计算,网络读到的潜变量也已经经过缓存轨迹;它不能把积累误差自动洗掉。判断质量时要看整段生成结果,尤其是动作连续性、物体身份、细节与提示词对应关系,而不是只看最后一个调用的缓存误差归零。 已有很少采样步的蒸馏模型可能没有多少安全的复用空间。短轨迹上每次预测都更重要,进一步减少完整网络调用可能迅速损害质量。动态改变条件的交互式生成、频繁切换控制信号的任务,也不应默认共享同一段缓存。先建立可靠基线,才能判断具体组合是否值得部署。 评测时固定权重、prompt、种子、分辨率、帧数、采样器和 guidance,分别测完整网络计算时间与端到端延迟。预热、设备同步、重复测量和尾延迟都要说明;不要把首次编译的基线与已预热的缓存版放在一起比较。质量样例应包含快速运动、镜头切换、文字、遮挡和多主体交互等容易暴露近似问题的内容。 本文给出的误差曲线只能帮助理解缓存的数值行为。没有真实模型权重,没有样本集,也没有测量硬件延迟。因此本文不提供生产阈值,不给出“无损”的结论,也不声称这些 toy 误差能预测真实视频的主观质量。 还要分别检查代理误判的两种代价。代理高估变化会增加完整计算,主要损失效率;代理低估变化会继续使用陈旧残差,主要增加质量风险。这两种错误不能只用一个平均相关系数概括。即使整体相关性很高,少数快速变化的步骤被漏掉,也可能成为最明显的失败样例。应保留逐步记录,把异常视频定位到具体刷新区间,再判断是代理不敏感、阈值过大还是缓存位置选错。 为避免测试集上的阈值被过度优化,可以先用一组提示词选择阈值,再在另一组提示词上固定参数评估。报告平均质量以外,还要记录最差样例以及变化最大的场景。缓存有时能带来某项评分的小幅上升,但近似轨迹改变本身并不保证改进;应通过更多独立样本判断这是随机波动还是稳定效果。不能挑出一段更好看的视频,就把整条路线称作质量提升技术。 缓存决策在不同请求中可能产生不同的完整计算次数,所以服务端延迟也会随内容变化。只报告平均命中率,会遮蔽慢请求的行为;应同时关注完整计算次数的分布和尾延迟。如果业务要求固定延迟,可以限制最长复用间隔或最低刷新次数,但这些额外约束需要重新纳入成本账本与质量验证。 07. 经典论文脉络 DDIM:Denoising Diffusion Implicit Models,2010.02502。它提供理解不同采样路径的基础;跨步缓存要先说明是否保留原有离散调用,再比较误差,不能把省模块与改步长混为一谈。 DeepCache,2312.00858。它把 U-Net 高层特征的跨步复用转成免训练加速方案,主要启发是选择合适的结构边界,而不是对所有中间张量一概缓存。 Pyramid Attention Broadcast,2408.12588。它把视频生成中的注意力复用纳入设计,提示我们不同模块可以有不同刷新节奏。本文只把它作为技术脉络,不复现其性能结果。 TeaCache,2411.19108。它用时间调制输入的变化代理和重标定来选择刷新时刻,把问题从固定周期推进到输入感知的缓存决策。 论文数值也要带条件。DeepCache 的摘要报告 SD v1.5 上 2.3 倍加速与 CLIP Score 下降 0.05;这是作者特定设置下的结果,不能泛化成所有扩散模型都同样受益。原始摘要 支持这组数字。 TeaCache v2 的表 1 中,OpenSora-Plan、65 帧、512×512 的基线延迟为 99.65 秒,slow 配置为 22.62 秒,对应 4.41 倍;VBench 从 80.39% 到 80.32%,差值是 0.07 个百分点。fast 配置在同表报告更高加速,但质量也有不同取舍,所以本文引用 slow 配置,避免把不同配置的最优速度与最优质量拼成一个结果。原文表 1 可直接复核。 这些工作属于相关路线,没有一个统一的阈值或通用缓存张量。先检查缓存边界,再看刷新规则,最后检查采样路径是否改变,是比较它们时更稳定的顺序。方法名称相似、都声称免训练,不代表工程实现可以直接互换。 08. 常见误解 “跨步缓存与 KV cache 是同一种精确复用。” 自回归 KV cache 通常复用固定前缀的计算结果,而扩散过程中潜变量和时间条件在变化。这里复用的是可能陈旧的近似特征,必须单独评估误差。是否等价还取决于模型路径,不能仅凭有个 cache 字段就判断。 “相邻特征相似,所以可以一直复用。” 相邻相似不等于相隔很多步仍相似,更不等于输出质量不变。累计预算关注缓存年龄,刷新机制关注何时恢复完整计算。二者缺一不可。 “阈值 0.16 表示允许 16% 的质量损失。” 阈值只是累计代理的比较值。它不是终点误差、FID、VBench 或主观质量的直接比例。本实验阈值与官方多项式的阈值甚至不在相同刻度上。 “缓存命中后跳过了采样器更新。” 本文所有版本都更新状态 40 次。省掉的是一部分网络计算,当前输入与输出头仍然可以变化。如果代码命中后直接跳过调度器,它执行的是另一种算法。 “最后一次完整计算能补回前面所有误差。” 最后一次局部预测变准确,不等于输入轨迹回到基线。误差传播推导和实验都把这两件事区分开。 “调用次数少三倍,就是端到端快三倍。” 命中步骤、其他固定模块、同步与内存操作仍有成本。本文最后一列只是显式假设的成本比,实际脚本还带额外离线诊断,因此不能拿它的运行时间当加速报告。 09. 动手验证 先把附录完整代码保存为 cache_demo.py,准备 Python 3.10 以上环境,执行: python -m pip install numpy matplotlib python cache_demo.py 脚本按照所在目录生成实验结果文件和 figures/cache_schedule.png。数值应与第 04 节一致;换 NumPy 或底层数值库时,浮点尾数可能略有不同。比对完整计算次数、刷新时刻和误差到所列精度,比要求截图或图片压缩字节完全一致更合适。 首先把阈值设成 0。每个步骤都会刷新,完整计算次数应等于 40,终点应与精确基线逐元素一致。附录已经用断言验证这个条件;如果失败,要先修缓存状态机,不要调阈值掩盖问题。 其次比较 0.08、0.16 和 0.32。在本次固定实验里,完整计算次数逐步减少,终点误差逐步增加。这是一个具体样本的趋势,不是所有系统的单调性定理:刷新位置改变、误差相互抵消、轨迹分叉,都可能让某个中间阈值的结果反而更接近基线。 再比较 adaptive_0.16 与 uniform_4。两者的成本模型使用相同的 11 次完整计算,但时刻并不相同。观察图中误差峰值,不只盯终点一个数。如果想研究预算分配,固定计算次数,再调整刷新位置,比仅仅换一个阈值更容易把原因看清。 最后修改种子或残差函数中时间变化的频率,重新运行整套对照,并保留新的输出。这一操作没有本文预先承诺的性能结果;它用来观察原先代理是否仍能判断残差变化。若输入代理很平缓、真实残差突然变化,就能构造“指标漏报”的反例。把反例加入测试,比只展示一条顺利的曲线更有价值。 实际接入模型之前,还应验证两次独立请求是否有相同基线行为、错误中断是否清理状态、同形状不同条件是否互相污染。本文实验用每次 simulate 独立初始化来验证复位;真实服务还需要针对并发与重入的检查。 10. 延伸阅读 先从 DDIM 与高阶采样器 理解调用路径,再用 DiT 找嵌入、主体和输出头的边界,最后通过 性能建模与 Profiling 实测哪些部分值得省。 可以对照 KV cache 理解缓存有效性,也可继续读 量化 比较另一种减少推理成本的方法。知识树中的少步蒸馏节点仍为 planned;它是下一条相关学习路线,尚无已发布链接。跨步缓存、量化与蒸馏组合时,应重新建立质量和延迟基线。 附录:完整代码 09 节用到的脚本全文如下(cache_demo.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 cache_demo.py """Deterministic residual-cache toy; Python 3.10+, pip install numpy matplotlib. Run: python cache_demo.py No trained diffusion weights; cost ratios below are accounting assumptions. """ from pathlib import Path import json import platform import numpy as np import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt STEPS = 40 SHAPE = (1, 4, 16) SEED = 7 rng = np.random.default_rng(SEED) X0 = rng.normal(size=SHAPE).astype(np.float64) W = rng.normal(size=(16, 16)) / 8.0 V = rng.normal(size=(16, 16)) / 8.0 def cheap_input(x, t): return x + 0.05 * np.sin(2 * np.pi * t) def proxy(h, t): return h * (1 + 0.3 * np.sin(2 * np.pi * t)) + 0.1 * np.cos(2 * np.pi * t) def residual(h, t): z = h for _ in range(4): z = np.tanh(z @ W) return 0.15 * h + 0.4 * (z @ V) + 0.08 * np.sin(6 * np.pi * t) def simulate(threshold=None, period=None): x = X0.copy() previous_proxy = None saved_residual = None budget = 0.0 refreshed, local_errors = [], [] for i in range(STEPS): t = 1.0 - i / (STEPS - 1) h = cheap_input(x, t) m = proxy(h, t) change = 0.0 if previous_proxy is None else float( np.mean(np.abs(m - previous_proxy)) / max(np.mean(np.abs(previous_proxy)), 1e-12)) budget += max(change, 0.0) boundary = i in (0, STEPS - 1) if threshold is None and period is None: calculate = True elif period is not None: calculate = boundary or i % period == 0 else: calculate = boundary or budget >= threshold if calculate: saved_residual = residual(h, t) budget = 0.0 output = h + saved_residual # Offline diagnostic only; extra evaluation is excluded from work accounting. exact = h + residual(h, t) local_errors.append(float(np.linalg.norm(output - exact))) refreshed.append(bool(calculate)) previous_proxy = m.copy() x = x - output / STEPS return {"x": x, "refreshed": refreshed, "local_errors": local_errors} def experiment(): baseline = simulate() rows = [] results = [] settings = [("exact", None, None), ("adaptive_0.08", 0.08, None), ("adaptive_0.16", 0.16, None), ("adaptive_0.32", 0.32, None), ("uniform_4", None, 4)] for name, threshold, period in settings: result = simulate(threshold, period) calls = sum(result["refreshed"]) relative_error = float(np.linalg.norm(result["x"] - baseline["x"]) / np.linalg.norm(baseline["x"])) # Full call = 1 unit; cache hit = 0.08 unit, solely for illustration. assumed_work = calls + (STEPS - calls) * 0.08 rows.append({"name": name, "full_calls": calls, "hits": STEPS - calls, "relative_endpoint_error": relative_error, "assumed_speed_ratio": STEPS / assumed_work, "refresh_indices": [i for i, flag in enumerate(result["refreshed"]) if flag]}) results.append(result) zero = simulate(threshold=0.0) assert np.array_equal(zero["x"], baseline["x"]) assert sum(zero["refreshed"]) == STEPS assert all(r["refreshed"][0] and r["refreshed"][-1] for r in results) assert np.array_equal(simulate(threshold=0.16)["x"], results[2]["x"]) assert all(np.isfinite(r["x"]).all() for r in results) return rows, results, baseline def make_figure(rows, results, destination): fig, axes = plt.subplots(2, 1, figsize=(11, 7), constrained_layout=True) colors = ["#2563eb", "#ea580c", "#16a34a", "#dc2626", "#9333ea"] for y, (row, result) in enumerate(zip(rows, results)): idx = np.flatnonzero(result["refreshed"]) axes[0].scatter(idx, np.full(len(idx), y), marker="s", s=38, color=colors[y]) axes[0].set_yticks(range(len(rows)), [r["name"] for r in rows]) axes[0].set_xlim(-1, STEPS) axes[0].set_xlabel("Sampling call index (0-based)") axes[0].set_title("Squares = full residual computation; gaps = cache reuse") for y, (row, result) in enumerate(zip(rows[1:], results[1:]), start=1): axes[1].plot(result["local_errors"], label=row["name"], linewidth=1.7, color=colors[y]) axes[1].set_xlabel("Sampling call index (0-based)") axes[1].set_ylabel("Local output L2 error") axes[1].set_title("Offline diagnostics on each cached trajectory; no quality metric") axes[1].legend(ncol=2, fontsize=9) axes[1].grid(alpha=0.25) fig.suptitle("Residual caching: refresh decisions and approximation error", fontsize=14) fig.savefig(destination, dpi=150) plt.close(fig) if __name__ == "__main__": rows, results, baseline = experiment() folder = Path(__file__).resolve().parent.parent (folder / "figures").mkdir(parents=True, exist_ok=True) make_figure(rows, results, folder / "figures" / "cache_schedule.png") record = {"seed": SEED, "steps": STEPS, "shape": list(SHAPE), "python": platform.python_version(), "numpy": np.__version__, "baseline_min": float(baseline["x"].min()), "baseline_max": float(baseline["x"].max()), "results": rows, "assertions": "zero-threshold exactness, endpoints, request reset, finite outputs passed"} (folder / "experiment_results.json").write_text( json.dumps(record, ensure_ascii=False, indent=2) + "\n", encoding="utf-8") print(f"shape={SHAPE}, steps={STEPS}, seed={SEED}") print(f"baseline_range=[{record['baseline_min']:.6f}, {record['baseline_max']:.6f}]") print("name full_calls hits endpoint_relative_error assumed_speed_ratio") for row in rows: print(f"{row['name']} {row['full_calls']} {row['hits']} " f"{row['relative_endpoint_error']:.6f} {row['assumed_speed_ratio']:.3f}") print("All assertions passed; figure=figures/cache_schedule.png")
-
AIGC 每日速读|2026-09-28|阿里 397B 只改提示词就涨 50 分,WanPE 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与编辑 5 篇 · 音视频与语音生成 2 篇 · 图像与 3D 生成 2 篇 · 多模态理解与评测 1 篇 重点论文标题列表 WanPE(南大):397B 分镜规划提示词 AV-GRPO(上海人工智能实验室):音视频联合生成的模态解耦 RL ⚡ TRACK(NVIDIA):免训练大小模型按步换班 ViRDM(美国东北大学):砍掉教师与批评家做因果后训练 EditVoice(厦门大学):变长非自回归零样本语音编辑 今日论文速览 1. WanPE:397B 分镜规划提示词 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation | 南京大学;Wan 团队(阿里巴巴集团);中国科学技术大学;复旦大学;清华大学 | arXiv:2609.30221 关键词:文生视频, 提示词增强, GRPO, 电影分镜, 评测基准 ⚠️ 前序问题:现代视频生成器已能生成 30 秒、并忠实遵循复杂条件,文本提示几乎直接决定多镜头序列里动作、机位轨迹、光效和声音如何展开。但现有的提示增强大多还停留在「可选扩写」层面,面对导演级的镜头级规划(分镜如何组织、跨镜头语义如何不漂)能力明显不足。 本文贡献:提出 WanPE——397B 参数的提示增强模型,在 105 万条真实视频上训练。核心有两块:一是 video-grounded 逆向构建(reverse SFT),从真实视频反推出镜头级电影分镜规划,让模型学到的是「怎么组织分镜」而不是「怎么把句子写长」;二是 Semantic-Consistency GRPO(SC-GRPO),用语义一致性奖励把用户意图在跨镜头、跨时间维度上保住。配套还建了 WanPEval:249 条人工标注请求,覆盖 5–30 秒时长与不同意图粒度,约 1.1 万次盲评 pairwise 比较。 WanPE training pipeline. Video-grounded reverse SFT and semantic-consistency GRPO. 实验效果:驱动 Wan3.0 生成器时,相对原始用户提示,5–15 秒人类偏好提升 10.66–18.84 分,30 秒竞技场提升 50.86 分。5–15 秒子集上专家偏好 S / Bradley–Terry 分数为 50.61 / 61.85,超过 Seedance 2.0(43.42 / 54.70)、MiniMax-H3(36.40 / 49.27)、Kling 3.0(20.80 / 37.40)与 HappyHorse 1.1(24.89 / 40.46)。消融显示逆向构建明显优于正向改写,SC-GRPO 在各模型规模上都能稳住语义保真。 Fine-grained expert evaluation on the 5-15 seconds subset of WanPEval. Left: Preference scores across generation durations and request-granularity levels. Right: Preference scores S across seven content categories. 批判点评:397B 这个体量本身就是最大的成本项,而表里的规模曲线并不支持它:4B 是 43.60 / 56.21,9B 是 46.00 / 58.01,397B 才 50.61 / 61.85——为了最后 5 分,参数量涨了两个数量级。更值得注意的是 30 秒子集:+WanPE-397B 的 Overall 60.24 只是险胜 Seedance 2.5 的 59.76,而且拆开看,动作类 50.00 被 Seedance 2.5 的 68.18 甩开一大截,知识类、演讲类也不占优。换句话说,WanPE 真正补齐的是「镜头语言」,动作生成本身的短板它一个字都没碰。 2. AV-GRPO:音视频联合生成的模态解耦 RL AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation | 上海人工智能实验室;香港理工大学;新加坡国立大学;南洋理工大学;浙江大学 | arXiv:2609.29816 关键词:音视频联合生成, 强化学习后训练, GRPO, 跨模态同步, 扩散模型 ⚠️ 前序问题:音视频联合生成里,异质多模态奖励互相纠缠导致信用分配困难,两个模态塔动力学差异大、联合优化极贵,而同步性评测又依赖成对样本、奖励没法公平比较——直接把 RL 后训练搬过来几乎处处碰壁。 本文贡献:提出 AV-GRPO 这一模态锚定的在线扩散 RL 框架,三个模块:模态锚定 rollout 解耦学习信号并稳定难度;轨迹锁定的冻结塔优化降低成本、重新分配信用;针对模态各自动力学的自适应目标与扰动强度。由此把耦合的多模态偏好学习拆成单模态子问题,实现精确奖励归因。同时构建了 5DAV 数据集,在五个维度上解耦样本、难度可控。基于 LTX-2.3 22B,8 卡 A800 上跑 LoRA 与全参两档。 Overview of the AV-GRPO training pipeline. 实验效果:JavisBench 上 AV-IB 从 0.224 提到 0.247,JavisScore 0.202 → 0.222,DeSync 0.708 → 0.607;VABench 上 Lip Sync 1.439 → 1.646、DeSync 0.726 → 0.542。在生成质量、语义对齐与跨模态同步三项上均超过 LTX-2.3,LoRA 与全参微调两档都成立。 Left: Radar chart comparing performance on the 5DAV and VGGSound datasets. Middle: Metrics are reported as relative percentage changes with respect to the baseline. Right: Comparison of model performance with different alternating step intervals. 批判点评:表里藏着一个不太好看的反差:LTX-2.3+AV-GRPO(lora) 在 Alignment(4.512 对 4.510)、Expressiveness(4.450 对 4.434)、Visual Realism(4.402 对 4.395)三项主观指标上,全都高于全参版。花了全参训练的成本,主观质量却没赢过 LoRA,说明这套「冻结塔 + 分塔信用分配」的收益主要落在同步类客观指标上,主观提升更接近采样噪声。而且这三项差距都在小数点后第三位,论文也没给方差或多次运行,显著性无从判断。 3. TRACK:免训练大小模型按步换班 Accelerating Video Diffusion via Training-Free Trajectory Routing | NVIDIA | arXiv:2609.30096 关键词:视频扩散加速, 免训练, 模型路由, 步级调度, 能耗优化 ⚠️ 前序问题:视频扩散推理昂贵:要把大模型跑很多个去噪步。即便做了步数蒸馏,剩下每一个蒸馏步依然要付一次完整的大模型前向,推理成本还是下不来。 本文贡献:TRACK(TRajectory-Aware Capacity routing via top-K selection)是一种异构去噪策略:离线校准阶段先跑一遍全大模型的参考轨迹,每一步同时收集小模型的预测,与大模型预测比较得到相对分歧分数(两边共享同一 latent、timestep、条件与 guidance),再把该信号跨校准集聚合成分步分歧分数图,据此决定切换策略——质量敏感步留给大模型(如 Wan 2.1 14B),低分歧步路由给小模型(1.3B)。推理时每步只执行被选中的那一个模型,不重训练、不改架构与调度器、也不需要在线双模型评估。 Training-Free Trajectory-Aware Capacity routing. Top: Offline calibration rolls out the all-large-model reference trajectory and, at every step, evaluates the large and small checkpoints using the same latent, timestep, conditioning, and guidance inputs. Bottom: Online inference applies that policy while preserving the shared latent representation and scheduler update. 实验效果:在 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo 四条管线上分别取得 1.95×、2.04×–2.73×、2.69×、2.17× 加速,聚合质量相当、DreamSim 多样性保留 >95%。在 A100 上用 NVML 实测,去噪能耗降低约 45%–60%:Wan 2.1 每视频省 194.57 kJ,折合每千条视频省 54.05 kWh(降 49.3%);Cosmos 3(Super/Edge)能耗降近 60%。 Speed--quality tradeoffs across video pipelines. Each panel compares the all-large model (baseline) and TRACK (ours) switching policy. All models retain comparable aggregate quality at the selected operating points in most quality dimensions. 批判点评:「质量相当」这个结论要挑一下口径:它取的是 VBench 的时间闪烁、运动平滑、主体一致性、背景一致性四个维度的均值——恰好是「换小模型不太容易崩」的那四个。真正的代价作者写在 Limitations 里:部署时必须同时驻留大小两个模型,显存占用反而高于单模型管线。另外对已经把步数压到 3–4 步的蒸馏管线(FastVideo 只有 2.17×),可换的步数本就只剩个位数,收益上限天然受限。 4. ViRDM:砍掉教师与批评家做因果后训练 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation | 美国东北大学;Adobe Research | arXiv:2609.28923 关键词:因果视频生成, 分布匹配, 后训练, 显存优化, VBench ⚠️ 前序问题:少步自回归视频扩散能实现低延迟流式生成,但现有后训练方法几乎都依赖 DMD:需要一个庞大的预训练教师和一个在线 critic,靠 diffusion score 估计分布差异。三套网络同时在线,资源开销成了主要门槛。 本文贡献:ViRDM 把教师与 critic 整个去掉,只让生成器对齐一份离线预计算的目标表征分布。三个障碍逐个击破:用一致性式采样 + 随机截断 clean-exit 监督(S 从 U{1..K} 采样,选中的那次评估才吃梯度)把梯度路径变得可行;用轻量 VAE 解码器压显存;用分阶段 vector–Jacobian product 拆解反传。此外还给出了视频 RDM 的生成种群规模与初始化策略(因果 ODE 初始化最优),并加了 flow 动力学正则来补表征分布对时间变化约束不足的问题。 Consistency-style sampling with stochastic exits for few-step video RDM. 实验效果:同样 8 卡 A100 的设置下,峰值显存从 77.1 GB/卡降到 48.3 GB/卡,后训练时间从 22 小时压到 2 小时,VBench Total 从 84.51 提到 84.87。只需 20 次生成器更新、16 A100 GPU-小时,比此前最佳少步因果基线高 0.36 分。用户研究中文本-视频对齐 40.4%、视觉质量 43.0% 均为四步因果方法里最高(Self Forcing 两项均为 32.6%)。 Replacing the resource-intensive teacher-critic stack with direct representation distribution matching for few-step causal video post-training. In the same 8-A100 parallelized training setting, this reduces peak memory from 77.1 to 48.3 GB per GPU and post-training time from 22 to 2 hours, while improving the VBench Total from 84.51 to 84.87. 批判点评:84.87 对 84.51 只涨了 0.36 分,而论文自己的消融表把原因说得很直白:要把 Dynamic Degree 维度单独剔掉再比,ViRDM 才更好看——说明动力学恰恰是 RDM 的软肋(表征分布对时间演化约束不足),得额外加 flow 正则才勉强补回来,等于承认「省掉教师 critic」的代价是引入了新的手工正则。另外 84.87 是在 Wan2.1-1.3B 这个 1.3B 小骨架上拿的,跟动辄 14B 的双向模型不在一个量级,跨量级横向对比要打折扣。 5. EditVoice:变长非自回归零样本语音编辑 EditVoice: Variable-Length Non-Autoregressive Zero-Shot TTS and Speech Editing with Edit Flows | 厦门大学 | arXiv:2609.29889 关键词:零样本 TTS, 语音编辑, 非自回归生成, Edit Flows, 变长序列建模 ⚠️ 前序问题:现有非自回归零样本 TTS 虽然能并行生成,但几乎都要在生成前先指定目标序列长度——长度得靠另一个模块预估,一旦估错就直接影响韵律与内容。 本文贡献:EditVoice 是首个变长 NAR 零样本 TTS:用 Edit Flows 通过插入、删除、替换三类编辑操作同时更新语音内容和序列长度。训练上采用 speech-infilling,把零样本 TTS 与文本驱动语音编辑统一到同一目标下,推理时前缀提示和后缀提示两种摆位都能用;提出 Complementary Prompt Sampling(CPS),按每类操作取两种摆位里速率更大的那个,利用互补的 Edit Flow 预测。还发现模型能编辑训练来源之外的语音(包括它自己生成的),据此做端到端编辑与免训练的后生成精炼。 Overview of the EditVoice zero-shot TTS inference pipeline. Stage one generates semantic speech tokens using CPS, and stage two applies post-generation refinement to the generated sequence before speech detokenization. 实验效果:在 10K 小时 GigaSpeech 上训练 Edit Flow 模型,在 Seed-TTS Eval EN、LibriSpeech-PC 上零样本 TTS 表现具竞争力,在 RealEdit 上语音编辑表现具竞争力。后生成精炼把 WER 从 2.66% 降到 1.55%,且 8 步生成 + 2 步精炼已经超过不做精炼的 16 步生成。 Post-generation refinement on Seed-TTS Eval EN. Starting from the same 8-step CPS output, WER and edits to generated tokens are measured over 8 refinement steps. The dashed line denotes 16-step CPS generation without refinement. 批判点评:全文只有 5 页 3 张图,实验规模偏薄:10K 小时训练的对比对象里有 CosyVoice 2 这类数据量级高一个档的系统,「competitive」具体竞争到什么程度得回表里逐项看。后精炼这个卖点本质是拿推理时算力换质量——8+2 步打败 16 步听起来漂亮,但总步数只少了 6 步,换成真实延迟并不划算。另外「能编辑非训练来源的语音」是意外发现而不是设计,作者没给系统的泛化边界评估,这条能力在多说话人、跨语种上会不会退化是未知数。 6. OREO:用 2D 编辑反馈对齐 3D 保真 OREO: Fidelity Alignment in 3D Generation via On-the-fly Rendering-Editing Optimization | 香港理工大学;腾讯 ARC Lab | arXiv:2609.29788 关键词:3D 生成, 保真对齐, 2D 扩散先验, 强化编辑, ECCV 2026 ⚠️ 前序问题:3D 生成模型进步很快,但产出的资产视觉保真度往往不够——几何、布局对得上,质感与细节就是差一口气,和 2D 扩散模型能达到的写实程度有明显落差。 本文贡献:OREO 是一个对齐框架,核心是不依赖静态数据集,而是建立动态优化闭环:把 3D 输出渲染出的视图交给 2D 模型做 Reinforced Editing,在保持几何、视角和内容不变的前提下提升视觉保真;这些被实时编辑过的渲染图反过来作为高质量 2D 伪目标,监督 3D 生成器从自己的样本里学习、逐步提升画质。 Overview of OREO. 实验效果:以 Trellis 为底座,对参考图 $x^{ref}$ 的 CLIP / DINO 相似度在 Conceptual Design 上从 0.7613 / 0.7916 提到 0.7834 / 0.8065,在 GSO 上从 0.7722 / 0.7022 提到 0.7764 / 0.7069;对比 Photo3D(0.7380 / 0.7837、0.7512 / 0.7034)同样领先。论文已被 ECCV 2026 接收。 Qualitative comparison of 2D feedback sources (Reinforced Editing / NanoBanana Pro / Qwen-Image-Edit). 批判点评:消融表里最刺眼的一行:去掉 Source Branch 后 ΔCLIP / ΔDINO 从 +0.0379 / +0.0298 直接翻成 −0.0523 / −0.0497——比不做对齐还差。整套方法对「保留源分支」这一条设计极其敏感,稳健性存疑。变体对比里把分布匹配换成 DMD,分数掉到 0.5393 / 0.5486,说明这条路和当前主流的 3D 蒸馏范式并不兼容。另外绝对增益全部停在小数点后第二位,而「视觉保真」这件事到头来还是用 CLIP / DINO 相似度做 proxy,离人眼判断有多远没人说得清。 7. ComplexSync:复杂场景 70FPS 实时唇形同步 ComplexSync: High-Fidelity and Real-Time Lip Sync in Complex Scenarios | 广州趣丸网络科技 | arXiv:2609.29225 关键词:唇形同步, 扩散蒸馏, 实时推理, 视觉基础模型, 基准评测 ⚠️ 前序问题:唇形同步要让口型动态与语音精确对齐。扩散模型生成质量高,但在遮挡、侧脸、复杂光照等复杂场景下容易失稳,而且推理延迟高到没法实际部署。 本文贡献:ComplexSync 是一套统一的扩散框架,三块设计:一是双流联合训练策略,抑制参考帧的信息泄漏同时保留自然动态;二是基于蒸馏的单步去噪加速方案,做到 70+ FPS 吞吐;三是关系对齐损失,借助视觉基础模型(VFM)的结构先验提升复杂场景因素下的同步精度与鲁棒性。此外还给出首个专门面向复杂唇形同步的 benchmark,含 200+ 条挑战视频序列与专门指标。 Overview of ComplexSync. (a) Dual-stream joint training strategy designed to suppress spatial information leakage and ensure high-fidelity synthesis. (b) Distillation-based acceleration scheme that facilitates single-step denoising for real-time inference. (c) Relational alignment loss leveraging VFMs to enhance synchronization precision and robustness under unconstrained conditions. 实验效果:在标准场景与复杂场景上均达到 SOTA,同时支持实时推理,吞吐超过 70 FPS。训练分三阶段:第一阶段 8 卡 A100 训 200K 步,第二阶段 4 卡 A100 训 50K 步,第三阶段再训 10K 步,分辨率 512×512。 Qualitative comparison with existing methods. Given that static images cannot fully capture critical temporal attributes such as synchronization, naturalness, and stability, we provide comprehensive video comparisons in the supplementary materials. 批判点评:三阶段累计 260K 步、起步就是 8 张 A100,这个训练预算对一家业务公司来说更像工程投入而非可复现的研究。全文只在 512×512 分辨率验证,而真实配音、数字人场景常见的是 1080p 以上——放大后的口型稳定性没有数据。定性对比仍然用静态帧,同步、自然度、稳定性这些纯时间属性都推给了补充视频,而这恰是唇形同步最容易「单帧好看、连起来崩」的地方。 8. AdaPilot:一套策略零样本迁移各生成器 AdaPilot: Towards Scene-Adaptive Policy Learning for Cross-Generator Text-to-Image Quality Optimization | 南洋理工大学;同花顺研究院 | arXiv:2609.29517 关键词:文生图, 强化学习, 跨生成器迁移, 多轮视觉反馈, 奖励设计 ⚠️ 前序问题:提升文生图质量的路线已经从生成器微调、提示优化走到了带多轮视觉反馈的强化学习,但现有策略都与特定生成器、特定任务深度耦合,学到的能力很难泛化成一套通用的质量优化策略——换个生成器就得重训。 本文贡献:AdaPilot 把多轮图像生成建模成马尔可夫决策过程,用端到端 RL 学一个场景自适应、可跨生成器迁移的质量优化策略。三点关键:策略与生成器内部解耦(只通过 prompt 和编码后的视觉观测交互,不碰梯度与内部状态),因此能跨生成器复用;场景感知奖励(AdaReward)把质量评估维度与任务语义自适应对齐;过程级奖励建模图像质量在多轮里的演化轨迹。实现上用 Qwen2.5-VL-7B-Instruct 作 agent,Qwen-Image-2512 作冻结生成器。 An illustration of the proposed AdaPilot. 实验效果:在 7 个指标(CLIP-T、HPS、GDino、Aesthetic、OCR 用于奖励,Realism、Physics 为留出维度)上超过 Flow-GRPO、T2I-R1、T2I-Copilot 等基线。跨生成器评测中,单一策略零样本迁移到未见过生成器(Qwen-Image、GPT-Image-1、Gemini-3-pro-Image-Preview 等)时,在所有被评生成器上仍保持正平均增益,OOD 数据集上每个维度都领先。 Averages over applicable evaluation metrics for four unseen image generators on four out-of-distribution datasets and overall, comparing results with and without AdaPilot to evaluate zero-shot cross-generator transfer. 批判点评:论文自己给的失败案例很说明问题:一张要求对比八位利物浦前锋的密集信息图,多轮迭代确实把版面理清了,但文字仍基本不可读、球员身份与属性不一致、图表数值不可验证,agent 明知有残缺陷还是终止了。这暴露了「策略只改 prompt」的天花板——当缺陷出在生成器自身的文字渲染与数值编码能力时,再聪明的提示改写也救不回来。另外训练时要同时部署 CLIP ViT-L/14、HPS v2.1、Grounding DINO、GLM-OCR 和 Qwen2.5-VL-72B 五个评估器算奖励,这套推理栈的成本并没有被算进收益里。 9. ZoomDiff:双摄平滑变焦的高保真插值 ZoomDiff: A High-Fidelity Diffusion Model for Dual-Camera Smooth Zooming | 哈尔滨工业大学;淘宝(阿里巴巴集团) | arXiv:2609.28083 关键词:双摄变焦, 帧插值, 扩散模型, 高频重建, 时间一致性 ⚠️ 前序问题:双摄像头之间的数字变焦切换,几何结构和色彩一致性上会出现肉眼可见的跳变。现有双摄平滑变焦(DCSZ)方法多在帧插值模型上微调,扛不住大视差与复杂几何变换;直接套扩散式帧插值模型,又因为条件引导不足、VAE 编码丢高频、时间一致性不够,保真度还是上不去。 本文贡献:ZoomDiff 在潜空间与像素空间同时吃透双摄输入:一是多步去噪过程中强化双图条件引导,提升几何一致性;二是把 VAE 编码器的 flow 对齐多尺度特征注回解码器(ref injector),把 VAE 编码时丢掉的高频细节补回来;三是引入 flow 引导的时间一致性监督($\mathcal{L}_{ftc}$)让转场更顺。并给出把步数从 25 压到 8 / 4 的适配方案。 The dual-camera images ($\mathbf{X}_0$ and $\mathbf{X}_F$) are fed into the VAE encoder and the semantic encoder. 实验效果:合成与真实数据集上全面领先:PSNR 23.80、SSIM 0.761、LPIPS 0.253、PSNR-div 23.01、FVD 131.332,真实集 MUSIQ 73.634、LIQE 4.874、DBCNN 0.692、DOVER 0.665,均为最优。步数压缩上,25 步 45.89s(FLOPs 743T)可压到 8 步 21.28s(2.16×)与 4 步 15.71s(2.92×)。 Visual comparisons on the synthetic dataset and the real-world dataset. Our method still produces more consistent results. 批判点评:两个反差值得记。其一,扩散类基线整体拉胯:Wan2.1 只有 17.71 PSNR、TRF 14.15、Framer 的 DOVER 只有 0.335,全都输给光流法(UPRNet 22.58、RIFE LPIPS 0.261)——说明「生成式先验」在这个任务上并非天然优势,ZoomDiff 的赢面来自双图条件引导与高频注入这两个工程补丁,而非换 backbone。其二,步数压缩后质量反而上升:8 步版 PSNR 24.08 高于 25 步版的 23.80,而去掉步数适配的 8 步版只有 22.32。也就是说 25 步其实是过采样,指标对步数并不单调,任何「步数越少越差」的外推在这里都不成立。 10. ODU-Bench:14 个全模态模型的需求理解评测 Omni Demand Understanding: A Benchmark for Contextual User-Intent Inference in Multimodal Interaction | 上海交通大学;上海创智学院;阿里巴巴;香港中文大学;清华大学;香港理工大学;南开大学;约翰斯·霍普金斯大学 | arXiv:2609.21392 关键词:多模态交互, 需求理解, 评测基准, 误触发, MLLM ⚠️ 前序问题:音视频自然交互正成为 AI 助手的重要入口,但现有交互能力基准主要评「回复质量」,漏掉了更基础的一问:模型能不能从复杂的多模态交互里正确推断用户的真实需求?现实中的需求在口语里往往是欠规格的,得靠视觉线索、声学线索和对话历史补;含糊表达、噪声环境进一步加剧难度。反过来,听起来像请求的 utterance 也可能根本不是给助手的需求,导致误触发。 本文贡献:把 Omni Demand Understanding(ODU)定义成一个独立的多模态上下文推断问题:给定交互流,模型必须判断是否存在需求,并从多模态与对话上下文推断意图,评测覆盖五个维度(M1 需求存在性、M2 关键点命中率、M3 时间跨度 IoU、M4 转录、M5 用户画像),同时覆盖单轮与多轮。ODU-Bench 用挑战驱动的 taxonomy、taxonomy 引导的 agentic 视频生成加真人录制交互来构建,标注从互补媒体证据重建并经人工校验。 Overview of the ODU-Bench construction pipeline. Challenge-driven targets are expanded into coarse-to-fine scripts, screened for plausibility and challenge validity, and realized as synthesized or human-recorded interactions. 实验效果:评测 14 个原生 MLLM:最强者 Gemini 3.1 Pro 也只能恢复 44.7% 必须从视觉、声学或对话上下文推断的关键信息;14 个模型里有 11 个在非需求场景上的误触发率(FTR)超过 50%。 Qualitative error analysis on English generated audio-visual scenes. (a)--(b) Demand-present cases; M2 reports covered/reference key points. (c)--(d) No-demand cases. 批判点评:44.7% 和「11/14 误触发率 >50%」这两个数字,真正打脸的是当前「先响应、后理解」的范式——模型宁可硬猜一个需求,也不愿意说「这不是需求」。可惜基准本身大量依赖 agentic 生成的交互与 LLM judge,虽然论文做了 judge 稳定性检验和真人录制对照(Δ = Rec − Syn),合成数据与真人数据之间的分布差仍是这套结论最大的外推风险:如果 agentic 生成场景的「挑战性」分布和真实用户偏得比较多,44.7% 这个数就未必能平移到线上。 趋势观察 生成的瓶颈正在往「输入端」和「调度端」挪 今天这十篇里有三篇在动生成流程的两端而不是中间:WanPE 用 397B 模型重写提示词,把导演级分镜规划搬到文本空间完成;TRACK 不改模型、不重训练,只决定每一步该派大模型还是小模型上场;AdaPilot 则干脆只通过 prompt 和视觉观测跟生成器打交道。共同点是:底座模型被当成黑箱,可优化的空间被挪到了它前面和外面——这对没算力训底座的团队是好事,对卖底座的团队不是。 「砍掉教师与 critic」成为后训练的新共识 ViRDM 把 DMD 的教师+critic+生成器三件套砍成只训生成器,8 卡 A100 下显存 77.1→48.3 GB、时间 22h→2h,VBench 还涨了 0.36;OREO 同样放弃静态数据与蒸馏范式,改用 2D 编辑实时产出伪目标做自我监督;AV-GRPO 冻结一塔训另一塔来降低 RL 成本。三条独立工作指向同一判断:昂贵的在线监督预算正在被更便宜的离线/自产目标替换,代价往往是引入新的手工正则(ViRDM 的 flow 正则就是这么来的)。 评测基准开始盯「理解」而不是「生成」 ODU-Bench 评测 14 个原生 MLLM 后发现,最强的 Gemini 3.1 Pro 也只能恢复 44.7% 必须靠上下文推断的关键信息,而且 11/14 的模型在非需求场景上误触发率超过 50%。这个数字比任何生成质量榜单都更能说明当前语音/视觉助手的实际状态:问题不在答得好不好,而在该不该答都还没判断对。ComplexSync 也顺手补了首个复杂场景唇形同步 benchmark,200+ 条挑战序列把遮挡、侧脸这些长期被平均掉的case单独拎出来。 人工智能炼丹君 整理 | 2026-09-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
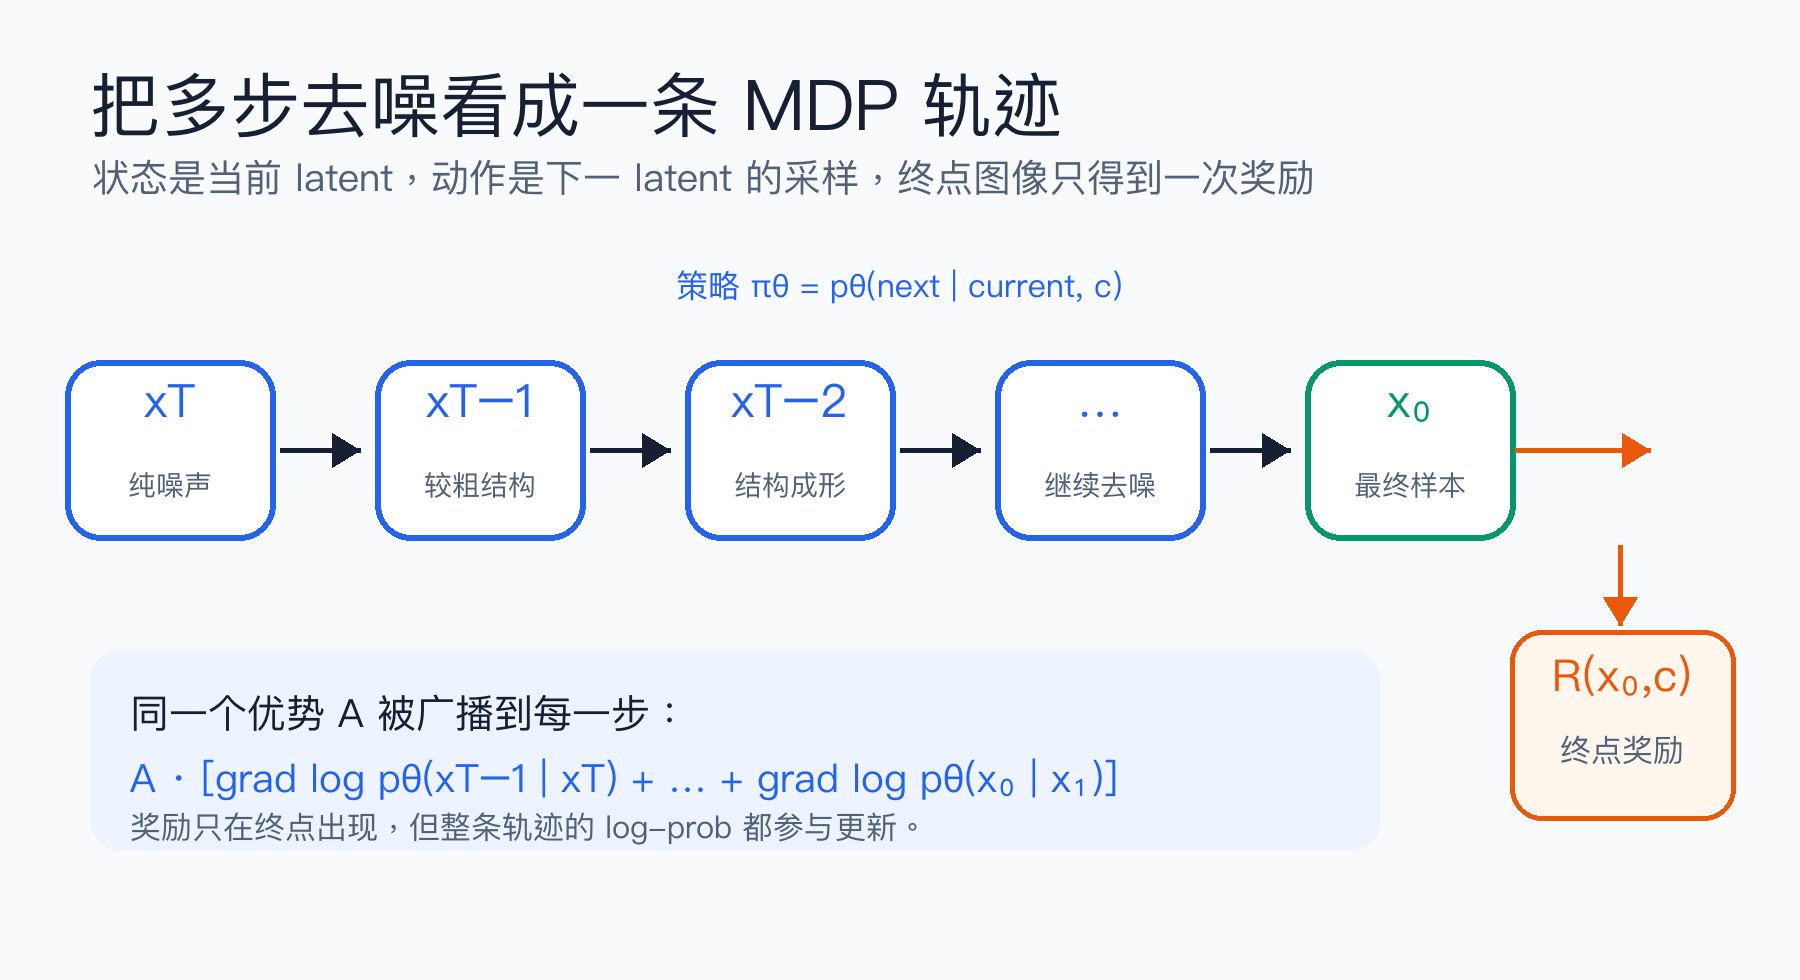
AIGC 基本功|把 RL 用到扩散模型上-DiffusionRL 把 RL 用到扩散模型上:从一张图的奖励到整条去噪轨迹的梯度 所属方向:对齐与强化学习 | 难度:前沿 | 前置知识:GRPO、DDIM 采样 关键词:DiffusionRL、DDPO、去噪轨迹、终点奖励、信用分配、DPOK、DRaFT 01. 为什么需要它 扩散模型通常先学习“像训练数据”,但产品真正关心的目标往往不是训练集似然:文字有没有正确渲染、人物是不是多了一根手指、构图是否讨喜、生成物能不能被某个下游系统识别、视频运动是否自然。这些目标可能来自人工打分、视觉语言模型、OCR、物理模拟器,甚至一段只能返回分数的业务程序。它们大多不可微,也不一定有成对偏好数据,却都能回答同一个问题:这张最终样本值多少分? 直接把最终图片当成一次普通动作,会丢掉扩散模型最重要的结构:图片不是一次生成的,而是从纯噪声开始,经过几十次随机去噪才得到的。假设采样有 50 步,最后的文字错了,到底是哪一步需要改?如果只对最终结果拟合,模型既看不到每一步在旧策略下出现的概率,也无法使用 PPO 的重要性比率约束更新;如果硬把 50 个概率相乘成一个轨迹比率,数值又很容易趋近 0 或爆炸。 DiffusionRL 的关键不是发明一种新的扩散网络,而是换一个观察角度: 把一次完整采样视为一条有限时域 MDP 轨迹;当前 latent 是状态,下一 latent 的随机采样是动作,最终图片的评分是终点奖励。 这样,奖励虽然只在最后出现,整条轨迹的 log-prob 仍然可以参与策略梯度。DDPO(Denoising Diffusion Policy Optimization)正是把这个视角变成了可训练算法:它允许我们用 JPEG 可压缩性、目标检测器、审美模型或人工反馈等黑盒奖励微调扩散模型,而不要求对奖励函数求导。 这也是理解视频生成 RL 的统一入口。图片去噪已经有“时间步 × latent”的信用分配;到了视频,还会再叠加帧间运动、时序一致性和长时奖励。先把图像版的轨迹与概率比率看清,后面的算法名字就不再是一堆孤立缩写。 02. 最小可用理解 给定提示词 $c$,采样从 $x_T\sim\mathcal N(0,I)$ 开始;每个去噪步骤都由模型定义一个策略 $p_\theta(x_{t-1}\mid x_t,c)$。 完整轨迹的概率是所有步骤概率的乘积,所以它的 log-prob 是逐步 log-prob 之和;终点奖励 $R(x_0,c)$ 因而能乘到每一步的 score function 上。 实际训练不直接做无约束 REINFORCE,而是像 PPO 一样保存旧策略的逐步 log-prob、重新计算新策略 log-prob、裁剪概率比率,并用基线或组内标准化降低方差。 图里有一个必须说准的细节:网络通常输出噪声、velocity 或转移均值的参数,但在 MDP 记号中,“动作”是实际采样出来的 $x_{t-1}$。也就是说,网络参数化动作分布,采样器从这个分布中抽出动作;不要把“网络输出”和“环境中发生的动作”混成一件事。 03. 数学推导 3.1 先把一次随机去噪写成概率分布 为避免被不同预测参数化淹没,先只保留采样器真正需要的形式。对当前 latent $x_t$,模型根据时间步 $t$ 和条件 $c$ 预测噪声,再由调度器算出一个转移均值: $$\mu_\theta(x_t,t,c).$$ 带随机性的 DDIM 步可以统一写成: $$x_{t-1}=\mu_\theta(x_t,t,c)+\sigma_t z_t,\qquad z_t\sim\mathcal N(0,I).$$ 因此条件转移是一个高斯策略: $$\pi_\theta(a_t\mid s_t)=p_\theta(x_{t-1}\mid x_t,t,c)=\mathcal N\!\left(x_{t-1};\mu_\theta(x_t,t,c),\sigma_t^2 I\right).$$ DDIM 中的随机强度由 $\eta$ 控制。训练 DDPO 时通常必须让 $\eta>0$,这样被纳入似然目标的随机步骤才有普通高斯密度可用于 log-prob 和重要性比率。注意 $\eta>0$ 仍不保证所有步骤 $\sigma_t>0$:落到干净端的终步可能方差为零,需排除该步或显式采用非零方差,不能直接算高斯 log-prob。若 $\eta=0$,转移退化为确定性映射,$\sigma_t=0$,直接套高斯 log-prob 会除以零;确定性采样仍可用于可微奖励反传,但不能不加处理地套用这套随机策略梯度。 3.2 MDP 的四个元素 把扩散采样改写成 MDP 时,可使用下面的对应关系: RL 概念 扩散采样中的对象 状态 $s_t$ 当前 latent、时间步和条件:$(x_t,t,c)$ 动作 $a_t$ 从模型给出的分布中采样下一 latent:$x_{t-1}$ 策略 $\pi_\theta$ 反向去噪转移 $p_\theta(x_{t-1}\mid x_t,t,c)$ 奖励 中间步骤通常为 0;解码 $x_0$ 后得到 $R(x_0,c)$ 这里的“环境”几乎没有额外动力学:动作 $x_{t-1}$ 本身就成为下一状态的一部分,时间步从 $t$ 减到 $t-1$。文本编码器、VAE 解码器和奖励模型通常不属于策略参数;真正更新的是 UNet、DiT 或其 LoRA 适配器。 3.3 终点一个分数,为什么每一步都有梯度 给定提示词,一条轨迹记作 $\tau=(x_T,x_{T-1},\ldots,x_0)$。因为初始噪声不依赖模型参数,轨迹概率可分解为: $$p_\theta(\tau\mid c)=p(x_T)\prod_{t=T}^{1}p_\theta(x_{t-1}\mid x_t,t,c).$$ 取对数后,乘积变为求和: $$\log p_\theta(\tau\mid c)=\log p(x_T)+\sum_{t=T}^{1}\log p_\theta(x_{t-1}\mid x_t,t,c).$$ 目标是最大化期望终点奖励: $$J(\theta)=\mathbb E_{c,\tau\sim p_\theta}[R(x_0,c)].$$ 应用 likelihood-ratio trick: $$\nabla_\theta J(\theta)=\mathbb E\!\left[R(x_0,c)\nabla_\theta\log p_\theta(\tau\mid c)\right]=\mathbb E\!\left[R(x_0,c)\sum_{t=T}^{1}\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,t,c)\right].$$ 这就是“奖励只在终点,梯度覆盖全轨迹”的来源。实践中会减去不依赖当前动作的基线 $b(c)$,得到优势: $$A=R(x_0,c)-b(c).$$ 减基线不会改变期望梯度,却能显著降低采样方差。若同一个 prompt 一次生成多张图,可以用组内均值和标准差做归一化: $$A_i=\frac{R_i-\operatorname{mean}(R_{1:G})}{\operatorname{std}(R_{1:G})+\epsilon}.$$ 组均值包含自身时,未标准化的中心化 score 估计在独立采样条件下有 $(1-1/G)$ 的缩放;随机标准差还会改变各组权重。因此上面的无偏基线证明不能直接套到组内标准化。它和 GRPO 的“组内相对分数”很相似,不过动作空间从 token 变成了高维 latent 转移。 3.4 每一步的 log-prob 到底怎么算 设动作 $x_{t-1}$ 有 $D$ 个独立高斯坐标、固定方差为 $\sigma_t^2>0$。真实联合 log-prob 必须对坐标求和: $$\ell_\theta=-\frac{\|x_{t-1}-\mu_\theta\|^2}{2\sigma_t^2}-D\log\sigma_t-\frac D2\log(2\pi).$$ 真实逐步联合概率比为 $r_t=\exp(\ell_\theta-\ell_{old})$。DDPO 作者实现 则把逐坐标 log-prob 取平均,即 $\bar\ell=\ell/D$,再计算 $$\bar r_t=\exp(\bar\ell_\theta-\bar\ell_{old})=r_t^{1/D}.$$ 这是一种控制高维数值尺度的工程替代比率,不再是严格的联合重要性权重;它也改变了 clip 的尺度。本文一维玩具 $D=1$ 时二者相同,多维复现时必须明确采用哪个约定。下式的 $r_t$ 应按所选约定解释。 PPO 风格的裁剪目标是: $$L_t(\theta)=\min\!\left(r_t A,\operatorname{clip}(r_t,1-\epsilon,1+\epsilon)A\right).$$ 训练代码通常最小化 $-L_t$。关键是先按转移计算比率再裁剪,不是先把所有 $r_t$ 相乘成一个轨迹比率。后者会随步数快速积累方差,也让某一步的异常比率拖垮整条样本。 3.5 同一个优势,不代表每一步得到同样的梯度 优势 $A$ 可以广播给每一步,但 score function 不同。对固定方差的高斯策略,有: $$\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,c)=\frac{x_{t-1}-\mu_\theta}{\sigma_t^2}\nabla_\theta\mu_\theta.$$ 时间步的噪声尺度、采样残差、网络 Jacobian 都不同,因此各步的梯度贡献不会相等。终点附近通常对最终结果影响更直接,但并不存在“最后一步天然包办所有学习”的定理;调度器与模型参数化会改变信用在各步之间的分布。 04. 代码实现 下面的玩具过程只有一个可训练标量 $\theta$,但保留了 DDPO 的核心结构:8 步高斯去噪、只在终点计算奖励、保存逐步 log-prob、用中心化优势做 REINFORCE,并在最后演示新旧策略的 PPO 比率。 状态转移是: $$x_{t-1}=0.72x_t+0.18\theta+0.45z_t,\qquad z_t\sim\mathcal N(0,1).$$ 终点目标为 1.5,奖励为: $$R(x_0)=-(x_0-1.5)^2.$$ 完整代码见文末。直接运行: python3 ddpo_minimal.py 真实输出如下: trajectory_shape= (4096, 9) transition_log_prob_shape= (4096, 8) before_terminal_mean= 0.0052 before_reward_mean= -2.6513 after_theta= 2.2677 after_terminal_mean= 1.3577 after_reward_mean= -0.4370 per_step_gradient= [0.0088 0.0085 0.014 0.024 0.0358 0.0435 0.0578 0.0883] gradient_sample_std_raw_centered= 1.6981 1.3899 ppo_ratio_mean_min_max= 1.0010 0.4051 2.2337 ppo_clip_fraction= 0.3108 history_first= [ 0. -0.0165 -2.7295] history_last= [ 2.2677 1.3601 -0.4503] 几个 shape 很重要:4096 条轨迹、每条 8 个转移,所以状态数组有 9 个点,而 log-prob 只有 8 个。训练前 $x_0$ 均值约为 0;40 次更新后移到 1.36,接近目标 1.5,平均奖励从 -2.65 提升到约 -0.44。奖励是负平方误差,所以“更大”意味着更接近 0,而不是数值绝对值更大。 中心化前后,单样本梯度估计的标准差从 1.70 降到 1.39。这只是最简单的 batch baseline;工业实现还会按 prompt 维护统计量,避免一个本来就容易拿高分的 prompt 主导更新。 最后把参数轻微扰动,逐步比率均值仍约为 1,但极端值已经到 0.41 和 2.23,有约 31% 的转移落到裁剪区间之外。这说明“平均比率看起来正常”不足以判断更新是否安全,还要看 clip fraction、KL 和比率分位数。 右图里越靠近终点的转移贡献越大,是这个线性玩具过程的收缩系数 0.72 造成的:早期扰动经过多次收缩后影响变小。真实扩散模型不会总呈现这种单调形状,但它直观说明了:即使每一步共享同一个终点优势,信用仍由每一步的局部概率结构决定。 05. 工业级实现对照 截至 2026 年 9 月,DDPO 论文作者维护的参考实现 kvablack/ddpo-pytorch 仍是理解训练循环最直接的代码入口。其 scripts/train.py 和带 log-prob 的 ddim_step_with_logprob 展示了完整数据流: 采样 rollout:从 prompt 和初始噪声出发,保存形状近似为 [batch, steps + 1, C, H, W] 的 latents,以及 [batch, steps] 的旧策略 log-prob。 只给终点打分:将 $x_0$ 经 VAE 解码成图片,用 JPEG 可压缩性、审美分数、目标检测、视觉语言模型或业务规则计算奖励。慢奖励可以并发执行,但返回时必须和样本一一对齐。 构造优势:对全批次奖励标准化,或用 per-prompt statistics tracker 做条件化标准化。同一条轨迹的优势广播到各去噪时间步。 打乱样本与时间步:实现不仅 shuffle 样本,还可对每个样本打乱时间步顺序,降低相邻去噪步相关性对小批次更新的影响。 重算 log-prob:把保存的 $(x_t,x_{t-1},t,c)$ 喂给当前模型,通过 patched DDIM step 得到新策略 log-prob,而不是重新采样一个 $x_{t-1}$。 PPO 裁剪更新:计算逐步新旧比率,应用 clipped surrogate loss;通常只训练 LoRA,以降低显存、通信和策略漂移。 这个实现细节解释了为什么训练内存明显大于普通推理:rollout 阶段要保存整条 latent 轨迹和旧 log-prob,更新阶段又要为当前时间步建立反向图。若 rollout batch 为 $B$、去噪步数为 $T$,一轮采样至少处理 $B\times T$ 次 UNet/DiT 前向;若每批 rollout 做 $K$ 个 inner epochs,更新成本还会近似再乘 $K$。梯度累积只改变峰值显存,不会凭空消除总计算量。 早期 Hugging Face TRL 版本曾提供 DDPOTrainer,但当前上游目录与公开 API 已发生重构。读旧教程时应锁定对应版本,不要假设 trl/trainer/ddpo_trainer.py 在最新版仍是稳定入口;本文因此把论文作者仓库作为代码锚点。 从 rollout 到 update 的数据契约 工程里最值得先写清的不是 Trainer 类,而是一条样本在两个阶段之间必须携带什么。rollout 结束后,每条样本至少要保存 prompt 或其编码、全部时间步、从初始噪声到终点的 latents、旧策略逐步 log-prob、最终图片、原始奖励和经过标准化的优势。若使用 classifier-free guidance,还必须固定无条件分支、guidance scale 和文本编码方式;否则更新阶段重算出来的均值并不是采样时那条策略的均值。 update 阶段只取保存的当前 latent 和下一 latent,调用当前模型重算同一个已发生动作的 log-prob。这里绝对不能重新抽噪声:PPO 问的是“新策略对旧动作给出多大概率”,不是“新策略这次随机采到了什么”。这个区别在 token PPO 中很直观——不会在更新时重采一句回答——换成连续 latent 后却很容易藏在调度器接口里。 还应给 rollout 批次分配不可变的 sample id,并把 prompt、随机种子、reward 版本、模型 checkpoint 和 scheduler 配置写进元数据。这样一旦某个 batch 的 ratio 或奖励异常,能够重放出同一条轨迹并定位问题。只记录最后的 PNG 不够,因为不同 latent 轨迹可能解码成肉眼相近的图片,而策略梯度依赖的是当时每一步的概率。 多卡训练时,全局优势标准化也必须基于所有进程聚合后的奖励,而不是每张卡各算各的。否则不同卡的 prompt 难度稍有偏差,就会得到不同的零点和尺度;随后再做梯度平均,相当于混合了多套不一致的目标。相反,若采用 per-prompt 统计器,应明确冷启动策略:某个 prompt 样本太少时回退到全局统计,避免标准差接近零导致优势被放大。 DPOK:为什么还要加 KL 纯奖励最大化很容易把模型推离预训练分布。DPOK(Diffusion Policy Optimization with KL regularization)在在线策略梯度中加入参考模型约束,可抽象为: $$J_{\text{DPOK}}(\theta)=\mathbb E[R(x_0,c)]-\beta\,D_{\mathrm{KL}}(p_\theta\|p_{\text{ref}}).$$ $\beta$ 越大,模型越保守;越小,越容易快速追逐奖励,也越容易丢失多样性或出现奖励投机。PPO clipping 约束的是一次更新相对旧策略的变化,reference KL 约束的是长期相对基座模型的漂移,两者作用并不相同。 DRaFT:奖励可微时,可以不走 score function 如果奖励模型对像素可微,且采样器的整条计算图可以保留,就能把梯度从奖励直接穿过 VAE 与采样步骤反传到扩散模型。DRaFT 将这一路线系统化,并提出截断反传等变体来控制内存与梯度不稳定。 两条路线的选择很清楚: DDPO / DPOK:奖励可以是完全黑盒,只需要返回标量;代价是策略梯度方差较高,需要大量 on-policy 样本。 DRaFT 类方法:能利用奖励的路径导数,梯度通常更直接;但奖励必须可微,且跨很多采样步骤保存或重算计算图,显存与稳定性是主要问题。 它们可以共享同一个奖励定义,却不能把“对奖励求导”和“用奖励乘 log-prob”混写成一套推导。 06. 代价与边界 6.1 它省下了什么 不需要奖励函数可微,外部 API、人工评分和离散程序都能接入。 不需要为每个目标重新制作大规模成对偏好数据;在线采样能探索当前策略真正会生成的区域。 能复用 PPO 的裁剪、KL、优势归一化和诊断工具,把更新幅度控制在可观察范围内。 6.2 它付出了什么 on-policy 成本高:策略一更新,旧 rollout 很快过期;数据复用能力弱于离线偏好优化。 终点信用粗糙:所有步骤共享终点优势,方差高;步数越多、latent 越高维,问题越明显。 奖励调用可能成为瓶颈:大型 VLM 或人工评分比去噪本身还慢,异步队列与缓存很重要。 探索与画质有冲突:增大 DDIM 的 $\eta$ 有利于随机策略探索,却可能改变原有采样质量与分布。 奖励投机不会自动消失:OCR 奖励可能鼓励巨大文字,审美分数可能压低多样性,检测器奖励可能诱导模型画出分类器偏爱的纹理。 6.3 上线前至少记录这些指标 不要只看 mean reward。最低限度还应记录: 奖励均值、标准差和分位数,按 prompt 类别拆分; 新旧策略的 approximate KL、ratio 分位数与 clip fraction; 每个时间步的 loss、KL 或梯度范数,检查是否只剩少数步在学习; 多样性指标和基础画质指标,防止奖励提高但模式坍缩; 人工盲评或独立奖励模型的 holdout 分数,防止只攻破训练用 reward; 无效图片、NaN、全黑/过曝和安全过滤命中率。 如果奖励模型本身正在更新,还要给 reward 版本打快照。否则同一条训练曲线纵轴含义会变化,前后 reward 数字不可直接比较。 6.4 奖励怎么配,往往比优化器更重要 真实系统几乎不会只用一个分数。以文字生成图片为例,可以同时有提示词一致性、OCR 正确率、审美、人体结构和安全性五类信号。最直接的做法是加权求和: $$R=w_{\text{prompt}}R_{\text{prompt}}+w_{\text{ocr}}R_{\text{ocr}}+w_{\text{aesthetic}}R_{\text{aesthetic}}-w_{\text{safety}}C_{\text{safety}}.$$ 但“都放进来”不等于问题解决了。不同奖励的量纲与波动范围可能差几个数量级:OCR 是 0 或 1,审美模型可能落在 1 到 10,安全惩罚可能只有极少数样本非零。若不先校准,权重看似相近,实际梯度却会被方差最大的那一项占满。稳妥做法是先在固定基座模型上采一批校准集,观察每项分布,再做裁剪、标准化或分位数映射;训练期间同时画出每个子奖励,不能只保存加权总分。 还要区分“软目标”和“硬约束”。图片里文字少一个字,通常是可连续改进的软目标;生成违法内容则不应靠一个可被其他高分抵消的负权重处理。硬约束更适合在采样前后用过滤器、拒绝策略或拉格朗日约束单独处理。否则模型可能发现:只要审美分足够高,安全惩罚也值得承受。 多目标之间还会发生真实冲突。把 OCR 权重拉高,模型可能把文字做得巨大而破坏构图;只奖励检测器置信度,可能得到边缘锐利但不自然的目标。应当用 Pareto 视角看结果:同一批 checkpoints 同时比较各子目标和人工偏好,选择没有被某一维明显支配的方案,而不是盯着一条总 reward 曲线挑最高点。 6.5 三个能快速定位实现错误的不变量 第一,rollout 保存的状态数必须比转移 log-prob 数多 1;若二者相等,通常漏了初始噪声或终点 latent。第二,当新旧模型参数完全相同时,逐步 ratio 应非常接近 1,approximate KL 应接近 0;否则多半是调度器、CFG 分支、时间步索引或 log-prob 归约维度不一致。第三,打乱 batch 顺序不应改变同一个样本的 reward、prompt、latents 与 log-prob 对齐关系。异步奖励最容易在这里悄悄错位:训练仍会运行,均值甚至会上升,但模型学到的是别人的分数。 调试时先用一个可以解析求解的低维过程,就像本文代码;确认梯度方向、ratio 和 baseline 都符合预期,再接入大模型。直接在多卡图像训练里找符号错误,通常会把昂贵计算浪费在最便宜的 bug 上。 这些不变量也适合写进自动化测试:用固定随机种子的十几条轨迹做快速回归,每次升级 diffusers、调度器或混合精度设置后先跑它,再启动昂贵的正式训练。 07. 经典论文脉络 Training Diffusion Models with Reinforcement Learning / DDPO(arXiv:2305.13301)把扩散去噪正式改写为多步决策过程,给出基于 likelihood ratio 的 DDPO,并展示了不可微奖励下的微调能力。它奠定了“去噪轨迹就是策略轨迹”的主框架。 DPOK: Reinforcement Learning for Fine-tuning Text-to-Image Diffusion Models(arXiv:2305.16381)把在线策略梯度与 KL 正则结合,强调奖励提升和预训练分布保持之间的平衡。 DRaFT: Directly Fine-tuning Diffusion Models on Differentiable Rewards(arXiv:2309.17400)转向可微奖励,通过采样链直接反传,并研究 full、截断和低方差版本,形成与 DDPO 互补的路线。 Reward-Directed Conditional Diffusion(arXiv:2307.07055)从 reward-conditioned / reward-directed 角度研究如何把黑盒目标引入扩散生成,说明“训练一个条件生成器”和“在线策略优化”是相关但不同的解法。 Diffusion Models for Reinforcement Learning: A Survey(arXiv:2311.01223)覆盖的是更宽的交叉方向:既包括用 RL 对齐扩散生成,也包括把扩散模型当作策略或规划器。阅读时要先辨认“RL 优化 diffusion”还是“diffusion 服务 RL”。 论文名称很像时,先看梯度从哪里来:若公式里是 $R\nabla\log p_\theta$,属于 score-function 策略梯度;若是 $\nabla_{x_0}R$ 沿采样链反传,则属于可微奖励路线;若训练数据是静态偏好对,通常又是离线偏好优化问题。 08. 常见误解 误解 1:模型预测的噪声就是 RL 动作 噪声预测是策略的参数化中间量。DDPO 的动作通常记为实际采样出的下一 latent $x_{t-1}$,策略概率才是 $p_\theta(x_{t-1}\mid x_t,c)$。只有这样,保存动作、重算 log-prob 和构造新旧比率才是一致的。 误解 2:奖励在最后,所以只有最后一步能更新 轨迹 log-prob 是逐步 log-prob 的和。终点奖励乘的是整条和,因此每个去噪转移都有 score-function 梯度。最后一步可能贡献较大,但不是唯一有梯度的一步。 误解 3:确定性 DDIM 也能原样计算 DDPO log-prob $\eta=0$ 时 $\sigma_t=0$,普通高斯 log-prob 不再成立。要么使用非零随机性,要么换成适合确定性路径的可微反传或其他估计器,不能简单给分母加一个 epsilon 就宣称理论等价。 误解 4:把所有逐步比率相乘,才是最“严格”的 PPO 轨迹比率在长链上方差巨大。DDPO 实践通常按去噪转移计算和裁剪 ratio;这是一种稳定的 surrogate,而不是把一个 50 步连乘数硬塞进普通 PPO 公式。 误解 5:同一奖励广播到每一步,所以每步学到的一样 优势相同,不等于 score function 相同。噪声方差、预测残差、网络敏感度和调度器权重都随时间步变化,逐步梯度自然不同。 误解 6:奖励不可微就无法优化扩散模型 DDPO 只需要采样结果和标量奖励,不需要奖励梯度。不可微带来的问题是估计方差和样本成本,而不是“没有任何梯度”。 误解 7:训练 reward 上升就代表模型全面变好 模型可能只学会利用 reward 的盲点。必须同时看独立评估、人工盲评、多样性、prompt 遵循和安全指标;最好用不同架构的 holdout reward 检查泛化。 09. 动手验证:四个改动看懂算法 文末代码只依赖 NumPy,建议依次改四个参数,每次固定随机种子并比较输出。 实验 A:把 steps 从 8 改为 16 预期状态 shape 从 (4096, 9) 变成 (4096, 17),log-prob shape 从 (4096, 8) 变成 (4096, 16)。更长轨迹会增加梯度求和项;在不调整学习率与归一化时,训练波动通常更明显。 实验 B:把 noise_std 从 0.45 降到 0.10 探索减弱,采样更集中;但 score function 含 $1/\sigma^2$,数值会更尖锐。过小噪声并不等于更稳定,极限到 0 反而失去这套高斯策略梯度的基础。 实验 C:删掉优势中心化 把 advantage = (reward - reward.mean()) / ... 改成直接使用 reward。gradient_sample_std_raw_centered 的第二个值会失去优势,训练曲线更抖。这个实验直观看到 baseline 改变方差而不改变目标最优点。 实验 D:增大新旧参数差 在 PPO 诊断部分增大 new_theta - old_theta。你会看到 ratio_min/max 更极端,clip_fraction 上升。工程上这对应学习率过大、inner epochs 过多或 KL 约束过弱。 进一步可把终点奖励改成离散黑盒:例如 reward = (abs(x0-target) < 0.25)。代码仍能训练,但由于奖励更稀疏,往往需要更大 batch、分层采样或更好的 baseline。这正是从玩具例子走向 OCR 成功率、目标检测命中和人工反馈时遇到的现实问题。 10. 延伸阅读 这篇位于“对齐与强化学习”路径的第三段: 策略梯度与 PPO 基础:理解 advantage、ratio、clipping 和 KL; 从 DPO 到 GRPO:去掉价值网络:理解组内相对优势; 本文 DiffusionRL:把 token 轨迹换成 latent 去噪轨迹; 视频生成中的强化学习与奖励模型:在去噪信用之外,再处理画质、运动与指令遵循的多目标奖励。 如果 DDIM 还不熟,先记住本文真正依赖的最小事实:它把 $x_t$ 和网络预测组合成下一步均值,并可用 $\eta$ 注入高斯随机性。从 DDIM 到高阶采样器 已展开采样公式、ODE/SDE 视角与高阶求解器。 最后用一句话收束: DiffusionRL 不是把一个 PPO 套在图片外面,而是把每次去噪转移变成可计概率的动作,再让终点奖励沿整条轨迹分配信用。 附录:完整代码 09 节用到的脚本全文如下(ddpo_minimal.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。 ddpo_minimal.py """NumPy-only toy DDPO: treat iterative denoising as a stochastic policy. This is an algebra demo, not an image generator. A scalar latent follows a short Gaussian reverse process. One parameter shifts every denoising mean, and a terminal reward teaches the process to end near a target value. """ from dataclasses import dataclass import numpy as np @dataclass(frozen=True) class ToyConfig: steps: int = 8 batch_size: int = 4096 contraction: float = 0.72 action_scale: float = 0.18 noise_std: float = 0.45 target: float = 1.5 def gaussian_log_prob(value, mean, std): """Elementwise log N(value; mean, std^2).""" return -0.5 * ((value - mean) / std) ** 2 - np.log(std * np.sqrt(2.0 * np.pi)) def rollout(theta, cfg, rng): """Sample x_T -> ... -> x_0 and retain every transition. Array index 0 stores x_T; index cfg.steps stores x_0. The transition mean is mu_theta = contraction * x_t + action_scale * theta. """ latents = np.empty((cfg.batch_size, cfg.steps + 1), dtype=np.float64) means = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) log_probs = np.empty((cfg.batch_size, cfg.steps), dtype=np.float64) latents[:, 0] = rng.normal(size=cfg.batch_size) for j in range(cfg.steps): mean = cfg.contraction * latents[:, j] + cfg.action_scale * theta next_latent = mean + cfg.noise_std * rng.normal(size=cfg.batch_size) latents[:, j + 1] = next_latent means[:, j] = mean log_probs[:, j] = gaussian_log_prob(next_latent, mean, cfg.noise_std) terminal = latents[:, -1] rewards = -(terminal - cfg.target) ** 2 return latents, means, log_probs, rewards def score_function(latents, means, cfg): """d log pi_theta(x_{t-1}|x_t) / d theta for every transition.""" residual = latents[:, 1:] - means return residual * cfg.action_scale / (cfg.noise_std**2) def policy_gradient(rewards, per_step_scores): """REINFORCE with a batch baseline; terminal advantage is broadcast to T steps.""" centered = rewards - rewards.mean() advantages = centered / (rewards.std() + 1e-8) trajectory_scores = per_step_scores.sum(axis=1) gradient = np.mean(advantages * trajectory_scores) per_step_gradient = np.mean(advantages[:, None] * per_step_scores, axis=0) return gradient, per_step_gradient, advantages def evaluate(theta, cfg, seed): rng = np.random.default_rng(seed) latents, means, log_probs, rewards = rollout(theta, cfg, rng) return { "terminal_mean": float(latents[:, -1].mean()), "reward_mean": float(rewards.mean()), "latents": latents, "means": means, "log_probs": log_probs, "rewards": rewards, } def train(cfg, updates=40, learning_rate=0.08, seed=7): theta = 0.0 history = [] rng = np.random.default_rng(seed) for update in range(updates + 1): latents, means, _, rewards = rollout(theta, cfg, rng) scores = score_function(latents, means, cfg) gradient, per_step_gradient, advantages = policy_gradient(rewards, scores) history.append((update, theta, latents[:, -1].mean(), rewards.mean(), gradient)) if update < updates: theta += learning_rate * gradient return theta, np.asarray(history), per_step_gradient, advantages, scores, rewards def ppo_diagnostics(theta_old, theta_new, cfg, seed=123, clip_range=0.2): """Re-evaluate old transitions under a candidate new policy.""" rng = np.random.default_rng(seed) latents, old_means, old_log_probs, rewards = rollout(theta_old, cfg, rng) new_means = cfg.contraction * latents[:, :-1] + cfg.action_scale * theta_new new_log_probs = gaussian_log_prob(latents[:, 1:], new_means, cfg.noise_std) ratios = np.exp(new_log_probs - old_log_probs) clipped = np.abs(ratios - 1.0) > clip_range return rewards, ratios, clipped if __name__ == "__main__": np.set_printoptions(precision=6, suppress=True) cfg = ToyConfig() before = evaluate(theta=0.0, cfg=cfg, seed=2026) theta, history, per_step_gradient, advantages, scores, rewards = train(cfg) after = evaluate(theta=theta, cfg=cfg, seed=2026) raw_gradient_samples = rewards * scores.sum(axis=1) centered_gradient_samples = (rewards - rewards.mean()) * scores.sum(axis=1) ppo_rewards, ratios, clipped = ppo_diagnostics( theta_old=0.0, theta_new=0.5, cfg=cfg ) print("trajectory_shape=", before["latents"].shape) print("transition_log_prob_shape=", before["log_probs"].shape) print("before_terminal_mean=", f"{before['terminal_mean']:.4f}") print("before_reward_mean=", f"{before['reward_mean']:.4f}") print("after_theta=", f"{theta:.4f}") print("after_terminal_mean=", f"{after['terminal_mean']:.4f}") print("after_reward_mean=", f"{after['reward_mean']:.4f}") print("per_step_gradient=", np.round(per_step_gradient, 4)) print( "gradient_sample_std_raw_centered=", f"{raw_gradient_samples.std():.4f}", f"{centered_gradient_samples.std():.4f}", ) print( "ppo_ratio_mean_min_max=", f"{ratios.mean():.4f}", f"{ratios.min():.4f}", f"{ratios.max():.4f}", ) print("ppo_clip_fraction=", f"{clipped.mean():.4f}") print("history_first=", np.round(history[0, 1:4], 4)) print("history_last=", np.round(history[-1, 1:4], 4)) assert before["latents"].shape == (cfg.batch_size, cfg.steps + 1) assert before["log_probs"].shape == (cfg.batch_size, cfg.steps) assert after["reward_mean"] > before["reward_mean"] assert abs(after["terminal_mean"] - cfg.target) < abs(before["terminal_mean"] - cfg.target) assert np.all(np.isfinite(ratios)) make_figures.py """Generate the explanatory figures for the DiffusionRL article. Requires NumPy, Matplotlib and Pillow. The numerical chart reuses the exact toy process from ddpo_minimal.py so the article and figure cannot drift apart. """ from pathlib import Path import matplotlib matplotlib.use("Agg") import matplotlib.pyplot as plt import numpy as np from PIL import Image, ImageDraw, ImageFont from ddpo_minimal import ToyConfig, train OUT = Path(__file__).resolve().parents[1] / "figures" OUT.mkdir(exist_ok=True) def _font(size, bold=False): candidates = ( "/System/Library/Fonts/PingFang.ttc", "/System/Library/Fonts/Hiragino Sans GB.ttc", "/usr/share/fonts/opentype/noto/NotoSansCJK-Bold.ttc" if bold else "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc", ) for path in candidates: try: return ImageFont.truetype(path, size) except OSError: pass raise RuntimeError("请安装中文字体后再生成 DiffusionRL 示意图") def trajectory_mdp(): image = Image.new("RGB", (1800, 980), "#f8fafc") draw = ImageDraw.Draw(image) ink, blue, green, orange, muted = "#172033", "#2563eb", "#059669", "#ea580c", "#526078" draw.text((90, 55), "把多步去噪看成一条 MDP 轨迹", font=_font(70, True), fill=ink) draw.text((92, 150), "状态是当前 latent,动作是下一 latent 的采样,终点图像只得到一次奖励", font=_font(38), fill=muted) draw.text((900, 285), "策略 πθ = pθ(next | current, c)", font=_font(32), fill=blue, anchor="mm") xs = [170, 480, 790, 1100, 1410] labels = ["xT", "xT−1", "xT−2", "…", "x₀"] subtitles = ["纯噪声", "较粗结构", "结构成形", "继续去噪", "最终样本"] for i, (x, label, subtitle) in enumerate(zip(xs, labels, subtitles)): color = blue if i < len(xs) - 1 else green draw.rounded_rectangle((x - 105, 360, x + 105, 540), radius=36, fill="#ffffff", outline=color, width=6) draw.text((x, 400), label, font=_font(46, True), fill=color, anchor="mm") draw.text((x, 485), subtitle, font=_font(28), fill=muted, anchor="mm") if i < len(xs) - 1: draw.line((x + 110, 450, xs[i + 1] - 120, 450), fill=ink, width=5) draw.polygon( [(xs[i + 1] - 120, 450), (xs[i + 1] - 148, 433), (xs[i + 1] - 148, 467)], fill=ink, ) draw.line((1515, 450, 1650, 450), fill=orange, width=5) draw.polygon([(1650, 450), (1622, 433), (1622, 467)], fill=orange) draw.rounded_rectangle((1510, 630, 1735, 820), radius=32, fill="#fff7ed", outline=orange, width=5) draw.text((1622, 675), "R(x₀,c)", font=_font(44, True), fill=orange, anchor="mm") draw.text((1622, 750), "终点奖励", font=_font(31), fill=muted, anchor="mm") draw.line((1620, 545, 1620, 625), fill=orange, width=5) draw.polygon([(1620, 625), (1603, 597), (1637, 597)], fill=orange) draw.rounded_rectangle((90, 650, 1380, 850), radius=30, fill="#eef4ff") draw.text((130, 685), "同一个优势 A 被广播到每一步:", font=_font(39, True), fill=ink) draw.text((130, 750), "A · [grad log pθ(xT−1 | xT) + … + grad log pθ(x₀ | x₁)]", font=_font(39), fill=blue) draw.text((130, 805), "奖励只在终点出现,但整条轨迹的 log-prob 都参与更新。", font=_font(31), fill=muted) image.save(OUT / "diffusion_rl_mdp.png", optimize=True) def cover(): image = Image.new("RGB", (1280, 720), "#081225") draw = ImageDraw.Draw(image) # A denoising trajectory that gradually changes from noise-like dots into a # clean latent. Keeping this code-native makes the cover deterministic. rng = np.random.default_rng(7) stages = [190, 400, 610, 820, 1030] palette = ["#60a5fa", "#38bdf8", "#2dd4bf", "#34d399", "#f59e0b"] for i, x in enumerate(stages): radius = 62 draw.ellipse((x - radius, 258 - radius, x + radius, 258 + radius), outline=palette[i], width=5) spread = 47 - i * 7 for _ in range(38 - i * 4): px = x + int(rng.normal(0, spread)) py = 258 + int(rng.normal(0, spread)) dot = 2 + i draw.ellipse((px - dot, py - dot, px + dot, py + dot), fill=palette[i]) if i < len(stages) - 1: draw.line((x + 72, 258, stages[i + 1] - 75, 258), fill="#94a3b8", width=4) draw.polygon( [(stages[i + 1] - 75, 258), (stages[i + 1] - 96, 246), (stages[i + 1] - 96, 270)], fill="#94a3b8", ) draw.rounded_rectangle((1068, 190, 1222, 326), radius=26, fill="#431407", outline="#f59e0b", width=4) draw.text((1145, 258), "+R", font=_font(48, True), fill="#fbbf24", anchor="mm") draw.text((92, 415), "把 RL 用到扩散模型上", font=_font(64, True), fill="#f8fafc") draw.text((96, 507), "DiffusionRL · DDPO · 去噪轨迹 · 信用分配", font=_font(34), fill="#93c5fd") draw.rounded_rectangle((94, 603, 426, 659), radius=25, fill="#1d4ed8") draw.text((260, 631), "AIGC 基本功", font=_font(28, True), fill="#ffffff", anchor="mm") image.save(OUT / "wechat_cover_diffusion_rl.png", optimize=True) def training_and_credit(): cfg = ToyConfig() _, history, per_step_gradient, _, _, _ = train(cfg) updates = history[:, 0] fig, axes = plt.subplots(1, 2, figsize=(11, 4.3)) ax = axes[0] ax.plot(updates, history[:, 3], color="#2563eb", linewidth=2.5, label="mean terminal reward") ax.set_xlabel("policy updates") ax.set_ylabel("reward (higher is better)") ax.grid(alpha=0.2) ax2 = ax.twinx() ax2.plot(updates, history[:, 2], color="#059669", linewidth=2.2, label="mean x0") ax2.axhline(cfg.target, color="#059669", linestyle="--", alpha=0.45, label="target") ax2.set_ylabel("terminal latent mean") lines = ax.get_lines() + ax2.get_lines() ax.legend(lines, [line.get_label() for line in lines], frameon=False, loc="center right") ax.set_title("Toy DDPO learns from terminal reward") ax = axes[1] steps = np.arange(cfg.steps) ax.bar(steps, per_step_gradient, color=plt.cm.Blues(np.linspace(0.45, 0.95, cfg.steps))) ax.set_xticks(steps, [f"{cfg.steps-i}→{cfg.steps-i-1}" for i in steps], rotation=40) ax.set_xlabel("denoising transition") ax.set_ylabel("estimated gradient contribution") ax.grid(axis="y", alpha=0.2) ax.set_title("Same reward, different credit per step") fig.suptitle("Terminal reward becomes a trajectory-level policy gradient", fontsize=15, weight="bold") fig.tight_layout() fig.savefig(OUT / "diffusion_rl_training_credit.png", dpi=190) plt.close(fig) if __name__ == "__main__": trajectory_mdp() training_and_credit() cover() for name in ( "diffusion_rl_mdp.png", "diffusion_rl_training_credit.png", "wechat_cover_diffusion_rl.png", ): print(OUT / name) 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
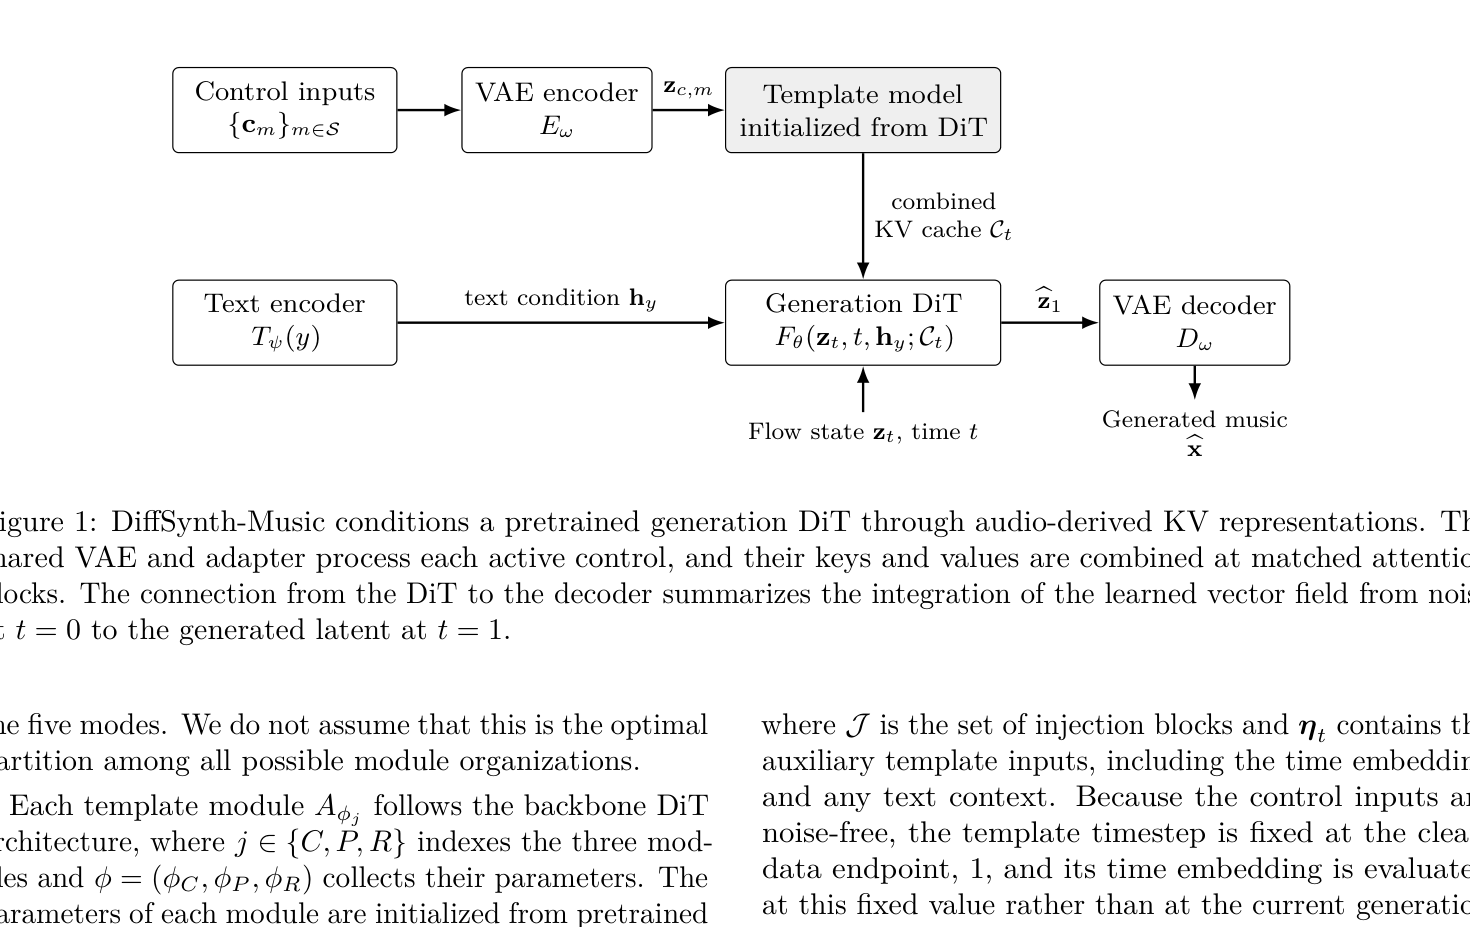
AIGC 每日速读|2026-09-15|阿里五路音频控制-DiffSynth-Music 今日 AIGC 论文速览 今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇 重点论文标题列表 DiffSynth-Music(阿里巴巴集团、上海交通大学):五路音频控制锁住节拍 StepAudio 3 Gen(阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音 Encore(百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏 DIAL(阿里巴巴集团、北京大学):调一个旋钮控人物像不像 Omni-Streaming Thinking(香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口 今日论文速览 1. DiffSynth-Music:五路音频控制锁住节拍 DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774 关键词:可控音乐生成,音频条件,KV缓存,扩散Transformer 前序问题:文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。 本文贡献:DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。 实验效果:相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。 批判点评:一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。 2. StepAudio 3 Gen:一套模型生成所有声音 StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945 关键词:通用音频生成,语音合成,声音设计,RVQ 前序问题:语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。 本文贡献:StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。 实验效果:TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。 批判点评:统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。 3. Encore:三十秒音画同步不跑偏 Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249 关键词:音视频联合生成,长视频生成,自适应信号路由,跨模态同步 前序问题:现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。 本文贡献:Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。 实验效果:扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。 批判点评:把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。 4. DIAL:调一个旋钮控人物像不像 Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507 关键词:多主体视频生成,注意力定位,保真强度控制,偏好优化 前序问题:多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。 本文贡献:作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。 实验效果:OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。 批判点评:把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。 5. Omni-Streaming Thinking:流式多模态会主动改口 Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128 关键词:流式多模态,音视频推理,状态修正,幻觉抑制 前序问题:流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。 本文贡献:OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。 实验效果:在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。 批判点评:显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。 6. Overpainting:灰色地带让模型自己发挥 Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811 关键词:图像编辑,三值遮罩,扩散模型,注意力dropout 前序问题:图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。 本文贡献:Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。 实验效果:遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。 批判点评:三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。 7. PLSR:3D网格切块做超分省显存 PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436 关键词:3D资产生成,超分辨率,体素扩散,渐进式生成 前序问题:扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。 本文贡献:PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。 实验效果:伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。 批判点评:把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。 8. SAS:稀疏注意力直接听损失 SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141 关键词:稀疏注意力,长上下文,上下文排序,端到端优化 前序问题:可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。 本文贡献:SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。 实验效果:在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。 批判点评:端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。 9. Mi-Ripple:修掉反复AI编辑的涟漪 Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317 关键词:图像修复,迭代编辑,频域伪影,配对再生成 前序问题:图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。 本文贡献:Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。 实验效果:14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。 批判点评:方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。 10. Duplex Cue:会说会停还要边听边改 Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117 关键词:全双工语音,重叠语音,对话适应,语音评测 前序问题:全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。 本文贡献:Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。 实验效果:保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。 批判点评:三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。 趋势观察 控制接口前移到模型内部 控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。 长时序生成靠显式上下文传播续命 Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。 编辑控制从硬遮罩转向软约束 Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。 算力不够时预算分配成为核心问题 PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。 人工智能炼丹君 整理 | 2026-09-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
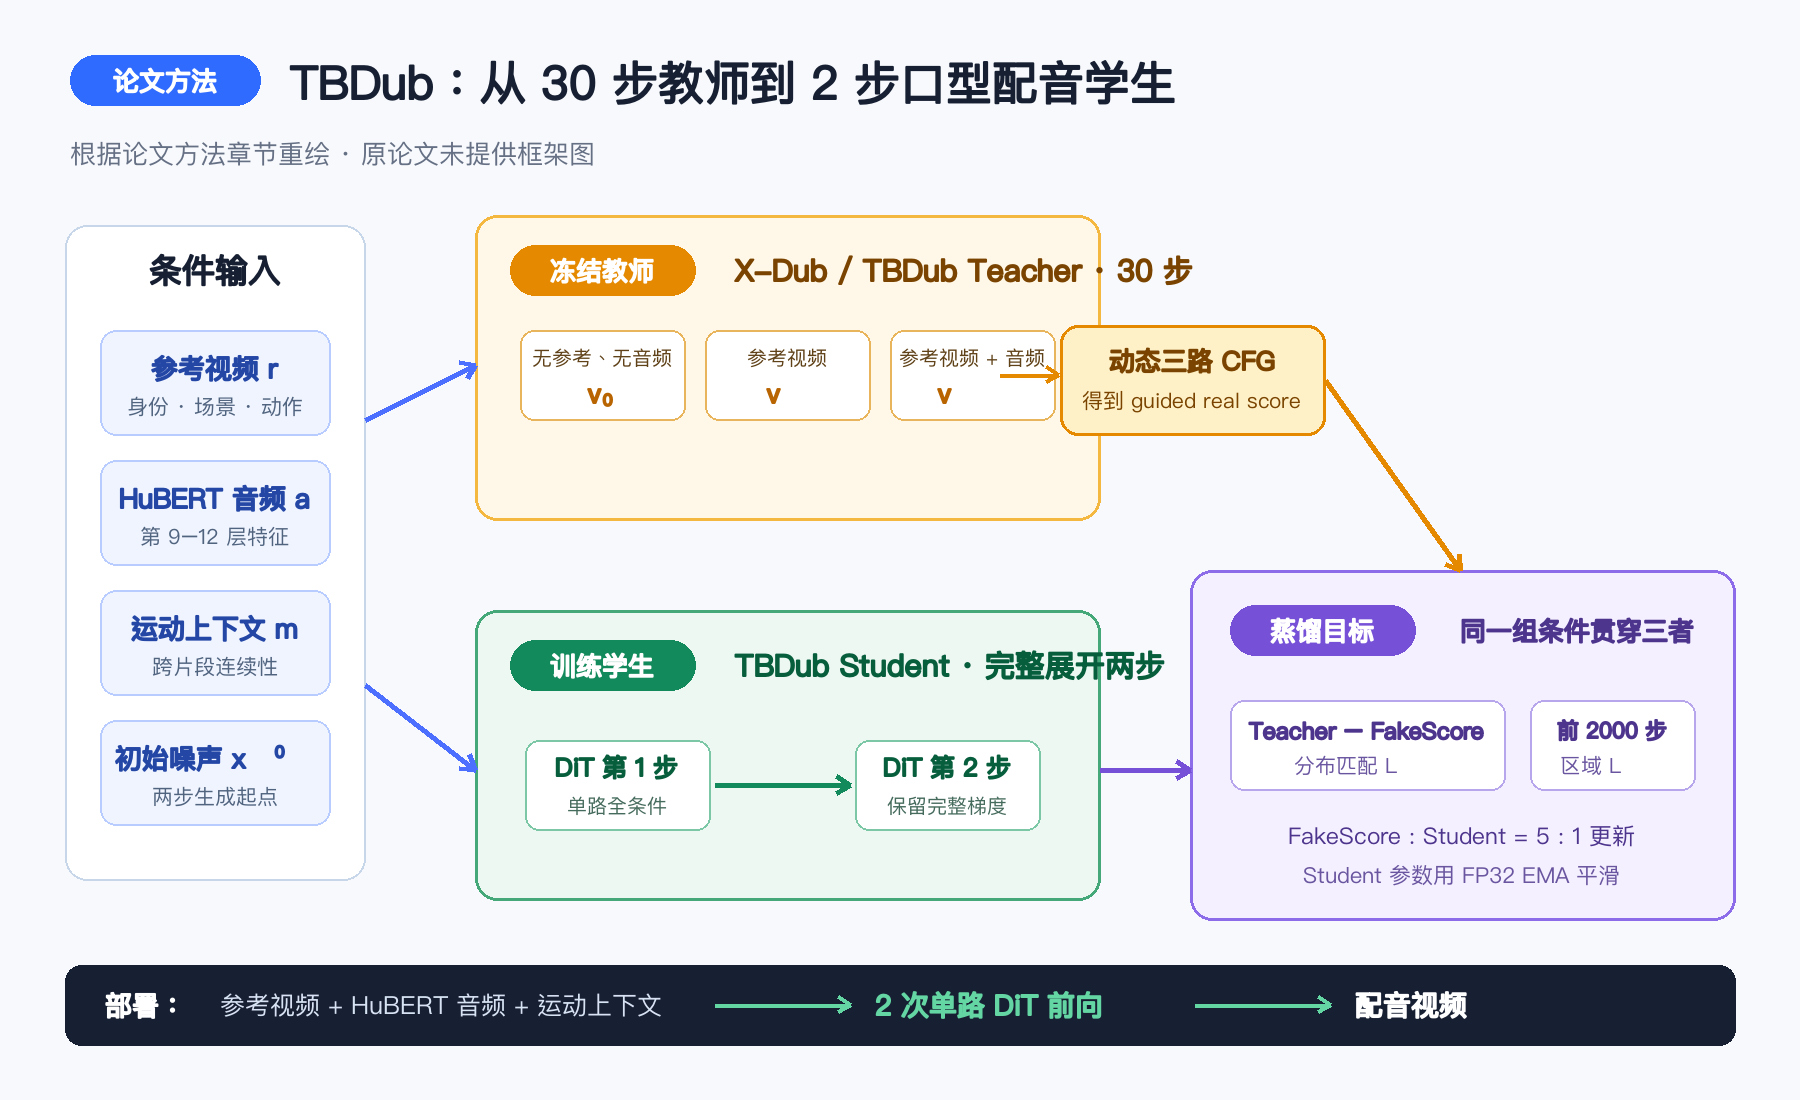
AIGC 每日速读|2026-09-09|阿里两步口型配音跑到7.13FPS-TBDub 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 TBDub(阿里巴巴淘天集团 TaoLive AIGC):两步口型配音跑到7.13FPS AlignGraft(新南威尔士大学):弱模型一次对齐全家复用 ⚡ SeRV(俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校):375小时数据生成3D手语 PAI-Actor(Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab):1080P多角色电影替换 MVWeaver(中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学):1861支MV教会歌曲转镜头 今日论文速览 1. TBDub:两步口型配音跑到7.13FPS TBDub: Production-Oriented Visual Dubbing | 阿里巴巴淘天集团 TaoLive AIGC | arXiv:2609.06144 关键词:视频编辑,视觉配音,少步蒸馏,口型同步 ⚠️ 前序问题:把原视频语音替换为新音频时,嘴形必须同步,同时还要保住身份、牙齿、光照、遮挡与背景。X-Dub 在干净数据上有效,但面对直播压缩、绿幕素材和上游生成视频时,容易出现嘴部粘连、身份漂移、边界闪烁,并且 30 步采样难以投入生产。 本文贡献:TBDub 先用生产域数据、失败规则、非对称条件退化、干净口腔先验和多层 HuBERT 音频特征,对完整视频 DiT 做任务自适应后训练,得到 30 步教师;再把 DMD/DMD2 改造为条件视频编辑蒸馏,对完整两步轨迹反向传播,并用分区重建监督稳定身份和口腔细节,得到两步学生。 编辑依据论文方法章节重绘;原论文未提供方法框架图。 实验效果:在 38 段 TalkVid 视频上,教师相对 X-Dub 的口型同步、身份一致性和视觉质量 MOS 分别提高 0.14、0.95 和 0.90 分。两步学生在单张 NVIDIA H20、512×512 的端到端计时中达到 7.13 FPS,总延迟降低 13.93 倍,DiT 阶段加速 42.49 倍,同时大体保留教师的画质与音画同步。 论文 Table 4:单张 NVIDIA H20、512×512、VAE-to-VAE 计时边界下的端到端生成吞吐量。 批判点评:38 段视频与单一 H20 配置仍不足以覆盖真实直播中的语言、脸型、遮挡和码率变化;音频前端使用英语 HuBERT,也需要跨语言检验。方法继承 Wan 与 X-Dub 的大部分能力,训练数据和生产过滤规则对结果贡献很大,不能只归因于两步蒸馏。 2. AlignGraft:弱模型一次对齐全家复用 Test-Time Weak-to-Strong Alignment: Transferring Implicit Rewards from Weak to Strong Flow Models | 新南威尔士大学 | arXiv:2609.05968 关键词:测试时对齐,流模型,弱到强迁移,偏好优化 ⚠️ 前序问题:每个新生成模型、检查点和奖励目标都重新做强化学习或偏好优化,成本高且把奖励强度永久写死。现有测试时对齐又常要求奖励函数梯度或另训价值模型,部署仍需保留奖励基础设施。 本文贡献:AlignGraft 保存一个弱模型的“基础版与已对齐版”模型对,把两者在每个采样步的速度差视为隐式奖励方向,再将这段差值加到同潜空间、同前向加噪核的强模型速度上。强模型保持冻结,测试时只用一个标量调节对齐强度,不需要奖励评估、反向传播或新的微调。 实验效果:把 SD3.5-Medium 的 GenEval 对齐迁移到 SD3.5-Large 后,强模型总分从 0.68 升到 0.90,接近源对齐模型的 0.93;位置关系从 0.28 升到 0.91,计数从 0.67 升到 0.84。相同思路也在 FLUX 同族模型和 Wan 1.3B 到 14B 视频模型间提升了多项偏好与对齐指标。 批判点评:迁移要求源模型对能在强模型状态上给出分布内信号,并共享潜空间和噪声过程;跨完全不同架构并非自动成立。弱模型学到的奖励偏差也会被一起移植,强度外推过大可能损害保真度。 3. SeRV:375小时数据生成3D手语 SeRV: Semantic-Aligned Residual Vector Quantization for American Sign Language Generation | 俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校 | arXiv:2609.05742 关键词:手语生成,残差向量量化,动作生成,语义对齐 ⚠️ 前序问题:手语动作令牌器通常只追求姿态重建,未必把文本语义组织进离散空间;后续生成器即使能复原大动作,也可能把承载词义的手形和细粒度关节做错。配对的文本与三维手语动作数据又很稀缺。 本文贡献:SeRV 在残差向量量化器中同时加入句子级动作文本对齐和令牌级文本条件监督,让粗到细的多层码本既可重建动作又可预测语义;随后用分层 GPT 逐级生成身体和手部令牌。团队还从 YouTube-ASL 视频恢复三维动作,构建 375 小时的动作文本基准。 实验效果:在 YouTube-ASL 上,身体与手部 DTW-JPE 分别为 4.98 和 6.70,优于 SOKE 的 5.42 和 7.44;SiBLEU-4 从 2.18 提升到 3.13。在 How2Sign 上身体与手部误差也最低,不过 MaDiS 的 SiBLEU-4 为 4.47,仍高于 SeRV 的 4.12。 批判点评:训练数据来自二维视频重建的三维动作,手指遮挡与视角误差可能被写进码本。DTW-JPE 与 SiBLEU 不能完全代表手语可理解性,仍需由聋人和专业手语者做语义、自然度与文化适切性评测;结论目前也只覆盖美国手语。 4. PAI-Actor:1080P多角色电影替换 PAI-Actor: Cinematic Multi-Character Replacement in Dynamic Scenes | Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab | arXiv:2609.05918 关键词:角色动画,视频编辑,多角色生成,自回归蒸馏 ⚠️ 前序问题:角色替换系统多围绕单张人物或单主体展开,面对电影中的多人互动、遮挡、手持物、相机运动和动态光影时,容易改坏背景或让身份漂移;双向视频模型画质高,却难扩展到长片段。 本文贡献:PAI-Actor 把多角色替换改写为结构引导的人体恢复:从电影中抹去原演员,以身体与人脸关联后的骨架和每个角色参考图作为条件,在约 3 万段电影片段上训练 1080P 双向 DiT。随后通过因果适配与 on-policy self-forcing,把双向教师蒸馏为可使用 KV 缓存的自回归视频到视频模型。 实验效果:论文在角色动画子集的大多数指标上优于对比方法,并展示多人身份、背景与姿态一致性。自回归学生可生成约 417 帧、17 秒的 1920×1056 视频,而双向教师因全局注意力不能扩展到该长度。 批判点评:训练三个阶段合计数百 GPU 小时,峰值显存约 114 至 136 GB,生产门槛很高。电影数据还涉及演员肖像、版权与合成滥用风险;失败案例中极端像素位移、复杂遮挡和长时身份漂移仍未解决。 5. MVWeaver:1861支MV教会歌曲转镜头 MVWeaver: A Hierarchical Music Video Generation Agent with a Learned Song-to-Visual Bridge | 中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学 | arXiv:2609.06478 关键词:音乐视频,生成智能体,分层规划,音画生成 ⚠️ 前序问题:自动音乐视频系统可以拼出漂亮镜头,却常停留在歌词字面联想:整首歌的情绪、人物动机和反复意象没有发展,镜头之间也缺少可追踪的概念与状态。 本文贡献:MVWeaver 先做结构化歌曲分析,再由视觉规划器生成全局概念、段落计划和可执行镜头,最后调用图像与视频模型渲染。关键的 song-to-visual bridge 来自 1861 组真实歌曲与 MV,包含歌曲侧、MV 侧以及教师推导的转译理由,并用 LoRA 微调大语言模型学习从听歌理解到视觉设计的中间桥。 实验效果:在 1 至 5 分评测中,MVWeaver 的歌曲解释、视觉发展、概念连贯和镜头连续得分分别为 4.08、3.63、4.30、4.10,均高于 AutoMV 和去掉桥接模块的版本;与所有对比方法成对比较后的总体用户偏好率为 67.06%,AutoMV 为 30.59%。 批判点评:1861 组真实 MV 的规模、文化分布和版权来源会影响桥接模型学到的视觉惯例。长视频一致性评分仍难覆盖完整观影体验;若歌曲分析出错,层级规划会把错误系统性传播到所有镜头。 6. ToPO:把整图偏好路由到词和像素 ToPO: Token-Conditioned Preference Routing for Attention-Based Latent Diffusion Models | 清华大学、电子科技大学、斯坦福大学 | arXiv:2609.03688 关键词:偏好优化,扩散模型,注意力,空间时间路由 ⚠️ 前序问题:一条成对偏好只说明整张图谁更好,却没有指出哪个提示词、空间位置和去噪时刻该更新。Diffusion-DPO 把全局信号铺到大量局部坐标,容易浪费梯度或修错区域。 本文贡献:ToPO 用冻结参考去噪器比较优选与劣选分支的局部平方残差,构造与小批次相关、停止梯度的可分空间时间路由;再用优选分支交叉注意力把内容词映射回空间,并加入像素中点排序项。整个过程不需要局部标签或另训奖励模型。 实验效果:在 SD-1.5 上,ToPO 的 GenEval 与 T2I-CompBench 平均分为 0.5092 和 0.4123,高于 Diffusion-DPO 的 0.4591 和 0.3521;在 SDXL 上 GenEval 为 0.6168,T2I-CompBench 为 0.4975,与 Diffusion-DPO 的 0.4974 近似持平。300 提示盲测的六组问题中,ToPO 均获得更多原始选择。 批判点评:路由依赖参考模型残差和交叉注意力的可解释性,未证明可直接迁移到所有 DiT 或无交叉注意力架构。盲测只公开聚合计数,不能进行参与者层面的显著性推断;部分 SDXL 自动指标也没有全面领先。 7. Diffuse2Seg:扩散模型零训练造分割标签 Diffuse2Seg: Diffusion Models Can Segment Anything Without Supervision | 柏林工业大学、CARIAD SE(大众汽车集团) | arXiv:2609.06491 关键词:开放世界分割,扩散特征,伪标签,无监督学习 ⚠️ 前序问题:SAM 的开放世界分割能力依赖 1100 万图像和超过 10 亿人工掩码,继续扩大标注极其昂贵。自监督视觉特征生成的伪标签又常偏向前景物体,难覆盖天空、道路等无定形区域。 本文贡献:Diffuse2Seg 不训练扩散模型,而是从文生图模型的自注意力中提取对象结构,将密集点网格通过保边的非线性 p-Laplacian 传播为软掩码,再合并为从部件到完整物体的多粒度实例图,去重后用于训练开放世界分割器。 实验效果:生成伪标签在五个领域的 AR1000 比此前最佳标签生成器高 4.3 至 7.1 个百分点。用这些标签训练的无检测器分割模型在 things 与 stuff+things 上分别提升 7.4 和 7.7 个百分点,并在后者超过检测器式 UnSAM 2.1 个百分点。 批判点评:伪标签会继承文生图训练数据的类别偏差,对小目标、透明物、医学或机器人极端域未必可靠。评测以平均召回为主,边界精度和错误标签对下游安全任务的影响仍需单独检查。 8. OAVC:只改目标不带跑背景 Object-Aware Background-Controlled Editing via Weighted Velocity Guidance | 卡内基梅隆大学、中国科学院计算技术研究所、中国科学院大学 | arXiv:2609.06288 关键词:图像编辑,视频编辑,免训练控制,整流流 ⚠️ 前序问题:免训练编辑通常把源提示与目标提示的速度差全局加到潜空间。目标之外的小残差虽然单步很弱,却会在多步积分中累积,最终带跑背景纹理、反射和物体边界。 本文贡献:OAVC 把“语义残差能在哪里生效”和“如何注入动力学”拆开:先在源提示下建立背景锚点和对象支持区,再用受约束的投影抑制会引发漂移的速度分量,并按时间和边界置信度加权注入目标语义。它不训练或修改预训练模型参数,可接到 SD3.5、FLUX 和视频流编辑器上。 实验效果:在 PIE-Bench 上,FLUX 版本相对 DNAEdit 将结构距离从 18.87 降至 4.07,背景 PSNR 从 24.99 dB 提升到 33.30 dB;SD3.5 版本也从 14.19 降至 4.11、从 26.66 dB 升到 32.64 dB。100 例盲测中,OAVC 赢下 94 个有明确结果的背景保持比较中的 74 个,占 78.7%。 批判点评:默认依赖 SAM3 提供对象支持区,分割遗漏或膨胀会直接限制编辑。它在背景保持上更强,但 CLIP 编辑性分数较低;人工评测也显示编辑实现偏好差异未达 0.05 显著水平,存在保真与改动强度的权衡。 9. AngelFingerprint:水印直接藏进编辑模型权重 AngelFingerprint: A Traceable, Explainable, and White-Box Stealthy Watermark for Text-Guided Image Editing | 台湾大学、日本国立信息学研究所 | arXiv:2609.04709 关键词:生成水印,图像溯源,文本引导编辑,白盒安全 ⚠️ 前序问题:常见生成水印只携带固定 ID,能说明图像来自哪个模型,却无法解释改了什么;水印若由独立编码器或后处理模块写入,在开源白盒场景中又容易被定位和移除。 本文贡献:AngelFingerprint 用 LoRA 把编辑提示的 CLIP 文本嵌入写进扩散模型权重,专用提取器再从像素恢复语义载荷。速度对齐锚点限制水印对编辑结果的扰动,仿照 JPEG 的 DCT 中频掩码避开显眼低频和脆弱高频,让架构、推理代码与计算图保持不变。 实验效果:在 MagicBrush 的 200 候选提示检索中,SD3-Medium 版本 Top-1 为 86.0%、MRR 为 0.917,而提示反演 Top-1 为 20%;UltraEdit 版本 Top-1 为 65.5%。中频滤波版本在水印开关之间得到 PSNR 22.91 dB、SSIM 0.704。 批判点评:把 LoRA 融入权重提高了隐蔽性,却没有证明能抵抗模型再训练、合并、剪枝或蒸馏等强白盒攻击。200 路封闭检索和单一编辑数据集规模有限;语义载荷也会带来隐私与滥用提示暴露问题。 10. Srijika:生成66套可安装印度字体 Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts | Loopdesk Technologies LLP | arXiv:2609.05661 关键词:字体生成,扩散模型,OpenType,印度文字 ⚠️ 前序问题:印度婆罗米系文字包含大量合字、半形和元音附标。只生成漂亮字形位图并不能得到可用字体,因为 cmap、GSUB 替换闭包、GPOS 定位和锚点关系必须共同满足排版引擎契约。 本文贡献:Srijika 不从零生成字体,而是保留完整模板字体的字符映射与替换闭包,用约 650 个开放许可字体族的检索系统 Lipika 将自然语言风格落到参考字体,再由参考条件潜扩散逐字重绘轮廓。内容门控、风格协调和排版簇验证会自动回退失败字形,最终重建为 TTF。 实验效果:系统产出 66 个 TTF,包含 57 个预设和 9 个开放词汇示例;全部通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在高难合字探针上复现模板字形 ID 序列,并审计 80,915 个字形与 54,812 个锚点。 批判点评:论文只与无学习基线比较,缺少独立风格指标、人类研究和完整 GPOS 视觉质量审计。检索编码器与评测嵌入的数据并非完全独立,风格提升可能被高估;工程上的回退机制保证可安装,却可能留下大量未真正重绘的字形。 趋势观察 少步与长视频开始接受完整系统计时 TBDub把视觉配音压到两步并报告VAE到VAE的端到端速度,PAI-Actor则诚实披露17秒视频仍需95分钟;生产可用性正在从采样步数口号转向全链路成本。 对齐信号从整图分数走向可迁移局部场 AlignGraft把弱模型对的速度差跨规模移植,ToPO把整图偏好分配到词元、空间和时间,说明生成对齐正从重复微调转向复用和精确分配。 生成系统更重视可验证的结构契约 SeRV用语义码本约束手语,OAVC显式限定对象区域,AngelFingerprint嵌入可恢复提示,Srijika复用OpenType闭包;输出是否可编辑、可追溯、可执行,正与视觉质量同样重要。 人工智能炼丹君 整理 | 2026-09-09 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
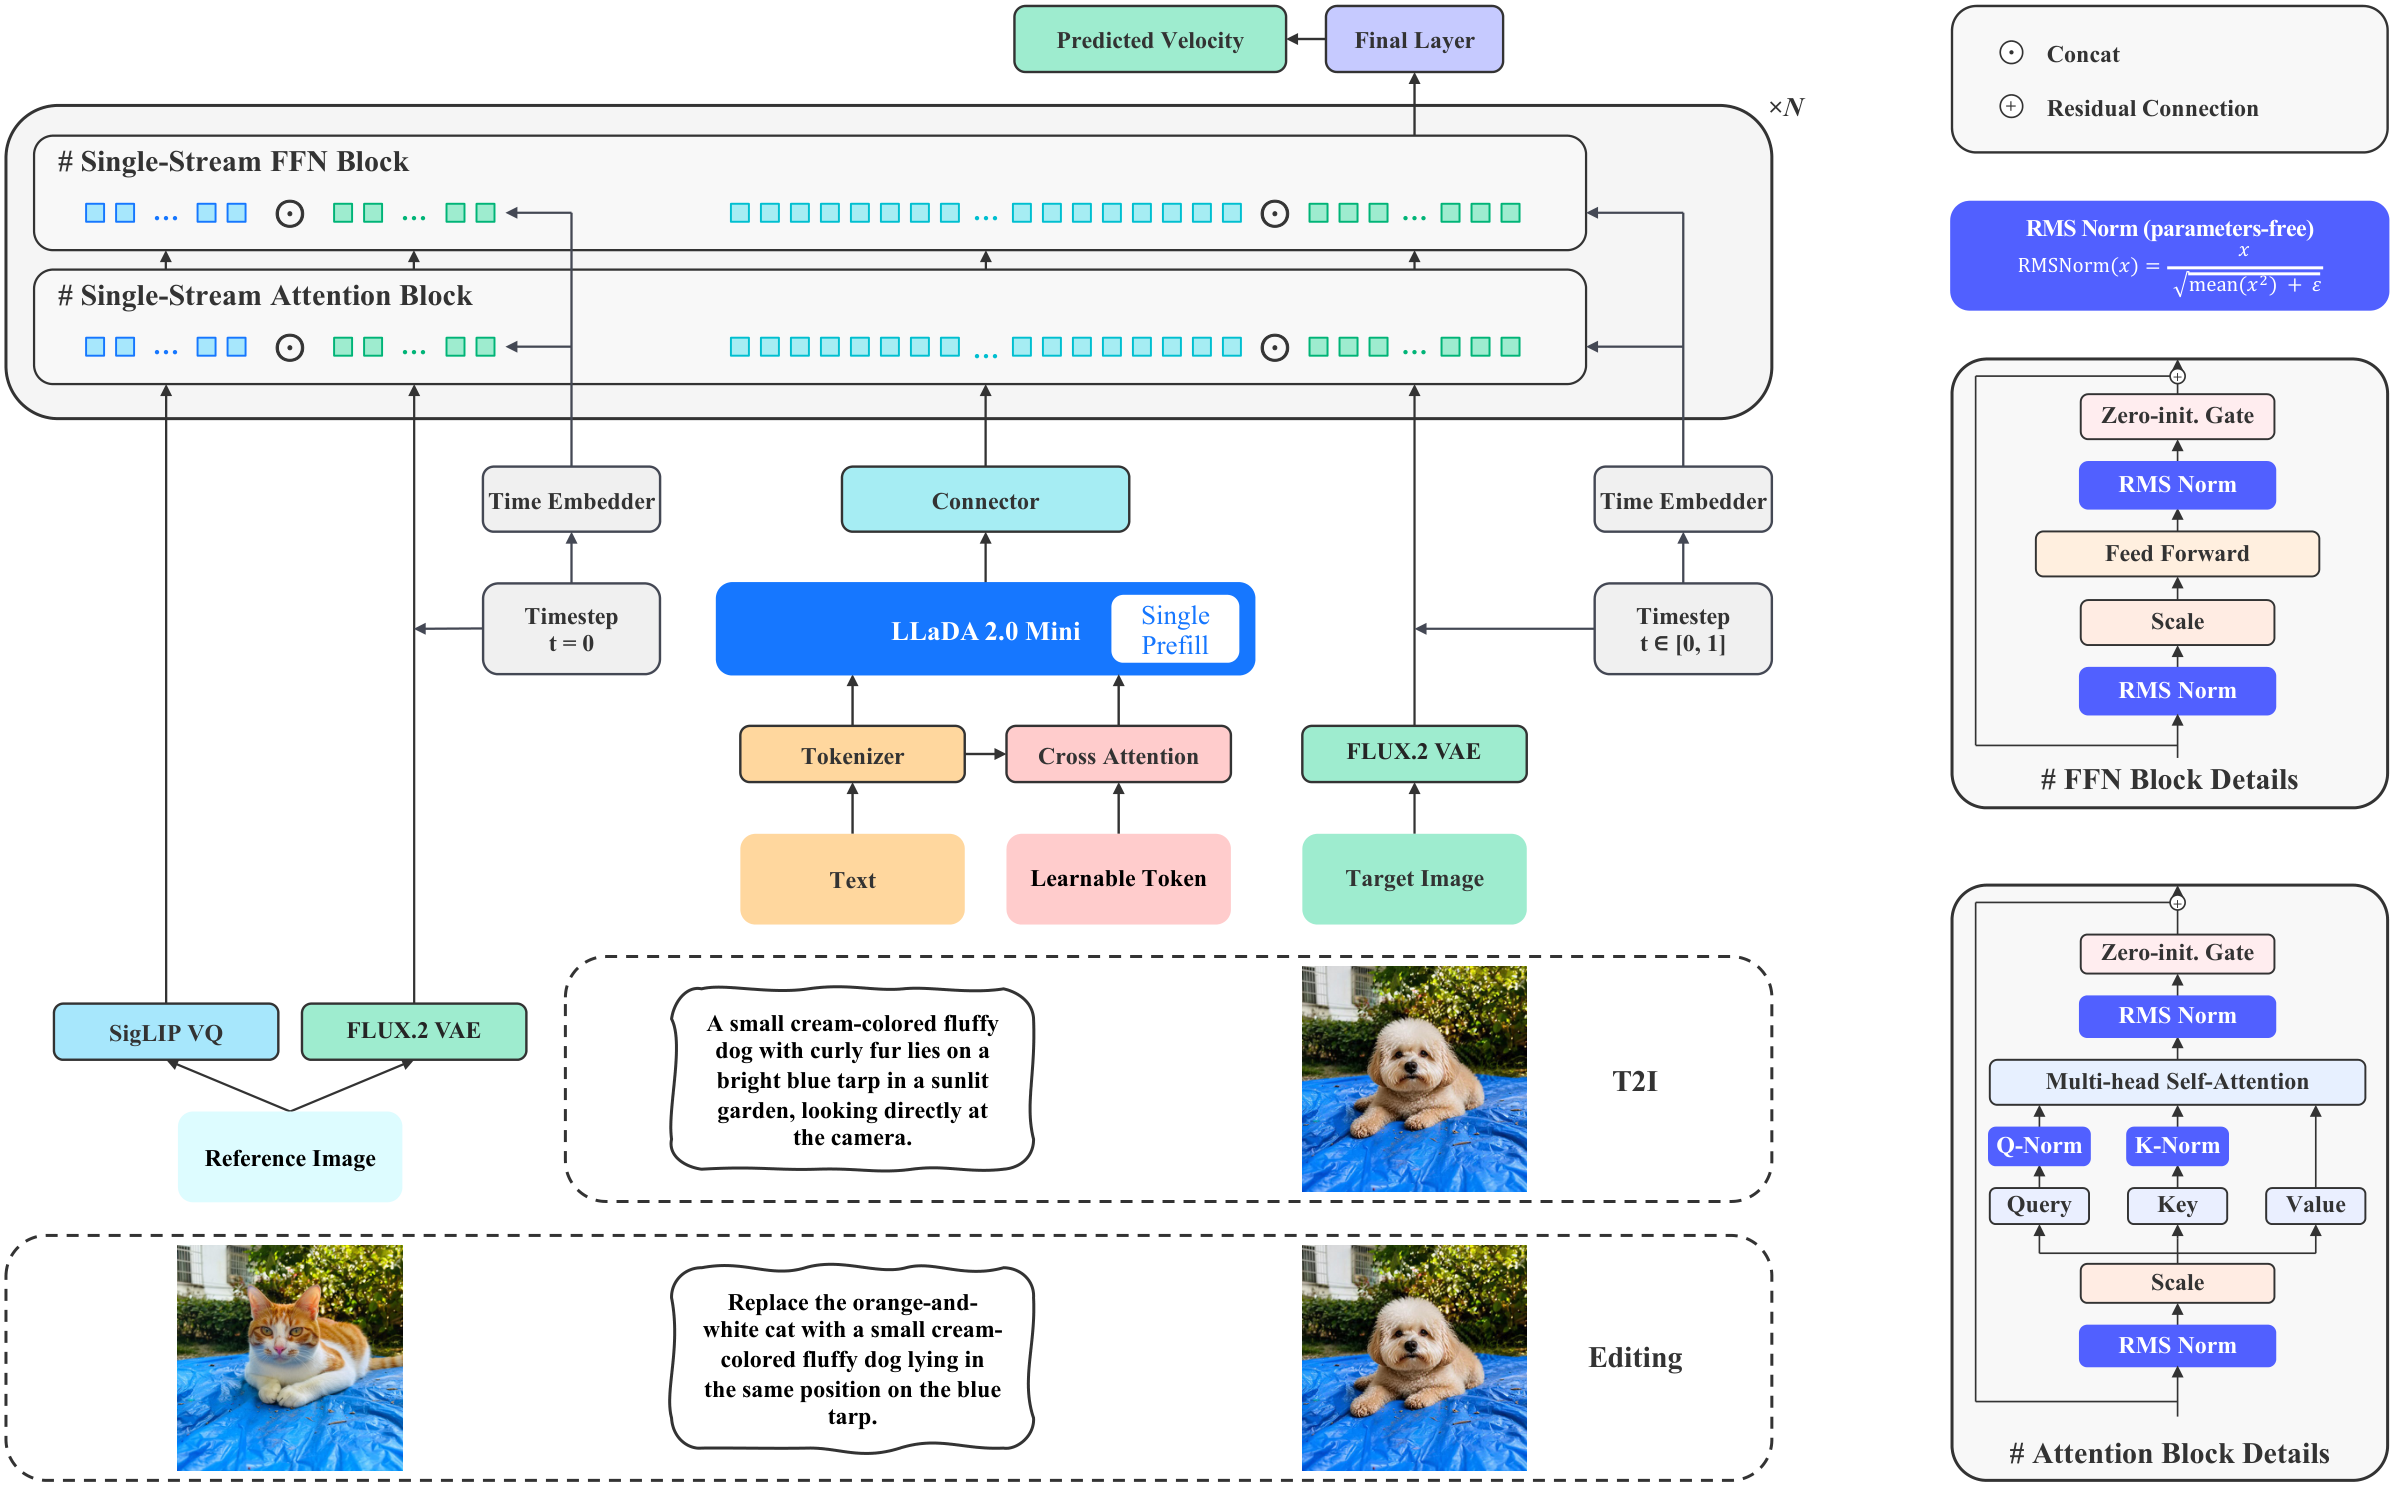
AIGC 每日速读|2026-09-08|蚂蚁从零训6B开源生图-LLaDA-Image 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 LLaDA-Image(Inclusion AI AGI Research Center):从零训练开放生图模型 DSAQuant(Robbyant、浙江大学、香港理工大学、香港科技大学):按去噪阶段做视频量化 ⚡ DM-Align(清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学):四步视频同时对齐与蒸馏 RA-GRPO(清华大学、快手科技):用反思轨迹稳定生成对齐 VoRTeC(清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学):用生成流做一步视频解码 今日论文速览 1. LLaDA-Image:从零训练开放生图模型 LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes | Inclusion AI AGI Research Center | arXiv:2609.03796 关键词:图像生成,开放模型,扩散语言模型,模型蒸馏 ⚠️ 前序问题:高质量图像生成模型常依赖不透明的数据配方、训练细节或已有模型权重,研究者难以复现从零训练过程;把理解、生成和编辑统一起来也容易牺牲其中一项能力。 本文贡献:作者从零训练一个 6B 参数 DiT,并接入冻结的 LLaDA2.0-Mini 视觉语言理解模块。训练先用纯图像预训练建立视觉先验,再做中期训练和图文统一训练;全流程使用 2.2 亿样本,其中 98% 为真实图像,并公开权重、代码和训练配方。团队还用 TwinFlow 将模型蒸馏为 2 至 4 步推理的 Turbo 版本。 实验效果:LLaDA-Image 在 Qwen-Image-Bench 英文与中文轨分别得到 53.53 和 53.38,领先当时其余开源模型;LongText-Bench 英文、中文得分为 0.923 和 0.913。编辑基准 GEdit-Bench 的英文、中文总分为 7.336 和 7.294,说明统一模型已具备较强的生成、文字渲染与编辑能力。 批判点评:2.2 亿样本的收集、清洗和训练成本仍然很高,公开配方也不会自动解决数据授权与可追溯性问题。报告覆盖模块很多,但部分组件的独立贡献和跨架构可迁移性仍需更多消融验证。 2. DSAQuant:按去噪阶段做视频量化 DSAQuant: Denoising-Stage-Aligned Quantization-Aware Training for Video Generation | Robbyant、浙江大学、香港理工大学、香港科技大学 | arXiv:2609.04031 关键词:视频生成,量化感知训练,低比特推理,部署优化 ⚠️ 前序问题:视频扩散模型压到 W4A4 或 W3A3 后,通常还能保住提示词语义、构图与粗粒度运动,却会明显丢失纹理、锐度和局部细节。传统量化训练把所有去噪时刻一视同仁,没有利用早期规划结构、后期补细节的分工。 本文贡献:DSAQuant 按去噪阶段切换监督目标:早期保持教师蒸馏以稳定全局结构与运动,后期逐渐转向目标驱动的细节重建;推理时在最后阶段关闭分类器自由引导,避免量化误差被 CFG 放大为高频伪影。方法同时覆盖 Wan 与 CogVideoX 系列。 实验效果:在 Wan2.1-1.3B 的 W4A4 设置下,DSAQuant 的 VBench 平均分为 67.21,高于 BF16 模型的 66.28 和 QVGen 对称量化的 63.56;在更激进的 W3A3 下,相对当时量化训练基线最高提升 6.60 分。 批判点评:论文重点验证生成质量,没有把端到端延迟、显存、能耗和不同硬件内核的实际收益放在同等位置;量化感知训练本身也有额外成本。后期关闭 CFG 可能改变文本对齐,需要在更广的提示与长视频任务上验证。 3. DM-Align:四步视频同时对齐与蒸馏 Joint Alignment and Distillation for Video Generation via Sample-Guided Distribution Matching | 清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学 | arXiv:2609.04283 关键词:视频生成,偏好对齐,分布匹配,少步蒸馏 ⚠️ 前序问题:视频生成的偏好对齐与少步蒸馏通常分成两段:先强化学习再蒸馏计算昂贵,先蒸馏再做强化学习又容易让模型坍塌。两段流程还要重复运行多步奖励评估,并在 ODE 与 SDE 轨迹间转换。 本文贡献:DM-Align 在一次分布匹配训练中同时叠加两种梯度:DMD2 梯度缩小真实模型与学生模型的分布差距,偏好梯度则利用成对偏好或组内探索,把生成分布推向人类偏好的样本。它把类似 DPO 与 GRPO 的信号写进同一训练目标,直接产出 4 次函数评估的视频模型。 实验效果:在 Wan2.1-T2V-1.3B、5 秒 832×480 视频上,组内模式以 4 NFE 得到 VBench 平均分 84.40、动态度 80.19;成对模式为 82.78。人工比较中,成对模式相对原模型净偏好提升 48%,相对单独 DMD2 提升 32%。 批判点评:实验集中在 1.3B 基模、5 秒 480p 视频,尚不足以说明长视频与更大模型也能稳定受益。样本引导仍依赖奖励或偏好数据,奖励偏差与奖励投机只是减轻,不能视为消失。 4. RA-GRPO:用反思轨迹稳定生成对齐 Step Back to Move Forward: Reflection-Aware Preference Optimization for Visual Generation | 清华大学、快手科技 | arXiv:2609.04282 关键词:偏好对齐,扩散模型,强化学习,奖励投机 ⚠️ 前序问题:生成模型用策略梯度对齐人类偏好时,探索常被局部最优牵引:奖励上升了,语义忠实度或真实感却可能下降。常规 GRPO 只从当前前向采样学习,很难主动修复已经偏离高概率数据流形的中间状态。 本文贡献:RA-GRPO 在训练中加入“向后反思”。Diffusion Reflection 在随机中间时刻用较弱估计器反演并校正潜变量,再由 Counterfactual Path Synthesis 把校正后的路径蒸馏回策略。反思只发生在优化阶段,因此部署时没有额外采样开销。 实验效果:在 FLUX.1-dev 与 HPSv2.1 提示集上,以 HPS 为奖励时,RA-GRPO 的 HPSv2.1、ImageReward、HPSv3 分别为 0.378、1.417、15.324,均高于论文复现的 DanceGRPO 与 MixGRPO;多目标 HPS+CLIP 训练也取得更均衡的自动指标。 批判点评:验证主要围绕 FLUX.1-dev、HPS 提示和自动奖励模型。弱估计器、指导强度与反思时刻的选择会影响稳定性;只看自动奖励仍可能漏掉新的投机模式,需要更大规模人工偏好与跨模型复核。 5. VoRTeC:用生成流做一步视频解码 VoRTeC: Taming Foundation Flow for One-step Real time Video Compression | 清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学 | arXiv:2609.02291 关键词:视频压缩,流模型,实时解码,超低码率 ⚠️ 前序问题:传统神经视频压缩在超低码率下容易模糊,而扩散式生成压缩通常需要多步采样,难以实时运行。如何借用强视频生成模型的先验,又不复制其昂贵迭代过程,是部署瓶颈。 本文贡献:VoRTeC 冻结 Wan2.1 流模型,只训练紧凑潜码与轨迹位置预测器,用多尺度先验把一次解码对齐到生成流。跨帧组复用尾帧,并缓存生成先验,以降低连续视频的重复计算;训练不需要访问基础流模型的参数或梯度,可在单张 A6000 上完成。 实验效果:论文报告在相近感知质量下可节省 58.12% 至 73.25% 码率,并达到低于 0.01 bpp;推理相对多步生成压缩加速 3 至 197 倍,720p 达 13 fps、480p 达 32 fps。 批判点评:速度依赖具体显卡、分辨率与缓存条件,不能直接外推到移动设备。对取证、医疗、遥感等要求像素真实性的场景,生成先验可能引入不可接受的幻觉,需要独立的保真约束与错误标记。 6. Editable Visual Design:让视觉设计真正可编辑 Editable Visual Design | 腾讯混元、中山大学、清华大学、香港中文大学、上海交通大学 | arXiv:2609.04034 关键词:视觉设计,智能体,图像生成,HTML CSS ⚠️ 前序问题:文生图可以快速给出海报或信息图,但输出通常是一张扁平位图,文字、图标和布局无法继续精确编辑;纯代码生成又容易缺少视觉想象与审美反馈。 本文贡献:该系统让视觉语言模型充当创意大脑、图像生成器充当视觉世界模拟器,先想象整体效果,再把素材隔离为独立资产并用原生 HTML/CSS 重建文字、层级与布局。Agent Design Replay 学习专业设计轨迹,智能体通过截图反馈持续比较和修改。 实验效果:论文用海报、信息图、营销物料和长文本版式等案例展示:输出中的文字保留为真实文本,元素可以用鼠标拖动,图层与样式可继续修改。论文当前以定性案例证明可编辑工作流,没有给出可横向比较的统一量化分数。 批判点评:缺少大规模用户研究、任务完成时间和跨基线量化评测,使“更专业”仍难精确判断。流程依赖图像生成和代码智能体的能力,素材版权、网页代码安全与复杂版式的兼容性也需要产品级约束。 7. Temporal Context Routing:把脚本精确路由到时间轴 The Missing Temporal Link: Temporal Context Routing for Script-Driven Audio-Video Generation | 北京大学、Qwen Applications、香港科技大学、香港中文大学、上海交通大学 | arXiv:2609.02367 关键词:音视频生成,时间控制,脚本驱动,多模态生成 ⚠️ 前序问题:脚本驱动的音视频生成会同时处理镜头、对白、动作和音效,但全局文本条件不知道某条指令应该在哪一秒生效,常出现切镜过早、对白错位或动作与声音不同步。 本文贡献:Temporal Context Routing 先把脚本事件映射到音频与视频共享的时间轴,再将每段提示的引导信号只路由到匹配的时空位置。它给现有联合音视频模型补上显式时间链接,而不用让所有帧共同接受整段脚本。 实验效果:在 200 条测试脚本上,镜头边界平均绝对误差从 1.11 秒降到 0.042 秒,下降约 96%;对白在 0.5 秒容差内的准确率从 28.3% 提升到 84.1%,同时视觉质量与音画同步指标保持相近。 批判点评:实验规模仍有限,长叙事、重叠对白、快速多事件和镜头外音源会让路由更复杂。用户研究偏好不能替代对叙事连贯性与错误恢复的长期评估。 8. Unreal Engine World Data:用虚幻引擎规模化造数据 Building Pretraining Data for World Models: An Unreal Engine-Based Pipeline for Action-Conditioned Video Generation | Joy Future Academy、京东、清华大学、香港科技大学 | arXiv:2609.03557 关键词:世界模型,合成数据,虚幻引擎,动作条件视频 ⚠️ 前序问题:动作条件世界模型需要既有可控动作轨迹、又有高质量画面的长视频数据。直接在游戏引擎中边运行物理、边实时渲染,容易因帧率波动破坏动作与画面对齐,也难在数百 GPU 上稳定扩展。 本文贡献:作者把流程拆成两段:PIE 先按真实物理运行并记录角色、控制和相机状态,MRQ 再离线重放轨迹并高质量渲染。系统加入缓存感知的任务分片、节点槽位、场景筛选、亮度与审美过滤,以及失败恢复、上传和健康检查。 实验效果:在 25 台服务器、共 200 张 RTX 5090 上,系统从 2384 个资产包整理出 429 个关卡与 40 个类人角色,生成 2691 小时 1080p 和 6076 小时 720p 动作条件视频,并用于 EchoWM 数据建设。 批判点评:合成场景仍有引擎域偏差,审美和亮度过滤可能进一步删掉困难样本;资产许可、人物动作覆盖和 200 GPU 的成本也决定了复现门槛。数据规模不能替代真实世界验证。 9. Structured-Prior Inpainting:给交通标志注入物理先验 Structured-Prior-Guided Diffusion Inpainting with Physical Consistency for Traffic Sign Augmentation | 高德地图、阿里巴巴集团 | arXiv:2609.02348 关键词:图像修复,合成数据,交通标志,物理一致性 ⚠️ 前序问题:稀有交通标志样本不足,但普通文生图或修复模型容易生成错误文字、色彩和边缘。视觉上“像标志”还不够,训练检测器需要类别语义、模板几何与法规颜色都准确。 本文贡献:方法把三类结构先验送入扩散修复:JSON 语义提示描述类别,正视矢量图通过 IP-Adapter 提供测量颜色,仿射对齐的矢量模板通过 ControlNet 约束几何;训练再加入 CIELAB 颜色 L1 损失和 Sobel 边缘损失,强化物理一致性。 实验效果:在 TT100K2021 零样本测试中,OCR 完全匹配率为 91.1%,而 12B 参数 FLUX.1 Fill 为 44.2%;基于 SD1.5 的方案推理时间约为其十四分之一。把合成图加入训练后,稀有类别 AP50 提升到原来的 1.23 至 7.40 倍。 批判点评:公开验证集中在一种交通标志数据源,检测增益会受合成比例、地区法规、拍摄距离和天气影响。用于道路安全前,还需跨国家模板、夜间、遮挡和极端退化测试,并保留可审计的生成记录。 10. Pitch-class Steering:用潜空间探针控制旋律 Pitch-class Steering for Diffusion-based Music Generation via Latent-space Probes | 卡内基梅隆大学、独立研究者 | arXiv:2609.04516 关键词:音乐生成,扩散模型,旋律控制,潜空间探针 ⚠️ 前序问题:文本能描述音乐风格,却很难要求扩散音乐模型严格跟随指定旋律。重新训练完整模型或改架构成本高,而 MIDI 条件又不一定能直接接入现有生成器。 本文贡献:作者用配对音频与 MIDI 训练一个 12.5 万参数卷积探针,从 Stable Audio Open 的 VAE 潜变量逐帧解码音高类别。生成时冻结基础模型,把探针的可微损失作为引导信号,在每步去噪中推动潜变量靠近目标旋律,不修改生成模型结构。 实验效果:在 9 个提示词与 3 条旋律组成的 27 次试验中,引导生成的旋律一致性相对无引导基线提升 2.4 倍;Wilcoxon 检验给出 p<1e-5。论文已被 IEEE MLSP 2026 接收。 批判点评:27 次试验规模很小,统计显著不等于覆盖多样音乐风格。每步反向传播引导会增加推理开销,配对 MIDI 数据的偏差也可能限制泛化;还需听感盲测和更长曲目验证。 趋势观察 生成训练开始公开到数据与优化器层级 LLaDA-Image不仅开放权重,还披露2.2亿样本、纯图像预训练、Muon与少步蒸馏配方,竞争焦点正从模型接口转向可复现的完整训练系统。 视频部署优化必须贴合去噪阶段 DSAQuant按阶段分配量化监督,DM-Align把偏好对齐和少步蒸馏并成一次训练,VoRTeC则预测生成流位置完成一步解码;三者都在利用生成轨迹的内部结构减少成本。 显式控制信号重新进入生成链路 时间路由、交通标志模板与音高探针分别把时间、物理几何和旋律注入生成过程,显示开放式文本提示正在与可验证、可定位的结构条件结合。 人工智能炼丹君 整理 | 2026-09-08 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-01|西湖大学让写代码的智能体当世界大脑CWM 今日 AIGC 论文速览 今日共 10 篇 · 世界模型与可执行状态 2 篇 · 长视频生成的记忆与一致性 2 篇 · 注意力与推理加速 1 篇 · 视频生成模型作为几何/物理先验 2 篇 · 生成式模型的规模律 1 篇 · 可控生成与工业落地 2 篇 重点论文标题列表 Code World Model(西湖大学 AGI Lab + 南洋理工大学):让写代码的智能体当世界大脑 LayerRecall(浙江大学 + 香港大学):只往记忆敏感层注入历史K/V SWA vs Linear Attention(Microsoft Applied Sciences Group):免训练滑窗高线性注意力2-10倍 DensityKV(Manifold AI + 清华大学):免训练把120秒历史压到3.28GiB CLAP(普林斯顿大学):人类视频也能训机器人世界模型 今日论文速览 1. Code World Model:让写代码的智能体当世界大脑 Code World Model: Coding Agent as World Brain | 西湖大学 AGI Lab + 南洋理工大学 | arXiv:2608.25927 关键词:世界模型,coding agent,可执行世界状态,proxy 视频,MiniMax-H3,时空约束,西湖大学,南洋理工 前序问题:现在的视频世界模型基本都是从视觉观测里学动力学,这条路有个结构性的短板:视频只呈现「发生了什么结果」,并不承载「为什么会这样、规则是什么」。于是模型学到的是像素层面的统计关联,而不是支配世界演化的知识与机制。后果很具体——持久性守不住。玩家砸碎的花瓶在几十帧之后可能自己复原,捡走的道具会重新出现在原地,因为「这个物体已经不存在了」这件事从来没有被显式记录,只是被寄望于模型的隐式记忆能扛住。开放式演化更是无从谈起:一个只会预测下一帧的模型没有可查询、可修改的世界状态,你无法问它「现在背包里有几把剑」,也无法让它在规则层面上一致地长期跑下去。真正缺的东西是一个显式、持久、可按规则更新的状态表示,而这恰好是视频模型这种表示形式最不擅长承载的。 本文贡献:Code World Model 的做法是把「世界如何演化」和「世界长什么样」彻底分开。前者交给语言模型的推理与编码能力:一个 coding agent 充当 world brain,接收交互意图,推理事件及其后果,然后写出可执行代码去更新一份持久的世界状态,从而保证演化是符合规则的、后果是留得住的。后者交给视频模型的生成先验。两者之间的桥梁是作者提出的 proxy representation——把世界状态编译成一段编码了逐帧时空约束的 proxy 视频(画面里是分割色块与骨架这类粗糙几何),再用它去条件化视频模型渲染出高保真观测。为此作者还建了数据管线,从游戏录像和真实视频里构造对齐的 proxy–observation 配对数据。实验用 MiniMax-H3 作为视频骨干在配对的 gameplay 数据上微调,结果它能跟随 coding agent 搭出的简单交互世界所给定的 proxy 时空规格,同时保留丰富的视觉细节与动态。 auto 实验效果:作者展示的核心结果是这套「代码管状态、视频管画面」的组合确实能跑通:微调后的 MiniMax-H3 遵循 proxy 指定的时空结构,把粗糙的色块骨架渲染成细节丰富的画面。视觉质量部分最值得注意的是数据效率——仅用五小时 GTA V 游戏录像做微调,模型就在角色、环境、运动方式和相机轨迹都不同的场景上表现出泛化能力,论文的 case 图里既有真人角色也有二次元角色(美少女战士造型),说明外观由文本与视频先验控制、运动由 proxy 控制这个分工是成立的。此外作者也在真实视频上构造了 proxy–observation 配对,说明这套表示不只适用于游戏。整体上论文的定位是可行性验证与范式提出,而不是刷榜。 auto 批判点评:这篇最有价值的地方是把「持久性」这个问题从模型能力问题重新定义成了系统架构问题。既然规则和状态本来就适合用代码表达,那硬要视频模型在隐空间里隐式维护它,本身就是拿错了工具;让 coding agent 写代码维护状态、视频模型只做渲染,是一个分工干净且可验证的设计——世界状态可以被打印、被断言、被单元测试,这在纯生成式世界模型里是做不到的。proxy 视频作为界面也选得务实:它同时携带几何与时序约束,又足够粗糙以至于生成模型有充分自由度补细节。但局限相当明显。第一,整套系统的天花板被 coding agent 顶住了——世界的规则得先被语言模型正确地推理并写成代码,稍微复杂的物理(流体、形变、多体接触)根本不是几行代码能覆盖的,论文验证的也确实是「simple interactive worlds」。第二,proxy 到观测这一步是有信息瓶颈的:proxy 只编码了粗粒度时空约束,那些不在 proxy 里的物理细节(材质变化、光影随事件的响应)就只能由视频模型自由发挥,未必与代码里的状态一致,这等于在系统中留了一道「状态与画面可能对不上」的缝。第三,实验缺少对照——没有和强视频世界模型在同一任务上比长程一致性,也没有量化「持久性」这个自己主打的卖点,比如「事件发生 N 秒后后果是否仍被正确渲染」这样的指标,读者只能从 case 里目测。 2. LayerRecall:只往记忆敏感层注入历史K/V LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation | 浙江大学 + 香港大学 | arXiv:2608.28460 关键词:长视频生成,记忆路由,分层注意力,K/V 检索,多镜头一致性,MemoBench,浙江大学,香港大学 前序问题:自回归视频扩散靠一个有界的近期上下文逐块生成,这让长视频在算力上变得可行,但也埋了一个必然的漏洞:基于时间邻近的缓存策略会把「暂时用不到」的历史逐出,而一旦某个主体、物体、场景或属性在几十秒后重新出现,需要的线索恰恰是刚被逐出的那部分。已有的记忆机制思路是给模型开一个通往非局部历史的通道,但作者指出一个关键区别——「能访问」不等于「会用」。他们的分析发现 video DiT 的各层对当前块、近期上下文与远期历史的偏好差异明显,也就是说层与层之间在记忆这件事上分工不同。这意味着长程记忆其实是两个耦合的决策:检索什么,以及在哪里用它。把历史无差别地灌进所有层,既浪费又可能干扰那些本该专注局部连续性的层。另一个现实约束是数据:高质量的长时程视频稀缺,显式的「记忆分配」标注更是根本不存在。 本文贡献:LayerRecall 是一个以当前状态为条件、按层选择的记忆路由器。它维护按层索引的记忆库存放有限的历史 K/V 候选,用当前块的隐状态算出一个查询(图中给出的形式是全局查询加上一个由 gate 与 MLP 调制的层相关增量 Δq),再用余弦相似度对各历史片段打分,决定检索哪些。关键的第二步是注入位置:检索到的状态只被送进事先剖析出的「记忆敏感层」,其余层完整保留原有的 sink、滑动窗口与当前块注意力上下文,因此局部连续性不受影响,额外开销也很小。为了摆脱对稀缺长视频和记忆分配标注的依赖,作者提出 Cross-Horizon Prediction Matching(CHPM),用短时程可得的监督信号来训练这个在预测空间工作的有界记忆路由器,绕开了显式标注。 auto 实验效果:在 100 条多镜头评测提示上,LayerRecall 在 MemoBench 与 MovieBench 上取得最好的整体结果,同时在 VBench-Long 上与其骨干持平——这个组合是它主张的核心证据:增强了长程恢复能力,但没有牺牲局部连续性。定性分析里作者展示了一个叫「记忆引导的自我纠正」的现象:三镜头序列中主体在第一镜头穿纯蓝内搭,第二镜头离场,第三镜头重新出现时最初带了错误的花纹,随后 LayerRecall 把早先的纯蓝外观召回,同时保住了人物身份、灰色开衫、正在进行的动作与场景结构,也就是说属性恢复是局部发生的,没有触发整体画面的重置。作者另外给了跨骨干可移植性与推理开销可忽略的分析,但明确把这一点表述为「在所测模型上的可移植性」而非普适的零样本适用性。 auto 批判点评:「层各有偏好,所以记忆要选层注入」是个漂亮且可验证的观察,也是这篇比一般「加个记忆库」工作高明的地方——它把注入位置当成与检索内容同等重要的决策变量,而选择性注入自然带来了低开销和不破坏局部注意力这两个副产品,工程上很讨喜。CHPM 用跨时程预测匹配替代不存在的记忆分配标注,也是务实的解法。需要保留的疑问有几点。首先,记忆敏感层是「剖析」出来的,这就引入了一个骨干相关的先验步骤,论文也诚实地把跨骨干结论限定在所测模型内;那么换一个架构差异较大的骨干时,这套剖析要重做多少、成本多高,是决定它能否成为通用组件的关键,文中讨论不足。其次,VBench-Long 只是持平,说明当前收益集中在「重现一致性」这个特定维度,对整体视频质量并无提升,这个边界读者应当清楚。第三,自我纠正那个案例虽然很有说服力,但它同时暴露一个隐忧:模型是在出错之后才召回正确属性的,也就是说错误已经被生成出来并停留了若干帧,路由器扮演的是事后修正而非事前预防;对需要严格连续性的应用,这种「先错后改」的行为模式本身就是一种瑕疵,论文没有量化它出现的频率与持续时长。 3. SWA vs Linear Attention:免训练滑窗高线性注意力2-10倍 Sliding-window beats linear attention | Microsoft Applied Sciences Group | arXiv:2608.28444 关键词:线性注意力,滑动窗口注意力,attention sink,KV cache,长上下文,推理加速,基线对比,微软 前序问题:二次复杂度注意力让大模型在内存和能耗上都不可持续:每个新 token 的代价都比前一个大,因为它的 key 和 value 必须被无限期地存在显存里。为了解决这个问题,一条备受关注的路线是把已经训好的模型改造成线性注意力(retrofitting),承诺以很低的成本换来常数级的状态开销和接近原始水平的性能,相关工作这几年数量可观。作者的批评切中要害:这条线一直没有和足够简单的基线做过认真对比。滑动窗口注意力(SWA)就是那个被跳过的对照组——它同样把每步的注意力开销限死在窗口大小内,同样让 KV 占用与序列长度解耦,但它不需要任何改造训练,是一行配置就能开启的方案。当一个研究方向连年在自己的评测里进步,却从未被最朴素的替代方案挑战过,那么这些进步究竟来自方法本身还是来自评测协议的选择,就成了一个必须回答的问题。 本文贡献:这篇不提新方法,而是补上那场缺失的对照实验:把带 attention sink 的 SWA 与经过 post-training 的线性注意力模型,在多个不同的 LLM 与多类下游任务上做系统比较。论文用一张注意力掩码对照图把三种方案的机制差异讲清楚:完整注意力是满的下三角;LoLCATs / Liger-GLA 这类混合方案在近处用 softmax、远处叠加线性注意力,覆盖整个下三角;带 sink 的 SWA 则只保留最左侧的 sink 列与主对角线附近的窗口带,其余位置直接留空。除了任务效果,作者还量化了解码吞吐与状态内存随上下文长度(128 到 256K)的变化曲线,把「快多少、省多少」和「准多少」放在同一张桌子上比较。最后给出的是一条明确的部署建议,而不是一个新架构。 auto 实验效果:结论是带 sink 的 SWA 在多个 LLM、多类下游任务上表现与 post-trained 线性注意力持平或更好;而在长上下文推理任务上差距被拉开——Needle-in-a-Haystack 与 BABILong 上 SWA 的表现是线性注意力的 2 到 10 倍。效率侧的曲线同样一边倒:完整注意力的解码吞吐从 128 上下文起就随长度持续下滑,到 256K 时降了一个多数量级,KV 占用则近乎线性地涨到 10³ MiB 量级;SWA(窗口 64 与 512)与线性方案的吞吐则在全区间基本是平的,内存占用保持在个位数 MiB 的常数水平,其中 SWA=64 的吞吐是所有方案中最高的。作者据此给出的建议相当直白:要降低推理内存成本,应该直接切到 SWA,而不是去 post-train 线性模型;线性注意力若要追上 SWA,恐怕得从头训练或投入远更大规模的 post-training。 auto 批判点评:这篇的价值不在技术新意而在方法论卫生:它用一个被长期忽略的朴素基线,检验了一个热门方向的实际收益,并且检验方式是公平的——同时报吞吐、内存与任务效果,而不是只挑有利维度。长上下文推理上 2 到 10 倍的差距尤其值得警惕,因为它指向一个具体的机制解释:线性注意力把历史压成固定大小的状态,本质上是有损压缩,需要精确回忆某个远处细节的任务(大海捞针正是如此)最容易暴露这种损失;而 SWA 虽然看不到远处,但它对窗口内的信息是无损的,配上 sink 又能保住那个对稳定性至关重要的锚点。不过这个结论的适用边界必须说清楚。首先它比较的对象是「post-trained」线性模型,作者自己也承认从头训练的线性注意力可能是另一回事,因此不能被读成「线性注意力这条路错了」。其次,SWA 的强项恰好是它的弱点的另一面:它在窗口外真的什么都看不到,那些需要跨越超长距离做全局聚合(而非精确检索)的任务,理论上应该更利于线性注意力,论文若能补上这类任务的反例会更完整。第三,attention sink 这个关键组件的贡献没有被单独拆开——SWA 好在哪里,有多少来自窗口本身、多少来自 sink,读者无法从现有结果中分离。 4. DensityKV:免训练把120秒历史压到3.28GiB DensityKV: Density-Guided KV Cache Compression for Long Video Generation | Manifold AI + 清华大学 | arXiv:2608.27922 关键词:长视频生成,KV cache 压缩,免训练,Soft-Riesz 密度,post-RoPE key,滑动窗口注意力,Manifold AI,清华大学 前序问题:自回归视频扩散用滑动窗口注意力实现流式生成,但每个新块都以之前生成的内容为条件,于是外观和运动上的误差会沿着 rollout 递归地传播放大。保留历史 K/V 记忆可以留住早先的主体与场景状态,对长时程一致性有实质帮助,但直接全存下来会带来两个问题。一是存储随 rollout 无限增长——生成得越久,这份历史档案就越大,没有上界;二是这些状态之间存在大量冗余:视频里的循环性内容(同一个人反复出现、同一片背景反复入画)会让相似的 key 一遍又一遍地被写进记忆,重复覆盖同一片区域,占了空间却没有带来新信息。已有的检索式方案(如 LongLive-RAG)保留全部被逐出的历史再按需检索,一致性是换来了,但存储代价随时长线性上升,这在实际部署里很快就不可接受。 本文贡献:DensityKV 是一个免训练的历史 K/V 库管理策略,核心思想是用「局部冗余度」来决定一个新状态该不该被收进记忆。它为每个注意力头维护独立的 token 级 K/V 库,并且只在 post-RoPE 的 key 上度量冗余——理由很具体:直接参与注意力路由计算的正是这些 post-RoPE key,冗余应当在真正影响路由的那个空间里衡量。度量方式是 Soft-Riesz 密度:候选 key 落在已有 key 的高密度邻域里就说明信息重复,予以拒收;落在稀疏区域则接纳。通过约束状态进入库之后的邻域密度增长,DensityKV 限制了历史的重复累积,同时保留那些真正携带不同状态的片段,且每个 value 与其 key 严格配对。在生成时,这个有界的压缩历史与本地滑动窗口一起被当前帧注意,不需要任何训练或改结构。 auto 实验效果:存储侧的对比最直观:随生成长度增加,检索式的 LongLive-RAG 的持久时序状态是线性增长的,30 秒 32.1 GiB、60 秒 64.3 GiB、120 秒 128.5 GiB;而 DensityKV 与 Deep Forcing 保持有界,120 秒时分别只有 3.28 GiB 和 3.76 GiB——DensityKV 是三者中最低的,且与 rollout 长度无关。质量侧,作者在三个自回归视频生成骨干与多个生成长度上做了评估,结论是在相同的历史 KV 容量上限下,DensityKV 提升了长时程一致性与生成稳定性,同时持久历史存储不随 rollout 增长。作者还在与 LongLive-RAG 对齐的评测协议下报告了 30/60/120 秒的单指标胜率统计,以及 120 秒长度上两组骨干–提示配对的定性对比。 auto 批判点评:把冗余度量放在 post-RoPE key 上是这篇最见功力的一个细节——很多 KV 压缩工作在 pre-RoPE 表示或 value 空间上做相似度判断,但真正决定「这个历史 token 会不会被注意到」的是加了位置编码之后的 key,度量空间和作用空间对齐了,判据才有意义。免训练、每头独立建库这两点也让它作为即插即用组件的门槛很低。可质疑之处主要在评估口径。第一,主要卖点是「有界存储 + 一致性更好」,但 Deep Forcing 同样有界(3.76 vs 3.28 GiB),两者差距其实很小,所以真正的胜负要看质量维度,而质量对比是在「相同容量上限」这个受控前提下给出的相对改善,加上以单指标胜率的形式汇报,读者很难判断绝对差距有多大——胜率高不代表差距显著。第二,密度判据本身是个启发式:Soft-Riesz 密度衡量的是表示空间里的几何拥挤程度,而「表示相近」并不严格等价于「语义冗余」,一个在视觉上关键但恰好落在密集区的状态会被误拒,论文没有分析这种误拒的代价。第三,方法针对的是「循环性内容造成的重复覆盖」,那么在场景持续大幅变化、几乎没有重复的视频上,密度筛选可用的压缩空间理应很小,此时它退化成什么行为、还有多少收益,文中缺少这类不利场景的讨论。 5. CLAP:人类视频也能训机器人世界模型 CLAP: Cross-Embodiment Video World Models are Zero-Shot Physical Simulators | 普林斯顿大学 | arXiv:2608.27406 关键词:跨本体,动作条件视频生成,世界模型,latent action,末端执行器位姿,零样本部署,DROID,普林斯顿 前序问题:当前最好的动作条件视频模型基本都被绑在单一机器人本体上,这让它们无法利用互联网上海量的异构视频——那些视频里其实包含了学习可泛化物理规律所需的丰富信号,只是拍摄主体从某型机械臂换成了人手或别的机器人。跨本体学习之所以难,症结在动作表示:不同机器人平台的动作空间差异极大(自由度不同、坐标系不同、抓取方式不同),而人类视频里根本就没有动作标注这回事。于是研究者面临一个两难,要么放弃海量人类视频只用带标注的机器人数据,要么用一个高度抽象的统一表示但丢掉精度。作者的出发点是一个物理上的判断:支配时空动力学的普适物理规律并不关心执行者是谁,所以跨本体的数据本应是可以共用的,缺的只是把异构动作对齐起来的机制。 本文贡献:CLAP 是一个跨本体动作条件视频生成框架,能在人类与机器人混合的互联网规模视频上训练。它先用三种表示来调和不同的动作空间:末端执行器位姿(精度高但需要标注与统一坐标系)、语言指令(对基础模型而言域间差异最小但精度差)、以及 latent action(可从无标注视频里自监督学到)。为了绕开每种表示各自的短板,作者设计了基于课程的跨本体学习配方:第一阶段用 latent action 在大量无标注视频上学基础物理先验,第二阶段再把这些先验落地到末端执行器动作空间,从而支持零样本部署到真实任务。作者把 latent action、课程版、末端执行器版分别做成了模型变体,并开源了全部代码与模型。 auto 实验效果:在 DROID 这类有挑战性的环境里,CLAP 接近或超过了当前最好的单本体视频模型;在 Bridge 这类较简单的域上只有轻微的保真度下降。在混合了多种本体的 OXE-Mix 数据上,latent action 版与课程版取得最高的预测精度,末端执行器版紧随其后。作者强调这些优势会通过少样本适配进一步复合放大——用 CLAP 作骨干微调后,在 G1 人形机器人上实现了高精度的动力学预测;论文也展示了对双臂 YAM 机器人的少样本适配。最终交付的是作者称为迄今最全面的一套动作条件视频世界模型,覆盖三种动作条件空间(末端执行器、语言、latent)与多种机器人形态,包括跨本体、DROID、Bridge、双臂 YAM 与 G1 人形。作者在附录中还主动澄清了几点:CLAP 并非普遍优于单本体模型,偶尔会不如为单一本体定制的模型;也没有哪一种动作表示能普遍胜出。 auto 批判点评:把跨本体的核心难点定位为「动作表示对齐」而不是「模型容量不够」,并且用三种表示各取所长、再用课程把它们串起来,这个设计是有物理直觉支撑的:先在无标注数据上用 latent action 学通用动力学,再用末端执行器位姿把抽象先验锚定到可执行的动作空间,顺序符合「先学规律后学接口」的逻辑。附录里主动写明「不普遍优于单本体模型」「没有单一最优表示」这类结论,在当下的论文风气里是值得肯定的诚实。但仍有值得追问的地方。第一,末端执行器位姿虽然比关节角通用,仍然是个偏「机械臂中心」的表示,用它去描述人手的复杂操作(多指协同、手内调整)必然是降维的,那么第二阶段的落地过程中,第一阶段从人类视频学到的精细动力学有多少能真正被继承下来,论文没有拆解。第二,主要指标是视频预测精度,而世界模型的最终价值在于能否支撑决策——预测得像不代表推演得对,如果没有下游策略学习或规划任务上的对照,「zero-shot physical simulator」这个说法是超出证据范围的。第三,Bridge 上的保真度下降虽然被描述为轻微,但它暴露的是跨本体学习的固有代价:容量被分摊到多个域,简单域上不如专用模型,这个 trade-off 在什么规模下会翻转,值得给出定量的规模分析。 6. Manifold4D:几何信息注入初始噪声而非条件 Manifold4D: Denoising on Point Cloud Rendered Manifolds for Video Re-shooting | 浙江大学 + Manifold Tech + 上海科技大学 + 剑桥大学 | arXiv:2608.28174 关键词:视频重拍,相机轨迹控制,flow matching,噪声流形,点云渲染,4D 重建,浙江大学,剑桥大学 前序问题:视频重拍要做的事是:给一段单目视频和一条用户指定的相机轨迹,把这段动态场景沿新轨迹重新渲染出来。主流做法是把目标几何显式地喂给网络——用逐帧深度把源视频抬升成 4D 点云,再沿目标轨迹光栅化成一张点云渲染图。问题出在这张渲染图和源视频被同时当作视觉条件送进网络:它们在每一个去噪步骤上互相竞争,模型被迫面对一个「信任困境」——该信渲染图几分?渲染图携带正确的目标视角几何但通常稀疏、有空洞、动态主体容易糊;源视频有完整的外观与运动但视角是错的。训练分布内还能靠数据学出一个折中,一旦遇到分布外的数据,这个折中就会失衡,表现为要么轨迹控制不准(太信源视频),要么画质崩坏(太信渲染图)。 本文贡献:作者的主张很干脆:一张已经与目标视角像素对齐的渲染图,压根不需要作为显式的条件流被送进网络。Manifold4D 把渲染图直接注入 flow matching 的初始噪声——生成不再从标准高斯噪声出发,而是从一个携带几何信息的新噪声流形出发,源视频因此成为唯一的视觉条件。这样一来渲染图恰好被使用一次,网络也从来不需要学习「怎么读懂这张渲染图」;在后续的每个去噪步骤里,模型可以专心处理源视频。具体流程是:由单目视频重建 4D 点云并沿目标轨迹渲染,渲染结果的 VAE latent 被注入噪声并 patchify 成 token,源视频同样编码成 token,两者在帧维度拼接后连同编码后的相机轨迹一起送入 DiT 去噪。作者还构建了 DAVIS-Traj 基准用于评测。 auto 实验效果:在自建的 DAVIS-Traj 基准和 Vista4D 评测集上,Manifold4D 在所有相机控制指标上都取得最好成绩:旋转误差分别降低 25% 和 27%,平移误差最多降低 32%,同时在视频保真度上与最强基线持平,并在真实场景的新视角光度质量上领先。用户研究显示它在轨迹跟随与动态一致性上有明显优势。两个补充实验支撑了它的核心主张:一是当偏航幅度超出训练范围时,它与基线的差距进一步拉大,说明这种几何注入方式的外推性更好;二是当刻意破坏渲染图(去掉运动掩码,让所有帧的动态点堆叠在一起把主体糊掉)时,模型仍能从源视频里恢复出正确的运动——这证明几何先验起的是引导作用,而不是压制生成。 auto 批判点评:这篇的核心洞察相当漂亮,而且是那种一旦说出来就显得理所当然的洞察:条件流的作用是给网络提供「需要被理解和转换」的信息,而一张已经和目标视角像素对齐的渲染图不需要被理解,它需要的只是被作为起点。把它挪到初始噪声里,等于把一个「网络得学着去信任多少」的软决策,换成了一个「先天就在那里」的硬约束,信任困境就此消失。两个验证实验也设计得很到位——外推区间差距拉大证明了几何先验的泛化性,故意破坏渲染图仍能恢复运动则证明了它没有过度依赖先验,一正一反把「引导而非覆盖」这个说法钉住了。需要注意的边界是:整套方法建立在「渲染图与目标视角像素对齐」这个前提上,而这个对齐完全依赖前置的深度估计与 4D 重建质量;深度出系统性错误时,错误会被直接编码进初始噪声,而此时网络甚至没有一个条件通道可以用来纠偏——鲁棒性实验破坏的是动态主体的清晰度(糊),并没有测试深度尺度或结构性错误这类更致命的失效。其次,视频保真度只是与最强基线持平,收益集中在相机控制精度上,读者不应把它理解为画质也更好。第三,DAVIS-Traj 是作者自建的基准,虽然同时在 Vista4D 上做了验证,但主基准自建这件事在轨迹幅度分布的选择上天然存在有利于自己方法的空间。 7. GeoNeXt:深度法向重写成下一帧预测 Video Generative Models as Geometry Learner | 萨里大学 + 帝国理工学院 | arXiv:2608.28549 关键词:单目深度估计,表面法向,视频扩散,几何先验,数据高效,零样本,ECCV,萨里大学 前序问题:用生成模型做几何估计现在有两条常见路径,各有各的浪费。第一条是拿现成的图像扩散模型分别为深度和法向训练任务专属模型,每个几何目标一个模型,这样做丢掉了一件本该利用的事——深度和法向在几何上是强相关的(法向可以由深度的梯度导出),分开训练等于放弃了联合建模的机会。第二条是改造图像扩散骨干(比如动自注意力结构)做联合微调,这条路能共享表示,但代价是通常需要大量标注数据,而带真值几何标注的数据本身就贵。作者认为这两条路的共同局限来自骨干选错了:图像扩散模型的先验是单帧的,而几何估计本质上需要跨视角、跨帧的结构化理解,这恰好是视频生成模型在预训练中天然获得的东西。 本文贡献:GeoNeXt 把预训练视频生成模型重新用作几何估计的统一且数据高效的框架,关键在于把任务创新性地表述成「下一帧预测」:图像和几何目标被放在同一个时间序列的不同槽位上,于是「从图像推几何」和「从几何推图像」都变成视频模型最擅长的那件事——预测序列的下一段。具体实现上,从预训练的 Stable Video Diffusion 出发,用冻结的 Stable Diffusion VAE 把 RGB 图像、深度、表面法向分别编码进隐空间;加噪时把图像 latent 复制到深度与法向这两个几何槽位,并通过拼接几何 latent 做进一步条件化;只微调 GeoNeXt U-Net(跳过 cross-attention),训练目标是图像、深度、法向三项重建损失之和。这样模型既继承了视频模型天然结构化的知识与更丰富的先验,又能联合建模图像与几何两个方向。 auto 实验效果:在多个数据集上的零样本单目深度与表面法向估计实验中,GeoNeXt 同时超过了此前的任务专属生成方法和统一生成方法,而且用的训练数据显著更少。更值得注意的是它与判别式方法的对比:论文称其性能可与那些多用了 100 倍以上数据训练的判别式 SOTA 方法相媲美,在若干基准上甚至更为突出。定性结果方面,作者展示的跨数据集深度对比显示 GeoNeXt 对精细结构的重建更好,法向对比则显示它产生的法向更准确、细节更多,能有效捕捉细小几何结构与表面朝向。整体上论文的卖点是数据效率——同等或更好的效果,训练数据少一到两个数量级。 auto 批判点评:「几何估计其实是个序列预测问题」这个重构是这篇的核心贡献,也是它数据效率高的原因所在——它没有让模型从头学几何,而是把几何塞进了模型已经很擅长的那个任务形式里,于是预训练里积累的时空结构先验可以直接复用。把图像 latent 复制到几何槽位这个细节也很聪明:它给了模型一个「几何应当与图像空间对齐」的强初始化,而不是让它从噪声里猜。真正的局限在于代价与定位。第一,视频扩散骨干比图像扩散骨干重得多,推理成本必然更高,而深度估计在实际应用里往往是实时或近实时的需求,论文若不给出与判别式方法的推理开销对比,「相媲美」这个结论在部署视角下是不完整的——用 100 倍少的数据换 N 倍的推理时间,是否划算取决于场景。第二,与判别式 SOTA 的关系被表述为「rivals」并在部分基准领先,这意味着并未全面超越,读者应把这篇的价值定位在数据效率而非绝对精度。第三,深度与法向的联合建模被当作卖点,但论文(从摘要层面)没有量化这种联合到底贡献了多少——如果单独训练两个 GeoNeXt 也能达到接近的效果,那「利用几何目标内在相关性」这个动机就削弱了,一个联合 vs 分离的消融是必要的。 8. ATA:单张参考图学出可加减属性向量 Attribute Token Arithmetic: Disentangled and Continuous Semantic Control for Visual Autoregressive Models | 莫纳什大学 | arXiv:2608.28082 关键词:视觉自回归,属性解耦,连续语义控制,向量算术,VAR,单图学习,免重训,莫纳什大学 前序问题:自回归文生图最近进展很快,用一个统一的生成框架就能做出高保真图像,但细粒度语义控制一直不好做,原因有两个:属性之间是纠缠的,以及文本表示和细粒度视觉表示之间存在错位。具体表现是你想让猫「胖一点」,改了提示词之后猫可能连品种和身份都变了;你想控制「胖」的程度,语言又给不出连续的刻度——「a fat cat」和「a very fat cat」之间没有可靠的插值。已有的自回归编辑方法要么需要重训模型或大规模监督,要么只能做离散的、整体性的替换,不能做「把这一个属性沿一条轴连续推一点」这种操作,更做不到把多个属性各自独立地叠加上去。 本文贡献:ATA 的灵感来自词嵌入里那个经典的向量算术性质:既然语义在嵌入空间里可以加减,那视觉属性也许可以。方法在预训练自回归模型的隐空间里直接找出对应视觉属性(论文举的例子是变老、变胖、情绪)的语义方向,而且这些方向只需从单张参考图学得,不需要重训模型也不需要大规模监督。做法上,给定一张参考图和一对语义只差一个属性的提示词(比如「A fat cat on the ground」与「A cat on the ground」),ATA 学出两个语义方向,并通过一个 Delta-Mod 模块把学到的方向加到 cross-attention 里对应的 VAR 对齐文本 token 上——关键是加到属性 token(「fat」)而不是身份 token(「cat」)上。生成时属性就可以通过与其他属性 token 的简单算术运算被连续调节与组合式叠加。 auto 实验效果:实验显示 ATA 实现了保持身份的、细粒度的、多属性同时调节的编辑效果,在可控性、通用性和计算效率三方面都优于已有的自回归编辑基线。作者展示的能力包括:连续调节单个属性强度并可将两个属性依次增强;跨类别的属性迁移——把「苹果形状」这个属性施加到「蛋糕」上时,ATA 是让蛋糕逐渐变成苹果形状的蛋糕,而基线方法直接把蛋糕变成了苹果,把原本定义在斯芬克斯猫上的「Sphynx」属性迁移到羊身上也能得到渐变的无毛效果;身份与属性的组合性——从三张参考图提取身份方向后与眼镜、帽子、项链、雾等属性方向自由重组,身份保持不变。消融实验支撑了「加到属性 token」这个设计:把方向优化到身份 token「cat」上会改变主体身份,加到与属性无关的 token「ground」上则完全不产生变胖效果。 auto 批判点评:这篇最有说服力的部分是那个消融:把方向加到「cat」会改身份、加到「ground」什么也不发生、只有加到「fat」才既变胖又保身份——这三条对照直接证明了语义方向的作用位置是可定位、可解释的,而不是碰巧调出来的效果。跨类别迁移那组结果也很能说明解耦的质量:基线把蛋糕变成苹果,ATA 变成苹果形状的蛋糕,前者是把属性当成了类别替换,后者才是真正把「形状」这一维从「是什么东西」里剥离出来。单张参考图、免重训这两点也让实用门槛很低。局限主要在适用范围。第一,方法绑定在视觉自回归(VAR)这一类模型的「VAR 对齐文本 token + cross-attention」结构上,是否能迁移到扩散类主流模型并不显然,而当前工业界的图像编辑主力仍是扩散模型,这限制了影响面。第二,整套机制依赖「提示词对里的差异恰好对应一个可分离的视觉属性」,那些语言上难以用单个 token 差异表达的属性(复杂光照、特定构图、多物体空间关系)恐怕找不到干净的方向,论文自己也保留了一张 limitations 图。第三,对比对象限定在自回归编辑基线,没有与更强的扩散类编辑方法同台,「优于已有方法」的适用范围应当按这个口径理解。 9. VATIX:9B驾驶视频模型的规模律实测 How Far Can 5,500 Hours of Driving Take You? A Scaling Law Analysis of Video Diffusion Models | valeo.ai + 索邦大学 | arXiv:2608.28404 关键词:规模律,视频扩散,自动驾驶,固定数据集,训练预算分配,nuScenes,开源SOTA,valeo.ai 前序问题:自动驾驶的视频生成走不通网络规模那条路:驾驶数据采集昂贵、受隐私法规约束、也不能随便抓取,所以模型必须在一个固定语料上把价值榨干。这就使得「算力该怎么花」变成一个真问题而不是学术趣味——同样的预算,是拿去把模型做大,还是拿去训得更久?还需不需要再采数据?在网络规模数据的语境下这些问题往往被「加数据就好」掩盖过去,但在固定语料的约束下必须正面回答。此前领域内缺少针对驾驶视频扩散模型、从零训练、覆盖足够宽参数区间的系统规模律研究,从业者只能凭直觉分配预算。 本文贡献:作者做了一次系统的规模律研究:从零训练一族参数量从 1M 到 9B 的视频扩散模型,在最多 5,500 小时的驾驶数据上按不同曝光量训练,观察验证损失如何随模型规模与训练曝光变化。模型架构是标准的 flow matching 视频 DiT:视频 latent 由 Wan encoder 编码后加噪,经 N 个 transformer 块处理,每块含空间注意力、时间注意力与 MLP,全部由 AdaLN 调制;时间步 t 与自车轨迹的 25 个 BEV waypoint 分别用正弦特征嵌入并各过一个 MLP,相加后切成 scale 与 shift 两份用于调制,输出是速度(v-prediction)。也就是说轨迹条件是通过调制通路而非 cross-attention 注入的。作者开源了代码与预训练模型,底层驾驶数据由 NATIX 分阶段单独发布。 auto 实验效果:验证损失在模型规模与训练曝光两个维度上都呈现一致的幂律。最实用的一条结论是两者的敏感度不对称:损失随训练曝光下降得远比随模型规模下降得快,因此在算力受限时,把预算投给更长的训练是提升一个固定模型最有效的方式;但更大的模型仍然能达到更低的渐近损失,所以当算力足够时,计算最优的扩展方向依然是把模型做大。基于这套分析作者训了一个 9B 参数模型,据其所知是在驾驶数据上从零训练的最大视频扩散模型,并在 nuScenes 上刷出了驾驶视频生成的开源新 SOTA。定性方面,5 秒生成的对比显示:20M 以下的小模型能抓住整体场景布局但很快跨帧丢失物体一致性;135M 的基础模型对场景理解更好(比如能正确预测车辆正在左转),但在更长时程上难以维持连贯动态;1.1B 模型进一步改善画质与场景结构,却仍有时间不一致并在约 2.5 秒后开始崩坏。 auto 批判点评:这类工作的价值不在方法新意而在把从业者的直觉换成可查的曲线,而且它选的约束条件——固定语料、不能靠抓数据解围——正是自动驾驶、医疗影像这些受限领域的真实处境,因此结论的可迁移性比在网络规模数据上做的规模律更强。「曝光的边际收益大于参数量、但大模型渐近更低」这个不对称结论也很有操作价值:它把「小算力延长训练、大算力放大模型」这条分界线画了出来。诚实之处在于定性结果没有粉饰,直接写明 1.1B 模型在约 2.5 秒后就开始崩坏。需要保留的疑问有三点。第一,所有规模律结论都建立在验证损失上,而扩散模型的验证损失与人类感知质量、下游可用性之间的相关性并不牢固——损失继续下降不一定换来更长的时间一致性,这恰好是驾驶视频最关键的属性,论文若能给出「损失 vs 崩坏时长」的对应关系会有力得多。第二,5,500 小时这个上界本身就是结论的边界:所有关于「还需不需要更多数据」的判断都是在这个尺度内的外推,超出后曲线是否仍成立无从检验。第三,架构是固定的单一族系(Wan encoder + AdaLN 调制的时空注意力块),而规模律对架构选择是敏感的,把轨迹通过 AdaLN 调制注入而非 cross-attention 也是一个具体选择,换一种条件注入方式时这些幂律的系数能否保持,文中未作讨论。 10. CommerceVibe:电商创意生成HTML而非像素 CommerceVibe: Learning to Design E-Commerce Creatives as Executable Visual Code via Dual-Feedback Reinforcement Learning | 同济大学 + 阿里巴巴 | arXiv:2608.27893 关键词:电商创意生成,可执行视觉代码,HTML/CSS 合成,双反馈强化学习,GRPO,VLM 评判,阿里巴巴,同济大学 前序问题:高质量电商创意图是展示商品和传达营销信息的关键。扩散模型让创意生成变得可规模化,也能产出视觉上很好看的图,但落到实际投放前总要返工,原因很实在:文字会畸变、商品细节不一致。更麻烦的是产物形态——扩散模型输出的是一张压平的位图,没有显式结构,因此难以编辑与复用,改一个价格数字都得重新生成整张图。还有第三个障碍在训练侧:电商创意的设计要求往往是复合的、带硬约束的(文字必须清晰可读、商品必须可见不被遮挡、版式必须合法),这类要求很难被编码成可验证的训练信号,而没有可验证信号就没法做有效的强化学习。 本文贡献:CommerceVibe 换掉了产物形态:把创意表示为可执行的视觉代码,生成任务因此被表述成条件化的 HTML/CSS 程序合成。给定商品图、设计要求和商品信息,它产出可渲染、可编辑、可复用的创意。为了让复合设计要求变成训练信号,作者提出双反馈强化学习:一路是基于规则的反馈,对渲染后的程序检查文字可读性、商品可见性和版式合法性——这些都是渲染完就能机械判定的硬指标;另一路是来自视觉语言模型的视觉反馈,从六个感知与商业维度评判渲染出的创意是否符合输入规格。两路信号互补,前者管约束满足,后者管依赖感知的质量。训练流程是先用超过 28,000 条电商样本对 Qwen3.5-9B 做监督微调建立基础创意能力,再用双反馈奖励通过 GRPO 做强化学习优化策略,最终一次推理直出创意。 auto 实验效果:在 1,300 例的基准上,优化后的 CommerceVibe 拿到 94.0/100 的加权分,而只做监督微调的版本是 87.3,也就是说双反馈强化学习贡献了约 6.7 分的提升,同时优于若干强外部模型。作者还请了五位电商设计专家做盲评,结果进一步验证了这些改进——这一点比自动指标更关键,因为规则分和 VLM 打分都可能被针对性优化,而人类专家的盲评是相对独立的检验。细粒度结果按 1,140 例单图与 160 例多图两类分别报告了检测器级别的规则子分和 VLM 评判各维度的评分。定性对比里作者用不同颜色的轮廓标出了文字、商品、版式、VLM 四类代表性问题的位置,未被识别出问题的类别则打绿勾。 auto 批判点评:把创意从位图改成 HTML/CSS 是一次典型的「换表示解决一类问题」:文字畸变消失了,因为文字是真的文字而不是画出来的像素;可编辑性有了,因为产物本来就是结构化代码;更妙的是它顺手解决了强化学习最缺的那件东西——可验证的奖励。渲染完的程序可以用检测器机械地判定文字是否可读、商品是否被遮挡、版式是否越界,这些硬约束在像素空间里很难可靠判定,在代码+渲染的组合里却是现成的。双反馈的分工也合理:规则管能判定的,VLM 管只能感知的。可质疑的地方集中在评估与边界。第一,奖励里有 VLM 打分,而基准的加权分很可能也包含 VLM 判定维度,这就存在训练信号与评测指标同源的隐患——94.0 这个分数有多少来自真实质量提升、多少来自对评判器偏好的拟合,需要更强的隔离设计,专家盲评是好的补充但只有五人。第二,HTML/CSS 表示的表达力有天花板:它擅长版式、文字与图层合成,但那些需要像素级生成的创意元素(商品与背景的自然融合、光影一致、艺术化质感)不是 CSS 能表达的,因此这套方案更准确的定位是「可编程版式合成」而非通用创意生成,与扩散模型是互补关系而非替代。第三,1,300 例基准与 28,000 条训练样本都来自同一电商生态,品类分布、审美规范高度同质,跨平台或跨文化的泛化能力没有证据支撑。 趋势观察 世界模型开始把「状态」从像素里拆出来,交给代码托管 — 今天最值得读的一篇工作提出了一个有点反直觉的分工:世界的演化规则不要让视频模型去学,交给会写代码的语言模型;视频模型只负责把状态渲染成好看的画面。Code World Model 让 coding agent 充当「世界大脑」,把事件与后果推理成可执行代码,代码维护一份持久化的世界状态,状态再被编译成一段粗糙的 proxy 视频去条件化视频模型。这个拆法直指纯视频世界模型的老毛病——视频只呈现「结果」,不承载「规则」,所以模型很难保证「我刚才砸碎的花瓶下一帧还是碎的」。把状态搬进代码后,持久性由程序保证而不是靠模型记性。同一天的 CLAP 从另一侧呼应:它用末端执行器位姿、语言指令、latent action 三种表示把人类视频和多种机器人本体统一到一个动作空间,让世界模型能吃下互联网规模的异构视频。两条路线的共同判断是:世界模型要往前走,得先把「动作/状态的表示」这件脏活干干净。 长视频一致性的战场已经从「窗口多大」转向「记什么、记在哪一层」 — LayerRecall 和 DensityKV 是今天最像一对的两篇,都在攻自回归视频扩散的历史记忆,但切入点完全不同。LayerRecall 的观察是:video DiT 的不同层对「当前/近期/远期」上下文的偏好并不一样,所以长程记忆是个双重决策——检索哪些历史 K/V,以及注入到哪几层。它只往少数「记忆敏感层」注入,其余层保留原来的 sink + 滑窗注意力,因此几乎零推理开销还能跨骨干迁移。DensityKV 则完全免训练,用 post-RoPE key 的 Soft-Riesz 局部密度判断新状态是否冗余:密度高就拒收,从而把持久历史存储限死在与 rollout 长度无关的常数上——120 秒生成时 LongLive-RAG 要 128.5 GiB,DensityKV 只用 3.28 GiB。两篇加在一起说明一件事:「无限长视频」这个目标的瓶颈已经不是注意力算得多快,而是历史怎么以有界代价被有选择地保留。 效率研究出现一波「回头验旧基线」的反思,结论不太体面 — 微软那篇《Sliding-window beats linear attention》标题就把结论说完了:带 sink 的滑动窗口注意力在多个 LLM、多个下游任务上打平或打赢经过 post-training 的线性注意力模型;在 Needle-in-a-Haystack 和 BABILong 这类长上下文推理上,SWA 高出 2 到 10 倍,而且它压根不需要 post-training。作者的批评相当直接——线性注意力这条线一直没有和足够简单的基线做过公平对比。这类工作在今天的效率研究里越来越重要:当一个方向在自己的评测里连年进步,却从未被最朴素的对照组挑战过,进步就可能是评测协议的产物。同一天 DensityKV 也是免训练路线,两篇一起构成一个信号:先把最便宜的方案做到位,再谈复杂改造。 视频生成模型正被反过来当作几何与物理的通用先验 — GeoNeXt 把单目深度与法向估计重写成「next-frames prediction」,直接复用预训练视频生成模型,理由是视频模型天然携带结构化的时空先验,比图像扩散模型更适合联合建模「图像↔几何」,实测能用远少的数据打赢那些多训 100 倍数据的判别式方法。Manifold4D 的思路更巧:视频重拍任务里点云渲染图和原视频作为两路条件会互相打架,模型不知道该信谁多少,于是它干脆不把渲染图当条件,而是注入到 flow matching 的初始噪声里——生成从一个「带几何信息的噪声流形」出发,渲染图只被用一次,网络也不必学会怎么读它,旋转误差因此降了 25% 与 27%。这两篇的共性是把视频生成模型当成基础设施而不是终点产品:它提供先验,任务只是换个输出头或换个注入位置。 人工智能炼丹君 整理 | 2026-09-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-27|浙大清华19B音视频4步2.5秒出片TurboT2VA 今日 AIGC 论文速览 今日共 10 篇 · 推理加速与少步蒸馏 1 篇 · 扩散后训练与奖励对齐 2 篇 · 音频统一理解与生成 1 篇 · 视觉 tokenizer 与表征组织 2 篇 · 图生 3D 与 PBR 资产 1 篇 · 物理接地图像编辑 1 篇 · 世界模型数据引擎 1 篇 · 大规模开源数据集 1 篇 重点论文标题列表 TurboT2VA(浙江大学、清华大学、天津大学、青岛大学、新加坡国立大学):19B音视频4步蒸馏2.5秒出片 DiffusionOPSD(字节跳动 Seed、新加坡国立大学、加州大学圣地亚哥分校、牛津大学、香港科技大学、马里兰大学、加州大学伯克利分校、杜克大学):把奖励梯度变成中间去噪目标 RVM(佐治亚理工学院、NVIDIA):奖励加权速度匹配替代策略梯度 FireRedAudio(小红书):理解与生成各走一条连续表征 AffineTok(复旦大学、阿里巴巴 Token Hub(Wan 团队)):语义仿射一致把gFID压到1.10 今日论文速览 1. TurboT2VA:19B音视频4步蒸馏2.5秒出片 TurboT2VA: Fast Large-Scale Text-to-Video-Audio Generation via Score-Regularized Consistency Distillation | 浙江大学、清华大学、天津大学、青岛大学、新加坡国立大学 | arXiv:2608.24674 关键词:少步蒸馏,一致性蒸馏,音视频联合生成,LTX-2,稀疏注意力,W8A8量化,浙大清华 前序问题:文本到「视频+音频」的联合生成能一次产出画面与声音同步的内容,但这类模型的推理成本高得离谱:采样轨迹长(40 步)、参数量大(19B)、而且视频流与音频流的计算特性完全不同,异构多模态计算让常规加速手段难以直接照搬。把大规模 T2VA 模型蒸馏成少步学生具体卡在三处:一是模态不均衡优化——视频与音频的损失尺度、收敛速度差异显著,共用一套归一化会让某一路主导梯度;二是连续时间一致性训练在这个规模上很难稳住,学生容易在训练中后期崩掉;三是质量与多样性的权衡——分布匹配类目标(DMD)虽然能把画质拉上去,却容易把生成多样性压塌,退化成少数几个模式。 本文贡献:TurboT2VA 的主体是一套双散度蒸馏框架加一条渐进课程。框架分三块:左侧对视频与音频分别做前向一致性蒸馏(各自沿教师 PF-ODE 学自己的一致性场,同时带跨模态一致性约束);中间是 T2VA 双流骨干,视频流与音频流各有 self-attention 与 text cross-attention,再通过 VA cross-attention 相互耦合;右侧做反向散度精修,用分布匹配把学生输出分布拉向教师分布。课程按 dCM 预热 → sCM 精修 → sCM+DMD 联合优化三段推进,先建立稳定且多样的生成轨迹,只有到最后才引入分布级精修——顺序反了就会先塌多样性。模态不均衡用 per-modality normalization 解决。除蒸馏之外还配了一套架构感知的推理栈:guarded W8A8 量化与算子融合、padded-text compaction、模态感知稀疏注意力,但明确保留跨模态与文本条件路径为 dense,不对音画同步这条链路做近似。 Overview of the proposed Dual-Divergence Distillation framework for T2VA acceleration. The left panel illustrates forward consistency distillation for video and audio modalities, the middle shows the T2VA backbone with cross-modal interaction, and the right panel depicts reverse divergence (distribution matching) refinement. 实验效果:在 LTX-2 上做 4 步蒸馏,标准评测分辨率 512×768 下生成器延迟从 50.52 秒降到 2.51 秒,20.1 倍加速,同时维持视觉质量、音频保真度、多样性与音画同步。高分辨率部署(1024×1792、121 帧、单卡 NVIDIA H20、batch size 1)下的完整栈拆解得很清楚:40 步教师基线 318.74 秒;加 W8A8 与算子融合得 1.37 倍,降至 233.34 秒;换成 4 步学生再得 19.18 倍,降至 12.16 秒;最后叠加 SageSLA 稀疏注意力(默认 ρ=0.3)再得 2.08 倍,落到 5.83 秒,整体 54.67 倍(仅生成器)。训练曲线消融跑到 7,500 全局步:分阶段 dCM→sCM→sCM+DMD 在进入联合阶段后反超直接做 sCM+DMD,并在训练后期保持更强表现;从同一段 dCM+sCM 前缀出发,分阶段 sCM+DMD 的 Javis 分数也高于纯 DMD 精修或只继续 sCM。 High-resolution inference acceleration, achieving a 54.67$\times$ generator-only speedup on one NVIDIA H20. 批判点评:20.1 倍与 54.67 倍都是 generator-only 延迟,不含 VAE 解码、文本编码与音频后处理,端到端加速会明显低于这两个数字,读者不要直接当成「出片时间快 54 倍」。更需要留意的是 54.67 倍把蒸馏(19.18 倍)和推理工程栈(1.37×2.08≈2.85 倍)的功劳乘在了一起——工程栈那部分与蒸馏方法本身无关,换任何一个模型都能拿,混在一个标题数字里报有夸大之嫌。质量侧只给了「strong visual quality / audio fidelity / synchronization」这类定性表述,没有 FVD、CLAP、AV-Sync offset 的绝对值,也没有与 40 步教师的逐项差距,而少步蒸馏最该被审视的恰恰是「掉了多少」。W8A8 前面挂了 guarded 这个限定词,说明存在必须保护的敏感层,但哪些层回退高精度、回退比例多少没有交代,这会影响别人复现时的实际加速比。稀疏注意力保留了 dense 跨模态路径,意味着收益会随音视频 token 配比波动,不同视频时长下的敏感性没测。全部结论只在 LTX-2 一个骨干上得到;H20 是国内特供算力卡,其显存带宽与算力配比和 H100 差异不小,量化与稀疏化的收益能否平移过去论文没有讨论。 2. DiffusionOPSD:把奖励梯度变成中间去噪目标 On-Policy Self-Distillation in Diffusion Models | 字节跳动 Seed、新加坡国立大学、加州大学圣地亚哥分校、牛津大学、香港科技大学、马里兰大学、加州大学伯克利分校、杜克大学 | arXiv:2608.24646 关键词:扩散后训练,on-policy自蒸馏,奖励梯度,中间监督,人类偏好对齐,字节Seed 前序问题:强化学习能把扩散模型对齐到人类偏好与任务目标上,但奖励是打在端点(生成图)上的,它不告诉某一步的中间去噪预测该往哪个方向改。这就是扩散 RL 的结构性困难:自回归模型有可解析的样本似然,可以直接套策略梯度;扩散模型没有,于是现有方法只能绕——要么从随机去噪转移拼出轨迹似然,要么用证据下界近似端点似然。两条路都要付额外的计算与算法复杂度,而换来的监督信号仍然稀疏地挂在轨迹末端,中间那几十步实际上是在盲走。 本文贡献:DiffusionOPSD 把「图像级奖励引导」直接转成「clean-output 预测的显式目标」。每一轮外循环里,一个冻结的 behavior policy 先生成轨迹,同时提供采样查询状态与 anchor;奖励梯度在每个 anchor 周围构造出有界的正目标与负目标;可训练 policy 以 detached supervision 的方式拟合这些目标(作者称之为 finite fitting),拟合完成后用指数移动平均更新刷新 behavior policy。这个结构的价值不只在效果——它把「目标构造」和「有限实现」拆成两个可以分别度量的环节,从而让扩散 RL 第一次变得可诊断。论文特意做了同 query 的受控实验来分别观测这两环。 Reward-to-policy paradigms. We contrast trajectory credit, late-state reward backpropagation, and endpoint supervision with our explicit intermediate targets constructed before finite fitting. 实验效果:在 SD 3.5-M 与已做过步蒸馏的 Z-Image-Turbo 两个骨干、10 个 evaluator 组成的 20 个 reward-matched 设置中,19 个取得最佳 held-out 分数;相比最强竞争方法最高提升 44.0%。训练成本上,相比 DiffusionNFT 在 SD 3.5-M 上省 40% GPU-hours、在 Z-Image-Turbo 上省 63%(实验用单节点 8×NVIDIA A800-SXM4-80GB)。人类标注偏好中,标注者在 64%、71%、90%、61% 的 prompt 上更喜欢 DiffusionOPSD 而非 base 模型、FlowGRPO、DiffusionNFT、ReFL;胜出原因的构成显示提示词对齐与视觉质量各占大头。鲁棒性 sweep 表明 query noise 从低到中、目标半径 ρ 从 0.08 到 0.40 都稳定在默认水平附近。最耐人寻味的是那个负面发现:受控同 query 实验里,reward 梯度目标的构造增益是 +0.03511、DiffusionNFT 端点是 −0.03551,但一次拟合更新之后,HPSv2.1 的目标序在 62.3% 的 prompt 上发生反转——构造阶段赢得多,不代表落地得多。 Robustness and human preference. Low-to-mid query noise and target radii from $0.08$ to $0.40$ remain near the default, while query noise $0.90$ and branch coefficient $10$ fall to $0.2884$ and $0.2961$. Annotators prefer DiffusionOPSD over the base model, FlowGRPO, DiffusionNFT, and ReFL on $64\%$, $71\%$, $90\%$, and $61\%$ of prompts. 批判点评:这篇最有价值的结论其实是负面的:目标构造增益与单次拟合实现增益之间只有弱相关(62.3% 反转率)。它说明方法的两个部件耦合得比论文正面叙事更松,但论文没有据此给出「目标半径该怎么选」的可操作准则,把一个诊断工具停在了诊断阶段。19/20 的胜率听起来压倒性,可 10 个 evaluator 背后只有少数几类 reward,同一 reward 下多个 evaluator 高度相关,等效独立比较数远小于 20,这个分母是被放大过的。44.0% 是「相对最强对手的最大提升」而不是中位提升,属于挑最好看的那一格报。鲁棒性图自己也暴露了边界——query noise 取 0.90、branch 系数取 10 时 ClipScore 掉到 0.2884 与 0.2961,说明超参窗口并不宽,而实际调参时未必知道自己在窗口的哪个位置。作者共 14 人以上、横跨 8 家单位,正文却以「DiffusionOPSD Team」匿名署名(真实名单只在附录),这类大团队技术报告的工程细节历来难以被外部独立复现。 3. RVM:奖励加权速度匹配替代策略梯度 Scaling Reinforcement Learning for Diffusion Models via Velocity Matching | 佐治亚理工学院、NVIDIA | arXiv:2608.23664 关键词:扩散奖励微调,速度匹配,免轨迹更新,VBench,动态跟踪奖励,NVIDIA 前序问题:奖励微调正在成为把扩散模型对齐到人类偏好与任务目标的主要工具,但现有方法基本是把大语言模型那套策略梯度机制整体继承过来的。问题在于扩散模型不像自回归模型,它对生成样本没有可计算的似然。结果是当前方案只能从随机去噪转移构造轨迹似然,或者用证据下界近似端点似然,两者都引入额外计算与算法复杂度。作者要论证的是一个更激进的判断:这套基于似然的机制对扩散奖励微调根本不是必需的。另外还有个实践层面的坑——标准偏好奖励在视频生成上会偏爱画面干净但几乎静止的输出,等于奖励模型在鼓励模型偷懒。 本文贡献:提出 reward-based velocity matching(RVM),一个直接作用在速度场上的免轨迹更新。流程是:从高斯噪声出发做 16 步 ODE rollout(不用 CFG)得到分组样本,用公开奖励模型加上自研的 dynamic-tracking(DT)运动奖励打分;每个生成样本只加噪一次得到 x_t,其速度目标为 v = ε − x0;然后用奖励加权的速度匹配损失做回归,额外带一个可选的 anchor 项控制相对参考速度场的漂移。方向上它强化高奖励生成对应的速度方向、抑制低奖励方向,不需要沿轨迹反传,也不需要任何似然项。论文进一步指出这是一个通用框架,RAM 与 DiffusionNFT 都可作为特例被恢复。文中还给出了轨迹损失与速度匹配的机制对比:轨迹损失提升的是被采样单步转移的似然,因而朝下一个去噪状态移动,而那个中间状态是随机的、不保证比当前更接近干净端点,目标方向因此含噪。 Overview of RVM. Left: RVM fine-tunes Wan2.1-1.3B with a simple reward-weighted velocity-matching loss. Grouped rollouts are scored using public reward models together with our dynamic-tracking (DT) reward, and each generated sample $\bm{x}^i_0$ is noised once to $\bm{x}^i_t$ and regressed toward its velocity target $\bm{v}^i=\bm{\epsilon}^i-\bm{x}^i_0$, with an optional anchor velocity $\bm{v}_{\mathrm{anc}}$ controlling model drift, avoiding trajectory storage and likelihood estimation. Right: on Wan2.1-1.3B, RVM achieves the best VBench Overall score at a fraction of the training cost of trajectory-based methods. 实验效果:在 Wan2.1-T2V-1.3B 上,RVM 用 525 GPU-h(8×H100,含 rollout、奖励评估、梯度更新三段)完成微调,FlowGRPO 需 1,159 GPU-h(2.2 倍)、DanceGRPO/TaRoS 需 6,171 GPU-h(11.8 倍);成本最低的同时拿到最高的 VBench Overall 84.13,FlowGRPO 为 75.91。引入 DT 奖励后运动幅度大幅改善,而 VBench 整体表现同时上升,说明「动起来」和「好看」并非必须二选一。另一个实用发现是:速度更新一旦简化,具体用哪种损失变体的影响就小于奖励与 anchor 的设计——这把调参重心从损失工程挪到了奖励工程。少步推理测试中,把训练好的 16 步时间网格子采样到 5 步与 4 步、保持同一 timestep schedule,VBench Total 仍然保持稳健。 GPU-hour cost comparison on Wan2.1-T2V-1.3B. Training time is decomposed into rollout, reward evaluation, and gradient update. % Note that despite being the cheapest, RVM attains the highest VBench Overall ($84.13$ vs. $75.91$ for FlowGRPO). 批判点评:提交件里作者块留的还是 ICLR 会议模板的占位符(Cranberry-Lemon University 那一段),真实作者信息在另一份 tex 文件里,说明投稿版本管理相当仓促,这类细节多少反映了工作的成熟度。「统一了 RAM 与 DiffusionNFT」的说法要打折看——特例关系通常依赖特定的权重函数与 anchor 取值,论文没有给出这些约化成立的严格条件表,缺了它这个 claim 更像叙事包装。VBench Overall 84.13 对 75.91 的差距确实不小,但作者自己就指出 VBench 系偏好奖励会偏爱静态高清画面、并因此专门做了 DT 奖励,那么再把 VBench Overall 当作主指标来宣布胜利,逻辑上有循环论证的味道。GPU-h 对比中 RVM 的 rollout 只用 16 步且不开 CFG,而基线是否在同等 rollout 预算与采样配置下测量没有交代清楚,成本优势里有多少来自算法、多少来自采样设置无法分离。主实验集中在 1.3B 规模,14B 级别模型上速度场回归是否仍然稳定、anchor 项该怎么随规模调整,都还是空白。 4. FireRedAudio:理解与生成各走一条连续表征 FireRedAudio: A General-Purpose Audio Language Model with Decoupled Continuous Representations for Understanding and Generation | 小红书 | arXiv:2608.24168 关键词:音频语言模型,统一理解生成,连续表征解耦,零样本TTS,语音编辑,小红书 前序问题:一个统一的音频模型既要识别和理解语言、副语言(情绪、说话人)与环境信息,又要支持语音合成与编辑。矛盾集中在表征这一层:理解任务偏好紧凑特征,因为长上下文建模吃不下高帧率细节;而语音生成需要可重建的特征,必须保留细粒度声学信息。用一套离散 token 同时服务两端,往往两头都不讨好——压得够紧就重建不回来,留得够细就撑不起一小时长音频的上下文。 本文贡献:FireRedAudio 共享一个 9B 参数的 LLM,但为理解与生成分设两条独立的连续输入表征。待识别或分析的音频走专用 Audio Encoder 加 Adapter;用于生成条件的语音输入走 RedAE 路径——RedAE 本身是个自编码器,把 50Hz 的音频帧压成 25Hz latent,训练时由一个冻结的教师 Audio Encoder 提供高层监督,并通过 iSTFT head 重建波形。LLM 直接输出文本,或者经 Flow Head 去条件一个 flow-matching DiT,产出连续声学 latent 再由 Decoder 还原成波形;DiT 的条件里同时包含历史干净 latent 与当前含噪 latent 以及 LLM 隐状态。经渐进多任务训练后,同一个模型支持 ASR、音频理解(可覆盖长达一小时的录音)、零样本 TTS、Instruct TTS,以及语义级与声学级两类语音编辑。作者称这是首个公开披露的、在单个可训练自回归 LLM 内为理解与生成分别提供连续输入表征的统一音频语言模型,代码已开源。 Overview of FireRedAudio. Decoupled continuous pathways encode inputs for understanding and generation. The shared LLM produces text or conditions a DiT to generate RedAE latents, which are decoded into waveforms. The inset illustrates the DiT conditioning for one audio step. 实验效果:综合评测下,音频理解与多语种 ASR 达到有竞争力或领先的水平;零样本 TTS 在内容准确率与说话人保持两项上都强;Instruct TTS 的指令跟随领先;语义与声学两类语音编辑相比 Ming-UniAudio-Edit 有大幅改善。长音频侧展示了四类能力:结构化组织(把录音解析成带 start/end、说话人、背景音、情绪的时间戳表格,量化的时间定位评测就聚焦这一项,达到秒级时间戳精度)、长文摘要(可按对象聚焦,如「只总结 Guest B」并给出 02:15/14:40/37:05 这类带时间锚点的要点)、时间↔内容双向检索(既能问「12:00 谁在说什么」也能问「定价模型在哪几个时间点被提到」)、以及跨录音证据的全局分析(如「为什么 Guest A 在 24:10 笑」需要串起 03:10 到 24:10 的多个证据节点)。这些结果支撑了一个结论:中等规模模型上,解耦的连续输入表征足以统一音频理解与连续潜空间语音生成。 Four representative long-form audio-understanding capabilities: structured organization, long-form summarization, bidirectional retrieval between time and content, and global analysis over evidence distributed across a recording. Our quantitative temporal-grounding evaluation focuses on structured organization. 批判点评:「首个公开披露」这个 claim 叠了三层限定词——publicly disclosed、within a single trainable autoregressive LLM、separate continuous input representations——本质是在一个足够窄的定义里宣称首创,读者要看清边界再决定这个「首个」值多少。9B LLM 的底座是什么、是否从某个开源模型继续训练,摘要完全没提,而这直接决定了工作量、复现难度与结果的归因。「competitive or leading」是典型的选择性表述,缺少与 Qwen-Audio、Step-Audio、Ming-UniAudio 等同类在主流 benchmark 上的逐项数字,读者无从判断领先幅度。一小时长音频理解的量化评测只覆盖「结构化组织」一项,摘要、双向检索、全局分析三项在图里是能力示意(带具体案例的界面示例)而非量化结果,这三项的真实可靠度目前无法评估。解耦两条表征的代价是推理时要同时维护两套编码器,额外的参数量与显存开销没有交代。语音编辑只对比了 Ming-UniAudio-Edit 一个基线,样本偏少。 5. AffineTok:语义仿射一致把gFID压到1.10 AffineTok: Semantic Affine Consistency for Diffusion-Friendly Visual Tokenizer | 复旦大学、阿里巴巴 Token Hub(Wan 团队) | arXiv:2608.23864 关键词:视觉tokenizer,语义对齐,扩散友好,SAC一致性,gFID,复旦阿里 前序问题:视觉 tokenizer 越来越流行往潜空间注入语义监督,好让下游扩散学得更轻松。但「语义究竟该怎么组织才有利于去噪」这个问题几乎没被认真研究过。现有做法是训一个 projector 直接从含噪 latent 预测语义——作者指出这实际预测的是「干净图语义的平均」,而扩散过程真正做的是先预测后验均值的干净 latent、再从它解码语义,也就是「平均后干净 latent 的语义」。这两者并不等价,把前者当目标去对齐,等于在优化一个错位的量。 本文贡献:论文先把问题形式化,定义语义恢复目标:去噪过程应当从含噪 latent 恢复出干净图的语义内容,好的 tokenizer 应当让这件事更容易。关键结果是一个正交分解——语义恢复误差可以正交拆成「从含噪 latent 直接做最优语义预测的误差」与「上述两种预测之间的误差」。第二项正是被忽略的一致性要求,作者命名为 Semantic Affine Consistency(SAC),并给出 tokenizer 侧的代理指标 M_SAC 用于在不训扩散模型的前提下诊断。方法层面 AffineTok 用两个纯训练期组件促进 SAC:Global Semantic Coordination Token(GSCT)是一个前置的可学习 token,与 patch embedding 一起送进 encoder,用来协调干净 latent 的语义组织、让「语义平均」这个操作仍然有意义,解码前该 token 即被丢弃;Posterior-Mean Semantic Alignment(PMSA)学一个后验均值预测器 G_post,从含噪输入预测后验均值 latent,再用语义投影器监督从中恢复出的语义。语义监督由冻结的 DINO 提供,两个组件推理时都不存在,因此零部署开销。 Overall framework of AffineTok. The input image is processed in parallel by a frozen VFM and a trainable tokenizer. Its encoder jointly maps patch embeddings and a prepended learnable GSCT to a global output and clean patch latents (z_0). After (z_0) is noised into (z_t), the resulting global and noisy patch representations receive semantic supervision; the global output is then discarded, while (z_t) is decoded for reconstruction. Along the PMSA path, (G_post) maps (z_t) to a posterior-mean estimate, and (S_post) maps the estimate to semantics. Only clean patch latents are retained downstream. 实验效果:M_SAC 在所评估的多个 tokenizer 与扩散模型规模上都紧跟生成质量,与 SiT-XL 的 gFID 达到 0.960 的 Pearson 相关,这构成了「用 SAC 指导 tokenizer 训练」的依据。ImageNet 256 上,相比基线在 20 epoch 时 gFID 降低 26%;继续训练后取得新的 SOTA——不用 classifier-free guidance 时 gFID 1.21,用 guidance 时 1.10。针对性语义探针(越低越好)显示:语义轴不一致率上,RecTok 在 θ>30° 为 58.3%,加 GSCT 降到 24.4%(降 58%);θ>35° 从 29.5% 降到 7.8%(降 73%);θ>40° 从 12.2% 降到 2.8%(降 77%)。严重失败率(Top-10 语义检索 miss)上,RecTok 在 t=0.7/0.8/0.9 三档为 5.6%/6.4%/15.1%,GSCT+PMSA 后降至 2.3%/3.1%/6.7%(分别降 59%/52%/56%)。 Targeted semantic probes for GSCT and PMSA (lower is better). Left: Cross-split semantic-axis inconsistency rates for RecTok and +GSCT across three angular thresholds. Right: Top-10 semantic retrieval miss rates for RecTok and +GSCT+PMSA under three severe noise levels. 批判点评:0.960 的 Pearson 相关是在有限数量的 tokenizer 与扩散规模上算出来的,样本点少时相关系数极易虚高,论文需要给出参与拟合的点数与置信区间,否则「M_SAC 可以当选型指标用」这个推论支撑不足。正交分解本身是恒等式变形,它严格说明 SAC 是语义恢复误差的一个必要成分,但不等于「提升 SAC 必然提升生成质量」——两者仍可能同源于第三个变量,论文的因果链是靠相关性搭起来的。gFID 1.10/1.21 是「继续训练」后的结果,基线是否在同等训练预算下评测需要核对,否则 SOTA 里混进了算力优势。语义探针的失败率依赖作者自定的角度阈值 θ,θ 从 30° 挪到 40° 时降幅从 58% 变成 77%,挑阈值的空间不小,读者应关注全曲线而非某一点。GSCT 与 PMSA 只在 ImageNet 256 的类条件生成上验证,能否迁移到文生图与视频 tokenizer 完全未知,而后者才是这条技术线的主战场。 6. KATok:按内容丢token压缩率推到252 Keep-or-Drop? Adaptive Tokenizer for Compact Video Representation | Kakao(韩国) | arXiv:2608.24293 关键词:视频tokenizer,自适应压缩,Gumbel-Softmax,时空冗余,潜在扩散,Kakao 前序问题:潜在扩散之所以能做高保真图像与视频合成,靠的是用 VAE 把数据压到紧凑潜空间来省算力。但常规 VAE 对视频并不合适——它采用固定压缩率,无法适配时空内容复杂度的巨大差异。一段几乎静止的镜头和一段剧烈运动的镜头会被压成同样多的 token:前者纯粹浪费,后者细节不够。固定码率这件事在图像上尚可忍受,到了视频这个冗余度极高、且冗余分布极不均匀的模态上就成了明显的浪费。 本文贡献:KATok 是一个基于 transformer 的 VAE,内含与 latent token 联合学习的自适应 token selector。视频先切成时空 patch 编码成连续 latent token;selector 用 Gumbel-Softmax 松弛为每个 token 预测 keep-or-drop 概率,也就是评估该 token 的内容丰富度,产出一份软 token-drop mask;这份 mask 与 decoder 的注意力共享,保证编解码两侧的 token 选择保持一致;decoder 则通过可学习的 granular query token 去注意保留下来的 latent,重建原始输入。直接把自适应 tokenization 接到扩散模型上会出问题——丢 token 会打乱原有的时空结构,导致生成时内容与位置错配。为此论文提出两种位置预测策略:cascaded generation 与 joint generation(内容与位置联合生成),用来保证空间一致性。 Overall architecture of KATok. A video is divided into spatio-temporal patches and encoded into continuous latent tokens. The adaptive token selector predicts per-token keep probabilities via Gumbel–Softmax relaxation, producing a soft token-drop mask shared with the decoder attention for consistent token selection. The decoder reconstructs the input via learnable query tokens by attending to the masked latent tokens, forming an end-to-end differentiable pipeline for adaptive token selection. 实验效果:在 SOTA 级压缩率下同时保持强重建与生成质量。压缩率随输入尺寸单调增长,这是自适应方案相对固定方案的核心优势:256²×16 帧约 133,384²×16 约 159,480²×16 约 183,512²×16 约 191,一路到 512²×32 帧达到 252;对照之下 ElasticTok 在测到的两个尺寸上都固定在约 102,OmniTokenizer 则是一条 96 的水平线。也就是说输入越大、冗余越多,KATok 的收益就越明显。进一步分析表明这个改善主要来自削减时空冗余、移除低信息量 token,定量与定性结果都支持这一点。消融图显示:朴素模型直接生成稀疏 latent 时会出现内容-位置错位(图中红框标出),而 joint content-position 与 cascaded 生成策略能缓解这个问题并提升整体生成质量。 Token scaling with video size. As spatial and temporal resolution increase, our method achieves progressively higher compression ratios, demonstrating efficient scalability across input sizes. In contrast, OmniTokenizer maintains a fixed compression ratio, and ElasticTok remains nearly flat. (Conventions and compression ratio definition follow Table.) 批判点评:「data-dependent 压缩」的另一面是 token 数变成不定长,这会直接冲击批处理效率、显存预算与推理调度。论文只在「空间错位」这一处正面应对(靠两个生成策略补救),完全没有量化不定长带来的吞吐损失——而这恰恰是工业落地时第一个要问的问题。压缩率 252 对 96 的对比要成立,前提是双方重建质量在同一水位,可论文对质量只用了「strong」这样的定性词,缺少同 PSNR/rFID 下的压缩率对照表。图里另一个可疑点是 ElasticTok——它本身就是弹性 token 方案,却几乎持平在 102,与其设计意图不符,很可能是基线配置未针对这些分辨率调优,这类对比对基线不太公平。keep-or-drop 是二元决策的松弛,对于「部分重要」的 token 没有中间档,直觉上不如按重要度分配比特数来得优雅。评测集是 UCF、Kinetics、Sky 一类经典短视频数据集,长视频与高动态场景没有覆盖,而那才是自适应压缩本该发挥最大价值的地方。 7. Luce:单图出可重光照PBR高斯资产 Luce: Relightable Gaussians for 3D Asset Generation | Apple | arXiv:2608.23943 关键词:图生3D,PBR材质,可重光照,高斯splatting,rectified flow,Apple 前序问题:高保真的图生 3D 需要一个同时刻画几何与外观的 3D 表示。而要支持重打光、并且能接进标准渲染管线,这个表示必须包含 PBR 模态——albedo、metallic-roughness 与表面法线。现实是主流生成式 3D 表示往往只产出「把光照烘死在外观里」的结果:单看渲染图挺漂亮,一旦塞进游戏引擎或影视管线换个环境光就露馅,因为模型从未把材质与光照分离。 本文贡献:Luce 把几何与 PBR 材质统一在一个体素化的多模态高斯云里,为每个模态配专属的高斯基元。流程分两段:表示转换阶段,给定一个 3D PBR 资产先渲染多视角图,再在稀疏体素网格上按模态各拟合一套高斯 splat(albedo、metallic-roughness、normals),得到 PBR Gaussians;一个结构化潜空间 VAE(SLatVAE)把这个表示编码成紧凑可扩散的 latent,并能解码回 PBR Gaussians。生成阶段,一个 rectified-flow transformer 从单张图生成该 latent,条件来自预训练图像编码器的多层特征(DINOv2 的 L6/L12/L18/L24),多层同时取用是为了兼顾语义上下文与细空间细节;先过 Sparse Structure Flow 定结构、再过 SLat Flow 出 latent、最后由 SLat Decoder 解成 PBR 高斯。产物可直接用 GS 渲染器配 IBL 环境贴图着色,也可选走 Mesh Decoder 导出带切向空间法线图的纹理网格。 Overview of Luce. (Top) Representation and SLatVAE. Given a 3D PBR asset, here a Toys4K sample, we render multiview images and fit per-modality Gaussian splats (albedo, metallic-roughness, normals) on a sparse voxel grid. A structured latent VAE (SLatVAE) encodes this representation into a compact, diffusible latent and decodes it back to PBR Gaussians. (Bottom) Generation pipeline. Given a single input image, a sparse-structure flow first predicts the sparse voxel layout. Conditioned on multi-layer DINOv2 features, SLatFlow then generates a PBR Gaussian latent at each active voxel. The structured latent decodes into relightable PBR Gaussians and also serves as input to the mesh decoder, which yields textured meshes with tangent-space normal maps and a complete PBR material set. 实验效果:Toys4K 上取得单图生 3D 的 SOTA,FID 相比最强基线改善 28%。论文另建了一个 AI 生成图像构成的 benchmark,在其上 CLIP 图文对齐分从最佳基线的 0.8299 提升到 0.8519。解码出的 PBR 模态可以在新环境贴图下通过标准 PBR 合成直接着色渲染,不需要抽网格、也不需要 UV 展开——这是相对「先出网格再烘材质」流程的实质简化。重光照验证里,论文把自家 deferred PBR 渲染器在高斯拟合上的输出与用 Blender EEVEE 渲染纹理网格的参考并排对照:同一把战锤在户外日光、草地、暮色、studio 点光、室内、拱廊六种环境贴图下,金属面的高光位置、锤头与手柄的整体色温都随环境同步变化,两条渲染路径的结果高度接近。生成资产还能保住文字、logo、铭文这类细节。 PBR shaded rendering. The decoded PBR modalities (albedo, metallic-roughness, normals) enable shaded rendering under novel environment maps via standard PBR compositing (Eq.), without mesh extraction or UV unwrapping. We compare our deferred PBR renderer on the GS fit against the textured mesh rendered with Blender EEVEE as a reference; the environment maps are listed in Appendix. 批判点评:重光照那组图容易被误读,需要说清楚:它比的是「自家 GS 渲染器 vs Blender EEVEE 渲染同一份纹理网格」,验证的是两条渲染路径自洽、材质分解没跑偏,而不是「重光照质量超越其他生成方法」——论文里没有与基线在重光照维度上的对比。FID 改善 28% 的评测集 Toys4K 是玩具类物体,几何规整、材质单纯,能否外推到复杂场景资产或有透射/次表面散射的材质,证据不足。CLIP 分 0.8519 对 0.8299 只差 0.022,落在 CLIP-score 的噪声量级内,属于弱证据;何况这个 benchmark 由作者自建,构成、规模与筛选标准都需要审视。为每个 PBR 模态各配一套高斯基元意味着基元数量成倍增长,训练与推理开销、体素网格分辨率上限论文摘要没有交代,而这决定了方法的实际可用规模。网格导出被标为 optional,说明主路径产物仍是高斯,要进现有 DCC 管线还差一步转换。作者全部来自 Apple,摘要未提代码或模型是否发布,短期内外部复现的可能性偏低。 8. TransPhy:看两张示例学会物理变换规则 TransPhy: Visual In-Context Learning for Physically Grounded Image Editing | 北京大学、商汤科技研究院、浙江大学 | arXiv:2608.24119 关键词:视觉上下文学习,物理接地编辑,MoE-LoRA,规则归纳,BAGEL,北大商汤 前序问题:视觉示例是指定图像变换的天然接口——很多变换用文字穷举描述极其困难,比如「让这块金属锈到这个程度」或者「让布料在这个受力下这样塌陷」。但现有视觉上下文学习(VICL)方法主要处理外观级的关系迁移,对物理接地的变换支持很有限,而后者的结果取决于材质属性、几何、物体交互与环境条件。给定一对 source-target 示例和一张查询图,物理接地的 VICL 要求模型做三件事:推断出被示范的是什么变换、把这个变换的效果适配到查询图特有的场景上下文、同时保住与规则无关的内容不被改动。 本文贡献:先建数据与评测:PhysVICL-74 含 74 条物理接地变换规则、5,240 对 source-target 图像,组合成近 7.5 万个训练与评测上下文;benchmark 划分把「新实例迁移」(同规则换物体)与「未见规则泛化」分开评,避免用同一个总分掩盖两种截然不同的难度。方法上 TransPhy 把任务分解成物理规则归纳与过渡对齐渲染两步:先预测被示范的规则,并生成一段针对查询图的显式目标状态描述(把隐式的视觉示范转成可检查的中间语言表示);再通过 token 级的混合专家适配合成目标图,专家路由由局部化的过渡线索引导。实现在统一模型 BAGEL 上:理解通路走 Text Encoder 与 ViT Encoder,生成通路走 VAE Encoder,各自经 projector 汇入 MM Attention;Token Level Align 模块用示例对的差分(1-Sim)算出过渡热图,经 Top ρ%、token merging、region refine 得到精炼的过渡证据,以 L_STC 监督对齐 router;MoE-LoRA 的多个专家承担规则渲染,配 router 负载均衡与 token 负载均衡两个约束。 Overview of TransPhy on BAGEL. The understanding and generation pathways encode the exemplar--query context; ViT-derived transition evidence aligns token-level routing, while MoE-LoRA experts render the inferred physical rule. 实验效果:在物理规则遵循度、查询一致性、未见规则泛化三项指标上均优于既有的视觉上下文编辑方法。机制侧的证据来自专家路由可视化:逐层的专家使用热图呈现明显分化(不同 MoE block 偏好不同专家,而非均匀使用),说明路由确实学到了结构而不是退化成平均;把全部 token 硬路由到单个专家时(分别强制走 Expert 0 至 Expert 3),同一张查询图会得到肉眼可辨的不同编辑结果,红框标注处差异最明显——这支持了「不同专家承担了不同的变换成分」这一设计假设,而不是彼此冗余的副本。 Expert routing visualization. Left: layer-wise expert-routing heat map. Right: results obtained by hard-routing all tokens through experts~0--3. 批判点评:74 条规则、5,240 对图像撑起「近 75K 个上下文」,说明上下文是由有限图像对组合放大出来的,这个数字的实际信息量远小于字面,读者不该把它当成 7.5 万个独立样本看。更关键的缺口是:物理接地变换的真值怎么来的——渲染引擎合成、真实拍摄,还是另一个生成模型产出?摘要完全没交代,而这直接决定这个 benchmark 是否真的「物理正确」,如果真值本身来自生成模型,整套评测就退化成模仿另一个模型的偏好。效果全部以定性优势描述(improves adherence / consistency / generalization),没有一个绝对数字,也没有与具体基线的逐项对比表,这在有自建 benchmark 的情况下尤其说不过去。专家路由图分辨率偏低,红框标注的差异需要放大才能辨认,作为核心机制证据偏弱。方法只在 BAGEL 一个统一模型上实现,对底座能力的依赖程度未知。「未见规则泛化」的划分粒度(留出整条规则,还是同族规则的变体)会极大影响难度,摘要没有说明。 9. Game2World:先擦掉HUD再拿游戏视频训世界模型 Game2World Engine: Unlocking In-the-Wild Gameplay Videos for World Model Training | Game2World 团队(通讯作者 Dongping Chen,论文未标注机构归属) | arXiv:2608.24680 关键词:世界模型数据,游戏录屏,HUD移除,数据引擎,视频编辑,AAAI2027 前序问题:电子游戏是视频世界模型训练数据的规模化来源——环境多样、交互复杂、野外录屏在互联网上近乎无限。但原始录屏有个结构性缺陷:它把游戏世界和屏幕空间界面纠缠在一起。血条、小地图、任务提示、按键提示、伤害数字这些 HUD 元素会引入游戏特定的偏置和与世界无关的动态,世界模型会把「UI 的变化」当成「世界的变化」学进去,最终产出的既不是干净的画面也不是可信的动力学。 本文贡献:提出 GameUI-Taxonomy 与 G2WEngine,把「游戏 UI 定位与移除」形式化成一套全栈框架。HUD 资产抽取一路是:质量过滤(303 款游戏共 65.72 小时)→ 关键帧采样(采出 1,010 个不同帧)→ 标签起草 → 人工精修(平均每帧 3.69 个 HUD 部件)→ UI 抽取(把裁剪块转成透明资产)。HUD 覆盖层合成一路是:多样性过滤(去掉近似帧)→ 基于语义的构图布局与资产选择 → 时序动画(区分静态与弹出式资产的轨迹)→ alpha 合成与 bbox 追踪,确保合成出来的 UI 在时间上是连贯的。据此构建 Game2World:96K 合成配对视频(带精确重建目标)+ 来自 303 款游戏的 1,079 段野外片段用于真实评测;资产库含 21 个分类下 5,132 个已验证 UI 元素。最后提出 GameCleaner——一个免 mask 的游戏 UI 移除模型,把多模态语义理解与视频编辑能力结合起来,不依赖预先给定的 mask 就能识别并移除多样 HUD,同时保住底层场景内容与时序动态。 Overview of G2WEngine, a scalable data engine that transforms in-the-wild gameplay videos into world-model-ready data through HUD asset extraction, temporally coherent UI synthesis, and downstream support for HUD understanding, removal, and clean gameplay generation. 实验效果:受控 pilot 实验中,用去 UI 录屏训练的世界模型整体 VideoReward 比用带 UI 数据训练的高 6.83%——这是整篇工作的因果论断落点。UI 移除评测上,GameCleaner 在合成视频上平均 AAR 达 95.36,超过最强的时序 mask 基线 57.3%;野外片段上取得最佳 AAR 80.05,背景保持度 99.8。消融给出两条实用曲线:数据规模方面,野外评测下带参考图的表现从 0.2 规模的约 62 分升到全量的约 79.5 分,且曲线尚未收敛,说明继续加数据仍有空间;参考图 drop ratio 方面,野外表现在 20% 附近最好(约 79.8),过高(50%、80%)反而掉到 56、55 附近,而合成集上的表现则对 drop ratio 几乎不敏感(一直在 93~96)——这个合成/野外的分歧本身就是提示。 Ablation study of data scaling and reference drop ratio during training. We find out that larger and more diverse dataset show generalizable result on in-the-wild evaluation and have not converge yet. 批判点评:6.83% 的 VideoReward 提升来自「受控 pilot」,而模型规模、训练配置、评测 prompt 数量摘要一概没交代。这是全文最关键的因果论断,证据却最薄:去掉 HUD 有益在直觉上显然成立,但提升幅度是否稳定、在多大模型上还成立,目前没有答案。「超过最强时序 mask 基线 57.3%」是相对提升,考虑到基线在合成集上的绝对 AAR 只有 60 出头,相对数字把绝对差距放大了不少。野外 AAR 80.05 与合成 95.36 之间那 15 分的落差是重要信号:它说明合成 UI 与真实 UI 之间仍有明显分布差,而合成数据恰恰是训练主力,这个 gap 才是方法的真实上限所在。1,079 段野外片段作为评测集偏小,303 款游戏的品类分布也未公开,UI 风格的长尾覆盖存疑。1,010 帧的人工精修量对应 5,132 个元素尚算合理,但 21 个分类的边界是否清晰、多标注者一致性如何,都没有报告。最后,arXiv comments 里作者直接留邮箱寻求科研合作与资金支持,正文中也缺失机构归属——这是一支早期自筹阶段的团队,工程可复现性需要谨慎预期。 10. LAION-BVD:1000万小时开源视频数据集 LAION-BVD: A 10-Million-Hour Open Video Dataset for Multimodal Pre-training | 图宾根大学与图宾根 AI 中心、LAION、于利希超算中心(JSC, FZJ)、Wynd Labs、马普智能系统研究所与 ELLIS Institute Tübingen、慕尼黑工业大学 MCML | arXiv:2608.24845 关键词:开源视频数据集,多模态预训练,CommonCrawl,音频文本,ViCLIP,LAION 前序问题:多模态预训练的视频侧长期缺开放的大规模数据。现有开源视频数据集规模有限(InternVid-10M 量级),真正的大数据集掌握在少数机构手里且不公开,社区因此无法在视频与音频模态上独立验证 scaling 结论——图文模态上 LAION-5B、DataComp-1B 已经把这条路打通了,视频侧却一直缺一个对应的公共基础设施。 本文贡献:LAION-BVD 从 CommonCrawl 中筛出 13 亿条平台特定视频 URL(BVD-URLs),用分布式基础设施实际下载了 8,000 万个视频、总时长 1,000 万小时(BVD-RAW),面向视频、音频、图像三种模态的预训练设计。数据管线用内容感知的场景检测切出片段,并为片段合成生成视频 caption 与音频 caption。派生子集包括:从 240 万视频按 10 秒到 30 分钟过滤并切片得到的 BVD-V-55M(5,500 万片段),再采样出 BVD-V-10M 与 BVD-V-50M;按 2 到 30 秒过滤得到的 BVD-A-1.7M 与 BVD-A-10M 音频片段;以及采样并筛选场景切换帧得到的 BVD-I-300M(3 亿张图像)。最后一条是个有意思的角度——把视频帧当作图文数据的替代来源,因为场景切换帧的视觉分布与常规网页图库明显不同。全量数据集已向研究社区发布。 LAION-BVD data curation pipeline. We source data from CommonCrawl and filter for platform-specific video URLs, resulting in 1.3B high-quality video candidates. Out of these, we successfully downloaded 10M video hours using a distributed infrastructure from which we create the BVD-* subsets. 实验效果:在这些数据上训练的模型在标准 video-text 与 audio-text benchmark 上具备竞争力,且随训练量或模型规模增长持续改善。ViCLIP 上,BVD-V-10M 与 BVD-V-50M 的平均检索约为 56.3 与 56.9、平均分类约为 68.2 与 68.4,两项都高于 DataComp-1B(约 45.0 与 62.6)与 InternVid-10M(约 52.8 与 67.6)。CLAP 音频文本上,BVD-A-10M 的曲线整体位于 Laion-Audio 之上,且随模型规模增长的斜率更陡,从约 42.9 升到约 46.8,而 Laion-Audio 同区间为 42.1 到 44.8。用场景切换帧训练的模型取得了强图文检索表现——这印证了「视频帧可作为图文数据替代源」的判断;但同一组实验也诚实报告了反面:LAION-BVD 的 ImageNet 零样本分类仍弱于网页 alt-text 基线。 LAION-BVD is an open web video dataset at unprecedented scale. It facilitates strong downstream performance for multimodal pretraining. Left: dataset scale in comparison with existing video datasets. Right: average downstream performance of ViCLIP (video-text, tab:exp_results_wise_ft) and scaling-trends of CLAP (audio-text, tab:exp_results_clap_pure) on standard benchmarks. These results demonstrate that LAION-BVD serves as valuable training data across both video and audio modalities. 批判点评:caption 是「synthetically generate」的,也就是模型产出的伪标签。这决定了数据集的语义上限,也会把 captioner 的偏置固化进所有下游模型,而摘要没说用的是哪个 captioner、也没做 caption 质量的人工抽检——对一个定位为公共基础设施的数据集来说,这是最该交代清楚的一项。1,000 万小时是「下载到的原始时长」,真正进入训练的是切片后的子集(如 BVD-V-50M),两个量级不能混着读,标题里的数字带有一定的宣传性质。ImageNet 零样本弱于 alt-text 基线是个诚实且重要的负面结果:它说明视频帧的分布优势偏检索、不利分类,但作者点出后没给成因分析,读者拿不到「什么时候该用这份数据」的判断依据。开源发布的到底是 URL 列表还是视频本体,极大影响长期可用性——CommonCrawl 系数据集普遍存在链接腐烂,几年后的实际复现率会显著下降。版权授权状态与内容安全过滤强度未在摘要交代,这类超大规模网络采集数据集的合规风险不容忽视。评测骨干只有 ViCLIP 与 CLAP 这类相对轻量的判别式模型,这份数据能否直接用于生成式视频预训练(也就是社区最想要的用法)完全没有验证。 趋势观察 扩散后训练同一天冒出两条「去似然化」路线,方向出奇一致 — 今天最值得放在一起读的是 DiffusionOPSD(字节 Seed)和 RVM(NVIDIA + Georgia Tech)。两篇互不引用、机构毫无交集,却在同一个判断上撞车:把大语言模型那套策略梯度机制搬到扩散模型上,是一条走歪了的路。原因很朴素——自回归模型有可解析的样本似然,扩散模型没有。为了凑出一个「似然」,现有方法要么从随机去噪转移拼轨迹似然,要么用 ELBO 近似端点似然,代价是额外计算与算法复杂度,而换来的信号依然只挂在端点上。两篇的解法各走一边:DiffusionOPSD 往「中间监督」走,用 reward 梯度在冻结 behavior policy 提供的 anchor 周围直接构造出有界的正负目标,让每一步的 clean-output 预测都有明确的去处;RVM 往「原生表示」走,干脆不要轨迹、不要似然,直接在速度场上做 reward 加权回归,并顺手把 RAM 与 DiffusionNFT 收成特例。省下来的算力是实打实的:DiffusionOPSD 相比 DiffusionNFT 减 40%~63% GPU-hours,RVM 在 Wan2.1-1.3B 上 525 GPU-h 就跑完,DanceGRPO/TaRoS 要 6,171。更值得留意的是 DiffusionOPSD 那个负面发现——目标构造增益更大,不代表一次拟合后的实现增益更大,HPSv2.1 的目标序在 62.3% 的 prompt 上会反转。这提示扩散 RL 的下一个瓶颈可能不在「怎么定目标」,而在「一步优化能吃进去多少」。 少步蒸馏已经不单独交付了,它和推理工程栈捆成了一个整体 — TurboT2VA 的数字拆解值得逐段看:LTX-2 19B 音视频联合模型,1024×1792、121 帧、单卡 NVIDIA H20 上,40 步教师 318.74 秒。先上 guarded W8A8 加算子融合,拿到 1.37×,降到 233.34 秒;再换成 4 步蒸馏学生,19.18×,降到 12.16 秒;最后叠一层模态感知稀疏注意力(SageSLA,ρ=0.3),再 2.08×,落到 5.83 秒。整体 54.67×。这条链条说明了一件事:单看蒸馏是 19.18×,单看工程栈是 1.37×2.08≈2.85×,但它们乘起来才是那个吓人的数字,任何一环单独宣传都会失真。另一个细节是稀疏化的边界——作者明确保留了跨模态与文本条件的 dense 路径,只对模态内注意力做稀疏。这不是保守,而是承认音画同步这件事经不起近似。反过来看 RVM 那篇也印证了同一件事:它测了从 16 步网格子采样到 5 步、4 步的鲁棒性,说明「少步」已经从加速技巧变成了模型必须自带的属性,而不是发布后再补的一层优化。 视觉 tokenizer 的竞争焦点,从「压得多」挪到了「压得让下游好学」 — AffineTok(复旦 + 阿里 Token Hub)和 KATok(Kakao)走的是同一个方向的两条腿。AffineTok 问的是语义该怎么组织:现有做法训一个 projector 从含噪 latent 直接预测语义,作者指出这预测的是「干净图语义的平均」,而扩散真正需要对齐的是「平均后干净 latent 的语义」——这两个东西不是一回事。他们把语义恢复误差做正交分解,识别出被忽略的一致性要求(Semantic Affine Consistency),并给出 tokenizer 侧代理指标 M_SAC,报告它与 SiT-XL 的 gFID 有 0.960 的 Pearson 相关。KATok 问的是比特该怎么分配:常规 VAE 用固定压缩率,静止镜头和剧烈运动被压成同样多的 token,前者浪费后者不够;它用 Gumbel-Softmax 给每个 token 学一个 keep-or-drop 概率,压缩率从 256²×16 帧的 133 一路涨到 512²×32 帧的 252,而 ElasticTok 固定在 102、OmniTokenizer 固定 96。一个管「语义排布」,一个管「码率分配」,共同点是都不再把 tokenizer 当成一个可以离线调好然后冻住的前置模块,而是当成对下游生成质量负直接责任的一环。AffineTok 的 GSCT 与 PMSA 都只在训练期存在、推理时丢弃,这个设计取向也很能说明问题——愿意为下游多付训练成本,但不肯多付一分部署开销。 世界模型的瓶颈正在从「模型」挪到「数据能不能直接用」 — Game2World 和 LAION-BVD 是今天的数据侧双响。前者盯的是一个很具体的脏活:游戏录屏是世界模型训练数据的规模化来源,但血条、小地图、任务提示这些 HUD 元素把游戏世界和屏幕空间界面纠缠在一起,模型会把 UI 的动态当成世界的动态学进去。G2WEngine 把这件事形式化成全栈流程——从 303 款游戏、65.72 小时录屏里抽出 5,132 个已验证 UI 元素(21 个分类),再把时序一致的 UI 覆盖层合成回干净录屏,造出 96K 配对视频用于训练、1,079 段野外片段用于评测,最后训一个免 mask 的 GameCleaner 擦干净。受控实验里,用去 UI 数据训练的世界模型整体 VideoReward 高 6.83%。后者走的是另一个极端:LAION-BVD 从 CommonCrawl 捞了 13 亿条视频 URL,下载 8,000 万个视频共 1,000 万小时,切片后派生出 BVD-V-55M、BVD-I-300M、BVD-A-10M 等一系列子集,ViCLIP 上 BVD-V-50M 的平均检索约 56.9、平均分类约 68.4,都高过 DataComp-1B 与 InternVid-10M。两篇合起来的信号是:视频生成这条线上,「有没有数据」的问题正在被「数据里有多少是能直接喂的」取代。也要留一句冷水——LAION-BVD 的 caption 是模型合成的伪标签,它的天花板就是那个 captioner 的天花板;而它诚实地报告了 ImageNet 零样本分类仍弱于网页 alt-text 基线,说明视频帧的分布优势偏检索、不利分类。 人工智能炼丹君 整理 | 2026-08-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-25|Meta让15B DiT优化器时间砍半Muon-DiT 今日 AIGC 论文速览 今日共 10 篇 · 训练与推理效率 3 篇 · 视频编辑与视角转换 2 篇 · 生成理解一体化 1 篇 · 3D 与数字人生成 2 篇 · 可控图像生成 1 篇 · 生成评测 1 篇 重点论文标题列表 Muon-DiT(Meta、南加州大学 (USC)):优化器时间砍掉一半的15B DiT InfinityEdit(浙江大学、阿里巴巴集团):编辑指令跟着直播流无限延伸 TextAnchor(哈尔滨工业大学、可灵 KlingAI Research):十张参考图编辑提速5.47倍 Grounded-Exo2Ego(NVIDIA):第三视角视频翻成第一视角 Libra(中科院自动化所 MAIS、中国科学院大学、鹏城实验室):视觉与语言各走各的路再架桥 今日论文速览 1. Muon-DiT:优化器时间砍掉一半的15B DiT Scaling Muon for Diffusion Transformers | Meta、南加州大学 (USC) | arXiv:2608.20818 关键词:Muon优化器,DiT训练,Scaling Law,Newton-Schulz,通信优化,Meta 前序问题:Muon 是一个矩阵感知的优化器,它通过在奇异方向之间平衡更新来改善大模型训练,在语言模型上已有不少正面报告。但它在扩散 Transformer 上到底有没有用、有用的话优势会不会随规模衰减,一直没有系统答案——扩散模型的训练目标(去噪回归)与语言模型的下一 token 预测差异很大,参数矩阵的谱结构也不同,语言模型上的结论没有理由直接迁移。更棘手的是端到端效率:Muon 的核心是每一个优化步都要做 5 步 Newton-Schulz 迭代(NS5)来正交化更新方向,再加上需要把动量完整物化出来,这两项在大规模分布式训练下会引入可观的计算与通信开销。理论上 Muon 用更少的步数达到同样质量,但如果每一步都更贵,省下的步数优势就被抵消了,实际墙钟时间可能反而更长。 本文贡献:作者先把 Muon 在 1.3B 到 15B 参数的 DiT 上的 scaling 行为建立起来,确认其相对 AdamW 的优化与生成质量优势跨越各个规模都存在。然后针对上述开销问题提出 Periodic Row-wise Muon:完整的 NS5 谱更新每 K 步才做一次,其余步骤基于当前动量做一个计算与通信开销都很低的行约束(row-wise constrained)更新。这个设计的直觉是谱正交化的收益具有一定的时间持久性,不需要每步重做;行归一化则以极低成本维持更新方向的量级平衡。配套的分布式实现是关键的另一半——非刷新步直接在分片后的动量上操作,避免全量物化;谱刷新步则通过分桶 all-gather 与通信-计算重叠来加速。方法层面与实现层面是协同设计的,不是先有算法再套一个工程实现。 实验效果:跨全部规模,Muon 相对 AdamW 把观察到的最佳生成质量提升了 12.9%~19.1%。相比原版 Muon,Periodic Row-wise Muon 在 1.3B~4B 上最佳生成质量的差距保持在 0.5% 以内,在 9B 上反而提升了 4.5%。效率侧:优化器时间减少 46.9%~54.3%,端到端单步时间减少 15.7%~24.3%,逻辑通信量降低 66.7%,达到各自最佳生成质量所需的有效训练时间减少 33.7%~64.8%。9B 模型的 profiler 时序图直观展示了这个差异:原版 Muon 每一步的 CPU 阶段都被红色的 NS5 块占据,归一化总时间 12.47;Periodic Row-wise Muon 只在第一步做紫色的周期性刷新,后两步是很窄的绿色行归一化块,总时间降到 10.26。 Generation quality for AdamW and Periodic Row-wise Muon. 批判点评:评价指标只用了 FD-DINO 这一项。它作为生成质量代理是合理的,但单一指标很难覆盖扩散模型关心的全部维度——文本对齐、多样性、失效模式都没有报告,「生成质量提升 12.9%~19.1%」这个数字的解释空间因此受限。周期 K 的选择论文中没有在摘要层面给出选取准则,而这是一个直接影响质量-效率权衡的超参,实际使用时需要重新搜索。另外 9B 上 Periodic 版本反而比 vanilla Muon 好 4.5% 这个结果有点反直觉(近似方法优于精确方法),论文归因不明,更可能是训练噪声或正则化副作用,而不是周期化本身带来的收益——15B 上并没有复现出同样的优势。最后,全部实验在 Meta 内部的训练栈上完成,通信优化的收益与具体的集群拓扑强相关,换一套硬件环境未必能复现 66.7% 的通信量下降对应的实际时间收益。 2. InfinityEdit:编辑指令跟着直播流无限延伸 InfinityEdit: Infinite Video Editing with a Lightweight Edit-Ignition Adapter | 浙江大学、阿里巴巴集团 | arXiv:2608.20910 关键词:无限视频编辑,流式生成,轻量适配器,因果注意力,阿里 前序问题:指令式视频编辑这两年靠大预训练模型已经做得不错,但绝大多数方法都建立在一个默认假设上:原地编辑。给定一段固定时长的源视频片段,把编辑后的视频与它逐帧对齐。这个模式在开放式的视频流面前直接失效——比如给一场正在进行的游戏直播换风格,或者给一个还在拍摄的镜头加一段运镜,编辑必须作用在陆续到来的未来帧上,而不是一个静态的输入片段。这个设定带来两个新困难:编辑必须是对流的忠实延续而不是逐帧重写,以及当编辑指令一条接一条累积时,生成质量不能持续退化。 本文贡献:作者先把这个任务形式化命名为无限视频编辑(infinite video editing)——给定前序片段和一条编辑请求,模型要生成延续这个流并施加该编辑的下一个片段,整个过程随无界的指令序列反复进行。为此他们设计了配套的数据收集管线,并在此基础上提出 InfinityEdit:一个给流式视频生成器加装无界编辑能力的轻量编辑适配器。适配器里有三个注意力模块,分工明确——历史交叉注意力用输入帧引导当前去噪帧,时序因果自注意力保证时间信息只从早期帧流向后期帧,编辑交叉注意力把编辑请求注入生成过程。推理时的调度是这个方法的巧妙之处:适配器只在编辑请求到达的那个 chunk 被激活(作者称之为 ignition chunk),后续 chunk 交还给原模型、用重置的锚定帧继续生成。这样既施加了编辑,又完整保留了原模型的无限生成能力,不会因为适配器一直在线而累积漂移。 Our adapter's architecture. It is composed of three attention modules. 实验效果:实验显示 InfinityEdit 在每条编辑下都能忠实延续视频流,并在无界编辑序列上保持稳定。定性对比最能说明问题:以一段山峰风景视频为源,连续施加「向上移动镜头」「拉远」「美式漫画风格」三条指令,Helios-Base 在第一条指令后就基本没有响应运镜;Anchor-Forcing 和 Infinity-RoPE 从第一轮开始画面就被云雾吞掉、山体结构丢失;SANA-Streaming 在第三轮的漫画风格化中把山体涂成了大片紫黄色块。InfinityEdit 三轮下来山峰主体的结构始终清晰可辨,运镜幅度与指令对应,漫画化时也保留了山形轮廓。长视频实验把每个编辑片段拉长到全序列超过 1000 帧,方法依然视觉稳定且持续实现每条指令。 Qualitative comparison with various methods on the streaming video editing task, where a sequence of editing instructions (here camera-movement and style edits) is applied continuously to a scenery source video. All methods share the same source video and editing instructions. Methods marked with $\dagger$ take no source video as input, while all other conditions are kept identical for fairness. 批判点评:18 页的篇幅对一个新任务定义加方法加数据管线来说偏紧,摘要里的实验结论全是定性表述(「忠实延续」「保持稳定」),没有给出量化的编辑成功率或与基线的数值差距,只能等正文核实。更值得追问的是评测本身——无限视频编辑这个任务是他们自己定义的,数据管线也是自建的,对比的基线(Helios-Base、Anchor-Forcing、Infinity-RoPE、Lucy-Edit、SANA-Streaming)都不是为这个设定设计的,在这种「主场作战」的比较里领先幅度容易被高估。推理时适配器只在 ignition chunk 激活、后续交回原模型这个调度虽然保护了无限生成能力,但也意味着编辑效果的持续性完全依赖锚定帧的传递,如果某条编辑的语义需要长时间维持(比如把整个场景换季),单 chunk 的激活是否够用是个未验证的问题。 3. TextAnchor:十张参考图编辑提速5.47倍 Anchoring Instruction Outside Mask: Exact Reference Caching for Efficient In-Context Diffusion Transformers | 哈尔滨工业大学、可灵 KlingAI Research | arXiv:2608.21229 关键词:参考图缓存,注意力掩码,on-policy蒸馏,多图编辑,可灵 前序问题:全模态生成里,上下文条件是核心机制——让扩散 Transformer 在同一条注意力序列里同时处理文本指令和视觉参考。问题是每张参考图会引入数千个 token,算力随参考图数量快速增长。现有的省法是结构化稀疏注意力,通过限制参考 token 与目标 token 之间的交互来砍计算。这个结构有个附带好处:参考图的 K 和 V 与去噪目标无关,因此可以算一次、跨所有去噪步复用。但代价同样明显——它把视觉参考与文本指令之间的通路也一并切断了,参考图「看不到」用户的指令,多参考图编辑里的指令跟随和参考保真度显著下滑。这是一个结构性的两难:要缓存就得解耦,一解耦指令就传不进去。 本文贡献:作者的破局点是同时重新设计 token 序列与注意力掩码,而不是在两难中做取舍。他们的 beyond-mask 设计引入静态文本锚点(时间步固定在 t=0 的文本 token),把指令连接到参考分支上,同时严格保持 K/V 精确复用的前提,且不增加任何参数。但这种直接的架构改造会掉生成质量,他们用两阶段的方式恢复:第一阶段是教师强制的速度蒸馏,在数据派生的插值点上查询教师;第二阶段是一段短的 on-policy 阶段,让教师在学生实际访问到的状态上做监督、修正沿轨迹的残余误差。作者称据其所知这是扩散模型中第一次用 on-policy 蒸馏来做架构恢复——这个组合思路(先改架构拿效率,再用蒸馏把质量补回来)本身比具体的加速数字更有普适价值。 Overview of instruction-aware exact caching. Top: Static text anchors condition the reference branch once during cache construction. Only the resulting reference K and V are retained and reused across denoising steps. Bottom: Comparison of attention structures, where rows denote queries and columns denote keys and values. 实验效果:在三个图像编辑基准上,方法与全注意力生成的质量持平。5 张参考图时把完整的 40 步去噪流程加速 3.92 倍,静态文本锚点带来的运行时开销可忽略;scaling 研究中 10 张参考图时加速比达到 5.47 倍。参考图数量与加速比的关系曲线很清晰:1 张时仅 1.82 倍,2 张 2.45 倍,5 张 3.86 倍,之后逐步爬升到 10 张时的 5.47 倍——全注意力的延迟从 1 张的约 40 秒涨到 10 张的约 970 秒,而本方法只从约 40 秒涨到约 175 秒,两条曲线的斜率差就是这套缓存机制的价值。定性对比中,隔离缓存(isolated condition)经常跟不上指令(图中红框标出的错误区域),而文本锚点版本的输出与 Qwen-Image-Edit-2511 的全注意力结果接近。 批判点评:加速比对参考图数量的强依赖需要被正确理解:单张参考图时只有 1.82 倍,这是绝大多数实际编辑场景的常态;5.47 倍要 10 张参考图才能拿到,而十图编辑是相当边缘的用例。也就是说这套方法的收益曲线与真实需求分布未必对齐。质量方面论文的说法是「matches full-attention generation quality」——匹配而非超越,考虑到还额外付出了两阶段蒸馏的训练成本,这个权衡是否划算取决于部署场景的推理量。on-policy 蒸馏作为架构恢复手段是个有意思的贡献,但论文没有报告这个恢复过程本身的成本(需要多少数据、多少 GPU 时),而这直接决定了该方法能否被复用到其他架构改造上。另外静态文本锚点把文本时间步固定在 t=0,这对训练时见过的时间步分布是一个分布外的用法,长期稳定性需要更多验证。 4. Grounded-Exo2Ego:第三视角视频翻成第一视角 Grounded-Exo2Ego: Structured Semantic Grounding for Robust Exocentric-to-Egocentric Video Generation | NVIDIA | arXiv:2608.20534 关键词:第一视角生成,视角转换,语义锚定,3D重建,NVIDIA 前序问题:从一段第三人称(exocentric)视频生成对应的第一人称(egocentric)视频,对 AR/VR 与具身智能都很关键——第一视角数据的采集成本远高于架好机位拍摄。但这个任务比常规的新视角合成难得多:视角变化极端,标准的几何条件(把场景重建成 3D 再从目标位姿渲染)在这种大跨度下变得高度不可靠,而且会出现大量在源视频里根本没被观察到的区域,几何重建对这些地方无能为力——渲染出来就是一片空洞。 本文贡献:作者在架构和数据两个层面同时下手。架构上是一个双分支的视频扩散模型:几何锚定分支把第三视角的颜色和深度抬升成 3D 重建、在目标 ego 位姿下渲染,用这个渲染结果条件化生成;语义锚定分支则跳出了主流的纯几何路线——用 captioning 提取逐物体的短语,经 LLM 转成物体 token,配合可学习的 register,通过带掩码的交叉注意力注入,让模型基于物体级上下文来合成那些几何搞不定的困难区域。另一个被忽视但影响巨大的发现是相机-重建失配问题:重建出的 3D 与相机位姿之间存在系统性错位,会严重拖累 exo-to-ego 的学习,他们为此设计了一个相机重定位算法,修正后全部指标都有实质提升。数据层面则做了一个全自动的合成数据引擎,在程序化生成的环境里生成并渲染绑定骨骼的 3D 角色。 Method overview. Geometric anchoring (top): Exocentric color and depth are lifted to a 3D reconstruction and rendered at the ego pose. Semantic grounding (bottom): Per-object context is extracted as segmentation masks and object tokens. The segmentation masks are reprojected into the ego-view as used as attention masks during cross-attention. The per-object masks encourages noisy tokens to attend to object information relevant to the specific region, providing spatial structure that grounds semantics onto pixels. 实验效果:在有挑战性的 EgoExo4D 数据集上,方法在所有指标上都大幅超过近期的 SOTA。详细消融验证了数据侧与架构侧每一项贡献各自的增益。teaser 图给出的定性对比很有说服力:同一个厨房场景,Vista4D 生成的第一视角画面里手部与台面结构完全错乱,EgoX 虽然保住了手的形态但物体摆放与真值不符,纯几何渲染(Grounded Rendering)在未观察区域留下大片彩色噪点和空洞,而本方法的输出在手部姿态、盘子位置、台面布局上都与 ground-truth 高度接近。 批判点评:语义锚定分支依赖 captioning 模型和 LLM 来产生物体级条件,这条链路的鲁棒性没有被讨论——captioning 出错或漏掉关键物体时,本该被语义补全的困难区域会退化成什么,论文没有给出失败案例分析。合成数据引擎用程序化环境加绑定骨骼角色,与真实第一视角视频之间的域差距是这类方法的老问题(真实 ego 视频有严重的运动模糊、鱼眼畸变、极端光照),论文说合成数据有用,但没说清在多大程度上依赖它。评测只在 EgoExo4D 上进行,这个数据集以厨房、自行车维修等结构化场景为主,泛化到户外或大范围移动场景的能力未知。另外相机重定位算法被描述为「实质提升所有指标」,这暗示原始 baseline 的一部分差距其实来自数据处理缺陷而非方法本身,与 SOTA 的比较中这部分收益应当被单独看待。 5. Libra:视觉与语言各走各的路再架桥 Decoupled Vision-Language System for Multimodal Understanding and Generation | 中科院自动化所 MAIS、中国科学院大学、鹏城实验室 | arXiv:2608.20382 关键词:生成理解一体化,解耦架构,Switch Attention,跨模态桥,中科院 前序问题:生成理解一体化的多模态大模型现在基本都走一条路:把图像 token 和文本 token 拼进同一个 Transformer,共享全部参数。这么做简单,但隐含了一个未经检验的假设——视觉和语言的表征需求是相同的,可以用同一套注意力和 FFN 权重来建模。实践中大家反复观察到理解与生成两个目标互相拖累:加强生成能力往往损害理解性能,反之亦然。问题的根源可能在于自模态建模(视觉内部的空间关系、语言内部的语法结构)和跨模态交互(图文对齐)本来就是两类不同的计算,硬塞进同一套参数里会产生干扰。 本文贡献:Libra 的做法是把两者显式分开:一个视觉系统、一个语言系统,中间用跨模态桥(cross-modal bridge)连接。解耦主要落在两个模块上——switch attention 和 switch FFN,它们根据当前处理的是自模态建模还是跨模态交互,动态路由计算流。这样每个模态能学到自己独有的表征,同时保持有效的跨模态理解。作者给出了两个配置:Libra-1 用于纯理解的图生文设定,Libra-2 用于理解与文生图统一的设定。除了架构本身,论文还讨论了 tokenization、位置编码和监督信号上的多项改进——比如混合图像 tokenization 把 CLIP 的连续信号与 VQGAN 的离散 ID 通过 LFQ 结合,因为直接把 VQGAN 的图像编码器换成 CLIP 会扭曲视觉信息。 An overview of the Libra architecture. The core design is the switch attention and the switch FFN that decoupling self-modal modeling and cross-modal interaction. We build two variants, Libra-1 and Libra-2, to discuss several improvements in tokenization, positional encoding, and supervision. 实验效果:实验表明专门的 Libra 设计让多模态理解与生成互相促进(而非互相拖累),在理解与生成两类基准上都取得了强性能。文生图的定性对比中,面对「悉尼歌剧院旁边是埃菲尔铁塔,蓝色夜空下爆炸的黄色星星和旋转的蓝色光晕」这种多要素长 prompt,SDXL 漏掉了铁塔、Show-O 把歌剧院画成了抽象色块,Libra-2 则把歌剧院、铁塔、星芒、蓝色漩涡都放进了画面;「一张脸左半边是爱因斯坦、右半边是机器人剖面」这条更考验组合能力的指令上,Libra-2 的结果左右分界清晰、机械结构细节完整。tokenizer 的消融图也直观显示直接用 CLIP 替换 VQGAN 编码器会让重建图像严重失真,而 Libra-1 的混合方案大幅缓解了这一点。 Comparison on text-to-image generation. We highlight the key parts of the text prompts, where Libra-2 demonstrates strong prompt-following capacity. % shows several text-to-image generation results of Libra-2. More results are presented in Sec.. In Fig, we compare the text-to-image generation results of Libra-2 with two baselines, StableDiffusionXL and Show-O, where StableDiffusionXL is a widely-used strong text-to-image generation model, and Show-O is a unified MLLM that use the most closed training 批判点评:摘要里的性能表述全是「strong performance」这类定性词,没有给出任何绝对数字或与具体基线的对比,无法判断领先幅度——这在一篇主打架构设计的论文里是个不小的信息缺失。解耦架构的直接代价是参数量:一个视觉系统加一个语言系统再加跨模态桥,参数规模相比同等能力的共享架构必然更大,论文没有报告参数量对齐后的公平比较,「互相促进」的结论也就有可能部分来自额外容量而非解耦本身。定性对比选的基线 SDXL 和 Show-O 都不是当前最强的文生图或统一模型,说服力有限。另外 switch attention/FFN 的路由是根据「当前是自模态还是跨模态」这个二元判断来做的,这个划分在实际的混合序列里如何精确界定,摘要层面没有交代。 6. DiffVC-ONE:一步扩散做视频压缩后处理 DiffVC-ONE: Diffusion-based Generative Video Compression with One-Step Video Diffusion Transformer | 武汉大学遥感信息工程学院 | arXiv:2608.20515 关键词:生成式视频压缩,一步扩散,视频DiT,时序一致性,武汉大学 前序问题:生成式视频压缩能在极低码率下恢复丰富的视觉细节——这是传统编码器做不到的,因为传统方法在低码率下只能丢细节,而生成模型可以「补」出合理的细节。但这条路上同时满足高时序一致性和低推理成本一直很困难:基于图像的方法逐帧处理,帧间容易闪烁;基于视频的方法能保证一致性,但多步扩散的推理成本在视频这个数据量级上难以承受。 本文贡献:DiffVC-ONE 建立在一步视频扩散 Transformer 之上,三个组件依次解决三个问题。统一单向 latent 压缩器(U2LC)用一个共享模型高效且统一地压缩紧凑的 latent 切片,避免为不同参考结构设计不同的压缩器。视频 DiT 的一步扩散增强器把重建出的 latent 切片当作内容锚点,对整个图像组(GOP)做单步的时空感知增强——注意这里是对整个 GOP 一起做,时序一致性因此有结构性保证,而不是靠逐帧后处理再想办法对齐。混合条件生成器从重建内容和量化信息里抽取结构、强度、语义三类条件:结构条件保留应当忠实还原的区域,强度条件控制生成增强的程度(这一点很重要——不是所有区域都该被生成模型「发挥」),语义条件在一步增强中补充内容感知的感知细节。 The framework of the proposed DiffVC-ONE. 实验效果:在多个标准基准上达到 SOTA 的感知质量和时序一致性,同时保持低推理成本。视觉对比给出了同一场景下各方法的码率(BPP)与放大细节:videoSRC15 的教堂穹顶场景中,DiffVC-ONE 的 BPP 是 0.0126(作为 1.00 倍基准),而 DiffVC 需要 0.0321(2.55 倍)、DiffVC-OSD 需要 0.0355(2.82 倍)才能达到相当的观感;鹦鹉羽毛的例子里 DiffVC-ONE 用 0.0059 BPP,对比 PLVC 的 0.0158(2.68 倍)和 VTM-17.0-LD 的 0.0074(1.25 倍),红黄羽毛的边界过渡更清晰。也就是说在相同感知质量下,码率大约只需要竞品的三分之一到二分之一。 Visual comparison between the proposed DiffVC-ONE and other representative methods. 批判点评:这是一篇工程完成度很高但方向偏窄的论文——生成式视频压缩距离实际部署还有距离,主要障碍是解码端需要跑一个视频 DiT,这个成本在终端设备上并不现实,「低推理成本」是相对于多步扩散而言的,不是相对于传统编解码器。论文只有两位作者,实验体量看起来主要靠 RD 曲线堆砌(6 个数据集 × 6 个指标 = 36 张子图),但这种密集的曲线图很难让读者判断在哪个码率区间优势最明显。另外生成式压缩有一个根本性的争议这篇没有正面回应:解码出的细节是模型「编」出来的而非真实存在的,在监控、医疗、取证这类场景下这是不可接受的属性,而 LPIPS/DISTS/FID 这类感知指标恰恰会奖励这种行为。强度条件的设计看起来是对这个问题的部分回应,但论文没有把它作为一个安全机制来讨论和验证。 7. MultiCube:拿包围盒指挥每个零件长在哪 MultiCube: Compositional 3D Generation With Part-Level Semantic and Spatial Control | Roblox、卡内基梅隆大学 (CMU)、斯坦福大学 | arXiv:2608.20448 关键词:组合式3D生成,部件级控制,布局适配器,两阶段扩散,Roblox 前序问题:游戏和动画里用的 3D 资产通常需要是组合式的——拆分成有语义意义的部件,这样才能单独换材质、做动画、改结构。最近的 3D 生成方法已经能从图像或文本 prompt 生成高质量的组合式物体,但这类全局条件缺少专业创作流程真正需要的部件级可控性:你可以说「一门带黄铜炮管和木轮底座的加农炮」,但没法指定炮管具体多长、轮子放在哪个位置。 本文贡献:MultiCube 的输入设计很直白:一个全局文本 prompt、一份指定期望部件的文本 schema、以及一个用包围盒标出各部件空间位置的布局。输出是由多个独立网格组成的 3D 物体,一个部件一个网格,且同时满足语义和空间条件。方法用两阶段扩散:第一阶段生成与 schema 和布局对齐的整体网格(monolithic shape),第二阶段把这个网格同时分解成各个部件——注意是同时而非逐个,因为部件之间存在相互约束。核心组件是 Part Layout Adapter,它独立于其他部件来编码每个部件的条件(文本标签走 Qwen-VL,包围盒走 Fourier + Linear),这个独立性保证了改动一个部件的条件不会牵动其他部件。第二阶段的多部件 DiT 之间插入 Cross-Part Attention,让各部件在生成时互相感知、保证接缝处的几何一致。 MultiCube uses a two-stage diffusion-based architecture. In Stage 1, it synthesizes a monolithic object conditioned on the input text prompt and part layout (a). In Stage 2, it takes the object latents produced in Stage 1 and decomposes them into multiple shapes, one for each specified part, guided by the part labels and bounding boxes (b). Spatial conditions are encoded with a Part Layout Adapter in Stage 1 and a lightweight embedding in Stage 2. 实验效果:实验显示方法能生成高质量的组合式 3D 物体并实现精确的部件级控制,包括那些仅靠文本或图像 prompt 难以达到的独特布局。定性结果覆盖面很广:婴儿车(车架/把手/座椅/顶篷/轮子五部件)、滑板(板面/桥/轮)、手电筒、树蛙、工具箱、摩托艇(船体/舷外机/螺旋桨/方向舵/挡风/座椅六部件)、黄铜提灯,以及喷气背包、加特林、火箭、军用水壶、飞碟、腕式弹弓、长剑等。每个例子里生成的形状都能看出与输入包围盒布局的对应关系——比如飞碟的「旋转外环」确实是一圈环绕结构、「诱捕光束发射器」在底部。 Full pipeline generation results. MultiCube generates compositional 3D objects from input text prompts and part layouts. Here, the part bounding box layouts are automatically generated using GPT-5.1; hence, the generation process from prompt to output shape is fully automatic. 批判点评:对创作者来说,手工摆包围盒本身就是一项不轻的工作量——这套方法把「描述物体」的负担转移成了「搭建粗模」的负担,是否真的降低了创作门槛取决于具体工作流。摘要没有给出任何量化指标(几何质量、部件分割准确率、布局遵循度都没有数字),也没有与 CubePart、PatchAlign3D 等基线的定量比较,「高质量」的判断只能靠看图。展示的例子都是结构相对规整的人造物体(工具、载具、武器),部件边界清晰;有机形体(树蛙那个例子是唯一的例外,且它的部件划分——身体/头/舌头/腿——也相当粗粒度)和部件间存在复杂拓扑连接的物体表现如何,从现有材料看不出来。另外包围盒作为空间条件只能表达轴对齐的粗略位置,无法表达旋转、弯曲等更细的姿态要求。 8. Xemo-Talker:把情绪监督放到次主成分上 Xemo-Talker: Unlock Emotions Explicitly for Audio-Driven Talking Portrait Synthesis | 利物浦大学、西交利物浦大学、昆山杜克大学、CMU、蚂蚁集团、平安科技 | arXiv:2608.14700 关键词:说话人视频,情绪控制,主成分分析,唇形同步,蚂蚁集团 前序问题:音频驱动的说话人头像里,精确的情绪控制一直做不好,因为现有系统依赖隐式的情绪调节——情绪信号混在整体条件里,控制间接且不充分。而如果直接在整个运动空间上加显式的情绪相关损失,又会撞上一个内在的权衡:唇形同步需要运动空间的主要能量方向被音频严格约束,情绪控制则要求这些方向能被情绪标签改动,两个目标在同一组维度上打架。 本文贡献:论文的核心发现是一个关于运动空间结构的观察:虽然情绪线索散布在整个运动空间中,但把判别性监督集中在次主成分(less-principal components)上,反而能取得更好的情绪-唇形平衡——因为主成分主要编码高能量的发音动作和头部姿态变化,情绪信息在这些方向上的占比被淹没了。基于这个洞察,Xemo-Talker 先学一个中性的语音到运动映射,保证稳定的发音和唇形同步(这一支冻结),再引入一个由次主子空间监督引导的轻量情绪分支(可训练)。为了强化情绪控制,他们设计了 Tri-Loss:类间分离、类内紧凑、以及次主对比学习三项。推理时输入音频、参考图像和情绪标签即可。 Overview of Xemo-Talker. (a) The Geometry Motion Predictor learns emotion-agnostic audio-driven motion through diffusion reconstruction, producing the complete 70-D facial motion sequence. (b) With the predictor frozen, the Geometry Emotion Branch encodes the target emotion and injects multi-scale residual features through zero-initialized adapters to refine the motion prediction. (c) The subspace-aware Tri-Loss organizes global emotion representations using classification and prototype alignment, while applying contrastive discrimination to the less-principal PCA projection. The predicted motion is converted into deformed keypoints and rendered by the frozen LivePortrait renderer. 实验效果:在情绪分类准确率上达到 SOTA,同时保持有竞争力的唇形同步和高推理效率,性能接近在真实视频上测得的水平。定性对比里最有说服力的是 Fear 与 Surprised 这一对——这两种情绪在面部表情上高度相似(都是睁大眼睛、张嘴),是情绪控制里最容易混淆的一对。图中同一身份在两种标签下生成的结果确实呈现出可区分的差异:Fear 时眉毛内侧上扬、嘴角向下、整体表情收紧,Surprised 时眉毛整体上抬、嘴张得更圆、眼睛睁得更大。男女两个身份上这个区分都成立。 Visual comparison of Fear and Surprised expressions from MEAD. 批判点评:「情绪分类准确率 SOTA」这个指标本身值得警惕:它衡量的是一个分类器能否认出生成视频的情绪,而 Tri-Loss 里的类间分离和类内紧凑恰恰是在直接优化这个可分性——存在把情绪做成夸张刻板表情来取悦分类器的风险,而人类观感上的自然度未必同步提升。论文没有报告用户研究,这个疑虑无法排除。次主成分承载情绪信息这个发现是基于 70 维运动空间的 PCA 方差谱得出的,这个运动表示来自 LivePortrait,结论是否依赖这个特定的运动表征、换一套 3DMM 或隐式表示还成不成立,没有验证。情绪标签是离散的类别(happy/sad/fear/...),这与真实表达中情绪的连续性和混合性不符,强度控制也不在建模范围内。另外机构列表横跨六家单位,实际的实验规模从 9 页的篇幅看应该有限。 9. OccluRank:给每个框加个序号定遮挡 OccluRank: Controllable Occlusion-Aware Layout-to-Image Generation by Adding Just an Ordinal Rank | 合肥工业大学、中国科学技术大学、字节跳动、中科院软件所 | arXiv:2608.20932 关键词:布局生成,遮挡顺序,序数条件,可控生成,字节跳动 前序问题:布局到图像生成通过包围盒实现显式的空间控制,但包围盒只能指定实例的位置,无法表达它们之间的遮挡关系——两个框重叠时,谁在前谁在后是未定义的。现有方法要么额外依赖深度图等几何条件(增加了输入负担),要么用复杂的推理阶段优化流程,要么把各实例的表征独立构建后简单聚合、完全不建模遮挡带来的相互作用。 本文贡献:OccluRank 的设计极简:给每个包围盒只加一个序数 rank。这个用户指定的遮挡顺序通过轻量的基于 rank 的条件注入编码进模型,配套的 Order-aware Instance Interaction(OII)模块在聚合前对 rank 条件化的实例表征做联合更新——具体是在每个空间位置 p 上取该位置的有效性掩码,把落在这里的多个实例特征送进一个 Transformer 做位置级的跨实例交互,让指定的顺序引导重叠实例之间的信息交换。整个过程不需要额外的几何输入,也不需要推理时的专门优化。数据侧他们构建了 OccluLayout:一个合成训练数据集,遮挡顺序和 amodal 标注直接从已知的场景几何导出,而不是用辅助预测模型从部分遮挡的图像里估计——这是个关键差别,估计出来的标注在遮挡严重时本身就不可靠。评测侧提出 OccluLayout-Bench,用多个多模态大模型评测器分别评估实例存在性、空间布局、属性和遮挡顺序,再加 FID 衡量整体图像质量。训练目标除了全局去噪损失还加了前景并集掩码上的局部去噪损失。 Overview of OccluRank. OccluRank constructs spatially aligned instance features, incorporates ordinal rank embeddings, and performs location-wise cross-instance interaction before aggregating into an Instance Semantic Map (ISM). The masked ISM is residually injected into selected cross-attention layers of SDXL. 实验效果:实验显示 OccluRank 更可靠地保留目标实例、遵循指定布局、实现期望的遮挡关系,同时属性一致性和整体图像质量与基线相当。定性对比中的差异相当明显:「猿在前、羊在后、鸡在最后、狐狸最远」这组布局里,CreatiLayout 把猿和羊糊成了一个畸形生物、LaRender 直接漏掉了羊和鸡,OccluRank 则四个实例齐全且前后关系正确;「大象/长颈鹿/斑马/斑马」那组里 OcclusionFormer 漏掉了长颈鹿、IFAdapter 的斑马与长颈鹿位置错乱,OccluRank 的四个动物按指定顺序排布。反向消融图进一步验证了控制力:把实例顺序反过来后,没有 rank embedding 的变体输出几乎不变(说明它根本没接收到顺序信号),完整模型则正确翻转了前后关系。 Qualitative comparison under overlapping layouts. $^\dagger$ denotes the official checkpoint without OccluLayout training. 批判点评:用多模态大模型当评测器来判断「遮挡顺序是否正确」是个方便但风险不小的选择——MLLM 本身对遮挡关系的判断能力就未经充分验证,用它评一个专门优化遮挡的模型,存在评测器与被评对象共享失败模式的可能。OccluLayout 是合成数据集,遮挡顺序从已知几何导出确实比估计可靠,但合成场景的物体摆放分布与真实照片差距多大、训练在合成数据上的模型在真实布局上的泛化如何,需要看正文的实验设计。序数 rank 只能表达全序的前后关系,现实中常见的交错遮挡(A 遮 B 的左半、B 遮 A 的右半,比如交叉的手臂)无法用一个标量序号表达。骨干用的是 SDXL,在当前时点已经不算前沿,这套 rank 条件化机制能否迁移到 DiT 架构的现代模型上是个开放问题。 10. CamWorldQA:给运镜可控的世界视频打分 CamWorldQA: Perceptual Quality Assessment of Camera-Controlled World Video Generation | 上海交通大学、埃因霍温理工大学 | arXiv:2608.18710 关键词:视频质量评测,相机控制,世界模型,无参考VQA,上海交大 前序问题:生成式视频模型现在已经能做相机可控的世界视频生成——用户给定一条相机轨迹,模型据此合成视频。但评估这类视频的质量没有合适的工具:现有的视频质量评估方法都是为自然视频设计的,捕捉不到相机可控生成特有的感知特性,比如视角一致性、运动连贯性和内容保持度。换句话说,这个方向的进展缺少一把合适的尺子。 本文贡献:作者构建了 CamWorldQA,第一个针对相机可控世界视频生成的感知质量评测基准。规模是 720 个生成视频,来自 6 种代表性生成方法、20 个多样化的源视频、6 种相机轨迹(Truck Left/Right、Dolly In/Out、Pedestal Up/Down)的组合,每个视频都通过主观实验获得了人工标注的感知质量分。在此基础上他们提出 CWQA,一个无参考的质量评估网络,用三个互补分支分别提取特征:光流分支用 RAFT 抽运动轨迹特征(1×512),运动分支用 SlowFast 的双通路抽运动特征(1×2304),空间分支用 ResNet-50 加多层级池化抽空间特征(1×7168)。三路特征经 Projection MLP 后通过自适应门控加权融合,再送进质量回归头输出分数。 Overview of the proposed CWQA method. 实验效果:实验表明 CWQA 在 CamWorldQA 数据集上显著超越现有的质量评估方法。demo 图给出了两个具体例子:一段 Truck Right 运镜的人物视频,人工打分 61.18,SimpleVQA 给 51.45(明显低估),CWQA 给 63.75,与人工判断接近;另一段 Pedestal Down 的风景视频人工只给 25.65(画面在下摇过程中出现了明显的内容坍塌),SimpleVQA 给 40.33(严重高估),CWQA 给 23.56。这两个例子恰好展示了通用 VQA 方法的典型失效模式——它们对生成视频里那种「画面清晰但内容不合理」的退化不敏感。MOS 分布图还显示不同生成方法、不同轨迹、不同内容类别之间的质量差异都相当显著。 Qualitative comparison of quality predictions from different VQA methods and CWQA. 批判点评:720 个视频、20 个源视频的规模在 VQA 基准里偏小,尤其是源视频只有 20 个,内容多样性有限,训练出的模型容易过拟合到这些特定场景。「显著超越现有方法」的比较对象是 SimpleVQA 这类为自然视频设计的通用方法,在专门数据集上被专门模型超过是预期内的结果,真正有意义的对比应该是与其他为生成视频设计的评测方法(如 VBench 的相关维度)比,摘要里没有提到。CWQA 的架构是三个现成骨干(RAFT/SlowFast/ResNet-50)加门控融合,方法层面的新意有限,价值主要在数据集。另外基准覆盖的 6 种相机轨迹都是单一的基本运镜,真实创作中的复合轨迹(边推边摇、弧形环绕)不在评测范围内,而这恰恰是相机控制最容易失效的地方。 趋势观察 优化器这一层终于被认真当成扩散模型的加速位点 — 过去两年扩散模型的提速几乎全部发生在推理侧——蒸馏减步数、缓存复用特征、量化降精度,训练侧则默认「AdamW 就够了」。今天 Meta 的这篇 Muon-DiT 把注意力挪回了训练:他们在 1.3B 到 15B 的 DiT 上系统跑通了 Muon 的 scaling 行为,确认它相对 AdamW 的生成质量优势(12.9%~19.1%)不随规模消失。更有价值的是他们诚实地承认了 Muon 在大规模下的代价——每步都做的 5 步 Newton-Schulz 迭代加上全量动量物化,会把 Muon 省下的步数优势重新吃掉。Periodic Row-wise Muon 的解法很朴素:昂贵的谱更新每 K 步做一次,其余步用便宜的行归一化更新顶上,再配合分片动量上直接算、bucketed all-gather 与通信计算重叠。结果是优化器时间砍掉 46.9%~54.3%,逻辑通信量降 66.7%。这提示一个被忽视的事实:当模型规模足够大时,优化器本身的算力与通信开销已经不是可以忽略的常数项了。 「缓存」正在从推理技巧升级为架构设计的一部分 — 可灵这篇 TextAnchor 的问题设定很典型:多参考图编辑里每张参考图带来数千 token,算力随参考图数量线性甚至更快地涨。现有做法用结构化稀疏注意力来砍——把参考图的 K/V 与去噪目标解耦,于是可以算一次复用到所有步。代价是参考图看不到文本指令了,指令跟随和参考保真度双双下滑。这篇的破法不在算子层面而在序列层面:加一段时间步固定在 t=0 的静态文本锚点,让参考分支在构建缓存时就能读到指令,同时保持 K/V 与去噪目标无关这个可缓存的前提。这个「改架构换缓存」的思路带来的副作用是生成质量掉了,他们又用教师强制的速度蒸馏加一段 on-policy 阶段把它补回来——据作者说这是扩散模型里第一次用 on-policy 蒸馏做架构恢复。5 张参考图下 40 步全流程加速 3.92 倍,10 张时到 5.47 倍。加速比随参考图数量增长而增长,这才是这类方法真正的价值所在。 视频生成的条件正在从「一段完整视频」变成「一个持续到来的流」 — 阿里的 InfinityEdit 指出了现有指令式视频编辑一个被默认接受的假设:原地编辑(in-place editing)。给定一段固定时长的源视频,逐帧对齐地改写它。这在直播换风格、给正在拍摄的镜头加运镜这类场景下直接失效——编辑必须延伸到还没到来的未来帧上。他们把这个设定命名为无限视频编辑,并配了一个只在编辑指令到达的那个 chunk 才激活的轻量适配器:历史交叉注意力锚住前序内容、时序因果自注意力保证信息只从早往晚流、编辑交叉注意力注入指令;后续 chunk 交回原模型并重置锚定帧,从而在施加编辑的同时不损害原模型的无限生成能力。超过 1000 帧的长序列上仍能稳定实现每一条指令。有意思的是今天还有一篇 NVIDIA 的 Grounded-Exo2Ego,走的是完全不同的技术路线(双分支视频扩散 + 3D 重建锚定 + 物体级语义补全),但两者面对的其实是同一类困难:当条件信号在大范围上不可靠或根本不存在时,生成模型该拿什么去锚定。 人工智能炼丹君 整理 | 2026-08-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-20|LumaAI首证扩散缩放定律要10倍数据(Abra) 今日 AIGC 论文速览 今日共 10 篇 · 训练缩放与数据基建 2 篇 · 图像编辑与超高分辨率 2 篇 · 视频编辑 2 篇 · 推理加速与高效架构 2 篇 · 生成评测与诊断 2 篇 重点论文标题列表 Abra(Luma AI):每参数200token是最优配比 EditBridge(上海交通大学·阿里 Qwen·新加坡国立大学):4K图像编辑61秒完成 ⚡ GRNEdit(西安电子科技大学·小米 MiLM Plus):2B模型打赢多个14B开源编辑器 CoinVE-200K(腾讯 PCG 在线视频事业部):一条指令同时改5处的数据集 LinCa(上海交通大学·阿里云终端智能计算·西安交大):5-7倍加速下文字仍不糊 今日论文速览 1. Abra:每参数200token是最优配比 Abra: Scaling Diffusion Image Training | Luma AI | arXiv:2608.17286 关键词:扩散缩放定律,IsoFLOP拟合,每参数200token,flow-matching,Luma AI ⚠️ 前序问题:语言模型这边,缩放定律早已是训练前沿模型的标准工具——给定算力预算,模型该多大、数据该多少,Chinchilla 给出了一条能直接照着执行的曲线。但视觉生成这边一直是空白:从业者知道模型越大越好、数据越多越好,却没人能回答「我有 10^21 FLOPs,参数和数据该怎么分」这个具体问题。此前少数几篇尝试过的工作,算力预算都偏小,拟合出的指数外推到实际训练规模时误差被放大得没法用。更麻烦的是,大家默认把 LLM 的经验直接搬过来——按 Chinchilla 的每参数 20 token 配比训扩散模型,而没有人验证过这个数字在视觉域是否成立。 本文贡献:这篇把这件事系统地做完了。作者构造了 Abra——一族受控的 flow-matching transformer,参数从 60M 覆盖到 2B,训练算力横跨 10^19 到 10^22 FLOPs 三个数量级,显著超出以往工作的预算上限。在这个规模上他们得到两个核心结论。第一,扩散模型的可预测性与语言模型一样好,损失随算力呈干净的幂律,IsoFLOP 曲线的最优点连成一条直线。第二也是最有价值的:扩散的计算最优点出现在每参数约 200 个图像 token,整整是 LLM Chinchilla 处方的十倍。第三个结论是给实践者的直接建议——与 LLM 不同,扩散模型对过训练相当鲁棒,所以拿不准时应该往「更多数据」而非「更大模型」的方向偏。最后他们证明这种可预测性不止于训练损失,还延伸到生成质量指标、最优 CFG 设置、表征质量,甚至训练曲线的形状本身都能坍缩到一个通用形式上。 Text-to-image diffusion transformers follow predictable scaling laws and require ten times as much data as a comparably sized language model to reach compute optimality. 实验效果:IsoFLOP 拟合给出 TPP = 191·C^0.0010(即最优 token-per-parameter 几乎不随算力变化,稳定在 200 附近),最优参数量 N = 0.0301·C^0.4951、最优数据量 D = 3.78·C^0.5049——两个指数都极接近 0.5,说明参数与数据应当同比例增长,这一点与 Chinchilla 一致,差别只在配比常数。过训练鲁棒性的证据来自 Iso-FLOP penalty 曲线:Abra 在 TPP 从 100 一路拉到 400 的区间内,惩罚基本贴着 0.2% 以下,而数字化重建的 Chinchilla LLM 曲线在 TPP 超过 100 后惩罚就迅速爬升到 3-5%。训练曲线的通用坍缩在 60M 到 2B 六个尺寸上验证,重标定后曲线几乎重合,相对波动收敛在 1% 以内。 Iso-FLOP suboptimality penalty $(L_N - L^*)/L^*$ versus TPP for the family (left) and the Chinchilla / Hoffmann et al. data (right), the latter figure-digitized by~besiroglu2024chinchilla and binned into log-$N$ model-size bands. Markers are the measured points ( evaluated checkpoints; digitized Chinchilla points); curves interpolate through them. The green/red bands mark the $0.2\%$ penalty threshold. 批判点评:这是今天这批里信息密度最高的一篇,而且是那种一旦被验证就会改变整个领域默认做法的工作。「每参数 200 token、是 LLM 的十倍」这个数字本身就足够有价值——它意味着相当多现有的文生图模型可能都处于数据不足的状态,一直在把预算错配到参数上。IsoFLOP 的两个指数分别是 0.4951 和 0.5049,加起来几乎正好是 1,这种干净程度说明拟合质量确实高,不是硬凑出来的。「对过训练鲁棒」这条实践建议也很务实:它把一个需要精确调参的问题变成了单边保守选择,工程上极其友好。不过要清醒几点。第一,最大只训到 2B 参数,而当前前沿文生图模型早已在 10B 量级以上,外推距离仍然不短——论文自己的图里最优点已经外推到 10^23 FLOPs 处的红点,这已是纯预测而非实测。第二,「200 token per parameter」这个数字必然依赖 tokenizer/patch 配置与图像分辨率,换一个 VAE 压缩率或 patch size,token 的信息量就变了,200 这个绝对值能否跨配置迁移,是使用者最需要知道却没有明确交代的。第三,全程使用 flow-matching transformer 这一种架构,结论对 UNet 或其他扩散形式是否成立未验证。第四,Chinchilla 的对比曲线是从原论文图里数字化重建的(论文自己在图注里标注了 curves are noisier than real per-run data),这个对照的严谨性弱于自己跑的实验,而「十倍」这个最抢眼的结论恰恰建立在这个对照上。第五,Luma AI 作为商业公司发布这份研究,代码与检查点是否开放决定了社区能否独立复现这条曲线。 2. EditBridge:4K图像编辑61秒完成 EditBridge: Towards Faithful and Efficient Ultra-High-Resolution Image Editing | 上海交通大学·阿里 Qwen·新加坡国立大学 | arXiv:2608.18063 关键词:超高分辨率编辑,扩散桥,分块稀疏注意力,4K保真,上交·阿里Qwen ⚠️ 前序问题:专业修图工作流里 4K 起步是常态,但扩散编辑模型基本卡在 1K 以下——注意力的二次复杂度加上显存墙,让高分辨率直接变成不可能。业界的通行绕法是两段式:先在低分辨率上编辑,再独立跑一次超分。这个做法看似合理,实际上埋了两个坑。一是信息发散:超分模型是在「猜」细节,它猜出来的东西与原始高分辨率图里真实存在的细节经常对不上——原图眼睛是棕色,低分编辑后超分给你补出一只绿色的眼睛,且补得很自信。二是纹理退化:超分要么把纹理磨得过平,要么锐化过头产生假质感。根子在于超分环节完全看不到原始 HR 图,它只能从 LR 结果凭空重建。 本文贡献:EditBridge 的做法是重新定义这一步在做什么。传统扩散是从噪声重新生成,而这里把细化过程形式化为一次结构化的数据到数据翻译:起点是 LR 编辑结果,终点是它的 HR 对应版本,整个过程显式地以原始 HR 源图为条件。这样一来,真实细节是「继承」来的而不是「猜」来的,信息发散问题从形式上就被堵住了。但引入 HR 源图作为条件会带来新的算力问题——两张超高分辨率图之间做全交叉注意力是不现实的。为此他们设计了先验引导的分块稀疏注意力:利用第一阶段编辑过程中已经产生的语义对应关系(用注意力图取 argmax 得到位置映射 π),把跨图交互限制在空间上真正对齐的区域内。也就是说,目标图的某个 chunk 只需要去看源图中与它对应的那几个 chunk,而不是全图。注意力被拆成两条路径:Path A 是域内自注意力,Path B 是先验引导的跨 chunk 稀疏注意力。 Overview of our proposed EditBridge. The upper section illustrates the inference process of the diffusion bridge, which transports the low-resolution edit to its high-resolution counterpart. The lower section details the construction of the correspondence prior and the proposed Prior-Guided Sparse Attention (PG-BSA) mechanism. 实验效果:在最高 4K 分辨率下实现高保真编辑且感知质量占优,2K 上相比基线取得 3.6 至 8.4 倍加速,4K 编辑可在 61 秒内完成——这个数字把超高分辨率编辑从「跑不动」推进到了可交互的区间。定性对比覆盖夜景霓虹招牌上的日文字符与水面倒影等细节密集场景,在 PISA-SR、Dit4SR、DiT-SR、TSD-SR、HiFlow 五个基线中,只有本方法保住了招牌上原本的文字笔画,其余方法要么把文字糊成噪点,要么改写成完全不同的字形。 Qualitative comparison at 2K resolution. Our method better preserves fidelity while enhancing visual clarity. 批判点评:这篇最值得肯定的是问题诊断的准确性:它没有把两段式方案的毛病归咎于「超分模型不够强」,而是指出结构性缺陷——超分环节看不到 HR 源图,所以必然只能幻觉。把修正手段定位在「让它看得到」而不是「让它更强」,这个判断决定了整个方案的正确性。复用第一阶段的注意力图来构建对应先验也很省——那份注意力本来就要算,等于白捡了一份稀疏化的依据,不需要额外的匹配网络。61 秒完成 4K 编辑这个数字给得具体且可验证,比笼统说「高效」有诚意得多。但有几处要打问号。第一,整个方法建立在「第一阶段的编辑注意力能给出可靠语义对应」这个前提上,而编辑幅度大的时候——比如把物体整个替换掉——目标区域在源图里压根不存在对应物,此时 π 映射会指向什么?这类场景恰恰是编辑任务里最常见也最难的,论文的示例(换伞的颜色、加一只小船)都属于局部小改动,大幅编辑下的行为没有交代。第二,3.6 到 8.4 倍这个区间跨度很大,说明加速比高度依赖图像内容与稀疏度,最坏情况是什么没说。第三,61 秒的硬件配置未在摘要中给出,A100 上的 61 秒和 H100 上的 61 秒不是一个概念。第四,方法仍然是两段式的,第一阶段 LR 编辑本身的质量上限直接决定了最终结果——如果 LR 阶段就改错了,桥接得再忠实也只是把错误高保真地放大到 4K。 3. GRNEdit:2B模型打赢多个14B开源编辑器 GRNEdit: Efficient General Video Editing from a New Binary-Evidence Perspective in Generative Refinement Networks | 西安电子科技大学·小米 MiLM Plus | arXiv:2608.16328 关键词:通用视频编辑,二元证据视角,生成式细化网络,空指令恒等通路,小米MiLM ⚠️ 前序问题:指令式通用视频编辑想用一个统一入口覆盖各种编辑操作,但现有方案在「怎么把源视频信息喂给模型」这一步上都很重:要么挂一条独立的重型条件分支,要么把源视频直接拼接进输入序列——前者增加大量参数,后者让序列长度翻倍,两条路都很贵。更本质的问题是,这些做法都把源视频当成一团需要重新理解的原始信息,而没有利用一个关键事实:编辑的绝大部分区域其实应该原封不动地保留下来。以「保持」为默认、只标注需要改的地方,信息量本该远小于从头重新描述整个视频。 本文贡献:GRNEdit 从 GRN(生成式细化网络)用 bit 组合编码视觉语义这一特性出发,把编辑语义重新表述成对每个 bit 的「保留还是翻转」的局部二元决策。这个视角转换是全文的支点:源信息不再是需要被重新编码的内容,而是支持当前二元状态的「坐标级证据」,而 GRN 主干继续负责把这些局部决策组合成全局连贯的生成语义。第一阶段用一个紧凑编码器把离散源码翻译为连续证据信号,在二元细化过程中持续注入。他们还借鉴 classifier-free guidance 的空提示训练,赋予空条件一个编辑专属含义——空指令即「不编辑」,由源重建来监督。这条恒等通路一石二鸟:既隐式强化了证据利用与内容保持,又在同一表示空间里产生了一个「源保持态」。于是第二阶段可以把每个编辑态与它对应的源保持态直接相减,用差异去修正那些第一阶段没定下来的目标 bit——这是一个相当巧妙的自我对照机制。 Overview of GRNEdit. Given a source video and an editing instruction, Stage I injects prompt-modulated source evidence into the GRN chunks through lightweight per-chunk projectors, each containing only about 3 M parameters for GRNEdit-2B and 7 M for GRNEdit-8B. Stage II refines the binary predictions by treating source evidence as support in keep regions and as counter-evidence in edit regions. 实验效果:仅用 0.6M 训练对、不到 3% 的条件化参数,GRNEdit-2B 与 GRNEdit-8B 在 OpenVE-Bench 上分别取得 4.03 与 4.18 分。2B 版本超过多个 14B 量级的开源编辑器,8B 版本与领先开源编辑器持平。第二阶段的监督设计在框架图中量化呈现:保持区域若用源信息使 p(target) 从 0.7 升到 0.9,交叉熵从 0.36 降到 0.11 作为奖励;编辑区域若照抄源信息使 p(target) 从 0.55 掉到 0.1,交叉熵从 0.6 升到 2.3 作为强惩罚——奖惩方向被显式分开。 Qualitative comparison across diverse editing tasks. GRNEdit performs more accurate edits while better preserving unedited content, whereas competing methods often miss the intended change or disrupt scene consistency. 批判点评:0.6M 数据加不到 3% 条件参数就让 2B 打赢 14B,这个效率比是今天最亮眼的工程数字,而且它不是靠更大的模型或更多的数据换来的,纯粹来自表示方式的重新选择。把编辑重述为 bit 级的保留或翻转,本质上是给模型换了一个更贴合任务的默认动作——从「重画」变成「保持」,这个先验一旦对了,学习难度会断崖式下降。空指令即恒等这条设计尤其漂亮:它不额外增加参数,却同时提供了内容保持的监督信号和第二阶段所需的对照基准,一个设计承担三个功能。但要看清几处限制。第一,整套方法深度绑定 GRN 这种二值化表示的骨干,对主流的连续 latent DiT 并不直接适用,普适性受限——这也解释了为什么它能这么省,代价是换不了底座。第二,OpenVE-Bench 上 4.03 对 4.18 这个 2B 与 8B 的差距只有 0.15,说明模型规模在这套方法下的边际收益极低,这既可以解读为「小模型就够」,也可以解读为「方法本身触到了天花板,加参数也没用」,论文倾向前一种解读但没有排除后一种。第三,「超过多个 14B 开源编辑器」这个表述里没点名是哪些,而开源 14B 编辑器的水平参差很大,这个对照的含金量无法判断。第四,0.6M 训练对相对于视频编辑任务的复杂度其实偏少,能力覆盖边界(能做哪些编辑类型、哪些做不了)没有说明。第五,两阶段推理意味着实际延迟是单阶段的两倍以上,效率优势主要体现在参数和训练成本上而非推理速度,摘要用 Efficient 一词容易造成误读。 4. CoinVE-200K:一条指令同时改5处的数据集 CoinVE-200K: A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing | 腾讯 PCG 在线视频事业部 | arXiv:2608.17566 关键词:复合指令视频编辑,数据集与基准,原子操作解耦,Wan2.1-14B,腾讯PCG ⚠️ 前序问题:指令式视频编辑的数据集这两年质量在稳步提升,但有一个共同盲区:几乎全部只覆盖单一编辑操作。而真实用户的诉求往往是复合的——「把背景换成森林,同时把她的黄裙子改成深蓝礼服,再把桌上那台搅拌机拿掉」,这是一条指令里塞了三个互相独立的编辑意图,模型必须同时理解它们、并在同一段视频里各自忠实执行且互不干扰。用只含单操作样本的数据训出来的模型,面对这种复合指令时要么只执行第一条,要么把几个操作混在一起相互污染。数据的形态直接锁死了模型的能力形态。 本文贡献:针对性地补上这块。CoinVE-200K 包含 1080p、最长 201 帧的视频编辑对,每个样本涉及 2 到 5 个原子编辑操作,作用对象覆盖人物、物体与背景,操作类型覆盖添加、移除、修改与风格化。所有样本经过一套生成加过滤的管线,从指令忠实度、视觉质量、时序一致性、复合多样性四个维度把关。配套发布 CoinVE-Bench,按主体、操作类型、指令复杂度分层评测。更进一步,他们训了 CoinVE-Edit——基于 Wan2.1-T2V-14B 与 Qwen3-VL-8B-Instruct 构建的 22B 复合视频编辑模型。这个模型的关键设计是把不同编辑指令的注意力做区域感知的解耦:每条指令经 MLLM 编码为一组可学习 token,由 Mask Predictor 预测其作用区域 M,GateNet 输出门控系数 g 决定该指令是否需要掩码约束,再通过 Q-Blending 交叉注意力按权重 w_q = 1 - βg(1-M) 融合多条指令的输出。这样每条指令只在自己的区域内生效,天然避免了多指令互相污染。 An overview of the proposed CoinVE-Edit framework. 实验效果:在 CoinVE-Bench 上,CoinVE-Edit 在指令遵循、复合编辑准确率、视觉质量与时序一致性四项上均取得强表现。定性对比展示了一条指令含 4 个操作的案例(替换搅拌碗、添加菜刀、替换台面、移除玉米粒),与 SAMA、可灵 O3、Seedance 2.0 三个对照相比,只有 CoinVE-Edit 把四个操作全部正确执行且未误改其余内容——对照方法普遍出现漏执行或连带改动无关区域的问题。 Quality comparison of compositional-instruction video editing on CoinVE-Bench. 批判点评:复合指令这个切入点选得准。单操作编辑在学术基准上已经做得相当好,但用户真实场景里很少有人只提一个要求,这中间的差距被整个领域忽略了,而它偏偏是产品化的关键一环。Q-Blending 那个门控加掩码的设计也合理:g 决定要不要约束、M 决定约束在哪,两个自由度分开,比硬性给每条指令分配固定区域灵活。1080p、201 帧、20 万对的规模在视频编辑数据集里属于第一梯队,腾讯在线视频事业部的资源背景也让这个量级可信。但几点要留意。第一,也是最关键的:数据集是「生成加过滤」构建的,那些 2-5 个操作的复合编辑对本身是用什么模型生成的?摘要没说。如果生成器本身就是现有编辑模型,那 CoinVE-200K 的质量天花板会被它锁死,而 CoinVE-Edit 训完能超过的也只是那些数据更少的模型,未必超过数据生产者。第二,CoinVE-Bench 由同一团队用同一套管线构建,与训练集共享分布,22B 模型在上面的领先有多少能迁移到真实用户指令,是个悬念——定性图里的对照模型都是在自家基准上被评的。第三,22B 的推理成本没有交代,201 帧 1080p 的复合编辑单次要多久,这直接决定它是研究原型还是可用工具。第四,「2 到 5 个原子操作」的分布如何?如果绝大多数样本是 2 个操作,那么 5 操作场景的实际支撑就很薄。第五,多指令解耦依赖 Mask Predictor 预测的区域准确,当两条指令的作用区域天然重叠时(改人物服装 + 改人物姿态),这套机制如何处理没有说明。 5. LinCa:5-7倍加速下文字仍不糊 LinCa: Accelerating Diffusion Models via Learnable Decomposed Feature Caching | 上海交通大学·阿里云终端智能计算·西安交大 | arXiv:2608.17973 关键词:扩散推理加速,可学习特征缓存,可逆分解重构,ECCV 2026,阿里云 ⚠️ 前序问题:扩散模型迭代采样的成本一直是落地的主要障碍,特征缓存是近年最被看好的加速路径——把某些时间步的中间特征存下来,后续步骤直接复用或外推预测,跳过昂贵的完整前向。问题在于,现有的免训练缓存方法都在用一套统一的预测策略处理所有特征。而实际上不同特征的时序动态差异极大:有些特征随时间步平滑变化,零阶复用就够;有些高频剧烈波动,必须用高阶外推才不失真。用一把尺子量所有东西,结果就是在高加速比下质量崩塌——具体表现为文字糊成一团、细结构错乱。 本文贡献:LinCa 的思路是先分解再分别对待。它引入一个轻量可逆网络,把缓存特征拆解为若干具有不同连续性的子成分,对每个成分匹配相应阶数的预测策略——平滑的用零阶(直接复用),次之用一阶,波动大的用二阶外推。可逆性在这里是关键设计而非装饰:严格可逆保证了子成分预测完后能无损重构回原始特征空间,不引入分解误差,形成一条完整的「分解-预测-重构」闭环。可逆投影用 RevNet 结构实现(可逆 1×1 卷积 + 加减耦合的 MLP 分支),前向与反向严格互逆。训练层面,他们为不同模型、不同时间步区段分别训练预测器,让方法能自适应各处不同的特征动态。整套东西是「学出来的」而非手工设计的,这是与既有免训练方法的根本区别。 实验效果:已被 ECCV 2026 接收。在 FLUX、Qwen-Image 与 HunyuanVideo 三个模型上验证,额外参数少于 0.2%,在 5 至 7 倍加速下保持接近无损的质量,显著优于既有方法。FLUX 上 5.51 倍加速的定性对比最能说明问题:提示词包含大段英文文字时,TeaCache、FORA、ToCa、DuCa、TaylorSeer 五个基线在相近加速比下文字均出现不同程度的糊化、笔画粘连或整体消失,而 LinCa 的文字与原始无加速结果几乎逐字符一致;橙子笑脸、马背上的电视机等构图元素也未出现基线中常见的物体丢失或结构错乱。 批判点评:把「统一策略」换成「按连续性分解后差异化处理」,这个思路对得很自然——特征动态本来就不均质,用一套策略是明显的欠拟合。可逆网络的选择尤其到位:如果用普通的编码器解码器做分解,重构误差会在数十个时间步里累积放大,把加速带来的收益抵消掉,而严格可逆从数学上消除了这个隐患。0.2% 参数换 5-7 倍加速的性价比很高,文字保持能力那张对比图也非常有说服力——文字是检验扩散加速方法最狠的探针,因为它对高频细节的破坏零容忍,五个基线全部翻车而 LinCa 几乎无损,这个差距不是调参能解释的。ECCV 2026 接收提供了同行评议背书。但要留意几点。第一,「学习」是双刃剑:需要为不同模型、不同时间步区段分别训练预测器,意味着换一个基座模型就要重新训一遍,而它对标的 TeaCache/TaylorSeer 等方法是完全免训练、即插即用的。0.2% 参数听起来很少,但训练流程的存在本身就是部署门槛,这个对比维度摘要没有正面回应。第二,可逆网络在每个缓存步都要跑前向与反向两次变换,这部分开销是否已计入 5-7 倍的加速统计口径,直接影响数字的诚实度。第三,三个验证模型都是 DiT 架构,对 UNet 类扩散模型是否有效未验证。第四,加速比只报到 7 倍,而基线方法在 5 倍附近就已明显退化,那么 LinCa 在 10 倍以上的表现如何、崩塌点在哪,是使用者最关心却未披露的信息。第五,「分解为不同连续性的子成分」这个划分是学出来的,缺乏可解释性——学到的成分究竟对应什么语义、划分是否稳定,论文没有做分析。 6. CapData:4.4亿图按能力依赖排课 From Corpora to Co-Evolving Capabilities: Capability-Centric Data Design for Generalist Image Generation | 阿里巴巴集团 | arXiv:2608.18076 关键词:图像生成数据基建,能力驱动排课,三引擎recaption,4.4亿图池,阿里巴巴 ⚠️ 前序问题:大规模图像生成的进步很大程度上来自数据侧——扩规模、提质量、做再平衡、重新写 caption。但常规做法有个结构性问题:每个任务的数据集都是孤立优化的。文生图数据管文生图,编辑数据管编辑,知识关联数据管知识关联,各建各的、各调各的。而真实情况是,生成能力之间存在依赖关系——模型得先能把文本和图像对上,才谈得上做图像到图像的变换;得先有稳定的视觉表达,才谈得上把知识实体正确渲染出来。数据如果不按这个依赖顺序组织,就会出现「教高级技能时基础还没打牢」的低效学习,算力被浪费在模型还接不住的监督信号上。 本文贡献:提出一套能力驱动的数据基础设施,把「针对能力构造监督」与「按能力对齐排课」耦合起来。三个专门但可互操作的数据引擎分别构建互补的关系型监督:T2I 引擎负责文本-图像接地(大规模图池 + 能力检索 + 多风格双语 recaption,覆盖 short/medium/long/dense/tags/entity 六种粒度),编辑引擎负责图像间变换(基础编辑、自然关联、专家自蒸馏等多维度策展 + T2I 对齐的编辑 recaption),知识引擎负责图像-知识关联(从 Wikidata 出发,PageRank 筛选实体后检索配图)。caption 专家横跨任务与粒度对齐 T2I 与编辑监督。多阶段课程沿能力获取的依赖顺序,联合演进任务构成、视觉概念分布、数据质量与图像分辨率,并由能力感知评测闭环——把失败案例送入 Failure Pool,触发邻近数据搜索与专家自蒸馏,再由分布控制器做缺口感知的重采样,持续失败的桶提高采样权重、已解决的降低权重。规模上策展出 4.4 亿图 T2I 语料、1.2 亿编辑对、超 2700 万图像-实体对,并用它从零训练 3B 与 6B 两个规模的多模态扩散模型。 Capability-specific data construction in our framework. Shared collection and wrangling feed three specialized but interoperable engines for visual expression, editing association, and knowledge-grounded reasoning. 实验效果:在 CPI-Bench 上做定量评测,并在多样的文生图与编辑场景做定性评估,结果显示广泛的视觉覆盖、多样的渲染能力,以及跨生成能力的有效迁移——即在一种能力上的数据投入能带动相关能力的提升,这正是「协同演化」这一命题的直接证据。 Capability-gap-driven active feedback loop. Capability-aware evaluation identifies failure cases, which seed neighboring-data retrieval and expert-driven construction. Gap-aware resampling then increases the weights of persistent failures and down-weights resolved gaps in subsequent training. 批判点评:把数据工程从「造语料」提升到「设计能力依赖图并据此排课」,这个视角在当前是稀缺的。大多数数据类论文的贡献是「我造了更多更好的数据」,而这篇的核心主张是「数据之间的组织顺序本身就是一种方法」,这是不同层级的命题。那个失败池 + 缺口感知重采样的闭环尤其务实——它把评测从「训完看看多少分」变成了「持续驱动下一轮数据采集」的控制信号,让数据基建具备了自我修复能力,而不是一次性的静态产物。4.4 亿图加 1.2 亿编辑对的规模,配合从零训练 3B/6B 两个尺度,工程投入相当扎实。但几处必须打问号。第一,全文没有给出任何具体数字——CPI-Bench 上得了多少分、与哪些基线比、领先多少,摘要用「broad coverage」「versatile rendering」「effective transfer」这类形容词全部带过,这在一篇以规模和方法论为卖点的论文里是硬伤,读者无法判断这套复杂基建的实际收益。第二,「按能力依赖顺序排课」这个核心主张需要消融来支撑——如果把课程顺序打乱,性能掉多少?没有这个对照,「依赖顺序很重要」就只是一个合理但未经检验的假设。第三,CPI-Bench 疑似自建,与训练数据的关系未说明。第四,整套基建的算力成本极高(4.4 亿图的策展、两个模型从零训练),学术界基本无法复现,其价值主要体现为工业界的方法论参考而非可直接采用的技术。第五,「能力依赖顺序」是人工设定的还是数据驱动得出的?如果是前者,那这套框架的效果高度依赖设计者的先验判断,泛化到新能力时需要重新人工设计。 7. MoE-ViE:1.7倍大模型的效果76%延迟 MoE-ViE: Mixture of Experts Vision Encoder for Efficient Image and Video Understanding | Meta | arXiv:2608.17402 关键词:视觉编码器,细粒度MoE,免辅助损失均衡,Group GEMM,Meta ⚠️ 前序问题:视觉编码器是多模态模型的关键部件,扩容它确实能带来性能提升,但稠密扩容的代价是算力与推理延迟同步上涨。MoE 在语言模型那边已经证明是高效扩容的答案——激活参数远小于总参数,容量涨而算力不涨。但把 MoE 用到 CLIP 风格的视觉编码器上,设计空间基本没人在 SOTA 水平上系统探索过:专家该多细粒度?路由怎么平衡?稀疏化带来的 kernel 开销怎么办?视频能力怎么加而不损失图像知识?这些问题各自都有多个可能答案,而缺少系统研究意味着大家只能凭直觉照搬 LLM 的配置。 本文贡献:Meta 把这个设计空间系统扫了一遍,给出四条结论加一套模型。第一,细粒度 MoE 拓扑(更多更小的专家)相比稠密基线和标准 MoE 都有实质增益——这与 LLM 领域近年的发现一致,但在视觉编码器上是首次在 SOTA 水平确认。第二,提出免辅助损失的负载均衡变体,避免了传统 aux-loss 对主任务的干扰,同时改善专家利用率。第三,设计专用 MoE kernel(Group GEMM + kernel fusion)来抵消稀疏计算带来的推理延迟开销——这一点很实在,MoE 理论 FLOPs 低但实际延迟常常因为访存不规则而吃亏,不做 kernel 优化的 MoE 在部署时经常「省了 FLOPs 但没省时间」。第四,为了在增强视频能力的同时保住图像知识,引入帧级蒸馏配合一种新的冻结机制:视频微调阶段专家与文本侧 MLP 全部冻结,只让预训练教师对第 i 帧的表示去蒸馏学生对整段视频的表示,从而把视频能力「加」上去而不覆写已有的图像能力。 Illustration of MoE-ViE architecture and training pipeline. MoE-ViE adopts a fine-grained MoE design with optimized MoE kernels for latency reduction. We first perform contrastive pretraining on large-scale image-text pairs. During video finetuning, we introduce frame-level distillation and expert freezing to preserve the pretrained image understanding capabilities. 实验效果:跨多个尺寸预训练的 MoE-ViE 系列一致优于对应的稠密版本。最大模型在零样本性能上匹配一个 1.7 倍于它的 SOTA 编码器,而延迟只有后者的 76%。与 LLM 对齐后,MoE-ViE 在图像与视频基准上超过所有对照编码器,包括激活参数多达 5 倍的模型。ImageNet 1K 错误率随 GFLOPs 的缩放曲线显示,ViT-B/32、ViT-B/16、ViT-L/14 三个骨干的 MoE 版本(实线)在各自算力区间内均位于稠密版本(虚线)下方,且差距在算力增大后不收敛。代码已开源,论文被 ECCV 2026 接收。 MoE-ViE vs. dense models at multiple scales. MoE-ViE consistently outperforms their dense counterparts under the same compute budget. 批判点评:这是一篇标准的工业界系统性研究:不追求单点创新,而是把一个设计空间扫清楚并交付可用的模型和 kernel。价值在于确定性——它把「视觉编码器该不该上 MoE、怎么上」从猜测变成了有依据的选择。专用 kernel 那部分尤其值得称道,因为它诚实地面对了 MoE 最常被回避的问题:理论 FLOPs 的节省经常在实际延迟上兑现不了,很多 MoE 论文只报 FLOPs 而绝口不提墙钟时间。这里直接给出 76% 延迟这个端到端数字,说明作者知道读者真正关心什么。冻结机制的设计也很克制——加视频能力时把专家全冻,本质是承认「不确定改动会不会伤到图像能力,那就干脆不改」,这种保守在多模态扩展里往往是对的。但要注意几点。第一,与本项目关注的生成方向的关联是间接的:视觉编码器主要服务理解任务,对生成的价值需要经过 MLLM 这一层传导,读者不应把这里的收益直接映射到生成质量上。第二,「匹配 1.7 倍大的 SOTA 编码器」——是哪个编码器?摘要没点名,而 SOTA 这个词在视觉编码器领域可以指向差异很大的几个模型。第三,76% 延迟是在什么硬件、什么 batch size 下测的没说,MoE 的延迟优势对 batch size 极度敏感,小 batch 下专家利用率低会显著劣化。第四,「超过激活参数多 5 倍的模型」这个比较用的是激活参数而非总参数,MoE 的总参数量通常远大于激活量,从显存占用角度看这个对比对 MoE 是有利但不完整的。第五,帧级蒸馏用单帧教师去教整段视频学生,这个设定对需要跨帧推理的能力(如动作识别、时序因果)是否够用,值得怀疑——它教会的可能主要是「每帧都看懂」而非「看懂帧之间发生了什么」。 8. WildMoire:用生成模型造出去摩尔纹标注 Improving Complex Moire Removal with Generative Supervision | 哈尔滨工业大学·阿里淘天集团 | arXiv:2608.17883 关键词:摩尔纹去除,生成式监督,数据引擎,6.8K训练对,哈工大·淘天 ⚠️ 前序问题:训练去摩尔纹模型需要成对数据——同一场景的带摩尔纹版本和干净版本。麻烦在于真实世界里最难处理的那类摩尔纹恰恰最难获得配对标注:拍公共显示屏、翻拍网络图片时产生的大尺度、多彩摩尔纹,其干净原图根本无从获取,因为你没法控制那块屏幕、也拿不到原始素材。现有数据集只能在受控环境下采集,覆盖的摩尔纹形态与真实野外场景差距很大。这构成一个死结:最需要解决的场景,恰恰是最拿不到监督信号的场景。 本文贡献:既然干净图拿不到,那就造一个。作者提出一套数据引擎来生成训练监督:先收集含复杂摩尔纹的真实图像并定位其中的屏幕区域,然后部署多个图像条件的生成基础模型(SDXL、Nano Banana 2、Qwen-Image-Edit、GPT Image 2、FLUX.2 五个)各自产出候选参考图,再对候选做 patch 级的质量控制来筛选出最优结果——后处理包含空间位置与色彩对齐、patch 裁剪、预过滤、最优 GT 选择四步。用这套范式构建了 WildMoire 数据集,含 6.8K 摩尔纹-GT 训练对,分辨率 1024×1024。评测侧另外采集了约 250 对带真实干净 GT 的独立测试集——这一点很关键,它保证了评测不是自己造的数据自己评。 Overview of WildMoir'e dataset construction. We first collect real screen-captured images containing complex moir'e and localize the display regions. Five image-conditioned generative models then produce candidate GT images. The candidates are processed at matched spatial locations through spatial and color alignment, synchronized patch extraction, pre-filtering, and optimal GT selection. This offline procedure yields 6.8K moir'e-GT pairs at 1024()1024 resolution. The plots on the right summarize the improvements obtained by training ESDNet, SDXL, and Qwen-Image-Edit with constructed WildMoir'e dataset. 实验效果:在 ESDNet、SDXL、Qwen-Image-Edit 三个不同类型的模型上验证,加入 WildMoire 训练后各项指标一致提升:PSNR 分别为 23.37 对 21.50、23.56 对 21.90、23.93 对 22.23;SSIM 为 0.7821 对 0.7341、0.7887 对 0.7522、0.7851 对 0.7578;无参考指标 MUSIQ 为 44.21 对 38.20、45.07 对 41.48、58.97 对 55.33;TOPIQ 为 0.3413 对 0.2770、0.3583 对 0.3203、0.4624 对 0.4276。三个模型、四个指标全部改善,方向一致。 Comparison of qualitative results. The first example emphasizes logo and text fidelity under broad color interference, while the second contains severe mixed chromatic patterns over fine scene textures. Nano-Banana-2 is relatively content-faithful but may retain moir'e, whereas GPT-Image-2 removes artifacts aggressively while replacing scene content and producing an overly digital-image appearance. Using WildMoir'e suppresses residual bands more effectively across all 3 trainable models. 批判点评:「用生成模型造监督信号来训练修复模型」这个思路本身是有循环论证风险的——生成模型自己也会产生伪影,用它的输出当 GT,等于把它的错误当成真理教给学生。这篇之所以站得住,全靠两个设计。一是不用单个生成模型,而是让五个模型各出候选再做 patch 级筛选,把「相信某个模型」换成「相信多个模型中被质控挑出来的那部分」,显著降低了单一模型偏差的传播。二是测试集用真实采集的干净 GT 而非生成的,评测环节的可信度得到了保证——如果测试集也是生成的,整篇的结论就没有意义了。三个模型上四项指标一致改善也排除了偶然性。但要看清限制。第一,6.8K 对的规模在数据驱动的低层视觉任务里偏小,PSNR 提升 1.7-1.9 dB 虽然明确但不算大幅度,而这个提升是在测试集只有 250 对的情况下测的,统计置信区间没有报告。第二,生成的 GT 本质上是「一个合理的干净版本」而非「真正的原始内容」——摩尔纹遮住的地方生成模型是在猜,猜得好看不等于猜得正确,而 PSNR/SSIM 是在与真实 GT 比对,所以训练数据的这种「合理但不真实」的偏差会以什么形式影响模型行为,值得进一步分析。第三,五个生成模型中多个是闭源商业模型(Nano Banana 2、GPT Image 2),意味着这套数据引擎的复现需要付费 API,且模型迭代后行为会变,数据可复现性存疑。第四,摩尔纹去除是个相对小众的低层任务,方法论的普适价值(用生成模型为难以获取 GT 的任务造监督)其实比这个具体应用更值得关注,但论文没有往这个方向延伸讨论。 9. TRACE-Bench:把多参考生成拆成四个算子 TRACE-Bench: Decomposing and Diagnosing Multi-Reference Image Generation | 上海交通大学 | arXiv:2608.16765 关键词:多参考图像生成,评测基准,四算子分解,属性解耦绑定,上海交大 ⚠️ 前序问题:多参考图生成——给几张参考图,要求把 A 的人物、B 的服装、C 的场景组合起来——的评测基准,目前都是按预定义任务类型组织的,比如「主体组合」「风格迁移」各设一类。但多参考本质上是组合性的,任务类型的笛卡尔积会爆炸,用有限的预定义类别去覆盖必然导致三个问题:覆盖碎片化(很多组合根本没被测到)、复杂度不受控(同一类别下的样例难度可能差几倍)、诊断价值近乎为零(知道模型在「主体组合」上得 0.6,但不知道是没抓对主体、没解耦属性还是没组合好)。 本文贡献:换一个视角:不按任务分类,按能力原子分解。作者观察到各种多参考任务其实共享一组原子操作,于是形式化出四个算子——Anchor(f,锚定参考图中的某个实体)、Disentangle(g,把实体的某个属性剥离出来)、Apply(⊕,把属性施加到目标上)、Compose(C,把多个结果组合成完整场景)。任何多参考提示词都能表示为这四个算子构成的组合公式,而公式中算子槽位的数量就是它的结构复杂度——复杂度从此变成了一个可精确控制的连续量而非模糊的难易标签。基于这套形式化构建 TRACE-Bench:约 1600 个评测样例,槽位数从 1 到 8 连续覆盖,由 631 个公式模板与约 4000 张参考图生成,涵盖多种艺术风格与真实主体。公式结构直接驱动两件事:算子对齐的评测协议(对每种能力单独打分)与诊断树分析(递归定位失败发生在公式的哪一层)。 Overview of the benchmark construction pipeline. Candidate images are first collected and filtered from multiple sources, then annotated through structured tagging. The tagged pool is then balanced through source-wise sampling and augmented with synthetic data. It is subsequently used for formula-template sampling and prompt construction. 实验效果:评测 9 个领先模型后得到了整体打分完全看不见的结论:主要瓶颈在解耦(g)与属性绑定(⊕),而非场景级组合(C)——这与直觉相反,人们通常认为「把多个东西组合到一起」才是难点。即使最好的模型在属性保真度上也只有 0.74 分。实体级锚定分数随参考图实体数量增加持续下降:Nano Banana 2 与 GPT-Image 1.5 从 2 个实体时的 0.78 降到 8 个实体时的约 0.55 与 0.49,EMU 3.5 从 0.70 降到 0.36,Qwen Image Edit 2511 从 0.60 降到 0.36——所有模型无一例外,且弱模型衰减更陡。已被 ACM MM 2026 接收。 Anchor performance versus template slot count (left) and reference-image entity count (right). 批判点评:把评测从「任务分类学」重构为「能力代数」,这是这篇真正的贡献。四个算子的抽象足够简洁,又足够表达绝大多数多参考场景,而槽位数作为复杂度度量把「难度」这个模糊概念变成了可控变量——这让基准第一次能回答「模型在复杂度 N 时开始崩」这类定量问题,而不只是给一个总分。诊断树的递归失败定位设计也很自然地从公式结构里长出来,不是额外硬加的模块。「瓶颈在解耦和属性绑定而非场景组合」这个发现具有明确的研究导向价值:它告诉后续工作该往哪儿使劲,而这正是一个基准最该产出的东西。实体数从 2 涨到 8 时所有模型锚定分数单调下降的曲线也很有说服力——它揭示了一个共性缺陷而非某个模型的问题。但几点要留意。第一,1600 个样例分摊到 1-8 共八个槽位档,平均每档 200 例,再按算子类型细分后每个诊断单元的样本量会相当小,per-capability 分数的统计稳定性存疑。第二,评测靠什么打分?摘要没说评分是人工还是 VLM 自动评。如果是 VLM 评分,那么「解耦和属性绑定是瓶颈」这个结论可能部分反映的是评委 VLM 在这两项上的判别偏好,而非被测模型的真实短板——这是自动评测基准的通病,需要人工一致性验证来排除。第三,四算子分解是作者提出的一种形式化,未必唯一,其完备性(是否所有多参考任务都能被这四个算子表达)缺乏论证。第四,9 个被测模型中包含 Nano Banana 2、GPT-Image 1.5 等闭源模型,其版本会持续更新,基准结论的时效性有限。 10. HarnessEval-W:评测世界模型要给出证据链 HarnessEval-W: Agentifying the Evaluation of Visual Worlds | MirroS·清华·北大·NVIDIA·UC Berkeley·上交·南洋理工 | arXiv:2608.16859 关键词:世界模型评测,智能体化流水线,层级证据树,人类偏好对齐,NVIDIA·清华 ⚠️ 前序问题:一个基准如果只吐出一个标量分数,那么它可信与否完全取决于你信不信它——分数背后的判断依据是不透明的。这个问题在世界模型评测上格外尖锐:判断一段 rollout 好不好,需要理解物理规律有没有被违反、因果链条对不对、世界状态的演化是否自洽。人类看一眼就知道哪里不对劲,但现有基准全靠暴力计算指标,算完给个数,没有任何可供检查或核验的推理链条。于是当两个模型分数接近时,你无从判断这个接近是真实的还是指标失灵。 本文贡献:把 LLM 生态里的 harness 范式搬到世界模型评测上,做成一条智能体化的评测流水线。核心区别在于它不套用固定评分表,而是先理解每个评测案例的上下文,把评测问题分解为若干可测量的子问题,再为每个子问题派生专门的子智能体——每个子智能体带着定制的上下文与诊断工具,只负责论证自己那一小块。父智能体随后校验汇总的证据并归纳为最终判定。这个层级化流程的产物不只是一个分数,而是一棵完整的证据树,每条推理链都可回溯查验。图中示例展示了这个过程:给定「让右夹爪把托盘上方的立方体举起来」这一意图性转换案例,系统先做案例专属的技能路由(启用 Intentional Change 与 Physical Plausibility,关闭 Offscreen Evolution 与 Drift Degradation),再由子智能体分别给出带理由的评分——target specificity 1.00、final state 0.25、no extra event 0.00(因为 rollout 里凭空出现了一只人手去捡立方体),最终聚合为 0.485。 Overview of the ourmodel evaluation pipeline. Given a case with its prompt and evaluation setting, the agentic planner routes the case to applicable skills from the skill library, recording an evidence-grounded reason for every activated and skipped skill (e.g., the Offscreen Evolution Verifier is skipped because all requested actions remain visible). Each activated skill spawns sub-agents that inspect the world model rollout for specific sub-questions, such as target visibility and final state validity; here, the Intentional Change Verifier detects an unrelated human intervention picking up the cube and zeroes the no-extra-event score. The collected evidence is finally aggregated into per-dimension scores and an interpretable final score. 实验效果:在 18 个代表性世界模型、330 个评测案例上应用,判定结果与人类偏好高度对齐:技能级别上与人类 Bradley-Terry 强度的相关性达到 ρ=0.93(意图类)与 ρ=0.87(物理类),Kendall τ 分别为 0.82 与 0.74。与最接近的既有 Wbench 协议对比,在意图与事件编辑任务上准确率 0.778 对 0.602、平局率 0.111 对 0.361;在物理与因果保真任务上准确率 0.717 对 0.319、平局率 0.018 对 0.522——平局率的大幅下降尤其说明问题:旧协议在超过一半的物理类对比中给不出区分,而本方法几乎总能分出高下。全流程开源为活体基准,接受社区贡献新技能与新案例。 Human alignment of ourmodel and its comparison with WBench. (a) Model-level human alignment: each point is one of the evaluated models; we fit a linear curve for both Intentional and Physical Transition. (b) Controlled comparison with the closest WBench protocols on the same data: we report pairwise accuracy (higher is better), draw rate, and Brier score (both lower is better). 批判点评:「评测的可信度来自论证而非分数」这个立论切中了当前评测体系的软肋。当各家模型在总分上越挤越近时,一个不能解释自己为什么这么打分的基准,实际上已经失去了指导价值。把评测拆成子问题再派智能体分别论证,得到的证据树让分数变得可审计——这是从「相信基准」到「检查基准」的转变。物理类平局率从 0.522 降到 0.018 是全文最有说服力的数字:它说明旧协议在过半的物理保真对比中根本没有分辨力,而这类失效在只看准确率时是看不出来的。ρ=0.93/0.87 的人类对齐度也相当高。作者阵容横跨 MirroS、清华、北大、NVIDIA、UC Berkeley 等十余家机构,Ziwei Liu 与 Ming-Yu Liu 在列,说明这是一次有组织的社区级基建投入而非单点工作。但要审视几点。第一,评测器本身是由 LLM/VLM 智能体构成的,那么它的判断能力上限就是这些基座模型的上限——当被测世界模型的能力超过评委模型的理解能力时,这套评测会失效,而这个交叉点何时到来没有讨论。第二,智能体化评测的成本远高于计算指标:330 个案例、每个案例派生多个子智能体,单次完整评测的 token 消耗与耗时未披露,这直接决定它能否作为常规回归测试使用。第三,「与人类偏好对齐」的人类标注规模、标注者背景与一致性未在摘要中交代,而 ρ=0.93 这类数字对标注质量极度敏感。第四,技能路由决定启用哪些评测维度,路由本身出错(该查物理却没查)会导致系统性漏判,而这类错误在证据树里恰恰是看不见的——树只记录做过的检查,不记录漏掉的。第五,作为活体基准接受社区贡献,长期的版本一致性与跨时间可比性如何保证,是这类开放基准共同的治理难题。 趋势观察 扩散模型的「训练配方学」正式补齐最后一块拼图 — 语言模型有 Chinchilla,视觉生成一直没有可对照的缩放定律。今天 Luma AI 的 Abra 把 10^19 到 10^22 FLOPs 三个数量级扫了一遍,给出「每参数 200 个图像 token」这个明确数字,是 LLM 的十倍;阿里的 CapData 则从数据侧回答同一个问题——不是单纯堆量,而是按能力依赖顺序编排课程。一个说算力该怎么分,一个说数据该怎么组织,共同标志着视觉生成开始有了可预测的工程学,而不再只是炼丹。 编辑任务集体转向「别从噪声重生成」 — EditBridge 把超高分辨率编辑重新形式化为 LR→HR 的数据到数据桥接而非从噪声重生,GRNEdit 把编辑语义拆成对每个 bit 的保留还是翻转决策,两者都在做同一件事:让模型只改该改的,其余部分从源头直接继承。这与传统「条件生成」范式的区别是根本性的——前者的默认动作是保持,后者的默认动作是重画,而编辑任务真正需要的恰恰是前者。 评测正在从「打一个分」变成「定位是哪一步错了」 — TRACE-Bench 把多参考图生成拆成 Anchor/Disentangle/Apply/Compose 四个算子,用公式结构定位失败发生在哪个算子上,发现瓶颈其实在解耦与属性绑定而非场景合成;HarnessEval-W 更进一步,让子智能体各自论证再汇总,把评测变成可查验的证据树。当模型能力普遍变强、总分趋同后,可诊断性比可比较性更值钱。 人工智能炼丹君 整理 | 2026-08-20 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-18|港科大数字人比LTX-2快33倍还能连说一分钟Omni… 今日 AIGC 论文速览 今日共 10 篇 · 实时流式数字人与音视频联合生成 1 篇 · MLLM 与 DiT 融合的视频生成架构 1 篇 · 视频生成推理加速 3 篇 · 个性化与可控图像生成 2 篇 · 生成式渲染与视频编辑 2 篇 · 图像编辑评测基准 1 篇 重点论文标题列表 Omni-LiveAvatar(港科大 iComAI Lab·Vivix Group):比LTX-2快33倍的分钟级流式数字人 BiVidGen(中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab):MLLM先写视觉token再交DiT渲染 SCOPE:免训练稀疏注意力提速1.99倍 ForgeWM:世界模型压到1步还听懂键鼠 CRAFT(SIGGRAPH Asia 2026):1万张参考图干掉200万配对数据 今日论文速览 1. Omni-LiveAvatar:比LTX-2快33倍的分钟级流式数字人 Omni-LiveAvatar: Minute-Level Real-Time Streaming Joint Audio-Video Avatar Generation | 港科大 iComAI Lab·Vivix Group | arXiv:2608.13602 前序问题:音视频联合生成模型是沉浸式数字人的底座,但现有模型几乎都依赖双向注意力加多步去噪,这两件事凑在一起决定了它只能生成很短的片段。双向注意力要求看到完整序列才能算,天生做不了流式;多步去噪又让单块延迟压不下来。于是「实时交互」和「长时长」这两个数字人最需要的属性,在当前架构下同时缺失——你要么生成几秒的高质量片段然后卡住,要么牺牲质量去换速度,而且一旦想连续说上一分钟,全局一致性(人物长相、音色、场景)就开始飘。 本文贡献:提出 Omni-LiveAvatar,第一个做到分钟级、实时、流式的音视频联合数字人生成框架,三个部件各解一个问题。一是渐进式自回归蒸馏管线,把一个大的双向音视频联合扩散模型转成少步自回归生成器,关键点是整个过程不需要额外的稳定化机制——同类工作常要靠各种辅助 trick 才能压住自回归的误差累积。二是同步的音视频长短期记忆,在有界显存预算下保住全局一致性,这是长时生成不漂的直接原因。三是分层滚动提示词规划策略,让语义可以连贯演进、提示词之间平滑切换,而不是每换一句话画面就跳一下。 Overview of Omni-LiveAvatar. The proposed progressive autoregressive distillation pipeline converts a large bidirectional audio-video diffusion model into a few-step causal generator without any auxiliary stabilization mechanism (top). At inference, the synchronized audio-video long-short-term memory preserves global consistency while retaining recent context within a bounded memory budget for minute-level streaming inference (middle), and the hierarchical rolling prompt planning organizes global and local prompts for smooth long-form semantic evolution (bottom). 实验效果:单张 NVIDIA H200 上,相对其教师模型 LTX-2 拿到 33 倍生成加速,且能实时产出分钟级、音视频同步的高质量数字人。质量维度上全面超过同期的加速类基线,具体覆盖视觉质量、音频质量、跨模态同步性和人物保真度四个方面。代码已开源。 Qualitative comparison of 5-second avatar generation. Omni-LiveAvatar generates realistic and temporally consistent avatars with visual quality comparable to Ovi and LTX-2, whereas OmniForcing exhibits noticeable realism degradation and Hallo-Live suffers from facial and hand artifacts as well as color drift. 批判点评:这篇的工程完成度是今天这批里最高的,33 倍加速加分钟级流式,两个指标同时拿下不容易,而且「不需要额外稳定化机制」这句如果站得住,实际价值比加速倍率本身更大——自回归视频生成的误差累积一直是靠各种补丁压住的,能去掉补丁说明蒸馏管线的设计确实抓住了主要矛盾。教师选 LTX-2 也是个务实选择,那是当前公开可用的强音视频联合模型之一。不过 33 倍这个数字要放在正确的语境里读:它是相对教师的加速比,而教师本身是多步双向模型,基数很慢,所以这个倍率更多说明「双向多步这条路在实时场景下浪费有多大」,而不等于绝对性能领先。真正该问的是绝对延迟——摘要只说「实时」,没给单块生成耗时和端到端首帧延迟,而数字人交互对这两个数字极其敏感,300 毫秒和 800 毫秒是完全不同的产品体验。分辨率和帧率也没披露,H200 是顶配卡,换到消费级或推理卡上还剩多少余量不清楚。另外「分钟级」和真正的开放式交互仍有距离:长短期记忆是有界预算,那就必然有遗忘边界,跑到第五分钟、第十分钟时人物一致性掉多少,论文只展示了分钟级。最后,音视频联合生成最难的其实是音画同步在长序列上的累积误差,摘要报了同步性优于基线,但没说这个优势是否随时长衰减。 2. BiVidGen:MLLM先写视觉token再交DiT渲染 Beyond Text Conditioning: A Systematic Study of MLLM-DiT Fusion for Video Generation | 中科院·Microsoft Research·中山大学·浙大·西交·上海AI Lab | arXiv:2608.14043 前序问题:DiT 已经是高保真视频生成的主流范式,但它做高层语义规划的能力一直很弱——给一句复杂提示词,它能画得很好看,却常常没把因果关系、动作顺序、多物体交互理清楚。图像生成那边已经证明把 MLLM 和扩散骨干混起来有明显优势,可这套思路在视频上基本没被认真研究过。更关键的是,现有少数尝试几乎都把 MLLM 当成一个冻结的特征编码器用,取它的隐层表示喂给 DiT,而 MLLM 最核心的能力——自回归地「生成」内容——完全没被调用。这就等于请了个会规划的大脑,却只让它当传感器。 本文贡献:系统性地拆解「MLLM 该怎么和 DiT 融合做视频生成」这个问题,明确拆成三问:什么样的中间表示适合做 MLLM 与 DiT 之间的桥梁、MLLM 该如何产出这个表示、DiT 在扩散渲染时该如何吸收它。三个发现:其一,由 EMA-based tokenizer 产出的离散语义视觉 token 提供了既稳定又有表达力的接口;其二,自回归因果建模适合生成这些 token;其三,显式的视觉 token 条件化比改写提示词(prompt refinement)或隐空间桥接(latent bridging)都更有效。基于这三点提出 BiVidGen 这一混合架构,让 MLLM 真正承担语义规划、DiT 负责扩散渲染。 Overview. BiVidGen consists of three main components. First, an EMA-based vision tokenizer provides discrete visual representations. Then, an MLLM predicts semantic visual tokens. Finally, the DiT renders high-fidelity videos conditioned on these planned tokens. 实验效果:论文以系统性对照实验为主体,逐一验证三个设计维度上的选择,最终 BiVidGen 在语义规划相关的生成任务上优于把 MLLM 当冻结编码器的既有做法。三条发现分别对应中间表示形式、生成方式、条件注入方式的消融结论。 Qualitative Comparisons. MLLM+DiT yields better causal transitions, temporal consistency, and semantic alignment than the DiT-only baseline in these examples. 批判点评:这篇的价值主要在「把问题问清楚」而不是「刷了个 SOTA」。它把 MLLM-DiT 融合这个此前靠直觉拼装的设计空间,拆成三个正交维度逐一做对照,最后给出的三条结论——离散语义 token 做接口、自回归生成、显式 token 条件化——对后续做这个方向的人是实打实的省时间,尤其「显式 token 条件化优于 prompt refinement 和 latent bridging」这条,直接排除了两条看起来很自然但实际次优的路径。EMA tokenizer 提供稳定接口这个发现也有说服力,离散化在生成任务里通常被担心信息损失,这里反而因为稳定性赢了。但摘要在最关键的地方留了空白:没有任何具体数字,没说在哪些 benchmark 上、相对哪些基线提升多少,也没交代 MLLM 和 DiT 各自的规模、训练数据量和总训练成本。对一篇以「系统性研究」自我定位的工作,这些恰恰是判断结论泛化性的关键——三条结论是在某个特定尺寸组合下成立,还是随规模稳定?其次,引入自回归 MLLM 生成视觉 token 必然带来额外推理延迟,视频生成本来就慢,这个代价有多大、值不值得,论文没有权衡分析。最后一个更根本的隐忧:既然 MLLM 现在承担了语义规划,那它规划错的时候会怎样?DiT 是有能力纠正一个错误的视觉 token 序列,还是会忠实地把错误渲染出来?这个失败模式没有讨论,而它直接决定了这套架构在实际产品中的鲁棒性。 3. SCOPE:免训练稀疏注意力提速1.99倍 SCOPE: Subspace Clustering with Online Per-Head Top-K Estimation for Sparse Video Attention | arXiv:2608.12780 前序问题:DiT 在时空 token 上的自注意力是二次复杂度,视频一长、分辨率一高就成为主要瓶颈。现有免训练稀疏注意力方法普遍用块级或簇级的代理分数来构造稀疏掩码,问题是这种粗粒度代理会把 key 之间的细微差异抹平,在激进稀疏率下高贡献的 key 就被漏掉了。还有一个更隐蔽的失败模式:代理分数容易产生过度集中的 softmax 分布,导致 Top-p 策略对某些 query 簇只保留极少的 key。用一个固定的 Top-k 下限可以缓解,但不同注意力头、不同输入的稀疏容忍度本来就不一样,共享一个固定值必然有头被切得太狠。 本文贡献:提出 SCOPE,免训练稀疏注意力框架,把 3D-RoPE 对齐的 key 子空间聚类和在线逐头 Top-k 估计结合起来。具体做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别独立聚类,再通过查找表聚合对应的质心分数,为每个 query 簇得到逐 key 的代理分数——粒度从块/簇细化到单个 key。在既有的 Top-p 与固定 Top-k 混合选择策略之上,SCOPE 在线推导每个头专属的 Top-k 值:对每个头,按 query 簇大小加权平均其初始保留 key 数,只对那些初始保留数低于该均值的 query 簇补充选取额外 key。最终稀疏注意力在选中的原始 key/value 上计算。 Overview of SCOPE. Queries are clustered in the full feature space, while each post-RoPE key is represented by temporal, height and width subspace assignments. Query-centroid slices score the corresponding subspace centroids to form lookup tables, and indexed summation reconstructs a proxy logit for every key. Hybrid Top-$p$/fixed-Top-$k$ selection produces the initial key counts, from which SCOPE estimates an online per-head Top-$k$ value. Sparse attention is computed using the selected original $K$ and $V$. 实验效果:在六种模型-任务配置上,SCOPE 在保真度和延迟两个维度上都稳定优于现有免训练基线。720p HunyuanVideo 上端到端加速最高 1.99 倍,同时相对稠密注意力保持 28.46 dB PSNR。 Attention recall and PSNR under matched attention density. SCOPE consistently achieves higher attention recall and PSNR than competing sparse attention methods at the same retained density. 批判点评:这篇的两个改动都很对症。按 RoPE 的三个物理维度分别聚类,比在混合后的高维空间里做一次聚类更合理——时间、高、宽三个方向的相似性结构本来就不同,混在一起聚必然互相干扰,这个设计有明确的几何动机而不是调参调出来的。逐头在线估计 Top-k 也踩在了痛点上:稀疏注意力的工程实践里,「哪个头能切多狠」向来是最难统一的,用全局固定值本质上是在拿最脆弱的那个头的容忍度当上限,牺牲了其余头的加速空间。1.99 倍加速配 28.46 dB PSNR 是个体面的组合,六种配置的覆盖也说明不是单点调优。但要注意几个尺度问题。28.46 dB 是相对稠密注意力的重建保真度,这个量级在图像上属于「肉眼可辨差异」的边缘,视频上更麻烦的是误差会沿时间累积——单帧 PSNR 达标不代表时序闪烁可接受,而摘要没给任何时序一致性指标。1.99 倍是「最高」值且只在 720p HunyuanVideo 上,其余五个配置的加速比没披露,实际期望值应该往下调。更根本的是,SCOPE 自己引入了聚类和查找表两层额外开销,这部分成本随 token 数如何增长、在什么序列长度以下会反而变慢,论文没给出盈亏平衡点,而这直接决定它能否用在短视频或低分辨率场景。最后,逐头 Top-k 用「簇大小加权均值」作为阈值是个启发式,为什么均值是对的、换成分位数会怎样,缺少分析。 4. ForgeWM:世界模型压到1步还听懂键鼠 ForgeWM: Progressive Causal Training for Few-Step Action-Conditioned Video World Models | arXiv:2608.14022 前序问题:动作条件视频世界模型要同时满足低延迟因果生成和对游戏原生控制信号的可靠响应。因果蒸馏已经能做到一步或少步视频合成,但把它扩展到交互式世界模型很难,症结在于离散的键盘状态和连续的鼠标运动必须在因果训练和自回归 rollout 的全过程中,始终与被时间压缩过的隐空间 chunk 保持对齐。视频 VAE 在时间维做了压缩,一个隐 chunk 对应多帧,而用户的按键是逐帧发生的——这个错位在多步生成里还能靠冗余步数糊过去,压到一两步就直接暴露成「动作响应不准」。 本文贡献:提出 ForgeWM,一个渐进式框架,通过四个阶段把双向的动作条件视频生成器转成高效的少步世界模型:域适应、teacher-forced 因果训练、因果一致性蒸馏、以及与双向教师做 on-policy 分布匹配。产出的是「按预算特化」的学生模型,分别在 1、2、4 步的稳态去噪预算下工作。ForgeWM 还支持一种双路径部署协议,把延迟敏感的交互与可选的回放期精修结合起来——一步学生先出草稿保存,之后再重新加噪并精修这份草稿,等于把「交互时要快」和「回放时要好」两个矛盾需求拆到了不同时间点。 Overview of ForgeWM. (A) Frame-aligned keyboard and mouse controls condition latent chunks. (B) A shared base yields a bidirectional teacher and budget-specialized causal students through four-stage training. (C) Deployment separates low-latency interaction from optional Replay-Time Refinement (Figure~fig:replay-refinement). 实验效果:在配对的 Minecraft 轨迹上,ForgeWM 在成像质量、参考对齐的运动指标上领先所评估的各系统,学生模型可在 1、2、4 步预算下运行。 Qualitative comparison. Rollouts at frames 0, 25, 51, and 76. Rows show the reference and three models. Controls are annotated once on the reference: each overlay shows dominant WASD and accumulated mouse-look to the next frame; the final frame has no outgoing control overlay. Left/right: daytime forest stream/rainy riverbank at night. 批判点评:把「动作对齐」识别为少步世界模型的核心障碍,这个判断是准的,而且它指出的错位很具体——时间压缩的隐 chunk 与逐帧动作信号之间的粒度不匹配,这不是靠加数据能解决的结构问题。四阶段渐进管线(域适应→teacher-forced→一致性蒸馏→on-policy 分布匹配)的顺序也有内在逻辑:先让模型适应域,再在有监督信号下学因果,最后用 on-policy 修正暴露出的分布偏移。双路径部署是全篇最有产品意识的设计——交互时用一步出草稿保延迟,回放时再加噪精修提质量,直接承认了「同一个模型不必在所有时刻都做同样的权衡」,这个思路可以迁移到很多实时生成场景。但实验范围是明显的短板:只在 Minecraft 上验证。Minecraft 的视觉复杂度低、纹理规整、物理规则简单且完全确定,是世界模型最友好的测试场,在这里报 SOTA 与在真实感游戏或真实视频上的可用性之间有很大鸿沟。「领先所评估的各系统」这个表述也偏保守,说明对比范围可能有限,具体的 FID/FVD 数值和延迟数字摘要都没给。一步学生的绝对质量损失多少同样没交代——1、2、4 步三档特化模型之间的质量-延迟曲线是这篇最该给的图,缺了它就无法判断「压到一步」是真可用还是仅仅可跑。另外双路径协议要为每次交互保存草稿,显存和存储开销在长会话下如何增长,也没有讨论。 5. CRAFT:1万张参考图干掉200万配对数据 CRAFT: Constrained Reward via Attention Fine-Tuning for Subject Personalization without Composed Targets | SIGGRAPH Asia 2026 | arXiv:2608.14403 前序问题:主体驱动的图像个性化——生成新图像同时保持一个或多个参考主体的身份——是视觉内容创作的基础能力。当前主流做法是在几十万到几百万组「参考图-合成目标」配对样本上微调预训练的 MMDiT,而每组合成目标都是主体出现在新场景中的一张合成图。造这些目标需要一条昂贵的多阶段流水线:LLM 生成提示词、T2I 合成目标图、参考主体抠取、VLM 质量过滤、对应关系标注。除了贵,这条路还有个隐性代价——方法被紧紧绑在某个特定的目标合成器和某一套数据清洗策略上,换个合成器结论就不一定成立。 本文贡献:提出 CRAFT,一个单步 ReFL 框架,用 LoRA 适配器微调预训练的「参考感知」MMDiT,训练数据只需 1 万张参考图加主体 mask,完全不需要合成目标监督。核心是「看哪里」原则:注意力级奖励把噪声 token 与短语 token 的注意力对齐到正确的参考主体上,由此得到的逐主体注意力 mask 再去门控一个像素级身份奖励,从而让图像空间的监督与学到的注意力路由保持一致。这等于把监督信号从「像素该长什么样」换成了「注意力该看哪个主体」,后者可以从参考图本身直接构造。 Overall pipeline of CRAFT. The denoising prefix is rolled out without gradients up to the reward step $t^\ast$, where two forward passes are performed: the frozen backbone $f_\text{base}$ produces $\mathbf{v}_\text{base}$, while the LoRA-adapted model $f_\text{LoRA}$ produces $\mathbf{v}_\text{LoRA}$ together with the cross-modal attention sub-blocks $\mathbf{A}_{N2R_k}$, $\mathbf{A}_{N2P_k}$, and $\mathbf{A}_{P_k 2 R_k}$. Following the Where to look principle, $\mathcal{R}_\text{ref}$ and $\mathcal{R}_\text{cons}$ shape noise- and phrase-token attention toward each reference subject (sec:method:attn_rewards); the resulting per-subject mask $\mathbf{m}^\text{noise}_k$ then gates the pixel-level identity reward $\mathcal{R}_\text{id}$ on the VAE-decoded pre-image $\hat{\mathbf{I}}$ (sec:method:pixel). Auxiliary terms $\mathcal{R}_\text{CLIP-T}$, $\mathcal{R}_\text{AES}$, and a velocity-space regularizer $\mathcal{L}_\text{anchor}$ are added for prompt fidelity, aesthetics, and stability (sec:method:loss). A single backward pass updates only the LoRA parameters. 实验效果:应用在 FLUX.2-klein-9B 上,CRAFT 在 XVerseBench 上达到 SOTA,且只用 1 万条纯参考数据,而此前的通用方法需要 15 万到超过 200 万组合成目标配对。同一套配方迁移到其他参考感知骨干上也能稳定提升性能。已被 ACM SIGGRAPH Asia 2026 接收。 Qualitative comparison with state-of-the-art subject-driven personalization models. 批判点评:1 万对 200 万,两个数量级的数据量差距还能拿 SOTA,这是今天最有冲击力的数字,而且它的说服力不在倍数本身,而在于它质疑的东西:如果两百万组精心合成的配对数据能被一万张参考图替代,那说明此前的数据流水线在很大程度上是在用外部监督重新教模型一些它内部已经编码好的东西。把监督从像素空间挪到注意力空间是关键一步——「主体身份」这个概念在 MMDiT 里本来就是通过注意力路由实现的,直接在这一层加约束比绕一圈从像素反推更直接。用注意力 mask 去门控像素奖励也很巧,避免了两种监督各说各话。迁移到其他参考感知骨干仍有效,说明不是单一模型上的过拟合。SIGGRAPH Asia 的接收也是一层背书。不过前提条件要看清楚:它要求骨干必须是「参考感知」的 MMDiT,也就是说模型本身已经具备处理参考图的结构,CRAFT 是在这个基础上做对齐微调,而不是从零赋予个性化能力——所以严格说它省掉的是「对齐阶段」的数据,而非全部。评测只报了 XVerseBench 一个基准,主体个性化的评测口径分歧很大,单一 benchmark 上的 SOTA 需要更多交叉验证,尤其是多主体组合、罕见物体这些困难设定。注意力级奖励依赖短语 token 与主体的正确对应,当提示词里出现代词、隐含指代或多个同类物体时这个对应如何建立,摘要没说。最后 1 万张参考图仍需主体 mask 标注,这部分成本虽远低于合成目标流水线,但并非零。 6. XYZFlow:不靠蒸馏拿到7.2倍教师加速 XYZFlow: Scaling Multi-dimensional Shortcut Flows for Efficient Generative Modeling | ICML 2026 | arXiv:2608.12276 前序问题:高保真图像生成始终卡在速度与质量的取舍上。扩散模型视觉效果强,代价是昂贵的迭代采样。现有的高效方法主流是把预训练模型蒸馏成少步采样器,但蒸馏本身是个难做的过程,而且质量上限严重依赖教师模型——教师有的毛病学生躲不开,教师没有的能力学生也长不出来。这意味着加速路线被绑死在「先有一个好教师」这个前提上,而且每换一个基础模型就要重跑一遍蒸馏。 本文贡献:提出 XYZFlow,从流匹配的多维度缩放这个角度重新思考高效生成,而不是走蒸馏路线。核心主张是:相比单步映射,通过结构化的多维条件化可以让概率路径更可辨识、更易学习,从而提升表达力。论文把自回归建模看作一种隐式的流直化——上下文越丰富,轨迹的歧义就越小。XYZFlow 用两个正交维度实现这个想法:时间维缩放,即在完整去噪历史上做非马尔可夫条件化;空间维缩放,通过「下一捷径预测」(Next Shortcut Prediction)顺序生成图像块,把已生成块的去噪轨迹当作后续块的先验。 Next Shortcut Prediction in XYZFlow. (Top-Left) Flow diagram showing the generation sequence, where a blue curve represents progressively strengthening constraints. (Top-Right) Visualization of a non-uniform patch-based denoising process: the first image patch undergoes the most denoising steps, while subsequent patches are generated with fewer steps (“shortcuts”). This forms a long autoregressive sequence where the denoising flow from prior patches (green and blue arrows) guides the denoising of subsequent ones. 实验效果:达到 SOTA 性能,相对教师模型实现 7.2 至 8.5 倍加速,同时 FID 保持竞争力。其中 Next Shortcut Prediction 在质量-延迟权衡上优于单纯的模型放大或步数削减两种做法。已被 ICML 2026 接收(16 页 5 图)。 Randomly selected examples of generated images from XYZFlow. XYZFlow shows high-quality generative modeling abilities. 批判点评:「自回归建模是隐式的流直化」这个视角是这篇最有价值的部分。流匹配领域一直在琢磨怎么把概率路径拉直,主流手段是改路径设计或加正则;这篇指出提供更丰富的条件上下文本身就在减少轨迹歧义,等于把自回归和流直化两条此前平行的技术线接上了,这个洞察比 7.2 倍这个数字更耐读。时间和空间两个正交维度的划分也干净——非马尔可夫地用完整去噪历史,加上按块顺序生成用已完成块当先验,两者确实互不重叠,可以独立叠加。绕开蒸馏这一点尤其实在,摆脱了对教师质量的依赖,ICML 2026 的接收说明理论部分经过了同行检验。但代价需要说清楚:空间维的 Next Shortcut Prediction 是顺序生成图像块,这天然引入了块间的串行依赖,跟扩散模型全图并行去噪的优势正好相反。摘要报的 7.2-8.5 倍加速想必已经包含这部分开销,但在什么分辨率下测的、块数增加时加速比如何衰减,是判断可扩展性的关键,而这些没披露。「FID 保持竞争力」这个措辞比「达到 SOTA」弱,暗示纯质量指标上可能有小幅让步,具体差多少应该给出。时间维的非马尔可夫条件化要保存完整去噪历史,显存开销随步数线性增长,与少步生成的初衷存在张力。另外全文以图像生成为主,视频这种时空 token 量级大得多的场景下,块间串行的代价会被放大多少,是个开放问题。 7. RGBX-Next:把DiT改造成可控生成式渲染器 RGBX-Next: Towards Realistic Generative Rendering from G-Buffers | NVIDIA·UCSB·UCSD·MBZUAI | arXiv:2608.13929 前序问题:扩散模型在图像、视频和流式生成上效果已经很好,但和传统 3D 渲染相比,它对生成结果缺乏精确控制。传统渲染管线里你能精确指定几何、材质、光照,改一个参数就得到可预期的变化;扩散模型给的是「大致符合描述」,无法承担需要确定性控制的生产任务。反过来传统渲染又缺少生成模型的真实感先验,物理正确不等于看起来像照片。这两条路各有各的强项,一直没能真正打通。 本文贡献:主张一条可行路径是把生成模型当作以传统渲染的 G-buffer 为条件的「学习型渲染器」。提出 RGBX-Next,一个统一的前向与逆向渲染生成框架:既能从图像、视频、流中估计 G-buffer(逆向),也能从 G-buffer 渲染出真实的图像、视频、流(前向)。核心贡献是给出了一套把扩散 Transformer(DiT)模型微调成生成式前向渲染器与逆向渲染器的通用配方。作者承诺公开全部模型。 High-level overview of our paper. We first describe a simple version of image and video models in sec:initial-rgbx, followed by an improved version using our QK type embedding and clean input tokens techniques in sec:improved-rgbx. We estimate G-buffers from real video data with our model in sec:dataset, and train models with X-patchify in sec:xpatchify. We discuss conditioning dropout and lighting control in sec:dropout-blurring,sec:lighting. We introduce streaming extensions of our models in sec:streaming. 实验效果:所得模型在真实感生成式渲染与内在分解(intrinsic decomposition)两个方向上都达到高质量。论文强调其提出的设计原则将有利于后续可控生成式前向与逆向渲染的研究。团队来自 NVIDIA 与 UCSB 等,作者包含多位实时渲染与逆向渲染方向的资深研究者。 The overall design of our $1/N$ streaming models. For each chunk, the model receives $N$ current input frames and one stitching frame from the previous chunk, whose input and output are already known, then produces the $N$ new output frames through a diffusion process. Optional long-context tokens provide a clean reference frame for long-term memory. For simplicity, the figure illustrates the rgbtox case with albedo as xx. 批判点评:把 G-buffer 当作生成模型的条件接口,这个设计的聪明之处在于它直接复用了图形学几十年积累下来的中间表示。G-buffer(法线、深度、albedo、粗糙度这些)本来就是渲染管线里为了解耦几何与着色而设计的,它天然是结构化、可编辑、语义明确的——比文本提示词或隐向量都更适合做精确控制的入口。前向和逆向统一在一个框架里也很自然,两者本质是同一映射的两个方向,共享表示能互相提供约束。作者阵容是这篇的隐性背书:Marco Salvi、Jan Novák、Ravi Ramamoorthi、Ling-Qi Yan、Miloš Hašan 都是渲染和逆向渲染方向的资深研究者,NVIDIA 主导加上承诺开源模型,落地可能性比多数学术工作高。但摘要的表述相当克制,也确实缺东西:全篇没有一个量化指标,「高质量」「有利于后续研究」这类措辞在一篇声称做 SOTA 级渲染的工作里偏软,无法与 RGB↔X 等前作直接比较。「通用配方」的具体内容摘要没展开——微调哪些层、G-buffer 如何编码注入、训练数据从何而来(合成渲染数据的域间隙如何处理),这些恰恰是能否复现的关键。前向渲染方向还有个绕不开的问题:生成模型对 G-buffer 的响应是否单调可预期?如果微调 albedo 一个通道会引起画面其他部分的连带变化,那「精确控制」这个卖点就打折了,而摘要没有这类可控性验证。流式(streams)支持被反复提及但没有延迟数字,实时渲染场景下这是硬门槛。 8. InstructVVT:视频试衣扔掉mask和pose先验 InstructVVT: Instruction-Driven Video Virtual Try-On without Auxiliary Spatial Priors | 南京大学·中国移动九天 | arXiv:2608.14070 前序问题:视频虚拟试衣是个约束极强的编辑任务:既要精确替换目标人物的衣服,又要严格保住原视频的空间结构和时序动态。现有方法严重依赖手工的辅助空间先验(mask、pose 等)来实现编辑控制,可这些先验在无约束的真实视频里很容易失效——遮挡、快速运动、罕见姿态都会让 pose 估计或分割崩掉。更本质的问题是,这类先验把丰富的视觉上下文压缩成了不完整的结构信号,信息通道太窄。此外标准的重建目标也无法充分刻画试衣任务特有的人类偏好(衣服贴合是否自然、褶皱是否合理)。 本文贡献:提出 InstructVVT,基于 DiT 的指令驱动、参考引导的视频试衣框架,推理时完全不需要空间先验。核心是双层参考条件化:一方面由 MLLM(挂可训练 LoRA)经 Connector 推断语义编辑 token,用于目标消歧与结构保持——也就是搞清楚「要换谁的哪件衣服、哪些部分不能动」;另一方面用一条轻量条件化通路把参考服装的细粒度外观显式注入,与源视频 latent 一起拼成多模态 DiT 输入。训练分两阶段:Stage 1 监督微调,Stage 2 用 DiffusionNFT 做强化学习——策略 DiT 采样 K 个候选视频,由冻结的 MLLM 奖励模型打分,经 NFT 损失更新策略并以 EMA 回写,以此对齐标准重建目标无法刻画的试衣偏好(贴合是否自然、褶皱是否合理)。 Overview of our InstructVVT framework. In the supervised training, the source video, reference garment, and instruction are encoded by a frozen MLLM with trainable query tokens $Q_e$, LoRA adapters~lora, and an MLP connector to produce MLLM edit tokens $C_e$. We adopt two embedding layers with identical architecture but independent parameters to encode video cue tokens $X_t$ and reference garment tokens $C_g$, respectively. The MLLM edit tokens $C_e$, video cue tokens $X_t$ and reference garment tokens $C_g$ are injected into each DiT block through cross-attention. The post-training stage applies DiffusionNFT~diffusionnft: a frozen EMA policy samples $K$ videos, a tailored reward model based on MLLM assigns score-token rewards, and the NFT loss updates the trainable DiT. 实验效果:在无约束真实视频上不依赖推理期空间先验即可完成试衣编辑,同时保持源视频的空间结构与时序动态。定性对比覆盖 ViViD、CatV2TON、MagicTryOn、TripVVT、UniVideo 五个基线,在领口结构、腰带细节与裙摆轮廓的保真度上更接近目标服装。论文 23 页 10 图,Dingbao Shao 与 Song Wu 为共同一作,Zili Yi 为通讯作者。 Qualitative comparisons on ViViD-S. The examples show that InstructVVT transfers the reference garment while preserving the source video appearance and temporal structure, complementing the quantitative ViViD-S results in Table~tab:vivid_s. 批判点评:去掉推理期空间先验这个方向是对的,理由比「少一步预处理」更深:mask 和 pose 本质是把高维视觉信息压成低维结构信号的有损投影,在真实视频里既容易估错,又丢掉了大量对编辑有用的上下文。用 MLLM 推断语义编辑 token 做目标消歧,思路上与今天 BiVidGen 那篇同源——都是让 MLLM 承担「理解要改什么」的规划角色,而非只做特征编码器。第二阶段引入 DiffusionNFT 强化学习也踩在了实处:试衣好不好看是典型的「重建损失说不清、人一眼能判断」的任务,用 MLLM 当奖励模型去对齐这类偏好,比继续堆重建监督更对症,而且 NFT 这条路线比 DPO 类方法更适合扩散模型的训练形态。不过摘要通篇没有任何量化结果,没有 benchmark 名称、没有与 ViViD/TripVVT 等的对比数字,也没说清基座 DiT 是哪个、训练数据规模多大——对一篇 23 页的工作,摘要层面的信息密度偏低。「不需要推理期空间先验」这个措辞要留意「推理期」三个字:训练阶段是否仍用 mask/pose 做监督没有交代,若训练仍需要,省下的是部署成本而非数据成本。服装细节保真是视频试衣最难的部分,logo、纹理、褶皱在人物运动中的一致性只笼统说保持时序动态,缺少针对细粒度纹理漂移的量化证据。MLLM 既参与推理条件生成、又在训练时充当奖励模型,两处都是重计算,逐块处理长视频时开销会被放大,但没有效率数字。RL 阶段还有个隐忧:MLLM 奖励模型自身的偏好偏差会被策略学去,而摘要没有讨论奖励过优化(reward hacking)的防护。 9. Concept Guidance:跳过特定层就能连续调美感 Concept Guidance: Precise, Training-Free Latent Control for Text-to-Image Generation | GCPR 2026 Oral·慕尼黑大学 CompVis | arXiv:2608.14172 前序问题:文生图扩散模型有两个严重限制实用性的短板。一是标准模型缺少内在机制来做连续的、概念特定的引导——比如想精确控制「这张图有多好看」,你没有一个可以平滑调节的旋钮,只能改提示词然后重新抽卡。二是在需要高局部连贯性的任务上不可靠,典型就是生成文字和人手,这两样几乎是扩散模型的经典失败案例。现有的可控生成方案大多要额外训练、外部模型或梯度回传,成本高且不通用。 本文贡献:引入「概念级互信息」(concept-wise mutual information)这一新概念,并发现不同层之间存在很大的、依赖于概念的差异——这说明特定结构的生成是局部化在网络的不同部分的。基于这个洞察提出 Concept Guidance(CoG):先量化每一层对特定概念的影响,然后用「跳过概念相关层后生成的预测」的加权组合来引导去噪。整套方法开箱即用,不需要额外训练、外部模型、梯度或提示词工程。 Concept Guidance precisely approximates the target direction by combining per-layer skip predictions using concept-relevant layers ($\alpha,\beta,\gamma$). It computes individual skip-layer noise predictions ($\epsilon_{[\theta\setminus \alpha]}, \epsilon_{[\theta\setminus \beta]}, \epsilon_{[\theta\setminus \gamma]}$) and extrapolates over them to precisely estimate the target direction. 实验效果:在多种目标和主流模型上都取得性能提升,覆盖 PixArt-alpha、SD3、SD3.5 与 FLUX.1-dev。代码已开源。被 GCPR 2026 接收为 Oral 报告,论文 28 页含补充材料。 Uncurated Comparison of Classifier-Free Guidance (CFG) ho2022classifier_free_guidance, Naive Skip-Guidance as found in Stable Diffusion 3 huggingfaceSD3, Spatio-Temporal Skip Guidance hyung2025spatiotemporal and Concept Guidance for Aesthetics (FLUX.1-dev). 批判点评:「概念的生成是按层局部化的」这个发现本身就有独立价值,它给扩散模型的可解释性提供了一个可操作的抓手:不是笼统地说某些层管结构、某些层管风格,而是用概念级互信息把「哪一层对哪个概念负责」量化出来。基于此的 CoG 走了一条很轻的路——通过跳过概念相关层来构造对比预测,再加权组合去引导,完全不需要训练、外部模型或梯度,这在实践中意味着可以直接挂到任何现成模型上。在 PixArt-alpha、SD3、SD3.5、FLUX.1-dev 四个架构上都有效,说明层级概念局部化不是某个模型的偶然特性,这个跨架构验证做得比较扎实,Ommer 组(Stable Diffusion 原作团队)在这个方向的判断力也值得信任,GCPR Oral 加开源代码进一步加分。但方法本身的边界需要看清。「跳过层」是个粗粒度干预,一层往往同时参与多个概念的生成,跳过它拿到的对比信号必然混入了对其他概念的扰动——摘要提到美感和局部连贯性(文字、手)两类目标,但没说多个概念同时引导时会不会互相冲突,而实际使用中「既要好看又要手正确」才是常态。「性能提升」缺少具体数字和评测口径,美感这类主观目标尤其需要说明是用自动指标(如 aesthetic predictor)还是人工评测,两者结论经常不一致,而且用某个 aesthetic 模型打分再优化它容易陷入自我强化。跳过层还意味着每步要多跑若干次前向来构造对比预测,推理成本的增加倍数摘要没给,这对本来就慢的扩散采样是实际负担。每个概念都需要先做一轮层影响量化,这个前置校准的成本和是否需要按模型重做,也没交代。 10. CPI-Bench:首个纳入多图编辑的评测基准 CPI-Bench: A Comprehensive, Practical and Intelligent Benchmark for Real-World Image Editing | arXiv:2608.14546 前序问题:图像编辑模型进展飞快、应用铺得越来越广,把这些能力直接部署到真实场景的需求越来越急。但现有基准仍局限在简单的单图任务上,覆盖维度有限,而且区分不开不同模型的性能差异——大家分数都挤在一起,看不出谁真的更强。结果就是它们无法可靠评估模型在复杂多图编辑、高要求推理指令、以及实际部署设定下的表现,而这三项恰恰是真实业务里最常遇到的。 本文贡献:提出 CPI-Bench,面向真实世界图像编辑的综合、实用、智能基准,由三个核心子集构成。CPI-General-Bench 全面覆盖多样的编辑任务,并首次把多图编辑评估纳入进来;CPI-Practical-Bench 聚焦高频真实用户应用场景;CPI-Intelligent-Bench 专门评估高要求的推理型编辑能力。三个子集分别对应「覆盖广度」「实用贴近度」「推理深度」三个此前被忽略的维度。 The overview of CPI-Bench. CPI-Bench decomposed into three distinct dimensions: CPI-General-Bench for comprehensive editing performance, CPI-Practical-Bench for real-world deployment efficacy, and CPI-Intelligent-Bench for reasoning-based editing tasks. 实验效果:论文给出主流图像编辑模型在该基准上的评测结果,13 页基准报告。最有说服力的是与 Arena 人类偏好排名的一致性对比:CPI-Bench 的 Spearman 相关系数达 0.994、平均绝对误差 0.12,而 GEdit-Bench 仅 0.548(MAE 1.50)、ImgEdit-Bench 0.814(MAE 0.88)、REDEdit-Bench 0.976(MAE 0.25)。评测覆盖 GPT-Image-2、Seedream5 Pro、Nano Banana Pro、Qwen-Image 2.0 Pro、Seedream4.5、Qwen-Image-Edit-2511、FLUX.2-klein-9B/4B 等主流模型。 Left: Model ranking trends across benchmarks compared against the Arena Image Edit Leaderboard~lmarena2024leaderboard. CPI-Bench we proposed demonstrates the closest alignment with Arena. Right: Spearman correlation coefficients and Mean Absolute Error (MAE) with Arena rank. CPI-Bench outperforms other benchmarks, achieving the highest correlation and the lowest error margin. 批判点评:把多图编辑正式纳入基准是这篇最实在的贡献。真实用户的编辑需求里,「把这张图的人放到那张图的场景里」「参照这张图的风格改那张」这类跨图操作占比很高,而现有基准几乎全是单图进单图出,评测口径和真实用法之间存在结构性错位。三子集的切分逻辑也清楚——覆盖广度、实用场景、推理深度,分别对应三种不同的失败模式。更关键的是它给出了一个可验证的自证方式:用与 Arena 人类偏好排名的 Spearman 相关性来衡量基准自身的有效性。0.994 对 GEdit-Bench 的 0.548,这个差距说明现有部分基准的排序与人类判断几乎脱节,而「基准该不该被信任」本来就该用这种方式检验,这个方法论比基准本身更值得借鉴。不过要注意几个问题。与 Arena 对齐这件事是双刃剑——相关性做到 0.994 意味着它高度拟合了当前 Arena 的偏好分布,但 Arena 本身有其偏差(用户构成、提问分布、审美倾向),过度对齐等于把这些偏差一并继承,而且一个与现有人类榜单几乎重合的基准,额外信息量到底有多少是可以追问的。评测模型只有 8 个且集中在头部闭源与 FLUX 系列,样本量偏小时 Spearman 系数本身就不稳定,换一批模型是否还有 0.99 需要验证。评测指标的具体实现(用 VLM 打分还是人工标注、多图编辑正确性如何自动判定)摘要没交代,而这决定了基准能否被独立复现;13 页篇幅对一个三子集基准来说偏紧,样本规模、任务分布、标注一致性检验都未见披露。「Intelligent」子集尤其需要说明「高要求推理」的操作化定义,否则容易变成难题集合而非能力维度。机构信息缺失也值得留意,基准类工作的中立性与作者团队是否同时在造编辑模型有直接关系。作为今天唯一的评测工作,它排在末位,但指出的评测盲区和自证方法都有实际价值。 趋势观察 今天的加速不再是「砍步数」,而是重新决定每一步该看什么 — SCOPE、ForgeWM、Omni-LiveAvatar 是今天最值得对读的一组,三篇都在做加速,但切入的层次完全不同,合起来正好画出视频生成推理优化的三层地图。SCOPE 动的是注意力内部:它不改模型、不训练,只是质疑现有免训练稀疏注意力用「块级/簇级代理分数」筛 key 这件事——粗粒度代理会把 key 之间的细微差异抹平,高贡献的 key 在激进稀疏下就被漏掉了。它的做法是把过了 RoPE 的 key 按时间、高、宽三个子空间分别聚类,再用查找表聚合质心分数,让代理分数细到单个 key;同时把 Top-k 的下限从「全局固定值」改成「每个头在线估计」,因为不同注意力头的稀疏容忍度本来就不一样,共享一个值必然有头被切狠了。ForgeWM 动的是采样步数,把双向生成器蒸成 1/2/4 步的学生。Omni-LiveAvatar 动的是生成范式,把双向扩散整体换成自回归流式。三者的加速倍率也恰好逐层放大:SCOPE 端到端 1.99 倍,ForgeWM 压到 1 步,Omni-LiveAvatar 相对教师 LTX-2 拿到 33 倍。这说明一件事——单靠某一层的优化很快会触顶,真正的量级提升来自换范式,但换范式的代价是要重训,而 SCOPE 这类免训练方法的价值恰恰在于它能直接叠加到任何已有模型上。值得注意的是三篇的适用边界完全不重叠,理论上可以叠乘,但没有任何一篇验证了叠加后的保真度损失是否线性累积,这大概是这个方向下一步最该做的实验。 MLLM 在生成管线里的角色正在从「编码器」升级为「规划器」 — BiVidGen 与 InstructVVT 从两个尺度上指向同一个转变。过去把 MLLM 接进扩散模型,绝大多数做法是拿它当一个更聪明的文本编码器——冻住权重,取最后一层特征喂给 DiT,MLLM 的自回归生成能力完全没被用到。BiVidGen 系统地拆了三个问题:中间表示该是什么、MLLM 怎么产出它、DiT 怎么吸收它,结论是离散语义视觉 token(EMA tokenizer 产出)作为接口最稳定,自回归因果建模是生成这些 token 的有效方式,而显式的视觉 token 条件化比改写提示词或隐空间桥接都更有效。这三条结论合起来等于说:MLLM 应该真的去「生成」一个视觉计划,而不是被动地提供特征。InstructVVT 在视频试衣这个具体任务上做了同样的事——它砍掉了对 mask、pose 这类手工空间先验的依赖,改由 MLLM 推断语义编辑 token 来做目标消歧和结构保持。这个转变的意义在于,手工先验在真实无约束视频里本来就容易失效,而且把丰富的视觉上下文压成了不完整的结构信号;让 MLLM 直接理解「要改什么」,信息通道宽得多。不过要注意,两篇都还没回答一个关键问题:MLLM 规划出错时,DiT 有没有能力纠正,还是会把错误的语义计划忠实地渲染出来。这个失败模式的分析在两篇里都缺失。 监督信号在变便宜:从「配对目标」退到「参考图 + 注意力对齐」 — CRAFT 这篇的数字值得单独拎出来看:主体个性化的主流做法要 15 万到 200 万组「参考图-合成目标」配对数据,而每一组目标都得靠 LLM 生提示词、T2I 合成、主体抠取、VLM 质检、对应关系标注这条多阶段流水线造出来,成本高,而且方法会被死死绑在某一个目标合成器和某一套数据清洗策略上。CRAFT 只用 1 万张参考图加主体 mask,完全不要合成目标,就在 XVerseBench 上做到了 SOTA。它的思路是把监督从像素空间挪到注意力空间——用注意力级奖励把噪声 token 和短语 token 的注意力对准正确的参考主体,再用得到的逐主体注意力 mask 去门控像素级身份奖励。往大了看,这跟 Concept Guidance 是同一个方向的两种表达:CoG 发现不同层对不同概念的贡献差异很大,于是通过跳过概念相关层来做引导,同样不需要额外训练、外部模型或梯度。两篇合起来提示一个判断——扩散模型内部其实已经有相当结构化的、按概念/主体组织的表示,过去我们花大钱造配对数据,某种程度上是在用外部监督重新教模型一些它内部已经编码好的东西。如果这个判断成立,个性化和可控生成的数据成本还有明显的下降空间。 人工智能炼丹君 整理 | 2026-08-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-17|AlayaLab世界模型连跑两小时画面不塌Evoke 今日 AIGC 论文速览 今日共 10 篇 · 长时交互式世界模型与外部记忆 1 篇 · 音频生成与零样本语音合成 2 篇 · 视频隐空间与超分重建 2 篇 · 可控图像生成与编辑 3 篇 · 文生 3D 优化机理 1 篇 · 生成质量奖励模型 1 篇 重点论文标题列表 Evoke(Alaya Lab·上海AI Lab·中科大):世界状态外置连跑两小时不塌 VoxAudio(浙江大学):台词与音景端到端一次生成 Phoenix TTS(滴滴·厦门大学):字错率低于真人录音本身 V-RAE(新加坡国立大学):冻结语义特征当隐空间快6倍 Princigram(上海AI Lab·上海交大):物理思维链治好受力方向画错 今日论文速览 1. Evoke:世界状态外置连跑两小时不塌 Alaya-EVOKE: From Linear-Scaling Supervision to Endless World | Alaya Lab·上海AI Lab·中科大 | arXiv:2608.13546 前序问题:交互式世界模型要同时满足三件事:持久记忆、即时响应、长程生成。可这三者在现有架构里互相拆台——把历史留在去噪器上下文或 KV 缓存里,成本随时长一路往上涨,于是「会话能开多久」和「能记住多少」变成一道零和题;而低延迟交互又依赖少步生成,少步学生的能力上限被它的教师死死压住。结果是长跑一段时间后画面开始漂移,而且这种漂移在短窗口内看起来还挺合理,很难被及时发现。 本文贡献:提出 Evoke,做法是把持久世界状态从模型里搬出去,同时重新设计教师。场景几何维护在一个外部的、按相机位姿索引的世界状态库(World State Bank)中,去噪器每步只检索与当前视角相关的信息,因此会话再长上下文也保持有界。教师不再被当成一个固定的生成器,而是专门为长程监督重新设计:它的稀疏注意力组合了块级分组、对选定远端帧的检索、以及一路线性注意力全局状态,让显存与计算随时长线性增长的同时支持长程监督。这种监督恰好能暴露那种「短窗口内看着合理」的内容漂移,而逐块条件化又让提示词切换和事件控制可以贯穿整个序列。最后用 30 秒的分布匹配目标在自强制 rollout 下训练,把这两项能力一起迁移给一个三步学生,且该学生不需要 classifier-free guidance。 With bounded retention, per-step cost does not grow with session length. The camera pose reads the world state bank into the target view; the student injects that render at the coarsest of its three coarse-to-fine evaluations, alongside a short parametric history and the current text condition. The emitted chunk then updates the store and the history. 实验效果:单张 H200、384×640 分辨率下,每个 1.5 秒块的生成耗时 2.11 秒。作为三步世界模型在 WBench 上达到 SOTA,同时在 VBench-Long 与 VBench-2.0 上保持竞争力。论文给出了长达 65.5 分钟的连续 rollout,饱和度、亮度、对比度全程稳定在合理区间而非逐渐冲淡或变暗,与 0-30 秒片段的余弦相似度也保持在真实视频 60 秒间隔的水平;观测到的漂移量明显低于「定向漂移正比于 i」和「扩散式漂移正比于 i 的平方根」两条参考曲线。 An hour-long session stays bounded rather than degrading. One continuous $65.5$,min Evoke rollout, three steps per chunk without classifier-free guidance ($2619$ chunks; faint per-chunk, bold two-minute mean). (a) Color is flat over the hour. (b) Scene identity plateaus at cosine $0.523$, the level real footage scores against itself $60$,s apart. (c) Opening-window shift stays far below unrelated-scene drift. A stability claim, not fidelity ($n=1$). 批判点评:这篇真正的贡献是把问题重新问了一遍。主流做法默认历史必须以某种形式驻留在注意力里,于是所有工程努力都花在「怎么把 KV 压得更狠」上,而压缩必然有损,长跑必然漂移,这条路的天花板是结构性的。Evoke 说历史不该放在注意力里——场景几何本质上是可以用相机位姿索引的空间数据结构,那就外置成检索库,去噪器只管当前视角。这一步跨出去之后,「上下文有界」就不是优化目标而是架构保证了,两小时 rollout 敢报出来正是这个底气。教师侧的设计同样值得注意:它承认了少步学生的上限由教师决定这件事,于是不是去改进蒸馏算法,而是先把教师改造成能提供长程监督的形态,这个因果链梳理得比多数同类工作清楚。不过要把期待校准好。2.11 秒生成 1.5 秒内容,意味着它还没到实时——是 1.4 倍的实时余量缺口,交互体验上属于「可用但有延迟感」,跟同期那些报 20 FPS 以上的数字人工作不在一个口径上,后者的场景约束也弱得多。分辨率 384×640 偏低,放大到 720p 以上时几何检索与渲染路径的开销是否还只占去噪器的 38%,论文没给。更关键的是外部世界状态库依赖相机位姿这个索引键,这在自由视角漫游里成立,但遇到大幅动态物体、场景本身发生不可逆变化(东西被打碎、被拿走)时,一个以几何为中心的状态表示能不能承载这些语义级变更是没有验证的——论文展示的多是相机运动下的场景重访。最后,两小时 demo 是精心挑选的连续 rollout,中途没有剧烈的提示词冲突,这跟真实交互里用户随时想推翻场景的用法差距不小。 2. VoxAudio:台词与音景端到端一次生成 VoxAudio: Vocalized Audio Synthesis via Multi-Reward Autoregressive Flow Matching | 浙江大学 | arXiv:2608.12951 前序问题:很多真实需求其实是「有人在某个环境里说话」——播客制作、视频配音都是这个形态,术语叫发声化音频合成。但现有文生音频系统面对引号里的台词只有两条烂路可选:要么把台词退化成一段听不清的人声嘟囔,要么甩给一个独立 TTS 模型生成后再做后期混音。后者的代价常被低估:一旦拆成两段,你就失去了对「台词什么时候出现」以及「它和场景声怎么互动」的控制权,时间轴对不齐、响度失衡、整体不连贯这三个问题会一起冒出来。 本文贡献:提出 VoxAudio,一个因果自回归流匹配模型,从三个层面同时下手。架构层面用块级因果分解,每块带独立噪声水平,使音频可以经滑动窗口流式推理配合 KV 缓存输出,且支持可变目标时长;为了能在任意块粒度上推理,预训练阶段刻意用随机化的块边界。偏好层面用多奖励的 Negative-aware FineTuning(NFT),联合优化语义保真度、语言准确性、听感质量与时间对齐四项。数据层面为补上发声内容缺失的监督信号,构建了 VoxCorpus——一个大规模语料库,其字幕直接引用嵌入语音的逐字转录并标注时间区间,同时给出带区间标注的 VoxBench 基准与一个时间对齐度量指标。 Comparison of Audio Generation Paradigms. Decoupled Pipeline: Conventional methods synthesize soundscapes and speech independently, requiring post-hoc mixing. VoxAudio: A unified system for vocalized audio synthesis from single prompts. 实验效果:在覆盖通用音频、语音、以及统一发声化音频三类任务的四个基准上验证了有效性与效率。代码与 demo 已公开。 Detailed architecture and attention mechanism of the Causal Diffusion Transformer. (a) The causal joint block facilitates interaction between audio latents and conditioning features; (b) The causal fused block refines integrated representations through deep self-attention; (c) The chunk-wise causal attention mask, where shaded regions indicate masked-out tokens, ensuring that each temporal chunk only attends to current and historical context. 批判点评:这篇的价值在于它拒绝了一个被行业默认了很久的妥协。「音效模型 + TTS + 后期混音」这套流水线之所以能长期存在,是因为它在多数场景下勉强够用,于是没人去问「为什么台词和环境声必须分两次生成」。VoxAudio 指出这个拆分恰好牺牲了最难补回来的那部分能力——时间上的因果关系。混音是后置操作,它能调响度、能对齐波形,但无法让环境声「因为有人说话」而改变,也无法让说话时机被场景事件驱动。端到端建模才能拿回这层控制。三个层面的设计也不是堆料:随机化块边界预训练是为了让推理时的块粒度可以自由选,这直接服务于流式;四路奖励里那个时间对齐项是专门补时间控制这个短板的,跟 VoxBench 的区间标注指标形成闭环,说明作者清楚自己在优化什么。但摘要在关键数字上相当吝啬——四个基准只说「验证了有效性与效率」,既没给具体分数,也没跟解耦流水线做量化对比,这让人很难判断端到端到底赢了多少、在哪些条件下会输。这类工作最需要回答的问题恰恰是:当台词很长、语义复杂时,端到端模型的语音清晰度能不能持住专用 TTS 的水平?摘要里没有正面交代。另外 VoxCorpus 的规模只说「大规模」,语言覆盖、说话人多样性、场景类型分布这些决定泛化能力的信息全部缺失,而这类需要逐字转录加时间区间标注的数据,标注成本高、容易在特定域上过拟合。多奖励 NFT 同时优化四个目标也存在标准的调权难题,摘要没提四项之间是否出现此消彼长。 3. Phoenix TTS:字错率低于真人录音本身 Phoenix TTS: High-Fidelity Synthesis and Voice Conversion via Flow-Matching-Driven Speech Tokenization | 滴滴·厦门大学 | arXiv:2608.11737 前序问题:零样本 TTS 系统里的语义 tokenizer,通常用有监督 ASR 或自监督目标来训练。但语音的语义与声学信息本质上无法彻底解耦,ASR 类目标为了聚焦语言内容会主动丢掉声学细节,依赖这类 tokenizer 的模型往往在音色相似度上难以做到最优。更根本的问题是这些 tokenizer 都是独立优化的,拿不到下游声学生成任务的任何直接监督,于是离散 token 与声学模型所需的连续空间之间横着一道特征鸿沟,把合成质量的上限提前焊死了。 本文贡献:提出 Phoenix TTS,一个把表示学习与生成式声学建模紧密耦合的统一框架。具体做法是:语音 tokenizer 一方面被优化去重建自监督特征以保持语义丰富度,另一方面同时接受来自 Flow Matching 训练损失的直接监督。通过这种联合训练范式,抽出的离散 token 既保留了必要的语义信息,又天然与下游 Flow Matching 模型的特征空间对齐,跨过了那道特征鸿沟。 UniSpeechTokenizer 实验效果:在 11 万小时数据上训练,字错率稳定低于真实录音本身(说明合成语音的可懂度已超过原始录音水平),同时保持稳健的零样本说话人相似度,与若干知名大规模基线相当或更优。作为统一训练的额外收获,学到的 tokenizer 可以无需任务特定微调直接迁移到零样本音色转换任务。 UniSpeechTokenizer 批判点评:这篇干的是修地基的活,不性感但要紧。语音合成这几年的注意力几乎全在声学模型和声码器上,tokenizer 被当成一个先训好就不动的预处理模块,很少有人回头问它的训练目标是否与下游需求一致。Phoenix TTS 把这个断层点了出来:ASR 目标天生要丢声学细节,因为对识别任务而言音色是噪声——可对合成任务而言音色恰恰是目标。目标函数错位,下游怎么优化都有个焊死的天花板。让 Flow Matching 损失直接回传到 tokenizer,本质是把「表示该长什么样」交给最终任务来定义,而不是让一个代理任务替它决定。音色转换能力免费掉出来,也从侧面印证了这个表示确实同时抓住了语义与声学两侧。不过「字错率低于真人录音」这个说法要小心读——它更可能说明合成语音吐字过于清晰规整、少了真人的口误连读与含混,在 ASR 眼里反而更好识别。这是可懂度的胜利,但不等于自然度更高,某种意义上甚至暗示了一种「过度清晰」的机器感;论文若不配 MOS 主观听测,这个数字容易被误读成全面超越真人。11 万小时的数据量也把复现门槛拉得很高,联合训练的收益里有多少来自方法本身、多少来自数据规模,摘要没有拆开;tokenizer 与 Flow Matching 联合训练还引入了耦合代价——换下游声学模型就得重训 tokenizer,牺牲了模块化,这个成本对工业迭代不算小。另外说话人相似度只说「相当或更优」,没给具体对比对象与数值,跨语言、带口音、低资源音色这些真实难点是否覆盖也未交代。 4. V-RAE:冻结语义特征当隐空间快6倍 V-RAE: Rethinking Video Latent Spaces for Generation | 新加坡国立大学 | arXiv:2608.13556 前序问题:隐空间视频生成依赖自编码器来定义一个紧凑空间供生成模型工作。视频自编码器的架构这几年演进了很多,但它们的隐空间基本还是围绕像素级重建来优化的,缺乏高层语义组织。问题在于——一个重建最优的隐空间,未必适合做生成建模。这两个目标长期被混为一谈,几乎没人认真区分过。 本文贡献:提出 V-RAE,一个视频表示自编码器,把紧凑的生成式隐变量直接构建在冻结的视觉基础模型表示之上。一个轻量的时序池化模块负责消除时间冗余同时保留语义结构,再由一个视频解码器从压缩特征中重建连续运动。作者用四个有代表性的冻结编码器在视频重建、语义探测、类别条件生成三类任务上做了评估。此外还提出 tFVD——一个时序一致性诊断指标,用来补上「重建质量不足以刻画生成效用」这个缺口。 V-RAE architecture. A frozen visual representation encoder produces temporally dense features, which are compressed by a lightweight temporal pooling module. The figure depicts the chunk-wise causal decoder used with image encoders. 实验效果:在 K600 上取得 2.13 rFVD,超过所有评测过的大规模预训练视频 VAE。其隐变量保留的语义信息显著多于常规视频 tokenizer 的隐变量。在匹配的生成设置下,最优变体在 UCF101 与 K600 上分别取得 117.86 与 19.16 的 gFVD,同时收敛速度最快达到 6 倍提升。论文还证明 tFVD 与下游生成质量的相关性比重建指标更可靠。此外在 Cityscapes 未来视频预测任务上,V-RAE 也在匹配预测设置下优于 Wan 2.2 VAE 的隐空间。 Temporal Reconstruction Error Difference (TRED) for RAEv2, Wan2.2 VAE, OmniTokenizer, and V-RAE on K600 validation examples. The heatmaps visualize temporally averaged TRED within high-frequency regions of interest, while the curves show spatially averaged TRED over consecutive frame transitions. 批判点评:这篇最有价值的是它把一个被默认了很久的等式拆开了:重建好 ≠ 适合生成。整个视频 VAE 社区的迭代逻辑基本是「刷低 rFVD,然后假定生成模型会因此受益」,而 V-RAE 直接指出这个传导链未经验证,还顺手给了 tFVD 作为更靠谱的代理指标——这个贡献可能比模型本身更持久,因为它改的是大家的评估习惯。用冻结视觉基础模型特征当隐空间底座这个做法也很省:既然 DINOv3、SigLIP2 这些编码器已经在海量数据上学到了良好组织的语义空间,那生成模型没必要从像素重建目标里重新长出语义结构。收敛快 6 倍这个数字最能说明问题——它说的不是生成质量上限更高,而是优化路径更顺,因为隐空间的语义组织已经替生成模型做掉了一部分工作。不过要注意实验口径。gFVD 报的是类别条件生成,数据集是 UCF101 与 K600,这是学术基准里的小规模设定,跟当下真正在跑的文生视频(大规模文本条件、开放域、高分辨率、长时序)距离相当远。冻结编码器天然带来分辨率与预训练域的双重约束——基础模型在图像域上训练,对高速运动、剧烈形变这类视频独有的内容是否还保有良好表示,摘要没给压力测试。「四个代表性冻结编码器」的结果也只报了最优变体,编码器选择对结果的敏感度有多大不清楚,如果换一个就掉很多,那这套方法的鲁棒性要打折。另外语义丰富的隐空间可能反过来损失细粒度纹理与高频细节,这在类别条件生成里不易暴露,但在真实应用里是硬指标。 5. Princigram:物理思维链治好受力方向画错 Towards Physics-Faithful Generation of Scientific Diagrams | 上海AI Lab·上海交大 | arXiv:2608.13112 前序问题:文生图早已做到照片级真实,但顶尖系统在生成科学示意图这件事上依然不可靠——因为示意图的价值不在好看,而在物理上是否成立:受力方向对不对、坐标系是否有效、热力学状态是否自洽、方程与所画场景是否匹配。这些模型训练用的是网络图像加物理内涵浅薄的配文,产出的示意图看起来合理但物理上是错的,用在教育与科学传播场景里是净负值。更麻烦的是现有评测器也不可靠:CLIP 打分器会把摩擦力方向画错的图打出更高分,开放词表检测器则完全抓不到物理量之间的几何关系。 本文贡献:提出 Princigram,一个物理保真的科学示意图生成器,以及配套数据管线。核心进展是结构化物理思维链(SP-CoT):一套按子学科划分的 schema,把一张物理示意图分解成横跨六个子学科的显式多步推理链,从场景识别、参数、受力或过程分析,到支配定律与综合。与自由形式思维链不同,SP-CoT 遵循固定 schema 并带严格保真规则,把视觉可见事实与物理推断结论分开,所有数学一律符号化表达;它既作为密集训练监督,也在推理时充当结构化的「思考」提示。据此整理并结构化标注了 430 万张物理图像,其中 115037 张带专家级标注,并适配了一个统一多模态骨干。另外提出 VeriphyT2IBench,其问题由每张留出示意图自身的结构化标注派生:每张图变成一组针对其对象、受力、状态的二元问题库,使评判模型的分数可以分解为一条条具名物理事实而非一个笼统总分。 Several challenges to physics-faithful scientific-diagram generation, and our approach. (a)~State-of-the-art multimodal generators produce diagrams that violate basic physics, such as mislabeled forces or incorrect circuit topology. (b)~The failure is generative rather than perceptual: a model that correctly describes the physics of a scene still generates it incorrectly. (c)~Appearance-based evaluation is unreliable in this setting, a CLIP-style scorer prefers the physically incorrect image (c.1), and an open-vocabulary detector cannot verify the geometric relations that determine correctness (c.2). (d)~Structured Physical Chain-of-Thought () addresses both problems by keeping data construction, annotation, training, and evaluation structured, finitely describable, and extensible. 实验效果:在 GenExam 的物理子集与 VeriphyT2IBench 上,Princigram 表明显式的物理结构化监督确实提升了生成科学示意图的物理保真度。数据侧完成 430 万张物理图像的整理与结构化标注,其中 115037 张达到专家级标注质量。 Overview of : data construction, structured supervision, and training--evaluation. % (a)~Data-curation pipeline. Four complementary sources---a manually curated seed, OpenDataLab~opendatalab, public web archives, and a textbook-procurement stream---are aggregated into a raw pool, then de-duplicated, resolution-filtered, and routed by a subdiscipline classifier into a structurally annotated corpus of ${\sim}4.3$M physics diagrams; a high-quality expert-level subset is split into training and held-out test data, and a balanced subset of the test split forms . % (b)~Corpus composition. Distribution of the corpus across the six physics subdisciplines and their sub-categories, showing a strongly long-tailed profile in which mechanics and quantum mechanics dominate while optics is rare. % (c)~ and how it is used. From a diagram and its prompt, a fixed five-step schema (scene; parameters; force or process analysis; coordinate systems and governing laws; and synthesis) makes the underlying physics explicit. These structured annotations drive three stages: pre-training on the ${\sim}4.2$M corpus-level pairs, supervised fine-tuning on the $109$K human-verified expert-level pairs, and evaluation on , where each generation is scored by answering the binary questions compiled from its own annotation (Local, Global, and Strict accuracy). 批判点评:这篇挑的是一个价值被严重低估的场景。T2I 的评价体系几乎全建立在「像不像真的」上,而科学示意图恰好是一类外观正确性无关的图像——一张受力箭头画反的斜面示意图可以渲染得极其精美,但它在教学里传递的是错误知识,负效用比不生成更大。作者把这一点说得很直白,也顺手戳破了评测环节的窘境:CLIP 打分器给错误图打高分这个例子相当有说服力,说明整条评估链条此前是失效的。SP-CoT 的设计有两点比较克制:固定 schema 而非自由思维链,是因为物理推理有确定结构,放开只会引入更多幻觉;严格区分「视觉可见事实」与「物理推断结论」,则避免了把模型的推断误当成图上真有的东西——这个区分是很多 CoT 类工作栽跟头的地方。VeriphyT2IBench 把分数拆成具名物理事实,也把「这张图错在哪」变成了可定位的信息而不是一个模糊总分。不过效果段的表述明显偏软——只说「提升了物理保真度」,没有任何具体分数或与基线的量化差距,这在一篇同时提出新基准的论文里是个显眼的空白,读者无法判断是从 40% 提到 70% 这种量级,还是只有几个点的边际改善。430 万张图像里仅 11.5 万带专家标注,占比 2.7%,剩下 97% 的语料级标注质量如何、噪声会不会反向污染物理保真度,没有交代。六个子学科的 schema 是人工设计的,这既是优点(结构可靠)也是天花板(覆盖范围受限),遇到跨学科题目或 schema 未涵盖的场景如何退化是未知的。最后,VeriphyT2IBench 由留出图自身标注派生,问题与训练数据同源,评判又依赖一个判官模型,存在既当裁判又当选手的风险,第三方独立验证仍然必要。 6. MotionCraft:视频超分做成世界状态预测 MotionCraft: Latent World Modeling with Sparse Attention for Visual Upscaling | 独立研究者团队·澳门大学 | arXiv:2608.08553 前序问题:视频超分要从低分辨率输入恢复高保真高分辨率视频,手机拍摄、流媒体、档案修复都靠它。但现有路线在局部细节保真、长程时空建模、感知真实感、效率这四项上互相拉扯:卷积对齐类方法能守住局部结构,可一遇大幅运动或复杂退化就崩;Transformer 类方法能抓长程依赖,但要在架构或算法上做适配才跑得动;近期的隐空间或扩散类生成器能合成丰富纹理,却需要专门的时序约束才能维持连贯。 本文贡献:提出 MotionCraft,一个可控的视频超分框架,把复原任务重新表述为受世界模型启发的运动感知隐状态预测,并把自适应稀疏注意力与一个用户可直接操作的显式控制接口整合进来。系统由三部分组成:稳健的运动融合(外部运动编码器与内部运动估计器并行,经光度一致性检查与置信度门控融合,再由残差校正器补偿偏差)、一个在局部性与定向非局部交互之间取平衡的隐空间世界 Transformer(LWT,内含自适应稀疏注意力与键值记忆缓存),以及一个紧凑的条件解码器,在流式约束下输出时序一致的高质量重建。 Overview of the MotionCraft framework for high-fidelity visual upscaling. The system initiates with Robust Motion Encoding and Fusion, where external motion signals and internal image-driven estimates are gated by a Photometric Inconsistency confidence map to compensate for systematic biases. The core Latent World Transformer (LWT) processes low-resolution latents using Adaptive Sparse Attention, which employs a differentiable soft top-$k$ selection to maintain locality while capturing long-range dependencies. Temporal persistence is managed through a Key-Value Memory Cache ($\mathcal{M}_{t-1}$). The Controllability Interface modulates the latent state via global scalars $\gamma$ and spatial gating maps $g_t$ to balance temporal smoothness and reconstruction fidelity. Finally, a Tiny Conditional Decoder performs distillation-based refinement to produce the high-resolution output $\hat{X}_t$. 实验效果:实证评估显示 MotionCraft 在重建与感知性能上都表现强劲,同时能在时序平滑度与重建保真度之间提供可预测的权衡。控制敏感度实验给出了这条权衡曲线:随着控制参数 γ 从 0.1 增至 2.0,运动平滑度评分从约 0.15 单调升至约 0.95,而 PSNR 从 29.00 dB 平缓降至 27.20 dB——下降幅度不到 2 dB,说明权衡是渐进可控而非断崖式的。 Control sensitivity. As $\gamma$ increases, motion smoothness rises monotonically while PSNR decreases gracefully, indicating a predictable trade-off between smoothness and fidelity. 批判点评:这篇的思路转换值得留意:把超分从「逐帧复原」重新表述为「运动感知的隐状态预测」,等于承认视频超分本质上是个时序建模问题而非图像问题的批量重复。世界模型的框架此前主要用在生成与决策上,挪到复原任务上是个不算显然的迁移。真正把它跟同类工作区分开的是那个显式控制接口——绝大多数超分方法把「时序平滑 vs 细节保真」这个取舍固化在训练里,用户拿到的是一个既定折中;MotionCraft 把这个旋钮交出来,且用 γ 曲线证明它单调可预测。对档案修复这类需求分化的场景(有人要平滑观感,有人要最大细节)这是实用的产品化设计,不只是刷指标。双运动路径加光度一致性检查的做法也务实,承认了外部光流在大运动与遮挡下会失效,用内部估计器与置信度门控做兜底而非盲信单一信号。但作者列为「独立研究者团队」这一点需要读者自行加权——12 位作者集体标注独立研究者,缺少机构算力与工程背书,可复现性与规模化能力都要打问号。效果段也偏定性:「强劲」「可预测的权衡」这类表述背后没给出与主流基线(如扩散类超分)的并列数值对比,无法判断它在绝对质量上处于什么位置;γ 曲线的 PSNR 区间落在 27-29 dB,在标准 VSR 基准上属于中等而非领先水平。「流式约束」被反复提及但未给出延迟或吞吐的具体数字,自适应稀疏注意力节省了多少计算也没量化——对一篇把效率列为核心动机的论文,这是关键缺口。 7. PixSDS:latent干净像素却在偷偷跑偏 PixSDS: Why Latent SDS Makes Noisy Pixels | 独立研究者 | arXiv:2608.12997 前序问题:分数蒸馏采样(SDS)通过用预训练扩散先验优化渲染图像来实现文生 3D,但在隐空间里做 SDS 常常产出结构化的色彩伪影与高频纹理噪声。这个现象长期被当作调参问题绕过,很少有人追问它的机理到底是什么。 本文贡献:识别出隐空间 SDS 的一个失效模式,成因是 VAE 诱导的像素漂移:被优化的图像可以沿着「VAE 编码器约束很弱」的像素空间方向移动,于是它的隐变量表示始终保持干净且语义合理,而图像本身却在悄悄累积可见伪影。作者用受控的 2D SDS 实验、VAE-only 优化实验,以及一份简化分析共同支撑这个诊断——分析表明当到像素的逆映射欠约束时,编码器式的隐空间目标会放大图像空间噪声。据此提出 PixSDS,一个轻量的 VAE 一致性梯度修复方法:解码一次隐空间 SDS 的前瞻步,把解码得到的图像作为像素空间优化的干净方向,从而减少沿 VAE 不一致方向的移动,且无需重训扩散模型、无需更换渲染器、无需替换 SDS 目标。 VAE-only optimization. Column 1 shows the target image $X$. Columns 2--7 show optimized images $Z_i$ from two different random initializations, with their decoded latents $\dec(\enc(Z_i))$ shown in the bottom-right inset. Even without a diffusion model, optimizing only through the VAE encoder produces structured noise in $Z_i$, while the decoded latents remain clean. 实验效果:在 2D 优化与文生 3D 生成上的实验表明,PixSDS 大幅减少了结构化伪影,同时保留了语义内容。集成到 DreamGaussian 第二阶段优化后,与原始 SDS 相比纹理更干净;接入 LucidDreamer 后,浮动的噪声高斯与结构化纹理伪影都有减少。代码已公开。 DreamGaussian comparison. We apply in the second optimization stage of DreamGaussian~tang2024dreamgaussian. Compared with SDS, produces cleaner textures and fewer structured artifacts. 批判点评:这是一篇教科书式的诊断型论文,全程一个人完成。它的方法论比结论更值得学习:先用 VAE-only 优化把「latent 干净、像素脏」这个反直觉现象单独隔离出来复现——这一步很关键,因为它证明了伪影的来源与扩散先验、与渲染器都无关,纯粹是 VAE 编码器的欠约束逆映射造成的;再用简化分析给出数学上的解释;最后修法极轻,不动扩散模型、不动渲染器、不动 SDS 目标,只补一个 VAE 一致的干净方向。「latent 看起来完全正常所以问题很难被发现」这个洞察尤其有意思——它意味着任何只监控隐空间指标的优化流程都会对这类退化完全失明,这个教训可以外推到所有在隐空间做优化的任务,不限于文生 3D。修补的普适性也已用两个不同的 3D 框架(DreamGaussian 与 LucidDreamer)交叉验证。局限同样清楚。单作者、无机构支持,实验规模注定有限:文生 3D 只验证了两个开源框架,对闭源或更大规模的 3D 生成系统是否同样适用未知。效果全部以定性描述给出——「大幅减少」「更干净」,没有任何量化指标(如 CLIP 分数、用户偏好率、伪影强度度量),这在 3D 生成领域虽属常见,但让改进幅度无法与其他去伪影方法横向比较。前瞻步需要额外解码一次,带来的计算开销未报告;超参数 β 虽做了敏感性分析但最优值如何随任务变化没有指导。最后,这个方法治的是 VAE 欠约束这一个特定失效模式,而 SDS 还有过饱和、Janus 多面等其他老问题,它对那些完全无效——读者不应把它理解为 SDS 的通用改进。 8. GST:学整个画家而非几张名作 Through Van Gogh's Eyes: Global Style Transfer with Diffusion Model | KIST·成均馆大学 (ECCV 2026) | arXiv:2608.11546 前序问题:艺术图像合成想复现的是某位艺术家的整体视觉身份,但现有方法往往抓不住这个「全局风格」。传统风格迁移是一对一的——把一张或少数几张参考画作的风格搬到内容图上,做作品级风格化有效,却无法代表一位艺术家更广的风格分布。而用艺术家名字作条件的文生图扩散模型(比如「……梵高风格」)虽然灵活,却受文本诱导偏差影响,往往只复现那几幅最出名作品的图案,把梵高简化成《星月夜》的漩涡。 本文贡献:提出全局风格迁移(GST)这一多对一的艺术图像合成范式,聚合目标艺术家的多幅作品,把它们共有的全局风格迁移到单张内容图上。为此提出全局风格引导(GSG),在扩散模型的中间特征空间(h-space)中学习一个残差的全局风格偏移量,且在固定提示词下进行——通过纯粹从视觉统计中学习艺术家级风格语义,GSG 规避了文本依赖带来的艺术偏差。另外提出内容对齐引导(CAG),一个免训练的感知引导机制,在允许艺术家特有的几何形变的同时保留内容图的语义结构。 Overall framework of Global Style Transfer (GST). (Left) Global Style Guidance (GSG) trains a lightweight Style Extraction Function $f_t$ on multiple artworks under the fixed prompt `A painting', learning a residual global style offset $\Delta \mathbf{h}_t$ that modulates the U-Net bottleneck representation $h_t$ in a text-independent manner. During reverse diffusion, $\Delta \mathbf{h}_t$ steers the denoising trajectory toward the artist's global style distribution. (Right) Content Alignment Guidance (CAG) first maps the content image $I_c$ into a noisy latent via DDIM inversion, then applies CLIP-based perceptual guidance at each timestep to align the semantic structure of the generated image with the content while permitting style-driven deformation, yielding artist-level stylization. 实验效果:在 WikiArt 上的实验表明,相比现有风格迁移与扩散式艺术合成方法,GST 在风格保真度、内容保留、输出多样性三项上都更优。论文展示了同一张内容图迁移到梵高、达利、塞尚、罗列赫、莫奈、希什金、库斯托季耶夫、雷诺阿八位艺术家风格的结果,各艺术家的笔触与色彩体系区分明显。 Global Style Transfer results across multiple artists for the same content image. Given the same content images $I_c$, our framework transfers the images into the global styles of eight different painters. All images are generated using a text-independent prompt (``A painting”) to eliminate stylistic bias in the diffusion model. For each content image $I_c$ (left column), our framework applies Global Style Guidance (GSG) to capture artist-specific global semantics and Content Alignment Guidance (CAG) to preserve flexible, style-based deformation of content. The results show that a single content image is rendered into distinctly different artistic styles across various artists, demonstrating our framework’s ability to synthesize artist-faithful images. 批判点评:这篇的问题定义比方法更有意思。风格迁移长期默认「风格」等于某张参考图的纹理统计,于是一对一是天然设定;而 GST 指出艺术家的风格其实是一个分布,任何单张作品都只是这个分布的一次采样,用一张画代表梵高在概念上就是错的。这个重新定义直接催生了多对一范式。它同时点出了 T2I 路线的一个隐性缺陷:文本条件下的「梵高风格」并非从画作学来,而是从图文配对数据里那几幅高频出现的名作学来,因此模型学到的是《星月夜》而不是梵高——这个「文本诱导偏差」的诊断很准。在 h-space 学残差偏移的做法也选得聪明:中间特征空间比 latent 更贴近语义,学偏移量而非重训模型让方法保持轻量,且完全绕开文本通道。CAG 免训练、允许几何形变这一点也符合艺术直觉——真正的风格迁移不该只换纹理,梵高会重画物体的形状。至于代价:论文自己给出的失败案例已经说明,当艺术家的数据集内容高度偏斜时方法会失灵(如罗列赫作品几乎全是山景,学到的「风格」里混进了山这个内容先验)——这是多对一范式的结构性弱点,风格与内容在聚合统计里本就纠缠。评测停在 WikiArt 且以风格保真度、内容保留、多样性三项定性对比为主,摘要未给具体数值;而艺术风格评估本身缺乏公认的客观指标,「更优」的可信度依赖主观实验设计的严谨程度。方法需要目标艺术家有足够多的作品,对小众或早逝艺术家不适用。最后必须提一句:这类工作把「批量复刻在世艺术家风格」的门槛进一步降低,版权与创作伦理的争议只会更尖锐,论文对此没有讨论。 9. SketchSense:看懂潦草草图再动笔补图 SketchSense: Learning to Interpret Imperfect Sketch Guidance for Image Inpainting | 独立研究者 | arXiv:2608.13186 前序问题:草图引导的图像补全提供了直观的结构控制,但真实草图往往混杂着可靠的全局意图与局部糟糕的笔画——过于密集、位置偏移、残缺不全,或者干脆是刻意不合常规的画法。现有方法基本二选一:要么整个去噪过程都把输入草图当固定条件,要么先把它精修成干净结构再合成 RGB。前者假设所有笔画一样可靠,局部错误会一路传播污染整张图;后者则必须在外观与语义上下文尚未浮现之前就把结构的歧义解决掉,属于信息不足时强行决策。 本文贡献:提出 SketchSense,通过同步去噪两条相互作用的 RGB 流与结构流来解读不完美的草图引导。双向注意力融合(Bidirectional Attention Fusion)把外观生成与结构恢复耦合起来,产出一个精修后的结构,这个结构同时暴露了模型对草图的动态理解过程;实现上复用 FLUX 块族的原生 QKV 作为共享基底,再由专门的联合注意力 QKV LoRA 产生增量。一个短语级目标负责对齐两条流的语义落地。草图感知空间调控(Sketch-Aware Spatial Regulation)进一步根据局部生成状态调整草图的使用方式,对注意力与融合过程做调制;另有一个可选的带符号先验,把「保留 vs 修正」的意图注入特征表示与注意力行为。 Motivation and overview of SketchSense. Fixed-sketch conditioning can propagate locally degraded strokes. SketchSense synchronously denoises RGB and structure, regulates sketch use through learned attention modulations and an optional signed prior, and exposes its interpretation as refined structure. 实验效果:在自然图像与结构复杂图像上的实验显示,在复原质量与结构保真度两方面都显著优于现有方法。论文以中国壁画补全为例,展示了在笔画密集、结构复杂的场景下,SketchSense 相比固定草图条件方法在细节上的改善。 Bidirectional Attention Fusion with adapted QKV reuse. Native QKV provides the shared base, and a dedicated joint-attention QKV LoRA produces fusion-specific $\Delta QKV$. Directional messages pass through a zero-initialized projection, split into $\Delta H_x^l$ and $\Delta H_e^l$, and enter their receiving branches through $g_x^l$ and $g_e^l$. 批判点评:这篇抓的痛点很真实:用户画的草图从来不是均匀可靠的,通常整体意图对、局部笔画烂。而现有两条路线都建立在一个错误前提上——固定条件假设笔画一致可靠,先精修则要求在信息不足时提前把歧义决断掉。SketchSense 的解法在时序安排上更合理:让结构解读与外观生成同步演进、互相喂信息,去噪早期外观尚模糊时不强行定结构,随着 RGB 逐渐清晰再反过来修正结构理解。「精修后的结构暴露了模型对草图的动态理解」这一点还带来了额外的可解释性——用户能看到模型把哪一笔当成了什么,这在交互式创作工具里是实打实的价值,比一个黑箱输出有用得多。可选的带符号先验也务实,它承认「这笔要保留还是要改」有时只有用户知道,那就把这个意图开放给用户显式指定,而不是让模型猜。但这篇是单作者工作,实验规模与工程完备度需要留意。效果段只有「显著优于现有方法」这类定性表述,没有任何量化指标或基线名单,而复原质量与结构保真度都有成熟的客观度量(FID、LPIPS、边缘一致性等),不给数值让改进幅度无从核实。方法本身叠了四个组件——双向注意力融合、短语级目标、草图感知空间调控、可选带符号先验,摘要未提消融,无法判断收益主要来自哪一处,也存在过度设计的可能。绑定 FLUX 块族的 QKV 复用意味着与特定架构耦合,迁移到其他 DiT 骨干需要重新适配。双流同步去噪必然增加计算量,开销未报告。最后,「刻意不合常规的笔画」与「画错的笔画」在模型看来可能无法区分,这个歧义如何处理是这类方法的固有难题。 10. MuseCritic:先写乐评再打分准度飙升 MuseCritic: Learning Multi-Aspect Song Rewards through Natural-Language Aesthetic Critiques | 复旦大学 | arXiv:2608.11755 前序问题:长篇歌曲生成模型在时长、结构完整性、声学复杂度上不断进步,让可靠的审美奖励对于对齐人类偏好变得越来越重要。但面向完整歌曲的奖励模型仍然很少,且现有评估器通常一次前向就直接吐出分数,不给任何可读的解释——既难以调试,也无法告诉生成模型究竟哪里不好。 本文贡献:提出 MuseCritic,一个半标量奖励模型:它先生成一段覆盖五个审美维度的自然语言评论,再把这段评论作为中间表示来预测连续的奖励分数。训练分两阶段:先由教师模型(Gemini-3-Pro)针对歌曲、评分细则与专家评分产出高质量评论用于监督微调;随后让微调后的模型生成自己的评论再做奖励学习,以缓解训练与推理之间的分布偏移。推理时同一骨干挂两个头,LM head 输出五维评论,RM head 给出五维分数。 Overview of the two-stage training and inference pipeline of method. In Stage~I, Gemini-3-Pro generates aesthetic critiques from songs, evaluation rubrics, and expert mean ratings to construct $\mathcal{D}_{\mathrm{off}}$, which is used to fine-tune a pretrained large language model into an SFT critique generator. In Stage~II, the SFT model replaces the teacher critiques with one self-generated five-aspect critique per song to construct $\mathcal{D}_{\mathrm{on}}$; a scalar reward head is then initialized, and is trained using expert mean ratings as regression targets. At inference time, first generates a five-aspect critique and then predicts five continuous aesthetic scores conditioned on the song, rubric, and self-generated critique. 实验效果:在 200 首 SongEval 歌曲组成的域内测试集上,宏平均均方误差从 0.2875 降到 0.2316,宏平均 LCC、SRCC、Kendall's tau 分别提升到 0.9068、0.8838、0.7178。在包含 733 组偏好对的域外 Music Arena 基准上取得 71.35% 的最高准确率。此外用 MuseCritic 配合 GRPO 训练,让 Muse-0.6B 在 SongEval 与 Audiobox Aesthetics 的全部九项审美指标上都获得提升。 Effect of natural-language aesthetic critiques on five-dimensional score distributions. Curves show expert ratings, full predictions, and predictions from the no-critique variant on the fixed SongEval test set. Coherence, Musicality, Memorability, Clarity, and Naturalness correspond to the five aesthetic dimensions. Without critiques, predictions cluster in a narrow high-score region; the full model more closely matches the range of expert ratings. 批判点评:这篇把「先说理由再打分」这个在 LLM 评判里已经验证过的思路,落到了音乐审美这个更主观的领域上,而且没有停在「评论只是副产品」的层面——评论被显式当作预测分数的中间表示,等于强制模型把打分依据外显出来再据此定分,这跟事后补一段解释有本质区别。第二阶段用模型自己生成的评论做奖励学习也处理得细:如果一直用教师评论训练,推理时喂的是自产评论,中间表示的分布就对不上,这个偏移点被明确指出并修掉了。可解释性在这里不只是锦上添花——生成模型拿到「和声设计缺少标志性钩子」这样的具体反馈,比拿到一个 3.7 分有用得多,而 GRPO 实验里九项指标全面提升,说明这个信号确实能反向优化生成质量,闭环是通的。域外 Music Arena 上 71.35% 的偏好准确率也比域内指标更能说明泛化。要留一分冷静的地方:域内 200 首、域外 733 组偏好对,规模都偏小,音乐风格与语言的覆盖面无从判断,长篇歌曲的审美又高度依赖文化语境,跨风格泛化能力存疑。域内 LCC 高到 0.9068 需要警惕——SongEval 的专家评分本身可能存在标注者一致性上限,逼近这个上限更多说明拟合了该标注体系的偏好,而非掌握了普适审美。71.35% 这个数字放在偏好判断任务里其实不算高,随机是 50%,说明近三成的人类偏好它判反了,作为 RLHF 奖励信号会引入可观噪声。教师用 Gemini-3-Pro 也意味着整套评论体系继承了该模型的审美倾向与盲区,五个审美维度同样是人工设定,未必覆盖音乐性的全部面向。MSE 从 0.2875 降到 0.2316 是约 19% 的相对改善,扎实但非量级突破。 趋势观察 今天的主线不是把模型做大,而是把「上下文」从模型里搬出去 — Evoke 与 V-RAE 是今天最值得对读的一组,它们从两个方向指向同一个判断:真正卡住长时生成的不是参数量,而是模型该记住什么、以什么形式记住。Alaya Lab 的 Evoke 把场景几何整体搬进一个相机位姿索引的外部世界状态库(World State Bank),去噪器每步只检索与当前视角相关的那一小块,于是上下文长度被彻底钉死——会话跑到两小时,单块生成时间仍是 2.11 秒,显存不涨。这跟主流做法正好相反:主流是把历史往 KV cache 里堆,堆到显存爆掉为止,于是「记得多久」和「能跑多久」变成一道零和题。Evoke 的答案是这道题本身出错了,历史不该放在注意力里。V-RAE 走的是另一条路但逻辑同源:它质疑视频 VAE 长期以来只为像素重建服务这件事,直接把冻结的视觉基础模型特征当作隐空间底座,只加一个轻量时序池化模块压掉冗余。结果是重建拿到 K600 上 2.13 rFVD 超过所有评测过的大规模视频 VAE,而生成侧收敛快了最多 6 倍——说明「重建最优的隐空间」和「适合生成的隐空间」本来就不是一回事,这个区分此前基本被行业忽略。两篇合起来给的信号很清楚:接下来一段时间的增量可能更多来自表示与记忆的重新设计,而不是继续堆 DiT 层数。 音频这边今天补的是「语音和音效终于长在一起」这个缺口 — VoxAudio 与 Phoenix TTS 都来自音频方向,但补的是产业链上两个不同的洞。浙大的 VoxAudio 针对的是一个被长期用胶带粘住的流程:要生成「有人在环境里说话」的音频,现有系统要么把台词退化成听不清的嘟囔,要么交给独立 TTS 生成再后期混音——后者的代价是彻底失去对「什么时候说、和场景怎么互动」的控制权。它用块因果自回归流匹配把二者合成一件事做,配上带逐字转录与时间区间标注的 VoxCorpus 语料,还能滑窗流式出音。滴滴与厦大的 Phoenix TTS 则往回追一层,质疑语音 tokenizer 的训练方式:传统 tokenizer 用 ASR 或自监督目标独立训练,为了抓语言内容会主动丢掉声学细节,于是下游声学模型的音色相似度天花板被提前焊死。它的做法是让 tokenizer 同时接受自监督特征重建和下游 Flow Matching 损失的直接监督,11 万小时数据训出来的系统字错率稳定低于真人录音,且免费附赠零样本音色转换能力。一个在往上做端到端整合,一个在往下修表示层的地基,共同点是都不满足于「拼几个现成模块」。 越来越多论文在做「诊断」而不是「刷分」,这是领域成熟的信号 — PixSDS 和 Princigram 今天都不是在原有指标上抢名次,而是先把一个大家默认能用的东西拆开看它为什么不对。PixSDS 追查文生 3D 里 latent SDS 那些结构化色斑与高频噪点,给出的诊断相当漂亮:VAE 诱导的像素漂移——优化中的图像可以沿着「VAE 编码器几乎不约束」的像素方向自由跑,于是它的 latent 看起来始终干净且语义正确,图像本身却在悄悄累积可见瑕疵。它用 VAE-only 优化实验把这个机理单独复现出来,修法也轻:解码一次 latent 前瞻步,拿解码图像当像素空间的干净方向,不重训扩散模型、不换渲染器。Princigram 则指出一个更尴尬的事实——T2I 早就做到照片级真实,但画科学示意图依然满是错的受力方向、无效坐标系,因为训练数据里的网图配文根本不含物理约束,生成出来「看着像、物理上全错」,用在教学与科学传播上是净负值。它的解法是结构化物理思维链(SP-CoT),把示意图按六个子学科拆成固定 schema 的多步推理,既当训练监督又当推理提示,并配 VeriphyT2IBench 把评分拆成一条条具名物理事实而不是一个笼统总分。这类工作短期不好看,长期决定了这个方向能不能被信任。 人工智能炼丹君 整理 | 2026-08-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注