
搜索到
87
篇与
ai
的结果
-
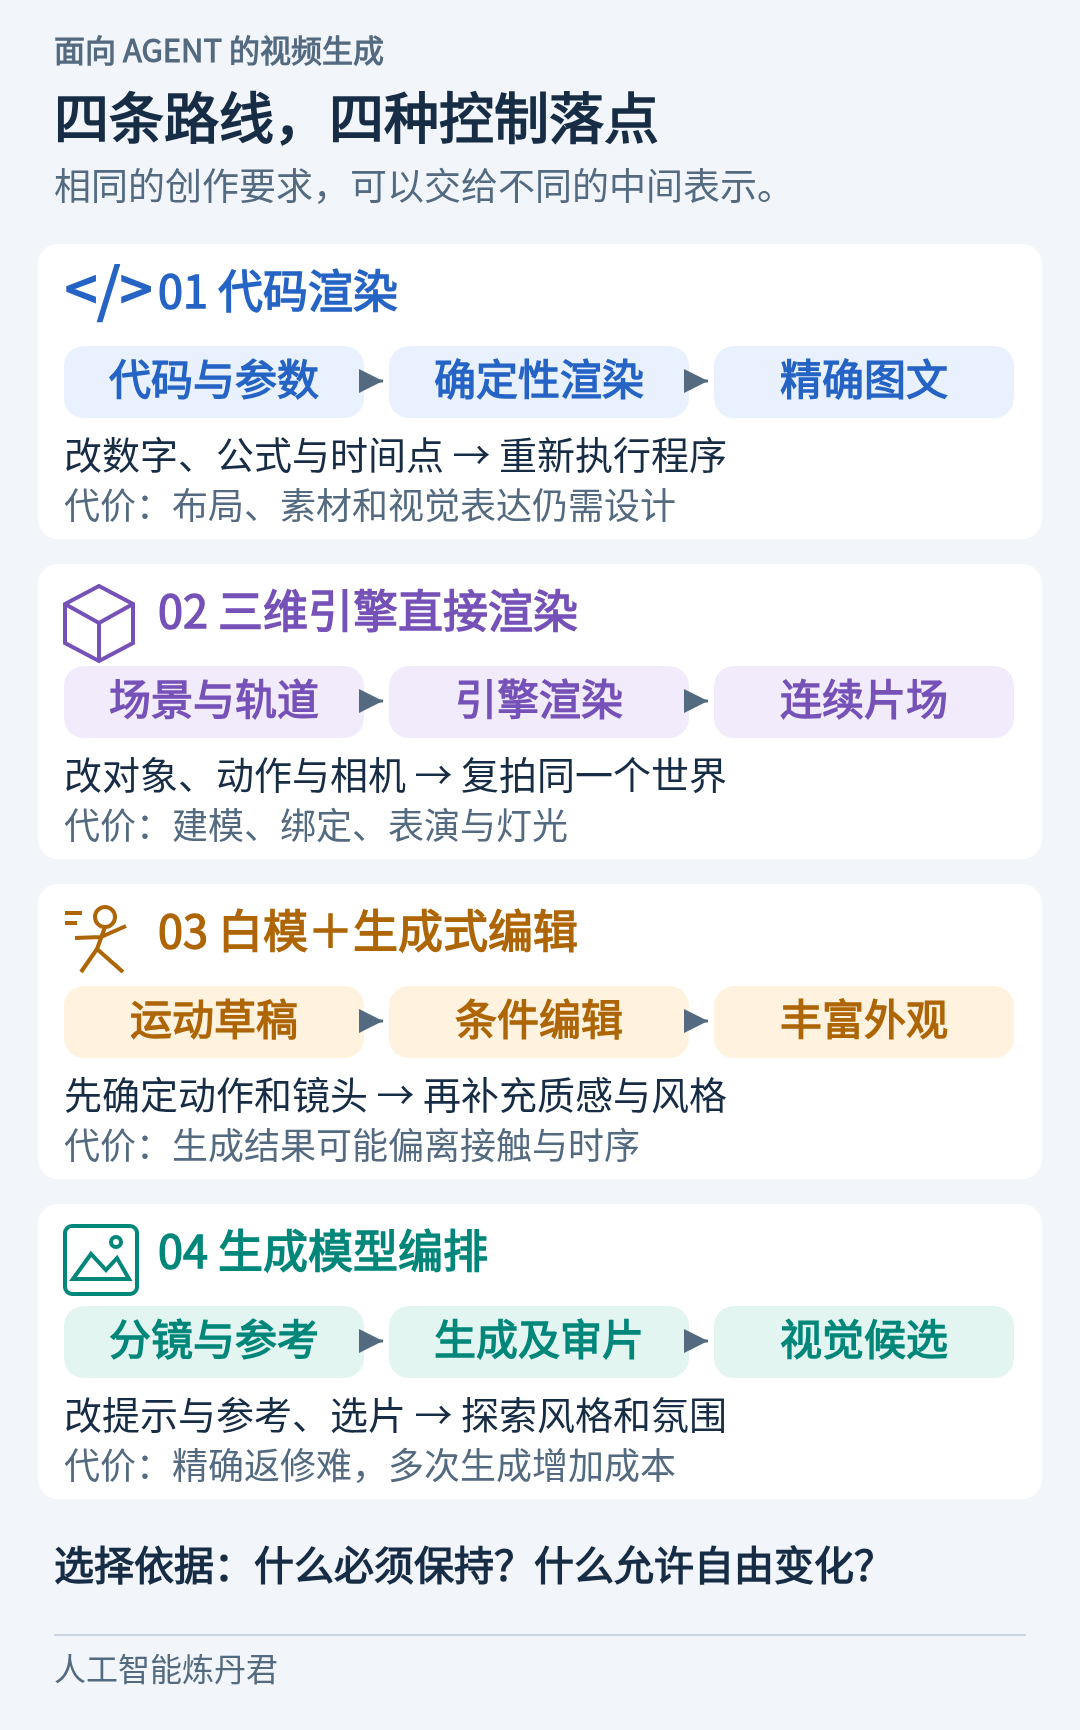
 AIGC 周末专题|2026-11-14|Agent视频:代码、Blender与虚幻 AIGC 周末专题深度解读:面向 Agent 的视频生成:代码、Blender白模与虚幻引擎 人工智能炼丹君 | 2026年11月14日(周六) 覆盖时间:2024-11-14 至 2026-11-14(仅收录此期间首发的研究或产品版本) 本期概述 本期 AIGC 周末专题聚焦面向 Agent 的视频生成:代码、Blender白模与虚幻引擎方向,精选 10 项代表工作进行深度解读。 2026 年 11 月,Fable 5.2 发布时,Ethan Mollick 给了它一个开放式任务:做出一件能嵌入文章、迅速吸引读者、展示模型能力的作品。他随后在文章中展示了一段用代码制作的影片,并表示自己只给了初始要求,没有追加反馈。一个原本需要创意、动画和制作工具共同参与的任务,被交给了通用 Agent。这个案例值得追问的,是从一句创作要求到一段可播放作品,中间的制作过程如何组织起来。 理解这件事,可以先看 Fable 5.2 在流程中的位置。官方规格列出的输出是文字;它可以生成代码、组织工具调用,把场景、相机、动画和声音的要求落实到可执行工程,再由浏览器或三维引擎渲染画面。这里,Agent 负责把创意转化为制作步骤,渲染工具负责把这些步骤变成视频。Mollick 的展示提供了一个具体入口,也把问题引向更广的范围:哪些视频适合这样做,哪些环节又需要生成模型参与? 沿着这个问题,会遇到几条不同的路线。数学讲解、信息图和品牌动画,可以把文字、图形与时间安排写成代码;需要稳定几何和连续机位的作品,可以让 Agent 操作三维场景、资产与时间轨道;希望保留动作和镜头、再丰富材质与风格的作品,可以先渲染白模,再用 diffusion 等生成模型重绘;面向更开放的叙事和画面探索,也可以由 Agent 拆分剧本、组织分镜,调用视频模型并审阅结果。它们都能产出视频,却把控制权放在不同的地方。 这种差别在修改第二版时最具体:字幕向左移一点,能否只改一个坐标?产品换成侧面镜头,能否保留同一套几何和材质?角色的动作已经满意,能否只换外观?答案取决于创作要求保存在代码、场景、时间轨道、运动条件,还是提示词与参考图里。选择路线时,需要同时考虑画面效果、哪些内容必须保持不变,以及一次局部修改会牵动多少制作环节。 本期从 Fable 5.2 的代码制作案例出发,选取近两年的十项代表工作,梳理代码渲染、三维片场、白模加生成式编辑,以及视频模型制片与审片之间的联系。下面先用路线图和时间线建立全局,再逐项讨论它们的机制、控制能力、制作成本与失败场景。 方向分布: 代码与程序化视频 3 篇 (Fable 5.2, TheoremExplainAgent, Code2Video) Blender白模与生成式编辑 1 篇 (VideoCoCo) 虚幻工具链与三维拍摄 4 篇 (Unreal Engine Agent工作流, Cutscene Agent, CineU, FilmAgent) 生成模型制片与审片 2 篇 (MovieAgent, VISTA) 2024-11-14—2026-11-14:8项研究与2项产品/工具链,比较可控性、制作成本与适用任务 技术路线总览 四条路线按 Agent 修改的对象区分:代码参数、三维场景、运动草稿、分镜与参考。图中同时标出输出优势与主要代价;它们可在同一作品中组合。 四条路线按 Agent 修改的对象区分:代码参数、三维场景、运动草稿、分镜与参考。图中同时标出输出优势与主要代价;它们可在同一作品中组合。 技术路线与时间线 2025 年的五项工作展示了两种进展:先把创意拆成可执行计划,再让画面或视听反馈参与修改。颜色对应前图路线;节点按首发月份排列,不代表直接继承。FilmAgent 使用 Unity 片场。 2025 年的五项工作展示了两种进展:先把创意拆成可执行计划,再让画面或视听反馈参与修改。颜色对应前图路线;节点按首发月份排列,不代表直接继承。FilmAgent 使用 Unity 片场。 2026 年的五项工作进一步强调时间轨道、运动与外观分工、共享状态和局部修复。研究、产品版本与实验性工具接口分别标注;UE 5.9 为预览版。 2026 年的五项工作进一步强调时间轨道、运动与外观分工、共享状态和局部修复。研究、产品版本与实验性工具接口分别标注;UE 5.9 为预览版。 1. Fable 5.2:闭源编码 Agent 怎样交付代码视频 工作: Claude Fable 5.2 来源: Fable 5.2 官方发布与代码视频案例 机构: Anthropic 关键词: 代码视频, 编码Agent, Three.js, 渲染工程, 场景编排 相关资料: Anthropic官方发布:2026-11-09 · Fable官方:代码动画与三维设计能力 · 官方平台规格:文字与图像输入,文字输出 · Ethan Mollick代码影片与场景工程 · Mollick公开Portals工程(独立于开场影片) · Portals第三方依赖声明 1.1 研究动机 核心问题: 怎样把一个视听创意组织成可以持续修改的代码工程? 讲解一段算法、制作品牌动画或演示三维结构时,创作者往往既要控制文字和几何,又要反复修改节奏。把这些要求交给通用编码 Agent,意味着它可以把创意落实为可执行工程:改一句文案、一个参数或一段时间安排,再由渲染器重新出画面。Fable 5.2 的案例展示了这条路线正在从短小动画走向更完整的视听制作。 前序工作及局限: 手工动画制作:对象、布局和时间都可控制,但建立和修改工程需要较多操作。 单次生成动画程序:长脚本中的依赖、布局和时间关系容易彼此冲突。 与前序工作的本质区别: 用通用编码 Agent 编排场景、动画与音轨,将运行反馈和画面检查用于修改工程。 1.2 方法原理 Diagram or chart prepared from the cited method and results. 图表详解:Fable 5.2:用代码与工具交付视频 Fable 5.2生成代码与工具指令,渲染器执行场景、动画和音轨,最终组合为视频。代码控制内容与时间参数,素材和渲染后端决定可实现的视觉风格。 1. 用程序表示画面和时间。 Fable 5.2 于 2026 年 11 月 9 日发布,官方规格为文字与图像输入、文字输出。它通过代码和工具指令组织几何、材质、相机、动画与声音,再由浏览器或三维引擎生成画面。视频的可控性来自工程中的对象与时间参数。 2. 让通用编码能力承担制作编排。 一个完整任务可以拆成场景搭建、动画、镜头、音轨和导出;代码执行和画面检查为下一轮修改提供反馈。相较专用视频网络,这种方式更容易接入已有字体、绘图库和工程资产,但模型也必须处理依赖、运行环境与跨模块协调。 3. 从 Portals 理解可复用的场景结构。 Mollick 公开的这一独立三维漫游项目使用 Three.js:场景模块返回三维场景、相机路径和时长,由公共引擎驱动播放,声音在浏览器中合成。把场景内容与播放逻辑分开后,可以替换一个世界而复用相机调度和界面。Portals 是三维工程案例;同文的开场代码影片是另一件作品。 1.3 核心创新 它把视频创作扩展为通用软件制作任务:Agent 可以编辑生成画面的规则,而不仅是请求另一段像素。对于有明确结构、需要重复改稿的内容,代码同时承担制作工具和可复用资产两种角色。这里展示的是编码与工具协作能力,不是新的视频生成网络。 1.4 实验结果 Diagram or chart prepared from the cited method and results. 图表详解:代码视频的收益:修改有明确落点 文字、公式与图形适合参数化修改;场景与镜头可以复用代码和资产;自然表演与叙事仍需要动画资源和视觉判断。系列内容能摊薄模板制作成本,一次性的高自由度探索则未必值得建立同样复杂的工程。 官方列出的用途包括代码动画、带声音的教育视频和三维世界。Mollick 展示了代码制作的发布影片,并公开 Portals 的场景、相机和声音工程;他将前者描述为一次用户提示后完成的作品。这个案例说明了可实现的制作形态,但一次创作中的工具执行和内部修改仍可很多,不能据此估计稳定交付率或平均制作成本。 1.5 关键洞察 优势在于可寻址修改:文字、颜色、位置、曲线和镜头时长都能对应代码。适合知识讲解、数据动画、几何演示及系列化视觉包装;同一模板可以替换内容反复使用。 画面复杂度会转化为工程复杂度。自然人物表演、衣料与毛发、复杂接触和写实布景需要动画系统、模拟器或外部资产,仅靠增加程序行数不会自然获得高质量表演。 执行正确只说明渲染规则可以运行。一个完全合法的程序仍可能表达错误因果、让对象穿模,或把关键动作放在镜头外;检查需要同时理解脚本目标、三维状态和画面随时间的变化。 需要明确资产来源和制作成本的团队,应把模型调用、外部素材、渲染及返工放在同一条成本链中。编码 Agent 能降低操作门槛,但不能消除素材准备和视觉设计的工作。 下一步的关键是让 Agent 围绕稳定的对象标识和时间线进行局部修改,并把画面问题定位回代码中的对象或参数。这样才能从完成一次演示走向可持续迭代的制作工具。 技术演进定位: 通用代码生成 → 可运行的场景与动画工程 → 工具执行和画面反馈。Fable 5.2 代表通用编码 Agent 进入视听制作的产品路线,可与专用动画框架、Blender 或游戏引擎组合;其价值取决于工程控制与审阅能力。 可能的后续方向: 建立跨场景的对象与时间关联,将视觉修改落到具体参数,同时保留无需修改的素材与镜头。 2. TheoremExplainAgent:让代码报错成为视频生成的反馈 工作: TheoremExplainAgent: Towards Video-based Multimodal Explanations for LLM Theorem Understanding 来源: ACL 2025 主会论文 机构: University of Waterloo;Votee AI;Vector Institute 关键词: 教学视频, Manim, 规划与编码, 执行反馈, TheoremExplainBench 相关资料: ACL 2025正式论文 · ACL 2025论文全文 · 官方项目及生成视频 · OpenAlex 学术引用记录(2026-11-14) 2.1 研究动机 核心问题: 怎样把长篇知识解释拆成可执行、可修复的动画制作步骤? 解释勾股定理时,模型可以把文字说得很流畅,却在动画里画错对应边,或让公式变化快于旁白。教学视频把抽象推理变成了一组必须相互吻合的对象:讲解步骤、数学符号、几何图形和播放时间。TheoremExplainAgent 用这个更具体的任务检验模型:能否把自己声称理解的定理,转成别人可以跟着看懂的长篇解释? 前序工作及局限: Manim 等程序化动画工具:提供图形和动画原语,但讲解顺序与内容仍由作者设计。 一次生成完整动画代码:讲解规划与程序实现混在一起,长程序出错后难以修复。 与前序工作的本质区别: 将讲解计划与动画编码分开,以真实运行错误驱动有限次修复。 2.2 方法原理 TheoremExplainAgent 由两个大语言模型 Agent 组成。输入一个定理后,规划 Agent 制定执行计划,编码 Agent 随后生成用于制作视觉内容与音频的 Python 脚本。 图表详解:方法框架(原论文图 2) TheoremExplainAgent 由两个大语言模型 Agent 组成。输入一个定理后,规划 Agent 制定执行计划,编码 Agent 随后生成用于制作视觉内容与音频的 Python 脚本。 先决定怎样讲,再决定怎样画。 Planner 把定理与背景组织成多个场景,为每个场景安排概念、可视化、动画、转场与旁白。这样,编码者面对的是有边界的讲解任务,而不是一次生成整部视频的长程序。 把表达落到 Manim 代码。 Coder 将场景计划写成 Python 动画,语音合成负责旁白;公式、图形和出现顺序成为可执行指令。渲染器实际运行这些指令,异常会返回编码者,最多进行五次修复尝试。 闭环首先解决“做得出来”。 执行错误提供了具体反馈:哪个调用无效、哪里缺少对象、程序为何中断。但一个公式盖住另一个公式,或者动画说明了错误的数学关系,未必触发异常。因此,程序修复保证的是进入成片阶段的机会,教学质量仍取决于前面的解释计划和画面表达。 2.3 核心创新 它把教学解释变成了可执行的中间表示:先有场景计划,再有动画代码,最后接受运行环境的约束。相比直接要求模型输出完整视频,错误更容易被定位到一个场景或一次调用;相比只让模型写证明,空间关系和时间顺序又暴露出文字中不明显的理解缺口。 2.4 实验结果 结构化视觉解释可以让复杂概念更直观,同时把文字解释中不易发现的推理错误暴露出来;图中以排序过程展示文字描述与逐步可视化的区别。 图表详解:可视化结果(原论文图 1) 结构化视觉解释可以让复杂概念更直观,同时把文字解释中不易发现的推理错误暴露出来;图中以排序过程展示文字描述与逐步可视化的区别。 TheoremExplainBench 包含数学、物理、化学和计算机科学的 240 个定理。o3-mini medium 的完整视频生成成功率为 93.8%,成功成片的综合评分约为 0.77,论文也展示了可达十分钟的输出。这里应同时看两层结果:93.8% 表明大多数任务能够完成制作,0.77 则反映生成出来的解释仍有质量差异。运行成功不等于推导和可视化都正确。 2.5 关键洞察 布局错误是这条路线的直接短板。对象错位、遮挡和尺寸不一致通常不会让 Python 报错,依靠异常修复无法消除这类问题。教学视频需要额外检查符号关系、可读性和旁白节奏。 检索到代码也不一定更好用。不相关的 Manim 示例会诱发错误调用,并增加 token 与制作时间;素材和示例必须服务当前讲解,而不是越多越好。 工程判断:它适合几何推导、算法过程等能用符号和图形表达的讲解。真人表演、复杂材质和开放场景不是 Manim 的优势;高风险教学内容还需要数学或领域专家把关,自动评分难以替代这一步。 技术演进定位: 代码视频从工具调用走向长篇教学流程:首先解决内容组织与执行可靠性。 可能的后续方向: 将代码检查、数学关系检查和画面可读性检查结合,分别处理运行错误、解释错误与视觉错误。 3. Code2Video:从修程序,走向看画面再改代码 工作: Code2Video: A Code-centric Paradigm for Educational Video Generation 来源: 2025 arXiv;2026 ICML 机构: Show Lab, National University of Singapore 关键词: 代码视频, 视觉反馈, Manim, 布局锚点, TeachQuiz 相关资料: arXiv摘要 · arXiv v1全文 · ICML 2026正式论文集(标题为Educational Video Creation) · 官方生成案例 · OpenAlex 学术引用记录(2026-11-14) 3.1 研究动机 核心问题: 程序执行成功之后,怎样根据观众实际看到的画面继续修复? 让动画代码运行起来以后,下一道难题是让观众跟得上:字幕不能压住示意图,公式需要在解释到它时出现,几个章节也不能各用一套符号。Code2Video 直接处理这种“程序成功、表达失败”的落差,把讲解结构、画面布局和渲染后的视觉反馈纳入同一条制作流程。 前序工作及局限: TheoremExplainAgent:通过计划与执行反馈提高长篇动画的制作完成率。 直接让视觉模型评价视频:能指出画面问题,但意见不容易转换为准确的代码修改。 与前序工作的本质区别: 以视觉锚点和占用表连接画面元素与代码位置,把审片意见落实到可编辑区域。 3.2 方法原理 Figure 4: Illustration of Code2Video. Given a user inquiry, Code2Video aims to render an educational video via Manim code writing: (i) the Planner converts a learning topic into a storyboard and retrieves visual assets; (ii) the Coder performs parallel code synthesis with scope-guided refinement to ensure efficiency and temporal consistency; (iii) the Critic uses visual anchor prompts to iteratively adjust spatial layout and clarity, yielding reproducible, educationally structured videos. 图表详解:方法框架(原论文图 4) Code2Video 的整体流程。给定用户问题,Planner 将学习主题转成分镜并检索视觉素材;Coder 并行合成代码并进行作用域引导的修复,以保证效率和时间一致性;Critic 使用视觉锚点提示反复调整空间布局与清晰度,生成可复现、结构化的教学视频。 用提纲维持讲解顺序。 Planner 根据主题和受众安排章节,再细化成逐句旁白与配套动画;图片和图标放入共享素材缓存,使不同片段沿用同一套视觉资源。 并行制作,逐步扩大修复范围。 各章节独立生成 Manim 程序。遇到错误时,ScopeRefine 先修出错行附近的代码,再扩展到对应讲解块,最后才重写整节。这个顺序尽量保住已经正确的部分。 让视觉意见能找到代码。 系统把画布离散成 6×6 锚点网格,为小元素分配点位,为大元素分配区域,并记录占用位置、缩放和代码行。Critic 同时看渲染视频和程序,发现遮挡或布局失衡后,通过这份对应关系调整局部代码。关键不是简单增加一个“打分模型”,而是让“公式挡住图了”变成可执行的修改。 3.3 核心创新 Code2Video 把画面与程序之间的对应关系显式保存下来。执行异常能定位错误调用,视觉锚点则帮助定位错误摆放;两种反馈分别处理“能不能运行”和“能不能看清”。章节并行与共享素材又把局部效率和整片一致性联系起来,使视觉返修不必总从整部程序重新开始。 3.4 实验结果 Figure 6: Qualitative comparison between Code2Video and Veo3 . Our approach generates videos with coherent logic flow, consistent semantics, and interpretable layouts. 图表详解:可视化结果(原论文图 6) Code2Video 与 Veo3 的定性比较。作者展示代码路线在所选教学案例中保持连贯的逻辑顺序、语义一致性和可解释布局的能力;这是论文所选案例,不是所有视频任务的统一排名。 arXiv v1 表 1 中,在同样使用 Claude Opus 4.1 的配置下,自动 TeachQuiz 从直接代码生成的 40.0 升至 86.0,美学均分从 37.8 升至 87.9。这说明该基准上,增加规划与反馈后,改善的不只是外观。TeachQuiz 测量的是模型屏蔽既有知识后,观看视频得到的答题增益;它提供了知识传递的代理指标,真实学生的理解、记忆与迁移仍需人类学习实验评价。 3.5 关键洞察 工程判断:锚点降低了布局搜索难度,也限定了表达方式。对于需要自由排版或复杂连续运动的场景,固定点位不能自动解决全部空间冲突,仍可能需要更细的布局约束。 视觉评委可能漏掉一闪而过的遮挡,人评对布局错误也比自动评分更敏感。一次成片总分难以说明每个时间点都清楚,短暂但关键的公式变化尤其值得检查。 工程判断:它适合可分章节、可复用图形素材的知识视频,并且比只靠异常修复更接近实际制作流程;代价是多轮生成、渲染与审片。若只需要几秒简单动画,这套流程的组织成本可能超过收益。 技术演进定位: 代码视频从执行修复走向视觉返修,并进一步评价知识传递效果。 可能的后续方向: 加强逐时刻布局检查与真实学习者评价,区分画面清楚、知识正确和真正学会三种目标。 4. VideoCoCo:Agent写Blender白模,再让生成模型补外观 工作: VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System 来源: 2026-07 首发,2026-08 修订 机构: CUHK、USTC 等联合团队 关键词: Blender, 白模, Code-as-CoT, 视频编辑, 物理一致性 相关资料: VideoCoCo 原论文 · VideoCoCo 官方代码与示例 · BlenderMCP 社区工具入口 4.1 研究动机 核心问题: 怎样既保留动作过程的可控性,又获得生成模型的写实外观? 一个物体先受撞击再破裂,与先破裂再被碰到,单帧都可能逼真,视频表达的因果却完全不同。VideoCoCo 把这种过程先写成 Blender 程序并渲染成白模,让生成模型主要负责外观。它试图降低一个模型同时猜测运动过程和生成写实画面的负担。 前序工作及局限: 文字分镜与关键帧:描述过程,但对相邻时刻的运动和接触约束较弱。 直接三维渲染:场景过程可编辑,精细外观需要资产、材质和灯光制作。 与前序工作的本质区别: 以 Blender 程序生成连续白模草稿,再由适配的编辑器处理外观,让过程控制与外观生成分工。 4.2 方法原理 Figure 2 summary: runnable Blender scenes provide temporal drafts; the editor transforms their appearance. See source for the original caption. 图表详解:VideoCoCo:Blender白模到生成视频(原论文图2) VideoCoCo 双引擎流程。第一阶段中,代码 Agent 根据提示规划并编写独立 Blender 程序,规定场景及其时间演化,在沙箱执行后得到低保真的时空草稿。第二阶段中,指令 Agent 根据原始提示和草稿生成编辑指令,与草稿一起输入视频编辑模型,得到最终高保真视频;草稿提供动态过程,编辑模型提供写实外观。 1. 先固定完整过程。 编码 Agent 根据提示编写 Blender Python,声明物体、属性及随时间的变化,再执行程序得到低保真白模视频。相较文字分镜或稀疏关键帧,每一帧都有明确的场景状态,动作先后和相机运动可以在上色前调整。 2. 再补外观。 指令 Agent 同时读取原提示和白模,描述材质、光照与视觉风格,避免重新定义已有运动。视频编辑器以白模和指令为条件生成成片。为弥合白模与真实视频的外观差异,论文用 VideoCoCo-3K 的 3,000 组三元组适配 OmniWeaving;Seedance 2.0 用于构造训练目标。 3. 分清 Blender 的两种出口。 直接渲染保留三维工程对对象和镜头的控制;白模加生成式编辑用部分确定性换取更丰富的外观。BlenderMCP 是让 Agent 执行 Python、读场景和看视图的社区接口,不是完整视频方法。作者工程用预览检查过程、修改脚本,交互检查与最终批量渲染也各有职责。 4.3 核心创新 白模成为两类系统共享的时间过程:程序引擎明确发生什么,生成式编辑器负责呈现成什么样。收益不仅来自增加 Agent,还来自连续的中间视频和针对白模条件的编辑器适配;仅把任意白模送进普通视频模型,不能假定获得同样效果。 4.4 实验结果 Diagram or chart prepared from the cited method and results. 图表详解:VideoCoCo:过程约束与编辑器适配的物理任务收益 数据:论文表 1、表 2。橙色为基础生成器,青色为加入VideoCoCo后的结果。左图采用0到1的一致性量表;右图为选定物理维度的百分制结果,未包括VBench的全部评价维度。两个面板分别读数,关注各自基线到完整方法的变化。 论文中,OmniWeaving 在 PhyGenBench 的平均物理一致性分数由 0.475 提升到 0.558;在 VBench-2.0 所选物理维度的平均分由 52.18% 提升到 77.88%,均为越高越好。后一数字是物理维度的结果,不是全部视频质量的总分。这组对照支持的是过程约束与编辑器适配对物理任务的帮助,不直接衡量人物表演、长篇叙事或制作效率。 4.5 关键洞察 适合动作顺序、轨迹和接触关系重要,而原始外观较简单的短片,例如机制演示和物理过程可视化。白模将动作问题提前到外观制作之前,便于先发现和修改过程错误;之后仍需重新运行编辑器。 程序显式表达过程,并不自动证明过程符合物理。Agent 可能把错误轨迹写成关键帧,静态合法的程序也可能产生错误动画;需要物理求解、接触约束或领域检查,而不能把可执行直接当作物理正确。 白模是生成条件,未必是最终像素必须遵守的硬约束。编辑器增加纹理、阴影和细节时,仍可能改变物体边界、接触瞬间或遮挡关系;越要求精确尺寸和可量测运动,越应优先考虑直接渲染。 成本包含程序构建、白模预览、生成式编辑和失败后的返工。只有当过程能稳定复用、外观需要变化时,前期建模投入才更容易摊薄;对一次性的复杂自然场景,这条链路可能比直接生成更重。 后续挑战是把接触、身份和事件时间从软条件变成可检查约束,并区分错误来自程序过程还是外观重绘。只有能定位到具体阶段,自动返修才不会把正确的部分重新做坏。 技术演进定位: 文字分镜或关键帧规划 → 可执行的连续白模视频 → 针对白模条件适配的生成式编辑。VideoCoCo 连接代码控制与扩散外观,但最终成片对时序和接触的忠实程度仍受编辑器约束能力影响。 可能的后续方向: 把接触与事件时序变成可检查约束,减少外观编辑对既有运动的破坏。 5. Unreal Engine Agent工作流:把场景、时间线与渲染交给Agent 工作: Unreal Engine 5.9 MegaJam Preview 来源: 2026-11 Epic 官方预览发布与渲染文档 机构: Epic Games 关键词: Unreal Engine, MCP, Level Sequence, Movie Render Graph, Agent工具链 相关资料: Epic 2026-11-09 UE 5.9 MegaJam Preview · Epic Movie Render Graph 脚本与完成回调 5.1 研究动机 核心问题: 怎样让创作指令持续对应到三维场景、镜头和动画轨道? 如果一个项目要持续修改角色、机位和剪辑,生成一段视频还不够,制作系统需要保留这些对象的身份和相互关系。Unreal 的作用是提供可编辑的场景与时间线,让 Agent 的操作落到具体资产、轨道和渲染任务上,而不是每轮重新猜测整段画面。 前序工作及局限: 传统三维编辑器:控制细致,操作和跨工具协调成本较高。 仅用提示生成镜头:外观变化灵活,精确复拍与局部返修较难。 与前序工作的本质区别: 把编辑器中的对象与渲染能力交给 Agent 操作,在同一工程内保留资产和时空关系。 5.2 方法原理 Diagram or chart prepared from the cited method and results. 图表详解:Unreal:Agent 可以把计划落实为引擎镜头 Agent通过Unreal工具与Python接口处理资产、场景和时间轴,再把渲染任务交给MRQ/MRG。创作目标需要对应到具体对象与轨道;UE5.9预览中的相关Agent能力仍为实验功能。 1. 把操作落到编辑器对象。 2026 年 11 月 9 日发布的 UE 5.9 MegaJam Preview 扩展了 Unreal MCP、编辑器内的 Unreal Assistant 及 Python API。Agent 可通过工具操作场景、资产、动画与渲染;MCP 和 Assistant 等相关功能仍标为 Experimental。 2. 用场景和时间线维持一致性。 Level 保存场景,Level Sequence 保存角色、相机与动画轨道。相机位置、焦距、角色运动和切镜时间都是独立的修改对象;换一个机位时,同一角色与布景可以继续使用。 3. 让渲染配置也可编排。 Movie Render Graph 用图管理渲染设置,脚本可修改暴露参数并接收执行完成回调。它负责将既定场景转成输出画面,创作规划和视觉审阅仍需上层系统完成。 4. 按任务选择画面后端。 实验性的 Unreal Canvas 可用提示、参考图或已有场景连接外部模型,生成图像、网格和视频。引擎渲染从几何生成像素,外部视频模型根据条件合成像素;二者可以互补,但具有不同的控制强度和误差来源。 5.3 核心创新 近期变化是将 Agent 接口接入已有三维制作环境,使资产、镜头、时间线和渲染设置都能进入工具调用链。相比重新生成视频,可编辑工程能承接持续改稿;相比只输出脚本,上层 Agent 也有机会读取修改后的实际状态。 5.4 实验结果 Diagram or chart prepared from the cited method and results. 图表详解:Unreal 的两条出口:直接渲染,或连接生成模型 同一场景有两条输出路径:直接渲染保留对几何、镜头和时间的工程控制;通过实验性Unreal Canvas连接外部模型,可以扩展外观变化,但增加生成约束保持与再生成成本。 官方公开了编辑器 Agent 连接、扩展 Python API、Unreal Canvas 以及渲染编程入口。这些接口扩大了可自动化的操作范围,但不构成一套已完成的自动导演系统,也没有给出与各视频生成论文同条件的画质或任务成功率对照。 5.5 关键洞察 适合已有三维资产的团队、游戏过场、虚拟拍摄及需要多版镜头的产品演示。同一工程能换角度、改时长并继续复用角色和布景,尤其有利于需求反复变化的制作。 前期资产、骨骼动画、材质与灯光决定效果上限。对于没有模型、只需要一次性自然场景的用户,搭工程的投入可能高于直接视频生成;接口增加不会自行补齐这些资产。 三维控制与最终审美是两层问题。镜头可以精确重复,但构图仍可能平庸,动画仍可能僵硬;上层系统需要理解动作与叙事,而不能只检查轨道存在和渲染完成。 UE 5.9 MegaJam Preview 是预览版本,相关 Agent 功能仍为实验性。工作流依赖具体 API、插件及资产兼容性,生产采用需固定版本并隔离升级,否则一次接口变化可能使整条制作链失效。 外部模型可以补充风格与细节,也可能改变几何和角色外观。未来更有价值的融合是保留场景、相机和时间约束,让生成结果能回到可编辑工程中,而不只是把引擎截图当作一次性参考图。 技术演进定位: 传统三维编辑器与脚本 → Agent 可调用的对象、时间线和渲染接口 → 引擎与外部生成模型协同。它提供制作基础设施;具体的规划、反馈和返修策略由 Cutscene Agent、CineU 等系统进一步实现。 可能的后续方向: 围绕持久场景状态设计上层规划和局部返修,使外部生成模型遵循工程中的镜头与时间约束。 6. Cutscene Agent:把对白、表演和镜头写进 Unreal 时间轴 工作: Cutscene Agent: An LLM Agent Framework for Automated 3D Cutscene Generation 来源: 2026 技术报告、官方项目与代码 机构: Kuaishou GameMind Lab 关键词: 视频生成Agent, Unreal Engine, MCP, Level Sequence, 视觉反馈, Cutscene Agent 相关资料: arXiv v1:体系、CutsceneBench 与限制 · 官方项目:演示资产与美术参与说明 · 官方代码与 UE 5.6 环境说明 · Photographer:已实现截图反馈循环 · 视角工具实际调用:编辑器视口相机 6.1 研究动机 核心问题: 怎样把对白、表演和摄影协调到可以继续精修的同一条时间线上? 对白从三秒变成五秒后,嘴型、动作、对方的反应和切镜点都可能需要调整。Cutscene Agent 把这类对白型三维过场落到 Unreal 的原生时间轴中,让角色、表演、声音和镜头能够协同修改,也为动画师继续加工保留入口。 前序工作及局限: 虚拟片场中的计划互评:能协调拍摄意图,但动作、声音与镜头仍需落实到具体时间段。 单独生成的短镜头:角色身份、口型和前后动作不易稳定连接。 与前序工作的本质区别: 让导演和专门角色共同编排原生轨道;视口反馈用于观察场景,成片摄影由时间线中的相机轨道控制。 6.2 方法原理 Diagram or chart prepared from the cited method and results. 图表详解:Cutscene Agent:Agent 在引擎里搭建可编辑镜头 导演分配动画、摄影与声音任务,在Unreal中组织可编辑的Level Sequence。每轮读取时间轴状态,协调角色动作、音轨和镜头。Photographer通过视口截图调整观察视角;成片摄影由时间线中的相机轨道控制。 1. 先读真实场景,再做下一步。 导演 Agent 通过 Cutscene Toolkit 查询角色、动画和音频资源,每轮决策前重新读取 Level Sequence 的轨道与时间段,减少文字计划与实际工程脱节。 2. 围绕同一时间轴分工。 场景、动画、摄影和声音专家分别处理站位、表演、机位以及对白和面部动画。语音生成、音轨挂载、面部动画生成与挂载有明确先后;相机模板以角色骨骼位置为参照,初始化过肩、主观、推拉和环绕等机位。 3. 区分观察与拍摄。 Photographer 根据视口截图调整编辑器观察视角,帮助看清对象和空间关系;成片机位由 Level Sequence 的相机轨道控制。这种局部视觉反馈有用,但不能等同于审阅整片并自动重写拍摄方案。 4. 留下可编辑的表演工程。 输出是原生角色、动画、声音和相机轨道,可继续渲染与加工。官方演示使用 MetaHuman,灯光和最终渲染由美术完成。 6.3 核心创新 重点是把导演分工、资源约束和真实时间轴状态连在一起,让对白制作中的长依赖链可执行、可修改。CutsceneBench 进一步分开评价工具操作、轨道完整性和最终视听效果,揭示了技术完成与艺术完成之间的距离。 6.4 实验结果 Diagram or chart prepared from the cited method and results. 图表详解:Cutscene Agent:会调用工具,还不等于会拍好 Opus 4.6 / GPT-5.4 的调用完成度为 100.0 / 95.7,摄影机覆盖为 96.4 / 93.5,叙事与摄影总分为 50.2 / 42.4。L1/L2 在每模型 65 场景上评价;L3 仅覆盖七个入选模型,每个抽取 25 段视频(五个层级各五段),由 Gemini 3.1 Pro 自动评分、满分 100。Qwen 2.5-72B 因结构完整性不足未纳入 L3;该分数不是人工偏好或成功率。 成片评分忽略环境保真度,重点在角色、对白、动作与摄影。 每个模型在 65 个场景中接受工具与结构评估。Opus 4.6 的轨道完整率、镜头覆盖率和时间一致性分别为 100.0%、96.4% 和 99.5%。进入成片评价的七个模型各取 25 段视频,由 Gemini 3.1 Pro 按剧本、角色、摄影与时间连贯性评分,每项 25 分;Opus 4.6、GPT-5.4、Sonnet 4.6 分别为 50.2、42.4、41.7。后者是模型评审量表,不是观众满意率;它与结构指标共同说明,轨道齐全之后仍有很大的镜头表达空间。 成片评分有意忽略环境保真度,重点评价角色、对白、动作与摄影,因此并非全画面美术质量评分。 6.5 关键洞察 最适合角色和动作库明确的对白过场、叙事原型和预演。通过改时间轴而不是重生成整个场景,可以保留角色身份、资产引用以及后续人工精修空间。 系统更多是在选择和组织已有表演资源。对复杂打斗、群体调度或细腻的情绪转折,动作库中缺少的表演不会因为导演指令更详细就自动出现;资产覆盖决定可拍题材。 多轨道同步具有连锁依赖。语音变化会影响口型和动作时长,继而影响反应镜头;单轨合法仍可能整体错位。因此关键检查对象应是轨道间的关系,而不只是调用成功或对象存在。 视口反馈帮助观察,不等于拥有完整电影判断。跨镜头连续性、节奏、视线关系和情感表达需要比较一段时间里的多镜头;论文列出的更广泛视觉专家仍是后续方向,最终美术工作也不能省略。 发展重点应是让台词、动作和镜头修改能够传播到直接依赖它们的轨道,同时保留其他已完成内容。这样的可控返修,比不断增加角色型 Agent 更能决定实际制作效率。 技术演进定位: 对白脚本与角色分工 → 引擎原生时间轴 → 真实状态回读与局部视口反馈。它承接虚拟制片的资产复用思路,把自动化重点放在表演编排及多轨道协调。 可能的后续方向: 把对白时长的变化传递给口型、动作和反应镜头;补充跨镜头的视线、节奏与连续性判断。 7. CineU:用引擎状态修复可编辑的多镜头视频 工作: Cinematize from Unreal: Agentic Choreography for Controllable World Simulation 来源: 2026 技术报告 机构: Tongji University;Microsoft Research Asia 关键词: 视频生成Agent, Unreal Engine, Sequencer, 多镜头编排, 局部修复, CineU 相关资料: arXiv 首发、作者与准确标题 · arXiv v1:方法、定性多镜头结果与消融 7.1 研究动机 核心问题: 修改一个对象或镜头时,怎样保留已有场景中仍然正确的部分? “让角色在屋顶行走,同时推拉变焦,再切到远景”包含空间、动作、镜头和时间的多重依赖。即使每个操作单独能执行,组合后也可能角色滑行、站位悬空或镜头错拍。CineU 把 Unreal 工程作为持续存在的世界状态,并围绕依赖关系安排执行和局部返修。 前序工作及局限: 独立镜头生成:不同镜头缺少共享实体和时间状态,局部要求容易破坏前后关系。 整段引擎代码重生成:已经正确的资产和镜头也会随重写而变化。 与前序工作的本质区别: 使用持续的世界状态、时间线与依赖关系定位失败,把修改限制在相关函数、对象与轨道。 7.2 方法原理 Diagram or chart prepared from the cited method and results. 图表详解:CineU:把任务拆开,把正确状态保留下来 CineU 将指令拆成有依赖的引擎操作,分工检索资产并生成代码。静态检查、执行轨迹和状态回读共同定位失败,再局部修订函数。多镜头共享场景与时间轴,保留正确资产和时序;创意判断不等同于自动验证。 1. 把需求拆成有关联的任务。 编排 Agent 管理环境、实体、摆放、动画和镜头;Sequencer 专家提供共同时间轴,让相机、动作和位移共享时长与轨道引用。 2. 在已有能力内构造操作。 论文配置有 300 多个验证资产和 60 多个代码模板。资源先从本地检索,再查外部市场;各专家只读取与自身任务相关的模板,减少误用 API 与不兼容资产的机会。 3. 把镜头意图转成关系约束。 包围盒近似支持“在屋顶上”“在旁边”等放置关系;推拉变焦同步相机距离与焦距,移动轨道与行走动画共享时间,避免对象只平移而不迈步。 4. 根据失败位置修复依赖范围。 系统依次检查程序、执行完成情况及引擎实际状态,修改导致失败的函数并保留已完成部分。换贴图通常只影响外观,换实体可能影响支撑几何,换动作则需重新同步位移;局部修改的范围由这些关系决定。 7.3 核心创新 它将持续存在的场景、明确的能力库和依赖感知返修结合。局部编辑不再等于只改一行代码,而是更新一个对象及其直接相关的空间、时间关系;这一点决定了多轮制作能否积累成果。 7.4 实验结果 Diagram or chart prepared from the cited method and results. 图表详解:CineU:知识、验证与局部修订分别贡献多少? 任务完成率:无/统一/专业知识为 18.4%/31.2%/47.8%;无/单阶段/多阶段验证为 16.8%/29.5%/47.8%;全量重生成/最小改动为 38.1%/47.8%。成功需执行、资产和时空约束同时满足;验证组首轮程序正确率均为 56.2%。不同配置的完成率不能代替视频美学评分。 论文表 4 中,完整配置的任务成功率为 47.8%,首次代码正确率为 56.2%,修正轮数为 5.6;单 Agent 对应为 11.5%、19.4% 和超过 10 轮。局部修复相对整段重生成,将成功率由 38.1% 提升至 47.8%,修正轮数由 7.8 降至 5.6。结果支持保留正确操作的价值;这些是配置级消融,不宜外推为任意资产和提示的成功率,也不能把修正轮数直接换算成时间成本。 7.5 关键洞察 适合需要重复修改的三维预演、相机运动设计和多镜头原型。与每轮重生成像素相比,角色、场景和相机仍有稳定身份,能够保留已确定的创作决策。 模板和资源库既提高可靠性,也限制表达范围。超出支持的动画、引擎接口或资产组合后,已有成功率未必保持;论文使用 UE 5.5 及更早版本,跨版本迁移仍需处理兼容性。 包围盒只近似对象的外形。它能约束大致站位,却难以表达凹面、细小接触、关节和柔性物体,因此几何摆放通过检查后,画面仍可能悬空、穿插或缺少可信动作。 状态正确与视觉意图正确之间仍有缺口。角色按时走完路径,相机也可以正好看向无关区域;系统的自动验证主要判断执行与约束,构图、节奏和情感仍需要另一层视觉判断。 最有希望的后续方向,是把画面中的关系错误映射回场景依赖,再做受约束的局部修复。困难在于避免修复振荡:调整站位改善接触,却又破坏取景,必须共同检查相关约束。 技术演进定位: 语言驱动三维操作 → 持久场景与多镜头时间轴 → 能力检索、关系检查和局部返修。相较对白型过场编排,CineU 更强调空间与时间依赖下的持续修改。 可能的后续方向: 把接触、遮挡和构图等视觉关系接到场景约束,协调彼此冲突的局部修复。 8. FilmAgent:把虚拟片场交给多Agent剧组 工作: FilmAgent: A Multi-Agent Framework for End-to-End Film Automation in Virtual 3D Spaces 来源: 2025 论文与官方 Unity 演示 机构: Harbin Institute of Technology (Shenzhen);Tsinghua University 关键词: 虚拟制片, Unity, 多Agent协作, 镜头规划, 角色连续性 相关资料: arXiv v1全文 · 官方项目与Unity视频 · OpenAlex 学术引用记录(2026-11-14) 8.1 研究动机 核心问题: 怎样协调剧本、演员与摄影,让拍摄计划在同一个三维片场执行? 同一句台词,用近景拍表情,还是用中景交代肢体动作,会改变观众对剧情的理解。人物站位、动作、对白和摄影无法各自独立决定。FilmAgent 把这类相互约束放进一个共享的 Unity 虚拟片场,让导演、编剧、演员和摄影 Agent 围绕同一场戏协作。 前序工作及局限: 单 Agent 生成剧本与镜头:需要同时处理人设、叙事和摄影,多种目标容易相互冲突。 传统虚拟制片:用场景和动作资产稳定执行拍摄,创作决策主要依赖人工。 与前序工作的本质区别: 用编剧修改、演员反馈和摄影讨论协调制作决策,再将计划映射为 Unity 的具体站位、动作与镜头。 8.2 方法原理 Original workflow diagram based on FilmAgent Figure 1 and method section. Not an experimental comparison. 图表详解:FilmAgent 的制作角色与三阶段流程 创意发展阶段把创作目标变成故事提纲;剧本阶段具体安排对白与角色动作,通过反馈检查动作能否在既有环境中实现;摄影阶段由摄影角色提出镜头,导演比较并确定拍摄方案,最后在虚拟三维片场执行。角色通过中间结果反馈和修订协作。流程依赖预建片场和动作库,复杂场景仍需要额外的资产准备。 先给剧组一个能拍摄的世界。 系统提供预建场景、站位、动作与摄影选项。Agent 的计划必须落到这些可执行的选择上,而不是只写出听起来专业的镜头描述。 剧本经历有分工的修改。 导演从创意组织角色与场景;编剧补充台词、站位和动作。导演检查情节与动作是否合理,演员从角色性格出发提出意见,再由编剧修改、导演确认。 摄影讨论服务叙事。 两个摄影 Agent 分别提出镜头方案,讨论分歧,再由导演裁决。最后,每句台词都绑定演员位置、动作和摄影机选项;语音长度决定对应片段的时间,在 Unity 中执行成片。这里的反馈主要发生在剧本和拍摄计划上,实际画面的视觉错误仍需要另外检查。 8.3 核心创新 多角色的作用不只是把一个长提示拆成几段。编剧关注叙事,演员检查人设,摄影关注可见信息,导演协调冲突;共同的三维环境又把讨论约束在同一组人物和地点上。角色连续性因此有了持久场景作为基础,而不是每个镜头重新猜测人物长什么样、站在哪里。 8.4 实验结果 Figure 2: A vertical view of one of the 3D spaces (the living room) in FilmAgent built with Unity. The environment is pre-configured with designated positions for actors and various camera setups for cinematography. These include static shots from multiple distances and dynamic shots that either follow or orbit around characters. Full camera setup of this space is provided in Figure 8 . 图表详解:可视化结果(原论文图 2) FilmAgent 在 Unity 中搭建的客厅俯视图。环境预先设置演员位置与摄影机方案,包含多种距离的静态镜头,以及跟随或环绕角色的动态镜头;完整摄影配置见论文附录图8。 论文以 15 个创意进行人评。GPT-4o 协作版的动作准确率为 0.88,情节、人设匹配和镜头评分分别为 3.53、4.44、3.53,后三项满分为 5 分。与单 Agent 版本的比较支持了分工与讨论在这个虚拟片场中的价值,也显示人设匹配比情节和摄影更容易做好。动作准确率与主观评分衡量不同问题,应分别看待。 8.5 关键洞察 控制范围来自资产库。15 个预建地点、21 类动作和预设镜头让计划容易执行,也限制了故事能发生在哪里、角色能做什么。扩大题材时,新增资产和动作的制作成本仍然存在。 以台词为单位绑定动作与镜头,对连续表演过于粗糙。一句长台词可能包含犹豫、转身、拿取物体和反应镜头,简单的一句一组安排难以表达这些节奏。 工程判断:这条路线适合资产可复用的对白短剧和预演,需要精细表演或开放写实场景时局限明显。多轮讨论增加调用成本,而计划层达成一致也不保证成片没有穿模、遮挡或剪辑问题。 技术演进定位: 多 Agent 协作与持久三维片场结合的代表,主要优化生成前的拍摄组织。 可能的后续方向: 细化到台词内部的动作与摄影节奏,并把实际画面的视觉反馈接回制作决策。 9. MovieAgent:把故事拆成可调用生成模型的镜头 工作: Automated Movie Generation via Multi-Agent CoT Planning 来源: 2025 技术报告与官方演示 机构: Show Lab, National University of Singapore 关键词: 多镜头生成, 分层规划, 角色参考, 工具编排, MoviePrompts 相关资料: arXiv v1全文 · 官方项目与视频 · 官方代码 9.1 研究动机 核心问题: 怎样把全片故事拆成彼此关联的场景与镜头,而不是孤立生成多个短片? 多镜头视频的困难常出现在两段之间:上一镜人物刚拿起杯子,下一镜杯子不见了;每段都好看,观众却不知道故事为什么这样发展。MovieAgent 尝试把全片的叙事关系先组织成层次清楚的计划,再让不同生成工具完成镜头。它处理的核心是长目标如何变成一串彼此有关的生成请求。 前序工作及局限: 短视频生成模型:能生成局部片段,但不自动维护全片的叙事目的与跨镜头身份。 人工分镜后逐镜调用模型:可以组织长视频,但需要持续手动传递角色与剧情信息。 与前序工作的本质区别: 通过故事、场景和镜头三级计划传递角色资料与叙事要求,再调用图像、视频和音频工具。 9.2 方法原理 Figure 2 : The Overall Pipeline for MovieAgent . The proposed framework employs a hierarchical CoT reasoning process with director, scene plan, and shot plan agents to automate long-form movie generation. 图表详解:方法框架(原论文图 2) MovieAgent 整体流程。框架使用导演、场景规划和镜头规划 Agent,通过分层推理自动组织长视频,再将结构化镜头要求交给后续生成工具。 角色资料贯穿全片。 输入包括故事梗概与角色库,角色库保存名字、参考图,需要对白时还提供声音样本,让后续镜头有共同的身份依据。 按叙事层次逐级细化。 Director Agent 先划分关键故事单元;Scene Plan Agent 依据地点、时间和冲突变化确定场景;Shot Plan Agent 再指定每镜中的人物、动作、景别、运镜与对白。每一级都把上一层的叙事意图转成更具体的制作要求。 用计划驱动不同后端。 系统可先生成角色定制的关键帧,再生成视频,也可调用一阶段定制视频模型;对白镜头还要组合语音和说话人动画。最终按计划拼接镜头。分层计划为生成提供上下文,但像素、动作和口型仍取决于各个后端是否遵循这些条件。 9.3 核心创新 它把故事、场景、镜头这三种尺度的决策分开:故事层解释为什么需要这场戏,场景层交代发生在哪里,镜头层决定观众看到什么。角色资料和叙事意图沿层级传递,使单镜头生成不再完全孤立。对于失败分析,这份计划也提供了区分“要求没有写清楚”与“生成模型没有做到”的依据。 9.4 实验结果 Figure 6 : Visualization Comparison for Different Methods. 图表详解:可视化结果(原论文图 6) 不同方法的生成结果可视化比较。图中展示角色、场景和镜头连续性的案例差别;应结合论文指定的模型组合与测试集解读,不将样例当作普遍保证。 MoviePrompts 包含 10 个故事梗概,并由两名专家评价。表 2 报告 MovieAgent 的主体一致性为 94.72%、运动平滑度为 97.84%、背景一致性为 93.52%;这些是论文指定工具组合下的指标,部分指标仍有更高的基线。它们说明多场景组织与较好的单项质量可以同时出现,但完整叙事还要检查镜头之间的因果、动作衔接与人物身份。 9.5 关键洞察 参考图传递的是身份条件,不是持续存在的三维人物。论文案例仍出现脸部失真、小人物身份混淆和复杂交互不跟随提示;结构化计划无法直接修正这些像素级失败。 层级拆分也会丢失过渡。一个场景可以描述清楚,相邻镜头却省略关键动作,让冲突或空间关系突然跳变。生成前的规划需要覆盖这些连接,生成后仍要看整段叙事是否成立。 工程判断:适合允许筛选与重做的故事样片、视觉预演和多场景创意探索。要求物体位置连续、表演严格衔接或精确口型时,仅靠提示和角色参考不够;多个生成与音频模块也增加等待和排错成本。测试集较小,其中八个梗概来自知名电影,原创长故事仍是更严格的检验。 技术演进定位: 生成模型之上的长视频组织层,重点是拍什么以及镜头如何相连。 可能的后续方向: 把跨镜头动作、物体状态与身份的检查接回返修流程,让计划与实际成片相互校正。 10. VISTA:看完视频再改提示词的真实闭环 工作: VISTA: A Test-Time Self-Improving Video Generation Agent 来源: 2025 技术报告与官方演示 机构: Google;National University of Singapore 关键词: 视频生成Agent, 多模态审片, 提示优化, 推理时计算, VISTA 相关资料: arXiv v1 全文与实验口径 · 官方项目与生成示例 · OpenAlex 引用记录(2026-11-14) 10.1 研究动机 核心问题: 怎样用已经生成的视频发现错误,并让下一轮生成更有方向? 同一条视频提示采样几次,可能一版动作正确但声音混乱,另一版画面漂亮却偏离故事。生成之前写得再详细,也看不到这些实际错误。VISTA 把问题改成一个迭代任务:先看片,指出最值得修正的地方,再调整下一次生成请求。 前序工作及局限: 生成前的分镜与提示扩写:能明确意图,但看不到这次采样实际出现的问题。 多次采样后选片:可以挑较好的一版,却未必利用失败原因改善下一次请求。 与前序工作的本质区别: 把候选比较、视觉与声音等多维批评、提示优化和重生成串成反馈闭环。 10.2 方法原理 The workflow of our proposed multi-agent framework, VISTA. [icon]: MLLM Agent; [icon]: Adversarial MLLM Agent; [icon]: Video Generation Agent. 图表详解:方法框架(论文图 1) 原 Figure 1 展示 VISTA 多 Agent 框架,图例区分多模态 LLM Agent、对抗式多模态 LLM Agent 与视频生成 Agent。根据第 2 节,本图显示先将用户意图改写成结构化场景 prompt,生成多个候选;以交换顺序的双向两两比较进行淘汰,选择最佳视频。随后在视觉、音频和语境三个维度分别由常规评委、对抗评委和汇总评委给出批评,推理 Agent 据此改写 prompt,重生成并与当前最佳结果重选;满足停止条件或迭代上限后交付最佳视频及其 prompt。 先产生可以比较的候选。 规划者将目标展开成带时间、人物、动作、镜头和声音的场景,也保留原始提示作为候选。多个视频生成后,通过交换左右顺序的两两比较选出当前最佳结果,减少单次比较的位置偏好。 把模糊的“不够好”拆开。 视觉、声音和语境各自设普通评委、对抗评委与裁决者,检查实际视频。这样可以分别讨论画面是否成立、声音是否匹配,以及成片是否遵循用户意图,而不是让一个总分掩盖不同问题。 修改请求,重新生成。 推理 Agent 汇总批评,改写提示,再调用视频模型,与保留的最佳候选比较,直到达到轮次或停滞条件。闭环作用于生成请求:新一轮会重新采样视频,并不是直接在原片上修改出错的某个对象。 10.3 核心创新 它把生成后的多模态观察变成下一轮优化依据。与只负责分镜的 Agent 相比,VISTA 能针对实际失败调整要求;与盲目多采样相比,它试图把额外计算用在有方向的修改上。多维批评提供错误描述,候选保留则避免每次改写都被迫接受更差结果。 10.4 实验结果 Summary of human results. The individual annotators’ results are in Appx.-Table 7. 图表详解:结果对比(论文图 4) 原图汇总人工评估,个人结果见附录表 7。第 4.2 节抽取 50 个 prompt,25 个单场景将 VISTA 与 VSR++ 比较,25 个多场景与 VSR 比较;5 位有 prompt 优化经验的标注员强制二选一,VISTA 获得 66.4% 偏好,对照为 33.6%。另外 3 位专家对完整迭代轨迹给出满分 5 分的改进评分:VISTA 为 3.78,VSR(++) 为 3.33;与直接 prompt(DP)比较,视觉质量为 3.77 对 3.36,音频质量为 3.47 对 3.21。补充成本来自 Figure 5:跨两个数据集的每轮均值约 0.7M 输入输出 token、28 个新采样视频,不含视频生成器内部 token。人工偏好不等于任务成功率,结果仅适用于论文设置。 主实验使用 Gemini 2.5 Flash 与 Veo 3。50 个提示由五名标注者做二选一评价:25 个单场景提示对比 VSR++,25 个多场景提示对比 VSR,比较第 5 轮结果。VISTA 获得 66.4% 偏好,基线为 33.6%,衡量的是这一设置下更受偏好的视频。收益伴随明显计算代价:跨两个数据集,每轮平均约 0.7M tokens、28 个新视频,且 token 数不包括视频生成器内部开销。 10.5 关键洞察 重生成提供的是重新尝试的机会,不是精确局部修改。修好声音可能同时改变原本正确的动作或构图;最佳候选可以保底,但无法保证所有改进累积在同一版视频上。 多个评委仍可能共享盲点。物理规律、细微身份变化和用户隐含意图都可能被误判,优化过程也可能更迎合评委偏好而非真实观看需求。50 个提示的人评提供了证据,但覆盖范围有限。 工程判断:适合愿意增加预算、以最终观感优先的短片探索,尤其是底层视频模型只能通过提示调用时。严格时间线、指定物体轨迹和可重复的局部返修更适合显式场景或代码控制;每轮的大量采样也不适合低延迟制作。 技术演进定位: 黑盒视频生成器之上的结果优化层,以更多推理与采样预算换取成片偏好的提升。 可能的后续方向: 提高批评的可靠性与修改效率,并结合局部编辑,让已正确的部分能够保留下来。 横向对比与技术脉络总结 选型取决于必须保持的内容、修改频率与资产条件。精确图文、多机位几何、运动与外观分工、氛围探索对应不同的优势,也各有制作成本和失败模式。 选型取决于必须保持的内容、修改频率与资产条件。精确图文、多机位几何、运动与外观分工、氛围探索对应不同的优势,也各有制作成本和失败模式。 核心技术趋势 从自然语言要求走向可编辑的场景与时间约束 同一个角色、物体和动作需要跨镜头保持对应关系。更有用的中间表示应连接脚本、场景对象、轨道和生成条件,让空间与时间要求能被执行、修改和追踪。 把精确过程与丰富外观分开处理 引擎保存几何、动作与相机,生成模型提供外观变化。发展重点是让生成条件真正保留关键约束,同时给材质、光照和细节留下自由度。 从整段重生成走向理解依赖的局部修改 修改台词、动作或角色尺寸会影响不同轨道。更可信的返修流程应知道变化会传到哪里,并尽量保留其他正确结果。 用分层反馈分配制作预算 先检查脚本、布局和粗动画,再投入最终渲染与生成,最后评价音画、表演和叙事。成本应覆盖候选筛选、返修与人工介入,并落到最终采用的成片上。 总结与展望 选型之后,还要算修改与复用的账 四条路线的差别,在第二版和第十版里尤其明显。下面比较的是修改的落点与代价,而不只是第一版画面是否漂亮。 代码渲染:精确表达可以复用,感染力仍需设计。 TheoremExplainAgent把讲解规划接到 Manim,Code2Video进一步把画面问题映射到代码位置。公式出现时间、箭头指向和数据都能直接修改,系列内容可以摊薄模板成本;但程序能执行,不等于讲解顺序合理或动画自然。复杂质感与表演仍依赖素材、动作和美术设计,通用编码 Agent 也绕不开这些制作工作。 三维引擎:复拍同一个世界,成本先花在资产上。 FilmAgent在预建片场安排拍摄,Cutscene Agent把分工落到原生时间轴,CineU强调共享状态与局部修复。产品换五个机位,可以复用几何;但延长台词会牵动口型、动作和反应镜头,改变角色身高会影响接触与构图。已有合适资产时复用收益较大,从零建模、绑定、布光时,准备工程可能比渲染更费力。 白模+生成:省下精细资产,不等于省下约束检查。 VideoCoCo先用 Blender 程序表达过程,再由适配的编辑器丰富外观。约束弱,模型可能重写动作;约束强,粗糙轮廓和僵硬运动也可能被保留。因而需要分别检查草稿运动是否合理,以及重绘是否保留接触、遮挡与时序;草稿错误可能向后传递,外观编辑还可能引入新的偏差。 生成模型编排:探索外观方便,精确返修更不确定。 MovieAgent分层规划故事与镜头,VISTA用视听语境反馈调整请求与候选。它们适合不值得先建完整三维世界的创意探索;但“动作再快一点”也可能同时改变脸、衣服或背景。多轮筛选的成本应按最终采用的成片计算,计入废弃候选、等待和人工精修。 实际制作可以按镜头混用:商标和字幕交给代码,产品特写保留三维几何,运动明确的镜头尝试白模重绘,开放的氛围镜头采用生成模型。核心问题是哪些内容必须保持,以及下一轮修改能否只动该动的部分。 主要挑战:从能生成,走向能准确修改 修改要求需要落到可编辑对象,再检查受影响的空间、时间和叙事依赖。这是对文中方法的综合分析与发展方向,不代表所有系统已经实现整个闭环。 完整的局部返修仍需将对象、时序与依赖检查连接成闭环。 1. 创作意图怎样落到可执行约束? “更有压迫感”涉及景别、运动、节奏与声音;“站在台阶上”涉及几何接触。前者需要观看结果和理解叙事,后者可以检查空间关系。Agent 必须区分这些要求,选择对应的表示与反馈,不能用同一个评分替代所有判断。 2. 多镜头怎样维护持续状态? 同一张角色参考图不足以记录刚拿起的杯子、视线方向或动作进度。场景工程能保存对象状态,仍需把剧本事件、时间轴与生成片段连接起来,否则换镜头后仍可能出现连续性错误。 3. 反馈怎样变成正确的局部修改? 遮挡可能来自站位、相机或剪辑时机;改站位又可能破坏接触。执行检查、场景验证、视觉判断和叙事理解各有作用。有效返修要定位对象、时间段和修改操作,并复查依赖,而不只是增加评委或重试次数。 4. 结构到外观怎样避免信息损失? 白模重绘可补充纹理,也可能改变边界、遮挡和接触。条件接口必须区分哪些约束不可变、哪些外观允许探索;仅凭泛化提示,很难同时做到保留运动和自由换风格。 5. 怎样衡量真正的交付质量与成本? 教学片看解释,产品片看外形和标识,叙事片看表演与剪辑;漂亮的单镜头不保证连起来成立。成本也应覆盖建模、废弃候选、重试与人工修整。只比单次调用价格,无法回答哪条路线更适合一部反复改稿的作品。 发展前景:让不同后端共享创作状态 共同的创作表示。 将剧本中的人物、道具和事件对应到场景实体、时间段与生成条件,让不同后端接续处理同一镜头。需要共享的是身份、动作和依赖关系,不要求所有后端具有相同内部结构。 约束下的局部编辑。 代码与三维工程已有明确的修改对象,生成模型还需要更强的区域、身份和时间保持能力。将编辑限制在指定对象或片段,并检查相关依赖,才能逐步接近实际剪辑和动画制作中的可控返修。 分阶段分配预算。 先用草图、白模和低分辨率视频解决故事、布局与时序,再精细渲染入选镜头。在创意分歧大或失败代价高的节点引入人工判断,由 Agent 承担可检验的执行与修复。系统的价值会越来越取决于能否稳定保留满意部分,完成第二版、第三版。 今日讨论 假如同一产品短片要反复更换卖点、机位和画风,你会把哪些内容保存在代码或三维工程中,哪些交给生成模型?你最希望下一版修改时保持哪一部分不变? 参考资料 Epic近期Agent工具链发布 DaS:2025年白模到视频条件示例 VideoCoCo 官方代码与示例 BlenderMCP 社区工具入口 人工智能炼丹君 | 2026-11-14 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
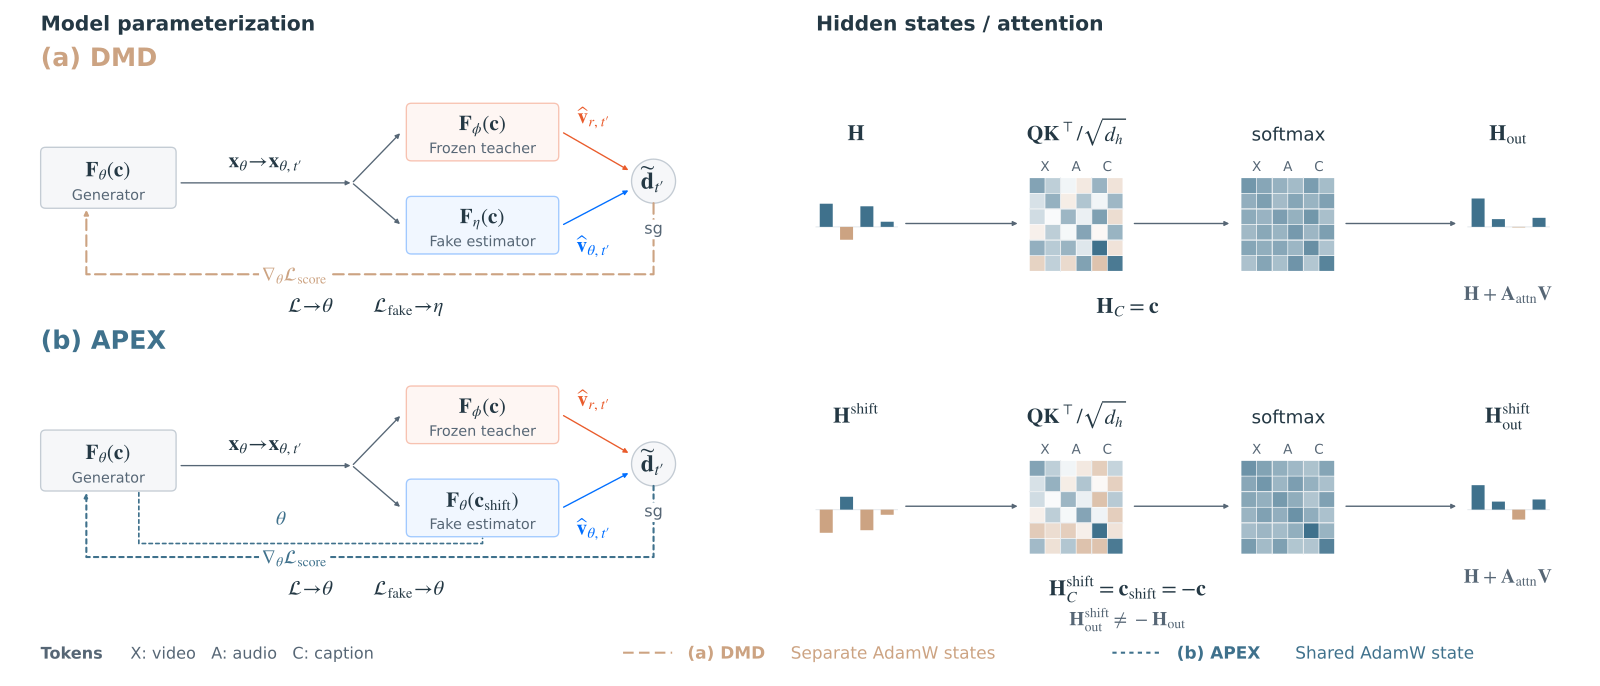
AIGC 每日速读|2026-11-13|清华流式视频指令偏好净胜30%-APEX 今日 AIGC 论文速览 今日共 10 篇 · 流式视频与偏好对齐 2 篇 · 生成加速 3 篇 · 几何视频与压缩重建 2 篇 · 图文生成 1 篇 · 语音与三维头像生成 2 篇 概览导读:三分钟流式视频中途改指令,人物仍要按要求行动。首篇 APEX 用同一网络兼做生成和假分数估计,70 例成对人工评测的指令遵循净偏好比 S2-Avatar 高 30 个百分点。接着看图像编辑与视频扩散缓存、稀疏注意力和语义 KV 压缩如何省计算;后半篇讨论视频偏好奖励、相机控制与压缩重建,再到文字图像、局部语音编辑和双人 3D 头像。不同论文的速度、质量和偏好口径不直接横比。 重点论文标题列表 APEX(清华):长视频指令偏好净胜30% IdealCache(电子科大):图像编辑缓存提速5.84倍 ESTRA(悉尼大学):视频注意力稀疏到5%仍清晰 SemanticKV(厦大):按指令保留视频记忆 GenRM-Flow(浙大):让视频生成器自己打偏好分 选读入口:想做会随指令变化的三分钟流式视频,先读 APEX;要给 Qwen-Image-Edit 或 HunyuanVideo 省推理时间,读 IdealCache;低密度注意力和长视频缓存预算分别看 ESTRA、SemanticKV。给视频生成器做偏好奖励读 GenRM-Flow;相机轨迹控制新画面看 UGG,极低码率重建看 ADE-GVC。海报中文字总拼错读 Four-Step DiT;多轮只改语音局部风格读 DialInstruct-TTS;双人虚拟头像的互动读 DiaHeads。 今日论文速览 1. APEX:长视频指令偏好净胜30% Few-Step Streaming Video Generation via Condition Shifting | 清华大学;生数科技;西湖大学 | arXiv:2611.14033 关键词:流式视频生成, 少步蒸馏, 条件偏移, 长视频, 指令遵循 前序问题:连续生成三分钟视频时,每个片段都要反复调用生成主干;常见分布匹配蒸馏另养一张“假分数”网络,增加训练显存和迭代时间。 方法直觉:同一生成器换一套文本条件,就让它在生成和估计自身分布之间切换;省掉独立假分数网络,仍保留冻结教师和生成历史回放。 本文贡献:把 APEX 的 condition shifting 扩展到流式视频:原文本条件负责出片,偏移后的条件负责估计生成分布的速度场;训练沿用 Self-Replay Forcing 和感知正则。这里的 NFE 是每片段对视频主干的调用次数,实验用 3 次,再接一次空间 Refiner。 Figure 2 : DMD and APEX in Self-Replay Forcing. DMD uses independent fake parameters η \eta ; APEX shares generator and fake parameters θ \theta and, by default, AdamW states. Teacher parameters ϕ \phi are frozen. Left: θ \mathbf{x}_{\theta} is the rollout/replay output, t ′ t^{\prime} the scoring time, ~ t ′ \widetilde{\mathbf{d}}_{t^{\prime}} the normalized correction, and sg \mathop{{\color[rgb]{1,0,0}\operatorname{sg}}}\nolimits stop-gradient. The correction contributes ∇ θ ℒ score \nabla_{\theta}\mathcal{L}_{\mathrm{score}} ; ℒ \mathcal{L} is the full generator objective. The fake-velocity subscript θ \theta identifies the generated distribution. Right: \mathbf{H} and out \mathbf{H}_{\mathrm{out}} denote input and output hidden states; C \mathbf{H}_{C} contains projected text tokens \mathbf{c} . Within each row, , , \mathbf{Q},\mathbf{K},\mathbf{V} are queries, keys, and values, and attn = softmax ( ⊤ / d h ) \mathbf{A}_{\mathrm{attn}}=\operatorname{softmax}(\mathbf{Q}\mathbf{K}^{\top}/\sqrt{d_{h}}) , with head dimension d h d_{h} . Superscript shift \mathrm{shift} marks states under shift = − \mathbf{c}_{\mathrm{shift}}=-\mathbf{c} . The single-head example uses fixed weights and omits the causal mask and other transformer operations; values are schematic. 实验效果:70 例、每例 180 秒的成对人工评测中,APEX 相对 S2-Avatar 的“指令遵循”净偏好为 +30.0%(胜率减败率),一致性和整体画质各 +4.3%;320 例 StreamAV-Bench 的 Progressive 指令分从 3.831 到 3.856。匹配训练设置下,峰值单卡分配显存低 4.4%,平均迭代时间短 9.2%,这是训练成本而非推理速度。 Figure 3 : Paired examples at 3 backbone NFE. (a) APEX retains both bags late in the sequence, while S2-Avatar shows one. (b) APEX brings the tube to the other hand for the applying instruction; S2-Avatar continues holding it at its side. Each pair uses the same reference and timestamps, with a common one-step 2 × 2\times Refiner. 批判点评:人工评测里运动质量偏向 S2-Avatar,音画同步多为平局;70 例三分钟长流和 3 NFE 加共同 Refiner 的结论不能外推到任意主干或时长。论文没有把少步采样写成相对 S2-Avatar 的端到端推理倍数。 2. IdealCache:图像编辑缓存提速5.84倍 IdealCache: Rethinking Cache Scheduling in Diffusion Transformers via Ideal Trajectories | 电子科技大学;独立研究者 | arXiv:2611.10340 关键词:图像编辑, 视频生成, 扩散加速, 特征缓存, 最短路径 前序问题:扩散 Transformer(DiT)的缓存通常模仿原始逐步去噪轨迹;但中间状态接近原轨迹,不保证最终编辑结果最好,还会把原轨迹当成隐形质量上限。 方法直觉:先定义希望到达的理想输出,再衡量跳过若干完整计算后偏离理想轨迹多少;把“在哪些步更新缓存”变成受计算预算约束的最短路径。 本文贡献:IdealCache 为每个输入构造候选目标形成理想轨迹集合,以缓存偏差作为图边权,离线搜索非均匀更新日程;推理时直接复用日程,不重训 DiT。ℬ 表示保留完整更新的预算,不是生成步数。原文覆盖 Qwen-Image、Qwen-Image-Edit 和 HunyuanVideo。 Figure 2: Cache deviation as edge weight. Starting from x t ∗ x_{t}^{*} on the ideal trajectory, a single full pass populates the cache with residuals Δ t , Δ t \Delta\mathbf{h}_{t},\Delta\mathbf{e}_{t} . We then take t − k t{-}k Euler updates that all reuse those residuals (red dashed), arriving at x ^ k \hat{x}_{k} . The squared distance to the ideal endpoint x k ∗ x_{k}^{*} is the cache-deviation edge weight w ( k → t ) w(k\to t) used in our graph. 实验效果:Qwen-Image-Edit 的 GEdit-Bench 上,ℬ=7 时批量为 1 的端到端墙钟速度为原 50 步的 5.84 倍,整体分 7.59;FlowEdit 上 ℬ=25 的背景保留 SSIM 从原流程 0.665 到 0.687,SSIM 越高表示与输入背景越相似。HunyuanVideo 在表内 ℬ=10 时为 4.32 倍。 Figure 3: Qualitative editing results on Qwen-Image-Edit. Our method achieves better background preservation in some cases while maintaining comparable editing quality. IdealCache with ℬ = 10 \mathcal{B}{=}10 ( ∼ \sim 4.2 × 4.2\times speedup) achieves visual quality comparable to the vanilla 50-step baseline. 批判点评:速度含文本编码、VAE 图像解码等固定开销,不等于单个 DiT 内核提速。FlowEdit 的 ℬ=10 背景 SSIM 0.679 仍较高,但 ImageReward 由原流程 1.054 降到 0.991;不同预算须在编辑保真和速度间取舍,离线理想轨迹构造也有成本。 3. ESTRA:视频注意力稀疏到5%仍清晰 ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration | 悉尼大学;澳大利亚联邦科学与工业研究组织 | arXiv:2611.10448 关键词:视频扩散, 稀疏注意力, 无训练加速, H20, 画质保真 前序问题:视频扩散 Transformer(DiT) 的长时空 token 让注意力昂贵;现有免训练稀疏法在密度很低时,近似误差会迅速破坏生成画面。 方法直觉:把计算预算留给真正重要的单个 key-value token;其余 token 由聚类代表近似,并根据组内离散程度修正代表权重。 本文贡献:ESTRA 先聚合相似 query 给单个 key 打分,再在 5% 或 1% 的精确交互预算内挑选 token;余下 key 用均值和方差校正模块(VCM) 表示。这里“密度”是精确计算的视频 query-key 交互占比,稀疏阶段之外还存在固定处理成本。 Figure 2: ESTRA overview. (a) Independent query and key clusters provide query centroids and K/V means. (b) Each centroid scores individual keys for selection shared by its query cluster. (c) VCM uses remaining-key spread and query norms to calibrate representative weights. (d) Original queries attend jointly to selected tokens and fixed cluster means, with log-count and VCM biases on representative logits. Colors identify clusters. Attention scaling is omitted. 实验效果:原文在 NVIDIA H20、720p、无密集预热的 Wan2.1-14B(81 帧)上,5% 密度端到端从 6838 秒到 2097 秒,即 3.26 倍;HunyuanVideo-13B(129 帧)从 6490 到 1378 秒,即 4.71 倍。其与密集输出的 Wan 画面 SSIM 为 0.489,高于 Sol-Attn 12.8% 密度时的 0.283;SSIM 越高表示结构越接近密集参考。 Figure 1: High-quality video generation at up to 99% attention sparsity. At 5% exact-interaction density, ESTRA more closely preserves the composition and appearance of the dense references than the baselines shown, while using higher sparsity and achieving greater end-to-end speedups. At 1%, the videos remain visually coherent, with particularly small changes in the HunyuanVideo example. Density denotes the fraction of video query–key interactions evaluated exactly; speedups are end to end on an NVIDIA H20. Additional examples are provided in Appendix D . 批判点评:把 5% 密度误读成整体计算量仅 5% 会夸大收益;在 1% 密度,Wan 的 VBench 动态程度从密集参考 66.98 降到 61.87。该时间受 H20、帧数、分辨率和具体内核影响,跨机器不可直接照搬。 4. SemanticKV:按指令保留视频记忆 Semantically Aligned KV Cache Compression for Efficient Agentic Autoregressive Video Generation | 厦门大学 | arXiv:2611.11452 关键词:自回归视频生成, KV 缓存, 语义约束, 长视频, 显存 前序问题:自回归视频越生成越长,历史帧的 键值(KV)缓存占满显存;普通压缩只看注意力热度,可能删掉对提示词中人物、动作和物件仍重要的状态。 方法直觉:先从计划中抽取必须遵循的语义约束,再找各约束关注的历史位置;每组都能为某个缓存 token 投票,避免少数约束被平均淹没。 本文贡献:SemanticKV 不重训生成器:文本交叉注意力定位语义相关视频位置,收集其自注意力 query;组内平均、组间取最大后做一次 top-k 保留,并维持剩余键值与位置不变。这里保留预算按字节约束,0.7 压缩率指约删去 70% KV。 Figure 2: Overview of SemanticKV . Semantic constraints ℛ \mathcal{R} are matched to prompt tokens. Text cross-attention identifies related video positions, from which we collect the generator’s self-attention queries. Their attention to each KV entry is averaged within groups and maximized across groups. A single top- k k selection retains high-scoring entries within the byte budget, together with states required by the backbone. Retained keys, values, and positions remain unchanged. 实验效果:Causal Forcing 的 5 秒视频综合评测 VBench、0.7 压缩率下,综合分 Total Score 为 84.10,对比最强压缩基线 84.05 和 Full KV 83.99;DiT-only FPS 提升 1.22 倍,KV 从 6.04 GB 到 1.81 GB。LongLive 2.0 的 60 秒实验中,KV 从 20.76 GB 到 6.23 GB,但 VBenchLong 总分从 80.12 降到 78.84。 Figure 4: Paired semantic fidelity on matched prompt–seed tuples. (a) Tie-aware superiority rates. (b) Mean paired differences with prompt-clustered bootstrap 95% confidence intervals. Positive differences favor SemanticKV ; Full KV is the uncompressed reference. 批判点评:方法依赖规划器提出的约束,漏掉的细节未必获保留;5 秒的分数优势很小,也不能等同于所有长视频质量提升。速度数字是 DiT-only,未含规划、筛选和验证全链路。 5. GenRM-Flow:让视频生成器自己打偏好分 GenRM-Flow: Generators are Process-aware Reward Models in Flow Matching | 浙江大学;Joy Future Academy;厦门大学;清华大学 | arXiv:2611.11421 关键词:视频生成, 偏好对齐, 流匹配, 奖励模型, FlowAWR 前序问题:视频偏好对齐常靠外部视觉语言模型或附加判别头评分;评分器没有直接使用视频生成器在噪声潜空间里的预测能力。 方法直觉:偏好微调后的生成器与冻结原模型,对同一视频的速度预测误差差值,本身可读成逐时刻奖励;用这份奖励替代外部判官指导再训练。 本文贡献:GenRM-Flow 从离线偏好目标推导隐式过程奖励:在流匹配噪声状态上比较当前策略与参考策略的速度预测误差,不新增打分头;将它接入按奖励加权微调视频生成器的 FlowAWR。文中不同偏好训练目标都是到目标策略的路径,不是附加奖励网络。 Figure 2: The pipeline of GenRM-Flow . (Panel A) Traditional paradigms rely on representational capacity , utilizing a frozen backbone (e.g., a VLM or base generator) as a feature extractor coupled with an auxiliary discriminative head. (Panel B) The proposed framework sources the reward directly from generative capacity . Following preference optimization, the implicit reward R D ( , c ) R^{D}(\mathbf{x},c) is algebraically extracted from the velocity-prediction errors. The scalar score is computed natively by contrasting the active policy (flame, θ ⋆ \theta^{\star} ) against a frozen reference (snowflake, θ ref \theta_{\mathrm{ref}} ), requiring no architectural modifications or auxiliary heads. 实验效果:原文留出偏好对比集上,Wan2.1-T2V-1.3B 的平均成对预测准确率为 86.79%,PAVRM 为 76.06%;同主干接入 FlowAWR 后,VBench 的动态程度从 PAVRM 的 67.83 到 73.46。14B 主干对应动态程度为 71.82 到 74.87;这些是作者协议内结果。 Figure 4: Qualitative comparison between PAVRM and GenRM-Flow as the per-step reward signal in FlowAWR with a 1.3B backbone. Both runs use FlowAWR with the same configuration, differing only in the reward signal. Red boxes mark localized structural deformations, spatial inconsistencies, and temporal artifacts produced by PAVRM. Across scenes, our reward yields visibly fewer geometric defects and better spatial and temporal continuity. 批判点评:奖励要运行当前与参考生成器的速度预测,不能把“无附加头”误写成零额外计算;奖励依赖已微调策略及参考策略。论文的原始奖励不做组内归一化时约 250 步出现策略坍塌,训练稳定性需要单独处理。 6. UGG:相机轨迹控制视频也补几何 UGG: Unified Generative Geometry Model | 麻省理工学院;加州大学圣迭戈分校;剑桥大学 | arXiv:2611.14440 关键词:相机控制视频, 4D 场景生成, 深度预测, 相机姿态, 条件补全 前序问题:给视频第一帧和相机轨迹,要补出连贯的中间画面;单独训练视频生成与几何预测模型,常让画面、深度和相机姿态彼此不一致。 方法直觉:把已看到的 RGB、深度和相机射线设为干净 token,缺失部分设为带噪 token;同一模型以“补空缺”完成视频生成或几何预测。 本文贡献:UGG(Unified Generative Geometry Model)将 RGB、深度及用密集射线图表示的相机姿态放进统一 transformer;各模态有专属投影和前馈层,共享多模态自注意力。还可采样多个可能场景并用可观测图像的几何证据选择。原文已接收 NeurIPS 2026。 Figure 2: Generative-predictive transformer. We model RGB, depth, and camera pose as spatially aligned tokens, with camera pose represented as dense ray maps. Partial observations are zero-noise context tokens, while missing modalities are noisy tokens to be denoised. A unified transformer processes all tokens with modality-specific projections and feed-forward layers together with shared multimodal self-attention, enabling information exchange across modalities. The decoded RGB, depth, and ray maps form a complete 4D scene representation for cross-modal generation, geometric prediction, and inference-time consistency search. 实验效果:RealEstate10K 双端点帧加目标相机轨迹的视频补全中,UGG 的 峰值信噪比 PSNR 为 25.73 dB、感知距离 LPIPS 为 0.061,对照 SEVA 为 25.25 dB、0.081;PSNR 越高、LPIPS 越低通常表示与真值更接近。但 DL3DV 同设定中,UGG 的 PSNR 16.61 dB 低于 SEVA 的 17.61 dB。 Figure 4: Qualitative comparison of camera-controlled generation. Given the first and last RGB frames and a target camera trajectory, we compare generated intermediate frames against ground truth and baseline video generation methods. UGG better preserves scene identity and dynamic content compared with the generic video completion baselines. 批判点评:“统一”不意味着每个数据集都最好;DL3DV 是明确反例。画面指标依赖真值和给定相机轨迹,也不直接证明开放世界长视频的物理一致性;测试时多样本搜索会增加推理成本。 7. Four-Step DiT:四步画海报字更准 Four-Step Text-Bearing Image Generation via Distillation with Local Response Regularization and Teacher-Guided Training | 清华大学 | arXiv:2611.12042 关键词:图文生成, 扩散蒸馏, 文字渲染, GLM-Image, 四步采样 前序问题:文字海报要同时画好场景和拼对字;把 50 步图像模型压成四步后,字符细节往往先坏掉。 方法直觉:让学生模型的局部去噪响应更平稳,同时用教师图像和合成字符串分阶段喂给它,使少数几步既管布局又管字形。 本文贡献:研究在 GLM-Image 的扩散 Transformer(DiT) 的分布匹配蒸馏中加入局部响应路径长度正则,并保留冻结的自回归视觉先验、字形编码器与 VAE;文字训练从短字符串逐步走到密集布局。四步是学生去噪转移次数,教师是 50 步,不能直接当成端到端 12.5 倍。 Figure 2: Four-step distillation with complementary response and data supervision. Frozen autoregressive and glyph encoders retain semantic and character conditions. Distribution matching transfers teacher synthesis behavior, while the path-length term regularizes the student’s local response. Teacher-guided progressive training combines explicit text examples with visually integrated typography; the VAE remains fixed. 实验效果:原文 1024×1024、NVIDIA A100 的单图推理从教师 5.818 秒到学生 1.742 秒,端到端快 3.34 倍,两者仍需 40 GB GPU 内存。CVTG-2K 单词准确率为 0.5045,四步 TDM 为 0.1690;图像组合生成评测 GenEval Overall 为 0.84 对 0.81。单词准确率是所生成文字与目标文本匹配的比例。 Figure 6: Qualitative comparison of four-step GLM-Image students. Within each three-column group, outputs are ordered as the student without text training, TDM, and our complete framework. Cases cover (a) an English poster, (b) a Chinese poster, (c) a bilingual sign, (d) product packaging, (e) multiline text, (f) a bilingual display, (g) object counting, and (h) spatial relations. The examples illustrate differences in literal text preservation, object counts, and spatial arrangement while retaining coherent scene appearance. 批判点评:加速来自蒸馏与专门文字训练,付出教师生成数据和训练成本;推理显存没有下降。数值只覆盖文中主干、A100 和评测集,不能据此保证任意长文本都不拼错。 8. ADE-GVC:按画面失真选视频去噪起点 When to Start Denoising? Adaptive Denoising Entry for Generative Video Compression | 北京航空航天大学;阿里巴巴集团;香港科技大学 | arXiv:2611.13620 关键词:生成式视频压缩, 扩散重建, 自适应去噪, 视频保真, 码率 前序问题:超低码率视频压缩会丢掉细节;扩散模型从固定噪声时刻开始重建,对失真轻重不同的片段常在保真与真实感之间失衡。 方法直觉:让轻度和重度压缩失真走不同的去噪起点,再把压缩痕迹作为时序条件输入视频扩散 Transformer(DiT);这样重建力度可随内容调整。 本文贡献:ADE-GVC 由潜变量压缩网络、时间适配器、起点预测器和视频扩散模型组成;预测器从压缩潜变量估计起始时刻 τ,适配器提供压缩感知条件。它输出的是原视频的压缩重建,不是从文本自由生成新视频。 Figure 3 : The overall architecture of ADE-GVC consists of a latent compression network (LCN), temporal adaptor (TA), timestep predictor (TP), and video diffusion model. The input video g \bm{V}_{g} is encoded into the clean latent 1 \bm{x}_{1} , which is compressed by the LCN into c \bm{x}_{c} and a compression-aware feature t \bm{f}_{t} . The TP predicts the denoising entry τ \tau from c \bm{x}_{c} , while the TA converts t \bm{f}_{t} into the visual context v \bm{c}_{v} . Conditioned on v \bm{c}_{v} , the VideoDiT denoises τ c \bm{x}^{c}_{\tau} , into ^ 1 \hat{\bm{x}}_{1} , which is decoded to reconstruct ^ 1 \hat{\bm{V}}_{1} . 实验效果:以 S²VC 为 BD-Rate 零点,HEVC-B 的感知距离 DISTS 口径 BD-Rate(等质量平均码率差) 为 −56.4%,GLC-Video 为 −13.4%;负值表示在相同感知失真水平下平均所需码率更低。论文另对 1920×1080、96 帧平均解码计时:优化后的 0.831 秒对原始 4.341 秒,约 5.11 倍,但这是其自身实现优化对照。 Figure 7 : Qualitative comparisons on a single frame in terms of representative VVC, PLVC, GLC-Video and our ADE-GVC methods. We also report the Bpp/DISTS metrics to quantify compression efficiency. 批判点评:不同指标口径会得出不同节省值,不能把 DISTS 与 PSNR 下的百分比混成一个总收益。起点预测和时间适配器需要训练;表中解码加速是并行化、编译和 bf16 累积作用,不是仅由自适应去噪带来。 9. DialInstruct-TTS:多轮只改一句话的语气 DialInstruct-TTS: Interactive Expressive Speech Generation via Multi-Turn Dialogue with Fine-Grained Temporal Control | 奈良先端科学技术大学院大学 | arXiv:2611.13875 关键词:语音生成, 多轮语音编辑, 局部风格控制, TTS, 内容保留 前序问题:一次性文本转语音(TTS)指令往往给整句话同一种语气;想只把中间一段改成低声说,通常要重写指令并重生成全句,已满意部分也会变化。 方法直觉:对话规划器每轮汇总最新要求和历史,形成按时间定位的风格计划;只修订目标潜变量,锁定其余片段。 本文贡献:DialInstruct-TTS 用 Qwen 系列规划器形成标出时间段与风格的 TemporalPlan,再由时序声学控制模块调整情绪、语速、音量和发声方式;reference-latent revision 负责保留非目标区域。它是生成语音的交互式局部编辑,不是通用对话代理。 Figure 2: Architecture of DialInstruct-TTS 实验效果:原文全局风格主观评测中,指令匹配均分为 4.283,对照 Qwen3-TTS 为 3.077;五轮语速修改中,“目标控制与内容都成功”为 15/20,有无非目标锁定的对照为 6/20。30 次最终偏好比较,多轮修订获 29 票,完整重述获 1 票;都是论文的指定主观协议。 Figure 4: Mean subjective ratings and final preference for full-restatement and multi-turn revision. Final preference is 1/30 versus 29/30, with no ties. Means are shown without error bars; numerical results are in Appendix E.4 . 批判点评:局部控制并不各项都稳:同一消融里音量修改成功仅 4/20。多轮流程引入规划和反复合成开销,论文偏好票数不能换算为统一的端到端编辑成功率。 10. DiaHeads:双人对话头像一起动 DiaHeads: Jointly Generating Coordinated 3D Dialogue Heads with Non-verbal Cues from Dual Audio | 中国科学技术大学 | arXiv:2611.06970 关键词:3D 头像生成, 音频驱动, 双人对话, 非语言动作, 注视 前序问题:各自按音频生成说话头像,容易得到两张嘴都动却没有互相看、点头或等待反馈的双人画面。 方法直觉:把两人的音轨放进同一条件,再让注视、摇头、点头、微笑四类离散提示和连续头部动作共享潜空间;模型一次生成两个人的动作。 本文贡献:DiaHeads 冻结双路 HuBERT 编码音频,用变分编码器融合连续 FLAME 头部参数与四类非语言 cue;时间相关的 flow prior 替代独立高斯先验,共享解码器同时输出两位参与者。FLAME 是 3D 人头参数模型。 Fig. 2: Overview of the proposed DiaHeads. The audio streams of both interlocutors are encoded by two frozen HuBERT backbones and fused into a conditioning vector c c by a transformer. A dual-branch variational encoder processes the continuous parameters ( F , G ) (F,G) and the discrete cues N N in separate branches, each conditioned on c c through FiLM modulation, and the two branches are combined through a product-of-experts posterior z ∼ ( μ , e σ / 2 ) z\sim\mathcal{N}(\mu,e^{\sigma/2}) , shown as the “Low-level Motion Encoder” and “High-level Cue Encoder”. A flow-based prior built from five residual coupling blocks, each consisting of a flip operation and a Conv1D coupling layer, replaces the standard Gaussian prior, and a shared VAE decoder, conditioned on c c through FiLM, jointly reconstructs the head parameters Y ^ \hat{Y} and the discrete cues of both interlocutors. The units at the bottom right detail the two SyncNet encoders, which are built from 1D convolution, batch normalization, and ReLU. 实验效果:CANDOR-FG 双人数据上,交互 DTW(两人动作时序不匹配程度,越低越好)为 0.3171,对照双人基线 DIM 为 0.7526;盲选中 DiaHeads 获 58 票,SadTalker 33 票、DIM 17 票。但单人头部 FLAME MSE 为 0.6662,高于 SadTalker 的 0.5523,精细动作保真并非全胜。 Fig. 5: Qualitative comparison of generated 3D head animations over a 30 s dialogue clip. Participant A is shown in blue and participant B in orange. Each method occupies two rows labeled A and B, sampled every 2.5 s. Our method produces appropriate mouth movements during overlapping speech at 8 s, marked by the purple box, and responsive nodding with mutual gaze at 20–23 s, marked by the yellow box, while the baselines show incorrect lip-sync and lack interactive behaviors. 批判点评:论文展示的是 3D 头像动画参数,不是直接输出真人视频;双人数据和四种 cue 限制了外推范围。交互协调改善与单人几何误差存在取舍;原文仅称准备投稿 IEEE Transactions on Multimedia,未写成已接收。 趋势观察 视频生成的计算预算不再只数采样步 APEX 省掉训练时的独立假分数网络;ESTRA 压低注意力精确交互,SemanticKV 精简历史缓存。三者改变的是不同成本,不能把倍数直接相加。 编辑和生成更看最终条件满足 IdealCache 用理想输出搜索缓存日程,UGG 用相机轨迹和几何共同约束中间帧,DialInstruct-TTS 则锁住语音中不需修改的区间。 评测必须保留反例和口径 APEX 的运动质量并非胜出;UGG 在 DL3DV 双端点帧设置的 PSNR 落后 SEVA;SemanticKV 的 60 秒总分低于 Full KV。 今日讨论 APEX 在 70 例三分钟视频中得到指令遵循 +30.0% 净偏好,但运动质量偏向 S2-Avatar。若为一条中途多次换商品动作的直播片段选生成器,你会怎样同时检验指令执行、人物连续性和动作自然度,何时不应为了指令偏好牺牲运动质量? 人工智能炼丹君 整理 | 2026-11-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
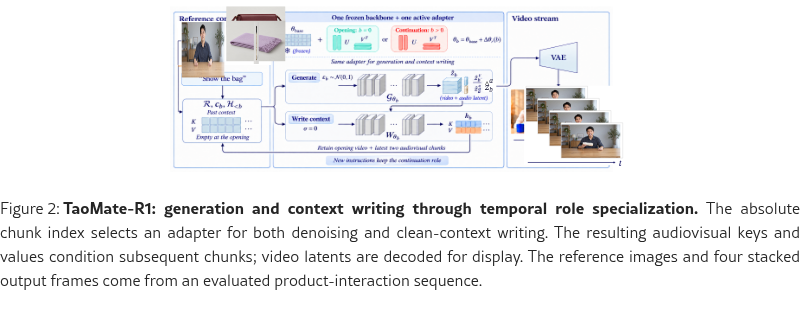
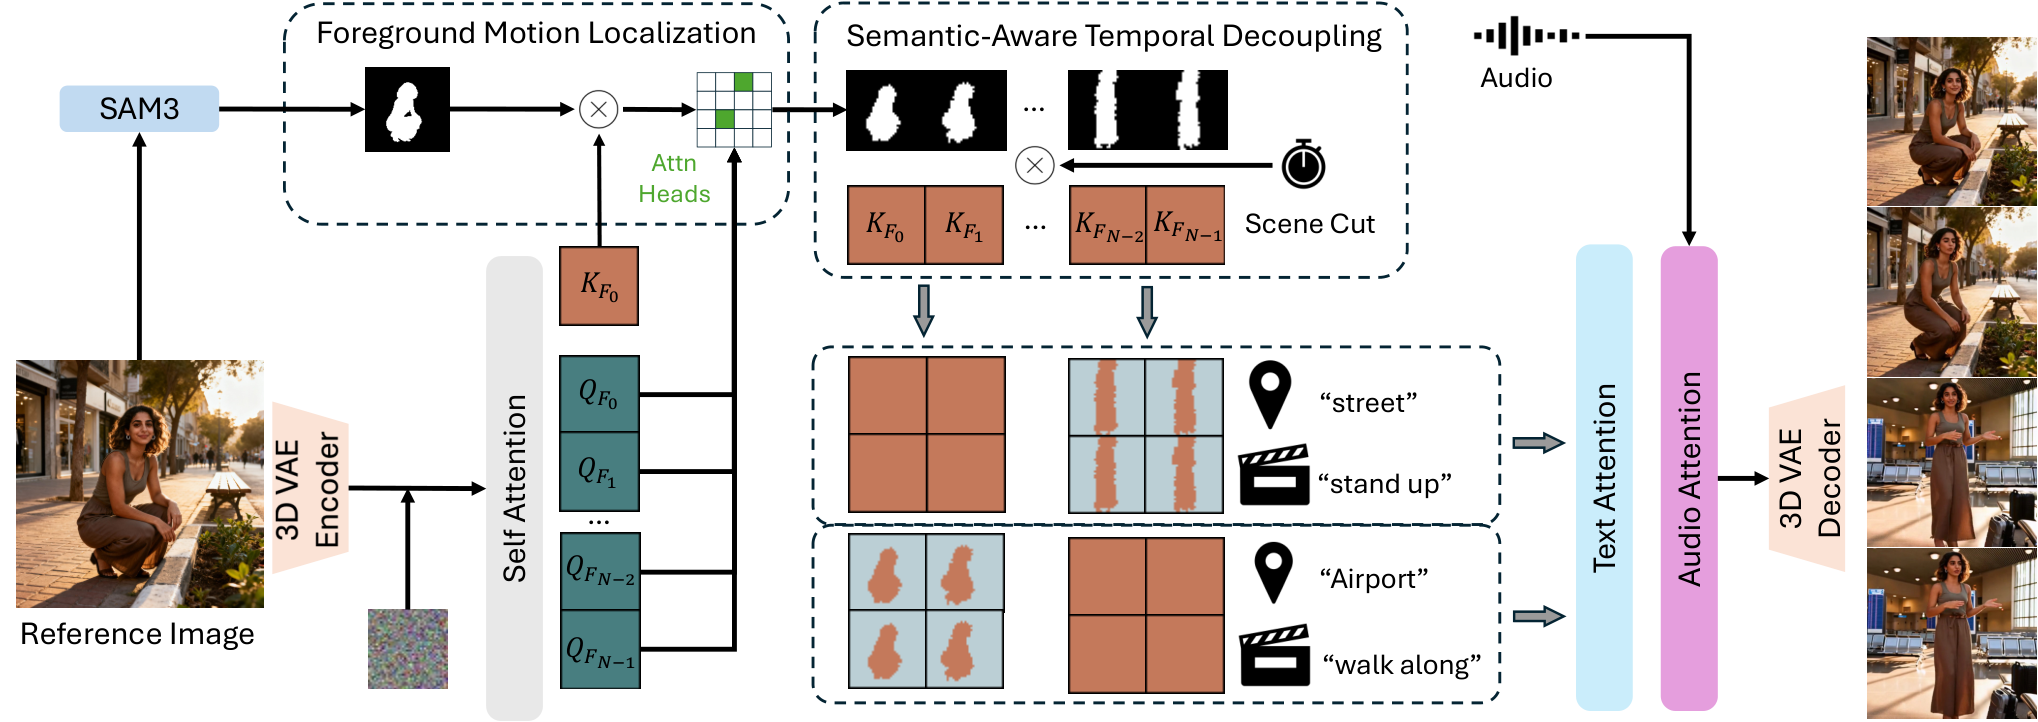
AIGC 每日速读|2026-11-12|阿里多参考长视频换指令不断档-TaoMate-R1 今日 AIGC 论文速览 今日共 10 篇 · 多参考与广告视频审修 2 篇 · 多场景视频与生成加速 3 篇 · 几何控制与图文生成 2 篇 · 三维动作生成 1 篇 · 生成结果评测 2 篇 重点论文标题列表 TaoMate-R1(阿里):多参考长视频换指令不断档 Review-and-Edit(Anoki):广告视频问题一键找到修复入口 OneReel(伊利诺伊大学香槟分校):多场景视频只共享少量关键帧 MG-Cache(北京邮电大学):视频去噪按时间层级双重缓存 FADE(四川大学):预测弯曲去噪轨迹少算视频 选读入口:要用多张参考图连续拍人和商品,先读 TaoMate-R1;要从广告成片定位错误并派给修复工具,读 Review-and-Edit。想控制跨场景一致性读 OneReel;要在既有 DiT 上提速,对照 MG-Cache 的缓存内存和 FADE 的离线校准。要画准钟表与披萨比例读 Angular Control;要让图文长文配图对位读 UniWeaver;做长序列 3D 动作看 FlashMotion。评估改图判官和视频物理常识,分别读 EditJudge-Bench 与 PhyRubric。 今日论文速览 1. TaoMate-R1:多参考长视频换指令不断档 TaoMate-R1: Temporal Role Specialization for Streaming Multi-Reference Video Generation | 阿里巴巴集团 | arXiv:2611.14307 关键词:视频生成, 多参考生成, 流式生成, LoRA, 场景连续性 前序问题:指定人物和商品后连续拍两分钟,提示词中途换动作或物品;按片段生成常在接缝处换掉人物、房间或亮度。 方法直觉:把“开场建景”和“后续延续”当成两种时间职责,各自用一套低秩适配器;同一职责既生成当前片段,也写入下一段要看的历史。 本文贡献:TaoMate-R1 在冻结的 MiniMax H3 主干上配两组 LoRA,而非按去噪与写历史两种操作分组。Self Gradient Forcing 让开场和延续适配器沿自己生成的历史联合训练。32 个多参考案例采用相同两适配器预算比较。 Figure 2: TaoMate-R1: generation and context writing through temporal role specialization. The absolute chunk index selects an adapter for both denoising and clean-context writing. The resulting audiovisual keys and values condition subsequent chunks; video latents are decoded for display. The reference images and four stacked output frames come from an evaluated product-interaction sequence. 实验效果:在 10 条约两分钟、指令会变化且共用教师音频条件的长流上,相对按操作分组,接缝平均亮度跳变从 1.96 降至 0.613;接缝 DINO 特征相似度从 0.973 到 0.990。DINO 是图像特征相似度,数值越高通常表示相邻帧外观更接近。该比较没有统一报告端到端推理延迟。 Figure 6: Scene continuity over a two-minute interaction. Each row combines the first frame’s left half, centre columns sampled every 0.5 s, and the last frame’s right half (case 006, 119 s). Grey ticks mark instruction changes; endpoints retain native aspect ratios. The bands contrast composition changes in clip-wise generation with stable presenter and table geometry in the TaoMate-R1 stream. 批判点评:这是按参考生成新音视频,不是对现成视频直接编辑。接缝更平稳不等于所有指令都执行成功:长流的问答遵循分为 0.980,按操作分组为 1.00;结论依赖这套主干、两适配器预算和共享音频条件。 2. Review-and-Edit:广告视频问题一键找到修复入口 Multimodal Judges Flag, Humans Decide: A Review-and-Edit Framework for AI-Generated Product Video Ads | Anoki 公司 | arXiv:2611.13178 关键词:生成视频审阅, 视频编辑, 商品一致性, 多模态评测, 人工复核 前序问题:电商商品页自动变成短广告后,镜头里商品形状、文案、旁白或字幕可能错;只给整条广告打一个好坏分,编辑者不知道该修哪一幕。 方法直觉:把广告按场景和六类问题拆开,让多模态 judge 先指出时间点与依据,再由人确认;每条确认的问题直达对应编辑工具。 本文贡献:系统检查商品、场景质量、发音、脚本、声音和字幕。门户把模型发现与商品照片、事实资料并列给审阅者;确认后可借别条广告的镜头、重生镜头、做视频到视频编辑或局部高分辨率修复。这里的核心是审修流程,视频生成与修复工具作为可替换后端。 Figure 3 : The production portal. Panels (a) to (c) show the review and panel (d) the edit page. (a) The review page for one ad: 1 the ad and its scenes, 2 the six questions, collapsed, each tagged when a judge flagged it, and 3 the evidence: the catalog photos, product facts, brand kit and script. (b) 4 A judge’s finding sits inside the question with its scene, kind and evidence; the reviewer accepts or rejects each with a thumbs up or down and 5 answers below, where “Product wrong” then asks which scenes are at fault. (c) 6 The scene judges’ finding above 7 the per-scene grid, with keep, swap out or no opinion for each scene, and 8 the secondary options for the kind of problem. (d) On the edit page: 9 the scenes with confirmed issues; 10 a confirmed issue opens the scene tool on its scene, with 11 the scene’s versions and 12 ways to change it: another ad’s scene of the same product, a new scene, or Repair, which fixes the scene in place, today by regenerating its clip at higher resolution. 实验效果:在自家流水线的 120 条广告、562 个场景中,辅助审阅标记约 60% 的场景有商品问题。对其中 60 条广告,辅助审阅的多数标记率为 58%,隐藏 judge 后两名审阅者为 26%;两组不能直接视作随机对照。另在盲标的 120 个场景上,商品 judge 的 AUC 为 0.84;它召回 29 个缺陷中的 26 个,但 56 个告警中仅 26 个是真缺陷。 Figure 2 : One generated 15 s ad ( video in our release) as judges and reviewers reviewed it, one row per question. Reviewers accepted the judges’ product findings and rejected nearly all of their pronunciation findings. They also marked the S3 and S4 captions and added two problems the judges missed in S2: an impossible motion in the scene and an unsupported claim in its line. 批判点评:高召回带来较多误报,必须保留人工决定;实验证据来自单一市场、英语旁白和一条内部生成流水线。研究没有证明全自动编辑或审核耗时一定缩短。 3. OneReel:多场景视频只共享少量关键帧 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学香槟分校;得州大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 稀疏注意力, 共享记忆, 多GPU 前序问题:多场景视频若所有帧彼此全连接,注意力成本随场景数迅速膨胀;分场景单独生成又容易让人物和物体跨场景变样。 方法直觉:场景内部保持完整注意力,跨场景只交换被挑出的代表帧;提示词和时长先划定每个场景的作用范围。 本文贡献:OneReel 无需再训练生成主干:对每个场景保留本地注意力,把聚类选出的潜变量代表帧放进有界共享记忆;再把本地及共享 K/V 打包为连续的可变长注意力输入,并按通信成本选择多 GPU 分工。理论上的跨场景注意力随场景数由平方变线性。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种生成模型的实验相对稠密注意力报告端到端 1.7–4.9 倍加速。40 个多场景请求中,HunyuanVideo-1.5 480p 的文本遵循分从稠密的 27.7 提至 61.9;同表的动作分从 34.5 到 64.1。分数只在论文这套多场景提示与评测协议下可比,性能还依赖共享记忆和多 GPU 打包实现。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:需事先给出场景提示及持续时间;代表帧太少会漏掉跨场景细节,太多则削弱加速。作者对一分钟长视频另加场景局部 RoPE,说明注意力作用域之外的时间位置编码同样影响效果。 4. MG-Cache:视频去噪按时间层级双重缓存 MG-Cache: Multi-Granularity Caching for Accelerating Diffusion Transformer Inference | 北京邮电大学 | arXiv:2611.11365 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 多粒度缓存 前序问题:扩散 Transformer 要重复计算几十次;各时间步和各层变化程度不同,统一跳过容易积累误差,高清长视频尤其耗时。 方法直觉:先用小批校准样本找出可跳过的去噪时间步,在线再按各层输入变化和重要性决定是否复用注意力或 MLP 的中间特征。 本文贡献:MG-Cache 的第一阶段离线分析时间步冗余,第二阶段对层内模块按稳定度与敏感度动态缓存;无需重新训练生成模型。论文在 HunyuanVideo 与 FLUX.1-dev 上同时测速度、画质和相对未缓存输出的保真度。 Figure 2 : Overview of the Multi-Granularity Cache (MG-Cache). We design a two-stage strategy to exploit computational redundancy during inference. Stage 1 performs a static offline analysis to identify and preserve critical timesteps based on a timestep feature table [ M ^ t ] [\hat{M}_{t}] constructed from a small batch of calibration dataset. Stage 2 introduces a dynamic layer-wise caching mechanism that computes layer importance scores and input stability to adaptively determine whether to reuse cached features. 实验效果:HunyuanVideo 文生视频、544×960、129 帧、原始 50 步条件下,慢档由 982.03 秒降至 358.86 秒,即 2.74 倍;VBench 从 75.45% 到 75.14%,PSNR 27.44 dB 是相对原始输出的像素保真度。bf16 层缓存对该分辨率需 49.8 GB,论文使用内存卸载;因此速度收益不能脱离缓存容量与数据搬运谈。 Figure 1 : Visual quality comparison. While achieving a higher speedup than baselines, our method also maintains superior fidelity to the original output. For instance, in the first row (Prompt 1), other methods exhibit blurring on the text "stop," whereas our method preserves text sharpness. 批判点评:离线校准和高分辨率层缓存是额外成本。快档可进一步提速,但同表 VBench 降到 74.13%;部署需按显存、内存和质量目标调阈值。 5. FADE:预测弯曲去噪轨迹少算视频 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:视频生成加速, 图像生成加速, Diffusion Transformer, 特征预测 前序问题:缓存法在跳过多个去噪步时通常按直线或整数阶变化外推特征;遇到弯曲且随时间变化的轨迹,误差会累积。 方法直觉:用分数阶动力学描述特征轨迹的弯曲程度;先离线测好各阶段和层的参数,在线按查表结果在完整计算和预测步之间交替。 本文贡献:FADE 用 Mittag–Leffler 分数阶算子外推 DiT 中间特征,离线校准最合适的阶数并存入多维查找表;推理时按时空位置取参数,减少被跳过步骤的计算且不微调主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频的同表条件下,原始 50 步耗时 190.2 秒、VBench 80.68%;FADE 在 N=6、m=1 设置下耗时 37.9 秒、VBench 80.12%。按列出的延迟相除,墙钟加速约 5.02 倍;表中 Spd. 列的 5.56 倍与 FLOPs 比 29,773/5,359 一致,两个口径不应混写。同预算 HiCache 为 37.8 秒和 79.93%,FADE 主要改善该表的质量而非进一步缩短时延。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:收益依赖离线校准的查找表及具体主干;换架构或采样预算需重新标定。VBench 相对原始生成仍下降 0.56 个百分点,不能把“保真”写成无损。 6. Angular Control:让画出来的时钟真指向指定时刻 Continuous Angular Control in Text-to-Image Generation via Geometric Token Encoding | 毕尔肯特大学;CISPA 亥姆霍兹信息安全中心;弗赖堡大学 | arXiv:2611.13172 关键词:图像生成, 几何控制, 扩散模型, 角度编码 前序问题:让文生图模型画 10:10 很容易,要求 1:45 时两根针常常还是落回惯见姿势;要求披萨只剩指定圆弧比例也有类似问题。 方法直觉:把时针、分针或扇区边界的角度编码成周期性的正弦和余弦 token,直接放进提示词;训练时由局部约束逐步放松到整物体约束,让数字位置落到正确部件。 本文贡献:该法在冻结文本编码器前插入角色专属几何 token,并用 LoRA 调整 SD 2.1 去噪器。Stochastic Localization Relaxation(SLR)混合部件框、物体框和无定位三种训练监督;推理无需输入框。另用指针互换偏好损失防止时针和分针角度对调。 Figure 2 : Left: Overview of our geometric token encoding framework, illustrated for clock-time control. The target clock time ( h , m ) (h,m) or fraction-sector boundaries are encoded as sinusoidal pairs and mapped through the projection network P P to produce role-specific geometric tokens h , m \mathbf{e}_{h},\mathbf{e}_{m} (or s , e \mathbf{e}_{s},\mathbf{e}_{e} ) injected into the prompt before the frozen text encoder. Both tasks share the same MLP architecture and condition a LoRA-adapted SD 2.1 denoising U-Net. Right: Stochastic Localization Relaxation (SLR). Training samples one of three localization regimes (55/30/15%): component-level CALL using component boxes, object-level CALL using a shared object box, and unconstrained standard cross-attention. No localization input is required at inference. 实验效果:时钟 Acc@6° 指两针都在目标角度 6° 内;四种未微调基线均低于 1%,本法在不同读图器下约 63–78%。圆形物体比例误差不超过 0.10 的 Acc@0.10,训练类为 89.5%,未见过的物体类为 88.8%,未见过的比例为 84.9%;基线约 20%。这些数字来自带精确角度标注的任务数据。 Figure 8 : Qualitative comparison of the original periodic encoding and the augmented encoding with the scalar fraction f f near the angular boundaries. The periodic encoding produces small sectors near 0 ∘ 0^{\circ} but may generate narrow slices even for complete-sector targets ( 360 ∘ 360^{\circ} ), reflecting its endpoint ambiguity. Adding f f distinguishes the endpoints and enables complete-object generation, but can produce oversized sectors for small target angles ( 1 ∘ 1^{\circ} – 5 ∘ 5^{\circ} ). Results are shown for pizza, pie, and cake. 批判点评:必须有任务专用的几何标注与训练;复杂场景或部件不清时精度会下降。0° 与 360° 的周期编码端点相同,附录增加比例标量虽能区分整圆,却可能放大小角度扇区。 7. UniWeaver:把文字和配图按任务一起编排 UniWeaver: Harnessing Unified Multimodal Models for Interleaved Text-Image Generation | 俄亥俄州立大学;伦敦大学学院;香港中文大学;香港科技大学(广州);香港大学 | arXiv:2611.13530 关键词:图文交错生成, 多模态生成, 规划, 视觉反馈 前序问题:用户只说“做一份操作指南”,统一多模态模型常先写完一段再补图,图与步骤错位,关键步骤也可能没有画面。 方法直觉:先确定每一段要讲什么、配什么图和共享风格,生成后再按可观察清单检查图片是否支持文字;失败时修正局部。 本文贡献:UniWeaver 是模型无关的图文交错生成工作流,包含任务范围、文字与图片规划、参考图分配和视觉复核。作者用该流程构造覆盖 20 类任务的 1 万条训练轨迹,并建立 120 条留出任务的 UniWeaver-Bench,从文字覆盖、写作质量、视觉覆盖与图文对齐评估终稿。 Figure 3: Overview of UniWeaver. ① UniWeaver introduces a structured workflow for interleaved text-image generation, with execution trajectories providing supervision for fine-tuning (Section 3.1 ). ② UniWeaver-10K Dataset provides 10,000 goal-only tasks paired with structured planning trajectories across 20 task families (Section 3.2 ). ③ UniWeaver-Bench systematically evaluates final interleaved outputs on 120 held-out tasks (Section 3.3 ). 实验效果:在同一 120 任务消融协议中,基于 BAGEL 的完整方法综合分 58.89;去掉共享视觉风格为 48.21,去掉任务目标为 53.01。分数按任务门禁通过率加权,只对过门任务计算;不能直接解读为每张图片质量提高 10.68 分。论文未给统一的额外模型调用成本与端到端耗时。 Figure 5: Qualitative comparison on two representative tasks. UniWeaver produces more coherent, actionable instructions with task-relevant visuals, while baselines exhibit repetitive content, missing details, or ineffective visual support. Zoom in for better view. 批判点评:这一流程依赖规划与视觉 judge,长文可能增加调用与返工成本;评测本身也依赖模型判分。图文能力提升并不自动代表单张图的生成模型更强。 8. FlashMotion:一万帧动作也能快生成 FlashMotion: Ultra-Fast Long-Term 3D Motion Generation | 腾讯 IEG Motus Group;中国人民大学;清华大学;得州大学达拉斯分校;武汉大学;南开大学;香港大学 | arXiv:2611.13626 关键词:3D动作生成, 文生动作, 音乐舞蹈, 语音手势, 少步采样 前序问题:游戏和虚拟人的长动作既要跟文本、音乐或语音走,又要少采样、少显存;长序列常出现脚滑、抖动或推理跟不上交互。 方法直觉:同时缩短“要采几步”和“每步有多贵”:用少步平均速度预测完整动作,再用轻量双向时序模块看前后动作与条件。 本文贡献:FlashMotion 将带运动学和动力学约束的 3D motion-space MeanFlow 与约 6000 万参数的 BiMamba/CoBiMamba 组合,支持文生动作、音乐生舞蹈和语音生手势;Adaptive Soft mask 用于动作中间段编辑。这里生成的是 3D 运动表示,后续骨骼绑定与渲染另算。 Fig. 2: Overview of FlashMotion . (a) Inference flow with clean-motion prediction and MeanFlow updates. (b) Training model inputs and output: noisy motion, conditions, and timesteps are mapped to the clean-motion target. (c) Shared BiMamba/CoBiMamba block. Dashed purple paths denote optional conditioning, omitted in BiMamba and used in CoBiMamba for condition-guided state selection. 实验效果:BABEL 长序列文生动作实验中,四步版 R@1 为 29.134%,对 DART 的 26.105%;R@1 是文本查询时正确动作排在第一的比例。RTX 3090、batch=1 的一万帧动作输出,论文报 46,303 FPS,对 DART 的 75 FPS;这是运动序列吞吐,不是最终视频渲染帧率。一阶段更快但 FID 更差,反映速度与分布质量取舍。 Fig. 3: Text-to-motion comparison under a shared sequence of 3 prompts. 批判点评:仿真中的动作可用于角色动画,但机器人执行和真实人体安全性不能由这些分数推导。速度比较受动作长度、硬件和只计模型生成的口径影响。 9. EditJudge-Bench:先测判官会不会看错改图 EditJudge-Bench: Auditing VLM Image-Edit Judges with Synthetic Ground Truth | 丹麦技术大学;Pioneer Centre for AI | arXiv:2611.12524 关键词:图像编辑评测, VLM判官, 合成真值, 反事实 前序问题:图像编辑榜常请视觉语言模型判断“改对了吗”,但真实改图既有意外副作用又没有精确真值,判官判错时很难归因。 方法直觉:用 Blender 场景参数生成编辑前后对,哪一物体、位置、材质或形状被改过都有确定答案;再让 VLM 判断编辑指令是否真的执行。 本文贡献:EditJudge-Bench 有 1,382 对合成图,覆盖九类编辑并配错误方向、错对象、无编辑等反事实指令;以 25 种判官配置检验指令核验可靠性,并比较不同提示模板和图文顺序。它评测的是编辑判官,不是推出新的图像编辑模型。 Figure 2: Overview of the nine edit types in EditJudge-Bench . The central inset shows the underlying Blender scene parameter modified by each edit: object position \mathbf{x} , rotation \mathbf{r} , scale \mathbf{s} , shape parameter θ \mathbf{\theta} , articulation joint ψ \mathbf{\psi} , material \mathbf{m} , visibility \mathbf{v} , lighting state \mathbf{l} , and camera state \mathbf{c} . Surrounding images show one rendered edit from the source image per category. Because each edit is a deterministic parameter change, magnitude and direction are known exactly. 实验效果:论文报告 GPT-4o 使用常见 VIEScore 模板的整体 AUROC 为 69.0%;AUROC 是随机抽一正一负时把正确编辑排得更高的概率。若干微调判官为 51.7–66.3%,图文顺序等提示格式可改变结果最多 14.1 个百分点。尽管测试图是合成的,判官排名与两项真人偏好榜的 Spearman 相关分别为 0.95 和 0.71。 Figure 3: Example image pairs in EditJudge-Bench . For each edit type, we show three original/edited image pairs from our benchmark. 批判点评:Blender 场景与真实照片仍有域差;排名相关高不表示任何单一判官在真实编辑上都可靠。旋转、形状等空间编辑尤其难判,应逐类审计。 10. PhyRubric:逐条指出生成视频违反哪条物理 PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation | 伊利诺伊大学芝加哥分校 | arXiv:2611.13576 关键词:视频生成评测, 物理常识, 细项量表, 时间戳诊断 前序问题:文生视频若小勺瞬间跳位、按钮还没按灯就亮,单个“物理分”说不清问题发生在哪一秒,也不利于修提示词。 方法直觉:在看到生成视频前,先把每条提示词拆成语义与物理预期;播放后逐项给出是否达成及对应时间戳。 本文贡献:PhyRubric 包含五个物理领域、34 类情境;PhyRubric-Bench 对十种文生视频模型做细项诊断,另用 3,788 条视频训练开源 PhyRubric-Judge。判官分别报语义遵循 SA、物理是否可评、物理分 PC,并给违反预期的证据。 Figure 2 : Overview of PhyRubric. (1) Rubric formulation : each caption is paired with a rubric covering semantic adherence (SA) and physical commonsense (PC), constructed before any video is seen and reused to score videos from all models. (2) PhyRubric-Bench : captions spanning five physical domains and their rubrics are drafted by LLMs and reviewed by humans. Videos from 10 T2V models are pre-annotated by an agent and verified by humans. (3) Train & Judge : an agentic annotator labels training videos to build PhyRubric-Train, on which we train PhyRubric-Judge. Given a video and its caption, the judge outputs an SA score, whether PC is assessable, a PC score, and a diagnosis of the violated expectation with timestamped evidence. 实验效果:在该榜单,JP 是全部视频中 SA 与 PC 都至少 4/5 的比例;Seedance 2.5 平均 JP 44.20%,Veo 3.1 为 36.20%,但并非跨数据集总排名。判官相对真人物理分的 Pearson r 为 0.32,Gemini 4 Argon 为 0.31;两者物理通过判别 AUC 均 0.68,说明自动诊断仍有明显误差。 Figure 7 : Two failure cases from PhyRubric-Bench. (a) A small squirt of ketchup becomes a full bowl and the spoon jumps between 1.50 s and 1.62 s. (b) The roof light is lit from the first frame, before the finger reaches the button at 2.30 s. 批判点评:PC 只对“物理可评”的视频平均,单看它会漏掉根本没生成目标事件的失败;JP 更适合合看。细项量表和时间戳需人审,诊断改写提示词的示例不能直接当作普遍修复率。 趋势观察 把长视频的共同信息压到必要位置 TaoMate-R1 按时间职责训练适配器,OneReel 只交换场景代表帧;一个处理生成历史角色,一个处理跨场景注意力。 加速仍要算额外状态成本 MG-Cache 在高分辨率视频需要大型层缓存;FADE 需要离线校准分数阶。两者速度数字均不可脱离各自硬件和采样设置。 可控生成与评测都转向可定位证据 Angular Control 把角度直接编码进 prompt,Review-and-Edit 按场景定位问题,EditJudge-Bench 与 PhyRubric 追问判官和物理诊断的可靠性。 今日讨论 TaoMate-R1 在十条两分钟长流上把接缝亮度跳变从 1.96 降到 0.613,但长流问答遵循分略低于按操作分组。若按开场与延续分组拍一条中途连续换五次商品指令的广告,哪些指标能同时验证接缝、人物身份和指令执行,何时该放弃这套分组? 人工智能炼丹君 整理 | 2026-11-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
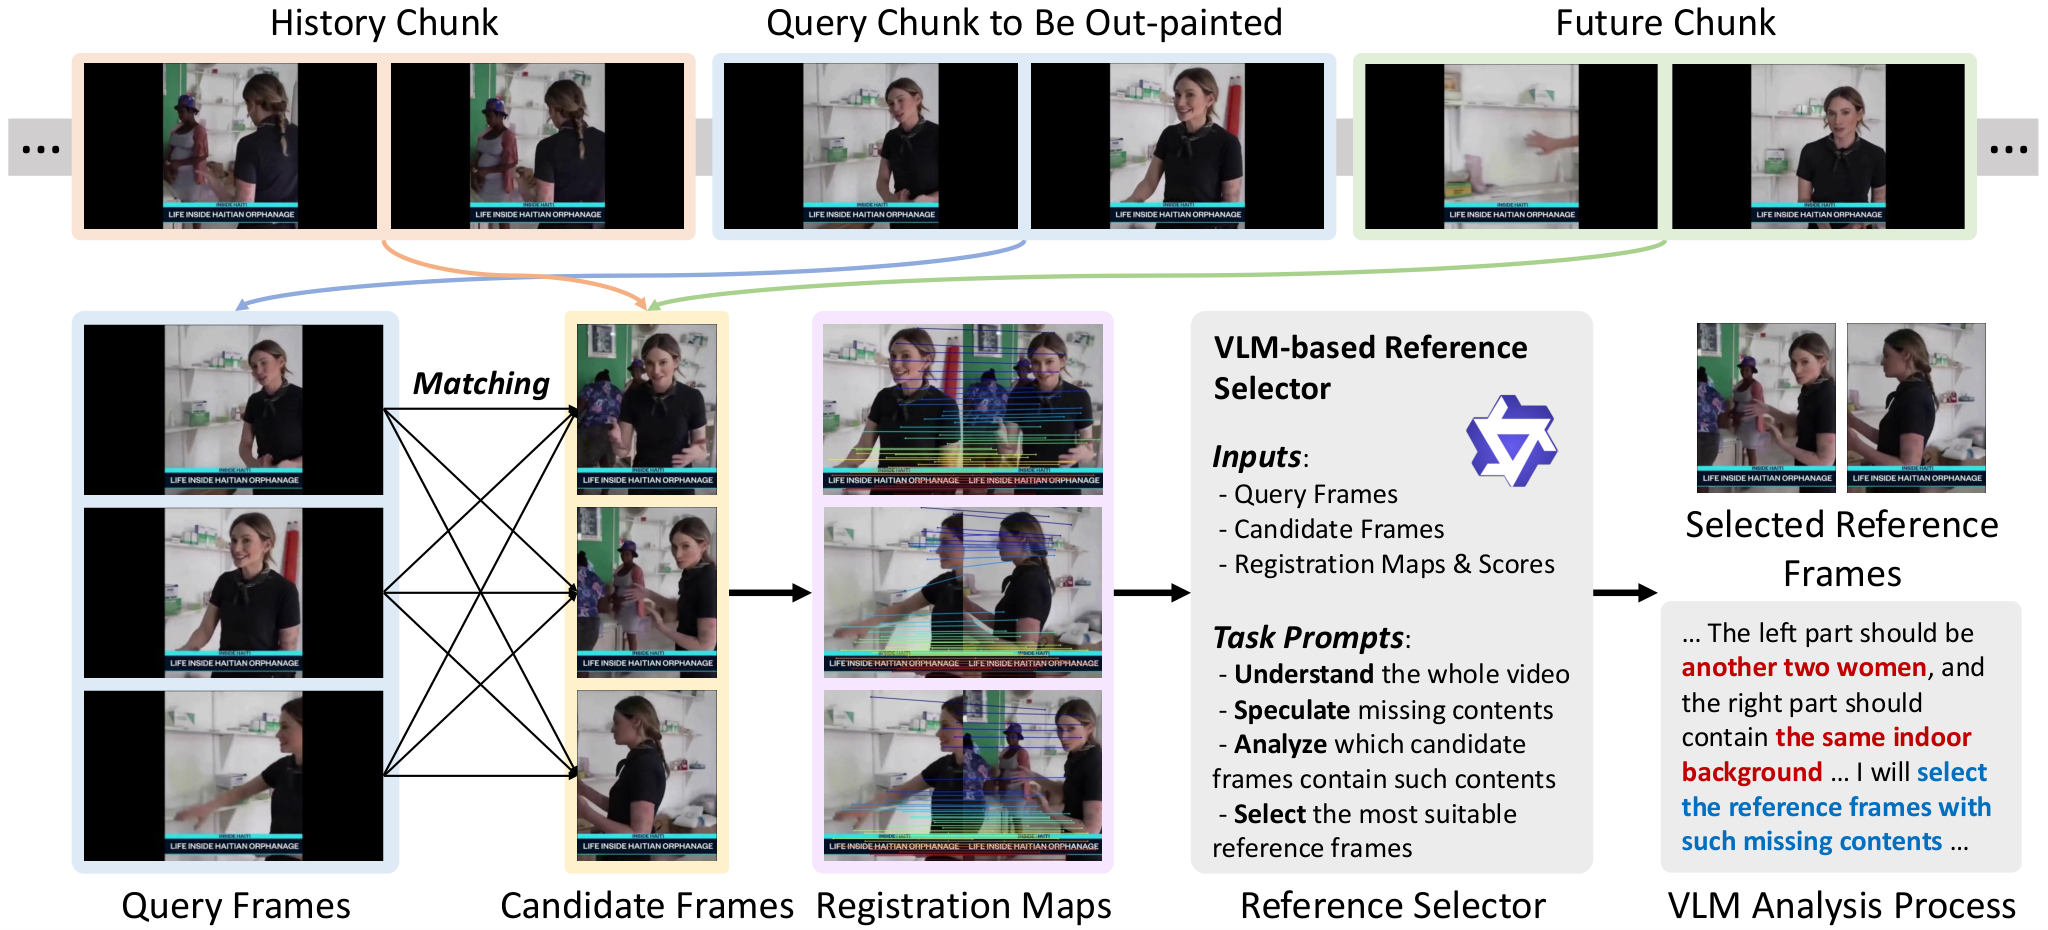
AIGC 每日速读|2026-11-11|南京大学给长视频扩画找回旧镜头-LongSCOP 今日 AIGC 论文速览 今日共 10 篇 · 视频扩画与分场景控制 3 篇 · 视频生成与推理系统 4 篇 · 图像与音频编辑 2 篇 · 物理三维场景 1 篇 重点论文标题列表 LongSCOP(南京大学):给长视频扩画找回旧镜头 SceneShifter(悉尼大学):换场景却不换人 ⚡ OneReel(伊利诺伊大学):多镜头共用四帧记忆 MPEG-Diffusion(Roblox):三成全分辨率 token 生成视频 V2C-Edit(台湾大学):图像改动由 VLM 逐步导航 选读入口:要给长片补画左右画面,先读 LongSCOP 的参考帧条件与时间代价;要按音频和台词切换人物所在场景,读 SceneShifter;多分镜同人并想缩短生成时间,读 OneReel。只想降低高清视频去噪成本,读 MPEG-Diffusion;图像指令常被忽略,读 V2C-Edit;物理运动失真,读 PhysOPSD。多轮续写与回退读 ReelCache;混音里只改一个声源读 STEER;去噪特征缓存读 FADE;布料家具三维场景读 SoftPAT3D。 今日论文速览 1. LongSCOP:给长视频扩画找回旧镜头 LongSCOP: Semantically Consistent Long Video Outpainting | 南京大学;香港大学;中国科学院深圳先进技术研究院;香港中文大学;深圳理工大学;索非亚大学 INSAIT | arXiv:2611.12445 关键词:视频扩画, 长视频编辑, 参考帧检索, 自强制训练 ⚠️ 前序问题:给长视频向画面外扩出内容时,按块生成容易在块与块之间闪烁、坍塌,人物和背景也会逐渐变样。只看当前几帧,可能错过前后已经露出的缺失区域。 方法直觉:若待补的画面区域在别的时刻出现过,就把那个时刻作为参照;训练时让模型接触自己的前一块预测,减少训练时用真帧、推理时用生成帧造成的误差积累。 本文贡献:LongSCOP 联合 self-forcing(自强制:以前一步生成帧作为训练条件)、潜变量校准和未来参考帧稳定逐块扩画;用配准分数筛候选,再由 Qwen3.5-VL-27B 推断缺失内容、选关键参考帧。作者还构建 6.2 万段训练视频和长视频扩画基准 LVO-Bench。 Figure 4: Illustration of key reference frame retrieval framework. Given query frames from current query chunk to be out-painted and candidate frames from both history chunk and future chunk, we aim to find the most suitable reference frames to out-paint current chunk. Specifically, we calculate the registration maps and scores for all query-candidate pairs, and then input them into a VLM, Qwen3.5-VL-27B [ 32 ] . The VLM is requested to understand the whole video, speculate the missing contents ( i.e. , contents to out-paint like the two women and the indoor background), analyze which candidate frames may contain such missing contents, finally select the most suitable reference frames. 实验效果:在 LVO-Bench 上,对照 VACE,结构相似度 SSIM 由 0.725 升至 0.749,峰值信噪比 PSNR 由 18.59 升至 19.87 dB,生成视频分布距离 FVD 由 225.5 降至 197.3(越低越好)。但以 Mast3R 检索处理 15 秒视频时,9B 版本由 VACE 的 13.5 分钟增至 16.5 分钟;27B 版本为 20.1 分钟。 Figure 5: Qualitative comparison. Our LongSCOP could achieve stable video out-painting results and maintain the semantic consistency over a long time horizon. The region circled by the yellow box indicates the original input region. Zoom in for better views. 批判点评:收益依赖长视频里确实有可借的参考帧;遮挡区域从未露出时,检索无法提供缺失外观。短片 DAVIS 上 LongSCOP 的 PSNR 20.04 dB 低于 Infinite-Canvas 的 20.80 dB,不能把长视频优势泛化为所有扩画。 2. SceneShifter:换场景却不换人 SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960 关键词:音驱人物动画, 多场景控制, 前景一致性, 稀疏注意力 ⚠️ 前序问题:一张人物参考图配一段音频,想让背景按指定时间从街道切到车站,人物却常跟着变脸、变衣服,或背景根本不切。 方法直觉:把同一场景内部的背景联系保留,切断不同场景背景之间的注意力;让前景人物跨场景继续互相看见,并从能追踪主体运动的注意力头提取动态前景掩码。 本文贡献:SceneShifter 无需重训,在时空自注意力中抑制跨场景背景 token 互看,保留跨场景人物联系;动态前景定位和转场上下文窗口分别处理大动作与切换边界,并建立 SceneShifterBench 测试切场时间、人物保持和画质。 Figure 3 : Pipeline of the proposed SceneShifter framework. 实验效果:在 MultiTalk 主干的 SceneShifterBench 上,场景切换成功率由基础模型 38.7% 升至 99.3%,切换时点准确率由 17.5% 升至 98.1%;对照 DiTCtrl 的时点准确率为 96.6%,但其衣着保持只有 31.7%,SceneShifter 为 100.0%。14 人、每准则 140 次盲评中,人物一致性获得 65.7% 偏好票。 Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone. 批判点评:方法无法让基础模型生成本来不会的大幅姿态动作;短于主干训练片长的场景,背景画质会下降。多主体互相遮挡时掩码可能合并,人物离开再进入后外观漂移。 3. OneReel:多镜头共用四帧记忆 OneReel: Efficient Multi-Scene Video Generation with Scene-Structured Attention | 伊利诺伊大学厄巴纳-香槟分校;得克萨斯大学奥斯汀分校;斯坦福大学 | arXiv:2611.10594 关键词:多场景视频生成, 场景结构注意力, 共享帧记忆, 推理加速 ⚠️ 前序问题:把多个分镜一起生成能让角色连续,却让所有镜头互相注意,成本随总长度快速增长;分镜各自生成又容易换人。 方法直觉:一个镜头保留内部完整注意力,只从其他镜头读少量代表帧。分镜提示和时长已给出边界,无须在去噪早期再猜哪里该跨镜头连接。 本文贡献:OneReel 用场景范围限定注意力,每步按潜帧聚类更新有界共享记忆;把本场景及共享 K/V(注意力键和值)打包成可高效执行的变长密集运算,并在多 GPU 上均衡分镜负载。固定共享帧数时,跨场景注意力成本随镜头数近似线性增长。 Figure 5: Scene-structured attention across model architectures. Rows denote queries and columns denote keys. Purple denotes scene-local interactions; orange denotes selected foreign video K/V from a shared memory. The example shows one head; text queries remain local. 实验效果:四种视频生成模型上的端到端加速相对密集注意力为 1.7–4.9 倍,相对已有稀疏方法为 1.2–2.2 倍。40 条多场景请求、HunyuanVideo-1.5 480p 下,CLIP 文本跟随分(自动图文匹配,越高越好)由密集方案 27.7% 升至 61.9%。默认四帧共享记忆相对不共享把 Text+ID(文本与人物身份联合分)由 17.0% 升至 24.3%,同时延迟增加 19%。 Figure 10: Minute-long generation with HunyuanVideo-1.5. OneReel captures the requested scene changes, while dense generation remains visually repetitive. 批判点评:收益以明确分镜提示和时长为前提;四帧共享是质量与延迟的折中,继续加至八帧只多 2.3 个百分点的 Text+ID,却再添 15% 延迟。跨场景一致性不能只凭文本跟随分推断,需看同一角色在镜头间是否稳定。 4. MPEG-Diffusion:三成全分辨率 token 生成视频 MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069 关键词:视频生成, 混合分辨率, 扩散 Transformer, 推理加速 ⚠️ 前序问题:视频扩散模型全画面高分辨率去噪昂贵;把主体裁为高清、背景低清,容易在交界处出现鬼影,还得事先知道主体在哪里。 方法直觉:让高清查询读高清键值、低清查询读低清键值,避免一个低清 token 强行代替多个高清 token;在解码前先把两种潜变量融合,让边界邻域一起解码。 本文贡献:MPEG-Diffusion 先以低分辨率跑前 k 步,再用冻结主干特征训练的线性头选高清区域;双分辨率注意力填补缺失键值,混合分辨率解码器合并潜变量。k 是开始分辨率分叉的去噪步,不是生成帧数。 Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts. 实验效果:Wan2.1 14B、720p、k=40 且总 token 预算相当于全高清的 30% 时,去噪阶段相对全高清加速 4.8 倍;同预算 Foveated Diffusion 为 5.2 倍,但 DOVER 自动质量分(越高越好)为 0.743,本文 0.794。k=25 的 38% token 设置下,本文为 3.3 倍、DOVER 0.803;750 次左右双视频投票中,对 Foveated Diffusion 的平局折半胜率为 90.1%。 Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ). 批判点评:4.8 倍指去噪时间,不是包含编码、解码的整条视频产线。质量未完全回到全高清:k=40 时 Wan2.1 14B 的 VBench 视频生成质量分为 83.9,高清基线 85.3;选高清区域的线性头也需要训练。 5. V2C-Edit:图像改动由 VLM 逐步导航 VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;台湾中央研究院 | arXiv:2611.10066 关键词:图像编辑, 流匹配, VLM 引导, 无反演编辑 ⚠️ 前序问题:用 FlowEdit 改图时,源图约束过紧会出现零编辑:背景保住了,请求的变化却没有发生。固定的源图耦合时序无法适应不同改动。 方法直觉:每个去噪时间步备好不同强度的编辑速度,让视觉语言模型比较候选结果是否真正执行指令;指令已基本实现时,再用空间掩码保护无需改动的区域。 本文贡献:V2C-Edit 是免训练的流式编辑控制:构造四种源图耦合速度,用 ILS(Instruction-Level Similarity,指令级相似度)逐步选方向,采用两阶段自适应掩码;ILS 评估改动本身,而非只比目标文案与整图的 CLIP 相似度。 Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F . 实验效果:FLUX 上的 MagicBrush 数据集,对照 FlowEdit,GPT 指令对齐分 5.56→6.07,Gemini 分 4.76→5.36;未编辑区域的 PSNR(峰值信噪比,越高越接近源图)为 17.48→17.44 dB,略降。H100 80GB 上 50 张图平均每张 26.44 秒、峰值 53GB;基础 FlowEdit 为 4.00 秒、36GB。 Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image. 批判点评:更强的指令完成度换来约 6.6 倍单图耗时和 17GB 额外峰值显存,非实时编辑方案;PSNR 也显示背景保留并未同步改善。ILS 依赖 VLM 逐步评估,在不同编辑指令和 VLM 上的稳定性要另验。 6. PhysOPSD:物理代码教视频动起来 PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴 Token Hub | arXiv:2611.12411 关键词:视频生成, 物理一致性, 自蒸馏, 可执行模拟 ⚠️ 前序问题:视频模型能画出逼真画面,仍会把摆锤、接触或流体运动画错。单靠文字很难给出可控制的物理过程,离线视频示例又把物理规律与外观混在一起。 方法直觉:用可执行模拟程序生成可调物理过程,作为训练期特权信息;对同一场景只改变一个物理参数,并保持生成噪声一致,让模型看到动态变化的原因。 本文贡献:PhysOPSD 用 PhysOPSD-Engine 把真实物理情境转成可验证模拟,构造密集与抽象两级物理草稿;在 on-policy self-distillation(模型用自己生成的样本接受教师纠正)中提供配对物理变体。代码是训练用物理条件,最终目标是生成视频。 Figure 3: Overview of our proposed PhysOPSD . 实验效果:用 3K 物理样本后,8.3B 主干在 PhyGround 的 Overall 从原 HunyuanVideo-1.5 的 66.3 升至 68.3;同规模 80K 样本 SFT 为 66.1,21K 样本 PhysHPO 为 67.0。VideoPhy-2 的 All 指标为 67.0,对照 PhysHPO 为 66.0。这里 K 表示千条训练实例。 Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 . 批判点评:改善仍依赖模拟程序覆盖目标物理现象,镜头外观与真实互动的泛化要单独测。表中 3K 只表示训练实例数;建立可执行模拟程序的成本、推理耗时与真实世界失败率仍需另验。 7. ReelCache:续写视频压住历史缓存 ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973 关键词:视频续写, KV 缓存压缩, 分块生成, 推理系统 ⚠️ 前序问题:逐块续写视频要保存旧块的注意力 K/V 缓存;用户回退、分叉时保留所有版本耗显存,删掉后重算又拖慢下一块。 方法直觉:同一块的缓存既有通道冗余,也有时空相关性;相邻块还共享部分基向量。先低秩分解,再像编码视频那样压系数,并把分叉历史组织成树。 本文贡献:ReelCache 在每层预测满足保留能量目标的秩,再压缩注意力缓存;跨块共享低秩基,树形管理恢复、回退和分叉。KV 是注意力的键和值,压缩的是生成过程的历史状态,不是最终视频文件。 Figure 9: Overview of ReelCache . 实验效果:五种视频模型上,对照文中缓存基线,KV 存储缩小 14.46–21.13 倍,下一块生成加快 1.25–3.36 倍,六项代表性 VBench 视频生成指标下降小于 1%。CausVid 上额外压缩开销约 0.2%,解压开销 3.2%;RAVEN 分别 0.8% 和 4.2%。 Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads. 批判点评:这项收益集中在长历史、多轮恢复和分叉;短片一次生成时,树形缓存管理的收益较小。VBench 的六项平均跌幅低于 1% 不代表每条视频完全无可见变化,仍需对关键主体做逐帧检查。 8. STEER:音频编辑先找对声源 Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630 关键词:音频编辑, 声源选择, 去噪轨迹, 后训练 ⚠️ 前序问题:混合音里说“只删掉狗叫”,统一音频编辑器可能误删说话声,或把所有声音一起变了。错误声源往往在早期去噪就选定,后续难纠正。 方法直觉:训练时多看决定声源的早期状态;再让模型从自身跑偏的中间状态继续去噪,学会把选错的声源拉回来。 本文贡献:STEER(Source-selection Training via Early-trajectory Emphasis and Recovery)分两阶段后训练:Emphasis 强化早期关键状态,Recovery 用自生成轨迹学习纠错;得到 SteerSound,并建立同时检查目标改到位和非目标保留的 Selective Audio Editing Benchmark。 Figure 1: Strengthening selective audio editing with STEER. Left: Existing editors may leave the target unchanged or modify non-target content. Middle: Early states shape final source selection, while later denoising tends to follow the established editing direction rather than revise it. Right: STEER addresses these failures through early-trajectory emphasis (Emphasis) and recovery training (Recovery), yielding SteerSound with more reliable selective editing. 实验效果:在自建选择性音频编辑基准上,原始基础编辑器的整体成功率 70.42%、选择性错误率 28.48%;两阶段后为 85.78% 和 8.45%。但在复杂音频编辑测试集,SteerSound 的生成 CLAP 音文匹配分(越高越好)从基础模型 0.223 略降到 0.220,KL 分布距离(越低越好)由 1.915 升到 2.133;选择性提升不等于所有生成指标齐升。 Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement. 批判点评:结果依赖作者构造的编辑任务与基准;不同声源重叠、指令模糊时仍需人工听感。两阶段后训练有额外数据和训练成本,论文摘要未给可直接推广的推理加速结论。 9. FADE:分数阶预测少算视频去噪 FADE: Fractional Anomalous Dynamics Extrapolation for Training-Free Diffusion Transformers Acceleration | 四川大学 | arXiv:2611.10514 关键词:扩散加速, 视频生成, 特征缓存, 分数阶动力学 ⚠️ 前序问题:扩散 Transformer 的中间特征随去噪步非线性变化,简单缓存或线性外推在弯曲轨迹处会积累误差,导致生成细节和运动失真。 方法直觉:先离线测不同层、步和位置适合的分数阶变化率,推理时按查找表选阶数,在完整计算步之间预测特征;分数阶算子允许比整数阶外推更灵活地贴近弯曲轨迹。 本文贡献:FADE(Fractional Anomalous Dynamics Extrapolation)离线建立多维阶数 LUT(查找表),在线交替执行完整计算与 Mittag–Leffler 分数阶特征预测;无需重新训练生成主干。 Figure 2 : Overall framework of FADE. FADE consists of an offline profiling stage and an online inference stage. The offline stage calibrates and stores the optimal fractional orders in a static LUT, while the online stage alternates between full-compute and prediction steps using LUT-retrieved orders for feature forecasting. The upper-right panel illustrates the geometric contrast between the FADE trajectory and the integer-order trajectory in the latent space. 实验效果:HunyuanVideo 文生视频、原始 50 步设置,完整推理为 190.2 秒、VBench 视频生成分 80.68%;同为 5359T FLOPs(T 为万亿次浮点运算估计)预算下,FADE 为 37.9 秒、80.12%,HiCache 为 37.8 秒、79.93%。表中 5.56 倍是 FLOPs 口径,按实际秒数约 5.0 倍。 Figure 5 : Qualitative comparison on text-to-video generation. 批判点评:离线 profile 与查找表构建有前置成本,跨模型或分辨率可能需重做;输出 VBench 仍比完整 50 步低 0.56 分,且表中同预算延迟几乎与 HiCache 持平,优势主要是质量。 10. SoftPAT3D:让布料玩具稳稳落座 SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087 关键词:文本到3D, 可变形物体, 物理仿真, 场景生成 ⚠️ 前序问题:文本生成的三维房间里,布料可能穿过椅面、玩具悬空;把软物体当刚体摆放,无法给后续仿真一个有效的静止初态。 方法直觉:先为布料、绳索等构造制造过程对应的自然形状和材料,再让它们与家具一起在统一接触求解器里落到平衡;失败时优化摆放位置。 本文贡献:SoftPAT3D 在文本到三维场景流程中,补全遮住的承托表面并建碰撞网格,为软体指定 rest shape(无外力自然形状)和材料,统一仿真接触、检查几何与提示符合度,再用可微仿真调整初始摆放。 Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ). 实验效果:主实验表的 34 个场景里,SoftPAT3D 生成 43 个软体,接触穿越为每千条边 0、穿透 0 mm,完成 21 个场景;对照刚体流程完成 2/32。共同的 13 个可渲染场景上,GPT-5.4 物理合理性评分从刚体流程 43 升至 90(0–100),CLIP 图文匹配分由 23.9 升至 28.2。 Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them. 批判点评:这些几何与评分结果依赖作者的场景集、碰撞建模和求解预算;34 个场景仍有 13 个未达到完整通过。模型处理的是静态平衡,不能直接推断复杂布料动态也正确。 趋势观察 长视频更需要选对历史 LongSCOP 检索前后帧补画缺失区域;OneReel 跨镜头只分享代表帧;ReelCache 压缩并恢复分叉历史。三者操作对象不同,分别是像素参考、注意力范围和缓存状态。 速度收益要看时间口径 MPEG-Diffusion 的 4.8 倍是去噪阶段;OneReel 报端到端 1.7–4.9 倍;FADE 表中 5.56 倍是 FLOPs,实际秒数约五倍。不同指标不可横比。 控制精度有代价 V2C-Edit 提高指令对齐却使单图耗时从 4.00 增至 26.44 秒;LongSCOP 的 VLM 参考帧检索也将 15 秒片处理从 13.5 增至 16.5 分钟。 今日讨论 LongSCOP 在 LVO-Bench 把 FVD 从 VACE 的 225.5 降到 197.3,却使 15 秒视频处理由 13.5 分钟增至 16.5 分钟。如何验证参考帧检索在遮挡区域从未露出的长视频上是否仍有收益,并用同一组输入比较扩画稳定性与时间成本? 人工智能炼丹君 整理 | 2026-11-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-11-11|悉尼大学让人物跨场景不丢-SceneShifter 今日 AIGC 论文速览 今日共 10 篇 · 视频场景控制与素材编排 2 篇 · 图像编辑与协同生成 2 篇 · 视频生成及缓存 3 篇 · 音频编辑 1 篇 · 工业缺陷图像与三维场景生成 2 篇 重点论文标题列表 SceneShifter(悉尼大学):说换场景就换且人物不丢 Clips2Story(纽约大学):散片按关键词剪成故事 ⚡ V2C-Edit(台湾大学):每一步都判断有没有改到位 MPEG-Diffusion(得州大学奥斯汀分校):只把主角用高清算 PhysOPSD(港科大):让可运行物理规则教视频 选读入口:想让人物视频按时换背景,先读 SceneShifter;素材库需要自动剪成主题故事,看 Clips2Story。要改一张图却常“没改到”,看 V2C-Edit;要给长视频降算力或支持回退分叉,分别看 MPEG-Diffusion 与 ReelCache。关心物理运动、选错音频声源、图像与掩码协同、工业缺陷造数、布料三维接触,则依次读 PhysOPSD、STEER、SnB、REDiff-AD、SoftPAT3D。 今日论文速览 1. SceneShifter:说换场景就换且人物不丢 SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960 关键词:视频生成, 多场景控制, 音频驱动动画, 注意力 ⚠️ 前序问题:一段音频驱动的人物视频要在指定帧从露台切到地铁。普通生成容易晚换背景,也可能在换景时把人脸或衣服一起改掉。 方法直觉:把背景和人物在时空注意力中分开:跨场景的背景不要互相引用,人物则仍可借前后场景维持身份。人物移动时,固定区域掩码会失效,需要随动作追踪。 本文贡献:SceneShifter 无需再训练生成主干。它在跨场景背景 token 间抑制自注意力,保留前景 token 的跨场景联系;从能追踪主体轨迹的注意力层和头提取动态前景掩码,再按提示时间切换场景。作者另建 SceneShifterBench,测场景切换时点、人物保留及视觉质量。 Figure 3 : Pipeline of the proposed SceneShifter framework. 实验效果:SceneShifterBench 的 MultiTalk 主干上,场景切换成功率从原模型的 38.7% 到 99.3%;场景时间准确率从 17.5% 到 98.1%。同表中 DiTCtrl 的成功率为 98.7%,但人物空间分为 0.847,对本法 0.943。数据是指定多场景提示下的生成对照;原文没有统一的端到端延迟数字,额外的掩码提取也需计入实际部署。 Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone. 批判点评:这是音频驱动的人物视频生成控制,不是把一段现成视频任意换景。大幅动作或人暂时消失后重入仍可能失去身份;附录给出该失败例。主干本身不会的动作,注意力控制也不能补出来。 2. Clips2Story:散片按关键词剪成故事 Clips2Story: Training-Free Video Storyboarding and Editing Using Multimodal Retrieval-Embedded Generation | 纽约大学;华盛顿大学;密歇根大学 | arXiv:2611.05992 关键词:视频编辑, 素材编排, 故事板, 多模态检索 ⚠️ 前序问题:素材库里只有打乱顺序的零散片段,编辑者想按“毕业”之类关键词拼成短片;按原片时间轴摘要会把无关镜头和旧叙事一并带入。 方法直觉:先找与主题相关的镜头,再让语言模型安排叙事顺序和衔接旁白,最后组装输出;素材选择与叙事组织是两个不同步骤。 本文贡献:Clips2Story-ND 为片段提取视觉与语音文字描述,检索候选,再把描述交给 LLM 生成可改的故事板和过渡旁白;系统拼接已选镜头,并检索旁白所需画面。作者从五类共 100 部长视频切片、打乱时间顺序,分别测试片段级和场景级素材池。 Figure 1: Overview of the proposed Clips2Story-ND pipeline. Given a pool of raw video footage and a user-specified keyword, we first extract textual descriptors from the video clips and retrieve those most relevant to the keyword. We then use an LLM to generate an editable storyboard with connective narration. Finally, we compose the output video by assembling the selected clips and retrieving accompanying visuals for the narration. 实验效果:15 人用五分量表评价三类视频各六段短片;Clips2Story-ND 相对 REGen 的叙事连贯性为 4.43±0.14 对 3.17±0.11,关键词对齐为 4.42±0.13 对 3.11±0.16。它依赖逐片描述、检索和 LLM 规划,原文未给可与扩散生成时延直接比较的统一耗时。 Figure 5: Genre-wise comparison of CLIPScore, VTGHLS, OPC, KR-Narration, KR-Frame, and KR-Caption under the scene-level setting. Error bars indicate 95% confidence intervals. Specific numbers can be found in Table 6 . 批判点评:这项工作主要是检索、剪辑和生成旁白,不合成全新视频镜头。100 部原片切碎再打乱是可控测试,开放素材库的版权、镜头语义偏差与叙事可编辑性仍需单测。 3. V2C-Edit:每一步都判断有没有改到位 VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;中央研究院 | arXiv:2611.10066 关键词:图像编辑, 流匹配, VLM 反馈, 区域保持 ⚠️ 前序问题:让图里钟面的数字换语言,同时保住背景。FlowEdit 的源图耦合太强时会出现 zero-edit:输出几乎和原图一样,目标变化没有发生。 方法直觉:不要把“贴近原图”的力度固定到所有去噪步;每一步比较几种编辑速度,并请视觉语言模型按指令判断哪种更像完成了编辑。 本文贡献:V2C-Edit 在不训练生成主干的条件下构造四种源图耦合程度的速度场。ILS(Instruction-Level Similarity,指令级相似度)比较预估改动与用户指令,选择该步速度;当语义改动足够且局部掩码不损伤 ILS 时,再限制无关区域的更新。实验用 FLUX 与 Stable Diffusion 3。 Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F . 实验效果:MagicBrush 的 FLUX 设置下,相对 FlowEdit,GPT-4.1 代评的指令对齐分(0–10,越高越按指令改)由 5.56 到 6.07,未编辑区域的 PSNR(像素保真度,越高越接近源图)为 17.48 对 17.44 dB;PIE-Bench 对应指令分 5.32 到 5.85、PSNR 21.82 到 21.84 dB。逐步 VLM 评估增加推理调用,论文未给统一端到端秒数。 Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image. 批判点评:同表在 Stable Diffusion 3 上,部分 CLIP 分和背景保真并非全胜;依赖 VLM 判断的指令质量也会影响速度选择。 4. MPEG-Diffusion:只把主角用高清算 MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069 关键词:视频生成, 混合分辨率, 扩散加速, 自选主体 ⚠️ 前序问题:视频扩散全画面用高清 token 去噪很贵;直接让背景低清,清晰区与模糊区的边界又容易出现重影,还常需要人预先圈主角。 方法直觉:让同一分辨率的查询读同分辨率的键和值,再在解码前融合两套潜变量;主角区域交给模型的早期特征来选。 本文贡献:MPEG-Diffusion 先在低分辨率运行前 k 个去噪步,随后线性头从冻结 DiT 特征预测高清区域;双分辨率注意力用线性映射补齐缺少的键值,混合分辨率解码器先融合高低清潜变量,再生成整帧。线性映射、区域头与解码器需训练,不能当作纯免训练加速。 Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts. 实验效果:仅处理约 30% 全分辨率 token 时,Wan2.1 14B 的去噪加速 4.8 倍,1.3B 为 3.8 倍,均相对全高清去噪;用户两两比较对既有混合分辨率方法的偏好超过 90%。14B 表中 VBench 质量分 82.9,对全高清 85.3;组件另有约 3% 运行开销的 1.3B 分解统计。加速数字不等于整条出片链路的同倍加速。 Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ). 批判点评:高清区域外仍以低分辨率生成,背景细节有明确预算代价;主角区域选择也依赖早期特征和训练标注。若目标是全景细节,需与全高清结果逐帧比较,而不能只看主角。 5. PhysOPSD:让可运行物理规则教视频 PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴集团 | arXiv:2611.12411 关键词:视频生成, 物理一致性, 在策略蒸馏, 可执行模拟 ⚠️ 前序问题:球碰撞、摆动和液体运动的视频看起来像真的,却常违反物理规律。离线监督训练跟不上模型自己生成的错误状态,物理奖励又稀疏。 方法直觉:把可执行模拟当作教师可见的额外条件:相同噪声下只改物理参数,学生就能看见运动因果变化,而不仅是另一段外观不同的参考视频。 本文贡献:PhysOPSD-Engine 将物理场景写成可验证的模拟程序,形成密集与抽象两级草稿。PhysOPSD 用 OPSD(在策略自蒸馏:在学生自身生成轨迹上获得密集教师纠正)训练视频模型;共享 rollout 噪声配对不同物理参数,使教师的纠正聚焦动力学变化。代码是训练期特权条件,目标仍是视频生成。 Figure 3: Overview of our proposed PhysOPSD . 实验效果:使用 3000 条后训练样本时,13B 主干在 PhyGround 总体物理分为 66.5,对 8 万条样本的 SFT 为 64.8、2.1 万条的 PhysHPO 为 65.8;同表 VBench 总质量 84.0 对 SFT 83.9。数字限于该评测与主干,训练还需编写、运行模拟并完成在策略采样,不能只按 3K 比较总成本。 Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 . 批判点评:模拟可参数化的摆、碰撞等场景是优势,也限制了覆盖面;难建模的开放世界动作未获同等保证。论文自身将模拟可落地动力学列为适用边界。 6. ReelCache:续写分叉少存历史缓存 ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973 关键词:长视频生成, KV 缓存, 分支续写, 低秩压缩 ⚠️ 前序问题:长视频按块生成并允许回退或分叉时,历史注意力 KV(键和值)缓存越存越大;丢掉旧缓存又要重算,下一块等待更久。 方法直觉:相邻块的通道基方向相似,保留少量方向和编码后的系数;编辑分支只复制必要的历史状态,让共同前缀复用。 本文贡献:ReelCache 在块内对 KV 做跨通道低秩分解,再视频编码系数;每层在线预测达到指定保留能量所需的秩。块间管理器复用、增补或重拟合基方向,把块状态组织为树,使 resume、rewind、fork 共用前缀。该方法处理缓存与下一块推理,不重新训练视频生成模型。 Figure 9: Overview of ReelCache . 实验效果:论文在五种视频生成模型的多轮长视频工作负载上,相对基线将 KV 存储降低 14.46–21.13 倍,下一块生成提速 1.25–3.36 倍;六个代表性 VBench 指标下降均小于 1%。这些是缓存场景的下一块延迟,不等于首段生成提速;压缩和解压也有额外计算,表中 CausVid 的解压令下一块生成慢约 3.2%。 Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads. 批判点评:收益取决于历史长度、分叉次数与缓存驻留策略。原文 HTML 标题区有模板警告,但 arXiv 论文题名与摘要可核;不能据模板文字推断会议接收。 7. STEER:改声音时先选对声源 Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630 关键词:音频编辑, 声源选择, 早期去噪, 在轨恢复 ⚠️ 前序问题:一句“只移除左边说话者”交给统一音频编辑器,模型可能把另一人删掉;早期去噪一旦选错,后面往往救不回来。 方法直觉:编辑目标是在去噪轨迹开头定下来的,因此训练应多看早期关键状态;再让模型从自己生成的偏离状态学会纠错。 本文贡献:STEER 是 Source-selection Training via Early-trajectory Emphasis and Recovery:第一阶段强调早期轨迹上的声源选择,第二阶段用模型自己生成的 rollout 状态训练恢复。作者训练基础多任务编辑器并得到 SteerSound,还建 Selective Audio Editing Benchmark,分别衡量目标声源改到位与非目标保留。 Figure 6 : Architecture of our base editor. 实验效果:在作者基础编辑器的选择性编辑基准上,整体任务成功率从 70.42% 到完整 STEER 的 85.78%,选错声源比例从 28.48% 降至 8.45%;只做早期强调则为 84.02% 和 9.99%。这是额外后训练所得,不是免训练插件;作者还在 UNISON 与 SAM Audio 上报告迁移效果。 Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement. 批判点评:选择性测试依赖作者构造的任务和自动评判规则,复杂重叠声源与极短目标音仍需试听验证。额外训练两阶段和自生成轨迹会增加训练成本,原文没有统一的单条推理时延对照。 8. SnB:两套生成器半路接上 Split and Bridge: Multimodal Generation via Diffusion Bridging | 佛蒙特大学;脑科学与智能技术卓越创新中心 | arXiv:2611.10441 关键词:多模态生成, 图像编辑, 扩散桥接, 图像与掩码 ⚠️ 前序问题:要同时生成图像和对应分割掩码,常见做法是重新训练一个共同潜空间;现有高质量单模态生成器难直接复用。 方法直觉:先让两条反向扩散轨迹共享一段路,再在分叉点用桥接模块把它们连起来;共享程度控制结构一致性与各自画质的取舍。 本文贡献:Split and Bridge(SnB)在采样时耦合预训练单模态扩散模型;从共同先验出发,t_split 处经 bridge 修改条件、模型或中间层,再走各自的去噪轨迹。可学习 bridge 增强跨模态映射,不需从头联合训练整套生成器。论文测图像与语义掩码配对,也展示图像编辑和交错协同生成。 Figure 1: SnB leverages pretrained diffusion models by coupling reverse trajectories during sampling. We start from a common state sampled from a prior, then at t s p l i t t_{split} , a bridge module is used to implement a score intervention on the reverse process. This intervention can be through modifying conditioning signals (e.g., prompts), changing diffusion models that estimate the score functions, or changing certain layers in the diffusion models. This flexibility applies SnB in various tasks, like interleaved co-generation (top left pair) and multimodal generation (top right pair). Learnable bridges allows stronger trajectory manipulation in mapping one modality to another. 实验效果:CelebAMask-HQ 的图像—掩码联合生成表中,t_split=50% 时 SnB 一致性 0.73、FID 60.84;MLD 对照为 0.68、121.69。FID 是生成图像与参考分布的距离,越低越好;分叉点改到 80% 时一致性升至 0.79,条件生成 FID 却恶化,说明不能只追一致性。bridge 需训练,额外模型和同步采样也有成本。 Figure 3: Qualitative comparison of SnB and previous top-down multimodal approaches on CelebAMask-HQ. SnB balances between coherence and quality of generated modality pairs. 批判点评:图像和掩码等可对齐模态更适合这套桥接;跨模态关联弱时共享噪声未必足够。论文所报是特定数据集与分叉比例,不代表任意两个预训练模型都能直接拼接。 9. REDiff-AD:借一张缺陷图造新缺陷 REDiff-AD: No Training and No Target Masks for Industrial Anomaly Image Generation via Diversity-Driven In-Context MMDiT | 台湾大学 | arXiv:2611.10875 关键词:缺陷图像生成, 少样本条件, 伪掩码, 整流流 ⚠️ 前序问题:工厂缺陷样本少,且换一种产品就重训生成器或画目标掩码很费事。目标是产生更多有变化的缺陷图及可用伪掩码。 方法直觉:把一张有掩码的参考缺陷和正常目标图放进同一个生成上下文,模型学到缺陷外观后迁移到目标;生成时的注意力还能反推缺陷出现在哪。 本文贡献:REDiff-AD 用冻结的整流流 MMDiT(多模态扩散 Transformer)做上下文缺陷迁移,不要求目标掩码。语义定位先给目标可编辑区域;AAM 加强弱缺陷参考,DOK 减少照搬参考形状;聚合目标到参考的注意力,再结合边缘和颜色得到像素级伪掩码。输入仍需一张带掩码的参考异常图。 Figure 3 : Overview of the proposed REDiff-AD model. Semantic localization first determines a loose editable region on the target. A frozen in-context MMDiT transfers the masked reference, with AAM strengthening weak anomalies and DOK reducing reference-shape copying. Aggregated target-to-reference attention is then refined into the output pseudo-mask. 实验效果:MVTec-AD 表中各类平均 KID(核 Inception 距离,越低表示生成分布越接近参考)为 31.09,对 O2MAG 的 47.63。RTX 5090 上,30 步设置每图耗时 16 秒、显存 9 GB,对 O2MAG 的 20 秒、16 GB;但合成图训练的平均异常分类准确率为 70.77%,低于 O2MAG 的 73.51%,生成指标优势不能直接当成判别收益。 Figure 4 : Qualitative illustration of the effects of DOK and AAM. DOK diversifies the geometry of the defect, while AAM improves the robustness of in-context defect generation. 批判点评:需要带掩码的参考缺陷,不能称为完全无标注。工业异常边界和实际缺陷多样性不同,伪掩码噪声可能影响下游定位;跨产品泛化要用新产品验证。 10. SoftPAT3D:布料玩偶生成后不穿模 SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087 关键词:文本生成3D, 可变形物体, 物理仿真, 场景编辑 ⚠️ 前序问题:文本生成的沙发和毯子看似搭在一起,三维网格里却可能相互穿透或漂浮;没有材料、自然形状和接触初态,也无法直接进仿真。 方法直觉:按布料或玩偶的制造方式恢复自然形状,补出被遮挡的支撑家具,再把整场景放进同一接触仿真里落到稳定状态。 本文贡献:SoftPAT3D 沿用文本到图像再到三维资产的前段流程,为可变形物体构造静止形状、材料参数和初始放置;重建支撑物的碰撞网格后统一求静态平衡。几何和视觉语言检查失败的场景可通过放置网格搜索与可微仿真梯度优化。生成结果可继续做物体移动、拉扯等三维编辑。 Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ). 实验效果:作者的 65 条提示上,本法结果均无不期望的物体互穿,而所比较系统各有互穿;这是论文的几何检查口径。代价是额外的资产补全、碰撞网格、材料赋值、仿真与可能的优化,原文没有与纯生成器统一计时的端到端速度对照。 Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them. 批判点评:仿真稳定与画面完全符合提示仍是两回事:论文展示了物体最终聚成一团等失败例。场景质量依赖碰撞网格和材料库,复杂软体或未知材质需另验。 趋势观察 把编辑作用点放到过程里 SceneShifter 改时空注意力里的背景连接,V2C-Edit 每步按指令选速度;STEER 则把声源选择放在去噪早段训练。 生成预算从平均分配转向按需分配 MPEG-Diffusion 只让关键区域保持高清;ReelCache 压缩并共享历史块 KV,二者分别针对空间 token 和长视频历史。 可执行结构给生成增加约束 PhysOPSD 用可编辑物理模拟作训练条件,SoftPAT3D 在三维场景完成后再用接触仿真消除互穿。 综合指标不能盖过任务失败 REDiff-AD 的生成 KID 较优,但平均下游分类准确率低于 O2MAG;Clips2Story 的叙事分须放回打乱素材的实验设定。 今日讨论 SceneShifter 在 MultiTalk 上将换景成功率从 38.7% 提到 99.3%,但附录也出现人物消失再入镜后身份改变的失败例。若连续换五个场景并有人物出入画,哪些指标能验证动态前景掩码是否同时保住切换帧精度、重入身份和推理时延? 人工智能炼丹君 整理 | 2026-11-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-10-04|商汤小模型绕圈反超6.5倍大模型,Looped-DiT 今日 AIGC 论文速览 今日共 10 篇 · 高效文生图架构 3 篇 · 统一多模态 1 篇 · 长视频与音视频生成 2 篇 · 生成推理加速 2 篇 · 视频强化学习与图像评测 2 篇 重点论文标题列表 Looped-DiT(商汤):260M循环4圈赢6.5倍大模型 Multimodal Flow(华科):图文全连续流建模,仅用150B词元 NEPA-DiT(密歇根大学):预测嵌入当条件,FID 1.32 MosaiChunk(康奈尔大学):只训13.6M路由,长视频回访不失忆 Soundwich(西蒙弗雷泽大学):冻结LTX-2.5免训练拆分音轨 今日论文速览 1. Looped-DiT:260M循环4圈赢6.5倍大模型 Looped Diffusion Transformer | 商汤科技;清华大学;南洋理工大学 | arXiv:2609.40305 关键词:文生图, 循环计算, 参数共享, 深度监督, 潜在推理 前序问题:文生图模型提质通常只有两条路:加参数或加去噪步数。语言模型里已验证的「循环复用同一组层」能在不增参数的前提下加深计算,但直接搬进 MMDiT 并不稳定:推理圈数超过训练值后性能先涨后跌,中间表示里可线性解码的空间位置信息逐圈流失。 本文贡献:Looped-DiT 把网络切成前段 6 块、循环段 5 块、后段 6 块,每个去噪步内让循环段共享权重重复 N 次(训练取 4 圈)。两项稳定手段:深度监督,每圈输出都经共享后段解码并计入 flow loss;自调制注意力,用门控或无参的 Exclusive Self-Attention 抑制注意力对局部信息的过度改写。 实验效果:260M 的 B/16 在 GenEval、DPG、PRISM、CoRe、Spatial、TIIF 六项均值 71.5,六项全部高于 1.7B 的 InternVL-U(均值 69.0),也高于 6.6B 的 Uni-CoT(66.8),单图推理算力约为 InternVL-U 的 1/4.9。参数对齐对照里,B/32 均值从 55.2 提到 59.1;同等推理预算下,加圈比加去噪步更划算。 批判点评:「参数不变」不等于「算力不变」:循环版每步推理 267 GFLOPs,是同参数基线的 1.83 倍,训练 1246 GFLOPs 更是 2.83 倍。按推理算力对齐时,加宽版 MiniT2I 已到 58.6,与 Looped-DiT 的 59.1 只差 0.5。分项看,循环擅长约束求解,需要常识推断的 CoRe/Generalization 只 +7.5,远不如文本 CoT 的 +22.2。 2. Multimodal Flow:图文全连续流建模,仅用150B词元 Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces | 华中科技大学;北京交通大学;地平线 | arXiv:2609.40362 关键词:统一多模态, 连续流匹配, 文生图, 视觉理解, 多模态预训练 前序问题:统一理解生成模型多走两条路:文本和图像都离散化,图像要过量化瓶颈;或文本离散、图像连续,两种目标与采样流程各写一套。全连续建模能让两种模态共用一个生成过程,但在多模态预训练规模上很少被系统验证。 本文贡献:MF-1 用冻结的 T5-small 与 SigLIP2 把文本块(每 8 个词元一块)和图像编码成连续表示,按顺序组织成 hyperchunk,交给一个 chunk-causal 的 flow 主干学习单一速度场;注意力投影共享、FFN 按模态分开。训练时并行预测多个目标块,推理时逐块生成,再由预训练图像解码器与单独训练的文本解码器还原。 实验效果:1.6B 版本只用 150B 预训练词元,GenEval 0.82、DPG 83.44,理解侧 POPE 86.1、MMBench 67.2。数据、优化与参数完全对齐时,全连续版 GenEval 0.713、MMBench 46.7,高于 Transfusion 式混合(0.669 / 33.7)与 Chameleon 式全离散(0.374 / 38.4)。 批判点评:生成强、理解弱:MMBench 67.2 落后同量级的 Janus-Pro(75.5)与 JanusFlow(74.9),VQAv2 72.6 也低于 JanusFlow 的 79.8(对方有预训练 LLM 初始化);DPG 83.44 还没追上纯生成的 SD3 Medium(84.08)。scaling 曲线上 1.6B 预训练阶段 GenEval 只到约 0.32,表中 0.82 是再经 5B 词元微调后的结果;「全连续」也依赖冻结编码器与外部解码器,图像输入仅 224 分辨率。 3. NEPA-DiT:预测嵌入当条件,FID 1.32 Embedding Prediction Helps Image Generation | 密歇根大学;卡内基梅隆大学 | arXiv:2610.02203 关键词:类别条件生成, 嵌入预测, 扩散 Transformer, 表征对齐, ImageNet 前序问题:DiT 里类别或文本只嵌入一次,每个去噪步复用同一个条件,「这个条件对眼前这张噪声图意味着什么」全留给生成器自己推断。NEPA(下一嵌入预测自回归)已能在连续嵌入上做自回归预测,作者想知道:能否用预测出的干净图嵌入替代固定条件。 本文贡献:把生成写成「条件 → 噪声图 → 干净图」的嵌入序列,干净图的 patch 嵌入正是条件与噪声图之后的「下一组嵌入」。作者训练 NEPA 模型用多嵌入预测(MEP)一次性预测全部干净嵌入;生成时 DiT 以这些预测为条件,并在每个去噪步按当前噪声状态重新计算,条件随采样进程自适应。 实验效果:ImageNet 256×256 上,NEPA-DiT-XL 结合 REPA,SDE-250 采样 FID 1.32、IS 311.0,ODE-96 采样 FID 1.57;训练为 NEPA 240 + 生成器 80 epoch,约为 REPA(800 epoch)训练算力的三分之一。九组规模交叉实验中,生成器或 NEPA 模型变大,FID 都单调下降。 批判点评:训练省了,推理贵了:多挂一个 711M 的 NEPA 网络,总参数约 1.39B,是 SiT-XL/2+REPA(675M)的两倍;同为 SDE-250,单图 160 TFLOPs,比对方的 91 TFLOPs 多 76%。换成更省的 ODE-96,FID 1.57 反而不如 REPA 原版的 1.42。若放开 tokenizer,表中 SFD、RAEv2 已做到 1.06。 4. MosaiChunk:只训13.6M路由,长视频回访不失忆 MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation | 康奈尔大学;加州大学伯克利分校;哈佛大学;Impossible Inc. | arXiv:2610.02153 关键词:自回归视频生成, 长时记忆, KV 缓存, 记忆路由, 场景回访 前序问题:自回归长视频受限于上下文窗口:物体或场景移出窗口后细节丢失,镜头转回来时往往「重新编」一个。整块检索历史 chunk 能补记忆,但固定显存预算下塞不了几块;滑动窗口则干脆遗忘。 本文贡献:作者先验证冻结的视频生成器能直接消费非连续拼接的历史 KV 并还原对应内容。MosaiChunk 据此把每个历史 chunk 聚成若干 section 并编码描述子,由轻量路由器全局挑出 top-N,在固定活跃显存预算内拼成一块跨时空的 KV 马赛克;生成器全程冻结,只自蒸馏训练路由器。同时发布 RememBench 回访基准,含 T2V 与 I2V 两个子集。 实验效果:在 MiniMax-H3 改造的自回归版 H3-AR(T2V)上,两块远程记忆预算下回访 CLIP 从滑窗基线 0.751 升到 0.936,LPIPS 从 0.652 降到 0.500,优于整块检索 MoC(0.841);LingBot-World-Infinity(I2V)180° 旋转回访 CLIP 0.793→0.863。路由器只有 13.65M 参数。 批判点评:自建基准涨幅大,公开基准涨幅小:WBench 的 Subject 一致性仅 88.10→88.38,两块预算下 Segment 一致性反从 97.47 掉到 94.94;T2V 的 Drift 也略升(0.050→0.055)。论文还写明评测用的是早期 checkpoint:T2V 计划训 4000 步、实取第 416 步,I2V 计划 4768 步、实取第 500 步,未解释为何不用训完的权重。 5. Soundwich:冻结LTX-2.5免训练拆分音轨 Soundwich: Video Generation with Layered and Controllable Audio | 西蒙弗雷泽大学;塞浦路斯大学;CYENS 卓越中心;特拉维夫大学 | arXiv:2610.00691 关键词:音视频联合生成, 音轨分离, 免训练, 时间控制, 可编辑音频 前序问题:联合音视频模型已能生成带同步声音的视频,但音频是一条混好的总轨:谁在何时说话、配乐和环境声都没法单独改。实际制作中,对白、音乐、音效、环境声都是分轨编辑的。 本文贡献:Soundwich 不做训练,直接改造冻结的 LTX-2.5:先把音频轨迹扩成 N 条可编辑分轨加一条内部场景轨,用缓存的「出声 / 静音」特征(timing carrier)在指定时间窗内回放或压制;再用 gather–broadcast 注意力让各分轨共享全局声学语境,并用实体掩码把每条分轨的跨模态注意力路由到画面中对应的发声者。 实验效果:15 个多声源场景上,时间窗成功率 93.1%、窗外误发声 1.7%、声源归属 90.0%,窗内 WER 0.060;同场景原版 LTX-2.5 窗成功率仅 20.4%,MiniMax H3 为 27.0%,Gemini Omni 为 85.0%。去掉 timing carrier,窗成功率从 93.3% 跌到 15.6%。 批判点评:评测规模很小:主表只有 15 个场景、每场景 3 个固定种子,场景广播模块的人评只收回 15 份问卷。真正接近的对手是闭源 Gemini Omni,WER 0.072 对 0.060、窗成功率 85.0% 对 93.1%,且它只有 14 个场景可计 WER。声源归属 90.0% 比朴素批量扩展的 82.2% 只高 7.8 个点。 6. DMAD:判别器替掉辅助分数网络,4步出片 DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation | 得州农工大学;字节跳动智能创作 | arXiv:2610.02188 关键词:少步蒸馏, 分布匹配, 对抗蒸馏, 视频生成, 音视频生成 前序问题:DMD 系列少步蒸馏要从「目标分数 − 学生分数」的差里取梯度,因此必须额外维护一个持续拟合学生分布的辅助扩散模型,显存与算力开销都大,在 14B、33B 级视频模型上尤其吃紧。 本文贡献:DMAD 把分布匹配改写成分类:共享主干上挂两个判别头,分别区分「真实数据 vs 学生」与「教师样本 vs 学生」,用 logit 直接学习对数密度比,学生只用作用在 logit 上的线性损失训练,无需拟合辅助分数。作者证明判别器最优时该损失恰好还原 DMD 的梯度,并用真实头在真实与教师样本间的 logit 差,自适应调节各噪声级上教师监督的权重。 实验效果:ImageNet-64 一步 FID 1.04(加投影判别器),SDXL 四步 COCO-10K FID 14.47,Wan2.1-14B 四步 VBench 85.15,均优于所比少步方法与多步教师。在 MiniMax-H3-33B 联合音视频生成上,四步学生人评总体偏好 79.1% 胜 DMD2、84.6% 胜 rCM;每次生成器更新耗时从 818.1s 降到 233.3s。 批判点评:人评高分主要来自画质与音质(对 DMD2 胜率 84.2% / 87.9%),提示词对齐只有 54.3% 对 45.7%,接近打平。AVGen-Bench 上音画同步 AV 分 49.1,低于 DMD2 的 56.7;唇形同步 30.6,离教师的 39.0 也远。SDXL 一步时 Patch FID 32.42,反而比 DMD2 的 26.98 差,细节保真不如整体 FID 好看。 7. FlashForward:复用在途KV,4卡流水线生成长视频 In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion | Meta;南洋理工大学 | arXiv:2609.32540 关键词:自回归视频扩散, KV 缓存, 流水线并行, 长视频生成, 推理加速 前序问题:少步自回归视频扩散按 chunk 逐段生成。为记住已生成内容,Self-Forcing、HiAR 等方法要额外跑「只更新缓存、不推进输出」的前向来重建干净或低噪 KV。可每次去噪前向本来就算出了当前 chunk 的 KV,这部分被白白浪费。 本文贡献:FlashForward 直接复用每个去噪阶段算出的「在途」KV:当前 chunk 完成一个阶段后,该阶段的缓存即可供下一个 chunk 使用,于是每张 GPU 负责一个去噪阶段,不同 chunk 在卡间流水并行。为弥补噪声历史带来的外观与运动漂移,再由 planner 预先生成稀疏的干净锚点 latent,从前后两侧约束 renderer 的轨迹。 实验效果:4 卡下,16 FPS、20 秒以上视频比 HiAR 快 1.16–1.69 倍、比 Self-Forcing 快 1.42–2.92 倍(1.3B 与 14B,480p / 720p)。1.3B 480p 生成 65 秒视频去噪耗时 21.3s(HiAR 24.7s、Self-Forcing 65.1s);VBench 总分 0.838,65 秒 VBench-Long 0.8395,高于 Self-Forcing 的 0.7806。 批判点评:提速依赖多卡流水:单卡 480p 下它比 Self-Forcing 还慢(20 秒视频 17.77s 对 17.44s,65 秒 59.64s 对 57.89s)。生成 5 秒短片时 4 卡耗时 2.21s,慢于 HiAR 的 2.06s,更慢于双向模型的 1.13s。14B 720p 峰值显存 112.8 GiB/卡,比 Self-Forcing 多约 20 GiB;20 秒视频语义分 0.748 也略低于 HiAR 的 0.757。 8. TVRL:用VLM梯度给视频token分功劳 Token-Level Video Reinforcement Learning | 美国东北大学 | arXiv:2610.01973 关键词:视频生成, 强化学习, GRPO, 信用分配, VLM 奖励 前序问题:视频生成的 RL 后训练通常给整段视频一个标量奖励。可视频的缺陷是局部的:有的 token 已满足提示词,有的才需要修。标量奖励定位不了错误,优化时既会扰动本来正确的区域,又对真正出错的区域用力不足。 本文贡献:TVRL 让奖励自己给出 token 级功劳:冻结 VLM 对提示词拆出的若干是非题给出答案似然,平均后作为视频级奖励;同一 VLM 对视频输入的梯度幅值,则标出哪些生成 token 最影响该得分。在 GRPO 中,组相对优势决定更新方向与强度,经 3×3 平滑、按问题条件化的 credit 图在裁剪策略比内重加权各去噪步的转移对数概率。 实验效果:以 HunyuanVideo-1.5 为底座、Qwen3.5-9B 作奖励,VBench-2.0 Overall 从 54.09 升到 57.69(+3.60),同设置 GRPO 仅 54.54。换 SAGE、Flow、Dance 三种 SDE 采样器,比匹配 GRPO 高 2.68–3.15;换 VideoAlign 等四种奖励模型,高 1.33–3.15。 批判点评:增益并不均匀:常识维度上 TVRL 常不如 GRPO(Qwen3.5-9B 奖励下 64.31 对 64.88,VideoScore2 下 64.60 对 64.89),VideoScore2 下 Human 维度也从 91.52 降到 90.79。评论家规模很关键:换成 Qwen3.5-0.8B 时 Overall 仅 51.85,比未训练的底座 54.09 还低。所有结果都只训 100 步(64 张 A100),单步耗时比 GRPO 多 18%。 9. PixelDense:4个冻结老师分两路对齐像素扩散 PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion | 弗吉尼亚大学;密歇根州立大学;Adobe;Arcade AI | arXiv:2610.00483 关键词:像素扩散, 表征对齐, 稠密预测, 文生图, 几何先验 前序问题:REPA 通过对齐预训练编码器特征来加速 DiT 训练,但对齐目标几乎都是 DINOv2、CLIP 这类语义编码器。已有分析指出起作用的是空间结构而非全局语义,那么专门预测结构的稠密预测模型(分割、深度)为何没人拿来当对齐老师? 本文贡献:在像素空间扩散上,作者先验证 SAM2、Depth Anything v2、Metric3D v2 单独加入都优于只用 DINOv2,但四个老师直接相加反而不如最好的单个几何老师,语义与几何梯度在同一投影上互相争抢。PixelDense 因此让 DINOv2+SAM2 走语义投影流、两个深度模型走几何投影流,再加权重空间正交惩罚让两流处在不相交子空间;老师全部冻结、推理时丢弃。 实验效果:在 PixelGen-XXL(512×512)上,GenEval Overall 0.7927→0.8093,DPG 78.7→78.9,HPS 0.280→0.282;同一配方不调参迁移到 DeCo,GenEval 0.8620→0.8690。部分加噪重建中,τ=0.5 时 COCO 全景 PQ 23.23→31.43;PIE-Bench 上 SDEdit 背景 PSNR 最多高 2.2 dB。论文已接收 NeurIPS 2026。 批判点评:几何探针涨得多,生成指标涨得少:GenEval 只 +0.017、DPG +0.2、HPS +0.002,DeCo 上 +0.007,计数项 58.75 仍低于 PixelGen 原版的 59。消融里单独的几何流(DA2+M3D)只有 0.7960,还不如 DINOv2+DA2 单老师的 0.8069。主实验只是在已发布权重上用 2 张 H200 微调 1 万步,从头训练仅给出「1.23 倍更快达到基线峰值」一项。 10. VIEScore2:16×16网格同时打分并圈出缺陷 VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations | 滑铁卢大学;NVIDIA;台湾大学(中国台湾);南洋理工大学 | arXiv:2610.00994 关键词:图像评测, 缺陷定位, 生成与编辑, GRPO, VLM 评估器 前序问题:现有合成图评估器大多只给一个标量分数,不说明依据在图上哪里;能定位缺陷的模型又通常不打分、也不支持编辑任务的条件图输入。生成与编辑的评测和奖励信号,缺一个「既能打分也能指位置」的统一接口。 本文贡献:VIEScore2 把图像表示为 N×N(默认 16×16)文本网格,单次前向同时输出感知质量、语义一致性分数与缺陷格子位置,支持可选条件图,覆盖文生图、编辑、参考图生成等任务。它基于 Qwen3-VL-8B 在 38K 条混合监督上先 SFT,再以 Dice 重叠、分数准确度与格式奖励做 GRPO,最后用无参数解析器把网格结果转成可读解释。 实验效果:主测试集整体分数 SRCC 0.601,高于同输入下最强的零样本通用 VLM Gemini-3-Flash(0.491)与 GPT-5.6-sol(0.437);联合评测网格 IoU 0.324,Qwen3-VL-8B 原版仅 0.070。缺陷定位在 6 个基准中 3 个第一、5 个进前三。 批判点评:整体领先主要来自训练同源数据:RichHF(0.692)与 EvalMuse(0.803)拉高均值,编辑类子集反被零样本 API 压过,TIE 0.429 对 Gemini-3-Flash 的 0.686,MRIE 0.417 对 GPT-5.6-sol 的 0.684。定位上,轻量的 SegFormer-b0 在主测试集 F1 拿到 0.493,与它的 0.506 相差无几;GRPO 之后 PQ 的 SRCC 还从 0.580 降到 0.558。 趋势观察 「加算力不加参数」成了今天的共同母题 Looped-DiT 让同一组块在每个去噪步里绕 4 圈,NEPA-DiT 每步重算一次预测嵌入当条件,两者都用额外推理算力换质量而不是加参数;但细看算力表,前者每步 1.83 倍 GFLOPs,后者单图多 76% TFLOPs,「小模型赢大模型」的账要连推理成本一起算。另一头,DMAD 与 FlashForward 继续在蒸馏和 KV 复用上压缩视频生成的步数与等待时间,TVRL 与 VIEScore2 则把奖励和评测从一个标量推进到 token 与网格级定位。 人工智能炼丹君 整理 | 2026-10-04 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-10-02|NVIDIA砍掉视觉编码器,PixelUMM图像视频同模 今日 AIGC 论文速览 今日共 10 篇 · 统一理解生成与三维细节 2 篇 · 推理式与可控视频生成 2 篇 · 音视频联合生成 1 篇 · 视频推理加速 4 篇 · 视频文字编辑评测 1 篇 重点论文标题列表 PixelUMM(NVIDIA):像素直进图像视频同模型 BTC3D(香港城市大学(东莞)):分块条件补3D细节 ThinkV2V(港中大):先推理再改视频 LIFT(加州大学圣迭戈分校):只画终帧也能控未来 StereoBind(西电):声源移动立体声跟着走 今日论文速览 1. PixelUMM:像素直进图像视频同模型 PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation | NVIDIA;滑铁卢大学 | arXiv:2609.38597 关键词:统一多模态, 像素空间, 图像生成, 视频生成, 视觉理解 前序问题:统一理解与生成模型通常给同一张图准备两套表示:ViT 特征服务理解,VAE latent 服务生成。这不只让视觉上下文变长,也把成熟的视觉语言预训练与生成接口绑在两条管线上。图像还能直接切 patch,视频却要同时兼容理解侧的采样帧与生成侧的连续时空块,统一接口更难。 本文贡献:PixelUMM 取消预训练视觉编码器和 VAE,把图像变成空间 patch、视频变成时空 tubelet,都只用一层线性投影接入 8B Mixture-of-Transformers。理解走自回归文本预测,生成在原始像素上做 flow matching;共享 attention 让干净条件与带噪目标直接交互。论文还系统比较 patch/tubelet 大小、线性头与卷积解码头,发现卷积头能压掉格子伪影。 实验效果:不使用视觉 encoder/tokenizer 时,PixelUMM 在图像理解 MMMU 得 41.67、视频理解 MVBench 得 70.53;图像生成 GenEval 原始 prompt 为 0.77,用 BAGEL-long 重写后为 0.83,DPG-Bench 为 85.74。视频生成 VBench 总分 83.24,处于统一模型可比区间,但不是各榜第一。 批判点评:“统一”仍有边界:理解与生成使用两套 Transformer expert,只共享 attention,并非一组参数同时做两件事。原始像素 token 让更小 patch 和 tubelet 虽然降低 loss,却直接抬高序列长度与训练成本。作者也提醒各模型训练数据不同,当前表格不能证明 encoder-free 架构本身更优;MMMU 41.67 与主流 8B VLM 仍有明显差距。 2. BTC3D:分块条件补3D细节 BTC3D: Blended Tile Conditioning for Detail-Enhancing Image-to-3D Generation | 香港城市大学(东莞);SB Intuitions;巴塞罗那自治大学 | arXiv:2609.39709 关键词:图像生成3D, 免训练, 分块条件, 细节保真, 流匹配 前序问题:扩散式 image-to-3D 已经能出像样模型,可一旦输入图细节丰富,纹理就糊成一团。主流做法把整张图压成一个全局条件特征,空间信息在这一步被压掉,作者称之为 detail attenuation;而想补细节通常要重训或微调大模型,对 3D 管线代价过高。 本文贡献:BTC3D 是推理时即插即用的免训练框架。它先验证 image-to-3D 模型存在「图像特征可加性」:把局部图块的特征相加,仍能得到语义一致且保留局部细节的 3D 输出。据此把输入图切成若干 tile,各自提取局部条件并按前景权重聚合成 blended tile embedding;再配一个 dynamic conditioning 调度,在扩散后期低噪声阶段逐步加大 tile 条件的权重,早期仍交给全局条件主导结构。 实验效果:在 3D-Arena 与 Toys4K 上,把 BTC3D 接到 TRELLIS、TRELLIS.2、Hunyuan3D-v2.1 上都提升了纹理与视觉保真,且保持全局结构一致。20 名参与者、400 次两两偏好测试中,接入 BTC3D 的 TRELLIS.2 拿到 67.25% 选票(269 票),基线只有 32.75%(131 票),纹理密集的样本优势最明显。 批判点评:收益主要靠人眼偏好而非几何或纹理指标说话,67.25% 也是相对自家基线的增幅,缺少跨方法横评;论文同时承认纹理稀疏的样本上两者偏好接近持平,说明方法吃的是「有没有细节可补」。另外 tile 切分与融合系数 α、β 都是人工超参,动态调度只按扩散时间步推进,不看当前生成内容。 3. ThinkV2V:先推理再改视频 ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing | 香港中文大学;字节跳动;浙江大学;俄亥俄州立大学 | arXiv:2609.38541 关键词:视频编辑, 多模态大模型, 显式推理, DiT, 指令跟随 前序问题:现有指令视频编辑器多把 MLLM 当语义编码器,直接把 prompt 压成条件。碰到“把会被雨淋湿的东西收起来”这类不直接点名目标的指令,模型必须先理解因果与对象关系,再决定改哪里;只抓关键词往往画面能改,却改错对象或违背真实意图。 本文贡献:ThinkV2V 让 MLLM 先显式分析源视频和指令,再通过 learnable-query connector 把推理结果送给多条件 DiT。训练采用从直接编辑到推理密集样本的 progressive curriculum;推理时生成多份候选编辑 prompt,迭代反思并选择最可靠的一份。团队同时整理 ThinkV2V-150K 与专门考隐式意图、因果编辑的 ThinkV2V-Bench。 实验效果:5B 编辑器在 ThinkV2V-Bench 上由 Seed-1.6-VL 评测的 Overall 为 2.72,高于 OpenVE-Edit 的 2.09 和 14B DITTO 的 2.02;Gemini-2.5-Pro 评测下为 2.61,也高于 ICVE 的 2.52。模型在 32 卡上分三阶段训练,最终 720p 推理,以小于多条 10B–14B 基线的规模拿到最佳综合分。 批判点评:核心结论依赖 Seed-1.6-VL 与 Gemini-2.5-Pro 充当裁判,复杂编辑的自动分数仍可能偏向更会“讲意图”的输出。Inference-Time Thinking Scaling 需要多候选生成、反思和筛选,论文没有把新增延迟与算力单独量化。150K 数据由既有模型与筛选流程构建,推理能力有多少来自 MLLM、多少来自数据课程,还缺更严格的因果拆分。 4. LIFT:只画终帧也能控未来 LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation | 加州大学圣迭戈分校;弗吉尼亚大学;Meta;Amazon;Lambda | arXiv:2609.38146 关键词:视频生成, 相机控制, 未来布局, on-policy self-distillation, 图生视频 前序问题:相机大幅移动时,首帧之外会露出全新区域。只给相机轨迹能控制“镜头往哪走”,却不能指定新区域里出现什么;逐帧框轨迹虽然能控布局,标注和交互成本又太高。真正实用的接口应允许用户只在未来关键帧画几个框,同时让中间过程自然长出来。 本文贡献:LIFT 把最后一帧的 bounding box 与局部 prompt 编成稀疏 layout latent,与首帧和噪声视频一起送入 DiT,相机 token 另行注入。训练时用拥有逐帧 dense layout 的冻结教师,在学生自己访问的 ODE 状态上做 on-policy self-distillation,把 dense 轨迹知识蒸馏给只看终帧布局的学生;同一个学生交替学习有布局与仅相机两种模式。 实验效果:LIFT 1.3B 在终帧布局控制上 mIoU 0.51,高于需要逐帧框的 MagicMotion 0.41;同时相机 RotErr 2.97、TransErr 0.59,视频 FVD 99.35。OPSD 只用 500×16=8000 次样本更新,直接或 dense-to-sparse SFT 都要 4000×32=12.8 万次,训练样本量缩到 1/16。 批判点评:布局接口仍只是 2D 框加局部文字,没有深度、朝向、遮挡和实例关系;相机一转,两个框在 3D 中究竟谁挡谁并未显式建模。所谓 1/16 训练量比较的是作者设定的更新预算,并不等于端到端数据与教师成本也缩到 1/16;OPSD 还依赖一个先用 dense layout 训练好的教师。 5. StereoBind:声源移动立体声跟着走 Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation | 西安电子科技大学;vivo 蓝图影像实验室 | arXiv:2609.38748 关键词:音视频联合生成, 立体声, 空间音频, 运动轨迹, 跨模态对应 前序问题:联合音视频模型已经能做到“画面里有什么就听到什么”和大致同步,却很少管声音来自哪里。AR/VR 中声源从左往右移动时,左右声道也应连续变化;只用文本或整段视频条件生成声音,往往知道是汽车声,却无法让声像跟随汽车轨迹。 本文贡献:StereoBind 把可见声源的 motion track 作为共同坐标系:Visual Motion Binding 绑定视觉运动与音频 token,Spatial Track Encoder 提供绝对位置,Residual Track RoPE 编码相对位移。团队用真实视频定位跟踪加合成立体声、再配合可控合成场景,构建 StereoWorld-29K,并用 StereoWorldBench 单独评测动态空间对应。 实验效果:在 StereoWorldBench 上,StereoBind 的 ILD-W 为 2.754、SELD-Acc 0.757、SMR-Err 14.86、AST-Ang 0.465、AST-Cal 0.314,五项空间指标都优于表中 Ovi、MiniMax-H3、LTX-2.5/2.3 及两条 video-to-spatial-audio 基线;视觉 Subject Consistency 0.955、Motion Smoothness 0.996,整体画面质量没有明显牺牲。 批判点评:当前条件是一条主要声源轨迹,训练和评测强调水平声像移动;多声源竞争、声源与听者同时运动、遮挡和完整 3D 声场仍被列为未来工作。空间指标全面领先不代表总体音质全面领先,Subject Consistency 0.955 低于 MiniMax-H3 的 0.968,Audio PQ 6.86 也只是略高于 6.81。 6. ReCaVSR:1080p单卡跑21.2FPS ReCaVSR: One-Step Streaming Diffusion Video Super-Resolution with Recycled Latents and Learned Cache Routing | 中国科学技术大学 | arXiv:2609.37831 关键词:视频超分辨率, 流式扩散, KV Cache, 一步生成, 实时推理 前序问题:扩散式视频超分画质好,却很难满足直播级延迟。现有流式方案要么多步去噪,要么每层都保留完整历史 KV;但视频超分当前帧已有低清观测,上一块超分 latent 也带着局部时序信息,继续为所有层保存同样长的历史既占显存又拖慢注意力。 本文贡献:ReCaVSR 基于 Wan2.2 做一步流式超分,把上一块生成的 SR latent 直接回收为下一块条件,再为每个 DiT 层学习不同的历史缓存范围,训练完导出固定路由。生成器用 sequential self-rollout 对齐真实因果推理;Multi-Scope Query 判别器同时看全局、空间窗口和时间 tube;LR-conditioned FlashDecoder 在解码时再次利用低清观测。 实验效果:单张 A100-80GB 输出 1080×1920 时达到 21.20 FPS、峰值显存 15.16GB,相对 FlashVSR Tiny 快 2.72 倍、少用 38.0% 显存,首个完整 RGB 输出的模型时间为 0.982 秒。LongVSR60 上 MUSIQ 57.89、CLIP-IQA 0.4932、DOVER 0.6075,后三项都高于列出的流式基线。 批判点评:它并非所有重建指标都第一:REDS30 的 PSNR 21.67 明显低于 RealViformer 23.32,说明生成式纹理仍会牺牲逐像素保真。缓存路由在训练后固定,遇到运动强度突变或硬切镜不能自适应;论文的长视频测试还是单段连续镜头,跨场景时旧 latent 和 KV 会不会污染新镜头尚未验证。 7. PARK:稀疏注意力快1.76倍 PARK: Accurate Block Retrieval for Sparse Attention in Video Diffusion Transformers | 华南理工大学 | arXiv:2609.38978 关键词:视频生成, 稀疏注意力, DiT, block retrieval, 免训练加速 前序问题:视频 DiT 的稀疏注意力通常先把 query 与 key 分块求均值,再按块检索。这个近似有两重错位:Softmax 前把多个 query 平均会抹掉各自偏好的 key;在原始 key 空间做欧氏聚类,也不保证同一簇的 key 在当前 query 下拥有相似 QK 分数。检索一旦选错块,要么掉画质,要么为了兜底算太多。 本文贡献:PARK 保留块内每一个原始 query,分别对 key block 做归一化后再平均分布,避免 query-centroid 代替整块偏好;key 侧则从当前 query 推导度量,先变换 key 再做 K-means,让欧氏距离对应 QK-score 误差。方法完全免训练,并把 PAMA 检索写成融合 GPU kernel,把准确率收益留住而不让检索开销反噬。 实验效果:在 Wan2.1-1.3B 上,PARK 将单次测试从 745 秒降到 423 秒,端到端 1.76 倍加速,同时 PSNR 27.52、SSIM 0.908、LPIPS 0.177,优于同表其他稀疏基线。跨 Wan2.2-14B、Wan2.1-14B、Wan2.1-1.3B 和 HunyuanVideo 四个模型,相对 dense 的加速范围为 1.53–1.76 倍。 批判点评:收益建立在四个视频扩散模型和固定检索配置上,作者明确没有验证 LLM 或其他多模态任务。主表中 Wan2.2 的 Aesthetic Quality 65.29% 仍低于 dense 的 65.56%,Wan2.1-1.3B 的 Background Consistency 96.87% 也低于 dense 的 96.99%;它更像高质量近似,而不是无损替换。 8. UnStep:免训练把视频推到50FPS UnStep: Training-Free Acceleration of Causal Video Diffusion with Fewer Steps Than Distillation | Meta 超级智能实验室 | arXiv:2609.32518 关键词:视频生成, 因果扩散, 免训练加速, KV Cache, 推理优化 前序问题:四步因果蒸馏已经比 50 步双向教师快,但 Self Forcing 在 H100 上仍只有 17 FPS。步数继续砍到一两步会掉质量,历史 KV 随视频变长继续膨胀;同时当 DiT 已经很少步,RoPE、cache 索引、attention 调度和 VAE 解码这些过去被遮住的系统开销反而成了瓶颈。 本文贡献:UnStep 是不改权重的推理 wrapper:后续块从四步减到两步,只保留 sink 加最近窗口;把已生成 latent 重新加到近干净噪声,再复用原有 clean-cache pass 做一次修正,并对 attention 的 V/O 投影做截断 SVD 抵消少步误差。系统侧再融合 RoPE、缓存系数、固定长度 attention,并把 VAE 改成 FP16 与 channels-last 卷积。 实验效果:同一 Self Forcing checkpoint 在 H100 上从 17.0 FPS 提到 49.8 FPS,VBench Total 反而从 84.31 到 84.56;相同 wrapper 套在 Causal Forcing 和 LongLive 1.0 上也都约 49.8 FPS。若推理时改成一步,H100 达 59.6 FPS;GB200 最快报告 77 FPS,全程没有重训。 批判点评:所有超参数只在 Self Forcing、5 秒 T2V、单张 H100 这一套设置上调过,迁移结果证明“能用”,不代表每个 checkpoint、GPU、任务和长度都最优。50 FPS 的成绩同时叠加算法减步与大量 H100 专用 kernel 优化,不能全部归功于新的生成算法;而训练自由的约束也限制了更激进稀疏或量化后的质量恢复。 9. DeCoPrune:剪85%缓存仍保上下文 DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency | 南洋理工大学;清华大学;普林斯顿大学 | arXiv:2609.39096 关键词:自回归视频, KV Cache, 训练自由剪枝, 长上下文, 一致性 前序问题:自回归视频扩散把每段历史都塞进 KV Cache,时间越长,显存和 attention 成本越大。固定滑窗只看远近,attention 权重或相似度剪枝又不直接回答“这个历史块是否提供了不可替代的信息”,所以容易把稍后 prompt 才会重新提到的物体细节一起删掉。 本文贡献:DeCoPrune 用同一条去噪轨迹里的中间 probe 与最终预测做差:没有历史支持时难以稳定去噪、step-to-final discrepancy 较大的 token 被判为更需要上下文,因此保留高差异 token,再物理压紧历史 KV。论文同时构建 CMBench,用一分钟上下文中的物体取放、场景恢复等续写任务专测“前文记没记住”,并提供按 attention head 类型分组的 HS 版本。 实验效果:主设置剪掉 85.43% 历史 KV,续写 FPS 从 FullKV 的 1.568 提到 6.489,快 4.14 倍;CMBench DINO 从 0.6803 只降到 0.6701。head-specialized 版本在 86.19% 剪枝率下 DINO 为 0.6783,几乎追平 FullKV,且 VBench 的图像质量项没有出现系统性崩塌。 批判点评:“剪掉 85%”并不等于显存有硬上限,作者明确承认剩余缓存仍随视频长度线性增长。Denoising consistency 是 future-agnostic 的:某个细节此刻很好去噪、因此被删掉,但未来指令恰好再次询问它时仍可能失忆。主干又集中在 LingBot World v2,其他开源模型的分钟级 FullKV 本身就不稳定,方法与 backbone 上限难完全拆开。 10. ViTeX-Bench:387段视频检验动态改字 ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing | 得州农工大学 | arXiv:2609.40356 关键词:视频编辑, 场景文字, 评测基准, 时序一致性, 编辑局部性 前序问题:视频里的招牌、球衣或屏幕改字,要同时满足字符串正确、跨帧不漂、背景不被改。通用视频编辑指标可能把“画面很稳但根本没改字”的结果评得很高,静态 OCR 又看不见闪烁与字符漂移,现有公开数据也缺少真实视频的成对编辑参考。 本文贡献:ViTeX-Bench 收集 387 段 720p、120 帧、24 FPS 真实视频,其中 230 段提供人工复核的成对训练编辑,157 段冻结测试。评测拆成文字正确性、视觉/时序质量、编辑局部性三轴共 13 个指标,并用 OCR 校准、人评相关性与 Pareto 前沿解释取舍;配套的 ViTeX-Edit-14B 用随运动对齐的 glyph-video 条件微调 VACE。 实验效果:八条基线中,ViTeX-Edit-14B 在 video-native 编辑器里 CharAcc 最高,为 0.688,text-crop Warp 1.53 也最低;相较 VideoPainter 的 CharAcc 0.619 提升 0.069。但逐帧 FLUX-Text 的 CharAcc 仍达 0.737,代价是 Warpc 13.01、字符跨帧严重漂。人评与 OCR 方法排名的 Spearman 相关系数为 0.95。 批判点评:这个基准把“漂亮、正确、稳定、局部”拆开是优点,也暴露了参考模型并非全面第一:ViTeX-Edit 的 SeqAcc 0.341 低于 FLUX-Text 0.528。数据以清晰、局部、拉丁文字为主;非拉丁切片里除 AnyText2 外其余编辑器 CharAcc 都低于 0.19,严重运动、曲面文字、密集排版的覆盖仍不足。 趋势观察 加速的战场从「少走几步」挪到了「每层只记该记的」 ReCaVSR 给每个 DiT 层学一个缓存跨度,PARK 修正稀疏注意力的块检索误差,UnStep 把两步采样、限窗 KV 与 kernel 优化叠进同一个免训练 wrapper,DeCoPrune 则用去噪一致性挑出真正依赖历史的 token,四篇都指向同一件事:视频模型已进入少步时代,下一轮效率竞争发生在缓存、检索与运行时细节。另一头,PixelUMM 去掉视觉编码器让像素直进统一模型,说明「统一」正在从拼模块转向砍模块。 人工智能炼丹君 整理 | 2026-10-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-10-01|一次蒸馏插遍54个模型,LongLive-Plug 今日 AIGC 论文速览 今日共 10 篇 · 视频与图像生成模型 5 篇 · 世界模型与音视频联合生成 1 篇 · 推理加速与模型压缩 2 篇 · 生成理解一体化与奖励模型 2 篇 重点论文标题列表 LongLive-Plug(NVIDIA):蒸馏一次,插遍54个模型 SplitMoE(国科大):专家拆两拨,人像涨9分 HelixWorld(港科大):24帧实时出声的世界 LDM-is-AE(港理工):不用分词器,FID 1.80 NesTok(华北电力大学):变长 token,gFID 1.46 今日论文速览 1. LongLive-Plug:蒸馏一次,插遍54个模型 LongLive-Plug: Once-for-All Distillation for Video Generation | NVIDIA | arXiv:2609.38154 关键词:视频生成, 扩散蒸馏, LoRA 复用, 少步采样, 免训练部署 前序问题:视频扩散模型每做一次下游特化就要重跑一遍蒸馏:要么为少步采样,要么为长视频补误差修正。论文在 Wan2.2-TI2V-5B 上算了账——四个任务各自的专用蒸馏再花 83.9、150.0、86.8、56.1 H100 卡时,合计 376.8,加上一次性底座蒸馏约 80 卡时,总共 456.8 卡时。能力是通用的,钱被重复付了四遍。 本文贡献:把「单遍 CFG」「少步采样」「自回归长时误差修正」各蒸馏成一个 LoRA 挂在底座上,之后插到任何结构兼容的下游模型即可用,下游不再重训。CFG LoRA 只在 w=5 的固定引导强度下训练,推理时靠调 LoRA 权重换引导强度;与少步 LoRA 叠加,下游同时保住少步生成和 CFG 可控。作者称下游新增条件分支、扩展输出通道后适配器仍可复用。 Once-for-all distillation: reusable LoRAs plug into compatible downstream models. 实验效果:在 Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3 三个底座家族、八个任务类别共 54 个下游模型上验证免训练部署。世界模型 SCOPE 上把朴素四步的 FVD 从 805.5 拉回 478.7,优于专用蒸馏的 502.1;ControlNet 上六项全优于朴素四步,深度 si-RMSE 从 2.135 降到 1.641、DOVER 从 8.90 升到 10.11;原生 20–50 步调度降到 1/5–1/12.5。 Downstream distillation cost: task-specific distillation accumulates while LongLive-Plug stays flat. 批判点评:省的是专用蒸馏的钱,80 卡时的一次性底座蒸馏照付,且只对同一底座家族有效。更关键的取舍藏在正文一句「相对任务专用蒸馏存在按指标而异的取舍」——插拔版不是全面反超,而是用 80 卡时换一个接近 456.8 卡时的结果。CFG LoRA 的引导控制是推理权重外推出来的,训练只见过 w=5 这一个点。 2. SplitMoE:专家拆两拨,人像涨9分 Breaking the Uniformity Trap: Scaling Video Diffusion Model via SplitMoE | 中国科学院大学;字节跳动;Canva Research;北京科技大学 | arXiv:2609.38140 关键词:视频生成, 混合专家, 稀疏路由, DiT 规模化, 负载均衡 前序问题:MoE 从 LLM 搬到视频生成上一直水土不服:token 级路由各自为政,再用负载均衡损失把使用率往均匀方向压,结果语义连贯的一块画面被拆到互不相关的专家里,作者称之为「均匀性陷阱」。视频数据时空冗余、语义长尾,本来就不该被均匀分配。 本文贡献:把专家池显式劈成两拨:语义专家抓高层语义抽象,通用专家兜住残差视觉信息和生成自由度。路由用原型引导,配合 pull-push 正则——pull 把原型锚在有意义的视觉语义上,push 防止原型塌缩冗余。两条 sigmoid 独立打分,一个 token 可以同时选中一个语义专家和一个通用专家,不必在所有专家间做全局 softmax 竞争。 Pipeline of SplitMoE: each Video MoE layer splits into Semantic and Generic branches with VAE-prototype induced semantic routing. 实验效果:在同等激活参数预算(A14B)下对比 Wan2.2 系列:Creativity 58.46%、Human Fidelity 84.47%、T2V-CompBench 属性一致性 84.63% 三项拿到全场第一,人像保真比 Wan2.2 的 75.33% 高出 9 个多点。对比同数据微调的密集 Wan2.2-FT 全维领先,且收敛更快——约 70% 训练步数就达到可比的验证扩散损失。 Qualitative comparison with baseline methods. 批判点评:「打破均匀性陷阱」的措辞比结果激进。它自己的表里 Physics 69.41% 输给 LTX-2 的 76.71%,Interaction 69.98% 输给 Wan2.2 的 73.29% 和 OmniWeaving 的 73.94%,Commonsense 64.89% 离 LongCat-Video 的 70.94% 差 6 个点。消融也显示去掉原型引导的 w/o PG 版本在 Commonsense 上 63.22% 与完整版 64.89% 差距很小,语义路由的主要收益其实集中在物理和人像两项。 3. HelixWorld:24帧实时出声的世界 HelixWorld: A Real-time Interactive Audio-Visual World Model | 香港科技大学;Noiz AI | arXiv:2609.38123 关键词:世界模型, 音视频生成, 实时交互, 空间音频, 因果蒸馏 前序问题:主流交互式世界模型全是哑巴:只管画面渲染和操控,声音这一维整个缺失。级联的视频转音频模型拿不到相机轨迹和用户动作,声场对不上自运动,串行延迟也谈不上实时;而把它们硬改成因果自回归,历史误差会迅速累积成灾难性多模态漂移。训练数据同样缺——现有世界模型数据集基本无声,视频语料里的音轨又常被后期配乐和旁白污染。 本文贡献:先用一个双向教师模型在自建的高保真空间音视频数据(真立体声 + 度量级相机位姿)上学 6-DoF 轨迹与动作条件,再用在线轨迹蒸馏把它压成少步因果学生,配合长程流式微调压掉曝光偏差。块内注意力保持双向以维持音视频交互,跨块注意力严格因果并配滑动 KV 缓存。同时提出 HelixBench,首次把空间声学一致性纳入世界模型评测。 Causal distillation pipeline: self-forcing rollout, online trajectory distillation, DMD, and long-horizon tuning. 实验效果:单张 NVIDIA H800 上稳态 RTF 0.77,768×512、24 FPS,含视频与音频解码。HelixBench 上因果学生 KL 1.3934、FAD 2.3872、IB 0.2987、Spatial 41.7583 全部第一;级联配音路线(HelixWorld+AudioX / ThinkSound / PrismAudio)的空间分甚至是负的,说明分离式生成根本抓不住声源位置。 Visual comparison under interactive control. 批判点评:WBench 导航榜上它平均 79.9 只排第 4,落后 Alaya-EVOKE-Turbo 82.0、EchoWM 81.0、Zing-0.5 81.0——「比肩 SOTA 无声世界模型」是有选择的比法。更反直觉的是音画同步:学生的 DeSync 0.5867 秒反而差于 LTX-2.3 base 的 0.4042 秒,CLAP 0.3016 也略低于级联的 HelixWorld+AudioX 0.3094,联合生成在语义对齐上没打赢「先出画面再配音」。 4. LDM-is-AE:不用分词器,FID 1.80 LDM-is-AE: Latent Diffusion Model is an Auto-Encoder for End-to-End Image Generation | 香港理工大学;OPPO 研究院 | arXiv:2609.37080 关键词:图像生成, 潜在扩散, 自编码器, 一阶段训练, 表示学习 前序问题:LDM 的两段式流程先训一个自编码器定住 latent 空间,再在里面训扩散。问题在于这个空间是为重建优化的,训练扩散时它是冻住的,天然与去噪动力学不匹配。而两阶段里最强的那批又几乎都挂着 DINOv2 这类外部视觉基础模型做监督,等于把表示学习的成本挪到表外。 本文贡献:核心观察是:LDM 骨干每一步去噪其实都在做 latent→feature→latent 的变换,这本身就是一次内部「解码—编码」。于是把 DiT 劈成互逆的两半 DiT-D 与 DiT-E,在中间特征上加一个轻量 MLP 头对齐到像素空间并施加图像域监督,把这条 latent→image→latent 路径显式化;零噪声时它自然等价于一次自编码。另配时间感知的辅助特征混合,避免对齐吃掉去噪容量。 Architecture and training design of LDM-is-AE: (a) network architecture and training pipeline; (b) time-aware auxiliary feature mixing. 实验效果:ImageNet 256×256 上 FID 1.80、IS 314,512×512 上 FID 1.90、IS 320——512 这一档超过了 JiT-H/32 的 1.94、REPA-SiT-XL/2 的 2.08。生成器训练 FLOPs 7.02,低于 JiT-H/16 的 14.0。自编码路径上 PSNR 27.57 高于 VAVAE 的 26.59 和 SDVAE 的 25.94。 Class-conditional ImageNet samples generated by LDM-is-AE at 256x256 resolution. 批判点评:FID 1.80 这个数得放在「不用 VFM 的一阶段方法」这个限定里看:两阶段挂 DINOv2 的 LightningDiT、REPA-SiT 仍然更好。更值得玩味的是它自己的重建口径——rFID 0.7879 明显差于 VAVAE 的 0.2650 和 REPA-E 的 0.4980,PSNR 最高却 rFID 最差,说明这个 latent 是奔着自然图像分布去的,压根不为「还原输入」负责,论文把这叫 diffusion-native,换个说法就是不忠于输入。 5. NesTok:变长 token,gFID 1.46 NesTok: Nested Self-Aligned 1D Tokenizer for Autoregressive Image Generation | 华北电力大学;中国科学技术大学;斯坦福大学 | arXiv:2609.36756 关键词:图像生成, 视觉分词器, 变长 token, 自回归生成, 嵌套对齐 前序问题:变长 1D 分词器想用一个 tokenizer 覆盖不同算力预算,主流做法是嵌套 dropout——随机截断 latent 序列并保留前缀,逼着前面的 token 装下最重要的信息。但「长度灵活」不等于「token 用得好」:已有工作发现序列加长后下游 AR 生成质量收益递减甚至倒退,尾部 token 基本成了摆设。 本文贡献:提出嵌套自对齐:跨长度联合优化重建,同时用全长序列去指导短序列,让短前缀逼近全长的重建质量,而不是只让前缀独立地「更重要」。配套的动机实验很直白——嵌套 dropout 训出来的码本在靠后位置归一化熵很低,码本多样性塌了,gFID 只有 2.46。 Overview of the nested self-aligned training pipeline. 实验效果:ImageNet 上 rFID 0.98,下游 AR 生成 gFID 1.46(带引导)、IS 295.9,在变长自回归图像生成这一档里是当前最好,优于 ReTok 的 2.27、One-D-Piece 的 2.35、DetailFlow-32 的 2.75,也远好于嵌套 dropout 基线的 2.46。 gFID with and without classifier-free guidance across different methods, model sizes, and token lengths. 批判点评:1.46 这个 SOTA 是「变长自回归」这个小池子里的 SOTA:同一张表上扩散路线的 Lightning-DiT-XL 带引导 gFID 1.35、REPA-XL/2 1.42 都更好。而重建口径更尴尬——rFID 0.98 远差于 LightningDiT 用的 KL tokenizer 0.28 和 SD-VAE 的 0.62,等于用重建质量换了生成质量。另外它仍是 VQ 分词器,390M 参数不算轻。 6. PixelDiff-GAN:加判别器,FID 降到28.6 Adversarial Training for Pixel Diffusion | Adobe Research;加州大学圣地亚哥分校;加州大学默塞德分校 | arXiv:2609.38170 关键词:图像生成, 像素扩散, 对抗训练, 后训练, 频谱分析 前序问题:像素扩散直接在 RGB 上出图,绕开了自编码器这个瓶颈,但产出的图像在细尺度自然图像统计上系统性偏低——说白了就是高频细节不够。这是个老问题,却一直没人系统性地验证对抗训练能不能补。 本文贡献:保留预训练模型原来的扩散/流匹配目标不动,只在非高噪声时间步上对预测输出额外加一个对抗损失,架构和采样流程一行不改。作者还做了归因:频带与幂律分析显示原模型系统性地欠产高频,对抗后训练正好把这部分谱功率补回来。 Noise-gate rationale: structure settles early, detail settles late. 实验效果:两个像素骨干上同时改善分布保真、覆盖率、提示对齐和感知质量。DeCo 上 FID 从 33.27 降到 28.59、pFID 27.9→24.4、CMMD 0.836→0.736、recall 0.361→0.406、DPG 81.6→83.3、TOPIQ 0.71→0.77、MANIQA 0.64→0.71;PixelGen 上 DPG 从 78.4 提到 80.8。1065 组配对样本的胜率也明显高于 latent 扩散的同类做法。 Pixel radial-profile band share over 30,000 images per model; gray = no-GAN, green = +GAN. 批判点评:FID 28.59 的绝对值放在今天并不好看,它赢的是「相对自己」这一档。真正有价值的是边界实验:同样的流程搬到 latent 扩散(PixArt / SANA)上没有可比增益,也几乎没加回解码后的高频功率——作者据此认为「能否直接触达被修正的图像统计」才是对抗后训练成不成立的关键。另外论文自己提到真实照片在 TOPIQ 上只拿 0.57,比生成的还低,等于承认无参考指标不足以单独作证。 7. DIET:砍半专家,57GB 变 30GB DIET: Deletion-response Expert Trimming for Video Diffusion Transformers | 西安交通大学;上海交通大学;阿里巴巴 Token Hub;阿里云 | arXiv:2609.37829 关键词:视频生成, MoE 剪枝, 专家裁剪, 免微调压缩, 推理加速 前序问题:MoE 的稀疏激活只省算力不省显存——所有专家的参数一个不少地躺在 checkpoint 里。整块删掉专家是最直接的瘦身办法,但现有一次性剪枝判据靠静态激活或路由频率打分,看不见「删掉某个专家、token 重新路由之后」这一层到底发生什么。而在这个规模上穷举多种删除组合,代价根本付不起。 本文贡献:用一次 all-expert 标定把条件/无条件 token 下所有专家输出和 router 状态全部录下来,之后重放任何单专家删除及其成组重路由,退化成对缓存状态的张量运算,零额外前向。在此基础上把「保留哪些专家」写成整体多样性损失:每个被删专家匹配到最近的保留专家,求和最近邻余弦距离作集合级覆盖损失。求解分两层——层内贪心+单交换+模拟退火,层间用回归指导的预算分配。 DIET overview: grouped MoE capture, replay-to-signature, intra-layer ODL, and inter-layer budget search. 实验效果:在 LingBot-Video 30B-A3B 上免微调剪掉 50% 专家(6144→3072),checkpoint 从 57GB 降到 30GB,48GB 单卡可部署;284 条固定用例上 VBench Total 反而从 0.7941 升到 0.8115。层间非均匀预算分配比均匀分配多拿 1.2 个点。所有保留预算下都优于从 LLM 移植过来的剪枝基线。 Primary evaluation and routing dynamics across candidate retention budgets. 批判点评:VBench 从 0.7941 涨到 0.8115 是这条工作最抓眼的数字,但幅度只有 1.7 个百分点,且出自自家固定的 284 条协议,更像「没掉点」而不是「变好了」。省下的是 27GB 存储,激活算力并没少——稀疏激活本来就只算一部分。另外这套标定缓存的前提是条件/无条件 token 可配对,CFG 之外的采样路径能否同样成立没有验证。 8. SoL-Refiner:一步上 4K,快 8.91 倍 SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video | NVIDIA | arXiv:2609.37969 关键词:视频生成, 超分辨率精修, 一步蒸馏, 强化学习后训练, 推理加速 前序问题:高分辨率视频生成的代价随时空 token 数暴涨。实用做法是先在低分辨率出片再用 refiner 精修,但常规 refiner 本身要跑好几个目标分辨率的去噪步,等于引入第二个采样瓶颈。而且多数 refiner 只针对自家基模型开发,换一个生成器还灵不灵几乎没人测。 本文贡献:从 LTX-2.3 出发走三步:高分辨率续训学精修映射、帧级奖励模型做 RL 后训练提升感知质量、最后一步蒸馏压成单步。推理侧配 TAE 小自编码器降低编解码开销,用 latent 上采样初始化,再由 Sol Video Inference Engine 执行单次 NFE。同时建了 Refiner-Bench——150 条对齐视频、统一输入协议,专门横向比 refiner。 Training and inference pipeline of SoL-Refiner. 实验效果:一步版在 Refiner-Bench 上 VBench 均值 0.81048、UniPercept 均值 60.4150,超过同为一档步数的 SEEDVR2 和三步的 LTX-2.3 Refiner。4K 上相对三步 LTX-2.3 Refiner,VBench 与 UniPercept 均值分别提升 3.86% 和 22.79%。叠满加速栈后 2K 延迟档精修提速 8.91 倍;配四步 MiniMax H3 基模型,整条两级流水线比直接全分辨率生成快 27 倍。 Performance across output resolutions: three-step LTX-2.3 Refiner vs one-step SoL-Refiner. 批判点评:一步版输给自家多步版——0.81048 对 23 步的 0.81691,主体一致性 0.92191、动态度 0.71333 都被多步版和 LTX-2.0 Refiner 压过。8.91 倍是「精修阶段」的加速,不是端到端;27 倍那个数则是把基模型也换成低分辨率四步 H3 之后的联合结果。另外 Refiner-Bench 是自建集,起点又是 LTX-2.3,公平性靠 shared-input 协议兜着。 9. OmniTaskonomy:19个生成任务换25项能力 OmniTaskonomy: When Does Visual Generation Improve Visual Understanding? | 加州大学伯克利分校;杜克大学;卡内基梅隆大学;华盛顿大学;Elorian;Impossible Research | arXiv:2609.38079 关键词:统一多模态, 生成理解一体化, 任务迁移, 梯度对齐, 训练课程 前序问题:生成能给理解带来多少好处,一直是笔糊涂账:已有工作普遍认为理解反哺生成容易,反过来收益微弱。但这在直觉上说不通——生成提供的是像素级稠密监督,覆盖外观、空间关系、几何,而这些恰恰也是识别、计数、空间推理、3D 感知需要的。 本文贡献:用「同一个底层视觉问题、两种输出模态」的受控配对来做因果分离:I2I 生成任务和 I2T 理解任务表达同一个问题,只换监督形式。再搭一个覆盖 19 个 I2I 生成任务与 25 项 I2T 理解能力的统一分类法 OmniTaskonomy(按识别、重建、重组三个基础问题组织),画出完整的迁移图谱。机制上用梯度对齐解释:生成与理解在理解分支 pre-attention RMSNorm 参数上的梯度对齐越强,迁移增益越大。 OmniTaskonomy: a unified taxonomy of I2I tasks and understanding capabilities under the three Rs. 实验效果:先做 I2I 再做 I2T 的课程能稳定提升理解表现,且增益随 I2I 数据量单调增长;混合训练则没有一致的规模收益。I2I 训练还能减少达到同一理解水平所需的 I2T 监督量,在 I2T 数据稀缺时收益最大。迁移图谱里既有直觉对应的组合(深度预测→度量 3D 推理、物体指向→计数、拼图重建→2D 排序),也有反直觉的(2.5D 分割→类别识别、Z-depth 预测→定位)。 Generation-to-understanding transfer across visual capabilities. 批判点评:结论的成立高度依赖课程顺序——先 I2I 后 I2T 才有效,混合训练就没有一致的规模收益,这更像是「课程设计」而非「生成天然有益」。迁移图谱是选择性的:作者自己也说收益 task-dependent,图里有多少格子是负增益论文没有全列。梯度对齐目前只是相关性分析,拿它做任务选择的先验还缺因果验证。 10. ThinkRM:先定评分表,9B 超 GPT-4.1 Think Before You Score: Thinking Reward Model for Visual Generation | 杭州电子科技大学;中国科学院自动化研究所;北京大学;商汤科技;复旦大学;西北工业大学;南洋理工大学;清华大学 | arXiv:2609.37372 关键词:奖励模型, 视觉生成评测, 评分细则, 偏好优化, 强化学习 前序问题:视觉奖励模型通常把任务条件和候选输出直接映射成一个标量分数,至于「这个 case 到底该评什么」完全隐在黑箱里。图像生成和图像编辑的评判标准差异极大,用一套固定标准硬套,细粒度区分能力必然上不去。 本文贡献:提出「先想清楚再打分」:为每个 case 先自适应地生成评分细则(rubric),再按细则做逐条评估,最后产出细粒度 pointwise 分数。训练上先做结构化 SFT 冷启动,再用成对偏好优化;作者发现常规成对偏好优化会引起分数极化,于是提出 Pairwise Dual-Group Relative Policy Optimization,在保留细粒度打分能力的同时提升判别力。 Thinking Reward Model (TRM) follows the Think-Before-You-Score paradigm, with RM and RL performance. 实验效果:9B 模型在 GenAI-T2I 上从基线的 58.9% 提到 71.2%、MMRB2-T2I 从 59.4% 提到 67.9%,两个榜上都超过 GPT-4.1;编辑侧 EditScore-ERB 0.750/0.639/0.743、EditReward-ERB 67.8%、MMRB2 从 53.0% 提到 58.2%。用它做奖励去优化 BAGEL、FLUX.1-dev、SD3.5-M 等多个生成模型,跨架构跨规模一致有提升。 Qualitative comparison of SenseNova-U1.5 before and after RL fine-tuning with TRM. 批判点评:「超过 GPT-4.1」是在特定榜单和特定打分协议下的结果,且作者明说 pointwise 模型只统计非平局预测的准确率,平局样本另算——这个口径会显著抬高数字。冷启动 SFT 已经把 58.9% 拉到 70.1%,后面的成对优化只再加 1.1 个点,说明真正吃重的是 rubric 监督数据本身。另外 8 家单位联合、训练只用约 4000 条偏好对,规模偏小。 趋势观察 蒸馏的计价单位从「每个模型」变成「每个底座家族」 LongLive-Plug 把少步采样、单遍 CFG、长时误差修正各做成一只 LoRA,一次 80 卡时的底座蒸馏换掉四个任务 376.8 卡时的专用蒸馏;SoL-Refiner 把多步精修压成一步再叠 TAE 与推理引擎拿到 8.91 倍;DIET 直接免微调砍掉一半专家把 57GB 压到 30GB。三篇下手的地方完全不同——一只 LoRA、一次 NFE、一半专家——但都在问同一个问题:这份能力到底要不要为每个落点重付一遍钱。 生成与理解之间的账开始被逐项结算 OmniTaskonomy 用 19 个生成任务对 25 项理解能力画出迁移图谱,结论是收益 selective 且强依赖「先 I2I 后 I2T」的课程;Think Before You Score 则反过来问评估侧——给每个 case 先拟一份评分细则再打分,9B 模型在两个榜上压过 GPT-4.1。前者说明「生成有益理解」不能当口号用,后者说明奖励模型缺的不是参数量而是「该评什么」这一步显式化。 人工智能炼丹君 整理 | 2026-10-01 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-29|阿里双Agent语音涨10.4分,Qwen-Audio 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 图像生成与编辑 3 篇 · 语音与动作生成 2 篇 · 数据集与评测 1 篇 重点论文标题列表 Qwen-Audio-Agent(阿里巴巴 Token Foundry):双Agent并行,座舱91.04% DyMD(北航):14B 压成 1.3B 四步 HetA-DiT(高通 AI 研究院):两成 token 走全注意力 Routed Forcing(清华大学):动力学+45%,嘴部不动 RWTD(字节跳动 Seed):一步模型 GenEval 0.80 今日论文速览 1. Qwen-Audio-Agent:双Agent并行,座舱91.04% Qwen-Audio-Agent Technical Report | 阿里巴巴 Token Foundry | arXiv:2609.25195 关键词:全双工语音, 智能体架构, 任务委派, 语音助手, 异步执行 前序问题:全双工语音助手要一边聊天一边干活,但一段对话里既混着「马上能答」的即时操作,也混着「要跑好几步」的长任务。现有做法要么让前台模型自己把工具全调完(长任务把对话卡死),要么整段委托给后台(用户干等,中途插一句还会把任务一起取消)。语音打断与任务取消、执行完成与结果回传被绑成一根绳,是这套系统要解决的核心矛盾。 本文贡献:提出前后台双 Agent 架构:Frontend Agent 只负责对话,并判断这一步是直接调工具还是委派出去;Backend Agent 在独立上下文里跑被委派的任务;Orchestration Runtime 负责维护任务状态、协调向用户要授权,并把结果排回对话。关键设计是把「语音打断」和「任务取消」解耦,把「执行完成」和「结果投递」解耦,所以后台在跑的时候对话还能继续往下聊。独立适配器让前台模型、后台 Agent、客户端可以分别替换,已在桌面助手、智能座舱、语音客服三类场景落地。 Foreground-background architecture of Qwen-Audio-Agent. 实验效果:内部座舱基准 134 个用例上,混合执行的任务成功率 91.04%,直接执行 72.39%、全部委派 80.60%。另在「三种配置都成功」的同一批轮次上做延迟评测,混合执行的平均任务执行延迟比这两个基线分别低 26.73% 和 30.91%。 Illustrative timeline of a delegated task. 批判点评:两个数字其实来自两个不同的评测集合:成功率是 134 个座舱用例,延迟只统计三种配置都跑成功的轮次——也就是说最难的那批(只有混合执行成功、基线直接失败)根本没进延迟统计,26.73% 的降幅是在对自己有利的子集上算出来的。另外 91.04% 比的是同一套系统的两种退化配置,没有跟任何外部语音智能体对照,报告也没给后台任务的绝对耗时。 2. DyMD:14B 压成 1.3B 四步 DyMD: Preserving Interaction Dynamics through Distribution Matching Distillation in Few-Step Video World Models | 北京航空航天大学;京东未来学院 | arXiv:2609.31349 关键词:视频世界模型, 分布匹配蒸馏, 少步生成, 具身智能, 交互动力学 前序问题:大视频扩散模型是很强的具身预测先验,但多步采样对交互式下游太贵。DMD 能把采样压到几步,代价却是机器人与物体之间的交互运动被抹掉:画面看着没问题,机械臂却基本不动,生成出来的世界对规划毫无用处。 本文贡献:从 teacher 信号和 fake-score 信号两头定位问题:弱重加噪让 teacher 后验一直集中在「没动作」的 rollout 附近,而动作更强的 rollout 又带来更大的 fake-score 拟合误差,反过来拖住生成器学动力学。DyMD 给两个自适应机制——temporal affinity 条件下的重加噪采样,按每条 rollout 当前交互保真度混合基础时间步表与 teacher 先验;dynamics-guided fake-score tracking,用噪声条件预测器估计每条 rollout 的拟合难度并上调其 critic 权重。14B teacher 蒸成 4 步 1.3B 学生,推理时不加任何辅助模块。 Overview of DyMD. 实验效果:具身视频基准上,相对 Base DMD 把 R-Bench 任务遵循度提 9.6 个百分点、PAI-Bench-G 的 Domain 分提 5.1 分,视觉质量基本持平。作为下游动作规划骨干,在两个 WorldArena 任务上平均成功率 34%,Base DMD 为 16%。 Visual comparison of interaction dynamics between Base DMD and DyMD at four NFE. 批判点评:34% 对 16% 看着翻倍,但绝对值仍只有三分之一,而且只在两个任务上测;全文反复验证的其实是主表那两个更朴素的数(9.6 / 5.1)。另外整套收益建立在「先用 V-JEPA 类特征算 temporal affinity」之上,这个额外前向的开销并没有计进推理成本。 3. HetA-DiT:两成 token 走全注意力 Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion | 高通 AI 研究院;波恩大学 | arXiv:2609.31050 关键词:视频扩散, 稀疏注意力, 推理加速, token 路由, DMD 前序问题:视频扩散的自注意力在长时空 token 序列上是二次开销。现有高效注意力基本对所有 token 一视同仁,但去噪难度在不同视频区域、不同时间步上差异极大,均匀省算力必然在最难的地方翻车。 本文贡献:提出 HetA-DiT:一个轻量不确定度分支预测每个 token 的去噪难度,据此把不确定的 token 送进稠密全局注意力、把更可信的 token 交给便宜的局部注意力。路由同时随内容和时间步自适应,并保留全局上下文,还留了一个参数控制质量-效率权衡。关键工程点是推理时不新增 Transformer 前向——不确定度估计直接复用上一个去噪步的结果,也因此能和少步 DMD 蒸馏兼容。 HetA-DiT. Heterogeneous self-attention computation assigned to tokens with different denoising complexities. 实验效果:在 DMD 蒸馏后的 Wan2.2-5B 与 Wan2.1-1.3B 上评测,VBench、VBench-2.0 和人工偏好上质量与基线可比,但只有约 20% 的 token 走稠密注意力。 Qualitative comparison of HetA-DiT to baseline DMD. 批判点评:摘要只说「维持可比质量」,没给 VBench 总分的具体差值;而「约 20% 走稠密」是路由比例、不是端到端加速比,局部注意力在真实硬件上能兑现多少要看实现,论文里也没有 wall-clock 延迟表。此外不确定度复用上一步估计,意味着第一个去噪步的路由其实是盲的。 4. Routed Forcing:动力学+45%,嘴部不动 Where and When to Force: Routed Forcing for Streaming Avatars | 清华大学;京东未来学院;东南大学 | arXiv:2609.30963 关键词:流式数字人, 蒸馏, DMD, 多样性塌缩, 区域路由 前序问题:Self Forcing 用 DMD 把双向视频扩散模型蒸成因果、少步的流式生成器,但 DMD 最小化的是 reverse KL,本质是 mode-seeking:学生会丢掉高动态模态、塌到静止输出上,把生成视频的动态和多样性一起压扁。 本文贡献:先把这种塌缩量化成一张区域异质图:人物区域(姿态、手势)多样性损失最大,音频驱动的嘴部损失很小,背景几乎不变。据此提出两维路由——Where:人物区域改用 Data-Forcing Distillation(拿真实视频当监督),嘴部与背景保留 DMD 以保口型和场景稳定;When:高噪声阶段开 DFD 注入真实动态,低噪声阶段切回 DMD 修细节,避免真实视频与学生 rollout 的空间差异带来模糊与伪影。 Routed Forcing routes distillation by semantic region and noise stage. 实验效果:相对 Self Forcing,动态最高提升 45%,多样性提升 7–25%,视频质量与口型同步基本保持。 Qualitative comparison of different training strategies. 批判点评:45% 是「最高」值,7–25% 的多样性区间跨了不同指标,主表里并不是每项都赢。更重要的是整套方法依赖先用分割模型对学生 rollout 抽人物 mask、用面部关键点抽嘴部 mask,这些前处理在流式实时场景里的开销没有被计入收益。 5. RWTD:一步模型 GenEval 0.80 Aligning One-Step Generative Models with Reward-Weighted Transport Distillation | 字节跳动 Seed;加州大学伯克利分校 | arXiv:2609.30840 关键词:一步生成, 奖励对齐, 最优传输, 蒸馏, 后训练 前序问题:一步生成器推理便宜,但后训练极难:通用隐式生成器既没有可算的似然,也没有去噪轨迹可借,而 GenEval、HPSv2 这类奖励往往根本不可导,梯度类方法又容易把图改得过度风格化。 本文贡献:提出 Reward-Weighted Transport Distillation,只要采样和标量奖励分数。它没有直接对齐常规的 reward-tilted 参考分布,而是构造自适应目标:把「当前分布」与「参考分布」分别倾斜后再混合——当前项吸收训练中已发现的改进,参考项把目标锚回预训练生成器。实现上用特征空间最优传输加不动点回归完成对齐。理论分析表明其不动点分布在 off-policy 倾斜参考与 on-policy 倾斜当前模型之间插值,给出了「适应奖励」与「保留先验」的权衡解释。 SANA Sprint 1.6B comparisons. RWTD improves alignment on difficult position prompts. 实验效果:把一步模型 SANA Sprint 1.6B 的 GenEval 从 0.73 提到 0.80;单独的偏好对齐实验显示跨奖励泛化良好,HPSv2 后训练在涨分的同时基本保住了组合能力与真实感。 Effect of mixed reward tilting on GenEval and held-out PickScore / diversity. 批判点评:0.73→0.80 是 GenEval 单项,摘要没说明其他指标是否同步变好。论文自己指出梯度类基线 FAV、DRaFT 在 HPSv2 上出现明显风格化、属于奖励过优化,而 RWTD 只是「大体保留真实感」——这说明 RWTD 同样在往奖励方向偏,只是偏得慢。另外最优传输做在特征空间,编码器选谁会直接影响结论。 6. SAP-DMD:两步采样救回高频细节 Spectral Amplitude Purification in Distribution Matching for Diffusion Distillation | 浙江大学;加州大学伯克利分校 | arXiv:2609.29116 关键词:扩散蒸馏, DMD, 频域分析, 一步生成, 细节恢复 前序问题:DMD 能让扩散模型几步出图,但优化动态长期被低频信号主导:方向误差的幅度谱高度集中在低频,弱的中高频信号被压住,细结构和纹理迟迟回不来。 本文贡献:提出 SAP-DMD,一个即插即用模块:自适应地调制 DMD 方向场的幅度谱,压掉幅度谱的支配性长尾,削弱低频主导,让中高频结构更快恢复。改动只在方向场上做,不替换骨干、不加参数。 2-step performance evolution during training on SD3.5 Medium. 实验效果:在 PixArt-α、SD3、SD3.5 上,2 步与 4 步采样下都更快收敛、生成质量更好。 Qualitative comparison of 4-step (top) and 2-step (bottom) generation. 批判点评:摘要通篇是定性表述——「更快收敛」「质量更好」,没有给任何一个具体数字,FID/CLIP 的实际对比全在正文表里。所谓「即插即用」也只在这三个文生图模型上验过,视频与编辑类任务没测。另外压低频本身是经验操作,压到什么程度靠阈值超参,论文没有给出选参依据。 7. FuseReg:换解码器 gFID 降 27% FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders | 布朗大学;南加州大学;莱斯大学;阿伯丁大学;圣母大学;马里兰大学;宾夕法尼亚大学 | arXiv:2609.31620 关键词:表征自编码器, 层融合, 正则化, 图像生成, 重建生成鸿沟 前序问题:表征自编码器(RAE)直接把预训练视觉编码器的特征当重建与扩散潜变量用。但要选哪些编码器层组成这个共享潜空间是个两难:浅层保像素细节更好,深层生成指标更好。固定启发式的层融合把两个本该分开优化的目标硬绑在了一起。 本文贡献:提出 FuseReg:不挑层,改为在随机采样的编码器层子集上训练。理论分析给出机制解释——子集采样显式惩罚了对跨层不一致的敏感性。结果是同一个解码器可以不重训地同时处理完整、稀疏、单层三种融合方式。 Cosine-similarity maps of decoder intermediate-block features under different layer fusions. 实验效果:ImageNet-256 + DINOv3-L 上,单个 FuseReg 解码器在三种融合下的 PSNR 都高于为固定融合专门训的解码器;只换解码器、生成器完全不动,RAEv2 DiT-XL 的无引导 gFID 降 27%;生成与扩散两阶段一起正则化,DiT-Base 的 gFID 降 29%。 One FuseReg decoder supports both sparse and single-layer fusions. 批判点评:27% 和 29% 都是相对自身基线的相对降幅,不是 gFID 绝对值,也没跟非 RAE 路线(如 SD-VAE)的潜空间横向比。另外随机子集训练要求训练时多跑几种融合,成本靠「一次训练多处可用」摊平——这个账只在论文自己的设定下成立。 8. Timo:40K 动作片段六维评测 Timo: $\textbf{T}$aming Mult$\textbf{i}$modal Diffusion Transformer for Human $\textbf{Mo}$tion Generation | 逐际动力 | arXiv:2609.30761 关键词:人体动作生成, MMDiT, flow matching, 运动学监督, 评测基准 前序问题:现有人体动作生成大多用 cross-attention 注入文本语义,忽略了动作与文本 token 之间的双向建模。直接把视觉生成里好用的 MMDiT 搬过来也不行:关节运动时间上连贯、跨关节相关性却很弱,MMDiT 配 flow matching 直接上会产出不协调、抖动严重的动作。 本文贡献:提出 kinematics-aware 的 MMDiT 框架 Timo:用全共享的多模态注意力做文本-动作双向建模,配合 flow matching、几何与旋转运动学监督(直接比较真实旋转及其随时间的变化),以及从「广泛动作学习」到「细节字幕对齐」的两阶段课程。同时构建了 6 个公开数据集、40,025 条留出片段的基准,在同一评测器与评分协议下测六个互补维度。 Kinematics-aware multimodal generation with a shared 24-block stack. 实验效果:定量与定性均明显超过现有方法,在六个维度中的五个上超过 Kimodo,基准平均分相对提升 40.8%。并在 LimX Luna、LimX Oli 两台实体人形机器人上完成重定向与跟踪执行。 Qualitative comparison across models and prompts. 批判点评:40.8% 是「基准平均分」的相对提升,而这个基准的作者就是本论文自己:六个维度、统一评测器都是他们定的,被比较的四个系统是「重新评测而非引用原文数字」,训练数据与表示各不相同,文中也承认自家数据含内部采集。机器人演示只做到重定向跟踪,没有闭环控制指标。 9. HyperErase:超网络一次前向出 LoRA HyperErase: Scale-Calibrated Hypernetwork for Multi-Concept Erasure in Text-to-Image Models | 哈尔滨工业大学(深圳);清华大学深圳国际研究生院;吉林大学;鹏城实验室;华南理工大学 | arXiv:2609.31154 关键词:概念擦除, 超网络, LoRA, 文生图, 模型安全 前序问题:概念擦除的主流做法是静态权重:训一个冻结的 adapter,遇到不同 prompt 变体就不好使,多概念叠加时还会发生参数互相干扰。 本文贡献:把概念擦除重构成「prompt 条件的参数摊销」:训一个超网络,把文本描述直接映射为该 prompt 专属的 LoRA 更新,不需要逐 prompt 做梯度优化,也免去手工合并 LoRA。为了让合成出的 adapter 稳且准,又提出 decoupled rectification——把 LoRA token 拆成 pattern 与 scale 两个子空间,对 scale 用平方根变换抑制乘性过缩放,并在推理时用教师给出的规范先验做校正。 Overview of HyperErase: hypernetwork-driven prompt-conditioned parameter synthesis. 实验效果:在主要概念类别上,擦除有效性、图像质量、语义对齐三者的权衡全面改善,性能接近「金标准」的单概念基线;一次前向就能为每个 prompt 变体产出专属 LoRA,推理期无需梯度更新。 Visual results of artist style erasure. 批判点评:摘要里「接近金标准单概念基线」是自我定位,实际是在 I2P / NudeNet 这类检测指标上逼近,而 FID、CLIP 的对比分散在不同概念类别的表里,没有一张表把三个维度同时摆在一起。另外超网络本身要先跑完 gold baseline 的擦除流程、收集 checkpoint-prompt 对,这个前置成本并没有被算进「免优化」的收益里。 10. TrafficImag:31K 样本的反事实路口 TrafficImag: A Benchmark for Counterfactual Roadside Traffic Video Generation | 德克萨斯大学奥斯汀分校;杜克大学 | arXiv:2609.30722 关键词:反事实生成, 路侧交通, 视频生成, 评测基准, 世界模型 前序问题:现成路侧交通数据集支持感知、预测和视觉问答,但不评「反事实视频生成」:改掉某一个交通参与者的行为之后,生成的未来既要符合道路拓扑,又不能扰动其余交通参与者。 本文贡献:TrafficImag 把大规模路侧数据(9,022 张标注图、7,043 段去重视频、31,145 条以参与者为中心的历史-未来样本)和一套可执行协议绑在一起,覆盖行为推理、干预感知的图像编辑、条件视频生成三类任务。每次干预都用「参与者级程序」来描述:目标参与者、意图行为、合法路线、交互顺序、时间约束,从而给异构基础模型提供统一评测接口。评测四个互补的有效性维度,端到端反事实只有四项全过才算成功。 Overview of the TrafficImag benchmark. 实验效果:在多个 SOTA 基础模型上,最强推理器的 macro F1 为 80.4%;完整条件接口把最好生成器的端到端成功率从 23.3% 拉到 55.0%。Oracle 研究显示条件视频执行仍是剩余的主要瓶颈。 Matched 8-second rollouts for a programmed left-turn counterfactual. 批判点评:55.0% 已经是最好的数,意味着接口给全后仍有近一半反事实做不成;而 20 个场景 × 3 次重复对百分比类指标来说置信区间很宽。论文自己也承认瓶颈在视频执行,也就是说这个基准当下更多是在给生成器记分,还没真正定位到路侧场景的语义难题。 趋势观察 少步蒸馏开始为「丢掉的东西」买单 今天十篇里有四篇在修蒸馏的副作用:DyMD 修的是机器人不再和物体交互,Routed Forcing 修的是数字人塌成静态,SAP-DMD 修的是低频把高频细节吃掉,RWTD 则换了个方向——先承认一步生成器的后训练很难做,再用最优传输把奖励塞进去。共同点是 NFE 已经不是瓶颈,蒸馏完之后「还剩什么」才是。 「对所有东西一视同仁」正在被放弃 HetA-DiT 只让约两成 token 走稠密注意力,Routed Forcing 按人物、嘴部、背景分区域换监督信号,FuseReg 干脆不挑层而是在随机层子集上训练。三篇方法毫不相干,但都在拒绝均匀处理——按 token、按区域、按层做差异化分配,成了这一批论文共享的默认动作。 人工智能炼丹君 整理 | 2026-09-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-28|阿里 397B 只改提示词就涨 50 分,WanPE 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与编辑 5 篇 · 音视频与语音生成 2 篇 · 图像与 3D 生成 2 篇 · 多模态理解与评测 1 篇 重点论文标题列表 WanPE(南大):397B 分镜规划提示词 AV-GRPO(上海人工智能实验室):音视频联合生成的模态解耦 RL ⚡ TRACK(NVIDIA):免训练大小模型按步换班 ViRDM(美国东北大学):砍掉教师与批评家做因果后训练 EditVoice(厦门大学):变长非自回归零样本语音编辑 今日论文速览 1. WanPE:397B 分镜规划提示词 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation | 南京大学;Wan 团队(阿里巴巴集团);中国科学技术大学;复旦大学;清华大学 | arXiv:2609.30221 关键词:文生视频, 提示词增强, GRPO, 电影分镜, 评测基准 ⚠️ 前序问题:现代视频生成器已能生成 30 秒、并忠实遵循复杂条件,文本提示几乎直接决定多镜头序列里动作、机位轨迹、光效和声音如何展开。但现有的提示增强大多还停留在「可选扩写」层面,面对导演级的镜头级规划(分镜如何组织、跨镜头语义如何不漂)能力明显不足。 本文贡献:提出 WanPE——397B 参数的提示增强模型,在 105 万条真实视频上训练。核心有两块:一是 video-grounded 逆向构建(reverse SFT),从真实视频反推出镜头级电影分镜规划,让模型学到的是「怎么组织分镜」而不是「怎么把句子写长」;二是 Semantic-Consistency GRPO(SC-GRPO),用语义一致性奖励把用户意图在跨镜头、跨时间维度上保住。配套还建了 WanPEval:249 条人工标注请求,覆盖 5–30 秒时长与不同意图粒度,约 1.1 万次盲评 pairwise 比较。 WanPE training pipeline. Video-grounded reverse SFT and semantic-consistency GRPO. 实验效果:驱动 Wan3.0 生成器时,相对原始用户提示,5–15 秒人类偏好提升 10.66–18.84 分,30 秒竞技场提升 50.86 分。5–15 秒子集上专家偏好 S / Bradley–Terry 分数为 50.61 / 61.85,超过 Seedance 2.0(43.42 / 54.70)、MiniMax-H3(36.40 / 49.27)、Kling 3.0(20.80 / 37.40)与 HappyHorse 1.1(24.89 / 40.46)。消融显示逆向构建明显优于正向改写,SC-GRPO 在各模型规模上都能稳住语义保真。 Fine-grained expert evaluation on the 5-15 seconds subset of WanPEval. Left: Preference scores across generation durations and request-granularity levels. Right: Preference scores S across seven content categories. 批判点评:397B 这个体量本身就是最大的成本项,而表里的规模曲线并不支持它:4B 是 43.60 / 56.21,9B 是 46.00 / 58.01,397B 才 50.61 / 61.85——为了最后 5 分,参数量涨了两个数量级。更值得注意的是 30 秒子集:+WanPE-397B 的 Overall 60.24 只是险胜 Seedance 2.5 的 59.76,而且拆开看,动作类 50.00 被 Seedance 2.5 的 68.18 甩开一大截,知识类、演讲类也不占优。换句话说,WanPE 真正补齐的是「镜头语言」,动作生成本身的短板它一个字都没碰。 2. AV-GRPO:音视频联合生成的模态解耦 RL AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation | 上海人工智能实验室;香港理工大学;新加坡国立大学;南洋理工大学;浙江大学 | arXiv:2609.29816 关键词:音视频联合生成, 强化学习后训练, GRPO, 跨模态同步, 扩散模型 ⚠️ 前序问题:音视频联合生成里,异质多模态奖励互相纠缠导致信用分配困难,两个模态塔动力学差异大、联合优化极贵,而同步性评测又依赖成对样本、奖励没法公平比较——直接把 RL 后训练搬过来几乎处处碰壁。 本文贡献:提出 AV-GRPO 这一模态锚定的在线扩散 RL 框架,三个模块:模态锚定 rollout 解耦学习信号并稳定难度;轨迹锁定的冻结塔优化降低成本、重新分配信用;针对模态各自动力学的自适应目标与扰动强度。由此把耦合的多模态偏好学习拆成单模态子问题,实现精确奖励归因。同时构建了 5DAV 数据集,在五个维度上解耦样本、难度可控。基于 LTX-2.3 22B,8 卡 A800 上跑 LoRA 与全参两档。 Overview of the AV-GRPO training pipeline. 实验效果:JavisBench 上 AV-IB 从 0.224 提到 0.247,JavisScore 0.202 → 0.222,DeSync 0.708 → 0.607;VABench 上 Lip Sync 1.439 → 1.646、DeSync 0.726 → 0.542。在生成质量、语义对齐与跨模态同步三项上均超过 LTX-2.3,LoRA 与全参微调两档都成立。 Left: Radar chart comparing performance on the 5DAV and VGGSound datasets. Middle: Metrics are reported as relative percentage changes with respect to the baseline. Right: Comparison of model performance with different alternating step intervals. 批判点评:表里藏着一个不太好看的反差:LTX-2.3+AV-GRPO(lora) 在 Alignment(4.512 对 4.510)、Expressiveness(4.450 对 4.434)、Visual Realism(4.402 对 4.395)三项主观指标上,全都高于全参版。花了全参训练的成本,主观质量却没赢过 LoRA,说明这套「冻结塔 + 分塔信用分配」的收益主要落在同步类客观指标上,主观提升更接近采样噪声。而且这三项差距都在小数点后第三位,论文也没给方差或多次运行,显著性无从判断。 3. TRACK:免训练大小模型按步换班 Accelerating Video Diffusion via Training-Free Trajectory Routing | NVIDIA | arXiv:2609.30096 关键词:视频扩散加速, 免训练, 模型路由, 步级调度, 能耗优化 ⚠️ 前序问题:视频扩散推理昂贵:要把大模型跑很多个去噪步。即便做了步数蒸馏,剩下每一个蒸馏步依然要付一次完整的大模型前向,推理成本还是下不来。 本文贡献:TRACK(TRajectory-Aware Capacity routing via top-K selection)是一种异构去噪策略:离线校准阶段先跑一遍全大模型的参考轨迹,每一步同时收集小模型的预测,与大模型预测比较得到相对分歧分数(两边共享同一 latent、timestep、条件与 guidance),再把该信号跨校准集聚合成分步分歧分数图,据此决定切换策略——质量敏感步留给大模型(如 Wan 2.1 14B),低分歧步路由给小模型(1.3B)。推理时每步只执行被选中的那一个模型,不重训练、不改架构与调度器、也不需要在线双模型评估。 Training-Free Trajectory-Aware Capacity routing. Top: Offline calibration rolls out the all-large-model reference trajectory and, at every step, evaluates the large and small checkpoints using the same latent, timestep, conditioning, and guidance inputs. Bottom: Online inference applies that policy while preserving the shared latent representation and scheduler update. 实验效果:在 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo 四条管线上分别取得 1.95×、2.04×–2.73×、2.69×、2.17× 加速,聚合质量相当、DreamSim 多样性保留 >95%。在 A100 上用 NVML 实测,去噪能耗降低约 45%–60%:Wan 2.1 每视频省 194.57 kJ,折合每千条视频省 54.05 kWh(降 49.3%);Cosmos 3(Super/Edge)能耗降近 60%。 Speed--quality tradeoffs across video pipelines. Each panel compares the all-large model (baseline) and TRACK (ours) switching policy. All models retain comparable aggregate quality at the selected operating points in most quality dimensions. 批判点评:「质量相当」这个结论要挑一下口径:它取的是 VBench 的时间闪烁、运动平滑、主体一致性、背景一致性四个维度的均值——恰好是「换小模型不太容易崩」的那四个。真正的代价作者写在 Limitations 里:部署时必须同时驻留大小两个模型,显存占用反而高于单模型管线。另外对已经把步数压到 3–4 步的蒸馏管线(FastVideo 只有 2.17×),可换的步数本就只剩个位数,收益上限天然受限。 4. ViRDM:砍掉教师与批评家做因果后训练 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation | 美国东北大学;Adobe Research | arXiv:2609.28923 关键词:因果视频生成, 分布匹配, 后训练, 显存优化, VBench ⚠️ 前序问题:少步自回归视频扩散能实现低延迟流式生成,但现有后训练方法几乎都依赖 DMD:需要一个庞大的预训练教师和一个在线 critic,靠 diffusion score 估计分布差异。三套网络同时在线,资源开销成了主要门槛。 本文贡献:ViRDM 把教师与 critic 整个去掉,只让生成器对齐一份离线预计算的目标表征分布。三个障碍逐个击破:用一致性式采样 + 随机截断 clean-exit 监督(S 从 U{1..K} 采样,选中的那次评估才吃梯度)把梯度路径变得可行;用轻量 VAE 解码器压显存;用分阶段 vector–Jacobian product 拆解反传。此外还给出了视频 RDM 的生成种群规模与初始化策略(因果 ODE 初始化最优),并加了 flow 动力学正则来补表征分布对时间变化约束不足的问题。 Consistency-style sampling with stochastic exits for few-step video RDM. 实验效果:同样 8 卡 A100 的设置下,峰值显存从 77.1 GB/卡降到 48.3 GB/卡,后训练时间从 22 小时压到 2 小时,VBench Total 从 84.51 提到 84.87。只需 20 次生成器更新、16 A100 GPU-小时,比此前最佳少步因果基线高 0.36 分。用户研究中文本-视频对齐 40.4%、视觉质量 43.0% 均为四步因果方法里最高(Self Forcing 两项均为 32.6%)。 Replacing the resource-intensive teacher-critic stack with direct representation distribution matching for few-step causal video post-training. In the same 8-A100 parallelized training setting, this reduces peak memory from 77.1 to 48.3 GB per GPU and post-training time from 22 to 2 hours, while improving the VBench Total from 84.51 to 84.87. 批判点评:84.87 对 84.51 只涨了 0.36 分,而论文自己的消融表把原因说得很直白:要把 Dynamic Degree 维度单独剔掉再比,ViRDM 才更好看——说明动力学恰恰是 RDM 的软肋(表征分布对时间演化约束不足),得额外加 flow 正则才勉强补回来,等于承认「省掉教师 critic」的代价是引入了新的手工正则。另外 84.87 是在 Wan2.1-1.3B 这个 1.3B 小骨架上拿的,跟动辄 14B 的双向模型不在一个量级,跨量级横向对比要打折扣。 5. EditVoice:变长非自回归零样本语音编辑 EditVoice: Variable-Length Non-Autoregressive Zero-Shot TTS and Speech Editing with Edit Flows | 厦门大学 | arXiv:2609.29889 关键词:零样本 TTS, 语音编辑, 非自回归生成, Edit Flows, 变长序列建模 ⚠️ 前序问题:现有非自回归零样本 TTS 虽然能并行生成,但几乎都要在生成前先指定目标序列长度——长度得靠另一个模块预估,一旦估错就直接影响韵律与内容。 本文贡献:EditVoice 是首个变长 NAR 零样本 TTS:用 Edit Flows 通过插入、删除、替换三类编辑操作同时更新语音内容和序列长度。训练上采用 speech-infilling,把零样本 TTS 与文本驱动语音编辑统一到同一目标下,推理时前缀提示和后缀提示两种摆位都能用;提出 Complementary Prompt Sampling(CPS),按每类操作取两种摆位里速率更大的那个,利用互补的 Edit Flow 预测。还发现模型能编辑训练来源之外的语音(包括它自己生成的),据此做端到端编辑与免训练的后生成精炼。 Overview of the EditVoice zero-shot TTS inference pipeline. Stage one generates semantic speech tokens using CPS, and stage two applies post-generation refinement to the generated sequence before speech detokenization. 实验效果:在 10K 小时 GigaSpeech 上训练 Edit Flow 模型,在 Seed-TTS Eval EN、LibriSpeech-PC 上零样本 TTS 表现具竞争力,在 RealEdit 上语音编辑表现具竞争力。后生成精炼把 WER 从 2.66% 降到 1.55%,且 8 步生成 + 2 步精炼已经超过不做精炼的 16 步生成。 Post-generation refinement on Seed-TTS Eval EN. Starting from the same 8-step CPS output, WER and edits to generated tokens are measured over 8 refinement steps. The dashed line denotes 16-step CPS generation without refinement. 批判点评:全文只有 5 页 3 张图,实验规模偏薄:10K 小时训练的对比对象里有 CosyVoice 2 这类数据量级高一个档的系统,「competitive」具体竞争到什么程度得回表里逐项看。后精炼这个卖点本质是拿推理时算力换质量——8+2 步打败 16 步听起来漂亮,但总步数只少了 6 步,换成真实延迟并不划算。另外「能编辑非训练来源的语音」是意外发现而不是设计,作者没给系统的泛化边界评估,这条能力在多说话人、跨语种上会不会退化是未知数。 6. OREO:用 2D 编辑反馈对齐 3D 保真 OREO: Fidelity Alignment in 3D Generation via On-the-fly Rendering-Editing Optimization | 香港理工大学;腾讯 ARC Lab | arXiv:2609.29788 关键词:3D 生成, 保真对齐, 2D 扩散先验, 强化编辑, ECCV 2026 ⚠️ 前序问题:3D 生成模型进步很快,但产出的资产视觉保真度往往不够——几何、布局对得上,质感与细节就是差一口气,和 2D 扩散模型能达到的写实程度有明显落差。 本文贡献:OREO 是一个对齐框架,核心是不依赖静态数据集,而是建立动态优化闭环:把 3D 输出渲染出的视图交给 2D 模型做 Reinforced Editing,在保持几何、视角和内容不变的前提下提升视觉保真;这些被实时编辑过的渲染图反过来作为高质量 2D 伪目标,监督 3D 生成器从自己的样本里学习、逐步提升画质。 Overview of OREO. 实验效果:以 Trellis 为底座,对参考图 $x^{ref}$ 的 CLIP / DINO 相似度在 Conceptual Design 上从 0.7613 / 0.7916 提到 0.7834 / 0.8065,在 GSO 上从 0.7722 / 0.7022 提到 0.7764 / 0.7069;对比 Photo3D(0.7380 / 0.7837、0.7512 / 0.7034)同样领先。论文已被 ECCV 2026 接收。 Qualitative comparison of 2D feedback sources (Reinforced Editing / NanoBanana Pro / Qwen-Image-Edit). 批判点评:消融表里最刺眼的一行:去掉 Source Branch 后 ΔCLIP / ΔDINO 从 +0.0379 / +0.0298 直接翻成 −0.0523 / −0.0497——比不做对齐还差。整套方法对「保留源分支」这一条设计极其敏感,稳健性存疑。变体对比里把分布匹配换成 DMD,分数掉到 0.5393 / 0.5486,说明这条路和当前主流的 3D 蒸馏范式并不兼容。另外绝对增益全部停在小数点后第二位,而「视觉保真」这件事到头来还是用 CLIP / DINO 相似度做 proxy,离人眼判断有多远没人说得清。 7. ComplexSync:复杂场景 70FPS 实时唇形同步 ComplexSync: High-Fidelity and Real-Time Lip Sync in Complex Scenarios | 广州趣丸网络科技 | arXiv:2609.29225 关键词:唇形同步, 扩散蒸馏, 实时推理, 视觉基础模型, 基准评测 ⚠️ 前序问题:唇形同步要让口型动态与语音精确对齐。扩散模型生成质量高,但在遮挡、侧脸、复杂光照等复杂场景下容易失稳,而且推理延迟高到没法实际部署。 本文贡献:ComplexSync 是一套统一的扩散框架,三块设计:一是双流联合训练策略,抑制参考帧的信息泄漏同时保留自然动态;二是基于蒸馏的单步去噪加速方案,做到 70+ FPS 吞吐;三是关系对齐损失,借助视觉基础模型(VFM)的结构先验提升复杂场景因素下的同步精度与鲁棒性。此外还给出首个专门面向复杂唇形同步的 benchmark,含 200+ 条挑战视频序列与专门指标。 Overview of ComplexSync. (a) Dual-stream joint training strategy designed to suppress spatial information leakage and ensure high-fidelity synthesis. (b) Distillation-based acceleration scheme that facilitates single-step denoising for real-time inference. (c) Relational alignment loss leveraging VFMs to enhance synchronization precision and robustness under unconstrained conditions. 实验效果:在标准场景与复杂场景上均达到 SOTA,同时支持实时推理,吞吐超过 70 FPS。训练分三阶段:第一阶段 8 卡 A100 训 200K 步,第二阶段 4 卡 A100 训 50K 步,第三阶段再训 10K 步,分辨率 512×512。 Qualitative comparison with existing methods. Given that static images cannot fully capture critical temporal attributes such as synchronization, naturalness, and stability, we provide comprehensive video comparisons in the supplementary materials. 批判点评:三阶段累计 260K 步、起步就是 8 张 A100,这个训练预算对一家业务公司来说更像工程投入而非可复现的研究。全文只在 512×512 分辨率验证,而真实配音、数字人场景常见的是 1080p 以上——放大后的口型稳定性没有数据。定性对比仍然用静态帧,同步、自然度、稳定性这些纯时间属性都推给了补充视频,而这恰是唇形同步最容易「单帧好看、连起来崩」的地方。 8. AdaPilot:一套策略零样本迁移各生成器 AdaPilot: Towards Scene-Adaptive Policy Learning for Cross-Generator Text-to-Image Quality Optimization | 南洋理工大学;同花顺研究院 | arXiv:2609.29517 关键词:文生图, 强化学习, 跨生成器迁移, 多轮视觉反馈, 奖励设计 ⚠️ 前序问题:提升文生图质量的路线已经从生成器微调、提示优化走到了带多轮视觉反馈的强化学习,但现有策略都与特定生成器、特定任务深度耦合,学到的能力很难泛化成一套通用的质量优化策略——换个生成器就得重训。 本文贡献:AdaPilot 把多轮图像生成建模成马尔可夫决策过程,用端到端 RL 学一个场景自适应、可跨生成器迁移的质量优化策略。三点关键:策略与生成器内部解耦(只通过 prompt 和编码后的视觉观测交互,不碰梯度与内部状态),因此能跨生成器复用;场景感知奖励(AdaReward)把质量评估维度与任务语义自适应对齐;过程级奖励建模图像质量在多轮里的演化轨迹。实现上用 Qwen2.5-VL-7B-Instruct 作 agent,Qwen-Image-2512 作冻结生成器。 An illustration of the proposed AdaPilot. 实验效果:在 7 个指标(CLIP-T、HPS、GDino、Aesthetic、OCR 用于奖励,Realism、Physics 为留出维度)上超过 Flow-GRPO、T2I-R1、T2I-Copilot 等基线。跨生成器评测中,单一策略零样本迁移到未见过生成器(Qwen-Image、GPT-Image-1、Gemini-3-pro-Image-Preview 等)时,在所有被评生成器上仍保持正平均增益,OOD 数据集上每个维度都领先。 Averages over applicable evaluation metrics for four unseen image generators on four out-of-distribution datasets and overall, comparing results with and without AdaPilot to evaluate zero-shot cross-generator transfer. 批判点评:论文自己给的失败案例很说明问题:一张要求对比八位利物浦前锋的密集信息图,多轮迭代确实把版面理清了,但文字仍基本不可读、球员身份与属性不一致、图表数值不可验证,agent 明知有残缺陷还是终止了。这暴露了「策略只改 prompt」的天花板——当缺陷出在生成器自身的文字渲染与数值编码能力时,再聪明的提示改写也救不回来。另外训练时要同时部署 CLIP ViT-L/14、HPS v2.1、Grounding DINO、GLM-OCR 和 Qwen2.5-VL-72B 五个评估器算奖励,这套推理栈的成本并没有被算进收益里。 9. ZoomDiff:双摄平滑变焦的高保真插值 ZoomDiff: A High-Fidelity Diffusion Model for Dual-Camera Smooth Zooming | 哈尔滨工业大学;淘宝(阿里巴巴集团) | arXiv:2609.28083 关键词:双摄变焦, 帧插值, 扩散模型, 高频重建, 时间一致性 ⚠️ 前序问题:双摄像头之间的数字变焦切换,几何结构和色彩一致性上会出现肉眼可见的跳变。现有双摄平滑变焦(DCSZ)方法多在帧插值模型上微调,扛不住大视差与复杂几何变换;直接套扩散式帧插值模型,又因为条件引导不足、VAE 编码丢高频、时间一致性不够,保真度还是上不去。 本文贡献:ZoomDiff 在潜空间与像素空间同时吃透双摄输入:一是多步去噪过程中强化双图条件引导,提升几何一致性;二是把 VAE 编码器的 flow 对齐多尺度特征注回解码器(ref injector),把 VAE 编码时丢掉的高频细节补回来;三是引入 flow 引导的时间一致性监督($\mathcal{L}_{ftc}$)让转场更顺。并给出把步数从 25 压到 8 / 4 的适配方案。 The dual-camera images ($\mathbf{X}_0$ and $\mathbf{X}_F$) are fed into the VAE encoder and the semantic encoder. 实验效果:合成与真实数据集上全面领先:PSNR 23.80、SSIM 0.761、LPIPS 0.253、PSNR-div 23.01、FVD 131.332,真实集 MUSIQ 73.634、LIQE 4.874、DBCNN 0.692、DOVER 0.665,均为最优。步数压缩上,25 步 45.89s(FLOPs 743T)可压到 8 步 21.28s(2.16×)与 4 步 15.71s(2.92×)。 Visual comparisons on the synthetic dataset and the real-world dataset. Our method still produces more consistent results. 批判点评:两个反差值得记。其一,扩散类基线整体拉胯:Wan2.1 只有 17.71 PSNR、TRF 14.15、Framer 的 DOVER 只有 0.335,全都输给光流法(UPRNet 22.58、RIFE LPIPS 0.261)——说明「生成式先验」在这个任务上并非天然优势,ZoomDiff 的赢面来自双图条件引导与高频注入这两个工程补丁,而非换 backbone。其二,步数压缩后质量反而上升:8 步版 PSNR 24.08 高于 25 步版的 23.80,而去掉步数适配的 8 步版只有 22.32。也就是说 25 步其实是过采样,指标对步数并不单调,任何「步数越少越差」的外推在这里都不成立。 10. ODU-Bench:14 个全模态模型的需求理解评测 Omni Demand Understanding: A Benchmark for Contextual User-Intent Inference in Multimodal Interaction | 上海交通大学;上海创智学院;阿里巴巴;香港中文大学;清华大学;香港理工大学;南开大学;约翰斯·霍普金斯大学 | arXiv:2609.21392 关键词:多模态交互, 需求理解, 评测基准, 误触发, MLLM ⚠️ 前序问题:音视频自然交互正成为 AI 助手的重要入口,但现有交互能力基准主要评「回复质量」,漏掉了更基础的一问:模型能不能从复杂的多模态交互里正确推断用户的真实需求?现实中的需求在口语里往往是欠规格的,得靠视觉线索、声学线索和对话历史补;含糊表达、噪声环境进一步加剧难度。反过来,听起来像请求的 utterance 也可能根本不是给助手的需求,导致误触发。 本文贡献:把 Omni Demand Understanding(ODU)定义成一个独立的多模态上下文推断问题:给定交互流,模型必须判断是否存在需求,并从多模态与对话上下文推断意图,评测覆盖五个维度(M1 需求存在性、M2 关键点命中率、M3 时间跨度 IoU、M4 转录、M5 用户画像),同时覆盖单轮与多轮。ODU-Bench 用挑战驱动的 taxonomy、taxonomy 引导的 agentic 视频生成加真人录制交互来构建,标注从互补媒体证据重建并经人工校验。 Overview of the ODU-Bench construction pipeline. Challenge-driven targets are expanded into coarse-to-fine scripts, screened for plausibility and challenge validity, and realized as synthesized or human-recorded interactions. 实验效果:评测 14 个原生 MLLM:最强者 Gemini 3.1 Pro 也只能恢复 44.7% 必须从视觉、声学或对话上下文推断的关键信息;14 个模型里有 11 个在非需求场景上的误触发率(FTR)超过 50%。 Qualitative error analysis on English generated audio-visual scenes. (a)--(b) Demand-present cases; M2 reports covered/reference key points. (c)--(d) No-demand cases. 批判点评:44.7% 和「11/14 误触发率 >50%」这两个数字,真正打脸的是当前「先响应、后理解」的范式——模型宁可硬猜一个需求,也不愿意说「这不是需求」。可惜基准本身大量依赖 agentic 生成的交互与 LLM judge,虽然论文做了 judge 稳定性检验和真人录制对照(Δ = Rec − Syn),合成数据与真人数据之间的分布差仍是这套结论最大的外推风险:如果 agentic 生成场景的「挑战性」分布和真实用户偏得比较多,44.7% 这个数就未必能平移到线上。 趋势观察 生成的瓶颈正在往「输入端」和「调度端」挪 今天这十篇里有三篇在动生成流程的两端而不是中间:WanPE 用 397B 模型重写提示词,把导演级分镜规划搬到文本空间完成;TRACK 不改模型、不重训练,只决定每一步该派大模型还是小模型上场;AdaPilot 则干脆只通过 prompt 和视觉观测跟生成器打交道。共同点是:底座模型被当成黑箱,可优化的空间被挪到了它前面和外面——这对没算力训底座的团队是好事,对卖底座的团队不是。 「砍掉教师与 critic」成为后训练的新共识 ViRDM 把 DMD 的教师+critic+生成器三件套砍成只训生成器,8 卡 A100 下显存 77.1→48.3 GB、时间 22h→2h,VBench 还涨了 0.36;OREO 同样放弃静态数据与蒸馏范式,改用 2D 编辑实时产出伪目标做自我监督;AV-GRPO 冻结一塔训另一塔来降低 RL 成本。三条独立工作指向同一判断:昂贵的在线监督预算正在被更便宜的离线/自产目标替换,代价往往是引入新的手工正则(ViRDM 的 flow 正则就是这么来的)。 评测基准开始盯「理解」而不是「生成」 ODU-Bench 评测 14 个原生 MLLM 后发现,最强的 Gemini 3.1 Pro 也只能恢复 44.7% 必须靠上下文推断的关键信息,而且 11/14 的模型在非需求场景上误触发率超过 50%。这个数字比任何生成质量榜单都更能说明当前语音/视觉助手的实际状态:问题不在答得好不好,而在该不该答都还没判断对。ComplexSync 也顺手补了首个复杂场景唇形同步 benchmark,200+ 条挑战序列把遮挡、侧脸这些长期被平均掉的case单独拎出来。 人工智能炼丹君 整理 | 2026-09-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-25|快手开源修图登顶,GEdit仍输GPT 今日 AIGC 论文速览 今日共 10 篇 · 图像编辑与生成安全 2 篇 · 统一预训练与视频运动 2 篇 · 多模态联合生成 2 篇 · 音频生成与后训练 2 篇 · 推理加速与视频评测 2 篇 重点论文标题列表 KwaiMind(快手):180万对数据炼电商修图 UVU(清华大学):视觉监督前移,RefCOCO涨7.7 ⚡ Unite-Audio(东京科学大学):117M音频生成,CLAP登顶 MotionSpec(卡迪夫大学):频谱轨迹约束视频运动 RecCAR(巴伊兰大学):反向注意力补齐,音画更同步 今日论文速览 1. KwaiMind:180万对数据炼电商修图 KwaiMind Technical Report | 快手 | arXiv:2609.26375 关键词:图像编辑,电商,CTR奖励,Ecom-Bench,在线强化学习 ⚠️ 前序问题:电商修图不是通用编辑:商品主体要一模一样、促销文字要渲染准确、图还得有点击欲。通用编辑模型在这三件事上都没专门优化,而电商数据的采集清洗又贵又杂,缺一套能稳定产出高质量配对数据的流水线。 本文贡献:快手发布 KwaiMind:多模态 DiT 底座,Agent 数据引擎维护约 180 万高质量编辑对;继续预训练加 SFT 后走偏好优化与在线 RL,用 VLM 通用裁判加 CTR、文字渲染、商品一致性三类专用奖励训练专精策略,再经 on-policy 蒸馏合并成单一模型;配套发布覆盖 11 类商业编辑任务的 Ecom-Bench。 Overview of the end-to-end data pipeline. Coordinator Agent routes samples through filtering, generation, captioning, and post-filtering with bounded feedback loops and human review. 实验效果:开源编辑器里综合最强:ImgEdit 4.15、GEdit 5.79、REDEdit 英/中 3.75/3.73,Ecom-Bench 视觉质量第一;CTR 引导优化把生成图预测 CTR 超过原图的比例从 12.16% 提到 37.41%,线上 A/B 实际 CTR 相对提升约 2.44%。 Overall comparison on general image editing benchmarks: ImgEdit, GEdit, and the English and Chinese splits of REDEdit. Hatched bars denote closed-source models. 批判点评:最强的限定词是开源:图上闭源模型全面更高——ImgEdit 被 Seedream 4.0 的 4.27 和 GPT-Image-2 的 4.20 压着,GEdit 上 Nano Banana 2 拿 7.02、GPT-Image-2 拿 7.10,比 KwaiMind 的 5.79 高出一大截,REDEdit 两个语种同样如此。真正立住的卖点其实是 CTR 这条商业指标,而不是编辑质量本身。 2. UVU:视觉监督前移,RefCOCO涨7.7 UVU: Improving Multimodal Understanding via Vision-Language Unified Autoregressive Paradigm | 清华大学;腾讯优图实验室;南京大学;格拉斯哥大学 | arXiv:2609.27915 关键词:统一自回归,像素级codebook,连续视觉编码,视觉监督,预训练 ⚠️ 前序问题:多模态大模型的细粒度视觉理解长期靠稀疏文本监督撑着,已有的视觉监督大多加在后训练阶段,那时视觉表征已基本定型,监督信号只能当辅助约束。要重塑感知骨干,得把视觉监督搬进预训练。 本文贡献:提出 UVU 视觉语言统一自回归范式:不用向量量化,SigLIP-2 连续视觉特征直接进 LM 解码器做下一 token 预测;设计大规模迭代层次聚类算法构建 20 万词表的像素级视觉 codebook,让图像 patch 与文本 token 在预训练期共享统一监督,模型由此内化视觉重建能力。 Overview of the UVU vision-language unified autoregressive framework. Continuous visual features from SigLIP-2 are projected and integrated with textual embeddings for autoregressive next-token prediction in an LM decoder, generating pixel-level image tokens. 实验效果:同为 3B/Qwen2.5 底座,RefCOCO 从 84.1 涨到 91.8、LISA 57.4→71.7、CVBench-3D 71.9→76.6、BLINK 46.9→52.8;相对去掉视觉监督的自版 UVU*,RefCOCO +6.2、LISA +12.1。注意力热图显示 UVU 更聚焦目标区域。 Comparison of visual attention heatmaps under three paradigms: from left to right, without visual supervision, AR + VQ, and UVU (Ours). 批判点评:对手没输干净:SEEDB 74.1 仍低于 LLaVA-OV 的 75.4,MMStar 55.0 输给 56.7,ScienceQA 91.3 远低于 GLM-4v 的 96.7;MME 2201.9 对 LLaVA-OV 2146.3 的领先也只有 2.6%。统一目前只覆盖理解侧,生成侧数据还没进训练,作者自己也在文中承认。 3. Unite-Audio:117M音频生成,CLAP登顶 UNITE-AUDIO: Joint Learning of Continuous Tokenization and Latent Flow Matching for Text-to-Audio Generation | 东京科学大学;清华大学;武汉大学;东京大学;蚂蚁集团 | arXiv:2609.28206 关键词:文本生成音频,联合训练,flow matching,Flow-GRPO,连续表征 ⚠️ 前序问题:文本生成音频的主流做法是两阶段:先训重建导向的音频 tokenizer 再冻结,然后在固定隐空间训生成模型。但为重建优化的表征未必适合生成,生成目标无法反过来塑造隐空间。 本文贡献:首个把连续音频表征学习和隐空间 flow matching 联合训练的 TTA 系统:掩码波形过在线编码器,EMA 编码器提供停止梯度的目标特征,重建与自监督生成预测耦合,让生成目标直接塑造隐空间;再用 Flow-GRPO 后训练强化文本条件对齐。 Overview of the proposed framework: (a) the reconstruction path and (b) the generation path. Blue denotes regions with gradient propagation, while gray denotes regions without gradient propagation. 实验效果:117M 隐空间生成模型(不含编解码器)在 AudioCaps-886 上 CLAP 0.534 全表最高(EzAudio 0.496、TangoFlux-RL 0.480),KL 1.057 最低,RTF 0.062;NFE 压到 4 时 RTF 仅 0.009 仍保 CLAP 0.512。 Comparison between conventional separate tokenizer-generator training and our joint single-stage training. 批判点评:分布指标难看:FD_OpenL3 84.76 是 EzAudio 38.26 的两倍多,FD_16k 43.25 也落后 GenAU 的 31.94,IS 11.34 不及 TangoFlux-RL 的 12.20——语义对齐赢了,音频分布保真还差得远;首个联合训练的含金量取决于你更看重 CLAP 还是 FD。 4. MotionSpec:频谱轨迹约束视频运动 MotionSpec: Spectral Trajectory Supervision for Motion-Consistent Video Generation | 卡迪夫大学;中国科大;华东师范大学 | arXiv:2609.28095 关键词:视频生成,运动一致性,傅里叶谱,光流,微调目标 ⚠️ 前序问题:文生视频单帧越来越真,运动却常失真:动作推进不一致、复杂动作下结构崩坏。标准生成目标对运动本身几乎没有专门约束,运动演化处于欠约束状态。 本文贡献:提出 MotionSpec 运动监督:谱轨迹一致性 STC 构造锚点相对的稠密运动轨迹,经时间傅里叶变换成运动谱体积,对齐幅度与相位同时约束运动强度和时序组织;辅以局部光流一致性 LFC 稳定相邻帧过渡,两者随时间步加权加进微调目标。 Overview of the pipeline. At each training step, the video generative model takes the prompt, timestep, noise level, and real data as inputs. 实验效果:在 Wan2.1 上微调,VMBench 均分 61.57→65.07,其中物体完整性 OIS 48.34→56.53、时序一致性 TCS 97.09→98.82;VideoJAM-Bench 运动分 85.3→93.61。定性对比里 Wan2.1 的骑车段后半程自行车几乎消失,MotionSpec 保留完整。 Qualitative Results. On the left are the results of Wan2.1, and on the right are the results of ours. 批判点评:外观分几乎没动:App 仅 81.95→82.20(+0.25);PAS 上单独用 LFC(24.27)反而高于完整版(23.74),说明两个目标存在拉扯。评测全部在 Wan2.1 一个底座上做,换模型的泛化性未知。 5. RecCAR:反向注意力补齐,音画更同步 All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation | 巴伊兰大学;NVIDIA | arXiv:2609.27901 关键词:联合视频生成,跨模态注意力,KL正则,音画同步,人体解剖 ⚠️ 前序问题:联合视频-动作/视频-音频生成的扩散 Transformer 里存在不对称:伴随模态到视频的对应很强,但反过来约束视频生成的对应路始终弱——视频听动作指令的能力远弱于动作看视频的能力,人体解剖崩坏、音画不同步由此而来。 本文贡献:把两个方向的跨模态对应表示成视频 token 上的分布,定义反向对应差距;提出 RecCAR,KL 正则把弱方向对齐到以视频到模态对应为固定参考的强方向,即插即用地微调 EchoMotion 这类联合生成模型。 Illustration of asymmetric reciprocal cross-modal correspondence. For a motion token corresponding to the head, the VM correspondence correctly localizes the head region in the video, while the reciprocal MV correspondence is dispersed. 实验效果:视频-动作联合生成 Human Anatomy 0.69→0.75,VMBench 多数指标超 EchoMotion、CoMoVi、FlowMo;视频-音频生成音画失同步从 0.804 降到 0.752。散点图上每个 prompt 的反向差距在微调后一致下降。 Qualitative comparison of RecCAR against EchoMotion, CoMoVi, and FlowMo across three representative scenes. 批判点评:增益以自家基线为参照:0.75 的解剖分意味着仍有约四分之一样本不达标,音频侧 0.752 的失同步也谈不上小;teaser 里对比的 LTX-2 只做了定性展示,未给出与闭源模型在同一协议下的量化差距。 6. GestureFAR:9.3毫秒每token的流式手势 GestureFAR: Streaming Co-Speech Gesture Generation with Flow Autoregression | 罗切斯特大学;东京大学;加州大学圣克鲁兹分校;加州大学洛杉矶分校;Meta | arXiv:2609.21576 关键词:手势生成,流式,flow自回归,蒸馏,实时交互 ⚠️ 前序问题:流式陪聊手势生成此前靠离散运动 token 自回归,把高维连续运动压进有限 codebook,真实感和多样性都受损;而连续方法又难以保证逐 token 因果,实时交互卡在延迟上。 本文贡献:提出流式手势生成框架 GestureFAR:因果 VAE 把全身动作编码成可流式的连续隐变量,Transformer 对音频-运动上下文自回归,每 token 配 flow-matching 头从连续分布采样下一潜变量;再冻结因果骨干,用一致性加分布匹配目标把多步 flow 头蒸馏成单步前向。 Overview of GestureFAR. GestureFAR generates co-speech gestures from streaming audio by autoregressing over continuous motion latents. 实验效果:BEAT2 流式组 FGD 3.08 全面最佳(LiveGesture 4.57、MIBURI 8.06),BC 0.741 接近离线最优;1 步蒸馏后每 token 9.3ms,是教师 8 步 24.4ms 的 2.6 倍速、MIBURI 62.9ms 的 6.8 倍速。 Qualitative comparison on BEAT2. We visualize generated full-body gestures from different methods under the same speech inputs, with the semantically salient words highlighted in red. 批判点评:BC 0.741 仍低于 MIBURI 的 0.790 和 LiveGesture 的 0.794,多样性 13.24 也略逊离线系;单步蒸馏换速度后 FGD 反而比教师还好(3.08 vs 3.17),这个反常更像评测协议的产物而非能力证明,文中未解释。 7. DeltaS:状态漂移选KV,六个基准+2.1 DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video | Maum AI;首尔大学;延世大学 | arXiv:2609.27470 关键词:KV缓存淘汰,流式视频,线性注意力,混合架构,训练无关 ⚠️ 前序问题:视频语言模型转向线性/全注意力混合架构后,线性注意力状态固定大小,但全注意力 KV 缓存仍随流式视频无限增长;流式场景下问题还没来就得决定淘汰谁,现有基于位置、注意力或 KV 本身的信号都拿不到这个先验。 本文贡献:提出训练无关的 DeltaS:读门控 delta 线性注意力的循环状态,用一块帧内状态的归一化变化量(状态漂移)衡量该块带来多少新信息,漂移大的块对应 KV 留存;信号计算只占前向的 1.9%,无需代理查询。 Overview of DeltaS. Each video chunk updates the recurrent linear-attention states, whose normalized changes yield a shared score for retaining the corresponding KV entries across full-attention layers. 实验效果:预算与留存策略对齐的受控比较里,状态漂移信号全面胜过位置/注意力/KV 三类基线;六个长视频基准平均超最强无查询基线 2.1 分,最长基准 LVBench 超 5.6 分。 Performance margin as a function of KV retention rate. DeltaS generally shows larger margins at lower retention rates. 批判点评:增益随留存率升高而收窄:留存 token 超过约四成后在 EgoS 上反而落后基线 0.7 分,高预算场景收益有限;hybrid 架构前提也把它限死在门控 delta 线性注意力这一类骨干上。 8. DriftAudio:一步生成后训练FAD降34% DriftAudio: Marginal Drifting for Distributional Post-Training of One-Step Text-to-Audio Generators | 悉尼科技大学 | arXiv:2609.27598 关键词:一步生成,分布后训练,文本生成音频,Drifting,FAD ⚠️ 前序问题:一步文本生成音频模型把推理成本打下来之后,生成分布仍欠火候;常规后训练依赖逐条件配对的真实样本,自由文本条件下一个 prompt 往往只有一两条真实参考,逐条件 Drifting 根本做不了。 本文贡献:提出 DriftAudio 边缘分布后训练:把 Drifting 从逐条件搬到边缘音频分布上做,在冻结的 PANNs 特征空间里用重采样真实样本、滚动生成的 FIFO 样本库和当前批次共同估计漂移场,得到 detached 训练目标只更新生成器,一步推理流程原样保留。 Overview of DriftAudio. The one-step generator remains text-conditioned, while Drifting is performed on the marginal audio distribution in feature space. 实验效果:从 MeanAudio 出发 FAD 降 33.9%、FD 降 17.6%,KL 与 CLAP 同步改善;从 FdAudio 出发 FAD 1.22→0.99,一步生成的分布质量明显抬升。 Mean and covariance components of FAD for the four evaluated models. Numbers above the bars denote total FAD. 批判点评:不是白捡的:从 FdAudio 出发时 IS 和 CLAP 出现回退,说明边缘分布对齐和条件保真之间存在交换;方法绑定冻结的 PANNs 特征空间,换更强的音频评价骨干是否还成立未验证。 9. InGuard:嵌入层安检,省一半去噪步 InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation | 阿里巴巴 AAIG | arXiv:2609.27620 关键词:文生图安全,内嵌护栏,嵌入改写,潜空间检测,RevGen ⚠️ 前序问题:T2I 的安全护栏都装在外面:前置 prompt 分类器加后置图像分类器,两者不用模型自身表征——prompt 检查准头有限,图像检查要等全量去噪烧完才跑,而且违规 prompt 只能一刀切拒绝,本可改写成安全输出的也被扔掉。 本文贡献:提出 InGuard 内嵌护栏:文本编码器嵌入上直接做风险三级分类(不安全/风险/良性),SAGE 对风险 prompt 做嵌入空间软门控改写使其输出安全图而非拒答,去噪中途用一步干净潜变量估计做潜空间检测,发现风险即刻提前终止;配套 RevGen Safety 基准,1 万条 prompt 由真实图反生成并注入受控 IP 角色。 Overview of our InGuard framework. Three complementary components work in sequence: prompt embedding risk classification, SAGE embedding-space safety enhancement, and latent detection with early termination. 实验效果:五个开源 T2I 模型上安全率 97.9%-98.8%,追平或超过外置护栏;良性扰动少 57.5%-73.5%,参数少约 3.7 倍,50%-55.6% 的去噪步被跳过;潜空间检测在 44%-50% 计算量处就逼近图像级 F1。 Pretraining effects on Avg F1 across five LDMs; latent detection vs denoising-step fraction used as a compute proxy. 批判点评:SAGE 改写不是万能的:论文自己承认增强失败时只能靠潜空间检测兜底拦截,等于承认存在漏改样本;RevGen 由自家反生成流水线构造,跨基准的代表性有待第三方复检。 10. CineGuard:11种运镜的抄袭检测 Did You Steal My Shot? Pioneering Camera Motion Plagiarism Detection in Generative Videos | 河海大学 | arXiv:2609.22267 关键词:运镜抄袭,生成视频,涡度,基准,版权保护 ⚠️ 前序问题:运镜是影视级 IP,但生成视频用一句 prompt 就能复刻高价值运镜;现有相似度检测都盯着画面内容,训练数据把运镜和内容缠在一起,传统光流又表达不了复杂相机运动——运镜抄袭至今无人管。 本文贡献:构建首个运镜分析基准 CineFlow:11 种运镜风格的模拟数据集把运镜与内容解耦;提出 CineGuard 检测网络,在光流上叠加流体力学涡度作为平移不变线索,3D 卷积提 tubelet 嵌入后过 ViT 主干加全局相机适配器,对比学习聚拢同运镜视频。 Architecture of the motion plagiarism detection network. The input flow is first augmented with vorticity, then a 3D convolution extracts tubelet embeddings. 实验效果:抄袭检测超最强基线 3.02 倍;在 Veo 3.1 与即梦的商业生成视频上,余弦相似度 0.56-0.83,基线全部落在 0.35 以下,Precision@5 最高 0.73 对基线约 0.27。 Performance of plagiarism detection on generative videos. Left: cosine similarity between videos. Right: Precision@5 for retrieving videos with the same motion label. 批判点评:局限写在图里:FPV Drone 这类复合运镜相似度掉到 0.56,是全表最低,混合运镜仍是软肋;基准是简单几何场景模拟出来的,真实影视素材上的迁移只有商业视频小样本佐证。 趋势观察 编辑模型的主战场从通用能力挪向行业指标 KwaiMind 把 CTR 预测直接做成奖励信号训进编辑模型,线上 A/B 实测 +2.44%;InGuard 则把安全检查搬进生成管线内部,省下一半去噪步。两条线指向同一件事:图像生成的竞争正在从「生成质量」转向「商业约束下的生成质量」,奖励函数和护栏的构造方式开始比骨干网络更值钱。 视觉监督正在从后训练前移到预训练 UVU 用像素级 codebook 把视觉监督直接塞进预训练,RefCOCO 一项涨 7.7 分;MotionSpec 则在视频微调里用频谱约束补上运动监督的缺口。共同逻辑:等表征定型再补监督太晚了,感知质量的上限在预训练阶段就被决定。 一步生成与流式生成进入质量补课期 DriftAudio 给一步 TTA 做边缘分布后训练,FAD 降三分之一;GestureFAR 用单步蒸馏把手势生成压到每 token 9.3ms;Unite-Audio 把去噪步数压到 4 还能保住 CLAP。速度战的下一程是质量战——谁能在一步、几步的预算里把分布差距补回来,谁就拿到实时产品化的门票。 混合架构的两组记忆开始学会协作 DeltaS 证明线性注意力的循环状态可以反过来指挥全注意力 KV 缓存的淘汰,六个长视频基准平均 +2.1;Unite-Audio 则让生成目标直接塑造 tokenizer 隐空间,打破「先冻结表征再训生成」的铁律。两篇都在挑战模块化管线里各训各的默认假设。 人工智能炼丹君 整理 | 2026-09-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注