今日 AIGC 论文速览
今日共 10 篇 · 语音与音频生成 2 篇 · 视频生成与物理一致 2 篇 · 图像编辑与三维生成 2 篇 · 生成理解一体化 2 篇 · 推理加速与评测 2 篇
重点论文标题列表
StepAudio 3 (StepFun-Audio Team):全双工语音模型98.9分登顶OmniVChat (CUHK):全模态对话视频2800题⚡ CompAdapt (HIT):物理视频生成PIS 0.862
KaiNinja (Alaya Lab):3D部件生成免分割器4DGS-Fixer (Goertek Alpha Labs):稀疏四视角重建4D高斯
今日论文速览
1. StepAudio 3:全双工语音模型98.9分登顶
StepAudio 3 Realtime Technical Report | StepFun-Audio Team | arXiv:2609.14005
关键词 :实时语音交互,全双工对话,边想边说,音频语言模型,MTP解码
⚠️ 前序问题 :实时语音交互要同时满足三件互相拉扯的事:听懂语音里丰富的声学线索(意图、情绪、环境),在对方还没说完时就能自然接话(停顿、附和、打断),以及先做足够深的推理再开口。传统做法要么把推理挪到对话之外、延迟跟着涨,要么为了低延迟直接砍掉推理深度——「想得深」和「答得快」长期被当成一对不可兼得的取舍。
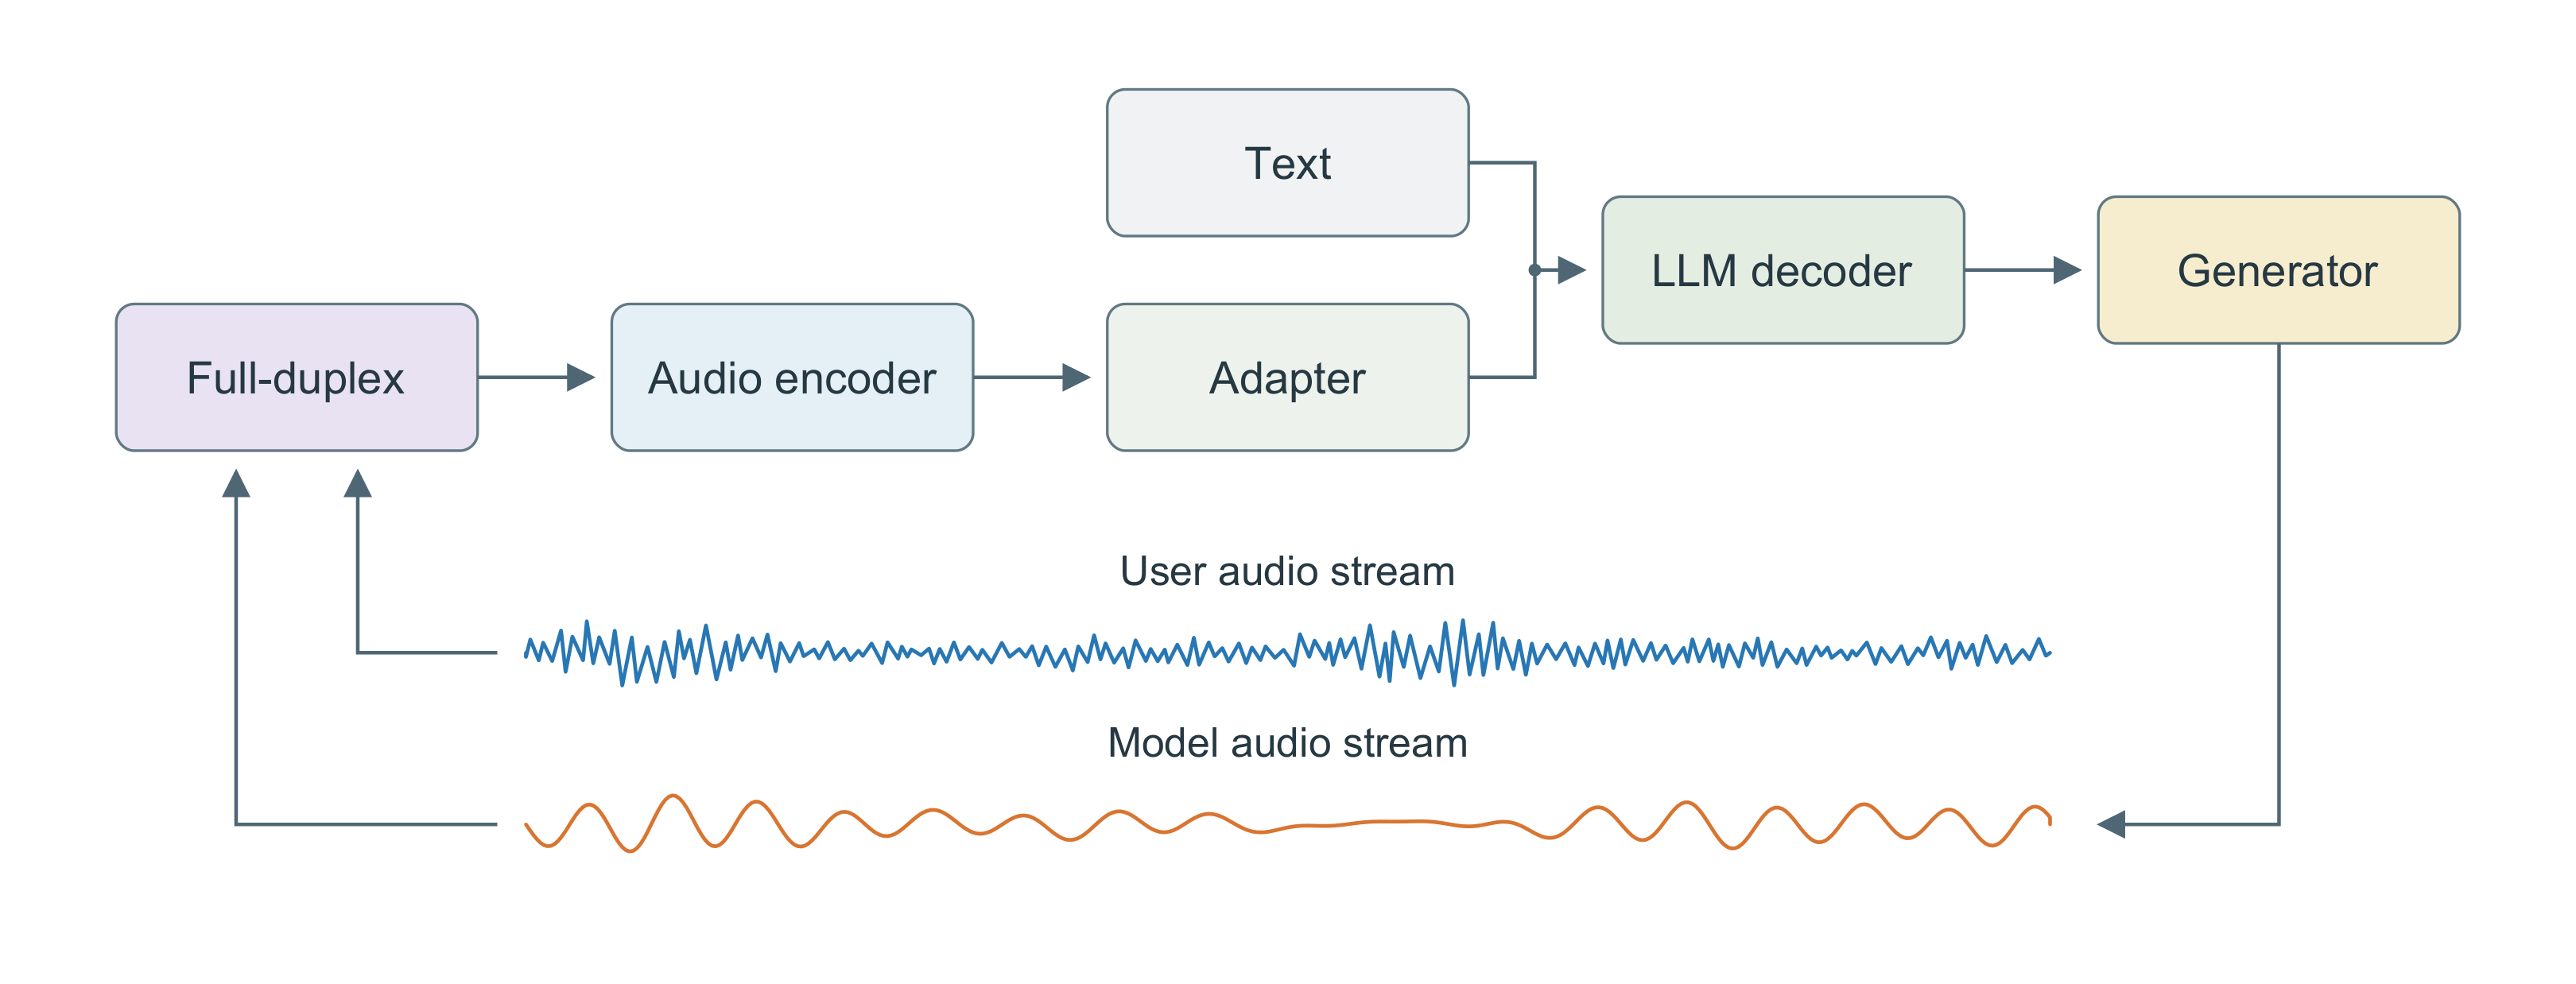
本文贡献 :StepAudio 3 Realtime 把整套系统组织成一个连续的「听—对话—思考—行动」循环。三个关键部件:Deep Perception 从原始音频里抽取丰富的声学线索来理解意图;Seamless Duplex 对同步的用户/模型双路音频流建模,处理停顿、附和与打断;核心创新是 Think-While-Speaking——让私有推理与语音输出并行执行,并用 Medusa 式的 MTP 解码加速思考,从而把「想」这一步塞进「说」的同一段时间窗里。训练侧配了一个 Adaptive Thinking 路由,先判断当前这一轮是否需要显式推理,若不需要就走 direct route、留一个空的 think block,避免为简单对话付出推理成本。此外集成了Voice Agent,在对话流不中断的前提下异步执行工具调用,把工具返回结果再融回对话。
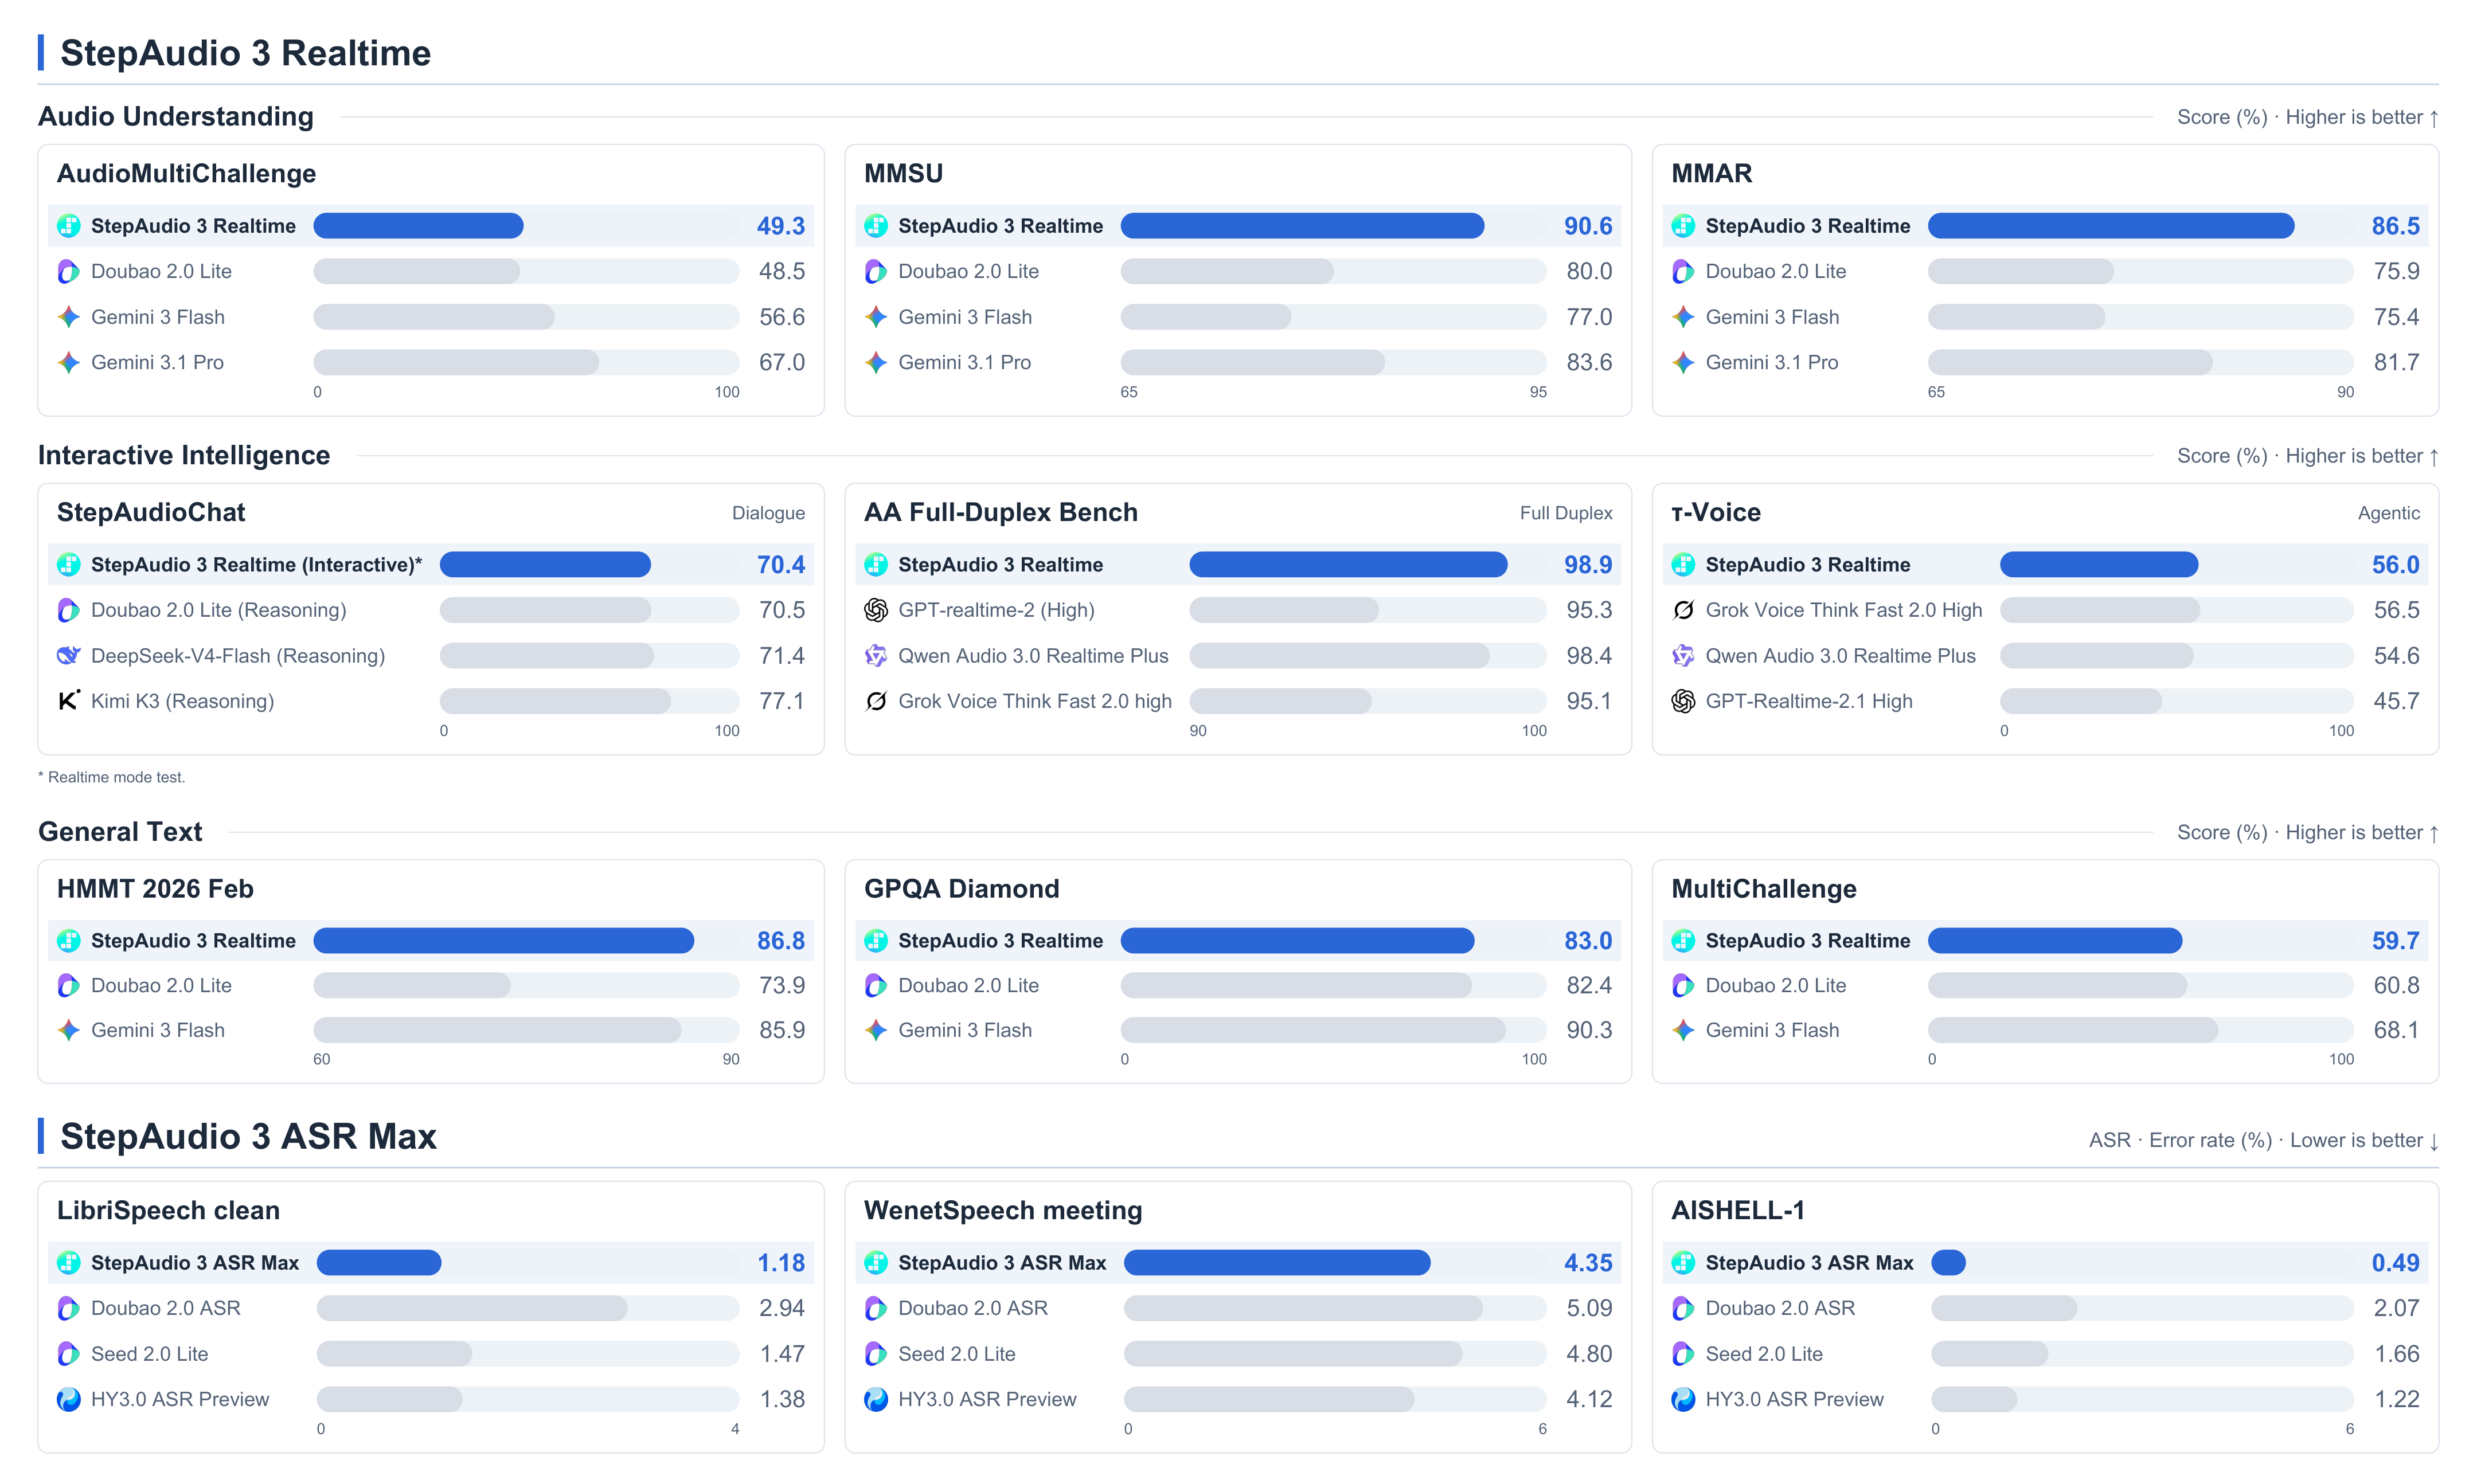
实验效果 :按官方技术报告的自测:推理模式下 StepAudioChat 宏平均 73.0,达到专用推理模型的水平;MMSU 90.6;Artificial Analysis Full-Duplex Bench Overall 98.9;τ-Voice 宏任务成功率 56.0%。同表里 ASR 侧 StepAudio 3 ASR Max 在 LibriSpeech clean 1.18、WenetSpeech meeting 4.35、AISHELL-1 0.49,三项均为全表最低错误率;音频理解侧 MMAR 86.5、AudioMultiChallenge 49.3;通用能力侧 HMMT 86.8、GPQA Diamond 83.0、MultiChallenge 59.7。
批判点评 :优势几乎全部集中在「实时语音交互」这一列:Full-Duplex Bench 98.9 领先 Doubao 2.0 Lite 的95.3 与同表 Gemini 系列的 95.1~98.4,ASR 三项也确实拿到最低错误率。但同一张表暴露了明确的短板——AudioMultiChallenge 49.3,比同表最好成绩 67.0 落后近 18 分;GPQA Diamond 83.0 低于同表最高的 90.3;MultiChallenge 59.7 也落后最好成绩 68.1。τ-Voice 上 56.0 与 Doubao 2.0 Lite 的 56.5 基本持平甚至略低,说明「边想边说」这套机制在需要长链条决策的智能体任务上还没转化成稳定优势。此外全部数字均为团队自评、无第三方复现,报告也没有给出 Think-While-Speaking 与串行思考在同等算力预算下的严格对照——增益里究竟有多少来自 MTP 解码加速、多少来自推理与发声的并行重叠,需要拆开才能判断架构本身的净贡献。
2. OmniVChat:全模态对话视频2800题
OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue | The Chinese University of Hong Kong;Alibaba Token Hub;Shanghai Jiao Tong University;Shanghai Innovation Institute;Zhejiang University | arXiv:2609.21465
关键词 :音视频对话,全模态模型,合成数据,强化学习奖励,基准评测
⚠️ 前序问题 :让全模态模型像人一样「看着你、听你说话就直接回应」,而不是先把语音转成文字、把视频转成描述再喂给语言模型。直接吃音视频能省掉转写带来的外部延迟与算力,也保住了表情、环境、手边物品这类感知线索。但这条路有两个卡点:一是人们用自己设备录的真实对话数据极其稀缺;二是同一个意图有无数种说法,好的回答往往要结合用户所处的环境与表情,用关键词匹配根本判不出回答质量。
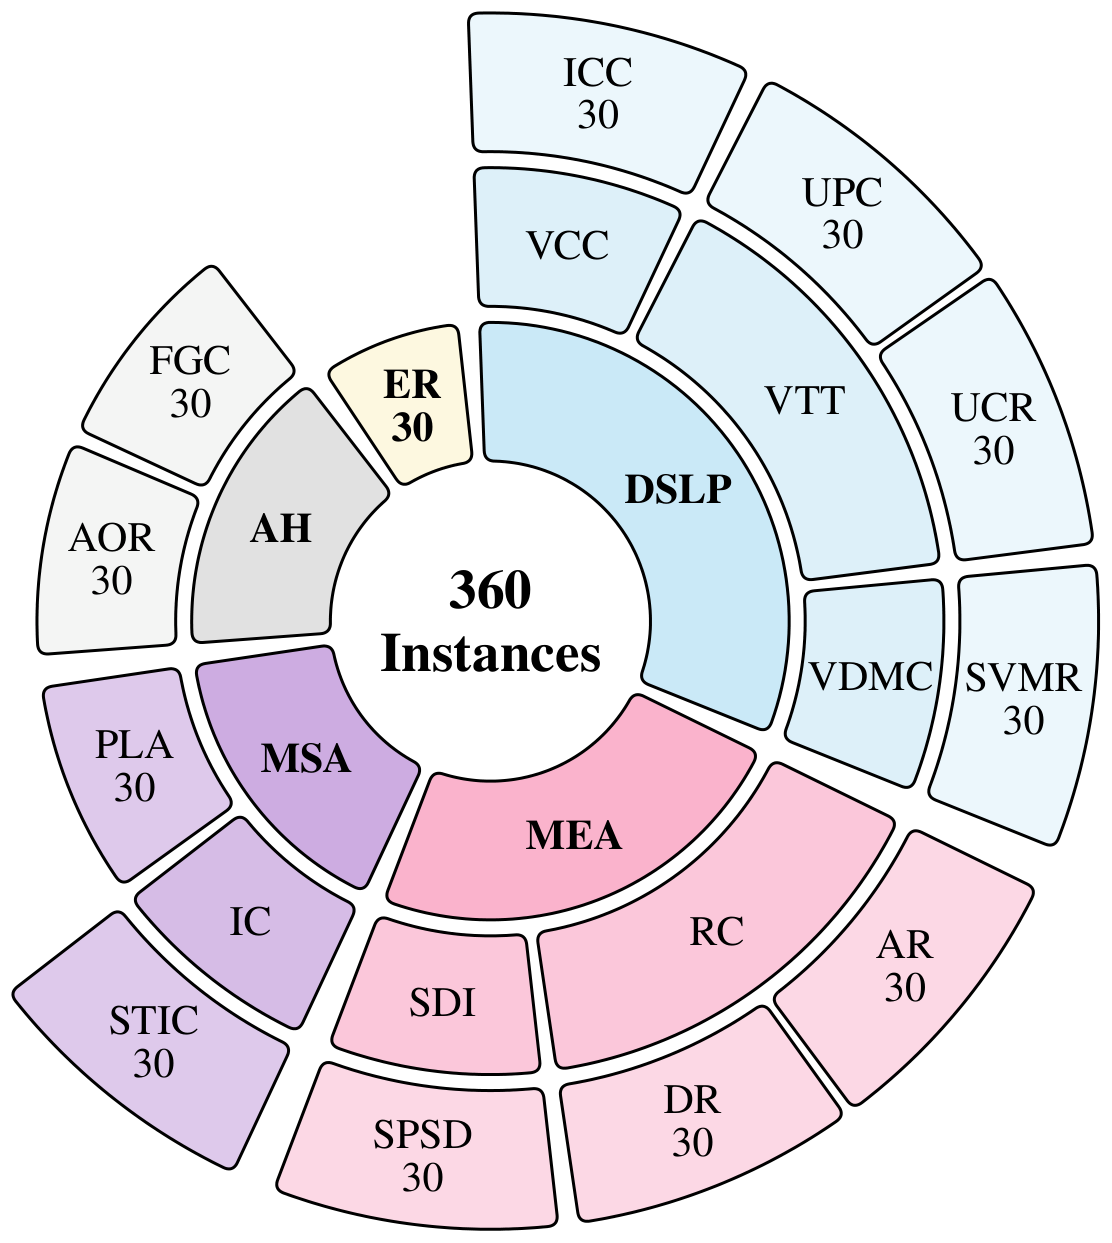
本文贡献 :论文把这条路线正式命名为 OmniVChat,并配齐了数据、评测、训练三件套。数据侧 OmniVChat-Studio 是一个多智能体合成引擎,用智能体协作加视频生成造出单轮与多轮的音视频对话;评测侧 OmniVChat-Bench 覆盖 5 大能力类、17 个子类、22 个场景域共 2800 条合成实例,另有人工实录的 OmniVChat-Bench-Human(360 条)作为真实分布对照;训练侧 OmniVChat-RL 给出一套把回答正确性、效率与风格联合起来的 rubric 奖励设计,直接在合成对话上训练 Qwen3-Omni-Instruct,验证奖励设计能否迁移到真实录制的对话上。
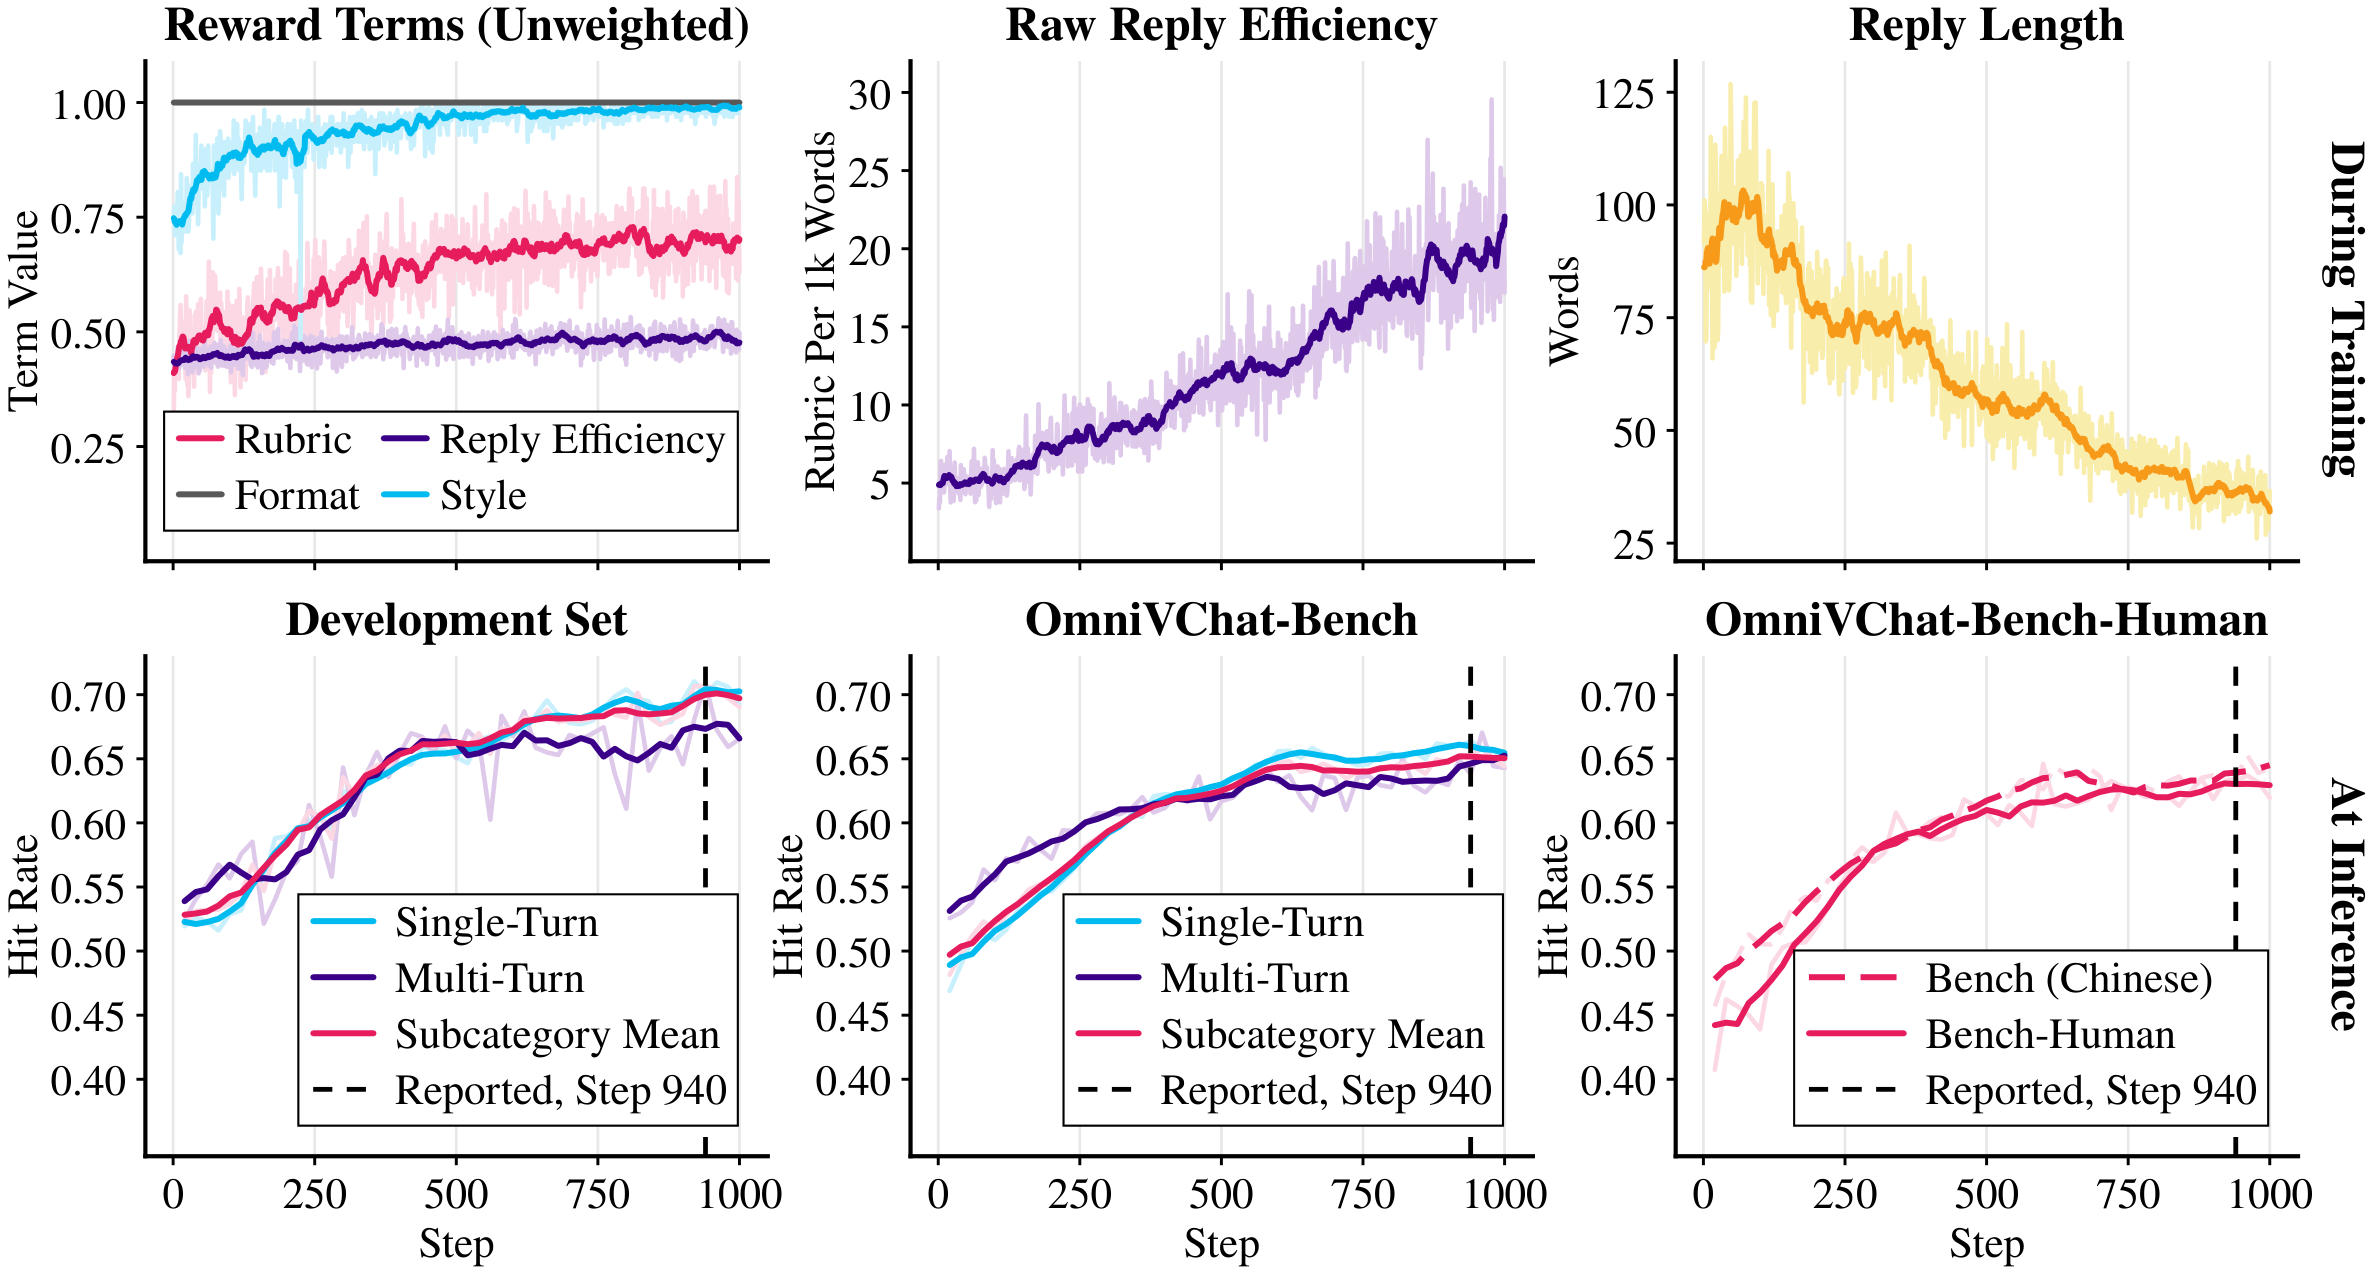
实验效果 :RL 训练满 1000 步(记录 51 个 checkpoint)后,OmniVChat-Bench 与人工录制的 OmniVChat-Bench-Human 命中率同步上涨,且合成集与实录集的曲线走势一致,论文还逐条给出了 16 个子类的学习曲线,说明在合成数据上得到的增益确实能迁移到真实对话。对比表里 Qwen3-Omni-Instruct 基线的综合命中率 0.186,训练后与 Qwen3.5-Omni-Plus 的 0.361、Doubao Seed 2.0 Lite 的 0.330 进入同一档。
批判点评 :最值得警惕的是奖励设计里的「效率」项。训练曲线显示 Reply Efficiency(每千词的 rubric 命中数)从约 5 涨到 20 的同时,平均回复长度从接近 100 词一路掉到 35 词左右——效率提升有相当一部分来自「少说几句」而不是「说得更准」,在固定 rubric 打分下这几乎必然发生,机制上和同期的 reference-free 语音指标那篇讲的 reward hacking 完全一致。第二,OmniVChat-Bench 全部是合成实例,而实录集只有 360 条,并且只覆盖十二个单轮子类中的一部分,所以「迁移到真实对话」的证据强度受限于实录集规模——论文自己也在多个子类上标注 Bench Only,意味着这些能力在真实录制条件下根本没有对照数据。第三,用合成对话同时做训练和评测,存在评测集与训练分布同源的风险,跨数据集的零样本能力没有被检验。
3. CompAdapt:物理视频生成PIS 0.862
CompAdapt: Adaptable Composite Motion Modeling for Physics-Consistent Text-to-Video Generation | Harbin Institute of Technology;Alibaba Taobao | arXiv:2609.21455
关键词 :文生视频,物理一致性,复合运动建模,神经动力学,一次性适配
⚠️ 前序问题 :扩散式文生视频能出画质、也能出时序连贯,但常常违反基本物理:物体不受重力、碰撞后穿模、运动类型中途乱切。已有的物理约束方法大多只会处理单一运动类型,还要人工指定物理参数,换一个没见过的物理环境就失灵。问题在于真实场景里的运动几乎都是复合的——耦合、多阶段转换、多物体碰撞,单一类型的动力学先验覆盖不了。
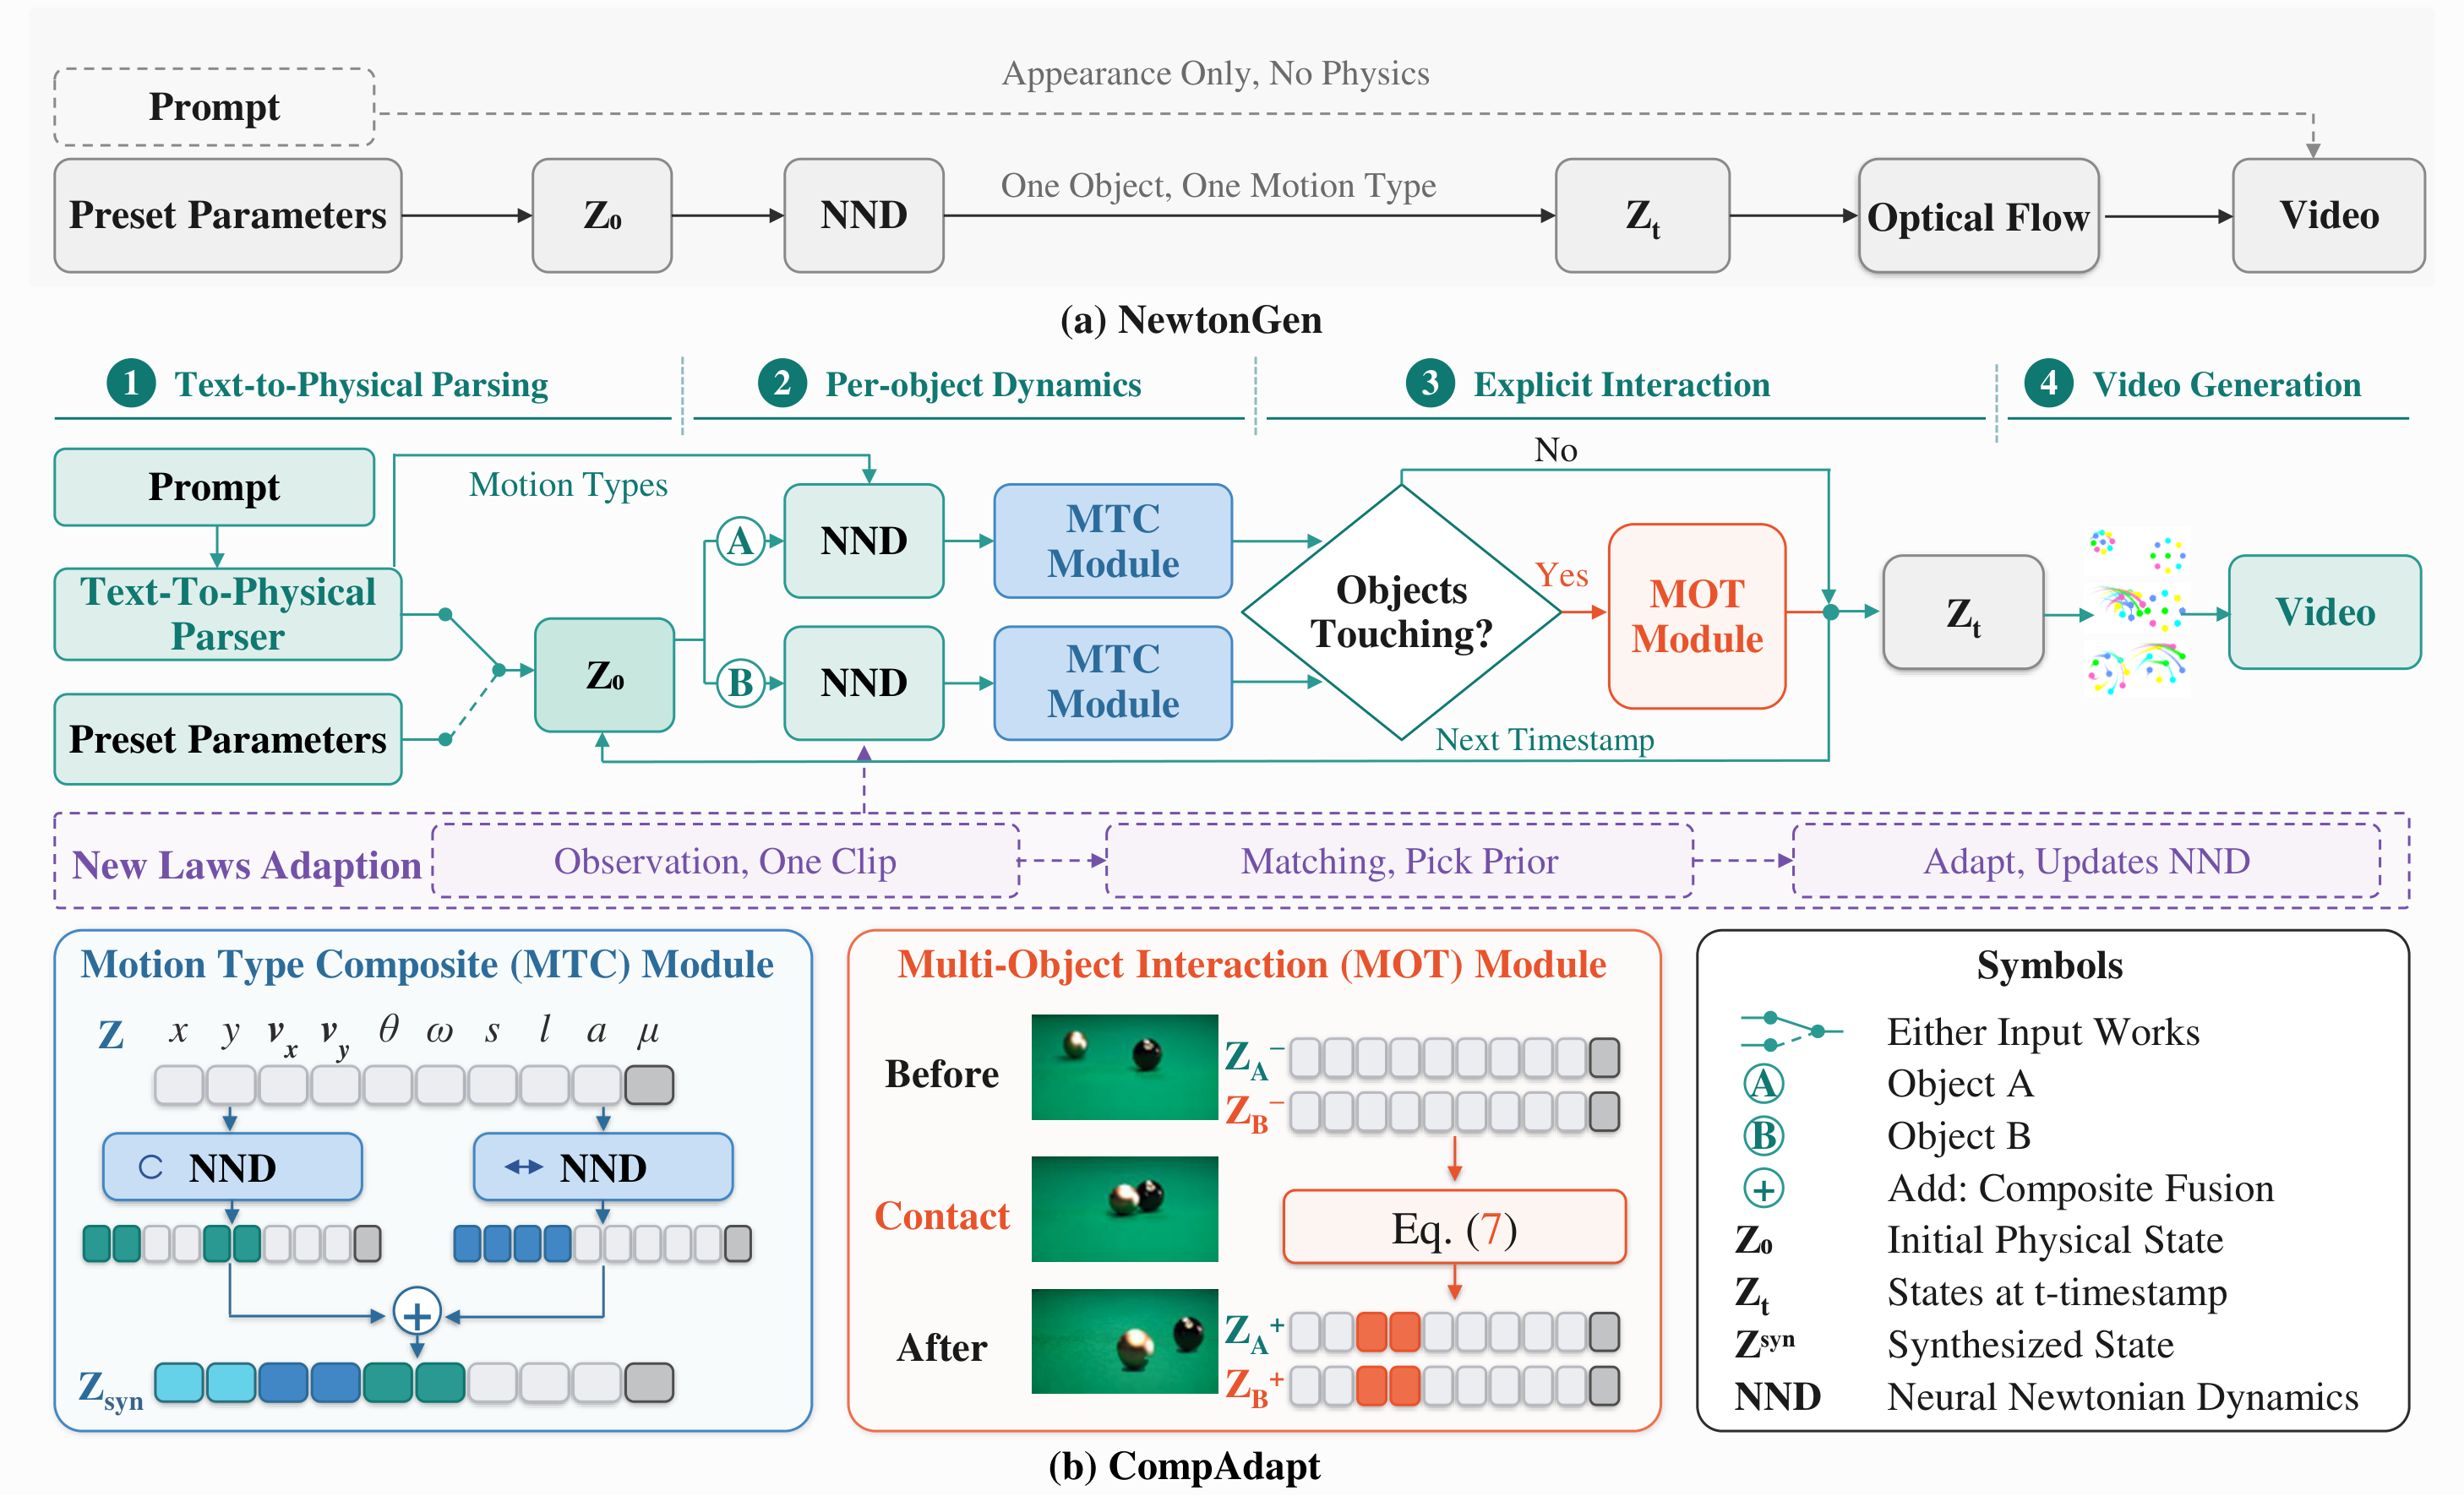
本文贡献 :CompAdapt 把神经动力学建模从单一运动类型扩展到复合物理行为。架构上有两个关键模块:Motion Type Composite(MTC)在潜空间里把多个运动类型按时间关系做算子级复合,Multi-Object Interaction(MOT)在检测到物体接触时切到显式的交互动力学。自然语言提示被解析成结构化的物理语义——运动类型、时序关系、初始物理参数——实现端到端指定,不再需要人工调参。跨新物理环境靠 dynamics-aware prior matching 做一次性适配,不必重训核心动力学模块;另有 physics-aware 潜特征融合模块负责高速与复杂运动下的画面保真。
实验效果 :消融实验:去掉 MTC 后 PIS 掉到 0.615,去掉时序建模掉到 0.589,去掉双 LLM 语义解析掉到 0.724,完整版 0.862;FID 15.0 / FVD 91.4 / PSNR 17.2 / SSIM 0.61,相比 Wan-Move(16.3 / 93.5 / 16.5 / 0.58)与 Go-with-the-Flow(17.5 / 96.7 / 14.9 / 0.56)在四项上均有改善,生成开销 2.9 与 Wan-Move 持平。定性部分把 NewtonGen、PhysT2V、Wan2.2、CogVideoX-5B、Veo3、Sora 全部拉到同一组提示下逐帧对照,覆盖抛体旋转、阻尼振荡、均匀加速、形变碰撞等组合运动。
批判点评 :三处需要打折。第一,主指标 PIS(物理一致性分数)由论文自行定义,没有第三方榜单或社区复现支撑,而它在消融中的跨度(0.589 → 0.862)恰恰是全文最大的增益来源,指标自证的风险较高。第二,所谓「复合运动」实际只覆盖 9 类情形,其中真正涉及物体接触的弹性碰撞仅 2 类,多物体场景仍是最薄的一环,所谓 multi-object collisions 的证据量偏小。第三,「一次性适配」并不等于「免数据」——流程本身仍需要目标环境的一段观测视频(one-shot reference)才能完成 prior matching,因此把它当作通用物理先验来用还有前置成本。论文 comments 自注为 NeurIPS 2026 投稿(23 页、4 图),尚未经同行评审。
4. KaiNinja:3D部件生成免分割器
KaiNinja: Extending Native 3D Generators to the Part Level | Alaya Lab;The University of Tokyo;UC Merced;Institute of Science Tokyo | arXiv:2609.15659
关键词 :三维生成,部件级建模,双体积表示,稀疏体素,免分割
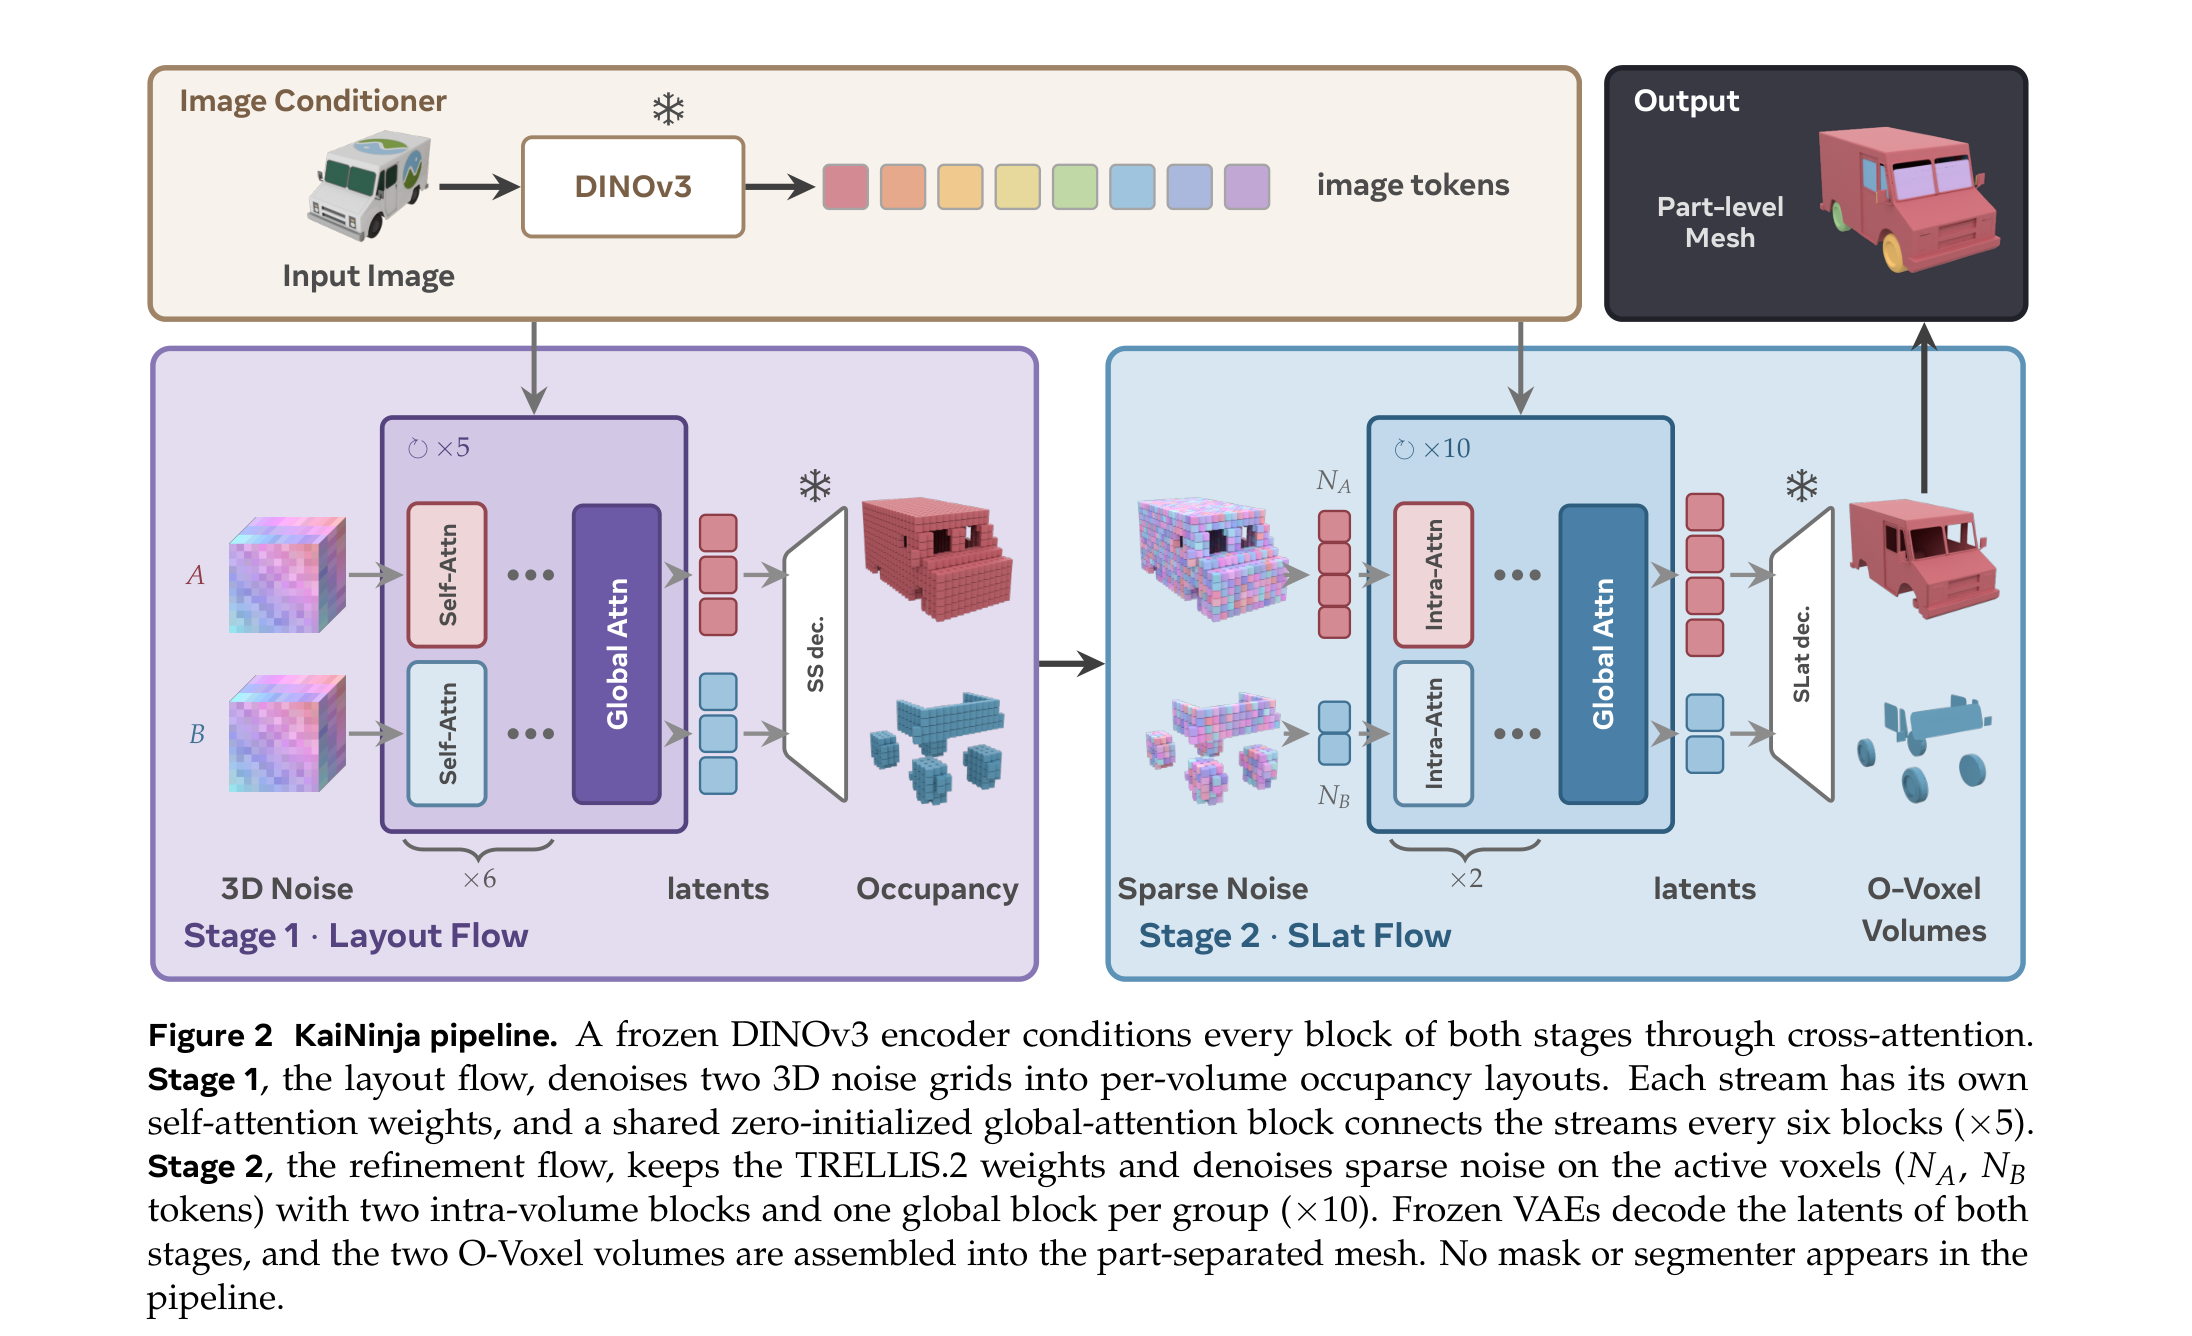
⚠️ 前序问题 :TRELLIS.2 这类原生 3D 生成器能把一张图变成高保真、带材质、非水密的网格,但输出是一个融合好的整体 ;而下游的编辑、绑定骨骼、物理仿真全都按部件操作。最直接的办法是在融合网格上再跑一个 3D 分割网络,可这样既慢、又被分割精度卡死。真正的技术障碍更基础:O-Voxel 网格每个体素只存一片表面,所以单个 volume 在任何分辨率下都无法表示两个部件贴合的那层界面 。
本文贡献 :论文提出双体积(dual-volume)表示来补上缺失的界面——同一位置存两套体积,让贴合面两侧各自有归属。KaiNinja 建立在 TRELLIS.2 的 O-Voxel 之上,分两阶段生成:Stage 1 的 Layout Flow 把 3D 噪声网格去噪成逐 volume 的 occupancy 布局,两条流各自有自注意力、再用零初始化的全局注意力块跨流通信;Stage 2 的 SLat Flow 复用 TRELLIS.2 权重,只在活跃体素上对稀疏噪声去噪,最后由 FVAE 解码成 O-Voxel 体积并装配成部件分离的网格。整条流水线里没有掩码、也没有分割器。训练数据来源混杂,包含 CAD 模型和由 LLM 驱动的智能体创作的资产,作者称这是首个用智能体创作的部件数据训练的 3D 生成模型。
实验效果 :相对不同范式的部件生成流水线,整体 Chamfer distance 降低 40%、严格部件 F-score 提升 16%;在held-out 测试集与训练未出现过的源上,KaiNinja 产出的部件数量都最接近真值,而 TRELLIS.2+X-Part、Hunyuan3D-2.1+X-Part、OmniPart、PartPacker 这几个基线常常把部件融在一起或者碎开。作者还报告一个反直觉现象:同样的骨干、同样的数据,加上部件级监督之后整体几何保真度反而也提升了。
批判点评 :「免分割器」是这篇最硬的卖点,而它恰好没有回答分割器方案真正的软肋——精度上限。论文比的是部件数量、Chamfer 距离与 F-score,没有给出「部件语义是否对得上真值」的证据:在训练未出现的源上,KaiNinja 的部件着色与真值明显对不齐(椅子、花瓶、水壶几行都能看出切分位置与真值不同),也就是说「切得开」和「切得对」之间仍有距离,而语义正确性恰恰是分割器方案此前唯一能保证的东西。其次,40% / 16% 相对的是各基线外挂 X-Part 分割器 后的组合结果,比的是「你的流水线 vs 别人的流水线」,而不是「dual-volume vs legacy O-Voxel」,无法分离表示本身的净贡献。第三,所谓「首个用智能体创作数据训练」目前只是自述,论文没有给出这类数据在训练集中的占比,也没有做数据来源的消融,因此这个卖点暂时无法验证。
5. 4DGS-Fixer:稀疏四视角重建4D高斯
4DGS-Fixer: Generative Sparse-View 4D Gaussian Splatting with Iterative Refinement Guided by Video Diffusion Priors | Goertek Alpha Labs;Singapore Institute of Technology;The Hong Kong University of Science and Technology | arXiv:2609.21176
关键词 :4D高斯泼溅,稀疏视角,视频扩散先验,迭代精修,动态场景重建
⚠️ 前序问题 :用稀疏视角视频重建动态场景是典型的病态问题:观测太少、信息缺失,再多优化技巧也补不出来。更具体的症结在初始化——只有几个输入视角时,COLMAP 只能重建出稀疏残缺的点云,大片区域没有足够的高斯基元支撑,后续优化根本无从下手。也就是说问题出在起点,不在优化器。
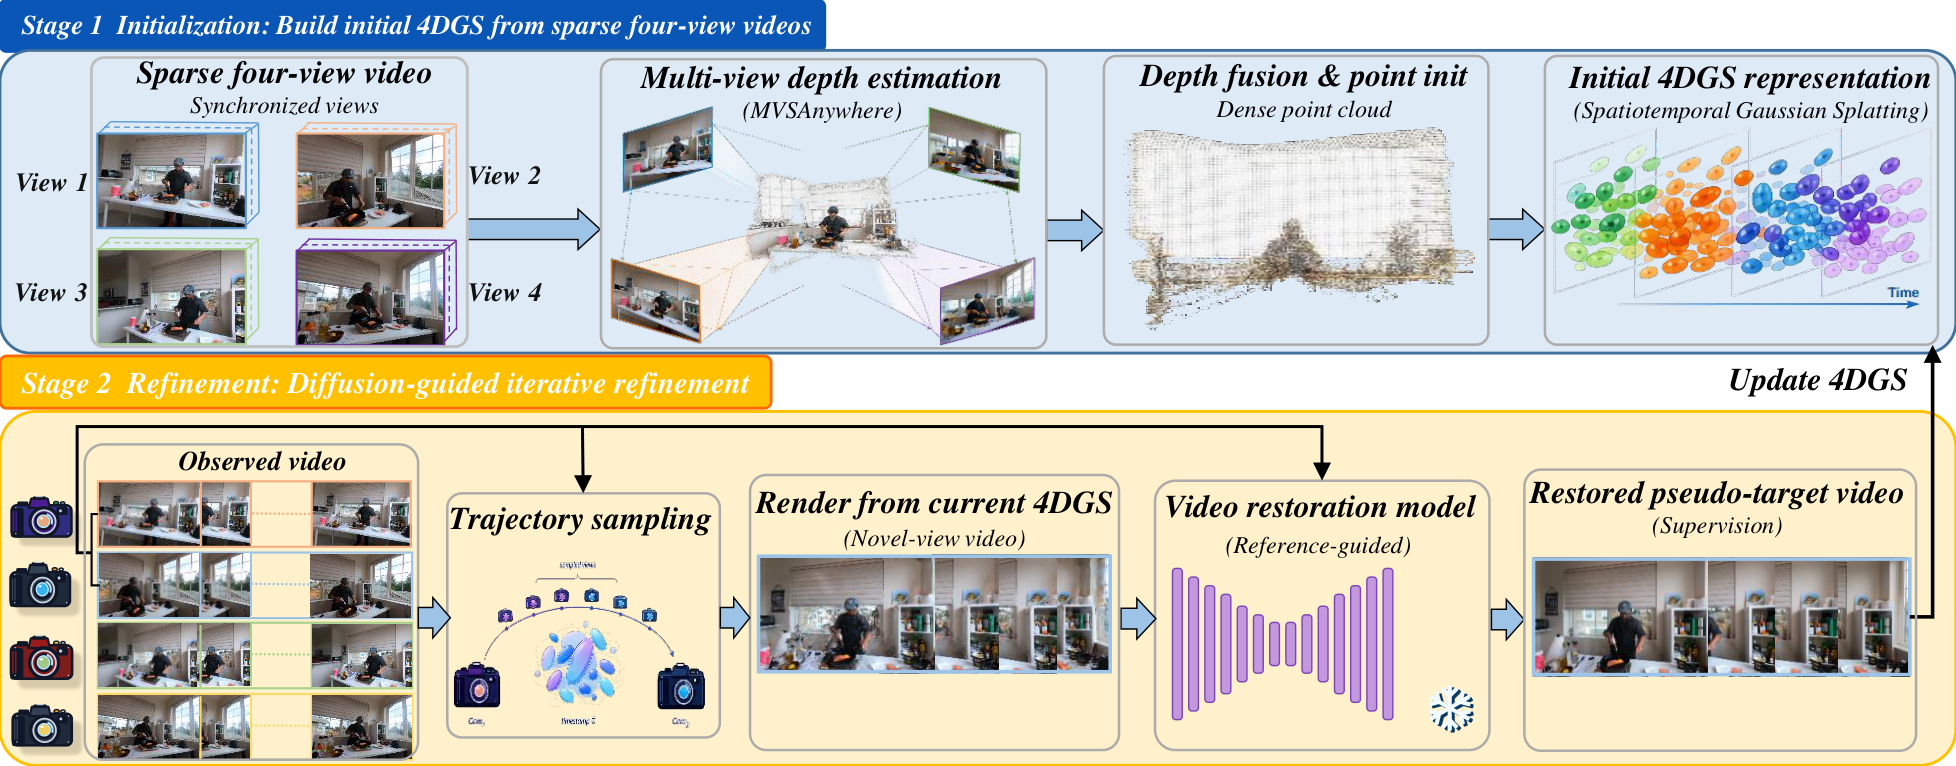
本文贡献 :论文给出一个两阶段的迭代精修框架。Stage 1 初始化:先对多路同步视频估计多视角深度图,把它们融合成稠密点云,为动态 4DGS 提供更完整的几何起点,替代 COLMAP 的稀疏点云。Stage 2 精修:沿新的相机轨迹渲染出视频,送进一个预训练的视频修复/恢复模型得到「修复后的伪目标视频」,再把它当作伪监督去迭代更新 4DGS 表示,多轮往复。整条链路的思路是用视频扩散先验补足缺失的观测信息,而不是继续在几何约束上加码。
实验效果 :在常用的稀疏视角动态基准上,相对此前最好的方法 PSNR 提升接近 2 dB,作者称 substantially outperforms 现有基线。定性对比给出 GT / 4C4D / Ours 三行并排结果,4DGS-Fixer 在人物细节与背景完整度上都比 4C4D 明显更干净、更少孔洞。论文 comments 标注已接收至 SIGGRAPH Asia TC。
批判点评 :整条链路的关键一步是「拿视频修复模型的输出当监督」,这带来一个绕不开的疑问:修复模型的幻觉会被原样写进 4DGS。用修复后的序列做伪监督,本质上是把生成先验的偏好当成真值——一旦输入视角极少、修复模型开始「编」,4DGS 就会忠实地记住这些编出来的内容;而 PSNR 的提升恰恰可能来自「补全得更像训练分布」而不是「更接近真实场景」。论文没有做「关掉修复模型、只保留深度稠密初始化」的对照,因此也说不清 2 dB 里有多少来自几何初始化、多少来自扩散先验。其次是部署成本:方法需要四路同步相机加一个预训练视频修复模型,实时性与泛化到非受控场景的能力都未讨论。源码层面还有个小瑕疵——LaTeX 里仍留着旧名「STGFixer pipeline」的残句没清理,说明从 STGFixer 改名到 4DGS-Fixer 之后并未完全同步。
6. RefineEdit:九类编辑背景保持最优
Refinement Is Inherently Editable: Training-Free Prompt-to-Prompt Image Editing with Generative Refinement Network | City University of Hong Kong (Dongguan);City University of Hong Kong;MBZUAI | arXiv:2609.20633
关键词 :图像编辑,免训练,生成式精修网络,二值图像码,背景保持
⚠️ 前序问题 :文本引导的图像编辑要在「改对」和「别乱改」之间走钢丝。扩散类编辑器靠空间控制(掩码、注意力图)来圈定改动范围,而掩码一旦不准,结果不是改不彻底就是动到无关区域;因果自回归类编辑器还有一层额外约束——解码顺序固定,前面已经决定的 token 后面没法回头修正,早期的一个坏决策会被一路带下去。
本文贡献 :论文换了一个编辑载体:不去控制扩散过程,而是在 Generative Refinement Network 的二值图像码 上做全局精修。核心机制是双分支耦合——编辑分支从源轨迹的某个中间状态初始化,复用已经成形的布局;两个分支对同一批源采样 bit 分别给出概率,用它们的带符号差值挑出「该改的位置和 bit」。被选中的 bit 进入编辑精修,其余 bit 复制源分支持续演化的状态,于是「定位」与「生成」被绑在同一个精修过程里,编辑证据可以随图像演化不断被重新评估。为跨精修步稳定,论文加了两道约束:adaptive spatial freezing 抑制掩码无谓扩张,finite bit locking 让最近选中的 bit 保持可编辑。整套方案免训练、不需要外部掩码,也不需要注意力控制。
实验效果 :在 PIE-Bench 的九类编辑任务上,RefineEdit 在 PSNR / LPIPS / MSE / SSIM 四项背景保持指标上全部最好,同时整图 CLIP 与被编辑区域 CLIP 也最高——「改得准」与「背景不崩」这次没有被做成取舍。定性部分与 LEDits++、FlowEdit、ChordEdit、MasaCtrl 在替换、添加、擦除、属性/姿态/颜色/材质/背景修改与风格迁移九类上逐一并排对比。
批判点评 :最大的边界条件藏在实验设置里:这套流程要求源图来自 GRN 自己的生成轨迹——编辑分支要「继承源状态」,因此它编辑不了任意真实照片 。论文在 limitation 里自己承认了这一点,但对普通用户而言,「只能改模型自己生成的图」和「能改我相册里的照片」是两个完全不同的产品。其次是超参:switch step(从第几步开始分叉)以及空间/bit 两个阈值都需要逐类调整,而且最优值是在同一个 PIE-Bench 评测集上选出来的 ,相当于用测试集选超参;论文的 limitation 也承认这些类别特定设置是在该基准上挑的,跨数据集泛化没有被验证。第三,九类各自用自己那一档配置,但真实用户不会先告诉系统「这次是换材质还是换背景」,多类混合的编辑场景仍未被覆盖。
7. QuAKE:W4A4 文生图量化误差校正
Quantization-Aware Kalman Estimation for Diffusion Sampling | Tsinghua University | arXiv:2609.21407
关键词 :扩散模型量化,推理加速,W4A4,卡尔曼滤波,采样校正
⚠️ 前序问题 :量化是扩散模型落地的现实路径,但 W4A4 这种激进压缩会让量化去噪器的输出明显偏离全精度版本,而误差还会沿时间步持续传播、越积越大。已有的采样期校正方法基本只看当前步的局部信息,没有利用整条轨迹的历史——而误差恰恰是跨时间步传播的,用局部信息去修一个全局累积的问题,方向就不对。
本文贡献 :论文把「用量化去噪器采样」重新表述成一个在线估计 问题:既然真实的全精度输出拿不到,那就用历史量化输出去把它估回来。QuAKE 是为此设计的量化感知 Kalman 估计器,用一个平滑轨迹先验叠加一个条件高斯观测模型,每一步以闭式解递归更新「输出窗口」的后验,再把后验均值喂给采样器。它不改动量化网络、天然支持任意高阶多步 ODE 采样器,是一个即插即用的轻量校正器。论文同时给出了量化噪声的实证统计(边缘分布接近高斯、联合分布呈明显相关结构、条件分布可线性拟合),用来说明为什么 Kalman 这一套假设在这类噪声上站得住。
实验效果 :在多个 W4A4 量化的文生图模型上,QuAKE 在「与全精度采样的分布差异」这一指标上持续领先:FLUX.1-dev + MJHQ-30K 上 FID 7.02 / KID 0.158,优于朴素量化的 7.30 / 0.257、TAC-Diffusion 的 7.31 / 0.304、Q-Drift 的 7.16 / 0.209;Sana-0.6B 上 7.90 / 0.289;PixArt-α 上 13.71 / 1.987;PixArt-Σ 上 15.99 / 3.401。开销按论文自己的测量几乎免费:FLUX.1-dev 单步延迟 22.2 ms(BF16)降到 6.2 ms(INT4 与 QuAKE 相同),DiT 体积 160 GiB 降到 102 / 104 GiB,端到端 23.51 s 降到 2.20 / 2.24 s。
批判点评 :有一个容易被标题盖住的细节:QuAKE 赢的是分布距离 (FID / KID),但在感知质量列上并不总是赢朴素量化 。以 FLUX.1-dev + MJHQ-30K 为例,IR 分数 QuAKE 0.8822 低于 Quantized 的 0.8887,CLIP-IQA 0.9042 也低于 0.9057——也就是说 Kalman 校正主要抹平的是低层分布偏差,并没有让图在感知偏好上更讨喜;如果优化目标是下游打分模型或人眼偏好,朴素 INT4 甚至可能更安全。这不是论文的错,但摘要里「持续优于已有方法」的表述容易被读成全面胜出。其次,效率那一组三个数字(6.2 vs 6.2 ms、102 vs 104 GiB、2.20 vs 2.24 s)方向一致地说明校正本身几乎免费,反过来也说明它的收益完全来自「估得更准」而不是「跑得更快」——真正的加速来自量化,QuAKE 只负责把量化弄坏的部分补回来。最后,全部实验集中在文生图,视频扩散这类时间步更多、误差累积更长的场景是否同样成立,尚未给出证据。
8. AURA:对话式音乐编辑只训91M
AURA: Unified Multimodal Framework for Conversational Music Editing | Aalto University;Technical University of Denmark;University of South Dakota;OpenRB Lab | arXiv:2609.14344
关键词 :音乐编辑,多轮对话,多模态大模型,LoRA,概念token
⚠️ 前序问题 :现有的指令式音乐编辑器是「一问一答」的:每条指令独立处理,用户想「先弱化鼓、再压一下高频、最后把情绪调柔和」这种逐步打磨的工作流根本走不通,因为模型记不住上一轮改了什么。此外,要改音乐光靠文字往往不够——用户脑子里想的是「这段场景听起来该是什么样」,而不是一串精确的音频术语。
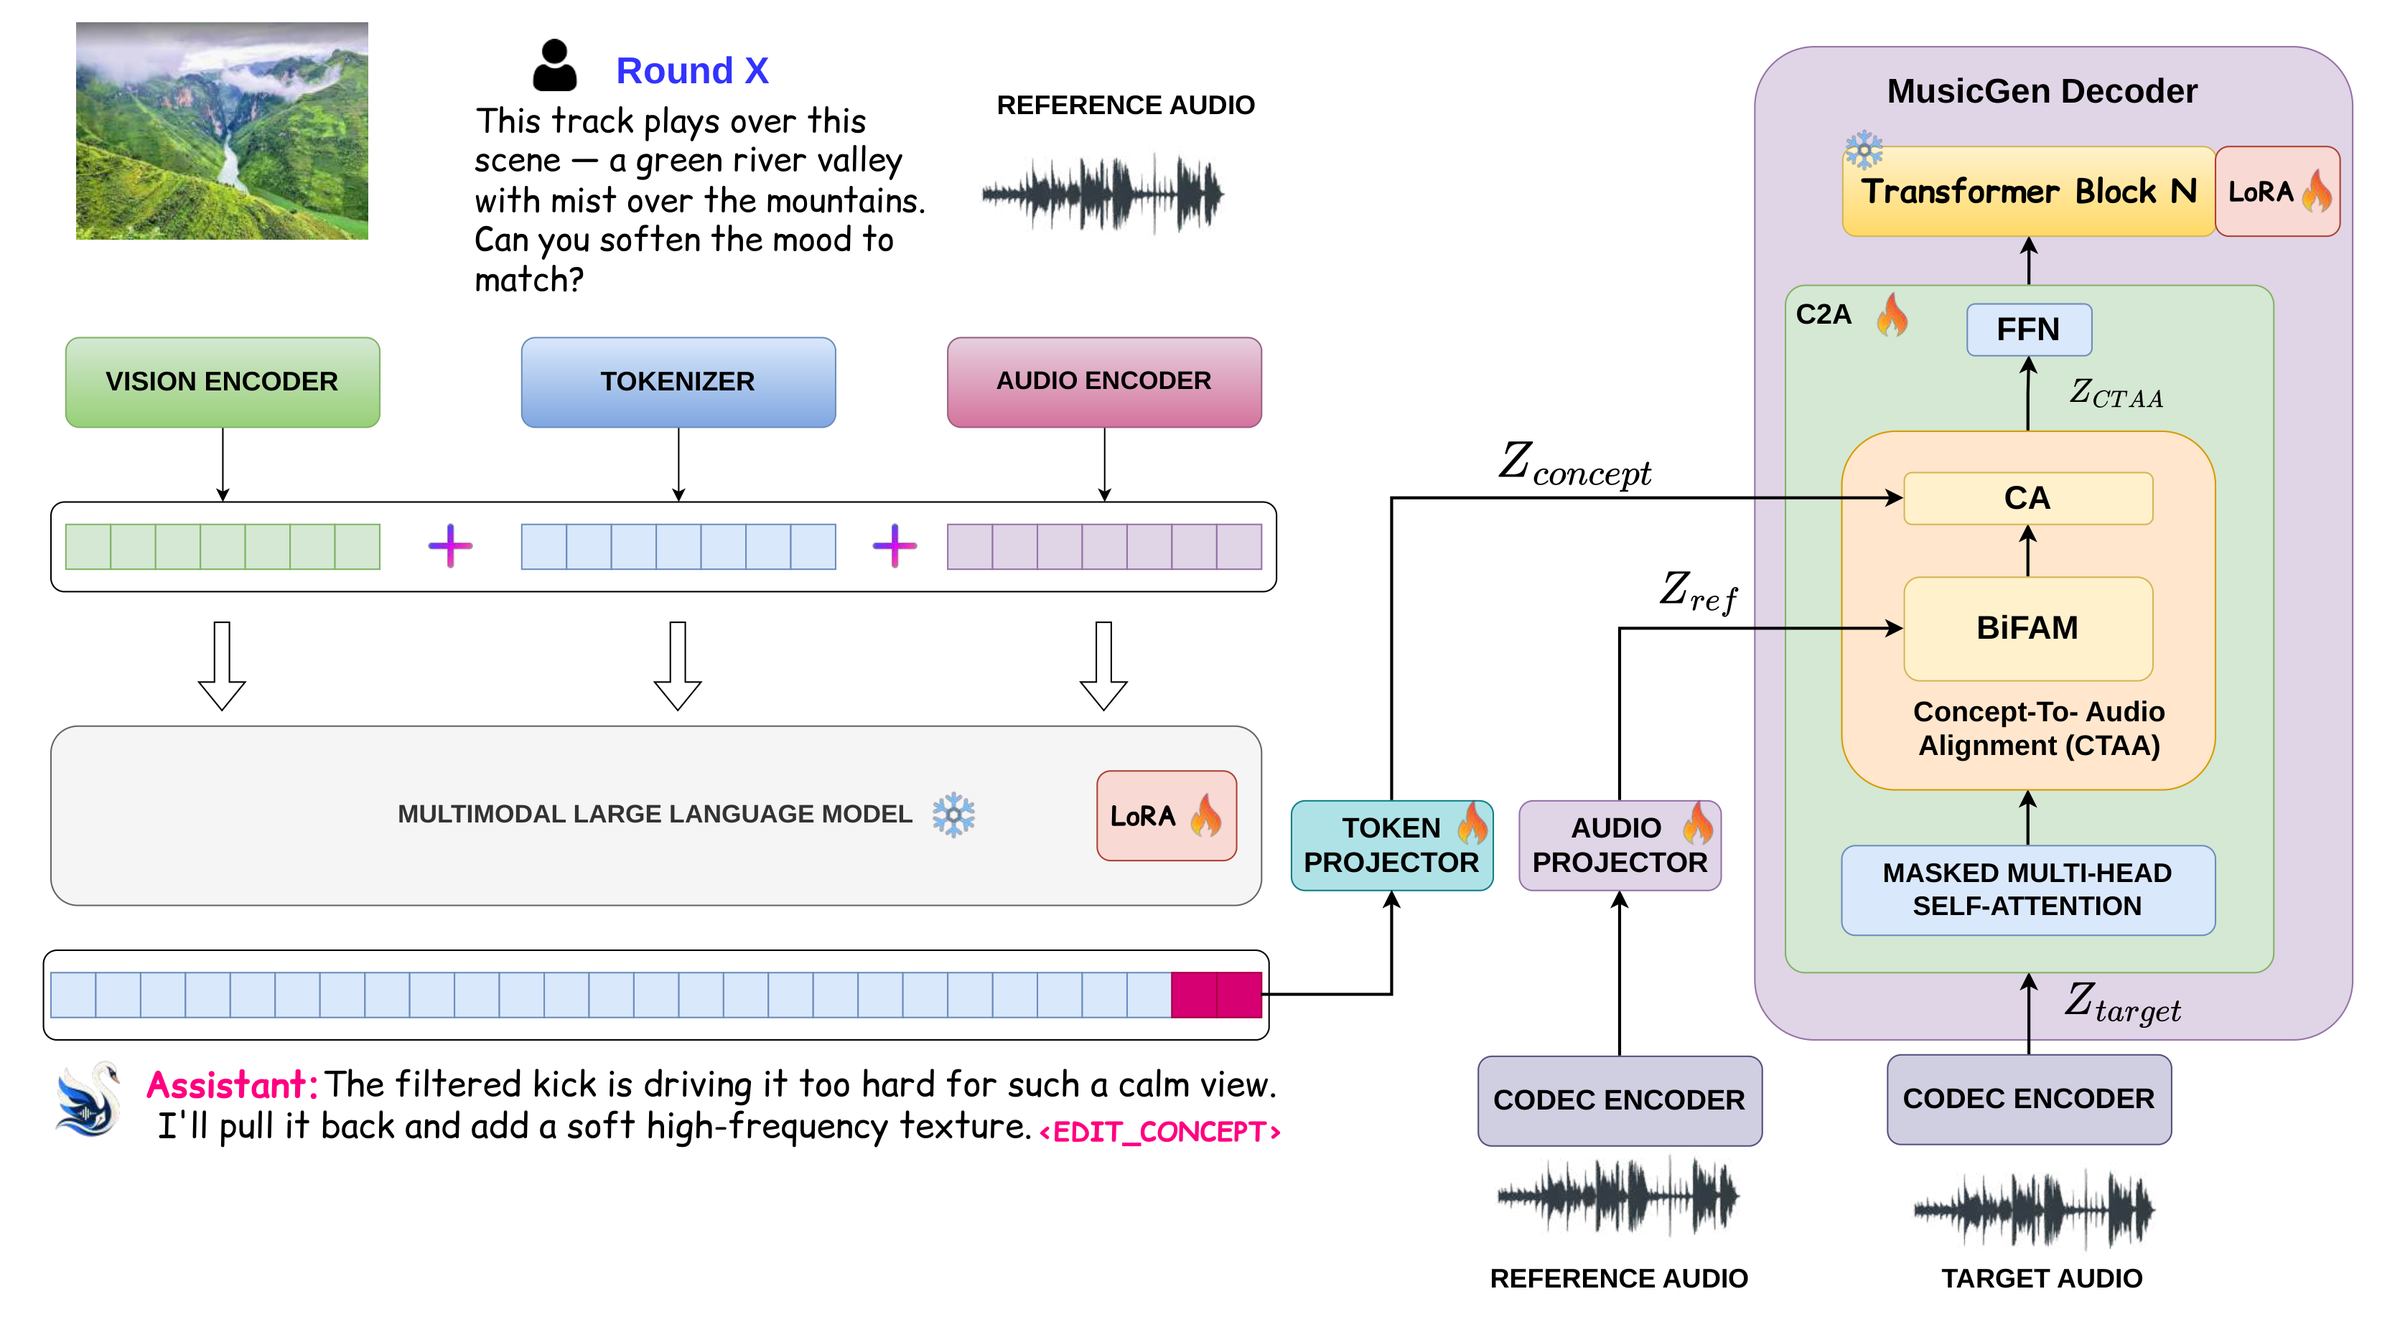
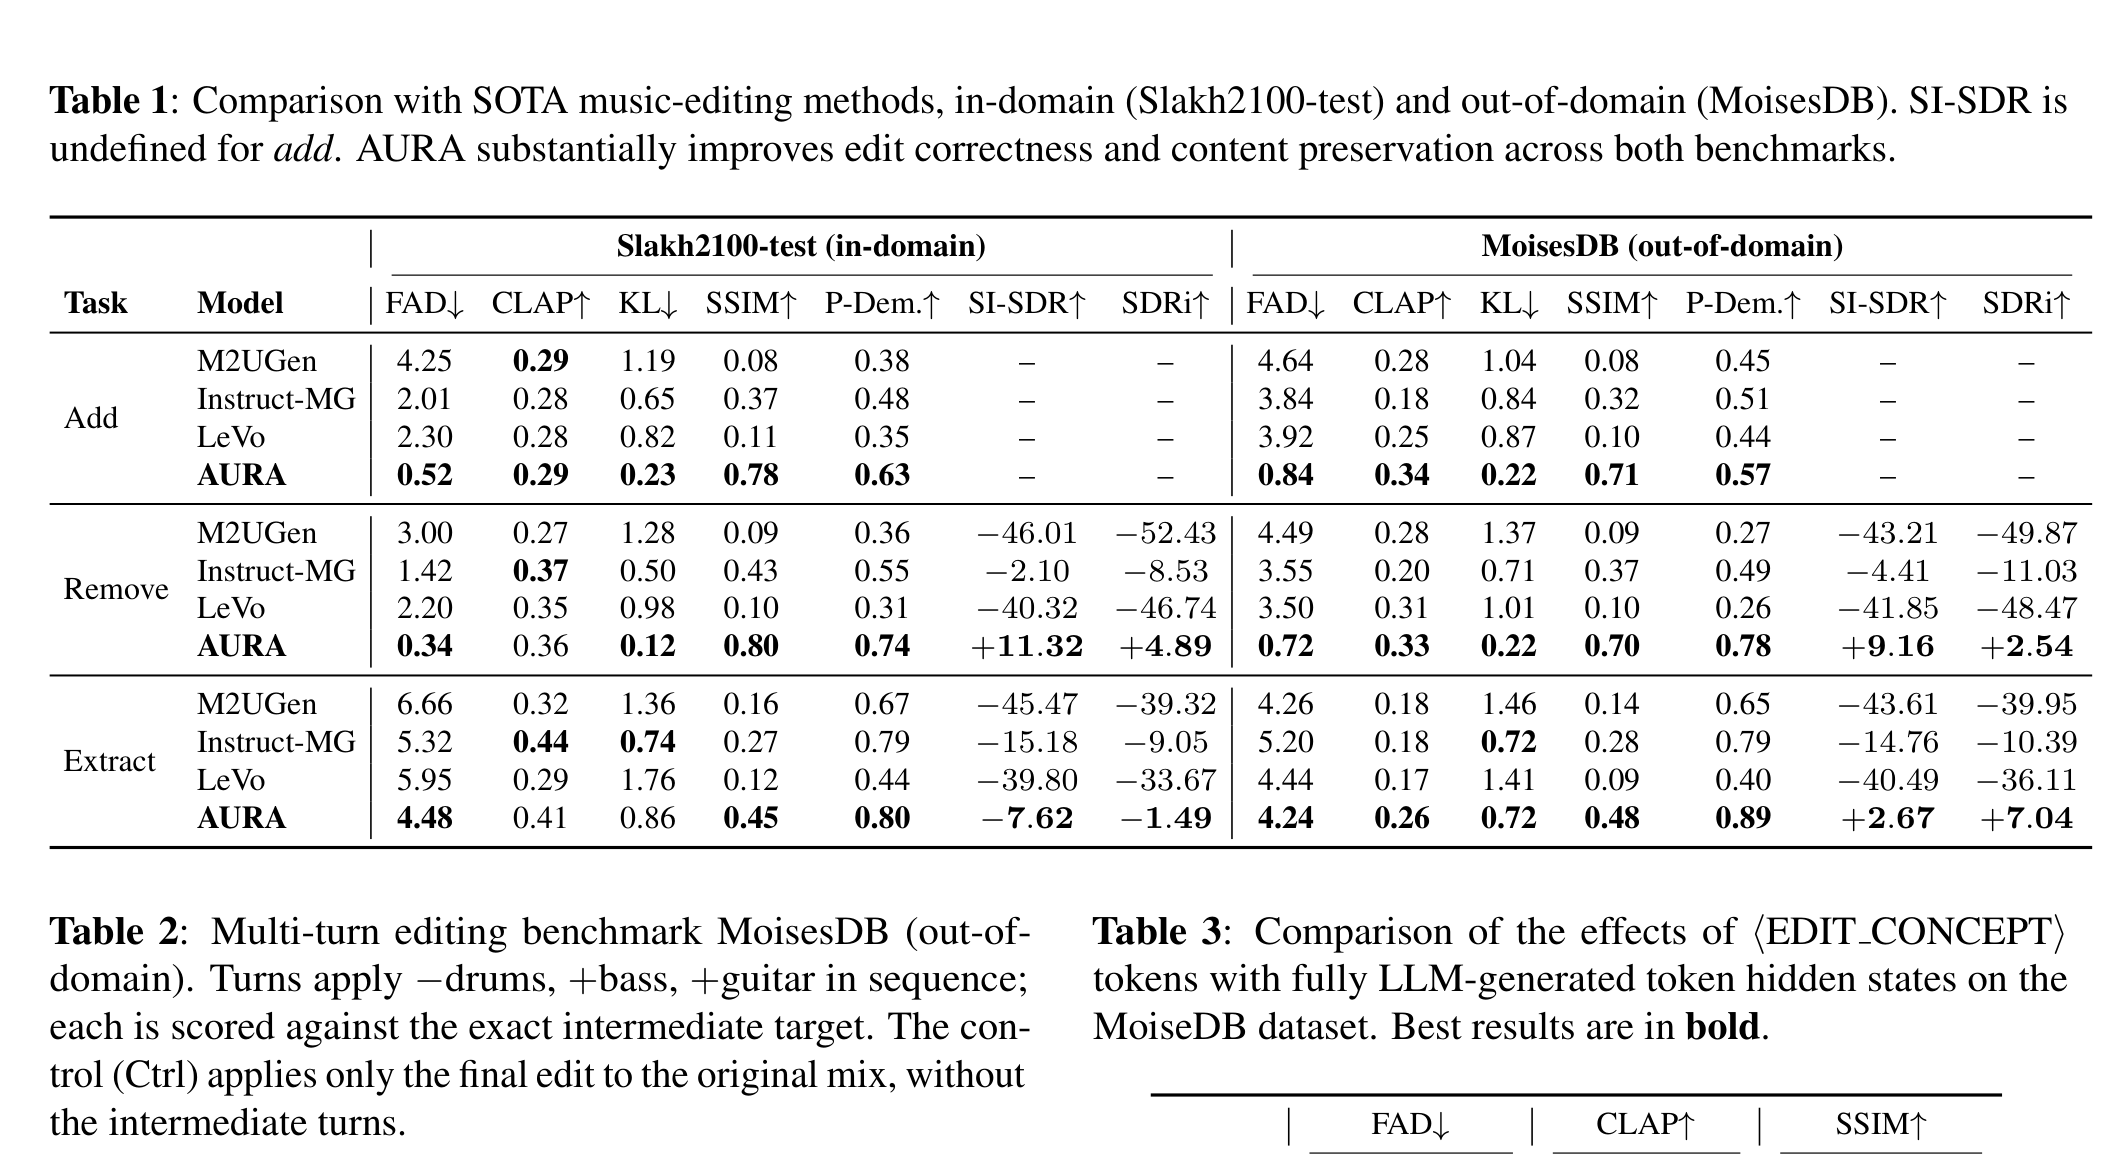
本文贡献 :AURA 把音乐编辑变成多轮对话。用一个多模态大模型读完整的对话历史、可选的一张图以及参考音频,把编辑意图蒸馏成一组紧凑的 concept token ;再由 concept-to-audio(C2A)模块把这些 token 与逐帧对齐的参考特征注入冻结的 MusicGen 骨干 ——内部通过交叉注意力与 BiFAM 做对齐,让编辑既精确又不碰无关内容。训练只更新 91M 参数(LoRA rank-64 / α=128 加两个投影器与 C2A),1.9B 骨干全程冻结;对话数据由 Slakh2100 合成,共 66,539 段多轮对话。
实验效果 :在域内 Slakh2100 与域外 MoisesDB 上同时评测:Add 任务的域外 FAD 0.84 对 Instruct-MG 的 3.84,Remove 任务域外 FAD 0.72 对 3.55,均为 4~5 倍降低;Remove 任务域内 SI-SDR +11.32 dB、SDRi +4.89,而 Instruct-MG 是 −2.10 / −8.53。消融显示对话历史确实起作用:只把最后一条指令喂给模型,Remove 的 SI-SDR 会掉到 −5.2 dB,SSIM 从 0.84 掉到 0.54。
批判点评 :摘要里「域外 4~5 倍 FAD 降低」是有选择性的——它只覆盖 Add 与 Remove 两个任务;在 Extract 上 AURA 是 4.24 对 Instruct-MG 的 5.20,只有约 1.2 倍,并没有复现那个量级。更要紧的是 Extract 的SI-SDR 虽然比基线好得多(−7.62 对 −15.18),但仍是负值 ,说明「从混音里把目标音轨抽出来」这个任务本身离可用还有距离。其次,Remove 的域内增益(+11.32 dB)看着最亮眼,但该任务的域内评测集就来自训练数据来源域(Slakh2100 合成),换到域外 MoisesDB 只剩 +2.54 dB,跌幅接近 4 倍,真正的跨域能力比表格第一屏呈现的要弱。第三,91M 可训练参数对 1.9B 冻结骨干确实是漂亮的效率数字,但它同时意味着能力上限被 MusicGen-medium 这个骨干锁死,而论文没有给出换更大骨干的对照。
9. Qwen-Audio-3.0-TTS:四代语音模型瓶颈迁移史
The Evolving Bottleneck in Speech Generation: Interface Co-design and Staged Alignment from CosyVoice to Qwen-Audio-3.0-TTS | Alibaba Token Foundry | arXiv:2609.16514
关键词 :语音合成,接口设计,瓶颈迁移,流匹配,阶段性对齐
⚠️ 前序问题 :语音合成的发展通常被叙述成「模型更大、tokenizer 更好、数据更多」,但这类叙事解释不了为什么某些改动立竿见影、某些就收效甚微。真正值得追问的是:每一代系统当下的主导瓶颈 在哪里——是表征不够内容对齐?是接口不能因果流式?是覆盖度与可学习性不足?还是模型容量与跨模块协调出了问题?
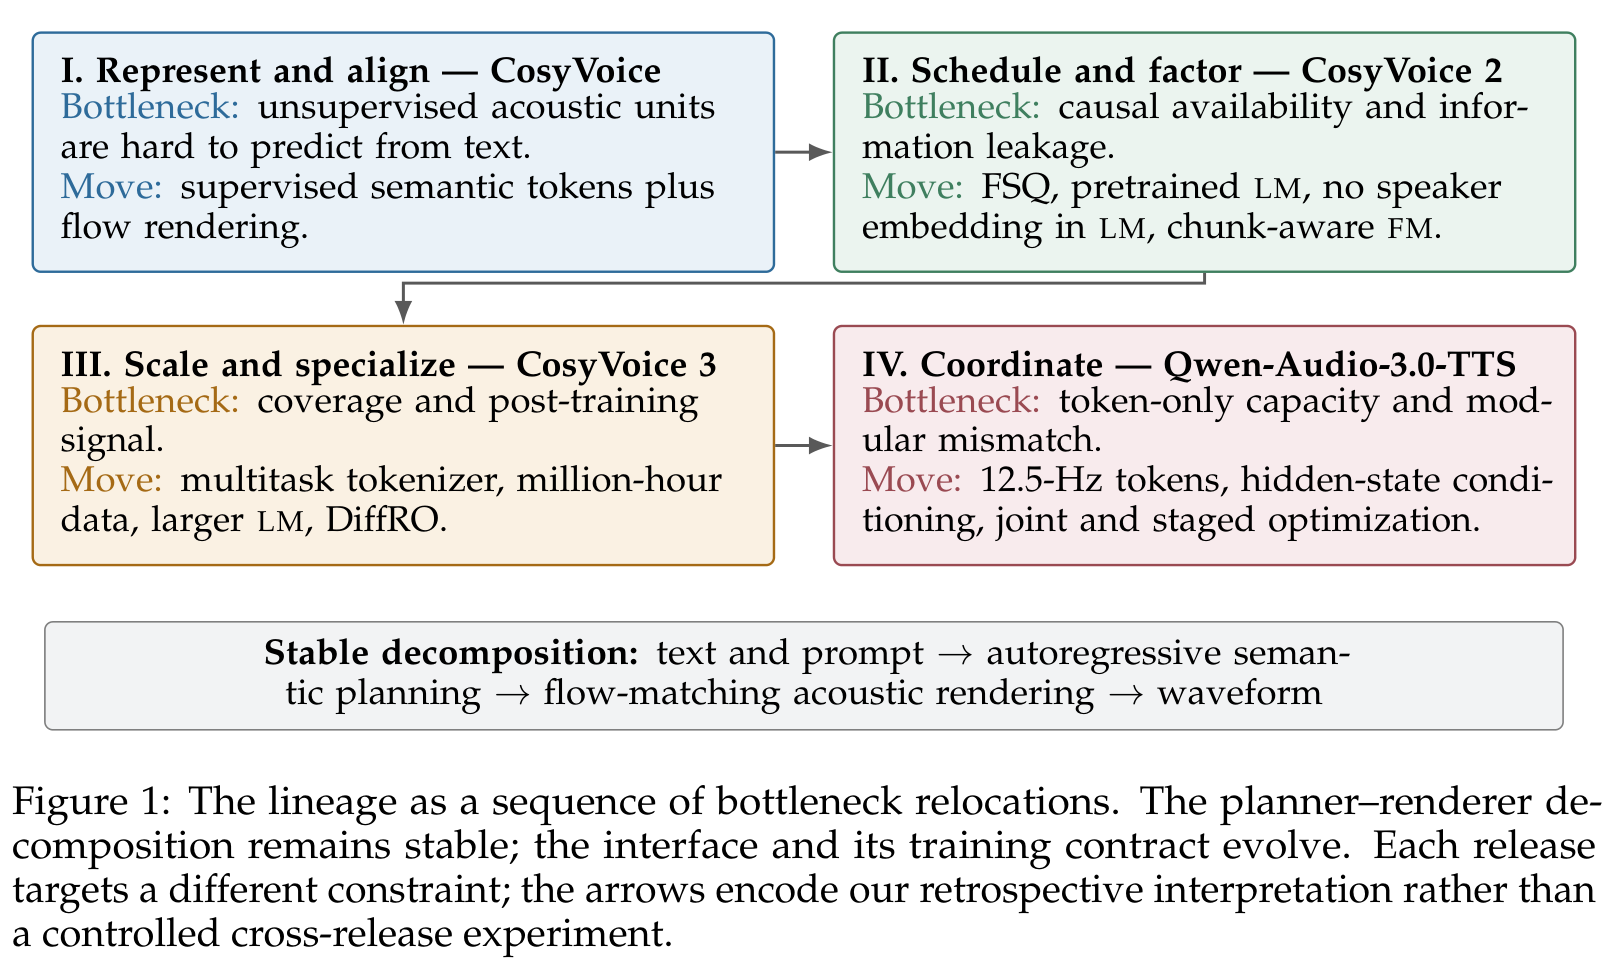
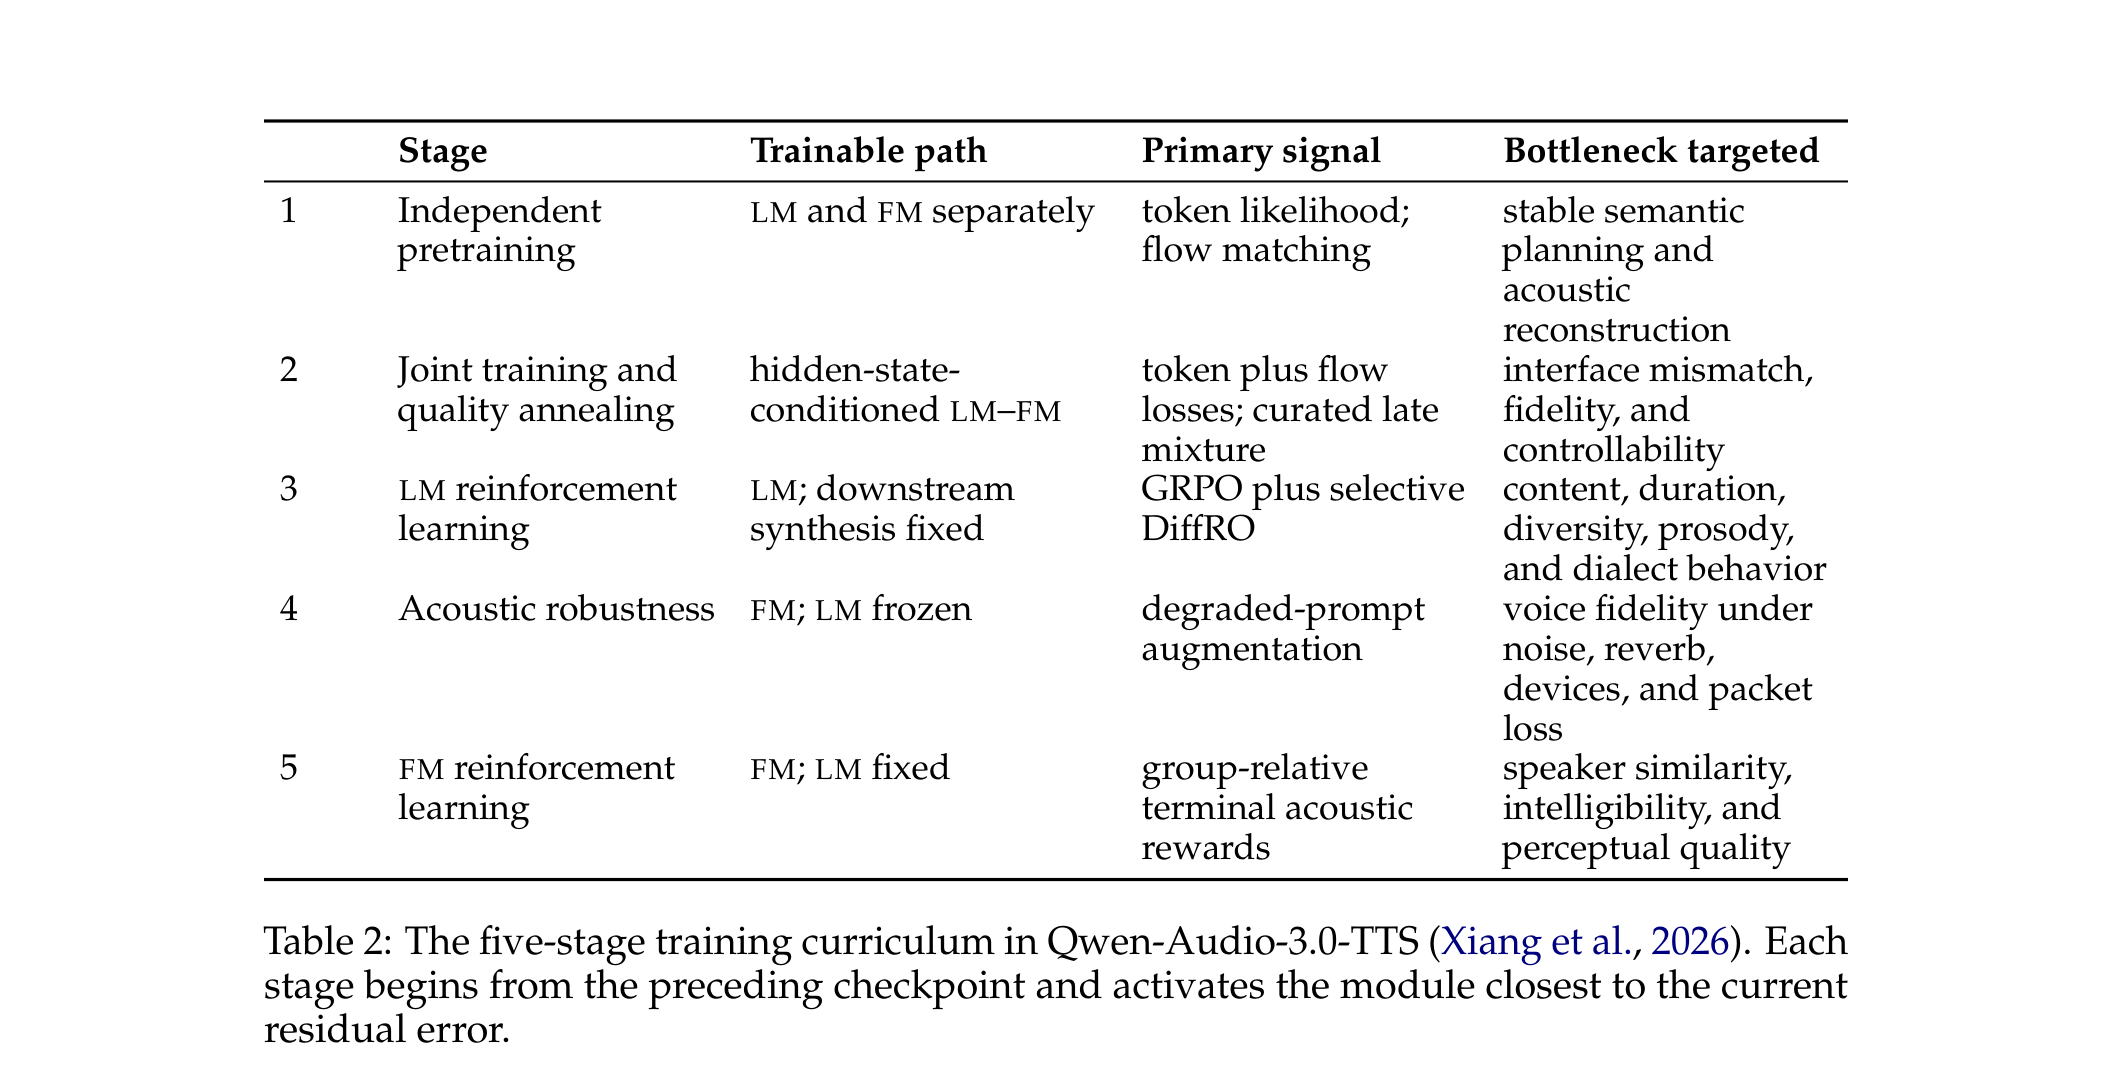
本文贡献 :这是一篇技术回顾(technical retrospective),沿 CosyVoice → CosyVoice 2 → CosyVoice 3 → Qwen-Audio-3.0-TTS 这条线给出另一种解释:进步来自瓶颈的反复迁移 。四代之间不变的是一条分解——自回归语言模型负责「规划」,flow-matching 模型负责「渲染」;变的是两者之间的接口契约 。作者把契约形式化成四个维度:representation(表征)、ownership(归属)、availability(可用性)、gradient reach(梯度可达性),并明确区分「单篇论文内的证据」与「跨论文比较」。每一代针对一个不同的约束:CosyVoice 立下监督式语义 token 这个内容对齐接口;CosyVoice 2 让接口对因果流式可用、把句级说话人嵌入从语言模型里移出;CosyVoice 3 靠多任务监督、数据与模型扩容、以及可微奖励优化(DiffRO)提升接口的可学习性与覆盖;Qwen-Audio-3.0-TTS 把帧率从 25 Hz 降到 12.5 Hz、渲染器改为条件在连续隐状态 而非离散 token 嵌入上,并用五阶段课程做联合分阶段对齐。
实验效果 :文中给出的实证来自各代公开系统:语义 token 的引入把中文 CER 从 2.56 降到 1.45、英文 WER 从 3.81 降到 2.57(CosyVoice 2 的模块消融);数据从约 17 万小时扩到 100 万小时、语言模型从 0.5B 扩到 1.5B(CosyVoice 3);Qwen-Audio-3.0-TTS 把帧率减半并保留 K=6561 的码本,五阶段课程依次为独立预训练、联合训练与质量退火、语言模型强化学习、声学鲁棒性、flow-matching 强化学习。
批判点评 :这篇最需要标注边界的地方,作者自己写在 Figure 1 的图注里:「箭头编码的是我们的回顾性解释,而非受控的跨版本实验」。也就是说「瓶颈迁移」是一个事后叙事 ,不是被控制变量检验过的因果结论——拿它指导新系统设计时,风险在于你可能把相关性当成了因果。另一个更具体的问题是证据来源:文中复现的 tokenizer 对比(例如把帧率减半同时保持 K=6561 会一并损伤内容一致性与相似度)引自 Xiang et al. (2026),属于「论文内对比」的二次引用,不是独立复现;Table 1 也是同样的性质。因此这篇更适合当作一份结构清晰的领域地图 来读——四维接口那套分析框架确实好用,也确实解释了「为什么改 tokenizer 有效、改渲染器无效」这类问题——但不宜当成可直接复制的工程配方。论文 comments 自注为 technical retrospective(11 页),本身也不以实验贡献为目标。
10. Ref-Free Metrics:13类语音指标在干净音频失效
The Limits of Reference-Free Speech Quality Metrics as Evaluators and Rewards on Modern Text-to-Speech | AGIGO;ETH Zurich;Sapienza University of Rome;University of Zurich | arXiv:2609.13150
关键词 :语音质量指标,无参考评测,奖励攻击,成对偏好,评测协议
⚠️ 前序问题 :UTMOS、DNSMOS、SCOREQ 这类无参考质量预测器,今天既是 TTS 的默认自动评测器,又越来越常被拿去做偏好优化的奖励信号。这两个角色都建立在同一个假设上:预测分数能跟上人类偏好。但这个假设在什么条件下成立、什么时候会崩,此前没有被系统检验过。
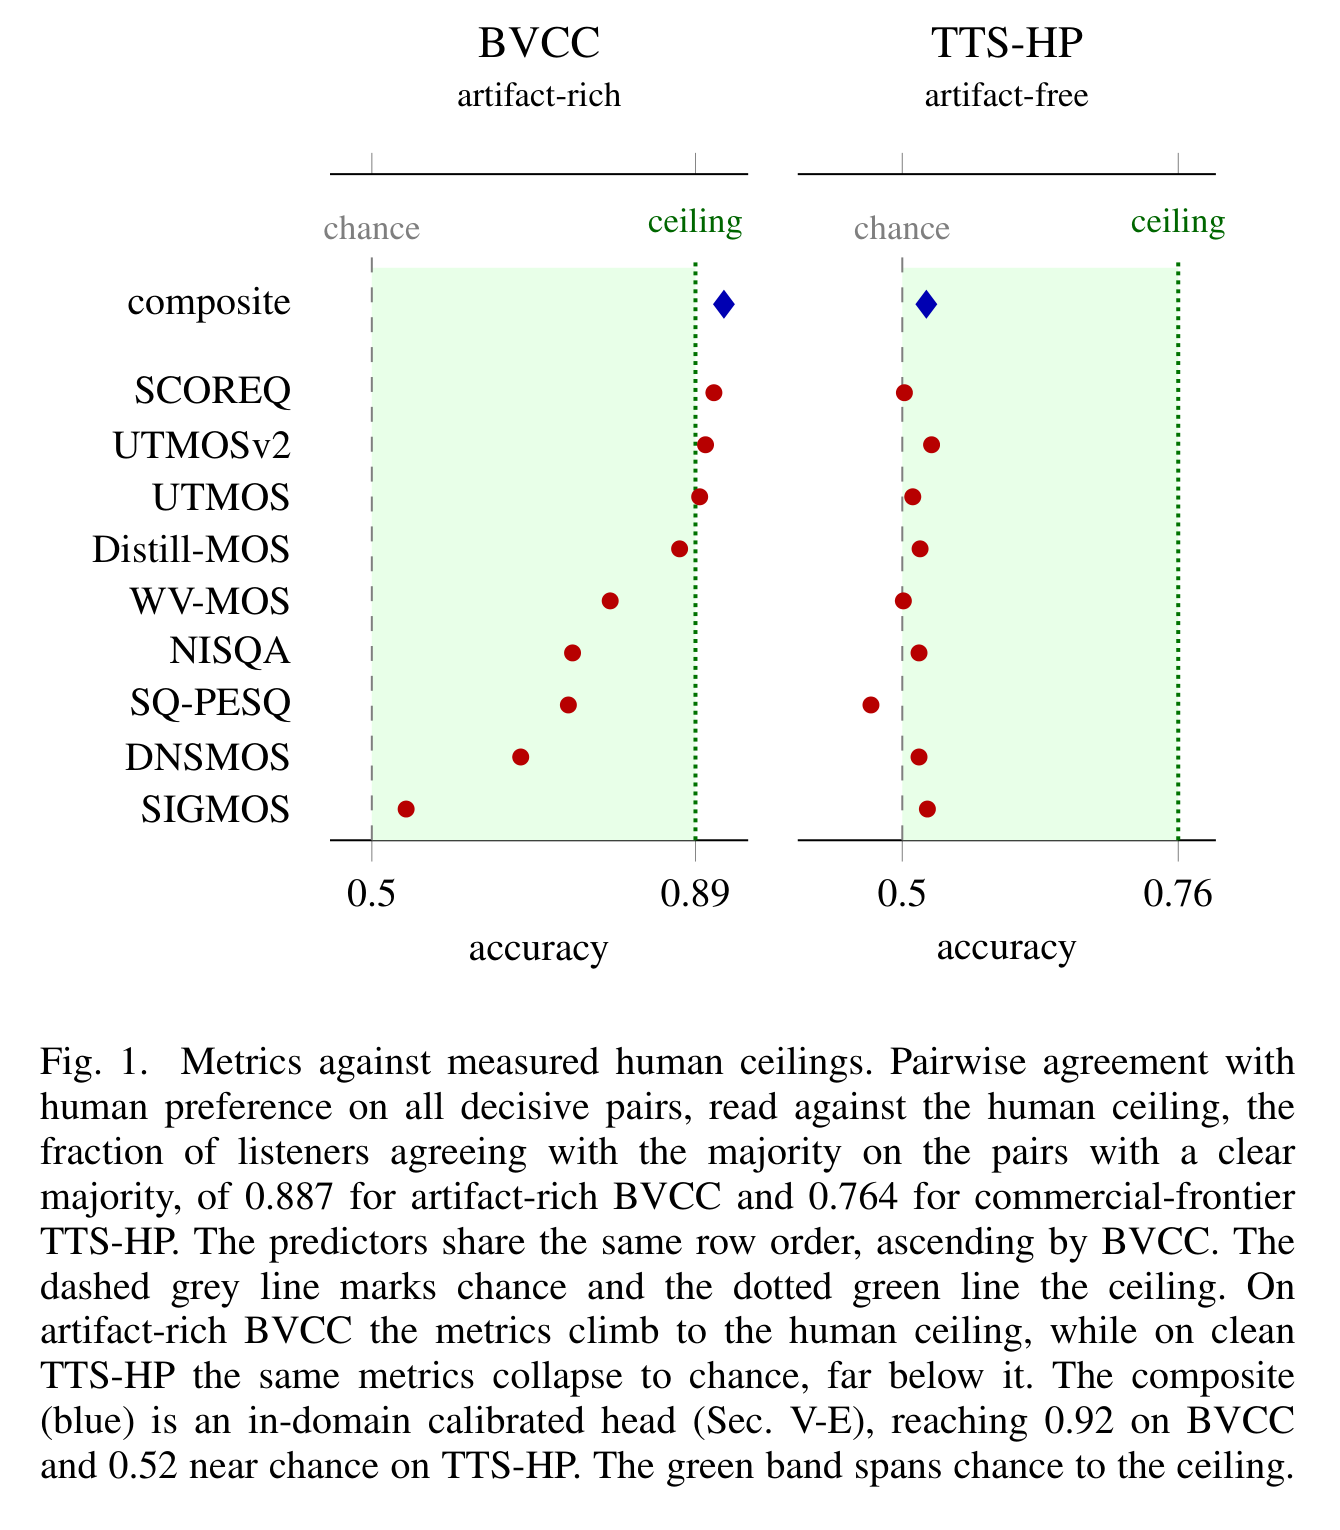
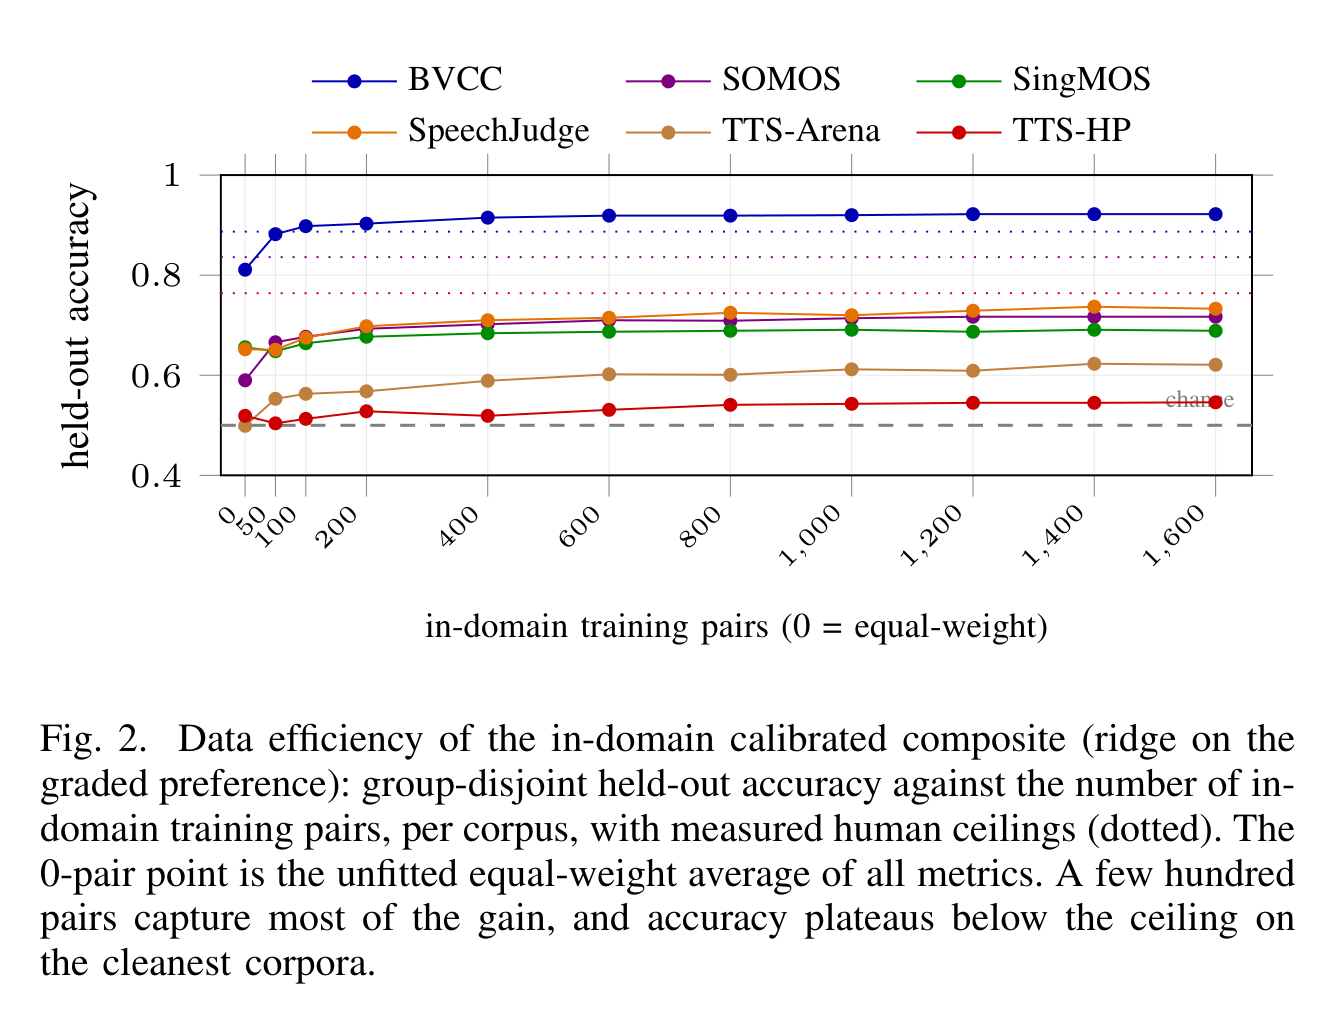
本文贡献 :论文把假设直接摆到台面上测。做法是构造一个成对判定任务——给两个音频片段,问预测器打分更高的那个是不是人更偏好的那个——然后在 6 个人工评分语料上跑,覆盖从「瑕疵明显」到「几近无瑕」的完整质量区间。评测对象包括 13 个无参考预测器家族(33 个分数变体)、13 个 Praat 韵律描述符,以及一批经典信号处理特征,每项都给出相对「随机基线」与「人类天花板」的位置。第二部分把这些指标当奖励用,对比单分数奖励与复合奖励在策略优化下的行为差异,并给出数据效率曲线。
实验效果 :结论相当刺。在瑕疵明显的 BVCC 上,各指标准确率能爬到人类天花板附近(天花板 0.887,标定的复合分数到 0.92);但一旦两边音频都干净(TTS-HP),没有任何单个预测器能可靠指认被偏好的样本 ,好几个的准确率甚至低于「直接挑时长更长的那个」这个傻瓜基线(argmax clip duration 在 BVCC 0.517、SOMOS 0.368、SingMOS 0.456、SpeechJudge 0.370、TTS-Arena 0.523、TTS-HP 0.524),复合分数也才 0.52,而人类天花板是 0.764。奖励侧更严重:优化单一分数会诱发 reward hacking——指标冲上去了,但独立留出评测器和人工听测同时变差;复合奖励能抵抗这个倾向。数据效率曲线还给了个实用兜底:每类只取 min(20%, 1000) 条域内成对数据拟合一个带正则的线性头,就能把准确率相对最好的单指标提升 +1.5%(BVCC)到 +6.6%(SOMOS)。
批判点评 :这篇的价值是给出一把尺子,而不是给出一个能用的指标——它自己也承认在干净音频上没有任何固定公式可迁移。要留意三点。第一,复合分数需要通过域内偏好标注拟合(论文用了 min(20%, 1000) 条域内成对数据),相对增益只有 +1.5% 到 +6.6%,也就是说「改用复合分数」这个建议的前提是你已经有该领域的偏好数据,对做通用 Reward Model 的人是不小的门槛。第二,它测的是成对偏好准确率 ,不是绝对 MOS 拟合度,「指标失效」的结论不能直接推成「MOS 预测不准」——在需要绝对分数的场景里结论需要重新验证。第三,时长基线之所以能赢,是因为评测语料里存在系统性的时长偏差,这提示「最好用的信号」可能来自数据偏置而非感知质量;反过来说,这也意味着任何在干净音频上得到的排行榜,都可能只是某个数据偏置的代理指标。
趋势观察
「边想边说」正在把推理的延迟藏起来
StepAudio 3 让私有推理与语音输出并行执行,用 Medusa 式 MTP 解码把思考压进说话的同一段时间窗;QuAKE 则把量化误差的校正重新表述成一个在线估计问题,用轨迹历史去猜全精度输出本该是什么。两者都在回答同一个问题:当「想清楚」和「立刻给」不能同时满足时,能不能把其中一件事塞进另一件事的时间窗里,而不是二选一。
物理一致性开始从「单类型」走向「复合行为」
CompAdapt 把神经动力学从单一运动类型扩到耦合运动、多阶段转换与多物体碰撞,并用一次性适配去应对没见过的物理律;4DGS-Fixer 干脆不追求几何自洽,改用视频扩散先验把缺失的观测补出来当伪监督。一个在约束上加码,一个在数据上放开,方向相反,但都承认了同一件事:稀疏观测下的物理,靠纯几何推不出来。
「部件」正在成为 3D 生成的新交付单位
KaiNinja 指出 O-Voxel 每个体素只存一片表面、单个 volume 在任何分辨率下都表示不了两个部件贴合的那层界面,于是用双体积表示把界面补上,全程不需要掩码或分割器。下游的编辑、绑骨与仿真要的正是部件而不是一整块表面。这提示 3D 生成的下一步未必是把表面做得更细,而是把语义切分做得更明确。
质量指标同时当评测和奖励,正在被自己的盲区反噬
语音侧,Ref-Free Metrics 那篇的 13 个无参考预测器在干净音频上集体失效,好几个甚至不如「挑最长的那个」,而优化单一分数会直接诱发 reward hacking;对话视频侧,OmniVChat 的效率项让平均回复长度从约 100 词掉到 35 词,效率上涨里混着「少说几句」。当同一个分数既当尺子又当奖励,它没测到的那部分就一定会被优化出来。
人工智能炼丹君 整理 | 2026-09-22
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注













评论 (0)