今日 AIGC 论文速览
今日共 10 篇 · 3D生成 1 篇 · 持久世界建模 2 篇 · 视频表征与3D控制 3 篇 · 个性化图像生成 1 篇 · 音频生成 2 篇 · 视频生成评测 1 篇
重点论文标题列表
- SILSA(伊利诺伊大学):省七成token保住孔洞
- Oneira(莫纳什大学):新物体能互动且留下后果
- World Observer(KAIST):镜头外的物体也继续演化
- SemanTok(Stability AI):小模型先学会视频语义
- Tacit-TTS(杜比实验室):免转写克隆语音快十倍
今日论文速览
1. SILSA:省七成token保住孔洞
SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation | 伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02201
关键词:图像生成3D, 切片潜空间, Rectified Flow, 拓扑约束
- 前序问题:高分辨率 3D 生成常先预测活跃体素,再补局部几何;连续曲面被拆成大量局部 token,细杆、孔洞和远距离连接容易断裂。增加体素数能补细节,却同时推高序列长度与训练显存。问题不只是模型画得像不像,还包括生成的网格是否保留原有结构。
- 本文贡献:SILSA 沿 x、y、z 三轴使用重叠的滑动窗口切片,每个 token 概括一段局部深度窗口。Slice VAE 将带朝向的表面采样编码成切片潜变量,再通过稀疏体积解码器重建网格;Volumetric Anchor Lattice 给三组切片共享的 3D 工作空间。切片级持久同调与相邻切片 Betti 转变损失约束连通分量和孔洞,图像条件 Rectified Flow 则一次生成整组潜变量。
 论文 Figure 2:SILSA 总览。沿 x、y、z 轴以重叠切片 latent 表示形状。拓扑感知 SliceVAE 将表面编码为固定的多轴切片 latent,再通过稀疏体积上采样解码为高分辨率网格。图像条件 Rectified Flow Transformer 生成 latent,并以 Volumetric Anchor Lattice 作为共享 3D 记忆协调不同轴。VAE 训练中的切片级持久同调与 Betti 转变损失监督连通分量、孔洞和拓扑一致性。
- 实验效果:表 3 中固定 384 个 token,对比最紧凑基线 Dora 的 1280 个减少 70.0%;batch size 4、单张 A100 下训练显存 8.7GB,对比 Dora 的 14.6GB 减少 40.4%,端到端推理 0.34 秒/形状,对比 0.82 秒减少约 58.5%。表 1 的 PSNR 为 32.74,SparseFlex 为 30.12;表 2 的 Betti-Err 为 1.582,对比 1.743。arXiv comments 明确标注 Accepted at NeurIPS 2026。
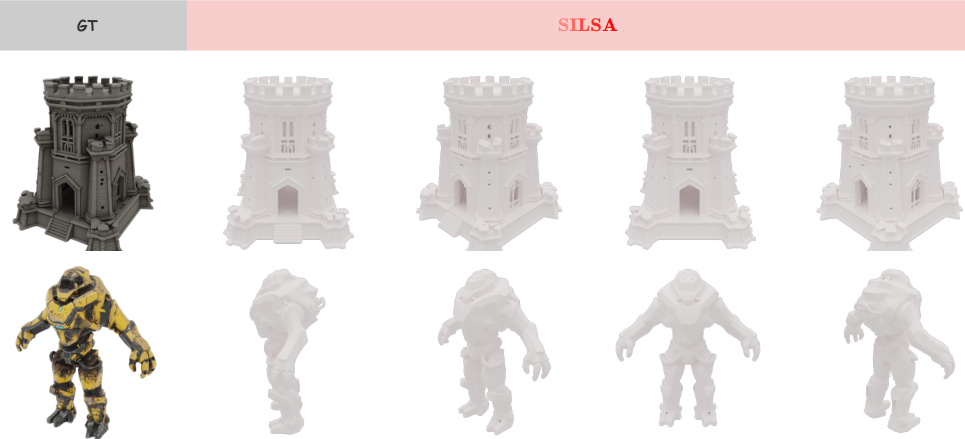 论文 Figure 3:自然场景输入图像的 image-to-3D 生成结果。图中展示 SILSA 从不同输入得到的 3D 形状;这是定性展示,不能仅凭样例推出分布外形状可靠性。
- 批判点评:这些数字来自不同对照:70% token、显存和延迟以 Dora 为参照,PSNR 与 Betti-Err 的强基线是 SparseFlex,不能拼成对同一模型的全面领先。切片拓扑监督改善结构,并不提供任意形状的拓扑保证;作者也承认分布外结构及信息不足的输入视角会降低保真。值得关注的是表示方式,而不是把单物体结果直接外推到完整场景。
2. Oneira:新物体能互动且留下后果
Oneira: From Open-Ended Generation to Open-World Interaction in Video World Models | 莫纳什大学;大连理工大学;香港中文大学(深圳);牛津大学;布里斯托大学 | arXiv:2610.01614
关键词:交互式视频生成, 显式世界状态, 状态持久性, 条件视频
- 前序问题:能生成新房间,不代表能持续与新房间里的东西互动。镜头发现一个新苹果,模型要把它变成可操作对象;把苹果拿走之后,再回头也应看到空桌面。纯视频续写往往把交互当作局部视觉效果,缺少记录事件后果并供后续片段查询的状态载体。
- 本文贡献:Oneira 用显式世界状态表把视频生成与交互闭环连接。coding agent 读取当前观察和目标,定位实体、规划动作并把结果写回表;探索中发现的新物体也会注册。渲染引擎沿相机轨迹把更新后的表转成粗条件视频,视频生成器结合首帧、可选记忆帧和分块 caption 补齐外观与动作;末帧和更新后的状态进入下一段。它的贡献落在生成可互动且状态连续的视频环境。
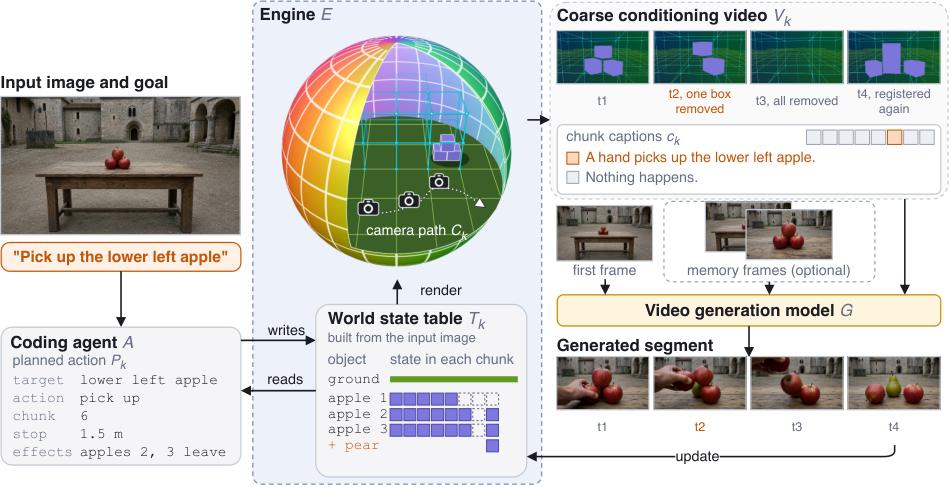 论文 Figure 2:Oneira 单片段流程。给定输入图像与目标,coding agent A 读取世界状态表并规划动作 P_k。引擎 E 将每个动作写入表,把更新结果 T_k 沿相机路径 C_k 渲染成粗条件视频 V_k(第 3.2 节)。交互表现为物体框的删除或重新着色;被移动物体的框暂时移除,静止后从生成帧重新注册,新露出的物体也如此。视频模型 G 结合首帧、可选记忆帧、V_k 与分块 caption c_k 生成片段(第 3.3 节),末帧与更新后的表启动下一段。球体仅为示意,条件与生成帧来自同一个 Oneira 片段。
- 实验效果:表 1 的 InteractionBench 包含 100 个交互案例和 50 条记忆链。Oneira 的交互成功率为 0.78、目标正确率 0.82,LingBot-World-V2 分别为 0.49、0.39;记忆部分 State 通过率 0.80,MiniMax-H3 Ref2VA 为 0.68。图 3 展示三个片段组成的 30 秒链,比较执行交互后转回原处的状态。
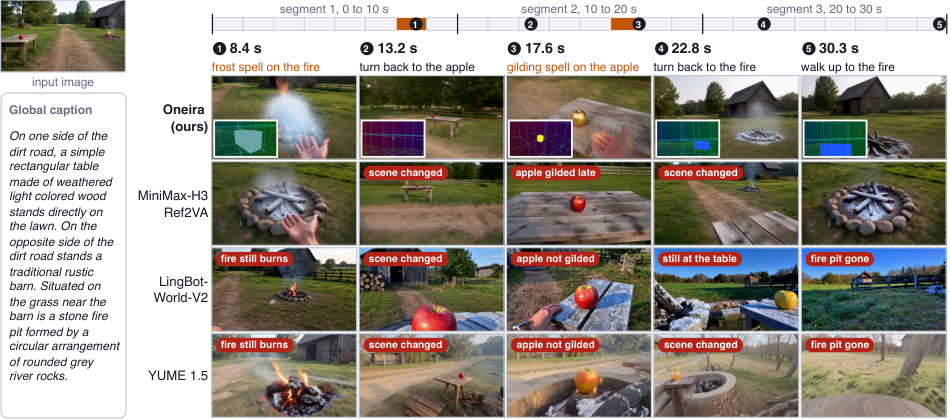 论文 Figure 3:三个片段组成的 30 秒链的定性比较。各列上方标出当时的动作,橙色单元格表示 caption 携带交互的 chunk,插图显示 Oneira 的条件视频。红色标签标注 baseline 帧中的失败。Oneira 在指定 chunk 控制两次交互,并在相机转回时维持改变后的状态。
- 批判点评:状态表使“后果被记住”更明确,却没有让底层视频模型成为物理仿真器。作者列出的动作空间仍是离散的,连续控制和精细接触并未解决;长时域视觉一致性仍受生成器能力限制。100 个交互案例与 50 条记忆链是作者的专用评测,不能等同于开放世界任意操作均可靠。
3. World Observer:镜头外的物体也继续演化
World Observer: Joint Actor-Observer Generation for Persistent World Modeling | 韩国科学技术院(KAIST)人工智能学院 | arXiv:2610.02162
关键词:视频世界模型, 全景观察者, 多视角生成, 镜头外动态
- 前序问题:视频世界模型通常只生成行动者当前看见的画面。汽车驶出视野之后,没有可见证据约束它继续前进;再次入镜时可能丢失、停住或变成别的车。仅保存旧图像能帮助记住外观,却不一定能维护镜头外持续发生的动态。
- 本文贡献:World Observer 把“行动”和“观察”拆成两个同步生成流:透视 actor 负责当前视角,全景 observer 持续观察选定区域,二者由共享 DiT 联合生成。共同全景源的 warping 建立几何对应;Observer Sink 从高分辨率初始全景取四个透视参考,帮助物体重返视野时恢复细节。观察者还能放在不同位置,或接收单独条件来控制画面外的事件。
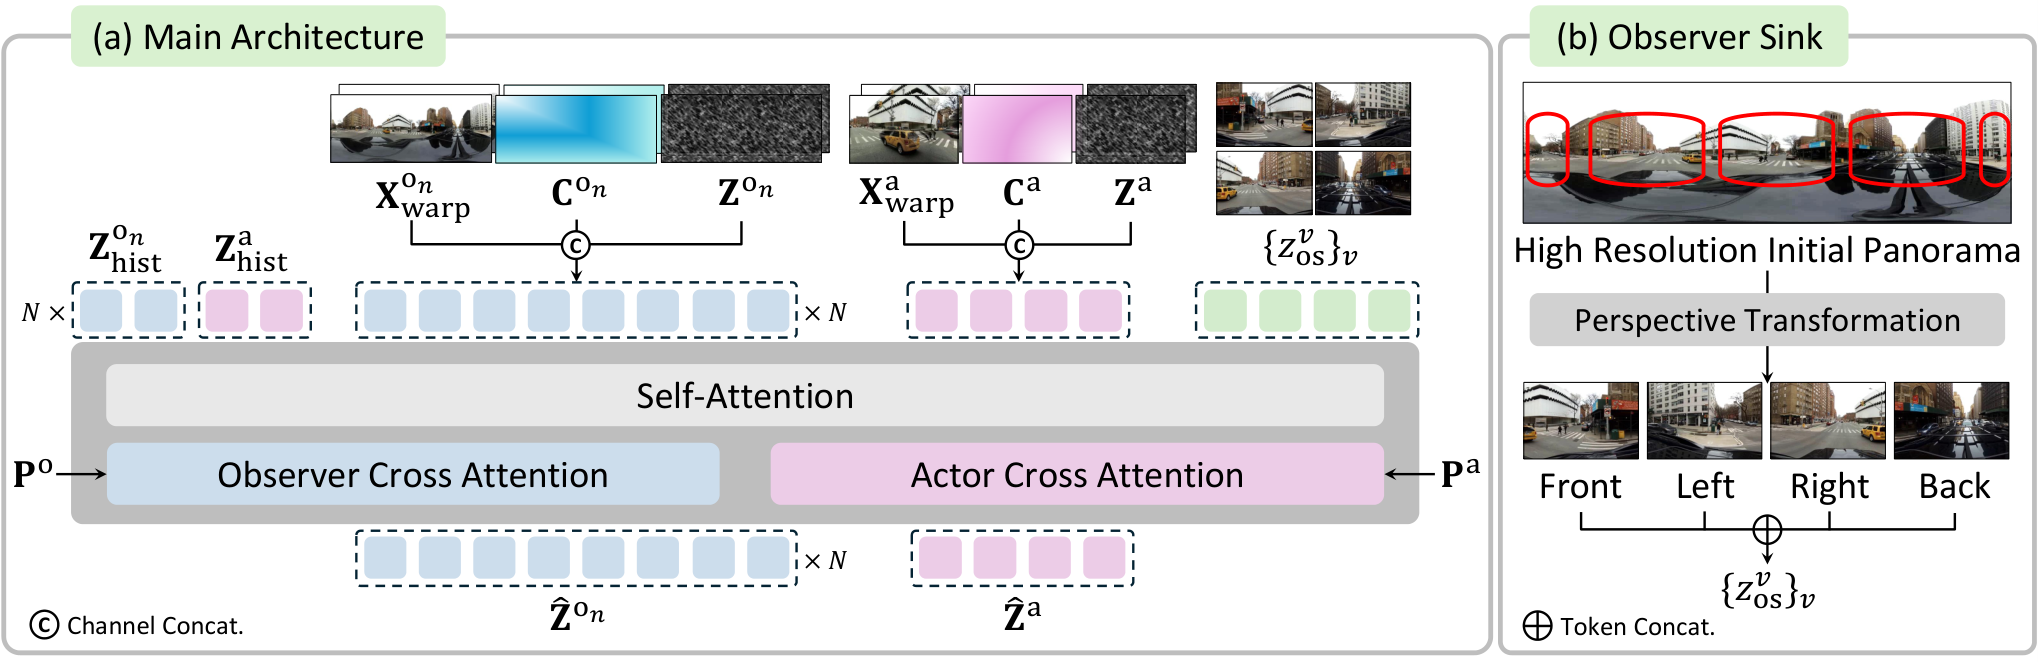 论文 Figure 4:模型总览。(a)World Observer 使用共享 DiT 联合生成 actor 与全景 observer 两条流。(b)Observer Sink 将高分辨率初始全景转换为四个透视参考,以保留精细外观信息。
- 实验效果:表 1 的真实/合成 OOV 测试中,单观察者 2B 模型的 FVD 为 291.7/196.2,LingBot-World 为 420.0/333.3;OOV-D_gt 为 0.426/0.531,对方为 0.337/0.340。多观察者仅在合成集测试,FVD 为 147.0,但 OOV-D_gt 为 0.528,略低于单观察者 0.531。因此视角增加改善部分指标,并非所有动态指标同步上涨。
 论文 Figure 7:与其他模型的定性比较。红框标出目标离开视野前与重新进入视野后的物体。已有模型常丢失物体、冻结其状态或不一致地重建它;World Observer 在视野外间隔后更好地保持物体身份与状态演化。
- 批判点评:方法目前需要全景条件,作者将从普通透视图补全全景列为后续方向;真实世界多观察者条件稀缺,多观察者优势只在合成集有证据。有限的观察者预算也无法覆盖整个世界。它更像把算力分配到感兴趣区域,而不是获得无限范围的世界记忆。
4. SemanTok:小模型先学会视频语义
SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation | Stability AI;卡尔斯鲁厄理工学院 | arXiv:2610.00686
关键词:视频tokenizer, 自回归生成, DINO语义监督, 可变长度token
- 前序问题:自回归视频生成需要先确定场景是什么,再补纹理细节。可变长度 tokenizer 虽能从粗到细输出,已有 decoder-REPA 对齐却可能利用带噪输入满足损失,未必迫使短 token 前缀本身承载语义;小 AR 模型因此仍可能生成类别不对或随时间漂移的画面。
- 本文贡献:SemanTok 保留 VideoFlexTok 的可变长度训练和 nested dropout,在编码端加入冻结 DINO 特征,并用轻量 Dense DINO 与 Class DINO 读出头,要求每个保留下来的 token 前缀单独预测教师语义。冻结 tokenizer 后,AR 模型按时间优先、由粗到细的顺序预测 token,再由扩散 decoder 还原视频。语义监督直接落在短前缀,而不只落在 decoder 的中间状态。
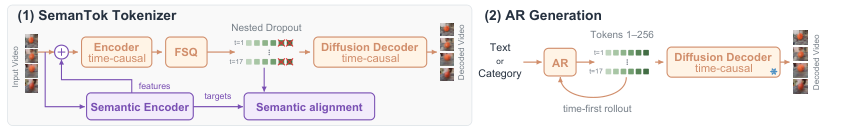 论文 Figure 2:方法总览。(1)tokenizer 训练:encoder、FSQ 与扩散 decoder 联合训练,nested dropout 使 decoder 能从任意 token 前缀重建视频。SemanTok 保留 VideoFlexTok 的训练方案(橙色),再加入冻结教师的语义监督:教师特征输入 encoder,每个保留的前缀都学习预测这些特征(紫色;细节见图 3)。(2)AR 训练与生成:冻结 tokenizer,AR 模型按时间优先、粗到细的顺序预测 token,步骤(1)的 decoder 将任意生成前缀渲染为视频。
- 实验效果:摘要与实验分析报告:201M 的 SemanTok AR 模型可匹配或超过约 3.4 倍规模的 VideoFlexTok AR 模型;附录表 4 中相应规模阶梯为 201M 和 679M。正文还报告在相同 AR 模型下,k=16 时每 token 预测约少用 32% 的 bits。图 7 比较同一 Kinetics-600 弹吉他类别的 rollout,201M 的 SemanTok 随时间退化更慢。
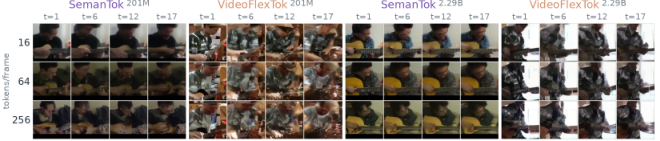 论文 Figure 7:SemanTok 在两种 AR 模型规模下保持优势。图中是同一 Kinetics-600 弹吉他类别的 class-to-video rollout。在 201M 模型下,SemanTok 随时间缓慢退化,而 VideoFlexTok 只在 t=1 时清晰。项目页提供视频。
- 批判点评:“小模型追上大模型”限定在作者的数据、token 预算与指标配置;参数量减少不等于端到端生成耗时同比减少。正文专门指出每帧仅 1 个 token 时不能兼顾全部目标,附录重建表也显示部分 PSNR/SSIM 逊于基线。语义更准和逐像素重建更准是两种目标,部署时仍需按预算权衡。
5. Tacit-TTS:免转写克隆语音快十倍
Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning | 杜比实验室 | arXiv:2609.38658
关键词:语音克隆, Masked LM, 非自回归生成, ReFlow蒸馏
- 前序问题:自回归 TTS 逐个预测语义 token,零样本音色克隆效果好但延迟高。非自回归系统更快,却常要求参考音频的转写;参考是陌生语言、婴儿咿呀或无意义发音时,ASR 生成的错误文本反而污染条件。目标是在不要求参考转写的同时降低生成耗时。
- 本文贡献:Tacit-TTS 从 IndexTTS2 蒸馏,将 text-to-semantic 阶段替换为 masked 非自回归生成,同时保留预训练的说话人和情绪条件。免训练长度估计结合参考音频语速与目标文本音节数,确定输出长度;连续潜表示和 ReFlow 蒸馏则加速下游 semantic-to-mel 的 flow-matching 渲染器,最后由 vocoder 合成波形。
 论文 Figure 2:Tacit-TTS 流程总览。输入为参考音频与目标文本,encoder 提取条件表征;text-to-semantic 模型通过 masked-LM 生成语义 token,semantic-to-mel 模型将其转成 mel 频谱,最后由 vocoder 合成波形。
- 实验效果:单张 NVIDIA A100 上,作者对超过 5 秒的语音报告相对 IndexTTS2 超过 10 倍加速。图 3 的端到端测试包含参考条件计算:4 秒输出约 9.0 倍、31 秒附近最高约 14.9 倍、125 秒为 11.8 倍。表 1 中 LibriSpeech speaker similarity 为 0.875,教师为 0.870;但 WER 为 5.54,教师为 3.115。参考语言另测试了 8 种语言及非词汇声音。
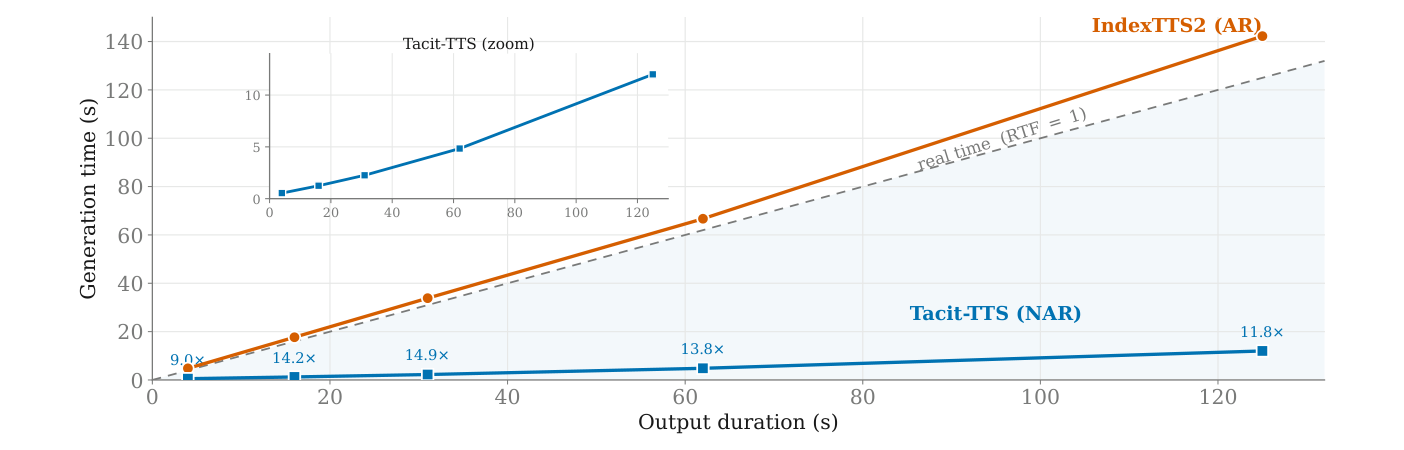 论文 Figure 3:IndexTTS2 与 Tacit-TTS 的端到端生成时间(包含参考条件计算)随输出时长的变化。使用同一参考片段,以固定段落重复延长输出。虚线表示实时速度;Tacit-TTS 曲线上方数字是相对教师的加速比,插图放大 Tacit-TTS 曲线。4 秒、31 秒附近和 125 秒的示例加速比约为 9.0、14.9 和 11.8 倍,不能当作全数据平均。
- 批判点评:更快没有消除质量损失:普通中文测试上的音色相似度和内容准确度仍落后于教师。图 3 使用固定段落重复拉长输出,最高 14.9 倍不能写成所有语音平均加速;长序列的全注意力成本也开始侵蚀收益。四个常规数据集的其他基线质量数字来自教师论文,而跨语言与非词汇测试由作者重跑,比较范围应分开理解。
6. 4Director:完整网格让物体转身不丢脸
4Director: Controlling Video World Models with Rigid 3D Geometry | Stability AI;伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02160
关键词:可控视频生成, 4D场景, 刚体网格, Motion Adapter
- 前序问题:2D 框只能指定物体在屏幕上的位置,不能完整表达深度和转向;3D 点或 blob 也缺少完整表面。镜头与物体同时移动时,模型容易每帧重新猜未观测几何,导致物体转了一半、遮挡出错或身份变化。专业创作需要把相机和物体轨迹放进统一的 3D 坐标系。
- 本文贡献:4Director 从输入图为每个物体一次重建 canonical mesh,每帧只施加一个指定刚体变换。网格、背景点云与相机共享坐标系,用户编排轨迹后渲染成深度视频;可训练 Motion Adapter 将几何条件注入预训练视频模型,后者补充外观、光照与非刚体动态。团队构建含 20,774 个片段的 RealCOD-Rigid,并以身份判断门控 mask IoU,形成 IG-IoU 指标。
 论文 Figure 3:4Director 总览。左侧:每个物体只重建一次为完整 canonical mesh,每帧用一次刚体变换移动;网格、背景点云与相机共享坐标系,用户在该坐标系指定物体与相机轨迹,并将场景渲染成深度视频(第 3.1 节)。右侧:可训练的 Motion Adapter 分支将刚体渲染注入预训练视频生成器,由后者补充外观、光照与非刚体动态(第 3.2 节);训练使用 RealCOD-Rigid(第 4 节)。
- 实验效果:表 1 中 4Director 的 FVD 为 370.4,SymphoMotion 为 405.4、VerseCrafter 为 484.7;IG-IoU 为 60.4,对应 52.9 和 54.8,camera RotErr 为 3.65°。图 5 对比共同相机与物体控制,显示其更完整地跟随指定转向;图 6 另展示物体离开视野后重返的定性案例。
 论文 Figure 5:相机与物体共同控制的定性比较。每个片段顶行展示输入图像和规定的轨迹,其下为四个 baseline、4Director 以及源视频按时间对齐的帧。箭头表示物体朝向,源视频中为绿色、生成视频中为红色。该组案例里只有 4Director 完成源视频的转向;baseline 保留原朝向、只转了一部分、模糊或丢失主体。
- 批判点评:完整网格减少逐帧几何猜测,却会把错误重建固定进控制条件。论文失败案例中,倒立舞者被当作一个刚体平移,生成结果一直保持初始姿态而没有跳舞,说明刚体轮廓可能压制应有的非刚体动作。IG-IoU 还依赖视觉语言裁判判断身份;作者的 VBench 优势多数在 2 个点以内,应避免把图中单例写成稳定保证。
7. GenCine:相机与物体在3D里一起编排
Generative Cinematographer: Composing Camera and Object Motion in 3D | 约翰斯霍普金斯大学 | arXiv:2610.02180
关键词:视频运动控制, 3D运动handle, XYZ引导图, LoRA
- 前序问题:同一条 2D 拖拽轨迹可能对应完全不同的 3D 运动;相机和物体一起动时,屏幕坐标更难区分“物体真的转身”和“镜头绕过去”。另一方面,整物体刚体控制过硬,人体、动物或机械臂的不同部分需要分别编排,而不必为每类对象建立物理模型。
- 本文贡献:GenCine 把单张图提升为可编辑的 3D 场景 scaffold,艺术家在共同世界坐标系里设置相机路径,并以局部 3D handle 控制前景不同部分。背景 XYZ、前景 XYZ 和恒定前景身份颜色图分别表达静态位置、动态位置和跨帧对应;有效性 mask 标记缺失条件。轻量 guidance branch 与 Wan 模型的 LoRA 学习这些控制,从真实视频恢复轨迹并结合合成数据训练。
 论文 Figure 3:GenCine 的 3D 控制流程。首先从 RGB 图估计深度与动态 mask,再提升为供动作编排的 3D 场景。艺术家通过 Blender 等 3D 界面,在共同世界坐标系指定相机和物体运动。控制转为背景 XYZ、前景 XYZ 和前景身份图,分别指示静态场景位置、移动 handle 的位置及身份。有效性 mask 区分可用条件与缺失值,动态 mask 标出初始前景。冻结的 Wan VAE 将图编码给视频模型;训练配对从视频运动恢复的条件,推理时同样的图表达艺术家编排的控制。
- 实验效果:表 1 的 Camera Shooting 上,GenCine 的 TransErr 为 1.00,Wan-Move 为 1.02;受控前景 R-LPIPS 为 0.18,对方为 0.19。Object Interactions 上整体 LPIPS 为 0.35,Wan-Move 为 0.37,但整体 PSNR 为 16.54,略低于 Go-w-Track 的 16.59。图 5 给出艺术家编排运动的定性对比,体现 3D 意图与 2D 投影控制的区别。
 论文 Figure 5:艺术家编排运动的定性比较。自上而下为 Living room、Bus 和 Robotic arm;每组按行展示 Wan-Move、VerseCrafter、Go-with-the-Track 和 GenCine。第一列为 3D 控制(GenCine)或共享的 2D 投影(baseline),随后四帧采样各控制区间。实线与虚线分别表示已执行和剩余目标路径,圆点表示当前目标,半透明 mask 表示投影目标区域。
- 批判点评:主要价值是可表达的控制接口,数值优势相当局部,不支持“全指标碾压”的结论。多个 handle 只是分段刚体近似,不能可靠表示复杂形变;单图深度估计出错、遮挡和超出归一化范围的运动都会影响控制。它与 4Director 各有取舍:局部操作更灵活,但没有完整网格带来的全表面约束。
8. PEARL:从用户历史推理个性化画面
Personalized Image Generation with Reasoning and Reflection | 范德堡大学;Adobe;马里兰大学帕克分校;佐治亚大学 | arXiv:2610.00737
关键词:个性化图像生成, 用户历史, 推理反思, DPO
- 前序问题:个性化图像生成通常依赖挑选好的参考图片,而真实用户偏好分散在评论、帖子、图片和 metadata 中。把某件商品放到什么环境、某个主题应采用什么风格,需要综合历史线索;检索一张最像的图片并不能完整表达生活方式与审美。
- 本文贡献:PEARL 将多模态 planner、reflector 与冻结图像生成器串成 reason-reflect 循环:先从历史形成场景计划并渲染,再根据实际图像与历史的不匹配修订计划。训练先蒸馏 silver personalization trajectory,再采用交替策略 DPO,用与用户历史相关的检索奖励优化两种策略。配套 benchmark 区分电商商品的 Personalized Scene Generation 和社交媒体的 Personalized Creative Generation。
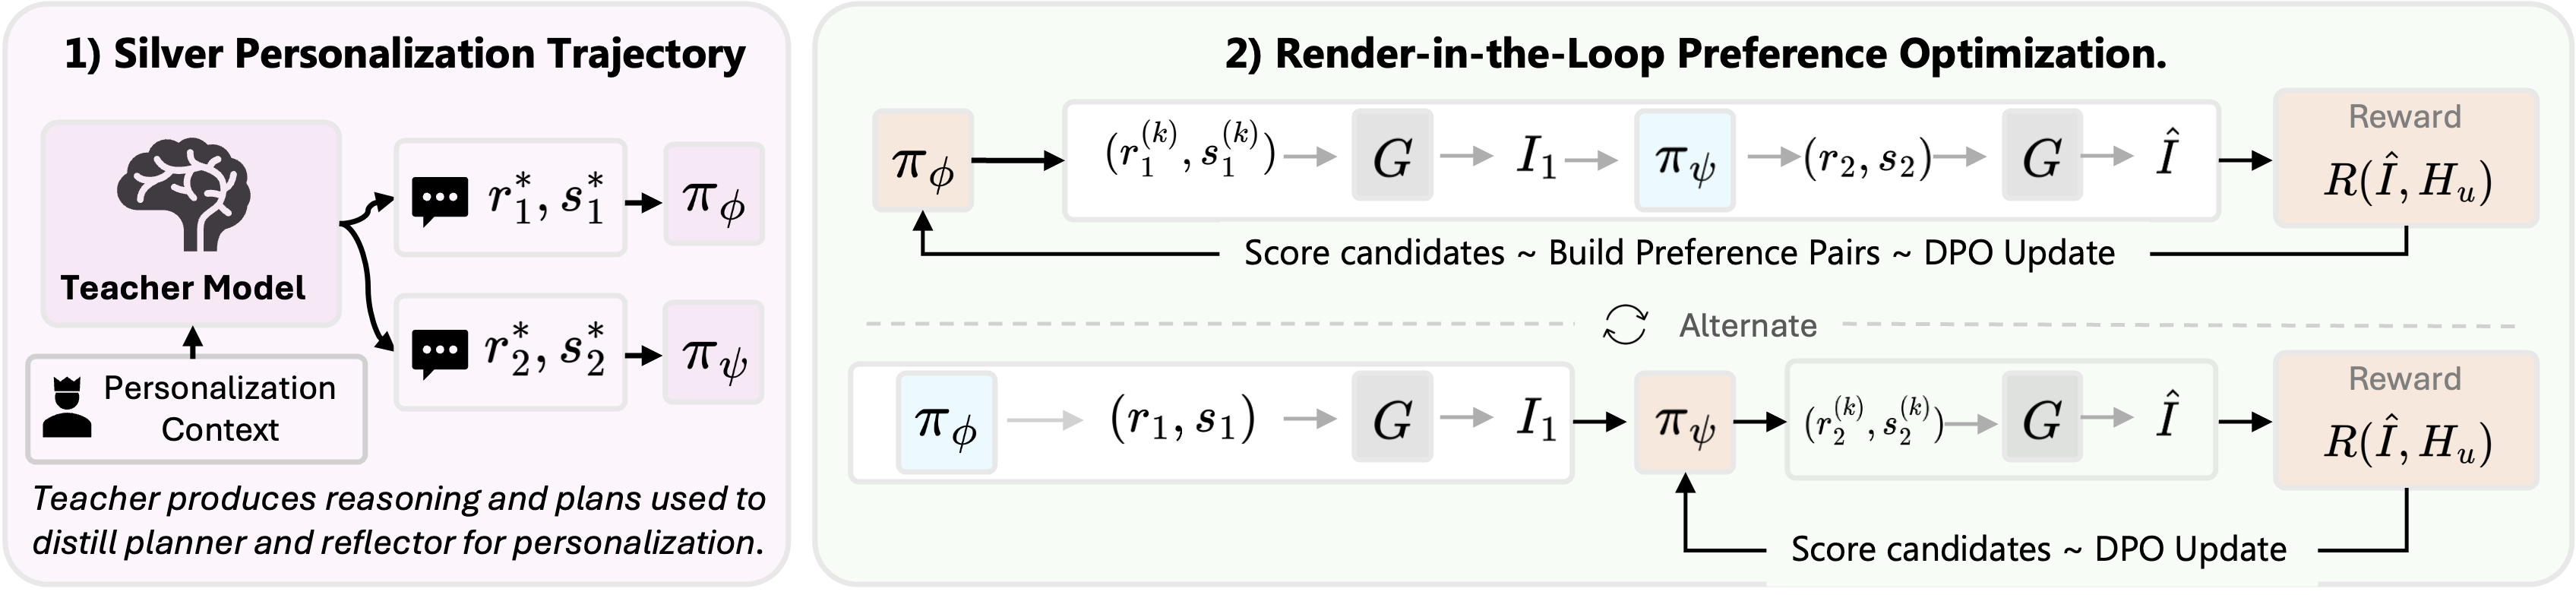 论文 Figure 2:Pearl 的训练流程。先用 Silver Personalization Trajectory 做 warm start,再通过 Render-in-the-Loop 优化两种策略。图左的教师产生推理与计划供 planner 和 reflector 蒸馏;图右把两种策略与冻结渲染器串接,按奖励给候选排序、构建偏好对并做交替 DPO 更新。
- 实验效果:表 1 的 Amazon 场景生成中,H@5 为 0.2297,PMG 为 0.2143;MLLM Overall 为 3.92,对方为 3.48。表 2 的 Instagram 创作生成中,跨类别 R@1 为 0.876,Pigeon 为 0.748,MLLM Overall 为 3.541,对方为 3.334。图 4 将两种任务的指标归一化后汇总,比较完整 PEARL 与移除 reflection 的版本。
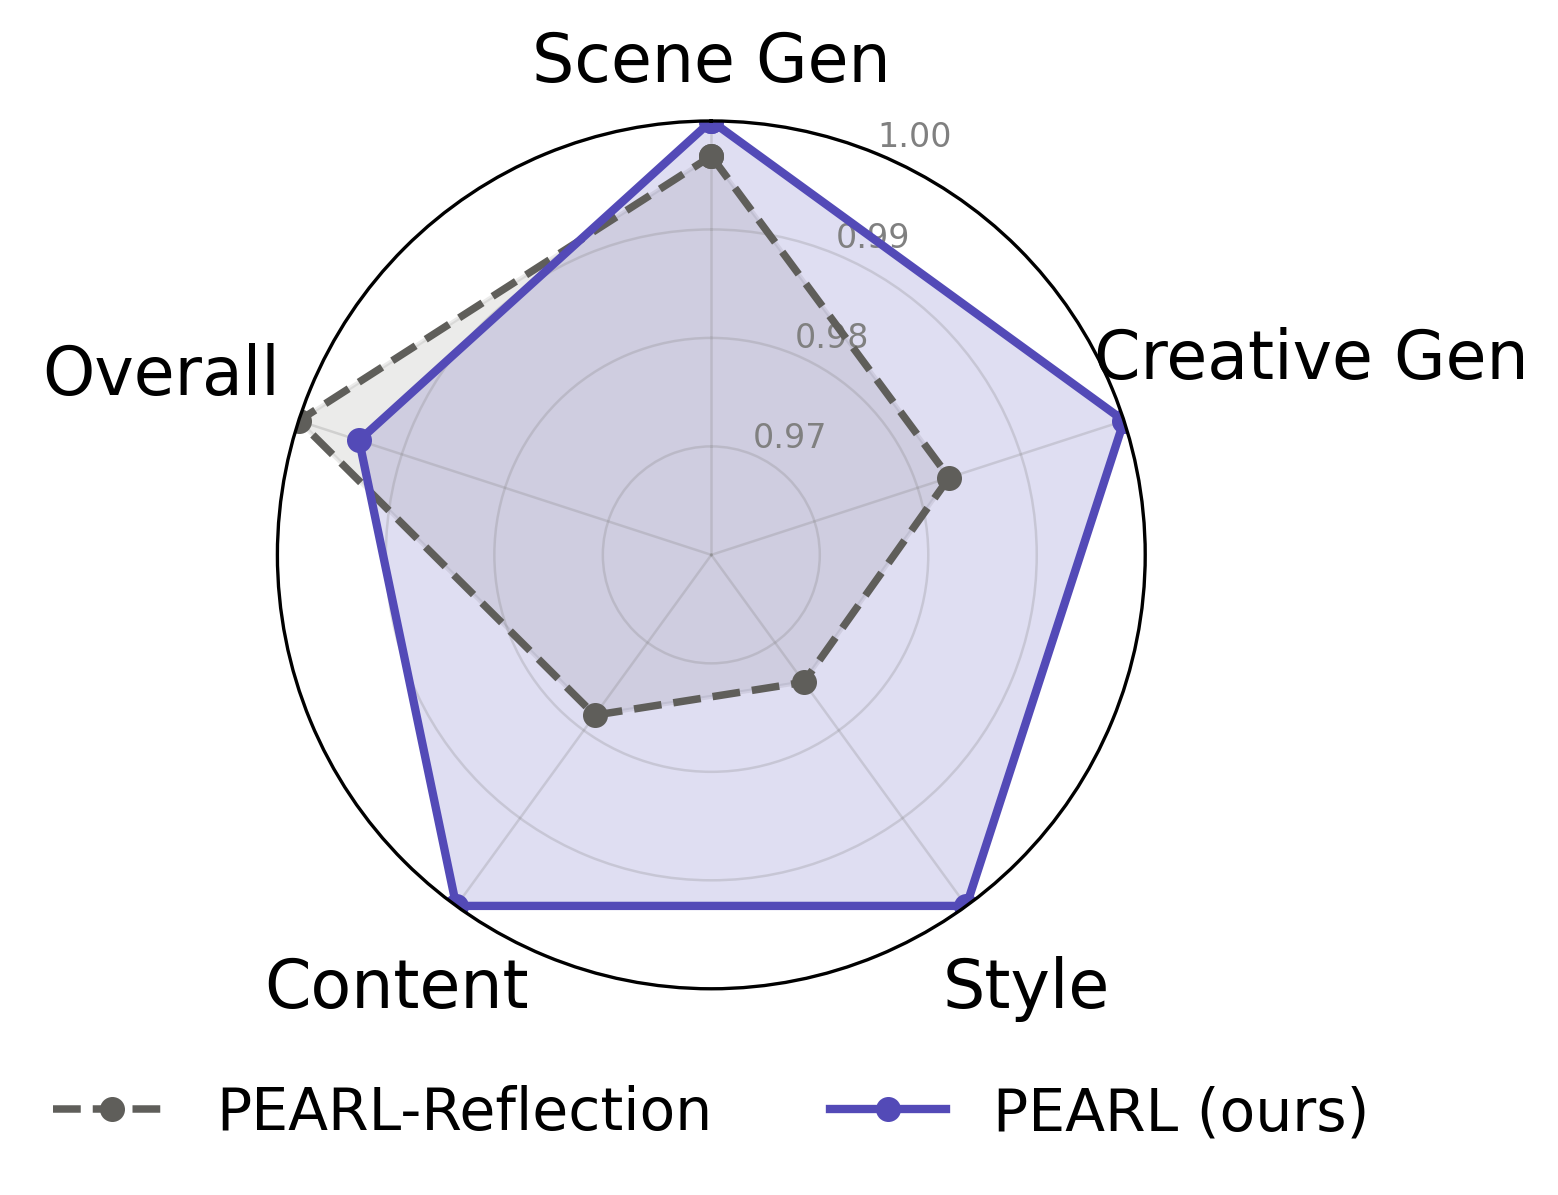 论文 Figure 4:消融:Pearl 与 Pearl -Reflection 的比较。该可视化对两种任务的指标进行归一化和汇总,展示保留 reflection 前后的差异;坐标是汇总后的相对值,不是原始 benchmark 分数。
- 批判点评:用户“喜欢”不等于模型能识别出用户:检索与 MLLM 分数只是偏好对齐的代理指标。作者明确指出电商场景没有每个用户—商品组合的自然真实目标图,只能间接评估;策略训练也只做了一轮交替 DPO。Instagram 的 LPIPS 和 MS-SSIM 并非最优,因此不能把摘要中的平均个性化提升写成所有画质指标普遍提升。
9. PLACE:让双耳声像跟随多模态条件
PLACE: Positional Latent Adaptation via Conditioned Embeddings for Binaural Audio Generation | 杜比实验室;佐治亚理工学院 | arXiv:2610.00630
关键词:双耳音频生成, 空间条件, 低秩latent适配, ILD与ITD
- 前序问题:音频与画面语义一致,还不一定听得出声音来自左边还是右边。现有空间声音生成器的条件接口常较固定,难以同时接收文本、视频和可选音频。想让耳机中的声像随场景变化,需要条件中的空间信息真正改变生成 latent,而不是只描述声源类别。
- 本文贡献:PLACE 基于 AudioX,增加 Perception Encoder Core 视频特征,将文本与视频表征对齐以提取空间线索,再用依赖条件的低秩变换调整生成 latent。适配器通过解码音频上的耳间声级差 ILD 和时间差 ITD 损失训练;五个预训练 encoder 与 SAO decoder 冻结,AudioX 通过 LoRA 微调。系统支持不同模态条件组合,而非只处理视频输入。
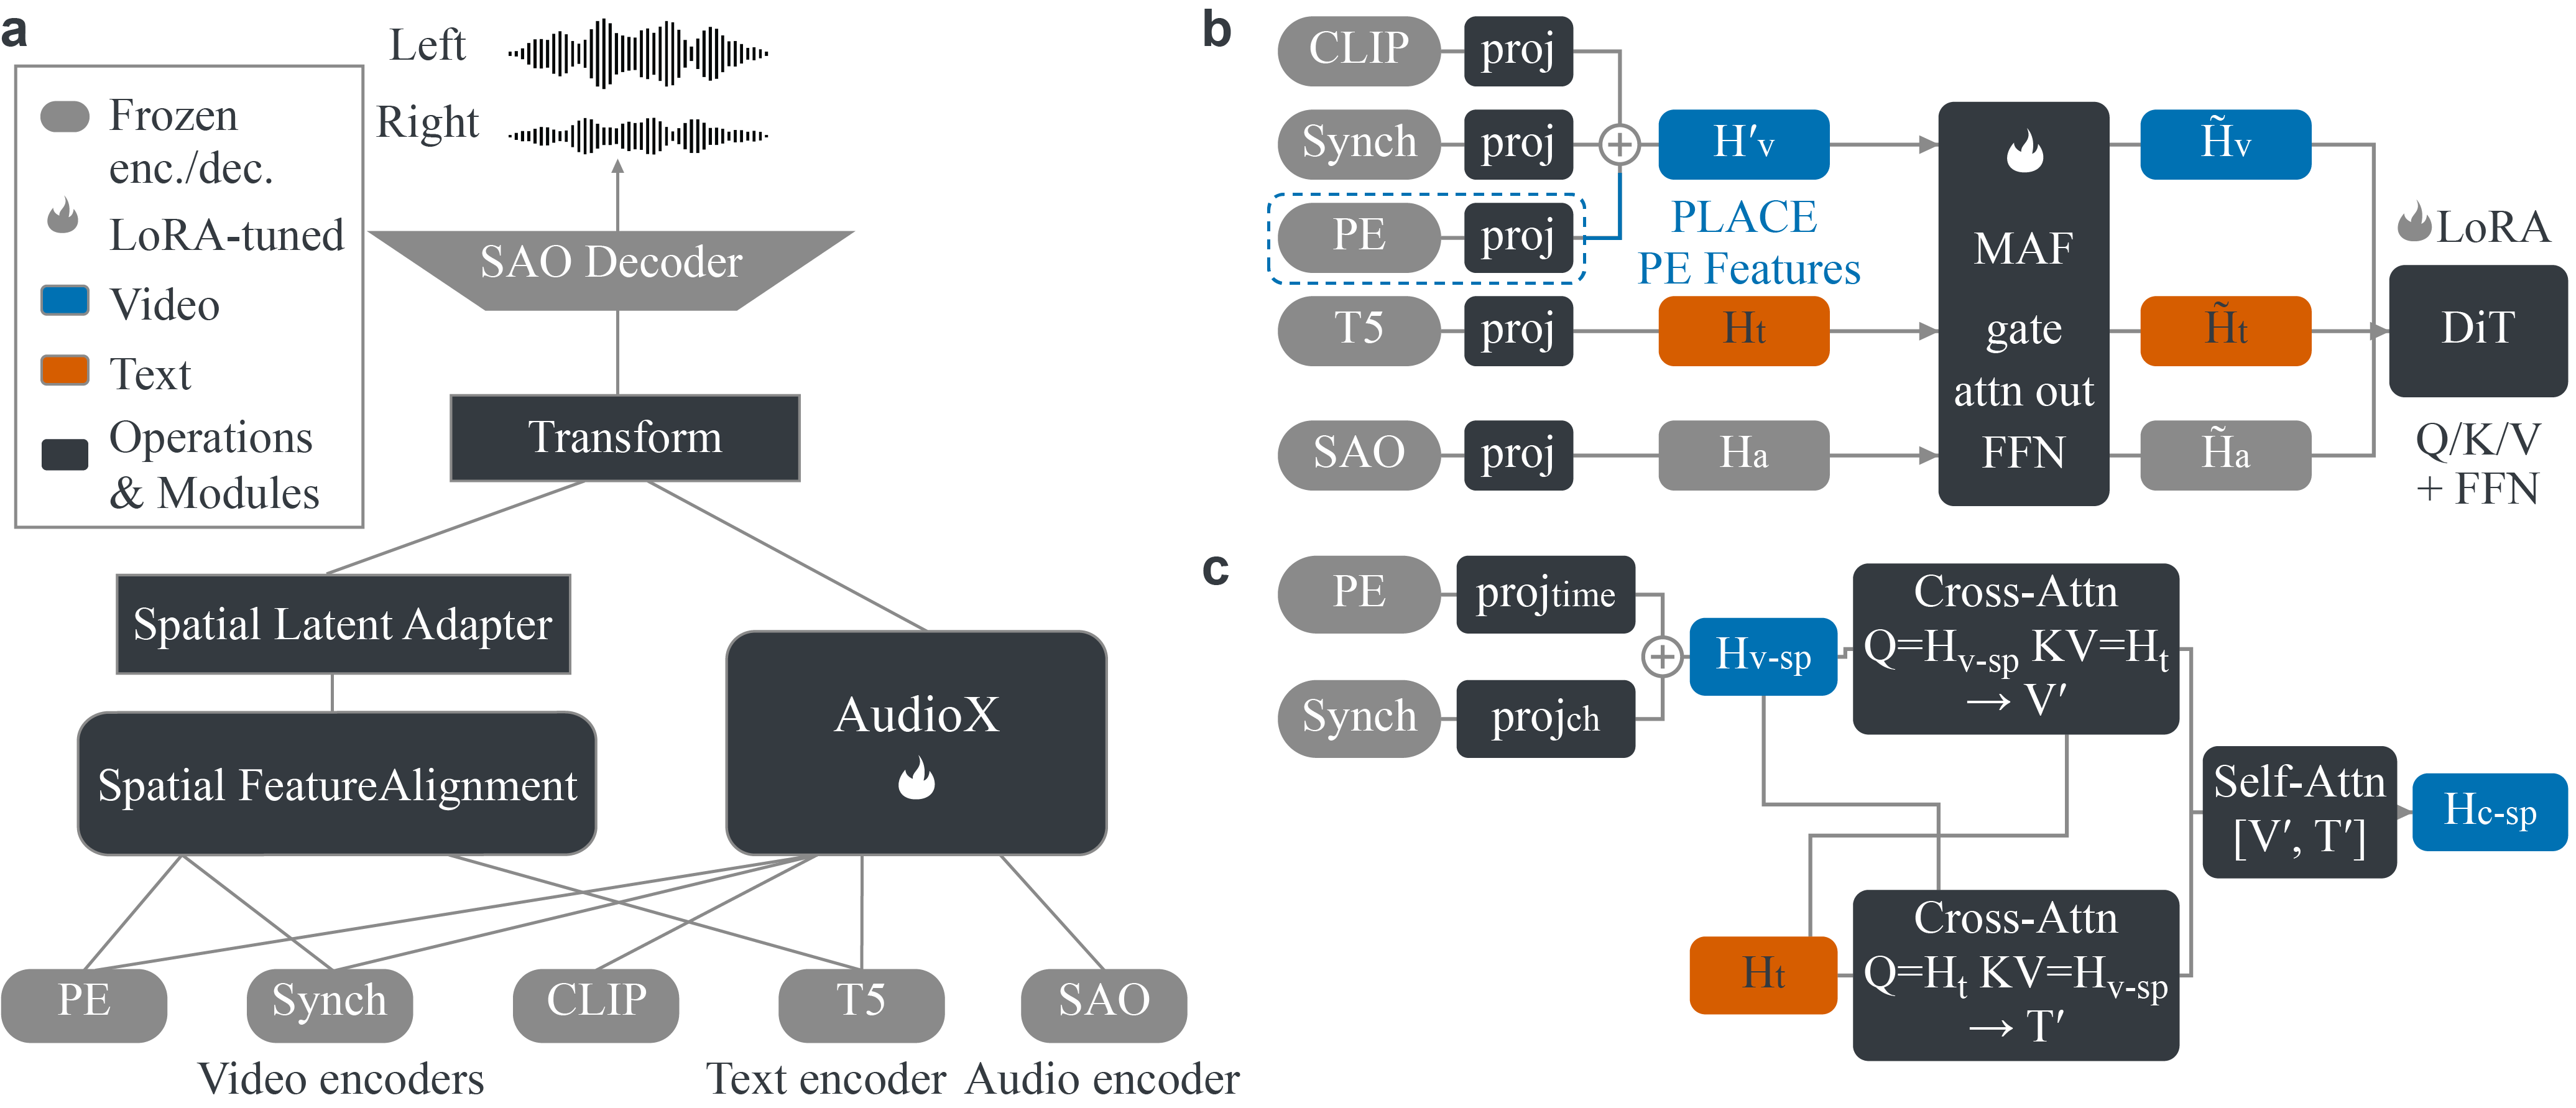 论文 Figure 1:PLACE 框架总览,蓝色突出视频特征路径,橙色突出文本路径。(a)AudioX 生成 latent,空间条件在冻结 SAO decoder 之前驱动其变换;五个预训练 encoder 与 decoder 全部冻结,AudioX 用 LoRA 微调。(b)投影后的 PE Core 特征在 MAF 模块之前补充 CLIP 与 Synchformer 特征。(c)文本—视频 cross-attention 与联合 self-attention 产生空间特征 H_c-sp。
- 实验效果:表 1 的 FAIR-Play split 1 上,ITD 误差 0.1077ms、ILD 误差 2.0495dB,ViSAGe 分别为 0.1136ms、2.1306dB;split 2 的 ITD 却较差。表 3 的分布外 T2A 听测平均分为 55.5,SpatialSonic 为 44.8;域内 V2A 为 65.3,对方 ViSAGe 为 44.9。原文只写 Submitted to ICASSP 2027,不能称为会议接收。
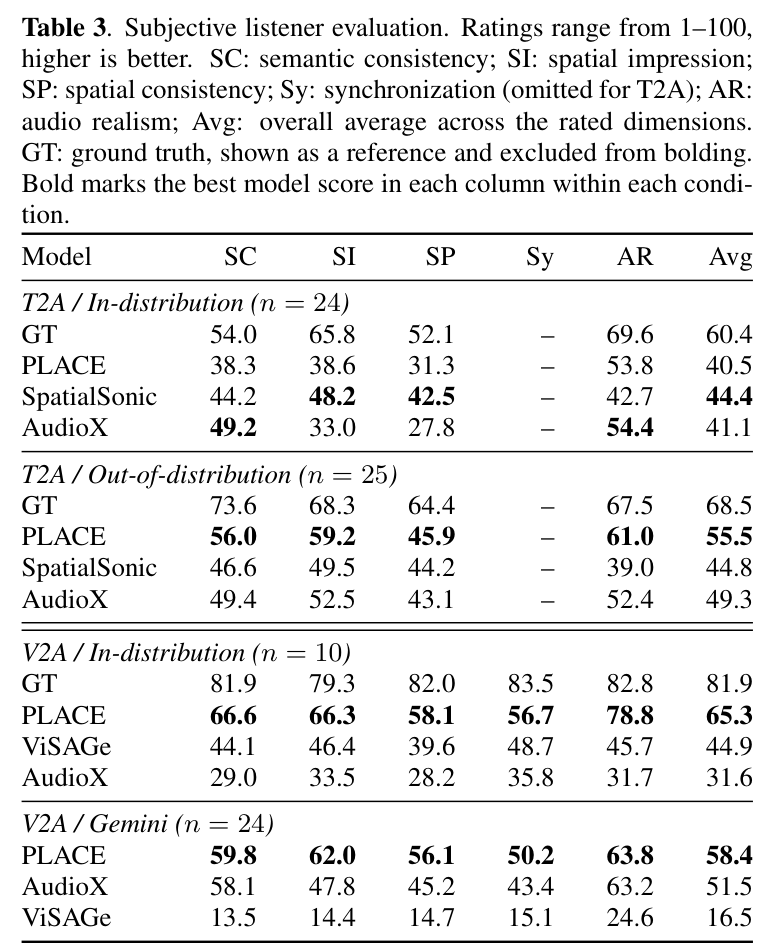 论文 Table 3:主观听测表。评分范围为 1–100,越高越好;SC 为语义一致性,SI 为空间感,SP 为空间一致性,Sy 为同步性(T2A 不评此项),AR 为音频真实感,Avg 为所评维度的均值。GT 是真实音频参考,不参与最佳模型加粗;粗体表示每种条件各列最优模型。表中区分域内与分布外 T2A、域内与 Gemini 视频条件 V2A;n 统计评分数。PLACE 在域内 T2A 均分 40.5,分布外 T2A 为 55.5,域内 V2A 为 65.3,Gemini V2A 为 58.4。
- 批判点评:收益取决于模态与分布。域内 T2A 听测均分仅 40.5,低于 SpatialSonic 的 44.4 和 AudioX 的 41.1;BEWO-1M SS-set 上 FSAD、ITD、ILD 也逊于 SpatialSonic,优势集中在原文定义的 SpatialCLAP 差值指标。听测表中的 n 是评分数,不能当作独立听众人数。空间一致性进步不等于全面音质领先。
10. VTR-Bench:视频逼真了字却还常写错
VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation | 香港城市大学;香港科技大学(广州);香港科技大学;西湖大学;电子科技大学 | arXiv:2610.01499
关键词:视频生成评测, 视觉文字渲染, WER, 关键帧引导
- 前序问题:广告、科学演示和界面视频里的文字常承担核心信息。模型能把灯光与动作做得漂亮,招牌仍可能拼错、缺字或小字不可读;只评审美与物理合理性无法发现这些问题。需要把文本正确性与画面任务完成度分开衡量。
- 本文贡献:VTR-Bench 用 300 个 prompt 覆盖五类场景,对具体文字载体分别转写并计算 WER,同时用每条 prompt 的 20 问 checklist 检查场景与运动要求。作者另外提出关键帧引导生成流程,由 Director agent 根据视觉反馈反复调整图像、首帧及运动计划,再生成视频。主贡献是生成模型评测与改进,符合 AIGC 范围,而不是通用视频理解。
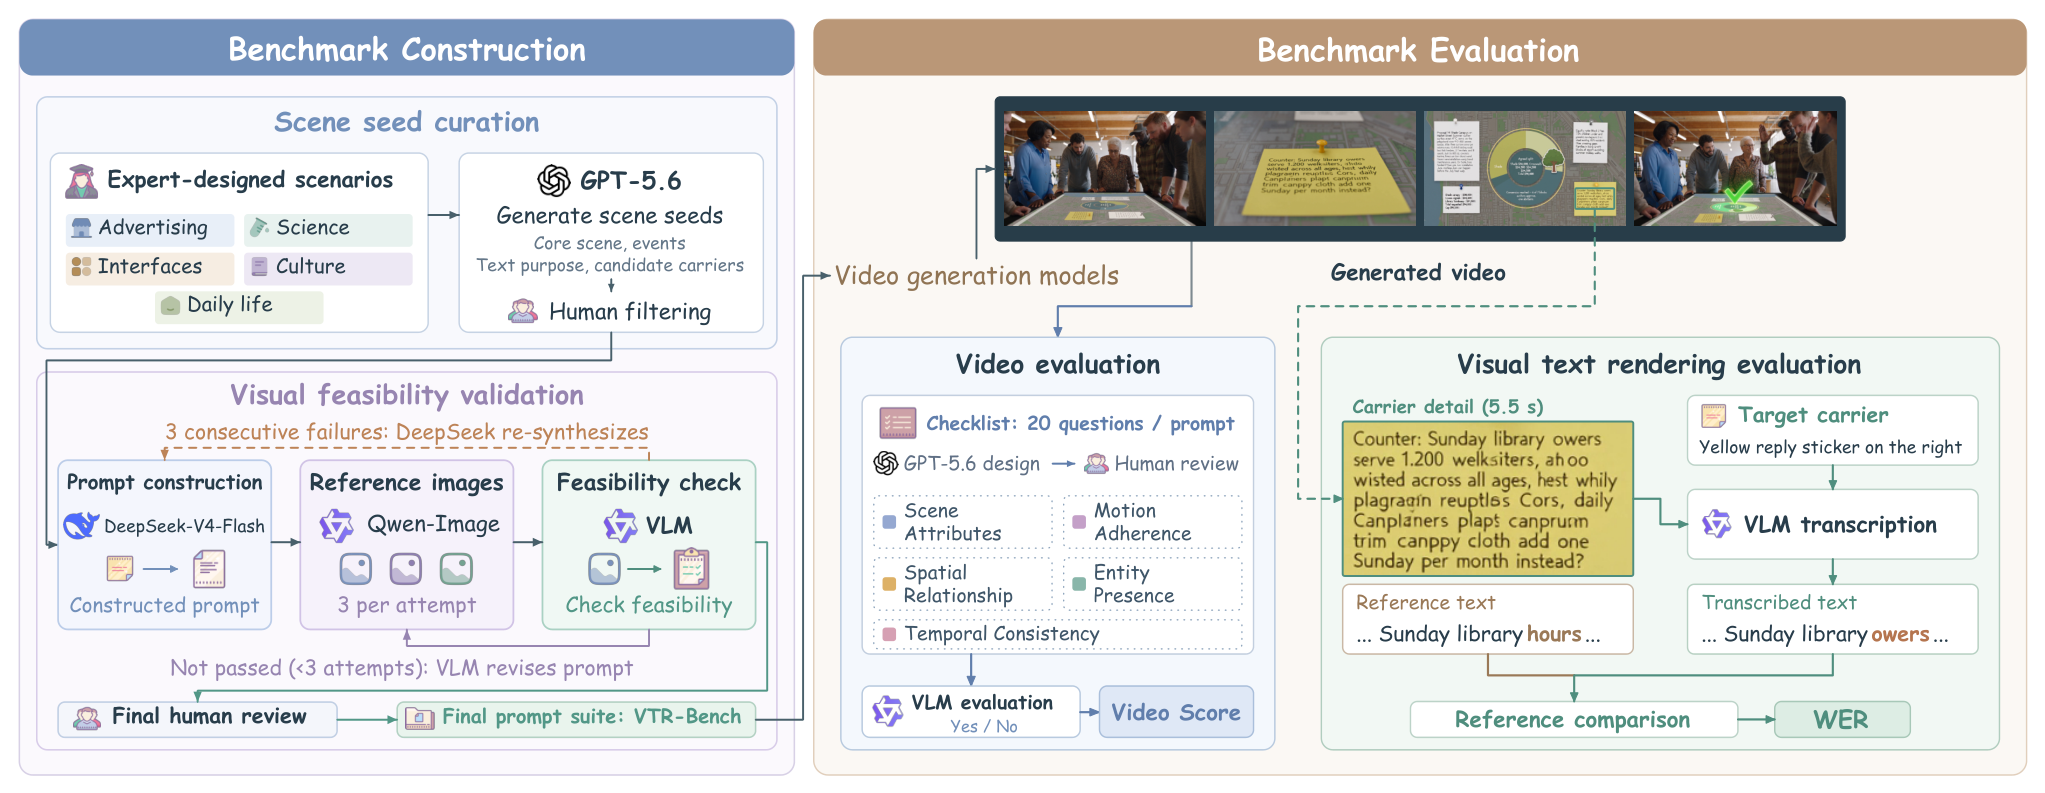 论文 Figure 2:VTR-Bench 总览。左侧:专家设计五种场景类别,引导场景 seed 生成与人工过滤;保留的 seed 用于构造 prompt,再通过参考图生成和 VLM 审查迭代完善,最后人工复核。右侧:生成视频在两个维度分别评估,Video Score 以 20 问 checklist 衡量场景与视频要求完成度,WER 比较针对具体文字载体的 VLM 转写与参考文字,衡量视觉文字保真。
- 实验效果:主表 1 比较 11 个视频模型,Wan3.0 的整体 WER 最低,为 0.250,Video Score 为 0.849;MiniMax H3 为 0.447/0.756,Seedance2.5 为 0.641/0.791。表 2 中 Qwen3.8-27B 对文字块 WER 的 Pearson 为 0.9541,视频级为 0.9842,支持其与人工转写的相关性。官方代码:VTR-Bench。
 论文 Figure 1:即使视频视觉上可信,现有视频模型仍难正确渲染文字。上方是 Seedance2.5 生成的视频;Video Score 是 20 问 checklist 中满足要求的比例,WER 是相对参考文字的词错误率。左下展示视频中的四种文字渲染问题,右下展示 11 个模型在 VTR-Bench 上的整体 WER。
- 批判点评:WER 是词级编辑距离,0.250 不等于“25% 的视频失败”,也不能推出每个视频都错四分之一。不同模型的分辨率与生成管线不同,排行榜还受评审模型影响;相关性高不意味着每条转写都正确。关键帧 agent 的迭代成本也应单独核算,不能把更高预算的改进当作单次生成能力。
趋势观察
从像素记忆走向状态载体
Oneira 显式记录交互后果,World Observer 持续生成选定区域的视角;两条路线都让镜头外状态获得约束,但尚未证明无限时域或全面物理可靠性。
控制接口先解决几何歧义
4Director 用完整刚体网格,GenCine 用局部运动 handle;它们共同把相机和物体放进世界坐标系,分别在完整几何与形变灵活性之间取舍。
短序列必须携带可用信息
SILSA 的切片潜变量与 SemanTok 的短语义前缀都减少局部 token 负担;这是不同任务中的表示设计趋势,不能把各论文加速数字横向相乘。
评测拆开能力与代价
视频里的字、音频的空间感、用户历史匹配和端到端耗时都需要独立指标。各论文测试集、评分口径和硬件不同,本期不做跨论文统一排行榜。
今日讨论
SILSA 用切片拓扑监督改善单物体孔洞与连通性;面对输入视角不充分或分布外形状,你会优先增加多视角条件,还是设计可验证的拓扑约束?
人工智能炼丹君 整理 | 2026-10-05







评论 (0)