今日 AIGC 论文速览
今日共 10 篇 · 高效文生图架构 3 篇 · 统一多模态 1 篇 · 长视频与音视频生成 2 篇 · 生成推理加速 2 篇 · 视频强化学习与图像评测 2 篇
重点论文标题列表
- Looped-DiT(商汤):260M循环4圈赢6.5倍大模型
- Multimodal Flow(华科):图文全连续流建模,仅用150B词元
- NEPA-DiT(密歇根大学):预测嵌入当条件,FID 1.32
- MosaiChunk(康奈尔大学):只训13.6M路由,长视频回访不失忆
- Soundwich(西蒙弗雷泽大学):冻结LTX-2.5免训练拆分音轨
今日论文速览
1. Looped-DiT:260M循环4圈赢6.5倍大模型
Looped Diffusion Transformer | 商汤科技;清华大学;南洋理工大学 | arXiv:2609.40305
关键词:文生图, 循环计算, 参数共享, 深度监督, 潜在推理
- 前序问题:文生图模型提质通常只有两条路:加参数或加去噪步数。语言模型里已验证的「循环复用同一组层」能在不增参数的前提下加深计算,但直接搬进 MMDiT 并不稳定:推理圈数超过训练值后性能先涨后跌,中间表示里可线性解码的空间位置信息逐圈流失。
- 本文贡献:Looped-DiT 把网络切成前段 6 块、循环段 5 块、后段 6 块,每个去噪步内让循环段共享权重重复 N 次(训练取 4 圈)。两项稳定手段:深度监督,每圈输出都经共享后段解码并计入 flow loss;自调制注意力,用门控或无参的 Exclusive Self-Attention 抑制注意力对局部信息的过度改写。
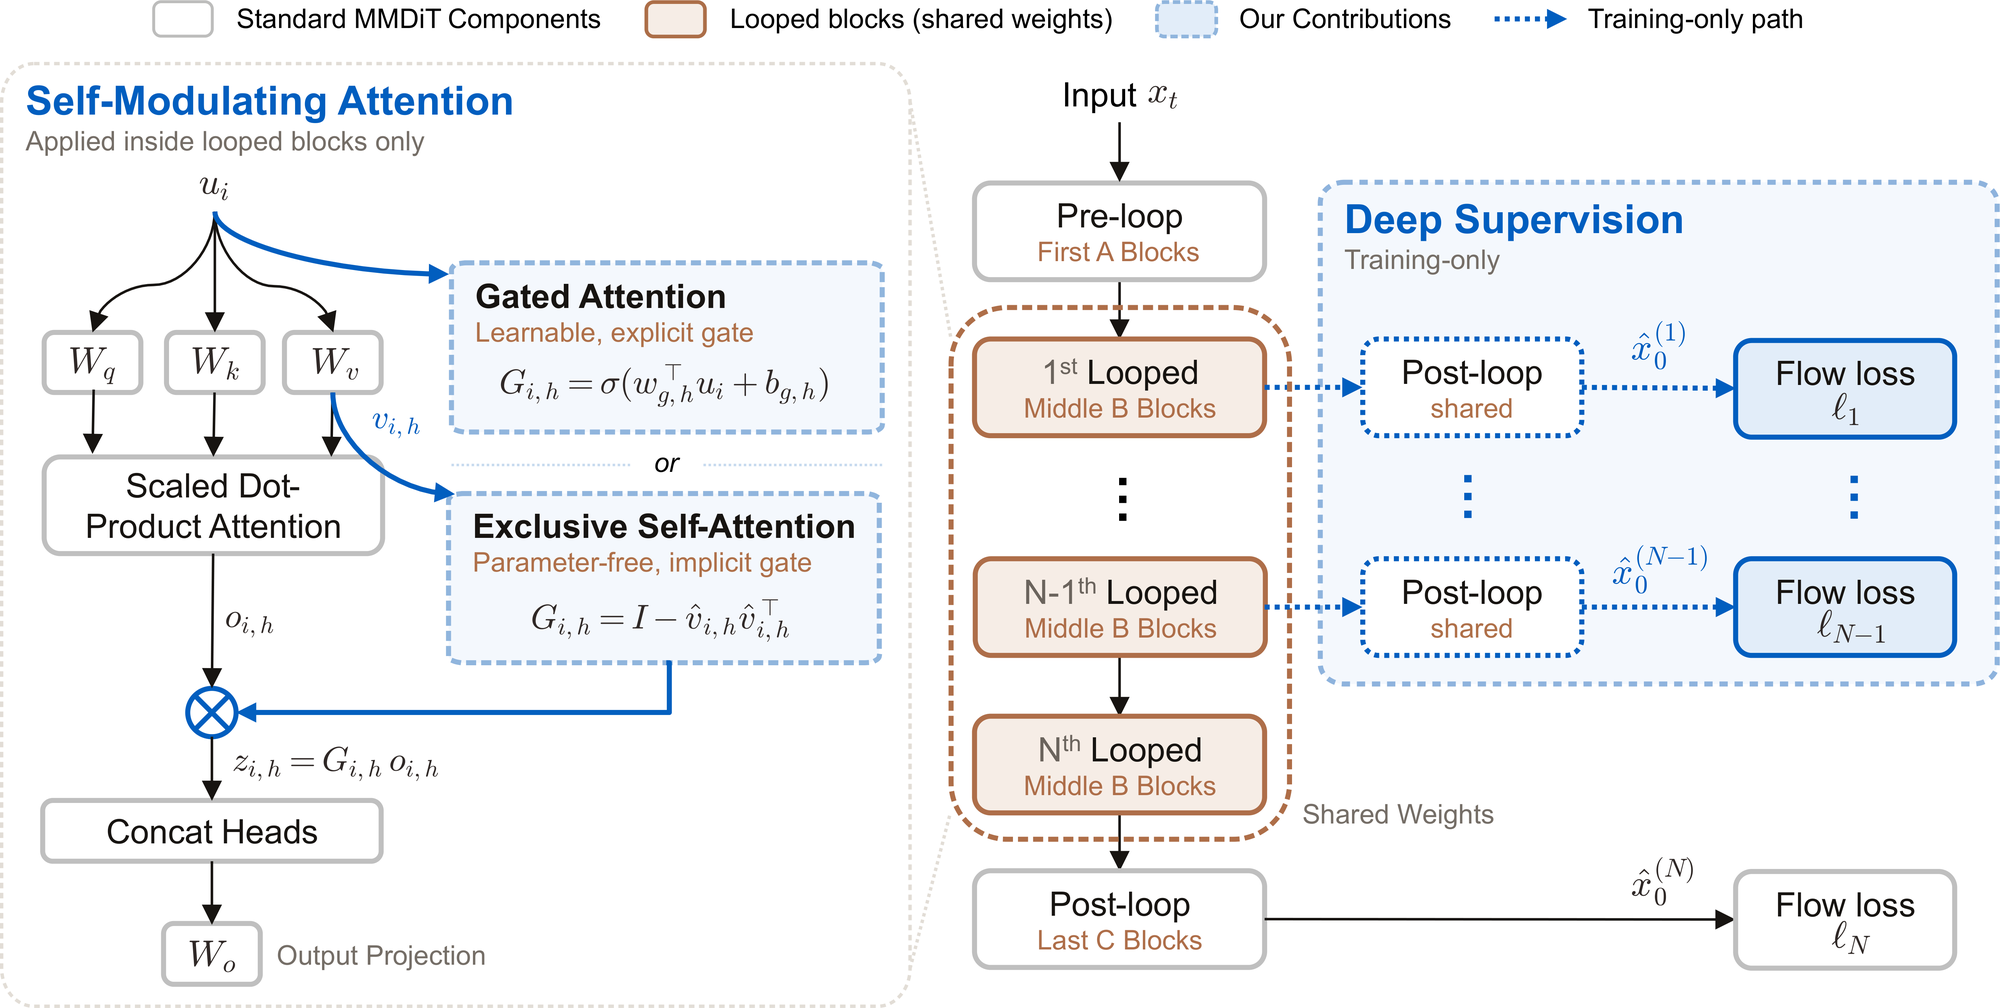
- 实验效果:260M 的 B/16 在 GenEval、DPG、PRISM、CoRe、Spatial、TIIF 六项均值 71.5,六项全部高于 1.7B 的 InternVL-U(均值 69.0),也高于 6.6B 的 Uni-CoT(66.8),单图推理算力约为 InternVL-U 的 1/4.9。参数对齐对照里,B/32 均值从 55.2 提到 59.1;同等推理预算下,加圈比加去噪步更划算。
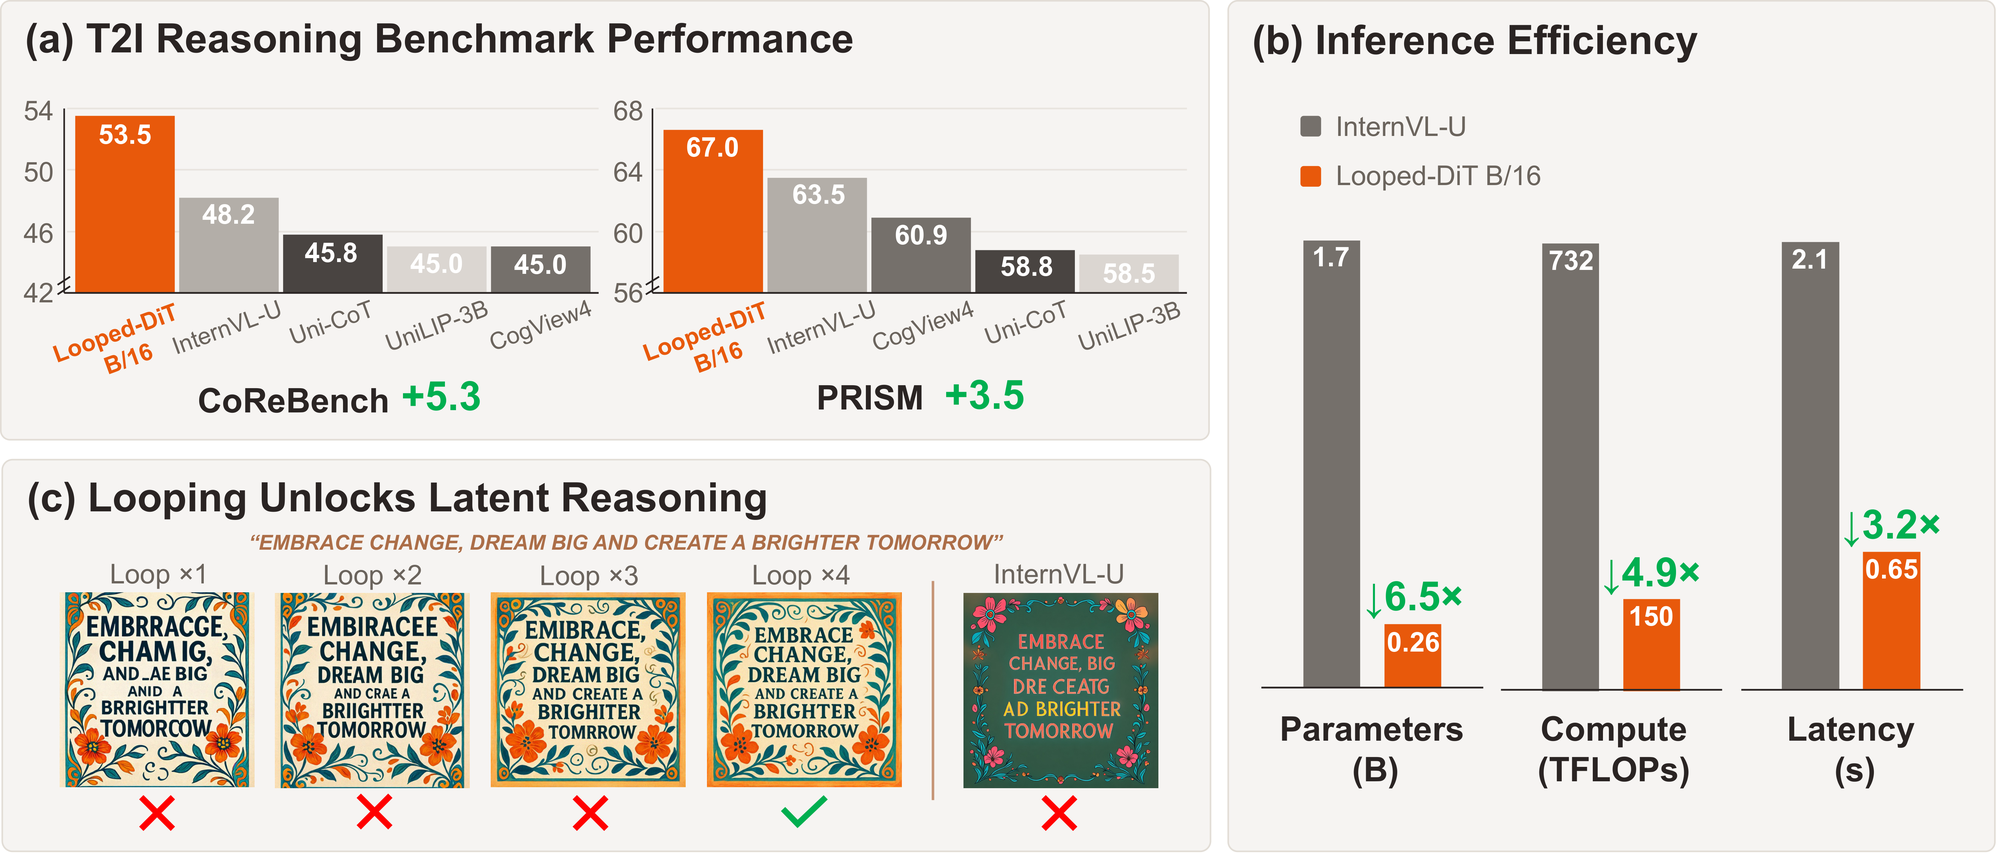
- 批判点评:「参数不变」不等于「算力不变」:循环版每步推理 267 GFLOPs,是同参数基线的 1.83 倍,训练 1246 GFLOPs 更是 2.83 倍。按推理算力对齐时,加宽版 MiniT2I 已到 58.6,与 Looped-DiT 的 59.1 只差 0.5。分项看,循环擅长约束求解,需要常识推断的 CoRe/Generalization 只 +7.5,远不如文本 CoT 的 +22.2。
2. Multimodal Flow:图文全连续流建模,仅用150B词元
Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces | 华中科技大学;北京交通大学;地平线 | arXiv:2609.40362
关键词:统一多模态, 连续流匹配, 文生图, 视觉理解, 多模态预训练
- 前序问题:统一理解生成模型多走两条路:文本和图像都离散化,图像要过量化瓶颈;或文本离散、图像连续,两种目标与采样流程各写一套。全连续建模能让两种模态共用一个生成过程,但在多模态预训练规模上很少被系统验证。
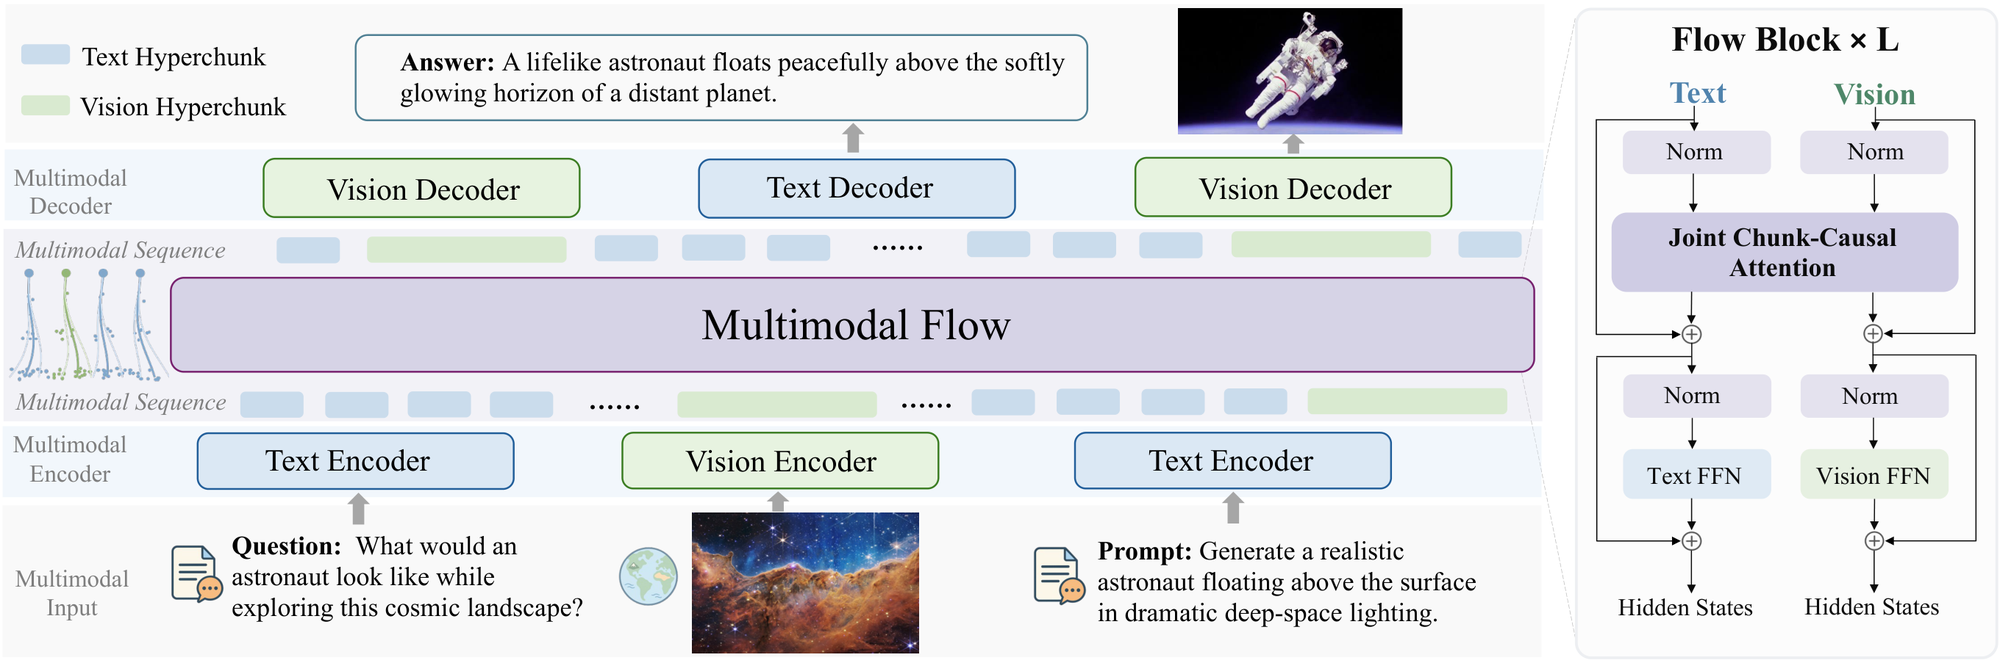
- 本文贡献:MF-1 用冻结的 T5-small 与 SigLIP2 把文本块(每 8 个词元一块)和图像编码成连续表示,按顺序组织成 hyperchunk,交给一个 chunk-causal 的 flow 主干学习单一速度场;注意力投影共享、FFN 按模态分开。训练时并行预测多个目标块,推理时逐块生成,再由预训练图像解码器与单独训练的文本解码器还原。
- 实验效果:1.6B 版本只用 150B 预训练词元,GenEval 0.82、DPG 83.44,理解侧 POPE 86.1、MMBench 67.2。数据、优化与参数完全对齐时,全连续版 GenEval 0.713、MMBench 46.7,高于 Transfusion 式混合(0.669 / 33.7)与 Chameleon 式全离散(0.374 / 38.4)。
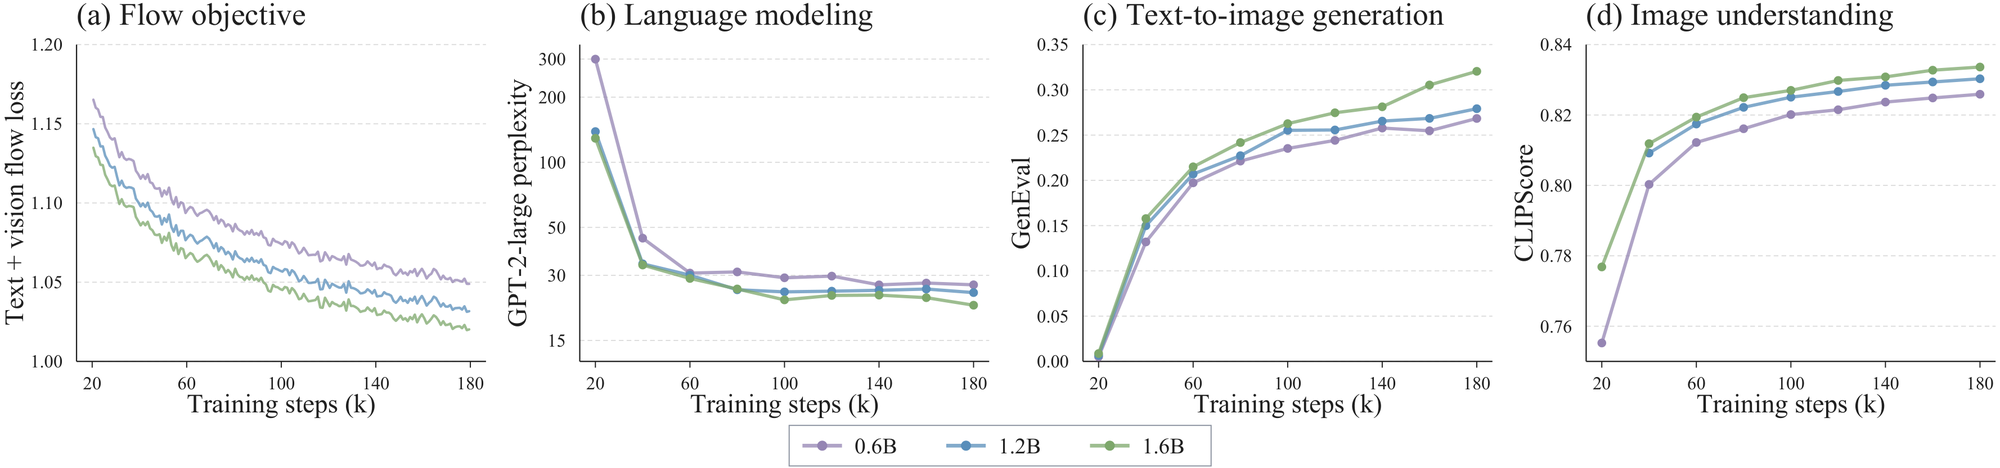
- 批判点评:生成强、理解弱:MMBench 67.2 落后同量级的 Janus-Pro(75.5)与 JanusFlow(74.9),VQAv2 72.6 也低于 JanusFlow 的 79.8(对方有预训练 LLM 初始化);DPG 83.44 还没追上纯生成的 SD3 Medium(84.08)。scaling 曲线上 1.6B 预训练阶段 GenEval 只到约 0.32,表中 0.82 是再经 5B 词元微调后的结果;「全连续」也依赖冻结编码器与外部解码器,图像输入仅 224 分辨率。
3. NEPA-DiT:预测嵌入当条件,FID 1.32
Embedding Prediction Helps Image Generation | 密歇根大学;卡内基梅隆大学 | arXiv:2610.02203
关键词:类别条件生成, 嵌入预测, 扩散 Transformer, 表征对齐, ImageNet
- 前序问题:DiT 里类别或文本只嵌入一次,每个去噪步复用同一个条件,「这个条件对眼前这张噪声图意味着什么」全留给生成器自己推断。NEPA(下一嵌入预测自回归)已能在连续嵌入上做自回归预测,作者想知道:能否用预测出的干净图嵌入替代固定条件。
- 本文贡献:把生成写成「条件 → 噪声图 → 干净图」的嵌入序列,干净图的 patch 嵌入正是条件与噪声图之后的「下一组嵌入」。作者训练 NEPA 模型用多嵌入预测(MEP)一次性预测全部干净嵌入;生成时 DiT 以这些预测为条件,并在每个去噪步按当前噪声状态重新计算,条件随采样进程自适应。

- 实验效果:ImageNet 256×256 上,NEPA-DiT-XL 结合 REPA,SDE-250 采样 FID 1.32、IS 311.0,ODE-96 采样 FID 1.57;训练为 NEPA 240 + 生成器 80 epoch,约为 REPA(800 epoch)训练算力的三分之一。九组规模交叉实验中,生成器或 NEPA 模型变大,FID 都单调下降。

- 批判点评:训练省了,推理贵了:多挂一个 711M 的 NEPA 网络,总参数约 1.39B,是 SiT-XL/2+REPA(675M)的两倍;同为 SDE-250,单图 160 TFLOPs,比对方的 91 TFLOPs 多 76%。换成更省的 ODE-96,FID 1.57 反而不如 REPA 原版的 1.42。若放开 tokenizer,表中 SFD、RAEv2 已做到 1.06。
4. MosaiChunk:只训13.6M路由,长视频回访不失忆
MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation | 康奈尔大学;加州大学伯克利分校;哈佛大学;Impossible Inc. | arXiv:2610.02153
关键词:自回归视频生成, 长时记忆, KV 缓存, 记忆路由, 场景回访
- 前序问题:自回归长视频受限于上下文窗口:物体或场景移出窗口后细节丢失,镜头转回来时往往「重新编」一个。整块检索历史 chunk 能补记忆,但固定显存预算下塞不了几块;滑动窗口则干脆遗忘。
- 本文贡献:作者先验证冻结的视频生成器能直接消费非连续拼接的历史 KV 并还原对应内容。MosaiChunk 据此把每个历史 chunk 聚成若干 section 并编码描述子,由轻量路由器全局挑出 top-N,在固定活跃显存预算内拼成一块跨时空的 KV 马赛克;生成器全程冻结,只自蒸馏训练路由器。同时发布 RememBench 回访基准,含 T2V 与 I2V 两个子集。
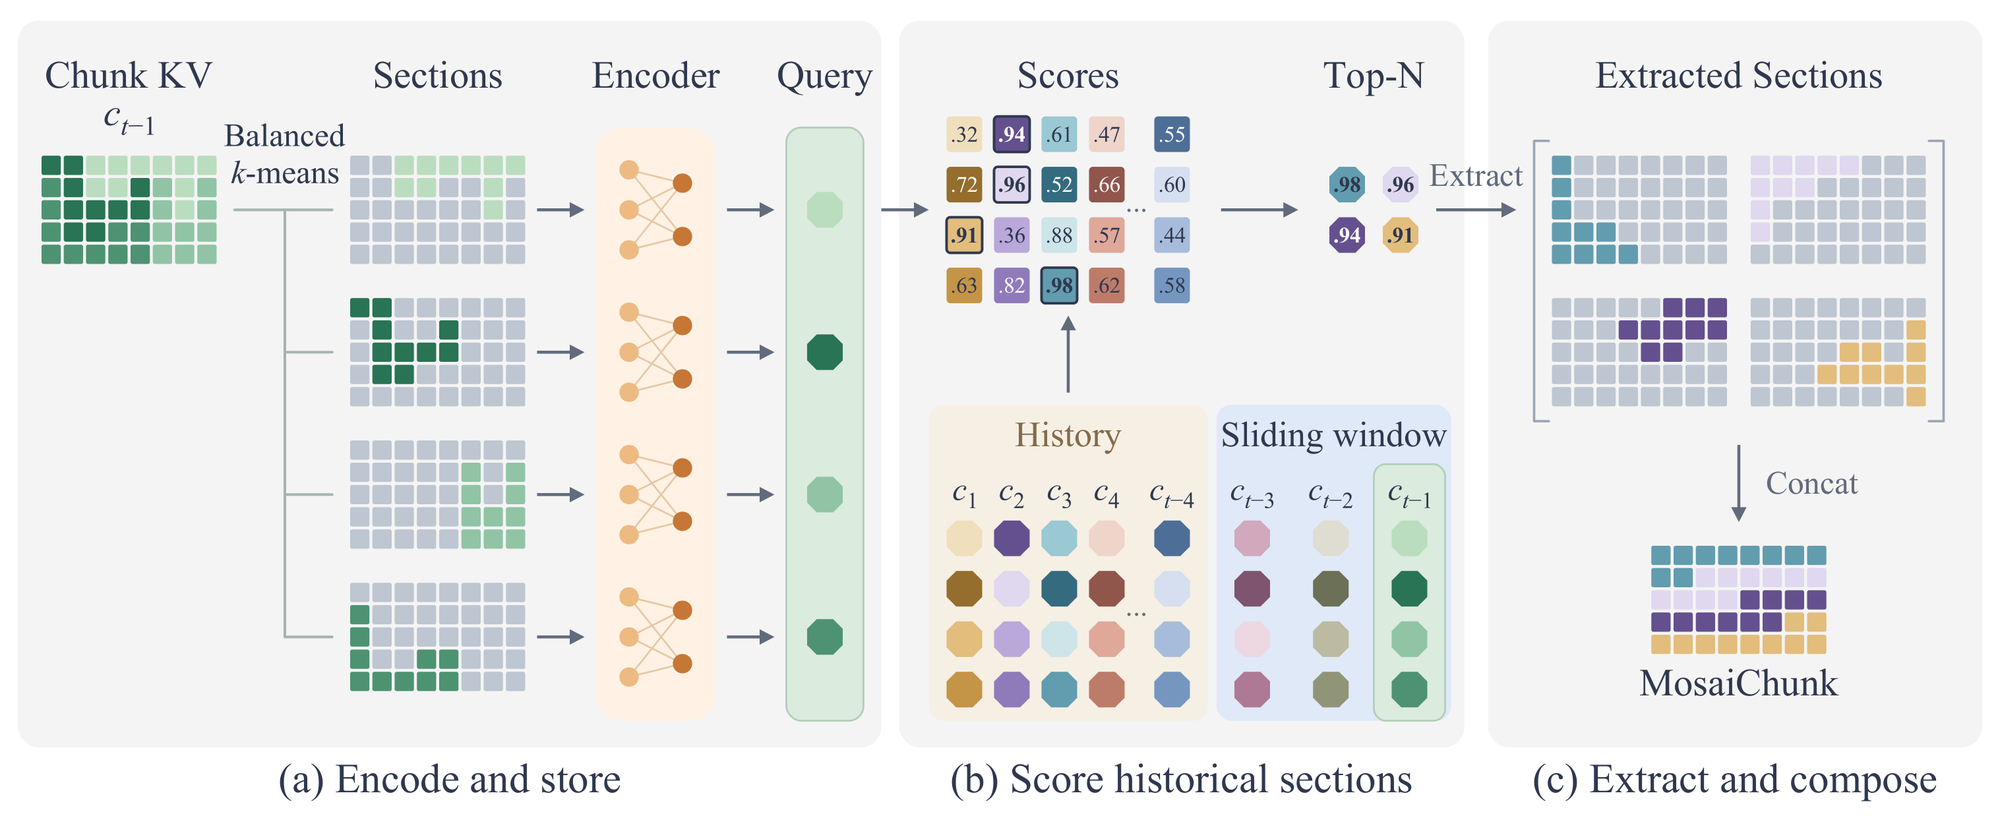
- 实验效果:在 MiniMax-H3 改造的自回归版 H3-AR(T2V)上,两块远程记忆预算下回访 CLIP 从滑窗基线 0.751 升到 0.936,LPIPS 从 0.652 降到 0.500,优于整块检索 MoC(0.841);LingBot-World-Infinity(I2V)180° 旋转回访 CLIP 0.793→0.863。路由器只有 13.65M 参数。

- 批判点评:自建基准涨幅大,公开基准涨幅小:WBench 的 Subject 一致性仅 88.10→88.38,两块预算下 Segment 一致性反从 97.47 掉到 94.94;T2V 的 Drift 也略升(0.050→0.055)。论文还写明评测用的是早期 checkpoint:T2V 计划训 4000 步、实取第 416 步,I2V 计划 4768 步、实取第 500 步,未解释为何不用训完的权重。
5. Soundwich:冻结LTX-2.5免训练拆分音轨
Soundwich: Video Generation with Layered and Controllable Audio | 西蒙弗雷泽大学;塞浦路斯大学;CYENS 卓越中心;特拉维夫大学 | arXiv:2610.00691
关键词:音视频联合生成, 音轨分离, 免训练, 时间控制, 可编辑音频
- 前序问题:联合音视频模型已能生成带同步声音的视频,但音频是一条混好的总轨:谁在何时说话、配乐和环境声都没法单独改。实际制作中,对白、音乐、音效、环境声都是分轨编辑的。
- 本文贡献:Soundwich 不做训练,直接改造冻结的 LTX-2.5:先把音频轨迹扩成 N 条可编辑分轨加一条内部场景轨,用缓存的「出声 / 静音」特征(timing carrier)在指定时间窗内回放或压制;再用 gather–broadcast 注意力让各分轨共享全局声学语境,并用实体掩码把每条分轨的跨模态注意力路由到画面中对应的发声者。
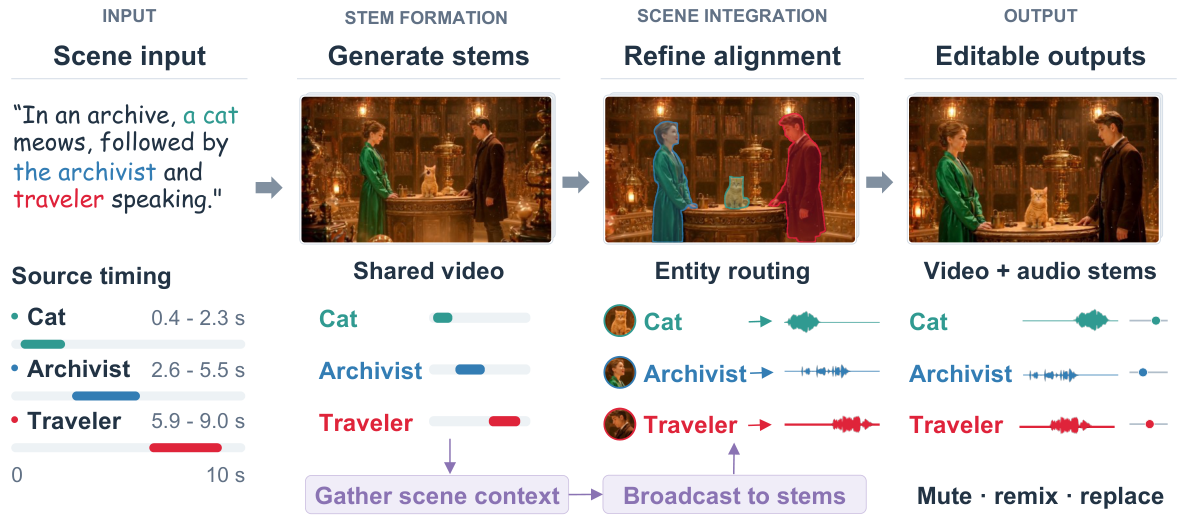
- 实验效果:15 个多声源场景上,时间窗成功率 93.1%、窗外误发声 1.7%、声源归属 90.0%,窗内 WER 0.060;同场景原版 LTX-2.5 窗成功率仅 20.4%,MiniMax H3 为 27.0%,Gemini Omni 为 85.0%。去掉 timing carrier,窗成功率从 93.3% 跌到 15.6%。
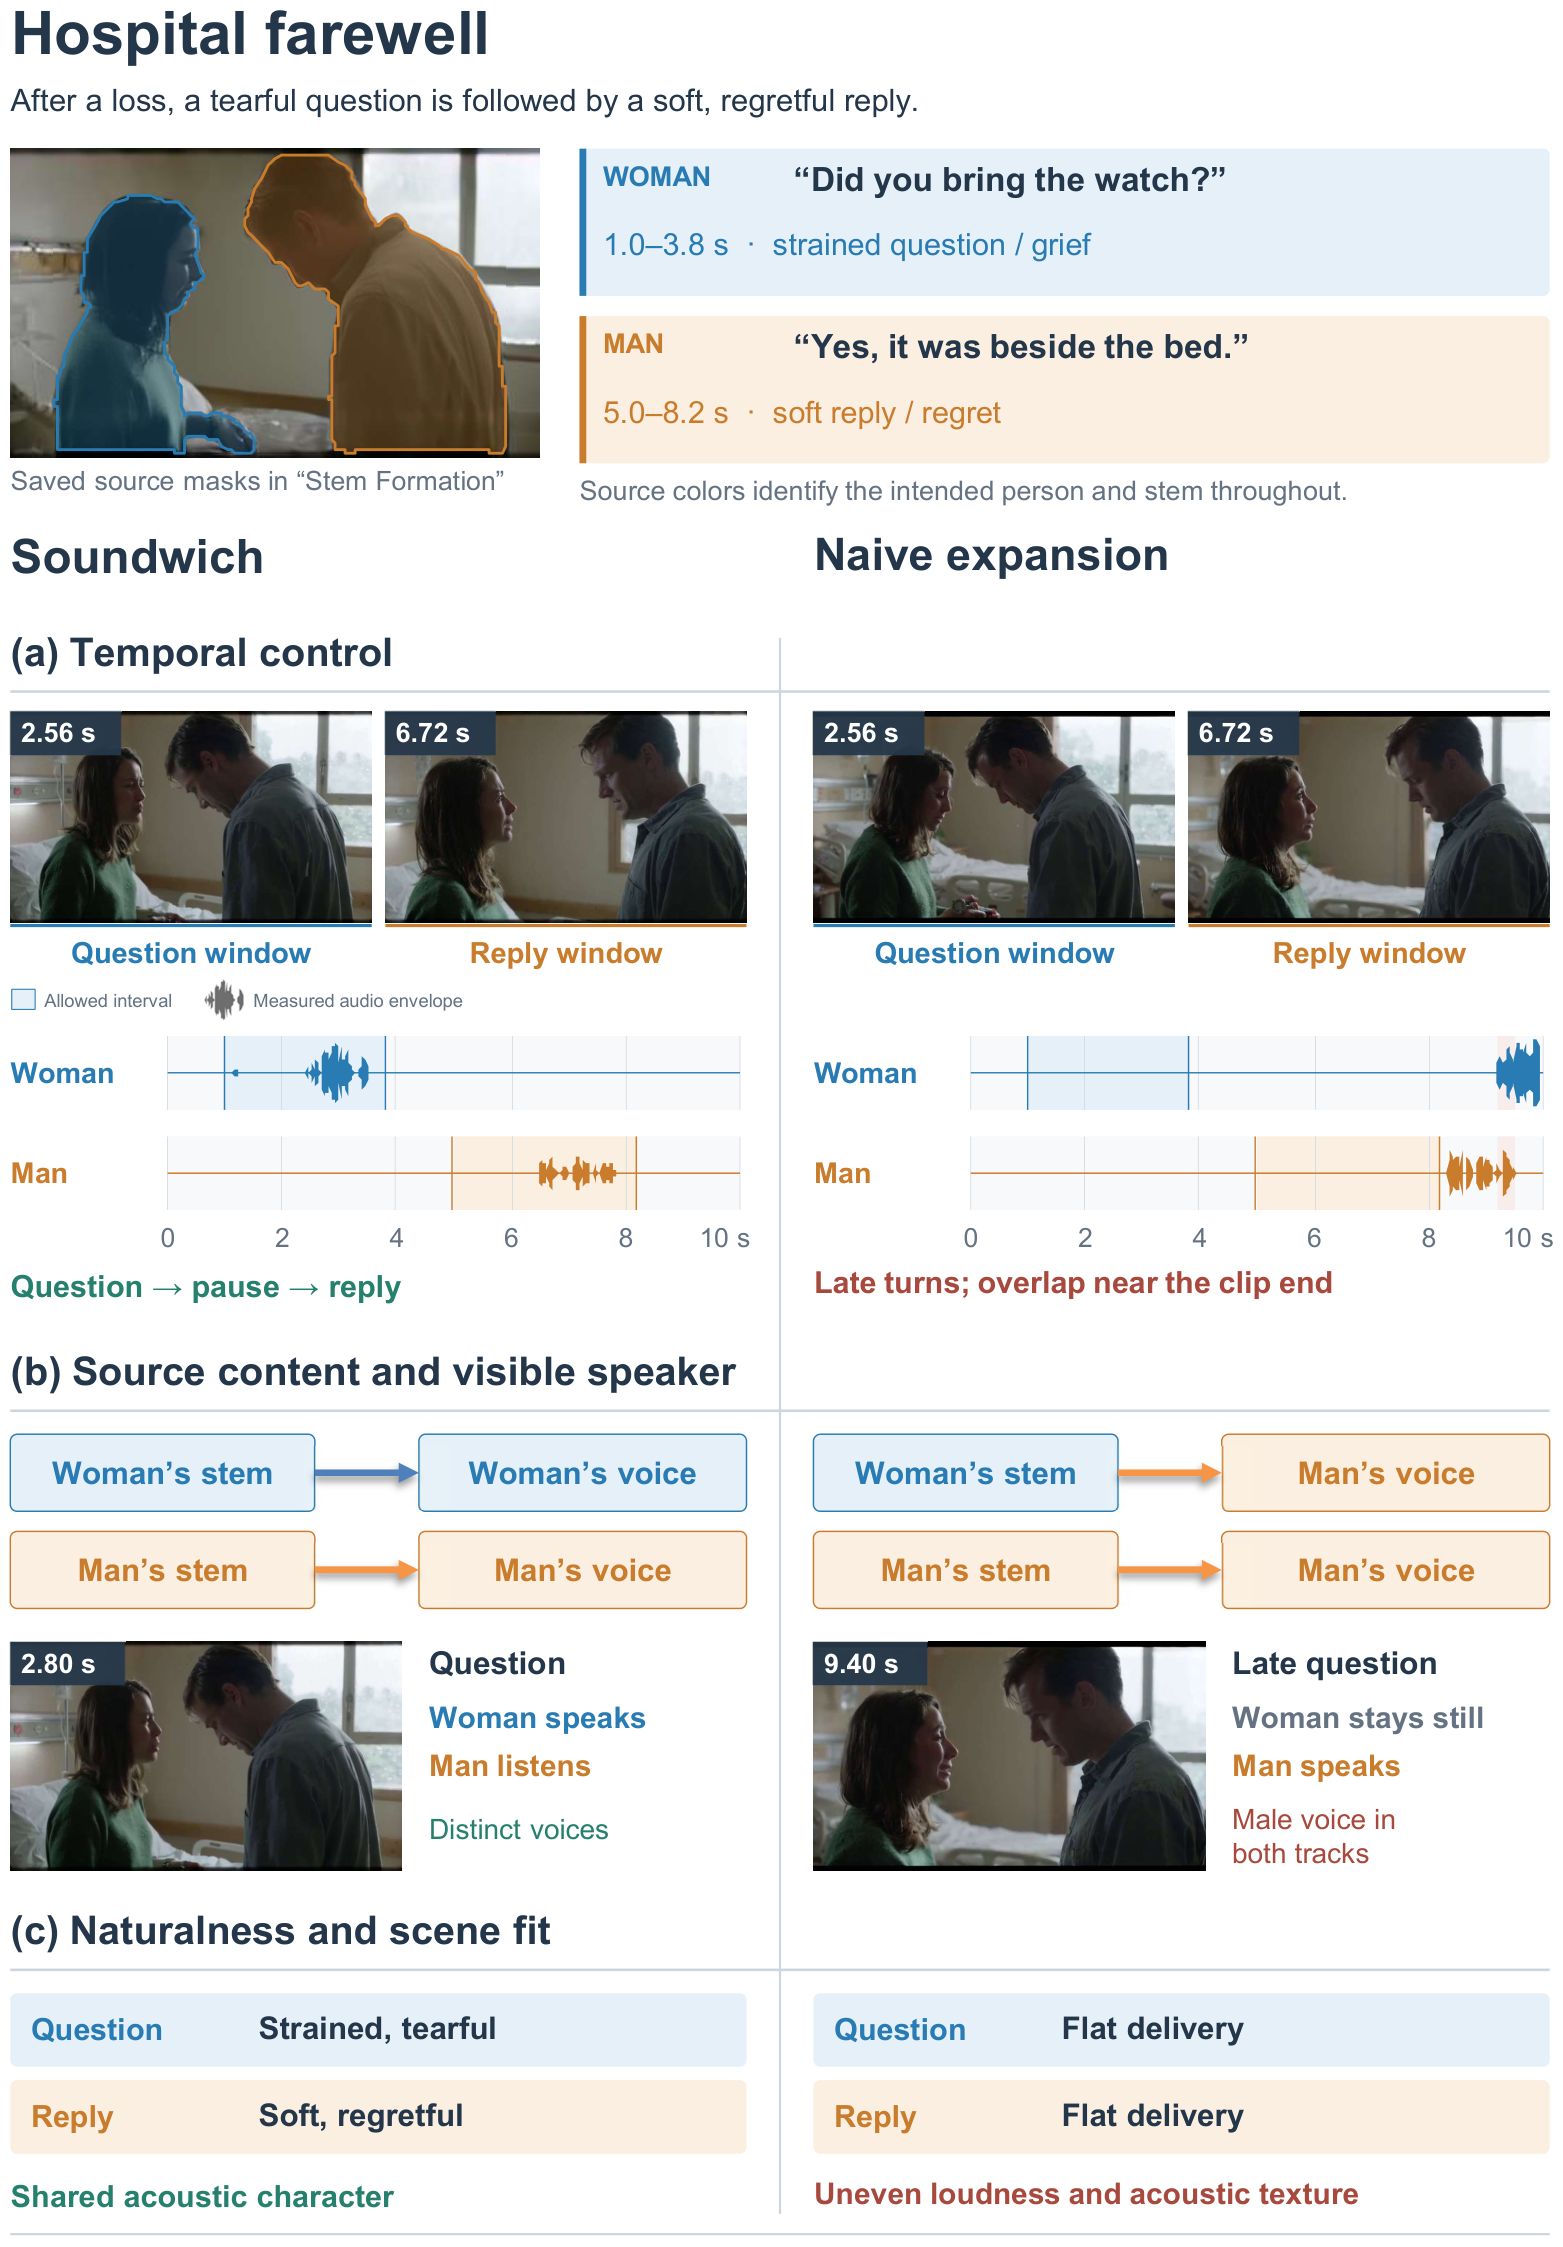
- 批判点评:评测规模很小:主表只有 15 个场景、每场景 3 个固定种子,场景广播模块的人评只收回 15 份问卷。真正接近的对手是闭源 Gemini Omni,WER 0.072 对 0.060、窗成功率 85.0% 对 93.1%,且它只有 14 个场景可计 WER。声源归属 90.0% 比朴素批量扩展的 82.2% 只高 7.8 个点。
6. DMAD:判别器替掉辅助分数网络,4步出片
DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation | 得州农工大学;字节跳动智能创作 | arXiv:2610.02188
关键词:少步蒸馏, 分布匹配, 对抗蒸馏, 视频生成, 音视频生成
- 前序问题:DMD 系列少步蒸馏要从「目标分数 − 学生分数」的差里取梯度,因此必须额外维护一个持续拟合学生分布的辅助扩散模型,显存与算力开销都大,在 14B、33B 级视频模型上尤其吃紧。
- 本文贡献:DMAD 把分布匹配改写成分类:共享主干上挂两个判别头,分别区分「真实数据 vs 学生」与「教师样本 vs 学生」,用 logit 直接学习对数密度比,学生只用作用在 logit 上的线性损失训练,无需拟合辅助分数。作者证明判别器最优时该损失恰好还原 DMD 的梯度,并用真实头在真实与教师样本间的 logit 差,自适应调节各噪声级上教师监督的权重。

- 实验效果:ImageNet-64 一步 FID 1.04(加投影判别器),SDXL 四步 COCO-10K FID 14.47,Wan2.1-14B 四步 VBench 85.15,均优于所比少步方法与多步教师。在 MiniMax-H3-33B 联合音视频生成上,四步学生人评总体偏好 79.1% 胜 DMD2、84.6% 胜 rCM;每次生成器更新耗时从 818.1s 降到 233.3s。
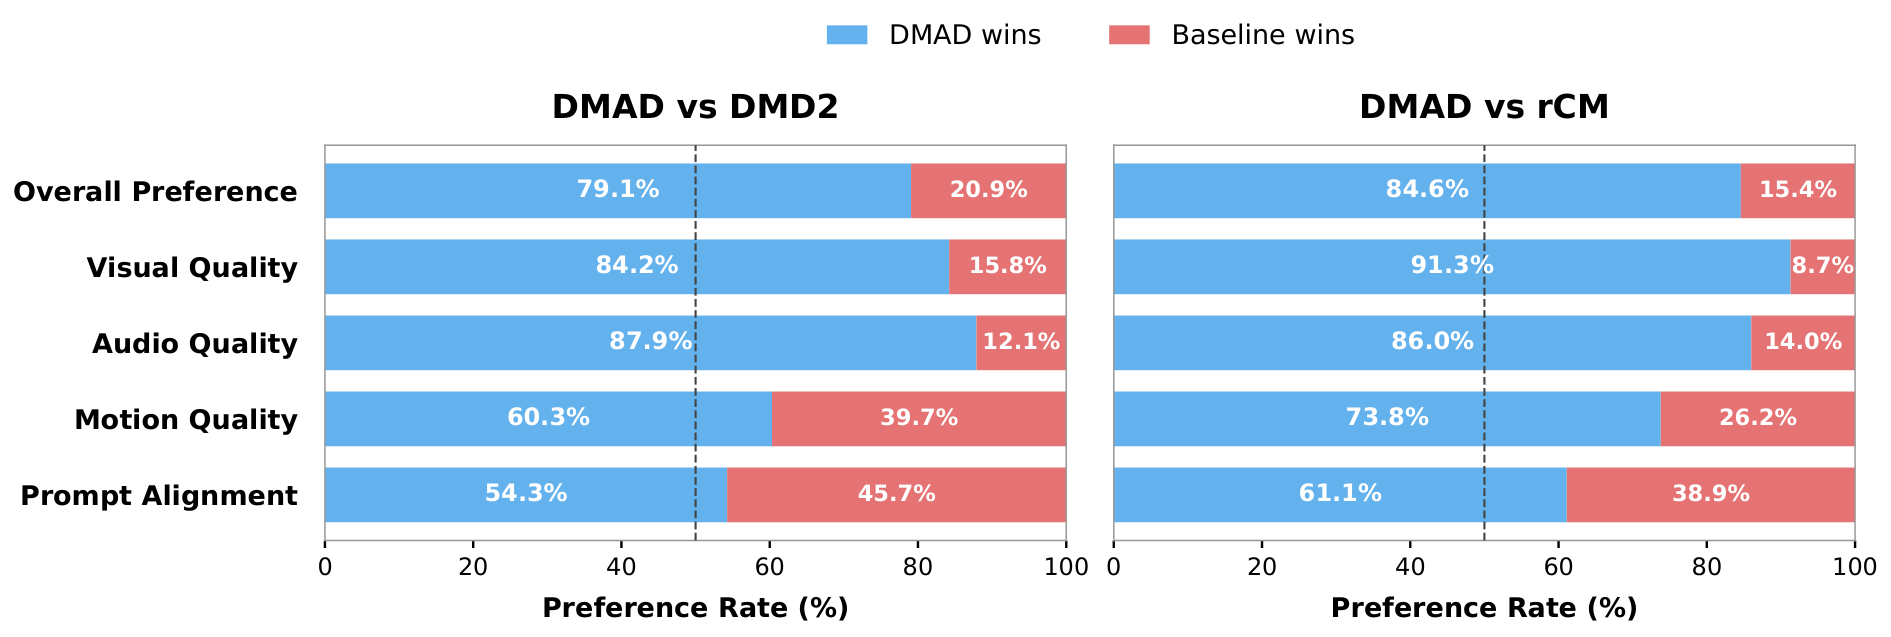
- 批判点评:人评高分主要来自画质与音质(对 DMD2 胜率 84.2% / 87.9%),提示词对齐只有 54.3% 对 45.7%,接近打平。AVGen-Bench 上音画同步 AV 分 49.1,低于 DMD2 的 56.7;唇形同步 30.6,离教师的 39.0 也远。SDXL 一步时 Patch FID 32.42,反而比 DMD2 的 26.98 差,细节保真不如整体 FID 好看。
7. FlashForward:复用在途KV,4卡流水线生成长视频
In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion | Meta;南洋理工大学 | arXiv:2609.32540
关键词:自回归视频扩散, KV 缓存, 流水线并行, 长视频生成, 推理加速
- 前序问题:少步自回归视频扩散按 chunk 逐段生成。为记住已生成内容,Self-Forcing、HiAR 等方法要额外跑「只更新缓存、不推进输出」的前向来重建干净或低噪 KV。可每次去噪前向本来就算出了当前 chunk 的 KV,这部分被白白浪费。
- 本文贡献:FlashForward 直接复用每个去噪阶段算出的「在途」KV:当前 chunk 完成一个阶段后,该阶段的缓存即可供下一个 chunk 使用,于是每张 GPU 负责一个去噪阶段,不同 chunk 在卡间流水并行。为弥补噪声历史带来的外观与运动漂移,再由 planner 预先生成稀疏的干净锚点 latent,从前后两侧约束 renderer 的轨迹。
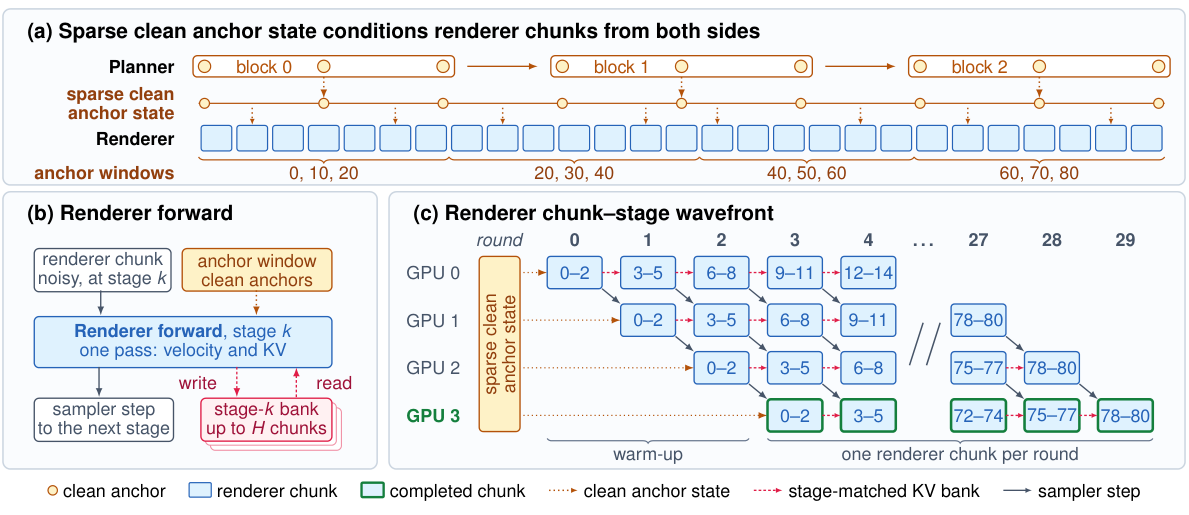
- 实验效果:4 卡下,16 FPS、20 秒以上视频比 HiAR 快 1.16–1.69 倍、比 Self-Forcing 快 1.42–2.92 倍(1.3B 与 14B,480p / 720p)。1.3B 480p 生成 65 秒视频去噪耗时 21.3s(HiAR 24.7s、Self-Forcing 65.1s);VBench 总分 0.838,65 秒 VBench-Long 0.8395,高于 Self-Forcing 的 0.7806。
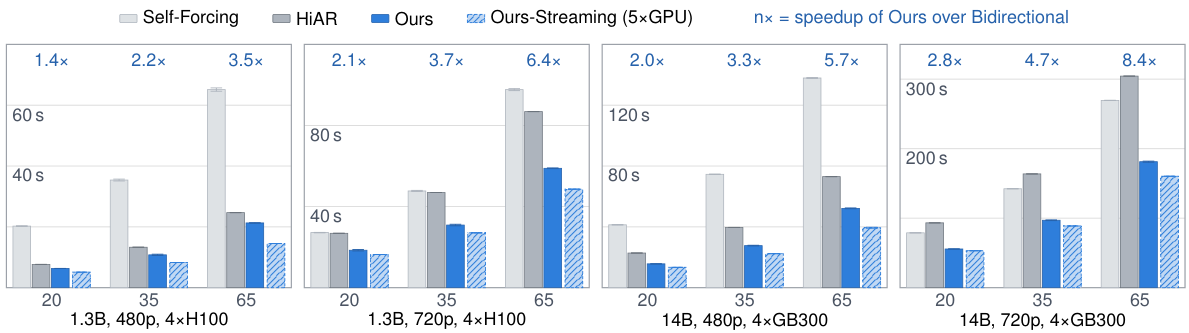
- 批判点评:提速依赖多卡流水:单卡 480p 下它比 Self-Forcing 还慢(20 秒视频 17.77s 对 17.44s,65 秒 59.64s 对 57.89s)。生成 5 秒短片时 4 卡耗时 2.21s,慢于 HiAR 的 2.06s,更慢于双向模型的 1.13s。14B 720p 峰值显存 112.8 GiB/卡,比 Self-Forcing 多约 20 GiB;20 秒视频语义分 0.748 也略低于 HiAR 的 0.757。
8. TVRL:用VLM梯度给视频token分功劳
Token-Level Video Reinforcement Learning | 美国东北大学 | arXiv:2610.01973
关键词:视频生成, 强化学习, GRPO, 信用分配, VLM 奖励
- 前序问题:视频生成的 RL 后训练通常给整段视频一个标量奖励。可视频的缺陷是局部的:有的 token 已满足提示词,有的才需要修。标量奖励定位不了错误,优化时既会扰动本来正确的区域,又对真正出错的区域用力不足。
- 本文贡献:TVRL 让奖励自己给出 token 级功劳:冻结 VLM 对提示词拆出的若干是非题给出答案似然,平均后作为视频级奖励;同一 VLM 对视频输入的梯度幅值,则标出哪些生成 token 最影响该得分。在 GRPO 中,组相对优势决定更新方向与强度,经 3×3 平滑、按问题条件化的 credit 图在裁剪策略比内重加权各去噪步的转移对数概率。
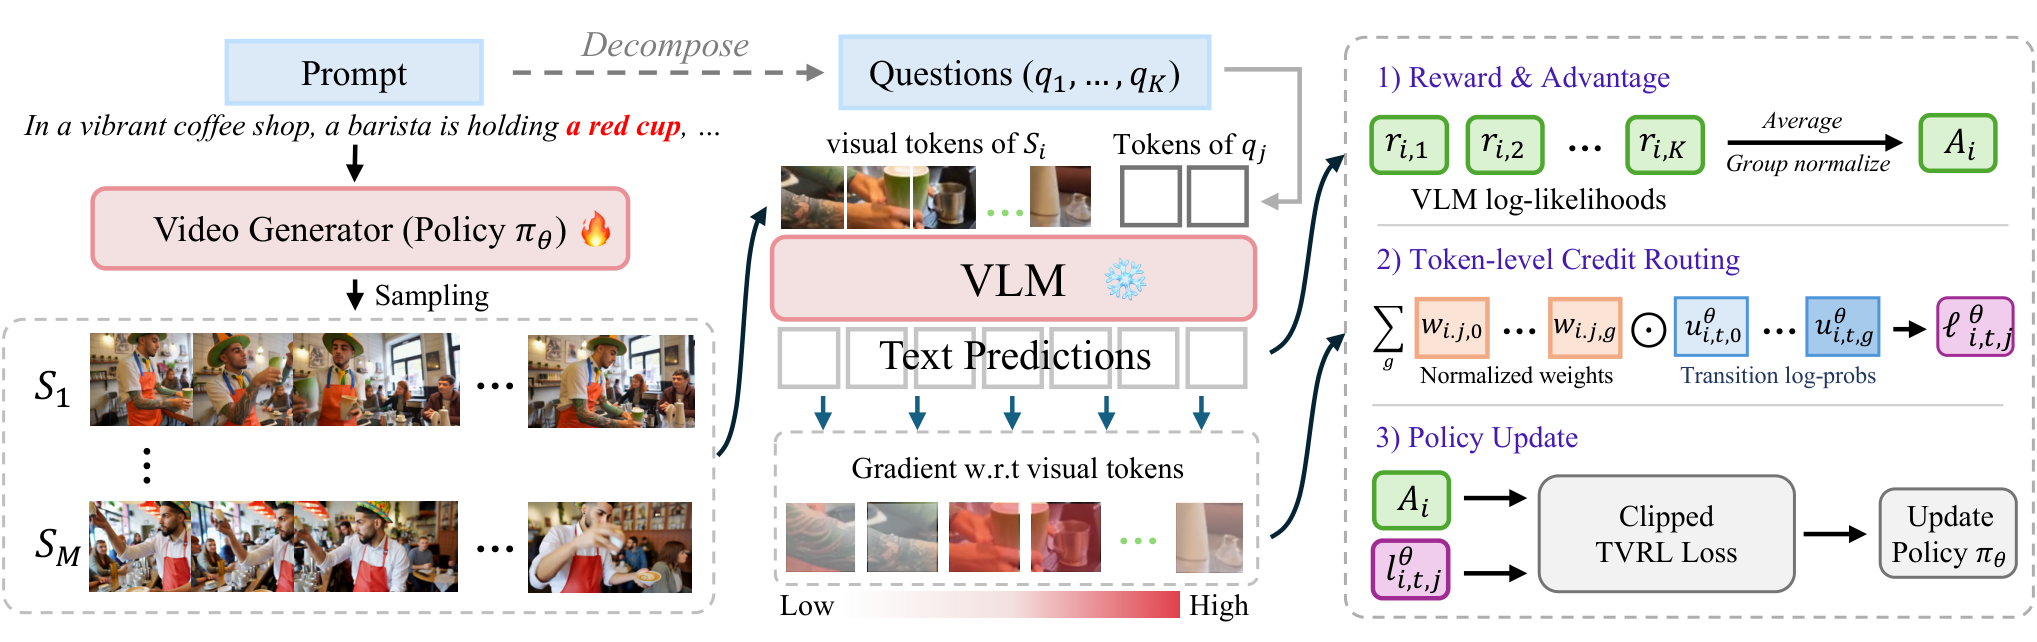
- 实验效果:以 HunyuanVideo-1.5 为底座、Qwen3.5-9B 作奖励,VBench-2.0 Overall 从 54.09 升到 57.69(+3.60),同设置 GRPO 仅 54.54。换 SAGE、Flow、Dance 三种 SDE 采样器,比匹配 GRPO 高 2.68–3.15;换 VideoAlign 等四种奖励模型,高 1.33–3.15。

- 批判点评:增益并不均匀:常识维度上 TVRL 常不如 GRPO(Qwen3.5-9B 奖励下 64.31 对 64.88,VideoScore2 下 64.60 对 64.89),VideoScore2 下 Human 维度也从 91.52 降到 90.79。评论家规模很关键:换成 Qwen3.5-0.8B 时 Overall 仅 51.85,比未训练的底座 54.09 还低。所有结果都只训 100 步(64 张 A100),单步耗时比 GRPO 多 18%。
9. PixelDense:4个冻结老师分两路对齐像素扩散
PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion | 弗吉尼亚大学;密歇根州立大学;Adobe;Arcade AI | arXiv:2610.00483
关键词:像素扩散, 表征对齐, 稠密预测, 文生图, 几何先验
- 前序问题:REPA 通过对齐预训练编码器特征来加速 DiT 训练,但对齐目标几乎都是 DINOv2、CLIP 这类语义编码器。已有分析指出起作用的是空间结构而非全局语义,那么专门预测结构的稠密预测模型(分割、深度)为何没人拿来当对齐老师?
- 本文贡献:在像素空间扩散上,作者先验证 SAM2、Depth Anything v2、Metric3D v2 单独加入都优于只用 DINOv2,但四个老师直接相加反而不如最好的单个几何老师,语义与几何梯度在同一投影上互相争抢。PixelDense 因此让 DINOv2+SAM2 走语义投影流、两个深度模型走几何投影流,再加权重空间正交惩罚让两流处在不相交子空间;老师全部冻结、推理时丢弃。

- 实验效果:在 PixelGen-XXL(512×512)上,GenEval Overall 0.7927→0.8093,DPG 78.7→78.9,HPS 0.280→0.282;同一配方不调参迁移到 DeCo,GenEval 0.8620→0.8690。部分加噪重建中,τ=0.5 时 COCO 全景 PQ 23.23→31.43;PIE-Bench 上 SDEdit 背景 PSNR 最多高 2.2 dB。论文已接收 NeurIPS 2026。

- 批判点评:几何探针涨得多,生成指标涨得少:GenEval 只 +0.017、DPG +0.2、HPS +0.002,DeCo 上 +0.007,计数项 58.75 仍低于 PixelGen 原版的 59。消融里单独的几何流(DA2+M3D)只有 0.7960,还不如 DINOv2+DA2 单老师的 0.8069。主实验只是在已发布权重上用 2 张 H200 微调 1 万步,从头训练仅给出「1.23 倍更快达到基线峰值」一项。
10. VIEScore2:16×16网格同时打分并圈出缺陷
VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations | 滑铁卢大学;NVIDIA;台湾大学(中国台湾);南洋理工大学 | arXiv:2610.00994
关键词:图像评测, 缺陷定位, 生成与编辑, GRPO, VLM 评估器
- 前序问题:现有合成图评估器大多只给一个标量分数,不说明依据在图上哪里;能定位缺陷的模型又通常不打分、也不支持编辑任务的条件图输入。生成与编辑的评测和奖励信号,缺一个「既能打分也能指位置」的统一接口。
- 本文贡献:VIEScore2 把图像表示为 N×N(默认 16×16)文本网格,单次前向同时输出感知质量、语义一致性分数与缺陷格子位置,支持可选条件图,覆盖文生图、编辑、参考图生成等任务。它基于 Qwen3-VL-8B 在 38K 条混合监督上先 SFT,再以 Dice 重叠、分数准确度与格式奖励做 GRPO,最后用无参数解析器把网格结果转成可读解释。
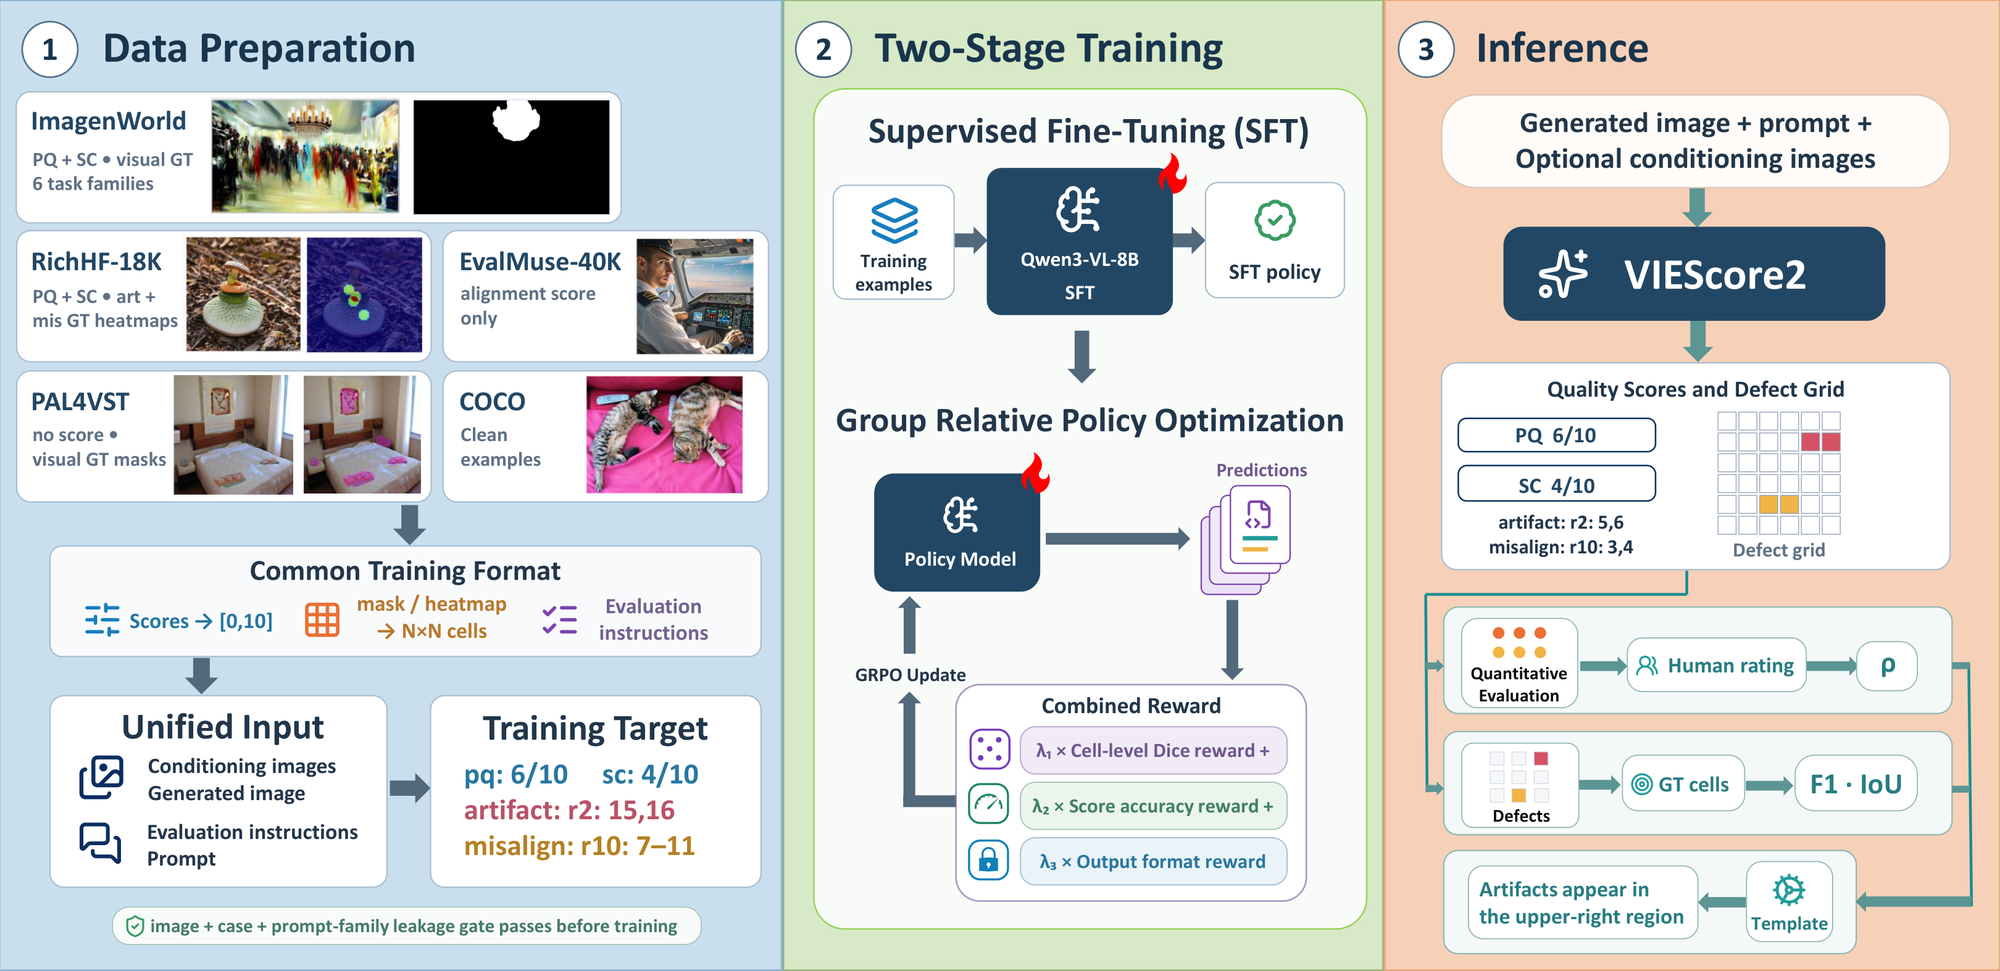
- 实验效果:主测试集整体分数 SRCC 0.601,高于同输入下最强的零样本通用 VLM Gemini-3-Flash(0.491)与 GPT-5.6-sol(0.437);联合评测网格 IoU 0.324,Qwen3-VL-8B 原版仅 0.070。缺陷定位在 6 个基准中 3 个第一、5 个进前三。

- 批判点评:整体领先主要来自训练同源数据:RichHF(0.692)与 EvalMuse(0.803)拉高均值,编辑类子集反被零样本 API 压过,TIE 0.429 对 Gemini-3-Flash 的 0.686,MRIE 0.417 对 GPT-5.6-sol 的 0.684。定位上,轻量的 SegFormer-b0 在主测试集 F1 拿到 0.493,与它的 0.506 相差无几;GRPO 之后 PQ 的 SRCC 还从 0.580 降到 0.558。
趋势观察
「加算力不加参数」成了今天的共同母题
Looped-DiT 让同一组块在每个去噪步里绕 4 圈,NEPA-DiT 每步重算一次预测嵌入当条件,两者都用额外推理算力换质量而不是加参数;但细看算力表,前者每步 1.83 倍 GFLOPs,后者单图多 76% TFLOPs,「小模型赢大模型」的账要连推理成本一起算。另一头,DMAD 与 FlashForward 继续在蒸馏和 KV 复用上压缩视频生成的步数与等待时间,TVRL 与 VIEScore2 则把奖励和评测从一个标量推进到 token 与网格级定位。
人工智能炼丹君 整理 | 2026-10-04
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注









评论 (0)