


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

同样走完采样器的每一步,能不能少算几次昂贵的去噪网络?跨步缓存把这个问题拆成两件事:复用什么,以及什么时候必须刷新。本文用残差缓存的最小实验解释机制,再对照 DeepCache 和 TeaCache 的真实实现。实验是人工构造的数值系统,不是视频模型的质量或速度复现。
本文承接 DDIM 与高阶采样器、DiT 和 性能建模与 Profiling。默认读者知道采样器会反复调用网络,不要求先读缓存论文。论文版本与固定提交源码核对日期为 2026-11-10。
一次视频生成中,潜变量在逐步变化,文本条件通常固定,网络却要一遍遍穿过相同的模块。假如两次调用的深层特征几乎一样,重新计算这部分就可能浪费时间。但“几乎一样”只是观测,不能推出“任意一次都可以省”。运动切换、条件变化和采样末期的细节修整,都可能让陈旧特征的误差显现。
这里最具体的失败场景是固定间隔缓存:先完整算一次,之后连续复用,直到计数器要求刷新。如果变化突然出现在间隔中间,策略不会因为内容变了而提前刷新。反过来,如果某段变化很慢,固定间隔也会做多余的完整计算。问题在于日历式排期没有感知当前输入,周期短会损失收益,周期长会增加近似误差。
本文实验保留全部 40 次状态更新。精确版本执行 40 次完整残差计算;自适应阈值为 0.16 时,只执行 11 次,复用 29 次。终点相对误差为 0.008222。它证明了在这个特定数值系统中确实可以减少计算次数,同时也证明输出发生了变化。它不证明视频质量达标,更不证明真实 GPU 上能得到相同的提速。
缓存适合回答“这个步骤里,哪些计算可以暂时沿用”。减少采样步数则改变采样器的离散路径。两种方法可以组合,但组合后的误差要重新评估:单独用缓存通过了一组样例,不意味着换成少步采样器后仍然通过。
第一,把网络拆成每步仍要计算的部分,以及准备复用的昂贵部分。第二,保存上次完整计算得到的特征或残差,用便宜的变化指标决定是否刷新。第三,即使命中缓存,当前输入仍然要参与输出,采样器仍然继续更新状态。
以残差形式为例,设当前嵌入是 $h_i$,完整模块输出为 $G(h_i,t_i,c)$。缓存保存的是 $R_i=G(h_i,t_i,c)-h_i$。如果上次刷新发生在 $r$,当前近似模块输出是 $h_i+R_r$。符号 $i$ 表示第几次网络调用,$t_i$ 是这次调用的时间条件,$c$ 是固定的文本等条件;$r$ 是缓存的生成时刻,通常小于当前 $i$。
这三句话的重点是“当前输入加旧残差”。如果直接把整个旧输出拿回来,连当前输入的变化也被抹掉了。残差复用仍然有误差,只是保留了输入的直通更新。DeepCache 的 U-Net 高层特征缓存并不等于这个残差写法,不能把所有缓存方法都称为同一个算法。
设 $E$ 是便宜的输入嵌入,$G$ 是昂贵模块,$H$ 是输出头。完整调用写为:
$$h_i=E(x_i,t_i,c),\quad R_i=G(h_i,t_i,c)-h_i,\quad y_i=H(h_i+R_i,t_i,c)$$
$x_i$ 是采样器当前的潜变量;$h_i$ 是网络内部的嵌入,不必与 $x_i$ 形状相同;$R_i$ 是昂贵模块对嵌入的修正;$y_i$ 是送回采样器的网络预测。这里的预测可以按模型定义代表噪声或速度,缓存逻辑本身不替模型选择参数化。等式只是代数分解,不要求模型专门训练一个名叫“残差缓存”的层。
命中缓存后,输入嵌入和输出头仍按当前条件计算:
$$\widehat{y}_i=H(h_i+R_r,t_i,c),\quad r<i$$
帽子表示近似计算。比较精确与近似时,先固定当前同一个 $h_i$:误差来自 $R_r$ 替代了 $R_i$,而不是来自状态已经分叉。若输出头在所讨论的局部区域满足 Lipschitz 条件,常数记作 $L_H$,那么:
$$\|\widehat{y}_i-y_i\|\leq L_H\|R_r-R_i\|$$
Lipschitz 条件的意思是输入变化不能被这个局部映射无限放大;$L_H$ 是放大上限。本文没有测出真实模型的 $L_H$,这个式子是带假设的分析工具,不是线上质量保证。它告诉我们,缓存内部误差小仍然需要考虑输出头的敏感性。
直接计算 $\|R_i-R_r\|$ 能判断缓存是否陈旧,但得到 $R_i$ 就已经做了昂贵计算。为了节省计算,需要先观察一个便宜的量 $m_i$。它可以由当前嵌入与时间条件构造。相邻调用的相对 L1 变化写为:
$$d_i=\frac{\operatorname{mean}|m_i-m_{i-1}|}{\max(\operatorname{mean}|m_{i-1}|,\varepsilon)}$$
$\operatorname{mean}$ 对张量所有元素取平均,绝对值逐元素计算,$\varepsilon$ 是防止除零的小正数。两次张量形状一致时,均值之比等于 L1 范数之比。这个值没有单位,反映变化相对之前幅度有多大。分母很小时,它也可能变得敏感,不能把这种数值问题误判成内容剧烈变化。
本文教学实现取 $\varepsilon=10^{-12}$。该保护和后面非负累计属于教学实现的防御性处理;不能据此声称官方代码逐字采用相同逻辑。
最直觉的想法是:如果每一步变化都很小,就一直复用。但缓存对应的是刷新时刻 $r$,不是上一时刻。利用三角不等式:
$$\|m_i-m_r\|\leq\sum_{j=r+1}^{i}\|m_j-m_{j-1}\|$$
这里 $j$ 遍历刷新之后的调用。即使单步变化很小,连续多步也会积累成明显差异,因此策略应保留“自上次刷新以来的变化预算”。把范数具体取成平均绝对值,记 $b_j=\max(\operatorname{mean}|m_{j-1}|,\varepsilon)$,则第 $j$ 步的绝对变化正好是 $b_j d_j$。逐项代入三角不等式得到
$$\operatorname{mean}|m_i-m_r|\leq\sum_{j=r+1}^{i}b_j d_j\leq b_{\max}\sum_{j=r+1}^{i}d_j$$
其中 $b_{\max}=\max_{r\lt j\leq i} b_j$。同一个累计相对值在不同输入幅度下可以对应不同的绝对变化。要进一步控制残差误差,还需要知道代理变化怎样约束残差变化。这里的代理只提供刷新信号。
实际决策可以采用累计代理:
$$\widetilde A_i=A_{i-1}+g(d_i),\quad \text{refresh if } \widetilde A_i\geq\delta$$
$\widetilde A_i$ 是做决策前的预算,$A_i$ 是本次调用结束后保存的预算。$g$ 将输入变化映射到预估的输出变化,$\delta$ 是刷新阈值。若刷新,保存新残差并令 $A_i=0$。若命中,令 $A_i=\widetilde A_i$。首次调用还没有相邻代理,直接完整计算并从零开始累计。TeaCache 使用多项式重标定来改善这种代理;拟合关系是经验估计,不会把统计相关性变成对所有样本成立的数学上界。TeaCache 原文第 3.2–3.3 节 给出了指标与累计决策。
本文取 $g(d)=d$,以便只观察状态机。阈值 0.16 因而只属于本实验的代理尺度,不能迁移成真实模型的推荐阈值。换掉嵌入幅度、时间调制或采样路径,同一个阈值对应的刷新频率就会改变。
现在让两条轨迹分别使用精确和近似输出。为便于推导,考虑显式 Euler 更新:
$$x_{i+1}=x_i+\Delta s_i v(x_i,s_i),\quad \widehat x_{i+1}=\widehat x_i+\Delta s_i\widehat{v}(\widehat x_i,s_i)$$
$s_i$ 是积分坐标,$\Delta s_i>0$ 是步长,$v$ 是精确向量场,$\widehat{v}$ 使用缓存近似。令 $e_i=\|\widehat x_i-x_i\|$ 表示轨迹差异,令 $\eta_i=\|\widehat{v}(\widehat x_i,s_i)-v(\widehat x_i,s_i)\|$ 表示在近似轨迹当前状态上的局部缓存误差。
令 $q_i=\widehat x_i-x_i$。在两条更新的差里加减 $v(\widehat x_i,s_i)$,得到
$$q_{i+1}=q_i+\Delta s_i[\widehat{v}(\widehat x_i,s_i)-v(\widehat x_i,s_i)]+\Delta s_i[v(\widehat x_i,s_i)-v(x_i,s_i)]$$
第一对方括号用同一个输入状态比较两次预测,范数为 $\eta_i$。第二对方括号来自轨迹分叉。若 $v$ 在覆盖两条轨迹的区域内对状态满足 Lipschitz 条件,其范数至多为 $Le_i$。再用三角不等式得到
$$e_{i+1}\leq(1+\Delta s_iL)e_i+\Delta s_i\eta_i$$
若初始状态相同,则 $e_0=0$。重复代入可得:
$$e_N\leq\sum_{i=0}^{N-1}\Delta s_i\eta_i\prod_{j=i+1}^{N-1}(1+\Delta s_jL)$$
空乘积取 1。这个展开说明早期误差会通过后续更新传播;最后一次强制刷新只能去掉最后一次局部缓存误差,不能恢复此前已经走偏的轨迹。真实系统可能局部收缩,实际误差小于这个上界;高阶求解器还涉及历史预测,不能把 Euler 的式子直接冒充所有采样器的误差定理。
令 $N$ 是总调用数,$K$ 是完整计算数,$C_0$ 是无缓存基线的一次调用成本,$C_r$ 是带缓存的刷新调用成本,$C_h$ 是命中调用成本。$C_o$ 表示两边相同的固定成本。用各类调用的代表性成本近似整条轨迹,可得
$$S=\frac{NC_0+C_o}{KC_r+(N-K)C_h+C_o}$$
把分母移到比较式另一侧并按刷新与命中分组,盈亏条件是
$$(N-K)(C_0-C_h)\gt K(C_r-C_0)$$
左边是命中省下的成本,右边是刷新额外增加的成本。$C_r$ 可以包含代理计算、缓存写入和同步。$C_h$ 仍含嵌入、判定、读缓存、输出头和采样器更新。文本编码、VAE 解码和输出处理等开销由 $C_o$ 计入。各类调用成本波动大时,可以直接对逐次计时求和。
第 04 节取 $C_0=C_r=1$、$C_h=0.08$、$C_o=0$,并代入真实的 $K$ 计算教学成本比。仍以 11 次刷新和 29 次命中为例,如果 $C_r=1.2$、$C_h=0.95$,命中节省 1.45 个单位,刷新却多花 2.20 个单位,总成本为 40.75,超过基线的 40。两种账本的命中率都是 72.5%。这些成本单位都来自假设,实际部署需要逐类测量。
完整脚本是文末的 cache_demo.py,依赖 NumPy 与 matplotlib,无需模型权重。它构造一个四层非线性残差函数,用固定随机种子产生输入和矩阵。输入形状是 $(B,L,D)=(1,4,16)$:一个批次、四个位置、十六个通道。张量使用 float64,目的是让读者稳定复核误差,不模拟混合精度推理。
脚本里的 cheap_input 对应 $E$,residual 对应 $R$,proxy 对应 $m$,budget 对应 $A$,threshold 对应 $\delta$。输出头取恒等映射。每次用当前 $h$ 加缓存残差得到预测,然后执行状态更新。积分坐标取 $s_i=i/N$,更新 $N$ 次,每次 $\Delta s_i=1/N$。输入网络的时间标签另取 $t_i=1-i/(N-1)$,只在 $i=0,\ldots,N-1$ 上求值。把代码中的 output 取负作为 $v$,就得到上一节的 Euler 形式。最后一次调用在 $s_{N-1}$,它产生更新后的终点 $s_N=1$。这套时间标签与积分坐标是教学系统的定义。
决策的核心代码如下;变量准备、精确对照、绘图及断言都在完整附录中:
budget += max(change, 0.0)
boundary = i in (0, STEPS - 1)
calculate = boundary or budget >= threshold
if calculate:
    saved_residual = residual(h, t)
    budget = 0.0
output = h + saved_residual
首次调用没有缓存,所以必须完整算。最后一次强制刷新属于本实现的策略。previous_proxy 每一步都更新,saved_residual 只有刷新时更新:把这两件事混淆,就会把“相邻变化累计”写成另一种算法。simulate 每次创建新的状态,避免后一条请求接着用前一条请求的残差。
为了画误差曲线,离线诊断会在每个命中步骤额外计算一次当前残差。刷新步骤已有当前残差,局部误差直接记为零。图中的误差比较固定在近似轨迹的当前输入上。附录的 cache_checks.py 用 diagnostics=False 关闭诊断,拦截残差函数逐次计数,并验证开关诊断时终点和刷新序列逐元素一致。这里的 full_calls 指实际策略需要的残差求值次数。
真实运行环境为 Python 3.11.9、NumPy 2.4.3。基线终点的元素范围为 [-0.791508, 0.614856]。输出如下:
shape=(1, 4, 16), steps=40, seed=7
baseline_range=[-0.791508, 0.614856]
name full_calls hits endpoint_relative_error assumed_speed_ratio
exact 40 0 0.000000 1.000
adaptive_0.08 18 22 0.004939 2.024
adaptive_0.16 11 29 0.008222 3.003
adaptive_0.32 7 33 0.026326 4.149
uniform_4 11 29 0.008672 3.003
All assertions passed; figure=figures/cache_schedule.png
终点相对误差的定义是近似终点与精确终点之差的 L2 范数,除以精确终点的 L2 范数。因此 0.008222 是这个定义下约 0.8222% 的差异,不是 VBench 下降,也不是图像中有 0.8222% 的像素出错。最后一列来自前节假设的成本模型,没有真实延迟单位。
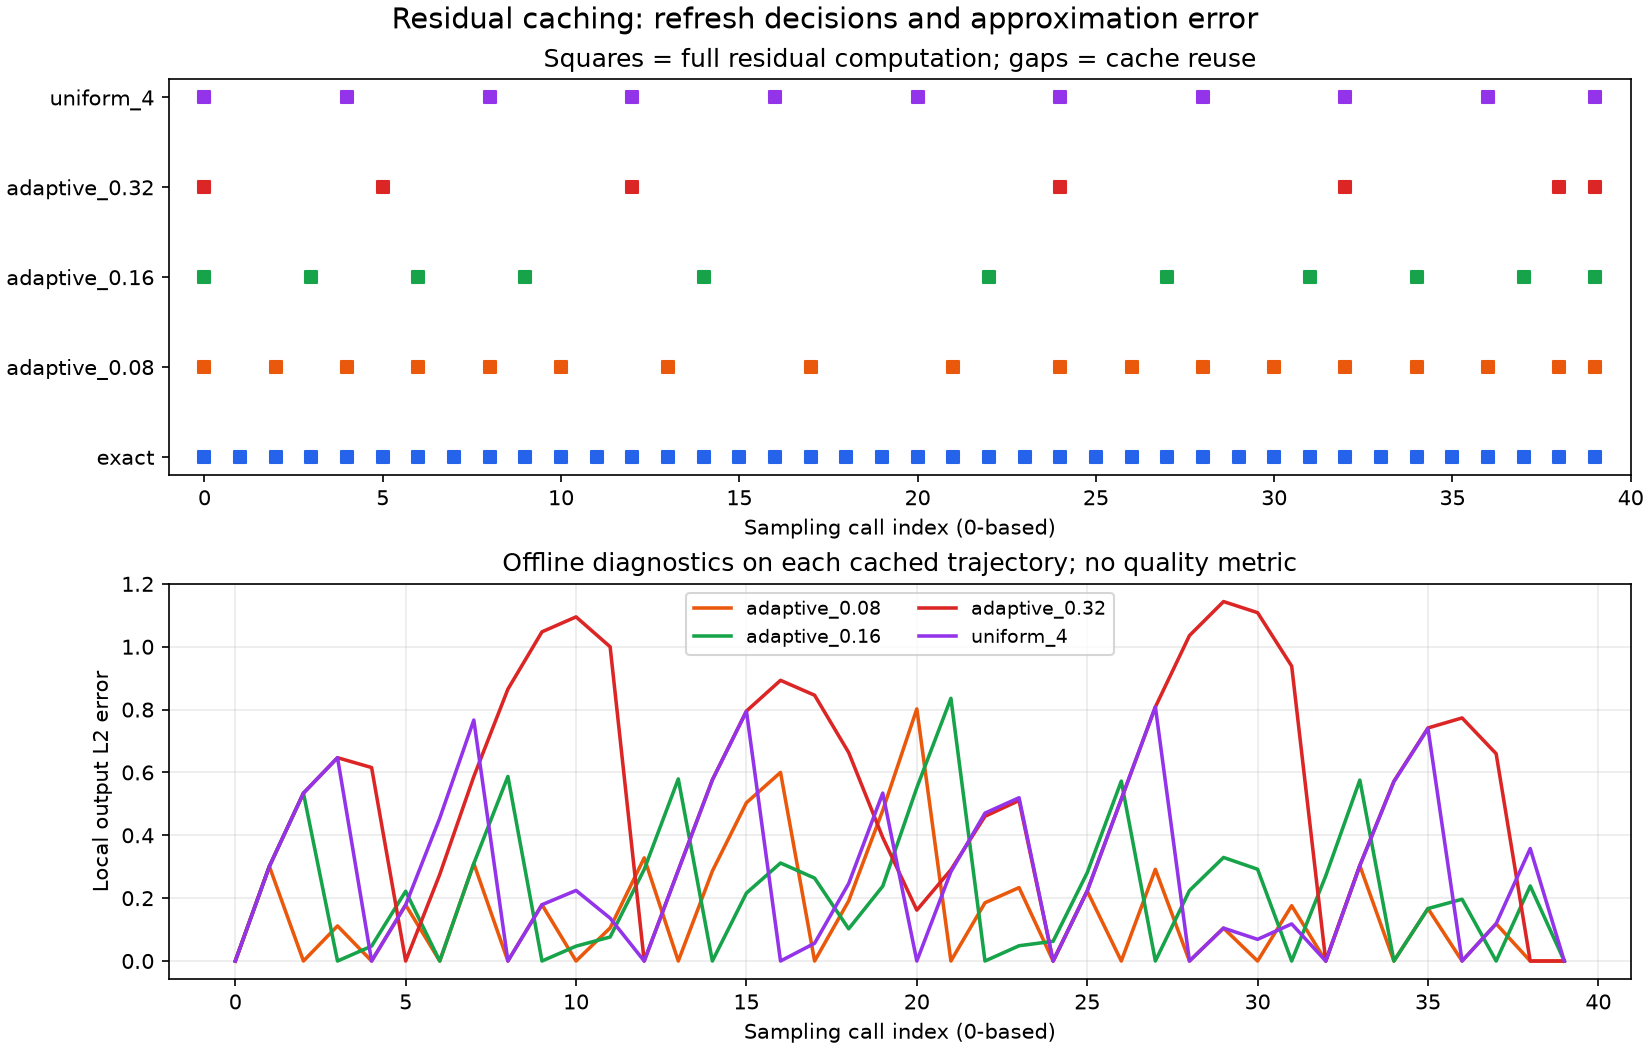
图上半部分每个方块表示一次完整残差计算,空缺表示复用;下半部分是离线诊断得到的局部输出 L2 误差。请先观察刷新是否集中在同一段,再看复用之间误差如何变化。曲线没有用感知质量指标,纵轴不能解读成画面可接受程度。配图由附录脚本生成,数据与上述输出来自同一次实验。
阈值 0.16 与固定间隔 4 都执行了 11 次完整计算,但终点误差略有差异。这是“同样预算也会因刷新位置不同而得到不同结果”的一个实例。它只有一个种子和一个人工系统,不能证明自适应策略在所有输入上优于固定间隔,更不能作为统计显著性结论。
DeepCache 原文第 3.3 节 利用 U-Net 的分支结构:当前浅层特征继续更新,较深分支的高层特征从缓存取回并拼接。它缓存的是特定网络位置的特征,并非本文抽象的整段残差。官方 DeepCache 官方包装器 提供 forward 包装与状态复位;对照时应先找缓存边界,再判断到底省掉了哪些模块。
TeaCache 的 HunyuanVideo 示例 在 teacache_forward 中用首个双流块的时间调制输入计算变化代理。内部调用先把相邻输入的平均绝对差除以上一次输入的平均绝对幅度,再直接累加多项式输出。这个提交没有给分母加 epsilon,也没有把多项式输出截到非负。累计值严格小于阈值时命中,达到阈值时刷新。首尾调用完整计算。命中后把旧的 Transformer 主体残差加到当前图像嵌入上,输出层照常运行。
教学版与上述示例的差异很明确:教学版没有文本分支、真实 patchify、注意力或权重,也没有拟合官方多项式;它只验证预算与残差状态机。真实代码还可能把张量变化转成 CPU 标量,这种同步的代价不能从“指标计算量很小”中自动排除。需要把判定开销也纳入测量。
工程上,缓存状态应属于一次请求,而不是一个可被并发请求共享的随意全局变量。prompt、负向条件、guidance、分辨率、帧数、模型权重或调度器变化时,复用旧状态没有语义依据。只检查张量形状远远不够;两个请求可以形状相同、内容完全不同。失败中断后重新开始生成,也要建立新的缓存生命周期。
若模型采用双分支 CFG,必须考虑条件与无条件分支的缓存分别有效。按 $y=y_u+w(y_c-y_u)$ 写,$y_u$ 与 $y_c$ 分别是无条件和条件预测,$w$ 是 guidance 系数。预测误差满足:
$$\|\Delta y\|\leq |w|\|\Delta y_c\|+|1-w|\|\Delta y_u\|$$
因此较大的 guidance 可能放大分支近似误差。这个式子是代数上的工程分析,不声称所有视频模型都执行双分支 CFG;有些采用蒸馏后的 guidance 条件。接入前要先确认实际预测路径,再决定状态如何隔离。
还要区分采样步和网络调用。调度器可能在一个名义步里求值多次,或重访相同的时间标签。缓存的计数器应跟随真实调用语义。如果只拿界面上显示的步数当数组长度,很容易在错误的位置刷新,或者提前把状态清零。应记录每次实际调用的时间标签、是否刷新和缓存来源,再与调度器对齐。
省的是昂贵模块重复计算,增加的是缓存内存、生命周期管理、判定开销和近似误差。保存一个形状为 $(B,L,D)$ 的残差张量,最低存储量为 $BLDb$ 字节,其中 $b$ 是每个元素的字节数;克隆的输入、多个分支及其他缓存还会额外占空间。长视频中 token 数很大,省算力并不自动省显存。
阈值没有通用刻度。代理的归一化方式、拟合数据、模型层、时间条件与采样器都影响其意义。在某模型上有效的多项式可能在另一个模型或调度器上失配。应在目标分布上先记录输入代理与真实残差变化的对应关系,再评估误判,不能只沿用别人仓库里的常数。
端点刷新是一种保守策略,不是一种证明。即使最后一次完整计算,网络读到的潜变量也已经经过缓存轨迹;它不能把积累误差自动洗掉。判断质量时要看整段生成结果,尤其是动作连续性、物体身份、细节与提示词对应关系,而不是只看最后一个调用的缓存误差归零。
已有很少采样步的蒸馏模型可能没有多少安全的复用空间。短轨迹上每次预测都更重要,进一步减少完整网络调用可能迅速损害质量。动态改变条件的交互式生成、频繁切换控制信号的任务,也不应默认共享同一段缓存。先建立可靠基线,才能判断具体组合是否值得部署。
评测时固定权重、prompt、种子、分辨率、帧数、采样器和 guidance,分别测完整网络计算时间与端到端延迟。预热、设备同步、重复测量和尾延迟都要说明;不要把首次编译的基线与已预热的缓存版放在一起比较。质量样例应包含快速运动、镜头切换、文字、遮挡和多主体交互等容易暴露近似问题的内容。
本文给出的误差曲线只能帮助理解缓存的数值行为。没有真实模型权重,没有样本集,也没有测量硬件延迟。因此本文不提供生产阈值,不给出“无损”的结论,也不声称这些 toy 误差能预测真实视频的主观质量。
还要分别检查代理误判的两种代价。代理高估变化会增加完整计算,主要损失效率;代理低估变化会继续使用陈旧残差,主要增加质量风险。这两种错误不能只用一个平均相关系数概括。即使整体相关性很高,少数快速变化的步骤被漏掉,也可能成为最明显的失败样例。应保留逐步记录,把异常视频定位到具体刷新区间,再判断是代理不敏感、阈值过大还是缓存位置选错。
为避免测试集上的阈值被过度优化,可以先用一组提示词选择阈值,再在另一组提示词上固定参数评估。报告平均质量以外,还要记录最差样例以及变化最大的场景。缓存有时能带来某项评分的小幅上升,但近似轨迹改变本身并不保证改进;应通过更多独立样本判断这是随机波动还是稳定效果。不能挑出一段更好看的视频,就把整条路线称作质量提升技术。
缓存决策在不同请求中可能产生不同的完整计算次数,所以服务端延迟也会随内容变化。只报告平均命中率,会遮蔽慢请求的行为;应同时关注完整计算次数的分布和尾延迟。如果业务要求固定延迟,可以限制最长复用间隔或最低刷新次数,但这些额外约束需要重新纳入成本账本与质量验证。
论文数值也要带条件。DeepCache 的摘要报告 Stable Diffusion v1.5 上 2.3 倍加速、CLIP Score 下降 0.05。原文图 1 标明这组速度结果使用 50 步 PLMS;这是作者特定设置下的结果,不能泛化成所有扩散模型都同样受益。论文摘要与图 1 支持这组数字。
TeaCache v2 的表 1 中,OpenSora-Plan 的 150 步基线使用 65 帧、512×512,延迟为 99.65 秒,slow 配置为 22.62 秒,对应 4.41 倍;VBench 从 80.39% 到 80.32%,差值是 0.07 个百分点。fast 配置在同表报告更高加速,但质量也有不同取舍,所以本文引用 slow 配置,避免把不同配置的最优速度与最优质量拼成一个结果。原文表 1 可直接复核。
这些工作属于相关路线,没有一个统一的阈值或通用缓存张量。先检查缓存边界,再看刷新规则,最后检查采样路径是否改变,是比较它们时更稳定的顺序。方法名称相似、都声称免训练,不代表工程实现可以直接互换。
“跨步缓存与 KV cache 是同一种精确复用。” 自回归 KV cache 通常复用固定前缀的计算结果,而扩散过程中潜变量和时间条件在变化。这里复用的是可能陈旧的近似特征,必须单独评估误差。是否等价还取决于模型路径,不能仅凭有个 cache 字段就判断。
“相邻特征相似,所以可以一直复用。” 相邻相似不等于相隔很多步仍相似,更不等于输出质量不变。累计预算关注缓存年龄,刷新机制关注何时恢复完整计算。二者缺一不可。
“阈值 0.16 表示允许 16% 的质量损失。” 阈值只是累计代理的比较值。它不是终点误差、FID、VBench 或主观质量的直接比例。本实验阈值与官方多项式的阈值甚至不在相同刻度上。
“缓存命中后跳过了采样器更新。” 本文所有版本都更新状态 40 次。省掉的是一部分网络计算,当前输入与输出头仍然可以变化。如果代码命中后直接跳过调度器,它执行的是另一种算法。
“最后一次完整计算能补回前面所有误差。” 最后一次局部预测变准确,不等于输入轨迹回到基线。误差传播推导和实验都把这两件事区分开。
“调用次数少三倍,就是端到端快三倍。” 命中步骤、其他固定模块、同步与内存操作仍有成本。本文最后一列只是显式假设的成本比,实际脚本还带额外离线诊断,因此不能拿它的运行时间当加速报告。
先把附录完整代码保存为 cache_demo.py,准备 Python 3.10 以上环境,执行:
python -m pip install numpy matplotlib
python cache_demo.py
单独保存脚本时,结果 JSON 和 figures/cache_schedule.png 都写到脚本所在目录。在仓库的文章 code/ 目录运行时,产物写到文章根目录。数值应与第 04 节一致;换 NumPy 或底层数值库时,浮点尾数可能略有不同。比对完整计算次数、刷新时刻和误差到所列精度,比要求截图或图片压缩字节完全一致更合适。
首先把阈值设成 0。每个步骤都会刷新,完整计算次数应等于 40,终点应与精确基线逐元素一致。附录已经用断言验证这个条件;如果失败,要先修缓存状态机,不要调阈值掩盖问题。
其次比较 0.08、0.16 和 0.32。在本次固定实验里,完整计算次数逐步减少,终点误差逐步增加。这是一个具体样本的趋势,不是所有系统的单调性定理:刷新位置改变、误差相互抵消、轨迹分叉,都可能让某个中间阈值的结果反而更接近基线。
再比较 adaptive_0.16 与 uniform_4。两者的成本模型使用相同的 11 次完整计算,但时刻并不相同。观察图中误差峰值,不只盯终点一个数。如果想研究预算分配,固定计算次数,再调整刷新位置,比仅仅换一个阈值更容易把原因看清。
再把 cache_checks.py 与 cache_demo.py 放在同一目录,运行
python cache_checks.py反例把便宜嵌入固定为零,把代理固定为全 1,只在索引 1 让真实残差的 64 个分量同时跳到 2。代理预算始终为零。阈值 0.16 的策略仅在索引 0 和 39 刷新,错过这次跳变。局部误差峰值为 $2\sqrt{64}=16$。最后一步的局部误差回到 0,终点仍相差 $16/40=0.4$。这条轨迹隔离了代理漏报与末次刷新之间的关系。
strategy work counts without diagnostics: 40, 40, 18, 11, 7, 11
invalid policies rejected: 10
constant proxy: refreshes=[0, 39], peak local L2=16.0, last local L2=0.0, endpoint L2=0.400000
实际接入模型之前,还应验证两次独立请求是否有相同基线行为、错误中断是否清理状态、同形状不同条件是否互相污染。本文实验用每次 simulate 独立初始化来验证复位;真实服务还需要针对并发与重入的检查。
先从 DDIM 与高阶采样器 理解调用路径,再用 DiT 找嵌入、主体和输出头的边界,最后通过 性能建模与 Profiling 实测哪些部分值得省。
可以对照 KV cache 理解缓存有效性,也可继续读 量化 比较另一种减少推理成本的方法。少步蒸馏 训练模型在更少的采样调用中逼近教师轨迹。跨步缓存、量化与蒸馏组合时,应重新建立质量和延迟基线。
09 节用到的脚本全文如下(cache_demo.py、cache_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""Deterministic residual-cache toy; Python 3.10+, pip install numpy matplotlib.
Run: python cache_demo.py
No trained diffusion weights; cost ratios below are accounting assumptions.
"""
from pathlib import Path
from math import isfinite
from numbers import Integral, Real
import json
import platform
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

STEPS = 40
SHAPE = (1, 4, 16)
SEED = 7
rng = np.random.default_rng(SEED)
X0 = rng.normal(size=SHAPE).astype(np.float64)
W = rng.normal(size=(16, 16)) / 8.0
V = rng.normal(size=(16, 16)) / 8.0

def cheap_input(x, t):
    return x + 0.05 * np.sin(2 * np.pi * t)

def proxy(h, t):
    return h * (1 + 0.3 * np.sin(2 * np.pi * t)) + 0.1 * np.cos(2 * np.pi * t)

def residual(h, t):
    z = h
    for _ in range(4):
        z = np.tanh(z @ W)
    return 0.15 * h + 0.4 * (z @ V) + 0.08 * np.sin(6 * np.pi * t)

def simulate(threshold=None, period=None, *, diagnostics=True):
    """Use exactly one cache policy, or compute every call with both unset."""
    if threshold is not None and period is not None:
        raise ValueError("choose threshold or period, not both")
    if threshold is not None and (
        isinstance(threshold, bool) or not isinstance(threshold, Real)
        or not isfinite(threshold) or threshold < 0
    ):
        raise ValueError("threshold must be finite and nonnegative")
    if period is not None and (
        isinstance(period, bool) or not isinstance(period, Integral) or period < 1
    ):
        raise ValueError("period must be a positive integer")

    x = X0.copy()
    previous_proxy = None
    saved_residual = None
    budget = 0.0
    refreshed, local_errors = [], []
    for i in range(STEPS):
        t = 1.0 - i / (STEPS - 1)
        h = cheap_input(x, t)
        m = proxy(h, t)
        change = 0.0 if previous_proxy is None else float(
            np.mean(np.abs(m - previous_proxy)) / max(np.mean(np.abs(previous_proxy)), 1e-12))
        budget += max(change, 0.0)
        boundary = i in (0, STEPS - 1)
        if threshold is None and period is None:
            calculate = True
        elif period is not None:
            calculate = boundary or i % period == 0
        else:
            calculate = boundary or budget >= threshold
        if calculate:
            saved_residual = residual(h, t)
            budget = 0.0
        output = h + saved_residual
        if diagnostics:
            # Offline comparison on this trajectory, never fed into the update.
            local_error = 0.0 if calculate else float(
                np.linalg.norm(output - (h + residual(h, t)))
            )
            local_errors.append(local_error)
        refreshed.append(bool(calculate))
        previous_proxy = m.copy()
        x = x - output / STEPS
    return {"x": x, "refreshed": refreshed, "local_errors": local_errors}

def experiment():
    baseline = simulate()
    rows = []
    results = []
    settings = [("exact", None, None), ("adaptive_0.08", 0.08, None),
                ("adaptive_0.16", 0.16, None), ("adaptive_0.32", 0.32, None),
                ("uniform_4", None, 4)]
    for name, threshold, period in settings:
        result = simulate(threshold, period)
        calls = sum(result["refreshed"])
        relative_error = float(np.linalg.norm(result["x"] - baseline["x"]) / np.linalg.norm(baseline["x"]))
        # Full call = 1 unit; cache hit = 0.08 unit, solely for illustration.
        assumed_work = calls + (STEPS - calls) * 0.08
        rows.append({"name": name, "full_calls": calls, "hits": STEPS - calls,
                     "relative_endpoint_error": relative_error,
                     "assumed_speed_ratio": STEPS / assumed_work,
                     "refresh_indices": [i for i, flag in enumerate(result["refreshed"]) if flag]})
        results.append(result)
    zero = simulate(threshold=0.0)
    assert np.array_equal(zero["x"], baseline["x"])
    assert sum(zero["refreshed"]) == STEPS
    assert all(r["refreshed"][0] and r["refreshed"][-1] for r in results)
    assert np.array_equal(simulate(threshold=0.16)["x"], results[2]["x"])
    assert all(np.isfinite(r["x"]).all() for r in results)
    return rows, results, baseline

def make_figure(rows, results, destination):
    fig, axes = plt.subplots(2, 1, figsize=(11, 7), constrained_layout=True)
    colors = ["#2563eb", "#ea580c", "#16a34a", "#dc2626", "#9333ea"]
    for y, (row, result) in enumerate(zip(rows, results)):
        idx = np.flatnonzero(result["refreshed"])
        axes[0].scatter(idx, np.full(len(idx), y), marker="s", s=38, color=colors[y])
    axes[0].set_yticks(range(len(rows)), [r["name"] for r in rows])
    axes[0].set_xlim(-1, STEPS)
    axes[0].set_xlabel("Sampling call index (0-based)")
    axes[0].set_title("Squares = full residual computation; gaps = cache reuse")
    for y, (row, result) in enumerate(zip(rows[1:], results[1:]), start=1):
        axes[1].plot(result["local_errors"], label=row["name"], linewidth=1.7, color=colors[y])
    axes[1].set_xlabel("Sampling call index (0-based)")
    axes[1].set_ylabel("Local output L2 error")
    axes[1].set_title("Offline diagnostics on each cached trajectory; no quality metric")
    axes[1].legend(ncol=2, fontsize=9)
    axes[1].grid(alpha=0.25)
    fig.suptitle("Residual caching: refresh decisions and approximation error", fontsize=14)
    fig.savefig(destination, dpi=150)
    plt.close(fig)

if __name__ == "__main__":
    rows, results, baseline = experiment()
    script_dir = Path(__file__).resolve().parent
    in_article_repo = script_dir.name == "code" and (script_dir.parent / "article.md").is_file()
    folder = script_dir.parent if in_article_repo else script_dir
    (folder / "figures").mkdir(parents=True, exist_ok=True)
    make_figure(rows, results, folder / "figures" / "cache_schedule.png")
    record = {"seed": SEED, "steps": STEPS, "shape": list(SHAPE),
              "python": platform.python_version(), "numpy": np.__version__,
              "baseline_min": float(baseline["x"].min()),
              "baseline_max": float(baseline["x"].max()), "results": rows,
              "assertions": "zero-threshold exactness, endpoints, request reset, finite outputs passed"}
    (folder / "experiment_results.json").write_text(
        json.dumps(record, ensure_ascii=False, indent=2) + "\n", encoding="utf-8")
    print(f"shape={SHAPE}, steps={STEPS}, seed={SEED}")
    print(f"baseline_range=[{record['baseline_min']:.6f}, {record['baseline_max']:.6f}]")
    print("name full_calls hits endpoint_relative_error assumed_speed_ratio")
    for row in rows:
        print(f"{row['name']} {row['full_calls']} {row['hits']} "
              f"{row['relative_endpoint_error']:.6f} {row['assumed_speed_ratio']:.3f}")
print("All assertions passed; figure=figures/cache_schedule.png")"""Numerical checks for the residual-cache demo. Run: python cache_checks.py."""
from unittest.mock import patch
import numpy as np
import cache_demo as demo
def check_work_counts():
for threshold, period, expected in (
(None, None, 40), (0.0, None, 40), (0.08, None, 18),
(0.16, None, 11), (0.32, None, 7), (None, 4, 11),
):
with patch.object(demo, "residual", wraps=demo.residual) as counted:
result = demo.simulate(threshold, period, diagnostics=False)
assert counted.call_count == sum(result["refreshed"]) == expected
with_diagnostics = demo.simulate(threshold, period)
assert np.array_equal(result["x"], with_diagnostics["x"])
assert result["refreshed"] == with_diagnostics["refreshed"]
assert not result["local_errors"] and len(with_diagnostics["local_errors"]) == demo.STEPS
print("strategy work counts without diagnostics: 40, 40, 18, 11, 7, 11")
def check_inputs():
rejected = 0
for kwargs in (
{"threshold": -1}, {"threshold": float("nan")}, {"threshold": float("inf")},
{"threshold": True}, {"threshold": "0.16"}, {"period": 0},
{"period": 1.5}, {"period": True}, {"period": -1},
{"threshold": 0.16, "period": 4},
):
try:
demo.simulate(**kwargs)
except ValueError:
rejected += 1
else:
raise AssertionError(f"Accepted invalid policy: {kwargs}")
print(f"invalid policies rejected: {rejected}")
def check_blind_proxy():
# Inject one hidden, one-call residual spike at zero-based call 1.
def residual_spike(h, t):
return np.full_like(h, 2.0 if t == 1.0 - 1 / (demo.STEPS - 1) else 0.0)
with (
patch.object(demo, "cheap_input", side_effect=lambda x, t: np.zeros_like(x)),
patch.object(demo, "proxy", side_effect=lambda h, t: np.ones_like(h)),
patch.object(demo, "residual", side_effect=residual_spike),
):
exact = demo.simulate()
cached = demo.simulate(threshold=0.16)
refreshes = np.flatnonzero(cached["refreshed"]).tolist()
assert refreshes == [0, demo.STEPS - 1]
assert np.count_nonzero(cached["local_errors"]) == 1
local_peak = max(cached["local_errors"])
endpoint = np.linalg.norm(cached["x"] - exact["x"])
assert local_peak == 16.0 and cached["local_errors"][-1] == 0.0
np.testing.assert_allclose(endpoint, 0.4, rtol=1e-14, atol=0)
print(f"constant proxy: refreshes={refreshes}, peak local L2={local_peak:.1f}, "
f"last local L2={cached['local_errors'][-1]:.1f}, endpoint L2={endpoint:.6f}")
if __name__ == "__main__":
check_work_counts()
check_inputs()
check_blind_proxy()

评论 (0)