


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:进阶 | 前置知识:DDPM 的训练目标与采样流程(
ddpm)、扩散过程的前向与反向推导(diffusion_math)
关键词:DDIM、DPM-Solver、确定性采样、二阶采样、步数、NFE
先给两个数字,都来自文末附录里能直接跑的脚本。
数字一:本例达到相同终点 RMS 阈值,扫描得到的评估预算相差 12.8 倍。 在二维八分量高斯混合上,score 有闭式解;配对相同初始噪声,比较同一有限区间概率流 ODE 的数值终点,并使用相同的末端 $\hat x_0$ 投影。这里的“精度”是到参考轨迹终点的距离,不能直接换算成图像质量、FID 或运行时间。
| 采样器 | 压到 1e-2 需要的模型评估次数 | 压到 1e-3 |
|---|---|---|
| DDIM(时间步等间隔) | 256 | > 384 |
| 数据预测指数中点法(教学单步二阶) | 63 | 255 |
| DPM-Solver++ 2M(多步二阶) | 40 | 128 |
| 3M(固定 v0.35.1 多步系数) | 20 | 64 |
| 3M(二次插值指数积分对照) | 20 | 48 |
DDIM 首次在扫描点 256 次评估达标,v0.35.1 系数版本在 20 次达标;比例为 12.8。扫描只检查指定预算,不证明整数 NFE 的全局最小值。中点法有限步每步两次评估、收尾一次,所以预算是 $2S-1$。少一次模型调用也不等于少同样比例的墙钟时间;真实网络还要计入算子、调度与引导的成本。
数字二:换采样器后,应重新核验缓存配置。 跨步复用特征依赖相邻去噪计算的冗余,但并非都通过输入位移阈值决定。DeepCache 的官方示例 使用更新间隔,TeaCache 则以时间嵌入相关变化估计模型输出差异。这里先固定同一模型、50 步网格与配对起点,分别跑 η=0/0.5/1,量最后十步“模型输入相对变化”:
| 采样器 | 最后 10 步输入相对变化 |
|---|---|
| DDIM(η=0) | 0.0197 |
| η=0.5 | 0.0667 |
| 跳步 DDIM 家族祖采样(η=1) | 0.1294 |
η=1 的最后十步平均输入位移代理是 η=0 的 6.6 倍。这提示换采样器后应重新校准缓存判据,但均值不能推出逐步命中率。例如十个变化量中九个为 0.01、一个为 1.21,均值是 0.13,2% 阈值仍会接受九步。实际复用间隔或变化判据也不等于此处的输入位移;本文没有实现特征缓存,没有测缓存命中率、缓存加速或画质退化。
所以这篇文章沿着“更新式 → 概率流 ODE → 指数积分 → 实际评估预算”来解释采样器。η=0 的 DDIM 对应一阶确定性格式,η>0 的同族更新带随机项;随机采样不能全部归为 ODE 积分。比较时要分别报告阶数、时间网格、终端处理和 NFE(number of function evaluations),再用适合任务的质量指标验收。
三句话讲完:
DDIM 给出了可复用同一噪声预测模型的采样族。 它用非马尔可夫联合前向过程保持条件边缘 $q(x_t\mid x_0)$,对应回归项仍在同一加噪边缘上计算。改变联合过程并不等于所有 ELBO 权重都不变;实践复用的是 DDPM 常用的共享简化噪声目标。η 控制随机项,η=0 是确定性的特殊情形。参见 DDIM 第 3–4 节。
η=0 的更新可以放进概率流 ODE 的数值积分框架。 对精确 score、正确初始边缘和精确连续求解,SDE 与概率流 ODE 共享边缘分布;给定一个初值,ODE 轨迹确定。有限步误差、模型误差和起始先验误差仍会改变生成分布。下面用配对初值观察两类离散路径。
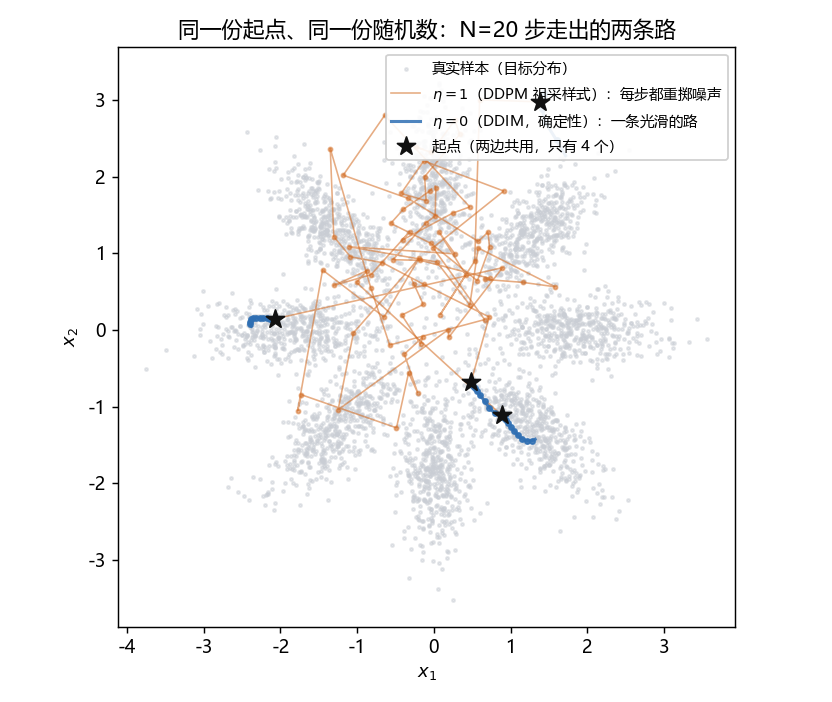
这张图要看的是:蓝色的 η=0 轨迹是一条平滑曲线,橙色 η=1 轨迹在同一份随机数下走成了折线——每一步都被注入的方向改变。"同一个采样器家族"的两种极端,轨迹的几何性质完全不同,缓存类加速盯的正是这个几何性质。
DDPM 的 fixed-small 祖先采样先估干净图,再缩放,再加后验噪声。这里用 $a_t=1-\beta_t$ 表示离散单步信号方差系数,$\bar\alpha_t=\prod_{i=1}^{t}a_i$ 表示累积系数,$\tilde\beta_t$ 是给定 $x_0,x_t$ 的后验方差,$z\sim\mathcal N(0,I)$ 是独立标准高斯噪声;终步不加噪声。后文连续振幅 $\alpha(t)=\sqrt{\bar\alpha(t)}$ 与 $a_t$ 区分。
$$x_{t-1} = \frac{1}{\sqrt{a_t}}\Big(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\Big) + \sqrt{\tilde\beta_t}z$$
DDIM 论文式 (12) 换了一个组织方式。令 $\hat x_0$ 是这一时刻对干净图的估计、$\epsilon_\theta$ 是模型输出的噪声预测,两者由 $\hat x_0 = (x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta)/\sqrt{\bar\alpha_t}$ 相互确定,则一步写成三项:
$$x_{t-1} = \underbrace{\sqrt{\bar\alpha_{t-1}}\hat x_0}_{\text{回数据的方向}} + \underbrace{\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}\epsilon_\theta}_{\text{沿当前噪声方向}} + \underbrace{\tilde\sigma_t z}_{\text{新掷的噪声}}$$
这里第二项必须使用目标时刻的总噪声方差 $1-\bar\alpha_{t-1}$,新注入噪声为
$$\tilde\sigma_t = \eta\sqrt{\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}}\sqrt{1-\frac{\bar\alpha_t}{\bar\alpha_{t-1}}}$$
每一项在干什么。 第一项是"这一时刻认为的干净图"乘上新时刻的 $\sqrt{\bar\alpha}$,也就是把估计值放到目标噪声水平上。第二项补偿两者的差额:前向过程是 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon$,要从 $x_t$ 走到 $x_{t-1}$,得把噪声幅度从 $\sqrt{1-\bar\alpha_t}$ 缩到 $\sqrt{1-\bar\alpha_{t-1}}$,这个缩放只能沿着"当前噪声方向"做——$\sqrt{1-\bar\alpha_{t-1}-\tilde\sigma_t^2}$ 正好是这两者的勾股差。第三项才是唯一带随机性的部分。
$\eta$ 是那个旋钮。 $\eta=0$ 时第三项消失,$\tilde\sigma_t=0$,迭代完全确定;$\eta=1$ 时 $\tilde\sigma_t$ 恰好等于 DDPM 的后验标准差,第二、三项合起来正好还原 DDPM 的加噪——在相同的完整时间表、fixed-small 方差、预测器及随机数下,$\eta=1$ 与该 DDPM 更新代数等价;跳步时应比较对应重排时间表的祖先采样,而不是原始 1000 步链。04 节会把这两条都量到浮点误差量级。
为什么可以有这个旋钮。 DDIM 从 $q_\eta(x_{t-1}\mid x_t,x_0)$ 与终点边缘构造非马尔可夫联合过程,保留每个条件边缘 $q(x_t\mid x_0)$。噪声回归仍使用这些边缘,所以同一简化目标训练出的模型能用于不同 η;不要把它说成任意联合过程的完整变分目标、最优解及训练权重都完全相同。η=0 的退化过程还应理解为确定性极限。
$\eta=0$ 时迭代没有随机项,它可以被看成一条 ODE 的离散格式。连续时间下,前向过程是 $dx = -\frac{1}{2}\beta(t)x\mathrm{d}t + \sqrt{\beta(t)}\mathrm{d}w$(第一项把 $x$ 往 0 拉,第二项持续注入白噪声),对应的概率流 ODE(与 SDE 共享所有边缘分布的那个确定性方程)是
$$\frac{dx}{dt} = -\frac{1}{2}\beta(t)\Big(x + \nabla_x\log p_t(x)\Big)$$
这个 score 漂移不是“噪声均值”(布朗增量的均值为零)。设前向漂移 $f=-\beta(t)x/2$、扩散强度平方 $g^2=\beta(t)$,其 Fokker–Planck 方程为 $\partial_t p=-\nabla\cdot(fp)+g^2\Delta p/2$。利用 $\Delta p=\nabla\cdot(p\nabla\log p)$,可改写为 $\partial_t p=-\nabla\cdot[(f-g^2\nabla\log p/2)p]$,正是上述 ODE 的连续性方程。该等价要求足够正则的密度、精确 score 与匹配初始分布;网络近似和有限步求解不自动保留精确边缘。原始 SDE 论文第 4.3 节 给出了这一概率流解释。
对平方损失的最优噪声预测,score 满足 $\nabla_x\log p_t(x)=-\epsilon_*(x,t)/\sigma(t)$;训练网络 $\epsilon_\theta$ 只是其近似。这里 $\alpha(t)=\sqrt{\bar\alpha(t)}$、$\sigma(t)=\sqrt{1-\bar\alpha(t)}$,两者是振幅,且 $\alpha^2+\sigma^2=1$。换坐标令 $\lambda=\log(\alpha/\sigma)=\tfrac12\log[\bar\alpha/(1-\bar\alpha)]$,后文记 $\alpha_s,\sigma_s$ 为当前噪声水平的振幅,$\alpha_t,\sigma_t$ 为目标的振幅;从噪声到数据时 $h=\lambda_t-\lambda_s>0$。
“半”来自 $\mathrm{SNR}=\alpha^2/\sigma^2$,所以 $\lambda=\tfrac12\log\mathrm{SNR}$。本线性 1000 步调度在最吵端 $\bar\alpha_T\approx4.036\times10^{-5}$、$\lambda_T\approx-5.06$,最早训练噪声端 $\bar\alpha_1=0.9999$、$\lambda_1\approx4.61$。两个坐标跨度的数字受单位选择影响,不能用“10 对 1000”直接证明哪一段更难。真正有用的是 $\lambda$ 能让线性部分被解析处理,并显式显示噪声尺度变化。
沿概率流解令 $m(\lambda)=\hat x_0(x(\lambda),\lambda)$。由 $d\lambda/dt=-\beta(t)/(2\sigma^2)$ 和 score 关系,得到 $dx/d\lambda=-\alpha^2x+\alpha m$。又有 $d\log\sigma/d\lambda=-\alpha^2$,故乘积分因子后 $d(x/\sigma)/d\lambda=(\alpha/\sigma)m=e^\lambda m$。把它从 $\lambda_s$ 积到 $\lambda_t$,利用 $\sigma_t e^{\lambda_t}=\alpha_t$,便得到下面的精确积分式。这里的“精确”指该 ODE 的积分恒等式;数值方法还要近似沿未知轨迹的 $m$。参见 DPM-Solver 的指数积分推导 与 DPM-Solver++ 的数据预测形式。
$$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\int_{0}^{h} e^{-(h-u)}\hat x_0(\lambda_s+u)du$$
这个式子值得停一下:它说明整步的解由"$\hat x_0$ 沿着 $\lambda$ 的变化曲线"加权积分决定,权重是 $e^{-(h-u)}$——越靠近区间右端(越干净的那端)权重越大。验证一下:如果 $\hat x_0$ 是常数,积分给出 $\alpha_t(1-e^{-h})\hat x_0$,加上第一项正好是 $\alpha_t \hat x_0+\sigma_t \epsilon$,也就是"一步跳到位"的精确解。所以步法阶数的本质,就是用多少个点上的 $\hat x_0$ 去逼近这条曲线。
把沿解轨迹的 $m(\lambda_s+u)$ 在 $u=0$ 展开;下式 $\hat x_0,\hat x_0',\hat x_0''$ 分别指当前 $m,m',m''$。导数是总导数,例如 $m'=\partial_\lambda\hat x_0+(\nabla_x\hat x_0)(dx/d\lambda)$,包含输入状态随轨迹变化,不能只对时间标签求偏导。泰勒展开需相应光滑性;逐项积分给出:
$$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t\Big[J_0\hat x_0 + J_1\hat x_0' + J_2\hat x_0'' + \cdots\Big]$$
$$J_0 = 1-e^{-h},\qquad J_1 = e^{-h}-1+h,\qquad J_2 = \frac{h^2-2h+2-2e^{-h}}{2}$$
小 $h$ 展开看数量级:$J_0\approx h$、$J_1\approx h^2/2$、$J_2\approx h^3/6$。所以导数项每高一阶,整步误差就多一个 $h$。
多步法用历史模型输出估计这些总导数。当前点为 $\lambda_0$,两个历史点满足 $\lambda_2\lt\lambda_1\lt\lambda_0$,目标点为 $\lambda_t=\lambda_0+h$。令 $m_j=\hat x_0(x(\lambda_j),\lambda_j)$,$h_0=\lambda_0-\lambda_1$、$h_1=\lambda_1-\lambda_2$,归一化步长比 $r_0=h_0/h$、$r_1=h_1/h$。这样全部差商都有明确单位:
$$D_{1,0}=(m_0-m_1)/r_0,\qquad D_{1,1}=(m_1-m_2)/r_1$$
$$D_1=D_{1,0}+\frac{r_0}{r_0+r_1}(D_{1,0}-D_{1,1}),\qquad D_2=\frac{D_{1,0}-D_{1,1}}{r_0+r_1}$$
在步长同比缩小、$r_0,r_1$ 为正且有界的条件下,在当前点展开,$D_{1,0}=hm'-hh_0m''/2+O(h^3)$,$D_{1,1}=hm'-h(h_0+h_1/2)m''+O(h^3)$;两者相减为 $h(h_0+h_1)m''/2+O(h^3)$。代回可见 $D_1=hm'+O(h^3)$、$D_2=h^2m''/2+O(h^3)$。因此用三点二次插值并精确做上述指数积分时,导数项为 $(J_1/h)D_1+(2J_2/h^2)D_2$。这个 2 来自二次项的归一化,而非随意调参。
这里必须区分两种实现:本地 d2_scale=1.0 复刻固定 diffusers v0.35.1 的多步数据预测更新;d2_scale=2.0 是二次插值指数积分对照版本。05 节直接执行原始上游方法并做外部二次函数检验,报告这两个具体公式的差异,不据此断言整个框架、其他分支或所有名义三阶方法都相同。一般三阶 ODE 求解器也不必对这种强迫函数一步精确。
把 03.1 的 DDIM 迭代($\eta=0$)和"只留 $J_0$"的一阶格式对照:$\eta=0$ 时第二项系数为 $\sqrt{1-\bar\alpha_{t-1}}$,第三项为 0,代入 $\hat x_0$ 的定义整理,得到
$$x_t = \frac{\sigma_t}{\sigma_s}x_s + \alpha_t(1-e^{-h})\hat x_0(\lambda_s)$$
与一阶格式逐项相同。所以"DDIM 是一阶方法"不是比喻,是恒等式——04 节用两套独立实现的代码把它验到约 $1.4\times10^{-14}$。
全部代码在文末附录,五个脚本:数值实验依赖 NumPy 2.x,配图另需 matplotlib:oracle_gmm.py(实验台与尺子)、ddim_family.py(η 家族)、dpm_solver_lab.py(λ 坐标与高阶格式)、spacing_lab.py(步数摆法)、make_figures.py(配图)。下面的数字是它们的真实输出。
要在二维上分离模型误差与数值误差,用八个各向异性高斯分量摆成环。权重 $w_k=1/8$、中心 $\mu_k$ 半径 1.8、局部径向/切向方差分别为 0.30/0.05(不是标准差)。加噪后中心变成 $\alpha\mu_k$、协方差变成 $\alpha^2\Sigma_k+\sigma^2I$;令 $\pi_k(x)$ 为观察到 $x$ 后的分量后验权重,则 score 为 $-\sum_k\pi_k(x)(\alpha^2\Sigma_k+\sigma^2I)^{-1}(x-\alpha\mu_k)$。附录按稳定 log-sum-exp 计算权重,并用有限差分验证。解析 score 消除了网络拟合误差,仍保留离散化、终端先验、收尾投影和浮点误差。
A. Oracle 自检:解析 score vs 有限差分
  t=    1  abar=0.999900  max|解析 - 差分| = 1.57e-08
  t=  200  abar=0.659039  max|解析 - 差分| = 4.99e-11
  t= 1000  abar=0.000040  max|解析 - 差分| = 3.10e-11
B. 端点检查:t=T 时协方差与 I 的最大差 = 3.834e-05
C. 尺子的噪声地板:SW1 真vs真 ×8 = 0.03055 ± 0.00452
D. 天花板:真样本当生成样本送进去  SW1 = 0.000000
有限差分只是自检解析公式与代码的一致性。第二项量的是每个分量协方差与 $I$ 的差,不是整个混合分布到标准高斯的完整距离;分量均值仍约有 0.0114 的模长。第三项是当前 4000 样本、512 个固定投影方向下的真对真抽样基线;基线大小不等于方法比较的显著性阈值。第四项为同一经验样本对自身的恒等零值,不能证明分布距离估计无偏。
ddim_family.py 的核心就是下面这个函数,变量名与 3.1 节一一对应:
def ddim_step(x, abar_cur, abar_tgt, eps, z, eta):
    """从 abar_cur 走到 abar_tgt(噪声变小)。返回 (x_tgt, x0_hat)。"""
    a_c, s_c = alpha_sigma(abar_cur)          # 当前时刻的 alpha_t / sigma_t
    a_t, s_t = alpha_sigma(abar_tgt)          # 目标时刻的 alpha_t / sigma_t
    x0 = (x - s_c * eps) / a_c                # 第一项用的 x0_hat
    var = (1 - abar_tgt) / (1 - abar_cur) * (1 - abar_cur / abar_tgt)
    sig_tilde = eta * np.sqrt(max(var, 0.0))  # 第三项:新掷噪声的幅度
    direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0))   # 第二项:勾股差
    return a_t * x0 + direc * eps + sig_tilde * z, x0
最后一行就是 3.1 节那三项,一次加法写完,没有任何按时刻分支的特判。跑个小验证,看 $\tilde\sigma_t$ 在轨迹两端各占多少:
_, ABAR = linear_schedule()
ts, grid = uniform_t_grid(50)             # 51 个 abar,grid[0] 最吵、grid[-1] = 1.0
x, zs = paired_noise(50, n=4, seed=4321)  # 起点 + 每一步要用的随机数
print("x.shape =", x.shape, "| grid 长度 =", len(grid))
for i in (0, 25, 48):
    for eta in (0.0, 1.0):
        a_c, s_c = alpha_sigma(grid[i])
        a_t, s_t = alpha_sigma(grid[i + 1])
        var = (1 - grid[i+1]) / (1 - grid[i]) * (1 - grid[i] / grid[i+1])
        sig_tilde = eta * np.sqrt(var)
        print(f"step {i:2d} eta={eta:.1f}   sigma_tilde = {sig_tilde:.6f}"
              f"   (该步总噪声幅度 {s_t:.4f})")
真实输出:
x.shape = (4, 2) | grid 长度 = 51
step  0 eta=0.0   sigma_tilde = 0.000000   (该步总噪声幅度 1.0000)
step  0 eta=1.0   sigma_tilde = 0.574284   (该步总噪声幅度 1.0000)
step 25 eta=0.0   sigma_tilde = 0.000000   (该步总噪声幅度 0.9509)
step 25 eta=1.0   sigma_tilde = 0.419845   (该步总噪声幅度 0.9509)
step 48 eta=0.0   sigma_tilde = 0.000000   (该步总噪声幅度 0.0760)
step 48 eta=1.0   sigma_tilde = 0.063819   (该步总噪声幅度 0.0760)
η=1 时,注入标准差占目标总噪声幅度的比例在示例起点约为 57%,第 48 步约为 84%。这描述三项分解中随机项的比例;它不能单独解释哪种采样器更好,因为漂移、方差、离散化和模型误差都会影响终点分布。
再看 η=1 的第 25 步:ddim_family.py D 节使用 4000 个配对起点、seed=1234,打印每项的 Euclidean RMS,即先求二维平方范数再对样本平均开根号:
eta=1 第 25 步三项 RMS: 回数据 0.2119 | 沿噪声方向 1.1114 | 新掷噪声 0.5924三个向量项的 RMS 描述该批样本的更新组成,既不能推出网络算力花在哪里,也不能单独证明加噪声有害。积分阶数衡量的是确定性更新对连续轨迹的逼近能力,分布质量要另测。
ddim_family.py 里故意写了两套互不相干的代码:一套照 DDPM Algorithm 2 的原式走 1000 步(一步不能跳),一套照 DDIM 式 (12) 走。喂同样的随机数:
A. 终点逐元素最大差 = 3.203e-14 终点 RMS = 1.35203.2e-14 是本次浮点累加误差的量级。这验证同一完整时间表、fixed-small 方差、同一噪声预测、没有额外裁剪及配对随机数下的代数等价;不涵盖 learned variance、不同终步处理或任意跳步实现。
dpm_solver_lab.py 里同样对待 DDIM 与一阶指数积分器:
A. max|DDIM(eta=0) - DPM-Solver-1|
  S= 20  uniform-t 1.399e-14   uniform-lambda 6.439e-15
  S= 50  uniform-t 1.144e-14   uniform-lambda 1.110e-14
两套记号、两套时间网格,输出差在 1e-14。DDIM 是一阶指数积分器,这句到这里可以当结论用了。
4000 次评估的二次插值版本与 2000 次版本在 1000 个配对初值上相差 1.162×10⁻⁸;这是参考解的自检尺度,不是严格误差上界。独立 RK4 直接积分 $dx/d\lambda=\sigma^2(x+\mathrm{score})$,在 128 个另取初值上,2000 与 4000 步相差 1.71×10⁻¹²,4000 步 RK4 与指数积分参考的 RMS 差为 1.11×10⁻⁹;两者使用同一有限端点和最后的 $\hat x_0$ 投影。横轴逐方法由 Counter 实计,包含额外启动评估,不能把各方法 NFE 平均后共用。
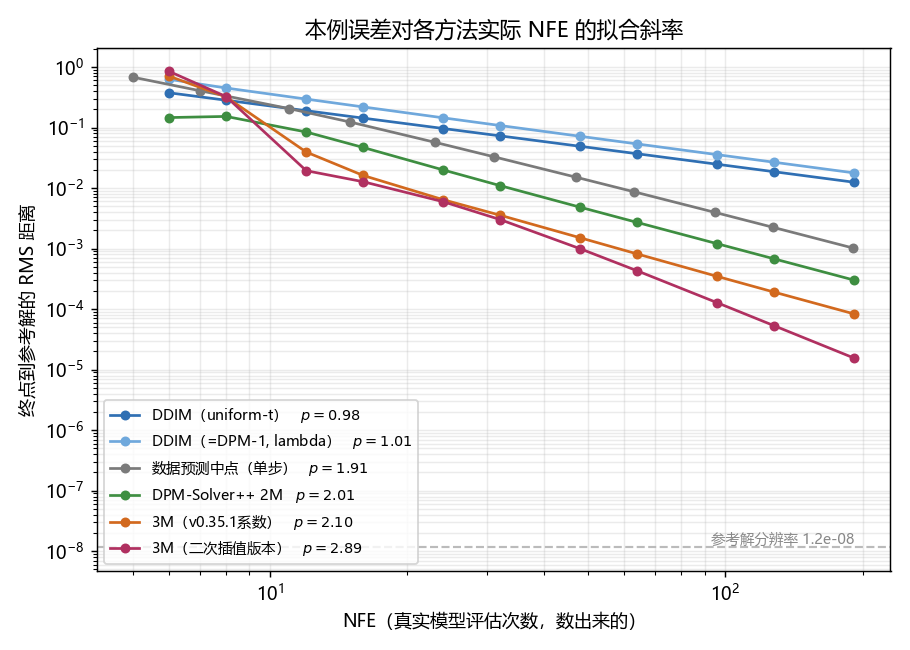
这张图要看的是斜率:DDIM 的误差衰减阶约 1,二阶方法约 2,二次插值系数对照接近 3;误差更小的曲线位于图的下方。纵轴量同一 ODE 路径的终点误差,不量模型学到的分布是否正确。
拟合出来:
| 采样器 | 实测拟合斜率 p | 备注 |
|---|---|---|
| DDIM(时间步等间隔) | 0.98 | 一阶格式,整数网格与收尾策略同时变化 |
| DDIM(λ 等间隔) | 1.01 | 一阶格式 |
| 数据预测指数中点法(单步) | 1.91 | 连续中点,有限步两次、收尾一次 |
| DPM-Solver++ 2M(多步) | 2.01 | 每步一次评估 |
| 3M(v0.35.1 多步系数) | 2.10 | 本实验区间呈二阶趋势 |
| 3M(二次插值指数积分版本) | 2.89 | 本实验接近三阶趋势 |
拟合只取真实 NFE≥24、误差大于参考自检尺度三倍的点,中点法为六点、其他方法七点。有限区间斜率不是普适阶数证明;网格量化、启动和末端投影都会影响它。图和正文重用相同随机数消耗顺序与初值,05 节补充系数的独立验证。
路径 RMS 与分布距离回答不同问题。SW1 在 512 个固定单位方向投影后计算等样本数的一维经验 Wasserstein-1,再对方向平均;4000 个生成样本与固定的 4000 个参考真样本比较。下表为更换生成起点的五次均值±总体标准差(NumPy std(ddof=0)),不是置信区间;参考样本与投影方向没更换。中点法的真实 NFE 分别是 9、19、49,其余方法为列中预算。
| 方法 / 名义预算 | 10 | 20 | 50 |
|---|---|---|---|
| DDIM(t) | 0.1292±0.006 | 0.0741±0.004 | 0.0420±0.007 |
| DDIM(λ) | 0.2180±0.006 | 0.1122±0.004 | 0.0516±0.007 |
| 指数中点法 | 0.1910±0.007 | 0.0569±0.004 | 0.0335±0.006 |
| 2M | 0.0731±0.006 | 0.0317±0.006 | 0.0328±0.005 |
| 3M | 0.0680±0.006 | 0.0277±0.005 | 0.0327±0.005 |
| 二次插值对照 | 0.0428±0.005 | 0.0279±0.004 | 0.0327±0.005 |
这里 3M 使用固定 v0.35.1 系数;中点法真实 NFE 为预算减一。
真对真八次基线是 0.0301±0.0026。20 次预算下 DDIM 与多步方法的差距明显,而 2M 与两种 3M 的近邻差别远小于该批重复的波动。50 次下 2M/3M/中点法的估计接近基线;DDIM(λ) 的 0.0516 不能被笼统说成与 0.033 完全一样。更多样本、投影和独立重复能提高分辨能力。RMS 可揭示路径误差,但两条不同耦合路径也可能产生相同边缘分布,所以它不能替代分布质量指标。
ddim_family.py 在 oracle 下扫一遍 η,再在欠拟合模型下扫一遍。所谓欠拟合是让模型以为数据是单个高斯(用真均值真协方差拟合),它在高噪声区几乎是对的、在低噪声区错得离谱——这是人为选择的一种误差结构,并不代表所有真实网络(也正好对应"训练时看到的是加噪数据分布"这件事)。
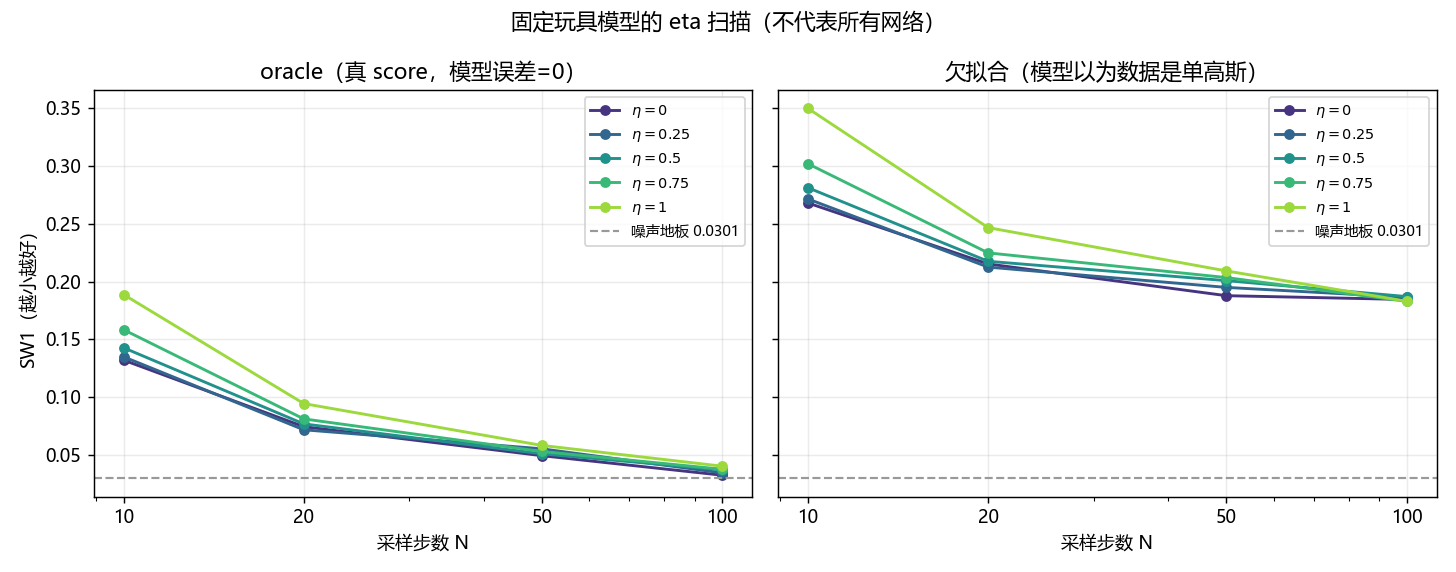
图中固定种子下多数格子 η=0 的 SW1 较低,但并不单调或全部最优。oracle 的 N=20 时 η=0.25 得 0.0719,低于 η=0 的 0.0746;单高斯近似在 N=20 也有 0.2124 对 0.2152,在 N=100 时 η=0.75 得 0.1828,低于 η=0 的 0.1845。这些小差别没有独立多种子置信区间,不能据此排名。这个例子能反驳“少步必然应调大 η”,也不能建立“确定性采样必胜”的新定律。
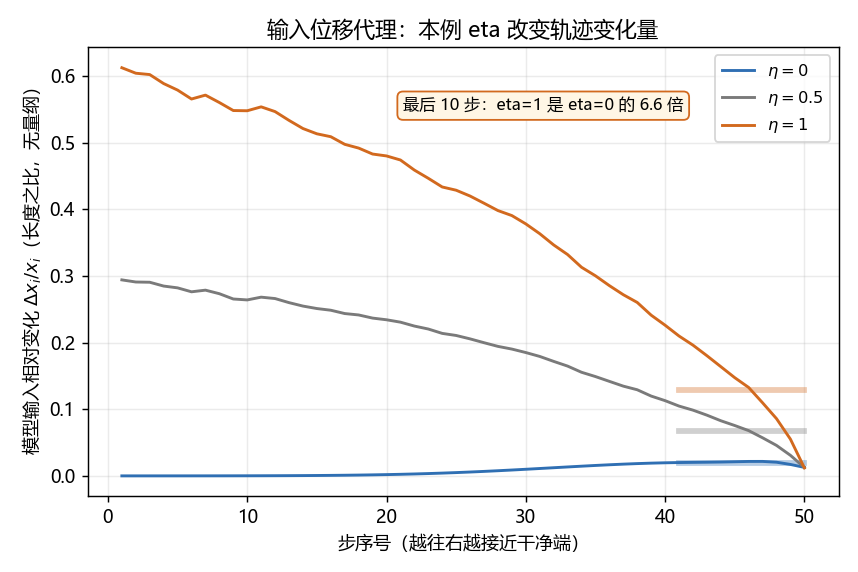
图量的是 $r_i=\sqrt{\mathbb E\|x_{i+1}-x_i\|^2}/\sqrt{\mathbb E\|x_i\|^2}$ 的逐步值,以及最后十步的均值;它不是逐样本相对误差的平均,也不是特征变化。有限网格最后一步直接投影,不能由图说步长趋于零。最后十步输入代理均值相差 6.6 倍;$\hat x_0$ 位移的平均绝对 RMS 为 0.0371 对 0.2407,约 6.5 倍,单位与数据相同。缓存判据若使用相应代理,应检查整条序列的分布与失败步,真实特征缓存则需另测。
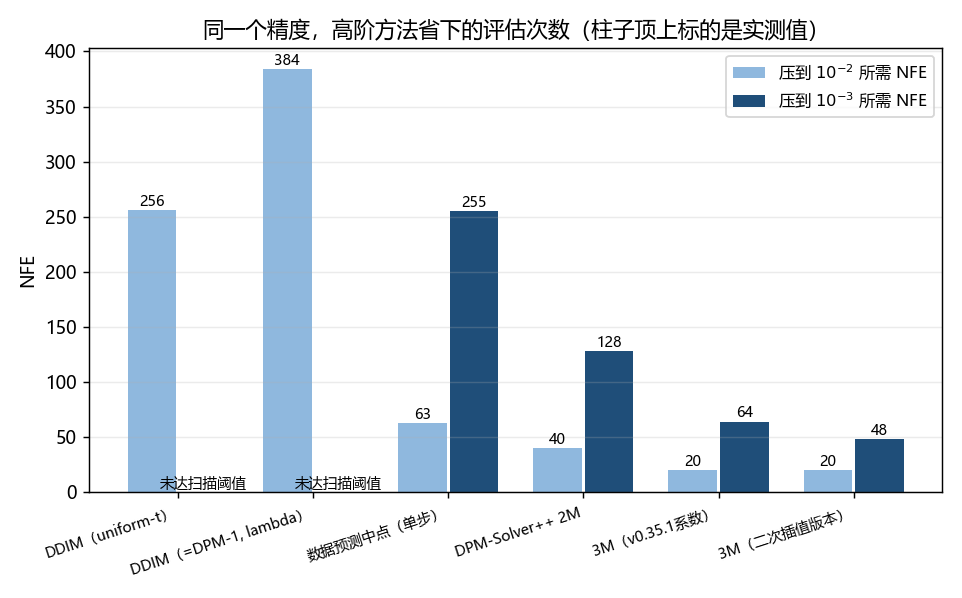
图中柱子为已扫描预算中首次达到指定路径 RMS 阈值的真实 NFE。solve_dpm2s 这个历史函数名保留,但它实现的是数据预测指数中点教学方法,不能写成对原始噪声预测 DPM-Solver-2 的逐项复现。有限步两次评估,$\sigma=0$ 的投影一步一次,故 $S$ 步实际为 $2S-1$ 次。未达标表示扫描到最大预算仍未达到,不是完整最优预算搜索。
阶数回答的是"步数变多时误差掉多快",没回答"步数摆在哪"。spacing_lab.py 固定 NFE=20、只改摆法,终点误差如下:
| 摆法 | DDIM(一阶) | 2M(二阶) |
|---|---|---|
| 在 $t$ 上等间隔(本文的时间网格) | 1.107e-01 | 5.285e-02 |
| 在 $\lambda$ 上等间隔 | 1.713e-01 | 2.897e-02 |
| 在 $\lambda$ 上等间隔、落回整数 $t$ | 1.712e-01 | 2.894e-02 |
| Karras / EDM($\rho=7$) | 1.873e-01 | 7.038e-02 |
| Karras($\rho=3$) | 2.655e-01 | 3.397e-01 |
本例的阶数、网格和收尾点要一起看。 固定 NFE=20,一阶方法在所测 $t$ 网格中的路径误差最低,2M 在所测 λ 网格中最低。Karras 网格这里也使用完全相同的 VP 振幅比 $\sigma/\alpha$ 端点约 158→0.01,并没有直接照搬 EDM 的 80→0.002;差别是内点密度。ρ=7 的最大有限 λ 间隔 1.019,ρ=3 为 2.455,λ 均匀网格为 0.509。ρ=7 也并非表里最差(ρ=3 更差);它在此误差指标上表现较差,不能解释成 EDM 的通用失败或只归因于单段步长。EDM 还包含预条件、Heun 更新、噪声注入等设计,本例只比较网格。EDM 原文。
uniform-t 为什么赢,值得追问一层。 它把 $\lambda$ 的上界截在了 +1.76(NFE=20 时),剩下的干净端交给最后那一步"直接输出 $\hat x_0$"。这条捷径是不是免费的?不是。沿高精度参考轨迹量"在 $\lambda$ 处直接输出 $\hat x_0$ 会偏多少":
| $\lambda$ | −0.23 | +0.74 | +1.71 | +2.67 | +3.64 |
|---|---|---|---|---|---|
| 提前收尾的偏差 | 5.234e-01 | 1.400e-01 | 4.398e-02 | 9.416e-03 | 1.280e-03 |
截得越早白送的偏差越大,而且这份偏差不随步数下降——它只取决于截在哪个 $\lambda$。在本例的候选截断点中,可观察到较低的总误差(2M,NFE=20,只改截断点):
| $\lambda_{max}$ | 1.0 | 2.0 | 2.5 | 3.0 | 4.61(走到底) |
|---|---|---|---|---|---|
| 终点误差 | 9.82e-02 | 2.80e-02 | 1.71e-02 | 1.81e-02 | 2.90e-02 |
这五个候选呈 U 形,最低点在 2.5,比"走到底"低约 1.7 倍;未证明连续截断范围的全局最优。这条也解释了 uniform-t 的行为为什么还不错:它的截断点随步数自动往右挪(NFE=20 时 1.76、50 时 2.55、100 时 3.1),等于一个廉价的自适应策略——但它是巧合,不是设计。
局部难度代理也有边界。 把一阶缺失项写成 $\delta_i\approx\alpha_{t_i}h^2m'/2$,可观察 $\alpha\|m'\|$ 的变化。本例在 λ<0 与 λ≥0 区间的平均分别约 0.1024、0.1000,峰值约 0.4417,出现在 λ≈−0.19 的中间段;两个区间均值接近不等于全区间难度均匀。该代理没有包含误差传播矩阵、末端投影或实际模型扰动,不能单独算出最优步数排布。
本节固定在 diffusers v0.35.1 的 DPMSolverMultistepScheduler,也回查 v0.30.0 多步源文件。结论限定到所读版本与分支;不能把浮动 main 链接当版本证据。
第一处:训练输出、积分参数化与随机过程是三个开关。 prediction_type 指网络输出的 ε / sample / v 等,convert_model_output 再转换成更新需要的数据或噪声预测;algorithm_type="dpmsolver++" 用数据预测积分,dpmsolver 用噪声预测。sde-dpmsolver 与 sde-dpmsolver++ 还改变漂移和随机项,不能说只是往同一条 ODE 原封不动加回噪声。某些新分支处理 flow sigmas,本例不覆盖它们。数据预测能改善某些引导问题,不能由参数化名称推断所有预测曲线都更光滑。
第二处:启动与终端需要单独处理。 历史不足时调度器按 lower_order_nums 降阶;lower_order_final 在低步数等条件下控制最后几步降阶,final_sigmas_type="zero" 让最后目标 σ=0。我们的循环明确在最后一步输出当前 $\hat x_0$;这是收尾近似,并非把高阶项带到 $h=\infty$ 就能无误差地处理整个剩余区间。以固定系数版本测试 warm2s=True,额外一次启动评估后拟合斜率为 2.13,默认为 2.10;影响不大,不能证明启动误差在其他配置中永远无关。
第三处:网格不是坐标变换本身。 源码提供 leading、trailing、默认 linspace 和其他 sigma 排布选项。本文 uniform_t_grid 先取 T→0 的整数节点,而 uniform_lambda_grid 保留 S 个有限模型评估点再附加完全干净目标,两者末端的有限评估位置不同。不能称为“只换内点、其他都一样”的比较。NFE=192 时,DDIM(t) RMS 为 1.245e−02,DDIM(λ) 为 1.775e−02;在扫描预算中分别于 256 和 384 次达到 1e−2。λ 坐标方便指数积分,并不自动证明 λ 均匀网格对所有方法最佳。离散训练时间标签是否可插值也要按网络核对,本文 oracle 接受任意累积系数。
第四处:把三阶系数差异验证到具体公式。 03.3 的 $D_2$ 表示 $h^2m''/2$;二次插值指数积分的末项需要 $2J_2D_2/h^2$。固定 v0.35.1 多步 dpmsolver++ 分支的代码则使用:
D2 = (D1_0 - D1_1) / (r0 + r1)
x_t = ((sigma_t / sigma_s0) * sample - alpha_t * (exp(-h) - 1) * D0
       + alpha_t * ((exp(-h) - 1) / h + 1) * D1
       - alpha_t * ((exp(-h) - 1 + h) / h**2 - 0.5) * D2)
上式与附录都采用括号组织赋值。最后一个系数正好为 $J_2/h^2$。另一方面,同版本单步源码 的三阶 heun 数据预测分支写的是 D2 = 2.0 * (D1_1 - D1_0) / (r0 - r1);它的节点及差商方向不同,所以不能只看一个 2 就断定两种算法完全等价。
本轮提取原始文件中的一、二、三阶方法及 _sigma_to_alpha_sigma_t,保持函数 AST 不变,以 PyTorch CPU float64 真执行。均匀和非均匀有限步、12 组噪声/步长组合的上游更新与本地 d2_scale=1.0 对照,最大差 1.24×10⁻¹⁴。调用不走弃用位置参数,使用 algorithm_type="dpmsolver++"、use_flow_sigmas=False;二阶设 midpoint。这验证实际更新分支,不是完整 diffusers 包、生产 scheduler 的所有配置或 GPU 图像生成复现。
再用外部指定的二次函数 $m(\lambda)=A+B\lambda+C\lambda^2/2$,切断模型输出对状态的依赖。指数积分的原函数为 $e^\lambda[A+B(\lambda-1)+C(\lambda^2-2\lambda+2)/2]$,所以不需要高分辨率梯形积分当“真值”。在 λ=0.3 起步、h 从 0.4 缩到 0.025,真实最大绝对误差为:
一阶:             4.17e-02 1.04e-02 2.57e-03 6.39e-04 1.59e-04
二阶midpoint:     8.16e-03 1.05e-03 1.32e-04 1.65e-05 2.07e-06
v0.35.1多步系数:  1.96e-03 2.46e-04 3.06e-05 3.81e-06 4.75e-07
二次插值版本:     6.66e-16 7.77e-16 7.77e-16 4.44e-16 6.11e-16
这里一阶局部误差按 h²、midpoint 按 h³,固定多步系数在该受控函数上也留下 h³ 项;二次插值版本到浮点量级。非均匀历史点同样核对。对二次插值做精确指数积分应具备这一精确性,一般名义三阶 ODE 方法却不必如此。结论是这两个具体指数更新在该归一化下不同,以及本地 GMM 的拟合趋势为 2.10 与 2.89;不把自行修改的系数称为经过真实图像验证的生产补丁,也不推断上游作者意图。
省了什么。 η=0 省掉每步随机噪声生成,固定初始状态时更新确定;本例轨迹位移较平滑,提供了校准缓存判据的动机。主要大幅减少神经网络调用的机制是重新选择过程、网格与更新格式,而不是高维采样中噪声生成本身必然很贵。本例路径误差的预算表不能直接当成生产提速或图像质量证明。
赔了什么。
midpoint / heun 是所读多步实现的二阶选项,不能与作者其他 API 的 solver 选项混用。默认低步数降阶是一种实际稳定化处理,不是自动的最优方案。什么时候保留随机过程。 如果任务定义本身要求随机转移、训练/蒸馏的路径分布或噪声注入,应先保证过程匹配。若目的是提高真实图像的覆盖与质量,则同时实测 ODE/SDE、η、引导强度和预算,而非套用此二维例子。本文的单高斯近似只代表一种人为误差结构。
什么时候值得上高阶。 本例约 20 次预算时多步方法已显著降低路径误差;预算极低时二次插值版本也可能不稳定(NFE=6 时误差约 0.8445,而 2M 约 0.1460)。这是高阶并非总优的具体反例。预算几百次时高阶仍可能更省达到同一路径阈值的评估次数,不能改口断言一阶必然更好;生产选择还要测单步成本、质量和可靠性。
这条脉络区分过程、数值更新和学习映射:它们可以组合,但对训练目标、初始分布与成本的要求不同。
误解一:DDIM 只是把 DDPM 步幅放大。 非马尔可夫前向族与可选随机项给出了额外自由度;η=0 也能走 1000 步,仍然是确定性更新。η=1 只有在完整时间表、fixed-small 方差、相同预测与终步处理时才有前文的 DDPM 等价关系。
误解二:少步必调大 η,或 η=0 必胜。 两个绝对判断都不成立。本例 N=10 的 η=0 比 η=1 的 SW1 低,但 N=20 的 η=0.25 又略低于 η=0;这些单次小差别不能外推。随机标准差占比或平均轨迹位移也不能单独推导质量排序。
误解三:名义阶数越高,任何预算都更省。 NFE=6 的二次插值版本比 2M 更差,启动和稳定性不可省。名义三阶与本文 2.10 的拟合斜率也不矛盾:应检查具体系数、网格、终端及渐近区,而非只读选项名字。03.3 的差商推导与 05 的原始方法实跑给出了可查的局部证据。
误解四:SW1 贴近真对真基线就失效了。 同一分布的两个经验样本仍有非零距离,它是有限样本效应;近邻差别需要更高分辨率的实验。对自身为零不证明估计无偏。配对路径 RMS 可以暴露求解误差,却不能给不同随机耦合的边缘分布作通用质量排名。
误解五:半 log-SNR 坐标、λ 均匀网格、Karras 网格是一件事。 第一项是推导坐标,后两项是评估点排布。本文同端点 Karras 只改内点密度,而 $t$ 网格还改变最后有限评估点;比较要写全这些条件。
误解六:平均输入变化大于阈值,缓存就零命中。 平均数不约束每一步,输入变化又不等于中间特征或残差变化。要证明缓存收益,必须真的实现缓存并量命中率、误差、速度和验收质量,本篇只提供输入位移代理。
在 Python 3.11、NumPy 2.4.6、matplotlib 3.10.7 的 Windows CPU 环境下,五个完整脚本全部 exit 0、stderr 为空。图示依赖 matplotlib;数值脚本依赖 NumPy 2.x。NumPy 的随机种子固定,主要实验种子 20260927,η 对照使用 paired_noise 的 1234,投影方向 7。实跑证据另用 PyTorch 2.10.0+cpu 核验原始更新方法;没有 GPU、训练权重或图像质量测试。安装依赖后按以下顺序运行;输出时间随 CPU 与线程设置变化。
cd outputs/fundamentals_files/ddim_samplers/code
python oracle_gmm.py        # ① 标定尺子(先量地板)
python ddim_family.py       # ② η 旋钮与缓存抖动
python dpm_solver_lab.py    # ③ 阶数、预算、三阶项的受控检验
python spacing_lab.py       # ④ 步数摆法与收尾点
python make_figures.py      # ⑤ 画图
四个具体的改动实验:
ddim_family.py η 扫描点,先看固定种子表,再更换多组种子。本例最后十步输入代理均值为 0.0197、0.0667、0.1294(η=0/0.5/1);记录逐步曲线,不用均值替代缓存命中率。dpm_solver_lab.py 已列出的 d2_scale=1.0 和 2.0 两种版本。真实 NFE 拟合为 2.10 与 2.89;二次强迫函数最后一个 h 的误差为 4.75e−07 与 6.11e−16。保留上游系数对照,别把教学版本直接当生产补丁。uniform_t_grid 与 uniform_lambda_grid:DDIM 拟合约 0.98/1.01,扫描到 1e−2 的 NFE 为 256/384。打印最后一个有限 λ,就会看到这不是只有内点密度不同的实验。量化网格可能因重复整数节点而缩短,预算必须读 Counter。spacing_lab.py 里比较 NFE=20、λ 上界 4.61 与 2.5。2M 路径 RMS 为 2.90e−02 与 1.71e−02;沿同一参考路径的提前投影误差也要一起记录。这展示固定预算内截断与积分误差的权衡,不保证 λ=2.5 对其他数据最优。09 节用到的脚本全文如下(oracle_gmm.py、ddim_family.py、dpm_solver_lab.py、spacing_lab.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
# -*- coding: utf-8 -*-
"""采样器实验的地基:一个 score 有闭式解的二维高斯混合 + 一把「尺子」。

为什么必须先把这两件事钉死:

1. 比较采样器时,最大的干扰项是**模型误差**。同一个噪声网络,在 t=1 和 t=1000
   上的误差可以差两个数量级,你根本分不清「这个采样器好」和「这个时间步好学」。
   用闭式 score(oracle),模型误差恒为 0,仍有终端先验偏差、收尾投影、离散化和浮点误差。
2. 比较采样器时,第二大的干扰项是**尺子本身的噪声**。切片 Wasserstein 距离
   是用有限样本估的,两个「都对」的分布之间也能量出一个正数。这个正数就是
   抽样基线;近邻差别需增加样本和重复,而非一律判成运气。

所以这个脚本干三件事:给出 oracle、给出尺子、量出地板。后面三个脚本全部
import 它,保证四处用到的目标分布、指标、随机数是同一套。

    python oracle_gmm.py

依赖:numpy, matplotlib(画图时才需要)
"""

import numpy as np

T = 1000          # 训练时的扩散步数
D = 2             # 数据维度(二维才画得出轨迹,也才跑得起闭式 score)
N_EVAL = 4000     # 评价用的样本数
N_DIRS = 512      # 切片 Wasserstein 的投影方向数


# ══════════════════════════════════════════════════════════════════
# 1. 噪声调度
# ══════════════════════════════════════════════════════════════════
def linear_schedule(T: int = T, b0: float = 1e-4, b1: float = 0.02):
    """DDPM / diffusers 默认的线性 beta 调度。

    返回 abar 的长度是 T+1:abar[t] = prod_{s<=t} (1 - beta_s),
    abar[0] = 1 表示「完全干净」。这样下标和论文里的 t 直接对齐,
    不用在 0-based / 1-based 之间来回换算。
    """
    betas = np.linspace(b0, b1, T)
    abar = np.concatenate([[1.0], np.cumprod(1.0 - betas)])
    return betas, abar


def alpha_sigma(abar_t: float):
    """给定 abar_t,返回 (alpha_t, sigma_t) = (sqrt(abar), sqrt(1-abar))。

    这是全文唯一的「坐标」:x_t = alpha_t * x_0 + sigma_t * eps。
    注意 alpha 是**信号尺度**,不是 DDPM 论文里的 alpha_t = 1 - beta_t。
    """
    return np.sqrt(abar_t), np.sqrt(1.0 - abar_t)


# ══════════════════════════════════════════════════════════════════
# 2. 目标分布:8 个切向拉长的高斯,摆成一个环
# ══════════════════════════════════════════════════════════════════
def make_target(K: int = 8, radius: float = 1.8, radial_var: float = 0.30, tangential_var: float = 0.05):
    """K 个分量均匀摆在一个半径 radius 的环上,每个分量沿径向拉长。

    为什么不用各向同性:各向同性的高斯混合,加噪之后很快变成一个圆球,
    各向同性混合的score仍可非线性;这里选各向异性来构造具体实验。
    径向拉长之后,环上的 score 场有明显曲率,离散化误差才显出来。
    """
    ang = np.linspace(0.0, 2.0 * np.pi, K, endpoint=False)
    mu = np.stack([radius * np.cos(ang), radius * np.sin(ang)], axis=1)
    Sig = np.zeros((K, D, D))
    for k, a in enumerate(ang):
        R = np.array([[np.cos(a), -np.sin(a)], [np.sin(a), np.cos(a)]])
        Sig[k] = R @ np.diag([radial_var, tangential_var]) @ R.T
    w = np.ones(K) / K
    return w, mu, Sig


def sample_true(n: int, w, mu, Sig, rng):
    """从目标分布抽样。"""
    k = rng.choice(len(w), size=n, p=w)
    L = np.linalg.cholesky(Sig[k])                     # (n, D, D)
    z = rng.standard_normal((n, D))
    return mu[k] + np.einsum("nij,nj->ni", L, z)


# ══════════════════════════════════════════════════════════════════
# 3. Oracle:加噪后分布的闭式 score,以及最优的 eps 预测
# ══════════════════════════════════════════════════════════════════
def _cov_at(abar_t: float, Sig):
    """q(x_t) 的第 k 个分量协方差:C_k = abar * Sig_k + (1 - abar) * I。"""
    return abar_t * Sig + (1.0 - abar_t) * np.eye(D)


def logp_and_score(x, abar_t: float, w, mu, Sig):
    """返回 (log q_t(x), score_t(x)),x 形状 (n, D)。

    q_t 是 K 个高斯的混合:第 k 个分量的均值是 sqrt(abar) * mu_k,
    协方差是 abar * Sig_k + (1 - abar) * I。score 是这个混合分布的
    对数梯度 = 各分量 score 的后验加权平均。
    """
    C = _cov_at(abar_t, Sig)                            # (K, D, D)
    inv = np.linalg.inv(C)
    ld = np.log(np.linalg.det(C))
    r = x[:, None, :] - np.sqrt(abar_t) * mu[None]      # (n, K, D)
    quad = np.einsum("nki,kij,nkj->nk", r, inv, r)
    lg = np.log(w)[None, :] - 0.5 * quad - 0.5 * ld[None, :]
    m = lg.max(axis=1, keepdims=True)
    p = np.exp(lg - m)
    Z = p.sum(axis=1, keepdims=True)
    logp = (m[:, 0] + np.log(Z[:, 0]))
    pi = p / Z                                          # 后验分量权重
    comp = -np.einsum("kij,nkj->nki", inv, r)           # 每个分量的 score
    score = np.einsum("nk,nki->ni", pi, comp)
    return logp, score


def eps_star(x, abar_t: float, w, mu, Sig):
    """MMSE 意义下最优的 eps 预测:eps* = -sigma_t * score_t(x)。

    因为 x_t = alpha x_0 + sigma * eps,对 x_t 求 log 梯度会得到
    grad log q_t = -E[eps | x_t] / sigma,所以最优的噪声预测就是
    score 乘一个 -sigma。后面所有采样器都拿它当「模型」。
    """
    _, s = logp_and_score(x, abar_t, w, mu, Sig)
    return -np.sqrt(1.0 - abar_t) * s


def x0_from_eps(x, abar_t: float, eps):
    """由 x_t 和 eps 反解 x_0:x_0 = (x_t - sigma_t * eps) / alpha_t。"""
    a, sg = alpha_sigma(abar_t)
    return (x - sg * eps) / a


# ══════════════════════════════════════════════════════════════════
# 4. 尺子:切片 Wasserstein-1 + 平均对数密度
# ══════════════════════════════════════════════════════════════════
def make_dirs(n_dirs: int = N_DIRS, seed: int = 7):
    """预先抽好投影方向,全篇共用同一组。

    这一条很重要:每次评价都重新抽方向的话,两组「同样好」的样本也会因为
    方向不同量出不同的数,这部分方差完全是无谓的。方向固定之后,
    A 和 B 的差别就只来自样本本身。
    """
    th = np.random.default_rng(seed).standard_normal((n_dirs, D))
    th /= np.linalg.norm(th, axis=1, keepdims=True)
    return th


def sliced_w1(X, Y, TH=None, n_dirs: int = N_DIRS, rng=None):
    """切片 W1:在 n_dirs 个随机方向上算一维 W1,再取平均。

    一维 W1 有闭式解:把两个样本集投影后排序,逐位相减取绝对值平均。
    单位和数据同单位(这里是「平均要挪多远」),比 MMD^2 好解释。
    """
    if TH is None:
        TH = make_dirs(n_dirs) if rng is None else None
    if TH is None:
        th = rng.standard_normal((n_dirs, X.shape[1]))
        th /= np.linalg.norm(th, axis=1, keepdims=True)
    else:
        th = TH
    a = np.sort(X @ th.T, axis=0)
    b = np.sort(Y @ th.T, axis=0)
    return float(np.abs(a - b).mean())


def mean_logp(X, w, mu, Sig):
    """生成样本在真实分布下的平均对数密度。"""
    lp, _ = logp_and_score(X, 1.0, w, mu, Sig)
    return float(lp.mean())


def evaluate(X, Xref, w, mu, Sig, lp_ref, TH):
    """一次评价,返回 (SW1, dlogp)。

    dlogp = 生成样本的平均 log 密度 − 真实样本的平均 log 密度。
    0仅表示平均log密度相同,不证明分布相同;正数也不等于质量更好。
    """
    return sliced_w1(X, Xref, TH=TH), mean_logp(X, w, mu, Sig) - lp_ref


# ══════════════════════════════════════════════════════════════════
# 5. 主流程:验 oracle、量尺子的噪声地板
# ══════════════════════════════════════════════════════════════════
def main():
    rng = np.random.default_rng(20260927)
    betas, abar = linear_schedule()
    w, mu, Sig = make_target()

    print("=" * 68)
    print("A. Oracle 自检:解析 score vs 有限差分")
    print("=" * 68)
    for t in (1, 50, 200, 500, 1000):
        x = sample_true(8, w, mu, Sig, rng)
        _, s = logp_and_score(x, abar[t], w, mu, Sig)
        h = 1e-5
        fd = np.zeros_like(s)
        for i in range(D):
            e = np.zeros(D)
            e[i] = h
            lp_p, _ = logp_and_score(x + e, abar[t], w, mu, Sig)
            lp_m, _ = logp_and_score(x - e, abar[t], w, mu, Sig)
            fd[:, i] = (lp_p - lp_m) / (2 * h)
        err = np.abs(fd - s).max()
        print(f"  t={t:5d}  abar={abar[t]:.6f}  max|解析 - 差分| = {err:.2e}")
    print("  有限差分与解析 score 数值一致;该自检不证明整体生成误差为零")

    # 顺便看一眼:oracle eps 在 t=1000 处还剩多少信息
    print()
    print("=" * 68)
    print("B. 端点检查:t=T 时分布离标准正态有多远")
    print("=" * 68)
    for t in (200, 500, 800, 1000):
        C = _cov_at(abar[t], Sig)
        dev = np.abs(C - np.eye(D)).max()
        print(f"  t={t:5d}  abar={abar[t]:.3e}  "
              f"各分量协方差与 I 的最大差 = {dev:.3e}")
    print("  越接近 t=T,加噪后的混合越接近一个标准正态球")

    # ── 尺子的噪声地板 ──
    print()
    print("=" * 68)
    print("C. 尺子的噪声地板:两批「都对」的样本之间也能量出距离")
    print("=" * 68)
    Xref = sample_true(N_EVAL, w, mu, Sig, rng)
    lp_ref = mean_logp(Xref, w, mu, Sig)
    print(f"  参考样本: {Xref.shape}, 真实样本自己的平均 logp = {lp_ref:.4f}")
    TH = make_dirs()
    sw_floor, lp_floor = [], []
    for r in range(8):
        Y = sample_true(N_EVAL, w, mu, Sig, np.random.default_rng(1000 + r))
        sw_floor.append(sliced_w1(Y, Xref, TH=TH))
        lp_floor.append(mean_logp(Y, w, mu, Sig))
    print(f"  SW1  真vs真 ×8: 均值 {np.mean(sw_floor):.5f}  "
          f"标准差 {np.std(sw_floor):.5f}  最大 {np.max(sw_floor):.5f}")
    print(f"  dlogp 真vs真 ×8: 均值 {np.mean(lp_floor) - lp_ref:+.4f}  "
          f"标准差 {np.std(lp_floor):.4f}")
    print("  → 当前抽样基线不能直接当作显著性阈值;近邻差别需更多重复")

    # ── 一个有参照的好答案长什么样 ──
    print()
    print("=" * 68)
    print("D. 天花板:把真样本直接当生成样本送进去")
    print("=" * 68)
    print(f"  SW1 = {sliced_w1(Xref, Xref, TH=TH):.6f}"
          f"   dlogp = {mean_logp(Xref, w, mu, Sig) - lp_ref:+.4f}")
    print("  (同一经验样本对自身为0;不说明有限样本分布估计无偏)")


if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""DDIM 家族:一个 eta 旋钮,把 DDPM 祖采样和 DDIM 串成一条线。
这个脚本回答三个问题:
1. **eta=1 的 DDIM 是不是就是 DDPM 祖采样?** 用两套独立的代码(一套写
DDPM Algorithm 2 的原式,一套写 DDIM 论文式 (12)),喂同样的随机数和
同样的起点,看输出能不能对到最后一位。能,那这条家族关系就不是传说。
2. **eta 到底该调多大?** 在 oracle score 下扫一遍:步数少的时候是不是
「加噪声更好」?在欠拟合模型下再扫一遍,看结论翻不翻。
3. **换采样器为什么缓存策略得重调?** 量每步「模型输入变了多少」:
确定性采样器的轨迹是光滑的,随机采样器每一步都往里砸一份新噪声。
python ddim_family.py
依赖:numpy(+ 同目录的 oracle_gmm.py)
"""
import numpy as np
from oracle_gmm import (T, linear_schedule, make_target, sample_true,
eps_star, x0_from_eps, alpha_sigma, sliced_w1,
mean_logp, make_dirs, N_EVAL, N_DIRS)
# ══════════════════════════════════════════════════════════════════
# 0. 时间步网格与模型
# ══════════════════════════════════════════════════════════════════
def uniform_t_grid(S: int, T: int = T):
"""本文在 t 上取整数等间隔节点;不宣称复刻 diffusers leading 端点。
返回 S+1 个 abar:起点 abar[T],终点 1.0(完全干净)。
"""
ts = np.round(np.linspace(0.0, T, S + 1)).astype(int)[::-1]
grid = np.array([1.0 if t == 0 else _ABAR[t] for t in ts], dtype=float)
return ts, grid
def paired_noise(S: int, n: int, seed: int = 1234):
"""给所有采样器**同一份**起点和同一批随机数。
这是整套实验最要紧的一条:如果每个配置各抽各的起点,配置之间就多了一份
抽样方差,量出来的差别里有多少是采样器的功劳根本说不清。配对之后,
eta=0 和 eta=1 的终点之差只能来自算法本身。
"""
r = np.random.default_rng(seed + S)
x_init = r.standard_normal((n, 2))
zs = [r.standard_normal((n, 2)) for _ in range(S)]
return x_init, zs
def make_model(kind: str, w, mu, Sig):
"""两种「模型」,用来分离离散化误差和模型误差。
oracle : 用的就是真 score,没有网络拟合误差;仍有离散化、终端先验、收尾与浮点误差。
gauss : 模型以为数据是一个单高斯(用真均值真协方差拟合),
也就是「容量不足以表达多峰」。高噪声区它几乎是对的,
低噪声区偏差较大;这只是一种人工误差结构,不代表所有网络。
"""
if kind == "oracle":
return lambda x, abar: eps_star(x, abar, w, mu, Sig)
if kind == "gauss":
m = (w[:, None] * mu).sum(axis=0)
S = ((w[:, None, None] * (Sig + np.einsum("ki,kj->kij", mu, mu))).sum(axis=0)
- np.outer(m, m))
w1, mu1, S1 = np.array([1.0]), m[None, :], S[None, :, :]
return lambda x, abar: eps_star(x, abar, w1, mu1, S1)
raise ValueError(kind)
# ══════════════════════════════════════════════════════════════════
# 1. DDIM 的一步(论文式 12,与 diffusers DDIMScheduler.step 逐项对齐)
# ══════════════════════════════════════════════════════════════════
def ddim_step(x, abar_cur, abar_tgt, eps, z, eta):
"""从 abar_cur 走到 abar_tgt(abar_tgt > abar_cur,噪声变小)。
x_tgt = sqrt(abar_tgt) * x0_hat
+ sqrt(sigma_tgt^2 - sigma_tilde^2) * eps ← 指向 x_t 的方向项
+ sigma_tilde * z ← 随机项
sigma_tilde = eta * sqrt( (1-abar_tgt)/(1-abar_cur) * (1 - abar_cur/abar_tgt) )
eta = 0 → 完全没有随机项,DDIM;
eta = 1 → 完整时间表时等于 fixed-small DDPM 后验标准差。
"""
if not (0 < abar_cur < abar_tgt <= 1 and 0 <= eta <= 1):
raise ValueError("要求0<abar_cur<abar_tgt<=1且0<=eta<=1")
a_c, s_c = alpha_sigma(abar_cur)
a_t, s_t = alpha_sigma(abar_tgt)
x0 = (x - s_c * eps) / a_c
var = (1.0 - abar_tgt) / (1.0 - abar_cur) * (1.0 - abar_cur / abar_tgt)
sig_tilde = eta * np.sqrt(max(var, 0.0))
direc = np.sqrt(max(s_t ** 2 - sig_tilde ** 2, 0.0))
return a_t * x0 + direc * eps + sig_tilde * z, x0
def ddpm_step(x, abar_cur, abar_tgt, eps, z, betas):
"""DDPM Algorithm 2 的原式,故意写成「另一套代码」用来交叉验证。
x_{t-1} = (x_t - beta_t / sqrt(1 - abar_t) * eps) / sqrt(alpha_t)
+ sqrt(beta_tilde_t) * z
只在相邻步(stride = 1)上成立,不能跳步。
"""
abar_prev = abar_tgt
beta_t = 1.0 - abar_cur / max(abar_prev, 1e-12) # = 1 - alpha_t
beta_tilde = (1.0 - abar_prev) / (1.0 - abar_cur) * beta_t
a_t = np.sqrt(max(abar_cur / max(abar_prev, 1e-12), 1e-12))
mean = (x - beta_t / np.sqrt(1.0 - abar_cur) * eps) / a_t
return mean + np.sqrt(max(beta_tilde, 0.0)) * z
def run_ddim(x, grid, model, eta, zs, track=False):
"""沿 grid 走一遍。grid[0] 最吵,grid[-1] = 1.0。
track=True 时额外返回每一步的 (x, x0_hat),D 节量「轨迹抖动」要用。
"""
xs, x0s = [x.copy()], []
for i in range(len(grid) - 1):
eps = model(x, grid[i])
z = zs[i] if zs is not None else 0.0
x, x0 = ddim_step(x, grid[i], grid[i + 1], eps, z, eta)
if track:
xs.append(x.copy())
x0s.append(x0.copy())
return x, (xs, x0s) if track else x0s
# ══════════════════════════════════════════════════════════════════
# 2. 主流程
# ══════════════════════════════════════════════════════════════════
_BETAS, _ABAR = linear_schedule()
def main():
rng = np.random.default_rng(20260927)
w, mu, Sig = make_target()
Xref = sample_true(N_EVAL, w, mu, Sig, rng)
lp_ref = mean_logp(Xref, w, mu, Sig)
ev_rng = np.random.default_rng(7)
model = make_model("oracle", w, mu, Sig)
# ── A. eta=1 的 DDIM 是不是 DDPM 祖采样 ──
print("=" * 70)
print("A. 交叉验证:DDIM(eta=1, stride=1) 是否等于 DDPM Algorithm 2")
print("=" * 70)
S = 1000
ts, grid = uniform_t_grid(S)
n = 400
x_init = rng.standard_normal((n, 2))
zs = [rng.standard_normal((n, 2)) for _ in range(S)]
x_ddpm = x_init.copy()
for i in range(S): # 原式,一步步走完 1000 步
t = ts[i]
x_ddpm = ddpm_step(x_ddpm, grid[i], grid[i + 1],
model(x_ddpm, grid[i]), zs[i], _BETAS)
x_ddim, _ = run_ddim(x_init.copy(), grid, model, eta=1.0, zs=zs)
d = np.abs(x_ddpm - x_ddim).max()
print(f" 两条独立实现,喂同样的 {S} 份随机数")
print(f" 终点逐元素最大差 = {d:.3e} 终点 RMS = {np.sqrt((x_ddim**2).mean()):.4f}")
print(f" → 差 {d:.1e},是浮点累加误差量级:eta=1 就是 DDPM 祖采样,不是「近似」")
# ── B. eta 扫描(oracle score)──
print()
print("=" * 70)
print("B. eta 扫描:步数越少,是不是越该加噪声?(oracle score,配对起点)")
print("=" * 70)
TH = make_dirs()
floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig,
np.random.default_rng(1000 + r)), Xref, TH=TH)
for r in range(6)]
print(f" 噪声地板 SW1 = {np.mean(floors):.4f} ± {np.std(floors):.4f}"
f"(真实样本对真实样本),仅作当前估计量的抽样基线")
NS = (10, 20, 50, 100)
print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS))
for eta in (0.0, 0.25, 0.5, 0.75, 1.0):
row = []
for S in NS:
ts, grid = uniform_t_grid(S)
x_init, zs = paired_noise(S, N_EVAL)
x, _ = run_ddim(x_init, grid, model, eta, zs)
row.append(sliced_w1(x, Xref, TH=TH))
print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row))
# ── C. 换个欠拟合的模型,结论翻不翻 ──
print()
print("=" * 70)
print("C. 同样的扫描,但把模型换成「以为数据是单高斯」")
print("=" * 70)
gm = make_model("gauss", w, mu, Sig)
print(f" {'eta':>5} " + " ".join(f"{'N=' + str(s):>10}" for s in NS))
for eta in (0.0, 0.25, 0.5, 0.75, 1.0):
row = []
for S in NS:
ts, grid = uniform_t_grid(S)
x_init, zs = paired_noise(S, N_EVAL)
x, _ = run_ddim(x_init, grid, gm, eta, zs)
row.append(sliced_w1(x, Xref, TH=TH))
print(f" {eta:5.2f} " + " ".join(f"{v:10.4f}" for v in row))
# ── D. 每步「模型输入变了多少」:缓存友好度 ──
print()
print("=" * 70)
print("D. 轨迹抖动:每步「模型输入」变了百分之几(缓存相关的一个输入代理量)")
print("=" * 70)
print(" 缓存类加速(按『这一步的输入和上一步差不多就复用上一步的特征』决策)")
print(" 这里只量输入位移代理;没有特征缓存/命中率/画质实测。")
print(f" {'eta':>5} {'最后10步 输入相对变化':>22} {'最后10步 x0_hat位移':>22}")
S = 50
ts, grid = uniform_t_grid(S)
x_init, zs = paired_noise(S, N_EVAL)
out = {}
for eta in (0.0, 0.5, 1.0):
_, (xs, x0s) = run_ddim(x_init.copy(), grid, model, eta, zs, track=True)
rel_x = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean())
/ np.sqrt(((xs[i] ** 2).sum(1)).mean()))
for i in range(len(xs) - 1)]
d_x0 = [float(np.sqrt((((x0s[i] - x0s[i - 1]) ** 2).sum(1)).mean()))
for i in range(1, len(x0s))]
out[eta] = (rel_x, d_x0)
print(f" {eta:5.1f} {np.mean(rel_x[-10:]):22.4f} {np.mean(d_x0[-10:]):22.4f}")
i = 25
_, (xs, _) = run_ddim(x_init.copy(), grid, model, 1.0, zs, track=True)
xcur = xs[i]
ac, sc = alpha_sigma(grid[i]); at, st = alpha_sigma(grid[i + 1])
eps = model(xcur, grid[i]); m = (xcur - sc * eps) / ac
var = (1 - grid[i + 1]) / (1 - grid[i]) * (1 - grid[i] / grid[i + 1])
rms = lambda v: float(np.sqrt(np.sum(v * v, axis=1).mean()))
print(" eta=1 第25步三项 Euclidean RMS:",
f"回数据={rms(at*m):.4f} 沿噪声方向={rms(np.sqrt(st*st-var)*eps):.4f}",
f"新掷噪声={rms(np.sqrt(var)*zs[i]):.4f}")
r0, r1 = out[0.0][0][-10:], out[1.0][0][-10:]
print(f" → eta=1 的输入抖动是 eta=0 的 {np.mean(r1) / np.mean(r0):.1f} 倍;"
f"按 eta=0 调出来的缓存阈值,换个采样器就完全不是一回事")
if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""从 DDIM 走到高阶:把时间轴换成 lambda,阶数就变成可以直接量出来的东西。
这个脚本做四件事:
1. **验证 DDIM 就是一阶 DPM-Solver。** 两套完全不同的代码(一套写 DDIM
论文式 12,一套写 lambda 空间的一阶指数积分器),同样的时间网格、
同样的模型,看输出是不是同一个数。是,那「DDIM 是一阶方法」就不是比喻。
2. **把阶数量出来。** 拿一条超高精度的参考解当真值,量各采样器终点到它的
距离。这个距离没有抽样噪声(起点配对、采样器确定),能干净地跨几个数量级,
于是「误差 ~ NFE^(-p)」里的 p 可以直接拟合出来。
3. **给出实用的步数-质量表。** 阶数是数值分析的语言,产品要的是
「20 步够不够」,所以再给一张 SW1 表(含抽样基线)。
4. **看高阶方法省下的评估次数到底落在哪。**
python dpm_solver_lab.py
依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py)
"""
import numpy as np
from oracle_gmm import (T, linear_schedule, make_target, sample_true,
eps_star, alpha_sigma, sliced_w1, make_dirs, N_EVAL)
from ddim_family import uniform_t_grid, make_model, ddim_step
_BETAS, _ABAR = linear_schedule()
_LAM = 0.5 * np.log(np.maximum(_ABAR, 1e-300) / np.maximum(1.0 - _ABAR, 1e-300))
# ══════════════════════════════════════════════════════════════════
# 0. lambda 坐标与网格
# ══════════════════════════════════════════════════════════════════
def lam_of_abar(abar):
"""half log-SNR:lambda = log(alpha) - log(sigma) = 0.5 * log(abar/(1-abar))。"""
return 0.5 * np.log(np.maximum(abar, 1e-300) / np.maximum(1.0 - abar, 1e-300))
def abar_of_lam(lam):
"""lambda 的反函数:abar = e^(2 lam) / (1 + e^(2 lam))。"""
e = np.exp(2.0 * lam)
return e / (1.0 + e)
def nearest_t(abar):
"""把连续的 abar 落到最近的训练时间步上(离散训练网络需按具体实现处理时间标签)。
注意 abar 是**递减**的,不能用 searchsorted(它只认递增数组),
老老实实找绝对值最小的那个下标。
"""
return int(np.clip(int(np.argmin(np.abs(_ABAR - abar))), 1, T))
def uniform_lambda_grid(S: int, quantize: bool = False):
"""在 lambda 上等间隔取 S 个点,再落回训练网格。
返回 S+1 个 abar:前 S 个是「要评估模型」的位置,最后一个是 1.0
(完全干净,sigma = 0,对应 lambda = +inf,只能用一阶收尾)。
quantize=True 会把每个 lambda 落回整数时间步。落回去之后可能撞车
(两个 lambda 落到同一个 t),撞车会让多步法的差商分母变成 0,
所以强制 t 严格递减。参考解要更细的分辨率,用 quantize=False 直接
吃连续的 abar —— oracle 认得任意 abar;真实模型的时间插值/标签须查训练约定。
"""
l0, l1 = _LAM[T], _LAM[1] # 从最吵到最干净
lams = np.linspace(l0, l1, S)
if not quantize:
return None, np.concatenate([abar_of_lam(lams), [1.0]])
ts = []
for l in lams:
t = nearest_t(abar_of_lam(l))
if ts and t >= ts[-1]:
t = ts[-1] - 1 # 强制严格递减,避免差商分母为 0
if t < 1:
break # 干净端训练网格已无分辨率,到此为止
ts.append(t)
ts = np.array(ts, dtype=int)
return ts, np.concatenate([_ABAR[ts], [1.0]])
class Counter:
"""包一层模型,数一下到底调了几次。NFE 不能靠嘴算。"""
def __init__(self, model):
self.m = model
self.n = 0
def __call__(self, x, abar):
self.n += 1
return self.m(x, abar)
# ══════════════════════════════════════════════════════════════════
# 1. 一阶指数积分器(DPM-Solver-1 / dpmsolver++ 的一阶更新)
# ══════════════════════════════════════════════════════════════════
def dpm_pp_first(x, m0, a_s, s_s, a_t, s_t):
"""x_t = (sigma_t/sigma_s) * x_s - alpha_t * (e^{-h} - 1) * x0_hat
h = lambda_t - lambda_s。sigma_t = 0 时 lambda_t = +inf,e^{-h} = 0,
整条式子退化成 x_t = x0_hat —— 最后一步自动正确,不用特判。
"""
if s_t <= 0.0:
return m0
h = (np.log(a_t) - np.log(s_t)) - (np.log(a_s) - np.log(s_s))
return (s_t / s_s) * x - a_t * (np.exp(-h) - 1.0) * m0
def dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type="midpoint"):
"""diffusers multistep_dpm_solver_second_order_update 的逐项复刻。
D1 是用上一步的 x0_hat 做差商估出来的导数:D1 ~ h * dx0/dlambda。
midpoint 和 heun 的区别只在 D1 前面的系数,两者都是二阶。
"""
lam_t = np.log(a_t) - np.log(s_t)
lam_s0, m0 = hist[-1]
lam_s1, m1 = hist[-2]
h = lam_t - lam_s0
h0 = lam_s0 - lam_s1
r0 = h0 / h
D0, D1 = m0, (m0 - m1) / r0
emh = np.exp(-h)
if solver_type == "midpoint":
return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0
- 0.5 * a_t * (emh - 1.0) * D1)
return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0
+ a_t * ((emh - 1.0) / h + 1.0) * D1)
def dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0):
"""三阶多步更新。
d2_scale=1.0 是 diffusers v0.35.1 的 dpmsolver++ 分支(也核对 v0.30.0)`multistep_dpm_solver_third_order_update`
的逐项复刻;d2_scale=2.0 是本文的二次插值指数积分对照版本。
两者的差别见 F 节的受控检验 —— 差的就是这一个 2。
"""
lam_t = np.log(a_t) - np.log(s_t)
lam_s0, m0 = hist[-1]
lam_s1, m1 = hist[-2]
lam_s2, m2 = hist[-3]
h = lam_t - lam_s0
h0, h1 = lam_s0 - lam_s1, lam_s1 - lam_s2
r0, r1 = h0 / h, h1 / h
D0 = m0
D1_0, D1_1 = (m0 - m1) / r0, (m1 - m2) / r1
D1 = D1_0 + (r0 / (r0 + r1)) * (D1_0 - D1_1)
D2 = d2_scale * (D1_0 - D1_1) / (r0 + r1)
emh = np.exp(-h)
return ((s_t / s_s) * x - a_t * (emh - 1.0) * D0
+ a_t * ((emh - 1.0) / h + 1.0) * D1
- a_t * ((emh - 1.0 + h) / h ** 2 - 0.5) * D2)
# ══════════════════════════════════════════════════════════════════
# 2. 五个采样器
# ══════════════════════════════════════════════════════════════════
def solve_ddim(grid, model, x):
"""DDIM(eta=0):论文式 12,完全不碰 lambda。"""
for i in range(len(grid) - 1):
eps = model(x, grid[i])
x, _ = ddim_step(x, grid[i], grid[i + 1], eps, 0.0, 0.0)
return x
def solve_dpm1(grid, model, x):
"""一阶指数积分器。理论上应该和 DDIM 逐位相同 —— A 节去验。"""
for i in range(len(grid) - 1):
a_s, s_s = alpha_sigma(grid[i])
a_t, s_t = alpha_sigma(grid[i + 1])
eps = model(x, grid[i])
m0 = (x - s_s * eps) / a_s
x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t)
return x
def solve_dpm2s(grid, model, x):
"""数据预测指数中点法:每步先在 lambda 中点落一脚,用中点的 x0 走完。
有限目标一步两次评估,sigma=0 收尾仅一次。中点的 x0 对积分的「加权平均」是二阶准确的,
所以整步的局部误差是 O(h^3),全局 O(h^2)。
"""
for i in range(len(grid) - 1):
a_s, s_s = alpha_sigma(grid[i])
a_t, s_t = alpha_sigma(grid[i + 1])
eps = model(x, grid[i])
m0 = (x - s_s * eps) / a_s
lam_s, lam_t = np.log(a_s) - np.log(s_s), None
if s_t <= 0.0: # 收尾:lambda_t = +inf,中点无从谈起
x = m0
continue
lam_t = np.log(a_t) - np.log(s_t)
lam_m = 0.5 * (lam_s + lam_t)
abar_m = abar_of_lam(lam_m) # oracle 用连续中点;整数标签版本需独立分析
a_m, s_m = alpha_sigma(abar_m)
x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m) # 先跳到中点
eps_m = model(x_m, abar_m)
m_m = (x_m - s_m * eps_m) / a_m # 中点处的 x0
x = dpm_pp_first(x, m_m, a_s, s_s, a_t, s_t) # 用中点 x0 走完整步
return x
def _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model):
"""在 lambda 的中点补一次评估,拿中点的 x0 走完整步(局部二阶)。
多步法开头那一步没有历史可用,只能降成一阶,而一阶在长度为 h 的区间上
局部误差是 O(h^2),这个误差会一路传到终点 —— 这可能影响全局阶数
的潜在来源之一。给第一步多花一次评估可对照,但不证明其他误差项不存在。
"""
lam_s, lam_t = np.log(a_s) - np.log(s_s), np.log(a_t) - np.log(s_t)
abar_m = abar_of_lam(0.5 * (lam_s + lam_t))
a_m, s_m = alpha_sigma(abar_m)
x_m = dpm_pp_first(x, m0, a_s, s_s, a_m, s_m)
eps_m = model(x_m, abar_m)
return (x_m - s_m * eps_m) / a_m
def solve_multistep(grid, model, x, order=2, solver_type="midpoint", warm2s=False,
d2_scale=2.0):
"""多步法(DPM-Solver++ 2M / 3M):一步一次评估,导数是拿历史 x0 做差商。
开头几步历史不够,自动降阶(和 diffusers 的 lower_order_nums 一样);
最后一步 sigma=0 强制降成一阶(和 final_sigmas_type="zero" 一样)。
warm2s=True 时,第一步改用中点法(多花一次评估)把局部精度提到二阶。
"""
hist = []
for i in range(len(grid) - 1):
a_s, s_s = alpha_sigma(grid[i])
a_t, s_t = alpha_sigma(grid[i + 1])
eps = model(x, grid[i])
m0 = (x - s_s * eps) / a_s
hist.append((np.log(a_s) - np.log(s_s), m0))
last = (i == len(grid) - 2)
if i == 0 and warm2s and s_t > 0.0:
x = dpm_pp_first(x, _midpoint_x0(x, m0, a_s, s_s, a_t, s_t, model),
a_s, s_s, a_t, s_t)
elif s_t <= 0.0 or len(hist) < 2 or last:
x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t)
elif order >= 3 and len(hist) >= 3:
x = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=d2_scale)
else:
x = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t, solver_type)
return x
# ══════════════════════════════════════════════════════════════════
# 3. 主流程
# ══════════════════════════════════════════════════════════════════
def rms_err(x, xref):
return float(np.sqrt(((x - xref) ** 2).sum(1).mean()))
def fit_slope(ns, errs, res, nfe_min=24):
"""在双对数上拟合 err ~ N^(-p),返回 p。
只取渐近段:NFE 太小的时候高阶方法还在「攒历史」(前几步被迫降阶),
这一段量出来的斜率既不是 1 也不是 3,什么都不说明;误差接近参考解
自检差值的点可能受参考误差影响,同样不能要。
"""
xs, ys = [], []
for n, e in zip(ns, errs):
if n >= nfe_min and e > 3.0 * res and np.isfinite(e) and e > 0:
xs.append(np.log(n))
ys.append(np.log(e))
if len(xs) < 3:
return float("nan"), 0
p = -np.polyfit(xs, ys, 1)[0]
return float(p), len(xs)
def local_err_test():
"""受控检验:规定 x0_hat(lambda) 是二次多项式,看各阶更新的局部误差阶。
本文要检验的是对二次插值函数做精确指数积分的系数归一化。
这类构造应对外部指定的二次函数精确;一般三阶ODE求解器不必有此性质。
这个检验把「公式对不对」和「轨迹好不好」彻底分开,谁也赖不着谁。
"""
rng = np.random.default_rng(3)
A, Bc, Cc = rng.standard_normal(2), rng.standard_normal(2), rng.standard_normal(2)
g = lambda lam: A + Bc * lam + 0.5 * Cc * lam ** 2
def exact_inc(lam_s, lam_t):
def primitive(lam):
return np.exp(lam) * (A + Bc * (lam - 1)
+ 0.5 * Cc * (lam * lam - 2 * lam + 2))
return primitive(lam_t) - primitive(lam_s)
hs = [0.4, 0.2, 0.1, 0.05, 0.025]
lam_s = 0.3
out = {}
for name in ("一阶", "二阶", "三阶-D2原式", "三阶-D2乘2"):
errs = []
for h in hs:
lam_t = lam_s + h
a_s, s_s = alpha_sigma(abar_of_lam(lam_s))
a_t, s_t = alpha_sigma(abar_of_lam(lam_t))
x = np.array([0.7, -0.4])
hist = [(lam_s - j * h, g(lam_s - j * h)) for j in (2, 1, 0)] # 老→新
if name == "一阶":
got = dpm_pp_first(x, g(lam_s), a_s, s_s, a_t, s_t)
elif name == "二阶":
got = dpm_pp_second(x, hist, a_s, s_s, a_t, s_t)
elif name == "三阶-D2原式":
got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=1.0)
else:
got = dpm_pp_third(x, hist, a_s, s_s, a_t, s_t, d2_scale=2.0)
want = (s_t / s_s) * x + s_t * exact_inc(lam_s, lam_t)
errs.append(float(np.abs(got - want).max()))
out[name] = errs
print(f" {name:>12}: " + " ".join(f"{e:.2e}" for e in errs))
print(" (h 从 0.4 缩到 0.025)")
print(" → 一阶 h^2、二阶 h^3 都对;三阶原式只有 h^3(等于二阶),")
print(" D2 乘 2 之后直接掉到 1e-14 —— 二次 x0_hat 下它一步就算准了")
def main():
rng = np.random.default_rng(20260927)
w, mu, Sig = make_target()
TH = make_dirs()
Xref = sample_true(N_EVAL, w, mu, Sig, rng)
model = make_model("oracle", w, mu, Sig)
# ── A. DDIM == 一阶 DPM-Solver ? ──
print("=" * 72)
print("A. 交叉验证:DDIM(eta=0) 与 lambda 空间一阶指数积分器是不是同一个东西")
print("=" * 72)
n = 500
for S in (20, 50):
_, grid_l = uniform_lambda_grid(S)
_, grid_t = uniform_t_grid(S)
for name, grid in (("uniform-t", grid_t), ("uniform-lambda", grid_l)):
x0 = rng.standard_normal((n, 2))
xa = solve_ddim(grid, model, x0.copy())
xb = solve_dpm1(grid, model, x0.copy())
print(f" S={S:3d} {name:>14} max|DDIM - DPM-Solver-1| = "
f"{np.abs(xa - xb).max():.3e}")
print(" → 两套代码、两套记号,输出差在浮点误差量级:DDIM 就是一阶方法")
# ── B. 参考解 ──
print()
print("=" * 72)
print("B. 参考解:3M 跑 4000 步当真值,再自查一下它自己收敛到哪")
print("=" * 72)
n_ref = 1000
x_init = rng.standard_normal((n_ref, 2))
_, g_fine = uniform_lambda_grid(4000, quantize=False)
_, g_mid = uniform_lambda_grid(2000, quantize=False)
xref = solve_multistep(g_fine, model, x_init.copy(), order=3)
xchk = solve_multistep(g_mid, model, x_init.copy(), order=3)
res = rms_err(xref, xchk)
print(f" 4000 步 vs 2000 步参考解的差 = {res:.3e}")
print(f" → 这个差值是当前参考解的自检尺度,比它小的差别不可信")
# ── C. 阶数 ──
print()
print("=" * 72)
print("C. 把阶数量出来:终点到参考解的 RMS 距离 vs 真实 NFE")
print("=" * 72)
NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192]
solvers = {
"DDIM (uniform-t)": lambda S: (uniform_t_grid(S)[1], solve_ddim, {}),
"DDIM (=DPM-1, lambda)": lambda S: (uniform_lambda_grid(S)[1], solve_ddim, {}),
"数据预测中点(单步)": lambda S: (uniform_lambda_grid(max(S // 2, 2))[1],
solve_dpm2s, {}),
"DPM-Solver++ 2M": lambda S: (uniform_lambda_grid(S)[1], solve_multistep,
{"order": 2}),
"3M(v0.35.1系数)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep,
{"order": 3, "d2_scale": 1.0}),
"3M(二次插值版本)": lambda S: (uniform_lambda_grid(S)[1], solve_multistep,
{"order": 3, "d2_scale": 2.0}),
}
print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers))
table = {k: [] for k in solvers}
nfes = {k: [] for k in solvers}
for S in NS:
row, real_n = [], []
for k, build in solvers.items():
grid, fn, kw = build(S)
c = Counter(model)
x = fn(grid, c, x_init.copy(), **kw)
row.append(rms_err(x, xref))
real_n.append(c.n)
for k, n in zip(solvers, real_n):
nfes[k].append(n)
table_k = list(solvers)
for k, v in zip(table_k, row):
table[k].append(v)
print(f" nominal={S:3d} " + " ".join(f"{n:3d}:{v:.3e}" for n,v in zip(real_n,row)))
print()
print(f" 拟合误差 ~ NFE^(-p)(只取 NFE>=24 且误差高于分辨率 {res:.1e}×3 的渐近段):")
for k in solvers:
p, m = fit_slope(nfes[k], table[k], res)
print(f" {k:>24} p = {p:.2f} (用了 {m} 个点)")
# ── D. SW1 走到哪一步就分不出高下了 ──
print()
print("=" * 72)
print("D. 分布层面SW1:换起点估计均值和标准差,参考样本固定")
print("=" * 72)
floors = [sliced_w1(sample_true(N_EVAL, w, mu, Sig,
np.random.default_rng(2000 + r)), Xref, TH=TH)
for r in range(8)]
print(f" 真样本 vs 真样本(8 次):{np.mean(floors):.4f} ± {np.std(floors):.4f}"
f" ← 当前样本量/投影/固定参考样本的抽样基线")
PS = [10, 20, 50]
print(f" {'NFE':>5} " + " ".join(f"{k:>14}" for k in solvers))
for S in PS:
row = []
for k, build in solvers.items():
grid, fn, kw = build(S)
vs = []
for r in range(5): # 换几份起点,量出估计量的抖动
c = Counter(model)
x = fn(grid, c, np.random.default_rng(900 + S * 100 + r)
.standard_normal((N_EVAL, 2)), **kw)
vs.append(sliced_w1(x, Xref, TH=TH))
row.append((c.n, np.mean(vs), np.std(vs)))
print(f" nominal={S:3d} " + " ".join(f"{v[0]}:{v[1]:.4f}±{v[2]:.3f}" for v in row))
print(" → 20 步时各采样器的差别还大于抖动;到 50 步大家都贴着地板,")
print(" SW1的近邻差别需更多样本/重复;C节RMS量的是同一路径误差,不能代替分布质量")
# ── E. 同一个精度,省多少次评估 ──
print()
print("=" * 72)
print("E. 把终点误差压到 1e-2 / 1e-3,最少要几次模型评估(实测扫描)")
print("=" * 72)
scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160, 192, 256, 384]
for k, build in solvers.items():
got = {}
for S in scan:
if len(got) == 2:
break
grid, fn, kw = build(S)
c = Counter(model)
e = rms_err(fn(grid, c, x_init.copy(), **kw), xref)
for tol in (1e-2, 1e-3):
if tol not in got and e <= tol:
got[tol] = c.n
s1 = got.get(1e-2, None)
s2 = got.get(1e-3, None)
f1 = f"NFE={s1:3d}" if s1 else f"未达标(max NFE={c.n})"
f2 = f"NFE={s2:3d}" if s2 else f"未达标(max NFE={c.n})"
print(f" {k:>24} 1e-2: {f1} 1e-3: {f2}")
# ── F. 受控检验:三阶更新到底几阶 ──
print()
print("=" * 72)
print("F. 受控检验:规定一条解析的 x0_hat(lambda),直接量局部误差")
print("=" * 72)
print(" 做法:不让 x0_hat 由 x 决定,而是规定它是 lambda 的二次多项式")
print(" g(lambda)。此时精确解就是 (sigma_t/sigma_s) x + sigma_t * 积分 e^lambda g。")
print(" 对二次插值做精确指数积分的版本应一步算准;一般三阶方法不要求这一性质。")
local_err_test()
# ── G. 卡住 3M 的不是开头那一步 ──
print()
print("=" * 72)
print("G. 是不是「第一步被迫降阶」拖累的?给第一步多花一次评估试试")
print("=" * 72)
for tag, kw in (("第一步一阶(默认)", {}),
("第一步改中点法(多 1 次评估)", {"warm2s": True})):
ns, es = [], []
for S in (24, 32, 48, 64, 96, 128, 192):
grid = uniform_lambda_grid(S)[1]
c = Counter(model)
got = solve_multistep(grid, c, x_init.copy(), order=3, d2_scale=1.0, **kw)
ns.append(c.n)
es.append(rms_err(got, xref))
p, _ = fit_slope(ns, es, res, nfe_min=24)
print(f" 3M(D2 原式)+ {tag:<22} 实测阶数 p = {p:.2f}")
print(" → 此对照只量起步处理对本组斜率的影响;系数检验见F节。")
if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""步数该往哪放:同样 20 次评估,换个摆法能差出一个数量级。
阶数(dpm_solver_lab.py 里量出来的 p)说的是「步数变多时误差掉多快」,
但没说「步数摆在哪」。这一篇的主角是**时间步的摆法**:
- 在 t 上等间隔(本文取 T 到 0 的整数节点)
- 在 lambda 上等间隔(DPM-Solver 的建议)
- 在 lambda 上等间隔但落回整数 t(整数标签需按实际网络处理)
- 在 log sigma 上等间隔
- Karras / EDM 的 rho=7 摆法(只移植网格,不复现整套 EDM)
判断标准是两条:确定性误差(终点到参考解的距离)和「难度曲线」——
沿着一条高精度参考轨迹量 |dx0_hat / d lambda|,看哪一段 lambda 上 x0_hat
变得最快;这是局部代理,不单独决定最优网格。
python spacing_lab.py
依赖:numpy(+ 同目录的 oracle_gmm.py / ddim_family.py / dpm_solver_lab.py)
"""
import numpy as np
from oracle_gmm import (T, linear_schedule, make_target, sample_true,
alpha_sigma, sliced_w1, make_dirs, N_EVAL)
from ddim_family import uniform_t_grid, make_model, ddim_step
from dpm_solver_lab import (uniform_lambda_grid, solve_ddim, solve_multistep,
solve_dpm2s, lam_of_abar, abar_of_lam, nearest_t,
Counter, rms_err, dpm_pp_first, dpm_pp_second, dpm_pp_third)
_BETAS, _ABAR = linear_schedule()
_LAM = lam_of_abar(_ABAR)
# ══════════════════════════════════════════════════════════════════
# 1. 五种摆法
# ══════════════════════════════════════════════════════════════════
def grid_uniform_t(S: int):
"""本文在 t 上取整数等间隔节点,端点与 leading 选项需分别核对。"""
return uniform_t_grid(S)[1]
def grid_uniform_lambda(S: int):
"""在 lambda 上等间隔,连续 abar(DPM-Solver 理论里的标准摆法)。"""
return uniform_lambda_grid(S, quantize=False)[1]
def grid_uniform_lambda_q(S: int):
"""在 lambda 上等间隔,但落回整数时间步(标签量化需按具体网络核对)。"""
return uniform_lambda_grid(S, quantize=True)[1]
def _ratio(abar):
"""EDM / diffusers 语境里的 sigma:sigma_t / alpha_t = e^{-lambda}。
注意这不是 sqrt(1-abar)。VP 调度下 lambda 就是 -log 这个量,
所以「在 log sigma 上等间隔」等于「在 lambda 上等间隔」——两者是同一个东西,
表里因此只留一种。
"""
return np.sqrt(np.maximum(1.0 - abar, 1e-300) / np.maximum(abar, 1e-300))
def grid_uniform_lambda_capped(S: int, lam_max: float):
"""在 lambda 上等间隔,但只走到 lam_max 就收尾。
为什么要这个变体:uniform-t 天然把 lambda 的上界截在某个值(NFE=20 时
是 +1.76),剩下的干净端交给最后那个「直接输出 x0_hat」的一阶收尾步。
如果 uniform-t 赢的原因是「截得早」而不是「t 本身特别」,那么把
uniform-lambda 截到同一个上界,两者就该差不多。
"""
l0 = _LAM[T]
lams = np.linspace(l0, lam_max, S)
return np.concatenate([abar_of_lam(lams), [1.0]])
def grid_karras(S: int, rho: float = 7.0):
"""Karras / EDM 的摆法:在 sigma^(1/rho) 上等间隔,EDM 原文取 rho=7。
sigma 用的是 EDM 的那个 sigma(= sigma_t/alpha_t),VP 下等于 e^{-lambda},
区间是 [_ratio(abar_T), _ratio(abar_1)] ≈ [158, 0.01]。
"""
r_hi, r_lo = _ratio(_ABAR[T]), _ratio(_ABAR[1])
r = (r_hi ** (1.0 / rho)
+ np.arange(S) / (S - 1) * (r_lo ** (1.0 / rho) - r_hi ** (1.0 / rho))) ** rho
return np.concatenate([1.0 / (1.0 + r ** 2), [1.0]])
GRIDS = {
"uniform-t": grid_uniform_t,
"uniform-lambda": grid_uniform_lambda,
"uniform-lambda(整数t)": grid_uniform_lambda_q,
"lambda截到1.8": lambda S: grid_uniform_lambda_capped(S, 1.8),
"lambda截到3.0": lambda S: grid_uniform_lambda_capped(S, 3.0),
"karras(rho=7)": grid_karras,
"karras(rho=3)": lambda S: grid_karras(S, rho=3.0),
}
# ══════════════════════════════════════════════════════════════════
# 2. 难度曲线:沿着参考轨迹看 x0_hat 在哪一段变得最快
# ══════════════════════════════════════════════════════════════════
def difficulty_profile(model, n=400, steps=1500, seed=5):
"""返回 (lam_mid, weight):一阶方法每一步的误差贡献权重。
推导:第 i 步的局部误差(在 x 的单位里)是
delta_i = sigma_{t_i} * ∫ e^lambda [x0(lam) - x0(lam_i)] d lambda
≈ sigma_{t_i} * e^{lam_i} * (h^2/2) * x0'(lam_i)
= alpha_{t_i} * e^{-h} * (h^2/2) * x0'(lam_i)
局部代理带 alpha_t 因子,还要同时观察沿轨迹的 x0 导数。
不能只由 alpha 小推出轨迹不动或误差无害;这也未计入传播与末端投影。
返回 alpha(lambda) * |dx0_hat / d lambda|,不是完整误差界。
"""
x = np.random.default_rng(seed).standard_normal((n, 2))
grid = uniform_lambda_grid(steps, quantize=False)[1]
lams, x0s, alphas = [], [], []
for i in range(len(grid) - 1):
a_s, s_s = alpha_sigma(grid[i])
a_t, s_t = alpha_sigma(grid[i + 1])
eps = model(x, grid[i])
m0 = (x - s_s * eps) / a_s
lams.append(lam_of_abar(grid[i]))
alphas.append(a_s)
x0s.append(m0.copy())
x = (s_t / s_s) * x - a_t * (np.exp(-(lam_of_abar(grid[i + 1])
- lam_of_abar(grid[i]))) - 1.0) * m0
if s_t <= 0:
break
lams = np.array(lams)
alphas = np.array(alphas)
x0s = np.array(x0s) # (steps, n, 2)
dx = np.sqrt(((np.diff(x0s, axis=0)) ** 2).sum(-1).mean(-1))
speed = dx / np.abs(np.diff(lams))
lam_mid = 0.5 * (lams[1:] + lams[:-1])
a_mid = 0.5 * (alphas[1:] + alphas[:-1])
return lam_mid, a_mid * speed, speed
# ══════════════════════════════════════════════════════════════════
# 3. 主流程
# ══════════════════════════════════════════════════════════════════
def main():
rng = np.random.default_rng(20260927)
w, mu, Sig = make_target()
model = make_model("oracle", w, mu, Sig)
TH = make_dirs()
Xref = sample_true(N_EVAL, w, mu, Sig, rng)
n_ref = 1000
x_init = rng.standard_normal((n_ref, 2))
g_ref = uniform_lambda_grid(3000, quantize=False)[1]
xref = solve_multistep(g_ref, model, x_init.copy(), order=3)
g_chk = uniform_lambda_grid(1500, quantize=False)[1]
res = rms_err(xref, solve_multistep(g_chk, model, x_init.copy(), order=3))
print("=" * 72)
print("A. 参考解分辨率")
print("=" * 72)
print(f" 3000 步 vs 1500 步 = {res:.2e}(误差表只能信到这个量级)")
# ── B. 摆法对比(确定性误差)──
print()
print("=" * 72)
print("B. 同样 NFE,步数摆在哪:终点到参考解的 RMS 距离")
print("=" * 72)
print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50))
+ " | " + " ".join(f"{'N=' + str(s):>9}" for s in (10, 20, 50)))
print(f" {'':>22} " + " ".join(f"{'DDIM':>9}" for _ in range(3))
+ " | " + " ".join(f"{'2M':>9}" for _ in range(3)))
for name, build in GRIDS.items():
row_a, row_b = [], []
for S in (10, 20, 50):
grid = build(S)
row_a.append(rms_err(solve_ddim(grid, model, x_init.copy()), xref))
row_b.append(rms_err(solve_multistep(grid, model, x_init.copy(),
order=2), xref))
print(f" {name:>22} " + " ".join(f"{v:9.3e}" for v in row_a)
+ " | " + " ".join(f"{v:9.3e}" for v in row_b))
# ── C. 摆法对比(分布层面)──
print()
print("=" * 72)
print("C. 同样的比较,换成 SW1(地板约 0.030,重复换起点看抖动)")
print("=" * 72)
print(f" {'摆法':>22} " + " ".join(f"{'N=' + str(s):>16}" for s in (10, 20)))
for name, build in GRIDS.items():
row = []
for S in (10, 20):
grid = build(S)
vs = []
for r in range(5):
x0 = np.random.default_rng(700 + S * 10 + r).standard_normal(
(N_EVAL, 2))
vs.append(sliced_w1(solve_multistep(grid, model, x0, order=2),
Xref, TH=TH))
row.append((np.mean(vs), np.std(vs)))
print(f" {name:>22} " + " ".join(f"{v[0]:.4f}±{v[1]:.3f}" for v in row))
# ── D. 难度曲线 ──
print()
print("=" * 72)
print("D. 难度曲线:x0_hat 在哪一段 lambda 上变化最快")
print("=" * 72)
lams, weight, raw = difficulty_profile(model)
lo = lams < 0
print(f" 只看 |dx0/dlambda|(不带 alpha 因子):"
f"噪声端 {raw[lo].mean():.3e} vs 干净端 {raw[~lo].mean():.3e}")
print(f" 乘上 alpha_t 之后的**误差权重**: "
f"噪声端 {weight[lo].mean():.3e} vs 干净端 {weight[~lo].mean():.3e}"
f" ← 干净端重 {weight[~lo].mean() / weight[lo].mean():.1f} 倍")
top = np.argsort(weight)[-5:][::-1]
print(" 权重最大的 5 段:")
for i in top:
print(f" lambda = {lams[i]:+6.2f} 权重 = {weight[i]:.3e}")
print(" → 本例噪声端/干净端平均局部代理权重接近,中段峰值更高。")
print(" 这是局部估计,未包含误差传播,不能单独证明最优网格。")
# ── E2. 收尾步不是免费的 ──
print()
print("=" * 72)
print("E2. 收尾步的代价:在 lambda_max 处直接输出 x0_hat,到底偏了多少")
print("=" * 72)
print(" 沿高精度参考轨迹取快照,对每个 lambda 量")
print(" || x0_hat(x_lambda, lambda) - 轨迹终点 || —— 这就是提前收尾的偏差。")
g_fine = uniform_lambda_grid(3000, quantize=False)[1]
x = x_init.copy()
snaps = []
history = []
for i in range(len(g_fine) - 1):
a_s, s_s = alpha_sigma(g_fine[i])
a_t, s_t = alpha_sigma(g_fine[i + 1])
eps = model(x, g_fine[i])
m0 = (x - s_s * eps) / a_s
if i % 60 == 0:
snaps.append((lam_of_abar(g_fine[i]),
float(np.sqrt(((m0 - xref[:n_ref]) ** 2).sum(1).mean()))))
history.append((lam_of_abar(g_fine[i]), m0))
if s_t <= 0 or len(history) < 2:
x = dpm_pp_first(x, m0, a_s, s_s, a_t, s_t)
elif len(history) < 3:
x = dpm_pp_second(x, history, a_s, s_s, a_t, s_t)
else:
x = dpm_pp_third(x, history, a_s, s_s, a_t, s_t, d2_scale=2.0)
if s_t <= 0:
break
for lam, d in snaps[::5]:
print(f" lambda = {lam:+6.2f} 提前收尾的偏差 = {d:.3e}")
print(" → 偏差随 lambda 单调下降:截得越早,这一步白送的误差越大,")
print(" 而且它**不随步数下降**(只取决于截在哪个 lambda)")
print()
print(" 于是 lambda_max 有个最优值(2M, N=20,只改截断点):")
for cap in (1.0, 1.5, 2.0, 2.5, 3.0, 3.5, 4.0, 4.61):
grid = grid_uniform_lambda_capped(20, cap)
e = rms_err(solve_multistep(grid, model, x_init.copy(), order=2), xref)
print(f" lambda_max = {cap:4.2f} 终点误差 = {e:.3e}")
print(" → 两头都变差:截太早是收尾偏差,截太晚是每步的 h 变大")
# ── E. 20 步时各摆法的落脚点 ──
print()
print("=" * 72)
print("E. NFE=20 时各摆法把步子落在 lambda 的哪几个位置")
print("=" * 72)
for name, build in GRIDS.items():
grid = build(20)
lam = np.array([lam_of_abar(g) if g < 1.0 else np.inf for g in grid])
lam_f = lam[np.isfinite(lam)]
print(f" {name:>22}: lambda 从 {lam_f[0]:+.2f} 到 {lam_f[-1]:+.2f},"
f"相邻间隔 min {np.diff(lam_f).min():.3f} / max {np.diff(lam_f).max():.3f}")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""给「从 DDIM 到高阶采样器」画五张图。
所有数字都是现场重算的:这里 import ddim_family / dpm_solver_lab 里的
采样器,重新跑一遍实验再画,不抄任何手打的表格。改了那边的实现,重跑
这个脚本图就会跟着变,不会出现「图上是旧数字、正文是新数字」。
五张图分别回答:
1. eta=0 和 eta=1 走的是两条什么样的路(同一份随机数,二维真轨迹)
2. eta 该调多大?oracle 模型下扫一遍,欠拟合模型下再扫一遍
3. 为什么换采样器缓存就得重调:模型输入每步变多少
4. 阶数:误差 vs NFE 的双对数斜率
5. 达到 1e-2 / 1e-3 到底要花几次模型评估
只依赖 numpy + matplotlib。跑法:python make_figures.py
"""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import oracle_gmm as OG
import ddim_family as DF
import dpm_solver_lab as DL
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(parents=True, exist_ok=True)
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "PingFang SC", "Arial Unicode MS", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.dpi"] = 130
RNG_SEED = 20260927
# ══════════════════════════════════════════════════════════════════
# 公共:目标分布、参考解、评估尺子
# ═════════════════════════════════════════════════════════════════=
def build_world():
rng = np.random.default_rng(RNG_SEED)
w, mu, Sig = OG.make_target()
Xref = OG.sample_true(OG.N_EVAL, w, mu, Sig, rng)
TH = OG.make_dirs()
return w, mu, Sig, Xref, TH
def floors(TH, Xref, w, mu, Sig, n=8, base=2000):
"""尺子的分辨率:真样本对真样本,量 n 次。"""
v = [OG.sliced_w1(OG.sample_true(OG.N_EVAL, w, mu, Sig,
np.random.default_rng(base + r)),
Xref, TH=TH) for r in range(n)]
return float(np.mean(v)), float(np.std(v))
# ══════════════════════════════════════════════════════════════════
# 图 1:两条轨迹
# ═════════════════════════════════════════════════════════════════=
def fig_traj(w, mu, Sig, Xref):
model = DF.make_model("oracle", w, mu, Sig)
S = 20
ts, grid = DF.uniform_t_grid(S)
n_show = 4
x_init, zs = DF.paired_noise(S, n_show, seed=4321)
fig, ax = plt.subplots(figsize=(6.4, 5.4))
ax.scatter(Xref[:, 0], Xref[:, 1], s=3, c="#C9CDD4", alpha=0.45,
label="真实样本(目标分布)")
styles = {1.0: ("#D2691E", 0.9, 5, r"$\eta=1$(DDPM 祖采样式):每步都重掷噪声"),
0.0: ("#2F6FB3", 1.7, 8, r"$\eta=0$(DDIM,确定性):一条光滑的路")}
for eta, (c, lw, ms, lab) in styles.items():
_, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True)
P = np.stack(xs, axis=1) # (n, S+1, 2)
for k in range(n_show):
ax.plot(P[k, :, 0], P[k, :, 1], "-", color=c, lw=lw,
alpha=0.85 if eta == 0.0 else 0.55,
zorder=4 if eta == 0.0 else 3,
label=lab if k == 0 else None)
ax.scatter(P[k, 1:-1, 0], P[k, 1:-1, 1], s=ms, color=c,
alpha=0.85 if eta == 0.0 else 0.5, zorder=4)
ax.scatter(x_init[:, 0], x_init[:, 1], s=110, marker="*", c="#111111",
zorder=6, label="起点(两边共用,只有 4 个)")
ax.set_xlabel(r"$x_1$")
ax.set_ylabel(r"$x_2$")
ax.set_title("同一份起点、同一份随机数:N=20 步走出的两条路")
ax.legend(loc="upper right", fontsize=8, framealpha=0.9)
ax.set_aspect("equal", adjustable="box")
fig.tight_layout()
p = OUT / "traj_eta.png"
fig.savefig(p)
plt.close(fig)
print(f" [1] {p.name} 轨迹 {n_show} 条 × 2 种 eta")
# ══════════════════════════════════════════════════════════════════
# 图 2:eta 扫描(oracle + 欠拟合)
# ═════════════════════════════════════════════════════════════════=
def fig_eta_sweep(w, mu, Sig, Xref, TH):
NS = (10, 20, 50, 100)
etas = (0.0, 0.25, 0.5, 0.75, 1.0)
flo, flo_sd = floors(TH, Xref, w, mu, Sig)
panels = {}
for tag, kind in (("oracle(真 score,模型误差=0)", "oracle"),
("欠拟合(模型以为数据是单高斯)", "gauss")):
model = DF.make_model(kind, w, mu, Sig)
panels[tag] = {e: [] for e in etas}
for e in etas:
for S in NS:
_, grid = DF.uniform_t_grid(S)
xi, zs = DF.paired_noise(S, OG.N_EVAL)
x, _ = DF.run_ddim(xi, grid, model, e, zs)
panels[tag][e].append(OG.sliced_w1(x, Xref, TH=TH))
fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.4), sharey=True)
cmap = plt.get_cmap("viridis")
for ax, (tag, tab) in zip(axes, panels.items()):
for i, e in enumerate(etas):
ax.plot(NS, tab[e], "o-", color=cmap(0.15 + 0.7 * i / (len(etas) - 1)),
lw=1.6, ms=5, label=r"$\eta=" + f"{e:g}" + r"$")
ax.axhline(flo, ls="--", c="#999999", lw=1.2,
label=f"噪声地板 {flo:.4f}")
ax.set_xscale("log")
ax.set_xticks(list(NS))
ax.set_xticklabels([str(s) for s in NS])
ax.set_xlabel("采样步数 N")
ax.set_title(tag)
ax.grid(alpha=0.25)
axes[0].set_ylabel("SW1(越小越好)")
axes[0].legend(fontsize=8)
axes[1].legend(fontsize=8)
fig.suptitle("固定玩具模型的 eta 扫描(不代表所有网络)", fontsize=12)
fig.tight_layout()
p = OUT / "eta_sweep.png"
fig.savefig(p)
plt.close(fig)
print(f" [2] {p.name} 地板 {flo:.4f}±{flo_sd:.4f};"
f"oracle N=10: eta0={panels['oracle(真 score,模型误差=0)'][0.0][0]:.4f}"
f" eta1={panels['oracle(真 score,模型误差=0)'][1.0][0]:.4f}")
# ══════════════════════════════════════════════════════════════════
# 图 3:每步「模型输入变了多少」
# ═════════════════════════════════════════════════════════════════=
def fig_cache_jitter(w, mu, Sig):
model = DF.make_model("oracle", w, mu, Sig)
S = 50
_, grid = DF.uniform_t_grid(S)
x_init, zs = DF.paired_noise(S, OG.N_EVAL)
fig, ax = plt.subplots(figsize=(6.6, 4.4))
cols = {0.0: "#2F6FB3", 0.5: "#7A7A7A", 1.0: "#D2691E"}
last10 = {}
for eta, c in cols.items():
_, (xs, _) = DF.run_ddim(x_init.copy(), grid, model, eta, zs, track=True)
rel = [float(np.sqrt((((xs[i + 1] - xs[i]) ** 2).sum(1)).mean())
/ np.sqrt(((xs[i] ** 2).sum(1)).mean()))
for i in range(len(xs) - 1)]
last10[eta] = float(np.mean(rel[-10:]))
ax.plot(range(1, len(rel) + 1), rel, "-", color=c, lw=1.6,
label=r"$\eta=" + f"{eta:g}" + r"$")
ax.plot([len(rel) - 9, len(rel)], [last10[eta], last10[eta]],
lw=3.2, color=c, alpha=0.35)
ax.set_xlabel("步序号(越往右越接近干净端)")
ax.set_ylabel(r"模型输入相对变化 $\Delta x_i / x_i$(长度之比,无量纲)")
ax.set_title("输入位移代理:本例 eta 改变轨迹变化量")
ax.legend(fontsize=9)
ax.grid(alpha=0.25)
ratio = last10[1.0] / last10[0.0]
ax.annotate(f"最后 10 步:eta=1 是 eta=0 的 {ratio:.1f} 倍",
xy=(0.42, 0.86), xycoords="axes fraction", fontsize=9,
bbox=dict(boxstyle="round,pad=0.35", fc="#FFF6E5", ec="#D2691E"))
fig.tight_layout()
p = OUT / "cache_jitter.png"
fig.savefig(p)
plt.close(fig)
print(f" [3] {p.name} 最后10步 eta0={last10[0.0]:.4f} "
f"eta0.5={last10[0.5]:.4f} eta1={last10[1.0]:.4f} 倍数 {ratio:.1f}")
# ══════════════════════════════════════════════════════════════════
# 图 4 + 图 5:阶数与评估预算
# ═════════════════════════════════════════════════════════════════=
def build_reference(w, mu, Sig):
"""超高分辨率参考解;顺手用 2000 步自查它的收敛精度。
随机数的取法与 dpm_solver_lab.py 的 B 节一模一样(同一个种子、同样的
消耗顺序:先抽一批真样本、再抽初始噪声),所以这里打印的分辨率和那边
是同一个数,图上和正文不会对不上。
"""
model = DF.make_model("oracle", w, mu, Sig)
rng = np.random.default_rng(RNG_SEED)
OG.sample_true(OG.N_EVAL, w, mu, Sig, rng)
for _ in range(4):
rng.standard_normal((500, 2)) # 与 dpm_solver_lab A节消耗一致
x_init = rng.standard_normal((1000, 2))
_, gf = DL.uniform_lambda_grid(4000, quantize=False)
_, gm = DL.uniform_lambda_grid(2000, quantize=False)
xref = DL.solve_multistep(gf, model, x_init.copy(), order=3, d2_scale=2.0)
xchk = DL.solve_multistep(gm, model, x_init.copy(), order=3, d2_scale=2.0)
return model, x_init, xref, DL.rms_err(xref, xchk)
def fig_order_and_budget(w, mu, Sig):
model, x_init, xref, res = build_reference(w, mu, Sig)
NS = [6, 8, 12, 16, 24, 32, 48, 64, 96, 128, 192]
solvers = {
"DDIM(uniform-t)": lambda S: (DF.uniform_t_grid(S)[1], DL.solve_ddim, {}),
"DDIM(=DPM-1, lambda)": lambda S: (DL.uniform_lambda_grid(S)[1],
DL.solve_ddim, {}),
"数据预测中点(单步)": lambda S: (DL.uniform_lambda_grid(max(S // 2, 2))[1],
DL.solve_dpm2s, {}),
"DPM-Solver++ 2M": lambda S: (DL.uniform_lambda_grid(S)[1],
DL.solve_multistep, {"order": 2}),
"3M(v0.35.1系数)": lambda S: (DL.uniform_lambda_grid(S)[1],
DL.solve_multistep,
{"order": 3, "d2_scale": 1.0}),
"3M(二次插值版本)": lambda S: (DL.uniform_lambda_grid(S)[1],
DL.solve_multistep,
{"order": 3, "d2_scale": 2.0}),
}
cols = ["#2F6FB3", "#6FA8DC", "#7A7A7A", "#3E8E41", "#D2691E", "#B03060"]
tab = {k: [] for k in solvers}
nfes = {k: [] for k in solvers}
for S in NS:
cn = []
for k, build in solvers.items():
grid, fn, kw = build(S)
c = DL.Counter(model)
tab[k].append(DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref))
cn.append(c.n)
for k, n in zip(solvers, cn):
nfes[k].append(n)
# ── 图 4:阶数 ──
fig, ax = plt.subplots(figsize=(7.0, 5.0))
for (k, errs), c in zip(tab.items(), cols):
p, _ = DL.fit_slope(nfes[k], errs, res)
ax.plot(nfes[k], errs, "o-", color=c, lw=1.5, ms=4.5,
label=f"{k} " + r"$p=" + f"{p:.2f}" + r"$")
ax.axhline(res, ls="--", c="#BBBBBB", lw=1.2)
ax.text(max(n[-1] for n in nfes.values()), res * 1.15, f"参考解分辨率 {res:.1e}", fontsize=8,
color="#888888", ha="right")
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel("NFE(真实模型评估次数,数出来的)")
ax.set_ylabel("终点到参考解的 RMS 距离")
ax.set_title("本例误差对各方法实际 NFE 的拟合斜率")
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=8, loc="lower left")
fig.tight_layout()
p4 = OUT / "order_nfe.png"
fig.savefig(p4)
plt.close(fig)
# ── 图 5:评估预算 ──
scan = [4, 6, 8, 10, 12, 16, 20, 24, 32, 40, 48, 64, 80, 96, 128, 160,
192, 256, 384]
got = {}
for k, build in solvers.items():
row = {}
for S in scan:
grid, fn, kw = build(S)
c = DL.Counter(model)
e = DL.rms_err(fn(grid, c, x_init.copy(), **kw), xref)
for tol in (1e-2, 1e-3):
if tol not in row and e <= tol:
row[tol] = c.n
got[k] = row
fig, ax = plt.subplots(figsize=(7.4, 4.6))
names = list(solvers)
xs = np.arange(len(names))
for j, (tol, lab) in enumerate(((1e-2, r"压到 $10^{-2}$ 所需 NFE"),
(1e-3, r"压到 $10^{-3}$ 所需 NFE"))):
vals, txt = [], []
for k in names:
v = got[k].get(tol)
vals.append(v if v else 0)
txt.append(str(v) if v else "未达扫描阈值")
bars = ax.bar(xs + (j - 0.5) * 0.38, vals, width=0.36,
color=["#8FB8DE", "#1F4E79"][j], label=lab)
for b, t in zip(bars, txt):
ax.text(b.get_x() + b.get_width() / 2, b.get_height() + 4, t,
ha="center", fontsize=8)
ax.set_xticks(xs)
ax.set_xticklabels(names, rotation=18, ha="right", fontsize=8)
ax.set_ylabel("NFE")
ax.set_title("同一个精度,高阶方法省下的评估次数(柱子顶上标的是实测值)")
ax.legend(fontsize=9)
ax.grid(alpha=0.25, axis="y")
fig.tight_layout()
p5 = OUT / "nfe_budget.png"
fig.savefig(p5)
plt.close(fig)
print(f" [4] {p4.name} 参考解分辨率 {res:.3e}")
print(f" [5] {p5.name} 1e-2 所需 NFE: "
+ " ".join(f"{k}={got[k].get(1e-2, '>384')}" for k in names))
print(f" 1e-3 所需 NFE: "
+ " ".join(f"{k}={got[k].get(1e-3, '>384')}" for k in names))
def main():
print("生成配图(数值全部现场重算)")
w, mu, Sig, Xref, TH = build_world()
fig_traj(w, mu, Sig, Xref)
fig_eta_sweep(w, mu, Sig, Xref, TH)
fig_cache_jitter(w, mu, Sig)
fig_order_and_budget(w, mu, Sig)
print("完成,输出目录:", OUT)
if __name__ == "__main__":
main()
评论 (0)