


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:生成范式 | 难度:进阶 | 前置知识:扩散过程的前向与反向推导(前向闭式解、反向后验、以及 ELBO 化简到「预测噪声」的那一步都在那篇推过,这里直接用结论)
关键词:DDPM、L_simple、ELBO 每步权重、采样方差、Algorithm 1/2、fixed_small / fixed_large
我第一次照着 DDPM 论文的公式老老实实实现训练目标,结果比「偷懒版」更差。
实验是这样的:数据是二维高斯,调度用原文的线性 $T=1000$,模型是一个跨时间步共享参数的小网络(18 个可学参数),三种目标各训一份,然后算生成分布的精确负对数似然。结果是:
| 训练目标 | 期望 NLL(nats,越小越好) |
|---|---|
| 等权 $L_{\text{simple}}$ | 1.898760 |
| 真 ELBO 每步权重 | 1.922295 |
差了 0.0235 nats。而 Ho 等人在原文里就明说了:他们把 ELBO 里那一串只跟 $t$ 有关的系数扔掉,直接等权,反而「sample quality 更好」。我当时以为这只是工程上的凑巧,跑完才发现不是——权重的形状和模型容量是绑在一起的。把同一个网络的时间基从 3 项加到 5 项(30 个参数),结论立刻反过来:真 ELBO 权重 1.880952,等权 1.881758,真 ELBO 反超。
第二个坑是采样方差。我一直把 $\tilde\beta_t$ 当成「真实后验方差」。实测把方差换成真正的后验协方差之后,生成分布的期望 NLL 从 1.881015 降到 1.880914,差的 0.000101 nats 全部来自把方差钉死成 $\tilde\beta_t$;生成协方差与真值的比值从 $[0.98946,\ 0.98713]$ 变成 $[1.0,\ 1.0]$。准确地说:$\tilde\beta_t I$ 是已知 $x_0$ 的条件后验协方差;对边缘反向 $q(x_{t-1}\mid x_t)$,它是全协方差分解中的下界。本例用它生成的分布偏窄,不能把数值幅度推广到所有数据。
第三个观察是权重分配。$t\ge2$ 的 ELBO KL 权重跨 120.4 倍,而低噪声端的噪声预测有很高的不可约误差。不可约误差不产生期望梯度;真正被权重重新分配的是可学习的超额误差及随机梯度噪声。后文的容量对照说明“加权在哪种模型上更合适”需要实测,不能把某个时间段断言成无用功。
这三个坑合起来就是这一篇要讲的事:DDPM 的训练目标和采样循环是两件独立的东西,前者管误差权重,后者管转移;在 $L_{simple}$ 下可以分别选择,但 ELBO 权重显式依赖反向方差,并非完全独立。把这两件事分开看,后面所有改进(DDIM、CFG、flow matching)才读得懂。
三句话:
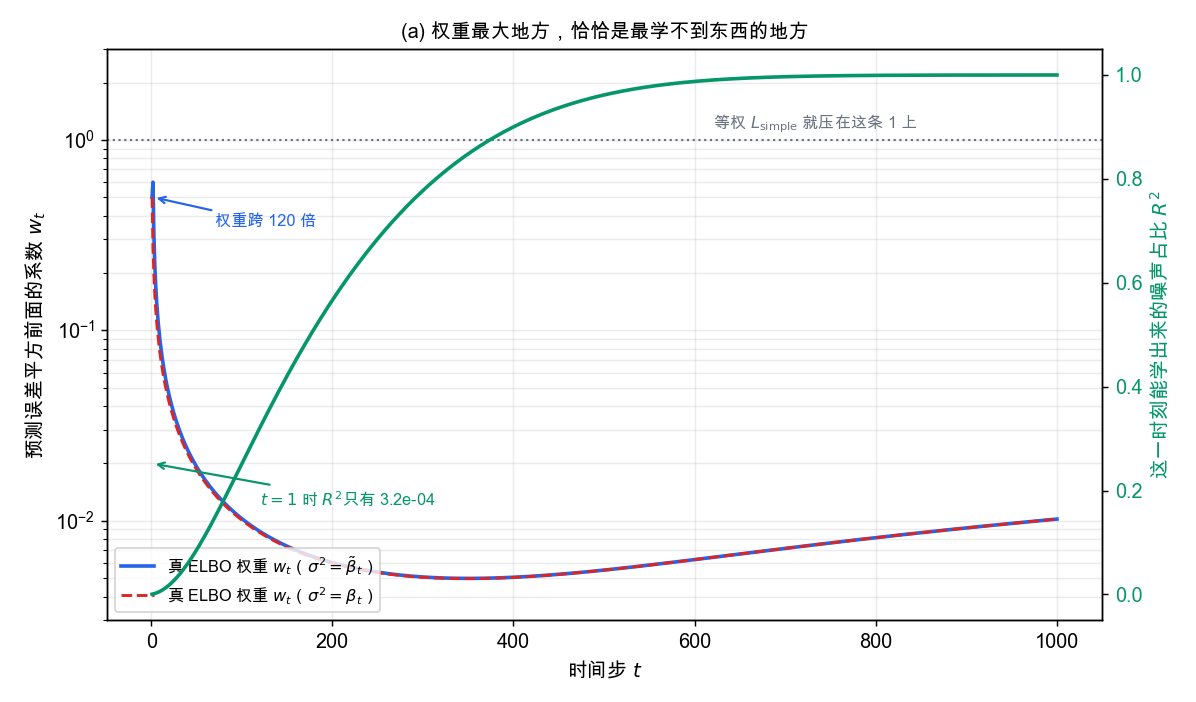
这张图要看什么:左轴的两条线是真 ELBO 权重(蓝实线 $\sigma^2=\tilde\beta_t$,红虚线 $\sigma^2=\beta_t$),灰色点线是「等权」压平到 1 的位置。右轴绿线是这一时刻噪声里能学出来的比例 $R^2$。两条曲线正好反向:权重在 $t$ 很小的地方冲到 0.6,而那里的 $R^2$ 几乎是 0;权重最低的 $t\approx350$,反而是 $R^2$ 爬到一半的地方。低噪声端权重大、可预测噪声占比小;右端并不遵循这个反向关系。这提示检查容量分配,不足以单独证明等权必然更优。
变分下界写出来是
$$L = \mathbb{E}_q\Big[-\log p_\theta(x_0|x_1) + \sum_{t=2}^{T} D_{\mathrm{KL}}\big(q(x_{t-1}|x_t,x_0)\,\|\,p_\theta(x_{t-1}|x_t)\big) + D_{\mathrm{KL}}\big(q(x_T|x_0)\,\|\,p(x_T)\big)\Big]$$
最后一项在固定前向过程与先验时没有可学参数;$L_0=-\log p_\theta(x_0|x_1)$ 也是训练目标的一部分。DDPM 为离散像素采用离散化高斯解码似然,连续数据可选连续密度;中间那一长串是下面推导的 KL 项。把它记为 $L_{t-1}$(下标是 $t-1$ 因为它监督的是「从 $t$ 走到 $t-1$」这一步)。
为什么这一项好算?因为 $q$ 和 $p_\theta$ 都是高斯,两个高斯的 KL 有闭式解。而 $q(x_{t-1}|x_t,x_0)$ 在后验那篇已经推过:$q=\mathcal{N}(\tilde\mu_t,\ \tilde\beta_t I)$,其中 $\tilde\beta_t$ 是一个不依赖 $x_t$ 的常数,$\tilde\mu_t$ 是 $x_t$ 与 $x_0$ 的线性组合。在反向方差固定、不由模型学习的前提下,KL 里唯一依赖模型的部分是均值之差:
$$L_{t-1} = \mathbb{E}_q\Big[\tfrac{1}{2\sigma_t^{2}}\big\|\tilde\mu_t(x_t,x_0)-\mu_\theta(x_t,t)\big\|^{2}\Big] + C$$
$C$ 是与参数无关的常数,$\sigma_t^2$ 是反向链在这一步选的方差。
$\tilde\mu_t$ 和 $\mu_\theta$ 用同一组系数线性组合,前者组合的是真 $x_0$,后者组合的是模型猜的 $\hat x_0$。把 $x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon)$ 和 $\hat x_0=\frac{1}{\sqrt{\bar\alpha_t}}(x_t-\sqrt{1-\bar\alpha_t}\,\varepsilon_\theta)$ 代进去,$x_t$ 那一项整整齐齐地消掉,剩下
$$\tilde\mu_t-\mu_\theta = -\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}\big(\varepsilon-\varepsilon_\theta\big)$$
注意这里出现的 $\sqrt{\bar\alpha_{t-1}}/\sqrt{\bar\alpha_t}=1/\sqrt{\alpha_t}$——这是整个化简能成立的关键一步,两个系数只差一个 $\sqrt{\alpha_t}$,所以差值是干净的单项。
平方之后:
$$L_{t-1} = \mathbb{E}\Big[w_t\big\|\varepsilon-\varepsilon_\theta\big\|^{2}\Big] + C,\qquad w_t=\frac{\beta_t^{2}}{2\sigma_t^{2}\alpha_t(1-\bar\alpha_t)}$$
这就是那个「只跟 $t$ 有关的系数」。固定方差时由调度和方差选择决定;若学习方差,就不能把相关项都视为与参数无关的常数。
代入两种方差选择,还能再化简一层:
$$w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_{t-1})}\ \ (\sigma_t^{2}=\tilde\beta_t),\qquad w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_t)}\ \ (\sigma_t^{2}=\beta_t)$$
两条式子的分母只差一个下标。附录 ddpm_lab.py 里解析式和化简式两条都算了,最大相对差 3.93×10⁻¹⁶($\tilde\beta$)和 4.13×10⁻¹⁶($\beta$),就是浮点误差级别。
$t=1$ 时 $\tilde\beta_1=0$,上述固定小方差高斯 KL 权重分母为零、分子非零,不能使用。它不是 $0/0$。ELBO 此时对应重建似然 $L_0$,需另行定义;不是“所有最后一步都不准有高斯密度”。本实验用 $\beta_1>0$ 的连续高斯重建权重补这一点,因此表中的 elbo_tilde 是这一连续数据约定,不是逐字复现离散像素 ELBO。
线性调度 $T=1000$、$\beta$ 从 $10^{-4}$ 到 $0.02$(原文 CIFAR-10 的配置),$\bar\alpha_T=4.0358\times10^{-5}$。实跑出来:
| $t$ | $\bar\alpha_t$ | $\beta_t$ | $w_t$($\sigma^2=\tilde\beta_t$) | $w_t$($\sigma^2=\beta_t$) | 相对 $t=500$ |
|---|---|---|---|---|---|
| 2 | 9.998e-01 | 0.00012 | 5.9967e-01 | 2.7269e-01 | 108.87 |
| 10 | 9.981e-01 | 0.00028 | 8.6437e-02 | 7.3717e-02 | 15.69 |
| 50 | 9.710e-01 | 0.00108 | 1.9279e-02 | 1.8583e-02 | 3.50 |
| 100 | 8.970e-01 | 0.00207 | 1.0267e-02 | 1.0081e-02 | 1.86 |
| 250 | 5.241e-01 | 0.00506 | 5.3733e-03 | 5.3432e-03 | 0.98 |
| 500 | 7.859e-02 | 0.01004 | 5.5082e-03 | 5.5034e-03 | 1.00 |
| 750 | 3.351e-03 | 0.01502 | 7.6506e-03 | 7.6502e-03 | 1.39 |
| 900 | 2.752e-04 | 0.01801 | 9.1717e-03 | 9.1716e-03 | 1.67 |
| 1000 | 4.036e-05 | 0.02000 | 1.0205e-02 | 1.0204e-02 | 1.85 |
最后一列是「相对 $t=500$ 的倍数」,等权相当于把这一列全压成 1.00。
形状是两端高、中间平的一个碗。$\tilde\beta$ 版本的最大值是最小值的 120.4 倍;$\beta$ 版本因为分母用的是 $1-\bar\alpha_t$ 而不是 $1-\bar\alpha_{t-1}$,在 $t$ 很小的地方发散得温和些,动态范围小很多。
左端 $1-\bar\alpha_{t-1}$ 很小,使权重大;中段分母增长与线性增大的 $\beta_t$ 互相抵消;右端 $1-\bar\alpha_t$ 趋近 1 后,$w_t\approx\beta_t/(2\alpha_t)$ 随 $\beta_t$ 上升。不能说 $t=250$ 时分母已饱和:表中此时 $1-\bar\alpha_t\approx0.476$。
这个式子不是我拍脑袋的,脚本里用两个高斯的 KL 数值核了一遍:随机取 $x_0$ 和 $\varepsilon$,令 $\varepsilon_\theta=\varepsilon+\delta$($\delta$ 是一个固定的小扰动),比较「数值算的 KL」与「$w_t\|\delta\|^2$」:
 t        KL(数值)          w_t*||delta||^2     相对差
   2      1.416848e-02      1.416848e-02        2.89e-13
   100    1.612712e-03      1.612712e-03        4.17e-14
   500    5.035556e-04      5.035556e-04        1.72e-15
   1000   2.188401e-03      2.188401e-03        1.61e-14
相对差在 $10^{-13}$ 量级,推导和代码对上了。
$w_t$ 只说明「这一步的误差在 ELBO 里值多少钱」,没说明这一步的误差能不能被压下去。真正该看的是贝叶斯地板:给定 $x_t$ 后 $\varepsilon$ 还剩多少不确定性。
数据是 $\mathcal{N}(\mu_0,S_0)$ 时,$x_t$ 的协方差是 $\bar\alpha_t S_0+(1-\bar\alpha_t)I$,条件方差有闭式解,地板就是
$$\mathrm{floor}(t)=\frac{1}{D}\,\mathrm{tr}\Big[\mathrm{Var}(\varepsilon\,|\,x_t)\Big]=\frac{D-(1-\bar\alpha_t)\,\mathrm{tr}\big[(\bar\alpha_tS_0+(1-\bar\alpha_t)I)^{-1}\big]}{D}$$
定义可学占比 $R^2(t)=1-\mathrm{floor}(t)$($\varepsilon$ 每维先验方差是 1)。实测:$t=1$ 时 $R^2=3.22\times10^{-4}$,$t=500$ 时 0.9616,$t=1000$ 时 1.0000。
在 $t=1$,噪声系数是 $\sqrt{1-\bar\alpha_1}=0.01$,$R^2=3.22\times10^{-4}$ 即约 0.0322%。这说明噪声有很大的条件方差,不说明最优预测毫无用途:生成所需 score 正由小的条件均值决定。$t=2$ 的 108.87 倍权重与 $t=1$ 的 $R^2$ 不能混为同一个时间步。
因此应把不可约地板与超额误差分开分析。不可约项对参数的期望梯度为零,有限容量如何分配精度、随机梯度方差多大,才决定加权目标的优化表现。
$\tilde\beta_t$ 是 $q(x_{t-1}|x_t,x_0)$ 的方差,条件是「已知 $x_0$」。但采样时我们没有 $x_0$,只有模型猜的 $\hat x_0$,它自己有误差。把这一层不确定性算进去,真实后验协方差是
$$\Sigma_t = \tilde\beta_t I + \Big(\tfrac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}\Big)^{2}\mathrm{Var}(x_0-\hat x_0\,|\,x_t)$$
多出来的第二项就是「均值估计不准」带来的。实测:用最优 $\varepsilon$ 预测器配 $\tilde\beta_t$,生成协方差只有真值的 $[0.98946,\ 0.98713]$;换成真实后验协方差,比值精确回到 $[1.0,\ 1.0]$,NLL 差 $3.56\times10^{-10}$ nats——在本例中极接近数据分布;仍有有限终点先验与数值误差。
这一节的结论对后面很重要:反向链的均值和方差是两件事。均值决定你往哪走,方差决定你抖多厉害;在这个高斯实验中,固定 $\tilde\beta_t$ 使协方差特征值约偏小 1.1%~1.3%;该数值不是通用结论。
def linear_beta(T=1000, b1=1e-4, bT=0.02):
    """DDPM 原文 CIFAR-10 用的线性调度。"""
    return np.linspace(b1, bT, T)


class Sched:
    """下标约定:abar[t]、beta[t]、bt[t] 里的 t 取 1..T;t=0 是数据本身。"""

    def __init__(self, beta):
        self.T = len(beta)
        self.beta = beta
        self.alpha = 1.0 - beta
        self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)])   # 长度 T+1
        self.bt = np.empty(self.T + 1)
        self.bt[0] = 0.0
        self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta

    def weight(self, which="tilde"):
        s2 = self.bt[1:] if which == "tilde" else self.beta
        with np.errstate(divide="ignore", invalid="ignore"):
            w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:]))
        if which == "tilde":
            # t=1 时 tilde_beta_1=0,分母为零。DDPM 把这一步交给 L_0 单独处理,
            # 这里退化地用 fixed_large 的权重顶上,只为让训练能跑。
            w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1]))
        return w
np.errstate 那一行不是装饰:\tilde\beta_1=0 会触发除零,不包起来的话 w/w.mean() 之后整条权重变成 nan,训练静悄悄地训出一个废模型。
要让「权重决定容量往哪搬」这件事看得见,模型必须跨时间步共享参数——否则每一步各自拟合,权重只影响每一步自己的收敛速度,看不出搬移效果。所以用一个仿射 $\varepsilon$ 预测器加固定时间基:
$$\varepsilon_\theta(x_t,t)=W\,\big[x_t\otimes\psi(t),\;\psi(t)\big],\qquad \psi(t)=\big[1,\ (t/T)^{0.5},\ t/T\big]$$
(指数取 $[0,0.5,1]$ 而不是 $[0,1,2]$:因为 $\sqrt{1-\bar\alpha_t}$ 在 $t$ 小的时候像 $\sqrt{t}$,纯整数次幂的多项式基在这一段拟合不出来,曲线会剧烈振荡。这是踩过的坑。)
训练集 $M=120000$ 条 $(x_0,t,\varepsilon)$,特征维度 9,可学参数 18 个。三种权重都归一化到均值 1(整体缩放不改变解,只为了让正则强度可比)。用带权岭回归一步算出闭式解,不做迭代。
一开始我用采样算 NLL,三种目标差 0.002~0.005 nats,而 2 万样本的蒙特卡洛误差就有 ±0.007——结论完全淹没在噪声里。改走闭式解:仿射模型下 $p_\theta(x_0)$ 仍是高斯,把密度沿反向链往前传,最后
$$\mathbb{E}\big[-\log p_\theta(x_0)\big]=H\big[\mathcal{N}(\mu_0,S_0)\big]+D_{\mathrm{KL}}\big(\mathcal{N}(\mu_0,S_0)\,\|\,\mathcal{N}(m,S)\big)$$
用 40 万样本复核,闭式解 1.880914 对蒙特卡洛 1.880890,差 $2.38\times10^{-5}$。两种独立实现(密度前向传播 / 线性映射复合)的均值差 $9.99\times10^{-16}$、协方差差 $5.00\times10^{-16}$。
三种目标 × 两种采样方差:
| 训练目标 | $\sigma^2=\tilde\beta_t$ | $\sigma^2=\beta_t$ | 差 | 生成 std / 真 std |
|---|---|---|---|---|
| uniform(等权) | 1.898760 | 1.895815 | −0.002945 | 0.9659 |
| elbo_tilde | 1.922295 | 1.924692 | +0.002396 | 1.0392 |
| elbo_large | 1.914947 | 1.917129 | +0.002181 | 1.0322 |
(最后一列是生成分布标准差与真分布标准差的比值,1 表示胖瘦刚好对上。等权明显偏窄,真 ELBO 权重的两个版本反而偏宽。)
「超额」= 实际 MSE − 贝叶斯地板,包括容量、有限样本、正则化与优化误差:
| $t$ | 可学占比 $R^2$ | 地板 | 等权超额 | 真 ELBO 超额 |
|---|---|---|---|---|
| 1 | 0.0003 | 0.9997 | 1.516e-01 | 1.017e-02 |
| 5 | 0.0022 | 0.9978 | 1.120e-01 | 6.824e-03 |
| 20 | 0.0182 | 0.9818 | 5.295e-02 | 3.897e-03 |
| 50 | 0.0853 | 0.9147 | 9.778e-03 | 7.323e-03 |
| 100 | 0.2510 | 0.7490 | 4.271e-03 | 2.560e-02 |
| 200 | 0.5663 | 0.4337 | 1.324e-02 | 2.820e-02 |
| 400 | 0.9000 | 0.1000 | 1.067e-03 | 4.463e-03 |
| 600 | 0.9876 | 0.0124 | 5.375e-03 | 1.349e-02 |
| 800 | 0.9993 | 0.0007 | 3.118e-04 | 1.082e-03 |
| 1000 | 1.0000 | 0.0000 | 1.337e-02 | 2.345e-02 |
分档汇总:低噪声档 $t\le50$,等权超额 5.140e-02,真 ELBO 5.137e-03(比值 0.10,好 10 倍);高噪声档 $t\ge400$,等权 3.459e-03,真 ELBO 8.060e-03(比值 2.33,差一倍多)。
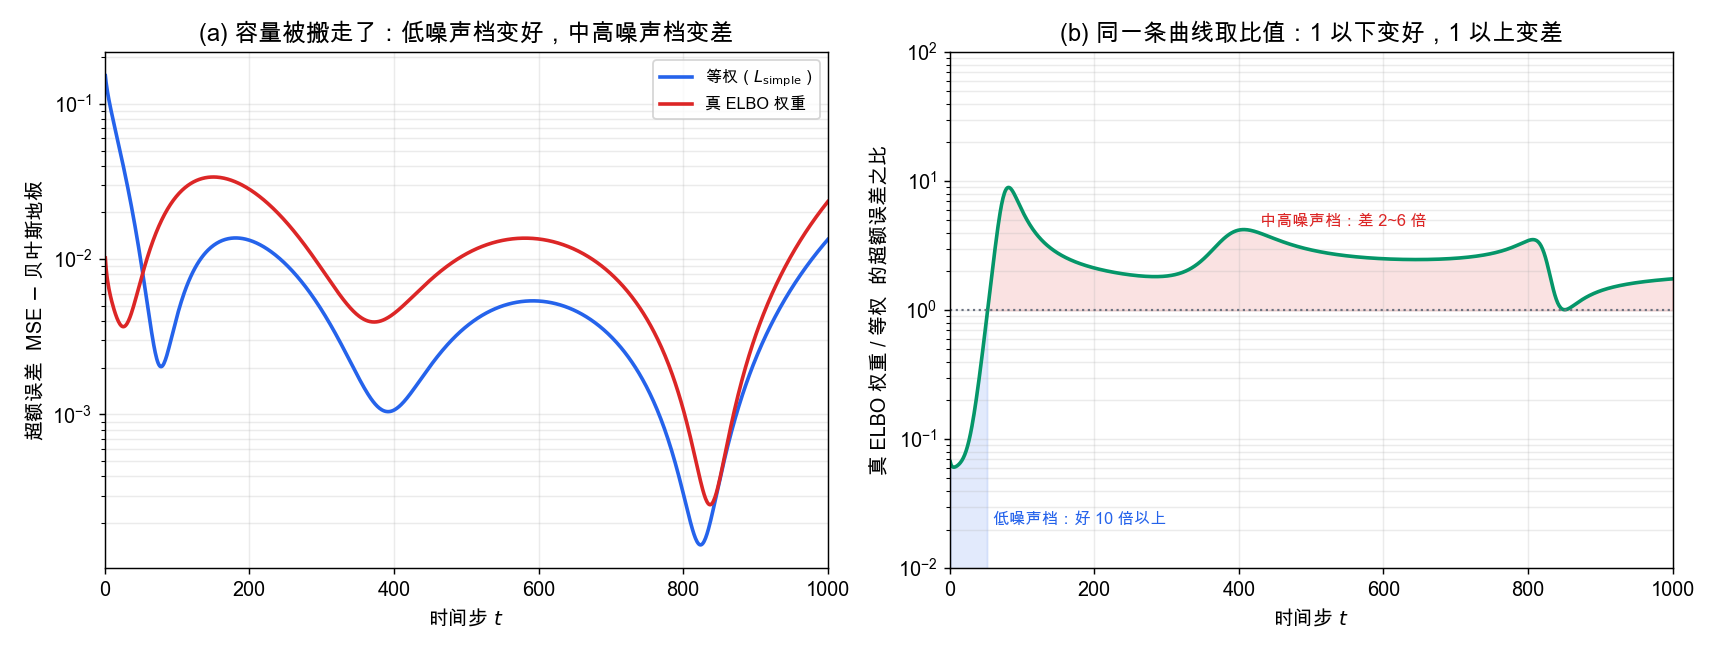
这张图要看什么:(a) 两条曲线的交叉点大约在 $t=70$——交叉点左边真 ELBO 权重更准,右边等权更准;(b) 取比值后看得更清楚,灰色填充区(比值 <1)是真 ELBO 占优的低噪声段,红色填充区(比值 >1)是等权占优的中高噪声段。加权不是全面变好,是把误差从一段搬到另一段。等权之所以赢,是因为搬走的那一头($t\le50$)本来误差就大到没救(1.5e-01 对地板 0.9997),而搬来的那一头($t\ge400$)绝对误差只有 1e-03 量级,赔得起。
时间基从 3 项加到 5 项($[0,0.5,1,1.5,2]$,30 个参数),其他完全不动:
| 容量档 | 时间基项数 | 可学参数 | NLL(等权) | NLL(真 ELBO) | 谁更好 | 低噪声档超额比 | 高噪声档超额比 |
|---|---|---|---|---|---|---|---|
| loose | 5 | 30 | 1.881758 | 1.880952 | 真 ELBO | 0.71 | 3.91 |
| tight | 3 | 18 | 1.898760 | 1.922295 | 等权 | 0.10 | 2.33 |
这张表说明两档容量的排序不同,不能推出“容量足够时 ELBO 自然赢”。ELBO、生成 NLL 和感知质量也不是同一个目标;EDM、Min-SNR 同时涉及预条件、噪声分布或多任务梯度冲突,不应仅归因为模型变大。
闭式解毕竟是玩具。附录 ddpm_train.py 给了一份 numpy 手写版:两层 MLP(输入 $10=2+8$ 维时间嵌入,隐层 64,输出 2),手写反向传播 + Adam,batch 256,20000 步,数据是 7 个高斯的混合(一个中心 + 六个环)。
def train(sc, w_full, steps, batch, rng, lr=1e-3):
    p = init_params(rng)
    opt = Adam(p, lr=lr)
    for _ in range(steps):
        # 1: t ~ Uniform({1, ..., T})   2: x_0 ~ q(x_0)   3: eps ~ N(0, I)
        t_idx = rng.integers(1, T + 1, size=batch)      # (256,)
        x0 = sample_mix(batch, rng)                     # (256, 2)
        eps = rng.standard_normal((batch, D))           # (256, 2)
        # 4: 一步加噪(闭式解,不需要真的走 t 步)
        a = sc.abar[t_idx]                              # (256,)
        xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps
        # 5: 梯度下降一步
        Z = np.concatenate([xt, time_embed(t_idx)], axis=1)   # (256, 10)
        h1, h2, out = forward(p, Z)                     # (256,64) (256,64) (256,2)
        opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1]))
    return p
三个 shape 值得停下来看一眼。第一,t_idx 是一个长度为 batch 的随机整数向量,不是标量——每个样本走不同的时间步,这是 $L_{\text{simple}}$ 里那个 $\mathbb{E}_t$ 的实现方式,也是「等权」的字面含义:每个 $t$ 被抽中的概率相同。第二,Z 的第二维是 $10 = 2 + 8$,其中 8 维来自 TIME_FREQ = (1,2,4,8) 的 cos/sin 时间嵌入;不把 $t$ 喂进去的话,网络不知道当前噪声档位,$L_{\text{simple}}$ 根本学不动。第三,w_full[t_idx - 1] 这个减一是全文最容易写错的地方:时间步 $t$ 从 1 数到 $T$,而数组下标从 0 开始。写反了整条权重会整体错位一步,$t$ 很小的地方拿到的是 $t+1$ 的权重——在动态范围 120 倍的曲线上,错位一步就能让训练目标面目全非。
Algorithm 2(采样) 是完整 1000 步链:
def sample_chain(sc, p, n, which="tilde", rng=None):
    x = rng.standard_normal((n, D))               # x_T ~ N(0, I)
    for t in range(T, 0, -1):
        eps_hat = predict_eps(p, x, t)
        a, a_prev = sc.abar[t], sc.abar[t - 1]
        alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1]
        mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t)
        sigma = np.sqrt(sc.bt[t]) if which == "tilde" else np.sqrt(beta_t)
        z = rng.standard_normal((n, D))
        x = mu + (sigma * z if t > 1 else 0.0)    # t == 1 时不加噪声
    return x
最后那行 if t > 1 else 0.0 就是 diffusers 里 if t > 0 的同一个判断(下标约定差 1):最后一步不加噪声。均值那一行是 $\tilde\mu_t$ 的另一种写法——把 $x_0$ 用 Tweedie 公式替掉之后 $\tilde\mu_t=\frac{1}{\sqrt{\alpha_t}}\big(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon_\theta\big)$,比 3.2 节那个两项组合的形式更紧凑,也是 diffusers 之外大多数实现采用的写法。
采样之后用三个指标打分:$\log p_0$ 相对真样本、到最近模式中心的距离比、模式覆盖数(某个分量占比超过 2% 才算被覆盖)。这三个指标是互补的——$\log p_0$ 只衡量落在高密度区,模式覆盖才告诉你有没有整个丢掉某个模式;实测两个网络都是 7/7,说明等权赢的不是覆盖面,是落在模式里的精度。
| 训练目标 | $\log p_0$ 相对真样本 | 到最近中心距离 / 真样本 | 模式覆盖 |
|---|---|---|---|
| uniform | −0.2208 ± 0.0195 | 1.0857 | 7/7 |
| elbo_tilde | −0.4212 ± 0.0062 | 1.1997 | 7/7 |
多峰数据上等权依然赢,而且差距比高斯那组更明显(0.20 vs 0.42 nats)。每步 MSE 剖面也和闭式解的预测一致:$t=1$ 处两个网络都是 ≈1.0(学不动),$t=1000$ 处 uniform 0.0016、elbo_tilde 0.0026(都学得很好)。
只换采样方差、不动网络:
| 方差选择 | $\log p_0$ 相对真样本 | 到最近中心距离 / 真样本 |
|---|---|---|
| $\tilde\beta_t$(fixed_small) | −0.2363 ± 0.0123 | 1.0968 |
| $\beta_t$(fixed_large) | −0.2640 ± 0.0129 | 1.1099 |
这里和 4.3 的高斯实验结论相反:高斯闭式解里 $\beta_t$ 把偏窄补回来了(std 比 0.9659 → 0.9720),多峰数据上 $\tilde\beta_t$ 反而更好。原因不神秘——两者的相对差主要集中在低噪声段,高噪声端反而很接近(见 3.3 节),多峰分布的模式之间本来就脆弱,注入更多噪声会把样本推离模式中心(距离比 1.0968 → 1.1099 就是这个效果)。方差选择取决于数据、预测误差、调度与评价指标,不能只按是否多峰判断,别把一维高斯的结论直接搬。
对照 huggingface/diffusers 的 src/diffusers/schedulers/scheduling_ddpm.py → DDPMScheduler.step(以 2026-09 时的实现为准)。这一份源码就是知识树里给这个节点配的 code_refs。
第一处差异:方差有六个分支,不是一个数。 我 4.1 节只写了 $\tilde\beta_t$ 和 $\beta_t$ 两种,框架里是 _get_variance() 的六个 variance_type:
if variance_type == "fixed_small":          # 默认:后验方差的下界
    variance = variance
elif variance_type == "fixed_small_log":    # 取 log 再 exp(0.5*log),代数上等价
    variance = torch.log(variance); variance = torch.exp(0.5 * variance)
elif variance_type == "fixed_large":        # 直接上 beta_t
    variance = current_beta_t
elif variance_type == "fixed_large_log":
    variance = torch.log(current_beta_t)
elif variance_type == "learned":            # 网络自己输出
    return predicted_variance
elif variance_type == "learned_range":      # 在 [tilde_beta, beta] 之间插值
    min_log = torch.log(variance); max_log = torch.log(current_beta_t)
    frac = (predicted_variance + 1) / 2
    variance = frac * max_log + (1 - frac) * min_log
值得注意的是 learned_range:它插值区间的两个端点恰好就是我 4.5 节扫描的那两个,而且是在 log 空间插值(这更合理,因为这两个量跨好几个数量级)。也就是说「$\tilde\beta_t$ 还是 $\beta_t$」在工业实现里不是二选一,而是交给网络学一个位置。
第二处差异:最后一步不加噪声。 源码里 variance = 0; if t > 0: ...。这正对应 3.2 节说的 $L_0$ 退化问题——$t=1$ 时 $\tilde\beta_1=0$,这是该采样算法的终步约定;连续数据模型仍可选择非零方差的终步重建分布。
第三处差异:累计噪声表预先计算,转移系数在 step 内由当前与目标时间步组合。 step() 里那两行:
pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t
current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t
pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample
展开就是 3.2 节的 $\tilde\mu_t$,$c_0=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}$、$c_x=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$,一字不差。
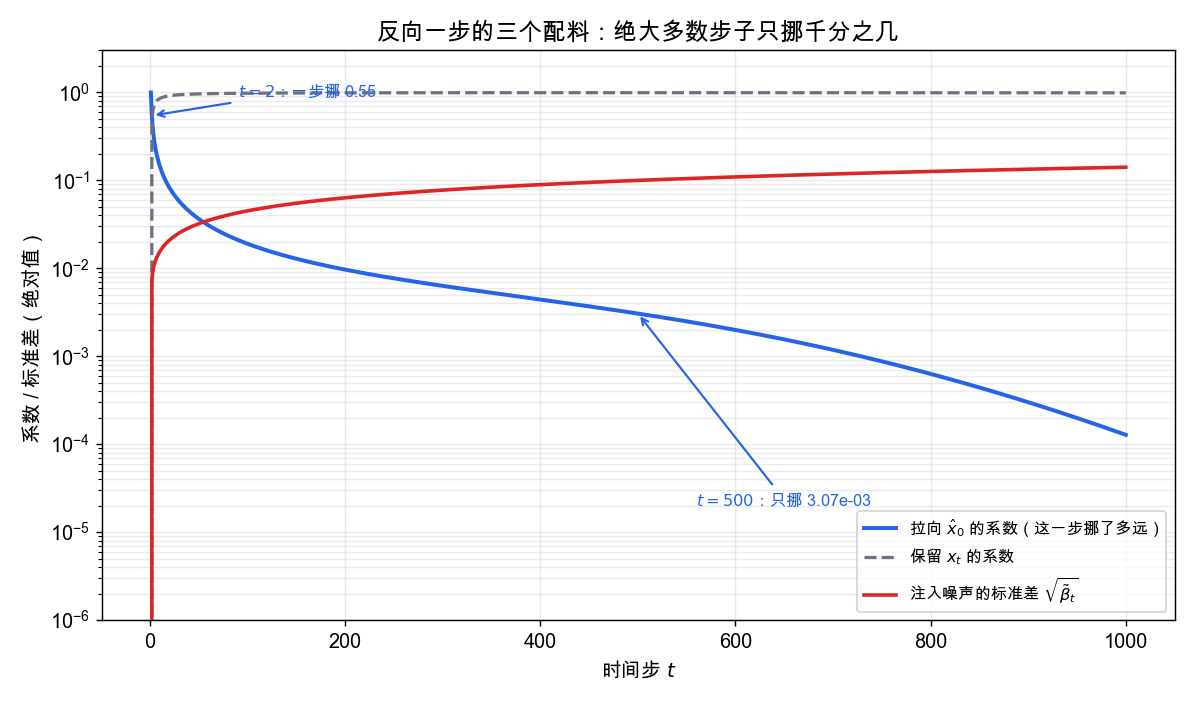
这张图要看什么:三条线是反向一步的三个配料随 $t$ 的变化——蓝线是「拉向 $\hat x_0$ 的系数」$c_0$,灰虚线是「保留 $x_t$ 的系数」$c_x$,红线是注入噪声的标准差 $\sqrt{\tilde\beta_t}$。绝大多数步子里 $c_0$ 在 1e-4 ~ 1e-2 量级,也就是一步只挪千分之几;只有最后几十步 $c_0$ 才冲到 1 附近,真正开始「成形」。这是完整 1000 步离散表下的系数,不意味着采样必须走满 1000 步。重排噪声表或换求解器后,模型可用更少的评估次数采样。
第四处差异:prediction_type 有三个选项。 epsilon(默认)、sample(直接预测 $x_0$)、v_prediction(预测 $v$)。源码把三者统一先转成 pred_original_sample,再走同一套系数——参数化只是换了个入口,反向一步的代数完全一样。参数化之间的权重差异在那篇《扩散过程的前向与反向推导》里算过($\varepsilon$ 1.0 倍、$v$ 2.5×10⁴、$x_0$ 2.5×10⁸)。
第五处:clip_sample=True 是默认开的。 把 pred_original_sample 夹到 $[-1,1]$。这在像素空间合理,在潜空间是错的——SD1.x 的 VAE 原始潜变量乘约 0.18215 后才送入扩散网络,尺度约归一到 1;但它并不被限制在 $[-1,1]$。因此不能照搬像素裁剪,是否关闭或采用其他限幅应遵循具体模型配置。
等权省了什么:不用管 $\tilde\beta_1=0$ 的退化,不用管 $L_0$ 的离散解码器,没有显式时间权重,但不保证每步的梯度范数一致(这点很重要——那篇前向反向推导里算过,$x_0$ 参数化跨 2.5×10⁸ 倍,梯度会被最吵的几步吃光)。
等权赔了什么:三档实测摆在一起看——
| 场景 | 等权 | 真 ELBO 权重 | 谁赢 |
|---|---|---|---|
| 容量宽裕(30 参数,高斯) | 1.881758 | 1.880952 | 真 ELBO |
| 容量吃紧(18 参数,高斯) | 1.898760 | 1.922295 | 等权 |
| 容量吃紧(MLP,7 峰混合) | −0.2208 | −0.4212 | 等权 |
怎么选择权重:若关注低噪声重建精度,应在任务数据上测量各时段超额误差与最终质量,比较等权与加权;本例的 10 倍误差比不能直接推出超分、修复都不该用等权。
采样方差的边界:高斯数据上 $\beta_t$ 把偏窄从 3.4% 补到 2.8%(补回 0.6 个百分点,还没补满);多峰数据上 $\beta_t$ 反而更差。所以别把「fixed_large 更大更对」当成通例——要不要更大方差,取决于你的数据是不是多峰、模式之间经不经得起抖。
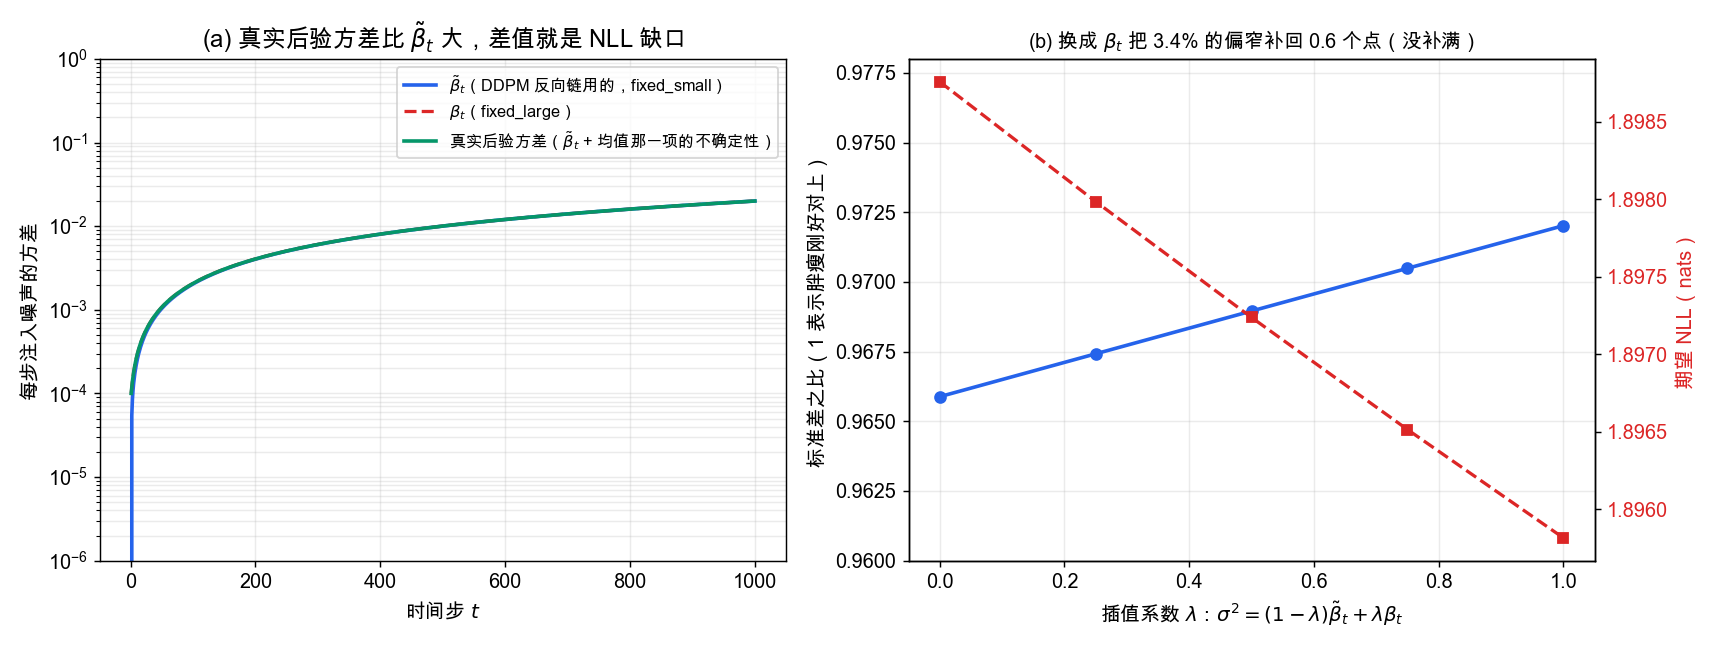
这张图要看什么:(a) 三条线是本高斯实验每步的方差——$\tilde\beta_t$(蓝)、$\beta_t$(红虚)、真实后验方差(绿)。绿线与蓝线的差异取决于时间步,较低噪声端尤其需关注,这个差值就是 3.5 节说的「均值估计不准」那一项,也是 NLL 上那 0.0001 nats 的全部来源。(b) 在 $\tilde\beta_t$ 与 $\beta_t$ 之间插值扫一遍:蓝线(左轴)是生成分布标准差与真分布之比,从 0.9659 单调爬到 0.9720;红线(右轴)是期望 NLL,几乎是一条平线。标准差之比是敏感指标,NLL 对这件事几乎不动——想判断方差选得对不对,同时检查 NLL 与协方差,不要只看一个指标。
采样成本要按同一口径计数:4000 样本 × 1000 步是 $4\times10^6$ 次样本级前向;训练 20000 步 × batch 256 是 $5.12\times10^6$ 次样本级前向,另有反向计算。不能拿样本级采样前向数除以训练优化器步数,声称采样贵 200 倍。批量大小与硬件利用率还会改变墙钟时间。
最后一个容易搞混的地方:训练目标(等权还是加权)和采样器(DDPM 随机链还是 DDIM 确定链)是两个正交的旋钮。本篇从头到尾只动前一个,采样器始终是 DDPM 原文那条随机链。换了训练目标不影响你能不能换采样器,反过来也一样——DDIM 那篇最关键的观察就是:DDPM 的训练目标根本没有约束反向链必须是一阶 Markov 的。把这两件事当成一件事,是读扩散模型文献时最普遍的混线。
learned_range,在 $\tilde\beta_t$ 与 $\beta_t$ 之间让网络选位置,且在 log 空间插值);二是余弦调度,改善低分辨率设置下线性噪声调度过快破坏信号、后段接近纯噪声的问题。①「$L_{\text{simple}}$ 就是 ELBO。」 不是。它丢掉了两样东西:每步的 $w_t$,以及 $L_0$ 那一项的离散解码器。它是一个设计选择,不是近似——丢掉的部分在数学上并不小($w_t$ 跨 120 倍),只是恰好在容量吃紧时更划算。
②「$\tilde\beta_t$ 是真实后验方差。」 不是,它是已知 $x_0$ 时的后验方差。采样时 $x_0$ 是猜的,猜错的那部分不确定性没算进去。实测真实后验方差在中后段比 $\tilde\beta_t$ 高一大截(图 3a 的绿线与蓝线),代价是生成分布偏窄 1.3%。
③「权重大意味着更容易学。」 权重衡量误差在目标中的代价,条件方差衡量不可约误差;两者不是同一个量。低噪声端 $R^2$ 小不意味着该步 score 不重要。
④「采样方差是训出来的。」 默认不是。fixed_small 是硬编码的 $\tilde\beta_t$,跟训练毫无关系;只有 learned / learned_range 才让网络参与,而且此时模型输出通道要翻倍(step() 里 model_output.shape[1] == sample.shape[1] * 2 那个判断就是干这个的)。
⑤「换方差只影响采样,不影响训练。」 一半对。方差确实不参与 $L_{\text{simple}}$ 的计算,但 $w_t$ 的公式里有 $\sigma_t^2$——所以用真 ELBO 权重训练时,你选的方差会通过 $w_t$ 反过来改变训练目标(表 3 里 elbo_tilde 和 elbo_large 是两种不同的训练目标,不只是两种采样方式)。
⑥「等权赢,所以加权分析没用了。」 本文两个容量档已经出现排序翻转;权重还与噪声调度、预条件、数据与优化相互作用。应在同一评测口径下选择,不能把一次玩具胜负当成普遍结论。
⑦「$T=1000$ 是个需要调的超参。」 不完全是。$T$ 决定了 $w_t$ 的动态范围,也决定了每步要挪多远;但它同时被 $\beta$ 调度绑住——改 $T$ 不改 $\beta$ 的端点,等于改了整条噪声表的形状。Improved DDPM 换余弦调度而不是换 $T$,正是因为这两个量不能分开调。
两个脚本都在附录,只依赖 numpy:
/usr/local/bin/python3 ddpm_lab.py                          # 闭式解实验室,几秒跑完
/usr/local/bin/python3 ddpm_train.py --steps 20000 --n-gen 4000   # 真网络版,几分钟
ddpm_lab.py 会依次打印六段(真实输出摘要,不是预期值):
t=1 的 tilde_beta_1 = 0.000e+00。loose 真 ELBO 赢(1.880952 vs 1.881758)、tight 等权赢(1.898760 vs 1.922295)。ddpm_train.py 的 A 段是梯度检查(有限差分相对差 9.92e-10),C 段是三种指标打分(uniform −0.2208±0.0195 / elbo_tilde −0.4212±0.0062),D 段只换采样方差($\tilde\beta_t$ −0.2363±0.0123 / $\beta_t$ −0.2640±0.0129)。
想自己动手改的话,三个地方最值得试:把 BASIS 从 3 项换成 5 项看结论翻转(F 段已经在做);把 T 从 1000 降到 100 看 $w_t$ 的动态范围怎么变;把数据从高斯换成 ddpm_train.py 的 7 峰混合,看方差选择的结论会不会反过来。
09 节用到的脚本全文如下(ddpm_lab.py、ddpm_train.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
# -*- coding: utf-8 -*-
"""DDPM 训练目标的最小实验室(闭式解版,只依赖 numpy,无 torch)。

这个脚本回答四个只能用数字回答的问题:

A. ELBO 里那一串「只跟 t 有关的系数」到底是什么形状。
   解析式 w_t = beta_t^2 / (2 sigma_t^2 alpha_t (1 - abar_t)),
   用两个高斯的 KL 数值核一遍,确认没推导错。

B. 用带权最小二乘训练一个**跨时间步共享参数**的 epsilon 网络
   (仿射 + 固定时间基),比较三种目标:
     uniform   —— DDPM 的 L_simple,等权
     elbo_tilde —— 真 ELBO 权重,sigma^2 = tilde_beta_t(diffusers 的 fixed_small)
     elbo_large —— 真 ELBO 权重,sigma^2 = beta_t(diffusers 的 fixed_large)
   模型容量故意给小(9 个时间基函数),所以权重真的会决定容量往哪搬。

C. 仿射模型下 p_theta(x_0) 是一个高斯,可以算出**精确 NLL**。
   用「密度沿链前向传播」算,再用「线性映射复合」交叉验证一遍。

D. 反向链的方差 sigma^2 到底该取 tilde_beta_t 还是 beta_t。
   在 beta_tilde 与 beta 之间插值扫一遍,看 NLL 与生成分布的胖瘦怎么变。

运行:  /usr/local/bin/python3 ddpm_lab.py
依赖:  numpy(无 GPU、无 torch)
"""

import os

import numpy as np

RNG_SEED = 20260927
T = 1000
D = 2

# ══════════════════════════════════════════════════════════════════
# 0. 噪声调度与前向过程的闭式量
# ══════════════════════════════════════════════════════════════════


def linear_beta(T=1000, b1=1e-4, bT=0.02):
    """DDPM 原文 CIFAR-10 用的线性调度。"""
    return np.linspace(b1, bT, T)


def cosine_beta(T=1000, s=0.008, clip=0.999):
    """Improved DDPM 的余弦调度:先定 abar(t) 再反解 beta。"""
    u = np.arange(1, T + 1) / T
    f = np.cos(((u + s) / (1 + s)) * np.pi / 2) ** 2
    f0 = np.cos((s / (1 + s)) * np.pi / 2) ** 2
    abar = f / f0
    beta = 1.0 - abar / np.concatenate([[1.0], abar[:-1]])
    return np.clip(beta, 1e-8, clip)


class Sched:
    """下标约定:abar[t]、beta[t]、bt[t] 中的 t 取 1..T;t=0 是数据本身。"""

    def __init__(self, beta):
        self.T = len(beta)
        self.beta = beta
        self.alpha = 1.0 - beta
        self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)])   # 长度 T+1
        # tilde_beta_t = (1 - abar_{t-1}) / (1 - abar_t) * beta_t
        self.bt = np.empty(self.T + 1)
        self.bt[0] = 0.0
        self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta

    def weight(self, which="tilde"):
        """ELBO 第 t 项里 ||eps - eps_theta||^2 前面的系数(长度 T,下标 0 对应 t=1)。

        which="tilde" -> sigma^2 = tilde_beta_t (fixed_small)
        which="large" -> sigma^2 = beta_t       (fixed_large)

        t=1 时 tilde_beta_1 = 0,权重分母为零(分子非零)。DDPM 把这一项交给 L_0(离散解码器)
        单独处理;这里为了让训练能跑,退化地用 fixed_large 的权重顶上。
        """
        s2 = self.bt[1:] if which == "tilde" else self.beta
        with np.errstate(divide="ignore", invalid="ignore"):
            w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:]))
        if which == "tilde":
            w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1]))
        return w

    def weight_simplified(self, which="tilde"):
        """上面那条式子化简之后的样子,用来核对代数没推错。"""
        denom = 1.0 - (self.abar[:-1] if which == "tilde" else self.abar[1:])
        with np.errstate(divide="ignore", invalid="ignore"):
            return self.beta / (2.0 * self.alpha * denom)


def q_sample(x0, t_idx, abar, rng):
    """x_t = sqrt(abar_t) x_0 + sqrt(1 - abar_t) eps,一步到位。"""
    a = abar[t_idx]
    if np.isscalar(a):
        a = np.full(len(x0), a)
    eps = rng.standard_normal(x0.shape)
    return np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps, eps


# ══════════════════════════════════════════════════════════════════
# 1. 数据:一个二维高斯(NLL 能算到机器精度)
# ══════════════════════════════════════════════════════════════════

MU0 = np.array([1.0, -0.5])
S0 = np.array([[0.60, 0.25], [0.25, 0.35]])


def sample_gauss(n, rng):
    L = np.linalg.cholesky(S0)
    return MU0 + rng.standard_normal((n, D)) @ L.T


def entropy_gauss(S):
    """高斯熵(nats)。"""
    _, ld = np.linalg.slogdet(S)
    return 0.5 * (D * np.log(2 * np.pi * np.e) + ld)


def kl_gauss(m0, S0_, m1, S1_):
    """KL( N(m0, S0_) || N(m1, S1_) ),闭式解。"""
    L = np.linalg.cholesky(S1_)
    y = np.linalg.solve(L, m1 - m0)
    Sinv_S0 = np.linalg.solve(S1_, S0_)
    _, ld1 = np.linalg.slogdet(S1_)
    _, ld0 = np.linalg.slogdet(S0_)
    return 0.5 * (np.trace(Sinv_S0) + y @ y - D + ld1 - ld0)


def expected_nll(m, S):
    """E_{x ~ p_data}[-log p_theta(x)] 的**精确值**。

    = 数据分布的熵 + KL(p_data || p_theta),两个高斯之间全是闭式解,
    没有蒙特卡洛噪声——用固定测试集估 NLL 时,2 万样本的波动有 ±0.007 nats,
    比我们要比的 0.002~0.004 nats 还大,所以这里必须用闭式解。
    """
    return entropy_gauss(S0) + kl_gauss(MU0, S0, m, S)


def gauss_nll(X, m, S):
    """多元高斯负对数似然(nats)。协方差病态时加抖动兜底。"""
    jitter = 0.0
    for _ in range(8):
        try:
            L = np.linalg.cholesky(S + jitter * np.eye(D))
            y = np.linalg.solve(L, (X - m).T)
            return 0.5 * (np.sum(y * y, axis=0)
                          + 2 * np.sum(np.log(np.diag(L))) + D * np.log(2 * np.pi))
        except np.linalg.LinAlgError:
            jitter = 1e-12 if jitter == 0.0 else jitter * 100.0
    raise RuntimeError("协方差矩阵无法正定化,说明反向链已经数值发散")


# ══════════════════════════════════════════════════════════════════
# 2. 模型:eps_theta(x, t) = B(psi_t) x + c(psi_t),参数跨 t 共享
#    psi 是固定的时间基(Fourier),只有 B、c 的系数是可学的
# ══════════════════════════════════════════════════════════════════

# 时间基故意取得很小:让「容量」成为真正的约束,权重才会决定容量往哪搬。
# 指数里出现 0.5,是因为最优的 B_t 与 sqrt(1 - abar_t) 成正比,
# 在 t 很小时它按 sqrt(t) 走 —— 用纯多项式去拟合会在开头剧烈震荡。
BASIS = {
    "loose": [0.0, 0.5, 1.0, 1.5, 2.0],   # 5 项:容量基本够用
    "tight": [0.0, 0.5, 1.0],             # 3 项:容量真的成了瓶颈
}
BASIS_EXP = BASIS["tight"]            # 默认用容量吃紧那一档,机制看得最清楚
K = len(BASIS_EXP)


def set_basis(name):
    global BASIS_EXP, K
    BASIS_EXP = BASIS[name]
    K = len(BASIS_EXP)
    return K


def psi_basis(t_arr):
    """t (1..T) -> (n, K) 的固定时间基,u = t / T in (0, 1]。"""
    u = np.asarray(t_arr, dtype=float) / T
    return np.stack([u ** e for e in BASIS_EXP], axis=-1)


def feats(x, psi):
    """拼特征:[x ⊗ psi, psi],最后一维长度 D*K + K。"""
    px = x[:, :, None] * psi[:, None, :]                 # (n, D, K)
    return np.concatenate([px.reshape(len(x), -1), psi], axis=1)


def fit_weighted_ridge(Phi, E, w, lam):
    """最小化 sum_i w_i ||W phi_i - eps_i||^2 + lam ||W||^2。"""
    P = Phi.shape[1]
    A = np.einsum("n,np,nq->pq", w, Phi, Phi) + lam * np.eye(P)
    Bmat = np.einsum("n,np,nd->pd", w, Phi, E)
    return np.linalg.solve(A, Bmat)


def model_Bc(W, psi_t):
    """把共享权重在某个时刻 t 上展开成 eps = B x + c。"""
    Wx = W[: D * K, :].reshape(D, K, D)                  # Wx[i, k, j]
    Bmat = np.einsum("ikj,k->ji", Wx, psi_t)
    cvec = psi_t @ W[D * K:, :]
    return Bmat, cvec


def optimal_Bc(sc, t):
    """高斯数据下 eps 的最优预测器(后验均值),用来做参考与验算。"""
    a = sc.abar[t]
    C = a * S0 + (1.0 - a) * np.eye(D)
    Bmat = np.sqrt(1.0 - a) * np.linalg.inv(C)
    cvec = -np.sqrt(a) * (Bmat @ MU0)
    return Bmat, cvec


def mse_analytic(Bmat, cvec, sc, t):
    """E||B x_t + c - eps||^2 的闭式解(对 D 维取了平均)。

    (x_t, eps) 是联合高斯:Var(x_t) = C_t = abar_t S0 + (1-abar_t) I,
    Cov(x_t, eps) = sqrt(1-abar_t) I,E[x_t] = sqrt(abar_t) mu0,E[eps] = 0。
    展开 ||B x_t + c - eps||^2 的期望即得下式,不用蒙特卡洛,没有抽样噪声。
    """
    a = sc.abar[t]
    C = a * S0 + (1.0 - a) * np.eye(D)
    m = np.sqrt(a) * MU0
    quad = np.trace(Bmat @ C @ Bmat.T)                    # Var(B x_t)
    bias = np.sum((Bmat @ m + cvec) ** 2)                 # 均值没对上的部分
    cross = 2.0 * np.sqrt(1.0 - a) * np.trace(Bmat)       # -2 Cov(B x_t, eps)
    return float((quad + bias - cross + D) / D)


def mse_floor(sc, t):
    """贝叶斯最优的 MSE 地板:Var(eps | x_t) 的迹除以 D。"""
    a = sc.abar[t]
    C = a * S0 + (1.0 - a) * np.eye(D)
    return float((D - (1.0 - a) * np.trace(np.linalg.inv(C))) / D)


def learnability(sc, t):
    """这一时刻的 eps 里,有多大比例是能从 x_t 里看出来的。

    R^2 = 1 - 地板 / Var(eps),Var(eps) 的每维是 1。
    """
    return 1.0 - mse_floor(sc, t)


# ══════════════════════════════════════════════════════════════════
# 3. 精确 NLL:把高斯密度沿反向链往前传
# ══════════════════════════════════════════════════════════════════

def _s2_mat(sigma2, t):
    """每步注入的噪声协方差:既接受标量(各向同性),也接受 (T+1, D, D)。"""
    if sigma2.ndim == 1:
        return sigma2[t] * np.eye(D)
    return sigma2[t]


def chain_moments_prop(sc, Bcfun, sigma2):
    """写法一:密度传播。x_{t-1} = M_t x_t + v_t + noise。"""
    m = np.zeros(D)
    S = np.eye(D)
    sig = np.atleast_1d(sigma2)
    for t in range(T, 0, -1):
        Bmat, cvec = Bcfun(t)
        kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t])
        M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1])
        v = -kk * cvec / np.sqrt(sc.alpha[t - 1])
        m = M @ m + v
        S = M @ S @ M.T + _s2_mat(sig, t)
    return m, S


def chain_moments_comp(sc, Bcfun, sigma2):
    """写法二:把整条链复合成一个仿射映射,再累加各步噪声。独立实现,用于交叉验证。"""
    m = np.zeros(D)
    S = np.zeros((D, D))
    Pprev = np.eye(D)
    for t in range(1, T + 1):
        Bmat, cvec = Bcfun(t)
        kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t])
        M = (np.eye(D) - kk * Bmat) / np.sqrt(sc.alpha[t - 1])
        v = -kk * cvec / np.sqrt(sc.alpha[t - 1])
        m = m + Pprev @ v
        S = S + Pprev @ _s2_mat(sigma2, t) @ Pprev.T
        Pprev = Pprev @ M
    S = S + Pprev @ Pprev.T          # x_T ~ N(0, I) 的那一坨
    return m, S


def sigma2_exact_posterior(sc):
    """真实后验 q(x_{t-1}|x_t) 的协方差(高斯数据下可算)。

    = tilde_beta_t I + Var(mu_t | x_t)
    = tilde_beta_t I + (beta_t^2 / (alpha_t (1 - abar_t))) Var(eps | x_t)
    第二项就是 DDPM 反向链扔掉的那部分:真实后验比 beta_tilde 更胖。
    """
    out = np.zeros((T + 1, D, D))
    for t in range(1, T + 1):
        a = sc.abar[t]
        C = a * S0 + (1.0 - a) * np.eye(D)
        var_eps = np.eye(D) - (1.0 - a) * np.linalg.inv(C)
        kk2 = sc.beta[t - 1] ** 2 / (sc.alpha[t - 1] * (1.0 - a))
        out[t] = sc.bt[t] * np.eye(D) + kk2 * var_eps
    return out


def sigma2_from_choice(sc, which="tilde", lam_mix=0.0):
    """反向链每步注入的方差。lam_mix 在 tilde_beta 与 beta 之间插值。"""
    if which == "tilde":
        base = sc.bt.copy()
        other = np.concatenate([[0.0], sc.beta])
    else:
        base = np.concatenate([[0.0], sc.beta])
        other = sc.bt.copy()
    return (1.0 - lam_mix) * base + lam_mix * other


# ══════════════════════════════════════════════════════════════════
# 4. 主流程
# ══════════════════════════════════════════════════════════════════

def section_A(sc):
    print("=" * 74)
    print("A. ELBO 每步权重:解析式 vs 两个高斯的 KL")
    print("=" * 74)
    w_tilde = sc.weight("tilde")
    w_large = sc.weight("large")
    ws_tilde = sc.weight_simplified("tilde")
    ws_large = sc.weight_simplified("large")

    ok = np.isfinite(ws_tilde) & (ws_tilde > 0)
    rel = np.max(np.abs(w_tilde[ok] - ws_tilde[ok]) / ws_tilde[ok])
    print(f"  化简式与原始式的最大相对差(tilde):{rel:.3e}")
    rel2 = np.max(np.abs(w_large - ws_large) / ws_large)
    print(f"  化简式与原始式的最大相对差(large):{rel2:.3e}")
    print(f"  t=1 的 tilde_beta_1 = {sc.bt[1]:.3e}(后验方差为 0 => 权重发散,"
          f"这就是 DDPM 要把 L_0 单独拿出来的原因)")
    print()
    print("  t      abar_t      beta_t    w_t(sigma^2=bt)   w_t(sigma^2=beta)   相对等权")
    for t in [2, 10, 50, 100, 250, 500, 750, 900, 1000]:
        print(f"  {t:<6d}{sc.abar[t]:<12.3e}{sc.beta[t-1]:<10.5f}"
              f"{w_tilde[t-1]:<18.4e}{w_large[t-1]:<20.4e}"
              f"{w_tilde[t-1] / w_tilde[499]:<10.2f}")
    print()
    span = w_tilde[1] / w_tilde.min()
    print(f"  sigma^2=tilde_beta 时,权重最大值(t=2)是最小值(t={int(np.argmin(w_tilde))+1})的 "
          f"{span:.1f} 倍")
    print(f"  等权 L_simple 相当于把这条曲线整体压平到 1")
    print()

    # 数值核对:KL( q(x_{t-1}|x_t,x_0) || p_theta(x_{t-1}|x_t) ) == w_t * ||delta_eps||^2
    rng = np.random.default_rng(RNG_SEED)
    print("  —— KL 数值核对(随机取 x_0, eps,令 eps_theta = eps + delta)——")
    print("   t        KL(数值)          w_t*||delta||^2     相对差")
    for t in [2, 100, 500, 1000]:
        x0 = sample_gauss(1, rng)[0]
        a = sc.abar[t]
        eps = rng.standard_normal(D)
        xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps
        delta = rng.standard_normal(D) * 0.3
        eps_hat = eps + delta
        kk = sc.beta[t - 1] / np.sqrt(1 - a)
        mu_tilde = (xt - kk * eps) / np.sqrt(sc.alpha[t - 1])
        mu_theta = (xt - kk * eps_hat) / np.sqrt(sc.alpha[t - 1])
        s2 = sc.bt[t]
        kl = np.sum((mu_tilde - mu_theta) ** 2) / (2 * s2)
        pred = w_tilde[t - 1] * np.sum(delta ** 2)
        print(f"   {t:<7d}{kl:<18.6e}{pred:<20.6e}{abs(kl-pred)/kl:<12.2e}")
    print()
    return w_tilde, w_large


def fit_three(sc, w_tilde, w_large, lam=1e-6):
    """三种权重各解一遍带权最小二乘。不打印任何东西,供 section_B / section_F 共用。"""
    rng = np.random.default_rng(RNG_SEED + 1)
    M = 120_000
    t_idx = rng.integers(1, T + 1, size=M)
    x0 = sample_gauss(M, rng)
    a = sc.abar[t_idx]
    eps = rng.standard_normal((M, D))
    xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps
    psi = psi_basis(t_idx)
    Phi = feats(xt, psi)

    # 三种权重都归一化到均值 1(整体缩放不改变无正则时的解,
    # 归一化只是为了让正则强度在三种目标下可比)
    schemes = {
        "uniform": np.ones(T),
        "elbo_tilde": w_tilde / w_tilde.mean(),
        "elbo_large": w_large / w_large.mean(),
    }
    lam = 1e-6
    W = {}
    for name, w_full in schemes.items():
        w = w_full[t_idx - 1]
        W[name] = fit_weighted_ridge(Phi, eps, w, lam)
    return W, schemes


def section_B(sc, w_tilde, w_large):
    print("=" * 74)
    print("B. 带权最小二乘训练:三种目标,共享参数,容量有限")
    print("=" * 74)
    W, schemes = fit_three(sc, w_tilde, w_large)
    print(f"  训练集:M=120000 条 (x_0, t, eps),时间基 {K} 项,特征维度 {K * (D + 1)},"
          f"可学参数 {K * (D + 1) * D} 个")
    print(f"  三种权重都归一化到均值 1(整体缩放不改变解,归一化只为让正则强度可比)")
    print(f"  权重动态范围:elbo_tilde 的 max/min = {w_tilde.max()/w_tilde.min():.1f}")
    print()
    return W, schemes


def model_moments(sc, Wm, which="tilde"):
    """把训练好的共享权重展开成整条反向链→后验的均值与协方差。"""
    s2 = sigma2_from_choice(sc, which)
    return chain_moments_prop(
        sc, lambda t: model_Bc(Wm, psi_basis(np.array([t]))[0]), s2)


def excess_bands(sc, W):
    """低噪声档 / 高噪声档的超额误差均值,以及 elbo 相对 uniform 的比值。"""
    lo = np.arange(1, 51)
    hi = np.arange(400, 1001)
    out = {}
    for band, idx in [("lo", lo), ("hi", hi)]:
        e = {}
        for name in ["uniform", "elbo_tilde"]:
            e[name] = float(np.mean([
                mse_analytic(*model_Bc(W[name], psi_basis(np.array([t]))[0]), sc, t) - mse_floor(sc, t)
                for t in idx]))
        out[band] = (e["uniform"], e["elbo_tilde"], e["elbo_tilde"] / e["uniform"])
    return out


def section_C(sc, W, schemes):
    print("=" * 74)
    print("C. 仿射模型下的精确 NLL(密度前向传播)")
    print("=" * 74)
    rng = np.random.default_rng(RNG_SEED + 2)
    Xtest = sample_gauss(400_000, rng)
    nll_true = expected_nll(MU0, S0)
    print(f"  参考:真分布 N(mu_0, S_0) 的熵 = {nll_true:.6f} nats"
          f"({nll_true / np.log(2) / D:.4f} bits/dim)")
    print(f"  蒙特卡洛复核(40 万样本):{gauss_nll(Xtest, MU0, S0).mean():.6f} nats"
          f",与闭式解差 {abs(gauss_nll(Xtest, MU0, S0).mean()-nll_true):.2e}")

    # 交叉验证两种写法
    m1, S1 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde"))
    m2, S2 = chain_moments_comp(sc, lambda t: optimal_Bc(sc, t), sigma2_from_choice(sc, "tilde"))
    print(f"  两种写法的差异:均值 {np.max(np.abs(m1-m2)):.2e},协方差 {np.max(np.abs(S1-S2)):.2e}")

    # 蒙特卡洛复核:真跑 20 万条链,比对经验均值/协方差
    rng3 = np.random.default_rng(RNG_SEED + 3)
    xs = rng3.standard_normal((200_000, D))
    for t in range(T, 0, -1):
        Bmat, cvec = optimal_Bc(sc, t)
        kk = sc.beta[t - 1] / np.sqrt(1.0 - sc.abar[t])
        mu = (xs - kk * (xs @ Bmat.T + cvec)) / np.sqrt(sc.alpha[t - 1])
        xs = mu + np.sqrt(sc.bt[t]) * rng3.standard_normal((200_000, D))
    print(f"  蒙特卡洛复核:均值差 {np.max(np.abs(xs.mean(0)-m1)):.2e},"
          f"协方差差 {np.max(np.abs(np.cov(xs.T)-S1)):.2e}")

    nll_opt = expected_nll(m1, S1)
    print(f"  「最优 eps 预测器 + sigma^2=tilde_beta」的期望 NLL = {nll_opt:.6f} nats,"
          f"比真分布差 {nll_opt - nll_true:+.6f} nats")
    print(f"  蒙特卡洛复核(同上 40 万样本):{gauss_nll(Xtest, m1, S1).mean():.6f} nats,"
          f"差 {abs(gauss_nll(Xtest, m1, S1).mean()-nll_opt):.2e}")
    print(f"  生成分布的协方差 diag = {np.diag(S1)},真值 diag = {np.diag(S0)} "
          f"=> 比值 {np.diag(S1)/np.diag(S0)}")

    # 把真实后验方差(而不是 tilde_beta)灌回反向链:应该精确还原数据分布
    s2_exact = sigma2_exact_posterior(sc)
    m3, S3 = chain_moments_prop(sc, lambda t: optimal_Bc(sc, t), s2_exact)
    nll_exact = expected_nll(m3, S3)
    print(f"  「最优 eps 预测器 + 真实后验方差」的期望 NLL = {nll_exact:.6f} nats,"
          f"比真分布差 {nll_exact - nll_true:+.2e} nats")
    print(f"  此时生成协方差 diag / 真值 = {np.diag(S3)/np.diag(S0)},"
          f"均值差 {np.max(np.abs(m3 - MU0)):.2e}")
    print("  =>  reverse 链的均值用最优 eps 预测器、方差用真实后验方差,"
          "就能精确还原数据分布;")
    print("     NLL 上剩下的那 0.0001 nats 完全是「把方差钉死成 tilde_beta」造成的。")
    print()

    print("  三种训练目标 × 两种采样方差的期望 NLL(nats,越小越好):")
    print("  训练目标         sigma^2=tilde_beta    sigma^2=beta      差         生成std/真std")
    rows = {}
    for name in ["uniform", "elbo_tilde", "elbo_large"]:
        Wm = W[name]
        out = {}
        for which in ["tilde", "large"]:
            m, S = model_moments(sc, Wm, which)
            out[which] = expected_nll(m, S)
            out[which + "_std"] = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0))))
        rows[name] = out
        print(f"  {name:<16}{out['tilde']:<22.6f}{out['large']:<18.6f}"
              f"{out['large']-out['tilde']:<+12.6f}{out['tilde_std']:.4f}")
    print()
    return rows, nll_true, nll_opt


def section_D(sc, W):
    print("=" * 74)
    print("D. 每步误差剖面:权重把「超额误差」搬到了哪")
    print("=" * 74)
    grid = list(range(1, 1001))
    floor = np.array([mse_floor(sc, t) for t in grid])
    learn = np.array([learnability(sc, t) for t in grid])
    prof = {}
    for name, Wm in W.items():
        mse = []
        for t in grid:
            Bmat, cvec = model_Bc(Wm, psi_basis(np.array([t]))[0])
            mse.append(mse_analytic(Bmat, cvec, sc, t))
        prof[name] = np.array(mse)

    print("  闭式解算的,没有蒙特卡洛噪声。『超额』= MSE − 贝叶斯地板。")
    print("   t     可学占比R^2  地板     uniform超额   elbo_tilde超额  elbo_large超额")
    for t in [1, 5, 20, 50, 100, 200, 400, 600, 800, 950, 1000]:
        i = t - 1
        print(f"  {t:<6d}{learn[i]:<12.4f}{floor[i]:<9.4f}"
              f"{prof['uniform'][i]-floor[i]:<14.3e}{prof['elbo_tilde'][i]-floor[i]:<16.3e}"
              f"{prof['elbo_large'][i]-floor[i]:.3e}")
    print()
    lo = slice(0, 50)          # t = 1..50
    hi = slice(399, 1000)      # t = 400..1000
    eu_u, eu_e = prof["uniform"] - floor, prof["elbo_tilde"] - floor
    print(f"  低噪声档 t<=50    :uniform 超额均值 {eu_u[lo].mean():.3e},"
          f"elbo_tilde {eu_e[lo].mean():.3e}(比值 {eu_e[lo].mean()/eu_u[lo].mean():.2f})")
    print(f"  高噪声档 t>=400   :uniform 超额均值 {eu_u[hi].mean():.3e},"
          f"elbo_tilde {eu_e[hi].mean():.3e}(比值 {eu_e[hi].mean()/eu_u[hi].mean():.2f})")
    print()
    print(f"  可学占比 R^2:t=1 时 {learn[0]:.2e},t=500 时 {learn[499]:.4f},"
          f"t=1000 时 {learn[999]:.4f}")
    print()
    return grid, prof, floor, learn


def section_E(sc, W):
    print("=" * 74)
    print("E. 采样方差该取 tilde_beta 还是 beta:在两者之间插值扫一遍")
    print("=" * 74)
    nll_true = expected_nll(MU0, S0)
    print("  lam 是插值系数:sigma^2 = (1-lam)*tilde_beta + lam*beta")
    print("   lam     NLL(uniform训练)  NLL(elbo_tilde训练)   生成 std / 真 std")
    out = {"lam": [], "nll_uniform": [], "nll_elbo": [], "std_ratio": []}
    for lam in [0.0, 0.25, 0.5, 0.75, 1.0]:
        s2 = sigma2_from_choice(sc, "tilde", lam_mix=lam)
        row, sr = [], 0.0
        for name in ["uniform", "elbo_tilde"]:
            m, S = chain_moments_prop(
                sc, lambda t: model_Bc(W[name], psi_basis(np.array([t]))[0]), s2)
            row.append(expected_nll(m, S))
            if name == "uniform":
                sr = float(np.mean(np.sqrt(np.diag(S)) / np.sqrt(np.diag(S0))))
        out["lam"].append(lam)
        out["nll_uniform"].append(row[0])
        out["nll_elbo"].append(row[1])
        out["std_ratio"].append(sr)
        print(f"  {lam:<7.2f}{row[0]:<19.6f}{row[1]:<22.6f}{sr:.4f}")
    best = out["lam"][int(np.argmin(np.abs(np.array(out["std_ratio"]) - 1.0)))]
    print(f"  生成分布的胖瘦刚好对上真分布的 lam ≈ {best:.2f}(这一列是最敏感的指标,"
          f"NLL 对 lam 几乎不动)")
    print(f"  参考:真分布熵 = {nll_true:.6f}")
    print()
    return out


def section_F(sc, w_tilde, w_large):
    """容量充足 vs 容量吃紧:『该不该扔掉系数』的答案会不会反过来。"""
    print("=" * 74)
    print("F. 同样两个目标,换一档模型容量:结论会反过来")
    print("=" * 74)
    print("  两档时间基都只动特征个数,训练数据、种子、正则强度完全一样。")
    print()
    print("  容量档  时间基项数  可学参数   NLL(等权)   NLL(真ELBO)   谁更好   低噪声档超额比  高噪声档超额比")
    out = {}
    for regime in ["loose", "tight"]:
        k = set_basis(regime)
        Wf, _ = fit_three(sc, w_tilde, w_large)
        n_u = expected_nll(*model_moments(sc, Wf["uniform"]))
        n_e = expected_nll(*model_moments(sc, Wf["elbo_tilde"]))
        bands = excess_bands(sc, Wf)
        better = "等权" if n_u < n_e else "真ELBO"
        n_par = k * (D + 1) * D
        out[regime] = dict(K=k, nll_uniform=n_u, nll_elbo=n_e, bands=bands, W=Wf)
        print(f"  {regime:<8}{k:<12}{n_par:<11}{n_u:<12.6f}{n_e:<14.6f}"
              f"{better:<9}{bands['lo'][2]:<16.2f}{bands['hi'][2]:.2f}")
    set_basis("tight")
    print()
    print("  列『超额比』= 真 ELBO 权重的超额误差 / 等权的超额误差,小于 1 表示更好。")
    print("  => 容量够用时真 ELBO 权重略胜,容量真的吃紧时它反而输给等权。")
    print()
    return out


def main():
    sc = Sched(linear_beta(T))
    print(f"调度:线性 T={T},beta 从 {sc.beta[0]:.1e} 到 {sc.beta[-1]:.3f},"
          f"abar_T = {sc.abar[T]:.4e}")
    print()
    w_tilde, w_large = section_A(sc)
    W, schemes = section_B(sc, w_tilde, w_large)
    print()
    rows, nll_true, nll_opt = section_C(sc, W, schemes)
    print()
    grid, prof, floor, learn = section_D(sc, W)
    print()
    mix = section_E(sc, W)
    print()
    regimes = section_F(sc, w_tilde, w_large)
    return dict(sched=sc, w_tilde=w_tilde, w_large=w_large, W=W,
                nll_rows=rows, nll_true=nll_true, nll_opt=nll_opt,
                grid=grid, prof=prof, floor=floor, learn=learn, mix=mix,
                regimes=regimes)


if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""照着 DDPM 原文 Algorithm 1 / Algorithm 2 写的最小实现(纯 numpy,无 torch)。
为什么还要写一遍神经网络版:ddpm_lab.py 用带权最小二乘的闭式解把「优化算法」
这个变量消掉了,代价是模型只能仿射。这里补上手写反向传播的两层 MLP,
在**多模态**的目标分布上跑完整的一千步采样,看训练目标的权重到底怎么影响
最后生成出来的东西。
A. 梯度核对:手写反向传播 vs 有限差分
B. Algorithm 1:按三种加权(等权 / ELBO / ELBO-large)训练三个网络
C. Algorithm 2:一千步采样,三种指标打分
D. 反向链方差 sigma^2 = tilde_beta 还是 beta
运行: /usr/local/bin/python3 ddpm_train.py # 默认 20000 步
/usr/local/bin/python3 ddpm_train.py --steps 40000
依赖: numpy
"""
import argparse
import os
import numpy as np
RNG_SEED = 20260927
T = 1000
D = 2
# ══════════════════════════════════════════════════════════════════
# 0. 调度(与 ddpm_lab.py 同一套,下标约定:t 取 1..T)
# ══════════════════════════════════════════════════════════════════
def linear_beta(T=1000, b1=1e-4, bT=0.02):
return np.linspace(b1, bT, T)
class Sched:
def __init__(self, beta):
self.beta = beta
self.alpha = 1.0 - beta
self.abar = np.concatenate([[1.0], np.cumprod(self.alpha)])
self.bt = np.empty(len(beta) + 1)
self.bt[0] = 0.0
self.bt[1:] = (1.0 - self.abar[:-1]) / (1.0 - self.abar[1:]) * beta
def weight(self, which="tilde"):
"""ELBO 第 t 项里 ||eps - eps_theta||^2 的系数。"""
s2 = self.bt[1:] if which == "tilde" else self.beta
with np.errstate(divide="ignore", invalid="ignore"):
w = self.beta ** 2 / (2.0 * s2 * self.alpha * (1.0 - self.abar[1:]))
if which == "tilde": # t=1 的 0/0 退化,用 fixed_large 顶上
w[0] = self.beta[0] / (2.0 * self.alpha[0] * (1.0 - self.abar[1]))
return w
# ══════════════════════════════════════════════════════════════════
# 1. 目标分布:7 个分量的二维高斯混合(环状 + 一个中心)
# ══════════════════════════════════════════════════════════════════
RING_R = 1.15
N_RING = 6
CENTERS = np.array(
[[RING_R * np.cos(2 * np.pi * k / N_RING), RING_R * np.sin(2 * np.pi * k / N_RING)]
for k in range(N_RING)] + [[0.0, 0.0]]
)
SCALES = np.array([0.17, 0.20, 0.16, 0.22, 0.18, 0.19, 0.28])
WEIGHTS = SCALES ** 2 # 分量越大越容易被采到,制造不均匀
WEIGHTS = WEIGHTS / WEIGHTS.sum()
def sample_mix(n, rng):
kk = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS)
return CENTERS[kk] + SCALES[kk][:, None] * rng.standard_normal((n, D))
def logp_mix(X):
"""混合分布在 X 处的对数密度(各分量都是各向同性高斯)。"""
d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1) # (n, K)
comp = np.log(WEIGHTS)[None, :] - 0.5 * d2 / SCALES[None, :] ** 2 \
- D * np.log(SCALES[None, :]) - 0.5 * D * np.log(2 * np.pi)
m = comp.max(axis=1, keepdims=True)
return (m[:, 0] + np.log(np.exp(comp - m).sum(axis=1)))
def nearest_center_dist(X):
d2 = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1)
return np.sqrt(d2.min(axis=1))
# ══════════════════════════════════════════════════════════════════
# 2. 时间嵌入 + 两层 MLP + 手写 Adam
# ══════════════════════════════════════════════════════════════════
TIME_FREQ = (1, 2, 4, 8) # 8 维时间基
def time_embed(t_arr):
u = np.asarray(t_arr, dtype=float) / T
cols = []
for w in TIME_FREQ:
cols.append(np.cos(w * np.pi * u))
cols.append(np.sin(w * np.pi * u))
return np.stack(cols, axis=-1)
N_IN = D + 2 * len(TIME_FREQ)
H = 64
def init_params(rng):
def he(fan_in, fan_out):
return rng.standard_normal((fan_in, fan_out)) * np.sqrt(2.0 / fan_in)
return {
"W1": he(N_IN, H), "b1": np.zeros(H),
"W2": he(H, H), "b2": np.zeros(H),
"W3": he(H, D), "b3": np.zeros(D),
}
def forward(p, Z):
h1 = np.maximum(Z @ p["W1"] + p["b1"], 0.0)
h2 = np.maximum(h1 @ p["W2"] + p["b2"], 0.0)
return h1, h2, h2 @ p["W3"] + p["b3"]
def backward(p, Z, h1, h2, out, eps, w):
"""d/d(theta) of mean_i w_i ||out_i - eps_i||^2。"""
n = len(Z)
dout = 2.0 * (w[:, None] * (out - eps)) / n
g = {}
g["W3"] = h2.T @ dout
g["b3"] = dout.sum(0)
dh2 = dout @ p["W3"].T
dh2[h2 <= 0] = 0.0
g["W2"] = h1.T @ dh2
g["b2"] = dh2.sum(0)
dh1 = dh2 @ p["W2"].T
dh1[h1 <= 0] = 0.0
g["W1"] = Z.T @ dh1
g["b1"] = dh1.sum(0)
return g
class Adam:
def __init__(self, p, lr=1e-3, b1=0.9, b2=0.999, eps=1e-8):
self.m = {k: np.zeros_like(v) for k, v in p.items()}
self.v = {k: np.zeros_like(v) for k, v in p.items()}
self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps
self.i = 0
def step(self, p, g):
self.i += 1
for k in p:
self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * g[k]
self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * g[k] ** 2
mh = self.m[k] / (1 - self.b1 ** self.i)
vh = self.v[k] / (1 - self.b2 ** self.i)
p[k] -= self.lr * mh / (np.sqrt(vh) + self.eps)
def predict_eps(p, x, t_idx):
Z = np.concatenate([x, time_embed(np.full(len(x), t_idx))], axis=1)
_, _, out = forward(p, Z)
return out
# ══════════════════════════════════════════════════════════════════
# 3. Algorithm 1(训练)与 Algorithm 2(采样)
# ══════════════════════════════════════════════════════════════════
def train(sc, w_full, steps, batch, rng, lr=1e-3):
"""DDPM 原文 Algorithm 1,一行不差地照抄。"""
p = init_params(rng)
opt = Adam(p, lr=lr)
for _ in range(steps):
# 1: t ~ Uniform({1, ..., T}) 2: x_0 ~ q(x_0) 3: eps ~ N(0, I)
t_idx = rng.integers(1, T + 1, size=batch)
x0 = sample_mix(batch, rng)
eps = rng.standard_normal((batch, D))
# 4: 一步加噪(闭式解,不需要真的走 t 步)
a = sc.abar[t_idx]
xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1.0 - a)[:, None] * eps
# 5: 梯度下降一步
Z = np.concatenate([xt, time_embed(t_idx)], axis=1)
h1, h2, out = forward(p, Z)
opt.step(p, backward(p, Z, h1, h2, out, eps, w_full[t_idx - 1]))
return p
def sample_chain(sc, p, n, which="tilde", rng=None):
"""DDPM 原文 Algorithm 2。which 决定 sigma^2 取 tilde_beta 还是 beta。"""
x = rng.standard_normal((n, D)) # x_T ~ N(0, I)
for t in range(T, 0, -1):
eps_hat = predict_eps(p, x, t)
a, a_prev = sc.abar[t], sc.abar[t - 1]
alpha_t, beta_t = sc.alpha[t - 1], sc.beta[t - 1]
# mu_tilde = (x_t - beta_t/sqrt(1-abar_t) * eps_hat) / sqrt(alpha_t)
mu = (x - beta_t / np.sqrt(1.0 - a) * eps_hat) / np.sqrt(alpha_t)
if which == "tilde":
sigma = np.sqrt(sc.bt[t])
else:
sigma = np.sqrt(beta_t)
z = rng.standard_normal((n, D))
x = mu + (sigma * z if t > 1 else 0.0) # t == 1 时不加噪声
return x
# ══════════════════════════════════════════════════════════════════
# 4. 主流程
# ══════════════════════════════════════════════════════════════════
def section_A():
print("=" * 74)
print("A. 手写反向传播 vs 有限差分")
print("=" * 74)
rng = np.random.default_rng(RNG_SEED)
sc = Sched(linear_beta(T))
p = init_params(rng)
n = 32
t_idx = rng.integers(1, T + 1, size=n)
x0 = sample_mix(n, rng)
eps = rng.standard_normal((n, D))
a = sc.abar[t_idx]
xt = np.sqrt(a)[:, None] * x0 + np.sqrt(1 - a)[:, None] * eps
Z = np.concatenate([xt, time_embed(t_idx)], axis=1)
w = np.ones(n)
h1, h2, out = forward(p, Z)
g = backward(p, Z, h1, h2, out, eps, w)
def loss():
_, _, o = forward(p, Z)
return float(np.mean(np.sum((o - eps) ** 2, axis=1)))
print(" 参数 解析梯度 有限差分 相对差")
worst = 0.0
for key in ["W1", "b1", "W2", "b2", "W3", "b3"]:
idx = tuple(0 for _ in p[key].shape)
h = 1e-6
orig = p[key][idx]
p[key][idx] = orig + h
lp = loss()
p[key][idx] = orig - h
lm = loss()
p[key][idx] = orig
num = (lp - lm) / (2 * h)
ana = g[key][idx]
rel = abs(num - ana) / max(abs(num), 1e-12)
worst = max(worst, rel)
print(f" {key:<8}{ana:<16.8e}{num:<16.8e}{rel:.2e}")
print(f" => 最大相对差 {worst:.2e}(有限差分自己的精度极限在 1e-6 量级)")
print()
return sc
def section_B(sc, steps):
print("=" * 74)
print("B. Algorithm 1:三种加权各训一个网络")
print("=" * 74)
w_tilde, w_large = sc.weight("tilde"), sc.weight("large")
schemes = {
"uniform": np.ones(T),
"elbo_tilde": w_tilde / w_tilde.mean(),
}
print(f" 步数 {steps},batch 256,两层 MLP({N_IN} -> {H} -> {H} -> {D}),Adam lr=1e-3")
print(f" elbo 权重的动态范围:max/min = {w_tilde.max()/w_tilde.min():.1f}")
models = {}
# 注意:不能用 hash(name)——Python 的字符串 hash 每次进程都变,结果会不可复现。
seed_of = {"uniform": 11, "elbo_tilde": 22, "elbo_large": 33}
for name, w in schemes.items():
rng = np.random.default_rng(RNG_SEED + seed_of.get(name, 44))
models[name] = train(sc, w, steps, 256, rng)
print(f" [{name}] 训练完成")
print()
return models
def _score(X, base_logp, base_dist):
"""三个指标:log p0 相对真样本、到最近模式中心的距离比、模式覆盖数。"""
dlogp = logp_mix(X).mean() - base_logp
dratio = nearest_center_dist(X).mean() / base_dist
assign = ((X[:, None, :] - CENTERS[None, :, :]) ** 2).sum(-1).argmin(1)
frac = np.bincount(assign, minlength=len(CENTERS)) / len(X)
return dlogp, dratio, int((frac > 0.02).sum())
def section_C(sc, models, n_gen, n_seed=3):
print("=" * 74)
print("C. Algorithm 2:一千步采样,三个指标打分")
print("=" * 74)
rng0 = np.random.default_rng(RNG_SEED + 77)
Xtrue = sample_mix(20_000, rng0)
base_logp = logp_mix(Xtrue).mean()
base_dist = nearest_center_dist(Xtrue).mean()
print(f" 基线(2 万真样本):log p0 均值 {base_logp:.4f},"
f"到最近模式中心距离均值 {base_dist:.4f}")
print(f" 每组用 {n_seed} 个不同的采样种子重复,报告均值 ± 标准差")
print()
print(" 训练目标 log p0 相对真样本 到最近中心距离/真样本 模式覆盖")
res = {}
for name, p in models.items():
dl, dr, cov = [], [], []
for s in range(n_seed):
rng = np.random.default_rng(RNG_SEED + 88 + s)
a, b, c = _score(sample_chain(sc, p, n_gen, "tilde", rng), base_logp, base_dist)
dl.append(a)
dr.append(b)
cov.append(c)
res[name] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)),
dratio=float(np.mean(dr)), frac=cov[0])
print(f" {name:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}"
f"{np.mean(dr):<22.4f}{cov[0]}/7")
print()
return res, base_logp, base_dist
def section_D(sc, models, n_gen, n_seed=3):
print("=" * 74)
print("D. 反向链方差:tilde_beta(fixed_small)还是 beta(fixed_large)")
print("=" * 74)
rng0 = np.random.default_rng(RNG_SEED + 77)
Xtrue = sample_mix(20_000, rng0)
base_logp = logp_mix(Xtrue).mean()
base_dist = nearest_center_dist(Xtrue).mean()
p = models["uniform"]
print(" 用 uniform(L_simple)训出来的那个网络,只换每步注入的方差:")
print(" 方差选择 log p0 相对真样本 到最近中心距离/真样本")
out = {}
for which in ["tilde", "large"]:
dl, dr = [], []
for s in range(n_seed):
rng = np.random.default_rng(RNG_SEED + 99 + s)
a, b, _ = _score(sample_chain(sc, p, n_gen, which, rng), base_logp, base_dist)
dl.append(a)
dr.append(b)
out[which] = dict(dlogp=float(np.mean(dl)), dlogp_std=float(np.std(dl, ddof=1)),
dratio=float(np.mean(dr)))
print(f" {which:<14}{np.mean(dl):<+10.4f} ± {np.std(dl, ddof=1):<10.4f}{np.mean(dr):.4f}")
print()
return out
def mse_profile(sc, models, rng_seed=RNG_SEED + 123):
"""每个时刻的 eps 预测误差(蒙特卡洛,用来画图)。"""
rng = np.random.default_rng(rng_seed)
grid = np.array([1, 2, 5, 10, 20, 50, 100, 200, 400, 600, 800, 950, 1000])
n = 6000
prof = {}
for name, p in models.items():
vals = []
for t in grid:
x0 = sample_mix(n, rng)
a = sc.abar[t]
eps = rng.standard_normal((n, D))
xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps
vals.append(float(np.mean((predict_eps(p, xt, t) - eps) ** 2)))
prof[name] = np.array(vals)
return grid, prof
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--steps", type=int, default=20000)
ap.add_argument("--n-gen", type=int, default=4000)
args = ap.parse_args()
sc = section_A()
models = section_B(sc, args.steps)
res, base_logp, base_dist = section_C(sc, models, args.n_gen)
dres = section_D(sc, models, args.n_gen)
grid, prof = mse_profile(sc, models)
print("=" * 74)
print("E. 每步预测误差(MSE,真 eps 的每维方差是 1)")
print("=" * 74)
print(" t uniform elbo_tilde")
for i, t in enumerate(grid):
print(f" {t:<7d}{prof['uniform'][i]:<12.4f}{prof['elbo_tilde'][i]:.4f}")
return dict(sched=sc, models=models, res=res, dres=dres, grid=grid, prof=prof)
if __name__ == "__main__":
main()# -*- coding: utf-8 -*-
"""画本文的四张图。数据源全部来自 ddpm_lab.py 的真实输出,不另造数。
weight_profile.png ELBO 每步权重 vs 这个时刻真正可学的信号占比
excess_error.png 两种训练目标把「超额误差」搬到了哪
variance_ledger.png 反向链每步注入的噪声:beta_tilde / beta / 真实后验
step_anatomy.png 反向一步的三个配料怎么随 t 变
运行: /usr/local/bin/python3 make_figures.py
依赖: numpy, matplotlib(字体 PingFang SC)
注意:matplotlib 的 mathtext 标签一律用 raw 字符串,且反斜杠后面只能跟字母
——源码会被 sync-code 原样搬进文章附录,反斜杠后面跟非字母会被体检器判成转义污染。
"""
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import ddpm_lab as LAB
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS", "Heiti TC", "sans-serif"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.facecolor"] = "white"
plt.rcParams["axes.facecolor"] = "white"
plt.rcParams["savefig.facecolor"] = "white"
plt.rcParams["font.size"] = 11
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
os.makedirs(FIGDIR, exist_ok=True)
C_MAIN, C_ALT, C_GREEN, C_GRAY = "#2563eb", "#dc2626", "#059669", "#6b7280"
T = LAB.T
D = LAB.D
# ─────────────────────────── 图 1:权重 vs 可学占比 ───────────────────────────
def fig_weight_profile(sc, w_tilde, w_large, learn):
fig, ax = plt.subplots(figsize=(9.2, 5.4))
tt = np.arange(1, T + 1)
ax.semilogy(tt, w_tilde, color=C_MAIN, lw=2.0,
label=r"真 ELBO 权重 $w_t$($\sigma^2=\tilde\beta_t$)")
ax.semilogy(tt, w_large, color=C_ALT, lw=1.6, ls="--",
label=r"真 ELBO 权重 $w_t$($\sigma^2=\beta_t$)")
ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":")
ax.text(620, 1.15, "等权 $L_{\mathrm{simple}}$ 就压在这条 1 上",
color=C_GRAY, fontsize=9)
ax.set_xlabel(r"时间步 $t$")
ax.set_ylabel(r"预测误差平方前面的系数 $w_t$")
ax.set_ylim(3e-3, 3.0)
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=9, loc="lower left")
ax2 = ax.twinx()
ax2.plot(tt, learn, color=C_GREEN, lw=2.0)
ax2.set_ylabel(r"这一时刻能学出来的噪声占比 $R^2$", color=C_GREEN)
ax2.set_ylim(-0.05, 1.05)
ax2.tick_params(axis="y", labelcolor=C_GREEN)
ax2.set_title("(a) 权重最大地方,恰恰是最学不到东西的地方", fontsize=11)
span = w_tilde.max() / w_tilde.min()
ax.annotate(rf"权重跨 {span:.0f} 倍", xy=(2, w_tilde[0]),
xytext=(70, 0.35), fontsize=9, color=C_MAIN,
arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2))
ax.annotate(rf"$t=1$ 时 $R^2$只有 {learn[0]:.1e}", xy=(1, 0.02),
xytext=(120, 0.012), fontsize=9, color=C_GREEN,
arrowprops=dict(arrowstyle="->", color=C_GREEN, lw=1.2))
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "weight_profile.png"), dpi=130)
plt.close(fig)
# ──────────────────────── 图 2:超额误差被搬到哪 ────────────────────────
def fig_excess(sc, grid, prof, floor, learn):
fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0))
tt = np.asarray(grid)
ax = axes[0]
ax.semilogy(tt, prof["uniform"] - floor, color=C_MAIN, lw=2.0,
label=r"等权($L_{\mathrm{simple}}$)")
ax.semilogy(tt, prof["elbo_tilde"] - floor, color=C_ALT, lw=2.0, label="真 ELBO 权重")
ax.set_xlabel(r"时间步 $t$")
ax.set_ylabel(r"超额误差 MSE $-$ 贝叶斯地板")
ax.set_title("(a) 容量被搬走了:低噪声档变好,中高噪声档变差")
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=9)
ax.set_xlim(0, 1000)
ax = axes[1]
ratio = (prof["elbo_tilde"] - floor) / (prof["uniform"] - floor)
ax.semilogy(tt, ratio, color=C_GREEN, lw=2.0)
ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":")
ax.fill_between(tt, 1e-3, ratio, where=(ratio < 1.0),
color=C_MAIN, alpha=0.13)
ax.fill_between(tt, 1.0, ratio, where=(ratio > 1.0),
color=C_ALT, alpha=0.13)
ax.set_xlabel(r"时间步 $t$")
ax.set_ylabel("真 ELBO 权重 / 等权 的超额误差之比")
ax.set_title("(b) 同一条曲线取比值:1 以下变好,1 以上变差")
ax.grid(alpha=0.25, which="both")
ax.set_xlim(0, 1000)
ax.set_ylim(1e-2, 1e2)
ax.text(60, 0.022, "低噪声档:好 10 倍以上", color=C_MAIN, fontsize=9)
ax.text(430, 4.5, "中高噪声档:差 2~6 倍", color=C_ALT, fontsize=9)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "excess_error.png"), dpi=130)
plt.close(fig)
# ───────────────────── 图 3:每步注入的噪声账本 ─────────────────────
def fig_variance(sc, mix):
s2_exact = LAB.sigma2_exact_posterior(sc)
tt = np.arange(1, T + 1)
tr_exact = np.array([np.trace(s2_exact[t]) / D for t in range(1, T + 1)])
fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.0))
ax = axes[0]
ax.semilogy(tt, sc.bt[1:], color=C_MAIN, lw=2.0,
label=r"$\tilde\beta_t$(DDPM 反向链用的,fixed_small)")
ax.semilogy(tt, sc.beta, color=C_ALT, lw=1.8, ls="--",
label=r"$\beta_t$(fixed_large)")
ax.semilogy(tt, tr_exact, color=C_GREEN, lw=2.0,
label=r"真实后验方差($\tilde\beta_t$ + 均值那一项的不确定性)")
ax.set_xlabel(r"时间步 $t$")
ax.set_ylabel("每步注入噪声的方差")
ax.set_title(r"(a) 真实后验方差比 $\tilde\beta_t$ 大,差值就是 NLL 缺口")
ax.set_ylim(1e-6, 1e0)
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=9)
ax = axes[1]
lam = np.asarray(mix["lam"])
sr = np.asarray(mix["std_ratio"])
nn = np.asarray(mix["nll_uniform"])
ax.plot(lam, sr, "o-", color=C_MAIN, lw=2.0, label="生成分布的标准差 / 真分布")
ax.axhline(1.0, color=C_GRAY, lw=1.2, ls=":")
ax.set_xlabel(r"插值系数 $\lambda$:$\sigma^2=(1-\lambda)\tilde\beta_t+\lambda\beta_t$")
ax.set_ylabel("标准差之比(1 表示胖瘦刚好对上)")
ax.set_ylim(0.960, 0.978)
ax2 = ax.twinx()
ax2.plot(lam, nn, "s--", color=C_ALT, lw=1.8, label="期望 NLL")
ax2.set_ylabel("期望 NLL(nats)", color=C_ALT)
ax2.tick_params(axis="y", labelcolor=C_ALT)
ax.set_title(r"(b) 换成 $\beta_t$ 把 3.4% 的偏窄补回 0.6 个点(没补满)", fontsize=11)
ax.grid(alpha=0.25)
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "variance_ledger.png"), dpi=130)
plt.close(fig)
# ──────────────────── 图 4:反向一步的三个配料 ────────────────────
def fig_step(sc):
tt = np.arange(1, T + 1)
abar_prev = sc.abar[:-1]
abar_cur = sc.abar[1:]
beta = sc.beta
# x_{t-1} = c_x * x_t + c_0 * x_hat0 + sigma_t * z
c_x = np.sqrt(sc.alpha) * (1.0 - abar_prev) / (1.0 - abar_cur)
c_0 = np.sqrt(abar_prev) * beta / (1.0 - abar_cur)
sigma = np.sqrt(sc.bt[1:])
fig, ax = plt.subplots(figsize=(9.2, 5.4))
ax.semilogy(tt, c_0, color=C_MAIN, lw=2.2,
label=r"拉向 $\hat x_0$ 的系数(这一步挪了多远)")
ax.semilogy(tt, c_x, color=C_GRAY, lw=1.8, ls="--",
label=r"保留 $x_t$ 的系数")
ax.semilogy(tt, sigma, color=C_ALT, lw=2.0,
label=r"注入噪声的标准差 $\sqrt{\tilde\beta_t}$")
ax.set_xlabel(r"时间步 $t$")
ax.set_ylabel("系数 / 标准差(绝对值)")
ax.set_title("反向一步的三个配料:绝大多数步子只挪千分之几")
ax.grid(alpha=0.25, which="both")
ax.legend(fontsize=9)
ax.set_ylim(1e-6, 3.0)
ax.annotate(rf"$t=500$:只挪 {c_0[499]:.2e}", xy=(500, c_0[499]),
xytext=(560, 2e-5), fontsize=9, color=C_MAIN,
arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2))
ax.annotate(rf"$t=2$:一步挪 {c_0[1]:.2f}", xy=(2, c_0[1]),
xytext=(90, 0.9), fontsize=9, color=C_MAIN,
arrowprops=dict(arrowstyle="->", color=C_MAIN, lw=1.2))
fig.tight_layout()
fig.savefig(os.path.join(FIGDIR, "step_anatomy.png"), dpi=130)
plt.close(fig)
def main():
sc = LAB.Sched(LAB.linear_beta(T))
w_tilde = sc.weight("tilde")
w_large = sc.weight("large")
grid = list(range(1, T + 1))
floor = np.array([LAB.mse_floor(sc, t) for t in grid])
learn = np.array([LAB.learnability(sc, t) for t in grid])
print(" 重新训练三份闭式解权重(与 ddpm_lab.py 同一套种子)...")
W, _ = LAB.section_B(sc, w_tilde, w_large)
prof = {}
for name, Wm in W.items():
prof[name] = np.array([
LAB.mse_analytic(*LAB.model_Bc(Wm, LAB.psi_basis(np.array([t]))[0]), sc, t)
for t in grid])
mix = LAB.section_E(sc, W)
fig_weight_profile(sc, w_tilde, w_large, learn)
fig_excess(sc, grid, prof, floor, learn)
fig_variance(sc, mix)
fig_step(sc)
print(" 四张图已写入 figures/")
return dict(sc=sc, W=W, prof=prof, floor=floor, learn=learn, mix=mix)
if __name__ == "__main__":
main()
评论 (0)