


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:数学基础 | 难度:入门 | 前置知识:无(会求导、会算期望即可)
关键词:变分推断、ELBO、重参数化、KL 散度、后验坍缩、β-VAE、IWAE、得分函数估计量
先摆三组在同一台机器上跑出来的数字,都出自文末附录,可以自己复现。
第一组:KL 项掉到 0,潜变量整条死掉。 固定解码器噪声 σ²=0.25,让四个独立数据方向分别具有方差 λ=4.0、1.0、0.25、0.0625,只改 KL 项的权重 β,看看最优解长什么样:
| 数据方向方差 λ | β=0.5 | β=1.0 | β=2.0 | β=4.0 | 死亡阈值 β* |
|---|---|---|---|---|---|
| 4.0 | MSE 0.125 存活 | MSE 0.250 存活 | MSE 0.500 存活 | MSE 1.000 存活 | 16.00 |
| 1.0 | MSE 0.125 存活 | MSE 0.250 存活 | MSE 0.500 存活 | MSE 1.000 死亡 | 4.00 |
| 0.25 | MSE 0.125 存活 | MSE 0.250 死亡 | 死亡 | 死亡 | 1.00 |
| 0.0625 | 死亡 | 死亡 | 死亡 | 死亡 | 0.25 |
死亡那一格的具体解是 a=0、s=1、KL=0:编码器把均值直接输出 0、方差输出 1,等于彻底放弃这个维度。此时重建误差精确等于 λ——也就是把 x 全猜成 0 的水平,这个维度一点信息都没传。问题在于看 loss 曲线你只会看到「KL 顺利降到 0,总损失还在降」,很难意识到这是失败而不是收敛。
第二组:把 ELBO 当成似然来监控,会被方差骗。 在一个 D=6、K=3 的高斯线性模型上,真实 log p(x) = -5.434331,解析 ELBO = -7.419767,两者差 1.985436。但用训练时真正用的那个单样本蒙特卡洛估计量去估 ELBO,重复 4000 次,标准差是 4.308——比它和 log p(x) 之间的差距还大一倍多,结果有 40.7% 的采样值直接越过了 -5.434 这条「上界」。如果你在 tensorboard 上画这条线当似然看,会得出完全错误的结论。
第三组:不用重参数化,梯度方差能大到没法训练。 同一个模型上估 ∇ E_q[log p(x|z)],重参数化的梯度方差和是 377.55,得分函数估计量是 3043.11,差 8.1 倍。听起来还能忍?把数据维度 D 从 8 拉到 2048:
| D | 重参数化方差 | 得分函数方差 | 比值 |
|---|---|---|---|
| 8 | 2.08 | 2 469 | 1 188× |
| 64 | 1.98 | 104 328 | 52 630× |
| 512 | 1.84 | 7 579 291 | 4 121 907× |
| 2048 | 1.84 | 114 230 222 | 61 916 893× |
重参数化的方差几乎不随 D 动,得分函数估计量按 D² 往上冲,到 D=2048(一张 45×45 的灰度图而已)比值是 6191 万倍。这不是「慢一点」的差别,是「能不能训」的差别。
这三组数字背后是同一件事:我们想最大化的是 log p(x),但它算不动,只能换成它的一个下界 ELBO 来优化;而换成下界之后,「换掉了什么」「这个下界的估计量有多吵」「梯度怎么穿过采样」这三笔账必须自己算清楚。不搞清楚 KL 项的价,你就不知道 β 该往哪调;不搞清楚下界的松紧,你就不知道扩散模型的训练目标从哪来。
三句话讲完核心:
生成模型的设定很简单:先从一个固定先验里采隐变量 $z \sim p(z)$(通常是标准正态),再用解码器生成观测 $x \sim p_\theta(x \mid z)$。要拟合数据,目标是对数边际似然:
$$\log p_\theta(x) = \log \int p_\theta(x \mid z) \, p(z) \, dz$$
麻烦全在这个积分上。$p_\theta(x \mid z)$ 是个神经网络,塞进积分里没有任何闭式解;用数值积分的话,z 是 K 维,网格点数随 K 指数爆炸,K=32 就已经不可能。而 K 小了模型表达能力又不够——这正是我们不愿意接受的取舍。
既然积分算不动,就绕开它。引入在目标分布支撑上为正、满足相关可积条件的以 x 为条件的分布 $q_\phi(z \mid x)$(后面简称 $q$),把被积函数乘一个 $q/q$:
$$\log p_\theta(x) = \log \int q_\phi(z \mid x) \, \frac{p_\theta(x, z)}{q_\phi(z \mid x)} \, dz = \log \mathbb{E}_{q_\phi}\!\left[\frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right]$$
log 是凹函数,Jensen 不等式给出 $\log \mathbb{E}[Y] \ge \mathbb{E}[\log Y]$,于是
$$\log p_\theta(x) \ge \mathbb{E}_{q_\phi}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] \equiv \mathcal{L}(\theta, \phi)$$
右边就是 ELBO(Evidence Lower Bound)。它好算:$\log p_\theta(x, z) = \log p_\theta(x \mid z) + \log p(z)$ 两项都能直接求值,期望用采样估计就行。代价是我们不再直接优化 log p(x),而是优化它的一个下界。
这是全文最关键的一步,也是最容易被跳过的一步。把 $\log p_\theta(x)$ 写成对 q 的期望(它和 z 无关,所以这么写是恒等的),再硬塞一个 $\log \frac{q}{q}$ 进去:
$$\log p_\theta(x) = \mathbb{E}_{q}\!\left[\log p_\theta(x)\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{p_\theta(z \mid x)}\right] = \mathbb{E}_{q}\!\left[\log \frac{p_\theta(x, z)}{q_\phi(z \mid x)}\right] + \mathbb{E}_{q}\!\left[\log \frac{q_\phi(z \mid x)}{p_\theta(z \mid x)}\right]$$
第一项正是 ELBO,第二项按定义就是 KL 散度。合起来:
$$\log p_\theta(x) = \mathcal{L}(\theta, \phi) + \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p_\theta(z \mid x)\big)$$
KL 恒非负,所以 $\mathcal{L} \le \log p_\theta(x)$,和 Jensen 的结论一致——但这一版多给了一个信息:等号成立当且仅当 q 等于真实后验。下界的松紧完全由 q 的质量决定,跟别的都没关系。
把 $\log p_\theta(x, z)$ 展开,ELBO 可以写成更有物理含义的形式:
$$\mathcal{L}(\theta, \phi) = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$
第一项是重建项:从 q 里采 z,解码器能不能还原出 x。第二项是先验对齐项:q 别离先验太远——因为生成时我们是从先验采 z 的,如果 q 把 z 放到了先验覆盖不到的地方,生成阶段就对不上了。
这里有个必须记住的区分,后面第 08 节还会回到它:
在我们那个 D=6 的例子里,这两个数是 3.364364 和 1.985436,不是一回事,也不是简单的包含关系。β-VAE 显式改的是先验 KL 的权重,但重新训练后 q 与生成模型都会变化,所以真实后验差距也会变化,且不保证变小。
顺带一个很容易漏掉的推论:把 KL 乘上 β 之后得到的目标
$$\mathcal{L}_\beta = \mathbb{E}_{q_\phi}\!\left[\log p_\theta(x \mid z)\right] - \beta \cdot \mathrm{KL}\big(q_\phi(z \mid x) \,\|\, p(z)\big)$$
当 $\beta\ge1$,仍有 $\mathcal L_\beta=\mathcal L-(\beta-1)\mathrm{KL}(q\Vert p)\le\mathcal L\le\log p_\theta(x)$,所以它仍是下界,只是更松;$0<\beta<1$ 时则不再保证下界。不同 β 的目标包含不同惩罚,不能直接当成同一种似然估计比较。
ELBO 对解码器参数 $\theta$ 的梯度没问题,重建项直接可导。麻烦在对 $\phi$ 的梯度:期望的分布本身依赖于 $\phi$,而采样操作不可导。设 $f(z) = \log p_\theta(x \mid z)$,要估的是 $\nabla_\phi \mathbb{E}_{q_\phi}[f(z)]$。
方法一:得分函数估计量(REINFORCE)。 直接把导数挪进期望:
$$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{q_\phi}\!\left[f(z) \, \nabla_\phi \log q_\phi(z \mid x)\right]$$
在可交换微分与积分、分布支持集不随参数变化等常见正则条件下,这个式子成立;它不要求 f 对 z 可导,也不要求 z 连续——代价是方差极大,因为整个 f 的量级都被乘进了梯度里。
方法二:重参数化。 把 z 写成参数的确定性函数外加一个与参数无关的噪声:
$$z = m_\phi(x) + s_\phi(x) \odot \epsilon, \quad \epsilon \sim \mathcal{N}(0, I)$$
于是期望可以改写成对 $\epsilon$ 的期望,导数直接进去:
$$\nabla_\phi \mathbb{E}_{q_\phi}[f(z)] = \mathbb{E}_{\epsilon}\!\left[\nabla_\phi f\big(m_\phi(x) + s_\phi(x) \odot \epsilon\big)\right] = \mathbb{E}_{\epsilon}\!\left[\nabla_z f(z) \cdot \nabla_\phi z\right]$$
关键在于 $\nabla_z f$ 用到了 f 对 z 的局部形状,相当于「知道往哪个方向挪 z 会让 f 变大」,这是方法一完全没有利用的信息。
方差为什么差这么多——一个具体的机制。 在高斯解码器下
$$f(z) = -\frac{D}{2}\log(2\pi\sigma^2) - \frac{\|x - Wz - b\|^2}{2\sigma^2}$$
第一项与 z 无关,是个常数。它对 $\nabla_z f$ 的贡献恒为 0,重参数化天然看不见它;但方法一要把整个 f(包括这个常数)乘上 $\nabla_\phi \log q$,常数按平方进方差。$D=2048$、$\sigma^2=1$ 时这个常数是 $-\frac{2048}{2}\log 2\pi \approx -1877$,平方之后就是 350 万量级——这正是第三组数字里那个 6191 万倍的来源。
实验也验证了这一点:给方法一减掉一个「预言机 baseline」(把 f 换成 $f - \mathbb{E}_q[f]$,常数的均值被减掉,期望不变),方差比从 61 916 893× 掉到 5.3×。所以差距主要来自那个常数项,不是来自「采样本身」。
单样本 ELBO 的缝是 $\mathrm{KL}(q \,\|\, p(z \mid x))$。要缩缝有两条路:把 q 变强(换更灵活的后验族),或者换一个更紧的界。后者的经典做法是 IWAE 的 k 样本界:
$$L_k = \mathbb{E}_{z_1 \dots z_k \sim q_\phi}\!\left[\log \frac{1}{k} \sum_{l=1}^{k} \frac{p_\theta(x, z_l)}{q_\phi(z_l \mid x)}\right]$$
注意顺序:先对 k 个重要性权重取平均,再取 log。单样本 ELBO 是「log 再取平均」(每个样本的 log 比值取期望),IWAE 是「平均再 log」,Jensen 保证后者更紧。可以证明 $\log p_\theta(x) \ge L_{k+1} \ge L_k \ge L_1 = \mathcal{L}$,在重要性权重满足支持覆盖与可积性等条件下,$k \to \infty$ 时收敛到 $\log p_\theta(x)$。
「换个顺序就更紧」这件事直觉上可以这么理解:单样本 ELBO 每次只看一个 z,好坏全押在它身上;IWAE 一次看 k 个,其中只要有一个 z 的 $p_\theta(x, z)/q_\phi(z \mid x)$ 特别大,平均权重就被拉上去,而 log 是凹函数,对这个「运气好」的样本惩罚得比线性小。所以 k 越大,越有机会碰到好样本,界越紧——本质上是用更多的采样换取更少的方差,跟蒙特卡洛里加样本降噪是同一回事,但这里降的是偏差而不是方差。
代价是:梯度不再是对单个样本的简单求和,k 个权重互相耦合(每个权重的梯度都带上了其他权重的归一化因子),总计算量随 k 线性上涨;编码器梯度的信噪比还可能随 k 增大而下降(见 Rainforth 等,2018),这反而不利于训练编码器——工程上这是个明确的取舍,不是免费的午餐。
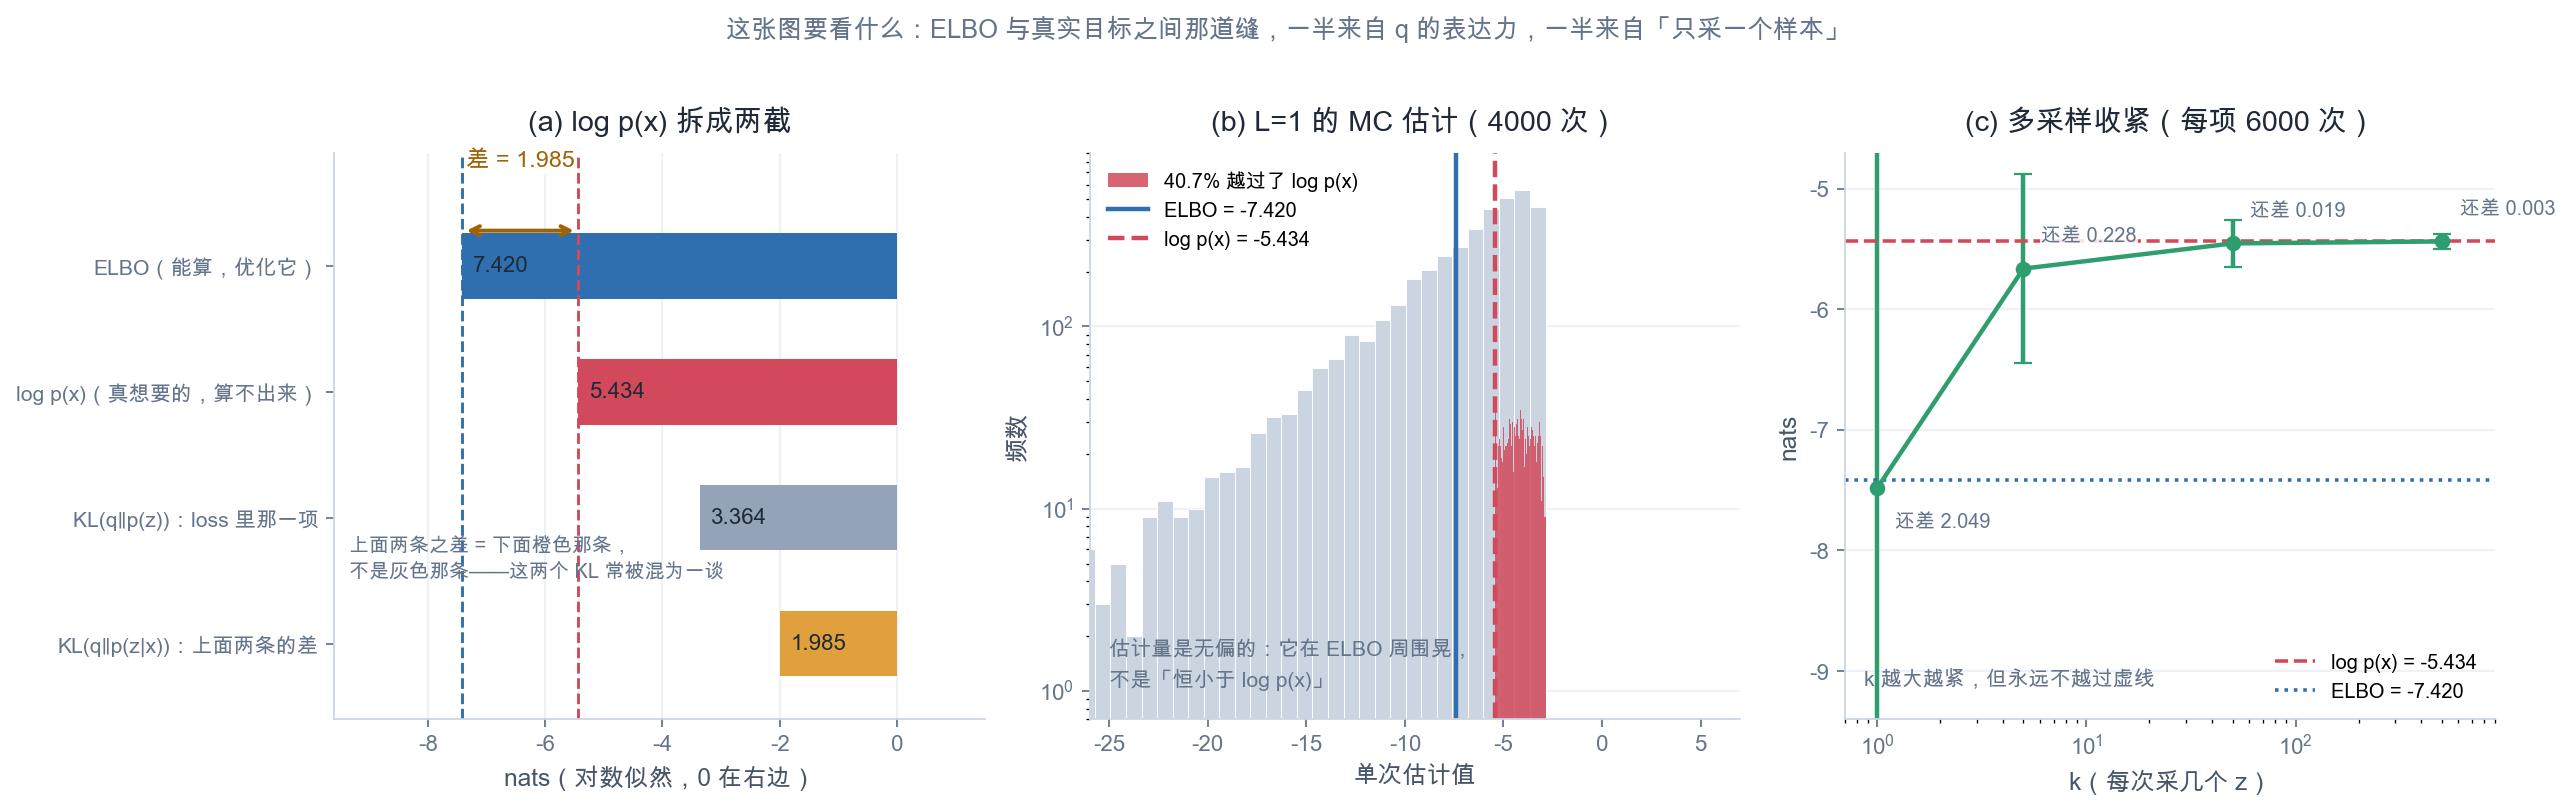
这张图要看什么:左图四根柱子——ELBO(-7.420)加 KL(q‖p(z|x))(1.985)正好等于 log p(x)(-5.434),而 KL(q‖p(z))(3.364)是另一根完全不同的柱子,别混。中图是单样本蒙特卡洛 ELBO 的 4000 次采样分布,标准差 4.31,虚线是真实上界 -5.434,40.7% 的样本落在它右边。右图是 IWAE 的 k 扫描,k 从 1 涨到 500,缝隙从 2.049 缩到 0.0026——同样是用重要性采样,换个顺序就差三个数量级。
要验证「差的那一项到底是什么」,必须三样东西都有解析解:边际似然、真实后验、ELBO。高斯线性模型满足这一点:$z \sim \mathcal{N}(0, I_K)$,$x \mid z \sim \mathcal{N}(Wz + b, \sigma^2 I_D)$。边际仍是高斯,后验是共轭高斯,ELBO 也能闭式算。
import numpy as np

D, K, SIGMA2 = 6, 3, 0.35 ** 2
W = np.random.default_rng(0).normal(0, 1, size=(D, K)) * 0.9
b = np.random.default_rng(1).normal(0, 0.3, size=(D,))

def true_posterior(x):
    """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。"""
    prec = np.eye(K) + W.T @ W / SIGMA2
    cov = np.linalg.inv(prec)
    return cov @ (W.T @ (x - b) / SIGMA2), cov

def elbo_analytic(x, m, s):
    """ELBO 的解析值。注意 ||x - Wz - b||^2 对 q 求期望会多出一项 trace。"""
    var = s ** 2
    resid = x - (W @ m + b)
    recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2)
                    + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2)
    kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var))
    return float(recon - kl), float(recon), float(kl)

def kl_gauss_gauss(m, s, mean2, cov2):
    """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。"""
    var, diff = s ** 2, mean2 - m
    cov2_inv = np.linalg.inv(cov2)
    _, logdet2 = np.linalg.slogdet(cov2)
    return 0.5 * (np.trace(cov2_inv @ np.diag(var)) + diff @ cov2_inv @ diff
                  - K + logdet2 - np.sum(np.log(var)))
重建项里那个 np.trace(W.T @ W @ np.diag(var)) 是最容易漏掉的一项:对 $z$ 求期望时,$\|x - Wz - b\|^2$ 里的 $Wz$ 项会因为 z 的随机性多出一份方差贡献。漏了它,ELBO 就不是下界了。
关键一步是故意把 q 指定错:取真实后验的均值再加扰动,协方差只留对角线并缩小 20%,让 q 比真后验更自信且忽略相关性。这样 KL(q‖p(z|x)) 严格大于 0,缝才看得见。跑起来:
[1] 解析三项
    E_q[log p(x|z)]      = -4.055403
    KL(q || p(z))        =  3.364364
    ELBO                 = -7.419767
    KL(q || p(z|x))      =  1.985436
    ELBO + KL(q||p(z|x)) = -5.434331
    log p(x)             = -5.434331
    |误差|                =  8.882e-16
恒等式对到 1e-15。同时注意:KL(q‖p(z))=3.364 比 KL(q‖p(z|x))=1.985 还大——这两个量的大小关系没有必然规律,别用其中一个去猜另一个。
同一个模型上,$\nabla_m$ 和 $\nabla_\ell$($\ell = \log s$)的解析梯度都能写出来,所以「谁对谁错」有标准答案,剩下的差别纯粹是方差:
def sample_reparam(x, m, s, W, b, sigma2, rng, n):
    """重参数化:z = m + s ⊙ ε,梯度经 z 反传。"""
    eps = rng.normal(size=(n, m.size))
    z = m + s * eps
    score_z = (x - (z @ W.T + b)) @ W / sigma2       # ∇_z log p(x|z)
    return score_z, score_z * s * eps                # ∂z/∂m = 1, ∂z/∂ℓ = s ⊙ ε

def sample_score(x, m, s, W, b, D, sigma2, rng, n, baseline=None):
    """得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。"""
    eps = rng.normal(size=(n, m.size))
    z = m + s * eps
    r = x - (z @ W.T + b)
    f = -0.5 * (D * np.log(2 * np.pi * sigma2)
                + np.einsum("nd,nd->n", r, r) / sigma2)
    if baseline is not None:
        f = f - baseline
    return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0)
两行代码的差别就是全部:重参数化用的是 $\nabla_z f$,得分函数用的是 $f$ 本身。跑 40000 次独立采样:
真实梯度(解析)
    ∇_m = [ 0.4228  4.9273 -0.6448]
    ∇_ℓ = [-1.9319 -2.4426 -3.8296]

估计量对比(40000 次独立采样,方差 = 6 个参数分量方差之和)
    重参数化                     方差和=     377.55  均值相对误差= 0.41%  达到5%需 n≈3068
    得分函数(无 baseline)         方差和=    3043.11  均值相对误差= 3.95%  达到5%需 n≈24722
    得分函数(预言机 baseline)       方差和=    1586.45  均值相对误差= 3.09%  达到5%需 n≈12889

    方差比:得分函数 / 重参数化 = 8.1×
            加 baseline 之后    = 4.2×
三个估计量的均值都对(无偏),差别全在方差。换算成「达到 5% 相对误差需要多少样本」,是 3068 对 24722。
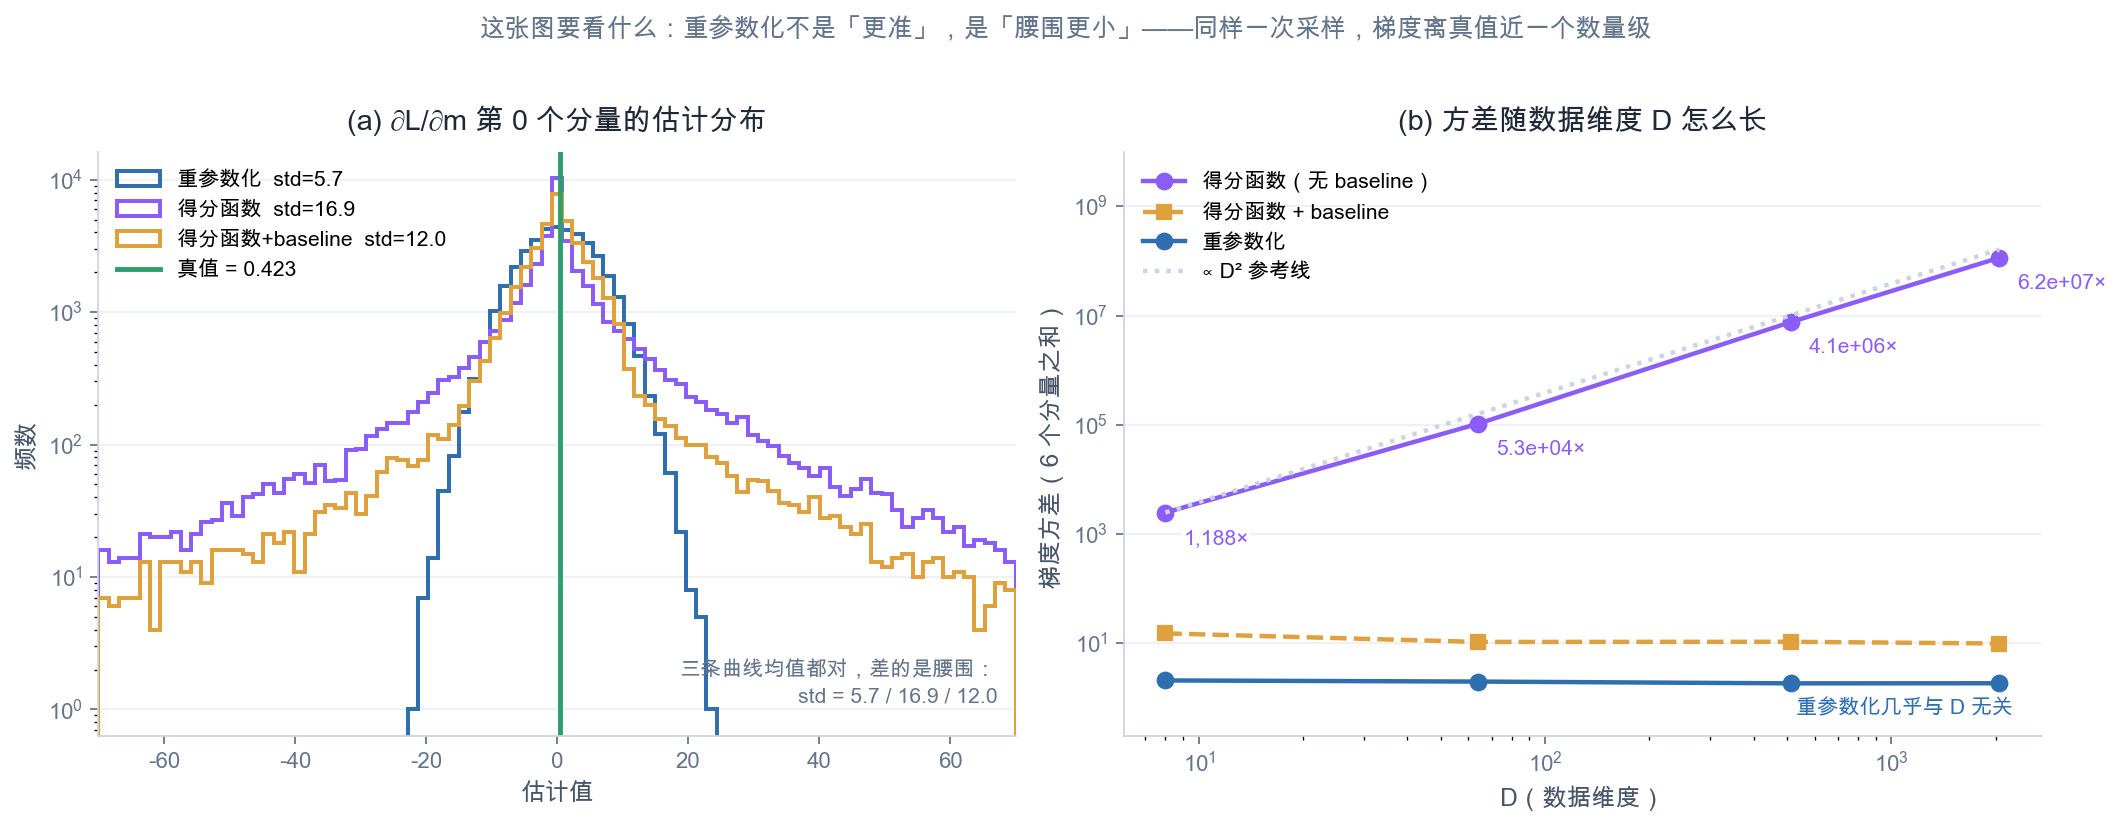
这张图要看什么:左图是 $\nabla_m$ 第 0 个分量(真值 0.4228)在三种估计量下的分布——均值都压在真值附近,标准差分别是 5.7、16.9、12.0,尾巴长度差一个量级。右图的双对数坐标里,重参数化那条线几乎是平的(方差 2.08 → 1.84),得分函数那条严格贴着 D² 参考线往上走;而把蓝色点(加了 baseline)和橙色点对比,比值从 1188× 一路到 6191 万×,加完 baseline 却稳定在 5~7×——说明炸掉的部分是那个常数项,不是采样噪声。
这一节的目标是要一个能解到全局最优的玩具模型,这样「维度死了」是解析结论而不是训练运气。构造:每个坐标独立,$x_j \sim \mathcal{N}(0, \lambda_j)$,$q(z_j \mid x_j) = \mathcal{N}(a_j x_j, s_j^2)$,$p(x_j \mid z_j) = \mathcal{N}(b_j z_j, \sigma^2)$。每个维度就是一份独立副本,逐个维度单独求最优即可:
SIGMA2 = 0.25          # 解码器观测噪声方差

def kl_of(a, lam, s):
    return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2))

def recon_mse(a, b, lam, s):
    """E_{x,z}[(x - b z)^2],重建误差的期望。"""
    return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2

def objective(p, lam, beta):
    a, b, ell = p
    s = np.exp(ell)
    return -recon_mse(a, b, lam, s) / (2 * SIGMA2) - beta * kl_of(a, lam, s)
目标对 $(a, b, \ell)$ 的梯度全部解析,脚本里再用中心差分核对一遍(实测最大偏差 5.5e-10),避免推错。优化必须多起点——$(a, b) = (0, 0)$ 就是「维度死亡」解,单起点很容易掉进去出不来。
跑完 β 扫描,把最优解和闭式预测放在一起对:
          λ     β      s²实测     βσ²/λ     a²λ实测      1-s²     MSE实测       βσ²
     1.0000  1.00   0.25000   0.25000   0.75000   0.75000   0.25000   0.25000
     1.0000  2.00   0.50000   0.50000   0.50000   0.50000   0.50000   0.50000
     1.0000  3.00   0.75000   0.75000   0.25000   0.25000   0.75000   0.75000
     0.2500  0.50   0.50000   0.50000   0.50000   0.50000   0.12500   0.12500
    最大偏差 = 5.53e-03  →  存活时最优解确实落在闭式上

    λ=4.0000  理论死亡阈值 β* = λ/σ² = 16.00
    λ=1.0000  理论死亡阈值 β* = λ/σ² = 4.00
    λ=0.2500  理论死亡阈值 β* = λ/σ² = 1.00
    λ=0.0625  理论死亡阈值 β* = λ/σ² = 0.25
存活时最优解落在闭式 $s^2 = \beta\sigma^2/\lambda$、$a^2\lambda = 1 - s^2$、$\mathrm{MSE} = \beta\sigma^2$ 上。这个闭式有个反直觉的推论:存活时的重建误差只由 β 和解码器噪声决定,跟这个维度携带多少信息 λ 无关——λ 只决定「这个维度值不值得用」。
最小实现里 KL 是两个高斯的闭式,工业代码也是闭式,但有几个地方长得不一样,值得逐个说明为什么。
1. 官方最小实现:pytorch/examples。 pytorch/examples 的 vae/main.py 里,loss_function 就是标准的 BCE 重建加闭式 KL,没有任何 β(以 2026-09 时的实现为准):
def loss_function(recon_x, x, mu, logvar):
    BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum')
    # 0.5 * sum(1 + log(sigma^2) - mu^2 - sigma^2)
    KLD = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())
    return BCE + KLD
和本文 3.4 节那一项完全对得上:$\mathrm{KL} = \frac{1}{2}\sum(\mu^2 + s^2 - 1 - \log s^2)$,代码里写成 -0.5 * sum(1 + logvar - mu^2 - exp(logvar)),logvar 就是 $\log s^2$。要加 β 得自己动手,官方示例没有。
2. 为什么参数化 logvar 而不是 s。 方差必须为正,直接学 s 要加约束;学 $\log s^2$ 则值域是全体实数,网络怎么输出都合法。diffusers 的 DiagonalGaussianDistribution 还额外做了截断(以 2026-09 时的实现为准):
self.mean, self.logvar = torch.chunk(parameters, 2, dim=1)
self.logvar = torch.clamp(self.logvar, -30.0, 20.0)
self.std = torch.exp(0.5 * self.logvar)
self.var = torch.exp(self.logvar)
clamp 到 [-30, 20] 是为了数值稳定:$\exp(20)$ 约为 4.85 亿,fp32 可表示但 fp16 已无法表示;下界 -30 避免过小方差与过大负 logvar。还需核对计算 dtype,截断本身不是所有精度下的安全保证。
3. 采样就是重参数化,一行代码。 同一个类里:
def sample(self, generator=None):
    sample = randn_tensor(self.mean.shape, generator=generator,
                          device=self.parameters.device, dtype=self.parameters.dtype)
    x = self.mean + self.std * sample
    return x
就是本文 3.5 的 $z = m + s \odot \epsilon$。mode() 直接返回均值——一些确定性编码场景使用 mode(),但 diffusers img2img 默认使用后验 sample(generator=...),训练和推理均可采样。
4. KL 的求和维度与归一化。 diffusers 里 kl() 写成(以 2026-09 时的实现为准):
return 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3])对通道、高、宽三个维度求和,得到的是每个样本一个标量,然后训练脚本再对 batch 取平均。这个区别很实际:如果对全部分量求和再除以元素总数,等价于把每个维度的 KL 权重除以 $C \times H \times W$——潜变量维度一多,KL 项的有效权重会相应减小,可能使先验对齐变弱、尺度漂移;过强 KL 才更直接推动后验坍缩。
5. 训练时 KL 根本不在模型里。 值得注意的是 AutoencoderKL 的模型文件里没有 kl_loss 这个东西,它只通过 encode() 返回 DiagonalGaussianDistribution 后验,KL 由外部训练脚本算。这是工程上的职责划分:模型只负责给出分布,损失函数怎么组合(KL 权重、perceptual loss、对抗损失)交给训练配置。
6. 潜空间的缩放。 SD1.x 常见 scaling_factor=0.18215 是乘到原始 latent 上的系数,对应原始标准差约 $1/0.18215\approx5.49$,缩放后才接近 1,不能把 0.18 当成原始潜空间尺度。它来自特定 VAE 与扩散训练的尺度约定,不由 ELBO 唯一决定。
7. 最小实现和工业实现的差异。 工业代码增加 logvar 截断、dtype 控制、分布采样接口及 latent 尺度约定。KL 逐维求和来自概率定义,batch 平均来自训练目标;它们不是任意工程细节。sample() 与 mode() 都有推理用途,要依具体管线选择。
省了什么。 把一个对 K 维积分的不可解问题,变成了「采样 + 两个可导项」,梯度能用标准反向传播算。这是 VAE、扩散模型、以及一大票潜变量模型能训练起来的全部前提。
赔了什么,四条。
一是下界不是似然。 优化 ELBO 不等于优化 log p(x),中间隔着 KL(q‖p(z|x))。在固定生成模型下,这个缝受 q 族表达能力与实际优化结果共同影响:均值场对角高斯拟合不了有相关性的真实后验,缝就永远在。本例里缝是 1.985 nats,在一个 log p(x) 只有 -5.43 的小模型上,数值上差约 36%,但连续对数密度受坐标单位影响,不宜把这个比例当作通用误差尺度。
二是 KL 的方向有偏好。 $\mathrm{KL}(q\Vert p(z\mid x))$ 是 reverse KL:当 $q$ 把概率放到真实后验很低的地方,代价很大,因此在受限的单峰近似族下常表现为 mode-seeking,可能只覆盖一个峰;反向的 $\mathrm{KL}(p\Vert q)$ 则倾向覆盖目标的质量,即 mass-covering。VAE 的模糊不能单归因于这个方向,逐像素重建目标、解码器分布与压缩瓶颈都有关。
三是推断被参数化摊平(amortized)之后又多了一层误差。 经典变分推断对每个 x 单独优化一组变分参数;VAE 用一个共享的编码器网络去输出所有 x 的 $m_\phi(x)$ 和 $s_\phi(x)$。这一步是为了快——测试时一次前向就得到后验,不用重新迭代——但它意味着 q 的可行域被限制在「神经网络能表达的那些分布」里。即便每个 x 单独看,最优的对角高斯后验就在那儿,共享编码器也可能一辈子到不了。所以总的缝其实是两笔账叠起来的:函数族的近似误差加上摊销误差。这也解释了为什么给编码器加容量在有些任务上能明显提 ELBO——在固定生成模型时,这改善的是近似推断。
四是加权 KL 会直接杀死维度。 这是第 4.3 节那张表的完整结论:
    λ=4.0000  在 β≤12.0 内都存活
    λ=1.0000  从 β=4.0 起死亡(β=1 时 KL=0.6931)
    λ=0.2500  从 β=1.0 起死亡
    λ=0.0625  从 β=0.25 起死亡
死亡阈值是 $\beta^\ast = \lambda / \sigma^2$。读出这个式子的含义:一个维度要活下来,它携带的信息量 λ 必须盖过「KL 的价」β 乘上「解码器噪声」σ²。β 翻倍,能活下来的维度门槛就翻倍;解码器越准(σ² 越小),越多的维度能活。这仅解释线性高斯模型的阈值。强大的自回归解码器可通过其他条件预测数据而忽略 z,不能简单等同于把固定高斯观测方差 σ² 调小。
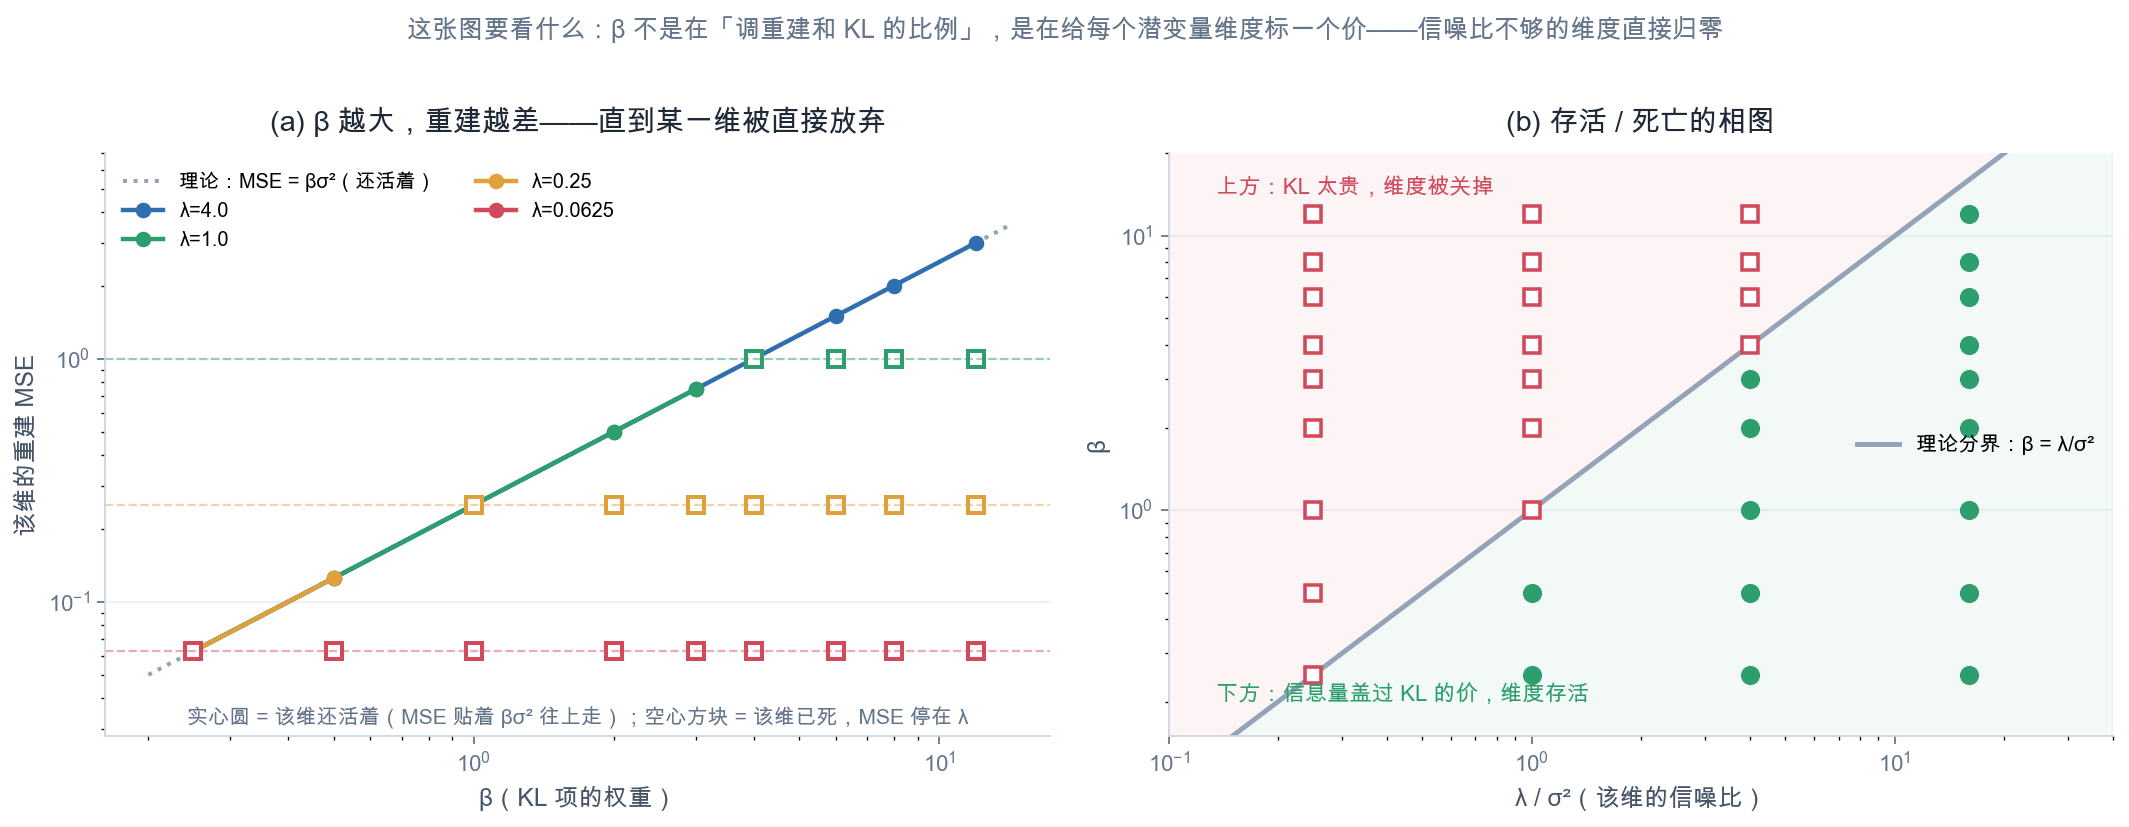
这张图要看什么:左图四条曲线是不同 λ 下重建 MSE 随 β 的变化,实心点表示维度存活、空心方块表示已死——注意存活段的 MSE 就是 $\beta\sigma^2$ 这条直线,跟 λ 无关;而死掉的段 MSE 平在 λ 上不再变化。右图是 $(\lambda, \beta)$ 平面上的相图,斜线是 $\beta = \lambda/\sigma^2$,线右上方全死、左下方全活。调 β 之前先看一眼这个平面:你真正要判断的是「这条线上方还有多少维度」。
缓解手段:free bits。 把每组 KL 换成 $\max(\mathrm{KL},C)$,是在 KL 小于 C 时去掉进一步压低它的梯度,给重建项使用这部分容量的机会;这不是保证至少传 C nats 的硬约束。下面的线性实验确实在边界附近找到更好的重建,但一般神经网络不保证被救活。实测(β=4):
          λ               C=0(纯 β)                 C=0.05                  C=0.2
     1.0000 a=0.000 KL=0.000 MSE=1.000  a=-0.308 KL=0.050 MSE=0.905  a=-0.574 KL=0.200 MSE=0.670
     0.2500 a=0.000 KL=0.000 MSE=0.250  a=-0.617 KL=0.050 MSE=0.226  a=-1.148 KL=0.200 MSE=0.168
λ=1.0 的维度被救回来了(MSE 1.000 → 0.670),λ=0.25 的也从 0.250 降到 0.168。代价是放松了对先验 KL 的惩罚;是否改善或损害解耦需要独立评估——这是一笔明码标价的交易。
什么时候不该用。 归一化流和自回归模型在相应建模假设下可计算精确似然,不一定需要变分下界;VQ 模型可精确计算离散 token 序列的自回归概率,但一般仍不能精确边缘化得到像素似然。ELBO 也不是训练高维生成模型的唯一途径,score matching、流匹配和对抗训练是其他路线。同一数据、同一似然约定下标准 ELBO 可比较为下界,但 q 的质量影响松紧,不能直接据此断言真实似然或感知质量的排序。
Kingma & Welling, 1312.6114(2013)——VAE 原文。贡献是把「变分推断 + 重参数化 + 神经网络编码器」拼成一个能用 SGD 训的东西,并给出 SGVB 估计量。它同时确立了沿用至今的 loss 形式:重建项减 KL。本文 3.2~3.5 节基本是这篇的复述。
Rezende, Mohamed & Wierstra, 1401.4082(2014)——几乎同期独立提出的重参数化,论文里叫 stochastic backpropagation。贡献是把这个方法从「VAE 的一个技巧」推广成「任何可微分概率模型上的通用推断方法」,并系统讨论了高斯之外的分布族怎么处理。想理解重参数化的适用边界(哪些分布能做、哪些只能退回得分函数),这篇比 VAE 原文讲得更清楚。
Burda, Grosse & Salakhutdinov, 1509.00519(2015)——IWAE。贡献就是本文 3.6 那个 $L_k$:把「log 再平均」换成「平均再 log」,得到一个随 k 单调变紧的界,并证明了收敛性。它澄清了一个当时普遍的误解——「多采几个样本只是降方差」,实际上换的是界本身。
Higgins et al., ICLR 2017——β-VAE。给 KL 项加权重 β > 1,换来更好的解耦表征。本文第 4.3 节那张表就是它的代价面:β 每翻一倍,重建误差也翻一倍,且维度按 $\beta^\ast = \lambda/\sigma^2$ 逐个死掉。
Bowman et al., 1511.06349(2015)——后验坍缩最早被认真对待的现场。用 VAE 做句子生成,强大的自回归解码器会直接忽略潜变量,KL 掉到 0。这篇提出的 KL annealing(训练初期把 β 从 0 慢慢涨到 1)至今还是最实用的缓解手段之一,效果依赖具体模型和优化过程,并非保证解决坍缩。
补充两篇:Kingma et al. 的 IAF(1606.04934)走的是另一条路——不改界,改 q,用可逆变换把后验族变强来直接缩小那个缝;Kingma & Welling 的综述(1906.02691)适合把上述脉络串起来通读。
误解一:「ELBO 里的 KL 就是 q 和真实后验的差距」。 ELBO 里减去的是 $\mathrm{KL}(q\Vert p(z))$;下界的差距是 $\mathrm{KL}(q\Vert p(z\mid x))$。调整 β 会通过训练改变 q 和生成模型,后者也可能变化,只是没有保证随前者一起下降。
误解二:「ELBO 是下界,所以蒙特卡洛估计值不会超过 log p(x)」。 下界性质是对期望成立的,不是对每个样本成立。本例单样本估计的标准差是 4.308,而缝只有 1.985,结果 40.7% 的样本越过了真实上界。看到自己的「ELBO」比之前算的 log p(x) 还大时,先别怀疑代码,这是正常的采样噪声。
误解三:「重参数化是为了让采样可微」。 更准确的说法是为了降低梯度估计量的方差。采样「不可微」这个表述本身就有问题:得分函数估计量里 $\nabla_\phi \log q_\phi$ 是对参数求导,完全可微,它对 f 连可导性都不要求。真正的区别是重参数化用上了 $\nabla_z f$ 这个局部信息,方差低几个数量级(D=2048 时差 6191 万倍)。
误解四:「KL 掉到 0 说明 KL 项优化到位了」。 这是后验坍缩的典型症状。本例 λ=1.0、β=4 时最优解就是 a=0、s=1、KL=0、MSE=1.000(正好等于 λ),编码器彻底放弃了这个维度。判断方法不是看 KL,而是看 $a^2\lambda$(Higgins 的 active unit 判据)——本文脚本里 active_unit() 就是干这个的。
误解五:「β 越大解耦越好,重建变差只是小代价」。 在线性模型中,最优 MSE 为 $\min(\beta\sigma^2,\lambda)$,连续增加后饱和;每维 KL 也连续趋零。离散的存活计数会出现台阶,但不意味着误差发生跳变。更强的 KL 约束还可能让所有维度关闭,不能只用 β 大小判断解耦质量。
三个脚本都只依赖 numpy,复制下来直接跑(完整代码见文末附录)。
python elbo_identity.py      # 约 5 秒
python reparam_gradients.py  # 约 15 秒
python beta_kl_weight.py     # 约 3 分钟(多起点优化)
实验一:把 q 的均值和边际方差改成真后验的对应量,看残留差距。 改 elbo_identity.py 里的 make_q,把 var = np.diag(cov).copy() * 0.8 + 0.05 改成直接返回真实后验的对角(var = np.diag(cov).copy()),均值扰动也去掉。预期:KL(q‖p(z|x)) 会从 1.985 掉下来但不会掉到 0——因为对角 q 还是拟合不了真实后验的相关性。这个残留量就是「均值场假设的代价」,值得亲眼看一次。
实验二:给得分函数估计量换一个真实的 baseline。 reparam_gradients.py 里用的是预言机 baseline($\mathbb{E}_q[f]$ 的解析值),实战拿不到。把它换成一个滑动平均的 f(比如前 100 个样本的均值)再跑,预期方差比从 8.1× 降到接近 4.2× 的水平——这解释了为什么 REINFORCE 类算法里 baseline 是标配而不是优化项。
实验三:给 β 扫描加一个 free bits,看能救回几个维度。 beta_kl_weight.py 已经内置 free_bits 参数,把 main() 里的 optimize(lam, 4.0, free_bits=C) 的 C 从 0.05 调到 0.5 再跑。预期:这个线性实验中 C=0.5 时低方差维度也能使用 latent,KL 可能停在 C 附近;这不代表一般模型保证传满 C nats,也不能从 KL 数值单独判断解耦程度。这就是那笔交易的完整价格表。
按知识树的依赖关系,从这篇出发有三个方向:
scaling_factor 的来历见 VAE 结构与训练目标。完整的知识树见博客目录页 AIGC 基本功知识树,按依赖顺序排好了先修课。
09 节用到的脚本全文如下(elbo_identity.py、reparam_gradients.py、beta_kl_weight.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""ELBO 恒等式核对:log p(x) = ELBO + KL(q || p(z|x))。

构造一个「后验有解析解」的模型,这样三样东西都能算到机器精度:
  * 边际似然 log p(x)          —— 高斯线性模型,边际仍是高斯
  * 真实后验 p(z|x)            —— 共轭高斯,闭式解
  * ELBO                       —— 重建项对 q 可解析求期望,KL 两项都是高斯闭式

有解析解才能验证「差的那一项到底是什么」,靠采样是验不出来的。

只依赖 numpy,直接 `python elbo_identity.py` 即可运行。
"""

import numpy as np

RNG = np.random.default_rng(20260925)

# ── 模型:z ~ N(0, I_K),x|z ~ N(W z + b, sigma^2 I_D) ──
D, K = 6, 3
SIGMA = 0.35          # 解码器观测噪声标准差
SIGMA2 = SIGMA ** 2

W = RNG.normal(0.0, 1.0, size=(D, K)) * 0.9   # 解码器权重
b = RNG.normal(0.0, 0.3, size=(D,))           # 解码器偏置


def make_one_x(rng=None):
    """从真实的边际分布里采一个 x,并返回它的解析 log p(x)。

    rng 可显式传入:这样 reparam_gradients / make_figures 拿到的是同一个 x,
    不会因为模块级 RNG 被别人消耗过而对不上数字。
    """
    if rng is None:
        rng = RNG
    z = rng.normal(size=(K,))
    x = W @ z + b + SIGMA * rng.normal(size=(D,))
    cov = W @ W.T + SIGMA2 * np.eye(D)
    sign, logdet = np.linalg.slogdet(cov)
    d = x - b
    quad = d @ np.linalg.solve(cov, d)
    log_px = -0.5 * (D * np.log(2 * np.pi) + logdet + quad)
    return x, log_px


def true_posterior(x):
    """p(z|x) 的闭式解:precision = I + W^T W / sigma^2。"""
    prec = np.eye(K) + W.T @ W / SIGMA2
    cov = np.linalg.inv(prec)
    mean = cov @ (W.T @ (x - b) / SIGMA2)
    return mean, cov


# ── 变分后验 q(z|x) = N(m, diag(s^2)):故意用「对角」错误指定 ──
def make_q(x, rng=None):
    """取真实后验的均值,协方差只留对角线并加一点扰动。

    真实后验是有相关性的(cov 非对角),q 强行对角 => KL(q||p(z|x)) > 0,
    这正是我们要留出来的那条缝。
    """
    if rng is None:
        rng = RNG
    mean, cov = true_posterior(x)
    m = mean + 0.15 * rng.normal(size=(K,))          # 均值也偏一点
    var = np.diag(cov).copy() * 0.8 + 0.05           # 方差偏小 => q 过自信
    return m, np.sqrt(var)


def log_gauss_diag(z, mean, var, ):
    """log N(z; mean, diag(var))(省略常数也行,但这里算全)。"""
    return float(-0.5 * np.sum(np.log(2 * np.pi * var)
                               + (z - mean) ** 2 / var))


def log_joint(x, z):
    """log p(x, z) = log p(x|z) + log p(z)。"""
    r = x - (W @ z + b)
    log_lik = -0.5 * (D * np.log(2 * np.pi * SIGMA2) + r @ r / SIGMA2)
    log_prior = -0.5 * (K * np.log(2 * np.pi) + z @ z)
    return log_lik + log_prior


def elbo_analytic(x, m, s):
    """ELBO 的解析值。

    E_q[log p(x|z)] 里 ||x - Wz - b||^2 对 q 求期望:
        ||x - Wm - b||^2 + tr(W^T W diag(s^2))
    第二项是采样噪声经过解码器放大出来的那部分,容易被漏掉。
    """
    var = s ** 2
    resid = x - (W @ m + b)
    recon = -0.5 * (D * np.log(2 * np.pi * SIGMA2)
                    + (resid @ resid + np.trace(W.T @ W @ np.diag(var))) / SIGMA2)
    kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var))
    return float(recon - kl), float(recon), float(kl)


def kl_gauss_gauss(m, s, mean2, cov2):
    """KL(N(m, diag(s^2)) || N(mean2, cov2)),两个高斯的闭式。"""
    var = s ** 2
    diff = mean2 - m
    cov2_inv = np.linalg.inv(cov2)
    trace = float(np.trace(cov2_inv @ np.diag(var)))
    quad = float(diff @ cov2_inv @ diff)
    _, logdet2 = np.linalg.slogdet(cov2)
    return 0.5 * (trace + quad - K + logdet2 - np.sum(np.log(var)))


def mc_elbo(x, m, s, L, rng):
    """蒙特卡洛 ELBO:L 个样本取平均(L=1 就是训练时实际用的那个)。"""
    eps = rng.normal(size=(L, K))
    z = m + s * eps
    log_lik = np.array([-0.5 * (D * np.log(2 * np.pi * SIGMA2)
                                + np.sum((x - (W @ zz + b)) ** 2) / SIGMA2)
                        for zz in z])
    var = s ** 2
    kl = 0.5 * np.sum(var + m ** 2 - 1.0 - np.log(var))
    return float(log_lik.mean() - kl)


def iwae_log_bound(x, m, s, k, rng):
    """IWAE 的 k 样本界:log (1/k) sum_l p(x,z_l)/q(z_l),用 logsumexp 稳算。"""
    eps = rng.normal(size=(k, K))
    z = m + s * eps
    var = s ** 2
    logw = np.array([log_joint(x, zz) - log_gauss_diag(zz, m, var) for zz in z])
    mx = logw.max()
    return float(mx + np.log(np.mean(np.exp(logw - mx))))


# ── 下面两个表被 main 与 make_figures 共用,种子固定 => 数字永远一致 ──
MC_LS = (1, 4, 16, 64)
MC_REP = 4000
IW_KS = (1, 5, 50, 500)
IW_REP = 6000


STATE_SEED = 20260925


def state():
    """文章与配图共用的那一份状态:同一个 x、同一个 q。

    用固定种子重放,保证单独跑本脚本与跑 make_figures 拿到同一组数字。
    """
    rng = np.random.default_rng(STATE_SEED)
    x, log_px = make_one_x(rng)
    m, s = make_q(x, rng)
    post_mean, post_cov = true_posterior(x)
    elbo, recon, kl = elbo_analytic(x, m, s)
    gap = kl_gauss_gauss(m, s, post_mean, post_cov)
    return dict(x=x, log_px=log_px, m=m, s=s, elbo=elbo, recon=recon,
                kl=kl, gap=gap)


def mc_table(st):
    """蒙特卡洛 ELBO 的均值 / 标准差 / 越过 log p(x) 的比例。"""
    rng = np.random.default_rng(7)
    out = {}
    for L in MC_LS:
        vals = np.array([mc_elbo(st["x"], st["m"], st["s"], L, rng)
                         for _ in range(MC_REP)])
        out[L] = dict(mean=float(vals.mean()), std=float(vals.std()),
                      frac=float(np.mean(vals > st["log_px"])), vals=vals)
    return out


def iwae_table(st):
    """IWAE 的 k 样本界。"""
    rng = np.random.default_rng(13)
    out = {}
    for k in IW_KS:
        vals = np.array([iwae_log_bound(st["x"], st["m"], st["s"], k, rng)
                         for _ in range(IW_REP)])
        out[k] = dict(mean=float(vals.mean()), std=float(vals.std()),
                      gap=float(st["log_px"] - vals.mean()), vals=vals)
    return out


def main():
    print("=" * 68)
    print("ELBO 恒等式核对   log p(x) = ELBO + KL(q || p(z|x))")
    print("=" * 68)
    print(f"模型: D={D}, K={K}, sigma={SIGMA}")

    st = state()
    x, log_px, m, s = st["x"], st["log_px"], st["m"], st["s"]
    elbo, recon, kl, gap = st["elbo"], st["recon"], st["kl"], st["gap"]

    print(f"\n[1] 解析三项")
    print(f"    E_q[log p(x|z)]      = {recon: .6f}")
    print(f"    KL(q || p(z))        = {kl: .6f}")
    print(f"    ELBO                 = {elbo: .6f}")
    print(f"    KL(q || p(z|x))      = {gap: .6f}")
    print(f"    ELBO + KL(q||p(z|x)) = {elbo + gap: .6f}")
    print(f"    log p(x)             = {log_px: .6f}")
    print(f"    |误差|                = {abs(elbo + gap - log_px): .3e}")

    # ── 蒙特卡洛波动:ELBO 的估计量是无偏的,不是恒小于 log p(x) ──
    print(f"\n[2] 蒙特卡洛估计的波动(每项 {MC_REP} 次重复)")
    print(f"    {'L':>5s} {'mean':>12s} {'std':>10s} {'超过 log p(x) 的比例':>22s}")
    mc = mc_table(st)
    for L in MC_LS:
        r = mc[L]
        print(f"    {L:5d} {r['mean']:12.5f} {r['std']:10.5f} {r['frac']:21.1%}")
    print(f"    log p(x) = {log_px:.5f}(上界本身),ELBO(解析) = {elbo:.5f}")

    # ── IWAE:k 越大越紧 ──
    print(f"\n[3] IWAE 的 k 样本界(每项 {IW_REP} 次重复)")
    print(f"    {'k':>5s} {'mean L_k':>12s} {'std':>9s} {'log p(x) - L_k':>16s}")
    iw = iwae_table(st)
    for k in IW_KS:
        r = iw[k]
        print(f"    {k:5d} {r['mean']:12.5f} {r['std']:9.5f} {r['gap']:16.5f}")
    print(f"    参考:单样本 MC ELBO 的均值 = {elbo:.5f}(= ELBO 解析值,不随 k 变)")

    print("\n结论:k 增大时 L_k 单调逼近 log p(x),但永远不越过;"
          "而「取平均再 log」和「log 再取平均」是两件事。")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""重参数化 vs 得分函数(REINFORCE)梯度估计量,方差实测。
要估的量:∇_φ E_{q_φ}[log p(x|z)],φ = (m, ℓ),ℓ = log s。
这一项没法解析求的时候只能采样,两种采样方式的方差差好几个数量级。
真实梯度在这个高斯线性模型里能解析算出来,所以「谁对谁错」有标准答案,
剩下的差别就纯粹是方差。
两部分实验:
A. 固定一个小模型(D=6),看三种估计量的分布
B. 扫数据维度 D,看方差比怎么长——这里才是重参数化真正救命的地方
只依赖 numpy,直接 `python reparam_gradients.py` 即可运行。
"""
import numpy as np
import elbo_identity as EI
from elbo_identity import (
D, K, SIGMA2, W, b, elbo_analytic, make_one_x, make_q,
)
N_TRIAL = 40000
# ══════════════════════════════════════════════════════════════
# A. 小模型:三种估计量的分布
# ══════════════════════════════════════════════════════════════
def true_grad(x, m, s, Wm, bm, sigma2):
"""∇_m 与 ∇_ℓ 的解析梯度,ℓ = log s。"""
g_m = Wm.T @ (x - (Wm @ m + bm)) / sigma2
g_ell = -(s ** 2) * np.diag(Wm.T @ Wm) / sigma2
return g_m, g_ell
def log_lik_rows(x, z, Wm, bm, Dm, sigma2):
"""批量算 log p(x|z),z: [n, K]。"""
r = x - (z @ Wm.T + bm)
return -0.5 * (Dm * np.log(2 * np.pi * sigma2)
+ np.einsum("nd,nd->n", r, r) / sigma2)
def sample_reparam(x, m, s, Wm, bm, sigma2, rng, n):
"""重参数化:z = m + s ⊙ ε,梯度经 z 反传。"""
eps = rng.normal(size=(n, m.size))
z = m + s * eps
score_z = (x - (z @ Wm.T + bm)) @ Wm / sigma2 # ∇_z log p(x|z)
return score_z, score_z * s * eps # ∂z/∂m=1, ∂z/∂ℓ=s⊙ε
def sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n, baseline=None):
"""得分函数:∇ E[f] = E[f · ∇ log q],f = log p(x|z)。"""
eps = rng.normal(size=(n, m.size))
z = m + s * eps
f = log_lik_rows(x, z, Wm, bm, Dm, sigma2)
if baseline is not None:
f = f - baseline
return f[:, None] * (eps / s), f[:, None] * (eps ** 2 - 1.0)
def summarize(name, gm_hat, ge_hat, g_m, g_ell):
var = float(np.var(gm_hat, axis=0).sum() + np.var(ge_hat, axis=0).sum())
gnorm = float(np.linalg.norm(np.concatenate([g_m, g_ell])))
err = float(np.linalg.norm(np.concatenate([gm_hat.mean(0) - g_m,
ge_hat.mean(0) - g_ell]))) / gnorm
n_needed = int(np.ceil((var ** 0.5 / (0.05 * gnorm)) ** 2))
print(f" {name:<24s} 方差和={var:11.2f} 均值相对误差={err:6.2%} "
f"达到5%需 n≈{n_needed}")
return var
def part_a():
print("=" * 68)
print("A. 小模型(D=6, σ=0.35):三种估计量的分布")
print("=" * 68)
# 与 elbo_identity.state() 同一颗种子 => 同一个 x、同一个 q
rng_state = np.random.default_rng(EI.STATE_SEED)
x, _ = make_one_x(rng_state)
m, s = make_q(x, rng_state)
g_m, g_ell = true_grad(x, m, s, W, b, SIGMA2)
_, recon, kl = elbo_analytic(x, m, s)
print(f"\n真实梯度(解析)")
print(f" ∇_m = {np.array2string(g_m, precision=4)}")
print(f" ∇_ℓ = {np.array2string(g_ell, precision=4)}")
print(f" E_q[log p(x|z)] = {recon:.4f},KL(q||p(z)) = {kl:.4f}")
rng = np.random.default_rng(11)
n = N_TRIAL
print(f"\n估计量对比({n} 次独立采样,方差 = 6 个参数分量方差之和)")
gm_r, ge_r = sample_reparam(x, m, s, W, b, SIGMA2, rng, n)
gm_s, ge_s = sample_score(x, m, s, W, b, D, SIGMA2, rng, n)
gm_sb, ge_sb = sample_score(x, m, s, W, b, D, SIGMA2, rng, n, baseline=recon)
v_r = summarize("重参数化", gm_r, ge_r, g_m, g_ell)
v_s = summarize("得分函数(无 baseline)", gm_s, ge_s, g_m, g_ell)
v_sb = summarize("得分函数(预言机 baseline)", gm_sb, ge_sb, g_m, g_ell)
print(f"\n 方差比:得分函数 / 重参数化 = {v_s / v_r:.1f}×")
print(f" 加 baseline 之后 = {v_sb / v_r:.1f}×")
print(f"\n∇_m 第 0 个分量(真值 {g_m[0]:.4f})的估计分布")
for name, g in (("重参数化", gm_r[:, 0]),
("得分函数", gm_s[:, 0]),
("得分函数+baseline", gm_sb[:, 0])):
print(f" {name:<20s} mean={g.mean():9.4f} std={g.std():8.3f} "
f"min={g.min():9.2f} max={g.max():9.2f}")
print(f"\n均值误差随样本数的收敛(∇_m 第 0 个分量)")
print(f" {'n':>7s} {'重参数化':>12s} {'得分函数':>12s}")
for n2 in (10, 100, 1000, 10000, N_TRIAL):
print(f" {n2:7d} {abs(gm_r[:n2, 0].mean() - g_m[0]):12.5f} "
f"{abs(gm_s[:n2, 0].mean() - g_m[0]):12.5f}")
return dict(g_m0=g_m[0], gm_r=gm_r[:, 0], gm_s=gm_s[:, 0], gm_sb=gm_sb[:, 0],
var_r=v_r, var_s=v_s, var_sb=v_sb)
# ══════════════════════════════════════════════════════════════
# B. 方差比随数据维度 D 怎么长
# ══════════════════════════════════════════════════════════════
def build_model(Dm, Km, seed):
"""构造一个 decoder 列范数归一化的线性高斯模型,让梯度尺度不随 D 漂。"""
rng = np.random.default_rng(seed)
Wm = rng.normal(size=(Dm, Km))
Wm /= np.linalg.norm(Wm, axis=0, keepdims=True) # 每列范数 = 1
bm = rng.normal(0.0, 0.3, size=(Dm,))
return Wm, bm
def part_b():
print("\n" + "=" * 68)
print("B. 方差比随数据维度 D 的变化(σ²=1,decoder 列范数归一化)")
print("=" * 68)
rng = np.random.default_rng(23)
rows = []
print(f"\n {'D':>6s} {'重参数化':>12s} {'得分函数':>14s} {'比值':>10s} "
f"{'+baseline 方差':>14s} {'比值':>10s}")
for Dm in (8, 64, 512, 2048):
Wm, bm = build_model(Dm, K, seed=1000 + Dm)
z_true = rng.normal(size=(K,))
x = Wm @ z_true + bm + rng.normal(size=(Dm,)) # σ² = 1
m = Wm.T @ (x - bm) # 一个合理的变分均值
s = np.full((K,), 0.6)
sigma2 = 1.0
n = 4000
gm_r, ge_r = sample_reparam(x, m, s, Wm, bm, sigma2, rng, n)
gm_s, ge_s = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n)
# 预言机 baseline:E_q[log p(x|z)] 的解析值
resid = x - (Wm @ m + bm)
recon = -0.5 * (Dm * np.log(2 * np.pi * sigma2)
+ (resid @ resid
+ np.trace(Wm.T @ Wm @ np.diag(s ** 2))) / sigma2)
gm_sb, ge_sb = sample_score(x, m, s, Wm, bm, Dm, sigma2, rng, n,
baseline=recon)
v_r = float(np.var(gm_r, axis=0).sum() + np.var(ge_r, axis=0).sum())
v_s = float(np.var(gm_s, axis=0).sum() + np.var(ge_s, axis=0).sum())
v_sb = float(np.var(gm_sb, axis=0).sum() + np.var(ge_sb, axis=0).sum())
rows.append((Dm, v_r, v_s, v_sb))
print(f" {Dm:6d} {v_r:12.2f} {v_s:14.2f} {v_s / v_r:9.1f}× "
f"{v_sb:14.2f} {v_sb / v_r:9.1f}×")
print("\n 为什么长这么快:f = log p(x|z) 的均值里有一大坨与参数无关的")
print(" 「底噪」(-D/2·log 2πσ² 占了主要部分),它进到 f·∇log q 里按平方")
print(" 放大;∇_z f 对它求导恒为 0,所以重参数化天然免疫。baseline 减掉的")
print(" 也正是这一坨——减完比值只剩 5 倍左右,说明差距主要来自常数项,")
print(" 不是来自「采样本身」。")
return rows
if __name__ == "__main__":
a = part_a()
rows = part_b()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""β-VAE 的 KL 加权:一个能解到最优的玩具模型,看潜变量维度怎么死掉。
构造:数据每个坐标独立,x_j ~ N(0, λ_j),潜变量每个坐标也独立,
q(z_j | x_j) = N(a_j x_j, s_j²),p(x_j | z_j) = N(b_j z_j, σ²)
这样每个维度就是一份独立副本,最优解可以逐个维度单独求,不用训练神经网络。
单维目标(要最大化),把 λ 与 σ² 都当作常数:
L(a, b, ℓ) = -[λ(1 - b a)² + b² s²] / (2σ²) - β · KL
KL = 0.5 · (a² λ + s² - 1 - log s²), s = exp(ℓ)
梯度全部解析,脚本里再用有限差分核对一遍,避免推错。
只依赖 numpy,直接 `python beta_kl_weight.py` 即可运行。
"""
import numpy as np
SIGMA2 = 0.25 # 解码器观测噪声方差
def kl_of(a, lam, s):
"""KL(N(a x, s²) || N(0, 1)),对 x ~ N(0, λ) 取期望后的形式。"""
return 0.5 * (a ** 2 * lam + s ** 2 - 1.0 - np.log(s ** 2))
def recon_mse(a, b, lam, s):
"""E_{x,z}[(x - b z)²],重建误差的期望。"""
return lam * (1.0 - b * a) ** 2 + b ** 2 * s ** 2
def objective(p, lam, beta, free_bits=None):
"""目标函数值(越大越好)。free_bits=C 时 KL 项取 max(KL, C)。"""
a, b, ell = p
s = np.exp(ell)
kl = kl_of(a, lam, s)
kl_eff = max(kl, free_bits) if free_bits is not None else kl
return -(recon_mse(a, b, lam, s)) / (2 * SIGMA2) - beta * kl_eff
def grad(p, lam, beta, free_bits=None):
"""解析梯度 ∇(∂L/∂a, ∂L/∂b, ∂L/∂ℓ)。"""
a, b, ell = p
s2 = np.exp(2 * ell)
g = np.zeros(3)
g[0] = lam * b * (1.0 - b * a) / SIGMA2
g[1] = (lam * a * (1.0 - b * a) - b * s2) / SIGMA2
g[2] = -b ** 2 * s2 / SIGMA2
if free_bits is None or kl_of(a, lam, np.exp(ell)) > free_bits:
# KL 项对 (a, b, ℓ) 的梯度
g[0] -= beta * a * lam
g[2] -= beta * (s2 - 1.0)
return g
def grad_fd(p, lam, beta, free_bits=None, h=1e-6):
"""中心差分梯度,用来核对解析梯度有没有推错。"""
g = np.zeros(3)
for i in range(3):
e = np.zeros(3)
e[i] = h
g[i] = (objective(p + e, lam, beta, free_bits)
- objective(p - e, lam, beta, free_bits)) / (2 * h)
return g
def optimize(lam, beta, free_bits=None, n_init=9, n_iter=12000, seed=0):
"""多起点梯度上升,返回最好的 (a, b, s)。
必须多起点:(a, b) = (0, 0) 是「维度死亡」解,单起点容易掉进去出不来。
"""
rng = np.random.default_rng(seed)
best_p, best_v = None, -np.inf
for k in range(n_init):
if k == 0:
p = np.array([0.9, 0.9, np.log(0.6)])
elif k == 1:
p = np.array([0.0, 0.0, 0.0]) # 死亡解,也让它试试
else:
p = np.array([rng.uniform(-1.5, 1.5),
rng.uniform(-1.5, 1.5),
rng.uniform(-1.2, 0.5)])
lr = 0.02
for t in range(n_iter):
g = grad(p, lam, beta, free_bits)
g = np.clip(g, -50.0, 50.0) # 梯度裁剪:b²s²/σ² 那一项能把参数炸飞
p = p + lr * g
# 数值保护,别让 exp(ℓ) 或 (a, b) 爆掉
p[0] = float(np.clip(p[0], -8.0, 8.0))
p[1] = float(np.clip(p[1], -8.0, 8.0))
p[2] = float(np.clip(p[2], -4.0, 1.0))
if t % 1000 == 999:
lr *= 0.6
# 收尾再磨一遍:β 很小的时候收敛慢,不磨的话 s² 会差到 1e-3
lr = 1e-4
for t in range(6000):
g = np.clip(grad(p, lam, beta, free_bits), -50.0, 50.0)
p = p + lr * g
v = objective(p, lam, beta, free_bits)
if v > best_v:
best_v, best_p = v, p
a, b, ell = best_p
return float(a), float(b), float(np.exp(ell)), float(best_v)
def active_unit(a, lam, thr=0.01):
"""Higgins 的 active unit 判据:Cov_x(E_q[z]) = a²λ 是否超过阈值。"""
return a ** 2 * lam > thr
# 文章与配图共用的扫描范围
LAMS = [4.0, 1.0, 0.25, 0.0625]
BETAS = [0.25, 0.5, 1.0, 2.0, 3.0, 4.0, 6.0, 8.0, 12.0]
def sweep(lams, betas, verbose=True):
"""扫 (λ, β) 网格,返回 {(λ, β): (a, b, s, MSE, KL, a²λ)}。"""
table = {}
if verbose:
print("\n[1] β 扫描:每个 (λ, β) 的最优解")
print(f"\n {'λ':>7s} {'β':>5s} {'a':>8s} {'b':>8s} {'s':>8s} "
f"{'重建MSE':>9s} {'KL':>8s} {'a²λ':>8s} {'存活':>5s}")
for lam in lams:
for beta in betas:
a, b, s, _ = optimize(lam, beta, seed=17)
kl = kl_of(a, lam, s)
mse = recon_mse(a, b, lam, s)
au = a ** 2 * lam
table[(lam, beta)] = (a, b, s, mse, kl, au)
if verbose:
print(f" {lam:7.4f} {beta:5.2f} {a:8.4f} {b:8.4f} {s:8.4f} "
f"{mse:9.4f} {kl:8.4f} {au:8.4f} "
f"{'是' if active_unit(a, lam) else '死':>5s}")
return table
def main():
print("=" * 72)
print("β-VAE 的 KL 加权:潜变量维度怎么死掉")
print(f"σ² = {SIGMA2}(解码器噪声),单维独立副本,多起点梯度上升求最优")
print("=" * 72)
# ── 先核对解析梯度 ──
print("\n[0] 解析梯度 vs 有限差分")
for lam, beta in ((4.0, 1.0), (0.25, 4.0)):
p = np.array([0.7, -0.4, np.log(0.8)])
ga, gf = grad(p, lam, beta), grad_fd(p, lam, beta)
print(f" λ={lam:<5} β={beta:<4} 解析={np.array2string(ga, precision=5)} "
f"差分={np.array2string(gf, precision=5)} 最大偏差={np.abs(ga - gf).max():.2e}")
table = sweep(LAMS, BETAS)
print("\n[2] 每个 λ 的「死亡阈值」:β 到多大时这个维度不再被用")
for lam in LAMS:
dead = [beta for beta in BETAS
if not active_unit(table[(lam, beta)][0], lam)]
if dead:
print(f" λ={lam:<7.4f} 从 β={min(dead)} 起死亡"
f"(β=1 时 KL={table[(lam, 1.0)][4]:.4f})")
else:
print(f" λ={lam:<7.4f} 在 β≤{max(BETAS)} 内都存活")
# ── 闭式解核对:存活时 s² = βσ²/λ,a²λ = 1 - s²,重建 MSE = βσ² ──
print("\n[2b] 闭式解核对(存活的格子才成立)")
print(f" {'λ':>7s} {'β':>5s} {'s²实测':>9s} {'βσ²/λ':>9s} "
f"{'a²λ实测':>9s} {'1-s²':>9s} {'MSE实测':>9s} {'βσ²':>9s}")
worst = 0.0
for lam in LAMS:
for beta in BETAS:
a, b, s, _, kl, au = table[(lam, beta)]
if not active_unit(a, lam):
continue
s2_pred = beta * SIGMA2 / lam
rows = (s ** 2, s2_pred, au, 1 - s ** 2,
recon_mse(a, b, lam, s), beta * SIGMA2)
print(f" {lam:7.4f} {beta:5.2f} " + " ".join(f"{v:9.5f}" for v in rows))
worst = max(worst, abs(s ** 2 - s2_pred),
abs(au - (1 - s ** 2)),
abs(recon_mse(a, b, lam, s) - beta * SIGMA2))
print(f" 最大偏差 = {worst:.2e} → 存活时最优解确实落在闭式上")
print(f" 推论:维度存活条件 s² < 1 ⟺ β < λ/σ²,即该维的信噪比要盖过 KL 的价")
for lam in LAMS:
print(f" λ={lam:<7.4f} 理论死亡阈值 β* = λ/σ² = {lam / SIGMA2:.2f}")
# ── free bits:把 KL 压在下界,维度就不会死 ──
print("\n[3] free bits 对照(β=4,KL 项取 max(KL, C))")
print(f" {'λ':>7s} {'C=0(纯 β)':>22s} {'C=0.05':>22s} {'C=0.2':>22s}")
for lam in LAMS:
cells = []
for C in (None, 0.05, 0.2):
a, b, s, _ = optimize(lam, 4.0, free_bits=C, seed=17)
cells.append(f"a={a:5.3f} KL={kl_of(a, lam, s):5.3f} "
f"MSE={recon_mse(a, b, lam, s):5.3f}")
print(f" {lam:7.4f} " + " ".join(f"{c:>22s}" for c in cells))
print("\n[4] 一个直觉:β 大了以后,模型宁可不要这个维度")
print(" λ=0.0625 时这个坐标的信息量本来就小于解码器噪声 σ²=0.25,")
print(" 用它换来的重建收益抵不上 KL 的代价,最优解就是把它整条关掉。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「变分下界与重参数化」的三张解释图。
数值全部来自同目录的三个脚本(elbo_identity / reparam_gradients /
beta_kl_weight),这里只负责把它们画出来——改了那几个脚本这里要重跑,
避免图与正文数字不一致。
三张图分别回答:
1. ELBO 离真实目标差多少,差的那一项是什么,多采样能不能补上
2. 重参数化到底省了多少方差,以及这个差距随数据维度怎么长
3. KL 项加权的 β 是怎么把潜变量维度一刀一刀切掉的
只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。
"""
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import Rectangle
import beta_kl_weight as BK
import elbo_identity as EI
import reparam_gradients as RG
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
})
INK = "#1f2937"
C_ELBO = "#2f6fb0" # ELBO:蓝
C_GAP = "#e0a03c" # 缺口:橙
C_BAD = "#d1495b" # 越界 / 死亡:红
C_OK = "#2f9e6f" # 收紧 / 存活:绿
C_SCORE = "#8b5cf6" # 得分函数:紫
def style(ax, title, xlabel=None, ylabel=None):
ax.set_title(title, fontsize=13.0, weight="bold", color=INK, pad=10)
if xlabel:
ax.set_xlabel(xlabel, fontsize=11, color="#475569")
if ylabel:
ax.set_ylabel(ylabel, fontsize=11, color="#475569")
ax.tick_params(labelsize=10, colors="#64748b")
for s in ("top", "right"):
ax.spines[s].set_visible(False)
for s in ("left", "bottom"):
ax.spines[s].set_color("#cbd5e1")
ax.grid(axis="y", color="#eef2f7", lw=1.0)
ax.set_axisbelow(True)
# ══════════════════════════════════════════════════════════════
# 图 1:ELBO 离 log p(x) 差多少
# ══════════════════════════════════════════════════════════════
def fig_elbo_gap():
st = EI.state()
mc = EI.mc_table(st)
iw = EI.iwae_table(st)
log_px, elbo, gap, kl_prior = st["log_px"], st["elbo"], st["gap"], st["kl"]
fig, axes = plt.subplots(1, 3, figsize=(16.2, 4.9))
fig.patch.set_facecolor("white")
# ── (a) 分解:两条横向长条 ──
ax = axes[0]
style(ax, "(a) log p(x) 拆成两截", "nats(对数似然,0 在右边)")
rows = [
("ELBO(能算,优化它)", elbo, C_ELBO, "white"),
("log p(x)(真想要的,算不出来)", log_px, C_BAD, "white"),
("KL(q‖p(z)):loss 里那一项", -kl_prior, "#94a3b8", "white"),
("KL(q‖p(z|x)):上面两条的差", -gap, C_GAP, "white"),
]
for i, (name, v, color, tc) in enumerate(rows):
y = len(rows) - 1 - i
ax.barh(y, -v, left=v, height=0.52, color=color)
ax.text(v + 0.18, y, f"{abs(v):.3f}", ha="left", va="center",
fontsize=10, color=INK, weight="bold")
ax.axvline(log_px, color=C_BAD, ls="--", lw=1.3)
ax.axvline(elbo, color=C_ELBO, ls="--", lw=1.3)
ax.annotate("", xy=(elbo, 3.28), xytext=(log_px, 3.28),
arrowprops=dict(arrowstyle="<->", color="#a16207", lw=1.8))
ax.text((elbo + log_px) / 2, 3.75, "差 = 1.985", ha="center", va="bottom",
fontsize=10.5, color="#a16207", weight="bold",
bbox=dict(fc="white", ec="none", alpha=0.9, pad=1.0))
ax.text(-9.35, 0.68, "上面两条之差 = 下面橙色那条,\n不是灰色那条——这两个 KL 常被混为一谈",
ha="left", va="center", fontsize=9, color="#64748b",
linespacing=1.5)
ax.set_yticks(range(len(rows)))
ax.set_yticklabels([r[0] for r in rows][::-1], fontsize=9.5)
ax.set_xlim(-9.6, 1.5)
ax.set_ylim(-0.6, 3.9)
ax.grid(axis="x", color="#eef2f7", lw=1.0)
ax.grid(axis="y", visible=False)
# ── (b) 单样本 MC 会越过上界 ──
ax = axes[1]
style(ax, f"(b) L=1 的 MC 估计({EI.MC_REP} 次)", "单次估计值", "频数")
vals = mc[1]["vals"]
ax.hist(vals, bins=70, color="#cbd5e1", edgecolor="white", lw=0.4)
over = vals[vals > log_px]
ax.hist(over, bins=70, color=C_BAD, alpha=0.85,
label=f"{mc[1]['frac']:.1%} 越过了 log p(x)")
ax.axvline(elbo, color=C_ELBO, lw=2.0, label=f"ELBO = {elbo:.3f}")
ax.axvline(log_px, color=C_BAD, lw=2.0, ls="--",
label=f"log p(x) = {log_px:.3f}")
ax.set_xlim(-26, 7)
ax.legend(fontsize=9, frameon=False, loc="upper left")
ax.set_yscale("log")
ax.set_ylim(0.7, 900)
ax.text(0.03, 0.05, "估计量是无偏的:它在 ELBO 周围晃,\n不是「恒小于 log p(x)」",
transform=ax.transAxes, ha="left", va="bottom", fontsize=9.5,
color="#64748b", linespacing=1.5)
# ── (c) IWAE 收紧 ──
ax = axes[2]
style(ax, f"(c) 多采样收紧(每项 {EI.IW_REP} 次)", "k(每次采几个 z)", "nats")
ks = np.array(EI.IW_KS, dtype=float)
means = np.array([iw[k]["mean"] for k in EI.IW_KS])
stds = np.array([iw[k]["std"] for k in EI.IW_KS])
ax.errorbar(ks, means, yerr=stds, fmt="o-", color=C_OK, lw=2.0,
capsize=4, markersize=6)
ax.axhline(log_px, color=C_BAD, ls="--", lw=1.6, label=f"log p(x) = {log_px:.3f}")
ax.axhline(elbo, color=C_ELBO, ls=":", lw=1.6, label=f"ELBO = {elbo:.3f}")
ax.set_xscale("log")
ax.set_ylim(-9.4, -4.7)
ax.set_xlim(0.7, 900)
for k, m in zip(ks, means):
ax.annotate(f"还差 {log_px - m:.3f}", (k, m), textcoords="offset points",
xytext=(8, 12 if k > 1 else -18), fontsize=9,
color="#64748b",
bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6))
ax.legend(fontsize=9, frameon=False, loc="lower right")
ax.text(0.03, 0.06, "k 越大越紧,但永远不越过虚线",
transform=ax.transAxes, fontsize=9.5, color="#64748b")
fig.suptitle("这张图要看什么:ELBO 与真实目标之间那道缝,"
"一半来自 q 的表达力,一半来自「只采一个样本」",
fontsize=11.5, color="#64748b", y=1.02)
fig.tight_layout()
p = OUT / "elbo_gap.png"
fig.savefig(p, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f" ✓ {p.name}")
# ══════════════════════════════════════════════════════════════
# 图 2:重参数化省了多少方差
# ══════════════════════════════════════════════════════════════
def fig_grad_variance():
a = RG.part_a()
rows = RG.part_b()
fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0))
fig.patch.set_facecolor("white")
# ── (a) 估计分布 ──
ax = axes[0]
style(ax, "(a) ∂L/∂m 第 0 个分量的估计分布", "估计值", "频数")
bins = np.linspace(-70, 70, 90)
for vals, color, name in ((a["gm_r"], C_ELBO, "重参数化"),
(a["gm_s"], C_SCORE, "得分函数"),
(a["gm_sb"], C_GAP, "得分函数+baseline")):
ax.hist(vals, bins=bins, histtype="step", lw=1.8, color=color,
label=f"{name} std={vals.std():.1f}")
ax.axvline(a["g_m0"], color=C_OK, lw=2.2,
label=f"真值 = {a['g_m0']:.3f}")
ax.set_xlim(-70, 70)
ax.set_yscale("log")
ax.legend(fontsize=9.5, frameon=False, loc="upper left")
ax.text(0.98, 0.05, "三条曲线均值都对,差的是腰围:\n"
f"std = {a['gm_r'].std():.1f} / {a['gm_s'].std():.1f} / "
f"{a['gm_sb'].std():.1f}",
transform=ax.transAxes, ha="right", va="bottom", fontsize=9.5,
color="#64748b", linespacing=1.5)
# ── (b) 随维度怎么长 ──
ax = axes[1]
style(ax, "(b) 方差随数据维度 D 怎么长", "D(数据维度)", "梯度方差(6 个分量之和)")
Ds = np.array([r[0] for r in rows], dtype=float)
vr = np.array([r[1] for r in rows])
vs = np.array([r[2] for r in rows])
vsb = np.array([r[3] for r in rows])
ax.loglog(Ds, vs, "o-", color=C_SCORE, lw=2.0, markersize=7,
label="得分函数(无 baseline)")
ax.loglog(Ds, vsb, "s--", color=C_GAP, lw=2.0, markersize=6,
label="得分函数 + baseline")
ax.loglog(Ds, vr, "o-", color=C_ELBO, lw=2.0, markersize=7,
label="重参数化")
# 斜率 2 的参考线
ref = vs[0] * (Ds / Ds[0]) ** 2
ax.loglog(Ds, ref, ":", color="#cbd5e1", lw=2.0, label="∝ D² 参考线")
for d, v, r in zip(Ds, vs, vr):
ratio = v / r
txt = f"{ratio:,.0f}×" if ratio < 1e4 else f"{ratio:.1e}×"
ax.annotate(txt, (d, v), textcoords="offset points", xytext=(8, -14),
fontsize=9.5, color=C_SCORE, weight="bold",
bbox=dict(fc="white", ec="none", alpha=0.85, pad=0.6))
ax.set_ylim(2e-1, 1e10)
ax.legend(fontsize=9.5, frameon=False, loc="upper left")
ax.text(0.97, 0.03, "重参数化几乎与 D 无关", transform=ax.transAxes,
fontsize=9.5, color=C_ELBO, ha="right", va="bottom", weight="bold")
fig.suptitle("这张图要看什么:重参数化不是「更准」,是「腰围更小」——"
"同样一次采样,梯度离真值近一个数量级",
fontsize=11.5, color="#64748b", y=1.02)
fig.tight_layout()
p = OUT / "grad_variance.png"
fig.savefig(p, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f" ✓ {p.name}")
# ══════════════════════════════════════════════════════════════
# 图 3:β 怎么把潜变量维度切掉
# ══════════════════════════════════════════════════════════════
def fig_beta_tradeoff():
table = BK.sweep(BK.LAMS, BK.BETAS, verbose=False)
s2 = BK.SIGMA2
fig, axes = plt.subplots(1, 2, figsize=(13.4, 5.0))
fig.patch.set_facecolor("white")
# ── (a) 重建误差 vs β ──
ax = axes[0]
style(ax, "(a) β 越大,重建越差——直到某一维被直接放弃",
"β(KL 项的权重)", "该维的重建 MSE")
colors = ["#2f6fb0", "#2f9e6f", "#e0a03c", "#d1495b"]
bgrid = np.linspace(0.2, 14, 100)
ax.plot(bgrid, bgrid * s2, ":", color="#94a3b8", lw=1.8,
label="理论:MSE = βσ²(还活着)")
for lam, c in zip(BK.LAMS, colors):
betas, mses, alive = [], [], []
for beta in BK.BETAS:
a, b, s, mse, kl, au = table[(lam, beta)]
betas.append(beta)
mses.append(mse)
alive.append(BK.active_unit(a, lam))
betas = np.array(betas)
mses = np.array(mses)
alive = np.array(alive)
ax.plot(betas[alive], mses[alive], "o-", color=c, lw=2.0,
markersize=6, label=f"λ={lam}")
if (~alive).any():
ax.plot(betas[~alive], mses[~alive], "s", color=c, markersize=7,
mfc="white", mew=1.8)
ax.axhline(mses[~alive][0], color=c, ls="--", lw=1.0, alpha=0.45)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_ylim(0.028, 7.0)
ax.legend(fontsize=9, frameon=False, loc="upper left", ncol=2)
ax.text(0.5, 0.012, "实心圆 = 该维还活着(MSE 贴着 βσ² 往上走);"
"空心方块 = 该维已死,MSE 停在 λ",
transform=ax.transAxes, ha="center", va="bottom", fontsize=9.5,
color="#64748b")
# ── (b) 相图 ──
ax = axes[1]
style(ax, "(b) 存活 / 死亡的相图", "λ / σ²(该维的信噪比)", "β")
snr = np.array(BK.LAMS) / s2
grid = np.logspace(-1, 1.6, 60)
ax.loglog(grid, grid, "-", color="#94a3b8", lw=2.2,
label="理论分界:β = λ/σ²")
ax.fill_between(grid, grid, 1e3, color=C_BAD, alpha=0.06)
ax.fill_between(grid, 1e-3, grid, color=C_OK, alpha=0.06)
for lam in BK.LAMS:
for beta in BK.BETAS:
a, b, s, mse, kl, au = table[(lam, beta)]
ok = BK.active_unit(a, lam)
ax.plot(lam / s2, beta, "o" if ok else "s",
color=C_OK if ok else C_BAD,
markersize=7, mfc=C_OK if ok else "white",
mew=1.6)
ax.text(0.05, 0.93, "上方:KL 太贵,维度被关掉", transform=ax.transAxes,
fontsize=10, color=C_BAD, weight="bold")
ax.text(0.05, 0.06, "下方:信息量盖过 KL 的价,维度存活",
transform=ax.transAxes, fontsize=10, color=C_OK, weight="bold")
ax.set_xlim(0.1, 40)
ax.set_ylim(0.15, 20)
ax.legend(fontsize=9.5, frameon=False, loc="center right")
ax.grid(axis="y", color="#eef2f7", lw=1.0)
fig.suptitle("这张图要看什么:β 不是在「调重建和 KL 的比例」,"
"是在给每个潜变量维度标一个价——信噪比不够的维度直接归零",
fontsize=11.5, color="#64748b", y=1.02)
fig.tight_layout()
p = OUT / "beta_tradeoff.png"
fig.savefig(p, bbox_inches="tight", facecolor="white")
plt.close(fig)
print(f" ✓ {p.name}")
if __name__ == "__main__":
print("生成配图 →", OUT)
fig_elbo_gap()
fig_grad_variance()
fig_beta_tradeoff()
print("完成:3 张")
评论 (0)