


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与位置编码 | 难度:进阶 | 前置知识:自注意力机制的计算与显存账本(本篇是它的直接后继)
关键词:FlashAttention、online softmax、tiling、IO感知、显存优化
上一篇《自注意力机制的计算与显存账本》结尾留了一个没解的结:N=4096 的视频 DiT,按保守教学分配模型计,单层注意力为 2.39 GiB 激活,无重算训练时按同一假设累加 32 层就是 76.5 GiB,尚未包含权重、梯度、优化器与 FFN。推理的临时激活则不能直接乘层数。当时摆出了两条出路:稀疏化(算得少,但要看清赔的是什么质量)和 FlashAttention。这一篇把后者讲透。
先把一个流传很广的说法钉死:FlashAttention 不是近似注意力。它算出来的就是标准的 softmax 注意力,在实数算术下等价,浮点下允许舍入差异(第 04 节有实测:本次 float64 实验最大绝对误差不超过 8.9e-16;这组输入的舍入量级,非通用误差保证)。它快的理由也不神秘——附录 io_ledger.py 给出的同类型元素教学账本,单头 d=64、N=4096 时:
两种实现的主导矩阵乘 FLOPs 相同,但重算和归一化开销不同。在这组 A100 参数的 roofline 模型中,朴素实现算术强度为 31.5 FLOP/byte,低于约 200 的平衡点;这支持优先优化 IO 的方向,不证明所有序列、硬件或近似注意力方法都必然更慢。本文 130 MiB、17.8 MiB 是脚本估算值,不是 GPU 访存计数器实测。
另一个结论更值钱:显式保存概率矩阵 P 的朴素实现仍需二次存储,S 本身通常不必一并保留,该显式物化实现的主导存储随 N 二次增长;FlashAttention 把这两个矩阵整个从显存里删掉了,训练激活从 O(N²) 降到 O(N)——在统一采用六份线性张量、忽略小的 LSE 与工作区的教学预算中,上面那个 76.5 GiB 降为 4.5 GiB。N=32768 的长视频任务,本文教学模型的朴素实现要约 4.54 TiB 激活,超过这里对比的单卡教学预算;融合侧同一账本为 36 GiB,仍未计 FFN、权重、优化器和完整工作区。FlashAttention 为长序列精确注意力减少了重要的容量障碍;具体模型能否训练还受其他层、并行策略和硬件影响。
三句话讲完核心思想:
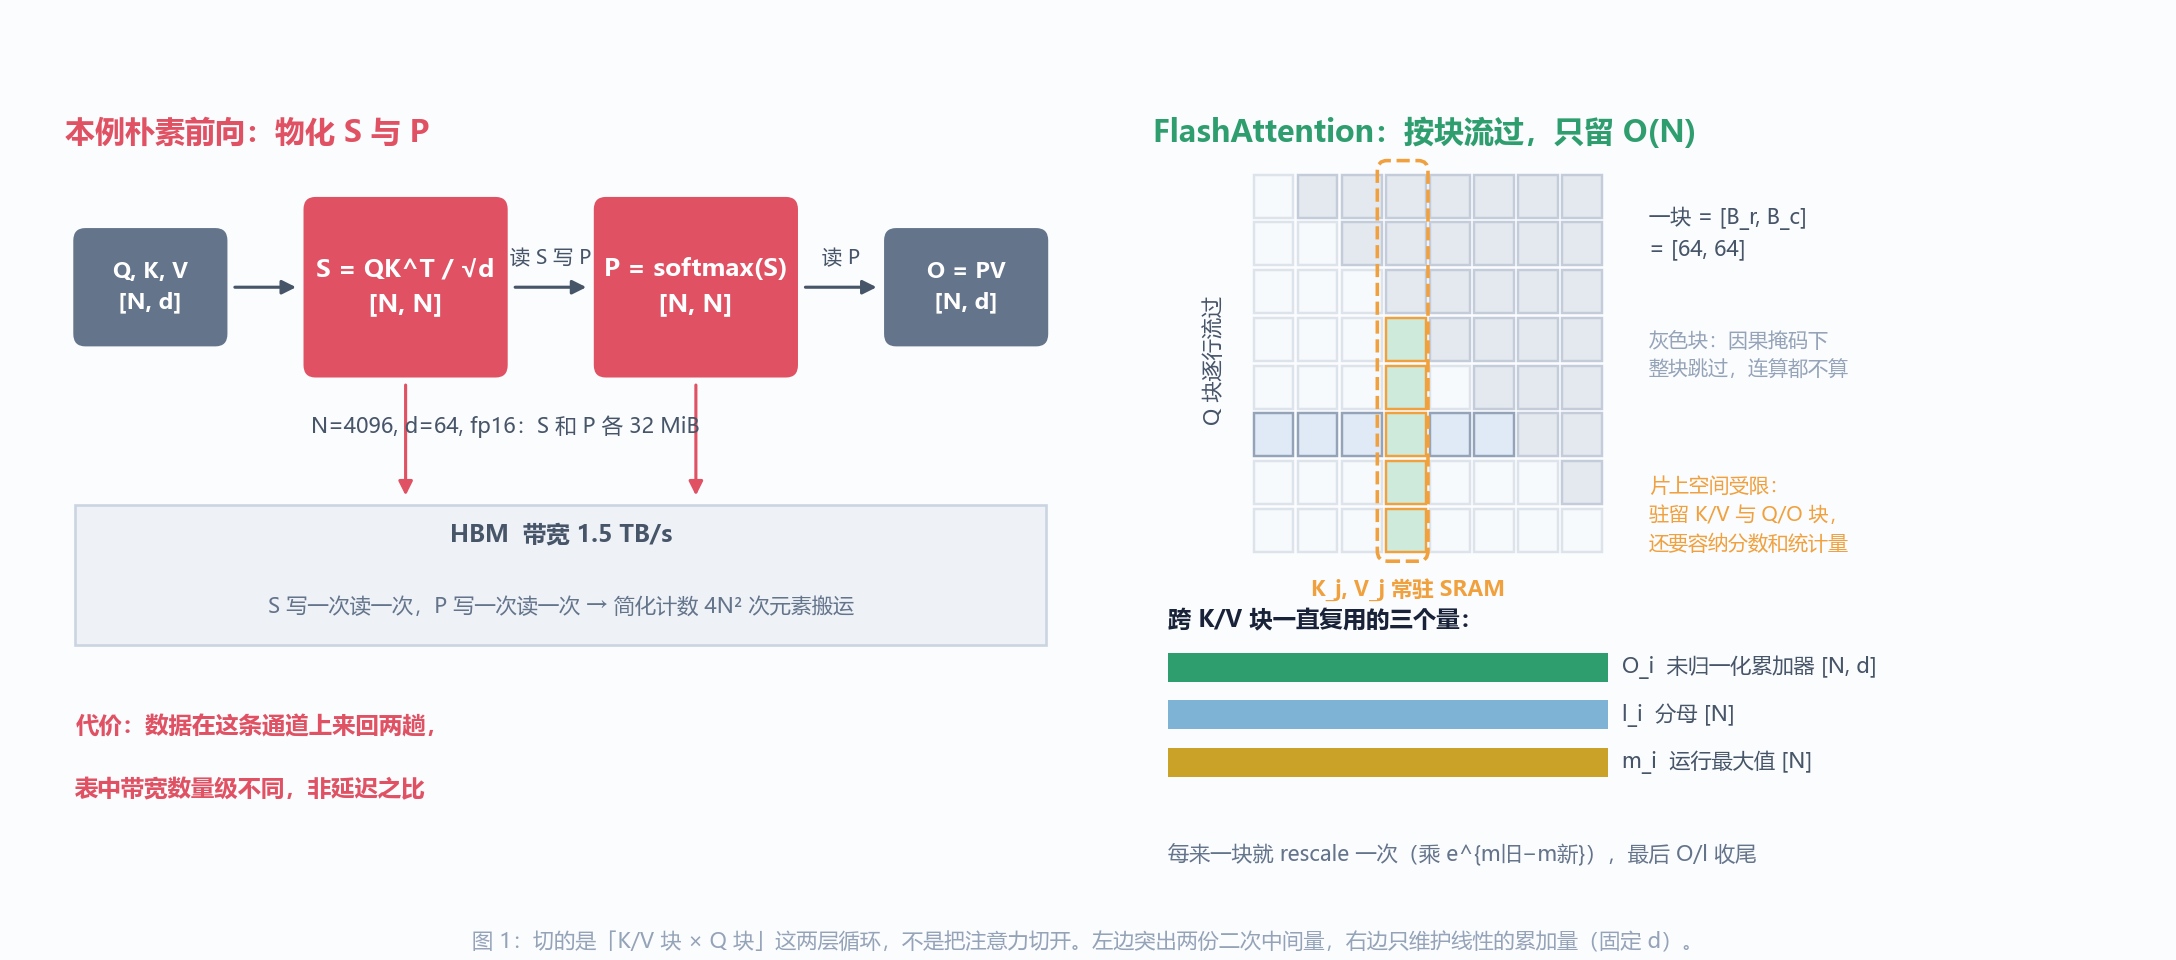
这张图要看什么:左边朴素实现的 S、P 两个 N×N 是该前向示意中的主要中间量,它们必须写回 HBM 再读回来;右边是同一个 N×N 被切成 B_r×B_c 的小块,K/V 块进 SRAM 常驻、Q 块逐行流过,跨块只有 O_i、l_i、m_i 三个 O(N) 的量一直活着。
设一行分数为 $s_1, \dots, s_N$,softmax 的定义是
$$p_i = \frac{\exp(s_i)}{\sum_{j=1}^{N} \exp(s_j)}$$
先修要求是矩阵乘、逐行 softmax 和链式法则;这里补齐指数换参考系与 softmax 雅可比,不需要先懂 CUDA。本文先讨论有限分数、至少一个未遮 key、无 dropout 的单头自注意力,$Q,K,V\in\mathbb R^{N\times d}$,$S=QK^\top/\sqrt d$;d 为头宽度。直接计算 $\exp(s)$ 会溢出,fp32 的阈值约为 $\log(\mathrm{finfo}(\mathrm{float32}).\mathrm{max})\approx88.72$。常用 safe softmax——先求这行的最大值 m,再算平移后的指数:
$$p_i = \frac{\exp(s_i - m)}{\sum_{j=1}^{N} \exp(s_j - m)}, \qquad m = \max_{1 \le j \le N} s_j$$
把指数共同平移 -m(数学上等价于分子分母同乘 $\exp(-m)$,实现不真的计算这个乘子),结果不变,但指数的输入全部落在 $(-\infty, 0]$,永不溢出。问题就出在这个 m 上:m 是对整行取的 max。你必须先把 N 个分数全部看过一遍才知道 m 是多少,然后才能开始算 exp——这解释了常见实现先保存分数再做 softmax 的流程;算法并不强制保存整个 N×N,也可重算分数或逐行处理,只是 IO 和效率不同。
而注意力输出对这一行还要再多两个量:分母 $l = \sum_j \exp(s_j - m)$,以及未归一化加权和 $U = \sum_j \exp(s_j - m)\, v_j$($v_j$ 是第 j 个 token 的 Value 向量)。最终输出 O 就是 $U / l$。
所以真正要回答的问题是:如果分数是一块一块到来的(事先不知道后面块里有什么),这三个量还能算吗?
能。做法是把「以 m 为参考系」改成「以当前的 m 为参考系,m 变了就整体换算」。
设 $J_t$ 为前 t 块中未被遮住的 key 下标集合,至少含一个有限分数;维护三个量:参考系最大值 $m^{(t)}$、分母 $l^{(t)}$、未归一化加权和 $U^{(t)}$,它们满足不变式
$$U^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})\, v_j, \qquad l^{(t)} = \sum_{j \in J_t} \exp(s_j - m^{(t)})$$
U 表示未归一化加权和,最终输出才记作 O;这样不把中途累加器与归一化结果混为同一量。现在第 $t+1$ 块到了,块内最大值是 $m_{\text{blk}}$。新的全局最大值是
$$m^{(t+1)} = \max(m^{(t)},\ m_{\text{blk}})$$
关键一步来了:旧累积量是按 $m^{(t)}$ 为参考系记的,而新的不变式要求参考系换成 $m^{(t+1)}$。把不变式里的 $\exp(s_j - m^{(t)})$ 拆成 $\exp(s_j - m^{(t+1)}) \cdot \exp(m^{(t+1)} - m^{(t)})$,旧量的换算系数就是 $\exp(m^{(t)} - m^{(t+1)})$:
$$l^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, l^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})$$
$$U^{(t+1)} = \exp(m^{(t)} - m^{(t+1)})\, U^{(t)} + \sum_{j \in \text{blk}} \exp(s_j - m^{(t+1)})\, v_j$$
每一步只是把指数拆成两项相乘再重新合并,等价性是代入即可验证的恒等式;所有块流完后 $U^{(T)}/l^{(T)}$ 与朴素 softmax 在实数算术下相同(差在浮点舍入,第 04 节实测 1e-16 量级)。这个「换参考系」的系数在论文和代码里叫 rescale,跨块最大值、求和与 rescale 都会带来额外的标量操作;它们不改变主导矩阵乘次数。
严谨一点可以正向验证不变式:假设第 t 步的不变式成立,那么
$$U^{(t+1)} = e^{m^{(t)} - m^{(t+1)}} \sum_{j \in J_t} e^{s_j - m^{(t)}} v_j + \sum_{j \in \text{blk}} e^{s_j - m^{(t+1)}} v_j = \sum_{j \in J_{t+1}} e^{s_j - m^{(t+1)}} v_j$$
(第一个等号就是递推式,第二个等号把 $e^{m^{(t)} - m^{(t+1)}}$ 乘进求和号里、指数相加后正好变回 $e^{s_j - m^{(t+1)}}$。)旧块和新块在同一个参考系下合并,不变式保持。$l$ 的证明一字不差,把 $v_j$ 去掉就行。归纳基础是初始状态 $m^{(0)} = -\infty$、$l^{(0)} = 0$、$U^{(0)} = 0$:第一个含有效 key 的块到来时换算系数按 0 处理(代码只在旧最大值有限的位置做减法,避免提前计算未定义差值),三个量直接等于该块的局部值。
三个细节值得停一下:
掩码把被遮分数设为 $-\infty$。若此前最大值有限,它的指数贡献为零。若一整行截至当前全被遮住,不能直接算 $-\infty-(-\infty)$;本文约定该行累计量为零,最终全遮行返回零输出、LSE 为 $-\infty$。这是接口约定,全遮行本身没有概率归一化定义。实现用带 where= 的 np.subtract 跳过未定义减法;普通 np.where 会先求值两个分支,不能保证避免 NaN 警告。更进一步,如果一整块都被遮住(Q 块整体在 K 块之前),这块连算都不用算,直接跳过。第 04 节实测这个「整块跳过」在 N=4096、块 64 时省掉 49.2% 的块。
这里的 $O=PV$ 指最终归一化输出,$G=\partial L/\partial O\in\mathbb R^{N\times d}$ 是上游梯度,$A=GV^\top=\partial L/\partial P\in\mathbb R^{N\times N}$。先对一行 softmax 求导,$\delta_{jk}$ 表示 j=k 时为 1、否则为 0:
$$\frac{\partial p_j}{\partial s_k}=p_j(\delta_{jk}-p_k)$$
把损失对各 $p_j$ 的导数 $A_j$ 代入链式法则,得到
$$\frac{\partial L}{\partial s_k}=\sum_j A_jp_j(\delta_{jk}-p_k)=p_k\left(A_k-\sum_j A_jp_j\right)$$
因此矩阵形式为
$$dS=P\odot\left(A-\operatorname{rowsum}(A\odot P)\right)$$
行和是 $N\times1$,沿 key 轴广播。继续对 $S=QK^\top/\sqrt d$ 与 $O=PV$ 求导:
$$dQ=dS\,K/\sqrt d,\qquad dK=dS^\top Q/\sqrt d,\qquad dV=P^\top G$$
反向真正巧的一步是先把行和算出来。对第 i 行,用内积线性性可得
$$\delta_i=\sum_j P_{ij}\langle G_i,V_j\rangle=\left\langle G_i,\sum_j P_{ij}V_j\right\rangle=\langle G_i,O_i\rangle$$
所以 $\delta=\operatorname{rowsum}(G\odot O)$,仅为 N 个数,无需为这项先构造完整 A/P。前向额外保存 O 和 $\mathrm{LSE}_i=m_i+\log l_i$;反向从 Q/K 重算局部分数,再用
$$P_{ij}=\exp(S_{ij}-\mathrm{LSE}_i)$$
恢复局部概率,把它和局部 $G_iV_j^\top-\delta_i$ 相乘得到 dS,立即累加到 dQ/dK/dV 后丢弃。Q/K/V、输出和梯度仍是 $O(Nd)$,局部 tile 为 $O(B_rB_c)$;只有在 d 与块大小固定时才能简称 O(N)。原论文附录 B 给出分块反向;附录 attention_backward 把上述步骤完整实现,第 4.6 节实际核验梯度。
以上推导无 dropout。若训练使用概率 dropout,令随机乘子为 $R/(1-p)$,p 为丢弃率;dV 和 dP 都要使用同一随机掩码重放,不能直接照抄本教学函数。LSE 仍对应 dropout 之前的 softmax。生产实现还需保留随机生成器状态,见第 05 节。
用重复计算换显存——这笔交易的换算率是:每层每个头多算一遍 QK^T 和一次 exp(具体比例取决于前后向统计口径与实现),对本文保守教学账本,这对应去掉 S、P、浮点 dropout 乘子三项;真实朴素反向通常不用同时保存 S,具体减少几份取决于实现。N=4096、本文简化模型上,单层激活 2.39 GiB → 0.141 GiB,17 倍。
设单头维度 d,片上存储预算为 M 个元素(不是字节);fp16 下 192 KiB 对应 M=98304。SRAM 里要同时放下 K 块、V 块(各 $B_c \times d$)和 Q 块、输出块(各 $B_r \times d$),论文 Algorithm 1 取(脚本对整数块大小向下取整)
$$B_c = \frac{M}{4d}, \qquad B_r = \min(B_c,\ d)$$
NVIDIA Ampere 文档 给出 A100 每个 SM 的 192 KiB 统一 L1/共享内存空间及共享内存配额;它不是全部可用于单个 block 的任意数组。以这一数量级作为教学预算,fp16 下 d=64 时 $B_c = 384$、$B_r = 64$——这是论文 IO 模型的粗略分块预算;真实 kernel 还受 score tile、累加器、寄存器、共享内存配额与 occupancy 约束,192 KiB 也不是每个 block 可独占的共享内存。
朴素实现的搬运量(单位:元素个数):QK^T 读 Q、K 各 Nd、写 S 一次 N²;softmax 读 S 写 P 各 N²;PV 读 P 一次 N²、读 V 写 O 各 Nd。合计 $4Nd + 4N^2$,主导项 4N²。
FlashAttention 的搬运量:K、V 各进 SRAM 一次($2Nd$);Q 块每换一个 K/V 块就要重读一遍,共 $T_c \cdot Nd$($T_c = \lceil N/B_c\rceil$ 是 K/V 块数);输出 O 同理要读出写回各一遍($2 T_c Nd$);l、m 两个 O(N) 的运行量共 $4T_c N$。合计约 $2Nd + 3T_cNd + 4T_cN$,代进去:
$$\text{HBM 搬运量} \;\approx\; 3 \cdot \frac{N}{B_c} \cdot Nd \;=\; \Theta\!\left(\frac{N^2 d^2}{M}\right)$$
两个量级一比:朴素是 $\Theta(N^2)$,Flash 是 $\Theta(N^2 d^2/M)$,比值 $d^2/M$ 在 d=64、fp16、M=98304 个元素(192 KiB) 时约等于 0.04——大 O 比例省略了常数,不能直接当作 25 倍的实际收益;脚本计入 Q/O 反复读写后的模型比值为 7.3 倍。原论文 Theorem 2 的前提为 $d\le M\le Nd$;其中线性项可被主导项吸收。若整份输入已能驻留片上,不能继续把 $N^2d^2/M$ 往下外推到低于读写输入输出的 $\Omega(Nd)$。小 N 时仍应保留线性项与取整。本文计数也忽略初始化、最终归一化、LSE 写回及多级缓存,提供对照账本而非 GPU 字节计数器。
一个预算反例:d=64、Bc=384、Br=64,若 Q/K/V 用 2 字节,而输出累加器、分数 tile 和统计量用 4 字节,仅这些数组就需 221696 字节,超过 192 KiB;这还未算额外概率 tile。因而同类型元素模型推得的 384 不能作为实际混合精度 kernel 的可用配置。真实实现会重用存储、分配寄存器并选不同 tile。
按本文简化模型,朴素注意力的算术强度在 N 远大于 d 时约为 d/2 FLOP/byte(fp16),所以固定 d=64 时接近 32;它会随 d 改变,并非与头维度无关。A100 示例的约 200 FLOP/byte 是 NVIDIA A100 白皮书 中 dense FP16 Tensor Core 峰值312 TFLOP/s与HBM带宽1555 GB/s之比,真实 softmax 的非矩阵乘指令、缓存与调度仍会影响性能。
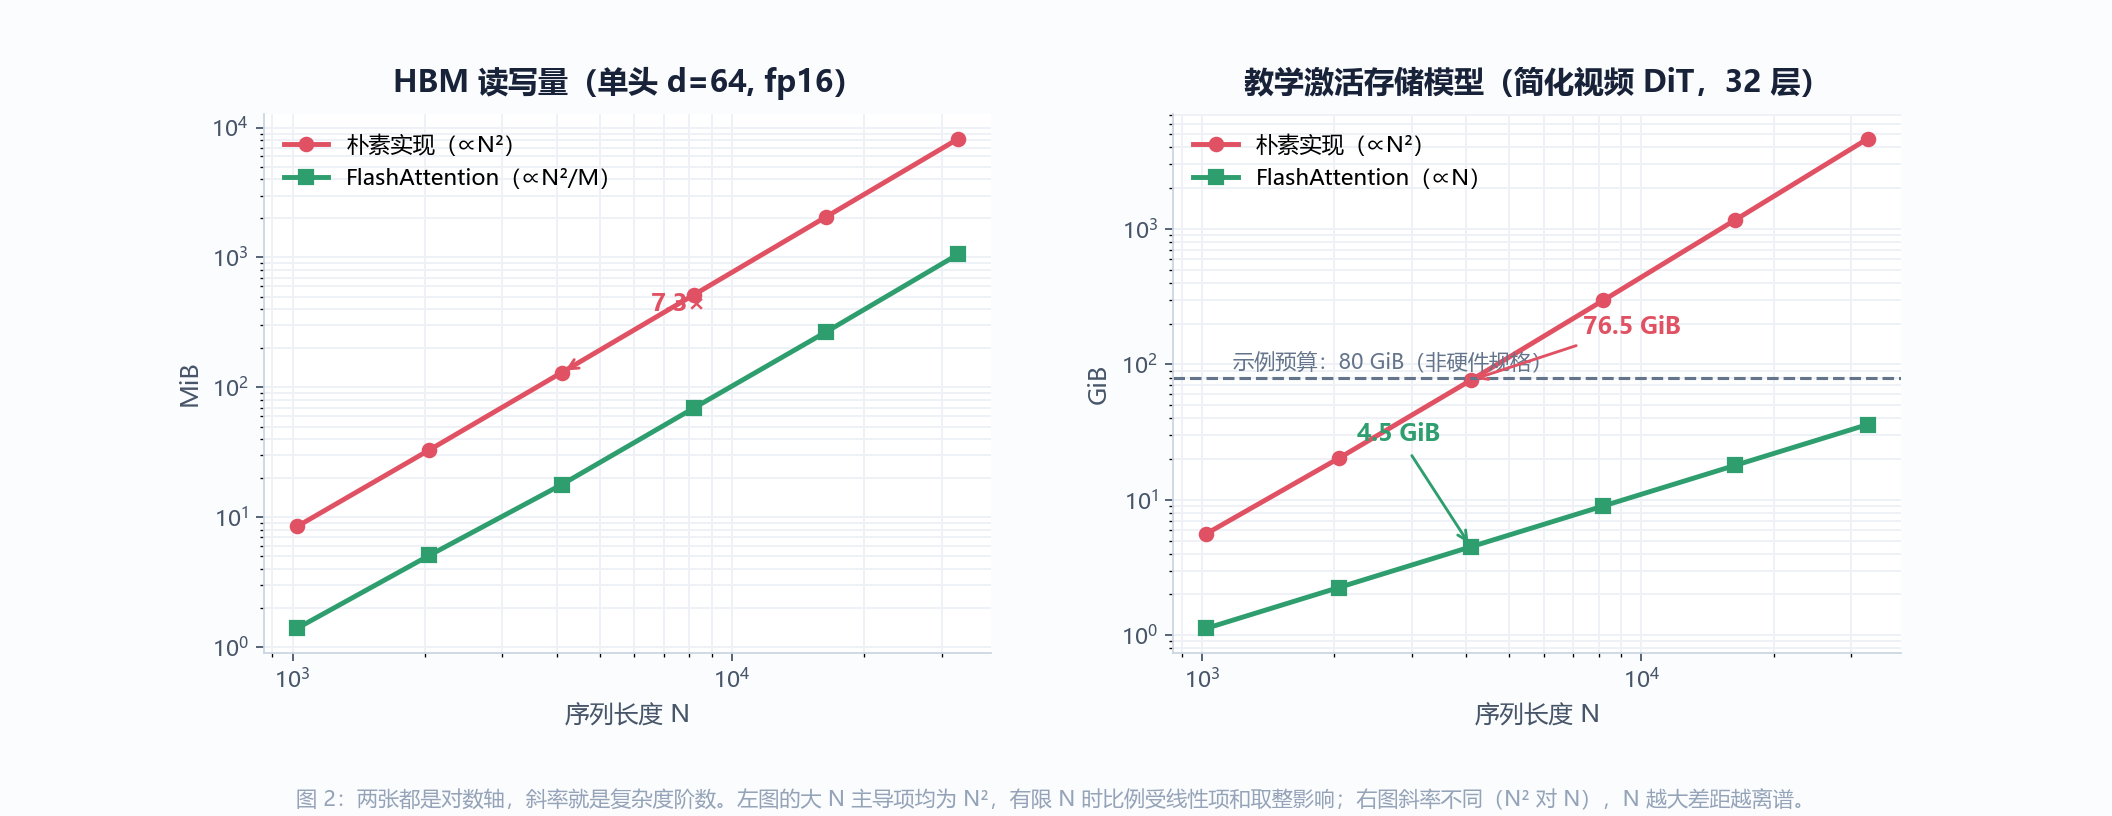
这张图要看什么:固定 d 与 SRAM 大小时,左图两者的大 N 主导项均为 N²,比值渐近趋于常数;线性项和取整会让有限 N 的比值变化;右图斜率不同(N² 对 N),N 越大两条线离得越远,朴素教学激活曲线越过示例 80 GiB 预算线的位置,FlashAttention 还有几百倍余量。
完整脚本在文末附录(flash_online_softmax.py、io_ledger.py、attention_checks.py、make_figures.py)。前三项数值/账本实验主要用 NumPy,梯度对拍还需 PyTorch,配图需 matplotlib。本次 2026-10-14 在 Windows、Python 3.11.9、NumPy 2.4.6、PyTorch 2.10.0+cpu、matplotlib 3.10.7 实跑;BLAS/OMP 线程设为 1。下面表格来自同一次完整运行,不是 GPU 性能复现。
先看一个能盯着看的例子(N=8、D=4、K/V 块大小 B_c=2,Q 整行一起处理):
# 局部Sij已设置掩码;m_old/l/O是已见块的累计量。
m_new = np.maximum(m_old, Sij.max(axis=-1))
shifted = np.full_like(Sij, -np.inf)
np.subtract(Sij, m_new[:, None], out=shifted,
            where=np.isfinite(m_new)[:, None])
Pij = np.exp(shifted)
delta = np.full_like(m_old, -np.inf)
np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old))
corr = np.exp(delta)
l[i0:i1] = l[i0:i1] * corr + Pij.sum(axis=-1)
O[i0:i1] = O[i0:i1] * corr[:, None] + Pij @ Vj
m[i0:i1] = m_new
和第 3.2 节逐符号对上:m_new 是 $m^{(t+1)}$,corr 是换参考系系数,Pij.sum 是块内指数和,Pij @ Vj 是块内加权和。代码内部 O 保存的是数学记号 U,函数最后才除以 l 得到归一化输出。全遮行不做除法,保持零输出。函数要求相同非空形状 [N,D] 与有限浮点输入;支持尾块、一维 key_valid 和等长因果掩码。float16 输入提升到 float32 累加并输出 float32;float64 保持 float64。它未实现非等长、GQA 或 dropout,不能当作完整 CUDA API 替代品。
实跑的逐块轨迹(第 0 号 query):
j= 0   m=+0.2968   l=1.7748   corr=0.0000
j= 2   m=+0.6071   l=3.0317   corr=0.7333
j= 4   m=+0.6071   l=3.9732   corr=1.0000
j= 6   m=+0.6071   l=5.3007   corr=1.0000
看两点:j=2 时新块里出现了更大的分数,m 被抬高、旧累积量被打了个 0.733 的折扣;j=4 之后 m 没再变,corr 恒为 1,rescale 白做——此时乘子在数学上为 1;具体 GPU kernel 是否跳过这些操作要核对实现,不能仅由轨迹推断。最大的单个临时矩阵只有 16 个元素([8, 2]),而 N×N 是 64;这里不等于同时存活临时数组的总元素数;代码对尾块和全遮行的额外检查也占临时空间。
attention_naive 是上一篇的标准实现(S、P 都落地),两者对拍:
     N    D  causal         最大绝对误差         相对误差
   256   64   False      5.551e-16    1.192e-15
   256   64    True      8.882e-16    3.520e-16
  1024   64   False      2.082e-16    8.962e-16
  1024   64    True      6.661e-16    2.332e-16
  2048   64   False      3.053e-16    1.205e-15
  2048   64    True      6.661e-16    2.856e-16
  4096   64   False      1.249e-16    9.209e-16
  4096   64    True      7.772e-16    2.426e-16
本次表的最大绝对误差为 1.2e-16 到 8.9e-16;这是此输入、规模与 float64 运算顺序下的结果。这就是「精确注意力」四个字的实测含义:不是「误差很小」,是算法本身和朴素 softmax 完全等价。
用 tracemalloc 量函数内新分配的峰值内存(float64、D=64、块 64×64;Q/K/V 已提前分配,不计入本表):
     N     naive 实测     naive 理论 2N²·8     flash 实测       比值
  1024       16.5 MiB             16.0 MiB        1.2 MiB    13.9x
  2048       65.0 MiB             64.0 MiB        2.2 MiB    29.4x
  4096      258.0 MiB            256.0 MiB        4.3 MiB    60.0x
  8192     1028.0 MiB           1024.0 MiB        8.5 MiB   121.0x
理论列只计 S/P;tracemalloc 表还包含输出、运行量和局部临时数组。NumPy 在此环境向 Python 跟踪器登记数组分配,这些数值与主导项一致;tracemalloc 不等于进程 RSS,也不覆盖所有 BLAS 内部缓冲,更不是 GPU 显存峰值。最后那行是阶数的直接证据:N 翻倍,naive 峰值 ×4(二次),flash 峰值 ×2(线性)。
     N      naive   flash(B=64)  flash/naive
  1024      13.6 ms         16.2 ms         1.2x
  2048      57.5 ms         65.4 ms         1.1x
  4096     230.0 ms        266.1 ms         1.2x
每个方法先预热一次,再量 5 次取墙钟中位数,包含 Python 循环与 NumPy分配,不计输入生成。这里 flash 教学循环慢约 1.1–1.2 倍;不同机器或本机再次运行可能变化。可能原因包括:乘加次数一样还多了 rescale 和逐块 exp;一次大矩阵乘被拆成 (N/64)² 个 64×64 小矩阵乘,BLAS 跑不满小块,Python 循环开销也进来了;CPU 也有 SRAM 缓存,但这里的 Python/NumPy 分块没有实现专门的缓存与线程优化,不能把它当作 GPU 内核速度的预测。第三张图展示 IO 模型为何支持在 GPU 上尝试这一优化。
本脚本朴素路径先计算全分数,再遮住未来 key,因此该路径不因掩码节省矩阵乘;这是所测实现的选择,不是所有精确算法的限制。FlashAttention 按「Q 块整体在 K 块之前就整块跳过」处理,N=4096、块 64 时实测:
  块总数(非因果)  : 4096
  块总数(因果跳过): 2080
  跳过的块占比      : 49.2%
保留的是含对角线的下三角,块数是 $T(T+1)/2$,占比 $(T+1)/2T$,T 大时趋近一半。对齐、等长且等块时,49.2% 是跳过的 tile 数比例;对角 tile 中仍有被遮元素,softmax/调度还有开销,所以不等于总 FLOPs 或延迟精确减半。时序因果视频注意力还须明确 token 排序与掩码定义。
attention_checks.py 对 N=1/7/17、float64/float32/float16 输入、因果/非因果、正常/全遮及部分遮 key、三组包含尾块的块大小组合,总计 108 组前向结果与 PyTorch 2.10 的 CPU math SDPA(float64 参考)对拍;最大绝对差为 2.33e-7。float16 输入先提升到 float32,并非模拟 GPU 的每一处精度行为。float64 分块反向对 autograd 最大差为 1.33e-15。另对 N=7、d=5 的 Q/K/V 共 105 个参数做中心差分,步长 1e-5,最大差为 8.74e-11;全遮行零输出约定也参与检验。
还实际提取并执行 FlashAttention v2.8.3 官方测试的 attention_ref 与 construct_local_mask 原函数 AST,CPU float64、不做默认 float32 upcast,对三种长度及两种因果设置核对输出与梯度。这是原始参考函数的检查,未安装或执行 CUDA kernel,不能据此声称 GPU 速度/低精度训练已复现。独立对拍支持实现正确性;第 03 节的恒等式才说明算法为何等价。
最小实现讲清了原理,但生产 kernel 和它有四处本质差异,每处都值得知道为什么:
第一,理论 tile 和工程配置要分清。 本次固定核对 flash-attention v2.8.3,入口为 flash_attn_func。flash_fwd_launch_template.h 中有基于头维度、架构、dropout/因果等条件的编译配置分支;Python _get_block_size_n 也说明应匹配 CUDA 块尺寸。静态分支选配置不等于每次运行都在线 autotune。$B_c=M/(4d)$ 只为 IO 分析提供同阶预算,实际还要计 score tile、寄存器、共享内存和 occupancy。本文不判断更新版本的 kernel 细节。
第二,减少非矩阵乘操作。 FlashAttention-2 使用未归一化输出累计,减少 rescale、除法等非矩阵乘工作。corr=1 时数学上无需改变旧值,但不能笼统声称所有 kernel 都按每行最大值是否变化来分支跳过。
第三,前向的结构是「外层 Q、内层 K/V」。 我们按论文 v1 的写法外层遍历 K/V 块;FlashAttention-2 把循环反过来(外层 Q 块),好处是输出 O 常驻寄存器不用反复读写、且不同 Q 块之间天然并行,能吃满更多 SM。论文 v1 的伪代码适合理解递推,v2 的循环结构才是现在 kernel 的样子。
第四,dropout 要重放随机过程。 固定接口保存 rng_state,反向从同一状态重建概率 dropout;flash_bwd_kernel.h 中可核对 Philox seed/offset 与块坐标。仅口头说“种子一样”仍不够:并行划分与计数器映射也必须一致。无需保存完整二次掩码,是特定 kernel 的实现能力,不代表所有朴素框架必定保存浮点掩码。
另一个易错边界是非等长因果对齐。 v2.8.3 接口明确对齐右下角;Nq=5、Nk=2 的保留矩阵为下面五行,前 3 行全遮时输出零。本文 NumPy函数只支持等长,因此不暗中把一种对齐当作另一种。PyTorch 2.10 SDPA 文档 的 is_causal 在非方形时定义左上对齐;跨 API 迁移要显式核对。
0 0
0 0
0 0
1 0
1 1
PyTorch SDPA 可以按环境选优化后端,也有 CPU/math 路径;调用该 API 本身不能证明使用了 CUDA FlashAttention。评估时还要把 dropout_p 显式设为 0,该函数不会因模型切换 eval 就自动关闭传入的 dropout。
原 FlashAttention 论文分别在 BERT-large/MLPerf、GPT-2/HuggingFace、Long Range Arena 上报告 15%、3 倍、2.4 倍端到端收益。这些模型、基线与任务不同,不能把三组数字当作只改变 N 的对照实验,更不能由它们证明收益严格随 N 单调增加。
排查问题时你会想知道「此刻到底在用哪个后端」。PyTorch 留了一个官方口子:
import torch
from torch.nn import functional as F
from torch.nn.attention import sdpa_kernel, SDPBackend

# CUDA环境使用;形状[B,H,N,D],输入half,关闭dropout。
q = k = v = torch.randn(1, 2, 128, 64, device="cuda", dtype=torch.float16)

with sdpa_kernel(SDPBackend.FLASH_ATTENTION):
    out = F.scaled_dot_product_attention(q, k, v, is_causal=True, dropout_p=0.0)
# 强制走 flash;如果这个头维度/掩码组合它不支持,应按官方后端约束排查告警或错误;本文CPU实跑明确选择MATH,
# 而不是悄悄退回 math 后端——「悄悄降级」正是性能莫名掉一半时最该先查的事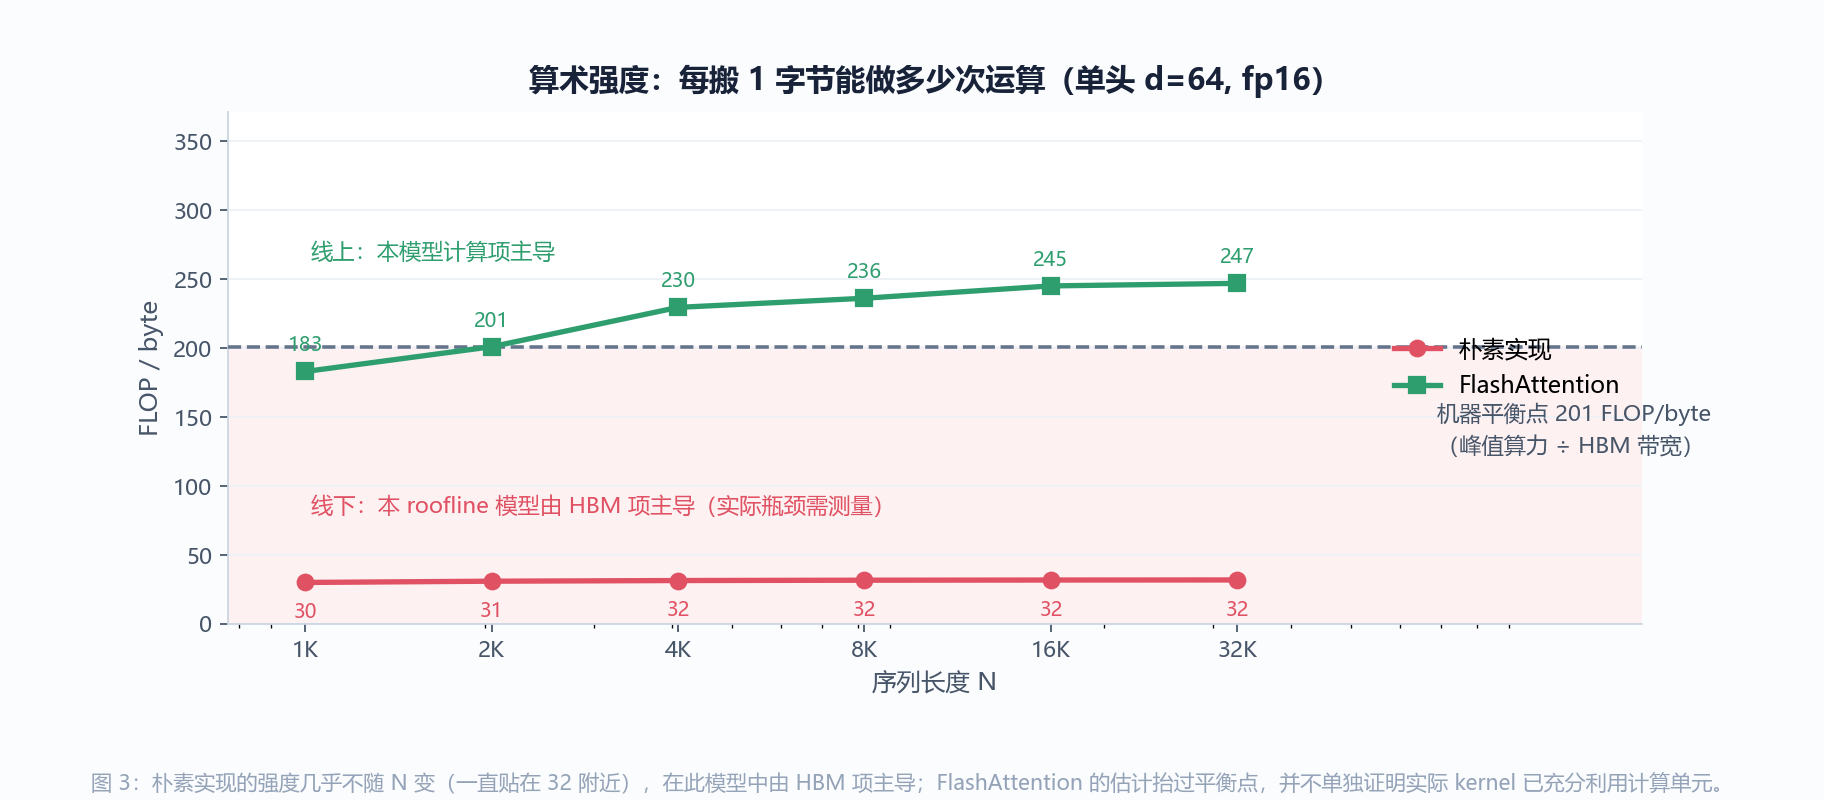
这张图要看什么:横轴是 N,纵轴是「每搬 1 字节做多少次运算」,灰色虚线是机器平衡点(201 FLOP/byte)。本模型中朴素实现的强度渐近接近 32;FlashAttention 的估计从 N=2048 起超过平衡点。这是按矩阵乘峰值做的模型分类,真实瓶颈还受非矩阵乘指令、缓存、并行度和调度影响。
FlashAttention 省下了 HBM 搬运和 N² 显存,赔进去的和没管住的也要说清楚。
代价:重计算和额外归一化操作。 反向要重算局部分数及概率,其中包含矩阵乘和逐元素运算,不能统称为固定 30% 的额外非矩阵乘开销。小序列的收益取决于 kernel、调度和硬件,没有统一的“序列短于512就亏损”阈值。
数值边界:实数算术等价不保证浮点逐位一致。 kernel 内部用 fp16/bf16 存储、fp32 累加,块内的归一化和朴素实现的一次性归一化在浮点上不同。对训练的影响需要结合 dtype、输入尺度与误差测试判断,但如果你在做数值敏感的分析(比如逐 token 概率对比),应建立与输入尺度、dtype 和应用需求匹配的容差,并检查遮罩及非有限值;不能仅凭“精确算法”就把所有数值差异判为正常舍入。
边界的核心一条:它改变存储阶数,但不消除精确稠密注意力的二次计算。 显存从 $O(N^2)$ 降到 $O(N)$,但算力还是 $\Theta(N^2 d)$、在第 3.4 节限定模型中,HBM 搬运为 $\Theta(N^2 d^2/M)$。N=32768 时 FlashAttention 的单头搬运是 1061 MiB——比朴素实现的 8.2 GiB 好得多,但随 N 继续平方增长这一点没变。上下文再往上涨(1M token),可以考虑稀疏注意力、线性注意力、状态空间模型或并行方案;它们各有建模或系统代价,是否合适须按任务验证。FlashAttention 的块结构恰恰是它们的底座:把注意力切成块之后,「整块跳过」才成为可能,第 4.5 节那个 49.2% 推广到任意稀疏模式就是块稀疏注意力。
不该用的场景:需要拿到完整注意力权重做分析或可视化的(P 从头到尾没存在过,想看它就得回到朴素实现);自定义的任意注意力偏置如果 kernel 不支持,绕过去的方法可能把优势吃掉;以及缺乏适配内核的环境;CPU 也有 SRAM 缓存,但本文 NumPy 循环没有实现专门的 CPU cache 优化(第 4.4 节的 CPU 实测就是例子)。
这条线的演进关系一句话各说清:
这条阅读线从流式归一化、低内存自注意力到 IO 与 GPU 调度,逐步解释同一数学操作为何能有不同的存储和运行代价。它是选定论文的演进关系,不是对所有先行工作或产品的首次性判断。
以下几条都值得单独记住,前两条我当初也信过:
跑文末附录的 flash_online_softmax.py(只依赖 numpy),预期输出与正文一致:
再运行附录 attention_checks.py,它用 seed=1024、N=1024、d=64、块 64×64,故意把正确函数的 corr = np.exp(delta) 替换成 corr = np.ones_like(delta);这是自动构造的错误反例。最大差实测为 0.275658、平均差为 0.013599。这项对比把“丢掉换参考系会出错”变成可重复实验,不让读者误把旧代码里的 np.where 当作必要写法。
最后改 io_ledger.py 开头的硬件常数(比如把 SRAM_PER_SM 调到 48 KiB,作为更小片上预算的假设,不能据此代表某款消费级卡),重跑看块大小和搬运量比值怎么变——你会看到 SRAM 越小,FlashAttention 相对朴素实现的搬运量优势越小,$d^2/M$ 里的 M 直接控制这一切。
按知识树的依赖关系,建议按这个顺序继续走:
延伸到知识树之外:想读 kernel 源码,从 Dao-AILab/flash-attention 的 flash_attn/flash_attn_interface.py 进,先读 forward 再读 backward;想读原始推导,Milakov & Gimelshein(1805.02867)给出了独立 softmax 在线归一化的直接推导。
09 节用到的脚本全文如下(io_ledger.py、flash_online_softmax.py、attention_checks.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""IO 账本:朴素注意力和 FlashAttention 在 HBM 上到底搬了多少字节。

这篇讲的是「为什么快」。答案不在 FLOPs 上——两者的乘加次数几乎一样——
而在于 GPU 有两级内存:

    HBM(显存)  带宽约 1.5 TB/s,容量 40~80 GB
    SRAM(片上) 带宽约 19 TB/s,但每个 SM 只有 192 KB

朴素实现把 N×N 的分数矩阵写回 HBM 再读出来,等于把数据在这条 13 倍带宽差的
通道上来回搬;FlashAttention 用 tiling 让这些中间结果根本不落 HBM。

下面的模型把每一笔读写都点清楚,参数是可调的,读者可以改硬件常数重算。
硬件数量级取自 FlashAttention 论文第2节与NVIDIA A100白皮书(40GB、非稀疏Tensor Core峰值)。

只依赖 numpy。直接 `python io_ledger.py` 即可运行。
"""

import numpy as np

# ── 硬件常数(A100 40GB 量级,论文第2节/NVIDIA白皮书)────────────────────
HBM_BW = 1.555e12        # HBM 带宽,字节/秒
SRAM_BW = 19.0e12        # 片上 SRAM 带宽,字节/秒
SRAM_PER_SM = 192 * 1024  # 每个 SM 的片上 SRAM,字节
FLOPS_PEAK = 312e12      # fp16 tensor core 峰值,FLOP/秒

GIB = 1024 ** 3
MIB = 1024 ** 2


# ────────────────────────────────────────────────────────────
# 块大小:SRAM 里能同时放下什么
# ────────────────────────────────────────────────────────────
def block_sizes(d, sram_bytes=SRAM_PER_SM, dtype_bytes=2):
    """返回 (B_r, B_c):Q 块行数与 K/V 块行数。

    SRAM 里要同时放下 K_j、V_j 两个 [B_c, d] 和 Q_i、O_i 两个 [B_r, d]。
    论文的取法是 B_c = M / (4d)、B_r = min(B_c, d),这里取整近似:
    先让 K_j+V_j 占掉一半 SRAM,Q 块则不超过 d 行(与分数tile的存储预算同阶)。
    """
    if d <= 0 or dtype_bytes <= 0 or sram_bytes < 4*d*dtype_bytes:
        raise ValueError("存储预算不足或参数非正")
    elems = sram_bytes / dtype_bytes
    B_c = max(1, int(elems // (4 * d)))
    B_r = min(B_c, d)
    return B_r, B_c


# ────────────────────────────────────────────────────────────
# HBM 读写量(单位:元素个数,乘 dtype_bytes 得字节)
# ────────────────────────────────────────────────────────────
def hbm_elems_naive(N, d):
    """朴素实现:S 和 P 都要落地。

    QK^T: 读 Q(Nd) + 读 K(Nd) + 写 S(N²)
    softmax: 读 S(N²) + 写 P(N²)
    PV:  读 P(N²) + 读 V(Nd) + 写 O(Nd)
    """
    return 4 * N * d + 4 * N * N


def hbm_elems_flash(N, d, B_r, B_c):
    """FlashAttention:外层遍历 K/V 块,内层遍历 Q 块。

    K、V 各读一遍(每个 j 块进 SRAM 后,内层 i 循环里一直复用)
    Q 每个 j 都要重读一遍:T_c · N·d
    O 每个 (j,i) 都要读出来再写回去(累加器跨 j 迭代):2 · T_c · N·d
    l、m 两个 O(N) 的运行量同理:4 · T_c · N
    """
    T_c = int(np.ceil(N / B_c))
    return 2 * N * d + 3 * T_c * N * d + 4 * T_c * N


def flops_attention(N, d):
    """两个 N×N 矩阵乘,一次 [M,K]×[K,N] 算 2MKN 个浮点运算。"""
    return 4 * N * N * d


def activation_bytes(N, d, H, B=1, dtype_bytes=2):
    """单层注意力的训练激活(反向要用的中间张量)。

    保守教学模型:6 个 [B,N,d_model] 线性项 + S/P/浮点乘子 3 个 [B,H,N,N]。
    此函数 d 是总宽度 d_model,不是其他 IO 函数中的头宽度。
    融合侧保留同样六份线性预算,忽略小的 LSE 与工作区;不是框架峰值测量。
    """
    lin = 6 * B * N * d * dtype_bytes
    quad = 3 * B * H * N * N * dtype_bytes
    return lin + quad, lin


def roofline(bytes_moved, flops):
    """算术强度(FLOP/byte)与两个理想下界时间。返回 (强度, 内存时间, 算力时间, 瓶颈)。"""
    intensity = flops / bytes_moved
    t_mem = bytes_moved / HBM_BW
    t_comp = flops / FLOPS_PEAK
    bound = "内存受限" if t_mem > t_comp else "算力受限"
    return intensity, t_mem, t_comp, bound


# ────────────────────────────────────────────────────────────
# 报表
# ────────────────────────────────────────────────────────────
def report_io():
    d, b = 64, 2                      # 单头维度 64,fp16
    B_r, B_c = block_sizes(d)
    print("=" * 74)
    print("1. SRAM 块大小与 HBM 读写量(单头,d=64,fp16)")
    print("=" * 74)
    print(f"  SRAM {SRAM_PER_SM / 1024:.0f} KB / SM,fp16 下能放 "
          f"{SRAM_PER_SM / b:.0f} 个元素")
    print(f"  → B_c = M/(4d) = {B_c},B_r = min(B_c, d) = {B_r}\n")
    print(f"{'N':>7} {'naive HBM':>12} {'flash HBM':>12} {'比值':>8} "
          f"{'naive 强度':>11} {'flash 强度':>11}")
    rows = []
    for N in (1024, 2048, 4096, 8192, 16384, 32768):
        nb = hbm_elems_naive(N, d) * b
        fb = hbm_elems_flash(N, d, B_r, B_c) * b
        fl = flops_attention(N, d)
        i_n, _, _, bound_n = roofline(nb, fl)
        i_f, _, _, bound_f = roofline(fb, fl)
        rows.append((N, nb, fb, i_n, i_f, bound_n, bound_f))
        print(f"{N:>7} {nb / MIB:>10.1f} MiB {fb / MIB:>10.1f} MiB "
              f"{nb / fb:>7.1f}x {i_n:>9.1f}  {i_f:>9.1f} ")
    print(f"\n  机器平衡点(峰值算力/带宽)= {FLOPS_PEAK / HBM_BW:.0f} FLOP/byte")
    print("  仅本理想模型:强度低于平衡点由HBM项主导,高于时由计算项主导。\n")
    print(f"{'N':>7} {'naive 瓶颈':>12} {'flash 瓶颈':>12}")
    for N, nb, fb, i_n, i_f, bn, bf in rows:
        print(f"{N:>7} {bn:>12} {bf:>12}")
    print("\n  注意:flash 的强度在 N 大时越过平衡点,模型说它变成算力受限了。")
    print("  但真实 kernel 达不到峰值——softmax 的 exp 走的是特殊函数单元,")
    print("  不走 tensor core,这个「非矩阵乘开销」正是 FlashAttention-2 之后")
    print("  继续优化的地方。峰值资源模型给出理想时间下界,不是实测速度承诺。")


def report_activation():
    d, H, B, b = 3072, 24, 1, 2
    print("\n" + "=" * 74)
    print("2. 教学激活存储模型(简化 Transformer:d=3072, H=24, B=1, 32 层, bf16)")
    print("=" * 74)
    print(f"{'N':>7} {'朴素/层':>12} {'Flash/层':>12} {'比值':>8} "
          f"{'朴素 32 层':>12} {'Flash 32 层':>13}")
    for N in (1024, 4096, 8192, 32768):
        naive, flash = activation_bytes(N, d, H, B, b)
        print(f"{N:>7} {naive / GIB:>10.2f} GiB {flash / GIB:>10.3f} GiB "
              f"{naive / flash:>7.0f}x {32 * naive / GIB:>10.1f} GiB "
              f"{32 * flash / GIB:>11.2f} GiB")
    n4096, f4096 = activation_bytes(4096, d, H, B, b)
    print(f"\n  N=4096 时,朴素实现单层 {n4096 / GIB:.2f} GiB,其中二次项占 "
          f"{100 * (1 - f4096 / n4096):.1f}%——")
    print("  这正是 attention_basics 那篇里「三个 N×N 吃掉 94%」的那一格。")
    print("  FlashAttention 删掉的就是这一格,剩下的是 O(N) 的线性项。")


def report_speed_limit():
    d, b = 64, 2
    B_r, B_c = block_sizes(d)
    print("\n" + "=" * 74)
    print("3. 理想时间下界:如果只受 HBM 带宽限制,两者各要多久(单头,d=64)")
    print("=" * 74)
    print(f"{'N':>7} {'FLOPs':>10} {'naive 内存时间':>16} {'flash 内存时间':>16} "
          f"{'纯带宽模型比':>9}")
    for N in (1024, 4096, 16384):
        nb = hbm_elems_naive(N, d) * b
        fb = hbm_elems_flash(N, d, B_r, B_c) * b
        fl = flops_attention(N, d)
        print(f"{N:>7} {fl / 1e9:>8.2f} G {nb / HBM_BW * 1e3:>14.3f} ms "
              f"{fb / HBM_BW * 1e3:>14.3f} ms {nb / fb:>8.1f}x")
    print("\n  此列只比较理想 HBM 时间,并非完整模型训练或实际 kernel 加速上界。")
    print("  论文的端到端训练加速与此处单头 IO 模型口径不同,不能直接相比。")


if __name__ == "__main__":
    report_io()
    report_activation()
report_speed_limit()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""online softmax 的正确性与显存代价实测(FlashAttention 的核心那一步)。
对比两种实现:
naive —— 先算出完整的 N×N 分数矩阵 S,再逐行 softmax 得到 P,最后算 O = P V
flash —— 按块流过 K/V,只维护三个 O(N) 的运行量:输出累加器 O、分母 l、
运行最大值 m(第 03 节递推式的直接实现)
无dropout且同一掩码时两者在实数算术下等价;求和顺序、dtype及临时数组不同。
这份脚本回答三个问题:
1. 递推式写出来的结果,和朴素 softmax 数学等价、数值误差多大?(1.1 节)
2. 峰值内存真的差一个 N 吗?(用 tracemalloc 量,不是估的)
3. 那算力呢?——在 CPU + numpy 上速度由实际运行环境决定,这一点必须诚实讲清楚
只依赖 numpy。直接 `python flash_online_softmax.py` 即可运行。
"""
import time
import tracemalloc
import numpy as np
NEG = -np.inf
# ────────────────────────────────────────────────────────────
# 两个被测实现
# ────────────────────────────────────────────────────────────
def attention_naive(Q, K, V, causal=False):
"""标准实现:S 和 P 都是完整的 N×N 常驻张量。"""
D = Q.shape[-1]
S = (Q @ K.T) / np.sqrt(D) # [N, N] ← 第一块 N×N
if causal:
S = np.where(np.triu(np.ones((Q.shape[0], K.shape[0])), 1) > 0, NEG, S)
S -= S.max(axis=-1, keepdims=True) # safe softmax,不改变结果
P = np.exp(S) # [N, N] ← 第二块 N×N
P /= P.sum(axis=-1, keepdims=True)
return P @ V
def attention_flash(Q, K, V, B_r, B_c, causal=False, trace=False, key_valid=None):
"""等长单头自注意力;输入有限,float16提升到float32累加。
key_valid是一维key保留掩码;全遮行按本文约定返回零输出、LSE=-inf。
支持尾块,不实现dropout、GQA、非等长因果对齐或GPU kernel。
"""
Q, K, V = (np.asarray(x) for x in (Q, K, V))
if Q.ndim != 2 or Q.shape != K.shape or Q.shape != V.shape or min(Q.shape) <= 0:
raise ValueError("Q/K/V必须为相同非空[N,D]浮点矩阵")
if not all(np.issubdtype(x.dtype, np.floating) and np.isfinite(x).all() for x in (Q,K,V)):
raise ValueError("仅支持有限浮点输入")
if any(not isinstance(b, (int, np.integer)) or isinstance(b, bool) or b <= 0 for b in (B_r,B_c)):
raise ValueError("块大小必须为正整数")
N, D = Q.shape
dtype = np.result_type(Q.dtype, K.dtype, V.dtype, np.float32)
Q, K, V = (x.astype(dtype, copy=False) for x in (Q,K,V))
valid = np.ones(N, dtype=bool) if key_valid is None else np.asarray(key_valid)
if valid.shape != (N,) or valid.dtype != bool:
raise ValueError("key_valid必须为[N]布尔数组")
scale = 1.0 / np.sqrt(D)
O = np.zeros((N, D), dtype=dtype)
l = np.zeros(N, dtype=dtype)
m = np.full(N, NEG, dtype=dtype)
peak_tmp = 0
for j0 in range(0, N, B_c):
Kj, Vj = K[j0:j0+B_c], V[j0:j0+B_c]
for i0 in range(0, N, B_r):
i1 = min(i0+B_r, N)
if causal and i1 <= j0:
continue
Qi = Q[i0:i1]
Sij = (Qi @ Kj.T) * scale
if not np.isfinite(Sij).all():
raise ValueError("点积溢出;需缩小输入或使用更高精度")
keep = np.broadcast_to(valid[j0:j0+B_c], Sij.shape).copy()
if causal:
keep &= (j0+np.arange(Sij.shape[1]))[None,:] <= np.arange(i0,i1)[:,None]
Sij = np.where(keep, Sij, NEG)
peak_tmp = max(peak_tmp, Sij.size)
m_old = m[i0:i1]
m_new = np.maximum(m_old, Sij.max(axis=-1))
# 对全遮行不计算-inf-(-inf),避免np.where提前求值导致NaN/警告。
shifted = np.full_like(Sij, NEG)
np.subtract(Sij, m_new[:,None], out=shifted, where=np.isfinite(m_new)[:,None])
Pij = np.exp(shifted)
delta = np.full_like(m_old, NEG)
np.subtract(m_old, m_new, out=delta, where=np.isfinite(m_old))
corr = np.exp(delta)
l[i0:i1] = l_old = l[i0:i1] * corr + Pij.sum(axis=-1)
O[i0:i1] = O[i0:i1] * corr[:,None] + Pij @ Vj
m[i0:i1] = m_new
if trace:
print(f" j={j0:>2} i={i0:>2} m={m_new[0]:+.4f} l={l_old[0]:.4f} corr={corr[0]:.4f}")
out = np.zeros_like(O)
np.divide(O, l[:,None], out=out, where=l[:,None]>0)
LSE = np.full_like(l, NEG)
active = l>0
LSE[active] = m[active]+np.log(l[active])
return out, LSE, peak_tmp
def attention_backward(Q, K, V, G, B_r=64, B_c=64, causal=False, key_valid=None):
"""无dropout的分块反向:从O/LSE重算局部P,不存完整P。"""
O, LSE, _ = attention_flash(Q,K,V,B_r,B_c,causal=causal,key_valid=key_valid)
Q,K,V,G = (np.asarray(x,dtype=O.dtype) for x in (Q,K,V,G))
if G.shape != O.shape or not np.isfinite(G).all():
raise ValueError("G必须为有限[N,D]梯度")
N,D=Q.shape
valid=np.ones(N,dtype=bool) if key_valid is None else np.asarray(key_valid)
dQ,dK,dV = (np.zeros_like(x) for x in (Q,K,V))
row_delta=(G*O).sum(axis=-1)
for i0 in range(0,N,B_r):
i1=min(i0+B_r,N)
for j0 in range(0,N,B_c):
j1=min(j0+B_c,N)
keep=np.broadcast_to(valid[j0:j1],(i1-i0,j1-j0)).copy()
if causal:
keep &= np.arange(j0,j1)[None,:] <= np.arange(i0,i1)[:,None]
S=(Q[i0:i1]@K[j0:j1].T)/np.sqrt(D)
logP=np.full_like(S,NEG)
np.subtract(S,LSE[i0:i1,None],out=logP,where=keep & np.isfinite(LSE[i0:i1,None]))
P=np.exp(logP)
dP=G[i0:i1]@V[j0:j1].T
dS=P*(dP-row_delta[i0:i1,None])
dQ[i0:i1] += dS@K[j0:j1]/np.sqrt(D)
dK[j0:j1] += dS.T@Q[i0:i1]/np.sqrt(D)
dV[j0:j1] += P.T@G[i0:i1]
return dQ,dK,dV
def peak_bytes(fn, *args, **kwargs):
"""跑一次 fn,返回 (结果, 峰值字节数)。用 tracemalloc 实测。"""
tracemalloc.start()
tracemalloc.reset_peak()
out = fn(*args, **kwargs)
_, peak = tracemalloc.get_traced_memory()
tracemalloc.stop()
return out, peak
def timed(fn, *args, repeat=5, **kwargs):
durations = []
fn(*args, **kwargs) # 预热一次,不计入统计
out = None
for _ in range(repeat):
t0 = time.perf_counter()
out = fn(*args, **kwargs)
durations.append(time.perf_counter() - t0)
return out, float(np.median(durations))
# ────────────────────────────────────────────────────────────
# 1. 递推式长什么样:一个能逐块打印的最小例子
# ────────────────────────────────────────────────────────────
def demo_recurrence():
rng = np.random.default_rng(0)
N, D, B_c = 8, 4, 2
Q = rng.normal(size=(N, D))
K = rng.normal(size=(N, D))
V = rng.normal(size=(N, D))
print("=" * 68)
print("1. online softmax 的递推过程(N=8, D=4, K/V 块大小 B_c=2)")
print("=" * 68)
print(" Q 块固定为整行(B_r=N),K/V 分成 4 块依次流过;")
print(" 每个K/V块打印第 0 号 query 的 m / l / corr,看它们怎么被逐次修正:\n")
_, _, peak = attention_flash(Q, K, V, B_r=N, B_c=B_c, trace=True)
print(f"\n 最大的单个临时矩阵只有 {peak} 个元素(并非临时内存总和) = [{N}, {B_c}],而 N×N = {N * N}")
# ────────────────────────────────────────────────────────────
# 2. 等价性:和朴素 softmax 逐位对得上吗
# ────────────────────────────────────────────────────────────
def demo_exactness():
print("\n" + "=" * 68)
print("2. 数值等价性(float64,非因果 / 因果两种掩码)")
print("=" * 68)
print(f"{'N':>6} {'D':>4} {'causal':>7} {'最大绝对误差':>14} {'相对误差':>12}")
for N in (256, 1024, 2048, 4096):
D = 64
rng = np.random.default_rng(N)
Q = rng.normal(size=(N, D))
K = rng.normal(size=(N, D))
V = rng.normal(size=(N, D))
for causal in (False, True):
ref = attention_naive(Q, K, V, causal)
got, _, _ = attention_flash(Q, K, V, B_r=64, B_c=64, causal=causal)
diff = np.abs(ref - got).max()
rel = diff / np.abs(ref).max()
print(f"{N:>6} {D:>4} {str(causal):>7} {diff:>14.3e} {rel:>12.3e}")
print("\n 误差量级是浮点舍入(1e-15),不是近似——FlashAttention 是精确算法。")
# ────────────────────────────────────────────────────────────
# 3. 峰值内存:是不是真的差一个 N
# ────────────────────────────────────────────────────────────
def demo_memory():
print("\n" + "=" * 68)
print("3. 峰值内存实测(tracemalloc,float64,D=64,B_r=B_c=64)")
print("=" * 68)
print(f"{'N':>6} {'naive 实测':>12} {'naive 理论 2N²·8':>18} "
f"{'flash 实测':>12} {'比值':>8}")
peaks = {}
for N in (1024, 2048, 4096, 8192):
D = 64
rng = np.random.default_rng(N)
Q = rng.normal(size=(N, D))
K = rng.normal(size=(N, D))
V = rng.normal(size=(N, D))
_, p_naive = peak_bytes(attention_naive, Q, K, V)
_, p_flash = peak_bytes(attention_flash, Q, K, V, 64, 64)
peaks[N] = (p_naive, p_flash)
print(f"{N:>6} {p_naive / 2**20:>10.1f} MiB "
f"{2 * N * N * 8 / 2**20:>16.1f} MiB "
f"{p_flash / 2**20:>10.1f} MiB {p_naive / p_flash:>7.1f}x")
g_n = peaks[8192][0] / peaks[4096][0]
g_f = peaks[8192][1] / peaks[4096][1]
print(f"\n N 从 4096 翻到 8192:naive 峰值 ×{g_n:.1f},flash 峰值 ×{g_f:.1f}")
print(" 这就是 O(N²) 和 O(N) 的区别:前者翻两倍(4×),后者跟着翻倍(2×)。")
print(" 朴素实现要同时留住 S 和 P 两个 N×N(理论列就是 2N²·8 字节,和实测对得上);")
print(" flash 只留 B_r×B_c 的块,剩下的是 O(N·D) 的输出累加器。")
# ────────────────────────────────────────────────────────────
# 4. 时间:CPU教学循环的实际耗时
# ────────────────────────────────────────────────────────────
def demo_time():
print("\n" + "=" * 68)
print("4. 墙钟时间(CPU + numpy,线程配置以运行环境为准;预热1次+5次中位数)——反直觉的一项是这个")
print("=" * 68)
print(f"{'N':>6} {'naive':>10} {'flash(B=64)':>13} {'flash/naive':>12}")
for N in (1024, 2048, 4096):
D = 64
rng = np.random.default_rng(N)
Q = rng.normal(size=(N, D))
K = rng.normal(size=(N, D))
V = rng.normal(size=(N, D))
_, t_naive = timed(attention_naive, Q, K, V)
_, t_flash = timed(attention_flash, Q, K, V, 64, 64)
print(f"{N:>6} {t_naive * 1e3:>9.1f} ms {t_flash * 1e3:>12.1f} ms "
f"{t_flash / t_naive:>11.1f}x")
print("\n 以上比值是本机本次计时,不能据此预测 GPU;可能影响速度的因素包括:")
print(" 1. 乘加次数一模一样,还额外多了每块的 rescale 和逐元素 exp;")
print(" 2. 一次大矩阵乘被拆成 (N/B)² 次 64×64 的小矩阵乘,")
print(" BLAS 在小块上根本跑不满,Python 循环开销也进来了;")
print(" 3. 最关键的:它省的是**内存搬运**,不是 FLOPs,")
print(" CPU 同样有 SRAM 缓存,但本示例没有专门优化缓存和线程,")
print(" 因此分块可能省容量,却被 Python 循环与小 GEMM 开销抵消。")
print(" 第 05 节讲GPU实现如何优化IO与调度,本文不实测GPU性能。")
# ────────────────────────────────────────────────────────────
# 5. 因果掩码:统计本实现跳过的全遮块比例
# ────────────────────────────────────────────────────────────
def demo_causal_blocks():
print("\n" + "=" * 68)
print("5. 因果掩码下实际算了多少块(N=4096, B_r=B_c=64)")
print("=" * 68)
N, B = 4096, 64
T_r = T_c = N // B
total = 0
for j in range(T_c):
for i in range(T_r):
if i * B + B <= j * B: # 整个 Q 块都在 K 块之前 → 全遮,跳过
continue
total += 1
print(f" 块总数(非因果) : {T_r * T_c}")
print(f" 块总数(因果跳过): {total}")
print(f" 跳过的块占比 : {100.0 * (1 - total / (T_r * T_c)):.1f}%")
print("\n 朴素实现就算加了因果掩码,N×N 的矩阵照样得整块算完再遮,")
print(" 本脚本朴素路径不跳块;flash省去全遮块,但并非精确减半(严格说是")
print(" (T²+T)/2 / T² ≈ 一半多一点的对角块保留)。")
if __name__ == "__main__":
np.set_printoptions(precision=4, suppress=True)
demo_recurrence()
demo_exactness()
demo_memory()
demo_time()
demo_causal_blocks()"""CPU数学对拍与反例;依赖numpy和torch。与GPU速度复现无关。"""
import inspect
import json
from pathlib import Path
import numpy as np
import torch
from torch.nn import functional as F
from torch.nn.attention import sdpa_kernel, SDPBackend
from flash_online_softmax import attention_flash, attention_backward
def main():
torch.set_num_threads(1)
rng=np.random.default_rng(42)
rows=[];grad_errors=[]
for N in (1,7,17):
D=5
for dtype in (np.float64,np.float32,np.float16):
Q,K,V=(rng.normal(size=(N,D)).astype(dtype) for _ in range(3))
for causal in (False,True):
for masked in (False,True):
valid=np.ones(N,dtype=bool)
if masked: valid[:min(3,N)]=False
keep=np.broadcast_to(valid,(N,N)).copy()
if causal: keep &= np.arange(N)[None,:] <= np.arange(N)[:,None]
# Math后端、float64参考用于隔离输入量化和分块舍入。
ts=[torch.tensor(x.astype(np.float64)[None,None],requires_grad=True) for x in (Q,K,V)]
with sdpa_kernel(SDPBackend.MATH):
ref=F.scaled_dot_product_attention(*ts,attn_mask=torch.tensor(keep),dropout_p=0.0)
G=rng.normal(size=(N,D));expected=torch.autograd.grad((ref*torch.tensor(G[None,None])).sum(),ts)
for br,bc in ((1,1),(3,2),(8,11)):
out,lse,_=attention_flash(Q,K,V,br,bc,causal=causal,key_valid=valid)
error=float(np.max(np.abs(out-ref.detach().numpy()[0,0])))
assert error < (2e-12 if dtype==np.float64 else 2e-6)
assert np.all(out[~keep.any(-1)]==0) and np.isneginf(lse[~keep.any(-1)]).all()
rows.append(dict(N=N,dtype=str(np.dtype(dtype)),causal=causal,masked=masked,block=[br,bc],max_abs=error))
if dtype==np.float64:
gs=attention_backward(Q,K,V,G,br,bc,causal=causal,key_valid=valid)
err=max(float(np.max(np.abs(g-e.numpy()[0,0]))) for g,e in zip(gs,expected))
assert err<2e-12;grad_errors.append(err)
Q,K,V=(rng.normal(size=(7,5)) for _ in range(3));G=rng.normal(size=(7,5));valid=np.array([False,False,True,True,False,True,True])
grads=attention_backward(Q,K,V,G,3,2,causal=True,key_valid=valid)
fd_errors=[];step=1e-5
for x,g in zip((Q,K,V),grads):
for idx in np.ndindex(x.shape):
old=x[idx];x[idx]=old+step;plus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G)
x[idx]=old-step;minus=np.sum(attention_flash(Q,K,V,3,2,causal=True,key_valid=valid)[0]*G);x[idx]=old
fd_errors.append(abs((plus-minus)/(2*step)-g[idx]))
assert max(fd_errors)<1e-8
# 仅为展示错误:删除rescale,其他代码保持一致。不要用于计算正确注意力。
src=inspect.getsource(attention_flash).replace('corr = np.exp(delta)','corr = np.ones_like(delta)')
ns=dict(np=np,NEG=-np.inf);exec(src,ns)
rng=np.random.default_rng(1024);Q,K,V=(rng.normal(size=(1024,64)) for _ in range(3))
correct=attention_flash(Q,K,V,64,64)[0];bad=ns['attention_flash'](Q,K,V,64,64)[0];diff=np.abs(correct-bad)
res=dict(passed=True,environment=dict(torch=torch.__version__,numpy=np.__version__,device='CPU',threads=1),forward_cases=rows,
forward_max_abs=max(x['max_abs'] for x in rows),autograd_max_abs=max(grad_errors),finite_difference_parameters=len(fd_errors),finite_difference_max_abs=max(fd_errors),
broken_rescale=dict(seed=1024,N=1024,D=64,max_abs=float(diff.max()),mean_abs=float(diff.mean())),errors=[],warnings=[])
Path(__file__).with_name('validation_results.json').write_text(json.dumps(res,indent=2),encoding='utf8')
print(json.dumps({k:v for k,v in res.items() if k!='forward_cases'},indent=2))
if __name__=='__main__':
with np.errstate(all='raise'): main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「FlashAttention」的三张解释图。
数值全部来自同目录下的 io_ledger.py(HBM 读写量、激活显存、算术强度),
改了那个脚本的话这里要跟着重跑,避免图与正文数字不一致。
三张图分别回答:
1. tiling 到底怎么切、什么留在 SRAM、什么留在 HBM
2. 两本账随 N 怎么长(HBM 读写量、教学激活存储模型)
3. 为什么说是「内存受限」变的「不那么受限」(算术强度对机器平衡点)
只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。
"""
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import FancyArrowPatch, FancyBboxPatch, Rectangle
from io_ledger import (
FLOPS_PEAK, HBM_BW,
activation_bytes, block_sizes, flops_attention,
hbm_elems_flash, hbm_elems_naive,
)
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
})
C_NAIVE = "#e05263" # 朴素实现:红
C_FLASH = "#2f9e6f" # FlashAttention:绿
C_SRAM = "#f0a03c" # SRAM 高亮:橙
C_GREY = "#94a3b8"
C_SKIP = "#e4e9f0"
INK = "#182238"
MIB = 1024 ** 2
GIB = 1024 ** 3
def _style(ax, title, xlabel=None, ylabel=None):
ax.set_title(title, fontsize=13.5, weight="bold", color=INK, pad=10)
if xlabel:
ax.set_xlabel(xlabel, fontsize=11, color="#475569")
if ylabel:
ax.set_ylabel(ylabel, fontsize=11, color="#475569")
ax.tick_params(colors="#475569", labelsize=10)
for s in ("top", "right"):
ax.spines[s].set_visible(False)
for s in ("left", "bottom"):
ax.spines[s].set_color("#cbd5e1")
ax.set_axisbelow(True)
def _box(ax, x, y, w, h, text, fc, fs=10.5, tc="white"):
ax.add_patch(FancyBboxPatch(
(x, y), w, h, boxstyle="round,pad=0.02,rounding_size=0.12",
linewidth=0, facecolor=fc, edgecolor="none"))
ax.text(x + w / 2, y + h / 2, text, ha="center", va="center",
fontsize=fs, color=tc, weight="bold", linespacing=1.5)
def _arrow(ax, x1, y1, x2, y2, label=None, color="#475569"):
ax.add_patch(FancyArrowPatch(
(x1, y1), (x2, y2), arrowstyle="-|>", mutation_scale=13,
linewidth=1.4, color=color, shrinkA=2, shrinkB=2))
if label:
ax.text((x1 + x2) / 2, max(y1, y2) + 0.22, label, ha="center",
fontsize=9, color=color)
def _caption(fig, text):
fig.text(0.5, 0.012, text, ha="center", fontsize=9.5, color="#94a3b8")
# ────────────────────────────────────────────────────────────
# 图 1:tiling 怎么切
# ────────────────────────────────────────────────────────────
def fig_tiling():
fig = plt.figure(figsize=(13.6, 6.0), facecolor="#fbfcfe")
# ── 左:朴素实现 ──
ax = fig.add_axes([0.03, 0.09, 0.46, 0.80])
ax.set_xlim(0, 10); ax.set_ylim(0, 7.4); ax.axis("off")
ax.text(0, 7.05, "本例朴素前向:物化 S 与 P", fontsize=13.5,
weight="bold", color=C_NAIVE)
_box(ax, 0.1, 5.1, 1.5, 1.1, "Q, K, V\n[N, d]", "#64748b", fs=10)
_box(ax, 2.4, 4.8, 2.0, 1.7, "S = QK^T / √d\n[N, N]", C_NAIVE, fs=11)
_box(ax, 5.3, 4.8, 2.0, 1.7, "P = softmax(S)\n[N, N]", C_NAIVE, fs=11)
_box(ax, 8.2, 5.1, 1.6, 1.1, "O = PV\n[N, d]", "#64748b", fs=10)
_arrow(ax, 1.65, 5.65, 2.35, 5.65)
_arrow(ax, 4.45, 5.65, 5.25, 5.65, "读 S 写 P")
_arrow(ax, 7.35, 5.65, 8.15, 5.65, "读 P")
ax.text(4.4, 4.25, "N=4096, d=64, fp16:S 和 P 各 32 MiB",
ha="center", fontsize=9.5, color="#475569")
ax.add_patch(Rectangle((0.1, 2.2), 9.7, 1.35, facecolor="#eef2f7",
edgecolor="#cbd5e1", linewidth=1.2))
ax.text(4.95, 3.2, "HBM 带宽 1.5 TB/s", ha="center", fontsize=10.5,
color="#475569", weight="bold")
ax.text(4.95, 2.5, "S 写一次读一次,P 写一次读一次 → 简化计数 4N² 次元素搬运",
ha="center", fontsize=9.5, color="#64748b")
_arrow(ax, 3.4, 4.75, 3.4, 3.6, color=C_NAIVE)
_arrow(ax, 6.3, 4.75, 6.3, 3.6, color=C_NAIVE)
ax.text(0.1, 1.35, "代价:数据在这条通道上来回两趟,",
fontsize=10.5, color=C_NAIVE, weight="bold")
ax.text(0.1, 0.75, "表中带宽数量级不同,非延迟之比", fontsize=10.5,
color=C_NAIVE, weight="bold")
# ── 右:FlashAttention ──
ax2 = fig.add_axes([0.53, 0.09, 0.44, 0.80])
ax2.set_xlim(0, 10); ax2.set_ylim(0, 7.4); ax2.axis("off")
ax2.text(0, 7.05, "FlashAttention:按块流过,只留 O(N)",
fontsize=13.5, weight="bold", color=C_FLASH)
T = 8
gx0, gy0, cell = 1.05, 3.1, 0.46
for i in range(T):
for j in range(T):
if i + 1 <= j: # 因果掩码下整块跳过(先判,优先级最高)
fc, ec = C_SKIP, "#c3ccd8"
elif j == 3: # 当前正在处理的 K/V 块列
fc, ec = "#cdeadb", C_SRAM
elif i == 5: # 当前 Q 块行
fc, ec = "#dfeaf6", "#94a3b8"
else:
fc, ec = "#f7fafc", "#dde3ea"
ax2.add_patch(Rectangle(
(gx0 + j * cell, gy0 + (T - 1 - i) * cell),
cell * 0.90, cell * 0.90,
facecolor=fc, edgecolor=ec, linewidth=1.1))
gtop = gy0 + T * cell
ax2.text(gx0 - 0.42, gy0 + T * cell / 2, "Q 块逐行流过",
fontsize=9.5, color="#475569", ha="center", va="center",
rotation=90)
ax2.add_patch(FancyBboxPatch(
(gx0 + 3 * cell - 0.06, gy0 - 0.06), cell * 1.02, T * cell + 0.12,
boxstyle="round,pad=0.03,rounding_size=0.1",
linewidth=1.6, edgecolor=C_SRAM, facecolor="none", linestyle="--"))
ax2.text(gx0 + 3.5 * cell, gy0 - 0.42, "K_j, V_j 常驻 SRAM",
ha="center", fontsize=9.5, color=C_SRAM, weight="bold")
ax2.text(gx0 + T * cell + 0.45, gtop - 0.35, "一块 = [B_r, B_c]\n= [64, 64]",
fontsize=9.5, color="#475569", va="top", linespacing=1.5)
ax2.text(gx0 + T * cell + 0.45, gtop - 1.55,
"灰色块:因果掩码下\n整块跳过,连算都不算",
fontsize=9, color="#94a3b8", va="top", linespacing=1.5)
ax2.text(gx0 + T * cell + 0.45, gtop - 2.95,
"片上空间受限:\n驻留 K/V 与 Q/O 块,\n还要容纳分数和统计量",
fontsize=9, color=C_SRAM, va="top", linespacing=1.5)
by = 1.85
ax2.text(0.15, by + 0.52, "跨 K/V 块一直复用的三个量:", fontsize=10.5,
color=INK, weight="bold")
for k, (label, color) in enumerate([
("O_i 未归一化累加器 [N, d]", C_FLASH),
("l_i 分母 [N]", "#7fb3d5"),
("m_i 运行最大值 [N]", "#c9a227")]):
ax2.add_patch(Rectangle((0.15, by - k * 0.46), 4.6, 0.28,
facecolor=color, edgecolor="none"))
ax2.text(4.9, by - k * 0.46 + 0.14, label, fontsize=9.5,
color="#475569", va="center")
ax2.text(0.15, 0.12, "每来一块就 rescale 一次(乘 e^{m旧−m新}),最后 O/l 收尾",
fontsize=9.5, color="#64748b")
_caption(fig, "图 1:切的是「K/V 块 × Q 块」这两层循环,不是把注意力切开。"
"左边突出两份二次中间量,右边只维护线性的累加量(固定 d)。")
fig.savefig(OUT / "tiling.png", facecolor="#fbfcfe")
plt.close(fig)
print(" figures/tiling.png")
# ────────────────────────────────────────────────────────────
# 图 2:两本账随 N 怎么长
# ────────────────────────────────────────────────────────────
def fig_curves():
d, b = 64, 2
B_r, B_c = block_sizes(d)
Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768])
naive_io = np.array([hbm_elems_naive(N, d) * b for N in Ns]) / MIB
flash_io = np.array([hbm_elems_flash(N, d, B_r, B_c) * b for N in Ns]) / MIB
fig, axes = plt.subplots(1, 2, figsize=(13.2, 5.1), facecolor="#fbfcfe")
fig.subplots_adjust(bottom=0.20, top=0.86, wspace=0.25)
ax = axes[0]
ax.loglog(Ns, naive_io, "o-", color=C_NAIVE, lw=2.2, ms=6,
label="朴素实现(∝N²)")
ax.loglog(Ns, flash_io, "s-", color=C_FLASH, lw=2.2, ms=6,
label="FlashAttention(∝N²/M)")
ax.annotate(f"{naive_io[2] / flash_io[2]:.1f}×",
xy=(Ns[2], naive_io[2]), xytext=(Ns[2] * 1.6, naive_io[2] * 3.0),
fontsize=11, color=C_NAIVE, weight="bold",
arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3))
ax.legend(fontsize=10, frameon=False, loc="upper left")
ax.grid(True, which="both", color="#eef2f7", lw=0.9)
_style(ax, "HBM 读写量(单头 d=64, fp16)", "序列长度 N", "MiB")
ax = axes[1]
d2, H, B = 3072, 24, 1
lay = 32
naive_act = np.array(
[activation_bytes(N, d2, H, B)[0] * lay for N in Ns]) / GIB
flash_act = np.array(
[activation_bytes(N, d2, H, B)[1] * lay for N in Ns]) / GIB
ax.loglog(Ns, naive_act, "o-", color=C_NAIVE, lw=2.2, ms=6,
label="朴素实现(∝N²)")
ax.loglog(Ns, flash_act, "s-", color=C_FLASH, lw=2.2, ms=6,
label="FlashAttention(∝N)")
ax.axhline(80, color="#64748b", ls="--", lw=1.4)
ax.text(Ns[0] * 1.15, 92, "示例预算:80 GiB(非硬件规格)", fontsize=9.5, color="#64748b")
ax.annotate("76.5 GiB", xy=(4096, naive_act[2]),
xytext=(4096 * 1.8, naive_act[2] * 2.2), fontsize=10.5,
color=C_NAIVE, weight="bold",
arrowprops=dict(arrowstyle="->", color=C_NAIVE, lw=1.3))
ax.annotate("4.5 GiB", xy=(4096, flash_act[2]),
xytext=(4096 * 0.55, flash_act[2] * 6.0), fontsize=10.5,
color=C_FLASH, weight="bold",
arrowprops=dict(arrowstyle="->", color=C_FLASH, lw=1.3))
ax.legend(fontsize=10, frameon=False, loc="upper left")
ax.grid(True, which="both", color="#eef2f7", lw=0.9)
_style(ax, "教学激活存储模型(简化视频 DiT,32 层)", "序列长度 N", "GiB")
_caption(fig, "图 2:两张都是对数轴,斜率就是复杂度阶数。"
"左图的大 N 主导项均为 N²,有限 N 时比例受线性项和取整影响;"
"右图斜率不同(N² 对 N),N 越大差距越离谱。")
fig.savefig(OUT / "io_curve.png", facecolor="#fbfcfe")
plt.close(fig)
print(" figures/io_curve.png")
# ────────────────────────────────────────────────────────────
# 图 3:算术强度 vs 机器平衡点
# ────────────────────────────────────────────────────────────
def fig_intensity():
d, b = 64, 2
B_r, B_c = block_sizes(d)
Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768])
naive_i = np.array([flops_attention(N, d) / (hbm_elems_naive(N, d) * b)
for N in Ns])
flash_i = np.array([flops_attention(N, d)
/ (hbm_elems_flash(N, d, B_r, B_c) * b) for N in Ns])
balance = FLOPS_PEAK / HBM_BW
fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe")
fig.subplots_adjust(bottom=0.22, top=0.86)
ax.axhspan(0, balance, color="#fdf1f2", zorder=0)
ax.axhline(balance, color="#64748b", ls="--", lw=1.6, zorder=3)
ax.text(Ns[-1] * 2.1, balance * 0.70,
f"机器平衡点 {balance:.0f} FLOP/byte\n(峰值算力 ÷ HBM 带宽)",
fontsize=10, color="#475569", va="center", linespacing=1.5)
ax.text(Ns[0] * 1.02, balance * 0.40,
"线下:本 roofline 模型由 HBM 项主导(实际瓶颈需测量)",
fontsize=10, color=C_NAIVE)
ax.text(Ns[0] * 1.02, balance * 1.32,
"线上:本模型计算项主导", fontsize=10, color=C_FLASH)
ax.semilogx(Ns, naive_i, "o-", color=C_NAIVE, lw=2.4, ms=7,
label="朴素实现", zorder=4)
ax.semilogx(Ns, flash_i, "s-", color=C_FLASH, lw=2.4, ms=7,
label="FlashAttention", zorder=4)
for x, v in zip(Ns, naive_i):
ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points",
xytext=(0, -16), ha="center", fontsize=9, color=C_NAIVE)
for x, v in zip(Ns, flash_i):
ax.annotate(f"{v:.0f}", (x, v), textcoords="offset points",
xytext=(0, 9), ha="center", fontsize=9, color=C_FLASH)
ax.set_xticks(Ns)
ax.set_xticklabels([f"{n // 1024}K" for n in Ns])
ax.set_xlim(Ns[0] * 0.75, Ns[-1] * 4.5)
ax.set_ylim(0, balance * 1.85)
ax.legend(fontsize=10.5, frameon=False, loc="center right")
ax.grid(axis="y", color="#eef2f7", lw=0.9)
_style(ax, "算术强度:每搬 1 字节能做多少次运算(单头 d=64, fp16)",
"序列长度 N", "FLOP / byte")
_caption(fig, "图 3:朴素实现的强度几乎不随 N 变(一直贴在 32 附近),"
"在此模型中由 HBM 项主导;FlashAttention 的估计抬过平衡点,"
"并不单独证明实际 kernel 已充分利用计算单元。")
fig.savefig(OUT / "intensity.png", facecolor="#fbfcfe")
plt.close(fig)
print(" figures/intensity.png")
if __name__ == "__main__":
print("生成配图:")
fig_tiling()
fig_curves()
fig_intensity()
评论 (0)