


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与位置编码 | 难度:入门 | 前置知识:无(这是知识树注意力方向的根节点)
关键词:自注意力、multi-head attention、QKV、复杂度、显存账本、缩放因子
先看一个真实会撞上的场景:你拿到一个约 3.62B 参数的简化 Transformer(批量 B=1、宽度 d=3072、头数 H=24、层数 L=32,权重和下面的教学张量均按 bf16 两字节),想在 1024×1024 的图生视频任务上训练,并保留各层激活供反向使用。VAE 八倍下采样、patch size 为 2 之后,单帧 latent 是 128×128、patch 网格是 64×64,单帧序列长度 N=4096(视频若联合多个潜帧,N 还要乘潜帧数)。模型权重 bf16 约 6.75 GiB,80 GB 的 A100/H100 看起来还装得下;但若用下面的显式中间量账本、无激活重算地保留 32 层,权重加注意力激活已经超过容量,还没算 FFN、梯度和优化器状态。这里是解释 OOM 风险的教学构造,不是某张 GPU 的峰值测量。
把账摊开看(怎么算出来的见第 03、04 节):一层注意力在 N=4096 时按下述教学账本计为 2.39 GiB 激活,32 层就是 76.5 GiB——是权重的 11 倍;这个乘法还假设这些层的相应中间量同时为反向传播保留。这说明只看权重大小无法判断是否 OOM;在这套训练存储假设下,激活已经超过预算,而且爆的是其中三个特定张量:分数矩阵、softmax 权重、浮点 dropout 乘子,各占 31.4%,三项合计吃掉单层激活的 94%。
按本文简化层结构,N=4096 时两个 N×N 矩阵乘只占整层前向 FLOPs 的 18.2%;它们与线性项之比在 N=18432 达到 1,只看 attention 投影则交叉点为 6144。这是运算量比例,不是运行时间比例;IO、kernel 形状与融合可能让 FLOPs 较少的部分反而更慢。
因此应同时记录 FLOPs、激活存储假设和实际时间线。N=32768 时,本文教学账本的一层存储为 145 GiB,二次项 FLOPs 占 64%;这些值用于理解增长趋势,不能替代实际框架的显存测量。
三句话讲完核心思想:
每个 token 经三组可学习的线性投影得到 Query、Key、Value;它们不是输入向量的三份原样拷贝。每个 token 再拿自己的 Query 和所有 token(包括自己)的 Key 做内积打分,分数过 softmax 变成权重,再对所有 Value 加权求和,得到这个 token 的新表示。权重由 Q/K、位置编码和掩码共同决定,输出内容还依赖 V。
计算和显存都分两笔:一笔随 N 线性(QKV 投影、输出投影、FFN),一笔随 N 二次(分数矩阵 S、softmax 权重 P、浮点 dropout 乘子各一份 B×H×N×N)。显存爆炸的几乎都是第二笔,这是显式保存中间量的教学实现假设;融合、重算或不使用 dropout 会改变这笔账。
「O(N²) 是瓶颈」有适用条件:二次项与线性项的比值是 N/(6d),占总量的比例是 N/(6d+N),N 小于 2d 时它连 attention 模块内部的一半都不到。在本例朴素存储方案下,N² 项先成为显存大头;实际耗时瓶颈仍需测量。
两 token 先走一遍。 暂取单头 D=1,某个 query 的数值为 1,两枚 key 分别为 1 和 0,两枚 value 分别为 10 和 0。缩放因子 √D=1,分数为 [1, 0],softmax 权重约 [0.731, 0.269],因此输出是 0.731×10+0.269×0≈7.31。若把两枚 key 都改成 1,分数同为 1,权重各 0.5,输出变成 5。这个反例说明:权重由 Q/K 的相对打分决定,而输出还取决于 V;注意力不是「把 Query 复制出来」,也不是看单个分数的绝对大小。
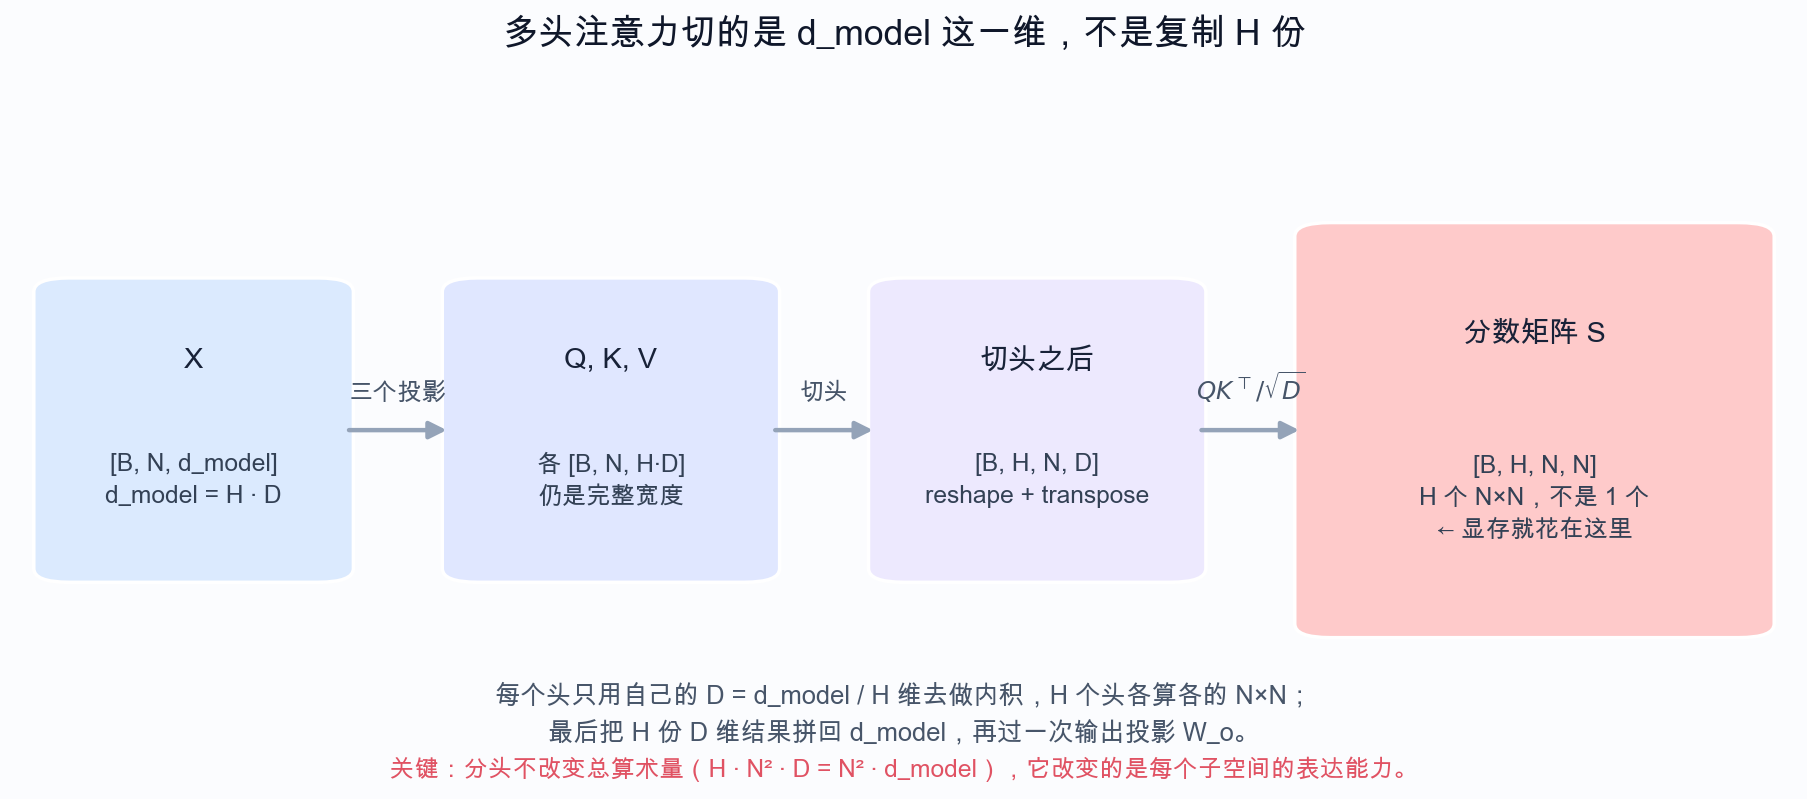
这张图要看什么:多头切的是 d_model 这个维度(H·D 拆成 H 份),不是把注意力复制 H 份;切分本身零算术开销,但分数矩阵从 1 个 N×N 变成 H 个 N×N,显存乘上 H。
设输入序列 $X \in \mathbb{R}^{N \times d}$,N 是 token 数,d 是每个 token 的向量维度(d_model)。三个投影矩阵 $W_q, W_k, W_v \in \mathbb{R}^{d \times d}$ 把每个 token 映射成查询、键、值:
$$Q = X W_q, \quad K = X W_k, \quad V = X W_v$$
每个 token 的 Query 要和所有 token 的 Key 算相似度,写成矩阵形式就是一次 $N \times D$ 对 $D \times N$ 的矩阵乘,得到分数矩阵 $S \in \mathbb{R}^{N \times N}$,其中 $S_{ij}$ 是第 i 个 token 对第 j 个 token 的打分:
$$S = \frac{Q K^{\top}}{\sqrt{D}}$$
本小节是单头,H=1、D=d,所以 Q/K/V 都是 N×D;下一小节切成 H 头后才有 D=d/H。除以 $\sqrt{D}$ 不是装饰,推导一下就知道:为解释尺度,暂假设每个坐标上的 $q_i$ 与 $k_i$ 相互独立、均值为 0、方差为 1,而且不同坐标的乘积不相关,那么点积的方差是
$$\mathrm{Var}(q \cdot k) = \sum_{i=1}^{D} \mathrm{Var}(q_i k_i) = D$$
点积的标准差随 $\sqrt{D}$ 线性增长。D=128 时分数的摆动幅度是 D=1 的 11 倍,softmax 拿到这么大的输入会直接饱和:最大的那个分数吃掉几乎全部权重,输出逼近 one-hot。接近 one-hot 时,softmax Jacobian 的多数项会很小;有限 logits 的精确 softmax 通常并非严格 one-hot,浮点舍入可能进一步使梯度消失。在这些假设下,除以 $\sqrt{D}$ 把分数方差归一回 1。训练后的 Q/K 未必满足独立与单位方差,同一 token 的 Q 与 K 也可能相关,所以这不是对所有模型 logits 的精确分布定理;它是控制初始化时维度增长效应的动机。第 04 节 D 从 8 扫到 256 的随机实验只检验这个动机。
分数过 softmax 变成权重(每行归一化,行内竞争):
$$P_{ij} = \frac{\exp(S_{ij})}{\sum_{j'} \exp(S_{ij'})}$$
最后对 Value 加权求和得到输出 $O = P V$,形状和输入一样是 $N \times d$。工程实现里 softmax 前要先减去每行最大值再取指数,防止 $\exp$ 上溢——这不改变结果,因为分子分母同乘了一个常数。
把 d 维切成 H 段,每段 D = d/H 维当作一个独立的「头」,各算各的注意力,最后拼回来过一个输出投影:
$$\mathrm{MHA}(X) = \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_H)\, W_o, \qquad \mathrm{head}_h = \mathrm{softmax}\!\left(\frac{Q_h K_h^{\top}}{\sqrt{D}}\right) V_h$$
$Q_h$ 是 $Q$ 的第 h 段 D 列。两个常被搞错的点:
一层 transformer 的前向 FLOPs(一次 $[M,K] \times [K,N]$ 矩阵乘算 $2MKN$ 个浮点运算):
线性项合计 $24 N d^2$,二次项是 $4 N^2 d$,比值等于 $N / (6d)$。令比值等于 1:
$$4 N^2 d = 24 N d^2 \quad \Longrightarrow \quad N^{\star} = 6d$$
d=3072 时 $N^{\star} = 18432$。如果只看 attention 模块内部(4 个投影对 2 个 N×N 乘),交叉点是 $N^{\star} = 2d = 6144$。你日常跑的 N=4096 在两条线之下——二次项占整层算力 18.2%,占模块内 40.0%。
下面采用一个刻意显式的教学分配模型:B 是批量、H 是头数、N 是 token 数、d 是总通道宽度;同时计入 X/Q/K/V/ctx/O,以及 S、P 和一份浮点 dropout 乘子,全部按 bf16 两字节估算。它只数某一层注意力中指定张量的字节总和,不是框架峰值,也不是反向传播的最低存储要求;未计权重、梯度、优化器、FFN、临时工作区及分配器开销。bool mask 通常只占一字节,dropout=0 时可省掉该项,S 也通常不必与 P 同时保留。
$$\text{单层激活} \approx 6 B N d \cdot 2 + 3 B H N^2 \cdot 2 \;\; \text{字节}$$
两笔相等解得 $N^{\star} = 2d/H$,d=3072、H=24 时 *N=256**——序列长度刚过几百,显存就已经被 N² 项主导了。算力和显存的交叉点差 72 倍(18432 对 256),这就是「算力瓶颈来得晚、显存瓶颈来得早」的定量出处。
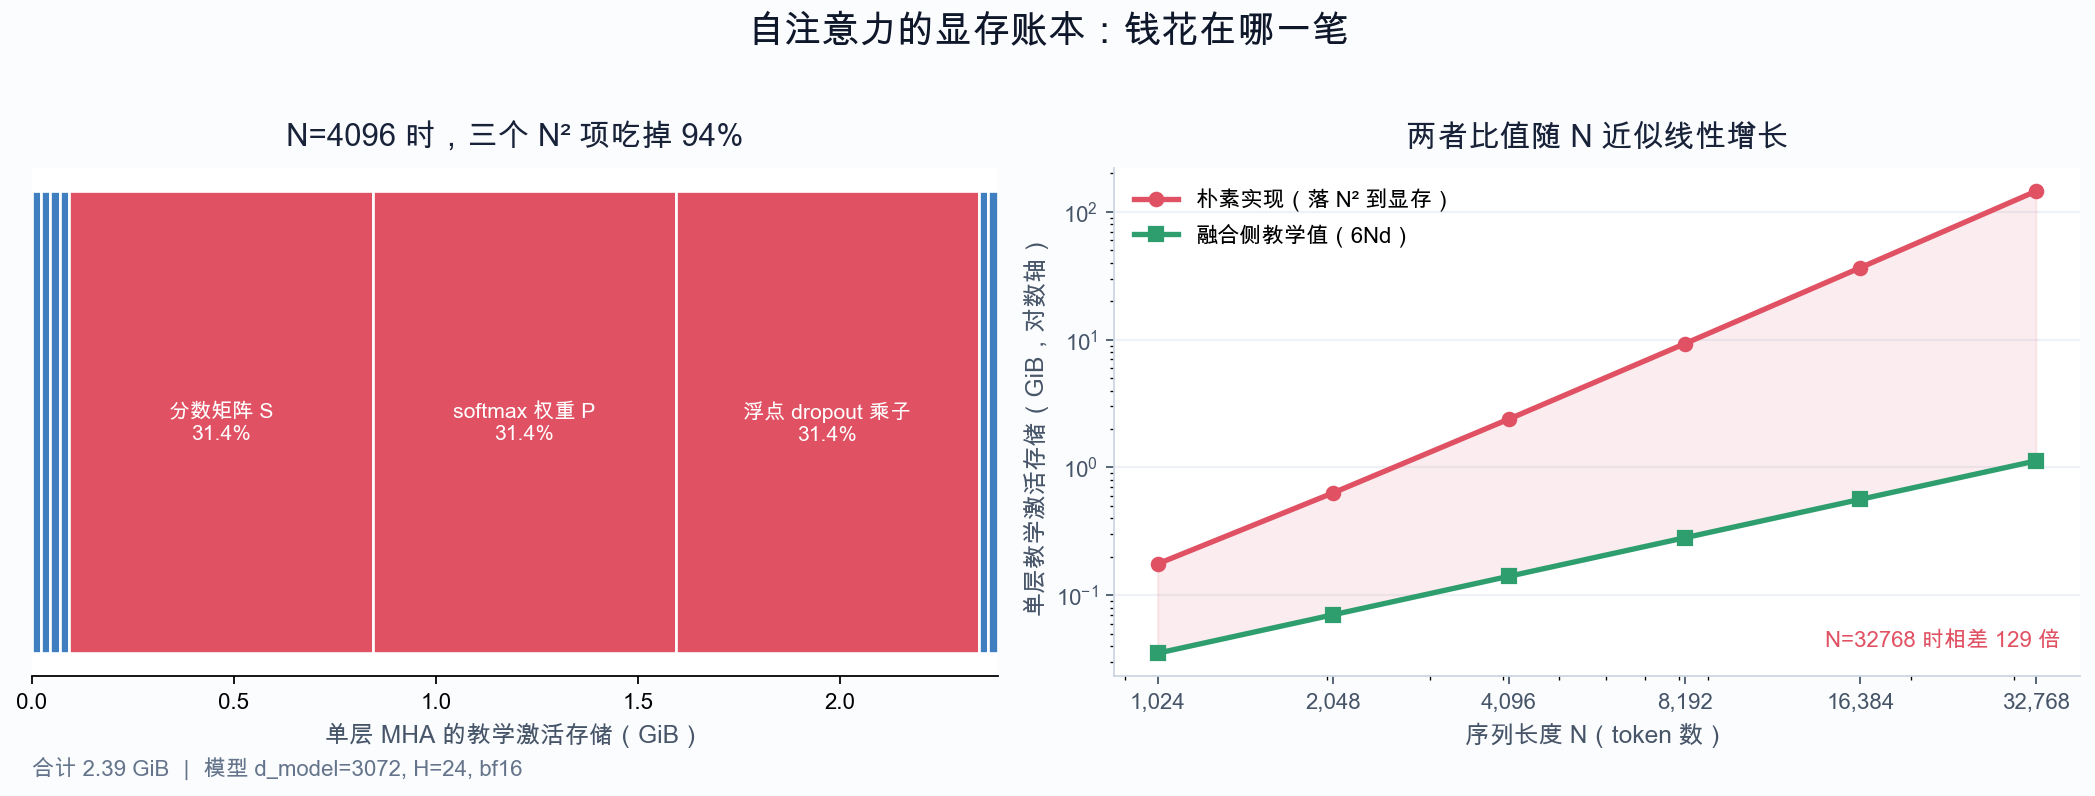
这张图要看什么:左边 N=4096 的堆叠条里红色三个格子(S、P、浮点 dropout 乘子)占 94%,线性项挤在边上几乎看不见;右边是对数轴,两条教学模型的比值随 N 近似线性增长,N=32768 时为 129 倍。融合侧统一按六份线性张量 6BNd·bytes 计,忽略小的 LSE 与内核工作区;这不是具体框架的峰值比。
完整脚本在文末附录(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py),只依赖 numpy。下面按执行顺序拆核心片段。形状、随机种子下的数值及静态账本已用附录脚本复跑;CPU 耗时随机器和运行条件变化,后面的表保留原稿 Linux 环境的一次样例,并给出本次复跑作对照。
def mha(X, W_q, W_k, W_v, W_o, H, causal=False):
    B, N, d_model = X.shape
    D = d_model // H
    Q = split_heads(X @ W_q, H)                     # [B, H, N, D]
    K = split_heads(X @ W_k, H)                     # [B, H, N, D]
    V = split_heads(X @ W_v, H)                     # [B, H, N, D]
    S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D)    # [B, H, N, N]
    if causal:
        mask = np.triu(np.ones((N, N), dtype=bool), k=1)
        S = np.where(mask, -np.inf, S)
    P = softmax(S, axis=-1)                         # [B, H, N, N]
    return merge_heads(P @ V) @ W_o, P              # [B, N, d_model]
切头函数值得单独看一眼——对这里连续的输入,它是 reshape 加 transpose 的视图变换;非连续输入的 reshape 可能触发拷贝:
def split_heads(t, H):
    B, N, d_model = t.shape
    D = d_model // H
    return t.reshape(B, N, H, D).transpose(0, 2, 1, 3)
配置 B=2、N=8、d_model=32、H=4 时各张量的真实形状:
[1] 各张量形状
    X      (2, 8, 32)   输入
    Q/K/V  (2, 4, 8, 8)   切头后 [B, H, N, D]
    S      (2, 4, 8, 8)   分数矩阵,N×N 是显存爆炸的源头
O (2, 8, 32) 输出,和输入同形脚本跑出来的校验结果:
[3] 性质校验
    (a) 权重行和为 1        : max|sum(P)-1| = 2.22e-16
    (b) 向量化 vs 四重循环   : max|O - O_loop| = 2.22e-16   allclose=True
    (c) 因果掩码上三角全 0   : max = 0.00e+00
        且下三角行和仍为 1   : max|sum-1| = 2.22e-16
    (d) 各头权重并不相同     : 头 0 与 H 头平均的平均绝对差 = 0.0223
        头之间的平均离散度   : 0.0206(0 表示所有头完全一样)
(b) 是最值得做的一次校验:把公式照定义抄成四重循环(一个 token 一个 token 地打分、归一、加权),结果和向量化版本在浮点精度内完全一致。下标搞反、transpose 方向写错这类 bug,靠肉眼很难发现,靠一个慢十倍但显然正确的对照实现能当场抓住。
D 扫描表(固定 scale=1,看 softmax 最大权重):
    固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变:
        D    分数标准差   最大权重(未缩放)   最大权重(缩放后)
         8      2.8587           0.9089            0.2711
        16      3.9246           0.9970            0.1718
        32      5.6569           1.0000            0.2427
        64      8.0203           1.0000            0.1547
       128     11.3903           1.0000            0.1322
       256     16.0367           1.0000            0.1619
和 3.1 节的推导对上了:分数标准差就是 $\sqrt{D}$(2.8587 ≈ √8,16.0367 ≈ √256)。本次随机样本在 D=16 时最大权重为 0.9970,之后若干行四舍五入显示 1.0000;这说明可能接近饱和,不能证明所有 token 的梯度严格为零。缩放后最大权重回落到 0.13~0.27,分布活着。另外注意主配置(D=8)下的对比:未缩放最大权重 0.5948,缩放后 0.2589——D 小的时候不缩放也能活,缩放用于控制点积随维度增长的方差;这组随机样本不构成某个 D 阈值的通用结论。
attention_memory.py 在 d_model=3072、H=24、B=1、bf16 下逐项清点:
[1] 逐项账本  B=1  N=4096  bf16(2 字节)
    分数矩阵 S          [B, H, N, N]        805,306,368    31.4%
    softmax 权重 P      [B, H, N, N]        805,306,368    31.4%
    浮点 dropout 乘子        [B, H, N, N]        805,306,368    31.4%
    输入 X / Q / K / V / ctx / O            各 25,165,824     1.0%
    合计                                    2,566,914,048       2.39 GiB
    → N² 项共     2.25 GiB,线性项共   144.00 MiB,N² 项占 94.1%
随 N 的增长(一层,不含 FFN):
[2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子)
          N         线性项        N² 项          合计    融合侧教学值   倍数
       1024   36.00 MiB  144.00 MiB  180.00 MiB         36.00 MiB     5.0x
       2048   72.00 MiB  576.00 MiB  648.00 MiB         72.00 MiB     9.0x
       4096  144.00 MiB    2.25 GiB    2.39 GiB        144.00 MiB    17.0x
       8192  288.00 MiB    9.00 GiB    9.28 GiB        288.00 MiB    33.0x
      16384  576.00 MiB   36.00 GiB   36.56 GiB        576.00 MiB    65.0x
      32768    1.12 GiB  144.00 GiB  145.12 GiB        1.12 GiB   129.0x
若训练时按同一教学假设保留每层中间量,且不做重算,才可再乘层数:L=32 层时,N=2048 的激活是 20.25 GiB(权重的 3.0 倍),N=8192 是 297 GiB(权重的 44 倍)。推理时不应把当前层临时激活直接乘 L;需要缓存历史的自回归推理另计 KV cache 随 N 和并发数 B 都线性涨:B=32、N=32768、L=80 时光 KV cache 就要 960 GiB,这就是为什么长上下文服务都把 GQA/MLA 当标配。
flops_ledger.py 的占比表(d=3072,含 FFN):
          N             线性项             二次项     二次项占比
       4096   927.71 GFLOPs   206.16 GFLOPs     18.2%
      16384     3.71 TFLOPs     3.30 TFLOPs     47.1%
      32768     7.42 TFLOPs    13.19 TFLOPs     64.0%
      65536    14.84 TFLOPs    52.78 TFLOPs     78.0%
脚本末尾有一段 CPU 微基准。下表是原稿 Linux 环境的一次实测(numpy float32,d_t=1024、16 头);这不是性能保证,也不能和新环境的时延逐项混用:
         N     投影 (ms)   QK^T (ms)      实测比   FLOPs 比
       256        1.64        2.36     1.44      0.25
      1024        6.64       60.80     9.16      1.00
      4096       21.36     1148.15    53.75      4.00
在原稿样例的 N=256 行,QK^T 的算术量只有投影的四分之一,耗时比却是 1.44。2026-10-08 在 Windows 上重跑同一脚本得到投影 3.39 ms、QK^T 12.37 ms,耗时比 3.65;N=4096 则为 27.13 ms 和 1257.98 ms。两组数值不同,恰好说明时延不是 FLOPs 公式能单独预测的。脚本给出的简化算术强度(AI = FLOPs / 估算访存字节)提示了一种原因:投影约 85~228,QK^T 约 21~31,后者还要写出 H·N² 项。但这些是模型估算,不是 CPU 硬件访存计数;一组耗时不足以排除 BLAS 实现、线程数、缓存命中和矩阵布局。应把它当作 profiler 要验证的假说,而不是由时延表证明的因果结论。FlashAttention 原论文则明确以减少 HBM 与片上 SRAM 之间的 IO 为目标,避免把完整 N×N 权重矩阵落到 HBM;它仍需计算全局注意力的二次项。
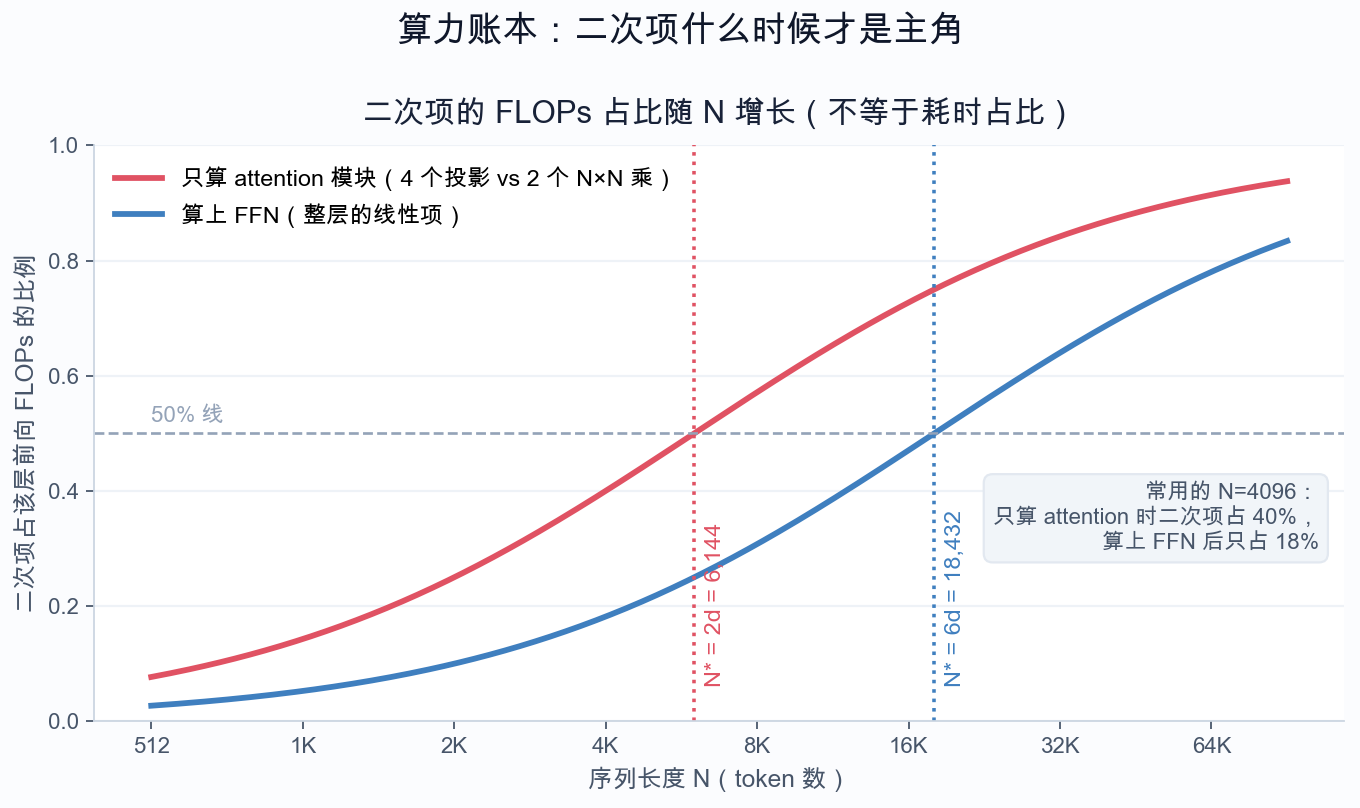
这张图要看什么:两条曲线是二次项算力占比随 N 的爬升,红蓝两条竖虚线分别是 N=2d=6144(只算 attention 模块)和 N=6d=18432(算上 FFN);你常用的 N=4096 在两条线左边很远的位置。
参考实现(以 2026-09 的 main 分支为准,上游重构频繁):
huggingface/transformers → modeling_llama.py:LlamaAttention.forwardhuggingface/transformers → masking_utils.py / integrations/flash_attention.py:attention 实现分发生产代码和第 04 节的最小实现有五处不一样,每一处都有理由。
HF 的 attention 实现 attn_implementation 有三档:
scaled_dot_product_attention,由 PyTorch 按硬件、dtype、mask 等选择 flash、memory-efficient 或 math 后端;不能仅凭 sdpa 名称断言没有 N×N 中间量。长序列训练通常优先评估可用的融合后端,但要检查硬件、dtype、掩码形式和是否需要显式注意力权重;不能把 sdpa 这个名字等同于必走 Flash kernel。融合实现常不返回完整 P;可视化注意力图或对 P 加自定义正则时,可能需要 eager、专门的导出路径或改变算法,收益与成本都要实测。
最小实现里我建了一个 $N \times N$ 的 bool 矩阵,这本身就又是一笔 N² 显存。支持的融合后端可以用 is_causal=True 或滑动窗口等结构化信息在内核内判断位置关系,从而避免显式的 N×N 因果掩码;但 eager、某些 padding/自定义 mask 或后端回退仍可能构造稠密掩码。是否落地要看实际分发路径,不能仅凭 API 名称保证。自己无条件创建 N×N causal mask,会额外消耗显存。
三个 $d \times d$ 投影合并成一个 $d \times 3d$(或直接 qkv_proj),一次 GEMM 出 Q、K、V。算术量不变,但少起两次 kernel、权重读取更连续。代价是 PyTorch 里要自己 chunk(3, dim=-1) 拆回来——本次核对的 modeling_llama.py 仍保留独立的 q_proj/k_proj/v_proj;融合 QKV 是另一些架构或执行后端的选择。
多头切分时 K、V 的头数用 $H_{kv} < H$(比如 8 对 32),多个 Query 头共享一组 KV。公式的改动只是把 $K_h$ 换成 $K_{\lfloor h/(H/H_{kv})\rfloor}$。它不改变 attention 核心两次矩阵乘的主导 FLOPs,但可以减少 K/V 投影的 FLOPs,省的是 KV cache 和 KV 的显存与带宽——推理时 KV cache 缩到 $H_{kv}/H$(LLaMA-3 70B 的 8/64 为 1/8)。这是在固定 Query 宽度时减少 KV 头数、压缩线性 KV 项的优化,而 FlashAttention 优化的是 N² 那一笔,两者正交,经常一起用。
无位置编码且无位置相关掩码的自注意力对 token 排列是等变的。位置信息可通过正弦表、可学习嵌入、RoPE 或掩码注入,其中 RoPE 的旋转点积体现相对位移,不应统称绝对位置编码。不同实现对 RoPE 的缓存策略并不相同。以 本次核对的 Hugging Face Llama 源码(2026-10-08)为例,LlamaRotaryEmbedding 把逆频率 inv_freq 存为非持久 buffer,而 forward 用 position_ids 计算当次的 cos/sin;不能把它描述成预先缓存整张 cos/sin 表。LlamaModel.forward 在未提供位置时按已缓存 token 数生成 position_ids,外部也能传入位置,例如 packed 序列需要明确处理段内位置。位置如何进入 Q/K,是 RoPE 那一篇的主题。
把 N² 落地换来了什么,又赔了什么。 朴素实现唯一的优点是 S、P 全程可见:可视化注意力图、或使用依赖完整 P 的蒸馏损失,需要访问相应权重。加到 logits 上的结构化 bias 则不必先物化 P;若内核支持其形式,可在分块时应用。导出完整 P 仍需相应的二次输出存储。工程上常见的折中是:训练用 sdpa/flash,分析时用小 N 的 eager 导出注意力图。
二次项的 FLOPs 收益要按序列长度评估。 若各项运行时间恰好与 FLOPs 成正比,N=4096 时消除占比 18.2% 的二次项,整层理想加速约为 1.22 倍;现实中的 IO 和融合会改变时间占比,因此这不是 FlashAttention 的实测加速上限。
多头的账要两头看。 头数 H 越大,每个头的 D = d/H 越小:每头维度 D 改变会影响子空间容量,但不存在这里能够证明的 D<32 通用质量阈值;固定 d=H·D 时,标准 MHA 的 KV cache 与 KV 投影参数量不因增加 H 而线性增长;若固定 D 则另当别论。所以现代模型反而从「H 越多越好」退到「适度头数 + GQA」:LLaMA-3 70B 用 64 个 Query 头配 8 个 KV 头。
什么时候根本不该用全局自注意力。 像素级 self-attention(把 H×W 个像素当 token)在中等分辨率下 N 就上了万,N² 显存直接不可行——这是 latent diffusion 在压缩空间里计算更经济的原因之一;卷积等其他算子的成本也同时下降。高分辨率密集预测里,窗口注意力、局部注意力是常态而不是妥协。
别只优化注意力。 N 小于 2d 时(d=3072 即 N<6144),attention 模块内部的算力大头是投影;FFN 属于整层的另一部分;显存侧倒是早就归 N² 管。所以「 profiling 之前先改结构」是赌博——performance_profiling 那一篇讲的账本方法就是为此准备的。
五篇连起来读的线索:注意力先是「一种对齐手段」(2014),再是「唯一的序列算子」(2017),然后 N² 账单到期,在这五篇代表作里,2019 年的路线砍格子,2022 年的路线改执行而保持精确注意力,2023 年的路线则着眼于自回归推理时线性增长的 KV cache。不同成本可以并存,后出现的方案不意味着前一笔账已消失。
「注意力是 O(N²),所以序列不长时它也是最慢的部分。」 N=4096、d=3072 时二次项只占本文层结构前向 FLOPs 的 18.2%,但不能据此猜测热点。应结合算术强度、硬件与 profiler 判断。
「多头注意力算 H 遍,所以比单头慢 H 倍。」 H·N²·D = N²·d,多头和全维单头的算术量完全相同;多的是 H 份 N×N 显存和 H 份小矩阵乘的调度开销,不是 H 倍算力。
「显存不够就是模型太大,换个更小的模型。」 d=3072、L=32 的模型权重 6.75 GiB,N=8192 时仅激活就 297 GiB。先算激活账(6B·N·d·bytes + 3B·H·N²·bytes 乘层数),再决定动不动模型。这套无重算训练账本提示应先比较开 gradient checkpointing、换 sdpa/flash、或降分辨率。
「除以 √D 是可要可不要的数值技巧。」 本次样本中未缩放 logits 更容易接近饱和;D=16 的最大权重实际为 0.9970,显示 1.0000 也不等于数学上梯度严格为零。它控制点积方差随维度增长;其他归一化或初始化设计也能缓解饱和,不能据此宣称不缩放就一定无法训练。
「浮点 dropout 乘子不占显存。」 bool mask 通常每元素一字节,而 bf16 为两字节;本文账本计的是两字节的浮点 dropout 乘子,两者不能混称。使用逐元素 dropout 的 eager 训练通常还需保留随机掩码或等价信息;占用取决于表示与实现,不一定恰好是一份 bf16 张量。FlashAttention 可以保存随机数状态并在分块反向时重建掩码。
把附录里的 mha_minimal.py 存下来直接跑(python mha_minimal.py),对照三处输出:
然后做两个改动观察变化:
H 从 4 改成 1 再改成 8,跑性质校验 (d):在 H=1 时头间离散度按定义为 0(没有第二个头);H=8 的数值要以实际重跑为准。这个随机初始化实验只展示不同投影可产生不同权重,不证明训练后各头必然学到互补功能,也不保证头数越多质量越高。flops_ledger.py 的 CPU 实测段,找到你机器上「实测比」超过「FLOPs 比」的 N 拐点,和理论交叉点 N*=2d 对一下差多少。预期最容易误判的是第二个:原稿样例在 N=256 的耗时比是 1.44,本次复跑是 3.65,而 FLOPs 比都是 0.25。这只说明两次运行里时延都没有跟着算术量成比例变化;是否由访存、调度或其他因素主导,还需用 profiler 在目标硬件上验证。
按知识树的依赖顺序,下一步建议这么走:
09 节用到的脚本全文如下(mha_minimal.py、attention_memory.py、flops_ledger.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""多头自注意力(MHA)的最小可运行实现:把公式逐行翻译成 numpy。

只依赖 numpy,直接 `python mha_minimal.py` 即可运行。
刻意不用 PyTorch:讲原理时框架的抽象反而是噪声,而且 numpy 谁都能跑。
生产实现见文章第 05 节对 transformers 的引用。

公式符号与代码变量名的对应关系
------------------------------
    X            输入序列              形状 [B, N, d_model]
    W_q/W_k/W_v  三个输入投影矩阵      形状 [d_model, d_model]
    W_o          输出投影矩阵          形状 [d_model, d_model]
    Q, K, V      查询 / 键 / 值        形状 [B, H, N, D]
    S            缩放后的注意力分数    形状 [B, H, N, N],S = Q K^T / sqrt(D)
    P            softmax 后的权重      形状 [B, H, N, N]
    O            注意力输出            形状 [B, N, d_model]

运行后你会看到:每一层的真实 shape、注意力权重的数值范围、
以及四条性质校验(行和为 1 / 与循环实现等价 / 缩放系数的影响 / 因果掩码)。
"""

import numpy as np

rng = np.random.default_rng(0)


def split_heads(t: np.ndarray, H: int) -> np.ndarray:
    """[B, N, H*D] -> [B, H, N, D]。

    多头不是「复制 H 份再算」,而是把 d_model 这个维度切成 H 段,
    每段独立算一次注意力,最后再拼回去。这一步只是 reshape + transpose,
    本身不做任何算术,但它决定了后面所有矩阵乘的形状。
    """
    B, N, d_model = t.shape
    D = d_model // H
    return t.reshape(B, N, H, D).transpose(0, 2, 1, 3)


def merge_heads(t: np.ndarray) -> np.ndarray:
    """[B, H, N, D] -> [B, N, H*D],split_heads 的逆操作。"""
    B, H, N, D = t.shape
    return t.transpose(0, 2, 1, 3).reshape(B, N, H * D)


def softmax(x: np.ndarray, axis: int = -1) -> np.ndarray:
    """数值稳定的 softmax:先减去最大值再取指数,避免 exp 溢出。"""
    x = x - x.max(axis=axis, keepdims=True)
    e = np.exp(x)
    return e / e.sum(axis=axis, keepdims=True)


def mha(X: np.ndarray, W_q, W_k, W_v, W_o, H: int, causal: bool = False):
    """完整的多头自注意力前向。返回 (输出, 注意力权重 P)。"""
    B, N, d_model = X.shape
    D = d_model // H

    # ① 三个投影:每个 token 独立地把自己映射成 query / key / value
    Q = split_heads(X @ W_q, H)          # [B, H, N, D]
    K = split_heads(X @ W_k, H)          # [B, H, N, D]
    V = split_heads(X @ W_v, H)          # [B, H, N, D]

    # ② 打分:每个 query 和所有 key 做内积,得到 N×N 的分数矩阵
    S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D)   # [B, H, N, N]

    # ③ 因果掩码:第 i 个 query 只能看 0..i 的 key
    if causal:
        mask = np.triu(np.ones((N, N), dtype=bool), k=1)
        S = np.where(mask, -np.inf, S)

    # ④ 归一化成权重,再对 V 做加权求和
    P = softmax(S, axis=-1)              # [B, H, N, N]
    ctx = P @ V                          # [B, H, N, D]

    # ⑤ 拼回 d_model,过输出投影
    O = merge_heads(ctx) @ W_o           # [B, N, d_model]
    return O, P


def mha_naive_loop(X, W_q, W_k, W_v, W_o, H):
    """完全不用矩阵乘的「照着定义抄」版本:四重循环。

    用来验证上面的向量化实现没有把下标搞反。逻辑等价但慢得多(O(B·H·N²·D))。
    """
    B, N, d_model = X.shape
    D = d_model // H
    Q = (X @ W_q).reshape(B, N, H, D).transpose(0, 2, 1, 3)
    K = (X @ W_k).reshape(B, N, H, D).transpose(0, 2, 1, 3)
    V = (X @ W_v).reshape(B, N, H, D).transpose(0, 2, 1, 3)

    out = np.zeros((B, H, N, D))
    for b in range(B):
        for h in range(H):
            for i in range(N):
                # 先逐个算出这一行 N 个分数,再 softmax,再加权求和
                s = np.array([float(Q[b, h, i] @ K[b, h, j]) / np.sqrt(D)
                              for j in range(N)])
                p = softmax(s)
                out[b, h, i] = p @ V[b, h]
    return merge_heads(out) @ W_o


def main():
    B, N, d_model, H = 2, 8, 32, 4
    D = d_model // H
    print(f"配置: B={B}  N={N}  d_model={d_model}  H={H}  D={D}")

    X = rng.normal(size=(B, N, d_model)) * 0.5
    W_q, W_k, W_v, W_o = (rng.normal(size=(d_model, d_model)) / np.sqrt(d_model)
                          for _ in range(4))

    # ── 1. 每一层的真实形状 ──────────────────────────────────
    Q = split_heads(X @ W_q, H)
    K = split_heads(X @ W_k, H)
    S = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(D)
    print("\n[1] 各张量形状")
    print(f"    X      {X.shape}   输入")
    print(f"    Q/K/V  {Q.shape}   切头后 [B, H, N, D]")
    print(f"    S      {S.shape}   分数矩阵,N×N 是显存爆炸的源头")
    print(f"    O      {mha(X, W_q, W_k, W_v, W_o, H)[0].shape}   输出,和输入同形")

    # ── 2. 分数的量级:为什么要除以 sqrt(D) ──────────────────
    raw = Q @ K.transpose(0, 1, 3, 2)          # 不除以 sqrt(D)
    print("\n[2] 缩放系数 sqrt(D) 的作用")
    print(f"    D = {D}, sqrt(D) = {np.sqrt(D):.4f}")
    print(f"    未缩放分数的标准差      : {raw.std():.4f}   分布范围 [{raw.min():.2f}, {raw.max():.2f}]")
    print(f"    缩放后分数的标准差      : {S.std():.4f}   分布范围 [{S.min():.2f}, {S.max():.2f}]")
    print(f"    未缩放 softmax 的最大权重: {softmax(raw).max():.4f}")
    print(f"    缩放后 softmax 的最大权重: {softmax(S).max():.4f}")

    # D 越大,不缩放的分数方差越大,softmax 越容易塌成 one-hot
    print("    固定 scale=1,扫一遍 D 看 softmax 最大权重怎么变:")
    print("        D    分数标准差   最大权重(未缩放)   最大权重(缩放后)")
    for D_test in (8, 16, 32, 64, 128, 256):
        q = rng.normal(size=(256, D_test))
        k = rng.normal(size=(256, D_test))
        s_raw = q @ k.T
        s_scaled = s_raw / np.sqrt(D_test)
        print(f"      {D_test:4d}   {s_raw.std():9.4f}   "
              f"{softmax(s_raw).max():14.4f}   {softmax(s_scaled).max():15.4f}")

    # ── 3. 性质校验 ────────────────────────────────────────
    print("\n[3] 性质校验")
    O, P = mha(X, W_q, W_k, W_v, W_o, H)
    print(f"    (a) 权重行和为 1        : max|sum(P)-1| = "
          f"{np.abs(P.sum(axis=-1) - 1).max():.2e}")

    O_loop = mha_naive_loop(X, W_q, W_k, W_v, W_o, H)
    print(f"    (b) 向量化 vs 四重循环   : max|O - O_loop| = "
          f"{np.abs(O - O_loop).max():.2e}   allclose="
          f"{np.allclose(O, O_loop)}")

    _, P_causal = mha(X, W_q, W_k, W_v, W_o, H, causal=True)
    upper = np.triu(P_causal, k=1)
    print(f"    (c) 因果掩码上三角全 0   : max = {upper.max():.2e}")
    print(f"        且下三角行和仍为 1   : max|sum-1| = "
          f"{np.abs(P_causal.sum(axis=-1) - 1).max():.2e}")

    # 随机初始化的不同投影产生不同权重;这不是训练后头功能分化的证据
    P_mean = P.mean(axis=1)                # [B, N, N],把 H 个头的权重平均
    diff = np.abs(P[0, 0] - P_mean[0]).mean()
    spread = np.abs(P[0] - P[0].mean(axis=0, keepdims=True)).mean()
    print(f"    (d) 各头权重并不相同     : 头 0 与 H 头平均的平均绝对差 = {diff:.4f}")
    print(f"        头之间的平均离散度   : {spread:.4f}(0 表示所有头完全一样)")

    # ── 4. 不看自己的极端情形:注意力塌缩成「复制」 ──────────
    print("\n[4] 极端情形:把 K 设成和 Q 完全一样(自注意力且 W_q=W_k)")
    X2 = rng.normal(size=(1, 4, d_model))
    Q2 = split_heads(X2 @ W_q, H)
    S2 = Q2 @ Q2.transpose(0, 1, 3, 2) / np.sqrt(D)
    P2 = softmax(S2)
    diag_share = np.trace(P2[0, 0]) / 4
    print(f"    对角线权重占比 = {diag_share:.4f}(1.0 表示每个 token 只关注自己)")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""自注意力的显存账本:把一层 attention 的每一笔开销都算成字节。
只依赖 numpy(其实只用到它做格式化,核心就是整数乘除)。
直接 `python attention_memory.py` 即可运行。
算的是「训练时一层 MHA 需要为反向传播留下来的激活」,
这是显式保留中间量的保守教学模型,并非框架实测或反向所需最小值。默认的模型尺寸
采用简化 Transformer:d_model=3072、H=24、D=128。
"""
import numpy as np
BYTES = {"fp32": 4, "fp16": 2, "bf16": 2, "fp8": 1}
MIB = 1024 ** 2
GIB = 1024 ** 3
def fmt(nbytes: float) -> str:
if nbytes >= GIB:
return f"{nbytes / GIB:8.2f} GiB"
if nbytes >= MIB:
return f"{nbytes / MIB:8.2f} MiB"
return f"{nbytes / 1024:8.2f} KiB"
def ledger(B: int, N: int, d_model: int, H: int, dtype: str = "bf16",
dropout: bool = True):
"""返回一层 MHA 的逐项激活显存(字节)。
N² 项有三个:分数矩阵 S、softmax 后的 P、以及与所选 dtype 同宽的浮点 dropout 乘子(非 bool mask)。
这三项就是 O(N²) 显存的真身——不是「注意力复杂度是 N²」这句话,
而是本教学模型假设同时保存的三个 B×H×N×N 张量;框架可复用或省略它们。
"""
b = BYTES[dtype]
linear = B * N * d_model * b # 每个 [B, N, d_model] 的张量
square = B * H * N * N * b # 每个 [B, H, N, N] 的张量
return {
"输入 X": linear,
"Q": linear,
"K": linear,
"V": linear,
"分数矩阵 S": square,
"softmax 权重 P": square,
"浮点 dropout 乘子": square if dropout else 0,
"加权和 ctx": linear,
"输出 O": linear,
}
def main():
d_model, H, D = 3072, 24, 128
print(f"模型尺寸: d_model={d_model} H={H} D={D} (H*D = {H * D})")
# ── 1. 单个 N 下的逐项账本 ──────────────────────────────
B, N = 1, 4096
items = ledger(B, N, d_model, H, "bf16")
total = sum(items.values())
print(f"\n[1] 逐项账本 B={B} N={N} bf16(2 字节)")
print(f" {'项目':<16}{'形状':<22}{'字节数':>14} 占比")
for name, nb in items.items():
shape = "[B, N, d_model]" if nb == B * N * d_model * 2 else "[B, H, N, N]"
print(f" {name:<16}{shape:<22}{nb:>14,} {nb / total:6.1%}")
print(f" {'合计':<16}{'':<22}{total:>14,} {fmt(total)}")
quad = sum(v for k, v in items.items() if "S" in k or "P" in k or "乘子" in k)
lin = total - quad
print(f" → N² 项共 {fmt(quad)},线性项共 {fmt(lin)},N² 项占 {quad / total:.1%}")
# ── 2. N 增长时账本怎么变 ───────────────────────────────
print("\n[2] N 增长时一层 MHA 的激活显存(B=1, bf16, 含 浮点 dropout 乘子)")
print(f" {'N':>7}{'线性项':>12}{'N² 项':>12}{'合计':>12} "
f"{'融合侧教学值':>15} 倍数")
for N in (1024, 2048, 4096, 8192, 16384, 32768):
it = ledger(1, N, d_model, H, "bf16")
q = it["分数矩阵 S"] + it["softmax 权重 P"] + it["浮点 dropout 乘子"]
l = sum(it.values()) - q
# 与 FlashAttention 文统一:六份线性量的教学预算,忽略小的 LSE 与工作区
flash = 6 * 1 * N * d_model * 2
print(f" {N:>7}{fmt(l):>12}{fmt(q):>12}{fmt(l + q):>12} "
f"{fmt(flash):>15} {(l + q) / flash:5.1f}x")
# ── 3. 交叉点:从哪个 N 开始 N² 项压过线性项 ────────────
# 3·B·H·N² = 6·B·N·d → N* = 2d / H
N_star = 2 * d_model / H
print("\n[3] 交叉点")
print(f" 3·B·H·N²·bytes = 6·B·N·d·bytes 解得 N* = 2d/H = {N_star:.0f}")
print(f" 也就是说 N 超过 {N_star:.0f} 之后,一层 attention 的激活显存")
print(f" 就由 N² 项主导;N=4096 时已经超出 {(4096 / N_star):.0f} 倍。")
# ── 4. 乘上层数:为什么 L 层比 N 更狠 ────────────────────
print("\n[4] 乘上层数 L(无重算训练,按上述教学模型保留各层中间量)")
print(f" {'L':>4}{'N=2048':>12}{'N=4096':>12}{'N=8192':>12} 说明")
for L in (12, 24, 32, 48):
row = []
for N in (2048, 4096, 8192):
tot = sum(ledger(1, N, d_model, H, "bf16").values())
row.append(fmt(tot * L))
print(f" {L:>4}{row[0]:>12}{row[1]:>12}{row[2]:>12}")
print(" 以上均未计入模型权重与优化器状态;梯度检查点减少内部保存量,但仍需保留边界激活,并非通用的 1/L。")
# ── 5. 推理侧的另一种账本:KV cache ─────────────────────
print("\n[5] 推理侧:KV cache 的账本(随 N 线性增长,但随并发数 B 线性增长)")
print(" 公式: 2 · B · N · L · H · D · bytes")
print(f" {'B':>4}{'N':>7}{'L=32':>12}{'L=80':>12}")
for B in (1, 8, 32):
for N in (4096, 32768):
r = []
for L in (32, 80):
nb = 2 * B * N * L * H * D * 2
r.append(fmt(nb))
print(f" {B:>4}{N:>7}{r[0]:>12}{r[1]:>12}")
# ── 6. 权重和激活谁更大 ────────────────────────────────
print("\n[6] 权重 vs 激活:别只盯着模型大小")
L = 32
# 一层 transformer 的权重:4 个 d×d 投影 + 2 个 FFN 的 4d×d
w_per_layer = (4 * d_model * d_model + 2 * d_model * 4 * d_model) * 2
print(f" 一层权重(4 个 d×d + FFN 的 2×4d×d,bf16): {fmt(w_per_layer)}")
print(f" L={L} 层总权重 : {fmt(w_per_layer * L)}")
for N in (2048, 8192):
act = sum(ledger(1, N, d_model, H, "bf16").values()) * L
print(f" N={N} 时 L={L} 层激活 : {fmt(act)} "
f"(是权重的 {act / (w_per_layer * L):.1f} 倍)")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""自注意力的算力账本:把一层 attention 拆成「线性项」和「二次项」两笔。
只依赖 numpy。直接 `python flops_ledger.py` 即可运行。
最后有一段 CPU 实测,耗时约 10 秒;不同机器数值会不同,看趋势即可。
FLOPs 口径:一次矩阵乘 [M,K] @ [K,N] 需要 M·K·N 次乘加(MAC),
一次乘加算 2 个浮点运算,所以 FLOPs = 2·M·K·N。全文统一用这个口径。
"""
import time
import numpy as np
def layer_flops(N: int, d: int, with_ffn: bool = True):
"""一层 transformer 的前向 FLOPs,拆成线性项和二次项。"""
# 4 个 d×d 投影:Q、K、V 三个输入投影 + 1 个输出投影
proj = 4 * 2 * N * d * d
# FFN:升到 4d 再降回来,两个矩阵乘
ffn = 2 * 2 * N * d * 4 * d if with_ffn else 0.0
# 注意力内部两个 N×N 的矩阵乘:QK^T 与 P·V
attn = 2 * 2 * N * N * d
return proj + ffn, attn
def fmt_flops(f: float) -> str:
for unit, scale in (("P", 1e15), ("T", 1e12), ("G", 1e9), ("M", 1e6)):
if f >= scale:
return f"{f / scale:7.2f} {unit}FLOPs"
return f"{f:7.2f} FLOPs"
def main():
d, H = 3072, 24
print(f"模型尺寸: d_model={d} H={H}")
# ── 1. 一层里两笔账各是多少 ─────────────────────────────
print("\n[1] 一层 transformer 的前向 FLOPs(N=4096, 含 FFN)")
linear, quad = layer_flops(4096, d)
print(f" 线性项(QKV 投影 + O 投影 + FFN): {fmt_flops(linear)}")
print(f" 二次项(QK^T 与 P·V) : {fmt_flops(quad)}")
print(f" 二次项占比 : {quad / (linear + quad):.1%}")
# 只看 attention 内部:4 个投影 vs 2 个 N×N 矩阵乘
l_attn_only, q_attn_only = layer_flops(4096, d, with_ffn=False)
print(f" 只算 attention 模块本身(去掉 FFN): 二次项占 "
f"{q_attn_only / (l_attn_only + q_attn_only):.1%}")
# ── 2. 交叉点:二次项什么时候超过线性项 ──────────────────
# 4N²d = 24Nd² → N* = 6d
print("\n[2] 交叉点")
print(f" 含 FFN : 4N²d = 24Nd² → N* = 6d = {6 * d}")
print(f" 只含投影: 4N²d = 8Nd² → N* = 2d = {2 * d}")
print(f" 结论:N 小于 {2 * d} 时,二次项的 FLOPs 少于 attention 投影,")
print(f" 这只比较运算量;是否为耗时瓶颈仍取决于访存、内核与硬件。")
# ── 3. 占比怎么随 N 变化 ───────────────────────────────
print("\n[3] 二次项占比随 N 变化(d=3072,含 FFN)")
print(f" {'N':>7}{'线性项':>16}{'二次项':>16}{'二次项占比':>10}")
for N in (512, 1024, 2048, 4096, 8192, 16384, 32768, 65536):
l, q = layer_flops(N, d)
print(f" {N:>7}{fmt_flops(l):>16}{fmt_flops(q):>16}{q / (l + q):>10.1%}")
# ── 4. 训练总算力:前向的三倍 ───────────────────────────
print("\n[4] 训练一个 token 的 FLOPs(前向 + 反向 ≈ 3 倍前向)")
for N in (2048, 4096, 8192):
l, q = layer_flops(N, d)
print(f" N={N:<6} 每 token 前向 {fmt_flops((l + q) / N)}"
f" 训练 {fmt_flops(3 * (l + q) / N)}")
# ── 5. CPU 实测:二次项的增长是不是真的更快 ──────────────
print("\n[5] CPU 实测(本机一次运行,看趋势不看绝对值;numpy float32)")
d_t, H_t = 1024, 16
rng = np.random.default_rng(0)
X = rng.normal(size=(4096, d_t)).astype(np.float32)
W = rng.normal(size=(d_t, d_t)).astype(np.float32) / np.sqrt(d_t)
def bench(fn, repeat=3):
best = float("inf")
for _ in range(repeat):
t0 = time.perf_counter()
fn()
best = min(best, time.perf_counter() - t0)
return best * 1000.0
print(f" {'N':>6}{'投影 (ms)':>12}{'QK^T (ms)':>12}{'实测比':>9}"
f"{'FLOPs 比':>10}")
measured = {}
for N in (256, 512, 1024, 2048, 4096):
x = X[:N]
t_proj = bench(lambda: x @ W)
D_t = d_t // H_t
Q = (x @ W)[:, :].reshape(N, H_t, D_t).transpose(1, 0, 2)
t_qk = bench(lambda: Q @ Q.transpose(0, 2, 1))
# 理论 FLOPs 比:二次项 / 一个投影
ratio_flops = (2 * N * N * d_t) / (2 * N * d_t * d_t)
measured[N] = t_qk / t_proj
print(f" {N:>6}{t_proj:>12.2f}{t_qk:>12.2f}"
f"{t_qk / t_proj:>9.2f}{ratio_flops:>10.2f}")
print(f" 注意看 N=256 那一行:QK^T 的算术量只有投影的 0.25 倍,")
print(f" 本次 QK^T / 投影耗时比为 {measured[256]:.2f}。耗时比不必等于 FLOPs 比。")
# ── 6. 算术强度:FLOPs 回答不了「为什么慢」 ───────────────
print("\n[6] 算术强度 AI = FLOPs / 访存字节(float32,4 字节/元素)")
print(" 估算 AI 较低提示应检查访存;是否实际受限需测硬件计数器。")
print(f" {'算子':<22}{'N=256':>12}{'N=1024':>12}{'N=4096':>12}")
rows = []
for N in (256, 1024, 4096):
# 投影 X[N,d] @ W[d,d]:读 X 与 W,写输出
f_proj = 2 * N * d_t * d_t
m_proj = (N * d_t + d_t * d_t + N * d_t) * 4
# QK^T:读 Q 与 K,写 N×N 的分数矩阵(H 份)
f_qk = 2 * N * N * d_t
m_qk = (2 * N * d_t + H_t * N * N) * 4
rows.append((N, f_proj / m_proj, f_qk / m_qk))
print(f" {'投影 X@W_q':<22}" +
"".join(f"{r[1]:>12.1f}" for r in rows))
print(f" {'注意力 QK^T':<22}" +
"".join(f"{r[2]:>12.1f}" for r in rows))
print(f" {'(投影 / QK^T)':<22}" +
"".join(f"{r[1] / r[2]:>12.1f}" for r in rows))
print(" 投影的 AI 高出 4~7 倍:权重矩阵被整批 token 复用,读一次能做 N 次乘加。")
print(" QK^T 的 AI 低:输出是 H·N²,写完就走,数据复用少。")
print(" 该估算不能解释本机时延;FlashAttention 原论文通过分块减少 HBM IO,")
print(" 避免显式落地完整 N×N 权重矩阵,但算术量仍是二次。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「自注意力机制的计算与显存账本」的三张解释图。
数值全部来自同目录下的 attention_memory.py 与 flops_ledger.py,
改了那两个脚本的话这里要跟着重跑,避免图与正文数字不一致。
只依赖 numpy + matplotlib,直接 `python make_figures.py` 即可运行。
"""
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import FancyBboxPatch
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
})
C_QUAD = "#e05263" # N² 项:红
C_LIN = "#3f7fbf" # 线性项:蓝
C_FLASH = "#2f9e6f" # FlashAttention:绿
C_GREY = "#94a3b8"
INK = "#182238"
MIB = 1024 ** 2
GIB = 1024 ** 3
def _style(ax, title, xlabel, ylabel):
ax.set_title(title, fontsize=14, weight="bold", color=INK, pad=10)
ax.set_xlabel(xlabel, fontsize=11, color="#475569")
ax.set_ylabel(ylabel, fontsize=11, color="#475569")
ax.tick_params(colors="#475569", labelsize=10)
for s in ("top", "right"):
ax.spines[s].set_visible(False)
for s in ("left", "bottom"):
ax.spines[s].set_color("#cbd5e1")
ax.grid(axis="y", color="#eef2f7", linewidth=1)
ax.set_axisbelow(True)
# ────────────────────────────────────────────────────────────
# 图 1:显存账本的构成
# ────────────────────────────────────────────────────────────
def fig_memory_ledger():
d_model, H = 3072, 24
b = 2 # bf16
fig, axes = plt.subplots(1, 2, figsize=(13.2, 4.9), facecolor="#fbfcfe")
# 左:N=4096 时的逐项占比(一根堆叠条)
ax = axes[0]
N = 4096
lin_item = 1 * N * d_model * b
quad_item = 1 * H * N * N * b
labels = ["输入 X", "Q", "K", "V", "分数矩阵 S", "softmax 权重 P",
"浮点 dropout 乘子", "加权和 ctx", "输出 O"]
sizes = [lin_item, lin_item, lin_item, lin_item,
quad_item, quad_item, quad_item, lin_item, lin_item]
colors = [C_LIN] * 4 + [C_QUAD] * 3 + [C_LIN] * 2
total = sum(sizes)
left = 0.0
for lab, s, c in zip(labels, sizes, colors):
ax.barh([0], [s / GIB], left=left / GIB, color=c,
edgecolor="white", linewidth=1.2, height=0.55)
if s / total > 0.05:
ax.text(left / GIB + s / GIB / 2, 0, f"{lab}\n{s / total:.1%}",
ha="center", va="center", fontsize=9.5, color="white",
weight="bold")
left += s
ax.set_xlim(0, total / GIB)
ax.set_yticks([])
for s in ("left", "top", "right"):
ax.spines[s].set_visible(False)
ax.set_xlabel("单层 MHA 的教学激活存储(GiB)", fontsize=11, color="#475569")
ax.set_title(f"N={N} 时,三个 N² 项吃掉 94%", fontsize=14,
weight="bold", color=INK, pad=10)
ax.text(0, -0.42, f"合计 {total / GIB:.2f} GiB | 模型 d_model={d_model}, "
f"H={H}, bf16", ha="left", fontsize=10, color="#64748b")
# 右:随 N 增长,朴素实现 vs FlashAttention
ax = axes[1]
Ns = np.array([1024, 2048, 4096, 8192, 16384, 32768])
lin = 6 * Ns * d_model * b # 与逐项账本相同:6 个 [B,N,d] 张量
quad = 3 * H * Ns ** 2 * b # 3 个 [B,H,N,N] 张量
naive = (lin + quad) / GIB
flash = (6 * Ns * d_model * b) / GIB # 统一教学线性预算,忽略小的 LSE
ax.plot(Ns, naive, "o-", color=C_QUAD, linewidth=2.4,
markersize=6, label="朴素实现(落 N² 到显存)")
ax.plot(Ns, flash, "s-", color=C_FLASH, linewidth=2.4,
markersize=6, label="融合侧教学值(6Nd)")
ax.fill_between(Ns, flash, naive, color=C_QUAD, alpha=0.10)
ax.set_yscale("log")
ax.set_xscale("log")
ax.set_xticks(Ns)
ax.set_xticklabels([f"{n:,}" for n in Ns], fontsize=9)
ax.legend(fontsize=10, frameon=False, loc="upper left")
_style(ax, "两者比值随 N 近似线性增长", "序列长度 N(token 数)",
"单层教学激活存储(GiB,对数轴)")
ax.text(0.98, 0.06, f"N=32768 时相差 {naive[-1] / flash[-1]:.0f} 倍",
transform=ax.transAxes, ha="right", fontsize=10, color=C_QUAD,
weight="bold")
fig.suptitle("自注意力的显存账本:钱花在哪一笔",
fontsize=17, weight="bold", color="#0f172a", y=1.03)
fig.tight_layout()
fig.savefig(OUT / "memory_ledger.png", bbox_inches="tight",
facecolor=fig.get_facecolor())
plt.close(fig)
# ────────────────────────────────────────────────────────────
# 图 2:算力账本里二次项的占比
# ────────────────────────────────────────────────────────────
def fig_flops_ratio():
d = 3072
Ns = np.logspace(9, 16.5, 300, base=2) # 512 ~ 92682
quad = 4 * Ns ** 2 * d
lin_proj = 8 * Ns * d * d # 只含 4 个投影
lin_all = lin_proj + 16 * Ns * d * d # 再算上 FFN
fig, ax = plt.subplots(figsize=(8.6, 5.0), facecolor="#fbfcfe")
r_only = quad / (quad + lin_proj)
r_all = quad / (quad + lin_all)
ax.plot(Ns, r_only, "-", color=C_QUAD, linewidth=2.6,
label="只算 attention 模块(4 个投影 vs 2 个 N×N 乘)")
ax.plot(Ns, r_all, "-", color=C_LIN, linewidth=2.6,
label="算上 FFN(整层的线性项)")
ax.axhline(0.5, color=C_GREY, linestyle="--", linewidth=1.2)
ax.text(Ns[0], 0.52, "50% 线", fontsize=10, color=C_GREY)
for N_star, color, tag in ((2 * d, C_QUAD, "N* = 2d = 6,144"),
(6 * d, C_LIN, "N* = 6d = 18,432")):
ax.axvline(N_star, color=color, linestyle=":", linewidth=1.6)
ax.text(N_star * 1.05, 0.06, tag, fontsize=10.5, color=color,
weight="bold", rotation=90, va="bottom")
ax.set_xscale("log", base=2)
ax.set_xticks([512, 1024, 2048, 4096, 8192, 16384, 32768, 65536])
ax.set_xticklabels(["512", "1K", "2K", "4K", "8K", "16K", "32K", "64K"])
ax.set_ylim(0, 1)
ax.legend(fontsize=10.5, frameon=False, loc="upper left")
_style(ax, "二次项的 FLOPs 占比随 N 增长(不等于耗时占比)",
"序列长度 N(token 数)", "二次项占该层前向 FLOPs 的比例")
ax.text(0.98, 0.30,
"常用的 N=4096:\n只算 attention 时二次项占 40%,\n算上 FFN 后只占 18%",
transform=ax.transAxes, ha="right", fontsize=10, color="#475569",
bbox=dict(boxstyle="round,pad=0.4", facecolor="#f1f5f9",
edgecolor="#e2e8f0"))
fig.suptitle("算力账本:二次项什么时候才是主角", fontsize=16,
weight="bold", color="#0f172a", y=1.00)
fig.tight_layout()
fig.savefig(OUT / "flops_ratio.png", bbox_inches="tight",
facecolor=fig.get_facecolor())
plt.close(fig)
# ────────────────────────────────────────────────────────────
# 图 3:多头到底切了什么
# ────────────────────────────────────────────────────────────
def fig_head_split():
fig, ax = plt.subplots(figsize=(11.4, 5.0), facecolor="#fbfcfe")
ax.set_xlim(0, 1)
ax.set_ylim(0, 1)
ax.axis("off")
def block(x, y, w, h, title, lines, color, fs=11):
ax.add_patch(FancyBboxPatch(
(x, y), w, h, boxstyle="round,pad=0.01,rounding_size=0.02",
facecolor=color, edgecolor="white", linewidth=1.6))
ax.text(x + w / 2, y + h * 0.74, title, ha="center", va="center",
fontsize=fs + 2, weight="bold", color=INK)
ax.text(x + w / 2, y + h * 0.33, "\n".join(lines), ha="center",
va="center", fontsize=fs, color="#334155", linespacing=1.5)
def arrow(x1, y, x2, label):
ax.annotate("", xy=(x2, y), xytext=(x1, y),
arrowprops=dict(arrowstyle="-|>", color=C_GREY,
linewidth=2.0, mutation_scale=16))
ax.text((x1 + x2) / 2, y + 0.045, label, ha="center", fontsize=11,
color="#475569", weight="bold")
# X
block(0.02, 0.30, 0.16, 0.42, "X", ["[B, N, d_model]", "d_model = H · D"],
"#dbeafe")
arrow(0.185, 0.51, 0.245, "三个投影")
# Q/K/V 未切头
block(0.25, 0.30, 0.17, 0.42, "Q, K, V", ["各 [B, N, H·D]", "仍是完整宽度"],
"#e0e7ff")
arrow(0.425, 0.51, 0.485, "切头")
# 切头后
block(0.49, 0.30, 0.17, 0.42, "切头之后", ["[B, H, N, D]", "reshape + transpose"],
"#ede9fe")
arrow(0.665, 0.51, 0.725, r"$QK^\top/\sqrt{D}$")
# 分数矩阵
block(0.73, 0.22, 0.25, 0.58, "分数矩阵 S",
["[B, H, N, N]", "H 个 N×N,不是 1 个", "← 显存就花在这里"],
"#fecaca", fs=11)
# 底部说明
ax.text(0.5, 0.10,
"每个头只用自己的 D = d_model / H 维去做内积,H 个头各算各的 N×N;\n"
"最后把 H 份 D 维结果拼回 d_model,再过一次输出投影 W_o。",
ha="center", va="center", fontsize=11.5, color="#475569",
linespacing=1.6)
ax.text(0.5, 0.02,
"关键:分头不改变总算术量(H · N² · D = N² · d_model),它改变的是每个子空间的表达能力。",
ha="center", va="center", fontsize=11, color=C_QUAD, weight="bold")
fig.suptitle("多头注意力切的是 d_model 这一维,不是复制 H 份",
fontsize=16, weight="bold", color="#0f172a", y=0.99)
fig.tight_layout()
fig.savefig(OUT / "head_split.png", bbox_inches="tight",
facecolor=fig.get_facecolor())
plt.close(fig)
if __name__ == "__main__":
fig_memory_ledger()
fig_flops_ratio()
fig_head_split()
print(f"已生成 3 张图到 {OUT}")
for p in sorted(OUT.glob("*.png")):
print(f" {p.name} {p.stat().st_size / 1024:.0f} KiB")
评论 (0)