


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:注意力与核心零件 | 难度:核心组件 | 前置知识:MHA
关键词:位置编码、RoPE、旋转位置编码、相对位置、复数旋转、长度外推
先说一个具体的失败场景。
你训了一个视频 DiT,训练时用 480p、49 帧。推理时想出 720p、97 帧,结果画面从第 50 帧开始漂——人物五官慢慢挪位,背景纹理开始流动。你换了采样器、加了 CFG、调了 shift,都没用。
先把这个假设例子的尺寸写全:训练输入是 832×480、49 帧,推理输入是 1280×720、97 帧。假设 VAE 空间压缩 8 倍、时间长度按 $T_{\text{latent}}=1+\lfloor(T-1)/4\rfloor$ 计算,再做空间 2×2 patchify;不再额外切时间 patch。两组宽高都能被 16 整除,不需要补边:
总量涨了约 4.44 倍,其中每帧 token 数涨约 2.31 倍、latent 帧数涨约 1.92 倍。网格从 $(13,30,52)$ 变成 $(25,45,80)$,依次对应时间、高、宽;空间 token 数的倍数不是任意一个轴的坐标缩放倍数。也就是说,模型要给四倍多的位置编号赋予意义,新增的较远坐标与注意力关系超出了训练范围(已有坐标仍然见过)。
这是一个待诊断的假设场景:位置编码、训练尺度、VAE、注意力规模和运动分布都可能造成失败,不能仅凭症状归因给 RoPE。
注意力机制本身是置换等变的:把输入序列的顺序打乱,输出也只是跟着打乱,每个 token 看到的上下文完全不变。换句话说,纯注意力分不清「第 3 帧」和「第 40 帧」。位置信息必须额外注入。
早期做法是可学习的绝对位置嵌入(learned absolute PE):给每个位置分配一个可训练向量,加到 token 上。这在训练长度内工作良好,但有个硬伤——没见过的位置没有对应向量。你训练时只见过 49 个位置,推理要 97 个,后面 48 个位置没有训练过的表项。可以扩表、插值或重新训练,但这些都要额外规定,质量也要验证;不能由“没表项”直接推出所有绝对位置方案必然失败。
RoPE 解决的正是这件事:它不给位置分配「向量」,而是给位置分配「旋转角度」。角度公式可计算到新位置;生成质量能否外推仍需训练或扩展策略验证。
三句话:
如果只记一件事:本文标准 RoPE 是乘上去的旋转,不是加上去的向量。 它保持被旋转向量的模长;加法通常不保持。这个几何差别值得理解,但不是哪一种位置编码质量更好的证明。带幅度缩放的 RoPE 扩展还要单独讨论。
还有一个位置要记准:它作用在每一层注意力的 $q$ 和 $k$ 上,不是输入层加一次,通常不旋转 $v$。这是本文及常用实现的约定,某些变体也会旋转 value,不能一概判错。
先补齐先修背景:注意力先做 $q=W_Qx$、$k=W_Kx$、$v=W_Vx$,再把 $q^\top k/\sqrt{d}$ 经掩码和 softmax 变成对 $v$ 的加权系数。这里 $d$ 是单个 head 的旋转维度,取正偶数;本文先考虑整个 head 都旋转。我们讨论的是 softmax 之前的单个点积,$1/\sqrt{d}$ 只是公共比例。
设 $x_m$ 是位置 $m$ 上的 token 特征,我们要找一个变换 $f$,使得变换后的 query 和 key 的内积满足:
$$\langle f(q, m), f(k, n) \rangle = g(q, k, m-n)$$
左边依赖两个绝对位置 $m$ 和 $n$,右边只依赖它们的差值 $m-n$。这就是「相对位置不变性」的精确表述。注意 $g$ 的具体形式我们不关心,只要求它不含 $m$、$n$ 的单独出现。这个性质也可叫共同平移不变性:同时把两者位置加同一个偏移,固定内容向量的点积不变。真实网络的内容向量、掩码及可见 token 集合仍可能变化。
二维情况下有个现成的东西满足这个条件:旋转。
把二维向量 $q = (q_0, q_1)$ 看成复数 $q_0 + iq_1$。复数乘法 $e^{im\theta}$ 的几何意义就是逆时针旋转 $m\theta$ 弧度,且不改变模长。
现在令 $f(q, m) = q e^{im\theta}$,算一下内积。复数域上的内积要取共轭:
$$\langle f(q,m), f(k,n) \rangle = \mathrm{Re}\left[(q e^{im\theta}) \overline{(k e^{in\theta})}\right] = \mathrm{Re}\left[q \bar{k} e^{i(m-n)\theta}\right]$$
关键一步在指数:$e^{im\theta} \cdot \overline{e^{in\theta}} = e^{im\theta} e^{-in\theta} = e^{i(m-n)\theta}$。绝对位置就这么消掉了,只留下 $(m-n)$。这就是 RoPE 的全部动机,后面所有工程细节都只是把这个二维结论铺到高维。
实际的 head_dim 是 64 或 128,不是 2。做法是把 $d$ 维切成 $d/2$ 组,每组两个相邻维度构成一个复数平面,第 $i$ 组用自己的旋转频率:
$$\theta_i = \text{base}^{-2i/d}, \quad i = 0, 1, \dots, d/2 - 1$$
这里的 base 就是代码里的 rope_theta;本文选 10000,不代表所有模型都用这个值。$i$ 是二维平面的组号,不是单个坐标号。
这个频率设计是理解 RoPE 行为的关键。展开看两端:
也就是说,高频维度负责区分近距离,低频维度负责区分远距离。一个位置差 1 的 token 对,主要靠前面几维的相位差来分辨;位置差较大时,高频相位已多次绕圈,而低频相位仍提供变化较慢的尺度;各频段并非互斥地负责某一距离。
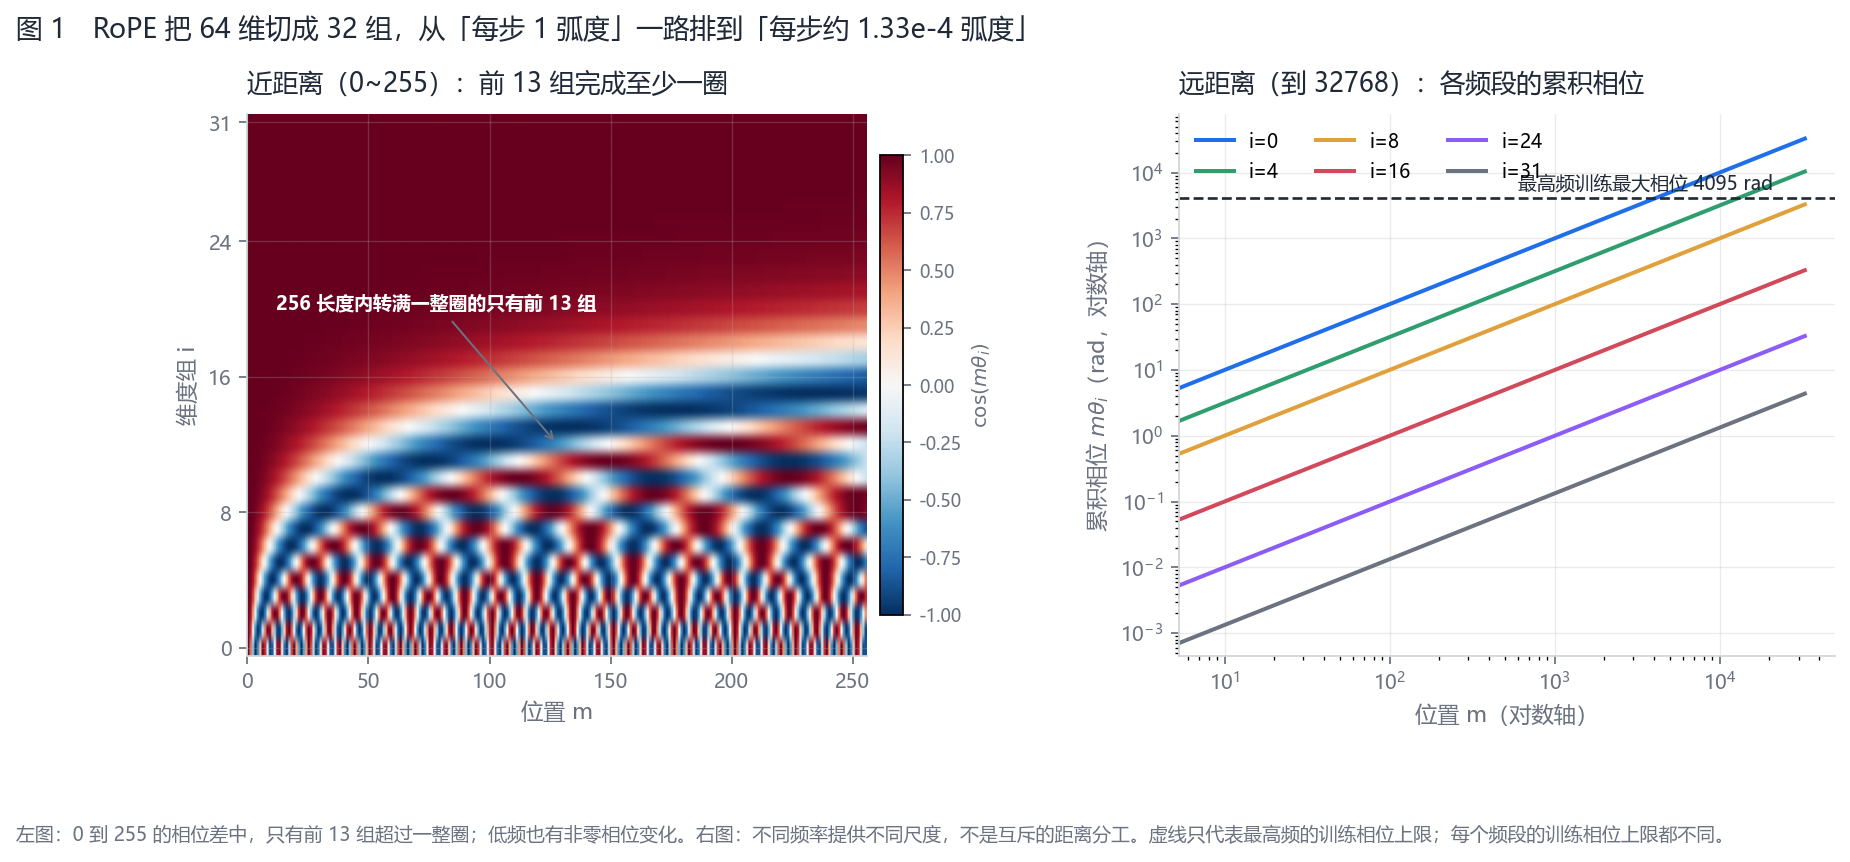
这张图要看什么:左图是 $\cos(m\theta_i)$ 的热力图(横轴位置、纵轴维度组)——256 长度内转满一整圈的只有前 13 组;这些高频组提供较大的近距离相位变化,维度索引越大,相位变化越慢,但并非不携带近距离位置信息;右图把位置拉到 32768,高频组早就转了几万弧度,低频组才刚积累出可分辨的相位。这是 32 组频率提供的多尺度结构,不是互斥的距离分工;后面的 PI、NTK-aware、YaRN 都会调整这组频率;YaRN 还包含注意力幅度修正,不能只理解成频率重分配(图由 code/make_figures.py 生成)。
这个结构直接解释了长度外推的两种主流做法:位置插值(PI)把所有位置除以一个缩放因子,等价于整体降低旋转速度;NTK-aware 缩放只调 base,让低频维度转得更慢而尽量保住高频维度的分辨率。它们改的都是同一组 $\theta_i$。
写成矩阵形式,RoPE 就是一个分块对角的旋转矩阵 $R_m$,第 $i$ 个 $2\times2$ 块为:
$$\begin{pmatrix} \cos m\theta_i & -\sin m\theta_i \\ \sin m\theta_i & \cos m\theta_i \end{pmatrix}$$
对固定的未旋转内容向量 $q,k$,矩阵推导完整写成:
$$\langle R_mq,R_nk\rangle=q^\top R_m^\top R_nk=q^\top R_{n-m}k$$
因为每块旋转都满足 $R_m^\top=R_{-m}$、$R_aR_b=R_{a+b}$。这和 3.2 节的 $(m-n)$ 没有冲突:复数写法取 $q\bar{k}$,矩阵写法让相位作用在右侧的 $k$ 上。展开第 $i$ 对坐标,令 $\Delta=n-m$,二者都得到:
$$ (q_{2i}k_{2i}+q_{2i+1}k_{2i+1})\cos(\Delta\theta_i)+(q_{2i+1}k_{2i}-q_{2i}k_{2i+1})\sin(\Delta\theta_i) $$
位置差的正负和正弦前的交叉项要一起看,不能只照抄其中一个符号。独立脚本 rope_validation.py 同时检查复数、矩阵和直接旋转三种计算,最大绝对差约 $5.72\times10^{-13}$。
$R_m$ 是正交矩阵,所以 $\|R_mq\|=\|q\|$。加法通常不同:
$$\|x+p_m\|^2=\|x\|^2+2x^\top p_m+\|p_m\|^2$$
于是同一个 $x$ 放在不同位置,其模长可能改变。rope_decay.py 用 seed=0、64 维 float64 输入和独立同尺度随机 PE 作演示:
原始向量模长                7.315344
RoPE 后(位置 0/1/100/511) 7.315344  7.315344  7.315344  7.315344
跨位置模长极差              8.88e-16
加法式 PE 后                9.843323  10.080425  10.808198  10.190631
跨位置模长极差              0.9649
这组随机 PE 不是训练后的绝对位置嵌入,不能当质量对照。模长保持让位置注入的几何作用更容易分析,但 $q,k$ 的方向变了,softmax 权重照样会变;模长也不能直接解释成 token 的重要性或置信度。如果某扩展把 cos/sin 同乘 $a$,旋转结果就会再乘 $a$,$q,k$ 点积变为原来的 $a^2$ 倍,已不满足这里的单位幅度保模长结论。
下面用 NumPy 写出完整最小实现,输入采用浮点数组,旋转维度为正偶数。它把逐对旋转直接展开,便于对照公式。
import numpy as np


def build_rope_cache(seq_len: int, dim: int, base: float = 10000.0):
    """预计算 RoPE 的 cos/sin 表。

    dim 必须是偶数:每两个相邻维度配成一个复数参与旋转。
    base 就是常说的 rope_theta,调它会按维度改变旋转速度;最高频 i=0 始终为 1。
    """
    assert dim % 2 == 0, f"dim 必须为偶数,收到 {dim}"
    # theta_i = base^(-2i/dim):i 越大转得越慢,对应越低的频率
    inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim))
    pos = np.arange(seq_len)
    freqs = np.outer(pos, inv_freq)              # [seq_len, dim/2]
    return np.cos(freqs), np.sin(freqs)


def apply_rope(x: np.ndarray, cos: np.ndarray, sin: np.ndarray) -> np.ndarray:
    """把旋转作用到 x 上。x: [seq_len, dim]

    最后一维两两配对看成复数 (x_even + i*x_odd),乘上 e^{i*m*theta}:
        实部 = x_even * cos - x_odd * sin
        虚部 = x_even * sin + x_odd * cos
    """
    x_even, x_odd = x[..., 0::2], x[..., 1::2]
    out = np.empty_like(x)
    out[..., 0::2] = x_even * cos - x_odd * sin
    out[..., 1::2] = x_even * sin + x_odd * cos
    return out
验证核心性质:固定一对向量,只改赋予它们的绝对位置,间距始终为 1。如果推导是对的,内积应该完全不变。
rng = np.random.default_rng(0)
seq_len, dim = 8, 64
cos, sin = build_rope_cache(seq_len, dim)
q = rng.standard_normal(dim)
k = rng.standard_normal(dim)

for shift in range(4):
    qr = apply_rope(q[None, :], cos[shift:shift + 1], sin[shift:shift + 1])
    kr = apply_rope(k[None, :], cos[shift + 1:shift + 2], sin[shift + 1:shift + 2])
    print(f"位置 ({shift}, {shift + 1}) → 内积 {float(qr[0] @ kr[0]):.6f}")
真实输出:
cos/sin 形状: (8, 32) (8, 32)
位置 1 的前 4 维 cos: [0.5403, 0.7318, 0.846, 0.9124]
位置 1 的末 2 维 cos: [1.0, 1.0]

同一对向量,平移绝对位置(间距恒为 1):
  位置 (0, 1) → 内积 -11.297869
  位置 (1, 2) → 内积 -11.297869
  位置 (2, 3) → 内积 -11.297869
  位置 (3, 4) → 内积 -11.297869

对照组,改变间距:
  间距 1      → 内积 -11.297869
  间距 2      → 内积 -12.637566
  间距 3      → 内积 -13.049657

未加 RoPE 的原始内积: -9.701179
三个数字值得盯一下。
第一,四行内积完全相同(-11.297869),小数点后六位都不差。这就是 3.1 节那个式子在数值上的体现:绝对位置从 (0,1) 挪到 (3,4),这些数打印到六位小数相同,底层浮点结果允许舍入误差;间距一变(1→2→3),这组向量的内积随之变化。
第二,位置 1 的前 4 维 cos 是 0.5403、0.7318、0.846、0.9124,递增。对应 $\theta_i$ 递减:第 0 维转了整整 1 弧度(cos 1 ≈ 0.5403),第 3 维只转了约 0.42 弧度。这就是「高频维度在前」的直接观测。
第三,末 2 维 cos 打印出来是 1.0。不是真的等于 1,而是最低频 $\theta_{31}=0.0001333521432$,其 cos 约为 0.9999999911,六位小数下显示成 1.0。这些维度在近距离上有很小但非零的相位变化;不能说它们只为远距离服务。NTK-aware 缩放对这些低频维度施加更大压缩;实际质量代价仍取决于训练后的频段使用方式。
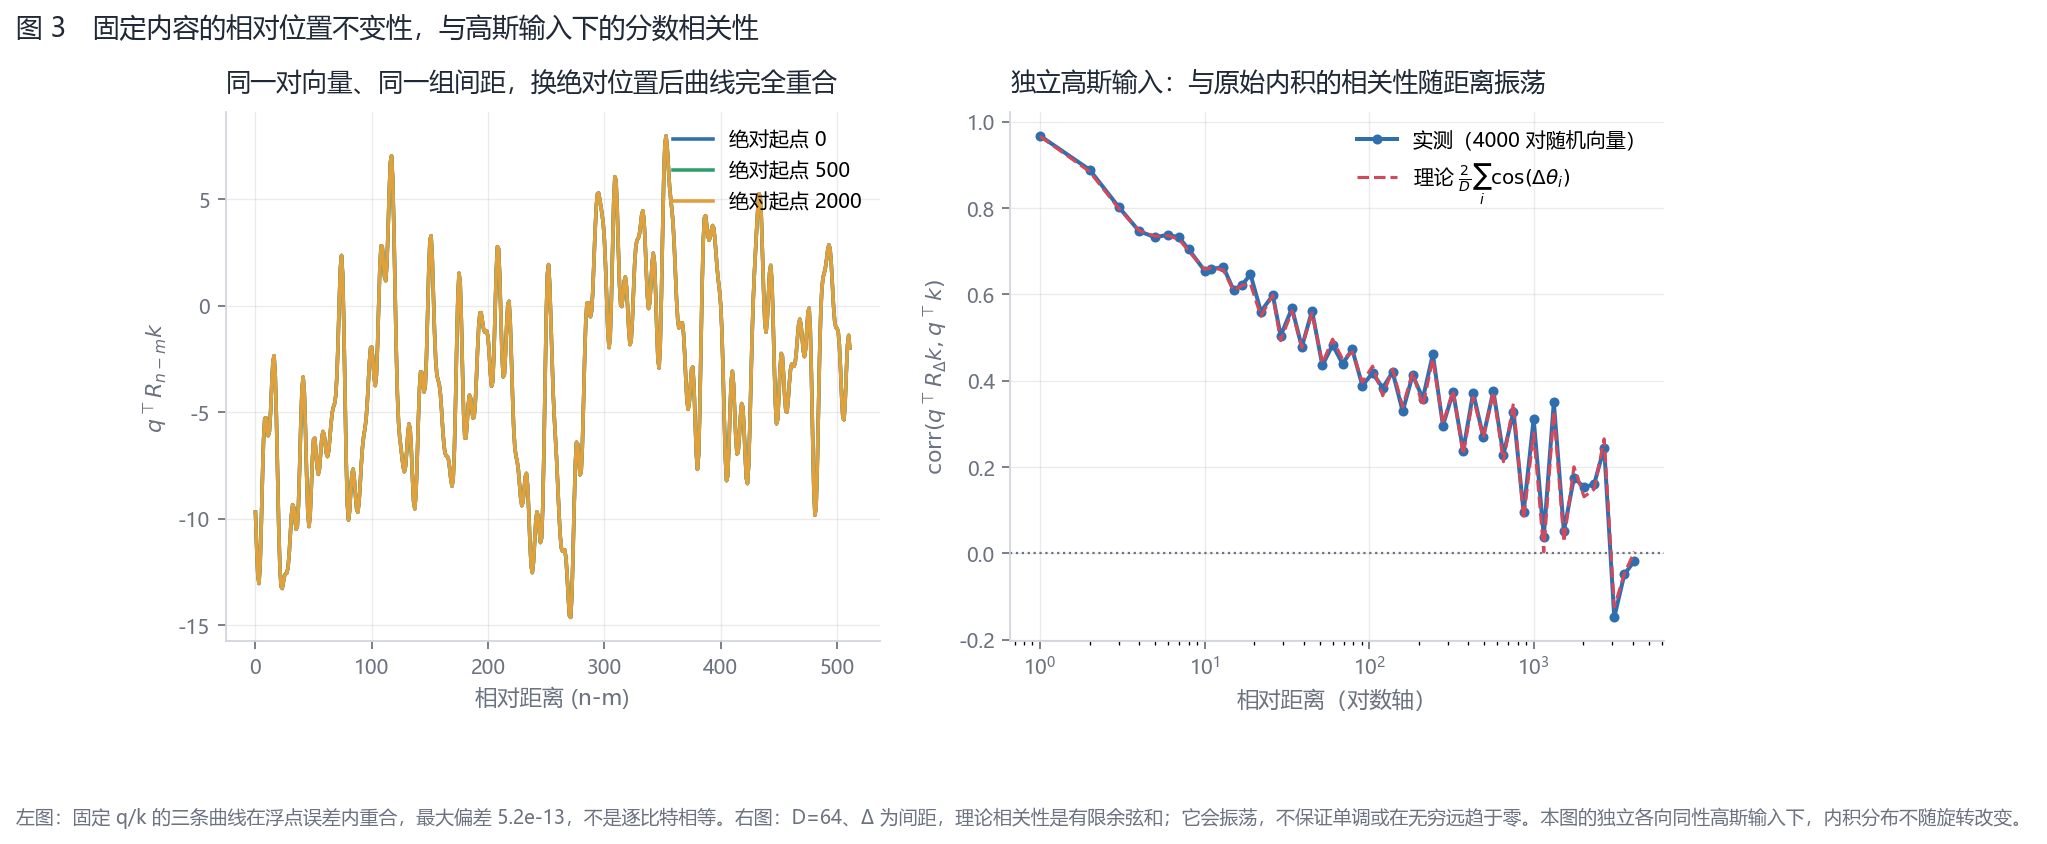
上面这张图(code/make_figures.py 图 3)把本节的两件事画在了一起。左图是平移不变性的可视化:同一对 $q$、$k$,把绝对起点放在 0 / 500 / 2000,逐点画出内积随相对距离的曲线——三条曲线完全重合(最大偏差 5.2e-13),这就是上面输出里「四行内积完全相同」的图形版。右图是另一个常被混着说的现象:距离越远,加了 RoPE 的分数与不加位置编码的原始内积的相关性在所采样的区间整体降低,但并不单调(4000 对随机向量实测,$\Delta=1$ 时 0.97、$\Delta=4096$ 时接近 0;对独立各向同性输入,虚线为 $\frac{2}{d}\sum_i\cos(\Delta\theta_i)$,d 是特征维度、Δ 是相对距离)。注意衰减的是这个相关性,不是内积本身的大小——旋转保模长,本文独立各向同性高斯向量的内积分布与距离无关(实验三会验证这一点)。
完整脚本见 code/rope_minimal.py。
3.3 节说过 PI 和 NTK-aware「改的都是同一组 $\theta_i$」。这句话用代码写出来就是两个短函数——把它们并排放一起,先看清两种方法的几何差别;适用维度和参数条件见下文。
def theta_original(dim=64, base=10000.0):
    return 1.0 / (base ** (np.arange(0, dim, 2) / dim))


def theta_pi(dim=64, base=10000.0, scale=8):
    """Position Interpolation:位置索引整体除以 scale。
    等价于把每个 theta_i 都乘上 1/scale——所有频率被同等减速。"""
    return theta_original(dim, base) / scale


def theta_ntk(dim=64, base=10000.0, scale=8):
    """NTK-aware:把 base 放大,让减速量随维度索引递增(频率越低减速越多)。"""
    if dim <= 2 or dim % 2 or scale <= 0 or base <= 0:
        raise ValueError("NTK-aware requires even dim > 2, positive scale and base")
    new_base = base * scale ** (dim / (dim - 2))
    return theta_original(dim, new_base)
跑 code/rope_extrapolate.py 看它们对各维度做了什么(外推 8 倍):
  维度 i      原始         PI(÷8)      NTK-aware    PI减速比  NTK减速比
     0   1.000e+00   1.250e-01   1.000e+00      8.00x     1.00x
     4   3.162e-01   3.953e-02   2.418e-01      8.00x     1.31x
     8   1.000e-01   1.250e-02   5.847e-02      8.00x     1.71x
    16   1.000e-02   1.250e-03   3.419e-03      8.00x     2.92x
    31   1.334e-04   1.667e-05   1.667e-05      8.00x     8.00x
PI 那一列减速比是齐刷刷的 8.00x,从最高频到最低频一视同仁。NTK 那一列从 1.00x 单调爬到 8.00x——最高频维度完全没动,最低频维度承担了全部的 8 倍压缩。
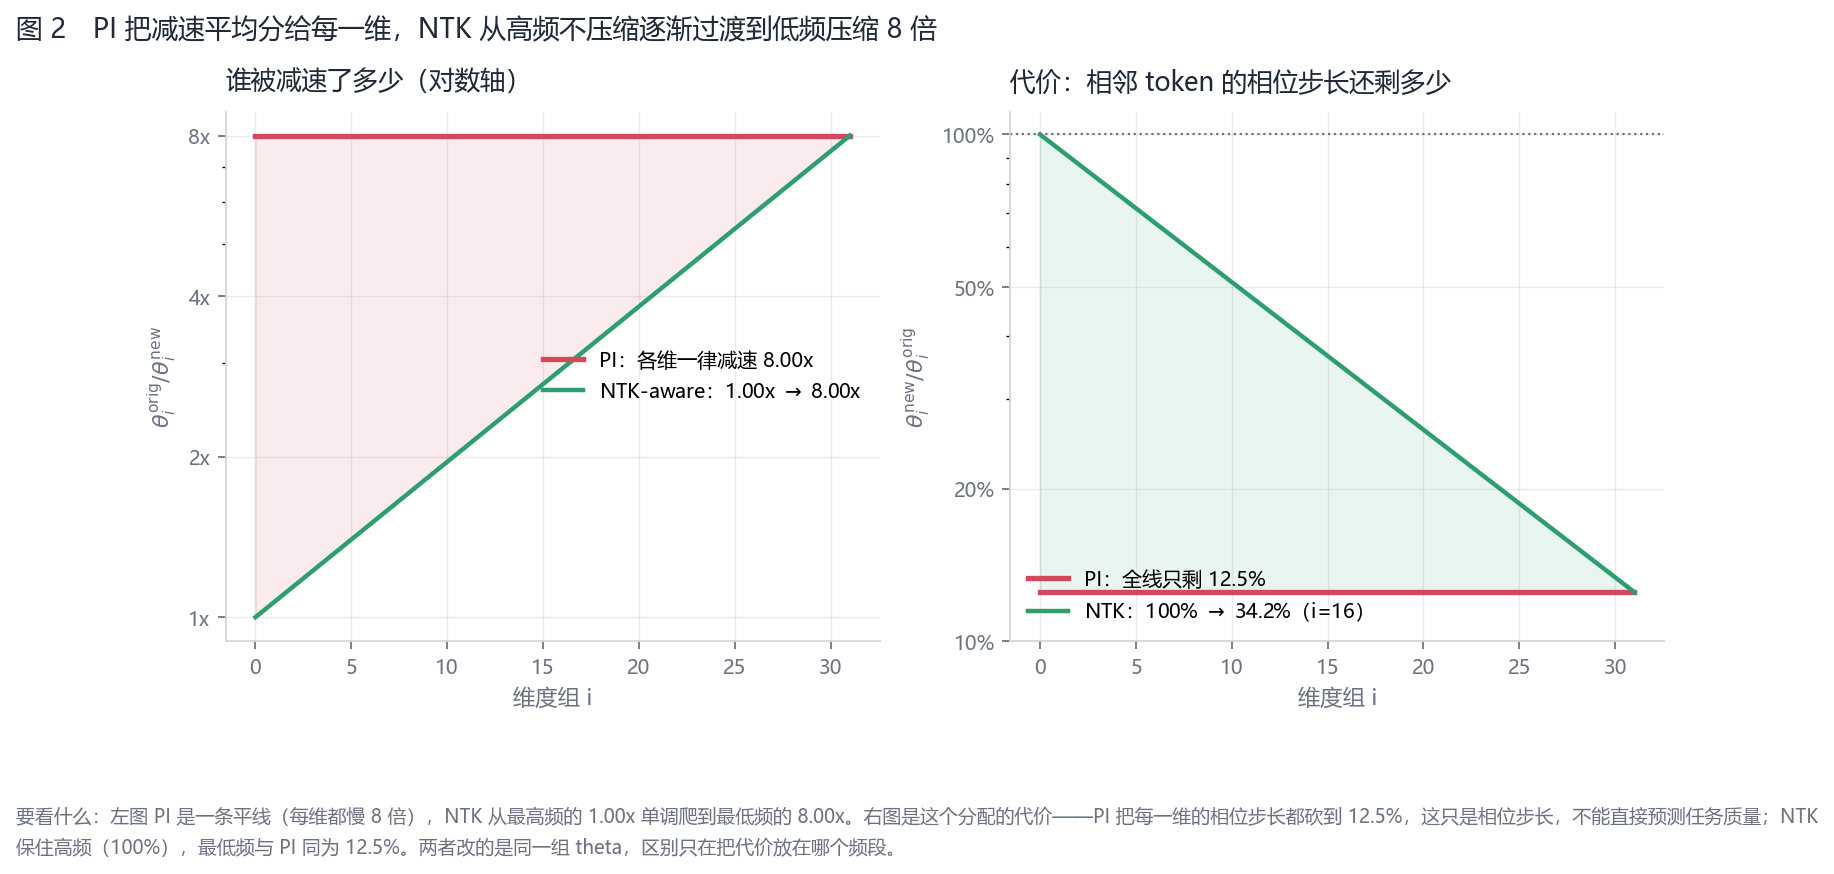
这张图要看什么:左图把上表画成曲线——PI 是一条平线(每维都慢 8 倍),NTK 从最高频的 1.00x 单调爬到最低频的 8.00x,两条线夹出的面积就是「NTK 少减的部分」;右图是代价,PI 把每一组的相邻坐标相位步长降到 12.5%,NTK 第 0 组保留 100%,第 16 组约 34.2%,最低频第 31 组为 12.5%。这些是相位步长的比例。两种方法改的是同一组 $\theta_i$,区别只在把这次外推的代价放在哪个频段。
先只量几何变化:相邻坐标的相位步长还剩多少:
  维度 i     原始        PI          NTK        PI保留   NTK保留
     0   1.000000  0.125000  1.000000    12.5%  100.0%
     4   0.316228  0.039528  0.241809    12.5%   76.5%
     8   0.100000  0.012500  0.058472    12.5%   58.5%
    16   0.010000  0.001250  0.003419    12.5%   34.2%
PI 让每维相邻位置的相位增量降到 12.5%;这可能影响局部分辨,但不等于任务指标必然下降,微调与模型适应会改变实际结果。NTK 在第 0 维保住了 100%,代价是第 16 维只剩 34.2%。
还有一个容易看漏的点。NTK 外推后,最高频维度在位置 32767 处的相位是 32767 弧度,仍然远超训练时见过的 4095:
  训练时见过的最大相位(位置 4095)     4095.0 rad
  原始(直接外推)           位置 32767    32767.0 rad   ← 超出 8.0 倍
  PI                 位置 32767     4095.9 rad   ← 接近但略超训练端点 4095
  NTK-aware          位置 32767    32767.0 rad   ← 超出 8.0 倍
这是该缩放的设计取舍:最高频保留原始步长,低频逐渐压缩。未展开相位超过训练最大值不等于必然失效,相位本身具有周期性;只有最低频获得完整 8 倍压缩,不能据此保证所有频段已回到训练范围或质量安全。PI 则把所有维度的相位范围压到接近训练区间,代价是相邻位置相位步长整体下降;精确端点对齐还需使用端点跨度比。上面的 NTK-aware 是固定缩放教学版。将新 base 代回频率定义可得:
$$\theta_i'=\theta_i s^{-2i/(d-2)},\quad d>2,\quad s>0$$
所以第 0 组不动,第 $d/2-1$ 组恰好除以 $s$。本文为延长窗口使用 $s\geq1$;$d=2$ 时这个公式没有定义。它不是固定版本 HF 的动态 NTK:后者会用当前长度改变 base,见 5.3 节。
PI 若要求目标末坐标精确映回训练末坐标,应选 $s=(L_{\text{new}}-1)/(L_{\text{train}}-1)$,两长度都大于 1。4096→32768 时是 8.0017094,而非 8;用长度比 8 会得到 4095.875,略超 4095。两种约定要写清,不能把舍入差说成方法失效。
YaRN 的 v2 原文在频段插值之外还讨论注意力温度修正;本文只复现 PI 与固定 NTK-aware 的频率几何,没有复现 YaRN 的训练或长上下文质量。
本节固定可复核的源码版本;它们是选定的实现快照,不表示当天最新版:
LlamaRotaryEmbedding、rotate_half、apply_rotary_pos_emb。dynamic_rope_update。get_1d_rotary_pos_embed、get_3d_rotary_pos_embed。下载的原文件保留 SHA256。本轮把上述类和函数的原始 AST 直接在 CPU 执行,提供简单配置对象及原生依赖;没有改写其数学实现,也不声称执行了完整模型或安装了完整框架。
下面按配对、频率缓存、坐标、精度四条线对照,再看视频的三轴扩展。
这是最容易踩的坑。本文把第 $2i$ 和 $2i+1$ 维配成一个复数(奇偶交错),而 HF 的写法是把第 $i$ 和第 $i + d/2$ 维配成一对(前后半切分):
def rotate_half(x):
    """Rotates half the hidden dims of the input."""
    x1 = x[..., : x.shape[-1] // 2]
    x2 = x[..., x.shape[-1] // 2 :]
    return torch.cat((-x2, x1), dim=-1)

q_embed = (q * cos) + (rotate_half(q) * sin)
配合 emb = torch.cat((freqs, freqs), dim=-1)(cos/sin 表沿最后一维复制两遍),展开就是 $x_i \cos - x_{i+d/2} \sin$ 和 $x_{i+d/2} \cos + x_i \sin$——和 3.3 节的旋转矩阵一模一样,只是谁跟谁配对换了。
那两者是等价的吗?我写了个脚本实测(code/rope_pairing.py):
=== 1. 两种配对都满足相对位置不变性 ===
  奇偶交错: 间距恒为 3 时内积 -13.049657,四个绝对位置间的最大波动 3.55e-15
  前后半切分: 间距恒为 3 时内积 -7.706177,四个绝对位置间的最大波动 1.78e-15

=== 2. 同一份权重下,两种配对给出的分数不同 ===
  奇偶交错   -13.049657
  前后半切分 -7.706177
  差值       5.343480  ← 不为 0,实现和权重必须配套

=== 3. 重排维度后两者完全一致 ===
  奇偶交错(原始排布)      -13.049657
  前后半切分(重排后权重)  -13.049657
差值 0.00e+00 ← 只差一个固定的维度置换三段结论连起来才是完整答案:作为位置编码方案两者等价(都满足相对位置不变性,波动 1e-15 是纯浮点误差),但对同一份权重不可互换(差了 5.34),因为它们只差一个固定的维度置换(重排后差值精确为 0)。
实践意义:移植权重时如果配对方式对不上,模型不会报错,只会变笨。这种 bug 极难查——loss 能降,输出也通顺,就是长距离能力莫名其妙地差。排查时要把 cos/sin 的复制方式与旋转算子一起核对:本节 Llama 的 cat((freqs, freqs)) 配 rotate_half;交错版的逐对旋转配 repeat_interleave。仅看一个 cat 不能推断陌生代码里所有后续维度重排。移植线性层时,若按 $q=W_Qx$ 记号,应同步置换 $W_Q,W_K$ 的输出行及偏置;GQA 也要逐 KV head 核对。
inv_freq 存成 buffer,而且不进 checkpointself.register_buffer("inv_freq", inv_freq, persistent=False)
self.original_inv_freq = self.inv_freq这是固定 v4.51.3 原代码,第二行是普通属性引用,不是注册第二份 buffer。保存频率避免反复做幂运算;这个版本仍会在 forward 计算给定位置的 cos/sin,并不缓存所有位置的完整三角函数表。persistent=False 的含义是:它让 inv_freq 不写进 state_dict。好处是改 rope_theta 做长度外推时,不必担心 checkpoint 里存着旧频率把新配置覆盖掉——在这里,模型构建时先由 config 建频率,再按所选策略更新。不能推广为所有模型都不保存频率。留一份 original_inv_freq 是给 dynamic NTK 用的:那类方法会随序列长度临时改频率,短序列时可能需要退回原值。CPU 原类实跑确认 state_dict 没有 inv_freq,动态类增长后会改频率,长度回到原窗口内会复原。
position_ids 而不是内部 arangedef forward(self, x, position_ids):
inv_freq_expanded = self.inv_freq[None, :, None].expand(position_ids.shape[0], -1, 1)
position_ids_expanded = position_ids[:, None, :].float()最小实现里位置就是 arange(seq_len),生产上不行,至少三个场景要显式传:
动态频率还会影响 KV cache。固定频率时,历史 key 在其绝对坐标旋转一次后可复用;但如果新 query 改用新频率,旧 key 仍是旧频率,点积就不再是同一个 $R_m^\top R_n$。需核对框架是否冻结整次生成的频率、重算缓存,或采用专门的兼容策略;单看频率更新函数不能保证缓存正确。
HF v4.51.3 的动态 NTK 具体用 $b'=b[f\ell/L_0-(f-1)]^{d/(d-2)}$,其中 $b$ 为旧 base、$f$ 为配置 factor、$\ell$ 为当前长度且至少取原窗口 $L_0$;不是把本文固定缩放里的 $s$ 直接替换成 $\ell/L_0$。原类 CPU 演示在 $d=8,L_0=4,f=2$ 的配置中,旧 key 与按最终频率重算的 key 给出点积差约 0.128828;这是明确的缓存混频反例,不是框架完整生成的测试。
with torch.autocast(device_type=device_type, enabled=False):
    freqs = (inv_freq_expanded @ position_ids_expanded).transpose(1, 2)
    emb = torch.cat((freqs, freqs), dim=-1)
    cos = emb.cos() * self.attention_scaling
注意它显式关闭 autocast,并先把位置和频率转成 FP32。BF16 有 8 位有效二进制精度(含隐含位),在 $[4096,8192)$ 的相邻可表示数间隔为 32;CPU 原生转换中,4096 和 4097 都会变成 4096。若先在 BF16 编号再转 FP32,丢失的坐标不会回来。频率本身先量化后再转高精度也同样不能恢复。
FP32 能避免这个例子的相邻坐标合并,但不等于任意长位置都安全;相位乘法与三角函数仍有误差,极长上下文应测目标范围,必要时用 FP64 等策略。固定 Llama 代码最后把 cos/sin 转回输入 dtype;“相位计算用 FP32”和“所有后续旋转必须 FP32”是两回事。本轮官方 FP32 输出与 NumPy float64 参考最大差约 $5.27\times10^{-5}$,同一份 FP32 cos/sin 下逐元素前向与输入梯度均精确对齐。
接手一个没见过的模型,想搞清它的 RoPE 怎么配的,按这个顺序问四个问题最快,也刚好对应上面四小节:
cat 还是 repeat_interleave——torch.cat((freqs, freqs)) 是前后半切分,repeat_interleave(freqs, 2) 是奇偶交错。这决定了权重能不能和别的实现互换。inv_freq 从哪来、会不会变? 搜 inv_freq 的赋值点。如果只在 __init__ 里算一次,就是静态 RoPE;如果 forward 里还会重算,大概是某种 dynamic NTK,那么推理时的行为会随序列长度变。position_ids 谁给的? 如果是内部 arange,还要核对是否加了 cache offset 或传入各段位置;从零重启才会破坏 KV cache 增量解码,多模态场景基本要改。float()、autocast、enabled=False。没有强制 fp32 的话,长序列下有精度隐患(5.4 节)。这四个问题都能靠 grep 在几分钟内回答,比通读整个 attention 实现快得多。
视频 DiT 的 token 有时间、高、宽三个坐标,做法是把 head_dim 切成三份,每份跑一遍 1D RoPE 再拼起来。本节固定 Diffusers 函数的一种分配是:
dim_t = embed_dim // 4        # 时间轴,占 25%
dim_h = embed_dim // 8 * 3    # 高,占 37.5%
dim_w = embed_dim // 8 * 3    # 宽,占 37.5%
这个 2:3:3 的分配是 CogVideoX 相关函数的一种维度预算,不能推广为所有视频模型的配置。各轴必须有可配对的偶数维度,需核对具体函数对 head_dim 的限制;64 维时是 16/24/24。CPU 原函数用时间 2、高 2、宽 3 的小网格,返回 cos/sin 均为 (12,64)。空间坐标还受 grid_type、裁剪范围和插值设置影响,不能只看 token 数。不能从空间占 75%、时间占 25% 推断哪个轴更先失败或失败症状;需结合训练范围、每轴频率和实际消融。详见3D RoPE。
固定频率、单位幅度时,共同平移不变性对任意可计算的位置都成立,但不会自动保证超出训练长度后的质量。真实模型学到的是内容与多频段相位、掩码、上下文长度的联合关系;逐个频段的角度还具有周期性。“未展开相位超出训练最大值”不是充分的失败判据。PI 论文展示的是特定模型及适配训练结果,不能简化成只换公式就普遍无损。
第一种量是独立各向同性高斯 $q,k$ 的内积分布。正交旋转后 $R_\Delta k$ 与 $k$ 同分布且仍独立于 $q$,所以整个分布不变。rope_decay.py 的 2000 次独立采样给出绝对内积均值:
不加 RoPE          6.2076
gap=1              6.3182
gap=64             6.2415
gap=1024           6.2583
gap=4000           6.4830
这些数的波动来自有限采样,不能据某一个值略高或略低得出趋势;也不能把各向同性高斯的结论套到所有输入上。
第二种量是固定相似向量的分数。例如 $q=k$ 时,第 $i$ 对的交叉项抵消,得到:
$$q^\top R_\Delta q=\sum_i(q_{2i}^2+q_{2i+1}^2)\cos(\Delta\theta_i)$$
全 1、64 维向量在 gap=0/1/16/64/1024/4000 时依次为 64、61.8337、38.7456、27.8122、16.8272、0.0989。seed=7 的所选随机自配对向量从 50.96 降至约 0.97,也会在部分距离回升。有限采样点的下降不是普遍衰减定律:只打开第 0 个坐标、其余置零,分数就是 $\cos\Delta$,gap=0/3/6 为 1、−0.989992、0.960170。距离增加,分数可以回升、变负,再接近原值;这个整数坐标反例由 rope_validation.py 实跑。
第三种量是图 3 的与未旋转分数的相关性。对独立标准高斯输入,令 $S_\Delta=q^\top R_\Delta k$、$S_0=q^\top k$,均值都为 0。展开求和并用 $E[q_aq_b]=E[k_ak_b]=\delta_{ab}$,只留下相同索引的项,所以:
$$\operatorname{Cov}(S_\Delta,S_0)=\operatorname{tr}(R_\Delta)=2\sum_i\cos(\Delta\theta_i),\quad \operatorname{Var}(S_\Delta)=\operatorname{Var}(S_0)=d$$
$$\operatorname{corr}(S_\Delta,S_0)=\frac{2}{d}\sum_i\cos(\Delta\theta_i)$$
这个相关系数下降不代表分数幅度下降。独立核验 seed=19、20000 对向量、gap=64,理论值 0.434565,样本值 0.425446;样本误差不应伪装成精确相等。有限余弦和可能振荡,也没有这里所证明的“无穷远必趋零”性质。原 RoFormer §3.4.3 还用 Abel 求和讨论上界。令 $M=d/2$、$a_i=q_i^{\mathbb C}\overline{k_i^{\mathbb C}}$(即第 $i$ 对坐标的复数乘积)、$a_M=0$,并令 $S_j=\sum_{i=0}^{j-1}e^{\mathrm{i}(m-n)\theta_i}$,这里 $\mathrm{i}$ 是虚数单位:
$$\left|\sum_{i=0}^{M-1}a_i e^{\mathrm{i}(m-n)\theta_i}\right|=\left|\sum_{j=1}^{M}S_j(a_{j-1}-a_j)\right|\leq\max_{1\leq j\leq M}|a_{j-1}-a_j|\sum_{j=1}^{M}|S_j|$$
它把内容系数的变化与部分相位和分开;上界的示意行为不等于每对输入的实际分数都单调下降。rope_validation.py 独立核验这个恒等变形和不等式。原文的分析、本文的相关性和固定向量分数需要分别阅读,也不能据此把真实视频身份漂移归因给 RoPE。
RoPE 用绝对坐标产生旋转,固定内容的成对点积才只依赖差值。若有固定在位置 0 的 BOS、首帧或条件 token,那么“到锚点的相对距离”已经提供位置线索。因果掩码、边界和其他条件也可能提供线索;这不等于模型必然学会准确计数。需要指定时间戳或特殊首帧时,应确认坐标、掩码和条件机制如何共同表达任务,而不能简单断言 RoPE 无法表达绝对位置。
统一口径:一次乘法加一次加法计 2 FLOPs,batch=1、$N=90000$、$H=24$ 个 query/key 头、head_dim $d=64$、$L=40$ 层,Q 和 K 都全维旋转,非 GQA。每个二维平面做 4 乘 2 加,即每个向量 $3d$ FLOPs:
$$F_{\text{RoPE}}=6LNHd=33.1776\;\text{GFLOPs}$$
同口径下,完整双向稠密注意力的两个矩阵乘 $QK^\top$ 和 $AV$ 共计:
$$F_{\text{attention}}=4LHN^2d=1990.656\;\text{TFLOPs}$$
旋转算术占比约 0.001667%。原文的 995.3 是这两个矩阵乘的 TMAC 近似量,不能直接写成 TFLOPs 再与旋转 FLOPs 相除。这里只数上述主项,不含线性投影、softmax、掩码、三角函数和访存;因果有效三角区域也不能照抄完整方阵预算。
cos/sin 按半维各存一张 FP32 表时是 $Nd\times4=23040000$ bytes,约 21.97 MiB;铺满 dim 是 46080000 bytes,约 43.95 MiB,BF16 存储再减半。这是可选预计算布局,不是所有实现都分配这张表;频率、坐标及 dtype 相同时才可共享。
独立旋转 kernel 还要读写 Q/K。FP16 下,仅读写这两者一次的理想最低数据量为 $4NHd\times2=1105920000$ bytes/层,未算表和中间张量;融合可减少额外往返。增量解码的新 query 对历史 cache 做注意力时,算量比例也不同于训练的整块 $N^2$。因此短序列、长 cache、kernel launch、融合、内存布局都要实际 profiling,不能从这笔 FLOPs 账得出“选 RoPE 从来不是性能问题”。
什么时候考虑其他方案:任务是否需要相对关系、模型是否已有训练好的位置机制、目标长度与硬件约束,决定采用或保留哪种方案。固定短序列仍可能从 RoPE 获益;也不能把“训练短、推理长”当成它唯一的价值。
这里按问题串联,不把不同机制压成“都只改同一组频率”:
(1,2,2) patchify 正好可对照第 01 节的尺寸账本;这里不把该报告当成具体 RoPE 频率配置的证据。轴维度、base、坐标与训练范围应分别查对应实现,不能据几个例子宣布所有视频 DiT 都采用同一配置。语言侧的插值思路可以成为视频各轴的候选策略,但不代表全部外推方法可直接无损移植。对 01 节的网格,时间/高/宽的长度比是 25/13、45/30、80/52;若按末坐标精确对齐则是 24/12、44/29、79/51。先决定每轴的坐标约定,再做模型消融与质量验收;总 token 数比 90000/20280 不应直接作为三个轴共同的插值系数。
「RoPE 是加在 embedding 上的」。 不是。它作用在每一层注意力的 $q$、$k$ 上,而且是乘法(旋转)。$v$ 在本文与常用实现里不旋转;存在其他变体,不能把所有旋转 value 的方案都判为错误。把它当成输入层的一次性操作,是最常见的理解错误。
「调大 rope_theta 就能延长上下文」。 公式能算到新位置,不保证质量。调大 base 不改最高频 $\theta_0=1$,其他组按不同幅度减慢;不能说所有高频一起降速,也不能由几何比例推出短距离任务必然下降。要说明固定还是动态策略、训练或适配条件,以及缓存如何处理。
「相对位置不变性意味着模型对绝对位置完全无感」。 不成立。注意力有 causal mask,第 0 个 token 只能看到自己,第 100 个能看到 100 个——这种「可见范围」本身就泄露了绝对位置。研究里管这叫隐式位置信息。
「间距相同分数就一定相同」。 还必须固定同一对内容向量 q、k;真实模型里的它们也会随上下文变化。真实模型里中间还夹着 softmax 归一化和 causal mask,同一对 token 在不同上下文里拿到的注意力权重是不同的。04 节验证的是旋转这一步的数学性质,不是整个注意力层的行为。
「RoPE 自带远程衰减」需要限定输入与统计口径。 独立各向同性高斯输入的内积分布不随旋转改变;所选相似向量可能在某些距离明显降低、在另一些距离回升。示例不是普遍衰减定律,也不能单独证明长视频质量的因果关系。
四组不需要模型权重的 CPU 小实验,用到的脚本全文都在文末附录,除绘图需要 matplotlib 外,下面的教学数值脚本只依赖 NumPy,复制存成同名文件即可运行。新增 rope_validation.py 还需把它导入的三个同目录脚本一并保存。官方源码 CPU 对照另在本地质检证据中记录,不是读者运行这组实验的依赖。另外跑一遍 make_figures.py 可以把本文三张配图重新生成(这个需要 matplotlib,其余脚本只要 NumPy)。
实验一:看外推在哪一步崩。 跑 rope_minimal.py,把 seq_len 从 8 改成 4096,然后对比位置 (0, 1) 和位置 (4000, 4001) 的内积。预期结果是两者在浮点误差内相等——因为固定频率的数学性质对任意位置都成立。这只能说明该性质并未失效,不能单凭它诊断真实模型外推失败的原因。这是本文最容易被误解的一点,值得亲手确认一次。
实验二:验证配对方式不能混用。 跑 rope_pairing.py,观察第 2、3 段输出。预期看到同一份权重下两种配对差 5.34,而重排维度后差值精确为 0。把 dim 改成 128 再跑一次,结论不变——这是结构性的,与维度大小无关。
实验三:亲手推翻一个常识。 跑 rope_decay.py,重点看 2a 和 2b 的差别。预期看到独立各向同性高斯输入的绝对内积均值只在采样误差内波动;全 1 自配对向量在所选 gap=4000 点下降约 99.8%,这不是所有 $q=k$ 都如此。再跑 rope_validation.py,看单频反例从 gap=3 的 −0.989992 回升到 gap=6 的 0.960170,并核对相关性公式。然后把 2b 里的向量换成两个弱相关的向量试试(比如 k = 0.5 * q + 0.5 * rng.standard_normal(dim)),看衰减幅度怎么随相似度变化——这是理解 06 节那笔账的最快路径。
实验四:给自己的模型算外推预算。 跑 rope_extrapolate.py,把 SCALE 从 8 改成某一个轴按指定坐标规则计算出的倍数(第 7.1 节给出三轴示例),看 PI 和 NTK 各自在近距离分辨率上要付多少。预期规律是 PI 的保留率恒等于 $1/\text{scale}$,而 NTK 的保留率在高频维度接近 1、随维度下降。这些频率变化只能说明位置编码的几何差异,不能直接预测生成质量。如果任务依赖纹理、口型等近距离细节,应在目标分辨率上比较 PI、NTK 与必要的适配训练,结合质量和长距离一致性决定方案。
读这篇之前建议先看:
读完这篇可以继续看:
09 节用到的脚本全文如下(make_figures.py、rope_validation.py、rope_decay.py、rope_minimal.py、rope_extrapolate.py、rope_pairing.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「旋转位置编码 RoPE」的三张解释图。

数值全部来自同目录的三个脚本(rope_minimal / rope_extrapolate / rope_decay),
这里只负责画——改了那边这里要重跑,免得图和正文数字打架。

三张图分别回答:
  1. 32 个频率是怎么分层铺在 64 维上的(高频相位在近距离变化更快)
  2. PI 与 NTK-aware 把这 8 倍外推的代价分别摊到了哪些频段
  3. 「相对位置不变」和「随距离衰减」在数值上长什么样

只依赖 numpy + matplotlib。跑法:python make_figures.py
"""

import textwrap
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np

import rope_decay as RD
import rope_extrapolate as RE

ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(parents=True, exist_ok=True)

plt.rcParams.update({
    "font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"],
    "axes.unicode_minus": False,
    "figure.dpi": 160,
    "savefig.bbox": "tight",
})

INK = "#1f2937"
MUTE = "#6b7280"
C_ORIG = "#2f6fb0"    # 原始 RoPE:蓝
C_PI = "#d1495b"      # PI:红
C_NTK = "#2f9e6f"     # NTK-aware:绿
C_BAD = "#d1495b"
C_OK = "#2f9e6f"


def style(ax, title, xlabel=None, ylabel=None):
    ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left")
    if xlabel:
        ax.set_xlabel(xlabel, fontsize=10, color=MUTE)
    if ylabel:
        ax.set_ylabel(ylabel, fontsize=10, color=MUTE)
    ax.tick_params(colors=MUTE, labelsize=9)
    for s in ("top", "right"):
        ax.spines[s].set_visible(False)
    for s in ("left", "bottom"):
        ax.spines[s].set_color("#d1d5db")
    ax.grid(alpha=0.25, linewidth=0.6)
    ax.set_axisbelow(True)


def footer(fig, text, width=118):
    """把「这张图要看什么」放到坐标轴下方。

    必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来,
    放在 0~0.05 之间的话会和 x 轴标签叠在一起。
    """
    wrapped = "\n".join(textwrap.wrap(text, width=width))
    fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE,
             va="top", ha="left", linespacing=1.6)


# ──────────────────────────────────────────────────────────────────────
# 图 1:32 个频率怎么分层铺在 64 维上
# ──────────────────────────────────────────────────────────────────────
def fig_freq_layers():
    dim = RE.DIM
    th = RE.theta_original()                      # [dim/2]
    pos_short = np.arange(0, 256)
    pos_long = np.arange(0, 32768, 8)

    cos_short = np.cos(np.outer(pos_short, th))   # [256, dim/2]
    phase_long = np.outer(pos_long, th)           # 累积相位(不取模)

    fig, axes = plt.subplots(1, 2, figsize=(12.8, 4.4))
    fig.subplots_adjust(wspace=0.42)

    ax = axes[0]
    im = ax.imshow(cos_short.T, aspect="auto", origin="lower",
                   cmap="RdBu_r", vmin=-1, vmax=1,
                   extent=[0, len(pos_short), -0.5, len(th) - 0.5])
    ax.set_yticks([0, 8, 16, 24, 31])
    cb = fig.colorbar(im, ax=ax, fraction=0.035, pad=0.02)
    cb.ax.tick_params(labelsize=8, colors=MUTE)
    cb.set_label(r"$\cos(m\theta_i)$", fontsize=9, color=MUTE)
    style(ax, "近距离(0~255):前 13 组完成至少一圈", "位置 m", "维度组 i")
    # 在 256 个位置内转满一整圈(2π)的维度组数
    n_moving = int((pos_short[-1] * th / (2 * np.pi) >= 1).sum())
    ax.annotate(f"256 长度内转满一整圈的只有前 {n_moving} 组",
                xy=(128, n_moving - 1), xytext=(12, n_moving + 7),
                fontsize=8.5, color="white", fontweight="bold",
                arrowprops=dict(arrowstyle="->", color=MUTE, lw=0.9))

    ax = axes[1]
    for i, c in zip([0, 4, 8, 16, 24, 31],
                    ["#1f6feb", "#2f9e6f", "#e0a03c",
                     "#d1495b", "#8b5cf6", "#6b7280"]):
        ax.plot(pos_long, phase_long[:, i], lw=1.8, color=c, label=f"i={i}")
    trained = (RE.TRAIN_LEN - 1) * th[0]
    ax.axhline(trained, color=INK, ls="--", lw=1.2)
    ax.text(600, trained * 1.35, f"最高频训练最大相位 {trained:.0f} rad",
            fontsize=8.5, color=INK)
    ax.set_xscale("log")
    ax.set_yscale("log")
    ax.legend(fontsize=8.5, frameon=False, loc="upper left", ncol=3)
    style(ax, "远距离(到 32768):各频段的累积相位",
          "位置 m(对数轴)", r"累积相位 $m\theta_i$(rad,对数轴)")

    fig.suptitle("图 1 RoPE 把 64 维切成 32 组,从「每步 1 弧度」一路排到「每步约 1.33e-4 弧度」",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
    footer(fig, "左图:0 到 255 的相位差中,只有前 13 组超过一整圈;低频也有非零相位变化。"
                "右图:不同频率提供不同尺度,不是互斥的距离分工。虚线只代表最高频的训练相位上限;"
                "每个频段的训练相位上限都不同。")
    fig.savefig(OUT / "rope_freq_layers.png")
    plt.close(fig)
    print(f"[图1] 相位变化>=2π 的维度组数(0→255): {n_moving}/{len(th)}")


# ──────────────────────────────────────────────────────────────────────
# 图 2:PI 与 NTK-aware 把 8 倍外推的代价摊在哪
# ──────────────────────────────────────────────────────────────────────
def fig_extrapolation():
    t_orig, t_pi, t_ntk = (RE.theta_original(), RE.theta_pi(), RE.theta_ntk())
    idx = np.arange(len(t_orig))
    slow_pi = t_orig / t_pi
    slow_ntk = t_orig / t_ntk
    keep_pi = t_pi / t_orig * 100
    keep_ntk = t_ntk / t_orig * 100

    fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3))

    ax = axes[0]
    ax.plot(idx, slow_pi, color=C_PI, lw=2.4, label=r"PI:各维一律减速 8.00x")
    ax.plot(idx, slow_ntk, color=C_NTK, lw=2.0, label=r"NTK-aware:1.00x $\to$ 8.00x")
    ax.fill_between(idx, slow_ntk, slow_pi, color=C_PI, alpha=0.10)
    ax.set_yscale("log")
    ax.set_yticks([1, 2, 4, 8])
    ax.yaxis.set_minor_formatter(plt.NullFormatter())
    ax.get_yaxis().set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}x"))
    ax.legend(fontsize=9, frameon=False, loc="center right")
    style(ax, "谁被减速了多少(对数轴)", "维度组 i",
          r"$\theta_i^{\mathrm{orig}} / \theta_i^{\mathrm{new}}$")

    ax = axes[1]
    ax.plot(idx, keep_pi, color=C_PI, lw=2.4, label="PI:全线只剩 12.5%")
    ax.plot(idx, keep_ntk, color=C_NTK, lw=2.0,
            label=rf"NTK:{keep_ntk[0]:.0f}% $\to$ {keep_ntk[16]:.1f}%(i=16)")
    ax.fill_between(idx, keep_pi, keep_ntk, color=C_NTK, alpha=0.10)
    ax.axhline(100, color=MUTE, ls=":", lw=1.0)
    ax.set_yscale("log")
    ax.set_yticks([10, 20, 50, 100])
    ax.get_yaxis().set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}%"))
    ax.legend(fontsize=9, frameon=False, loc="lower left")
    style(ax, "代价:相邻 token 的相位步长还剩多少", "维度组 i",
          r"$\theta_i^{\mathrm{new}} / \theta_i^{\mathrm{orig}}$")

    fig.suptitle("图 2 PI 把减速平均分给每一维,NTK 从高频不压缩逐渐过渡到低频压缩 8 倍",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
    footer(fig, "要看什么:左图 PI 是一条平线(每维都慢 8 倍),NTK 从最高频的 1.00x 单调爬到"
                "最低频的 8.00x。右图是这个分配的代价——PI 把每一维的相位步长都砍到 12.5%,"
                "这只是相位步长,不能直接预测任务质量;NTK 保住高频(100%),最低频与 PI 同为 12.5%。"
                "两者改的是同一组 theta,区别只在把代价放在哪个频段。")
    fig.savefig(OUT / "rope_extrapolation.png")
    plt.close(fig)
    print(f"[图2] NTK 减速比: i=0 {slow_ntk[0]:.2f}x -> i=31 {slow_ntk[-1]:.2f}x;"
          f"相位步长保留 i=16: PI {keep_pi[16]:.1f}% / NTK {keep_ntk[16]:.1f}%")


# ──────────────────────────────────────────────────────────────────────
# 图 3:相对位置不变 + 随距离衰减
# ──────────────────────────────────────────────────────────────────────
def fig_relativity():
    dim, seq_len = 64, 8192
    cos, sin = RD.build_rope_cache(seq_len, dim)
    rng = np.random.default_rng(0)

    # ── 左:同一对 q,k,只平移绝对位置,内积应当逐点不变 ──
    q = rng.standard_normal(dim)
    k = rng.standard_normal(dim)
    gaps = np.arange(0, 512)
    starts = [0, 500, 2000]
    curves = {}
    for s in starts:
        qr = RD.apply_rope(q[None, :], cos[s:s + 1], sin[s:s + 1])[0]
        kr_all = RD.apply_rope(
            np.repeat(k[None, :], len(gaps), 0),
            cos[s:s + len(gaps)], sin[s:s + len(gaps)])
        curves[s] = kr_all @ qr

    # ── 右:距离越远,RoPE 把「无位置编码的原始内积」改写得多彻底 ──
    # 独立各向同性高斯输入:corr(q^T R_gap k, q^T k) = (2/dim) Σ_i cos(gap θ_i)。
    # 注意:这是「与原始内积的相关性」衰减,不是内积的绝对值变小——
    # 独立各向同性高斯输入的内积分布与距离无关(RMS 为 sqrt(dim))。
    Q = rng.standard_normal((4000, dim))
    K = rng.standard_normal((4000, dim))
    s0 = np.einsum("ij,ij->i", Q, K)
    th = 1.0 / (10000.0 ** (np.arange(0, dim, 2) / dim))
    probe = np.unique(np.round(np.geomspace(1, 4096, 60)).astype(int))
    emp, theo = [], []
    for g in probe:
        qr = RD.apply_rope(Q, cos[0:1], sin[0:1])
        kr = RD.apply_rope(K, cos[g:g + 1], sin[g:g + 1])
        sg = np.einsum("ij,ij->i", qr, kr)
        emp.append(float(np.corrcoef(sg, s0)[0, 1]))
        theo.append(float(2.0 / dim * np.sum(np.cos(g * th))))

    fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3))

    ax = axes[0]
    cols = {0: C_ORIG, 500: C_NTK, 2000: "#e0a03c"}
    for s in starts:
        ax.plot(gaps, curves[s], lw=1.6, color=cols[s], label=f"绝对起点 {s}")
    ax.legend(fontsize=9, frameon=False, loc="upper right")
    style(ax, "同一对向量、同一组间距,换绝对位置后曲线完全重合",
          "相对距离 (n-m)", r"$q^\top R_{n-m} k$")

    ax = axes[1]
    ax.plot(probe, emp, marker="o", ms=3.5, lw=1.8, color=C_ORIG,
            label="实测(4000 对随机向量)")
    ax.plot(probe, theo, lw=1.4, ls="--", color=C_BAD,
            label=r"理论 $\frac{2}{D}\sum_i\cos(\Delta\theta_i)$")
    ax.axhline(0, color=MUTE, ls=":", lw=1.0)
    ax.set_xscale("log")
    ax.legend(fontsize=9, frameon=False, loc="upper right")
    style(ax, "独立高斯输入:与原始内积的相关性随距离振荡",
          "相对距离(对数轴)", r"$\mathrm{corr}(q^\top R_{\Delta} k, q^\top k)$")

    fig.suptitle("图 3 固定内容的相对位置不变性,与高斯输入下的分数相关性",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
    max_dev = max(float(np.abs(curves[s] - curves[0]).max()) for s in starts)
    footer(fig, f"左图:固定 q/k 的三条曲线在浮点误差内重合,最大偏差 {max_dev:.1e},不是逐比特相等。"
                "右图:D=64、Δ 为间距,理论相关性是有限余弦和;它会振荡,不保证单调或在无穷远趋于零。"
                "本图的独立各向同性高斯输入下,内积分布不随旋转改变。")
    fig.savefig(OUT / "rope_relativity.png")
    plt.close(fig)
    print(f"[图3] 不同绝对起点的最大逐点偏差: {max_dev:.2e};"
          f"corr: d=1 {emp[0]:.3f} → d={probe[-1]} {emp[-1]:.3f}")


def main():
    fig_freq_layers()
    fig_extrapolation()
    fig_relativity()
    print(f"[OK] 三张图已写入 {OUT}")
    for f in sorted(OUT.glob("*.png")):
        print(f"  {f.name}  {f.stat().st_size / 1024:.0f} KB")


if __name__ == "__main__":
main()"""RoPE 独立数学核验与反例;只需 NumPy,运行 python rope_validation.py。"""
import json
from pathlib import Path
import numpy as np
from rope_minimal import build_rope_cache, apply_rope
from rope_extrapolate import theta_original, theta_pi, theta_ntk
from rope_pairing import rope_interleaved, rope_half_split, interleave_to_half
def validate():
rng = np.random.default_rng(19)
dim = 64
q, k = rng.normal(size=(2, dim))
th = theta_original(dim)
def rotate(x, p):
angle = p * th
return apply_rope(x, np.cos(angle), np.sin(angle))
m, n = 127, 4021
actual = float(rotate(q, m) @ rotate(k, n))
relative = float(q @ rotate(k, n - m))
zq, zk = q[0::2] + 1j*q[1::2], k[0::2] + 1j*k[1::2]
complex_score = float(np.real(np.sum(zq*np.conj(zk)*np.exp(1j*(m-n)*th))))
assert max(abs(actual-relative), abs(actual-complex_score)) < 1e-11
# Abel summation: a finite upper bound does not assert monotonic scores.
a = zq*np.conj(zk)
a_next = np.concatenate((a[1:], [0]))
partial = np.cumsum(np.exp(1j*(m-n)*th))
abel = np.sum(partial*(a-a_next))
direct = np.sum(a*np.exp(1j*(m-n)*th))
assert abs(abel-direct) < 1e-11
abel_bound = float(np.max(abs(a-a_next))*np.sum(abs(partial)))
assert abs(direct) <= abel_bound
cq, sk = build_rope_cache(8192, dim)
assert abs(np.linalg.norm(apply_rope(q, cq[4096], sk[4096]))-np.linalg.norm(q)) < 1e-12
perm_error = max(float(np.max(np.abs(interleave_to_half(rope_interleaved(q,p,dim))-rope_half_split(interleave_to_half(q),p,dim)))) for p in [0,1,127,4096])
assert perm_error < 1e-12
# Independent exact moment calculation: Cov(q^T R k,q^T k)=tr(R), Var=d.
gap = 64
rot = np.column_stack([rotate(v, gap) for v in np.eye(dim)])
trace_correlation = float(np.trace(rot)/dim)
formula_correlation = float(2*np.cos(gap*th).sum()/dim)
assert abs(trace_correlation-formula_correlation) < 1e-14
Q, K = rng.normal(size=(2, 20000, dim))
scores0 = np.einsum('ij,ij->i', Q, K)
sg = np.einsum('ij,ij->i', Q, apply_rope(K,cq[gap],sk[gap]))
corr = float(np.corrcoef(scores0,sg)[0,1])
assert abs(corr-formula_correlation) < .03
# One active plane: scores return upward at integer gap 6; no universal decay.
one = np.zeros(dim);one[0] = 1
counter = {str(p): float(one@rotate(one,p)) for p in [0,3,6]}
assert counter['6'] > .95 and counter['3'] < -.98
# A fixed key at coordinate 0 is an anchor; translating only q changes its score.
anchor = {str(p): float(rotate(one,p)@one) for p in [0,1,2]}
assert anchor['0'] != anchor['1']
s = 8
pi, ntk = theta_pi(scale=s), theta_ntk(scale=s)
expected_ntk = th*s**(-2*np.arange(dim//2)/(dim-2))
assert np.allclose(ntk,expected_ntk,rtol=1e-14,atol=0)
exact_scale = (32768-1)/(4096-1)
endpoint = (32768-1)/exact_scale
assert endpoint == 4095
# Standalone accounting: multiply+add=2 FLOPs; full QK^T and AV, no masks.
N,H,d,L = 90000,24,64,40
rotation = 6*N*H*d*L
attention = 4*N*N*H*d*L
results = dict(sign_identity_abs=max(abs(actual-relative),abs(actual-complex_score)),
abel_identity_abs=float(abs(abel-direct)),abel_bound=abel_bound,
pairing_vector_max_abs=perm_error,lowest_frequency=float(th[-1]),lowest_period=float(2*np.pi/th[-1]),
gaussian_correlation=dict(samples=20000,seed=19,gap=gap,theory=formula_correlation,empirical=corr),
nonmonotonic_counterexample=counter,fixed_anchor_scores=anchor,
ntk_lowest_retention=float(ntk[-1]/th[-1]),pi_highest_retention=float(pi[0]/th[0]),
exact_endpoint_scale=exact_scale,exact_endpoint=endpoint,
video=dict(train_grid=[13,30,52],target_grid=[25,45,80],train_tokens=13*30*52,target_tokens=25*45*80,
axis_length_ratios=[25/13,45/30,80/52],axis_endpoint_ratios=[24/12,44/29,79/51]),
cost=dict(rotation_flops=rotation,dense_attention_flops=attention,rotation_percent=100*rotation/attention,
half_table_bytes=N*d*4,full_table_bytes=2*N*d*4,qk_fp16_min_read_write_per_layer_bytes=4*N*H*d*2),
environment=dict(numpy=np.__version__,dtype='float64',hardware='CPU'),passed=True)
return results
if __name__ == '__main__':
result = validate()
print(json.dumps(result,ensure_ascii=False,indent=2))
Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,ensure_ascii=False,indent=2)+'\n',encoding='utf8')"""观测 RoPE 的两个常被口头断言、但很少有人实测的性质。
1. 旋转不改变模长(对比加法式绝对位置嵌入)
2. 所选输入的内积随距离变化;并非普遍衰减定律
运行 `python rope_decay.py` 复现。
"""
import numpy as np
def build_rope_cache(seq_len, dim, base=10000.0):
inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim))
freqs = np.outer(np.arange(seq_len), inv_freq)
return np.cos(freqs), np.sin(freqs)
def apply_rope(x, cos, sin):
out = np.empty_like(x)
out[..., 0::2] = x[..., 0::2] * cos - x[..., 1::2] * sin
out[..., 1::2] = x[..., 0::2] * sin + x[..., 1::2] * cos
return out
def demo_norm_preserved(rng, dim=64, seq_len=512):
"""旋转保模长,加法不保。"""
cos, sin = build_rope_cache(seq_len, dim)
x = rng.standard_normal(dim)
print("=== 1. 模长是否被位置编码改变 ===")
print(f" 原始向量模长 {np.linalg.norm(x):.6f}")
norms = [np.linalg.norm(apply_rope(x[None, :], cos[p:p + 1], sin[p:p + 1]))
for p in (0, 1, 100, 511)]
print(f" RoPE 后(位置 0/1/100/511) "
f"{' '.join(f'{n:.6f}' for n in norms)}")
print(f" 跨位置模长极差 {max(norms) - min(norms):.2e}")
# 加法式绝对位置嵌入:同尺度的可学习向量直接相加
pe = rng.standard_normal((seq_len, dim))
add_norms = [np.linalg.norm(x + pe[p]) for p in (0, 1, 100, 511)]
print(f" 加法式 PE 后 "
f"{' '.join(f'{n:.6f}' for n in add_norms)}")
print(f" 跨位置模长极差 "
f"{max(add_norms) - min(add_norms):.4f} ← 同一个 token 的模长被位置改写了")
def _score(cos, sin, q, k, gap):
qr = apply_rope(q[None, :], cos[0:1], sin[0:1])
kr = apply_rope(k[None, :], cos[gap:gap + 1], sin[gap:gap + 1])
return float(qr[0] @ kr[0])
GAPS = (1, 4, 16, 64, 256, 1024, 4000)
def demo_long_range_decay(rng, dim=64, seq_len=4096, trials=2000):
"""「RoPE 自带远程衰减」到底成不成立——分两种输入分布看。
结论:本文独立各向同性高斯 q/k 的内积分布不变;所选 q=k 示例会振荡。
"""
cos, sin = build_rope_cache(seq_len, dim)
print("\n=== 2a. 随机无关的 q/k:取 |内积| 均值 ===")
baseline = float(np.mean([abs(float(rng.standard_normal(dim) @ rng.standard_normal(dim)))
for _ in range(trials)]))
print(f" 不加 RoPE {baseline:.4f} (基线)")
for gap in GAPS:
m = float(np.mean([abs(_score(cos, sin, rng.standard_normal(dim),
rng.standard_normal(dim), gap))
for _ in range(trials)]))
print(f" 相对距离 {gap:>5} {m:.4f} ({m / baseline * 100:5.1f}% of 基线)")
print(" → 没有衰减趋势。独立各向同性高斯输入在正交旋转下分布不变。")
print("\n=== 2b. q = k(高度相似的一对 token)===")
for name, vec in (("全 1 向量", np.ones(dim)),
("某个随机向量", np.random.default_rng(7).standard_normal(dim))):
# gap=0 时位置 0 的旋转角为 0,内积就是未加 RoPE 的原值
head = _score(cos, sin, vec, vec, 0)
print(f" {name}(gap=0 时内积 {head:.2f}):")
for gap in GAPS:
s = _score(cos, sin, vec, vec, gap)
print(f" 相对距离 {gap:>5} {s:+9.4f} ({s / head * 100:5.1f}% of gap=0)")
print(" → 这些采样点多低于 gap=0,也有回升;不代表任意输入或距离都衰减。")
if __name__ == "__main__":
demo_norm_preserved(np.random.default_rng(0))
demo_long_range_decay(np.random.default_rng(1))#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""RoPE 的最小可运行实现,验证「注意力分数只依赖相对位置」这一核心性质。
只依赖 numpy,直接 python rope_minimal.py 即可运行。
刻意不用 PyTorch:讲原理时框架的抽象反而是噪声,而且 numpy 谁都能跑。
生产实现见文章第 05 节对 transformers 的引用。
"""
import numpy as np
def build_rope_cache(seq_len: int, dim: int, base: float = 10000.0):
"""预计算 RoPE 的 cos/sin 表。
dim 必须是偶数:每两个相邻维度配成一个复数参与旋转。
base 就是常说的 rope_theta,调它会按维度改变旋转速度;最高频 i=0 始终为 1。
"""
assert dim % 2 == 0, f"dim 必须为偶数,收到 {dim}"
# theta_i = base^(-2i/dim):i 越大转得越慢,对应越低的频率
inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim))
pos = np.arange(seq_len)
freqs = np.outer(pos, inv_freq) # [seq_len, dim/2]
return np.cos(freqs), np.sin(freqs)
def apply_rope(x: np.ndarray, cos: np.ndarray, sin: np.ndarray) -> np.ndarray:
"""把旋转作用到 x 上。x: [seq_len, dim]
最后一维两两配对看成复数 (x_even + i*x_odd),乘上 e^{i*m*theta}:
实部 = x_even * cos - x_odd * sin
虚部 = x_even * sin + x_odd * cos
"""
x_even, x_odd = x[..., 0::2], x[..., 1::2]
out = np.empty_like(x)
out[..., 0::2] = x_even * cos - x_odd * sin
out[..., 1::2] = x_even * sin + x_odd * cos
return out
if __name__ == "__main__":
rng = np.random.default_rng(0)
seq_len, dim = 8, 64
cos, sin = build_rope_cache(seq_len, dim)
print(f"cos/sin 形状: {cos.shape} {sin.shape}")
print(f"位置 1 的前 4 维 cos: {np.round(cos[1, :4], 4).tolist()}")
print(f"位置 1 的末 2 维 cos: {np.round(cos[1, -2:], 6).tolist()}")
# 固定一对向量,只改赋予它们的绝对位置,间距始终为 1
q = rng.standard_normal(dim)
k = rng.standard_normal(dim)
print("\n同一对向量,平移绝对位置(间距恒为 1):")
for shift in range(4):
qr = apply_rope(q[None, :], cos[shift:shift + 1], sin[shift:shift + 1])
kr = apply_rope(k[None, :], cos[shift + 1:shift + 2],
sin[shift + 1:shift + 2])
print(f" 位置 ({shift}, {shift + 1}) → 内积 {float(qr[0] @ kr[0]):.6f}")
print("\n对照组,改变间距:")
for gap in (1, 2, 3):
qr = apply_rope(q[None, :], cos[0:1], sin[0:1])
kr = apply_rope(k[None, :], cos[gap:gap + 1], sin[gap:gap + 1])
print(f" 间距 {gap} → 内积 {float(qr[0] @ kr[0]):.6f}")
print(f"\n未加 RoPE 的原始内积: {float(q @ k):.6f}")"""两种长度外推方法(PI / NTK-aware)到底改了什么。
结论先说:它们改的是同一组 theta_i,区别只在「怎么分配这次减速」。
运行 `python rope_extrapolate.py` 复现。
"""
import numpy as np
DIM = 64
BASE = 10000.0
TRAIN_LEN = 4096 # 训练时见过的长度
SCALE = 8 # 想外推到 8 倍,即 32768
def theta_original(dim=DIM, base=BASE):
return 1.0 / (base ** (np.arange(0, dim, 2) / dim))
def theta_pi(dim=DIM, base=BASE, scale=SCALE):
"""Position Interpolation:位置索引整体除以 scale。
等价于把每个 theta_i 都乘上 1/scale——所有频率被同等减速。
"""
return theta_original(dim, base) / scale
def theta_ntk(dim=DIM, base=BASE, scale=SCALE):
"""NTK-aware:把 base 放大,让减速量随维度索引递增(频率越低减速越多)。
base' = base * scale^(d/(d-2)),于是高频维度几乎不受影响,
最低频维度与 PI 同样减速 scale 倍,其余维度的减速更少。
"""
if dim <= 2 or dim % 2 or scale <= 0 or base <= 0:
raise ValueError("NTK-aware requires even dim > 2, positive scale and base")
new_base = base * scale ** (dim / (dim - 2))
return theta_original(dim, new_base)
def main():
t_orig, t_pi, t_ntk = theta_original(), theta_pi(), theta_ntk()
print("=== 1. 三种方案下各维度的旋转速度 theta_i ===")
print(" 维度 i 原始 PI(÷8) NTK-aware PI减速比 NTK减速比")
for i in (0, 1, 4, 8, 16, 24, 31):
print(f" {i:>4} {t_orig[i]:.3e} {t_pi[i]:.3e} {t_ntk[i]:.3e}"
f" {t_orig[i] / t_pi[i]:>7.2f}x {t_orig[i] / t_ntk[i]:>7.2f}x")
print(f" → PI 对每一维都减速 {t_orig[0] / t_pi[0]:.2f}x(均匀);"
f"NTK 从最高频的 {t_orig[0] / t_ntk[0]:.2f}x 递增到最低频的 "
f"{t_orig[-1] / t_ntk[-1]:.2f}x(越低频压得越狠)")
print("\n=== 2. 外推到 8 倍长度后,各方案在第 0 维(最高频)的相位 ===")
target = TRAIN_LEN * SCALE
trained_max = (TRAIN_LEN - 1) * t_orig[0]
print(f" 训练时见过的最大相位(位置 {TRAIN_LEN - 1}) {trained_max:9.1f} rad")
for name, th in (("原始(直接外推)", t_orig), ("PI", t_pi), ("NTK-aware", t_ntk)):
v = (target - 1) * th[0]
flag = ("落在训练区间内" if v <= trained_max else
f"接近但略超训练端点 {trained_max:g}" if v <= trained_max * 1.01 else
f"超出 {v / trained_max:.1f} 倍")
print(f" {name:<18} 位置 {target - 1} {v:9.1f} rad ← {flag}")
print(" → NTK 在最高频维度上「不作为」是刻意的,它保留高频相位步长,逐渐压缩更低频的相位步长")
print("\n=== 3. 代价:相位步长还剩多少 ===")
print(" (相邻位置差 1 时转过的角度,按维度看。越小表示单个频段角度变化更小;不直接代表任务质量)")
print(" 维度 i 原始 PI NTK PI保留 NTK保留")
for i in (0, 4, 8, 16):
print(f" {i:>4} {t_orig[i]:.6f} {t_pi[i]:.6f} {t_ntk[i]:.6f}"
f" {t_pi[i] / t_orig[i] * 100:5.1f}% {t_ntk[i] / t_orig[i] * 100:5.1f}%")
print(f" → PI 在每一维都只保留 {t_pi[0] / t_orig[0] * 100:.1f}% 的相位步长;"
f"NTK 在第 0 维保留 {t_ntk[0] / t_orig[0] * 100:.1f}%、"
f"第 16 维只剩 {t_ntk[16] / t_orig[16] * 100:.1f}%。")
print(" 两者都在同一组 theta 上做手脚,只是把代价放在了不同频段——"
"\n YaRN 进一步把这个分配变成可调的分段策略。")
if __name__ == "__main__":
main()"""对照 RoPE 的两种维度配对方式,并验证它们只差一个固定置换。
奇偶交错(本文最小实现):第 2i 维和第 2i+1 维配成一个复数
前后半切分(HuggingFace):第 i 维和第 i+d/2 维配成一个复数
结论先说:两者都满足相对位置不变性,但对同一份权重不可互换。
运行 `python rope_pairing.py` 复现下面的数值。
"""
import numpy as np
def rope_interleaved(x, pos, dim, base=10000.0):
"""奇偶交错配对:(x_0,x_1), (x_2,x_3), ... 每对是一个复平面。"""
inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim))
ang = pos * inv_freq # [dim/2]
cos, sin = np.cos(ang), np.sin(ang)
out = np.empty_like(x)
out[0::2] = x[0::2] * cos - x[1::2] * sin
out[1::2] = x[0::2] * sin + x[1::2] * cos
return out
def rope_half_split(x, pos, dim, base=10000.0):
"""前后半切分配对:(x_i, x_{i+d/2})。等价于 HF 的 rotate_half 写法。
HF 把 cos/sin 表沿最后一维复制两遍(cat((freqs, freqs))),
于是 q*cos + rotate_half(q)*sin 展开后就是下面两行。
"""
half = dim // 2
inv_freq = 1.0 / (base ** (np.arange(0, dim, 2) / dim))
ang = pos * inv_freq # [dim/2]
cos, sin = np.cos(ang), np.sin(ang)
x1, x2 = x[:half], x[half:]
return np.concatenate([x1 * cos - x2 * sin,
x2 * cos + x1 * sin])
def interleave_to_half(x):
"""把奇偶交错的排布重排成前后半切分的排布。
交错版的第 2i 维(复数实部)搬到前半的第 i 位,
第 2i+1 维(虚部)搬到后半的第 i 位。
"""
return np.concatenate([x[0::2], x[1::2]])
def attn_score(rope_fn, q, k, m, n, dim):
return float(rope_fn(q, m, dim) @ rope_fn(k, n, dim))
def main():
rng = np.random.default_rng(0)
dim = 64
q = rng.standard_normal(dim)
k = rng.standard_normal(dim)
print("=== 1. 两种配对都满足相对位置不变性 ===")
for name, fn in (("奇偶交错", rope_interleaved),
("前后半切分", rope_half_split)):
scores = [attn_score(fn, q, k, m, m + 3, dim) for m in range(4)]
spread = max(scores) - min(scores)
print(f" {name}: 间距恒为 3 时内积 {scores[0]:.6f},"
f"四个绝对位置间的最大波动 {spread:.2e}")
print("\n=== 2. 同一份权重下,两种配对给出的分数不同 ===")
s_i = attn_score(rope_interleaved, q, k, 0, 3, dim)
s_h = attn_score(rope_half_split, q, k, 0, 3, dim)
print(f" 奇偶交错 {s_i:.6f}")
print(f" 前后半切分 {s_h:.6f}")
print(f" 差值 {abs(s_i - s_h):.6f} ← 不为 0,实现和权重必须配套")
print("\n=== 3. 重排维度后两者完全一致 ===")
qp, kp = interleave_to_half(q), interleave_to_half(k)
s_h_perm = attn_score(rope_half_split, qp, kp, 0, 3, dim)
print(f" 奇偶交错(原始排布) {s_i:.6f}")
print(f" 前后半切分(重排后权重) {s_h_perm:.6f}")
print(f" 差值 {abs(s_i - s_h_perm):.2e}"
f" ← 只差一个固定的维度置换")
if __name__ == "__main__":
main()

评论 (0)