


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:对齐与强化学习 | 难度:前沿专题 | 前置知识:DiffusionRL、FlowMatching
关键词:视频强化学习、奖励模型、Flow-GRPO、时序一致性奖励、人类偏好、reward hacking
先看一个用于说明奖励投机的假设场景;下面的“两千步”不是本文实际运行的视频实验记录。
你有一个文生视频模型,想用 RL 把它对齐到人类偏好。你手上有个打分器,在图像上验证过效果不错——清晰度、细节、构图都能打分。你把它接上视频,跑 GRPO,训了两千步。奖励曲线漂亮地往上走。
然后你去看生成结果:画面几乎不动了。
人物站在原地,衣角不飘,背景纹理纹丝不动。prompt 明明写着 "a person walking across the street",模型给你一张会呼吸的照片。
这不是 bug,是模型算得比你清楚。静止画面有一系列白拿的好处:
而它放弃的只有「动态性」这一项。如果静止带来的加分超过动态性与指令遵循等全部损失,那么静止可能比运动拿到更高奖励,RL 会毫不犹豫地找到它。
视频奖励增加了运动与时序一致性维度。在有限模型能力下,运动幅度与形变、闪烁等伪影可能存在经验权衡;这不是“运动必然降低画质”的物理定律。图像的清晰度、构图、语义也可能冲突,不能假设图像奖励天然相容。
后面几节会把这笔账算成具体数字——用 VisionReward 真实发布的 29 个权重。
三句话:
这概括了 GRPO 的组内优势机制;完整目标还包含后文的概率比、裁剪和可选 KL。它省掉 critic 的代价是必须一次采一组,好处是少训一个网络、少一堆调不动的超参。
如果只记一件事:RL 不会给你「更好的视频」,只会给你「奖励更高的视频」。这两者的差距全部藏在奖励模型里。本文一半篇幅在讲奖励模型,不是跑题。
目标很直白:最大化生成样本的期望奖励。
$$J(\theta) = \mathbb{E}_{x \sim \pi_\theta} [r(x)]$$
其中 $\pi_\theta$ 是生成模型(策略),$x$ 是一条采样出来的视频,$r(x)$ 是奖励模型给的分。对参数求梯度,用对数导数技巧:
$$\nabla_\theta J = \mathbb{E}_{x \sim \pi_\theta} [r(x) \nabla_\theta \log \pi_\theta(x)]$$
这个式子能用,但方差大得没法训。原因是 $r(x)$ 的绝对值直接乘在梯度上:假如所有样本的奖励都在 8.0 到 8.2 之间,那么每个样本都在说「往我这边推」,只是力度略有差别。真正有用的信息是「谁比谁好」,而不是「绝对分多高」。
标准解法是减一个基线 $b$:
$$\nabla_\theta J = \mathbb{E}[(r(x) - b) \nabla_\theta \log \pi_\theta(x)]$$
只要 $b$ 与 $x$ 无关,这个替换是无偏的(因为 $\mathbb{E}[b \nabla_\theta \log \pi_\theta] = b \nabla_\theta \mathbb{E}[1] = 0$)。PPO 那一路用一个学出来的价值网络当 $b$,GRPO 的选择更省事——同一个 prompt 采一组,用组内均值当基线:
$$A_i = \frac{r_i - \mathrm{mean}(r_1, \dots, r_G)}{\mathrm{std}(r_1, \dots, r_G)+\varepsilon}$$
这里不能直接套用上面的无偏证明:组均值含有 $r_i$,依赖当前样本。固定 prompt、独立同分布采样且不除标准差时,
$$E[(r_i-\bar r)\nabla\log\pi_\theta(x_i)]=(1-1/G)\nabla J.$$
使用不含自身的 leave-one-out 均值可消除该缩放;除以随机组标准差还会改变样本及 prompt 的相对权重。$\varepsilon>0$ 防止同分组除零,同分组的奖励优势为零。标准化是有用的工程选择,不能据此宣称完整 GRPO 无偏;奖励均值高本身也不等于期望梯度大。
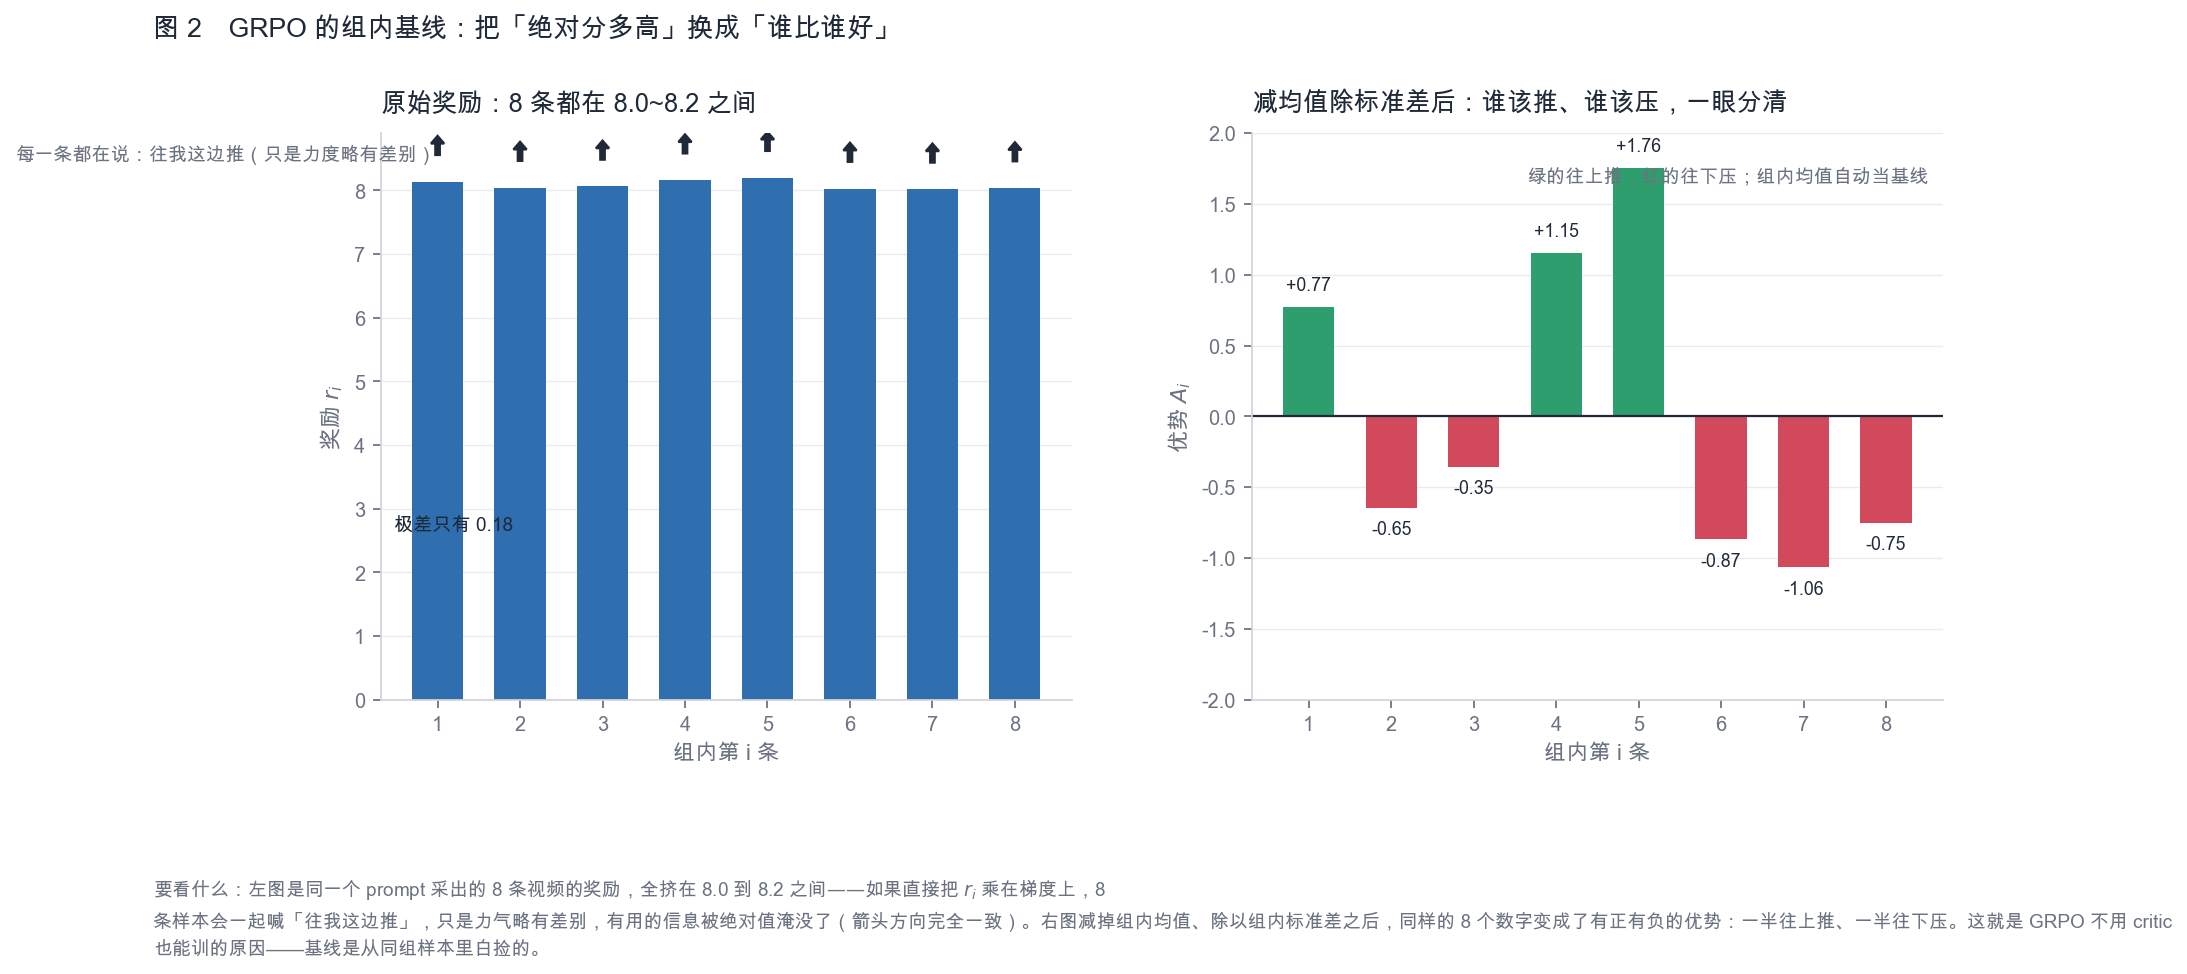
这张图要看什么:左图是同一个 prompt 采出的 8 条视频的奖励,全挤在 8.0 到 8.2 之间——如果直接把 $r_i$ 乘在梯度上,8 条样本会一起喊「往我这边推」,有用的信息全被绝对值淹没(箭头方向完全一致)。右图减掉组内均值、除以组内标准差之后,同样的 8 个数字变成了有正有负的优势:绿的往上推、红的往下压。这就是 GRPO 不用 critic 也能训的原因——基线是从同组样本里白捡的(图由 code/make_figures.py 生成,下同)。
GRPO 出自 DeepSeekMath(arXiv:2402.03300),原本是给语言模型的数学推理用的,后来被搬到视觉生成上。
上面那个式子是骨架。真实的 GRPO 目标还包着两层保护,后面 04 节的最小实现会把它们省掉,这里先说清省的是什么。
第一层是重要性采样比的截断(沿用 PPO 的做法):
$$\mathcal{L} = -\mathbb{E}\left[ \min\left( \rho_i A_i, \ \mathrm{clip}(\rho_i, 1-\epsilon, 1+\epsilon) A_i \right) \right]$$
式子里的 $\rho_i$ 是新旧策略的概率比,$\rho_i = \pi_\theta(x_i) / \pi_{\theta_{\text{old}}}(x_i)$。采样用的是旧策略 $\pi_{\theta_{\text{old}}}$,更新的是新策略 $\pi_\theta$,$\rho_i$ 修正这个偏差。clip 截断的是朝有利方向继续外推的收益,不保证每个 ratio 都在区间内,也不是 KL 的硬约束。神经网络共享参数,仍可能越界;需结合 KL 和梯度日志监控。视觉去噪实现通常按每个随机转移计算 ratio,不能把这里的整段视频记号误当成可直接算出的边缘密度。
第二层是对参考模型的 KL 惩罚:
$$\mathcal{L}_{\text{total}} = \mathcal{L} + \beta \, \mathrm{KL}\left[ \pi_\theta \, \| \, \pi_{\text{ref}} \right]$$
$\pi_{\text{ref}}$ 通常是 RL 开始前的初始模型。这一项把策略拴在原始分布附近,是对付 reward hacking 最基础的护栏——因为大多数 hack(比如 01 节那个静止画面)都要求策略跑到离原始分布很远的地方去。$\beta$ 调的就是「允许它跑多远」。
代价是 $\beta$ 很难调:太大则学不动,太小则护栏形同虚设,而合适的值随任务和奖励模型变化。这也是为什么 04 节要先把护栏拆掉看清裸的优化行为——理解 hacking 怎么发生,比直接套护栏更重要。
Flow matching 的 ODE 为 $dx_t/dt=v_\theta(x_t,t)$。本文用 $t=1$ 表示噪声、$t=0$ 表示数据:给定初始噪声,逐步转移是确定性的条件 delta,不能直接代入高斯转移 log-prob 做 PPO/GRPO。
这不等于输出没有概率分布。随机初值经正则、可逆的 ODE 流仍可产生具有边缘密度的输出,CNF 可用散度积分计算密度;可微奖励还可以沿 ODE 用路径导数优化,确定性策略梯度也有自己的适用条件。受限的是本文这条“随机逐步转移似然 + score function”的路线。
Flow-GRPO 第 4.2 节 为它构造反向时间 SDE:
$$dx_t=\left[v_\theta(x_t,t)-\frac{\sigma_t^2}{2}\nabla\log p_t(x_t)\right]dt+\sigma_t\,d\bar W_t,\qquad dt<0.$$
由于时间从 1 向 0 走,score 修正前是减号;离散噪声标准差为 $\sigma_t\sqrt{-dt}$。若改用从噪声出发递增的时间坐标,漂移和 score 符号必须一起变换。准确 score、匹配的速度场与连续时间求解条件下,SDE 和 ODE 共享边缘分布;近似网络、有限步长及 RL 更新会带来偏差,不能保证实现后精确不变。
这使被训练的非退化转移具有可计算的高斯 log-prob。终步若噪声为零,仍要排除或另行处理,不能对零方差求对数密度。Flow-GRPO 还用 Denoising Reduction 减少训练采样步数、保留完整推理步数;这是论文所测任务上的经验结果,需在视频任务重新验证。
现在缺的是 $r(x)$。视频的「好」是多维的,而人类偏好数据通常只有「A 比 B 好」这种成对比较,信息量很稀疏。
VisionReward(arXiv:2412.21059)的做法是把打分拆成一串可解释的是非题,再线性加权:
$$r(x) = \frac{1}{K} \sum_{k=1}^{K} w_k \cdot a_k(x), \quad a_k(x) \in \{+1, -1\}$$
其中 $a_k$ 是一个视觉语言模型对第 $k$ 个问题的回答(yes 记 $+1$,no 记 $-1$),$w_k$ 是该问题的权重。视频版一共 $K = 29$ 个问题,从「是否满足 prompt 的全部要求」到「细节是否精细」。
这个设计有两个好处。可解释:分低的时候能看出是哪一维拖的,不是一个黑盒数字。可控:想让模型更重视某一维,直接改 $w_k$ 就行。
代价是它把「好」压成了一个线性组合。而线性组合最容易被套利——下一节就用它真实发布的权重,把套利空间算出来。
VisionReward 的打分逻辑短到可以完整贴出来。这是它仓库里 inference-video.py 的核心两行(2026-08 的 main 分支):
answers = np.array([1 if answer == 'yes' else -1 for answer in answers])
return np.mean(answers * weight).item()有个细节值得停一下:no 记的是 $-1$,不是 $0$。这让答错变成实打实的扣分,而不只是「没拿到加分」。同一个维度上,yes 和 no 之间差了 $2 w_k$ 而不是 $w_k$——算套利空间时这个因子 2 不能漏。
29 个权重是仓库里 VisionReward_Video/weight.json 直接给出的。先看看它们长什么样(code/reward_hacking.py):
29 个维度,权重总和 6.2772,均值 0.2165
最高 1.1418(指令-未完全失败)
最低 0.0085(细节-不粗糙)
最高/最低 = 134 倍

指令遵循三档合计 2.3486,占总权重 37.4%
构图+色彩合计 0.0924,占总权重 1.5%两个数字值得盯着看。最高和最低差 134 倍——这不是一个「各维度都重要」的均衡奖励,而是有着强烈倾向的。指令遵循三档占了 37.4%,构图加色彩只占 1.5%:在真实的人类偏好数据里,指令三档的权重合计是构图与色彩权重合计的约 25 倍。但这不是人类把指令遵循看得比整体美感重 25 倍的因果结论:其他维度也反映画质,且题目相关性、回答频率与权重尺度会影响解释。
这个结构反直觉但合理——观众要的是他要的东西,不是一张漂亮但无关的图。
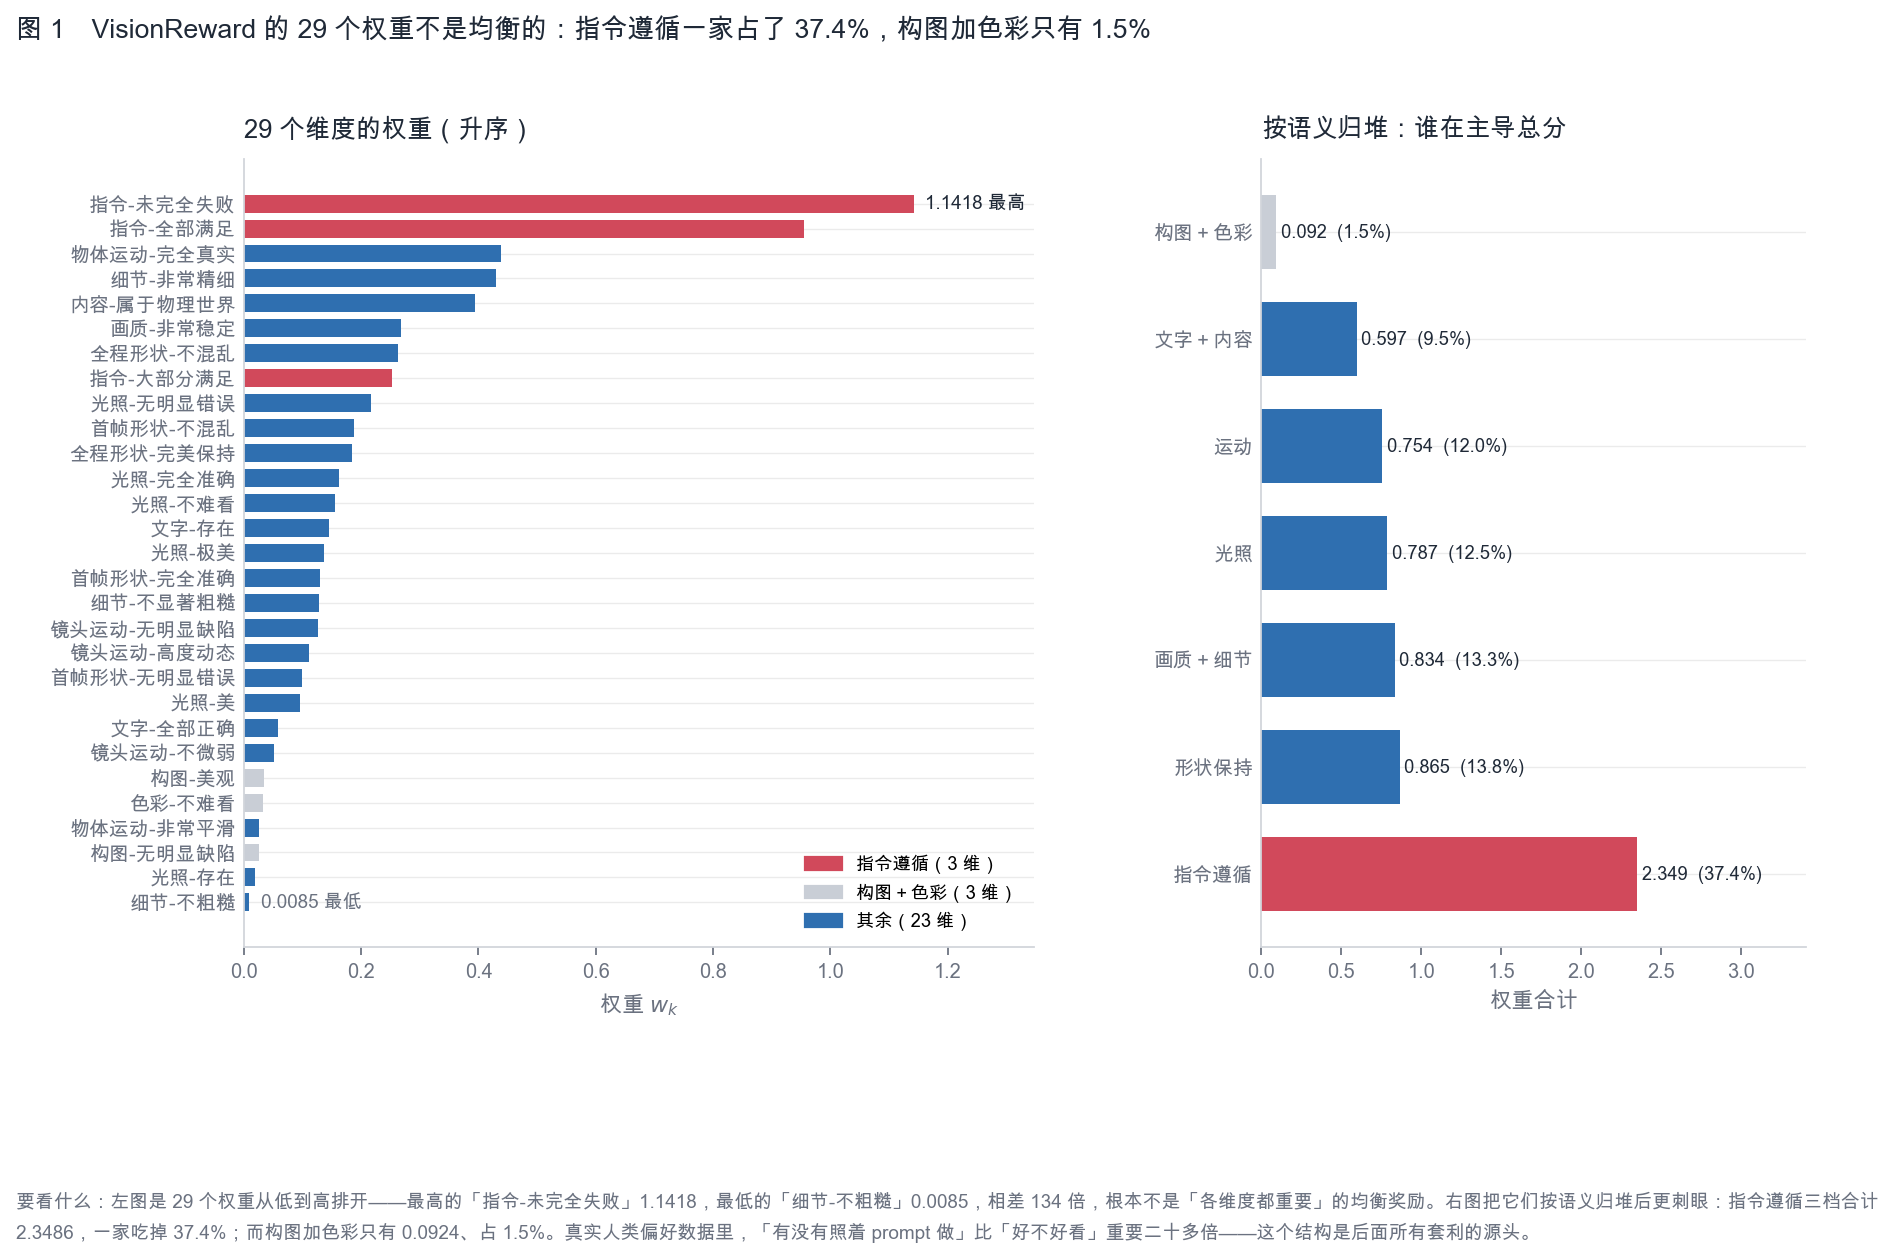
这张图要看什么:左图把 29 个权重从低到高排开——最高的「指令-未完全失败」1.1418,最低的「细节-不粗糙」0.0085,相差 134 倍(红色是指令遵循三档,灰色是构图加色彩)。右图按语义归堆后更刺眼:指令遵循合计 2.3486、一家吃掉 37.4%,构图加色彩只有 0.0924、占 1.5%。指令三档的权重合计是构图与色彩这两组的二十多倍——记住这个比例,4.2 和 4.4 节的套利与翻转全是从它推出来的。
回到 01 节那个静止画面。它能白拿哪些分、要放弃哪些分,现在可以精确算:
静止能白拿:全程形状保持+不混乱+画质稳定 = 0.7166
静止要放弃:镜头高度动态+不微弱         = 0.1634
净收益 +0.5532  (yes/no 相差 2 个单位,实际影响 ×2 = +1.1064)
上述 +1.1064 是未除以 $K$ 的加权和变化;score() 实际变化是 $1.1064/29\approx0.03815$。权重总和 6.2772 对应分数上限 0.2165,分数全范围宽度约 0.4329,因此这笔差额约占全范围 8.8%。这只是所选维度的局部账,不能省略指令等其他维度后宣称静止全局最优。
那它会不会因为违背 prompt 而被罚回来?我构造了两个视频画像对比(prompt 要求「人物走过街道」):
视频 A(几乎静止的精致画面,没照做 prompt)  +0.1220
视频 B(照做了 prompt,但有形变和抖动)      +0.1144
奖励模型更偏好:A(静态)   差值 0.0076
静态那个赢了。 拆开看差异来自哪:
  -1.9088  指令-全部满足
  +0.8586  细节-非常精细
  +0.5372  画质-非常稳定
  +0.5272  全程形状-不混乱
  -0.5048  指令-大部分满足
  +0.3688  全程形状-完美保持
静态视频在指令遵循上亏了 2.41(这是权重最高的维度!),但靠画质那几项一点点堆回来,最后反超 0.0076。
需要说清楚:这两个 yes/no 画像是我按各维度语义人工假设的,不是真实模型的输出,所以这个结论说明的是「权重结构允许这样的套利」,不是「VisionReward 实际会这么判」。差值只有 0.0076 也说明它非常接近临界——是否会被优化器实际找到,还取决于策略可达性、采样噪声与正则约束,不能由这一对假设画像推断必然收敛。
手工构造画像终究不如让算法自己找。下面是完整的单参数 GRPO(code/grpo_minimal.py),策略只有一个参数:运动强度 $m$。
维度压到 1 维是刻意的——才能看清 GRPO 究竟把策略推向哪里。玩具概率按人为假设设定:$m$ 越大,指令遵循和动态性越容易拿 yes,形状保持、画质稳定、细节精细越容易拿 no。
def grpo(steps=400, group=32, lr=0.35, sigma=0.15, theta0=0.0, seed=0,
         weight=None):
    rng = np.random.default_rng(seed)
    theta = theta0

    for step in range(steps):
        # 策略:m = clip(sigmoid(theta) + noise),高斯探索
        mu = 1 / (1 + np.exp(-theta))
        eps = rng.normal(0, sigma, group)
        ms = np.clip(mu + eps, 0.0, 1.0)

        rs = np.array([reward(m, rng, weight) for m in ms])

        # 组内相对优势:减均值除标准差(3.1 节那个式子)
        adv = (rs - rs.mean()) / (rs.std() + 1e-8)

        # ∂mu/∂theta = mu(1-mu)
        grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu))
        theta += lr * grad

    return 1 / (1 + np.exp(-theta))


m_final = grpo()
print(f"GRPO 收敛到 m = {m_final:.4f}")     # GRPO 收敛到 m = 0.9657
十几行,没有 critic,也刻意去掉了 3.1.1 节那两层护栏(clip 和 KL)——保留的是组标准化 REINFORCE 示意,不是完整 PPO/GRPO 更新。代码中的高斯 score 对应裁剪前潜在动作 $a=\mu+\epsilon$,环境再执行 $m=\mathrm{clip}(a,0,1)$;不能把它当成裁剪后混合分布的普通高斯 log-prob。用完整的 29 个权重跑:
  step      运动强度 m    组内平均奖励
     0        0.5000        -0.0238
    80        0.9227        +0.0395
   160        0.9420        +0.0346
   320        0.9649        +0.0452
   399        0.9660        +0.0370

  GRPO 收敛到 m = 0.9657
  → 策略选择:动态(照做了 prompt)
没有 hack。 策略从中性的 0.5 一路推到 0.966,选择了照做 prompt。换三个不同初值(0.27 / 0.50 / 0.73)出发,都收敛到 0.977 附近,说明这不是初值凑巧。
原因就是 4.1 节那个 37.4%:指令遵循的权重足够大,压住了画质维度的全部诱惑。这是玩具里的结果,不能验证 Flow-GRPO 的视频表现。Flow-GRPO 在其图像实验中他们报告「very little reward hacking occurred」,奖励涨上去了而画质和多样性没有明显退化。
那 01 节那个失败场景怎么发生的?答案在奖励模型上,不在算法上。
01 节的设定是「手上有个在图像上验证过的打分器」——图像打分器很可能根本不看时序,或者对指令遵循的权重远没有这么高。把三个指令遵循维度的权重置零,模拟这种情况,同一个 GRPO 再跑一遍:
  step      运动强度 m    组内平均奖励
     0        0.5000        -0.0016
    80        0.0305        +0.0269
   160        0.0178        +0.0363
   320        0.0099        +0.0396
   399        0.0084        +0.0324

  收敛到 m = 0.0084(完整权重下是 0.9657)
从 0.966 翻转到 0.008。 策略选择了几乎完全静止。注意中间那列奖励——它一路从 $-0.0016$ 涨到 $+0.04$,总体上也比初始值高,但逐步有明显随机波动。这就是 01 节说的:奖励曲线不能告诉你模型学到了什么。
奖励曲面看得更清楚——同一组物理约束,两种权重下的形状完全相反:
    m      完整权重     去掉指令遵循
  0.0     -0.0393      +0.0393
  0.3     -0.0298      +0.0228
  0.5     +0.0006      -0.0006
  0.8     +0.0446      -0.0322
  1.0     +0.0379      -0.0394
  → 完整权重的最高点在 m = 0.8(+0.0446)
  → 去掉指令遵循后最高点在 m = 0.0(+0.0393)
完整权重下曲面在 $m = 0.8$ 处见顶;去掉指令遵循后,在这一玩具设定下整体偏向低运动强度;表格是每点 4000 次随机采样的估计,不能仅凭稀疏网格确立精确单调性或全局最优。

这张图要看什么:左图是同一组物理约束下的奖励曲面——完整权重(蓝实线)在 $m=0.8$ 附近见顶,去掉指令遵循三档后(红虚线)整条曲线翻转成单调递减,最高点直接落到 $m=0$。右图是同一个 GRPO、同一个初值跑 400 步:蓝线冲到 0.966(照做 prompt),红线掉到 0.008(躺平)。而两条浅色细线是各自的组内平均奖励——二者总体奖励改善,但都有采样噪声,不能靠奖励曲线判断是否符合需求。奖励曲线不能告诉你模型学到了什么。
结论落在这里:reward hacking 不是算法出了毛病,而是它精确地最大化了你真正写下来的那个目标。 同一个 GRPO、同一个物理约束,只改奖励的权重结构,行为就翻转了。查 hacking 该去查奖励函数,而不是调 RL 的超参。
还要区分两种目标:图中的曲面是在固定运动强度 $m$ 上的采样均值,策略优化的却是高斯探索后再裁剪的期望奖励。$\mu=0.966$ 是裁剪前策略均值参数,不是实际运动强度的期望;它与网格中 $m=0.8$ 的峰值不能直接比较。因此这些数字不能证明“策略梯度过冲”,更不能归因为探索噪声必然造成方向性偏置。
参考实现(以 2026-08 的 main 分支为准,上游会重构):
THUDM/VisionReward → inference-video.py:score、compare_two_videosTHUDM/VisionReward → VisionReward_Video/weight.json:29 个线性权重上面的最小实现把奖励当成一个现成函数,生产上它是个 VLM,差别都在这。
score() 的实际流程是:抽帧、对每个问题拼一次 prompt、让 VLM 输出 yes/no。29 个问题就是 29 次 VLM 前向。
这直接决定了 RL 训练的成本结构。GRPO 每步要采一组(比如 8 条视频),每条视频要 29 次 VLM 前向,也就是每个训练步 232 次前向——而这还没算生成那 8 条视频本身的去噪开销。奖励计算不是附带开销,它经常是训练循环里最贵的一环。这也是 Flow-GRPO 要做 Denoising Reduction 的现实压力来源。
仓库里有两个文件长得很像:
VisionReward_video_qa.txt:64 个问题,用于细粒度查询(问模型某一项如何)VisionReward_video_qa_select.txt:29 个问题,用于打分inference-video.py 顶部读的是 _select 那个:
QUESTIONS_PATH = "VisionReward_Video/VisionReward_video_qa_select.txt"
WEIGHT_PATH = "VisionReward_Video/weight.json"
29 条问题对应 29 个权重,一一对齐。拿 64 个那份去乘权重会直接维度不匹配——这算好事,至少会报错。
想判断 A 和 B 哪个好,直觉是各算一次 score() 再比大小。它没这么做——compare_two_videos() 的结尾是:
answers1 = np.array([1 if answer == 'yes' else -1 for answer in answers1])
answers2 = np.array([1 if answer == 'yes' else -1 for answer in answers2])

diff = answers1 - answers2

return np.sum(diff * weight).item() > 0先求两个答案向量的逐维差 diff,再加权求和判正负。
只要两次打分使用同一组答案与权重,这与比较两个 score() 完全等价(仅差正的常数 $K$),并不能阻止不同维度相互抵消。VisionReward 论文的“多维一致性”另指偏好优化时筛选在各语义维度都一致占优的样本对;不是把减法移到加权和里面。
VisionReward 报告的两个结果:
这两个百分比对应不同指标与实验,不能相除推断“奖励改进被 RL 放大了”。VisionReward 的偏好优化还包括 DPO 等流程;本文引用的是论文报告结果,不是视频 GRPO 的对照实测。
杠杆是双向的。 持续优化可能放大奖励偏差,但幅度不是由 5.4 节的两个异质指标决定的。奖励模型里一个不起眼的偏见——比如偏爱暖色调、偏爱中心构图——在评测里可能只是一两个百分点,但 RL 会把它当成目标,训几千步之后就是全部输出都发黄。奖励模型的偏见不会被平均掉,会被放大。
优化的是奖励,不是质量。 这句话看着像废话,但它有个实践推论:奖励曲线上升不能作为训练成功的证据。4.4 节那次 hack 的奖励曲线($-0.0016 \to +0.04$)和 4.3 节那次成功训练长得一模一样。
那怎么才能发现?三个手段,按性价比排:
至于用第二个奖励模型交叉验证——听起来对称,实际有个陷阱:如果两个奖励模型是用同源的偏好数据训的,它们很可能共享同样的盲区,交叉验证会一起点头。要用就得选训练数据和架构都不同的。
成本很实在。 按 5.1 节的账,每个训练步是「$G$ 条视频的完整采样+ $29G$ 次 VLM 前向」。视频采样本身就比图像贵一个量级(多了时间维度),再乘上组大小,这是 RL 在视频上落地慢的主要原因。Denoising Reduction 这类工程手段不是优化项,是可行性前提。
线性加权是双刃剑。 它带来可解释性,也带来可套利性——线性函数没有交互项,意味着「这一维差到极点」不会拖累其他维度的加分。真实的人类判断不是这样的:一个完全静止的「视频」在人眼里直接不合格,不管它多精细。线性模型表达不了这种否决关系,所以 04 节那个套利在数学上成立。
什么时候不该用 RL。 如果你的问题能用更直接的手段解决,就别上 RL。想让输出更清晰——去修数据和 VAE;想让它听懂 prompt——先确认是不是文本编码器或者标注质量的问题。RL 适合的是「说得清好坏、但写不出损失函数」的目标,比如整体美感、运动自然度这类只能靠比较来表达的偏好。上 RL 之前先问一句:我的奖励模型真的比我的损失函数更懂这件事吗?
这条线分两支:怎么优化和拿什么当奖励。两支交替推进。
奖励这一支:
优化这一支:
需要说明:Flow-GRPO 的实验是在文生图上做的(SD3.5-M),不是视频。它之所以是视频 RL 的关键前置,是因为主流视频模型也是 flow matching 训的,ODE→SDE 那套推导可以直接搬过来——但视频上的实证还远没有图像充分。
「奖励涨了就是训好了」。 01 节整节都在讲这件事。奖励是你自己写的目标函数,模型最大化它是本分。奖励上升唯一证明的是优化在工作,不是效果在变好。
「reward hacking 是 RL 算法的问题,换个算法就好了」。04.4 节那个对照实验就是为了拆掉这个想法:同一个 GRPO,只改奖励权重,行为从 $m = 0.966$ 翻到 $m = 0.008$。算法只是执行者。出了 hacking 该去审奖励函数。
「GRPO 比 PPO 好」。 它主要是更省——不用训 critic,少一个网络和一堆超参。省掉 critic 的代价是必须一次采一组样本才能估出基线,采样开销更大。在视频这种采样极贵的场景里,这个权衡并不是无脑赚。
「多加几个奖励维度就能防 hacking」。 加维度确实提高了套利难度,但只要还是线性加权,套利空间就存在——4.2 节那个例子里有 29 个维度,静态依然套出了 1.1 的净收益。真正起作用的是权重结构(指令遵循占 37.4% 才压住了它),以及 DPOK 那种把策略拴在原始分布附近的 KL 护栏。
「flow matching 模型可以直接套用扩散模型的 RL 方法」。按随机转移似然做 PPO/GRPO 时,需要先定义非退化随机转移,例如 3.2 节的 ODE→SDE 路线。确定性 ODE 的输出边缘密度、可微奖励路径导数等另有方法,并不是所有 RL 都必须给每一步加噪。
三个实验,用到的脚本全文都在文末附录,纯 NumPy,没有 GPU 依赖,复制存成同名文件就能跑。
实验一:给自己的奖励函数算套利空间。 跑 reward_hacking.py,看第 2 段那笔账。然后把你自己项目里奖励各维度的权重填进 DIMS,重算一遍「静止能白拿 / 要放弃」的净收益。预期结论是:只要净收益为正,你的模型早晚会发现它。
实验二:找出翻转的临界点。 跑 grpo_minimal.py,把指令遵循的三个权重乘一个系数 $c$(改 weight_without_instruction 为按比例缩放),从 $c = 1.0$ 逐步降到 $0$,看收敛的 $m$ 在哪一步从 0.97 掉到 0.01。预期是个比较陡的转折而不是平滑过渡——这意味着奖励权重的微小改动可能导致行为质变,调权重时值得扫一遍而不是只试一个值。
实验三:验证组大小对方差的影响。 还是 grpo_minimal.py,把 group 从 32 改成 4、8、64,各跑三个不同 seed。预期看到组越小、收敛点越不稳定——因为组内均值和标准差是用这几个样本估的,样本太少基线就不可靠。还要一起权衡采样成本、同分组概率、奖励稀疏度和并行吞吐。
本文三张配图由 make_figures.py 生成(这个需要额外装 pip install matplotlib,其余脚本只要 NumPy)。想复现就把权重换成你自己的:左边的权重账本换成你的 29 维,右边的曲面和 GRPO 轨迹会直接告诉你你的奖励函数在纵容哪种躺平。
这篇在知识树里是 L4(前沿专题),前面还有三级台阶。如果 03 节读起来吃力,按下面顺序补更省时间:
读完这篇可以继续看:
09 节用到的脚本全文如下(make_figures.py、reward_hacking.py、grpo_minimal.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「视频生成中的强化学习与奖励模型」的三张解释图。

数值一律从同目录两个脚本里取(reward_hacking 的 29 个真实权重、
grpo_minimal 的奖励曲面与 GRPO 轨迹),这里只负责画——那边改了这里要重跑,
免得图和正文数字打架。

三张图分别回答:
  1. 29 个奖励权重的账本长什么样(为什么「有没有照做」压过「好不好看」)
  2. 组内优势到底把什么信息抽出来了(原始奖励看着都一样,标准化后才有正负)
  3. 只改奖励权重、不动算法,GRPO 为什么会从「照做」翻转成「躺平」

只依赖 numpy + matplotlib。跑法:python make_figures.py
"""

import textwrap
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np

import grpo_minimal as G
from reward_hacking import NAMES, WEIGHT

ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(parents=True, exist_ok=True)

plt.rcParams.update({
    "font.sans-serif": ["PingFang SC", "Arial Unicode MS", "DejaVu Sans"],
    "axes.unicode_minus": False,
    "figure.dpi": 160,
    "savefig.bbox": "tight",
})

INK = "#1f2937"
MUTE = "#6b7280"
C_INSTR = "#d1495b"    # 指令遵循:红
C_OTHER = "#2f6fb0"    # 其余维度:蓝
C_AES = "#c9ced6"      # 构图/色彩:灰
C_FULL = "#2f6fb0"     # 完整权重
C_NOIN = "#d1495b"     # 去掉指令遵循
C_POS = "#2f9e6f"      # 优势为正
C_NEG = "#d1495b"      # 优势为负

# 维度分组(下标对应 reward_hacking.DIMS 的顺序)
GROUPS = [
    ("指令遵循", [0, 1, 2], C_INSTR),
    ("构图+色彩", [3, 4, 6], C_AES),
    ("光照", [7, 8, 9, 10, 11, 12], C_OTHER),
    ("形状保持", [13, 14, 15, 16, 17], C_OTHER),
    ("运动", [5, 18, 19, 20, 21], C_OTHER),
    ("画质+细节", [22, 23, 24, 25], C_OTHER),
    ("文字+内容", [26, 27, 28], C_OTHER),
]


def style(ax, title, xlabel=None, ylabel=None):
    ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left")
    if xlabel:
        ax.set_xlabel(xlabel, fontsize=10, color=MUTE)
    if ylabel:
        ax.set_ylabel(ylabel, fontsize=10, color=MUTE)
    ax.tick_params(colors=MUTE, labelsize=9)
    for s in ("top", "right"):
        ax.spines[s].set_visible(False)
    for s in ("left", "bottom"):
        ax.spines[s].set_color("#d1d5db")
    ax.grid(alpha=0.25, linewidth=0.6, axis="y")
    ax.set_axisbelow(True)


def footer(fig, text, width=118):
    """把「这张图要看什么」放到坐标轴下方。

    必须放在 y<0:bbox_inches="tight" 会把负坐标的 artist 一起收进来,
    放在 0~0.05 之间会和 x 轴标签叠在一起。
    """
    wrapped = "\n".join(textwrap.wrap(text, width=width))
    fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE,
             va="top", ha="left", linespacing=1.6)


# ──────────────────────────────────────────────────────────────────────
# 图 1:29 个奖励权重的账本
# ──────────────────────────────────────────────────────────────────────
def fig_weight_ledger():
    order = np.argsort(WEIGHT)                      # 从小到大,画出来是升序
    colors = [C_INSTR if i in (0, 1, 2) else
              C_AES if i in (3, 4, 6) else C_OTHER for i in order]
    labels = [NAMES[i] for i in order]

    fig, axes = plt.subplots(1, 2, figsize=(12.6, 6.4),
                             gridspec_kw={"width_ratios": [1.45, 1]})
    fig.subplots_adjust(wspace=0.34)

    ax = axes[0]
    ax.barh(np.arange(29), WEIGHT[order], color=colors, height=0.72)
    ax.set_yticks(np.arange(29))
    ax.set_yticklabels(labels, fontsize=7.6)
    ax.set_xlim(0, WEIGHT.max() * 1.18)
    ax.tick_params(axis="y", length=0)
    style(ax, "29 个维度的权重(升序)", "权重 $w_k$", None)
    # 最高 / 最低标注
    ax.text(WEIGHT[order][-1] + 0.02, 28, f"{WEIGHT.max():.4f} 最高",
            fontsize=8.5, color=INK, va="center")
    ax.text(WEIGHT[order][0] + 0.02, 0, f"{WEIGHT.min():.4f} 最低",
            fontsize=8.5, color=MUTE, va="center")

    # 图例:红=指令遵循,灰=构图色彩,蓝=其余
    from matplotlib.patches import Patch
    ax.legend(handles=[
        Patch(color=C_INSTR, label="指令遵循(3 维)"),
        Patch(color=C_AES, label="构图+色彩(3 维)"),
        Patch(color=C_OTHER, label="其余(23 维)"),
    ], fontsize=8.2, frameon=False, loc="lower right")

    ax = axes[1]
    gcolor = {name: c for name, _, c in GROUPS}
    gs = [(name, float(WEIGHT[idx].sum())) for name, idx, _ in GROUPS]
    gs.sort(key=lambda t: -t[1])
    total = WEIGHT.sum()
    ys = np.arange(len(gs))
    # 颜色必须按排序后的名字取:按 GROUPS 顺序 zip 会跟排序后的柱子错位
    ax.barh(ys, [v for _, v in gs],
            color=[gcolor[n] for n, _ in gs], height=0.7)
    ax.set_yticks(ys)
    ax.set_yticklabels([n for n, _ in gs], fontsize=9)
    ax.tick_params(axis="y", length=0)
    for i, (_, v) in enumerate(gs):
        ax.text(v + 0.03, i, f"{v:.3f}  ({v / total * 100:.1f}%)",
                fontsize=8.2, color=INK, va="center")
    ax.set_xlim(0, max(v for _, v in gs) * 1.45)
    style(ax, "按语义归堆:谁在主导总分", "权重合计", None)

    fig.suptitle("图 1 VisionReward 的 29 个权重不是均衡的:"
                 "指令遵循一家占了 37.4%,构图加色彩只有 1.5%",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
    footer(fig, "要看什么:左图是 29 个权重从低到高排开——最高的「指令-未完全失败」1.1418,"
                "最低的「细节-不粗糙」0.0085,相差 134 倍,根本不是「各维度都重要」的均衡奖励。"
                "右图把它们按语义归堆后更刺眼:指令遵循三档合计 2.3486,一家吃掉 37.4%;"
                "而构图加色彩只有 0.0924、占 1.5%。真实人类偏好数据里,"
                "「有没有照着 prompt 做」比「好不好看」重要二十多倍——这个结构是后面所有套利的源头。")
    fig.savefig(OUT / "reward_weight_ledger.png")
    plt.close(fig)
    print(f"[图1] 29 维权重合计 {total:.4f};最高 {WEIGHT.max():.4f}/最低 {WEIGHT.min():.4f}"
          f" = {WEIGHT.max() / WEIGHT.min():.0f} 倍;指令遵循占 "
          f"{WEIGHT[[0, 1, 2]].sum() / total * 100:.1f}%")


# ──────────────────────────────────────────────────────────────────────
# 图 2:组内优势把「谁比谁好」抽出来
# ──────────────────────────────────────────────────────────────────────
def fig_group_advantage():
    rng = np.random.default_rng(2024)
    rs = 8.0 + rng.random(8) * 0.2          # 同一个 prompt 采 8 条,分都挤在 8.0~8.2
    adv = (rs - rs.mean()) / (rs.std() + 1e-8)
    idx = np.arange(1, 9)

    fig, axes = plt.subplots(1, 2, figsize=(12.6, 4.6))
    fig.subplots_adjust(wspace=0.26)

    ax = axes[0]
    ax.bar(idx, rs, color=C_OTHER, width=0.62)
    ax.set_ylim(0, 8.9)
    ax.set_xticks(idx)
    style(ax, "原始奖励:8 条都在 8.0~8.2 之间", "组内第 i 条", "奖励 $r_i$")
    for i, v in zip(idx, rs):
        ax.arrow(i, v + 0.42, 0, 0.30, width=0.055, color=INK,
                 length_includes_head=True, head_width=0.16, head_length=0.12)
    ax.text(0.99, 8.72, "每一条都在说:往我这边推(只是力度略有差别)",
            fontsize=8.6, color=MUTE, ha="right", va="top")
    ax.text(0.02, 0.30, f"极差只有 {rs.max() - rs.min():.2f}",
            fontsize=8.6, color=INK, transform=ax.transAxes)

    ax = axes[1]
    cols = [C_POS if a >= 0 else C_NEG for a in adv]
    ax.bar(idx, adv, color=cols, width=0.62)
    ax.axhline(0, color=INK, lw=1.0)
    ax.set_xticks(idx)
    ax.set_ylim(-2.0, 2.0)
    for i, v in zip(idx, adv):
        ax.text(i, v + (0.09 if v >= 0 else -0.09), f"{v:+.2f}",
                ha="center", va="bottom" if v >= 0 else "top",
                fontsize=8, color=INK)
    style(ax, "减均值除标准差后:谁该推、谁该压,一眼分清",
          "组内第 i 条", "优势 $A_i$")
    ax.text(0.98, 0.94, "绿的往上推,红的往下压;组内均值自动当基线",
            fontsize=8.6, color=MUTE, ha="right", va="top",
            transform=ax.transAxes)

    fig.suptitle("图 2 GRPO 的组内基线:把「绝对分多高」换成「谁比谁好」",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.04)
    footer(fig, "要看什么:左图是同一个 prompt 采出的 8 条视频的奖励,全挤在 8.0 到 8.2 之间——"
                "如果直接把 $r_i$ 乘在梯度上,8 条样本会一起喊「往我这边推」,只是力气略有差别,"
                "有用的信息被绝对值淹没了(箭头方向完全一致)。右图减掉组内均值、除以组内标准差之后,"
                "同样的 8 个数字变成了有正有负的优势:一半往上推、一半往下压。"
                "这就是 GRPO 不用 critic 也能训的原因——基线是从同组样本里白捡的。")
    fig.savefig(OUT / "group_advantage.png")
    plt.close(fig)
    print(f"[图2] 8 条奖励 {rs.min():.3f}~{rs.max():.3f}(极差 {rs.max() - rs.min():.3f});"
          f"优势 {adv.min():+.2f}~{adv.max():+.2f}")


# ──────────────────────────────────────────────────────────────────────
# 图 3:只改奖励权重,同一个 GRPO 翻转
# ──────────────────────────────────────────────────────────────────────
def _trace_grpo(weight=None, seed=0, steps=400, group=32, lr=0.35, sigma=0.15):
    """复刻 grpo_minimal.grpo 的循环,只是把每步的 m 和组内平均奖励记下来。

    抽随机的顺序必须和原函数完全一致,否则数字对不上正文。
    """
    rng = np.random.default_rng(seed)
    theta = 0.0
    ms, rr = [], []
    for _ in range(steps):
        mu = 1 / (1 + np.exp(-theta))
        eps = rng.normal(0, sigma, group)
        m_clip = np.clip(mu + eps, 0.0, 1.0)
        r = np.array([G.reward(m, rng, weight) for m in m_clip])
        adv = (r - r.mean()) / (r.std() + 1e-8)
        grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu))
        theta += lr * grad
        ms.append(mu)
        rr.append(float(r.mean()))
    return np.array(ms), np.array(rr), 1 / (1 + np.exp(-theta))


def fig_surface_flip():
    w_no = G.weight_without_instruction()

    # 奖励曲面:与 grpo_minimal.main 同口径(rng=7,每点 4000 次采样)
    rng = np.random.default_rng(7)
    grid = np.linspace(0, 1, 21)
    surf_full, surf_no = [], []
    for m in grid:
        surf_full.append(float(np.mean([G.reward(m, rng) for _ in range(4000)])))
        surf_no.append(float(np.mean([G.reward(m, rng, w_no) for _ in range(4000)])))
    surf_full = np.array(surf_full)
    surf_no = np.array(surf_no)

    # 正文引用的那张 11 点表,峰值标注以它为准
    rng2 = np.random.default_rng(7)
    tbl = np.linspace(0, 1, 11)
    tf, tn = [], []
    for m in tbl:
        # 抽随机顺序与 grpo_minimal.main 完全一致(逐点交错),否则峰值数字对不上正文
        tf.append(float(np.mean([G.reward(m, rng2) for _ in range(4000)])))
        tn.append(float(np.mean([G.reward(m, rng2, w_no) for _ in range(4000)])))
    tf, tn = np.array(tf), np.array(tn)
    pk_f, pk_n = tbl[int(tf.argmax())], tbl[int(tn.argmax())]

    ms_full, rr_full, m_end_full = _trace_grpo(weight=None, seed=0)
    ms_no, rr_no, m_end_no = _trace_grpo(weight=w_no, seed=0)

    fig, axes = plt.subplots(1, 2, figsize=(12.6, 5.0))
    fig.subplots_adjust(wspace=0.30)

    ax = axes[0]
    ax.plot(grid, surf_full, lw=2.4, color=C_FULL, label="完整 29 维权重")
    ax.plot(grid, surf_no, lw=2.4, color=C_NOIN, ls="--", label="去掉指令遵循三档")
    ax.axhline(0, color="#9ca3af", lw=0.8)
    ax.scatter([pk_f], [tf.max()], s=70, color=C_FULL, zorder=5)
    ax.scatter([pk_n], [tn.max()], s=70, color=C_NOIN, zorder=5)
    ax.annotate(f"最高点 m={pk_f:.1f}", (pk_f, tf.max()),
                textcoords="offset points", xytext=(10, -30),
                fontsize=8.6, color=C_FULL,
                arrowprops=dict(arrowstyle="->", color=C_FULL, lw=1.0))
    ax.annotate(f"最高点 m={pk_n:.1f}", (pk_n, tn.max()),
                textcoords="offset points", xytext=(18, 26),
                fontsize=8.6, color=C_NOIN,
                arrowprops=dict(arrowstyle="->", color=C_NOIN, lw=1.0))
    ax.legend(fontsize=8.6, frameon=False, loc="lower center")
    style(ax, "同一组物理约束,两种权重下的奖励曲面形状完全相反",
          "运动强度 $m$", "期望奖励 $r$")

    ax = axes[1]
    ax.plot(ms_full, lw=2.4, color=C_FULL, label="m(完整权重)")
    ax.plot(ms_no, lw=2.4, color=C_NOIN, ls="--", label="m(去掉指令遵循)")
    ax.set_ylim(-0.05, 1.05)
    ax.set_xlabel("训练步", fontsize=10, color=MUTE)
    ax.set_ylabel("运动强度 $m$", fontsize=10, color=MUTE)
    ax2 = ax.twinx()
    ax2.plot(rr_full, lw=1.1, color=C_FULL, alpha=0.45)
    ax2.plot(rr_no, lw=1.1, color=C_NOIN, alpha=0.45, ls="--")
    ax2.set_ylabel("组内平均奖励(浅色细线)", fontsize=9, color=MUTE)
    ax2.tick_params(colors=MUTE, labelsize=8.5)
    ax2.spines["top"].set_visible(False)
    h1, l1 = ax.get_legend_handles_labels()
    ax.legend(h1, l1, fontsize=8.6, frameon=False, loc="center right")
    style(ax, "同一个 GRPO 跑 400 步:一条冲到 0.97,一条躺到 0.01",
          None, None)
    ax.set_ylabel("运动强度 $m$", fontsize=10, color=MUTE)
    ax.set_xlabel("训练步", fontsize=10, color=MUTE)
    ax.text(0.02, 0.06, f"完整权重收敛 m={m_end_full:.3f}\n"
                        f"去掉指令遵循收敛 m={m_end_no:.3f}",
            fontsize=8.4, color=INK, transform=ax.transAxes,
            va="bottom", bbox=dict(fc="white", ec="#d1d5db", lw=0.7, pad=4))

    fig.suptitle("图 3 奖励曲线一样漂亮,学到的东西完全相反",
                 fontsize=12, color=INK, x=0.012, ha="left", y=1.03)
    footer(fig, "要看什么:左图是同一组物理约束下的奖励曲面。完整权重(蓝实线)在 m=0.8 附近见顶,"
                "去掉指令遵循三档后(红虚线)整条曲线翻转成单调递减,最高点直接落到 m=0——彻底不动才是最优解。"
                "右图是同一个 GRPO、同一个初值跑 400 步:蓝线冲到 0.966 选择照做 prompt,"
                "红线掉到 0.008 选择躺平。而两条浅色细线是各自的组内平均奖励——它们都在稳步上涨,"
                "形状和一次成功的训练没有任何区别。奖励曲线不能告诉你模型学到了什么。")
    fig.savefig(OUT / "reward_surface_flip.png")
    plt.close(fig)
    print(f"[图3] 曲面峰值:完整 m={pk_f:.1f} ({tf.max():+.4f}),"
          f"去掉指令 m={pk_n:.1f} ({tn.max():+.4f});"
          f"GRPO 收敛 {m_end_full:.4f} vs {m_end_no:.4f}")


def main():
    fig_weight_ledger()
    fig_group_advantage()
    fig_surface_flip()
    print(f"[OK] 三张图已写入 {OUT}")
    for f in sorted(OUT.glob("*.png")):
        print(f"  {f.name}  {f.stat().st_size / 1024:.0f} KB")


if __name__ == "__main__":
main()"""用 VisionReward 的真实权重,算一遍「静态视频能不能骗到高分」。
权重与问题取自 THUDM/VisionReward(2026-08 的 main 分支):
VisionReward_Video/weight.json 29 个线性权重
VisionReward_Video/VisionReward_video_qa_select.txt 29 个 yes/no 问题
打分公式同 inference-video.py 的 score():yes=+1,no=-1,乘权重后取均值。
注意:下面两个视频的 yes/no 画像是**按各维度语义做的人工假设**,
不是真实模型的输出。它用来说明权重结构本身允许什么样的套利,
不构成对 VisionReward 实际表现的评测。
运行 `python reward_hacking.py`。
"""
import numpy as np
# (权重, 维度简称) —— 顺序与上游 weight.json 严格一致
DIMS = [
(0.9544, "指令-全部满足"),
(0.2524, "指令-大部分满足"),
(1.1418, "指令-未完全失败"),
(0.0350, "构图-美观"),
(0.0252, "构图-无明显缺陷"),
(0.1260, "镜头运动-无明显缺陷"),
(0.0322, "色彩-不难看"),
(0.1629, "光照-完全准确"),
(0.2167, "光照-无明显错误"),
(0.0197, "光照-存在"),
(0.1360, "光照-极美"),
(0.0965, "光照-美"),
(0.1549, "光照-不难看"),
(0.1294, "首帧形状-完全准确"),
(0.0989, "首帧形状-无明显错误"),
(0.1884, "首帧形状-不混乱"),
(0.1844, "全程形状-完美保持"),
(0.2636, "全程形状-不混乱"),
(0.1117, "镜头运动-高度动态"),
(0.0517, "镜头运动-不微弱"),
(0.0256, "物体运动-非常平滑"),
(0.4390, "物体运动-完全真实"),
(0.2686, "画质-非常稳定"),
(0.4293, "细节-非常精细"),
(0.0085, "细节-不粗糙"),
(0.1276, "细节-不显著粗糙"),
(0.0580, "文字-全部正确"),
(0.1446, "文字-存在"),
(0.3942, "内容-属于物理世界"),
]
WEIGHT = np.array([w for w, _ in DIMS])
NAMES = [n for _, n in DIMS]
Y, N = 1, -1
# 视频 A:几乎静止的精致画面。prompt 要求「人物走过街道」,它只给了个站着的人。
STATIC = [
N, N, Y, # 指令:没走,但也不算完全没关系
Y, Y, # 构图:精心构图
Y, # 镜头运动无缺陷(没动,自然没缺陷)
Y, # 色彩
Y, Y, Y, Y, Y, Y, # 光照:静态画面容易做好
Y, Y, Y, # 首帧形状:完美
Y, Y, # 全程形状:不动=完美保持
N, N, # 镜头动态:没有
Y, Y, # 物体运动:平滑(无运动可挑)、真实(无违反物理)
Y, # 画质稳定:不动=极稳
Y, Y, Y, # 细节:静态可以渲染很精细
Y, Y, # 文字
Y, # 属于物理世界
]
# 视频 B:真的走起来了,但运动带来形变、抖动和轻微模糊。
DYNAMIC = [
Y, Y, Y, # 指令:确实照做了
N, Y, # 构图:运动中构图一般
Y, # 镜头运动无明显缺陷
Y, # 色彩
N, Y, Y, N, Y, Y, # 光照:运动中光照没那么完美
Y, Y, Y, # 首帧形状:还行
N, N, # 全程形状:走动中有形变 ← 运动的代价
Y, Y, # 镜头动态:有
Y, Y, # 物体运动:平滑且真实
N, # 画质稳定:运动带来抖动 ← 运动的代价
N, Y, Y, # 细节:动态模糊,不够精细 ← 运动的代价
Y, Y, # 文字
Y, # 属于物理世界
]
def score(answers):
"""复刻 inference-video.py 的 score()。"""
a = np.array(answers)
assert len(a) == len(WEIGHT), f"维度不匹配: {len(a)} vs {len(WEIGHT)}"
return float(np.mean(a * WEIGHT))
def main():
print("=== 1. 权重结构 ===")
print(f" 29 个维度,权重总和 {WEIGHT.sum():.4f},均值 {WEIGHT.mean():.4f}")
print(f" 最高 {WEIGHT.max():.4f}({NAMES[int(WEIGHT.argmax())]})")
print(f" 最低 {WEIGHT.min():.4f}({NAMES[int(WEIGHT.argmin())]})")
print(f" 最高/最低 = {WEIGHT.max() / WEIGHT.min():.0f} 倍")
instr = WEIGHT[0] + WEIGHT[1] + WEIGHT[2]
print(f"\n 指令遵循三档合计 {instr:.4f},占总权重 {instr / WEIGHT.sum() * 100:.1f}%")
aes = WEIGHT[3] + WEIGHT[4] + WEIGHT[6]
print(f" 构图+色彩合计 {aes:.4f},占总权重 {aes / WEIGHT.sum() * 100:.1f}%")
print("\n=== 2. 静态套利的账 ===")
shape_stable = WEIGHT[[16, 17, 22]].sum()
motion = WEIGHT[[18, 19]].sum()
print(f" 静止能白拿:全程形状保持+不混乱+画质稳定 = {shape_stable:.4f}")
print(f" 静止要放弃:镜头高度动态+不微弱 = {motion:.4f}")
print(f" 净收益 {shape_stable - motion:+.4f}"
f" (yes/no 相差 2 个单位,实际影响 ×2 = {(shape_stable - motion) * 2:+.4f})")
print("\n=== 3. 两个视频的实际得分 ===")
s_static, s_dynamic = score(STATIC), score(DYNAMIC)
print(f" 视频 A(几乎静止的精致画面,没照做 prompt) {s_static:+.4f}")
print(f" 视频 B(照做了 prompt,但有形变和抖动) {s_dynamic:+.4f}")
winner = "A(静态)" if s_static > s_dynamic else "B(动态)"
print(f" 奖励模型更偏好:{winner} 差值 {abs(s_static - s_dynamic):.4f}")
print("\n=== 4. 差异来自哪几个维度 ===")
diff = (np.array(STATIC) - np.array(DYNAMIC)) * WEIGHT
order = np.argsort(-np.abs(diff))
print(" (正值=这一维让静态视频占便宜)")
for i in order[:8]:
if diff[i] != 0:
print(f" {diff[i]:+.4f} {NAMES[i]}")
if __name__ == "__main__":
main()"""GRPO 的最小可运行实现,跑在 VisionReward 的真实权重上。
策略只有一个参数:运动强度 m。这是刻意的——把维度压到 1 维,
才能看清 GRPO 到底把策略推向哪里,而不是被高维噪声淹没。
人为设定的玩具权衡(不是视频物理定律或真实 VLM 的测量):
m 越大 → 指令遵循、动态性维度更容易拿 yes
m 越大 → 形状保持、画质稳定、细节精细更容易拿 no(运动带来形变/抖动/模糊)
prompt 明确要求运动("a person walking across the street"),
所以「照做」在语义上就等于 m 要大。看 GRPO 最后选了什么。
运行 `python grpo_minimal.py`。
"""
import numpy as np
from reward_hacking import WEIGHT, NAMES
# 各维度对运动强度 m 的敏感方向
# +1: m 越大越容易 yes -1: m 越大越容易 no 0: 与 m 无关
SENSITIVITY = np.zeros(29)
SENSITIVITY[[0, 1, 2]] = +1.0 # 指令遵循(prompt 要求运动)
SENSITIVITY[[18, 19]] = +1.0 # 镜头动态
SENSITIVITY[[20, 21]] = +0.3 # 运动平滑/真实:要有运动才谈得上,但过猛会假
SENSITIVITY[[16, 17]] = -1.0 # 全程形状保持
SENSITIVITY[22] = -1.0 # 画质稳定
SENSITIVITY[[23, 24, 25]] = -0.7 # 细节精细(动态模糊)
SENSITIVITY[[7, 8, 10, 11]] = -0.3 # 光照准确/美观:运动中更难保持
def yes_prob(m):
"""给定运动强度 m∈[0,1],各维度答 yes 的概率。
基线 0.5 表示「说不准」,敏感度把它往两边拉。
"""
return np.clip(0.5 + SENSITIVITY * (m - 0.5) * 1.6, 0.02, 0.98)
def sample_video(m, rng):
"""按概率采一个 yes/no 画像,yes=+1 no=-1。"""
return np.where(rng.random(29) < yes_prob(m), 1, -1)
# 指令遵循的三个维度。把它们置零就得到一个「只看画质」的奖励模型,
# 用来对照权重结构对 reward hacking 的影响。
INSTRUCTION_DIMS = [0, 1, 2]
def reward(m, rng, weight=None):
"""复刻 inference-video.py 的 score():np.mean(answers * weight)。"""
w = WEIGHT if weight is None else weight
return float(np.mean(sample_video(m, rng) * w))
def weight_without_instruction():
w = WEIGHT.copy()
w[INSTRUCTION_DIMS] = 0.0
return w
def grpo(steps=400, group=32, lr=0.35, sigma=0.15, theta0=0.0, seed=0,
weight=None, verbose=False):
"""单参数 GRPO,返回收敛后的运动强度 m。
每步采 group 个动作,用组内均值/标准差做 baseline 得到 advantage,
再按 advantage 加权更新——不需要 critic,这是 GRPO 的核心简化。
为了看清裸的优化行为,这里省掉了 PPO 式的 clip 和对参考模型的 KL 惩罚。
"""
rng = np.random.default_rng(seed)
theta = theta0
for step in range(steps):
# 策略:m = clip(sigmoid(theta) + noise),高斯探索
mu = 1 / (1 + np.exp(-theta))
eps = rng.normal(0, sigma, group)
ms = np.clip(mu + eps, 0.0, 1.0)
rs = np.array([reward(m, rng, weight) for m in ms])
# 组内相对优势:减均值除标准差
adv = (rs - rs.mean()) / (rs.std() + 1e-8)
# 潜在动作 a = mu + eps 的高斯 score,m=clip(a) 只是环境映射。
# 这不是含边界原子质量的裁剪后 m 分布的逐点 log-density。
# ∂mu/∂theta = mu(1-mu)
grad = float(np.mean(adv * eps / sigma ** 2) * mu * (1 - mu))
theta += lr * grad
if verbose and (step % 80 == 0 or step == steps - 1):
print(f" {step:>4} {mu:.4f} {float(rs.mean()):+.4f}")
return 1 / (1 + np.exp(-theta))
def main():
print("=== 1. 优化前后的运动强度 ===")
print(" step 运动强度 m 组内平均奖励")
m_final = grpo(verbose=True)
print(f"\n GRPO 收敛到 m = {m_final:.4f}")
verdict = "静态(放弃了 prompt 要求的运动)" if m_final < 0.35 else \
"动态(照做了 prompt)" if m_final > 0.65 else "折中"
print(f" → 策略选择:{verdict}")
print("\n=== 2. 从不同初值出发是否都收敛到同一处 ===")
for name, t0 in (("偏静态 (m≈0.27)", -1.0), ("中性 (m=0.50)", 0.0),
("偏动态 (m≈0.73)", 1.0)):
mf = grpo(theta0=t0, seed=1)
print(f" 初值 {name:<18} → 收敛 m = {mf:.4f}")
print("\n=== 3. 奖励曲面:各运动强度的期望得分 ===")
rng = np.random.default_rng(7)
w_no_instr = weight_without_instruction()
print(" m 完整权重 去掉指令遵循 (每点 4000 次采样)")
best, best_no = (-9e9, None), (-9e9, None)
for m in np.linspace(0, 1, 11):
r = float(np.mean([reward(m, rng) for _ in range(4000)]))
r2 = float(np.mean([reward(m, rng, w_no_instr) for _ in range(4000)]))
best = max(best, (r, m))
best_no = max(best_no, (r2, m))
print(f" {m:.1f} {r:+.4f} {r2:+.4f}")
print(f" → 完整权重的最高点在 m = {best[1]:.1f}({best[0]:+.4f})")
print(f" → 去掉指令遵循后最高点在 m = {best_no[1]:.1f}({best_no[0]:+.4f})")
print("\n=== 4. 对照:奖励模型不看指令遵循时,GRPO 选什么 ===")
print(" step 运动强度 m 组内平均奖励")
m_hack = grpo(weight=w_no_instr, seed=0, verbose=True)
print(f"\n 收敛到 m = {m_hack:.4f}"
f"(完整权重下是 {m_final:.4f})")
print(" → 同一个算法、同一个物理约束,只改奖励的权重结构,"
"\n 策略就从「照做」翻转成「静止不动」。这就是 reward hacking 的来源:"
"\n 不是算法坏了,是它精确地最大化了你真正写下来的那个目标。")
print("\n=== 5. 两个收敛点在各维度上的差别 ===")
p_ok, p_hack = yes_prob(m_final), yes_prob(m_hack)
gap = (p_hack - p_ok) * WEIGHT
order = np.argsort(np.abs(gap))[::-1]
print(" (正值=hack 后的策略在这一维更容易拿 yes)")
for i in order[:6]:
print(f" {gap[i]:+.4f} {NAMES[i]}"
f" (yes 概率 {p_ok[i]:.2f} → {p_hack[i]:.2f})")
if __name__ == "__main__":
main()



评论 (0)