AIGC 周末专题深度解读:3DGS 的工程化转折:从「重建得出来」到「传得动、跑得起、管得住」
人工智能炼丹君 整理 | 2026年8月23日(周日)
本期概述
本期 AIGC 周末专题聚焦3DGS 的工程化转折:从「重建得出来」到「传得动、跑得起、管得住」 方向,精选 7 篇 代表性论文进行深度解读。
方向分布:
动态场景流式传输与存储压缩 2 篇 (S2GS, QuARC-GS)
边缘设备与 VR 实时渲染的系统级加速 1 篇 (MetaSapiens-v2)
把 3DGS 转成生成模型可用的结构化隐空间 1 篇 (GS-Voxel)
语言可查询的实例级场景理解 1 篇 (GroupForward)
物理采集缺陷的成像模型修正 1 篇 (RS-Avatar)
版权保护与原生水印 1 篇 (NGS-Marker)
含 ICLR 2026 × 1、阿里高德 × 1、Max Planck / EPFL × 1、上海AI Lab × 1、港理工 × 1
技术路线与时间线
质量竞赛期(2023.07 — 2024.06)
描述 :3DGS 问世后,主线是在标准基准上刷 PSNR 与训练/渲染速度。部署问题被写在 Limitation 段落里。
关键节点 :
2023.07 :3D Gaussian Splatting:显式高斯 + 光栅化,实时新视角合成2023.10 :4DGS / Deformable-GS:把 3DGS 扩展到动态场景2024.02 :Scaffold-GS:锚点式层次组织,为后续压缩打下结构基础2024.06 :3DGStream:在线动态流式重建的早期尝试
压缩与部署萌芽(2024.07 — 2026.03)
描述 :研究者开始正视存储与算力开销,压缩、剪枝、量化成为独立课题;同时语义 3DGS 与前馈 3DGS 让场景可被语言查询。
关键节点 :
2024.09 :LangSplat / 语义 3DGS:给高斯挂语义特征支持语言查询2024.12 :QUEEN:动态高斯流式重建的强基线,本期两篇的对比对象2025.05 :前馈 3DGS(pixelSplat / MVSplat 系):稀疏视角直接预测高斯2026.01 :TRELLIS 类结构化隐空间三维生成兴起,为 GS-Voxel 铺路
工程化转折(2026.08)
描述 :本期集中出现的七篇标志着关注点全面转向部署:边缘设备、VR 头显、生成隐空间、语言查询、成像缺陷、版权保护。稀疏化与结构化成为共同手法。
关键节点 :
2026.08.21 :S²GS:结构化稀疏门控,Jetson 上 60+ FPS2026.08.20 :QuARC-GS:量化锚点残差,每帧存储压到 1/112026.08.19 :MetaSapiens v2:注视点渲染 + 加速器,平均 30.9×2026.08.19 :GS-Voxel:免拟合结构化隐空间,城市级 3DGS 生成2026.08.18 :GroupForward / RS-Avatar / NGS-Marker:查询、成像、版权三个新维度
论文 : S²GS:结构化稀疏高斯流,让自由视点视频在 Jetson 边缘设备上跑到 60+ FPSarXiv : 2608.19639 机构 : 香港理工大学关键词 : 自由视点视频, 动态3DGS, 流式传输, 可微稀疏门控, 边缘设备
1.1 研究动机
核心问题: FVV 流式重建的每帧优化时间与存储占用都超出边缘 IoT 设备能力,根因是把每帧当独立场景重建、为静止区域反复存完整高斯参数
自由视点视频(FVV)的流式重建是远程呈现、数字孪生可视化这类沉浸式 IoT 服务的底层能力:观众能自由改变视角,而画面是实时从多相机流重建出来的。问题在于现有方法的两项开销都卡在边缘设备的能力之外——每帧的优化时间太长(来不及跟上采集帧率),存储占用太大(传不动)。这两项开销同源:把每一帧都当作一个独立的场景来重建,为大量实际静止的区域反复存储完整的高斯参数。要让 FVV 真的跑在 Jetson 这类资源受限的边缘 IoT 设备上,就必须找到一种只更新「真正在动」的那部分的机制,而且这个机制自身的判断开销不能高。
前序工作及局限:
3DGStream / QUEEN :已引入逐帧增量更新,但更新决策靠人工阈值,稀疏化不进优化目标Scaffold-GS 锚点表示 :提供了层次组织基础,但未用于时序稀疏决策
与前序工作的本质区别: 空间用流式八叉树捕捉相关性,时间用 HFP + Gumbel-Sigmoid/ML-STE 把动态线索离散化为可微的稀疏更新掩码,前向硬稀疏、反向梯度可穿
1.2 方法原理
Overview of the proposed S²GS framework. (a) The streaming octree representation is initialized using root Gaussian primitives from the first frame and subsequently represents FVVs with multi-resolution grids, enabling hierarchical allocation of Gaussian residuals and efficient point queries for FVV streaming. (b) A structured gating mechanism is introduced to induce sparse Gaussian residual updates through hierarchical feature propagation, differentiable sampling with Gumbel-Sigmoid, and multi-level (ML) discretization using a straight-through estimator (STE). (c) A sparse regularization loss is incorporated to enable efficient end-to-end optimization of structured gates and sparse residual updates.
S²GS 要回答的问题是「哪些高斯值得更新」,而它的答案分两层。第一层是空间结构:单个高斯的运动是孤立信号,噪声大且无法泛化,而流式八叉树把邻近高斯组织成层次结构后,「这一整块区域在动」这个判断远比「这一个点在动」稳健。层次特征传播就是沿这个结构把动态线索从叶节点汇聚到根节点。第二层是可微决策:过去的做法是拿动态置信度过一个人工阈值,问题是阈值不参与优化,选错了只能手调。S²GS 把置信度先过一个可学习的软门控得到连续值,再用 Gumbel-Sigmoid 加多级直通估计器把它变成 0/1 硬掩码——前向是硬稀疏(真的省算力和存储),反向梯度能穿过(决策边界被光度损失和稀疏正则共同塑形)。多级离散方案则是在纯二元门控之上补一层细粒度:不只是「更不更新」,还能表达「更新多少」,避免细微动态被一刀切掉。最终每帧只需解码被选中锚点的残差增量,与基底相加即得当前帧场景。
1.3 核心创新
提出 Structured Sparse Gaussian Streaming(S²GS),核心思路是利用结构感知的时序稀疏性 来选择性地更新高斯残差。它把稀疏化拆成空间与时间两个维度分别处理:空间上用流式八叉树(streaming octree)把高斯残差按层次组织起来,捕捉空间相关性以指导更新;时间上设计一套结构化门控机制(structured gating),由层次特征传播(HFP)加 Gumbel-Sigmoid 采样组成,把层次化的动态线索转换成稀疏的残差更新决策,并且整个决策过程在可微优化框架下完成。此外用多级离散方案(multi-level discrete scheme)对残差更新做更细粒度的控制,避免稀疏化损失精细的动态细节。
1.4 实验结果
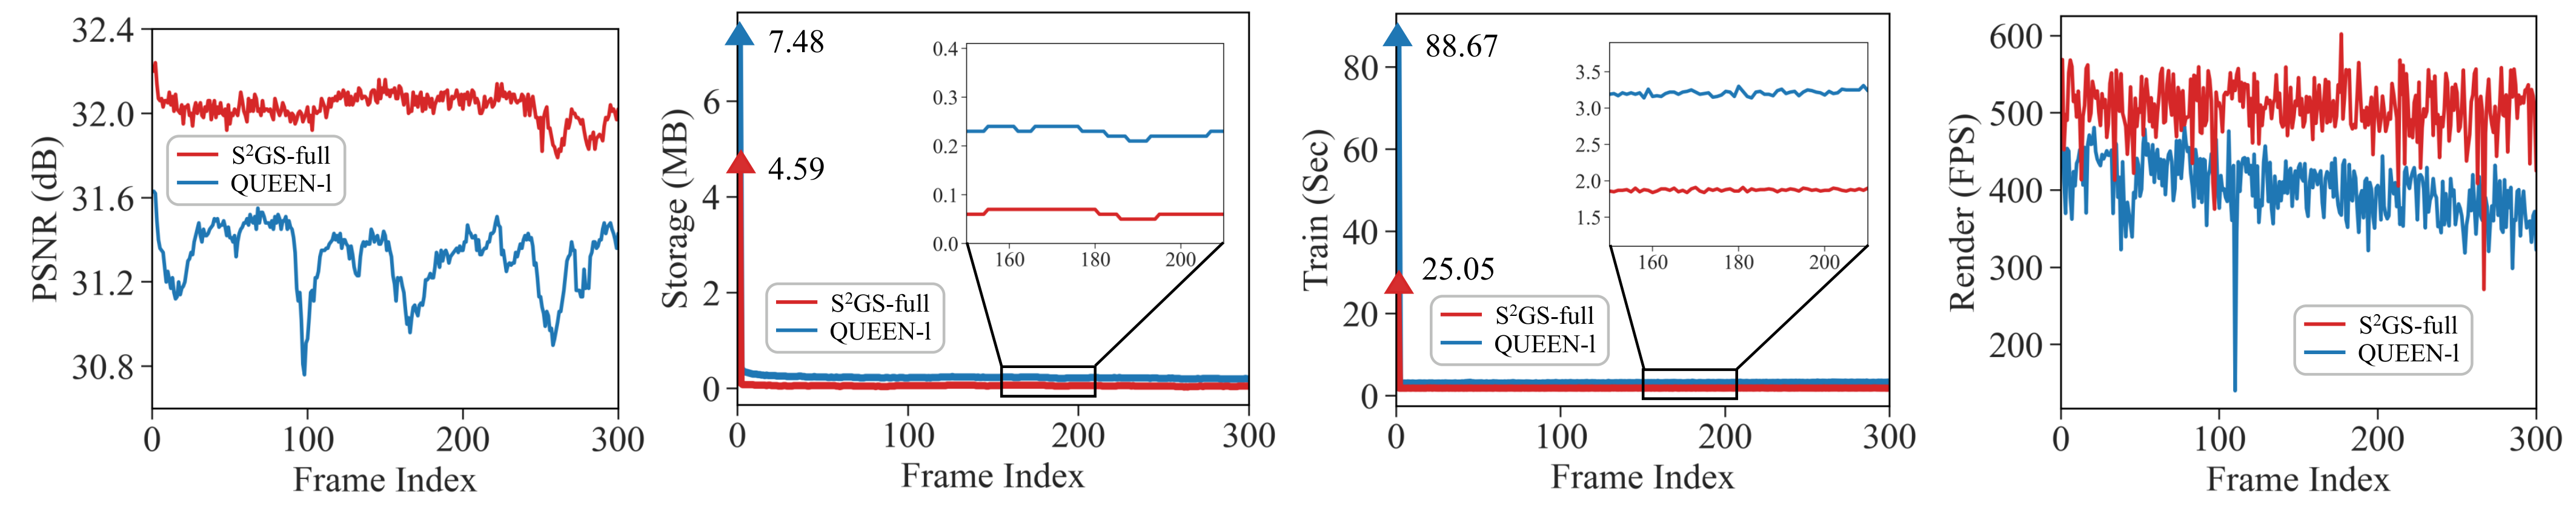
Trend comparison of PSNR, storage cost, training time, and rendering throughput for S²GS-full and QUEEN-l on the Vrheadset scene from the Meet Room dataset. The triangle ($\blacktriangle$) denotes the metric value at the first frame.
在消费级 GPU、工业级边缘 IoT 设备与一套物理远程呈现测试台三类环境上做了实验。RTX 4090 上相比 QUEEN,每帧优化时间减少 59%,存储成本减少 85%;论文给出的逐帧曲线显示 S²GS-full 在 300 帧上 PSNR 稳定在 32.0 dB 左右,高于 QUEEN-l 的 31.2 dB,同时存储从 7.48 MB 降到 4.59 MB、训练时间从 88.67 秒降到 25.05 秒(首帧),渲染帧率也整体高于 QUEEN。在 Jetson AGX Orin 上,S²GS 在所有被评测方法中取得最高渲染吞吐(60+ FPS)与最低能耗。实验还包含光照变化与设备拔插等扰动场景。项目主页、代码与补充材料均已公开。
1.5 关键洞察
测试序列长度与真实会话时长差距大 — 论文的逐帧曲线做到 300 帧量级,而远程呈现的真实会话是几十分钟量级。残差结构的稳定性关键取决于基底帧能撑多久——误差是否沿残差链累积、需不需要周期性重设基底,在数百帧的窗口里看不出来与 QuARC-GS 等同期压缩工作无法直接比较 — S²GS 报的是相比 QUEEN 的相对提升(存储 -85%),同期 QuARC-GS 报的是每帧存储压到 SOTA 的 1/11,两者基线、数据集与画质工作点都不同。动态 3DGS 流式传输已有足够多工作,却缺一条公认的率-失真曲线,读者无法判断孰优门控机制自身的开销未单独拆解 — HFP 沿八叉树做层次传播、Gumbel-Sigmoid 采样、多级离散化都是额外计算。论文报告了总体优化时间的下降,但没有把「门控判断本身花了多少」从「因稀疏而省下多少」中拆开,无法判断这套机制在更小的模型或更弱的设备上是否仍然划算
技术演进定位: 首个在边缘 IoT 设备与物理远程呈现测试台上完成端到端验证的动态 3DGS 流式方案
可能的后续方向:
基底帧重设策略自适应化,支撑分钟级以上长会话
与神经视频编码的率-失真框架对齐,给出可比的 BD-rate
门控决策与传输侧带宽自适应联合优化
论文 : QuARC-GS:量化锚点残差编码,把动态场景每帧存储压到 SOTA 的 1/11arXiv : 2608.18285 机构 : 美国杜克大学(Duke University)等关键词 : 动态场景压缩, 量化感知训练, 锚点残差编码, 变化门控致密化, 率-失真
2.1 研究动机
核心问题: 在线 FVV 流式传输中,详细场景表示的存储需求与在线场景的速度需求互相拉扯,逐帧表示存在大量运动冗余与外观冗余
NeRF 与高斯泼溅在新视角合成上已经能从任意角度渲出高质量画面,也被扩展到了动态三维场景。但要做可持续的在线自由视点视频流式传输——尤其是较长的视频——仍然困难:详细的场景表示带来巨大的存储需求,而在线场景又要求足够快的重建与渲染速度。这两个约束互相拉扯:为了压缩存储就要简化表示,简化表示又会掉画质或拖慢重建。问题的症结在于逐帧表示中存在大量冗余——运动上的(大部分锚点其实几乎不动)、外观上的(静止区域被反复致密化)。
前序工作及局限:
QUEEN / ReCon-GS / 3DGStream :在线动态高斯流式重建,但存储仍在数百 KB 到数 MB 量级4DGC / ComGS :已做动态高斯压缩,但量化多为训练后处理,掉画质
与前序工作的本质区别: 量化进入优化循环(量化感知),网络主动把变形往格点靠;致密化判据从视空间梯度大小改为梯度差分,静止但纹理复杂的区域不再被反复致密化
2.2 方法原理
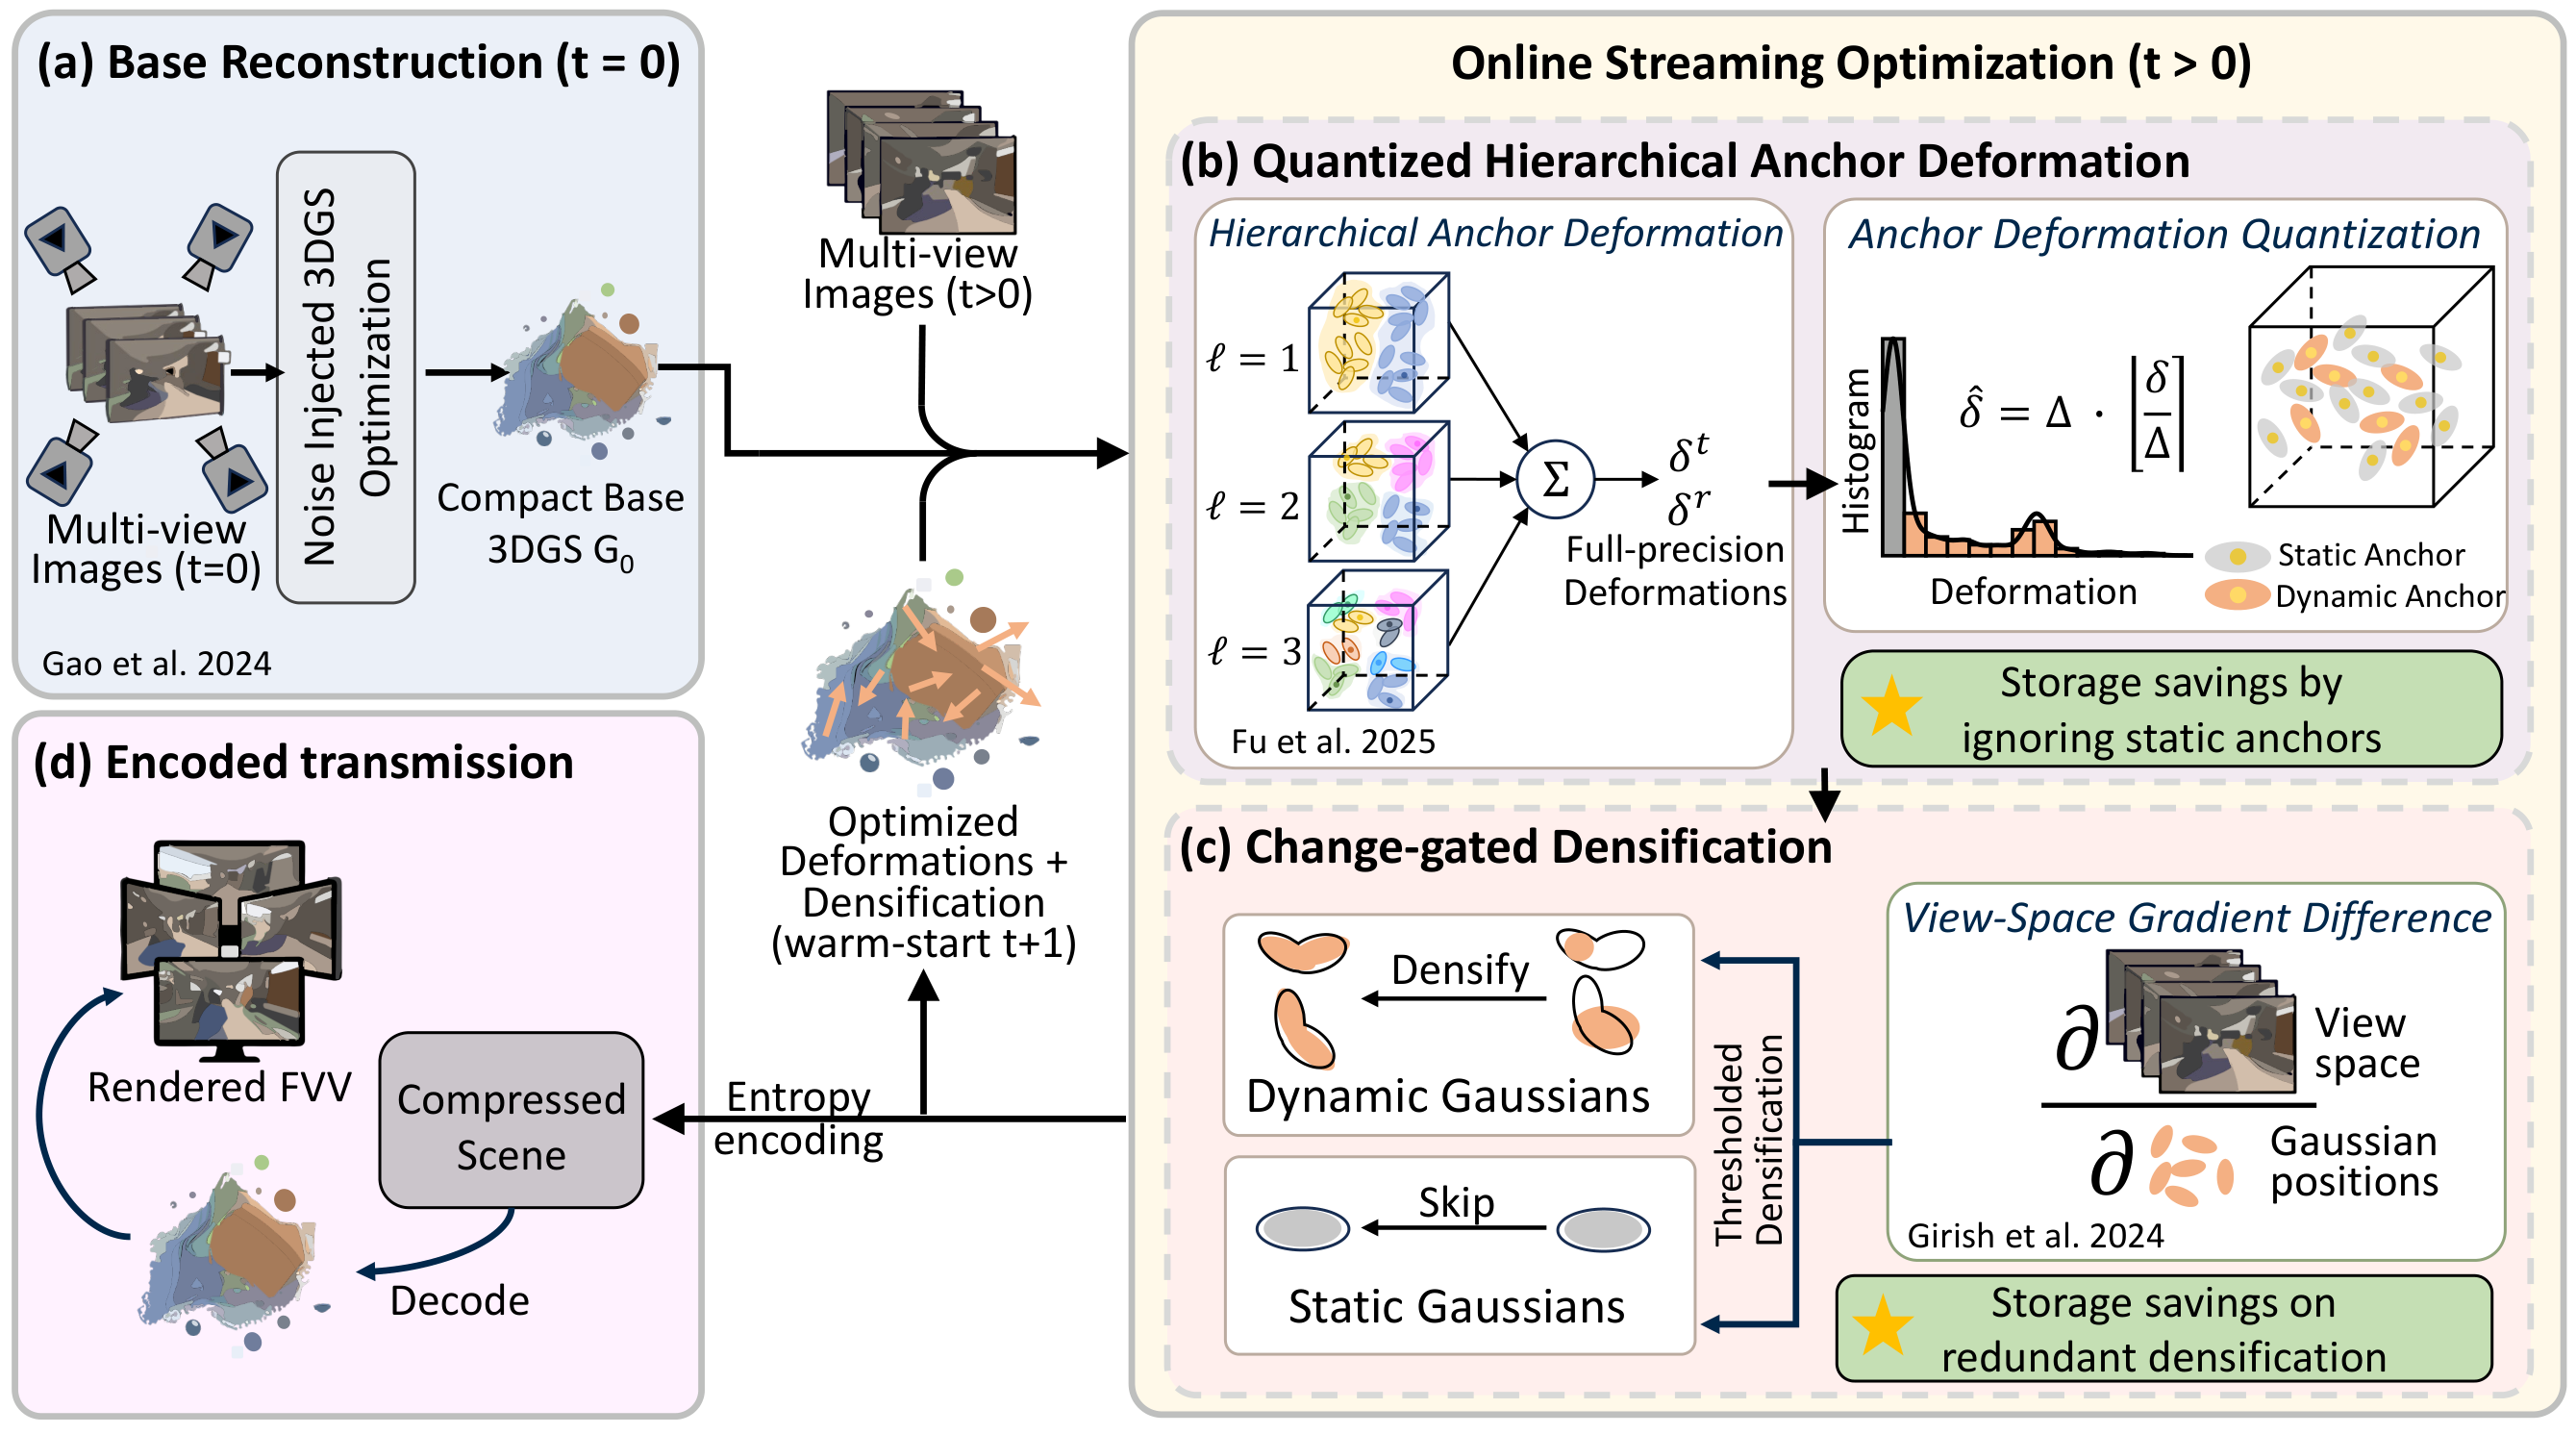
Overview of QuARC-GS for online FVV: (a) QuARC-GS starts with a base 3DGS from multi-view images at $t=0$ optimized with noise injection. This canonical 3DGS will be causally transformed to represent the scene at subsequent time points ($t>0$). (b) Following, QuARC-GS takes advantage of a hierarchical anchor-based representation of the deformation of the Gaussian 6D poses ($\delta_r, \delta_t$). Our insight was to quantize these deformations, resulting in a large number of static anchors thereby delivering substantial storage savings. (c) Complementarily, QuARC-GS includes a novel module that stems growth in number of Gaussians based on view-space gradients, resulting in storage savings. (d) The quantized anchor residuals and incremental Gaussian attributes are used to warm-start the next frame, or entropy-coded and transmitted to enable FVV.
QuARC-GS 的两个模块各自针对一类冗余。运动冗余的处理是量化:动态场景中锚点的变形量分布是长尾的——绝大多数锚点的变形接近零(对应静止区域),少数锚点有显著变形。论文的变形直方图清楚展示了这一点。既然如此,用固定步长 Δ 做量化就能自然地把长尾的零附近部分压成 0,静态锚点因此完全不占存储,而真正有大变形的动态锚点仍被保留下来。这里的巧妙之处是「量化感知」——量化被放进优化循环,网络在训练时就知道自己的输出会被离散化,因此会主动把变形往量化格点上靠,而不是训练完再截断(后者会掉画质)。外观冗余的处理是门控致密化:标准 3DGS 的致密化靠视空间梯度大小判断哪里需要更多高斯,但在动态场景的流式设定下,一个静止但纹理复杂的区域每帧都会有大梯度,于是每帧都被致密化一次,纯属浪费。QuARC-GS 改用视空间梯度与高斯位置梯度的差分 作为判据,这个量只在内容真正发生时序变化时才大,静止区域即使纹理复杂也不会触发。
2.3 核心创新
提出 QuARC-GS(Quantized Anchored Residual Coding Gaussian Streaming),一个量化感知的 4D 场景优化框架。整体结构是「单个规范帧 + 高度压缩的逐帧残差」,压缩由两个互补策略完成。第一是量化感知的锚点变形 (quantization-aware anchor deformation):把全精度变形量按步长 Δ 量化,抑制掉不显著的运动更新,同时保留有意义的变形,从而在低存储的流式约束下维持重建质量——关键在于「量化感知」,即量化不是训练后的后处理,而是进入优化目标的。第二是变化门控的致密化 (change-gated densification):只在真正表现出时序变化的区域分配新高斯,用视空间梯度差分作为判据,从根本上消除冗余的外观更新。
2.4 实验结果
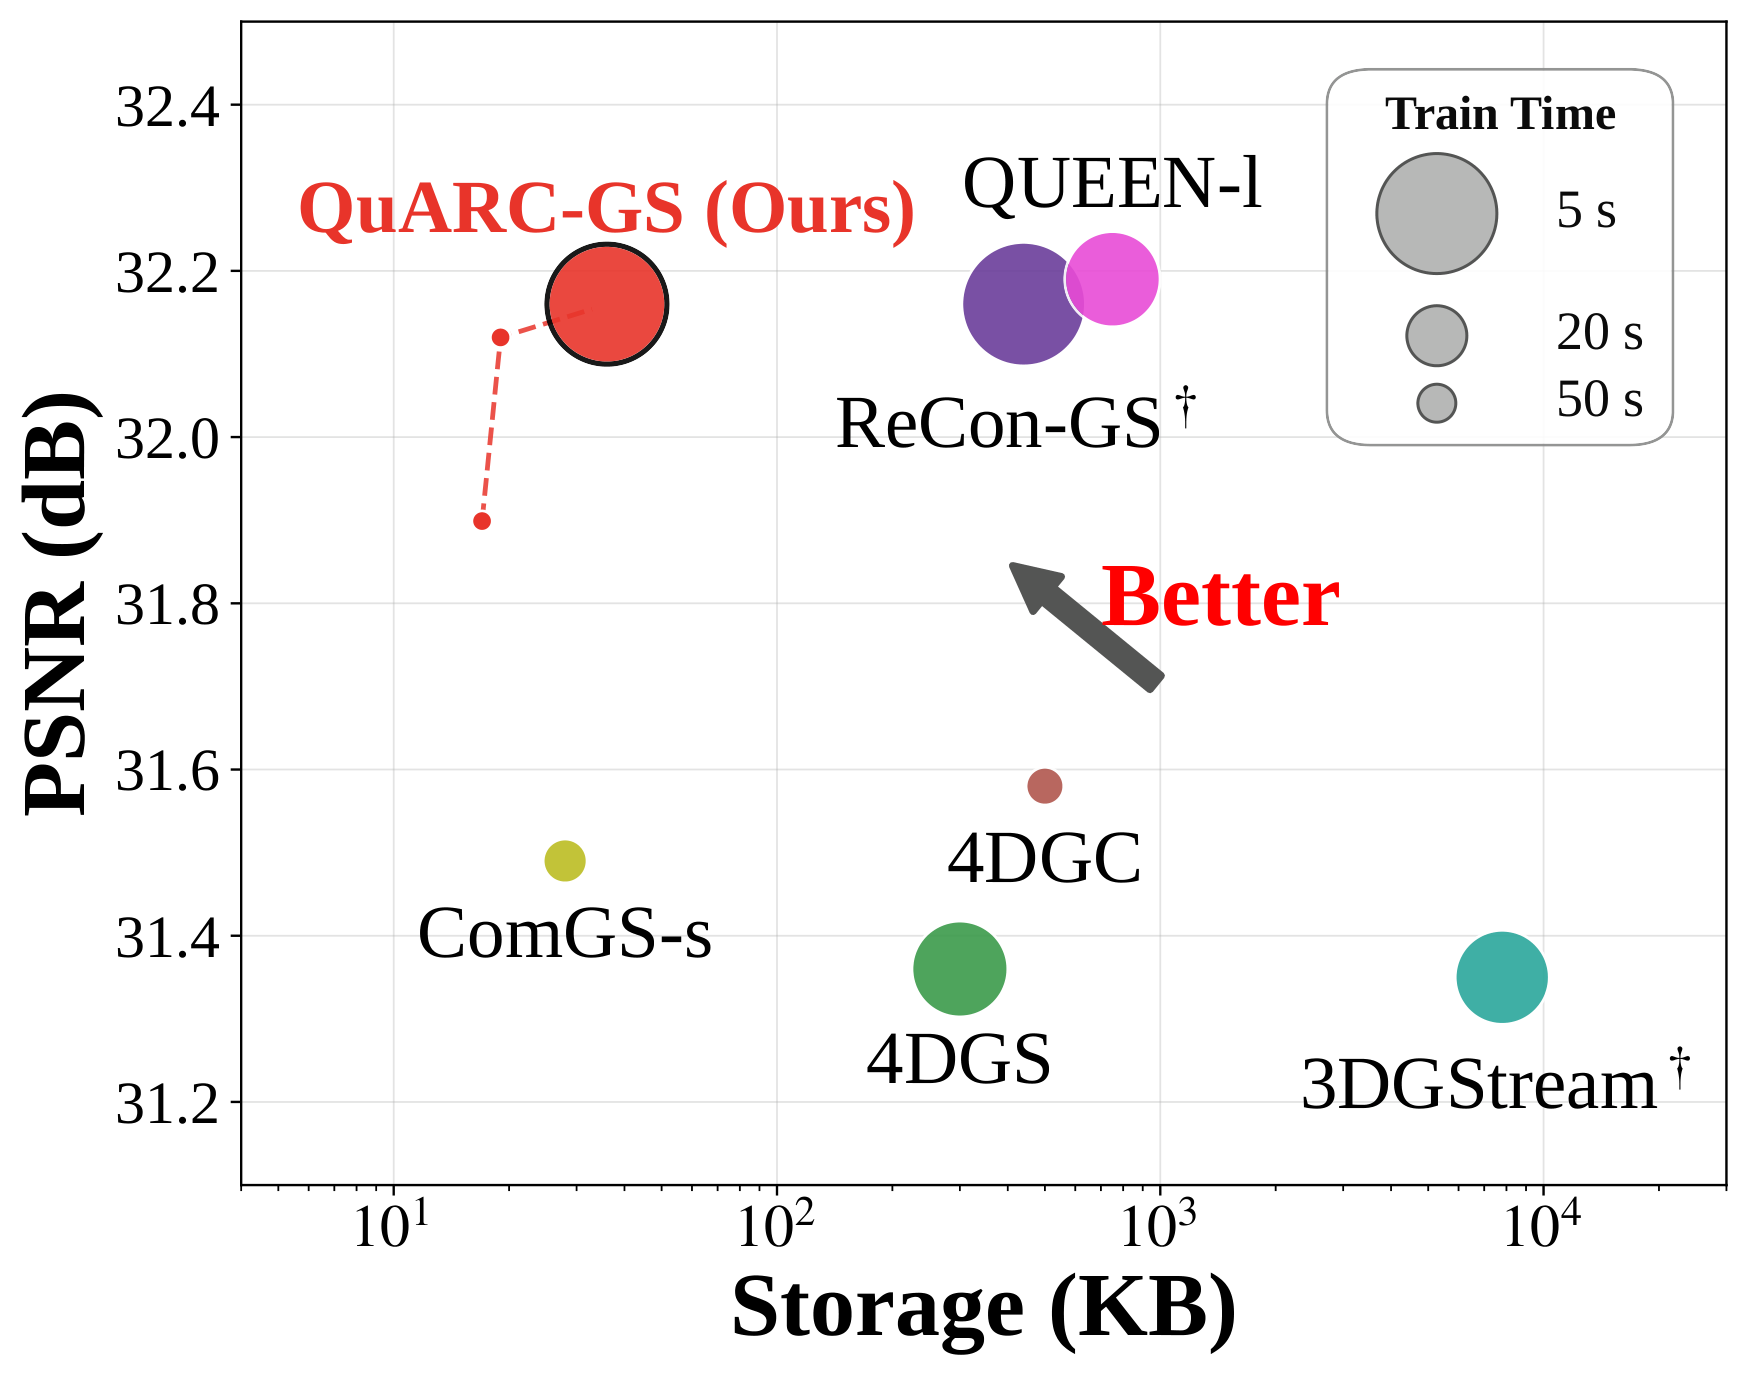
Rate-distortion comparison on N3DV. QuARC-GS streams dynamic scenes at a fraction of the per-frame storage of recent online methods (ReCon-GS$\dagger$, QUEEN, ComGS, 4DGC, 3DGStream$\dagger$) and the offline 4DGS, while matching their rendering quality. Methods marked with $\dagger$ are reproduced by us in the same environment.
在常用动态场景数据集上,QuARC-GS 在保持有竞争力的重建质量与训练速度的同时,把每帧存储相比 SOTA 削减最多 11×。论文的率-失真散点图(横轴存储对数刻度、纵轴 PSNR、点大小表示训练时间)显示:QuARC-GS 位于约 32.16 dB / 30~40 KB 的位置,而 QUEEN-l 与 ReCon-GS 在相近画质(32.19 / 32.15 dB)下需要 500~800 KB,4DGS 约 300 KB 且仅 31.36 dB,3DGStream 更是要 8000 KB 量级。虚线显示的是 QuARC-GS 自身在不同工作点上的率-失真轨迹,最低存储点约 18 KB 时仍有 31.90 dB。论文含 9 页正文、5 张图、3 张表。
2.5 关键洞察
量化步长 Δ 的选择准则缺失 — 整个方法的压缩率由步长 Δ 直接决定——Δ 越大压得越狠、掉的动态细节越多。论文展示了不同工作点的率-失真轨迹,但没有给出「给定目标码率或目标画质时该怎么选 Δ」的可操作准则,实际部署时仍需人工扫参变形分布的长尾假设对剧烈运动场景可能失效 — 量化能大幅压缩的前提是变形分布集中在零附近。这个假设在大多数区域静止的场景(会议室、单人表演)成立,但在整体镜头运动或大范围场景变化时,几乎所有锚点都有显著变形,量化的收益会急剧下降。论文未报告这类场景的结果与同期 S²GS 的定位重合但无相互比较 — 同一周的 S²GS 也是「基底 + 稀疏残差 + 可学习稀疏决策」,两者在思路层面高度同构,QuARC-GS 用量化实现稀疏、S²GS 用门控实现稀疏。二者互不引用(时间上不可能),但这也说明领域缺一个统一基准:11× 与 85% 无法互相换算
技术演进定位: 把量化感知训练从网络权重迁移到高斯变形参数的首个动态 3DGS 压缩方案
可能的后续方向:
量化步长按内容自适应或按目标码率反解
与神经熵编码模型联合优化,进一步压缩残差码流
扩展到镜头大幅运动、变形分布不再长尾的场景
论文 : MetaSapiens v2:注视点感知剪枝加立体扭曲,VR 实时神经渲染平均加速 30.9×arXiv : 2608.17969 机构 : 罗切斯特大学(University of Rochester), 上海交通大学关键词 : 点基神经渲染, 注视点渲染, VR/AR实时渲染, 硬件加速器, 立体扭曲
3.1 研究动机
核心问题: VR/AR 设备算力功耗受限且双眼渲染需求翻倍,而现有 PBNR 按同一质量渲染全画面,把算力浪费在人眼外围视野看不清的区域
点基神经渲染(Point-Based Neural Rendering, PBNR)正在渗入社会各个方面,背后是 AR/VR 与数字孪生对实时照片级渲染日益增长的需求。但在 VR/AR 设备上实现实时 PBNR 非常困难:这类设备算力与功耗都受限,而 VR 需要双眼各渲一遍,算力需求直接翻倍。更关键的是,现有方法把整个画面按同一质量标准渲染,完全没有利用人类视觉系统的一个基本事实——人眼在外围视野的视锐度(visual acuity)远低于中央凹(fovea)区域,把算力均匀撒在整幅画面上,本质是把大部分算力浪费在了人眼根本看不清的地方。
前序工作及局限:
MetaSapiens v1 :首次尝试注视点 PBNR,但未处理双目冗余与负载不均衡传统注视点渲染 :在光栅化中成熟,但迁移到连续跨 tile 的高斯图元会产生衰减伪影神经渲染加速器(NeuRex / GSCore 等) :为渲染定制硬件的先例,但未考虑 FR 场景
与前序工作的本质区别: 四项组合:以渲染速度为目标的效率感知剪枝、配套高效图元的 PBNR 注视点渲染、双眼选择性扭曲复用、以及解决 FR 负载不均衡的双目加速器设计
3.2 方法原理
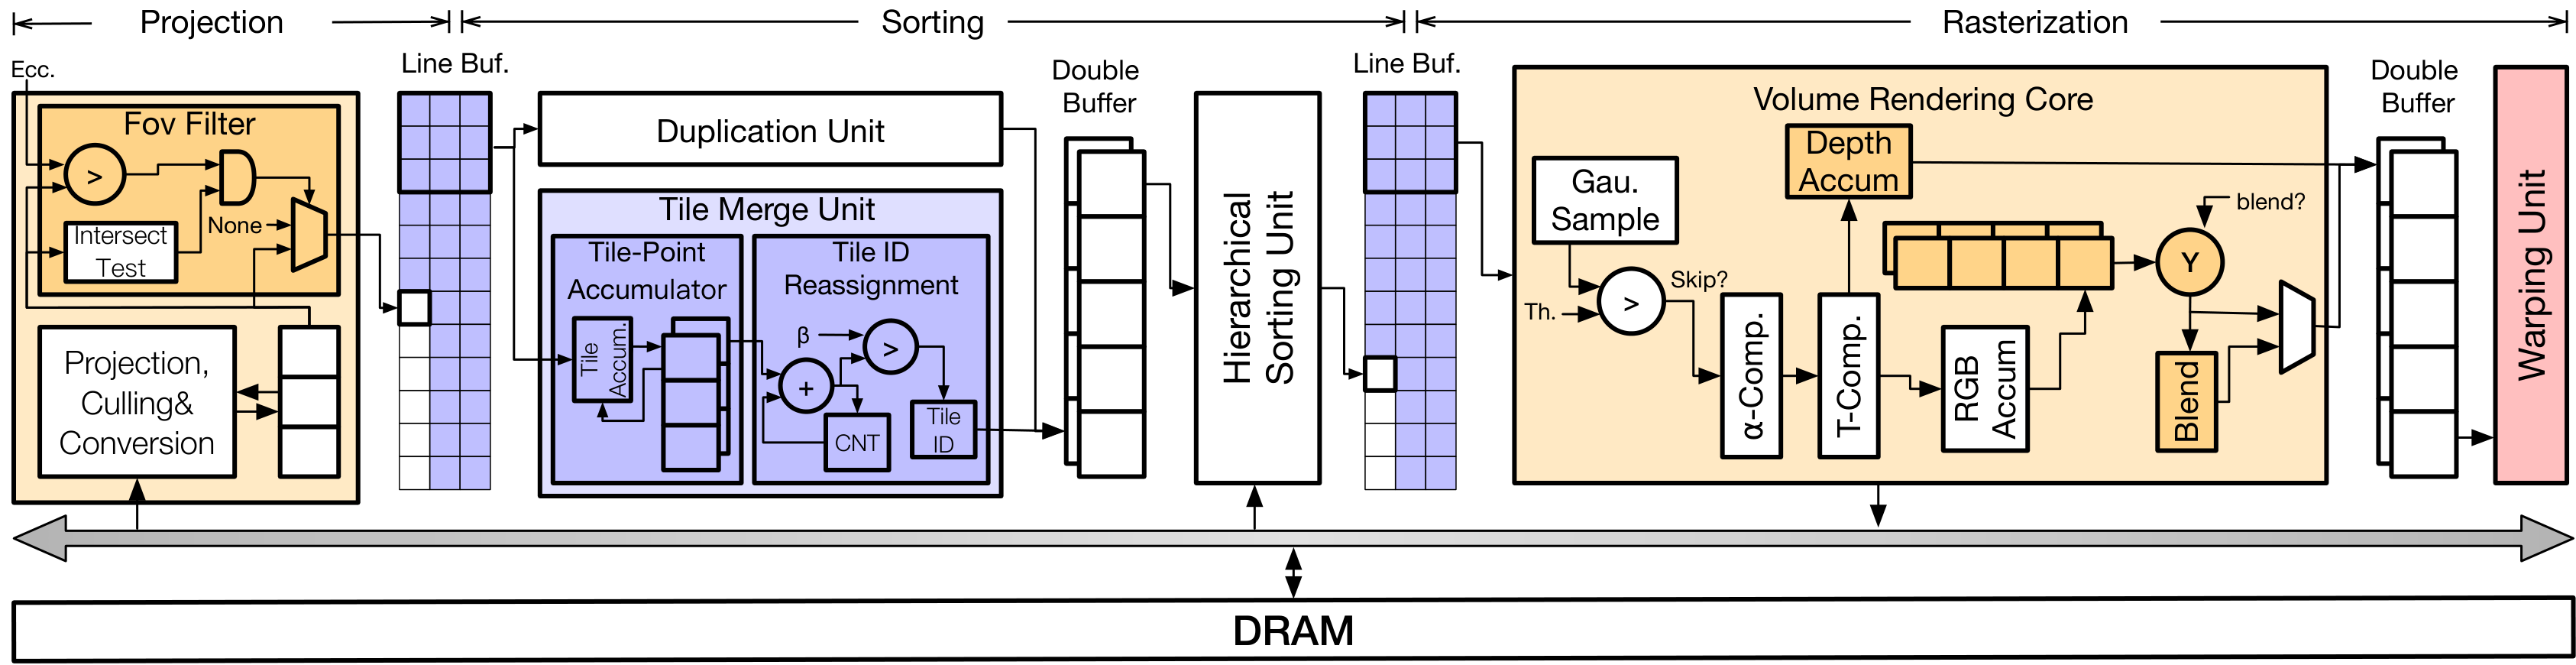
The overall architecture design. The the basic pipeline is similar to that of GSCore, a recent PBNR accelerator. We augment the baseline to support FR (yellow-colored) and warping (pink-colored), and to address the workload imbalance issue in PBNR/FR (blue-colored).
MetaSapiens v2 的思路是把「人眼看不清的地方少算」这一原则贯穿算法与硬件两层。算法层的关键洞察是:注视点渲染在传统光栅化里很好做(外围降分辨率即可),但在 PBNR 里不好做——高斯图元是连续的、跨 tile 的,简单降分辨率会导致外围出现明显的高斯衰减伪影(论文给出了 falloff 在 1/8/128 三档下的对比图)。因此它设计了配套的高效图元表示,让外围质量的下降平滑可控。效率感知剪枝则把「剪掉哪些高斯」的目标从传统的重建误差换成渲染速度,因为这两者并不等价——一个图元的重要性与它的渲染开销无关。硬件层要解决的是 FR 引入的新问题:注视点区域图元密集、外围稀疏,各 tile 的工作量差异巨大,通用 GPU 的调度会因此严重欠载。加速器用 Tile Merge Unit 做 tile-point 累加与 tile ID 重分配来均衡负载,用 FoV Filter 在投影阶段就把无贡献图元挡掉,用专门的 Warping Unit 承担双目复用。整条管线用行缓冲与双缓冲把 DRAM 访问收敛成流式模式。
3.3 核心创新
提出 MetaSapiens v2,在保持人类视觉质量的前提下实现 VR/AR 设备上的实时神经渲染,由四项技术组合而成。第一是效率感知的剪枝 (efficiency-aware pruning),直接以渲染速度为优化目标裁剪高斯图元。第二是面向 PBNR 的注视点渲染 (Foveated Rendering, FR)方法,配一种高效的图元表示,利用人眼外围视野的低视锐度放松该区域的渲染质量以换取速度。第三是选择性扭曲 (selective warping):利用双眼画面之间的冗余,一只眼的渲染结果经扭曲复用到另一只眼,减少双目渲染的计算开销。第四是一套面向双目注视点渲染的加速器设计 ,解决 FR 下 PBNR 特有的负载不均衡(load imbalance)问题,并在硬件层面支持扭曲操作。
3.4 实验结果
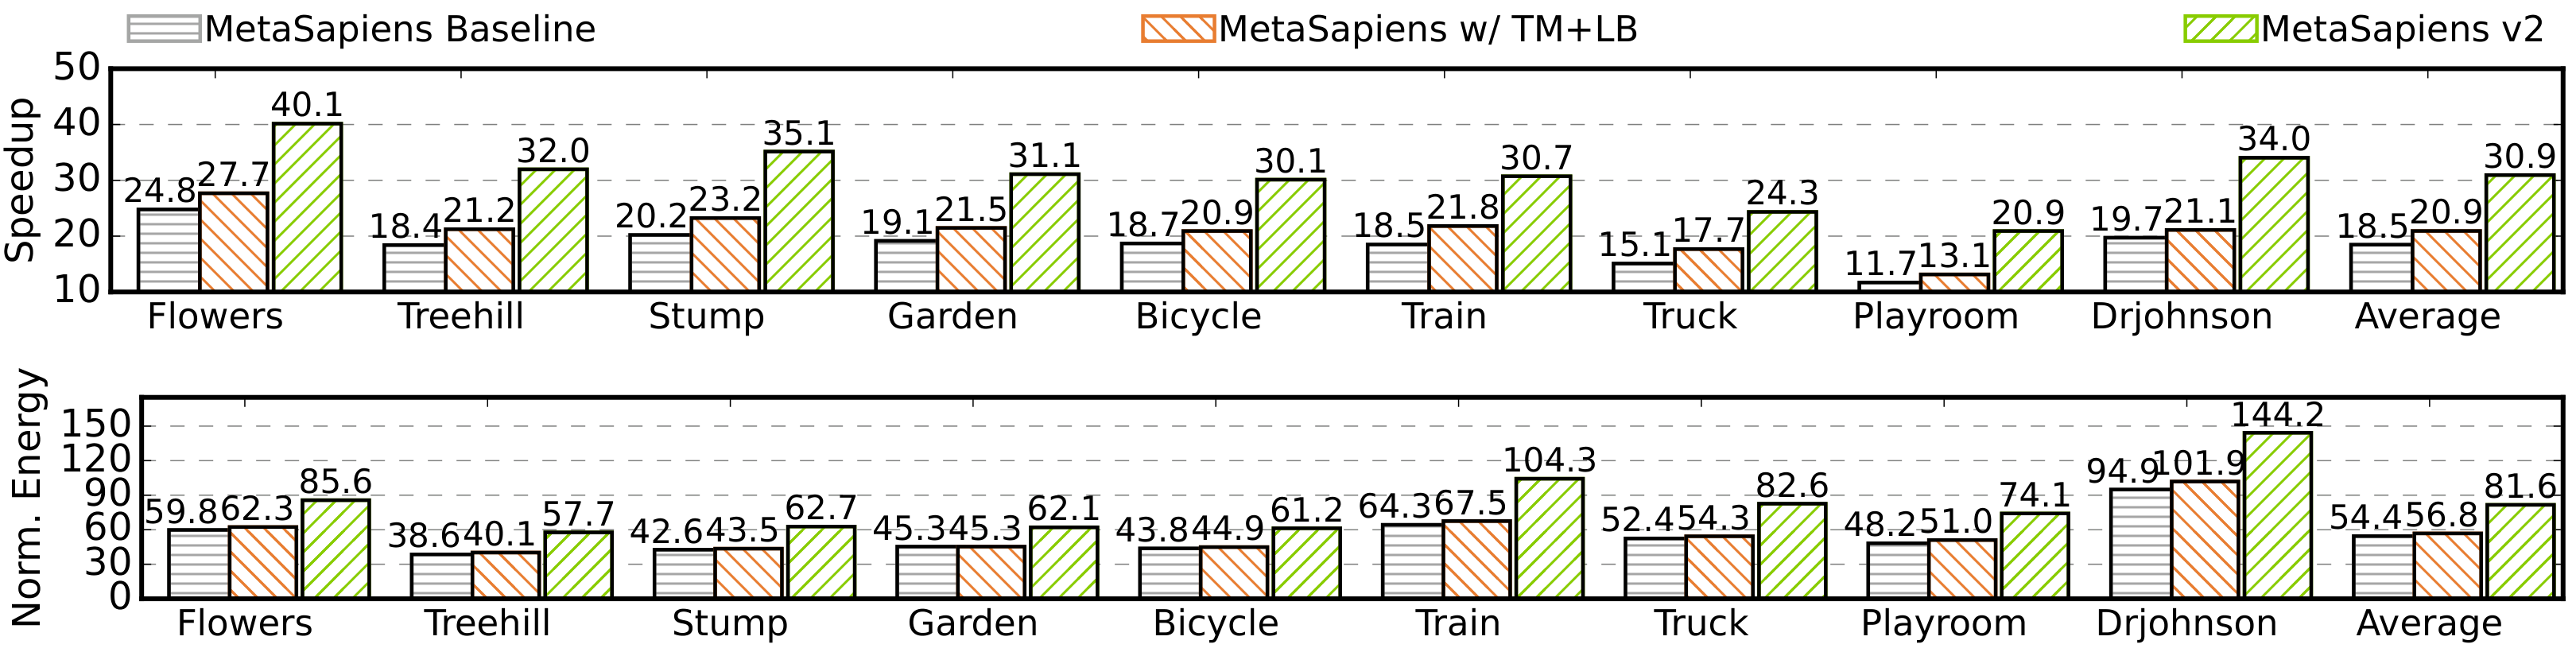
Performance and energy comparison of different accelerator variants.
论文报告 MetaSapiens v2 相比现有 PBNR 模型取得一个数量级(order of magnitude)的加速,同时保持视觉质量。加速比柱状图显示,在 Mip-NeRF360 等九个场景上,MetaSapiens 基线平均 18.5×,加上 Tile Merge 与负载均衡(TM+LB)后 20.9×,完整的 MetaSapiens v2 达到平均 30.9×;单场景最高为 Flowers 的 40.1×,最低为 Playroom 的 20.9×。论文含 14 页正文、20 张图、2 张表,另有能耗对比、PSNR-FPS 权衡曲线、主观实验与 GPU 消融等结果。
3.5 关键洞察
「保持视觉质量」的判据与注视点渲染的本质冲突 — 注视点渲染的核心就是主动放弃外围视野质量,而 PSNR/SSIM 这类全画面均值指标恰恰无法反映这种取舍是否被人眼察觉。论文做了主观实验,但样本规模、被试人数与统计显著性在摘要层面看不到,这是该方向的通病注视追踪误差的鲁棒性未讨论 — 整套方法的前提是知道用户当前注视点在哪。真实 VR 头显的眼动追踪存在延迟与角度误差,一旦注视点估计偏离,被降质的外围区域会落进中央凹——这是注视点渲染最典型的失效模式,摘要与图表清单中未见对应实验加速比含硬件加速器贡献,与纯软件方法不可直接比较 — 30.9× 的平均加速包含了专用加速器设计的收益,而对比基线是运行在通用硬件上的 PBNR 模型。这个比较对说明「软硬协同的上限」有价值,但读者容易误读为算法层面的改进幅度,论文需要更清晰地拆分两部分贡献
技术演进定位: 首个覆盖算法到加速器硬件的双目注视点 PBNR 系统
可能的后续方向:
与眼动追踪联合设计,容忍注视点估计延迟与误差
注视点感知剪枝从离线预处理改为运行时动态调整
扩展到动态场景与 4D 高斯的注视点渲染
论文 : GS-Voxel:免拟合结构化隐空间,让预优化好的 3DGS 直接进生成模型arXiv : 2608.17988 机构 : 阿里高德(Amap, Alibaba), 浙江大学, 北京大学关键词 : 结构化隐空间, 3DGS生成, 因子化VAE, 流匹配, 城市级场景
4.1 研究动机
核心问题: 可扩展三维隐空间生成器都在结构化张量上工作,而预优化 3DGS 是无序、空间不规则、图元数量差异极大的,两者结构性错配
可扩展的三维隐空间生成器基本都在结构化张量上工作——这是卷积、注意力这套工具链的前提。但预优化好的 3DGS 重建恰恰相反:它是无序的(高斯之间没有固定顺序)、空间不规则的(分布随场景内容变化)、图元数量差异极大的(一个场景几万,另一个几百万)。这个错配意味着,过去几年积累的海量 3DGS 重建资产无法直接喂给生成模型。已有的做法是为每个场景做额外的拟合优化(fitting)把它转成规则表示,但这在大规模场景上代价高得不现实。
前序工作及局限:
TRELLIS 类结构化隐空间三维生成 :确立了稀疏体素隐表示范式,但输入不是既有 3DGS 重建逐场景拟合式转换 :可把 3DGS 转成规则表示,但大规模场景上代价不现实
与前序工作的本质区别: 确定性、免逐场景优化的体素化(TopK 不透明度排序建立顺序、保留子体素偏移守住几何精度、8-bit 量化控数值范围),再用 GS 专用因子化 VAE 分路编码几何与属性,隐容量随占据体素数增长
4.2 方法原理
Deterministic conversion from a compatible pre-optimized 3DGS reconstruction to GS-Voxel.
GS-Voxel 的核心是「怎么把无序点集变成规则张量而不丢关键信息,且不做逐场景优化」。它的三步是结构化、量化、因子化编码。结构化解决顺序问题:体素内的高斯按不透明度降序取 TopK 后拼接,这给了一个确定性的顺序(不透明度是内容属性,不依赖存储顺序),不足 K 个就零填充,低不透明度的直接过滤——后者本身也是有效的稀疏化,因为几乎透明的高斯对渲染贡献极小。子体素位置的保留很关键:如果只记录体素索引,高斯就被量化到体素中心,几何精度会大幅下降;保留体素内偏移则让精度不受体素分辨率限制。量化把五类属性(位置、尺度、不透明度、颜色、旋转)各自归一到合适区间后压到 8-bit,这一步让隐空间的数值范围可控。因子化编码是针对 3DGS 特性的设计:体素几何(哪些格子被占据)与高斯属性(每个格子里的高斯长什么样)是两类性质完全不同的信息,混在一个 VAE 里编码会互相干扰,分开编码则各自可用更合适的归纳偏置。最终隐表示的容量随占据体素数增长,这让大场景不必被固定的图元预算截断。
4.3 核心创新
提出 GS-Voxel,一个免拟合(fitting-free)的结构化隐空间框架,并在大规模航拍三维高斯场景生成上做了验证。它把兼容的预优化 3DGS 重建确定性地 转换为稀疏活跃体素,不需要任何逐场景优化,同时保留被选中图元的子体素位置(sub-voxel position)与渲染属性。随后用一个 GS 专用的因子化 VAE(factorized VAE)分别编码体素几何与局部高斯属性,得到稀疏三维隐表示——关键性质是隐表示的尺寸随被占据体素数增长,而不是被一个全场景固定的图元数上限卡住。在 GS-Voxel 隐空间中训练图像条件的流模型来生成航拍 3DGS 场景,并用重叠感知的分块推理(overlap-aware tiled inference)把合成范围扩展到超过单个训练裁剪块的大面积场景。
4.4 实验结果
Large-area 3DGS generation (2/2). Overlap-aware tiled inference produces a large-area 3DGS primitive set from the satellite-view condition.
论文展示 GS-Voxel 能为预优化的航拍 3DGS 重建提供结构化隐表示,且隐容量随占据体素数增长。最直观的成果是大面积场景生成:论文给出的城市生成结果显示,由卫星视角图像条件生成的街区级 3DGS 场景包含完整的路网、行道树、建筑屋顶细节(含屋顶太阳能板、停车场车辆、环形交叉口的彩色路面标识),并附三个局部放大视角验证细节可用。方法概览图展示了「3DGS → GS-voxel → Latent」的确定性转换与解码链路。
4.5 关键洞察
缺少定量指标,成果主要以定性渲染图呈现 — 摘要的结论表述是「提供了结构化隐表示」「隐容量随占据体素数增长」,属于性质陈述而非性能声明,没有给出 PSNR/FID 这类可比数字。城市生成图很有说服力,但读者无法判断与其他 3D 生成方法的相对位置「兼容的预优化 3DGS」这个前提条件模糊 — 摘要明确说输入是 compatible pre-optimized 3DGS。什么样的重建算兼容、不兼容会怎样、用不同重建管线产出的 3DGS 能否混用,都没有交代。这直接决定了「盘活已有 3DGS 资产」这个卖点的实际覆盖面TopK 拼接对高密度体素的信息丢失未评估 — 体素内按不透明度取 TopK,超出 K 的高斯被丢弃。在几何复杂或高斯堆叠密集的区域(如植被、栏杆),实际高斯数可能远超 K,这部分丢失对渲染质量的影响需要 K 的消融实验支撑,摘要与图表未见
技术演进定位: 首个让预优化 3DGS 资产可直接进入隐空间三维生成的转换框架
可能的后续方向:
扩展到动态 4D 高斯场景的生成
结合文本条件做可控的大规模城市场景编辑
给出 TopK 与体素分辨率的联合选择准则
论文 : GroupForward:实例分组的前馈高斯泼溅,让 3D 场景能听懂复杂指代arXiv : 2608.17535 机构 : 上海交通大学, 北京航空航天大学, 上海人工智能实验室, 华东师范大学关键词 : 前馈3DGS, 实例分组, 3D指代分割, 场景图推理, VLM
5.1 研究动机
核心问题: 前馈语义 3DGS 缺乏显式实例区分,只支持类别或短语级查询,无法回答需要区分同类多实例并理解空间关系的指代表达
具身智能体需要同时重建和理解三维环境。前馈语义 3DGS(feed-forward semantic 3DGS)在这方面很高效:从稀疏多视角观测直接构造出带语义的场景表示,不需要逐场景优化。但现有方法有个结构性缺陷——缺乏显式的实例区分,主要只支持基于类别或短语的语义查询。这意味着智能体能回答「哪些是椅子」,但回答不了「从第一个视角看左边那台显示器」这类需要区分同类多个实例、还要理解空间关系的指代表达。技术上的根因是现有做法给每个高斯挂一个高维语义特征,这种表示天然是逐点的、类别级的,无法表达「这些点属于同一个物体」。
前序工作及局限:
pixelSplat / MVSplat / Uni3R :前馈 3DGS,从稀疏视角直接预测高斯但不含实例结构LangSplat / 语义 3DGS :给每个高斯挂高维语义特征,逐点独立、无物体级分组Sa2VA 等二维指代分割 :语言理解强但无 3D 输出
与前序工作的本质区别: 用低维实例嵌入替代高维语义特征并聚类成跨视角一致 3D 实例,语义改在实例级聚合;再用 3D 场景图加三路相关性检索候选,交由 VLM 在结构化实例证据上做常识推理
5.2 方法原理
Overview of GroupForward and the Referential Scene Reasoning Framework (RSRF). Given sparse, unposed, and uncalibrated multi-view images, GroupForward reconstructs cross-view consistent 3D instance groups with compact instance embeddings and aggregates open-vocabulary semantics at the instance level. RSRF further organizes the instance groups into a 3D scene graph and integrates structured graph evidence with multi-view observations for VLM-based complex referential reasoning and 3D referring segmentation.
GroupForward 的关键取舍在于把语义信息的载体从「高维特征」换成「低维实例嵌入 + 实例级聚合」。给每个高斯挂 CLIP 级别的高维特征有个隐藏代价:特征维度高、显存吃紧,而且这种表示本质是逐点独立的——两个属于同一把椅子的高斯,它们的特征相似只是因为长得像,模型并不知道它们是同一个物体。实例嵌入的做法反过来:嵌入本身很低维(只需支撑聚类),但通过实例损失被约束成跨视角一致,聚类后就得到了显式的物体级分组。语义则不再逐点存储,而是在实例级别聚合与传播——一个实例只需要一份语义,既省存储又更稳健。这个改动的真正价值在下游:有了显式实例,就能构造 3D 场景图,把「左边那台显示器」这类指代拆解为在图上做候选检索加关系判断。RSRF 的检索用三种相关性(语义、几何、跨视角可见性)缩小候选集,然后把结构化的实例证据连同多视角原图一起交给 VLM 做最终判断——这一步是必要的,因为像「我想坐在门附近,该坐哪」这类表达需要常识推理,几何与语义相似度算不出来。
5.3 核心创新
提出 GroupForward,一个实例分组的前馈高斯泼溅模型,从稀疏、无位姿(unposed)、未标定(uncalibrated)的多视角图像中同时重建几何、外观、实例结构与语义。关键改动是不再给每个高斯挂高维语义特征,而是学习紧凑的实例嵌入 (compact instance embedding),把高斯分组为跨视角一致的 3D 实例——这把前馈语义 3DGS 从「逐高斯语义特征渲染」重构为「实例级语义聚合与传播」。在实例分组之上进一步提出指代场景推理框架(Referential Scene Reasoning Framework, RSRF)来做复杂 3D 指代分割:RSRF 构造实例分组的 3D 场景图,为给定的指代表达检索候选实例,再由视觉语言模型在结构化的实例证据与多视角观测上推理,从候选中确定被指代的那个实例。
5.4 实验结果
Qualitative comparisons of referential scene reasoning. Our method correctly grounds target instances with accurate novel-view segmentation and corresponding 3D outputs, while competing methods fail to ground the target instances or lack native 3D outputs.
在语义重建与指代推理两类任务上的实验验证了实例分组重建与推理框架的有效性。论文给出的定性对比显示,在四组指代表达(左侧显示器、靠垃圾架的容器、门附近可坐的位置、洗手的地方)上,GroupForward 的新视角分割结果比 Uni3R 与 Sa2VA 更准确;更关键的是 3D 输出一栏——Uni3R 在部分样例上给出的是空结果或错误的多物体,Sa2VA 完全不产出 3D 结果,而 GroupForward 能给出单一、正确的三维物体。这一列直接体现了实例分组带来的能力差异。
5.5 关键洞察
缺少定量数字支撑 — 摘要的结论是「实验证明了有效性」,未给出 mIoU、Acc@0.25 这类 3D 指代分割的标准指标。定性对比图很有说服力,但四组样例无法说明方法在困难指代(多同类物体、否定式表达)上的表现RSRF 依赖外部 VLM,性能上界被它决定 — 复杂指代的最终判断交给 VLM,这让整个系统的推理能力与 VLM 选型强绑定。论文未讨论换用不同规模 VLM 时的性能变化,也未报告 VLM 调用带来的延迟——这对具身智能体的实时性是硬约束实例嵌入的聚类超参敏感性未讨论 — 从嵌入到 3D 实例要经过聚类,聚类的粒度直接决定了「一个物体」的定义(椅子整体还是椅背/椅腿分开)。这个粒度对下游指代推理影响巨大,但摘要与流程图未交代聚类方法与超参选择
技术演进定位: 首个在实例分组基础上支持复杂 3D 指代推理的前馈语义 3DGS
可能的后续方向:
实例粒度层次化(物体-部件),支持部件级指代
端到端联合训练 VLM 与实例分组,降低对外部模型依赖
扩展到动态场景与多轮对话式交互指代
论文 : RS-Avatar:卷帘快门视频里的高斯化身,改一个合成算子就够了arXiv : 2608.17314 机构 : 澳门大学(University of Macau)关键词 : 高斯化身, 卷帘快门, 子帧渲染, 成像模型, 新视角合成
6.1 研究动机
核心问题: 化身重建默认「一帧的每个像素观测同一瞬间」,但卷帘快门逐行曝光使同帧内头脚相差数十毫秒运动,畸变被烘进规范表示并在新视角新姿态下持续存在
可动画人体化身的重建长期建立在一个无声的假设上:一帧图像的每个像素都观测到人体运动的同一瞬间。但卷帘快门(rolling shutter, RS)传感器是逐行曝光的——一帧之内,运动中的人的头部与脚部之间相差几十毫秒的关节运动,每一条扫描线看到的都是不同的姿态。把这样的视频喂给最先进的化身方法,畸变会被烘进规范表示(canonical representation)里,之后以剪切(shear)和抖动(wobble)的形式在新视角、新姿态下持续存在。更糟的是,多相机阵列中每台相机都有自己的读出时序,于是即便几何是正确的,驱动重建的多视角一致性也被破坏了。
前序工作及局限:
GauHuman / 3DGS-Avatar 等高斯化身 :把卷帘视频当瞬时曝光处理,畸变被吸收进规范空间Deblur-NeRF / BAD-Gaussians :提供了子帧渲染机制,但合成算子是时间均匀平均RS-SfM / RS-NeRF :已把逐行曝光建模进三维重建,但未涉及可动画人体化身
与前序工作的本质区别: 只把子帧渲染的合成算子从均匀平均换成按标定扫描线掩码的逐行选取,规范表示、warping、光栅化器全部不变;并给出反面证据——直接套用模糊模型不仅无效,还低于对快门无感知的基线
6.2 方法原理
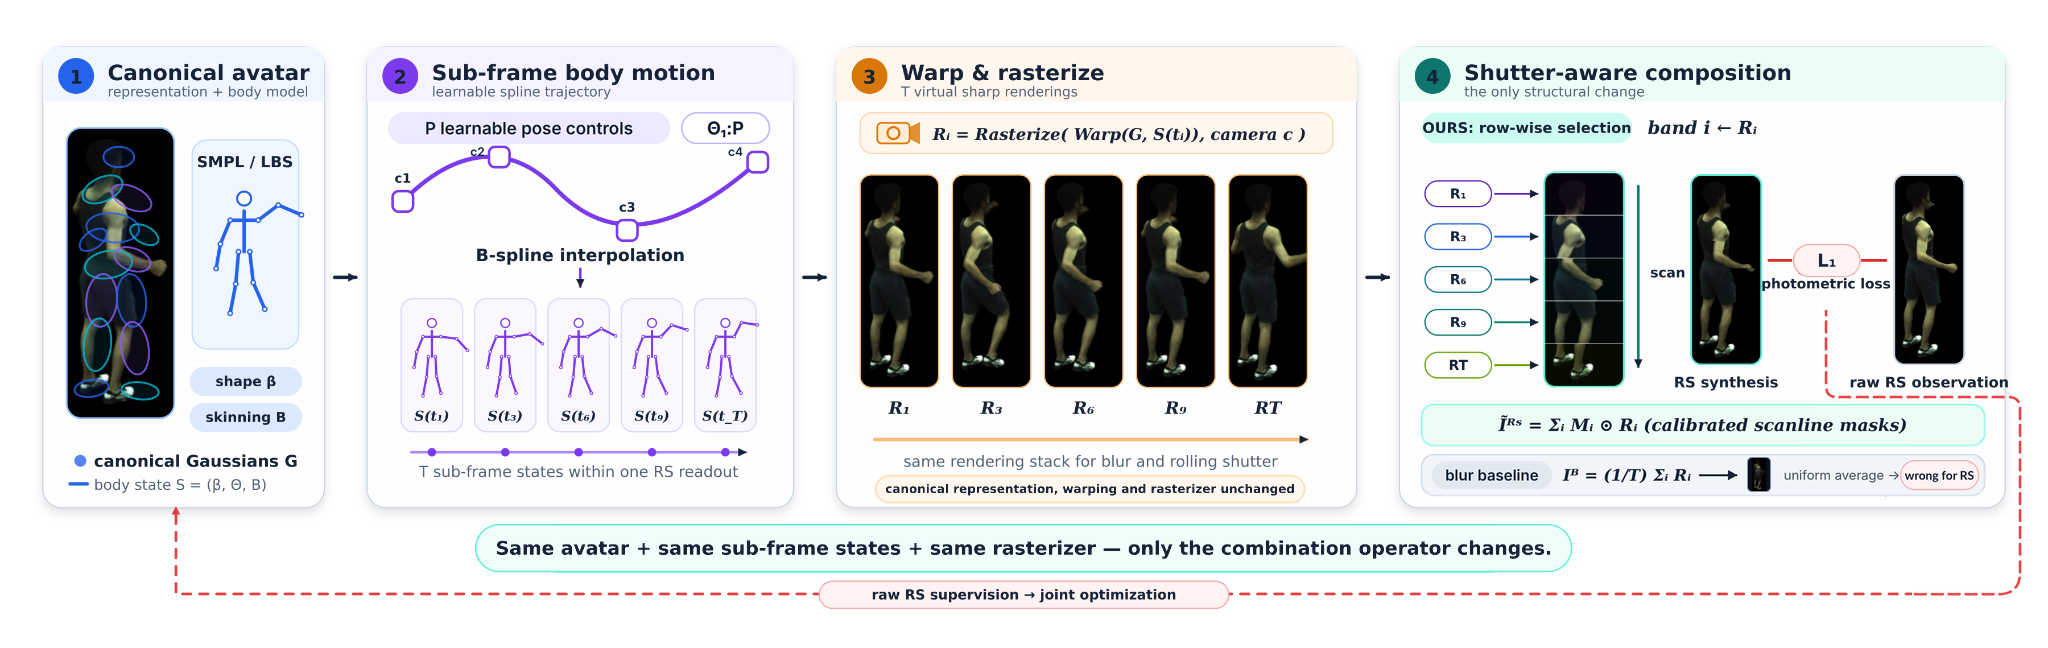
Overview of RS-Avatar. Per-frame spline control points give $T$ sub-frame body states; the canonical Gaussians are warped to each and rasterized into the stack $R_1\dots R_T$ (stages 1--3). Stage 4 is the method: band $i$ of the synthesized frame is taken from the rendering at the instant that band was read out, so the observation selects among the renderings where the blur model beneath it averages them. The raw RS frames are the only supervision.
这篇论文的价值在于把一个物理成像事实精确地映射成一行代码级的改动。它的推理链条是这样的:任何运动感知的化身方法为了处理运动模糊,都已经具备「在一次曝光内渲染多个子帧姿态」的机制——用 B 样条从少量可学习控制点插值出 T 个子帧状态,各自 warp 并光栅化。模糊与卷帘的区别只在于如何把这 T 张渲染合成一张:模糊是时间上的均匀平均(每个像素都是全部子帧的平均),卷帘是空间上的逐行选取(第 i 条扫描线只取第 i 个子帧)。因此只需把平均算子换成按扫描线掩码的加权选取,其余部分完全不动。论文特别强调了反面结论的价值:直接套用运动模糊模型处理卷帘视频不仅无效,还比完全忽略快门效应更差。这说明子帧渲染机制虽然通用,但合成算子必须与真实成像过程严格对应——用错了算子,多出来的子帧自由度反而成了拟合错误目标的工具。
6.3 核心创新
提出 RS-Avatar,直接从卷帘快门视频重建清晰、无畸变、可动画的 3D 高斯化身。它的表述极为简洁:一个运动感知的化身本来就会在若干子帧时刻渲染人体,模糊模型(blur model)是把这些渲染做平均,而卷帘快门模型则是把它们逐扫描线合成 (composites them scanline by scanline)。换掉这个算子是唯一需要的修改——规范表示、warping、光栅化器全部不变。论文还基于 ZJU-MoCap 构建了 RS-ZJU 基准。一个反直觉的发现是:建立在同一套子帧机制上的运动感知模糊模型并不能迁移到卷帘场景,实际表现甚至低于完全不考虑快门的基线——「机制是可复用的,算子不是」。
6.4 实验结果
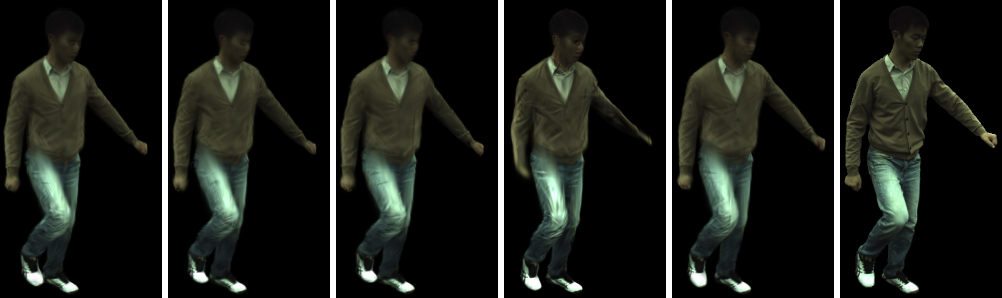
Novel-view synthesis on RS-ZJU at $K\!=\!11$, held-out camera. The outstretched forearm sweeps the largest image-space distance within one readout, and is where the methods differ.
在基于 ZJU-MoCap 构建的 RS-ZJU 基准上,相比「当作瞬时曝光来训练」的做法,RS-Avatar 在每一个 被试对象上都提升了新视角合成质量。反面对照同样明确:建立在同一套子帧机制上的运动模糊模型不仅没有迁移成功,表现还低于对快门无感知(shutter-oblivious)的基线。论文的定性对比图展示了六个视角下的行走化身渲染,肢体边缘(尤其手臂与腿部)保持清晰,没有出现卷帘畸变典型的剪切与抖动。
6.5 关键洞察
扫描线掩码需要标定,实际相机的读出时序未必可得 — 方法依赖「标定的扫描线掩码」把子帧与图像行对应起来。这在受控实验里可以测量,但消费级相机通常不公开读出时序,多相机阵列还要处理各自不同的时序偏移。若掩码估计有误,逐行选取的算子可能反而引入新的畸变基准由 ZJU-MoCap 合成而来,缺真实卷帘数据验证 — RS-ZJU 是从全局快门的 ZJU-MoCap 构造出的卷帘数据。合成时的读出模型是理想的,而真实 CMOS 传感器还有行间曝光重叠、读出噪声等因素。缺少真实 RS 相机拍摄数据的验证,方法的实用性存疑子帧数 T 与控制点数 P 的开销未量化 — 每帧要做 T 次 warp 与光栅化,训练开销随 T 线性增长。论文强调「唯一的改动是合成算子」,但这个改动的前提是已有子帧机制——对本来不做运动感知的化身方法,引入 T 倍渲染开销并非小事,摘要未给出 T 的取值与耗时对比
技术演进定位: 首个卷帘快门感知的可动画高斯化身重建,并明确「子帧机制可复用、合成算子不可复用」
可能的后续方向:
从视频自估计扫描线读出时序,去掉标定依赖
采集真实卷帘相机的多视角人体数据集
推广到卷帘视频的通用动态场景重建
论文 : NGS-Marker:原生水印堵上 3DGS 的版权漏洞——偷走一部分高斯也能验主arXiv : 2608.17447 机构 : 浙江大学, 浙江省地理信息科学重点实验室关键词 : 3DGS水印, 版权保护, 部分侵权, 渐进式注入, ICLR 2026
7.1 研究动机
核心问题: 现有 3DGS 水印只保护渲染出的图像,底层高斯图元无防护;攻击者抽取复用部分高斯即可绕过检测(部分侵权)
随着 3DGS 快速发展与普及,有效的版权保护变得越来越关键。但现有 3DGS 水印技术主要保护渲染出的图像 ——靠预训练解码器从渲染图里读水印,底层的三维高斯图元本身却毫无防护。这留下一个尖锐的漏洞:论文称之为部分侵权(Partial Infringement)——攻击者只需抽取并复用一部分高斯(比如把场景里某个物体单独扒出来用),既不需要完整场景,也绕过了基于渲染图的检测,现有方法对此完全无效。这个威胁在 3DGS 真正成为可流通的三维资产时才会浮现,而这一天已经到了。
前序工作及局限:
GaussianMarker 等 3DGS 水印 :靠预训练解码器从渲染图读水印,对图元级抽取完全无效HiDDeN 等深度图像水印 :提供注入器-提取器联合训练范式,但载体是二维图像点云与网格水印 :三维资产版权保护的更早尝试,未适配高斯参数化
与前序工作的本质区别: 原生水印——直接在高斯参数中注入扰动,注入器与提取器联合训练后再用畸变邻域采样做基于梯度的渐进式注入确保全场景覆盖,使任意局部区域可解出所有权;并扩展为原生加渲染图的混合保护与多模态水印
7.2 方法原理
Overview of NGS-Marker. The watermark injector ($\mathcal{P}_g + \mathcal{P}_d$) is jointly trained with the message extractor $\mathcal{E}$. The trained extractor can guide a gradient-based optimization to protect the target 3D scene. Once the private watermark is embedded in $\mathcal{G}^w$, users can verify copyright ownership directly from the native 3D data without rendering.
NGS-Marker 要同时满足两个互相拉扯的目标:水印要能从任意局部区域读出(鲁棒性),又不能明显影响渲染质量(不可感知性)。它的设计是两阶段的。第一阶段联合训练注入器与提取器:注入器用交叉注意力把消息特征融进局部高斯特征,输出对高斯参数的扰动;提取器则从被扰动的局部高斯里把消息读回来。这一阶段用普通的 k-NN 采样构造局部子集,训练出一对配合默契的编解码器。第二阶段是渐进式嵌入:冻结提取器,用畸变邻域采样(模拟攻击者可能做的各种局部抽取与扰动)对整个场景做梯度下降,让水印信号覆盖到场景的每一处。这里的「渐进」很关键——一次性在全场景注入会导致强度不均,某些区域信号过弱以致局部抽取后读不出来。用梯度驱动逐步扩展覆盖,能保证任意局部区域的信号强度都达标。混合保护则是承认两种水印各有所长:原生水印防的是图元级抽取,渲染图水印防的是截图与二次分发,二者叠加才覆盖完整威胁模型。
7.3 核心创新
提出 NGS-Marker,一个面向 3DGS 的原生(native)水印框架。它整合了联合训练的水印注入器(watermark injector)与消息解码器(message decoder),并采用基于梯度的渐进式注入策略(gradient-based progressive injection)确保全场景覆盖,从而能从任意局部区域 解码出所有权信息。论文进一步把 NGS-Marker 扩展为混合保护(hybrid protection,把原生水印与间接的渲染图水印结合)并支持多模态水印。
7.4 实验结果
Simulated partial infringement scenarios on public datasets. It can be observed that NGS-Marker enables precise and fine-grained copyright protection.
大量实验表明 NGS-Marker 能有效防御部分侵权,同时为真实部署提供实用的灵活性。论文的定性图显示,在三个场景(厨房台面、公园长椅与树、玻璃房植物与人)上,水印场景与原始渲染在视觉上难以区分,而热力图(红色高亮)显示水印信号可从局部物体区域被正确检出。论文为 ICLR 2026 接收,图表规模较大(正文 5 图加附录 10 图,含多个大尺寸定性对比)。
7.5 关键洞察
「任意局部区域」的下界未量化 — 核心卖点是从任意局部区域都能解码,但一个局部区域至少要含多少高斯、占场景多大比例才能可靠解出,摘要没有给出。攻击者只需把抽取粒度压到这个阈值以下就能规避,这个数字是评估方案实用性的关键与压缩、量化等下游处理的兼容性未讨论 — 水印靠在高斯参数上注入扰动实现,而同期的 QuARC-GS/GS-Voxel 恰恰要对高斯参数做量化与稀疏化。水印扰动很可能被量化步长抹掉,或被稀疏门控当成噪声丢弃。3DGS 资产的真实流通链路必然包含压缩,这个兼容性问题绕不开自适应攻击者的威胁模型偏弱 — 论文防的是抽取局部高斯复用这类被动攻击。但若攻击者知道 NGS-Marker 的存在,可以做重优化(用水印场景的渲染图重新训练一个干净 3DGS)来洗掉水印。这类白盒自适应攻击在图像水印领域是标准评测项,摘要中未见
技术演进定位: 首次提出 3DGS 部分侵权威胁模型并给出局部可验证的原生水印方案(ICLR 2026)
可能的后续方向:
量化可解码的最小局部规模,给出可证明的鲁棒性下界
与高斯压缩/量化管线联合设计,让水印在压缩后存活
评估重优化类白盒自适应攻击下的鲁棒性
横向对比与技术脉络总结
横向对比:本期 3DGS 工程化七篇技术对比
论文
解决的部署瓶颈
核心机制
稀疏化/结构化手法
关键数字
验证环境
机构
S²GS
FVV 流式传输:每帧优化时间与存储双高
流式八叉树 + 结构化门控(HFP + Gumbel-Sigmoid)
可微离散门控决定哪些锚点残差需更新
优化时间 -59%、存储 -85%(vs QUEEN, RTX 4090);Jetson AGX Orin 上 60+ FPS
消费级 GPU + 边缘 IoT + 物理远程呈现测试台
香港理工大学
QuARC-GS
动态场景在线流式传输的存储成本
规范帧 + 量化感知锚点变形 + 变化门控致密化
量化把长尾变形压零,梯度差分门控致密化
每帧存储最多压到 SOTA 的 1/11;约 32.16 dB @ 30~40 KB
常用动态场景数据集(N3DV 等)
杜克大学等
MetaSapiens v2
VR/AR 头显上的实时 PBNR,双眼渲染算力翻倍
效率感知剪枝 + 注视点渲染 + 选择性立体扭曲 + 专用加速器
按注视点剔除图元、外围降质、双眼冗余复用
平均 30.9× 加速(基线 18.5×,+TM/LB 20.9×),最高 40.1×
九个标准场景 + 加速器仿真 + 主观实验
罗切斯特大学 / 上海交通大学
GS-Voxel
预优化 3DGS 无法喂给结构化隐空间生成器
确定性体素化 + 因子化 VAE(几何/属性分路)+ 图像条件流模型
TopK 不透明度排序拼接、8-bit 量化、稀疏活跃体素
隐容量随占据体素数增长;重叠感知分块生成城市级场景
航拍/卫星条件的大规模城市场景生成
阿里高德 / 浙江大学 / 北京大学
GroupForward
语义 3DGS 只支持类别/短语查询,无实例区分
紧凑实例嵌入 + 聚类成跨视角一致 3D 实例 + RSRF 场景图 + VLM 推理
高维语义特征换成低维实例嵌入,语义在实例级聚合
3D 输出优于 Uni3R(空/多物体)与 Sa2VA(无 3D 输出)
语义重建 + 3D 指代分割定性对比
上海交通大学 / 北航 / 上海AI Lab / 华东师大
RS-Avatar
卷帘快门视频导致化身规范表示被烘进畸变
把子帧渲染的平均算子换成逐扫描线合成算子
不涉及(结构不变,只换合成算子)
RS-ZJU 上每一个被试对象的新视角合成均提升;模糊模型迁移失败且低于无感知基线
RS-ZJU(由 ZJU-MoCap 合成)
澳门大学
NGS-Marker
3DGS 部分侵权:抽走一部分高斯即绕过渲染图水印
注入器-提取器联合训练 + 基于梯度的渐进式注入 + 混合/多模态水印
不涉及(反向:主动在参数中注入扰动)
任意局部区域可解码所有权;ICLR 2026 接收
多场景定性对比 + 部分侵权攻击实验
浙江大学 / 浙江省地理信息科学重点实验室
核心技术趋势
「静态基底 + 稀疏残差」成为动态 3DGS 的默认结构
本期两篇流式传输工作(S2GS、QuARC-GS)虽出自完全不同的团队,却给出了几乎同构的方案:先重建一个规范帧(canonical frame)作为基底,之后每帧只编码与基底的差异残差。这个结构之所以反复出现,是因为它精确匹配了动态场景的统计事实——绝大多数区域在相邻帧间是静止的,为它们重复存储完整高斯参数是纯粹的浪费。QuARC-GS 靠这一点把每帧存储压到 SOTA 的 1/11,S2GS 相比 QUEEN 减少 85% 存储。这已经不是某个技巧,而是这个子领域的基础设施。
更新决策从启发式阈值升级为可微门控
残差结构解决了「存什么」,但还剩一个更难的问题:哪些残差值得更新?早期方法靠手调阈值(梯度大于某值就致密化),本周两篇都换成了可学习的离散决策。S2GS 用 Gumbel-Sigmoid 加多级直通估计器(ML-STE)把层次动态线索转成稀疏更新掩码,让「更新与否」这个二元决策在反向传播中可微;QuARC-GS 则用视空间梯度差分做变化门控,只在真正发生时序变化的区域分配新高斯。共同逻辑是:稀疏化本身应当被优化目标驱动,而不是被人类先验决定。
评测环境从 A100 集群下沉到 Jetson 与头显
这是本期最直观的变化。S2GS 的实验矩阵横跨消费级 GPU、工业级边缘 IoT 设备与一套物理远程呈现测试台,核心结论报在 Jetson AGX Orin 上(60+ FPS、最低能耗);MetaSapiens v2 更进一步,直接给出了面向双眼注视点渲染的加速器硬件设计,讨论的是负载不均衡与线缓冲区(line buffer)这类体系结构问题。当论文开始画 DRAM 数据通路图而不只是画损失曲线,说明这个领域已经进入了软硬件协同设计阶段。
3DGS 正在被改造成生成模型的输入格式
GS-Voxel 揭示了一个被长期忽视的错配:可扩展的三维隐空间生成器都在结构化张量上工作,而预优化好的 3DGS 重建恰恰是无序、空间不规则、图元数量差异极大的。它的解法是确定性地把 3DGS 转成稀疏活跃体素,不做额外的逐场景拟合(fitting-free),再用 GS 专用的因子化 VAE 分别编码体素几何与局部高斯属性。这个方向的意义超出单篇论文——它意味着过去几年积累的海量 3DGS 重建资产,有可能被直接盘活成生成模型的训练数据。
从「渲染得像」转向「查得到、管得住」
另外三篇代表了 3DGS 走向应用后必然出现的需求。GroupForward 指出现有前馈语义 3DGS 只支持类别或短语查询,缺乏显式实例区分,于是把每个高斯挂高维语义特征改成学习紧凑实例嵌入并聚类成跨视角一致的 3D 实例,再让 VLM 在实例证据上做复杂指代推理。NGS-Marker 则揪出了一个尖锐的现实漏洞:现有 3DGS 水印只保护渲染出的图片,攻击者若直接抽走一部分高斯图元复用,水印形同虚设——它的原生水印方案让任意局部区域都能解出版权信息。这些问题在纯学术语境下不存在,只有当 3DGS 真的成为一种流通资产时才会浮现。
核心技术难点与开放问题
四大核心难点
1. 动态 3DGS 压缩缺统一标尺
本期两篇流式压缩工作思路高度同构(基底 + 稀疏残差 + 可学习稀疏决策),但报数方式完全不同:QuARC-GS 是「每帧存储压到 SOTA 的 1/11」,S²GS 是「相比 QUEEN 存储 -85%、优化时间 -59%」。基线不同、数据集不同、画质工作点不同,两个数字无法互相换算。这个子领域已经有足够多的工作,却还没有一条像视频编码 BD-rate 那样的公认率-失真曲线,导致进步只能靠各自的相对提升自证。建立统一基准(固定数据集、固定画质点、报存储+训练时间+渲染 FPS 三元组)是当务之急。
2. 稀疏化与长时间稳定性的张力
残差结构的收益完全建立在「基底帧长期有效」之上。一旦场景发生结构性变化——有人走进画面、灯光整体切换、镜头大幅移动——残差量会爆炸,稀疏化的收益急剧退化。QuARC-GS 的量化能压缩的前提正是变形分布集中在零附近,这在大部分区域静止的场景成立,但对整体镜头运动就不成立了。S²GS 的实验包含光照变化与设备拔插场景是加分项,但两篇都在数百帧量级测试,而真实远程呈现会话是几十分钟。误差沿残差链的累积规律、基底重设的触发准则,目前都是空白。
3. 注视点渲染的质量评估方法学缺失
MetaSapiens v2 暴露的是整个注视点渲染方向的评测困境:这类方法的本质是主动放弃人眼看不清区域的质量,因此 PSNR/SSIM 这类全画面均值指标在原理上就无法判断取舍是否成功——外围质量下降会拉低 PSNR,但如果人眼察觉不到,那正是方法的目标而非缺陷。需要的是与注视点位置相关的加权感知指标,以及考虑眼动追踪延迟与误差的鲁棒性评测。此外,加速比里算法贡献与专用硬件贡献混在一起,也让读者难以判断纯软件层面的改进幅度。
4. 3DGS 作为生成模型输入的信息损失未被量化
GS-Voxel 打开了「盘活已有 3DGS 资产」的方向,但转换链路上有三处有损操作,各自的代价都没被量化:体素内 TopK 拼接会丢弃超出 K 的高斯(植被、栏杆这类密集区域可能远超 K)、8-bit 量化会损失参数精度、低不透明度过滤会移除弱贡献高斯。更根本的是「兼容的预优化 3DGS」这个前提没有定义——不同重建管线产出的高斯在尺度分布、不透明度分布上差异很大,能否混用直接决定这个方向的实际覆盖面。缺了这些消融,方法在新数据上只能靠试。
5. 多目标优化的兼容性完全未被讨论
这是把本期七篇放在一起才看得见的问题。一个真实的 3DGS 产品链路需要同时满足:被生成模型采样(GS-Voxel 要求量化到 8-bit 的规则体素)、被压缩流式传输(S²GS/QuARC-GS 要求激进丢弃不显著更新)、被水印保护(NGS-Marker 要求在参数中注入可检出扰动)、被语言查询(GroupForward 要求携带实例嵌入)。这些要求彼此冲突显而易见:量化步长可能抹掉水印扰动,稀疏门控可能把水印当噪声丢弃,实例嵌入是额外的每高斯负载而压缩正要削减负载。目前没有任何一篇讨论这种叠加,而这恰恰是工程化落地必须回答的。
今日讨论
把这七篇放在一起看,3DGS 的工程化转向已经相当清晰:关注点从「重建得出来」全面转向「传得动、跑得起、管得住」。但方向一致也让几个共同空白格外刺眼。
最突出的是缺统一标尺。两篇压缩工作思路几乎同构,报数却一个是「压到 SOTA 的 1/11」、一个是「相比 QUEEN 减少 85%」,基线与画质工作点都不同,无法互相换算——这个子领域还没有像视频编码 BD-rate 那样的公认曲线。其次是长时稳定性没被检验:残差结构的收益全押在「基底帧长期有效」上,而测试只做到数百帧,真实远程呈现会话是几十分钟。
但最根本的问题只有把七篇并置才看得见:它们各自的优化目标彼此冲突。GS-Voxel 为了做生成要把高斯量化到 8-bit,NGS-Marker 为了水印要在参数里注入扰动,两篇压缩工作则要激进丢弃不显著的更新。一个真实产品链路需要同时被生成、被压缩传输、被水印保护、被语言查询,而这些操作的兼容性目前无人讨论——量化后的高斯还能承载水印吗?水印扰动会被稀疏门控当成噪声丢掉吗?
你认为 3DGS 的下一个瓶颈在哪:继续做表示压缩,还是像 GS-Voxel 那样把它彻底纳入生成模型的隐空间?欢迎在评论区讨论。
人工智能炼丹君 整理 | 数据来源:arXiv 2026-08-16 ~ 2026-08-22
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注













评论 (0)