搜索到
13
篇与
多模态
的结果
-
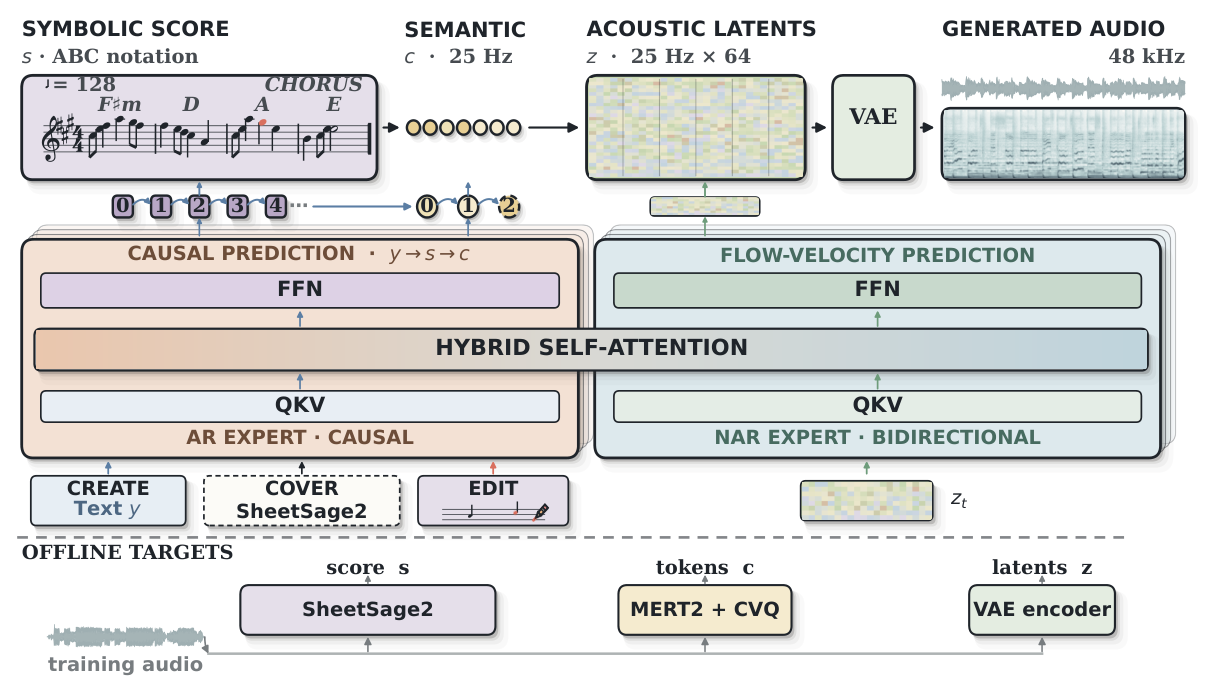
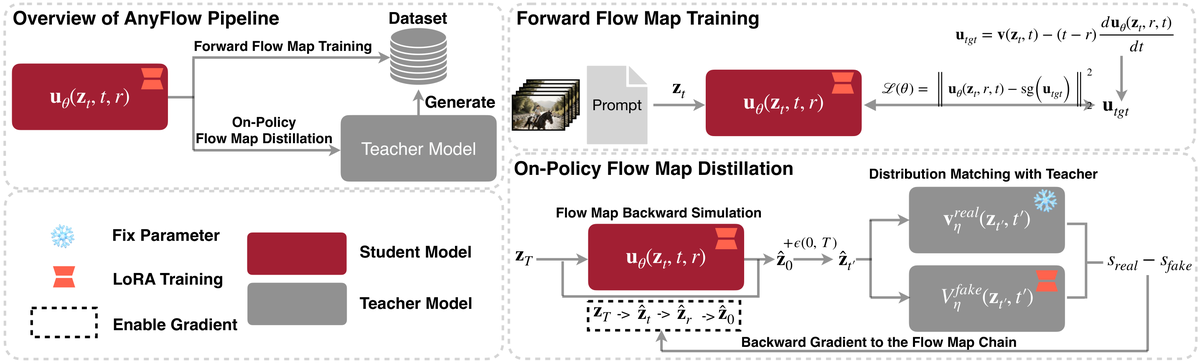
 AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-28|阿里 397B 只改提示词就涨 50 分,WanPE 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与编辑 5 篇 · 音视频与语音生成 2 篇 · 图像与 3D 生成 2 篇 · 多模态理解与评测 1 篇 重点论文标题列表 WanPE(南大):397B 分镜规划提示词 AV-GRPO(上海人工智能实验室):音视频联合生成的模态解耦 RL ⚡ TRACK(NVIDIA):免训练大小模型按步换班 ViRDM(美国东北大学):砍掉教师与批评家做因果后训练 EditVoice(厦门大学):变长非自回归零样本语音编辑 今日论文速览 1. WanPE:397B 分镜规划提示词 WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation | 南京大学;Wan 团队(阿里巴巴集团);中国科学技术大学;复旦大学;清华大学 | arXiv:2609.30221 关键词:文生视频, 提示词增强, GRPO, 电影分镜, 评测基准 ⚠️ 前序问题:现代视频生成器已能生成 30 秒、并忠实遵循复杂条件,文本提示几乎直接决定多镜头序列里动作、机位轨迹、光效和声音如何展开。但现有的提示增强大多还停留在「可选扩写」层面,面对导演级的镜头级规划(分镜如何组织、跨镜头语义如何不漂)能力明显不足。 本文贡献:提出 WanPE——397B 参数的提示增强模型,在 105 万条真实视频上训练。核心有两块:一是 video-grounded 逆向构建(reverse SFT),从真实视频反推出镜头级电影分镜规划,让模型学到的是「怎么组织分镜」而不是「怎么把句子写长」;二是 Semantic-Consistency GRPO(SC-GRPO),用语义一致性奖励把用户意图在跨镜头、跨时间维度上保住。配套还建了 WanPEval:249 条人工标注请求,覆盖 5–30 秒时长与不同意图粒度,约 1.1 万次盲评 pairwise 比较。 WanPE training pipeline. Video-grounded reverse SFT and semantic-consistency GRPO. 实验效果:驱动 Wan3.0 生成器时,相对原始用户提示,5–15 秒人类偏好提升 10.66–18.84 分,30 秒竞技场提升 50.86 分。5–15 秒子集上专家偏好 S / Bradley–Terry 分数为 50.61 / 61.85,超过 Seedance 2.0(43.42 / 54.70)、MiniMax-H3(36.40 / 49.27)、Kling 3.0(20.80 / 37.40)与 HappyHorse 1.1(24.89 / 40.46)。消融显示逆向构建明显优于正向改写,SC-GRPO 在各模型规模上都能稳住语义保真。 Fine-grained expert evaluation on the 5-15 seconds subset of WanPEval. Left: Preference scores across generation durations and request-granularity levels. Right: Preference scores S across seven content categories. 批判点评:397B 这个体量本身就是最大的成本项,而表里的规模曲线并不支持它:4B 是 43.60 / 56.21,9B 是 46.00 / 58.01,397B 才 50.61 / 61.85——为了最后 5 分,参数量涨了两个数量级。更值得注意的是 30 秒子集:+WanPE-397B 的 Overall 60.24 只是险胜 Seedance 2.5 的 59.76,而且拆开看,动作类 50.00 被 Seedance 2.5 的 68.18 甩开一大截,知识类、演讲类也不占优。换句话说,WanPE 真正补齐的是「镜头语言」,动作生成本身的短板它一个字都没碰。 2. AV-GRPO:音视频联合生成的模态解耦 RL AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation | 上海人工智能实验室;香港理工大学;新加坡国立大学;南洋理工大学;浙江大学 | arXiv:2609.29816 关键词:音视频联合生成, 强化学习后训练, GRPO, 跨模态同步, 扩散模型 ⚠️ 前序问题:音视频联合生成里,异质多模态奖励互相纠缠导致信用分配困难,两个模态塔动力学差异大、联合优化极贵,而同步性评测又依赖成对样本、奖励没法公平比较——直接把 RL 后训练搬过来几乎处处碰壁。 本文贡献:提出 AV-GRPO 这一模态锚定的在线扩散 RL 框架,三个模块:模态锚定 rollout 解耦学习信号并稳定难度;轨迹锁定的冻结塔优化降低成本、重新分配信用;针对模态各自动力学的自适应目标与扰动强度。由此把耦合的多模态偏好学习拆成单模态子问题,实现精确奖励归因。同时构建了 5DAV 数据集,在五个维度上解耦样本、难度可控。基于 LTX-2.3 22B,8 卡 A800 上跑 LoRA 与全参两档。 Overview of the AV-GRPO training pipeline. 实验效果:JavisBench 上 AV-IB 从 0.224 提到 0.247,JavisScore 0.202 → 0.222,DeSync 0.708 → 0.607;VABench 上 Lip Sync 1.439 → 1.646、DeSync 0.726 → 0.542。在生成质量、语义对齐与跨模态同步三项上均超过 LTX-2.3,LoRA 与全参微调两档都成立。 Left: Radar chart comparing performance on the 5DAV and VGGSound datasets. Middle: Metrics are reported as relative percentage changes with respect to the baseline. Right: Comparison of model performance with different alternating step intervals. 批判点评:表里藏着一个不太好看的反差:LTX-2.3+AV-GRPO(lora) 在 Alignment(4.512 对 4.510)、Expressiveness(4.450 对 4.434)、Visual Realism(4.402 对 4.395)三项主观指标上,全都高于全参版。花了全参训练的成本,主观质量却没赢过 LoRA,说明这套「冻结塔 + 分塔信用分配」的收益主要落在同步类客观指标上,主观提升更接近采样噪声。而且这三项差距都在小数点后第三位,论文也没给方差或多次运行,显著性无从判断。 3. TRACK:免训练大小模型按步换班 Accelerating Video Diffusion via Training-Free Trajectory Routing | NVIDIA | arXiv:2609.30096 关键词:视频扩散加速, 免训练, 模型路由, 步级调度, 能耗优化 ⚠️ 前序问题:视频扩散推理昂贵:要把大模型跑很多个去噪步。即便做了步数蒸馏,剩下每一个蒸馏步依然要付一次完整的大模型前向,推理成本还是下不来。 本文贡献:TRACK(TRajectory-Aware Capacity routing via top-K selection)是一种异构去噪策略:离线校准阶段先跑一遍全大模型的参考轨迹,每一步同时收集小模型的预测,与大模型预测比较得到相对分歧分数(两边共享同一 latent、timestep、条件与 guidance),再把该信号跨校准集聚合成分步分歧分数图,据此决定切换策略——质量敏感步留给大模型(如 Wan 2.1 14B),低分歧步路由给小模型(1.3B)。推理时每步只执行被选中的那一个模型,不重训练、不改架构与调度器、也不需要在线双模型评估。 Training-Free Trajectory-Aware Capacity routing. Top: Offline calibration rolls out the all-large-model reference trajectory and, at every step, evaluates the large and small checkpoints using the same latent, timestep, conditioning, and guidance inputs. Bottom: Online inference applies that policy while preserving the shared latent representation and scheduler update. 实验效果:在 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo 四条管线上分别取得 1.95×、2.04×–2.73×、2.69×、2.17× 加速,聚合质量相当、DreamSim 多样性保留 >95%。在 A100 上用 NVML 实测,去噪能耗降低约 45%–60%:Wan 2.1 每视频省 194.57 kJ,折合每千条视频省 54.05 kWh(降 49.3%);Cosmos 3(Super/Edge)能耗降近 60%。 Speed--quality tradeoffs across video pipelines. Each panel compares the all-large model (baseline) and TRACK (ours) switching policy. All models retain comparable aggregate quality at the selected operating points in most quality dimensions. 批判点评:「质量相当」这个结论要挑一下口径:它取的是 VBench 的时间闪烁、运动平滑、主体一致性、背景一致性四个维度的均值——恰好是「换小模型不太容易崩」的那四个。真正的代价作者写在 Limitations 里:部署时必须同时驻留大小两个模型,显存占用反而高于单模型管线。另外对已经把步数压到 3–4 步的蒸馏管线(FastVideo 只有 2.17×),可换的步数本就只剩个位数,收益上限天然受限。 4. ViRDM:砍掉教师与批评家做因果后训练 ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation | 美国东北大学;Adobe Research | arXiv:2609.28923 关键词:因果视频生成, 分布匹配, 后训练, 显存优化, VBench ⚠️ 前序问题:少步自回归视频扩散能实现低延迟流式生成,但现有后训练方法几乎都依赖 DMD:需要一个庞大的预训练教师和一个在线 critic,靠 diffusion score 估计分布差异。三套网络同时在线,资源开销成了主要门槛。 本文贡献:ViRDM 把教师与 critic 整个去掉,只让生成器对齐一份离线预计算的目标表征分布。三个障碍逐个击破:用一致性式采样 + 随机截断 clean-exit 监督(S 从 U{1..K} 采样,选中的那次评估才吃梯度)把梯度路径变得可行;用轻量 VAE 解码器压显存;用分阶段 vector–Jacobian product 拆解反传。此外还给出了视频 RDM 的生成种群规模与初始化策略(因果 ODE 初始化最优),并加了 flow 动力学正则来补表征分布对时间变化约束不足的问题。 Consistency-style sampling with stochastic exits for few-step video RDM. 实验效果:同样 8 卡 A100 的设置下,峰值显存从 77.1 GB/卡降到 48.3 GB/卡,后训练时间从 22 小时压到 2 小时,VBench Total 从 84.51 提到 84.87。只需 20 次生成器更新、16 A100 GPU-小时,比此前最佳少步因果基线高 0.36 分。用户研究中文本-视频对齐 40.4%、视觉质量 43.0% 均为四步因果方法里最高(Self Forcing 两项均为 32.6%)。 Replacing the resource-intensive teacher-critic stack with direct representation distribution matching for few-step causal video post-training. In the same 8-A100 parallelized training setting, this reduces peak memory from 77.1 to 48.3 GB per GPU and post-training time from 22 to 2 hours, while improving the VBench Total from 84.51 to 84.87. 批判点评:84.87 对 84.51 只涨了 0.36 分,而论文自己的消融表把原因说得很直白:要把 Dynamic Degree 维度单独剔掉再比,ViRDM 才更好看——说明动力学恰恰是 RDM 的软肋(表征分布对时间演化约束不足),得额外加 flow 正则才勉强补回来,等于承认「省掉教师 critic」的代价是引入了新的手工正则。另外 84.87 是在 Wan2.1-1.3B 这个 1.3B 小骨架上拿的,跟动辄 14B 的双向模型不在一个量级,跨量级横向对比要打折扣。 5. EditVoice:变长非自回归零样本语音编辑 EditVoice: Variable-Length Non-Autoregressive Zero-Shot TTS and Speech Editing with Edit Flows | 厦门大学 | arXiv:2609.29889 关键词:零样本 TTS, 语音编辑, 非自回归生成, Edit Flows, 变长序列建模 ⚠️ 前序问题:现有非自回归零样本 TTS 虽然能并行生成,但几乎都要在生成前先指定目标序列长度——长度得靠另一个模块预估,一旦估错就直接影响韵律与内容。 本文贡献:EditVoice 是首个变长 NAR 零样本 TTS:用 Edit Flows 通过插入、删除、替换三类编辑操作同时更新语音内容和序列长度。训练上采用 speech-infilling,把零样本 TTS 与文本驱动语音编辑统一到同一目标下,推理时前缀提示和后缀提示两种摆位都能用;提出 Complementary Prompt Sampling(CPS),按每类操作取两种摆位里速率更大的那个,利用互补的 Edit Flow 预测。还发现模型能编辑训练来源之外的语音(包括它自己生成的),据此做端到端编辑与免训练的后生成精炼。 Overview of the EditVoice zero-shot TTS inference pipeline. Stage one generates semantic speech tokens using CPS, and stage two applies post-generation refinement to the generated sequence before speech detokenization. 实验效果:在 10K 小时 GigaSpeech 上训练 Edit Flow 模型,在 Seed-TTS Eval EN、LibriSpeech-PC 上零样本 TTS 表现具竞争力,在 RealEdit 上语音编辑表现具竞争力。后生成精炼把 WER 从 2.66% 降到 1.55%,且 8 步生成 + 2 步精炼已经超过不做精炼的 16 步生成。 Post-generation refinement on Seed-TTS Eval EN. Starting from the same 8-step CPS output, WER and edits to generated tokens are measured over 8 refinement steps. The dashed line denotes 16-step CPS generation without refinement. 批判点评:全文只有 5 页 3 张图,实验规模偏薄:10K 小时训练的对比对象里有 CosyVoice 2 这类数据量级高一个档的系统,「competitive」具体竞争到什么程度得回表里逐项看。后精炼这个卖点本质是拿推理时算力换质量——8+2 步打败 16 步听起来漂亮,但总步数只少了 6 步,换成真实延迟并不划算。另外「能编辑非训练来源的语音」是意外发现而不是设计,作者没给系统的泛化边界评估,这条能力在多说话人、跨语种上会不会退化是未知数。 6. OREO:用 2D 编辑反馈对齐 3D 保真 OREO: Fidelity Alignment in 3D Generation via On-the-fly Rendering-Editing Optimization | 香港理工大学;腾讯 ARC Lab | arXiv:2609.29788 关键词:3D 生成, 保真对齐, 2D 扩散先验, 强化编辑, ECCV 2026 ⚠️ 前序问题:3D 生成模型进步很快,但产出的资产视觉保真度往往不够——几何、布局对得上,质感与细节就是差一口气,和 2D 扩散模型能达到的写实程度有明显落差。 本文贡献:OREO 是一个对齐框架,核心是不依赖静态数据集,而是建立动态优化闭环:把 3D 输出渲染出的视图交给 2D 模型做 Reinforced Editing,在保持几何、视角和内容不变的前提下提升视觉保真;这些被实时编辑过的渲染图反过来作为高质量 2D 伪目标,监督 3D 生成器从自己的样本里学习、逐步提升画质。 Overview of OREO. 实验效果:以 Trellis 为底座,对参考图 $x^{ref}$ 的 CLIP / DINO 相似度在 Conceptual Design 上从 0.7613 / 0.7916 提到 0.7834 / 0.8065,在 GSO 上从 0.7722 / 0.7022 提到 0.7764 / 0.7069;对比 Photo3D(0.7380 / 0.7837、0.7512 / 0.7034)同样领先。论文已被 ECCV 2026 接收。 Qualitative comparison of 2D feedback sources (Reinforced Editing / NanoBanana Pro / Qwen-Image-Edit). 批判点评:消融表里最刺眼的一行:去掉 Source Branch 后 ΔCLIP / ΔDINO 从 +0.0379 / +0.0298 直接翻成 −0.0523 / −0.0497——比不做对齐还差。整套方法对「保留源分支」这一条设计极其敏感,稳健性存疑。变体对比里把分布匹配换成 DMD,分数掉到 0.5393 / 0.5486,说明这条路和当前主流的 3D 蒸馏范式并不兼容。另外绝对增益全部停在小数点后第二位,而「视觉保真」这件事到头来还是用 CLIP / DINO 相似度做 proxy,离人眼判断有多远没人说得清。 7. ComplexSync:复杂场景 70FPS 实时唇形同步 ComplexSync: High-Fidelity and Real-Time Lip Sync in Complex Scenarios | 广州趣丸网络科技 | arXiv:2609.29225 关键词:唇形同步, 扩散蒸馏, 实时推理, 视觉基础模型, 基准评测 ⚠️ 前序问题:唇形同步要让口型动态与语音精确对齐。扩散模型生成质量高,但在遮挡、侧脸、复杂光照等复杂场景下容易失稳,而且推理延迟高到没法实际部署。 本文贡献:ComplexSync 是一套统一的扩散框架,三块设计:一是双流联合训练策略,抑制参考帧的信息泄漏同时保留自然动态;二是基于蒸馏的单步去噪加速方案,做到 70+ FPS 吞吐;三是关系对齐损失,借助视觉基础模型(VFM)的结构先验提升复杂场景因素下的同步精度与鲁棒性。此外还给出首个专门面向复杂唇形同步的 benchmark,含 200+ 条挑战视频序列与专门指标。 Overview of ComplexSync. (a) Dual-stream joint training strategy designed to suppress spatial information leakage and ensure high-fidelity synthesis. (b) Distillation-based acceleration scheme that facilitates single-step denoising for real-time inference. (c) Relational alignment loss leveraging VFMs to enhance synchronization precision and robustness under unconstrained conditions. 实验效果:在标准场景与复杂场景上均达到 SOTA,同时支持实时推理,吞吐超过 70 FPS。训练分三阶段:第一阶段 8 卡 A100 训 200K 步,第二阶段 4 卡 A100 训 50K 步,第三阶段再训 10K 步,分辨率 512×512。 Qualitative comparison with existing methods. Given that static images cannot fully capture critical temporal attributes such as synchronization, naturalness, and stability, we provide comprehensive video comparisons in the supplementary materials. 批判点评:三阶段累计 260K 步、起步就是 8 张 A100,这个训练预算对一家业务公司来说更像工程投入而非可复现的研究。全文只在 512×512 分辨率验证,而真实配音、数字人场景常见的是 1080p 以上——放大后的口型稳定性没有数据。定性对比仍然用静态帧,同步、自然度、稳定性这些纯时间属性都推给了补充视频,而这恰是唇形同步最容易「单帧好看、连起来崩」的地方。 8. AdaPilot:一套策略零样本迁移各生成器 AdaPilot: Towards Scene-Adaptive Policy Learning for Cross-Generator Text-to-Image Quality Optimization | 南洋理工大学;同花顺研究院 | arXiv:2609.29517 关键词:文生图, 强化学习, 跨生成器迁移, 多轮视觉反馈, 奖励设计 ⚠️ 前序问题:提升文生图质量的路线已经从生成器微调、提示优化走到了带多轮视觉反馈的强化学习,但现有策略都与特定生成器、特定任务深度耦合,学到的能力很难泛化成一套通用的质量优化策略——换个生成器就得重训。 本文贡献:AdaPilot 把多轮图像生成建模成马尔可夫决策过程,用端到端 RL 学一个场景自适应、可跨生成器迁移的质量优化策略。三点关键:策略与生成器内部解耦(只通过 prompt 和编码后的视觉观测交互,不碰梯度与内部状态),因此能跨生成器复用;场景感知奖励(AdaReward)把质量评估维度与任务语义自适应对齐;过程级奖励建模图像质量在多轮里的演化轨迹。实现上用 Qwen2.5-VL-7B-Instruct 作 agent,Qwen-Image-2512 作冻结生成器。 An illustration of the proposed AdaPilot. 实验效果:在 7 个指标(CLIP-T、HPS、GDino、Aesthetic、OCR 用于奖励,Realism、Physics 为留出维度)上超过 Flow-GRPO、T2I-R1、T2I-Copilot 等基线。跨生成器评测中,单一策略零样本迁移到未见过生成器(Qwen-Image、GPT-Image-1、Gemini-3-pro-Image-Preview 等)时,在所有被评生成器上仍保持正平均增益,OOD 数据集上每个维度都领先。 Averages over applicable evaluation metrics for four unseen image generators on four out-of-distribution datasets and overall, comparing results with and without AdaPilot to evaluate zero-shot cross-generator transfer. 批判点评:论文自己给的失败案例很说明问题:一张要求对比八位利物浦前锋的密集信息图,多轮迭代确实把版面理清了,但文字仍基本不可读、球员身份与属性不一致、图表数值不可验证,agent 明知有残缺陷还是终止了。这暴露了「策略只改 prompt」的天花板——当缺陷出在生成器自身的文字渲染与数值编码能力时,再聪明的提示改写也救不回来。另外训练时要同时部署 CLIP ViT-L/14、HPS v2.1、Grounding DINO、GLM-OCR 和 Qwen2.5-VL-72B 五个评估器算奖励,这套推理栈的成本并没有被算进收益里。 9. ZoomDiff:双摄平滑变焦的高保真插值 ZoomDiff: A High-Fidelity Diffusion Model for Dual-Camera Smooth Zooming | 哈尔滨工业大学;淘宝(阿里巴巴集团) | arXiv:2609.28083 关键词:双摄变焦, 帧插值, 扩散模型, 高频重建, 时间一致性 ⚠️ 前序问题:双摄像头之间的数字变焦切换,几何结构和色彩一致性上会出现肉眼可见的跳变。现有双摄平滑变焦(DCSZ)方法多在帧插值模型上微调,扛不住大视差与复杂几何变换;直接套扩散式帧插值模型,又因为条件引导不足、VAE 编码丢高频、时间一致性不够,保真度还是上不去。 本文贡献:ZoomDiff 在潜空间与像素空间同时吃透双摄输入:一是多步去噪过程中强化双图条件引导,提升几何一致性;二是把 VAE 编码器的 flow 对齐多尺度特征注回解码器(ref injector),把 VAE 编码时丢掉的高频细节补回来;三是引入 flow 引导的时间一致性监督($\mathcal{L}_{ftc}$)让转场更顺。并给出把步数从 25 压到 8 / 4 的适配方案。 The dual-camera images ($\mathbf{X}_0$ and $\mathbf{X}_F$) are fed into the VAE encoder and the semantic encoder. 实验效果:合成与真实数据集上全面领先:PSNR 23.80、SSIM 0.761、LPIPS 0.253、PSNR-div 23.01、FVD 131.332,真实集 MUSIQ 73.634、LIQE 4.874、DBCNN 0.692、DOVER 0.665,均为最优。步数压缩上,25 步 45.89s(FLOPs 743T)可压到 8 步 21.28s(2.16×)与 4 步 15.71s(2.92×)。 Visual comparisons on the synthetic dataset and the real-world dataset. Our method still produces more consistent results. 批判点评:两个反差值得记。其一,扩散类基线整体拉胯:Wan2.1 只有 17.71 PSNR、TRF 14.15、Framer 的 DOVER 只有 0.335,全都输给光流法(UPRNet 22.58、RIFE LPIPS 0.261)——说明「生成式先验」在这个任务上并非天然优势,ZoomDiff 的赢面来自双图条件引导与高频注入这两个工程补丁,而非换 backbone。其二,步数压缩后质量反而上升:8 步版 PSNR 24.08 高于 25 步版的 23.80,而去掉步数适配的 8 步版只有 22.32。也就是说 25 步其实是过采样,指标对步数并不单调,任何「步数越少越差」的外推在这里都不成立。 10. ODU-Bench:14 个全模态模型的需求理解评测 Omni Demand Understanding: A Benchmark for Contextual User-Intent Inference in Multimodal Interaction | 上海交通大学;上海创智学院;阿里巴巴;香港中文大学;清华大学;香港理工大学;南开大学;约翰斯·霍普金斯大学 | arXiv:2609.21392 关键词:多模态交互, 需求理解, 评测基准, 误触发, MLLM ⚠️ 前序问题:音视频自然交互正成为 AI 助手的重要入口,但现有交互能力基准主要评「回复质量」,漏掉了更基础的一问:模型能不能从复杂的多模态交互里正确推断用户的真实需求?现实中的需求在口语里往往是欠规格的,得靠视觉线索、声学线索和对话历史补;含糊表达、噪声环境进一步加剧难度。反过来,听起来像请求的 utterance 也可能根本不是给助手的需求,导致误触发。 本文贡献:把 Omni Demand Understanding(ODU)定义成一个独立的多模态上下文推断问题:给定交互流,模型必须判断是否存在需求,并从多模态与对话上下文推断意图,评测覆盖五个维度(M1 需求存在性、M2 关键点命中率、M3 时间跨度 IoU、M4 转录、M5 用户画像),同时覆盖单轮与多轮。ODU-Bench 用挑战驱动的 taxonomy、taxonomy 引导的 agentic 视频生成加真人录制交互来构建,标注从互补媒体证据重建并经人工校验。 Overview of the ODU-Bench construction pipeline. Challenge-driven targets are expanded into coarse-to-fine scripts, screened for plausibility and challenge validity, and realized as synthesized or human-recorded interactions. 实验效果:评测 14 个原生 MLLM:最强者 Gemini 3.1 Pro 也只能恢复 44.7% 必须从视觉、声学或对话上下文推断的关键信息;14 个模型里有 11 个在非需求场景上的误触发率(FTR)超过 50%。 Qualitative error analysis on English generated audio-visual scenes. (a)--(b) Demand-present cases; M2 reports covered/reference key points. (c)--(d) No-demand cases. 批判点评:44.7% 和「11/14 误触发率 >50%」这两个数字,真正打脸的是当前「先响应、后理解」的范式——模型宁可硬猜一个需求,也不愿意说「这不是需求」。可惜基准本身大量依赖 agentic 生成的交互与 LLM judge,虽然论文做了 judge 稳定性检验和真人录制对照(Δ = Rec − Syn),合成数据与真人数据之间的分布差仍是这套结论最大的外推风险:如果 agentic 生成场景的「挑战性」分布和真实用户偏得比较多,44.7% 这个数就未必能平移到线上。 趋势观察 生成的瓶颈正在往「输入端」和「调度端」挪 今天这十篇里有三篇在动生成流程的两端而不是中间:WanPE 用 397B 模型重写提示词,把导演级分镜规划搬到文本空间完成;TRACK 不改模型、不重训练,只决定每一步该派大模型还是小模型上场;AdaPilot 则干脆只通过 prompt 和视觉观测跟生成器打交道。共同点是:底座模型被当成黑箱,可优化的空间被挪到了它前面和外面——这对没算力训底座的团队是好事,对卖底座的团队不是。 「砍掉教师与 critic」成为后训练的新共识 ViRDM 把 DMD 的教师+critic+生成器三件套砍成只训生成器,8 卡 A100 下显存 77.1→48.3 GB、时间 22h→2h,VBench 还涨了 0.36;OREO 同样放弃静态数据与蒸馏范式,改用 2D 编辑实时产出伪目标做自我监督;AV-GRPO 冻结一塔训另一塔来降低 RL 成本。三条独立工作指向同一判断:昂贵的在线监督预算正在被更便宜的离线/自产目标替换,代价往往是引入新的手工正则(ViRDM 的 flow 正则就是这么来的)。 评测基准开始盯「理解」而不是「生成」 ODU-Bench 评测 14 个原生 MLLM 后发现,最强的 Gemini 3.1 Pro 也只能恢复 44.7% 必须靠上下文推断的关键信息,而且 11/14 的模型在非需求场景上误触发率超过 50%。这个数字比任何生成质量榜单都更能说明当前语音/视觉助手的实际状态:问题不在答得好不好,而在该不该答都还没判断对。ComplexSync 也顺手补了首个复杂场景唇形同步 benchmark,200+ 条挑战序列把遮挡、侧脸这些长期被平均掉的case单独拎出来。 人工智能炼丹君 整理 | 2026-09-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-24|阿里Qwen3.8-Omni发布,视频推理输Gemini 今日 AIGC 论文速览 今日共 10 篇 · 全模态基座与语音智能体 2 篇 · 视频编辑与生成智能体 2 篇 · 生成推理加速与量化 2 篇 · 视觉Tokenizer与音视频生成 2 篇 · 奖励模型与生成安全评测 2 篇 重点论文标题列表 Qwen3.8-Omni(Qwen Team, Alibaba Group):原生全模态智能体,百万上下文 VideoX-Qwen(Nanjing University):120万对指令视频编辑数据 QuantWM(Harbin Institute of Technology (Shenzhen)):2比特KV量化压住时序闪烁 Flash-dLLM(VILA Lab, MBZUAI):扩散LLM提速五倍且不伤精度 VideoGen-Agent(Princeton University):RL教会智能体用工具做视频 今日论文速览 1. Qwen3.8-Omni:原生全模态智能体,百万上下文 Qwen3.8-Omni: Towards Native Omni-Modal Agents | Qwen Team, Alibaba Group | arXiv:2609.25611 关键词:全模态智能体,稀疏MoE,百万上下文,视频剪辑,插件框架 前序问题:全模态模型此前主要强调感知和交互,真正的长程智能体任务——调工具、跑多步、把一段素材剪辑成片——要靠外挂 harness 拼,而现有 agent harness 对音频和视频没有原生支持。缺一个在多模态上原生 co-training、又不丢文本能力的底座。 本文贡献:发布 Qwen3.8-Omni-Flash:Thinker 继承 Qwen3.8-Next 的稀疏 MoE 骨干(GDN 与交错注意力混合),上下文扩到 100 万 token;原生多模态 co-training 把文本侧的智能体能力迁移到音视频任务,再经多教师蒸馏合并领域专精策略;配套开源 Qwen-MM-Plugins 插件框架与 Qwen-Live-Harness 实时交互框架。 Qwen3.8-Omni-Flash is a unified end-to-end model capable of processing multiple modalities 实验效果:WildClawBench-MM 从上代 34.5 涨到 71.0(+36.5)、AgenticVBench 14.5→36.8、OmniGAIA 57.2→74.0;Video-MME-v2 47.9→65.0。开智能体模式后 LVOmniBench 63.3→73.6,OmniVideoBench 单次 query 消耗 token 从 14.6 万降到 7.9 万(约 -45.7%)。 The overview of Qwen3.8-Omni-Flash-Realtime and Qwen-Live-Harness 批判点评:摘要口气很大,但表格里对手没输干净:Gemini 3.8 Flash 在三个视频推理基准的静态设置上全面更高,开智能体后 OmniVideoBench(70.1 vs 67.8)和 Video-MME-v2 仍被压着;teaser 图的 OmniCap-IF 一栏 Flash 拿 20.2,落在上代 Plus 的 28.3 和 Muse Spark 1.2 的 26.8 之后。所谓「领先」主要立在自己参与的新评测上。 2. VideoX-Qwen:120万对指令视频编辑数据 VideoX-Qwen: Data-Centric Instruction-Based Video Editing | Nanjing University;Jiutian Research | arXiv:2609.26015 关键词:指令视频编辑,数据合成,Qwen3-VL,Wan,成对监督 前序问题:通用视频编辑缺的不是模型而是监督:编辑要在执行指令的同时保住无关主体、场景结构和时序连续性,而成对(源视频、指令、目标视频)数据的规模和任务覆盖都远远不够,指令视频编辑长期落后于图像编辑。 本文贡献:一条可扩产的数据流水线:Qwen3-VL-235B 做源视频筛选与目标解析,加/删走 SAM3 加 Minimax-Remover,替换/属性走 Qwen-Image-Edit 首帧编辑加 WanAnimate 传播,自动通过率 89%,产出 120 万条方向性编辑对(每组任务超 40 万条)。模型侧统一 Qwen-Wan 编辑器:多模态语义条件加稠密源视频 latent 引导,图像-视频三阶段渐进训练。 Paired-video construction pipeline 实验效果:100 例对比 UniVideo 和 Kling O1:11 项指标里 9 项均值最优,覆盖指令遵循、编辑质量、内容保持、结构与感知相似度和视频分布质量。 Qualitative comparisons on compound and attribute editing 批判点评:「9/11 最优」的另一面是 11 项里输了 2 项,且对比规模只有 100 例;加/删两条数据路线直接复用 Minimax-Remover 和 WanAnimate,编辑对质量上限被这些现成生成器封顶。论文把「逐条校验富化后的指令」画成 proposed extension(虚线框),等于承认 120 万对里指令与实际编辑的一致性还没有被逐一验证。 3. QuantWM:2比特KV量化压住时序闪烁 QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for World Models and Video Generation | Harbin Institute of Technology (Shenzhen);National University of Singapore | arXiv:2609.26425 关键词:KV cache量化,视频生成加速,世界模型,注意力补偿,训练无关 前序问题:视频生成和世界模型的 KV cache 是部署瓶颈,已有 2-bit 量化方法在 VBench 这类指标上「几乎无损」,但作者实测发现:指标没掉,画面却在闪——逐帧指标天生看不见时序问题。 本文贡献:训练无关、严格因果的 2-bit KV 量化框架。诊断先行:Key 的量化重建误差比 Value 小,输出退化却更大,因为小扰动就能改变 QK^T 注意力 logits、挪走 Query 选中的时序-空间 token。对症两招:QSAC 聚类联合历史 Query 敏感度与残差范围选 INT2 友好的 Key 质心;PSAC 用低秩投影沿 Query 主子空间补偿残余 Key 误差。 Overview of QuantWM's inference system 实验效果:Causal-Forcing、LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 五个底模上,KV cache 最高压缩 6.20×,图像与视频质量指标全面超过现有 2-bit 方法,额外开销有限,且保持严格因果可流式推理。 Visual comparison of BF16, K16V2, K2V16 and K2V2 on world models 批判点评:这篇最值钱的是诊断而不是方法:它解释了为什么「VBench 几乎无损」的结论靠不住——逐帧指标对时序闪烁盲。但时序改善的验收仍以看图为主,论文没给出时序稳定性的量化指标;6.20× 的压缩上限是在 93 帧生成这一档测的,更长序列的收益未报告。 4. Flash-dLLM:扩散LLM提速五倍且不伤精度 Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs | VILA Lab, MBZUAI | arXiv:2609.26796 关键词:扩散语言模型,KV cache,并行解码,Triton,推理加速 前序问题:扩散 LLM 靠并行去噪生成文本,但双向注意力让自回归那套 KV cache 直接失效;已有加速工作把 KV cache 和并行解码分开研究,两者合用时 GPU 显存 I/O 反而成了主要瓶颈。 本文贡献:训练无关两件套。Flash-Cache:把 QKV 投影、RoPE、cache 写入、注意力计算融进一个 I/O 感知的融合 Triton 核,砍掉冗余访存;Flash-Verify:让 dLLM 自己既当 drafter 又当 verifier 做草稿-验证式并行解码,不挂辅助模型。 Overview of Flash-dLLM 实验效果:LLaDA-1.5 上对此前最强的 Elastic-Cache 在 GSM8K/HumanEval 分别提速 5.1 倍和 11.0 倍;Flash-Cache 加 Flash-Verify 达到精度 83.02%、吞吐 210.6 tokens/s(Elastic-Cache 为 82.79%、41.7);batch 16 显存约 26GB,对照 Fast-dLLM 的 50GB 降约 48%,后者在 batch 24 直接 OOM。 Throughput and peak memory versus batch size on GSM8K 批判点评:赢面都在 dLLM 阵营内部:可扩展性图里自回归的 Llama3 在 batch 32 的吞吐仍高于 Flash-dLLM,「扩散 LLM 加速后追平 AR」还没有发生。精度与吞吐是硬权衡(80.2% 到 83.2% 对应 278 降到 186 tokens/s),宣传里 81 倍是对无 cache 基线的倍数,直接引用容易被误读成对 SOTA 的提速。 5. VideoGen-Agent:RL教会智能体用工具做视频 VideoGen-Agent: Reinforcing Video Generation Agents | Princeton University;Stanford University;UC Davis;MMLab, CUHK;BenchFlow;GWU | arXiv:2609.24997 关键词:生成智能体,强化学习,工具调用,视频生成,VABench 前序问题:视频生成模型面对需要专业知识、特定身份、物理一致或时序事件的 prompt 经常直接翻车:太极招式做不对、指定角色画不像、物理参数乱来。单靠扩大底模收益有限,缺一个会检索、仿真、检测来补信息的生成智能体。 本文贡献:六类任务上训一个共享策略:先在教师轨迹上 SFT 建立工具使用习惯(检索文本/图像、仿真、目标检测、深度估计等),再用类别感知混合奖励(工具调用合法性、任务适配度、视频质量)做 RL。配套 VABench:600 条 held-out prompt,覆盖程序知识、单/多实体身份、物理一致、场景合成、多镜头时序。 Overview of VideoGen-Agent 实验效果:VABench 上从底模 56.5 提到 75.6(+19.1 分);把生成工具换成更强的 Seedance 2.0 后,不重训智能体就到 86.1;人评 84.3% 偏好升级配置而非最强独立基线。 Qualitative comparison on Procedural Knowledge generation 批判点评:86.1 这档数字藏着归因问题:从 75.6 到 86.1 的增量完全来自换生成工具,智能体一行代码没动——agent 框架的收益上限被底模和工具质量强绑定,这一段「白捡的分」其实是底模的分。混合奖励里「视频质量」一项依赖 VLM 裁判打分,裁判偏差会直接写进策略,论文未讨论防 reward hacking 的机制。 6. Vorch-Human:一个模型统一说话人与歌声视频 Vorch-Human: Unified Multi-Task Human-Centric Generation via Long-Horizon Continuation | Vorch Team;Harbin Institute of Technology, Shenzhen;Tongji University | arXiv:2609.26117 关键词:音视频统一生成,数字人,扩散transformer,长视频,身份保持 前序问题:以人为核心的音视频生成被拆成好几个模型:语音驱动数字人、参考音色合成说话视频、外观加声音参考生成场景,各自训练各自维护。它们本质上是同一组模态、只是条件不同的任务。 本文贡献:双流音视频扩散 transformer,在传统 noisy 音频/视频接口之外增加 clean 条件 token 组,用 per-token 任务嵌入、时间位置类型、条件掩码和共享多模态 prompt 编码器,把驱动语音、音色样本、首帧、主体图统一进一个模型;两级数据管线做说话人聚类与跨片段身份串联;长视频靠冻结 latent 前缀递归、每段只生成新后缀。 Role-aware unified human-centric architecture 实验效果:5 分钟长生成保持身份一致与音画同步;GSB 人评对 LongCat-Video-Avatar-1.5:动作/姿态/表情净偏好 +46.9%,口型准确度 +47.5%,单人音视频驱动整体净偏好 +27.1%。 Raw GSB breakdown for LongCat-Video-Avatar-1.5 批判点评:同一张 GSB 图的另一半:视觉质量净偏好 -13.1%,多人场景再输 -9.2%——赢的两项全在「跟音频对齐」上,纯画质反而输给 LongCat,摘要里 strong identity preservation 的措辞没覆盖这个短板。署名主体写作「Vorch Team」,机构披露不完整,技术报告性质明显。 7. StableVQ:三招治住VQ码本训练崩溃 StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training | Huazhong University of Science and Technology;KlingAI Research;South China Normal University | arXiv:2609.26774 关键词:VQ tokenizer,码本利用率,训练稳定,自回归生成,ImageNet 前序问题:共享投影 codebook 把 VQ tokenizer 的利用率推上去之后,训练稳定性成了新瓶颈:码本利用长期趴在低位、出现永久死码、甚至在 26 万步附近突然崩到 0。现有方法各打各的补丁,缺少对根因的解释。 本文贡献:把根因归结为 Encoder-Decoder 与 Codebook 的「纠缠训练」:两个子系统各自都无法独立完成任务,只能靠碰巧合作维持。三个零参数改动:Dynamic STE 按量化距离压低不可靠梯度;Region VQ Loss 让激活码向邻近未激活码按比例传播目标;Decoupled Schedule 给两个子系统各配独立学习率调度。 Three characteristic failure modes of VQ training 实验效果:ImageNet 256 重建:262k 码本 120 epoch rFID 0.92(对照 FVQ 1.29、SimVQ 3.16),16k 码本 1.13;鲁棒性指标 UR-AUC 60.59,比 FVQ 的 8.08、SimVQ 的 2.17 高一个量级;只用单个线性投影层就追平需要 ViTBlock 投影器的 FVQ。 Qualitative reconstruction comparison with a 16k codebook 批判点评:主张是「治崩溃」,但主表里 FVQ 和 SimVQ 在各自标准配置下利用率本来就是 100%,差距全在故意制造码本-token 分布错配的鲁棒性测试里拉开——这三招买的更像「最坏情况的保险」,常态训练收益主要是 rFID 那 0.2 到 0.4。下游生成只给「competitive」,FID 全表在附录。 8. Qwen-Audio 3.1:全双工误答率从73%压到13% Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction | Alibaba Token Foundry, Alibaba Group | arXiv:2609.25176 关键词:全双工语音,语音智能体,GRPO,在线蒸馏,工具调用 前序问题:实时语音助手要同时干三件互相打架的事:理解还在演化的请求、执行动作、遵守对话规则(何时说、何时闭嘴、是否插话)。上一代在背景有人说话时 73% 的轮次会错误应答,全双工的「闭嘴」比「会说」更难。 本文贡献:Think/Act/Speak and Coordinate 三层:Core-Cocktail SFT 加 M2-OPD 多教师在线策略蒸馏迁移文本能力;自进化可执行环境加多粒度 rollout 的 GRPO 教工具调用与参数落地;全双工决策模型独立管「说不说」。另给 Voice Harness 前后台原型:对话在前台、任务在后台异步跑。 Qwen-Audio-3.1-Realtime model framework for continuous spoken interaction 实验效果:tau-Voice 半双工改编任务成功 78.4%→82.0%(Airline 64.0%→74.0%);Full-Duplex-Bench v1.5 背景语音应答率 73.0%→13.0%、恢复率 0.26→0.87;FLEURS 宏平均 WER 9.01→3.98;WebSearch1K 检索调用从 4.37 次降到 1.05 次(-76%)。 Qwen-Audio-3.1-Realtime post-training pipeline 批判点评:两个回撤写在正文里:EVA-A 的 Mean 分从 70.50 掉到 66.26,WebSearch1K 的 F1 从 60.87% 降到 58.61%——少说话、少调用是把双刃剑;Daily Chat 和 persona 交互的 Spoken 分也在微跌。摘要只报提升项,回撤要翻到结果表才看得见,读技术报告别只读开头。 9. RULER:六项Rubric奖励治SVG生成 RULER: Instance-aware Rubric Rewards for SVG Generation | Ant Group;The Hong Kong University of Science and Technology (Guangzhou);Independent Researcher;University of Oxford | arXiv:2609.25270 关键词:SVG生成,Rubric奖励,GRPO,reward hacking,视觉裁判 前序问题:自然语言生成 SVG 是没有绝对真值的开放任务:CLIP、Aesthetic 这些在自然图像上标定的标量指标迁到风格化矢量图上会误判,直接拿来当 RL 奖励还会触发 reward hacking——评测和优化同时失去可靠信号。 本文贡献:实例化 rubric 奖励:每条指令由前沿模型生成六项 rubric(语义、视觉、风格三轴),裁判 VLM 逐项给渲染 rollout 打分,加权满意度经 GRPO 优化。rubric 只从文本推导,不需要配对 SVG 真值、也不需要人类偏好标注。训练用 Qwen3-VL-8B 做裁判,与评测用的 GPT-5-mini 分开。 Qualitative comparison of scalable vector graphics generation between RULER and four baselines 实验效果:MMSVG-Illustration/Icon 上 rubric 分从 0.432/0.395 提到 0.693/0.683,超过专用 SVG 模型、追平大得多的 DeepSeek-V3;人评盲测对自家 Qwen3-8B 骨干胜率 89.7%、对 Qwen3-32B 66.1%;消融显示去掉语义轴掉 10.1%、换静态 rubric 掉 22.7%。 Ablation of rubric design on MMSVG-Illustration and MMSVG-Icon 批判点评:「追平 DeepSeek-V3」在可视化图里并非全赢:五个示例里同心圆靶一栏 DeepSeek-V3 的 0.94 高于 Ours 的 0.92;Ours 的 CLIP 分(0.28-0.35)与基线几乎无差,说明传统指标确实分不出好坏,但反过来也意味着 rubric 分数与人类直觉的对应完全押在裁判 VLM 上。人评规模只有 150 条 prompt。 10. Moderation Gap:三成有害视频骗过逐帧审核 The Temporal Moderation Gap: Text-to-Video Safety Filters Are Blind to Harm in Motion | National University of Singapore;University of New South Wales;Fuzhou University | arXiv:2609.26233 关键词:文生视频,安全审核,帧序,红队测试,评测方法 前序问题:T2V 服务的安全栈是从图像生成继承的:关键词过滤加随机抽 8 帧逐帧检查。这套栈对「伤害只存在于帧序」的视频天然失明——闯红灯、往转动的车床里伸手、误服药片,每一帧单看都无害。 本文贡献:理论上证明:任何忽略帧序的审核器只要放行某片段,就必然放行其良性重排。实测未修改的基准 prompt 就能让 32.7% 的 Sequential-Action 目标落入审核盲区,改写、拆场景、反馈式搜索都无显著改善(McNemar p≥0.12)——不需要任何 prompt 技巧就能触发。修复方向是读帧序:时序感知检测器 AUC 0.74,逐帧检查等于抛硬币。 The temporal moderation gap 实验效果:对 97 帧全部打分发现:约三分之一的交付片段只是把不安全帧藏起来,其余按帧序整体看仍有害,尽管每一帧都通过了审核;用户实验确认人能区分片段与其重排的安全性。 Three Sequential-Action gap clips 批判点评:论文顺带揭了一个测量陷阱:在搜索出的 prompt 上用它自己的渲染种子打分,会把 7.5% 的单次生成率虚标成 46.7%——这个坑对所有做安全评测的人都成立。但修复方案的 AUC 0.74 离可用尚远,且全部证据来自 Sequential-Action 一类动作伤害,跨帧累积的暗示性内容等其他类型未覆盖。 趋势观察 全模态模型开始从「能听会说」转向「能干活」 Qwen3.8-Omni 把上下文推到 100 万 token 并配好插件与实时 harness,Qwen-Audio-3.1-Realtime 则把「何时闭嘴」当成一等公民单独训练。两条线指向同一件事:多模态模型的竞争正在从感知指标挪向任务成功率,模型外面的 harness、插件和记忆管理层开始决定产品形态。 视频编辑与视频生成的瓶颈,先卡在数据而不是模型 VideoX-Qwen 用 120 万对合成编辑数据喂出一个统一编辑器,VideoGen-Agent 则用六类任务的教师轨迹加 RL 教模型调用工具。两者都在补同一个洞:指令视频任务缺少可靠的监督与反馈信号,谁的流水线能稳定产出高质量配对数据,谁就拿到上限。 加速这条线在「省显存」和「省访存」上分头推进,且都是训练无关 QuantWM 发现 2-bit KV 量化的真正受害者是时序稳定性而非单帧指标,用注意力补偿把闪烁压回去;Flash-dLLM 则把瓶颈定位到 GPU 显存 I/O,用融合核加自验证并行解码把吞吐推到 210.6 tokens/s。共同点是都不动训练,靠推理系统层的重新安排。 评测开始把「裁判本身」当成被审对象 RULER 证明静态标量指标在 SVG 上失灵,改用逐指令生成的 rubric 当奖励;Moderation Gap 则证明逐帧安全审核对帧序盲。两者都在说同一件事:在开放生成任务里,裁判的构造方式本身就是被评测对象,默认信任任何单一打分器都危险。 人工智能炼丹君 整理 | 2026-09-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-11|阿里13模型不会专业剪辑-CutCraft 今日 AIGC 论文速览 今日共 10 篇 · 音视频创作评测与安全 2 篇 · 可编程世界与物理视频 2 篇 · 生成后训练与统一多模态 2 篇 · 图像编辑与多视角生成 2 篇 · 设计自动化与合成数据 2 篇 重点论文标题列表 CutCraft(阿里巴巴、上海交通大学、复旦大学等):13模型不会专业剪辑 Programmable World Model(Alaya Lab):规则状态准确率98% ⚡ DIVA(Peng Li 等(ACM MM 2026)):参考图放大越狱风险 GGF(上海交通大学、中国电信人工智能研究院、中国科学技术大学):模型用自绘图反哺理解 FlowCPO(西湖大学、浙江大学、快手可灵团队):离线对齐GenEval达0.84 今日论文速览 1. CutCraft:13模型不会专业剪辑 Beyond Coherence: Benchmarking Professional Editing-Technique Execution in Multi-Shot Audio-Video Generation | 阿里巴巴、上海交通大学、复旦大学等 | arXiv:2609.08275 关键词:音视频生成,多镜头,剪辑评测,生成智能体 ⚠️ 前序问题:多镜头音视频模型已经能做出连贯、电影感强的片段,但现有评测多看画质、同步和物理合理性,无法判断模型是否真的执行了 J-cut、L-cut、转场时机和蒙太奇等专业剪辑指令。看起来像电影,不代表遵守了剪辑语法。 本文贡献:CutCraft 把结构化多镜头提示扩展为显式剪辑规格,并用镜头结构对齐、专家模型指标、工具化多模态判断和规则问答构成分层评测。作者还给出一个生成智能体基线:先规划镜头,再逐镜生成,最后做后期合成,使剪辑语义变成可执行步骤。 实验效果:对 13 个闭源与开源音视频生成模型的测试显示,当前系统普遍能维持内容连贯,却经常错过规定镜头数、转场关系和高阶蒙太奇;美学质量与剪辑指令遵循只有弱相关。智能体基线说明把剪辑拆成规划、生成和合成后更容易显式执行专业语法。 批判点评:混合评测仍依赖专家模型和多模态裁判,复杂剪辑意图可能被评分器误读。后期拼接能提升指令遵循,却可能掩盖底层生成模型不会原生控制镜头的问题;基准对真实剪辑师工作流、版权素材和长叙事的覆盖仍有限。 2. Programmable World Model:规则状态准确率98% Programmable World Model | Alaya Lab | arXiv:2609.10540 关键词:世界模型,视频生成,可编程状态,交互游戏 ⚠️ 前序问题:交互式视频世界模型能生成逼真的下一帧,却通常把角色生命值、阵营、库存和任务进度隐含在像素历史里。实体离开画面后,模型容易忘记它是否存活;自然语言提示也只能描述结果,无法保证规则在长时间交互中被稳定执行。 本文贡献:Programmable World Model 把世界状态演化与视觉生成拆开。编码智能体把自然语言规则写成可执行程序,轻量引擎维护包含屏外实体和非视觉属性的权威状态;状态增强的 3D 定向包围盒再经确定性编译器投影成身份、语义和运动方向控制图,预训练视频模型只负责把状态渲染成画面。 实验效果:在作者新建的 CombatStateBench 上,系统的存活角色数量准确率达到 94%,状态准确率达到 98%,并能在长时战斗交互中维持实体状态。它还支持用户预先编写游戏机制、逐个控制实体,并在镜头移开后继续保存世界事实。 批判点评:显式引擎让规则可验证,但也把开放世界压缩成包围盒、离散属性和手写转移规则;复杂物理、细粒度姿态与不可预设事件仍交给生成器补全。论文基准集中于战斗场景,面对大规模地图、多玩家并发和长期程序错误时的扩展性仍待验证。 3. DIVA:参考图放大越狱风险 The Price of Consistency: Exploiting Visual Anchors for Multimodal Jailbreaking in Video Generation | Peng Li 等(ACM MM 2026) | arXiv:2609.07216 关键词:视频生成,安全评测,多模态越狱,参考图控制 ⚠️ 前序问题:图生视频用参考图锁住主体和场景,提高时空一致性,但安全系统往往只重点审查文字。模型原本可能把危险提示漂移成无害内容,视觉锚点却会把生成过程拉回参考图中的危险意图,形成一致性越强、逃逸空间越小的安全悖论。 本文贡献:DIVA 是一个免训练多模态越狱框架,把危险意图拆成静态参考图和看似普通的运动提示,并用双重标准筛选兼顾隐蔽性与语义保真度的组合。论文同时提出 TI2VSafetyBench,用于专门评测多条件视频生成中的视觉锚定风险。 实验效果:作者在多家主流商业平台和开源视频模型上测试,DIVA 的攻击成功率显著高于纯文本攻击,说明只过滤提示词不足以覆盖图像与运动描述共同表达的风险。论文已被 ACM MM 2026 接收。 批判点评:攻击依赖先获得合适的危险参考图,现实系统还可能在上传、编码和输出阶段做二次视觉审核。公开越狱流程有双重用途风险;防御评估需要同时覆盖输入图、运动文本、跨模态组合和生成结果,且必须在平台更新后持续重测。 4. GGF:模型用自绘图反哺理解 Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models | 上海交通大学、中国电信人工智能研究院、中国科学技术大学 | arXiv:2609.08282 关键词:统一多模态,自训练,流模型,图像生成 ⚠️ 前序问题:统一多模态模型把理解和生成放进同一网络,却仍把两种能力当作独立任务训练。直接用模型自生成图像做自训练又会放大漏物体、属性错误和空间关系失真,缺少一种让生成经验反哺理解、再由理解修正生成的闭环。 本文贡献:生成接地反馈 GGF 只使用文本提示和模型自己的视觉梦境。流级反馈在同一噪声潜变量上比较文本、图像与修复条件的预测方向,把图像接地信息传回文本条件;梦境回放则通过描述和再想象,让可验证事实在两次生成间保持一致,并分离无关经验。 实验效果:在采用不同理解—生成融合设计的统一模型上,GGF 都带来一致的文生图提升,同时让视觉理解获得幅度较小但稳定的增益。方法不依赖额外成对图文数据,说明模型自身生成的图像可以成为双向训练信号。 批判点评:自生成经验仍受初始模型能力上限约束,流级一致不保证图像事实正确。回放和修复增加训练计算,如何过滤系统性偏见、避免错误闭环以及在闭源生成器上复现,仍是落地障碍。 5. FlowCPO:离线对齐GenEval达0.84 FlowCPO: A Unified Divergence View of Preference Alignment for Flow Models | 西湖大学、浙江大学、快手可灵团队 | arXiv:2609.09905 关键词:流模型,偏好对齐,离线优化,前向KL ⚠️ 前序问题:流与扩散模型的偏好对齐分成在线强化学习和离线偏好优化两派:前者必须不断从当前模型采样,成本高;后者常用正样本微调或似然比近似,既难解释与在线目标的关系,简化回归损失还可能无下界。 本文贡献:FlowCPO 用散度视角统一这些方法,并提出无需在线回滚的离线前向 KL 目标,同时利用偏好和拒绝样本。在线性插值及明确正则条件下,作者把前向 KL 上界化为可在固定数据上优化的对比流匹配损失,并证明该损失非负。 实验效果:在域内实验、CFG=3.0 时,FlowCPO 的平均 GenEval 与 OCR 分数分别为 0.84 和 0.87,高于 FlowDPO 的 0.81 和 0.74。域外测试中它取得最佳 GenEval,但多项奖励分数低于 RFT,结果并非全面领先。 批判点评:理论上界依赖线性插值和正则条件,真实大模型训练是否满足需要验证。离线数据省掉采样,却继承偏好数据覆盖与标注偏差;负样本权重、参考先验和插值系数也会带来额外调参成本。 6. PhysFlow:5万物理视频教会运动 PhysFlow: Physics-Aware Optical Flow for Motion Controllable Video Generation | 中科院自动化所、中国科学技术大学、北京航空航天大学、中关村学院 | arXiv:2609.08215 关键词:视频生成,物理一致性,光流,运动控制 ⚠️ 前序问题:视频生成器能做出漂亮纹理,却常出现碰撞错误、非刚体变形失真和前景背景接触不合理。完整物理引擎依赖准确 3D 重建和材料参数,文字或稀疏轨迹又不足以描述像素级形变,需要一种介于模拟状态和最终外观之间的密集运动表示。 本文贡献:PhysFlow 把生成拆成两步:PA-Flow 根据速度、加速度、密度和杨氏模量生成物理感知光流,分别建模全局运动与局部形变;FlowRender 再以光流视频为条件合成纹理。配套 PhysVideo 用物理引擎与 3D Gaussian Splatting 构建显式监督。 实验效果:PhysVideo 包含 1 万个前景物体和 5 万段带运动、材料属性标注的视频。实验显示 PhysFlow 在保持视觉质量的同时提升物理合理性,并能从单图处理非刚体运动、物体交互及前景背景接触。 批判点评:光流适合二维位移,却无法显式表达遮挡后的三维结构、拓扑变化和长期守恒量;两阶段误差也会累积。方法仍需用户或数据提供材料与运动属性,开放世界里这些参数通常难以可靠获得。 7. MIEdit:千组编辑基准无需调参 Multi-History-Step SDE Inversion for Image Editing with Superior Regional Awareness | 中科院自动化所、国科大(ECCV 2026) | arXiv:2609.06602 关键词:图像编辑,SDE反演,语义遮罩,免训练 ⚠️ 前序问题:免训练扩散编辑要在重建原图与服从新提示之间取舍。现有 ODE/SDE 反演步数多、编辑幅度受限,增大 CFG 还可能产生伪影;非编辑区域保护通常需要额外遮罩输入或独立分支。 本文贡献:MIEdit 用预测—校正的多历史步 SDE 反演,在每一步复用至少两个历史项,以更少步数提高稳定性和编辑可塑性;同时调整噪声日程缓解大幅编辑冲突。IASM 在反演早期借助 CFG 方向自动生成语义角度遮罩,并贯穿后续采样约束区域。 实验效果:作者构建 EditEval++,覆盖 30 个细粒度任务和超过 1,000 组图像—文本—遮罩三元组。实验显示 MIEdit 在无需微调、无需外部遮罩的条件下超过所比较方法,并能把输入重建到数值精度范围。论文已被 ECCV 2026 接收。 批判点评:多历史项会增加缓存与实现复杂度,自动遮罩质量仍依赖基础模型的 CFG 响应。论文主要围绕扩散 SDE 编辑,迁移到流匹配模型、超高分辨率和多对象关系编辑时是否稳定还未充分验证。 8. StreetDiff:全景约束街景多视角 StreetDiff: Multi-view Street Scenes Generation via Cross-view Consistent Multi-view Stable Diffusion with Structure Prompts | 深圳大学 | arXiv:2609.09890 关键词:多视角生成,街景,全景图,结构控制 ⚠️ 前序问题:多视角扩散在室内或简单自然场景表现不错,面对道路、建筑和动态目标密集的城市街景时,镜头旋转后容易重复物体、扭曲建筑和破坏布局。相邻视角注意力缺少球面几何对应,难维持全局结构。 本文贡献:StreetDiff 让全景分支负责全局布局、透视分支负责局部细节,并用 Panorama Alignment Module 按球面投影建立跨视角注意力约束。结构提示可来自分割图、轮廓或草图;作者还构建带文本和密集结构标注的 HDR 城市全景数据集 Street360。 实验效果:实验显示 StreetDiff 在街景生成质量和多视角几何一致性上超过所比较基线,尤其改善纯文本条件下的建筑与道路结构;它无需修改扩散骨干即可注入几何对齐。 批判点评:球面全景是有效的全局脚手架,但真实街区包含强遮挡、动态交通和大范围深度变化,二维投影约束仍可能失效。Street360 的地域与天气覆盖、从合成多视角到可导航 3D 场景的差距也需要检验。 9. LoGAN:少量字形扩展27种语言 LoGAN: Multilingual Font Localization with Generative Agents | Netflix(ECCV 2026) | arXiv:2609.07029 关键词:字体生成,多语言,VLM智能体,扩散模型 ⚠️ 前序问题:把一个品牌字体或电影 Logo 本地化到新语言,不只是生成单个字形,还要保留笔画风格、纹理、颜色、字距和字偶距。通用生图模型常改乱排版,传统字体生成又难从拉丁字母跨到结构复杂的中日韩字符。 本文贡献:LoGAN 用 VLM 智能体协调字形级扩散、少样本风格微调、字距与字偶距迁移以及纹理扩展模块。输入少量原字体字形或 Logo 字母后,系统分别解决结构、排版和材质,再组合成目标语言的完整字符集。 实验效果:论文覆盖超过 27 种语言,包括拉丁、希腊、西里尔与中日韩文字;在字体和真实 Logo 数据上,相比字体专用模型及 FLUX、Nano-Banana 等编辑模型取得更高字形保真度,并更好保持风格、纹理和字距。400 个电影 Logo 样本中有 44% 基于字体制作。 批判点评:多模块流水线提升可控性,也放大任一环节的误差和运行成本。少数字形可能不足以覆盖复杂脚本的部件组合、书写规范与文化设计语义;字体版权、人工修字和完整字符编码支持仍是商业落地条件。 10. AnomalyCraft-700K:4万异常视频70万标注 AnomalyCraft-700K: Component-Level Controllable and Verifiable Synthetic Anomalies for Fine-Grained Video Anomaly Understanding | 西北工业大学、新加坡管理大学 | arXiv:2609.06978 关键词:视频生成,异常检测,合成数据,多模态理解 ⚠️ 前序问题:真实异常视频稀少、难控制,已有合成数据通常只按类别或整句提示生成,提示与画面细节不一定一致,也缺少靠近正常—异常边界的困难正常样本,模型容易根据表面线索而非事件语义判断。 本文贡献:AnomalyCraft 把异常事件拆成场景、背景、主体、物体和有向交互五类组件,通过三阶段生成逐步放松非关键约束。相同组件同时作为核验单元,定位并人工修正视频—文本偏差;每个异常类别还配套语义接近但实际正常的困难反例。 实验效果:数据集包含超过 4 万段视频和 70 万条任务级文本标注,覆盖从异常检测、检索、描述到细粒度推理的六类任务。传统模型和多模态大模型评测都显示,它能为异常检测与理解提供有效监督。 批判点评:合成器的视觉偏差可能成为捷径,组件级人工修正也带来高成本和主观性。模型在该数据上提升不代表真实监控、开放场景和未见异常同样受益,需与真实数据混合训练并做跨域验证。 趋势观察 生成评测开始检查专业过程 CutCraft不再只看画质和连贯性,而是逐项检查镜头、转场和音画剪辑语法,说明创作模型的评价对象正在从结果扩展到过程执行。 世界模型从像素记忆走向权威状态 Programmable World Model把规则与实体状态交给可执行引擎,生成模型退回渲染器角色;可验证状态开始成为长期交互的一等公民。 条件越强,跨模态安全面越大 DIVA揭示参考图既提升一致性也会固定危险意图;安全策略需要联合审查图像、文字运动条件与输出,而不能只过滤提示词。 生成模型用结构中间态换取控制 从PhysFlow的光流、StreetDiff的全景几何到MIEdit的语义角度遮罩,低维且可解释的中间表示正在连接高层意图与像素生成。 人工智能炼丹君 整理 | 2026-09-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-06|京东22B音画同修让百年老片复活OmniVR 今日 AIGC 论文速览 今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇 重点论文标题列表 OmniVR(中科大·京东探索研究院):22B让百年老片音画一起复活 JoyAI-Video-Edit(京东Joy Future Academy):16B单卡30FPS实时剪视频 ContextMaster(清华·南京大学·快手可灵·上科大·港科大):固定预算多镜头创作跑16.74FPS OmniPack(西北工业大学·北大·阿里·清华):无训练6.8%算力保住92.9% STEP-OPD(上海交大·阿里):蒸馏学生越过教师得分0.961 今日论文速览 1. OmniVR:22B让百年老片音画一起复活 OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224 关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东 前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。 本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。 实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。 批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。 2. JoyAI-Video-Edit:16B单卡30FPS实时剪视频 JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974 关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东 前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。 本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。 实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。 批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。 3. ContextMaster:固定预算多镜头创作跑16.74FPS ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956 关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵 前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。 本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。 实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。 批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。 4. OmniPack:无训练6.8%算力保住92.9% OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812 关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速 前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。 本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。 实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。 批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。 5. STEP-OPD:蒸馏学生越过教师得分0.961 STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887 关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成 前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。 本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。 实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。 批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。 6. TD-V2A:帧间差分让视频配音FAD降至0.53 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902 关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征 前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。 本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。 实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。 批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。 7. CAPE-T2V:训练推理两头对齐提示词 CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046 关键词:文生视频,提示增强,训练推理对齐,Caption,可灵 前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。 本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。 实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。 批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。 8. Two-Stage Token Pruning:只留10%视频Token还涨7分 Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112 关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon 前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。 本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。 实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。 批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。 9. OmniEdit-Bench:五赛道揭穿视频编辑假高分 OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049 关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相 前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。 本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。 实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。 批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。 10. CSGen:2.4万样本守住血管道路裂缝 CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655 关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM 前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。 本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。 实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。 批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。 趋势观察 音视频联合模型开始从内容生成反向进入修复 — OmniVR 直接复用 22B 音视频生成骨干,同时恢复老片画面、声音与同步关系;统一生成先验正在吞并过去彼此独立的增强管线。 视频编辑从固定短片走向实时、有状态和开放时长 — JoyAI 用两步自回归扩散在单 B200 达到 720p 约 30 FPS,ContextMaster 则以固定预算上下文支撑多轮多镜头创作,视频模型正从一次生成器变成持续工作的创作系统。 Token压缩从固定比例升级为内容与问题共同决定 — OmniPack 先保全局音视频结构、再按问题做语义精炼,Amazon 两阶段方案先删重复帧、再按谱冗余决定每帧预算;高效推理正在告别一刀切剪枝。 生成后训练不再满足于复刻教师或单边修补接口 — STEP-OPD 沿教师相对基础模型的能力方向继续外推,CAPE-T2V 则让同一个 Prompt Enhancer 同时定义训练与推理文本分布,优化目标从局部模仿转向端到端系统对齐。 视频能力评测开始补齐时间、声音与隐式推理 — OmniEdit-Bench 的五赛道显示最强商业编辑模型综合仍不足 40 分;TD-V2A 也证明只看语义无法评价配音,时间差分与同步指标将成为音视频系统的基本维度。 人工智能炼丹君 整理 | 2026-08-06 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-22|华为40万美元逼近闭源Boogu-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 2 篇 · 视频编辑与长视频一致性 5 篇 · 视频插帧与生成效率 1 篇 · 情绪语音生成 1 篇 · 像素扩散技术综述 1 篇 重点论文标题列表 Boogu-Image-0.1(华为香港AI Lab·港大·港科大):40万美元逼近闭源图像模型 D2DF(西交·国家电网AI Lab·浙工大·百度):视频消物一秒只需一步 SlotMem(港大·清华):按角色寻址记住长片人物 ReBind(快手可灵·港科大·南大·北大):显式绑定多参考视频编辑 FlowMimic(字节):图片编辑数据实时变视频 今日论文速览 1. Boogu-Image-0.1:40万美元逼近闭源图像模型 Boogu-Image-0.1: Boosting Open Agentic Multimodal Generation via Understanding under a Minimal Budget | 华为香港AI Lab·港大·港科大 | arXiv:2607.13125 关键词:统一多模态,文生图,图像编辑,Agent推理,开源模型 前序问题:Nano-Banana-Pro、GPT-Image-2 等闭源系统靠模型理解、提示改写与推理时编排形成系统级优势,但内部配方不公开;开源社区如何在有限数据和算力下同时做好文生图、快速推理、指令编辑和中英文字渲染,缺少可复现路线。 本文贡献:发布 Boogu-Image-0.1 开源统一理解生成模型族,含 Base、Turbo、Edit、Edit-Turbo。核心不是只堆生成骨干,而是强化多模态编码器、Agent 式提示重写、数据质量和训练管线,并用 Agentic inference-time scaling 把理解能力转成生成与编辑质量;权重、代码和训练配方均以 Apache 2.0 开源。 实验效果:仅使用 2.0862 亿张去重图像,Base 理论训练成本约 40 万美元;标准基准上持续匹敌或超过其他开源模型,结果逼近领先闭源系统,并覆盖高质量文生图、快速推理、指令编辑和中英文字渲染。 批判点评:「华为团队用 40 万美元把开源模型推近闭源系统」兼具机构信号与成本冲击力,且把系统级配方完整开放,比单点榜单更有价值。但“理论训练成本”未必包含数据、失败实验与基础设施总成本;逼近闭源的结论也依赖所选基准,真实复杂编辑和生产稳定性仍需社区复验。 2. D2DF:视频消物一秒只需一步 From Draft to Draft-Free: One-Step Video Object Removal via Privileged Distillation and Fast Planting | 西交·国家电网AI Lab·浙工大·百度 | arXiv:2607.14976 关键词:视频编辑,物体移除,一步生成,一致性蒸馏,视频修复 前序问题:视频物体移除中,光流/注意力传统方法容易留伪影、结果不自然;扩散方法更真实却需要多步去噪,速度难以实用,而且常依赖外部粗糙移除稿作为输入。 本文贡献:提出 D2DF 三阶段框架:先训练教师把低质移除草稿多步精修成高保真视频;再用先验特权一致性蒸馏(PPCD)将能力压到一步学生;最后以基于时序掩码 Transformer 的自引导快速植入(SGFP),在潜空间自动生成场景一致伪草稿,得到完全不依赖外部草稿的一步模型。 实验效果:有草稿和无草稿两版在多项指标上均达 SOTA,质量与效率超过传统及多步生成方法;单个视频的去噪过程约 1 秒。 批判点评:从“多步精修草稿”蒸馏到“无草稿一步消物”,既解决速度又去掉外部依赖,1 秒数字极具产品价值。但 SGFP 伪草稿的场景推断仍可能在大面积遮挡、复杂动态背景中失真,一步模型的失败可修复性也弱于多步迭代。 3. SlotMem:按角色寻址记住长片人物 SlotMem: Character-Addressable Internal Memory for Narrative Long Video Generation | 港大·清华 | arXiv:2607.15772 关键词:长视频生成,角色一致性,内部记忆,DiT,叙事视频 前序问题:叙事长视频中角色跨场景、隔很久再出现时容易换脸。全局记忆的检索线索并不针对身份,现有角色方法又把身份和姿态、背景等偶然因素混在粗粒度帧级 KV 中,有限容量下还缺少持续更新。 本文贡献:提出可按角色寻址的内部记忆 SlotMem:Character-Semantic Probe 从交叉注意力中定位角色相关 token;Memory Encoder 把 DiT token 压成紧凑的逐角色 slot;Memory Writer 随生成保守更新每个角色的新观察;Character-Wise Cross-Attention 只把对应角色记忆注入同一人物的局部 token。 实验效果:在多个叙事长视频基准上,相比现有方法显著改善跨长时间间隔的角色一致性,同时维持相当的视频总体质量;代码已开源。 批判点评:把“记住整帧”改成“按角色地址读写”,对多角色长片身份漂移非常对症,内存也更省。但角色探针一旦漏检或多人遮挡、换装,错误可能写回并长期污染;如何处理新角色、身份合并与开放世界角色数量仍是难点。 4. ReBind:显式绑定多参考视频编辑 ReBind: Multi-Reference Video Editing via Structured Instructions with Explicit Reference Relationships | 快手可灵·港科大·南大·北大 | arXiv:2607.14681 关键词:视频编辑,多参考,结构化指令,可灵,视觉绑定 前序问题:多参考图条件视频编辑需要明确“哪个参考提供哪个属性”,但自然语言指令通常不写清参考关系,通用 MLLM 也难稳定生成,导致人物、材质、灯光等来源互相串线。 本文贡献:提出 ReBind,以在语义位置嵌入 reference token 的结构化指令作为中间表示,显式绑定视觉属性与来源。ReBind-Instruct 通过两阶段渐进训练学习生成精确参考关系;ReBind-Edit 则轻量适配文生视频模型,按绑定关系协调多个参考源。 实验效果:ReBind-Instruct 的指令质量显著超过通用 MLLM;ReBind-Edit 在参考图条件视频编辑中达到开源方法 SOTA,能更准确组合多视觉来源。 批判点评:把多参考歧义从“模型自己猜”变成结构化显式绑定,是复杂编辑走向可控生产的关键一步,可灵团队也有真实产品场景。但需要专用 MLLM 先生成中间指令,链路更长;参考关系正确不代表遮挡、几何和时间一致性一定正确。 5. FlowMimic:图片编辑数据实时变视频 FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry | 字节 | arXiv:2607.18227 关键词:视频编辑,数据生成,光流,图像视频统一,免Mask 前序问题:视频编辑数据采集依赖人工 mask、I2V/ControlNet 合成和 VLM 过滤,不仅耗时、易引错,任务多样性也远落后图像编辑;推理时还常需外部 MLLM 或显式 mask 才能定位编辑区域。 本文贡献:提出像素对时序扭曲流场,可从图像编辑样本实时生成对应视频编辑样本,并证明仅用这类数据即可学习多层级视频编辑。将图像视作视频特例,以生成/编辑两种 modality mimic loss 让图像与视频能力互相模仿;再加入指代表达分割等感知任务和区域感知潜空间、注意力损失,让模型内化“理解指令—定位区域—只改该处”的能力。 实验效果:无需人工视频 mask 与传统重型合成管线,即可在线扩展多种视频编辑任务;同一模型统一图像/视频生成与编辑,并实现推理期免 mask 的区域感知编辑。 批判点评:把海量图像编辑数据通过流场实时“升格”为视频数据,直击视频编辑数据荒,字节背景也说明工程价值。但扭曲流场能模拟的运动与遮挡仍有限,由图像任务迁移出的时序规律未必覆盖真实长视频和复杂镜头运动。 6. STBridge:让模型说的和画的一致 STBridge: Shared-Target Alignment for Bridging Understanding and Generation in UMMs | 腾讯优图·吉林大学 | arXiv:2607.17140 关键词:统一多模态,理解生成对齐,图像编辑,强化学习,腾讯优图 前序问题:统一多模态模型虽然共用架构,却可能正确描述目标、实际编辑出另一回事;语言输出与视觉输出分居不同空间,在细粒度实体、属性、空间关系和局部细节上尤其缺乏同一目标约束。 本文贡献:提出共享目标对齐 STBridge:在图像编辑中,让目标 caption 表达期望视觉结果、编辑图像实现同一结果,以共同目标状态串起理解和生成。训练采用 align-then-optimize:先监督微调建立共享目标通道,再以序列强化学习优化围绕目标的跨任务协同。 实验效果:在视觉理解、图像生成和图像编辑基准上均持续优于初始化模型;对齐分析确认“模型描述的目标”和“模型生成的结果”之间差距明显缩小。 批判点评:指出“共架构不等于共语义”,并用共享目标把说与画绑在一起,是统一模型后训练的重要方向。但依赖高质量目标 caption 和顺序 RL,目标文本可能成为新的信息瓶颈;复杂视觉变化也未必能被一句 caption 完整表达。 7. TANGO:测试时绕开长视频死路 Test-Time Noise Guided Adaptation for Realistic Autoregressive Video Generation | CERTH·阿姆斯特丹大学 | arXiv:2607.15849 关键词:自回归视频,测试时适配,长视频,噪声引导,FVD 前序问题:自回归视频扩散可生成任意长视频,却会累积误差并逐渐偏离训练条件分布;即使每帧看起来都在真实流形上,某些轨迹也可能走到模型无法继续的“终点”,后续必然崩坏。 本文贡献:提出测试时终点规避 TANGO:假设可良好延续的未来轨迹,其预测噪声应匹配前向加噪的各向同性高斯分布。模型先向前预测一步,用自身充当输出批评器;一旦预测噪声偏离期望分布,就搜索替代轨迹,避免驶入终点,无需重新训练骨干。 实验效果:相对 SOTA,VBench 绝对提升 3.1%,15 秒视频上的平均 FVD 降低 28.3%;代码已开放。 批判点评:让扩散模型用噪声分布自检未来能不能走通,比只把当前帧拉回真实流形更深入,测试时即可插入。但前瞻搜索增加推理开销,各向同性噪声假设未必适合所有内容,且只能绕路、不能补足模型缺失的动态知识。 8. SPEED:一步像素扩散插帧快63% SPEED: One-Step Pixel Diffusion for High-quality Video Frame Interpolation | ACM MM 2026·复旦·B站 | arXiv:2607.15585 关键词:视频插帧,像素扩散,一步生成,4K,ACM MM 前序问题:扩散视频插帧有两大瓶颈:潜空间经 VAE 解码不可避免丢失细节,多步采样又带来高显存与高延迟;尤其 4K 插帧中,精细纹理与效率难兼得。 本文贡献:提出一步像素扩散 SPEED:渐进多阶段架构配动态 patch 缩放,学习多尺度运动、结构和外观;Noise-Update-Only Attention 只更新噪声、保护干净条件帧语义并把计算降近 50%;漂移感知时间步采样与定制目标直接在像素空间预测图像,实现不降质的一步推理。 实验效果:SNU-FILM 上 LPIPS 降低 8.8%,推理加快 63.3%、显存降低 10.6%;在高难 4K 基准上 LPIPS 最多优于先前方法 51.5%,达到 SOTA。 批判点评:一步、像素空间、4K 三个难点同时拿下,复旦+B站且获 ACM MM 2026,数字很硬。但像素扩散训练成本可能转移到离线阶段,动态 patch 与多阶段结构更复杂;插帧 SOTA 不等同于通用视频生成可直接受益。 9. AuEmoChat:离散情绪token让对话更真 AuEmoChat: Authentic Emotion Understanding and Rendering for Conversational Speech Synthesis | ACM MM 2026·内蒙古大学·港中文深圳 | arXiv:2607.15755 关键词:对话语音合成,情绪生成,Flow Matching,Token合并,TTS 前序问题:对话语音合成要理解多轮上下文并表现像人的细腻情绪,但现有方法常把情绪压成七类等有限标签;同时历史中的冗余多模态 token 干扰上下文理解,导致声音情感僵硬或前后不一致。 本文贡献:提出 AuEmoChat:AuEmoCodec 用有限标量量化从大规模情绪语音学习离散真实情绪 token 空间;AuEmoToMe 在保留情绪相关上下文的同时合并冗余多轮 token;自回归文本-语音模型预测目标情绪与语音 token,最后用 Authentic Emotion Flow Matching 联合对话上下文、情绪和声学先验渲染语音。 实验效果:在 NCSSD-EmCap 上超过 SOTA 对话语音合成基线,生成语音的情绪表达更丰富、更真实;代码与语音演示计划开放。 批判点评:从少数人工情绪标签转向数据驱动的离散情绪空间,并同时处理多轮冗余,贴近真实对话产品。但“真实情绪”评价主观且受数据文化偏差影响,离散 token 也可能把连续情绪重新切碎;跨语言、跨说话人泛化仍是关键。 10. Pixel-Space DiT:像素DiT绕开VAE细节瓶颈 Pixel-Space Diffusion Transformers | 北大·Stanford·Cornell·南大 | arXiv:2607.17585 关键词:像素扩散,DiT,VAE,生成综述,统一多模态 前序问题:潜扩散靠 VAE 压缩实现高效高分辨率生成,但固定视觉 tokenizer 会丢纹理和结构细节,重建目标与生成目标分离也限制端到端优化;直接像素扩散则面临高维建模、噪声调度、损失加权和 token 效率难题。 本文贡献:系统综述 Pixel-Space Diffusion Transformer,从模型架构、连续生成机制和统一多模态建模三条线梳理直接在原始像素上扩散的方法,讨论如何去掉 VAE 瓶颈,并让像素、文本与任务条件进入共享 token 空间由同一 Transformer 处理。 实验效果:归纳当前像素 DiT 的代表方法、核心挑战与技术路线,指出其在高保真单阶段生成及理解生成一体化视觉基座上的潜力,并给出未来研究方向。 批判点评:像素空间正在重新成为生成主线,这篇综述适合建立全景认知;但它不是新算法、没有单一实验突破,且像素 DiT 的巨大训练成本与 token 数仍是现实约束,应放在今日列表末尾而非主推。 趋势观察 开源图像模型开始公开系统级配方 — Boogu-Image 不只开权重,还公开强编码器、Agent 提示改写、数据与训练管线,以约 40 万美元理论成本逼近闭源系统,竞争从单模型走向完整生成系统。 视频编辑同时冲刺一步化与免标注数据 — D2DF 把视频消物压到一步约 1 秒,FlowMimic 则把图像编辑样本实时变成视频数据;一个砍推理成本,一个砍数据成本。 长视频从全局缓存转向结构化记忆与自检 — SlotMem 按角色地址读写身份记忆,TANGO 在测试时用预测噪声自检轨迹死路,长视频一致性开始从粗粒度历史帧走向可解释内部状态。 复杂编辑把视觉来源和目标语义显式绑定 — ReBind 用 reference token 绑定多参考来源,STBridge 用共享目标绑定模型说的与画的,可控编辑正在减少让模型自行猜测的隐式接口。 生成底座向像素空间与真实情绪扩展 — SPEED 以一步像素扩散实现 4K 插帧,Pixel-Space DiT 总结绕开 VAE 的技术路线;AuEmoChat 则把生成边界扩到多轮对话中的细腻情绪语音。 人工智能炼丹君 整理 | 2026-07-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
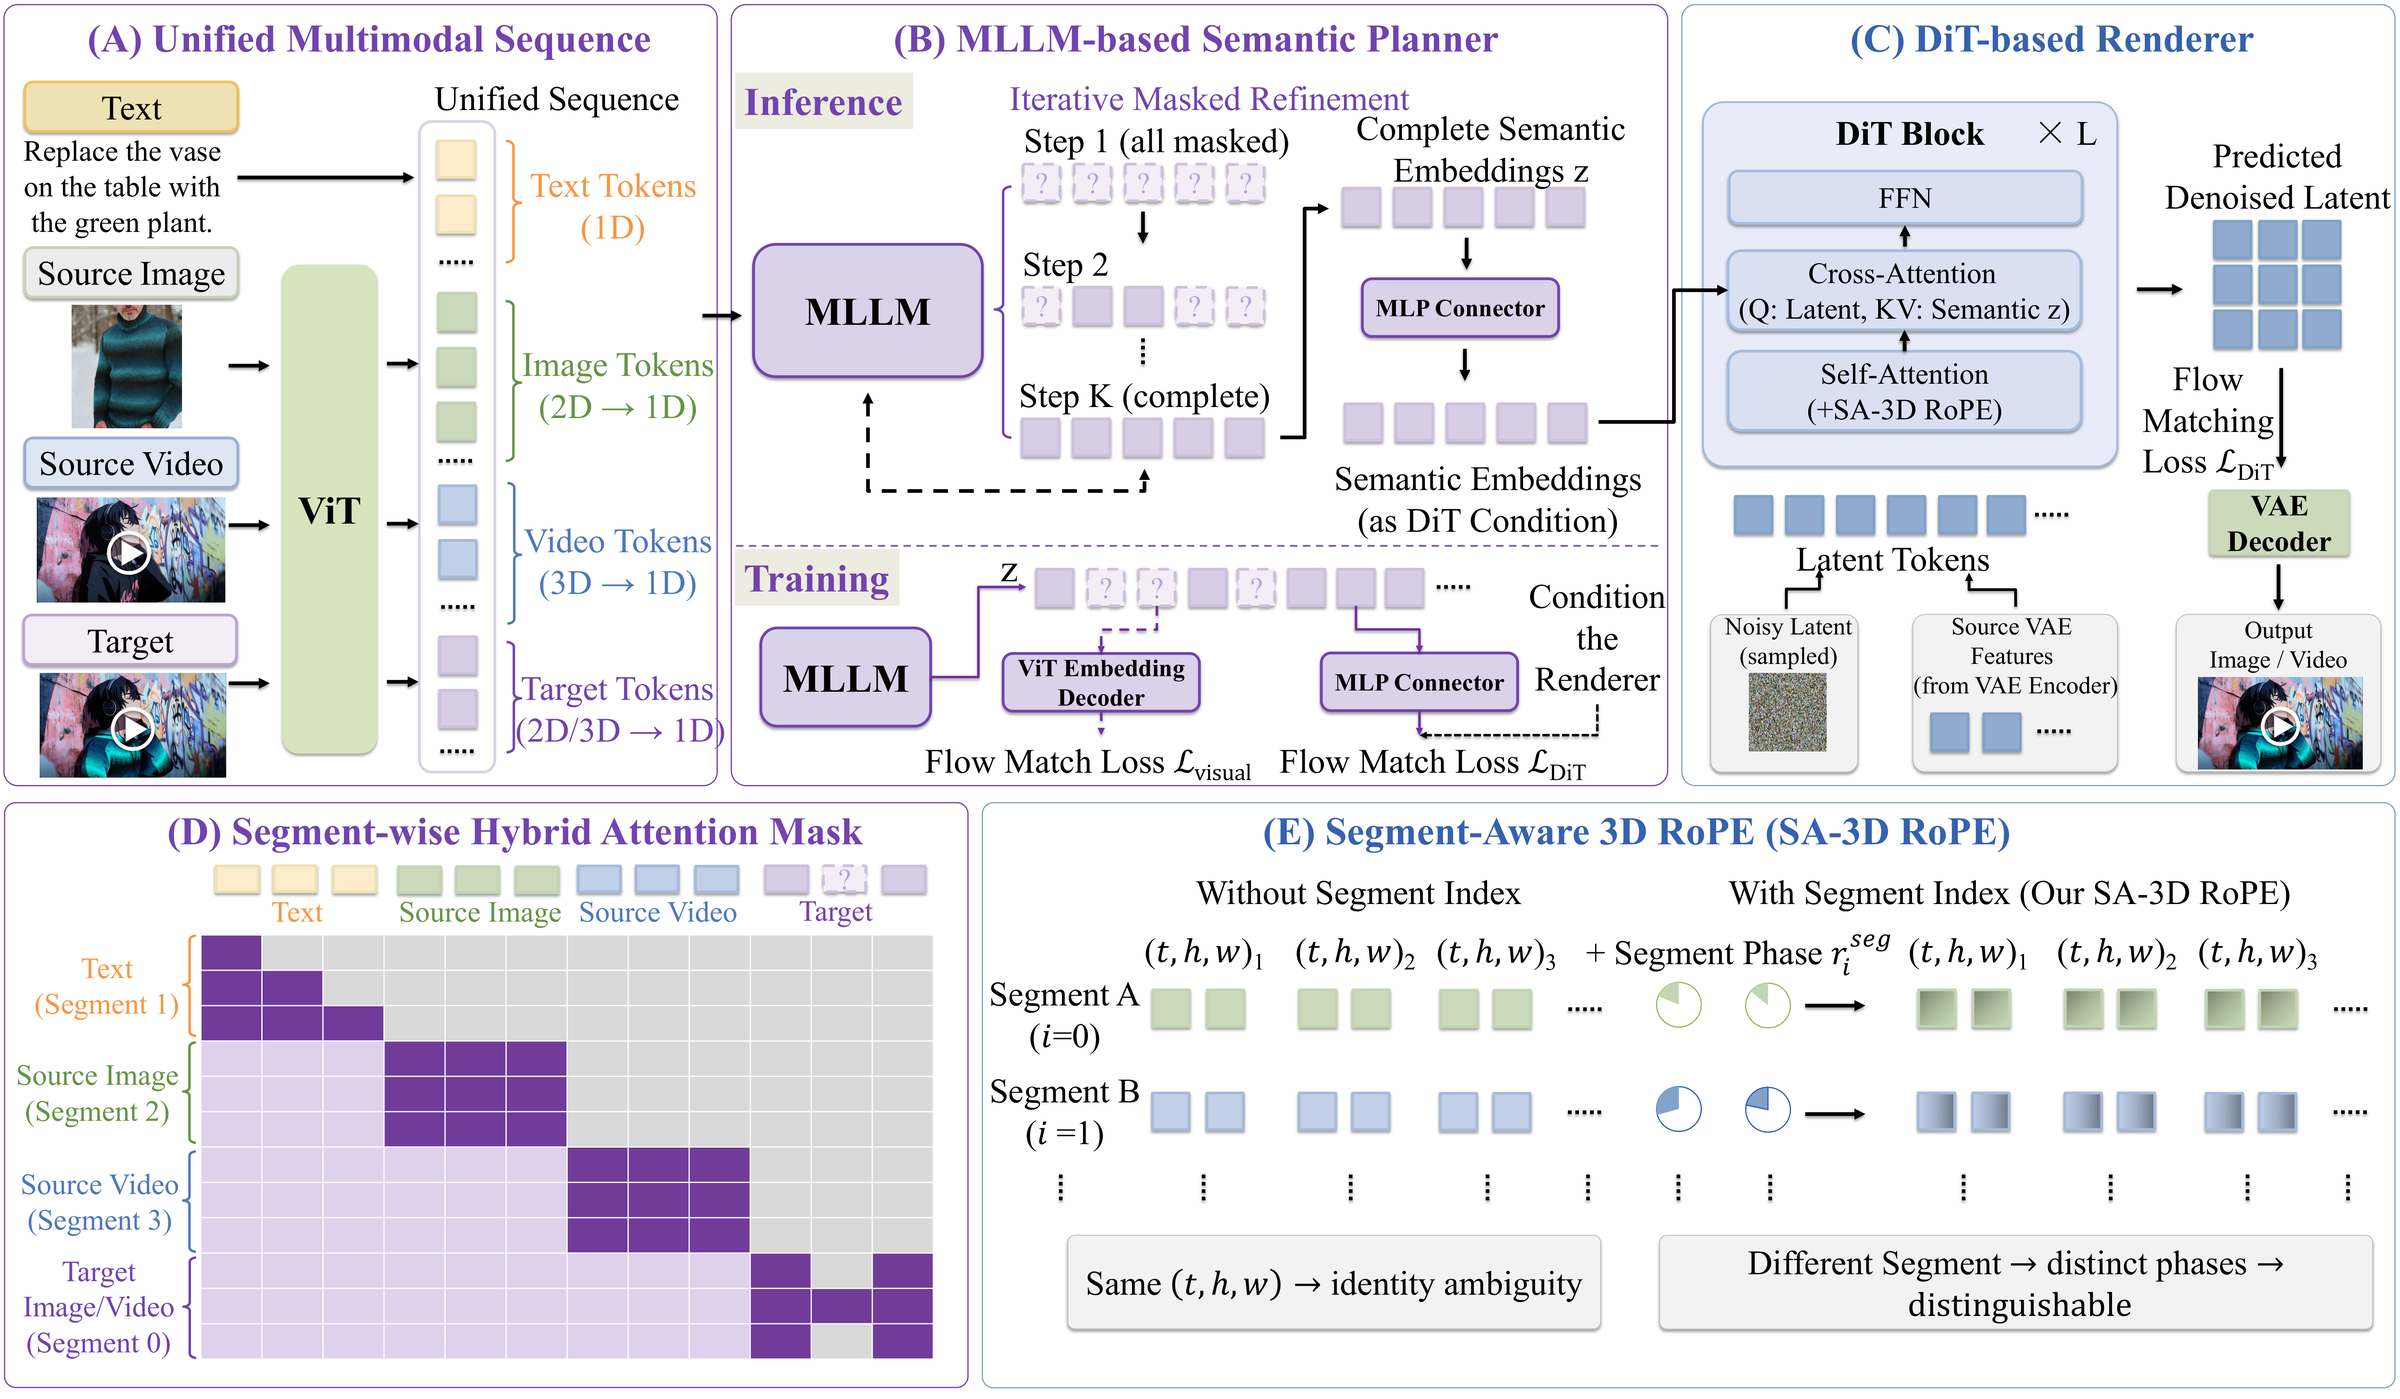
AIGC 每日速读|2026-07-21|腾讯混元4步视频胜50步强化扩散MeanFlowNFT 今日 AIGC 论文速览 今日共 5 篇 · 生成强化学习与少步加速 1 篇 · 视频DiT系统加速 1 篇 · 世界模型与科学多模态生成 2 篇 · 多模态智能体安全 1 篇 重点论文标题列表 MeanFlowNFT(腾讯混元·港科大):4步视频胜50步强化扩散 FVAttn(腾讯微信·中山大学·北大):稀疏注意力提速4.41倍 Orbis 2(弗赖堡大学):分层世界模型兼顾远景细节 S1-Omni(ScienceOne AI·文歌科技):统一200类科学任务推理生成 Lucid(UC Irvine):不可见扰动毒化智能体记忆 今日论文速览 1. MeanFlowNFT:4步视频胜50步强化扩散 MeanFlowNFT: Bringing Forward-Process RL to Average-Velocity Generators | 腾讯混元·港科大 | arXiv:2607.15273 关键词:视频生成,MeanFlow,强化学习,少步采样,奖励对齐 前序问题:MeanFlow 通过预测时间区间平均速度实现少步生成,但现有 DiffusionNFT 前向过程强化学习优化的是瞬时速度,两者目标不匹配;如何在保留 MeanFlow 少步采样优势的同时做可靠奖励对齐,仍未解决。 本文贡献:提出 MeanFlowNFT:利用连接平均速度与瞬时速度的 MeanFlow 恒等式,构造诱导瞬时速度预测器,再把 DiffusionNFT 目标施加到该预测器上,使奖励优化在数学上成立;实际采样仍走平均速度,因此保留快速少步生成,并证明继承 DiffusionNFT 的严格策略改进保证。 实验效果:图像与视频生成均稳定提升基线;SD3.5-M 的 8 项指标中 6 项超过此前 SOTA 少步 RL 生成器。Wan2.1 上仅 4 步即获 VBench 84.33,超过 50 步 LongCat-Video RL 的 82.57。 批判点评:把瞬时速度 RL 桥接到平均速度生成器,既有理论保证又拿出「4 步胜 50 步」的工业级数字,腾讯混元背景也很接近落地。但仍依赖 DiffusionNFT 的奖励与训练设定,少步模型在复杂长视频、细粒度运动上的稳定性,以及不同奖励下是否都能保持严格改进仍需扩验。 2. FVAttn:稀疏注意力提速4.41倍 FVAttn: Adaptive Sparse Attention with Runtime Load Balancing for Video Generation | 腾讯微信·中山大学·北大 | arXiv:2607.16190 关键词:视频DiT,稀疏注意力,负载均衡,多GPU,推理加速 前序问题:高分辨率视频 DiT 的长时空序列让自注意力成为主瓶颈;免训练 Top-p 稀疏注意力虽省计算,却在多 GPU 序列并行下造成各注意力头负载不均,最慢 rank 拖住全局同步,稀疏收益被等待开销吃掉。 本文贡献:提出 FVAttn 免训练稀疏注意力系统:以 Top-p 路由、Top-k 安全下限和视频感知分块构造稀疏前端,再按当前真实 mask 在运行时修复调度。运行时负载均衡通过 P2P 迁移少量重头缩短关键路径;Slack-Aware Sparse Augmentation 用额外高价值块填充非关键 rank 的空闲,并将调度与迁移开销同计算重叠。 实验效果:在步蒸馏 Wan2.2 I2V 上把平均负载不均衡从 1.34 降至 1.08;相对 FlashAttention,注意力提速 4.41×、DiT 推理提速 2.02–2.11×,同时保持有竞争力的视频质量。 批判点评:抓住「稀疏了却被最慢 GPU 拖死」这一系统瓶颈,运行时搬重头+用高价值块填空闲的设计很工程化,4.41× 注意力提速也扎实。但收益依赖多 GPU 序列并行、专用调度与 P2P 拓扑,单卡无红利;跨模型、不同显卡互联与更长视频下的迁移开销边界仍待验证。 3. Orbis 2:分层世界模型兼顾远景细节 Orbis 2: A Hierarchical World Model for Driving | 弗赖堡大学 | arXiv:2607.15898 关键词:驾驶世界模型,分层预测,Diffusion Forcing,DINOv2,长时生成 前序问题:现有驾驶世界模型通常只在单一抽象层预测:要么追求像素保真却缺空间推理与语义理解,要么长时滚动误差不断累积,难同时服务真实下游规划与高质量生成。 本文贡献:提出分层驾驶世界模型,将未来预测拆成两个时间与抽象尺度:高层预测器在压缩 DINOv2 语义潜空间中预测长时粗场景结构和子目标;低层生成器在 VAE 潜空间中受高层输出条件约束,生成短时精细画面。训练上先用 diffusion forcing 获得更丰富表征,再用 teacher forcing 微调以稳定自回归滚动。 实验效果:在标准驾驶世界模型评测上全面达到 SOTA,覆盖长时生成保真、反事实场景下的转向响应,以及内部表征质量;兼得高感知保真与更强空间、语义表示。 批判点评:「高层管远景语义、低层补近景细节」符合驾驶规划的天然层级,两阶段训练也把 diffusion forcing 的表征优势与 teacher forcing 的稳定性拼起来。但系统复杂、两级误差会相互传递,对极端交通事件和跨城市域偏移的可靠性,以及是否真能改善闭环驾驶安全仍需实车验证。 4. S1-Omni:统一200类科学任务推理生成 S1-Omni: A Unified Multimodal Reasoning Model for Scientific Understanding, Prediction, and Generation | ScienceOne AI·文歌科技 | arXiv:2607.15686 关键词:AI4S,统一多模态,科学生成,分子生成,科学图像 前序问题:AI for Science 被领域模型、工具增强 LLM 与科学语言模型割裂,不同模型各管蛋白、分子、材料或图像,难在同一模型里联合建模异构数据、科学规律和专家知识。 本文贡献:提出 S1-Omni,以三部分统一科学理解、预测与生成:把自然语言、CIF、SMILES、蛋白序列、光谱和科学图像映入共享任务空间;在数据构造、验证与训练中注入科学定律和专家知识;按任务连接原生领域解码器,支持属性预测、光谱到分子生成、蛋白位点/结构预测、科学图像生成与编辑。S1-Omni-Corpus 覆盖 200 类科学任务和数百万推理样本。 实验效果:在 60 多个科学基准上评测,多数基准超过 GPT-5.5 与 Gemini-3.1-Pro,并在若干任务上匹敌或超过领域专用模型。 批判点评:将符号序列、科学图像与领域规律放进统一模型,200 类任务与 60+ 基准规模很有冲击力。但跨领域总榜容易掩盖单任务深度,科学定律是否真正进入推理而非数据相关性、闭源强基线的评测公平性,以及科学生成结果的实验可验证性都需独立复核。 5. Lucid:不可见扰动毒化智能体记忆 Do Agents Dream of False Memories? Black-box Visual Attacks on Long-term Memory in Multimodal AI Agents | UC Irvine | arXiv:2607.15657 关键词:多模态智能体,长期记忆,视觉攻击,记忆投毒,安全 前序问题:多模态智能体把历史图文写进长期记忆并在未来检索,却默认视觉数据可信、没有语义完整性验证;攻击者若只改图片、不能碰文本与模型,是否仍能持续污染后续生成,尚未被系统研究。 本文贡献:提出 Lucid 黑盒视觉攻击框架,在不知道目标 MLLM、检索编码器或文本通道的严格图像边界威胁模型下,构造肉眼不可见扰动:有历史文本上下文时做 memory poisoning,替换被文本强化的良性图像并扭曲回忆;无上下文时做 memory injection,让图像直接注入攻击者叙事。覆盖图结构、LLM 摘要及商业系统等五种黑盒记忆架构。 实验效果:跨多种对话领域,记忆投毒攻击成功率达 61.6%,记忆注入达 58.4%,暴露出多模态长期记忆「检索相似即信任」的结构性漏洞。 批判点评:只靠不可见图片扰动、完全黑盒就能让错误记忆跨会话持续生效,攻击面比单轮越狱更危险,数字也足够醒目。但实验仍依赖代理视觉编码器的迁移性;现实平台的图片重压缩、重编码与人工审核可能削弱攻击,论文主要揭示风险,防御机制尚未闭环。 趋势观察 少步生成与强化学习开始真正合流 — MeanFlowNFT 用平均-瞬时速度恒等式把前向过程 RL 接进 MeanFlow,Wan2.1 四步 VBench 84.33 超过 50 步 RL 模型,奖励对齐不再必须牺牲采样效率。 视频加速从算法稀疏深入分布式调度 — FVAttn 不只剪注意力,还在运行时迁移重头、填平 GPU 空闲,把稀疏注意力的 rank 拖尾变成可优化的系统问题。 世界模型走向语义与细节分层 — Orbis 2 用 DINO 高层预测远期语义、VAE 低层生成近景细节,世界模型从单尺度像素预测转向面向规划的层级抽象。 统一多模态扩展到科学原生对象 — S1-Omni 将 CIF、SMILES、蛋白、光谱与科学图像纳入同一模型,统一生成理解正从通用图文扩到原生科学表示。 长期记忆成为多模态智能体新攻击面 — Lucid 证明肉眼不可见的图片扰动可在黑盒条件下持续污染跨会话记忆,安全边界正从当前提示扩展到历史视觉证据。 人工智能炼丹君 整理 | 2026-07-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-25|字节Bernini让MLLM规划DiT渲染视频 今日 AIGC 论文速览 今日共 11 篇 · 统一视频生成与编辑 2 篇 · Unified Audio 与音乐生成 2 篇 · 文生图基础架构与高清解码 3 篇 · 视频世界模型与可控生成 2 篇 · 高效推理与长上下文 2 篇 重点论文标题列表 Bernini:MLLM做语义规划DiT做像素渲染 StepAudio 2.5:单一音频基础模型三任务全SOTA ⚡ PiD:512潜变量→2048图像 <1秒解码 SCOPE:首个跨游戏FPS世界模型zero-shot迁移 DecQ:8个查询+3.9%算力把RAE重建拉满 今日论文速览 1. Bernini:MLLM做语义规划DiT做像素渲染 Bernini: Latent Semantic Planning for Video Diffusion | 字节跳动 Bernini Team | arXiv:2605.22344 关键词:统一视频生成·MLLM 规划·DiT 渲染·SA-3D RoPE·CoT ⚠️ 前序问题:MLLM 擅长跨模态推理与语义对齐,扩散模型擅长高保真像素合成——但目前两条路线要么混入一个端到端 unified model(损失各自强项),要么靠 adapter 松耦合(语义传递不充分)。视频生成与编辑亟需一种新分工,能把 MLLM 的语义规划能力和 DiT 的像素渲染能力同时榨干 本文贡献:提出 Bernini 统一视频生成与编辑框架:MLLM 规划器直接在 ViT embedding 空间预测目标语义表征(不是文本),DiT 渲染器以这个语义 plan 为主条件,文本特征 + 编辑场景下的源视频 VAE 特征做辅助引导。规划器和渲染器分开训练 + 轻量协同微调,保住各自预训练能力。引入 SA-3D RoPE(Segment-Aware 3D RoPE)处理多视觉输入,并在规划器中引入 CoT reasoning 把「理解」翻译成「生成指令」 实验效果:在多项视频生成与视频编辑 benchmark 上达到 SOTA;编辑任务上 MLLM 的预训练理解力可直接迁移为强泛化能力——挑战性编辑场景下尤其明显 批判点评:「MLLM 当规划器、扩散模型当渲染器」是非常合理的下一代统一架构分工——既避免了端到端 unified model 的能力打架,也比 adapter 路线传递了更丰富的语义。但论文用 ViT embedding 而非文本作为接口让组件互换性变差,规划器换到其他 MLLM 需要重新对齐;SA-3D RoPE 在多视觉输入场景的扩展上限(如 5+ 参考图)未充分测试 2. StepAudio 2.5:单一音频基础模型三任务全SOTA StepAudio 2.5 Technical Report | 阶跃星辰 StepFun | arXiv:2605.23463 关键词:Unified Audio·ASR·TTS·实时对话·RLHF ⚠️ 前序问题:Unified audio-language model 是大趋势,可现实是它们在 ASR/TTS/实时对话三件事上常常打不过专用系统——语义理解、生成合成、低延迟对话天生有结构与目标差异。如何让一个 backbone 同时压过三个专用 SOTA 是开放挑战 本文贡献:StepAudio 2.5 把「模态接口统一」与「目标分化」分两层处理:文本与音频共享多模态表征空间作为底座,任务特化由「数据构造 + 优化目标 + 解码策略」三件事决定。重头戏是把 post-training 从标准 SFT 升级为「任务定制 RLHF」——ASR 用可验证 multi-token decoding 提速、TTS 用 preference-based RLHF + context-rich supervision 保表现力、Realtime 用 generative reward modeling 框架优化人格一致与低延迟 实验效果:在 ASR / TTS / Realtime 三个方向的标准 benchmark 上同时达到 SOTA,证明「单一音频语言基础模型在三个目标上压过专用系统」是可行的——RLHF 是统一 backbone「分化部署」的关键钥匙 批判点评:把「目标分化交给 RLHF」是非常聪明的分工——既保住统一架构的训练效率,又给三个任务留出独立优化空间。但论文的 RLHF 训练成本巨大且对各任务的奖励信号设计依赖深,落地复现门槛高;与 GPT-4o / Gemini 这种闭源多模态对话模型的实时对话直接对比缺失 3. PiD:512潜变量→2048图像 <1秒解码 PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion | NVIDIA, 多伦多大学, Vector Institute | arXiv:2605.23902 关键词:Pixel Diffusion·高清解码·DMD2 蒸馏·6× 加速·RAE ⚠️ 前序问题:T2I 主流采用「潜空间扩散 + decoder 还原像素」两段式,但 decoder 是重建优化的——只学逆向 encoder,并不主动合成细节。当目标分辨率拉到百万级(megapixel),decoder 的计算变得非常昂贵,画质上限也被牢牢锁死 本文贡献:提出 PiD(Pixel Diffusion Decoder):把「latent → pixel」decoding 改写成「条件像素扩散」,统一了解码与超分两步。直接在高分辨率像素空间去噪,原生支持 4× / 8× 上采样;通过轻量 sigma-aware adapter 把含噪 latent 注入像素扩散 backbone,使 PiD 能在 latent 还没去噪完时提前接手,让上游 latent diffusion 提前停步。再用 DMD2 蒸馏把推理压到 4 步。同时支持普通 VAE latent 和语义 latent(SigLIP/DINOv2,给 RAE 模型用) 实验效果:512×512 latent 解码为 2048×2048 像素在消费级 RTX 5090 上 <1 秒(峰值 13GB),在 GB200 上最快 210ms——比 cascaded diffusion-based super-resolution 快约 6×,视觉保真度也更好。直接把「高清文生图」的推理成本拉到接近实用区间 批判点评:把 decoder 从「重建优化」改为「条件生成优化」是非常正确的方向——这是 RAE 路线之外又一条反思 latent decoding 的工作。<1 秒 2K 解码 + 6× 加速是少有的同时省时又提质的硬数字;但 PiD 与原生 pixel-space 扩散(如 PixArt-Σ pixel)之间的对比仍未完全展开,DMD2 4-step 蒸馏的稳定性如何随分辨率扩展仍需观察 4. SCOPE:首个跨游戏FPS世界模型zero-shot迁移 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 国科大 UCAS-Terminus AI Lab, 新加坡国立 NUS, 浙江大学, 港科大广州 | arXiv:2605.23345 关键词:FPS 世界模型·视频扩散·跨游戏迁移·CrossFPS·per-pixel 条件 ⚠️ 前序问题:FPS(第一人称射击)游戏的可玩世界模型,每一帧都要响应高频重叠的多种操作信号,同时还不能扰动屏幕中无关区域。已有方案要么全图注入动作信号(粒度太粗),要么只在单款游戏上训(无法跨游戏迁移) 本文贡献:观察到 FPS 操作具有「空间选择性」:开火/换弹只影响武器周围的局部 scope,而镜头/移动指令影响全局背景。SCOPE 在预训练视频扩散 transformer 的每个 block 插入条件模块,把特征重塑成 per-pixel 时序序列,每个位置根据本地视觉内容计算自己的动作响应——不依赖任何分割标注就把 in-scope 效果与 out-of-scope 生成分开。同时构建 CrossFPS:首个多游戏 FPS 数据集(7 款游戏、69K 帧对齐 10-DoF 控制信号片段),让模型学到游戏无关的视觉-动作映射 实验效果:训得的世界模型在多个未见场景上 zero-shot 迁移成功,动作响应度强、scope 分离精确,跨游戏泛化效果优——首次让 FPS 世界模型走出「单游戏专门训」的范式 批判点评:「scope 局部 vs 全局」的解构是非常贴近 FPS 物理直觉的观察,per-pixel 时序条件注入比全图条件优雅得多。CrossFPS 数据集让 FPS 世界模型有了 ImageNet 时刻的基础;但 10-DoF 控制信号离真实玩家的复杂连招仍有距离,对长 horizon 一致性(数百帧战斗)效果论文未充分披露 5. DecQ:8个查询+3.9%算力把RAE重建拉满 DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders | 复旦大学, 上海 AI Lab | arXiv:2605.22777 关键词:RAE·DINOv2·细节 Query·重建生成解耦·3.9% 算力 ⚠️ 前序问题:Representation Autoencoder(RAE,把视觉基础模型当 tokenizer encoder)能让 latent diffusion 收敛更快、生成更好——但 VFM 必须冻住,限制了细粒度重建能力。如果反过来微调 VFM 解锁重建,又会破坏预训练语义空间、拖累生成。重建 vs 生成长期是 trade-off 本文贡献:DecQ 思路简单优雅:用一组轻量「detail-condensing queries」通过 condenser 模块从中间层 VFM 特征里抽取细粒度信息,再把这些 query 拼到 decoder 端辅助重建,同时在生成建模阶段与 patch token 一起被预测。深浅两层信息都被聚合,无需碰 VFM 主权重,重建-生成 trade-off 被巧妙绕开 实验效果:DINOv2-based RAE 上仅加 8 个 query 和 3.9% 额外算力,PSNR 从 19.13 dB 提到 22.76 dB(重建端 +3.6dB);生成端比 RAE 收敛快 3.3×,无 guidance FID 1.41、有 guidance FID 1.05——重建与生成同时提升且开销可忽略 批判点评:「不碰冻结 VFM、只加一组 query 当辅助通道」是非常 ROI 高的设计,是「冻结 vs 微调」之外的第三条路。从 PSNR / FID 数字看是确凿的正向贡献;但 8 个 query 是否够撑起更大分辨率(512+)下的细节量级仍待验证,与最新 token-merging / FlexQuery 等类似工作的对比略浅 6. SEGA:DiT训练免微调按频段动态缩放注意力 SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers | 多伦多大学, Vector Institute | arXiv:2605.22668 关键词:DiT·分辨率外推·RoPE·训练免微调·频段自适应 ⚠️ 前序问题:DiT 在训练分辨率之外生成时画质显著掉,目前 training-free 方案常用 RoPE 外推 + 注意力 scaling 修正,但 scaling 都是一刀切——对 RoPE 各分量(含不同频段)施加同样的缩放,导致「全局结构 vs 细节恢复」此消彼长 本文贡献:提出 SEGA:完全 training-free,根据每个去噪步 latent 的空间-频段结构,动态地对 RoPE 不同分量分别 scaling。低频分量保结构、高频分量恢细节,按内容自适应分配——而不是固定常数 实验效果:多个目标分辨率上一致提升 DiT 高分辨率合成质量,超过现有 training-free 基线;不需要重训,可即插即用 批判点评:「不同频段差别 scaling 而不是常数」是经过谱分析后的小而正确的改进,对 DiT 高清生成是廉价收益。但论文主要在 SD3/FLUX 系列上验证,更激进外推倍率(如 4×)下是否仍稳健没充分展开;与 ScaleCrafter / FreeU 等同类训练免微调方案的端到端定量对比较少 7. Gated DeltaNet-2:线性注意力擦写解耦1.3B全面胜出 Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention | NVIDIA | arXiv:2605.22791 关键词:线性注意力·Gated DeltaNet·擦写解耦·长上下文·NVIDIA ⚠️ 前序问题:线性注意力把无界 softmax cache 压缩成固定 recurrent state,难点不在于「忘掉什么」而在于「怎么编辑这个压缩记忆而不打乱已有联系」。已有 Delta-rule 模型用 scalar gate 同时控制 key 端的擦除和 value 端的写入——一个标量做两件事,能力被绑死 本文贡献:Gated DeltaNet-2(GDN-2)泛化了 Gated DeltaNet 与 KDA:把 erase 与 write 解耦成两个 channel-wise gate(擦除门 b_t / 写入门 w_t);两者塌缩到同一 scalar 时退化为 KDA,再叠加 decay 塌缩则退化为 Gated DeltaNet。配套给出 fast-weight 更新视角、chunkwise WY 算法(channel-wise decay 吸收到非对称 erase 因子)、gate-aware backward——保住了高效并行训练 实验效果:1.3B 参数在 100B FineWeb-Edu tokens 上训完,在语言建模/常识推理/检索上综合超过 Mamba-2 / GDN / KDA / Mamba-3 变体;在 RULER 长上下文 needle-in-a-haystack 多 key retrieval 上优势最大,纯循环与混合架构都强。代码开源 批判点评:「擦除/写入解耦」是 linear attention 设计上一个本应早被做的细节修正——一个 gate 控两件事本来就是工程妥协。GDN-2 是少有「同时改写规则又保住并行训练」的设计;但论文聚焦语言建模,对视觉生成场景(视频扩散 / 多模态 backbone)线性注意力替换的实际收益尚需后续验证,1.3B 规模在 7B+ 是否仍领先 Mamba-3 也是开放问题 8. Geo-Align:首个相机控制视频生成RL几何奖励 Geo-Align: Video Generation Alignment via Metric Geometry Reward | 中科大, 上海 AI Lab, 浙大 | arXiv:2605.23903 关键词:相机控制视频·RL 对齐·metric 3D 奖励·video re-rendering ⚠️ 前序问题:相机控制视频生成(video-to-video re-rendering)此前几乎全靠合成数据上的 SFT,真实多视角同步视频极度稀缺,模型在真实 OOD 视频上对物理尺度与相机轨迹的遵循非常差——「能拍但不像」一直没解决 本文贡献:Geo-Align 首次为相机控制视频再渲染提出 RL 框架:基于预训练模型,用「尺度感知感知奖励」对齐。具体而言引入 metric 3D estimator 从生成视频中抽取精确相机轨迹,对 rotation / translation 偏差显式惩罚;数据 pipeline 精心设计——以真实条件视频 + 合成数据派生的目标相机轨迹训练,消除对 paired data 的依赖 实验效果:相机可控性与视觉保真度同时优于现有 SFT 基线,验证 metric geometry 奖励是补救「合成 → 真实」迁移损耗的有效手段——是 video re-rendering 的下一步 批判点评:把 video re-rendering 从 SFT 推进到 RL + 几何奖励是必然的下一步,metric 3D estimator 当 reward model 思路漂亮;但 metric 3D estimator 本身的精度上限直接决定奖励质量,对动态场景(人物快速运动、遮挡)的估计误差如何不被奖励放大需要后续验证 9. LMDM:消费级笔记本跑实时音乐扩散 Live Music Diffusion Models: Efficient Fine-Tuning and Post-Training of Interactive Diffusion Music Generators | UC San Diego, CMU, Mila, Northeastern | arXiv:2605.22717 关键词:音乐扩散·实时生成·KV Cache·ARC-Forcing·consumer GPU ⚠️ 前序问题:现在最强的「实时流式音乐生成」走的是 discrete-AR(离散自回归)路线,训练和推理都要工业级算力。开源社区强势的音频扩散是双向、非流式的——理论上不能做实时演奏 本文贡献:LMDM 重新审视 block-wise outpainting 扩散管线:识别出诸多推理瓶颈是它比 discrete-AR 慢的根因,提出 block-wise KV Caching 补回;进一步引入 ARC-Forcing post-training,无需 RL 或 reward model 就能稳健做对齐,缓解 error accumulation 实验效果:扩散模型首次在推理复杂度上反超离散 AR 路线,能在消费级游戏本上本地实时跑——支持文条件生成、草图条件音乐合成、jamming;论文还展示了 LMDM 作为「generative delay」在真人音乐家即兴演奏中的真实艺术家-AI 合作 批判点评:把扩散从「非流式」拉到「实时演奏」是开源社区音频生成的关键一步——把 KV Cache 思路从语言模型迁过来很合理。但和 Suno/Udio 这类闭源系统直接对比缺失,对极长(>10 分钟)持续演奏的稳定性论文未深入讨论;ARC-Forcing 替代 RLHF 的 robustness 在不同流派/复杂编曲下的表现仍需更多实验 10. ETCHR:图像编辑器即多模态推理助手 ETCHR: Editing To Clarify and Harness Reasoning | 上海 AI Lab, 港中文 | arXiv:2605.23897 关键词:Think with Images·图像编辑·推理增强·VLM 奖励·MLLM 解耦 ⚠️ 前序问题:MLLM「think with images」范式越来越火,但 toolkit 路线被固定动作束缚,unified 路线产生的中间图常常很噪。如果想用「专用图像编辑器」当 MLLM 的视觉推理助手,会遇到两个 gap:(1) language-side,被动指令跟随的编辑器无法把抽象问题映射成合适的视觉变换;(2) generation-side,推理深度增加时编辑正确性快速退化 本文贡献:ETCHR 提出一个「question-conditioned, reasoning-aware」图像编辑器,与下游 understanding model 完全解耦。两阶段训练:第一阶段 Reasoning Imitation(在编辑轨迹上 SFT),第二阶段 Reasoning Enhancement(用 VLM-derived 奖励同时优化编辑正确性 + 下游推理准确率)。解耦让 ETCHR 可以 plug into 任意开闭源 MLLM 而无需重训 实验效果:覆盖细粒度感知/图表理解/逻辑推理/拼图复原/3D 理解 5 类任务,Pass@1 平均提升:Qwen3-VL-8B +4.82(55.95→60.77)、Gemini-3.1-Flash-Lite +5.47(65.08→70.55)、1T MoE Kimi K2.5 +4.61(76.55→81.16)——证明 reasoning-aware editor 通用有效 批判点评:「编辑器作为 MLLM 的可插拔视觉推理助手」是非常正确的下一步分工,比 toolkit / unified 两条路线都更模块化。但 ETCHR 训练强依赖 VLM-derived rewards,奖励信号的偏差可能复制到编辑器;与最新 unified MLLM(如 GPT-4o Image / Bagel)端到端的 think-with-image 能力对比还需要更全面 11. Swift Sampling:泰勒展开找时序惊奇帧0.02倍开销 Swift Sampling: Selecting Temporal Surprises via Taylor Series | Microsoft Research India | arXiv:2605.22678 关键词:长视频·帧选择·预测编码·Taylor 展开·训练免微调 ⚠️ 前序问题:长视频里大部分帧冗余,关键信息藏在「时序惊奇」——视觉特征偏离了预测轨迹的瞬间。已有 training-free 帧选择要么靠辅助网络(额外算力),要么靠视频特化的超参(不通用) 本文贡献:受脑科学预测编码启发,Swift Sampling 把视频建模成视觉 latent 空间里可微的轨迹,计算 velocity 和 acceleration,用 Taylor 展开预测后续帧的「预期路径」。偏离预期最猛的帧 = 时序惊奇帧 = 应被采样的关键帧。训练免微调、几乎零额外开销 实验效果:比基线只多 0.02× 算力开销(比领先方法的 overhead 还低 30×)。3 个长视频 QA benchmark + 10 个下游任务上一致优于 uniform sampling 与其他 query-agnostic 基线;长视频小预算场景下提升最大(+12.5 分准确率) 批判点评:「预测编码 → Taylor 外推 → 惊奇帧」的链条简洁且物理直觉强,几乎零成本是工程上极少见的免费收益。但 Swift Sampling 是 query-agnostic 的——任务相关的关键帧(需要 query-conditional)仍是它的盲区,未来与 query-aware 方法的组合空间巨大 趋势观察 统一架构出现新分工:MLLM 当语义规划器,扩散/像素模型当渲染器 — Bernini 用 MLLM 在 ViT embedding 空间预测目标语义,DiT 拿这个 plan 当主条件渲染像素;ETCHR 把编辑器训成 MLLM 可插拔的视觉推理助手——「端到端 unified」之外,「语义规划 + 像素渲染」的分工路线正在成型。这条路线把各组件的预训练能力都榨干,比 adapter 更深、比端到端更模块化 像素空间扩散解码器替代传统 VAE:高清/高效解码的新范式 — PiD 把 latent→pixel 改成条件像素扩散,512 latent <1 秒解到 2048 像素(消费级 RTX 5090),比 cascaded SR 快 6× 且画质更好;DecQ 不动 RAE 冻结 VFM 只加 8 个 query + 3.9% 算力就让重建 PSNR +3.6dB、生成收敛快 3.3×——「decoder 该重建还是该生成」的争论开始让位给「decoder 应同时承担解码与上采样」的新范式 Unified Audio 模型靠任务定制 RLHF 同时压过专用系统 — StepAudio 2.5 把 ASR/TTS/Realtime 三件事架在共享 backbone 上,让任务分化交给「数据 + RLHF reward + 解码策略」三件套——ASR 用可验证 multi-token decoding、TTS 用 preference RLHF、Realtime 用 generative reward modeling,最终三项 benchmark 同时 SOTA。证明「unified 不必妥协」的关键钥匙是 RLHF 视频生成对齐从 SFT 走向几何/物理约束的强化学习 — Geo-Align 首次给相机可控视频再渲染加 RL:用 metric 3D estimator 抽取相机轨迹,对 rotation/translation 偏差显式给奖励,不再依赖稀缺的 paired 真实多视角数据。SCOPE 的 per-pixel 时序条件设计也隐含「空间选择性」的物理直觉——视频生成的对齐方式开始引入几何/物理约束 推理期免训练优化在文生图/长视频/长上下文遍地开花 — SEGA 给 DiT 做按频段自适应注意力 scaling 解决高分辨率外推;Swift Sampling 用 Taylor 展开找时序惊奇帧选关键帧(0.02× 开销 +12.5 分);GDN-2 把线性注意力的 erase/write 解耦改善长上下文检索——「免训练 + 信号利用」的范式从图像扩散扩到视频/语言全场景,给落地侧带来快速收益 人工智能炼丹君 整理 | 2026-05-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-21|智能编辑成统一模型通用任务Uni-Edit 今日 AIGC 论文速览 今日共 13 篇 · 统一多模态与图像编辑 2 篇 · 视频生成与编辑 5 篇 · 高效推理与稀疏注意力 3 篇 · 安全与可控生成 2 篇 · 图像复原与评测 2 篇 重点论文标题列表 Uni-Edit:智能编辑成为统一模型唯一训练任务 FullFlow:只训LoRA把T2I升级成双向多模态 ⚡ DVG:时空联合自适应HunyuanVideo提速7倍 BA-Att:块预降采样稀疏注意力提速7倍 FlowLong:滑窗加流形约束推理期出长视频 今日论文速览 1. Uni-Edit:智能编辑成为统一模型唯一训练任务 Uni-Edit: Intelligent Editing Is A General Task For Unified Model Tuning | CUHK MMLab | arXiv:2605.21487 关键词:UMM 统一多模态·智能图像编辑·通用任务·BAGEL·Janus-Pro ⚠️ 前序问题:统一多模态模型(UMM,理解+生成+编辑三件事一起做)当前主要靠混合多任务训练。但任务之间天生冲突,逼出了复杂的多阶段 pipeline、海量数据混合和各种平衡 trick——结果只是性能折中而非真正互相增强 本文贡献:提出 Uni-Edit:智能图像编辑作为 UMM tuning 的「第一个通用任务」。一个任务、一个训练阶段、一个数据集就能同时提升理解/生成/编辑三种能力。为此构建首个自动化可扩展智能编辑数据合成 pipeline:把多样 VQA 数据转化为带嵌入问题和嵌套逻辑的复杂编辑指令,得到 Uni-Edit-148k 数据集(reasoning-intensive 指令 + 高质量编辑图像) 实验效果:BAGEL 与 Janus-Pro 上仅用 Uni-Edit 单任务训练即获得三种能力的全面增强,无需任何辅助操作;模型/数据/代码已开源在 HuggingFace 和 GitHub 批判点评:「编辑作为通用任务」的洞察是范式级——编辑天生需要「理解 + 生成」两件事,这是其作为通用任务的根本理由;但 Uni-Edit-148k 是 VQA 数据合成的,复杂场景下指令质量上限仍受 VQA 数据集决定;BAGEL/Janus-Pro 之外能否泛化到更多 UMM(OmniGen/UniGen)需要后续验证 2. FullFlow:只训LoRA把T2I升级成双向多模态 FullFlow: Upgrading Text-to-Image Flow Matching Models for Bidirectional Vision-Language Generation | ETH Zürich, Google Zurich | arXiv:2605.20316 关键词:统一多模态·LoRA 升级·Rectified Flow·双向生成·参数高效 ⚠️ 前序问题:现代 T2I 扩散模型有强视觉先验,但只暴露在单向 text→image 生成。从 T2I 衍生的统一视觉语言模型要么靠大规模联合预训练,要么大幅重训文本通路——两者都浪费了 T2I backbone 已经学到的强图像先验 本文贡献:提出 FullFlow 参数高效配方:只训 LoRA 适配器和轻量 text head 就把预训练的 rectified-flow T2I 模型升级成双向 vision-language 生成器。图像保持原生连续 flow,文本走离散 insertion 过程;图像/文本独立 timestep 让推理变成「二维生成空间」中的轨迹选择,单 backbone 同时支持 text→image / image→text / 联合采样 / partial-text 预测 实验效果:在 SD3 上同等可训参数和 LoRA rank 下,T2I FID 62.7 → 31.6,I2T CIDEr 2.0 → 99.4(远超之前 SOTA Dual Diffusion);峰值 VRAM 从 ~84GB 降到 ~38GB,吞吐 8×(双 RTX A5000 训 24h,仅训 ~5% backbone 参数);同样配方迁移到 FLUX.1-dev 并支持 partial-text 做下游 VQA 批判点评:5% 参数开销实现双向多模态是非常高 ROI 的工程贡献——把扩散视觉先验「升级 vs 重建」拉到了正确选择;但 image→text CIDEr 99.4 vs Dual Diffusion 2.0 的对比量级悬殊,可能反映 baseline 设置问题;与原生统一模型(BAGEL/Janus)的端到端能力对比缺失 3. DVG:时空联合自适应HunyuanVideo提速7倍 Dynamic Video Generation: Shaping Video Generation Across Time and Space | 上海交大, 华南理工, 清华大学 | arXiv:2605.21042 关键词:视频扩散加速·时空联合·渐进分辨率·HunyuanVideo·近无损 ⚠️ 前序问题:视频扩散每步要处理大量 token,迭代去噪极昂贵。最近渐进分辨率采样在早期阶段降 latent 分辨率取得加速,但 scale 到视频上仍困难——时序维度引入跨视频差异巨大的时空需求,只压一个维度要么加速有限要么质量退化 本文贡献:提出 DVG(Dynamic Video Generation)框架:跨时间和空间联合分配计算,自动选择内容感知(content-aware)的加速策略,无需手工调参或重训。通过学习每个视频的最佳时空降采样模式,实现近无损加速 实验效果:HunyuanVideo / HunyuanVideo-1.5 上达到 7× 加速;与蒸馏组合可达 18× 加速;近无损跨模型跨任务,可作为大规模高效视频生成系统的关键组件——代码开源 批判点评:把渐进分辨率从空间扩到时空联合是合理的下一步,自动 content-aware 策略避免了手工 schedule;但加速倍数高度依赖底模容量与内容多样性,对极端运动场景的 robustness 论文未充分披露;7×→18× 的复合是否保留各自的画质底线需更细粒度评测 4. BA-Att:块预降采样稀疏注意力提速7倍 Efficient Long-Context Modeling in Diffusion Language Models via Block Approximate Sparse Attention | 香港科大, 港大, 浙大, 港中文 | arXiv:2605.19726 关键词:扩散语言模型·稀疏注意力·块降采样·FlashAttention·长上下文 ⚠️ 前序问题:扩散语言模型(DLM)能做全局连贯、双向、可控文本生成,但 scale 到超长序列仍昂贵。现有 block-sparse attention 用固定采样模式(尾部、反斜对角条带)选块——这种 prior-driven 采样会漏关键 token、分布偏移下不稳定 本文贡献:提出 BA-Att 框架:block-wise 预降采样操作在压缩空间识别 informative 区域,避免依赖脆弱的位置先验。理论上定义 oracle post-downsample attention map,形式化前 vs 后降采样方案的近似误差;引入轻量 norm-sorting 模块和协方差补偿修正(用对角 QK 方差近似完整协方差),降复杂度 实验效果:比 FlashAttention 加速最高 6.95×;50% 稀疏度下保持接近 full-attention 性能,跨语言模型/多模态语言模型/视频生成模型一致——证明高效率和强泛化 批判点评:把 sparse attention 的「选块」从 prior-based 升级到 learned downsampled space 是非常正确的方向,6.95× 加速比 FlashAttention 还快是亮眼的工程数字;但 50% 稀疏率下「接近 full」的具体差距需更精细评测;对极长上下文(1M+)的渐近行为仅理论保证而无实测 5. FlowLong:滑窗加流形约束推理期出长视频 FlowLong: Inference-time Long Video Generation via Manifold-constrained Tweedie Matching | KAIST, Amazon | arXiv:2605.20910 关键词:长视频生成·推理期方法·Tweedie matching·滑窗·流形约束 ⚠️ 前序问题:把视频扩散模型生成时长扩到长序列一直没解决:双向模型扩展紧绑架构且长距退化严重,自回归模型有 exposure bias 累积漂移并产生重复运动。现有 training-free 方案没有同时跨这两条路线 本文贡献:提出 architecture-agnostic 推理期长视频生成方法:滑动重叠窗口生成长视频,相邻窗口预测的 clean sample 通过 Tweedie matching 在重叠区强制流形约束 + 时序一致;high-noise 阶段用 stochastic early-phase sampling,每次 Tweedie matching 校正后注入新噪声同步窗口轨迹,再切到 deterministic ODE sampling 保留细节 实验效果:可生成数倍于原生窗口长度的视频,时序一致性和视觉质量超越 training-free 与自回归两类基线;同一思路无微调即可扩展到音视频联合生成、文生 3DGS——证明这套方法是通用的 批判点评:Tweedie matching 在窗口边界做修正是 elegant 的解法,几乎是「无需训练」的最简扩展;但滑窗推理时延比单 pass 显著增加,长视频对内存的累积压力不算小;与原生因果模型(如 Causal Forcing++/Mutual Forcing)相比,缺少同等长度下的直接对比 6. StreamGVE:少步流式生成做训练免视频编辑 StreamGVE: Training-Free Video Editing via Few-Step Streaming Video Generation | UBC ECE | arXiv:2605.21466 关键词:视频编辑·训练免微调·少步流式生成·noise-to-data·双分支 ⚠️ 前序问题:视频编辑方法可行但要花很多昂贵迭代且编辑结果质量勉强。作者把症结归因到「data-to-data」范式——它和现代生成模型(noise-to-data)天生不兼容,绕远路反而拉低了编辑质量 本文贡献:从 noise-to-data 视角重做视频编辑:基于预训练的流式生成模型构建 StreamGVE,保留 few-step 采样并无缝注入源视频条件;引入双分支快速采样(self-attention bridge + cross-attention grounding/boosting)兼顾采样和条件;提出 source-oriented guidance 提目标质量,再加 visual prompting 增强编辑灵活性 实验效果:在多种视频编辑任务上一致超越现有方法,即使在 few-step 设置下也能以最少时间代价完成;方法对不同底模具有鲁棒性和泛化能力 批判点评:把视频编辑「从 data-to-data 转向 noise-to-data」是个范式级洞察,能直接复用流式生成模型的少步能力——很省工;但在风格迁移、物体替换等具体编辑任务上的优势是否一致需要更细分对比;source-oriented guidance 的强度调参成本未明 7. FlowErase-RL:首个GRPO范式的概念擦除框架 FlowErase-RL: Rethinking Concept Erasure as Reward Optimization in Flow Matching Models | 哈工大深圳, 清华深圳, 吉林大学, 鹏城实验室, 清华大学 | arXiv:2605.19739 关键词:Flow Matching·概念擦除·GRPO·安全生成·双路径奖励 ⚠️ 前序问题:Flow Matching 文生图模型质量飞涨同时安全风险也在加剧,要擦除有害/不想要的概念。现有方案要么是推理期干预(效果有限),要么靠 SFT(依赖精对齐数据 + 多概念扩展性差)——擦除问题一直缺少更优范式 本文贡献:首次把概念擦除重新表述为 reward optimization 问题,提出基于 GRPO 的 FlowErase-RL:(1) 双路径动态奖励——CE(Concept Erasure)奖励抑制目标概念,NS(Non-target Space)奖励保住生成质量;(2) 性能驱动的自适应切换策略,无需显式监督就能稳定训练;通用支持裸露/物体/艺术风格三类擦除 实验效果:裸露/物体/艺术风格三类擦除均达 SOTA,图像质量与语义对齐保持很好;对抗攻击鲁棒性强,多概念场景扩展性好——开辟了 Flow Matching 安全可控生成的新范式 批判点评:把擦除从 SFT 转向 RL 是聪明的——擦除本质是分布偏移而非分类,RL 的奖励更贴合;但 GRPO 训练成本不低,CE/NS 双奖励的权重边界对效果影响多大未深入消融;擦除概念之间的相互干扰(擦了概念 A 影响概念 B 的生成)这一长尾问题未充分讨论 8. CPC-VAR:首次给VAR模型做持续多概念个性化 CPC-VAR: Continual Personalized and Compositional Generation in Visual Autoregressive Models | 哈工大深圳, 清华深圳国际研究生院, 鹏城实验室, 华南理工 | arXiv:2605.19750 关键词:持续学习·VAR 个性化·概念神经元·多概念合成·解纠缠 ⚠️ 前序问题:Visual Autoregressive(VAR)做文生图效率高,但现有 VAR 个性化只能静态训单概念——序列学新概念时旧概念会被灾难性遗忘,多概念合成又会出现特征纠缠和属性不一致。这是 VAR 个性化生成的两个老大难 本文贡献:首次系统研究 VAR 持续个性化生成,提出统一框架。两个核心组件:(1) GCNS(Gradient-based Concept Neuron Selection),找到每个概念相关的神经元,只约束跨任务冲突参数,不扩展模型也能抗遗忘;(2) 上下文感知组合策略:多分支特征建模 + 空间条件引导的局部 cross-attention 融合,做精确解纠缠的多概念合成 实验效果:长序列持续个性化场景下显著领先现有 baseline,多概念图像合成上也优于现有方法,证明 VAR 完全有能力做可扩展可控的个性化生成 批判点评:VAR 个性化第一次被系统化研究是好事,神经元级别的 GCNS 设计也比经典扩散模型路线(DreamBooth/LoRA)更经济;但实验是否覆盖到 10+ 概念的真实长尾、跨概念组合的失败模式分析略浅,VAR 底模本身的天花板(vs 扩散模型)没有正面比较 9. DyMoS:一个标量旋钮控 I2V 运动幅度 Rebalancing Reference Frame Dominance to Improve Motion in Image-to-Video Models | 延世大学 Yonsei, GIST, Adobe Research | arXiv:2605.19398 关键词:I2V·运动控制·注意力 rebalance·训练免微调·DyMoS ⚠️ 前序问题:I2V(image-to-video)相比 T2V 生成的视频普遍过于静态。前人方案靠削弱或修改图像条件来增加运动,但要么需要额外训练,要么牺牲了对参考图像的保真度——「动起来 vs 像参考图」是个长期 tradeoff 本文贡献:识别出「reference-frame dominance」是动作抑制的核心机制:非参考帧对参考帧 key token 分配过多 self-attention,导致参考信息被过度跨时传播、压制了帧间动态。提出 DyMoS(Dynamic Motion Slider):训练免微调、模型无关,初始去噪步 rebalance 生成帧到参考帧的注意力路径,输入图和模型权重都不动,只引入一个标量参数连续控制运动强度 实验效果:多个 SOTA I2V backbone 上一致提升运动动态,同时保持视觉质量和对参考图的保真度;提供 user 一个可调的运动旋钮 批判点评:把「动起来 vs 像参考图」从冲突变成可调旋钮是非常实用的工程贡献;但 attention rebalance 的具体公式对不同架构可能需重新调,论文给出的 generality 主要在 SD 系列底模;标量旋钮是否能控制不同方向的运动(横向 vs 纵向)需要更细粒度评测 10. MSAVBench:首个多镜头音视频生成评测基准 MSAVBench: Towards Comprehensive and Reliable Evaluation of Multi-Shot Audio-Video Generation | 复旦大学, 港大, 阿里通义实验室, 浙大, 北大 | arXiv:2605.20183 关键词:多镜头音视频·评测基准·导演级控制·自适应分镜·MSAVBench ⚠️ 前序问题:视频生成正从单镜头扩展到复杂多镜头音视频(MSAV)叙事,但评测仍是基础性挑战——现有 benchmark 范围有限、数据多样性不足、评测流水线僵化,无法系统可靠地评估现代 MSAV 模型 本文贡献:推出 MSAVBench 首个面向多镜头音视频生成的综合评测基准 + 自适应混合评测框架。覆盖视频/音频/镜头/参考四个维度,多种任务设置,最多 15 个镜头,挑战性的非真实场景。评测框架的鲁棒性来自三件事:分镜分割的自适应 self-correction、主观指标的实例级 rubric、复杂判断的工具溯源证据抽取 实验效果:与人类判断的 Spearman 秩相关达 91.5%,对齐度极高;系统评测 19 个 SOTA 闭源/开源模型显示:当前系统在导演级控制和细粒度音视频同步上仍有困难,模块化/agentic 生成 pipeline 是缩小开源-闭源差距的有前途路径;benchmark 数据和评测代码将开源 批判点评:把音视频生成评测从「单镜头质量」推进到「多镜头叙事 + 导演级控制」是必要的下一步;91.5% Spearman 与人类对齐很高,自适应分镜 self-correction 是工程亮点;但 15 个镜头作为基准上限对真正的长视频(>5 分钟、几十个镜头)覆盖度有限;非真实场景的标注成本与一致性如何控制仍是开放问题 11. CogOmniControl:专用CogVLM认知创意意图引导生成 CogOmniControl: Reasoning-Driven Controllable Video Generation via Creative Intent Cognition | 澳门大学 SKL-IOTSC, 腾讯 Online-Video BU | arXiv:2605.19995 关键词:可控视频生成·专业 VLM·创意意图认知·闭环 harness·in-context ⚠️ 前序问题:视频扩散模型对 abstract / 稀疏 / 复杂条件依然脆弱——专业制作工作流(分镜草图、黏土渲染等)下表现差。现有方案要么用 adapter 注入条件,要么把通用 VLM 耦合到扩散 backbone——能力鸿沟仍在,难以输出对齐用户创意意图的视频 本文贡献:提出 CogOmniControl 推理驱动框架:把可控视频生成因式分解为「创意意图认知」+「生成」。专门用真实动漫制作数据训了一个专业版 CogVLM,比通用 VLM 更准确地从稀疏抽象条件中识别用户创意意图,转译成密集 reasoning 输出;CogOmniDiT 通过 in-context generation 统一多种条件,并用 RL 对齐到 CogVLM reasoning 输出。进一步利用 CogVLM 做评测与 Best-of-N 选择,整个框架是闭环 harness 架构。同时发布 CogReasonBench / CogControlBench 来自专业工作流的真实创意意图数据 实验效果:两个 benchmark 上一致超越现有开源模型,在分镜草图、黏土渲染等专业条件下尤其明显——证明专业 VLM 介入的认知能力对可控生成是有效的 批判点评:专业 VLM 当「创意意图认知器」是个新颖思路,引入 reasoning 缓解条件稀疏问题——但训练专业版 VLM 的数据规模有限,跨垂直域(动漫→真人/工业)泛化未验证;闭环 harness 架构推理时延偏高,落地工业流水线存在挑战 12. DiSI:单模型连续滑动失真感知权衡 Disentangling Generation and Regression in Stochastic Interpolants for Controllable Image Restoration | 同济大学, 复旦大学 | arXiv:2605.21381 关键词:图像复原·Stochastic Interpolant·生成-回归解耦·失真感知权衡·像素空间 ⚠️ 前序问题:图像复原(IR)领域生成式(Diffusion/Flow Matching)擅长合成真实纹理但慢且像素保真度差;经典回归式方法单步高效像素准确——两条路线长期不能兼得 本文贡献:提出 DiSI 统一框架:把底层 Stochastic Interpolant 过程显式解耦为独立的生成分量和回归分量。这种解耦让模型在「纯回归 → 全生成」之间连续可控过渡。技术上提供两条具体采样轨迹和统一 sampler 支持任意轨迹的少步推理;网络是像素空间的双分支 U-Net 风格 transformer(专用分支增强条件引导同时保高吞吐) 实验效果:在多种 IR 任务上以高效率取得有竞争力的结果;独有特性:单一模型推理期就能控制失真-感知 tradeoff(distortion-perception trade-off),不再需要训多个模型 批判点评:把 SI 过程拆成生成+回归两个可独立调用的分量,在理论上很优雅,给「失真-感知」连续控制提供了第一种统一手段;但实际 IR 任务中如何选择最佳轨迹(用户需指定 tradeoff?)的 UI/控制接口论文未深入讨论;与最新 OSEDiff/PASD 等方法的端到端对比有所欠缺 13. ABSS:初始几步注意力筛 seed 提画质 Boosting Text-to-Image Diffusion Models via Core Token Attention-Based Seed Selection | Brandeis University | arXiv:2605.19532 关键词:文生图·Seed Selection·Cross-Attention·训练免微调·SD ⚠️ 前序问题:文生图扩散模型的输出对随机 seed 极度敏感——不同 seed 同 prompt 画质和文图对齐差异巨大。但「该用哪个 seed」一直靠盲选,缺乏系统的预选机制 本文贡献:观察到一个关键现象:在前几步去噪过程中,对 prompt 中 core token(content-bearing words)的 cross-attention dynamic 强烈预测最终生成质量。基于此提出 ABSS(Attention-Based Seed Selection),训练免微调即插即用:候选 seed 跑前几步,用对 core token 的 cross-attention 打分排序,只保留 top-k 完成完整生成,不需要固定阈值 实验效果:三个 benchmark 上 Stable Diffusion 各变体的文图对齐和视觉质量一致提升,人工偏好与对齐指标都有改善;可作为现有 seed 优化 pipeline 的轻量预选附加组件叠加额外收益 批判点评:很经济的工程发现:把 seed 筛选问题转换为前几步 attention 信号读取,几乎没有计算开销;但这种基于 attention 的代理指标在跨架构(DiT/MMDiT)的可迁移性需要进一步验证;core token 的提取依赖 prompt parsing 的鲁棒性 趋势观察 「编辑」开始成为统一多模态模型的核心训练任务 — Uni-Edit 把智能编辑提为 UMM 单一通用训练任务,BAGEL/Janus-Pro 上一个数据集就能同时提理解/生成/编辑——「编辑作为通用任务」的认知正在替代「混合多任务训练」的范式。FullFlow 用同样的精简思路(只训 5% 参数)把 T2I 升级成双向多模态,从「重训」走向「升级」 视频生成加速进入「时空联合 + 稀疏注意力」阶段 — DVG 把渐进分辨率从单空间扩到时空联合,HunyuanVideo 上 7× 加速 + 蒸馏达 18×;BA-Att 用块预降采样稀疏注意力比 FlashAttention 还快 6.95×。视频扩散下一阶段的加速重心从单维度优化转向「时空 + 稀疏」组合拳 长视频生成从训练扩展走向「推理期方法」 — FlowLong 用 Tweedie matching 滑窗 training-free 把视频时长扩到数倍——这条 inference-time 路线和 Mutual Forcing/Causal Forcing++ 的训练侧路线形成互补,意味着长视频不一定要重新训模型 I2V 运动控制和文生图 seed 选择都被「单一标量旋钮 + Attention 信号」攻破 — DyMoS 用一个标量参数控 I2V 运动幅度(attention rebalance);ABSS 用初始几步 cross-attention 信号筛 seed——共同点是把「需要训练才能解决」的问题,转化为「读取已有 attention 信号」的免训练方案 概念擦除从 SFT 范式跨入 RL 范式 — FlowErase-RL 首次用 GRPO 做 Flow Matching 概念擦除,CE+NS 双路径动态奖励替代精对齐 SFT 数据——证明在 Flow Matching 时代,「擦除」本质上更适合用 RL 的分布偏移视角而非分类监督视角 人工智能炼丹君 整理 | 2026-05-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-19|长视频生成FP4训推全栈LongLive-2.0 今日 AIGC 论文速览 今日共 13 篇 · 长视频生成与训推优化 2 篇 · 扩散推理加速与量化 4 篇 · 视频编辑与实时特效 2 篇 · 统一多模态生成 1 篇 · 音频生成与综述 2 篇 · 扩散 RL 后训练 2 篇 重点论文标题列表 LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× TACache:Rectified Flow 训练免训练加速 4.14× Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Lance:原生统一图像视频理解生成 MoE 模型 StreamingEffect:单 H200 实时 720p 人像视频特效 今日论文速览 1. LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× LongLive-2.0: An NVFP4 Parallel Infrastructure for Long Video Generation | NVIDIA | arXiv:2605.18739 关键词:长视频生成·NVFP4·序列并行·AR 视频扩散·Song Han 前序问题:长视频生成的训练和推理同时卡在显存和速度上:现有 Self-Forcing 系列依赖 ODE 初始化 + DMD 蒸馏,流程冗长;推理端把 KV cache 与计算精度压不下去,使得分钟级、多镜头、可交互的 AR 视频生成在大模型规模下难以落地 本文贡献:提出 LongLive-2.0:首个 NVFP4 端到端长视频生成训练 + 推理基础设施。(1) 训练侧的 Balanced SP——把 teacher-forcing 布局与序列并行(SP)协同设计,在每个 rank 上配对干净历史 + 噪声目标的时间块,并搭配 SP-aware 分块 VAE 编码;(2) 直接把扩散模型微调成长时多镜头交互式 AR 模型,跳过 ODE 初始化 + DMD 蒸馏;(3) 推理侧 Blackwell 上跑 W4A4 NVFP4,KV cache 也量化到 NVFP4,配合异步流式 VAE 解码 实验效果:训练加速 2.15×、推理加速 1.84×;LongLive-2.0-5B 在保持 benchmark 强表现的同时达到 45.7 FPS 推理;可独立 LoRA 切换为 4 步 / 2 步实时生成模式,是首个面向长视频生成的 NVFP4 训推一体系统 批判点评:把 NVFP4 这种 Blackwell 新精度从推理推到训练全链路是工程级里程碑,5B 跑出 45.7 FPS 把长视频 AR 推到了实时门槛;但 NVFP4 对硬件的强绑定限制了非 Blackwell 集群的复现路径,量化 KV cache 在多镜头切换时的累积误差也值得长期追踪 2. TACache:Rectified Flow 训练免训练加速 4.14× Accelerating Rectified Flow Models via Trajectory-Aware Caching | 上海交大, 军事科学院, 华为 | arXiv:2605.16789 关键词:Rectified Flow·训练-free 加速·缓存·正交分解·扩散推理 前序问题:扩散与 Rectified Flow 模型靠迭代评估速度场出图/出视频,计算昂贵;现有 cache 方法靠跳步加速,但粗略的近似在长跳步区间累积误差大,激进加速下质量明显劣化 本文贡献:提出 TACache(Trajectory-Aware Cache)训练-free 加速框架,遵循「先跳步后补偿」范式:对 RF 轨迹上离散速度加速度做正交分解(平行 + 正交残差),分离每步近似误差的幅值与方向来源;离线阶段用幅值 / 方向累积阈值生成跳步表,在线阶段结合样本历史正交方向重构被跳过的速度,无需额外模型评估 实验效果:在 BAGEL、FLUX.1-dev、Wan2.1-1.3B 上分别实现文生图 4.14×、文生视频 2.11× 加速;在所有 reference-based fidelity 指标上一致优于已有 cache 类方法 批判点评:「先跳步后补偿」+ 速度加速度正交分解,把 cache 类方法从经验调参推到了误差可控的工程范式;但分解效果对模型与数据集分布敏感,离线统计在 prompt 分布漂移时是否仍稳定,还需要更长尾的验证 3. Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Aurora: Unified Video Editing with a Tool-Using Agent | 罗切斯特大学, Adobe | arXiv:2605.18748 关键词:视频编辑·VLM Agent·工具调用·统一扩散·欠规范请求 前序问题:现有统一视频编辑模型把文本、源视频、参考图喂进同一个 DiT 一把搞定替换 / 删除 / 风格 / 参考插入;设计很灵活,但默认用户已提供了 model-ready 的文本、参考图与空间锚定——真实请求里这些往往缺失 本文贡献:提出 Aurora:把工具增强 VLM agent 与统一视频扩散 transformer 配对——agent 把原始用户请求映射成对齐 transformer 条件通道的结构化编辑计划,先解决「文本和视觉欠规范」再生成;用监督数据训练完整编辑规划 + 参考图选取,再用偏好对训练鲁棒工具调用与指令润色;并发布 AgentEdit-Bench 评估「欠规范用户请求」下的 agentic 视频编辑能力 实验效果:在 AgentEdit-Bench 与两个现有视频编辑 benchmark 上,Aurora 显著超越纯指令 baseline;VLM agent 还能迁移到其他冻结的视频编辑模型,作为通用前置规划层 批判点评:把视频编辑里「用户输入欠规范」这一真实痛点显式拆解给 VLM agent 处理,是务实且可迁移的范式;但 agent 错误规划带来的级联编辑错误尚未充分量化,agent + DiT 的端到端延迟也是落地前要解决的关键 4. Lance:原生统一图像视频理解生成 MoE 模型 Lance: Unified Multimodal Modeling by Multi-Task Synergy | 字节跳动 Intelligent Creation Lab | arXiv:2605.18678 关键词:统一多模态·MoE·双流架构·原生训练·图像视频生成 前序问题:统一多模态模型要么靠模型尺寸堆量、要么沿用图文为主的设计,在「图像 + 视频 × 理解 + 生成 + 编辑」的全格子上很难一并打通;理解和生成两条能力路径互相干扰,多模态 token 异质性也让位置编码难以兼顾 本文贡献:提出 Lance:原生轻量级统一多模态模型,从零训练,采用「双流 MoE + 共享交错多模态序列」架构——联合上下文学习同时把理解与生成的能力路径解耦;引入 modality-aware RoPE 缓解异质视觉 token 的相互干扰;训练采用分阶段多任务范式,配合自适应数据调度同时强化语义理解与视觉生成 实验效果:图像和视频生成上大幅超越现有开源统一模型,同时保持强多模态理解能力,证明统一不必靠堆参数,「能力路径解耦」是更可持续的统一范式 批判点评:「统一上下文 + 解耦能力路径」的设计直击当前统一模型最大痛点:什么都做但什么都不极致;不过双流 MoE 的训练稳定性、与闭源旗舰模型的差距,以及在更长视频上的可扩展性仍待时间检验 5. StreamingEffect:单 H200 实时 720p 人像视频特效 StreamingEffect: Real-Time Human-Centric Video Effect Generation | 新加坡国立 Show Lab | arXiv:2605.17019 关键词:视频编辑·实时流式·人像特效·因果蒸馏·VideoEffect-130K 前序问题:电商直播、娱乐、Vlog 等场景需要实时人像视频特效,但缺数据、缺可部署的编辑模型;视频编辑的高效蒸馏几乎没人做,现有加速大多围绕文生视频,无法保住身份、背景与时序一致性 本文贡献:提出 StreamingEffect:上下文式视频编辑架构 + 因果 AR 学生蒸馏,把采样从 50 步压到 4 步;支持关键帧控制——可以在线注入参考特效帧并沿流传播,实现交互式编辑;同时构建 VideoEffect-130K 数据集——70K 特效视频 + 60K 编辑视频、600 类特效,是已知最大的人像视频特效数据集 实验效果:在单张 H200 GPU 上实现实时高质量 720p 视频编辑,数据集和方法共同填补了「人像视频特效实时编辑」的开源生态空白 批判点评:把视频编辑显式当作「实时流式 + 关键帧可控」问题来解,配套 130K 高质量数据是最大的工程贡献;但 600 类特效的覆盖度、4 步学生在长流式生成下身份漂移、以及 H200 之外的部署门槛,是产品化关键考验 6. MeanFlow-LSE:MeanFlow 蒸馏推到 80B 工业级模型 Stabilizing, Scaling & Enhancing MeanFlow for Large-scale Diffusion Distillation | 西电, 腾讯混元 | arXiv:2605.17834 关键词:MeanFlow·扩散蒸馏·大规模训练·HunyuanImage·少步生成 前序问题:MeanFlow 因公式简洁、表现强劲在少步蒸馏受关注,但优化目标不稳定 + 「mean-seeking bias」限制了它在大规模工业模型上的应用,蒸馏到 12B / 80B 级别经常训练崩溃或质量塌陷 本文贡献:(1) 引入 warm-up 技术,用离散解替代原 MeanFlow 微分解,避免 stop-gradient 项含未训好模型导致的训练崩溃;等模型对平均速度场有初步拟合后再切回微分解继续精炼;(2) 引入轨迹分布对齐作为辅助目标,缓解极少步推理下复杂目标分布上的 mean-seeking bias,让学生模型轨迹分布贴近教师 实验效果:在 FLUX.1-dev(12B)上超越现有蒸馏方法;推到 80B 的 SOTA 工业模型 HunyuanImage 3.0,依然展现出鲁棒泛化与强表现,是首次把 MeanFlow 蒸馏验证到 80B 量级 批判点评:warm-up + 轨迹分布对齐两步组合直击 MeanFlow 在大模型上的两大顽疾,工程上意义重大;但 warm-up 阶段 / 切换时机依赖经验设定,对不同 backbone 的迁移性还需更系统消融 7. I2V-Survey:图生视频扩散首份系统综述 Image-to-Video Diffusion: From Foundations to Open Frontiers | 港城大, 格里菲斯大学等 | arXiv:2605.17248 关键词:图生视频·扩散综述·I2V·taxonomy·开放挑战 前序问题:图生视频(I2V)已成为生成模型的核心方向,对内容一致性、身份保留与运动连贯性的要求都比通用视频生成更严;但现有论文大多把 I2V 当作通用视频生成的子话题,缺乏专门的 taxonomy 与系统分析 本文贡献:把扩散 I2V 单独立题,系统梳理任务定义、模型架构、数据集、评测指标,并按架构和训练范式给出 taxonomy;进一步抽取 4 个核心设计——条件编码 / 时序建模 / 噪声先验 / 时空上采样,配合典型应用与开放挑战 实验效果:为 I2V 这一独立子方向提供首份结构化综述,给出可复用的 4 大设计轴和应用-挑战双视角,便于研究者和工程团队系统理解技术路径 批判点评:把 I2V 从「视频生成的角落」抬到独立子方向,「4 个核心设计 + taxonomy」是清晰可用的索引框架;但综述截止时间内未能覆盖最新一波因果 / 实时 I2V,未来需要持续更新追踪 8. WavFlow:原始波形空间直生高保真音频 WavFlow: Audio Generation in Waveform Space | Meta AI, 东北大学 | arXiv:2605.18749 关键词:音频生成·波形空间·Flow Matching·V2A·T2A 前序问题:现代音频生成几乎都依赖潜空间压缩,引入额外复杂度并潜在丢失信息;但波形空间维度极高、能量分布稀疏,让扩散模型直接在波形上建模长期失败 本文贡献:提出 WavFlow:直接在原始波形空间生成高保真音频,无中间表示。通过 waveform patchify 把音频重塑为 2D token grid,引入 amplitude lifting 对齐信号尺度,使 flow matching 中的 x-prediction 优化稳定;并构建自动化数据流水线,整理 500 万视频-文本-音频三元组,从零学习细粒度声学模式 实验效果:在视频转音频 VGGSound 上取得 FD_PaSST 59.98 / IS_PANNs 17.40 / DeSync 0.44;在文生音频 AudioCaps 上 FD_PANNs 10.63 / IS_PANNs 12.62,与已有潜空间方法持平或超越,证明中间压缩并非高质量音频合成的必要条件 批判点评:「不要 latent,直接干波形」是颇有勇气的反潮流路线,patchify + amplitude lifting 是让 flow 在波形上稳的关键工程;但波形 flow matching 的训练成本与采样开销比 latent 方案高得多,工业级落地需要更激进的加速 9. TAPE:时序感知 token 剪枝免训加速视频扩散 Temporal Aware Pruning for Efficient Diffusion-based Video Generation | 匹兹堡大学, IIT, Rutgers, Microsoft AI | arXiv:2605.17837 关键词:视频扩散·token 剪枝·训练-free 加速·时序一致性·ViT 前序问题:视频扩散 ViT 架构出视频质量高,但长时空序列上的注意力计算极贵;已有 token 剪枝多基于 attention、按帧独立操作,难以保住跨帧时序连贯,naive 应用会产生背景不稳、闪烁、画质下降 本文贡献:提出 TAPE 训练-free 时序感知剪枝:(i) 时序平滑对齐相邻帧的 token 重要性,抑制选择抖动;(ii) 在选定层做 token 重选,使剪枝匹配各层的不同语义关注,避免误差在特定区域累积;(iii) 时间步级预算调度——早期噪声重的步骤激进剪、后期保真关键步骤放宽 实验效果:显著提速的同时保持高视觉保真度,超越前期 token reduction 方法;作为 plug-in 训练-free 加速,能直接套到现有视频扩散模型上 批判点评:把 token 剪枝从「每帧独立」拉回「时序感知」是补足视频域专属约束的正确方向,三项设计互相协同;但激进时间步预算调度对极长视频的累积误差、以及 ViT 之外架构的迁移性仍是开放问题 10. SafeDiffusion-R1:在线 GRPO + CLIP 引导奖励安全对齐 SafeDiffusion-R1: Online Reward Steering for Safe Diffusion Post-Training | MBZUAI | arXiv:2605.18719 关键词:扩散安全·在线 RL·GRPO·CLIP 引导·内容审核 前序问题:扩散模型移除预训练中学到的不安全内容,现有方法要么需要昂贵的 unsafe-text 配 safe-image 监督数据,要么走离线 RL / SFT 在合成数据上训,灾难性遗忘严重,生成质量明显劣化,扩展性差 本文贡献:提出在线 RL 框架:在正负 prompt 上跑 GRPO;引入 steering reward 机制利用 CLIP 嵌入空间的固有性质——把文本表示推向正向安全方向、远离负向,无需为每个安全维度单独训 reward 模型;在线策略让模型从包括显式不安全 prompt 在内的多样请求中学习而不灾难性遗忘 实验效果:不当内容下降到 18.07%(vs SD v1.4 的 48.9%),裸露检测 15 vs baseline 646;GenEval 组合生成质量从 42.08% 提升到 47.83%;安全增益泛化到 7 类未见有害 prompt 类别 批判点评:把「安全对齐」从离线 SFT 推到在线 GRPO,叠加 CLIP 嵌入引导避开 reward 模型训练,工程友好且可扩展;但 CLIP 嵌入方向偏向、对抗性提示下 steering 的鲁棒性,仍需对抗压力测试持续追踪 11. CGPO:按 reward 方差自适应难度的文生图 RL Curriculum Group Policy Optimization: Adaptive Sampling for Unleashing the Potential of Text-to-Image Generation | 北邮, 中国电信 TeleAI | arXiv:2605.17807 关键词:文生图·GRPO·课程学习·自适应采样·RL 对齐 前序问题:文生图 RL(特别是 GRPO 系)训练时统一采样策略忽视了样本难度与模型当前能力的匹配,训练效率低,模型常在已掌握或还远不能掌握的 prompt 上空转 本文贡献:提出 CGPO 自适应课程训练框架:每条 prompt 生成一组图像由 reward 模型打分,用组内 reward 方差作为「prompt 不一致性」的在线 proxy——方差高说明模型部分掌握但未稳定,正是最该多采的可学习 prompt,从而提高其采样概率;再用比例公平优化做类别校准,平衡多类别数据集的训练难度 实验效果:在 GenEval、T2I-CompBench++、DPG Bench 上一致提升生成性能,为 GRPO 类文生图 RL 提供可即插即用的课程化增强 批判点评:用 reward 方差当「可学习 prompt」proxy 是优雅且无需额外标注的设计;但 reward 模型本身的偏差会被该 proxy 放大,长期训练下需要监控 reward hacking 12. DiRotQ:PCA 旋转感知 W4A4 DiT 量化 DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers | d-Matrix | arXiv:2605.16732 关键词:DiT·4-bit 量化·PCA 旋转·W4A4·FLUX 前序问题:DiT 出图质量 SOTA 但推理代价高;激进 PTQ 到 4-bit 能省算力却经常严重掉点;已有 smoothing / mixed precision / rotation / low-rank residual 等方法都只能部分缓解,与 FP16/BF16 仍有可见差距 本文贡献:提出 DiRotQ W4A4 PTQ 框架——通过 PCA 找到激活方差主成分所在的低秩子空间,对该子空间用更高精度保留,其余分量量化到 4-bit;推理时用校准得到的正交变换把激活旋转到 PCA 基,逆旋转离线融入权重;再叠加 GPTQ 的权重量化形成完整 W4A4 系统,并给出 Triton kernel 端到端加速 实验效果:在 PixArt-Σ MJHQ-30K 上取得 FID 15.9 / PSNR 19.1 dB,超越 SVDQuant(FID 18.9 / 17.6);12B FLUX.1-dev 在单卡 RTX 4090 上显存降 2.1×,推理比 BF16 加速 2.3×;并首次提出 VLM-as-a-Judge 评测协议 批判点评:把 PCA 子空间高精度保留 + 离线融入权重的设计,把旋转量化做到了 W4A4 的较好均衡,落地友好;但 PCA 校准对长尾 prompt 的覆盖度、VLM-as-a-Judge 与人类偏好的对齐度,是后续要追踪的关键 13. SpectralProgressive:频谱先粗后细动态扩展分辨率 Spectral Progressive Diffusion for Efficient Image and Video Generation | Stanford | arXiv:2605.18736 关键词:频谱扩散·渐进分辨率·训练-free 加速·视频生成·去噪调度 前序问题:扩散模型在频域里隐式自回归生成——低频先出、高频后出;在噪声主导的早期对全分辨率做计算大量冗余,但目前没人把这一观察系统化用于推理加速 本文贡献:提出 Spectral Progressive Diffusion 通用框架——沿去噪轨迹渐进扩展分辨率;设计频谱噪声扩展机制,并从模型自身的功率谱推出最优分辨率调度;支持 training-free 加速和一种新的微调配方,进一步同时改善效率与质量 实验效果:在多个 SOTA 预训练图像和视频生成模型上获得显著加速,且画质保持;为预训练扩散模型提供一条「无需重训」的频谱渐进推理路线 批判点评:把扩散「频谱自回归」的隐式行为显式化为分辨率调度,思路清晰且与 cache 等加速正交;但频谱调度对噪声分布的假设强依赖训练分布,跨数据集与跨模态迁移性需更广验证 趋势观察 NVFP4 把长视频生成训推一体化推到实用门槛 — LongLive-2.0 把 NVFP4 从纯推理量化推到训练 + KV cache + 异步流式 VAE 解码全链路,5B 模型跑出 45.7 FPS——下一代视频生成基础设施开始与 Blackwell 硬件深度协同,长视频 AR 真正走向「可部署的实时」 扩散加速从 cache 推到「频谱 + 时序 + 量化」三路同时压榨 — TACache 从轨迹正交分解给跳步补偿、TAPE 从时序感知做 token 剪枝、SpectralProgressive 从频谱调度动态扩展分辨率、DiRotQ 从 PCA 旋转把 DiT 推到 W4A4——扩散推理优化第一次在「时间步 / 空间 token / 数值精度 / 频谱通道」四个轴上系统并进 视频编辑进入 agent 时代 — Aurora 把模糊用户请求交给 VLM agent 拆解成结构化编辑计划再喂给 DiT;StreamingEffect 配套 130K 数据 + 4 步因果蒸馏直接做实时人像特效——视频编辑从「模型一把吃下所有输入」转向「agent 解码意图 + 模型专注生成」 统一多模态从堆参数走向「能力路径解耦」 — Lance 用「双流 MoE + 共享交错序列」把理解与生成的能力路径显式解耦,配合 modality-aware RoPE 处理 token 异质性;证明轻量原生设计也能在「图像 + 视频 × 理解 + 生成 + 编辑」全格子上同时领先 扩散 RL 对齐从 reward 工程走向 reward 机制 — SafeDiffusion-R1 用 CLIP 嵌入做 steering reward 替代专门 reward 模型;CGPO 把 reward 方差当 prompt 难度 proxy 实现自适应采样——扩散 RL 后训练正在从「堆 reward 模型」转向「挖 reward 信号本身的几何」 人工智能炼丹君 整理 | 2026-05-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-14|视频扩散从少步到任意步AnyFlow 今日 AIGC 论文速览 今日共 6 篇 · 视频扩散与推理加速 2 篇 · 图像生成与表征 2 篇 · 图像编辑与对齐评测 1 篇 · RL 后训练方法论 1 篇 重点论文标题列表 AnyFlow:——首个基于 flow map AsymFlow:rank-asymmetric ⚡ Qwen-Image-VAE-2.0:高压缩 VAE 套件 Edit-Compass:EditReward-Compass Orthrus:双视图框架 今日论文速览 1. AnyFlow:——首个基于 flow map AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation | 新加坡国立大学 Show Lab, MIT, NVIDIA | arXiv:2605.13724 关键词:视频扩散·Flow Map·On-Policy 蒸馏·Any-Step·推理加速 ⚠️ 前序问题:近一年的少步视频生成几乎被一致性蒸馏(Consistency Distillation)统治,4-8 步即可出图,但只要把采样步数从 4 加到 16/32 画质反而塌——CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为,无法服务「任意步数」推理需求 本文贡献:提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架:(1) 把蒸馏目标从端点一致性映射 z_t→z_0 升级为流图过渡 z_t→z_r,让学生学会任意时间区间的跳跃;(2) Flow Map Backward Simulation 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏,缓解少步采样的离散化误差和因果生成的 exposure bias 实验效果:在双向 DiT 与因果两类视频扩散骨干、1.3B 到 14B 全规模区间一致达到或超越 consistency baseline;当步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势 批判点评:把蒸馏目标从端点一致性升级到任意区间流图是范式级创新,FMBS 的 on-policy 反向模拟在视频域是首次系统化提出;但论文未公开 VBench/UCF-FVD 等具体数值,复现门槛在 1B-14B 教师 + 大规模 on-policy rollout,数据与算力两端都不低 2. AsymFlow:rank-asymmetric Asymmetric Flow Models | Stanford, ETH | arXiv:2605.12964 关键词:Flow Matching·像素扩散·非对称参数化·FLUX.2·文生图 ⚠️ 前序问题:高维像素空间下做 flow matching 速度预测时,模型必须建模与图像同维的高维噪声,即使数据本身有强低秩结构也只能用满秩参数化硬扛,导致像素扩散与潜空间模型间长期存在显著质量差距 本文贡献:提出 AsymFlow:rank-asymmetric 速度参数化——噪声预测限制在低秩子空间、数据预测保持满维,不改网络结构与训练/采样流程即可解析恢复完整速度;首次给出潜空间预训练→像素空间微调的可行路径,让 FLUX.2 klein 9B 的潜空间先验直接初始化像素生成 实验效果:ImageNet 256×256 取得 1.57 FID,大幅超越同类 DiT/JiT 像素扩散;从 FLUX.2 klein 9B 微调出的像素文生图模型在 HPSv3、DPG-Bench、GenEval 上全面超越其潜空间基模,主观真实感显著提升 批判点评:rank-asymmetric 视角直击像素扩散的本质瓶颈,无侵入式参数化是工程甜点;但低秩子空间的秩选择、与 FLUX.2 这种顶级模型的耦合是否过强、跨数据集泛化能力都还需更大规模验证 3. Qwen-Image-VAE-2.0:高压缩 VAE 套件 Qwen-Image-VAE-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.13565 关键词:图像 VAE·高压缩·文本渲染·扩散兼容·视觉分词器 ⚠️ 前序问题:高压缩比 VAE 在重建保真度和 diffusability 之间长期难以兼得——压得越狠下游 DiT 越难训,文本密集场景(文档、海报)的字符更是首当其冲糊掉 本文贡献:提出 Qwen-Image-VAE-2.0 高压缩 VAE 套件:架构上引入 Global Skip Connections + 扩展潜空间通道;训练上用十亿级图像 + 合成渲染引擎专项强化文本场景;潜空间用增强语义对齐策略让其更适合扩散建模;编解码器采用非对称 + attention-free 主干降低编码开销 实验效果:在公开重建基准上达到 SOTA;提出 OmniDoc-TokenBench 文档专项评测,在高压缩比下兼顾通用与文本场景;下游 DiT 实验显示其 diffusability 显著优于现有高压缩基线,收敛速度明显加快 批判点评:把 VAE 当成独立产品打磨——文档专项 benchmark + 文本渲染合成数据是务实的工程亮点;但相对其他高压缩 VAE 的提升幅度需等论文公开数值后比较,「diffusability」的量化定义仍偏经验 4. Edit-Compass:EditReward-Compass Edit-Compass & EditReward-Compass: A Unified Benchmark for Image Editing and Reward Modeling | 字节跳动 Doubao Team 等 | arXiv:2605.13062 关键词:图像编辑·Reward Model·多维评测·RL 对齐·Benchmark ⚠️ 前序问题:现有图像编辑 benchmark 难度不足、评测维度粗放,已无法区分前沿模型;与此同时图像编辑 RL 越来越依赖 reward model,但 reward model 评测仍停留在脱离实际 RL 场景的设定上,导致编辑模型与 reward model 都缺少可靠裁判 本文贡献:提出 Edit-Compass + EditReward-Compass 统一评测套件:前者含 2,388 条精标实例,覆盖世界知识推理、视觉推理、多图编辑等六级递进任务,采用结构化推理 + 细粒度 rubric 多维评分;后者含 2,251 对偏好对,模拟真实 RL 优化中的 reward 场景 实验效果:为前沿编辑模型提供了能拉开差距的多维难度梯度,配套的 reward model 评测能反映 RL 训练中 reward model 的真实表现,为后续编辑模型与 reward model 的迭代提供统一坐标系 批判点评:把「编辑能力」和「reward model 能力」两条评测线收编进同一套 benchmark 是踏实的基础工作;2,251 对偏好对的标注一致性、reward 评测对真实 RL 收益的预测力,是这类工作走向社区共识的关键门槛 5. Orthrus:双视图框架 Orthrus: Memory-Efficient Parallel Token Generation via Dual-View Diffusion | Adobe Research, University of Oregon | arXiv:2605.12825 关键词:并行解码·扩散语言模型·KV Cache·推理加速·双视图 ⚠️ 前序问题:自回归 LLM 生成保真度高但串行解码慢,扩散语言模型可并行却质量退化、训练贵、收敛缺乏严格保证——视觉/多模态 token 生成场景同样面临「快」与「准」难以兼得 本文贡献:提出 Orthrus 双视图框架:在冻结的 AR LLM 上挂载一个轻量可训练扩散并行视图,两视图共用同一份高保真 KV Cache——AR 头负责 prefill 构建准确表征、扩散头负责并行解码;通过两视图共识机制保证无损推理,把扩散并行解码移植到 Transformer 几乎零侵入 实验效果:在保证完全等价生成(lossless)的前提下,相比纯自回归提供最高 7.8x 加速,KV Cache 内存仅增加 O(1),参数增量极小;为视觉/多模态自回归 token 生成提供直接可用的并行加速路线 批判点评:把扩散当成 AR 的「并行外设」而不是替代品,借共识机制保留 AR 保真度,工程上很优雅;但 7.8x 加速属上限值,真实任务下并行步内的拒绝率与吞吐曲线值得进一步给出,扩散头训练成本也未充分披露 6. Beyond-GRPO:奖励分配原则 Beyond GRPO and On-Policy Distillation: An Empirical Sparse-to-Dense Reward Principle for Language-Model Post-Training | Meta | arXiv:2605.12483 关键词:LLM 后训练·GRPO·On-Policy 蒸馏·奖励密度·稀疏到稠密 ⚠️ 前序问题:在「可验证标注极其稀缺」的后训练场景下,主流做法(在部署模型本身上跑 GRPO)忽视了一个奖励密度原则:稀疏的序列级奖励应该用在能产生有效探索的强模型上、稠密的 token 级奖励才适合把行为压缩进小模型,这一直觉对生成模型的 RL 对齐同样关键 本文贡献:提出 Sparse-to-Dense 奖励分配原则:把宝贵的可验证数据先「上游」给强 teacher 跑 GRPO 做探索,再以稠密蒸馏的形式「下游」灌给小学生,最后在学生侧再补一段稀疏 RL;具体配方为 forward-KL warmup → OPD on-policy → 学生侧 GRPO 的三段桥 实验效果:在 Qwen3-1.7B 学生固定的前提下,先在 8B teacher 上 RL 再蒸馏全面优于直接在学生上 GRPO;学生侧后续 GRPO 把 MATH 从 75.4% 提升到 78.5%、比 replay baseline 高 2.8 分,AIME 端点也最强 批判点评:「奖励密度」的视角让 GRPO 与 OPD 不再对立而成同一光谱的两端,对资源紧张团队的实践指导价值很高;但结论建立在数学这一可验证任务上,对图像/多模态生成等弱验证任务能否平移仍待验证 趋势观察 视频扩散从「少步」走向「任意步」 — AnyFlow 把蒸馏目标从端点一致性升级到任意区间的 flow map,叠加 on-policy 反向模拟,让一个学生模型在 1/4/16/32 步上都呈现良性 scaling——少步视频生成第一次有了真正的「test-time 预算自由度」 像素扩散借势潜空间预训练 — AsymFlow 用 rank-asymmetric 速度参数化把高维噪声预测限制在低秩子空间,并首次跑通了「FLUX.2 klein 9B 潜空间→像素空间」的微调路径——像素扩散与潜空间扩散开始走向「初始化共享、后期分化」的新协作方式 VAE 不再是配角,而是产品 — Qwen-Image-VAE-2.0 把高压缩 VAE 当作独立产品打磨:Global Skip Connections + 扩展通道 + 文档专项 benchmark,承认了「VAE 决定 DiT 上限」的事实,VAE 进入「文本可读、扩散友好、推理便宜」的三维竞赛 编辑模型与 reward model 同台同尺 — Edit-Compass 把「图像编辑能力」和「reward model 能力」并入同一评测套件,并把 reward model 评测从脱节场景改造成贴合 RL 实战的偏好对——前沿编辑模型的 RL 对齐第一次有了配套的统一坐标系 稀疏-稠密奖励分配成为后训练新共识 — Beyond-GRPO 给出一条简单规则:稀缺可验证数据先在强 teacher 上做稀疏 RL,再以稠密蒸馏下沉到小学生,最后学生侧补稀疏 RL;这一原则同样适用于多模态生成模型的 reward 分配,正在成为下一代 alignment pipeline 的骨架 人工智能炼丹君 整理 | 2026-05-14