搜索到
12
篇与
图像编辑
的结果
-
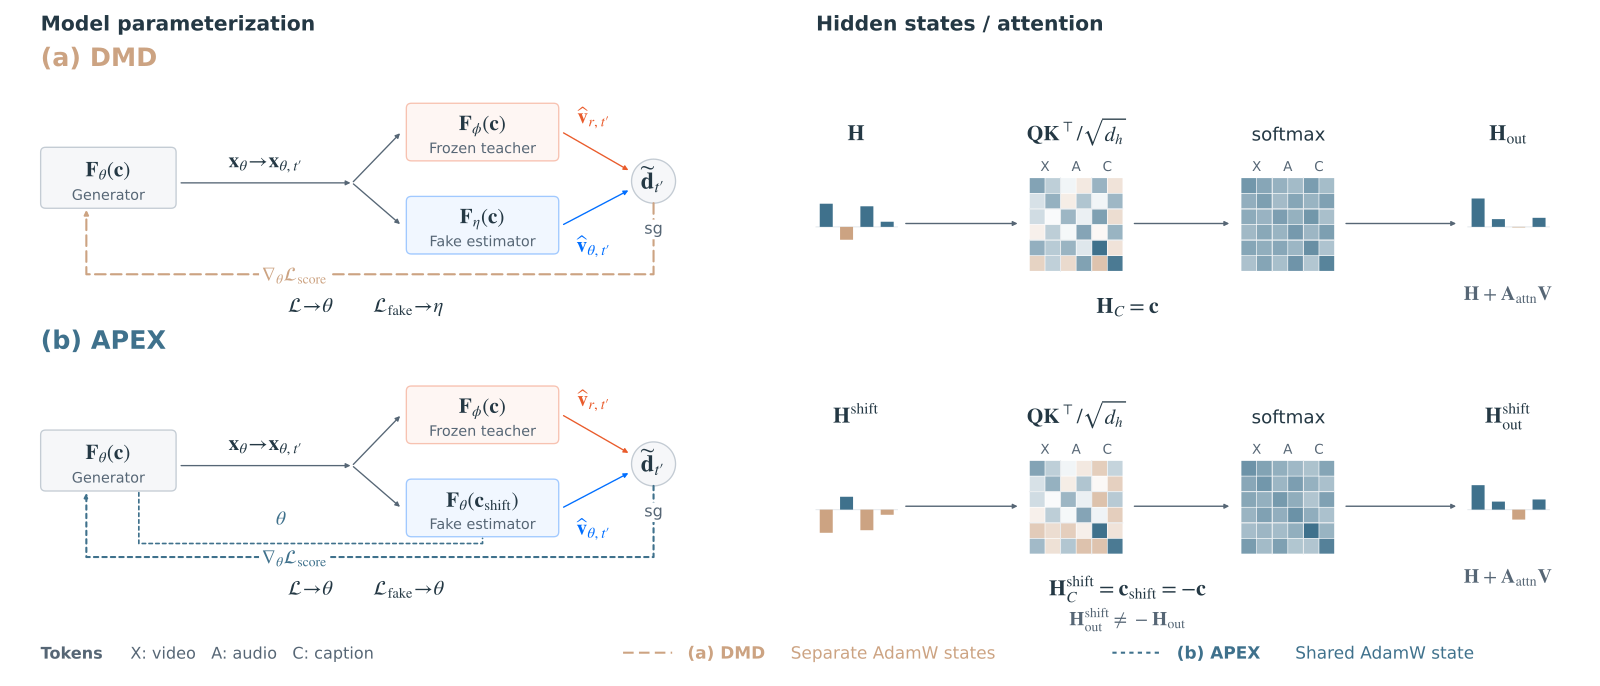
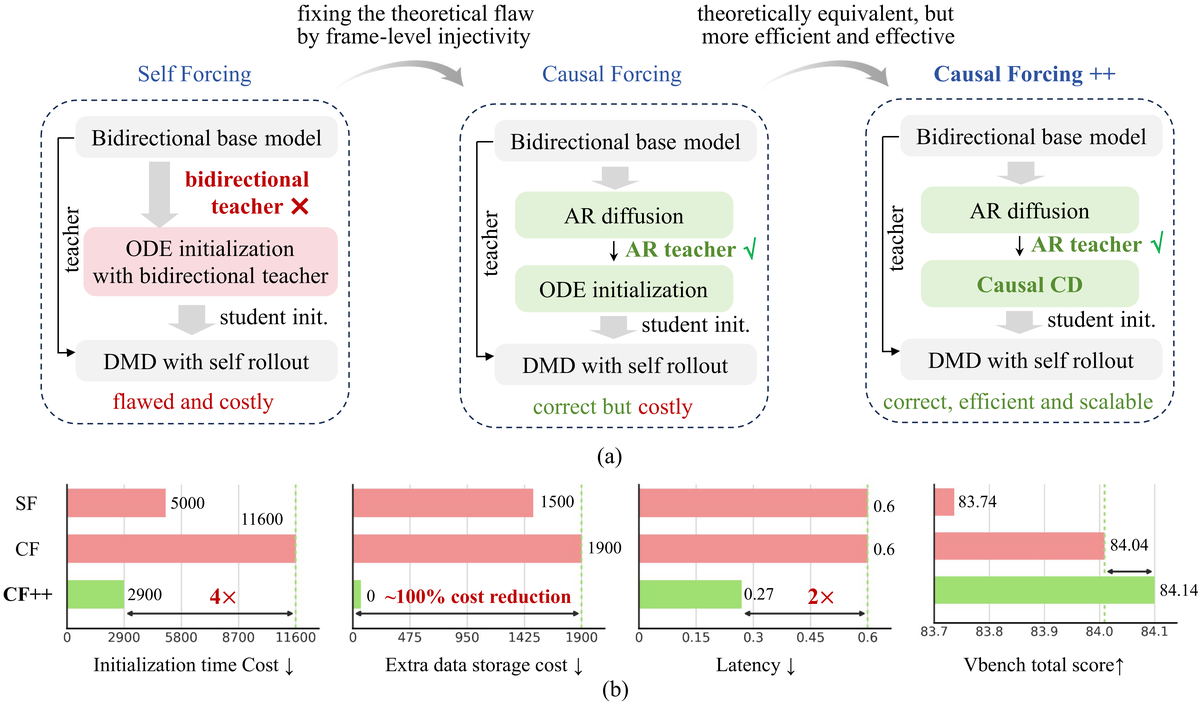
 AIGC 每日速读|2026-11-13|清华流式视频指令偏好净胜30%-APEX 今日 AIGC 论文速览 今日共 10 篇 · 流式视频与偏好对齐 2 篇 · 生成加速 3 篇 · 几何视频与压缩重建 2 篇 · 图文生成 1 篇 · 语音与三维头像生成 2 篇 概览导读:三分钟流式视频中途改指令,人物仍要按要求行动。首篇 APEX 用同一网络兼做生成和假分数估计,70 例成对人工评测的指令遵循净偏好比 S2-Avatar 高 30 个百分点。接着看图像编辑与视频扩散缓存、稀疏注意力和语义 KV 压缩如何省计算;后半篇讨论视频偏好奖励、相机控制与压缩重建,再到文字图像、局部语音编辑和双人 3D 头像。不同论文的速度、质量和偏好口径不直接横比。 重点论文标题列表 APEX(清华):长视频指令偏好净胜30% IdealCache(电子科大):图像编辑缓存提速5.84倍 ESTRA(悉尼大学):视频注意力稀疏到5%仍清晰 SemanticKV(厦大):按指令保留视频记忆 GenRM-Flow(浙大):让视频生成器自己打偏好分 选读入口:想做会随指令变化的三分钟流式视频,先读 APEX;要给 Qwen-Image-Edit 或 HunyuanVideo 省推理时间,读 IdealCache;低密度注意力和长视频缓存预算分别看 ESTRA、SemanticKV。给视频生成器做偏好奖励读 GenRM-Flow;相机轨迹控制新画面看 UGG,极低码率重建看 ADE-GVC。海报中文字总拼错读 Four-Step DiT;多轮只改语音局部风格读 DialInstruct-TTS;双人虚拟头像的互动读 DiaHeads。 今日论文速览 1. APEX:长视频指令偏好净胜30% Few-Step Streaming Video Generation via Condition Shifting | 清华大学;生数科技;西湖大学 | arXiv:2611.14033 关键词:流式视频生成, 少步蒸馏, 条件偏移, 长视频, 指令遵循 前序问题:连续生成三分钟视频时,每个片段都要反复调用生成主干;常见分布匹配蒸馏另养一张“假分数”网络,增加训练显存和迭代时间。 方法直觉:同一生成器换一套文本条件,就让它在生成和估计自身分布之间切换;省掉独立假分数网络,仍保留冻结教师和生成历史回放。 本文贡献:把 APEX 的 condition shifting 扩展到流式视频:原文本条件负责出片,偏移后的条件负责估计生成分布的速度场;训练沿用 Self-Replay Forcing 和感知正则。这里的 NFE 是每片段对视频主干的调用次数,实验用 3 次,再接一次空间 Refiner。 Figure 2 : DMD and APEX in Self-Replay Forcing. DMD uses independent fake parameters η \eta ; APEX shares generator and fake parameters θ \theta and, by default, AdamW states. Teacher parameters ϕ \phi are frozen. Left: θ \mathbf{x}_{\theta} is the rollout/replay output, t ′ t^{\prime} the scoring time, ~ t ′ \widetilde{\mathbf{d}}_{t^{\prime}} the normalized correction, and sg \mathop{{\color[rgb]{1,0,0}\operatorname{sg}}}\nolimits stop-gradient. The correction contributes ∇ θ ℒ score \nabla_{\theta}\mathcal{L}_{\mathrm{score}} ; ℒ \mathcal{L} is the full generator objective. The fake-velocity subscript θ \theta identifies the generated distribution. Right: \mathbf{H} and out \mathbf{H}_{\mathrm{out}} denote input and output hidden states; C \mathbf{H}_{C} contains projected text tokens \mathbf{c} . Within each row, , , \mathbf{Q},\mathbf{K},\mathbf{V} are queries, keys, and values, and attn = softmax ( ⊤ / d h ) \mathbf{A}_{\mathrm{attn}}=\operatorname{softmax}(\mathbf{Q}\mathbf{K}^{\top}/\sqrt{d_{h}}) , with head dimension d h d_{h} . Superscript shift \mathrm{shift} marks states under shift = − \mathbf{c}_{\mathrm{shift}}=-\mathbf{c} . The single-head example uses fixed weights and omits the causal mask and other transformer operations; values are schematic. 实验效果:70 例、每例 180 秒的成对人工评测中,APEX 相对 S2-Avatar 的“指令遵循”净偏好为 +30.0%(胜率减败率),一致性和整体画质各 +4.3%;320 例 StreamAV-Bench 的 Progressive 指令分从 3.831 到 3.856。匹配训练设置下,峰值单卡分配显存低 4.4%,平均迭代时间短 9.2%,这是训练成本而非推理速度。 Figure 3 : Paired examples at 3 backbone NFE. (a) APEX retains both bags late in the sequence, while S2-Avatar shows one. (b) APEX brings the tube to the other hand for the applying instruction; S2-Avatar continues holding it at its side. Each pair uses the same reference and timestamps, with a common one-step 2 × 2\times Refiner. 批判点评:人工评测里运动质量偏向 S2-Avatar,音画同步多为平局;70 例三分钟长流和 3 NFE 加共同 Refiner 的结论不能外推到任意主干或时长。论文没有把少步采样写成相对 S2-Avatar 的端到端推理倍数。 2. IdealCache:图像编辑缓存提速5.84倍 IdealCache: Rethinking Cache Scheduling in Diffusion Transformers via Ideal Trajectories | 电子科技大学;独立研究者 | arXiv:2611.10340 关键词:图像编辑, 视频生成, 扩散加速, 特征缓存, 最短路径 前序问题:扩散 Transformer(DiT)的缓存通常模仿原始逐步去噪轨迹;但中间状态接近原轨迹,不保证最终编辑结果最好,还会把原轨迹当成隐形质量上限。 方法直觉:先定义希望到达的理想输出,再衡量跳过若干完整计算后偏离理想轨迹多少;把“在哪些步更新缓存”变成受计算预算约束的最短路径。 本文贡献:IdealCache 为每个输入构造候选目标形成理想轨迹集合,以缓存偏差作为图边权,离线搜索非均匀更新日程;推理时直接复用日程,不重训 DiT。ℬ 表示保留完整更新的预算,不是生成步数。原文覆盖 Qwen-Image、Qwen-Image-Edit 和 HunyuanVideo。 Figure 2: Cache deviation as edge weight. Starting from x t ∗ x_{t}^{*} on the ideal trajectory, a single full pass populates the cache with residuals Δ t , Δ t \Delta\mathbf{h}_{t},\Delta\mathbf{e}_{t} . We then take t − k t{-}k Euler updates that all reuse those residuals (red dashed), arriving at x ^ k \hat{x}_{k} . The squared distance to the ideal endpoint x k ∗ x_{k}^{*} is the cache-deviation edge weight w ( k → t ) w(k\to t) used in our graph. 实验效果:Qwen-Image-Edit 的 GEdit-Bench 上,ℬ=7 时批量为 1 的端到端墙钟速度为原 50 步的 5.84 倍,整体分 7.59;FlowEdit 上 ℬ=25 的背景保留 SSIM 从原流程 0.665 到 0.687,SSIM 越高表示与输入背景越相似。HunyuanVideo 在表内 ℬ=10 时为 4.32 倍。 Figure 3: Qualitative editing results on Qwen-Image-Edit. Our method achieves better background preservation in some cases while maintaining comparable editing quality. IdealCache with ℬ = 10 \mathcal{B}{=}10 ( ∼ \sim 4.2 × 4.2\times speedup) achieves visual quality comparable to the vanilla 50-step baseline. 批判点评:速度含文本编码、VAE 图像解码等固定开销,不等于单个 DiT 内核提速。FlowEdit 的 ℬ=10 背景 SSIM 0.679 仍较高,但 ImageReward 由原流程 1.054 降到 0.991;不同预算须在编辑保真和速度间取舍,离线理想轨迹构造也有成本。 3. ESTRA:视频注意力稀疏到5%仍清晰 ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration | 悉尼大学;澳大利亚联邦科学与工业研究组织 | arXiv:2611.10448 关键词:视频扩散, 稀疏注意力, 无训练加速, H20, 画质保真 前序问题:视频扩散 Transformer(DiT) 的长时空 token 让注意力昂贵;现有免训练稀疏法在密度很低时,近似误差会迅速破坏生成画面。 方法直觉:把计算预算留给真正重要的单个 key-value token;其余 token 由聚类代表近似,并根据组内离散程度修正代表权重。 本文贡献:ESTRA 先聚合相似 query 给单个 key 打分,再在 5% 或 1% 的精确交互预算内挑选 token;余下 key 用均值和方差校正模块(VCM) 表示。这里“密度”是精确计算的视频 query-key 交互占比,稀疏阶段之外还存在固定处理成本。 Figure 2: ESTRA overview. (a) Independent query and key clusters provide query centroids and K/V means. (b) Each centroid scores individual keys for selection shared by its query cluster. (c) VCM uses remaining-key spread and query norms to calibrate representative weights. (d) Original queries attend jointly to selected tokens and fixed cluster means, with log-count and VCM biases on representative logits. Colors identify clusters. Attention scaling is omitted. 实验效果:原文在 NVIDIA H20、720p、无密集预热的 Wan2.1-14B(81 帧)上,5% 密度端到端从 6838 秒到 2097 秒,即 3.26 倍;HunyuanVideo-13B(129 帧)从 6490 到 1378 秒,即 4.71 倍。其与密集输出的 Wan 画面 SSIM 为 0.489,高于 Sol-Attn 12.8% 密度时的 0.283;SSIM 越高表示结构越接近密集参考。 Figure 1: High-quality video generation at up to 99% attention sparsity. At 5% exact-interaction density, ESTRA more closely preserves the composition and appearance of the dense references than the baselines shown, while using higher sparsity and achieving greater end-to-end speedups. At 1%, the videos remain visually coherent, with particularly small changes in the HunyuanVideo example. Density denotes the fraction of video query–key interactions evaluated exactly; speedups are end to end on an NVIDIA H20. Additional examples are provided in Appendix D . 批判点评:把 5% 密度误读成整体计算量仅 5% 会夸大收益;在 1% 密度,Wan 的 VBench 动态程度从密集参考 66.98 降到 61.87。该时间受 H20、帧数、分辨率和具体内核影响,跨机器不可直接照搬。 4. SemanticKV:按指令保留视频记忆 Semantically Aligned KV Cache Compression for Efficient Agentic Autoregressive Video Generation | 厦门大学 | arXiv:2611.11452 关键词:自回归视频生成, KV 缓存, 语义约束, 长视频, 显存 前序问题:自回归视频越生成越长,历史帧的 键值(KV)缓存占满显存;普通压缩只看注意力热度,可能删掉对提示词中人物、动作和物件仍重要的状态。 方法直觉:先从计划中抽取必须遵循的语义约束,再找各约束关注的历史位置;每组都能为某个缓存 token 投票,避免少数约束被平均淹没。 本文贡献:SemanticKV 不重训生成器:文本交叉注意力定位语义相关视频位置,收集其自注意力 query;组内平均、组间取最大后做一次 top-k 保留,并维持剩余键值与位置不变。这里保留预算按字节约束,0.7 压缩率指约删去 70% KV。 Figure 2: Overview of SemanticKV . Semantic constraints ℛ \mathcal{R} are matched to prompt tokens. Text cross-attention identifies related video positions, from which we collect the generator’s self-attention queries. Their attention to each KV entry is averaged within groups and maximized across groups. A single top- k k selection retains high-scoring entries within the byte budget, together with states required by the backbone. Retained keys, values, and positions remain unchanged. 实验效果:Causal Forcing 的 5 秒视频综合评测 VBench、0.7 压缩率下,综合分 Total Score 为 84.10,对比最强压缩基线 84.05 和 Full KV 83.99;DiT-only FPS 提升 1.22 倍,KV 从 6.04 GB 到 1.81 GB。LongLive 2.0 的 60 秒实验中,KV 从 20.76 GB 到 6.23 GB,但 VBenchLong 总分从 80.12 降到 78.84。 Figure 4: Paired semantic fidelity on matched prompt–seed tuples. (a) Tie-aware superiority rates. (b) Mean paired differences with prompt-clustered bootstrap 95% confidence intervals. Positive differences favor SemanticKV ; Full KV is the uncompressed reference. 批判点评:方法依赖规划器提出的约束,漏掉的细节未必获保留;5 秒的分数优势很小,也不能等同于所有长视频质量提升。速度数字是 DiT-only,未含规划、筛选和验证全链路。 5. GenRM-Flow:让视频生成器自己打偏好分 GenRM-Flow: Generators are Process-aware Reward Models in Flow Matching | 浙江大学;Joy Future Academy;厦门大学;清华大学 | arXiv:2611.11421 关键词:视频生成, 偏好对齐, 流匹配, 奖励模型, FlowAWR 前序问题:视频偏好对齐常靠外部视觉语言模型或附加判别头评分;评分器没有直接使用视频生成器在噪声潜空间里的预测能力。 方法直觉:偏好微调后的生成器与冻结原模型,对同一视频的速度预测误差差值,本身可读成逐时刻奖励;用这份奖励替代外部判官指导再训练。 本文贡献:GenRM-Flow 从离线偏好目标推导隐式过程奖励:在流匹配噪声状态上比较当前策略与参考策略的速度预测误差,不新增打分头;将它接入按奖励加权微调视频生成器的 FlowAWR。文中不同偏好训练目标都是到目标策略的路径,不是附加奖励网络。 Figure 2: The pipeline of GenRM-Flow . (Panel A) Traditional paradigms rely on representational capacity , utilizing a frozen backbone (e.g., a VLM or base generator) as a feature extractor coupled with an auxiliary discriminative head. (Panel B) The proposed framework sources the reward directly from generative capacity . Following preference optimization, the implicit reward R D ( , c ) R^{D}(\mathbf{x},c) is algebraically extracted from the velocity-prediction errors. The scalar score is computed natively by contrasting the active policy (flame, θ ⋆ \theta^{\star} ) against a frozen reference (snowflake, θ ref \theta_{\mathrm{ref}} ), requiring no architectural modifications or auxiliary heads. 实验效果:原文留出偏好对比集上,Wan2.1-T2V-1.3B 的平均成对预测准确率为 86.79%,PAVRM 为 76.06%;同主干接入 FlowAWR 后,VBench 的动态程度从 PAVRM 的 67.83 到 73.46。14B 主干对应动态程度为 71.82 到 74.87;这些是作者协议内结果。 Figure 4: Qualitative comparison between PAVRM and GenRM-Flow as the per-step reward signal in FlowAWR with a 1.3B backbone. Both runs use FlowAWR with the same configuration, differing only in the reward signal. Red boxes mark localized structural deformations, spatial inconsistencies, and temporal artifacts produced by PAVRM. Across scenes, our reward yields visibly fewer geometric defects and better spatial and temporal continuity. 批判点评:奖励要运行当前与参考生成器的速度预测,不能把“无附加头”误写成零额外计算;奖励依赖已微调策略及参考策略。论文的原始奖励不做组内归一化时约 250 步出现策略坍塌,训练稳定性需要单独处理。 6. UGG:相机轨迹控制视频也补几何 UGG: Unified Generative Geometry Model | 麻省理工学院;加州大学圣迭戈分校;剑桥大学 | arXiv:2611.14440 关键词:相机控制视频, 4D 场景生成, 深度预测, 相机姿态, 条件补全 前序问题:给视频第一帧和相机轨迹,要补出连贯的中间画面;单独训练视频生成与几何预测模型,常让画面、深度和相机姿态彼此不一致。 方法直觉:把已看到的 RGB、深度和相机射线设为干净 token,缺失部分设为带噪 token;同一模型以“补空缺”完成视频生成或几何预测。 本文贡献:UGG(Unified Generative Geometry Model)将 RGB、深度及用密集射线图表示的相机姿态放进统一 transformer;各模态有专属投影和前馈层,共享多模态自注意力。还可采样多个可能场景并用可观测图像的几何证据选择。原文已接收 NeurIPS 2026。 Figure 2: Generative-predictive transformer. We model RGB, depth, and camera pose as spatially aligned tokens, with camera pose represented as dense ray maps. Partial observations are zero-noise context tokens, while missing modalities are noisy tokens to be denoised. A unified transformer processes all tokens with modality-specific projections and feed-forward layers together with shared multimodal self-attention, enabling information exchange across modalities. The decoded RGB, depth, and ray maps form a complete 4D scene representation for cross-modal generation, geometric prediction, and inference-time consistency search. 实验效果:RealEstate10K 双端点帧加目标相机轨迹的视频补全中,UGG 的 峰值信噪比 PSNR 为 25.73 dB、感知距离 LPIPS 为 0.061,对照 SEVA 为 25.25 dB、0.081;PSNR 越高、LPIPS 越低通常表示与真值更接近。但 DL3DV 同设定中,UGG 的 PSNR 16.61 dB 低于 SEVA 的 17.61 dB。 Figure 4: Qualitative comparison of camera-controlled generation. Given the first and last RGB frames and a target camera trajectory, we compare generated intermediate frames against ground truth and baseline video generation methods. UGG better preserves scene identity and dynamic content compared with the generic video completion baselines. 批判点评:“统一”不意味着每个数据集都最好;DL3DV 是明确反例。画面指标依赖真值和给定相机轨迹,也不直接证明开放世界长视频的物理一致性;测试时多样本搜索会增加推理成本。 7. Four-Step DiT:四步画海报字更准 Four-Step Text-Bearing Image Generation via Distillation with Local Response Regularization and Teacher-Guided Training | 清华大学 | arXiv:2611.12042 关键词:图文生成, 扩散蒸馏, 文字渲染, GLM-Image, 四步采样 前序问题:文字海报要同时画好场景和拼对字;把 50 步图像模型压成四步后,字符细节往往先坏掉。 方法直觉:让学生模型的局部去噪响应更平稳,同时用教师图像和合成字符串分阶段喂给它,使少数几步既管布局又管字形。 本文贡献:研究在 GLM-Image 的扩散 Transformer(DiT) 的分布匹配蒸馏中加入局部响应路径长度正则,并保留冻结的自回归视觉先验、字形编码器与 VAE;文字训练从短字符串逐步走到密集布局。四步是学生去噪转移次数,教师是 50 步,不能直接当成端到端 12.5 倍。 Figure 2: Four-step distillation with complementary response and data supervision. Frozen autoregressive and glyph encoders retain semantic and character conditions. Distribution matching transfers teacher synthesis behavior, while the path-length term regularizes the student’s local response. Teacher-guided progressive training combines explicit text examples with visually integrated typography; the VAE remains fixed. 实验效果:原文 1024×1024、NVIDIA A100 的单图推理从教师 5.818 秒到学生 1.742 秒,端到端快 3.34 倍,两者仍需 40 GB GPU 内存。CVTG-2K 单词准确率为 0.5045,四步 TDM 为 0.1690;图像组合生成评测 GenEval Overall 为 0.84 对 0.81。单词准确率是所生成文字与目标文本匹配的比例。 Figure 6: Qualitative comparison of four-step GLM-Image students. Within each three-column group, outputs are ordered as the student without text training, TDM, and our complete framework. Cases cover (a) an English poster, (b) a Chinese poster, (c) a bilingual sign, (d) product packaging, (e) multiline text, (f) a bilingual display, (g) object counting, and (h) spatial relations. The examples illustrate differences in literal text preservation, object counts, and spatial arrangement while retaining coherent scene appearance. 批判点评:加速来自蒸馏与专门文字训练,付出教师生成数据和训练成本;推理显存没有下降。数值只覆盖文中主干、A100 和评测集,不能据此保证任意长文本都不拼错。 8. ADE-GVC:按画面失真选视频去噪起点 When to Start Denoising? Adaptive Denoising Entry for Generative Video Compression | 北京航空航天大学;阿里巴巴集团;香港科技大学 | arXiv:2611.13620 关键词:生成式视频压缩, 扩散重建, 自适应去噪, 视频保真, 码率 前序问题:超低码率视频压缩会丢掉细节;扩散模型从固定噪声时刻开始重建,对失真轻重不同的片段常在保真与真实感之间失衡。 方法直觉:让轻度和重度压缩失真走不同的去噪起点,再把压缩痕迹作为时序条件输入视频扩散 Transformer(DiT);这样重建力度可随内容调整。 本文贡献:ADE-GVC 由潜变量压缩网络、时间适配器、起点预测器和视频扩散模型组成;预测器从压缩潜变量估计起始时刻 τ,适配器提供压缩感知条件。它输出的是原视频的压缩重建,不是从文本自由生成新视频。 Figure 3 : The overall architecture of ADE-GVC consists of a latent compression network (LCN), temporal adaptor (TA), timestep predictor (TP), and video diffusion model. The input video g \bm{V}_{g} is encoded into the clean latent 1 \bm{x}_{1} , which is compressed by the LCN into c \bm{x}_{c} and a compression-aware feature t \bm{f}_{t} . The TP predicts the denoising entry τ \tau from c \bm{x}_{c} , while the TA converts t \bm{f}_{t} into the visual context v \bm{c}_{v} . Conditioned on v \bm{c}_{v} , the VideoDiT denoises τ c \bm{x}^{c}_{\tau} , into ^ 1 \hat{\bm{x}}_{1} , which is decoded to reconstruct ^ 1 \hat{\bm{V}}_{1} . 实验效果:以 S²VC 为 BD-Rate 零点,HEVC-B 的感知距离 DISTS 口径 BD-Rate(等质量平均码率差) 为 −56.4%,GLC-Video 为 −13.4%;负值表示在相同感知失真水平下平均所需码率更低。论文另对 1920×1080、96 帧平均解码计时:优化后的 0.831 秒对原始 4.341 秒,约 5.11 倍,但这是其自身实现优化对照。 Figure 7 : Qualitative comparisons on a single frame in terms of representative VVC, PLVC, GLC-Video and our ADE-GVC methods. We also report the Bpp/DISTS metrics to quantify compression efficiency. 批判点评:不同指标口径会得出不同节省值,不能把 DISTS 与 PSNR 下的百分比混成一个总收益。起点预测和时间适配器需要训练;表中解码加速是并行化、编译和 bf16 累积作用,不是仅由自适应去噪带来。 9. DialInstruct-TTS:多轮只改一句话的语气 DialInstruct-TTS: Interactive Expressive Speech Generation via Multi-Turn Dialogue with Fine-Grained Temporal Control | 奈良先端科学技术大学院大学 | arXiv:2611.13875 关键词:语音生成, 多轮语音编辑, 局部风格控制, TTS, 内容保留 前序问题:一次性文本转语音(TTS)指令往往给整句话同一种语气;想只把中间一段改成低声说,通常要重写指令并重生成全句,已满意部分也会变化。 方法直觉:对话规划器每轮汇总最新要求和历史,形成按时间定位的风格计划;只修订目标潜变量,锁定其余片段。 本文贡献:DialInstruct-TTS 用 Qwen 系列规划器形成标出时间段与风格的 TemporalPlan,再由时序声学控制模块调整情绪、语速、音量和发声方式;reference-latent revision 负责保留非目标区域。它是生成语音的交互式局部编辑,不是通用对话代理。 Figure 2: Architecture of DialInstruct-TTS 实验效果:原文全局风格主观评测中,指令匹配均分为 4.283,对照 Qwen3-TTS 为 3.077;五轮语速修改中,“目标控制与内容都成功”为 15/20,有无非目标锁定的对照为 6/20。30 次最终偏好比较,多轮修订获 29 票,完整重述获 1 票;都是论文的指定主观协议。 Figure 4: Mean subjective ratings and final preference for full-restatement and multi-turn revision. Final preference is 1/30 versus 29/30, with no ties. Means are shown without error bars; numerical results are in Appendix E.4 . 批判点评:局部控制并不各项都稳:同一消融里音量修改成功仅 4/20。多轮流程引入规划和反复合成开销,论文偏好票数不能换算为统一的端到端编辑成功率。 10. DiaHeads:双人对话头像一起动 DiaHeads: Jointly Generating Coordinated 3D Dialogue Heads with Non-verbal Cues from Dual Audio | 中国科学技术大学 | arXiv:2611.06970 关键词:3D 头像生成, 音频驱动, 双人对话, 非语言动作, 注视 前序问题:各自按音频生成说话头像,容易得到两张嘴都动却没有互相看、点头或等待反馈的双人画面。 方法直觉:把两人的音轨放进同一条件,再让注视、摇头、点头、微笑四类离散提示和连续头部动作共享潜空间;模型一次生成两个人的动作。 本文贡献:DiaHeads 冻结双路 HuBERT 编码音频,用变分编码器融合连续 FLAME 头部参数与四类非语言 cue;时间相关的 flow prior 替代独立高斯先验,共享解码器同时输出两位参与者。FLAME 是 3D 人头参数模型。 Fig. 2: Overview of the proposed DiaHeads. The audio streams of both interlocutors are encoded by two frozen HuBERT backbones and fused into a conditioning vector c c by a transformer. A dual-branch variational encoder processes the continuous parameters ( F , G ) (F,G) and the discrete cues N N in separate branches, each conditioned on c c through FiLM modulation, and the two branches are combined through a product-of-experts posterior z ∼ ( μ , e σ / 2 ) z\sim\mathcal{N}(\mu,e^{\sigma/2}) , shown as the “Low-level Motion Encoder” and “High-level Cue Encoder”. A flow-based prior built from five residual coupling blocks, each consisting of a flip operation and a Conv1D coupling layer, replaces the standard Gaussian prior, and a shared VAE decoder, conditioned on c c through FiLM, jointly reconstructs the head parameters Y ^ \hat{Y} and the discrete cues of both interlocutors. The units at the bottom right detail the two SyncNet encoders, which are built from 1D convolution, batch normalization, and ReLU. 实验效果:CANDOR-FG 双人数据上,交互 DTW(两人动作时序不匹配程度,越低越好)为 0.3171,对照双人基线 DIM 为 0.7526;盲选中 DiaHeads 获 58 票,SadTalker 33 票、DIM 17 票。但单人头部 FLAME MSE 为 0.6662,高于 SadTalker 的 0.5523,精细动作保真并非全胜。 Fig. 5: Qualitative comparison of generated 3D head animations over a 30 s dialogue clip. Participant A is shown in blue and participant B in orange. Each method occupies two rows labeled A and B, sampled every 2.5 s. Our method produces appropriate mouth movements during overlapping speech at 8 s, marked by the purple box, and responsive nodding with mutual gaze at 20–23 s, marked by the yellow box, while the baselines show incorrect lip-sync and lack interactive behaviors. 批判点评:论文展示的是 3D 头像动画参数,不是直接输出真人视频;双人数据和四种 cue 限制了外推范围。交互协调改善与单人几何误差存在取舍;原文仅称准备投稿 IEEE Transactions on Multimedia,未写成已接收。 趋势观察 视频生成的计算预算不再只数采样步 APEX 省掉训练时的独立假分数网络;ESTRA 压低注意力精确交互,SemanticKV 精简历史缓存。三者改变的是不同成本,不能把倍数直接相加。 编辑和生成更看最终条件满足 IdealCache 用理想输出搜索缓存日程,UGG 用相机轨迹和几何共同约束中间帧,DialInstruct-TTS 则锁住语音中不需修改的区间。 评测必须保留反例和口径 APEX 的运动质量并非胜出;UGG 在 DL3DV 双端点帧设置的 PSNR 落后 SEVA;SemanticKV 的 60 秒总分低于 Full KV。 今日讨论 APEX 在 70 例三分钟视频中得到指令遵循 +30.0% 净偏好,但运动质量偏向 S2-Avatar。若为一条中途多次换商品动作的直播片段选生成器,你会怎样同时检验指令执行、人物连续性和动作自然度,何时不应为了指令偏好牺牲运动质量? 人工智能炼丹君 整理 | 2026-11-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
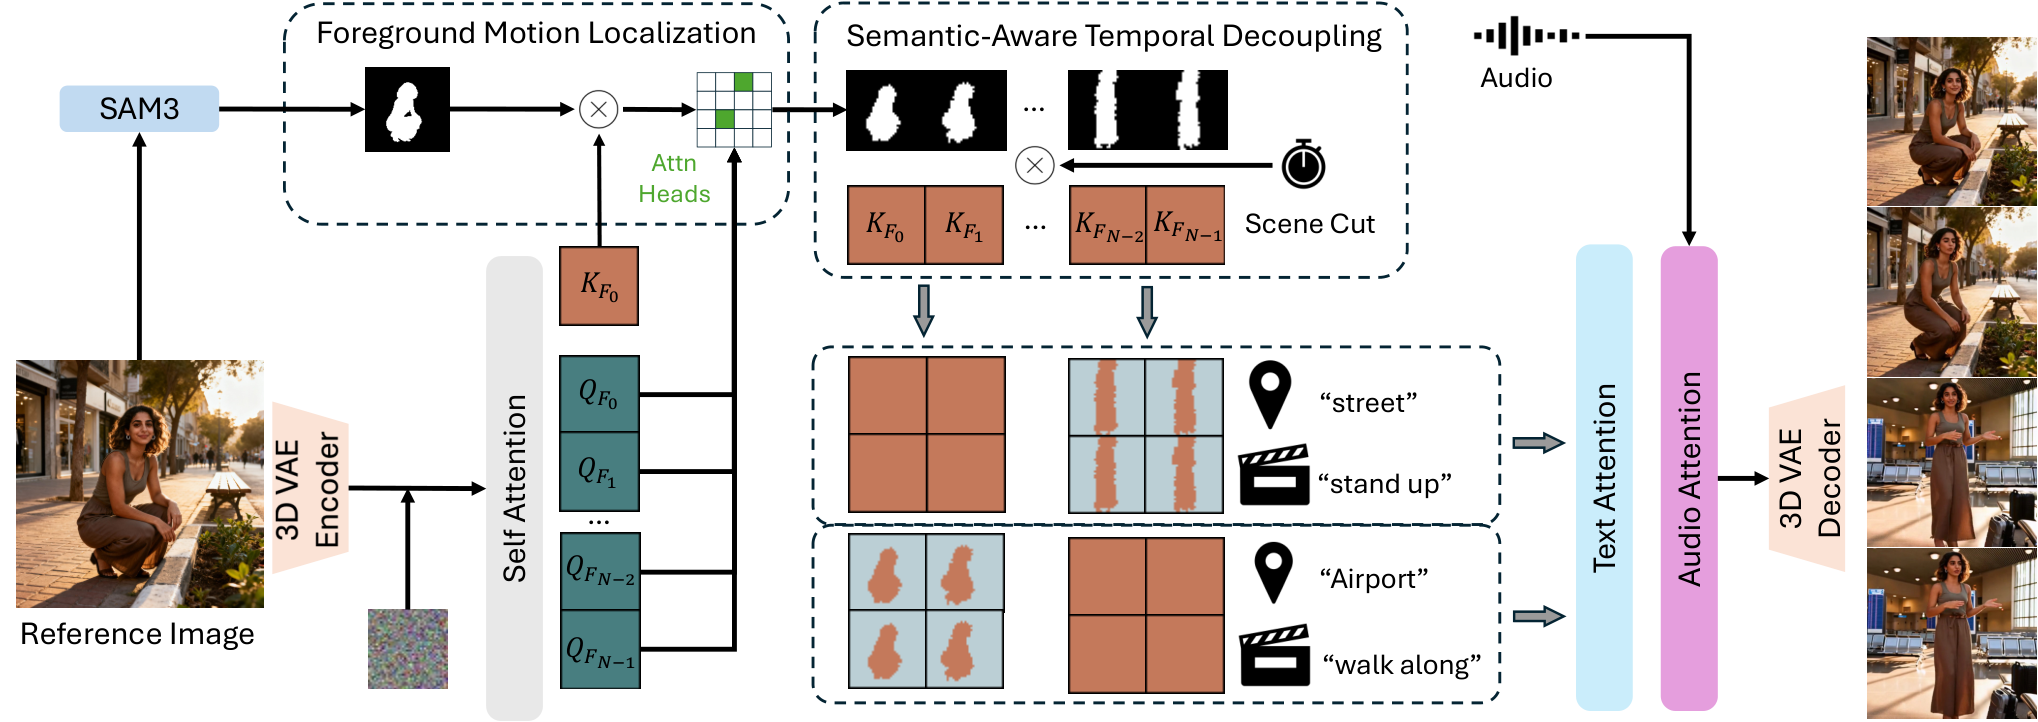
AIGC 每日速读|2026-11-11|悉尼大学让人物跨场景不丢-SceneShifter 今日 AIGC 论文速览 今日共 10 篇 · 视频场景控制与素材编排 2 篇 · 图像编辑与协同生成 2 篇 · 视频生成及缓存 3 篇 · 音频编辑 1 篇 · 工业缺陷图像与三维场景生成 2 篇 重点论文标题列表 SceneShifter(悉尼大学):说换场景就换且人物不丢 Clips2Story(纽约大学):散片按关键词剪成故事 ⚡ V2C-Edit(台湾大学):每一步都判断有没有改到位 MPEG-Diffusion(得州大学奥斯汀分校):只把主角用高清算 PhysOPSD(港科大):让可运行物理规则教视频 选读入口:想让人物视频按时换背景,先读 SceneShifter;素材库需要自动剪成主题故事,看 Clips2Story。要改一张图却常“没改到”,看 V2C-Edit;要给长视频降算力或支持回退分叉,分别看 MPEG-Diffusion 与 ReelCache。关心物理运动、选错音频声源、图像与掩码协同、工业缺陷造数、布料三维接触,则依次读 PhysOPSD、STEER、SnB、REDiff-AD、SoftPAT3D。 今日论文速览 1. SceneShifter:说换场景就换且人物不丢 SceneShifter: Training-free Multi-Scene Temporal Control for Audio-driven Human Animation | 悉尼大学;南洋理工大学;威斯康星大学麦迪逊分校 | arXiv:2611.09960 关键词:视频生成, 多场景控制, 音频驱动动画, 注意力 ⚠️ 前序问题:一段音频驱动的人物视频要在指定帧从露台切到地铁。普通生成容易晚换背景,也可能在换景时把人脸或衣服一起改掉。 方法直觉:把背景和人物在时空注意力中分开:跨场景的背景不要互相引用,人物则仍可借前后场景维持身份。人物移动时,固定区域掩码会失效,需要随动作追踪。 本文贡献:SceneShifter 无需再训练生成主干。它在跨场景背景 token 间抑制自注意力,保留前景 token 的跨场景联系;从能追踪主体轨迹的注意力层和头提取动态前景掩码,再按提示时间切换场景。作者另建 SceneShifterBench,测场景切换时点、人物保留及视觉质量。 Figure 3 : Pipeline of the proposed SceneShifter framework. 实验效果:SceneShifterBench 的 MultiTalk 主干上,场景切换成功率从原模型的 38.7% 到 99.3%;场景时间准确率从 17.5% 到 98.1%。同表中 DiTCtrl 的成功率为 98.7%,但人物空间分为 0.847,对本法 0.943。数据是指定多场景提示下的生成对照;原文没有统一的端到端延迟数字,额外的掩码提取也需计入实际部署。 Figure 4 : Qualitative results generated by the base model, DiTCtrl, SwitchCraft, and our method using the MultiTalk backbone. 批判点评:这是音频驱动的人物视频生成控制,不是把一段现成视频任意换景。大幅动作或人暂时消失后重入仍可能失去身份;附录给出该失败例。主干本身不会的动作,注意力控制也不能补出来。 2. Clips2Story:散片按关键词剪成故事 Clips2Story: Training-Free Video Storyboarding and Editing Using Multimodal Retrieval-Embedded Generation | 纽约大学;华盛顿大学;密歇根大学 | arXiv:2611.05992 关键词:视频编辑, 素材编排, 故事板, 多模态检索 ⚠️ 前序问题:素材库里只有打乱顺序的零散片段,编辑者想按“毕业”之类关键词拼成短片;按原片时间轴摘要会把无关镜头和旧叙事一并带入。 方法直觉:先找与主题相关的镜头,再让语言模型安排叙事顺序和衔接旁白,最后组装输出;素材选择与叙事组织是两个不同步骤。 本文贡献:Clips2Story-ND 为片段提取视觉与语音文字描述,检索候选,再把描述交给 LLM 生成可改的故事板和过渡旁白;系统拼接已选镜头,并检索旁白所需画面。作者从五类共 100 部长视频切片、打乱时间顺序,分别测试片段级和场景级素材池。 Figure 1: Overview of the proposed Clips2Story-ND pipeline. Given a pool of raw video footage and a user-specified keyword, we first extract textual descriptors from the video clips and retrieve those most relevant to the keyword. We then use an LLM to generate an editable storyboard with connective narration. Finally, we compose the output video by assembling the selected clips and retrieving accompanying visuals for the narration. 实验效果:15 人用五分量表评价三类视频各六段短片;Clips2Story-ND 相对 REGen 的叙事连贯性为 4.43±0.14 对 3.17±0.11,关键词对齐为 4.42±0.13 对 3.11±0.16。它依赖逐片描述、检索和 LLM 规划,原文未给可与扩散生成时延直接比较的统一耗时。 Figure 5: Genre-wise comparison of CLIPScore, VTGHLS, OPC, KR-Narration, KR-Frame, and KR-Caption under the scene-level setting. Error bars indicate 95% confidence intervals. Specific numbers can be found in Table 6 . 批判点评:这项工作主要是检索、剪辑和生成旁白,不合成全新视频镜头。100 部原片切碎再打乱是可控测试,开放素材库的版权、镜头语义偏差与叙事可编辑性仍需单测。 3. V2C-Edit:每一步都判断有没有改到位 VLM as an Editing Pilot: VLM-Steered Velocity Control for Flow-Based Image Editing | 台湾大学;加州大学戴维斯分校;台湾清华大学;中央研究院 | arXiv:2611.10066 关键词:图像编辑, 流匹配, VLM 反馈, 区域保持 ⚠️ 前序问题:让图里钟面的数字换语言,同时保住背景。FlowEdit 的源图耦合太强时会出现 zero-edit:输出几乎和原图一样,目标变化没有发生。 方法直觉:不要把“贴近原图”的力度固定到所有去噪步;每一步比较几种编辑速度,并请视觉语言模型按指令判断哪种更像完成了编辑。 本文贡献:V2C-Edit 在不训练生成主干的条件下构造四种源图耦合程度的速度场。ILS(Instruction-Level Similarity,指令级相似度)比较预估改动与用户指令,选择该步速度;当语义改动足够且局部掩码不损伤 ILS 时,再限制无关区域的更新。实验用 FLUX 与 Stable Diffusion 3。 Figure 3 : Overview of the proposed V2C-Edit pipeline. (1) Coupling-Controlled Velocities: Construct four editing velocities with different coupling behaviors. (2) Instruction-Level VLM Steering: Select the optimal velocity at each timestep using ILS. (3) Two-Stage Adaptive Masking: Apply spatial masking when semantic alignment is sufficient and the masked update maintains ILS. The VLM query templates are provided in Appendix F . 实验效果:MagicBrush 的 FLUX 设置下,相对 FlowEdit,GPT-4.1 代评的指令对齐分(0–10,越高越按指令改)由 5.56 到 6.07,未编辑区域的 PSNR(像素保真度,越高越接近源图)为 17.48 对 17.44 dB;PIE-Bench 对应指令分 5.32 到 5.85、PSNR 21.82 到 21.84 dB。逐步 VLM 评估增加推理调用,论文未给统一端到端秒数。 Figure 4 : Qualitative comparisons of text-based image editing methods. Our method achieves the highest fidelity to the editing instruction while maintaining strong background consistency with the source image. 批判点评:同表在 Stable Diffusion 3 上,部分 CLIP 分和背景保真并非全胜;依赖 VLM 判断的指令质量也会影响速度选择。 4. MPEG-Diffusion:只把主角用高清算 MPEG-Diffusion: Mixed-Resolution Video Generation | 得克萨斯大学奥斯汀分校;Roblox | arXiv:2611.12069 关键词:视频生成, 混合分辨率, 扩散加速, 自选主体 ⚠️ 前序问题:视频扩散全画面用高清 token 去噪很贵;直接让背景低清,清晰区与模糊区的边界又容易出现重影,还常需要人预先圈主角。 方法直觉:让同一分辨率的查询读同分辨率的键和值,再在解码前融合两套潜变量;主角区域交给模型的早期特征来选。 本文贡献:MPEG-Diffusion 先在低分辨率运行前 k 个去噪步,随后线性头从冻结 DiT 特征预测高清区域;双分辨率注意力用线性映射补齐缺少的键值,混合分辨率解码器先融合高低清潜变量,再生成整帧。线性映射、区域头与解码器需训练,不能当作纯免训练加速。 Figure 2 : Overview of MPEG-Diffusion. The first k k of T T steps run at LR. At step k k , a linear head selects the HR region M M (part 2), and the remaining steps denoise M M at HR and the rest at LR. In dual-resolution attention (part 1), each query reads the K/V of its own resolution, with missing entries (dashed) filled from the other resolution by linear maps. The mixed-resolution decoder (part 3) merges the HR and LR latents into one HR video. Flames mark trained parts. 实验效果:仅处理约 30% 全分辨率 token 时,Wan2.1 14B 的去噪加速 4.8 倍,1.3B 为 3.8 倍,均相对全高清去噪;用户两两比较对既有混合分辨率方法的偏好超过 90%。14B 表中 VBench 质量分 82.9,对全高清 85.3;组件另有约 3% 运行开销的 1.3B 分解统计。加速数字不等于整条出片链路的同倍加速。 Figure 8 : Qualitative comparison on faces (Wan2.1 14B, k = 25 k=25 , same seed). Prompt: a young man steps into a surprise party. Both baselines show clear artifacts where the HR and LR regions meet, with one eye sharp and the other ghosted (arrows). Ours shows no visible degradation and is close to HR (more examples in Appendix A ). 批判点评:高清区域外仍以低分辨率生成,背景细节有明确预算代价;主角区域选择也依赖早期特征和训练标注。若目标是全景细节,需与全高清结果逐帧比较,而不能只看主角。 5. PhysOPSD:让可运行物理规则教视频 PhysOPSD: Code as Privilege for Physically Plausible Video Generation | 香港科技大学;阿里巴巴集团 | arXiv:2611.12411 关键词:视频生成, 物理一致性, 在策略蒸馏, 可执行模拟 ⚠️ 前序问题:球碰撞、摆动和液体运动的视频看起来像真的,却常违反物理规律。离线监督训练跟不上模型自己生成的错误状态,物理奖励又稀疏。 方法直觉:把可执行模拟当作教师可见的额外条件:相同噪声下只改物理参数,学生就能看见运动因果变化,而不仅是另一段外观不同的参考视频。 本文贡献:PhysOPSD-Engine 将物理场景写成可验证的模拟程序,形成密集与抽象两级草稿。PhysOPSD 用 OPSD(在策略自蒸馏:在学生自身生成轨迹上获得密集教师纠正)训练视频模型;共享 rollout 噪声配对不同物理参数,使教师的纠正聚焦动力学变化。代码是训练期特权条件,目标仍是视频生成。 Figure 3: Overview of our proposed PhysOPSD . 实验效果:使用 3000 条后训练样本时,13B 主干在 PhyGround 总体物理分为 66.5,对 8 万条样本的 SFT 为 64.8、2.1 万条的 PhysHPO 为 65.8;同表 VBench 总质量 84.0 对 SFT 83.9。数字限于该评测与主干,训练还需编写、运行模拟并完成在策略采样,不能只按 3K 比较总成本。 Figure 5: Qualitative results of PhysOPSD . More results are shown in Figures 14 , 15 , 16 and 17 . 批判点评:模拟可参数化的摆、碰撞等场景是优势,也限制了覆盖面;难建模的开放世界动作未获同等保证。论文自身将模拟可落地动力学列为适用边界。 6. ReelCache:续写分叉少存历史缓存 ReelCache: An Efficient KV Cache Compression and Management System for Multi-Round Video Generation | 匹兹堡大学;Google | arXiv:2611.09973 关键词:长视频生成, KV 缓存, 分支续写, 低秩压缩 ⚠️ 前序问题:长视频按块生成并允许回退或分叉时,历史注意力 KV(键和值)缓存越存越大;丢掉旧缓存又要重算,下一块等待更久。 方法直觉:相邻块的通道基方向相似,保留少量方向和编码后的系数;编辑分支只复制必要的历史状态,让共同前缀复用。 本文贡献:ReelCache 在块内对 KV 做跨通道低秩分解,再视频编码系数;每层在线预测达到指定保留能量所需的秩。块间管理器复用、增补或重拟合基方向,把块状态组织为树,使 resume、rewind、fork 共用前缀。该方法处理缓存与下一块推理,不重新训练视频生成模型。 Figure 9: Overview of ReelCache . 实验效果:论文在五种视频生成模型的多轮长视频工作负载上,相对基线将 KV 存储降低 14.46–21.13 倍,下一块生成提速 1.25–3.36 倍;六个代表性 VBench 指标下降均小于 1%。这些是缓存场景的下一块延迟,不等于首段生成提速;压缩和解压也有额外计算,表中 CausVid 的解压令下一块生成慢约 3.2%。 Figure 15: P50 and P90 next-chunk latency of ReelCache compared to baselines across models and workloads. 批判点评:收益取决于历史长度、分叉次数与缓存驻留策略。原文 HTML 标题区有模板警告,但 arXiv 论文题名与摘要可核;不能据模板文字推断会议接收。 7. STEER:改声音时先选对声源 Steer Unified Audio Editing Toward Reliable Source Selection | 中国人民大学;腾讯;香港大学;香港中文大学 | arXiv:2611.10630 关键词:音频编辑, 声源选择, 早期去噪, 在轨恢复 ⚠️ 前序问题:一句“只移除左边说话者”交给统一音频编辑器,模型可能把另一人删掉;早期去噪一旦选错,后面往往救不回来。 方法直觉:编辑目标是在去噪轨迹开头定下来的,因此训练应多看早期关键状态;再让模型从自己生成的偏离状态学会纠错。 本文贡献:STEER 是 Source-selection Training via Early-trajectory Emphasis and Recovery:第一阶段强调早期轨迹上的声源选择,第二阶段用模型自己生成的 rollout 状态训练恢复。作者训练基础多任务编辑器并得到 SteerSound,还建 Selective Audio Editing Benchmark,分别衡量目标声源改到位与非目标保留。 Figure 6 : Architecture of our base editor. 实验效果:在作者基础编辑器的选择性编辑基准上,整体任务成功率从 70.42% 到完整 STEER 的 85.78%,选错声源比例从 28.48% 降至 8.45%;只做早期强调则为 84.02% 和 9.99%。这是额外后训练所得,不是免训练插件;作者还在 UNISON 与 SAM Audio 上报告迁移效果。 Figure 3 : Bidirectional early-trajectory interventions on source selection. Corrective (top) and corruptive (bottom) prefix interventions are evaluated on 100 validation examples per task. Bars show per-step corrective or corruptive counts, while curves show the corresponding cumulative effects. For each task, k 80 k_{80} denotes the shortest intervention prefix length at which the cumulative effect reaches 80%. Removal consistently exhibits a shorter k 80 k_{80} than replacement. 批判点评:选择性测试依赖作者构造的任务和自动评判规则,复杂重叠声源与极短目标音仍需试听验证。额外训练两阶段和自生成轨迹会增加训练成本,原文没有统一的单条推理时延对照。 8. SnB:两套生成器半路接上 Split and Bridge: Multimodal Generation via Diffusion Bridging | 佛蒙特大学;脑科学与智能技术卓越创新中心 | arXiv:2611.10441 关键词:多模态生成, 图像编辑, 扩散桥接, 图像与掩码 ⚠️ 前序问题:要同时生成图像和对应分割掩码,常见做法是重新训练一个共同潜空间;现有高质量单模态生成器难直接复用。 方法直觉:先让两条反向扩散轨迹共享一段路,再在分叉点用桥接模块把它们连起来;共享程度控制结构一致性与各自画质的取舍。 本文贡献:Split and Bridge(SnB)在采样时耦合预训练单模态扩散模型;从共同先验出发,t_split 处经 bridge 修改条件、模型或中间层,再走各自的去噪轨迹。可学习 bridge 增强跨模态映射,不需从头联合训练整套生成器。论文测图像与语义掩码配对,也展示图像编辑和交错协同生成。 Figure 1: SnB leverages pretrained diffusion models by coupling reverse trajectories during sampling. We start from a common state sampled from a prior, then at t s p l i t t_{split} , a bridge module is used to implement a score intervention on the reverse process. This intervention can be through modifying conditioning signals (e.g., prompts), changing diffusion models that estimate the score functions, or changing certain layers in the diffusion models. This flexibility applies SnB in various tasks, like interleaved co-generation (top left pair) and multimodal generation (top right pair). Learnable bridges allows stronger trajectory manipulation in mapping one modality to another. 实验效果:CelebAMask-HQ 的图像—掩码联合生成表中,t_split=50% 时 SnB 一致性 0.73、FID 60.84;MLD 对照为 0.68、121.69。FID 是生成图像与参考分布的距离,越低越好;分叉点改到 80% 时一致性升至 0.79,条件生成 FID 却恶化,说明不能只追一致性。bridge 需训练,额外模型和同步采样也有成本。 Figure 3: Qualitative comparison of SnB and previous top-down multimodal approaches on CelebAMask-HQ. SnB balances between coherence and quality of generated modality pairs. 批判点评:图像和掩码等可对齐模态更适合这套桥接;跨模态关联弱时共享噪声未必足够。论文所报是特定数据集与分叉比例,不代表任意两个预训练模型都能直接拼接。 9. REDiff-AD:借一张缺陷图造新缺陷 REDiff-AD: No Training and No Target Masks for Industrial Anomaly Image Generation via Diversity-Driven In-Context MMDiT | 台湾大学 | arXiv:2611.10875 关键词:缺陷图像生成, 少样本条件, 伪掩码, 整流流 ⚠️ 前序问题:工厂缺陷样本少,且换一种产品就重训生成器或画目标掩码很费事。目标是产生更多有变化的缺陷图及可用伪掩码。 方法直觉:把一张有掩码的参考缺陷和正常目标图放进同一个生成上下文,模型学到缺陷外观后迁移到目标;生成时的注意力还能反推缺陷出现在哪。 本文贡献:REDiff-AD 用冻结的整流流 MMDiT(多模态扩散 Transformer)做上下文缺陷迁移,不要求目标掩码。语义定位先给目标可编辑区域;AAM 加强弱缺陷参考,DOK 减少照搬参考形状;聚合目标到参考的注意力,再结合边缘和颜色得到像素级伪掩码。输入仍需一张带掩码的参考异常图。 Figure 3 : Overview of the proposed REDiff-AD model. Semantic localization first determines a loose editable region on the target. A frozen in-context MMDiT transfers the masked reference, with AAM strengthening weak anomalies and DOK reducing reference-shape copying. Aggregated target-to-reference attention is then refined into the output pseudo-mask. 实验效果:MVTec-AD 表中各类平均 KID(核 Inception 距离,越低表示生成分布越接近参考)为 31.09,对 O2MAG 的 47.63。RTX 5090 上,30 步设置每图耗时 16 秒、显存 9 GB,对 O2MAG 的 20 秒、16 GB;但合成图训练的平均异常分类准确率为 70.77%,低于 O2MAG 的 73.51%,生成指标优势不能直接当成判别收益。 Figure 4 : Qualitative illustration of the effects of DOK and AAM. DOK diversifies the geometry of the defect, while AAM improves the robustness of in-context defect generation. 批判点评:需要带掩码的参考缺陷,不能称为完全无标注。工业异常边界和实际缺陷多样性不同,伪掩码噪声可能影响下游定位;跨产品泛化要用新产品验证。 10. SoftPAT3D:布料玩偶生成后不穿模 SoftPAT3D: Physics-Augmented Text-to-3D Scene Generation with Deformables | 斯坦福大学 | arXiv:2611.11087 关键词:文本生成3D, 可变形物体, 物理仿真, 场景编辑 ⚠️ 前序问题:文本生成的沙发和毯子看似搭在一起,三维网格里却可能相互穿透或漂浮;没有材料、自然形状和接触初态,也无法直接进仿真。 方法直觉:按布料或玩偶的制造方式恢复自然形状,补出被遮挡的支撑家具,再把整场景放进同一接触仿真里落到稳定状态。 本文贡献:SoftPAT3D 沿用文本到图像再到三维资产的前段流程,为可变形物体构造静止形状、材料参数和初始放置;重建支撑物的碰撞网格后统一求静态平衡。几何和视觉语言检查失败的场景可通过放置网格搜索与可微仿真梯度优化。生成结果可继续做物体移动、拉扯等三维编辑。 Figure 2 : Overview of SoftPAT3D. Each card shows the state of one prompt at that point of the pipeline, and its label names the step that produced it. (a) The prompt is expanded into a reference image, segmented and lifted as in PAT3D, and the support hidden under each deformable object is inpainted, regenerated and converted into a collision mesh (Sec. 3.4 ). (b) Each deformable object receives a rest shape from its manufacturing process under a size prior (Sec. 3.2 ), a material from the material library and a placement above the part the prompt names (Sec. 3.4 ). (c) One simulation brings the scene to equilibrium under a single contact barrier (Sec. 3.3 ), and the result passes the geometric checks and the prompt check (Sec. 3.5 ); a scene that fails enters placement optimization (Sec. 3.6 ). 实验效果:作者的 65 条提示上,本法结果均无不期望的物体互穿,而所比较系统各有互穿;这是论文的几何检查口径。代价是额外的资产补全、碰撞网格、材料赋值、仿真与可能的优化,原文没有与纯生成器统一计时的端到端速度对照。 Figure 5 : Vertical sections, cloth in red, furniture in grey, cloth inside the furniture in dark red, and a dashed line where the cloth floats above its support. Top: GPT-6 Astra; the blanket and the towel hang above their seats, the quilt runs through the mattress, the pillow sits inside the backrest, and the skirt ripples in mid-air. Bottom: ours; the cloth rests on the support, wraps its edges and hangs from them. 批判点评:仿真稳定与画面完全符合提示仍是两回事:论文展示了物体最终聚成一团等失败例。场景质量依赖碰撞网格和材料库,复杂软体或未知材质需另验。 趋势观察 把编辑作用点放到过程里 SceneShifter 改时空注意力里的背景连接,V2C-Edit 每步按指令选速度;STEER 则把声源选择放在去噪早段训练。 生成预算从平均分配转向按需分配 MPEG-Diffusion 只让关键区域保持高清;ReelCache 压缩并共享历史块 KV,二者分别针对空间 token 和长视频历史。 可执行结构给生成增加约束 PhysOPSD 用可编辑物理模拟作训练条件,SoftPAT3D 在三维场景完成后再用接触仿真消除互穿。 综合指标不能盖过任务失败 REDiff-AD 的生成 KID 较优,但平均下游分类准确率低于 O2MAG;Clips2Story 的叙事分须放回打乱素材的实验设定。 今日讨论 SceneShifter 在 MultiTalk 上将换景成功率从 38.7% 提到 99.3%,但附录也出现人物消失再入镜后身份改变的失败例。若连续换五个场景并有人物出入画,哪些指标能验证动态前景掩码是否同时保住切换帧精度、重入身份和推理时延? 人工智能炼丹君 整理 | 2026-11-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
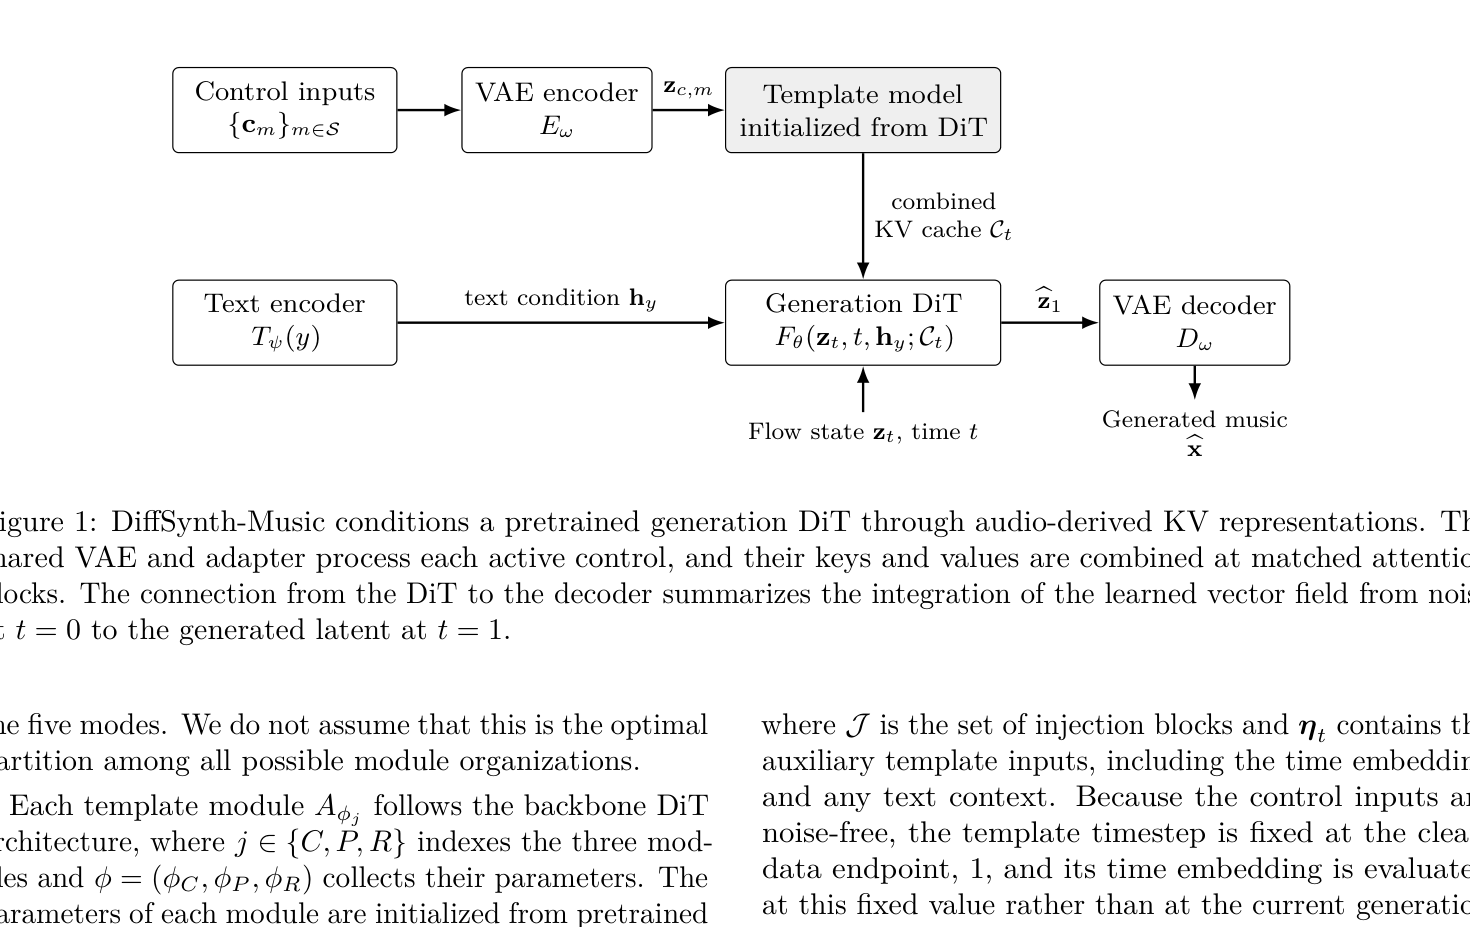
AIGC 每日速读|2026-09-15|阿里五路音频控制-DiffSynth-Music 今日 AIGC 论文速览 今日共 10 篇 · 可控与统一音频生成 2 篇 · 长时音视频与可控视频生成 2 篇 · 图像编辑与画质修复 2 篇 · 3D 资产生成 1 篇 · 流式交互与语音评测 2 篇 · 高效长上下文 1 篇 重点论文标题列表 DiffSynth-Music(阿里巴巴集团、上海交通大学):五路音频控制锁住节拍 StepAudio 3 Gen(阶跃星辰 StepFun-Audio 团队):一套模型生成所有声音 Encore(百度、北京理工大学 · SIGGRAPH Asia 2026):三十秒音画同步不跑偏 DIAL(阿里巴巴集团、北京大学):调一个旋钮控人物像不像 Omni-Streaming Thinking(香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学):流式多模态会主动改口 今日论文速览 1. DiffSynth-Music:五路音频控制锁住节拍 DiffSynth-Music: Audio-Conditioned KV-Cache Adapters for Controllable Music Generation | 阿里巴巴集团、上海交通大学 | arXiv:2609.12774 关键词:可控音乐生成,音频条件,KV缓存,扩散Transformer 前序问题:文字与歌词能规定歌曲主题和唱词,却难以精确约束节拍、旋律、伴奏、演唱韵律和参考风格;把多种音频条件逐步送进扩散模型又会反复增加计算。 本文贡献:DiffSynth-Music 从同一音乐 DiT 初始化 Control、Prosody、Reference 三个模板模型,先由共享 VAE 编码控制音频,再把逐层 KV 缓存注入生成主干。模板端固定在干净数据端点,每种控制只前向一次,五类条件还能组合使用。 实验效果:相对冻结主干,节拍条件把 Beat-F1 从 0.3031 提到 0.8496;人声条件把 V-MSE 从 0.0158 降到 0.0006,伴奏条件把 A-MSE 从 0.0221 降到 0.0023;参考条件的 MuLan-A 从 0.6836 升到 0.8088。 批判点评:一次缓存让多条件控制更便宜,但三个模板模型仍带来额外参数和训练维护成本。实验以单条件为主,真正创作常同时叠加节拍、人声、伴奏与参考音频,组合冲突和听感质量仍需更大规模人评。 2. StepAudio 3 Gen:一套模型生成所有声音 StepAudio 3 Gen Technical Report | 阶跃星辰 StepFun-Audio 团队 | arXiv:2609.12945 关键词:通用音频生成,语音合成,声音设计,RVQ 前序问题:语音、歌声、音乐与音效通常使用不同生成器和离散表示,混合声音任务很难在一套模型里保持文本能力、说话人一致性与声学细节。 本文贡献:StepAudio 3 Gen 以 12.5 Hz 的 16×2048 共享 RVQ 空间直接自回归建模通用音频:主干沿时间预测首码本,轻量因果 Transformer 再沿码本轴补齐其余十五层;渐进预训练与 RVQ Adaptor 缓解音频能力对语言能力的干扰。 实验效果:TTS 人类偏好 Elo 达 1755.33,对五个商业系统的汇总胜率为 82.0%;声音设计 Elo 为 1668.5、汇总胜率 75.5%;风格一致性中文平均 85.2%,英文平均 77.7%。 批判点评:统一离散建模简化了产品管线,但十六层 RVQ 的级联预测仍可能积累误差。报告覆盖多类声音,公开复现仍取决于训练数据、偏好标注与完整模型权重。 3. Encore:三十秒音画同步不跑偏 Encore: Infinite Audio-Video Generation with Adaptive Signal Routing | 百度、北京理工大学 · SIGGRAPH Asia 2026 | arXiv:2609.04249 关键词:音视频联合生成,长视频生成,自适应信号路由,跨模态同步 前序问题:现有音视频生成能做出同步良好的短片,但时长受限;长视频方法靠分块迭代延长时长,却完全没有音频。联合生成长音视频比单做任何一边都难:每一块都要同时保住视频时序连贯、音频时序连贯和跨模态同步,而这三路条件信号进入模型的通路各不相同。 本文贡献:Encore 把难题拆成两层:局部连续性交给带显式跨块上下文传播的迭代生成,全局一致性交给带位移位置编码的参考音视频信号。在此之上提出自适应信号路由(ASR),在自注意力内加逐层逐头可学习偏置、在交叉注意力输出上加可学习缩放,让模型自行调节每路条件信号的影响强度。端到端联合训练后,推理时全程以真值模态为条件即可支持无限长的音频转视频与视频转音频。 实验效果:扩展后的 VerseBench 长音视频评测上,身份一致性 ID 为 0.86、音画同步 LSE-C 为 2.36、AV-A 为 0.88,三项均为最佳;误差累积 ΔAS 0.02、ΔID 0.07,明显低于次优的 0.06 与 0.22。短片设置下 LSE-C 为 3.46,对 LTX-2.3 的 2.36。 批判点评:把长音视频拆成局部续接加全局参考,确实压住了 30 秒级的身份漂移与场景突变。但 ASR 的逐层逐头可学习参数把调参负担转移到了训练侧,消融显示去掉任一路缩放都会让同步指标明显掉档。画面美学仍落后于 OVI 与 LTX2.3,且所谓无限长目前只验证到 30 秒量级,更长时长的累积行为没有给出。 4. DIAL:调一个旋钮控人物像不像 Harnessing Intrinsic Subject-Aware Attention for Controllable Multi-Subject Video Generation | 阿里巴巴集团、北京大学 | arXiv:2609.11507 关键词:多主体视频生成,注意力定位,保真强度控制,偏好优化 前序问题:多主体视频生成卡在两件事上:保真强度不可调——模型要么因训练数据偏置产生生硬的贴图感,要么对输入敏感到无法控制;以及语义漂移——主体中途消失、属性出错、多个参考身份互相串味。 本文贡献:作者发现 DiT 内部某些注意力块天然形成内在空间定位图(ISGM),能准确定位参考主体。DIAL 据此双阶段复用这一内部信号:低噪声阶段用 ISGM 构造注意力偏置矩阵,推理时逐主体调节引导强度 γ 即可控制身份保真度,无需重训;高噪声阶段用同一张图零成本构造偏好对做强化学习,把注意力锚定到参考主体上抑制漂移。 实验效果:OpenS2V-Eval 上,Kaleido 主干总分从 56.00 提到 γ=16 时的 61.14,人脸相似度从 31.81 升到 60.64,双双超过最强通用基线 SkyReels-v3 的 59.26 与 VACE-14B 的 55.09。第二阶段单独作用(γ=0)把主体出现率从 155/320 提到 163/320。 批判点评:把控制接口接到模型自带的注意力结构上、省掉外挂模块,这个思路很干净。但 ISGM 出现在哪一层依赖对具体主干的经验观察,换骨干要重新找;保真度提升伴随真实感与美学分下滑,γ 给多少仍靠人工判断。第二阶段的偏好对由 ISGM 自评构造,评判标准与被优化对象同源,存在自我确认的风险。 5. Omni-Streaming Thinking:流式多模态会主动改口 Omni-Streaming Thinking | 香港大学、香港科技大学(广州)、LIGHTSPEED、萨塞克斯大学 | arXiv:2609.15128 关键词:流式多模态,音视频推理,状态修正,幻觉抑制 前序问题:流式音视频模型常在声音尚未说完时依据画面提前下结论;一旦错误判断写入记忆,后续音频即使否定它,模型仍会沿着旧状态回答。 本文贡献:OST 把输出拆成已见证据、未来证据预测和待验证主张,并为主张绑定验证时间窗。音频与视觉证据分开保存;遇到矛盾后,反驳过程削弱旧主张及其依赖状态,回答门控只在关键主张满足条件时放行。主干冻结为 Qwen3-Omni-30B-A3B,仅做轻量适配。 实验效果:在五个流式与音视频基准上,OST 相对最强开放基线平均提升超过 10%;OST-DiagBench 的 d′ 达 2.95,而开放基线最高 1.38。SOVBench-O 平均准确率由 81.6 提至 87.8,SOVBench-T F1 由 90.5 提至 92.4。 批判点评:显式状态与反驳链能减少过早承诺,却依赖主张拆分、模态归因和验证时间窗都足够准确。复杂直播中矛盾可能长期不闭合,额外结构化输出也会增加延迟和训练标注成本。 6. Overpainting:灰色地带让模型自己发挥 Overpainting: Localized Context-aware Diffusion Image Editing | Adobe Research、威廉与玛丽学院 | arXiv:2609.10811 关键词:图像编辑,三值遮罩,扩散模型,注意力dropout 前序问题:图像编辑要么给定二值遮罩、严格只改框内,结果生硬且边界突兀;要么纯靠文字提示,改哪里完全不受控。用户真正想表达的「这块必须改、这一圈可以顺带调、其余别动」没有对应接口。 本文贡献:Overpainting 用白/灰/黑三值 trimap 表达这三档意图:白色必须编辑、灰色允许编辑、黑色不得改动。实现上在预训练图像编辑扩散模型外挂 LoRA,用联合注意力在源图、遮罩与噪声三路输入间传信息,并以注意力 dropout 平衡信息流。配套的自动数据流水线先用语言编辑模型造候选图像对,筛掉过度编辑、编辑不足与整体偏移的失败样本,再从可用样本反解出 trimap。 实验效果:遮罩估计网络微调后 F1 达 0.955、IoU 0.916,对比阈值像素差的 0.733 与 0.607。MISATO@1K 补全评测上 LPIPS 0.189、FID 20.58,远好于 FLUX-Kontext 的 0.372 与 92.09。180 个人工整理的例子上,50% 注意力 dropout 在遮罩遵循与编辑质量之间取得平衡点。 批判点评:三值 trimap 比二值遮罩更贴近真实修图意图,把「顺带调一下」这件事显式化了。但灰区给模型多大自由度只能靠 dropout 率这一个全局参数调,用户画的灰区宽窄也会显著改变结果,论文自己的遮罩变体实验就显示同一提示词能得到差异很大的输出。训练数据由 FLUX.1 Kontext 自动生成再筛选,模型学到的编辑分布因此被上游模型的偏好圈住。 7. PLSR:3D网格切块做超分省显存 PLSR: Progressive and Localized Super-Resolution of 3D Objects via Localized Latent Voxel Diffusion | 香港中文大学、广东工业大学、香港城市大学、莫纳什大学 | arXiv:2609.06436 关键词:3D资产生成,超分辨率,体素扩散,渐进式生成 前序问题:扩散式 3D 生成模型被固定分辨率卡住,细节上不去;直接把分辨率整体拉高,显存与算力又会爆掉。 本文贡献:PLSR 在已有 3D 生成基座上做超分,把全局超分拆成关联式的局部子任务:粗网格编码成低分辨率条件,上采样出高分辨率隐变量的稀疏体素骨架后切成固定大小 patch,每个 patch 关联裁剪对应的低分辨率条件与输入图像,逐 patch 去噪再聚合成全局预测。整轮结果还能当作下一轮的低分辨率条件,渐进逼近更高分辨率,基座只需低成本微调。 实验效果:伪真值几何评测上 LPIPS 0.109、FID 55.89、Chamfer 距离 0.0139、F1 0.145,四项全面优于 TRELLIS.2 在 1536 与 2560 两档分辨率下的结果;纹理评测 LPIPS 0.125、FID 59.89。开放世界 ELO 评分中几何总体质量 1855、纹理 1633,高于 TRELLIS.2(1536) 的 1790 与 1599。 批判点评:把全局超分拆成局部 patch 换来了显存友好,重叠推理与渐进式两个消融也都验证有效。但逐 patch 去噪要遍历所有 patch,分辨率越高调用次数越多,省的是显存不是时间。接缝主要靠低分辨率条件当锚点加重叠区抑制,论文也承认无重叠时仍有残留。开放世界评测依赖模型打分,与人工审美的一致性没有交叉验证。 8. SAS:稀疏注意力直接听损失 SAS: Simple Attention Sparsification via End-to-End Optimization of Context Ranking | 腾讯混元、香港科技大学(广州)、香港科技大学 | arXiv:2609.13141 关键词:稀疏注意力,长上下文,上下文排序,端到端优化 前序问题:可训练稀疏注意力通常用硬 Top-K 选上下文,语言模型损失无法穿过离散选择,只能蒸馏稠密注意力权重;有限预算因此可能保留“像教师”却不真正影响最终预测的块。 本文贡献:SAS 在训练时把选择器连续分数以对数门的形式注入注意力 softmax,让语言模型损失直接更新上下文排序;归一化门校准历史块与始终保留的当前块,Triton 内核把这一机制嵌入 FlashAttention 风格计算。 实验效果:在 2048 token 预算、Qwen3-4B 上,AIME24 比 SeerAttention-R 高 13.02 分(68.85 对 55.83);Qwen3-14B 的 LongBench 8K+ 为 53.9 对 51.5。SGLang 解码在 512K、batch 1 最多降延迟 5.6 倍,batch 8、64K 最多约 13 倍加速。 批判点评:端到端损失对下游任务更直接,但选择器只在数学数据上训练,跨领域稳定性仍受主干与查询分布影响;预填充仍采用稠密注意力,因此长输入首 token 成本没有同时消失。 9. Mi-Ripple:修掉反复AI编辑的涟漪 Mi-Ripple: Restoring Images Degraded by Iterative AI Editing | 弥阳科技、中国科学院软件研究所、上海交通大学、天津大学 | arXiv:2609.11317 关键词:图像修复,迭代编辑,频域伪影,配对再生成 前序问题:图像被生成模型反复编辑后会积累低频起伏、色带与周期纹理,内容看似正确却越来越“塑料”;普通锐化或去噪可能同时损伤真实边缘。 本文贡献:Mi-Ripple 先在频域用陷波定位并抑制迭代编辑形成的周期分量,再通过配对再生成构造更干净的参考,对剩余伪影做修复;流程把可测量的频谱异常与生成式细节恢复结合。 实验效果:14 次只做陷波的测试中,整图 CIELAB 亮度残差标准差为 0.08–0.44;配对再生成把参考中的碎屑密度降低 45%。三个示例的尺度纹理指数分别从 25.3%、41.1%、20.0% 降至 11.1%、12.1%、0.0%。 批判点评:方法针对可见的周期性退化更有解释性,但配对再生成可能改动原图身份与细节。若伪影频率与真实重复纹理重合,陷波也可能误删内容,仍需要区域级保真检查。 10. Duplex Cue:会说会停还要边听边改 Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents | Besimple AI | arXiv:2609.13117 关键词:全双工语音,重叠语音,对话适应,语音评测 前序问题:全双工语音评测常把模型行为简化为继续说或停下来,却漏掉人类常用的第三种反应:保留话轮,同时吸收听者补充的词、纠正或澄清。 本文贡献:Duplex Cue 把听者意图区分为回应、协作与打断,把说者行为标成原样继续、话内适应或让出话轮。研究从无脚本英语对话中提取 300 个经人工确认的提示,并在相同提示下比较人类录音与 PersonaPlex 延续。 实验效果:保留 208 对活跃且可评分样本;66 个协作提示中,人类话内适应率为 68.2%,PersonaPlex 为 34.8%,相差 33.4 个百分点。模型更多原样继续(42.4%)或让出话轮(22.7%);自动评分与人工在 142 项中一致 108 项,κ=0.641。 批判点评:三分法比“停没停”更接近自然对话,但判断适应需要理解语义依赖,自动评审本身可能偏向表面复述。要成为训练目标,还需扩展语言、说话风格、噪声与真实网络延迟。 趋势观察 控制接口前移到模型内部 控制不再靠外挂模块,而是接到主干已有的结构上:DiffSynth-Music 用可复用 KV 缓存组合五路音频,StepAudio 3 Gen 用共享离散码本统一语音、歌声、音乐与音效,DIAL 干脆直接复用 DiT 自带的注意力定位图。 长时序生成靠显式上下文传播续命 Encore 把长音视频拆成局部连续性与全局一致性两层,用跨块上下文传播加参考信号压住 30 秒后的身份漂移,误差累积指标 ΔID 从次优的 0.22 降到 0.07——长程生成的胜负手不在单帧画质,而在误差累积。 编辑控制从硬遮罩转向软约束 Overpainting 用白灰黑三值 trimap 区分「必须改、可以改、不能改」,Mi-Ripple 用频域陷波只删周期分量,都在回答「哪里该动、动多少」,而不是一刀切地框定编辑区域。 算力不够时预算分配成为核心问题 PLSR 把全局 3D 超分拆成可迭代的局部 patch 去噪换显存,SAS 在固定注意力预算下端到端学上下文排序——两条线都承认资源有限,转而研究怎么把预算花在刀刃上。 人工智能炼丹君 整理 | 2026-09-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
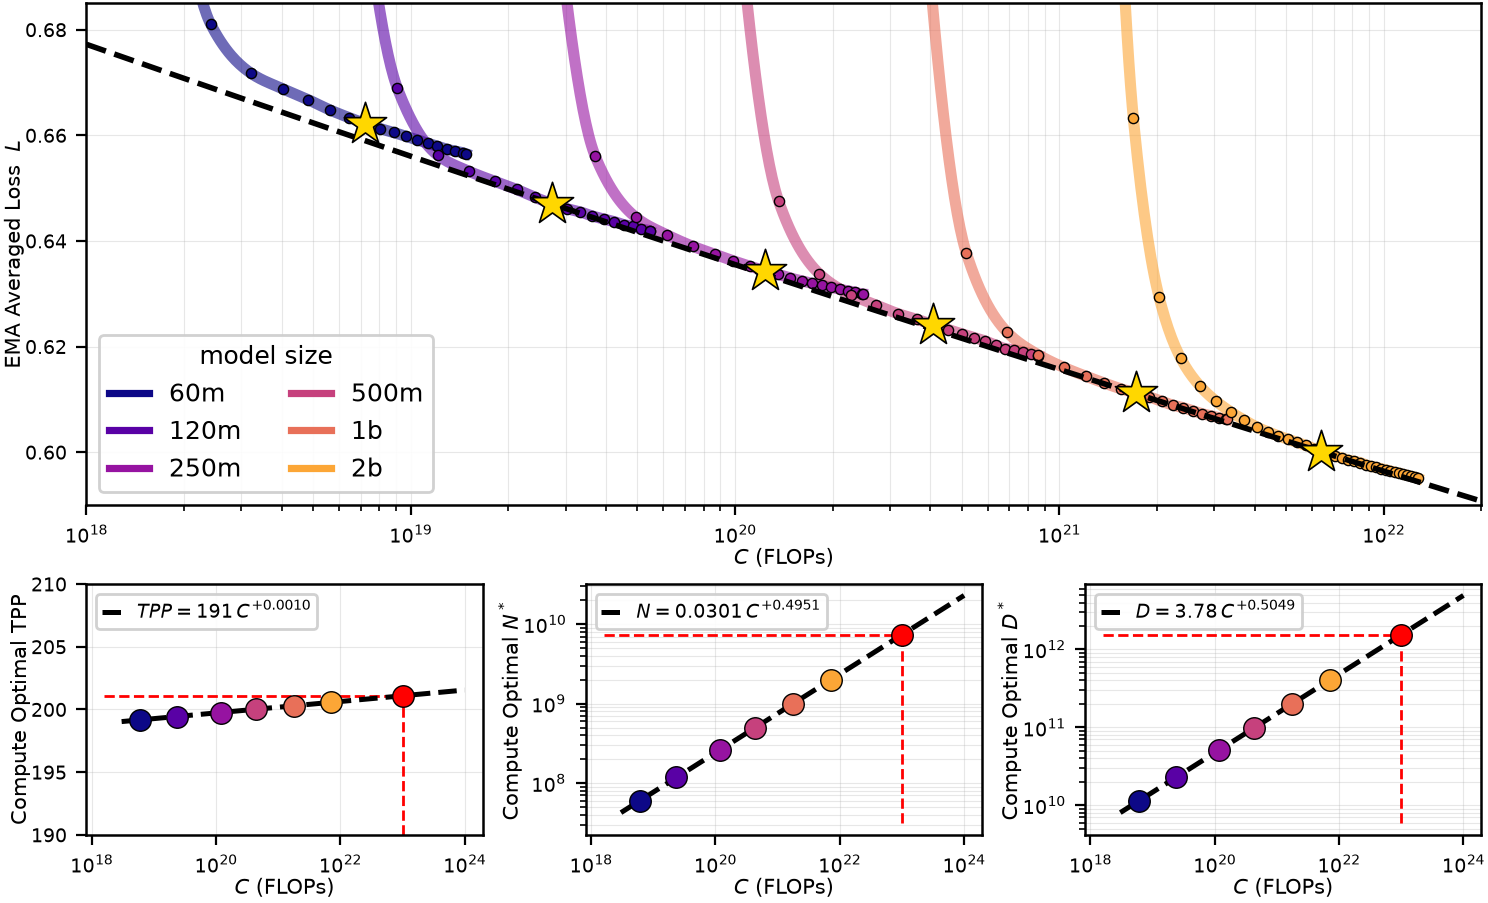
AIGC 每日速读|2026-08-20|LumaAI首证扩散缩放定律要10倍数据(Abra) 今日 AIGC 论文速览 今日共 10 篇 · 训练缩放与数据基建 2 篇 · 图像编辑与超高分辨率 2 篇 · 视频编辑 2 篇 · 推理加速与高效架构 2 篇 · 生成评测与诊断 2 篇 重点论文标题列表 Abra(Luma AI):每参数200token是最优配比 EditBridge(上海交通大学·阿里 Qwen·新加坡国立大学):4K图像编辑61秒完成 ⚡ GRNEdit(西安电子科技大学·小米 MiLM Plus):2B模型打赢多个14B开源编辑器 CoinVE-200K(腾讯 PCG 在线视频事业部):一条指令同时改5处的数据集 LinCa(上海交通大学·阿里云终端智能计算·西安交大):5-7倍加速下文字仍不糊 今日论文速览 1. Abra:每参数200token是最优配比 Abra: Scaling Diffusion Image Training | Luma AI | arXiv:2608.17286 关键词:扩散缩放定律,IsoFLOP拟合,每参数200token,flow-matching,Luma AI ⚠️ 前序问题:语言模型这边,缩放定律早已是训练前沿模型的标准工具——给定算力预算,模型该多大、数据该多少,Chinchilla 给出了一条能直接照着执行的曲线。但视觉生成这边一直是空白:从业者知道模型越大越好、数据越多越好,却没人能回答「我有 10^21 FLOPs,参数和数据该怎么分」这个具体问题。此前少数几篇尝试过的工作,算力预算都偏小,拟合出的指数外推到实际训练规模时误差被放大得没法用。更麻烦的是,大家默认把 LLM 的经验直接搬过来——按 Chinchilla 的每参数 20 token 配比训扩散模型,而没有人验证过这个数字在视觉域是否成立。 本文贡献:这篇把这件事系统地做完了。作者构造了 Abra——一族受控的 flow-matching transformer,参数从 60M 覆盖到 2B,训练算力横跨 10^19 到 10^22 FLOPs 三个数量级,显著超出以往工作的预算上限。在这个规模上他们得到两个核心结论。第一,扩散模型的可预测性与语言模型一样好,损失随算力呈干净的幂律,IsoFLOP 曲线的最优点连成一条直线。第二也是最有价值的:扩散的计算最优点出现在每参数约 200 个图像 token,整整是 LLM Chinchilla 处方的十倍。第三个结论是给实践者的直接建议——与 LLM 不同,扩散模型对过训练相当鲁棒,所以拿不准时应该往「更多数据」而非「更大模型」的方向偏。最后他们证明这种可预测性不止于训练损失,还延伸到生成质量指标、最优 CFG 设置、表征质量,甚至训练曲线的形状本身都能坍缩到一个通用形式上。 Text-to-image diffusion transformers follow predictable scaling laws and require ten times as much data as a comparably sized language model to reach compute optimality. 实验效果:IsoFLOP 拟合给出 TPP = 191·C^0.0010(即最优 token-per-parameter 几乎不随算力变化,稳定在 200 附近),最优参数量 N = 0.0301·C^0.4951、最优数据量 D = 3.78·C^0.5049——两个指数都极接近 0.5,说明参数与数据应当同比例增长,这一点与 Chinchilla 一致,差别只在配比常数。过训练鲁棒性的证据来自 Iso-FLOP penalty 曲线:Abra 在 TPP 从 100 一路拉到 400 的区间内,惩罚基本贴着 0.2% 以下,而数字化重建的 Chinchilla LLM 曲线在 TPP 超过 100 后惩罚就迅速爬升到 3-5%。训练曲线的通用坍缩在 60M 到 2B 六个尺寸上验证,重标定后曲线几乎重合,相对波动收敛在 1% 以内。 Iso-FLOP suboptimality penalty $(L_N - L^*)/L^*$ versus TPP for the family (left) and the Chinchilla / Hoffmann et al. data (right), the latter figure-digitized by~besiroglu2024chinchilla and binned into log-$N$ model-size bands. Markers are the measured points ( evaluated checkpoints; digitized Chinchilla points); curves interpolate through them. The green/red bands mark the $0.2\%$ penalty threshold. 批判点评:这是今天这批里信息密度最高的一篇,而且是那种一旦被验证就会改变整个领域默认做法的工作。「每参数 200 token、是 LLM 的十倍」这个数字本身就足够有价值——它意味着相当多现有的文生图模型可能都处于数据不足的状态,一直在把预算错配到参数上。IsoFLOP 的两个指数分别是 0.4951 和 0.5049,加起来几乎正好是 1,这种干净程度说明拟合质量确实高,不是硬凑出来的。「对过训练鲁棒」这条实践建议也很务实:它把一个需要精确调参的问题变成了单边保守选择,工程上极其友好。不过要清醒几点。第一,最大只训到 2B 参数,而当前前沿文生图模型早已在 10B 量级以上,外推距离仍然不短——论文自己的图里最优点已经外推到 10^23 FLOPs 处的红点,这已是纯预测而非实测。第二,「200 token per parameter」这个数字必然依赖 tokenizer/patch 配置与图像分辨率,换一个 VAE 压缩率或 patch size,token 的信息量就变了,200 这个绝对值能否跨配置迁移,是使用者最需要知道却没有明确交代的。第三,全程使用 flow-matching transformer 这一种架构,结论对 UNet 或其他扩散形式是否成立未验证。第四,Chinchilla 的对比曲线是从原论文图里数字化重建的(论文自己在图注里标注了 curves are noisier than real per-run data),这个对照的严谨性弱于自己跑的实验,而「十倍」这个最抢眼的结论恰恰建立在这个对照上。第五,Luma AI 作为商业公司发布这份研究,代码与检查点是否开放决定了社区能否独立复现这条曲线。 2. EditBridge:4K图像编辑61秒完成 EditBridge: Towards Faithful and Efficient Ultra-High-Resolution Image Editing | 上海交通大学·阿里 Qwen·新加坡国立大学 | arXiv:2608.18063 关键词:超高分辨率编辑,扩散桥,分块稀疏注意力,4K保真,上交·阿里Qwen ⚠️ 前序问题:专业修图工作流里 4K 起步是常态,但扩散编辑模型基本卡在 1K 以下——注意力的二次复杂度加上显存墙,让高分辨率直接变成不可能。业界的通行绕法是两段式:先在低分辨率上编辑,再独立跑一次超分。这个做法看似合理,实际上埋了两个坑。一是信息发散:超分模型是在「猜」细节,它猜出来的东西与原始高分辨率图里真实存在的细节经常对不上——原图眼睛是棕色,低分编辑后超分给你补出一只绿色的眼睛,且补得很自信。二是纹理退化:超分要么把纹理磨得过平,要么锐化过头产生假质感。根子在于超分环节完全看不到原始 HR 图,它只能从 LR 结果凭空重建。 本文贡献:EditBridge 的做法是重新定义这一步在做什么。传统扩散是从噪声重新生成,而这里把细化过程形式化为一次结构化的数据到数据翻译:起点是 LR 编辑结果,终点是它的 HR 对应版本,整个过程显式地以原始 HR 源图为条件。这样一来,真实细节是「继承」来的而不是「猜」来的,信息发散问题从形式上就被堵住了。但引入 HR 源图作为条件会带来新的算力问题——两张超高分辨率图之间做全交叉注意力是不现实的。为此他们设计了先验引导的分块稀疏注意力:利用第一阶段编辑过程中已经产生的语义对应关系(用注意力图取 argmax 得到位置映射 π),把跨图交互限制在空间上真正对齐的区域内。也就是说,目标图的某个 chunk 只需要去看源图中与它对应的那几个 chunk,而不是全图。注意力被拆成两条路径:Path A 是域内自注意力,Path B 是先验引导的跨 chunk 稀疏注意力。 Overview of our proposed EditBridge. The upper section illustrates the inference process of the diffusion bridge, which transports the low-resolution edit to its high-resolution counterpart. The lower section details the construction of the correspondence prior and the proposed Prior-Guided Sparse Attention (PG-BSA) mechanism. 实验效果:在最高 4K 分辨率下实现高保真编辑且感知质量占优,2K 上相比基线取得 3.6 至 8.4 倍加速,4K 编辑可在 61 秒内完成——这个数字把超高分辨率编辑从「跑不动」推进到了可交互的区间。定性对比覆盖夜景霓虹招牌上的日文字符与水面倒影等细节密集场景,在 PISA-SR、Dit4SR、DiT-SR、TSD-SR、HiFlow 五个基线中,只有本方法保住了招牌上原本的文字笔画,其余方法要么把文字糊成噪点,要么改写成完全不同的字形。 Qualitative comparison at 2K resolution. Our method better preserves fidelity while enhancing visual clarity. 批判点评:这篇最值得肯定的是问题诊断的准确性:它没有把两段式方案的毛病归咎于「超分模型不够强」,而是指出结构性缺陷——超分环节看不到 HR 源图,所以必然只能幻觉。把修正手段定位在「让它看得到」而不是「让它更强」,这个判断决定了整个方案的正确性。复用第一阶段的注意力图来构建对应先验也很省——那份注意力本来就要算,等于白捡了一份稀疏化的依据,不需要额外的匹配网络。61 秒完成 4K 编辑这个数字给得具体且可验证,比笼统说「高效」有诚意得多。但有几处要打问号。第一,整个方法建立在「第一阶段的编辑注意力能给出可靠语义对应」这个前提上,而编辑幅度大的时候——比如把物体整个替换掉——目标区域在源图里压根不存在对应物,此时 π 映射会指向什么?这类场景恰恰是编辑任务里最常见也最难的,论文的示例(换伞的颜色、加一只小船)都属于局部小改动,大幅编辑下的行为没有交代。第二,3.6 到 8.4 倍这个区间跨度很大,说明加速比高度依赖图像内容与稀疏度,最坏情况是什么没说。第三,61 秒的硬件配置未在摘要中给出,A100 上的 61 秒和 H100 上的 61 秒不是一个概念。第四,方法仍然是两段式的,第一阶段 LR 编辑本身的质量上限直接决定了最终结果——如果 LR 阶段就改错了,桥接得再忠实也只是把错误高保真地放大到 4K。 3. GRNEdit:2B模型打赢多个14B开源编辑器 GRNEdit: Efficient General Video Editing from a New Binary-Evidence Perspective in Generative Refinement Networks | 西安电子科技大学·小米 MiLM Plus | arXiv:2608.16328 关键词:通用视频编辑,二元证据视角,生成式细化网络,空指令恒等通路,小米MiLM ⚠️ 前序问题:指令式通用视频编辑想用一个统一入口覆盖各种编辑操作,但现有方案在「怎么把源视频信息喂给模型」这一步上都很重:要么挂一条独立的重型条件分支,要么把源视频直接拼接进输入序列——前者增加大量参数,后者让序列长度翻倍,两条路都很贵。更本质的问题是,这些做法都把源视频当成一团需要重新理解的原始信息,而没有利用一个关键事实:编辑的绝大部分区域其实应该原封不动地保留下来。以「保持」为默认、只标注需要改的地方,信息量本该远小于从头重新描述整个视频。 本文贡献:GRNEdit 从 GRN(生成式细化网络)用 bit 组合编码视觉语义这一特性出发,把编辑语义重新表述成对每个 bit 的「保留还是翻转」的局部二元决策。这个视角转换是全文的支点:源信息不再是需要被重新编码的内容,而是支持当前二元状态的「坐标级证据」,而 GRN 主干继续负责把这些局部决策组合成全局连贯的生成语义。第一阶段用一个紧凑编码器把离散源码翻译为连续证据信号,在二元细化过程中持续注入。他们还借鉴 classifier-free guidance 的空提示训练,赋予空条件一个编辑专属含义——空指令即「不编辑」,由源重建来监督。这条恒等通路一石二鸟:既隐式强化了证据利用与内容保持,又在同一表示空间里产生了一个「源保持态」。于是第二阶段可以把每个编辑态与它对应的源保持态直接相减,用差异去修正那些第一阶段没定下来的目标 bit——这是一个相当巧妙的自我对照机制。 Overview of GRNEdit. Given a source video and an editing instruction, Stage I injects prompt-modulated source evidence into the GRN chunks through lightweight per-chunk projectors, each containing only about 3 M parameters for GRNEdit-2B and 7 M for GRNEdit-8B. Stage II refines the binary predictions by treating source evidence as support in keep regions and as counter-evidence in edit regions. 实验效果:仅用 0.6M 训练对、不到 3% 的条件化参数,GRNEdit-2B 与 GRNEdit-8B 在 OpenVE-Bench 上分别取得 4.03 与 4.18 分。2B 版本超过多个 14B 量级的开源编辑器,8B 版本与领先开源编辑器持平。第二阶段的监督设计在框架图中量化呈现:保持区域若用源信息使 p(target) 从 0.7 升到 0.9,交叉熵从 0.36 降到 0.11 作为奖励;编辑区域若照抄源信息使 p(target) 从 0.55 掉到 0.1,交叉熵从 0.6 升到 2.3 作为强惩罚——奖惩方向被显式分开。 Qualitative comparison across diverse editing tasks. GRNEdit performs more accurate edits while better preserving unedited content, whereas competing methods often miss the intended change or disrupt scene consistency. 批判点评:0.6M 数据加不到 3% 条件参数就让 2B 打赢 14B,这个效率比是今天最亮眼的工程数字,而且它不是靠更大的模型或更多的数据换来的,纯粹来自表示方式的重新选择。把编辑重述为 bit 级的保留或翻转,本质上是给模型换了一个更贴合任务的默认动作——从「重画」变成「保持」,这个先验一旦对了,学习难度会断崖式下降。空指令即恒等这条设计尤其漂亮:它不额外增加参数,却同时提供了内容保持的监督信号和第二阶段所需的对照基准,一个设计承担三个功能。但要看清几处限制。第一,整套方法深度绑定 GRN 这种二值化表示的骨干,对主流的连续 latent DiT 并不直接适用,普适性受限——这也解释了为什么它能这么省,代价是换不了底座。第二,OpenVE-Bench 上 4.03 对 4.18 这个 2B 与 8B 的差距只有 0.15,说明模型规模在这套方法下的边际收益极低,这既可以解读为「小模型就够」,也可以解读为「方法本身触到了天花板,加参数也没用」,论文倾向前一种解读但没有排除后一种。第三,「超过多个 14B 开源编辑器」这个表述里没点名是哪些,而开源 14B 编辑器的水平参差很大,这个对照的含金量无法判断。第四,0.6M 训练对相对于视频编辑任务的复杂度其实偏少,能力覆盖边界(能做哪些编辑类型、哪些做不了)没有说明。第五,两阶段推理意味着实际延迟是单阶段的两倍以上,效率优势主要体现在参数和训练成本上而非推理速度,摘要用 Efficient 一词容易造成误读。 4. CoinVE-200K:一条指令同时改5处的数据集 CoinVE-200K: A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing | 腾讯 PCG 在线视频事业部 | arXiv:2608.17566 关键词:复合指令视频编辑,数据集与基准,原子操作解耦,Wan2.1-14B,腾讯PCG ⚠️ 前序问题:指令式视频编辑的数据集这两年质量在稳步提升,但有一个共同盲区:几乎全部只覆盖单一编辑操作。而真实用户的诉求往往是复合的——「把背景换成森林,同时把她的黄裙子改成深蓝礼服,再把桌上那台搅拌机拿掉」,这是一条指令里塞了三个互相独立的编辑意图,模型必须同时理解它们、并在同一段视频里各自忠实执行且互不干扰。用只含单操作样本的数据训出来的模型,面对这种复合指令时要么只执行第一条,要么把几个操作混在一起相互污染。数据的形态直接锁死了模型的能力形态。 本文贡献:针对性地补上这块。CoinVE-200K 包含 1080p、最长 201 帧的视频编辑对,每个样本涉及 2 到 5 个原子编辑操作,作用对象覆盖人物、物体与背景,操作类型覆盖添加、移除、修改与风格化。所有样本经过一套生成加过滤的管线,从指令忠实度、视觉质量、时序一致性、复合多样性四个维度把关。配套发布 CoinVE-Bench,按主体、操作类型、指令复杂度分层评测。更进一步,他们训了 CoinVE-Edit——基于 Wan2.1-T2V-14B 与 Qwen3-VL-8B-Instruct 构建的 22B 复合视频编辑模型。这个模型的关键设计是把不同编辑指令的注意力做区域感知的解耦:每条指令经 MLLM 编码为一组可学习 token,由 Mask Predictor 预测其作用区域 M,GateNet 输出门控系数 g 决定该指令是否需要掩码约束,再通过 Q-Blending 交叉注意力按权重 w_q = 1 - βg(1-M) 融合多条指令的输出。这样每条指令只在自己的区域内生效,天然避免了多指令互相污染。 An overview of the proposed CoinVE-Edit framework. 实验效果:在 CoinVE-Bench 上,CoinVE-Edit 在指令遵循、复合编辑准确率、视觉质量与时序一致性四项上均取得强表现。定性对比展示了一条指令含 4 个操作的案例(替换搅拌碗、添加菜刀、替换台面、移除玉米粒),与 SAMA、可灵 O3、Seedance 2.0 三个对照相比,只有 CoinVE-Edit 把四个操作全部正确执行且未误改其余内容——对照方法普遍出现漏执行或连带改动无关区域的问题。 Quality comparison of compositional-instruction video editing on CoinVE-Bench. 批判点评:复合指令这个切入点选得准。单操作编辑在学术基准上已经做得相当好,但用户真实场景里很少有人只提一个要求,这中间的差距被整个领域忽略了,而它偏偏是产品化的关键一环。Q-Blending 那个门控加掩码的设计也合理:g 决定要不要约束、M 决定约束在哪,两个自由度分开,比硬性给每条指令分配固定区域灵活。1080p、201 帧、20 万对的规模在视频编辑数据集里属于第一梯队,腾讯在线视频事业部的资源背景也让这个量级可信。但几点要留意。第一,也是最关键的:数据集是「生成加过滤」构建的,那些 2-5 个操作的复合编辑对本身是用什么模型生成的?摘要没说。如果生成器本身就是现有编辑模型,那 CoinVE-200K 的质量天花板会被它锁死,而 CoinVE-Edit 训完能超过的也只是那些数据更少的模型,未必超过数据生产者。第二,CoinVE-Bench 由同一团队用同一套管线构建,与训练集共享分布,22B 模型在上面的领先有多少能迁移到真实用户指令,是个悬念——定性图里的对照模型都是在自家基准上被评的。第三,22B 的推理成本没有交代,201 帧 1080p 的复合编辑单次要多久,这直接决定它是研究原型还是可用工具。第四,「2 到 5 个原子操作」的分布如何?如果绝大多数样本是 2 个操作,那么 5 操作场景的实际支撑就很薄。第五,多指令解耦依赖 Mask Predictor 预测的区域准确,当两条指令的作用区域天然重叠时(改人物服装 + 改人物姿态),这套机制如何处理没有说明。 5. LinCa:5-7倍加速下文字仍不糊 LinCa: Accelerating Diffusion Models via Learnable Decomposed Feature Caching | 上海交通大学·阿里云终端智能计算·西安交大 | arXiv:2608.17973 关键词:扩散推理加速,可学习特征缓存,可逆分解重构,ECCV 2026,阿里云 ⚠️ 前序问题:扩散模型迭代采样的成本一直是落地的主要障碍,特征缓存是近年最被看好的加速路径——把某些时间步的中间特征存下来,后续步骤直接复用或外推预测,跳过昂贵的完整前向。问题在于,现有的免训练缓存方法都在用一套统一的预测策略处理所有特征。而实际上不同特征的时序动态差异极大:有些特征随时间步平滑变化,零阶复用就够;有些高频剧烈波动,必须用高阶外推才不失真。用一把尺子量所有东西,结果就是在高加速比下质量崩塌——具体表现为文字糊成一团、细结构错乱。 本文贡献:LinCa 的思路是先分解再分别对待。它引入一个轻量可逆网络,把缓存特征拆解为若干具有不同连续性的子成分,对每个成分匹配相应阶数的预测策略——平滑的用零阶(直接复用),次之用一阶,波动大的用二阶外推。可逆性在这里是关键设计而非装饰:严格可逆保证了子成分预测完后能无损重构回原始特征空间,不引入分解误差,形成一条完整的「分解-预测-重构」闭环。可逆投影用 RevNet 结构实现(可逆 1×1 卷积 + 加减耦合的 MLP 分支),前向与反向严格互逆。训练层面,他们为不同模型、不同时间步区段分别训练预测器,让方法能自适应各处不同的特征动态。整套东西是「学出来的」而非手工设计的,这是与既有免训练方法的根本区别。 实验效果:已被 ECCV 2026 接收。在 FLUX、Qwen-Image 与 HunyuanVideo 三个模型上验证,额外参数少于 0.2%,在 5 至 7 倍加速下保持接近无损的质量,显著优于既有方法。FLUX 上 5.51 倍加速的定性对比最能说明问题:提示词包含大段英文文字时,TeaCache、FORA、ToCa、DuCa、TaylorSeer 五个基线在相近加速比下文字均出现不同程度的糊化、笔画粘连或整体消失,而 LinCa 的文字与原始无加速结果几乎逐字符一致;橙子笑脸、马背上的电视机等构图元素也未出现基线中常见的物体丢失或结构错乱。 批判点评:把「统一策略」换成「按连续性分解后差异化处理」,这个思路对得很自然——特征动态本来就不均质,用一套策略是明显的欠拟合。可逆网络的选择尤其到位:如果用普通的编码器解码器做分解,重构误差会在数十个时间步里累积放大,把加速带来的收益抵消掉,而严格可逆从数学上消除了这个隐患。0.2% 参数换 5-7 倍加速的性价比很高,文字保持能力那张对比图也非常有说服力——文字是检验扩散加速方法最狠的探针,因为它对高频细节的破坏零容忍,五个基线全部翻车而 LinCa 几乎无损,这个差距不是调参能解释的。ECCV 2026 接收提供了同行评议背书。但要留意几点。第一,「学习」是双刃剑:需要为不同模型、不同时间步区段分别训练预测器,意味着换一个基座模型就要重新训一遍,而它对标的 TeaCache/TaylorSeer 等方法是完全免训练、即插即用的。0.2% 参数听起来很少,但训练流程的存在本身就是部署门槛,这个对比维度摘要没有正面回应。第二,可逆网络在每个缓存步都要跑前向与反向两次变换,这部分开销是否已计入 5-7 倍的加速统计口径,直接影响数字的诚实度。第三,三个验证模型都是 DiT 架构,对 UNet 类扩散模型是否有效未验证。第四,加速比只报到 7 倍,而基线方法在 5 倍附近就已明显退化,那么 LinCa 在 10 倍以上的表现如何、崩塌点在哪,是使用者最关心却未披露的信息。第五,「分解为不同连续性的子成分」这个划分是学出来的,缺乏可解释性——学到的成分究竟对应什么语义、划分是否稳定,论文没有做分析。 6. CapData:4.4亿图按能力依赖排课 From Corpora to Co-Evolving Capabilities: Capability-Centric Data Design for Generalist Image Generation | 阿里巴巴集团 | arXiv:2608.18076 关键词:图像生成数据基建,能力驱动排课,三引擎recaption,4.4亿图池,阿里巴巴 ⚠️ 前序问题:大规模图像生成的进步很大程度上来自数据侧——扩规模、提质量、做再平衡、重新写 caption。但常规做法有个结构性问题:每个任务的数据集都是孤立优化的。文生图数据管文生图,编辑数据管编辑,知识关联数据管知识关联,各建各的、各调各的。而真实情况是,生成能力之间存在依赖关系——模型得先能把文本和图像对上,才谈得上做图像到图像的变换;得先有稳定的视觉表达,才谈得上把知识实体正确渲染出来。数据如果不按这个依赖顺序组织,就会出现「教高级技能时基础还没打牢」的低效学习,算力被浪费在模型还接不住的监督信号上。 本文贡献:提出一套能力驱动的数据基础设施,把「针对能力构造监督」与「按能力对齐排课」耦合起来。三个专门但可互操作的数据引擎分别构建互补的关系型监督:T2I 引擎负责文本-图像接地(大规模图池 + 能力检索 + 多风格双语 recaption,覆盖 short/medium/long/dense/tags/entity 六种粒度),编辑引擎负责图像间变换(基础编辑、自然关联、专家自蒸馏等多维度策展 + T2I 对齐的编辑 recaption),知识引擎负责图像-知识关联(从 Wikidata 出发,PageRank 筛选实体后检索配图)。caption 专家横跨任务与粒度对齐 T2I 与编辑监督。多阶段课程沿能力获取的依赖顺序,联合演进任务构成、视觉概念分布、数据质量与图像分辨率,并由能力感知评测闭环——把失败案例送入 Failure Pool,触发邻近数据搜索与专家自蒸馏,再由分布控制器做缺口感知的重采样,持续失败的桶提高采样权重、已解决的降低权重。规模上策展出 4.4 亿图 T2I 语料、1.2 亿编辑对、超 2700 万图像-实体对,并用它从零训练 3B 与 6B 两个规模的多模态扩散模型。 Capability-specific data construction in our framework. Shared collection and wrangling feed three specialized but interoperable engines for visual expression, editing association, and knowledge-grounded reasoning. 实验效果:在 CPI-Bench 上做定量评测,并在多样的文生图与编辑场景做定性评估,结果显示广泛的视觉覆盖、多样的渲染能力,以及跨生成能力的有效迁移——即在一种能力上的数据投入能带动相关能力的提升,这正是「协同演化」这一命题的直接证据。 Capability-gap-driven active feedback loop. Capability-aware evaluation identifies failure cases, which seed neighboring-data retrieval and expert-driven construction. Gap-aware resampling then increases the weights of persistent failures and down-weights resolved gaps in subsequent training. 批判点评:把数据工程从「造语料」提升到「设计能力依赖图并据此排课」,这个视角在当前是稀缺的。大多数数据类论文的贡献是「我造了更多更好的数据」,而这篇的核心主张是「数据之间的组织顺序本身就是一种方法」,这是不同层级的命题。那个失败池 + 缺口感知重采样的闭环尤其务实——它把评测从「训完看看多少分」变成了「持续驱动下一轮数据采集」的控制信号,让数据基建具备了自我修复能力,而不是一次性的静态产物。4.4 亿图加 1.2 亿编辑对的规模,配合从零训练 3B/6B 两个尺度,工程投入相当扎实。但几处必须打问号。第一,全文没有给出任何具体数字——CPI-Bench 上得了多少分、与哪些基线比、领先多少,摘要用「broad coverage」「versatile rendering」「effective transfer」这类形容词全部带过,这在一篇以规模和方法论为卖点的论文里是硬伤,读者无法判断这套复杂基建的实际收益。第二,「按能力依赖顺序排课」这个核心主张需要消融来支撑——如果把课程顺序打乱,性能掉多少?没有这个对照,「依赖顺序很重要」就只是一个合理但未经检验的假设。第三,CPI-Bench 疑似自建,与训练数据的关系未说明。第四,整套基建的算力成本极高(4.4 亿图的策展、两个模型从零训练),学术界基本无法复现,其价值主要体现为工业界的方法论参考而非可直接采用的技术。第五,「能力依赖顺序」是人工设定的还是数据驱动得出的?如果是前者,那这套框架的效果高度依赖设计者的先验判断,泛化到新能力时需要重新人工设计。 7. MoE-ViE:1.7倍大模型的效果76%延迟 MoE-ViE: Mixture of Experts Vision Encoder for Efficient Image and Video Understanding | Meta | arXiv:2608.17402 关键词:视觉编码器,细粒度MoE,免辅助损失均衡,Group GEMM,Meta ⚠️ 前序问题:视觉编码器是多模态模型的关键部件,扩容它确实能带来性能提升,但稠密扩容的代价是算力与推理延迟同步上涨。MoE 在语言模型那边已经证明是高效扩容的答案——激活参数远小于总参数,容量涨而算力不涨。但把 MoE 用到 CLIP 风格的视觉编码器上,设计空间基本没人在 SOTA 水平上系统探索过:专家该多细粒度?路由怎么平衡?稀疏化带来的 kernel 开销怎么办?视频能力怎么加而不损失图像知识?这些问题各自都有多个可能答案,而缺少系统研究意味着大家只能凭直觉照搬 LLM 的配置。 本文贡献:Meta 把这个设计空间系统扫了一遍,给出四条结论加一套模型。第一,细粒度 MoE 拓扑(更多更小的专家)相比稠密基线和标准 MoE 都有实质增益——这与 LLM 领域近年的发现一致,但在视觉编码器上是首次在 SOTA 水平确认。第二,提出免辅助损失的负载均衡变体,避免了传统 aux-loss 对主任务的干扰,同时改善专家利用率。第三,设计专用 MoE kernel(Group GEMM + kernel fusion)来抵消稀疏计算带来的推理延迟开销——这一点很实在,MoE 理论 FLOPs 低但实际延迟常常因为访存不规则而吃亏,不做 kernel 优化的 MoE 在部署时经常「省了 FLOPs 但没省时间」。第四,为了在增强视频能力的同时保住图像知识,引入帧级蒸馏配合一种新的冻结机制:视频微调阶段专家与文本侧 MLP 全部冻结,只让预训练教师对第 i 帧的表示去蒸馏学生对整段视频的表示,从而把视频能力「加」上去而不覆写已有的图像能力。 Illustration of MoE-ViE architecture and training pipeline. MoE-ViE adopts a fine-grained MoE design with optimized MoE kernels for latency reduction. We first perform contrastive pretraining on large-scale image-text pairs. During video finetuning, we introduce frame-level distillation and expert freezing to preserve the pretrained image understanding capabilities. 实验效果:跨多个尺寸预训练的 MoE-ViE 系列一致优于对应的稠密版本。最大模型在零样本性能上匹配一个 1.7 倍于它的 SOTA 编码器,而延迟只有后者的 76%。与 LLM 对齐后,MoE-ViE 在图像与视频基准上超过所有对照编码器,包括激活参数多达 5 倍的模型。ImageNet 1K 错误率随 GFLOPs 的缩放曲线显示,ViT-B/32、ViT-B/16、ViT-L/14 三个骨干的 MoE 版本(实线)在各自算力区间内均位于稠密版本(虚线)下方,且差距在算力增大后不收敛。代码已开源,论文被 ECCV 2026 接收。 MoE-ViE vs. dense models at multiple scales. MoE-ViE consistently outperforms their dense counterparts under the same compute budget. 批判点评:这是一篇标准的工业界系统性研究:不追求单点创新,而是把一个设计空间扫清楚并交付可用的模型和 kernel。价值在于确定性——它把「视觉编码器该不该上 MoE、怎么上」从猜测变成了有依据的选择。专用 kernel 那部分尤其值得称道,因为它诚实地面对了 MoE 最常被回避的问题:理论 FLOPs 的节省经常在实际延迟上兑现不了,很多 MoE 论文只报 FLOPs 而绝口不提墙钟时间。这里直接给出 76% 延迟这个端到端数字,说明作者知道读者真正关心什么。冻结机制的设计也很克制——加视频能力时把专家全冻,本质是承认「不确定改动会不会伤到图像能力,那就干脆不改」,这种保守在多模态扩展里往往是对的。但要注意几点。第一,与本项目关注的生成方向的关联是间接的:视觉编码器主要服务理解任务,对生成的价值需要经过 MLLM 这一层传导,读者不应把这里的收益直接映射到生成质量上。第二,「匹配 1.7 倍大的 SOTA 编码器」——是哪个编码器?摘要没点名,而 SOTA 这个词在视觉编码器领域可以指向差异很大的几个模型。第三,76% 延迟是在什么硬件、什么 batch size 下测的没说,MoE 的延迟优势对 batch size 极度敏感,小 batch 下专家利用率低会显著劣化。第四,「超过激活参数多 5 倍的模型」这个比较用的是激活参数而非总参数,MoE 的总参数量通常远大于激活量,从显存占用角度看这个对比对 MoE 是有利但不完整的。第五,帧级蒸馏用单帧教师去教整段视频学生,这个设定对需要跨帧推理的能力(如动作识别、时序因果)是否够用,值得怀疑——它教会的可能主要是「每帧都看懂」而非「看懂帧之间发生了什么」。 8. WildMoire:用生成模型造出去摩尔纹标注 Improving Complex Moire Removal with Generative Supervision | 哈尔滨工业大学·阿里淘天集团 | arXiv:2608.17883 关键词:摩尔纹去除,生成式监督,数据引擎,6.8K训练对,哈工大·淘天 ⚠️ 前序问题:训练去摩尔纹模型需要成对数据——同一场景的带摩尔纹版本和干净版本。麻烦在于真实世界里最难处理的那类摩尔纹恰恰最难获得配对标注:拍公共显示屏、翻拍网络图片时产生的大尺度、多彩摩尔纹,其干净原图根本无从获取,因为你没法控制那块屏幕、也拿不到原始素材。现有数据集只能在受控环境下采集,覆盖的摩尔纹形态与真实野外场景差距很大。这构成一个死结:最需要解决的场景,恰恰是最拿不到监督信号的场景。 本文贡献:既然干净图拿不到,那就造一个。作者提出一套数据引擎来生成训练监督:先收集含复杂摩尔纹的真实图像并定位其中的屏幕区域,然后部署多个图像条件的生成基础模型(SDXL、Nano Banana 2、Qwen-Image-Edit、GPT Image 2、FLUX.2 五个)各自产出候选参考图,再对候选做 patch 级的质量控制来筛选出最优结果——后处理包含空间位置与色彩对齐、patch 裁剪、预过滤、最优 GT 选择四步。用这套范式构建了 WildMoire 数据集,含 6.8K 摩尔纹-GT 训练对,分辨率 1024×1024。评测侧另外采集了约 250 对带真实干净 GT 的独立测试集——这一点很关键,它保证了评测不是自己造的数据自己评。 Overview of WildMoir'e dataset construction. We first collect real screen-captured images containing complex moir'e and localize the display regions. Five image-conditioned generative models then produce candidate GT images. The candidates are processed at matched spatial locations through spatial and color alignment, synchronized patch extraction, pre-filtering, and optimal GT selection. This offline procedure yields 6.8K moir'e-GT pairs at 1024()1024 resolution. The plots on the right summarize the improvements obtained by training ESDNet, SDXL, and Qwen-Image-Edit with constructed WildMoir'e dataset. 实验效果:在 ESDNet、SDXL、Qwen-Image-Edit 三个不同类型的模型上验证,加入 WildMoire 训练后各项指标一致提升:PSNR 分别为 23.37 对 21.50、23.56 对 21.90、23.93 对 22.23;SSIM 为 0.7821 对 0.7341、0.7887 对 0.7522、0.7851 对 0.7578;无参考指标 MUSIQ 为 44.21 对 38.20、45.07 对 41.48、58.97 对 55.33;TOPIQ 为 0.3413 对 0.2770、0.3583 对 0.3203、0.4624 对 0.4276。三个模型、四个指标全部改善,方向一致。 Comparison of qualitative results. The first example emphasizes logo and text fidelity under broad color interference, while the second contains severe mixed chromatic patterns over fine scene textures. Nano-Banana-2 is relatively content-faithful but may retain moir'e, whereas GPT-Image-2 removes artifacts aggressively while replacing scene content and producing an overly digital-image appearance. Using WildMoir'e suppresses residual bands more effectively across all 3 trainable models. 批判点评:「用生成模型造监督信号来训练修复模型」这个思路本身是有循环论证风险的——生成模型自己也会产生伪影,用它的输出当 GT,等于把它的错误当成真理教给学生。这篇之所以站得住,全靠两个设计。一是不用单个生成模型,而是让五个模型各出候选再做 patch 级筛选,把「相信某个模型」换成「相信多个模型中被质控挑出来的那部分」,显著降低了单一模型偏差的传播。二是测试集用真实采集的干净 GT 而非生成的,评测环节的可信度得到了保证——如果测试集也是生成的,整篇的结论就没有意义了。三个模型上四项指标一致改善也排除了偶然性。但要看清限制。第一,6.8K 对的规模在数据驱动的低层视觉任务里偏小,PSNR 提升 1.7-1.9 dB 虽然明确但不算大幅度,而这个提升是在测试集只有 250 对的情况下测的,统计置信区间没有报告。第二,生成的 GT 本质上是「一个合理的干净版本」而非「真正的原始内容」——摩尔纹遮住的地方生成模型是在猜,猜得好看不等于猜得正确,而 PSNR/SSIM 是在与真实 GT 比对,所以训练数据的这种「合理但不真实」的偏差会以什么形式影响模型行为,值得进一步分析。第三,五个生成模型中多个是闭源商业模型(Nano Banana 2、GPT Image 2),意味着这套数据引擎的复现需要付费 API,且模型迭代后行为会变,数据可复现性存疑。第四,摩尔纹去除是个相对小众的低层任务,方法论的普适价值(用生成模型为难以获取 GT 的任务造监督)其实比这个具体应用更值得关注,但论文没有往这个方向延伸讨论。 9. TRACE-Bench:把多参考生成拆成四个算子 TRACE-Bench: Decomposing and Diagnosing Multi-Reference Image Generation | 上海交通大学 | arXiv:2608.16765 关键词:多参考图像生成,评测基准,四算子分解,属性解耦绑定,上海交大 ⚠️ 前序问题:多参考图生成——给几张参考图,要求把 A 的人物、B 的服装、C 的场景组合起来——的评测基准,目前都是按预定义任务类型组织的,比如「主体组合」「风格迁移」各设一类。但多参考本质上是组合性的,任务类型的笛卡尔积会爆炸,用有限的预定义类别去覆盖必然导致三个问题:覆盖碎片化(很多组合根本没被测到)、复杂度不受控(同一类别下的样例难度可能差几倍)、诊断价值近乎为零(知道模型在「主体组合」上得 0.6,但不知道是没抓对主体、没解耦属性还是没组合好)。 本文贡献:换一个视角:不按任务分类,按能力原子分解。作者观察到各种多参考任务其实共享一组原子操作,于是形式化出四个算子——Anchor(f,锚定参考图中的某个实体)、Disentangle(g,把实体的某个属性剥离出来)、Apply(⊕,把属性施加到目标上)、Compose(C,把多个结果组合成完整场景)。任何多参考提示词都能表示为这四个算子构成的组合公式,而公式中算子槽位的数量就是它的结构复杂度——复杂度从此变成了一个可精确控制的连续量而非模糊的难易标签。基于这套形式化构建 TRACE-Bench:约 1600 个评测样例,槽位数从 1 到 8 连续覆盖,由 631 个公式模板与约 4000 张参考图生成,涵盖多种艺术风格与真实主体。公式结构直接驱动两件事:算子对齐的评测协议(对每种能力单独打分)与诊断树分析(递归定位失败发生在公式的哪一层)。 Overview of the benchmark construction pipeline. Candidate images are first collected and filtered from multiple sources, then annotated through structured tagging. The tagged pool is then balanced through source-wise sampling and augmented with synthetic data. It is subsequently used for formula-template sampling and prompt construction. 实验效果:评测 9 个领先模型后得到了整体打分完全看不见的结论:主要瓶颈在解耦(g)与属性绑定(⊕),而非场景级组合(C)——这与直觉相反,人们通常认为「把多个东西组合到一起」才是难点。即使最好的模型在属性保真度上也只有 0.74 分。实体级锚定分数随参考图实体数量增加持续下降:Nano Banana 2 与 GPT-Image 1.5 从 2 个实体时的 0.78 降到 8 个实体时的约 0.55 与 0.49,EMU 3.5 从 0.70 降到 0.36,Qwen Image Edit 2511 从 0.60 降到 0.36——所有模型无一例外,且弱模型衰减更陡。已被 ACM MM 2026 接收。 Anchor performance versus template slot count (left) and reference-image entity count (right). 批判点评:把评测从「任务分类学」重构为「能力代数」,这是这篇真正的贡献。四个算子的抽象足够简洁,又足够表达绝大多数多参考场景,而槽位数作为复杂度度量把「难度」这个模糊概念变成了可控变量——这让基准第一次能回答「模型在复杂度 N 时开始崩」这类定量问题,而不只是给一个总分。诊断树的递归失败定位设计也很自然地从公式结构里长出来,不是额外硬加的模块。「瓶颈在解耦和属性绑定而非场景组合」这个发现具有明确的研究导向价值:它告诉后续工作该往哪儿使劲,而这正是一个基准最该产出的东西。实体数从 2 涨到 8 时所有模型锚定分数单调下降的曲线也很有说服力——它揭示了一个共性缺陷而非某个模型的问题。但几点要留意。第一,1600 个样例分摊到 1-8 共八个槽位档,平均每档 200 例,再按算子类型细分后每个诊断单元的样本量会相当小,per-capability 分数的统计稳定性存疑。第二,评测靠什么打分?摘要没说评分是人工还是 VLM 自动评。如果是 VLM 评分,那么「解耦和属性绑定是瓶颈」这个结论可能部分反映的是评委 VLM 在这两项上的判别偏好,而非被测模型的真实短板——这是自动评测基准的通病,需要人工一致性验证来排除。第三,四算子分解是作者提出的一种形式化,未必唯一,其完备性(是否所有多参考任务都能被这四个算子表达)缺乏论证。第四,9 个被测模型中包含 Nano Banana 2、GPT-Image 1.5 等闭源模型,其版本会持续更新,基准结论的时效性有限。 10. HarnessEval-W:评测世界模型要给出证据链 HarnessEval-W: Agentifying the Evaluation of Visual Worlds | MirroS·清华·北大·NVIDIA·UC Berkeley·上交·南洋理工 | arXiv:2608.16859 关键词:世界模型评测,智能体化流水线,层级证据树,人类偏好对齐,NVIDIA·清华 ⚠️ 前序问题:一个基准如果只吐出一个标量分数,那么它可信与否完全取决于你信不信它——分数背后的判断依据是不透明的。这个问题在世界模型评测上格外尖锐:判断一段 rollout 好不好,需要理解物理规律有没有被违反、因果链条对不对、世界状态的演化是否自洽。人类看一眼就知道哪里不对劲,但现有基准全靠暴力计算指标,算完给个数,没有任何可供检查或核验的推理链条。于是当两个模型分数接近时,你无从判断这个接近是真实的还是指标失灵。 本文贡献:把 LLM 生态里的 harness 范式搬到世界模型评测上,做成一条智能体化的评测流水线。核心区别在于它不套用固定评分表,而是先理解每个评测案例的上下文,把评测问题分解为若干可测量的子问题,再为每个子问题派生专门的子智能体——每个子智能体带着定制的上下文与诊断工具,只负责论证自己那一小块。父智能体随后校验汇总的证据并归纳为最终判定。这个层级化流程的产物不只是一个分数,而是一棵完整的证据树,每条推理链都可回溯查验。图中示例展示了这个过程:给定「让右夹爪把托盘上方的立方体举起来」这一意图性转换案例,系统先做案例专属的技能路由(启用 Intentional Change 与 Physical Plausibility,关闭 Offscreen Evolution 与 Drift Degradation),再由子智能体分别给出带理由的评分——target specificity 1.00、final state 0.25、no extra event 0.00(因为 rollout 里凭空出现了一只人手去捡立方体),最终聚合为 0.485。 Overview of the ourmodel evaluation pipeline. Given a case with its prompt and evaluation setting, the agentic planner routes the case to applicable skills from the skill library, recording an evidence-grounded reason for every activated and skipped skill (e.g., the Offscreen Evolution Verifier is skipped because all requested actions remain visible). Each activated skill spawns sub-agents that inspect the world model rollout for specific sub-questions, such as target visibility and final state validity; here, the Intentional Change Verifier detects an unrelated human intervention picking up the cube and zeroes the no-extra-event score. The collected evidence is finally aggregated into per-dimension scores and an interpretable final score. 实验效果:在 18 个代表性世界模型、330 个评测案例上应用,判定结果与人类偏好高度对齐:技能级别上与人类 Bradley-Terry 强度的相关性达到 ρ=0.93(意图类)与 ρ=0.87(物理类),Kendall τ 分别为 0.82 与 0.74。与最接近的既有 Wbench 协议对比,在意图与事件编辑任务上准确率 0.778 对 0.602、平局率 0.111 对 0.361;在物理与因果保真任务上准确率 0.717 对 0.319、平局率 0.018 对 0.522——平局率的大幅下降尤其说明问题:旧协议在超过一半的物理类对比中给不出区分,而本方法几乎总能分出高下。全流程开源为活体基准,接受社区贡献新技能与新案例。 Human alignment of ourmodel and its comparison with WBench. (a) Model-level human alignment: each point is one of the evaluated models; we fit a linear curve for both Intentional and Physical Transition. (b) Controlled comparison with the closest WBench protocols on the same data: we report pairwise accuracy (higher is better), draw rate, and Brier score (both lower is better). 批判点评:「评测的可信度来自论证而非分数」这个立论切中了当前评测体系的软肋。当各家模型在总分上越挤越近时,一个不能解释自己为什么这么打分的基准,实际上已经失去了指导价值。把评测拆成子问题再派智能体分别论证,得到的证据树让分数变得可审计——这是从「相信基准」到「检查基准」的转变。物理类平局率从 0.522 降到 0.018 是全文最有说服力的数字:它说明旧协议在过半的物理保真对比中根本没有分辨力,而这类失效在只看准确率时是看不出来的。ρ=0.93/0.87 的人类对齐度也相当高。作者阵容横跨 MirroS、清华、北大、NVIDIA、UC Berkeley 等十余家机构,Ziwei Liu 与 Ming-Yu Liu 在列,说明这是一次有组织的社区级基建投入而非单点工作。但要审视几点。第一,评测器本身是由 LLM/VLM 智能体构成的,那么它的判断能力上限就是这些基座模型的上限——当被测世界模型的能力超过评委模型的理解能力时,这套评测会失效,而这个交叉点何时到来没有讨论。第二,智能体化评测的成本远高于计算指标:330 个案例、每个案例派生多个子智能体,单次完整评测的 token 消耗与耗时未披露,这直接决定它能否作为常规回归测试使用。第三,「与人类偏好对齐」的人类标注规模、标注者背景与一致性未在摘要中交代,而 ρ=0.93 这类数字对标注质量极度敏感。第四,技能路由决定启用哪些评测维度,路由本身出错(该查物理却没查)会导致系统性漏判,而这类错误在证据树里恰恰是看不见的——树只记录做过的检查,不记录漏掉的。第五,作为活体基准接受社区贡献,长期的版本一致性与跨时间可比性如何保证,是这类开放基准共同的治理难题。 趋势观察 扩散模型的「训练配方学」正式补齐最后一块拼图 — 语言模型有 Chinchilla,视觉生成一直没有可对照的缩放定律。今天 Luma AI 的 Abra 把 10^19 到 10^22 FLOPs 三个数量级扫了一遍,给出「每参数 200 个图像 token」这个明确数字,是 LLM 的十倍;阿里的 CapData 则从数据侧回答同一个问题——不是单纯堆量,而是按能力依赖顺序编排课程。一个说算力该怎么分,一个说数据该怎么组织,共同标志着视觉生成开始有了可预测的工程学,而不再只是炼丹。 编辑任务集体转向「别从噪声重生成」 — EditBridge 把超高分辨率编辑重新形式化为 LR→HR 的数据到数据桥接而非从噪声重生,GRNEdit 把编辑语义拆成对每个 bit 的保留还是翻转决策,两者都在做同一件事:让模型只改该改的,其余部分从源头直接继承。这与传统「条件生成」范式的区别是根本性的——前者的默认动作是保持,后者的默认动作是重画,而编辑任务真正需要的恰恰是前者。 评测正在从「打一个分」变成「定位是哪一步错了」 — TRACE-Bench 把多参考图生成拆成 Anchor/Disentangle/Apply/Compose 四个算子,用公式结构定位失败发生在哪个算子上,发现瓶颈其实在解耦与属性绑定而非场景合成;HarnessEval-W 更进一步,让子智能体各自论证再汇总,把评测变成可查验的证据树。当模型能力普遍变强、总分趋同后,可诊断性比可比较性更值钱。 人工智能炼丹君 整理 | 2026-08-20 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-19|阿里像素空间T2I反超潜空间Z-Image-Pixel 今日 AIGC 论文速览 今日共 10 篇 · 图片生成与编辑 4 篇 · 视频生成与加速 3 篇 · 音视频生成 2 篇 · 统一修复与智能体路由 2 篇 重点论文标题列表 Z-Image-Pixel(阿里 Token Hub·港科大·南京大学·UC San Diego):像素空间T2I首个能打的配方 SQuad(Qualcomm AI Research):注意力FLOPs降67倍且VBench不掉 Qwen-Video-Edit(Reve·UT Austin):帧排成一张大图就能改视频 PixRestore(港理工 视觉计算实验室·OPPO 研究院):50M参数无VAE一步修复 EqF(UC San Diego·Harvard):去掉噪声条件换来闭环采样 今日论文速览 1. Z-Image-Pixel:像素空间T2I首个能打的配方 An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models | 阿里 Token Hub·港科大·南京大学·UC San Diego | arXiv:2608.16887 前序问题:文生图这几年几乎被潜空间扩散垄断,原因很实在:VAE 先把 1024×1024 压成几十倍小的潜表示,注意力算力才降到可承受的范围。但这笔交易的代价一直存在——VAE 是有损压缩,高频细节、小面积结构、文字边缘都会在编解码往返中被磨掉,而且 VAE 本身还得单独训练、单独维护,成了管线里一个没人愿意碰的黑盒。像素空间扩散能绕开这一切,直接在原始像素上做去噪,此前也不断有人尝试,但研究几乎全停留在小规模或类别条件的玩具设定里。真正的问题从来不是「像素空间能不能生成图」,而是「在大规模文生图这个真实战场上,像素空间到底怎么训才能追上潜空间」——这个配方一直是空白。 本文贡献:这篇给出了那份缺失的配方。作者先做了一个关键的负面观察并把它坐实:直接在像素空间做大规模预训练,收敛速度显著慢于潜空间——这不是调参不到位,而是像素空间预训练的固有劣势。既然如此,就不要硬碰硬。他们提出 latent-to-pixel 策略:先在潜空间高效地把生成先验学到手,再在后训练阶段迁移到像素空间。真正的贡献密度在于对这次「迁移」做了系统性的设计空间扫描,逐项确定了五个关键选择——权重初始化怎么做、数据配比怎么调、预测目标选什么、解码器架构如何设计、噪声调度如何安排。最终固化出一套可复现的实践配方,并放出 Z-Image-Pixel 模型。这是一篇典型的「把方向从可行推到可用」的工程实证工作。 Qualitative samples over training iterations. The latent space model consistently demonstrates faster image structure learning and superior final image quality in pre-training progress. 实验效果:按该配方训出的像素空间模型,在质量上匹配或超过对应的潜空间同行,同时端到端推理速度提升 3.18 至 4.75 倍——去掉 VAE 编解码环节的收益在这里被兑现成了实打实的吞吐。收敛性对比图显示,纯像素空间预训练在 GenEval 上到 150K 步仍停在 0.54 附近,而潜空间 50K 步就已达到 0.73 并趋于饱和,两条曲线的差距直观解释了为什么必须先借潜空间起步。 Evaluation curves over training steps. The model trained in the latent space consistently achieve superior results (measured by GenEval~geneval and DPG~dpg) and faster convergence compared to those trained in the pixel space. 批判点评:这类经验性研究的价值往往被低估。它没有提出新架构、新损失,但把一个「大家都觉得应该可行、却没人跑通」的方向变成了可落地的配方,而且诚实地把负面结果——像素空间直接预训练更慢——放在了论证链条的开头,这比藏起来只报好消息的做法可信得多。3.18 到 4.75 倍这个加速区间也给得克制,说明作者知道加速比依赖分辨率和采样步数配置。不过要清醒看待几点。第一,latent-to-pixel 意味着它并没有真正摆脱 VAE,只是把 VAE 从推理期挪到了训练期——你仍然需要一个训好的潜空间模型作为起点,声称的「无 VAE」只在部署侧成立,训练侧的依赖链其实变长了。第二,「匹配或超过潜空间同行」这个表述里的「匹配」占多大比重、在哪些指标上真正超过,摘要没有拆开,而 GenEval/DPG 这类指标对细节保真其实不敏感——恰恰是像素空间最该发力的地方缺少针对性证据。第三,五个设计维度的扫描是在什么规模下做的没有说明,小规模上得出的最优选择在更大模型上是否还成立,是这类经验配方的通病。第四,作者团队来自阿里 Token Hub,模型命名 Z-Image-Pixel 暗示其属于 Z-Image 系列,是否会开放权重和完整训练细节,决定了这份配方的实际社区价值——配方类论文如果不放代码,复现门槛会高得离谱。 2. SQuad:注意力FLOPs降67倍且VBench不掉 SQuad: Sub-Quadratic Attention Distillation for Efficient Video Generation | Qualcomm AI Research | arXiv:2608.16585 前序问题:视频 DiT 的算力几乎全被自注意力吃掉,而它的成本随 latent token 数 n 呈 O(n²) 增长。视频的 token 数天生就大——Wan 2.2 5B 在 81 帧 704×1280 下 n 就到 18480——于是这一项直接主导了运行时与显存,成为分辨率和时长的硬天花板。学界的常规解法是把满 softmax 的 QK^T 换成更便宜的核:线性注意力 O(n) 或低秩近似 O(nk)。这些替身确实便宜,但几乎从没真正恢复原始注意力的表达力,留下一道顽固的质量鸿沟。问题的本质是效率与表达力之间的取舍被推到了极端——要么二次成本,要么掉点。 本文贡献:SQuad 选了取舍曲线上一个被忽略的中间点:O(n√n)。做法是把注意力拆成两段——先在局部窗口内做精细注意力,再以窗口为单位做全局注意力,两段复合出 n√n 的复杂度,天然平衡效率与表达力。更务实的是训练路径:从零训一个自己的视频 DiT 成本高到不现实,所以他们直接把预训练的满 softmax DiT 蒸馏成 SQuad-Attention 版本,分两阶段进行——先做 Flow-Matching 有监督微调对齐行为,再用改进的分布匹配蒸馏 DMD2,后者额外让采样本身也变少步。也就是说这套方法同时压了单步成本和总步数两个乘数。 % attention. Left: full softmax Self-Attention at $\mathcal{O}(n^2)$ complexity. Right: factorizes it into a local pass within $\mathcal{O}(\sqrt{n})$ windows followed by a global pass across the windows, giving a full receptive field at $\mathcal{O}(n\sqrt{n})$ complexity with a true softmax throughout.% 实验效果:在 Wan 2.2 5B 文生视频上,SQuad 的 VBench 达到 83.20,二次复杂度教师为 83.08——质量基本持平甚至略优。同时每步每块的注意力 FLOPs 降低约 67 倍,注意力延迟同步大幅下降。FLOPs 缩放曲线在三个模型规模上都做了验证:Wan 2.2 5B(n=18480)从 4.2 降到 0.063 TFLOPs/block 即 67 倍,Wan 2.1 1.3B(n=32760)为 90 倍,Wan 2.1 14B 为 88 倍,且实测点与理论 O(n√n) 曲线吻合良好——说明这个复杂度改善不是纸面推导,且在 1.3B 到 14B 的规模区间内稳定成立。 Wan 2.2 5B 批判点评:这是今天这批里工程收益最锋利的一篇。67 倍注意力 FLOPs 削减配合 VBench 不掉分,而且理论复杂度和实测曲线对得上,说服力比单纯报几个基准数字强得多。局部加全局的两段结构也不新奇——Swin 那一脉早有类似思路——但把它作为蒸馏目标而不是从头训练的架构,这个选择很关键:它让方法能直接嫁接到已有的强基座上,这才是工业界真正用得上的形态。不过 67 倍需要精确解读:这是「每步每块注意力」这一层的削减,不等于端到端加速 67 倍。DiT 里还有 FFN、cross-attention、归一化和 VAE 解码,注意力占比再高也不是 100%,Amdahl 定律在这里毫不留情——摘要给的注意力延迟改善才是更接近真相的数字,而端到端墙钟时间完全没披露,这是最该补的一格。其次值得肯定的是 FLOPs 缩放在 1.3B/5B/14B 三个规模上都验证了(分别为 90×/67×/88×),削减倍率没有随规模崩塌,这比只测单一规模有说服力;但质量侧的 VBench 只在 5B 上报了一个数,14B 上蒸馏后是否同样不掉分并没有交代——FLOPs 省得下来不等于质量守得住,这两件事需要分别举证。第三,VBench 对长程时序一致性和复杂运动的分辨力有限,而局部窗口注意力最可能损伤的恰恰是跨远帧的关联,只报 VBench 总分难以排除这类退化。最后 DMD2 蒸馏本身会带来多样性收缩的已知副作用,论文把它与注意力替换打包在一起评估,两者各自的贡献和代价被混在了一个数字里。 3. Qwen-Video-Edit:帧排成一张大图就能改视频 Qwen-Video-Edit: Instruction-Based Video Editing by Repurposing an Image Editing Model | Reve·UT Austin | arXiv:2608.14790 前序问题:指令式视频编辑的主流做法是拿视频预训练的生成基座开刀:找一个视频 DiT,让它同时条件于源视频和编辑指令,然后花很大代价适配。这条路的成本结构很不友好——视频基座本身训练昂贵,适配又要构造视频编辑三元组数据,而高质量视频编辑数据的稀缺程度远超图像。于是整个方向被卡在「数据不够、算力不够」的双重瓶颈里,而同期图像编辑模型早已相当强大。一个自然但少有人认真验证的问题是:能不能不要视频基座,直接让图像编辑模型去改视频? 本文贡献:作者证明这条捷径真的走得通,而且用一串「零训练观察」把设计逻辑铺得很干净。核心操作是把 Wan 2.1 视频 VAE 的 latent 帧当成一张大虚拟图像的若干 tile 平铺,然后对每个 tile 复用图像编辑器原有的位置编码——也就是说,从模型视角看这压根不是视频,就是一张它早就熟悉的拼贴图。两个 latent 空间之间用一对轻量输入输出投影桥接,且这对投影从编辑器自己的 patchify/unpatchify 层热启动,使得初始化时一段静态视频被嵌入的方式与一张图像完全一致。整体在公开的 Ditto-1M 编辑三元组上微调,再可选地用 Wan 2.2 跑几步去噪作为时序增强器。支撑这套设计的观察链很有说服力:原装图像编辑器已经能编辑以联络表形式呈现的视频;它不在乎 token 来自一次联合编码还是逐帧编码后在 latent 空间缝合;它甚至能零样本编辑真实视频 latent 到明显可辨识的程度——微调要补的只剩保真度那一段。 Overview. Video latent frames are embedded as tiles of a virtual image grid and edited by the image editing transformer; only the two projections (warm-started from the editor's own patchify/unpatchify layers) and the transformer weights (LoRA or full) are trained. 实验效果:从 Qwen-Image-Edit 出发,无需任何视频生成预训练即可完成指令式视频编辑。流程图显示除 In-Proj 与 Out-Proj 两个轻量投影和 DiT 本体外,Wan 2.1 VAE 编解码与 Wan 2.2 增强器全程冻结,可训练部分被压到极小。定性结果覆盖全局风格迁移与局部主体替换等任务,人物换成机器人这类大幅编辑仍保持了动作与场景的连贯。 批判点评:这篇最漂亮的地方不是结果而是论证方式:那条零训练观察链把「为什么这样可行」讲成了一个可验证的递进过程,而不是先做完再编故事。把视频摊成联络表这个操作听起来近乎取巧,但作者恰恰用它揭示了一个有意思的事实——强图像编辑模型内部已经隐含了相当程度的跨帧一致性能力,只是从没被这样调用过。投影层从 patchify 热启动的设计也很讲究,保证了初始化即合理。但取巧的代价必须点明。第一,把帧铺成 tile 意味着帧间关系只能靠二维位置编码隐式表达,模型没有任何显式的时间轴概念,短片段可能侥幸过关,帧数一多、运动一快,这种隐式关联大概率崩塌——而 tile 数量还直接受图像编辑器分辨率上限约束,这是个硬天花板,摘要没说能处理多少帧。第二,需要 Wan 2.2 做「可选时序增强」这件事本身就是自证:如果时序一致性真的够好,为什么还要额外几步去噪来补?这个「可选」组件在多少比例的案例里其实是必需的,是关键信息。第三,训练数据是公开的 Ditto-1M,编辑类型分布决定了能力边界,超出分布的指令表现如何未知。第四,全文只报了定性结果和「结果表明」,没有与专门视频编辑模型的定量对比——考虑到这是一份 report 而非完整论文,可以理解,但也意味着现在还无法判断它离 SOTA 有多远。 4. PixRestore:50M参数无VAE一步修复 PixRestore: Unified Image Restoration via Pixel Diffusion Transformer | 港理工 视觉计算实验室·OPPO 研究院 | arXiv:2608.16793 前序问题:统一图像修复想用一个模型处理各种退化——模糊、噪声、低分辨率、压缩失真等——从低质图恢复高质内容。近来主流做法是挪用大型预训练文生图潜扩散模型,借它的容量和生成先验。但这条路有两处结构性别扭。一是潜扩散里的 VAE 会丢掉对修复最敏感的细节——修复任务的评判标准恰恰是细节保真,而 VAE 的有损压缩正好打在痛点上。二是文生图先验是开放式合成的,它倾向于「编」出看起来合理但与原图内容不符的东西,在修复语境下这就是伪影。换句话说,借来的能力和任务的要求存在方向性冲突。 本文贡献:PixRestore 索性不借了:一个无 VAE 的像素空间 DiT,扩散骨干完全从零训练,不依赖任何文生图预训练。它直接在 patch 化的像素上做 flow matching,既保住细粒度细节,又把 token 序列长度控制在可处理范围。为适配不同退化类型,模型学会用低质与高质图的 DINO 特征相似度来预测各层特征的可靠性:可靠层的特征被融合为稠密条件注入,不可靠层则接受更强的高质特征监督以促使其学会去除退化——这是个挺聪明的自适应机制,让同一套参数能对不同退化做出不同的内部路由。训练用大规模多场景多退化语料,最后再用基于 DINO 的对抗目标把它微调成一步生成器。 Overview of PixRestore. A frozen vision encoder extracts multi-layer features from the LQ image, and an adaptive layer router predicts per-layer weights to fuse them into a single conditioning feature. The LQ image and the noisy state $x_t$ are patchified, then processed by $N$ DiT blocks, and finally decoded into the HQ output. 实验效果:仅约 50M 参数,在公开基准与真实世界测试集上取得有竞争力的结果,且推理为一步生成,效率优势明显。框架图显示 LQ 图像经 Vision Encoder 提取多层特征后由 Adaptive Layer Router 产生逐层权重,门控加权求和为 Fused Feature,再通过 Pixel DiT 的 cross-attention 注入——整条路径无 VAE 参与。 PixRestore achieves the best overall performance in terms of restoration quality, model size, and inference speed. Top-left: radar charts comparing PSNR, LPIPS, and degradation removal performance across eight degradation types. Top-right: GFLOPs versus inference latency, where the bubble size denotes the number of parameters. Bottom: visual comparisons on eight restoration tasks. With only about 50M parameters and single-step inference, PixRestore achieves the best overall restoration quality while being the most efficient among diffusion-based methods. 批判点评:50M 参数加一步推理这个组合在修复领域相当有竞争力,尤其对照那些动辄搬 SD 全量权重的方案,参数量差了两个数量级。用 DINO 特征相似度来判定层可靠性是这篇最有想法的设计:它把「哪些层可信」从人工先验变成了数据驱动的预测,而且 DINO 特征对退化的敏感度确实适合做这个裁判。从零训练而非微调 T2I 的选择也自洽——既然认定 T2I 先验方向不对,就不该半信半疑地用。但几处需要留意。第一,从零训练意味着放弃了大模型先验带来的语义理解能力,在极端退化、需要「猜」出内容的场景下,50M 从零模型很可能力不从心——摘要只说「有竞争力」而非超越,这个措辞值得注意。第二,一步生成器是用对抗目标蒸出来的,GAN 训练的稳定性和模式覆盖问题不会因为换成 DINO 判别器就消失,对分布外退化的鲁棒性存疑。第三,「大规模多场景多退化语料」是自建的,覆盖哪些退化、按什么比例混合,直接决定了泛化边界,而这恰恰是统一修复模型最容易过拟合评测集的地方。第四,团队来自港理工与 OPPO,考虑到 50M 和一步推理的组合,这个模型的真实目标场景大概是手机端 ISP 后处理,那么就该给出移动端实测延迟——公开基准上的 GFLOPs 说明不了端侧的真实表现。 5. EqF:去掉噪声条件换来闭环采样 Equilibrium Forcing: Adaptive Video Generation Without Noise Conditioning | UC San Diego·Harvard | arXiv:2608.14706 前序问题:基于扩散和 flow matching 的自回归视频生成,有两个被当作理所当然的设定:训练目标是刚性的,采样调度是静态的。模型在训练时被告知当前噪声水平是多少,推理时则按一张预先排好的时间表逐步去噪。这套组合的后果是推理过程完全无法根据数据本身做调整——不管当前这一帧生成得好还是烂,采样器都按同一张表往下走。对自回归视频生成来说这尤其致命,因为误差会沿时间轴累积,而一个不会看反馈的采样器没有任何自我纠正的机会。 本文贡献:EqF 的切入点相当反直觉:把噪声水平条件整个去掉。作者提出一个简化框架,让视频去噪生成模型不再接收噪声水平作为输入,从而把「学习去噪场」和「如何采样」这两件事彻底解耦。这个解耦是关键——一旦模型不再绑定于特定噪声水平,推理时就可以自由设计算法,包括闭环运行:根据当前样本反馈动态调整后续采样行为,而不是照表执行。作者还给出了较为深入的分析,解释移除噪声条件为何能让模型获得数据相关的推理性质,并进而超过标准的噪声条件方法。图 1 把这件事讲得很清楚:训练得到的均衡传输去噪场乘上一个推理期的 attractor warp η,共同诱导出最终的采样地形——去噪场与采样调度在数学形式上被分成了两个可独立操作的因子。 Equilibrium Forcing Overview. is trained with a simple unmodulated equilibrium denoising objective (left), which can be shaped at inference time through the $\eta$ warp (middle). The sampling landscape here is shaped to be an attractor, with the magnitude decreasing as the sample descends and converges (right). 实验效果:在有挑战性的自回归视频生成基准上提升了视频质量与一致性。固定算力缩放实验显示,EqF 配合 NAG 采样在 100 步时 FVD 已降至约 74,250 步时进一步降到 60 以下,而标准 flow matching 从 50 步到 250 步始终在 102 至 122 区间徘徊几乎不随算力改善——说明闭环采样确实把额外算力换成了质量,而静态调度做不到这一点。 批判点评:这篇的价值在于挑战了一个几乎没人质疑过的默认设定。噪声水平条件从 DDPM 起就是标配,大家默认它是必需的,EqF 反过来论证它其实是一种约束——因为它把去噪场和采样调度绑死了,而解绑后能换来推理期自适应。图 1 那个「去噪场 × attractor warp = 采样地形」的分解也把抽象主张落成了可理解的几何图像。固定算力缩放曲线是全文最有力的证据:FM 的曲线几乎水平,意味着多给算力也白给,而 EqF 能持续下降,这个对比比任何单点 FVD 数字都更能说明问题。但要保持警惕。第一,摘要通篇没有具体的基线名称、数据集名称和绝对指标,只说「有挑战性的基准」和「超过标准方法」,这种表述在视频生成领域的可比性极低——FVD 对分辨率、帧数、特征提取器都极度敏感,脱离配置的数字无法横向对照。第二,最好的曲线来自 EqF+NAG 组合,而 NAG 是额外的采样技巧,那么增益中有多少来自「去掉噪声条件」这个核心主张、多少来自 NAG,图里 EqM 系列的存在暗示做了消融,但摘要没给结论。第三,闭环采样意味着推理时要评估反馈信号,这必然带来额外计算,而「固定算力」的口径是按采样步数还是按实际 FLOPs 对齐,直接影响结论成立与否。第四,去掉噪声条件对训练稳定性和收敛速度的影响未提,这类架构级简化往往在别处付出代价。第五,方法在视频上验证,是否迁移到图像生成没说——如果这个洞察真的普适,图像上应该更容易验证,没做反而值得琢磨。 6. ConceptEdit:1200万编辑对与稠密监督 Unlocking the Potential of Image Editing via Concept Scaling and Dense Supervision | 上海交通大学·蚂蚁集团 | arXiv:2608.16812 前序问题:现有图像编辑框架基本沿用文生图扩散模型的训练范式,但把这套范式挪到编辑任务上会暴露两处内在错配。第一是对编辑概念的粒度关注不足——文生图关心的是「画出什么」,编辑关心的是「精确改动什么而不动其余」,后者需要远为细致的概念划分,而现有数据集的标签粒度远远不够。第二是监督信号过于稀疏导致训练低效:一对图像通常只承载一个编辑操作,模型每看一对样本只学到一件事,样本效率极低。这两个问题叠加,使得编辑模型的能力增长严重受制于数据的组织方式而非模型容量。 本文贡献:两条线同时发力。数据侧建立了一套超过 1000 个细粒度编辑概念的分层分类体系,并基于改进的合成框架构建 ConceptEdit-12M,一千二百万高质量编辑对。这里的关键设计是「库驱动」——先有概念库再据此合成,从而有效纠正了生成数据常见的分布坍缩问题,同时保住数据保真度;这是合成数据工作最容易翻车的地方,作者显然意识到了。训练侧提出稠密监督策略:把多个互不干扰的编辑概念合成到单对图像里,让一次前向承载多个学习信号,从而同时提升训练效率与最终性能。此外还发布 ConceptEdit-Bench,一个细粒度评测套件,用于诊断模型在大量真实场景下的能力分布。四阶段流程图显示,概念库构建后由 VLM 生成指令与 VQA 检查清单,经 Flux.2 / Qwen-Image-Edit / Nano Banana2 等多模型执行编辑,最后由 VLM 结合思维链做通过、重写或拒绝的三态判决。 Overview of the improved synthesis framework. Stage 1: Library Construction leveraging LLM world knowledge. Stage 2: Semantic Matching and Instruction Generation including VQA checklists. Stage 3: Image Synthesis using various editing models. Stage 4: Instance Specific Verification using VQA. 实验效果:训练结果显著超越先前工作,验证了稠密监督策略的有效性。配套的 ConceptEdit-Bench 支持按概念维度做细粒度诊断,而非只给一个整体分数。 (a) Edit Concept Scaling. Left: The previous paradigm is restricted by coarse categories and limited diversity. Right: Our approach scales up to 1,000+ fine-grained concepts to ensure a balanced and rich distribution. (b) Dense Supervision. Left: Conventional training relies on single edit pairs with sparse supervision signals. Right: Our composite edit strategy provides dense supervision, enhancing training efficiency. 批判点评:这是一篇典型的「数据即方法」论文,而且把数据工程做得比多数同类扎实。1000+ 概念的分层体系加 1200 万编辑对,规模上足以改变下游模型的能力上限;四阶段管线里那个 VQA 检查清单 + 思维链判决的设计尤其值得学——它把「这次编辑成功了吗」拆成若干可验证的具体问题(文字是否清晰、眼睑是否变形、脸型是否保持),而不是笼统打分,这才是合成数据质量能立住的原因。稠密监督的思路也很直接有效:既然一对图只学一件事太浪费,那就塞进多个互不干扰的概念,本质是在提升每单位算力的信息密度。但要打几个问号。第一,全部数据由 Flux.2、Qwen-Image-Edit、Nano Banana2 等现成模型生成,这意味着 ConceptEdit-12M 的能力天花板被这些教师模型锁定——学生能学到的编辑质量原则上不会超过教师,「显著超越先前工作」更可能是超越了那些数据更少的工作,而非超越数据生产者本身。第二,「互不干扰」的判定标准是什么没有说明,编辑概念之间的干扰往往是隐性的(改表情可能牵动脸型),判定不严会引入标签噪声,而这种噪声在稠密监督下会被放大。第三,评测基准由数据生产方自己发布,与训练数据共享概念体系和合成管线,同分布优势难以排除——ConceptEdit-Bench 上的领先有多少能迁移到真实用户指令上是个悬念。第四,摘要只说「显著超越」,没有任何具体数字或基线名称,这在一篇以规模为核心卖点的论文里偏弱。第五,12M 数据的合成算力成本未披露,而这直接决定了这条路径是否可被社区复现。 7. SyncSparse:稀疏化不能牺牲音画同步 Efficient Audio-Visual Generation via Synchrony-Aware Cross-Modal Sparse Attention | 上海交通大学·阿里 Token Hub·阿里云 | arXiv:2608.15522 前序问题:音视频联合生成模型能在统一扩散过程里同时合成同步的画面与声音,但推理开销一直很高——长视频 token 序列要在每个去噪步反复算注意力。视频生成领域已经积累了不少加速手段:低比特量化、注意力稀疏化、特征缓存。麻烦在于这些方法都是为纯视频模型设计的,直接搬到音视频模型上会忽略音频与视频两个分支之间的交互,进而破坏音画同步——而同步性恰恰是音视频生成的核心价值,画面再清晰、声音再干净,只要唇形和语音对不上,整个结果就废了。这是一个典型的「加速方法对模态盲视」的问题。 本文贡献:作者的关键观察是:双向音视频交叉注意力揭示了两个分支之间的结构化交互模式,高响应往往集中在少数与声音相关的视觉与时间位置上。也就是说,同步性并非均匀分布在所有 token 上,而是由一小撮关键 token 承载。据此提出受保护的稀疏注意力策略——对同步关键的 token 保留高保真的完整计算,只对冗余的注意力部分做稀疏化。整套框架是同步感知的:通过在加速过程中显式考虑跨模态依赖,在提效的同时守住音画对齐。框架图显示五步流水线:双流输入、交叉注意力显著性计算、Top-k 音频 query 保护性选择、受保护稀疏注意力、以及同步感知指示器,后者用 Δ_sync = max(Δ_v, Δ_a, λ_pΔ_p, λ_sΔ_s) 决定当前时间步是复用缓存还是重新计算。 Overview of the proposed synchronization-aware acceleration framework. Cross-modal interactions between audio and video branches are used to guide protected sparse attention and cache reuse. 实验效果:在提升推理效率的同时保持了视频质量、音频质量与音画同步三项指标。缓存策略图显示去噪时间步被自适应地划分为 Cached、Reused (Skip) 与 Recompute (Update) 三类,仅在同步信号变化剧烈时才触发重算。 Qualitative comparison of dense inference, unprotected acceleration, and our protected acceleration. The protected computation path better preserves salient visual structures and reduces local artifacts under acceleration. 批判点评:这篇的问题意识比方法本身更值得称道:它指出了一个正在发生但少有人明说的隐患——加速方法的迁移往往是模态盲视的,在纯视频上验证过的稀疏化和缓存策略被直接用到音视频模型上,而评测指标里如果没有同步性这一项,退化会完全隐形。「同步性集中在少数 token 上」这个观察也很自然地导出了保护式稀疏化,逻辑闭环。Δ_sync 取四路信号最大值的设计偏保守但合理——宁可多算几步也不冒同步崩掉的风险。不过整份摘要在效果层面几乎是零信息量:只说「提升效率」「保持质量」,没有任何加速倍率、没有基线名称、没有具体指标数值,这在一篇以效率为核心卖点的论文里是硬伤——读者无法判断它是快了 1.5 倍还是 5 倍,而这个区间决定了方法有没有实用价值。其次,Top-k 保护的 k 如何选择、保护比例与加速比之间的权衡曲线长什么样,是这类方法最核心的超参问题,摘要完全没碰。第三,方法建立在「能拿到双向交叉注意力图」的前提上,这对某些架构(如把音频当额外 token 拼进同一序列做自注意力的设计)并不成立,适用范围有限制。第四,摘要文本里出现了多处 this http URL 的替换残留,说明投稿时的自动化处理出了问题,虽然不影响技术内容,但反映出打磨程度。第五,与 SQuad 那种把加速做成蒸馏目标的思路相比,这里仍是训练无关的推理期启发式,上限受限于原模型。 8. GenRouter:按需路由省95%执行成本 GenRouter: Unified Workflow Routing for Agentic Image Generation | 港科大(广州)·港中文·Google DeepMind | arXiv:2608.16721 前序问题:文生图模型已经基本解决了原始像素合成这个基础难题,社区注意力转向如何满足越来越复杂的用户请求。为此出现了各种智能体式图像生成工作流,给静态推理加上外部知识检索、迭代推理等高级能力。但这些工作流大多各自为政,采用固定的一刀切拓扑——不管请求是「画一只猫」还是「按照这三张参考图合成一个符合物理规律的复杂场景」,都走同一条重型管线。结果是严重的算力错配:简单查询被强行推过昂贵的流水线,成本和延迟全花在不需要的环节上。 本文贡献:GenRouter 是第一个统一的智能体图像生成工作流路由框架。第一步是 GenCanvas,把各种异构的智能体管线标准化为一组通用基础原语和可执行模板——rewrite、decompose、search、reason、skill、verify、refine、sketch 等,这一步的意义在于把「不同工作流」变成「同一空间里的不同组合」,否则路由无从谈起。在这个统一空间上,GenRouter 通过三个机制把异构 prompt 自适应地路由到最优工作流:需求画像分析请求特征,经验匹配复用历史轨迹,帕累托过滤在质量、成本、延迟等多目标间取舍。系统还能通过累积经验持续自我演化。框架图显示 prompt 先被编码为雷达图形式的 Task Signature,经 Trajectory Memory 与 Route Memory 双记忆匹配后,在帕累托平面上按质量-成本-延迟三轴筛出最终路由。 Overview of our proposed (Left) and (Right) . 实验效果:在多个基准上取得更优的视觉对齐,同时相比重型静态管线降低执行成本超过 95%、延迟降低 65%。系统还能通过累积经验实现零样本泛化能力的持续提升。 Qualitative comparison. Left side shows cost (scaled by $0.01$); right side shows latency. 批判点评:这篇抓住的痛点很真实:智能体式生成的成本失控问题在实际部署里比论文里严重得多,而「所有请求走同一条重型管线」几乎是当前所有 agentic 图像生成工作的默认形态。GenCanvas 那层标准化抽象是全文最有价值的部分——把异构管线归约到统一原语空间,路由才有了数学基础,这个工程判断是对的。帕累托过滤而非单目标优化也符合真实场景,因为质量、成本、延迟的权衡本来就该交给使用方而不是硬编码。95% 成本削减听起来夸张,但如果基线真是无差别走重型管线,这个数字反而说明了原方案有多浪费——它衡量的是「浪费被消除了多少」而非「效率被提升了多少」。也正因如此,这个数字高度依赖测试集里简单请求的占比:如果基准里大部分是简单 prompt,95% 几乎是自动达成的,而真实流量分布未必如此,论文应当给出按请求复杂度分层的成本曲线。第二,路由器本身也要跑推理——需求画像、经验匹配、帕累托过滤都不免费,这部分开销是否计入了「执行成本」的统计口径,直接影响结论的诚实度。第三,「自我演化」依赖经验累积,冷启动阶段的表现和收敛所需的请求量没有交代,而这决定了它在新部署环境里多久才能变得有用。第四,路由错误的代价不对称——把复杂请求误路由到轻量工作流会直接产出劣质结果,摘要说「更优的视觉对齐」,但没给误路由率,这才是用户实际会感知到的风险。 9. StructFlow:让噪声也带上空间结构 Spatially-Grounded Flow Matching: Structured Source Distributions for Image Generation | 马里兰大学·Netflix | arXiv:2608.15452 前序问题:当前 flow matching 模型学的是把源分布——独立同分布的高斯噪声——传输到自然图像的目标分布。但这个源分布完全不含任何空间结构的概念,而图像本质上是局部相关的:邻近像素强相关。作者的假设很有意思:正因为噪声是独立采样的,模型在训练时被隐式地鼓励去利用「噪声较小的邻居」作为上下文,从而部分绕开了真正学习图像局部结构这件事。换句话说,源分布的设计与图像域的归纳偏置是相互对抗的——我们给了模型一个走捷径的机会,它就不会好好学结构。 本文贡献:StructFlow 把空间局部性直接编码进源分布:让一个小区域内的像素共享一个公共噪声成分。这个改动很轻,但改变了传输路径的几何性质——路径变得与图像区域在几何上对齐,从而带来通用 flow matching 难以提供的三个性质:天然尊重边界的细粒度局部编辑、稳健的结构保持、以及图像之间平滑的语义插值。作者还证明这些好处能延伸到大型预训练模型上,通过一个轻量的后训练阶段即可植入,不必从零重训。噪声构造图清楚展示了机制:图像先被划分为超像素,每个超像素分配一个 anchor 分量,区域内部再叠加噪声,最终得到的相关噪声在去噪轨迹上使得结构从早期就开始显现,而标准 flow matching 的不相关噪声则要到很晚才浮现结构。 modelname Noise Construction. introduces locality in the source distribution sampling instead of i.i.d gaussian sampling in normal flow matching. % 实验效果:在多个数据集上、无条件、类别条件与文本条件三种设定下、使用不同架构验证有效。类别条件 ImageNet 256×256 上 FID 从 18.50 改善到 17.24、sFID 从 14.04 改善到 10.03;但无条件 FFHQ 256×256 上 Precision 从 0.250 提升到 0.350、ImgReward 从 0.500 提升到 0.720 的同时,FID 反而从 22.68 退到 25.80、Recall 从 0.200 掉到 0.160。结构保持实验显示,给定同一组超像素划分、更换随机种子时,生成结果的构图与主体轮廓保持一致而颜色、材质、身份等属性自由变化——说明超像素划分确实成了一个可控的结构句柄。 Comparison with baseline. Evaluated across a diverse set of metrics for robust assessment, performs on par with standard flow matching and outperforms it in some cases. 批判点评:这是今天这批里最优雅的一篇:改动只在源分布,不动架构、不动损失、不动采样器,却换来局部编辑、结构保持、语义插值三个下游能力,而且能通过轻量后训练植入已有大模型。那个「独立噪声让模型偷懒依赖低噪邻居」的假设也相当锐利,属于对训练动力学的真实洞察,而不是拍脑袋的启发式。结构保持图的说服力很强——固定超像素、换种子,构图不变而属性变化,这直接证明了源分布的结构确实被继承到了输出。不过要留意几处。第一,超像素划分本身成了新的输入依赖:生成时需要一份划分,无条件生成场景下这份划分从哪来?如果是随机生成的,那它的分布就成了新的隐式先验,可能引入难以察觉的偏置;如果要用户提供,那这就从「更好的生成」变成了「另一种条件生成」,可比性发生了变化。第二,让区域内共享噪声成分本质上降低了源分布的熵,理论上会压缩可生成的多样性——而这个担心在论文自己的数据里就被证实了:无条件 FFHQ 上 Recall 从基线 0.200 掉到 0.160、FID 从 22.68 退到 25.80、FID-DINO 从 232.4 退到 267.3,同时 Precision 从 0.250 冲到 0.350。这是一组非常典型的「保真度换多样性」权衡信号,说明 StructFlow 生成的样本更精致但覆盖面更窄。摘要只说「有效」,把这个方向性代价藏进了图里,读者若不看 baseline_comparison 这张图很容易被误导。类别条件 ImageNet 上表现则相反(FID、sFID、Recall 全面改善),说明这个代价与是否有强条件信号高度相关——条件越弱,熵损失越致命。第三,「轻量后训练即可植入大模型」这个结论只说了成立,没给成本量化和在哪个模型上验证,而这是该方法能否被采纳的关键。第四,超像素的粒度是一个新超参,粒度过粗会锁死构图、过细则退化为独立噪声,最优粒度是否依赖数据集和分辨率未讨论。第五,作者两人分属马里兰大学与 Netflix,工作在 Netflix 实习期间完成,考虑到 Netflix 的业务场景,这套方法在视频生成上的表现是个自然的下一步,但本文未涉及。 10. CineDub:免裁脸免分离的多人配音 CineDub: Scaling End-to-End Video Dubbing to Multi-Speaker Dialogues with Coherent Sound Effects | 中科大·蚂蚁集团·莫纳什大学 | arXiv:2608.15734 前序问题:真实场景下的自动视频配音被两个互相矛盾的约束卡住。层级式方法依赖脆弱的多阶段预处理——人脸裁剪、说话人分离等——这些前置步骤严重限制了数据可扩展性和实际部署:任一环节出错,后面全崩。整体式方法直接在未裁剪视频上操作,避开了预处理,但代价是时序对齐薄弱,而且在多说话人场景下会出现说话人-话语归属的歧义:模型不知道这句话该由画面里哪个人说。于是配音这件事在「脆弱但精确」和「鲁棒但混乱」之间左右为难,而影视配音恰恰是多说话人、多轮对话的典型场景。 本文贡献:CineDub 是一个统一的扩散模型,能直接从未裁剪视频完成精确的多说话人对话配音,既不需要人脸裁剪也不需要说话人日志。核心是隐式耦合整体条件化范式:整体视觉表示与一种语义捆绑的转写格式被独立编码,却通过跨模态训练隐式耦合起来,从而解决说话人歧义并支持精确的多人多轮对话配音。基于整体视觉特征捕获的统一时序线索,作者进一步把 CineDub 扩展到语音与音效的联合生成,为此引入环境音到语言的课程学习以缓解子任务退化,并设计解耦的文本分支控制机制来解决同时生成时的跨提示词干扰。同时发布两个真实场景基准。框架图显示视觉侧分为 Dense Temporal(Synchformer)、Global Semantic(CLIP)与 Transcription(Gemma-T5)三支冻结编码器,转写格式用 / 标记切分不同说话人的语句,音频与转写元 token 分别经交叉注意力注入主干。 Overview of CineDub under the ICHC paradigm. The holistic visual condition $\mathbf{c}_v$ (left), extracted by SynchFormer (Sec.~sec:visual_condition), encodes both event-level audio-visual correspondences and fine-grained lip-sync alignment. To address the speaker assignment ambiguity in $\mathbf{c}_v$, the semantic-bundled transcription $\mathbf{c}_t$ (right) provides per-segment speaker-utterance grounding cues, implicitly coupling with $\mathbf{c}_v$ via multi-conditional training (Sec.~sec:text_condition). CineDub adopts a unified DiT backbone that supports both joint video-to-speech-and-audio generation and each subtask. $\mathbf{c}_t$ and $\mathbf{c}_a$ are routed through decoupled textual branches to prevent cross-prompt interference, with learnable meta-tokens replacing inactive branches during single-task inference (Sec.~sec:decoupled_attn). 实验效果:实现了从未裁剪视频直接进行多说话人多轮对话配音,并扩展到语音与音效的联合生成。同时释出 CineDub-Multi(多说话人对话配音)等两个真实场景基准。论文已被 ACM MM 2026 接收。 Visualization of SynchFormer self-attention maps (magenta: active speaker; white: inactive speaker). (a)~Single-speaker setting: attention concentrates on the lip region. (b)~Two-speaker setting: attention dynamically shifts to the active speaker across turns. (c)~Failure cases: attention drifts to a non-speaking face during overlapping speech or becomes ambiguous at shot boundaries. 批判点评:「不需要人脸裁剪和说话人日志」是这篇最实在的卖点。做过配音管线的人都知道,那些预处理步骤是主要的故障源和数据规模瓶颈,能去掉它们,工程价值立刻显现。用带 / 标记的语义捆绑转写格式来消解说话人归属歧义,是个巧妙的取舍——把「谁在说」这个视觉难题部分转移到了文本侧的结构化表示上,绕开了视觉说话人定位的老大难。三支冻结编码器分工也清晰:Synchformer 管密集时序、CLIP 管全局语义、Gemma-T5 管文本,各司其职且都不训练,成本可控。ACM MM 2026 接收提供了一定的同行评议背书。但几点需要审视。第一,转写格式承担了消歧的主要负担,意味着推理时需要一份带说话人切分标记的高质量转写——这份输入从哪来?如果需要人工标注或依赖 ASR 加日志,那么「不需要说话人日志」只是把它从视觉管线挪到了文本管线,端到端的依赖并没有真正消除,摘要在这一点上表述得偏乐观。第二,同时生成语音与音效带来的「跨提示词干扰」用解耦文本分支来解决,但音效与语音在时间上天然重叠(说话时门在响),这种物理层面的耦合能否靠表示层解耦干净,值得怀疑。第三,两个基准都由作者团队自建,与训练数据的分布关系未说明,同分布优势难以排除。第四,摘要没有任何定量结果——没有同步性指标、没有音质指标、没有与层级式方法的对比数字,一篇声称解决多说话人歧义的论文却不给说话人归属准确率,是明显的缺口。第五,环境音到语言的课程学习是为缓解子任务退化而引入的,说明联合生成确实存在能力互斥,那么相比两个独立模型分别生成再混音,联合方案的净收益有多大并不明确。 趋势观察 像素空间正在夺回 VAE 让出的地盘 — 今天有四篇论文从不同角度指向同一个结论:VAE 潜空间不是免费的午餐。阿里的 Z-Image-Pixel 给出了首个能与潜空间掰手腕的像素空间 T2I 训练配方,港理工的 PixRestore 干脆不要 VAE 从零训像素 DiT,PixelControl 指出潜空间压缩会削弱细结构控制信号。VAE 换来的是算力,代价是细节与保真度——当算力配方被打通后,这笔交易开始被重新审视。 注意力加速从「手工稀疏」走向「蒸馏出来的结构」 — Qualcomm 的 SQuad 不再手写稀疏模式,而是把满 softmax 教师蒸馏成 O(n√n) 的局部+全局两段注意力,在 Wan 2.2 5B 上 VBench 83.20 对 83.08 基本无损而注意力 FLOPs 降 67 倍。上交与阿里的 SyncSparse 则说明:稀疏化不能对模态盲视,音视频模型直接套用视频加速方法会破坏音画同步。 「不训新模型」成为一种正当的方法论 — Qwen-Video-Edit 直接把图像编辑模型当视频编辑器用(帧排成一张大图),KeyID 走训练无关路线,EqF 把噪声条件整个去掉换来推理期自适应,MLLM 语义纠偏在采样循环里插反馈。视频基座训练成本高企之后,研究重心明显从「造模型」转向「榨干已有模型的隐含能力」。 人工智能炼丹君 整理 | 2026-08-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-29|Apple端侧Siri语音16倍实时仅21MB 今日 AIGC 论文速览 今日共 10 篇 · 端侧音频与数字人生成 2 篇 · 视觉生成推理加速 2 篇 · 可控视频编辑与专业评测 3 篇 · 全模态表示与扩散蒸馏 2 篇 · 视频模型视觉推理 1 篇 重点论文标题列表 Apple Audio DiT(Apple):端侧Siri语音16倍实时仅21MB Sol-Attn(NVIDIA):在线稀疏注意力让视频快2.3倍 UniGen-AR(CMU·UIUC·Toyota Research):一个自回归模型做15项视觉任务 AptAvatar(阿里淘天):14B数字人两步720P提速60倍 EgoPlay(Snap·KAUST):看到事件发生后才开始编辑视频 今日论文速览 1. Apple Audio DiT:端侧Siri语音16倍实时仅21MB Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers | Apple | arXiv:2607.23811 关键词:端侧TTS,Siri,音频DiT,RVQ,Apple 前序问题:Siri Expressive Voices要在设备上实时生成可配置、富表现力的语音,但语义音频token转高保真波形的detokenizer受AMX算力和内存严格限制。传统Transformer或GAN随序列长度线性甚至平方增长,难以持续合成长音频。 本文贡献:Apple提出解耦时间与RVQ深度的三组件架构:流式编码器、时间解码器和深度解码器。单个可复用的DiT式深度解码器通过stage conditioning自回归生成全部RVQ层,取代每层一个解码器;因果滑窗注意力配合固定窗口KV缓存,使运行内存不随语音长度增长。 实验效果:部署在Apple Matrix Coprocessor上,每步约10ms、约16倍实时,峰值运行内存仅21MB,端侧资产329MB,可连续合成20到320秒音频。AFM 3 Core Advanced中以10亿参数激活规模运行,相比上一代端侧TTS,整体MOS从3.87升至4.15,对话语音从3.82升至4.24。 批判点评:这是今日最强工业落地:Apple不仅给结构,还给AMX上的时延、内存、资产和MOS,证明十亿级音频生成可真正驻留端侧。代价是方案深度绑定Apple硬件与AFM token体系,16倍实时不能直接外推到通用CPU/GPU;320秒以上稳定性和多语言覆盖也未披露。 2. Sol-Attn:在线稀疏注意力让视频快2.3倍 Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification | NVIDIA | arXiv:2607.24027 关键词:稀疏注意力,视频生成,NVIDIA,免训练,推理加速 前序问题:视频DiT的长token序列让注意力成为推理瓶颈。现有免训练动态稀疏要么固定保留比例、要么按累计概率动态分配,路由预算僵硬或失衡,还要显式生成代理分数图;直接丢掉未选块则在高稀疏率下明显伤质量。 本文贡献:提出免训练Sol-Attn,将动态路由、稀疏计算与近似修正合进同一次online softmax。在线块阈值直接比较代理分数选关键KV块,不物化完整代理图,预算动态且可控;未选块的代理分数被复用来近似其贡献,避免keep-or-drop造成的信息断崖。 实验效果:在保持视觉质量的同时,视频生成端到端提速2.1倍、视频编辑提速2.3倍,并在图像与视频任务上推进免训练稀疏注意力的质量—效率前沿。 批判点评:Sol-Attn的价值不只是稀疏,而是把路由开销和遗漏补偿塞进online softmax一遍完成,NVIDIA背景也意味着内核可落地。但提速依赖模型、序列长度和阈值;代理分数对被丢块的近似在快速运动、小目标或精细文字场景中仍可能失真。 3. UniGen-AR:一个自回归模型做15项视觉任务 UniGen-AR: Unifying Visual Generation with Auto-Regressive Modeling | CMU·UIUC·Toyota Research | arXiv:2607.24157 关键词:统一视觉生成,自回归,VAR,MLLM,VQ-VAE 前序问题:文生图、编辑、修复和传统感知仍由不同模型负责;扩散虽能统一多种图像输出,但迭代采样延迟高,限制统一视觉生成在交互场景落地。 本文贡献:提出UniGen-AR,将通用MLLM与next-scale视觉自回归(VAR)解码器结合。MLLM把自由文本指令和控制信号编码为统一序列,VAR用一套权重和统一提示接口生成图像输出,覆盖四大家族15项以上任务且无需任务专用头。消融指出VQ-VAE码本大小和层级是VAR扩展的关键。 实验效果:相对扩散基线推理延迟最多降低19倍,同时保持或提升输出质量;单模型覆盖文生图、图像编辑、修复、感知等15项以上任务。 批判点评:用VAR替代扩散解码器,把统一视觉生成的效率问题正面解决,19倍延迟优势非常醒目。但自回归速度会受视觉token数量影响,VQ-VAE码本带来的量化误差仍在;15任务统一不等于每项都超过专用SOTA。 4. AptAvatar:14B数字人两步720P提速60倍 AptAvatar: Fast and Vivid Long-Form Audio-Driven Video Generation for Production-Ready Avatars | 阿里淘天 | arXiv:2607.24013 关键词:数字人,音频驱动,两步生成,分布蒸馏,阿里 前序问题:生产级音频驱动数字人既要快,又要保持身份、动作表现力和长视频稳定。现有加速常靠因果注意力、短时间窗、缩小模型或分辨率换速度,在极端两步生成时质量尤其容易塌。 本文贡献:提出14B长视频数字人AptAvatar。端点锚定分布蒸馏在普通DMD外加入Anchor Score Estimator,用冻结四步桥接生成器定义可达到的轨迹端点,指导两步学生;Self-Generated History Replay复用早期checkpoint输出作为分块训练历史,近似推理时自生成上下文而无需昂贵在线rollout。 实验效果:仅2次函数评估即可生成720P长视频数字人,推理提速60倍,同时保持视觉保真、鲜活动作、长时身份一致和文本动作控制。 批判点评:14B、720P、两步和60倍同时成立,说明淘天已瞄准直播与营销生产链。端点锚降低了两步蒸馏难度,但训练依赖四步桥接器和历史checkpoint缓存,流水线并不轻;摘要也未给绝对FPS,生产“实时”仍需硬件数据。 5. EgoPlay:看到事件发生后才开始编辑视频 EgoPlay: Event-Triggered Video Editing for Egocentric Streams | Snap·KAUST | arXiv:2607.24560 关键词:视频编辑,事件触发,第一视角,Snap,流式生成 前序问题:第一视角连续视频需要“当X发生时再做Y”,模型既要识别事件发生与否和时刻,又必须完整保留事件前画面、只改后续。检测器串联编辑器容易误触发并产生误差传递。 本文贡献:提出端到端事件触发V2V编辑器EgoPlay,在一个视频扩散模型中联合学习事件识别、时间克制和像素编辑,支持未发生事件与多事件提示。团队构建10.6万组事件触发片段—提示数据,训练双向编辑器并导出可逐块流式推理的因果版本;评测拆分触发后质量、触发前保持和假触发鲁棒性。 实验效果:相对EgoEdit,编辑质量、视觉质量和背景一致性分别提升17.7%、16.9%、16.4%;相对VLM检测器+编辑器串联基线分别提升15.7%、14.5%、13.5%,GPU内存还不到其一半。 批判点评:EgoPlay把视频编辑从“全片执行指令”升级为事件驱动程序,对AR眼镜和第一视角Agent很关键。风险是模型同时承担检测与生成,触发判断难单独校准;Ego4D里的事件覆盖有限,安全敏感场景不能只依赖生成模型自判。 6. FilmBench:电影学院用专业镜头语言重测视频模型 FilmBench: A Film-Grade Benchmark for Cinematic Video Generation | 阿里·北京电影学院·虎鲸文娱 | arXiv:2607.24241 关键词:视频评测,电影语言,多镜头,阿里,FilmOps 前序问题:多数视频生成基准用网页或LLM提示,并由通用多模态模型打总体画质、文本一致和流畅度,测到的是“像视频”,而非导演真正关心的镜头设计、动态美学和多镜头叙事。 本文贡献:提出电影级T2V/R2V基准FilmBench,与导演、北电教师和制片团队共同设计。1169条提示反推自20类获奖电影片段,其中1056条为多镜头真实shot list;评价体系含3轴、12组件、T2V 35项加R2V 3项子指标,并开放电影语言算子FilmOps和专家级自动评测Agent。 实验效果:评测9个T2V和7个R2V模型,自动评测对人类模型排名的Spearman相关分别达0.95和0.96。现有模型在动态美学上普遍不足,且从单镜头到多镜头性能明显下降,弱模型跌幅更大。 批判点评:FilmBench把视频评测从VBench式通用指标拉到专业电影语言,是生成视频走向影视生产的重要基础设施。但获奖电影反推提示可能偏向成熟电影美学,自动Agent即使排名相关高,也不代表每个镜头级解释都可靠;版权与参考片段可复现性同样重要。 7. OmniVAE:音视频VAE先对齐再联合生成 OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation | 复旦·上海创新院·MOSI·上交 | arXiv:2607.23855 关键词:音视频生成,VAE,跨模态对齐,复旦,全模态 前序问题:联合音视频生成通常分别训练音频VAE和视频VAE,两套潜空间没有细粒度对应,下游生成器不得不从零学习“哪个画面该配哪个声音”,增加同步学习难度。 本文贡献:提出联合训练的OmniVAE。除重建目标外,以片段级音视频对比学习捕获时间—语义对应并对齐潜空间;同时把预训练音频和视频语义编码器特征分别蒸馏进对应潜变量,让两种表示既保留重建能力,又更容易被下游联合生成模型学习。 实验效果:两种对齐目标持续提升潜空间可学习性,使下游文生音视频获得更高生成质量与更准确跨模态同步,验证统一表征应从VAE底座开始。 批判点评:多数工作把同步压力全留给生成DiT,OmniVAE提前在tokenizer阶段对齐,方向很对。但对比目标可能把音画关系压成粗语义相似,口型、碰撞声等毫秒级同步仍需生成器建模;联合VAE也会降低替换单一模态编码器的灵活性。 8. PDM:拆开CFG正负分支修复扩散蒸馏 Rethinking Classifier-Free Guidance in On-Policy Diffusion Distillation | 阿里通义千问 | arXiv:2607.24731 关键词:扩散蒸馏,CFG,在线策略,PDM,视频控制 前序问题:在线策略扩散蒸馏通常直接匹配教师与学生经CFG合成后的速度,但这个总目标无法唯一约束正、负两个分支:两边误差可互相抵消。当教师负分支含学生拿不到的特权信息时,正分支变好反而会伴随负分支恶化。 本文贡献:论文将该失败模式命名为负分支不对称(NBA),并提出分支感知的Positive-Direction Matching(PDM):分别约束正条件预测与CFG条件方向,使监督可识别,不再让合成结果掩盖分支错误。方法用于从稠密到稀疏的视频控制蒸馏。 实验效果:朴素CFG匹配对推理guidance scale高度敏感,PDM在不同引导尺度下实现更稳健、有效的知识迁移,修复教师负分支存在特权条件时的对抗误差动态。 批判点评:它揭示了一个容易被总loss掩盖的蒸馏病灶:CFG结果对了,不代表两个分支学对了。分析价值高于单项榜单。不过当前验证集中在稠密到稀疏视频控制,PDM对文生图少步蒸馏、不同负提示schema的普适性仍需实证。 9. VIPE:先改输入图片再让视频模型推理 Visual Prompt Engineering for Video Models | Google DeepMind | arXiv:2607.25537 关键词:视觉提示工程,视频模型,视觉推理,Google DeepMind,图像编辑 前序问题:视频生成模型正成为视觉推理基础模型,但用户仍主要优化文字提示。对于迷宫、物理轨迹等任务,原始抽象图像可能不符合模型训练分布,仅改文字无法消除视觉输入本身的表达障碍。 本文贡献:提出视觉提示工程VIPE:调用图像编辑模型自动修改任务图像的呈现方式,例如把抽象草图转成写实场景,再交给视频模型推理。它不改目标问题,只优化视觉prompt,使输入更贴近视频模型容易理解和模拟的分布。 实验效果:VIPE在多种任务上提升视频模型视觉推理,效果甚至可超过传统文本提示工程和测试时扩展,且额外计算较低。 批判点评:“不是改问题文字,而是改给模型看的世界”是很有启发的提示工程范式,Google DeepMind视频模型背景也值得关注。但编辑器可能偷偷改变物理条件或答案线索,提升不一定来自更强推理;必须验证语义与几何约束在改图前后严格等价。 10. TriLayer:视频扩散直接生成可编辑RGBA图层 Explicit Layer Modeling for Video Object Insertion and Layer Decomposition | POSTECH | arXiv:2607.25802 关键词:视频编辑,RGBA,图层分解,物体插入,扩散模型 前序问题:多数视频编辑没有显式图层表示,物体插入、复用和后期调整只能隐式推断或逐场景优化。缺少前景RGBA监督,也让阴影、反射等伴随视觉效果难与背景正确合成。 本文贡献:构建TriLayer大规模三元视频数据,逐帧对齐合成画面、背景和含物体外观及视觉效果的前景层。基于此提出双分支DBL-Diffusion,通过共享去噪和跨分支交互联合建模RGB合成与RGBA前景;DBL-Insert生成可后期编辑的插入图层,DBL-Decompose恢复前景与背景。 实验效果:显式图层建模显著提升视频物体插入保真度和图层分解质量,并让生成结果可用于真实合成与灵活后期修改。 批判点评:从最终RGB转向可编辑RGBA资产,是视频生成接入专业后期管线的重要一步。难点在于TriLayer数据如何获得真实透明度和复杂光效监督;半透明、运动模糊、反射及跨层光照很难被单一RGBA层完整表达。 趋势观察 生成模型开始进入端侧十亿参数时代 — Apple在AMX上以21MB峰值内存运行十亿参数激活规模音频生成,达到16倍实时;端侧生成竞争从小模型转向架构与硬件协同。 视觉生成加速分化为稀疏与自回归两条路线 — Sol-Attn用在线稀疏让视频编辑快2.3倍,UniGen-AR以VAR替代扩散让统一视觉任务延迟最多降19倍,计算范式本身成为核心变量。 视频产品同时追求极少步与事件驱动 — AptAvatar把14B数字人压到两步并提速60倍,EgoPlay则只在事件发生后编辑;视频生成正从整段离线采样走向低延迟、条件触发的连续服务。 评测和输出格式开始对接专业生产 — FilmBench用电影学院镜头语言重测模型,TriLayer直接生成RGBA图层;行业关注点从画面像真转向镜头设计、资产复用和后期可编辑性。 统一模型向底层表征与视觉提示延伸 — OmniVAE在VAE阶段对齐音视频,PDM拆解CFG分支监督,VIPE直接优化模型看到的图像;性能提升越来越依赖输入、tokenizer和训练目标的联合设计。 人工智能炼丹君 整理 | 2026-07-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-28|Meta单H200实时视频22.84帧MsForcing 今日 AIGC 论文速览 今日共 10 篇 · 实时与长视频生成 2 篇 · 视频测试时扩展与多人物生成 2 篇 · 理解生成统一表征 1 篇 · 可控视频与图像编辑 3 篇 · 生成部署与音频创作 2 篇 重点论文标题列表 Ms. Forcing(Brown·MIT·Meta):单卡实时视频生成22.84帧 Self Gradient Forcing(京东探索研究院):5秒训练窗口外推数分钟 CachedSearch(Google·UT Austin·CU Boulder):63%成本保留94.7%搜索收益 Twins(ICML 2026·腾讯混元·港中文):理解生成共享视觉Token GroupVideo(中科院自动化所·蚂蚁):多人物定制视频不再串脸 今日论文速览 1. Ms. Forcing:单卡实时视频生成22.84帧 Ms. Forcing: Efficient Streaming Video Generation with Multi-Scale Patchification and Attention | Brown·MIT·Meta | arXiv:2607.20940 关键词:流式视频,实时生成,多尺度Patch,滚动扩散,DMD 前序问题:流式视频扩散虽可支持交互式世界模拟,但传统逐帧生成同时嵌套自回归与多步去噪,难以实时。滚动窗口把不同噪声级的连续帧并行去噪,却仍用同样细的空间粒度处理所有状态,浪费大量计算。 本文贡献:提出 Ms. Forcing:多尺度 Patchification(MSP)按噪声级给高噪状态分配更粗 patch,使活动窗口 token 减少45%;多尺度自注意力(MSSA)按查询尺度匹配可见 KV 密度,继续压低注意力成本。固定窗口位置决定全部尺度,计算图保持静态且硬件友好;同噪声级 DMD(H-DMD)则用来自同一源噪声级的干净预测组装训练视频,缩小训练序列与推理滚动的错位。 实验效果:单张 H200 上达到22.84 FPS,比 Rolling Forcing 快39.6%;同时在短视频和长视频设置中显著提升 VBench。 批判点评:这是今日最硬的工业数字:单 H200 首次把流式扩散推到实时帧率,而且不是单纯牺牲质量换速度。关键洞察是高噪帧无需看清每个像素。但22.84 FPS依赖H200与固定窗口配置,分辨率、模型规模和端到端编码开销需一并看;高噪粗粒度也可能损伤快速出现的小物体。 2. Self Gradient Forcing:5秒训练窗口外推数分钟 Self Gradient Forcing: Native Long Video Extrapolation | 京东探索研究院 | arXiv:2607.20368 关键词:长视频,自回归扩散,Self Forcing,KV缓存,梯度训练 前序问题:Self Forcing让模型在自身生成历史上训练,缓解训练看真值、推理看生成结果的暴露偏差;但历史KV缓存只是冻结状态,未来帧损失无法反向教会早期帧“如何写入更有用的记忆”,形成历史上下文梯度缺口。 本文贡献:提出两遍训练的Self Gradient Forcing(SGF),无需穿过完整串行 rollout 反传。第一遍无梯度执行与推理一致的自回归滚动,在抽样退出步记录自生成上下文与噪声潜变量;第二遍并行重算该步的上下文KV和未来对上下文的因果注意力,让未来视频潜变量损失监督历史记忆的写入方式。 实验效果:在逐帧与分块长时实验、不同初始化下,角色身份、背景布局和时间稳定性均强于Self Forcing;仅用5秒训练窗口即可原生外推到数分钟视频。 批判点评:它把长视频问题从“怎样读取历史”推进到“怎样写好历史”,5秒训练到数分钟外推非常抓眼。两遍法避免全序列反传,工程上也现实。不过数分钟不等于全程有意义,身份和背景稳定之外,长期叙事、动作因果与新内容丰富度仍可能衰减。 3. CachedSearch:63%成本保留94.7%搜索收益 CachedSearch: Training-Free Cached Exploration for Test-Time Search in Video Diffusion | Google·UT Austin·CU Boulder | arXiv:2607.23159 关键词:测试时搜索,视频扩散,缓存加速,Best-of-N,免训练 前序问题:测试时best-of-N搜索能让小视频模型接近大模型,却需2到10倍计算,因为所有候选都完整去噪、最后大多被丢弃。缓存可让单次生成快2到3倍,但若近似误差打乱验证器排序,就可能选错赢家。 本文贡献:首次系统研究缓存对视频候选排序的影响,并提出免训练CachedSearch:用激进缓存低成本探索所有种子,仅把缓存阶段的赢家用全计算重生成。缓存与完整生成的每提示中位Spearman相关达0.905,错误主要集中在分数近乎打平的候选,因而影响自限;方案与验证器和搜索算法解耦。 实验效果:N=8时以63%成本保留best-of-N的94.7%收益;同预算可搜索两倍宽度,收益高38%。结论覆盖1.3B到14B、Wan/LTX/CogVideoX/Hunyuan六个模型;叠加中途剪枝可节省3.11倍探索计算并保留88.6%收益。 批判点评:“便宜试遍、只精修赢家”是测试时扩展最直接的降本路线,跨四个模型家族也增强了可信度。但它仍依赖奖励器排序是否符合人类偏好,近似搜索会放大奖励黑客;新架构还需重新校准缓存参数,并非完全零配置。 4. Twins:理解生成共享视觉Token Twins: Learn to Predict Unified Representations with Focal Loss | ICML 2026·腾讯混元·港中文 | arXiv:2607.22531 关键词:统一多模态,视觉Token,ViT,VAE,Flow Matching 前序问题:统一多模态模型常用ViT语义特征做理解、VAE低层潜变量做生成,两套连续表征不一致。直接联合预测时,DiT容易拟合ViT却学不好VAE分布,难以同时满足理解、重建和生成。 本文贡献:提出Twins连续统一表征:在同一token网格按通道拼接SigLIP2 ViT特征与FLUX.2 VAE潜变量,不增加序列长度和注意力成本。团队将失衡归因于频率偏置、内在维度及条件相关/无关不确定性差异,并把Focal Loss思想改造成flow matching焦点回归,重点提升误差大的VAE维度。 实验效果:ImageNet上相对朴素MSE最高改善10.57 gFID,且不使用classifier-free guidance;多模态理解表现保持竞争力,重建保真度也提升。 批判点评:它用最简单的通道拼接绕开两套视觉接口,再用损失重加权处理“语义易学、细节难学”,ICML与混元背景值得关注。但共享token仍是两种预训练特征的并置而非真正涌现的统一空间,推理通道宽度和解码链路成本并未消失。 5. GroupVideo:多人物定制视频不再串脸 GroupVideo: Multi-Identity Customized Text-to-Video Generation | 中科院自动化所·蚂蚁 | arXiv:2607.21027 关键词:视频生成,多人物,身份保持,Video DiT,定制视频 前序问题:身份定制视频大多只支持单人;把多张人脸简单拼接成条件会造成身份混淆,人物表情与动作像把静态脸“贴”到视频上,缺乏自然性。 本文贡献:提出基于Video DiT的GroupVideo。视觉对齐联合编码多张人脸提供稳健身份参考,语义感知器负责提升动作自然度;带空间引导的ID定位模块配合边界框约束与mask正则,将身份信息限制在对应脸部区域,抑制人物间特征串扰。团队还构建2万条高质量多身份视频数据集。 实验效果:在多角色视频中,身份一致性与动作自然度均超过现有方法,并改善多人物同时出现时的身份保真;新增2万条多ID数据为后续研究提供基础。 批判点评:多人物是定制视频迈向真实叙事必须补的一环,显式ID定位比条件拼接更靠谱。局限是训练仍依赖框和mask约束,2万条数据对人物组合、遮挡与长时交互的覆盖有限;多人身份正确也不保证彼此动作逻辑自然。 6. AgentHOI:多Agent先推理再生成人物交互 AgentHOI: Multi-Agent Reasoning for Human-Object-Interaction Video Generation via Implicit Representation Alignment | 腾讯混元·中科院大学 | arXiv:2607.22241 关键词:HOI视频,多Agent,动作规划,腾讯混元,视频扩散 前序问题:人和物体交互视频不仅要让主体动起来,还要理解接触、受力与动作先后。现有方法依赖显式姿态或运动轨迹,扩展到不同物体和复杂指令时成本高、泛化弱。 本文贡献:提出thinking-before-generation的AgentHOI:感知、交互和运动规划多个Agent先把高层文本意图拆成带秒级时间区间的执行计划;再用隐式文本-运动对齐,将文本到动作先验蒸馏进视频扩散模型,使推理时无需额外运动输入。 实验效果:在穿戴、骑乘等高难物体中心场景中,显著提升交互自然度、物体外观保持和复杂文本指令遵循;代码已开源。 批判点评:混元把Agent推理从提示改写推进到动作规划,适合HOI这种先讲逻辑再画运动的任务。但文本计划无法完整表达连续接触力学,Agent链中的错误会被生成模型忠实放大;“自然”仍主要靠视觉评价而非物理正确性。 7. InnoText:一个DiT同时生成编辑中英文字 InnoText: A Unified Model for Visual Text Generation and Editing | 中山大学·京东·中科院 | arXiv:2607.22101 关键词:视觉文字,DiT,图像编辑,中文生成,统一模型 前序问题:视觉文字既要求字形结构规则又要求可读,小字号和中文尤其困难。UNet常生成乱码,现有DiT又多只做生成或编辑单项任务,造成重复训练、风格不一致和跨任务泛化不足。 本文贡献:提出统一DiT框架InnoText,在单模型内同时完成视觉文字生成与编辑。字体大小感知调制(FSAM)适配不同尺度,小字符感知增强专攻细粒度字形,任务特定区域加权损失按生成/编辑区域自适应优化;同时构建覆盖多字体、字号和背景的高质量中英双语数据集。 实验效果:实验显示生成准确率和编辑质量均优于对比方法,可输出更清晰、连贯且与背景融合自然的中英文字图像。 批判点评:把生成与编辑合并对海报、电商和本地化设计很实用,中英双语也比只测拉丁字母更有说服力。但摘要缺少量化幅度,视觉文字真正难点还包括长段排版、罕见字和任意语言,当前双语数据的外推边界待验证。 8. WhereEdit:一步编辑自动找到该改哪里 WhereEdit: Mask-aware Local Latent Editing for One-Step Image Editing | 中科院西安光机所·西交·武大 | arXiv:2607.20883 关键词:一步编辑,局部控制,AutoMask,免训练,图像编辑 前序问题:一步文生图模型让实时编辑成为可能,但现有方法主要靠文字做全局语义搬运,缺少“改哪里”的显式空间控制;即便加入区域约束,目标区修改强度也常不够,背景还容易被连带改变。 本文贡献:提出免训练、免反演的WhereEdit,把一步编辑改写为局部自适应语义运输。AutoMask从模型内部token注意力自动发现相关区域,Amplified Conditional Transport只在局部强化条件变化,同时保护非目标区域与结构一致性;额外区域监督实验进一步验证显式空间推理的价值。 实验效果:PIE-Bench上持续超过现有一步图像编辑方法,在保持一步生成效率的同时取得更高编辑质量;使用真值mask还能继续提升。 批判点评:WhereEdit补上了一步编辑最关键的空间控制,且无需训练和反演,适合交互产品。但AutoMask依赖模型注意力能正确指向目标,抽象属性、多个同类物体和大范围几何变化时容易选错区域;真值mask继续提升也说明自动定位尚未到顶。 9. KroQuant:DiT权重激活都压到4比特 KroQuant: Kronecker-Structured Block Transforms for Efficient Post-Training Quantization of Diffusion Transformers | EPFL·AMD | arXiv:2607.21446 关键词:DiT量化,W4A4,Kronecker变换,AMD,后训练量化 前序问题:DiT做W4A4后训练量化时,线性层输入中的离群激活超出4-bit表示范围,生成质量会严重下降。已有通道缩放损精度,Hadamard变换块大且在线成本高,完整可学习变换又要每层每步执行昂贵矩阵乘。 本文贡献:提出KroQuant,对每32个激活元素应用可学习的Kronecker结构可逆变换,参数不到逐通道缩放一半;块内结构可由tensor core小GEMM执行。离线LoRaQ权重校准再吸收剩余逐权重量化误差,把激活侧变换与权重侧修正结合。 实验效果:MI350 GPU上量化器内核最多比SmoothQuant快14%;PixArt-Σ、SANA、FLUX.1-schnell在W4A4(MXFP4e2)下,比SVDQuant和LoRaQ更接近全精度参考,同时保持或提升图像质量。 批判点评:权重和激活同时4-bit才真正触及DiT部署成本,AMD与EPFL给出的硬件内核数字比只报离线指标更可信。但14%是量化器kernel而非整条生成链路,端到端提速取决于去噪步数和算子占比;Kronecker块大小也可能需按新架构重调。 10. SoundscapeAgent:Agent把声景拆成可编辑时间线 SoundscapeAgent: Agentic Soundscape Construction for Controllable Synthesis and Scalable Audio-Language Supervision | 武汉大学·腾讯混元 | arXiv:2607.21857 关键词:音频生成,创作Agent,声景,腾讯混元,音频语言 前序问题:单次文本到音频把规划、音源选择、时间布局和混音都藏在黑盒里,用户难以控制多事件声景,也无法获得包含事件角色与时间关系的结构化音频语言监督。 本文贡献:提出SoundscapeAgent:LLM Agent把用户意图转成可执行场景计划,通过检索和按需生成获取音频素材,再按可控时间线渲染多事件混音并导出对齐元数据。用户可指定工具并直接编辑计划,实现human-in-the-loop;同一流水线还能规模化生成结构化音频语言训练数据。 实验效果:听测和客观指标显示其生成质量可与文本到音频基线竞争;使用Agent合成数据训练的模型,在下游音频推理上持续超过仅用真实数据的基线。 批判点评:它把“生成一段声音”升级为可检查、可修改的音频工程时间线,既服务创作又反哺理解数据。但检索素材的版权、来源域偏差和混音物理真实性会进入训练集;Agent生成元数据规模大不等于监督准确,仍需质量过滤。 趋势观察 流式视频正式跨过实时帧率门槛 — Ms. Forcing按噪声级动态分配空间精度,单H200达到22.84 FPS;生成加速开始从缓存和蒸馏转向更细的计算粒度调度。 长视频训练开始补上记忆写入梯度 — Self Gradient Forcing让未来损失反向监督历史KV如何写入,仅用5秒窗口外推数分钟,长时一致性从扩展上下文转向优化内部记忆。 测试时扩展进入低成本探索阶段 — CachedSearch证明缓存近似基本保留候选排序,只对赢家全精度重生成,以63%成本拿回94.7%收益,best-of-N正在变得更可部署。 理解生成统一不再只靠共享架构 — Twins直接拼接ViT语义与VAE细节表征,并用焦点回归修复优化失衡;统一模型竞争转向token空间和训练目标的共同设计。 创作Agent从改写提示走向显式规划 — AgentHOI先规划人-物动作,SoundscapeAgent把音源与时间线变成可执行计划;图像、视频、音频生成都在从单次提示走向可检查的中间状态。 人工智能炼丹君 整理 | 2026-07-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-22|华为40万美元逼近闭源Boogu-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 2 篇 · 视频编辑与长视频一致性 5 篇 · 视频插帧与生成效率 1 篇 · 情绪语音生成 1 篇 · 像素扩散技术综述 1 篇 重点论文标题列表 Boogu-Image-0.1(华为香港AI Lab·港大·港科大):40万美元逼近闭源图像模型 D2DF(西交·国家电网AI Lab·浙工大·百度):视频消物一秒只需一步 SlotMem(港大·清华):按角色寻址记住长片人物 ReBind(快手可灵·港科大·南大·北大):显式绑定多参考视频编辑 FlowMimic(字节):图片编辑数据实时变视频 今日论文速览 1. Boogu-Image-0.1:40万美元逼近闭源图像模型 Boogu-Image-0.1: Boosting Open Agentic Multimodal Generation via Understanding under a Minimal Budget | 华为香港AI Lab·港大·港科大 | arXiv:2607.13125 关键词:统一多模态,文生图,图像编辑,Agent推理,开源模型 前序问题:Nano-Banana-Pro、GPT-Image-2 等闭源系统靠模型理解、提示改写与推理时编排形成系统级优势,但内部配方不公开;开源社区如何在有限数据和算力下同时做好文生图、快速推理、指令编辑和中英文字渲染,缺少可复现路线。 本文贡献:发布 Boogu-Image-0.1 开源统一理解生成模型族,含 Base、Turbo、Edit、Edit-Turbo。核心不是只堆生成骨干,而是强化多模态编码器、Agent 式提示重写、数据质量和训练管线,并用 Agentic inference-time scaling 把理解能力转成生成与编辑质量;权重、代码和训练配方均以 Apache 2.0 开源。 实验效果:仅使用 2.0862 亿张去重图像,Base 理论训练成本约 40 万美元;标准基准上持续匹敌或超过其他开源模型,结果逼近领先闭源系统,并覆盖高质量文生图、快速推理、指令编辑和中英文字渲染。 批判点评:「华为团队用 40 万美元把开源模型推近闭源系统」兼具机构信号与成本冲击力,且把系统级配方完整开放,比单点榜单更有价值。但“理论训练成本”未必包含数据、失败实验与基础设施总成本;逼近闭源的结论也依赖所选基准,真实复杂编辑和生产稳定性仍需社区复验。 2. D2DF:视频消物一秒只需一步 From Draft to Draft-Free: One-Step Video Object Removal via Privileged Distillation and Fast Planting | 西交·国家电网AI Lab·浙工大·百度 | arXiv:2607.14976 关键词:视频编辑,物体移除,一步生成,一致性蒸馏,视频修复 前序问题:视频物体移除中,光流/注意力传统方法容易留伪影、结果不自然;扩散方法更真实却需要多步去噪,速度难以实用,而且常依赖外部粗糙移除稿作为输入。 本文贡献:提出 D2DF 三阶段框架:先训练教师把低质移除草稿多步精修成高保真视频;再用先验特权一致性蒸馏(PPCD)将能力压到一步学生;最后以基于时序掩码 Transformer 的自引导快速植入(SGFP),在潜空间自动生成场景一致伪草稿,得到完全不依赖外部草稿的一步模型。 实验效果:有草稿和无草稿两版在多项指标上均达 SOTA,质量与效率超过传统及多步生成方法;单个视频的去噪过程约 1 秒。 批判点评:从“多步精修草稿”蒸馏到“无草稿一步消物”,既解决速度又去掉外部依赖,1 秒数字极具产品价值。但 SGFP 伪草稿的场景推断仍可能在大面积遮挡、复杂动态背景中失真,一步模型的失败可修复性也弱于多步迭代。 3. SlotMem:按角色寻址记住长片人物 SlotMem: Character-Addressable Internal Memory for Narrative Long Video Generation | 港大·清华 | arXiv:2607.15772 关键词:长视频生成,角色一致性,内部记忆,DiT,叙事视频 前序问题:叙事长视频中角色跨场景、隔很久再出现时容易换脸。全局记忆的检索线索并不针对身份,现有角色方法又把身份和姿态、背景等偶然因素混在粗粒度帧级 KV 中,有限容量下还缺少持续更新。 本文贡献:提出可按角色寻址的内部记忆 SlotMem:Character-Semantic Probe 从交叉注意力中定位角色相关 token;Memory Encoder 把 DiT token 压成紧凑的逐角色 slot;Memory Writer 随生成保守更新每个角色的新观察;Character-Wise Cross-Attention 只把对应角色记忆注入同一人物的局部 token。 实验效果:在多个叙事长视频基准上,相比现有方法显著改善跨长时间间隔的角色一致性,同时维持相当的视频总体质量;代码已开源。 批判点评:把“记住整帧”改成“按角色地址读写”,对多角色长片身份漂移非常对症,内存也更省。但角色探针一旦漏检或多人遮挡、换装,错误可能写回并长期污染;如何处理新角色、身份合并与开放世界角色数量仍是难点。 4. ReBind:显式绑定多参考视频编辑 ReBind: Multi-Reference Video Editing via Structured Instructions with Explicit Reference Relationships | 快手可灵·港科大·南大·北大 | arXiv:2607.14681 关键词:视频编辑,多参考,结构化指令,可灵,视觉绑定 前序问题:多参考图条件视频编辑需要明确“哪个参考提供哪个属性”,但自然语言指令通常不写清参考关系,通用 MLLM 也难稳定生成,导致人物、材质、灯光等来源互相串线。 本文贡献:提出 ReBind,以在语义位置嵌入 reference token 的结构化指令作为中间表示,显式绑定视觉属性与来源。ReBind-Instruct 通过两阶段渐进训练学习生成精确参考关系;ReBind-Edit 则轻量适配文生视频模型,按绑定关系协调多个参考源。 实验效果:ReBind-Instruct 的指令质量显著超过通用 MLLM;ReBind-Edit 在参考图条件视频编辑中达到开源方法 SOTA,能更准确组合多视觉来源。 批判点评:把多参考歧义从“模型自己猜”变成结构化显式绑定,是复杂编辑走向可控生产的关键一步,可灵团队也有真实产品场景。但需要专用 MLLM 先生成中间指令,链路更长;参考关系正确不代表遮挡、几何和时间一致性一定正确。 5. FlowMimic:图片编辑数据实时变视频 FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry | 字节 | arXiv:2607.18227 关键词:视频编辑,数据生成,光流,图像视频统一,免Mask 前序问题:视频编辑数据采集依赖人工 mask、I2V/ControlNet 合成和 VLM 过滤,不仅耗时、易引错,任务多样性也远落后图像编辑;推理时还常需外部 MLLM 或显式 mask 才能定位编辑区域。 本文贡献:提出像素对时序扭曲流场,可从图像编辑样本实时生成对应视频编辑样本,并证明仅用这类数据即可学习多层级视频编辑。将图像视作视频特例,以生成/编辑两种 modality mimic loss 让图像与视频能力互相模仿;再加入指代表达分割等感知任务和区域感知潜空间、注意力损失,让模型内化“理解指令—定位区域—只改该处”的能力。 实验效果:无需人工视频 mask 与传统重型合成管线,即可在线扩展多种视频编辑任务;同一模型统一图像/视频生成与编辑,并实现推理期免 mask 的区域感知编辑。 批判点评:把海量图像编辑数据通过流场实时“升格”为视频数据,直击视频编辑数据荒,字节背景也说明工程价值。但扭曲流场能模拟的运动与遮挡仍有限,由图像任务迁移出的时序规律未必覆盖真实长视频和复杂镜头运动。 6. STBridge:让模型说的和画的一致 STBridge: Shared-Target Alignment for Bridging Understanding and Generation in UMMs | 腾讯优图·吉林大学 | arXiv:2607.17140 关键词:统一多模态,理解生成对齐,图像编辑,强化学习,腾讯优图 前序问题:统一多模态模型虽然共用架构,却可能正确描述目标、实际编辑出另一回事;语言输出与视觉输出分居不同空间,在细粒度实体、属性、空间关系和局部细节上尤其缺乏同一目标约束。 本文贡献:提出共享目标对齐 STBridge:在图像编辑中,让目标 caption 表达期望视觉结果、编辑图像实现同一结果,以共同目标状态串起理解和生成。训练采用 align-then-optimize:先监督微调建立共享目标通道,再以序列强化学习优化围绕目标的跨任务协同。 实验效果:在视觉理解、图像生成和图像编辑基准上均持续优于初始化模型;对齐分析确认“模型描述的目标”和“模型生成的结果”之间差距明显缩小。 批判点评:指出“共架构不等于共语义”,并用共享目标把说与画绑在一起,是统一模型后训练的重要方向。但依赖高质量目标 caption 和顺序 RL,目标文本可能成为新的信息瓶颈;复杂视觉变化也未必能被一句 caption 完整表达。 7. TANGO:测试时绕开长视频死路 Test-Time Noise Guided Adaptation for Realistic Autoregressive Video Generation | CERTH·阿姆斯特丹大学 | arXiv:2607.15849 关键词:自回归视频,测试时适配,长视频,噪声引导,FVD 前序问题:自回归视频扩散可生成任意长视频,却会累积误差并逐渐偏离训练条件分布;即使每帧看起来都在真实流形上,某些轨迹也可能走到模型无法继续的“终点”,后续必然崩坏。 本文贡献:提出测试时终点规避 TANGO:假设可良好延续的未来轨迹,其预测噪声应匹配前向加噪的各向同性高斯分布。模型先向前预测一步,用自身充当输出批评器;一旦预测噪声偏离期望分布,就搜索替代轨迹,避免驶入终点,无需重新训练骨干。 实验效果:相对 SOTA,VBench 绝对提升 3.1%,15 秒视频上的平均 FVD 降低 28.3%;代码已开放。 批判点评:让扩散模型用噪声分布自检未来能不能走通,比只把当前帧拉回真实流形更深入,测试时即可插入。但前瞻搜索增加推理开销,各向同性噪声假设未必适合所有内容,且只能绕路、不能补足模型缺失的动态知识。 8. SPEED:一步像素扩散插帧快63% SPEED: One-Step Pixel Diffusion for High-quality Video Frame Interpolation | ACM MM 2026·复旦·B站 | arXiv:2607.15585 关键词:视频插帧,像素扩散,一步生成,4K,ACM MM 前序问题:扩散视频插帧有两大瓶颈:潜空间经 VAE 解码不可避免丢失细节,多步采样又带来高显存与高延迟;尤其 4K 插帧中,精细纹理与效率难兼得。 本文贡献:提出一步像素扩散 SPEED:渐进多阶段架构配动态 patch 缩放,学习多尺度运动、结构和外观;Noise-Update-Only Attention 只更新噪声、保护干净条件帧语义并把计算降近 50%;漂移感知时间步采样与定制目标直接在像素空间预测图像,实现不降质的一步推理。 实验效果:SNU-FILM 上 LPIPS 降低 8.8%,推理加快 63.3%、显存降低 10.6%;在高难 4K 基准上 LPIPS 最多优于先前方法 51.5%,达到 SOTA。 批判点评:一步、像素空间、4K 三个难点同时拿下,复旦+B站且获 ACM MM 2026,数字很硬。但像素扩散训练成本可能转移到离线阶段,动态 patch 与多阶段结构更复杂;插帧 SOTA 不等同于通用视频生成可直接受益。 9. AuEmoChat:离散情绪token让对话更真 AuEmoChat: Authentic Emotion Understanding and Rendering for Conversational Speech Synthesis | ACM MM 2026·内蒙古大学·港中文深圳 | arXiv:2607.15755 关键词:对话语音合成,情绪生成,Flow Matching,Token合并,TTS 前序问题:对话语音合成要理解多轮上下文并表现像人的细腻情绪,但现有方法常把情绪压成七类等有限标签;同时历史中的冗余多模态 token 干扰上下文理解,导致声音情感僵硬或前后不一致。 本文贡献:提出 AuEmoChat:AuEmoCodec 用有限标量量化从大规模情绪语音学习离散真实情绪 token 空间;AuEmoToMe 在保留情绪相关上下文的同时合并冗余多轮 token;自回归文本-语音模型预测目标情绪与语音 token,最后用 Authentic Emotion Flow Matching 联合对话上下文、情绪和声学先验渲染语音。 实验效果:在 NCSSD-EmCap 上超过 SOTA 对话语音合成基线,生成语音的情绪表达更丰富、更真实;代码与语音演示计划开放。 批判点评:从少数人工情绪标签转向数据驱动的离散情绪空间,并同时处理多轮冗余,贴近真实对话产品。但“真实情绪”评价主观且受数据文化偏差影响,离散 token 也可能把连续情绪重新切碎;跨语言、跨说话人泛化仍是关键。 10. Pixel-Space DiT:像素DiT绕开VAE细节瓶颈 Pixel-Space Diffusion Transformers | 北大·Stanford·Cornell·南大 | arXiv:2607.17585 关键词:像素扩散,DiT,VAE,生成综述,统一多模态 前序问题:潜扩散靠 VAE 压缩实现高效高分辨率生成,但固定视觉 tokenizer 会丢纹理和结构细节,重建目标与生成目标分离也限制端到端优化;直接像素扩散则面临高维建模、噪声调度、损失加权和 token 效率难题。 本文贡献:系统综述 Pixel-Space Diffusion Transformer,从模型架构、连续生成机制和统一多模态建模三条线梳理直接在原始像素上扩散的方法,讨论如何去掉 VAE 瓶颈,并让像素、文本与任务条件进入共享 token 空间由同一 Transformer 处理。 实验效果:归纳当前像素 DiT 的代表方法、核心挑战与技术路线,指出其在高保真单阶段生成及理解生成一体化视觉基座上的潜力,并给出未来研究方向。 批判点评:像素空间正在重新成为生成主线,这篇综述适合建立全景认知;但它不是新算法、没有单一实验突破,且像素 DiT 的巨大训练成本与 token 数仍是现实约束,应放在今日列表末尾而非主推。 趋势观察 开源图像模型开始公开系统级配方 — Boogu-Image 不只开权重,还公开强编码器、Agent 提示改写、数据与训练管线,以约 40 万美元理论成本逼近闭源系统,竞争从单模型走向完整生成系统。 视频编辑同时冲刺一步化与免标注数据 — D2DF 把视频消物压到一步约 1 秒,FlowMimic 则把图像编辑样本实时变成视频数据;一个砍推理成本,一个砍数据成本。 长视频从全局缓存转向结构化记忆与自检 — SlotMem 按角色地址读写身份记忆,TANGO 在测试时用预测噪声自检轨迹死路,长视频一致性开始从粗粒度历史帧走向可解释内部状态。 复杂编辑把视觉来源和目标语义显式绑定 — ReBind 用 reference token 绑定多参考来源,STBridge 用共享目标绑定模型说的与画的,可控编辑正在减少让模型自行猜测的隐式接口。 生成底座向像素空间与真实情绪扩展 — SPEED 以一步像素扩散实现 4K 插帧,Pixel-Space DiT 总结绕开 VAE 的技术路线;AuEmoChat 则把生成边界扩到多轮对话中的细腻情绪语音。 人工智能炼丹君 整理 | 2026-07-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-06-02|微软实时流式数字人视频比肩大模型 今日 AIGC 论文速览 今日共 9 篇 · 实时与高效视频生成 2 篇 · 视频与图像编辑 3 篇 · 自回归与多模态生成 2 篇 · 可信与安全生成 2 篇 重点论文标题列表 实时流式数字人(微软研究院):语音驱动实时流式肖像视频 AlbedoEdit(马普所·NVIDIA·UCSB):反照率引导统一视频编辑 MT-EditFlow(Apple·UCLA·UT Austin):RL优化多轮图像编辑 边界保护量化(中科院大学·华为昇腾):Wan2.1视频DiT零损W8A8 RDA(中南大学·牛津·微软):免重训提升AR文字渲染 今日论文速览 1. 实时流式数字人:语音驱动实时流式肖像视频 Real-Time Generation of Streamable Talking Portrait Video with Reference-Guided Deep Compression VAEs | 微软研究院 | arXiv:2606.01620 关键词:数字人,流式生成,因果VAE,Rectified Flow,实时 前序问题:视频扩散模型画质虽好但算力高,难以用于实时交互式数字人场景。 本文贡献:提出面向流式场景的「语音+参考图」驱动数字人视频生成框架:用因果视频 VAE 做深度潜空间压缩,配自回归潜空间去噪生成器。VAE 可接入可变数量参考图作为引导,让网络聚焦动态信息而非静态外观,从而同时提升压缩率与重建质量;并把残差自编码范式扩展到时空因果建模,生成器基于 Rectified Flow Transformer 分块自回归产出视频潜变量。 实验效果:实现高质量数字人视频的实时生成,速度显著快于基线大模型;在真实感、生动性与视频质量上与大模型持平甚至更优。 批判点评:「因果 VAE + 参考图引导 + 分块自回归 RFT」把流式实时数字人做到与大模型同档画质,工程价值很高。但验证集中在语音驱动的正面肖像窄域,缺乏对长时序漂移、侧脸大幅运动、多说话人等极端场景的系统评测,实时性也强依赖特定硬件。 2. AlbedoEdit:反照率引导统一视频编辑 AlbedoEdit: Unified Instance-Level Video Editing with Albedo Guidance | 马普所·NVIDIA·UCSB | arXiv:2606.01362 关键词:视频编辑,反照率,实例级,物体插入,纹理编辑 前序问题:细粒度实例级视频编辑(插入/删除/纹理)要么只有粗语义控制,要么任务专用、难通用。 本文贡献:提出统一视频编辑框架 AlbedoEdit,同时支持物体插入、删除与纹理编辑。核心洞察是本征反照率图不含光照、镜面、阴影与互反射,是指定外观编辑的理想用户接口。基于视频基座模型微调,把源 RGB 视频按用户编辑的首帧反照率翻译为编辑后 RGB 视频;在覆盖三类编辑的配对合成数据集上训练,隐式学会协调编辑内容并模拟高光、软阴影、镜面反射等真实视觉效果。 实验效果:在物体插入、删除、纹理编辑上定性定量均超越 SOTA 视频编辑方法,且单一框架统一支持三类任务。 批判点评:用「反照率」作编辑接口巧妙绕开了光照纠缠,统一三类编辑很优雅。但训练依赖配对合成数据集,真实视频与合成域之间的差距、以及用户能否方便地编辑反照率图(而非直接画 RGB)是落地的现实门槛。 3. MT-EditFlow:RL优化多轮图像编辑 MT-EditFlow: Reinforcement Learning for Multi-Turn Image Editing with Flow Matching | Apple·UCLA·UT Austin | arXiv:2606.01985 关键词:多轮编辑,强化学习,流匹配,GRPO,奖励建模 前序问题:单轮训练的编辑模型在多轮交互编辑中会因「一轮失败毁全程」和误差累积而崩溃。 本文贡献:提出流匹配强化学习框架 MT-EditFlow,把多轮视角与多奖励统一进 GRPO 与 NFT 两类 RL 方法。系统分析轮级聚合打分策略、VLM 推理模式(权衡奖励偏差与方差)、优势融合层级(防奖励黑客),并发现把聚合优势广播到整条编辑轨迹,能弥合局部规划与全局多轮成功之间的鸿沟。 实验效果:在多个基座上显著提升;把 FLUX.1-Kontext-dev 的第 3 轮整体表现提升 6.85 分,超过 Qwen-Image-Edit 等开源 SOTA,并保持高边际成功率、降低暴露偏差。 批判点评:把多轮编辑当作序列决策、用 RL 显式优化轨迹级奖励,方向对路。但奖励信号高度依赖 VLM 打分,VLM 自身偏差会被放大;6.85 分的提升也主要在 turn-3 这一特定设置,更长交互的稳健性仍待验证。 4. 边界保护量化:Wan2.1视频DiT零损W8A8 Boundary-Protection W8A8 HiFloat8 Quantization for Large-Scale Text-to-Video Diffusion Transformers | 中科院大学·华为昇腾 | arXiv:2606.00957 关键词:量化,W8A8,HiFloat8,视频DiT,昇腾NPU 前序问题:视频 DiT 逐块激活分布异质,首尾块统计特性与中间块根本不同,均匀量化失效。 本文贡献:面向 Wan2.1-T2V-14B 在昇腾 910B 上的 W8A8 HiFloat8 量化,对全部 40 个注意力块做逐块激活分析(max-abs、标准差、峰度、99 分位),提出边界保护策略:首 2 块、尾 3 块保留 BF16,其余 35 块用 W8A8 HiF8 量化,兼顾误差遏制与输出保真。 实验效果:PTQ 在 VBench 全部 5 个维度上持平甚至略超 BF16 基线,5-prompt 内无可测精度损失;消融证明须同时保护首尾才有效;量化 35 块省约 12GB 显存,单卡可推理。 批判点评:把「边界块敏感」这一经验观察落到具体保护配置,工程实用且有消融支撑。但评测仅 5 条 prompt、样本量太小,统计说服力有限;QAT 在单卡下反而不如 PTQ,且当前工具链软件量化更慢,硬件原生 HiF8 收益尚未真正兑现。 5. RDA:免重训提升AR文字渲染 Residual Decoder Adapter: ID-Preserving Tokenizer Adaption for Autoregressive Text Rendering | 中南大学·牛津·微软 | arXiv:2606.01911 关键词:自回归生成,文字渲染,Tokenizer,残差适配器,OCR 前序问题:视觉自回归模型文字渲染笔画模糊、字形错乱,根源在 tokenizer 重建细节不足,但重训代价高。 本文贡献:提出 Residual Decoder Adapter(RDA):不改 token 空间、事后升级 tokenizer——引入与原码本共享分布的配对码本,以及在像素空间学习重建图与真值微小残差的并行分支,从而非侵入式增强 tokenizer 且兼容已有 AR 模型,无需重训 tokenizer 与生成模型。 实验效果:大幅提升文字渲染:微调 Janus-Pro 的 OCR 准确率在 TextVisionBlend 从 24.52% 升至 58.26%、StyledTextSynth 从 12.75% 升至 36.81%。 批判点评:「残差适配器」思路精巧,免重训就能补齐文字短板,迁移成本低。但本质是给解码器打补丁、治标性质,token 空间本身的信息瓶颈未动;提升集中在 OCR 类指标,对复杂版式、多语言长文本的泛化仍需更多验证。 6. TFinv:免训练一步扩散反演编辑 Training-free image inversion for one-step diffusion models | 巴塞罗那CVC·MBZUAI·吉大 | arXiv:2606.01380 关键词:图像反演,一步扩散,免训练,图像编辑,PIE-Bench 前序问题:一步扩散模型的真实图像反演与编辑受限于初始潜变量可编辑性与图文 Caption Gap 两大障碍。 本文贡献:提出免训练框架 TFinv:迭代噪声对齐 (iterNA) 缩小初噪与高斯分布的差距、后缀学习 (suffL) 用可学习后缀 token 增强图文对齐,实现精确反演到初噪并便于编辑;并提出基于 mask 的局部编辑以保护背景完整性。 实验效果:在 PIE-Bench 上达到一步扩散编辑 SOTA,效率显著优于多步反演方法。 批判点评:免训练把一步扩散的反演难题拆成「初噪可编辑性 + 图文对齐」两个可操作因子,干净利落。但推理时仍需迭代对齐与后缀学习,并非真正零开销;评测主要在 PIE-Bench,对复杂多物体场景的编辑保真度还需更广验证。 7. ProductWebGen:商品网页生成评测基准 ProductWebGen: Benchmarking Multimodal Product Webpage Generation | 上海交大·快手 | arXiv:2606.01022 关键词:商品网页,多模态生成,统一模型,图像编辑,基准 前序问题:从商品图+指令生成可渲染 HTML 网页需要严格视觉一致与高保真指令遵循,缺乏系统基准。 本文贡献:推出 ProductWebGen 基准:500 个测试样本、13 个品类,每样本含源图、视觉内容指令与网页指令;系统对比两类工作流——编辑式(LLM+图像编辑模型分别生成 HTML 与图)与统一模型式(单 UM 同时生成)。并构建 SFT 数据集 ProductWebGen-1k(1000 组真实商品图+LLM 生成 HTML),在开源 UM BAGEL 上验证有效。 实验效果:编辑式在网页指令遵循与内容吸引力上领先,统一模型式在满足视觉内容指令上更有优势;SFT 数据显著提升 BAGEL 表现。 批判点评:把多模态生成能力落到电商网页这一真实落地场景,任务设计与双工作流对比都很务实。但 500 样本规模偏小、评测多依赖模型/人工主观打分,且「可渲染 HTML」的工程正确性与跨浏览器一致性等硬指标尚未充分覆盖。 8. SafeGen-Bench:图生视频安全性评测基准 SafeGen-Bench: Benchmarking Safety in Image-Conditioned Text-to-Video Generation | 威斯康星·清华·JHU | arXiv:2606.01481 关键词:视频安全,图生视频,红队评测,内容护栏,基准 前序问题:现有视频安全基准只测恶意文本,忽视「安全文本+安全图像」组合仍可能生成有害内容。 本文贡献:推出 SafeGen-Bench 评测条件式 T2V(图生视频)安全性:定义 10 类恶意类别,聚焦时序与行为相关风险,精选多源起始帧配对文本 prompt 模拟真实输入;评测多个条件 T2V 模型,并测试文本/图像护栏的有效性。 实验效果:当前模型难以稳定规避恶意内容,不安全分数最高达 44.5(尤其在追求高质量时);单模态护栏不足以防御,7 类恶意类别下失败率达 80%。 批判点评:点出「安全输入也能合成有害视频」这一被忽视的真实风险并量化护栏失效,警示意义强。但 10 类恶意类别与起始帧选择带主观性,'unsafety score' 的判定依赖评估模型,跨文化/跨场景的有害定义边界也较模糊。 9. KG-FairDiff:知识图谱引导T2I去偏 KG-FairDiff: Knowledge Graph-Guided Prompt Refinement for Demographically Fair Text-to-Image Generation | Sharif·KTH·Vanderbilt | arXiv:2606.01282 关键词:文生图,公平性,去偏,知识图谱,prompt改写 前序问题:文生图系统继承训练数据的人口与文化刻板印象,重训不可行、固定模板又忽视文化语境。 本文贡献:提出模型无关的推理时框架 KG-FairDiff,把公平感知的 prompt 改写形式化为约束优化并做成闭环:约 1200 条文化/偏见三元组的知识图谱检索结构化上下文、LLM 改写器提出修订、验证器只接受能降低基于散度的公平损失且保持语义保真的 prompt;证明改写循环有限步终止,并审计 8 个广泛部署的生成器。 实验效果:在保持 prompt 语义的同时,显著降低性别、种族、年龄及交叉维度的差异,提供无需重训、可直接部署的公平化方案。 批判点评:不碰闭源权重、用推理时 prompt 改写+知识图谱做去偏,部署友好且有终止性证明,务实。但公平损失与目标分布的设定本身带价值判断,1200 条三元组的覆盖与文化偏向也会引入新偏差;强行改写 prompt 可能损害用户原意,'去偏'与'忠实'的取舍仍是开放问题。 趋势观察 实时化成为视频生成主线 — 微软用因果 VAE+分块自回归 RFT 把数字人做到实时流式,边界保护量化让 14B 视频 DiT 单卡零损部署,'又快又省'是今天最强信号。 编辑从单轮走向多轮/实例级 — MT-EditFlow 用 RL 优化多轮编辑轨迹,AlbedoEdit 用反照率统一实例级视频编辑,编辑的可控性与交互性同步进化。 免训练/事后增强降低改造成本 — TFinv 免训练做一步扩散反演,RDA 免重训给 tokenizer 打残差补丁,KG-FairDiff 推理时改写 prompt 去偏——都在追求'不动主模型'。 评测与安全补齐落地短板 — ProductWebGen 补电商网页生成基准,SafeGen-Bench 揭示图生视频的安全盲区,工具与红队评测正追上生成能力。 多极化算力与机构同台 — 微软、马普所、NVIDIA、Apple 与上海交大、中科院大学+华为昇腾、中南大学同日发声,研究力量与算力底座多极化。 人工智能炼丹君 整理 | 2026-06-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-15|实时视频2步出帧Causal Forcing++ 今日 AIGC 论文速览 今日共 8 篇 · 实时 AR 视频与世界模型 3 篇 · 相机控制与视频生成 2 篇 · 图像编辑持续学习 1 篇 · 扩散模型 RL 后训练 1 篇 · 视频世界模型评测 1 篇 重点论文标题列表 Causal Forcing++:因果一致性蒸馏 Warp-as-History:把相机引起的形变直接转化为「相机扭曲 ACE-LoRA:动态正则化框架 RefDecoder:参考条件视频 VAE decoder DiffusionOPD:多任务训练范式 今日论文速览 1. Causal Forcing++:因果一致性蒸馏 Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation | 清华 TSAIL, 生数科技 | arXiv:2605.15141 关键词:少步AR视频·因果一致性蒸馏·实时交互生成·世界模型·Genie3 前序问题:实时交互式视频生成需要低延迟、流式、可控的 rollout。现有自回归扩散蒸馏在 chunk-wise 4 步取得了不错效果,但 chunk 粒度过粗、采样延迟仍然不可忽略;当尝试更激进的 frame-wise 1-2 步时,少步 AR 学生的初始化策略要么目标错位、要么不能少步生成、要么算力代价大到无法 scale 本文贡献:提出 Causal Forcing++ 因果一致性蒸馏(Causal CD)流水线:核心观察是 Causal CD 学习与 Causal ODE 蒸馏相同的 AR-条件流图,但只需在相邻时间步之间用一次教师 ODE 步在线提供监督,无需预先计算并存储完整 PF-ODE 轨迹——既高效又易优化;进一步把流水线扩展到 Genie3 风格的 action-conditioned 世界模型 实验效果:在 frame-wise 2 步设定下,全面超越 SOTA 4 步 chunk-wise Causal Forcing:VBench Total +0.1、VBench Quality +0.3、VisionReward +0.335,同时首帧延迟降低 50%、Stage 2 训练成本降至约 1/4 批判点评:把蒸馏从 chunk-wise 4 步推进到 frame-wise 2 步,是实时交互式视频生成可用性上的关键一步——把瓶颈识别为「初始化」是非常贴切的诊断;但 1-2 步生成对教师 ODE 误差的放大效应、以及在更复杂 action 条件下的稳定性还需更多压力测试 2. Warp-as-History:把相机引起的形变直接转化为「相机扭曲 Warp-as-History: Generalizable Camera-Controlled Video Generation from One Training Video | 上海交大, 上海 AI Lab | arXiv:2605.15182 关键词:相机控制·视频生成·零样本·伪历史·LoRA 微调 前序问题:相机可控视频生成已经很成熟,但现有方法普遍需要在大规模带相机标注的视频上做后训练(额外的 camera encoder、控制分支、注意力/位置编码改造);training-free 方案则把代价转嫁到测试时优化或 denoising 时的额外 guidance,依然不便宜 本文贡献:提出 Warp-as-History:把相机引起的形变直接转化为「相机扭曲后的伪历史」,在 frozen 视频生成模型自带的「视觉历史」通路中喂进去——目标帧位置编码对齐、剔除没有有效观测来源的 token,无需训练或架构改动即可零样本服从相机轨迹;可选用一段相机标注视频做轻量 LoRA 微调进一步提升泛化能力 实验效果:在多个数据集上的实验显示:完全 training-free 即可让冻结视频生成模型获得不平凡的相机轨迹跟随能力;只用「一段」相机标注视频做 LoRA 微调,即可在未见视频上同时改善相机贴合度、画质与运动动态 批判点评:把相机可控问题视作「历史 warp」是一个非常优雅的视角,几乎不增加任何训练成本;但 zero-shot 能力依赖底模的「视觉历史」通路是否足够强,没有该通路的扩散视频模型迁移性可能受限;另外极端轨迹下的孔洞填充质量值得关注 3. ACE-LoRA:动态正则化框架 ACE-LoRA: Adaptive Orthogonal Decoupling for Continual Image Editing | 上海交大, vivo AI Lab | arXiv:2605.14948 关键词:持续学习·图像编辑·LoRA·正交解耦·CIE-Bench 前序问题:现有 SOTA 扩散模型靠参数高效微调(LoRA 等)适配各类图像编辑任务,但真实业务需要在不断到来的新任务上持续学习同时保留旧任务能力;图像编辑的持续学习问题至今几乎没人系统研究,灾难性遗忘问题严重 本文贡献:提出 ACE-LoRA 动态正则化框架:通过 Adaptive Orthogonal Decoupling 自动识别并正交化任务间干扰,再用 Rank-Invariant Historical Information Compression 解决持续更新中的可扩展性瓶颈;同时发布 CIE-Bench——业内首个面向图像编辑的持续学习评测基准 实验效果:在指令保真度、视觉真实感、抗遗忘鲁棒性上一致优于现有 baseline,建立了「图像编辑持续学习」这一子方向的标准方法+标准评测 批判点评:把「持续学习」首次正式带到图像编辑领域,问题设定和 benchmark 都非常务实;但 14 维基因式正交化的超参对任务序列分布的鲁棒性、以及面对几十个长尾编辑任务时压缩策略的极限,需要更长任务流的实测 4. RefDecoder:参考条件视频 VAE decoder RefDecoder: Enhancing Visual Generation with Conditional Video Decoding | University of Washington, UNC | arXiv:2605.15196 关键词:视频 VAE·参考条件 decoder·视频生成·即插即用·VBench 前序问题:主流 latent 视频扩散模型的 denoising 网络条件丰富,但 VAE decoder 几乎都是无条件的——这种结构性不对称导致细节流失、与输入参考图不一致,是当前视频生成「看起来糊糊的」的隐藏元凶 本文贡献:提出 RefDecoder 参考条件视频 VAE decoder:用一个轻量图像编码器把参考帧映射成细节丰富的高维 token,在 decoder 每个 upsampling stage 与去噪后的视频 latent token 共同处理(reference attention),让 decoder 也获得与 denoising 网络对等的条件信息 实验效果:在 Wan 2.1、VideoVAE+ 等多个 decoder backbone 上一致提升 PSNR 最多 +2.1dB(Inter4K / WebVid / Large Motion);可直接热插拔进现有视频生成系统,无需额外微调,VBench I2V 上主体一致性、背景一致性、综合质量全面提升;天然泛化到风格迁移、视频编辑精修等任务 批判点评:这是一项「补条件」的低风险高收益工作,可即插即用是工程师最爱的属性;但 decoder 端注入参考可能在大幅运动场景下与 latent 表示冲突,长视频累积误差与 reference token 选择策略仍有优化空间 5. DiffusionOPD:多任务训练范式 DiffusionOPD: A Unified Perspective of On-Policy Distillation in Diffusion Models | 阿里 Wan Team, 复旦 | arXiv:2605.15055 关键词:扩散模型 RL·On-Policy 蒸馏·多任务·Wan Team·文生图 前序问题:强化学习是改进文生图扩散模型的强力工具,但现有方法大多局限于单任务优化——多任务联合 RL 受困于跨任务干扰和不平衡,级联 RL 又笨重且易遗忘 本文贡献:提出 DiffusionOPD 多任务训练范式:先独立训练任务专属 teacher,再沿学生自己的 rollout 轨迹做 Online Policy Distillation 把多 teacher 能力蒸馏到统一学生;理论上首次把 OPD 框架从离散 token 提升到连续状态 Markov 过程,给出闭式 per-step KL 目标,统一 SDE 与 ODE refinement,方差更低、泛化更好 实验效果:一致超越多奖励 RL 与级联 RL 基线,训练效率与最终性能两端均占优,在所有评测基准上达到 SOTA 批判点评:把 OPD 严格地搬上连续扩散是漂亮的理论延伸,多任务版本对落地非常有价值;但 teacher 数量增加后蒸馏的 token-level KL 是否仍稳定、teacher 与学生 capacity 失配时的下界,仍需更大规模实验 6. RAVEN:框架 RAVEN: Real-time Autoregressive Video Extrapolation with Consistency-model GRPO | 帝国理工 AGI Lab | arXiv:2605.15190 关键词:实时 AR 视频·一致性模型·CM-GRPO·训练-测试对齐·流式生成 前序问题:因果自回归视频扩散模型靠把过去内容外推未来 chunk 实现实时流式生成,蒸馏自高保真双向教师后已能少步推理;但训练时 history 分布与推理时实际 rollout 分布之间的 gap 一直限制长序列的生成质量 本文贡献:提出 RAVEN training-time test 框架:把每次自身 rollout 重打包为「干净历史端点 + 噪声去噪状态」交错序列,让训练注意力对齐推理时的外推方式,同时让下游 chunk loss 监督未来预测所依赖的历史表示;进一步提出 CM-GRPO,把 consistency 采样步重新表达为条件高斯转移,直接在该核上做在线 RL,避免了之前 flow-model RL 公式中的 Euler-Maruyama 辅助过程 实验效果:RAVEN 在质量、语义、动态度多维评测上超越近期因果视频蒸馏 baseline;CM-GRPO 与 RAVEN 组合后进一步提升性能 批判点评:把 training-test 不一致问题正面解决并配套 CM-GRPO 是组合拳;但 RAVEN 重打包对长序列内存占用的影响、CM-GRPO 在更复杂奖励上的稳定性,还需要在更大模型尺度上验证 7. SANA-WM:2.6B 参数原生面向 1 SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer | NVIDIA, MIT, 港科大 | arXiv:2605.15178 关键词:世界模型·分钟级视频·Hybrid Linear Attention·6-DoF 相机·开源 前序问题:一分钟级别的世界模型既要画质媲美 LingBot-World、HY-WorldPlay 这些产业级大模型,又要在算力、数据、推理硬件三方面都「能用得起」——目前几乎没有开源方案能同时做到 本文贡献:提出 SANA-WM:2.6B 参数原生面向 1 分钟视频生成的开源世界模型——(1) Hybrid Linear Attention 把 frame-wise Gated DeltaNet 与 softmax attention 混合,长上下文内存可控;(2) Dual-Branch Camera Control 保证 6-DoF 轨迹精确跟随;(3) 两阶段生成 + long-video refiner;(4) 鲁棒标注流水线从公开视频中提取 metric-scale 6-DoF 相机姿态作为动作标签 实验效果:仅用约 213K 公开视频片段、64 张 H100 训练 15 天,每个 60s 720p clip 单 GPU 即可生成;蒸馏量化版可在单卡 RTX 5090 上 NVFP4 量化下 34 秒生成 60s 720p;在 1 分钟世界模型 benchmark 上动作跟随精度强于现有开源 baseline,画质相当但吞吐高 36 倍 批判点评:把「分钟级世界模型」做到能在单张消费卡上跑动,是世界模型走向开发者手里的关键一步;但 1 分钟仍然依赖「stage-2 refiner」这一外置模块,端到端 1 分钟生成质量与商业闭源仍有差距 8. PDI-Bench:几何一致性量化框架 Quantitative Video World Model Evaluation for Geometric-Consistency | UCSD, 港科大等 | arXiv:2605.15185 关键词:视频世界模型·几何一致性·评测基准·3D 重建·物理推理 前序问题:生成视频模型越来越被当作隐式世界模型来研究,但「生成视频是否产生了物理合理的 3D 结构与运动」一直缺乏客观度量——现有评测要么靠人工打分要么靠学习式 grader,对几何失败的诊断力都很弱 本文贡献:提出 PDI-Bench(Perspective Distortion Index)几何一致性量化框架:先用 SAM 2、MegaSaM、CoTracker3 抽取物体级观测,单目重建到 3D 世界坐标,再算三类射影几何残差——尺度-深度对齐、3D 运动一致性、3D 结构刚性;配套 PDI-Dataset 覆盖多种压力测试场景 实验效果:在多个 SOTA 视频生成器上揭示了通用感知指标完全捕获不到的「几何特定失败模式」,为「物理基础视频生成 / 物理世界模型」的进展提供了可诊断信号 批判点评:把视频世界模型评测从「看起来对不对」推进到「几何上对不对」是必要的下一步,依托成熟 3D 工具链让指标可复现;但单目重建本身的误差对 PDI 指标的噪声有多大、对真实开放世界长尾场景的覆盖度,是后续要补的关键证据 趋势观察 实时交互视频生成进入 frame-wise 时代 — Causal Forcing++ 把少步 AR 视频从 chunk-wise 4 步压缩到 frame-wise 2 步,首帧延迟降一半;RAVEN 用 training-time test + CM-GRPO 直击 history 分布漂移——实时交互视频已经从「能动」进入「秒级响应」 相机控制从「重训」走向「零样本 + 一段视频微调」 — Warp-as-History 把相机条件转译为 frozen 模型自带的视觉历史通路,零样本即跟随;只用一段视频做 LoRA 即可泛化到未见素材——相机可控视频生成从「依赖大规模标注」滑向「轻数据即用」 VAE decoder 不再是哑终端 — RefDecoder 指出主流视频扩散模型 decoder 长期处于「无条件」状态,导致细节流失;用 reference attention 给 decoder 也加上条件,PSNR 直接 +2.1dB——decoder 端的条件化正成为视频生成的下一个低悬果实 世界模型走向消费级硬件 — SANA-WM 用 Hybrid Linear Attention + 量化在单卡 RTX 5090 上跑出 34 秒生成 60 秒 720p——分钟级世界模型第一次具备了「开发者本地可玩」的硬件包络 评测从感知质量转向几何/物理一致性 — PDI-Bench 把视频世界模型的考评从「看起来真不真」转到「几何上对不对」,借助成熟 3D 工具链给出射影几何残差——这预示着视频生成下一阶段的评测竞赛是「物理可解释性」 人工智能炼丹君 整理 | 2026-05-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-14|视频扩散从少步到任意步AnyFlow 今日 AIGC 论文速览 今日共 6 篇 · 视频扩散与推理加速 2 篇 · 图像生成与表征 2 篇 · 图像编辑与对齐评测 1 篇 · RL 后训练方法论 1 篇 重点论文标题列表 AnyFlow:——首个基于 flow map AsymFlow:rank-asymmetric ⚡ Qwen-Image-VAE-2.0:高压缩 VAE 套件 Edit-Compass:EditReward-Compass Orthrus:双视图框架 今日论文速览 1. AnyFlow:——首个基于 flow map AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation | 新加坡国立大学 Show Lab, MIT, NVIDIA | arXiv:2605.13724 关键词:视频扩散·Flow Map·On-Policy 蒸馏·Any-Step·推理加速 ⚠️ 前序问题:近一年的少步视频生成几乎被一致性蒸馏(Consistency Distillation)统治,4-8 步即可出图,但只要把采样步数从 4 加到 16/32 画质反而塌——CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为,无法服务「任意步数」推理需求 本文贡献:提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架:(1) 把蒸馏目标从端点一致性映射 z_t→z_0 升级为流图过渡 z_t→z_r,让学生学会任意时间区间的跳跃;(2) Flow Map Backward Simulation 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏,缓解少步采样的离散化误差和因果生成的 exposure bias 实验效果:在双向 DiT 与因果两类视频扩散骨干、1.3B 到 14B 全规模区间一致达到或超越 consistency baseline;当步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势 批判点评:把蒸馏目标从端点一致性升级到任意区间流图是范式级创新,FMBS 的 on-policy 反向模拟在视频域是首次系统化提出;但论文未公开 VBench/UCF-FVD 等具体数值,复现门槛在 1B-14B 教师 + 大规模 on-policy rollout,数据与算力两端都不低 2. AsymFlow:rank-asymmetric Asymmetric Flow Models | Stanford, ETH | arXiv:2605.12964 关键词:Flow Matching·像素扩散·非对称参数化·FLUX.2·文生图 ⚠️ 前序问题:高维像素空间下做 flow matching 速度预测时,模型必须建模与图像同维的高维噪声,即使数据本身有强低秩结构也只能用满秩参数化硬扛,导致像素扩散与潜空间模型间长期存在显著质量差距 本文贡献:提出 AsymFlow:rank-asymmetric 速度参数化——噪声预测限制在低秩子空间、数据预测保持满维,不改网络结构与训练/采样流程即可解析恢复完整速度;首次给出潜空间预训练→像素空间微调的可行路径,让 FLUX.2 klein 9B 的潜空间先验直接初始化像素生成 实验效果:ImageNet 256×256 取得 1.57 FID,大幅超越同类 DiT/JiT 像素扩散;从 FLUX.2 klein 9B 微调出的像素文生图模型在 HPSv3、DPG-Bench、GenEval 上全面超越其潜空间基模,主观真实感显著提升 批判点评:rank-asymmetric 视角直击像素扩散的本质瓶颈,无侵入式参数化是工程甜点;但低秩子空间的秩选择、与 FLUX.2 这种顶级模型的耦合是否过强、跨数据集泛化能力都还需更大规模验证 3. Qwen-Image-VAE-2.0:高压缩 VAE 套件 Qwen-Image-VAE-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.13565 关键词:图像 VAE·高压缩·文本渲染·扩散兼容·视觉分词器 ⚠️ 前序问题:高压缩比 VAE 在重建保真度和 diffusability 之间长期难以兼得——压得越狠下游 DiT 越难训,文本密集场景(文档、海报)的字符更是首当其冲糊掉 本文贡献:提出 Qwen-Image-VAE-2.0 高压缩 VAE 套件:架构上引入 Global Skip Connections + 扩展潜空间通道;训练上用十亿级图像 + 合成渲染引擎专项强化文本场景;潜空间用增强语义对齐策略让其更适合扩散建模;编解码器采用非对称 + attention-free 主干降低编码开销 实验效果:在公开重建基准上达到 SOTA;提出 OmniDoc-TokenBench 文档专项评测,在高压缩比下兼顾通用与文本场景;下游 DiT 实验显示其 diffusability 显著优于现有高压缩基线,收敛速度明显加快 批判点评:把 VAE 当成独立产品打磨——文档专项 benchmark + 文本渲染合成数据是务实的工程亮点;但相对其他高压缩 VAE 的提升幅度需等论文公开数值后比较,「diffusability」的量化定义仍偏经验 4. Edit-Compass:EditReward-Compass Edit-Compass & EditReward-Compass: A Unified Benchmark for Image Editing and Reward Modeling | 字节跳动 Doubao Team 等 | arXiv:2605.13062 关键词:图像编辑·Reward Model·多维评测·RL 对齐·Benchmark ⚠️ 前序问题:现有图像编辑 benchmark 难度不足、评测维度粗放,已无法区分前沿模型;与此同时图像编辑 RL 越来越依赖 reward model,但 reward model 评测仍停留在脱离实际 RL 场景的设定上,导致编辑模型与 reward model 都缺少可靠裁判 本文贡献:提出 Edit-Compass + EditReward-Compass 统一评测套件:前者含 2,388 条精标实例,覆盖世界知识推理、视觉推理、多图编辑等六级递进任务,采用结构化推理 + 细粒度 rubric 多维评分;后者含 2,251 对偏好对,模拟真实 RL 优化中的 reward 场景 实验效果:为前沿编辑模型提供了能拉开差距的多维难度梯度,配套的 reward model 评测能反映 RL 训练中 reward model 的真实表现,为后续编辑模型与 reward model 的迭代提供统一坐标系 批判点评:把「编辑能力」和「reward model 能力」两条评测线收编进同一套 benchmark 是踏实的基础工作;2,251 对偏好对的标注一致性、reward 评测对真实 RL 收益的预测力,是这类工作走向社区共识的关键门槛 5. Orthrus:双视图框架 Orthrus: Memory-Efficient Parallel Token Generation via Dual-View Diffusion | Adobe Research, University of Oregon | arXiv:2605.12825 关键词:并行解码·扩散语言模型·KV Cache·推理加速·双视图 ⚠️ 前序问题:自回归 LLM 生成保真度高但串行解码慢,扩散语言模型可并行却质量退化、训练贵、收敛缺乏严格保证——视觉/多模态 token 生成场景同样面临「快」与「准」难以兼得 本文贡献:提出 Orthrus 双视图框架:在冻结的 AR LLM 上挂载一个轻量可训练扩散并行视图,两视图共用同一份高保真 KV Cache——AR 头负责 prefill 构建准确表征、扩散头负责并行解码;通过两视图共识机制保证无损推理,把扩散并行解码移植到 Transformer 几乎零侵入 实验效果:在保证完全等价生成(lossless)的前提下,相比纯自回归提供最高 7.8x 加速,KV Cache 内存仅增加 O(1),参数增量极小;为视觉/多模态自回归 token 生成提供直接可用的并行加速路线 批判点评:把扩散当成 AR 的「并行外设」而不是替代品,借共识机制保留 AR 保真度,工程上很优雅;但 7.8x 加速属上限值,真实任务下并行步内的拒绝率与吞吐曲线值得进一步给出,扩散头训练成本也未充分披露 6. Beyond-GRPO:奖励分配原则 Beyond GRPO and On-Policy Distillation: An Empirical Sparse-to-Dense Reward Principle for Language-Model Post-Training | Meta | arXiv:2605.12483 关键词:LLM 后训练·GRPO·On-Policy 蒸馏·奖励密度·稀疏到稠密 ⚠️ 前序问题:在「可验证标注极其稀缺」的后训练场景下,主流做法(在部署模型本身上跑 GRPO)忽视了一个奖励密度原则:稀疏的序列级奖励应该用在能产生有效探索的强模型上、稠密的 token 级奖励才适合把行为压缩进小模型,这一直觉对生成模型的 RL 对齐同样关键 本文贡献:提出 Sparse-to-Dense 奖励分配原则:把宝贵的可验证数据先「上游」给强 teacher 跑 GRPO 做探索,再以稠密蒸馏的形式「下游」灌给小学生,最后在学生侧再补一段稀疏 RL;具体配方为 forward-KL warmup → OPD on-policy → 学生侧 GRPO 的三段桥 实验效果:在 Qwen3-1.7B 学生固定的前提下,先在 8B teacher 上 RL 再蒸馏全面优于直接在学生上 GRPO;学生侧后续 GRPO 把 MATH 从 75.4% 提升到 78.5%、比 replay baseline 高 2.8 分,AIME 端点也最强 批判点评:「奖励密度」的视角让 GRPO 与 OPD 不再对立而成同一光谱的两端,对资源紧张团队的实践指导价值很高;但结论建立在数学这一可验证任务上,对图像/多模态生成等弱验证任务能否平移仍待验证 趋势观察 视频扩散从「少步」走向「任意步」 — AnyFlow 把蒸馏目标从端点一致性升级到任意区间的 flow map,叠加 on-policy 反向模拟,让一个学生模型在 1/4/16/32 步上都呈现良性 scaling——少步视频生成第一次有了真正的「test-time 预算自由度」 像素扩散借势潜空间预训练 — AsymFlow 用 rank-asymmetric 速度参数化把高维噪声预测限制在低秩子空间,并首次跑通了「FLUX.2 klein 9B 潜空间→像素空间」的微调路径——像素扩散与潜空间扩散开始走向「初始化共享、后期分化」的新协作方式 VAE 不再是配角,而是产品 — Qwen-Image-VAE-2.0 把高压缩 VAE 当作独立产品打磨:Global Skip Connections + 扩展通道 + 文档专项 benchmark,承认了「VAE 决定 DiT 上限」的事实,VAE 进入「文本可读、扩散友好、推理便宜」的三维竞赛 编辑模型与 reward model 同台同尺 — Edit-Compass 把「图像编辑能力」和「reward model 能力」并入同一评测套件,并把 reward model 评测从脱节场景改造成贴合 RL 实战的偏好对——前沿编辑模型的 RL 对齐第一次有了配套的统一坐标系 稀疏-稠密奖励分配成为后训练新共识 — Beyond-GRPO 给出一条简单规则:稀缺可验证数据先在强 teacher 上做稀疏 RL,再以稠密蒸馏下沉到小学生,最后学生侧补稀疏 RL;这一原则同样适用于多模态生成模型的 reward 分配,正在成为下一代 alignment pipeline 的骨架 人工智能炼丹君 整理 | 2026-05-14