搜索到
17
篇与
视频编辑
的结果
-
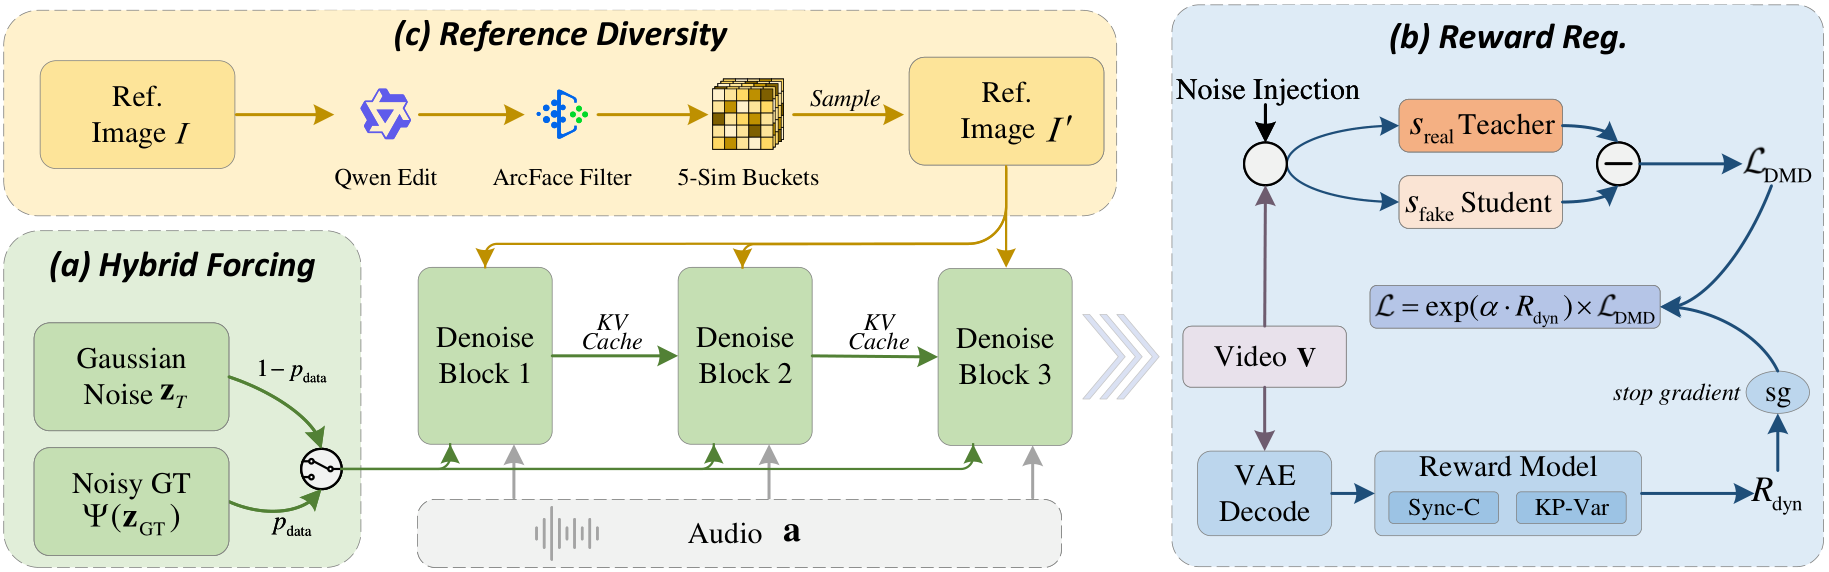
 AIGC 每日速读|2026-10-02|NVIDIA砍掉视觉编码器,PixelUMM图像视频同模 今日 AIGC 论文速览 今日共 10 篇 · 统一理解生成与三维细节 2 篇 · 推理式与可控视频生成 2 篇 · 音视频联合生成 1 篇 · 视频推理加速 4 篇 · 视频文字编辑评测 1 篇 重点论文标题列表 PixelUMM(NVIDIA):像素直进图像视频同模型 BTC3D(香港城市大学(东莞)):分块条件补3D细节 ThinkV2V(港中大):先推理再改视频 LIFT(加州大学圣迭戈分校):只画终帧也能控未来 StereoBind(西电):声源移动立体声跟着走 今日论文速览 1. PixelUMM:像素直进图像视频同模型 PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation | NVIDIA;滑铁卢大学 | arXiv:2609.38597 关键词:统一多模态, 像素空间, 图像生成, 视频生成, 视觉理解 前序问题:统一理解与生成模型通常给同一张图准备两套表示:ViT 特征服务理解,VAE latent 服务生成。这不只让视觉上下文变长,也把成熟的视觉语言预训练与生成接口绑在两条管线上。图像还能直接切 patch,视频却要同时兼容理解侧的采样帧与生成侧的连续时空块,统一接口更难。 本文贡献:PixelUMM 取消预训练视觉编码器和 VAE,把图像变成空间 patch、视频变成时空 tubelet,都只用一层线性投影接入 8B Mixture-of-Transformers。理解走自回归文本预测,生成在原始像素上做 flow matching;共享 attention 让干净条件与带噪目标直接交互。论文还系统比较 patch/tubelet 大小、线性头与卷积解码头,发现卷积头能压掉格子伪影。 实验效果:不使用视觉 encoder/tokenizer 时,PixelUMM 在图像理解 MMMU 得 41.67、视频理解 MVBench 得 70.53;图像生成 GenEval 原始 prompt 为 0.77,用 BAGEL-long 重写后为 0.83,DPG-Bench 为 85.74。视频生成 VBench 总分 83.24,处于统一模型可比区间,但不是各榜第一。 批判点评:“统一”仍有边界:理解与生成使用两套 Transformer expert,只共享 attention,并非一组参数同时做两件事。原始像素 token 让更小 patch 和 tubelet 虽然降低 loss,却直接抬高序列长度与训练成本。作者也提醒各模型训练数据不同,当前表格不能证明 encoder-free 架构本身更优;MMMU 41.67 与主流 8B VLM 仍有明显差距。 2. BTC3D:分块条件补3D细节 BTC3D: Blended Tile Conditioning for Detail-Enhancing Image-to-3D Generation | 香港城市大学(东莞);SB Intuitions;巴塞罗那自治大学 | arXiv:2609.39709 关键词:图像生成3D, 免训练, 分块条件, 细节保真, 流匹配 前序问题:扩散式 image-to-3D 已经能出像样模型,可一旦输入图细节丰富,纹理就糊成一团。主流做法把整张图压成一个全局条件特征,空间信息在这一步被压掉,作者称之为 detail attenuation;而想补细节通常要重训或微调大模型,对 3D 管线代价过高。 本文贡献:BTC3D 是推理时即插即用的免训练框架。它先验证 image-to-3D 模型存在「图像特征可加性」:把局部图块的特征相加,仍能得到语义一致且保留局部细节的 3D 输出。据此把输入图切成若干 tile,各自提取局部条件并按前景权重聚合成 blended tile embedding;再配一个 dynamic conditioning 调度,在扩散后期低噪声阶段逐步加大 tile 条件的权重,早期仍交给全局条件主导结构。 实验效果:在 3D-Arena 与 Toys4K 上,把 BTC3D 接到 TRELLIS、TRELLIS.2、Hunyuan3D-v2.1 上都提升了纹理与视觉保真,且保持全局结构一致。20 名参与者、400 次两两偏好测试中,接入 BTC3D 的 TRELLIS.2 拿到 67.25% 选票(269 票),基线只有 32.75%(131 票),纹理密集的样本优势最明显。 批判点评:收益主要靠人眼偏好而非几何或纹理指标说话,67.25% 也是相对自家基线的增幅,缺少跨方法横评;论文同时承认纹理稀疏的样本上两者偏好接近持平,说明方法吃的是「有没有细节可补」。另外 tile 切分与融合系数 α、β 都是人工超参,动态调度只按扩散时间步推进,不看当前生成内容。 3. ThinkV2V:先推理再改视频 ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing | 香港中文大学;字节跳动;浙江大学;俄亥俄州立大学 | arXiv:2609.38541 关键词:视频编辑, 多模态大模型, 显式推理, DiT, 指令跟随 前序问题:现有指令视频编辑器多把 MLLM 当语义编码器,直接把 prompt 压成条件。碰到“把会被雨淋湿的东西收起来”这类不直接点名目标的指令,模型必须先理解因果与对象关系,再决定改哪里;只抓关键词往往画面能改,却改错对象或违背真实意图。 本文贡献:ThinkV2V 让 MLLM 先显式分析源视频和指令,再通过 learnable-query connector 把推理结果送给多条件 DiT。训练采用从直接编辑到推理密集样本的 progressive curriculum;推理时生成多份候选编辑 prompt,迭代反思并选择最可靠的一份。团队同时整理 ThinkV2V-150K 与专门考隐式意图、因果编辑的 ThinkV2V-Bench。 实验效果:5B 编辑器在 ThinkV2V-Bench 上由 Seed-1.6-VL 评测的 Overall 为 2.72,高于 OpenVE-Edit 的 2.09 和 14B DITTO 的 2.02;Gemini-2.5-Pro 评测下为 2.61,也高于 ICVE 的 2.52。模型在 32 卡上分三阶段训练,最终 720p 推理,以小于多条 10B–14B 基线的规模拿到最佳综合分。 批判点评:核心结论依赖 Seed-1.6-VL 与 Gemini-2.5-Pro 充当裁判,复杂编辑的自动分数仍可能偏向更会“讲意图”的输出。Inference-Time Thinking Scaling 需要多候选生成、反思和筛选,论文没有把新增延迟与算力单独量化。150K 数据由既有模型与筛选流程构建,推理能力有多少来自 MLLM、多少来自数据课程,还缺更严格的因果拆分。 4. LIFT:只画终帧也能控未来 LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation | 加州大学圣迭戈分校;弗吉尼亚大学;Meta;Amazon;Lambda | arXiv:2609.38146 关键词:视频生成, 相机控制, 未来布局, on-policy self-distillation, 图生视频 前序问题:相机大幅移动时,首帧之外会露出全新区域。只给相机轨迹能控制“镜头往哪走”,却不能指定新区域里出现什么;逐帧框轨迹虽然能控布局,标注和交互成本又太高。真正实用的接口应允许用户只在未来关键帧画几个框,同时让中间过程自然长出来。 本文贡献:LIFT 把最后一帧的 bounding box 与局部 prompt 编成稀疏 layout latent,与首帧和噪声视频一起送入 DiT,相机 token 另行注入。训练时用拥有逐帧 dense layout 的冻结教师,在学生自己访问的 ODE 状态上做 on-policy self-distillation,把 dense 轨迹知识蒸馏给只看终帧布局的学生;同一个学生交替学习有布局与仅相机两种模式。 实验效果:LIFT 1.3B 在终帧布局控制上 mIoU 0.51,高于需要逐帧框的 MagicMotion 0.41;同时相机 RotErr 2.97、TransErr 0.59,视频 FVD 99.35。OPSD 只用 500×16=8000 次样本更新,直接或 dense-to-sparse SFT 都要 4000×32=12.8 万次,训练样本量缩到 1/16。 批判点评:布局接口仍只是 2D 框加局部文字,没有深度、朝向、遮挡和实例关系;相机一转,两个框在 3D 中究竟谁挡谁并未显式建模。所谓 1/16 训练量比较的是作者设定的更新预算,并不等于端到端数据与教师成本也缩到 1/16;OPSD 还依赖一个先用 dense layout 训练好的教师。 5. StereoBind:声源移动立体声跟着走 Here the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation | 西安电子科技大学;vivo 蓝图影像实验室 | arXiv:2609.38748 关键词:音视频联合生成, 立体声, 空间音频, 运动轨迹, 跨模态对应 前序问题:联合音视频模型已经能做到“画面里有什么就听到什么”和大致同步,却很少管声音来自哪里。AR/VR 中声源从左往右移动时,左右声道也应连续变化;只用文本或整段视频条件生成声音,往往知道是汽车声,却无法让声像跟随汽车轨迹。 本文贡献:StereoBind 把可见声源的 motion track 作为共同坐标系:Visual Motion Binding 绑定视觉运动与音频 token,Spatial Track Encoder 提供绝对位置,Residual Track RoPE 编码相对位移。团队用真实视频定位跟踪加合成立体声、再配合可控合成场景,构建 StereoWorld-29K,并用 StereoWorldBench 单独评测动态空间对应。 实验效果:在 StereoWorldBench 上,StereoBind 的 ILD-W 为 2.754、SELD-Acc 0.757、SMR-Err 14.86、AST-Ang 0.465、AST-Cal 0.314,五项空间指标都优于表中 Ovi、MiniMax-H3、LTX-2.5/2.3 及两条 video-to-spatial-audio 基线;视觉 Subject Consistency 0.955、Motion Smoothness 0.996,整体画面质量没有明显牺牲。 批判点评:当前条件是一条主要声源轨迹,训练和评测强调水平声像移动;多声源竞争、声源与听者同时运动、遮挡和完整 3D 声场仍被列为未来工作。空间指标全面领先不代表总体音质全面领先,Subject Consistency 0.955 低于 MiniMax-H3 的 0.968,Audio PQ 6.86 也只是略高于 6.81。 6. ReCaVSR:1080p单卡跑21.2FPS ReCaVSR: One-Step Streaming Diffusion Video Super-Resolution with Recycled Latents and Learned Cache Routing | 中国科学技术大学 | arXiv:2609.37831 关键词:视频超分辨率, 流式扩散, KV Cache, 一步生成, 实时推理 前序问题:扩散式视频超分画质好,却很难满足直播级延迟。现有流式方案要么多步去噪,要么每层都保留完整历史 KV;但视频超分当前帧已有低清观测,上一块超分 latent 也带着局部时序信息,继续为所有层保存同样长的历史既占显存又拖慢注意力。 本文贡献:ReCaVSR 基于 Wan2.2 做一步流式超分,把上一块生成的 SR latent 直接回收为下一块条件,再为每个 DiT 层学习不同的历史缓存范围,训练完导出固定路由。生成器用 sequential self-rollout 对齐真实因果推理;Multi-Scope Query 判别器同时看全局、空间窗口和时间 tube;LR-conditioned FlashDecoder 在解码时再次利用低清观测。 实验效果:单张 A100-80GB 输出 1080×1920 时达到 21.20 FPS、峰值显存 15.16GB,相对 FlashVSR Tiny 快 2.72 倍、少用 38.0% 显存,首个完整 RGB 输出的模型时间为 0.982 秒。LongVSR60 上 MUSIQ 57.89、CLIP-IQA 0.4932、DOVER 0.6075,后三项都高于列出的流式基线。 批判点评:它并非所有重建指标都第一:REDS30 的 PSNR 21.67 明显低于 RealViformer 23.32,说明生成式纹理仍会牺牲逐像素保真。缓存路由在训练后固定,遇到运动强度突变或硬切镜不能自适应;论文的长视频测试还是单段连续镜头,跨场景时旧 latent 和 KV 会不会污染新镜头尚未验证。 7. PARK:稀疏注意力快1.76倍 PARK: Accurate Block Retrieval for Sparse Attention in Video Diffusion Transformers | 华南理工大学 | arXiv:2609.38978 关键词:视频生成, 稀疏注意力, DiT, block retrieval, 免训练加速 前序问题:视频 DiT 的稀疏注意力通常先把 query 与 key 分块求均值,再按块检索。这个近似有两重错位:Softmax 前把多个 query 平均会抹掉各自偏好的 key;在原始 key 空间做欧氏聚类,也不保证同一簇的 key 在当前 query 下拥有相似 QK 分数。检索一旦选错块,要么掉画质,要么为了兜底算太多。 本文贡献:PARK 保留块内每一个原始 query,分别对 key block 做归一化后再平均分布,避免 query-centroid 代替整块偏好;key 侧则从当前 query 推导度量,先变换 key 再做 K-means,让欧氏距离对应 QK-score 误差。方法完全免训练,并把 PAMA 检索写成融合 GPU kernel,把准确率收益留住而不让检索开销反噬。 实验效果:在 Wan2.1-1.3B 上,PARK 将单次测试从 745 秒降到 423 秒,端到端 1.76 倍加速,同时 PSNR 27.52、SSIM 0.908、LPIPS 0.177,优于同表其他稀疏基线。跨 Wan2.2-14B、Wan2.1-14B、Wan2.1-1.3B 和 HunyuanVideo 四个模型,相对 dense 的加速范围为 1.53–1.76 倍。 批判点评:收益建立在四个视频扩散模型和固定检索配置上,作者明确没有验证 LLM 或其他多模态任务。主表中 Wan2.2 的 Aesthetic Quality 65.29% 仍低于 dense 的 65.56%,Wan2.1-1.3B 的 Background Consistency 96.87% 也低于 dense 的 96.99%;它更像高质量近似,而不是无损替换。 8. UnStep:免训练把视频推到50FPS UnStep: Training-Free Acceleration of Causal Video Diffusion with Fewer Steps Than Distillation | Meta 超级智能实验室 | arXiv:2609.32518 关键词:视频生成, 因果扩散, 免训练加速, KV Cache, 推理优化 前序问题:四步因果蒸馏已经比 50 步双向教师快,但 Self Forcing 在 H100 上仍只有 17 FPS。步数继续砍到一两步会掉质量,历史 KV 随视频变长继续膨胀;同时当 DiT 已经很少步,RoPE、cache 索引、attention 调度和 VAE 解码这些过去被遮住的系统开销反而成了瓶颈。 本文贡献:UnStep 是不改权重的推理 wrapper:后续块从四步减到两步,只保留 sink 加最近窗口;把已生成 latent 重新加到近干净噪声,再复用原有 clean-cache pass 做一次修正,并对 attention 的 V/O 投影做截断 SVD 抵消少步误差。系统侧再融合 RoPE、缓存系数、固定长度 attention,并把 VAE 改成 FP16 与 channels-last 卷积。 实验效果:同一 Self Forcing checkpoint 在 H100 上从 17.0 FPS 提到 49.8 FPS,VBench Total 反而从 84.31 到 84.56;相同 wrapper 套在 Causal Forcing 和 LongLive 1.0 上也都约 49.8 FPS。若推理时改成一步,H100 达 59.6 FPS;GB200 最快报告 77 FPS,全程没有重训。 批判点评:所有超参数只在 Self Forcing、5 秒 T2V、单张 H100 这一套设置上调过,迁移结果证明“能用”,不代表每个 checkpoint、GPU、任务和长度都最优。50 FPS 的成绩同时叠加算法减步与大量 H100 专用 kernel 优化,不能全部归功于新的生成算法;而训练自由的约束也限制了更激进稀疏或量化后的质量恢复。 9. DeCoPrune:剪85%缓存仍保上下文 DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency | 南洋理工大学;清华大学;普林斯顿大学 | arXiv:2609.39096 关键词:自回归视频, KV Cache, 训练自由剪枝, 长上下文, 一致性 前序问题:自回归视频扩散把每段历史都塞进 KV Cache,时间越长,显存和 attention 成本越大。固定滑窗只看远近,attention 权重或相似度剪枝又不直接回答“这个历史块是否提供了不可替代的信息”,所以容易把稍后 prompt 才会重新提到的物体细节一起删掉。 本文贡献:DeCoPrune 用同一条去噪轨迹里的中间 probe 与最终预测做差:没有历史支持时难以稳定去噪、step-to-final discrepancy 较大的 token 被判为更需要上下文,因此保留高差异 token,再物理压紧历史 KV。论文同时构建 CMBench,用一分钟上下文中的物体取放、场景恢复等续写任务专测“前文记没记住”,并提供按 attention head 类型分组的 HS 版本。 实验效果:主设置剪掉 85.43% 历史 KV,续写 FPS 从 FullKV 的 1.568 提到 6.489,快 4.14 倍;CMBench DINO 从 0.6803 只降到 0.6701。head-specialized 版本在 86.19% 剪枝率下 DINO 为 0.6783,几乎追平 FullKV,且 VBench 的图像质量项没有出现系统性崩塌。 批判点评:“剪掉 85%”并不等于显存有硬上限,作者明确承认剩余缓存仍随视频长度线性增长。Denoising consistency 是 future-agnostic 的:某个细节此刻很好去噪、因此被删掉,但未来指令恰好再次询问它时仍可能失忆。主干又集中在 LingBot World v2,其他开源模型的分钟级 FullKV 本身就不稳定,方法与 backbone 上限难完全拆开。 10. ViTeX-Bench:387段视频检验动态改字 ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing | 得州农工大学 | arXiv:2609.40356 关键词:视频编辑, 场景文字, 评测基准, 时序一致性, 编辑局部性 前序问题:视频里的招牌、球衣或屏幕改字,要同时满足字符串正确、跨帧不漂、背景不被改。通用视频编辑指标可能把“画面很稳但根本没改字”的结果评得很高,静态 OCR 又看不见闪烁与字符漂移,现有公开数据也缺少真实视频的成对编辑参考。 本文贡献:ViTeX-Bench 收集 387 段 720p、120 帧、24 FPS 真实视频,其中 230 段提供人工复核的成对训练编辑,157 段冻结测试。评测拆成文字正确性、视觉/时序质量、编辑局部性三轴共 13 个指标,并用 OCR 校准、人评相关性与 Pareto 前沿解释取舍;配套的 ViTeX-Edit-14B 用随运动对齐的 glyph-video 条件微调 VACE。 实验效果:八条基线中,ViTeX-Edit-14B 在 video-native 编辑器里 CharAcc 最高,为 0.688,text-crop Warp 1.53 也最低;相较 VideoPainter 的 CharAcc 0.619 提升 0.069。但逐帧 FLUX-Text 的 CharAcc 仍达 0.737,代价是 Warpc 13.01、字符跨帧严重漂。人评与 OCR 方法排名的 Spearman 相关系数为 0.95。 批判点评:这个基准把“漂亮、正确、稳定、局部”拆开是优点,也暴露了参考模型并非全面第一:ViTeX-Edit 的 SeqAcc 0.341 低于 FLUX-Text 0.528。数据以清晰、局部、拉丁文字为主;非拉丁切片里除 AnyText2 外其余编辑器 CharAcc 都低于 0.19,严重运动、曲面文字、密集排版的覆盖仍不足。 趋势观察 加速的战场从「少走几步」挪到了「每层只记该记的」 ReCaVSR 给每个 DiT 层学一个缓存跨度,PARK 修正稀疏注意力的块检索误差,UnStep 把两步采样、限窗 KV 与 kernel 优化叠进同一个免训练 wrapper,DeCoPrune 则用去噪一致性挑出真正依赖历史的 token,四篇都指向同一件事:视频模型已进入少步时代,下一轮效率竞争发生在缓存、检索与运行时细节。另一头,PixelUMM 去掉视觉编码器让像素直进统一模型,说明「统一」正在从拼模块转向砍模块。 人工智能炼丹君 整理 | 2026-10-02 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-24|阿里Qwen3.8-Omni发布,视频推理输Gemini 今日 AIGC 论文速览 今日共 10 篇 · 全模态基座与语音智能体 2 篇 · 视频编辑与生成智能体 2 篇 · 生成推理加速与量化 2 篇 · 视觉Tokenizer与音视频生成 2 篇 · 奖励模型与生成安全评测 2 篇 重点论文标题列表 Qwen3.8-Omni(Qwen Team, Alibaba Group):原生全模态智能体,百万上下文 VideoX-Qwen(Nanjing University):120万对指令视频编辑数据 QuantWM(Harbin Institute of Technology (Shenzhen)):2比特KV量化压住时序闪烁 Flash-dLLM(VILA Lab, MBZUAI):扩散LLM提速五倍且不伤精度 VideoGen-Agent(Princeton University):RL教会智能体用工具做视频 今日论文速览 1. Qwen3.8-Omni:原生全模态智能体,百万上下文 Qwen3.8-Omni: Towards Native Omni-Modal Agents | Qwen Team, Alibaba Group | arXiv:2609.25611 关键词:全模态智能体,稀疏MoE,百万上下文,视频剪辑,插件框架 前序问题:全模态模型此前主要强调感知和交互,真正的长程智能体任务——调工具、跑多步、把一段素材剪辑成片——要靠外挂 harness 拼,而现有 agent harness 对音频和视频没有原生支持。缺一个在多模态上原生 co-training、又不丢文本能力的底座。 本文贡献:发布 Qwen3.8-Omni-Flash:Thinker 继承 Qwen3.8-Next 的稀疏 MoE 骨干(GDN 与交错注意力混合),上下文扩到 100 万 token;原生多模态 co-training 把文本侧的智能体能力迁移到音视频任务,再经多教师蒸馏合并领域专精策略;配套开源 Qwen-MM-Plugins 插件框架与 Qwen-Live-Harness 实时交互框架。 Qwen3.8-Omni-Flash is a unified end-to-end model capable of processing multiple modalities 实验效果:WildClawBench-MM 从上代 34.5 涨到 71.0(+36.5)、AgenticVBench 14.5→36.8、OmniGAIA 57.2→74.0;Video-MME-v2 47.9→65.0。开智能体模式后 LVOmniBench 63.3→73.6,OmniVideoBench 单次 query 消耗 token 从 14.6 万降到 7.9 万(约 -45.7%)。 The overview of Qwen3.8-Omni-Flash-Realtime and Qwen-Live-Harness 批判点评:摘要口气很大,但表格里对手没输干净:Gemini 3.8 Flash 在三个视频推理基准的静态设置上全面更高,开智能体后 OmniVideoBench(70.1 vs 67.8)和 Video-MME-v2 仍被压着;teaser 图的 OmniCap-IF 一栏 Flash 拿 20.2,落在上代 Plus 的 28.3 和 Muse Spark 1.2 的 26.8 之后。所谓「领先」主要立在自己参与的新评测上。 2. VideoX-Qwen:120万对指令视频编辑数据 VideoX-Qwen: Data-Centric Instruction-Based Video Editing | Nanjing University;Jiutian Research | arXiv:2609.26015 关键词:指令视频编辑,数据合成,Qwen3-VL,Wan,成对监督 前序问题:通用视频编辑缺的不是模型而是监督:编辑要在执行指令的同时保住无关主体、场景结构和时序连续性,而成对(源视频、指令、目标视频)数据的规模和任务覆盖都远远不够,指令视频编辑长期落后于图像编辑。 本文贡献:一条可扩产的数据流水线:Qwen3-VL-235B 做源视频筛选与目标解析,加/删走 SAM3 加 Minimax-Remover,替换/属性走 Qwen-Image-Edit 首帧编辑加 WanAnimate 传播,自动通过率 89%,产出 120 万条方向性编辑对(每组任务超 40 万条)。模型侧统一 Qwen-Wan 编辑器:多模态语义条件加稠密源视频 latent 引导,图像-视频三阶段渐进训练。 Paired-video construction pipeline 实验效果:100 例对比 UniVideo 和 Kling O1:11 项指标里 9 项均值最优,覆盖指令遵循、编辑质量、内容保持、结构与感知相似度和视频分布质量。 Qualitative comparisons on compound and attribute editing 批判点评:「9/11 最优」的另一面是 11 项里输了 2 项,且对比规模只有 100 例;加/删两条数据路线直接复用 Minimax-Remover 和 WanAnimate,编辑对质量上限被这些现成生成器封顶。论文把「逐条校验富化后的指令」画成 proposed extension(虚线框),等于承认 120 万对里指令与实际编辑的一致性还没有被逐一验证。 3. QuantWM:2比特KV量化压住时序闪烁 QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for World Models and Video Generation | Harbin Institute of Technology (Shenzhen);National University of Singapore | arXiv:2609.26425 关键词:KV cache量化,视频生成加速,世界模型,注意力补偿,训练无关 前序问题:视频生成和世界模型的 KV cache 是部署瓶颈,已有 2-bit 量化方法在 VBench 这类指标上「几乎无损」,但作者实测发现:指标没掉,画面却在闪——逐帧指标天生看不见时序问题。 本文贡献:训练无关、严格因果的 2-bit KV 量化框架。诊断先行:Key 的量化重建误差比 Value 小,输出退化却更大,因为小扰动就能改变 QK^T 注意力 logits、挪走 Query 选中的时序-空间 token。对症两招:QSAC 聚类联合历史 Query 敏感度与残差范围选 INT2 友好的 Key 质心;PSAC 用低秩投影沿 Query 主子空间补偿残余 Key 误差。 Overview of QuantWM's inference system 实验效果:Causal-Forcing、LingBot-World-v2、HY-World 1.5、Matrix-Game-2、Longcat-Video 五个底模上,KV cache 最高压缩 6.20×,图像与视频质量指标全面超过现有 2-bit 方法,额外开销有限,且保持严格因果可流式推理。 Visual comparison of BF16, K16V2, K2V16 and K2V2 on world models 批判点评:这篇最值钱的是诊断而不是方法:它解释了为什么「VBench 几乎无损」的结论靠不住——逐帧指标对时序闪烁盲。但时序改善的验收仍以看图为主,论文没给出时序稳定性的量化指标;6.20× 的压缩上限是在 93 帧生成这一档测的,更长序列的收益未报告。 4. Flash-dLLM:扩散LLM提速五倍且不伤精度 Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs | VILA Lab, MBZUAI | arXiv:2609.26796 关键词:扩散语言模型,KV cache,并行解码,Triton,推理加速 前序问题:扩散 LLM 靠并行去噪生成文本,但双向注意力让自回归那套 KV cache 直接失效;已有加速工作把 KV cache 和并行解码分开研究,两者合用时 GPU 显存 I/O 反而成了主要瓶颈。 本文贡献:训练无关两件套。Flash-Cache:把 QKV 投影、RoPE、cache 写入、注意力计算融进一个 I/O 感知的融合 Triton 核,砍掉冗余访存;Flash-Verify:让 dLLM 自己既当 drafter 又当 verifier 做草稿-验证式并行解码,不挂辅助模型。 Overview of Flash-dLLM 实验效果:LLaDA-1.5 上对此前最强的 Elastic-Cache 在 GSM8K/HumanEval 分别提速 5.1 倍和 11.0 倍;Flash-Cache 加 Flash-Verify 达到精度 83.02%、吞吐 210.6 tokens/s(Elastic-Cache 为 82.79%、41.7);batch 16 显存约 26GB,对照 Fast-dLLM 的 50GB 降约 48%,后者在 batch 24 直接 OOM。 Throughput and peak memory versus batch size on GSM8K 批判点评:赢面都在 dLLM 阵营内部:可扩展性图里自回归的 Llama3 在 batch 32 的吞吐仍高于 Flash-dLLM,「扩散 LLM 加速后追平 AR」还没有发生。精度与吞吐是硬权衡(80.2% 到 83.2% 对应 278 降到 186 tokens/s),宣传里 81 倍是对无 cache 基线的倍数,直接引用容易被误读成对 SOTA 的提速。 5. VideoGen-Agent:RL教会智能体用工具做视频 VideoGen-Agent: Reinforcing Video Generation Agents | Princeton University;Stanford University;UC Davis;MMLab, CUHK;BenchFlow;GWU | arXiv:2609.24997 关键词:生成智能体,强化学习,工具调用,视频生成,VABench 前序问题:视频生成模型面对需要专业知识、特定身份、物理一致或时序事件的 prompt 经常直接翻车:太极招式做不对、指定角色画不像、物理参数乱来。单靠扩大底模收益有限,缺一个会检索、仿真、检测来补信息的生成智能体。 本文贡献:六类任务上训一个共享策略:先在教师轨迹上 SFT 建立工具使用习惯(检索文本/图像、仿真、目标检测、深度估计等),再用类别感知混合奖励(工具调用合法性、任务适配度、视频质量)做 RL。配套 VABench:600 条 held-out prompt,覆盖程序知识、单/多实体身份、物理一致、场景合成、多镜头时序。 Overview of VideoGen-Agent 实验效果:VABench 上从底模 56.5 提到 75.6(+19.1 分);把生成工具换成更强的 Seedance 2.0 后,不重训智能体就到 86.1;人评 84.3% 偏好升级配置而非最强独立基线。 Qualitative comparison on Procedural Knowledge generation 批判点评:86.1 这档数字藏着归因问题:从 75.6 到 86.1 的增量完全来自换生成工具,智能体一行代码没动——agent 框架的收益上限被底模和工具质量强绑定,这一段「白捡的分」其实是底模的分。混合奖励里「视频质量」一项依赖 VLM 裁判打分,裁判偏差会直接写进策略,论文未讨论防 reward hacking 的机制。 6. Vorch-Human:一个模型统一说话人与歌声视频 Vorch-Human: Unified Multi-Task Human-Centric Generation via Long-Horizon Continuation | Vorch Team;Harbin Institute of Technology, Shenzhen;Tongji University | arXiv:2609.26117 关键词:音视频统一生成,数字人,扩散transformer,长视频,身份保持 前序问题:以人为核心的音视频生成被拆成好几个模型:语音驱动数字人、参考音色合成说话视频、外观加声音参考生成场景,各自训练各自维护。它们本质上是同一组模态、只是条件不同的任务。 本文贡献:双流音视频扩散 transformer,在传统 noisy 音频/视频接口之外增加 clean 条件 token 组,用 per-token 任务嵌入、时间位置类型、条件掩码和共享多模态 prompt 编码器,把驱动语音、音色样本、首帧、主体图统一进一个模型;两级数据管线做说话人聚类与跨片段身份串联;长视频靠冻结 latent 前缀递归、每段只生成新后缀。 Role-aware unified human-centric architecture 实验效果:5 分钟长生成保持身份一致与音画同步;GSB 人评对 LongCat-Video-Avatar-1.5:动作/姿态/表情净偏好 +46.9%,口型准确度 +47.5%,单人音视频驱动整体净偏好 +27.1%。 Raw GSB breakdown for LongCat-Video-Avatar-1.5 批判点评:同一张 GSB 图的另一半:视觉质量净偏好 -13.1%,多人场景再输 -9.2%——赢的两项全在「跟音频对齐」上,纯画质反而输给 LongCat,摘要里 strong identity preservation 的措辞没覆盖这个短板。署名主体写作「Vorch Team」,机构披露不完整,技术报告性质明显。 7. StableVQ:三招治住VQ码本训练崩溃 StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training | Huazhong University of Science and Technology;KlingAI Research;South China Normal University | arXiv:2609.26774 关键词:VQ tokenizer,码本利用率,训练稳定,自回归生成,ImageNet 前序问题:共享投影 codebook 把 VQ tokenizer 的利用率推上去之后,训练稳定性成了新瓶颈:码本利用长期趴在低位、出现永久死码、甚至在 26 万步附近突然崩到 0。现有方法各打各的补丁,缺少对根因的解释。 本文贡献:把根因归结为 Encoder-Decoder 与 Codebook 的「纠缠训练」:两个子系统各自都无法独立完成任务,只能靠碰巧合作维持。三个零参数改动:Dynamic STE 按量化距离压低不可靠梯度;Region VQ Loss 让激活码向邻近未激活码按比例传播目标;Decoupled Schedule 给两个子系统各配独立学习率调度。 Three characteristic failure modes of VQ training 实验效果:ImageNet 256 重建:262k 码本 120 epoch rFID 0.92(对照 FVQ 1.29、SimVQ 3.16),16k 码本 1.13;鲁棒性指标 UR-AUC 60.59,比 FVQ 的 8.08、SimVQ 的 2.17 高一个量级;只用单个线性投影层就追平需要 ViTBlock 投影器的 FVQ。 Qualitative reconstruction comparison with a 16k codebook 批判点评:主张是「治崩溃」,但主表里 FVQ 和 SimVQ 在各自标准配置下利用率本来就是 100%,差距全在故意制造码本-token 分布错配的鲁棒性测试里拉开——这三招买的更像「最坏情况的保险」,常态训练收益主要是 rFID 那 0.2 到 0.4。下游生成只给「competitive」,FID 全表在附录。 8. Qwen-Audio 3.1:全双工误答率从73%压到13% Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction | Alibaba Token Foundry, Alibaba Group | arXiv:2609.25176 关键词:全双工语音,语音智能体,GRPO,在线蒸馏,工具调用 前序问题:实时语音助手要同时干三件互相打架的事:理解还在演化的请求、执行动作、遵守对话规则(何时说、何时闭嘴、是否插话)。上一代在背景有人说话时 73% 的轮次会错误应答,全双工的「闭嘴」比「会说」更难。 本文贡献:Think/Act/Speak and Coordinate 三层:Core-Cocktail SFT 加 M2-OPD 多教师在线策略蒸馏迁移文本能力;自进化可执行环境加多粒度 rollout 的 GRPO 教工具调用与参数落地;全双工决策模型独立管「说不说」。另给 Voice Harness 前后台原型:对话在前台、任务在后台异步跑。 Qwen-Audio-3.1-Realtime model framework for continuous spoken interaction 实验效果:tau-Voice 半双工改编任务成功 78.4%→82.0%(Airline 64.0%→74.0%);Full-Duplex-Bench v1.5 背景语音应答率 73.0%→13.0%、恢复率 0.26→0.87;FLEURS 宏平均 WER 9.01→3.98;WebSearch1K 检索调用从 4.37 次降到 1.05 次(-76%)。 Qwen-Audio-3.1-Realtime post-training pipeline 批判点评:两个回撤写在正文里:EVA-A 的 Mean 分从 70.50 掉到 66.26,WebSearch1K 的 F1 从 60.87% 降到 58.61%——少说话、少调用是把双刃剑;Daily Chat 和 persona 交互的 Spoken 分也在微跌。摘要只报提升项,回撤要翻到结果表才看得见,读技术报告别只读开头。 9. RULER:六项Rubric奖励治SVG生成 RULER: Instance-aware Rubric Rewards for SVG Generation | Ant Group;The Hong Kong University of Science and Technology (Guangzhou);Independent Researcher;University of Oxford | arXiv:2609.25270 关键词:SVG生成,Rubric奖励,GRPO,reward hacking,视觉裁判 前序问题:自然语言生成 SVG 是没有绝对真值的开放任务:CLIP、Aesthetic 这些在自然图像上标定的标量指标迁到风格化矢量图上会误判,直接拿来当 RL 奖励还会触发 reward hacking——评测和优化同时失去可靠信号。 本文贡献:实例化 rubric 奖励:每条指令由前沿模型生成六项 rubric(语义、视觉、风格三轴),裁判 VLM 逐项给渲染 rollout 打分,加权满意度经 GRPO 优化。rubric 只从文本推导,不需要配对 SVG 真值、也不需要人类偏好标注。训练用 Qwen3-VL-8B 做裁判,与评测用的 GPT-5-mini 分开。 Qualitative comparison of scalable vector graphics generation between RULER and four baselines 实验效果:MMSVG-Illustration/Icon 上 rubric 分从 0.432/0.395 提到 0.693/0.683,超过专用 SVG 模型、追平大得多的 DeepSeek-V3;人评盲测对自家 Qwen3-8B 骨干胜率 89.7%、对 Qwen3-32B 66.1%;消融显示去掉语义轴掉 10.1%、换静态 rubric 掉 22.7%。 Ablation of rubric design on MMSVG-Illustration and MMSVG-Icon 批判点评:「追平 DeepSeek-V3」在可视化图里并非全赢:五个示例里同心圆靶一栏 DeepSeek-V3 的 0.94 高于 Ours 的 0.92;Ours 的 CLIP 分(0.28-0.35)与基线几乎无差,说明传统指标确实分不出好坏,但反过来也意味着 rubric 分数与人类直觉的对应完全押在裁判 VLM 上。人评规模只有 150 条 prompt。 10. Moderation Gap:三成有害视频骗过逐帧审核 The Temporal Moderation Gap: Text-to-Video Safety Filters Are Blind to Harm in Motion | National University of Singapore;University of New South Wales;Fuzhou University | arXiv:2609.26233 关键词:文生视频,安全审核,帧序,红队测试,评测方法 前序问题:T2V 服务的安全栈是从图像生成继承的:关键词过滤加随机抽 8 帧逐帧检查。这套栈对「伤害只存在于帧序」的视频天然失明——闯红灯、往转动的车床里伸手、误服药片,每一帧单看都无害。 本文贡献:理论上证明:任何忽略帧序的审核器只要放行某片段,就必然放行其良性重排。实测未修改的基准 prompt 就能让 32.7% 的 Sequential-Action 目标落入审核盲区,改写、拆场景、反馈式搜索都无显著改善(McNemar p≥0.12)——不需要任何 prompt 技巧就能触发。修复方向是读帧序:时序感知检测器 AUC 0.74,逐帧检查等于抛硬币。 The temporal moderation gap 实验效果:对 97 帧全部打分发现:约三分之一的交付片段只是把不安全帧藏起来,其余按帧序整体看仍有害,尽管每一帧都通过了审核;用户实验确认人能区分片段与其重排的安全性。 Three Sequential-Action gap clips 批判点评:论文顺带揭了一个测量陷阱:在搜索出的 prompt 上用它自己的渲染种子打分,会把 7.5% 的单次生成率虚标成 46.7%——这个坑对所有做安全评测的人都成立。但修复方案的 AUC 0.74 离可用尚远,且全部证据来自 Sequential-Action 一类动作伤害,跨帧累积的暗示性内容等其他类型未覆盖。 趋势观察 全模态模型开始从「能听会说」转向「能干活」 Qwen3.8-Omni 把上下文推到 100 万 token 并配好插件与实时 harness,Qwen-Audio-3.1-Realtime 则把「何时闭嘴」当成一等公民单独训练。两条线指向同一件事:多模态模型的竞争正在从感知指标挪向任务成功率,模型外面的 harness、插件和记忆管理层开始决定产品形态。 视频编辑与视频生成的瓶颈,先卡在数据而不是模型 VideoX-Qwen 用 120 万对合成编辑数据喂出一个统一编辑器,VideoGen-Agent 则用六类任务的教师轨迹加 RL 教模型调用工具。两者都在补同一个洞:指令视频任务缺少可靠的监督与反馈信号,谁的流水线能稳定产出高质量配对数据,谁就拿到上限。 加速这条线在「省显存」和「省访存」上分头推进,且都是训练无关 QuantWM 发现 2-bit KV 量化的真正受害者是时序稳定性而非单帧指标,用注意力补偿把闪烁压回去;Flash-dLLM 则把瓶颈定位到 GPU 显存 I/O,用融合核加自验证并行解码把吞吐推到 210.6 tokens/s。共同点是都不动训练,靠推理系统层的重新安排。 评测开始把「裁判本身」当成被审对象 RULER 证明静态标量指标在 SVG 上失灵,改用逐指令生成的 rubric 当奖励;Moderation Gap 则证明逐帧安全审核对帧序盲。两者都在说同一件事:在开放生成任务里,裁判的构造方式本身就是被评测对象,默认信任任何单一打分器都危险。 人工智能炼丹君 整理 | 2026-09-24 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
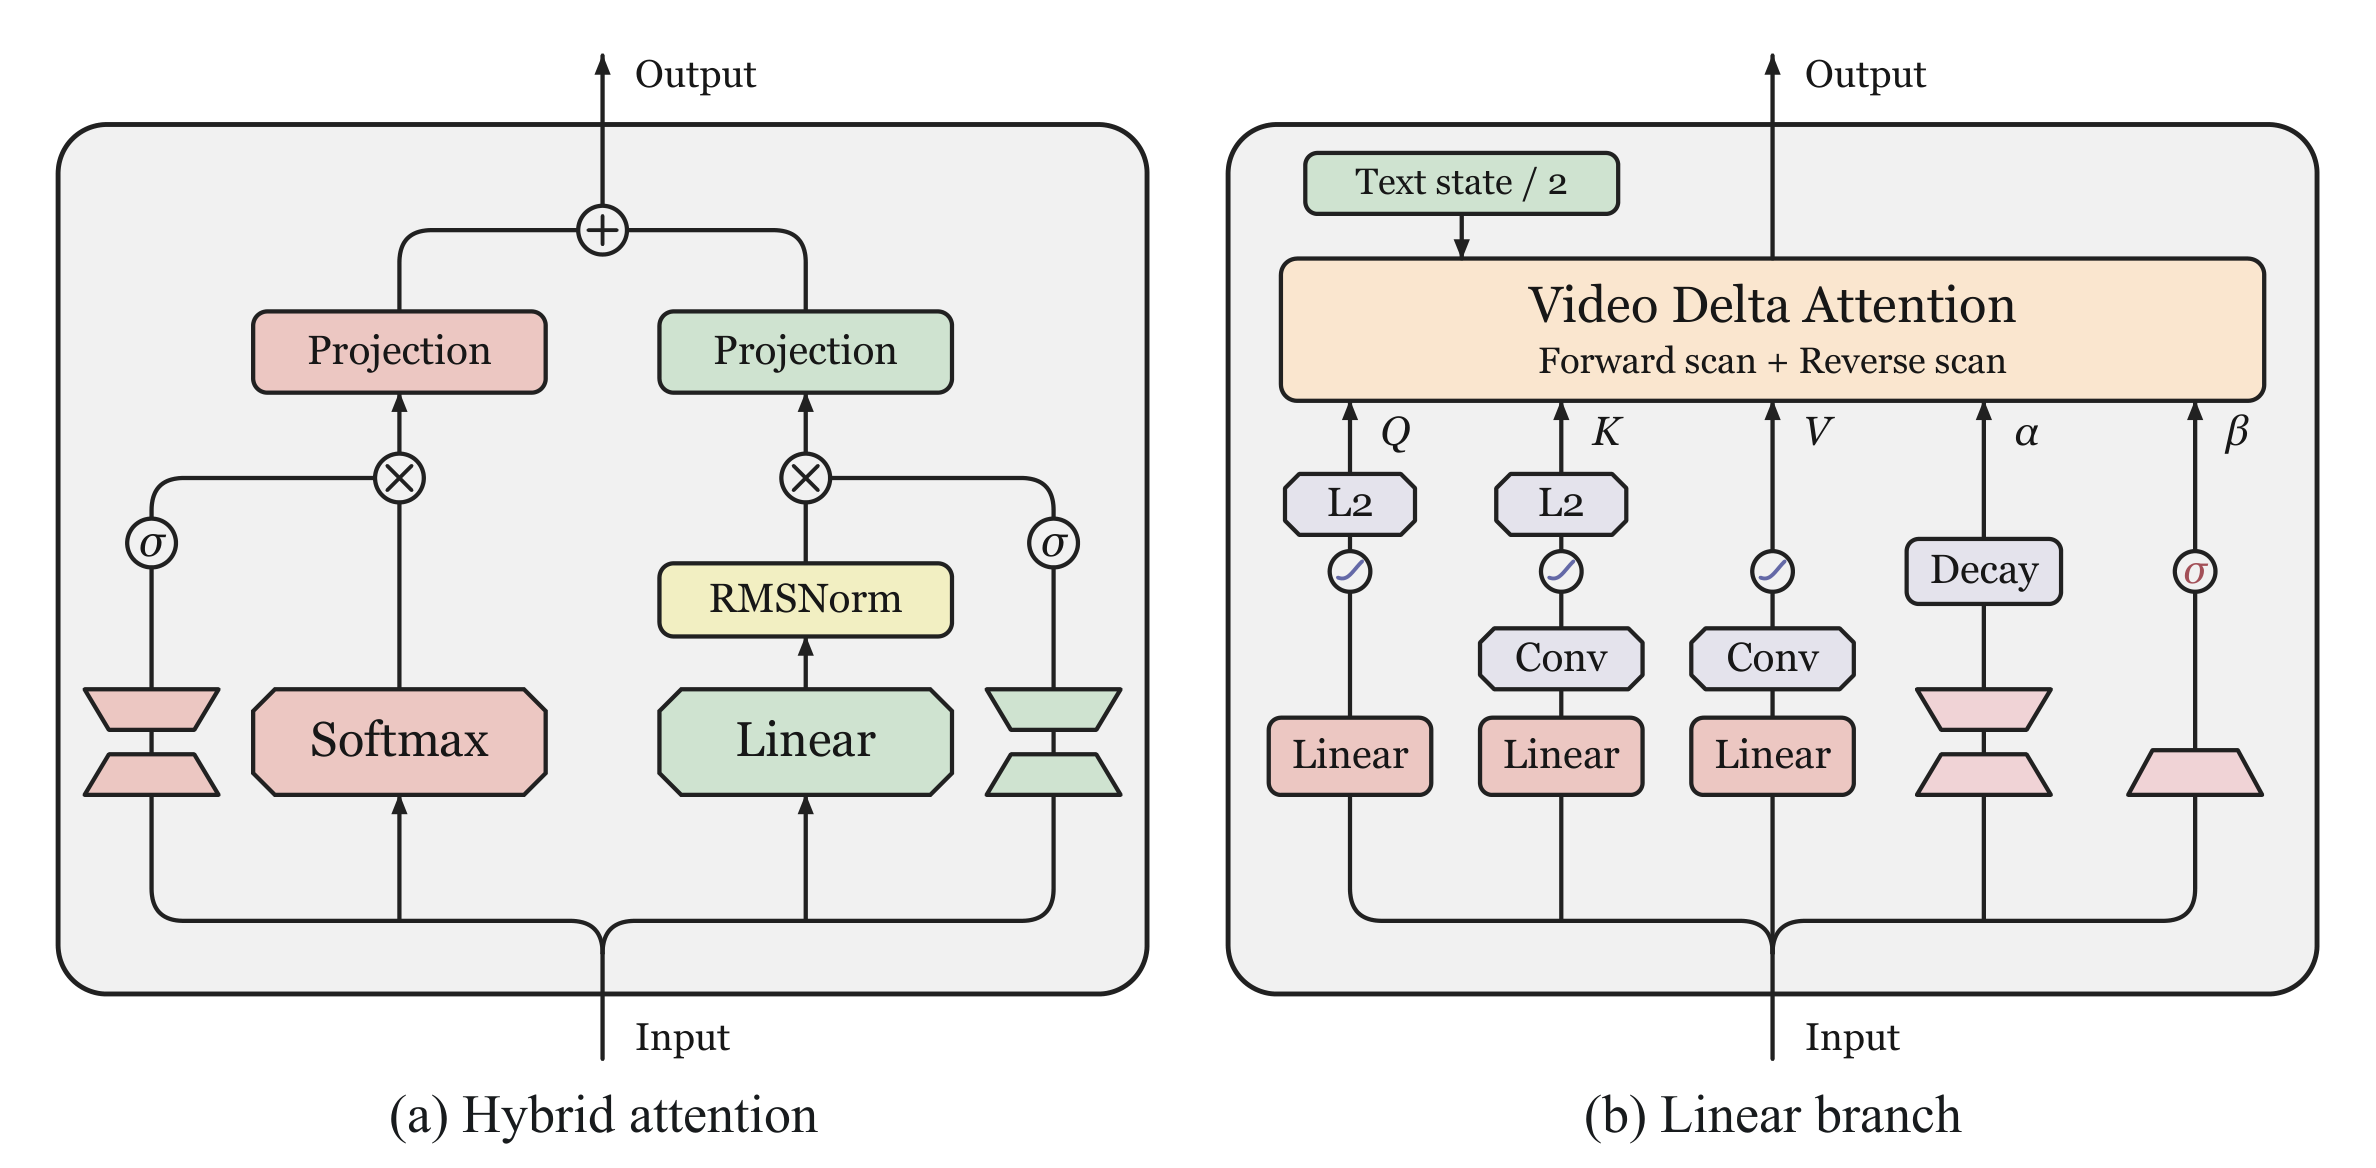
AIGC 每日速读|2026-09-21|伯克利线性注意力让H3视频快14.5倍-VDN 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 Video DeltaNet(UC Berkeley × Impossible Inc. × UT Austin):线性注意力让H3快14.5倍 dQwen3.5(University of Texas at Austin):混合骨干省一半适配token Edit-VAR(中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学):免训练免反演改视频 Paint-Anything(ByteDance Seed × 浙江大学 × 南京大学):写个十六进制就能上色 StepAudio 3 Music(StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego):先写ABC谱再生成5分半歌 今日论文速览 1. Video DeltaNet:线性注意力让H3快14.5倍 Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation | UC Berkeley × Impossible Inc. × UT Austin | arXiv:2609.20744 关键词:视频扩散模型,线性注意力,混合注意力,推理加速 前序问题:视频扩散模型每一步去噪都要把又长又宽的时空 token 序列过一遍注意力,算力全压在这里。线性注意力在大语言模型里已经被验证好用,但直接搬到视频模型上会丢掉细粒度交互,画面质量跟着掉——于是「省算力」和「保质量」一直是二选一。 本文贡献:论文提出 Video DeltaNet(VDN),不做纯替换而是双分支并存:局部 Softmax 注意力管近处的细粒度交互,双向线性记忆管长程视频上下文。线性分支的核心是 Video Delta Attention(VDA),它不按 token 逐个更新记忆,而是以「帧」为单位、把该帧的全部空间 token 一起吸收进去,一帧只更新一次。两个分支各有独立的输出投影和可学习门控来校准配比;适配则走分阶段的教师对齐配方(Stage A1 先单独对齐每个线性分支,A2 再端到端训练组装后的混合层),把新通路渐进地塞进已预训练的模型里。作者把 VDN 落在 MiniMax H3 上,只对 video-to-video 这类交互用混合注意力,凡是牵涉文本或音频的交互仍然保留 Softmax。 实验效果:配合八步蒸馏和优化过的 SGLang 服务栈,VDN-H3 在 8 张 NVIDIA B200 上生成 14.3 秒 768p 视频,DiT 去噪只用 6.70 秒,相对同样 8 卡、50 步的 dense H3 基线提速 14.5 倍。质量方面:50 步时 Stage B 后的 VDN-H3 与蒸馏前的 Dense H3 基本持平(美学、技术、学习质量、FIRM 各项接近,仅两个端点保真度指标略降);八步时在五项无参考质量指标上全部最高,VQA_T 比 FastH3 v2 高 10.78 分;四步时同样在五项上超过 Dense H3 加 Larry 适配器与 FastH3 v1,VQA_T 领先 FastH3 v1 达 12.64 分。 批判点评:这篇的价值在于把「线性注意力用于视频」从整体替换改成了按交互类型分流:视频与视频之间用线性,涉及文本、音频的跨模态交互留给 Softmax,承认了不同交互对精度的敏感度本就不一样,比一刀切务实得多。以帧为单位更新记忆也和视频 tokenizer 的时间结构对齐(H3 的 VAE 按五个连续潜帧为一个时间块解码,窗口顺着它走以免 Softmax 边界切断 tokenizer 的自然时间单元)。要留意的是 14.5 倍里混进了八步蒸馏和服务栈优化的贡献,架构本身的净收益要看 50 步那组对照;论文也明确说八步那组的显著性标记是各变体与 Dense 50 比,并非 VDN-H3 直接对 FastH3。另外全部结论都长在 MiniMax H3 这一个骨干上,换模型是否还成立尚无证据。 2. dQwen3.5:混合骨干省一半适配token dQwen3.5: Hybrid-Attention Diffusion Language Models | University of Texas at Austin | arXiv:2609.20751 关键词:扩散语言模型,混合注意力,模型适配,并行解码 前序问题:把预训练好的自回归模型改造成扩散语言模型(DLM)是条省钱路线,但几乎所有现成改造都从全注意力 Transformer 出发。问题是自回归这边早就转向了注意力与 RNN 层交错的混合架构,而 RNN 结构上就是因果的,要把它双向化并不容易——骨干和目标范式对不上。 本文贡献:作者索性直接试:以 Qwen3.5 为起点,在 0.8B、2B、4B、9B 四个规模上做自回归到扩散的适配,得到 dQwen3.5 系列,并拿一个全注意力模型做对照,专门回答两个问题——混合骨干是否是高效的适配起点,适配出来的模型还保不保留定义 DLM 的并行与任意序解码行为。评测统一用同一套解码方案(默认画布 1024)而非各家自带的推理配方,并用 trunk(去掉 embedding 与输出头)参数量作为容量口径对齐比较组。 实验效果:混合骨干确实更省:达到同一训练 loss 所需的 token 量大约只要全注意力对照的一半,配图上逐个 loss 档位统计的中位数是 2.21 倍 token 效率差。跨规模看,dQwen3.5 在任意序解码行为上与全注意力 DLM 相似,并行解码下表现强劲——HumanEval 与 MBPP 上 1× 到 8× 加速区间基本压住全注意力对照。 批判点评:结论有用且反直觉:结构上「不适合」双向化的混合骨干,反而是更划算的 DLM 起点,这对想复用现成混合架构权重的人是直接的好消息。但配图暴露了摘要没提的代价——在 MATH500 上,100B token 档的混合版明显落后全注意力对照(1× 时约 9.3% 对 15.8%),数学推理这一块的损失不小,只有在 4× 以上高加速区间才靠后者衰减更快而追平。作者自己在注释里也怀疑退化可能来自训练数据混合不如 Qwen3/Qwen3.5 原始配方,这等于承认「骨干差异」和「数据差异」还没被干净地分离。另外全部比较都在基座 checkpoint 上做,后训练被明确排除在外,而后训练对下游表现影响很大,所以这套结论离「能直接上线」还有距离。 3. Edit-VAR:免训练免反演改视频 Edit-VAR: Taming Visual Autoregressive Model for Precise Video Editing | 中山大学 × 华南理工大学 × 清华大学 × 山东大学 × 南开大学 × 湖南大学 | arXiv:2609.21268 关键词:视频编辑,视觉自回归,免训练,token替换 前序问题:文本引导的视频编辑要改对目标内容,同时保住没被编辑区域的外观和时间连贯。训练型方法控制力强但吃数据吃算力;免训练方法分两条路,免反演的不用恢复轨迹,可它那套保源引导会限制编辑强度、让语义改动做不彻底;反演型先恢复潜轨迹再重生成,近似误差会累积,导致源内容漂移和时间不一致。 本文贡献:Edit-VAR 是第一个基于预训练视觉自回归视频模型、既免训练又免反演的文本引导视频编辑框架。它把源视频直接编码成多尺度离散 token,用概率引导的条件 token 替换来保源;再用注意力引导的 token 级与尺度感知调制,只在与编辑相关的位置和生成阶段选择性放松源约束。Scale-Decoupled Generation 以「晚期尺度解除约束」的形式实现,负责重新生成运动一致的细节、减少纹理碎裂。另有残差引导的 token 剪枝,利用最后两个高分辨率尺度上的冗余来压推理开销。 实验效果:大量实验加一项盲测用户研究显示,Edit-VAR 在编辑保真度、源内容保持、时间连贯性和推理效率上整体优于现有免训练视频编辑方法。定性对比里,同样把「red boat hull」改成「dark blue boat hull」、把「tree frog」改成「poison dart frog」,VACE 会连船型和背景一起改,RAVE 整片色调偏移、青蛙变成纯绿,Edit-VAR 则只换掉目标物的颜色与纹理,港口的其他船、水面倒影和叶片细节都留住了。 批判点评:把编辑搬到离散多尺度 token 上做,绕开了连续扩散反演的误差累积,这个切换是这篇最实在的地方——问题定位在「反演」而不是泛泛的「一致性」,配套的概率引导替换也把「保源还是接受编辑」变成了可按 token 判定的显式比较。但摘要通篇只给「整体优于」的定性结论,没有一个具体数字,编辑保真与源保持之间的权衡到底移动了多少无从判断;残差剪枝说是降推理成本,省了多少、掉不掉质量也没披露。更根本的限制是它绑在视觉自回归视频模型上,而这类骨干的开源生态和画质上限目前都不如主流扩散视频模型,方法再好也受骨干天花板约束。 4. Paint-Anything:写个十六进制就能上色 Paint-Anything: Unified Any-Color Control for Image Generation and Editing | ByteDance Seed × 浙江大学 × 南京大学 | arXiv:2609.20816 关键词:图像生成,图像编辑,颜色控制,数据管线 前序问题:专业设计需要的是任意颜色控制:用任一 24 位十六进制值指定某个物体的目标颜色,生成和编辑都得听话。以往工作在颜色生成、编辑、上色上各做一块,却往往依赖专门的颜色表示或特制的推理流程,不通用。而大语言模型这边提供了一个更简单的起点——连小模型都已经能把十六进制值和颜色语义对上。 本文贡献:Paint-Anything 直接把十六进制写进文本提示(包在 color 标签里)由文本编码器编码,通过物体级颜色监督学出一套生成与编辑共享的 hex-prompt 接口。配套数据管线从真实图像构建 Paint-500K:经 VLM 定位、SAM3 掩码、CIE 空间颜色提取、编辑对合成、过滤与重新描述而成。关键设计是:真实图像有阴影,标签只能算近似颜色,所以再补一批纯色锚点——它们的像素与配对的十六进制严格一致;而这些锚点只在高噪声时间步参与训练,低噪声阶段仍交给自然图像,避免把纯色的平坦质感带进成品。论文还提出 Any Color Benchmark(ACBench),含 ACBench-T2I 与 ACBench-Edit 两部分,专门量物体级十六进制颜色保真度。 实验效果:在 FLUX.2-4B 上,Paint-Anything 把 ACBench-T2I 和 ACBench-Edit 分数相对基座分别提升 85.3% 和 28.3%,并在参与比较的方法中取得最高的平均 CompColor 分。消融实验支持这套训练配方。定性对比里基座 FLUX.2-4B 常给出「语义上说得通但数值上离要求很远」的颜色——要 #FF5634 的车身给成偏红、要 #000080 的沙漠绿洲给成亮蓝,Paint-Anything 则能贴住指定色值。 批判点评:「纯色锚点只在高噪声时段用」这个细节是全文最值得抄的一笔:它承认了监督信号在不同噪声尺度上的可信度不同,用时间步做分工而不是简单混数据,比多数「加一路干净监督」的做法更讲究。把十六进制塞进文本提示、不引入专门颜色编码器,也让它能直接挂在现成模型上。但 85.3% 是相对基座的提升,基座本身在这项上分数低,相对增幅容易放大;编辑侧只有 28.3%,两者差距说明编辑任务里颜色约束和内容保持的冲突还没解决好。更要紧的是 ACBench 是作者自建的评测,「在自家基准上提升最多」这件事需要外部复现才能定性。另外全部结果都在 FLUX.2-4B 上,跨骨干的可迁移性未验证。 5. StepAudio 3 Music:先写ABC谱再生成5分半歌 StepAudio 3 Music Technical Report | StepFun(阶跃星辰)× ACE × 香港中文大学 × UC San Diego | arXiv:2609.16034 关键词:音乐生成,音频tokenizer,MoE,流匹配DiT 前序问题:长篇音乐生成要同时满足两件事:既能按开放域文本指令走,又得让和声、节奏、旋律结构立得住。以重建为导向的音频 tokenizer 会把音乐结构和精细声学细节混在一起,产出高熵 token 不好建模;而模型若只是端到端硬生,编曲结构就成了隐式的、不可控的副产物。 本文贡献:StepAudio 3 Music 走离散与连续混合的设计。StepAudio Music Tokenizer 把音频表示成 50 Hz 的单码本流(码本 65536 条),靠语义引导的自监督与多任务训练同时保住音乐结构和重建所需信息;论文用受控对比(统一 25 Hz 帧率)比较了单码本 VQ、Semantic RVQ、Acoustic RVQ 三种离散瓶颈,以及不同 DiT 配置,才定下这个方案。渲染侧由流匹配 DiT 预测连续的 StepAudio VAE 潜变量,再由 VAE 解码器还原 48 kHz 音频。显式规划则交给一个 MoE 自回归模型:它先用 ABC 记谱法产出中间编曲方案(ABC-CoT),再去预测音乐 token,让和声、节奏、旋律结构成为生成上下文的一部分。渐进式训练课程加监督微调支撑歌曲与纯器乐生成、由干声生成伴奏、翻唱合成,最长 5 分 30 秒。 实验效果:经 DPO 强化学习后,模型在 AudioBox 的 Content Enjoyment、Content Usefulness、Production Quality 三项以及 MuQ-MuLan 相似度上取得所评系统中的最高分,SongBench 结果具备竞争力。在 Artificial Analysis Music Arena Vocals 初步榜上 Quality Elo 为 1105。 批判点评:「先写 ABC 谱再生成音频」把编曲从隐式副产物提成了显式可读的中间态,这既是可控性抓手也是可调试性抓手,是这篇最有辨识度的设计;单码本 50 Hz 加流匹配 DiT 的分工,也把「离散好建模」和「连续好还原」各自的长处分开用了。但榜单要看细账:Vocals 榜上它实际是第 4 名(前面是 Suno V5.5 的 1170、Mureka V9 的 1159、Mureka V8 的 1140),摘要里「仅次于 Suno V5.5 和 Mureka」的说法把 Mureka 两个版本折叠了,读起来比实际名次靠前。更关键的是它的投票样本只有 2119,而同榜 Suno、MiniMax 等都在 1 万以上,95% 置信区间也宽到 ±14,和第 5 名 Suno V5(1097,±6)的差距在统计上并不稳。论文自己也说明这些评测衡量的是生成质量,并不直接度量对单个 ABC 音符、和弦、小节的遵循程度——也就是说 ABC-CoT 到底被执行得多准,目前没有直接证据。 6. PhysStream:边生成边推物理的流式视频 PhysStream: Streaming Physics-Grounded Video Generation with Structured Scene Memory and Fine-Grained Motion Control | University of Pennsylvania × Snap Inc. × KAUST | arXiv:2609.17521 关键词:视频生成,物理一致性,自回归,交互控制 前序问题:视频生成的交互控制正从粗糙提示走向对动态场景做细粒度、物理上有意义的操纵。但现有可控方法要么要求生成开始前就给出完整控制时间表,要么用像素空间信号去规定物体位置——那是在指派位置,而不是在指定物理动力学。 本文贡献:PhysStream 是面向物理接地的图生视频的自回归模型,带两样东西。一是结构化场景记忆:位置图与物体跟踪图都从已生成的帧里在线导出,边生成边更新。二是用稀疏的速度增量信号做细粒度运动控制,这些信号编码的是物理量,让模型去学底层动力学而不是背位置。训练分两阶段:先用运动控制条件微调一个双向模型,再训练一个因果自回归模型并额外接入结构化场景记忆,进一步提升物理一致性。 实验效果:PhysStream 支持对多物体桌面刚体场景做交互式的、生成中途的控制——这是此前方法不具备的能力。合成基准上运动分布距离(FVMD)比最强基线降低 33%,轨迹误差降低 12%;野外对比中超过 85% 的情况被人类评估者更偏好。长时程上,配图里一只玉色茶杯在桌面随机走动,从 t=0 一路走到 t=180 帧,远超 49 帧的训练窗口,仍持续跟随随机注入的速度增量交互并保持外观不崩。 批判点评:「控制信号编码物理量而非像素位置」这个取舍是关键:它把可控性问题从「让模型听话地摆物体」改成「让模型学会动力学然后自己推演」,这也是它能支持生成中途插入交互、而不需要预先排好完整控制表的根因。结构化场景记忆从已生成帧在线导出,避免了额外的外部状态追踪,工程上干净。但作者自己单列了一张图说明一致性指标的局限——FlashMotion 的一致性分数和本方法相当,却有明显伪影和幻觉物体,DragStream 生成近乎静止的画面也能拿高分,这等于承认 33% 和 12% 这两个提升所依赖的指标体系本身可信度有限,真正支撑结论的是那 85% 的人类偏好。适用范围也偏窄:主战场是多物体桌面刚体,非刚体只给了弹跳球和布料两个微调后的演示,离通用物理场景还远。 7. DeepSeek-V4.1-Flash:每token只留890字节KV DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression | DeepSeek-AI | arXiv:2609.19969 关键词:KV cache压缩,MoE,长上下文,推理成本 前序问题:长时程智能体大规模铺开后,模型负载越来越偏输入重。尽管此前工作已大幅降低长上下文计算成本,prefill 仍然很贵,而庞大的 KV cache 继续挤占 HBM 与 SSD 容量、吃掉数据传输带宽。算力、存储、带宽这三份需求合起来,构成了进一步压低部署成本的主要瓶颈。 本文贡献:DeepSeek-V4.1-Flash 是一个多模态 MoE 模型,骨干 552B 参数,支持最长 100 万 token 上下文。它采用因果编码器-解码器(CED)架构:解码时每 token 激活 16B 参数,prefill 时只激活 8B,这对智能体这类输入重负载显著改善成本效率。为把 KV cache 压缩推到极限,模型把 Compressed Sparse Attention 2(CSA2)里的跨层 KV cache 复用与 FP4 KV 缓存结合起来,使常驻 HBM 的全局 KV cache 降到每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一。再通过名为 SWA Bounded Replay 的部署优化,把常驻 SSD 或主机内存的持久 KV cache 压到约八分之一。论文另外精简了 V4 架构并引入若干高效扩展,在 45T token 的多模态语料上预训练并做了完整后训练。 实验效果:KV cache 占用大幅缩小的同时,性能明显好于基线。单 token decode FLOPs 随上下文增长的曲线上,V4.1-Flash 到 1024K 仍基本持平在 25 GFLOPs 上下,而 V4-Flash 已升到约 55、V3.2 约 600、V1 超过 3000。预训练阶段在自建留出集上,V4.1-Flash-Base 的 BPB 在所有任务上均低于 V4-Flash-Base 与 V4-Pro-Base。代码智能体基准上性能随 RL 训练规模持续提升,把最大上下文进一步扩到 1M token 后,在极长时程任务上还能继续涨。模型权重已在 HuggingFace 放出。 批判点评:890 字节每 token 这个数字值得记住:它把长上下文的讨论从「模型记不记得住」彻底拽到了「cache 放不放得下、搬不搬得动」,而 prefill 8B、decode 16B 的非对称激活更是直接冲着智能体负载「输入远大于输出」的真实形状去的,属于按负载画像改架构。但 FLOPs 曲线也显示,在约 100K 以下的上下文里 V4.1-Flash 反而略高于 V4-Flash(约 23 对 19 GFLOPs),这套设计是拿短上下文的一点效率换长上下文的大幅收敛,主要跑短请求的场景未必划算。另外 FP4 KV 缓存在什么任务上会先露出精度问题、SWA Bounded Replay 对首 token 延迟的影响如何,摘要都没交代;593 位作者的技术报告里工程优化与架构贡献高度耦合,外部想复现出同样的 890 字节与同等质量,难度不低。 8. The Weight Is Over:12GB显卡跑亚秒出图 The Weight Is Over - Interactive Diffusion on Consumer GPUs | Adobe × NVIDIA | arXiv:2609.21849 关键词:端侧推理,扩散加速,文本编码器蒸馏,显存预算 前序问题:端侧推理正在爆发,但势头几乎全在语言模型那边。扩散管线吃显存、对延迟敏感,还要编排文本编码器、Transformer、解码器以及后处理若干环节,这套流程远没有大模型推理循环那么标准化,落到消费级设备上格外难办。 本文贡献:论文在性能、质量、模型体积这个三角里找可落地的点,给出三项贡献:一个嵌入翻译器,把小文本编码器映射到大编码器的表示空间,从而砍掉权重与延迟;一套可复现的扫参配方,用来在扩散管线的速度/质量/显存三角里做导航;以及一个端侧交互式图像生成编辑器,在较新的 GPU 上实现亚秒级首图时间(TTFI)。 实验效果:跨设备扫参结果最能说明问题。RTX 4070 Ti(12 GB,可用约 11.2 GB)上,只要常驻权重预算没超出可用显存,每步延迟稳定在数百毫秒量级;一旦越过 11.2 GB 就触发 host-paging、必须从主机流式取权重,每步延迟直接跳到 10^4 毫秒级,相当于一个断崖。工作站级 RTX PRO 6000 Blackwell(96 GB)上「什么都放得下」,此时主导排序的就变成精度——NVFP4 最快,FP8 次之,FP16/BF16 落后。嵌入翻译器的容量门槛也量出来了:187M 的翻译器能紧跟 4B 参考编码器,29M 就会漂到「看着合理但内容不对」(要狐狸给猫、要拉面给黄色玩偶),3.5M 则塌缩成一种同质的暗黑森林风格。 批判点评:这篇的实用价值不在某个新模块,而在把「显存预算」立成了一等约束并画出了那条断崖:越过可用显存的惩罚不是线性变慢而是一到两个数量级,这意味着端侧调优的第一目标应该是「压进预算」而不是「提高吞吐」,顺序搞反了后面全是白做。把翻译器容量与语义保真的关系摸到 187M/29M/3.5M 三个档,也给了很实际的选型下界。但工作偏工程报告:只有两位作者、两台设备,没有跨更多消费级显卡的统计;质量评价主要靠定性图,缺少 FID 之类的量化指标,「187M 紧跟 4B」到底差多少无法量化。亚秒 TTFI 也限定在「较新的 GPU」上,对更老的消费级卡是什么表现没有交代。 9. MuSeC:语义声学分流的音乐codec Rethinking Music Tokenization: A Semantic Codec toward High-Fidelity LLM Music Generation | 西北工业大学 ASLP × 吉利汽车研究院(宁波) | arXiv:2609.21240 关键词:音乐tokenizer,语义codec,残差量化,音乐信息检索 前序问题:离散音频 tokenization 已成为原始波形与自回归建模之间的关键接口,所以音乐 tokenizer 得同时做到两件互相拉扯的事:支持高保真重建,又要产出适合语言建模的离散序列。以重建为导向的 tokenizer 常把音乐结构和精细声学细节混在一起,产出高熵 token 难建模;而语义引导的替代方案本是为语音设计的,套到音乐上不合身,往往还伤重建质量。 本文贡献:论文先把「音乐语义内容」重新定义成一个可度量的概念——以下游音乐信息检索(MIR)任务表现为锚。循着这个定义提出 MuSeC:一个音乐语义 codec,直接从混合信号里把语义与声学内容解耦,不需要做源分离。结构上,冻结的 SSL 编码器加 k-means 提供语义 token,另一路声学 RVQ 流捕捉细粒度声学信息,两路拼接后送解码器做高保真重建,训练时还有判别器提供对抗损失。 实验效果:MuSeC 在保住高保真重建所需信息的同时,产出对语言模型更友好的离散单元,重建质量有提升,token 序列也更可预测,为高保真 LLM 音乐生成提供了实际基础。MIR 任务上的自消融显示,完整 MuSeC(S1A16)在 GuitarSet/Chords(0.3648 对 0.1713)、EMO/R2A(0.6520 对 0.6110)、EMO/R2V(0.3696 对 0.3578)等任务上明显好于纯 k-means 量化版本,也普遍好于只有声学的 A16 变体。 批判点评:把「语义」从形容词变成以 MIR 任务表现为锚的可测量量,是这篇方法论上最扎实的一步——有了口径,语义与声学的分流才有得优化,而不是凭感觉设计码本。不做源分离直接从混合信号解耦,也省掉了一个容易引入误差的前置环节。但消融图显示优势并不一致:GTZAN/Genre 上 MuSeC-S1A16 是 0.5345,反而低于 k-means 的 0.6034,Lyrics 上两者基本持平(0.4903 对 0.4993);更重要的是全部设置都明显低于连续 LeVo BEST-RQ 这条语义上限(多数任务差 0.1 以上),说明离散化的语义损失远未补齐。另外论文标题指向「高保真 LLM 音乐生成」,但实际只做到 codec 这一层,接上语言模型后端到端能好多少并没有验证,「更可预测的 token 序列」目前也缺少熵或困惑度之类的直接数字支撑。 10. OmniVBench:1.2万条清单查参考跑没跑偏 OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation | 腾讯 × 香港科技大学(广州) | arXiv:2609.22069 关键词:视频生成评测,参考到视频,数据集,因子级评估 前序问题:参考到视频(R2V)生成正朝着越来越通用、越来越多样的参考控制演进,催生了所谓全模态 R2V 这一范式。但现有基准跟不上:测试用例覆盖的参考类型与组合都有限,评估协议大多只看整体参考一致性,忽略了参考因子是否被正确保留、解耦并路由到对应目标。同时全模态 R2V 训练数据构建成本高,合适的训练资源很稀缺。 本文贡献:论文同时给出 OmniVBench 与 Omni-R2V Dataset,一个管评测一个管训练。OmniVBench 把 R2V 评测扩展到更广的参考类型、更细的控制任务和更丰富的参考组合,覆盖 7 个任务族、18 个细粒度任务,横跨内容、运动、风格、结构、叙事与多参考设定,共 813 个评测用例。核心是因子级评估:用 12172 条针对具体用例的检查清单条目,逐条判断意图中的参考因子是否被忠实保留、是否被正确解耦并绑定到目标、是否按指令实现。Omni-R2V Dataset 主要取材于大规模专业视频素材库,包含 34 万条处理好的训练样本,覆盖多种参考类型与多参考组合,并给出各任务专用的参考-目标配对构建管线。 实验效果:对先进的开源与闭源 R2V 模型做的大范围评测显示,各任务族和各评估维度上都存在明显性能差距,暴露了当前 R2V 模型的残留局限。配图给出的多参考用例里,RF(参考保真)/IR(指令遵循)两项分数分化极大:UniVideo 只有 33.2/14.8,LoomVideo 43.1/36.7,OmniWeaving 48.0/56.0,Kling 3.0 Omni 62.9/100,Bernini 85.2/69.7,Gemini Omni 91.2/100,而 MiniMax H3、Seedance 2.0 与 Seedance 2.5 在该用例上拿到 100/100。 批判点评:把「参考一致性」拆成保留、解耦、路由三件事,是这套基准最有价值的判断——多参考场景真正容易错的不是「像不像」,而是把 A 参考的属性贴到了 B 目标上,而整体一致性分数恰恰看不出这类串台。12172 条逐用例清单让这种错误变得可指认。数据侧 34 万条专业素材样本对社区也是实打实的补给。但代价是清单法对判定器的依赖很重:谁来回答这 1.2 万条问题、判定器自身的偏差和一致性如何,摘要没有交代,而这直接决定分数可信度。813 个评测用例摊到 18 个细粒度任务上平均每任务仅四十余例,统计功效对细分结论偏弱;配图那个用例里三个模型同时打满 100/100,也提示清单在强模型区间容易饱和、区分度下降。另外基准与数据集同源、且出自同一团队,用该数据训练的模型在该基准上的成绩需要额外小心解读。 趋势观察 注意力的省法,从「换掉它」变成「按交互类型分流」 Video DeltaNet 只在视频与视频之间用线性注意力,凡涉及文本或音频的交互仍留给 Softmax;dQwen3.5 则把注意力与 RNN 交错的混合骨干当成扩散语言模型的适配起点。两篇的共同前提是承认不同交互对精度的敏感度本来就不同,一刀切替换必然在某处付出代价。 长上下文的成本,已经从算力转到显存和带宽 DeepSeek-V4.1-Flash 把常驻 HBM 的全局 KV 压到每 token 890 字节、持久部分再压到八分之一,并用 prefill 8B、decode 16B 的非对称激活去贴合智能体负载的真实形状;The Weight Is Over 则量出消费级显卡越过可用显存后延迟跳升两个数量级的断崖。两者都在说:放不放得下、搬不搬得动,已经比算得快不快更决定部署成本。 生成过程正在被拆出显式的中间态 StepAudio 3 Music 先用 ABC 记谱产出编曲方案再预测音乐 token,PhysStream 把位置图与跟踪图作为结构化场景记忆在线维护,Edit-VAR 缓存源概率与交叉注意力图再逐 token 决定保源还是改。把过去隐含在权重里的东西显式化,换来的是可控性与可调试性。 评测开始追问「参考有没有被放对位置」 OmniVBench 把参考一致性拆成保留、解耦、路由三件事,用 1.2 万条逐用例清单指认把 A 的属性贴到 B 上的串台;Paint-Anything 自建 ACBench 专量物体级十六进制色值保真;MuSeC 干脆把「音乐语义」定义成下游 MIR 任务表现。三者都不再满足于一个整体相似度分数。 人工智能炼丹君 整理 | 2026-09-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
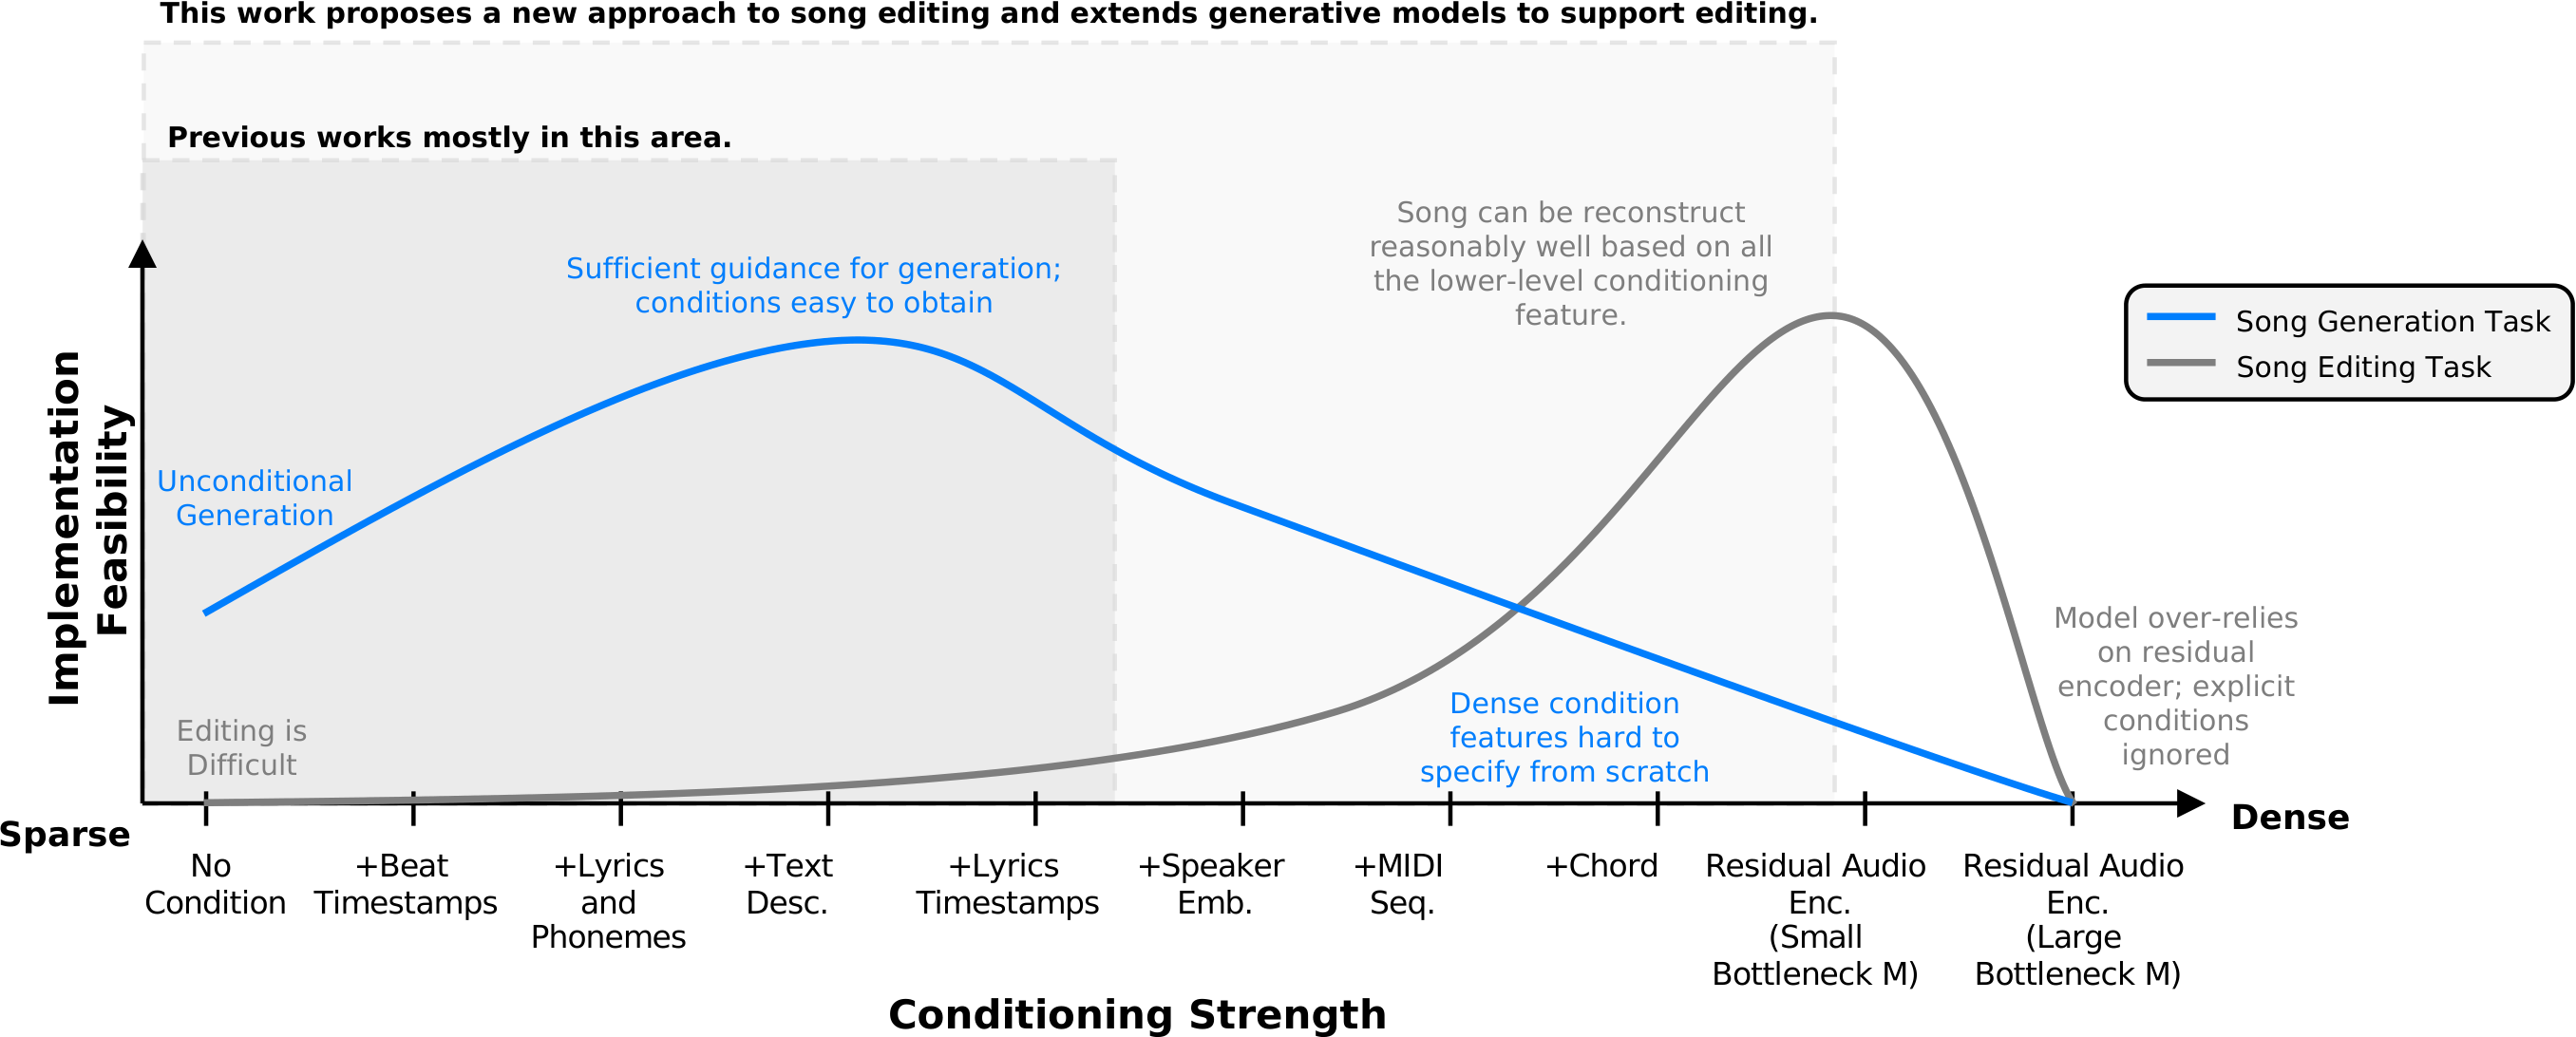
AIGC 每日速读|2026-09-17|Meta一个模型既写歌又改歌-SongCraft 今日 AIGC 论文速览 今日共 10 篇 · 音乐与歌曲生成 2 篇 · 视频生成与世界模型 2 篇 · 视频编辑与采样效率 2 篇 · 长语音稳定生成 2 篇 · 生成评测与溯源 2 篇 重点论文标题列表 SongCraft(Meta AI):一套模型统一歌曲生成编辑 SlotDiT(University of Bonn):用 slot 潜空间省算力提成功率 AlayaVista(Alaya Lab;Beijing Institute of Technology;The University of Tokyo):全景状态驱动流式世界模型 MDN-Control(Wuhan University):掩码深度噪声协同视频编辑 ADSC(SAP;National University of Singapore;A*STAR I2R):按样本收敛动态缩短采样 今日论文速览 1. SongCraft:一套模型统一歌曲生成编辑 SongCraft: Unified Song Generation and Editing with Reconstructive Learning | Meta AI | arXiv:2609.16315 关键词:歌曲生成,音频编辑,流匹配,重建预训练 前序问题:歌曲生成与歌曲编辑通常由两套系统完成:生成只接收歌词等稀疏条件,编辑却需要保留人声、旋律和结构等稠密属性,分别训练会重复成本且难共享能力。 本文贡献:SongCraft用重建式预训练随机切换稀疏生成分支和稠密编辑分支,共享潜空间流匹配主干;编辑时抽取歌词时间戳、MIDI、和弦、歌手等属性并只改目标条件,生成时仅保留歌词、节拍和描述。 实验效果:统一模型的歌词WER为0.133;主观A4平均分7.45、SongEval为3.62。它的可懂度领先,但SongEval整体质量仍低于Levo的3.95;瓶颈加长还会同时降低音高、歌手和歌词可编辑性。 批判点评:统一生成与属性级编辑是实用方向,重建预训练减少成对编辑数据依赖;但质量与可编辑性存在明显折中,当前主要针对有限时长与条件类型,更长歌曲和复杂编曲仍是后续工作。 2. SlotDiT:用 slot 潜空间省算力提成功率 SlotDiT: Object-Centric Representations for Diffusion Transformers | University of Bonn | arXiv:2609.17414 关键词:扩散Transformer,对象中心表示,潜空间设计,机器人控制 前序问题:视频DiT通常在像素或稠密视觉潜空间中预测,容易把大量算力花在背景纹理上,也难以显式跟踪承担动作的对象;机器人控制真正关心的是对象状态及其随指令发生的变化。 本文贡献:SlotDiT 让文本条件 DiT 直接在 slot 潜空间里工作:先把场景分解成一组对象级的 slot,再依据指令与已观测上下文自回归去噪未来的 slot 轨迹。论文的落点是系统性比较潜空间设计——在统一 DiT 框架下把 slot 表示与 VAE 式、语义对齐式潜空间放在一起对照。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 实验效果:每帧只需 10 个 token(VAE 类基线为 256)。CLIPort 的 PutInBowl 任务上成功率 73.0%,次优的 TextOCVP 为 50.0%,VAE 类基线仅 0.5%–10.0%;LT-syn 的六种设置下为 17.0%–74.5%,均居首。生成 39 帧的吞吐 9.33 FPS,快于最快基线的 6.71 FPS,相对 SD-VAE 基准提速 5.68 倍(单卡 A6000)。 % Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines. 批判点评:论文自己点明了一个反直觉结论:视觉质量指标好不等于任务能完成——VAE 基线的感知分更高,指令跟随与任务成功率却大幅落后。代价是 slot 数量固定、外观细节受限,视频生成质量只能算与基线持平而非更优;评测也集中在 CLIPort 与 LT-syn 两类机器人环境,开放世界泛化尚无证据。 3. AlayaVista:全景状态驱动流式世界模型 AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video | Alaya Lab;Beijing Institute of Technology;The University of Tokyo | arXiv:2609.14462 关键词:世界模型,视频生成,相机控制,全景状态 前序问题:相机连续移动时,普通视频生成模型只看局部视口,离开画面的区域容易被遗忘,重新转回时场景会漂移;直接维护高分辨率全景又会让生成和渲染成本过高。 本文贡献:AlayaVista把360度全景作为持续演化的全局状态,再按相机轨迹选择视口、渲染低分辨率透视潜变量,并用局部视频细化器恢复高清画面;全景状态和当前视角因此分离更新,支持流式相机控制。 实验效果:在 MUGEN-HQ 上,AlayaVista 的跨视角一致性 0.9240、旋转误差 2.132 均为最优,平移误差 0.03312 优于 HY-World 2.0 的 0.03885,但仍高于带显式 3D 高斯支架的 MoVerse(0.02746);动态性 0.9200 偏低,作者认为是长时漫游中局部运动被衰减所致。 批判点评:全景记忆能减少回看漂移,但系统包含全景生成、潜空间渲染和局部细化三段,训练与部署都较重;评测集中在合成式或精选全景数据,长时间真实街景中的几何稳定性仍需验证。 4. MDN-Control:掩码深度噪声协同视频编辑 MDN-Control: Mask-Depth-Noise Guided Region Control for Multi-Subject Video Editing | Wuhan University | arXiv:2609.16475 关键词:视频编辑,多主体控制,遮挡建模,免训练方法 前序问题:多主体视频编辑时,目标人物常被邻近主体或遮挡区域干扰,属性会串到无关对象;只靠文本和掩码也难以同时保持身份、边界与背景。 本文贡献:MDN-Control不再训练新模型,而是组合掩码引导定位、深度感知遮挡软门控和噪声潜变量检索:前者锁定主体,中间模块随去噪阶段调整遮挡约束,后者从候选噪声中选择更匹配指令的初始化。 实验效果:在MSVBench上,方法取得Warp-Err 2.87、CLIP-T 27.09、CLIP-F 95.72、Q-Edit 9.43与CM-Err 2.75;实验在单张NVIDIA L40上完成,并包含20段视频的用户研究。 Overview of MDN-Control. Mask-guided localization localizes the target, depth-aware occlusion control guides editing near occlusions, and noise latent prompting initializes appearance generation. Denoising uses mask-depth guidance at early steps and mask-only guidance thereafter. 批判点评:免训练组合便于迁移到现有DiT,但噪声检索的增益不大,部分固定随机种子甚至更好;20段主观测试规模也偏小,复杂相机运动和长遮挡下的稳定性还未充分覆盖。 5. ADSC:按样本收敛动态缩短采样 Efficient Text-to-Image Generation: An Adaptive Step Schedule Controller for Diffusion Models | SAP;National University of Singapore;A*STAR I2R | arXiv:2609.16572 关键词:文生图,扩散采样,自适应步数,推理加速 前序问题:文生图扩散模型通常给所有提示词使用同一去噪步数,但简单样本早已收敛仍继续计算,复杂样本又可能因固定短计划而欠采样。 本文贡献:ADSC 准备一组步长不同的采样日程,在每个时间步评估误差项的差异,据此在日程之间动态切换,让简单提示词早收敛早停、复杂提示词保留更多步数;控制器无需额外训练,也不改动基础扩散模型。 Effect of text prompt and seed combinations on diffusion steps for generating visually sufficient images. Step counts shown are examples; optimal steps may vary. 实验效果:在COCO的DDIM实验中平均18.89步、0.79秒/图;与固定19步的0.78秒几乎相同,但CLIP-I为95.70,高于固定19步的92.40,CLIP-T均为31.4,优势主要来自按样本分配步数。 The denoising process begins with the longest schedule (e.g. 40 steps in the example) and transitions to shorter schedules (20 followed by 10) upon detecting convergence. 批判点评:方法实现简单且可插拔,不过同等平均步数下墙钟时间没有加速,控制器判断还增加少量开销;论文比较的不同基线并非始终严格等算力,效率结论应区分步数、质量和实际延迟。 6. LACI:回滚重生成压住长语音失败 Taming Long-form Text-to-Speech | Argmax, Inc.;University of Virginia;Bilkent University | arXiv:2609.16989 关键词:长文本语音合成,推理期干预,错误回滚,语音克隆可靠性 前序问题:自回归TTS在超长文本上会突然跳过整段内容或重复、幻觉;平均WER掩盖了少数灾难性失败,而重新训练模型对已有开源系统成本很高。 本文贡献:LACI(Localized Attention-Constrained Inference,局部注意力约束推理)是纯推理期方法,不改动模型权重:近实时检测 TTS 生成错误,回滚到错误起点,再施加临时护栏重新生成,额外开销可忽略。论文另提出滑窗版说话人相似度 wSIM,用来暴露常规 SIM measure 不到的失败模式。 实验效果:Qwen3-TTS-0.6B 在超过 1500 词的提示上,10 个随机种子里的最差 WER 从 35.2% 降到 3.4%,甚至优于它在 500 词以内短文本上 5.4% 的可靠性;120 秒参考音频下最差 wSIM 从 0.01 升到 0.47;WER 超过 30% 的灾难性生成比例从 26% 降到 1% 以下。 批判点评:推理期干预能给现成开源模型直接止损,不必重训,这是它最实用的地方;但前提是错误可被近实时检出,回滚重生成也会推高长文本的尾部延迟。更值得注意的是超过 1300 词之后失败开始抗拒重生成,LACI 只把失败比例从 70% 压到 57%,反而不及对照方法 ACI 的 34%,作者认为这是模型自身的连贯性上限而非检测不到。 7. DiTAR+:扩张上下文抑制长语音漂移 DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis | ASLP@NPU, Northwestern Polytechnical University | arXiv:2609.13909 关键词:语音生成,扩散Transformer,长上下文,说话人一致性 前序问题:连续潜变量自回归扩散语音模型在长序列中会逐块积累误差,出现说话人漂移、重复或无法终止;简单扩大历史上下文又让局部声学细节成为捷径。 本文贡献:DiTAR+用扩张上下文采样跨更远的历史块建模宏观一致性,同时在浅层对历史声学块做分层掩码,把语义对齐与声学渲染分开,减少模型复制局部声学模式。 The overall architecture of the proposed DiTAR+ framework. (a) The standard two-stage DiTAR baseline. (b) Hierarchical Acoustic Masking (HAM), which masks historical acoustic context in shallow layers to decouple semantic alignment and acoustic rendering. (c) Dilated Context Sampling (DCS), which expands the macro-receptive field via dilated sampling while preserving temporal continuity. 实验效果:在SeedTTS评测中,DiTAR+的Seed-EN WER为1.672、Seed-ZH为0.985;中文困难集WER为9.893,低于DiTAR的12.478;25至35秒长语音WER从2.778降至2.173,说话人相似度从0.741升至0.759。 Chunk-level speaker similarity over continuous generation steps (3.0,s per chunk). The standard baseline experiences severe speaker drift in the long tail, whereas DCS effectively stabilizes the temporal coherence. 批判点评:DCS与HAM直接针对长尾漂移,消融也显示两者互补;但困难集和长语音集为内部构造,论文没有充分量化扩张上下文带来的吞吐、显存和首音延迟成本。 8. CMA-OT:课程式多尺度舞蹈配乐对齐 CMA-OT: Hierarchical Expert Supervision for Dance-to-Music Generation | HKUST(GZ);Tencent | arXiv:2609.13118 关键词:舞蹈配乐,多尺度对齐,最优传输,音乐生成 前序问题:舞蹈配乐既要踩准局部节拍,又要匹配段落级风格;单尺度动作特征或固定对齐损失容易顾此失彼,尤其在动作与音乐结构非一一对应时。 本文贡献:CMA-OT从预训练Jukebox专家提取底层、中层和高层音乐知识,课程式地由局部节奏过渡到全局语义,并用尺度感知的Fused Gromov-Wasserstein最优传输对齐舞蹈与音乐表示。 实验效果:在AIST++上,CMA-OT取得BCS 99.14、BHS 99.12、F1 99.12、FADp 12.50、FADc 0.26;MotionComposer的FADp/FADc为27.52/0.49。TikTok上FADp/FADc为27.53/0.38,也优于30.61/0.81。 批判点评:多尺度课程把节拍和风格监督组织得较清楚,但系统依赖Jukebox专家与额外最优传输计算;AIST++和TikTok仍是较窄的数据分布,指标提升不等同于真实音乐审美或版权可用性。 9. VOR-Bench:细粒度评测视频对象移除 VOR-Bench: A Human Perception-Driven Benchmark for Video Object Removal | Beijing University of Posts and Telecommunications;China Telecom AI Technology;Xi'an Jiaotong University | arXiv:2609.16878 关键词:视频对象移除,评测基准,视觉语言模型,主观一致性 前序问题:视频对象移除常用有缺陷的参考视频或逐帧图像指标,既可能把错误参考当真值,也难以判断对象是否删净、背景是否连续以及结果是否符合常识。 本文贡献:VOR-Bench 由三部分组成:VORD 数据集提供 150 对配对编辑视频与涂鸦式掩码,覆盖模型生成、工具渲染与相机实拍三类来源,另构建 300 对的扩展集验证规模是否足够;rMPAF 流程把图像级对象移除与微调后的视频生成模型结合,自动产出运动连贯的配对视频;VOR-MDSM 则是按三个评价维度微调的 VLM 打分模型。 实验效果:论文报告VOR-MDSM三项偏好判断与人工评分的Spearman相关系数均超过0.9,整体高于VideoLLaMA3、Qwen3-VL-8B和Gemini-3.1-Pro;基准覆盖相机采集、模型生成和工具渲染三类视频。 批判点评:细粒度维度比单一PSNR更接近真实观感,但150/300对数据仍小,VLM裁判也在相近任务分布上训练和验证;论文中的数据与模型发布仍带未来时态,可复现性要看正式开放程度。 10. RAIN:区域感知一跳提取语义水印 RAIN: Region-Aware Inversion Network for Semantic Watermark Extraction | Independent Researcher | arXiv:2609.14856 关键词:生成水印,扩散反演,鲁棒提取,模型归属 前序问题:Gaussian Shading等语义水印把信息埋在扩散初始噪声里,传统提取要多步反演大模型,代价高且在压缩、裁剪、噪声等失真后容易累积误差。 本文贡献:RAIN把终端噪声恢复改写为高信噪比端点上的条件回归,用小型双分支NAFNet一次预测水印决策所需的噪声区域;训练时加入有限集合的最坏失真样本,强化区域边界而非逐点精确重建。 Extraction pipeline used in our implementation. 实验效果:在1000条COCO样本的SD 2.1匹配评测中,干净图比特准确率99.99%;JPEG Q=25为98.15%,缩放到0.25为98.93%。其一次提取仅14.394 GFLOPs、15.468M参数,FARI为682.675 GFLOPs、868.469M参数。 Redrawn from Tables 3 and 4 of RAIN: extraction backbone cost and bit accuracy under matched SD 2.1 distortions. 批判点评:把目标从精确噪声恢复改成区域判别很契合水印任务,但盐椒噪声下93.11%的比特准确率低于OSI的99.71%,极端亮度下也非最优;当前证据绑定Gaussian Shading与特定Stable Diffusion设置。 趋势观察 生成系统开始压缩“状态”而非只压缩网络 SlotDiT 把视频压成少量 slot,AlayaVista把漫游场景压成持续全景状态,MDN-Control则把编辑约束拆成掩码、深度与噪声。共同方向是先确定任务真正需要保存的状态,再把DiT算力集中到这些变量。 推理时控制器成为低成本升级路径 ADSC按样本切换去噪日程,LACI检测跳读后回滚,MDN-Control组合现成控制信号。三者都尽量不重训主模型,把可靠性或效率问题移到可观测、可干预的推理环节。 评测从单一保真度转向任务与失败尾部 VOR-Bench用三维主观语义评分替代单一图像指标;LACI报告最差采样和灾难性失败率;SlotDiT直接看机器人完成率。平均分仍重要,但能否解释具体失败正成为更强的证据。 音频生成继续争夺长程结构控制 DiTAR+扩张历史上下文,SongCraft统一稀疏生成与稠密编辑条件,CMA-OT以多尺度音乐专家监督舞蹈配乐。不同任务都在处理局部声学质量与长程语义结构之间的矛盾。 人工智能炼丹君 整理 | 2026-09-17 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
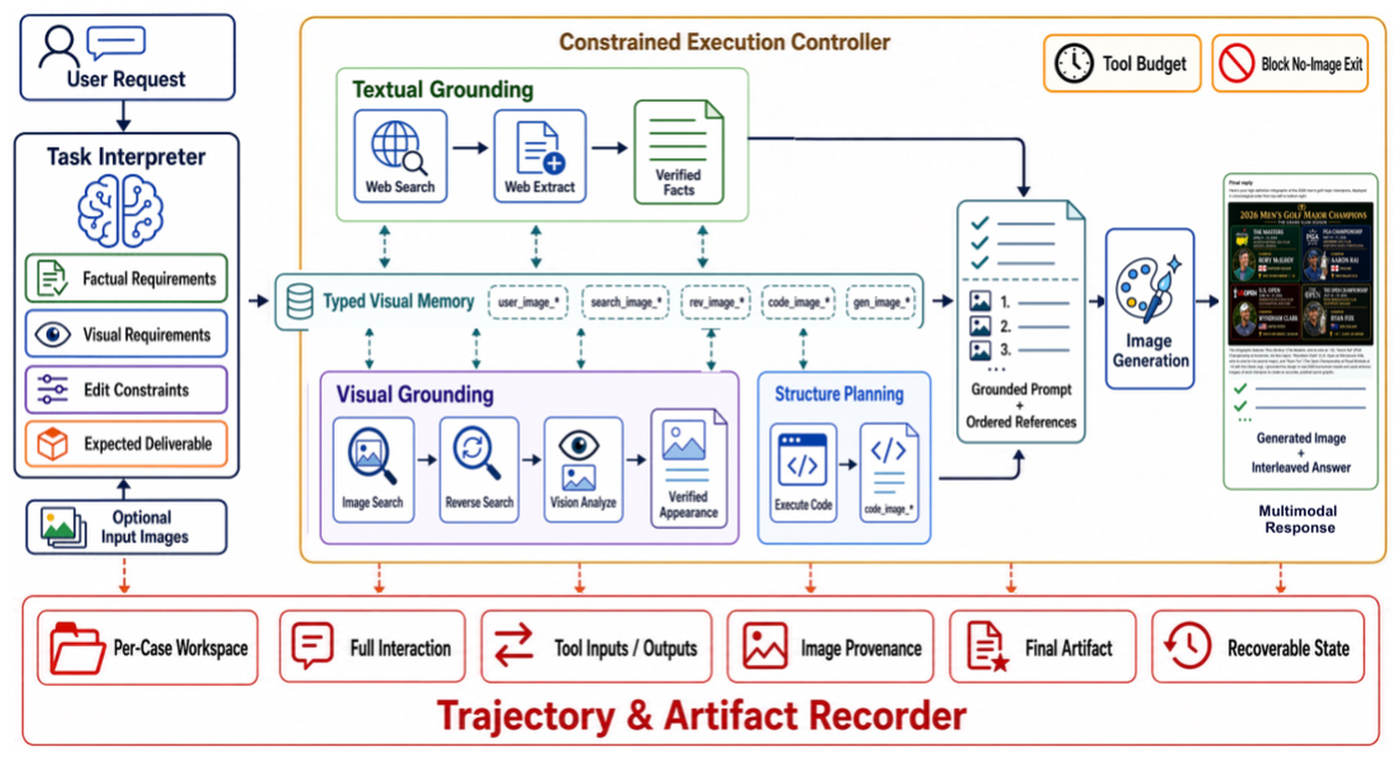
AIGC 每日速读|2026-09-07|腾讯3B活跃参数逼近万亿代理-WeAgent 今日 AIGC 论文速览 今日共 10 篇 重点论文标题列表 WeAgent-MMGenEdit(腾讯微信 AI(Weixin AI, Tencent)):3B活跃参数逼近万亿代理 PriorEdit3D(北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室):7秒完成无配对3D编辑 ⚡ ReaDiT(伊利诺伊大学厄巴纳-香槟分校(UIUC)):一个DiT块控制图像与视频 EditVid(伊利诺伊大学厄巴纳-香槟分校(UIUC)):免训练视频编辑跃升19分 FlashRender(EverEx、延世大学、高丽大学):4步完成相机轨迹重拍 今日论文速览 1. WeAgent-MMGenEdit:3B活跃参数逼近万亿代理 WeAgent-MMGenEdit: A Full-Stack Recipe for Multimodal Agentic Image Generation and Editing | 腾讯微信 AI(Weixin AI, Tencent) | arXiv:2609.05171 关键词:代理式图像生成,多模态检索,视觉证据验证,多参考编辑,强化学习,双语基准,WeAgent ⚠️ 前序问题:知识密集型图像生成真正难的不是把搜索接口接到模型上,而是让正确证据进入最终像素。现有代理常凭标题或元数据选图,没有逐张检查视觉内容;同一个策略又要规划、筛选并背着不断增长的上下文,容易混淆实体;即便找到了正确文字和图片,松散附件也没有明确绑定人物、属性和空间位置。结果是代理能说对事实,却仍会在信息图、多人物组合或时事更新中画错对象与版式。 本文贡献:WeAgent-MMGenEdit 给出一套从运行时、数据、基准到双侧后训练的完整配方。WeAgent-Harness 按“检索—验证—整合—交付”组织七类工具,把证据以稳定 ID 存入持久工作区,并用独立视觉工具显式验图;通过代码把核实后的文字、图片和布局编成稠密视觉载体,再交给生成器。数据管线构造约 2.3 万条 SFT 轨迹和 1.47 万个 RL 任务,每个任务都带代理链、生成输入和最终图像三层清单。策略侧先 SFT 再做清单约束 RL,图像侧也用多参考 SFT 和多目标 RL 训练。 实验效果:自建 WeBench-MMGenEdit 含 300 个经人工审核的中英双语任务,生成与编辑、中文与英文各占一半,94% 的任务需要至少五跳检索,69.3% 的编辑任务含多张用户图片。在同一 Harness 和 GPT-Image-2 后端下,30B 总参数、3B 活跃参数的 WeAgent-RL 相对同规模 Qwen3-VL 基线,生成加权均分提高 12.45 分,编辑加权均分提高 16.72 分;其表现接近 1T 总参数的 Kimi-K2.6 代理。 批判点评:这篇最有价值的设计是把证据量与策略上下文解耦:图片和网页留在持久工作区,策略只传稳定引用,需要时再验,这比把所有像素塞进上下文更适合长轨迹。三层清单也能把“搜索错了”“提示没带全”和“后端没画对”分开归因。代价是整套系统依赖搜索、视觉检查、代码渲染、图像生成和多名裁判,成本与故障面都不小;对网页时效、来源可信度和恶意内容的防护也没有被一个高分基准自动解决。 2. PriorEdit3D:7秒完成无配对3D编辑 Learning 3D Editing without Paired Supervision via Generative Prior Distillation | 北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室 | arXiv:2609.04942 关键词:3D编辑,生成先验蒸馏,无配对监督,分布匹配,多视图一致性,前馈模型,PriorEdit3D ⚠️ 前序问题:指令驱动 3D 编辑缺少高质量的编辑前后成对资产。测试时优化方法每个对象都要重新迭代,速度慢;用复杂管线制造伪配对数据又容易把 2D 编辑器的结构漂移和几何伪影写进监督。只在主视角追求文本对齐还会出现“正面看起来对、转到侧面就塌掉”的投影欺骗,因此需要在没有成对 3D 真值的条件下同时约束指令、身份和三维几何。 本文贡献:PriorEdit3D 用可微渲染把三种已训练基础模型的先验直接蒸馏进前馈 3D 编辑器:主编辑视角由 2D 图像编辑模型提供像素视觉目标;新视角由视觉语言模型判断指令遵循与源对象身份;3D-aware Distribution Matching 则在图生 3D 教师的 latent 流形内约束编辑结果,阻止单视角监督导致几何坍塌。整个方法无需反演、无需局部掩码,也不依赖真实的成对 3D 编辑数据。 实验效果:在作者的 PriorEdit3D 测试集上,方法达到 24.37 PSNR、0.94 SSIM、71.96 FID,LLM 身份保持率 93.13%、指令遵循率 86.92%,单个编辑在 A100 上约 7 秒;对比的 Nano3D 为 19.90 PSNR、103.50 FID、14 秒。迁移到 ABO 与 GSO 后,方法的 FVD 为 168.78、LLM 指令遵循率 68.41%,也优于表中对比项。 批判点评:把视觉、语义和几何先验拆给三个教师是合理的,因为单一 2D 教师无法提供背面约束。消融也显示 VLM 与 3D 分布匹配各自补不同缺口。不过教师的偏差会层层传递:图像编辑器决定风格,VLM 决定语义容忍度,图生 3D 教师决定几何流形;遇到教师不熟悉的物体、透明材质或拓扑大改时,前馈速度优势可能换来保守编辑。 3. ReaDiT:一个DiT块控制图像与视频 ReaDiT Guidance: Control for Image and Video Generation using Diffusion Transformer Features | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04649 关键词:Diffusion Transformer,空间控制,特征读出,深度控制,姿态控制,视频运动控制,ReaDiT ⚠️ 前序问题:ControlNet 一类适配器能给扩散模型加入深度、姿态或边缘条件,但通常复制大块网络,需要大量成对数据;扩展到视频时参数和训练成本进一步放大。完全免训练的特征引导虽然轻,却可能只支持单一骨干或单一模态。问题因此变成:能否不让生成模型在前向时直接吃控制图,只从其内部表征读出空间误差,再反向调整噪声 latent。 本文贡献:ReaDiT 从冻结 DiT 的单个中间块提取特征,用一个带时间步条件的多尺度读出器预测深度、姿态或边缘,再把预测与目标控制图之间的损失梯度施加到当前 latent。生成骨干不直接接收控制条件,这种隐式条件化让同一思路可以覆盖图像和视频;在视频上还能用光流或相机轨迹目标控制运动。其图像版本约 53M 参数,远小于论文估算的 1.487B 参数 ControlNet 图像适配器。 实验效果:图像实验中,ReaDiT 在生成图控制条件上取得深度 RMSE 0.2492、姿态 PCK@0.2 0.5380、姿态 mAP 0.3709 和边缘 ODS 0.6968,多数指标优于 1.487B 参数的 ControlNet。视频空间控制中,它把 RG 的深度 RMSE 从 0.4610 降到 0.4225,姿态 PCK 从 0.1892 提到 0.3651,边缘 ODS 从 0.5304 提到 0.6101。 批判点评:只读一个 DiT 块就能跨图像与视频工作,说明预训练生成特征里已经包含可用空间信息;这比为每种骨干复制一套大适配器更容易维护。它的限制也来自同一点:读出器知道“当前画面离目标多远”,却不一定知道最稳定的生成路径,强梯度在遮挡、快速运动或互相冲突的控制图下可能牺牲画质。工程采用前应同时测控制误差、生成质量和额外反向传播的延迟。 4. EditVid:免训练视频编辑跃升19分 One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04190 关键词:视频编辑,免训练方法,稀疏因果记忆,身份保持,latent混合,多参考编辑,EditVid ⚠️ 前序问题:逐帧调用图像编辑器会造成闪烁、身份漂移和背景误改;专用视频编辑模型又需要昂贵训练,并常被限定在指令编辑或主体替换中的一种。一个统一框架必须同时解决相邻帧局部连续、远距离身份一致和编辑区域边界三件事,还要保留现代图像 MM-DiT 的多种编辑能力。 本文贡献:EditVid 冻结图像 MM-DiT,在推理期组合三个机制:稀疏因果记忆复用上一帧选定的注意力键值,保持局部连续;基于对应关系的后注意力 token 注入把锚帧身份带到远帧;软 latent 混合让目标区域接受编辑,同时保护背景。相同框架覆盖风格迁移、属性修改、对象插入、局部编辑和主体替换,也支持指令与参考图两种条件。 实验效果:在 FiVE 基准上,EditVid 达到 78.16 FiVE-Acc,最强的已评估免训练基线为 58.95,提升 19.21 分;在 IVEBench 上取得有竞争力的结果。面对 7 个对比方法的用户研究中,EditVid 获得 51.8% 的总体偏好率。 批判点评:三个机制分别对应短期、长期和空间局部性,职责划分清楚,且能复用强图像编辑器的新能力。风险在于对应关系是整个系统的支点:快速运动、长期遮挡或主体外观剧变会让锚帧 token 注入错误位置,造成“身份保持”反而覆盖合理变化。软混合也依赖编辑区域估计,细发丝、透明物体和反射场景会更难处理。 5. FlashRender:4步完成相机轨迹重拍 FlashRender: Few-Step Generative Rendering via Camera-Controlled Video MeanFlow | EverEx、延世大学、高丽大学 | arXiv:2609.03563 关键词:生成式渲染,相机控制,MeanFlow,少步采样,视频重拍,在策略蒸馏,FlashRender ⚠️ 前序问题:生成式渲染要把源视频沿新的相机轨迹“重拍”。传统多步扩散不仅慢,而且相机条件在不同采样步的作用不一致,这种离散化误差会弯曲去噪轨迹;直接做少步蒸馏时,学生还会在自己的 rollout 状态上积累误差,导致几何和画质同时下降。 本文贡献:FlashRender 先用 Representation Transformation and Alignment(RETA)把源视频隐藏表征对齐到冻结视觉几何模型提取的目标视角特征,把相机变换直接编码进源流,使控制在各采样步更一致。随后用 MeanFlow 目标拟合曲率更低的轨迹,最后用 on-policy flow-map distillation 针对学生自己的固定少步 rollout 修正误差。模型基于 Wan2.1-1.3B-CamCtrl,只需 4 次函数评估。 实验效果:论文报告在视频质量和几何一致性上可匹配多步基线,同时把采样成本降低 25 倍,并在分布外目标相机轨迹上取得更好的可控性。示例以 480×832 分辨率、单张 NVIDIA B200 测速,可在数秒内完成任意长度输入视频的目标轨迹重拍。 批判点评:方法最有启发的是先修控制不一致、降低轨迹曲率,再做少步蒸馏,而不是让学生同时吞下几何误差和时间离散误差。它仍依赖冻结几何模型提供可靠目标视角特征;反射、透明物体、动态遮挡和非刚体场景可能让几何先验失真。4 步设定很适合交互预览,但影视生产还需要评估细纹理和长镜头接缝。 6. PRISM-Bench:35项细则专门考生成音频 PRISM-Bench: An Audio-Centric Diagnostic Benchmark for Text-to-Audio-Video Generation | 上海人工智能实验室、美团 | arXiv:2609.04867 关键词:音视频生成,评测基准,音频质量,跨模态同步,MLLM裁判,屏内声源,PRISM-Bench ⚠️ 前序问题:文本到音视频评测通常把音频当成视频质量的附属项,或把声音单独拿出来测,无法回答模型究竟是声音本身差、声源和画面对不上,还是提示词中的音乐与对话没被执行。屏内声源需要精确同步,屏外环境声又不能被错误绑定到可见对象,两者混在总分里会掩盖失败类型。 本文贡献:PRISM-Bench 以音频为中心,把 900 个经人工核验的样本沿两条正交轴拆分:音频类型分语音、音乐和一般声音,声源可见性分屏内与屏外;再从音画一致、音频质量、表现力和提示遵循四个维度定义 35 项细粒度标准。评估采用相对真值参考的盲测并排比较,由增强的多模态大模型裁判执行,避免只给单个生成结果打绝对分。 实验效果:该裁判协议与人类评审的平均一致率超过 70%。对近期文本到音视频系统的测试显示,前沿闭源模型与开源模型之间仍有明显差距;各系统更容易优化总体感知保真度,却在复杂的音画 grounding 与控制上失分,尤其是音乐生成和需要同步的屏内声源。论文已被 ACM Multimedia 2026 接收。 批判点评:按音频类型与声源可见性做二维切片,比继续堆一个总分更能指导模型改进,特别适合发现“画面对了但声音错了”的情况。局限是音频体验高度依赖耳机、响度校准、语言和音乐文化,35 项标准越细,标注一致性和裁判稳定性越难保证;报告结果时应保留分项雷达图,不宜只引用单一排名。 7. WorldReward:分块裁判同时看动作和画质 WorldReward: Reward Modeling for Camera-Conditioned World Models | 复旦大学、腾讯混元、上海创智学院、上海交通大学、上海人工智能实验室 | arXiv:2609.03952 关键词:世界模型,奖励模型,相机控制,视频偏好,视觉语言模型,强化学习,WorldReward ⚠️ 前序问题:相机条件世界模型既要执行移动和旋转指令,又要保持外观、几何和运动自然。几何奖励能估轨迹,却看不出画面是否崩坏;图像奖励能看单帧质量,却忽略动作和时序。把整段长视频与完整动作序列一次交给 VLM,又会让短暂的局部动作证据淹没在长上下文中。 本文贡献:WorldReward 把成对视频按动作边界切成小块,每块整理为源图、帧网格与四个动作面板组成的六图证据,让 VLM 分别判断动作一致性和视觉质量,再由投票聚合成视频级偏好。训练数据由前沿 VLM 生成结构化理由,经工具代理审计与定向人工复核;作者另建 WorldReward-Bench,覆盖平移、旋转与复合相机轨迹。 实验效果:在人工标注的三分类偏好一致率上,WorldReward 的动作、外观和运动三项分别为 77.63%、81.32% 和 73.03%,比 GPT-5.5 高 3.42、1.45 和 3.56 个百分点。用于 HY-WorldPlay 1.5 的强化学习后,约 381 帧长时域的基础动作准确率从 WorldCompass 的 76.56% 提到 78.84%,HPSv3 质量分从 3.72 提到 3.94。 批判点评:按动作切块是解决长上下文稀释的直接方法,而且把动作和画质分开投票,避免高画质掩盖不听指令。投票也会丢掉动作间的因果关系:单块都判断正确,不代表整条轨迹的累计位姿闭环正确。下一步更需要把局部裁判与全局状态估计结合,并验证奖励模型是否会被生成器找到视觉捷径。 8. Puffin-World:1600万样本统一原生3D状态 Puffin-World: Scaling a Unified Multimodal Model with Native 3D World States | 南洋理工大学 S-Lab、密歇根大学、北京交通大学、ACE Robotics | arXiv:2609.04196 关键词:世界模型,3D生成,物理理解,深度重建,相机表示,多模态模型,Puffin-World ⚠️ 前序问题:世界模型常把物理理解、相机控制、图像生成、深度估计和 3D 重建拆成多个离线模块。模块间坐标定义与误差不一致,闭环探索时会累积漂移;模型只生成外观而没有重力、尺度和几何等显式状态,也很难判断新的视图是否仍处在同一个物理世界。 本文贡献:Puffin-World 在一个多模态架构中联合建模三类原生世界状态:物理状态包含重力场与纬度,几何状态为深度,外观状态为图像;统一 Omni-Camera 表示支持不同自由度与相机动作。模型既把物理动力传播到未来帧,也在同一生成过程中耦合外观与几何,从而让自由视角生成同时输出可重建的底层结构。训练集 Puffin-16M 包含 1500 万视觉-语言-相机三元组和 100 万条挑战性运动轨迹。 实验效果:论文展示统一模型可执行相机到世界的物理理解、自由视角空间模拟、3D 世界生成和重建,并支持模仿与自校准探索等交错闭环应用。作者公开了代码、模型和数据;摘要层面没有给出单一总分,而用多任务结果证明同一原生状态表示能覆盖此前分离的能力。 批判点评:把深度和图像一起生成、把相机属性锚定到真实坐标,是走向闭环 3D 世界模型的正确方向;显式重力还能约束“看起来合理但物理方向错了”的画面。最大疑问在数据标定:重力、纬度、深度和相机真值的噪声分布不同,大规模混合后谁主导训练并不透明。模型还能生成稳定视图,不等于已经学会接触、质量和材料等完整动力学。 9. EraseSAE:单义特征做视频概念手术 EraseSAE: Surgical Concept Erasure in Text-to-Video Diffusion Models via Sparse Autoencoders | 中国科学技术大学、安徽省数字安全重点实验室、HiDream.ai | arXiv:2609.03629 关键词:概念删除,视频扩散,稀疏自编码器,单义特征,时空掩码,生成安全,EraseSAE ⚠️ 前序问题:视频扩散模型从松散数据学习到版权角色、不安全内容等概念。现有删除方法直接改权重或用粗粒度方向抑制,但概念在 DiT 激活中分散且与背景、动作和风格纠缠,容易出现删不干净或把无关内容一起毁掉的问题。视频还多一层时间一致性要求,逐帧独立干预会产生闪烁。 本文贡献:EraseSAE 采用“分解—归因—删除”流程。Partitioned Convolutional Sparse Autoencoder 以分区双分支卷积把稠密时空激活拆成更可解释的稀疏单义特征;对目标提示和硬负提示做对比对数比归因,离线锁定概念核;推理时再按时间步生成时空掩码,只在概念真正激活的区域调制 classifier-free guidance,尽量保留其他对象和背景。 实验效果:在 CogVideoX 的三档裸体概念测试中,EraseSAE 的生成率为 2.62%、7.13% 和 77.80%,对比 T2VUnlearning 为 2.88%、10.89% 和 51.98%;其主体一致性为 94.30%,推理约 3.66 秒/帧。在 HunyuanVideo 上 Ring-A-Bell 裸体率为 5.13%,低于 T2VUnlearning 的 9.95%,主体一致性为 96.04%。Flux.1 的 I2P 显式内容总量也从原始 605 降到 160。 批判点评:以单义稀疏特征定位概念,比全局权重擦除更容易解释和审计,时空掩码也适合视频。不过“单义”来自稀疏自编码器的近似分解,不保证一个核只表达一个人类概念;对隐喻、组合提示或跨文化表达,硬负提示可能覆盖不足。部署时应同时报告删除率、误删率、绕过攻击和不同语言提示,不能只看平均主体一致性。 10. SVDtrunc:FLUX保留68%参数近乎无损 Importance-Aware Low-Rank Distillation of Diffusion Transformers | 海德堡大学、Zuse School ELIZA、达姆施塔特工业大学、hessian.AI | arXiv:2609.04646 关键词:Diffusion Transformer,模型压缩,低秩分解,知识蒸馏,FLUX,参数效率,SVDtrunc ⚠️ 前序问题:DiT 已成为高质量文生图骨干,但参数规模让显存、加载和部署成本居高不下。直接对所有投影矩阵用相同比例截断 SVD,忽略了不同块的重要性;大语言模型上的经验还让工程师担心低秩压缩会突然崩溃。需要先判断 DiT 的冗余分布,再在全局参数预算下决定哪些块可以多压。 本文贡献:作者发现 FLUX.dev 的 SVD 截断退化较平滑,冗余分散在全网络投影矩阵,而不是集中在少数 Transformer 块。SVDtrunc 先分别压缩每个块并生成探测图像,以相对原模型的质量变化给块排序;随后在全局预算下给不重要块分配更低秩,最后对全部块做模块化知识蒸馏与 rectified-flow 微调。该方法还能与减少采样步数的蒸馏叠加。 实验效果:SVDtrunc 在 GenEval、HPSv2 和 DPG 三个基准的综合比较中,在各压缩档位都优于论文纳入的竞争方法。FLUX.dev 保留 68% 原参数时接近完整模型性能,保留 57% 时仍有竞争力;实验覆盖保留 40% 至 90% 参数的区间,且无需微调的版本也保持较强结果。 批判点评:先用生成质量探测块重要性,比按权重范数或统一秩分配更贴近最终目标;发现 DiT 对低秩截断呈平滑退化也为工程压缩提供了有用经验。代价是每个块都要构造探测模型并生成一批图,前期搜索成本高,而且重要性依赖提示分布。若部署域与探测集差异大,原先被判定不重要的块可能正负责罕见概念。 趋势观察 代理式生成开始补上“证据进入像素”的最后一公里 WeAgent-MMGenEdit 不满足于给图像模型接一个搜索框,而是把外部证据拆成检索、逐图核验、结构化整合和最终交付四步,并让策略端与图像端分别做 SFT 和强化学习。PriorEdit3D 与 ReaDiT 也在降低监督门槛:前者从图像编辑器、视觉语言模型和图生 3D 教师蒸馏三类先验,后者只读一个 DiT 中间块,就用 53M 参数支持图像与视频的多类空间控制。 视频生成的竞争焦点转向控制稳定性与可核算效率 EditVid 用稀疏因果记忆、跨帧对应注入和软 latent 混合,把免训练视频编辑的 FiVE-Acc 从 58.95 提到 78.16。FlashRender 先修复不同采样步之间的相机控制不一致,再用 MeanFlow 和在策略蒸馏压到 4 次模型评估,采样成本降低 25 倍。SVDtrunc 则按块重要性给 FLUX 分配低秩预算,保留 68% 参数时仍接近完整模型性能。 评测与安全正在从单一总分转向可诊断的局部证据 WorldReward 按动作切分长视频并分别判断动作一致性与画质,避免局部指令证据被长上下文稀释。PRISM-Bench 把音频类型与声源是否可见交叉拆分,用 35 项细则暴露音乐和屏内同步声源的薄弱点。EraseSAE 也把概念删除落到稀疏单义特征和时空掩码上,不过最难的一档概念仍有 77.80% 生成率,说明精细归因并不等于问题已经解决。 人工智能炼丹君 整理 | 2026-09-07 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-28|京东JoyAI-Echo-1.5给长视频装上跨镜头记忆 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与世界模型 2 篇 · 视频编辑与剪辑规划 2 篇 · 自回归图像生成加速 1 篇 · 3D 资产纹理与物理化 2 篇 · 数字人与语音交互 2 篇 · 评测与度量审计 1 篇 重点论文标题列表 JoyAI-Echo-1.5(京东 Joy Future Academy):跨镜头记忆守住身份与音色 4DStreamCtrl(北京大学、腾讯混元):单卡 480p 20FPS 交互式 4D 控制 RefVideo-6M(中国电信 TeleAI、香港中文大学、中山大学、复旦大学、清华大学):600 万参考式编辑对反转构造 MTAR(佛山大学、香港大学、中山大学):训练时间砍 76% 推理零开销 RefineCut(香港中文大学(深圳)、vivo AI Lab、中国科学院大学、东南大学、北京大学):8B 开源规划器闭环出剪辑时间线 今日论文速览 1. JoyAI-Echo-1.5:跨镜头记忆守住身份与音色 Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds | 京东 Joy Future Academy | arXiv:2608.23383 关键词:长视频生成,音视频联合生成,跨镜头记忆,世界模型,少步因果蒸馏,分离RoPE,京东 前序问题:视频生成正在从「几秒一个孤立片段」走向「长篇叙事」和「可进入的交互世界」,但这一步跨过去要同时满足三个互相拉扯的要求:跨越多个镜头保持人物长相和声音不漂移、持续响应用户的控制输入、以及在长时间 rollout 中不崩坏。已有做法各有短板——纯靠拉长注意力窗口的方案显存和算力随长度爆炸;单纯依赖首帧条件的方案在第二个镜头之后身份就开始跑偏;世界模型类方案能响应导航输入,却往往把控制信号编码成与几何脱节的抽象向量,导致视角变化不符合真实相机运动。更棘手的是音频:语音身份(音色)与画面身份必须同步维持,而长序列里音画一致性的退化通常比画面本身更早被听出来。 本文贡献:JoyAI-Echo-1.5 是一套统一的音视频生成系统,做成两个针对性变体,共享同一套记忆条件化设计。长视频变体的核心是可组合的跨镜头记忆:从多个此前镜头聚合视觉证据(单帧视觉记忆),同时从「语音过滤后的整镜头音频」中提取说话人线索(音频记忆),两类记忆与文本、图像条件可以任意组合。关键设计是分离的 RoPE 坐标——记忆条目不与当前生成窗口共用位置编码,而是各自分配独立的坐标基点(μ 依次取 500/550/600 且 σ=0),从而让模型把记忆当作「可检索的外部条目」而非「更长的上下文」。世界模型变体则把异构导航输入(键盘、轨迹等)统一换算为标定过的 6-DoF 公制相机轨迹,经几何感知的条件通路注入,使控制与操作设备无关。为支撑长时程效率,作者把双向音视频骨干改造成因果少步生成器:先用渐进 teacher forcing,再在自生成 rollout 上做短时程与长时程的 Self-Gradient Forcing;蒸馏侧采用音视频联合 DMD,视频分支全量微调、音频分支走 LoRA 的非对称优化,并给音频额外加 patch 判别器与 latent RMS 能量匹配做稳定化。 Overview of memory-conditioned long-form generation and few-step acceleration in JoyAI-Echo-1.5. 实验效果:长视频设定下,JoyAI-Echo-1.5 在跨镜头一致性、视觉质量、文本对齐与语音保真度四项上均优于既有长视频基线;与自家 1.0 版本的同故事对比可以看到人物长相在第 0/5/10/15/20/23 镜头间明显更稳。世界模型变体在 WBench 上取得平均 81.7 分排名第一,并在 SANA-WM-Bench 上拿到领先的视觉质量与长时程持久性。作者还展示了在 Director Agent 编排下生成 10 分钟连续音视频叙事的案例。代码与项目页已开源(jd-opensource/JoyAI-Echo)。 Qualitative comparison between JoyAI-Echo-1.5 and JoyAI-Echo-1.0 under the same long-form story. Frames sampled from temporally separated shots demonstrate the improved character consistency, scene stability, and visual rendering of JoyAI-Echo-1.5. 批判点评:这是今天最有系统完成度的一篇,把记忆、几何控制、rollout 感知训练三件事拧成了一条可交付的产线,「记忆用独立 RoPE 坐标编址」这个设计尤其值得借鉴——它把长时程一致性从算力问题重新定义成检索问题。但要清醒看待几点:一是作者自己的对比图(v1 vs v1.5)虽然显示身份更稳,但这是自家版本迭代的自证,跨镜头一致性缺少与外部强基线在同一故事下的逐镜头量化;二是 WBench 81.7 的第一名含金量取决于该榜单的竞争密度与提交时间窗口,且世界模型变体与长视频变体是两套权重,「统一系统」在部署时实际是双栈;三是 10 分钟叙事依赖 Director Agent 做镜头编排,这层是外部 agent 而非模型内生能力,把它算作模型的长时程能力会高估;四是音频分支只用 LoRA 而视频全量微调,这个非对称选择在论文里更多是稳定性权衡的结果,音频质量上限是否被 LoRA 限制没有充分消融。 2. 4DStreamCtrl:单卡 480p 20FPS 交互式 4D 控制 4DStreamCtrl: Interactive Video Generation with Online 4D Control | 北京大学、腾讯混元 | arXiv:2608.25479 关键词:视频生成,4D控制,3D point track,流式生成,因果蒸馏,相机控制,北大腾讯混元 前序问题:生成视频已经足够逼真,但要真正当成交互工具用,必须能精细指定「物体和相机随时间怎么动」——而现有方法各自只覆盖一角:相机参数类方法能调视角但搬不动物体;2D 轨迹类方法在图像平面上操作,忽略深度与遮挡,导致物体沿轨迹移动时尺度和前后关系失真;近期的 3D 方法补上了几何,却只能离线跑且视频长度固定。换句话说,没有一种方法同时做到「相机与物体都是 3D 一致可控」加「实时流式生成」。这两个要求还互相冲突:3D 一致性通常需要全序列联合优化,而流式生成要求因果、恒定显存。 本文贡献:作者的核心主张是:相机运动、物体轨迹、深度这三件事可以统一进单一的 3D point track 表征,一个模型在一次前向里就能同时做相机与物体的联合控制、深度编辑和运动迁移。为了规模化学到这个接口,他们从野外视频挖掘 3D 运动监督,构建 OpenVidHD-Motion3D 数据集,并用一个轻量的 Geometric Motion Head 把 3D tracks 与文本编码为 2D 与深度运动特征,与含噪 latent 融合后送入带 3D RoPE 的 DiT,再解码成视频——这个编码器插在预训练视频扩散模型上,不需要重训骨干。关键一步在于这个编码器是时序可分离的,因此可以把模型蒸馏成因果流式学生:生成任意长视频只需四步去噪,且显存与长度无关。 Overview of 4DStreamCtrl capabilities. (a) Motion transfer. Given a source video, we extract decomposed 4D representations of camera motion, human motion, and background structure, which transfer to a new scene via image style transfer while preserving the original motion. 实验效果:统一设计在运动控制精度上超过此前的相机专用、2D 轨迹和离线 3D 方法,同时覆盖了它们各自孤立支持的模态。4DStreamCtrl 在单张高端 GPU 上以 20 FPS 生成 480p 视频,在数百帧尺度上保持时序连贯,作者称这是首次实现交互式 4D 可控流式生成。控制点数量消融显示质量在训练时使用的 256 条 track 处达到峰值(PSNR 18.27、SSIM 0.64、LPIPS 0.23),点数过少(16)或过多(1024)都会明显掉点。 Effect of the number of control points on student model generation. PSNR, SSIM, LPIPS, and EPE as the inference-time track count varies from 16 to 1024. Quality peaks at the training count of 256. 批判点评:把相机、物体、深度三种控制统一到 point track 这一个表征上,是这篇最漂亮的地方——它让「一次前向多种控制」成为可能,而不是堆三个适配器。工程指标也扎实:单卡 20 FPS 加长度无关显存,确实够得上交互门槛。需要注意的是:一是 point track 的质量完全依赖上游 3D 追踪器,野外视频挖掘出的监督在遮挡、快速运动、低纹理场景下必然带噪,论文没有量化追踪误差如何传导到控制精度;二是 track 数量的敏感性不小(1024 点时 PSNR 从 18.27 掉回 16.21),说明模型对推理期配置的鲁棒性有限,实际部署需要把点数锁在训练值附近,这对「艺术家自由指定轨迹」的宣称是个约束;三是作者自己的失败案例图承认长时程下小人脸与背景物体会逐渐模糊、并出现因果不一致的交互(蛋糕莫名缺一块),说明四步因果学生在细节保真上仍有代价;四是 480p 分辨率对「交互式创作工具」偏低,抬到 720p/1080p 后 20 FPS 能否维持是未知数。 3. RefVideo-6M:600 万参考式编辑对反转构造 RefVideo-6M: A Reliable Reference-Based Dataset for Instructional Video Editing | 中国电信 TeleAI、香港中文大学、中山大学、复旦大学、清华大学 | arXiv:2608.26101 关键词:视频编辑,参考式编辑,数据集,Mixture-of-Tokens,指令编辑,TeleAI,中国电信 前序问题:指令式视频编辑这两年的进展主要靠大规模数据集推动,但现有数据集有两个硬伤。第一是「目标视频本身是生成的」:多数数据集的编辑后视频由自动编辑模型产出,本身就带伪影和瑕疵,拿它当监督信号等于教学生模仿一个不合格的老师,误差会被继承甚至放大。第二是「只有文字没有参考图」:大部分公开数据集依赖纯文本指令,而真实的精确编辑往往需要视觉参考——要把这件衣服换成那件、把人脸保持成这个身份、把材质换成这块纹理,光靠文字描述无法唯一确定目标,也无法保持身份一致。 本文贡献:RefVideo-6M 用一个反转技巧同时解决这两个问题:把无伪影的真实视频当作编辑「目标」,再用多个编辑专家反向生成质量筛选过的「输入」条件——也就是把原视频与编辑后视频的角色对调,从而保证监督端永远是真实画面。数据规模为 500 万视频编辑样本加 100 万图像编辑样本,覆盖 26 类视频编辑任务与 6 类图像编辑任务,并提供约 600 万个视觉参考,参考类型相当多样:圈选、边界框、光照方向、外扩掩码、背景图、风格、纹理、物体、人物、服装。构造管线除了八个开源专家外,作者还自训了四个专家来补覆盖。配套模型 RefMoT 采用 Mixture-of-Tokens 设计来高效吸收参考信息:视频/参考/文本/条件文本四路 token 各有独立的 QKV 投影与 FFN,但共享 AdaLN 与注意力,并用结构化掩码控制哪几路可以互相看见,从而在降低训练成本的同时提升参考引导编辑质量。 Overview of RefMoT. RefMoT adopts a Mixture-of-Tokens design to efficiently incorporate reference information, reducing training cost while improving reference-guided editing quality and preserving strong generalization. 实验效果:数据集覆盖 26 个视频编辑任务与 6 个图像编辑任务,视频长度以 81 帧和 129 帧两档为主,任务分布上物体添加/移除/换色/重纹理等局部编辑占主体。作者提供了有参考与无参考两种设定下的用户研究界面与对比,RefMoT 在参考引导编辑质量与泛化性上均有提升,同时训练成本低于将参考直接拼接进序列的朴素做法。 Statistics of RefVideo-6M. The dataset includes 26 editing tasks and 6 image editing tasks. 批判点评:「把真实视频当目标、反向合成输入」这个反转思路是本篇最有价值的部分,它绕开了「用生成数据训生成模型」的误差累积陷阱,思路干净且可复用到图像编辑之外的领域。RefMoT 的 Mixture-of-Tokens 也是务实设计——共享注意力省算力、独立 FFN 保模态特性。但几点必须打问号:一是反转策略只对「可逆」任务成立,物体移除反转成物体添加是自然的,但风格迁移、重打光这类反转后语义并不对称的任务,输入条件的真实性依然依赖那 12 个专家的质量,论文没有按任务类型拆开报告数据可靠性;二是「600 万参考」的口径包含圈选、边界框这类几何提示,与真正的图像参考混在一个数字里,容易高估视觉参考的规模;三是评测以用户研究为主,缺少在公开视频编辑基准上与其他数据集训练的同架构模型做控制变量对比,「数据集更好」的结论强度受限;四是 81/129 帧的长度上限意味着这套数据对长视频编辑基本无覆盖。 4. MTAR:训练时间砍 76% 推理零开销 Efficient Training with Foresight: Multi-Token Auxiliary Supervision for Autoregressive Image Generation | 佛山大学、香港大学、中山大学 | arXiv:2608.25386 关键词:自回归图像生成,多token预测,训练加速,对比正则,语义丢弃,DINOv3,ACM MM 2026 前序问题:自回归图像生成把图像当作离散 token 序列建模,扩展性好、保真度高,但传统的 next-token prediction(NTP)有三个连在一起的毛病:监督稀疏且近视——每步只预测紧邻的下一个 token,模型学不到稍远处的结构;表征区分度不足——采样得到的 token 表示彼此不够可分;训练成本高——必须在完整 token 序列上做密集计算,而图像 token 里有大量低信息量的背景与平坦区域,这些位置消耗了同等算力却贡献很少学习信号。已有加速手段多数动的是推理侧或架构,训练阶段「每一步梯度携带多少信息」这个维度反而少有人碰。 本文贡献:MTAR 是个纯训练期框架,三个组件全部只在训练时生效、推理时零额外开销。一是多 token 预测(MTP):在原有 NTP 头之外再加一个 MTP 头,对「当前 token 正下方」的 token 提供辅助监督,把稀疏近视的信号加密成对多个未来 token 的联合监督(论文记作 MTP(R₁,B) 配置)。二是 token 级对比正则(TCR):对采样到的 token 表示走共享权重的 MLP 得到相似度矩阵,同类拉近异类推远,显式提升表征可分性。三是语义丢弃(SD):用 DINOv3 为每张图提取 token 重要度图,丢掉低重要度 token 只保留语义显著的位置参与训练,保留 token 沿用其原始空间索引以免位置信息错乱——作者还对比了 SigLIP2,发现 DINOv3 的重要度图在 50% 保留率下更好地保住了 VQ 解码后的结构。 Overview of the proposed framework. (a) Overall framework under the MTP (R$_1$, B) setting: besides the original NTP (R$_1$) head, an additional MTP head is introduced to provide auxiliary supervision for the token directly below the current token. (b) TCR: Sampled token representations are projected by a shared MLP to compute a similarity matrix. 实验效果:在 ImageNet 上,相比 LlamaGen,MTAR 拿到最多 0.95 更低的 FID 与 39% 更快的训练;而在总量口径上(LlamaGen 训练 300 epoch,MTAR 只训 100 epoch),Base 模型训练时间从 115 小时降到 30 小时(降 74%)、显存从 45 GiB 降到 31 GiB(降 30%),Large 模型从 175 小时降到 42 小时(降 76%)、显存从 97 GiB 降到 73 GiB(降 25%)。即使只用 1/3 的训练迭代数,性能仍与基线相当或更好。 Comparison of total training time (hours) and total GPU memory usage across all training GPUs between LlamaGen and MTAR for the Base and Large models, along with the corresponding FID values. LlamaGen is trained for 300 epochs, whereas MTAR is trained for only 100 epochs. 批判点评:这篇的价值在于把优化战场从推理侧挪回训练侧,且三个组件都不污染推理路径——对工程落地非常友好,尤其 SD 用现成视觉基座的重要度图来分配算力,思路简单但有效。但读数字时必须小心口径:论文摘要里的「39% faster」与配图里的「降 74~76%」不是一回事,后者把 epoch 数从 300 砍到 100 一起算进去了,等于把「收敛更快」和「单步更省」混在同一个百分比里;如果只看同迭代数,真实加速是 39%。其次,MTP 只对「正下方」一个 token 加监督,比语言模型里成熟的多 token 预测要保守得多,为什么选这个方向、能否推广到更远距离缺少系统消融。第三,SD 引入了对 DINOv3 的外部依赖,重要度图的偏好会隐式塑造生成分布(比如系统性弱化背景细节),这个副作用没有被评估。最后,实验规模停在 ImageNet 256×256 与 LlamaGen Base/Large,能否在更大规模或文本条件生成上复现,仍是开放问题。 5. RefineCut:8B 开源规划器闭环出剪辑时间线 Plans You Can Check: Verifier-Grounded Learning of an Open-Weight Planner for Executable Video-Editing | 香港中文大学(深圳)、vivo AI Lab、中国科学院大学、东南大学、北京大学 | arXiv:2608.25622 关键词:视频剪辑规划,可执行时间线,验证器,开源规划器,DPO,EMNLP 2026,vivo 前序问题:实际的视频剪辑远不只是像素生成:剪辑师要把一份创作 brief、一个素材池、音乐元数据和一堆硬性约束,转成一条可执行的时间线——选哪些片段、怎么裁、怎么排、用什么转场、总时长和音乐怎么对齐。这个「决策层」此前基本被忽略,或者被简单包装成「给前沿大模型套个 workflow」的做法。这条路有三个问题:规划过程隐式不可复现、生成的方案无法被机器验证、也没法拿来训练自己的模型。更麻烦的是这个任务没有唯一正确答案——同一个 brief 有很多种合理剪法,所以直接模仿老师的输出并不合适。 本文贡献:RefineCut 把这件事定义为「可执行视频剪辑规划」,并训练一个紧凑的开源权重规划器而非包装前沿模型。规划器通过结构化补丁(patch)编辑一条带类型的时间线,覆盖片段选择、裁剪、排序、转场、时长与音乐对齐;每个补丁由一个确定性验证器实际应用并对照显式的约束账本(constraint ledger)逐条检查。因为不存在唯一正解,训练不直接模仿老师:作者把每个多老师分支都通过验证器重放一遍,只保留「验证器认为最好」的修复作为监督(verified SFT)。第二阶段 RefineCut-Evo 让学生用验证器加任务评分表给自己的修复打分,挑高边际的偏好对做 DPO 训练。最终这个 8B 规划器在推理时完全跑在闭合验证器回路里,不再需要调用任何老师模型。 Overview of RefineCut. Verifier replay and self-improvement turns noisy trajectories into an evolved planner. 实验效果:论文构建了 RefineCut-Bench(3578 条任务)用于评测。系统的实际形态是一个闭环编辑 agent:维护时间线状态与约束账本(时长边界、转场规则、步数预算 ≤3、禁用项、风格一致性),规划器输出 RefinePatch,验证后重算状态并接受或拒绝,循环不超过 3 次,最终产出可执行的 final_plan.json。作者用 GPT-5.4、DeepSeek-V4-Pro、Qwen3-Max 作为多老师来源,并明确展示了「老师选择 ≠ 验证器最优」的错配现象,这正是 verified SFT 的动机。 RefineCut learns an open-weight planning layer that turns editing intent into executable edit plans. 批判点评:把「剪辑决策」从像素生成里剥出来单独建模,并且用确定性验证器做监督筛选,这个问题定义本身就是贡献——它让一个原本靠 prompt 碰运气的环节变得可复现、可验证、可训练,「老师选择 ≠ 验证器最优」的观察也很有说服力。8B 能本地跑、推理期不依赖老师,对产品化是实打实的好处。但天花板明显被验证器框住了:验证器只能检查可形式化的约束(时长、转场规则、禁用项),而剪辑质量里最关键的节奏感、情绪曲线、镜头语言恰恰无法写成账本条目——所以「verifier-best」未必等于「人觉得好」,论文若没有充分的人工偏好评测,这个 gap 就是悬着的。其次多老师全是闭源前沿模型,数据构造成本与可复现性受制于这些 API,且学生的能力上限被老师分布圈定。第三,步数预算 ≤3 是个相当紧的约束,复杂 brief 下是否够用没有讨论。最后 RefineCut-Bench 由作者自建,缺少第三方基准交叉验证。 6. GLOSS:单形状自监督纹理刷进 Blender GLOSS: Geometric Local Self-Similarity Learning for Faithful Reference-Guided Texture Fill | NVIDIA、普林斯顿大学、多伦多大学 | arXiv:2608.25461 关键词:3D纹理生成,参考引导,几何自相似,PBR材质,Blender插件,SIGGRAPH Asia,NVIDIA 前序问题:纹理艺术家想为一个已有 3D 形状快速试多种外观,条件图像生成本来很合适,但当前最强的方法仍有两个缺口。一是保真度:生成整个物体纹理时很难同时贴合精细几何细节和单视图参考,留给艺术家引导的空间很小——模型倾向于按自己的全局理解重画,而不是老老实实跟随参考。二是灵活性:现有自动模型多数是「给个全局提示、一键出整体纹理」,艺术家无法从不同来源交互式、可控地探索多种纹理组合。这类方法通常还要在大规模 3D 数据集上训练,数据门槛高。 本文贡献:GLOSS 走了一条反直觉的路线:不追求在大 3D 数据集上学通用先验,而是针对单个 3D 形状训练一个「形状专属」的局部纹理生成与补全模型,利用自然与人造形状中普遍存在的几何自相似性以及几何-纹理相关性。具体做法是在该未贴图形状的大量单视图生成图像上训练网络,让它学会通过关注局部几何(比如鳞片走向)来为局部区域上色,并忠实跟随作为条件的纹理参考块。训练完成后,任何新参考都能通过逐块 inpainting 迁移成整个目标物体的纹理。作者还展示了批量多注意力可视化,说明目标图像中心 patch 如何跨批次关注参考图像的各个 patch。 We train a GLOSS network on many single-view generated images of one untextured 3D shape (left), allowing it to learn how to texture local shape regions by attending to local geometry (such as scales) and faithfully following conditional texture patches. 实验效果:质量上达到或优于强图像条件纹理生成基线,同时额外支持局部几何条件下的纹理修补(由艺术家挑选参考引导),并可泛化到 PBR 材质与未见网格做纹理迁移。作者把这个纹理填充能力做成 Blender 插件,与若干 3D 纹理专业人士做了试点,对模型的可控性、实用性与创作启发性反馈积极。论文也诚实给出失败案例:语义纹理错配,以及几何与纹理相关性低时的失效。 Data and Training: we use off-the-shelf models to generate training data for our local texture inpainting model. Steps A to F show the patch data generation pipeline. 批判点评:「per-shape 专属模型」这个取向很有意思——放弃泛化换取对单个资产的极致保真与可控,正好命中艺术家工作流里「这一个模型要做到位」的真实需求,而且大幅降低了数据门槛。做成 Blender 插件并请真实从业者试用,这种落地闭环在学术论文里不多见,值得加分。但代价也很直白:每换一个形状就要重新训练一个网络,论文摘要没有给出单形状训练耗时,这直接决定它是「可用工具」还是「demo」;如果一个资产要等数小时,交互式探索的价值就被抵消了。其次「几何自相似性」这个前提有明确适用边界——鳞片、砖墙、织物这类重复结构受益明显,而光滑无特征或语义强依赖(比如人脸、品牌标识)的表面会退化,作者的失败案例也承认了几何-纹理相关性低时失效。第三,专业人士试点是小样本主观反馈,缺少与现有商业工具的定量对照。最后,作者之一因会议地点原因撤出 SIGGRAPH Asia 2026 发表,属论文外信息,但说明该工作原定投向图形学顶会。 7. Gen2Physics:材质分割 mIoU 15.6 涨到 48.3 Gen2Physics: Grounding Generated 3D Meshes in Physics via Multi-View Material Decomposition | Google DeepMind、Google Research、布里斯托大学 | arXiv:2608.23869 关键词:3D生成,物理仿真,材质分解,多视图一致性,VLM精修,水密子网格,Google DeepMind 前序问题:生成式模型现在能产出高保真 3D 网格,但这些输出缺少交互仿真、游戏和机器人所需的物理属性——它们只是「看起来对」的壳,没有材质、密度、内部结构信息,扔进物理引擎里行为完全不对。此前的物理化工作大多针对体素或神经场等体表征,与标准物理引擎不兼容,需要额外转换;而且它们通常把整个网格当作单一均质物体处理,一把钳子的金属头和塑料柄被赋予同一个密度,自由落体和碰撞行为自然失真。 本文贡献:Gen2Physics 是一套统一自动的框架,直接在网格上操作以产出可立即仿真的资产。管线三段:先用微调过的 Vision Transformer(论文亦称 DPT)在多视图 2D 渲染上做稠密材质分割;再做稳健的 2D-to-3D 一致性投影——把资产每个面投影到各渲染视图上并考虑遮挡,按跨视图投票为每个面指定材质标签,从而把噪声大、视图间不一致的 2D 掩码聚合成一致的 3D 材质图;最后由视觉语言模型(VLM)引导精修,利用上下文推理分配物理属性并推断内部几何(实心还是空心)。通过把表面 patch 转成带不同密度的体,该方法让物理上合理的动力学仿真成为可能,并输出每种材质各自水密的子网格。作者同时构建了 PartNet-Material 数据集,通过人工为资产每个部件指定材质标签得到稠密分割掩码。 Process of our 2D-to-3D consistency projection. A fine-tuned ViT predicts material segmentation masks, which are possibly noisy and not consistent across views. We project each face of our asset onto the rendered views, taking into account occlusions. For each face, we assign a label corresponding to the cross-view vote. 实验效果:在 ABO-500 与 PartNet-Material 两个基准上,Gen2Physics 把此前物理化管线的材质分割精度提升一倍多(mIoU 从 15.6 提到 48.3),同时在质量估计精度上与体表征方法持平,并且是唯一能输出「每材质水密子网格」的方法。定性对比中可以看到 NeRF2Physics 与 PUGS 的材质分割碎片化严重(椅子、水壶、钳子上出现大片错误标签),而 Gen2Physics 的结果与人工标注的 GT 分割高度接近。 We compare Gen2Physics (Ours), NeRF2Physics, and PUGS on a material identification task. The visualizations show that the 2D-to-3D consistency projection and VLM refinement proposed in Gen2Physics ensure more coherent and accurate material segmentations. In contrast, NeRF2Physics and PUGS produce fragmented predictions. 批判点评:选题很实用:生成 3D 的下一个瓶颈确实是「能不能进引擎」,而不是「像不像」。直接在网格上做、输出每材质水密子网格这两个工程决策,让结果可以无缝喂给标准物理引擎,比一堆需要转换的体方法更贴近生产。mIoU 从 15.6 翻到 48.3 的幅度很大,定性图上与 GT 的接近程度也支持这个数字。但必须看清基线的起点极低——15.6 mIoU 本身已经接近不可用,翻一倍后的 48.3 也谈不上可靠,意味着仍有过半的面材质判错,直接用于精密仿真风险不小。其次「实心还是空心」由 VLM 上下文推理给出,这是一个没有视觉证据支撑的猜测(外观看不出内部),论文若未单独评估这一项的准确率,那么质量估计「持平体方法」的结论可能建立在互相抵消的误差上。第三,材质类别只覆盖木/金属/织物/玻璃/塑料/皮革/橡胶七类,复合材质、涂层、透明件这些真实资产里的常见情况无法表达。最后 PartNet-Material 是作者自建且人工标注,规模与标注一致性未披露。 8. Super Star:只用已生成语音在线出手势 Super Star: Towards Streaming Real-time Interactive Agents for Digital Humans | 上海科技大学、腾讯光子工作室(LIGHTSPEED) | arXiv:2608.24909 关键词:数字人,协同语音手势,流式生成,因果自回归,自演化数据,ACM MM 2026,腾讯光子 前序问题:协同语音手势生成(co-speech gesture)此前几乎都在离线设定下研究:拿到一整段完整语音,再合成配套手势。但真实场景里的交互式数字人必须在线生成——只能用当前已经产生的回复音频,还要满足严格的延迟约束。这让已有方法直接失效,因为它们要么依赖未来语音信息(离线双向建模),要么推理延迟太大。这是个结构性错配,不是调参能解决的:一旦不能看未来,手势与语音的同步就要靠因果预测完成,而手势的自然度恰恰很依赖对整句韵律的预判。 本文贡献:作者形式化了「面向交互式数字人的在线协同语音手势生成」这一任务,并提出一个实时交互框架,把流式语音回复模块与在线手势生成模块耦合起来。手势生成器设计为因果多模态自回归模型,从流式回复语音与运动历史预测身体动作,因此无需访问未来语音即可做到低延迟、语音对齐的手势合成——具体结构上,Omni 模型接收用户音频/查询文本/第一视角视觉,输出文本-音频 token 流,经流式 coder decoder 后与组合式身体 token 一起进入若干层因果自注意力加带音频注意力掩码的多头交叉注意力,最后由 motion decoder 输出动作。为支撑这个设定,作者还设计了面向虚拟陪伴场景的离线数据合成管线:用话题与情绪感知的主体语料库构造多样的人机对话,再针对 agent 回复生成协同语音手势(用到 TTS、动作捕捉与音色克隆,16 台相机加 50 个标记点)。为弥合离线构造与在线部署的差距,他们建立自演化训练回路,把线上交互中收集的用户反馈重新灌回数据生成流程,实现对用户偏好的持续适配。 Overview of Super Star. (a) Offline interactive data synthesis and self-evolving loop pipeline for constructing virtual-companion-oriented training data that continuously adapts to user preferences. (b) Online real-time interaction pipeline, where a streaming speech response module is coupled with an online gesture generator. 实验效果:实验显示该框架在延迟-质量权衡上更优,语音-动作同步性更强,用户偏好度高于有竞争力的既有基线。定性对比中,给定同一段流式回复语音,该方法比基线反应更及时、手势更自然同步。论文被 ACM Multimedia 2026 接收。 Qualitative comparison of online co-speech gesture generation. Given the same streaming response speech, our method reacts more promptly and generates more natural and synchronized gestures than existing baselines. 批判点评:把任务从离线搬到在线并明确「不能看未来语音」这个约束,是这篇的主要贡献——它承认了产品场景的真实限制,而不是在离线设定里继续刷指标。自演化回路(线上反馈回灌数据生成)也是个务实的工程闭环,配合腾讯光子的背景,看得出是冲着实际数字人产品去的。但论文的量化披露偏弱:摘要通篇是「更优」「更强」「更高」,没有给出延迟的毫秒数、同步性指标的具体数值,而延迟恰恰是这个任务的核心卖点,缺了数字就无法判断是否真达到交互门槛。其次训练数据完全由自建管线合成(LLM 造对话 + TTS + 音色克隆 + 动捕),合成数据的分布偏差会直接塑造手势风格,且「虚拟陪伴」场景的定向语料使结论难以外推到其他交互类型。第三,自演化回路依赖线上用户反馈,存在偏好漂移与正反馈放大的风险,论文未讨论如何防止手势风格被少数活跃用户带偏。最后,评测以用户研究为主,缺少与工业级数字人系统的端到端延迟对照。 9. CSAVocoder:因果流式空间音频恒定显存 CSAVocoder: A Causal Spatial Audio Vocoder Towards Real-Time Spatial Audio Generation | 浙江大学 | arXiv:2608.25404 关键词:空间音频,声码器,因果流式,GAN,通道间线索,实时生成,浙江大学 前序问题:空间音频声码器负责把生成模型产出的梅尔谱转成空间音频波形,是沉浸式内容链路的最后一环。问题是绝大多数神经声码器是为单声道设计的,直接扩展到空间音频会损害空间质量——因为它们逐通道独立重建,完全忽略了通道间线索(inter-channel cues),而人耳判断声源方位恰恰依赖左右耳的时间差与强度差。此外实时应用还要求严格因果与恒定显存,这与常见的非因果、看全局上下文的声码器架构直接冲突。 本文贡献:CSAVocoder 是一个因果的 GAN 空间音频声码器,把波形保真度与空间渲染联合优化。框架引入两个针对性设计:一是 Spatial Adaptor,把多通道梅尔谱与动态的声源-听者位姿信息融合,让声码器知道当前的空间关系而不只是频谱内容;二是空间一致性判别器,专门监督通道间线索是否被正确重建,而不是只看单通道波形像不像。为满足实时要求,作者设计了严格因果、带状态的生成器,支持高效流式推理且显存开销恒定——这一点对长时间连续渲染尤其关键。 Overview of our model architecture. 实验效果:在大规模空间音频数据集上,CSAVocoder 的空间类指标全面超过所有对照声码器(含扩散类声码器),同时在常规音频质量指标上保持有竞争力,并达到实时性能。评测同时走客观与主观两条轨:客观侧除常规音频指标外,还把音频切成 1 秒片段、计算预测与真值嵌入的余弦相似度再平均,得到空间一致性分数;主观侧设计了 MOS-Q(音质,关注清晰度/自然度/有无金属噪声与毛刺,明确要求评分者忽略空间定位)与 MOS-P(空间感知,关注左右声道强度变化的声像准确度、远近距离感、以及空间效果与文字描述的匹配度,明确要求忽略音质因素)两套独立的听测量表,把「音质」与「定位」解耦打分。定性上,本方法在左右(L/R)双通道的梅尔谱重建上比 HiFi-GAN、WaveFM、Vocos、CarGAN、FarGAN 更接近 Ground Truth,高频谐波结构的保留差距可见。 Qualitative comparison of mel-spectrogram reconstruction on left (L) and right (R) channels against Ground Truth and baseline vocoders. 批判点评:补的是一个真实且常被忽视的缺口:整条空间音频生成链路的研究重心都在声学场建模和方位控制上,最后落地成波形这一环却长期沿用单声道声码器,通道间线索的损失会把前面所有的空间建模努力打折。架构上三处设计都对得上问题:Cross-Channel Attention 显式建模通道关系而非逐通道独立重建、空间位姿经 FiLM 动态调制进骨干、以及 PixelShuffle1d 配 State Cache 实现严格因果加恒定显存的流式推理。评测设计也比同类工作用心——把 MOS-Q 与 MOS-P 拆成两套量表、并在指导语里互相排除干扰因素,这是空间音频主观评测中容易被偷懒省掉的一步。不足在于:一是摘要层面量化信息极少,「competitive audio quality」这种措辞通常意味着单通道音质并未领先,实际是拿一部分单声道保真度换空间保真度,这个权衡的具体幅度要看正文表格;二是对比基线(HiFi-GAN、Vocos、CarGAN、FarGAN)多为单声道声码器的直接扩展,缺少与专门设计的空间音频声码器的正面对照,「空间指标全面超越」的含金量因此受限;三是空间一致性用「1 秒片段嵌入余弦相似度」来度量,这个代理指标是否真的对应人耳定位误差没有被验证,而它恰恰是论文的主打客观指标;四是覆盖范围止于 FOA/双通道,更高阶 Ambisonics 的可扩展性未知。 10. AV-Sync Audit:四个同步度量互相不一致 What Do Audio-Visual Synchronization Metrics Actually Measure? | 弗吉尼亚理工大学、Accenture | arXiv:2608.25157 关键词:音视频同步,度量审计,可靠性,Kendall tau,Krippendorff alpha,ECCV 2026 Workshop 前序问题:自动音视频同步度量被广泛用来给音视频生成模型排名、甚至直接当训练目标,但它们本身很少被当作「测量仪器」来审计——我们默认分数高就是同步好,却没检验过这些分数在受控扰动下是否单调、对预处理是否敏感、彼此之间是否一致。这是个基础但危险的盲区:如果度量本身不可靠,那么基于它的模型选择和训练优化都可能在优化噪声。 本文贡献:作者在统一的可靠性协议下联合审计四个常用度量——AV-Align、ImageBind AV-relevance、JavisScore、Synchformer/DeSync,检查六个维度:受控扰动下的单调性、预处理敏感性、排名不确定性、度量间一致性、与 PEAVS 人类对齐代理的一致性,以及学习式融合能否改善。结论不是「某个度量胜出」,而是一次坐标轴分裂:不同度量测的根本不是同一件事。基于此,作者主张报告方式应改为「可靠性卡片」(Reliability Card)——给出按度量家族拆分的结果与置信区间,而不是一个赤裸的同步分数。 Kendall tau against known desynchronization for four AV-sync metrics under controlled distortion families. 实验效果:Synchformer/DeSync 是最强的时间偏移追踪器(τ=0.84),在 Shift 与 Speed 两类扰动上明显领先;ImageBind/JavisScore 则更贴合 PEAVS 人类对齐代理(τ=0.20)与内容破坏类扰动,在 Mute 扰动上反超;AV-Align 是最弱的独立度量,在 Speed 与 Shuffle 上 Kendall τ 几乎为零甚至落到负区间。四个度量互相之间严重不一致(Krippendorff α=0.066),跨度量相关矩阵显示 ImageBind 与 JavisScore 高度相关(0.78),而 Synchformer 与两者近乎零相关(-0.00/0.00),AV-Align 与所有其他度量均为轻微负相关。线性与简单 kNN 融合都没能在 PEAVS 一致性上超过最佳单一度量。 Cross-metric correlation matrix among the four audio-visual synchronization metrics. 批判点评:这是今天最该被从业者读到的一篇,尽管它既没有新模型也没有新数据集。把度量当仪器做体检、并给出「坐标轴分裂而非单一赢家」的结论,直接质疑了当前音视频生成领域一大批论文的评测有效性——尤其 α=0.066 这个数字,意味着四个度量对同一批样本的排序几乎相互独立,那么「我们在 X 度量上 SOTA」的说法可信度非常有限。融合也救不了,这个负面结果同样有价值。局限要说清楚:一是这只是 ECCV Workshop 的非归档 poster,作者仅两人且一位来自咨询公司,实验规模与审稿强度都远低于主会论文;二是「人类对齐」用的是 PEAVS 代理而非新采集的人工标注,代理本身的有效性成为整个结论链的单点依赖,若 PEAVS 有偏,τ=0.20 的解读会翻转;三是审计只覆盖四个度量与四类受控扰动(Shift/Speed/Shuffle/Mute),真实生成模型的失效模式(如语义不匹配、口型错位)未必落在这四类里;四是文章给出了「可靠性卡片」的建议格式,但没有推动出可直接调用的工具或标准实现,落地阻力不小。 趋势观察 「记忆」成为长时序生成的一等公民,而不再是上下文窗口的副产品 — 今天两篇最重的视频工作给出了同一个判断:把长视频做长,靠的不是把注意力窗口拉宽,而是显式设计要记什么、以什么坐标记。JoyAI-Echo-1.5 把跨镜头记忆拆成「单帧视觉记忆 + 语音过滤后的音频记忆」两路,并用分离的 RoPE 坐标给记忆条目单独编址(μ=500/550/600),让身份与音色能跨任意镜头组合被检索;4DStreamCtrl 则把记忆压进 3D point track 这一几何表征里,使显存与视频长度解耦。两者都放弃了「全序列自注意力」的暴力路线,转向「结构化外部条件」——这与前两周 On-Policy 蒸馏、长视频记忆一致性专题里看到的趋势完全一致,说明长时程一致性已经从「算力问题」被重新定义成「表征与检索问题」。 少步蒸馏从「加速手段」升级为长视频的可行性前提 — 值得注意的是,今天两篇长视频工作都不是先做好质量再顺手蒸馏,而是把因果化少步生成写进了主线设计。JoyAI-Echo-1.5 用渐进 teacher forcing 加短/长时程 Self-Gradient Forcing,把双向骨干直接改造成因果少步生成器;4DStreamCtrl 蒸馏出四步因果学生,才换来单卡 480p、20 FPS 的交互式流式生成。逻辑很清楚:长视频天然要求流式、要求恒定显存、要求可交互,这三条都无法在多步双向采样上成立。蒸馏因此不再是「便宜版」,而是「唯一能跑的版本」——这与 08-27 TurboT2VA 把少步蒸馏与工程推理栈捆绑交付是同一条脉络的延续。 训练效率的抓手从「改架构」转向「改监督信号密度」 — MTAR 提供了另一个角度:不动推理架构、不加推理开销,纯粹在训练阶段动刀。多 token 预测把稀疏近视的 next-token 监督加密,token 级对比正则提升表征可分性,语义丢弃按 DINOv3 的重要度图砍掉低信息 token 的冗余计算——三者叠加拿到相比 LlamaGen 训练时间降 74~76%、显存降 25~30%、FID 最多低 0.95 的结果,而且只用 1/3 迭代数就追平基线。这个思路值得关注:当推理侧的优化空间被少步蒸馏和量化榨得差不多之后,训练侧「每一步梯度携带多少信息」正在成为新的效率战场。 评测层的自省开始追上生成层:度量本身需要被审计 — 今天有两篇工作在往同一个方向使劲,却站在生成与评测的两端。AV-Sync Audit 把四个常用音视频同步度量当作「测量仪器」逐一体检,结论相当刺眼:Synchformer 追时间偏移最强(τ=0.84),但 ImageBind/JavisScore 更贴合人类偏好代理(τ=0.20),四者互相之间几乎不一致(Krippendorff α=0.066),线性与 kNN 融合都没能超过最佳单一度量。MatReplace、VGA-BenchV2 这类基准同日出现也在补同一块短板。这提示一个容易被忽略的风险:如果我们一直用互相矛盾的单一分数去排名和训练生成模型,那么榜单进步与真实体验提升之间的相关性可能远比想象中脆弱。 人工智能炼丹君 整理 | 2026-08-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-25|Meta让15B DiT优化器时间砍半Muon-DiT 今日 AIGC 论文速览 今日共 10 篇 · 训练与推理效率 3 篇 · 视频编辑与视角转换 2 篇 · 生成理解一体化 1 篇 · 3D 与数字人生成 2 篇 · 可控图像生成 1 篇 · 生成评测 1 篇 重点论文标题列表 Muon-DiT(Meta、南加州大学 (USC)):优化器时间砍掉一半的15B DiT InfinityEdit(浙江大学、阿里巴巴集团):编辑指令跟着直播流无限延伸 TextAnchor(哈尔滨工业大学、可灵 KlingAI Research):十张参考图编辑提速5.47倍 Grounded-Exo2Ego(NVIDIA):第三视角视频翻成第一视角 Libra(中科院自动化所 MAIS、中国科学院大学、鹏城实验室):视觉与语言各走各的路再架桥 今日论文速览 1. Muon-DiT:优化器时间砍掉一半的15B DiT Scaling Muon for Diffusion Transformers | Meta、南加州大学 (USC) | arXiv:2608.20818 关键词:Muon优化器,DiT训练,Scaling Law,Newton-Schulz,通信优化,Meta 前序问题:Muon 是一个矩阵感知的优化器,它通过在奇异方向之间平衡更新来改善大模型训练,在语言模型上已有不少正面报告。但它在扩散 Transformer 上到底有没有用、有用的话优势会不会随规模衰减,一直没有系统答案——扩散模型的训练目标(去噪回归)与语言模型的下一 token 预测差异很大,参数矩阵的谱结构也不同,语言模型上的结论没有理由直接迁移。更棘手的是端到端效率:Muon 的核心是每一个优化步都要做 5 步 Newton-Schulz 迭代(NS5)来正交化更新方向,再加上需要把动量完整物化出来,这两项在大规模分布式训练下会引入可观的计算与通信开销。理论上 Muon 用更少的步数达到同样质量,但如果每一步都更贵,省下的步数优势就被抵消了,实际墙钟时间可能反而更长。 本文贡献:作者先把 Muon 在 1.3B 到 15B 参数的 DiT 上的 scaling 行为建立起来,确认其相对 AdamW 的优化与生成质量优势跨越各个规模都存在。然后针对上述开销问题提出 Periodic Row-wise Muon:完整的 NS5 谱更新每 K 步才做一次,其余步骤基于当前动量做一个计算与通信开销都很低的行约束(row-wise constrained)更新。这个设计的直觉是谱正交化的收益具有一定的时间持久性,不需要每步重做;行归一化则以极低成本维持更新方向的量级平衡。配套的分布式实现是关键的另一半——非刷新步直接在分片后的动量上操作,避免全量物化;谱刷新步则通过分桶 all-gather 与通信-计算重叠来加速。方法层面与实现层面是协同设计的,不是先有算法再套一个工程实现。 实验效果:跨全部规模,Muon 相对 AdamW 把观察到的最佳生成质量提升了 12.9%~19.1%。相比原版 Muon,Periodic Row-wise Muon 在 1.3B~4B 上最佳生成质量的差距保持在 0.5% 以内,在 9B 上反而提升了 4.5%。效率侧:优化器时间减少 46.9%~54.3%,端到端单步时间减少 15.7%~24.3%,逻辑通信量降低 66.7%,达到各自最佳生成质量所需的有效训练时间减少 33.7%~64.8%。9B 模型的 profiler 时序图直观展示了这个差异:原版 Muon 每一步的 CPU 阶段都被红色的 NS5 块占据,归一化总时间 12.47;Periodic Row-wise Muon 只在第一步做紫色的周期性刷新,后两步是很窄的绿色行归一化块,总时间降到 10.26。 Generation quality for AdamW and Periodic Row-wise Muon. 批判点评:评价指标只用了 FD-DINO 这一项。它作为生成质量代理是合理的,但单一指标很难覆盖扩散模型关心的全部维度——文本对齐、多样性、失效模式都没有报告,「生成质量提升 12.9%~19.1%」这个数字的解释空间因此受限。周期 K 的选择论文中没有在摘要层面给出选取准则,而这是一个直接影响质量-效率权衡的超参,实际使用时需要重新搜索。另外 9B 上 Periodic 版本反而比 vanilla Muon 好 4.5% 这个结果有点反直觉(近似方法优于精确方法),论文归因不明,更可能是训练噪声或正则化副作用,而不是周期化本身带来的收益——15B 上并没有复现出同样的优势。最后,全部实验在 Meta 内部的训练栈上完成,通信优化的收益与具体的集群拓扑强相关,换一套硬件环境未必能复现 66.7% 的通信量下降对应的实际时间收益。 2. InfinityEdit:编辑指令跟着直播流无限延伸 InfinityEdit: Infinite Video Editing with a Lightweight Edit-Ignition Adapter | 浙江大学、阿里巴巴集团 | arXiv:2608.20910 关键词:无限视频编辑,流式生成,轻量适配器,因果注意力,阿里 前序问题:指令式视频编辑这两年靠大预训练模型已经做得不错,但绝大多数方法都建立在一个默认假设上:原地编辑。给定一段固定时长的源视频片段,把编辑后的视频与它逐帧对齐。这个模式在开放式的视频流面前直接失效——比如给一场正在进行的游戏直播换风格,或者给一个还在拍摄的镜头加一段运镜,编辑必须作用在陆续到来的未来帧上,而不是一个静态的输入片段。这个设定带来两个新困难:编辑必须是对流的忠实延续而不是逐帧重写,以及当编辑指令一条接一条累积时,生成质量不能持续退化。 本文贡献:作者先把这个任务形式化命名为无限视频编辑(infinite video editing)——给定前序片段和一条编辑请求,模型要生成延续这个流并施加该编辑的下一个片段,整个过程随无界的指令序列反复进行。为此他们设计了配套的数据收集管线,并在此基础上提出 InfinityEdit:一个给流式视频生成器加装无界编辑能力的轻量编辑适配器。适配器里有三个注意力模块,分工明确——历史交叉注意力用输入帧引导当前去噪帧,时序因果自注意力保证时间信息只从早期帧流向后期帧,编辑交叉注意力把编辑请求注入生成过程。推理时的调度是这个方法的巧妙之处:适配器只在编辑请求到达的那个 chunk 被激活(作者称之为 ignition chunk),后续 chunk 交还给原模型、用重置的锚定帧继续生成。这样既施加了编辑,又完整保留了原模型的无限生成能力,不会因为适配器一直在线而累积漂移。 Our adapter's architecture. It is composed of three attention modules. 实验效果:实验显示 InfinityEdit 在每条编辑下都能忠实延续视频流,并在无界编辑序列上保持稳定。定性对比最能说明问题:以一段山峰风景视频为源,连续施加「向上移动镜头」「拉远」「美式漫画风格」三条指令,Helios-Base 在第一条指令后就基本没有响应运镜;Anchor-Forcing 和 Infinity-RoPE 从第一轮开始画面就被云雾吞掉、山体结构丢失;SANA-Streaming 在第三轮的漫画风格化中把山体涂成了大片紫黄色块。InfinityEdit 三轮下来山峰主体的结构始终清晰可辨,运镜幅度与指令对应,漫画化时也保留了山形轮廓。长视频实验把每个编辑片段拉长到全序列超过 1000 帧,方法依然视觉稳定且持续实现每条指令。 Qualitative comparison with various methods on the streaming video editing task, where a sequence of editing instructions (here camera-movement and style edits) is applied continuously to a scenery source video. All methods share the same source video and editing instructions. Methods marked with $\dagger$ take no source video as input, while all other conditions are kept identical for fairness. 批判点评:18 页的篇幅对一个新任务定义加方法加数据管线来说偏紧,摘要里的实验结论全是定性表述(「忠实延续」「保持稳定」),没有给出量化的编辑成功率或与基线的数值差距,只能等正文核实。更值得追问的是评测本身——无限视频编辑这个任务是他们自己定义的,数据管线也是自建的,对比的基线(Helios-Base、Anchor-Forcing、Infinity-RoPE、Lucy-Edit、SANA-Streaming)都不是为这个设定设计的,在这种「主场作战」的比较里领先幅度容易被高估。推理时适配器只在 ignition chunk 激活、后续交回原模型这个调度虽然保护了无限生成能力,但也意味着编辑效果的持续性完全依赖锚定帧的传递,如果某条编辑的语义需要长时间维持(比如把整个场景换季),单 chunk 的激活是否够用是个未验证的问题。 3. TextAnchor:十张参考图编辑提速5.47倍 Anchoring Instruction Outside Mask: Exact Reference Caching for Efficient In-Context Diffusion Transformers | 哈尔滨工业大学、可灵 KlingAI Research | arXiv:2608.21229 关键词:参考图缓存,注意力掩码,on-policy蒸馏,多图编辑,可灵 前序问题:全模态生成里,上下文条件是核心机制——让扩散 Transformer 在同一条注意力序列里同时处理文本指令和视觉参考。问题是每张参考图会引入数千个 token,算力随参考图数量快速增长。现有的省法是结构化稀疏注意力,通过限制参考 token 与目标 token 之间的交互来砍计算。这个结构有个附带好处:参考图的 K 和 V 与去噪目标无关,因此可以算一次、跨所有去噪步复用。但代价同样明显——它把视觉参考与文本指令之间的通路也一并切断了,参考图「看不到」用户的指令,多参考图编辑里的指令跟随和参考保真度显著下滑。这是一个结构性的两难:要缓存就得解耦,一解耦指令就传不进去。 本文贡献:作者的破局点是同时重新设计 token 序列与注意力掩码,而不是在两难中做取舍。他们的 beyond-mask 设计引入静态文本锚点(时间步固定在 t=0 的文本 token),把指令连接到参考分支上,同时严格保持 K/V 精确复用的前提,且不增加任何参数。但这种直接的架构改造会掉生成质量,他们用两阶段的方式恢复:第一阶段是教师强制的速度蒸馏,在数据派生的插值点上查询教师;第二阶段是一段短的 on-policy 阶段,让教师在学生实际访问到的状态上做监督、修正沿轨迹的残余误差。作者称据其所知这是扩散模型中第一次用 on-policy 蒸馏来做架构恢复——这个组合思路(先改架构拿效率,再用蒸馏把质量补回来)本身比具体的加速数字更有普适价值。 Overview of instruction-aware exact caching. Top: Static text anchors condition the reference branch once during cache construction. Only the resulting reference K and V are retained and reused across denoising steps. Bottom: Comparison of attention structures, where rows denote queries and columns denote keys and values. 实验效果:在三个图像编辑基准上,方法与全注意力生成的质量持平。5 张参考图时把完整的 40 步去噪流程加速 3.92 倍,静态文本锚点带来的运行时开销可忽略;scaling 研究中 10 张参考图时加速比达到 5.47 倍。参考图数量与加速比的关系曲线很清晰:1 张时仅 1.82 倍,2 张 2.45 倍,5 张 3.86 倍,之后逐步爬升到 10 张时的 5.47 倍——全注意力的延迟从 1 张的约 40 秒涨到 10 张的约 970 秒,而本方法只从约 40 秒涨到约 175 秒,两条曲线的斜率差就是这套缓存机制的价值。定性对比中,隔离缓存(isolated condition)经常跟不上指令(图中红框标出的错误区域),而文本锚点版本的输出与 Qwen-Image-Edit-2511 的全注意力结果接近。 批判点评:加速比对参考图数量的强依赖需要被正确理解:单张参考图时只有 1.82 倍,这是绝大多数实际编辑场景的常态;5.47 倍要 10 张参考图才能拿到,而十图编辑是相当边缘的用例。也就是说这套方法的收益曲线与真实需求分布未必对齐。质量方面论文的说法是「matches full-attention generation quality」——匹配而非超越,考虑到还额外付出了两阶段蒸馏的训练成本,这个权衡是否划算取决于部署场景的推理量。on-policy 蒸馏作为架构恢复手段是个有意思的贡献,但论文没有报告这个恢复过程本身的成本(需要多少数据、多少 GPU 时),而这直接决定了该方法能否被复用到其他架构改造上。另外静态文本锚点把文本时间步固定在 t=0,这对训练时见过的时间步分布是一个分布外的用法,长期稳定性需要更多验证。 4. Grounded-Exo2Ego:第三视角视频翻成第一视角 Grounded-Exo2Ego: Structured Semantic Grounding for Robust Exocentric-to-Egocentric Video Generation | NVIDIA | arXiv:2608.20534 关键词:第一视角生成,视角转换,语义锚定,3D重建,NVIDIA 前序问题:从一段第三人称(exocentric)视频生成对应的第一人称(egocentric)视频,对 AR/VR 与具身智能都很关键——第一视角数据的采集成本远高于架好机位拍摄。但这个任务比常规的新视角合成难得多:视角变化极端,标准的几何条件(把场景重建成 3D 再从目标位姿渲染)在这种大跨度下变得高度不可靠,而且会出现大量在源视频里根本没被观察到的区域,几何重建对这些地方无能为力——渲染出来就是一片空洞。 本文贡献:作者在架构和数据两个层面同时下手。架构上是一个双分支的视频扩散模型:几何锚定分支把第三视角的颜色和深度抬升成 3D 重建、在目标 ego 位姿下渲染,用这个渲染结果条件化生成;语义锚定分支则跳出了主流的纯几何路线——用 captioning 提取逐物体的短语,经 LLM 转成物体 token,配合可学习的 register,通过带掩码的交叉注意力注入,让模型基于物体级上下文来合成那些几何搞不定的困难区域。另一个被忽视但影响巨大的发现是相机-重建失配问题:重建出的 3D 与相机位姿之间存在系统性错位,会严重拖累 exo-to-ego 的学习,他们为此设计了一个相机重定位算法,修正后全部指标都有实质提升。数据层面则做了一个全自动的合成数据引擎,在程序化生成的环境里生成并渲染绑定骨骼的 3D 角色。 Method overview. Geometric anchoring (top): Exocentric color and depth are lifted to a 3D reconstruction and rendered at the ego pose. Semantic grounding (bottom): Per-object context is extracted as segmentation masks and object tokens. The segmentation masks are reprojected into the ego-view as used as attention masks during cross-attention. The per-object masks encourages noisy tokens to attend to object information relevant to the specific region, providing spatial structure that grounds semantics onto pixels. 实验效果:在有挑战性的 EgoExo4D 数据集上,方法在所有指标上都大幅超过近期的 SOTA。详细消融验证了数据侧与架构侧每一项贡献各自的增益。teaser 图给出的定性对比很有说服力:同一个厨房场景,Vista4D 生成的第一视角画面里手部与台面结构完全错乱,EgoX 虽然保住了手的形态但物体摆放与真值不符,纯几何渲染(Grounded Rendering)在未观察区域留下大片彩色噪点和空洞,而本方法的输出在手部姿态、盘子位置、台面布局上都与 ground-truth 高度接近。 批判点评:语义锚定分支依赖 captioning 模型和 LLM 来产生物体级条件,这条链路的鲁棒性没有被讨论——captioning 出错或漏掉关键物体时,本该被语义补全的困难区域会退化成什么,论文没有给出失败案例分析。合成数据引擎用程序化环境加绑定骨骼角色,与真实第一视角视频之间的域差距是这类方法的老问题(真实 ego 视频有严重的运动模糊、鱼眼畸变、极端光照),论文说合成数据有用,但没说清在多大程度上依赖它。评测只在 EgoExo4D 上进行,这个数据集以厨房、自行车维修等结构化场景为主,泛化到户外或大范围移动场景的能力未知。另外相机重定位算法被描述为「实质提升所有指标」,这暗示原始 baseline 的一部分差距其实来自数据处理缺陷而非方法本身,与 SOTA 的比较中这部分收益应当被单独看待。 5. Libra:视觉与语言各走各的路再架桥 Decoupled Vision-Language System for Multimodal Understanding and Generation | 中科院自动化所 MAIS、中国科学院大学、鹏城实验室 | arXiv:2608.20382 关键词:生成理解一体化,解耦架构,Switch Attention,跨模态桥,中科院 前序问题:生成理解一体化的多模态大模型现在基本都走一条路:把图像 token 和文本 token 拼进同一个 Transformer,共享全部参数。这么做简单,但隐含了一个未经检验的假设——视觉和语言的表征需求是相同的,可以用同一套注意力和 FFN 权重来建模。实践中大家反复观察到理解与生成两个目标互相拖累:加强生成能力往往损害理解性能,反之亦然。问题的根源可能在于自模态建模(视觉内部的空间关系、语言内部的语法结构)和跨模态交互(图文对齐)本来就是两类不同的计算,硬塞进同一套参数里会产生干扰。 本文贡献:Libra 的做法是把两者显式分开:一个视觉系统、一个语言系统,中间用跨模态桥(cross-modal bridge)连接。解耦主要落在两个模块上——switch attention 和 switch FFN,它们根据当前处理的是自模态建模还是跨模态交互,动态路由计算流。这样每个模态能学到自己独有的表征,同时保持有效的跨模态理解。作者给出了两个配置:Libra-1 用于纯理解的图生文设定,Libra-2 用于理解与文生图统一的设定。除了架构本身,论文还讨论了 tokenization、位置编码和监督信号上的多项改进——比如混合图像 tokenization 把 CLIP 的连续信号与 VQGAN 的离散 ID 通过 LFQ 结合,因为直接把 VQGAN 的图像编码器换成 CLIP 会扭曲视觉信息。 An overview of the Libra architecture. The core design is the switch attention and the switch FFN that decoupling self-modal modeling and cross-modal interaction. We build two variants, Libra-1 and Libra-2, to discuss several improvements in tokenization, positional encoding, and supervision. 实验效果:实验表明专门的 Libra 设计让多模态理解与生成互相促进(而非互相拖累),在理解与生成两类基准上都取得了强性能。文生图的定性对比中,面对「悉尼歌剧院旁边是埃菲尔铁塔,蓝色夜空下爆炸的黄色星星和旋转的蓝色光晕」这种多要素长 prompt,SDXL 漏掉了铁塔、Show-O 把歌剧院画成了抽象色块,Libra-2 则把歌剧院、铁塔、星芒、蓝色漩涡都放进了画面;「一张脸左半边是爱因斯坦、右半边是机器人剖面」这条更考验组合能力的指令上,Libra-2 的结果左右分界清晰、机械结构细节完整。tokenizer 的消融图也直观显示直接用 CLIP 替换 VQGAN 编码器会让重建图像严重失真,而 Libra-1 的混合方案大幅缓解了这一点。 Comparison on text-to-image generation. We highlight the key parts of the text prompts, where Libra-2 demonstrates strong prompt-following capacity. % shows several text-to-image generation results of Libra-2. More results are presented in Sec.. In Fig, we compare the text-to-image generation results of Libra-2 with two baselines, StableDiffusionXL and Show-O, where StableDiffusionXL is a widely-used strong text-to-image generation model, and Show-O is a unified MLLM that use the most closed training 批判点评:摘要里的性能表述全是「strong performance」这类定性词,没有给出任何绝对数字或与具体基线的对比,无法判断领先幅度——这在一篇主打架构设计的论文里是个不小的信息缺失。解耦架构的直接代价是参数量:一个视觉系统加一个语言系统再加跨模态桥,参数规模相比同等能力的共享架构必然更大,论文没有报告参数量对齐后的公平比较,「互相促进」的结论也就有可能部分来自额外容量而非解耦本身。定性对比选的基线 SDXL 和 Show-O 都不是当前最强的文生图或统一模型,说服力有限。另外 switch attention/FFN 的路由是根据「当前是自模态还是跨模态」这个二元判断来做的,这个划分在实际的混合序列里如何精确界定,摘要层面没有交代。 6. DiffVC-ONE:一步扩散做视频压缩后处理 DiffVC-ONE: Diffusion-based Generative Video Compression with One-Step Video Diffusion Transformer | 武汉大学遥感信息工程学院 | arXiv:2608.20515 关键词:生成式视频压缩,一步扩散,视频DiT,时序一致性,武汉大学 前序问题:生成式视频压缩能在极低码率下恢复丰富的视觉细节——这是传统编码器做不到的,因为传统方法在低码率下只能丢细节,而生成模型可以「补」出合理的细节。但这条路上同时满足高时序一致性和低推理成本一直很困难:基于图像的方法逐帧处理,帧间容易闪烁;基于视频的方法能保证一致性,但多步扩散的推理成本在视频这个数据量级上难以承受。 本文贡献:DiffVC-ONE 建立在一步视频扩散 Transformer 之上,三个组件依次解决三个问题。统一单向 latent 压缩器(U2LC)用一个共享模型高效且统一地压缩紧凑的 latent 切片,避免为不同参考结构设计不同的压缩器。视频 DiT 的一步扩散增强器把重建出的 latent 切片当作内容锚点,对整个图像组(GOP)做单步的时空感知增强——注意这里是对整个 GOP 一起做,时序一致性因此有结构性保证,而不是靠逐帧后处理再想办法对齐。混合条件生成器从重建内容和量化信息里抽取结构、强度、语义三类条件:结构条件保留应当忠实还原的区域,强度条件控制生成增强的程度(这一点很重要——不是所有区域都该被生成模型「发挥」),语义条件在一步增强中补充内容感知的感知细节。 The framework of the proposed DiffVC-ONE. 实验效果:在多个标准基准上达到 SOTA 的感知质量和时序一致性,同时保持低推理成本。视觉对比给出了同一场景下各方法的码率(BPP)与放大细节:videoSRC15 的教堂穹顶场景中,DiffVC-ONE 的 BPP 是 0.0126(作为 1.00 倍基准),而 DiffVC 需要 0.0321(2.55 倍)、DiffVC-OSD 需要 0.0355(2.82 倍)才能达到相当的观感;鹦鹉羽毛的例子里 DiffVC-ONE 用 0.0059 BPP,对比 PLVC 的 0.0158(2.68 倍)和 VTM-17.0-LD 的 0.0074(1.25 倍),红黄羽毛的边界过渡更清晰。也就是说在相同感知质量下,码率大约只需要竞品的三分之一到二分之一。 Visual comparison between the proposed DiffVC-ONE and other representative methods. 批判点评:这是一篇工程完成度很高但方向偏窄的论文——生成式视频压缩距离实际部署还有距离,主要障碍是解码端需要跑一个视频 DiT,这个成本在终端设备上并不现实,「低推理成本」是相对于多步扩散而言的,不是相对于传统编解码器。论文只有两位作者,实验体量看起来主要靠 RD 曲线堆砌(6 个数据集 × 6 个指标 = 36 张子图),但这种密集的曲线图很难让读者判断在哪个码率区间优势最明显。另外生成式压缩有一个根本性的争议这篇没有正面回应:解码出的细节是模型「编」出来的而非真实存在的,在监控、医疗、取证这类场景下这是不可接受的属性,而 LPIPS/DISTS/FID 这类感知指标恰恰会奖励这种行为。强度条件的设计看起来是对这个问题的部分回应,但论文没有把它作为一个安全机制来讨论和验证。 7. MultiCube:拿包围盒指挥每个零件长在哪 MultiCube: Compositional 3D Generation With Part-Level Semantic and Spatial Control | Roblox、卡内基梅隆大学 (CMU)、斯坦福大学 | arXiv:2608.20448 关键词:组合式3D生成,部件级控制,布局适配器,两阶段扩散,Roblox 前序问题:游戏和动画里用的 3D 资产通常需要是组合式的——拆分成有语义意义的部件,这样才能单独换材质、做动画、改结构。最近的 3D 生成方法已经能从图像或文本 prompt 生成高质量的组合式物体,但这类全局条件缺少专业创作流程真正需要的部件级可控性:你可以说「一门带黄铜炮管和木轮底座的加农炮」,但没法指定炮管具体多长、轮子放在哪个位置。 本文贡献:MultiCube 的输入设计很直白:一个全局文本 prompt、一份指定期望部件的文本 schema、以及一个用包围盒标出各部件空间位置的布局。输出是由多个独立网格组成的 3D 物体,一个部件一个网格,且同时满足语义和空间条件。方法用两阶段扩散:第一阶段生成与 schema 和布局对齐的整体网格(monolithic shape),第二阶段把这个网格同时分解成各个部件——注意是同时而非逐个,因为部件之间存在相互约束。核心组件是 Part Layout Adapter,它独立于其他部件来编码每个部件的条件(文本标签走 Qwen-VL,包围盒走 Fourier + Linear),这个独立性保证了改动一个部件的条件不会牵动其他部件。第二阶段的多部件 DiT 之间插入 Cross-Part Attention,让各部件在生成时互相感知、保证接缝处的几何一致。 MultiCube uses a two-stage diffusion-based architecture. In Stage 1, it synthesizes a monolithic object conditioned on the input text prompt and part layout (a). In Stage 2, it takes the object latents produced in Stage 1 and decomposes them into multiple shapes, one for each specified part, guided by the part labels and bounding boxes (b). Spatial conditions are encoded with a Part Layout Adapter in Stage 1 and a lightweight embedding in Stage 2. 实验效果:实验显示方法能生成高质量的组合式 3D 物体并实现精确的部件级控制,包括那些仅靠文本或图像 prompt 难以达到的独特布局。定性结果覆盖面很广:婴儿车(车架/把手/座椅/顶篷/轮子五部件)、滑板(板面/桥/轮)、手电筒、树蛙、工具箱、摩托艇(船体/舷外机/螺旋桨/方向舵/挡风/座椅六部件)、黄铜提灯,以及喷气背包、加特林、火箭、军用水壶、飞碟、腕式弹弓、长剑等。每个例子里生成的形状都能看出与输入包围盒布局的对应关系——比如飞碟的「旋转外环」确实是一圈环绕结构、「诱捕光束发射器」在底部。 Full pipeline generation results. MultiCube generates compositional 3D objects from input text prompts and part layouts. Here, the part bounding box layouts are automatically generated using GPT-5.1; hence, the generation process from prompt to output shape is fully automatic. 批判点评:对创作者来说,手工摆包围盒本身就是一项不轻的工作量——这套方法把「描述物体」的负担转移成了「搭建粗模」的负担,是否真的降低了创作门槛取决于具体工作流。摘要没有给出任何量化指标(几何质量、部件分割准确率、布局遵循度都没有数字),也没有与 CubePart、PatchAlign3D 等基线的定量比较,「高质量」的判断只能靠看图。展示的例子都是结构相对规整的人造物体(工具、载具、武器),部件边界清晰;有机形体(树蛙那个例子是唯一的例外,且它的部件划分——身体/头/舌头/腿——也相当粗粒度)和部件间存在复杂拓扑连接的物体表现如何,从现有材料看不出来。另外包围盒作为空间条件只能表达轴对齐的粗略位置,无法表达旋转、弯曲等更细的姿态要求。 8. Xemo-Talker:把情绪监督放到次主成分上 Xemo-Talker: Unlock Emotions Explicitly for Audio-Driven Talking Portrait Synthesis | 利物浦大学、西交利物浦大学、昆山杜克大学、CMU、蚂蚁集团、平安科技 | arXiv:2608.14700 关键词:说话人视频,情绪控制,主成分分析,唇形同步,蚂蚁集团 前序问题:音频驱动的说话人头像里,精确的情绪控制一直做不好,因为现有系统依赖隐式的情绪调节——情绪信号混在整体条件里,控制间接且不充分。而如果直接在整个运动空间上加显式的情绪相关损失,又会撞上一个内在的权衡:唇形同步需要运动空间的主要能量方向被音频严格约束,情绪控制则要求这些方向能被情绪标签改动,两个目标在同一组维度上打架。 本文贡献:论文的核心发现是一个关于运动空间结构的观察:虽然情绪线索散布在整个运动空间中,但把判别性监督集中在次主成分(less-principal components)上,反而能取得更好的情绪-唇形平衡——因为主成分主要编码高能量的发音动作和头部姿态变化,情绪信息在这些方向上的占比被淹没了。基于这个洞察,Xemo-Talker 先学一个中性的语音到运动映射,保证稳定的发音和唇形同步(这一支冻结),再引入一个由次主子空间监督引导的轻量情绪分支(可训练)。为了强化情绪控制,他们设计了 Tri-Loss:类间分离、类内紧凑、以及次主对比学习三项。推理时输入音频、参考图像和情绪标签即可。 Overview of Xemo-Talker. (a) The Geometry Motion Predictor learns emotion-agnostic audio-driven motion through diffusion reconstruction, producing the complete 70-D facial motion sequence. (b) With the predictor frozen, the Geometry Emotion Branch encodes the target emotion and injects multi-scale residual features through zero-initialized adapters to refine the motion prediction. (c) The subspace-aware Tri-Loss organizes global emotion representations using classification and prototype alignment, while applying contrastive discrimination to the less-principal PCA projection. The predicted motion is converted into deformed keypoints and rendered by the frozen LivePortrait renderer. 实验效果:在情绪分类准确率上达到 SOTA,同时保持有竞争力的唇形同步和高推理效率,性能接近在真实视频上测得的水平。定性对比里最有说服力的是 Fear 与 Surprised 这一对——这两种情绪在面部表情上高度相似(都是睁大眼睛、张嘴),是情绪控制里最容易混淆的一对。图中同一身份在两种标签下生成的结果确实呈现出可区分的差异:Fear 时眉毛内侧上扬、嘴角向下、整体表情收紧,Surprised 时眉毛整体上抬、嘴张得更圆、眼睛睁得更大。男女两个身份上这个区分都成立。 Visual comparison of Fear and Surprised expressions from MEAD. 批判点评:「情绪分类准确率 SOTA」这个指标本身值得警惕:它衡量的是一个分类器能否认出生成视频的情绪,而 Tri-Loss 里的类间分离和类内紧凑恰恰是在直接优化这个可分性——存在把情绪做成夸张刻板表情来取悦分类器的风险,而人类观感上的自然度未必同步提升。论文没有报告用户研究,这个疑虑无法排除。次主成分承载情绪信息这个发现是基于 70 维运动空间的 PCA 方差谱得出的,这个运动表示来自 LivePortrait,结论是否依赖这个特定的运动表征、换一套 3DMM 或隐式表示还成不成立,没有验证。情绪标签是离散的类别(happy/sad/fear/...),这与真实表达中情绪的连续性和混合性不符,强度控制也不在建模范围内。另外机构列表横跨六家单位,实际的实验规模从 9 页的篇幅看应该有限。 9. OccluRank:给每个框加个序号定遮挡 OccluRank: Controllable Occlusion-Aware Layout-to-Image Generation by Adding Just an Ordinal Rank | 合肥工业大学、中国科学技术大学、字节跳动、中科院软件所 | arXiv:2608.20932 关键词:布局生成,遮挡顺序,序数条件,可控生成,字节跳动 前序问题:布局到图像生成通过包围盒实现显式的空间控制,但包围盒只能指定实例的位置,无法表达它们之间的遮挡关系——两个框重叠时,谁在前谁在后是未定义的。现有方法要么额外依赖深度图等几何条件(增加了输入负担),要么用复杂的推理阶段优化流程,要么把各实例的表征独立构建后简单聚合、完全不建模遮挡带来的相互作用。 本文贡献:OccluRank 的设计极简:给每个包围盒只加一个序数 rank。这个用户指定的遮挡顺序通过轻量的基于 rank 的条件注入编码进模型,配套的 Order-aware Instance Interaction(OII)模块在聚合前对 rank 条件化的实例表征做联合更新——具体是在每个空间位置 p 上取该位置的有效性掩码,把落在这里的多个实例特征送进一个 Transformer 做位置级的跨实例交互,让指定的顺序引导重叠实例之间的信息交换。整个过程不需要额外的几何输入,也不需要推理时的专门优化。数据侧他们构建了 OccluLayout:一个合成训练数据集,遮挡顺序和 amodal 标注直接从已知的场景几何导出,而不是用辅助预测模型从部分遮挡的图像里估计——这是个关键差别,估计出来的标注在遮挡严重时本身就不可靠。评测侧提出 OccluLayout-Bench,用多个多模态大模型评测器分别评估实例存在性、空间布局、属性和遮挡顺序,再加 FID 衡量整体图像质量。训练目标除了全局去噪损失还加了前景并集掩码上的局部去噪损失。 Overview of OccluRank. OccluRank constructs spatially aligned instance features, incorporates ordinal rank embeddings, and performs location-wise cross-instance interaction before aggregating into an Instance Semantic Map (ISM). The masked ISM is residually injected into selected cross-attention layers of SDXL. 实验效果:实验显示 OccluRank 更可靠地保留目标实例、遵循指定布局、实现期望的遮挡关系,同时属性一致性和整体图像质量与基线相当。定性对比中的差异相当明显:「猿在前、羊在后、鸡在最后、狐狸最远」这组布局里,CreatiLayout 把猿和羊糊成了一个畸形生物、LaRender 直接漏掉了羊和鸡,OccluRank 则四个实例齐全且前后关系正确;「大象/长颈鹿/斑马/斑马」那组里 OcclusionFormer 漏掉了长颈鹿、IFAdapter 的斑马与长颈鹿位置错乱,OccluRank 的四个动物按指定顺序排布。反向消融图进一步验证了控制力:把实例顺序反过来后,没有 rank embedding 的变体输出几乎不变(说明它根本没接收到顺序信号),完整模型则正确翻转了前后关系。 Qualitative comparison under overlapping layouts. $^\dagger$ denotes the official checkpoint without OccluLayout training. 批判点评:用多模态大模型当评测器来判断「遮挡顺序是否正确」是个方便但风险不小的选择——MLLM 本身对遮挡关系的判断能力就未经充分验证,用它评一个专门优化遮挡的模型,存在评测器与被评对象共享失败模式的可能。OccluLayout 是合成数据集,遮挡顺序从已知几何导出确实比估计可靠,但合成场景的物体摆放分布与真实照片差距多大、训练在合成数据上的模型在真实布局上的泛化如何,需要看正文的实验设计。序数 rank 只能表达全序的前后关系,现实中常见的交错遮挡(A 遮 B 的左半、B 遮 A 的右半,比如交叉的手臂)无法用一个标量序号表达。骨干用的是 SDXL,在当前时点已经不算前沿,这套 rank 条件化机制能否迁移到 DiT 架构的现代模型上是个开放问题。 10. CamWorldQA:给运镜可控的世界视频打分 CamWorldQA: Perceptual Quality Assessment of Camera-Controlled World Video Generation | 上海交通大学、埃因霍温理工大学 | arXiv:2608.18710 关键词:视频质量评测,相机控制,世界模型,无参考VQA,上海交大 前序问题:生成式视频模型现在已经能做相机可控的世界视频生成——用户给定一条相机轨迹,模型据此合成视频。但评估这类视频的质量没有合适的工具:现有的视频质量评估方法都是为自然视频设计的,捕捉不到相机可控生成特有的感知特性,比如视角一致性、运动连贯性和内容保持度。换句话说,这个方向的进展缺少一把合适的尺子。 本文贡献:作者构建了 CamWorldQA,第一个针对相机可控世界视频生成的感知质量评测基准。规模是 720 个生成视频,来自 6 种代表性生成方法、20 个多样化的源视频、6 种相机轨迹(Truck Left/Right、Dolly In/Out、Pedestal Up/Down)的组合,每个视频都通过主观实验获得了人工标注的感知质量分。在此基础上他们提出 CWQA,一个无参考的质量评估网络,用三个互补分支分别提取特征:光流分支用 RAFT 抽运动轨迹特征(1×512),运动分支用 SlowFast 的双通路抽运动特征(1×2304),空间分支用 ResNet-50 加多层级池化抽空间特征(1×7168)。三路特征经 Projection MLP 后通过自适应门控加权融合,再送进质量回归头输出分数。 Overview of the proposed CWQA method. 实验效果:实验表明 CWQA 在 CamWorldQA 数据集上显著超越现有的质量评估方法。demo 图给出了两个具体例子:一段 Truck Right 运镜的人物视频,人工打分 61.18,SimpleVQA 给 51.45(明显低估),CWQA 给 63.75,与人工判断接近;另一段 Pedestal Down 的风景视频人工只给 25.65(画面在下摇过程中出现了明显的内容坍塌),SimpleVQA 给 40.33(严重高估),CWQA 给 23.56。这两个例子恰好展示了通用 VQA 方法的典型失效模式——它们对生成视频里那种「画面清晰但内容不合理」的退化不敏感。MOS 分布图还显示不同生成方法、不同轨迹、不同内容类别之间的质量差异都相当显著。 Qualitative comparison of quality predictions from different VQA methods and CWQA. 批判点评:720 个视频、20 个源视频的规模在 VQA 基准里偏小,尤其是源视频只有 20 个,内容多样性有限,训练出的模型容易过拟合到这些特定场景。「显著超越现有方法」的比较对象是 SimpleVQA 这类为自然视频设计的通用方法,在专门数据集上被专门模型超过是预期内的结果,真正有意义的对比应该是与其他为生成视频设计的评测方法(如 VBench 的相关维度)比,摘要里没有提到。CWQA 的架构是三个现成骨干(RAFT/SlowFast/ResNet-50)加门控融合,方法层面的新意有限,价值主要在数据集。另外基准覆盖的 6 种相机轨迹都是单一的基本运镜,真实创作中的复合轨迹(边推边摇、弧形环绕)不在评测范围内,而这恰恰是相机控制最容易失效的地方。 趋势观察 优化器这一层终于被认真当成扩散模型的加速位点 — 过去两年扩散模型的提速几乎全部发生在推理侧——蒸馏减步数、缓存复用特征、量化降精度,训练侧则默认「AdamW 就够了」。今天 Meta 的这篇 Muon-DiT 把注意力挪回了训练:他们在 1.3B 到 15B 的 DiT 上系统跑通了 Muon 的 scaling 行为,确认它相对 AdamW 的生成质量优势(12.9%~19.1%)不随规模消失。更有价值的是他们诚实地承认了 Muon 在大规模下的代价——每步都做的 5 步 Newton-Schulz 迭代加上全量动量物化,会把 Muon 省下的步数优势重新吃掉。Periodic Row-wise Muon 的解法很朴素:昂贵的谱更新每 K 步做一次,其余步用便宜的行归一化更新顶上,再配合分片动量上直接算、bucketed all-gather 与通信计算重叠。结果是优化器时间砍掉 46.9%~54.3%,逻辑通信量降 66.7%。这提示一个被忽视的事实:当模型规模足够大时,优化器本身的算力与通信开销已经不是可以忽略的常数项了。 「缓存」正在从推理技巧升级为架构设计的一部分 — 可灵这篇 TextAnchor 的问题设定很典型:多参考图编辑里每张参考图带来数千 token,算力随参考图数量线性甚至更快地涨。现有做法用结构化稀疏注意力来砍——把参考图的 K/V 与去噪目标解耦,于是可以算一次复用到所有步。代价是参考图看不到文本指令了,指令跟随和参考保真度双双下滑。这篇的破法不在算子层面而在序列层面:加一段时间步固定在 t=0 的静态文本锚点,让参考分支在构建缓存时就能读到指令,同时保持 K/V 与去噪目标无关这个可缓存的前提。这个「改架构换缓存」的思路带来的副作用是生成质量掉了,他们又用教师强制的速度蒸馏加一段 on-policy 阶段把它补回来——据作者说这是扩散模型里第一次用 on-policy 蒸馏做架构恢复。5 张参考图下 40 步全流程加速 3.92 倍,10 张时到 5.47 倍。加速比随参考图数量增长而增长,这才是这类方法真正的价值所在。 视频生成的条件正在从「一段完整视频」变成「一个持续到来的流」 — 阿里的 InfinityEdit 指出了现有指令式视频编辑一个被默认接受的假设:原地编辑(in-place editing)。给定一段固定时长的源视频,逐帧对齐地改写它。这在直播换风格、给正在拍摄的镜头加运镜这类场景下直接失效——编辑必须延伸到还没到来的未来帧上。他们把这个设定命名为无限视频编辑,并配了一个只在编辑指令到达的那个 chunk 才激活的轻量适配器:历史交叉注意力锚住前序内容、时序因果自注意力保证信息只从早往晚流、编辑交叉注意力注入指令;后续 chunk 交回原模型并重置锚定帧,从而在施加编辑的同时不损害原模型的无限生成能力。超过 1000 帧的长序列上仍能稳定实现每一条指令。有意思的是今天还有一篇 NVIDIA 的 Grounded-Exo2Ego,走的是完全不同的技术路线(双分支视频扩散 + 3D 重建锚定 + 物体级语义补全),但两者面对的其实是同一类困难:当条件信号在大范围上不可靠或根本不存在时,生成模型该拿什么去锚定。 人工智能炼丹君 整理 | 2026-08-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-21|中科大揪出蒸馏后数字人变木头人DynaForcing 今日 AIGC 论文速览 今日共 10 篇 · 推理加速与蒸馏 3 篇 · 奖励模型与偏好对齐 1 篇 · 语音与音频驱动生成 2 篇 · 3D 与部件级生成 1 篇 · 视频编辑 2 篇 · 生成评测 1 篇 重点论文标题列表 DynaForcing(中国科学技术大学、南京大学、合肥工业大学、清华大学(ACM MM 2026)):蒸馏后数字人静止的真凶是反向KL VA-Judger(复旦大学、上海创智学院、华为诺亚方舟实验室):拼指标当奖励就是在教模型作弊 ⚡ SparsePR(Texas A&M University):22%密度换2.61倍加速靠残差回填 MDD(南京理工大学、华为):轻量模型管幅度缓存管方向 FireRedTTS3(小红书):冻结音频编码器当语义老师稳住自回归 今日论文速览 1. DynaForcing:蒸馏后数字人静止的真凶是反向KL DynaForcing: Overcoming Dynamic Collapse in Self-Forcing Distillation for Streaming Avatar Generation | 中国科学技术大学、南京大学、合肥工业大学、清华大学(ACM MM 2026) | arXiv:2608.17707 关键词:动态崩塌,DMD蒸馏,自强制,数字人,反向KL,ACM MM 2026 ⚠️ 前序问题:音频驱动数字人要同时满足三件事:口型对得上、表情有起伏、还能实时流式出帧。近期的做法是用自强制(self-forcing)配合分布匹配蒸馏(DMD)把多步教师压成少步学生,实时性确实拿到了,但这条路上藏着一个此前没人系统刻画过的失效模式:学生模型会收敛到一个近乎静止的最优解——单帧看上去画质很好,时序动态却被严重压制。这对数字人是致命的,因为哪怕只丢一点点运动幅度,口型同步和表情自然度就跟着崩。更麻烦的是常规评测发现不了:感知质量指标在这个过程中甚至还在上升,只有专门看动态幅度的指标才会暴露问题。 本文贡献:作者先把病因拆成两条。第一条来自 DMD 的目标函数本身——反向 KL 具有模式寻求(mode-seeking)倾向,会主动偏向低运动模式,因为静止解在分布上更「安全」。第二条来自无锚点的自条件:学生用自己上一步的输出继续往下推,一旦运动开始衰减,这个反馈回路会把衰减不断放大。对应地,DynaForcing 在三个不同层面下药。数据层的 Hybrid Forcing 把 rollout 按概率锚定到真实动态上,切断反馈回路;损失层的 Dynamics-Aware Reward Regularization 借 DMD 的强化学习解释引入显式运动奖励(用 Sync-C 和关键点方差构造 R_dyn,以 exp(α·R_dyn) 缩放 DMD 损失),直接对冲反向 KL 的偏置;条件层的 Reference Perturbation 用 Qwen-Edit 加 ArcFace 过滤造出五档相似度的扰动参考图,把身份从静态细节里解耦出来,逼模型只能靠音频去驱动运动。工程上还额外贡献了计算图剪枝与梯度重放,把自强制训练的显存开销压掉一个数量级以上。 Overview of . Three strategies intervene at different levels of the self-forcing training pipeline: (a) Hybrid Forcing at the input level, (b) dynamics-aware reward regularization at the loss level, and (c) reference perturbation at the conditioning level. 实验效果:动态幅度从崩塌状态恢复到与教师相当的水平:Dyn-Deg 从 0.31 提到 0.73,唇音同步 Sync-C 从 7.03 提到 7.68,而视觉质量指标同时改善,也就是说质量与动态的权衡在整个训练过程中被解开了,不再需要靠早停去凑一个折中点。训练曲线图给出的证据更直观:原始自强制方案在 T2V 和 Avatar 两个设定下,Dynamic Degree 都在 4000 步左右骤降到接近 0(Avatar 上 Sync-C 先冲到 7.8 再一路滑到 5 以下),而同期 Imaging Quality 和 Aesthetic Quality 几乎是平的甚至微升——这正是「只看画质指标会完全漏掉崩塌」的实证。作为对照,教师强制版的 CausVid 动态维持在 0.4-0.7 区间波动而不崩。 Dynamic collapse in self-forcing distillation. (a)~Text-to-video (Self-Forcing~huang2025self): VBench~huang2023vbench dynamic degree drops from 0.80 to 0.00 while visual quality improves. (b)~Audio-driven avatar (LiveAvatar~huang2025liveavatar): Sync-C and ExpVar degrade while IQA and ASE improve. (c)~Comparing self-forcing with CausVid~yin2025slow (GT-anchored): CausVid's dynamic degree fluctuates around 0.43 without collapsing, confirming that unanchored self-conditioning, not DMD distillation itself, drives the collapse. 批判点评:这篇的价值主要在诊断而非疗法。把「蒸馏后数字人变木头人」这个从业者都遇到过但说不清的现象,明确归因到反向 KL 的模式寻求性质加上无锚自条件的正反馈,并且用训练曲线证明感知质量指标对此完全不敏感——这个洞察本身就值得记下来,它意味着任何做少步蒸馏的团队都该在评测里补一个动态幅度指标,否则等于在盲飞。三条策略也确实分别对准三个不同层面,不是同质化的堆料。但要清醒几点。第一,Dyn-Deg 0.31→0.73 这个数字很漂亮,但 Dynamic Degree 本身是 VBench 系的粗粒度指标,它变高既可能是恢复了有意义的表情运动,也可能是引入了额外抖动,论文没有给出区分二者的证据(比如人眼评测里对「运动是否自然」的单独打分)。第二,Dynamics-Aware Reward 用 exp(α·R_dyn) 缩放损失,α 的取值必然敏感——给太大就变成鼓励乱动,论文对这个超参的鲁棒区间交代不足。第三,Reference Perturbation 依赖 Qwen-Edit 生成扰动参考图,这引入了对外部编辑模型能力的隐性依赖,换一个编辑器扰动分布就变了,结论的可迁移性未验证。第四,实验主要在 Avatar 场景,通用 T2V 上只给了崩塌现象的展示而非完整修复效果,「这套方法是否同样适用于一般视频蒸馏」仍是开放问题。 2. VA-Judger:拼指标当奖励就是在教模型作弊 VA-Judger: Reward Modeling from Human Preference Feedback for Joint Video-Audio Generation | 复旦大学、上海创智学院、华为诺亚方舟实验室 | arXiv:2608.18607 关键词:视听联合生成,奖励模型,人类偏好,思维链,维度级GRPO,LTX-2 ⚠️ 前序问题:要用强化学习后训练视听联合生成模型,第一件事是得有奖励信号。现在的通行做法是把音质、画质、音画同步度这几个单项指标加权拼成一个总分。问题在于这些指标各自只看一个感知维度,谁都没有捕捉到「文本提示、视频、音频三者之间的整体语义与时序连贯性」——而恰恰是后者决定了人类会不会觉得这段内容好。用拼出来的指标当优化目标,模型很快学会 reward hacking:每一项分数都刷得很高,成品放给人看却依然割裂、不忠于提示。这是奖励建模里的经典陷阱,只是在视听双模态下更隐蔽,因为可选的单项指标更多,堆起来看着更「全面」。 本文贡献:作者先补数据:构建 VAPref-10K,包含 9K 条提示和 10.3K 组细粒度成对比较,样本来自多个开源生成模型,标注由人类完成。再补评测:提出 VA-Judger-Bench,同时设置域内和域外的模型对比,专门检验奖励模型是否真的与人类偏好对齐,而不是只在训练分布上过拟合。核心方法 VA-Judger 是一个带思维链的 omni 奖励模型,训练分三段推进:第一段格式蒸馏,从质量差距明显的对子里学会结构化输出(提示对齐、音画一致性、音质、画质、完整度五个维度先想再答);第二段人类对齐,对质量接近的难例用拒绝采样,只保留与人类标注结论一致的解释链,再做 SFT;第三段维度级 GRPO,把人类反馈拆解到各个质量维度上分别给奖励,比单一二元偏好标签提供的信号密度高得多。三段的设计逻辑是从易到难、从格式到判断、从粗到细。 Overview of the VA-Judger training pipeline. Stage 1 cold-starts the model on easy preference pairs. Stage 2 aligns the model on harder pairs through human rejection sampling. Stage 3 performs GRPO using answer-level and dimension-level rewards grounded in human reasons. 实验效果:在域内和域外两套评测上,VA-Judger 预测人类偏好的准确率都超过拼指标的基线。更有说服力的是下游验证:用它的奖励去后训练视听生成模型,人类偏好率从 LTX-2 原始模型的 10.08%、OmniNFT 后训练的 27.63%,提升到 62.3%——三者相加正好 100%,说明这是一次三方对比的人类投票,而不是各自独立打分,62.3% 意味着在超过六成的对局里人类选了 VA-Judger 后训练的结果。 Human preference rates over 200 three-way comparisons. For each prompt, participants select the best video-audio output among LTX-2, LTX-2 post-trained with OmniNFT, and LTX-2 post-trained with VA-Judger. 批判点评:这篇把奖励建模里那个人人都懂但很少被正面处理的问题挑出来讲清楚了:单项指标线性加权不是「近似人类偏好」,而是「定义了一个可被刷分的新目标」。用 CoT 结构强制模型先在五个维度上给出理由再下结论,配合拒绝采样只保留结论正确的解释链,这套做法在文本奖励模型上已被验证过,搬到视听双模态并补上维度级 GRPO 是合理的推进。下游 10.08%/27.63%/62.3% 这个三方对比也比单看奖励模型准确率更有说服力,因为它证明奖励确实能转化成生成质量。但几点需要打问号。第一,训练数据的 CoT 由 Gemini 3.1 生成,这意味着奖励模型的判断风格与偏好倾向被教师模型的先验深度塑造,「与人类对齐」这个说法实际上是「与被人类标注筛选过的 Gemini 解释对齐」,两者不完全等价。第二,10.3K 组成对比较放在双模态偏好建模里并不算多,尤其还要覆盖 9K 条不同提示,平均每条提示只有约一组比较,难以刻画同一提示下的偏好分布。第三,下游验证只在 LTX-2 一个模型上做,而奖励模型最怕的就是与特定生成器的失效模式耦合——换一个音画同步机制不同的底座还能否维持 62.3% 的领先,论文没有回答。第四,域外评测虽然设置了,但「域外」仅指未见过的生成模型对比,提示分布仍来自同一批,真正的分布外泛化并未检验。 3. SparsePR:22%密度换2.61倍加速靠残差回填 Partition the Support, Reconstruct the Residual: Training-Free Sparse Attention for Video Generation and World Models | Texas A&M University | arXiv:2608.18484 关键词:免训练稀疏注意力,块稀疏,残差重建,响应耦合分块,视频生成,世界模型 ⚠️ 前序问题:免训练的块稀疏注意力是给视频 transformer 加速的主流手段,但作者指出这条路上有两个被含糊处理的前提。第一,「注意力按行高度集中」这个观察本身并不能直接给出一个可执行的稀疏算子——共享同一块路由的多个查询,它们各自真正需要的 key 支撑集可能重叠得很差,池化后的并集会被撑得很大,稀疏度名义上高、实际执行的键值对并不少。第二,「保留了多少注意力质量」这个常用判据也不足以决定被跳过的交互会带来多大的 softmax 后误差,因为 softmax 是非线性的,丢掉的 logit 质量与输出偏差之间没有简单对应。换句话说,现有方法在「怎么分块」和「丢了多少」这两个关键环节上都在用代理指标做决策。 本文贡献:SparsePR 由两个部件组成。响应耦合分块(Response-Coupled Partitioning)不再对查询向量本身做 K-means,而是对采样查询的 key 响应做聚类,形成配对的 K/V 组,用组质心诱导出「查询-响应」坐标系再共享路由——这样落到同一路由的查询在支撑集上真正是相似的,图里给出的对比很直观:语义聚类下五个块的支撑集并集大小为 5,响应耦合聚类下降到 2。探针拟合残差重建(Probe-Fitted Residual Reconstruction)则拿一小批精确计算的查询行做探针,测出稠密输出与稀疏输出之差,在探针残差张成的输出子空间里拟合一个逐调用的仿射修正(b, B),再把这个修正加回稀疏输出上。整套流程免训练、逐调用自适应,不需要改模型权重。 Overview of SparsePR. Response-Coupled Partitioning builds executable K/V and query groups, and Probe-Fitted Residual Reconstruction uses exact probe rows to correct the sparse output. 实验效果:在四个异构的视频生成与世界模型上,SparsePR 一致降低了注意力重建误差。误差-密度权衡曲线显示,在 HunyuanVideo、Wan2.2、Cosmos-Predict2.5、Cosmos3-Nano 上,响应耦合分块的均值误差与 p99 误差都稳定低于语义分块,且优势在低密度端更明显。消融给出的归因是:探针拟合贡献了误差下降的主要部分,响应耦合分块主要负责降低硬丢弃误差、并在探针预算有限时改善重建质量。端到端上,在实际执行的键值对密度 22.0%-26.0% 时保持生成质量,取得 1.48 倍到 2.61 倍的整体加速。 Cross-model density sensitivity. Mean (top) and p99 (bottom) normalized attention-output error versus total executed-pair density for semantic and response-coupled partitioning under the same residual-repair configuration. The dashed line marks the (22%) reference density. 批判点评:这篇的问题定义比方法更值得读。「行稀疏集中不等于可执行稀疏算子」和「保留注意力质量不等于输出误差小」这两句话,把大量免训练稀疏注意力工作的隐含假设直接点破了,而且给出了可量化的反例——支撑集并集从 5 降到 2 这个数字,说明分块几何本身就能带来一倍以上的实际计算量差异,这是纯靠调稀疏率调不出来的。探针拟合仿射修正的思路也务实:既然误差主要落在一个低维子空间里,那就用少量精确行把它估出来补回去,成本可控。不过要注意几点。第一,1.48x-2.61x 的区间跨度很大,论文没有清楚交代这个区间对应的模型与分辨率组合,读者无法判断自己的场景落在哪一端;22.0%-26.0% 的密度区间同理。第二,探针本身要精确计算若干查询行,这部分开销随探针预算线性增长,而重建质量又依赖探针数量,端到端加速比与重建质量之间存在一个论文未充分暴露的权衡曲线。第三,评估以注意力重建误差为主,生成质量只说「保持」,缺少 VBench 之类的完整对照表,「误差降低」到「人眼看不出差别」之间还差一层证据。第四,作者机构在视频生成方向积累有限,四个模型的实验规模也不算大,工业级长视频场景下响应耦合聚类的开销是否仍可忽略,值得实测后再判断。 4. MDD:轻量模型管幅度缓存管方向 Magnitude-Direction Decoupling for Fast Video Generation with Flow Matching Models | 南京理工大学、华为 | arXiv:2608.17695 关键词:流匹配加速,幅度方向解耦,缓存复用,CFG复用,Wan2.1,华为 ⚠️ 前序问题:流匹配视频生成的效果已经很好,但迭代去噪带来的算力开销极高。一个自然的想法是:并非每一步都需要完整的大模型,有些步骤可以换成更便宜的替代品。现实中的两种替代手段各有毛病——直接缓存复用上一步的输出,或者直接换一个轻量模型来预测,都会让采样轨迹偏离原始去噪路径,最终画质和内容丰富度都掉下来。问题的症结在于,此前的加速工作把「用便宜的东西替代」当成一个整体决策,而没有去问:模型输出这个向量里,究竟哪一部分是轻量模型能可靠给出的,哪一部分必须靠别的机制补。 本文贡献:作者的实证分析给出了一个干净的拆分:把去噪输出看作幅度与方向两个分量,轻量模型能稳健地捕捉幅度分量,而缓存则能提供可靠的方向指引。基于这个观察,MDD 让方向校准后的轻量模型去替代原模型完成部分步骤——轻量模型负责出幅度,缓存负责纠方向,从而在加速的同时把轨迹偏移修正回来。此外 MDD 还在 classifier-free guidance 上做了进一步节省:CFG 需要跑条件和无条件两路,而作者发现两路的幅度信息可以复用,于是只算一路幅度,进一步压掉推理开销。整套方案不改模型权重,属于即插即用的采样器级加速。 实验效果:在多个基准上 MDD 优于既有加速方法,在 Wan2.1 上最高取得 2.95 倍加速,同时保持较高的视觉保真度与内容丰富度。支撑「幅度可替代、方向靠缓存」这一判断的实证曲线显示:在整个扩散过程中,大模型与残差复用、大模型与小模型两条余弦相似度曲线的走势差异明显(方向上小模型不可靠),而幅度比值曲线则长期贴近 1.0(幅度上小模型可靠);CFG 的条件/无条件两路幅度曲线在大部分时间步高度重合,只在末段分离,这是幅度复用可行的直接依据。 批判点评:把加速的替代决策从「整体换不换」细化到「幅度换、方向不换」,这个拆分角度是这篇最有价值的部分——它给后续工作提供了一个可复用的分析框架:先看输出向量的哪个分量对替代鲁棒,再决定用什么机制补另一个分量。CFG 幅度复用也是顺手捡的一笔便宜,工程上很容易落地。但这篇的呈现有明显短板。第一,论文的核心框架图用 TikZ 绘制、正文只有一个 tex 文件,可提取的图仅剩分析曲线,方法结构的可读性偏弱。第二,2.95 倍是「最高」值且限定在 Wan2.1 上,其他模型上的加速比与质量代价没有在摘要层面交代,实际收益范围不明。第三,「保持高视觉保真度」缺少人眼评测支撑,而幅度/方向解耦这类近似最容易在长时序上累积出细微的运动不连贯,这恰恰是自动指标最不敏感的地方。第四,方向来自缓存意味着对相邻步的相似性有隐含假设,在采样步数被压得很少(比如 4-8 步)的场景下相邻步差异变大,这套解耦是否还成立,论文未做低步数极限的验证。 5. FireRedTTS3:冻结音频编码器当语义老师稳住自回归 FireRedTTS3: Unified Speech Generation and Editing with Semantically Enriched Speech Representations | 小红书 | arXiv:2608.17492 关键词:连续自回归TTS,语音编辑,语义蒸馏,零样本音色克隆,指令控制,小红书 ⚠️ 前序问题:新一代连续自回归 TTS 直接在连续语音表征上工作,好处是保留了丰富的声学细节,同时能吃到文本 LLM 的指令跟随能力,音色克隆、指令化音色设计、语音编辑这些能力一下都打开了。代价是自回归固有的误差累积——生成越长,偏移越大,吐字和音色都可能跑偏。既有的缓解方案要么额外挂语义模块,要么搞多阶段 tokenizer 训练流程,要么把自回归架构改得很复杂,都是在系统复杂度上付账。作者想要的是在表征层面而不是架构层面解决这件事。 本文贡献:做法相当简洁:拿一个在多种语音理解任务上训练好的、冻结的音频编码器当语义教师,用它去正则化音频特征空间。这样做的效果是文本-语音对齐变好、自回归生成更稳定,而整个系统结构保持简单,不需要额外语义模块也不需要多阶段 tokenizer 流程。架构上分三块:RedAE tokenizer 把 24kHz 音频经 50Hz 序列压到 25Hz 潜表征,同时受重构损失和语义蒸馏损失双重约束;FireRedTTS3-Base 是 Backbone Transformer 加 Flow Head 与 Stop Predictor,做多语言多方言的零样本音色克隆;FireRedTTS3-Instruct 在此之上支持统一的音色克隆、指令化音色设计和语音编辑(例如「删除第一个词」这类编辑指令直接以文本形式输入)。代码与模型已开源。 An overview of FireRedTTS3, including (a) the RedAE Tokenizer with semantic supervision, (b) FireRedTTS3-Base for multilingual and multi-dialect voice cloning, and (c) FireRedTTS3-Instruct for voice cloning, instruction-controlled voice design, and speech editing. 实验效果:FireRedTTS3-Base 在 Seed-TTS-Eval 和 MiniMax-MLS-Test 上取得对比系统中最好的平均语音可懂度与说话人相似度;FireRedTTS3-Instruct 在 InstructTTSEval 和 Ming-Freeform-Audio-Edit 上超过竞争系统。作者据此论证:语义信息丰富的连续语音表征配上简单架构,就足以支撑稳定、可控、高保真的语音生成与编辑。 批判点评:这篇的取向很对我的胃口——不加模块、不加阶段,只在表征约束上动手,用一个现成的冻结理解模型当语义锚。这个思路的可迁移性其实超出 TTS:任何连续自回归生成任务,只要该模态存在成熟的理解侧编码器,都可以照这个套路给特征空间加语义正则。小红书把 Base 和 Instruct 两个变体分开发布也很实用,前者专注克隆质量,后者覆盖指令与编辑。但要注意的地方不少。第一,「简单」是相对的——冻结音频编码器本身就是一个在多任务上训过的大模型,把它算进系统开销后,与「额外挂语义模块」的复杂度差距没有摘要说得那么大,只是训练流程更短。第二,效果论证全部依赖自动指标(可懂度、说话人相似度),而语音生成里最关键的自然度、韵律合理性与情感恰当性都必须靠 MOS 类主观评测,摘要层面完全没提。第三,语音编辑的评测只在 Ming-Freeform-Audio-Edit 上做,这个基准的覆盖广度和难度分布尚未被社区充分检验,单一基准上的领先说服力有限。第四,论文只给出一张架构图,缺少可视化的实验对照,无法判断误差累积到底被压住了多少——「更稳定」这个说法需要长句合成的失败率曲线来支撑。 6. MegaParts:300部件3D生成靠离散token压出来 MegaParts: Scaling Part-Aware 3D Object Generation to 300 Parts via Token-Efficient Autoregressive Modeling | 香港大学、上海人工智能实验室、复旦大学、同济大学、浙江大学 | arXiv:2608.14783 关键词:部件级3D生成,自回归,向量量化,自适应长度tokenizer,256k上下文,上海AI Lab ⚠️ 前序问题:可控建模、编辑、关节化这些图形学应用都需要把物体表示成语义部件的有机组合,所以部件感知的 3D 生成很重要。但现有方法扩不上去:部件数一多,生成精细几何所需的 token 长度和显存就贵得离谱,于是大家只能停在几个到十几个部件的量级,而真实的复杂物体——一台钢琴、一架投石机——动辄上百个部件。这是一个纯粹的规模瓶颈,不是质量瓶颈。 本文贡献:MegaParts 把结构化序列建模和一个 token 高效的向量量化形状 tokenizer 结合起来。tokenizer 的目标函数是「在保证高保真重建的前提下最小化 token 用量」,因此学到的离散潜表征长度能随几何复杂度自适应——简单部件少花 token,复杂部件多花。在这个紧凑表征之上训一个大语言模型,在统一的结构化序列里依次生成物体包围盒、部件包围盒和部件形状 token,配合高效长上下文训练策略,支持最多 300 个部件、序列长度最长 256k token。架构图显示生成分两级:全局布局 token 负责规划(chain of thought 形式给出各部件的 bbox 与 token 预算),局部形状 token 负责逐部件生成几何,最后通过 SDF 与 Marching Cubes 出网格。 Overview of MegaParts. Our framework consists of two stages. Top: we learn a token-efficient vector-quantized representation for part geometry. Bottom: we train a part-aware autoregressive generator that represents a 3D object as a structured sequence conditioned on a text prompt and optional object- and part-level bounding boxes. If bounding boxes are absent, the model first predicts the object box and part boxes, followed by autoregressive generation of local shape tokens for each part. The decoded part geometries are then assembled into the final part-aware 3D asset. 实验效果:网格质量高于自回归与扩散基线,作者据此论证压缩后的离散部件 token 不仅解决了可扩展性,还提升了可达到的几何保真度。teaser 图给出的四个例子分别是 164、300、287、159 个部件的复杂物体(机械人形、投石机、伞状结构、三角钢琴),每个部件都以独立颜色区分且保持了可分离的语义结构,直观说明了「上百部件」这个量级不是统计口径而是真的能生成出来。 批判点评:「先把 token 压到极致,再让 LLM 原生自回归」这条路径在 3D 生成里的说服力正在变强,这篇把部件数推到 300、上下文推到 256k,是个实打实的规模跃升,而且顺手给出一个反直觉结论——压缩不但没损失保真度,反而提升了可达到的几何质量。两级生成(全局布局规划 + 局部形状填充)的分工也很自然,本质上是把 3D 建模里「先摆结构再抠细节」的人类流程编码进了序列顺序。需要冷静看的地方:第一,「网格质量高于基线」缺少具体数值,而部件级生成的基线本身就少,对比的公平性(同等算力、同等训练数据)无从判断。第二,300 部件是上限而非常态,论文没有交代部件数从 10 增到 300 过程中质量与耗时的退化曲线,实用价值主要取决于这条曲线的形状。第三,256k 上下文的训练成本必然可观,「高效长上下文策略」具体省了多少、单次生成的推理延迟是多少秒级还是分钟级,摘要层面没有回答,而这直接决定它是产品可用还是仅供研究。第四,部件的语义划分质量依赖训练数据里的部件标注,而高质量部件级 3D 数据本身稀缺,这套方法在标注体系之外的物体类别上泛化如何,是个真实的隐忧。 7. VicEdit:40万条数据把编辑指令从文字换成示例 VicEdit: Learning to Edit Videos from Visual In-Context Examples | 上海交通大学、腾讯优图实验室、浙江大学 | arXiv:2608.16745 关键词:视觉上下文编辑,视频编辑,模态自适应语义蒸馏,双上下文注入,VicEdit-400K,腾讯优图 ⚠️ 前序问题:指令式视频编辑已经做得不错了,但纯文本指令有个绕不过去的瓶颈:细腻纹理和复杂动态很难用语言讲清楚。你可以说「把花瓶涂成深番茄红」,但「深番茄红」到底是哪个红、光泽如何、材质反射怎样,文字给不出精确答案;「转成雪天」这类全局风格更是如此。这个感知鸿沟导致模型要么改得不够(干脆不动),要么改得过头(风格漂移、结构崩坏)。 本文贡献:作者提出视觉上下文编辑这一范式,把编辑条件从文本指令升级为多模态视觉引导,支持单张图像、图像对、视频对三种参考形式。配套造了 VicEdit-400K——首个大规模视觉上下文视频编辑数据集,用自动化流程生成 40 万条高质量样本、覆盖十类任务,并做了多维度过滤保证视觉保真与语义一致。方法上 VicEdit 要解决的核心问题是异构参考的统一:模态自适应语义蒸馏(Modality-Adaptive Semantic Distillation)从不同形式的视觉参考里抽出模态特定的语义 token,双上下文注入(Dual-Context Injection)再把这些视觉 token 与文本指令 token 拼接后送进 DiT 的交叉注意力,让生成同时受视觉与文本两路信号约束。MLLM 侧用 LoRA 微调,DiT 的自注意力冻结、交叉注意力可训。 . It consists of 1) MASD modulates base queries $Q_{base}$ with modality embeddings $E_m$ to distill visual tokens $T_{vis}$; 2) DCI applies a semantic shift to calibrate instruction extraction, yielding dual-context tokens. These unified embeddings are injected into a Video DiT to steer the generation process. All examples presented in the figure are collected from the open-source OpenVE~he2025openve. 实验效果:在 VicEditBench 上,VicEdit 在基础指令编辑和视觉上下文编辑两类任务上都取得最优。定性对比很直观:三个案例分别是局部风格(把花瓶涂成深番茄红)、全局风格(转成雪天)、局部移除(去掉时钟及其阴影)。基线们的失败模式各异——Lucy-Edit 和 NovaEdit 大量出现 No Change(干脆没动),VideoCoF 出现 Flat Coloring(上色平板无质感),Kiwi-Edit 则是 Severe Artifacts 和 Inpainting Failure;VicEdit 在三个案例上分别达到自然编辑、和谐风格化与完全移除。 Comparison with baselines on visual in-context editing tasks. All examples presented in the figure are collected from the open-source OpenVE~he2025openve and Senorita~zisenorita. 批判点评:「文字讲不清纹理和动态」这个判断本身没有争议,用视觉示例当条件也是图像编辑那边已经验证过的路子,这篇的贡献主要在于把它系统地搬到视频域并且把数据这一环补齐——40 万条、十类任务的规模在视频编辑数据集里是可观的,光这一项就有实际价值。技术上把三种异构参考(单图/图对/视频对)统一成模态特定语义 token,再与文本双路注入,设计是干净的。但要注意几点。第一,VicEdit-400K 由自动化流程生成,也就是说训练数据的编辑效果上限被生成流程所用的模型决定,「高质量」是过滤后的相对高质量,模型很可能继承了造数据时那些模型的偏好与瑕疵。第二,评测在自建的 VicEditBench 上进行,而这个基准与训练数据同源,域内优势难以排除——同组作者另一篇 PersonaShot 就明确指出现有视频评测在跨镜头连续性上普遍失灵,自建基准的覆盖面同样需要外部检验。第三,定性图里基线大面积出现 No Change 这个失败模式值得警惕:这更像是基线在该提示形式下未被正确调用,而非能力缺失,公平性存疑。第四,三种参考形式的相对贡献没有拆开,实际使用中「给一张图」和「给一对视频」的成本差异巨大,读者需要知道最便宜的那档能拿到多少收益。 8. MSEditor:多视角数据改造成跨镜头监督信号 MSEditor: Toward Consistent Multi-Shot Video Editing | 香港科技大学(广州)、香港科技大学、百度、清华大学(ECCV 2026) | arXiv:2608.17559 关键词:多镜头视频编辑,跨镜头一致性,监督适配器,跨镜头打包,ECCV 2026,百度 ⚠️ 前序问题:对一整条多镜头视频做统一修改,难点不在单镜头编辑本身,而在镜头之间。多镜头视频由时序上不连续的片段拼成,视角、机位尺度、主体姿态在切镜处大幅跳变,逐镜头独立编辑会导致严重的身份漂移,误差还会沿序列累积放大。要做到连贯,模型必须建立可靠的跨镜头语义感知,在这些断裂的边界之间维持主体外观稳定与视觉连续。而这类任务的高质量训练数据几乎不存在——没人专门去拍「同一编辑在多镜头下的前后对照」。 本文贡献:MSEditor 是首个专门面向一致性多镜头视频编辑的框架。数据这一环用了个巧办法:把现成的多视角视频数据集改造过来提供跨镜头监督——多视角天然就是「同一主体在不同视角下」,正好对应多镜头的核心难点。架构上引入监督适配器(Supervisory Adapter)把跨镜头信息注入扩散骨干,让模型学到身份一致的表征;这个适配器块与冻结的 DiT 块并行,只有适配器的 patchify、cross attention 与 FFN 可训。为了压住累积误差并保证长程时序连贯,还设计了跨镜头打包(Cross-Shot Packing)策略,在自注意力窗口内动态聚合语义相关的镜头,而非只看相邻帧。推理时先编辑首帧,再连同编辑掩码一起驱动整条多镜头序列。 Overview of our method. Top: Given an input multi-shot video and corresponding editing masks, our method first trains a Supervisory Adapter to inject multi-shot information into the diffusion backbone. We also introduce two key strategies: Cross-Shot Packing and Sparse Cross-Attention to keep the consistency during training. Bottom: During inference, editing is performed on the first frame and produces coherent and identity-preserving multi-shot video output. 实验效果:在作者整理的多镜头视频编辑基准上,MSEditor 在身份保持、时序稳定性和整体视觉质量上显著优于既有方法。四镜头编辑的定性对比(把黄色跑车改成蝙蝠车 Tumbler)显示:TokenFlow 基本没改动,Ins2V2 出现严重色偏和结构失真,VACE 在近景轮胎镜头里编辑出了完全不同的车,Ditto 在多个镜头间外观不统一,而 MSEditor 在四个镜头(含远景、轮胎特写、逆光剪影)里保持了一致的车身形态与材质。 Qualitative comparison results with the state-of-the-art methods. We compare our multi-shot approach against leading single-shot video editing baselines on a four-shot editing task. The results show that our method successfully executes the complex subject replacement, demonstrating superior cross-shot temporal consistency. 批判点评:「拿多视角视频数据集当多镜头编辑的监督来源」是这篇最聪明的一步——它把一个数据不存在的问题,转化成一个已有数据的重新解释问题,成本几乎为零而监督信号的语义正好对上。跨镜头打包按语义相关性而非时间邻近去聚合上下文,也比简单扩窗口更贴合多镜头的结构特点。ECCV 2026 接收和港科大+百度的组合也说明这套方案经过了同行审视。但几点需要留意。第一,多视角与多镜头并不完全等价:多视角是同时刻不同机位,主体姿态与光照基本一致;真实多镜头往往跨时间、跨场景、主体状态本身在变化。用前者监督后者,在「状态确实应该变化」的镜头切换上可能反而过度约束。第二,评测基准由作者自行整理,规模与构成细节不明,「显著优于」缺少可核对的数值。第三,推理链路依赖首帧编辑质量,首帧一旦有瑕疵会被跨镜头传播机制放大到全序列,这个失效模式论文未讨论。第四,定性对比里 TokenFlow 出现「基本没改动」的结果,与 VicEdit 那篇里基线的 No Change 现象类似,都提示当前多镜头编辑的基线调用方式尚未标准化,横向对比结果需要谨慎解读。 9. AnyTalk:零动画数据给任意角色配口型 AnyTalk: Speech Animation for Arbitrary Characters Leveraging a Video Generation Model | KAIST(TVCG 接收) | arXiv:2608.16143 关键词:3D语音动画,视频扩散先验,零动画数据,blendshape优化,蒸馏实时化,KAIST ⚠️ 前序问题:给 3D 角色做音频驱动的语音动画,现有方法要么依赖该角色专属的动画训练数据,要么需要费力的绑定与重拓扑。这两条路都把成本卡在了「每来一个新角色就得重做一遍」上,风格化角色尤其吃亏——它们的面部拓扑和 blendshape 配置千差万别,几乎不可能有现成动画数据。作者想问的是:既然视频扩散模型已经在海量真人说话视频上学到了强大的运动先验,能不能把这份先验直接借给任意 3D 角色,从而完全绕开动画数据这一环。 本文贡献:AnyTalk 分两步走。第一步是角色专属微调(Character-specific Fine-tuning, CsF):拿目标 3D 角色的渲染图配上置零的音频嵌入(代表「无运动」)去微调预训练视频扩散模型——用零音频教模型「这个角色静止时长什么样」,从而在不需要任何动画数据的前提下把角色外观注入模型,同时保住大规模视频扩散模型原有的运动先验。第二步是把生成的说话头视频提升回 3D:通过一个优化过程估计 blendshape 参数,得到真正可用的 3D 语音动画。架构上用 ReferenceNet 加去噪 UNet 的双塔结构,音频经交叉注意力分别产出 pose、expression、lip 三路控制信号再经 adapter 注入。为了实用性,作者还把 AnyTalk 蒸馏成一个精简网络 AnyTalk_RT,实现实时性能。代码已开源。 Finetuning process of $D_{CsF}$. The rendered images of the target 3D character and the zero condition $C_{zero}$ are used to form a pair for fine-tuning the model. To preserve the motion prior, only the spatial residual network of denoising UNet is trained (flame icon), while the other layers remain frozen. 实验效果:方法可在多样的面部网格与 blendshape 配置上生成口型同步的动画,显著降低人工投入与数据需求。定性对比在同一个风格化卡通角色上进行,逐词展示九个时间点的口型:ScanTalk、DiffSpeaker+NFR、CodeTalker+NFR 三个基线在整段发音里嘴部开合幅度都很小、近乎静止,而 AnyTalk 在 child/native/grace/beauty/attire 等词上给出了明显区分的口型(含张口、圆唇等不同形状),这在风格化角色上尤为关键,因为这类角色缺乏专属训练数据、基线只能靠迁移硬套。 Comparison with baselines on Morphy. Each phoneme and its corresponding frame are presented for comparison. Ours best follows the given audio with wider mouth opening and precise lip closure, while ScanTalk, DiffSpeaker + NFR, and CodeTalker + NFR exhibit only subtle movement. 批判点评:用「置零音频嵌入」来做外观注入而不污染运动先验,这个技巧很聪明——它等价于告诉模型「这是该角色的静态基底」,剩下的运动能力完全交还给预训练先验,从而实现零动画数据。把视频生成的 2D 结果再优化回 blendshape 参数,也让产出物真正落在图形学生产管线里可用(能改、能复用、能接绑定),而不只是一段像素视频,这一点比多数 talking-head 工作更务实。TVCG 接收和额外蒸馏出实时版本也说明工程完成度不低。不过限制很明显。第一,整条链路依赖一次角色专属微调,也就是说「任意角色」的代价是每个角色都要微调一次,虽然免了动画数据但没免掉 per-character 训练,与真正的零样本仍有距离。第二,2D 视频再反解 blendshape 会引入两层误差(视频生成本身的误差 + 参数拟合误差),细微的唇形细节容易在这个过程中被平滑掉。第三,定性对比中基线普遍表现为「几乎不动」,这更可能是基线在风格化非人角色上的固有失效,而非同等条件下的公平比较——在真人网格上的对比才更能说明方法上限。第四,蒸馏版 AnyTalk_RT 的质量损失没有在摘要层面量化,实时与保真之间的取舍不明。 10. PersonaShot:16指标测出画质与叙事的断层 PersonaShot: Benchmarking Person-Centric Narrative Continuity in Multi-Shot Video Generation | 上海交通大学、腾讯优图实验室、浙江大学 | arXiv:2608.16717 关键词:多镜头评测,叙事连续性,物理连续性,情感动态,电影语法,腾讯优图 ⚠️ 前序问题:视频生成正从单镜头片段走向多镜头叙事,而人物角色是这类叙事的核心锚点。但现有基准主要评角色外观或单镜头质量,没人去量「人物的物理状态与情绪状态在切镜之后是否还连贯」。另一个被忽略的问题是评测方法的针对性:物理连续性、面部动态、电影关系这三类判断所需的证据完全不同——一个要看视觉空间关系,一个要看时序面部变化,一个要看镜头之间的关系逻辑,用一套通用打分器同时应付三者必然失准。 本文贡献:PersonaShot 是首个以人物为中心的多镜头叙事连续性基准,含约 1000 个多镜头片段和 16 项指标,覆盖三个维度:因果物理连续性(空间布局连续性 SLC、物体状态持久性 OSP、几何尺度一致性 GSC)、情感动态(表情自然度 EN、面部动作时序连贯 FATC、情绪-叙事对齐 ENA、情绪弧连贯 EAC)、电影语法(导演叙事排序 DNS、镜头切换恰当性 ST、切换节奏对齐 TRA、180 度规则遵守 180R、视线匹配正确性 EM)。评估分三个时间层级:镜头内状态、跨镜头转换、序列级轨迹。方法上把大型多模态教师的推理蒸馏成轻量的、按指标定制的专家评估器,每个评估器只依赖其指标所需的那类证据(视觉/时序/关系),再与专家人工判断做对齐。 Overview of PersonaShot evaluation framework. Given generated multi-shot videos and prompts, PersonaShot extends conventional quality assessment with three specialist dimensions for narrative-level evaluation: causal physical continuity, affective dynamics, and cinematic grammar. 实验效果:评测揭示不同 SOTA 模型呈现出各异的能力剖面,并暴露出感知质量与跨镜头叙事连续性之间存在明显落差——视觉上很有说服力的视频,仍频繁出现物理状态重置、情绪突变和电影关系断裂。雷达图对比 Seedance、HoloCine、EchoShot 三个模型:Seedance 在物体状态、几何尺度、表情自然度、180 度规则上明显领先,HoloCine 在物理连续性维度接近但在情绪弧和视线匹配上落后,EchoShot 整体最弱且在电影语法一侧塌陷严重。失败案例图给出的典型问题包括空间布局漂移(人物与电话亭的相对位置在三个镜头间跳变)。人类研究表明作者的评估器与专家判断高度一致。 Overview of PersonaShot's person-centric evaluation. Top: Qualitative examples illustrating our three core dimensions: physical continuity, affective dynamics, and cinematic grammar. Bottom: Quantitative comparison across fine-grained metrics for specific state-of-the-arts, revealing their distinct capability profiles. 批判点评:这篇最有价值的产出是那句结论:画质好和叙事连续没有必然关系,视觉惊艳的多镜头视频依然会出现物理状态重置和越轴。这对做多镜头生成的团队是个直接警告——现有的 VBench 类指标测不出这些问题,模型在这些维度上的退化是完全隐形的。把 16 个指标按证据类型分派给不同的专家评估器,而不是用一个通用 VLM 打全部分,是方法上的正确取舍;把电影语法(180 度规则、视线匹配、切换节奏)纳入自动评测也是此前少见的尝试。不过也有几点要保留。第一,约 1000 个多镜头片段对 16 项指标来说样本偏薄,尤其电影语法这类指标本身依赖具体拍摄语境,样本不足容易让排名不稳。第二,评估器由大型多模态教师蒸馏而来,因此整套基准的判断上限被教师模型的理解能力封顶——它测不出教师本身看不懂的问题,而电影语法恰恰是当前 MLLM 较弱的一环。第三,「与专家判断高度一致」的一致性数值、标注者数量与信度系数在摘要层面缺失。第四,与同组的 VicEdit 共享大部分作者,两篇分别造基准与造方法,需要留意后续是否出现自家基准上自家方法领先的循环论证。 趋势观察 蒸馏加速的代价终于被摆到台面上 — 今天有三篇论文从不同角度谈同一件事:把大模型压成快模型,损失的到底是什么。DynaForcing 给出了最锋利的答案——DMD 自强制蒸馏里的反向 KL 天然偏向低运动模式,学生模型会收敛到一个「画面精美但几乎不动」的伪最优解,作者把这个现象命名为动态崩塌,并且用训练曲线证明它不是偶发而是系统性的:Dynamic Degree 一路掉到 0.31,而感知质量指标反倒还在涨,所以只看 FID/IQA 的评测体系根本发现不了。SparsePR 从另一头切入,指出「保留了多少注意力质量」这个常用指标并不能决定被跳过的交互带来多大的 softmax 后误差,于是干脆用少量精确行拟合一个仿射修正把残差补回来。MDD 则把加速拆成幅度和方向两个分量,发现轻量模型能可靠承担幅度、缓存能可靠提供方向。三篇的共同信号是:加速研究正在从「跑得多快」转向「快的同时到底丢了哪一维」,而这一维往往不在主流指标里。 评测正在从「像不像」转向「成不成」 — PersonaShot 和 VA-Judger 都在推同一件事:单帧或单镜头的画质分数已经不足以区分模型好坏。PersonaShot 用 16 个指标覆盖物理连续性、情感动态和电影语法三层,结论直接而尴尬——视觉上很惊艳的多镜头视频,经常出现人物物理状态在切镜后被重置、情绪突变、越轴违规,也就是说画质和叙事连续性之间存在明显断层。VA-Judger 则指出把音质、画质、同步度三个单项指标线性加权当奖励,本身就是在鼓励 reward hacking:模型学会了把每项刷高,但整体听起来看起来仍然不连贯。它的解法是训一个带思维链的 omni 奖励模型,先从质量差距明显的对子里学格式,再用拒绝采样对齐人类对难例的解释,最后做维度级 GRPO。两篇一前一后,说明生成评测的重心正在从感知保真度移向任务完成度与跨镜头一致性。 视频编辑的条件通道从文字扩到了视觉 — VicEdit 提出的判断很直白:文字讲不清细腻纹理和复杂动态。所以它把编辑指令从纯文本升级为单图、图对、视频对三种视觉参考,并配了 40 万条数据的 VicEdit-400K。MSEditor 面对的则是另一个维度的难题——多镜头视频天然由视角、机位、姿态都不连续的片段拼成,逐镜头编辑必然身份漂移。它的做法是把多视角视频数据集改造成跨镜头监督信号,再用跨镜头打包策略在自注意力窗口内聚合语义相关的镜头。两篇一起看能发现视频编辑正在同时向两个方向扩张:条件端从文本扩到视觉示例,时序端从单镜头扩到整条多镜头序列,而这两个扩张都倚赖新造的数据而非新造的架构。 人工智能炼丹君 整理 | 2026-08-21 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-20|LumaAI首证扩散缩放定律要10倍数据(Abra) 今日 AIGC 论文速览 今日共 10 篇 · 训练缩放与数据基建 2 篇 · 图像编辑与超高分辨率 2 篇 · 视频编辑 2 篇 · 推理加速与高效架构 2 篇 · 生成评测与诊断 2 篇 重点论文标题列表 Abra(Luma AI):每参数200token是最优配比 EditBridge(上海交通大学·阿里 Qwen·新加坡国立大学):4K图像编辑61秒完成 ⚡ GRNEdit(西安电子科技大学·小米 MiLM Plus):2B模型打赢多个14B开源编辑器 CoinVE-200K(腾讯 PCG 在线视频事业部):一条指令同时改5处的数据集 LinCa(上海交通大学·阿里云终端智能计算·西安交大):5-7倍加速下文字仍不糊 今日论文速览 1. Abra:每参数200token是最优配比 Abra: Scaling Diffusion Image Training | Luma AI | arXiv:2608.17286 关键词:扩散缩放定律,IsoFLOP拟合,每参数200token,flow-matching,Luma AI ⚠️ 前序问题:语言模型这边,缩放定律早已是训练前沿模型的标准工具——给定算力预算,模型该多大、数据该多少,Chinchilla 给出了一条能直接照着执行的曲线。但视觉生成这边一直是空白:从业者知道模型越大越好、数据越多越好,却没人能回答「我有 10^21 FLOPs,参数和数据该怎么分」这个具体问题。此前少数几篇尝试过的工作,算力预算都偏小,拟合出的指数外推到实际训练规模时误差被放大得没法用。更麻烦的是,大家默认把 LLM 的经验直接搬过来——按 Chinchilla 的每参数 20 token 配比训扩散模型,而没有人验证过这个数字在视觉域是否成立。 本文贡献:这篇把这件事系统地做完了。作者构造了 Abra——一族受控的 flow-matching transformer,参数从 60M 覆盖到 2B,训练算力横跨 10^19 到 10^22 FLOPs 三个数量级,显著超出以往工作的预算上限。在这个规模上他们得到两个核心结论。第一,扩散模型的可预测性与语言模型一样好,损失随算力呈干净的幂律,IsoFLOP 曲线的最优点连成一条直线。第二也是最有价值的:扩散的计算最优点出现在每参数约 200 个图像 token,整整是 LLM Chinchilla 处方的十倍。第三个结论是给实践者的直接建议——与 LLM 不同,扩散模型对过训练相当鲁棒,所以拿不准时应该往「更多数据」而非「更大模型」的方向偏。最后他们证明这种可预测性不止于训练损失,还延伸到生成质量指标、最优 CFG 设置、表征质量,甚至训练曲线的形状本身都能坍缩到一个通用形式上。 Text-to-image diffusion transformers follow predictable scaling laws and require ten times as much data as a comparably sized language model to reach compute optimality. 实验效果:IsoFLOP 拟合给出 TPP = 191·C^0.0010(即最优 token-per-parameter 几乎不随算力变化,稳定在 200 附近),最优参数量 N = 0.0301·C^0.4951、最优数据量 D = 3.78·C^0.5049——两个指数都极接近 0.5,说明参数与数据应当同比例增长,这一点与 Chinchilla 一致,差别只在配比常数。过训练鲁棒性的证据来自 Iso-FLOP penalty 曲线:Abra 在 TPP 从 100 一路拉到 400 的区间内,惩罚基本贴着 0.2% 以下,而数字化重建的 Chinchilla LLM 曲线在 TPP 超过 100 后惩罚就迅速爬升到 3-5%。训练曲线的通用坍缩在 60M 到 2B 六个尺寸上验证,重标定后曲线几乎重合,相对波动收敛在 1% 以内。 Iso-FLOP suboptimality penalty $(L_N - L^*)/L^*$ versus TPP for the family (left) and the Chinchilla / Hoffmann et al. data (right), the latter figure-digitized by~besiroglu2024chinchilla and binned into log-$N$ model-size bands. Markers are the measured points ( evaluated checkpoints; digitized Chinchilla points); curves interpolate through them. The green/red bands mark the $0.2\%$ penalty threshold. 批判点评:这是今天这批里信息密度最高的一篇,而且是那种一旦被验证就会改变整个领域默认做法的工作。「每参数 200 token、是 LLM 的十倍」这个数字本身就足够有价值——它意味着相当多现有的文生图模型可能都处于数据不足的状态,一直在把预算错配到参数上。IsoFLOP 的两个指数分别是 0.4951 和 0.5049,加起来几乎正好是 1,这种干净程度说明拟合质量确实高,不是硬凑出来的。「对过训练鲁棒」这条实践建议也很务实:它把一个需要精确调参的问题变成了单边保守选择,工程上极其友好。不过要清醒几点。第一,最大只训到 2B 参数,而当前前沿文生图模型早已在 10B 量级以上,外推距离仍然不短——论文自己的图里最优点已经外推到 10^23 FLOPs 处的红点,这已是纯预测而非实测。第二,「200 token per parameter」这个数字必然依赖 tokenizer/patch 配置与图像分辨率,换一个 VAE 压缩率或 patch size,token 的信息量就变了,200 这个绝对值能否跨配置迁移,是使用者最需要知道却没有明确交代的。第三,全程使用 flow-matching transformer 这一种架构,结论对 UNet 或其他扩散形式是否成立未验证。第四,Chinchilla 的对比曲线是从原论文图里数字化重建的(论文自己在图注里标注了 curves are noisier than real per-run data),这个对照的严谨性弱于自己跑的实验,而「十倍」这个最抢眼的结论恰恰建立在这个对照上。第五,Luma AI 作为商业公司发布这份研究,代码与检查点是否开放决定了社区能否独立复现这条曲线。 2. EditBridge:4K图像编辑61秒完成 EditBridge: Towards Faithful and Efficient Ultra-High-Resolution Image Editing | 上海交通大学·阿里 Qwen·新加坡国立大学 | arXiv:2608.18063 关键词:超高分辨率编辑,扩散桥,分块稀疏注意力,4K保真,上交·阿里Qwen ⚠️ 前序问题:专业修图工作流里 4K 起步是常态,但扩散编辑模型基本卡在 1K 以下——注意力的二次复杂度加上显存墙,让高分辨率直接变成不可能。业界的通行绕法是两段式:先在低分辨率上编辑,再独立跑一次超分。这个做法看似合理,实际上埋了两个坑。一是信息发散:超分模型是在「猜」细节,它猜出来的东西与原始高分辨率图里真实存在的细节经常对不上——原图眼睛是棕色,低分编辑后超分给你补出一只绿色的眼睛,且补得很自信。二是纹理退化:超分要么把纹理磨得过平,要么锐化过头产生假质感。根子在于超分环节完全看不到原始 HR 图,它只能从 LR 结果凭空重建。 本文贡献:EditBridge 的做法是重新定义这一步在做什么。传统扩散是从噪声重新生成,而这里把细化过程形式化为一次结构化的数据到数据翻译:起点是 LR 编辑结果,终点是它的 HR 对应版本,整个过程显式地以原始 HR 源图为条件。这样一来,真实细节是「继承」来的而不是「猜」来的,信息发散问题从形式上就被堵住了。但引入 HR 源图作为条件会带来新的算力问题——两张超高分辨率图之间做全交叉注意力是不现实的。为此他们设计了先验引导的分块稀疏注意力:利用第一阶段编辑过程中已经产生的语义对应关系(用注意力图取 argmax 得到位置映射 π),把跨图交互限制在空间上真正对齐的区域内。也就是说,目标图的某个 chunk 只需要去看源图中与它对应的那几个 chunk,而不是全图。注意力被拆成两条路径:Path A 是域内自注意力,Path B 是先验引导的跨 chunk 稀疏注意力。 Overview of our proposed EditBridge. The upper section illustrates the inference process of the diffusion bridge, which transports the low-resolution edit to its high-resolution counterpart. The lower section details the construction of the correspondence prior and the proposed Prior-Guided Sparse Attention (PG-BSA) mechanism. 实验效果:在最高 4K 分辨率下实现高保真编辑且感知质量占优,2K 上相比基线取得 3.6 至 8.4 倍加速,4K 编辑可在 61 秒内完成——这个数字把超高分辨率编辑从「跑不动」推进到了可交互的区间。定性对比覆盖夜景霓虹招牌上的日文字符与水面倒影等细节密集场景,在 PISA-SR、Dit4SR、DiT-SR、TSD-SR、HiFlow 五个基线中,只有本方法保住了招牌上原本的文字笔画,其余方法要么把文字糊成噪点,要么改写成完全不同的字形。 Qualitative comparison at 2K resolution. Our method better preserves fidelity while enhancing visual clarity. 批判点评:这篇最值得肯定的是问题诊断的准确性:它没有把两段式方案的毛病归咎于「超分模型不够强」,而是指出结构性缺陷——超分环节看不到 HR 源图,所以必然只能幻觉。把修正手段定位在「让它看得到」而不是「让它更强」,这个判断决定了整个方案的正确性。复用第一阶段的注意力图来构建对应先验也很省——那份注意力本来就要算,等于白捡了一份稀疏化的依据,不需要额外的匹配网络。61 秒完成 4K 编辑这个数字给得具体且可验证,比笼统说「高效」有诚意得多。但有几处要打问号。第一,整个方法建立在「第一阶段的编辑注意力能给出可靠语义对应」这个前提上,而编辑幅度大的时候——比如把物体整个替换掉——目标区域在源图里压根不存在对应物,此时 π 映射会指向什么?这类场景恰恰是编辑任务里最常见也最难的,论文的示例(换伞的颜色、加一只小船)都属于局部小改动,大幅编辑下的行为没有交代。第二,3.6 到 8.4 倍这个区间跨度很大,说明加速比高度依赖图像内容与稀疏度,最坏情况是什么没说。第三,61 秒的硬件配置未在摘要中给出,A100 上的 61 秒和 H100 上的 61 秒不是一个概念。第四,方法仍然是两段式的,第一阶段 LR 编辑本身的质量上限直接决定了最终结果——如果 LR 阶段就改错了,桥接得再忠实也只是把错误高保真地放大到 4K。 3. GRNEdit:2B模型打赢多个14B开源编辑器 GRNEdit: Efficient General Video Editing from a New Binary-Evidence Perspective in Generative Refinement Networks | 西安电子科技大学·小米 MiLM Plus | arXiv:2608.16328 关键词:通用视频编辑,二元证据视角,生成式细化网络,空指令恒等通路,小米MiLM ⚠️ 前序问题:指令式通用视频编辑想用一个统一入口覆盖各种编辑操作,但现有方案在「怎么把源视频信息喂给模型」这一步上都很重:要么挂一条独立的重型条件分支,要么把源视频直接拼接进输入序列——前者增加大量参数,后者让序列长度翻倍,两条路都很贵。更本质的问题是,这些做法都把源视频当成一团需要重新理解的原始信息,而没有利用一个关键事实:编辑的绝大部分区域其实应该原封不动地保留下来。以「保持」为默认、只标注需要改的地方,信息量本该远小于从头重新描述整个视频。 本文贡献:GRNEdit 从 GRN(生成式细化网络)用 bit 组合编码视觉语义这一特性出发,把编辑语义重新表述成对每个 bit 的「保留还是翻转」的局部二元决策。这个视角转换是全文的支点:源信息不再是需要被重新编码的内容,而是支持当前二元状态的「坐标级证据」,而 GRN 主干继续负责把这些局部决策组合成全局连贯的生成语义。第一阶段用一个紧凑编码器把离散源码翻译为连续证据信号,在二元细化过程中持续注入。他们还借鉴 classifier-free guidance 的空提示训练,赋予空条件一个编辑专属含义——空指令即「不编辑」,由源重建来监督。这条恒等通路一石二鸟:既隐式强化了证据利用与内容保持,又在同一表示空间里产生了一个「源保持态」。于是第二阶段可以把每个编辑态与它对应的源保持态直接相减,用差异去修正那些第一阶段没定下来的目标 bit——这是一个相当巧妙的自我对照机制。 Overview of GRNEdit. Given a source video and an editing instruction, Stage I injects prompt-modulated source evidence into the GRN chunks through lightweight per-chunk projectors, each containing only about 3 M parameters for GRNEdit-2B and 7 M for GRNEdit-8B. Stage II refines the binary predictions by treating source evidence as support in keep regions and as counter-evidence in edit regions. 实验效果:仅用 0.6M 训练对、不到 3% 的条件化参数,GRNEdit-2B 与 GRNEdit-8B 在 OpenVE-Bench 上分别取得 4.03 与 4.18 分。2B 版本超过多个 14B 量级的开源编辑器,8B 版本与领先开源编辑器持平。第二阶段的监督设计在框架图中量化呈现:保持区域若用源信息使 p(target) 从 0.7 升到 0.9,交叉熵从 0.36 降到 0.11 作为奖励;编辑区域若照抄源信息使 p(target) 从 0.55 掉到 0.1,交叉熵从 0.6 升到 2.3 作为强惩罚——奖惩方向被显式分开。 Qualitative comparison across diverse editing tasks. GRNEdit performs more accurate edits while better preserving unedited content, whereas competing methods often miss the intended change or disrupt scene consistency. 批判点评:0.6M 数据加不到 3% 条件参数就让 2B 打赢 14B,这个效率比是今天最亮眼的工程数字,而且它不是靠更大的模型或更多的数据换来的,纯粹来自表示方式的重新选择。把编辑重述为 bit 级的保留或翻转,本质上是给模型换了一个更贴合任务的默认动作——从「重画」变成「保持」,这个先验一旦对了,学习难度会断崖式下降。空指令即恒等这条设计尤其漂亮:它不额外增加参数,却同时提供了内容保持的监督信号和第二阶段所需的对照基准,一个设计承担三个功能。但要看清几处限制。第一,整套方法深度绑定 GRN 这种二值化表示的骨干,对主流的连续 latent DiT 并不直接适用,普适性受限——这也解释了为什么它能这么省,代价是换不了底座。第二,OpenVE-Bench 上 4.03 对 4.18 这个 2B 与 8B 的差距只有 0.15,说明模型规模在这套方法下的边际收益极低,这既可以解读为「小模型就够」,也可以解读为「方法本身触到了天花板,加参数也没用」,论文倾向前一种解读但没有排除后一种。第三,「超过多个 14B 开源编辑器」这个表述里没点名是哪些,而开源 14B 编辑器的水平参差很大,这个对照的含金量无法判断。第四,0.6M 训练对相对于视频编辑任务的复杂度其实偏少,能力覆盖边界(能做哪些编辑类型、哪些做不了)没有说明。第五,两阶段推理意味着实际延迟是单阶段的两倍以上,效率优势主要体现在参数和训练成本上而非推理速度,摘要用 Efficient 一词容易造成误读。 4. CoinVE-200K:一条指令同时改5处的数据集 CoinVE-200K: A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing | 腾讯 PCG 在线视频事业部 | arXiv:2608.17566 关键词:复合指令视频编辑,数据集与基准,原子操作解耦,Wan2.1-14B,腾讯PCG ⚠️ 前序问题:指令式视频编辑的数据集这两年质量在稳步提升,但有一个共同盲区:几乎全部只覆盖单一编辑操作。而真实用户的诉求往往是复合的——「把背景换成森林,同时把她的黄裙子改成深蓝礼服,再把桌上那台搅拌机拿掉」,这是一条指令里塞了三个互相独立的编辑意图,模型必须同时理解它们、并在同一段视频里各自忠实执行且互不干扰。用只含单操作样本的数据训出来的模型,面对这种复合指令时要么只执行第一条,要么把几个操作混在一起相互污染。数据的形态直接锁死了模型的能力形态。 本文贡献:针对性地补上这块。CoinVE-200K 包含 1080p、最长 201 帧的视频编辑对,每个样本涉及 2 到 5 个原子编辑操作,作用对象覆盖人物、物体与背景,操作类型覆盖添加、移除、修改与风格化。所有样本经过一套生成加过滤的管线,从指令忠实度、视觉质量、时序一致性、复合多样性四个维度把关。配套发布 CoinVE-Bench,按主体、操作类型、指令复杂度分层评测。更进一步,他们训了 CoinVE-Edit——基于 Wan2.1-T2V-14B 与 Qwen3-VL-8B-Instruct 构建的 22B 复合视频编辑模型。这个模型的关键设计是把不同编辑指令的注意力做区域感知的解耦:每条指令经 MLLM 编码为一组可学习 token,由 Mask Predictor 预测其作用区域 M,GateNet 输出门控系数 g 决定该指令是否需要掩码约束,再通过 Q-Blending 交叉注意力按权重 w_q = 1 - βg(1-M) 融合多条指令的输出。这样每条指令只在自己的区域内生效,天然避免了多指令互相污染。 An overview of the proposed CoinVE-Edit framework. 实验效果:在 CoinVE-Bench 上,CoinVE-Edit 在指令遵循、复合编辑准确率、视觉质量与时序一致性四项上均取得强表现。定性对比展示了一条指令含 4 个操作的案例(替换搅拌碗、添加菜刀、替换台面、移除玉米粒),与 SAMA、可灵 O3、Seedance 2.0 三个对照相比,只有 CoinVE-Edit 把四个操作全部正确执行且未误改其余内容——对照方法普遍出现漏执行或连带改动无关区域的问题。 Quality comparison of compositional-instruction video editing on CoinVE-Bench. 批判点评:复合指令这个切入点选得准。单操作编辑在学术基准上已经做得相当好,但用户真实场景里很少有人只提一个要求,这中间的差距被整个领域忽略了,而它偏偏是产品化的关键一环。Q-Blending 那个门控加掩码的设计也合理:g 决定要不要约束、M 决定约束在哪,两个自由度分开,比硬性给每条指令分配固定区域灵活。1080p、201 帧、20 万对的规模在视频编辑数据集里属于第一梯队,腾讯在线视频事业部的资源背景也让这个量级可信。但几点要留意。第一,也是最关键的:数据集是「生成加过滤」构建的,那些 2-5 个操作的复合编辑对本身是用什么模型生成的?摘要没说。如果生成器本身就是现有编辑模型,那 CoinVE-200K 的质量天花板会被它锁死,而 CoinVE-Edit 训完能超过的也只是那些数据更少的模型,未必超过数据生产者。第二,CoinVE-Bench 由同一团队用同一套管线构建,与训练集共享分布,22B 模型在上面的领先有多少能迁移到真实用户指令,是个悬念——定性图里的对照模型都是在自家基准上被评的。第三,22B 的推理成本没有交代,201 帧 1080p 的复合编辑单次要多久,这直接决定它是研究原型还是可用工具。第四,「2 到 5 个原子操作」的分布如何?如果绝大多数样本是 2 个操作,那么 5 操作场景的实际支撑就很薄。第五,多指令解耦依赖 Mask Predictor 预测的区域准确,当两条指令的作用区域天然重叠时(改人物服装 + 改人物姿态),这套机制如何处理没有说明。 5. LinCa:5-7倍加速下文字仍不糊 LinCa: Accelerating Diffusion Models via Learnable Decomposed Feature Caching | 上海交通大学·阿里云终端智能计算·西安交大 | arXiv:2608.17973 关键词:扩散推理加速,可学习特征缓存,可逆分解重构,ECCV 2026,阿里云 ⚠️ 前序问题:扩散模型迭代采样的成本一直是落地的主要障碍,特征缓存是近年最被看好的加速路径——把某些时间步的中间特征存下来,后续步骤直接复用或外推预测,跳过昂贵的完整前向。问题在于,现有的免训练缓存方法都在用一套统一的预测策略处理所有特征。而实际上不同特征的时序动态差异极大:有些特征随时间步平滑变化,零阶复用就够;有些高频剧烈波动,必须用高阶外推才不失真。用一把尺子量所有东西,结果就是在高加速比下质量崩塌——具体表现为文字糊成一团、细结构错乱。 本文贡献:LinCa 的思路是先分解再分别对待。它引入一个轻量可逆网络,把缓存特征拆解为若干具有不同连续性的子成分,对每个成分匹配相应阶数的预测策略——平滑的用零阶(直接复用),次之用一阶,波动大的用二阶外推。可逆性在这里是关键设计而非装饰:严格可逆保证了子成分预测完后能无损重构回原始特征空间,不引入分解误差,形成一条完整的「分解-预测-重构」闭环。可逆投影用 RevNet 结构实现(可逆 1×1 卷积 + 加减耦合的 MLP 分支),前向与反向严格互逆。训练层面,他们为不同模型、不同时间步区段分别训练预测器,让方法能自适应各处不同的特征动态。整套东西是「学出来的」而非手工设计的,这是与既有免训练方法的根本区别。 实验效果:已被 ECCV 2026 接收。在 FLUX、Qwen-Image 与 HunyuanVideo 三个模型上验证,额外参数少于 0.2%,在 5 至 7 倍加速下保持接近无损的质量,显著优于既有方法。FLUX 上 5.51 倍加速的定性对比最能说明问题:提示词包含大段英文文字时,TeaCache、FORA、ToCa、DuCa、TaylorSeer 五个基线在相近加速比下文字均出现不同程度的糊化、笔画粘连或整体消失,而 LinCa 的文字与原始无加速结果几乎逐字符一致;橙子笑脸、马背上的电视机等构图元素也未出现基线中常见的物体丢失或结构错乱。 批判点评:把「统一策略」换成「按连续性分解后差异化处理」,这个思路对得很自然——特征动态本来就不均质,用一套策略是明显的欠拟合。可逆网络的选择尤其到位:如果用普通的编码器解码器做分解,重构误差会在数十个时间步里累积放大,把加速带来的收益抵消掉,而严格可逆从数学上消除了这个隐患。0.2% 参数换 5-7 倍加速的性价比很高,文字保持能力那张对比图也非常有说服力——文字是检验扩散加速方法最狠的探针,因为它对高频细节的破坏零容忍,五个基线全部翻车而 LinCa 几乎无损,这个差距不是调参能解释的。ECCV 2026 接收提供了同行评议背书。但要留意几点。第一,「学习」是双刃剑:需要为不同模型、不同时间步区段分别训练预测器,意味着换一个基座模型就要重新训一遍,而它对标的 TeaCache/TaylorSeer 等方法是完全免训练、即插即用的。0.2% 参数听起来很少,但训练流程的存在本身就是部署门槛,这个对比维度摘要没有正面回应。第二,可逆网络在每个缓存步都要跑前向与反向两次变换,这部分开销是否已计入 5-7 倍的加速统计口径,直接影响数字的诚实度。第三,三个验证模型都是 DiT 架构,对 UNet 类扩散模型是否有效未验证。第四,加速比只报到 7 倍,而基线方法在 5 倍附近就已明显退化,那么 LinCa 在 10 倍以上的表现如何、崩塌点在哪,是使用者最关心却未披露的信息。第五,「分解为不同连续性的子成分」这个划分是学出来的,缺乏可解释性——学到的成分究竟对应什么语义、划分是否稳定,论文没有做分析。 6. CapData:4.4亿图按能力依赖排课 From Corpora to Co-Evolving Capabilities: Capability-Centric Data Design for Generalist Image Generation | 阿里巴巴集团 | arXiv:2608.18076 关键词:图像生成数据基建,能力驱动排课,三引擎recaption,4.4亿图池,阿里巴巴 ⚠️ 前序问题:大规模图像生成的进步很大程度上来自数据侧——扩规模、提质量、做再平衡、重新写 caption。但常规做法有个结构性问题:每个任务的数据集都是孤立优化的。文生图数据管文生图,编辑数据管编辑,知识关联数据管知识关联,各建各的、各调各的。而真实情况是,生成能力之间存在依赖关系——模型得先能把文本和图像对上,才谈得上做图像到图像的变换;得先有稳定的视觉表达,才谈得上把知识实体正确渲染出来。数据如果不按这个依赖顺序组织,就会出现「教高级技能时基础还没打牢」的低效学习,算力被浪费在模型还接不住的监督信号上。 本文贡献:提出一套能力驱动的数据基础设施,把「针对能力构造监督」与「按能力对齐排课」耦合起来。三个专门但可互操作的数据引擎分别构建互补的关系型监督:T2I 引擎负责文本-图像接地(大规模图池 + 能力检索 + 多风格双语 recaption,覆盖 short/medium/long/dense/tags/entity 六种粒度),编辑引擎负责图像间变换(基础编辑、自然关联、专家自蒸馏等多维度策展 + T2I 对齐的编辑 recaption),知识引擎负责图像-知识关联(从 Wikidata 出发,PageRank 筛选实体后检索配图)。caption 专家横跨任务与粒度对齐 T2I 与编辑监督。多阶段课程沿能力获取的依赖顺序,联合演进任务构成、视觉概念分布、数据质量与图像分辨率,并由能力感知评测闭环——把失败案例送入 Failure Pool,触发邻近数据搜索与专家自蒸馏,再由分布控制器做缺口感知的重采样,持续失败的桶提高采样权重、已解决的降低权重。规模上策展出 4.4 亿图 T2I 语料、1.2 亿编辑对、超 2700 万图像-实体对,并用它从零训练 3B 与 6B 两个规模的多模态扩散模型。 Capability-specific data construction in our framework. Shared collection and wrangling feed three specialized but interoperable engines for visual expression, editing association, and knowledge-grounded reasoning. 实验效果:在 CPI-Bench 上做定量评测,并在多样的文生图与编辑场景做定性评估,结果显示广泛的视觉覆盖、多样的渲染能力,以及跨生成能力的有效迁移——即在一种能力上的数据投入能带动相关能力的提升,这正是「协同演化」这一命题的直接证据。 Capability-gap-driven active feedback loop. Capability-aware evaluation identifies failure cases, which seed neighboring-data retrieval and expert-driven construction. Gap-aware resampling then increases the weights of persistent failures and down-weights resolved gaps in subsequent training. 批判点评:把数据工程从「造语料」提升到「设计能力依赖图并据此排课」,这个视角在当前是稀缺的。大多数数据类论文的贡献是「我造了更多更好的数据」,而这篇的核心主张是「数据之间的组织顺序本身就是一种方法」,这是不同层级的命题。那个失败池 + 缺口感知重采样的闭环尤其务实——它把评测从「训完看看多少分」变成了「持续驱动下一轮数据采集」的控制信号,让数据基建具备了自我修复能力,而不是一次性的静态产物。4.4 亿图加 1.2 亿编辑对的规模,配合从零训练 3B/6B 两个尺度,工程投入相当扎实。但几处必须打问号。第一,全文没有给出任何具体数字——CPI-Bench 上得了多少分、与哪些基线比、领先多少,摘要用「broad coverage」「versatile rendering」「effective transfer」这类形容词全部带过,这在一篇以规模和方法论为卖点的论文里是硬伤,读者无法判断这套复杂基建的实际收益。第二,「按能力依赖顺序排课」这个核心主张需要消融来支撑——如果把课程顺序打乱,性能掉多少?没有这个对照,「依赖顺序很重要」就只是一个合理但未经检验的假设。第三,CPI-Bench 疑似自建,与训练数据的关系未说明。第四,整套基建的算力成本极高(4.4 亿图的策展、两个模型从零训练),学术界基本无法复现,其价值主要体现为工业界的方法论参考而非可直接采用的技术。第五,「能力依赖顺序」是人工设定的还是数据驱动得出的?如果是前者,那这套框架的效果高度依赖设计者的先验判断,泛化到新能力时需要重新人工设计。 7. MoE-ViE:1.7倍大模型的效果76%延迟 MoE-ViE: Mixture of Experts Vision Encoder for Efficient Image and Video Understanding | Meta | arXiv:2608.17402 关键词:视觉编码器,细粒度MoE,免辅助损失均衡,Group GEMM,Meta ⚠️ 前序问题:视觉编码器是多模态模型的关键部件,扩容它确实能带来性能提升,但稠密扩容的代价是算力与推理延迟同步上涨。MoE 在语言模型那边已经证明是高效扩容的答案——激活参数远小于总参数,容量涨而算力不涨。但把 MoE 用到 CLIP 风格的视觉编码器上,设计空间基本没人在 SOTA 水平上系统探索过:专家该多细粒度?路由怎么平衡?稀疏化带来的 kernel 开销怎么办?视频能力怎么加而不损失图像知识?这些问题各自都有多个可能答案,而缺少系统研究意味着大家只能凭直觉照搬 LLM 的配置。 本文贡献:Meta 把这个设计空间系统扫了一遍,给出四条结论加一套模型。第一,细粒度 MoE 拓扑(更多更小的专家)相比稠密基线和标准 MoE 都有实质增益——这与 LLM 领域近年的发现一致,但在视觉编码器上是首次在 SOTA 水平确认。第二,提出免辅助损失的负载均衡变体,避免了传统 aux-loss 对主任务的干扰,同时改善专家利用率。第三,设计专用 MoE kernel(Group GEMM + kernel fusion)来抵消稀疏计算带来的推理延迟开销——这一点很实在,MoE 理论 FLOPs 低但实际延迟常常因为访存不规则而吃亏,不做 kernel 优化的 MoE 在部署时经常「省了 FLOPs 但没省时间」。第四,为了在增强视频能力的同时保住图像知识,引入帧级蒸馏配合一种新的冻结机制:视频微调阶段专家与文本侧 MLP 全部冻结,只让预训练教师对第 i 帧的表示去蒸馏学生对整段视频的表示,从而把视频能力「加」上去而不覆写已有的图像能力。 Illustration of MoE-ViE architecture and training pipeline. MoE-ViE adopts a fine-grained MoE design with optimized MoE kernels for latency reduction. We first perform contrastive pretraining on large-scale image-text pairs. During video finetuning, we introduce frame-level distillation and expert freezing to preserve the pretrained image understanding capabilities. 实验效果:跨多个尺寸预训练的 MoE-ViE 系列一致优于对应的稠密版本。最大模型在零样本性能上匹配一个 1.7 倍于它的 SOTA 编码器,而延迟只有后者的 76%。与 LLM 对齐后,MoE-ViE 在图像与视频基准上超过所有对照编码器,包括激活参数多达 5 倍的模型。ImageNet 1K 错误率随 GFLOPs 的缩放曲线显示,ViT-B/32、ViT-B/16、ViT-L/14 三个骨干的 MoE 版本(实线)在各自算力区间内均位于稠密版本(虚线)下方,且差距在算力增大后不收敛。代码已开源,论文被 ECCV 2026 接收。 MoE-ViE vs. dense models at multiple scales. MoE-ViE consistently outperforms their dense counterparts under the same compute budget. 批判点评:这是一篇标准的工业界系统性研究:不追求单点创新,而是把一个设计空间扫清楚并交付可用的模型和 kernel。价值在于确定性——它把「视觉编码器该不该上 MoE、怎么上」从猜测变成了有依据的选择。专用 kernel 那部分尤其值得称道,因为它诚实地面对了 MoE 最常被回避的问题:理论 FLOPs 的节省经常在实际延迟上兑现不了,很多 MoE 论文只报 FLOPs 而绝口不提墙钟时间。这里直接给出 76% 延迟这个端到端数字,说明作者知道读者真正关心什么。冻结机制的设计也很克制——加视频能力时把专家全冻,本质是承认「不确定改动会不会伤到图像能力,那就干脆不改」,这种保守在多模态扩展里往往是对的。但要注意几点。第一,与本项目关注的生成方向的关联是间接的:视觉编码器主要服务理解任务,对生成的价值需要经过 MLLM 这一层传导,读者不应把这里的收益直接映射到生成质量上。第二,「匹配 1.7 倍大的 SOTA 编码器」——是哪个编码器?摘要没点名,而 SOTA 这个词在视觉编码器领域可以指向差异很大的几个模型。第三,76% 延迟是在什么硬件、什么 batch size 下测的没说,MoE 的延迟优势对 batch size 极度敏感,小 batch 下专家利用率低会显著劣化。第四,「超过激活参数多 5 倍的模型」这个比较用的是激活参数而非总参数,MoE 的总参数量通常远大于激活量,从显存占用角度看这个对比对 MoE 是有利但不完整的。第五,帧级蒸馏用单帧教师去教整段视频学生,这个设定对需要跨帧推理的能力(如动作识别、时序因果)是否够用,值得怀疑——它教会的可能主要是「每帧都看懂」而非「看懂帧之间发生了什么」。 8. WildMoire:用生成模型造出去摩尔纹标注 Improving Complex Moire Removal with Generative Supervision | 哈尔滨工业大学·阿里淘天集团 | arXiv:2608.17883 关键词:摩尔纹去除,生成式监督,数据引擎,6.8K训练对,哈工大·淘天 ⚠️ 前序问题:训练去摩尔纹模型需要成对数据——同一场景的带摩尔纹版本和干净版本。麻烦在于真实世界里最难处理的那类摩尔纹恰恰最难获得配对标注:拍公共显示屏、翻拍网络图片时产生的大尺度、多彩摩尔纹,其干净原图根本无从获取,因为你没法控制那块屏幕、也拿不到原始素材。现有数据集只能在受控环境下采集,覆盖的摩尔纹形态与真实野外场景差距很大。这构成一个死结:最需要解决的场景,恰恰是最拿不到监督信号的场景。 本文贡献:既然干净图拿不到,那就造一个。作者提出一套数据引擎来生成训练监督:先收集含复杂摩尔纹的真实图像并定位其中的屏幕区域,然后部署多个图像条件的生成基础模型(SDXL、Nano Banana 2、Qwen-Image-Edit、GPT Image 2、FLUX.2 五个)各自产出候选参考图,再对候选做 patch 级的质量控制来筛选出最优结果——后处理包含空间位置与色彩对齐、patch 裁剪、预过滤、最优 GT 选择四步。用这套范式构建了 WildMoire 数据集,含 6.8K 摩尔纹-GT 训练对,分辨率 1024×1024。评测侧另外采集了约 250 对带真实干净 GT 的独立测试集——这一点很关键,它保证了评测不是自己造的数据自己评。 Overview of WildMoir'e dataset construction. We first collect real screen-captured images containing complex moir'e and localize the display regions. Five image-conditioned generative models then produce candidate GT images. The candidates are processed at matched spatial locations through spatial and color alignment, synchronized patch extraction, pre-filtering, and optimal GT selection. This offline procedure yields 6.8K moir'e-GT pairs at 1024()1024 resolution. The plots on the right summarize the improvements obtained by training ESDNet, SDXL, and Qwen-Image-Edit with constructed WildMoir'e dataset. 实验效果:在 ESDNet、SDXL、Qwen-Image-Edit 三个不同类型的模型上验证,加入 WildMoire 训练后各项指标一致提升:PSNR 分别为 23.37 对 21.50、23.56 对 21.90、23.93 对 22.23;SSIM 为 0.7821 对 0.7341、0.7887 对 0.7522、0.7851 对 0.7578;无参考指标 MUSIQ 为 44.21 对 38.20、45.07 对 41.48、58.97 对 55.33;TOPIQ 为 0.3413 对 0.2770、0.3583 对 0.3203、0.4624 对 0.4276。三个模型、四个指标全部改善,方向一致。 Comparison of qualitative results. The first example emphasizes logo and text fidelity under broad color interference, while the second contains severe mixed chromatic patterns over fine scene textures. Nano-Banana-2 is relatively content-faithful but may retain moir'e, whereas GPT-Image-2 removes artifacts aggressively while replacing scene content and producing an overly digital-image appearance. Using WildMoir'e suppresses residual bands more effectively across all 3 trainable models. 批判点评:「用生成模型造监督信号来训练修复模型」这个思路本身是有循环论证风险的——生成模型自己也会产生伪影,用它的输出当 GT,等于把它的错误当成真理教给学生。这篇之所以站得住,全靠两个设计。一是不用单个生成模型,而是让五个模型各出候选再做 patch 级筛选,把「相信某个模型」换成「相信多个模型中被质控挑出来的那部分」,显著降低了单一模型偏差的传播。二是测试集用真实采集的干净 GT 而非生成的,评测环节的可信度得到了保证——如果测试集也是生成的,整篇的结论就没有意义了。三个模型上四项指标一致改善也排除了偶然性。但要看清限制。第一,6.8K 对的规模在数据驱动的低层视觉任务里偏小,PSNR 提升 1.7-1.9 dB 虽然明确但不算大幅度,而这个提升是在测试集只有 250 对的情况下测的,统计置信区间没有报告。第二,生成的 GT 本质上是「一个合理的干净版本」而非「真正的原始内容」——摩尔纹遮住的地方生成模型是在猜,猜得好看不等于猜得正确,而 PSNR/SSIM 是在与真实 GT 比对,所以训练数据的这种「合理但不真实」的偏差会以什么形式影响模型行为,值得进一步分析。第三,五个生成模型中多个是闭源商业模型(Nano Banana 2、GPT Image 2),意味着这套数据引擎的复现需要付费 API,且模型迭代后行为会变,数据可复现性存疑。第四,摩尔纹去除是个相对小众的低层任务,方法论的普适价值(用生成模型为难以获取 GT 的任务造监督)其实比这个具体应用更值得关注,但论文没有往这个方向延伸讨论。 9. TRACE-Bench:把多参考生成拆成四个算子 TRACE-Bench: Decomposing and Diagnosing Multi-Reference Image Generation | 上海交通大学 | arXiv:2608.16765 关键词:多参考图像生成,评测基准,四算子分解,属性解耦绑定,上海交大 ⚠️ 前序问题:多参考图生成——给几张参考图,要求把 A 的人物、B 的服装、C 的场景组合起来——的评测基准,目前都是按预定义任务类型组织的,比如「主体组合」「风格迁移」各设一类。但多参考本质上是组合性的,任务类型的笛卡尔积会爆炸,用有限的预定义类别去覆盖必然导致三个问题:覆盖碎片化(很多组合根本没被测到)、复杂度不受控(同一类别下的样例难度可能差几倍)、诊断价值近乎为零(知道模型在「主体组合」上得 0.6,但不知道是没抓对主体、没解耦属性还是没组合好)。 本文贡献:换一个视角:不按任务分类,按能力原子分解。作者观察到各种多参考任务其实共享一组原子操作,于是形式化出四个算子——Anchor(f,锚定参考图中的某个实体)、Disentangle(g,把实体的某个属性剥离出来)、Apply(⊕,把属性施加到目标上)、Compose(C,把多个结果组合成完整场景)。任何多参考提示词都能表示为这四个算子构成的组合公式,而公式中算子槽位的数量就是它的结构复杂度——复杂度从此变成了一个可精确控制的连续量而非模糊的难易标签。基于这套形式化构建 TRACE-Bench:约 1600 个评测样例,槽位数从 1 到 8 连续覆盖,由 631 个公式模板与约 4000 张参考图生成,涵盖多种艺术风格与真实主体。公式结构直接驱动两件事:算子对齐的评测协议(对每种能力单独打分)与诊断树分析(递归定位失败发生在公式的哪一层)。 Overview of the benchmark construction pipeline. Candidate images are first collected and filtered from multiple sources, then annotated through structured tagging. The tagged pool is then balanced through source-wise sampling and augmented with synthetic data. It is subsequently used for formula-template sampling and prompt construction. 实验效果:评测 9 个领先模型后得到了整体打分完全看不见的结论:主要瓶颈在解耦(g)与属性绑定(⊕),而非场景级组合(C)——这与直觉相反,人们通常认为「把多个东西组合到一起」才是难点。即使最好的模型在属性保真度上也只有 0.74 分。实体级锚定分数随参考图实体数量增加持续下降:Nano Banana 2 与 GPT-Image 1.5 从 2 个实体时的 0.78 降到 8 个实体时的约 0.55 与 0.49,EMU 3.5 从 0.70 降到 0.36,Qwen Image Edit 2511 从 0.60 降到 0.36——所有模型无一例外,且弱模型衰减更陡。已被 ACM MM 2026 接收。 Anchor performance versus template slot count (left) and reference-image entity count (right). 批判点评:把评测从「任务分类学」重构为「能力代数」,这是这篇真正的贡献。四个算子的抽象足够简洁,又足够表达绝大多数多参考场景,而槽位数作为复杂度度量把「难度」这个模糊概念变成了可控变量——这让基准第一次能回答「模型在复杂度 N 时开始崩」这类定量问题,而不只是给一个总分。诊断树的递归失败定位设计也很自然地从公式结构里长出来,不是额外硬加的模块。「瓶颈在解耦和属性绑定而非场景组合」这个发现具有明确的研究导向价值:它告诉后续工作该往哪儿使劲,而这正是一个基准最该产出的东西。实体数从 2 涨到 8 时所有模型锚定分数单调下降的曲线也很有说服力——它揭示了一个共性缺陷而非某个模型的问题。但几点要留意。第一,1600 个样例分摊到 1-8 共八个槽位档,平均每档 200 例,再按算子类型细分后每个诊断单元的样本量会相当小,per-capability 分数的统计稳定性存疑。第二,评测靠什么打分?摘要没说评分是人工还是 VLM 自动评。如果是 VLM 评分,那么「解耦和属性绑定是瓶颈」这个结论可能部分反映的是评委 VLM 在这两项上的判别偏好,而非被测模型的真实短板——这是自动评测基准的通病,需要人工一致性验证来排除。第三,四算子分解是作者提出的一种形式化,未必唯一,其完备性(是否所有多参考任务都能被这四个算子表达)缺乏论证。第四,9 个被测模型中包含 Nano Banana 2、GPT-Image 1.5 等闭源模型,其版本会持续更新,基准结论的时效性有限。 10. HarnessEval-W:评测世界模型要给出证据链 HarnessEval-W: Agentifying the Evaluation of Visual Worlds | MirroS·清华·北大·NVIDIA·UC Berkeley·上交·南洋理工 | arXiv:2608.16859 关键词:世界模型评测,智能体化流水线,层级证据树,人类偏好对齐,NVIDIA·清华 ⚠️ 前序问题:一个基准如果只吐出一个标量分数,那么它可信与否完全取决于你信不信它——分数背后的判断依据是不透明的。这个问题在世界模型评测上格外尖锐:判断一段 rollout 好不好,需要理解物理规律有没有被违反、因果链条对不对、世界状态的演化是否自洽。人类看一眼就知道哪里不对劲,但现有基准全靠暴力计算指标,算完给个数,没有任何可供检查或核验的推理链条。于是当两个模型分数接近时,你无从判断这个接近是真实的还是指标失灵。 本文贡献:把 LLM 生态里的 harness 范式搬到世界模型评测上,做成一条智能体化的评测流水线。核心区别在于它不套用固定评分表,而是先理解每个评测案例的上下文,把评测问题分解为若干可测量的子问题,再为每个子问题派生专门的子智能体——每个子智能体带着定制的上下文与诊断工具,只负责论证自己那一小块。父智能体随后校验汇总的证据并归纳为最终判定。这个层级化流程的产物不只是一个分数,而是一棵完整的证据树,每条推理链都可回溯查验。图中示例展示了这个过程:给定「让右夹爪把托盘上方的立方体举起来」这一意图性转换案例,系统先做案例专属的技能路由(启用 Intentional Change 与 Physical Plausibility,关闭 Offscreen Evolution 与 Drift Degradation),再由子智能体分别给出带理由的评分——target specificity 1.00、final state 0.25、no extra event 0.00(因为 rollout 里凭空出现了一只人手去捡立方体),最终聚合为 0.485。 Overview of the ourmodel evaluation pipeline. Given a case with its prompt and evaluation setting, the agentic planner routes the case to applicable skills from the skill library, recording an evidence-grounded reason for every activated and skipped skill (e.g., the Offscreen Evolution Verifier is skipped because all requested actions remain visible). Each activated skill spawns sub-agents that inspect the world model rollout for specific sub-questions, such as target visibility and final state validity; here, the Intentional Change Verifier detects an unrelated human intervention picking up the cube and zeroes the no-extra-event score. The collected evidence is finally aggregated into per-dimension scores and an interpretable final score. 实验效果:在 18 个代表性世界模型、330 个评测案例上应用,判定结果与人类偏好高度对齐:技能级别上与人类 Bradley-Terry 强度的相关性达到 ρ=0.93(意图类)与 ρ=0.87(物理类),Kendall τ 分别为 0.82 与 0.74。与最接近的既有 Wbench 协议对比,在意图与事件编辑任务上准确率 0.778 对 0.602、平局率 0.111 对 0.361;在物理与因果保真任务上准确率 0.717 对 0.319、平局率 0.018 对 0.522——平局率的大幅下降尤其说明问题:旧协议在超过一半的物理类对比中给不出区分,而本方法几乎总能分出高下。全流程开源为活体基准,接受社区贡献新技能与新案例。 Human alignment of ourmodel and its comparison with WBench. (a) Model-level human alignment: each point is one of the evaluated models; we fit a linear curve for both Intentional and Physical Transition. (b) Controlled comparison with the closest WBench protocols on the same data: we report pairwise accuracy (higher is better), draw rate, and Brier score (both lower is better). 批判点评:「评测的可信度来自论证而非分数」这个立论切中了当前评测体系的软肋。当各家模型在总分上越挤越近时,一个不能解释自己为什么这么打分的基准,实际上已经失去了指导价值。把评测拆成子问题再派智能体分别论证,得到的证据树让分数变得可审计——这是从「相信基准」到「检查基准」的转变。物理类平局率从 0.522 降到 0.018 是全文最有说服力的数字:它说明旧协议在过半的物理保真对比中根本没有分辨力,而这类失效在只看准确率时是看不出来的。ρ=0.93/0.87 的人类对齐度也相当高。作者阵容横跨 MirroS、清华、北大、NVIDIA、UC Berkeley 等十余家机构,Ziwei Liu 与 Ming-Yu Liu 在列,说明这是一次有组织的社区级基建投入而非单点工作。但要审视几点。第一,评测器本身是由 LLM/VLM 智能体构成的,那么它的判断能力上限就是这些基座模型的上限——当被测世界模型的能力超过评委模型的理解能力时,这套评测会失效,而这个交叉点何时到来没有讨论。第二,智能体化评测的成本远高于计算指标:330 个案例、每个案例派生多个子智能体,单次完整评测的 token 消耗与耗时未披露,这直接决定它能否作为常规回归测试使用。第三,「与人类偏好对齐」的人类标注规模、标注者背景与一致性未在摘要中交代,而 ρ=0.93 这类数字对标注质量极度敏感。第四,技能路由决定启用哪些评测维度,路由本身出错(该查物理却没查)会导致系统性漏判,而这类错误在证据树里恰恰是看不见的——树只记录做过的检查,不记录漏掉的。第五,作为活体基准接受社区贡献,长期的版本一致性与跨时间可比性如何保证,是这类开放基准共同的治理难题。 趋势观察 扩散模型的「训练配方学」正式补齐最后一块拼图 — 语言模型有 Chinchilla,视觉生成一直没有可对照的缩放定律。今天 Luma AI 的 Abra 把 10^19 到 10^22 FLOPs 三个数量级扫了一遍,给出「每参数 200 个图像 token」这个明确数字,是 LLM 的十倍;阿里的 CapData 则从数据侧回答同一个问题——不是单纯堆量,而是按能力依赖顺序编排课程。一个说算力该怎么分,一个说数据该怎么组织,共同标志着视觉生成开始有了可预测的工程学,而不再只是炼丹。 编辑任务集体转向「别从噪声重生成」 — EditBridge 把超高分辨率编辑重新形式化为 LR→HR 的数据到数据桥接而非从噪声重生,GRNEdit 把编辑语义拆成对每个 bit 的保留还是翻转决策,两者都在做同一件事:让模型只改该改的,其余部分从源头直接继承。这与传统「条件生成」范式的区别是根本性的——前者的默认动作是保持,后者的默认动作是重画,而编辑任务真正需要的恰恰是前者。 评测正在从「打一个分」变成「定位是哪一步错了」 — TRACE-Bench 把多参考图生成拆成 Anchor/Disentangle/Apply/Compose 四个算子,用公式结构定位失败发生在哪个算子上,发现瓶颈其实在解耦与属性绑定而非场景合成;HarnessEval-W 更进一步,让子智能体各自论证再汇总,把评测变成可查验的证据树。当模型能力普遍变强、总分趋同后,可诊断性比可比较性更值钱。 人工智能炼丹君 整理 | 2026-08-20 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-06|京东22B音画同修让百年老片复活OmniVR 今日 AIGC 论文速览 今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇 重点论文标题列表 OmniVR(中科大·京东探索研究院):22B让百年老片音画一起复活 JoyAI-Video-Edit(京东Joy Future Academy):16B单卡30FPS实时剪视频 ContextMaster(清华·南京大学·快手可灵·上科大·港科大):固定预算多镜头创作跑16.74FPS OmniPack(西北工业大学·北大·阿里·清华):无训练6.8%算力保住92.9% STEP-OPD(上海交大·阿里):蒸馏学生越过教师得分0.961 今日论文速览 1. OmniVR:22B让百年老片音画一起复活 OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224 关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东 前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。 本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。 实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。 批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。 2. JoyAI-Video-Edit:16B单卡30FPS实时剪视频 JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974 关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东 前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。 本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。 实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。 批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。 3. ContextMaster:固定预算多镜头创作跑16.74FPS ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956 关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵 前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。 本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。 实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。 批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。 4. OmniPack:无训练6.8%算力保住92.9% OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812 关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速 前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。 本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。 实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。 批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。 5. STEP-OPD:蒸馏学生越过教师得分0.961 STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887 关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成 前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。 本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。 实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。 批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。 6. TD-V2A:帧间差分让视频配音FAD降至0.53 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902 关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征 前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。 本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。 实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。 批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。 7. CAPE-T2V:训练推理两头对齐提示词 CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046 关键词:文生视频,提示增强,训练推理对齐,Caption,可灵 前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。 本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。 实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。 批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。 8. Two-Stage Token Pruning:只留10%视频Token还涨7分 Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112 关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon 前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。 本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。 实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。 批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。 9. OmniEdit-Bench:五赛道揭穿视频编辑假高分 OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049 关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相 前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。 本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。 实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。 批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。 10. CSGen:2.4万样本守住血管道路裂缝 CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655 关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM 前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。 本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。 实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。 批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。 趋势观察 音视频联合模型开始从内容生成反向进入修复 — OmniVR 直接复用 22B 音视频生成骨干,同时恢复老片画面、声音与同步关系;统一生成先验正在吞并过去彼此独立的增强管线。 视频编辑从固定短片走向实时、有状态和开放时长 — JoyAI 用两步自回归扩散在单 B200 达到 720p 约 30 FPS,ContextMaster 则以固定预算上下文支撑多轮多镜头创作,视频模型正从一次生成器变成持续工作的创作系统。 Token压缩从固定比例升级为内容与问题共同决定 — OmniPack 先保全局音视频结构、再按问题做语义精炼,Amazon 两阶段方案先删重复帧、再按谱冗余决定每帧预算;高效推理正在告别一刀切剪枝。 生成后训练不再满足于复刻教师或单边修补接口 — STEP-OPD 沿教师相对基础模型的能力方向继续外推,CAPE-T2V 则让同一个 Prompt Enhancer 同时定义训练与推理文本分布,优化目标从局部模仿转向端到端系统对齐。 视频能力评测开始补齐时间、声音与隐式推理 — OmniEdit-Bench 的五赛道显示最强商业编辑模型综合仍不足 40 分;TD-V2A 也证明只看语义无法评价配音,时间差分与同步指标将成为音视频系统的基本维度。 人工智能炼丹君 整理 | 2026-08-06 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-29|Apple端侧Siri语音16倍实时仅21MB 今日 AIGC 论文速览 今日共 10 篇 · 端侧音频与数字人生成 2 篇 · 视觉生成推理加速 2 篇 · 可控视频编辑与专业评测 3 篇 · 全模态表示与扩散蒸馏 2 篇 · 视频模型视觉推理 1 篇 重点论文标题列表 Apple Audio DiT(Apple):端侧Siri语音16倍实时仅21MB Sol-Attn(NVIDIA):在线稀疏注意力让视频快2.3倍 UniGen-AR(CMU·UIUC·Toyota Research):一个自回归模型做15项视觉任务 AptAvatar(阿里淘天):14B数字人两步720P提速60倍 EgoPlay(Snap·KAUST):看到事件发生后才开始编辑视频 今日论文速览 1. Apple Audio DiT:端侧Siri语音16倍实时仅21MB Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers | Apple | arXiv:2607.23811 关键词:端侧TTS,Siri,音频DiT,RVQ,Apple 前序问题:Siri Expressive Voices要在设备上实时生成可配置、富表现力的语音,但语义音频token转高保真波形的detokenizer受AMX算力和内存严格限制。传统Transformer或GAN随序列长度线性甚至平方增长,难以持续合成长音频。 本文贡献:Apple提出解耦时间与RVQ深度的三组件架构:流式编码器、时间解码器和深度解码器。单个可复用的DiT式深度解码器通过stage conditioning自回归生成全部RVQ层,取代每层一个解码器;因果滑窗注意力配合固定窗口KV缓存,使运行内存不随语音长度增长。 实验效果:部署在Apple Matrix Coprocessor上,每步约10ms、约16倍实时,峰值运行内存仅21MB,端侧资产329MB,可连续合成20到320秒音频。AFM 3 Core Advanced中以10亿参数激活规模运行,相比上一代端侧TTS,整体MOS从3.87升至4.15,对话语音从3.82升至4.24。 批判点评:这是今日最强工业落地:Apple不仅给结构,还给AMX上的时延、内存、资产和MOS,证明十亿级音频生成可真正驻留端侧。代价是方案深度绑定Apple硬件与AFM token体系,16倍实时不能直接外推到通用CPU/GPU;320秒以上稳定性和多语言覆盖也未披露。 2. Sol-Attn:在线稀疏注意力让视频快2.3倍 Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification | NVIDIA | arXiv:2607.24027 关键词:稀疏注意力,视频生成,NVIDIA,免训练,推理加速 前序问题:视频DiT的长token序列让注意力成为推理瓶颈。现有免训练动态稀疏要么固定保留比例、要么按累计概率动态分配,路由预算僵硬或失衡,还要显式生成代理分数图;直接丢掉未选块则在高稀疏率下明显伤质量。 本文贡献:提出免训练Sol-Attn,将动态路由、稀疏计算与近似修正合进同一次online softmax。在线块阈值直接比较代理分数选关键KV块,不物化完整代理图,预算动态且可控;未选块的代理分数被复用来近似其贡献,避免keep-or-drop造成的信息断崖。 实验效果:在保持视觉质量的同时,视频生成端到端提速2.1倍、视频编辑提速2.3倍,并在图像与视频任务上推进免训练稀疏注意力的质量—效率前沿。 批判点评:Sol-Attn的价值不只是稀疏,而是把路由开销和遗漏补偿塞进online softmax一遍完成,NVIDIA背景也意味着内核可落地。但提速依赖模型、序列长度和阈值;代理分数对被丢块的近似在快速运动、小目标或精细文字场景中仍可能失真。 3. UniGen-AR:一个自回归模型做15项视觉任务 UniGen-AR: Unifying Visual Generation with Auto-Regressive Modeling | CMU·UIUC·Toyota Research | arXiv:2607.24157 关键词:统一视觉生成,自回归,VAR,MLLM,VQ-VAE 前序问题:文生图、编辑、修复和传统感知仍由不同模型负责;扩散虽能统一多种图像输出,但迭代采样延迟高,限制统一视觉生成在交互场景落地。 本文贡献:提出UniGen-AR,将通用MLLM与next-scale视觉自回归(VAR)解码器结合。MLLM把自由文本指令和控制信号编码为统一序列,VAR用一套权重和统一提示接口生成图像输出,覆盖四大家族15项以上任务且无需任务专用头。消融指出VQ-VAE码本大小和层级是VAR扩展的关键。 实验效果:相对扩散基线推理延迟最多降低19倍,同时保持或提升输出质量;单模型覆盖文生图、图像编辑、修复、感知等15项以上任务。 批判点评:用VAR替代扩散解码器,把统一视觉生成的效率问题正面解决,19倍延迟优势非常醒目。但自回归速度会受视觉token数量影响,VQ-VAE码本带来的量化误差仍在;15任务统一不等于每项都超过专用SOTA。 4. AptAvatar:14B数字人两步720P提速60倍 AptAvatar: Fast and Vivid Long-Form Audio-Driven Video Generation for Production-Ready Avatars | 阿里淘天 | arXiv:2607.24013 关键词:数字人,音频驱动,两步生成,分布蒸馏,阿里 前序问题:生产级音频驱动数字人既要快,又要保持身份、动作表现力和长视频稳定。现有加速常靠因果注意力、短时间窗、缩小模型或分辨率换速度,在极端两步生成时质量尤其容易塌。 本文贡献:提出14B长视频数字人AptAvatar。端点锚定分布蒸馏在普通DMD外加入Anchor Score Estimator,用冻结四步桥接生成器定义可达到的轨迹端点,指导两步学生;Self-Generated History Replay复用早期checkpoint输出作为分块训练历史,近似推理时自生成上下文而无需昂贵在线rollout。 实验效果:仅2次函数评估即可生成720P长视频数字人,推理提速60倍,同时保持视觉保真、鲜活动作、长时身份一致和文本动作控制。 批判点评:14B、720P、两步和60倍同时成立,说明淘天已瞄准直播与营销生产链。端点锚降低了两步蒸馏难度,但训练依赖四步桥接器和历史checkpoint缓存,流水线并不轻;摘要也未给绝对FPS,生产“实时”仍需硬件数据。 5. EgoPlay:看到事件发生后才开始编辑视频 EgoPlay: Event-Triggered Video Editing for Egocentric Streams | Snap·KAUST | arXiv:2607.24560 关键词:视频编辑,事件触发,第一视角,Snap,流式生成 前序问题:第一视角连续视频需要“当X发生时再做Y”,模型既要识别事件发生与否和时刻,又必须完整保留事件前画面、只改后续。检测器串联编辑器容易误触发并产生误差传递。 本文贡献:提出端到端事件触发V2V编辑器EgoPlay,在一个视频扩散模型中联合学习事件识别、时间克制和像素编辑,支持未发生事件与多事件提示。团队构建10.6万组事件触发片段—提示数据,训练双向编辑器并导出可逐块流式推理的因果版本;评测拆分触发后质量、触发前保持和假触发鲁棒性。 实验效果:相对EgoEdit,编辑质量、视觉质量和背景一致性分别提升17.7%、16.9%、16.4%;相对VLM检测器+编辑器串联基线分别提升15.7%、14.5%、13.5%,GPU内存还不到其一半。 批判点评:EgoPlay把视频编辑从“全片执行指令”升级为事件驱动程序,对AR眼镜和第一视角Agent很关键。风险是模型同时承担检测与生成,触发判断难单独校准;Ego4D里的事件覆盖有限,安全敏感场景不能只依赖生成模型自判。 6. FilmBench:电影学院用专业镜头语言重测视频模型 FilmBench: A Film-Grade Benchmark for Cinematic Video Generation | 阿里·北京电影学院·虎鲸文娱 | arXiv:2607.24241 关键词:视频评测,电影语言,多镜头,阿里,FilmOps 前序问题:多数视频生成基准用网页或LLM提示,并由通用多模态模型打总体画质、文本一致和流畅度,测到的是“像视频”,而非导演真正关心的镜头设计、动态美学和多镜头叙事。 本文贡献:提出电影级T2V/R2V基准FilmBench,与导演、北电教师和制片团队共同设计。1169条提示反推自20类获奖电影片段,其中1056条为多镜头真实shot list;评价体系含3轴、12组件、T2V 35项加R2V 3项子指标,并开放电影语言算子FilmOps和专家级自动评测Agent。 实验效果:评测9个T2V和7个R2V模型,自动评测对人类模型排名的Spearman相关分别达0.95和0.96。现有模型在动态美学上普遍不足,且从单镜头到多镜头性能明显下降,弱模型跌幅更大。 批判点评:FilmBench把视频评测从VBench式通用指标拉到专业电影语言,是生成视频走向影视生产的重要基础设施。但获奖电影反推提示可能偏向成熟电影美学,自动Agent即使排名相关高,也不代表每个镜头级解释都可靠;版权与参考片段可复现性同样重要。 7. OmniVAE:音视频VAE先对齐再联合生成 OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation | 复旦·上海创新院·MOSI·上交 | arXiv:2607.23855 关键词:音视频生成,VAE,跨模态对齐,复旦,全模态 前序问题:联合音视频生成通常分别训练音频VAE和视频VAE,两套潜空间没有细粒度对应,下游生成器不得不从零学习“哪个画面该配哪个声音”,增加同步学习难度。 本文贡献:提出联合训练的OmniVAE。除重建目标外,以片段级音视频对比学习捕获时间—语义对应并对齐潜空间;同时把预训练音频和视频语义编码器特征分别蒸馏进对应潜变量,让两种表示既保留重建能力,又更容易被下游联合生成模型学习。 实验效果:两种对齐目标持续提升潜空间可学习性,使下游文生音视频获得更高生成质量与更准确跨模态同步,验证统一表征应从VAE底座开始。 批判点评:多数工作把同步压力全留给生成DiT,OmniVAE提前在tokenizer阶段对齐,方向很对。但对比目标可能把音画关系压成粗语义相似,口型、碰撞声等毫秒级同步仍需生成器建模;联合VAE也会降低替换单一模态编码器的灵活性。 8. PDM:拆开CFG正负分支修复扩散蒸馏 Rethinking Classifier-Free Guidance in On-Policy Diffusion Distillation | 阿里通义千问 | arXiv:2607.24731 关键词:扩散蒸馏,CFG,在线策略,PDM,视频控制 前序问题:在线策略扩散蒸馏通常直接匹配教师与学生经CFG合成后的速度,但这个总目标无法唯一约束正、负两个分支:两边误差可互相抵消。当教师负分支含学生拿不到的特权信息时,正分支变好反而会伴随负分支恶化。 本文贡献:论文将该失败模式命名为负分支不对称(NBA),并提出分支感知的Positive-Direction Matching(PDM):分别约束正条件预测与CFG条件方向,使监督可识别,不再让合成结果掩盖分支错误。方法用于从稠密到稀疏的视频控制蒸馏。 实验效果:朴素CFG匹配对推理guidance scale高度敏感,PDM在不同引导尺度下实现更稳健、有效的知识迁移,修复教师负分支存在特权条件时的对抗误差动态。 批判点评:它揭示了一个容易被总loss掩盖的蒸馏病灶:CFG结果对了,不代表两个分支学对了。分析价值高于单项榜单。不过当前验证集中在稠密到稀疏视频控制,PDM对文生图少步蒸馏、不同负提示schema的普适性仍需实证。 9. VIPE:先改输入图片再让视频模型推理 Visual Prompt Engineering for Video Models | Google DeepMind | arXiv:2607.25537 关键词:视觉提示工程,视频模型,视觉推理,Google DeepMind,图像编辑 前序问题:视频生成模型正成为视觉推理基础模型,但用户仍主要优化文字提示。对于迷宫、物理轨迹等任务,原始抽象图像可能不符合模型训练分布,仅改文字无法消除视觉输入本身的表达障碍。 本文贡献:提出视觉提示工程VIPE:调用图像编辑模型自动修改任务图像的呈现方式,例如把抽象草图转成写实场景,再交给视频模型推理。它不改目标问题,只优化视觉prompt,使输入更贴近视频模型容易理解和模拟的分布。 实验效果:VIPE在多种任务上提升视频模型视觉推理,效果甚至可超过传统文本提示工程和测试时扩展,且额外计算较低。 批判点评:“不是改问题文字,而是改给模型看的世界”是很有启发的提示工程范式,Google DeepMind视频模型背景也值得关注。但编辑器可能偷偷改变物理条件或答案线索,提升不一定来自更强推理;必须验证语义与几何约束在改图前后严格等价。 10. TriLayer:视频扩散直接生成可编辑RGBA图层 Explicit Layer Modeling for Video Object Insertion and Layer Decomposition | POSTECH | arXiv:2607.25802 关键词:视频编辑,RGBA,图层分解,物体插入,扩散模型 前序问题:多数视频编辑没有显式图层表示,物体插入、复用和后期调整只能隐式推断或逐场景优化。缺少前景RGBA监督,也让阴影、反射等伴随视觉效果难与背景正确合成。 本文贡献:构建TriLayer大规模三元视频数据,逐帧对齐合成画面、背景和含物体外观及视觉效果的前景层。基于此提出双分支DBL-Diffusion,通过共享去噪和跨分支交互联合建模RGB合成与RGBA前景;DBL-Insert生成可后期编辑的插入图层,DBL-Decompose恢复前景与背景。 实验效果:显式图层建模显著提升视频物体插入保真度和图层分解质量,并让生成结果可用于真实合成与灵活后期修改。 批判点评:从最终RGB转向可编辑RGBA资产,是视频生成接入专业后期管线的重要一步。难点在于TriLayer数据如何获得真实透明度和复杂光效监督;半透明、运动模糊、反射及跨层光照很难被单一RGBA层完整表达。 趋势观察 生成模型开始进入端侧十亿参数时代 — Apple在AMX上以21MB峰值内存运行十亿参数激活规模音频生成,达到16倍实时;端侧生成竞争从小模型转向架构与硬件协同。 视觉生成加速分化为稀疏与自回归两条路线 — Sol-Attn用在线稀疏让视频编辑快2.3倍,UniGen-AR以VAR替代扩散让统一视觉任务延迟最多降19倍,计算范式本身成为核心变量。 视频产品同时追求极少步与事件驱动 — AptAvatar把14B数字人压到两步并提速60倍,EgoPlay则只在事件发生后编辑;视频生成正从整段离线采样走向低延迟、条件触发的连续服务。 评测和输出格式开始对接专业生产 — FilmBench用电影学院镜头语言重测模型,TriLayer直接生成RGBA图层;行业关注点从画面像真转向镜头设计、资产复用和后期可编辑性。 统一模型向底层表征与视觉提示延伸 — OmniVAE在VAE阶段对齐音视频,PDM拆解CFG分支监督,VIPE直接优化模型看到的图像;性能提升越来越依赖输入、tokenizer和训练目标的联合设计。 人工智能炼丹君 整理 | 2026-07-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-23|阿里高德5090单卡实时世界模型ABot-World-0 今日 AIGC 论文速览 今日共 10 篇 · 交互式世界模型 2 篇 · 高效图像/视频生成与编辑 3 篇 · 可控与电影级视频生成 2 篇 · 生成新用途与安全 2 篇 · 音乐生成 1 篇 重点论文标题列表 ABot-World-0(阿里·高德AMAP):单卡5090实时交互世界模型 AlayaWorld(Alaya Lab):15B交互式长时程世界模型开源 Mage-Flow(Microsoft):微软4B高效图像生成与编辑 OSVE(高丽大学):首个单步视频编辑快155倍 HeadCast(快手可灵):免训练按注意力头加速AR视频 今日论文速览 1. ABot-World-0:单卡5090实时交互世界模型 ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU | 阿里·高德AMAP | arXiv:2607.19191 关键词:世界模型,实时交互,自回归视频,蒸馏,单卡部署 前序问题:交互式视频世界模型要同时具备交互、持久时空一致、稳定长时程生成与高效响应,且此前多依赖重型算力,难在消费级单卡上实时长时程运行。 本文贡献:提出动作条件视频世界模型 ABot-World-0,配套横跨 AAA 游戏/仿真引擎/互联网视频的多源数据基建(WorldExplorer 训练反馈驱动采集 + 14 项确定性质检 + VLM 评估 + 动作/文本同步标注);训练上把双向动作条件教师经 teacher forcing 与 ODE 蒸馏渐进蒸成因果学生,并提 LongForcing 对齐长自 rollout 与扩展时程教师、抑制分布与自回归漂移;原始键盘动作作统一控制接口,参考角色记忆保第三人称身份一致;部署上协同设计流式推理栈(轻量 VAE 解码、高效注意力、内存感知调度、低比特 DiT)。 实验效果:在优化的低比特配置下,单张 NVIDIA RTX 5090 桌面 GPU 上以最高 16FPS 流式生成 720P 视频,动作到首帧延迟 1.2s、峰值显存约 19GiB;在 WorldRoamBench 与长交互 rollout 上展现有竞争力的可控性与连贯的长时程世界演化。 批判点评:把交互式世界模型压进消费级单卡(5090/16FPS/19GiB)是极硬的工程落地,多源数据基建+LongForcing 抑漂移思路完整、阿里高德背景也贴近实景重建。但 16FPS/720P 距真正丝滑仍有距离、低比特下的画质代价、超长时程一致与物理合理性、以及对开放动作的泛化仍需检验。 2. AlayaWorld:15B交互式长时程世界模型开源 AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report | Alaya Lab | arXiv:2607.18367 关键词:世界模型,交互生成,自回归蒸馏,长时程,开源 前序问题:视频世界模型能即时从文本/图像/视频生成可交互环境,但要落地需同时具备交互、持久时空一致、稳定长时程生成与高效响应四大耦合能力。 本文贡献:提出交互式长时程视频世界模型 AlayaWorld:基于 15B 视频扩散 Transformer,在相机轨迹与可切换文本提示下自回归生成短潜块;有界视觉上下文融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近帧条件;用自 rollout 收集的损坏历史与预测残差训练以降长期漂移;提出离散自回归蒸馏(结合分布匹配蒸馏、self-forcing++、一致性蒸馏)把推理从约 30 步降到每块 4 步。 实验效果:生成 540p/720p、24fps 视频,在 iWorld-Bench 上长时程生成最佳;定位为全栈、开源、长期项目,为交互式视频世界模型研究提供可扩展基座。 批判点评:15B 世界模型+四步蒸馏+全栈开源,对社区推进交互式世界模型很有价值,几何对齐空间记忆+损坏历史训练也对症长程漂移。但 24fps/720p 的实时性、复杂交互下的一致与可控、以及开源基座的训练成本与数据获取门槛,仍是从 demo 到产品要迈的坎。 3. Mage-Flow:微软4B高效图像生成与编辑 Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing | Microsoft | arXiv:2607.19064 关键词:图像生成,图像编辑,原生分辨率,VAE,少步蒸馏 前序问题:大规模视觉生成器越来越强,但训练、微调与部署成本高昂,难以兼顾高分辨率质量与交互级效率。 本文贡献:推出紧凑 4B 生成栈 Mage-Flow:由轻量高保真潜表征分词器 Mage-VAE 与原生分辨率多模态扩散 Transformer(整流流匹配)协同设计。Mage-VAE 用单步扩散式编解码+锚定潜表征正则,在保持强公开 VAE 重建质量的同时把分词成本降一个数量级以上;配合原生分辨率打包与栈级 CUDA 核融合,端到端训练吞吐提升约 2.5 倍。基于此构建 Base/RL 对齐/Turbo 三档、覆盖生成与编辑:Diffusion-NFT 提升指令遵循/文字渲染/美学/编辑保真,配对抗感知引导的少步蒸馏产出 4 步 Turbo。 实验效果:尽管规模紧凑,Mage-Flow 与 Mage-Flow-Edit 在标准生成/编辑基准上具竞争力;Turbo 变体让高分辨率交互实用——单张 A100、1024² 下生成仅 0.59s、编辑仅 1.02s,显存占用小。 批判点评:微软用「分词器-骨干-系统」协同把 4B 小模型的高分辨率生成/编辑做到 0.59s/1.02s,工业化落地感很强、成本友好。但 4B 规模在极致画质/复杂语义/长文本渲染上的天花板、与十亿级大模型的差距,以及 RL 对齐/蒸馏带来的多样性与保真权衡,仍需在更广场景验证。 4. OSVE:首个单步视频编辑快155倍 OSVE: One Step Video Editing with One Step Diffusion Models | 高丽大学 | arXiv:2607.19895 关键词:视频编辑,单步扩散,噪声预测,时序一致,实时 前序问题:扩散模型的文本引导视频编辑因多步采样与反演而慢得不实用。 本文贡献:提出 OSVE,首个成功把单步文生图(T2I)模型适配到高质量视频编辑的框架,攻克反演、可编辑性与时序一致三大难题:训练一个可学习编码器单次前向预测每帧初始噪声以绕开慢速迭代反演,并用结构感知编辑(SAE)损失在结构对齐图对上训练以在编辑中保留源视频几何;提出统一帧编辑(UFE)拼接帧潜表征在单步生成中促成跨帧注意力保时序连贯;对长视频用带锚帧的滑窗保全局一致。 实验效果:编辑质量匹配或超过 SOTA 多步方法,同时快约 155~171 倍,为实用实时视频编辑铺路;代码开源。 批判点评:把单步 T2I 迁到视频编辑、直接预测初始噪声避开反演,155~171 倍提速+结构保持的设计很漂亮,实时编辑价值大。但依赖结构对齐图对训练编码器、单步生成对大幅/复杂编辑的上限、以及长视频滑窗拼接处的一致,仍需更强样例检验。 5. HeadCast:免训练按注意力头加速AR视频 HeadCast: Casting Attention Heads for Efficient Autoregressive Video Generation | 快手可灵 | arXiv:2607.20125 关键词:自回归视频,推理加速,KV缓存,注意力头,免训练 前序问题:自回归(AR)视频扩散是长视频/流式合成的有力范式,但持续增长的 KV cache 让注意力成为主导推理成本(高分辨率下每帧 token 众多);现有缓存淘汰用粗糙启发式致帧间闪烁,或需重训。 本文贡献:提出免训练、即插即用的加速框架 HeadCast:基于「预训练 AR 模型注意力头呈稳定异质行为」的观察,短暖机后在最大噪声步一次性把每个注意力头分为 Sink/Dummy/Spatial/Global 四类,并把单体 KV cache 重构为按头分路径;关键是保留维持长程时序一致的 Global 头。因 Spatial 路径在固定网格上运算,其节省随分辨率增长。 实验效果:在多个 SOTA AR 模型上,720P 加速至多 1.62 倍、1080P 至多 1.95 倍,VBench 质量与全注意力持平且基本无闪烁;代码开源。 批判点评:「按注意力头功能分类+分路径缓存」免训练即插即用、且分辨率越高越省,对长视频/流式生成的推理成本是很实用的解法(可灵背景更贴落地)。但一次性分类的稳健性、四类原型对不同模型的普适、以及在极长序列/更高分辨率下保真与加速的平衡,仍需更多模型验证。 6. ShotPlan:可学习规划token做电影级多镜头 ShotPlan: Cinematic Video Generation with Learnable Planning Token | 中国电信TeleAI·哈工大 | arXiv:2607.17675 关键词:电影级生成,多镜头,规划token,转场,视频扩散 前序问题:现有视频生成在单镜头上效果惊艳,但电影级生成需要连贯叙事与有效多镜头组合、需显式镜头规划,仍受限。 本文贡献:提出 ShotPlan,在视频扩散基座上做显式多镜头电影级生成:引入可学习规划 token 捕捉镜头级转场线索、可与原视频生成 token 无缝融合以控制转场时间戳;规划 token 配分数时间旋转位置编码(FRoPE),使镜头转场可在帧级建模。 实验效果:显著超过现有电影级视频生成方法,提供更灵活的镜头管理与更强的镜头间一致性。 批判点评:用「可学习规划 token+帧级 FRoPE」把多镜头转场显式化,是对电影级叙事生成痛点的对症设计,中国电信 TeleAI 出品。但多镜头的叙事连贯不止转场时机,人物/场景跨镜头一致、复杂运镜与更长叙事的可控性,以及与专业剪辑的差距仍需更多验证。 7. The generator is the tracker:视频生成器即多目标跟踪器 The generator is the tracker: Multi-object tracking by painting persistent identity colours | 康奈尔大学 | arXiv:2607.17120 关键词:多目标跟踪,视频生成,身份一致,重识别,LoRA 前序问题:多目标跟踪(MOT)传统被拆成检测+关联,身份靠轨迹缓存、运动模型、外观嵌入等外部状态维护;能否让视频生成器直接用像素维护这种状态? 本文贡献:微调 22B 文生视频扩散模型(LTX-2.3)配轻量上下文 LoRA,把 RGB 片段翻译成 ID-map 片段——每个人被涂成随时间持久的独特纯色(同色=同身份);长视频以链式窗口生成、每窗以上一窗清理后的尾部为条件,短续训教模型延展给定着色,身份便无需跟踪器/运动模型/重识别模块地沿链流动。 实验效果:DanceTrack 测试榜上达 40.3 HOTA(据称首个上榜且无检测器/无跟踪栈的生成式跟踪器),虽低于专用 SOTA(≥70),但误差画像独特——关联分 AssA 44.1 超原基准全部跟踪器,短板仅在检测;同样生成窗改用经典事后关联得分差一倍(18.2 HOTA);383 个遮挡事件中以 42% 条件率在间隙后重获身份(外观嵌入基线为 0),表明其着色是涌现的重识别信号。 批判点评:「让生成器用像素维护身份」把 MOT 重构为着色生成,关联能力与遮挡重识别的涌现很惊艳、思路极具启发。但 40.3 HOTA 距实用尚远(检测是硬短板)、依赖 22B 大模型链式生成成本高、极密集/快速场景下的可扩展性仍是问题,更像范式验证而非即用方案。 8. Keyframe-Anchored:序列动作视频的身份保持 Keyframe-Anchored Identity Preservation for Sequential-Action Video Generation | 中科大 | arXiv:2607.17985 关键词:身份保持,文生视频,关键帧,序列动作,免训练 前序问题:保身份的文生视频要在整段视频中维持指定主体可识别性;IPVG26 挑战把它从单一整体提示扩展到带时间戳的动作序列——主体须按序完成一串不同动作且身份一致,而端到端生成器随运动累积易外观漂移。 本文贡献:提出免训练三阶段流水线:动作感知提示润色阶段先把输入改写为指定每个动作终态的图像生成提示;保身份生成阶段以参考身份与前一帧联合条件产出关键帧序列,从而解耦时不变外观与时变姿态;身份感知推理增强阶段用多参考引导与身份驱动噪声搜索合成中间片段,双重强化采样期身份保真。 实验效果:在 IPVG26 官方 Track 2 榜排名第三,展现有竞争力的性能与较强通用性。 批判点评:用「关键帧锚定+解耦外观与姿态」免训练做序列动作身份保持,工程组合清晰、竞赛第三也证明有效。但依赖关键帧质量与多阶段拼接,中间片段合成的动作流畅、长序列多动作下的累积漂移,以及免训练相对专门训练方法的天花板仍待观察。 9. BSB:时序一致性越狱商用T2V Between Safe Boundaries: Exploiting Temporal Consistency for Jailbreaking Text-To-Video Generation Models | 中科大 | arXiv:2607.17279 关键词:文生视频,越狱攻击,时序一致性,MCTS,AI安全 前序问题:文生视频(T2V)模型广泛部署,其对越狱攻击的鲁棒性引发担忧;现有方法多从文生图迁移,未利用视频固有的时序一致性、需大量视频查询优化(黑盒不可行)、且对抗提示搜索靠启发式局部信号缺结构化探索。 本文贡献:提出结构化、查询高效的 T2V 越狱框架 BSB:利用时序一致性,把有害意图编码为两个各自无害的「边界状态」之间的转变,攻击那些插值时易在中间帧产生不安全内容的边界状态对;为避免在视频空间直接评估所有候选的高昂开销,BSB 在更廉价的文本代理空间做蒙特卡洛树搜索(MCTS),并用稀疏视频级评估定期校准。 实验效果:在 Veo 3.1、Sora 2、Seedance、Kling v1 等主流商用 T2V 上,BSB 超越所有现有越狱基线,攻击成功率较最强对手平均相对提升 18.6%;揭示时序一致性是被忽视却关键的攻击面。 批判点评:把「时序一致性」从能力变成攻击面、用文本代理空间 MCTS 做查询高效黑盒越狱,视角新颖且对主流商用模型有效,安全警示意义大。但作为攻击方法需警惕滥用、防御侧的对应缓解未深入,攻击在持续迭代的商用安全策略下的长期有效性也存疑。 10. Full-Song:分层自回归+流匹配全曲生成 Pushing the Frontier of Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering | 阿里(Token Foundry) | arXiv:2607.20253 关键词:歌曲生成,自回归,流匹配,RVQ,翻唱 前序问题:从歌词、文本描述与音乐属性生成高质量全长歌曲仍具挑战,且需统一支持词到歌、纯器乐、翻唱等多任务。 本文贡献:提出统一歌曲生成框架,支持歌词到歌、器乐生成、翻唱三任务:语义感知分词器把音频编码为 8 码本 RVQ token;hybird-LM 在其上做分层自回归音频 token 建模生成全曲;FullDiT 在连续 VAE 潜空间以码本 token/歌词/文本为条件做全曲流匹配以提升保真;翻唱用旋律模块从参考音频抽取并离散化旋律线索、在保留原旋律的同时引导生成;并探索 DPO/GRPO/OPD 做 hybird-LM 后训练、对 FullDiT 用基于流的 GRPO 提升音乐性与渲染质量。 实验效果:在多语种自动基准与 Artificial Analysis 带人声音乐榜上,框架在所评设置下取得有竞争力的表现。 批判点评:「分层自回归规划+流匹配渲染」的双阶段设计兼顾结构与音质、还统一了词到歌/器乐/翻唱三任务(阿里出品),工程完整。但全曲生成对长程结构、人声吐字与音乐性要求极高,多任务统一下各子任务的上限、翻唱的版权与旋律保真边界,以及主观音乐性的稳定性仍需更多盲测检验。 趋势观察 世界模型冲进消费级实时 — ABot-World-0 单张 RTX5090 跑 720P/16FPS 实时交互世界、AlayaWorld 15B 开源长时程世界模型,交互式世界模型正从云端走向桌面单卡。 高效小模型吃下生成与编辑 — 微软 Mage-Flow 用 4B 栈把 1024² 生成压到 0.59s、编辑 1.02s,'紧凑协同设计'让高分辨率生成编辑走向交互实用。 少步/免训练把视频推向实时 — OSVE 首次让单步 T2I 做视频编辑快 155~171 倍、HeadCast 免训练按注意力头分类加速 AR 视频,效率优化在编辑与长视频两端并进。 视频生成能力外溢到感知与叙事 — '生成器即跟踪器'用视频生成做多目标跟踪、ShotPlan 用规划 token 做多镜头电影级叙事,生成模型的能力正外溢到跟踪、导演等新任务。 生成的可信与安全被正面拷问 — BSB 用时序一致性越狱主流商用 T2V(攻击成功率相对+18.6%),揭示视频生成安全的新攻击面,安全治理需跟上能力跃迁。 人工智能炼丹君 整理 | 2026-07-23 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注