搜索到
12
篇与
文生图
的结果
-
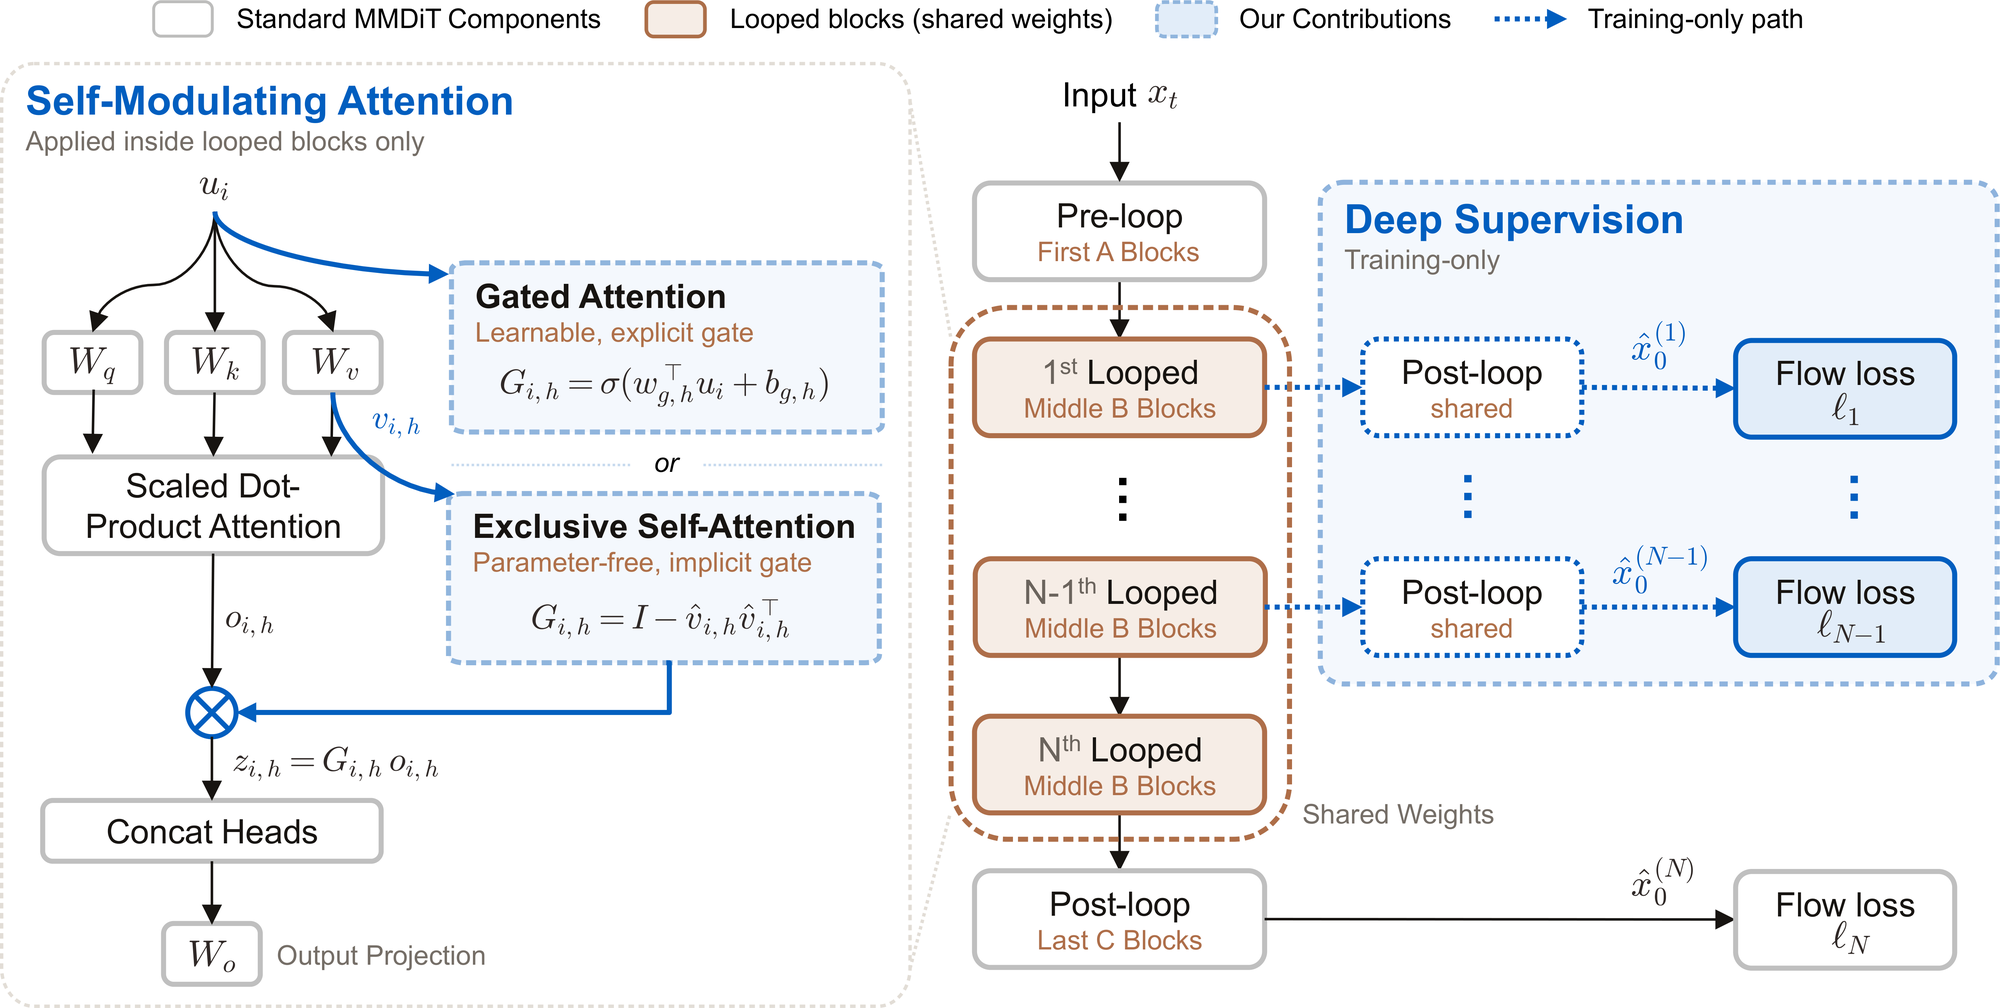
 AIGC 每日速读|2026-10-04|商汤小模型绕圈反超6.5倍大模型,Looped-DiT 今日 AIGC 论文速览 今日共 10 篇 · 高效文生图架构 3 篇 · 统一多模态 1 篇 · 长视频与音视频生成 2 篇 · 生成推理加速 2 篇 · 视频强化学习与图像评测 2 篇 重点论文标题列表 Looped-DiT(商汤):260M循环4圈赢6.5倍大模型 Multimodal Flow(华科):图文全连续流建模,仅用150B词元 NEPA-DiT(密歇根大学):预测嵌入当条件,FID 1.32 MosaiChunk(康奈尔大学):只训13.6M路由,长视频回访不失忆 Soundwich(西蒙弗雷泽大学):冻结LTX-2.5免训练拆分音轨 今日论文速览 1. Looped-DiT:260M循环4圈赢6.5倍大模型 Looped Diffusion Transformer | 商汤科技;清华大学;南洋理工大学 | arXiv:2609.40305 关键词:文生图, 循环计算, 参数共享, 深度监督, 潜在推理 前序问题:文生图模型提质通常只有两条路:加参数或加去噪步数。语言模型里已验证的「循环复用同一组层」能在不增参数的前提下加深计算,但直接搬进 MMDiT 并不稳定:推理圈数超过训练值后性能先涨后跌,中间表示里可线性解码的空间位置信息逐圈流失。 本文贡献:Looped-DiT 把网络切成前段 6 块、循环段 5 块、后段 6 块,每个去噪步内让循环段共享权重重复 N 次(训练取 4 圈)。两项稳定手段:深度监督,每圈输出都经共享后段解码并计入 flow loss;自调制注意力,用门控或无参的 Exclusive Self-Attention 抑制注意力对局部信息的过度改写。 实验效果:260M 的 B/16 在 GenEval、DPG、PRISM、CoRe、Spatial、TIIF 六项均值 71.5,六项全部高于 1.7B 的 InternVL-U(均值 69.0),也高于 6.6B 的 Uni-CoT(66.8),单图推理算力约为 InternVL-U 的 1/4.9。参数对齐对照里,B/32 均值从 55.2 提到 59.1;同等推理预算下,加圈比加去噪步更划算。 批判点评:「参数不变」不等于「算力不变」:循环版每步推理 267 GFLOPs,是同参数基线的 1.83 倍,训练 1246 GFLOPs 更是 2.83 倍。按推理算力对齐时,加宽版 MiniT2I 已到 58.6,与 Looped-DiT 的 59.1 只差 0.5。分项看,循环擅长约束求解,需要常识推断的 CoRe/Generalization 只 +7.5,远不如文本 CoT 的 +22.2。 2. Multimodal Flow:图文全连续流建模,仅用150B词元 Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces | 华中科技大学;北京交通大学;地平线 | arXiv:2609.40362 关键词:统一多模态, 连续流匹配, 文生图, 视觉理解, 多模态预训练 前序问题:统一理解生成模型多走两条路:文本和图像都离散化,图像要过量化瓶颈;或文本离散、图像连续,两种目标与采样流程各写一套。全连续建模能让两种模态共用一个生成过程,但在多模态预训练规模上很少被系统验证。 本文贡献:MF-1 用冻结的 T5-small 与 SigLIP2 把文本块(每 8 个词元一块)和图像编码成连续表示,按顺序组织成 hyperchunk,交给一个 chunk-causal 的 flow 主干学习单一速度场;注意力投影共享、FFN 按模态分开。训练时并行预测多个目标块,推理时逐块生成,再由预训练图像解码器与单独训练的文本解码器还原。 实验效果:1.6B 版本只用 150B 预训练词元,GenEval 0.82、DPG 83.44,理解侧 POPE 86.1、MMBench 67.2。数据、优化与参数完全对齐时,全连续版 GenEval 0.713、MMBench 46.7,高于 Transfusion 式混合(0.669 / 33.7)与 Chameleon 式全离散(0.374 / 38.4)。 批判点评:生成强、理解弱:MMBench 67.2 落后同量级的 Janus-Pro(75.5)与 JanusFlow(74.9),VQAv2 72.6 也低于 JanusFlow 的 79.8(对方有预训练 LLM 初始化);DPG 83.44 还没追上纯生成的 SD3 Medium(84.08)。scaling 曲线上 1.6B 预训练阶段 GenEval 只到约 0.32,表中 0.82 是再经 5B 词元微调后的结果;「全连续」也依赖冻结编码器与外部解码器,图像输入仅 224 分辨率。 3. NEPA-DiT:预测嵌入当条件,FID 1.32 Embedding Prediction Helps Image Generation | 密歇根大学;卡内基梅隆大学 | arXiv:2610.02203 关键词:类别条件生成, 嵌入预测, 扩散 Transformer, 表征对齐, ImageNet 前序问题:DiT 里类别或文本只嵌入一次,每个去噪步复用同一个条件,「这个条件对眼前这张噪声图意味着什么」全留给生成器自己推断。NEPA(下一嵌入预测自回归)已能在连续嵌入上做自回归预测,作者想知道:能否用预测出的干净图嵌入替代固定条件。 本文贡献:把生成写成「条件 → 噪声图 → 干净图」的嵌入序列,干净图的 patch 嵌入正是条件与噪声图之后的「下一组嵌入」。作者训练 NEPA 模型用多嵌入预测(MEP)一次性预测全部干净嵌入;生成时 DiT 以这些预测为条件,并在每个去噪步按当前噪声状态重新计算,条件随采样进程自适应。 实验效果:ImageNet 256×256 上,NEPA-DiT-XL 结合 REPA,SDE-250 采样 FID 1.32、IS 311.0,ODE-96 采样 FID 1.57;训练为 NEPA 240 + 生成器 80 epoch,约为 REPA(800 epoch)训练算力的三分之一。九组规模交叉实验中,生成器或 NEPA 模型变大,FID 都单调下降。 批判点评:训练省了,推理贵了:多挂一个 711M 的 NEPA 网络,总参数约 1.39B,是 SiT-XL/2+REPA(675M)的两倍;同为 SDE-250,单图 160 TFLOPs,比对方的 91 TFLOPs 多 76%。换成更省的 ODE-96,FID 1.57 反而不如 REPA 原版的 1.42。若放开 tokenizer,表中 SFD、RAEv2 已做到 1.06。 4. MosaiChunk:只训13.6M路由,长视频回访不失忆 MosaiChunk: Compositing Spatio-Temporal Memory for Autoregressive Video Generation | 康奈尔大学;加州大学伯克利分校;哈佛大学;Impossible Inc. | arXiv:2610.02153 关键词:自回归视频生成, 长时记忆, KV 缓存, 记忆路由, 场景回访 前序问题:自回归长视频受限于上下文窗口:物体或场景移出窗口后细节丢失,镜头转回来时往往「重新编」一个。整块检索历史 chunk 能补记忆,但固定显存预算下塞不了几块;滑动窗口则干脆遗忘。 本文贡献:作者先验证冻结的视频生成器能直接消费非连续拼接的历史 KV 并还原对应内容。MosaiChunk 据此把每个历史 chunk 聚成若干 section 并编码描述子,由轻量路由器全局挑出 top-N,在固定活跃显存预算内拼成一块跨时空的 KV 马赛克;生成器全程冻结,只自蒸馏训练路由器。同时发布 RememBench 回访基准,含 T2V 与 I2V 两个子集。 实验效果:在 MiniMax-H3 改造的自回归版 H3-AR(T2V)上,两块远程记忆预算下回访 CLIP 从滑窗基线 0.751 升到 0.936,LPIPS 从 0.652 降到 0.500,优于整块检索 MoC(0.841);LingBot-World-Infinity(I2V)180° 旋转回访 CLIP 0.793→0.863。路由器只有 13.65M 参数。 批判点评:自建基准涨幅大,公开基准涨幅小:WBench 的 Subject 一致性仅 88.10→88.38,两块预算下 Segment 一致性反从 97.47 掉到 94.94;T2V 的 Drift 也略升(0.050→0.055)。论文还写明评测用的是早期 checkpoint:T2V 计划训 4000 步、实取第 416 步,I2V 计划 4768 步、实取第 500 步,未解释为何不用训完的权重。 5. Soundwich:冻结LTX-2.5免训练拆分音轨 Soundwich: Video Generation with Layered and Controllable Audio | 西蒙弗雷泽大学;塞浦路斯大学;CYENS 卓越中心;特拉维夫大学 | arXiv:2610.00691 关键词:音视频联合生成, 音轨分离, 免训练, 时间控制, 可编辑音频 前序问题:联合音视频模型已能生成带同步声音的视频,但音频是一条混好的总轨:谁在何时说话、配乐和环境声都没法单独改。实际制作中,对白、音乐、音效、环境声都是分轨编辑的。 本文贡献:Soundwich 不做训练,直接改造冻结的 LTX-2.5:先把音频轨迹扩成 N 条可编辑分轨加一条内部场景轨,用缓存的「出声 / 静音」特征(timing carrier)在指定时间窗内回放或压制;再用 gather–broadcast 注意力让各分轨共享全局声学语境,并用实体掩码把每条分轨的跨模态注意力路由到画面中对应的发声者。 实验效果:15 个多声源场景上,时间窗成功率 93.1%、窗外误发声 1.7%、声源归属 90.0%,窗内 WER 0.060;同场景原版 LTX-2.5 窗成功率仅 20.4%,MiniMax H3 为 27.0%,Gemini Omni 为 85.0%。去掉 timing carrier,窗成功率从 93.3% 跌到 15.6%。 批判点评:评测规模很小:主表只有 15 个场景、每场景 3 个固定种子,场景广播模块的人评只收回 15 份问卷。真正接近的对手是闭源 Gemini Omni,WER 0.072 对 0.060、窗成功率 85.0% 对 93.1%,且它只有 14 个场景可计 WER。声源归属 90.0% 比朴素批量扩展的 82.2% 只高 7.8 个点。 6. DMAD:判别器替掉辅助分数网络,4步出片 DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation | 得州农工大学;字节跳动智能创作 | arXiv:2610.02188 关键词:少步蒸馏, 分布匹配, 对抗蒸馏, 视频生成, 音视频生成 前序问题:DMD 系列少步蒸馏要从「目标分数 − 学生分数」的差里取梯度,因此必须额外维护一个持续拟合学生分布的辅助扩散模型,显存与算力开销都大,在 14B、33B 级视频模型上尤其吃紧。 本文贡献:DMAD 把分布匹配改写成分类:共享主干上挂两个判别头,分别区分「真实数据 vs 学生」与「教师样本 vs 学生」,用 logit 直接学习对数密度比,学生只用作用在 logit 上的线性损失训练,无需拟合辅助分数。作者证明判别器最优时该损失恰好还原 DMD 的梯度,并用真实头在真实与教师样本间的 logit 差,自适应调节各噪声级上教师监督的权重。 实验效果:ImageNet-64 一步 FID 1.04(加投影判别器),SDXL 四步 COCO-10K FID 14.47,Wan2.1-14B 四步 VBench 85.15,均优于所比少步方法与多步教师。在 MiniMax-H3-33B 联合音视频生成上,四步学生人评总体偏好 79.1% 胜 DMD2、84.6% 胜 rCM;每次生成器更新耗时从 818.1s 降到 233.3s。 批判点评:人评高分主要来自画质与音质(对 DMD2 胜率 84.2% / 87.9%),提示词对齐只有 54.3% 对 45.7%,接近打平。AVGen-Bench 上音画同步 AV 分 49.1,低于 DMD2 的 56.7;唇形同步 30.6,离教师的 39.0 也远。SDXL 一步时 Patch FID 32.42,反而比 DMD2 的 26.98 差,细节保真不如整体 FID 好看。 7. FlashForward:复用在途KV,4卡流水线生成长视频 In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion | Meta;南洋理工大学 | arXiv:2609.32540 关键词:自回归视频扩散, KV 缓存, 流水线并行, 长视频生成, 推理加速 前序问题:少步自回归视频扩散按 chunk 逐段生成。为记住已生成内容,Self-Forcing、HiAR 等方法要额外跑「只更新缓存、不推进输出」的前向来重建干净或低噪 KV。可每次去噪前向本来就算出了当前 chunk 的 KV,这部分被白白浪费。 本文贡献:FlashForward 直接复用每个去噪阶段算出的「在途」KV:当前 chunk 完成一个阶段后,该阶段的缓存即可供下一个 chunk 使用,于是每张 GPU 负责一个去噪阶段,不同 chunk 在卡间流水并行。为弥补噪声历史带来的外观与运动漂移,再由 planner 预先生成稀疏的干净锚点 latent,从前后两侧约束 renderer 的轨迹。 实验效果:4 卡下,16 FPS、20 秒以上视频比 HiAR 快 1.16–1.69 倍、比 Self-Forcing 快 1.42–2.92 倍(1.3B 与 14B,480p / 720p)。1.3B 480p 生成 65 秒视频去噪耗时 21.3s(HiAR 24.7s、Self-Forcing 65.1s);VBench 总分 0.838,65 秒 VBench-Long 0.8395,高于 Self-Forcing 的 0.7806。 批判点评:提速依赖多卡流水:单卡 480p 下它比 Self-Forcing 还慢(20 秒视频 17.77s 对 17.44s,65 秒 59.64s 对 57.89s)。生成 5 秒短片时 4 卡耗时 2.21s,慢于 HiAR 的 2.06s,更慢于双向模型的 1.13s。14B 720p 峰值显存 112.8 GiB/卡,比 Self-Forcing 多约 20 GiB;20 秒视频语义分 0.748 也略低于 HiAR 的 0.757。 8. TVRL:用VLM梯度给视频token分功劳 Token-Level Video Reinforcement Learning | 美国东北大学 | arXiv:2610.01973 关键词:视频生成, 强化学习, GRPO, 信用分配, VLM 奖励 前序问题:视频生成的 RL 后训练通常给整段视频一个标量奖励。可视频的缺陷是局部的:有的 token 已满足提示词,有的才需要修。标量奖励定位不了错误,优化时既会扰动本来正确的区域,又对真正出错的区域用力不足。 本文贡献:TVRL 让奖励自己给出 token 级功劳:冻结 VLM 对提示词拆出的若干是非题给出答案似然,平均后作为视频级奖励;同一 VLM 对视频输入的梯度幅值,则标出哪些生成 token 最影响该得分。在 GRPO 中,组相对优势决定更新方向与强度,经 3×3 平滑、按问题条件化的 credit 图在裁剪策略比内重加权各去噪步的转移对数概率。 实验效果:以 HunyuanVideo-1.5 为底座、Qwen3.5-9B 作奖励,VBench-2.0 Overall 从 54.09 升到 57.69(+3.60),同设置 GRPO 仅 54.54。换 SAGE、Flow、Dance 三种 SDE 采样器,比匹配 GRPO 高 2.68–3.15;换 VideoAlign 等四种奖励模型,高 1.33–3.15。 批判点评:增益并不均匀:常识维度上 TVRL 常不如 GRPO(Qwen3.5-9B 奖励下 64.31 对 64.88,VideoScore2 下 64.60 对 64.89),VideoScore2 下 Human 维度也从 91.52 降到 90.79。评论家规模很关键:换成 Qwen3.5-0.8B 时 Overall 仅 51.85,比未训练的底座 54.09 还低。所有结果都只训 100 步(64 张 A100),单步耗时比 GRPO 多 18%。 9. PixelDense:4个冻结老师分两路对齐像素扩散 PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion | 弗吉尼亚大学;密歇根州立大学;Adobe;Arcade AI | arXiv:2610.00483 关键词:像素扩散, 表征对齐, 稠密预测, 文生图, 几何先验 前序问题:REPA 通过对齐预训练编码器特征来加速 DiT 训练,但对齐目标几乎都是 DINOv2、CLIP 这类语义编码器。已有分析指出起作用的是空间结构而非全局语义,那么专门预测结构的稠密预测模型(分割、深度)为何没人拿来当对齐老师? 本文贡献:在像素空间扩散上,作者先验证 SAM2、Depth Anything v2、Metric3D v2 单独加入都优于只用 DINOv2,但四个老师直接相加反而不如最好的单个几何老师,语义与几何梯度在同一投影上互相争抢。PixelDense 因此让 DINOv2+SAM2 走语义投影流、两个深度模型走几何投影流,再加权重空间正交惩罚让两流处在不相交子空间;老师全部冻结、推理时丢弃。 实验效果:在 PixelGen-XXL(512×512)上,GenEval Overall 0.7927→0.8093,DPG 78.7→78.9,HPS 0.280→0.282;同一配方不调参迁移到 DeCo,GenEval 0.8620→0.8690。部分加噪重建中,τ=0.5 时 COCO 全景 PQ 23.23→31.43;PIE-Bench 上 SDEdit 背景 PSNR 最多高 2.2 dB。论文已接收 NeurIPS 2026。 批判点评:几何探针涨得多,生成指标涨得少:GenEval 只 +0.017、DPG +0.2、HPS +0.002,DeCo 上 +0.007,计数项 58.75 仍低于 PixelGen 原版的 59。消融里单独的几何流(DA2+M3D)只有 0.7960,还不如 DINOv2+DA2 单老师的 0.8069。主实验只是在已发布权重上用 2 张 H200 微调 1 万步,从头训练仅给出「1.23 倍更快达到基线峰值」一项。 10. VIEScore2:16×16网格同时打分并圈出缺陷 VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations | 滑铁卢大学;NVIDIA;台湾大学(中国台湾);南洋理工大学 | arXiv:2610.00994 关键词:图像评测, 缺陷定位, 生成与编辑, GRPO, VLM 评估器 前序问题:现有合成图评估器大多只给一个标量分数,不说明依据在图上哪里;能定位缺陷的模型又通常不打分、也不支持编辑任务的条件图输入。生成与编辑的评测和奖励信号,缺一个「既能打分也能指位置」的统一接口。 本文贡献:VIEScore2 把图像表示为 N×N(默认 16×16)文本网格,单次前向同时输出感知质量、语义一致性分数与缺陷格子位置,支持可选条件图,覆盖文生图、编辑、参考图生成等任务。它基于 Qwen3-VL-8B 在 38K 条混合监督上先 SFT,再以 Dice 重叠、分数准确度与格式奖励做 GRPO,最后用无参数解析器把网格结果转成可读解释。 实验效果:主测试集整体分数 SRCC 0.601,高于同输入下最强的零样本通用 VLM Gemini-3-Flash(0.491)与 GPT-5.6-sol(0.437);联合评测网格 IoU 0.324,Qwen3-VL-8B 原版仅 0.070。缺陷定位在 6 个基准中 3 个第一、5 个进前三。 批判点评:整体领先主要来自训练同源数据:RichHF(0.692)与 EvalMuse(0.803)拉高均值,编辑类子集反被零样本 API 压过,TIE 0.429 对 Gemini-3-Flash 的 0.686,MRIE 0.417 对 GPT-5.6-sol 的 0.684。定位上,轻量的 SegFormer-b0 在主测试集 F1 拿到 0.493,与它的 0.506 相差无几;GRPO 之后 PQ 的 SRCC 还从 0.580 降到 0.558。 趋势观察 「加算力不加参数」成了今天的共同母题 Looped-DiT 让同一组块在每个去噪步里绕 4 圈,NEPA-DiT 每步重算一次预测嵌入当条件,两者都用额外推理算力换质量而不是加参数;但细看算力表,前者每步 1.83 倍 GFLOPs,后者单图多 76% TFLOPs,「小模型赢大模型」的账要连推理成本一起算。另一头,DMAD 与 FlashForward 继续在蒸馏和 KV 复用上压缩视频生成的步数与等待时间,TVRL 与 VIEScore2 则把奖励和评测从一个标量推进到 token 与网格级定位。 人工智能炼丹君 整理 | 2026-10-04 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
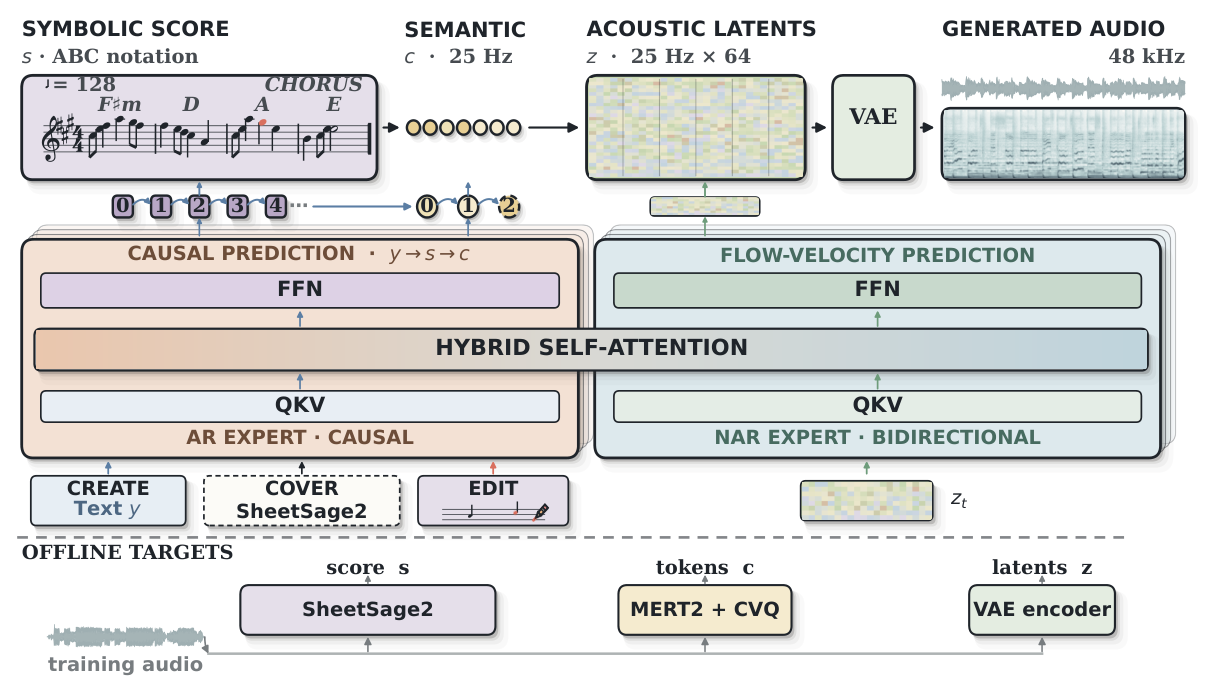
AIGC 每日速读|2026-09-30|港科大先写谱再唱,YuE2 逼近 Suno 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与推理加速 4 篇 · 蒸馏与一步生成 3 篇 · 统一模型与自我反思 1 篇 · 音乐与音频生成 1 篇 · 数据集与评测 1 篇 重点论文标题列表 YuE2(港科大):先写谱再唱出来,49.3%胜 WorldAttention(阿里巴巴达摩院):单卡22帧,内核快14倍 PDMD(加州大学圣迭戈分校):一行代码,VBench 涨 1.03 GeoShrink(香港科技大学(广州)):两行代码换五倍,PSNR+3.10 MGFlow(清华大学):一步打赢四步,FDr 1.45 今日论文速览 1. YuE2:先写谱再唱出来,49.3%胜 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality | 香港科技大学;M-A-P;HKGAI;Tokenwave.AI;纽约大学;斯坦福大学;MBZUAI;Noiz;ACE Studio | arXiv:2609.33757 关键词:音乐生成, 符号音乐, 音频生成, 可控创作, 多模态 前序问题:符号音乐模型把旋律、和声、节奏、曲式写得很清楚,但通常停在「谱」这一步,出不了成品录音;音频模型能吐出完整歌曲,作曲过程却完全隐式,用户没法改。真正可用的创作工具要的是「先看懂谱、再决定怎么唱」。更麻烦的是训练数据:现成录音没有对齐的乐谱,符号监督和语义监督双双缺失。 本文贡献:用一个 AR-NAR 混合的 Mixture-of-Transformers 把两件事接成一条链:先写出可读的乐谱(指定旋律与和声),展开成 25 Hz 语义音乐 token,最后落成 25 Hz 连续声学 latent,由 48 kHz 立体声 VAE 解码成整首歌。为从「没有对齐乐谱的录音」里学会这套流程,配套提出 MERT2 提供语义监督、SheetSage2 提供符号监督。由于中间产物是人类可读的乐谱,同一 checkpoint 能跟着谱面编辑改动并保住未改动部分,还能零样本翻唱,外部大模型也可把反馈译成谱面修订,实现 agentic 改曲。 Composing in symbols, performing in audio. 实验效果:同一 checkpoint 下,专家对「带符号规划」的整体偏好为 49.3%,不规划只有 34.6%。WildSongBench 上 SongBench Global Avg 得 6.73,超过所有受评公开基线;best-of-8 取 6.96,是全部受评系统中的最高均值。专家听测中 best-of-8 优于 Suno v4.5,对 v5 接近持平。MERT2 在 MARBLE 的 15 项指标中 14 项刷新最佳;SheetSage2 在 lead-sheet 转录对比的 15 组指标对中 12 组领先。 Expert preferences for YuE2 versus six proprietary song generators across all six criteria. 批判点评:49.3% 对 34.6% 看着是压倒性优势,其实只是同一套系统的两种采样策略互相比,净增益不到 15 个百分点。真正硬的对标是 Suno v6:论文自己给的专家偏好里对 v6 的 overall 胜率只有 31.6%、败率 59.3%,是明显劣势——「frontier quality」只在 v4.5 / v5 这一档站得住。另外 best-of-8 的 6.96 需要 8 倍采样成本,56 页技术报告也没有同行评审背书。 2. WorldAttention:单卡22帧,内核快14倍 WorldAttention: An Efficient Attention Architecture for Interactive Video World Models | 阿里巴巴达摩院;浙江大学;香港科技大学;湖畔实验室;阿里巴巴 TRE | arXiv:2609.34606 关键词:视频世界模型, 稀疏注意力, KV 缓存, 推理加速, 长视频生成 前序问题:交互式视频世界模型要按文本指令持续生成长时间、时间连贯的视频。滑动窗口能把计算量封住,代价是历史上下文被直接砍掉,长程交互能力塌掉;而保留全历史 KV 缓存在计算和显存上都不可行——注意力的二次复杂度让开销爆掉,KV 缓存的线性增长迟早把显存吃满。两条路都不通,问题落在「既要长历史,又要低延迟」上。 本文贡献:提出系统级协同设计的注意力架构,两手一起改:一是 Hybrid Sparse Attention(HSA),把线性全局注意力和头自适应稀疏注意力并在双分支里,按注意力头动态决定稀疏度;二是 Hierarchical KV Cache(HKV),把历史 KV 组织成跨多层存储的语义索引页,先做 prompt 级检索再做 page 级检索,粗到细地把需要的页取回并控制 GPU 驻留量。两项设计都配了定制 kernel,把理论上的效率真正落到硬件上。 Overall architecture of WorldAttention. 实验效果:定制 kernel 相对 FlashAttention-3 带来 14.02 倍 kernel 级加速,叠加 HKV 后端到端加速 2.21 倍;单张 NVIDIA H100 上维持 22.0 FPS。VBench-Long 上质量得分 86.55 且吞吐最快,主体一致性 0.9472;InterVBench 上主体一致性 0.9668。B200 上跨模型规模与分辨率的端到端加速为 2.06 到 2.46 倍。 Attention kernel speedup. 批判点评:14.02 倍是 attention kernel 这一层的数字,端到端只剩 2.21 倍,落差本身就是论文的自我交代:HSA 单次执行 633 微秒里,稀疏 block 注意力 kernel 只占 11.78 微秒(1.86%),大头是 KV 连续拷贝(31.00%)和线性分支(39.78%)。也就是说 kernel 做得再快,杠杆也被内存搬运和线性分支吃掉。另外质量侧的「超越此前 SOTA」只给了主体一致性等少数几项,没有给出相对最强基线的完整指标表。 3. PDMD:一行代码,VBench 涨 1.03 PDMD: Projected Distribution Matching Distillation for Video Diffusion Models | 加州大学圣迭戈分校;字节跳动 | arXiv:2609.35768 关键词:视频生成, 扩散蒸馏, 分布匹配, 少步生成, 批评者误差 前序问题:视频扩散模型动辄要几十次去噪评估,DMD 能把 NFE 压到个位数,但蒸馏出来的样本会在训练过程中逐步退化:画面越来越过饱和、纹理出现不自然的伪影。作者把根因定位到 critic 误差——它混进学生更新之后会随训练步数累积,而 DMD 本身没有任何机制把这个误差拦下来。 本文贡献:提出 PDMD:把 DMD 更新中「与学生-critic 端点残差平行」的那个分量投影掉。作者证明,在固定噪声查询点上,这个残差正是 critic 端点误差的无偏估计;在高维假设下,投影能移除恒定比例的 critic 误差,同时只丢掉可忽略比例的 ideal DMD 信号。整个改动对 DMD 只动一行代码,不引入额外损失、额外网络、额外数据、额外模型前向,也不需要多阶段训练。 2D comparison of projection directions (20-point moving average). 实验效果:Wan2.1 上 4 NFE 取得 VBench 总分 83.73,比对齐设置的 DMD 高 1.03 分。MiniMax-H3 音视频联合生成上,VideoGen-Eval 视觉总分 83.17,比最强蒸馏基线高 0.41 分,且在受评的 4-NFE 模型中 6 项音频指标全部拿到最好成绩。定性对比与用户研究在视觉质量、运动、音频质量上都偏向 PDMD。 Quality, semantic, and total scores on the 387 VideoGen-Eval prompts. 批判点评:1.03 和 0.41 都是小数点后两位的量级提升,放在 VBench 总分 80 多的量级上更像「修退化」而不是「提上限」——它的价值本来就在于 DMD 已经开始崩的那段区间,基线越健康收益越小。MiniMax-H3 的 0.41 分是相对「最强蒸馏基线」而非 teacher,论文没给与未蒸馏模型的差距。另外投影只保证移除「恒定比例」误差,这个结论建立在高维假设之上,实际有限维下的常数有多大并未量化。 4. GeoShrink:两行代码换五倍,PSNR+3.10 GeoShrink: Accelerating Diffusion Transformers with Two Lines of Code | 香港科技大学(广州);格里菲斯大学;CSIRO Data61;JITRI 深度感知研究所 | arXiv:2609.33723 关键词:推理加速, 扩散Transformer, 免训练, 采样求解器, 特征预测 前序问题:扩散 Transformer 的推理成本几乎全部来自沿采样轨迹反复调用模型。已有的免训练加速多走特征缓存路线,在不同去噪步之间复用或预测中间表示;但这类方法动的是模型内部结构,接入成本高,而且缓存什么、什么时候更新都要重新调。能不能完全不碰模型,只在求解器接口上做文章。 本文贡献:提出 GeoShrink:保留原始求解器网格,只在预先规定的一组锚点上真正调用模型。被跳过的阶段,它把「最近一次观测到的增量」按几何保留比例加回最近的精确输出,作为求解器要的那个场。这个规则从弦切线传输和往返线投影推出来,并给出一条几何锚间距原则:在固定覆盖率和首段跨度下,让相邻最大间隔的扩张最小。误差分析刻画了预测误差的几何闭合与传播,全程不假设能拿到未来模型输出。改动只需两行代码。 Overview of GeoShrink. 实验效果:在约 5 倍加速下,FLUX 的 PSNR 比所列最强基线高 3.10 dB。HunyuanVideo 上报告 4.99 倍加速,ChronoMagic-Bench-150 的 PSNR 比最强保真基线高 5.44 dB。在固定评估预算下对比,运动、音频、音乐、3D 生成上也都有明显增益,实验覆盖图像、视频、动作、音频以及适配后的 3D 后端。 Speed-quality trade-off: GeoShrink yields a better Pareto frontier on SD3.5 Medium. 批判点评:全文主打指标是 PSNR,这是保真度指标而不是感知质量指标——5.44 dB 的 PSNR 增益可以对应肉眼几乎无差别的画面,也可以对应明显更糊的结果,论文没有补 FID 或人类偏好。另外「比所列最强基线高」里的基线集合是作者自选的,到底是跟哪些缓存类方法比、有没有包含最新的同类工作,从摘要看不出来。锚间距原则也只在给定覆盖率和首段跨度这组约束下最优。 5. MGFlow:一步打赢四步,FDr 1.45 Unifying Distributional Training for One-Step Visual Generation | 清华大学;复旦大学;西安交通大学;北京大学;浙江大学;DeepSeek;字节跳动 Seed;加州大学伯克利分校;智源研究院 | arXiv:2609.35763 关键词:一步生成, 分布匹配, 高斯混合, Wasserstein梯度流, 文生图 前序问题:一步生成器的分布训练有很多条彼此看起来不相干的路线:FD-Loss 用高斯矩匹配,Drifting 用核密度做 KL 匹配,各自都能work,但没人说清楚它们之间的关系是什么,也说不清「分布建模」和「匹配差异」这两件事哪一件在起作用。缺少统一视角的直接后果是,新方法只能靠试,无法判断某一处改动到底改的是哪一环。 本文贡献:给出一个统一的理论框架:把「分布建模」与「匹配差异度」拆开,再用 Wasserstein 梯度流把全局目标和逐点特征更新连起来。在这个框架下,FD-Loss 和 Gaussian-kernel Drifting 分别被还原为高斯最优传输和基于核密度的 KL 匹配两个特例。框架进一步催生 MGFlow:用高斯混合来建模特征分布,粒度可调,介于全局矩和逐样本表示之间;它同时支持最优传输和基于分数的匹配,并用带质量约束的样本分配配成对分量更新,专门解决「混合模型表达力提升」本身解决不了的 mode collapse。 A unified view of distributional training. 实验效果:ImageNet 256×256 上大幅超过 FD-Loss 基线,pMF-H 取得 FDr⁶ 1.45、JiT-H 取得 1.64,均为当前最佳。文生图方面,把 FLUX.2 [klein] 4B 后训练成一步生成器,在 GenEval 和 PickScore 两个指标上都超过了原始的四步模型。 One-step text-to-image samples from FLUX.2 [klein] 4B post-trained with MGFlow. 批判点评:FDr⁶ 是论文自报指标,对比表里的基线也是作者自己跑的,跨论文可比性存疑;ImageNet-256 是类条件生成的老基准,没有在更大规模或更高分辨率上验证。文生图部分只报了 GenEval 和 PickScore 两个自动指标,没给人类偏好,而「一步超过四步」这种反直觉结论恰恰最需要人工评测背书。另外九家机构联合署名,真正的方法贡献集中在统一框架和高斯混合这两点上,工程验证面其实偏窄。 6. REPI:16万步追平700万步 Scaffold Then Internalize: Representation Injection for Diffusion Transformers | 中山大学;Video Rebirth;香港理工大学 | arXiv:2609.35292 关键词:扩散Transformer, 表示对齐, 训练加速, 表示注入, 图像生成 前序问题:REPA 类方法靠「把扩散 Transformer 的隐状态投影到预训练视觉编码器空间」来加速训练,方向是单向的:扩散模型被迫去迎合编码器。反过来那条路没人走过——让编码器表示直接参与去噪过程。问题在于直接注入会破坏扩散模型自身的表示结构,注入之后模型到底学到了什么、推理时还要不要带着编码器,都没人回答。 本文贡献:提出 REPI(REPresentation Injection),走 scaffold-then-internalize 两段式:第一阶段「搭脚手架」,用投影后的编码器 K/V 临时替换扩散 Transformer 原生的 K/V,只保留它自己的 Query,让外部表示先替模型把去噪这件事撑起来;第二阶段「内化」,模型恢复到使用自己的 K/V,同时用一个内化目标把自身 K/V 对齐到投影后的编码器表示。推理时编码器和投影层全部丢掉,不留下任何额外开销。 Overview of REPI. (a) Scaffold. (b) Internalization. 实验效果:在 SiT-B、SiT-L、SiT-XL 等多种骨干上一致优于 REPA,且两者高度互补——叠加后收益远超任一单独使用。SiT-XL 上,REPI + REPA 训练 200K 步就已经超过 REPA 训练 400K 步的结果。最亮眼的是:仅用 160K 步,REPI + REPA 就能匹配 vanilla SiT 训练 7M 步的效果,相当于 43.5 倍以上的提速。 REPI accelerates diffusion transformer training across model scales. 批判点评:43.5 倍的对照物是「什么都不加的 vanilla SiT」,这个基线本身不含任何加速手段,比值因此被放大;更有信息量的是和 REPA 的等步数对比,那部分增益要小得多。另外从 FID-步数曲线看,REPI 做的是把曲线「提前」,并没有把收敛上限抬高——训练足够久之后差距会收窄。论文也明确指出最大收益来自与 REPA 叠加,单独用 REPI 的绝对提升要看主表才清楚。代码目前标注为即将开源。 7. UMM-Reflection:自己改自己图,GenEval+12 Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning | 南洋理工大学;上海交通大学;东京大学 | arXiv:2609.35767 关键词:统一多模态模型, 强化学习, 自我反思, 图像编辑, 文生图 前序问题:统一多模态模型既能看图又能画图,理论上应该能自己修自己的输出:先诊断这张图错在哪,再改,看着改完的结果继续诊断。但「这次修改到底有没有用」只有渲染出来才知道,所以反思文本和图像生成必须沿着整条回路联合学习。SFT 冷启动能学会走流程却找不到高成功率的修复路径;而只优化渲染器或只优化某一个头的朴素 RL,又把大部分收益留在桌上。 本文贡献:提出 UMM-Reflection,在同一个统一模型内部对完整反思轨迹做 RL。关键设计是 sibling trajectories 共享同一张初始图像,这样 group-relative advantage 比较的就是不同「反思策略」而不是不同起点;再用一个轨迹级 advantage 同时更新反思 token 和基于 flow 的修订,避免逐轮信用分配带来的组合爆炸。信用跨轮次流动、同时流向同一模型的两种角色,推理时不需要任何 verifier。 UMM-Reflection RL. 实验效果:在 BAGEL 上相对 SFT 把 GenEval 提升 12.05 分,且增益能迁移到训练中完全没用过的 WISE(+10.97)、OneIG-Bench(+3.48)、T2I-CompBench++(+4.63)。 Learning dynamics of the 1,000-update RL run. 批判点评:+12.05 分是相对 SFT 冷启动版本,不是相对原始 BAGEL 或当前 SOTA 生成模型,绝对值要在主表里才看得清。整套实验只在一个统一模型(BAGEL)上做,换骨干是否成立未知。训练侧每条轨迹最多三轮反思、每组 16 条 rollout,为了拿到稳定的 group-relative advantage 开销不小;而三轮上限本身就意味着更长链条的迭代修复能力没有被验证——尽管推理免 verifier 是实打实的优势。 8. Elastic Forcing:扔掉两个打分模型,84.64 From Scores to Samples: Elastic Forcing for Autoregressive Video Generation | 清华大学人工智能学院;西安交通大学 IAIR;复旦大学相辉研究院;北京大学 | arXiv:2609.35491 关键词:视频生成, 自回归生成, 蒸馏, MMD, 后训练 前序问题:少步自回归视频生成基本都挂在 DMD 上,而 DMD 需要两样重资产:一个双向扩散 teacher,和一个在线更新的 fake-score 模型。前者限制了「能学什么」——必须有一个现成的目标分布 teacher;后者让后训练的内存和计算开销居高不下,模型一大就跑不动。两者的存在使得「直接向参考视频学」这条路一直没走通。 本文贡献:提出 Elastic Forcing:不学 teacher 给出的真假分数,而是直接从参考视频学 rollout 分布,后训练阶段两个 score model 全部去掉。做法是在冻结的自监督视频表示空间里最小化 MMD(最大均值差异),并用 Nyström–Monte Carlo 混合估计器在近似偏差与采样方差之间取平衡;再配合省内存的 replay 和梯度子采样让这个目标变得可训练。移除辅助 score model 之后,14B 后训练可以放进 8 张 H200。 Demonstration of Elastic Forcing. 实验效果:在与 Self-Forcing 完全相同的架构和初始化下,1.3B 模型把 VBench 总分从 83.80 提到 84.64,同时保持 17 FPS。去掉辅助 score model 使 14B 规模的后训练在 8 张 H200 GPU 上成为可能。除了蒸馏,直接从参考视频学习还能在没有目标专用扩散 teacher 的情况下习得新的视觉风格、语义概念和空间先验。 Additional demonstrations of our 14B model. 批判点评:83.80 到 84.64 只有 0.84 分,而且这个对照是与 Self-Forcing 同架构同初始化的自体基线,不是与当前最强少步方法比。14B 那部分论文只说「使后训练成为可能」,没有给出 14B 的量化评测结果,也没有和带 score model 的同等规模方案做效率对比——省下来的显存到底换来多少质量,读者看不到。MMD 估计器本身还需要在 Nyström 近似偏差和 Monte Carlo 方差之间调参,这个权衡的敏感度没在摘要里交代。 9. GEAR:几何只当地址,12项全第一 Geometry as Address: Routing Attention to Visual Memory for Long-Horizon Camera-Controlled Video Generation | 浙江大学 CAD&CG 国家重点实验室;香港科技大学(广州);LIGHTSPEED | arXiv:2609.34722 关键词:视频生成, 相机控制, 长程记忆, 几何先验, 记忆检索 前序问题:长程相机可控视频生成要从不断膨胀的视觉历史里把之前看过的内容取回来。现有做法要么在历史上下文里隐式检索,要么把历史重建成持久的 3D 记忆:前者检索低效、token 越堆越多,后者会因为全局融合不断累积几何误差,跑几十秒之后画面就漂了。矛盾在于几何信息到底该被用来「解释场景」还是只用来「定位」。 本文贡献:核心洞察是:几何不需要解释场景,它只需要决定「视觉记忆该从哪里读」,而「该恢复什么」交给注意力去判断。GEAR 据此把几何当作视觉记忆的显式 token 级地址——不把历史观测融进一个持久的全局 3D 表示,而是保留为逐帧 latent,只用逐帧几何与目标视角建立 token 级对应关系,从而避开全局融合的误差累积。由这些对应关系引导,Geometric Correspondence Attention(GCA)在去噪时把几何匹配上的历史特征选择性注入到噪声目标 patch。另外用 Invisible Octree 累积可见性证据,把几何上合理但实际被遮挡的对应关系剔掉。 System overview. 实验效果:在 DL3DV 与 WorldScore 的全部 12 项指标上取得最佳:SSIM 0.3645、LPIPS 0.4459、FVD 837.59、TransErr 0.0116、RotErr 0.1228、ATE 0.0436、Content Alignment 0.7423、Photo Consistency 0.9732、Style Consistency 0.8700、主观分 0.5018、Revisit SSIM 0.6489、Revisit LPIPS 0.2019。支持沿高难度轨迹生成分钟级视频。 Out-of-domain qualitative comparison for minute-long generation. 批判点评:主观分只有 0.5018,刚过一半,说明「12 项全第一」里最贴近人的那一项优势最薄。FVD 837.59 的绝对值也谈不上低。对比集合是「带 memory 机制的近期方法」,没有与不带记忆的强基线在同等时长下对照,因此无法判断这套地址机制相对「干脆不记忆」的净收益。此外整套方法依赖每帧几何(位姿与深度)可用,相机轨迹是外部给定的,几何估计本身的误差如何传导到地址精度只做了定性讨论。 10. ORAV:380题9种角色,人机86% ORAV: Benchmarking Audio-Video Generation from Multimodal Contexts | 清华大学人工智能学院;腾讯混元 | arXiv:2609.34843 关键词:音视频生成, 多模态参考, 基准评测, 组合式生成, 评测协议 前序问题:用异构多模态参考(图、视频、音频混着给)去生成音视频成了一个新课题,它同时要求两件事:对生成结果有组合式控制,对多模态上下文有 grounded 理解。但现有基准基本只覆盖单参考或同构参考,评测协议也沿用通用视频质量指标,无法判断「模型有没有照着指令把指定参考里的指定内容取出来并正确组合」。没有基准,就没法追踪这一方向的进展。 本文贡献:提出 ORAV Bench,包含 380 个任务实例,每个实例带 2 到 10 个参考,覆盖 9 种语义角色和 30 种角色组合;指令负责说明各参考之间的关系,媒体本身提供要被落实的身份、动态和音频特征。评测上设计了一套参考感知的成对比较协议:先分别准备视觉和听觉证据,再逐个比较每个参考「本应贡献什么」,最后在两种呈现顺序下核对总体裁决,以消解顺序偏差。 Omni-reference audio-video generation requires selectively composing information from heterogeneous references. 实验效果:在留出实例上,该协议与人类判断的有效一致率达到 86.08%。对 5 个前沿系统的评测显示,总体排名掩盖了各系统在不同参考组合上的能力差异;暴露出的一个反复出现的失败模式是:模型生成了与某个参考高度相似、但并非指令所要求的内容。可复现的逐点诊断在质量、参考亲和度、语音三个维度上揭示出彼此独立的行为差异。 Performance across composition signatures. 批判点评:86.08% 是「有效一致率」,已经剔除了不可用判断和顺序冲突的样本,分母比全部配对要小,实际一致性更接近的下界没有给出。5 个受评系统在摘要里被匿名处理为 frontier systems,读者无法核对评测对象;380 个实例摊到 30 种角色组合后每种只剩十几个,论文也承认只有共享实例数不少于 8 个的 14 个 signature 才重拟合了胜率。作为纯基准工作,它不提供任何模型或训练方案,落地价值取决于社区是否跟进。 趋势观察 加速的战场从算法层下移到系统层 今天十篇里有三篇在跟计算成本较劲,但下手的层级完全不同:WorldAttention 直接写定制 kernel 并重排 KV 的内存层级,GeoShrink 干脆绕开模型、只在求解器接口上抠掉五分之四的调用,Elastic Forcing 则是把两个 score model 整个删掉换来 14B 后训练的可行性。共同点是单纯改注意力数学已经不够,谁把内存搬运和调用次数一起管起来谁才拿到真实收益。 「先搭脚手架再拆掉」成了训练范式的共识动作 REPI 用编码器 K/V 临时替换扩散 Transformer 的原生 K/V,等模型内化之后在推理时把编码器整体丢弃;PDMD 只对 DMD 动一行代码、不加任何额外网络或损失;UMM-Reflection 在训练时用冻结 verifier 打分、推理时一个 verifier 都不需要。三篇方向毫不相干,却都在做同一件事:把复杂度全部留在训练期,交付一个结构不变、开销不增的推理模型。 人工智能炼丹君 整理 | 2026-09-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
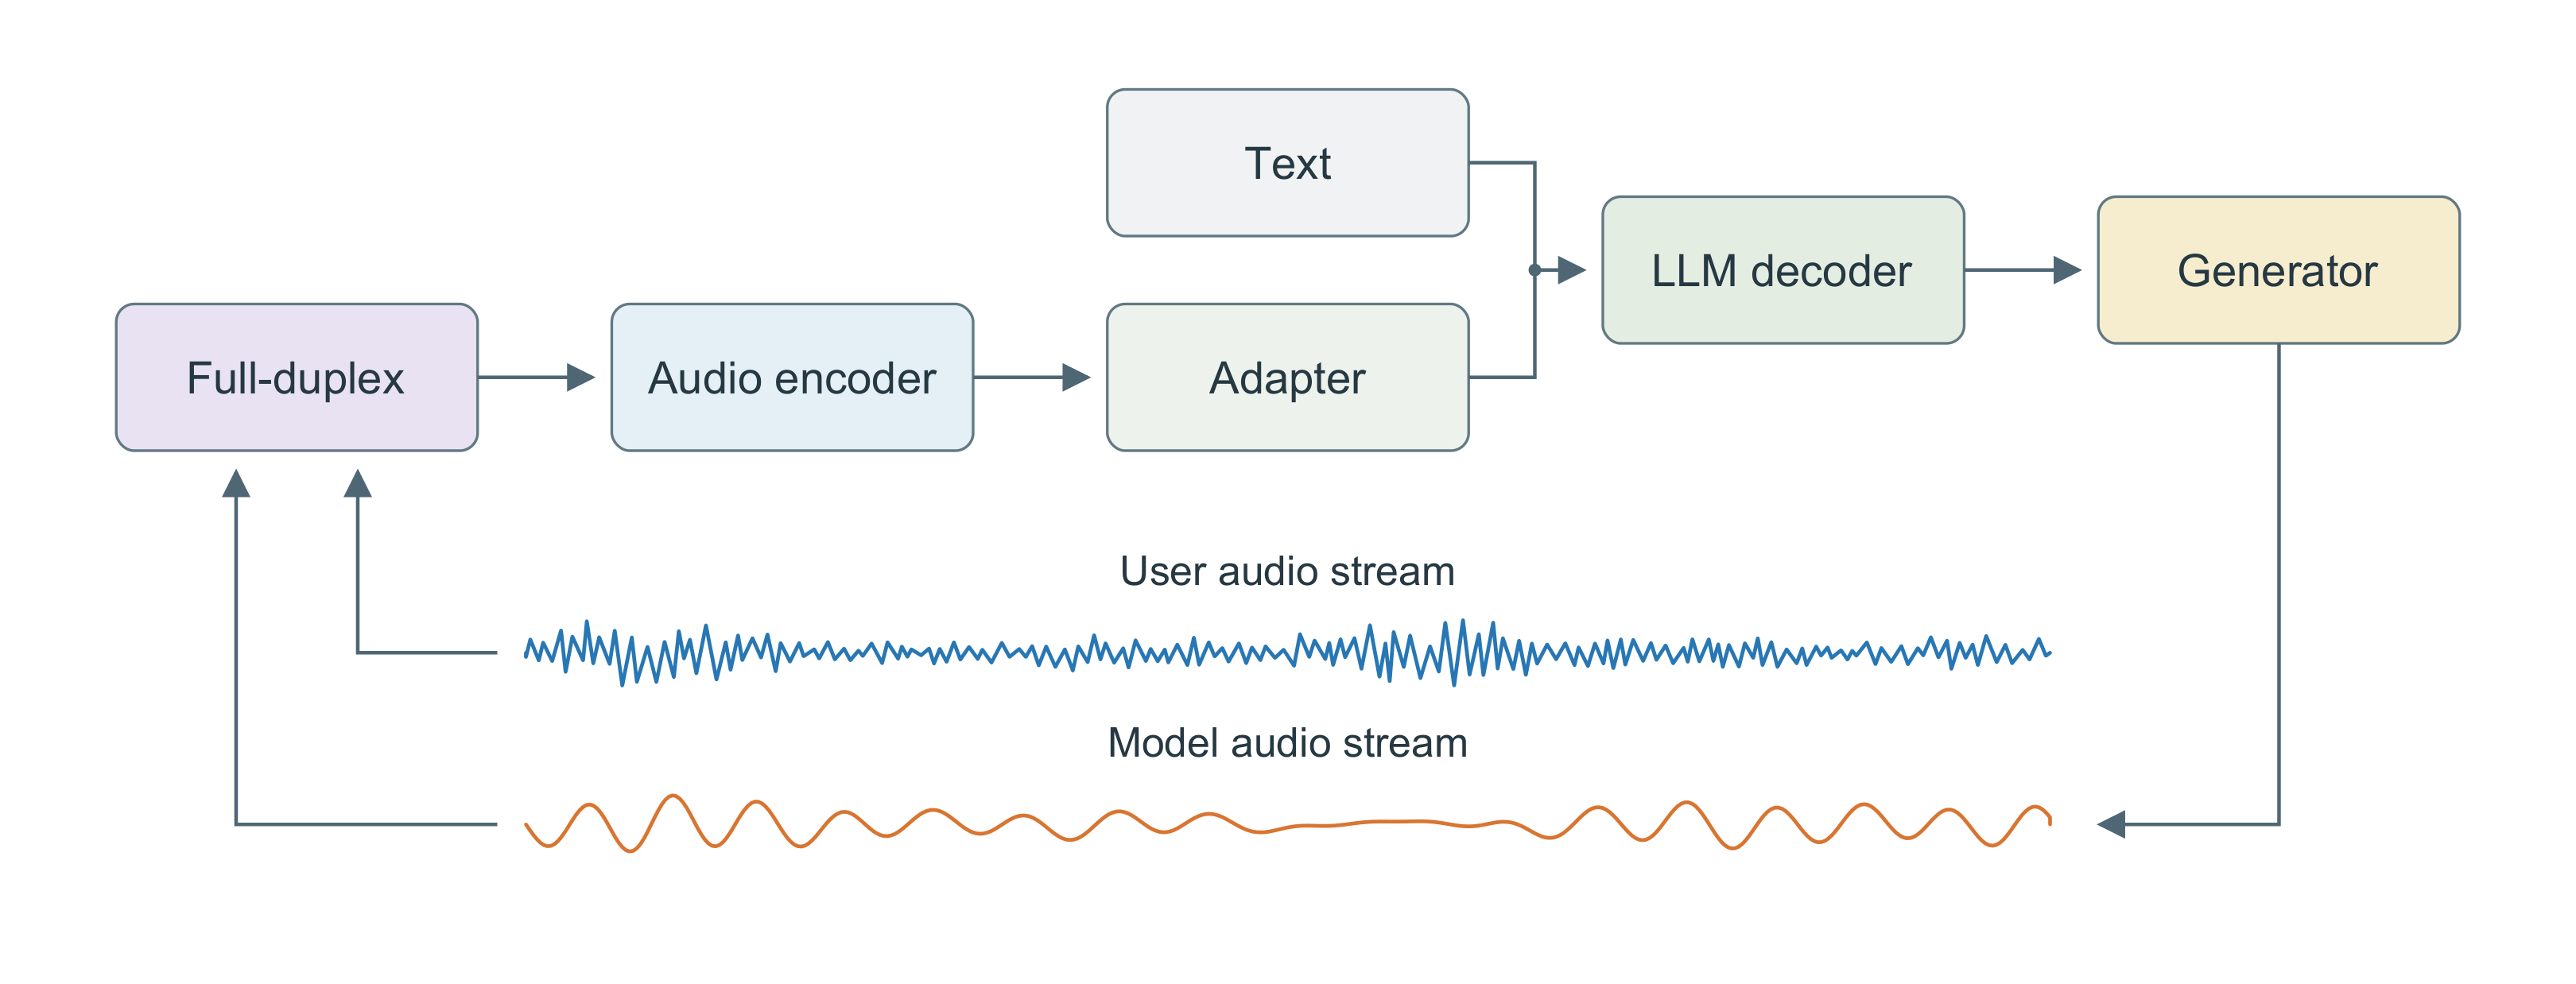
AIGC 每日速读|2026-09-22|阶跃星辰全双工98.9登顶,清华W4A4逼近FP16 今日 AIGC 论文速览 今日共 10 篇 · 语音与音频生成 2 篇 · 视频生成与物理一致 2 篇 · 图像编辑与三维生成 2 篇 · 生成理解一体化 2 篇 · 推理加速与评测 2 篇 重点论文标题列表 StepAudio 3(StepFun-Audio Team):全双工语音模型98.9分登顶 OmniVChat(CUHK):全模态对话视频2800题 ⚡ CompAdapt(HIT):物理视频生成PIS 0.862 KaiNinja(Alaya Lab):3D部件生成免分割器 4DGS-Fixer(Goertek Alpha Labs):稀疏四视角重建4D高斯 今日论文速览 1. StepAudio 3:全双工语音模型98.9分登顶 StepAudio 3 Realtime Technical Report | StepFun-Audio Team | arXiv:2609.14005 关键词:实时语音交互,全双工对话,边想边说,音频语言模型,MTP解码 ⚠️ 前序问题:实时语音交互要同时满足三件互相拉扯的事:听懂语音里丰富的声学线索(意图、情绪、环境),在对方还没说完时就能自然接话(停顿、附和、打断),以及先做足够深的推理再开口。传统做法要么把推理挪到对话之外、延迟跟着涨,要么为了低延迟直接砍掉推理深度——「想得深」和「答得快」长期被当成一对不可兼得的取舍。 本文贡献:StepAudio 3 Realtime 把整套系统组织成一个连续的「听—对话—思考—行动」循环。三个关键部件:Deep Perception 从原始音频里抽取丰富的声学线索来理解意图;Seamless Duplex 对同步的用户/模型双路音频流建模,处理停顿、附和与打断;核心创新是 Think-While-Speaking——让私有推理与语音输出并行执行,并用 Medusa 式的 MTP 解码加速思考,从而把「想」这一步塞进「说」的同一段时间窗里。训练侧配了一个 Adaptive Thinking 路由,先判断当前这一轮是否需要显式推理,若不需要就走 direct route、留一个空的 think block,避免为简单对话付出推理成本。此外集成了Voice Agent,在对话流不中断的前提下异步执行工具调用,把工具返回结果再融回对话。 实验效果:按官方技术报告的自测:推理模式下 StepAudioChat 宏平均 73.0,达到专用推理模型的水平;MMSU 90.6;Artificial Analysis Full-Duplex Bench Overall 98.9;τ-Voice 宏任务成功率 56.0%。同表里 ASR 侧 StepAudio 3 ASR Max 在 LibriSpeech clean 1.18、WenetSpeech meeting 4.35、AISHELL-1 0.49,三项均为全表最低错误率;音频理解侧 MMAR 86.5、AudioMultiChallenge 49.3;通用能力侧 HMMT 86.8、GPQA Diamond 83.0、MultiChallenge 59.7。 批判点评:优势几乎全部集中在「实时语音交互」这一列:Full-Duplex Bench 98.9 领先 Doubao 2.0 Lite 的95.3 与同表 Gemini 系列的 95.1~98.4,ASR 三项也确实拿到最低错误率。但同一张表暴露了明确的短板——AudioMultiChallenge 49.3,比同表最好成绩 67.0 落后近 18 分;GPQA Diamond 83.0 低于同表最高的 90.3;MultiChallenge 59.7 也落后最好成绩 68.1。τ-Voice 上 56.0 与 Doubao 2.0 Lite 的 56.5 基本持平甚至略低,说明「边想边说」这套机制在需要长链条决策的智能体任务上还没转化成稳定优势。此外全部数字均为团队自评、无第三方复现,报告也没有给出 Think-While-Speaking 与串行思考在同等算力预算下的严格对照——增益里究竟有多少来自 MTP 解码加速、多少来自推理与发声的并行重叠,需要拆开才能判断架构本身的净贡献。 2. OmniVChat:全模态对话视频2800题 OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue | The Chinese University of Hong Kong;Alibaba Token Hub;Shanghai Jiao Tong University;Shanghai Innovation Institute;Zhejiang University | arXiv:2609.21465 关键词:音视频对话,全模态模型,合成数据,强化学习奖励,基准评测 ⚠️ 前序问题:让全模态模型像人一样「看着你、听你说话就直接回应」,而不是先把语音转成文字、把视频转成描述再喂给语言模型。直接吃音视频能省掉转写带来的外部延迟与算力,也保住了表情、环境、手边物品这类感知线索。但这条路有两个卡点:一是人们用自己设备录的真实对话数据极其稀缺;二是同一个意图有无数种说法,好的回答往往要结合用户所处的环境与表情,用关键词匹配根本判不出回答质量。 本文贡献:论文把这条路线正式命名为 OmniVChat,并配齐了数据、评测、训练三件套。数据侧 OmniVChat-Studio 是一个多智能体合成引擎,用智能体协作加视频生成造出单轮与多轮的音视频对话;评测侧 OmniVChat-Bench 覆盖 5 大能力类、17 个子类、22 个场景域共 2800 条合成实例,另有人工实录的 OmniVChat-Bench-Human(360 条)作为真实分布对照;训练侧 OmniVChat-RL 给出一套把回答正确性、效率与风格联合起来的 rubric 奖励设计,直接在合成对话上训练 Qwen3-Omni-Instruct,验证奖励设计能否迁移到真实录制的对话上。 实验效果:RL 训练满 1000 步(记录 51 个 checkpoint)后,OmniVChat-Bench 与人工录制的 OmniVChat-Bench-Human 命中率同步上涨,且合成集与实录集的曲线走势一致,论文还逐条给出了 16 个子类的学习曲线,说明在合成数据上得到的增益确实能迁移到真实对话。对比表里 Qwen3-Omni-Instruct 基线的综合命中率 0.186,训练后与 Qwen3.5-Omni-Plus 的 0.361、Doubao Seed 2.0 Lite 的 0.330 进入同一档。 批判点评:最值得警惕的是奖励设计里的「效率」项。训练曲线显示 Reply Efficiency(每千词的 rubric 命中数)从约 5 涨到 20 的同时,平均回复长度从接近 100 词一路掉到 35 词左右——效率提升有相当一部分来自「少说几句」而不是「说得更准」,在固定 rubric 打分下这几乎必然发生,机制上和同期的 reference-free 语音指标那篇讲的 reward hacking 完全一致。第二,OmniVChat-Bench 全部是合成实例,而实录集只有 360 条,并且只覆盖十二个单轮子类中的一部分,所以「迁移到真实对话」的证据强度受限于实录集规模——论文自己也在多个子类上标注 Bench Only,意味着这些能力在真实录制条件下根本没有对照数据。第三,用合成对话同时做训练和评测,存在评测集与训练分布同源的风险,跨数据集的零样本能力没有被检验。 3. CompAdapt:物理视频生成PIS 0.862 CompAdapt: Adaptable Composite Motion Modeling for Physics-Consistent Text-to-Video Generation | Harbin Institute of Technology;Alibaba Taobao | arXiv:2609.21455 关键词:文生视频,物理一致性,复合运动建模,神经动力学,一次性适配 ⚠️ 前序问题:扩散式文生视频能出画质、也能出时序连贯,但常常违反基本物理:物体不受重力、碰撞后穿模、运动类型中途乱切。已有的物理约束方法大多只会处理单一运动类型,还要人工指定物理参数,换一个没见过的物理环境就失灵。问题在于真实场景里的运动几乎都是复合的——耦合、多阶段转换、多物体碰撞,单一类型的动力学先验覆盖不了。 本文贡献:CompAdapt 把神经动力学建模从单一运动类型扩展到复合物理行为。架构上有两个关键模块:Motion Type Composite(MTC)在潜空间里把多个运动类型按时间关系做算子级复合,Multi-Object Interaction(MOT)在检测到物体接触时切到显式的交互动力学。自然语言提示被解析成结构化的物理语义——运动类型、时序关系、初始物理参数——实现端到端指定,不再需要人工调参。跨新物理环境靠 dynamics-aware prior matching 做一次性适配,不必重训核心动力学模块;另有 physics-aware 潜特征融合模块负责高速与复杂运动下的画面保真。 实验效果:消融实验:去掉 MTC 后 PIS 掉到 0.615,去掉时序建模掉到 0.589,去掉双 LLM 语义解析掉到 0.724,完整版 0.862;FID 15.0 / FVD 91.4 / PSNR 17.2 / SSIM 0.61,相比 Wan-Move(16.3 / 93.5 / 16.5 / 0.58)与 Go-with-the-Flow(17.5 / 96.7 / 14.9 / 0.56)在四项上均有改善,生成开销 2.9 与 Wan-Move 持平。定性部分把 NewtonGen、PhysT2V、Wan2.2、CogVideoX-5B、Veo3、Sora 全部拉到同一组提示下逐帧对照,覆盖抛体旋转、阻尼振荡、均匀加速、形变碰撞等组合运动。 批判点评:三处需要打折。第一,主指标 PIS(物理一致性分数)由论文自行定义,没有第三方榜单或社区复现支撑,而它在消融中的跨度(0.589 → 0.862)恰恰是全文最大的增益来源,指标自证的风险较高。第二,所谓「复合运动」实际只覆盖 9 类情形,其中真正涉及物体接触的弹性碰撞仅 2 类,多物体场景仍是最薄的一环,所谓 multi-object collisions 的证据量偏小。第三,「一次性适配」并不等于「免数据」——流程本身仍需要目标环境的一段观测视频(one-shot reference)才能完成 prior matching,因此把它当作通用物理先验来用还有前置成本。论文 comments 自注为 NeurIPS 2026 投稿(23 页、4 图),尚未经同行评审。 4. KaiNinja:3D部件生成免分割器 KaiNinja: Extending Native 3D Generators to the Part Level | Alaya Lab;The University of Tokyo;UC Merced;Institute of Science Tokyo | arXiv:2609.15659 关键词:三维生成,部件级建模,双体积表示,稀疏体素,免分割 ⚠️ 前序问题:TRELLIS.2 这类原生 3D 生成器能把一张图变成高保真、带材质、非水密的网格,但输出是一个融合好的整体;而下游的编辑、绑定骨骼、物理仿真全都按部件操作。最直接的办法是在融合网格上再跑一个 3D 分割网络,可这样既慢、又被分割精度卡死。真正的技术障碍更基础:O-Voxel 网格每个体素只存一片表面,所以单个 volume 在任何分辨率下都无法表示两个部件贴合的那层界面。 本文贡献:论文提出双体积(dual-volume)表示来补上缺失的界面——同一位置存两套体积,让贴合面两侧各自有归属。KaiNinja 建立在 TRELLIS.2 的 O-Voxel 之上,分两阶段生成:Stage 1 的 Layout Flow 把 3D 噪声网格去噪成逐 volume 的 occupancy 布局,两条流各自有自注意力、再用零初始化的全局注意力块跨流通信;Stage 2 的 SLat Flow 复用 TRELLIS.2 权重,只在活跃体素上对稀疏噪声去噪,最后由 FVAE 解码成 O-Voxel 体积并装配成部件分离的网格。整条流水线里没有掩码、也没有分割器。训练数据来源混杂,包含 CAD 模型和由 LLM 驱动的智能体创作的资产,作者称这是首个用智能体创作的部件数据训练的 3D 生成模型。 实验效果:相对不同范式的部件生成流水线,整体 Chamfer distance 降低 40%、严格部件 F-score 提升 16%;在held-out 测试集与训练未出现过的源上,KaiNinja 产出的部件数量都最接近真值,而 TRELLIS.2+X-Part、Hunyuan3D-2.1+X-Part、OmniPart、PartPacker 这几个基线常常把部件融在一起或者碎开。作者还报告一个反直觉现象:同样的骨干、同样的数据,加上部件级监督之后整体几何保真度反而也提升了。 批判点评:「免分割器」是这篇最硬的卖点,而它恰好没有回答分割器方案真正的软肋——精度上限。论文比的是部件数量、Chamfer 距离与 F-score,没有给出「部件语义是否对得上真值」的证据:在训练未出现的源上,KaiNinja 的部件着色与真值明显对不齐(椅子、花瓶、水壶几行都能看出切分位置与真值不同),也就是说「切得开」和「切得对」之间仍有距离,而语义正确性恰恰是分割器方案此前唯一能保证的东西。其次,40% / 16% 相对的是各基线外挂 X-Part 分割器后的组合结果,比的是「你的流水线 vs 别人的流水线」,而不是「dual-volume vs legacy O-Voxel」,无法分离表示本身的净贡献。第三,所谓「首个用智能体创作数据训练」目前只是自述,论文没有给出这类数据在训练集中的占比,也没有做数据来源的消融,因此这个卖点暂时无法验证。 5. 4DGS-Fixer:稀疏四视角重建4D高斯 4DGS-Fixer: Generative Sparse-View 4D Gaussian Splatting with Iterative Refinement Guided by Video Diffusion Priors | Goertek Alpha Labs;Singapore Institute of Technology;The Hong Kong University of Science and Technology | arXiv:2609.21176 关键词:4D高斯泼溅,稀疏视角,视频扩散先验,迭代精修,动态场景重建 ⚠️ 前序问题:用稀疏视角视频重建动态场景是典型的病态问题:观测太少、信息缺失,再多优化技巧也补不出来。更具体的症结在初始化——只有几个输入视角时,COLMAP 只能重建出稀疏残缺的点云,大片区域没有足够的高斯基元支撑,后续优化根本无从下手。也就是说问题出在起点,不在优化器。 本文贡献:论文给出一个两阶段的迭代精修框架。Stage 1 初始化:先对多路同步视频估计多视角深度图,把它们融合成稠密点云,为动态 4DGS 提供更完整的几何起点,替代 COLMAP 的稀疏点云。Stage 2 精修:沿新的相机轨迹渲染出视频,送进一个预训练的视频修复/恢复模型得到「修复后的伪目标视频」,再把它当作伪监督去迭代更新 4DGS 表示,多轮往复。整条链路的思路是用视频扩散先验补足缺失的观测信息,而不是继续在几何约束上加码。 实验效果:在常用的稀疏视角动态基准上,相对此前最好的方法 PSNR 提升接近 2 dB,作者称 substantially outperforms 现有基线。定性对比给出 GT / 4C4D / Ours 三行并排结果,4DGS-Fixer 在人物细节与背景完整度上都比 4C4D 明显更干净、更少孔洞。论文 comments 标注已接收至 SIGGRAPH Asia TC。 批判点评:整条链路的关键一步是「拿视频修复模型的输出当监督」,这带来一个绕不开的疑问:修复模型的幻觉会被原样写进 4DGS。用修复后的序列做伪监督,本质上是把生成先验的偏好当成真值——一旦输入视角极少、修复模型开始「编」,4DGS 就会忠实地记住这些编出来的内容;而 PSNR 的提升恰恰可能来自「补全得更像训练分布」而不是「更接近真实场景」。论文没有做「关掉修复模型、只保留深度稠密初始化」的对照,因此也说不清 2 dB 里有多少来自几何初始化、多少来自扩散先验。其次是部署成本:方法需要四路同步相机加一个预训练视频修复模型,实时性与泛化到非受控场景的能力都未讨论。源码层面还有个小瑕疵——LaTeX 里仍留着旧名「STGFixer pipeline」的残句没清理,说明从 STGFixer 改名到 4DGS-Fixer 之后并未完全同步。 6. RefineEdit:九类编辑背景保持最优 Refinement Is Inherently Editable: Training-Free Prompt-to-Prompt Image Editing with Generative Refinement Network | City University of Hong Kong (Dongguan);City University of Hong Kong;MBZUAI | arXiv:2609.20633 关键词:图像编辑,免训练,生成式精修网络,二值图像码,背景保持 ⚠️ 前序问题:文本引导的图像编辑要在「改对」和「别乱改」之间走钢丝。扩散类编辑器靠空间控制(掩码、注意力图)来圈定改动范围,而掩码一旦不准,结果不是改不彻底就是动到无关区域;因果自回归类编辑器还有一层额外约束——解码顺序固定,前面已经决定的 token 后面没法回头修正,早期的一个坏决策会被一路带下去。 本文贡献:论文换了一个编辑载体:不去控制扩散过程,而是在 Generative Refinement Network 的二值图像码上做全局精修。核心机制是双分支耦合——编辑分支从源轨迹的某个中间状态初始化,复用已经成形的布局;两个分支对同一批源采样 bit 分别给出概率,用它们的带符号差值挑出「该改的位置和 bit」。被选中的 bit 进入编辑精修,其余 bit 复制源分支持续演化的状态,于是「定位」与「生成」被绑在同一个精修过程里,编辑证据可以随图像演化不断被重新评估。为跨精修步稳定,论文加了两道约束:adaptive spatial freezing 抑制掩码无谓扩张,finite bit locking 让最近选中的 bit 保持可编辑。整套方案免训练、不需要外部掩码,也不需要注意力控制。 实验效果:在 PIE-Bench 的九类编辑任务上,RefineEdit 在 PSNR / LPIPS / MSE / SSIM 四项背景保持指标上全部最好,同时整图 CLIP 与被编辑区域 CLIP 也最高——「改得准」与「背景不崩」这次没有被做成取舍。定性部分与 LEDits++、FlowEdit、ChordEdit、MasaCtrl 在替换、添加、擦除、属性/姿态/颜色/材质/背景修改与风格迁移九类上逐一并排对比。 批判点评:最大的边界条件藏在实验设置里:这套流程要求源图来自 GRN 自己的生成轨迹——编辑分支要「继承源状态」,因此它编辑不了任意真实照片。论文在 limitation 里自己承认了这一点,但对普通用户而言,「只能改模型自己生成的图」和「能改我相册里的照片」是两个完全不同的产品。其次是超参:switch step(从第几步开始分叉)以及空间/bit 两个阈值都需要逐类调整,而且最优值是在同一个 PIE-Bench 评测集上选出来的,相当于用测试集选超参;论文的 limitation 也承认这些类别特定设置是在该基准上挑的,跨数据集泛化没有被验证。第三,九类各自用自己那一档配置,但真实用户不会先告诉系统「这次是换材质还是换背景」,多类混合的编辑场景仍未被覆盖。 7. QuAKE:W4A4 文生图量化误差校正 Quantization-Aware Kalman Estimation for Diffusion Sampling | Tsinghua University | arXiv:2609.21407 关键词:扩散模型量化,推理加速,W4A4,卡尔曼滤波,采样校正 ⚠️ 前序问题:量化是扩散模型落地的现实路径,但 W4A4 这种激进压缩会让量化去噪器的输出明显偏离全精度版本,而误差还会沿时间步持续传播、越积越大。已有的采样期校正方法基本只看当前步的局部信息,没有利用整条轨迹的历史——而误差恰恰是跨时间步传播的,用局部信息去修一个全局累积的问题,方向就不对。 本文贡献:论文把「用量化去噪器采样」重新表述成一个在线估计问题:既然真实的全精度输出拿不到,那就用历史量化输出去把它估回来。QuAKE 是为此设计的量化感知 Kalman 估计器,用一个平滑轨迹先验叠加一个条件高斯观测模型,每一步以闭式解递归更新「输出窗口」的后验,再把后验均值喂给采样器。它不改动量化网络、天然支持任意高阶多步 ODE 采样器,是一个即插即用的轻量校正器。论文同时给出了量化噪声的实证统计(边缘分布接近高斯、联合分布呈明显相关结构、条件分布可线性拟合),用来说明为什么 Kalman 这一套假设在这类噪声上站得住。 实验效果:在多个 W4A4 量化的文生图模型上,QuAKE 在「与全精度采样的分布差异」这一指标上持续领先:FLUX.1-dev + MJHQ-30K 上 FID 7.02 / KID 0.158,优于朴素量化的 7.30 / 0.257、TAC-Diffusion 的 7.31 / 0.304、Q-Drift 的 7.16 / 0.209;Sana-0.6B 上 7.90 / 0.289;PixArt-α 上 13.71 / 1.987;PixArt-Σ 上 15.99 / 3.401。开销按论文自己的测量几乎免费:FLUX.1-dev 单步延迟 22.2 ms(BF16)降到 6.2 ms(INT4 与 QuAKE 相同),DiT 体积 160 GiB 降到 102 / 104 GiB,端到端 23.51 s 降到 2.20 / 2.24 s。 批判点评:有一个容易被标题盖住的细节:QuAKE 赢的是分布距离(FID / KID),但在感知质量列上并不总是赢朴素量化。以 FLUX.1-dev + MJHQ-30K 为例,IR 分数 QuAKE 0.8822 低于 Quantized 的 0.8887,CLIP-IQA 0.9042 也低于 0.9057——也就是说 Kalman 校正主要抹平的是低层分布偏差,并没有让图在感知偏好上更讨喜;如果优化目标是下游打分模型或人眼偏好,朴素 INT4 甚至可能更安全。这不是论文的错,但摘要里「持续优于已有方法」的表述容易被读成全面胜出。其次,效率那一组三个数字(6.2 vs 6.2 ms、102 vs 104 GiB、2.20 vs 2.24 s)方向一致地说明校正本身几乎免费,反过来也说明它的收益完全来自「估得更准」而不是「跑得更快」——真正的加速来自量化,QuAKE 只负责把量化弄坏的部分补回来。最后,全部实验集中在文生图,视频扩散这类时间步更多、误差累积更长的场景是否同样成立,尚未给出证据。 8. AURA:对话式音乐编辑只训91M AURA: Unified Multimodal Framework for Conversational Music Editing | Aalto University;Technical University of Denmark;University of South Dakota;OpenRB Lab | arXiv:2609.14344 关键词:音乐编辑,多轮对话,多模态大模型,LoRA,概念token ⚠️ 前序问题:现有的指令式音乐编辑器是「一问一答」的:每条指令独立处理,用户想「先弱化鼓、再压一下高频、最后把情绪调柔和」这种逐步打磨的工作流根本走不通,因为模型记不住上一轮改了什么。此外,要改音乐光靠文字往往不够——用户脑子里想的是「这段场景听起来该是什么样」,而不是一串精确的音频术语。 本文贡献:AURA 把音乐编辑变成多轮对话。用一个多模态大模型读完整的对话历史、可选的一张图以及参考音频,把编辑意图蒸馏成一组紧凑的 concept token;再由 concept-to-audio(C2A)模块把这些 token 与逐帧对齐的参考特征注入冻结的 MusicGen 骨干——内部通过交叉注意力与 BiFAM 做对齐,让编辑既精确又不碰无关内容。训练只更新 91M 参数(LoRA rank-64 / α=128 加两个投影器与 C2A),1.9B 骨干全程冻结;对话数据由 Slakh2100 合成,共 66,539 段多轮对话。 实验效果:在域内 Slakh2100 与域外 MoisesDB 上同时评测:Add 任务的域外 FAD 0.84 对 Instruct-MG 的 3.84,Remove 任务域外 FAD 0.72 对 3.55,均为 4~5 倍降低;Remove 任务域内 SI-SDR +11.32 dB、SDRi +4.89,而 Instruct-MG 是 −2.10 / −8.53。消融显示对话历史确实起作用:只把最后一条指令喂给模型,Remove 的 SI-SDR 会掉到 −5.2 dB,SSIM 从 0.84 掉到 0.54。 批判点评:摘要里「域外 4~5 倍 FAD 降低」是有选择性的——它只覆盖 Add 与 Remove 两个任务;在 Extract 上 AURA 是 4.24 对 Instruct-MG 的 5.20,只有约 1.2 倍,并没有复现那个量级。更要紧的是 Extract 的SI-SDR 虽然比基线好得多(−7.62 对 −15.18),但仍是负值,说明「从混音里把目标音轨抽出来」这个任务本身离可用还有距离。其次,Remove 的域内增益(+11.32 dB)看着最亮眼,但该任务的域内评测集就来自训练数据来源域(Slakh2100 合成),换到域外 MoisesDB 只剩 +2.54 dB,跌幅接近 4 倍,真正的跨域能力比表格第一屏呈现的要弱。第三,91M 可训练参数对 1.9B 冻结骨干确实是漂亮的效率数字,但它同时意味着能力上限被 MusicGen-medium 这个骨干锁死,而论文没有给出换更大骨干的对照。 9. Qwen-Audio-3.0-TTS:四代语音模型瓶颈迁移史 The Evolving Bottleneck in Speech Generation: Interface Co-design and Staged Alignment from CosyVoice to Qwen-Audio-3.0-TTS | Alibaba Token Foundry | arXiv:2609.16514 关键词:语音合成,接口设计,瓶颈迁移,流匹配,阶段性对齐 ⚠️ 前序问题:语音合成的发展通常被叙述成「模型更大、tokenizer 更好、数据更多」,但这类叙事解释不了为什么某些改动立竿见影、某些就收效甚微。真正值得追问的是:每一代系统当下的主导瓶颈在哪里——是表征不够内容对齐?是接口不能因果流式?是覆盖度与可学习性不足?还是模型容量与跨模块协调出了问题? 本文贡献:这是一篇技术回顾(technical retrospective),沿 CosyVoice → CosyVoice 2 → CosyVoice 3 → Qwen-Audio-3.0-TTS 这条线给出另一种解释:进步来自瓶颈的反复迁移。四代之间不变的是一条分解——自回归语言模型负责「规划」,flow-matching 模型负责「渲染」;变的是两者之间的接口契约。作者把契约形式化成四个维度:representation(表征)、ownership(归属)、availability(可用性)、gradient reach(梯度可达性),并明确区分「单篇论文内的证据」与「跨论文比较」。每一代针对一个不同的约束:CosyVoice 立下监督式语义 token 这个内容对齐接口;CosyVoice 2 让接口对因果流式可用、把句级说话人嵌入从语言模型里移出;CosyVoice 3 靠多任务监督、数据与模型扩容、以及可微奖励优化(DiffRO)提升接口的可学习性与覆盖;Qwen-Audio-3.0-TTS 把帧率从 25 Hz 降到 12.5 Hz、渲染器改为条件在连续隐状态而非离散 token 嵌入上,并用五阶段课程做联合分阶段对齐。 实验效果:文中给出的实证来自各代公开系统:语义 token 的引入把中文 CER 从 2.56 降到 1.45、英文 WER 从 3.81 降到 2.57(CosyVoice 2 的模块消融);数据从约 17 万小时扩到 100 万小时、语言模型从 0.5B 扩到 1.5B(CosyVoice 3);Qwen-Audio-3.0-TTS 把帧率减半并保留 K=6561 的码本,五阶段课程依次为独立预训练、联合训练与质量退火、语言模型强化学习、声学鲁棒性、flow-matching 强化学习。 批判点评:这篇最需要标注边界的地方,作者自己写在 Figure 1 的图注里:「箭头编码的是我们的回顾性解释,而非受控的跨版本实验」。也就是说「瓶颈迁移」是一个事后叙事,不是被控制变量检验过的因果结论——拿它指导新系统设计时,风险在于你可能把相关性当成了因果。另一个更具体的问题是证据来源:文中复现的 tokenizer 对比(例如把帧率减半同时保持 K=6561 会一并损伤内容一致性与相似度)引自 Xiang et al. (2026),属于「论文内对比」的二次引用,不是独立复现;Table 1 也是同样的性质。因此这篇更适合当作一份结构清晰的领域地图来读——四维接口那套分析框架确实好用,也确实解释了「为什么改 tokenizer 有效、改渲染器无效」这类问题——但不宜当成可直接复制的工程配方。论文 comments 自注为 technical retrospective(11 页),本身也不以实验贡献为目标。 10. Ref-Free Metrics:13类语音指标在干净音频失效 The Limits of Reference-Free Speech Quality Metrics as Evaluators and Rewards on Modern Text-to-Speech | AGIGO;ETH Zurich;Sapienza University of Rome;University of Zurich | arXiv:2609.13150 关键词:语音质量指标,无参考评测,奖励攻击,成对偏好,评测协议 ⚠️ 前序问题:UTMOS、DNSMOS、SCOREQ 这类无参考质量预测器,今天既是 TTS 的默认自动评测器,又越来越常被拿去做偏好优化的奖励信号。这两个角色都建立在同一个假设上:预测分数能跟上人类偏好。但这个假设在什么条件下成立、什么时候会崩,此前没有被系统检验过。 本文贡献:论文把假设直接摆到台面上测。做法是构造一个成对判定任务——给两个音频片段,问预测器打分更高的那个是不是人更偏好的那个——然后在 6 个人工评分语料上跑,覆盖从「瑕疵明显」到「几近无瑕」的完整质量区间。评测对象包括 13 个无参考预测器家族(33 个分数变体)、13 个 Praat 韵律描述符,以及一批经典信号处理特征,每项都给出相对「随机基线」与「人类天花板」的位置。第二部分把这些指标当奖励用,对比单分数奖励与复合奖励在策略优化下的行为差异,并给出数据效率曲线。 实验效果:结论相当刺。在瑕疵明显的 BVCC 上,各指标准确率能爬到人类天花板附近(天花板 0.887,标定的复合分数到 0.92);但一旦两边音频都干净(TTS-HP),没有任何单个预测器能可靠指认被偏好的样本,好几个的准确率甚至低于「直接挑时长更长的那个」这个傻瓜基线(argmax clip duration 在 BVCC 0.517、SOMOS 0.368、SingMOS 0.456、SpeechJudge 0.370、TTS-Arena 0.523、TTS-HP 0.524),复合分数也才 0.52,而人类天花板是 0.764。奖励侧更严重:优化单一分数会诱发 reward hacking——指标冲上去了,但独立留出评测器和人工听测同时变差;复合奖励能抵抗这个倾向。数据效率曲线还给了个实用兜底:每类只取 min(20%, 1000) 条域内成对数据拟合一个带正则的线性头,就能把准确率相对最好的单指标提升 +1.5%(BVCC)到 +6.6%(SOMOS)。 批判点评:这篇的价值是给出一把尺子,而不是给出一个能用的指标——它自己也承认在干净音频上没有任何固定公式可迁移。要留意三点。第一,复合分数需要通过域内偏好标注拟合(论文用了 min(20%, 1000) 条域内成对数据),相对增益只有 +1.5% 到 +6.6%,也就是说「改用复合分数」这个建议的前提是你已经有该领域的偏好数据,对做通用 Reward Model 的人是不小的门槛。第二,它测的是成对偏好准确率,不是绝对 MOS 拟合度,「指标失效」的结论不能直接推成「MOS 预测不准」——在需要绝对分数的场景里结论需要重新验证。第三,时长基线之所以能赢,是因为评测语料里存在系统性的时长偏差,这提示「最好用的信号」可能来自数据偏置而非感知质量;反过来说,这也意味着任何在干净音频上得到的排行榜,都可能只是某个数据偏置的代理指标。 趋势观察 「边想边说」正在把推理的延迟藏起来 StepAudio 3 让私有推理与语音输出并行执行,用 Medusa 式 MTP 解码把思考压进说话的同一段时间窗;QuAKE 则把量化误差的校正重新表述成一个在线估计问题,用轨迹历史去猜全精度输出本该是什么。两者都在回答同一个问题:当「想清楚」和「立刻给」不能同时满足时,能不能把其中一件事塞进另一件事的时间窗里,而不是二选一。 物理一致性开始从「单类型」走向「复合行为」 CompAdapt 把神经动力学从单一运动类型扩到耦合运动、多阶段转换与多物体碰撞,并用一次性适配去应对没见过的物理律;4DGS-Fixer 干脆不追求几何自洽,改用视频扩散先验把缺失的观测补出来当伪监督。一个在约束上加码,一个在数据上放开,方向相反,但都承认了同一件事:稀疏观测下的物理,靠纯几何推不出来。 「部件」正在成为 3D 生成的新交付单位 KaiNinja 指出 O-Voxel 每个体素只存一片表面、单个 volume 在任何分辨率下都表示不了两个部件贴合的那层界面,于是用双体积表示把界面补上,全程不需要掩码或分割器。下游的编辑、绑骨与仿真要的正是部件而不是一整块表面。这提示 3D 生成的下一步未必是把表面做得更细,而是把语义切分做得更明确。 质量指标同时当评测和奖励,正在被自己的盲区反噬 语音侧,Ref-Free Metrics 那篇的 13 个无参考预测器在干净音频上集体失效,好几个甚至不如「挑最长的那个」,而优化单一分数会直接诱发 reward hacking;对话视频侧,OmniVChat 的效率项让平均回复长度从约 100 词掉到 35 词,效率上涨里混着「少说几句」。当同一个分数既当尺子又当奖励,它没测到的那部分就一定会被优化出来。 人工智能炼丹君 整理 | 2026-09-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-09-18|高通揪出长视频KV错配-Recency Forcing 今日 AIGC 论文速览 今日共 10 篇 · 视频生成与长时程一致性 2 篇 · 生成模型评测与审计 2 篇 · 推理与采样加速 2 篇 · 语音与音乐生成 2 篇 · 视频修复与图像应用 2 篇 重点论文标题列表 Recency Forcing(Qualcomm AI Research):按距离衰减注意力救长视频 MiniMax-H3-Reason(National University of Singapore;Fudan University;Tencent):全模态模型物理推理仅四成 ⚡ Diagonal Sparsity(KAIST;Agency for Defense Development;Seoul National University):对角稀疏把吞吐拉到3.1倍 VibeAvatar(Peking University):口型与美感分阶段各管各的 AVR(New York University;University of Technology Sydney):能抄就抄抄不到才让扩散补 今日论文速览 1. Recency Forcing:按距离衰减注意力救长视频 Recency Forcing: Bridging the Long-Horizon Gap in Autoregressive Video Generation | Qualcomm AI Research | arXiv:2609.19729 关键词:自回归视频生成,长时程一致性,KV cache,注意力偏置 ⚠️ 前序问题:自回归视频生成一拉长就退化。论文把根因定位到一处被忽视的训练-推理不一致:训练时短片段的全部上下文帧都在 KV cache 里,推理时显存约束却会把远处帧逐出 cache,等于抽走了模型当初赖以生成的上下文。作者称之为 KV 淘汰错配(KV eviction mismatch)。 本文贡献:思路不是用截断上下文去模拟淘汰——那会连模型仍需要的时间信息一起丢掉、破坏运动连贯——而是保留上下文,同时让远处帧的影响逐步衰减,等它们真被淘汰时影响已可忽略。论文先用扰动式敏感度指标 positional response R(Δ, t_denoise) 量出上下文影响随时间距离陡峭衰减、且在不同去噪步上系统性变化;据此提出 Temporal Response Bias(TRB),把一个非正的、随时间步变化的偏置直接加在 softmax 之前的注意力 logits 上。配套的 Biased Attention Reparameterization(BAR)是个等价改写,把偏置移到 softmax 之外,使 TRB 退化成一次标准 FlashAttention 调用。 实验效果:在 VBench 与 VBench-Long 上取得长时程生成的 state-of-the-art 质量,且不增加推理成本。60 秒视频的定性对比里,Self-Forcing 出现色彩漂移,LongLive 产生场景重复,DeepForcing 引入模糊,Recency Forcing 则保持了画面稳定与运动连贯。方法不改动上下文长度与训练目标,免训练与训练两种模式都能用,BAR 的等价改写让偏置的额外开销为零。 批判点评:把长视频退化归到 KV cache 淘汰这个具体的工程约束上,而不是笼统归因于「误差累积」,定位比多数同类工作清晰,BAR 让它零开销落地也务实。但摘要只给 state-of-the-art 的结论、未披露具体分数,免训练与训练两种模式的增益差距、TRB 偏置形状换骨干后是否还成立,都要看正文;VBench 系列本身偏重视觉质量,长时程的叙事与物体持久性未必能被它完全反映。 2. MiniMax-H3-Reason:全模态模型物理推理仅四成 Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model | National University of Singapore;Fudan University;Tencent | arXiv:2609.18323 关键词:全模态生成模型,物理世界推理,跨模态整合,评测基准 ⚠️ 前序问题:全模态生成模型把文本、图像、视频、音频统一建模,MiniMax-H3 正是在共享潜空间里同时做多模态理解与音视频联合生成的代表。但多模态对齐到底有没有提升模型的世界推理能力?现有面向视频生成与世界模型的评测大多受限于单一输入模态,且提示词与目标视频内容高度重合,回答不了这个问题。 本文贡献:论文构建了围绕物理世界推理四个互补维度的评测框架,专门为全模态输入设计任务:隐式提示搭配多帧、音频-图像、前缀视频、音频-视频四类场景。关键设计是每一路模态只提供事件的部分证据,模型必须跨模态整合互补线索,才能推断出潜在的事件状态与未来动态。 实验效果:517 个评测实例上,MiniMax-H3 总体成功率 41.97%。分维度看,基于视频的决策推理最高、为 56.00%,基于音频的消歧推理最弱、只有 27.40%。作者据此认为要真正吃到多模态输入的红利,关键仍在有效的跨模态整合。 批判点评:用「每种模态只给部分证据」的设定逼出跨模态整合能力,比提示词与目标高度重合的常规评测更有区分度,音频维度 27.40% 也确实点出了当前全模态模型的短板。但全文只评了 MiniMax-H3 一个模型,没有同代横向对比,41.97% 这个绝对值究竟是模型不行还是任务过难无从判断;517 个实例摊到四个维度上,每个维度的样本量也偏薄。 3. Diagonal Sparsity:对角稀疏把吞吐拉到3.1倍 Understanding and Exploiting Diagonal Attention Sparsity in Autoregressive Image Generation | KAIST;Agency for Defense Development;Seoul National University | arXiv:2609.19702 关键词:自回归图像生成,稀疏注意力,KV cache,推理加速 ⚠️ 前序问题:自回归图像生成因为能直接复用基于 transformer 的 LLM 服务设施而成为多模态系统的一种范式,但每次请求要吐出上千个视觉 token,解码越来越被注意力计算中的 KV cache 访问卡住。稀疏注意力在文本 LLM 推理上已被充分研究,可它的稀疏性假设能不能迁移到自回归图像生成,此前没人说得清。 本文贡献:论文首次系统刻画了自回归图像生成中的注意力稀疏性,覆盖多种负载与代表性开源模型,发现三个和文本场景不一样的性质:prefill 与 decode 阶段存在明显不对称、注意力强烈集中在 prompt token 与局部 token 上、以及视觉 token 的空间局部性带来一种独特的对角稀疏模式。据此提出对角感知稀疏注意力,在最近窗口内沿对角方向选择性跳过 KV 条目。 实验效果:基于 FlexGen、FlashAttention-2 与自定义 kernel 实现在 GPU 服务系统上,相比稠密推理最高取得 3.1 倍吞吐与 1.19 倍延迟改善,质量损失低于 2%。 批判点评:把稀疏模式追到「视觉 token 的空间局部性」这一来源、而不是照搬文本 LLM 的稀疏假设,是这篇最扎实的地方,3.1 倍吞吐也有工程说服力。但「质量损失低于 2%」用的是哪个指标、在哪些负载上成立,摘要没交代;对角模式依赖光栅扫描式的 token 排布,换扫描顺序或改分辨率后是否还成立同样存疑。 4. VibeAvatar:口型与美感分阶段各管各的 VibeAvatar: Aligning Phonetic Kinematics and Human Aesthetics for High-Fidelity Talking Avatar Synthesis | Peking University | arXiv:2609.18632 关键词:说话人视频合成,语音驱动,GRPO,流匹配 ⚠️ 前序问题:多模态说话人视频合成要从一张参考肖像加一段语音生成逼真视频。扩散类方法进步很快,却始终难以同时拿到准确的唇部发音、符合人类偏好的运动美感和高效推理这三样。 本文贡献:论文的判断是:发音准确性和运动美感来自根本不同的源头,应该在互补的阶段分别处理,而不是塞给单个生成器隐式地一起学。VibeAvatar 因此把两个目标解耦——条件阶段用 Phonetic Kinematics Adapter(PKA)把面向识别的语音特征转成发音-运动条件;后训练阶段用 Aesthetic Motion Policy(AMP),以 GRPO 优化一个流一致的随机采样策略。运动生成器本身是轻量流模型,工作在紧凑的一维 warp 潜空间里。 实验效果:客观指标与用户研究上,发音、美感、效率三项均达到 state-of-the-art;生成 10 秒 512px 视频耗时不到 10 秒,显存占用约 3GB。 批判点评:「发音归条件阶段、美感归后训练」是个干净的分工,把 GRPO 用在采样策略而不是生成器权重上也省掉了重训成本,约 3GB 显存意味着消费级显卡能跑。但美感由 GRPO 所对齐的偏好定义,口味会不会过拟合到特定标注群体值得警惕;摘要只给了效率数字,发音与美感的具体分数、以及更长时长下的身份漂移都得看正文。 5. AVR:能抄就抄抄不到才让扩散补 Copy What Is Seen, Generate What Is Not: Training-Free Anomaly-Aware Video Restoration | New York University;University of Technology Sydney | arXiv:2609.18836 关键词:视频修复,异常检测,免训练方法,扩散修补 ⚠️ 前序问题:监控系统检测到异常后往往还得把画面修好,但这两件事一直被分开研究:免训练的异常检测止步于一个分数或标签,免训练的视频编辑则只听用户提示词、不听检测器。 本文贡献:AVR 只用冻结的预训练模型就把两端接上,而且只在画面确实没有证据可抄的地方才生成内容。先由运动证据把开放词表提案收敛成时空掩码;再用片段自身算出的背景先验,填掉异常曾经遮挡过的每一个像素,只把「任何一帧都没出现过」的部分交给扩散合成;最后一个冻结的验证器逐片段决定该信任经典修复、先验锚定修复还是背景条件修复。 实验效果:三个监控数据集上、覆盖全参考异常注入与真实异常两种设定:oracle 掩码下 AVR 的全帧保真度领先,在编辑区域内与三个训练过的视频 inpainting 方法持平,用自己产出的掩码时优于「先检测再生成」的流水线,同时压住了残留异常与自由扩散带来的闪烁。 批判点评:「能抄就抄、抄不到才生成」的取舍很贴监控取证的需求——少生成一分就少一分臆造风险,全程冻结模型也免了训练成本。但它靠运动证据圈定异常,静止或缓慢的异常可能整个漏掉;oracle 掩码下的领先说明上限不错,自产掩码下的成绩才是实际水平,三个监控数据集的场景多样性也仍有限。 6. CPR:作曲演奏精修三段渲染钢琴 CPR: Combining global composing, local performing and full-sequence refining in piano rendering with continuous autoregressive modelling | The Chinese University of Hong Kong, Shenzhen | arXiv:2609.18216 关键词:钢琴渲染,连续自回归,流匹配,音乐生成 ⚠️ 前序问题:提示词条件下的钢琴 MIDI-to-Music 渲染,要在忠实还原目标音符的同时复现参考录音的音色。现有方法分两条路:离散 codec 的自回归模型有因果时序建模能力,但量化会丢掉声学细节;流匹配更能保住声学结构,代价是全序列注意力开销大、语义结构反而更差。 本文贡献:连续自回归模型直接在连续表示上工作,既兼有自回归的条件跟随能力与流匹配的分布建模能力,又绕开量化瓶颈、计算成本更低。CPR 据此拆成三段:Composer 自回归预测连续隐状态,Performer 经局部流匹配生成 24kHz 声学潜变量,Refiner 再把波形上采样到 48kHz。论文另引入 Bottlenecked Representation Alignment(BREPA)与 Modality-Time RoPE(MT-RoPE),分别强化 Composer 隐状态里的音乐语义结构和跨模态时间对齐。 实验效果:P-MUSE-eval 上,CPR 只用 4 步(NFE=4)就输出 48kHz 音频,onset F1 78.4 与 FAD_clap 0.129 均为最佳;音色相似度 89.3 略低于需要 25 步的 P-MUSE(90.6),但明显优于 MIDI-VALLE 的 83.4。另有 13 位听众对 14 个样本的 MOS 主观评测。 批判点评:三段分工把「写什么音」「怎么弹出来」「采样率补齐」拆开,绕过离散量化这个老瓶颈,4 步出 48kHz 相对 P-MUSE 的 25 步是实打实的效率优势。但音色相似度并未超过 P-MUSE,说明连续表示在音色保真上还没占到便宜;MOS 只有 13 位听众评 14 个样本,样本量偏小,评测也集中在钢琴单一乐器上。 7. Self-Distilled TTS:模型自己教自己念生词 Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech | Independent Researcher;KOWRO Inc. | arXiv:2609.17234 关键词:语音合成,自蒸馏,发音控制,口音标注 ⚠️ 前序问题:直接读原始文本的 TTS 没有词典,碰上生僻词只能靠猜。已有的补救要么拿录音训练一条专门的发音与口音通道,要么从示例里一个词一个词地改。 本文贡献:这篇两样都不做。让冻结的骨干去读一个含有它本来就念得对的常见词的句子,再把它自己的输出当作同一句话的教师——只是把那个词替换成带标注的、指定口音的读法。这一对训练样本就是方法的全部。 实验效果:Sarashina2.2-TTS 上,经筛选的评测者(Fleiss' kappa = 0.85)在 0.89 的未见词上听出了指定口音,而无法表达口音的假名方案只有 0.57、没有赢下任何一组对比,自然度没有可测量的损害。未经调整迁移到自回归、扩散和编码器-解码器骨干后,319 个词上的读法正确率比不做编辑高出 0.25 到 0.47;CosyVoice 2 上三个词里有两个能带上口音,但在 Irodori 上不行,论文分析了原因。 批判点评:用模型自己的输出当教师、只换一个词构成训练对,简洁到几乎没有额外数据成本,跨骨干迁移也说明思路不绑架构。但它天然受限于「骨干本来就念得对的常见词」这个起点,词表外的音素组合未必覆盖得到;Irodori 上失效说明迁移并非无条件成立,日语音高重音之外的语言是否同样奏效也还没有证据。 8. JewelTry:免掩码珠宝试戴还管尺寸 JewelTry: Mask-Free Scale Aware Jewelry Virtual Try-On | Amazon | arXiv:2609.16626 关键词:虚拟试戴,免掩码扩散,尺寸感知,评测基准 ⚠️ 前序问题:虚拟试穿让顾客看到上身效果,已是网购的重要技术。服装类进展很大,珠宝却因为体积小、结构刚性、对细节高度敏感而一直是难啃的品类:既要忠实迁移外观,还得相对佩戴者有正确的尺寸和位置。现有珠宝试戴多依赖掩码引导,而免掩码方法又缺乏建模产品尺寸的显式引导。 本文贡献:论文先建了 JVTO-Bench,提供带真实产品尺寸标注的「参考-源-目标」三元组,覆盖四大珠宝品类。在此之上提出免掩码扩散框架 JewelTry:尺寸适配器把产品实际尺寸编码成一个 scale token,让模型在上下文中学到珠宝与人体解剖结构之间的尺寸关系;再用单向条件注意力与注意力精修损失,同时保住参考珠宝的粗粒度几何与细粒度结构细节。 实验效果:实验显示 JewelTry 在视觉保真度、背景保持、物体一致性与尺寸准确性之间取得平衡,为免掩码、尺寸感知的珠宝虚拟试戴立了一个较强基线。 批判点评:把「尺寸对不对」变成可编码的条件而不是靠掩码兜底,抓住了珠宝区别于服装的真正难点,配套放出带真实尺寸标注的 benchmark 也补上了这一方向的评测空白。但摘要通篇没给量化指标,「取得平衡」这类表述无法判断相对现有方法的实际差距;四个品类对珠宝这种长尾品类而言覆盖面也偏窄。 9. MSR:多张参考图各占一个 slot MSR: Multiple Subject Reference for Video Generation | Licon Studio | arXiv:2609.18393 关键词:多主体视频生成,参考图条件,LoRA,流匹配 ⚠️ 前序问题:让视频生成器同时吃多张参考图时,既要保住每个主体的外观,又要把每张图和它该扮演的角色对上,否则属性就会串到别的对象身上。 本文贡献:MSR 是面向 LTX 视频生成的 slot 感知条件方案:每张参考图被独立编码成一段静态片段、对应一组单独的潜 token;一个紧凑的傅里叶特征 MLP 给它加上数值化的 slot 嵌入,再用随 slot 变化的时间偏移改写这组 token 的旋转位置坐标。这些参考组被前置到带噪的目标 token 之前,在仅针对目标的流匹配训练中充当干净上下文。整套方案用 LoRA 实现,权重与推理工作流已开源。 实验效果:论文给的是定性结果:示例展示了包含不同角色与参考环境的写实及风格化场景组合;开发过程中的观察显示,相对更早的连续参考基线,参考混淆有所减少,但相似服装、复杂衣物和视角变化仍然困难。另有一个补充实验在冻结视觉参数的前提下加入了语音参考条件。 批判点评:用独立 token 组加 slot 嵌入来绑定「哪张图对应哪个角色」,思路直接,靠 LoRA 就能低成本落地,开源权重与工作流对想复现的人友好。但这更像一份技术报告而非完整论文:全文没有定量实验,「参考混淆减少」只是开发观察而非受控对比,缺少与基线的可比指标;作者自己也承认相似服装与视角变化仍未解决。 10. Newer Is Not Fairer:新版文生图并没有更公平 Newer Is Not Fairer: Gender Stereotyping in Text-to-Image AI Across Model Generations | Northeastern University | arXiv:2609.18007 关键词:文生图,性别偏见,模型审计,公平性评测 ⚠️ 前序问题:文生图模型已经在专业与创意场景里广泛使用,但它们如何呈现不同职业的性别、以及更新的模型是不是更公平,跨代际地看仍缺乏系统证据。 本文贡献:论文评测了 20 个职业、5 种提示词模板、4 代 Stable Diffusion(SD 1.5、SD 2.1、SDXL、SD 3 Medium),每个「职业×模型」单元生成 100 张、共 8000 张图,全部用 DeepFace 判定性别,并与美国劳工统计局(BLS)的真实劳动力数据对照,所有显著性检验都做了 Benjamini-Hochberg 多重校正。 实验效果:8000 张开源模型图像中 76.4% 为男性(95% CI [75.1%, 78.7%]);更扎眼的是历史上女性主导的职业里仍有 57.6% 生成男性。相对 BLS 数据,模型平均低估女性 20–46 个百分点,本就接近性别均衡的职业偏差最大——科学家 BLS 女性占 48%、模型输出 82–99% 为男性,清洁工 BLS 女性占 46%、模型输出 80–92% 为男性。代际并非稳步改善:偏差从 SD 1.5 一路恶化到 SDXL,到 SD 3 Medium 才部分回落。与 GPT-image-1 在五个职业上的初步对比显示商业模型偏差更低,但实际效应很小(Cramér's V = 0.080)且属探索性。没有任何一个模型达到性别均衡。 批判点评:8000 张图、多重检验校正、对照 BLS 真实就业数据,这套设计让结论比常见的偏见讨论扎实得多,「更新不等于更公平」的代际发现尤其有价值。但性别判定依赖 DeepFace 的二元分类,本身有误差且无法涵盖非二元表达;20 个职业、5 个模板的提示词空间偏窄,与 GPT-image-1 的对比作者也标注为探索性,撑不起开源与商业模型孰优孰劣的强结论。 趋势观察 长上下文的瓶颈,从「记不记得住」变成「cache 放不放得下」 Recency Forcing 把长视频退化追到 KV cache 淘汰这一工程约束,Diagonal Sparsity 直接冲着自回归图像生成的 KV 访问瓶颈去。两篇都不再泛泛谈误差累积,而是把注意力的显存与访存代价当成一等问题来解。 生成质量的定义权,正在交给后训练与采样策略 VibeAvatar 把运动美感交给 GRPO 在后训练阶段对齐,而不是让生成器隐式地学;CPR 用连续自回归绕开量化,再分三段把语义结构、局部声学与采样率分工。共同前提是承认单个生成器学不好多个互相冲突的目标。 评测开始审问模型「到底懂不懂」,而不只是「像不像」 MiniMax-H3 的评测让每种模态只给部分证据,逼模型跨模态整合才能答对;Newer Is Not Fairer 用 8000 张图对照真实就业数据,把「新版是否更公平」变成可证伪的问题。两者都不满足于保真度分数。 免训练与轻量适配,正在成为落地的默认路径 AVR 全程冻结预训练模型、只在没有证据可抄的地方才生成;MSR 用 LoRA 给现成视频模型加多主体条件;Self-Distilled TTS 让模型自己的输出当教师。共同动机都是避开重训成本。 人工智能炼丹君 整理 | 2026-09-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-29|字节斯坦福让视频记住走远的人RingForcing 今日 AIGC 论文速览 今日共 10 篇 · 长视频记忆与一致性 3 篇 · 实时流式生成与编辑 3 篇 · 单图世界建模 1 篇 · 后训练与奖励建模 2 篇 · 流式音视频评测 1 篇 重点论文标题列表 Ring Forcing(Stanford University、MIT、北京大学、UC Berkeley、字节跳动):环形训练把记忆拉到分钟级 EditaLive(澳门大学、vivo BlueImage Lab、大湾区大学 GVC Lab):两步采样做到14.47FPS直播换装 TetherMem(华中科技大学、小米 MiLM Plus):主体查身份场景查近景各走一路 RECAP-Forcing(UC San Diego):按外观新鲜度存而非按时间存 Magpie(Mogo AI、南京大学、南安普顿大学):引擎管规则生成模型只管画 今日论文速览 1. Ring Forcing:环形训练把记忆拉到分钟级 Ring Forcing: Towards Precise Long-Term Memory for Autoregressive Video Diffusion | Stanford University、MIT、北京大学、UC Berkeley、字节跳动 | arXiv:2608.26794 关键词:自回归视频扩散,长时记忆,物体恒存性,稀疏RoPE,历史压缩,字节跳动,Stanford 前序问题:视频生成往长时长走,真正的瓶颈不是画质而是记忆。作者把它拆成两个必须同时成立的能力:一是「物体恒存性」——一个人走出画面几十秒后再进来,长相要和原来一致,而不是换了个人;二是「记忆容量」——模型得能处理超长上下文,真正用上很久以前的信息。已有做法往往只顾一头:能精确复现细节的,可用的时间跨度很短;把上下文拉得很长的,又保不住身份。更棘手的是训练目标本身的矛盾——如果强迫模型严格照抄历史,生成会变得僵死、失去多样性;如果放松约束,它就干脆不去看远处的历史,因为预测邻近帧永远是更省力的捷径。 本文贡献:Ring Forcing 的核心是一个环形训练策略:把原视频与反转后的视频首尾相接成环,随机裁掉开头一段,再在中间「挖掉」一部分作为隐藏的真值(Hidden GT),同时施加 Ring Context Drop。这样一来,要预测的目标帧其内容只能从远距离历史里取回,模型没有走捷径的余地,从而在「严格遵循历史」与「保持生成多样性」之间取得平衡。为扩容记忆,作者用压缩加时间步组合的策略,在固定序列长度下把有效历史跨度推到分钟级,并让感受野覆盖整段历史。第三个部件是稀疏 RoPE:让位置编码可以灵活、可扩展地适配记忆条目,同时尽量复用预训练先验,实验显示它比标准按索引排布的 RoPE 收敛更快、重建质量更好。作者还设计了双流结构,在不增加序列长度的前提下让组合策略稳定优于两个单独基线。 Overview of the Ring-Structured Training Strategy. We construct a sequence ring by concatenating a linear raw video with its reversed counterpart. By unrolling the ring into a conditioning sequence, the target frames are naturally embedded into the distant history as the Hidden GT, which essentially forces the autoregressive generator to learn explicit long-range retrieval. To prevent trivial shortcuts, a Random Head Crop is applied to truncate boundary information leakage, while a Random Context Drop is used to balance history adherence and generation diversity. 实验效果:在作者构建的 A-D-R Benchmark(出现—消失—再现)与一分钟通用长视频基准上,Ring Forcing 在分钟级连贯性和物体恒存性上明显优于现有方法。定性对比里,同一段一分钟美术馆漫游,FramePack 的画面逐步漂移、LongCat 后半段结构开始崩坏、LongLive 的展品在切换中被替换,而 Ring Forcing 始终保持雕塑与展厅结构稳定;穿越遮挡后再出现的物体也能保持原有外观。人类偏好评测中它在美学、自然度与总体偏好上均取得最佳,说明记忆机制的增强没有以画质退化为代价。 Qualitative results of 60-second long video generation. The visualization demonstrates the model's capability to maintain overall consistency and visual quality throughout a 1-minute duration in general scenarios. 批判点评:这篇的价值在于把长视频一致性从「算力/上下文长度问题」重新定义成「检索问题」,而环形训练是一个相当巧妙的构造——它用数据组织方式强制模型放弃预测邻近帧的捷径,比单纯加损失项更根本。稀疏 RoPE 也和昨天 JoyAI-Echo-1.5 的「给记忆单独编址」思路撞在一起,可以认为这是当前的一个共识方向。需要保留的疑问有三点:一是自建 A-D-R Benchmark 虽然针对性强,但也意味着「恒存性」这个最关键指标缺少第三方基准交叉验证,作者说的 SOTA 主要在自家尺子上量出;二是环形训练依赖把视频反转,这对有明确因果方向的内容(倒水、物体破碎)是否引入了反物理先验,论文没有讨论;三是分钟级的说法建立在「压缩+时间步组合」之上,压缩必然有损,论文没有量化到底丢了什么、在多长时间尺度上开始失效。 2. EditaLive:两步采样做到14.47FPS直播换装 EditaLive! Unified Character Video Editing for Live Streaming | 澳门大学、vivo BlueImage Lab、大湾区大学 GVC Lab | arXiv:2608.27123 关键词:人像视频编辑,直播流式生成,少步蒸馏,稀疏注意力,Wan-Animate,vivo 前序问题:常规视频编辑关注的是整体场景,而直播场景真正在意的是人——观众盯着的是主播的脸和动作。把现有视频编辑方法直接搬到以人为主体的直播上有两个硬伤:一是面部表情容易失配,改完之后人物的微表情和原视频对不上,观感立刻失真;二是这些方法通常要多次离线推理,延迟根本不满足实时互动。一个看似可行的折中是「先用图像编辑器改首帧、再驱动动画」,但这条级联路径不是端到端的,延迟叠加,而且长序列下外观会持续漂移。此外这类任务还缺训练数据——成对的「编辑前后视频」几乎无法大规模构造。 本文贡献:EditaLive 从预训练的图像动画模型 Wan-Animate 出发,利用它天然把外观与动作解耦的特性,将其改造成指令驱动的人像视频编辑器:做法是只编辑参考帧、再重建视频,从而绕开成对视频数据的构造难题,配套自建了 CharEdit-50K 数据集(用 GPT 生成增删改与风格化四类互逆指令对,经 Qwen-Image-Edit 与 Nano Banana 2 合成候选,再做角色一致性、可逆性、编辑准确性等质量过滤)。为满足实时性,作者把模型从双向改为因果流式,并设计对齐的自 rollout 蒸馏,把模型压缩成两步采样器;其中 Align Forcing 与 Fixed RoPE 用来缩小训练与推理的差距,First-frame Preserved Sparse Attention(FPSA,稀疏率 75%)负责过滤冗余历史信息以抑制外观漂移。 Overview of the three-stage training pipeline of EditaLive. (a) Appearance--Motion Decoupled Editing reformulates character video editing as appearance editing with explicit body and facial motion preservation. (b) Causal Streaming Adaptation converts bidirectional modeling into causal generation using clean historical context and causal attention. (c) Aligned Self-Rollout Distillation compresses the model into a two-step sampler, where Align Forcing and Fixed RoPE align training with streaming inference, and FPSA improves long-term appearance stability. 实验效果:在单张 NVIDIA H100 上,EditaLive 端到端吞吐 14.47 FPS、平均块间延迟 0.829 秒,实现了亚秒级流式延迟。作者承认专用流式基线的原始速度更快,但那些基线的编辑成功率最高只有 0.428,而 EditaLive 达到 0.720;相较最快的双向基线 LucyEdit,它在吞吐与延迟上都有数量级改善。消融图显示去掉 Align Forcing 后风格化结果的色调与身份明显跑偏,去掉 FPSA 与 Fixed RoPE 则在第 900 帧附近出现可见的外观退化。 Ablation study on causal streaming adaptation and aligned self-rollout distillation. 批判点评:这篇的工程判断很清晰:直播编辑的真实约束是「实时」,所以宁可牺牲一点原始吞吐去换编辑成功率,这个取舍是对的——0.428 的成功率在产品里等于不可用。用「只编辑参考帧」绕开成对视频数据的构造,也是个聪明的降本设计。但有几处需要保持警惕:一是数据管线重度依赖闭源模型(GPT 5.5 生成指令、Nano Banana 2 与 Qwen-Image-Edit 合成图像),这意味着数据分布继承了这些模型的偏好和缺陷,复现成本也不低;二是它的能力边界被基座 Wan-Animate 框定,本质是「外观替换」,涉及大幅改变体型或需要新增遮挡关系的编辑恐怕难以胜任,论文的 limitation 图也暗示了这点;三是 FPSA 固定 75% 稀疏率是个经验值,在快速运镜或多人入画时是否仍然安全,缺少压力测试。 3. TetherMem:主体查身份场景查近景各走一路 Tether the Subject, Release the Scene: Query-Aware Memory Routing for Long-Horizon Autoregressive Video Generation | 华中科技大学、小米 MiLM Plus | arXiv:2608.26902 关键词:自回归视频生成,记忆路由,免训练,场景推进,长视频一致性,小米 前序问题:流式自回归视频模型逐块生成,靠历史记忆维持一致性。问题是现有方法对「主体查询」和「场景查询」用的是同一套访问策略——都同等地看历史。这确实稳住了主体身份,但副作用是把背景、视角和场景结构也一并锁死在此前的状态上:人物在走动,可街景却始终是同一条街,怎么走都走不出去。作者把这个失效模式命名为「记忆锚定的场景推进不足」,并指出它很容易被漏掉——因为常用的一致性指标和运动指标都不会报警,画面里确实有局部运动,一致性也确实很高,唯独缺了「场景在推进」这件事。 本文贡献:TetherMem 是一个免训练、面向冻结视频生成器的查询感知时空记忆路由器。它把主体查询与场景查询分开处理,并用「区域」和「新旧程度」两类先验来调制各自对历史的访问权重:主体查询保留承载身份的历史,场景查询则主动降低对主体历史和陈旧背景的依赖。具体实现上,用时间对齐的离线掩码区分主体区域与场景区域,再在归一化记忆路由中给不同年龄的记忆条目加上对数偏置,使得主体侧倾向「拴住」身份记忆、场景侧倾向「放开」并偏向近期背景。相比此前只做帧级时间筛选(选择保留哪些帧、粒度粗且不区分查询类型)的做法,它把筛选粒度下沉到了「哪类查询看哪块区域的哪段历史」。 Overview of TetherMem. (a) End-to-end routing preserves identity memory for subject queries and favors recent backgrounds for scene queries. (b) Prior methods select memory frames, whereas TetherMem routes query roles within the retrieved history. 实验效果:在来自 10 位标注者的 2400 次盲测成对比较中,TetherMem 在八个流式长视频基线里取得最高的期望偏好度:整体质量 0.780、场景推进 0.769。完整的 30 秒视频上,它能让背景、视角和场景状态持续变化,同时保住主体的可辨识度与时间连续性;架构图中的定性对比显示,基线要么表现为「场景冻结」(一直是同一条街),要么是「伪推进」(换了街景但布局照旧),而 TetherMem 能走出「街道→店面→广场」的真实推进。作者提供的证据散点图还显示它在「身份 EP × 场景推进 EP」平面上明显位于右上角,优于 LongLive-RAG 与 MemRoPE 等基线。 The evaluation landscape exposes two distinct gaps. (a) Identity EP versus scene-progression EP shows that strong identity can coexist with weak progression. (b) nT versus human progression shows that coherent translation is informative but incomplete: Causal Forcing has high nT and low human progression. Values are the method-level aggregates from Table. 批判点评:这篇最有价值的部分其实不是方法而是问题定义——它指出了一个被现有指标系统性掩盖的失效模式,并且说清了为什么「一致性高、有运动」还能是坏结果。这种把「指标满分但体验不对」显式化的工作,往往比再涨两个点更有意义。免训练、面向冻结模型也让它容易被复用。但要注意几点:一是核心结论几乎完全依赖人类偏好评测,没有自动指标佐证——这一方面是诚实的(作者自己论证了现有指标测不出场景推进),另一方面也让结果难以被独立复现和横向比较,作者若能顺势提出一个可自动计算的场景推进指标,贡献会大得多;二是方法依赖「时间对齐的离线掩码」来区分主体与场景,这个前置分割的质量直接决定路由效果,遇到多主体、主体与背景纠缠或分割失败时会怎样退化,论文没有充分交代;三是「主体拴住、场景放开」是一个人为设定的二分,对于「主体本身就该随场景改变」(如换装、光照剧变)的情形,这套先验可能反而成为约束。 4. RECAP-Forcing:按外观新鲜度存而非按时间存 RECAP-Forcing: Retaining Content Appearances for Long Video Generation | UC San Diego | arXiv:2608.26671 关键词:长视频生成,KV缓存,外观索引记忆,光流新颖度,免训练,UCSD 前序问题:长视频自回归生成面临一个根本的记忆取舍:注意力窗口有限,模型必须决定从不断膨胀的历史里留下什么。现有方法几乎都按时间来组织记忆——保留最近的帧,把更早的压缩或直接丢弃。作者认为这个索引方式本身就错了:一段长视频不只是帧的序列,而是一批不断登场的主体、物体和场景,它们的身份必须长期保持一致。按时间存有两个恶果:同一内容会被反复重复存储,且随时间衰减,最终导致信息永久丢失;同时记忆开销与视频长度成正比,越长越吃不消。 本文贡献:RECAP-Forcing 换了个索引轴:按「外观新颖度」组织记忆,而不是按时间。做法是在内容首次可见的那一刻,就把它对应的 KV 缓存留存下来——包括入画的新主体、被遮挡后重新露出的区域、新引入的场景,优先保留「新颖」而非「近期」。这样记忆规模与「新引入内容的总量」成正比,而不是与视频长度成正比,长程一致性因此变成记忆结构本身的显式属性。框架把两个机制统一在同一原则下:视频开头所有内容都是新的,此时用 attention sink 保住初始场景;随着视频推进,再用基于光流的新颖度库延续同一原则——用 RAFT 算前后帧光流,转成新颖度图,挑出新颖 patch,取其对应的逐层 KV 入队到记忆库。整套方法免训练、无额外可学习参数。 What should a long-term video memory store? The same rollout, indexed two ways. Top: the man is recorded at his first appearance ($t_1$); each later frame depicts something new: a passing car ($t_2$), a pedestrian ($t_3$), another passer-by ($t_4$). Bottom Left: frame-indexed memory re-stores old and new content alike at every step, then compresses or evicts it as time passes, so memory pressure grows with video length. Bottom Right: appearance-indexed memory (RECAP-Forcing) stores content when it newly appears, at canonical temporal position $0$, memory scales with the amount of newly appearing content, not with its duration. 实验效果:作为推理期免训练方法,RECAP-Forcing 在多个强基线上一致提升了视觉质量与语义保真度,并优于既有的记忆方法。一分钟长视频的定性对比很直观:基线在「第二个主体入画」的场景里逐渐丢失内容身份并开始漂移退化——尾随的 SUV 化成尘土并出现复制、岩石人裂开并偏离路径;而 RECAP-Forcing 在保住主体身份与视觉一致性的同时没有牺牲运动幅度。记忆可视化图显示,被选中留存的 patch 确实集中在新出现的角色与新露出的区域上,说明新颖度判据按预期工作。 Qualitative results on four one-minute prompts. Across all scenes, the baseline loses subject identity, style, scale, or background consistency. In contrast, RECAP-Forcing preserves the subject(s) and the full scene throughout the minute. 批判点评:「按外观索引而非按时间索引」是今天三篇记忆论文里最简洁、也最容易迁移的一个想法——免训练、无新增参数、可直接挂在现有模型上,这类工作的实际影响力往往比需要重训的方案更大。「记忆增长应当与新内容量成正比、而非与视频长度成正比」这句话本身就值得记下来。需要打折扣的地方也很明确:一是判据完全依赖光流的新颖度,而光流在快速运镜、大面积遮挡、剧烈光照变化下本就不可靠,此时「新颖」可能只是估计误差,论文没有给出失效分析;二是留存策略只进不出,若视频里持续引入新内容,记忆库会单调膨胀,论文声称规模与新内容量成正比,但没有交代长时间运行下的上限与淘汰机制;三是三位作者仅在自选基线上做相对比较,缺少与本文另两篇(Ring Forcing / TetherMem)这类同期方案的直接对话,读者难以判断三条路线的相对优劣。 5. Magpie:引擎管规则生成模型只管画 Magpie: Real-Time World Renderer for Interactive Games | Mogo AI、南京大学、南安普顿大学 | arXiv:2608.27168 关键词:实时世界渲染,交互式游戏,生成式渲染,白盒画面,游戏引擎解耦,Mogo AI 前序问题:现代游戏开发重度依赖传统图形管线:建模、材质、动画、灯光、特效、运行时优化,每一环都要人力,导致美术资产昂贵、原型周期漫长。视频基础模型已经开始改变影视制作,但游戏和线性媒体有本质区别——游戏不只要求画面连续真实,还要求玩法规则、物体状态和交互结果稳定且可复现。换句话说,同样的操作与状态在指定规则下必须保持稳定的含义,这一点是纯生成式方案最难保证的:一旦让生成模型接管世界状态,规则就变得不可控、不可复现,游戏也就不成立了。 本文贡献:Magpie 的关键设计是把玩法执行与视觉生成彻底分开。设计师照常在游戏引擎里定义场景与规则;运行时,游戏引擎负责解算玩家操作、维护世界状态,并输出「白盒画面」(只有几何、布局、遮挡与主要运动的灰模渲染);独立的 Render Server 再把白盒画面转成最终的高保真视觉,流式回传给客户端。初始化时用一段文本提示与首帧图像确定视觉风格,交互过程中白盒帧是唯一持续的去噪条件,相机位姿只用来检索相关的视觉历史。数据侧,作者在 Unreal Engine 里搭可控场景,由训练过的真人操作员而非脚本或自动智能体来玩,采集约 300 小时、30 多个场景的成对交互视频(1920×1080、60 FPS),并要求操作员刻意反复经过困难视角、交互边界、状态转换与静止间隔;除双路视频外还记录相机位姿、操作输入、碰撞、状态转换与事件信息,共享时间戳。 Magpie system overview. Designers define layouts, interactions, rules, and numerical parameters in the game engine. The User Client forwards player actions to the Game Engine, which executes gameplay and emits white-box observations. The independent Render Server converts those observations into generated video and streams the result back to the client. Gameplay state and rule execution remain inside the engine. 实验效果:Magpie 5B 的 Render Server 在单张 NVIDIA H100 上以块级自回归推理运行:每块含 5 个潜在帧,首块解码为 17 帧、后续每块 20 帧。作者提供的运行时时序图给出了完整的延迟构成——引擎录制约 830 毫秒(20 帧 / 24fps)、渲染约 620 毫秒,从用户输入到画面显示端到端约 1550 毫秒,块输出本身覆盖约 830 毫秒。系统层面,它保住了玩法的可设计性与可复现性,并降低了早期游戏原型对完整视觉资产的依赖。 Chunk-level interaction and rendering timeline. At 24 FPS, the Game Engine records 20 white-box frames in approximately 830 ms. After transfer, the Render Server generates the corresponding chunk in approximately 620 ms; transfer and buffering account for the short intervals between stages. The first action-aligned visual response therefore appears after roughly 1550 ms, while subsequent output chunks are displayed over approximately 830 ms. 批判点评:这篇的价值主要在系统架构而非模型创新,而它的克制恰恰是最值得学的地方——不追求端到端接管一切,而是承认「规则可复现」这条底线只有传统引擎守得住,把生成模型限定在渲染层。用真人操作员而非脚本采集数据、并刻意覆盖交互边界与困难视角,也是一个容易被忽视但对交互场景很关键的细节。不过必须实话实说:约 1550 毫秒的端到端延迟离真正可玩还有相当距离——它对回合制或慢节奏探索或许够用,但对任何需要即时反馈的玩法(动作、竞技)都不可接受,论文标题里的 real-time 更接近「流式」而非游戏工业界理解的实时。另外它是技术报告体裁,缺少与其他世界模型的量化横向对比,也没有交代白盒画面的抽象程度如何影响生成质量——白盒给得太粗,模型要猜的东西太多;给得太细,又回到了要做美术资产的老路,这个权衡点在哪,读者看不到答案。 6. SpatialCrafter:先出几何代理再补高频细节 SpatialCrafter: Single Image World Modeling with Generative 3D Proxies | 香港科技大学、阿里巴巴通义实验室、群核科技、吉林大学 | arXiv:2608.27073 关键词:单图场景生成,世界模型,3D代理,视频扩散,几何注入,港科大,通义 前序问题:从一张图生成可自由探索的三维场景,在游戏、机器人和 VR 里都是刚需。现有基于视频扩散模型的做法通常依赖不完整的条件信号——稀疏点云或二维全景图,由此带来三个连锁问题:模型要靠随机猜测填补缺失信息(幻觉)、长距离漫游时画面逐渐漂移、三维一致性不达标。根子在于条件信号本身没有提供完整可靠的几何约束,于是视频模型既要负责编造几何又要负责渲染外观,两件事互相干扰。 本文贡献:SpatialCrafter 引入一个全局 3D 代理,把生成过程拆成「代理生成」与「外观精修」两阶段。代理阶段用 Point-anchored Sparse Structure(PaSS)Flow 模块,从输入图与点云出发预测空间对齐、几何一致的稀疏体素结构,再经 SLAT 扩散得到粗糙 3D 场景。精修阶段把视频扩散模型重新定位为「生成式延迟渲染器」,只负责在代理给定的几何之上合成高频写实细节。为了让代理与预训练视频模型更好结合,作者提出 Parallel Geometry Injection(把粗糙 RGBD 视频经 VAE 编码后与噪声潜变量做宽度/通道拼接注入)和 Proxy-Aware Corruption 训练策略,提升对代理瑕疵的鲁棒性,同时避免破坏预训练的生成流形;视频 DiT 主体冻结、仅用 LoRA 微调。此外作者构建了 115K 场景的大规模数据集,称是首个面向图生场景任务的混合数据集。 Overview of SpatialCrafter. Given a single image and a camera trajectory, we first construct a global 3D proxy using a native 3D generator with Point-Anchored Sparse Structure (PaSS) Flow Matching. This proxy then serves as a reliable coarse 3D prior for the Generative Deferred Refiner, which transforms it into photorealistic RGB-D video sequences via Parallel Geometry Injection and Proxy-Aware Corruption. 实验效果:在 DL3DV 与 RE10K 等合成与真实数据集上,SpatialCrafter 大幅优于现有方法,消除了长程漂移,并在快速相机运动与极端视角变化下保持稳健一致。视觉质量以 FVD、PSNR、LPIPS、SSIM 对齐真值序列衡量,作者报告在三个基准上全面领先。定性对比图很能说明问题:同一输入下 Voyager 整体偏暗甚至近乎全黑、GEN3C 出现严重纹理糊化与结构错乱、ViewCrafter 把家具糊成一片,而 SpatialCrafter 的结果在几何结构与材质细节上都最接近 GT。 Qualitative comparison with SOTA methods. SpatialCrafter significantly surpasses the baseline methods under extreme challenging camera motions, yielding photorealistic and spatially consistent novel view synthesis. Please refer to the supplementary material for more comparison results. 批判点评:「先保几何、再补外观」的分工是这篇最扎实的判断——把视频扩散模型从「同时编造几何和外观」的双重负担里解放出来,长程漂移自然缓解,这与 Magpie 用白盒画面约束生成是同一个思路,可以看作今天的一条隐性共识。Proxy-Aware Corruption 这个细节也很实用:既然代理必然有瑕疵,训练时就主动注入瑕疵,比事后修补更合理。但要注意:一是整个链路的上限被第一阶段的代理质量锁死,稀疏体素代理在细长结构、透明与反射材质上先天薄弱,论文没有给出代理失败时的退化分析;二是两阶段串联意味着推理开销叠加,而论文对「可探索」这个卖点没有给出交互延迟或帧率数据,实际能否支撑实时漫游是未知的;三是 115K 场景数据集里合成数据占比与真实数据的配比没有充分交代,而「首个混合数据集」的说法需要这个信息才站得住。 7. LiveVVT:22.39FPS实时视频换装 LiveVVT: High-Fidelity Video Virtual Try-On in Real Time | 清华大学、中关村学院、华南理工大学、北京交通大学 | arXiv:2608.26714 关键词:视频虚拟试穿,流式扩散,滚动窗口,渐进蒸馏,全局外观记忆,清华 前序问题:基于扩散的视频虚拟试穿靠双向时空建模拿到了很高的视觉保真度,但代价是必须拿到完整片段才能推理,在需要持续输出的实际部署里延迟和算力开销都不可接受。直接把模型改成因果的又会破坏预训练的双向先验,画质明显下滑。于是形成一个两难:要画质就没法实时,要实时就保不住画质。此外流式场景还有长时程难题——服装细节和已穿着的整体外观必须在整段视频里稳定,不能越穿越走形。 本文贡献:LiveVVT 是一个滚动式流式扩散框架,在因果递归生成中保留有界的双向建模:在固定大小的窗口内,它对多个视频块联合去噪、只做有界的前瞻,从而保住局部双向交互,同时每次迭代吐出一个干净块。窗口之外用两套互补记忆维持长程一致性——有界的时间记忆负责传递近期动态与遮挡上下文(FIFO 队列,入新汰旧),持久的全局外观记忆只在开始时从目标服装与一张正面试穿关键帧构建一次,之后全程锚定服装细节与穿着后的整体外观。训练上采用三阶段渐进蒸馏:先做双向 VVT 学习,再用教师轨迹回归完成少步因果适配,最后用 Collaborative Matching Distillation 把教师分布匹配与真实视频上的滚动流匹配耦合起来,让优化目标与递归推理方式对齐。 Overview of LiveVVT. (a) Rolling streaming try-on emits one clean chunk per update from a staggered-noise window with persistent global appearance memory $\mathcal{A}=(\mathcal{A}_g,\mathcal{A}_f)$ and temporal memory $\mathcal{H}_k$. (b) Bidirectional VVT learning, teacher-trajectory regression, and CoMD progressively transfer offline bidirectional priors to few-step streaming generation. 实验效果:在成对与非成对的长序列基准上,LiveVVT 相比同规模模型取得更优的生成质量。效率对比图给出明确数字:LiveVVT 达到 22.39 FPS、单次更新延迟 1.56,而 MagicTryOn 为 1.97 FPS / 41.11、CatV2TON 1.69 FPS / 47.88、ViViD 1.44 FPS / 56.25、VACE 仅 0.31 FPS / 157.8;相对 MagicTryOn 吞吐提升 11.37 倍,延迟降低 26.35 倍。 Comparison of latency and throughput between LiveVVT and state-of-the-art methods. 批判点评:「有界窗口内保留双向性」是这类流式改造里比较务实的折中——完全因果化会丢掉预训练先验,完全双向又不能流式,在窗口内保留局部双向交互是个合理的中间态,这与今天 EditaLive 的思路高度一致,说明这已经成为流式视频生成的一种标准做法。把外观记忆做成「只构建一次、全程锚定」也很聪明:服装是整段视频里唯一恒定的东西,没必要反复重新编码。需要注意的是:一是效率数字来自作者自绘的对数坐标图且未标注硬件,22.39 FPS 是在什么分辨率、什么显卡上取得的并不清楚,与基线是否同配置也无从核对,这在以速度为主要卖点时是个明显缺口;二是「相比同规模模型更优」的措辞回避了与更大模型的直接比较;三是全局外观记忆依赖一张正面试穿关键帧,人物大幅转身、侧背面出现时服装的未见部分如何保持合理,论文没有给出针对性分析。 8. Self-OPD:去掉教师用自己分叉当监督 Self-OPD: On-Policy Distillation for Flow Matching Models without Teacher | 清华大学、浙江大学、阿里巴巴 | arXiv:2608.26872 关键词:on-policy蒸馏,流匹配,无教师,奖励对齐,多目标优化,阿里 前序问题:On-policy 蒸馏(OPD)靠一个预训练的专用教师提供稠密监督信号,在大语言模型上很成功,最近也被搬到流匹配模型上。但这套范式有两个明显负担:一是每换一个优化目标就得训一个对应的专用教师,算力成本高得离谱;二是教师与学生的分布存在差异,会让误差沿生成轨迹不断累积放大。也就是说,教师既贵又不完全可靠。 本文贡献:Self-OPD 是面向流匹配模型的无教师 OPD 框架,把学生自己的探索转化为逐步监督。在每个时间步,它把确定性的下一状态预测分叉成 K 条随机 SDE 候选,用 ODE 采样器把它们各自推演完,再拿各自的奖励与一个确定性的自参考基线比较,得到归一化后的优势。速度场用「全分支推拉」目标优化:高优势的分支吸引学生靠近,低优势的分支在方向感知衰减与 SDE 方差归一化下把学生推开。面对多目标对齐时,Self-OPD 在奖励层面融合归一化分数,从而避免不同目标的梯度直接冲突。 Self-OPD pipeline. Top: The student branches its prediction into $K$ SDE paths (blue), generates images via ODE rollouts (purple), and scores them ($r^+, r^{\mathrm{ref}}, r^-$). Bottom-left: Rewards define a self-referenced advantage $A_k$ that pulls toward high-reward velocities $v_+$ and pushes away from low-reward velocities $v_-$. Bottom-right: A direction-aware coefficient $d_k$ gates the push to prevent it from counteracting the pull, resulting in the multi-branch loss $\mathcal{L}_{\text{Self-OPD}}$. 实验效果:在单一奖励与混合奖励基准上,Self-OPD 均优于此前的强化学习与 OPD 方法,且不需要任何任务专用教师。作者提供的雷达图显示:单奖励设定下它在 GenEval(strict / cont.)、HPSv2、PickScore、OCR 五个维度上全面包住 SD3.5-Base、Flow-GRPO、GRPO-Guard、Flow-OPD(教师)与 DiffusionOPD(教师);混合奖励设定下它在七个维度上整体领先,仅在 HPSv2(sep.) 与 PickScore(sep.) 两项上略逊于 DiffusionOPD 教师方案。 Overview of Self-OPD. 批判点评:去掉教师这件事的意义主要在成本结构上——「每个新目标都要训一个专用教师」本来就是 OPD 落地的最大阻碍,用学生自己的随机分叉构造对照来替代,方向是对的,也和 RubricRM 的「让评价适配输入」共享同一种去中心化思路。在奖励层面而非梯度层面融合多目标,回避梯度冲突,也是个干净的工程选择。但这套方法的天花板明显受奖励模型限制:所有监督信号都来自奖励打分,一旦奖励有偏,自我强化会把偏差放大,而论文正是用 HPSv2、PickScore、GenEval 这些奖励来训练又用它们来评测,存在自我印证的风险,缺少人类偏好评测作为独立校验。另外每步分叉 K 条候选并各自完整推演,训练开销不会低,作者虽给了 training_efficiency 图,但与「省掉训练教师」的成本节约究竟净赚多少,没有算总账。混合奖励下两项指标落后于教师方案,也说明无教师并非全面免费。 9. RubricRM:先给指令定评分表再打分 RubricRM: Generative Reward Modeling via Dynamic Rubrics for Image Generation and Editing | 北京大学、阿里巴巴、阿里巴巴达摩院 | arXiv:2608.26956 关键词:奖励模型,动态评分细则,文生图,图像编辑,GRPO,EMNLP2026,阿里 前序问题:奖励模型是对齐视觉生成模型的关键部件,但现有视觉奖励模型大多只输出一个标量分数,或者依赖一套固定评价标准。这在文生图和指令图像编辑上尤其不合适——不同输入需要的评价维度本来就不同:一句要求渲染文字的提示,该看的是文字准确度;一句要求改背景的编辑指令,该看的是主体是否被保住。用同一把尺子量所有任务,既损失可解释性,也丧失任务敏感性。 本文贡献:RubricRM 是一个成对生成式奖励建模框架,把打分拆成两步:先针对具体输入生成专属的评分细则(包含评价维度、各维度权重与打分标准),再依照该细则为候选图像打分。作者为文生图与图像编辑分别训练专用模型,采用两阶段流程:监督微调让模型学会「基于细则打分」这一范式,随后用 GRPO 配合细粒度的维度级奖励(同时考虑方向与绝对误差)进一步提升打分质量。训练数据覆盖常见物体、风格、构图、推理、文字、世界知识等广泛类别;作者还引入了饱和过滤,从其训练曲线看,不做过滤时奖励均值会崩塌、熵急剧下降、回复长度暴涨,加入过滤后三者都保持平稳。 Inference and training pipeline of RubricRM. (A) RubricRM supports both text-to-image and image-editing preference selection. At inference time, the model first dynamically generates a rubric conditioned on the input, including scoring criteria and corresponding weights, and then scores each image along each dimension based on the rubric, all within a single inference pass. (B) Training is conducted in two stages. The model is first supervised fine-tuned on synthesized rubric data to learn the paradigm of rubric generation followed by scoring, and is then further optimized with GRPO using dimension-level rewards.-0.6cm 实验效果:在多个生成与编辑基准上,RubricRM 优于既有的专用奖励模型,并且在骨干模型更小的情况下仍能与强闭源 MLLM 裁判保持竞争力。模型、数据与代码已开源。论文被 EMNLP 2026 主会接收。作者给出的数据分布显示,文生图侧覆盖常见物体 92.9%、风格 69.4%、构图与透视 52.2%、世界知识 15.8%、逻辑推理 9.0%、文字渲染 6.4%;编辑侧以物体编辑 45.9%、属性编辑 25.7%、背景编辑 18.1% 为主。 批判点评:「先定标准再打分」在思路上是对的——把评价标准从固定尺子变成随输入生成,同时顺带解决了可解释性(读者能看到每个维度的得分构成),这比单纯堆一个标量分数进步明显。用维度级奖励做 GRPO 而不是只用最终偏好,也让训练信号更稠密。但有几个隐忧:一是评分细则本身由模型生成,谁来保证细则的合理性?如果细则生成偏了,后续打分再精确也是错的,论文没有对细则质量做独立评估;二是这类框架天然存在自我一致性偏好的风险——用同一个骨干生成细则又用它打分,容易系统性偏爱某类图像;三是数据分布明显长尾,文字渲染仅 6.4%、逻辑推理 9.0%,而这两项恰恰是当前文生图最容易出错、最需要奖励模型把关的能力,覆盖如此之低,实际把关效果值得怀疑。作者的饱和过滤消融倒是很有说服力,可惜这类训练稳定性细节在正文里份量偏轻。 10. StreamAV-Bench:13个系统流式音视频集体翻车 StreamAV-Bench: A Comprehensive Benchmark for Streaming Audio-Video Generation | 北京智源研究院、北京大学、可灵、清华大学、中国科学技术大学 | arXiv:2608.26336 关键词:流式音视频生成,评测基准,长时程稳定性,交互响应,状态保持,智源,可灵 前序问题:生成模型正把视频生成推向无边界的流式音视频生成,用于实时交互世界。但现有基准评的都是「已完成的序列」,抓不住流式特有的性质——比如生成过程中能否持续响应新指令、长时间跑下去质量是否漂移、交互后的状态能否被后续保持和复用。缺了这类评测,流式音视频模型的真实短板就是不可见的。 本文贡献:StreamAV-Bench 是首个专门面向流式音视频生成的综合基准,建立了统一评测框架,分两条赛道:渐进赛道测指令遵循与长时程稳定性(单一提示,生成 60/120/180 秒,考察描述全局状态的能力);交互赛道测交互响应与状态保持复用(初始提示 + 在 30/60/90/120/150 秒处陆续注入更新提示)。基准覆盖 32 个细粒度维度,含经专家验证的评测用例(渐进 160、专家验证 320、交互 160),在内容复杂度(实体/活动/音频复杂度)与更新复杂度(交互类型/更新模态/时间依赖)两轴上组织,场景-音频联合覆盖 8 个场景×5 个音频域,主体-风格 5 类×4 种视觉风格,并采用双人评审加裁决的流程保证质量。指标侧分渐进赛道(指令达成与漂移、质量漂移、音视频漂移、视觉一致性)、交互赛道(更新达成率、响应延迟、视听状态保持、历史依赖遵循)与共享指标(视觉/音频质量、跨模态对齐、原生边界连续性、FPS、首块时间)。 We present StreamAV-Bench, a comprehensive benchmark for streaming audio-video generation. (a) The benchmark includes a progressive track to assess instruction adherence and long-horizon stability, and an interactive track to measure interactive response alongside state retention and reuse. (b) The benchmark covers content complexity in both tracks and update complexity in the interactive track, with 320 expert-verified scenarios that span 8 scene domains, 5 audio domains, 5 subject categories, and 4 visual styles. (c) The evaluation is driven by a unified framework of 32 fine-grained dimensions, computed with expert models, MLLMs, and corresponding checklists. 实验效果:作者对 13 个代表性系统做了大规模评测,结论是当前模型普遍存在两类问题:渐进生成中出现时间漂移,交互控制时存在响应瓶颈。作者给出的失效分类图把问题拍得很清楚,共八类:指令漂移、质量退化、视觉不一致、音视频漂移、更新达成失败、基于提示的连续性失败、状态保持失败、历史复用失败——例如「一只灰猫」生成到后面变成暹罗猫,或指令要求关窗而输出毫无反应。时序演化曲线显示,视觉美学与视觉质量随时长(30→180 秒)单调下滑,而音频质量与音视频同步大致持平,说明退化主要发生在视觉侧。 Qualitative failure cases. Common failure modes in representative streaming generation models. 批判点评:评测类工作的价值取决于它能否暴露此前看不见的问题,这篇在这点上是合格的——八类失效模式的分类图信息密度很高,「视觉随时长单调退化、音频基本持平」这个观察也很有用,它提示流式生成的瓶颈主要在视觉侧而非音频侧,对后续研究是明确的指路。32 个维度加专家双评加裁决,工程量也扎实。但需要提醒:一是它与今天的 Ring Forcing、TetherMem、RECAP-Forcing 撞在同一天,而后三者解决的正是这里暴露的长时程漂移,遗憾的是本文的 13 个被测系统并未包含这些最新记忆方法,因此「普遍存在时间漂移」的结论可能已经部分过时;二是 32 个维度虽全面,但维度越多越容易稀释重点,论文没有交代哪些维度与人类整体观感相关性最高;三是渐进赛道最长只到 180 秒,而「无边界流式」的宣称需要更长时程才能验证,三分钟恐怕还不足以暴露真正的长程问题。 趋势观察 长视频记忆从「压缩历史」转向「给历史建索引」 — 今天有三篇同时冲向自回归长视频的记忆瓶颈,且给出了三种互不相同的索引方式:Ring Forcing 用环形训练强迫模型去远距离历史里检索,并给记忆配了稀疏 RoPE;TetherMem 按「查询是主体还是场景」分流,主体查身份记忆、场景查近期背景;RECAP-Forcing 干脆不按时间存,改按「外观是否新出现」存。共同前提是承认了一件事——固定注意力窗口下,决定成败的不是能塞多少历史,而是能否精准取回需要的那一条。值得注意的是三者都在弱化「时间近=更重要」这个默认假设。 少步蒸馏正在从「加速技巧」变成流式产品的入场券 — EditaLive 把编辑模型压到两步采样、LiveVVT 做三阶段渐进蒸馏并配 Collaborative Matching Distillation,两者的动机都不是刷速度榜,而是「不做到实时这个功能就不成立」——直播换装、直播换脸本质上不允许离线多步推理。它们也都撞上同一个矛盾:强行改成因果会破坏预训练的双向先验、画质掉档,于是解法趋同——在有界窗口内保留局部双向性,再用蒸馏把训练与流式推理对齐。 生成模型开始被当作「渲染器」嵌进既有工业管线 — Magpie 的做法很克制也很务实:不让生成模型接管游戏逻辑,而是把玩法执行留在游戏引擎里,引擎只输出白盒画面,再由独立 Render Server 生成最终视觉。这保住了游戏最不能丢的东西——规则可复现、状态可控。SpatialCrafter 也是类似思路,先出一个几何正确的 3D proxy,再让视频扩散模型只负责补高频细节。两者都在退一步:不追求端到端全能,而是把生成模型放在「渲染」这一层,让可控性由传统方法兜底。 后训练开始摆脱对「更强教师」的依赖 — Self-OPD 把 on-policy 蒸馏里的教师直接去掉,让模型自己分叉出 K 条 SDE 候选、用奖励算优势来自我监督;RubricRM 则让奖励模型先针对当前指令生成评分细则再打分,而不是套一把固定尺子。方向是一致的:监督信号从「外部权威给答案」转向「模型自己产生可比较的对照」。这条路的隐患也明显——自我对照的天花板受限于奖励模型本身的判别力,一旦奖励有偏,自我强化会把偏差放大。 人工智能炼丹君 整理 | 2026-08-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-19|阿里像素空间T2I反超潜空间Z-Image-Pixel 今日 AIGC 论文速览 今日共 10 篇 · 图片生成与编辑 4 篇 · 视频生成与加速 3 篇 · 音视频生成 2 篇 · 统一修复与智能体路由 2 篇 重点论文标题列表 Z-Image-Pixel(阿里 Token Hub·港科大·南京大学·UC San Diego):像素空间T2I首个能打的配方 SQuad(Qualcomm AI Research):注意力FLOPs降67倍且VBench不掉 Qwen-Video-Edit(Reve·UT Austin):帧排成一张大图就能改视频 PixRestore(港理工 视觉计算实验室·OPPO 研究院):50M参数无VAE一步修复 EqF(UC San Diego·Harvard):去掉噪声条件换来闭环采样 今日论文速览 1. Z-Image-Pixel:像素空间T2I首个能打的配方 An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models | 阿里 Token Hub·港科大·南京大学·UC San Diego | arXiv:2608.16887 前序问题:文生图这几年几乎被潜空间扩散垄断,原因很实在:VAE 先把 1024×1024 压成几十倍小的潜表示,注意力算力才降到可承受的范围。但这笔交易的代价一直存在——VAE 是有损压缩,高频细节、小面积结构、文字边缘都会在编解码往返中被磨掉,而且 VAE 本身还得单独训练、单独维护,成了管线里一个没人愿意碰的黑盒。像素空间扩散能绕开这一切,直接在原始像素上做去噪,此前也不断有人尝试,但研究几乎全停留在小规模或类别条件的玩具设定里。真正的问题从来不是「像素空间能不能生成图」,而是「在大规模文生图这个真实战场上,像素空间到底怎么训才能追上潜空间」——这个配方一直是空白。 本文贡献:这篇给出了那份缺失的配方。作者先做了一个关键的负面观察并把它坐实:直接在像素空间做大规模预训练,收敛速度显著慢于潜空间——这不是调参不到位,而是像素空间预训练的固有劣势。既然如此,就不要硬碰硬。他们提出 latent-to-pixel 策略:先在潜空间高效地把生成先验学到手,再在后训练阶段迁移到像素空间。真正的贡献密度在于对这次「迁移」做了系统性的设计空间扫描,逐项确定了五个关键选择——权重初始化怎么做、数据配比怎么调、预测目标选什么、解码器架构如何设计、噪声调度如何安排。最终固化出一套可复现的实践配方,并放出 Z-Image-Pixel 模型。这是一篇典型的「把方向从可行推到可用」的工程实证工作。 Qualitative samples over training iterations. The latent space model consistently demonstrates faster image structure learning and superior final image quality in pre-training progress. 实验效果:按该配方训出的像素空间模型,在质量上匹配或超过对应的潜空间同行,同时端到端推理速度提升 3.18 至 4.75 倍——去掉 VAE 编解码环节的收益在这里被兑现成了实打实的吞吐。收敛性对比图显示,纯像素空间预训练在 GenEval 上到 150K 步仍停在 0.54 附近,而潜空间 50K 步就已达到 0.73 并趋于饱和,两条曲线的差距直观解释了为什么必须先借潜空间起步。 Evaluation curves over training steps. The model trained in the latent space consistently achieve superior results (measured by GenEval~geneval and DPG~dpg) and faster convergence compared to those trained in the pixel space. 批判点评:这类经验性研究的价值往往被低估。它没有提出新架构、新损失,但把一个「大家都觉得应该可行、却没人跑通」的方向变成了可落地的配方,而且诚实地把负面结果——像素空间直接预训练更慢——放在了论证链条的开头,这比藏起来只报好消息的做法可信得多。3.18 到 4.75 倍这个加速区间也给得克制,说明作者知道加速比依赖分辨率和采样步数配置。不过要清醒看待几点。第一,latent-to-pixel 意味着它并没有真正摆脱 VAE,只是把 VAE 从推理期挪到了训练期——你仍然需要一个训好的潜空间模型作为起点,声称的「无 VAE」只在部署侧成立,训练侧的依赖链其实变长了。第二,「匹配或超过潜空间同行」这个表述里的「匹配」占多大比重、在哪些指标上真正超过,摘要没有拆开,而 GenEval/DPG 这类指标对细节保真其实不敏感——恰恰是像素空间最该发力的地方缺少针对性证据。第三,五个设计维度的扫描是在什么规模下做的没有说明,小规模上得出的最优选择在更大模型上是否还成立,是这类经验配方的通病。第四,作者团队来自阿里 Token Hub,模型命名 Z-Image-Pixel 暗示其属于 Z-Image 系列,是否会开放权重和完整训练细节,决定了这份配方的实际社区价值——配方类论文如果不放代码,复现门槛会高得离谱。 2. SQuad:注意力FLOPs降67倍且VBench不掉 SQuad: Sub-Quadratic Attention Distillation for Efficient Video Generation | Qualcomm AI Research | arXiv:2608.16585 前序问题:视频 DiT 的算力几乎全被自注意力吃掉,而它的成本随 latent token 数 n 呈 O(n²) 增长。视频的 token 数天生就大——Wan 2.2 5B 在 81 帧 704×1280 下 n 就到 18480——于是这一项直接主导了运行时与显存,成为分辨率和时长的硬天花板。学界的常规解法是把满 softmax 的 QK^T 换成更便宜的核:线性注意力 O(n) 或低秩近似 O(nk)。这些替身确实便宜,但几乎从没真正恢复原始注意力的表达力,留下一道顽固的质量鸿沟。问题的本质是效率与表达力之间的取舍被推到了极端——要么二次成本,要么掉点。 本文贡献:SQuad 选了取舍曲线上一个被忽略的中间点:O(n√n)。做法是把注意力拆成两段——先在局部窗口内做精细注意力,再以窗口为单位做全局注意力,两段复合出 n√n 的复杂度,天然平衡效率与表达力。更务实的是训练路径:从零训一个自己的视频 DiT 成本高到不现实,所以他们直接把预训练的满 softmax DiT 蒸馏成 SQuad-Attention 版本,分两阶段进行——先做 Flow-Matching 有监督微调对齐行为,再用改进的分布匹配蒸馏 DMD2,后者额外让采样本身也变少步。也就是说这套方法同时压了单步成本和总步数两个乘数。 % attention. Left: full softmax Self-Attention at $\mathcal{O}(n^2)$ complexity. Right: factorizes it into a local pass within $\mathcal{O}(\sqrt{n})$ windows followed by a global pass across the windows, giving a full receptive field at $\mathcal{O}(n\sqrt{n})$ complexity with a true softmax throughout.% 实验效果:在 Wan 2.2 5B 文生视频上,SQuad 的 VBench 达到 83.20,二次复杂度教师为 83.08——质量基本持平甚至略优。同时每步每块的注意力 FLOPs 降低约 67 倍,注意力延迟同步大幅下降。FLOPs 缩放曲线在三个模型规模上都做了验证:Wan 2.2 5B(n=18480)从 4.2 降到 0.063 TFLOPs/block 即 67 倍,Wan 2.1 1.3B(n=32760)为 90 倍,Wan 2.1 14B 为 88 倍,且实测点与理论 O(n√n) 曲线吻合良好——说明这个复杂度改善不是纸面推导,且在 1.3B 到 14B 的规模区间内稳定成立。 Wan 2.2 5B 批判点评:这是今天这批里工程收益最锋利的一篇。67 倍注意力 FLOPs 削减配合 VBench 不掉分,而且理论复杂度和实测曲线对得上,说服力比单纯报几个基准数字强得多。局部加全局的两段结构也不新奇——Swin 那一脉早有类似思路——但把它作为蒸馏目标而不是从头训练的架构,这个选择很关键:它让方法能直接嫁接到已有的强基座上,这才是工业界真正用得上的形态。不过 67 倍需要精确解读:这是「每步每块注意力」这一层的削减,不等于端到端加速 67 倍。DiT 里还有 FFN、cross-attention、归一化和 VAE 解码,注意力占比再高也不是 100%,Amdahl 定律在这里毫不留情——摘要给的注意力延迟改善才是更接近真相的数字,而端到端墙钟时间完全没披露,这是最该补的一格。其次值得肯定的是 FLOPs 缩放在 1.3B/5B/14B 三个规模上都验证了(分别为 90×/67×/88×),削减倍率没有随规模崩塌,这比只测单一规模有说服力;但质量侧的 VBench 只在 5B 上报了一个数,14B 上蒸馏后是否同样不掉分并没有交代——FLOPs 省得下来不等于质量守得住,这两件事需要分别举证。第三,VBench 对长程时序一致性和复杂运动的分辨力有限,而局部窗口注意力最可能损伤的恰恰是跨远帧的关联,只报 VBench 总分难以排除这类退化。最后 DMD2 蒸馏本身会带来多样性收缩的已知副作用,论文把它与注意力替换打包在一起评估,两者各自的贡献和代价被混在了一个数字里。 3. Qwen-Video-Edit:帧排成一张大图就能改视频 Qwen-Video-Edit: Instruction-Based Video Editing by Repurposing an Image Editing Model | Reve·UT Austin | arXiv:2608.14790 前序问题:指令式视频编辑的主流做法是拿视频预训练的生成基座开刀:找一个视频 DiT,让它同时条件于源视频和编辑指令,然后花很大代价适配。这条路的成本结构很不友好——视频基座本身训练昂贵,适配又要构造视频编辑三元组数据,而高质量视频编辑数据的稀缺程度远超图像。于是整个方向被卡在「数据不够、算力不够」的双重瓶颈里,而同期图像编辑模型早已相当强大。一个自然但少有人认真验证的问题是:能不能不要视频基座,直接让图像编辑模型去改视频? 本文贡献:作者证明这条捷径真的走得通,而且用一串「零训练观察」把设计逻辑铺得很干净。核心操作是把 Wan 2.1 视频 VAE 的 latent 帧当成一张大虚拟图像的若干 tile 平铺,然后对每个 tile 复用图像编辑器原有的位置编码——也就是说,从模型视角看这压根不是视频,就是一张它早就熟悉的拼贴图。两个 latent 空间之间用一对轻量输入输出投影桥接,且这对投影从编辑器自己的 patchify/unpatchify 层热启动,使得初始化时一段静态视频被嵌入的方式与一张图像完全一致。整体在公开的 Ditto-1M 编辑三元组上微调,再可选地用 Wan 2.2 跑几步去噪作为时序增强器。支撑这套设计的观察链很有说服力:原装图像编辑器已经能编辑以联络表形式呈现的视频;它不在乎 token 来自一次联合编码还是逐帧编码后在 latent 空间缝合;它甚至能零样本编辑真实视频 latent 到明显可辨识的程度——微调要补的只剩保真度那一段。 Overview. Video latent frames are embedded as tiles of a virtual image grid and edited by the image editing transformer; only the two projections (warm-started from the editor's own patchify/unpatchify layers) and the transformer weights (LoRA or full) are trained. 实验效果:从 Qwen-Image-Edit 出发,无需任何视频生成预训练即可完成指令式视频编辑。流程图显示除 In-Proj 与 Out-Proj 两个轻量投影和 DiT 本体外,Wan 2.1 VAE 编解码与 Wan 2.2 增强器全程冻结,可训练部分被压到极小。定性结果覆盖全局风格迁移与局部主体替换等任务,人物换成机器人这类大幅编辑仍保持了动作与场景的连贯。 批判点评:这篇最漂亮的地方不是结果而是论证方式:那条零训练观察链把「为什么这样可行」讲成了一个可验证的递进过程,而不是先做完再编故事。把视频摊成联络表这个操作听起来近乎取巧,但作者恰恰用它揭示了一个有意思的事实——强图像编辑模型内部已经隐含了相当程度的跨帧一致性能力,只是从没被这样调用过。投影层从 patchify 热启动的设计也很讲究,保证了初始化即合理。但取巧的代价必须点明。第一,把帧铺成 tile 意味着帧间关系只能靠二维位置编码隐式表达,模型没有任何显式的时间轴概念,短片段可能侥幸过关,帧数一多、运动一快,这种隐式关联大概率崩塌——而 tile 数量还直接受图像编辑器分辨率上限约束,这是个硬天花板,摘要没说能处理多少帧。第二,需要 Wan 2.2 做「可选时序增强」这件事本身就是自证:如果时序一致性真的够好,为什么还要额外几步去噪来补?这个「可选」组件在多少比例的案例里其实是必需的,是关键信息。第三,训练数据是公开的 Ditto-1M,编辑类型分布决定了能力边界,超出分布的指令表现如何未知。第四,全文只报了定性结果和「结果表明」,没有与专门视频编辑模型的定量对比——考虑到这是一份 report 而非完整论文,可以理解,但也意味着现在还无法判断它离 SOTA 有多远。 4. PixRestore:50M参数无VAE一步修复 PixRestore: Unified Image Restoration via Pixel Diffusion Transformer | 港理工 视觉计算实验室·OPPO 研究院 | arXiv:2608.16793 前序问题:统一图像修复想用一个模型处理各种退化——模糊、噪声、低分辨率、压缩失真等——从低质图恢复高质内容。近来主流做法是挪用大型预训练文生图潜扩散模型,借它的容量和生成先验。但这条路有两处结构性别扭。一是潜扩散里的 VAE 会丢掉对修复最敏感的细节——修复任务的评判标准恰恰是细节保真,而 VAE 的有损压缩正好打在痛点上。二是文生图先验是开放式合成的,它倾向于「编」出看起来合理但与原图内容不符的东西,在修复语境下这就是伪影。换句话说,借来的能力和任务的要求存在方向性冲突。 本文贡献:PixRestore 索性不借了:一个无 VAE 的像素空间 DiT,扩散骨干完全从零训练,不依赖任何文生图预训练。它直接在 patch 化的像素上做 flow matching,既保住细粒度细节,又把 token 序列长度控制在可处理范围。为适配不同退化类型,模型学会用低质与高质图的 DINO 特征相似度来预测各层特征的可靠性:可靠层的特征被融合为稠密条件注入,不可靠层则接受更强的高质特征监督以促使其学会去除退化——这是个挺聪明的自适应机制,让同一套参数能对不同退化做出不同的内部路由。训练用大规模多场景多退化语料,最后再用基于 DINO 的对抗目标把它微调成一步生成器。 Overview of PixRestore. A frozen vision encoder extracts multi-layer features from the LQ image, and an adaptive layer router predicts per-layer weights to fuse them into a single conditioning feature. The LQ image and the noisy state $x_t$ are patchified, then processed by $N$ DiT blocks, and finally decoded into the HQ output. 实验效果:仅约 50M 参数,在公开基准与真实世界测试集上取得有竞争力的结果,且推理为一步生成,效率优势明显。框架图显示 LQ 图像经 Vision Encoder 提取多层特征后由 Adaptive Layer Router 产生逐层权重,门控加权求和为 Fused Feature,再通过 Pixel DiT 的 cross-attention 注入——整条路径无 VAE 参与。 PixRestore achieves the best overall performance in terms of restoration quality, model size, and inference speed. Top-left: radar charts comparing PSNR, LPIPS, and degradation removal performance across eight degradation types. Top-right: GFLOPs versus inference latency, where the bubble size denotes the number of parameters. Bottom: visual comparisons on eight restoration tasks. With only about 50M parameters and single-step inference, PixRestore achieves the best overall restoration quality while being the most efficient among diffusion-based methods. 批判点评:50M 参数加一步推理这个组合在修复领域相当有竞争力,尤其对照那些动辄搬 SD 全量权重的方案,参数量差了两个数量级。用 DINO 特征相似度来判定层可靠性是这篇最有想法的设计:它把「哪些层可信」从人工先验变成了数据驱动的预测,而且 DINO 特征对退化的敏感度确实适合做这个裁判。从零训练而非微调 T2I 的选择也自洽——既然认定 T2I 先验方向不对,就不该半信半疑地用。但几处需要留意。第一,从零训练意味着放弃了大模型先验带来的语义理解能力,在极端退化、需要「猜」出内容的场景下,50M 从零模型很可能力不从心——摘要只说「有竞争力」而非超越,这个措辞值得注意。第二,一步生成器是用对抗目标蒸出来的,GAN 训练的稳定性和模式覆盖问题不会因为换成 DINO 判别器就消失,对分布外退化的鲁棒性存疑。第三,「大规模多场景多退化语料」是自建的,覆盖哪些退化、按什么比例混合,直接决定了泛化边界,而这恰恰是统一修复模型最容易过拟合评测集的地方。第四,团队来自港理工与 OPPO,考虑到 50M 和一步推理的组合,这个模型的真实目标场景大概是手机端 ISP 后处理,那么就该给出移动端实测延迟——公开基准上的 GFLOPs 说明不了端侧的真实表现。 5. EqF:去掉噪声条件换来闭环采样 Equilibrium Forcing: Adaptive Video Generation Without Noise Conditioning | UC San Diego·Harvard | arXiv:2608.14706 前序问题:基于扩散和 flow matching 的自回归视频生成,有两个被当作理所当然的设定:训练目标是刚性的,采样调度是静态的。模型在训练时被告知当前噪声水平是多少,推理时则按一张预先排好的时间表逐步去噪。这套组合的后果是推理过程完全无法根据数据本身做调整——不管当前这一帧生成得好还是烂,采样器都按同一张表往下走。对自回归视频生成来说这尤其致命,因为误差会沿时间轴累积,而一个不会看反馈的采样器没有任何自我纠正的机会。 本文贡献:EqF 的切入点相当反直觉:把噪声水平条件整个去掉。作者提出一个简化框架,让视频去噪生成模型不再接收噪声水平作为输入,从而把「学习去噪场」和「如何采样」这两件事彻底解耦。这个解耦是关键——一旦模型不再绑定于特定噪声水平,推理时就可以自由设计算法,包括闭环运行:根据当前样本反馈动态调整后续采样行为,而不是照表执行。作者还给出了较为深入的分析,解释移除噪声条件为何能让模型获得数据相关的推理性质,并进而超过标准的噪声条件方法。图 1 把这件事讲得很清楚:训练得到的均衡传输去噪场乘上一个推理期的 attractor warp η,共同诱导出最终的采样地形——去噪场与采样调度在数学形式上被分成了两个可独立操作的因子。 Equilibrium Forcing Overview. is trained with a simple unmodulated equilibrium denoising objective (left), which can be shaped at inference time through the $\eta$ warp (middle). The sampling landscape here is shaped to be an attractor, with the magnitude decreasing as the sample descends and converges (right). 实验效果:在有挑战性的自回归视频生成基准上提升了视频质量与一致性。固定算力缩放实验显示,EqF 配合 NAG 采样在 100 步时 FVD 已降至约 74,250 步时进一步降到 60 以下,而标准 flow matching 从 50 步到 250 步始终在 102 至 122 区间徘徊几乎不随算力改善——说明闭环采样确实把额外算力换成了质量,而静态调度做不到这一点。 批判点评:这篇的价值在于挑战了一个几乎没人质疑过的默认设定。噪声水平条件从 DDPM 起就是标配,大家默认它是必需的,EqF 反过来论证它其实是一种约束——因为它把去噪场和采样调度绑死了,而解绑后能换来推理期自适应。图 1 那个「去噪场 × attractor warp = 采样地形」的分解也把抽象主张落成了可理解的几何图像。固定算力缩放曲线是全文最有力的证据:FM 的曲线几乎水平,意味着多给算力也白给,而 EqF 能持续下降,这个对比比任何单点 FVD 数字都更能说明问题。但要保持警惕。第一,摘要通篇没有具体的基线名称、数据集名称和绝对指标,只说「有挑战性的基准」和「超过标准方法」,这种表述在视频生成领域的可比性极低——FVD 对分辨率、帧数、特征提取器都极度敏感,脱离配置的数字无法横向对照。第二,最好的曲线来自 EqF+NAG 组合,而 NAG 是额外的采样技巧,那么增益中有多少来自「去掉噪声条件」这个核心主张、多少来自 NAG,图里 EqM 系列的存在暗示做了消融,但摘要没给结论。第三,闭环采样意味着推理时要评估反馈信号,这必然带来额外计算,而「固定算力」的口径是按采样步数还是按实际 FLOPs 对齐,直接影响结论成立与否。第四,去掉噪声条件对训练稳定性和收敛速度的影响未提,这类架构级简化往往在别处付出代价。第五,方法在视频上验证,是否迁移到图像生成没说——如果这个洞察真的普适,图像上应该更容易验证,没做反而值得琢磨。 6. ConceptEdit:1200万编辑对与稠密监督 Unlocking the Potential of Image Editing via Concept Scaling and Dense Supervision | 上海交通大学·蚂蚁集团 | arXiv:2608.16812 前序问题:现有图像编辑框架基本沿用文生图扩散模型的训练范式,但把这套范式挪到编辑任务上会暴露两处内在错配。第一是对编辑概念的粒度关注不足——文生图关心的是「画出什么」,编辑关心的是「精确改动什么而不动其余」,后者需要远为细致的概念划分,而现有数据集的标签粒度远远不够。第二是监督信号过于稀疏导致训练低效:一对图像通常只承载一个编辑操作,模型每看一对样本只学到一件事,样本效率极低。这两个问题叠加,使得编辑模型的能力增长严重受制于数据的组织方式而非模型容量。 本文贡献:两条线同时发力。数据侧建立了一套超过 1000 个细粒度编辑概念的分层分类体系,并基于改进的合成框架构建 ConceptEdit-12M,一千二百万高质量编辑对。这里的关键设计是「库驱动」——先有概念库再据此合成,从而有效纠正了生成数据常见的分布坍缩问题,同时保住数据保真度;这是合成数据工作最容易翻车的地方,作者显然意识到了。训练侧提出稠密监督策略:把多个互不干扰的编辑概念合成到单对图像里,让一次前向承载多个学习信号,从而同时提升训练效率与最终性能。此外还发布 ConceptEdit-Bench,一个细粒度评测套件,用于诊断模型在大量真实场景下的能力分布。四阶段流程图显示,概念库构建后由 VLM 生成指令与 VQA 检查清单,经 Flux.2 / Qwen-Image-Edit / Nano Banana2 等多模型执行编辑,最后由 VLM 结合思维链做通过、重写或拒绝的三态判决。 Overview of the improved synthesis framework. Stage 1: Library Construction leveraging LLM world knowledge. Stage 2: Semantic Matching and Instruction Generation including VQA checklists. Stage 3: Image Synthesis using various editing models. Stage 4: Instance Specific Verification using VQA. 实验效果:训练结果显著超越先前工作,验证了稠密监督策略的有效性。配套的 ConceptEdit-Bench 支持按概念维度做细粒度诊断,而非只给一个整体分数。 (a) Edit Concept Scaling. Left: The previous paradigm is restricted by coarse categories and limited diversity. Right: Our approach scales up to 1,000+ fine-grained concepts to ensure a balanced and rich distribution. (b) Dense Supervision. Left: Conventional training relies on single edit pairs with sparse supervision signals. Right: Our composite edit strategy provides dense supervision, enhancing training efficiency. 批判点评:这是一篇典型的「数据即方法」论文,而且把数据工程做得比多数同类扎实。1000+ 概念的分层体系加 1200 万编辑对,规模上足以改变下游模型的能力上限;四阶段管线里那个 VQA 检查清单 + 思维链判决的设计尤其值得学——它把「这次编辑成功了吗」拆成若干可验证的具体问题(文字是否清晰、眼睑是否变形、脸型是否保持),而不是笼统打分,这才是合成数据质量能立住的原因。稠密监督的思路也很直接有效:既然一对图只学一件事太浪费,那就塞进多个互不干扰的概念,本质是在提升每单位算力的信息密度。但要打几个问号。第一,全部数据由 Flux.2、Qwen-Image-Edit、Nano Banana2 等现成模型生成,这意味着 ConceptEdit-12M 的能力天花板被这些教师模型锁定——学生能学到的编辑质量原则上不会超过教师,「显著超越先前工作」更可能是超越了那些数据更少的工作,而非超越数据生产者本身。第二,「互不干扰」的判定标准是什么没有说明,编辑概念之间的干扰往往是隐性的(改表情可能牵动脸型),判定不严会引入标签噪声,而这种噪声在稠密监督下会被放大。第三,评测基准由数据生产方自己发布,与训练数据共享概念体系和合成管线,同分布优势难以排除——ConceptEdit-Bench 上的领先有多少能迁移到真实用户指令上是个悬念。第四,摘要只说「显著超越」,没有任何具体数字或基线名称,这在一篇以规模为核心卖点的论文里偏弱。第五,12M 数据的合成算力成本未披露,而这直接决定了这条路径是否可被社区复现。 7. SyncSparse:稀疏化不能牺牲音画同步 Efficient Audio-Visual Generation via Synchrony-Aware Cross-Modal Sparse Attention | 上海交通大学·阿里 Token Hub·阿里云 | arXiv:2608.15522 前序问题:音视频联合生成模型能在统一扩散过程里同时合成同步的画面与声音,但推理开销一直很高——长视频 token 序列要在每个去噪步反复算注意力。视频生成领域已经积累了不少加速手段:低比特量化、注意力稀疏化、特征缓存。麻烦在于这些方法都是为纯视频模型设计的,直接搬到音视频模型上会忽略音频与视频两个分支之间的交互,进而破坏音画同步——而同步性恰恰是音视频生成的核心价值,画面再清晰、声音再干净,只要唇形和语音对不上,整个结果就废了。这是一个典型的「加速方法对模态盲视」的问题。 本文贡献:作者的关键观察是:双向音视频交叉注意力揭示了两个分支之间的结构化交互模式,高响应往往集中在少数与声音相关的视觉与时间位置上。也就是说,同步性并非均匀分布在所有 token 上,而是由一小撮关键 token 承载。据此提出受保护的稀疏注意力策略——对同步关键的 token 保留高保真的完整计算,只对冗余的注意力部分做稀疏化。整套框架是同步感知的:通过在加速过程中显式考虑跨模态依赖,在提效的同时守住音画对齐。框架图显示五步流水线:双流输入、交叉注意力显著性计算、Top-k 音频 query 保护性选择、受保护稀疏注意力、以及同步感知指示器,后者用 Δ_sync = max(Δ_v, Δ_a, λ_pΔ_p, λ_sΔ_s) 决定当前时间步是复用缓存还是重新计算。 Overview of the proposed synchronization-aware acceleration framework. Cross-modal interactions between audio and video branches are used to guide protected sparse attention and cache reuse. 实验效果:在提升推理效率的同时保持了视频质量、音频质量与音画同步三项指标。缓存策略图显示去噪时间步被自适应地划分为 Cached、Reused (Skip) 与 Recompute (Update) 三类,仅在同步信号变化剧烈时才触发重算。 Qualitative comparison of dense inference, unprotected acceleration, and our protected acceleration. The protected computation path better preserves salient visual structures and reduces local artifacts under acceleration. 批判点评:这篇的问题意识比方法本身更值得称道:它指出了一个正在发生但少有人明说的隐患——加速方法的迁移往往是模态盲视的,在纯视频上验证过的稀疏化和缓存策略被直接用到音视频模型上,而评测指标里如果没有同步性这一项,退化会完全隐形。「同步性集中在少数 token 上」这个观察也很自然地导出了保护式稀疏化,逻辑闭环。Δ_sync 取四路信号最大值的设计偏保守但合理——宁可多算几步也不冒同步崩掉的风险。不过整份摘要在效果层面几乎是零信息量:只说「提升效率」「保持质量」,没有任何加速倍率、没有基线名称、没有具体指标数值,这在一篇以效率为核心卖点的论文里是硬伤——读者无法判断它是快了 1.5 倍还是 5 倍,而这个区间决定了方法有没有实用价值。其次,Top-k 保护的 k 如何选择、保护比例与加速比之间的权衡曲线长什么样,是这类方法最核心的超参问题,摘要完全没碰。第三,方法建立在「能拿到双向交叉注意力图」的前提上,这对某些架构(如把音频当额外 token 拼进同一序列做自注意力的设计)并不成立,适用范围有限制。第四,摘要文本里出现了多处 this http URL 的替换残留,说明投稿时的自动化处理出了问题,虽然不影响技术内容,但反映出打磨程度。第五,与 SQuad 那种把加速做成蒸馏目标的思路相比,这里仍是训练无关的推理期启发式,上限受限于原模型。 8. GenRouter:按需路由省95%执行成本 GenRouter: Unified Workflow Routing for Agentic Image Generation | 港科大(广州)·港中文·Google DeepMind | arXiv:2608.16721 前序问题:文生图模型已经基本解决了原始像素合成这个基础难题,社区注意力转向如何满足越来越复杂的用户请求。为此出现了各种智能体式图像生成工作流,给静态推理加上外部知识检索、迭代推理等高级能力。但这些工作流大多各自为政,采用固定的一刀切拓扑——不管请求是「画一只猫」还是「按照这三张参考图合成一个符合物理规律的复杂场景」,都走同一条重型管线。结果是严重的算力错配:简单查询被强行推过昂贵的流水线,成本和延迟全花在不需要的环节上。 本文贡献:GenRouter 是第一个统一的智能体图像生成工作流路由框架。第一步是 GenCanvas,把各种异构的智能体管线标准化为一组通用基础原语和可执行模板——rewrite、decompose、search、reason、skill、verify、refine、sketch 等,这一步的意义在于把「不同工作流」变成「同一空间里的不同组合」,否则路由无从谈起。在这个统一空间上,GenRouter 通过三个机制把异构 prompt 自适应地路由到最优工作流:需求画像分析请求特征,经验匹配复用历史轨迹,帕累托过滤在质量、成本、延迟等多目标间取舍。系统还能通过累积经验持续自我演化。框架图显示 prompt 先被编码为雷达图形式的 Task Signature,经 Trajectory Memory 与 Route Memory 双记忆匹配后,在帕累托平面上按质量-成本-延迟三轴筛出最终路由。 Overview of our proposed (Left) and (Right) . 实验效果:在多个基准上取得更优的视觉对齐,同时相比重型静态管线降低执行成本超过 95%、延迟降低 65%。系统还能通过累积经验实现零样本泛化能力的持续提升。 Qualitative comparison. Left side shows cost (scaled by $0.01$); right side shows latency. 批判点评:这篇抓住的痛点很真实:智能体式生成的成本失控问题在实际部署里比论文里严重得多,而「所有请求走同一条重型管线」几乎是当前所有 agentic 图像生成工作的默认形态。GenCanvas 那层标准化抽象是全文最有价值的部分——把异构管线归约到统一原语空间,路由才有了数学基础,这个工程判断是对的。帕累托过滤而非单目标优化也符合真实场景,因为质量、成本、延迟的权衡本来就该交给使用方而不是硬编码。95% 成本削减听起来夸张,但如果基线真是无差别走重型管线,这个数字反而说明了原方案有多浪费——它衡量的是「浪费被消除了多少」而非「效率被提升了多少」。也正因如此,这个数字高度依赖测试集里简单请求的占比:如果基准里大部分是简单 prompt,95% 几乎是自动达成的,而真实流量分布未必如此,论文应当给出按请求复杂度分层的成本曲线。第二,路由器本身也要跑推理——需求画像、经验匹配、帕累托过滤都不免费,这部分开销是否计入了「执行成本」的统计口径,直接影响结论的诚实度。第三,「自我演化」依赖经验累积,冷启动阶段的表现和收敛所需的请求量没有交代,而这决定了它在新部署环境里多久才能变得有用。第四,路由错误的代价不对称——把复杂请求误路由到轻量工作流会直接产出劣质结果,摘要说「更优的视觉对齐」,但没给误路由率,这才是用户实际会感知到的风险。 9. StructFlow:让噪声也带上空间结构 Spatially-Grounded Flow Matching: Structured Source Distributions for Image Generation | 马里兰大学·Netflix | arXiv:2608.15452 前序问题:当前 flow matching 模型学的是把源分布——独立同分布的高斯噪声——传输到自然图像的目标分布。但这个源分布完全不含任何空间结构的概念,而图像本质上是局部相关的:邻近像素强相关。作者的假设很有意思:正因为噪声是独立采样的,模型在训练时被隐式地鼓励去利用「噪声较小的邻居」作为上下文,从而部分绕开了真正学习图像局部结构这件事。换句话说,源分布的设计与图像域的归纳偏置是相互对抗的——我们给了模型一个走捷径的机会,它就不会好好学结构。 本文贡献:StructFlow 把空间局部性直接编码进源分布:让一个小区域内的像素共享一个公共噪声成分。这个改动很轻,但改变了传输路径的几何性质——路径变得与图像区域在几何上对齐,从而带来通用 flow matching 难以提供的三个性质:天然尊重边界的细粒度局部编辑、稳健的结构保持、以及图像之间平滑的语义插值。作者还证明这些好处能延伸到大型预训练模型上,通过一个轻量的后训练阶段即可植入,不必从零重训。噪声构造图清楚展示了机制:图像先被划分为超像素,每个超像素分配一个 anchor 分量,区域内部再叠加噪声,最终得到的相关噪声在去噪轨迹上使得结构从早期就开始显现,而标准 flow matching 的不相关噪声则要到很晚才浮现结构。 modelname Noise Construction. introduces locality in the source distribution sampling instead of i.i.d gaussian sampling in normal flow matching. % 实验效果:在多个数据集上、无条件、类别条件与文本条件三种设定下、使用不同架构验证有效。类别条件 ImageNet 256×256 上 FID 从 18.50 改善到 17.24、sFID 从 14.04 改善到 10.03;但无条件 FFHQ 256×256 上 Precision 从 0.250 提升到 0.350、ImgReward 从 0.500 提升到 0.720 的同时,FID 反而从 22.68 退到 25.80、Recall 从 0.200 掉到 0.160。结构保持实验显示,给定同一组超像素划分、更换随机种子时,生成结果的构图与主体轮廓保持一致而颜色、材质、身份等属性自由变化——说明超像素划分确实成了一个可控的结构句柄。 Comparison with baseline. Evaluated across a diverse set of metrics for robust assessment, performs on par with standard flow matching and outperforms it in some cases. 批判点评:这是今天这批里最优雅的一篇:改动只在源分布,不动架构、不动损失、不动采样器,却换来局部编辑、结构保持、语义插值三个下游能力,而且能通过轻量后训练植入已有大模型。那个「独立噪声让模型偷懒依赖低噪邻居」的假设也相当锐利,属于对训练动力学的真实洞察,而不是拍脑袋的启发式。结构保持图的说服力很强——固定超像素、换种子,构图不变而属性变化,这直接证明了源分布的结构确实被继承到了输出。不过要留意几处。第一,超像素划分本身成了新的输入依赖:生成时需要一份划分,无条件生成场景下这份划分从哪来?如果是随机生成的,那它的分布就成了新的隐式先验,可能引入难以察觉的偏置;如果要用户提供,那这就从「更好的生成」变成了「另一种条件生成」,可比性发生了变化。第二,让区域内共享噪声成分本质上降低了源分布的熵,理论上会压缩可生成的多样性——而这个担心在论文自己的数据里就被证实了:无条件 FFHQ 上 Recall 从基线 0.200 掉到 0.160、FID 从 22.68 退到 25.80、FID-DINO 从 232.4 退到 267.3,同时 Precision 从 0.250 冲到 0.350。这是一组非常典型的「保真度换多样性」权衡信号,说明 StructFlow 生成的样本更精致但覆盖面更窄。摘要只说「有效」,把这个方向性代价藏进了图里,读者若不看 baseline_comparison 这张图很容易被误导。类别条件 ImageNet 上表现则相反(FID、sFID、Recall 全面改善),说明这个代价与是否有强条件信号高度相关——条件越弱,熵损失越致命。第三,「轻量后训练即可植入大模型」这个结论只说了成立,没给成本量化和在哪个模型上验证,而这是该方法能否被采纳的关键。第四,超像素的粒度是一个新超参,粒度过粗会锁死构图、过细则退化为独立噪声,最优粒度是否依赖数据集和分辨率未讨论。第五,作者两人分属马里兰大学与 Netflix,工作在 Netflix 实习期间完成,考虑到 Netflix 的业务场景,这套方法在视频生成上的表现是个自然的下一步,但本文未涉及。 10. CineDub:免裁脸免分离的多人配音 CineDub: Scaling End-to-End Video Dubbing to Multi-Speaker Dialogues with Coherent Sound Effects | 中科大·蚂蚁集团·莫纳什大学 | arXiv:2608.15734 前序问题:真实场景下的自动视频配音被两个互相矛盾的约束卡住。层级式方法依赖脆弱的多阶段预处理——人脸裁剪、说话人分离等——这些前置步骤严重限制了数据可扩展性和实际部署:任一环节出错,后面全崩。整体式方法直接在未裁剪视频上操作,避开了预处理,但代价是时序对齐薄弱,而且在多说话人场景下会出现说话人-话语归属的歧义:模型不知道这句话该由画面里哪个人说。于是配音这件事在「脆弱但精确」和「鲁棒但混乱」之间左右为难,而影视配音恰恰是多说话人、多轮对话的典型场景。 本文贡献:CineDub 是一个统一的扩散模型,能直接从未裁剪视频完成精确的多说话人对话配音,既不需要人脸裁剪也不需要说话人日志。核心是隐式耦合整体条件化范式:整体视觉表示与一种语义捆绑的转写格式被独立编码,却通过跨模态训练隐式耦合起来,从而解决说话人歧义并支持精确的多人多轮对话配音。基于整体视觉特征捕获的统一时序线索,作者进一步把 CineDub 扩展到语音与音效的联合生成,为此引入环境音到语言的课程学习以缓解子任务退化,并设计解耦的文本分支控制机制来解决同时生成时的跨提示词干扰。同时发布两个真实场景基准。框架图显示视觉侧分为 Dense Temporal(Synchformer)、Global Semantic(CLIP)与 Transcription(Gemma-T5)三支冻结编码器,转写格式用 / 标记切分不同说话人的语句,音频与转写元 token 分别经交叉注意力注入主干。 Overview of CineDub under the ICHC paradigm. The holistic visual condition $\mathbf{c}_v$ (left), extracted by SynchFormer (Sec.~sec:visual_condition), encodes both event-level audio-visual correspondences and fine-grained lip-sync alignment. To address the speaker assignment ambiguity in $\mathbf{c}_v$, the semantic-bundled transcription $\mathbf{c}_t$ (right) provides per-segment speaker-utterance grounding cues, implicitly coupling with $\mathbf{c}_v$ via multi-conditional training (Sec.~sec:text_condition). CineDub adopts a unified DiT backbone that supports both joint video-to-speech-and-audio generation and each subtask. $\mathbf{c}_t$ and $\mathbf{c}_a$ are routed through decoupled textual branches to prevent cross-prompt interference, with learnable meta-tokens replacing inactive branches during single-task inference (Sec.~sec:decoupled_attn). 实验效果:实现了从未裁剪视频直接进行多说话人多轮对话配音,并扩展到语音与音效的联合生成。同时释出 CineDub-Multi(多说话人对话配音)等两个真实场景基准。论文已被 ACM MM 2026 接收。 Visualization of SynchFormer self-attention maps (magenta: active speaker; white: inactive speaker). (a)~Single-speaker setting: attention concentrates on the lip region. (b)~Two-speaker setting: attention dynamically shifts to the active speaker across turns. (c)~Failure cases: attention drifts to a non-speaking face during overlapping speech or becomes ambiguous at shot boundaries. 批判点评:「不需要人脸裁剪和说话人日志」是这篇最实在的卖点。做过配音管线的人都知道,那些预处理步骤是主要的故障源和数据规模瓶颈,能去掉它们,工程价值立刻显现。用带 / 标记的语义捆绑转写格式来消解说话人归属歧义,是个巧妙的取舍——把「谁在说」这个视觉难题部分转移到了文本侧的结构化表示上,绕开了视觉说话人定位的老大难。三支冻结编码器分工也清晰:Synchformer 管密集时序、CLIP 管全局语义、Gemma-T5 管文本,各司其职且都不训练,成本可控。ACM MM 2026 接收提供了一定的同行评议背书。但几点需要审视。第一,转写格式承担了消歧的主要负担,意味着推理时需要一份带说话人切分标记的高质量转写——这份输入从哪来?如果需要人工标注或依赖 ASR 加日志,那么「不需要说话人日志」只是把它从视觉管线挪到了文本管线,端到端的依赖并没有真正消除,摘要在这一点上表述得偏乐观。第二,同时生成语音与音效带来的「跨提示词干扰」用解耦文本分支来解决,但音效与语音在时间上天然重叠(说话时门在响),这种物理层面的耦合能否靠表示层解耦干净,值得怀疑。第三,两个基准都由作者团队自建,与训练数据的分布关系未说明,同分布优势难以排除。第四,摘要没有任何定量结果——没有同步性指标、没有音质指标、没有与层级式方法的对比数字,一篇声称解决多说话人歧义的论文却不给说话人归属准确率,是明显的缺口。第五,环境音到语言的课程学习是为缓解子任务退化而引入的,说明联合生成确实存在能力互斥,那么相比两个独立模型分别生成再混音,联合方案的净收益有多大并不明确。 趋势观察 像素空间正在夺回 VAE 让出的地盘 — 今天有四篇论文从不同角度指向同一个结论:VAE 潜空间不是免费的午餐。阿里的 Z-Image-Pixel 给出了首个能与潜空间掰手腕的像素空间 T2I 训练配方,港理工的 PixRestore 干脆不要 VAE 从零训像素 DiT,PixelControl 指出潜空间压缩会削弱细结构控制信号。VAE 换来的是算力,代价是细节与保真度——当算力配方被打通后,这笔交易开始被重新审视。 注意力加速从「手工稀疏」走向「蒸馏出来的结构」 — Qualcomm 的 SQuad 不再手写稀疏模式,而是把满 softmax 教师蒸馏成 O(n√n) 的局部+全局两段注意力,在 Wan 2.2 5B 上 VBench 83.20 对 83.08 基本无损而注意力 FLOPs 降 67 倍。上交与阿里的 SyncSparse 则说明:稀疏化不能对模态盲视,音视频模型直接套用视频加速方法会破坏音画同步。 「不训新模型」成为一种正当的方法论 — Qwen-Video-Edit 直接把图像编辑模型当视频编辑器用(帧排成一张大图),KeyID 走训练无关路线,EqF 把噪声条件整个去掉换来推理期自适应,MLLM 语义纠偏在采样循环里插反馈。视频基座训练成本高企之后,研究重心明显从「造模型」转向「榨干已有模型的隐含能力」。 人工智能炼丹君 整理 | 2026-08-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-30|Adobe世界模型16FPS实时生成分钟视频 今日 AIGC 论文速览 今日共 10 篇 · 实时世界模型与未来预测 2 篇 · 图像视频生成加速 2 篇 · 全模态推理与数字人 2 篇 · 语音与图像生成控制 2 篇 · 生成安全与任务修复 2 篇 重点论文标题列表 Wonder(Adobe Research·约翰霍普金斯):16FPS实时生成分钟级可探索世界 GARFIELD(ECCV 2026·慕尼黑大学):不生成画面也能快97倍预测未来 PDD(NVIDIA·魏茨曼研究所):一次网络前向并行预测多步去噪 OmniCache(UT Austin):四级缓存让扩散推理最多快35% OmniDelta(阿里Qwen·浙大·CMU·中科院):只留25%音视频Token仍提速1.64倍 今日论文速览 1. Wonder:16FPS实时生成分钟级可探索世界 Wonder: Video World Model Done Better | Adobe Research·约翰霍普金斯 | arXiv:2607.26037 关键词:视频世界模型,实时生成,相机控制,长期记忆,Adobe 前序问题:从一张图构建可交互世界,不仅要按相机控制实时生成新视角,还要在分钟级探索中记住已见区域,允许用户返回旧地点,并维持几何、外观和动态一致。普通视频生成的控制、记忆和训练管线彼此割裂。 本文贡献:提出通用视频世界模型Wonder,联合设计相机控制、稀疏记忆与蒸馏训练。稠密坐标场把相机运动和朝向渲染成空间对齐的视觉证据;稀疏注意力记忆从不断增长的历史中只检索少量相关token,计算不随上下文长度线性增长;多项修正改善Self-Forcing式蒸馏的控制遵循、多样性和长期记忆。 实验效果:可从图片或条件视频构建可玩世界,以16 FPS实时合成分钟级视频,支持相机导航、探索未知区域、重访旧区域和对已有动态场景重新运镜,同时保持长期几何、外观与动态连贯。 批判点评:Adobe把世界模型最关键的实时性、可控相机和长期记忆放进同一系统,16 FPS分钟级结果足以指向交互创作。但“可探索”仍是视频生成而非显式3D模拟,重访一致不代表真实几何闭环;分钟级稳定性的场景复杂度与硬件成本需结合演示判断。 2. GARFIELD:不生成画面也能快97倍预测未来 Schrödinger's Cat: Probabilistic Representation and Prediction of Potential Scene Kinematics | ECCV 2026·慕尼黑大学 | arXiv:2607.25984 关键词:运动预测,概率分布,世界模型,ECCV,不确定性 前序问题:从局部观察预测场景未来,本质上存在多条可能轨迹。视频预测往往把算力花在外观,或只采样少量轨迹,既无法显式表示完整运动分布,也难定位“哪个物体、哪个时刻”最不确定。 本文贡献:提出未来运动潜分布的目标感知表示GARFIELD。给定图像和可选稀疏时空约束,模型学习结构化时空潜变量;同一表示既能联合采样全部轨迹,也可由确定性密度解码器直接读取底层运动分布。新增约束可逐步收窄特定物体与时刻的不确定性。 实验效果:运动规划表现可与大型视频生成模型竞争,轨迹采样快97倍;运动密度估计比对生成模型做Monte Carlo采样快两个数量级,可用于交互探索和不确定性感知规划。 批判点评:它把“未来长什么样”拆成“未来可能怎么动”,避免为规划浪费画面生成算力,97倍数字很有说服力。但潜运动分布不直接保证外观、碰撞和语义合理,复杂可变形物体与长时人类行为可能仍需视频级世界知识。 3. PDD:一次网络前向并行预测多步去噪 Parallel Decoding Distillation for Fast Image and Video Generation | NVIDIA·魏茨曼研究所 | arXiv:2607.26004 关键词:并行解码,扩散蒸馏,NVIDIA,少步生成,Flow Matching 前序问题:视频扩散和流模型采样迭代慢,主流少步蒸馏依赖VSD与对抗损失,训练难稳定且容易模式坍塌,表现为视频多样性下降和运动不足。 本文贡献:提出并行解码蒸馏PDD,以简化、可扩展的轨迹蒸馏替代复杂对抗训练。每次网络评估同时预测多个去噪步,学习平均速度表示,无需JVP或有限差分回归速度导数;架构兼容任意预训练扩散/flow模型,并允许推理时选择不同NFE。 实验效果:在LTX-2.3文生视频/音频、Wan 14B文生视频和Qwen-Image文生图上,仅4到8 NFE即达到SOTA,并显著改善生成视频多样性。 批判点评:PDD横跨图像、视频和音频,说明并行解码可能成为通用少步蒸馏接口;不依赖VSD和GAN也降低训练风险。不过摘要只报4–8步SOTA,缺少相对速度与训练成本;一次预测多步是否会在极端动作中积累轨迹偏差仍需细看。 4. OmniCache:四级缓存让扩散推理最多快35% OmniCache: Multidimensional Hierarchical Feature Caching for Diffusion Models | UT Austin | arXiv:2607.23844 关键词:扩散缓存,免训练,推理加速,视频生成,层级复用 前序问题:高分辨率图像和视频扩散在多步采样中反复计算相似中间特征。现有缓存通常只利用单一维度冗余,或通过token合并求平均,容易破坏位置顺序和时空结构。 本文贡献:提出免训练多维层级缓存OmniCache,系统利用帧内、帧间、运动和去噪步四类冗余,并设计Token、Frame、Block与Layered四级缓存。方法通过相似度选择可缓存特征、跳过重复计算,再恢复位置一致的激活;空间特征可在时间层复用,时间特征也可在空间层复用。 实验效果:在保持视觉保真与运动连贯的同时,SD3、SVD-XT和Latte推理延迟分别最多降低35%、25%和28%,无需改权重或重新训练。 批判点评:OmniCache把缓存从“跨步复用一层”扩成时空、模块与层级协同,覆盖图像和视频骨干。局限是三组模型的最高收益不同,缓存命中率高度依赖内容运动;快速镜头和大形变可能减少复用,四级策略本身也增加调度复杂度。 5. OmniDelta:只留25%音视频Token仍提速1.64倍 OmniDelta: Skill-Driven Budget Allocation for Token Compression in OmniLLMs | 阿里Qwen·浙大·CMU·中科院 | arXiv:2607.25669 关键词:全模态LLM,Token压缩,Qwen,预算分配,推理加速 前序问题:全模态LLM的音频和视频token很长,现有压缩多关注“保留哪些token”,却默认模态间和模态内预算固定。查询与音视频的直接相似度难判断该给哪种模态更多预算,均匀切分又会漏掉关键片段。 本文贡献:提出免训练技能驱动框架OmniDelta。音频与视频skill pool先根据查询意图在两种模态间移动固定总预算,再依据局部复杂度和时间冗余,把各模态预算细分到音频片段与视频帧;局部预算可与已有剪枝器组合,总保留率不变,只改变算力花在哪里。 实验效果:在四个音视频基准和两款Qwen2.5-Omni模型上建立新的准确率—效率Pareto前沿。Qwen2.5-Omni-7B仅保留25% token时,GPU内存降低22%,端到端提速1.64倍。 批判点评:OmniDelta抓住了压缩前更上游的问题:先决定预算给谁,再决定删谁。数字实用且无需训练。但skill pool若误判意图,会在剪枝前就饿死关键模态;复杂跨模态推理可能无法被单一预算分配准确刻画。 6. FacialTalker:看懂人脸表情再生成共情语音 Let Me Look at You: Advanced Facial Expression Modeling for Conversational Speech Synthesis | 内蒙古大学·港中文深圳 | arXiv:2607.24430 关键词:对话语音,表情建模,DPO,视觉Token,TTS 前序问题:对话语音合成需要生成符合上下文的自然、共情声音,但现有系统常忽略说话人面部表情这一细腻情绪信号;同时缺少大规模自然对话的同步语音—视频数据。 本文贡献:提出基于LLM的表情感知语音系统FacialTalker。AUTokenizer以单码本将逐帧Action Unit组合离散成紧凑视觉token;DualDPO同时对视觉token和语音token施加偏好约束,联合优化表情理解与语音语义。团队还通过自动流水线从真实网络对话构建VSDD-1K。 实验效果:VSDD-1K含超过1033小时同步说话人视频与语音,85%以上帧有人脸。客观和主观实验均超过强基线,语音更自然、富表现力且与对话情境更一致。 批判点评:从“听上下文”扩展到“看对方表情”,更贴近真实对话Agent;1033小时数据也是重要资产。但网络视频中的表情、声音与身份偏差复杂,自动采集可能带来隐私和标注噪声;Action Unit离散token也未必覆盖微妙文化差异。 7. TaoMate:固定身份锚撑住长时实时数字人 TaoMate: Anchor-Guided Memory Bridging Evolving and Reference States for Real-Time Audio-Video Digital Human Generation | 阿里淘天 | arXiv:2607.24359 关键词:数字人,音视频生成,持久记忆,身份锚,阿里 前序问题:长时实时数字人的有界缓存只能保留近期动作和语音,旧身份信息会被遗忘;看完整历史又昂贵且会传播累积错误,导致跨分段外观漂移和音画失步。 本文贡献:提出锚点引导持久记忆TaoMate:保留不可变视觉身份锚,将完成的音视频块压缩成定容动态状态,并用模态专用残差注意力检索,不扩展活动缓存。参考感知调制联合动态与锚点外观统计;保持锚点的因果上下文蒸馏覆盖不同rollout长度、前缀来源和历史可靠性,且支持跨块阶段并行。 实验效果:在自回归长视频延续中保持跨提示分段的稳定外观和强音画同步,并通过阶段并行加速少步联合音视频生成,无需为特定流水线重新训练。 批判点评:AptAvatar解决两步速度,TaoMate则补长期记忆,两者显示淘天正搭建数字人完整栈。不可变锚可稳身份,却可能压制随时间合理变化的发型、光照或服饰;摘要没有绝对FPS和长视频时长,实时结论还需硬件指标。 8. PRISM:让模型看生成结果自己改提示词 PRISM: Prompt Refinement via Image-grounded Self-rewarding Mechanism for Text-to-Image Generation | 哈工深·中大·华南理工·广工 | arXiv:2607.24353 关键词:提示优化,文生图,自奖励,VLM,图像诊断 前序问题:文生图对提示词写法高度敏感,现有优化多在文本侧改写、扩写,或依赖外部奖励,缺少对实际生成图的结构化诊断,也难学到可复用的提示优化策略。 本文贡献:提出图像接地自奖励提示优化PRISM,闭合“提示—生成图—视觉诊断—再改提示”反馈环。统一VLM先经多任务监督微调,识别语义一致、审美质量和人类偏好问题;再以理想点与Chebyshev混合奖励进行自奖励优化,学习针对具体视觉缺陷的提示策略。 实验效果:实验显示PRISM同时提升整体图像质量与细粒度语义对齐,并能输出可解释的视觉反馈,支持有针对性的提示修正;代码已开放。 批判点评:让模型先看成片再改提示,比盲目扩写更接近人类创作迭代。风险在于VLM既当诊断器又参与自奖励,可能强化自身偏好与评分漏洞;提示变好也可能只是对特定生成器过拟合。 9. I2VShield:低算力主动阻止照片被做成视频 I2VShield: An Efficient Proactive Defense Framework against DiT-based Image-to-Video Models | 中山大学 | arXiv:2607.25522 关键词:图生视频,隐私保护,对抗扰动,DiT,主动防御 前序问题:图生视频被用于未经授权地驱动个人照片。现有主动保护主要针对模型做梯度对抗攻击,防御者自己就需要大显存GPU,普通用户难以使用。 本文贡献:提出面向DiT图生视频的生成式对抗防御I2VShield。文本自适应扰动生成器结合对抗学习,以较低计算产生视觉不可察觉扰动;无目标多模态注意力破坏(MAD)直接放大DiT内部注意力特征与干净输入的偏差,破坏后续时空一致生成。 实验效果:在多个数据集和主流DiT图生视频模型上获得有竞争力的保护效果,尤其能破坏时空连贯,同时显著降低防御扰动生成的计算成本。 批判点评:它把隐私保护从事后检测前移到上传前防御,且试图摆脱大GPU门槛,现实意义强。但扰动可能被平台压缩、裁剪或重编码削弱,跨黑盒模型转移性与对抗升级仍是关键;主动破坏也可能影响合法编辑。 10. Noise-Free LoRA:去掉随机噪声一步修图反超多步扩散 Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors | 首尔大学 | arXiv:2607.25390 关键词:图像修复,一步扩散,LoRA,无噪声,任务驱动 前序问题:任务驱动图像修复既要画面好看,又要提升分类、分割、检测和OCR。扩散先验有帮助,但随机噪声让同一输入输出不稳定,可能破坏下游任务一致性。 本文贡献:论文发现预训练扩散先验可以直接做确定性、无噪声的一步前向,关键在适配器选择:LoRA能稳定提升,而ControlNet式条件并不奏效。在此基础上加入任务保持GAN训练,用感知质量约束与任务目标共同优化,避免修得好看却损伤识别。 实验效果:无噪声一步LoRA超过传统多步扩散TDIR基线,在分类、分割、检测上持续提升,并在真实退化图像与OCR中验证泛化;GAN阶段进一步改善观感而不牺牲任务表现。 批判点评:“去掉噪声、只跑一步”反而更适合任务修复,说明生成多样性在恢复场景可能是负资产。结论对端侧预处理很有价值,但优势依赖预训练扩散先验与LoRA任务适配;不同退化混合下的确定性输出也可能固化错误细节。 趋势观察 世界模型开始同时追求实时、分钟级与可回访 — Wonder以16FPS生成分钟级可探索世界并支持重访,系统重点从短视频画质转向控制、稀疏记忆和长期一致性的协同设计。 预测未来不必先生成完整视频 — GARFIELD直接建模多未来运动分布,轨迹采样快97倍、密度估计快两个数量级,规划模型正从像素预测转向结构化运动不确定性。 生成加速从单一技巧走向跨模型接口 — PDD用并行解码覆盖LTX、Wan与Qwen-Image,OmniCache则在SD3、SVD和Latte间复用四类冗余,通用性成为加速方法的新门槛。 全模态系统开始精细分配每一个Token预算 — OmniDelta只保留25%音视频token仍提速1.64倍,说明压缩关键不只是选token,而是先根据任务决定预算给音频还是视频。 生成系统从内容质量扩展到情感、隐私与任务可靠性 — FacialTalker看表情生成共情语音,I2VShield保护照片免被视频化,Noise-Free LoRA则优先保证下游识别一致性,生成技术开始承担更多系统责任。 人工智能炼丹君 整理 | 2026-07-30 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-29|Apple端侧Siri语音16倍实时仅21MB 今日 AIGC 论文速览 今日共 10 篇 · 端侧音频与数字人生成 2 篇 · 视觉生成推理加速 2 篇 · 可控视频编辑与专业评测 3 篇 · 全模态表示与扩散蒸馏 2 篇 · 视频模型视觉推理 1 篇 重点论文标题列表 Apple Audio DiT(Apple):端侧Siri语音16倍实时仅21MB Sol-Attn(NVIDIA):在线稀疏注意力让视频快2.3倍 UniGen-AR(CMU·UIUC·Toyota Research):一个自回归模型做15项视觉任务 AptAvatar(阿里淘天):14B数字人两步720P提速60倍 EgoPlay(Snap·KAUST):看到事件发生后才开始编辑视频 今日论文速览 1. Apple Audio DiT:端侧Siri语音16倍实时仅21MB Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers | Apple | arXiv:2607.23811 关键词:端侧TTS,Siri,音频DiT,RVQ,Apple 前序问题:Siri Expressive Voices要在设备上实时生成可配置、富表现力的语音,但语义音频token转高保真波形的detokenizer受AMX算力和内存严格限制。传统Transformer或GAN随序列长度线性甚至平方增长,难以持续合成长音频。 本文贡献:Apple提出解耦时间与RVQ深度的三组件架构:流式编码器、时间解码器和深度解码器。单个可复用的DiT式深度解码器通过stage conditioning自回归生成全部RVQ层,取代每层一个解码器;因果滑窗注意力配合固定窗口KV缓存,使运行内存不随语音长度增长。 实验效果:部署在Apple Matrix Coprocessor上,每步约10ms、约16倍实时,峰值运行内存仅21MB,端侧资产329MB,可连续合成20到320秒音频。AFM 3 Core Advanced中以10亿参数激活规模运行,相比上一代端侧TTS,整体MOS从3.87升至4.15,对话语音从3.82升至4.24。 批判点评:这是今日最强工业落地:Apple不仅给结构,还给AMX上的时延、内存、资产和MOS,证明十亿级音频生成可真正驻留端侧。代价是方案深度绑定Apple硬件与AFM token体系,16倍实时不能直接外推到通用CPU/GPU;320秒以上稳定性和多语言覆盖也未披露。 2. Sol-Attn:在线稀疏注意力让视频快2.3倍 Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification | NVIDIA | arXiv:2607.24027 关键词:稀疏注意力,视频生成,NVIDIA,免训练,推理加速 前序问题:视频DiT的长token序列让注意力成为推理瓶颈。现有免训练动态稀疏要么固定保留比例、要么按累计概率动态分配,路由预算僵硬或失衡,还要显式生成代理分数图;直接丢掉未选块则在高稀疏率下明显伤质量。 本文贡献:提出免训练Sol-Attn,将动态路由、稀疏计算与近似修正合进同一次online softmax。在线块阈值直接比较代理分数选关键KV块,不物化完整代理图,预算动态且可控;未选块的代理分数被复用来近似其贡献,避免keep-or-drop造成的信息断崖。 实验效果:在保持视觉质量的同时,视频生成端到端提速2.1倍、视频编辑提速2.3倍,并在图像与视频任务上推进免训练稀疏注意力的质量—效率前沿。 批判点评:Sol-Attn的价值不只是稀疏,而是把路由开销和遗漏补偿塞进online softmax一遍完成,NVIDIA背景也意味着内核可落地。但提速依赖模型、序列长度和阈值;代理分数对被丢块的近似在快速运动、小目标或精细文字场景中仍可能失真。 3. UniGen-AR:一个自回归模型做15项视觉任务 UniGen-AR: Unifying Visual Generation with Auto-Regressive Modeling | CMU·UIUC·Toyota Research | arXiv:2607.24157 关键词:统一视觉生成,自回归,VAR,MLLM,VQ-VAE 前序问题:文生图、编辑、修复和传统感知仍由不同模型负责;扩散虽能统一多种图像输出,但迭代采样延迟高,限制统一视觉生成在交互场景落地。 本文贡献:提出UniGen-AR,将通用MLLM与next-scale视觉自回归(VAR)解码器结合。MLLM把自由文本指令和控制信号编码为统一序列,VAR用一套权重和统一提示接口生成图像输出,覆盖四大家族15项以上任务且无需任务专用头。消融指出VQ-VAE码本大小和层级是VAR扩展的关键。 实验效果:相对扩散基线推理延迟最多降低19倍,同时保持或提升输出质量;单模型覆盖文生图、图像编辑、修复、感知等15项以上任务。 批判点评:用VAR替代扩散解码器,把统一视觉生成的效率问题正面解决,19倍延迟优势非常醒目。但自回归速度会受视觉token数量影响,VQ-VAE码本带来的量化误差仍在;15任务统一不等于每项都超过专用SOTA。 4. AptAvatar:14B数字人两步720P提速60倍 AptAvatar: Fast and Vivid Long-Form Audio-Driven Video Generation for Production-Ready Avatars | 阿里淘天 | arXiv:2607.24013 关键词:数字人,音频驱动,两步生成,分布蒸馏,阿里 前序问题:生产级音频驱动数字人既要快,又要保持身份、动作表现力和长视频稳定。现有加速常靠因果注意力、短时间窗、缩小模型或分辨率换速度,在极端两步生成时质量尤其容易塌。 本文贡献:提出14B长视频数字人AptAvatar。端点锚定分布蒸馏在普通DMD外加入Anchor Score Estimator,用冻结四步桥接生成器定义可达到的轨迹端点,指导两步学生;Self-Generated History Replay复用早期checkpoint输出作为分块训练历史,近似推理时自生成上下文而无需昂贵在线rollout。 实验效果:仅2次函数评估即可生成720P长视频数字人,推理提速60倍,同时保持视觉保真、鲜活动作、长时身份一致和文本动作控制。 批判点评:14B、720P、两步和60倍同时成立,说明淘天已瞄准直播与营销生产链。端点锚降低了两步蒸馏难度,但训练依赖四步桥接器和历史checkpoint缓存,流水线并不轻;摘要也未给绝对FPS,生产“实时”仍需硬件数据。 5. EgoPlay:看到事件发生后才开始编辑视频 EgoPlay: Event-Triggered Video Editing for Egocentric Streams | Snap·KAUST | arXiv:2607.24560 关键词:视频编辑,事件触发,第一视角,Snap,流式生成 前序问题:第一视角连续视频需要“当X发生时再做Y”,模型既要识别事件发生与否和时刻,又必须完整保留事件前画面、只改后续。检测器串联编辑器容易误触发并产生误差传递。 本文贡献:提出端到端事件触发V2V编辑器EgoPlay,在一个视频扩散模型中联合学习事件识别、时间克制和像素编辑,支持未发生事件与多事件提示。团队构建10.6万组事件触发片段—提示数据,训练双向编辑器并导出可逐块流式推理的因果版本;评测拆分触发后质量、触发前保持和假触发鲁棒性。 实验效果:相对EgoEdit,编辑质量、视觉质量和背景一致性分别提升17.7%、16.9%、16.4%;相对VLM检测器+编辑器串联基线分别提升15.7%、14.5%、13.5%,GPU内存还不到其一半。 批判点评:EgoPlay把视频编辑从“全片执行指令”升级为事件驱动程序,对AR眼镜和第一视角Agent很关键。风险是模型同时承担检测与生成,触发判断难单独校准;Ego4D里的事件覆盖有限,安全敏感场景不能只依赖生成模型自判。 6. FilmBench:电影学院用专业镜头语言重测视频模型 FilmBench: A Film-Grade Benchmark for Cinematic Video Generation | 阿里·北京电影学院·虎鲸文娱 | arXiv:2607.24241 关键词:视频评测,电影语言,多镜头,阿里,FilmOps 前序问题:多数视频生成基准用网页或LLM提示,并由通用多模态模型打总体画质、文本一致和流畅度,测到的是“像视频”,而非导演真正关心的镜头设计、动态美学和多镜头叙事。 本文贡献:提出电影级T2V/R2V基准FilmBench,与导演、北电教师和制片团队共同设计。1169条提示反推自20类获奖电影片段,其中1056条为多镜头真实shot list;评价体系含3轴、12组件、T2V 35项加R2V 3项子指标,并开放电影语言算子FilmOps和专家级自动评测Agent。 实验效果:评测9个T2V和7个R2V模型,自动评测对人类模型排名的Spearman相关分别达0.95和0.96。现有模型在动态美学上普遍不足,且从单镜头到多镜头性能明显下降,弱模型跌幅更大。 批判点评:FilmBench把视频评测从VBench式通用指标拉到专业电影语言,是生成视频走向影视生产的重要基础设施。但获奖电影反推提示可能偏向成熟电影美学,自动Agent即使排名相关高,也不代表每个镜头级解释都可靠;版权与参考片段可复现性同样重要。 7. OmniVAE:音视频VAE先对齐再联合生成 OmniVAE: An Audio-Video VAE with Cross-Modal Alignment for Joint Generation | 复旦·上海创新院·MOSI·上交 | arXiv:2607.23855 关键词:音视频生成,VAE,跨模态对齐,复旦,全模态 前序问题:联合音视频生成通常分别训练音频VAE和视频VAE,两套潜空间没有细粒度对应,下游生成器不得不从零学习“哪个画面该配哪个声音”,增加同步学习难度。 本文贡献:提出联合训练的OmniVAE。除重建目标外,以片段级音视频对比学习捕获时间—语义对应并对齐潜空间;同时把预训练音频和视频语义编码器特征分别蒸馏进对应潜变量,让两种表示既保留重建能力,又更容易被下游联合生成模型学习。 实验效果:两种对齐目标持续提升潜空间可学习性,使下游文生音视频获得更高生成质量与更准确跨模态同步,验证统一表征应从VAE底座开始。 批判点评:多数工作把同步压力全留给生成DiT,OmniVAE提前在tokenizer阶段对齐,方向很对。但对比目标可能把音画关系压成粗语义相似,口型、碰撞声等毫秒级同步仍需生成器建模;联合VAE也会降低替换单一模态编码器的灵活性。 8. PDM:拆开CFG正负分支修复扩散蒸馏 Rethinking Classifier-Free Guidance in On-Policy Diffusion Distillation | 阿里通义千问 | arXiv:2607.24731 关键词:扩散蒸馏,CFG,在线策略,PDM,视频控制 前序问题:在线策略扩散蒸馏通常直接匹配教师与学生经CFG合成后的速度,但这个总目标无法唯一约束正、负两个分支:两边误差可互相抵消。当教师负分支含学生拿不到的特权信息时,正分支变好反而会伴随负分支恶化。 本文贡献:论文将该失败模式命名为负分支不对称(NBA),并提出分支感知的Positive-Direction Matching(PDM):分别约束正条件预测与CFG条件方向,使监督可识别,不再让合成结果掩盖分支错误。方法用于从稠密到稀疏的视频控制蒸馏。 实验效果:朴素CFG匹配对推理guidance scale高度敏感,PDM在不同引导尺度下实现更稳健、有效的知识迁移,修复教师负分支存在特权条件时的对抗误差动态。 批判点评:它揭示了一个容易被总loss掩盖的蒸馏病灶:CFG结果对了,不代表两个分支学对了。分析价值高于单项榜单。不过当前验证集中在稠密到稀疏视频控制,PDM对文生图少步蒸馏、不同负提示schema的普适性仍需实证。 9. VIPE:先改输入图片再让视频模型推理 Visual Prompt Engineering for Video Models | Google DeepMind | arXiv:2607.25537 关键词:视觉提示工程,视频模型,视觉推理,Google DeepMind,图像编辑 前序问题:视频生成模型正成为视觉推理基础模型,但用户仍主要优化文字提示。对于迷宫、物理轨迹等任务,原始抽象图像可能不符合模型训练分布,仅改文字无法消除视觉输入本身的表达障碍。 本文贡献:提出视觉提示工程VIPE:调用图像编辑模型自动修改任务图像的呈现方式,例如把抽象草图转成写实场景,再交给视频模型推理。它不改目标问题,只优化视觉prompt,使输入更贴近视频模型容易理解和模拟的分布。 实验效果:VIPE在多种任务上提升视频模型视觉推理,效果甚至可超过传统文本提示工程和测试时扩展,且额外计算较低。 批判点评:“不是改问题文字,而是改给模型看的世界”是很有启发的提示工程范式,Google DeepMind视频模型背景也值得关注。但编辑器可能偷偷改变物理条件或答案线索,提升不一定来自更强推理;必须验证语义与几何约束在改图前后严格等价。 10. TriLayer:视频扩散直接生成可编辑RGBA图层 Explicit Layer Modeling for Video Object Insertion and Layer Decomposition | POSTECH | arXiv:2607.25802 关键词:视频编辑,RGBA,图层分解,物体插入,扩散模型 前序问题:多数视频编辑没有显式图层表示,物体插入、复用和后期调整只能隐式推断或逐场景优化。缺少前景RGBA监督,也让阴影、反射等伴随视觉效果难与背景正确合成。 本文贡献:构建TriLayer大规模三元视频数据,逐帧对齐合成画面、背景和含物体外观及视觉效果的前景层。基于此提出双分支DBL-Diffusion,通过共享去噪和跨分支交互联合建模RGB合成与RGBA前景;DBL-Insert生成可后期编辑的插入图层,DBL-Decompose恢复前景与背景。 实验效果:显式图层建模显著提升视频物体插入保真度和图层分解质量,并让生成结果可用于真实合成与灵活后期修改。 批判点评:从最终RGB转向可编辑RGBA资产,是视频生成接入专业后期管线的重要一步。难点在于TriLayer数据如何获得真实透明度和复杂光效监督;半透明、运动模糊、反射及跨层光照很难被单一RGBA层完整表达。 趋势观察 生成模型开始进入端侧十亿参数时代 — Apple在AMX上以21MB峰值内存运行十亿参数激活规模音频生成,达到16倍实时;端侧生成竞争从小模型转向架构与硬件协同。 视觉生成加速分化为稀疏与自回归两条路线 — Sol-Attn用在线稀疏让视频编辑快2.3倍,UniGen-AR以VAR替代扩散让统一视觉任务延迟最多降19倍,计算范式本身成为核心变量。 视频产品同时追求极少步与事件驱动 — AptAvatar把14B数字人压到两步并提速60倍,EgoPlay则只在事件发生后编辑;视频生成正从整段离线采样走向低延迟、条件触发的连续服务。 评测和输出格式开始对接专业生产 — FilmBench用电影学院镜头语言重测模型,TriLayer直接生成RGBA图层;行业关注点从画面像真转向镜头设计、资产复用和后期可编辑性。 统一模型向底层表征与视觉提示延伸 — OmniVAE在VAE阶段对齐音视频,PDM拆解CFG分支监督,VIPE直接优化模型看到的图像;性能提升越来越依赖输入、tokenizer和训练目标的联合设计。 人工智能炼丹君 整理 | 2026-07-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-22|华为40万美元逼近闭源Boogu-Image 今日 AIGC 论文速览 今日共 10 篇 · 统一图像生成与编辑 2 篇 · 视频编辑与长视频一致性 5 篇 · 视频插帧与生成效率 1 篇 · 情绪语音生成 1 篇 · 像素扩散技术综述 1 篇 重点论文标题列表 Boogu-Image-0.1(华为香港AI Lab·港大·港科大):40万美元逼近闭源图像模型 D2DF(西交·国家电网AI Lab·浙工大·百度):视频消物一秒只需一步 SlotMem(港大·清华):按角色寻址记住长片人物 ReBind(快手可灵·港科大·南大·北大):显式绑定多参考视频编辑 FlowMimic(字节):图片编辑数据实时变视频 今日论文速览 1. Boogu-Image-0.1:40万美元逼近闭源图像模型 Boogu-Image-0.1: Boosting Open Agentic Multimodal Generation via Understanding under a Minimal Budget | 华为香港AI Lab·港大·港科大 | arXiv:2607.13125 关键词:统一多模态,文生图,图像编辑,Agent推理,开源模型 前序问题:Nano-Banana-Pro、GPT-Image-2 等闭源系统靠模型理解、提示改写与推理时编排形成系统级优势,但内部配方不公开;开源社区如何在有限数据和算力下同时做好文生图、快速推理、指令编辑和中英文字渲染,缺少可复现路线。 本文贡献:发布 Boogu-Image-0.1 开源统一理解生成模型族,含 Base、Turbo、Edit、Edit-Turbo。核心不是只堆生成骨干,而是强化多模态编码器、Agent 式提示重写、数据质量和训练管线,并用 Agentic inference-time scaling 把理解能力转成生成与编辑质量;权重、代码和训练配方均以 Apache 2.0 开源。 实验效果:仅使用 2.0862 亿张去重图像,Base 理论训练成本约 40 万美元;标准基准上持续匹敌或超过其他开源模型,结果逼近领先闭源系统,并覆盖高质量文生图、快速推理、指令编辑和中英文字渲染。 批判点评:「华为团队用 40 万美元把开源模型推近闭源系统」兼具机构信号与成本冲击力,且把系统级配方完整开放,比单点榜单更有价值。但“理论训练成本”未必包含数据、失败实验与基础设施总成本;逼近闭源的结论也依赖所选基准,真实复杂编辑和生产稳定性仍需社区复验。 2. D2DF:视频消物一秒只需一步 From Draft to Draft-Free: One-Step Video Object Removal via Privileged Distillation and Fast Planting | 西交·国家电网AI Lab·浙工大·百度 | arXiv:2607.14976 关键词:视频编辑,物体移除,一步生成,一致性蒸馏,视频修复 前序问题:视频物体移除中,光流/注意力传统方法容易留伪影、结果不自然;扩散方法更真实却需要多步去噪,速度难以实用,而且常依赖外部粗糙移除稿作为输入。 本文贡献:提出 D2DF 三阶段框架:先训练教师把低质移除草稿多步精修成高保真视频;再用先验特权一致性蒸馏(PPCD)将能力压到一步学生;最后以基于时序掩码 Transformer 的自引导快速植入(SGFP),在潜空间自动生成场景一致伪草稿,得到完全不依赖外部草稿的一步模型。 实验效果:有草稿和无草稿两版在多项指标上均达 SOTA,质量与效率超过传统及多步生成方法;单个视频的去噪过程约 1 秒。 批判点评:从“多步精修草稿”蒸馏到“无草稿一步消物”,既解决速度又去掉外部依赖,1 秒数字极具产品价值。但 SGFP 伪草稿的场景推断仍可能在大面积遮挡、复杂动态背景中失真,一步模型的失败可修复性也弱于多步迭代。 3. SlotMem:按角色寻址记住长片人物 SlotMem: Character-Addressable Internal Memory for Narrative Long Video Generation | 港大·清华 | arXiv:2607.15772 关键词:长视频生成,角色一致性,内部记忆,DiT,叙事视频 前序问题:叙事长视频中角色跨场景、隔很久再出现时容易换脸。全局记忆的检索线索并不针对身份,现有角色方法又把身份和姿态、背景等偶然因素混在粗粒度帧级 KV 中,有限容量下还缺少持续更新。 本文贡献:提出可按角色寻址的内部记忆 SlotMem:Character-Semantic Probe 从交叉注意力中定位角色相关 token;Memory Encoder 把 DiT token 压成紧凑的逐角色 slot;Memory Writer 随生成保守更新每个角色的新观察;Character-Wise Cross-Attention 只把对应角色记忆注入同一人物的局部 token。 实验效果:在多个叙事长视频基准上,相比现有方法显著改善跨长时间间隔的角色一致性,同时维持相当的视频总体质量;代码已开源。 批判点评:把“记住整帧”改成“按角色地址读写”,对多角色长片身份漂移非常对症,内存也更省。但角色探针一旦漏检或多人遮挡、换装,错误可能写回并长期污染;如何处理新角色、身份合并与开放世界角色数量仍是难点。 4. ReBind:显式绑定多参考视频编辑 ReBind: Multi-Reference Video Editing via Structured Instructions with Explicit Reference Relationships | 快手可灵·港科大·南大·北大 | arXiv:2607.14681 关键词:视频编辑,多参考,结构化指令,可灵,视觉绑定 前序问题:多参考图条件视频编辑需要明确“哪个参考提供哪个属性”,但自然语言指令通常不写清参考关系,通用 MLLM 也难稳定生成,导致人物、材质、灯光等来源互相串线。 本文贡献:提出 ReBind,以在语义位置嵌入 reference token 的结构化指令作为中间表示,显式绑定视觉属性与来源。ReBind-Instruct 通过两阶段渐进训练学习生成精确参考关系;ReBind-Edit 则轻量适配文生视频模型,按绑定关系协调多个参考源。 实验效果:ReBind-Instruct 的指令质量显著超过通用 MLLM;ReBind-Edit 在参考图条件视频编辑中达到开源方法 SOTA,能更准确组合多视觉来源。 批判点评:把多参考歧义从“模型自己猜”变成结构化显式绑定,是复杂编辑走向可控生产的关键一步,可灵团队也有真实产品场景。但需要专用 MLLM 先生成中间指令,链路更长;参考关系正确不代表遮挡、几何和时间一致性一定正确。 5. FlowMimic:图片编辑数据实时变视频 FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry | 字节 | arXiv:2607.18227 关键词:视频编辑,数据生成,光流,图像视频统一,免Mask 前序问题:视频编辑数据采集依赖人工 mask、I2V/ControlNet 合成和 VLM 过滤,不仅耗时、易引错,任务多样性也远落后图像编辑;推理时还常需外部 MLLM 或显式 mask 才能定位编辑区域。 本文贡献:提出像素对时序扭曲流场,可从图像编辑样本实时生成对应视频编辑样本,并证明仅用这类数据即可学习多层级视频编辑。将图像视作视频特例,以生成/编辑两种 modality mimic loss 让图像与视频能力互相模仿;再加入指代表达分割等感知任务和区域感知潜空间、注意力损失,让模型内化“理解指令—定位区域—只改该处”的能力。 实验效果:无需人工视频 mask 与传统重型合成管线,即可在线扩展多种视频编辑任务;同一模型统一图像/视频生成与编辑,并实现推理期免 mask 的区域感知编辑。 批判点评:把海量图像编辑数据通过流场实时“升格”为视频数据,直击视频编辑数据荒,字节背景也说明工程价值。但扭曲流场能模拟的运动与遮挡仍有限,由图像任务迁移出的时序规律未必覆盖真实长视频和复杂镜头运动。 6. STBridge:让模型说的和画的一致 STBridge: Shared-Target Alignment for Bridging Understanding and Generation in UMMs | 腾讯优图·吉林大学 | arXiv:2607.17140 关键词:统一多模态,理解生成对齐,图像编辑,强化学习,腾讯优图 前序问题:统一多模态模型虽然共用架构,却可能正确描述目标、实际编辑出另一回事;语言输出与视觉输出分居不同空间,在细粒度实体、属性、空间关系和局部细节上尤其缺乏同一目标约束。 本文贡献:提出共享目标对齐 STBridge:在图像编辑中,让目标 caption 表达期望视觉结果、编辑图像实现同一结果,以共同目标状态串起理解和生成。训练采用 align-then-optimize:先监督微调建立共享目标通道,再以序列强化学习优化围绕目标的跨任务协同。 实验效果:在视觉理解、图像生成和图像编辑基准上均持续优于初始化模型;对齐分析确认“模型描述的目标”和“模型生成的结果”之间差距明显缩小。 批判点评:指出“共架构不等于共语义”,并用共享目标把说与画绑在一起,是统一模型后训练的重要方向。但依赖高质量目标 caption 和顺序 RL,目标文本可能成为新的信息瓶颈;复杂视觉变化也未必能被一句 caption 完整表达。 7. TANGO:测试时绕开长视频死路 Test-Time Noise Guided Adaptation for Realistic Autoregressive Video Generation | CERTH·阿姆斯特丹大学 | arXiv:2607.15849 关键词:自回归视频,测试时适配,长视频,噪声引导,FVD 前序问题:自回归视频扩散可生成任意长视频,却会累积误差并逐渐偏离训练条件分布;即使每帧看起来都在真实流形上,某些轨迹也可能走到模型无法继续的“终点”,后续必然崩坏。 本文贡献:提出测试时终点规避 TANGO:假设可良好延续的未来轨迹,其预测噪声应匹配前向加噪的各向同性高斯分布。模型先向前预测一步,用自身充当输出批评器;一旦预测噪声偏离期望分布,就搜索替代轨迹,避免驶入终点,无需重新训练骨干。 实验效果:相对 SOTA,VBench 绝对提升 3.1%,15 秒视频上的平均 FVD 降低 28.3%;代码已开放。 批判点评:让扩散模型用噪声分布自检未来能不能走通,比只把当前帧拉回真实流形更深入,测试时即可插入。但前瞻搜索增加推理开销,各向同性噪声假设未必适合所有内容,且只能绕路、不能补足模型缺失的动态知识。 8. SPEED:一步像素扩散插帧快63% SPEED: One-Step Pixel Diffusion for High-quality Video Frame Interpolation | ACM MM 2026·复旦·B站 | arXiv:2607.15585 关键词:视频插帧,像素扩散,一步生成,4K,ACM MM 前序问题:扩散视频插帧有两大瓶颈:潜空间经 VAE 解码不可避免丢失细节,多步采样又带来高显存与高延迟;尤其 4K 插帧中,精细纹理与效率难兼得。 本文贡献:提出一步像素扩散 SPEED:渐进多阶段架构配动态 patch 缩放,学习多尺度运动、结构和外观;Noise-Update-Only Attention 只更新噪声、保护干净条件帧语义并把计算降近 50%;漂移感知时间步采样与定制目标直接在像素空间预测图像,实现不降质的一步推理。 实验效果:SNU-FILM 上 LPIPS 降低 8.8%,推理加快 63.3%、显存降低 10.6%;在高难 4K 基准上 LPIPS 最多优于先前方法 51.5%,达到 SOTA。 批判点评:一步、像素空间、4K 三个难点同时拿下,复旦+B站且获 ACM MM 2026,数字很硬。但像素扩散训练成本可能转移到离线阶段,动态 patch 与多阶段结构更复杂;插帧 SOTA 不等同于通用视频生成可直接受益。 9. AuEmoChat:离散情绪token让对话更真 AuEmoChat: Authentic Emotion Understanding and Rendering for Conversational Speech Synthesis | ACM MM 2026·内蒙古大学·港中文深圳 | arXiv:2607.15755 关键词:对话语音合成,情绪生成,Flow Matching,Token合并,TTS 前序问题:对话语音合成要理解多轮上下文并表现像人的细腻情绪,但现有方法常把情绪压成七类等有限标签;同时历史中的冗余多模态 token 干扰上下文理解,导致声音情感僵硬或前后不一致。 本文贡献:提出 AuEmoChat:AuEmoCodec 用有限标量量化从大规模情绪语音学习离散真实情绪 token 空间;AuEmoToMe 在保留情绪相关上下文的同时合并冗余多轮 token;自回归文本-语音模型预测目标情绪与语音 token,最后用 Authentic Emotion Flow Matching 联合对话上下文、情绪和声学先验渲染语音。 实验效果:在 NCSSD-EmCap 上超过 SOTA 对话语音合成基线,生成语音的情绪表达更丰富、更真实;代码与语音演示计划开放。 批判点评:从少数人工情绪标签转向数据驱动的离散情绪空间,并同时处理多轮冗余,贴近真实对话产品。但“真实情绪”评价主观且受数据文化偏差影响,离散 token 也可能把连续情绪重新切碎;跨语言、跨说话人泛化仍是关键。 10. Pixel-Space DiT:像素DiT绕开VAE细节瓶颈 Pixel-Space Diffusion Transformers | 北大·Stanford·Cornell·南大 | arXiv:2607.17585 关键词:像素扩散,DiT,VAE,生成综述,统一多模态 前序问题:潜扩散靠 VAE 压缩实现高效高分辨率生成,但固定视觉 tokenizer 会丢纹理和结构细节,重建目标与生成目标分离也限制端到端优化;直接像素扩散则面临高维建模、噪声调度、损失加权和 token 效率难题。 本文贡献:系统综述 Pixel-Space Diffusion Transformer,从模型架构、连续生成机制和统一多模态建模三条线梳理直接在原始像素上扩散的方法,讨论如何去掉 VAE 瓶颈,并让像素、文本与任务条件进入共享 token 空间由同一 Transformer 处理。 实验效果:归纳当前像素 DiT 的代表方法、核心挑战与技术路线,指出其在高保真单阶段生成及理解生成一体化视觉基座上的潜力,并给出未来研究方向。 批判点评:像素空间正在重新成为生成主线,这篇综述适合建立全景认知;但它不是新算法、没有单一实验突破,且像素 DiT 的巨大训练成本与 token 数仍是现实约束,应放在今日列表末尾而非主推。 趋势观察 开源图像模型开始公开系统级配方 — Boogu-Image 不只开权重,还公开强编码器、Agent 提示改写、数据与训练管线,以约 40 万美元理论成本逼近闭源系统,竞争从单模型走向完整生成系统。 视频编辑同时冲刺一步化与免标注数据 — D2DF 把视频消物压到一步约 1 秒,FlowMimic 则把图像编辑样本实时变成视频数据;一个砍推理成本,一个砍数据成本。 长视频从全局缓存转向结构化记忆与自检 — SlotMem 按角色地址读写身份记忆,TANGO 在测试时用预测噪声自检轨迹死路,长视频一致性开始从粗粒度历史帧走向可解释内部状态。 复杂编辑把视觉来源和目标语义显式绑定 — ReBind 用 reference token 绑定多参考来源,STBridge 用共享目标绑定模型说的与画的,可控编辑正在减少让模型自行猜测的隐式接口。 生成底座向像素空间与真实情绪扩展 — SPEED 以一步像素扩散实现 4K 插帧,Pixel-Space DiT 总结绕开 VAE 的技术路线;AuEmoChat 则把生成边界扩到多轮对话中的细腻情绪语音。 人工智能炼丹君 整理 | 2026-07-22 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-16|字节Seed读回提示当奖励SpectraReward 今日 AIGC 论文速览 今日共 5 篇 · 文生图强化学习与奖励 1 篇 · 视频生成潜空间与物理评测 2 篇 · 文生图个性化 1 篇 · 统一视觉表示与编辑 1 篇 重点论文标题列表 SpectraReward(港大·字节Seed·北大):MLLM读回提示当零样本奖励 VideoRAE(港中文深圳·华科·中科大):冻结视频基座炼成生成潜空间 Seriality Gap(UC Berkeley):视频扩散缺可扩展串行算力 IdentityTuning(特拉维夫大学·Cornell):免训练调身份token改五官 RINO(约翰霍普金斯·CMU·UCSC·Rice):万物皆RGB统一视觉接口 今日论文速览 1. SpectraReward:MLLM读回提示当零样本奖励 Read It Back: Pretrained MLLMs Are Zero-Shot Reward Models for Text-to-Image Generation | 港大·字节Seed·北大 | arXiv:2607.11886 关键词:文生图,强化学习,奖励模型,MLLM,零样本 前序问题:文生图强化学习的上限取决于奖励模型,但偏好标注贵、迭代慢;现有零样本 MLLM 奖励要么靠打分/logit(校准噪声大),要么做问题分解验证(工程复杂),缺一个免标注、免微调、开箱即用的奖励方案。 本文贡献:提出 SpectraReward:冻结预训练 MLLM,对生成图像做一次图像条件、teacher-forced 前向,用「原提示在图像条件下的平均 token 对数似然」当奖励,直接复用图文对齐能力,无需偏好标签与奖励微调。另对统一多模态模型提出 Self-SpectraReward——用策略自身理解分支当生成分支奖励,形成无外部奖励/知识的闭环自改进。 实验效果:覆盖 2 个扩散模型、3 种 RL 算法、4 大家族 9 个 MLLM 骨干(4B–235B)、5 个 OOD 文生图基准;BAGEL 上 TIIF-Bench +10.0、GenEval +4.3/5.5,并超过 AlphaGRPO。Self-SpectraReward 可匹敌甚至超过大得多的外部奖励模型,说明奖励-策略分布对齐比单纯放大奖励模型更关键。 批判点评:把「提示能否从图像读回来」做成训练免费奖励,绕开偏好数据与裁判噪声,字节 Seed+港大背景、实验覆盖面也扎实。但似然奖励对短/模板化提示可能不够敏感,Self-SpectraReward 依赖统一多模态架构,且「更大 MLLM 未必更好」意味着落地仍需仔细选骨干而非盲目缩放。 2. VideoRAE:冻结视频基座炼成生成潜空间 VideoRAE: Taming Video Foundation Models for Generative Modeling via Representation Autoencoders | 港中文深圳·华科·中科大 | arXiv:2607.14088 关键词:视频生成,表征自编码器,视频基座模型,潜空间,DiT 前序问题:视频生成多依赖 3D-VAE 潜空间,但传统 3D-VAE 主要优化像素重建,语义与时空结构偏弱;V-JEPA 2、VideoMAEv2 等视频基座理解强,却少有人验证其冻结表征能否压成紧凑、可重建、利于生成的视频潜。 本文贡献:提出 VideoRAE:用冻结视频基座编码器的多尺度层级特征,经轻量 1D 自注意力投影器压缩;同时支持扩散 Transformer 的连续潜与自回归的离散 token(多码本高维量化)。解码时用与冻结 VFM 教师的局部-全局表征对齐目标保语义,无需 KL 正则。 实验效果:连续/离散两套设定下重建均强;UCF-101 上 AR/DiT 的 class-to-video gFVD 分别达 40 与 93(SOTA),收敛约比竞品自编码器快 5×;在受控 2B 文生视频实验中替换 LTX-VAE 亦更快收敛。 批判点评:把「理解向视频基座」改造成「生成友好潜空间」,连续+离散双轨、对齐目标替代 KL,方向很对、收敛数字漂亮。但依赖外部冻结 VFM 教师、投影器与量化设定仍有设计敏感度,开放域长视频/文生视频上相对专用 VAE 的画质上限仍需更大规模验证。 3. Seriality Gap:视频扩散缺可扩展串行算力 The Seriality Gap in Video Diffusion Models | UC Berkeley | arXiv:2607.13031 关键词:视频扩散,物理推理,世界模型,串行性,评测 前序问题:多球碰撞要求逐步推演因果链,但标准双向视频扩散在因果链变长时性能塌陷,即使加更多去噪步也救不回来;此前缺少把「依赖事件结构」与「视频长度」拆开的受控诊断。 本文贡献:在多球硬球动力学上定义串行性缺口(Seriality Gap):双向去噪循环无法提供可扩展的串行算力。用等长单球对照隔离「依赖事件」而非长度;干预实验比较自回归/分块生成与加深骨干等能增加有效串行计算的手段,并理论证明对确定性视频预测去噪步并不增加串行深度。 实验效果:双向扩散随碰撞链变长显著变差,单球对照下缺口基本消失;加去噪步无法弥合缺口,而自回归/更小时间块与加深网络更有效。常见失败含穿透、球数错乱、颜色身份互换。 批判点评:用极简硬球探针+理论证明把「看起来会动」和「真有串行因果算力」拆开,Berkeley 诊断很犀利,对「视频扩散当世界模型」泼了冷水。但设定高度合成、与开放域文生视频差距大,迁移边界需谨慎;主要是诊断而非即插即用修补方案。 4. IdentityTuning:免训练调身份token改五官 Latent-Identity Tuning in Text-to-Image Personalization Models | 特拉维夫大学·Cornell | arXiv:2607.11885 关键词:文生图,个性化,身份调谐,人脸,潜空间 前序问题:人脸生成与编辑精度要求极高,轻微改动就会改变身份感;现有个性化方法忠实复现身份,却几乎无法「改身份本身」(如加胡子、改鼻子、加雀斑)并让改后身份在后续所有生成中保持一致。 本文贡献:定义身份调谐(identity tuning):直接改个性化编码器里编码身份的潜表示,而非改单张图。无需额外训练,利用冻结编码器架构挖掘潜语义方向;身份潜由一组扮演不同角色、常对应特定面部区域的 token 组成,可在选定 token 子空间内做局部、细粒度、语义连贯的编辑。 实验效果:定性和定量实验显示可做多样局部人脸编辑(改鼻子、加雀斑/胡子、控眼睛开合、迁移眉毛等),且改后身份能跨多样提示一致生成到新场景。 批判点评:把「改一张脸」升级成「改可复用的身份 latent」,免训练挖方向、token-区域对应清晰,产品叙事很强。但依赖特定个性化编码器结构,跨模型迁移与全身/多主体场景、以及极端 stylization 下身份连贯性仍待用户侧验证。 5. RINO:万物皆RGB统一视觉接口 Let RGB Be the Language of Vision | 约翰霍普金斯·CMU·UCSC·Rice | arXiv:2607.12450 关键词:统一视觉,图像编辑,零样本,RGB表示,条件生成 前序问题:视觉任务表示碎片化——RGB、one-hot mask、连续深度图各用各的编解码与适配器,难像 LLM 用文本那样用统一接口自由交互;多数视觉基座仍像任务专家而非通用视觉学习者。 本文贡献:提出 RINO(RGB In and RGB Out):掩码、深度等结构化视觉信号一律表示为 RGB,通用视觉任务统一成 RGB→RGB 图像编辑问题;在通用图像编辑骨干(如 Qwen-Image-Edit)上仅用无参数数据转换模块,不做任务专用微调,共享与自然图像相同的编解码架构与参数。 实验效果:零样本覆盖 20+ 理解/生成任务:深度估计 δ₁ 达 0.938,接近 Depth Anything 专家模型;条件生成在既有协议下刷新零样本 SOTA;人评亦认可其理解与生成结果。 批判点评:「让 RGB 当视觉的语言」把理解与条件生成压进同一编辑接口,零样本广度与深度数字都有冲击力。但 RGB 编码连续几何/离散标签必有信息损失,复杂开放词汇分割与精细控制仍可能输给专用头,且强依赖强编辑骨干的先验——换弱骨干时统一范式收益会否缩水仍待看。 趋势观察 文生图 RL 奖励转向「免训即用」 — SpectraReward 用 MLLM 图像条件提示似然当奖励,Self-SpectraReward 更让理解分支自赏生成分支,奖励设计从偏好标注/裁判打分转向复用预训练对齐与策略自身理解。 视频基座表征开始反哺生成潜空间 — VideoRAE 把冻结 V-JEPA/VideoMAE 表征压成连续/离散生成潜,收敛快于传统 3D-VAE,理解向视频基座正成为新一代视频 tokenizer 的候选。 视频生成的「世界模型」能力被探针拆穿 — Seriality Gap 证明双向视频扩散缺可扩展串行算力,碰撞链一长就塌、加去噪步也救不回来,评测正从画质指标转向可控物理探针。 人像个性化从复现身份走向调谐身份 — IdentityTuning 免训练挖掘身份 token 方向,一次改鼻子/胡子/雀斑后跨提示一致生成,产品叙事从「像我」升级到「按我想要的样子像我」。 统一视觉接口押宝「万物皆 RGB」 — RINO 把 mask/深度/姿态条件统一成 RGB 编辑,零样本逼近专家深度模型,统一多模态正从「文本接口」扩到「共享视觉语言」。 人工智能炼丹君 整理 | 2026-07-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-03|北航ETH免训练让FLUX画图提速25倍MrFlow 今日 AIGC 论文速览 今日共 5 篇 · 文生图生成加速与效率 2 篇 · 可控图生视频 1 篇 · 生成安全与对齐 1 篇 · 多模态视觉推理与评测 1 篇 重点论文标题列表 MrFlow(北航·ETH苏黎世):免训练多分辨率提速25倍 GEAR(北大·腾讯混元):端到端联训VQ与自回归 TrajLoc(Amazon·特拉维夫大学):注意力高斯热图控多物体 SAGE(中佛罗里达大学):揭穿安全对齐高效用假象 PixelEyes(武汉大学·UC Merced):解耦推理与感知精准定位 今日论文速览 1. MrFlow:免训练多分辨率提速25倍 Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling | 北航·ETH苏黎世 | arXiv:2607.01642 关键词:文生图,流匹配,免训练加速,多分辨率,超分辨率 前序问题:文生图扩散/流匹配质量随规模提升而算力暴涨(Qwen-Image-20B 单张 1024² 在 A100 上采样达 47 秒);已有免训练多分辨率加速在潜空间做上采样并选择性修改局部,常带来明显模糊或伪影。 本文贡献:提出 MrFlow——面向预训练流匹配模型的免训练多分辨率加速:分阶段「低分辨率快速生成主结构 → 像素空间用轻量预训练 GAN 超分 → 注入低强度噪声做高频重采样 → 高分辨率精修细节」,利用图像在不同分辨率下的结构一致与细节差异实现由粗到细的高效生成,无需任何训练或运行时动态识别,且可与时间步蒸馏正交叠加。 实验效果:在 FLUX.1-dev 与 Qwen-Image 上端到端加速达 10×,OneIG 指标较加速前差距控制在 1% 以内,显著超越其他免训练加速策略;叠加预训练蒸馏权重后进一步冲到 25× 加速。 批判点评:把「先低分辨率出结构、再像素超分、最后高分辨率精修」串成免训练流水线,几乎零训练成本换来 10-25× 提速、还能与蒸馏正交叠加,对 FLUX/Qwen-Image 这类主流模型即插即用,工程性价比极高。但收益依赖轻量 GAN 超分网络质量(论文也承认 Real-ESRGAN 最平衡),像素超分对强纹理/文字细节可能引入偏差、需高分辨率步纠正,极端 25× 场景仍要借蒸馏权重、并非纯免训练。 2. GEAR:端到端联训VQ与自回归 GEAR: Guided End-to-End AutoRegression for Image Synthesis | 北大·腾讯混元 | arXiv:2606.32039 关键词:自回归生成,VQ tokenizer,表征对齐,端到端训练,ImageNet 前序问题:视觉生成通常两阶段训练——先训 tokenizer 做重建再冻结,再在其离散索引/连续潜上训生成器;这种解耦让 tokenizer 完全不知道生成器「什么好建模」,且 VQ 索引不可微、直通估计(STE)会崩,梯度无法回传到 tokenizer。 本文贡献:提出 GEAR,端到端联合训练 VQ tokenizer 与自回归(AR)生成器,用表征对齐引导。关键是对码本分配做「双读出」:硬 one-hot 分支用下一 token 预测训练 AR,可微软分支携带表征对齐损失、只回传去引导 tokenizer——让 AR 主动把 tokenizer 推向自己更易预测的索引分布,把对齐负担从 tokenizer 转移到 AR(与扩散侧「让潜变量本身更语义」的做法正相反)。 实验效果:相比强基线 LlamaGen-REPA,ImageNet gFID 收敛最高提速 10×,学到明显更好的 patch 级、空间连贯特征,并可泛化到多种量化器(VQVAE/LFQ/IBQ)与文生图任务。 批判点评:用「双读出」优雅绕开 VQ 不可微、把表征对齐负担从 tokenizer 挪到 AR,是对两阶段范式的一次范式级反思,收敛提速 10× 且跨量化器/文生图泛化,北大+腾讯混元背景也更接近落地。但端到端联训的稳定性与显存开销、软分支对齐目标的设计敏感度,以及在更大分辨率/更大码本下能否延续优势仍待验证。 3. TrajLoc:注意力高斯热图控多物体 TrajLoc: Trajectory-Attention Localization for Multi-Object Motion Control | Amazon·特拉维夫大学 | arXiv:2607.00861 关键词:图生视频,多物体控制,轨迹控制,交叉注意力,身份保持 前序问题:图生视频(I2V)里控制多物体运动,既要保各自身份、又要遵循不同目标轨迹;已有方法把多条轨迹揉进共享的稠密条件信号,物体越多、路径交叉遮挡时对象级对应越难保持。 本文贡献:提出 TrajLoc,为每个物体施加严格的逐对象空间约束、彼此隔离:直接在注意力层里把每个物体 token 的交叉注意力权重替换为「以其每帧目标位置为中心的高斯热图」;同一套逐对象 token 接口通过可学习嵌入携带轨迹与深度,并以编码首帧外观替代物体 token 来保持身份一致。 实验效果:在含最多 20 个同时受控物体及分布外真实场景的六个数据集上,视觉保真与轨迹遵循度一致提升;应用于 CogVideoX-5B 与 Wan2.1-14B 两种异构骨干,较最强基线平均 +4.3 dB PSNR、轨迹终点误差降低 51%。 批判点评:用「把交叉注意力权重直接换成高斯热图」实现逐物体硬空间约束,简洁、可跨 CogVideoX/Wan2.1 骨干迁移,20 物体拥挤场景下轨迹终点误差降 51% 很实在。但高斯热图是相对刚性的先验,对形变大/尺度剧变或非刚体运动可能过约束,深度与轨迹共用一套 token 的表达上限、以及热图中心定位对细粒度交互(接触/穿插)的处理仍待观察。 4. SAGE:揭穿安全对齐高效用假象 The Illusion of High Utility in Safety Alignment of Text-to-Image Diffusion Models | 中佛罗里达大学 | arXiv:2607.00402 关键词:文生图,安全对齐,语义坍缩,几何正则,TIFA 前序问题:文生图安全对齐要压制有害生成同时保住良性提示的效用,但现有「高安全+高效用」的结论多建立在 FID/CLIPScore 等粗粒度全局指标上,对细粒度语义正确性不敏感,制造了「高效用假象」。 本文贡献:用结构化评测(TIFA 问答式忠实度)戳穿假象——安全对齐模型在物体数量、属性、关系上语义保真明显下滑;进而定位根因为文本编码器嵌入空间的「语义坍缩」(嵌入分布收缩+提示间相似结构扭曲),且与结构化效用损失强相关。据此提出结构感知几何正则(SAGE),在对齐时显式保住嵌入分布展度与提示间关系结构。 实验效果:SAGE 恢复了结构化效用(TIFA 较此前 SOTA +5.0%),同时保持强安全性能与有竞争力的粗粒度效用分数(已被 ECCV 2026 接收)。 批判点评:从「粗指标掩盖语义退化」这一反直觉观察出发、用嵌入几何正则对症「语义坍缩」,视角犀利、从诊断到方案闭环完整,TIFA +5.0% 也证明可恢复细粒度效用。但方案聚焦文本编码器嵌入几何、对更深层去噪网络诱发的语义损失覆盖有限,安全与效用的权衡在更强攻击/更广有害概念下能否稳住、以及 TIFA 之外评测的一致性仍需扩验。 5. PixelEyes:解耦推理与感知精准定位 PixelEyes: Decoupling Perception and Reasoning for Pinpoint Visual Evidence Seeking | 武汉大学·UC Merced | arXiv:2607.00115 关键词:多轮视觉推理,MLLM,指代分割,视觉搜索,评测基准 前序问题:多轮视觉推理里,MLLM 反复定位失败导致轨迹又长又冗余;根因是推理与感知纠缠在同一模型内——边推理边定位,定位不准又触发更多推理轮次、把轨迹撑大。 本文贡献:提出 PixelEyes,把推理与感知显式解耦:推理器只决定「找什么」,专用感知工具回答「在哪」。含两招——(1) 掩码引导视觉搜索:调用指代分割模型给出掩码级精确定位,免去推理器补偿粗糙 grounding;(2) 语义区域广度优先搜索(BFS):把探索组织为对语义区域的 BFS,消除反复裁剪错误子区域造成的冗余回路。并通过重合成专家轨迹构建 PixelEyes-6K 数据集,另建零提示视觉搜索基准 Pinpoint-Bench(含实例级掩码/框,区分定位失败与推理失败)。 实验效果:近期 SOTA 的 MLLM 与视觉推理智能体在 Pinpoint-Bench 上仍留有很大提升空间,印证其质量与难度;代码与模型已开源。 批判点评:把「推理定位纠缠」拆成「推理器+分割感知工具」两件事、再用语义区域 BFS 剪掉冗余回路,思路清晰且直击多轮视觉搜索的实际痛点,配套 Pinpoint-Bench 也补齐了「定位 vs 推理」失败区分的评测缺口。但方案依赖外部指代分割模型精度、分割错误会直接卡住定位,BFS 在超大图/极多语义区域下的开销,以及它属视觉理解/grounding 而非生成、与生成一体化的结合仍需后续工作。 趋势观察 免训练加速把文生图推向实时 — MrFlow 用分阶段多分辨率+像素超分免训练冲到 10-25×,加速正从「靠蒸馏训练」转向「零训练即插即用」,让 FLUX/Qwen-Image 这类大模型的推理成本快速下探。 端到端联训打破生成的两阶段范式 — GEAR 用双读出让 AR 反过来引导 tokenizer,把「先训 tokenizer 再训生成器」的解耦范式改成端到端联合优化,ImageNet 收敛提速 10×,范式级重构正在自回归生成里发生。 可控生成从单目标走向多物体精细约束 — TrajLoc 在注意力层用逐物体高斯热图硬约束最多 20 个物体的轨迹与身份,可控视频生成的粒度从「整体运动」细化到「每个实例的路径」。 生成安全开始正视效用的真实代价 — SAGE 揭穿安全对齐「高效用假象」,用结构化评测与嵌入几何正则守住细粒度语义,安全研究从「粗指标达标」转向「细粒度效用可验证」。 视觉智能体靠解耦感知与评测基准补短板 — PixelEyes 把推理与感知解耦、配套 Pinpoint-Bench,多轮视觉搜索开始用专用感知工具+可区分失败类型的基准来定位瓶颈。 人工智能炼丹君 整理 | 2026-07-03 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-19|长视频生成FP4训推全栈LongLive-2.0 今日 AIGC 论文速览 今日共 13 篇 · 长视频生成与训推优化 2 篇 · 扩散推理加速与量化 4 篇 · 视频编辑与实时特效 2 篇 · 统一多模态生成 1 篇 · 音频生成与综述 2 篇 · 扩散 RL 后训练 2 篇 重点论文标题列表 LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× TACache:Rectified Flow 训练免训练加速 4.14× Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Lance:原生统一图像视频理解生成 MoE 模型 StreamingEffect:单 H200 实时 720p 人像视频特效 今日论文速览 1. LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× LongLive-2.0: An NVFP4 Parallel Infrastructure for Long Video Generation | NVIDIA | arXiv:2605.18739 关键词:长视频生成·NVFP4·序列并行·AR 视频扩散·Song Han 前序问题:长视频生成的训练和推理同时卡在显存和速度上:现有 Self-Forcing 系列依赖 ODE 初始化 + DMD 蒸馏,流程冗长;推理端把 KV cache 与计算精度压不下去,使得分钟级、多镜头、可交互的 AR 视频生成在大模型规模下难以落地 本文贡献:提出 LongLive-2.0:首个 NVFP4 端到端长视频生成训练 + 推理基础设施。(1) 训练侧的 Balanced SP——把 teacher-forcing 布局与序列并行(SP)协同设计,在每个 rank 上配对干净历史 + 噪声目标的时间块,并搭配 SP-aware 分块 VAE 编码;(2) 直接把扩散模型微调成长时多镜头交互式 AR 模型,跳过 ODE 初始化 + DMD 蒸馏;(3) 推理侧 Blackwell 上跑 W4A4 NVFP4,KV cache 也量化到 NVFP4,配合异步流式 VAE 解码 实验效果:训练加速 2.15×、推理加速 1.84×;LongLive-2.0-5B 在保持 benchmark 强表现的同时达到 45.7 FPS 推理;可独立 LoRA 切换为 4 步 / 2 步实时生成模式,是首个面向长视频生成的 NVFP4 训推一体系统 批判点评:把 NVFP4 这种 Blackwell 新精度从推理推到训练全链路是工程级里程碑,5B 跑出 45.7 FPS 把长视频 AR 推到了实时门槛;但 NVFP4 对硬件的强绑定限制了非 Blackwell 集群的复现路径,量化 KV cache 在多镜头切换时的累积误差也值得长期追踪 2. TACache:Rectified Flow 训练免训练加速 4.14× Accelerating Rectified Flow Models via Trajectory-Aware Caching | 上海交大, 军事科学院, 华为 | arXiv:2605.16789 关键词:Rectified Flow·训练-free 加速·缓存·正交分解·扩散推理 前序问题:扩散与 Rectified Flow 模型靠迭代评估速度场出图/出视频,计算昂贵;现有 cache 方法靠跳步加速,但粗略的近似在长跳步区间累积误差大,激进加速下质量明显劣化 本文贡献:提出 TACache(Trajectory-Aware Cache)训练-free 加速框架,遵循「先跳步后补偿」范式:对 RF 轨迹上离散速度加速度做正交分解(平行 + 正交残差),分离每步近似误差的幅值与方向来源;离线阶段用幅值 / 方向累积阈值生成跳步表,在线阶段结合样本历史正交方向重构被跳过的速度,无需额外模型评估 实验效果:在 BAGEL、FLUX.1-dev、Wan2.1-1.3B 上分别实现文生图 4.14×、文生视频 2.11× 加速;在所有 reference-based fidelity 指标上一致优于已有 cache 类方法 批判点评:「先跳步后补偿」+ 速度加速度正交分解,把 cache 类方法从经验调参推到了误差可控的工程范式;但分解效果对模型与数据集分布敏感,离线统计在 prompt 分布漂移时是否仍稳定,还需要更长尾的验证 3. Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Aurora: Unified Video Editing with a Tool-Using Agent | 罗切斯特大学, Adobe | arXiv:2605.18748 关键词:视频编辑·VLM Agent·工具调用·统一扩散·欠规范请求 前序问题:现有统一视频编辑模型把文本、源视频、参考图喂进同一个 DiT 一把搞定替换 / 删除 / 风格 / 参考插入;设计很灵活,但默认用户已提供了 model-ready 的文本、参考图与空间锚定——真实请求里这些往往缺失 本文贡献:提出 Aurora:把工具增强 VLM agent 与统一视频扩散 transformer 配对——agent 把原始用户请求映射成对齐 transformer 条件通道的结构化编辑计划,先解决「文本和视觉欠规范」再生成;用监督数据训练完整编辑规划 + 参考图选取,再用偏好对训练鲁棒工具调用与指令润色;并发布 AgentEdit-Bench 评估「欠规范用户请求」下的 agentic 视频编辑能力 实验效果:在 AgentEdit-Bench 与两个现有视频编辑 benchmark 上,Aurora 显著超越纯指令 baseline;VLM agent 还能迁移到其他冻结的视频编辑模型,作为通用前置规划层 批判点评:把视频编辑里「用户输入欠规范」这一真实痛点显式拆解给 VLM agent 处理,是务实且可迁移的范式;但 agent 错误规划带来的级联编辑错误尚未充分量化,agent + DiT 的端到端延迟也是落地前要解决的关键 4. Lance:原生统一图像视频理解生成 MoE 模型 Lance: Unified Multimodal Modeling by Multi-Task Synergy | 字节跳动 Intelligent Creation Lab | arXiv:2605.18678 关键词:统一多模态·MoE·双流架构·原生训练·图像视频生成 前序问题:统一多模态模型要么靠模型尺寸堆量、要么沿用图文为主的设计,在「图像 + 视频 × 理解 + 生成 + 编辑」的全格子上很难一并打通;理解和生成两条能力路径互相干扰,多模态 token 异质性也让位置编码难以兼顾 本文贡献:提出 Lance:原生轻量级统一多模态模型,从零训练,采用「双流 MoE + 共享交错多模态序列」架构——联合上下文学习同时把理解与生成的能力路径解耦;引入 modality-aware RoPE 缓解异质视觉 token 的相互干扰;训练采用分阶段多任务范式,配合自适应数据调度同时强化语义理解与视觉生成 实验效果:图像和视频生成上大幅超越现有开源统一模型,同时保持强多模态理解能力,证明统一不必靠堆参数,「能力路径解耦」是更可持续的统一范式 批判点评:「统一上下文 + 解耦能力路径」的设计直击当前统一模型最大痛点:什么都做但什么都不极致;不过双流 MoE 的训练稳定性、与闭源旗舰模型的差距,以及在更长视频上的可扩展性仍待时间检验 5. StreamingEffect:单 H200 实时 720p 人像视频特效 StreamingEffect: Real-Time Human-Centric Video Effect Generation | 新加坡国立 Show Lab | arXiv:2605.17019 关键词:视频编辑·实时流式·人像特效·因果蒸馏·VideoEffect-130K 前序问题:电商直播、娱乐、Vlog 等场景需要实时人像视频特效,但缺数据、缺可部署的编辑模型;视频编辑的高效蒸馏几乎没人做,现有加速大多围绕文生视频,无法保住身份、背景与时序一致性 本文贡献:提出 StreamingEffect:上下文式视频编辑架构 + 因果 AR 学生蒸馏,把采样从 50 步压到 4 步;支持关键帧控制——可以在线注入参考特效帧并沿流传播,实现交互式编辑;同时构建 VideoEffect-130K 数据集——70K 特效视频 + 60K 编辑视频、600 类特效,是已知最大的人像视频特效数据集 实验效果:在单张 H200 GPU 上实现实时高质量 720p 视频编辑,数据集和方法共同填补了「人像视频特效实时编辑」的开源生态空白 批判点评:把视频编辑显式当作「实时流式 + 关键帧可控」问题来解,配套 130K 高质量数据是最大的工程贡献;但 600 类特效的覆盖度、4 步学生在长流式生成下身份漂移、以及 H200 之外的部署门槛,是产品化关键考验 6. MeanFlow-LSE:MeanFlow 蒸馏推到 80B 工业级模型 Stabilizing, Scaling & Enhancing MeanFlow for Large-scale Diffusion Distillation | 西电, 腾讯混元 | arXiv:2605.17834 关键词:MeanFlow·扩散蒸馏·大规模训练·HunyuanImage·少步生成 前序问题:MeanFlow 因公式简洁、表现强劲在少步蒸馏受关注,但优化目标不稳定 + 「mean-seeking bias」限制了它在大规模工业模型上的应用,蒸馏到 12B / 80B 级别经常训练崩溃或质量塌陷 本文贡献:(1) 引入 warm-up 技术,用离散解替代原 MeanFlow 微分解,避免 stop-gradient 项含未训好模型导致的训练崩溃;等模型对平均速度场有初步拟合后再切回微分解继续精炼;(2) 引入轨迹分布对齐作为辅助目标,缓解极少步推理下复杂目标分布上的 mean-seeking bias,让学生模型轨迹分布贴近教师 实验效果:在 FLUX.1-dev(12B)上超越现有蒸馏方法;推到 80B 的 SOTA 工业模型 HunyuanImage 3.0,依然展现出鲁棒泛化与强表现,是首次把 MeanFlow 蒸馏验证到 80B 量级 批判点评:warm-up + 轨迹分布对齐两步组合直击 MeanFlow 在大模型上的两大顽疾,工程上意义重大;但 warm-up 阶段 / 切换时机依赖经验设定,对不同 backbone 的迁移性还需更系统消融 7. I2V-Survey:图生视频扩散首份系统综述 Image-to-Video Diffusion: From Foundations to Open Frontiers | 港城大, 格里菲斯大学等 | arXiv:2605.17248 关键词:图生视频·扩散综述·I2V·taxonomy·开放挑战 前序问题:图生视频(I2V)已成为生成模型的核心方向,对内容一致性、身份保留与运动连贯性的要求都比通用视频生成更严;但现有论文大多把 I2V 当作通用视频生成的子话题,缺乏专门的 taxonomy 与系统分析 本文贡献:把扩散 I2V 单独立题,系统梳理任务定义、模型架构、数据集、评测指标,并按架构和训练范式给出 taxonomy;进一步抽取 4 个核心设计——条件编码 / 时序建模 / 噪声先验 / 时空上采样,配合典型应用与开放挑战 实验效果:为 I2V 这一独立子方向提供首份结构化综述,给出可复用的 4 大设计轴和应用-挑战双视角,便于研究者和工程团队系统理解技术路径 批判点评:把 I2V 从「视频生成的角落」抬到独立子方向,「4 个核心设计 + taxonomy」是清晰可用的索引框架;但综述截止时间内未能覆盖最新一波因果 / 实时 I2V,未来需要持续更新追踪 8. WavFlow:原始波形空间直生高保真音频 WavFlow: Audio Generation in Waveform Space | Meta AI, 东北大学 | arXiv:2605.18749 关键词:音频生成·波形空间·Flow Matching·V2A·T2A 前序问题:现代音频生成几乎都依赖潜空间压缩,引入额外复杂度并潜在丢失信息;但波形空间维度极高、能量分布稀疏,让扩散模型直接在波形上建模长期失败 本文贡献:提出 WavFlow:直接在原始波形空间生成高保真音频,无中间表示。通过 waveform patchify 把音频重塑为 2D token grid,引入 amplitude lifting 对齐信号尺度,使 flow matching 中的 x-prediction 优化稳定;并构建自动化数据流水线,整理 500 万视频-文本-音频三元组,从零学习细粒度声学模式 实验效果:在视频转音频 VGGSound 上取得 FD_PaSST 59.98 / IS_PANNs 17.40 / DeSync 0.44;在文生音频 AudioCaps 上 FD_PANNs 10.63 / IS_PANNs 12.62,与已有潜空间方法持平或超越,证明中间压缩并非高质量音频合成的必要条件 批判点评:「不要 latent,直接干波形」是颇有勇气的反潮流路线,patchify + amplitude lifting 是让 flow 在波形上稳的关键工程;但波形 flow matching 的训练成本与采样开销比 latent 方案高得多,工业级落地需要更激进的加速 9. TAPE:时序感知 token 剪枝免训加速视频扩散 Temporal Aware Pruning for Efficient Diffusion-based Video Generation | 匹兹堡大学, IIT, Rutgers, Microsoft AI | arXiv:2605.17837 关键词:视频扩散·token 剪枝·训练-free 加速·时序一致性·ViT 前序问题:视频扩散 ViT 架构出视频质量高,但长时空序列上的注意力计算极贵;已有 token 剪枝多基于 attention、按帧独立操作,难以保住跨帧时序连贯,naive 应用会产生背景不稳、闪烁、画质下降 本文贡献:提出 TAPE 训练-free 时序感知剪枝:(i) 时序平滑对齐相邻帧的 token 重要性,抑制选择抖动;(ii) 在选定层做 token 重选,使剪枝匹配各层的不同语义关注,避免误差在特定区域累积;(iii) 时间步级预算调度——早期噪声重的步骤激进剪、后期保真关键步骤放宽 实验效果:显著提速的同时保持高视觉保真度,超越前期 token reduction 方法;作为 plug-in 训练-free 加速,能直接套到现有视频扩散模型上 批判点评:把 token 剪枝从「每帧独立」拉回「时序感知」是补足视频域专属约束的正确方向,三项设计互相协同;但激进时间步预算调度对极长视频的累积误差、以及 ViT 之外架构的迁移性仍是开放问题 10. SafeDiffusion-R1:在线 GRPO + CLIP 引导奖励安全对齐 SafeDiffusion-R1: Online Reward Steering for Safe Diffusion Post-Training | MBZUAI | arXiv:2605.18719 关键词:扩散安全·在线 RL·GRPO·CLIP 引导·内容审核 前序问题:扩散模型移除预训练中学到的不安全内容,现有方法要么需要昂贵的 unsafe-text 配 safe-image 监督数据,要么走离线 RL / SFT 在合成数据上训,灾难性遗忘严重,生成质量明显劣化,扩展性差 本文贡献:提出在线 RL 框架:在正负 prompt 上跑 GRPO;引入 steering reward 机制利用 CLIP 嵌入空间的固有性质——把文本表示推向正向安全方向、远离负向,无需为每个安全维度单独训 reward 模型;在线策略让模型从包括显式不安全 prompt 在内的多样请求中学习而不灾难性遗忘 实验效果:不当内容下降到 18.07%(vs SD v1.4 的 48.9%),裸露检测 15 vs baseline 646;GenEval 组合生成质量从 42.08% 提升到 47.83%;安全增益泛化到 7 类未见有害 prompt 类别 批判点评:把「安全对齐」从离线 SFT 推到在线 GRPO,叠加 CLIP 嵌入引导避开 reward 模型训练,工程友好且可扩展;但 CLIP 嵌入方向偏向、对抗性提示下 steering 的鲁棒性,仍需对抗压力测试持续追踪 11. CGPO:按 reward 方差自适应难度的文生图 RL Curriculum Group Policy Optimization: Adaptive Sampling for Unleashing the Potential of Text-to-Image Generation | 北邮, 中国电信 TeleAI | arXiv:2605.17807 关键词:文生图·GRPO·课程学习·自适应采样·RL 对齐 前序问题:文生图 RL(特别是 GRPO 系)训练时统一采样策略忽视了样本难度与模型当前能力的匹配,训练效率低,模型常在已掌握或还远不能掌握的 prompt 上空转 本文贡献:提出 CGPO 自适应课程训练框架:每条 prompt 生成一组图像由 reward 模型打分,用组内 reward 方差作为「prompt 不一致性」的在线 proxy——方差高说明模型部分掌握但未稳定,正是最该多采的可学习 prompt,从而提高其采样概率;再用比例公平优化做类别校准,平衡多类别数据集的训练难度 实验效果:在 GenEval、T2I-CompBench++、DPG Bench 上一致提升生成性能,为 GRPO 类文生图 RL 提供可即插即用的课程化增强 批判点评:用 reward 方差当「可学习 prompt」proxy 是优雅且无需额外标注的设计;但 reward 模型本身的偏差会被该 proxy 放大,长期训练下需要监控 reward hacking 12. DiRotQ:PCA 旋转感知 W4A4 DiT 量化 DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers | d-Matrix | arXiv:2605.16732 关键词:DiT·4-bit 量化·PCA 旋转·W4A4·FLUX 前序问题:DiT 出图质量 SOTA 但推理代价高;激进 PTQ 到 4-bit 能省算力却经常严重掉点;已有 smoothing / mixed precision / rotation / low-rank residual 等方法都只能部分缓解,与 FP16/BF16 仍有可见差距 本文贡献:提出 DiRotQ W4A4 PTQ 框架——通过 PCA 找到激活方差主成分所在的低秩子空间,对该子空间用更高精度保留,其余分量量化到 4-bit;推理时用校准得到的正交变换把激活旋转到 PCA 基,逆旋转离线融入权重;再叠加 GPTQ 的权重量化形成完整 W4A4 系统,并给出 Triton kernel 端到端加速 实验效果:在 PixArt-Σ MJHQ-30K 上取得 FID 15.9 / PSNR 19.1 dB,超越 SVDQuant(FID 18.9 / 17.6);12B FLUX.1-dev 在单卡 RTX 4090 上显存降 2.1×,推理比 BF16 加速 2.3×;并首次提出 VLM-as-a-Judge 评测协议 批判点评:把 PCA 子空间高精度保留 + 离线融入权重的设计,把旋转量化做到了 W4A4 的较好均衡,落地友好;但 PCA 校准对长尾 prompt 的覆盖度、VLM-as-a-Judge 与人类偏好的对齐度,是后续要追踪的关键 13. SpectralProgressive:频谱先粗后细动态扩展分辨率 Spectral Progressive Diffusion for Efficient Image and Video Generation | Stanford | arXiv:2605.18736 关键词:频谱扩散·渐进分辨率·训练-free 加速·视频生成·去噪调度 前序问题:扩散模型在频域里隐式自回归生成——低频先出、高频后出;在噪声主导的早期对全分辨率做计算大量冗余,但目前没人把这一观察系统化用于推理加速 本文贡献:提出 Spectral Progressive Diffusion 通用框架——沿去噪轨迹渐进扩展分辨率;设计频谱噪声扩展机制,并从模型自身的功率谱推出最优分辨率调度;支持 training-free 加速和一种新的微调配方,进一步同时改善效率与质量 实验效果:在多个 SOTA 预训练图像和视频生成模型上获得显著加速,且画质保持;为预训练扩散模型提供一条「无需重训」的频谱渐进推理路线 批判点评:把扩散「频谱自回归」的隐式行为显式化为分辨率调度,思路清晰且与 cache 等加速正交;但频谱调度对噪声分布的假设强依赖训练分布,跨数据集与跨模态迁移性需更广验证 趋势观察 NVFP4 把长视频生成训推一体化推到实用门槛 — LongLive-2.0 把 NVFP4 从纯推理量化推到训练 + KV cache + 异步流式 VAE 解码全链路,5B 模型跑出 45.7 FPS——下一代视频生成基础设施开始与 Blackwell 硬件深度协同,长视频 AR 真正走向「可部署的实时」 扩散加速从 cache 推到「频谱 + 时序 + 量化」三路同时压榨 — TACache 从轨迹正交分解给跳步补偿、TAPE 从时序感知做 token 剪枝、SpectralProgressive 从频谱调度动态扩展分辨率、DiRotQ 从 PCA 旋转把 DiT 推到 W4A4——扩散推理优化第一次在「时间步 / 空间 token / 数值精度 / 频谱通道」四个轴上系统并进 视频编辑进入 agent 时代 — Aurora 把模糊用户请求交给 VLM agent 拆解成结构化编辑计划再喂给 DiT;StreamingEffect 配套 130K 数据 + 4 步因果蒸馏直接做实时人像特效——视频编辑从「模型一把吃下所有输入」转向「agent 解码意图 + 模型专注生成」 统一多模态从堆参数走向「能力路径解耦」 — Lance 用「双流 MoE + 共享交错序列」把理解与生成的能力路径显式解耦,配合 modality-aware RoPE 处理 token 异质性;证明轻量原生设计也能在「图像 + 视频 × 理解 + 生成 + 编辑」全格子上同时领先 扩散 RL 对齐从 reward 工程走向 reward 机制 — SafeDiffusion-R1 用 CLIP 嵌入做 steering reward 替代专门 reward 模型;CGPO 把 reward 方差当 prompt 难度 proxy 实现自适应采样——扩散 RL 后训练正在从「堆 reward 模型」转向「挖 reward 信号本身的几何」 人工智能炼丹君 整理 | 2026-05-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注