今日 AIGC 论文速览
今日共 10 篇 · 视频生成与长时程一致性 2 篇 · 生成模型评测与审计 2 篇 · 推理与采样加速 2 篇 · 语音与音乐生成 2 篇 · 视频修复与图像应用 2 篇
重点论文标题列表
Recency Forcing (Qualcomm AI Research):按距离衰减注意力救长视频MiniMax-H3-Reason (National University of Singapore;Fudan University;Tencent):全模态模型物理推理仅四成⚡ Diagonal Sparsity (KAIST;Agency for Defense Development;Seoul National University):对角稀疏把吞吐拉到3.1倍
VibeAvatar (Peking University):口型与美感分阶段各管各的AVR (New York University;University of Technology Sydney):能抄就抄抄不到才让扩散补
今日论文速览
1. Recency Forcing:按距离衰减注意力救长视频
Recency Forcing: Bridging the Long-Horizon Gap in Autoregressive Video Generation | Qualcomm AI Research | arXiv:2609.19729
关键词 :自回归视频生成,长时程一致性,KV cache,注意力偏置
⚠️ 前序问题 :自回归视频生成一拉长就退化。论文把根因定位到一处被忽视的训练-推理不一致:训练时短片段的全部上下文帧都在 KV cache 里,推理时显存约束却会把远处帧逐出 cache,等于抽走了模型当初赖以生成的上下文。作者称之为 KV 淘汰错配(KV eviction mismatch)。
本文贡献 :思路不是用截断上下文去模拟淘汰——那会连模型仍需要的时间信息一起丢掉、破坏运动连贯——而是保留上下文,同时让远处帧的影响逐步衰减,等它们真被淘汰时影响已可忽略。论文先用扰动式敏感度指标 positional response R(Δ, t_denoise) 量出上下文影响随时间距离陡峭衰减、且在不同去噪步上系统性变化;据此提出 Temporal Response Bias(TRB),把一个非正的、随时间步变化的偏置直接加在 softmax 之前的注意力 logits 上。配套的 Biased Attention Reparameterization(BAR)是个等价改写,把偏置移到 softmax 之外,使 TRB 退化成一次标准 FlashAttention 调用。
实验效果 :在 VBench 与 VBench-Long 上取得长时程生成的 state-of-the-art 质量,且不增加推理成本。60 秒视频的定性对比里,Self-Forcing 出现色彩漂移,LongLive 产生场景重复,DeepForcing 引入模糊,Recency Forcing 则保持了画面稳定与运动连贯。方法不改动上下文长度与训练目标,免训练与训练两种模式都能用,BAR 的等价改写让偏置的额外开销为零。
批判点评 :把长视频退化归到 KV cache 淘汰这个具体的工程约束上,而不是笼统归因于「误差累积」,定位比多数同类工作清晰,BAR 让它零开销落地也务实。但摘要只给 state-of-the-art 的结论、未披露具体分数,免训练与训练两种模式的增益差距、TRB 偏置形状换骨干后是否还成立,都要看正文;VBench 系列本身偏重视觉质量,长时程的叙事与物体持久性未必能被它完全反映。
2. MiniMax-H3-Reason:全模态模型物理推理仅四成
Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model | National University of Singapore;Fudan University;Tencent | arXiv:2609.18323
关键词 :全模态生成模型,物理世界推理,跨模态整合,评测基准
⚠️ 前序问题 :全模态生成模型把文本、图像、视频、音频统一建模,MiniMax-H3 正是在共享潜空间里同时做多模态理解与音视频联合生成的代表。但多模态对齐到底有没有提升模型的世界推理能力?现有面向视频生成与世界模型的评测大多受限于单一输入模态,且提示词与目标视频内容高度重合,回答不了这个问题。
本文贡献 :论文构建了围绕物理世界推理四个互补维度的评测框架,专门为全模态输入设计任务:隐式提示搭配多帧、音频-图像、前缀视频、音频-视频四类场景。关键设计是每一路模态只提供事件的部分证据,模型必须跨模态整合互补线索,才能推断出潜在的事件状态与未来动态。
实验效果 :517 个评测实例上,MiniMax-H3 总体成功率 41.97%。分维度看,基于视频的决策推理最高、为 56.00%,基于音频的消歧推理最弱、只有 27.40%。作者据此认为要真正吃到多模态输入的红利,关键仍在有效的跨模态整合。
批判点评 :用「每种模态只给部分证据」的设定逼出跨模态整合能力,比提示词与目标高度重合的常规评测更有区分度,音频维度 27.40% 也确实点出了当前全模态模型的短板。但全文只评了 MiniMax-H3 一个模型,没有同代横向对比,41.97% 这个绝对值究竟是模型不行还是任务过难无从判断;517 个实例摊到四个维度上,每个维度的样本量也偏薄。
3. Diagonal Sparsity:对角稀疏把吞吐拉到3.1倍
Understanding and Exploiting Diagonal Attention Sparsity in Autoregressive Image Generation | KAIST;Agency for Defense Development;Seoul National University | arXiv:2609.19702
关键词 :自回归图像生成,稀疏注意力,KV cache,推理加速
⚠️ 前序问题 :自回归图像生成因为能直接复用基于 transformer 的 LLM 服务设施而成为多模态系统的一种范式,但每次请求要吐出上千个视觉 token,解码越来越被注意力计算中的 KV cache 访问卡住。稀疏注意力在文本 LLM 推理上已被充分研究,可它的稀疏性假设能不能迁移到自回归图像生成,此前没人说得清。
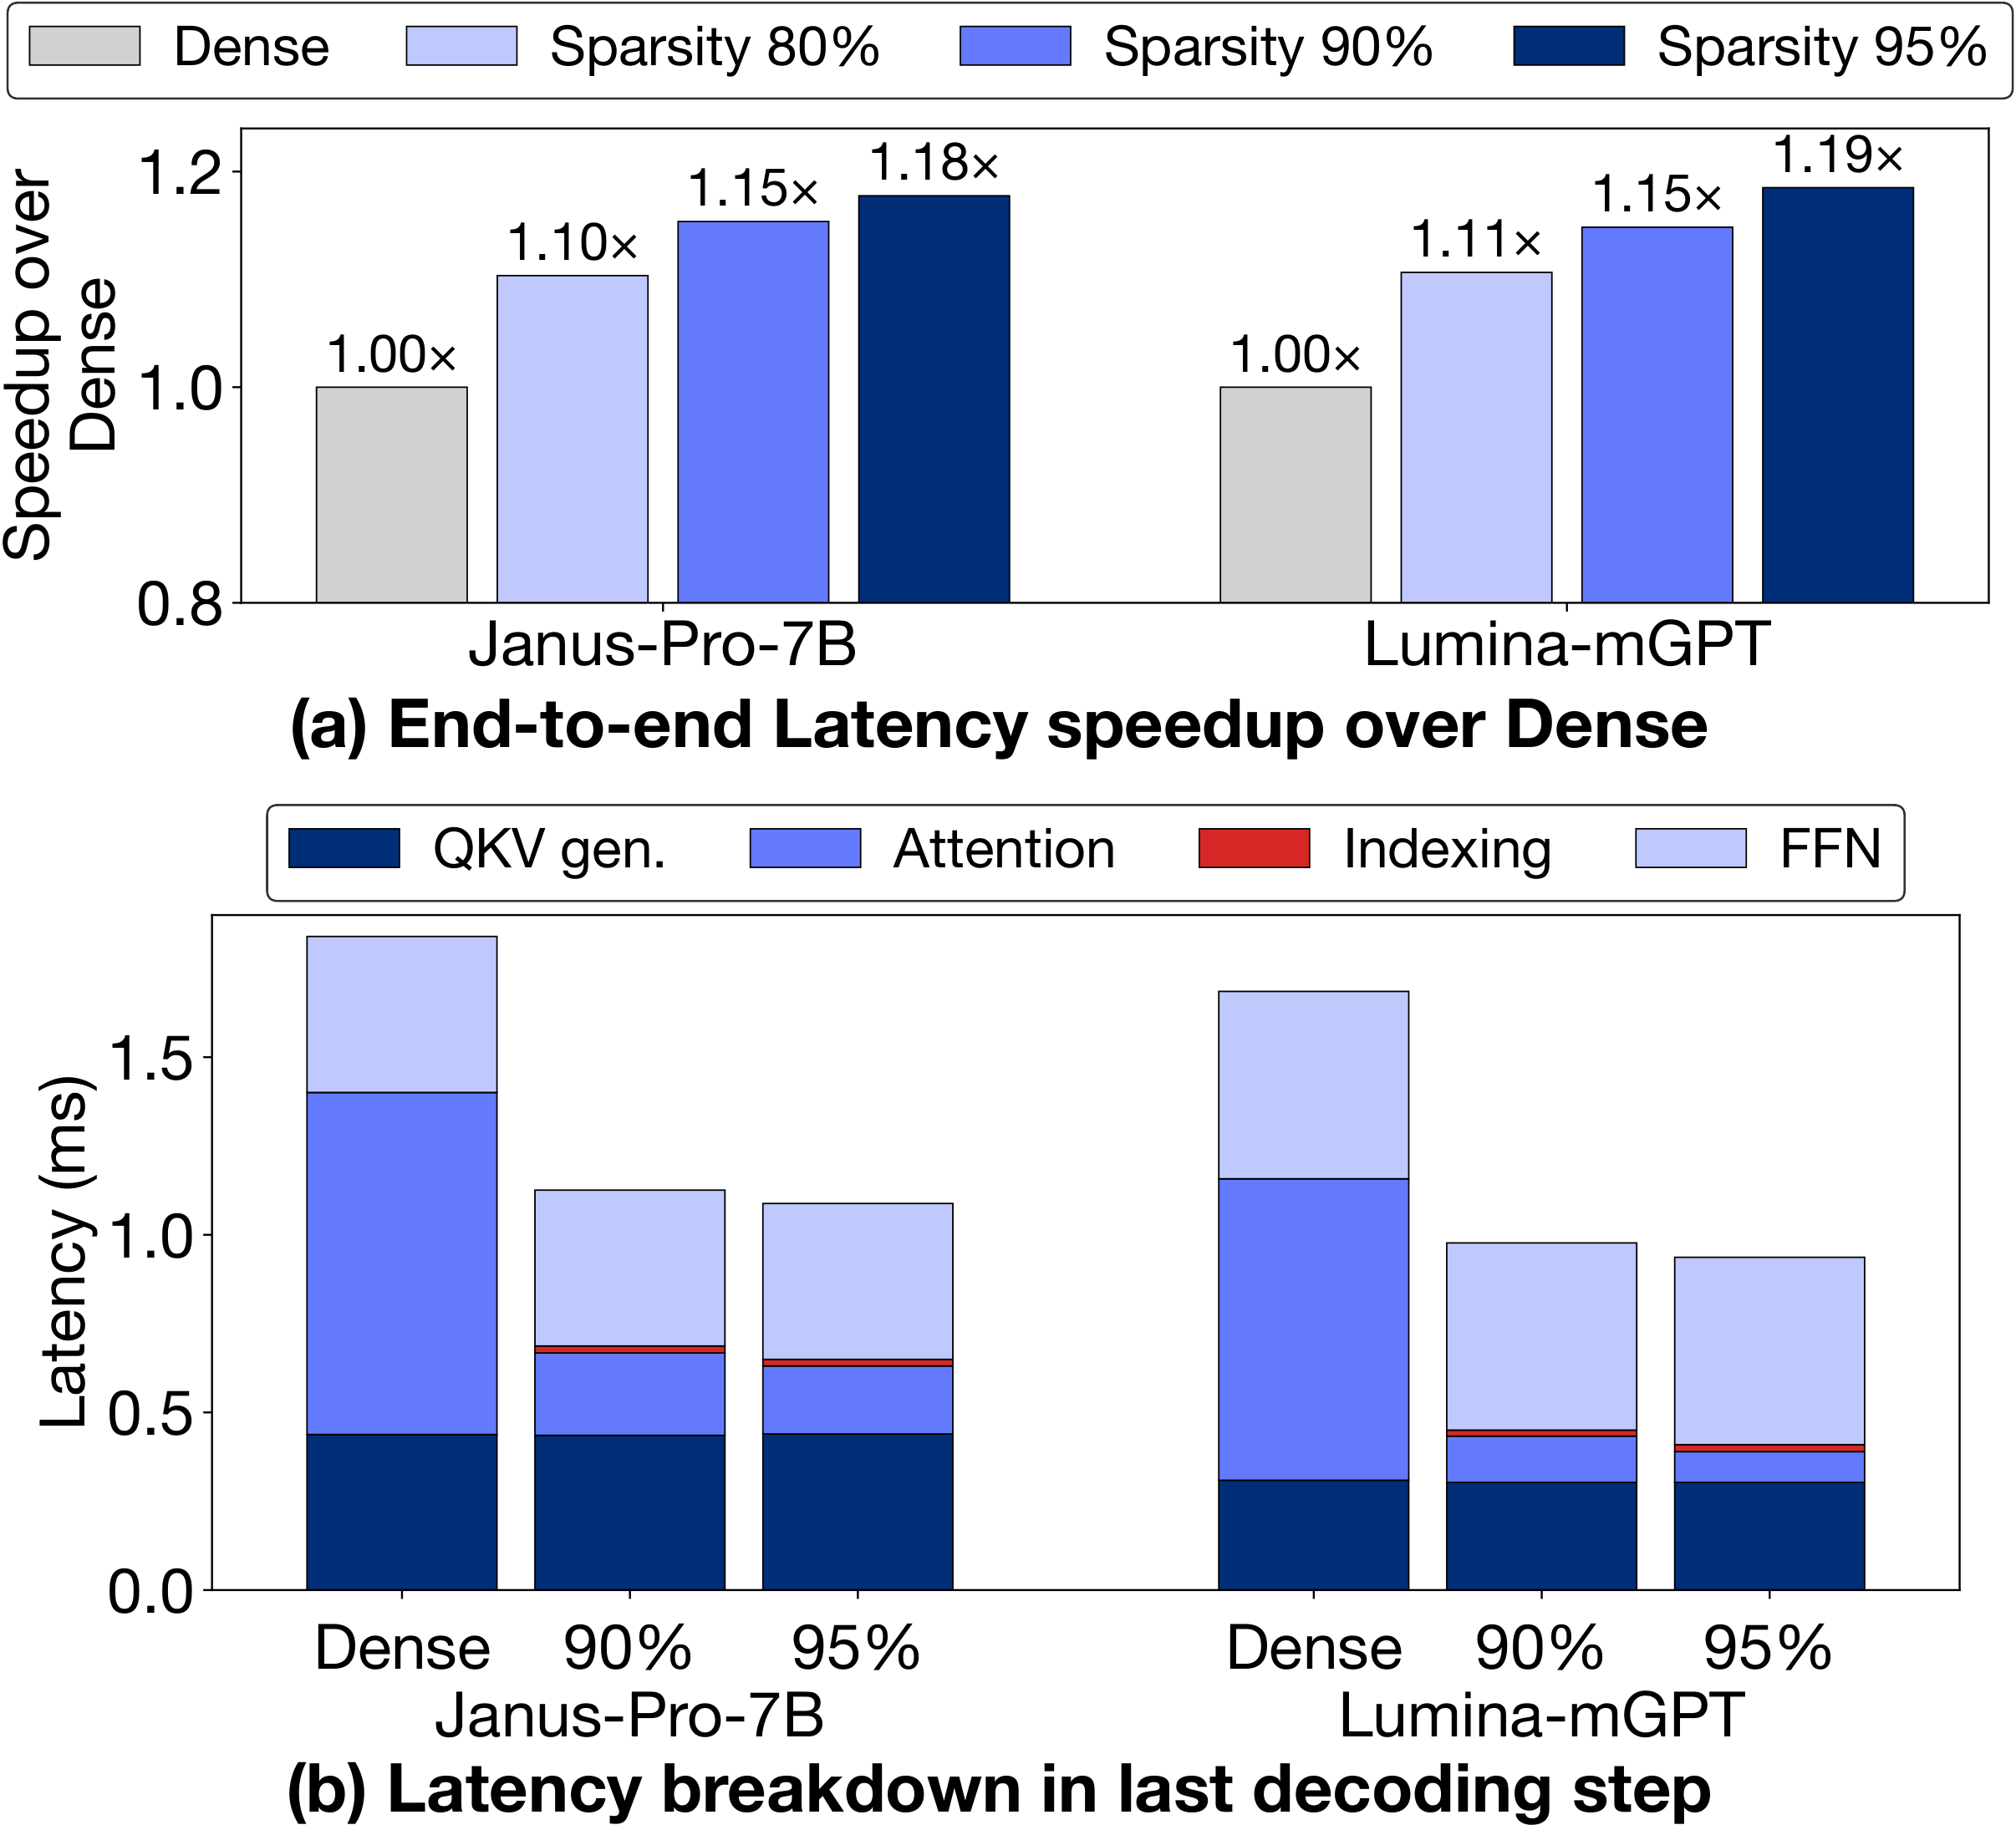
本文贡献 :论文首次系统刻画了自回归图像生成中的注意力稀疏性,覆盖多种负载与代表性开源模型,发现三个和文本场景不一样的性质:prefill 与 decode 阶段存在明显不对称、注意力强烈集中在 prompt token 与局部 token 上、以及视觉 token 的空间局部性带来一种独特的对角稀疏模式。据此提出对角感知稀疏注意力,在最近窗口内沿对角方向选择性跳过 KV 条目。
实验效果 :基于 FlexGen、FlashAttention-2 与自定义 kernel 实现在 GPU 服务系统上,相比稠密推理最高取得 3.1 倍吞吐与 1.19 倍延迟改善,质量损失低于 2%。
批判点评 :把稀疏模式追到「视觉 token 的空间局部性」这一来源、而不是照搬文本 LLM 的稀疏假设,是这篇最扎实的地方,3.1 倍吞吐也有工程说服力。但「质量损失低于 2%」用的是哪个指标、在哪些负载上成立,摘要没交代;对角模式依赖光栅扫描式的 token 排布,换扫描顺序或改分辨率后是否还成立同样存疑。
4. VibeAvatar:口型与美感分阶段各管各的
VibeAvatar: Aligning Phonetic Kinematics and Human Aesthetics for High-Fidelity Talking Avatar Synthesis | Peking University | arXiv:2609.18632
关键词 :说话人视频合成,语音驱动,GRPO,流匹配
⚠️ 前序问题 :多模态说话人视频合成要从一张参考肖像加一段语音生成逼真视频。扩散类方法进步很快,却始终难以同时拿到准确的唇部发音、符合人类偏好的运动美感和高效推理这三样。
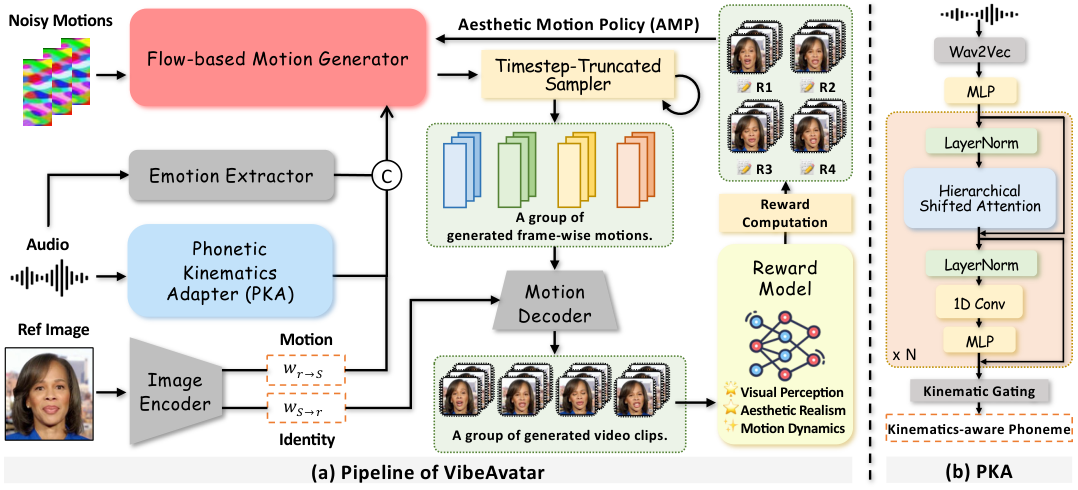
本文贡献 :论文的判断是:发音准确性和运动美感来自根本不同的源头,应该在互补的阶段分别处理,而不是塞给单个生成器隐式地一起学。VibeAvatar 因此把两个目标解耦——条件阶段用 Phonetic Kinematics Adapter(PKA)把面向识别的语音特征转成发音-运动条件;后训练阶段用 Aesthetic Motion Policy(AMP),以 GRPO 优化一个流一致的随机采样策略。运动生成器本身是轻量流模型,工作在紧凑的一维 warp 潜空间里。
实验效果 :客观指标与用户研究上,发音、美感、效率三项均达到 state-of-the-art;生成 10 秒 512px 视频耗时不到 10 秒,显存占用约 3GB。
批判点评 :「发音归条件阶段、美感归后训练」是个干净的分工,把 GRPO 用在采样策略而不是生成器权重上也省掉了重训成本,约 3GB 显存意味着消费级显卡能跑。但美感由 GRPO 所对齐的偏好定义,口味会不会过拟合到特定标注群体值得警惕;摘要只给了效率数字,发音与美感的具体分数、以及更长时长下的身份漂移都得看正文。
5. AVR:能抄就抄抄不到才让扩散补
Copy What Is Seen, Generate What Is Not: Training-Free Anomaly-Aware Video Restoration | New York University;University of Technology Sydney | arXiv:2609.18836
关键词 :视频修复,异常检测,免训练方法,扩散修补
⚠️ 前序问题 :监控系统检测到异常后往往还得把画面修好,但这两件事一直被分开研究:免训练的异常检测止步于一个分数或标签,免训练的视频编辑则只听用户提示词、不听检测器。
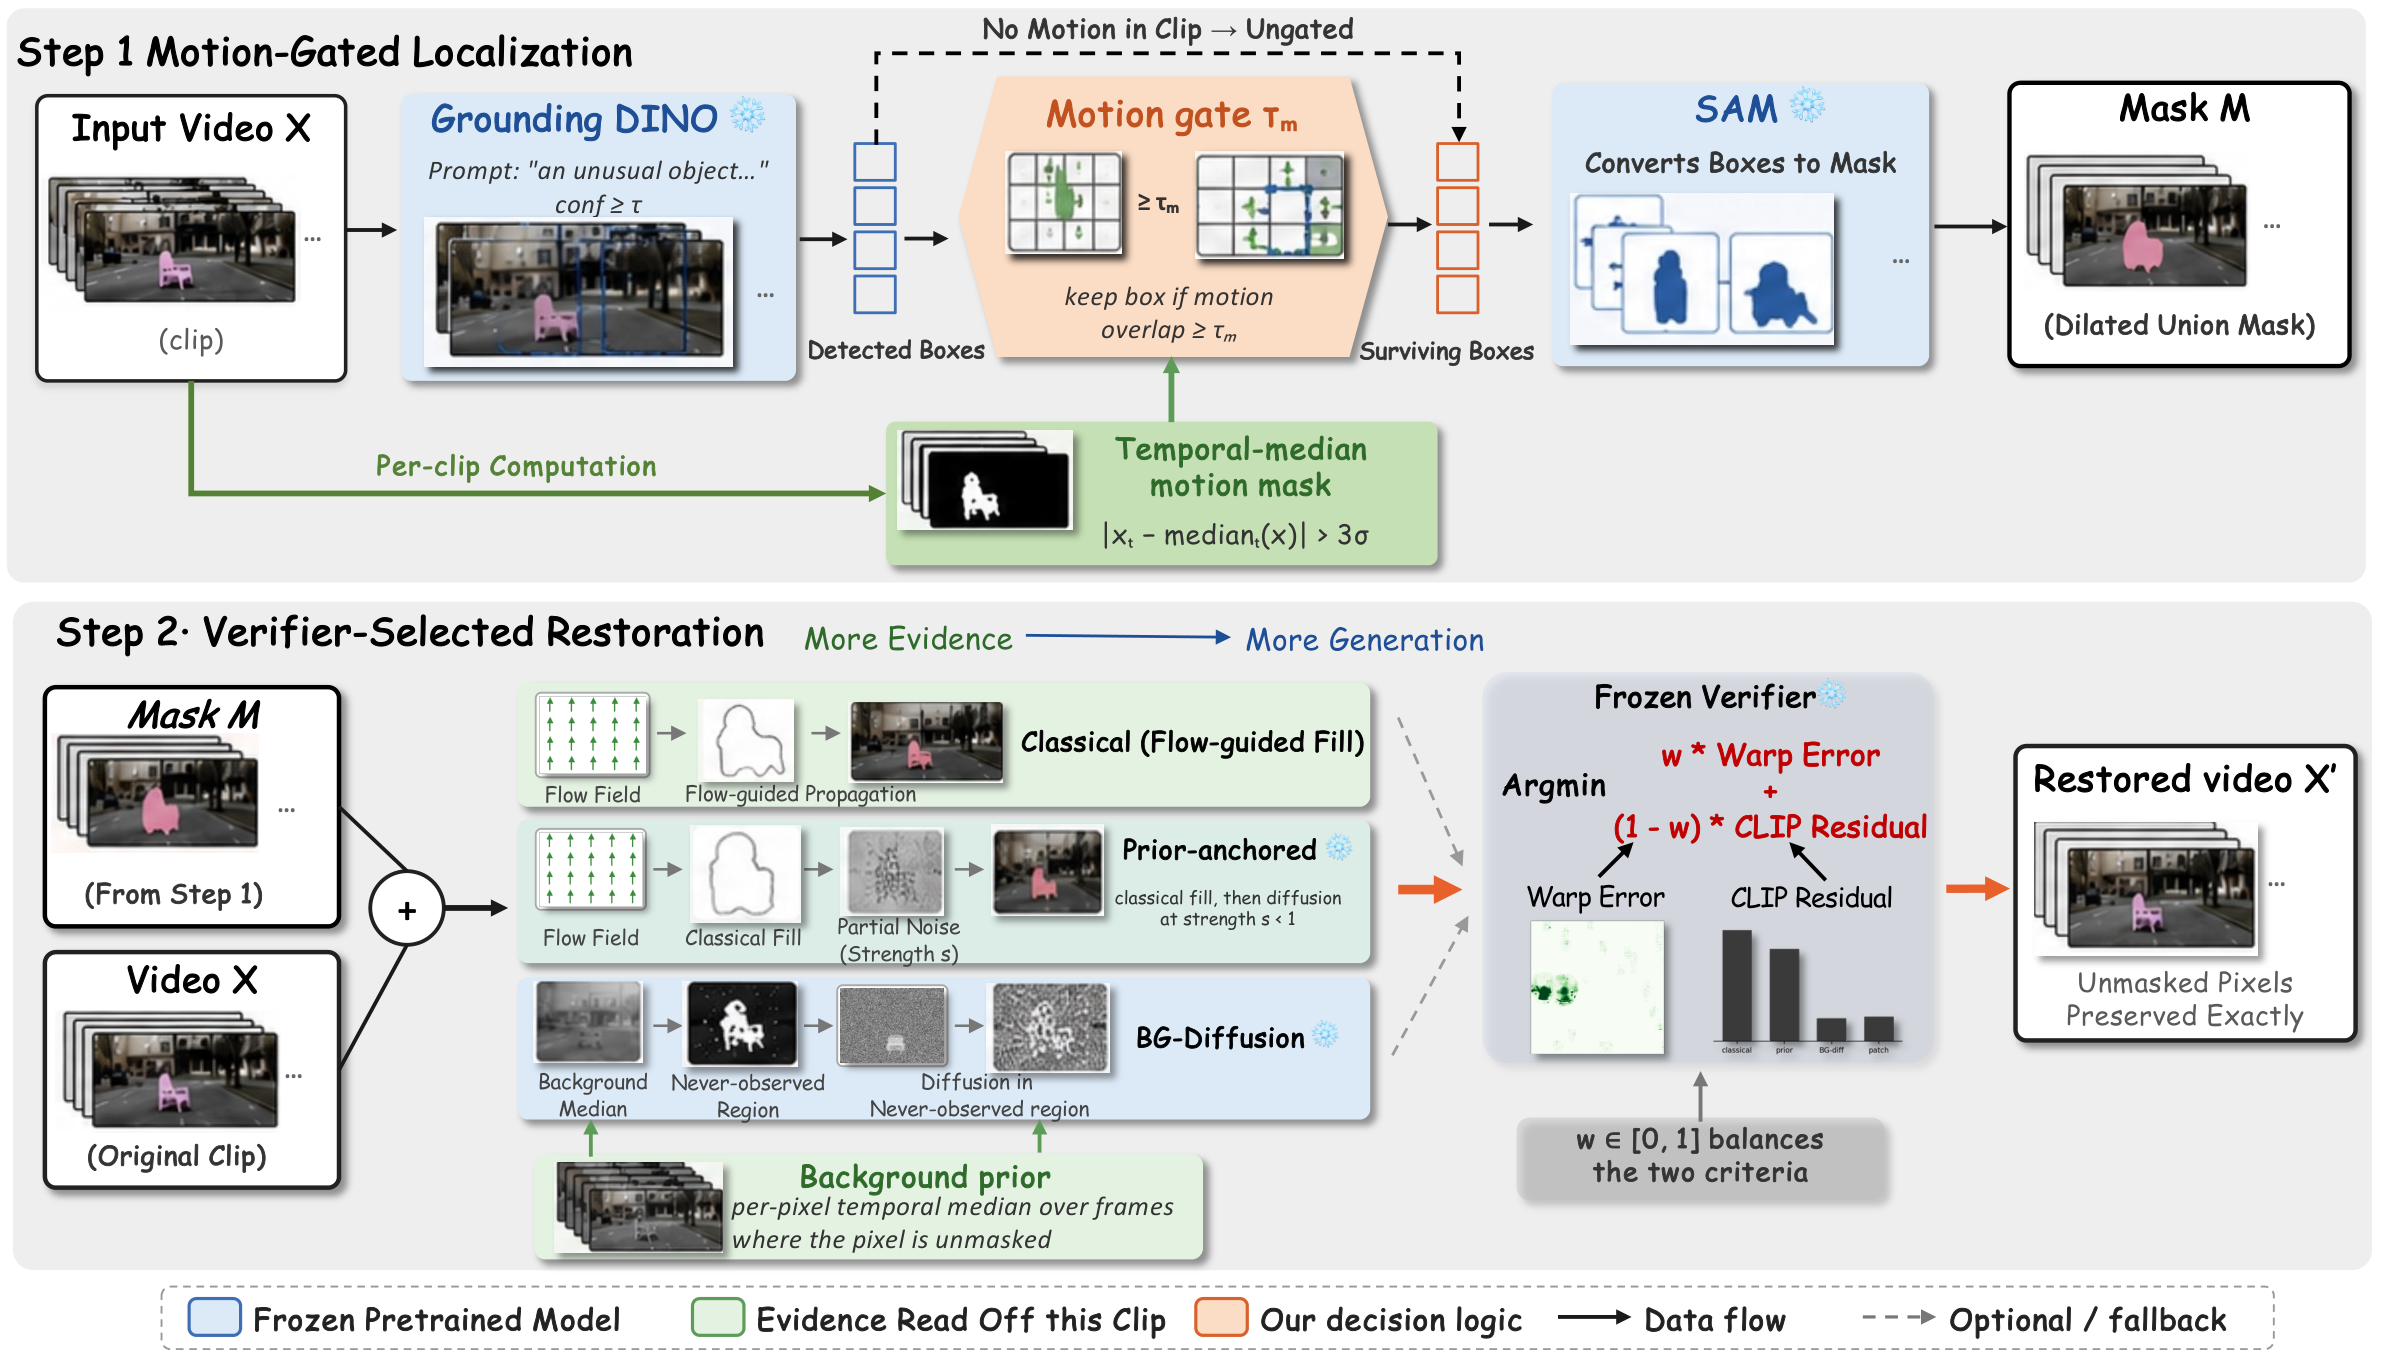
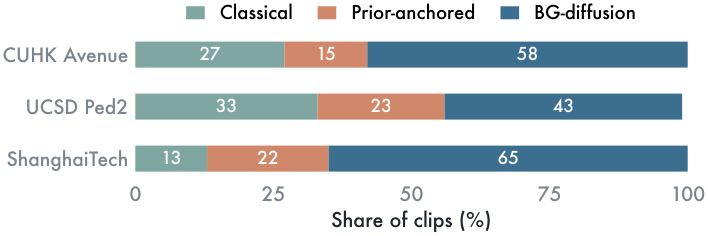
本文贡献 :AVR 只用冻结的预训练模型就把两端接上,而且只在画面确实没有证据可抄的地方才生成内容。先由运动证据把开放词表提案收敛成时空掩码;再用片段自身算出的背景先验,填掉异常曾经遮挡过的每一个像素,只把「任何一帧都没出现过」的部分交给扩散合成;最后一个冻结的验证器逐片段决定该信任经典修复、先验锚定修复还是背景条件修复。
实验效果 :三个监控数据集上、覆盖全参考异常注入与真实异常两种设定:oracle 掩码下 AVR 的全帧保真度领先,在编辑区域内与三个训练过的视频 inpainting 方法持平,用自己产出的掩码时优于「先检测再生成」的流水线,同时压住了残留异常与自由扩散带来的闪烁。
批判点评 :「能抄就抄、抄不到才生成」的取舍很贴监控取证的需求——少生成一分就少一分臆造风险,全程冻结模型也免了训练成本。但它靠运动证据圈定异常,静止或缓慢的异常可能整个漏掉;oracle 掩码下的领先说明上限不错,自产掩码下的成绩才是实际水平,三个监控数据集的场景多样性也仍有限。
6. CPR:作曲演奏精修三段渲染钢琴
CPR: Combining global composing, local performing and full-sequence refining in piano rendering with continuous autoregressive modelling | The Chinese University of Hong Kong, Shenzhen | arXiv:2609.18216
关键词 :钢琴渲染,连续自回归,流匹配,音乐生成
⚠️ 前序问题 :提示词条件下的钢琴 MIDI-to-Music 渲染,要在忠实还原目标音符的同时复现参考录音的音色。现有方法分两条路:离散 codec 的自回归模型有因果时序建模能力,但量化会丢掉声学细节;流匹配更能保住声学结构,代价是全序列注意力开销大、语义结构反而更差。
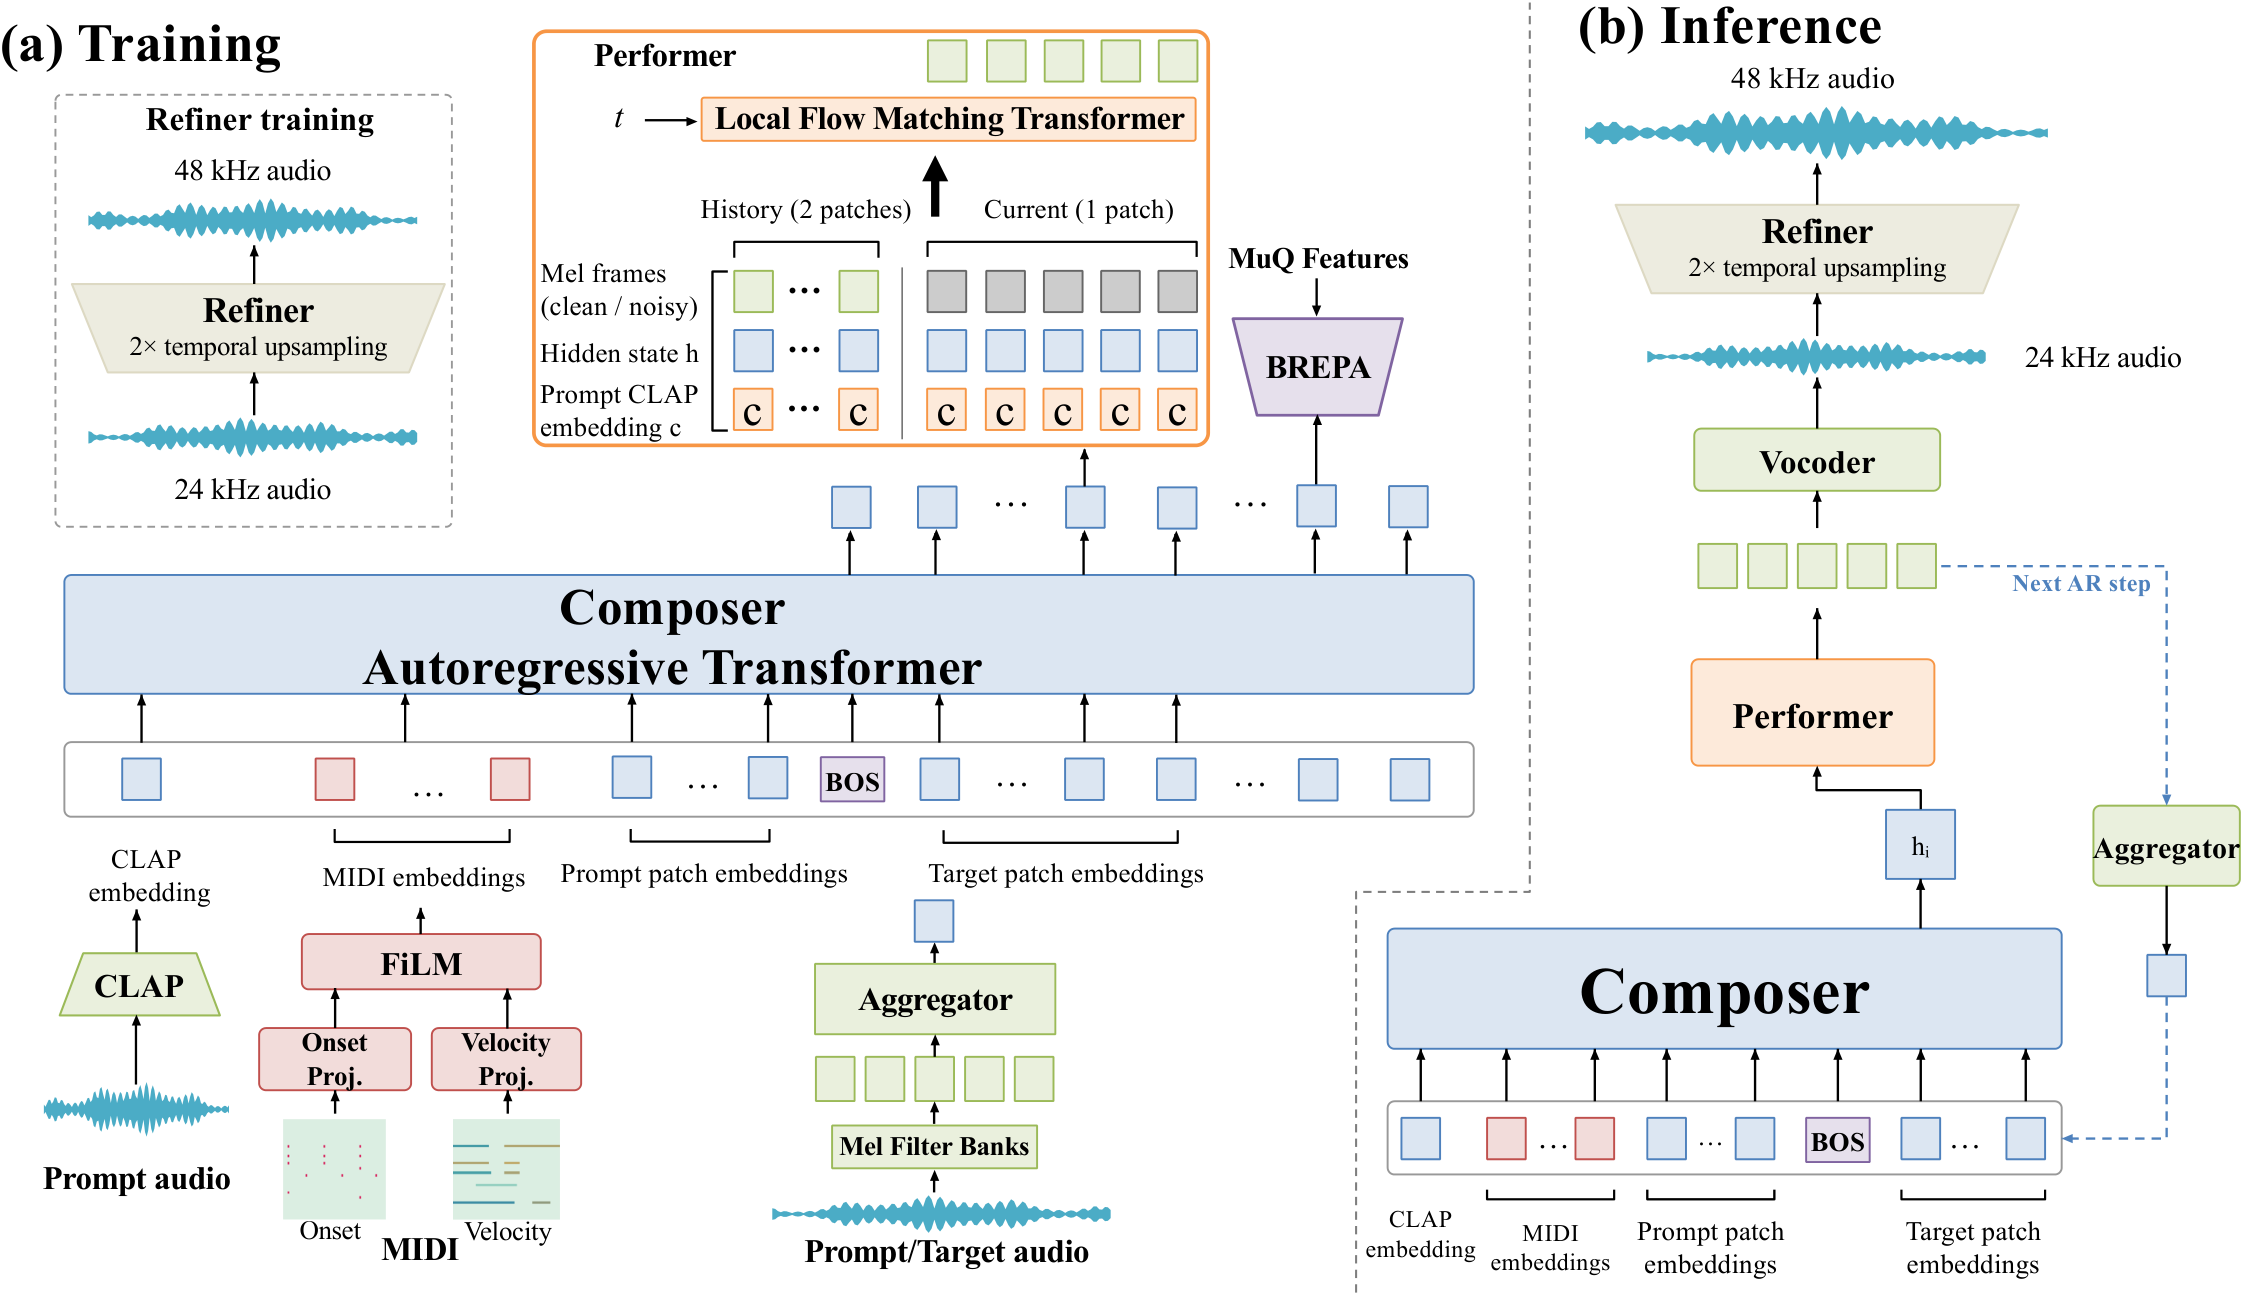
本文贡献 :连续自回归模型直接在连续表示上工作,既兼有自回归的条件跟随能力与流匹配的分布建模能力,又绕开量化瓶颈、计算成本更低。CPR 据此拆成三段:Composer 自回归预测连续隐状态,Performer 经局部流匹配生成 24kHz 声学潜变量,Refiner 再把波形上采样到 48kHz。论文另引入 Bottlenecked Representation Alignment(BREPA)与 Modality-Time RoPE(MT-RoPE),分别强化 Composer 隐状态里的音乐语义结构和跨模态时间对齐。
实验效果 :P-MUSE-eval 上,CPR 只用 4 步(NFE=4)就输出 48kHz 音频,onset F1 78.4 与 FAD_clap 0.129 均为最佳;音色相似度 89.3 略低于需要 25 步的 P-MUSE(90.6),但明显优于 MIDI-VALLE 的 83.4。另有 13 位听众对 14 个样本的 MOS 主观评测。批判点评 :三段分工把「写什么音」「怎么弹出来」「采样率补齐」拆开,绕过离散量化这个老瓶颈,4 步出 48kHz 相对 P-MUSE 的 25 步是实打实的效率优势。但音色相似度并未超过 P-MUSE,说明连续表示在音色保真上还没占到便宜;MOS 只有 13 位听众评 14 个样本,样本量偏小,评测也集中在钢琴单一乐器上。
7. Self-Distilled TTS:模型自己教自己念生词
Self-Distilled Pronunciation and Accent Control for Neural Text-to-Speech | Independent Researcher;KOWRO Inc. | arXiv:2609.17234
关键词 :语音合成,自蒸馏,发音控制,口音标注
⚠️ 前序问题 :直接读原始文本的 TTS 没有词典,碰上生僻词只能靠猜。已有的补救要么拿录音训练一条专门的发音与口音通道,要么从示例里一个词一个词地改。
本文贡献 :这篇两样都不做。让冻结的骨干去读一个含有它本来就念得对的常见词的句子,再把它自己的输出当作同一句话的教师——只是把那个词替换成带标注的、指定口音的读法。这一对训练样本就是方法的全部。实验效果 :Sarashina2.2-TTS 上,经筛选的评测者(Fleiss' kappa = 0.85)在 0.89 的未见词上听出了指定口音,而无法表达口音的假名方案只有 0.57、没有赢下任何一组对比,自然度没有可测量的损害。未经调整迁移到自回归、扩散和编码器-解码器骨干后,319 个词上的读法正确率比不做编辑高出 0.25 到 0.47;CosyVoice 2 上三个词里有两个能带上口音,但在 Irodori 上不行,论文分析了原因。批判点评 :用模型自己的输出当教师、只换一个词构成训练对,简洁到几乎没有额外数据成本,跨骨干迁移也说明思路不绑架构。但它天然受限于「骨干本来就念得对的常见词」这个起点,词表外的音素组合未必覆盖得到;Irodori 上失效说明迁移并非无条件成立,日语音高重音之外的语言是否同样奏效也还没有证据。
8. JewelTry:免掩码珠宝试戴还管尺寸
JewelTry: Mask-Free Scale Aware Jewelry Virtual Try-On | Amazon | arXiv:2609.16626
关键词 :虚拟试戴,免掩码扩散,尺寸感知,评测基准
⚠️ 前序问题 :虚拟试穿让顾客看到上身效果,已是网购的重要技术。服装类进展很大,珠宝却因为体积小、结构刚性、对细节高度敏感而一直是难啃的品类:既要忠实迁移外观,还得相对佩戴者有正确的尺寸和位置。现有珠宝试戴多依赖掩码引导,而免掩码方法又缺乏建模产品尺寸的显式引导。
本文贡献 :论文先建了 JVTO-Bench,提供带真实产品尺寸标注的「参考-源-目标」三元组,覆盖四大珠宝品类。在此之上提出免掩码扩散框架 JewelTry:尺寸适配器把产品实际尺寸编码成一个 scale token,让模型在上下文中学到珠宝与人体解剖结构之间的尺寸关系;再用单向条件注意力与注意力精修损失,同时保住参考珠宝的粗粒度几何与细粒度结构细节。
实验效果 :实验显示 JewelTry 在视觉保真度、背景保持、物体一致性与尺寸准确性之间取得平衡,为免掩码、尺寸感知的珠宝虚拟试戴立了一个较强基线。
批判点评 :把「尺寸对不对」变成可编码的条件而不是靠掩码兜底,抓住了珠宝区别于服装的真正难点,配套放出带真实尺寸标注的 benchmark 也补上了这一方向的评测空白。但摘要通篇没给量化指标,「取得平衡」这类表述无法判断相对现有方法的实际差距;四个品类对珠宝这种长尾品类而言覆盖面也偏窄。
9. MSR:多张参考图各占一个 slot
MSR: Multiple Subject Reference for Video Generation | Licon Studio | arXiv:2609.18393
关键词 :多主体视频生成,参考图条件,LoRA,流匹配
⚠️ 前序问题 :让视频生成器同时吃多张参考图时,既要保住每个主体的外观,又要把每张图和它该扮演的角色对上,否则属性就会串到别的对象身上。
本文贡献 :MSR 是面向 LTX 视频生成的 slot 感知条件方案:每张参考图被独立编码成一段静态片段、对应一组单独的潜 token;一个紧凑的傅里叶特征 MLP 给它加上数值化的 slot 嵌入,再用随 slot 变化的时间偏移改写这组 token 的旋转位置坐标。这些参考组被前置到带噪的目标 token 之前,在仅针对目标的流匹配训练中充当干净上下文。整套方案用 LoRA 实现,权重与推理工作流已开源。实验效果 :论文给的是定性结果:示例展示了包含不同角色与参考环境的写实及风格化场景组合;开发过程中的观察显示,相对更早的连续参考基线,参考混淆有所减少,但相似服装、复杂衣物和视角变化仍然困难。另有一个补充实验在冻结视觉参数的前提下加入了语音参考条件。批判点评 :用独立 token 组加 slot 嵌入来绑定「哪张图对应哪个角色」,思路直接,靠 LoRA 就能低成本落地,开源权重与工作流对想复现的人友好。但这更像一份技术报告而非完整论文:全文没有定量实验,「参考混淆减少」只是开发观察而非受控对比,缺少与基线的可比指标;作者自己也承认相似服装与视角变化仍未解决。
10. Newer Is Not Fairer:新版文生图并没有更公平
Newer Is Not Fairer: Gender Stereotyping in Text-to-Image AI Across Model Generations | Northeastern University | arXiv:2609.18007
关键词 :文生图,性别偏见,模型审计,公平性评测
⚠️ 前序问题 :文生图模型已经在专业与创意场景里广泛使用,但它们如何呈现不同职业的性别、以及更新的模型是不是更公平,跨代际地看仍缺乏系统证据。
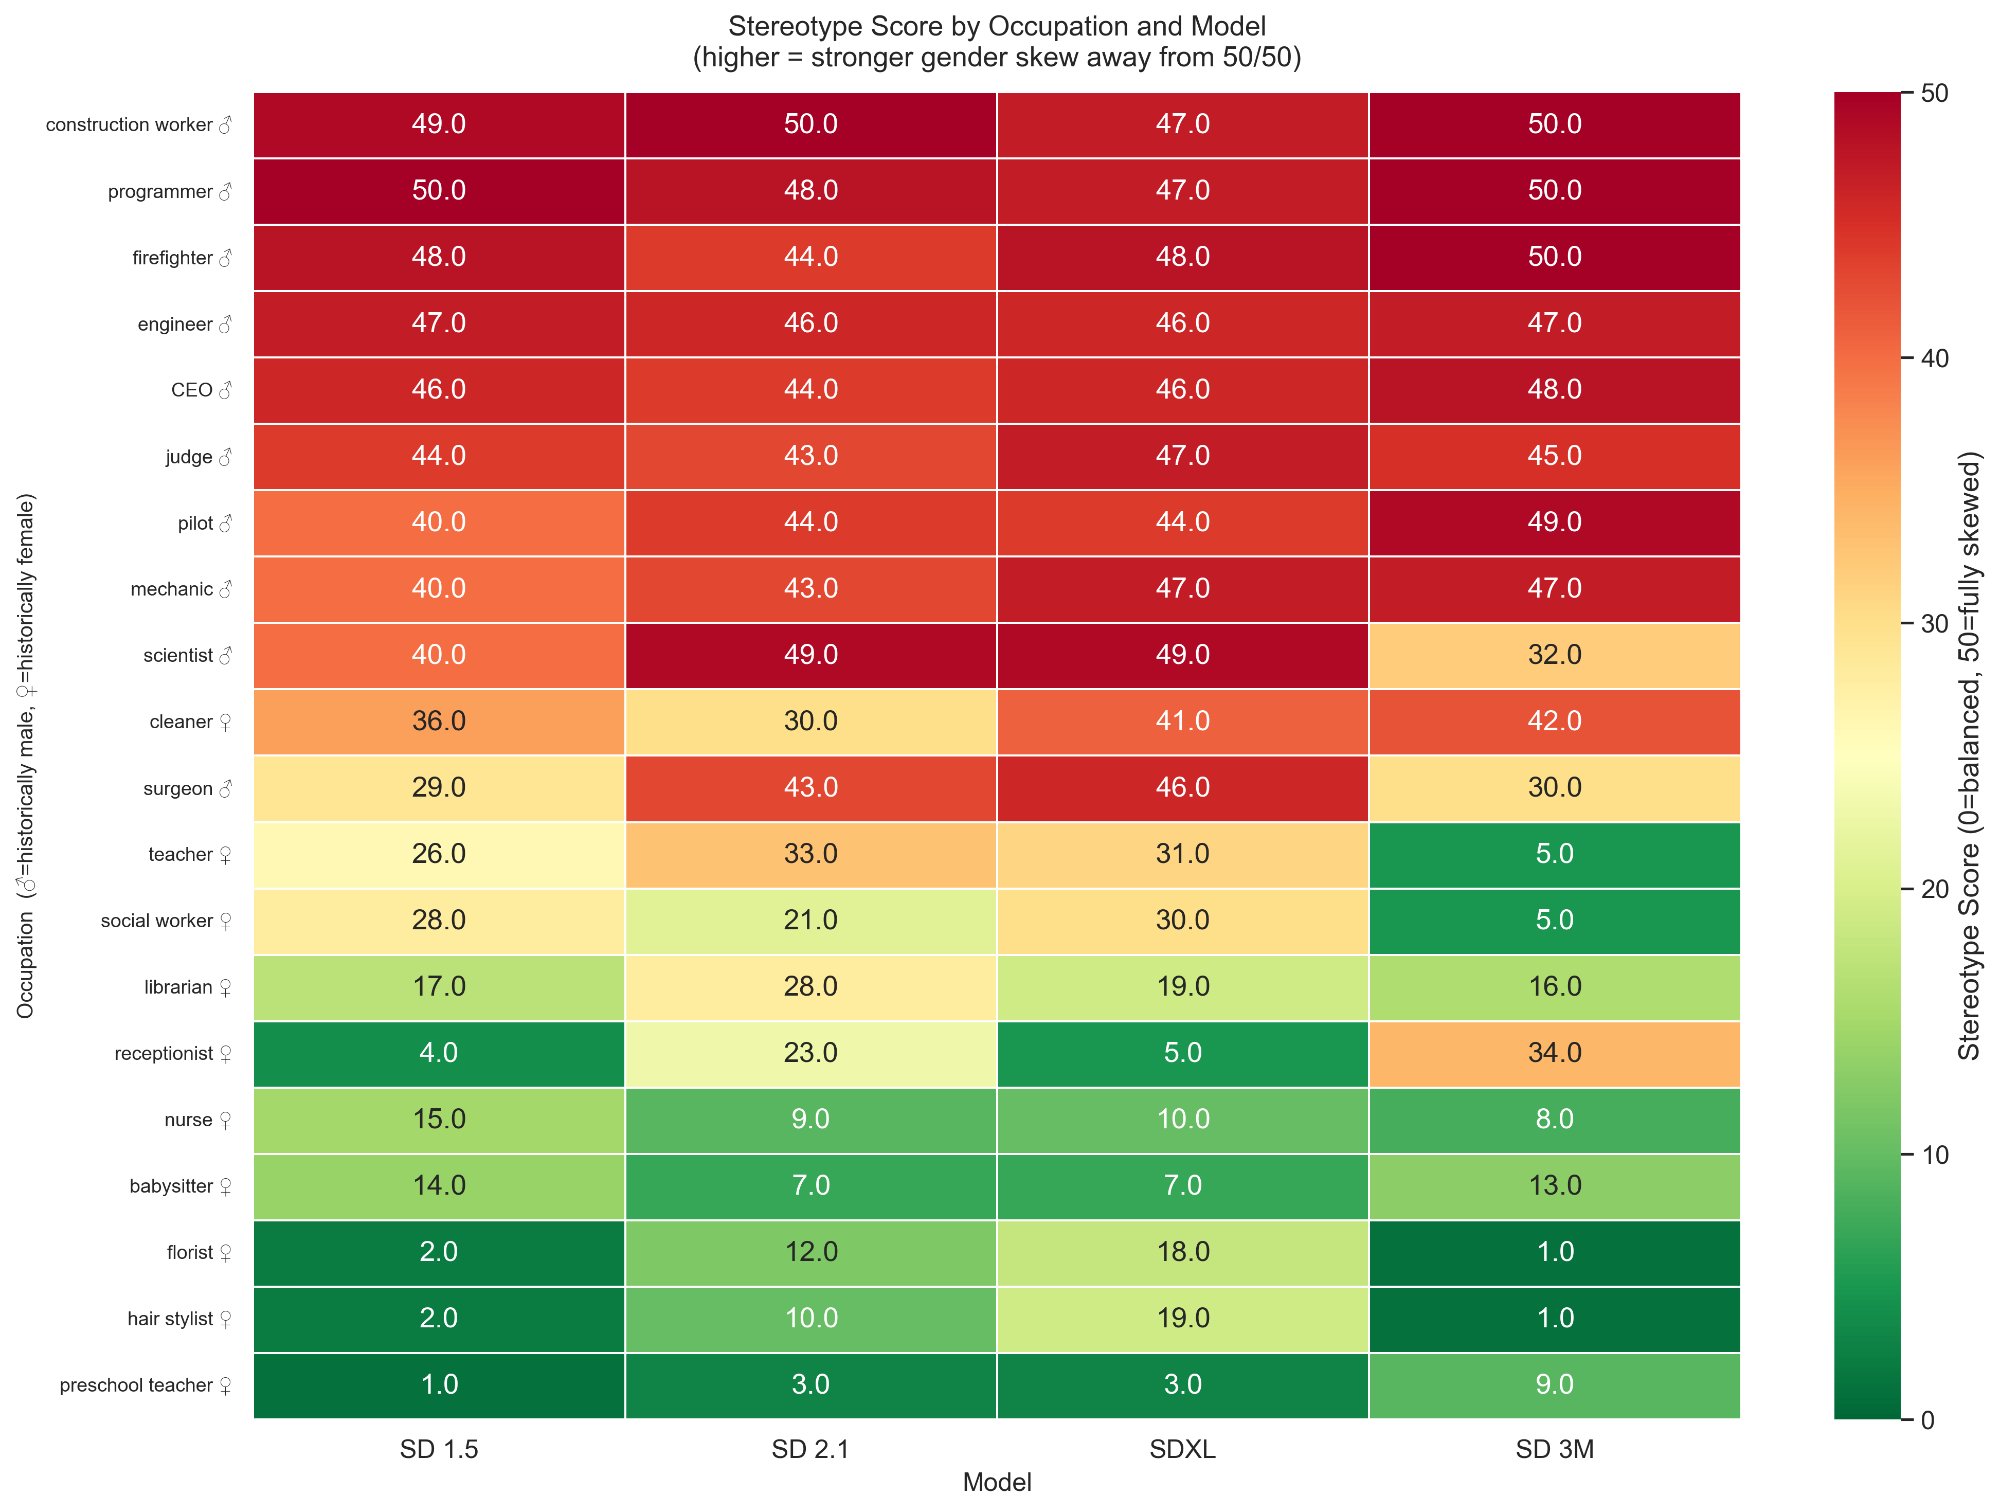
本文贡献 :论文评测了 20 个职业、5 种提示词模板、4 代 Stable Diffusion(SD 1.5、SD 2.1、SDXL、SD 3 Medium),每个「职业×模型」单元生成 100 张、共 8000 张图,全部用 DeepFace 判定性别,并与美国劳工统计局(BLS)的真实劳动力数据对照,所有显著性检验都做了 Benjamini-Hochberg 多重校正。
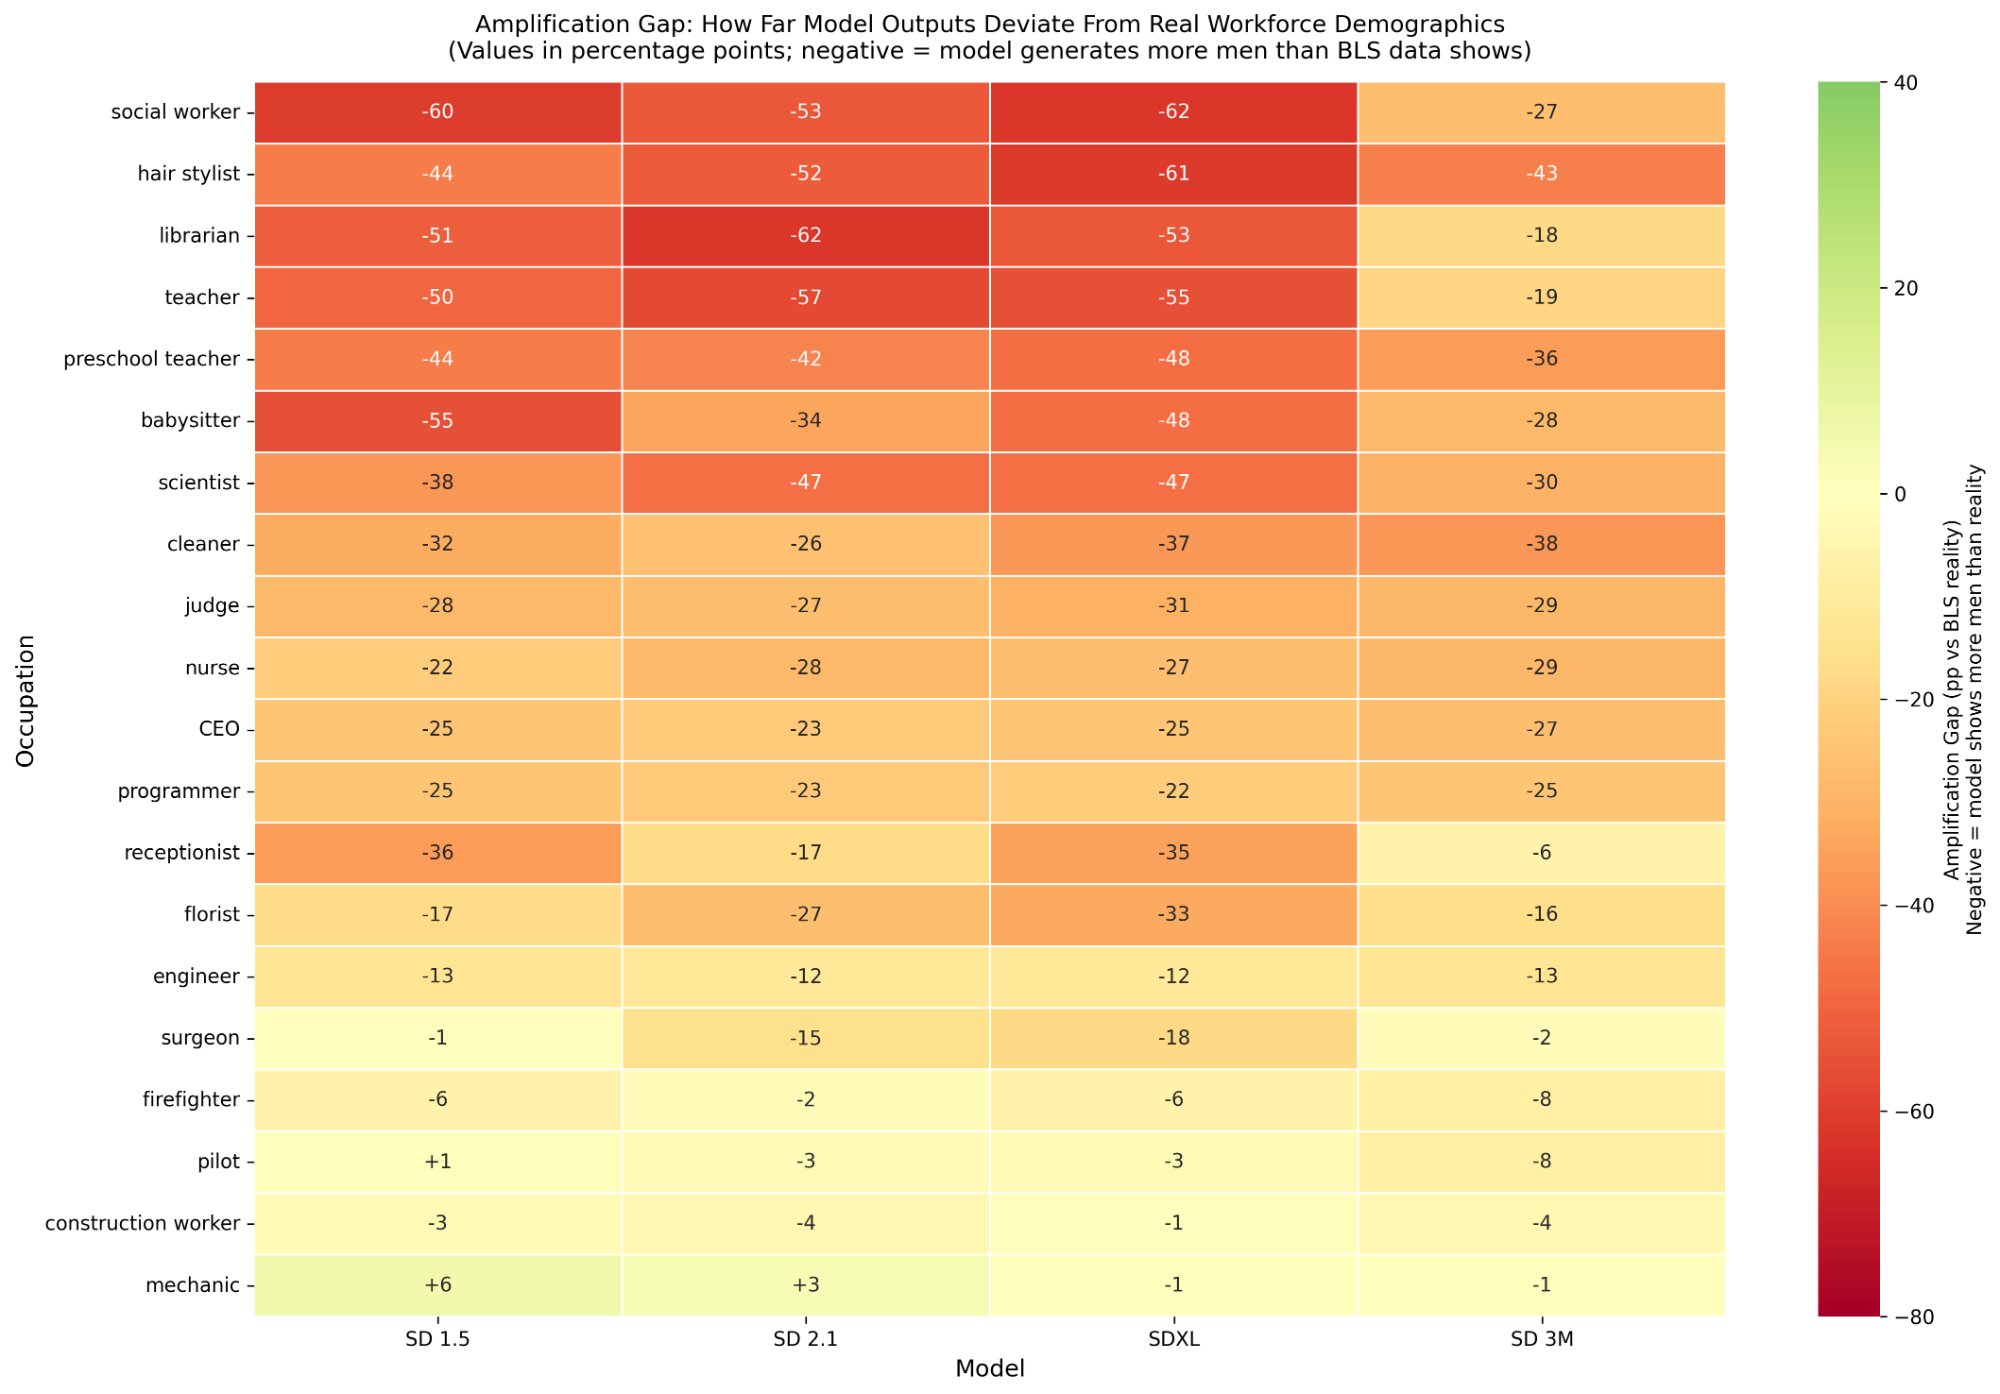
实验效果 :8000 张开源模型图像中 76.4% 为男性(95% CI [75.1%, 78.7%]);更扎眼的是历史上女性主导的职业里仍有 57.6% 生成男性。相对 BLS 数据,模型平均低估女性 20–46 个百分点,本就接近性别均衡的职业偏差最大——科学家 BLS 女性占 48%、模型输出 82–99% 为男性,清洁工 BLS 女性占 46%、模型输出 80–92% 为男性。代际并非稳步改善:偏差从 SD 1.5 一路恶化到 SDXL,到 SD 3 Medium 才部分回落。与 GPT-image-1 在五个职业上的初步对比显示商业模型偏差更低,但实际效应很小(Cramér's V = 0.080)且属探索性。没有任何一个模型达到性别均衡。
批判点评 :8000 张图、多重检验校正、对照 BLS 真实就业数据,这套设计让结论比常见的偏见讨论扎实得多,「更新不等于更公平」的代际发现尤其有价值。但性别判定依赖 DeepFace 的二元分类,本身有误差且无法涵盖非二元表达;20 个职业、5 个模板的提示词空间偏窄,与 GPT-image-1 的对比作者也标注为探索性,撑不起开源与商业模型孰优孰劣的强结论。
趋势观察
长上下文的瓶颈,从「记不记得住」变成「cache 放不放得下」
Recency Forcing 把长视频退化追到 KV cache 淘汰这一工程约束,Diagonal Sparsity 直接冲着自回归图像生成的 KV 访问瓶颈去。两篇都不再泛泛谈误差累积,而是把注意力的显存与访存代价当成一等问题来解。
生成质量的定义权,正在交给后训练与采样策略
VibeAvatar 把运动美感交给 GRPO 在后训练阶段对齐,而不是让生成器隐式地学;CPR 用连续自回归绕开量化,再分三段把语义结构、局部声学与采样率分工。共同前提是承认单个生成器学不好多个互相冲突的目标。
评测开始审问模型「到底懂不懂」,而不只是「像不像」
MiniMax-H3 的评测让每种模态只给部分证据,逼模型跨模态整合才能答对;Newer Is Not Fairer 用 8000 张图对照真实就业数据,把「新版是否更公平」变成可证伪的问题。两者都不满足于保真度分数。
免训练与轻量适配,正在成为落地的默认路径
AVR 全程冻结预训练模型、只在没有证据可抄的地方才生成;MSR 用 LoRA 给现成视频模型加多主体条件;Self-Distilled TTS 让模型自己的输出当教师。共同动机都是避开重训成本。
人工智能炼丹君 整理 | 2026-09-18
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注













评论 (0)