AIGC 每日速读|2026-09-17|Meta一个模型既写歌又改歌-SongCraft

人工智能炼丹君
2026-09-17 / 0 评论 / 9 阅读 / 正在检测是否收录...

今日 AIGC 论文速览

今日共 10 篇 · 音乐与歌曲生成 2 篇 · 视频生成与世界模型 2 篇 · 视频编辑与采样效率 2 篇 · 长语音稳定生成 2 篇 · 生成评测与溯源 2 篇

重点论文标题列表

  • SongCraft(Meta AI):一套模型统一歌曲生成编辑
  • SlotDiT(University of Bonn):用 slot 潜空间省算力提成功率
  • AlayaVista(Alaya Lab;Beijing Institute of Technology;The University of Tokyo):全景状态驱动流式世界模型
  • MDN-Control(Wuhan University):掩码深度噪声协同视频编辑
  • ADSC(SAP;National University of Singapore;A*STAR I2R):按样本收敛动态缩短采样


今日论文速览

1. SongCraft:一套模型统一歌曲生成编辑

SongCraft: Unified Song Generation and Editing with Reconstructive Learning | Meta AI | arXiv:2609.16315

关键词:歌曲生成,音频编辑,流匹配,重建预训练

  • 前序问题:歌曲生成与歌曲编辑通常由两套系统完成:生成只接收歌词等稀疏条件,编辑却需要保留人声、旋律和结构等稠密属性,分别训练会重复成本且难共享能力。
  • 本文贡献:SongCraft用重建式预训练随机切换稀疏生成分支和稠密编辑分支,共享潜空间流匹配主干;编辑时抽取歌词时间戳、MIDI、和弦、歌手等属性并只改目标条件,生成时仅保留歌词、节拍和描述。
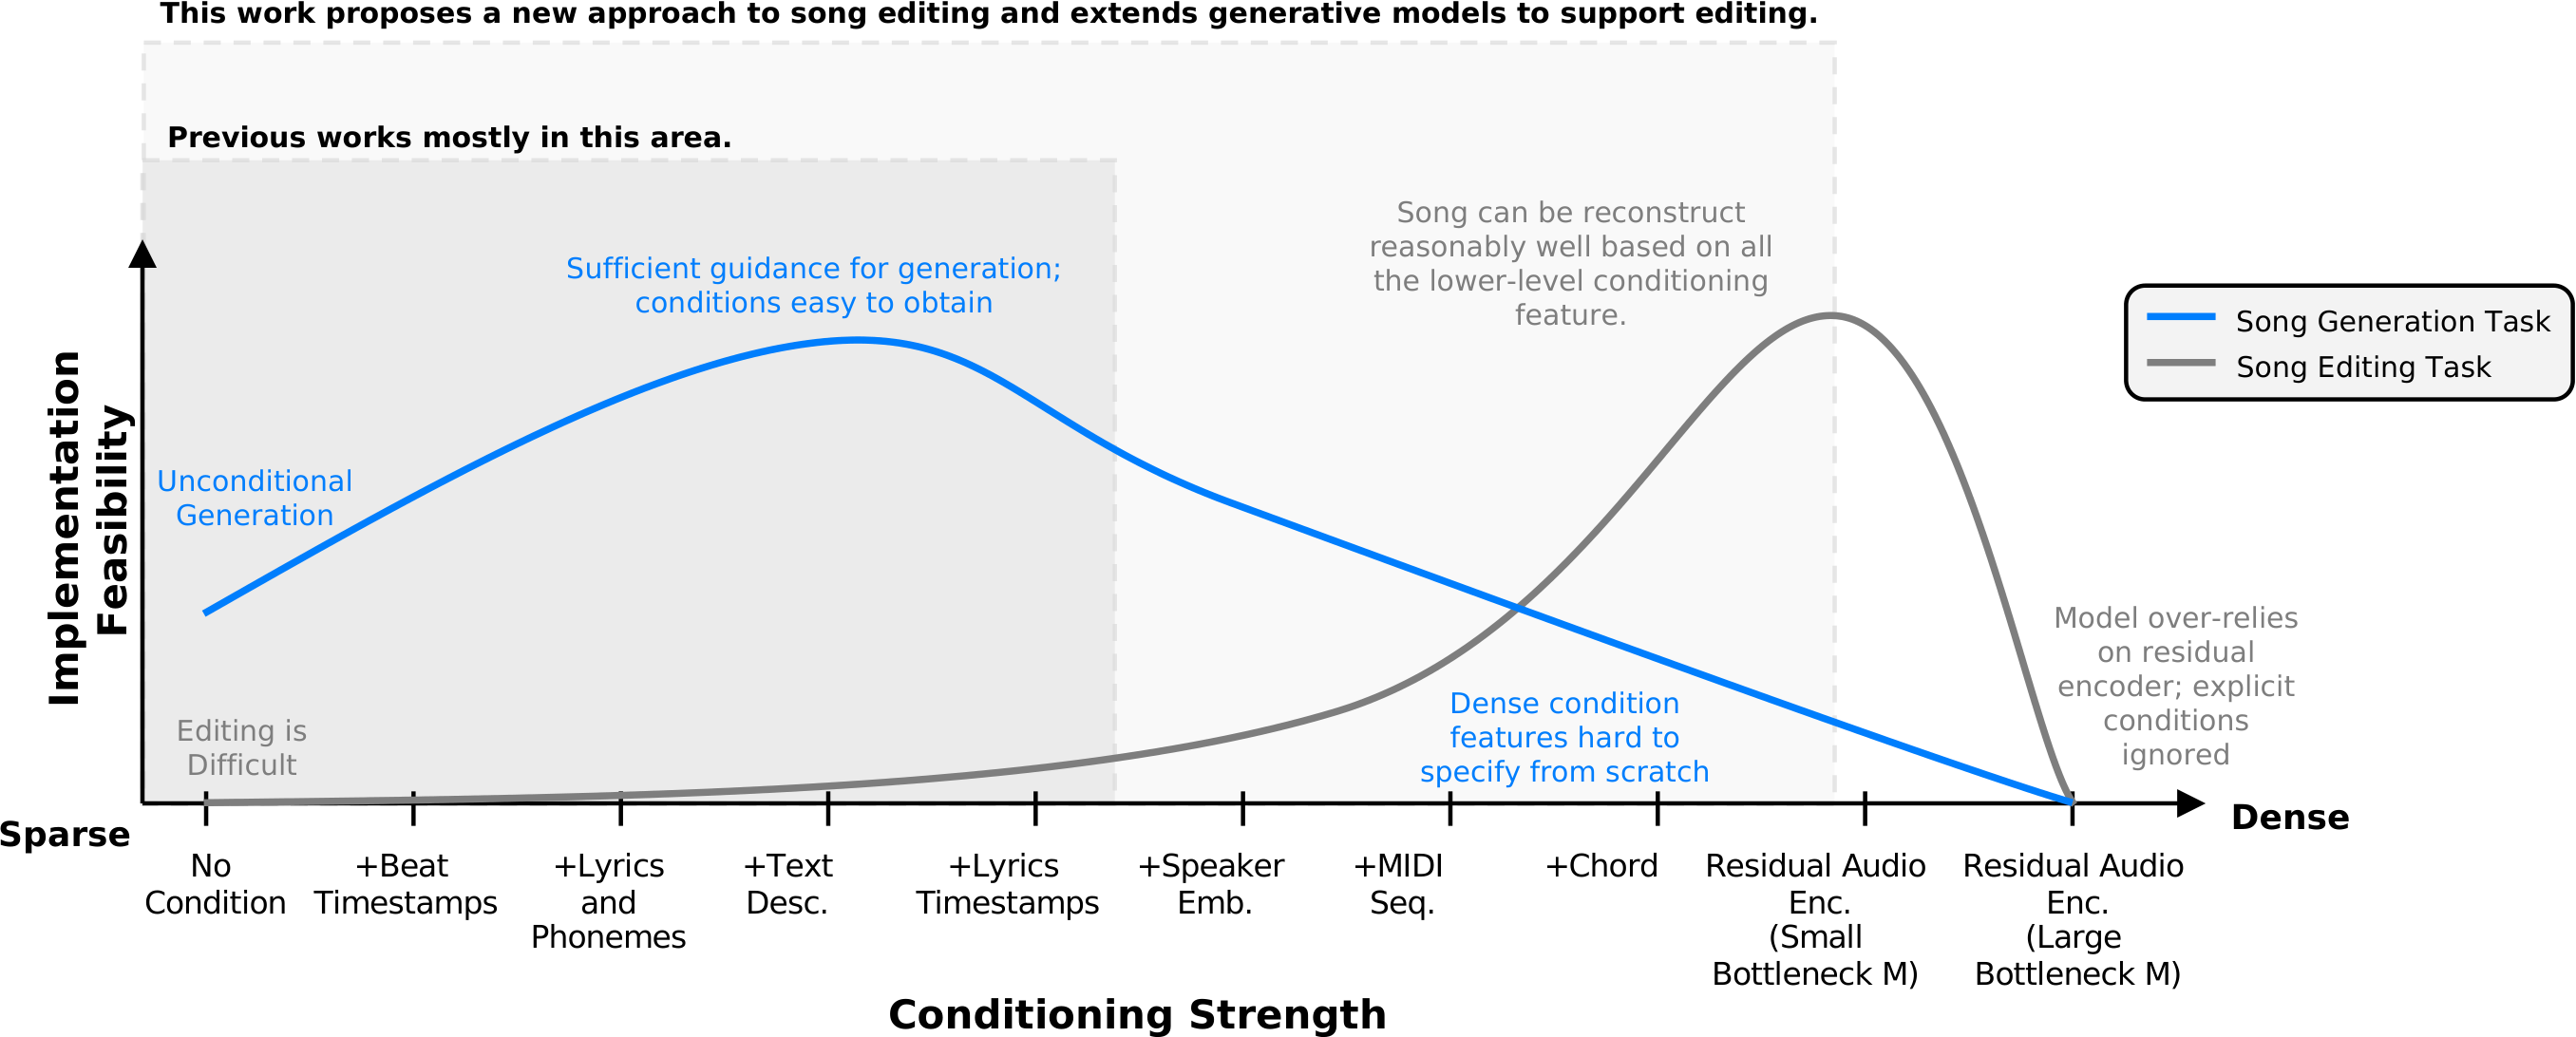
Implementation feasibility of generation and editing task with different conditioning strength. Existing systems operate on the left side, using sparse conditions such as text and lyrics for generation. We extend to the right side by introducing dense attribute-level conditions including word-level timestamps, vocal MIDI, chords, and speaker embedding. With sparse conditioning, the model generates diverse outputs. With dense conditioning, it reconstructs a specific target. Editing is achieved by modifying one condition while keeping others fixed. Note that the editing task refers to the reconstruction-based editing introduced in this paper.
  • 实验效果:统一模型的歌词WER为0.133;主观A4平均分7.45、SongEval为3.62。它的可懂度领先,但SongEval整体质量仍低于Levo的3.95;瓶颈加长还会同时降低音高、歌手和歌词可编辑性。
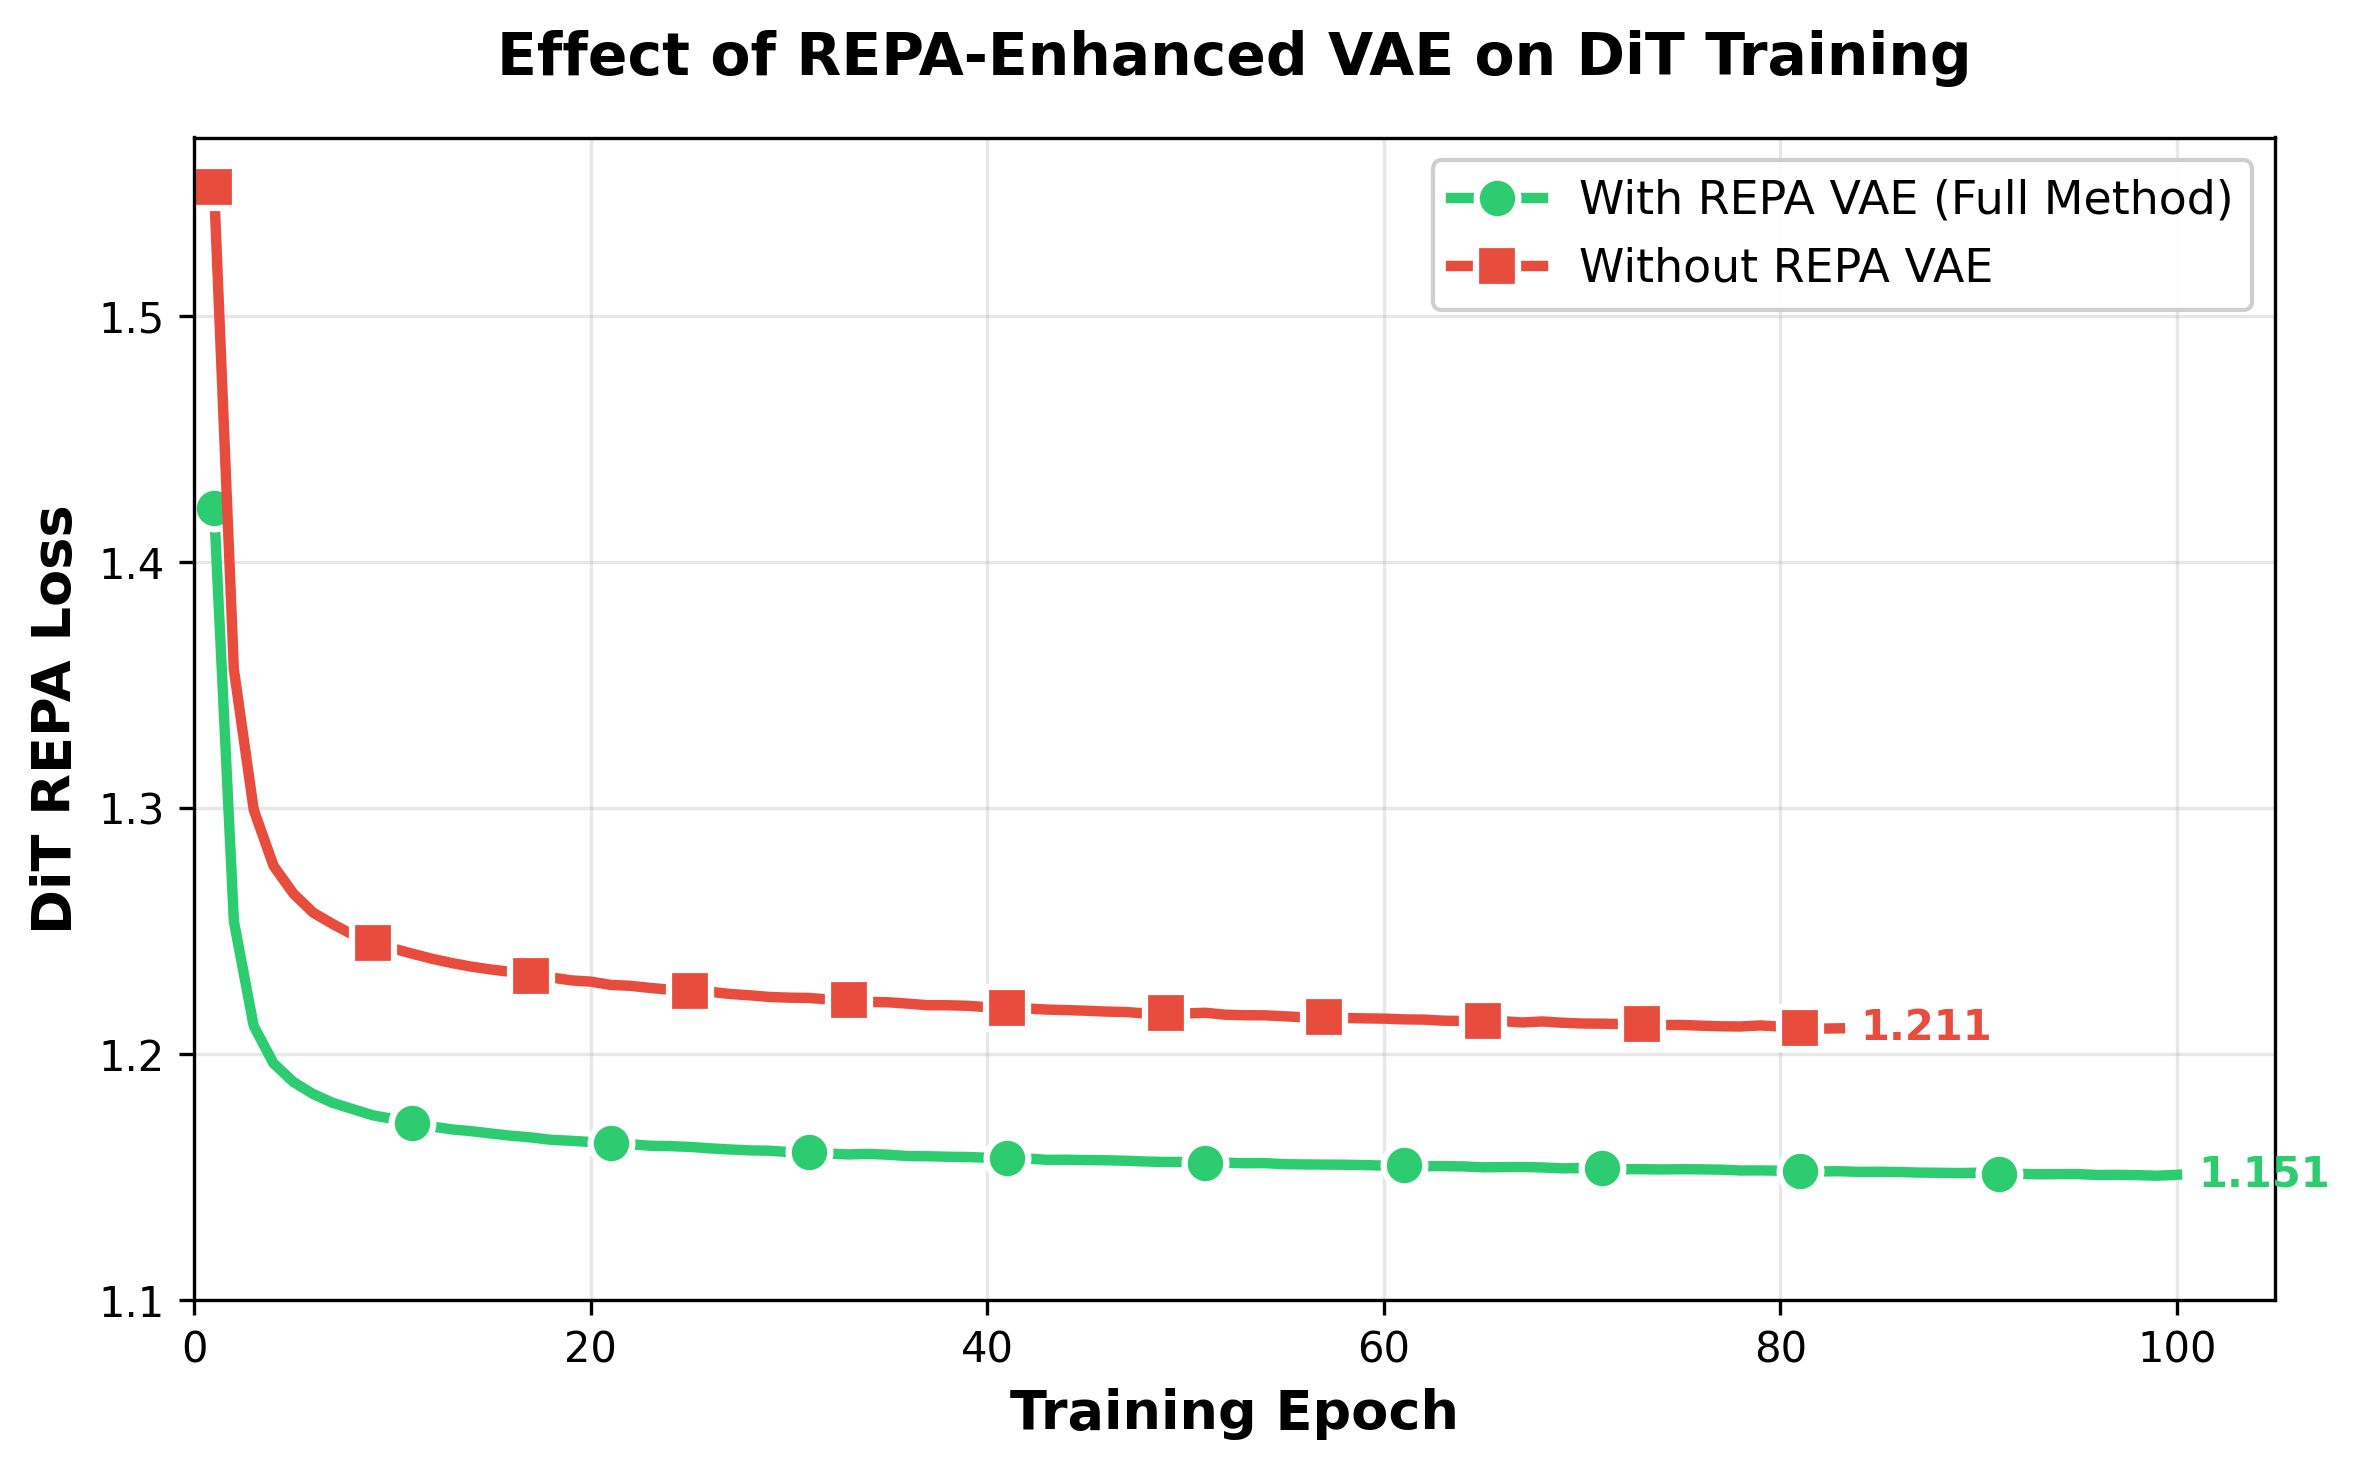
Left. Editability metrics decrease monotonically with bottleneck length $M$. Vocal MIDI accuracy (within $\pm$1 semitone), speaker similarity, and lyrics editability (computed as $1{-}\text{WER}$) all degrade as the model increasingly relies on the residual encoder. Horizontal dashed lines indicate floor values when the perturbation on conditions are ignored. Right. DiT REPA loss during training, comparing models trained on REPA-enhanced VAE latents versus standard VAE latents. Pre-aligning the VAE latent space enables the DiT to achieve lower REPA loss at convergence.
 % reaching 1.151 versus 1.211, indicating that semantically structured latents facilitate downstream representation learning.
  • 批判点评:统一生成与属性级编辑是实用方向,重建预训练减少成对编辑数据依赖;但质量与可编辑性存在明显折中,当前主要针对有限时长与条件类型,更长歌曲和复杂编曲仍是后续工作。

2. SlotDiT:用 slot 潜空间省算力提成功率

SlotDiT: Object-Centric Representations for Diffusion Transformers | University of Bonn | arXiv:2609.17414

关键词:扩散Transformer,对象中心表示,潜空间设计,机器人控制

  • 前序问题:视频DiT通常在像素或稠密视觉潜空间中预测,容易把大量算力花在背景纹理上,也难以显式跟踪承担动作的对象;机器人控制真正关心的是对象状态及其随指令发生的变化。
  • 本文贡献:SlotDiT 让文本条件 DiT 直接在 slot 潜空间里工作:先把场景分解成一组对象级的 slot,再依据指令与已观测上下文自回归去噪未来的 slot 轨迹。论文的落点是系统性比较潜空间设计——在统一 DiT 框架下把 slot 表示与 VAE 式、语义对齐式潜空间放在一起对照。
slot 视频预测框架
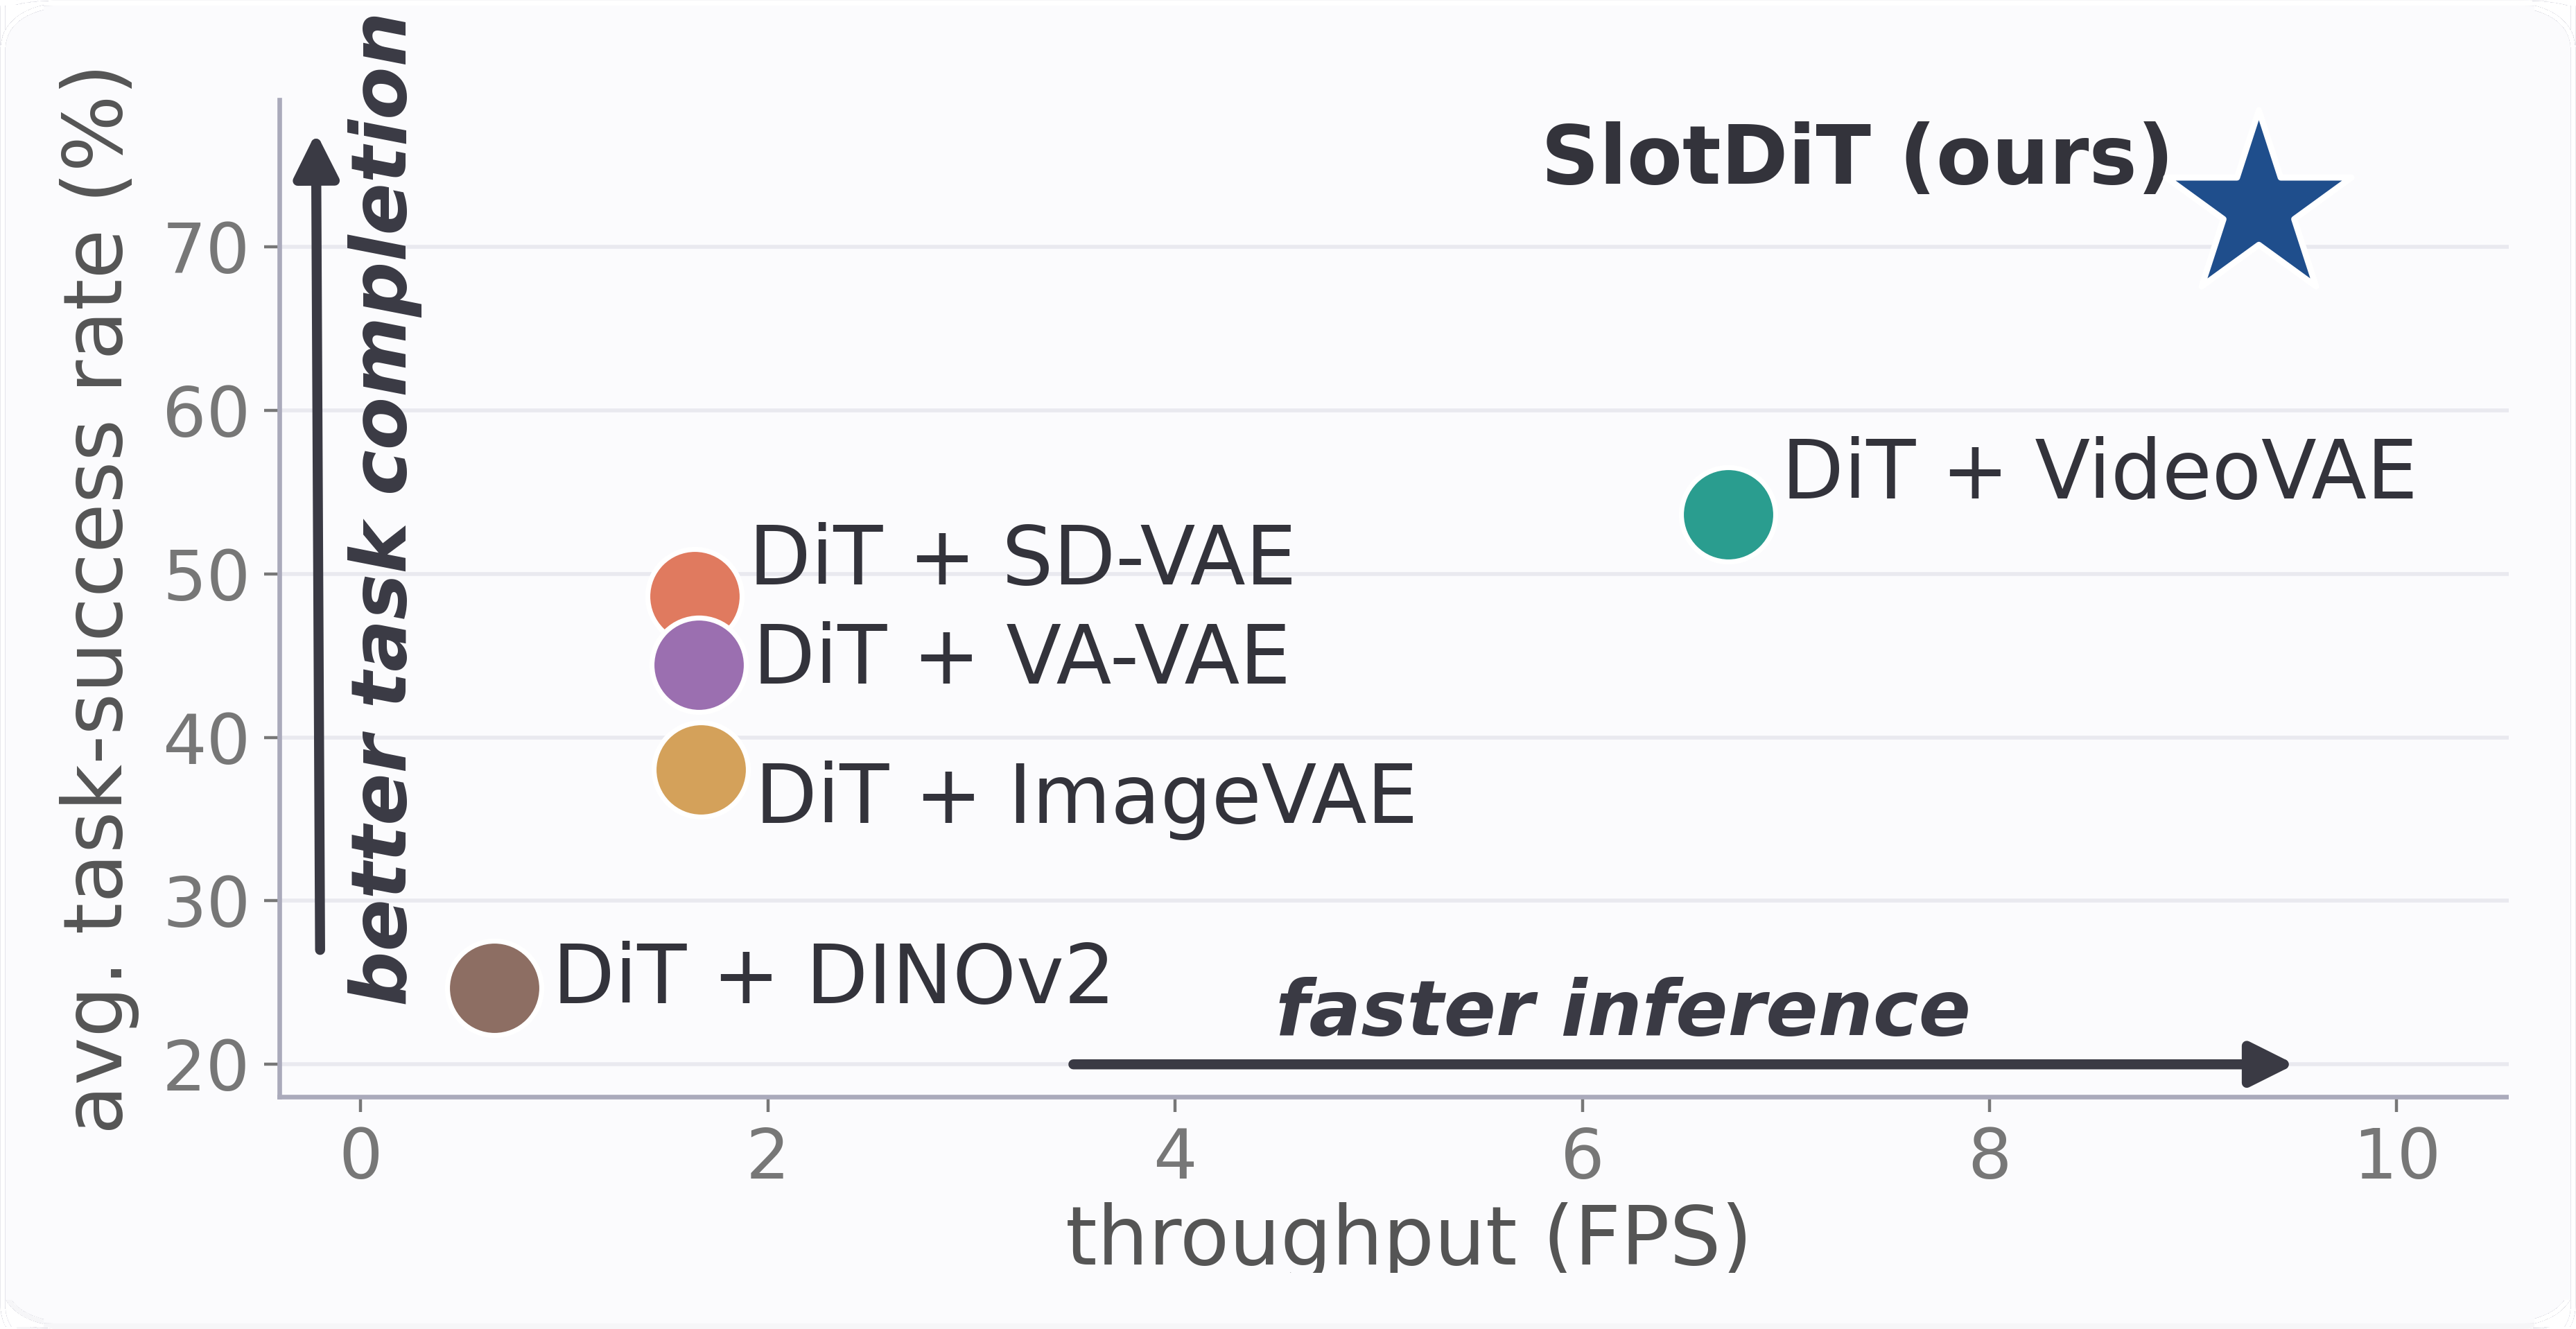
% Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines.
  • 实验效果:每帧只需 10 个 token(VAE 类基线为 256)。CLIPort 的 PutInBowl 任务上成功率 73.0%,次优的 TextOCVP 为 50.0%,VAE 类基线仅 0.5%–10.0%;LT-syn 的六种设置下为 17.0%–74.5%,均居首。生成 39 帧的吞吐 9.33 FPS,快于最快基线的 6.71 FPS,相对 SD-VAE 基准提速 5.68 倍(单卡 A6000)。
任务成功率与吞吐的双重提升
% Overview of SlotDiT. % (a) Given a reference image $\ImageT{1}$ and text instruction $\Caption$, SlotDiT parses the scene into an object-centric slot representation $\SlotsT{1}$. % Conditioned on the encoded instruction and context slots, an object-centric diffusion transformer (DiT) autoregressively denoises future slot trajectories $\PredSlotsT{2}, \ldots, \PredSlotsT{T+1}$, % optionally decoded into future video frames $\PredImageT{2},\, \ldots,\, \PredImageT{T+1}$. % % (b) Comparison of SlotDiT's slot-based latent space against established representation spaces used in DiTs. % % (c) Across four robotic datasets, SlotDiT achieves higher task-completion rates while remaining substantially more efficient than the baselines.
  • 批判点评:论文自己点明了一个反直觉结论:视觉质量指标好不等于任务能完成——VAE 基线的感知分更高,指令跟随与任务成功率却大幅落后。代价是 slot 数量固定、外观细节受限,视频生成质量只能算与基线持平而非更优;评测也集中在 CLIPort 与 LT-syn 两类机器人环境,开放世界泛化尚无证据。

3. AlayaVista:全景状态驱动流式世界模型

AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video | Alaya Lab;Beijing Institute of Technology;The University of Tokyo | arXiv:2609.14462

关键词:世界模型,视频生成,相机控制,全景状态

  • 前序问题:相机连续移动时,普通视频生成模型只看局部视口,离开画面的区域容易被遗忘,重新转回时场景会漂移;直接维护高分辨率全景又会让生成和渲染成本过高。
  • 本文贡献:AlayaVista把360度全景作为持续演化的全局状态,再按相机轨迹选择视口、渲染低分辨率透视潜变量,并用局部视频细化器恢复高清画面;全景状态和当前视角因此分离更新,支持流式相机控制。
MUGEN curation pipeline. We collect, preprocess, annotate, and filter panoramic videos to construct MUGEN, then obtain MUGEN-HQ through quality-aware stratified sampling.
  • 实验效果:在 MUGEN-HQ 上,AlayaVista 的跨视角一致性 0.9240、旋转误差 2.132 均为最优,平移误差 0.03312 优于 HY-World 2.0 的 0.03885,但仍高于带显式 3D 高斯支架的 MoVerse(0.02746);动态性 0.9200 偏低,作者认为是长时漫游中局部运动被衰减所致。
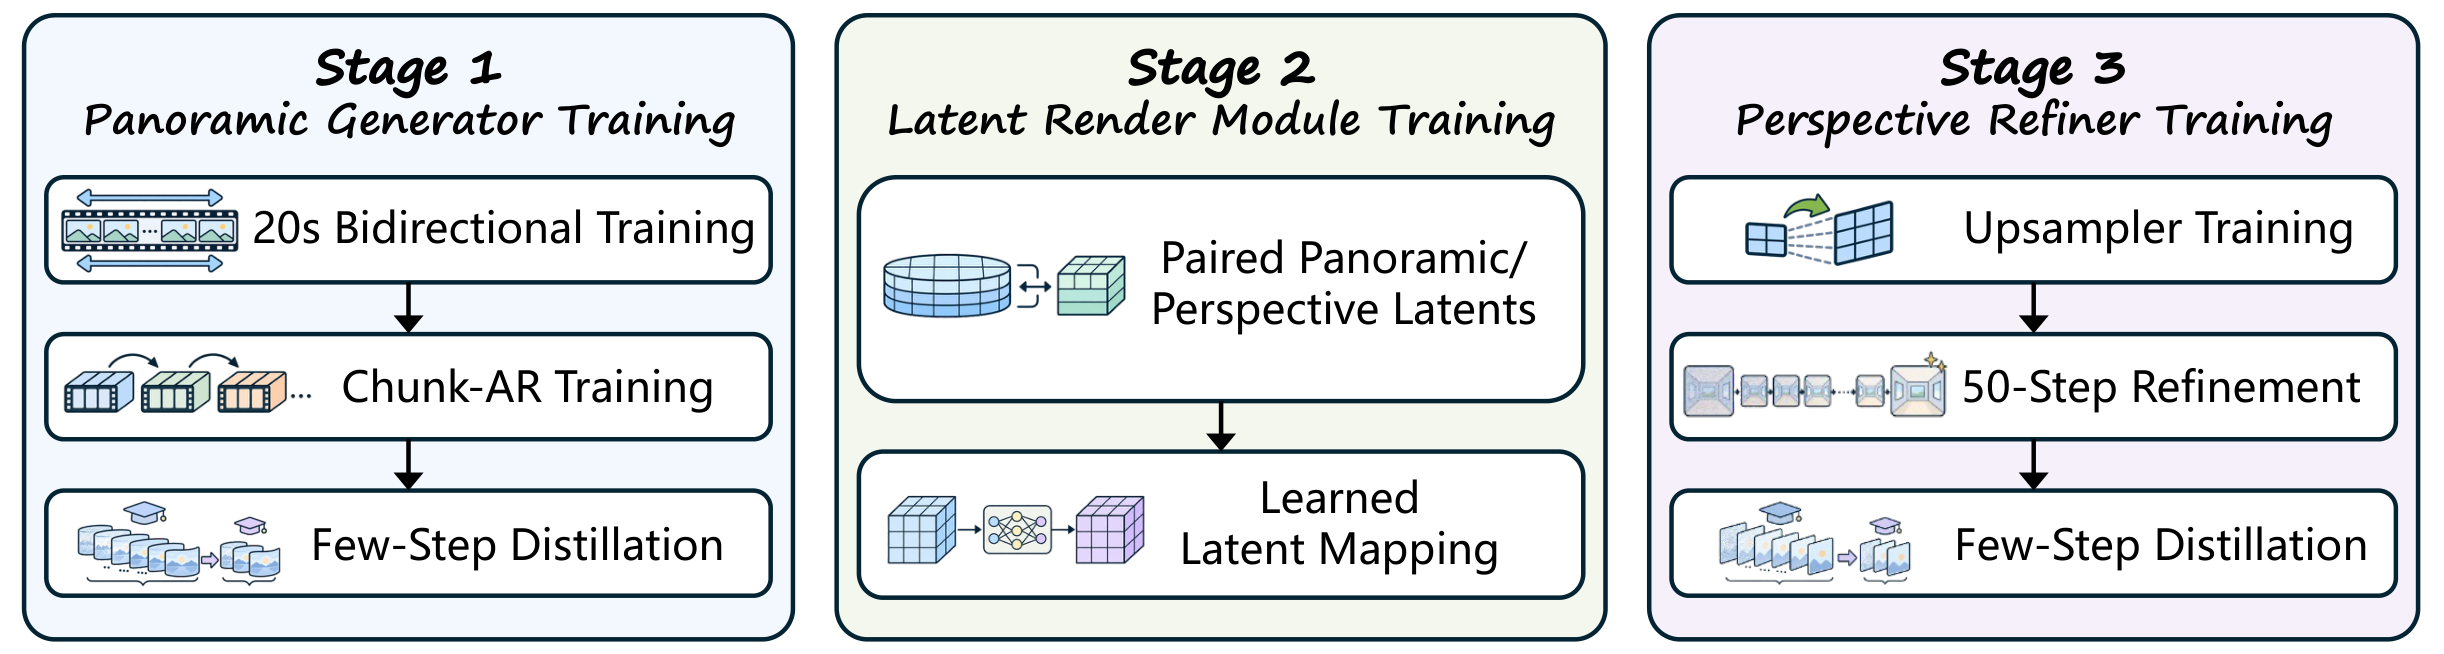
Training stages of AlayaVista.
 Panoramic generation, latent rendering, and perspective refinement are trained separately; perspective refinement begins with latent upsampler training.
  • 批判点评:全景记忆能减少回看漂移,但系统包含全景生成、潜空间渲染和局部细化三段,训练与部署都较重;评测集中在合成式或精选全景数据,长时间真实街景中的几何稳定性仍需验证。

4. MDN-Control:掩码深度噪声协同视频编辑

MDN-Control: Mask-Depth-Noise Guided Region Control for Multi-Subject Video Editing | Wuhan University | arXiv:2609.16475

关键词:视频编辑,多主体控制,遮挡建模,免训练方法

  • 前序问题:多主体视频编辑时,目标人物常被邻近主体或遮挡区域干扰,属性会串到无关对象;只靠文本和掩码也难以同时保持身份、边界与背景。
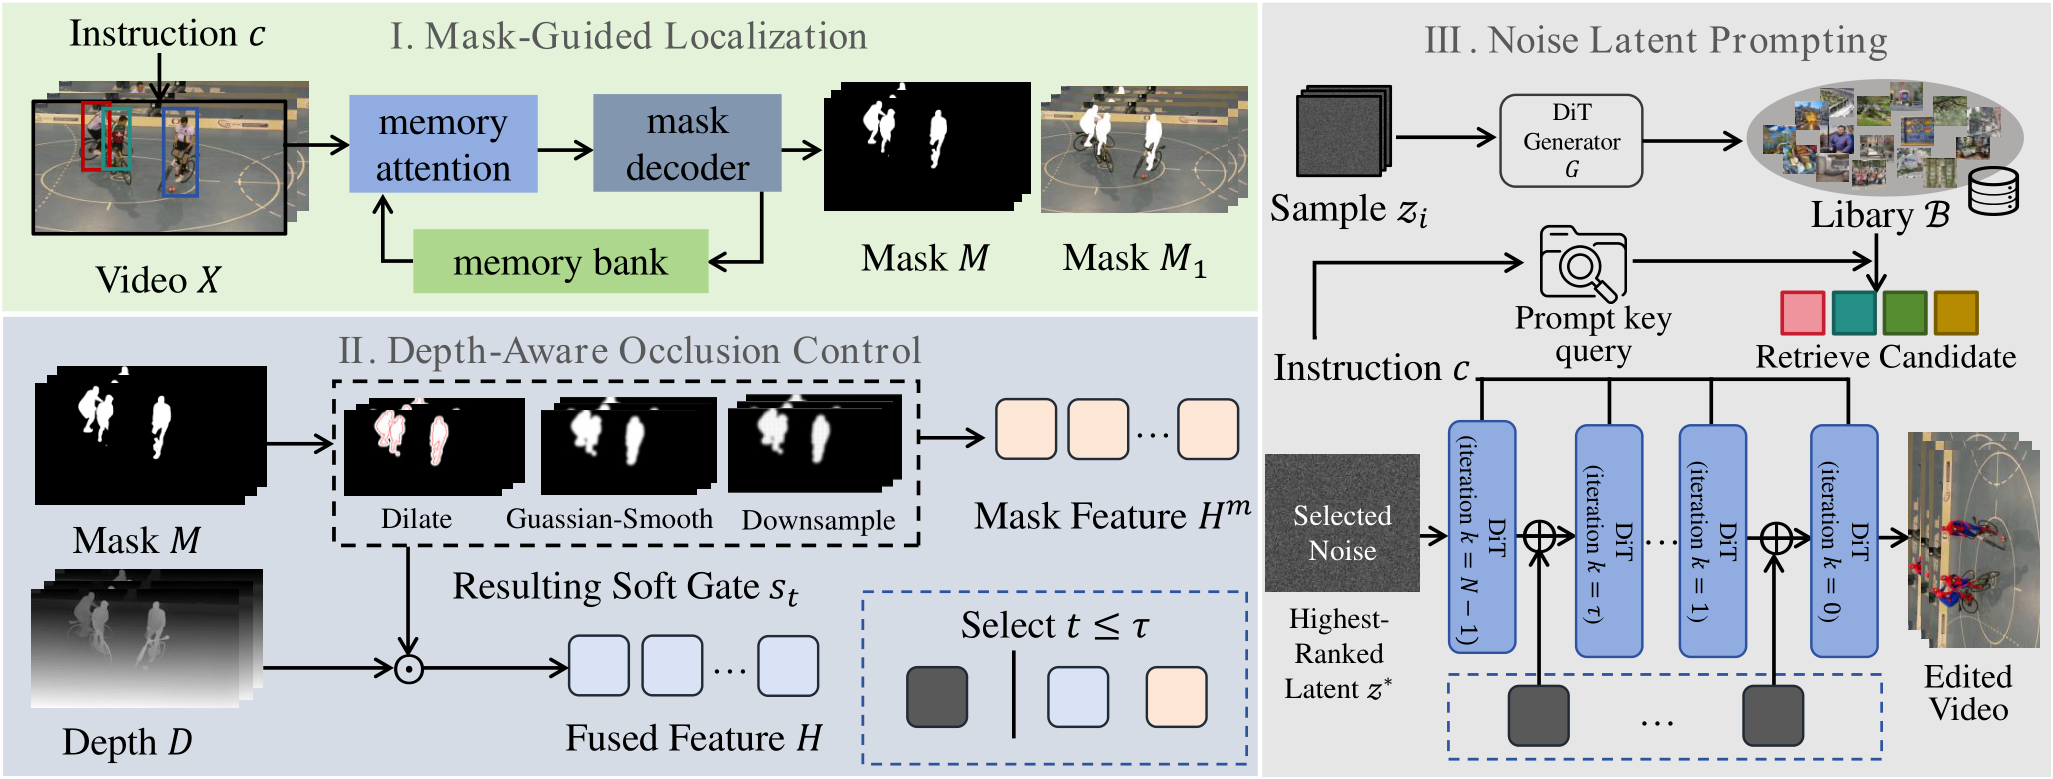
  • 本文贡献:MDN-Control不再训练新模型,而是组合掩码引导定位、深度感知遮挡软门控和噪声潜变量检索:前者锁定主体,中间模块随去噪阶段调整遮挡约束,后者从候选噪声中选择更匹配指令的初始化。
Motivation of multi-subject target-region video editing. The designated subject should be edited despite occlusion and neighboring-subject interference, while non-target subjects and the background remain unchanged.
  • 实验效果:在MSVBench上,方法取得Warp-Err 2.87、CLIP-T 27.09、CLIP-F 95.72、Q-Edit 9.43与CM-Err 2.75;实验在单张NVIDIA L40上完成,并包含20段视频的用户研究。
掩码、深度与噪声三路控制
Overview of MDN-Control. Mask-guided localization localizes the target, depth-aware occlusion control guides editing near occlusions, and noise latent prompting initializes appearance generation. Denoising uses mask-depth guidance at early steps and mask-only guidance thereafter.
  • 批判点评:免训练组合便于迁移到现有DiT,但噪声检索的增益不大,部分固定随机种子甚至更好;20段主观测试规模也偏小,复杂相机运动和长遮挡下的稳定性还未充分覆盖。

5. ADSC:按样本收敛动态缩短采样

Efficient Text-to-Image Generation: An Adaptive Step Schedule Controller for Diffusion Models | SAP;National University of Singapore;A*STAR I2R | arXiv:2609.16572

关键词:文生图,扩散采样,自适应步数,推理加速

  • 前序问题:文生图扩散模型通常给所有提示词使用同一去噪步数,但简单样本早已收敛仍继续计算,复杂样本又可能因固定短计划而欠采样。
  • 本文贡献:ADSC 准备一组步长不同的采样日程,在每个时间步评估误差项的差异,据此在日程之间动态切换,让简单提示词早收敛早停、复杂提示词保留更多步数;控制器无需额外训练,也不改动基础扩散模型。
短日程即可稳定生成的样本
Effect of text prompt and seed combinations on diffusion steps for generating visually sufficient images. Step counts shown are examples; optimal steps may vary.
  • 实验效果:在COCO的DDIM实验中平均18.89步、0.79秒/图;与固定19步的0.78秒几乎相同,但CLIP-I为95.70,高于固定19步的92.40,CLIP-T均为31.4,优势主要来自按样本分配步数。
收敛后切换到更短采样日程
The denoising process begins with the longest schedule (e.g. 40 steps in the example) and transitions to shorter schedules (20 followed by 10) upon detecting convergence.
  • 批判点评:方法实现简单且可插拔,不过同等平均步数下墙钟时间没有加速,控制器判断还增加少量开销;论文比较的不同基线并非始终严格等算力,效率结论应区分步数、质量和实际延迟。

6. LACI:回滚重生成压住长语音失败

Taming Long-form Text-to-Speech | Argmax, Inc.;University of Virginia;Bilkent University | arXiv:2609.16989

关键词:长文本语音合成,推理期干预,错误回滚,语音克隆可靠性

  • 前序问题:自回归TTS在超长文本上会突然跳过整段内容或重复、幻觉;平均WER掩盖了少数灾难性失败,而重新训练模型对已有开源系统成本很高。
  • 本文贡献:LACI(Localized Attention-Constrained Inference,局部注意力约束推理)是纯推理期方法,不改动模型权重:近实时检测 TTS 生成错误,回滚到错误起点,再施加临时护栏重新生成,额外开销可忽略。论文另提出滑窗版说话人相似度 wSIM,用来暴露常规 SIM measure 不到的失败模式。
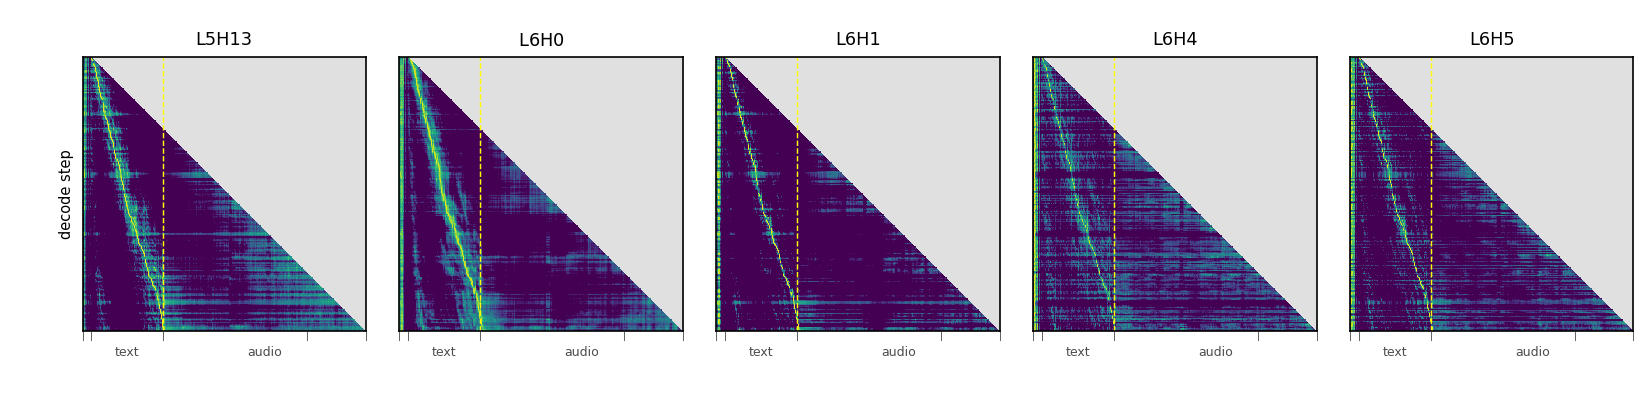
Audio-text alignment heads in autoregressive neural codec language models.
 All variants of Qwen3-TTS and VoxCPM2 have emergent alignment heads that map corresponding audio and text tokens.
 Shown are the attention heatmaps of Qwen3-TTS-0.6B-CustomVoice's alignment heads, which are consistent across text and speaker prompts.
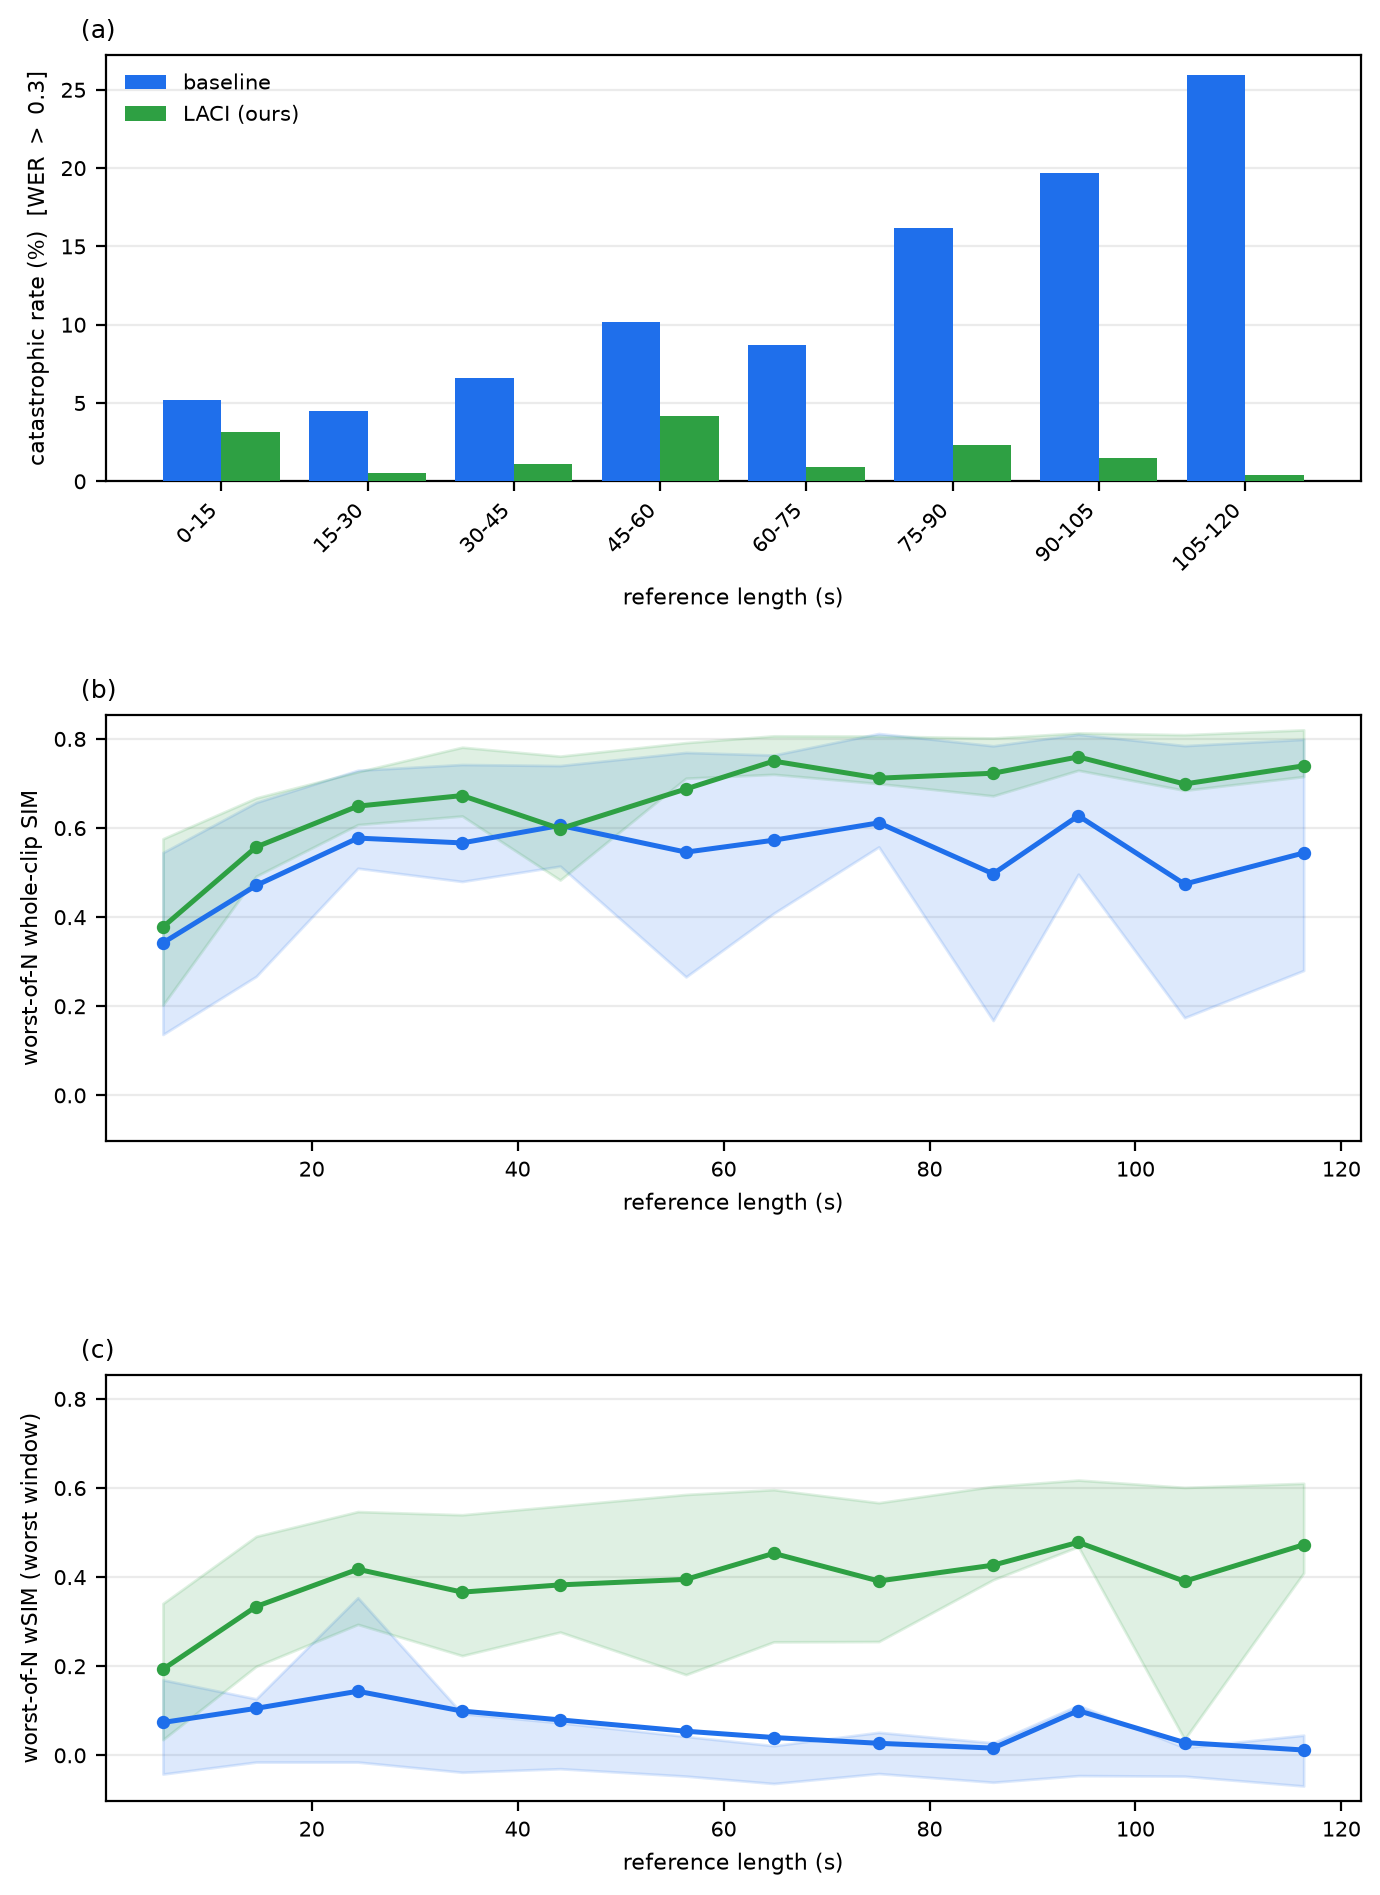
  • 实验效果:Qwen3-TTS-0.6B 在超过 1500 词的提示上,10 个随机种子里的最差 WER 从 35.2% 降到 3.4%,甚至优于它在 500 词以内短文本上 5.4% 的可靠性;120 秒参考音频下最差 wSIM 从 0.01 升到 0.47;WER 超过 30% 的灾难性生成比例从 26% 降到 1% 以下。
Qwen3-TTS-0.6B voice cloning reliability vs. reference audio length.
 (a) Catastrophic failure rate (WER above 30%) grows from 5% to 26% as reference audio grows to 120 seconds, while LACI keeps it below 5%.
 (b) Worst-of-$N$ SIM across 10 RNG seeds improves with LACI.
 (c) Worst-of-$N$ wSIM collapses for the baseline while LACI holds it high.
  • 批判点评:推理期干预能给现成开源模型直接止损,不必重训,这是它最实用的地方;但前提是错误可被近实时检出,回滚重生成也会推高长文本的尾部延迟。更值得注意的是超过 1300 词之后失败开始抗拒重生成,LACI 只把失败比例从 70% 压到 57%,反而不及对照方法 ACI 的 34%,作者认为这是模型自身的连贯性上限而非检测不到。

7. DiTAR+:扩张上下文抑制长语音漂移

DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis | ASLP@NPU, Northwestern Polytechnical University | arXiv:2609.13909

关键词:语音生成,扩散Transformer,长上下文,说话人一致性

  • 前序问题:连续潜变量自回归扩散语音模型在长序列中会逐块积累误差,出现说话人漂移、重复或无法终止;简单扩大历史上下文又让局部声学细节成为捷径。
  • 本文贡献:DiTAR+用扩张上下文采样跨更远的历史块建模宏观一致性,同时在浅层对历史声学块做分层掩码,把语义对齐与声学渲染分开,减少模型复制局部声学模式。
扩张上下文与分层声学掩码
The overall architecture of the proposed DiTAR+ framework. (a) The standard two-stage DiTAR baseline. (b) Hierarchical Acoustic Masking (HAM), which masks historical acoustic context in shallow layers to decouple semantic alignment and acoustic rendering. (c) Dilated Context Sampling (DCS), which expands the macro-receptive field via dilated sampling while preserving temporal continuity.
  • 实验效果:在SeedTTS评测中,DiTAR+的Seed-EN WER为1.672、Seed-ZH为0.985;中文困难集WER为9.893,低于DiTAR的12.478;25至35秒长语音WER从2.778降至2.173,说话人相似度从0.741升至0.759。
连续生成中的说话人相似度
Chunk-level speaker similarity over continuous generation steps (3.0,s per chunk). The standard baseline experiences severe speaker drift in the long tail, whereas DCS effectively stabilizes the temporal coherence.
  • 批判点评:DCS与HAM直接针对长尾漂移,消融也显示两者互补;但困难集和长语音集为内部构造,论文没有充分量化扩张上下文带来的吞吐、显存和首音延迟成本。

8. CMA-OT:课程式多尺度舞蹈配乐对齐

CMA-OT: Hierarchical Expert Supervision for Dance-to-Music Generation | HKUST(GZ);Tencent | arXiv:2609.13118

关键词:舞蹈配乐,多尺度对齐,最优传输,音乐生成

  • 前序问题:舞蹈配乐既要踩准局部节拍,又要匹配段落级风格;单尺度动作特征或固定对齐损失容易顾此失彼,尤其在动作与音乐结构非一一对应时。
  • 本文贡献:CMA-OT从预训练Jukebox专家提取底层、中层和高层音乐知识,课程式地由局部节奏过渡到全局语义,并用尺度感知的Fused Gromov-Wasserstein最优传输对齐舞蹈与音乐表示。
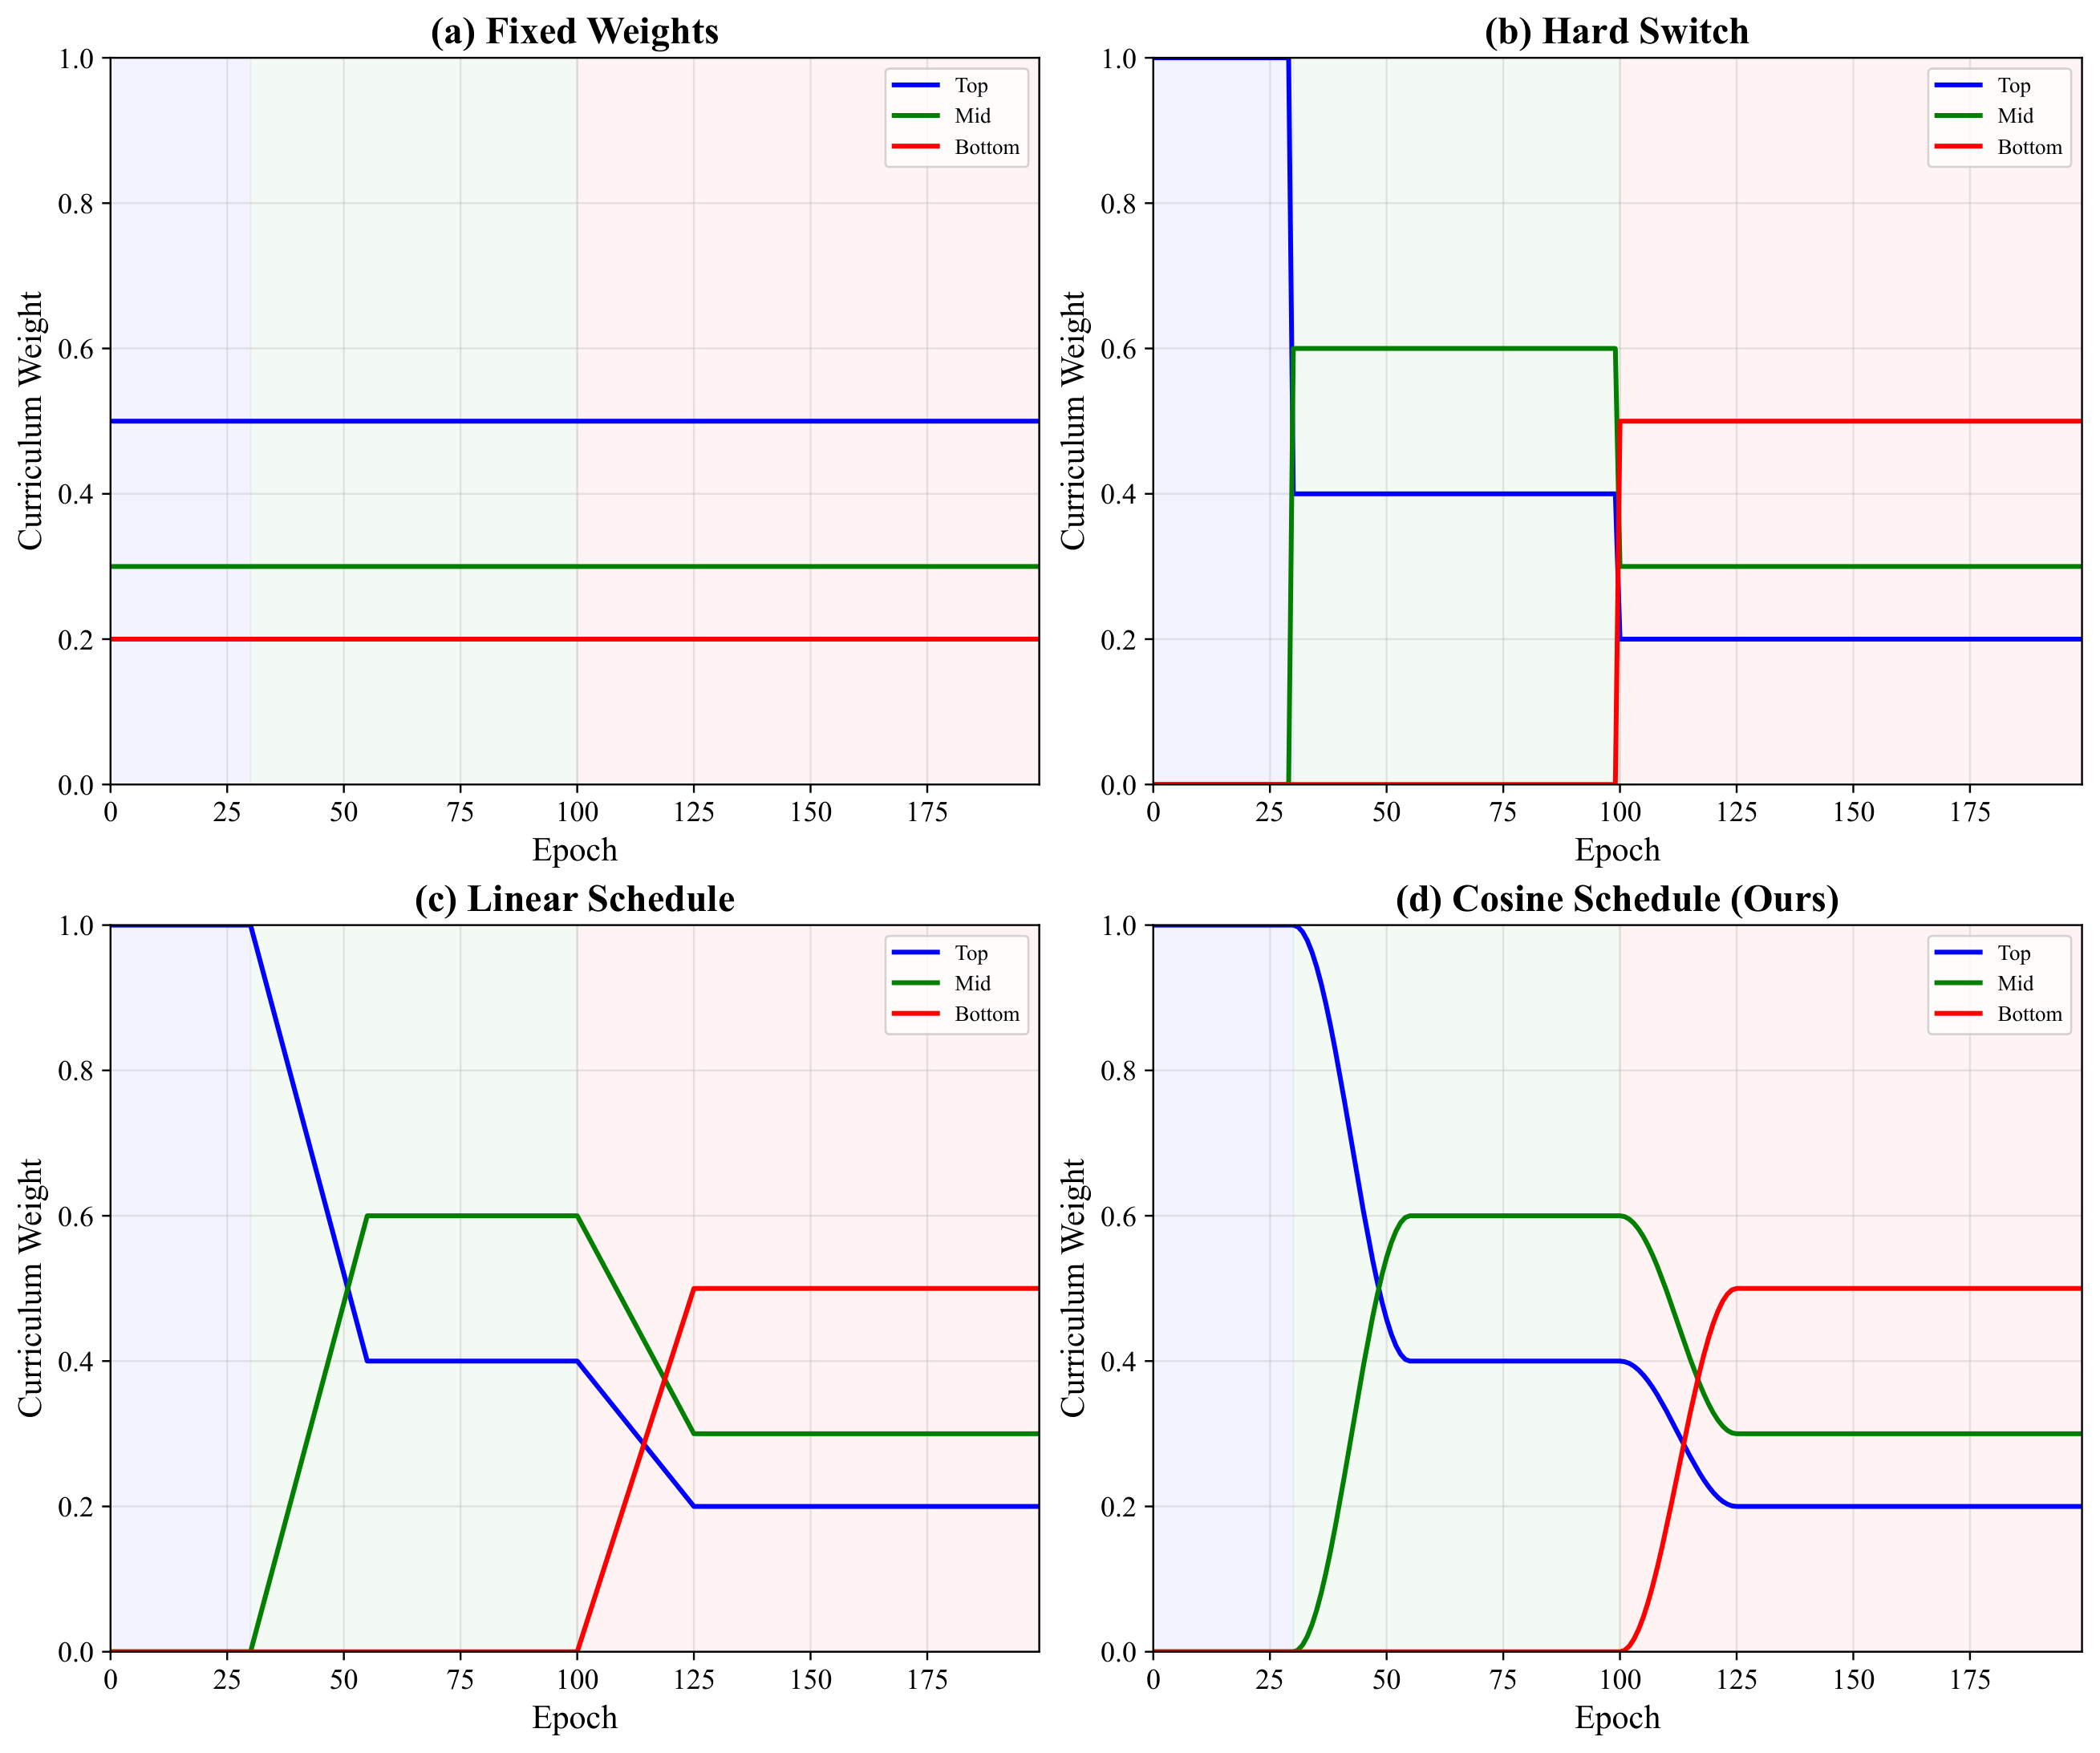
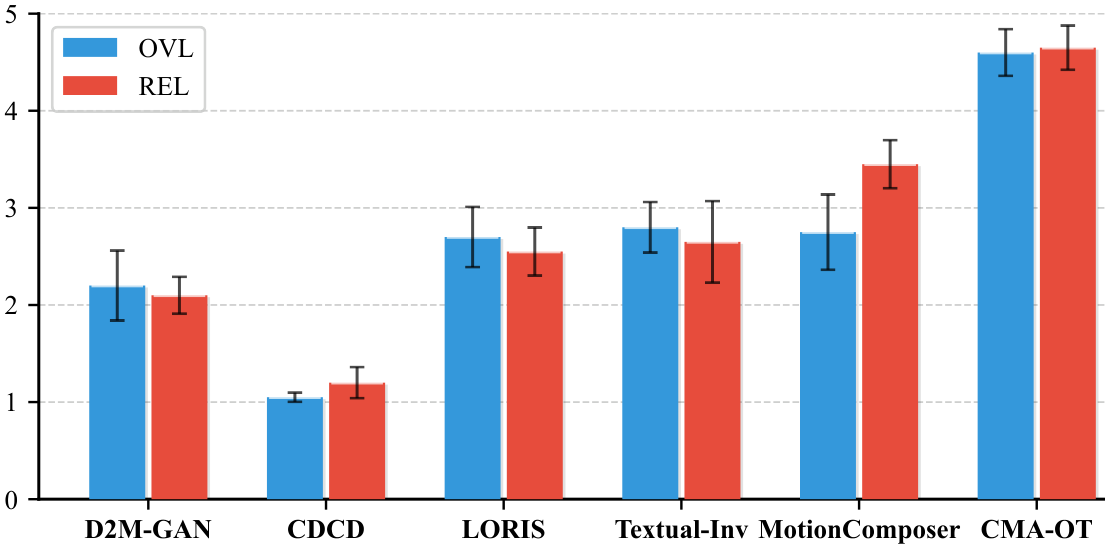
Comparison of curriculum learning strategies.
 The cosine-annealed schedule achieves smoother and more stable transitions across training epochs compared to fixed, hard-switch, and linear schemes, facilitating consistent optimization across hierarchical levels.
  • 实验效果:在AIST++上,CMA-OT取得BCS 99.14、BHS 99.12、F1 99.12、FADp 12.50、FADc 0.26;MotionComposer的FADp/FADc为27.52/0.49。TikTok上FADp/FADc为27.53/0.38,也优于30.61/0.81。
Subjective Evaluation. User study results on rhythmic consistency and musical quality across different D2M methods.
  • 批判点评:多尺度课程把节拍和风格监督组织得较清楚,但系统依赖Jukebox专家与额外最优传输计算;AIST++和TikTok仍是较窄的数据分布,指标提升不等同于真实音乐审美或版权可用性。

9. VOR-Bench:细粒度评测视频对象移除

VOR-Bench: A Human Perception-Driven Benchmark for Video Object Removal | Beijing University of Posts and Telecommunications;China Telecom AI Technology;Xi'an Jiaotong University | arXiv:2609.16878


关键词:视频对象移除,评测基准,视觉语言模型,主观一致性

  • 前序问题:视频对象移除常用有缺陷的参考视频或逐帧图像指标,既可能把错误参考当真值,也难以判断对象是否删净、背景是否连续以及结果是否符合常识。
  • 本文贡献:VOR-Bench 由三部分组成:VORD 数据集提供 150 对配对编辑视频与涂鸦式掩码,覆盖模型生成、工具渲染与相机实拍三类来源,另构建 300 对的扩展集验证规模是否足够;rMPAF 流程把图像级对象移除与微调后的视频生成模型结合,自动产出运动连贯的配对视频;VOR-MDSM 则是按三个评价维度微调的 VLM 打分模型。
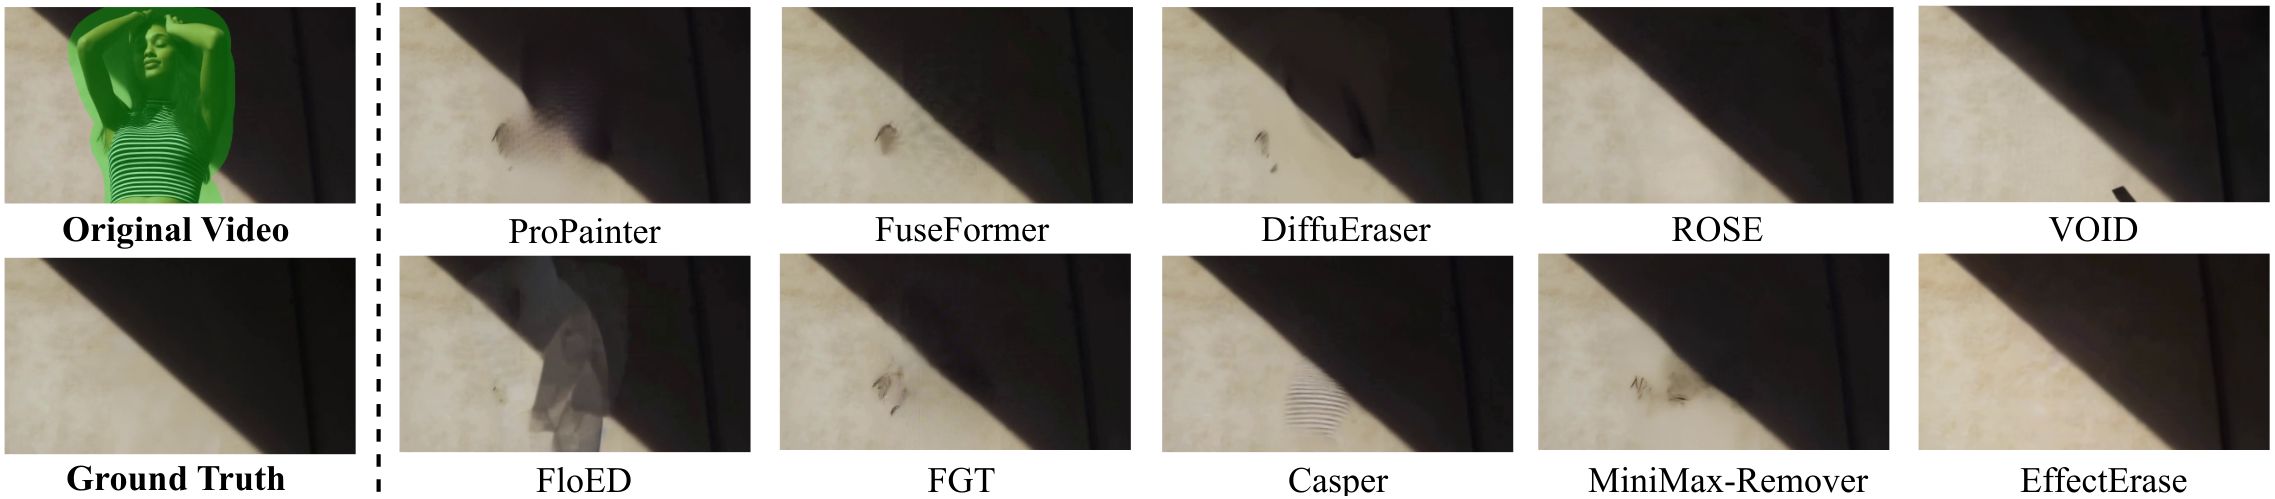
The visual results of different models. The video frames on the left depict the original video and ground-truth video.
  • 实验效果:论文报告VOR-MDSM三项偏好判断与人工评分的Spearman相关系数均超过0.9,整体高于VideoLLaMA3、Qwen3-VL-8B和Gemini-3.1-Pro;基准覆盖相机采集、模型生成和工具渲染三类视频。
The visual results of different models across three data types: model-generated data, camera-captured data and tool-rendered data.
  • 批判点评:细粒度维度比单一PSNR更接近真实观感,但150/300对数据仍小,VLM裁判也在相近任务分布上训练和验证;论文中的数据与模型发布仍带未来时态,可复现性要看正式开放程度。

10. RAIN:区域感知一跳提取语义水印

RAIN: Region-Aware Inversion Network for Semantic Watermark Extraction | Independent Researcher | arXiv:2609.14856

关键词:生成水印,扩散反演,鲁棒提取,模型归属

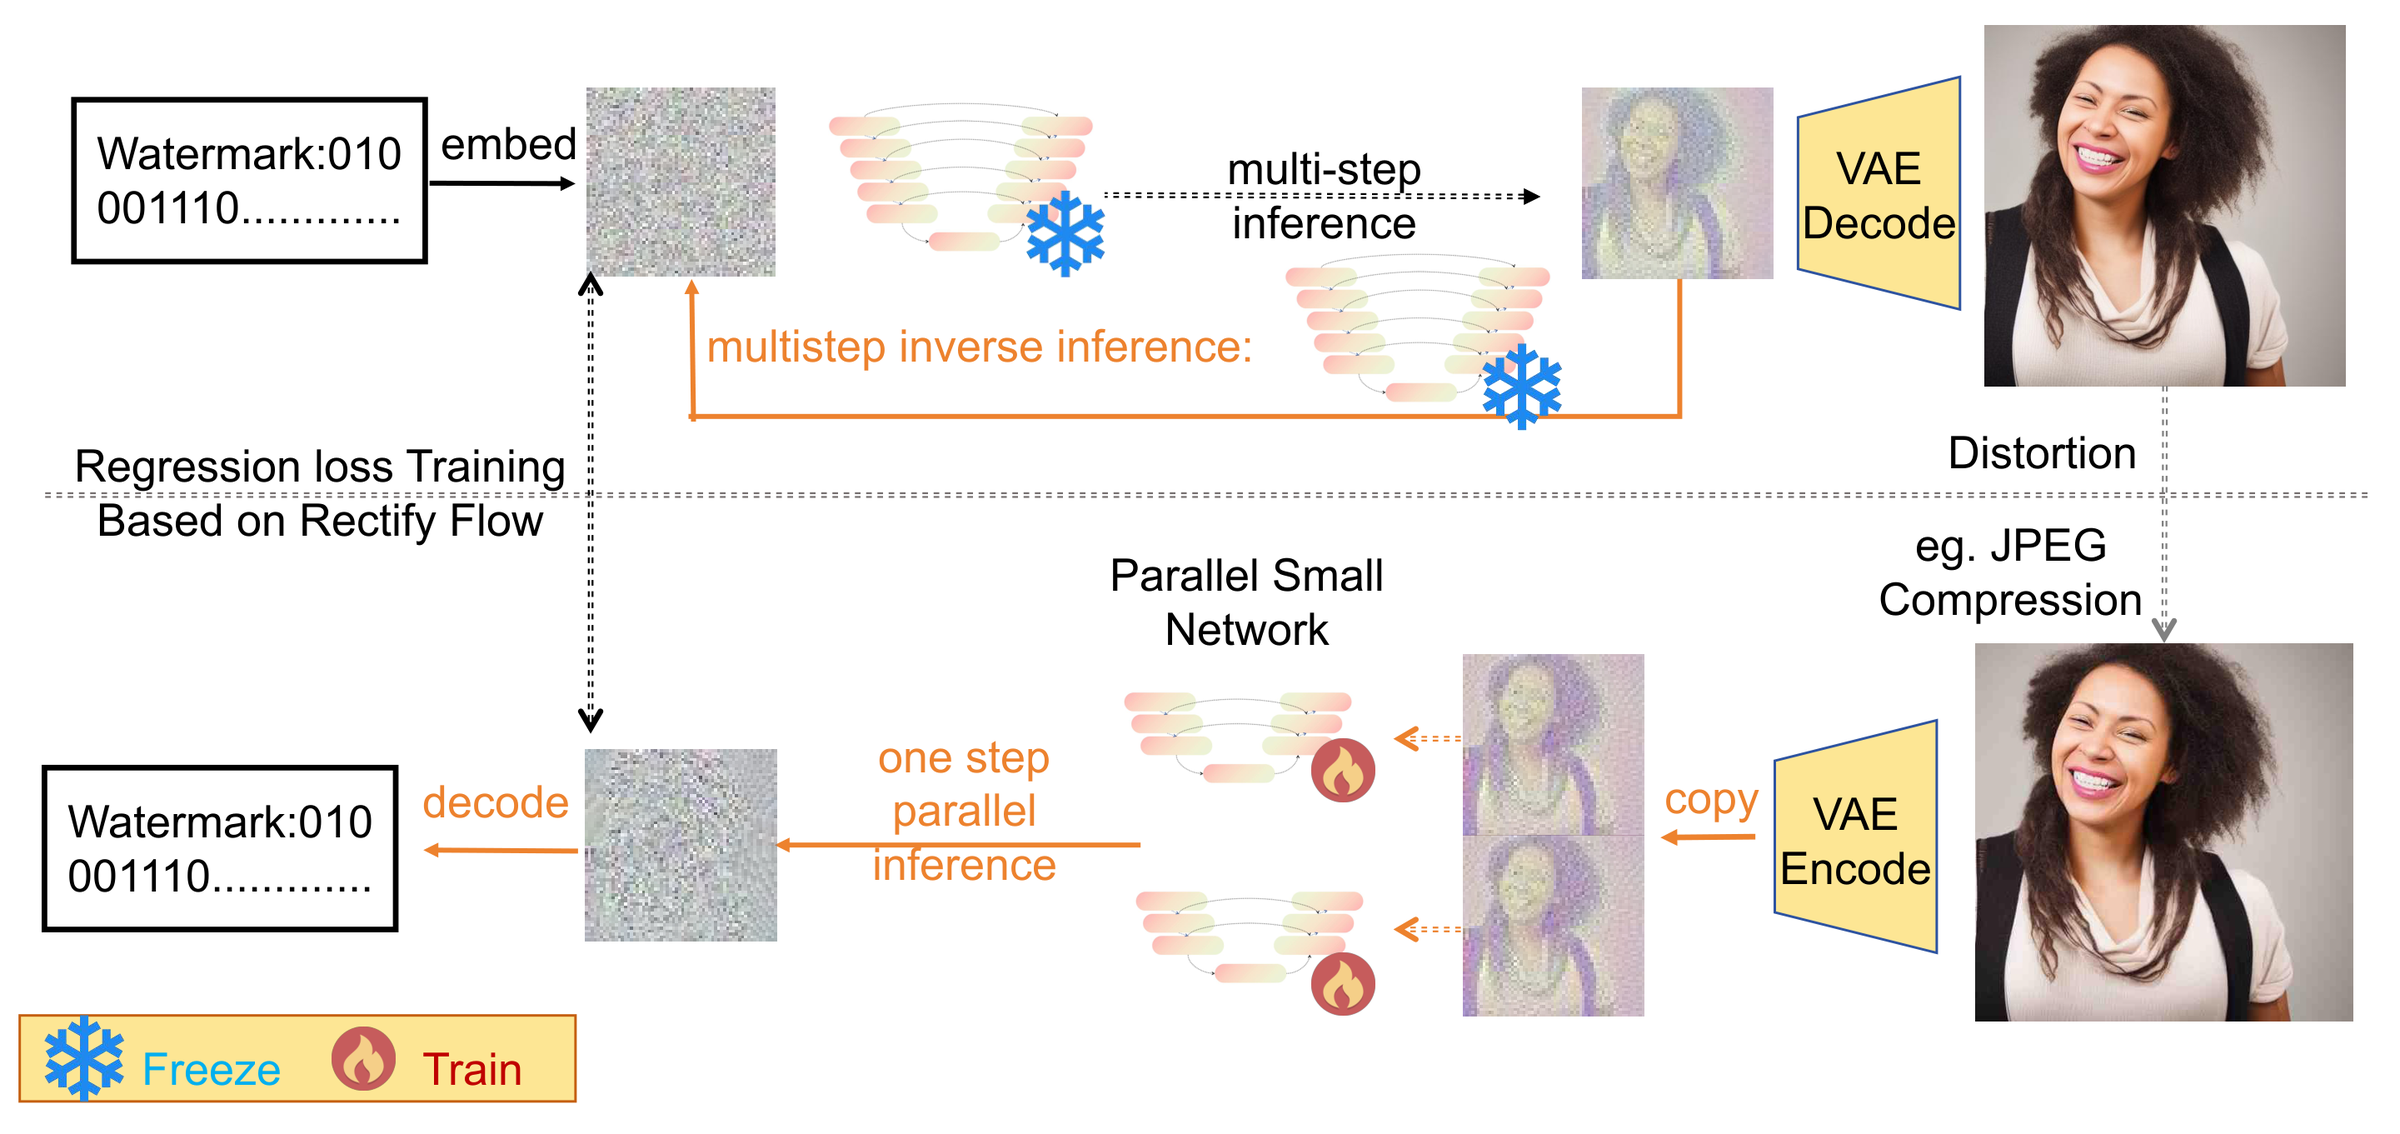
  • 前序问题:Gaussian Shading等语义水印把信息埋在扩散初始噪声里,传统提取要多步反演大模型,代价高且在压缩、裁剪、噪声等失真后容易累积误差。
  • 本文贡献:RAIN把终端噪声恢复改写为高信噪比端点上的条件回归,用小型双分支NAFNet一次预测水印决策所需的噪声区域;训练时加入有限集合的最坏失真样本,强化区域边界而非逐点精确重建。
从多步反演到一跳区域判别
Extraction pipeline used in our implementation.
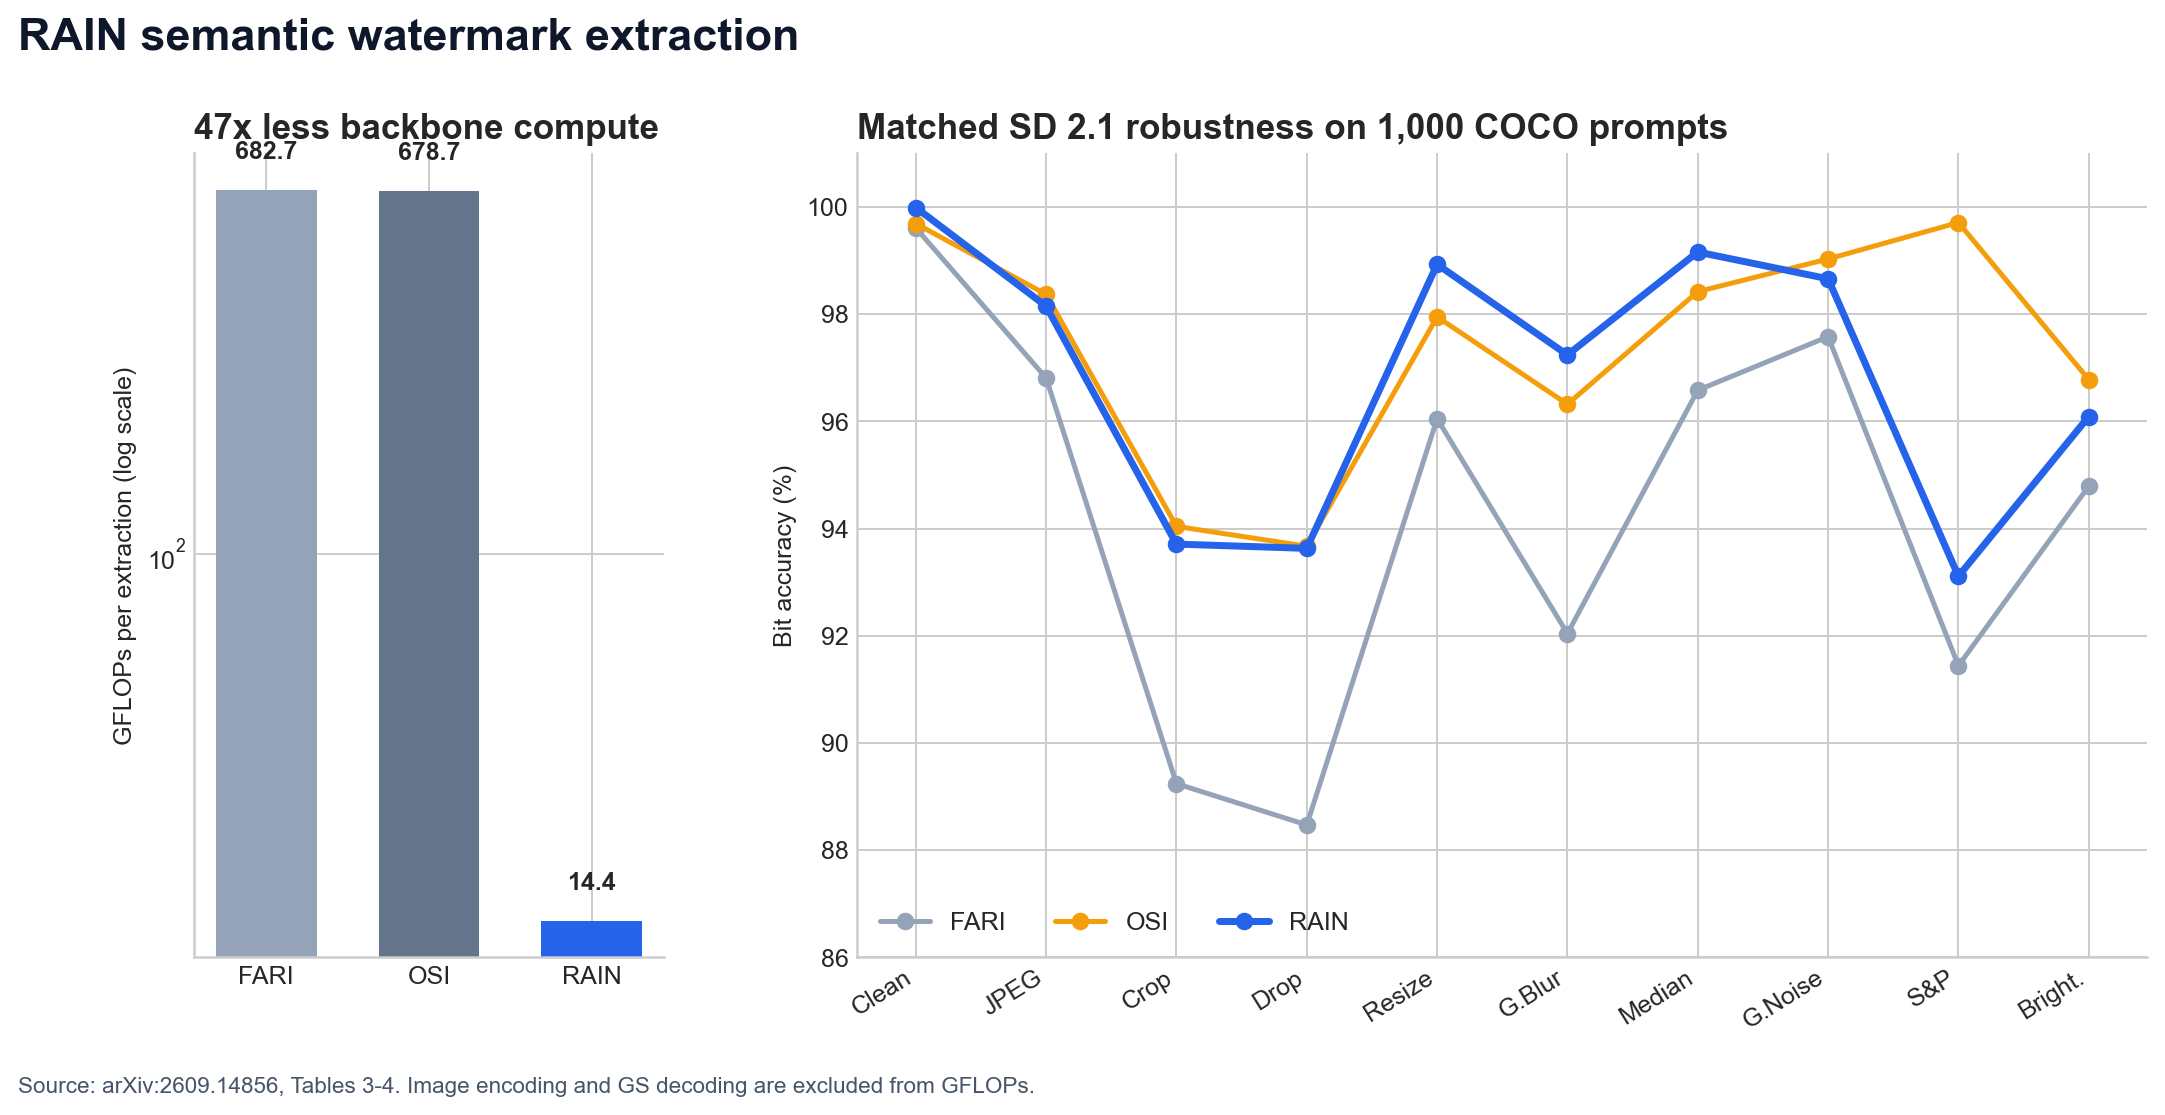
  • 实验效果:在1000条COCO样本的SD 2.1匹配评测中,干净图比特准确率99.99%;JPEG Q=25为98.15%,缩放到0.25为98.93%。其一次提取仅14.394 GFLOPs、15.468M参数,FARI为682.675 GFLOPs、868.469M参数。
一跳提取的算力与鲁棒性对比
Redrawn from Tables 3 and 4 of RAIN: extraction backbone cost and bit accuracy under matched SD 2.1 distortions.
  • 批判点评:把目标从精确噪声恢复改成区域判别很契合水印任务,但盐椒噪声下93.11%的比特准确率低于OSI的99.71%,极端亮度下也非最优;当前证据绑定Gaussian Shading与特定Stable Diffusion设置。

趋势观察

生成系统开始压缩“状态”而非只压缩网络

SlotDiT 把视频压成少量 slot,AlayaVista把漫游场景压成持续全景状态,MDN-Control则把编辑约束拆成掩码、深度与噪声。共同方向是先确定任务真正需要保存的状态,再把DiT算力集中到这些变量。

推理时控制器成为低成本升级路径

ADSC按样本切换去噪日程,LACI检测跳读后回滚,MDN-Control组合现成控制信号。三者都尽量不重训主模型,把可靠性或效率问题移到可观测、可干预的推理环节。

评测从单一保真度转向任务与失败尾部

VOR-Bench用三维主观语义评分替代单一图像指标;LACI报告最差采样和灾难性失败率;SlotDiT直接看机器人完成率。平均分仍重要,但能否解释具体失败正成为更强的证据。

音频生成继续争夺长程结构控制

DiTAR+扩张历史上下文,SongCraft统一稀疏生成与稠密编辑条件,CMA-OT以多尺度音乐专家监督舞蹈配乐。不同任务都在处理局部声学质量与长程语义结构之间的矛盾。


人工智能炼丹君 整理 | 2026-09-17


更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」

每日更新 · 论文精选 · 深度解读 · 技术脉络

微信搜索 人工智能炼丹君 或扫描下方二维码关注

扫码关注「人工智能炼丹君」

0

评论 (0)

取消
粤ICP备2021042327号