


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:表征与压缩 | 难度:工程实战 | 前置知识:视频 VAE 的时空压缩结构(本文第 02 节另补最小背景)
关键词:重建损失、KL 损失、LPIPS、感知损失、GAN 损失、判别器、loss 权重
训练一个视频 VAE,最朴素的想法是「编码器压缩、解码器还原,加个 L1 或 KL 就够了」。不同目标可能暴露不同问题,效果取决于瓶颈、数据和训练配方:
只用 L1/L2 + KL:有些设置中画面较稳,却明显发糊 —— 头发丝、文字、树叶这种高频纹理全被抹掉,人脸带着一层「塑料感」。在存在重建不确定性时,这与逐像素回归的性质有关,但不能断言 L1/L2 + KL 必然不可用(L2 的最优解是条件期望,天然倾向平均、发糊)。
加上 GAN 想救清晰度:判别器过早发力或双方训练失衡时,解码器可能走样 —— 出现棋盘格、闪烁、甚至凭空捏造纹理;训练损失曲线看起来在降,重建却越来越假。
把图像那套搬到视频上:每一帧单独看 PSNR 都不错,连起来播放却疯狂闪烁,相邻帧的纹理在抖动。单帧指标的全局均值不能唯一刻画误差在时间上的排列。
这些现象需要分别检查像素误差、潜变量正则、特征距离和时空统计。许多视频 VAE 会组合像素重建、KL、感知与对抗项,但是否全部启用要看消融。为什么 HunyuanVideo 报告 §4.1.1 的 KL 系数是 $10^{-6}$,感知与对抗系数是 0.1 和 0.05?归约、输入范围、梯度与训练阶段都会影响有效强度;只看四个标量的大小,推不出这组权重。
本文把每一项「在管什么失真、数学上长什么样、量级有多大、什么时候帮倒忙」逐一拆开,教学数值来自随文可跑的 NumPy 脚本,论文配方则单独标原始来源;配图额外依赖 matplotlib。本轮核对还执行了 PyTorch 官方源码的 CPU 损失分支,但没有训练真实视频 VAE 或测量 GPU 性能。
最小背景(前置 VideoVAE):本文讨论采用 3D 因果卷积的连续高斯视频 VAE;其他架构也存在。这类模型把一段视频 $x\in\mathbb{R}^{B\times C\times T\times H\times W}$ 压成低维潜变量 $z$,其中 $B,C,T,H,W$ 分别是 batch、通道、帧数、高和宽(例如时间约 $4\times$、空间各 $8\times$,具体帧数还取决于首帧与 padding 规则),解码器再从 $z$ 重建出 $r$。编码器输出一个对角高斯后验 $q(z\mid x)=\mathcal{N}(\mu,\sigma^2)$,训练目标要同时满足三件事:重建要像、潜变量分布要规整(好让后面的扩散模型去建模)、压缩率要够高。loss 就是在这三者之间做权衡的旋钮。
三句话讲清四项损失:
像素损失(L1/L2)和 KL 是「保正确」的:前者逐像素对齐,后者惩罚每个输入的后验偏离所选先验;它同时影响均值和方差,并可能使后验坍缩,不能理解成只做数值限幅。
LPIPS 感知损失和 GAN 对抗损失是「保好看」的:LPIPS 在预训练深度网络的特征空间里比较,提供与人类局部失真判断有经验相关性的特征距离;GAN 让一个判别器去挑刺,逼着解码器还原高频细节。
四项的数值范围、归约和梯度不同,需要定义有效权重;GAN 可用「晚启动 + 自适应权重」控制末层梯度比例:先让重建项把解码器教到成形,再让判别器入场,并按两项在最后一层上的梯度范数之比动态调权。视频还要额外盯时间维(时空判别器或帧间一致性项)。
VAE 最大化证据下界(ELBO)。写成「最小化负 ELBO」,目标天然裂成两项:
$$\mathcal{L} = \underbrace{-\mathbb{E}_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)]}_{\text{重建项}} + \underbrace{D_{\mathrm{KL}}\big(q_\phi(z\mid x)\,\|\,p(z)\big)}_{\text{KL 正则项}}$$
逐项解释符号:$\phi$ 是编码器参数、$\theta$ 是解码器参数;$q_\phi(z\mid x)$ 是编码器给出的后验分布;$p_\theta(x\mid z)$ 是解码器的似然;$p(z)=\mathcal{N}(0,I)$ 是标准正态先验。重建项要求「从采样出的 $z$ 能还原 $x$」,KL 项要求「后验别离先验太远」—— 它是潜变量的正则项,鼓励与先验对齐;它不保证感知空间的平滑或连通,也不是所有 latent 扩散能够学习的必要条件。
当后验取对角高斯 $q_\phi(z\mid x)=\mathcal{N}(\mu_\phi(x),\,\mathrm{diag}(\sigma_\phi(x)^2))$、先验取标准正态时,KL 有解析解(不用采样、不用估计)。令 $\ell_j=\log\sigma_j^2$(工程上网络直接预测 $\ell$,数值更稳):
$$D_{\mathrm{KL}} = -\frac{1}{2}\sum_{j=1}^{d_z}\Big(1+\ell_j-\mu_j^2-\exp(\ell_j)\Big)$$
这里求和下标 $j$ 跑遍所有潜变量维度。直觉:$\tfrac12\mu_j^2$ 惩罚均值偏离 0,$-(1+\ell_j-e^{\ell_j})$ 惩罚方差偏离 1($\ell=0$ 即 $\sigma^2=1$ 时该项为 0)。
从似然到工程的 mean loss 还隔着尺度。设每样本有 $P=CTHW$ 个像素通道元素、$d_z$ 个潜变量元素、batch 大小为 $B$。若条件独立像素服从固定尺度 $a>0$ 的 Laplace 分布,则:
$$-\log p_\theta(x\mid z)=\frac{1}{a}\sum_{i=1}^{P}|x_i-r_i|+P\log(2a)$$
忽略与模型参数无关的常数,再把每样本负 ELBO 整体乘 $a/P$,得到 $\mathcal L_{\mathrm{pix,mean}}+(a/P)\mathcal K_{\mathrm{batchmean}}$。若改用固定方差 $s^2$ 的高斯似然,像素平方和的系数是 $1/(2s^2)$。因此 L1/L2 的概率解释还依赖似然尺度,任意添加 LPIPS/GAN 后也不再是原始负 ELBO 的逐项恒等改写。VAE 原文附录 B 给出了高斯 KL 的来源。
定义三种容易混淆的 KL 归约:
$$k_{bj}=\frac12[\mu_{bj}^2+\exp(\ell_{bj})-1-\ell_{bj}],\quad \mathcal K_{\mathrm{sum}}=\sum_{b,j}k_{bj},\quad \mathcal K_{\mathrm{batchmean}}=\frac{\mathcal K_{\mathrm{sum}}}{B},\quad \mathcal K_{\mathrm{mean}}=\frac{\mathcal K_{\mathrm{sum}}}{Bd_z}$$
保持加权项及梯度相同,系数必须满足 $\beta_{\mathrm{batchmean}}=B\beta_{\mathrm{sum}}$、$\beta_{\mathrm{mean}}=Bd_z\beta_{\mathrm{sum}}$。这是同一批元素的纯换算;若改分辨率或采样分布,则不能只套一个常数。KL 的导数是 $\partial k/\partial\mu=\mu$、$\partial k/\partial\ell=(e^\ell-1)/2$;由 $e^\ell\ge1+\ell$ 可知 KL 非负且在 $\mu=\ell=0$ 为零。接近零时可用 expm1(logvar)-logvar 减轻相减消去,大 logvar 仍需按模型约束避免指数溢出。
第一个容易被忽略的坑是「求和 vs 平均」。教科书公式对 $d_z$ 个维度求和;而像素损失通常对全部像素求平均。两者元素个数差着几个数量级,直接相加 KL 会凭「项数多」碾压重建。随文脚本 vaeloss_terms.py 在一个合成视频上实测:
# 解析 KL,logvar 是网络直接预测的 log(sigma^2)
kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar))
kl_sum, kl_mean = kl_per_element.sum(), kl_per_element.mean()
l1 = np.mean(np.abs(x - r))
print("L1 = %.5f" % l1)                              # 0.03158
print("KL(sum) = %.3f  KL(mean) = %.4f" % (kl_sum, kl_mean))
print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1))
输出(视频 $2\times3\times8\times32\times32$,latent $2\times4\times2\times4\times4$,像素 49152 个、全 batch 的 latent 共 256 个数值(每样本 128 个)):
L1 重建 (mean)                 0.03158
KL (全 batch sum,教学口径)             57.66490
KL (mean,换口径)              0.22525
KL(sum)/L1 的量级倍数 :        1826.0x
归约口径是解释小 KL 系数时必须检查的因素之一,但不能由这个 toy 直接反推实际系数。本文用于对照的连续 LDM 实现对每样本 latent 求和,再对 batch 平均;其他目标可以另定义口径;这里为演示求和效应,57.66 是整个 batch 的和,batch=2 时常见口径为 28.83。本轮输出的 batchmean 精确为 28.83245,mean 为 0.22525。复制同一批样本两遍时,batchmean/mean 不变,全 batch sum 翻倍。抄权重之前先对齐归约、输入范围和似然尺度。
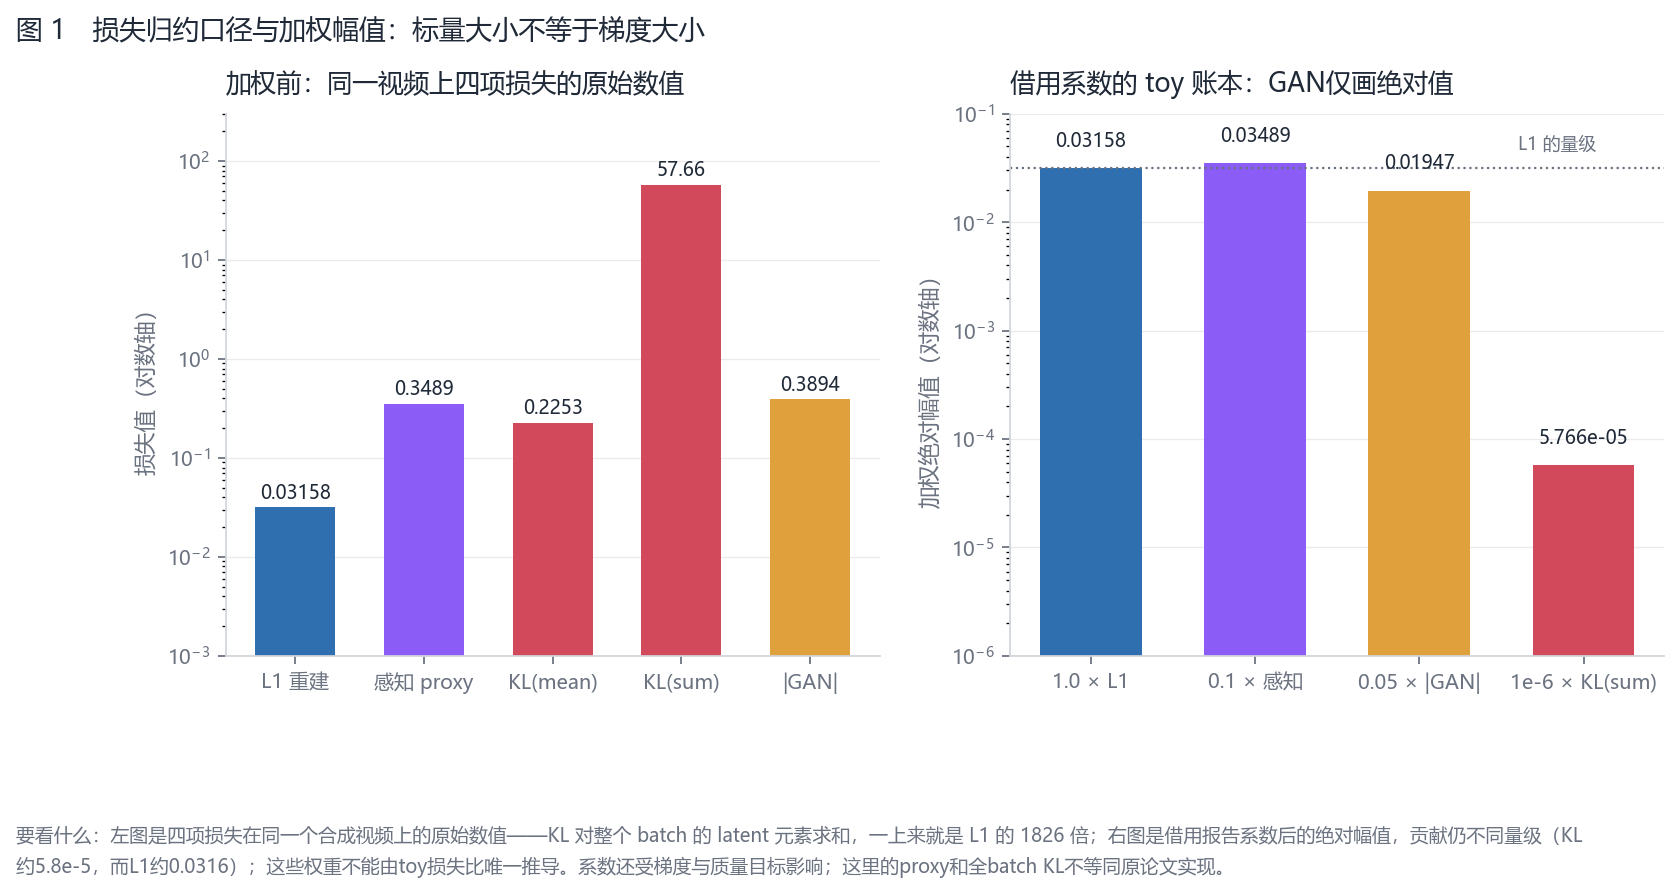
这张图要看什么:左图在同一个合成视频上比较原始标量,其中 KL(sum)=57.66490 是全 batch 总和,L1(mean)=0.03158。右图仅借用 HunyuanVideo 系数,展示 toy 各项的绝对幅值:像素 0.03158、特征代理 0.03489、GAN 的绝对值 0.01947、KL 约 $5.77\times10^{-5}$。实际合成 GAN 项是负的,总目标为 0.04706;图中的正柱不是正向贡献。代理不是 LPIPS,logit 不是实际判别器输出,这不是原模型配方复现,也不能按标量大小判断梯度平衡。图由 code/make_figures.py 生成。
$$\mathcal{L}_{\mathrm{pix}} = \frac{1}{BP}\sum_{b=1}^{B}\sum_{i=1}^{P}|x_{bi}-r_{bi}|$$
L2(MSE)对大误差平方加权,其逐点最优解是给定 $z$ 下所有可能输出的条件均值—— 面对「这块纹理可能是 A 也可能是 B」的不确定性,它选择把 A、B 平均掉,结果就是模糊。单个绝对误差对预测值的导数为 $\pm1$,本式 mean 归约后为 $\pm1/(BP)$,其逐点最优解是条件中位数,不会因为误差大就给出更强的「往平均靠」的驱动力,对异常值通常更稳健,但条件中位数也可能模糊,不能保证所有纹理更锐利。L1 在零点用次梯度处理;小误差处梯度不随残差线性缩小,但这并不能推出它必然产生颗粒。条件均值/中位数结论要求在给定表示下存在不确定性、且优化限定为该逐点风险;若模型可精确重建,两者都能为零。也有工作(如 LTX-Video)在像素项里混用 MSE 与小波域 L1(Video-DWT),在多尺度上约束。
像素距离有个致命问题:同样大小的像素误差,人眼感受天差地别。一个全局亮度偏移,MSE 不小但某个特征度量可能不敏感;一团等量的逐点噪声,MSE 相同却把纹理毁了。LPIPS(Learned Perceptual Image Patch Similarity)改用在 ImageNet 上预训练的分类网络(VGG/Alex,参数冻结)提特征,再在特征空间量距离:
$$\mathcal{L}_{\mathrm{LPIPS}}(x,r)=\sum_k\frac{1}{H_kW_k}\sum_{u,v}\sum_c a_c^k(\hat y_{cuv}^k(x)-\hat y_{cuv}^k(r))^2$$
符号:$y^k$ 是第 $k$ 层特征,$c,u,v$ 分别是通道及空间坐标;$a_c^k$ 是直接作用于平方差的学习通道系数,对应实现中无 bias 的 $1\times1$ 卷积。VGG 版本取 relu1_2、relu2_2、relu3_3、relu4_3、relu5_3 五层;也存在 AlexNet 等版本。每个空间位置的通道向量先除以其 L2 范数加 epsilon,空间平均、通道加权求和、跨层相加,最后才按 batch 归约。这里是沿通道归一化向量,不是逐通道独立归一化一整幅特征图。论文学习的非负通道系数也可写成某个权重的平方,但实现只乘一次线性系数,不应把 checkpoint 权重再平方。LPIPS 在 BAPPS 失真判断上得到经验支持,不能保证所有语义、亮度或颜色变化都符合人的感受。
pixel_vs_perceptual.py 用一个免权重的多尺度高通特征(高斯差分 DoG)复现 LPIPS 的结构,对比三种退化:
# A:全局亮度偏移;B:同等 L2 能量的逐点噪声;C:高斯模糊
rA = x + delta                          # delta = 0.12
rB = x + rng.normal(0, delta, x.shape)  # 标准差同为 0.12
# 像素 MSE:A 约等于 B;特征距离:B 远大于 A
真实输出:
重建方式                       像素MSE    感知距离   感知/像素
A 亮度偏移(整体+0.12)          0.01440    0.00008     0.01
B 逐点噪声(σ=0.12)             0.01426    0.64084    44.93
C 高斯模糊                     0.00508    0.50163    98.69
A、B 的像素 MSE 在期望上相等,本次有限样本只差 0.95%,但特征距离里 B 是 A 的约 $8\times10^3$ 倍;模糊 C 的像素误差最小,感知距离却很高。高通教学代理天然抑制直流亮度,因此本例差距尤其大;真实 LPIPS 使用学习特征和权重,不能据此断言它对亮度或颜色变化不敏感。
GAN 引入一个判别器 $D$,训练它区分真实帧与重建帧;解码器(生成器)则努力骗过它。一种常用设计是 PatchGAN 式判别器:不输出整图真假,而是对每个空间 patch 打分,主要约束其感受野内的统计,常改善局部纹理,但并非数学上只看高频。最常用的 hinge 形式:
$$\mathcal{L}_{D} = \tfrac{1}{2}\Big(\mathbb{E}_{\text{real}}[\max(0,\,1-D(x))]+\mathbb{E}_{\text{recon}}[\max(0,\,1+D(r))]\Big)$$
$$\mathcal{L}_{G}^{\mathrm{adv}} = -\mathbb{E}_{r}[D(r)]$$
判别器希望真帧打分大于 1、重建打分小于 -1;生成器希望重建打分尽量大(为正)。gan_schedule.py 用合成 logits 算了判别器在三种强弱下的损失:
起步:判别器分不清     D(hinge)=1.0126  G(hinge)=-0.0312   real≈ 0.01  fake≈ 0.03
分离:尚有部分margin残差         D(hinge)=0.0767  G(hinge)= 1.2067   real≈ 1.21  fake≈-1.21
分离:margin已满足    D(hinge)=0.0000  G(hinge)= 5.9713   real≈ 6.02  fake≈-5.97
注意判别器 hinge loss 为 0 只说明这些样本的 margin 已满足,此时判别器对应损失的梯度为 0;不意味着生成器梯度消失。这里 $\mathcal L_G=-\mathbb E[D(r)]$ 对平均 fake logit 的导数是 −1;若有 $M$ 个等权 logit,对每个的导数为 $-1/M$,传回解码器的梯度还取决于判别器对输入的导数。仅看 +6/−6 logits 无法判断梯度是否健康。
其一,GAN 晚启动(warm-up)。重建项还没把解码器教出基本形状时,判别器挑的「毛病」没有意义,甚至会把训练带偏。taming 的做法是一个开关 adopt_weight,在第 $t_{\mathrm{start}}$ 步前把对抗权重置 0:
$$f(t)=\begin{cases}0,&t\lt t_{\mathrm{start}}\\ f_0,&t\ge t_{\mathrm{start}}\end{cases}$$
这里 $t$ 是优化步、$t_{\mathrm{start}}$ 是启用阈值、$f_0$ 是固定系数。脚本教学取 disc_start=2000、$f_0=0.05$ 时,step 0 和 1999 的权重为 0,step 2000 起跳到 0.05。
其二,自适应对抗权重。固定系数在重建与 GAN 梯度相对强弱变化时可能不合适。VQGAN 在指定的解码器末层权重 $w_L$ 上比较合并重建项与生成器对抗项的梯度范数,以一个停止梯度的系数调节 GAN;这不是基于标量 loss 大小调权,也不包含 KL/codebook 梯度。
$$d=\kappa\,\mathrm{stopgrad}\left[\mathrm{clip}\left(\frac{\|\nabla_{w_L}\mathcal L_{\mathrm{rec}}\|_2}{\|\nabla_{w_L}\mathcal L_G^{\mathrm{adv}}\|_2+10^{-4}},0,10^4\right)\right],\qquad\lambda_{\mathrm{adv}}(t)=f(t)d$$
其中 $\mathcal L_{\mathrm{rec}}$ 包含像素与加权 LPIPS,$\kappa$ 是 discriminator_weight,$f(t)$ 对应 disc_factor 的启用开关。原实现先 clamp 范数比,再 detach,再乘 $\kappa$;最终损失还要乘 $f(t)$,不能漏算或重复算。detach 表示把该系数当本次更新的常量,避免对范数比再次求导。未触发上限、GAN 梯度远大于 epsilon 时,加权 GAN 的末层范数约为 $f(t)\kappa$ 倍重建范数;这不保证方向一致、全网络平衡或收敛。adaptive_weight.py 固定线性判别器,构造两个权重点并验证解析梯度(W[0,0] 上 0.012371 与 0.255913 均与中心差分一致):
大残差权重点  L_rec=0.73740  ||∇rec||=0.4071  ||∇gan||=4.2840  d_weight=0.0950
小残差权重点  L_rec=0.00071  ||∇rec||=0.0127  ||∇gan||=4.2840  d_weight=0.0030
在这个没有训练的构造中,GAN 梯度固定为 4.2840,重建梯度缩小,系数由 0.095 变为约 0.003(约 32 倍)。真实训练中分子、分母都在变,比例可能升高;即使系数变大,GAN 的实际加权梯度也可能变小。不能把这两个权重点当成通用学习曲线。
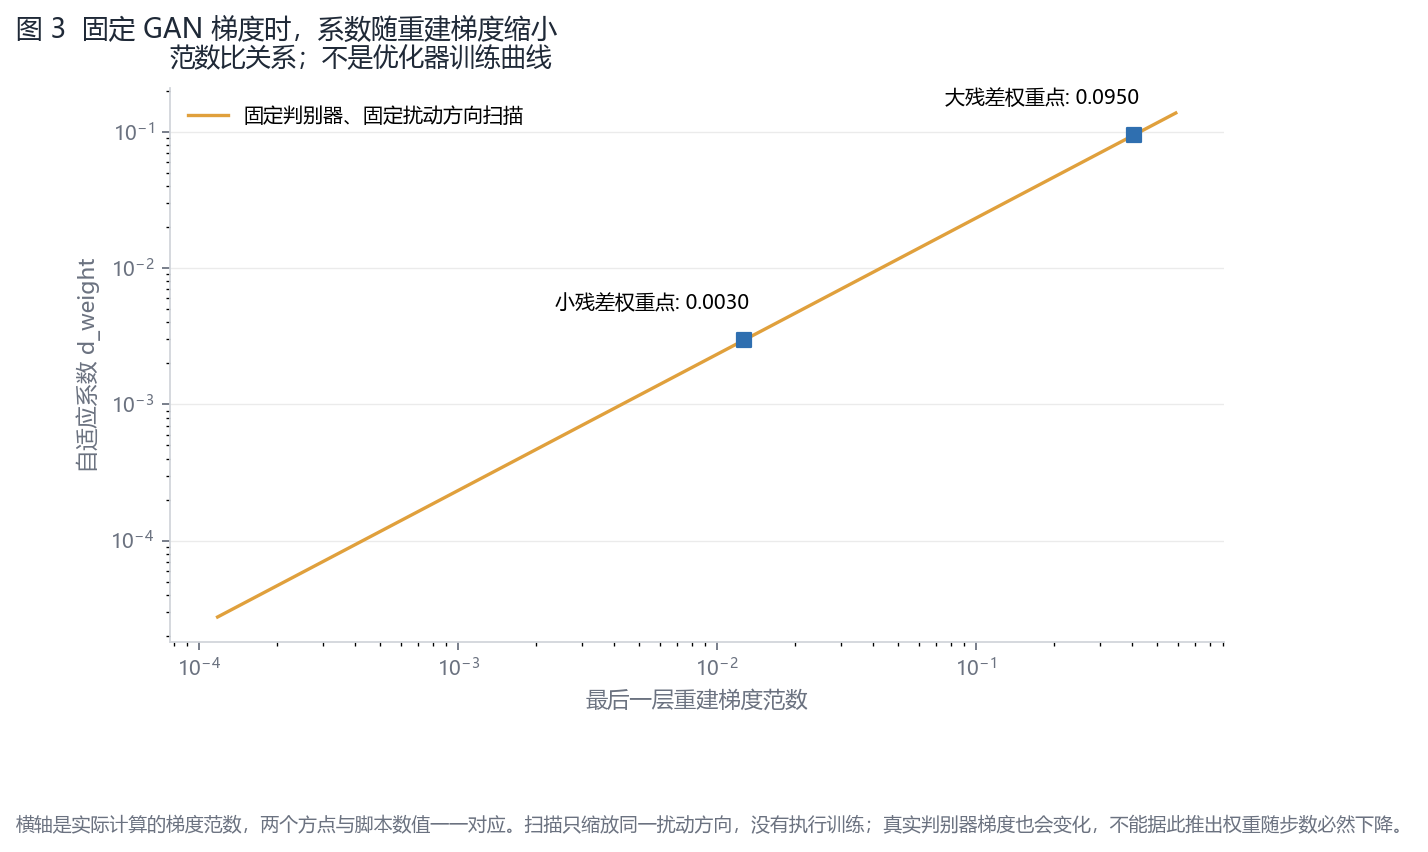
这张图要看什么:横轴是实际末层重建梯度范数,纵轴是自适应系数。曲线固定同一扰动方向并逐次缩小它;两个独立方点使用脚本原有的大/小残差权重。原图把初始化附近的权重画在 0.05 扰动幅度处,横轴与采样点不对应,本轮改为可核算的梯度横轴。图不是优化器训练轨迹。$f(t)$ 管是否启用,$d$ 管启用后比例;两者相乘才是最终权重。
把四项合起来,连续潜变量视频 VAE 的生成器目标是:
$$\mathcal{L}_{G} = \lambda_{\mathrm{pix}}\mathcal{L}_{\mathrm{pix}}+\lambda_{\mathrm{p}}\mathcal{L}_{\mathrm{LPIPS}}+\lambda_{\mathrm{kl}}\mathcal{L}_{\mathrm{KL}}+\lambda_{\mathrm{adv}}(t)\,\mathcal{L}_{G}^{\mathrm{adv}}$$
(VQGAN 是离散码本,没有 KL,对应位置换成 codebook/commitment 损失;连续 KL-VAE 才是上面这版。)判别器另用 $\mathcal{L}_D$ 单独更新,二者交替。
视频多了时间维,单帧损失均值不足以唯一刻画帧间误差。temporal_consistency.py 构造了一段运动视频,给两种重建:A 加逐帧独立噪声(播放时闪烁),B 加跨帧恒定的退化(不闪),两者单帧空间 L1 几乎相同:
重建                 单帧空间L1   时序差分L1   时序差分MSE
A 逐帧独立噪声(闪)    0.06393      0.09018      0.01275
B 跨帧恒定退化(稳)    0.06340      0.00455      0.00003
单帧 L1 几乎相等(0.0639 对 0.0634),时序差分 MSE 却差了约 393 倍。
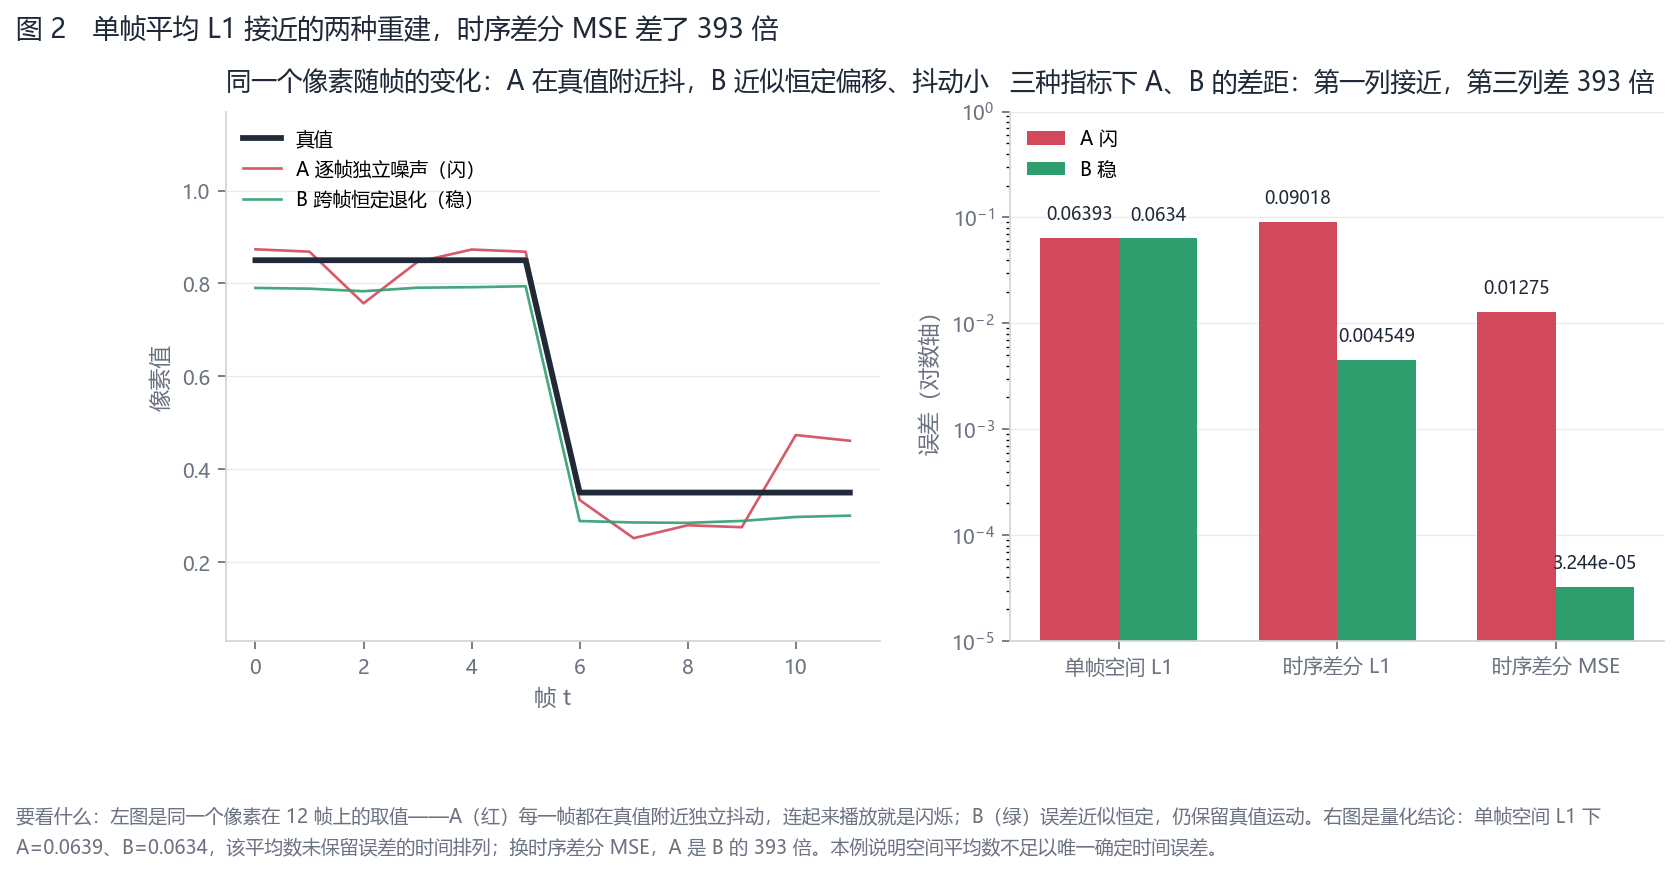
这张图要看什么:左图是同一像素的时间轨迹,右图比较三种误差。A 为逐帧独立噪声,B 为固定屏幕坐标的噪声加 5% 抖动,B 仍随真实视频运动;固定屏幕坐标误差不代表沿运动物体轨迹的纹理完全一致。L1 接近而时间差分 MSE 相差约 393 倍。B 总方差在期望上为 $1.0025\sigma^2$,并非与 A 严格等能量。实验说明平均空间误差遗漏时间排列,不能从中断言真实视频闪烁的根因一定是选错指标;表示容量、训练、归一化与分块相位也要检查。
可选办法包括让判别器看时空片段,或添加相对真值的时间误差。但直接要求相邻重建帧一致会压制真实运动。令 $e_t=r_t-x_t$,不用光流时可定义:
$$\mathcal L_{\Delta}=\frac{1}{BC(T-1)HW}\sum_{b,c,t,h,w}|(r_{bcthw}-r_{bc,t-1,h,w})-(x_{bcthw}-x_{bc,t-1,h,w})|=\mathrm{mean}|\Delta e|$$
这里 $t=1,\ldots,T-1$、$T\ge2$。完美重建运动视频时该项为零,原始的 $\mathrm{mean}|\Delta r|$ 却为正;冻结成第一帧时原始帧差为零,反而会奖励错误。另一方面,任意跨帧恒定误差 $e_t=c$ 也使 $\mathcal L_{\Delta}=0$,所以它必须配合空间项,不能单独保证重建质量。
若有从当前像素指向上一帧采样坐标的反向光流 $F_{t\to t-1}$,令 $\mathcal W(v,F)$ 是把上一帧采样到当前坐标的 warp。用有效且未遮挡的像素掩码 $m$,可比较重建和真值的运动补偿残差:
$$\mathcal L_{\mathrm{warp,res}}=\frac{\sum m_t\left|[r_t-\mathcal W(r_{t-1},F)]-[x_t-\mathcal W(x_{t-1},F)]\right|}{\sum m_t}$$
求和覆盖 batch、通道、时间和空间,掩码按相同维度广播后计数,分母非零;没有有效像素的样本应按明确规则跳过并报告。两边使用同一冻结光流、采样约定和掩码;线性 warp 下等于比较 $e_t-\mathcal W(e_{t-1},F)$。原文未经真值校正的 $|r_t-\mathcal W(r_{t-1},F)|$ 隐含亮度恒定等假设,在遮挡、光照变化或流估计错误时即使完美重建也可能非零。这是目标设计示例,不是以上项目统一采用的配方;随文只实跑无光流的差分与整数平移反例,没有声称复现完整光流网络。
随文 5 个脚本只依赖 numpy,python 脚本名.py 即可运行,完整版在文末附录;另有 make_figures.py 需要 matplotlib,负责本文三张配图。这里串起主干。
(1)四项损失与量级对照(vaeloss_terms.py):在合成视频上算 L1、解析 KL(sum/mean 两种口径)、感知代理、GAN,核心是 KL 解析式:
kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar))
kl_sum = kl_per_element.sum()          # 包含 batch 的教学总和;每样本KL通常先sum再batch mean
l1 = np.mean(np.abs(x - r))            # 工程口径:对像素求平均
print("KL(sum)/L1 = %.0f 倍" % (kl_sum / l1))   # 1826 倍
(2)像素 vs 感知(pixel_vs_perceptual.py):多尺度高斯差分特征加逐通道归一化,复现 LPIPS「在特征空间量距离」的结构。再次强调这是教学代理:本体用预训练分类网络特征与在 BAPPS 上学习的通道权重(见第 05 节真实代码)。
(3)GAN 损失与 warm-up(gan_schedule.py):
def hinge_d(real, fake):
    return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) +
                  np.mean(np.maximum(0.0, 1.0 + fake)))
def adopt_weight(weight, step, threshold=0, value=0.0):
return value if step < threshold else weight(4)自适应权重(adaptive_weight.py):对迷你线性解码器用解析梯度(并用中心差分校验)算范数比:
d_weight = np.clip(np.linalg.norm(g_rec) /
                   (np.linalg.norm(g_gan) + 1e-4), 0.0, 1e4)
print("早期 %.3f -> 后期 %.4f" % (w_early, w_late)) # 0.095 -> 0.003(5)时间一致性(temporal_consistency.py):比较全局平均 L1 与真值校正后的帧差误差,构造平均 L1 相近、时间排列不同的反例。vaeloss_checks.py 另验证 KL 归约及梯度、hinge 极端值、移动视频/冻结视频/固定误差反例;其完整代码同样在附录。
这些脚本的真实输出已散落在第 03 节,文末附录给出可直接运行的完整源码。
最小实现是为了讲清原理,生产代码有几处关键的工程化。最权威的参照是 VQGAN 的损失模块(知识树锚点):
VQLPIPSWithDiscriminator.forward(固定提交 3ba01b2,本轮核对日期 2026-11-02)对照本文的四项,它的生成器一步几乎是公式的逐行翻译:
rec_loss = torch.abs(inputs - reconstructions)              # L1 像素
if self.perceptual_weight > 0:
    p_loss = self.perceptual_loss(inputs, reconstructions)  # LPIPS
    rec_loss = rec_loss + self.perceptual_weight * p_loss
nll_loss = torch.mean(rec_loss)
logits_fake = self.discriminator(reconstructions)
g_loss = -torch.mean(logits_fake)                          # hinge 生成损失
d_weight = self.calculate_adaptive_weight(nll_loss, g_loss, last_layer)
loss = (nll_loss + d_weight * disc_factor * g_loss
        + self.codebook_weight * codebook_loss.mean())         # VQ:codebook;连续 VAE 换成 KL
与最小实现的差异,每一处都有来由:
重建与感知合并成 nll_loss 一起算梯度:自适应权重需要对「合并后的重建项」和「GAN 项」分别在最后一层求梯度(torch.autograd.grad(..., retain_graph=True)),LPIPS 仍有独立的 perceptual_weight,只是加权后并入用于求范数比的重建项。
两类优化分支,调用顺序由训练器负责:optimizer_idx==0 更新生成器(含重建、LPIPS、codebook、GAN),==1 才更新判别器;判别器那一路对输入 .detach(),不让梯度流回解码器。
LPIPS 本体(taming/modules/losses/lpips.py):先过一个 ScalingLayer(把通常约定为 $[-1,1]$ 的输入变到 VGG 的归一化统计,shift/scale 是写死的常数),再取 VGG16 的 5 个 relu 特征,每个位置沿通道归一化、过学来的 $1\times1$ 卷积、空间平均、跨层求和 —— 正是公式 3.3 的完整实现,特征网络先经过分类预训练,通道权重来自 BAPPS 学习后的 checkpoint,两者在该损失中冻结。冻结参数不等于对整个 LPIPS 前向使用 no_grad:训练生成器仍需把重建图的梯度传回解码器。
连续 KL-VAE 要核对真实目标。LDM 的固定版本 LPIPSWithDiscriminator.forward 对 (rec_loss / exp(logvar) + logvar) 求总和再除 batch,KL 也求和再除 batch;logvar 是学习尺度参数。VQ 版本对重建与感知合并项直接 mean,且最后加 codebook mean,二者不能只替换一行。两个构造器虽保存 pixel_weight,所核对 forward 并未乘它,不能因参数名就假设像素系数已生效。
以下配方对应明确论文版本;正文数值以原报告为来源,不要跨项目照抄。HunyuanVideo v1 §4.1.1 Eq.(1)、LTX-Video v1 §2.1、Seedance 1.0 v1 §2.1、H3AE v2 §3.3/表5分别核对:
| 模型 | 损失组合与权重(论文原文) |
|---|---|
| HunyuanVideo (2412.03603) | $L_1$ + $0.1L_{\mathrm{lpips}}$ + $0.05L_{\mathrm{adv}}$ + $10^{-6}L_{\mathrm{kl}}$;从零联合训练视频与图像;系数来自报告式(1),不据此推断未展开的归约细节 |
| LTX-Video (2501.00103) | 像素 MSE 加 Video-DWT(小波域 L1)加 LPIPS 加 Reconstruction-GAN;并讨论 causal /non-causal VAE 的取舍 |
| Seedance 1.0 (2506.09113) | L1 加 KL 加 LPIPS 加对抗损失;用类 PatchGAN 的混合判别器同时约束外观与运动 |
| H3AE (2504.10567) | 反方证据:在该设置中辅助项有不同指标取舍;先训练重建+KL,再用重编码后验之间的 KL 做潜一致性微调,非普适胜出结论 |
表中 HunyuanVideo 给出了这里列出的四个明确系数,其他项目采用不同目标或归一化,不能据此称权重“高度趋同”。toy 的数值只解释口径为何重要,不能从 1826 倍损失比推导出真实训练必需的 $10^{-6}$ 权重。
本轮在 PyTorch 2.10.0+cpu 上执行固定源码的完整损失类 forward:以小型确定性特征/判别器替代预训练网络构造,核对 VQ 与连续 KL 两版的生成器/判别器分支、启用边界、detach、归约、学习尺度和自适应系数;另执行原 LPIPS forward、ScalingLayer、归一化函数并与独立公式对照。这只验证损失代数与 autograd 路径,没有真实 VGG checkpoint、人类感知评测或视频 GAN 训练;official_validation.json 保存夹具和源码哈希。
每一项都在解决一类失真,也都引入新的代价:
L1/L2:目标直接、易于解释;存在信息丢失和不确定性时逐点最优解可能平均掉细节,但 L2 低不等于必糊,L1 也不必然颗粒重。
KL:去掉它可能使后验更确定、尺度约束变弱,但没有 KL 的自编码器或 VQ latent 也可以训练扩散模型;但权重过大、瓶颈太紧,重建细节会被牺牲。不能只凭 $10^{-6}$ 就判定有效正则弱:归约、梯度与潜变量维数都会影响强度,换套实现需要重新定标。
LPIPS:贴人眼,但它的「审美」被冻结在 VGG 的自然图像特征里 —— 对医学影像、动画、线稿等域外数据可能偏置;它偏纹理,有时会鼓励「看起来有细节」的伪纹理。
GAN:可以改善局部统计,也会引入两方优化、额外算力及伪纹理风险;warm-up、自适应权重、谱归一化等是可选稳定化手段,不是所有项目都必须同时用。原 taming 判别器并不能仅因使用 hinge 就被认作带谱归一化。感知—失真边界说明最优可达目标可能冲突,不表示每一次改善观感都必须降低 PSNR;一个尚未优化好的模型可以同时改善两者。参见 The Perception-Distortion Tradeoff。
视频时间项 / 3D 判别器:能压闪烁,但显著增算力、增训练时长;光流估计本身在遮挡和大运动处会出错,warp 损失可能误伤真实运动。
H3AE v2 表5还提供了具体反例:同一基础模型分别追加辅助目标训练 10K iterations,baseline 的 PSNR/LPIPS/rFVD 为 29.48/0.2627/147.1;加 LPIPS 为 29.07/0.224/148.9,潜一致性为 29.58/0.2541/142.2。潜一致性相对 baseline 同时改善这些指标,但 LPIPS 分数仍不及专门加 LPIPS 的 0.224,不能说它逐指标胜过所有辅助项。这些是该论文数据与设置的结果,也不能据此断言所有高压缩 VAE 都应删 GAN。原始表5 是比较依据。
Auto-Encoding Variational Bayes(VAE,arXiv:1312.6114,2013):系统化 VAE 的变分目标与路径梯度估计;不能把变分下界、高斯潜变量或 KL 的历史起源都归于这一篇。
Neural Discrete Representation Learning(VQ-VAE,arXiv:1711.00937,2017):改走离散码本,用 codebook/commitment 损失替代 KL,是 VQGAN 的前身。
Image-to-Image Translation with Conditional Adversarial Networks(pix2pix / PatchGAN,arXiv:1611.07004,2016 年首发,2017 年 CVPR):把判别器做成局部 patch 判定器,确立了「局部对抗项与像素重建互补」的分工。
The Unreasonable Effectiveness of Deep Features as a Perceptual Metric(LPIPS,arXiv:1801.03924,CVPR 2018):在 BAPPS 局部失真判断任务中验证深度特征距离与人类判断的相关性,并学习通道权重;这不证明它对所有数据域和视频时间失真都更好。
Taming Transformers for High-Resolution Image Synthesis(VQGAN,arXiv:2012.09841,2021):L1、LPIPS、PatchGAN、codebook 四件套定型,配套自适应 GAN 权重与 warm-up,是本文工业对照的母本。
CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer(arXiv:2408.06072)与 HunyuanVideo: A Systematic Framework For Large Video Generative Models(arXiv:2412.03603):把这套组合搬到 3D 因果视频 VAE,后者给出明确四项系数,时空判别器示例另见 Seedance 报告。
H3AE: High Compression, High Speed, and High Quality AutoEncoder for Video Diffusion Models(arXiv:2504.10567,2025):对「判别损失是否值得」提出反方证据,代表这条线仍在演进。
「KL 权重抄 HunyuanVideo 的 $10^{-6}$ 就行」:错。权重取决于你的 KL 是 sum 还是 mean、latent 与像素各有多少元素、有没有做 loss balancing。本文实测同一组数据 sum 口径 KL 是 mean 口径 L1 的 1826 倍;换个压缩率或归一化,$10^{-6}$ 可能过大或过小。先统一口径,再谈数字。
「LPIPS 就是拿 VGG 特征算 L2」:漏了两个关键件 —— 沿通道的归一化和在 BAPPS 上学出来的 $1\times1$ 权重;输入还要先过 scaling layer 换到 VGG 的数值域。少了归一化,距离会被少数高响应通道主导。
「生成器 GAN 损失算出来是负数,训练崩了」:hinge 生成器目标下 $\mathcal{L}_G=-\mathbb{E}[D(r)]$(logistic non-saturating 常写成 $\mathbb E[\mathrm{softplus}(-D(r))]$,是另一种公式),为负只说明假样本 logit 的均值为正;它不是重建质量合格或所有样本都骗过判别器的证明;该盯的是梯度和平衡,不是损失正负。
「判别器越强,重建越清晰」:hinge margin 饱和会让判别器损失梯度为 0,但生成器目标对平均 fake logit 的导数为 −1,对每个等权 logit 则为 $-1/M$,不能把 D loss=0 当成生成器梯度消失的证据。应检查两侧梯度、学习率、更新频率和样本质量,再决定是否使用晚启动、正则或自适应权重。
「L1/L2 越低画面越好」:同一数据范围下 PSNR 由 MSE 定义,MSE 下降就提高 PSNR;这本身不代表观感变差。只有给定有损表示下的不确定性等条件满足时,条件均值解释才适用。感知项的收益和像素误差变化应实测。要同时看像素指标和感知 / 对抗指标。
「视频 VAE 把图像四项 loss 直接套到 3D 卷积上就行」:单帧损失的全局均值不足以刻画时间排列(实测单帧 L1 几乎相同、时序误差差 393 倍)。应额外评估时序误差,按消融结果决定是否需要时空判别器、Video-DWT 或显式帧间约束;时间网络结构本身也能学习一致性。
「四项应该从头一起训」:主流做法是重建加 KL(有时加 LPIPS)先预热,第 disc_start 步才开 GAN;H3AE 甚至主张慎用判别损失。晚启动是一种稳定训练的办法,是否必需以及何时启动需依据具体实验。
5 个脚本都在本文附录,仅需 numpy(pip install numpy);vaeloss_checks.py 同样只需 NumPy;第 6 个原脚本 make_figures.py 额外需要 matplotlib,用来重画本文配图。预期关键结果如下(随机种子已固定):
运行 vaeloss_terms.py:看到 L1 约 0.0316、KL (sum) 约 57.7、KL (mean) 约 0.225,以及「KL (sum)/L1 约 1826 倍」和 借用 HunyuanVideo 系数的 toy 加权值 —— 认识口径与系数换算,并区别标量大小、梯度大小和训练质量。
运行 pixel_vs_perceptual.py:亮度偏移与同能量噪声的像素 MSE 几乎相等(差小于 1%),但感知距离相差约三个数量级(噪声约为偏移的 $8\times10^3$ 倍)。
运行 gan_schedule.py:warm-up 在 step 2000 起跳;margin 满足时 D (hinge)=0.0000 而 G 约 5.97,同时检查脚本新增的 logit 导数:D margin 梯度归零,G 对 fake logit 的导数仍非零。
运行 adaptive_weight.py:先看有限差分与解析梯度在输出精度内一致,再看固定判别器下 d_weight 从大残差点 0.095 降到小残差点约 0.003(约 32 倍)。
运行 temporal_consistency.py:闪烁与稳定两种重建的单帧 L1 约 0.063 几乎相同,时序 MSE 却差约 393 倍 —— 理解视频为何要单独约束时间维。
运行 make_figures.py(这个需要额外装 pip install matplotlib):重新生成本文三张配图 —— 量级账本(加权前 vs 加权后)、闪烁轨迹与指标对比、固定判别器下系数与梯度范数的关系。在账本与 make_figures.py 中同时把 KL 系数从 $10^{-6}$ 改为 $10^{-4}$ 并重跑再看图 1,KL 项由约 $5.8\times10^{-5}$ 升到 $5.8\times10^{-3}$,仍低于这里约 0.0316 的 L1,不能声称已经压过所有项。
运行 vaeloss_checks.py:应输出 passed: true,移动视频的原始帧差为 0.03125,完美重建的真值校正项为 0;冻结首帧的原始帧差为 0,但校正项为 0.03125。192 个末层权重坐标的重建/GAN 梯度差分别不超过 $1.21\times10^{-10}$ 和 $5.96\times10^{-11}$。
建议进一步动手:把 vaeloss_terms.py 里的 KL 从 sum() 改成 mean(),观察 HunyuanVideo 配方里 KL 项的相对权重需要相应放大多少倍,就能切身体会「权重不能跨口径照抄」。
读这篇之前建议先看已发布的前置:
变分下界与重参数化:KL 解析式与重参数化技巧的完整推导。
VAE 结构与训练目标:编码器 / 解码器、scaling factor、后验坍缩。
视频 VAE 的时空压缩结构:3D 因果卷积、时间 / 空间压缩比与分块解码。
读完这篇可以继续看:
视频生成评测:VBench 与人工验收:学会在分维度指标上看出「总分没变、时序一致性掉了」这类压缩副作用。
FID / CLIP Score 到底测了什么:感知与分布距离指标的适用边界,与本文 LPIPS/GAN 的质量观互补。
离散化表征:VQ-VAE 与 VQGAN:本文连续 KL-VAE 的「离散码本」对照版本,codebook 损失替代 KL。
09 节用到的脚本全文如下(vaeloss_terms.py、make_figures.py、pixel_vs_perceptual.py、gan_schedule.py、adaptive_weight.py、temporal_consistency.py、vaeloss_checks.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""视频 VAE 四类损失的最小可运行对照:L1 / KL / 感知 / GAN。

只依赖 numpy,直接 `python vaeloss_terms.py` 复现。

这一步不训练任何网络,只把四项损失放到同一个合成视频张量上算一遍,
回答一个最容易把人带沟里的问题:它们的「数值量级」根本不在一个频道上,
演示归约和权重的关系;不能由 toy 标量比推导真实训练配方。
"""

import numpy as np

rng = np.random.default_rng(0)


# ----------------------------------------------------------------------
# 一个迷你的多尺度「特征提取器」,用来演示感知损失的*结构*。
# 注意:它不是 LPIPS 本体——LPIPS 用的是在 BAPPS 上学过权重的 VGG/Alex
# 特征(见工业对照一节的 taming/lpips.py)。这里用可分离高斯 + 差分(DoG)
# 构造确定性的多尺度边缘特征,目的是让「在特征空间而非像素空间比较」
# 这件事可以离线、免权重地跑起来。
# ----------------------------------------------------------------------
def _gauss_kernel(size=5, sigma=1.0):
    ax = np.arange(size) - (size - 1) / 2.0
    k = np.exp(-(ax ** 2) / (2 * sigma ** 2))
    return k / k.sum()


def _conv_separable(img, k):
    """对最后两轴(H, W)做可分离卷积;img 形状 [..., H, W],边界 reflect。"""
    pad = len(k) // 2
    x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect")
    acc = np.zeros_like(img)
    for i, w in enumerate(k):
        acc += w * x[..., i:i + img.shape[-2], :]
    x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect")
    acc = np.zeros_like(img)
    for j, w in enumerate(k):
        acc += w * x[..., :, j:j + img.shape[-1]]
    return acc


def _normalize_channels(feat, eps=1e-10):
    # 对应 LPIPS 的 normalize_tensor:沿通道维归一化
    norm = np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True))
    return feat / (norm + eps)


def feature_stack(x):
    """x: [B, C, T, H, W] -> 多尺度边缘特征列表(先把 T 折叠进 batch)。"""
    B, C, T, H, W = x.shape
    f = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W)
    k = _gauss_kernel(5, 1.0)
    b1 = _conv_separable(f, k)
    b2 = _conv_separable(_conv_separable(b1, k), k)
    dog1 = f - b1          # 高频细节
    dog2 = b1 - b2         # 中频边缘
    feats = [_normalize_channels(f), _normalize_channels(dog1), _normalize_channels(dog2)]
    return feats


def perceptual_proxy(x, y):
    """结构对齐 LPIPS:逐层归一化特征差的平方,空间平均后跨层求和。"""
    total = 0.0
    for fx, fy in zip(feature_stack(x), feature_stack(y)):
        total += np.mean((fx - fy) ** 2)
    return total


def make_video(B=2, T=8, H=32, W=32):
    """合成一段有运动内容的视频:移动的亮圆 + 网格背景,取值[0,1]。"""
    x = np.zeros((B, 3, T, H, W), dtype=np.float64)
    yy, xx = np.mgrid[0:H, 0:W]
    for b in range(B):
        for t in range(T):
            cx = W * (0.3 + 0.5 * t / (T - 1))
            cy = H * (0.3 + 0.15 * np.sin(2 * np.pi * t / T))
            circle = ((xx - cx) ** 2 + (yy - cy) ** 2) < (H * 0.12) ** 2
            grid = ((xx // 8 + yy // 8) % 2) * 0.15
            frame = 0.2 + grid
            frame[circle] = 0.95
            x[b, 0, t] = frame
            x[b, 1, t] = frame * 0.9
            x[b, 2, t] = frame * 0.7
    return x


def degrade(x):
    """重建结果:轻微模糊 + 小噪声 + 偏色,模拟一个训练中段的解码器。"""
    B, C, T, H, W = x.shape
    flat = x.transpose(0, 2, 1, 3, 4).reshape(B * T, C, H, W)
    k = _gauss_kernel(3, 0.8)
    out = _conv_separable(flat, k)
    out = out + rng.normal(0, 0.02, out.shape)
    out[:, 0] += 0.03                       # 轻微红色偏置
    return np.clip(out, 0, 1).reshape(B, T, C, H, W).transpose(0, 2, 1, 3, 4)


def main():
    x = make_video()
    r = degrade(x)
    print("视频张量 x / r :", x.shape, " 取值范围 %.2f~%.2f" % (x.min(), x.max()))

    # 编码器输出的后验 q(z|x):latent 在时间压缩4x、空间压缩8x
    B, C, T, H, W = x.shape
    Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8
    mu = 0.3 * rng.standard_normal((B, Cz, Tz, Hz, Wz))
    logvar = -1.0 + 0.2 * rng.standard_normal((B, Cz, Tz, Hz, Wz))
    n_pix = B * C * T * H * W
    n_lat = mu.size
    print("latent 形状    :", mu.shape, " 像素数=%d latent数=%d\n" % (n_pix, n_lat))

    # ① 像素重建 L1(对全部元素求平均,量纲与像素一致,O(0.01~0.1))
    l1 = np.mean(np.abs(x - r))

    # ② KL 解析式(标准正态先验)。注意它天然是「求和」式
    kl_per_element = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar))
    kl_sum = kl_per_element.sum()  # 包含batch的教学总和,非每样本KL均值
    kl_mean = kl_per_element.mean()
    kl_batchmean = kl_per_element.reshape(B, -1).sum(axis=1).mean()

    # ③ 感知损失(多尺度特征距离,不等同真实 LPIPS,通道也被 mean 而非 learned sum)
    l_p = perceptual_proxy(x, r)

    # ④ GAN 生成器损失。这里直接喂一组判别器对假图的打分 logits
    #    hinge 生成损失 = -mean(logits_fake);先假设判别器刚起步、打分偏正
    logits_fake = rng.normal(0.3, 0.5, size=64)
    g_loss = -np.mean(logits_fake)

    print("%-28s %10s" % ("损失项", "原始数值"))
    print("-" * 40)
    print("%-28s %10.5f" % ("L1 重建 (mean)", l1))
    print("%-28s %10.5f" % ("KL (全batch sum,教学)", kl_sum))
    print("%-28s %10.5f" % ("KL (mean,换口径)", kl_mean))
    print("%-28s %10.5f" % ("感知 proxy", l_p))
    print("%-28s %10.5f" % ("GAN  g=-mean(D(r))", g_loss))

    print("KL (每样本sum,再batch mean) = %.5f" % kl_batchmean)
    print("\n--- 归约对照;非工业模型复现 ---")
    # 若直接把 sum 口径的 KL 与 mean 口径的 L1 相加,KL 会凭元素数量碾压:
    print("KL(sum)/L1 的量级倍数 : %.1fx" % (kl_sum / l1))
    print("借用报告系数的 toy 账本(感知proxy/合成logit/全batch KL,非原模型损失):")
    total = l1 + 0.1 * l_p + 0.05 * g_loss + 1e-6 * kl_sum
    print("  各项贡献: L1=%.5f  proxy=%.5f  GAN=%.5f  KL=%.6f"
          % (l1, 0.1 * l_p, 0.05 * g_loss, 1e-6 * kl_sum))
    print("  合计 = %.5f" % total)
    print("\n结论:归约决定系数换算;标量贡献不能替代梯度与质量消融。")


if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「视频 VAE 的常见 loss 组合」的三张解释图。
数值一律从同目录的三个脚本里取(vaeloss_terms / temporal_consistency /
adaptive_weight),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。
三张图分别回答:
1. 四项损失的原始量级差着几个数量级,借用系数后各项的绝对值;非工业模型实测
2. 单帧指标完全分不开的两种重建,时间维损失一眼看穿
3. 固定线性判别器下的梯度范数比例
只依赖 numpy + matplotlib。跑法:python make_figures.py
"""
import textwrap
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import adaptive_weight as AW
import temporal_consistency as TC
import vaeloss_terms as VT
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(parents=True, exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["Microsoft YaHei", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
"savefig.bbox": "tight",
})
INK = "#1f2937"
MUTE = "#6b7280"
C_PIX = "#2f6fb0" # 像素项:蓝
C_PERC = "#8b5cf6" # 感知项:紫
C_GAN = "#e0a03c" # 对抗项:橙
C_KL = "#d1495b" # KL:红
C_A = "#d1495b" # 闪烁重建
C_B = "#2f9e6f" # 稳定重建
C_GT = "#1f2937" # 真值
def style(ax, title, xlabel=None, ylabel=None):
ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left")
if xlabel:
ax.set_xlabel(xlabel, fontsize=10, color=MUTE)
if ylabel:
ax.set_ylabel(ylabel, fontsize=10, color=MUTE)
ax.tick_params(colors=MUTE, labelsize=9)
for s in ("top", "right"):
ax.spines[s].set_visible(False)
for s in ("left", "bottom"):
ax.spines[s].set_color("#d1d5db")
ax.grid(alpha=0.25, linewidth=0.6, axis="y")
ax.set_axisbelow(True)
def footer(fig, text, width=118):
"""把「这张图要看什么」放到坐标轴下方。
必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来,
放在 0~0.05 之间的话会和 x 轴标签叠在一起。
"""
wrapped = "\n".join(textwrap.wrap(text, width=width))
fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE,
va="top", ha="left", linespacing=1.6)
# ──────────────────────────────────────────────────────────────────────
# 图 1:四项损失的量级账本
# ──────────────────────────────────────────────────────────────────────
def fig_magnitudes():
x, r = VT.make_video(), VT.degrade(VT.make_video())
# 与 vaeloss_terms.main 完全同口径重算一遍(rng 序列一致)
B, C, T, H, W = x.shape
Cz, Tz, Hz, Wz = 4, T // 4, H // 8, W // 8
mu = 0.3 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz))
logvar = -1.0 + 0.2 * VT.rng.standard_normal((B, Cz, Tz, Hz, Wz))
l1 = float(np.mean(np.abs(x - r)))
kl_el = -0.5 * (1 + logvar - mu ** 2 - np.exp(logvar))
kl_sum, kl_mean = float(kl_el.sum()), float(kl_el.mean())
lp = float(VT.perceptual_proxy(x, r))
gan = abs(float(-np.mean(VT.rng.normal(0.3, 0.5, size=64))))
fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.4))
ax = axes[0]
names = ["L1 重建", "感知 proxy", "KL(mean)", "KL(sum)", "|GAN|"]
vals = [l1, lp, kl_mean, kl_sum, gan]
cols = [C_PIX, C_PERC, C_KL, C_KL, C_GAN]
bars = ax.bar(names, vals, color=cols, width=0.62)
ax.set_yscale("log")
ax.set_ylim(1e-3, 3e2)
for b, v in zip(bars, vals):
ax.text(b.get_x() + b.get_width() / 2, v * 1.25, f"{v:.4g}",
ha="center", fontsize=8.5, color=INK)
style(ax, "加权前:同一视频上四项损失的原始数值",
None, "损失值(对数轴)")
ax = axes[1]
wnames = ["1.0 × L1", "0.1 × 感知", "0.05 × |GAN|", "1e-6 × KL(sum)"]
wvals = [l1, 0.1 * lp, 0.05 * gan, 1e-6 * kl_sum]
wcols = [C_PIX, C_PERC, C_GAN, C_KL]
bars = ax.bar(wnames, wvals, color=wcols, width=0.62)
ax.set_yscale("log")
ax.set_ylim(1e-6, 1e-1)
for b, v in zip(bars, wvals):
ax.text(b.get_x() + b.get_width() / 2, v * 1.6, f"{v:.4g}",
ha="center", fontsize=8.5, color=INK)
ax.axhline(l1, color=MUTE, ls=":", lw=1.0)
ax.text(2.6, l1 * 1.5, "L1 的量级", fontsize=8, color=MUTE)
style(ax, "借用系数的 toy 账本:GAN仅画绝对值",
None, "加权绝对幅值(对数轴)")
fig.suptitle("图 1 损失归约口径与加权幅值:标量大小不等于梯度大小",
fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
footer(fig, "要看什么:左图是四项损失在同一个合成视频上的原始数值——KL 对整个 batch 的 latent 元素"
"求和,一上来就是 L1 的 1826 倍;右图是借用报告系数后的绝对幅值,"
"贡献仍不同量级(KL 约5.8e-5,而L1约0.0316);这些权重不能由toy损失比唯一推导。"
"系数还受梯度与质量目标影响;这里的proxy和全batch KL不等同原论文实现。")
fig.savefig(OUT / "loss_magnitudes.png")
plt.close(fig)
print(f"[图1] L1={l1:.5f} KL_sum={kl_sum:.5f} 倍数={kl_sum / l1:.0f}x;"
f"加权后贡献 L1={l1:.5f} KL={1e-6 * kl_sum:.2e}")
# ──────────────────────────────────────────────────────────────────────
# 图 2:单帧指标看不见的闪烁
# ──────────────────────────────────────────────────────────────────────
def fig_temporal():
x = TC.make_sequence() # [T,1,H,W]
fixed = TC.SIGMA * TC.rng.standard_normal(x.shape[1:])[None]
rA = x + TC.SIGMA * TC.rng.standard_normal(x.shape)
rB = x + fixed + 0.05 * TC.SIGMA * TC.rng.standard_normal(x.shape)
# 取一条穿过运动边缘的水平线上的一个像素,看它随帧的取值
t_axis = np.arange(TC.T)
y0, x0 = TC.H // 2, 30
gt = x[:, 0, y0, x0]
a = rA[:, 0, y0, x0]
b = rB[:, 0, y0, x0]
fig, axes = plt.subplots(1, 2, figsize=(11.6, 4.3))
ax = axes[0]
ax.plot(t_axis, gt, lw=2.6, color=C_GT, label="真值", zorder=3)
ax.plot(t_axis, a, lw=1.2, color=C_A, alpha=0.9,
label="A 逐帧独立噪声(闪)")
ax.plot(t_axis, b, lw=1.2, color=C_B, alpha=0.9,
label="B 跨帧恒定退化(稳)")
ax.set_ylim(gt.min() - 4 * TC.SIGMA, gt.max() + 4 * TC.SIGMA)
ax.legend(fontsize=8.5, frameon=False, loc="upper left")
style(ax, "同一个像素随帧的变化:A 在真值附近抖,B 近似恒定偏移、抖动小",
"帧 t", "像素值")
ax = axes[1]
mets = ["单帧空间 L1", "时序差分 L1", "时序差分 MSE"]
va = [TC.spatial_l1(rA, x), TC.temporal_error(rA, x), TC.temporal_mse(rA, x)]
vb = [TC.spatial_l1(rB, x), TC.temporal_error(rB, x), TC.temporal_mse(rB, x)]
xg = np.arange(len(mets))
w = 0.36
ba = ax.bar(xg - w / 2, va, w, color=C_A, label="A 闪")
bb = ax.bar(xg + w / 2, vb, w, color=C_B, label="B 稳")
ax.set_yscale("log")
ax.set_ylim(1e-5, 1)
for bars in (ba, bb):
for b_ in bars:
ax.text(b_.get_x() + b_.get_width() / 2, b_.get_height() * 1.5,
f"{b_.get_height():.4g}", ha="center", fontsize=8, color=INK)
ax.set_xticks(xg)
ax.set_xticklabels(mets)
ax.legend(fontsize=8.5, frameon=False, loc="upper left")
style(ax, "三种指标下 A、B 的差距:第一列接近,第三列差 393 倍",
None, "误差(对数轴)")
fig.suptitle("图 2 单帧平均 L1 接近的两种重建,时序差分 MSE 差了 393 倍",
fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
footer(fig, "要看什么:左图是同一个像素在 12 帧上的取值——A(红)每一帧都在真值附近独立抖动,"
"连起来播放就是闪烁;B(绿)误差近似恒定,仍保留真值运动。"
"右图是量化结论:单帧空间 L1 下 A=0.0639、B=0.0634,该平均数未保留误差的时间排列;"
"换时序差分 MSE,A 是 B 的 393 倍。本例说明空间平均数不足以唯一确定时间误差。")
fig.savefig(OUT / "temporal_flicker.png")
plt.close(fig)
print(f"[图2] 单帧L1 A={va[0]:.5f}/B={vb[0]:.5f};时序MSE A={va[2]:.5f}/B={vb[2]:.5f}"
f"({va[2] / max(vb[2], 1e-12):.0f}x)")
# ──────────────────────────────────────────────────────────────────────
# 图 3:自适应 GAN 权重随训练自动变小
# ──────────────────────────────────────────────────────────────────────
def fig_adaptive():
b = np.zeros(AW.D)
early = AW.rng.standard_normal((AW.dz, AW.D)) * 0.05
late = AW.W_star + AW.rng.standard_normal((AW.dz, AW.D)) * 0.01
sweep_rng = np.random.default_rng(7)
direction = sweep_rng.standard_normal((AW.dz, AW.D))
norms, weights = [], []
for scale in np.logspace(-4, -0.3, 30):
g_rec, g_gan = AW.grads(AW.W_star + scale * direction, b)
norms.append(np.linalg.norm(g_rec))
weights.append(AW.adaptive_weight(g_rec, g_gan))
fig, ax = plt.subplots(figsize=(8.5, 4.5))
ax.plot(norms, weights, color=C_GAN, label="固定判别器、固定扰动方向扫描")
points = []
for W, label in [(early, "大残差权重点"), (late, "小残差权重点")]:
g_rec, g_gan = AW.grads(W, b)
gn, ratio = np.linalg.norm(g_rec), AW.adaptive_weight(g_rec, g_gan)
points.append(ratio)
ax.scatter([gn], [ratio], color=C_PIX, marker="s", zorder=3)
ax.annotate(f"{label}: {ratio:.4f}", (gn, ratio), xytext=(-85, 14), textcoords="offset points", fontsize=9)
ax.set_xscale("log"); ax.set_yscale("log"); ax.legend(frameon=False, fontsize=9)
style(ax, "范数比关系;不是优化器训练曲线", r"最后一层重建梯度范数", "自适应系数 d_weight")
fig.suptitle("图 3 固定 GAN 梯度时,系数随重建梯度缩小", x=.012, ha="left", color=INK)
footer(fig, "横轴是实际计算的梯度范数,两个方点与脚本数值一一对应。扫描只缩放同一扰动方向,"
"没有执行训练;真实判别器梯度也会变化,不能据此推出权重随步数必然下降。")
fig.savefig(OUT / "adaptive_weight_curve.png"); plt.close(fig)
print(f"[图3] synthetic d_weight {points[0]:.4f} -> {points[1]:.4f}")
def main():
fig_magnitudes()
fig_temporal()
fig_adaptive()
print(f"[OK] 三张图已写入 {OUT}")
for f in sorted(OUT.glob("*.png")):
print(f" {f.name} {f.stat().st_size / 1024:.0f} KB")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""用固定多尺度代理演示像素与特征距离的差别:相同的像素误差,感知质量可以天差地别。
只依赖 numpy,直接 `python pixel_vs_perceptual.py` 复现。
我们构造三种「重建」,让其中两种的像素 MSE 在期望上相等:
A. 全局亮度偏移 —— 亮度敏感度由所选代理决定;
B. 同等 L2 能量的逐点噪声 —— 直接污染纹理与细节,观感很差;
C. 高斯模糊 —— 抹掉高频细节。
然后分别在「像素空间」和一个多尺度特征空间里比较距离。
"""
import numpy as np
rng = np.random.default_rng(1)
def _gauss_kernel(size=5, sigma=1.0):
ax = np.arange(size) - (size - 1) / 2.0
k = np.exp(-(ax ** 2) / (2 * sigma ** 2))
return k / k.sum()
def _conv_separable(img, k):
pad = len(k) // 2
x = np.pad(img, ((0, 0),) * (img.ndim - 2) + ((pad, pad), (0, 0)), mode="reflect")
acc = np.zeros_like(img)
for i, w in enumerate(k):
acc += w * x[..., i:i + img.shape[-2], :]
x = np.pad(acc, ((0, 0),) * (img.ndim - 2) + ((0, 0), (pad, pad)), mode="reflect")
acc = np.zeros_like(img)
for j, w in enumerate(k):
acc += w * x[..., :, j:j + img.shape[-1]]
return acc
def _norm(feat, eps=1e-10):
return feat / (np.sqrt(np.sum(feat ** 2, axis=1, keepdims=True)) + eps)
def perceptual_proxy(x, y):
"""多尺度高通特征上的归一化距离(LPIPS 的结构代理,非本体)。"""
def feats(z):
k = _gauss_kernel(5, 1.0)
b1 = _conv_separable(z, k)
b2 = _conv_separable(_conv_separable(b1, k), k)
return [_norm(z), _norm(z - b1), _norm(b1 - b2)]
return sum(np.mean((a - b) ** 2) for a, b in zip(feats(x), feats(y)))
def make_textured_image(H=64, W=64):
"""一张同时含锐边、细密纹理和平滑区域的图。"""
yy, xx = np.mgrid[0:H, 0:W].astype(np.float64)
img = 0.5 + 0.25 * np.sin(xx / 2.0) * np.sin(yy / 2.0) # 细密纹理
img += 0.3 * (xx > W / 2) # 一条锐边
checker = ((xx // 4 + yy // 4) % 2) * 0.15 # 棋盘格
img += checker
img = np.clip(img, 0, 1)
return np.stack([img, img * 0.92, img * 0.8], axis=0)[None] # [1,C,H,W]
def mse(a, b):
return float(np.mean((a - b) ** 2))
def main():
x = make_textured_image()
delta = 0.12 # 统一的 L2 误差能量
rA = x + delta # A:全局亮度偏移(不 clip,保证误差严格等于 delta)
rB = x + rng.normal(0, delta, x.shape) # B:零均值逐点噪声,标准差=delta
rC = _conv_separable(x, _gauss_kernel(7, 1.6)) # C:模糊
rows = [
("A 亮度偏移(整体+%.2f)" % delta, rA),
("B 逐点噪声(σ=%.2f)" % delta, rB),
("C 高斯模糊", rC),
]
print("%-26s %12s %12s %14s" % ("重建方式", "像素MSE", "感知距离", "感知/像素 比"))
print("-" * 68)
for name, r in rows:
pm = mse(x, r)
pp = perceptual_proxy(x, r)
print("%-26s %12.5f %12.5f %14.2f" % (name, pm, pp, pp / (pm + 1e-12)))
mseA, mseB = mse(x, rA), mse(x, rB)
pA, pB = perceptual_proxy(x, rA), perceptual_proxy(x, rB)
print("\n关键对照:A 与 B 的像素 MSE 相差仅 %.2f%%," % (100 * abs(mseA - mseB) / mseA))
print("但特征空间里 B(噪声)的感知距离是 A(亮度偏移)的 %.1f 倍。" % (pB / pA))
print("这是含原图特征的固定代理,非真实LPIPS或人类偏好实验;高通分支抑制直流。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""GAN 两项的最小演示:hinge / vanilla 损失,以及判别器的 warm-up 调度。
只依赖 numpy,直接 `python gan_schedule.py` 复现。
视频 VAE 里对抗损失通常不是从头开:先用 L1+KL+LPIPS 把解码器训到大致成形,
第 disc_start 步才把判别器权重从 0 抬起来(taming 里的 adopt_weight)。
本脚本同时给出两种常见判别损失的数值,并展示margin满足不等于生成器梯度消失。
"""
import numpy as np
rng = np.random.default_rng(3)
def adopt_weight(weight, global_step, threshold=0, value=0.0):
"""taming-transformers 里的原逻辑:threshold 之前强制为 value(通常是0)。"""
return value if global_step < threshold else weight
def hinge_d(real, fake):
return 0.5 * (np.mean(np.maximum(0.0, 1.0 - real)) +
np.mean(np.maximum(0.0, 1.0 + fake)))
def hinge_g(fake):
return float(-np.mean(fake))
def vanilla_d(real, fake):
softplus = lambda z: np.log1p(np.exp(-np.abs(z))) + np.maximum(z, 0.0)
return 0.5 * (np.mean(softplus(-real)) + np.mean(softplus(fake)))
def evaluate(real, fake, tag):
print("%-28s D(hinge)=%.4f D(vanilla)=%.4f G(hinge)=%.4f 均值打分 real=%.2f fake=%.2f"
% (tag, hinge_d(real, fake), vanilla_d(real, fake),
hinge_g(fake), real.mean(), fake.mean()))
def main():
# ① warm-up 调度:disc_start=2000
print("== adopt_weight 调度(disc_start=2000, 目标权重 0.05) ==")
for step in (0, 1999, 2000, 5000):
w = adopt_weight(0.05, step, threshold=2000)
print(" step=%5d -> 对抗权重 = %.3f" % (step, w))
# ② 判别器在三种强弱下的损失
print("\n== 判别器强弱与损失信号 ==")
# 平衡初期:真假打分都在 0 附近
real0 = rng.normal(0.0, 0.3, 256)
fake0 = rng.normal(0.0, 0.3, 256)
evaluate(real0, fake0, "起步:判别器分不清")
# 健康:真≈+1,假≈-1,仍留梯度
real1 = rng.normal(1.2, 0.4, 256)
fake1 = rng.normal(-1.2, 0.4, 256)
evaluate(real1, fake1, "分离:尚有部分margin残差")
# 过强:真≈+6,假≈-6,判别器 hinge 梯度为 0,但生成器对 fake logit 仍有梯度
real2 = rng.normal(6.0, 0.5, 256)
fake2 = rng.normal(-6.0, 0.5, 256)
evaluate(real2, fake2, "分离:margin已满足")
d_fake_grad = 0.5 * (fake2 > -1.0) / fake2.size
g_fake_grad = -np.ones_like(fake2) / fake2.size
print("\nD 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(d_fake_grad))
print("G 对 fake logit 梯度范数 = %.6f" % np.linalg.norm(g_fake_grad))
print("D margin 饱和不表示 G 梯度消失;参数梯度还取决于判别器输入雅可比。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""复现 VQGAN 的自适应 GAN 权重 calculate_adaptive_weight。
只依赖 numpy,直接 `python adaptive_weight.py` 复现。
本实验构造大残差/小残差两个权重点,固定线性判别器;没有进行训练。
真实训练中的两个梯度都可能变化,范数比未必随步数下降。
VQGAN 的做法是让两项在「最后一层」上的梯度范数之比来决定权重:
d_weight = ||∇_last L_rec|| / (||∇_last L_gan|| + 1e-4),再 clamp 到 [0,1e4]
我们用一个可解析求导的迷你线性解码器,精确算出两个梯度范数,
并用有限差分抽查一个分量,证明数值不是凑出来的。
"""
import numpy as np
rng = np.random.default_rng(2)
N, D, dz = 16, 24, 8 # 样本数、像素维、latent 维
Z = rng.standard_normal((N, dz))
W_star = rng.standard_normal((dz, D)) * 0.3
X = Z @ W_star # 真实数据:线性可完美拟合
# 一个固定的微型判别器打分函数 s(x)=x @ a(教学用,参数冻结)
a = rng.standard_normal((D,))
def decode(W, b):
return Z @ W + b
def rec_loss(W, b):
"""重建项:L2(L1 同理,范数比机制不变)。"""
return float(np.mean((decode(W, b) - X) ** 2))
def gan_g_loss(W, b):
"""生成器 hinge 损失 -mean(D(r))。"""
s = decode(W, b) @ a
return float(-np.mean(s))
def grads(W, b):
R = decode(W, b) - X
g_rec = (2.0 / (N * D)) * Z.T @ R # ∂L_rec/∂W(mean 对 N*D)
# g=-mean_n(s_n),s_n=Σ_d xhat_nd·a_d:mean 只对 N,分母是 N,不是 N*D
s_coef = -(1.0 / N) * Z.sum(axis=0) # ∂g/∂W_kd = -(1/N)(Σ_n z_nk) a_d
g_gan = np.outer(s_coef, a)
return g_rec, g_gan
def adaptive_weight(g_rec, g_gan, cap=1e4):
w = np.linalg.norm(g_rec) / (np.linalg.norm(g_gan) + 1e-4)
return float(np.clip(w, 0.0, cap))
def finite_diff_check(W, b, eps=1e-6):
"""用中心差分抽查 W[0,0] 上的两个梯度,验证解析解。"""
out = []
for fn in (rec_loss, gan_g_loss):
Wp, Wm = W.copy(), W.copy()
Wp[0, 0] += eps
Wm[0, 0] -= eps
out.append((fn(Wp, b) - fn(Wm, b)) / (2 * eps))
return out
def stage(W, b, name):
lrec = rec_loss(W, b)
lgan = gan_g_loss(W, b)
g_rec, g_gan = grads(W, b)
w = adaptive_weight(g_rec, g_gan)
print("%-22s L_rec=%8.5f L_gan=%8.4f ||∇rec||=%8.4f ||∇gan||=%7.4f d_weight=%7.4f"
% (name, lrec, lgan, np.linalg.norm(g_rec), np.linalg.norm(g_gan), w))
return w
def main():
b = np.zeros(D)
# 阶段一:解码器刚初始化,离最优很远(重建残差大)
W_early = rng.standard_normal((dz, D)) * 0.05
# 阶段二:接近收敛(在最优解上加很小扰动,残差小)
W_late = W_star + rng.standard_normal((dz, D)) * 0.01
print("== 有限差分校验(W[0,0]) ==")
fd_rec, fd_gan = finite_diff_check(W_early, b)
g_rec, g_gan = grads(W_early, b)
print("解析 ∂Lrec/∂W00=%.6f 差分=%.6f" % (g_rec[0, 0], fd_rec))
print("解析 ∂Lgan/∂W00=%.6f 差分=%.6f\n" % (g_gan[0, 0], fd_gan))
print("== 固定判别器下两个合成权重点(未训练) ==")
w_early = stage(W_early, b, "大残差权重点")
w_late = stage(W_late, b, "小残差权重点")
print("\n此构造中 d_weight 从 %.3f 降到 %.4f(约 %.0f 倍),GAN 项被自动调小。"
% (w_early, w_late, w_early / max(w_late, 1e-12)))
print("这仅比较最后一层的梯度范数,不保证方向一致、全模型平衡或真实训练单调下降。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""视频 VAE 为什么必须额外盯「时间维」:同样的单帧画质,闪烁程度可以天差地别。
只依赖 numpy,直接 `python temporal_consistency.py` 复现。
构造一段运动视频,再给两种重建:
A. 逐帧独立噪声 —— 每一帧单独看误差不大,连起来播放却疯狂闪烁;
B. 跨帧恒定的退化(同一固定纹理噪声)—— 单帧误差与 A 近似,但随机抖动更小。
全局平均空间 L1 未保留误差的时间排列;相邻帧差分的时序一致性损失一眼区分。
"""
import numpy as np
rng = np.random.default_rng(4)
T, H, W = 12, 48, 64
SIGMA = 0.08
def make_sequence():
yy, xx = np.mgrid[0:H, 0:W].astype(np.float64)
x = np.zeros((T, H, W))
for t in range(T):
cx = 8 + 4 * t # 一条匀速移动的竖边
frame = 0.25 + 0.5 * (xx >= cx)
frame += 0.1 * ((xx // 6 + yy // 6) % 2)
x[t] = frame
return np.clip(x, 0, 1)[:, None] # [T,1,H,W]
def spatial_l1(r, x):
return float(np.mean(np.abs(r - x)))
def frame_diff(v):
return v[1:] - v[:-1]
def temporal_error(r, x):
"""相邻帧差分一致性:||Δr - Δx||(静止背景上 GT 帧差为0,闪烁直接显现)。"""
return float(np.mean(np.abs(frame_diff(r) - frame_diff(x))))
def temporal_mse(r, x):
return float(np.mean((frame_diff(r) - frame_diff(x)) ** 2))
def main():
x = make_sequence()
fixed_noise = SIGMA * rng.standard_normal(x.shape[1:])[None] # [1,1,H,W] 跨帧恒定
rA = x + SIGMA * rng.standard_normal(x.shape) # 逐帧独立噪声 -> 闪烁
# 稳定退化:以跨帧恒定噪声为主,只掺 5% 的逐帧抖动(更贴近真实解码器)
rB = x + fixed_noise + 0.05 * SIGMA * rng.standard_normal(x.shape)
print("期望主噪声尺度相近(σ=%.2f,B另有5%%抖动),比较单帧空间误差与时间维误差:\n" % SIGMA)
print("%-22s %14s %16s %16s" % ("重建", "单帧空间L1", "时序差分L1", "时序差分MSE"))
print("-" * 72)
for name, r in (("A 逐帧独立噪声(闪)", rA), ("B 跨帧恒定退化(稳)", rB)):
print("%-22s %14.5f %16.5f %16.5f"
% (name, spatial_l1(r, x), temporal_error(r, x), temporal_mse(r, x)))
print("\n单帧空间 L1 几乎相等(A=%.4f vs B=%.4f),但时序 MSE 上 A 约为 B 的 %.0f 倍。"
% (spatial_l1(rA, x), spatial_l1(rB, x),
temporal_mse(rA, x) / max(temporal_mse(rB, x), 1e-12)))
print("这个合成反例说明为何应评估时间维;不能单凭它判定真实模型闪烁根因:")
print(" · 把判别器扩到时空(3D/PatchGAN、LTX 的 Video-DWT);")
print(" · 或用GT校正帧差/遮挡掩码warp,经消融判断是否加入训练目标。")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""独立核对本文归约、梯度和时间反例,只需 NumPy;不训练视频VAE。"""
import json
from pathlib import Path
import numpy as np
import adaptive_weight as aw
import temporal_consistency as tc
from gan_schedule import hinge_d, hinge_g, vanilla_d, adopt_weight
def central_gradient(fn, value, eps=1e-6):
result = np.zeros_like(value)
for index in np.ndindex(value.shape):
plus, minus = value.copy(), value.copy()
plus[index] += eps
minus[index] -= eps
result[index] = (fn(plus) - fn(minus)) / (2 * eps)
return result
def main():
rng = np.random.default_rng(91)
kl_errors = []
for batch, dims in [(1, 1), (2, 7), (3, 16), (4, 128)]:
mu, logvar = rng.normal(size=(batch, dims)), rng.normal(size=(batch, dims))
kl = .5 * (mu * mu + np.expm1(logvar) - logvar)
total = kl.sum()
bm, mean = kl.sum(1).mean(), kl.mean()
assert np.all(kl >= 0)
assert np.isclose(total, batch * bm) and np.isclose(total, batch * dims * mean)
beta = 2e-4
assert np.isclose(beta * total, beta * batch * bm)
assert np.isclose(beta * total, beta * batch * dims * mean)
copies = np.concatenate([kl, kl], 0)
assert np.isclose(copies.sum(), 2 * total)
assert np.isclose(copies.sum(1).mean(), bm)
fn_mu = lambda v: .5 * (v * v + np.expm1(logvar) - logvar).sum()
fn_lv = lambda v: .5 * (mu * mu + np.expm1(v) - v).sum()
kl_errors += [float(np.max(np.abs(central_gradient(fn_mu, mu) - mu))),
float(np.max(np.abs(central_gradient(fn_lv, logvar) - .5 * np.expm1(logvar))))]
assert max(kl_errors) < 2e-7
weight = rng.normal(size=(aw.dz, aw.D)) * .1
bias = np.zeros(aw.D)
gr, gg = aw.grads(weight, bias)
err_rec = float(np.max(np.abs(central_gradient(lambda w: aw.rec_loss(w, bias), weight) - gr)))
err_gan = float(np.max(np.abs(central_gradient(lambda w: aw.gan_g_loss(w, bias), weight) - gg)))
assert max(err_rec, err_gan) < 1e-8
assert aw.adaptive_weight(np.zeros(3), np.ones(3)) == 0
assert aw.adaptive_weight(np.ones(3), np.zeros(3)) == 1e4
# 真实重建与冻结重建:原始帧差可能奖励错误,真值校正项能区分。
x = tc.make_sequence()
frozen = np.repeat(x[:1], len(x), axis=0)
perfect_raw = float(np.mean(np.abs(tc.frame_diff(x))))
frozen_raw = float(np.mean(np.abs(tc.frame_diff(frozen))))
assert perfect_raw > 0 and frozen_raw == 0
assert tc.temporal_error(x, x) == 0 and tc.temporal_error(frozen, x) > 0
fixed = x + .12
assert tc.temporal_error(fixed, x) < 1e-15 and tc.spatial_l1(fixed, x) > .1
# 周期整数平移的已知对应关系,另有亮度变化;并非学习光流实验。
base = rng.normal(size=(8, 10))
previous, current = base, np.roll(base, 1, axis=1) + .1
warp_previous = np.roll(previous, 1, axis=1)
raw_warp = float(np.mean(np.abs(current - warp_previous)))
error_prev, error_current = rng.normal(size=base.shape), rng.normal(size=base.shape)
recon_prev, recon_current = previous + error_prev, current + error_current
residual_recon = recon_current - np.roll(recon_prev, 1, axis=1)
residual_truth = current - warp_previous
corrected = np.mean(np.abs(residual_recon - residual_truth))
independent = np.mean(np.abs(error_current - np.roll(error_prev, 1, axis=1)))
assert np.isclose(corrected, independent)
perfect_residual = current - np.roll(previous, 1, axis=1)
corrected_warp = float(np.mean(np.abs(perfect_residual - residual_truth)))
assert np.isclose(raw_warp, .1) and corrected_warp == 0
# hinge margin饱和与logistic溢出边界;阈值含等号。
real, fake = np.array([2., 6.]), np.array([-2., -6.])
assert hinge_d(real, fake) == 0 and hinge_g(fake) == 4
gfd = central_gradient(hinge_g, fake)
assert np.allclose(gfd, -.5)
assert np.isfinite(vanilla_d(np.array([1e4, -1e4]), np.array([-1e4, 1e4])))
assert [adopt_weight(.05, t, 2000) for t in [0, 1999, 2000]] == [0., 0., .05]
# 范数相同仍可方向相反,不能推导优化目标一致。
grec, gadv = np.array([-1.]), np.array([1.])
ratio = aw.adaptive_weight(grec, gadv)
combined = float(np.linalg.norm(grec + ratio * gadv))
assert combined < 1.1e-4
out = dict(passed=True,kl_shapes=4,kl_max_gradient_error=max(kl_errors),
decoder_gradient_coordinates=weight.size,decoder_rec_max_error=err_rec,
decoder_gan_max_error=err_gan,perfect_motion_raw_difference=perfect_raw,
frozen_motion_corrected_error=tc.temporal_error(frozen, x),
constant_error_temporal=tc.temporal_error(fixed, x),
brightness_change_raw_warp=raw_warp,perfect_corrected_warp=corrected_warp,
opposite_gradient_combined_norm=combined,errors=[],warnings=[])
Path(__file__).with_name('validation_results.json').write_text(json.dumps(out,indent=2),encoding='utf8')
print(json.dumps(out,indent=2))
if __name__ == '__main__':
main()

评论 (0)