


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:表征与压缩 | 难度:进阶 | 前置知识:变分下界与重参数化(本篇是它的直接后继,ELBO 与重参数化在那里推过,这里只用结论)
关键词:VAE、编码器、解码器、潜空间、KL 权重、后验坍缩、scaling factor
先看一个可复现的尺度错误:预训练扩散模型要求 VAE latent 乘以 vae.config.scaling_factor,却把原始 latent 直接送进去。张量形状仍正确,但它已经偏离训练分布。下面用一维高斯去噪器量化这个误差;这些数字来自教学模型,不是 Stable Diffusion 图像质量实验,不能据此断言真实图像一定发灰或过曝。
这不是玄学,可以精确算出来。设潜空间真实标准差是 $\sigma$,扩散模型的噪声表却是按「数据方差为 1」标定的。在完全干净那一端($\bar{\alpha}\to1$)两种估计相同;噪声增加时它们的均值系数比会偏离 1,但绝对误差差距在两端都趋零。MMSE 指最小均方误差估计。用高斯模型可以算出,单位方差假设的后验均值系数是匹配真实方差系数的
$$r(\bar{\alpha}) = \bar{\alpha} + \frac{1 - \bar{\alpha}}{\sigma^{2}}$$
倍。$\sigma = 5.49$(这是由 SD1.x 常用配置系数反推的尺度,第 03.4 节会讲为什么)时,$\bar{\alpha} = 0.5$ 处 $r = 0.5166$——幅度只剩一半。实测的均方误差从本该有的 0.9682 涨到 7.8154,恶化 8.07 倍。这是高斯教学模型的估计误差,不是图像实测。
反着错也一样疼。如果你的 VAE 是规规矩矩训的(潜空间方差约等于 1),却照抄 Stable Diffusion 的 0.18215,那么 $\sigma$ 变成 0.18215,同一个 $\bar{\alpha}=0.5$ 处 $r = 15.5699$——幅度被放大 15.6 倍,教学去噪器的后验均值幅度被高估。这仍是一维教学类比,不是换 VAE 后图像表现的预测。
还有第三种错法:训练扩散模型时没有统一 latent 与噪声调度的尺度。LDM 原文 D.1 与附录 G观察到,论文中的 KL 正则自编码器具有较高 latent 方差,这会改变给定噪声调度的信噪比并影响高分辨率卷积采样;作者据此对 latent 做缩放。
这段观察针对 LDM 论文中具体的 KL / VQ 自编码器:KL latent 的高方差改变了给定噪声调度下的信噪比,影响高分辨率卷积采样;论文所用 VQ latent 的方差接近 1。它不表示所有 VQ 码本天然归一化,也不表示尺度错误一定对应某一种视觉伪影。
最后是 KL 权重本身的坑。在我的最小实验里,把 KL 权重 $\beta$ 从 0.1 调到 1,重建 MSE 从 0.2119 跳到 1.0000——1.0000 就是「什么都不学、直接输出均值」的分数(数据逐维方差已被归一化成 1)。八维都低于本文的 KL 诊断阈值,平均 KL 很小但非精确零,提示近似后验坍缩。
这一篇就把这三件事串起来:VAE 的结构决定了潜空间里有什么,KL 权重决定了还剩下什么,而潜变量尺度的使用约定解释为何要遵守 0.18215 这类配置。
三句话:
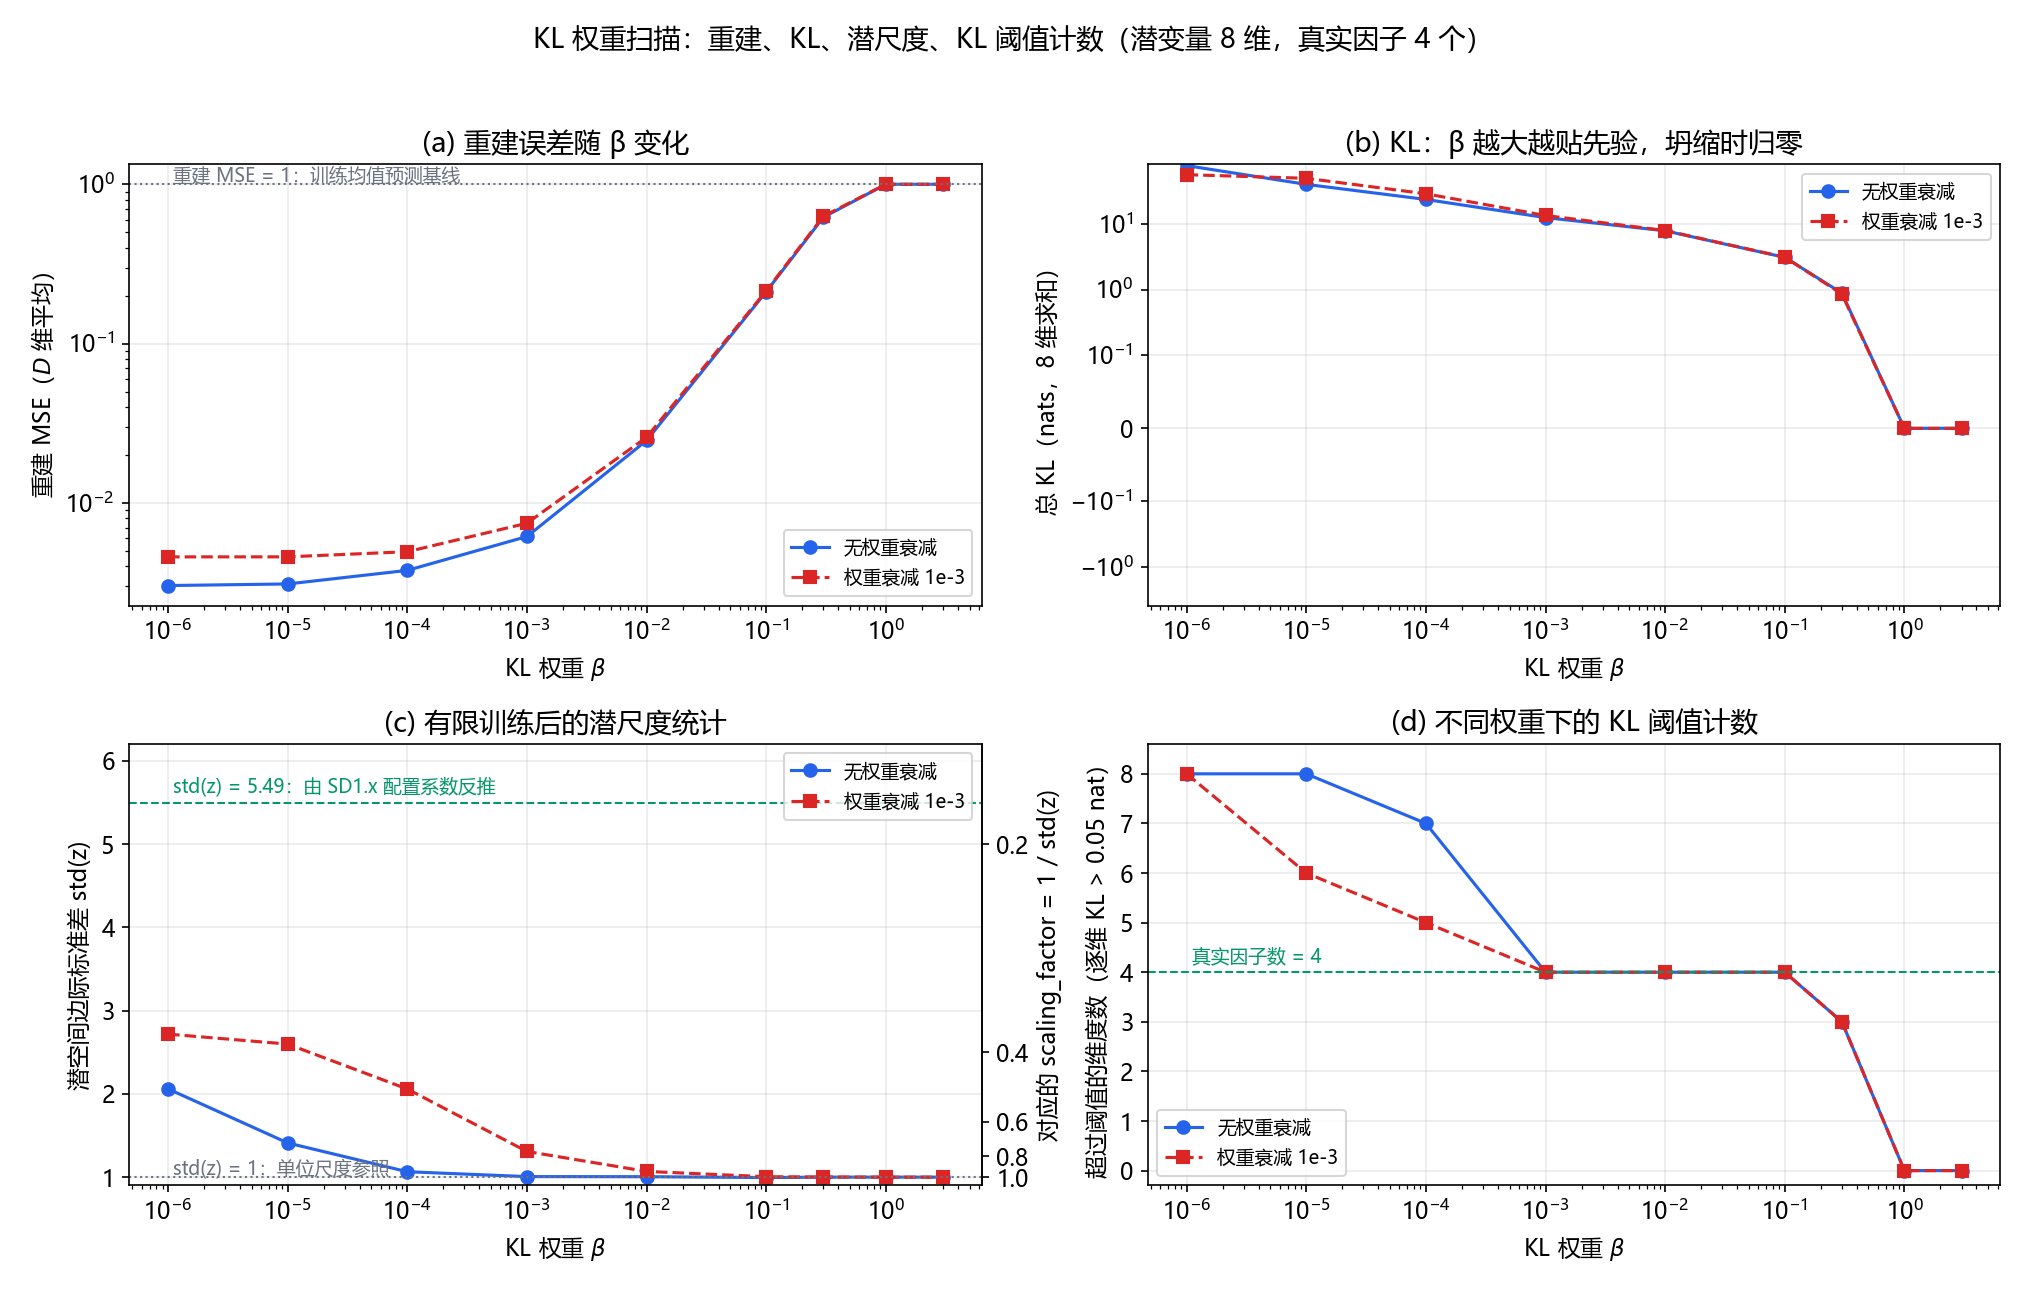
这张图要看什么:四张子图连起来读。(a) 重建 MSE 在 $\beta$ 超过 0.1 后逐渐上升到 1.0 那条虚线,提示本实验的重建已接近均值预测基线;(b) 总 KL 随权重增大趋近零,提示近似后验接近先验;(c) 潜空间边际标准差:蓝线(无权重衰减)在较大 $\beta$ 下接近 1,红线是同 seed 加 L2 梯度的对照;横轴是不同训练任务的超参数,不是同一次训练的时间轨迹,绿虚线是由 SD1.x 系数倒数构造的 5.49 参照;(d) 还活着的维度数从 8 一路掉到 0,中间在 4 这个地方有个明显的台阶——数值上与合成数据的驱动因子数相同,但不能证明解耦。
设数据 $x \in \mathbb{R}^{D}$,潜变量 $z \in \mathbb{R}^{d}$。VAE 的编码器不输出一个 $z$,它输出一个分布:
$$q_{\phi}(z \mid x) = \mathcal{N}\!\left(z;\ \mu_{\phi}(x),\ \text{diag}\left(\sigma_{\phi}^{2}(x)\right)\right)$$
网络实际算出来的是 $\mu$ 和对数方差 $\text{logvar}$ 两组数,各 $d$ 个。为什么是 logvar 而不是方差:网络输出可取任意实数,而方差必须为正。在精确算术下,$\sigma^2=\exp(\text{logvar})$ 保证正值;用对数参数表达很小的方差也方便。浮点计算仍可能溢出或下溢,因此要同时核对截断和 dtype,不能说取对数自动解决数值问题。本实验 $\beta=10^{-6}$ 时跨维后验噪声标准差 RMS 约 0.009,描述的是各维方差平均后开方,不是每个样本统一的方差。
如果只调用不记录参数依赖的普通采样接口,自动微分通常无法得到通过该样本的路径梯度;也可使用 score-function 估计。这里采用 AEVB 的重参数化,把参数依赖写成:
$$z = \mu + \sigma \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I)$$
$\odot$ 是逐元素乘。随机性全部塞进 $\epsilon$ 里,$\mu$ 和 $\sigma$ 变成普通可导函数。这使本实现可以对固定噪声样本直接反向传播;它不是唯一可用的梯度估计方法。
解码器给的是似然,取对角高斯:
$$p_{\theta}(x \mid z) = \mathcal{N}\!\left(x;\ \text{dec}_{\theta}(z),\ \sigma_{\text{dec}}^{2} I\right)$$
取对数:
$$\log p_{\theta}(x \mid z) = -\frac{\lVert x - \text{dec}_{\theta}(z) \rVert^{2}}{2\sigma_{\text{dec}}^{2}} - \frac{D}{2}\log\left(2\pi\sigma_{\text{dec}}^{2}\right)$$
当 $\sigma_{\text{dec}}>0$ 固定时,第二项与 $z$ 和解码器均值参数无关,是训练中的常数;若学习这个方差,就不能丢掉它。所以重建项就是平方误差之和除以 $2\sigma_{\text{dec}}^{2}$——「重建用 MSE」不是拍脑袋定的,它是高斯似然的必然结果,而 $\sigma_{\text{dec}}$ 就是重建项的隐式权重。日志里那种 recon + beta * kl 的写法,还要明确 reduction:若 recon 是逐元素均值,则标准负 ELBO 按同尺度缩放后的 KL 系数为 $2\sigma_{\text{dec}}^{2}/D$。
把两件事拼起来,ELBO 给出下面的不等式:
$$\log p(x) \ge \mathbb{E}_{q}\left[\log p_{\theta}(x|z)\right] - \text{KL}\!\left(q_{\phi}(z|x)\,\Vert\,p(z)\right)$$
先验取标准正态 $p(z)=\mathcal{N}(0,I)$。加入可调权重后,我们最小化以下目标;$\beta=1$ 时才是上述负 ELBO 去掉固定常数:
$$J = \frac{\mathbb{E}_{q}\left[\lVert x - \text{dec}_{\theta}(z) \rVert^{2}\right]}{2\sigma_{\text{dec}}^{2}} + \beta \sum_{j=1}^{d} \text{KL}_{j}, \qquad \text{KL}_{j} = \text{KL}\!\left(\mathcal{N}(\mu_{j}, \sigma_{j}^{2})\,\Vert\,\mathcal{N}(0,1)\right)$$
$\beta$ 是我们插进去的旋钮:$\beta = 1$ 是标准 ELBO,$\beta>1$ 是 $\beta$-VAE 采用的权衡路线,但是否解耦取决于数据、模型和优化,没有普遍保证。本文后面的数值脚本使用逐元素 MSE,因此其 $\beta_{\text{toy}}$ 与本式 $\beta$ 的关系为 $\beta_{\text{toy}}=2\sigma_{\text{dec}}^2\beta/D$;不能把脚本的 1 自动叫作标准 ELBO。注意 KL 是对维度求和而不是求平均,这一点第 05 节还会回来算账。
两个对角高斯之间的 KL 有闭式解。按定义 $\text{KL}(q \Vert p) = \mathbb{E}_{q}[\log q] - \mathbb{E}_{q}[\log p]$ 分头算。因为逐维独立,下面只看第 $j$ 维。
先算 $\mathbb{E}_{q}[\log q]$。$q_{j} = \mathcal{N}(\mu_{j}, \sigma_{j}^{2})$,所以
$$\log q_{j}(z_{j}) = -\frac{1}{2}\log(2\pi\sigma_{j}^{2}) - \frac{(z_{j} - \mu_{j})^{2}}{2\sigma_{j}^{2}}$$
对 $q_{j}$ 取期望时,右边第二项的期望是 $\sigma_{j}^{2} / (2\sigma_{j}^{2}) = 1/2$,于是
$$\mathbb{E}_{q_{j}}\left[\log q_{j}\right] = -\frac{1}{2}\left(1 + \log 2\pi + \log \sigma_{j}^{2}\right)$$
只有三项,和 $\mu_{j}$ 无关——这一点值得停一下:在 $\mu_{j}$ 上平移一个高斯分布,它的熵不变。
再算 $\mathbb{E}_{q}[\log p]$。先验 $p_{j} = \mathcal{N}(0,1)$,同样展开
$$\mathbb{E}_{q_{j}}\left[\log p_{j}\right] = -\frac{1}{2}\log 2\pi - \frac{\mathbb{E}_{q_{j}}\left[z_{j}^{2}\right]}{2}$$
这里用到 $z_{j} = \mu_{j} + \sigma_{j}\epsilon$,所以 $\mathbb{E}_{q_{j}}[z_{j}^{2}] = \mu_{j}^{2} + \sigma_{j}^{2}$——这就是 $z$ 的二阶矩,它才是把 $\mu$ 拉进公式的那一项。
两者相减,$-\frac{1}{2}\log 2\pi$ 正好抵消:
$$\text{KL}_{j} = \frac{1}{2}\left(\mu_{j}^{2} + \sigma_{j}^{2} - \log \sigma_{j}^{2} - 1\right)$$
对 $j$ 求和即得总 KL。这个式子里每一块都有明确的物理含义,逐项读:
$\mu_{j}^{2}$ 是均值偏离先验中心的成本。 不同输入的均值发生变化可以传递信息,但这一项不是互信息本身。即使所有输入的均值都是 0,只要方差仍依赖输入,潜变量也可能携带信息;只有整个条件分布都与输入无关时,这一维才不传信息。逐维 KL 同时包含信息代价与聚合后验偏离先验的代价,不能把 8~12 nats 直接叫作有效信息量。
$\sigma_j^2$ 与 $-\log\sigma_j^2$ 共同约束方差:函数 $t-\log t-1$ 对 $t>0$ 非负,唯一最小点在 $t=1$。连同 $\mu_j^2$,单样本 KL 为零恰好要求均值 0、方差 1。
要把 KL 叫作信息预算,还要区分数据分布 $p_{\text{data}}(x)$ 与生成模型 $p_\theta(x)$,并定义联合分布 $q(x,z)=p_{\text{data}}(x)q_\phi(z\mid x)$。在对数中插入聚合后验 $q(z)$:
$$\mathbb E_{p_{\text{data}}}\mathrm{KL}(q_\phi(z\mid x)\Vert p(z))=I_q(X;Z)+\mathrm{KL}(q(z)\Vert p(z))$$
第一项是 $\mathbb E_q\log[q_\phi(z\mid x)/q(z)]$,表示输入与潜变量的互信息;第二项是聚合后验偏离先验的成本。这个恒等式来自把对数比拆成两项并分别积分,不要求神经网络近似。平均 KL 约束两项总和,不能把每个 KL 数值都叫有效信息。
两个反例帮助区分统计对象。若所有输入都得到 $q(z\mid x)=\mathcal N(3,1)$,平均 KL 为 4.5 nats,但 $I_q(X;Z)=0$,没有输入信息。在线性模型未坍缩解中,$m^2v+s^2=1$,所以聚合后验恰好等于先验;取 $\lambda=0.2$ 时互信息为 $-\tfrac12\log0.2\approx0.8047$ nats,仍在传信息。二者分别说明“KL 大”与“边际像先验”都不能单独判断信息或坍缩。
上面的直觉可以算到精确解。把模型简化到最狠:一维数据 $x \sim \mathcal{N}(0, v)$,线性编码器 $q(z|x) = \mathcal{N}(mx, s^{2})$($m$ 是缩放系数,$s^{2}$ 是固定的后验方差),线性解码器 $p(x|z) = \mathcal{N}(wz, \sigma_{\text{dec}}^{2})$。这里要求 $v>0$、$\sigma_{\text{dec}}>0$、$\beta>0$、$s>0$,观测噪声固定。目标函数展开成
$$J(w, m, s) = \frac{v(1 - wm)^{2} + w^{2} s^{2}}{2\sigma_{\text{dec}}^{2}} + \frac{\beta}{2}\left(m^{2} v + s^{2} - \log s^{2} - 1\right)$$
第一项里的 $v(1-wm)^{2}$ 是「编码-解码这条路的增益偏离 1 有多远」,$w^{2}s^{2}$ 是「采样噪声被放大 $w$ 倍后落在输出上的方差」;第二项就是上一节的 KL。三个未知数各求一次偏导并置零:
$$\frac{\partial J}{\partial w} = \frac{-v m(1 - wm) + w s^{2}}{\sigma_{\text{dec}}^{2}} = 0, \qquad \frac{\partial J}{\partial m} = \frac{-v w(1 - wm)}{\sigma_{\text{dec}}^{2}} + \beta m v = 0, \qquad \frac{\partial J}{\partial s} = \frac{w^{2} s}{\sigma_{\text{dec}}^{2}} + \beta\left(s - \frac{1}{s}\right) = 0$$
记路增益 $u := wm$(它就是「潜变量被真正使用的程度」),把 $\partial_m$ 的式子两边乘 $w$ 换成 $u$,可以整理出 $w^{2}(1-u) = \beta \sigma_{\text{dec}}^{2} u$;再从 $\partial_w$ 得到 $w^{2} s^{2} = v u (1-u)$;从 $\partial_s$ 得到 $s^{2}\left(\beta + w^{2}/\sigma_{\text{dec}}^{2}\right) = \beta$。三式联立,令
$$\lambda := \frac{\beta \sigma_{\text{dec}}^{2}}{v}$$
解出来是一组非常干净的东西:
$$u = 1 - \lambda, \qquad s^{2} = \lambda, \qquad w^{2} = v(1 - \lambda)$$
代回验一遍:$\partial_m$ 要求 $w(1-u)/\sigma_{\text{dec}}^{2}=\beta m$。乘以 $w$,代入 $w^2=v(1-\lambda)$ 和 $1-u=\lambda$,得到 $v(1-\lambda)\lambda/\sigma_{\text{dec}}^{2}=\beta(1-\lambda)$。在未坍缩区间约去 $1-\lambda$,正好得到 $\lambda=\beta\sigma_{\text{dec}}^{2}/v$。第 04.2 节的数值优化与此吻合。
$\lambda$ 的读法:它是 KL 权重乘观测噪声方差,再除以数据方差的无量纲比值。这个比例决定一切:
仅检验驻点不足以证明全局阈值。先固定 $w$,目标对 $m$ 是凸二次、对 $s^2>0$ 严格凸。令 $b=\beta\sigma_{\text{dec}}^2$,分别求极小得 $m=w/(w^2+b)$ 与 $s^2=b/(w^2+b)$。代回后令 $t=b/(w^2+b)\in(0,1]$:
$$J(t)=\frac{v}{2\sigma_{\text{dec}}^2}t-\frac{\beta}{2}\log t$$
其导数在 $t=\lambda$ 为零,二阶导数为 $\beta/(2t^2)>0$,所以全局最小点为 $t=\min(\lambda,1)$。这补足上面阈值的证明。$\beta\to0^+$ 是极限,恰好 $\beta=0$ 时方差可趋零但不满足我们要求的严格正方差,不能直接套用内部驻点。
现在把「编码器」反过来看会得到什么分布。训练完之后,把所有 $x$ 编码一遍,潜变量的边际分布是
$$q(z) = \int q_{\phi}(z \mid x)\, p_{\text{data}}(x)\, \mathrm{d}x$$
这是个混合分布。对每一维分别算方差,用全方差公式:
$$\text{Var}(z_{j}) = \underbrace{\text{Var}_{p_{\text{data}}}\!\left[\mu_{j}(x)\right]}_{\text{均值变化}} + \underbrace{\mathbb{E}_{p_{\text{data}}}\!\left[\sigma_{j}^{2}(x)\right]}_{\text{采样噪声}}$$
左边是 scaling_factor 要归一化的东西,右边两项来源完全不同:前一项是「不同样本被编码到不同位置」,后一项是「每个样本自己抖多少」。下表先对每维方差取平均再开方,不能先平均标准差再平方,也不能把两项标准差直接相加。方差占比不是互信息。实测拆账($\beta$ 从小到大):
| $\beta$ | 均值变化 std RMS | 后验噪声 std RMS | 边际 std RMS | 均值变化方差占比 |
|---|---|---|---|---|
| 1e-06 | 2.060 | 0.009 | 2.060 | 100% |
| 1e-05 | 1.411 | 0.014 | 1.411 | 100% |
| 0.0001 | 1.004 | 0.355 | 1.065 | 89% |
| 0.001 | 0.726 | 0.697 | 1.007 | 52% |
| 0.01 | 0.705 | 0.717 | 1.005 | 49% |
| 0.1 | 0.620 | 0.779 | 0.995 | 39% |
| 0.3 | 0.406 | 0.914 | 1.000 | 16% |
| 1 | 0.003 | 1.000 | 1.000 | 0% |
$\beta = 10^{-3}$ 附近有个交叉点:总方差中的均值变化与平均后验方差约各占一半。较小权重处均值变化贡献更大,较大权重处平均后验方差贡献更大——$\beta = 1$ 时 $z$ 就是一坨噪声,$\text{std}_x(\mu)$ 只剩 0.003。
那么 scaling_factor 是什么?在 LDM 的 std-rescaling 分支,它是首个训练 batch 后验样本展平标准差的倒数;使用预训练模型则遵守保存的配置,不能在当前 batch 上重新标定。LDM 的 固定版本原始标定代码 使用 1. / z.flatten().std();diffusers 文档中的标准差描述要结合实际乘法方向理解。本文 toy 的跨维 RMS 也不等于一般的展平标准差:设 $\bar\mu_j=\mathbb E_x\mu_j(x)$,把通道视作均匀随机索引,则展平方差还多出 $\mathrm{Var}_j(\bar\mu_j)$。本次 $\beta=10^{-6}$ 无 L2 的 RMS 为 2.0596,按总体方差估计的展平 std 为 2.0617。LDM 代码 torch.std() 还使用样本方差修正;它是单 batch 后验样本的估计量,不是对整个数据分布的精确标准差。
$$z_{\text{scaled}} = s \cdot z, \qquad s = \frac{1}{\text{std}(z)}$$
SD1.x 的 官方推理配置取 $s=0.18215$;diffusers v0.35.1 的 AutoencoderKL 默认也为此值,具体 checkpoint 可能覆盖默认,倒过来就是 $\text{std}(z) = 5.4900$、$\text{Var}(z) = 30.1399$。为什么需要这一步,LDM D.1 用信噪比的语言回答了:扩散模型的噪声表 $\sigma_t$ 是相对数据尺度标定的,把这个比值写出来
$$\text{SNR} = \frac{\text{Var}(z)\,\bar{\alpha}}{1 - \bar{\alpha}}$$
单位数据方差假设对应 $\bar{\alpha}/(1-\bar{\alpha})$;本高斯模型的实际 SNR 是它的 30.14 倍,即约 14.79 dB。噪声方差仍为 $1-\bar{\alpha}$,变的是信号方差,不能说实际噪声被缩小了 30 倍。
接下来用一维高斯后验均值说明尺度不匹配怎样造成估计偏差,不能把它翻译成真实图像发灰或过曝。假设扩散模型是在单位方差潜空间上训好的,那它的去噪器就是一个高斯 MMSE 估计:先验 $z_{0} \sim \mathcal{N}(0, \sigma_{p}^{2} I)$,观测 $z_{t} = \sqrt{\bar{\alpha}}\,z_{0} + \sqrt{1-\bar{\alpha}}\,\epsilon$,后验均值是
$$\hat{z}_{0} = \frac{\sigma_{p}^{2}\sqrt{\bar{\alpha}}}{\sigma_{p}^{2}\bar{\alpha} + 1 - \bar{\alpha}}\, z_{t}$$
代入 $\sigma_{p}^{2} = 1$ 得 $\hat{z}_{0} = \sqrt{\bar{\alpha}}\, z_{t}$;而真实潜空间的标准差是 $\sigma$,正确的 MMSE 估计要用 $\sigma_{p}^{2} = \sigma^{2}$。两者相除就是第 01 节那个 $r(\bar{\alpha}) = \bar{\alpha} + (1-\bar{\alpha})/\sigma^{2}$。$\sigma = 5.49$ 时它在 $\bar{\alpha} \to 0$ 处趋于 $1/\sigma^{2} = 0.033$,这是两个均值系数之比的极限。在 $\bar{\alpha}=0$ 时两种后验均值都为零,输出比本身是 $0/0$,两种 MSE 均为 $\sigma^2$;不能据极限比值认为纯噪声端的绝对误差差距最大。
对同一观察过程还可精确算错假设估计器的 MSE:
$$M_{\text{bad}}=(1-\bar{\alpha})^2\sigma^2+\bar{\alpha}(1-\bar{\alpha})$$
匹配该尺度的理论最小 MSE 为 $M_{\text{good}}=\sigma^2(1-\bar{\alpha})/(\sigma^2\bar{\alpha}+1-\bar{\alpha})$,相减得到:
$$M_{\text{bad}}-M_{\text{good}}=\frac{\bar{\alpha}(1-\bar{\alpha})^2(\sigma^2-1)^2}{\sigma^2\bar{\alpha}+1-\bar{\alpha}}$$
差距非负,在两端都趋零。若先缩放原数据并维持原噪声表,SNR 也随之改变;因此表中的匹配估计器与“正确缩放后同一步”不是同一个观察问题。
完整脚本在文末附录(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py),依赖 NumPy 与 matplotlib。2026-10-13 在 Windows CPU 上完整重跑;Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7,BLAS 使用单线程。训练脚本默认优先读同目录缓存,--full 才重新训练;复制附录到空目录时会从头计算。下面是实跑输出,运行时间受机器影响,不能保证两分钟完成。反向传播手写,另以 PyTorch CPU 自动微分与固定噪声中心差分核验。
模型就是 3.1 节那套,符号一一对应:
def forward(self, x, eps):
    p = self.p
    h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0)
    mu = h1 @ p["Wmu"] + p["bmu"]                     # 后验均值
    lv_raw = h1 @ p["Wlv"] + p["blv"]
    lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX)      # logvar 截断,防 exp 溢出
    sig = np.exp(0.5 * lv)                            # 后验标准差 sigma
    z = mu + sig * eps                                # 重参数化
    g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0)
    xhat = g1 @ p["V2"] + p["c2"]
    return xhat, dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw,
                      sig=sig, z=z, g1=g1, xhat=xhat, eps=eps)

@staticmethod
def losses(x, xhat, mu, lv, sig):
    recon = float(np.mean((xhat - x) ** 2))                        # 重建:MSE
    kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0)  # 逐维 KL(3.2 节那个式子)
    return recon, kl_dim, float(np.sum(kl_dim))                    # 对维度求和
数据是合成的:64 个观测维度由 4 个高斯因子线性混合而成,再除以训练集逐维标准差使方差为 1,未减样本均值。输出逐维训练均值的 MSE 精确为 1;输出零还会含样本均值平方。潜变量给了 8 维,故意比真实因子数多一倍,看模型怎么选。编码器/解码器各一层 128 宽的隐藏层,Adam,250 epoch,把逐维平均 KL 大于 0.05 nat 计为“超过 KL 阈值”。这不是另一种按后验均值方差定义的 active units 指标,也不是互信息测试。数据/初始化/批次与训练噪声/评估噪声种子分别为 0/1/2/3;4096 个样本训练后仍在同一训练集评估,每样本采 8 次取平均,因此这里展示训练拟合而非测试泛化。
跑两轮:一组不加重衰减,一组给权重加上 $10^{-3}$ 的衰减。结果:
    weight_decay      beta    重建MSE        总KL    std(z)    1/std   KL阈值计数
-----------------------------------------------------------------------------------
               0     1e-06     0.0030     76.958    2.0596   0.4855      8/8
               0     1e-05     0.0031     39.861    1.4107   0.7088      8/8
               0    0.0001     0.0038     23.512    1.0651   0.9389      7/8
               0     0.001     0.0062     12.454    1.0067   0.9934      4/8
               0      0.01     0.0247      7.843    1.0055   0.9946      4/8
               0       0.1     0.2119      3.092    0.9952   1.0048      4/8
               0       0.3     0.6206      0.884    1.0000   1.0000      3/8
               0         1     1.0000      0.000    1.0001   0.9999      0/8
               0         3     1.0001      0.000    1.0000   1.0000      0/8
           0.001     1e-06     0.0046     55.983    2.7174   0.3680      8/8
           0.001     1e-05     0.0046     49.327    2.5978   0.3849      6/8
           0.001    0.0001     0.0049     28.672    2.0580   0.4859      5/8
           0.001     0.001     0.0075     13.409    1.3082   0.7644      4/8
           0.001      0.01     0.0259      7.917    1.0689   0.9355      4/8
           0.001       0.1     0.2148      3.107    1.0051   0.9949      4/8
           0.001       0.3     0.6302      0.858    1.0017   0.9983      3/8
           0.001         1     1.0000      0.000    1.0000   1.0000      0/8
           0.001         3     1.0000      0.000    1.0000   1.0000      0/8
三件事一眼可见:
第一,重建误差逐渐上升,而阈值计数呈台阶。 $\beta$ 从 $10^{-2}$ 到 0.1、0.3、1,MSE 是 $0.0247\to0.2119\to0.6206\to1.0000$;超过 KL 阈值的维度数为 $4\to4\to3\to0$。总 KL 打印到三位小数为 0.000 不代表数学上精确为零,应连同逐维均值和方差判断近似坍缩。
第二,计数与因子数相等是一项观察。 $\beta=10^{-3}$ 时逐维 KL 约为 [2.96, 0.002, 3.19, 0.004, 3.12, 3.18, 0.001, 0.001]。超过阈值的四维与合成数据四个驱动因子的数量相同;不能据此证明一维对应一个因子、模型发现了真实因子,或冗余维度一定关闭。
第三,相同训练算法在不同正则下产生不同尺度。 无 L2 时从 1.0067($\beta=10^{-3}$)到 2.0596($\beta=10^{-6}$);L2 系数 $10^{-3}$、$\beta=10^{-6}$ 时为 2.7174,对应 RMS 倒数 0.3680。这是有限训练的配对观察,不能证明 SD 的 5.49 来自同一机制。
代码把 wd * W 加入 Adam 的梯度,作用于五组编码器/解码器矩阵,是耦合 L2 正则,不是 AdamW。单看解码器,放大 latent 可以缩小相应权重;但编码器权重与后验方差也会同时变化,所以完整正则不能只归因为“小解码器偏好”。本实验固定单个 seed,没有跨 seed 统计,不能推出一般尺度漂移机制。
3.3 节那组闭式解值得单独验,因为「后验坍缩阈值 $\lambda = 1$」这个结论如果错了,整篇文章的框架就错了。做法是直接对 $(w, m, \log s)$ 做梯度下降。
def closed_form(beta, v=V, sigma_x=SIGMA_X):
    lam = beta * sigma_x ** 2 / v
    if lam >= 1.0:                  # lambda >= 1:坍缩
        return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True)
    u = 1.0 - lam
    return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False)
($v = 1$、$\sigma_{\text{dec}} = 1$,所以 $\lambda = \beta$、坍缩阈值 $\beta^{\ast} = 1$。)对照结果:
  beta   lambda |    u=wm 预测        拟合 |    s^2 预测        拟合 |    w^2 预测        拟合 | 坍缩
  0.05    0.050 |     0.9500    0.9500 |    0.0500    0.0500 |    0.9500    0.9500 | 否
   0.1    0.100 |     0.9000    0.9000 |    0.1000    0.1000 |    0.9000    0.9000 | 否
   0.2    0.200 |     0.8000    0.8000 |    0.2000    0.2000 |    0.8000    0.8000 | 否
   0.4    0.400 |     0.6000    0.6000 |    0.4000    0.4000 |    0.6000    0.6000 | 否
   0.6    0.600 |     0.4000    0.4000 |    0.6000    0.6000 |    0.4000    0.4000 | 否
   0.8    0.800 |     0.2000    0.2000 |    0.8000    0.8000 |    0.2000    0.2000 | 否
  0.95    0.950 |     0.0500    0.0500 |    0.9500    0.9500 |    0.0500    0.0500 | 否
     1    1.000 |     0.0000    0.0000 |    1.0000    1.0000 |    0.0000    0.0000 | 是
   1.2    1.200 |     0.0000    0.0000 |    1.0000    1.0000 |    0.0000    0.0000 | 是
     2    2.000 |     0.0000    0.0000 |    1.0000    1.0000 |    0.0000    0.0000 | 是
     5    5.000 |     0.0000    0.0000 |    1.0000    1.0000 |    0.0000    0.0000 | 是

未坍缩区间内,闭式解与数值拟合的最大偏差:5.91e-06

坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0):
  beta=0.05   dJ/dw=+0.00e+00  dJ/dm=+0.00e+00  dJ/ds=+0.00e+00
  beta=0.5    dJ/dw=+0.00e+00  dJ/dm=+0.00e+00  dJ/ds=+0.00e+00
  beta=1      dJ/dw=+0.00e+00  dJ/dm=+0.00e+00  dJ/ds=+0.00e+00
  beta=5      dJ/dw=+0.00e+00  dJ/dm=+0.00e+00  dJ/ds=+0.00e+00

坍缩点 vs 解析解的目标函数值(谁小谁是最优):
  beta=0.05   J(解析解)=  0.09989  J(坍缩点)=  0.50000
  beta=0.5    J(解析解)=  0.42329  J(坍缩点)=  0.50000
  beta=0.9    J(解析解)=  0.49741  J(坍缩点)=  0.50000
  beta=1      J(解析解)=  0.50000  J(坍缩点)=        —
beta=2 J(解析解)= 0.50000 J(坍缩点)= —三处细节值得留意。偏差 5.91e-06 是有限步优化与闭式解的一致性检查,全局正确性来自 3.3 节的消元证明。梯度恒等于 0 说明坍缩点在任意 $\beta$ 下都是驻点——它一直「在那儿」,$\lambda \ge 1$ 时它只是终于变成了最小值。$\beta = 0.9$ 时两者的目标值只差 0.0026,只说明本线性目标的最优值接近坍缩值;不是势垒或坍缩速度的测量,不能据此推断真实网络的训练动力学。
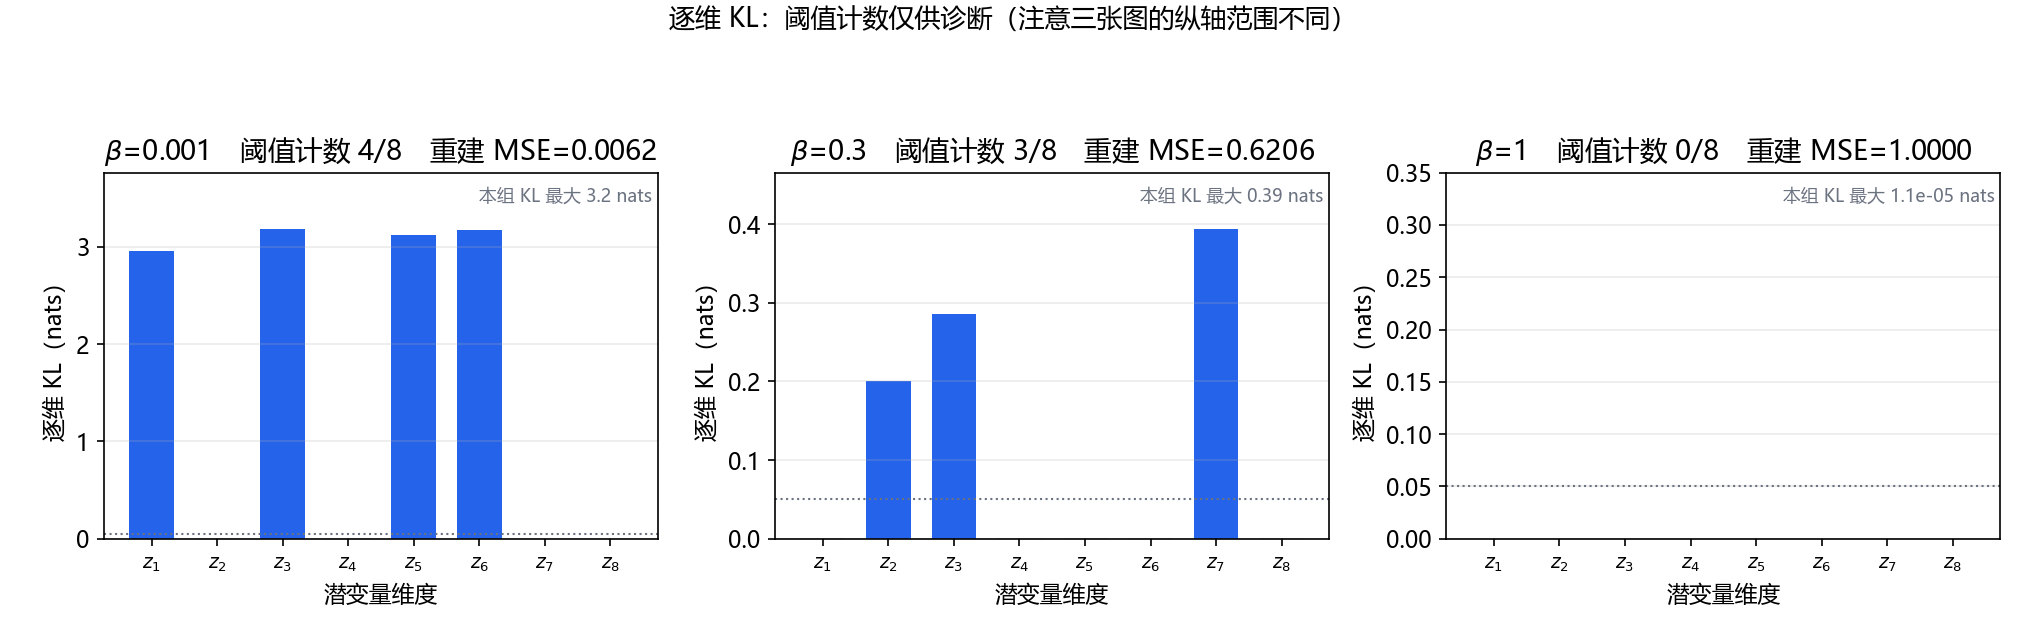
这张图要看什么:三张子图是三档 $\beta$ 下逐维 KL 的柱状图,蓝色是超过 0.05 nat 阈值的维度,灰色是低于阈值的维度。注意三张图的纵轴量级完全不同(3.19 / 0.39 / 0.00001 nats,差五个数量级),各图保留至少 0.35 nat 的纵轴范围以显示阈值线,并标注本组 KL 最大值而非纵轴上限——如果共享纵轴,后两张会被压成一条线,看不出结构。$\beta = 10^{-3}$ 时是 4 根高柱加 4 根贴地;$\beta = 0.3$ 时只剩 3 根矮柱,重建 MSE 已经涨到 0.6206;$\beta = 1$ 时一根都没有。
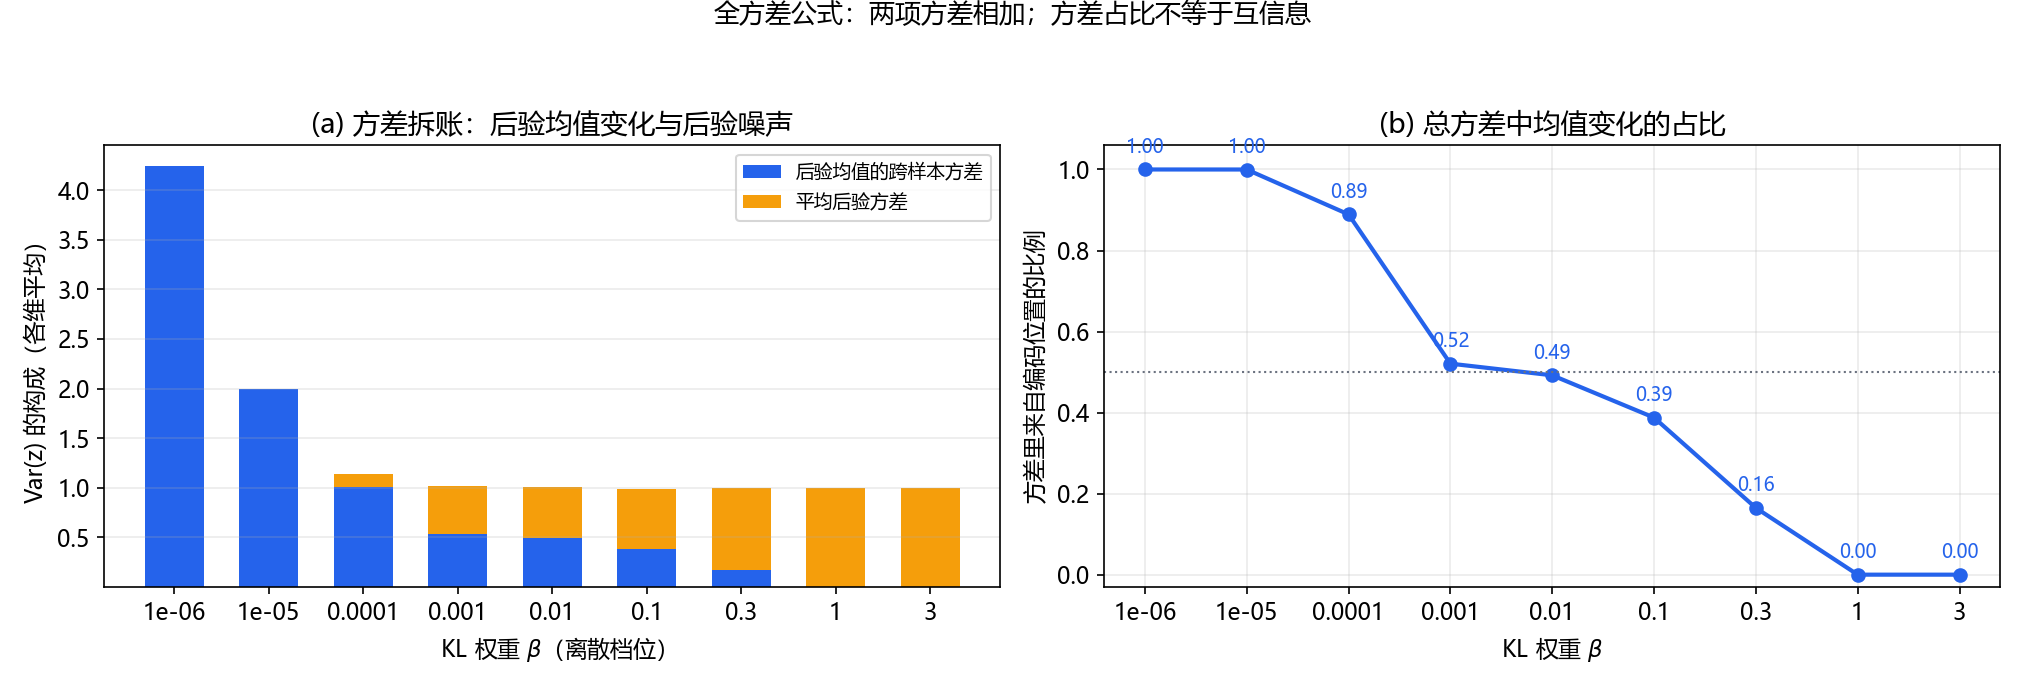
这张图左侧按全方差公式堆叠两项方差:跨样本后验均值方差、平均后验方差;右侧显示第一项占总方差的比例。两项方差相加后开方才得到边际标准差,标准差本身不能直接堆叠。这个分解描述二阶统计,不能等同于信息与噪声的互信息分解。
这张图帮助理解尺度与信息的区别:相同的边际方差可以来自不同的均值/条件方差组合。缩放只调整统计尺度,不保证 latent 的语义分布匹配,也不能单凭 std 判断是否坍缩。
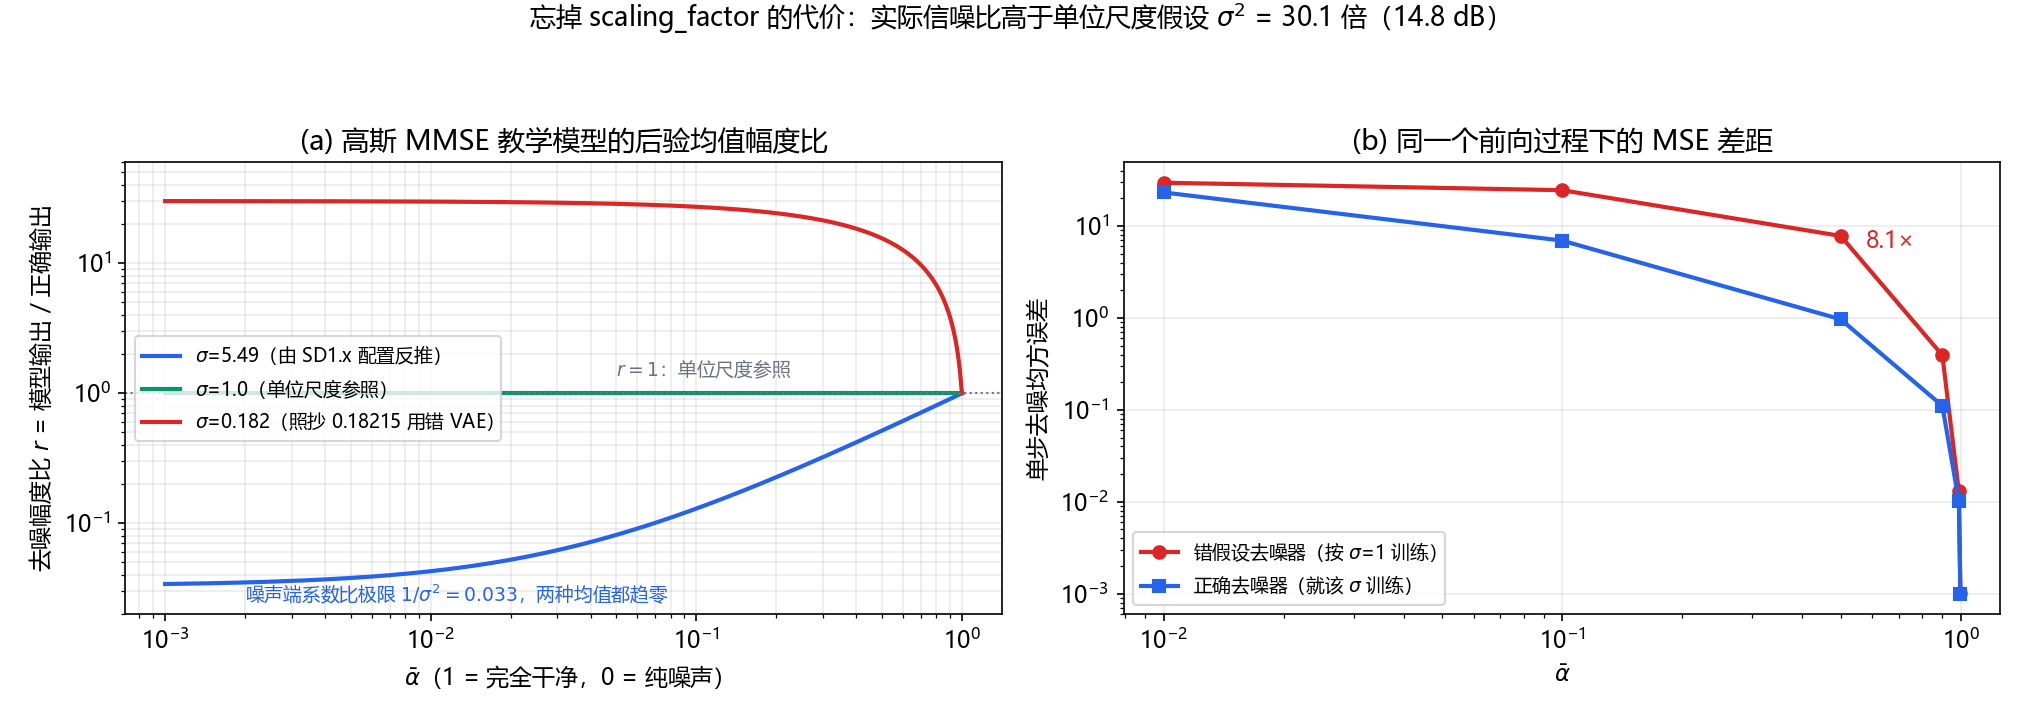
这张图要看什么:左图的纵轴是对数的,三条线分别是三种潜空间尺度下的去噪幅度比 $r$。绿线 $\sigma = 1.0$ 平在 $r = 1$ 上(正确);蓝线是按 SD1.x 配置倒数构造的教学情形 $\sigma = 5.49$,$\bar{\alpha}$ 越小掉得越狠,最左端贴在 $1/\sigma^{2} = 0.033$,也就是幅度只剩 3.3%(后验均值幅度偏小);红线是反向错误——潜空间其实是单位方差却照抄了 0.18215,$\sigma$ 变成 0.182,$r$ 冲到 30 倍(后验均值幅度偏大)。右图是同一个前向过程下两种去噪器的均方误差,中段拉开 8 倍,两端收敛($\bar{\alpha} \to 1$ 时都没噪声要除,$\bar{\alpha} \to 0$ 时都没信息可用——误差差距最大的地方在中间,这跟直觉不太一样)。
   alpha_bar |      错假设 MSE       正确 MSE         理论后验方差       恶化倍数
       0.999 |       0.0010       0.0010         0.0010       1.03x
        0.99 |       0.0130       0.0101         0.0101       1.28x
         0.9 |       0.3933       0.1106         0.1107       3.55x
         0.5 |       7.8154       0.9682         0.9679       8.07x
         0.1 |      24.5816       6.9502         6.9305       3.54x
        0.01 |      29.6359      23.2187        23.1056       1.28x
「理论后验方差」一列是和蒙特卡洛结果并排校核的:$\bar{\alpha}=0.5$ 处 0.9679 对 0.9682,这一格的差值约 $3\times10^{-4}$;其他格的采样波动会更大,不能把单个差值当作整张表的误差保证。
以下核对固定 diffusers v0.35.1 的 AutoencoderKL 与 DiagonalGaussianDistribution,以及 LDM 固定提交 a506df5756472e2ebaf9078affdde2c4f1502cd4 的标定和训练损失。源码版本固定于链接;2026-10-13 执行了原分布类与 retrieve_latents 函数的 CPU 最小对照,未运行预训练权重或整条生成管线。
编码链路(AutoencoderKL._encode / encode):encoder(x) → quant_conv → 把结果塞进 DiagonalGaussianDistribution。和最小实现的差异有四处:
x 是一个 64 维向量,一层矩阵乘就够;图像要保留空间结构,所以编码器是卷积堆栈,以 SD1.x 的 $f=8$ 配置为例,输出 [B, 2*z_channels, H/8, W/8],每个 latent 空间位置各出一组 $(\mu, \text{logvar})$。KL 也因此对每个元素都算一次。quant_conv 是 1×1 卷积,默认从 `2latent_channels映到同样的通道数**。编码器已经输出均值与 logvar 所需的双倍通道;这里做通道混合,随后torch.chunk(parameters, 2, dim=1)` 分成两组,不是在 quant_conv 这一步翻倍。logvar 被硬截断到 $[-30, 20]$,这一行是 self.logvar = torch.clamp(self.logvar, -30.0, 20.0)。别小看它:$\exp(20) = 4.85\times10^{8}$,$\exp(-30) = 9.36\times10^{-14}$。我的最小实现里也照抄了这个阈值。不加截断,很大的 logvar 会增大 KL,极小值会压低采样标准差;exp(20) 在 float16 中仍会溢出,截断不能替代 dtype 控制。手写实现对截断外的 logvar 原始输出置零梯度;边界处不可微,验证避开端点。encode 返回的是后验分布,不乘 scaling factor。这一步由调用方负责——pipeline 里显式写 latents = vae.encode(image).latent_dist.sample() * vae.config.scaling_factor。这个设计是个典型的「容易漏」:它不在 encode 里面,所以复制粘贴半段代码就会丢掉。推理时用 sample() 还是 mode():两者都合法,必须与具体管线的约定一致。mode() 返回均值,适合需要确定性编码的实验;sample(generator=...) 返回后验样本,固定随机生成器也能复现。diffusers 的 Stable Diffusion img2img 中 retrieve_latents 默认走 sample,所以不能说图生图、修补必须用 mode()。deterministic=True 是把分布对象的方差与标准差置零的特殊模式,不等于重新训练过的普通自编码器。
KL 的实现细节:kl() 里写的是 0.5 * torch.sum(torch.pow(self.mean, 2) + self.var - 1.0 - self.logvar, dim=[1, 2, 3])。跟 3.2 节那个式子逐字对上(var 就是 $\sigma^{2}$,logvar 就是 $\log\sigma^{2}$),只是求和范围从「8 个潜变量维度」变成「$4 \times 64 \times 64 = 16384$ 个元素」,对四维图像 latent 返回每个样本一个标量。此方法默认只求和第 1、2、3 维,把五维视频张量直接传入会留下最后一维;本次 CPU 实跑时参数张量形状如下,分成均值和 logvar 后,KL 返回 [2,4]。参数张量与默认输出的对应关系:
parameters: [2, 8, 2, 3, 4]
mean/logvar: [2, 4, 2, 3, 4]
kl() default: [2, 4]
所以视频模型必须核对专用实现或显式归约全部非 batch 维,不能把图像接口原样套上去。这一点是全文最容易被忽略的工程事实:KL 是逐元素求和的,所以潜变量个数一变,同一个 $\beta$ 数值的含义完全不同。LDM 用 $10^{-6}$、我的实验用 $10^{-3}\sim1$,这两个数不能直接比较。LDM 的 原损失实现把重建/感知项按 batch 平均的元素和计算,KL 也先求元素和再按 batch 平均;本脚本重建却按元素平均。比较 $\beta$ 必须同时记录形状、归约、似然尺度以及感知/对抗项。
视频 VAE 上这条线怎么延伸:时间维一起下采样,例如一种时空压缩约定下为 [B, C, T/4, H/8, W/8];实际首帧/因果边界及倍率依模型而定,KL 求和范围又大了一个量级。KL 虽逐元素求和,但编码器、解码器会耦合各维,不能保证各维独立开关。元素数增大时还要同时看重建项如何归约,不能仅凭维度数断言同一 β 必然关闭更多维度——这也是为什么视频 VAE 的 loss 配比需要单开一篇(见 视频 VAE 的常见 loss 组合)。
带 shift 的 VAE 要区分编码和解码方向:例如 diffusers 的 SD3 管线 在解码前使用 $z_{\text{raw}}=z_{\text{diffusion}}/\text{scale}+\text{shift}$;对应的正向变换才是 $z_{\text{diffusion}}=(z_{\text{raw}}-\text{shift})\cdot\text{scale}$。读取具体 checkpoint 的配置和管线,不把 SD1.x 的常数套到 SD3 / FLUX。
VAE 是有损压缩,需要先量重建误差。 以 $f=8$、4 latent 通道为例,512×512 RGB 图变成 $4\times64\times64=16384$ 个 latent 元素,元素数比为 48。这不是文件字节压缩比,也不是 FLOPs 加速比,后者还取决于 dtype、网络通道和实现。细纹理、文字等是否损失要通过具体 VAE 重建验证;生成先验可以猜出合理细节,却不能保证恢复压缩前同一张图的真实细节。
减小 $\beta$ 可能改善拟合,却不能保证全局性能单调。 本 toy 展示重建与正则的权衡,实际网络还受优化、结构与其他损失影响。更大的平均 KL 既可能承载信息,也可能表示聚合后验偏离先验。换 VAE 时核对语义、通道、尺度、shift 和扩散模型训练约定,一个标量缩放不能保证兼容。
增大 $\beta$ 会提高信息代价,但阈值来自指定模型。 在线性闭式模型中,未坍缩区 MSE 为 $\beta\sigma_{\text{dec}}^2$,到阈值后连续接到 $v$;逐维 KL 连续趋零。本文神经 toy 在脚本 $\beta=1$ 附近拟合接近均值基线,不能把 1 称为所有 VAE 的坍缩阈值。
保真任务要实测而非一律排除 latent。 超分、医学或文档生成需要核对细节保真和任务指标,可比较像素空间、低压缩倍率或多尺度方案。LDM 原文本身也展示了超分模型,所以“超分不能用 latent”不成立。算力收益与压缩误差需要一起评估。
另一条路线:VQ。 用有限码本替换连续高斯,带来量化误差、码本容量与使用率等另一组权衡。LDM 论文观察到它所用的 VQ latent 方差接近 1;这不是离散化的数学保证,码本仍然可以整体缩放,是否需要归一化要看实际训练分布。
顺着这条线看,故事其实是「潜空间的统计性质从哪儿来」在被一步步讲清楚:2013 年给了目标函数,2017 年研究权重与表征的权衡,2017—2021 年发展离散化和感知训练路线,2022 年把压缩与 latent 尺度约定纳入扩散模型设计。各路线有不同目标,不能概括为前者被后者彻底替代。
误解一:KL 既然是正则项,越大越好。 KL 确实可以看作正则,也可用信息预算解释,但增强它会牺牲重建。第 09 节的密集扫描显示 MSE 从 $0.0650$ 到 $0.8881$ 逐步上升;台阶出现在人为设阈值的存活维度计数,不能把稀疏扫描误读为“中间没有过渡”。
误解二:任意 KL 权重下都在拟合原模型的真实后验。 当 $\beta=1$ 且变分族足够时,最优 $q$ 可以等于该生成模型的真实后验;本文线性高斯模型就是例子。$\beta\ne1$ 则改变权衡,存活区 $s^2=\beta\sigma_{\text{dec}}^2/v$ 同时依赖权重、观测噪声和数据方差 $v$,不能说与数据无关。
误解三:聚合后验等于先验就意味着坍缩。 逐样本 $q(z\mid x)$ 和聚合后验 $q(z)=\int q(z\mid x)p_{\text{data}}(x)\,dx$ 是两个对象。本文未坍缩线性解满足 $m^2v+s^2=(1-\lambda)+\lambda=1$,因而 $q(z)=\mathcal N(0,1)$,但 $m\ne0$,仍然传递信息。真正的完全坍缩要求几乎所有输入的整个 $q(z\mid x)$ 都等于同一个先验。
误解四:scaling factor 是固定的魔法常数。 LDM 的标定实现使用首个训练 batch 的 latent 展平后的标准差,令缩放因子为其倒数;这不是逐通道独立归一化。使用预训练模型时应遵守 checkpoint 保存的系数,不能随手在一张新图上重估并替换。换 VAE 还可能改变 latent 的语义和通道分布,重算一个标量不保证与原扩散模型兼容。
误解五:后验采样只在训练时用。 官方 img2img 管线默认也会采样;固定 generator 可以控制随机性。mode() 是去掉编码采样噪声的一种选择,必须核对训练与推理的分布约定,不能统一替换所有管线。
误解六:截断范围等于所有精度下的安全范围。 [-30,20] 是实现中的防护范围,但 exp(20) 超过 fp16 最大有限值,实际还要看计算 dtype 和 VAE 是否上转 fp32。实验中的 logvar 约 −9.4 离 −30 很远,不能仅凭这个数断言已接近数值崩溃。
三个小实验,训练扫描较慢,时间取决于 CPU/BLAS;缓存输出不等于本次训练。建议保存 stdout 并核对种子与配置。
实验一:确认坍缩是「跳」还是「滑」。 一行命令:
python vae_minimal.py --betas=0.03,0.05,0.1,0.2,0.5 --wd=0实测($\text{weight\_decay} = 0$,$250$ epoch,随机种子固定,可复现):
| $\beta$ | $0.03$ | $0.05$ | $0.1$ | $0.2$ | $0.5$ |
|---|---|---|---|---|---|
| 重建 MSE | $0.0650$ | $0.1057$ | $0.2119$ | $0.4200$ | $0.8881$ |
| 总 KL | $5.580$ | $4.554$ | $3.092$ | $1.677$ | $0.196$ |
| 存活维度 | $4/8$ | $4/8$ | $4/8$ | $4/8$ | $1/8$ |
结论:重建误差逐渐增加,存活维度的计数呈台阶。 这里把每维 KL 超过 0.05 nat 计为存活,所以计数天然离散。在线性模型中,每维 KL 为 $-\tfrac12\log\lambda$(未坍缩时),连续趋向 0,并不会从 3 直接跳到 0;应同时观察逐维 KL、重建与均值/方差统计。
实验二:比较耦合 L2 系数对固定 seed 的影响。 把权重衰减单独开到 $10^{-2}$:
python vae_minimal.py --wd=0.01三档权重衰减下 $\text{std}(z)$ 的对照(同一批 $\beta$,小权重处的统计尺度变化更明显):
| $\beta$ | $\text{wd} = 0$ | $\text{wd} = 10^{-3}$ | $\text{wd} = 10^{-2}$ |
|---|---|---|---|
| $10^{-6}$ | $2.0596$ | $2.7174$ | $2.6747$ |
| $10^{-5}$ | $1.4107$ | $2.5978$ | $2.6385$ |
| $10^{-4}$ | $1.0651$ | $2.0580$ | $2.5400$ |
| $10^{-3}$ | $1.0067$ | $1.3082$ | $2.0464$ |
| $10^{-2}$ | $1.0055$ | $1.0689$ | $1.3657$ |
| $10^{-1}$ | $0.9952$ | $1.0051$ | $1.0523$ |
| $3\times10^{-1}$ | $1.0000$ | $1.0018$ | $1.0000$ |
看这张表的方式是看「回到 1.00 的那个拐点」在往右挪:$\text{wd} = 0$ 时 $\beta \ge 10^{-3}$ 就已经归位;$\text{wd} = 10^{-3}$ 时要到 $\beta \ge 10^{-2}$;$\text{wd} = 10^{-2}$ 时要一路推到 $\beta \ge 0.3$。权重衰减把「潜尺度失控」的区间往大 $\beta$ 方向整整推了两个数量级。一个诚实的补充:$10^{-6}$ 那一档 $10^{-2}$ 的 $2.6747$ 反而略低于 $10^{-3}$ 的 $2.7174$,说明这三个有限训练结果不严格单调;单 seed、三个档位不足以证明饱和或一般因果机制。
实验三:反向验证 scaling factor。 指定另外两个标定系数各跑一次;这个参数通过 $\sigma=1/s$ 构造不同数据方差,不是在同一个 SD latent 上分别应用 0.5 和 2.0(--sf 会把整张表按新系数重算):
python latent_scaling.py --sf=0.5
python latent_scaling.py --sf=2.0
实际结果:
| $\text{scaling factor}$ | $\text{std}(z)$ | $r$ 在 $\bar{\alpha}=0.999$ | $r$ 在 $\bar{\alpha}=0.01$ | $\bar{\alpha}=0.5$ 处 MSE 比值 |
|---|---|---|---|---|
| $0.18215$(SD1.x 系数对应 toy) | $5.4900$ | $0.9990$ | $0.0428$ | $8.07\times$ |
| $0.5$(另一标定系数) | $2.0000$ | $0.9992$ | $0.2575$ | $1.57\times$ |
| $2.0$(另一标定系数) | $0.5000$ | $1.0030$ | $3.9700$ | $1.56\times$ |
$\sigma = 2$ 时 $r$ 全程在 1 以下(最低 $0.2575$,正是 $1/\sigma^{2} = 0.25$ 加上 $\bar{\alpha}$ 那一项),该高斯估计器的幅度偏小;$\sigma = 0.5$ 时 $r$ 全程在 1 以上(最高 $3.97$,趋近 $1/\sigma^{2} = 4$),该高斯估计器的幅度偏大。在这个高斯模型中:$r$ 是大于还是小于 1,只取决于 $\sigma$ 是大于还是小于 1;当 $\bar{\alpha}\to0$ 时系数比趋向 $1/\sigma^2$,但两个后验均值本身趋零、MSE 差也趋零。表中 8.07 倍是 $\bar{\alpha}=0.5$ 的有限 Monte Carlo 误差比,不能与噪声端 0.0428 的系数比混为一项指标。它说明与预训练模型尺度约定一致的重要性,不提供真实图像质量或完整采样链的性能保证。
logvar 截断那类技巧在 fp16 下会变得更关键。09 节用到的脚本全文如下(vae_minimal.py、collapse_closed_form.py、latent_scaling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""最小 VAE:numpy 手写反向传播,扫 KL 权重 beta,观察潜空间统计量怎么变。

这篇文章要回答的问题是:KL 权重 beta 调大调小,到底改变了什么?
本脚本做两轮对照实验:

  条件 A(无权重衰减):观察不同 beta 下的潜尺度,不能预设所有 beta 都接近 1。
  条件 B(权重衰减 1e-3):对五组编码/解码权重同时加入 L2 梯度;
                          与条件 A 比较固定 seed 的训练结果,不能单独归因解码器。

两轮对照展示本模型在有限优化下的尺度变化。平均 KL 同时惩罚信息与
聚合后验偏离先验,不能保证每个 beta 的边际尺度精确等于 1。
固定 seed 的结果不能反推 Stable Diffusion 的训练轨迹或一般因果机制。

运行:  python vae_minimal.py
依赖:  numpy
"""

import os
import json
import numpy as np

# ── 固定随机性,保证正文里贴的每个数字都能复现 ─────────────────────────
DATA_SEED = 0
INIT_SEED = 1
BATCH_SEED = 2
EVAL_SEED = 3

N_TRAIN = 4096      # 训练样本数
D_OBS = 64          # 观测维度(类比一张图的像素数)
H_HID = 128         # 编码器/解码器隐藏层
D_LAT = 8           # 潜变量维度
K_FAC = 4           # 合成数据的真实因子数(< D_LAT,故意留出冗余维度)
EPOCHS = 250
BATCH = 256
LR = 3e-3
LOGVAR_MIN, LOGVAR_MAX = -30.0, 20.0   # 与 diffusers DiagonalGaussianDistribution 一致

BETAS = [1e-6, 1e-5, 1e-4, 1e-3, 1e-2, 1e-1, 3e-1, 1.0, 3.0]
WD_LIST = [0.0, 1e-3]                  # 两轮对照:无权重衰减 / 有权重衰减


# ─────────────────────────── 合成数据 ───────────────────────────
def make_data(n=N_TRAIN, d=D_OBS, k=K_FAC, seed=DATA_SEED):
    """x = A u + 观测噪声,u 是 k 维高斯因子。

    教学数据由 k=4 个高斯因子驱动,并带观测噪声;不宣称真实图像只有四因子。
    潜变量维度 D_LAT=8 > 4,留出冗余以便比较逐维 KL;后验坍缩不要求冗余维度。
    最后仅除以训练集逐维标准差,不减样本均值。输出逐维训练均值时 MSE 精确为 1;
    输出零时会额外含样本均值平方。下文 evaluate 也使用同一训练集,不是泛化测试。
    """
    rng = np.random.default_rng(seed)
    A = rng.normal(size=(d, k)) / np.sqrt(k)
    U = rng.normal(size=(n, k))
    X = U @ A.T + 0.05 * rng.normal(size=(n, d))
    X = X / X.std(axis=0, keepdims=True)      # 逐维方差 = 1
    return X


# ─────────────────────────── 模型 ───────────────────────────
class VAE:
    """编码器 x -> h -> (mu, logvar),解码器 z -> g -> x_hat。

    符号与正文第 03 节一致:
        h      = relu(x W1 + b1)              编码器隐藏层
        mu     = h Wmu + bmu                  后验均值
        logvar = h Wlv + blv                  后验对数方差(网络出的是 log sigma^2)
        z      = mu + exp(0.5 logvar) * eps   重参数化
        x_hat  = relu(z V1 + c1) V2 + c2      解码器
    """

    def __init__(self, d_obs=D_OBS, h=H_HID, d_lat=D_LAT, seed=INIT_SEED):
        rng = np.random.default_rng(seed)
        sc = lambda fan_in, fan_out: rng.normal(
            scale=np.sqrt(2.0 / (fan_in + fan_out)), size=(fan_in, fan_out)
        )
        self.p = {}
        self.p["W1"] = sc(d_obs, h)
        self.p["b1"] = np.zeros(h)
        self.p["Wmu"] = sc(h, d_lat)
        self.p["bmu"] = np.zeros(d_lat)
        self.p["Wlv"] = sc(h, d_lat)
        self.p["blv"] = np.zeros(d_lat)
        self.p["V1"] = sc(d_lat, h)
        self.p["c1"] = np.zeros(h)
        self.p["V2"] = sc(h, d_obs)
        self.p["c2"] = np.zeros(d_obs)
        self.d_obs, self.h, self.d_lat = d_obs, h, d_lat

    def forward(self, x, eps):
        p = self.p
        h1 = np.maximum(x @ p["W1"] + p["b1"], 0.0)
        mu = h1 @ p["Wmu"] + p["bmu"]
        lv_raw = h1 @ p["Wlv"] + p["blv"]
        lv = np.clip(lv_raw, LOGVAR_MIN, LOGVAR_MAX)   # 防 exp 溢出,见第 05 节
        sig = np.exp(0.5 * lv)
        z = mu + sig * eps
        g1 = np.maximum(z @ p["V1"] + p["c1"], 0.0)
        xhat = g1 @ p["V2"] + p["c2"]
        cache = dict(x=x, h1=h1, mu=mu, lv=lv, lv_raw=lv_raw, sig=sig,
                     z=z, g1=g1, xhat=xhat, eps=eps)
        return xhat, cache

    @staticmethod
    def losses(x, xhat, mu, lv, sig):
        """recon = 逐元素均方误差;kl = 0.5 * sum_d(mu^2 + var - 1 - logvar)。

        注意 kl 是对潜变量维度「求和」而不是求平均——这是标准写法,
        比较 beta 还需同时记录重建归约和张量形状,不能仅按潜维数推断最优行为。
        """
        recon = float(np.mean((xhat - x) ** 2))
        kl_dim = 0.5 * np.mean(mu ** 2 + sig ** 2 - lv - 1.0, axis=0)  # [d]
        return recon, kl_dim, float(np.sum(kl_dim))

    def backward(self, cache, beta):
        """全部手推。grad 的形状与 self.p 一一对应。"""
        p = self.p
        x, h1, mu, lv, lv_raw, sig, z, g1, xhat, eps = (
            cache[k] for k in ["x", "h1", "mu", "lv", "lv_raw", "sig", "z", "g1", "xhat", "eps"]
        )
        B, D = x.shape[0], self.d_obs
        g = {k: np.zeros_like(v) for k, v in p.items()}

        # 重建项:recon = mean((xhat - x)^2),d/d(xhat) = 2 (xhat - x) / (B*D)
        dxhat = 2.0 * (xhat - x) / (B * D)
        g["V2"] += g1.T @ dxhat
        g["c2"] += dxhat.sum(axis=0)
        dg1 = (dxhat @ p["V2"].T) * (g1 > 0)          # relu
        g["V1"] += z.T @ dg1
        g["c1"] += dg1.sum(axis=0)
        dz = dg1 @ p["V1"].T                          # [B, d]

        # 重参数化:dz 同时流回 mu 与 logvar 两条支路
        dmu = dz + beta * mu / B                      # KL 对 mu 的导数 = beta * mu
        dlv = dz * (0.5 * sig * eps) + beta * 0.5 * (sig ** 2 - 1.0) / B
        # 被 clamp 的位置梯度必须截断,否则会用未截断的 logvar 继续更新
        dlv = dlv * ((lv_raw > LOGVAR_MIN) & (lv_raw < LOGVAR_MAX))

        g["Wmu"] += h1.T @ dmu
        g["bmu"] += dmu.sum(axis=0)
        g["Wlv"] += h1.T @ dlv
        g["blv"] += dlv.sum(axis=0)
        dh1 = (dmu @ p["Wmu"].T + dlv @ p["Wlv"].T) * (h1 > 0)
        g["W1"] += x.T @ dh1
        g["b1"] += dh1.sum(axis=0)
        return g


# ─────────────────────────── Adam ───────────────────────────
class Adam:
    def __init__(self, params, lr=LR, b1=0.9, b2=0.999, eps=1e-8):
        self.m = {k: np.zeros_like(v) for k, v in params.items()}
        self.v = {k: np.zeros_like(v) for k, v in params.items()}
        self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps
        self.t = 0

    def step(self, params, grads):
        self.t += 1
        for k in params:
            self.m[k] = self.b1 * self.m[k] + (1 - self.b1) * grads[k]
            self.v[k] = self.b2 * self.v[k] + (1 - self.b2) * grads[k] ** 2
            mhat = self.m[k] / (1 - self.b1 ** self.t)
            vhat = self.v[k] / (1 - self.b2 ** self.t)
            params[k] -= self.lr * mhat / (np.sqrt(vhat) + self.eps)


def train(beta, X, weight_decay=0.0, epochs=EPOCHS, batch=BATCH, seed=BATCH_SEED):
    """训练一个 VAE。weight_decay 是本次实验的关键对照变量。"""
    rng = np.random.default_rng(seed)
    model = VAE()
    opt = Adam(model.p)
    n = X.shape[0]
    for _ in range(epochs):
        perm = rng.permutation(n)
        for s in range(0, n, batch):
            xb = X[perm[s:s + batch]]
            eps = rng.normal(size=(xb.shape[0], D_LAT))
            xhat, cache = model.forward(xb, eps)
            model.losses(xb, xhat, cache["mu"], cache["lv"], cache["sig"])
            grads = model.backward(cache, beta)
            if weight_decay > 0:                      # 只对权重做衰减,偏置不管
                for k in ["W1", "Wmu", "Wlv", "V1", "V2"]:
                    grads[k] += weight_decay * model.p[k]
            opt.step(model.p, grads)
    return model


def evaluate(model, X, beta, weight_decay=0.0, n_repeat=8):
    """统计潜空间性质,并把边际标准差拆成两半:

        Var(z_j) = Var_x(mu_j(x)) + E_x[sigma_j(x)^2]

    前一半是「不同样本被编码到不同位置」,后一半是「每个样本自己抖多少」。
    scaling_factor 要归一化的是两者之和的开方。
    """
    rng = np.random.default_rng(EVAL_SEED)
    n, d = X.shape[0], D_LAT
    mu_all = np.empty((n, d))
    var_all = np.empty((n, d))
    recon_all = 0.0
    kl_dim_all = np.zeros(d)

    for s in range(0, n, 512):
        xb = X[s:s + 512]
        B = xb.shape[0]
        h1 = np.maximum(xb @ model.p["W1"] + model.p["b1"], 0.0)
        mu = h1 @ model.p["Wmu"] + model.p["bmu"]
        lv = np.clip(h1 @ model.p["Wlv"] + model.p["blv"], LOGVAR_MIN, LOGVAR_MAX)
        var = np.exp(lv)
        sig = np.sqrt(var)
        mu_all[s:s + B] = mu
        var_all[s:s + B] = var
        # 逐维 KL:先对 batch 求和,最后统一除以总样本数
        kl_dim_all += 0.5 * np.sum(mu ** 2 + var - lv - 1.0, axis=0) / n
        # 用同一个 mu 重复采样 n_repeat 次,估计解码器实际看到的抖动有多大
        eps = rng.normal(size=(B, n_repeat, d))
        z = mu[:, None, :] + sig[:, None, :] * eps
        z_flat = z.reshape(-1, d)
        h1d = np.maximum(z_flat @ model.p["V1"] + model.p["c1"], 0.0)
        xhat = (h1d @ model.p["V2"] + model.p["c2"]).reshape(B, n_repeat, D_OBS)
        recon_all += np.sum((xhat - xb[:, None, :]) ** 2) / (n * n_repeat * D_OBS)

    std_mu = mu_all.std(axis=0)                                   # [d]
    mean_sig = np.sqrt(var_all.mean(axis=0))                      # [d]
    marginal_std = np.sqrt(std_mu ** 2 + var_all.mean(axis=0))    # [d]
    overall_std = float(np.sqrt(np.mean(marginal_std ** 2)))
    return dict(
        beta=beta,
        weight_decay=weight_decay,
        recon=float(recon_all),
        kl=float(np.sum(kl_dim_all)),
        kl_dim=kl_dim_all.tolist(),
        std_mu=std_mu.tolist(),
        mean_sig=mean_sig.tolist(),
        marginal_std=marginal_std.tolist(),
        overall_std=overall_std,
        scaling_factor=1.0 / overall_std,
        active_dims=int(np.sum(kl_dim_all > 0.05)),   # 仅为本实验 KL 阈值计数,不是互信息/AU
        mean_mu=mu_all.mean(axis=0).tolist(),
        flat_std=float(np.sqrt(np.mean(marginal_std ** 2) + np.var(mu_all.mean(axis=0)))),
        data_mean_mse=float(np.mean((X-X.mean(axis=0)) ** 2)),
        data_zero_mse=float(np.mean(X ** 2)),
    )


def sweep(wd_list=None, betas=None, verbose=True):
    wd_list = WD_LIST if wd_list is None else wd_list
    betas = BETAS if betas is None else betas
    X = make_data()
    out = {}
    for wd in wd_list:
        rows = []
        for beta in betas:
            model = train(beta, X, weight_decay=wd)
            rows.append(evaluate(model, X, beta, weight_decay=wd))
        out[f"wd={wd:g}"] = rows
        if verbose:
            print(f"--- weight_decay = {wd:g} ---")
            for m in rows:
                print(f"  beta={m['beta']:<8g} recon={m['recon']:.4f} "
                      f"kl={m['kl']:9.3f}  std(z)={m['overall_std']:7.4f}  "
                      f"1/std={m['scaling_factor']:7.4f}  active={m['active_dims']}/{D_LAT}")
    return out


CACHE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "beta_sweep.json")


def load_or_sweep(path=CACHE):
    """图与正文共用同一份结果,避免图文数字漂移。"""
    if os.path.exists(path):
        with open(path) as f:
            rows=json.load(f)
        if set(rows) != {f"wd={wd:g}" for wd in WD_LIST}:
            raise ValueError("Figure cache does not contain the two default paired sweeps")
        return rows
    res = sweep()
    with open(path, "w") as f:
        json.dump(res, f, indent=2)
    return res


def _parse_cli(argv):
    """正文 09 节的两个实验就是靠这两个参数复现的:

        python vae_minimal.py --betas 0.03,0.05,0.1,0.2,0.5 --wd 0
        python vae_minimal.py --wd 0.01
    """
    wd_list, betas, full = None, None, False
    for a in argv:
        if a.startswith("--betas="):
            betas = [float(t) for t in a.split("=", 1)[1].split(",")]
        elif a.startswith("--wd="):
            wd_list = [float(t) for t in a.split("=", 1)[1].split(",")]
        elif a == "--full":
            full = True
    return wd_list, betas, full


if __name__ == "__main__":
    import sys

    wd_list, betas, force = _parse_cli(sys.argv[1:])
    custom = wd_list is not None or betas is not None
    if os.path.exists(CACHE) and not force and not custom:
        # 扫描要跑 9 x 2 x 250 = 4500 个 epoch,读缓存是为了让「跑一遍就有输出」
        # 这句话成立;想从头算就加 --full。指定了自定义参数就不走缓存。
        with open(CACHE) as f:
            res = json.load(f)
        print(f"[缓存] 读 {os.path.basename(CACHE)};加 --full 可重跑约 5 分钟的完整扫描")
    else:
        if custom:
            print(f"自定义扫描:wd={wd_list or WD_LIST} beta={betas or BETAS}")
        else:
            print("开始完整扫描(9 个 beta x 2 组权重衰减 x 250 epoch,约 5 分钟)...")
        res = sweep(wd_list, betas)
        if not custom:
            with open(CACHE, "w") as f:
                json.dump(res, f, indent=2)

    print(f"\n{'='*84}")
    print(f"{'weight_decay':>14} {'beta':>9} {'重建MSE':>10} {'总KL':>10} "
          f"{'std(z)':>9} {'1/std':>8} {'存活维度':>8}")
    print(f"{'-'*84}")
    for key, rows in res.items():
        for m in rows:
            print(f"{key:>14} {m['beta']:>9g} {m['recon']:>10.4f} {m['kl']:>10.3f} "
                  f"{m['overall_std']:>9.4f} {m['scaling_factor']:>8.4f} "
                  f"{m['active_dims']:>5}/{D_LAT}")

    print("\n潜尺度拆账(std_mu = 跨维均值变化标准差 RMS;mean_sig = 跨维采样噪声标准差 RMS):")
    for key, rows in res.items():
        print(f"  {key}")
        for m in rows:
            frac = np.mean(np.array(m["std_mu"]) ** 2) / (
                np.mean(np.array(m["std_mu"]) ** 2) + np.mean(np.array(m["mean_sig"]) ** 2))
            print(f"    beta={m['beta']:<8g} std_mu={np.sqrt(np.mean(np.array(m['std_mu']) ** 2)):6.3f} "
                  f"mean_sig={np.sqrt(np.mean(np.array(m['mean_sig']) ** 2)):6.3f} std(z)={m['overall_std']:6.3f} "
f"均值变化方差占比={frac:5.1%}")"""一维线性 VAE 的闭式解:后验坍缩的阈值到底在哪。
第 03 节推了这么一个结论:
设 数据 x ~ N(0, v),编码器 q(z|x) = N(m x, s^2),
解码器 p(x|z) = N(w z, sigma_x^2)(sigma_x 固定,等价于重建项的权重),
目标 J = [v(1-wm)^2 + w^2 s^2] / (2 sigma_x^2)
+ beta * 0.5 * (m^2 v + s^2 - log s^2 - 1)
令 lambda = beta * sigma_x^2 / v,则驻点为
u := w m = 1 - lambda (潜变量被真正使用的程度)
s^2 = lambda (后验方差)
w^2 = v (1 - lambda) (解码器权重)
当 lambda > 1 时此分支要求 w^2 < 0,不存在实数解;lambda = 1 接到坍缩点,最优解退化为坍缩点 (w, m, s) = (0, 0, 1)。
这个脚本用数值优化去拟合 (w, m, s),逐项对照闭式解,
顺便验证「坍缩点永远是一个驻点」这件事。
运行: python collapse_closed_form.py
依赖: numpy
"""
import numpy as np
V = 1.0 # 数据方差
SIGMA_X = 1.0 # 解码器的观测噪声标准差,固定(它就是重建项的隐式权重)
# ─────────────────────────── 目标函数与梯度 ───────────────────────────
def objective(w, m, s, beta, v=V, sigma_x=SIGMA_X):
recon = (v * (1.0 - w * m) ** 2 + w ** 2 * s ** 2) / (2.0 * sigma_x ** 2)
kl = 0.5 * beta * (m ** 2 * v + s ** 2 - np.log(s ** 2) - 1.0)
return recon + kl
def grad(w, m, s, beta, v=V, sigma_x=SIGMA_X):
dJ_dw = (-v * m * (1.0 - w * m) + w * s ** 2) / sigma_x ** 2
dJ_dm = -v * w * (1.0 - w * m) / sigma_x ** 2 + beta * m * v
dJ_ds = w ** 2 * s / sigma_x ** 2 + beta * (s - 1.0 / s)
return dJ_dw, dJ_dm, dJ_ds
def fit(beta, v=V, sigma_x=SIGMA_X, steps=20000, lr=0.02, seed=0):
"""对 (w, m, log s) 做梯度下降。用 log s 参数化保证 s > 0。"""
rng = np.random.default_rng(seed)
w = rng.normal() * 0.5
m = rng.normal() * 0.5
t = rng.normal() * 0.5 # s = exp(t)
for i in range(steps):
s = np.exp(t)
gw, gm, gs = grad(w, m, s, beta, v, sigma_x)
# 对 t 的梯度要过一次链式法则
w -= lr * gw
m -= lr * gm
t -= lr * gs * s
return w, m, np.exp(t)
def closed_form(beta, v=V, sigma_x=SIGMA_X):
if beta <= 0 or v <= 0 or sigma_x <= 0:
raise ValueError("beta, v and sigma_x must be positive")
lam = beta * sigma_x ** 2 / v
if lam >= 1.0: # 坍缩
return dict(lam=lam, u=0.0, s2=1.0, w2=0.0, collapsed=True)
u = 1.0 - lam
return dict(lam=lam, u=u, s2=lam, w2=v * u, collapsed=False)
# ─────────────────────────── 主流程 ───────────────────────────
if __name__ == "__main__":
betas = [0.05, 0.1, 0.2, 0.4, 0.6, 0.8, 0.95, 1.0, 1.2, 2.0, 5.0]
print(f"v = {V}, sigma_x = {SIGMA_X}, lambda = beta * sigma_x^2 / v = {SIGMA_X**2/V} * beta")
print(f"闭式预测:坍缩阈值 beta* = v / sigma_x^2 = {V / SIGMA_X**2:g}\n")
print(f"{'beta':>6} {'lambda':>8} | {'u=wm 预测':>10} {'拟合':>9} "
f"| {'s^2 预测':>9} {'拟合':>9} | {'w^2 预测':>9} {'拟合':>9} | 坍缩")
max_err = 0.0
for beta in betas:
cf = closed_form(beta)
w, m, s = fit(beta)
u_fit = w * m
err = max(abs(u_fit - cf["u"]), abs(s ** 2 - cf["s2"]), abs(w ** 2 - cf["w2"]))
max_err = max(max_err, err) if not cf["collapsed"] else max_err
print(f"{beta:>6g} {cf['lam']:>8.3f} | {cf['u']:>10.4f} {u_fit:>9.4f} "
f"| {cf['s2']:>9.4f} {s**2:>9.4f} | {cf['w2']:>9.4f} {w**2:>9.4f} "
f"| {'是' if cf['collapsed'] else '否'}")
print(f"\n未坍缩区间内,闭式解与数值拟合的最大偏差:{max_err:.2e}")
# 坍缩点是不是永远的驻点?
print("\n坍缩点 (w, m, s) = (0, 0, 1) 处的梯度(应当恒为 0):")
for beta in [0.05, 0.5, 1.0, 5.0]:
gw, gm, gs = grad(0.0, 0.0, 1.0, beta)
print(f" beta={beta:<6g} dJ/dw={gw:+.2e} dJ/dm={gm:+.2e} dJ/ds={gs:+.2e}")
# 坍缩点在不同 beta 下到底是不是最优?比一下目标函数值
print("\n坍缩点 vs 解析解的目标函数值(谁小谁是最优):")
for beta in [0.05, 0.5, 0.9, 1.0, 2.0]:
cf = closed_form(beta)
if cf["collapsed"]:
j_star = objective(0.0, 0.0, 1.0, beta)
j_alt = None
else:
w2 = cf["w2"]
w = np.sqrt(w2)
m = cf["u"] / w
j_star = objective(w, m, np.sqrt(cf["s2"]), beta)
j_alt = objective(0.0, 0.0, 1.0, beta)
alt = " —" if j_alt is None else f"{j_alt:9.5f}"
print(f" beta={beta:<6g} J(解析解)={j_star:9.5f} J(坍缩点)={alt}")"""scaling_factor 到底在补什么:把「潜空间标准差」翻译成「信噪比」。
Stable Diffusion 的 VAE 有个著名常数 0.18215。它是这么用的:
编码: z_scaled = z * 0.18215 (交给扩散模型之前)
解码: z = z_scaled / 0.18215 (交给解码器之前)
核对 checkpoint 配置与实际乘除方向。LDM 原始实现 std-rescaling 分支
用首个 batch 后验样本的展平标准差倒数,并非逐通道独立归一化。
0.18215 是 SD1.x 配置中的缩放系数,1/s 只是它对应的标定尺度,
不表示本脚本实测了该预训练 VAE 的当前输出统计。
本脚本把这段话变成可算的数。核心结论是两条:
1. 若扩散模型是在单位方差潜空间上训练的,它对 z_0 的后验均值估计就是
z_hat_0 = sqrt(alpha_bar) * z_t
(高斯先验 N(0, I) 下的 MMSE 估计)。而真实潜空间标准差是 sigma 时,
正确的 MMSE 估计是
z_hat_0 = sigma^2 sqrt(alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar) * z_t
两者之比 r = alpha_bar + (1 - alpha_bar) / sigma^2。
r 是后验均值系数之比;不能由一维高斯结果推断真实图像亮度或伪影。
2. 每一层的真实信噪比是 sigma^2 * alpha_bar / (1 - alpha_bar),
模型以为的是 alpha_bar / (1 - alpha_bar),整整差 sigma^2 倍
(20*log10(sigma) 分贝)。
运行: python latent_scaling.py
依赖: numpy
"""
import numpy as np
SD_SCALING_FACTOR = 0.18215 # diffusers AutoencoderKL 的默认值
ABARS = [0.999, 0.99, 0.9, 0.5, 0.1, 0.01]
def latent_std_from_scaling(s):
"""scaling_factor 是潜空间边际标准差的倒数。"""
if not np.isfinite(s) or s <= 0:
raise ValueError("scaling factor must be finite and positive")
return 1.0 / s
def mmse_model(z_t, abar):
"""在「潜空间方差 = 1」的假设下训练出来的高斯 MMSE 去噪器。"""
return np.sqrt(abar) * z_t
def mmse_true(z_t, abar, sigma):
"""潜空间真实标准差为 sigma 时的高斯 MMSE 去噪器。"""
return sigma ** 2 * np.sqrt(abar) / (sigma ** 2 * abar + 1.0 - abar) * z_t
def amplitude_ratio(abar, sigma):
"""模型输出 / 正确输出 = alpha_bar + (1 - alpha_bar) / sigma^2。"""
return abar + (1.0 - abar) / sigma ** 2
def snr(abar, sigma):
"""真实信噪比 Var(z_0 的信号成分) / Var(噪声成分) = sigma^2 * abar / (1 - abar)。"""
return sigma ** 2 * abar / (1.0 - abar)
def mmse_mse(abar, sigma):
"""高斯 MMSE 估计的理论误差,就是后验方差。"""
return sigma ** 2 * (1.0 - abar) / (sigma ** 2 * abar + 1.0 - abar)
def demo_step(abar, sigma, n=400000, seed=0):
"""蒙特卡洛:固定同一个前向过程,比较两个去噪器。
est_model:按「潜空间方差 = 1」训练出来的理想去噪器,用在方差为 sigma^2 的
潜空间上,是忘缩放的一种教学类比。
est_true :同一前向过程就该 sigma 匹配的理想估计器。对原始 z0 缩放但保持
原噪声表,会改变观察到的 SNR;所以它不等价于正确缩放的同一步 MSE。
"""
rng = np.random.default_rng(seed)
z0 = sigma * rng.normal(size=n)
eps = rng.normal(size=n)
z_t = np.sqrt(abar) * z0 + np.sqrt(1.0 - abar) * eps
est_model = mmse_model(z_t, abar)
est_true = mmse_true(z_t, abar, sigma)
return (float(np.mean((est_model - z0) ** 2)),
float(np.mean((est_true - z0) ** 2)))
if __name__ == "__main__":
import sys
# 正文 09 节实验三:换一个反事实的 scaling_factor 重算整张表
# python latent_scaling.py --sf=0.5
# python latent_scaling.py --sf=2.0
for a in sys.argv[1:]:
if a.startswith("--sf="):
SD_SCALING_FACTOR = float(a.split("=", 1)[1])
sigma_sd = latent_std_from_scaling(SD_SCALING_FACTOR)
print("=" * 72)
print("一、0.18215 意味着什么")
print("=" * 72)
print(f" scaling_factor = {SD_SCALING_FACTOR}")
print(f" 潜空间边际标准差 sigma = 1 / {SD_SCALING_FACTOR} = {sigma_sd:.4f}")
print(f" 潜空间边际方差 Var(z) = {sigma_sd**2:.4f}")
print(f" 信噪比偏移 = {20*np.log10(sigma_sd):.2f} dB")
print()
print(" 对照:若某个 VAE 的潜空间方差真的接近 1(LDM 说 VQ 版就是如此),")
print(" scaling_factor 就应当接近 1,完全不需要 rescale。")
print()
print("=" * 72)
print("二、忘掉 scaling factor,去噪幅度错多少")
print("=" * 72)
print(" r = 模型输出 / 正确输出;r=1 才是正确的")
print(f" {'alpha_bar':>10} | " + " | ".join(f"sigma={s:<7.4g}" for s in [sigma_sd, 1.0, SD_SCALING_FACTOR]))
for abar in ABARS:
rs = [amplitude_ratio(abar, s) for s in [sigma_sd, 1.0, SD_SCALING_FACTOR]]
print(f" {abar:>10g} | " + " | ".join(f"{r:>13.4f}" for r in rs))
print()
print("=" * 72)
print("三、蒙特卡洛实测:单步去噪的均方误差(n=400000)")
print("=" * 72)
print(f" {'alpha_bar':>10} | {'错假设 MSE':>12} {'正确 MSE':>12} {'理论后验方差':>14} {'恶化倍数':>10}")
for abar in ABARS:
m_bad, m_good = demo_step(abar, sigma_sd)
print(f" {abar:>10g} | {m_bad:>12.4f} {m_good:>12.4f} {mmse_mse(abar, sigma_sd):>14.4f} "
f"{m_bad/m_good:>10.2f}x")
print()
print(" 读法:固定同一个前向过程 z_t = sqrt(alpha_bar) z_0 + sqrt(1-alpha_bar) eps,")
print(" 「错假设」是拿了按单位方差潜空间训好的去噪器却喂未缩放的 latent,")
print(" 「正确」是同一观察过程就该 sigma 匹配的估计器;不是正确缩放的同一步实测。")
print(f" 「理论后验方差」= sigma^2 (1-alpha_bar) / (sigma^2 alpha_bar + 1 - alpha_bar),")
print(f" 与蒙特卡洛的「正确」一列应当吻合(校核 alpha_bar=0.5:"
f"{mmse_mse(0.5, sigma_sd):.4f} vs 实测 {demo_step(0.5, sigma_sd)[1]:.4f})")
print()
print("=" * 72)
print("四、反向的错误:换了个方差接近 1 的 VAE,却照抄 0.18215")
print("=" * 72)
print(f" {'alpha_bar':>10} | {'r(幅度被放大的倍数)':>24}")
for abar in ABARS:
print(f" {abar:>10g} | {amplitude_ratio(abar, SD_SCALING_FACTOR):>24.4f}")
print()
print(" r >> 1:高斯后验均值系数偏大;不能推断生成图过曝或结构模糊。")
print()
print("=" * 72)
print("五、信噪比视角(LDM D.1 的定义 Var(z) / sigma_t^2)")
print("=" * 72)
print(f" {'alpha_bar':>10} | {'模型以为的 SNR':>16} {'真实 SNR':>16} {'倍数':>10}")
for abar in ABARS:
a = abar / (1.0 - abar)
b = snr(abar, sigma_sd)
print(f" {abar:>10g} | {a:>16.4f} {b:>16.4f} {b/a:>10.2f}x")"""画本文的四张图。数据源全部来自 vae_minimal.py / latent_scaling.py 的真实输出,
不另造数,避免图文数字漂移。
beta_sweep.png beta 扫描全景:重建 / KL / 潜尺度 / KL 阈值计数
latent_scale_split.png 潜尺度的拆账:编码位置 vs 采样噪声
scaling_snr.png 忘掉 scaling_factor 的后果:幅度比 + 单步去噪 MSE
collapse_profile.png 后验坍缩的指纹:逐维 KL 怎么一个个死掉
运行: python make_figures.py
依赖: numpy, matplotlib(Windows 优先 Microsoft YaHei,其他平台需中文字体)
"""
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import vae_minimal as VM
import latent_scaling as LS
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False
plt.rcParams["figure.facecolor"] = "white"
plt.rcParams["axes.facecolor"] = "white"
plt.rcParams["savefig.facecolor"] = "white"
plt.rcParams["font.size"] = 11
HERE = os.path.dirname(os.path.abspath(__file__))
FIGDIR = os.path.join(os.path.dirname(HERE), "figures")
os.makedirs(FIGDIR, exist_ok=True) # exist_ok 必须带,否则目录已存在会 PermissionError
C_MAIN, C_ALT = "#2563eb", "#dc2626"
C_GRAY = "#6b7280"
def _b(rows):
return np.array([r["beta"] for r in rows])
# ─────────────────────────── 图 1:beta 扫描全景 ───────────────────────────
def fig_beta_sweep(res):
rows0 = res["wd=0"]
rows1 = res["wd=0.001"]
fig, axes = plt.subplots(2, 2, figsize=(13.5, 8.6))
ax = axes[0][0]
ax.plot(_b(rows0), [r["recon"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减")
ax.plot(_b(rows1), [r["recon"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3")
ax.set_xscale("log")
ax.set_yscale("log")
ax.axhline(1.0, color=C_GRAY, lw=1, ls=":")
ax.text(1.1e-6, 1.05, "重建 MSE = 1:训练均值预测基线", color=C_GRAY, fontsize=9)
ax.set_xlabel(r"KL 权重 $\beta$")
ax.set_ylabel("重建 MSE($D$ 维平均)")
ax.set_title("(a) 重建误差随 β 变化")
ax.legend(fontsize=9)
ax.grid(alpha=0.25)
ax = axes[0][1]
ax.plot(_b(rows0), [r["kl"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减")
ax.plot(_b(rows1), [r["kl"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3")
ax.set_xscale("log")
ax.set_yscale("symlog", linthresh=1e-1)
ax.set_xlabel(r"KL 权重 $\beta$")
ax.set_ylabel("总 KL(nats,8 维求和)")
ax.set_title("(b) KL:β 越大越贴先验,坍缩时归零")
ax.legend(fontsize=9)
ax.grid(alpha=0.25)
ax = axes[1][0]
ax.plot(_b(rows0), [r["overall_std"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减")
ax.plot(_b(rows1), [r["overall_std"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3")
ax.axhline(1.0, color=C_GRAY, lw=1, ls=":")
ax.text(1.1e-6, 1.03, "std(z) = 1:单位尺度参照", color=C_GRAY, fontsize=9)
ax.axhline(LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR), color="#059669", lw=1, ls="--")
ax.text(1.1e-6, 5.62, "std(z) = 5.49:由 SD1.x 配置系数反推", color="#059669", fontsize=9)
ax.set_xscale("log")
ax.set_xlabel(r"KL 权重 $\beta$")
ax.set_ylabel("潜空间边际标准差 std(z)")
ax.set_ylim(0.9, 6.2)
ax.set_title("(c) 有限训练后的潜尺度统计")
ax.legend(fontsize=9, loc="upper right")
ax.grid(alpha=0.25)
reciprocal = lambda x: np.divide(1.0, x, out=np.full_like(x, np.inf, dtype=float), where=x != 0)
ax2 = ax.secondary_yaxis("right", functions=(reciprocal, reciprocal))
ax2.set_ylabel("对应的 scaling_factor = 1 / std(z)")
ax = axes[1][1]
ax.plot(_b(rows0), [r["active_dims"] for r in rows0], "o-", color=C_MAIN, label="无权重衰减")
ax.plot(_b(rows1), [r["active_dims"] for r in rows1], "s--", color=C_ALT, label="权重衰减 1e-3")
ax.axhline(4, color="#059669", lw=1, ls="--")
ax.text(1.1e-6, 4.2, "真实因子数 = 4", color="#059669", fontsize=9)
ax.set_xscale("log")
ax.set_xlabel(r"KL 权重 $\beta$")
ax.set_ylabel("超过阈值的维度数(逐维 KL > 0.05 nat)")
ax.set_ylim(-0.3, 8.6)
ax.set_title("(d) 不同权重下的 KL 阈值计数")
ax.legend(fontsize=9, loc="lower left")
ax.grid(alpha=0.25)
fig.suptitle("KL 权重扫描:重建、KL、潜尺度、KL 阈值计数(潜变量 8 维,真实因子 4 个)",
fontsize=13, y=0.98)
fig.tight_layout(rect=[0, 0, 1, 0.96])
out = os.path.join(FIGDIR, "beta_sweep.png")
fig.savefig(out, dpi=150)
plt.close(fig)
return out
# ─────────────────────────── 图 2:潜尺度拆账 ───────────────────────────
def fig_scale_split(res):
rows = res["wd=0"]
betas = _b(rows)
std_mu = np.array([np.mean(np.array(r["std_mu"]) ** 2) for r in rows]) # 编码位置的跨样本波动
mean_sig = np.array([np.mean(np.array(r["mean_sig"]) ** 2) for r in rows]) # 采样噪声 RMS
x = np.arange(len(betas))
fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.6))
ax = axes[0]
ax.bar(x, std_mu, 0.62, label=r"后验均值的跨样本方差", color=C_MAIN)
ax.bar(x, mean_sig, 0.62, bottom=std_mu,
label=r"平均后验方差", color="#f59e0b")
ax.set_xticks(x)
ax.set_xticklabels([f"{b:g}" for b in betas])
ax.set_xlabel(r"KL 权重 $\beta$(离散档位)")
ax.set_ylabel("Var(z) 的构成(各维平均)")
ax.set_title("(a) 方差拆账:后验均值变化与后验噪声")
ax.legend(fontsize=9)
ax.grid(alpha=0.25, axis="y")
ax = axes[1]
frac = std_mu / (std_mu + mean_sig)
ax.plot(x, frac, "o-", color=C_MAIN, lw=2)
ax.axhline(0.5, color=C_GRAY, lw=1, ls=":")
ax.set_xticks(x)
ax.set_xticklabels([f"{b:g}" for b in betas])
ax.set_xlabel(r"KL 权重 $\beta$")
ax.set_ylabel("方差里来自编码位置的比例")
ax.set_ylim(-0.03, 1.06)
ax.set_title("(b) 总方差中均值变化的占比")
ax.grid(alpha=0.25)
for i, (xi, fi) in enumerate(zip(x, frac)):
ax.annotate(f"{fi:.2f}", (xi, fi), textcoords="offset points",
xytext=(0, 8), ha="center", fontsize=9, color=C_MAIN)
fig.suptitle("全方差公式:两项方差相加;方差占比不等于互信息",
fontsize=12.5, y=1.0)
fig.tight_layout(rect=[0, 0, 1, 0.95])
out = os.path.join(FIGDIR, "latent_scale_split.png")
fig.savefig(out, dpi=150)
plt.close(fig)
return out
# ─────────────────────────── 图 3:scaling factor 的后果 ───────────────────────────
def fig_scaling_snr():
sigma_sd = LS.latent_std_from_scaling(LS.SD_SCALING_FACTOR)
abar = np.logspace(-3, np.log10(0.9999), 400)
fig, axes = plt.subplots(1, 2, figsize=(13.5, 4.8))
ax = axes[0]
for sigma, lab, col in [(sigma_sd, rf"$\sigma$={sigma_sd:.2f}(由 SD1.x 配置反推)", C_MAIN),
(1.0, r"$\sigma$=1.0(单位尺度参照)", "#059669"),
(LS.SD_SCALING_FACTOR, rf"$\sigma$={LS.SD_SCALING_FACTOR:.3f}(照抄 0.18215 用错 VAE)", C_ALT)]:
ax.plot(abar, LS.amplitude_ratio(abar, sigma), "-", color=col, lw=2, label=lab)
ax.axhline(1.0, color=C_GRAY, lw=1, ls=":")
ax.text(5e-2, 1.35, "$r=1$:单位尺度参照", color=C_GRAY, fontsize=9)
ax.text(2e-3, 0.025, r"噪声端系数比极限 $1/\sigma^2=0.033$,两种均值都趋零", color=C_MAIN, fontsize=9)
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_ylim(2e-2, 6e1)
ax.set_xlabel(r"$\bar{\alpha}$(1 = 完全干净,0 = 纯噪声)")
ax.set_ylabel("去噪幅度比 $r$ = 模型输出 / 正确输出")
ax.set_title("(a) 高斯 MMSE 教学模型的后验均值幅度比")
ax.legend(fontsize=9, loc="center left")
ax.grid(alpha=0.25, which="both")
ax = axes[1]
abars = np.array(LS.ABARS)
bad, good = [], []
for a in abars:
b_, g_ = LS.demo_step(a, sigma_sd, n=400000)
bad.append(b_)
good.append(g_)
ax.plot(abars, bad, "o-", color=C_ALT, lw=2, label=r"错假设去噪器(按 $\sigma$=1 训练)")
ax.plot(abars, good, "s-", color=C_MAIN, lw=2, label=r"正确去噪器(就该 $\sigma$ 训练)")
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel(r"$\bar{\alpha}$")
ax.set_ylabel("单步去噪均方误差")
ax.set_title("(b) 同一个前向过程下的 MSE 差距")
ax.legend(fontsize=9)
ax.grid(alpha=0.25)
i5 = int(np.argmin(np.abs(abars - 0.5)))
ax.annotate(f"{bad[i5]/good[i5]:.1f}×", (abars[i5], bad[i5]),
textcoords="offset points", xytext=(12, -6), color=C_ALT, fontsize=11)
fig.suptitle(r"忘掉 scaling_factor 的代价:实际信噪比高于单位尺度假设 $\sigma^2$ = 30.1 倍(14.8 dB)",
fontsize=12.5, y=1.0)
fig.tight_layout(rect=[0, 0, 1, 0.94])
out = os.path.join(FIGDIR, "scaling_snr.png")
fig.savefig(out, dpi=150)
plt.close(fig)
return out
# ─────────────────────────── 图 4:坍缩指纹 ───────────────────────────
def fig_collapse_profile(res):
rows = res["wd=0"]
picks = [1e-3, 3e-1, 1.0] # 三档:够用 / 正在坍缩 / 完全坍缩
# 每张子图各自缩放:三档之间差 20 倍,共享 y 轴会把另两张压成一条线
fig, axes = plt.subplots(1, 3, figsize=(13.5, 4.2))
d = len(rows[0]["kl_dim"])
for ax, beta in zip(axes, picks):
row = min(rows, key=lambda r: abs(r["beta"] - beta))
kl = np.array(row["kl_dim"])
colors = [C_MAIN if v > 0.05 else "#d1d5db" for v in kl]
ax.bar(np.arange(d), kl, 0.68, color=colors)
ax.axhline(0.05, color=C_GRAY, lw=1, ls=":")
ax.set_xticks(np.arange(d))
ax.set_xticklabels([f"$z_{j+1}$" for j in range(d)], fontsize=9)
ax.set_xlabel("潜变量维度")
ax.set_ylim(0, max(0.35, kl.max() * 1.18))
ax.set_title(rf"$\beta$={row['beta']:g} 阈值计数 {row['active_dims']}/{d} "
f"重建 MSE={row['recon']:.4f}")
ax.grid(alpha=0.25, axis="y")
ax.text(0.99, 0.92, f"本组 KL 最大 {kl.max():.2g} nats", transform=ax.transAxes,
ha="right", fontsize=8.5, color=C_GRAY)
axes[0].set_ylabel("逐维 KL(nats)")
axes[1].set_ylabel("逐维 KL(nats)")
axes[2].set_ylabel("逐维 KL(nats)")
fig.suptitle("逐维 KL:阈值计数仅供诊断(注意三张图的纵轴范围不同)",
fontsize=12.5, y=0.99)
fig.tight_layout(rect=[0, 0, 1, 0.91])
out = os.path.join(FIGDIR, "collapse_profile.png")
fig.savefig(out, dpi=150)
plt.close(fig)
return out
if __name__ == "__main__":
res = VM.load_or_sweep()
for fn in [fig_beta_sweep, fig_scale_split, fig_collapse_profile]:
print("写出", fn(res))
print("写出", fig_scaling_snr())
评论 (0)