


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:数学基础 | 难度:入门 | 前置知识:变分下界与重参数化(KL、重参数化技巧、重参数化梯度)
关键词:马尔可夫链、前向扩散、反向去噪、随机微分方程、score matching、DDPM、DDIM、DPM-Solver
先摆四组数字,全部来自文末附录里六个能直接跑的脚本。
第一组:同一个 score 下比较不同采样器。 在 2D 七分量高斯混合上,score 有闭式解,可以排除神经网络拟合误差。下表记录一次固定种子实验的 dlogp,即生成样本与参考样本的平均 $\log p_0(x)$ 之差。它只是一个分布统计量:0 只说明这一个均值相同,不代表分布完全相同;正值也不是“生成得更好”。
| 配置 | score 评估次数 | dlogp |
|---|---|---|
| DDPM 祖采样 N=1000 | 1000 | −0.032 |
| DDPM 祖采样 N=200 | 200 | +0.089 |
| DDIM(η=0)N=50 | 50 | +0.090 |
| Heun 二阶 N=50 | 100 | +0.019 |
DDIM@50 与 DDPM@200 在这次运行中的 dlogp 接近,但不能据此得出通用的“4 倍提速”。Heun@50 的 +0.019 与 DDPM@1000 的 −0.032 也不足以证明谁更准确:还需重复随机种子、估计差值的不确定性,并结合模式占比和模式内半径等指标。比较成本时要按 score 调用次数 NFE 计,Heun 每步调用两次。
不把这件事算清楚,调 num_inference_steps 就是盲猜:既不知道收益的量级,也分不清收益里哪部分来自「换了算法的阶数」、哪部分来自「少走了冤枉路」。
第二组:调度改变了各噪声水平上的计算分配。 本实验把线性调度换成余弦,DDIM@50 的单次 dlogp 从 0.090 变到 0.050。线性调度有 74.1% 的离散步处在单位方差参考下 SNR<1 的区域,这描述了噪声水平分配,并不证明这些步骤“没有用”;高噪声阶段也负责形成全局结构。0.040 的差值需要重复实验确认,不能称为已经验证的 1.8 倍质量提升。
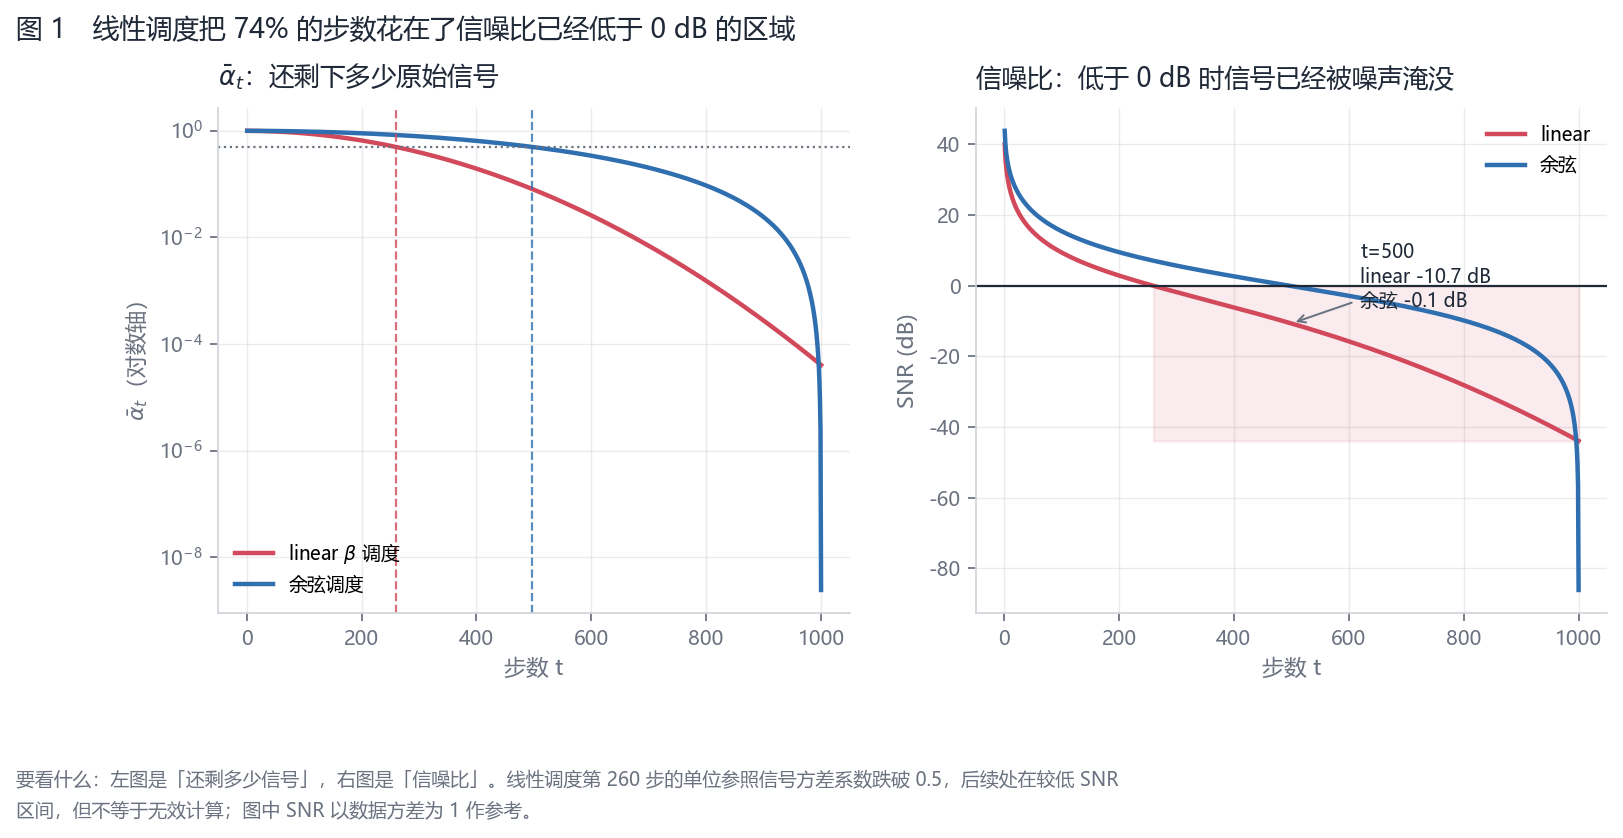
这张图要看什么:左图是信号方差系数,右图是在数据方差为 1 的约定下的信噪比。虚线标出 $\bar\alpha=0.5$ 的位置;低于这条线仍可能保留有用语义,不能把阴影区直接标成无效计算。
第三组:换个参数化(ε / v / x₀),等于给每个时间步换了 8 个数量级的权重。 三种参数化描述的是同一个量,但作为最小二乘目标并不等价。把它们的损失都折算回「对 ε 误差的权重」:ε 参数化恒为 1;v 参数化跨 2.5×10⁴ 倍;x₀ 参数化跨 2.5×10⁸ 倍(t=1 时 1.0×10⁻⁴,t=1000 时 2.5×10⁴)。这表明改变参数化会改变隐式时间权重。DDPM 的简化目标是经样本质量实验支持的重新加权,不能仅由此表推出其唯一理由。
第四组:验证手段本身有个坑。 我第一版是用 MMD² 给采样器排序的,跑出来的表看着非常漂亮:Heun 在 N≥10 就顶到「噪声地板」,其余采样器一路降到 0 以下。问题是那个「地板」是单次抽样的运气值——拿真实样本去对真实样本、重复 8 次,MMD² 的标准差是 ±3.6×10⁻⁴,比 N≥100 时各采样器之间的差别还大。发现它的办法很笨:做一次噪声标定。附录里的 mmd_noise_check.py 就是干这个的。分布距离的估计量本身有方差,用它排序前先量一下噪声。
三句话。
第一句:前向是一串手工设好的加噪,能一步算出来。 它形式上是一条 1000 步的马尔可夫链,但因为每步加的都是高斯,累乘之后仍然是高斯,所以 $q(x_t|x_0)$ 有闭式解,不需要真的跑 1000 次。
第二句:固定前向过程下,反向漂移由边缘 score 决定。 给定 $x_t$ 预测本次噪声,均方误差最优答案是噪声的条件均值,等于 score 的一个时间相关倍率,通常不等于本次实际噪声。精确 score、正确终端分布和连续过程下,生成可归结为数值求解;有限步反向核的近似及模型误差还要分别检查。
第三句:采样器既选择过程,也选择离散化。 DDPM / 反向 SDE、DDIM / 概率流 ODE 的随机性与漂移不同;求解器还要选择参数化、时间网格、阶数、方差和预测后处理,不能只把它们看作同一个更新式改几个系数。
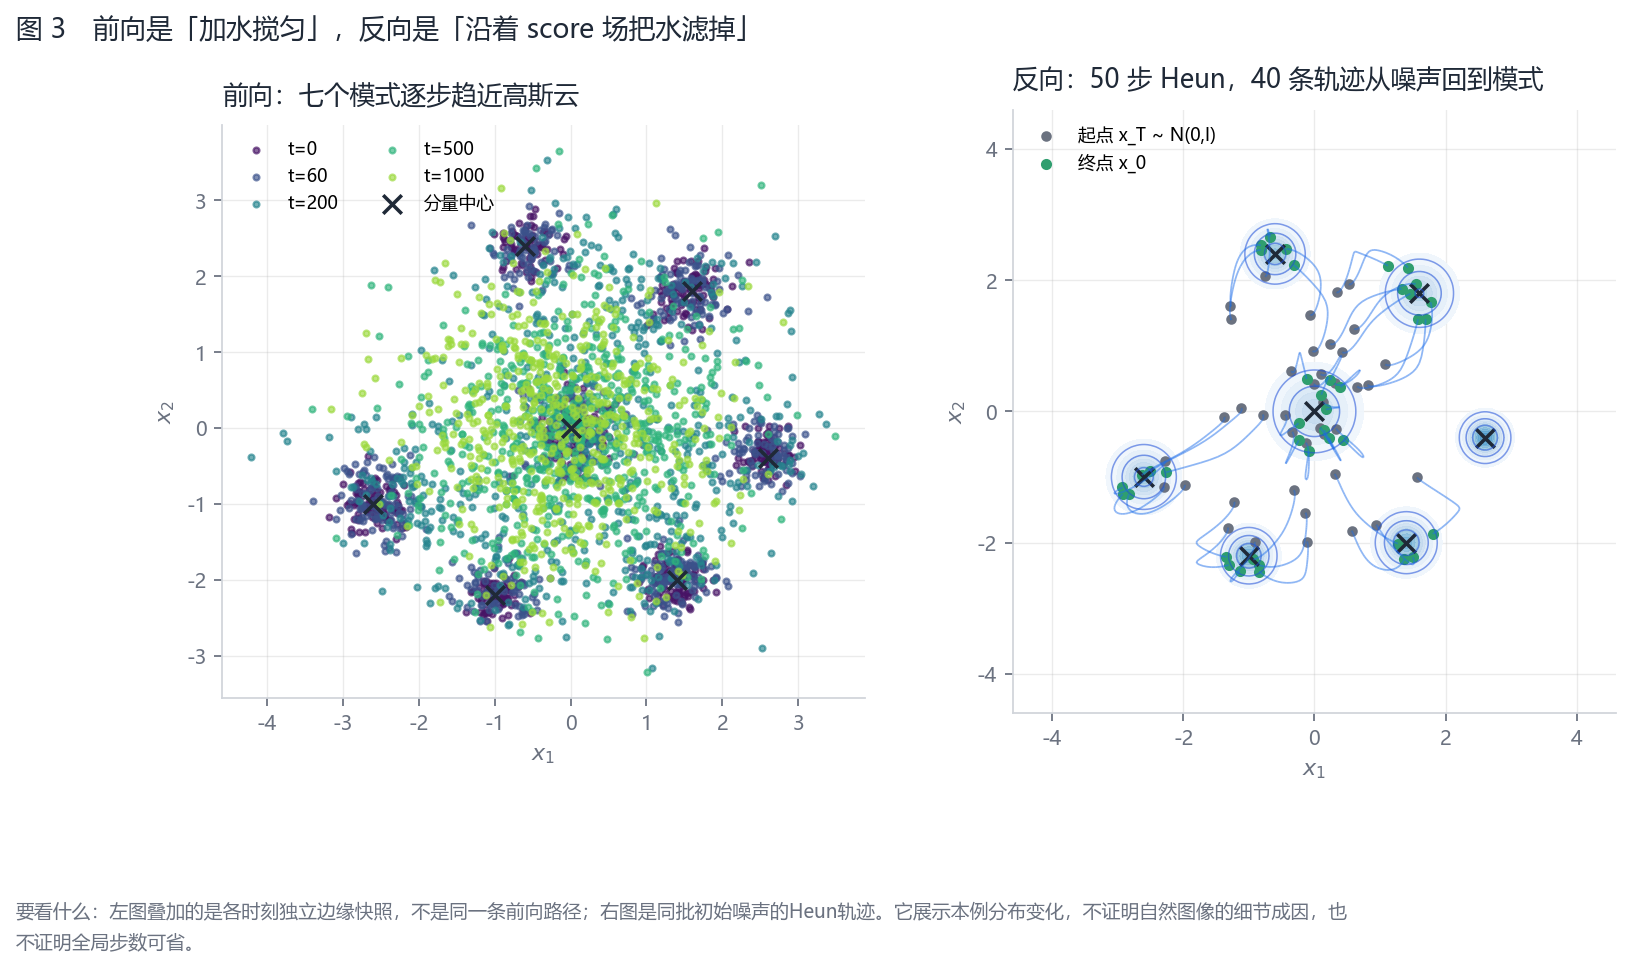
这张图要看什么:左图叠加各时刻独立抽样的边缘快照,展示模式逐渐被噪声混合;它不是同一批样本的连续前向路径。右图记录 40 条初始噪声的 Heun 轨迹,展示本例如何回到模式附近,不能据此推断自然图像的布局、细节或可省步数。
设原始数据 $x_0 \sim p_0$。前向过程每一步只做一件事:往上加一点高斯噪声。
$$q(x_t|x_{t-1}) = \mathcal{N}(x_t; \sqrt{\alpha_t}\,x_{t-1},\ \beta_t I)$$
这里 $\alpha_t = 1 - \beta_t$,而 $\beta_t$ 是方差而不是标准差——这个记号是 DDPM 原文定的,容易看错。写成重参数化形式就是 $x_t = \sqrt{\alpha_t}\,x_{t-1} + \sqrt{\beta_t}\,\varepsilon$。
现在把两步接起来看:
$$x_t = \sqrt{\alpha_t\alpha_{t-1}}\,x_{t-2} + \sqrt{\alpha_t\beta_{t-1}}\,\varepsilon_1 + \sqrt{\beta_t}\,\varepsilon_2$$
两个独立高斯的线性组合仍是高斯,噪声方差为 $(\alpha_t\beta_{t-1}+\beta_t)I$。代入 $\beta_{t-1}=1-\alpha_{t-1}$、$\beta_t=1-\alpha_t$,得到 $\alpha_t(1-\alpha_{t-1})+(1-\alpha_t)=1-\alpha_t\alpha_{t-1}$。这才是两步方差的正确化简。
于是归纳下去,任意步数都能一步算出来。记 $\bar\alpha_t = \prod_{s\le t}\alpha_s$:
$$q(x_t|x_0) = \mathcal{N}\big(x_t;\ \sqrt{\bar\alpha_t}\,x_0,\ (1-\bar\alpha_t)I\big)$$
这就是整个扩散模型里唯一一条「白送」的公式,训练时要多少步的加噪样本都能直接算。这里使用独立、零均值、各向同性高斯噪声,因而协方差简化成标量乘 $I$。各向同性不是高斯闭式解的必要条件:若第 $t$ 步噪声协方差为 $Q_t$,则 $\Sigma_t=\alpha_t\Sigma_{t-1}+Q_t$,仍为高斯条件分布;若改用非高斯噪声,本文这条高斯密度式一般不再成立。$p_t(x_t)=\int q(x_t\mid x_0)p_0(x_0)dx_0$ 是边缘密度,未必高斯,须与 $q(x_t\mid x_0)$ 分清。
附录里的 forward_diffusion.py 拿 20 万样本对着验了一遍:用「逐步迭代 1000 次」和「一步闭式」两条路分别算 $x_t$ 的均值与方差,误差量级都在 $10^{-3}$,正好是 20 万样本的蒙特卡洛噪声水平(t=1000 时闭式方差误差 6.20×10⁻³,逐步方差误差 6.19×10⁻³,两者接近是统计核对,不能替代上面的代数证明;两条路径使用独立噪声,不逐样本比对)。
我们需要 $q(x_{t-1}\mid x_t)$;先求已知 $x_0$ 的条件后验。令 $y=x_{t-1}$,利用前向马尔可夫性:
$$q(y\mid x_t,x_0)\propto q(x_t\mid y)q(y\mid x_0)$$
把两个高斯的指数展开,丢掉与 $y$ 无关的项:
$$\log q(y\mid x_t,x_0)= -\frac12 A_t\|y\|^2+b_t^\top y+C$$
$$A_t=\frac{\alpha_t}{\beta_t}+\frac{1}{1-\bar\alpha_{t-1}},\qquad b_t=\frac{\sqrt{\alpha_t}}{\beta_t}x_t+\frac{\sqrt{\bar\alpha_{t-1}}}{1-\bar\alpha_{t-1}}x_0$$
$A_t$ 是标量精度,$b_t$ 是线性项,$C$ 为常数;配方成 $-A_t\|y-A_t^{-1}b_t\|^2/2$。使用 $\bar\alpha_t=\alpha_t\bar\alpha_{t-1}$ 化简,就得到 DDPM 式 (6)、(7):
$$q(x_{t-1}\mid x_t,x_0)=\mathcal N(\tilde\mu_t,\tilde\beta_t I)$$
$$\tilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t$$
$$\tilde\mu_t=c_t x_0+d_t x_t,\quad c_t=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t},\quad d_t=\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}$$
上面的精度配方用于 $t\ge2$;$t=1$ 时 $x_{t-1}=x_0$ 已知,是点质量,不能在精度表达式里除以零。此时闭式系数的极限给出 $\tilde\beta_1=0$。
采样时 $x_0$ 未知,要对 $q(x_0\mid x_t)$ 积分。全期望与全协方差给出:
$$\mathbb E[x_{t-1}\mid x_t]=c_t\mathbb E[x_0\mid x_t]+d_t x_t$$
$$\operatorname{Cov}(x_{t-1}\mid x_t)=\tilde\beta_t I+c_t^2\operatorname{Cov}(x_0\mid x_t)$$
所以把 $x_0$ 替换为最优均值可得到真实反向均值,却不能同时得到真实反向协方差。一般数据下真实逆核还是混合分布。反例:一维等权双峰 $x_0\sim\tfrac12\mathcal N(-2,0.04)+\tfrac12\mathcal N(2,0.04)$,观测 $x_t=0$、$\bar\alpha_t=0.9$,后验均值为 0,但方差约为 2.19;用零方差均值回到 0 会丢掉两个峰。diffusion_checks.py 独立算出分量均值、分量方差及总方差。有限步 DDPM 高斯核与最后的均值去噪属于近似,不能因 score 精确就宣称逆核精确。
以前向链 $q(x_{1:T}\mid x_0)$ 为变分分布,生成链为 $p_\theta(x_{0:T})$。Jensen 不等式给出 $\mathrm{ELBO}\le\log p_\theta(x_0)$,因此负 ELBO 是负对数似然的上界:
$$-\log p_\theta(x_0)\le -\mathrm{ELBO}=L_T+\sum_{t=2}^T\mathbb E_q L_{t-1}+\mathbb E_q L_0$$
$$L_{t-1}=\mathrm{KL}(q(x_{t-1}\mid x_t,x_0)\Vert p_\theta(x_{t-1}\mid x_t))$$
设模型方差为固定的 $\sigma_t^2 I$。高斯 KL 展开为:
$$L_{t-1}=\frac{\|\tilde\mu_t-\mu_\theta\|^2}{2\sigma_t^2}+\frac D2\left(\frac{\tilde\beta_t}{\sigma_t^2}-1+\log\frac{\sigma_t^2}{\tilde\beta_t}\right)$$
$D$ 是数据维数。若方差固定,第二项对均值网络是常数;只有 $\sigma_t^2=\tilde\beta_t$ 时它才为零,不能把“同协方差”当成所有 DDPM 的前提。若方差可学习,这一项参与优化。
由 $x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon$ 解出 $x_0$ 再代回均值:
$$\tilde\mu_t=\frac1{\sqrt{\alpha_t}}\left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\varepsilon\right)$$
把实际噪声 $\varepsilon$ 换成网络输出 $\varepsilon_\theta(x_t,t)$ 得到 $\mu_\theta$。两均值之差是一个确定倍率乘噪声残差,所以固定方差下与网络有关的项为:
$$w_t\|\varepsilon-\varepsilon_\theta(x_t,t)\|^2,\qquad w_t=\frac{\beta_t^2}{2\sigma_t^2\alpha_t(1-\bar\alpha_t)}$$
DDPM 式 (12)、(14) 改用均匀抽取 $t$ 的简化目标:
$$L_{\text{simple}}=\mathbb E_{t,x_0,\varepsilon}\|\varepsilon-\varepsilon_\theta(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\varepsilon,t)\|^2$$
这是依据样本质量实验选择的重新加权目标,通常不等于原 ELBO。对每个噪声时刻,理想无限容量的 MSE 最优解是条件均值;有限共享网络的梯度和训练结果仍会随权重变化。06 节将另一类“输出参数化的代数权重”换算到噪声残差空间,它与这里的 ELBO 权重 $w_t$ 是不同概念。
离散步号是 $t=0,\ldots,T$,连续时间是 $u=t/T\in[0,1]$,步长 $\Delta u=1/T$。离散 $\beta_t$ 是无量纲方差,连续 $\beta(u)$ 是每单位时间的噪声率。令 $\beta_t\approx\beta(u)\Delta u$ 并展开 $\sqrt{1-\beta_t}\approx1-\beta_t/2$,得到 VP-SDE:
$$dx=-\tfrac12\beta(u)x\,du+\sqrt{\beta(u)}\,dw_u$$
$w_u$ 为标准布朗运动,正向增量协方差为 $du\,I$。记 $a(u)=\exp(-\int_0^u\beta(v)dv)$,边缘协方差为 $a(u)\operatorname{Cov}(x_0)+(1-a(u))I$;只有初始单位协方差才严格保持单位协方差。
有限离散表与指定连续率是两个设计。 本实验将线性表端点乘 $T$ 得到连续线性率 0.1 到 20;在 $u=1$,其 $a(u)$ 与离散乘积相差约 7.01%。这个差包含 $\log(1-\beta_t)\ne-\beta_t$ 的有限步效应及率插值/求积约定,不能称为所有连续化不可避免的固定误差。更直接的精确嵌入是每个区间取:
$$\beta_{\text{exact}}(u)=-T\log(1-\beta_t),\qquad (t-1)/T\lt u\le t/T$$
此时区间积分为 $-\log(1-\beta_t)$,边界处 $a(t/T)=\prod_{j=1}^t(1-\beta_j)=\bar\alpha_t$,前向转移也完全对应。附录独立核对该等式。本文采样器使用 $L=\log(a_{\text{prev}}/a_{\text{cur}})$,等于使用累计噪声钟作为积分变量。
为解释 score 系数,写一般标量扩散 $dx=f(x,u)du+g(u)dw_u$ 的 Fokker–Planck 方程:
$$\partial_u p=-\nabla\cdot(fp)+\tfrac12 g^2\Delta p$$
定义边缘 score $s=\nabla\log p$,有 $ps=\nabla p$,从而 $\Delta p=\nabla\cdot(ps)$。代入得连续性方程:
$$\partial_u p=-\nabla\cdot\left[(f-\tfrac12 g^2s)p\right]$$
所以速度 $f-\tfrac12g^2s$ 的确定性 ODE 与正向 SDE 具有同一系列边缘分布。反向 SDE 定理及概率流推导 给出:
$$dx=\left[-\tfrac12\beta x-\beta s(x,u)\right]du+\sqrt\beta\,d\bar w_u\quad\text{(反向 SDE)}$$
$$dx=\left[-\tfrac12\beta x-\tfrac12\beta s(x,u)\right]du\quad\text{(概率流 ODE)}$$
这里反向求解 $du\lt0$;反向布朗增量协方差是 $|du|I$,不是负的 $du I$。为消除实现歧义,可用递增反向时间 $\tau=1-u$:SDE 漂移为 $\beta(x/2+s)$,噪声增量为 $\sqrt{\beta\Delta\tau}z$;ODE 漂移为 $\beta(x+s)/2$。它们从同一正确终端分布出发、使用精确 score 并满足正则性条件时,才有相同目标边缘;路径联合分布不同,有限求解器也不同。
记一次反向区间的积分:
$$L=\int_{u_{\text{prev}}}^{u_{\text{cur}}}\beta(u)du=\log\frac{a_{\text{prev}}}{a_{\text{cur}}}>0$$
在累计噪声钟中冻结当前 $x,s$,Euler 漂移更新为 $x\leftarrow x+L(x/2+c s)$,$c=1$ 对应 SDE,$c=1/2$ 对应 ODE;前者另加 $\sqrt Lz$。不能只删 SDE 的噪声而保留完整 score 系数。反例:稳态 $p=\mathcal N(0,I)$ 的 score 为 $-x$,概率流速度恰为 0;删噪声后的 SDE 漂移却是 $-\beta x/2$,会错误收缩方差。diffusion_checks.py 在 $L=0.1$ 给出删噪声方差 0.9025、Euler–Maruyama 方差 1.0025、精确 ODE 方差 1;EM 的 0.0025 是有限步误差。
令 $a=\bar\alpha_t$、$b=\sqrt{1-a}$。实际训练样本满足 $x_t=\sqrt a x_0+b\varepsilon$。条件高斯的 score 为 $\nabla_{x_t}\log q(x_t\mid x_0)=-\varepsilon/b$。对 $x_0$ 的后验取平均,并把求导移入积分(需可微及可积条件),得到边缘 score 的恒等式:
$$s_t(x_t)=\mathbb E\left[\nabla_{x_t}\log q(x_t\mid x_0)\mid x_t\right]=-\frac{\mathbb E[\varepsilon\mid x_t]}{\sqrt{1-a}}$$
因此应写 $\hat\varepsilon_{\text{MMSE}}=\mathbb E[\varepsilon\mid x_t]=-\sqrt{1-a}s_t(x_t)$。网络只看到 $x_t,t$,不同 $x_0,\varepsilon$ 能形成同一观测,不能恢复每次真实噪声。MSE 的条件分解说明其不可约误差:
$$\mathbb E[\|\varepsilon-h(x_t)\|^2\mid x_t]=\operatorname{tr}\operatorname{Cov}(\varepsilon\mid x_t)+\|\mathbb E[\varepsilon\mid x_t]-h(x_t)\|^2$$
把 $\mathbb E[\varepsilon\mid x_t]$ 代回加噪等式,得 Tweedie 公式:
$$\mathbb E[x_0\mid x_t]=\frac{x_t+(1-a)s_t(x_t)}{\sqrt a}$$
高斯先验反例:$x_0,\varepsilon$ 独立且皆标准正态,此时 $x_t$ 也为标准正态,$\mathbb E[\varepsilon\mid x_t]=\sqrt{1-a}x_t$,但条件噪声协方差为 $aI$。本文 $D=2,a=0.25$ 的最优期望平方误差为 0.5,并非 0。零预测器的向量 RMSE 基线是 $\sqrt D$;只有独立标准高斯“瞎猜”才是 $\sqrt{2D}$。
v 参数化 定义实际 target 为 $v=\sqrt a\varepsilon-\sqrt{1-a}x_0$。联合变换及逆变换是:
$$\begin{pmatrix}x_t\\v\end{pmatrix}=\begin{pmatrix}\sqrt a&\sqrt{1-a}\\-\sqrt{1-a}&\sqrt a\end{pmatrix}\begin{pmatrix}x_0\\\varepsilon\end{pmatrix}$$
$$x_0=\sqrt a x_t-\sqrt{1-a}v,\qquad \varepsilon=\sqrt{1-a}x_t+\sqrt a v$$
矩阵转置乘自身等于单位阵,保持联合向量范数;这一性质不保证所有单输出预测或反解都不会放大误差。固定 $x_t$ 时,$\delta\varepsilon=\sqrt a\delta v$、$\delta x_0=-\sqrt{1-a}\delta v$;反解 $v$ 从噪声残差会除以 $\sqrt a$,高噪声时仍可能放大。对条件均值取同一线性变换也成立,网络的 MSE 最优 $v$ 输出是 $\mathbb E[v\mid x_t]$。
score_bridges.py 保留所有数值核对:Tweedie 对精确混合后验均值最大差约 $10^{-15}\sim10^{-13}$,两种 MMSE 噪声算法差约 $10^{-16}\sim10^{-15}$,实际 $(x_0,\varepsilon)$ 用实际 $v$ 重建差约 $10^{-15}$。100 万样本的自归一化重要性采样提供独立后验均值核对,有限样本有偏且有抽样误差,ESS 仅诊断权重集中程度,不是误差保证。
真实扩散模型的采样误差来自两处:score 估计得不准,以及数值积分不准。想把第二处单独看清楚,就得让第一处等于零——用一个 score 有闭式解的目标分布。
办法是选高斯混合:$p_0 = \sum_k w_k\mathcal{N}(\mu_k, s_k^2 I)$。前向加噪之后,第 $k$ 个分量的均值缩到 $\sqrt{\bar\alpha_t}\mu_k$、方差变成 $\bar\alpha_t s_k^2 + (1-\bar\alpha_t)$,仍然是各向同性高斯,所以 $p_t$ 还是高斯混合,且
$$\nabla_x\log p_t(x) = -\sum_k r_k(x)\frac{x - \sqrt{\bar\alpha_t}\mu_k}{\bar\alpha_t s_k^2 + (1-\bar\alpha_t)},\qquad r_k(x) = \frac{w_k\mathcal{N}_k(x)}{\sum_j w_j\mathcal{N}_j(x)}$$
$r_k$ 就是「这个样本属于第 $k$ 个分量」的责任度,是标准的软分配。由此排除 score 拟合误差;剩下的差异还包含有限终端高斯近似、逆核与终步去噪近似、积分误差及样本统计误差。
这里有个调参坑值得记一下:我第一版用了 3 个很宽的分量(标准差 0.45/0.35/0.55),结果五种采样器全部顶到 MMD 噪声地板上,分不出高下。换成 7 个紧分量(标准差 0.16~0.30)之后差距才显出来——目标太光滑,分辨不出采样器的差别。这是本 toy 的分辨力调整;自然图像的误差可能同时影响布局、模式覆盖和细节,不能从低维混合外推唯一成因。
核心就几行,除了算 $\bar\alpha$ 之外没有任何魔法:
def linear_beta(T=1000, beta_1=1e-4, beta_T=0.02):
    return np.linspace(beta_1, beta_T, T)

def alpha_bar_from_beta(beta):
    return np.cumprod(1.0 - beta)

def q_sample(x0, t_idx, alpha_bar, rng):
    a = alpha_bar[t_idx]
    eps = rng.standard_normal(x0.shape)
    return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps
q_sample 就是 3.1 节那个闭式解。余弦调度多两行——按 $\bar\alpha_t$ 定义式算完之后要把 β 截到 0.999 以内,因为 $t=T$ 时 $\cos(\pi/2)=0$ 会让最后一步 $\beta=1$,实操直接炸:
def cosine_beta(T=1000, s=0.008, clip=0.999):
    t = np.arange(1, T + 1) / T
    f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2
    f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2
    beta = beta_from_alpha_bar(f / f0)        # 反解出每步的 beta
return np.clip(beta, None, clip)DDPM 祖采样——用高斯核近似反向转移。对一般数据,即使均值来自精确 score,有限步高斯核也不等于真实反向条件分布。把 3.2 节的 $\tilde\mu_t$ 和 $\tilde\beta_t$ 抄进来,再把 $\hat x_0$ 换成 Tweedie 公式:
def run_ddpm(x, alpha_bar, taus, rng):
    for j in range(len(taus) - 1):
        t_cur, t_prev = taus[j], taus[j + 1]
        a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev)
        alpha_j = a_cur / a_prev              # 跨 k 步的等效 alpha
        beta_j = 1.0 - alpha_j
        s = score_at(x, alpha_bar, t_cur)
        mean = (x + beta_j * s) / np.sqrt(alpha_j)
        var = beta_j * (1.0 - a_prev) / (1.0 - a_cur)
        x = mean + np.sqrt(var) * rng.standard_normal(x.shape)
    return x
Euler-Maruyama(反向 SDE)——把 $L$ 和 $c=1$ 代进 3.4 节的结果:
def run_em(x, alpha_bar, taus, rng):
    for j in range(len(taus) - 1):
        L = _log_step(alpha_bar, taus[j], taus[j + 1])
        s = score_at(x, alpha_bar, taus[j])
        x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape)
    return x
概率流 ODE——唯一的改动是 score 系数减半、噪声项删掉:
def run_ode(x, alpha_bar, taus, rng):
    for j in range(len(taus) - 1):
        L = _log_step(alpha_bar, taus[j], taus[j + 1])
        s = score_at(x, alpha_bar, taus[j])
        x = x + 0.5 * L * (x + s)
    return x
Heun 二阶——Euler 预测一步,再用终点的 score 校正一次。每步两次评估:
def run_heun(x, alpha_bar, taus, rng):
    for j in range(len(taus) - 1):
        L = _log_step(alpha_bar, taus[j], taus[j + 1])
        s0 = score_at(x, alpha_bar, taus[j])
        d0 = 0.5 * L * (x + s0)
        x1 = x + d0                                    # Euler 预测
        s1 = score_at(x1, alpha_bar, taus[j + 1])      # 终点再评估一次
        d1 = 0.5 * L * (x1 + s1)
        x = x + 0.5 * (d0 + d1)
    return x
DDIM 单独说,因为它长得不像上面四个。它先把样本一步跳到 $\hat x_0$,再按目标时刻的 $\bar\alpha$ 重新加回噪声:
$$x_{t-1} = \sqrt{\bar\alpha_{t-1}}\,\hat x_0 + \sqrt{1-\bar\alpha_{t-1}}\,\hat\varepsilon$$
$\hat x_0$ 用 Tweedie 公式算、$\hat\varepsilon$ 用 $\varepsilon=-\sqrt{1-\bar\alpha_t}s$ 算。η=0 的 DDIM 在小步长极限对应概率流 ODE,其 score 漂移系数为反向 SDE 的一半;DDPM 的均值更新对应后者,两者并不在代数上相同。
七个分量、每档生成 4000 个样本、参照集 8000 个真实样本。三个统计量扣除参照样本的估计值;0 仅表示该统计量相同,不能保证模式比例、半径或整个分布正确:
| 采样器 | N=10 | N=25 | N=50 |
|---|---|---|---|
| DDPM | −0.365 | +0.266 | +0.249 |
| DDIM | −0.248 | +0.124 | +0.090 |
| EM(SDE) | −2.725 | −0.756 | −0.347 |
| Euler(ODE) | −2.340 | −0.792 | −0.348 |
| Heun | +0.546 | +0.084 | +0.019 |
| 采样器 | N=100 | N=200 | N=1000 |
|---|---|---|---|
| DDPM | +0.174 | +0.089 | −0.032 |
| DDIM | +0.057 | +0.032 | +0.007 |
| EM(SDE) | −0.189 | −0.100 | −0.081 |
| Euler(ODE) | −0.159 | −0.074 | −0.014 |
| Heun | +0.005 | +0.002 | +0.001 |
上表是单次实验的 dlogp。两批独立真实样本在这次运行中的差值约 0.053;这不是经重复估计的标准差或置信区间。表格主要帮助识别量级很大的离散化偏差,微小差异不做显著性排序。三点读法:
补充两个不同统计量:按模式归属估算的分量占比 TV,以及模式内均方半径的相对误差。在 N=50 的本次运行中,Heun 为 0.011 / 0.066,DDIM 为 0.014 / 0.155,DDPM 为 0.019 / 0.340,Euler-ODE 为 0.017 / 0.358。这里数值分别为占比误差偏移 dTV 与半径误差偏移 dspread,并非未经扣基线的绝对误差;它们分别检查模式比例与分散程度,排序并非处处一致,也要估计采样误差。
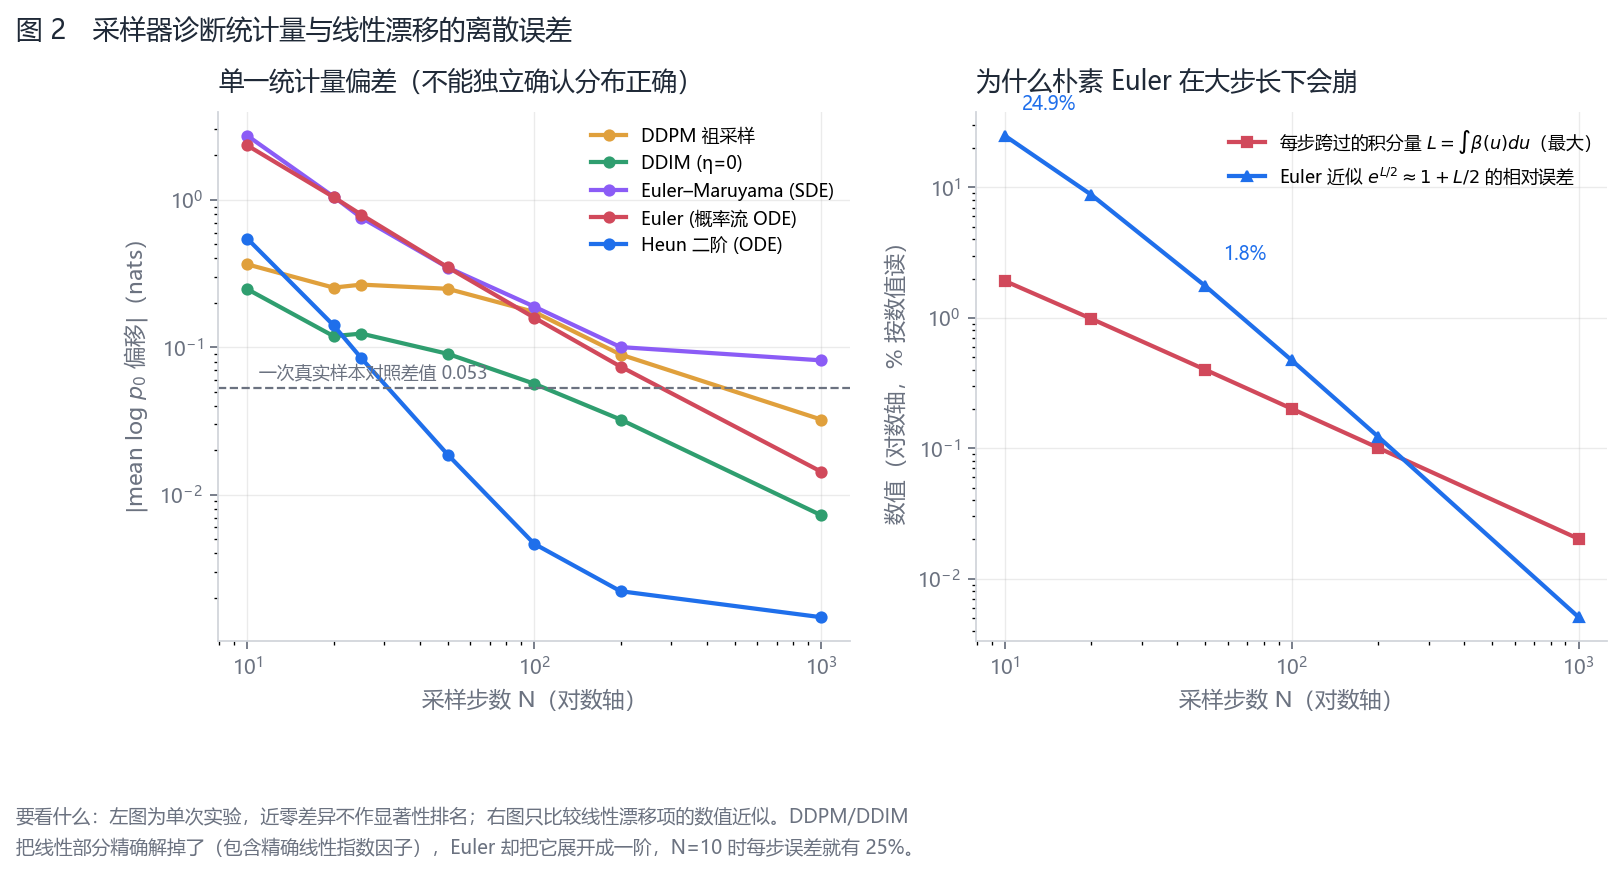
这张图要看什么:左图画的是单个诊断统计量的偏差,参考虚线只表示一次真实样本对照差值,不是置信区间。右图比较线性漂移项的指数因子和 Euler 近似,解释大步长为何可能困难;完整 score 场同时参与更新,不能仅用这一项定量归因全部误差。
按相同 NFE 复核。 新增 diffusion_checks.py 每种方法做五个独立种子,每次生成 4000 个、参考 8000 个样本;Heun 用 25 步,其他方法 50 步,实际计数都为 50 次 score 调用。下面报告跨种子的均值和样本标准差(ddof=1),标准差不是置信区间,也不是对单次抽样标准误的替代。
| 方法 | 步数 | NFE | 平均 dlogp | 跨种子 SD |
|---|---|---|---|---|
| ddpm | 50 | 50 | +0.2751 | 0.0081 |
| ddim | 50 | 50 | +0.0840 | 0.0129 |
| em | 50 | 50 | -0.3231 | 0.0233 |
| ode | 50 | 50 | -0.3707 | 0.0270 |
| heun | 25 | 50 | +0.0775 | 0.0141 |
每次独立生成与参考样本的密度均值差,还可估计 iid 标准误 $\sqrt{s_g^2/n_g+s_r^2/n_r}$,两批样本独立时方差相加;完整数值由脚本打印。少量重复只帮助观察稳健性,不代表真实图像模型上的方法排名。
dlogp 等于 0 的反例。 在二维标准高斯目标下,把所有样本放到半径 $\sqrt2$ 的圆上,期望 $\log p$ 与真实高斯完全相同;但半径四次矩是 4,真实高斯为 8,径向分布显然不同。该解析反例说明单个均值相同也可严重失真,不能把密度偏移当作完整分布距离。
固定带宽的 MMD 平方 U 统计量可能为负,而总体 MMD 平方非负;8 次真实样本对照中约 $3.6\times10^{-4}$ 是用 ddof=0 计算的这一组经验散布,既不是通用噪声下界,也不是置信区间。mmd2 默认用待比较样本选带宽,此时数据自适应值不能直接套固定核的无偏性;严谨评测应以独立数据固定带宽。模式归属使用最近均值,重叠分量可能错分;缺少某模式样本时半径误差置 1 是教学约定,不能视作准确总体 TV 或缺失模式的半径估计。MMD 原始论文 给出固定核估计的定义。
把上面第 1 点挖到底。概率流 ODE 里线性部分 $\tfrac12\beta x$ 的精确解是 $e^{L/2}$,而 Euler 用的是它的一阶展开 $1+L/2$。线性子问题的相对误差为 $1-(1+L/2)e^{-L/2}$,随正 $L$ 增大而趋近 1:
| 采样步数 N | 每步最大积分量 $L_{\max}$ | $e^{L/2}$ 与 $1+L/2$ 的相对误差 |
|---|---|---|
| 10 | 1.9197 | 24.95% |
| 20 | 0.9852 | 8.80% |
| 50 | 0.4002 | 1.75% |
| 100 | 0.2011 | 0.47% |
| 200 | 0.1008 | 0.12% |
| 1000 | 0.0202 | 0.01% |
DDPM 与 DDIM 的更新含精确线性指数因子。 从当前到前一时刻,因子为 $\sqrt{a_{\text{prev}}/a_{\text{cur}}}=e^{L/2}$,不是孤立的 $\sqrt{a}$。DDIM 还近似积分剩余噪声预测项;DDPM 仍使用近似高斯逆核。因此该表仅解释线性子项,不能单独证明完整误差大小或工业选择。DPM-Solver 系统利用半线性结构构造积分器,反向 SDE 的 Euler–Maruyama 与 predictor–corrector 也有实际用途。
高阶方法也需要合适的步长。 本次 Heun@10 的 dlogp 为 +0.546,DDIM@10 为 −0.248,说明这个网格上的 Heun 出现明显偏聚拢。原因可能包括稳定域、非线性 score 与步长的相互作用;不能说二阶校正必然放大线性项误差,更不能推广为 DPM-Solver 高阶算法在所有少步数任务上都更差。
以下以 diffusers v0.35.1 / scheduling_ddpm.py 的 DDPMScheduler.add_noise、step 和 _get_variance 为准;已获取固定版本原始源码并执行原方法,核验日为 2026-10-15。
add_noise 就是 3.1 节的闭式解,一字不差:
sqrt_alpha_prod = alphas_cumprod[timesteps] ** 0.5
sqrt_one_minus_alpha_prod = (1 - alphas_cumprod[timesteps]) ** 0.5
noisy_samples = sqrt_alpha_prod * original_samples + sqrt_one_minus_alpha_prod * noise第一个值得注意的细节:noise 是从外面传进来的,不是在函数里采的。因为训练时需要知道「这次加的是哪个 ε」才能算损失——如果接口内部采样且不返回噪声,就无法直接取得 target;接口当然也可以选择同时返回噪声。该实现还把累计表移到样本设备,系数转为样本 dtype,先展平 timestep 系数再逐维增加尾轴,支持批量样本广播。整数 timestep 是从 0 开始的数组下标,本文理论 $t=1$ 对应源码 timestep 0。
第二个细节:alphas_cumprod 在 __init__ 里用 torch.cumprod(1 - betas) 一次算好并缓存。1000 个数,每个训练步都要按 timestep 取,重新累乘显然不划算。这就是 3.1 节那条「白送」的公式在工程上的直接体现。
step 的均值在对齐配置时与本文等价。 它写的是 DDPM 原文公式 (7) 的系数形式:
current_alpha_t = alpha_prod_t / alpha_prod_t_prev
current_beta_t = 1 - current_alpha_t
pred_original_sample = (sample - beta_prod_t ** 0.5 * model_output) / alpha_prod_t ** 0.5   # 即 Tweedie
pred_original_sample_coeff = (alpha_prod_t_prev ** 0.5 * current_beta_t) / beta_prod_t
current_sample_coeff = current_alpha_t ** 0.5 * beta_prod_t_prev / beta_prod_t
pred_prev_sample = pred_original_sample_coeff * pred_original_sample + current_sample_coeff * sample
把 pred_original_sample_coeff 和 current_sample_coeff 代进 3.2 节的 $\tilde\mu_t$ 表达式展开,$x_t$ 的系数会化简成 $1/\sqrt{\alpha_j}$、$\varepsilon$ 的系数化简成 $-\beta_j/(\sqrt{\alpha_j}\sqrt{1-\bar\alpha_{\text{cur}}})$,也就是 $\tilde\mu = (x_t + \beta_j s)/\sqrt{\alpha_j}$——和我 4.3 节那个「一行 DDPM」完全一样。current_alpha_t = alpha_prod_t / alpha_prod_t_prev 对应的正是我的 alpha_j,所以 diffusers 支持跳步(strided)采样;这里只在相同 prediction_type、方差与不启用 clipping/thresholding 的条件下和最小实现等价。
三处工程实现要额外核对的差异:
第一,调度不是自由参数,是分类的。beta_schedule 有 linear / scaled_linear / squaredcos_cap_v2 / sigmoid 几个分支;我 4.2 节实现的余弦调度在它这里叫 squaredcos_cap_v2,走的是通用函数 betas_for_alpha_bar——先给定 $\bar\alpha(t)$ 的解析式,再按 $1 - \bar\alpha(t_2)/\bar\alpha(t_1)$ 反解出每步 β,并且硬编码 max_beta=0.999。这正好对上我 cosine_beta 里那句 clip,不是巧合:$t=T$ 时 $\cos(\pi/2)=0$ 会给出 $\beta_T=1$,必须截。
第二,有限终端 SNR 会引入起点分布近似。线性表的 $\bar\alpha_T=4.0358\times10^{-5}$,仍保留少量数据成分;推理却常从标准高斯开始。diffusers 的 rescale_betas_zero_snr 对应 Lin 等,2023 的修正,但要与训练的参数化、时刻采样和起点设置一起核对。对已有 epsilon checkpoint 不能只开一个开关就假定兼容,零 SNR 下若仍用除以 $\sqrt{\bar\alpha_T}$ 的公式还会遇到奇异点。
第三,参数化是可切换的输出头。prediction_type 支持 epsilon / sample / v_prediction 三选一,step 开头那个 if-elif 就干这件事。三种模式对 pred_original_sample 的算法不同,但固定方差的后续均值系数计算共用——这正是 3.5 节「它们描述同一个量」在工程上的样子。也正因如此,采样端转换形式可由配置选择,但 checkpoint 的训练目标必须匹配,不能把 epsilon 权重仅改一行配置就当作 v 预测器,代价藏在 06 节的权重表里。
固定官方方法的真实对照。 将 v0.35.1 中原始 add_noise、get_velocity、step、_get_variance、previous_timestep 的函数体按 AST 原样取出,在 PyTorch 2.10.0+cpu 上执行。对 float32/float64 以及 [2,3]、[2,1,3,4]、[2,1,2,3,4] 六组加噪/速度广播核对,差为 0;自定义 timestep [999,799,399,49,0] 与三个 prediction_type 共 15 组均值/方差对照,最大误差小于 $10^{-10}$。独立后验配方及 KL 权重最大误差约 $9.68\times10^{-14}$。为了单独检查均值,实跑用零噪声适配器替代随机数入口;原函数体未改,这不等于完整 diffusers 包或 GPU 模型复现。
注意默认 clip_sample=True 会裁剪预测的 $x_0$ 到约定范围,教学等价对照关闭它;另有实际裁剪分支对照。fixed_small 方差会被数值下界截到 $10^{-20}$。当源码 timestep 为 0 时不调用随机数;若自定义最后时刻大于 0、previous_timestep 为 −1,它仍会走噪声分支,加一个极小噪声,与本文严格零方差最终均值略有差别。若使用 learned 方差,还要核对双通道输出及 _get_variance 分支,本文的固定方差核不能代表它们。
代价一:换参数化不是改记号,是改损失权重。 把三种参数化都折算回「对 $\varepsilon$ 误差的权重」(推导见 score_bridges.py 的文档串:x₀ 的损失 $\|\delta x_0\|^2$ 折成 $\varepsilon$ 误差要乘倍率,v 的误差因为 $\delta\varepsilon = \sqrt{\bar\alpha_t}\,\delta v$ 也要乘):
| t | $\bar\alpha_t$ | ε 参数化的权重 | v 参数化的权重 | x₀ 参数化的权重 |
|---|---|---|---|---|
| 1 | 9.999×10⁻¹ | 1.0000 | 1.0001 | 1.0001×10⁻⁴ |
| 100 | 8.970×10⁻¹ | 1.0000 | 1.1148 | 1.1480×10⁻¹ |
| 500 | 7.859×10⁻² | 1.0000 | 1.2725×10¹ | 1.1725×10¹ |
| 900 | 2.752×10⁻⁴ | 1.0000 | 3.6336×10³ | 3.6326×10³ |
| 1000 | 4.036×10⁻⁵ | 1.0000 | 2.4778×10⁴ | 2.4777×10⁴ |
这张表是等价残差之间的代数权重,不是网络参数梯度的实测值。 ε、v、x₀ 三种目标的输出尺度、网络雅可比以及时间采样方式都会影响梯度。等权 ε 损失在这里对应 ε 残差权重恒为 1;不能据此断言各时刻梯度相同,也不能仅凭该表断言 x₀ 目标一定被高噪声支配或无法训练。
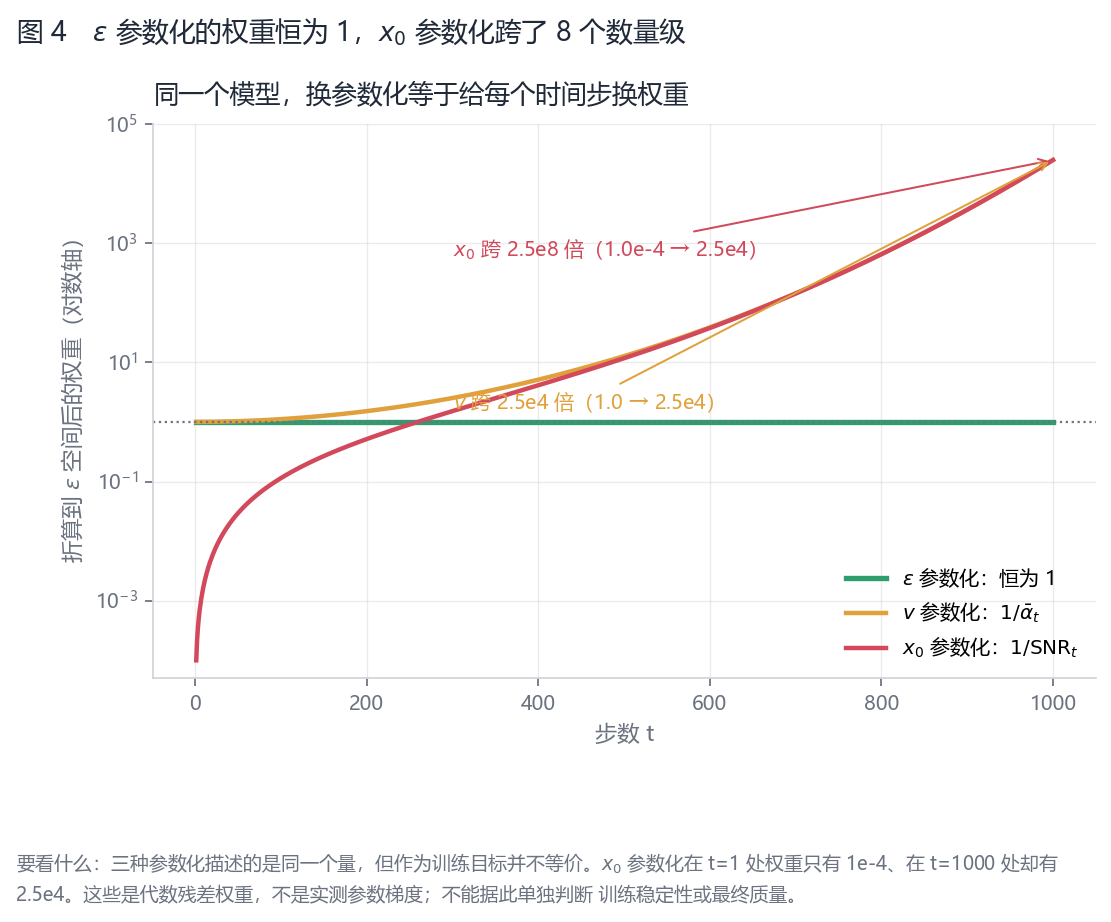
这张图要看什么:把不同输出误差换算到 ε 误差时,各自带上不同时间权重。曲线说明训练目标不等价,不是实测梯度图;实际训练还要连同参数化和时间采样权重一起分析。
代价二:阶数更高也要选择合适的网格。 Heun@10 的表现说明本实验的大步长不合适,不是对所有高阶求解器的否定。DPM-Solver 专门利用扩散 ODE 的半线性结构,不能从朴素 Heun 的结果推导它的少步数表现。
代价三:随机项改变有限步采样的误差与方差。 DDIM 的 η 从 0 到 1,本次 N=50 的 dlogp 为 0.090、0.065、0.092、0.169、0.249。这里 η=1 配上相同时间网格和方差选择可恢复所实现的 DDPM 更新,但不能把单次结果概括为“噪声没有用”。在精确 score、连续时间和正确初始分布下,反向 SDE 与概率流 ODE 都能得到相同边缘分布;有限步误差的优劣取决于具体离散化。
边界:这套实验测不到模型误差。 oracle score 排除了训练误差,却仍有有限终端分布近似、离散化和样本统计误差;它不是现实图像模型误差的严格下界。真实网络的误差还会与采样轨迹交互,必须在目标 checkpoint 上另做实验。
边界:高斯混合不是自然图像。 这里的数据维数、模态结构、score 光滑性和引导强度都很简单。表格适合验证公式与数值方法,不能当作真实模型加速倍率或通用采样器排名。
ODE 也能生成多样样本与估计似然。 确定性只意味着固定初始噪声对应固定轨迹;不同随机初值仍可覆盖整个数据分布。原始 score-SDE 论文 就利用概率流 ODE 计算似然。在向量场满足正则条件时精确流可逆,但有限步 DDIM / ODE 数值求解一般不能无误差反演。
按任务给一张实验决策表(密度偏移绝对值仅衡量一个统计量,须结合覆盖、半径和抽样波动):
| 步数预算 | 该选谁 | 实测依据 |
|---|---|---|
| 8~10 步 | 在目标模型上比较合适的少步采样器 | 本 toy 的 Heun@10 偏聚拢,不能推出其他高阶方法的排名 |
| 20~50 步 | Heun 是本实验可考虑的方案 | Heun@50 的 dlogp 为 0.019,需结合其他指标和重复试验 |
| 100~200 步 | 同 NFE 比较,避免只按步数选 | N=200:Heun 0.002、DDIM 0.032、DDPM 0.089 |
| 要多样性 | ODE / SDE 都可,比较分布覆盖 | ODE 的多样性来自随机初值;SDE 还增加路径随机性 |
| 要反演 / 要编辑 | 可考虑概率流 ODE / DDIM | 理想流可逆;有限步反演仍有数值和模型误差 |
表格只总结当前教学实验能支持的选择。没有实测的 PNDM / DPM-Solver 不参与排名;真实模型应以同等 NFE、重复种子与多个质量指标比较。
① 1503.03585(Sohl-Dickstein et al., 2015)——把扩散搬进生成模型。 用非平衡热力学里的一个想法:先定义一个把数据逐步破坏成噪声的正向过程,再学它的反向过程。贡献是框架本身,同时研究了高斯与二项扩散等设置,展示了可训练的生成扩散框架;这里不对其所有应用的实用性作统一判断。
② 2006.11239(Ho et al., 2020)——DDPM,把目标改成「预测噪声」。 三件事:把 $\tilde\mu_t$ 参数化成预测 $\varepsilon$;指出把 ELBO 里那一串只跟 t 有关的系数扔掉、直接用等权的 $L_{\text{simple}}$ 反而效果更好;给出 3.2 节那套 $\tilde\beta_t / \tilde\mu_t$ 的闭式解。该参数化与经验重新加权推动了图像扩散质量;早期工作已有可训练目标,不能把历史概括为此前无法训练。
③ 2011.13456(Song et al., 2021)——把离散和连续统一起来。 这篇是本节点的锚点。它做了两件大事:把 DDPM(VP-SDE)和它自己那套 score matching(VE-SDE)统一到同一个 SDE 框架下,把它们写成不同漂移与扩散系数下的 SDE,并由相应 Fokker–Planck 方程构造边缘等价的概率流 ODE;以及提出了概率流 ODE——同一个边缘分布、确定性求解、还能用现成的 ODE 求解器(原文使用自适应 RK45 / Dormand–Prince,见附录 D.2、D.4)。3.4 节那两条式子就出自这里。
④ 2010.02502(Song et al., 2021)——DDIM,确定性采样。 把反向链改成不含随机项的确定性映射:样本轨迹只由 $x_T$ 决定,跳步采样不再需要「一步一小步」的假设。两篇作者不同:DDIM 的第一作者是 Jiaming Song,score-SDE 的第一作者是 Yang Song——DDIM 本质上就是概率流 ODE 的一个(指数积分器风格的)离散化。原文在特定模型与数据上展示少步生成及显著采样加速;具体质量取决于模型、步数与指标,不能称所有任务 50 步等于 1000 步。
⑤ 2102.09672(Nichol & Dhariwal, 2021)——余弦调度。 指出线性调度把信噪比压得太快(就是 01 节第二组数字里那 74%),改成 $\bar\alpha_t = \cos^2(\cdot)$ 之后低步数下的质量明显更好。这篇的价值在于它把「调度」从工程细节变成了有图像解释的设计问题:$\bar\alpha_t$ 的形状决定了「每个时刻还剩多少信息量」,而余弦的形状让信息量的衰减更均匀。
在这五篇之外还有两条重要支线:v 参数化与渐进蒸馏 探讨不同预测目标和低步数训练;零终端 SNR 分析特定训练/推理噪声设置的不一致。前者不是对所有尺度问题的自动修复,后者也不意味着每个有限时间非零 SNR 过程都定义错误。它们都是在这条主线已经跑通之后,针对具体失效模式的补丁。
误解一:「DDPM 和 DDIM 是同一条 ODE 的两种离散化。」 DDPM 是带噪声的高斯反向马尔可夫链,连续极限对应反向 SDE;η=0 的 DDIM 是确定性路径,可联系到概率流 ODE。二者的连续边缘分布可一致,但漂移中的 score 系数不同:SDE 是 1,ODE 是 1/2,不能只把 DDPM 的噪声删除就得到 DDIM。
误解二:「反向过程就是把噪声一步步减掉。」 方向反了。反向 drift 是 $+\tfrac12\beta x + \beta s$,$x$ 那一项是往外推的。前向把分布压向原点,score 与线性项合起来才决定方向;对稳态标准高斯,反向 SDE 的总漂移向内,概率流速度为零,不能把每个样本都理解成向外吹。我按「减掉」实现了三个采样器,全部崩掉(4.3 节那个符号坑),而错误版本跑起来并不报错、只是数值不对——这类 bug 只能靠对着闭式解核对来抓。
误解三:「换个参数化只是记号问题,等价就是等价。」 描述的对象等价,作为训练目标不等价。权重表跨 8 个数量级(06 节),这不是小差异。代数转换对任意兼容输出都成立,不要求网络先收敛;不同的未加权训练目标、共享参数及时间采样通常产生不同优化过程。
误解四:「换成 mean log p 就能可靠排序。」 MMD / FID 需要估计不确定性,mean log p 同样需要,而且单个均值不能刻画完整分布。对两批真实样本只算一次差值,不能据此画置信区间;必须重复抽样或用适当的标准误 / bootstrap 分析。
误解五:「ODE 无随机项,所以没有多样性;SDE 多走几步只会累积坏噪声。」 随机性可以来自初始噪声,也可以来自路径。精确连续过程下两者都可得到正确分布;更多步数通常减少相应数值方法的离散误差,但有限模型、引导、网格与算力约束下仍应实测。
误解六:「$\bar\alpha_t$ 和 $1-\bar\alpha_t$ 加起来是 1,所以信噪比就是 $\bar\alpha_t$。」 信噪比是 $\bar\alpha_t/(1-\bar\alpha_t)$,不是 $\bar\alpha_t$。以单位数据方差为参考,t=500 时线性调度 $\bar\alpha_{500}=7.86\times10^{-2}$,看着还有 7.9% 的信号,但信噪比只有 0.085(−10.7 dB)——信号和噪声的幅度比已经掉到 1:3.4 以下。只看 $\bar\alpha$ 会严重高估「还剩多少信息」。
六个脚本都在文末完整附录里,保存到同一目录后用 Python 3 运行。除绘图脚本外只依赖 NumPy,绘图另需 matplotlib。本次实际环境为 Windows、Python 3.11.9、NumPy 2.4.6、matplotlib 3.10.7;BLAS 单线程。主实验种子 20260926 保持,新增核对种子见脚本,未测试 GPU 或真实图像吞吐。
python forward_diffusion.py     # 前向闭式解核对 + 两种调度对比 + 终端 SNR
python reverse_sampling.py      # 五种采样器 × 七档步数的主实验
python score_bridges.py         # Tweedie / ε / v 四条恒等式核对 + 权重表
python mmd_noise_check.py       # 先量一下 MMD² 自己的噪声
python make_figures.py          # 生成四张图
python diffusion_checks.py      # 条件target/后验/精确嵌入/同NFE五种子反例
值得自己动手改着看的四处:
第一,把 N 设成 10,看 DDIM 和 Euler 谁先崩。 预期:DDIM 的 dlogp 是 −0.248(偏散、没收敛完),Euler 是 −2.340(散得离谱)。对照 4.5 节的最大积分量与线性子项误差,并检查覆盖和半径;它们提供诊断线索,不能独立解释全部误差。
第二,给 run_ode 加一个符号。 把 x + 0.5 * L * (x + s) 改成 x - 0.5 * L * (x + s) 再跑,观察分布是否继续被收缩,并记录实际统计量,勿把旧试跑数字当作本环境必然输出。稳态高斯的解析方差反例可先由 diffusion_checks.py 验证。这就是 3.4 节那个 $du<0$ 的坑。
第三,把目标分布的 SCALES 从 0.16~0.24 改成 0.45 附近。 检查估计噪声是否遮住方法差异;结果依赖分量、种子、带宽与样本量,不预设所有方法必然相同。这是 4.1 节那个「目标太光滑就分不出来」的第二遍确认。
第四,改 forward_diffusion.py 里的 linear_beta,把 beta_T 从 0.02 降到 0.01。 预期:$\bar\alpha_T$ 变大(终端残留信号变多),t=500 的 SNR 也跟着变。可以顺着看 05 节说的那个「非零终端 SNR」到底有多敏感。
原始来源:2015 扩散框架、DDPM、score-SDE、DDIM、Improved DDPM、渐进蒸馏、DPM-Solver、零终端 SNR、MMD 原始论文。工业源码固定到 diffusers v0.35.1。
09 节用到的脚本全文如下(mmd_noise_check.py、forward_diffusion.py、diffusion_checks.py、score_bridges.py、reverse_sampling.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""MMD^2 估计噪声核对:本样本量和带宽下,微小差异不足以可靠排序。

写这篇的时候第一版主指标就是 MMD^2,跑出来的表看着很漂亮(Heun 在
N>=10 就顶到"噪声地板",其余采样器数值一路降到 0 以下)。问题是那个
"噪声地板"是单次抽样的运气值:把真实样本对真实样本重复 8 次,MMD^2
的标准差是 3.6e-4,比 N>=100 时各采样器之间的差别还大。

所以正文改用三个可直接计算但仍有抽样波动的统计量(mean log p_0 / 分量占比
TV / 模式内半径),MMD^2 只留作低步数区间的旁证。

跑法:python mmd_noise_check.py
"""
import numpy as np

from forward_diffusion import sample_data
from reverse_sampling import mmd2, run_ddpm, make_stride
from forward_diffusion import alpha_bar_from_beta, linear_beta, T, D

ab = alpha_bar_from_beta(linear_beta(T))

print("A. 真实样本 vs 真实样本(应当 ~0),重复 8 次,看估计量的散布")
for bw in [None, 1.9, 1.0, 0.5]:
    vals = []
    for k in range(8):
        a = sample_data(2000, np.random.default_rng(1000 + k))
        b = sample_data(2000, np.random.default_rng(5000 + k))
        v, used = mmd2(a, b, bw=bw)
        vals.append(v)
    vals = np.array(vals)
    print(f"  bw={str(bw):>5} (实取{used:.2f})  mean={vals.mean():+.3e}  "
          f"std={vals.std():.3e}  min={vals.min():+.3e}  max={vals.max():+.3e}")

print()
print("B. ddpm@1000 换 8 个不同的初始噪声种子")
for bw in [None, 1.0, 0.5]:
    ref = sample_data(4000, np.random.default_rng(7))
    vals = []
    for k in range(8):
        rng = np.random.default_rng(3000 + k)
        x = rng.standard_normal((2000, D))
        x = run_ddpm(x, ab, make_stride(1000, T), rng)
        v, used = mmd2(x, ref, bw=bw)
        vals.append(v)
    vals = np.array(vals)
    print(f"  bw={str(bw):>5} (实取{used:.2f})  mean={vals.mean():+.3e}  "
          f"std={vals.std():.3e}")
    print(f"        -> {np.array2string(vals, precision=3, formatter={'float': lambda v: f'{v:+.2e}'})}")

print()
print("C. 极端对照:把样本整体平移 0.5,看各带宽的分辨力")
ref = sample_data(4000, np.random.default_rng(7))
for shift in [0.05, 0.1, 0.2, 0.5]:
    y = sample_data(2000, np.random.default_rng(11)) + shift
    row = f"  shift={shift:.2f}  "
    for bw in [1.9, 1.0, 0.5, 0.25]:
        v, _ = mmd2(y, ref, bw=bw)
        row += f"bw={bw}:{v:+.2e}  "
print(row)#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""扩散前向过程:闭式解、噪声调度、信噪比。
只依赖 numpy。正文里出现的每一个数字都由本脚本打印,不手填。
要回答三个问题:
1. q(x_t | x_0) 的闭式解是不是真的成立(蒙特卡洛对着验)
2. 线性调度和余弦调度把"难度"分配得有多不一样(看 alpha_bar / SNR)
3. 前向终点的分布离标准正态到底差多少(决定了 L_T 那一项有多大)
运行: python forward_diffusion.py
"""
import numpy as np
SEED = 20260926
T = 1000 # 总步数,与 DDPM 原文一致
D = 2 # 玩具数据维度
# ── 玩具数据:2D 七分量各向同性高斯混合(环状 + 一个中心分量)──────────
# 分量故意取紧(标准差 0.16~0.30):score 场的曲率大,离散化误差才显出来。
# 换成 3 个宽分量(标准差 ~0.5)的话,oracle score 下所有采样器都会直接顶到
# MMD 噪声地板上,分不出高下——这是调这个玩具问题时踩的第一个坑。
WEIGHTS = np.array([0.14, 0.13, 0.15, 0.12, 0.14, 0.13, 0.19])
MEANS = np.array([[-2.6, -1.0],
[-1.0, -2.2],
[1.4, -2.0],
[2.6, -0.4],
[1.6, 1.8],
[-0.6, 2.4],
[0.0, 0.0]])
SCALES = np.array([0.22, 0.18, 0.20, 0.16, 0.24, 0.20, 0.30])
def sample_data(n, rng):
"""从 p_0 采 n 个样本。"""
k = rng.choice(len(WEIGHTS), size=n, p=WEIGHTS)
return MEANS[k] + SCALES[k][:, None] * rng.standard_normal((n, D))
# ── 噪声调度 ──────────────────────────────────────────────────────────
def linear_beta(T=T, beta_1=1e-4, beta_T=0.02):
"""DDPM 原文的线性调度,beta 从 1e-4 均匀涨到 0.02。"""
return np.linspace(beta_1, beta_T, T)
def cosine_beta(T=T, s=0.008, clip=0.999):
"""Nichol & Dhariwal 的余弦调度,返回 beta_t。
alpha_bar_t = cos^2(((t/T + s)/(1+s)) * pi/2) / cos^2((s/(1+s)) * pi/2)
分母只是为了让 t=0 时 alpha_bar=1。
按 t=T 代入会得到 alpha_bar_T = 0(cos(pi/2)=0),也就是最后一步 beta=1,
实操上会炸。原文和 diffusers 都会把 beta 截到 0.999 以内,这里照做。
"""
t = np.arange(1, T + 1) / T
f = np.cos(((t + s) / (1 + s)) * np.pi / 2) ** 2
f0 = (np.cos((s / (1 + s)) * np.pi / 2)) ** 2
a_bar = f / f0
beta = beta_from_alpha_bar(a_bar)
return np.clip(beta, None, clip)
def cosine_alpha_bar(T=T, s=0.008, clip=0.999):
"""截尾之后的余弦调度的 alpha_bar,与 cosine_beta 一致。"""
return alpha_bar_from_beta(cosine_beta(T, s, clip))
def alpha_bar_from_beta(beta):
"""alpha_bar_t = prod_{s<=t} (1 - beta_s),t = 1..T。"""
return np.cumprod(1.0 - beta)
def beta_from_alpha_bar(alpha_bar):
"""反解出每步的 beta_t = 1 - alpha_bar_t / alpha_bar_{t-1}。"""
prev = np.concatenate([[1.0], alpha_bar[:-1]])
return 1.0 - alpha_bar / prev
def snr_db(alpha_bar):
"""信噪比 alpha_bar/(1-alpha_bar),取 10*log10。"""
return 10.0 * np.log10(alpha_bar / (1.0 - alpha_bar))
def q_sample(x0, t_idx, alpha_bar, rng):
"""x_t = sqrt(alpha_bar_t) * x_0 + sqrt(1 - alpha_bar_t) * eps。
t_idx 是 0-based 的数组下标,对应 alpha_bar[t_idx]。
"""
a = alpha_bar[t_idx]
eps = rng.standard_normal(x0.shape)
return np.sqrt(a) * x0 + np.sqrt(1.0 - a) * eps, eps
# ── 加噪后分布的解析形式(反向采样要用 oracle score)──────────────────
def noised_mixture(alpha_bar_t):
"""p_t 仍是高斯混合:第 k 个分量的均值缩到 sqrt(a)*mu_k,
协方差变成 a*Sigma_k + (1-a)*I。因为 Sigma_k = s_k^2 I,结果仍是各向同性。
"""
a = alpha_bar_t
means = np.sqrt(a) * MEANS
var = a * SCALES ** 2 + (1.0 - a) # 每个分量的方差(标量)
return WEIGHTS, means, var
def log_density(x, weights, means, var):
"""各向同性高斯混合的 log 密度,x: [n, 2]。"""
n, d = x.shape
# [n, K]
sq = ((x[:, None, :] - means[None, :, :]) ** 2).sum(-1)
comp = -0.5 * (sq / var[None, :] + d * np.log(2 * np.pi * var)[None, :])
mx = comp.max(axis=1, keepdims=True)
e = np.exp(comp - mx)
mix = (weights[None, :] * e).sum(1)
return (np.log(mix) + mx[:, 0])
def score_fn(x, alpha_bar_t):
"""nabla_x log p_t(x) 的闭式解。混合权重用 log-sum-exp 稳住数值。"""
w, m, v = noised_mixture(alpha_bar_t)
n, d = x.shape
sq = ((x[:, None, :] - m[None, :, :]) ** 2).sum(-1)
comp = -0.5 * (sq / v[None, :] + d * np.log(2 * np.pi * v)[None, :])
mx = comp.max(axis=1, keepdims=True)
e = np.exp(comp - mx)
resp = w[None, :] * e
resp = resp / resp.sum(1, keepdims=True) # [n, K] 责任度
# grad log N(x; m_k, v_k I) = -(x - m_k)/v_k
return -(resp[:, :, None] * (x[:, None, :] - m[None, :, :]) / v[None, :, None]).sum(1)
# ──────────────────────────────────────────────────────────────────────
# A. 闭式解核对
# ──────────────────────────────────────────────────────────────────────
def check_closed_form(rng, alpha_bar, n=200_000):
"""一步一步加噪 1000 次,和闭式解 x_t = sqrt(a) x_0 + sqrt(1-a) eps 对着验。"""
x0 = sample_data(n, rng)
out = []
for t_idx in [49, 199, 499, 999]:
a = alpha_bar[t_idx]
# 路径 1:逐步迭代
x = x0.copy()
beta = beta_from_alpha_bar(alpha_bar)
for i in range(t_idx + 1):
x = np.sqrt(1.0 - beta[i]) * x + np.sqrt(beta[i]) * rng.standard_normal(x.shape)
# 路径 2:独立噪声闭式抽样;只比较边缘统计量,不逐样本配对
xt_cf, _ = q_sample(x0, t_idx, alpha_bar, rng)
# 逐样本比不了(噪声不同),比统计量
out.append({
"t": t_idx + 1,
"alpha_bar": a,
"mean_step": np.abs(x.mean(0) - np.sqrt(a) * x0.mean(0)).max(),
"var_step": np.abs(x.var(0) - (a * x0.var(0) + (1 - a))).max(),
"var_cf": np.abs(xt_cf.var(0) - (a * x0.var(0) + (1 - a))).max(),
})
return out
# ──────────────────────────────────────────────────────────────────────
# B. 调度对比
# ──────────────────────────────────────────────────────────────────────
def schedule_report():
lin_b = linear_beta(T)
lin_a = alpha_bar_from_beta(lin_b)
cos_b = cosine_beta(T)
cos_a = alpha_bar_from_beta(cos_b)
rows = []
for t in [1, 50, 100, 250, 500, 750, 900, 1000]:
rows.append({
"t": t,
"lin_a": lin_a[t - 1],
"cos_a": cos_a[t - 1],
"lin_snr": snr_db(lin_a[t - 1]),
"cos_snr": snr_db(cos_a[t - 1]),
"lin_b": lin_b[t - 1],
"cos_b": cos_b[t - 1],
})
return lin_b, lin_a, cos_b, cos_a, rows
def half_life(alpha_bar):
"""alpha_bar 掉到 0.5 是第几步——一半的采样步数花在这之后。"""
idx = np.argmax(alpha_bar < 0.5)
return int(idx) + 1 if alpha_bar[idx] < 0.5 else T
# ──────────────────────────────────────────────────────────────────────
# C. 区分边缘终端 KL 与 ELBO 的条件终端 KL
# ──────────────────────────────────────────────────────────────────────
def terminal_kl(alpha_bar_T):
"""KL( q(x_T) || N(0,I) ),q(x_T) 是七分量高斯混合。
没有闭式解,用蒙特卡洛:E_{q(x_T)}[ log q(x_T) - log N(0,I) ]
"""
rng = np.random.default_rng(SEED + 7)
x = sample_data(400_000, rng)
w, m, v = noised_mixture(alpha_bar_T)
eps = rng.standard_normal(x.shape)
xt = np.sqrt(alpha_bar_T) * x + np.sqrt(1.0 - alpha_bar_T) * eps
lq = log_density(xt, w, m, v)
ln = -0.5 * ((xt ** 2).sum(1) + D * np.log(2 * np.pi))
return float((lq - ln).mean()), float((lq - ln).std() / np.sqrt(len(xt)))
def terminal_elbo_kl(alpha_bar_T):
"""E_data KL(q(x_T|x_0) || N(0,I)) 的闭式值。"""
if not 0 <= alpha_bar_T < 1:
raise ValueError("alpha_bar_T must lie in [0,1)")
second_moment = np.sum(WEIGHTS * (np.sum(MEANS ** 2, axis=1) + D * SCALES ** 2))
return 0.5 * (alpha_bar_T * second_moment - D * alpha_bar_T
- D * np.log1p(-alpha_bar_T))
def main():
rng = np.random.default_rng(SEED)
print("=" * 68)
print("A. 闭式解核对:逐步迭代 vs 一步闭式(20 万样本,2D)")
print("=" * 68)
lin_b, lin_a, cos_b, cos_a, _rows = schedule_report()
for r in check_closed_form(rng, lin_a):
print(f" t={r['t']:>4} alpha_bar={r['alpha_bar']:.6e} "
f"|均值差|={r['mean_step']:.2e} 逐步方差误={r['var_step']:.2e} "
f"闭式方差误={r['var_cf']:.2e}")
print()
print("=" * 68)
print("B. 两种调度把信息怎么抹掉的")
print("=" * 68)
print(f" {'t':>5} {'alpha_bar(linear)':>18} {'alpha_bar(cosine)':>18} "
f"{'SNR_dB(lin)':>12} {'SNR_dB(cos)':>12}")
for r in _rows:
print(f" {r['t']:>5} {r['lin_a']:>18.6e} {r['cos_a']:>18.6e} "
f"{r['lin_snr']:>12.2f} {r['cos_snr']:>12.2f}")
print(f"\n alpha_bar 掉到 0.5 的步数:linear = {half_life(lin_a)},"
f"cosine = {half_life(cos_a)}")
print(f" 也就是说 linear 调度下,{100 * np.mean(lin_a < 0.5):.1f}% 的步数"
f"花在信噪比已经低于 0 dB 的区域")
print()
print("=" * 68)
print("C. 边缘终端 KL 和 ELBO 条件终端 KL(不同对象)")
print("=" * 68)
for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]:
kl, se = terminal_kl(aT)
print(f" {name:>7}: E_data KL(q(x_T|x_0)||N(0,I)) = {terminal_elbo_kl(aT):.6e} nats")
print(f" {name:>7}: alpha_bar_T={aT:.6e} KL(q(x_T)||N(0,I)) = {kl:.6e} nats"
f" (±{se:.1e})")
print()
print("=" * 68)
print("D. 连续时间对账:beta(t) = T * beta_i,积分出来的 alpha_bar 对不对")
print("=" * 68)
b_min, b_max = T * float(lin_b[0]), T * float(lin_b[-1])
print(f" beta_min = {b_min:.4f}(Song et al. VP-SDE 默认 0.1)"
f" beta_max = {b_max:.4f}(默认 20)")
for t in [0.25, 0.5, 0.75, 1.0]:
i = int(round(t * T)) - 1
a_cont = np.exp(-(b_min * t + 0.5 * (b_max - b_min) * t * t))
print(f" t={t:.2f} 离散 alpha_bar={lin_a[i]:.6e} "
f"连续 exp(-int beta)={a_cont:.6e} 相对差={abs(lin_a[i] - a_cont) / lin_a[i]:.2e}")
print()
print("=" * 68)
print("E. 终点还剩多少原始信号(非零终端 SNR 问题)")
print("=" * 68)
for name, aT in [("linear", lin_a[-1]), ("cosine", cos_a[-1])]:
amp = np.sqrt(aT)
snr_T = aT / (1.0 - aT)
print(f" {name:>7}: alpha_bar_T={aT:.6e} sqrt(alpha_bar_T)={amp:.6e}"
f" => x_T 里原始信号的振幅占比 {amp * 100:.4f}%")
print(f" 终端 SNR = {snr_T:.4e}(= {snr_db(aT):.2f} dB),"
f"若设计为纯高斯终端则应为 0;有限时间允许非零值")
if __name__ == "__main__":
main()"""NumPy checks for conditional targets, posterior uncertainty and sampling statistics.
Run: python diffusion_checks.py. No model weights or GPU are required.
"""
import json
from pathlib import Path
import numpy as np
import forward_diffusion as fd
import reverse_sampling as rs
def main():
rng = np.random.default_rng(20261015)
ab = fd.alpha_bar_from_beta(fd.linear_beta())
x = rng.normal(size=(30, fd.D))
h = 1e-5
score_errors = []
for t in [1, 50, 500, 1000]:
a = ab[t - 1]
w, m, v = fd.noised_mixture(a)
finite_diff = np.empty_like(x)
for d in range(fd.D):
step = np.zeros_like(x)
step[:, d] = h
finite_diff[:, d] = (fd.log_density(x + step, w, m, v)
- fd.log_density(x - step, w, m, v)) / (2 * h)
score_errors.append(float(np.max(np.abs(finite_diff - fd.score_fn(x, a)))))
assert max(score_errors) < 1e-7
# Conditioning a standard Gaussian prior leaves nonzero target uncertainty.
a = 0.25
x0 = rng.normal(size=(100000, fd.D))
eps = rng.normal(size=x0.shape)
xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps
eps_mean = np.sqrt(1 - a) * xt # marginal score is -xt
mmse = float(np.mean(np.sum((eps - eps_mean) ** 2, axis=1)))
assert abs(mmse - fd.D * a) < 0.006
target_example = dict(empirical_mmse=mmse,analytic_mmse=fd.D*a,
zero_predictor_rmse=np.sqrt(fd.D),
independent_gaussian_predictor_rmse=np.sqrt(2*fd.D))
# q(x0|xt=0) for a symmetric two-mode prior: mean=0 hides both modes.
a, s2, mu = 0.9, 0.04, 2.0
vt = a * s2 + 1 - a
posterior_component_mean = (1 - a) * mu / vt
posterior_component_var = s2 * (1 - a) / vt
posterior_var = posterior_component_var + posterior_component_mean ** 2
posterior_example = dict(component_means=[-posterior_component_mean,
posterior_component_mean],
within_component_variance=posterior_component_var,
true_variance=posterior_var,
plugin_final_variance=0.0,plugin_final_mean=0.0)
assert posterior_var > 2
# Exact finite-interval embedding: exp(-int rate)=prod(1-beta).
b = fd.linear_beta()
rates = -fd.T * np.log1p(-b)
embedded = np.exp(-np.cumsum(rates) / fd.T)
embedding_error = float(np.max(np.abs(embedded - ab)))
assert embedding_error < 2e-14
# Stationary N(0,I): reverse SDE needs the full score, ODE drift is zero.
L = 0.1
correct_em_variance = (1 - L/2)**2 + L
deleted_noise_variance = (1 - L/2)**2
ode_variance = 1.0
assert abs(correct_em_variance - 1) < 0.003
assert deleted_noise_variance < 0.91
# A radius-sqrt(D) sphere has the Gaussian's exact expected log-density,
# but different radial fourth moment. This is a distribution counterexample.
gaussian_logp = -fd.D/2 * (1 + np.log(2*np.pi))
sphere_logp = -0.5 * (fd.D + fd.D*np.log(2*np.pi))
counterexample = dict(dlogp=sphere_logp-gaussian_logp,
sphere_radius_fourth_moment=fd.D**2,
gaussian_radius_fourth_moment=fd.D*(fd.D+2))
assert abs(counterexample['dlogp']) < 1e-14
# Same NFE=50 for all methods; five independent runs, not a confidence band.
configs = [('ddpm',50),('ddim',50),('em',50),('ode',50),('heun',25)]
repeated = []
for name, n in configs:
vals, ses = [], []
for k in range(5):
seed = 70000 + 100*k
ref = fd.sample_data(8000,np.random.default_rng(seed))
gen_rng = np.random.default_rng(seed+1)
initial = gen_rng.standard_normal((4000,fd.D))
before = rs.SCORE_CALLS
generated = rs.SAMPLERS[name][0](initial,ab,rs.make_stride(n),gen_rng)
nfe = rs.SCORE_CALLS-before
assert nfe == 50 and np.isfinite(generated).all()
lg = fd.log_density(generated,fd.WEIGHTS,fd.MEANS,fd.SCALES**2)
lr = fd.log_density(ref,fd.WEIGHTS,fd.MEANS,fd.SCALES**2)
vals.append(float(lg.mean()-lr.mean()))
ses.append(float(np.sqrt(lg.var(ddof=1)/len(lg)+lr.var(ddof=1)/len(lr))))
repeated.append(dict(method=name,steps=n,nfe=nfe,seeds=5,dlogp_runs=vals,
dlogp_mean=float(np.mean(vals)),
across_seed_sd=float(np.std(vals,ddof=1)),
iid_standard_errors=ses))
results = dict(passed=True,score_gradient_max_abs=max(score_errors),
conditional_target=target_example,posterior=posterior_example,
exact_embedding_max_abs=embedding_error,
stationary_gaussian=dict(correct_em_variance=correct_em_variance,
delete_noise_variance=deleted_noise_variance,
probability_flow_variance=ode_variance),
density_counterexample=counterexample,repeated_sampling=repeated,
errors=[],warnings=[])
target = Path(__file__).with_name('validation_results.json')
target.write_text(json.dumps(results,ensure_ascii=False,indent=2)+'\n',encoding='utf8')
print(json.dumps(results,ensure_ascii=False,indent=2))
if __name__ == '__main__':
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""把 score / epsilon / x_0 / v 四种参数化钉死在同一组恒等式上。
扩散模型的代码里同一个东西有四种写法,换参数化是家常便饭(SD 2.x 用 v,
不同checkpoint分别采用epsilon、v或x_0,必须检查训练目标配置)。这篇要说的是:
它们描述的是同一个量,但**作为训练目标并不等价**——换参数化等于给每个
时间步偷偷换了一个权重。
跑法:python score_bridges.py
"""
import numpy as np
from forward_diffusion import (
D, SEED, T, MEANS, SCALES, WEIGHTS,
alpha_bar_from_beta, linear_beta, noised_mixture,
sample_data, score_fn,
)
ALPHA_BAR = alpha_bar_from_beta(linear_beta(T))
def abar(t):
"""t 是 1-based 步号。"""
return 1.0 if t == 0 else float(ALPHA_BAR[t - 1])
def score_at(x, t):
return score_fn(x, abar(t))
# ──────────────────────────────────────────────────────────────────────
# A. 精确后验均值 E[x_0 | x_t]
# ──────────────────────────────────────────────────────────────────────
def posterior_mean_exact(x, t):
"""q(x_0 | x_t) 仍是高斯混合,第 k 个分量:
后验权重 r_k = 与 score 里用的是同一份责任度
后验方差 C_k = (1/s_k^2 + alpha_bar/(1-alpha_bar))^{-1}
后验均值 m_k = C_k * (mu_k / s_k^2 + sqrt(alpha_bar) * x_t / (1-alpha_bar))
"""
a = abar(t)
if a >= 1.0:
return x.copy()
_, m_t, v_t = noised_mixture(a) # 加噪后各分量的均值 / 方差
n = x.shape[0]
sq = ((x[:, None, :] - m_t[None, :, :]) ** 2).sum(-1)
logc = -0.5 * (sq / v_t[None, :] + D * np.log(2 * np.pi * v_t)[None, :])
mx = logc.max(1, keepdims=True)
resp = WEIGHTS[None, :] * np.exp(logc - mx)
resp = resp / resp.sum(1, keepdims=True) # [n, K]
s2 = SCALES ** 2
C = 1.0 / (1.0 / s2 + a / (1.0 - a)) # [K]
mk = C[None, :, None] * (MEANS[None, :, :] / s2[None, :, None]
+ np.sqrt(a) * x[:, None, :] / (1.0 - a))
return (resp[:, :, None] * mk).sum(1)
def tweedie_mean(x, t):
"""Tweedie:E[x_0 | x_t] = (x_t + (1 - alpha_bar_t) * score) / sqrt(alpha_bar_t)。"""
a = abar(t)
if a >= 1.0:
return x.copy()
return (x + (1.0 - a) * score_at(x, t)) / np.sqrt(a)
def eps_from_score(x, t):
"""E[eps|x_t] = -sqrt(1 - alpha_bar_t) * marginal score。"""
a = abar(t)
return -np.sqrt(1.0 - a) * score_at(x, t)
def eps_from_x0(x, x0_hat, t):
"""反解:eps = (x_t - sqrt(alpha_bar_t) * x_0) / sqrt(1 - alpha_bar_t)。"""
a = abar(t)
return (x - np.sqrt(a) * x0_hat) / np.sqrt(1.0 - a)
def v_target(x0, eps, t):
"""v = sqrt(alpha_bar) * eps - sqrt(1 - alpha_bar) * x_0。"""
a = abar(t)
return np.sqrt(a) * eps - np.sqrt(1.0 - a) * x0
def recover_from_v(x, v, t):
"""v 和 x_t 之间是一个旋转:x_0 = a*x_t - b*v,eps = b*x_t + a*v。
变换矩阵 [[a, b], [-b, a]] 行列式为 a^2+b^2=1,所以它是正交的——
这也保证联合向量范数;固定 x_t 时 eps 误差为 sqrt(a)*delta_v,不能推成任意误差无放大。
"""
a, b = np.sqrt(abar(t)), np.sqrt(1.0 - abar(t))
return a * x - b * v, b * x + a * v
# ──────────────────────────────────────────────────────────────────────
# B. 蒙特卡洛交叉验证(不靠闭式解,纯重要性采样)
# ──────────────────────────────────────────────────────────────────────
def is_posterior_mean(xi, t, n=1_000_000, seed=SEED + 11):
"""E[x_0 | x_t = xi] 的自归一化重要性采样估计。
x_0^i 就是从 p_0 里采的,所以权重直接取 q(xi | x_0^i) 即可,
不需要知道归一化常数。
"""
rng = np.random.default_rng(seed)
x0 = sample_data(n, rng)
a = abar(t)
b2 = 1.0 - a
sq = ((xi[None, :] - np.sqrt(a) * x0) ** 2).sum(1)
logw = -0.5 * sq / b2
logw -= logw.max()
w = np.exp(logw)
ess = w.sum() ** 2 / (w ** 2).sum()
return (w[:, None] * x0).sum(0) / w.sum(), ess
# ──────────────────────────────────────────────────────────────────────
# C. 三种参数化在 epsilon 空间下的每步权重
# ──────────────────────────────────────────────────────────────────────
def loss_weights(t):
"""把三种参数化的训练损失都换算回"相当于给 eps 误差加了多大权重"。
- eps 参数化:delta_eps = delta_u -> 权重 1
- x_0 参数化:eps = (x_t - sqrt(a) x_0)/sqrt(1-a)
delta_eps = -sqrt(a/(1-a)) * delta_u -> 权重 a/(1-a) = SNR
反过来,x_0 的损失 ||delta_u||^2 折算成 eps 误差是
||delta_eps||^2 = SNR * ||delta_x0||^2,
即 x_0 损失对 eps 误差的权重是 1/SNR
- v 参数化 :eps = sqrt(1-a)*x_t + sqrt(a)*v,delta_eps = sqrt(a) * delta_v
-> v 损失折算成 eps 误差的权重是 1/a = 1/alpha_bar
返回 (权重_eps, 权重_v, 权重_x0),都是"乘在 ||delta_eps||^2 上的系数"。
"""
a = abar(t) if t > 0 else 1.0
snr = a / (1.0 - a)
return 1.0, 1.0 / a, 1.0 / snr
def main():
rng = np.random.default_rng(SEED)
print("=" * 72)
print("A. Tweedie 恒等式核对:闭式后验均值 vs 公式 (x_t + (1-a) s)/sqrt(a)")
print("=" * 72)
print(f" {'t':>5} {'alpha_bar':>14} {'最大绝对误差':>16} {'x_t 范数均值':>14}")
for t in [1, 50, 100, 250, 500, 750, 1000]:
x = sample_data(2000, rng)
xt, _ = (np.sqrt(abar(t)) * x
+ np.sqrt(1 - abar(t)) * rng.standard_normal(x.shape), None)
e1 = posterior_mean_exact(xt, t)
e2 = tweedie_mean(xt, t)
err = np.abs(e1 - e2).max()
print(f" {t:>5} {abar(t):>14.6e} {err:>16.3e} "
f"{np.linalg.norm(xt, axis=1).mean():>14.4f}")
print()
print("=" * 72)
print("B. MMSE eps 与边缘 score 的换算:两条路算条件均值是否一致")
print("=" * 72)
print(f" {'t':>5} {'|eps(score) - eps(x_0)| 最大':>28}")
for t in [50, 250, 500, 1000]:
x0 = sample_data(2000, rng)
eps_true = rng.standard_normal(x0.shape)
a = abar(t)
xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps_true
# 路线 1:从 score
e_s = eps_from_score(xt, t)
# 路线 2:从 Tweedie 反解出的 x_0
e_x = eps_from_x0(xt, tweedie_mean(xt, t), t)
print(f" {t:>5} {np.abs(e_s - e_x).max():>28.3e}")
# 顺便看看 MMSE 估计量离真实 eps 有多远(这是"复原不了"的那部分)
print(f" (MMSE 估计量与本次真实 eps 的 RMSE = "
f"{np.sqrt(((e_s - eps_true) ** 2).sum(1).mean()):.4f},"
f"零预测基线 sqrt(D)={np.sqrt(D):.4f};独立标准高斯猜测基线 sqrt(2D)={np.sqrt(2 * D):.4f})")
print()
print("=" * 72)
print("C. v 参数化:它与 (x_t, eps, x_0) 之间是一个旋转")
print("=" * 72)
for t in [50, 500, 1000]:
x0 = sample_data(2000, rng)
eps = rng.standard_normal(x0.shape)
a = abar(t)
xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * eps
v = v_target(x0, eps, t)
x0_rec, eps_rec = recover_from_v(xt, v, t)
print(f" t={t:>5} 重建 x_0 误差={np.abs(x0_rec - x0).max():.3e} "
f"重建 eps 误差={np.abs(eps_rec - eps).max():.3e} "
f"v 的范数均值={np.linalg.norm(v, axis=1).mean():.4f}")
print()
print("=" * 72)
print("D. 蒙特卡洛交叉验证(100 万样本的重要性采样,不依赖上面的闭式解)")
print("=" * 72)
print(f" {'t':>5} {'Tweedie':>22} {'重要性采样':>22} {'有效样本数':>12}")
for t in [50, 250, 500, 1000]:
xi = sample_data(1, rng)[0]
xi = np.sqrt(abar(t)) * xi + np.sqrt(1 - abar(t)) * rng.standard_normal(2)
tm = tweedie_mean(xi[None, :], t)[0]
im, ess = is_posterior_mean(xi, t)
print(f" {t:>5} {np.array2string(tm, precision=4):>22} "
f"{np.array2string(im, precision=4):>22} {ess:>12.0f}")
print()
print("=" * 72)
print("E. 换参数化 = 给每个时间步换权重(折算回 eps 空间的系数)")
print("=" * 72)
print(f" {'t':>5} {'alpha_bar':>13} {'w_eps':>12} {'w_v':>14} {'w_x0':>14}")
for t in [1, 10, 50, 100, 250, 500, 750, 900, 1000]:
we, wv, wx = loss_weights(t)
print(f" {t:>5} {abar(t):>13.6e} {we:>12.4f} {wv:>14.4e} {wx:>14.4e}")
wes, wvs, wxs = zip(*[loss_weights(t) for t in range(1, T + 1)])
print(f"\n eps 参数化: 权重恒为 1,动态范围 {max(wes) / min(wes):.1f}")
print(f" v 参数化: 权重 {min(wvs):.4e} ~ {max(wvs):.4e},"
f"动态范围 {max(wvs) / min(wvs):.3e}")
print(f" x_0 参数化: 权重 {min(wxs):.4e} ~ {max(wxs):.4e},"
f"动态范围 {max(wxs) / min(wxs):.3e}")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""反向采样:五种采样器在"同一个 oracle score"下的正面对比。
这一节要回答的是:反向 SDE 与概率流 ODE 的漂移不同,为什么工业界
能搞出 DDPM / DDIM / DPM-Solver / Euler / Heun 这么多种采样器?差别到底
在哪里?
关键设计:目标分布用 2D 高斯混合,加噪之后仍然是高斯混合,所以
nabla_x log p_t(x) 有闭式解。也就是说这里的 score 是**理论最优**的,
不掺任何网络拟合误差——差异来自离散化、有限终端噪声近似以及蒙特卡洛波动。
五种采样器:
ddpm DDPM 祖采样(ancestral),高斯反向核近似,每步注噪声
ddim DDIM,eta=0,确定性
em Euler-Maruyama 解反向 SDE,一阶,注噪声
ode Euler 解概率流 ODE,一阶,确定性
heun Heun 二阶解概率流 ODE,每步两次 score 评估
运行: python reverse_sampling.py
"""
import numpy as np
from forward_diffusion import (
D, SEED, T, MEANS, SCALES, WEIGHTS,
alpha_bar_from_beta, cosine_beta, linear_beta,
log_density, sample_data, score_fn,
)
# ──────────────────────────────────────────────────────────────────────
# 时间步工具
# ──────────────────────────────────────────────────────────────────────
def make_stride(n_steps, T=T):
"""把 0..T 均匀切成 n_steps 段,返回 1-based 的 t 序列(含 T 与 0)。
例:n_steps=50, T=1000 -> [1000, 980, 960, ..., 20, 0]
"""
idx = np.linspace(T, 0, n_steps + 1).astype(int)
# 保证严格递减且唯一
idx = np.unique(idx)[::-1]
return list(idx)
def abar_at(alpha_bar, t):
"""t 是 1-based 步号;t=0 时 alpha_bar=1(即 x_0 本身)。"""
return 1.0 if t == 0 else float(alpha_bar[t - 1])
SCORE_CALLS = 0
def score_at(x, alpha_bar, t):
global SCORE_CALLS
SCORE_CALLS += 1
return score_fn(x, abar_at(alpha_bar, t))
# ──────────────────────────────────────────────────────────────────────
# 五种采样器
# ──────────────────────────────────────────────────────────────────────
def _tweedie_x0(x, s, a_cur):
"""Tweedie 公式:E[x_0 | x_t] = (x_t + (1-a_t) * score) / sqrt(a_t)。"""
return (x + (1.0 - a_cur) * s) / np.sqrt(a_cur)
def _eps_from_score(s, a_cur):
"""epsilon 与 score 的换算:E[epsilon | x_t] = -sqrt(1 - a_t) * marginal score。"""
return -np.sqrt(1.0 - a_cur) * s
def run_ddpm(x, alpha_bar, taus, rng, **kw):
"""DDPM 祖采样:用精确反向均值配固定高斯方差,有限步并非精确逆核。
x_{t-1} = (x_t + beta_t * s) / sqrt(alpha_t) + sigma_t * z
sigma_t^2 = beta_t * (1 - abar_{t-1}) / (1 - abar_t)
"""
for j in range(len(taus) - 1):
t_cur, t_prev = taus[j], taus[j + 1]
a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev)
alpha_j = a_cur / a_prev
beta_j = 1.0 - alpha_j
if beta_j < 1e-12:
continue
s = score_at(x, alpha_bar, t_cur)
mean = (x + beta_j * s) / np.sqrt(alpha_j)
var = beta_j * (1.0 - a_prev) / (1.0 - a_cur)
x = mean + np.sqrt(max(var, 0.0)) * rng.standard_normal(x.shape)
return x
def run_ddim(x, alpha_bar, taus, rng, **kw):
"""DDIM,eta=0:先跳到去噪后的 x_0,再重新加回 target 时刻的噪声。
x_{t-1} = sqrt(abar_{t-1}) * xhat_0 + sqrt(1 - abar_{t-1}) * eps_hat
"""
for j in range(len(taus) - 1):
t_cur, t_prev = taus[j], taus[j + 1]
a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev)
s = score_at(x, alpha_bar, t_cur)
xhat0 = _tweedie_x0(x, s, a_cur)
eps_hat = _eps_from_score(s, a_cur)
x = np.sqrt(a_prev) * xhat0 + np.sqrt(max(1.0 - a_prev, 0.0)) * eps_hat
return x
def _log_step(alpha_bar, t_cur, t_prev):
"""跨一步"累积"起来的积分量 L = int beta du = log(alpha_bar_{prev}/alpha_bar_{cur}) > 0。
这一步很关键:正向 SDE 的时间是 u = t/T,从 0 涨到 1;反向采样是让 u
**往回走**,所以 du 是负的。改用递增反向时间后,drift 符号整体翻转;
完整score与线性项共同决定方向,稳态高斯的ODE速度为零。
用 L 记这段区间上 beta 的积分,Euler 步就写成:
dx = +L * (0.5 x + c * s) (c=1 是 SDE,c=1/2 是 ODE)
"""
a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev)
return float(np.log(a_prev / a_cur))
def run_em(x, alpha_bar, taus, rng, **kw):
"""Euler-Maruyama 解反向 SDE:全量 score + 注入噪声。
反向 SDE 的 drift 里 score 的系数是 **1 倍**(不是 ODE 的半倍),
另外每步还要加 sqrt(L) 的噪声。
"""
for j in range(len(taus) - 1):
L = _log_step(alpha_bar, taus[j], taus[j + 1])
if L < 1e-12:
continue
s = score_at(x, alpha_bar, taus[j])
x = x + L * (0.5 * x + s) + np.sqrt(L) * rng.standard_normal(x.shape)
return x
def run_ode(x, alpha_bar, taus, rng, **kw):
"""Euler 解概率流 ODE:半倍 score,无噪声。
和 EM 只差两处:score 系数从 1 减到 0.5,噪声项整个去掉。
"""
for j in range(len(taus) - 1):
L = _log_step(alpha_bar, taus[j], taus[j + 1])
if L < 1e-12:
continue
s = score_at(x, alpha_bar, taus[j])
x = x + 0.5 * L * (x + s)
return x
def run_heun(x, alpha_bar, taus, rng, **kw):
"""Heun 二阶解概率流 ODE:Euler 预测一步,再用终点的 score 校正一次。
每步两次 score 评估(NFE = 2 * n_steps)。
"""
for j in range(len(taus) - 1):
L = _log_step(alpha_bar, taus[j], taus[j + 1])
if L < 1e-12:
continue
s0 = score_at(x, alpha_bar, taus[j])
d0 = 0.5 * L * (x + s0)
x1 = x + d0 # Euler 预测
s1 = score_at(x1, alpha_bar, taus[j + 1]) # 在目标时刻再评估一次
d1 = 0.5 * L * (x1 + s1)
x = x + 0.5 * (d0 + d1)
return x
SAMPLERS = {
"ddpm": (run_ddpm, 1),
"ddim": (run_ddim, 1),
"em": (run_em, 1),
"ode": (run_ode, 1),
"heun": (run_heun, 2),
}
# ──────────────────────────────────────────────────────────────────────
# 评价:MMD^2(RBF 核,median heuristic)
# ──────────────────────────────────────────────────────────────────────
def _rbf_kernels(a, b, bw):
sa = (a ** 2).sum(1)
sb = (b ** 2).sum(1)
d2 = sa[:, None] + sb[None, :] - 2.0 * a @ b.T
return np.exp(-d2 / (2.0 * bw ** 2))
def mmd2(x, y, bw=None, n_cap=1500):
"""固定且独立于待评估样本的带宽下是MMD^2无偏估计;自动带宽为数据自适应诊断。"""
rng = np.random.default_rng(0)
if len(x) > n_cap:
x = x[rng.choice(len(x), n_cap, replace=False)]
if len(y) > n_cap:
y = y[rng.choice(len(y), n_cap, replace=False)]
if bw is None:
allp = np.vstack([x[:800], y[:800]])
d2 = ((allp[:, None, :] - allp[None, :, :]) ** 2).sum(-1)
bw = float(np.sqrt(np.median(d2) / 2.0))
bw = max(bw, 1e-3)
kxx = _rbf_kernels(x, x, bw)
kyy = _rbf_kernels(y, y, bw)
kxy = _rbf_kernels(x, y, bw)
n, m = len(x), len(y)
# 去掉对角线才无偏
t1 = (kxx.sum() - np.trace(kxx)) / (n * (n - 1))
t2 = (kyy.sum() - np.trace(kyy)) / (m * (m - 1))
t3 = kxy.mean()
return float(t1 + t2 - 2 * t3), bw
def mean_logp(x):
"""生成样本在真实 p_0 下的平均 log 密度。
比 MMD 更能抓一种特定的失败:采样器把样本堆到高密度区(过聚拢),
或者样本飘到分量之间的低密度地带。
"""
return float(log_density(x, WEIGHTS, MEANS, SCALES ** 2).mean())
def assign_components(x):
"""按最近的均值把样本归到混合分量上(分量标准差同量级,够用)。"""
d = ((x[:, None, :] - MEANS[None, :, :]) ** 2).sum(-1)
return d.argmin(1)
def tv_weights(x):
"""经验分量占比与真实权重之间的全变差距离。
抓的是"各模式的比例对不对"——模式丢了一个、或者某个模式被过度采样,
这个数会涨,而 mean log p 未必涨(甚至可能更漂亮)。
"""
idx = assign_components(x)
n = len(x)
hist = np.bincount(idx, minlength=len(WEIGHTS)) / n
return float(0.5 * np.abs(hist - WEIGHTS).sum())
def mode_spread_err(x):
"""每个分量内部样本的均方半径,与理论值 D*s_k^2 的相对误差(取各分量最大)。
抓的是"样本落在模式的中心但挤成一团"或者"散得太开"。
"""
idx = assign_components(x)
errs = []
for k in range(len(WEIGHTS)):
sel = x[idx == k]
if len(sel) < 30:
errs.append(1.0)
continue
r2 = ((sel - MEANS[k]) ** 2).sum(1).mean()
errs.append(abs(r2 / (D * SCALES[k] ** 2) - 1.0))
return float(max(errs))
def moment_err(x, y):
"""均值与协方差的绝对误差(作为 MMD 之外的直观补充)。"""
return float(np.abs(x.mean(0) - y.mean(0)).max()), \
float(np.abs(np.cov(x.T) - np.cov(y.T)).max())
# ──────────────────────────────────────────────────────────────────────
# 主实验
# ──────────────────────────────────────────────────────────────────────
def sweep(n_list=(10, 20, 25, 50, 100, 200, 1000), n_samples=4000,
schedule="linear", seed=SEED):
"""固定一份真实样本做参照,扫采样器 × 步数。"""
alpha_bar = (alpha_bar_from_beta(linear_beta(T)) if schedule == "linear"
else alpha_bar_from_beta(cosine_beta(T)))
ref = sample_data(8000, np.random.default_rng(seed))
# 噪声地板:两份**独立**真实样本之间的 MMD^2。
# 单次值不是置信区间;细微差异需要重复抽样评估。
ref_b = sample_data(4000, np.random.default_rng(seed + 999))
floor, bw = mmd2(ref[:4000], ref_b)
# 三个主指标都先在大样本真实数据上算一遍当基线,后面一律报"相对基线的偏移",
# 理想期望下匹配的统计量差为0,有限样本仍有波动,0也不保证整个分布匹配。
base = {
"logp": mean_logp(ref),
"tv": tv_weights(ref),
"spread": mode_spread_err(ref),
}
# 一次对照差值(不是标准误或置信区间)
noise = {
"logp": mean_logp(ref_b) - base["logp"],
"tv": tv_weights(ref_b) - base["tv"],
"spread": mode_spread_err(ref_b) - base["spread"],
}
results = {"_floor": floor, "_bw": bw, "_base": base, "_noise": noise}
for name, (fn, mult) in SAMPLERS.items():
for n in n_list:
rng = np.random.default_rng(seed + 1)
x = rng.standard_normal((n_samples, D))
taus = make_stride(n, T)
before_nfe = SCORE_CALLS
x = fn(x, alpha_bar, taus, rng)
actual_nfe = SCORE_CALLS - before_nfe
assert actual_nfe == (len(taus) - 1) * mult
m2, _ = mmd2(x, ref, bw=bw)
me, ce = moment_err(x, ref)
results[(name, n)] = {
"mmd2": m2, "nfe": actual_nfe, "mean_err": me, "cov_err": ce,
"dlogp": mean_logp(x) - base["logp"],
"dtv": tv_weights(x) - base["tv"],
"dspread": mode_spread_err(x) - base["spread"],
"finite": bool(np.isfinite(x).all()),
}
return results, bw
def stride_stats(n_list=(10, 20, 50, 100, 200, 1000), T=T):
"""每一步跨过的"积分量" L = int beta du,以及 Euler 近似 e^{L/2} 会错多少。
DDPM / DDIM 的更新里线性部分是**精确**解掉的(直接乘 sqrt(alpha_bar)),
Euler 却把它展开成一阶:e^{L/2} ≈ 1 + L/2。步长越大这两个差得越远,
这是一个线性子项的诊断,不能单独归因非线性完整采样误差。
"""
alpha_bar = alpha_bar_from_beta(linear_beta(T))
out = []
for n in n_list:
taus = make_stride(n, T)
Ls = np.array([_log_step(alpha_bar, taus[j], taus[j + 1])
for j in range(len(taus) - 1)])
lm = float(Ls.max())
err = float(np.abs(np.exp(lm / 2) - (1 + lm / 2)) / np.exp(lm / 2))
out.append({"n": n, "L_max": lm, "L_mean": float(Ls.mean()),
"euler_err": err})
return out
def ablation_noise(n=50, n_samples=4000, seed=SEED):
"""把 DDIM 的 eta 从 0 拉到 1,看"注入噪声"这一项单独值多少钱。
eta=0 -> DDIM(确定性);eta=1 -> 等价 DDPM 祖采样。
sigma_t = eta * sqrt(beta_t * (1 - abar_{t-1}) / (1 - abar_t))
"""
alpha_bar = alpha_bar_from_beta(linear_beta(T))
ref = sample_data(8000, np.random.default_rng(seed))
base_logp, base_tv, bw0 = _ablation_baseline(seed)
out = []
taus = make_stride(n, T)
for eta in [0.0, 0.25, 0.5, 0.75, 1.0]:
rng = np.random.default_rng(seed + 1)
x = rng.standard_normal((n_samples, D))
for j in range(len(taus) - 1):
t_cur, t_prev = taus[j], taus[j + 1]
a_cur, a_prev = abar_at(alpha_bar, t_cur), abar_at(alpha_bar, t_prev)
alpha_j = a_cur / a_prev
beta_j = 1.0 - alpha_j
if beta_j < 1e-12:
continue
s = score_at(x, alpha_bar, t_cur)
xhat0 = _tweedie_x0(x, s, a_cur)
eps_hat = _eps_from_score(s, a_cur)
var = beta_j * (1.0 - a_prev) / (1.0 - a_cur)
sig = eta * np.sqrt(max(var, 0.0))
coeff = np.sqrt(max(1.0 - a_prev - sig ** 2, 0.0))
x = np.sqrt(a_prev) * xhat0 + coeff * eps_hat + sig * rng.standard_normal(x.shape)
m2, _ = mmd2(x, ref, bw=bw0)
out.append({"eta": eta, "mmd2": m2,
"dlogp": mean_logp(x) - base_logp,
"dtv": tv_weights(x) - base_tv})
return out
def _ablation_baseline(seed=SEED):
ref = sample_data(8000, np.random.default_rng(seed))
_, bw0 = mmd2(ref[:2000], sample_data(2000, np.random.default_rng(seed + 3)))
return mean_logp(ref), tv_weights(ref), bw0
def main():
print("=" * 74)
print("主实验:同一个 oracle score,五种采样器 × 七档步数")
print(f"目标:2D 七分量高斯混合;参照集 8000 真实样本;每档生成 {4000} 个")
print("主指标是 dlogp / dTV / dspread 三个(都扣掉了真实样本自己的基线,"
"0 = 仅该统计量匹配)")
print("MMD^2 只列出来做旁证——它自身的噪声有 ±3.6e-4,见 mmd_noise_check.py")
print("=" * 74)
res, bw = sweep()
floor = res["_floor"]
base, noise = res["_base"], res["_noise"]
n_list = [10, 20, 25, 50, 100, 200, 1000]
print(f" MMD^2(噪声 ±3.6e-4,所以微小差异需重复抽样确认):")
print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list))
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
row = f" {name:<8}"
for n in n_list:
row += f"{res[(name, n)]['mmd2']:>13.2e}"
print(row)
print()
print(" 主指标 1 —— mean log p_0 相对真实样本的偏移(nats,0 = 仅该统计量匹配):")
print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list))
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
row = f" {name:<8}"
for n in n_list:
row += f"{res[(name, n)]['dlogp']:>13.3f}"
print(row)
print()
print(" 主指标 2 —— 分量占比的全变差距离偏移(0 = 与参照占比误差相同):")
print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list))
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
row = f" {name:<8}"
for n in n_list:
row += f"{res[(name, n)]['dtv']:>13.4f}"
print(row)
print()
print(" 主指标 3 —— 模式内均方半径的相对误差(0 = 与参照半径误差相同):")
print(f" {'采样器':<8}" + "".join(f"{'N=' + str(n):>13}" for n in n_list))
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
row = f" {name:<8}"
for n in n_list:
row += f"{res[(name, n)]['dspread']:>13.4f}"
print(row)
print()
print("=" * 74)
print("为什么 DDIM 大步长扛得住、Euler 扛不住:看每步跨过的 L 有多大")
print("=" * 74)
print(f" {'N':>6} {'L_max':>10} {'L_mean':>10} {'e^(L/2) 与 1+L/2 的相对误差':>30}")
for r in stride_stats():
print(f" {r['n']:>6} {r['L_max']:>10.4f} {r['L_mean']:>10.4f} "
f"{r['euler_err'] * 100:>27.2f}%")
print(f"\n 基线:真实样本 mean log p_0 = {base['logp']:.4f},"
f"TV = {base['tv']:.4f},spread err = {base['spread']:.4f}")
print(f" 指标自身噪声(另一份独立真实样本对基线的偏移):"
f"logp {noise['logp']:+.4f} / TV {noise['tv']:+.4f} / "
f"spread {noise['spread']:+.4f}")
print()
print(" 按 NFE(score 评估次数)对齐再看一遍——Heun 每步算两次:")
print(f" {'采样器':<8} {'N':>6} {'NFE':>6} {'dlogp':>11} {'dspread':>11}")
for name, n in [("ddpm", 1000), ("ddpm", 200), ("ddim", 50), ("ddim", 100),
("em", 50), ("ode", 50), ("heun", 25), ("heun", 50),
("ode", 200)]:
r = res[(name, n)]
print(f" {name:<8} {n:>6} {r['nfe']:>6} {r['dlogp']:>11.4f} "
f"{r['dspread']:>11.4f}")
print()
print("=" * 74)
print("关键对照:50 步能追上 1000 步吗(主指标看 dlogp,0 = 仅mean log p统计量一致)")
print("=" * 74)
for name, n in [("ddpm", 1000), ("ddim", 50), ("heun", 50),
("ode", 50), ("em", 50), ("ddpm", 50)]:
r = res[(name, n)]
print(f" {name:<6} N={n:<5} NFE={r['nfe']:<5} "
f"dlogp={r['dlogp']:+.4f} dTV={r['dtv']:+.4f} "
f"dspread={r['dspread']:+.4f} MMD^2={r['mmd2']:+.2e}")
print()
print("=" * 74)
print("消融:只改 eta(注入多少噪声),其余完全不动,N=50")
print("=" * 74)
print(f" {'eta':>6} {'dlogp':>12} {'dTV':>12} {'MMD^2':>13}")
for r in ablation_noise():
print(f" {r['eta']:>6.2f} {r['dlogp']:>12.4f} {r['dtv']:>12.4f} "
f"{r['mmd2']:>13.2e}")
print()
print("=" * 74)
print("换余弦调度再跑一遍(N=50)")
print("=" * 74)
res_c, _ = sweep(n_list=(50,), schedule="cosine")
print(f" {'采样器':<8} {'dlogp(linear)':>15} {'dlogp(cosine)':>15}")
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
print(f" {name:<8} {res[(name, 50)]['dlogp']:>15.4f} "
f"{res_c[(name, 50)]['dlogp']:>15.4f}")
print()
print(f" (参照:MMD^2 噪声地板 = {floor:.3e},RBF 带宽 = {bw:.3f};"
f"真实样本 mean log p_0 = {base['logp']:.4f})")
if __name__ == "__main__":
main()#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""生成「扩散过程的前向与反向推导」的四张解释图。
数值一律从同目录的三个脚本里取(forward_diffusion / reverse_sampling /
score_bridges),这里只负责画——改了那边这里要重跑,免得图和正文数字打架。
四张图分别回答:
1. 噪声调度到底把"难度"怎么分配到 1000 步上的
2. 五种采样器的误差随步数怎么降,以及每步跨过的积分量有多大
3. 前向把数据流推成球、反向沿轨迹走回七个模式,长什么样
4. 换参数化等价于给每个时间步换了多大权重(跨 10 个数量级)
只依赖 numpy + matplotlib。跑法:python make_figures.py
"""
import textwrap
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.collections import LineCollection
import forward_diffusion as FD
import reverse_sampling as RS
import score_bridges as SB
ROOT = Path(__file__).resolve().parents[1]
OUT = ROOT / "figures"
OUT.mkdir(parents=True, exist_ok=True)
plt.rcParams.update({
"font.sans-serif": ["Microsoft YaHei", "SimHei", "DejaVu Sans"],
"axes.unicode_minus": False,
"figure.dpi": 160,
"savefig.bbox": "tight",
})
INK = "#1f2937"
MUTE = "#6b7280"
C_LIN = "#d1495b" # 线性调度 / 差的一侧:红
C_COS = "#2f6fb0" # 余弦调度:蓝
C_DDPM = "#e0a03c"
C_DDIM = "#2f9e6f"
C_EM = "#8b5cf6"
C_ODE = "#d1495b"
C_HEUN = "#1f6feb"
C_OK = "#2f9e6f"
C_BAD = "#d1495b"
def sci(v):
"""2.48e+08 -> 2.5e8,读起来省事。"""
return f"{v:.1e}".replace("e+0", "e").replace("e+", "e").replace("e-0", "e-")
def style(ax, title, xlabel=None, ylabel=None):
ax.set_title(title, fontsize=11.5, color=INK, pad=10, loc="left")
if xlabel:
ax.set_xlabel(xlabel, fontsize=10, color=MUTE)
if ylabel:
ax.set_ylabel(ylabel, fontsize=10, color=MUTE)
ax.tick_params(colors=MUTE, labelsize=9)
for s in ("top", "right"):
ax.spines[s].set_visible(False)
for s in ("left", "bottom"):
ax.spines[s].set_color("#d1d5db")
ax.grid(alpha=0.25, linewidth=0.6)
ax.set_axisbelow(True)
def footer(fig, text, width=72):
"""把「这张图要看什么」放到坐标轴下方。
必须放在 y<0 的位置:bbox_inches="tight" 会把负坐标的 artist 一起收进来,
放在 0~0.05 之间的话会和 x 轴标签叠在一起。
"""
wrapped = "\n".join(textwrap.wrap(text, width=width))
fig.text(0.012, -0.13, wrapped, fontsize=8.5, color=MUTE,
va="top", ha="left", linespacing=1.6)
# ──────────────────────────────────────────────────────────────────────
# 图 1:噪声调度怎么分配难度
# ──────────────────────────────────────────────────────────────────────
def fig_schedule():
lin_b, lin_a, cos_b, cos_a, rows = FD.schedule_report()
ts = np.arange(1, FD.T + 1)
snr_lin = FD.snr_db(lin_a)
snr_cos = FD.snr_db(cos_a)
fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.1))
ax = axes[0]
ax.plot(ts, lin_a, color=C_LIN, lw=2.0, label=r"linear $\beta$ 调度")
ax.plot(ts, cos_a, color=C_COS, lw=2.0, label="余弦调度")
ax.set_yscale("log")
ax.axhline(0.5, color=MUTE, ls=":", lw=1.0)
for x, c, lbl in [(FD.half_life(lin_a), C_LIN, f"linear 跌破 0.5:第 {FD.half_life(lin_a)} 步"),
(FD.half_life(cos_a), C_COS, f"余弦跌破 0.5:第 {FD.half_life(cos_a)} 步")]:
ax.axvline(x, color=c, ls="--", lw=1.0, alpha=0.8)
ax.legend(fontsize=8.5, frameon=False, loc="lower left")
style(ax, r"$\bar\alpha_t$:还剩下多少原始信号", "步数 t", r"$\bar\alpha_t$(对数轴)")
ax = axes[1]
ax.plot(ts, snr_lin, color=C_LIN, lw=2.0, label="linear")
ax.plot(ts, snr_cos, color=C_COS, lw=2.0, label="余弦")
ax.axhline(0.0, color=INK, lw=1.0)
ax.fill_between(ts, snr_lin.min(), 0.0, where=(snr_lin < 0),
color=C_LIN, alpha=0.10)
i500 = 499
ax.annotate(f"t=500\nlinear {snr_lin[i500]:.1f} dB\n余弦 {snr_cos[i500]:.1f} dB",
xy=(500, snr_lin[i500]), xytext=(620, -6),
fontsize=8.5, color=INK,
arrowprops=dict(arrowstyle="->", color=MUTE, lw=0.9))
ax.legend(fontsize=8.5, frameon=False, loc="upper right")
style(ax, "信噪比:低于 0 dB 时信号已经被噪声淹没", "步数 t", "SNR (dB)")
fig.suptitle("图 1 线性调度把 74% 的步数花在了信噪比已经低于 0 dB 的区域",
fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
footer(fig, "要看什么:左图是「还剩多少信号」,右图是「信噪比」。线性调度第 260 步的单位参照信号方差系数跌破 0.5,"
"后续处在较低 SNR 区间,但不等于无效计算;图中 SNR 以数据方差为 1 作参考。")
fig.savefig(OUT / "schedule_snr.png")
plt.close(fig)
# ──────────────────────────────────────────────────────────────────────
# 图 2:采样器误差随步数怎么降 + 每步跨过的积分量
# ──────────────────────────────────────────────────────────────────────
def fig_samplers(res=None):
if res is None:
res, _ = RS.sweep()
n_list = [10, 20, 25, 50, 100, 200, 1000]
cols = {"ddpm": C_DDPM, "ddim": C_DDIM, "em": C_EM,
"ode": C_ODE, "heun": C_HEUN}
names = {"ddpm": "DDPM 祖采样", "ddim": "DDIM (η=0)", "em": "Euler–Maruyama (SDE)",
"ode": "Euler (概率流 ODE)", "heun": "Heun 二阶 (ODE)"}
fig, axes = plt.subplots(1, 2, figsize=(11.2, 4.3))
ax = axes[0]
for name in ["ddpm", "ddim", "em", "ode", "heun"]:
y = [abs(res[(name, n)]["dlogp"]) for n in n_list]
ax.plot(n_list, y, marker="o", ms=4.5, lw=1.9,
color=cols[name], label=names[name])
ax.set_xscale("log")
ax.set_yscale("log")
ax.axhline(0.0528, color=MUTE, ls="--", lw=1.0)
ax.text(11, 0.062, "一次真实样本对照差值 0.053", fontsize=8, color=MUTE)
ax.legend(fontsize=8, frameon=False, loc="upper right")
style(ax, "单一统计量偏差(不能独立确认分布正确)",
"采样步数 N(对数轴)", r"$|$mean log $p_0$ 偏移$|$(nats)")
ax = axes[1]
st = RS.stride_stats()
ns = [r["n"] for r in st]
ax.plot(ns, [r["L_max"] for r in st], marker="s", ms=4.5, lw=1.9,
color=C_ODE, label=r"每步跨过的积分量 $L=\int\beta(u)du$(最大)")
ax.plot(ns, [r["euler_err"] * 100 for r in st], marker="^", ms=4.5, lw=1.9,
color=C_HEUN, label=r"Euler 近似 $e^{L/2}\approx 1+L/2$ 的相对误差")
ax.set_xscale("log")
ax.set_yscale("log")
for r in st:
if r["n"] in (10, 50):
ax.annotate(f"{r['euler_err'] * 100:.1f}%",
xy=(r["n"], r["euler_err"] * 100),
xytext=(r["n"] * 1.15, r["euler_err"] * 100 * 1.6),
fontsize=8.5, color=C_HEUN)
ax.legend(fontsize=8, frameon=False, loc="upper right")
style(ax, "为什么朴素 Euler 在大步长下会崩",
"采样步数 N(对数轴)", "数值(对数轴,% 按数值读)")
fig.suptitle("图 2 采样器诊断统计量与线性漂移的离散误差",
fontsize=12, color=INK, x=0.012, ha="left", y=1.02)
footer(fig, "要看什么:左图为单次实验,近零差异不作显著性排名;右图只比较线性漂移项的数值近似。DDPM/DDIM 把线性部分"
"精确解掉了(包含精确线性指数因子),Euler 却把它展开成一阶,N=10 时每步误差就有 25%。")
fig.savefig(OUT / "sampler_scaling.png")
plt.close(fig)
return res
# ──────────────────────────────────────────────────────────────────────
# 图 3:前向流形被推成球,反向轨迹走回七个模式
# ──────────────────────────────────────────────────────────────────────
def fig_trajectories():
rng = np.random.default_rng(FD.SEED)
ab = FD.alpha_bar_from_beta(FD.linear_beta(FD.T))
x0 = FD.sample_data(600, rng)
snaps = [0, 60, 200, 500, 1000]
cols_f = plt.cm.viridis(np.linspace(0.05, 0.85, len(snaps)))
# 反向:从同一批噪声出发,用 Heun 走 50 步,记录轨迹
x = rng.standard_normal((40, FD.D))
taus = RS.make_stride(50, FD.T)
paths = [x.copy()]
for j in range(len(taus) - 1):
L = RS._log_step(ab, taus[j], taus[j + 1])
if L < 1e-12:
continue
s0 = RS.score_at(x, ab, taus[j])
d0 = 0.5 * L * (x + s0)
x1 = x + d0
s1 = RS.score_at(x1, ab, taus[j + 1])
x = x + 0.5 * (d0 + 0.5 * L * (x1 + s1))
paths.append(x.copy())
fig, axes = plt.subplots(1, 2, figsize=(11.4, 4.9))
ax = axes[0]
for t, c in zip(snaps, cols_f):
a = 1.0 if t == 0 else float(ab[t - 1])
xt = np.sqrt(a) * x0 + np.sqrt(1 - a) * rng.standard_normal(x0.shape)
ax.scatter(xt[:, 0], xt[:, 1], s=7, color=c, alpha=0.65,
label=f"t={t}")
ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70,
color=INK, linewidths=1.6, label="分量中心")
ax.legend(fontsize=8, frameon=False, loc="upper left", ncol=2)
style(ax, "前向:七个模式逐步趋近高斯云", r"$x_1$", r"$x_2$")
ax.set_aspect("equal")
ax = axes[1]
# 背景:p_0 的密度等高线
g = np.linspace(-4.6, 4.6, 220)
GX, GY = np.meshgrid(g, g)
grid = np.stack([GX.ravel(), GY.ravel()], 1)
lp = FD.log_density(grid, FD.WEIGHTS, FD.MEANS, FD.SCALES ** 2)
dens = np.exp(lp - lp.max()).reshape(GX.shape)
ax.contourf(GX, GY, dens, levels=np.linspace(0.02, 1.0, 12),
cmap="Blues", alpha=0.9, vmin=0.0, vmax=1.6)
ax.contour(GX, GY, dens, levels=[0.05, 0.2, 0.5], colors="#1d4ed8",
linewidths=0.7, alpha=0.55)
P = np.stack(paths, 1) # [n, steps, 2]
for i in range(P.shape[0]):
seg = P[i]
ax.add_collection(LineCollection(
[seg[k:k + 2] for k in range(len(seg) - 1)],
colors="#1f6feb", linewidths=0.8, alpha=0.5))
ax.scatter(P[:, 0, 0], P[:, 0, 1], s=14, color=MUTE, label="起点 x_T ~ N(0,I)")
ax.scatter(P[:, -1, 0], P[:, -1, 1], s=16, color=C_OK, label="终点 x_0")
ax.scatter(FD.MEANS[:, 0], FD.MEANS[:, 1], marker="x", s=70,
color=INK, linewidths=1.6)
ax.legend(fontsize=8, frameon=False, loc="upper left")
style(ax, "反向:50 步 Heun,40 条轨迹从噪声回到模式", r"$x_1$", r"$x_2$")
ax.set_aspect("equal")
fig.suptitle("图 3 前向是「加水搅匀」,反向是「沿着 score 场把水滤掉」",
fontsize=12, color=INK, x=0.012, ha="left", y=1.0)
footer(fig, "要看什么:左图叠加的是各时刻独立边缘快照,不是同一条前向路径;右图是同批初始噪声的Heun轨迹。"
"它展示本例分布变化,不证明自然图像的细节成因,也不证明全局步数可省。")
fig.savefig(OUT / "trajectories.png")
plt.close(fig)
# ──────────────────────────────────────────────────────────────────────
# 图 4:换参数化 = 换每步权重
# ──────────────────────────────────────────────────────────────────────
def fig_param_weights():
ts = np.arange(1, FD.T + 1)
w = np.array([SB.loss_weights(t) for t in ts]) # [T, 3]
fig, ax = plt.subplots(figsize=(7.6, 4.5))
ax.plot(ts, w[:, 0], color=C_OK, lw=2.4, label=r"$\varepsilon$ 参数化:恒为 1")
ax.plot(ts, w[:, 1], color=C_DDPM, lw=2.0, label=r"$v$ 参数化:$1/\bar\alpha_t$")
ax.plot(ts, w[:, 2], color=C_BAD, lw=2.0, label=r"$x_0$ 参数化:$1/\mathrm{SNR}_t$")
ax.set_yscale("log")
ax.axhline(1.0, color=MUTE, ls=":", lw=1.0)
ax.annotate(rf"$x_0$ 跨 {sci(w[-1, 2] / w[0, 2])} 倍(1.0e-4 → 2.5e4)",
xy=(1000, w[-1, 2]), xytext=(300, 6e2), fontsize=9, color=C_BAD,
arrowprops=dict(arrowstyle="->", color=C_BAD, lw=0.9))
ax.annotate(rf"$v$ 跨 {sci(w[-1, 1] / w[0, 1])} 倍(1.0 → 2.5e4)",
xy=(1000, w[-1, 1]), xytext=(300, 1.6e0), fontsize=9, color=C_DDPM,
arrowprops=dict(arrowstyle="->", color=C_DDPM, lw=0.9))
ax.set_ylim(5e-5, 1e5)
ax.legend(fontsize=9, frameon=False, loc="lower right")
style(ax, "同一个模型,换参数化等于给每个时间步换权重",
"步数 t", r"折算到 $\varepsilon$ 空间后的权重(对数轴)")
fig.suptitle(r"图 4 $\varepsilon$ 参数化的权重恒为 1,$x_0$ 参数化跨了 8 个数量级",
fontsize=12, color=INK, x=0.012, ha="left", y=1.03)
footer(fig, "要看什么:三种参数化描述的是同一个量,但作为训练目标并不等价。$x_0$ 参数化在 t=1 处权重只有"
" 1e-4、在 t=1000 处却有 2.5e4。这些是代数残差权重,不是实测参数梯度;不能据此单独判断 "
"训练稳定性或最终质量。")
fig.savefig(OUT / "param_weights.png")
plt.close(fig)
def main():
fig_schedule()
res = fig_samplers()
fig_trajectories()
fig_param_weights()
print(f"[OK] 四张图已写入 {OUT}")
for f in sorted(OUT.glob("*.png")):
print(f" {f.name} {f.stat().st_size / 1024:.0f} KB")
if __name__ == "__main__":
main()
评论 (0)