


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:分布式训练 | 难度:进阶 | 前置知识:无节点级先修;需要向量范数、导数与梯度的基本概念
关键词:混合精度、FP16、BF16、FP8、loss scaling、溢出、数值稳定
同一份训练代码,把 BF16 改成 FP16,吞吐可能更高,也可能几十步后 loss 直接变成 NaN。另一个常见现场是:模型看起来正常收敛,但某些参数长期没有变化;检查梯度才发现,一些绝对值不超过 $2^{-25}\approx2.98\times10^{-8}$ 的梯度在 round-to-nearest-even 写回 FP16 时已经变成了 0。
这不是“半精度不准”一句话能解释的。训练里的风险至少有三种:数太大,越过该转换路径的舍入溢出边界而成为 inf;数太小,舍入后落到 0(或硬件将次正规数 flush-to-zero);数虽然在范围内,却因为有效位太少,在加法里被大数吞掉。三者的修复手段不同:loss scaling 能救小梯度,却救不了激活溢出;换 BF16 能扩展动态范围,却不会自动改善尾数精度;把归约留在 FP32 能减小累加误差,却不代表所有输入和权重都要回到 FP32。
为什么还要承担这些麻烦?因为 Transformer 的大头通常是矩阵乘(GEMM,通用矩阵乘法)。现代加速器对低精度矩阵乘提供更高吞吐,权重和激活每元素从 4 字节降到 2 字节也能减小显存与带宽压力。Mixed Precision Training 给出的核心配方是:低精度做大部分前后向,保留 FP32 主权重进行更新,并对 loss 缩放以防小梯度消失;其特定模型与实验保持了精度。低精度张量本身的字节可减半,总训练显存是否下降还取决于主权重、梯度和优化器状态,6.1 节给出两套账本。
“混合”的重点不是选一个统一 dtype,而是给不同数值角色分工。大 GEMM 适合低精度输入,softmax、归一化、loss 和长归约通常需要更大的范围或更高精度,优化器状态又有自己的要求。自动混合精度(Automatic Mixed Precision,AMP)的价值正是把逐算子的 dtype 路由表和梯度缩放流程标准化。
一个数字能说明 FP16 与 BF16 的性格差异:FP16 最大有限值只有 65504,而 BF16 与 FP32 一样有 8 位指数,最大值约 $3.39\times10^{38}$。反过来,FP16 有 10 位小数尾数,1 附近的间隔约 $9.77\times10^{-4}$;BF16 只有 7 位尾数,间隔约 $7.81\times10^{-3}$。BF16 更不容易炸,FP16 在可表示范围内更细;“更稳定”与“更精确”不是同一维度。
三句话先建立框架:
如果只记一个检查顺序:先问异常发生在前向还是反向,再区分 overflow、underflow 与 rounding,最后才决定换 dtype、调 scale,还是把局部算子提升到 FP32。
AMP 中常见的四种角色也要分开:参数存储 dtype、算子输入 dtype、乘法累加 dtype、优化器状态 dtype。日志打印“BF16 training”并不能证明四者都是 BF16。很多 GEMM 是 BF16 输入、FP32 累加;Adam 的一阶矩和二阶矩仍为 FP32;某些框架还会保存 FP32 主权重。
对非零正规数,一个二进制浮点数可写成(次正规数没有隐含的前导 1):
$$x=(-1)^s(1.f)_2\,2^{e-\mathrm{bias}}$$
$s$ 是符号位,$e$ 是指数域,$f$ 是小数域。指数位数决定动态范围,尾数位数决定相邻可表示数的间距。FP16 是 1 位符号、5 位指数、10 位小数;BF16 是 1、8、7;FP32 是 1、8、23。这里的“小数位”不含正规数隐含的前导 1,所以有效二进制位分别为 11、8、24;指数全 0/全 1 留给边界及特殊值。于是:
机器 epsilon 是 1 与下一个可表示数的间隔;下面列的是 epsilon。在 round-to-nearest 模式下,通常定义的 unit roundoff 为这些值的一半:
$$\epsilon_{\mathrm{FP16}}=2^{-10},\qquad \epsilon_{\mathrm{BF16}}=2^{-7},\qquad \epsilon_{\mathrm{FP32}}=2^{-23}$$
epsilon 描述的是 1 向上的间距,不是所有数的固定绝对误差。对没有溢出或下溢的正规结果,最近舍入常用模型为 $\operatorname{fl}(x)=x(1+\delta)$,$|\delta|\le u$,其中 $u=\epsilon/2$;次正规区应使用绝对误差界,不能直接套相对界。这个界可以从间距看出:设 $p$ 是小数位数、$E$ 是实际二进制指数。在区间 $[2^E,2^{E+1})$,相邻数间距为 $2^{E-p}$,最近舍入误差至多半个间距;除以至少 $2^E$ 的输入幅值,就得到 $u=2^{-p-1}$。相应推导只描述单次舍入,不包含前序算子误差。
因此 $1+10^{-4}$ 写入 FP16 或 BF16 都舍入为 1。更危险的是参数更新:若权重 $w=1$,学习率乘梯度只有 $10^{-5}$,直接在低精度权重上做 $w-\eta g$,变化会被舍掉。FP32 主权重就是在高精度副本上累计细小更新,再把结果舍入给低精度前后向。
在 round-to-nearest-even 且保留次正规数时,绝对值不超过 $2^{-25}$ 的 FP16 输入舍入为零;介于这个阈值和 $2^{-24}$ 之间的数可能舍入为最小次正规数,而非一律为零。支持 flush-to-zero 的执行路径还需另查硬件与算子规则。
设损失为 $L(\theta)$,参数为 $\theta$,真实梯度为 $g=\nabla_\theta L$。取与参数无关、同一次累积期间固定的正常数 $S$。在精确算术下,把 loss 乘常数 $S$ 后反向:
$$g_s=\nabla_\theta(SL)=S\nabla_\theta L=Sg$$
只要在优化器读取梯度前除以 $S$,就恢复原梯度:
$$g=\frac{g_s}{S}$$
关键是量化顺序。若 $g=10^{-8}$,先写入 FP16 会变 0,之后再乘任何数都救不回来;若先由链式法则得到 $Sg=1.024\times10^{-5}$,它能被 FP16 表示,写回后再用 FP32 除以 1024,就能保留接近 $10^{-8}$ 的非零值。浮点计算实际得到的是 $Q(Sg)/S$,一般不恰等于 $g$;而真实反向还包含中间张量的舍入,不能把单次梯度量化模拟当成完整训练误差模型。
能否用一个 scale 同时容纳所有梯度?设需要保留的最小非零幅值为 $g_{\min}$,最大幅值为 $g_{\max}$。在 FP16 最近偶数舍入且保留次正规数的简单写回模型下,非零所需条件和一个避免溢出的充分条件是:
$$Sg_{\min}>2^{-25},\qquad Sg_{\max}\le65504$$
因此必须寻找两者交集。65504 是保守安全上界;真正向 inf 的最近舍入边界是 65520。若梯度同时有 $10^{-8}$ 和 $10^5$,下界要求 $S>2.98023224$,安全上界却是 $S\le0.65504$;即使使用 65520 边界也无交集。任何动态策略都不能用一个标量消除这个范围冲突。若路径将 FP16 次正规数清零,保留到正规区约需 $Sg_{\min}\ge2^{-14}$,限制更强。这里尚未计入中间反向的溢出。
静态 scale 要人工选 $S$。太小救不了下溢,太大会让大梯度越过 FP16 的安全范围,甚至舍入成 inf。动态 GradScaler 维护随训练变化的 $S_t$:
$$S_{t+1}=\begin{cases}\beta S_t,&g_s\text{ 含 inf/NaN}\\ \gamma S_t,&\text{连续 }K\text{ 步有限}\\ S_t,&\text{其他情况}\end{cases}$$
$\beta<1$ 是回退因子,$\gamma>1$ 是增长因子,$K$ 是增长间隔。出现非有限梯度时必须跳过 optimizer step,否则坏更新会污染权重和 Adam 状态。PyTorch 文档还提醒:scale 不保证始终大于 1,BF16 预训练模型强转 FP16 时可能因数值过大而一路回退。
直接计算 softmax:
$$p_i=\frac{e^{x_i}}{\sum_j e^{x_j}}$$
若 $x_i$ 很大,指数会溢出。稳定写法先减最大值 $m=\max_jx_j$:
$$p_i=\frac{e^{x_i-m}}{\sum_j e^{x_j-m}}$$
对一行至少有一个有效有限 logit、其余有限或被遮罩为负无穷的输入,最大指数为 1,分母至少为 1;对有限有效 logits,分子分母同除 $e^m$ 证明结果不变。它避免了 exp 的正向溢出,却不能保证所有小概率非零,也不能挽回输入先变成 inf 的损失。全行被 mask 为负无穷时,$-\infty-(-\infty)$ 是 NaN,必须明确选择报错、跳行或该算子的零输出约定。若输入已有正 inf,同样不能直接套减 max 公式。LayerNorm 方差也不宜用 $E[x^2]-E[x]^2$ 的低精度朴素形式:两个接近的大数相减会灾难性消减。长向量求和误差还会随项数累积,不能由此推出所有归约都自动在 FP32 完成:先检查设备策略、输出与累加 dtype。
numeric_stability.py 给出两个不依赖 GPU 的反例。把 256 与 256 个 1 逐项相加,BF16 每步舍入得到 256,而高精度求和后只量化一次得到 512:在 256 这个区间,BF16 相邻值差 2,256+1 恰在中点并向偶数舍回 256。这里模拟顺序加法,不能用来估计厂商 GEMM 的误差。
对数据 9999、10001,真实总体方差为 1;模拟 FP32 的 $E[x^2]-E[x]^2$ 得到 0。用中心化形式可避免这次大数相减,但若先写成 BF16,两个输入都成 9984,之后即使用 FP32 中心化也只能得到 0。稳定算法和输入信息完整性是两件事。
还要区分“算子输出 dtype”和“内部累加 dtype”。矩阵乘输入、输出可以是 BF16,但硬件乘积常进入 FP32 accumulator,最终再舍入回 BF16。若自定义 kernel 把 accumulator 也降成 16 位,它不再与常规 AMP 拥有同样数值性质。
FP8 常见 E4M3 与 E5M2。FP8 Formats for Deep Learning 用 E4M3 提供较多有效位,用 E5M2 提供较大范围。本文具体指该论文的 E4M3(常标为 E4M3FN)和 E5M2:前者最大有限值 448、最小次正规数 $2^{-9}$,不编码无穷;后者最大有限值 57344、最小次正规数 $2^{-16}$,包含 inf/NaN。不能把这些范围推广到所有名为 E4M3 的变体。格式定义与转换策略也要分开:有限大值是饱和、报错还是转特殊值,由具体转换模式决定。
原始张量很难恰好落进狭窄范围,通常给每个张量或块维护正的反量化尺度 $a$:
$$q=Q_{\mathrm{FP8}}(x/a),\qquad x_{\mathrm{deq}}=a\,q$$
这里 $Q$ 是选定舍入及越界策略的 FP8 转换,$x_{\mathrm{deq}}$ 是还原到高精度的近似值。若格式上限为 $F$,对非零有限张量可取 $a=\operatorname{amax}(|x|)/F$,于是最大幅值映到 $F$;全零张量应另取安全尺度,不能除以零。很多库把 $1/a$ 称作 scale,符号恰好相反。
例如使用 E4M3 的 $F=448$,向量中若出现 44800 的异常值,张量尺度 $a=100$;普通值 1 被映成 0.01,在该格式最近舍入下约为 0.009765625,还原后是 0.9765625。没有该异常值时所需尺度不同;这说明 amax 选取改变误差分配,不证明任何块缩放必定改善最终任务。若每步都同步全局 amax,又会引入开销;不同方案会用历史窗口、延迟缩放或块缩放。例如 TE 2.13 delayed scaling 利用历史 amax 预测下一次 scale,减少额外读张量;突然增大的异常值可能超出历史预测,因此还要检查饱和比例,不能把历史尺度当作当步最大值保证。FP8 的正确性同时依赖格式、粒度、尺度更新、异常值分布和高精度累加,不能机械替换 dtype 字符串。
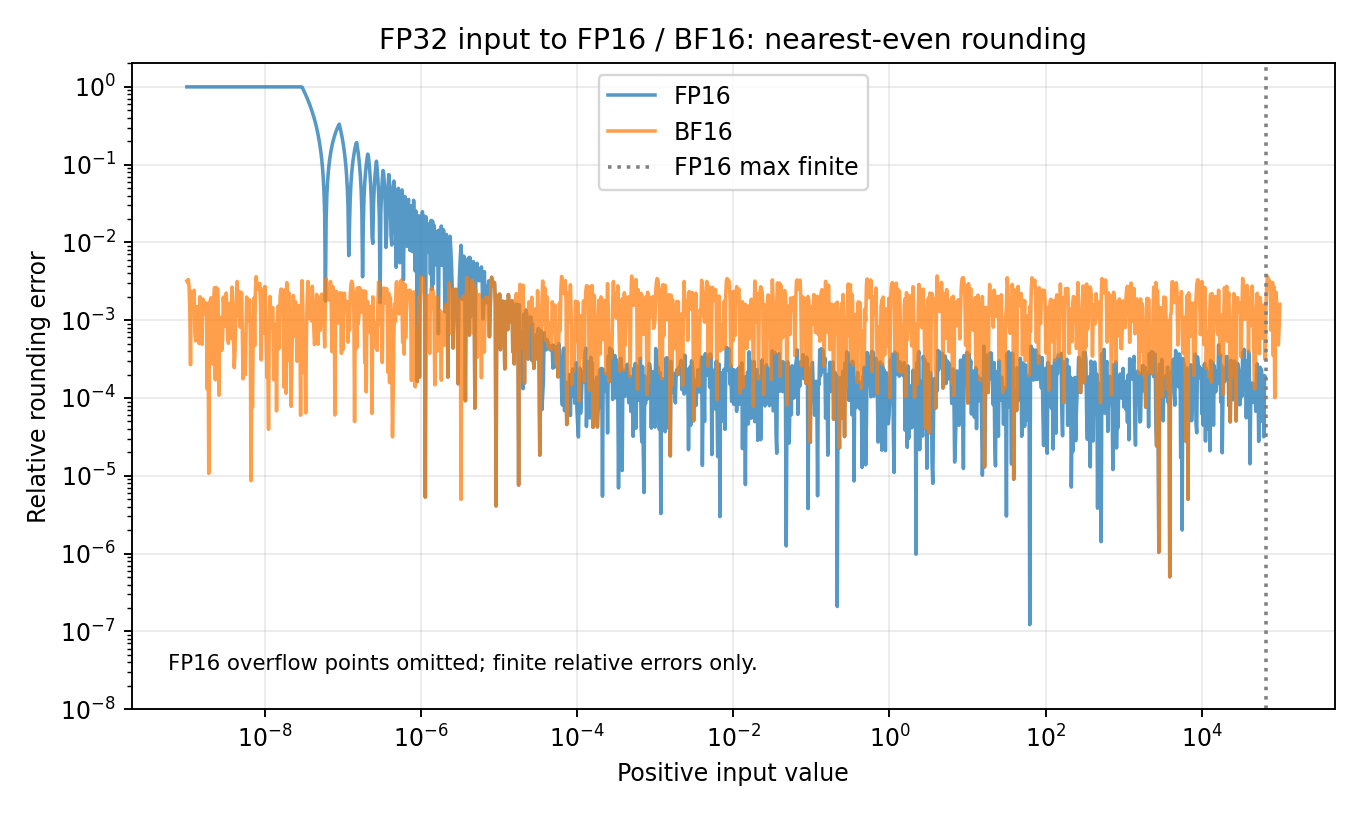
图要比较动态范围与精度:输入先转成 FP32,再分别转换为 FP16/BF16;这是脚本实际比较的路径。小数值端 FP16 可能舍入为零(相对误差 1),超过最大有限值后溢出;BF16 的范围更宽,但正规数的尾数精度更低。精确可表示点的误差为零,图中作绘图下限处理;非有限溢出点被省略而非画成零误差,FP16 上限用竖线标出。
float_formats.py、loss_scaling_sim.py、numeric_stability.py 只依赖 Python 标准库;amp_probe.py 需要 PyTorch,配图脚本需要 NumPy/matplotlib。文末附录提供全部五个文件。
float_formats.py 用 IEEE 二进制打包模拟 FP16;BF16 路径先转 FP32,再按舍入位和保留位奇偶加偏置,截去低 16 位,且单独保留 NaN 分类。这是 FP32→BF16 的最近偶数舍入,不是任意 Python 双精度数直接到 BF16 的转换。反例 $1+2^{-8}+2^{-26}$ 高于 BF16 中点:直接最近舍入应为 1.0078125,先转 FP32 却恰落中点,再转 BF16 得 1。不同输入精度必须写明。
真实输出:
format exp frac min_normal max_finite epsilon_at_1
FP16    5   10 6.1035e-05 6.5504e+04 9.7656e-04
BF16    8    7 1.1755e-38 3.3895e+38 7.8125e-03
FP32    8   23 1.1755e-38 3.4028e+38 1.1921e-07

value -> FP16 | BF16
1.0001 -> 1 | 1
1e-05 -> 1.00136e-05 | 1.00136e-05
100000 -> inf | 99840
100000 在 FP16 变成 inf,在 BF16 仍有限;1.0001 在两种 16 位格式里都舍入成 1。动态范围与精度的区别由此可见。
loss_scaling_sim.py 把五个小梯度直接量化,再先乘 1024、量化、最后除回去:
shape=(5,), loss_scale=1024
gradient       direct_fp16    scaled_fp16/unscaled
  1.000e-08    0.000e+00      1.001e-08
  3.000e-08    5.960e-08      2.998e-08
  1.000e-07    1.192e-07      1.000e-07
  1.000e-06    1.013e-06      1.000e-06
  1.000e-05    1.001e-05      9.999e-06
nonzero: direct=4/5, scaled=5/5
$10^{-8}$ 直接写 FP16 已为 0,缩放路径却保留为 $1.001\times10^{-8}$。这不是凭空增加精度:量化误差仍在,只是把数搬进可表示区间。
实际 AMP 流程用 amp_probe.py 复现:固定 seed 7,FP32 参数的线性层接收形状 [6,4] 的输入,输出 [6,2],CPU FP16 autocast 前向,MSE 与参数梯度为 FP32。这里故意用 CPU 支持的路径检查控制流程;它不是 CUDA Tensor Core 吞吐或完整 DiT 收敛实验。运行:
python amp_probe.py关键顺序是 autocast 包住前向/loss,退出后 scale(loss).backward,再 unscale、裁剪、scaler.step、update;完整可执行循环在附录,包含 model、数据和 optimizer 的定义。第三步在梯度中注入 inf,这一步不做无意义的非有限 norm 裁剪,仍由 scaler.step 检查并跳过更新。实际结果:
| step | loss(前向) | update 后 scale | 参数最大变化 |
|---|---|---|---|
| 0 | 1.087817 | 8 | 0.055877 |
| 1 | 0.930182 | 16 | 0.105419 |
| 2(注入 inf) | 0.675444 | 8 | 0 |
| 3 | 0.675444 | 8 | 0.147829 |
| 4 | 0.412640 | 16 | 0.168862 |
增长间隔设为 2,因此前两次有限 step 后 scale 翻倍;inf step 跳过且回退,下一次前向 loss 仍相同。另从 scale=1 注入 inf,真实回退到 0.5。脚本在完整 step 1 后保存/恢复 model、带 momentum 的 optimizer 和 scaler,续跑后三步与不断点结果逐位相同。这里无 dropout 且数据预先生成;一般训练仍要保存 RNG、数据游标和分布式状态。BF16 autocast 的另一分支实际得到 BF16 输出、FP32 MSE 和 FP32 参数梯度,无 scaler。
实跑环境为 Windows、Python 3.11.9、PyTorch 2.10.0+cpu,单 CPU 线程;图使用 NumPy 2.4.6、matplotlib 3.10.7。环境复用项目已有局部依赖,未改系统安装。不同版本/kernel 的末位或阈值不要求逐位相同,本次验收的是上述有限性、跳步、scale 与恢复关系。
梯度裁剪必须在 unscale 之后,若对放大后的梯度仍用阈值 C 裁剪,反缩放后的有效阈值会变成 C/S。令梯度范数为 4、$S=1024$、阈值为 1,先裁 scaled grad 再除 S 只剩 0.0009765625;先反缩放再裁才得到 1。证明是 $\operatorname{clip}_C(Sg)/S=g\min(1,C/(S\|g\|))$,与 $\operatorname{clip}_C(g)$ 不同(库实现还可能加入小的稳定常数)。若用 BF16,通常保留 autocast 而不用 GradScaler;是否省略仍应由实际梯度分布验证。
本文对照固定 PyTorch v2.10.0 的 torch/amp/grad_scaler.py#GradScaler 中 GradScaler.scale 把 loss 乘当前尺度;unscale 按 device 与 dtype 分组检查并反缩放梯度;step 只在没有 inf/NaN 时调用优化器;update 再根据各 optimizer 的 found-inf 状态调整尺度。它还处理稀疏梯度、多设备、多优化器、checkpoint state dict 和惰性初始化,这些都是最小模拟没有覆盖的工程边界。
官方 PyTorch 2.10 AMP 文档 推荐统一使用 torch.autocast 与 torch.amp.GradScaler;旧的 torch.cuda.amp 接口已标记弃用。autocast 只包前向和 loss,backward 放在上下文外。不要启用 autocast 后再全局 model.half,否则会绕开逐算子的安全策略。
本次还把下载的 v2.10.0 GradScaler 整份原始模块直接加载到 CPU,使用与第 04 节相同数据执行五个 step;输出、scale、inf 跳步与最终参数均与安装的 2.10.0+cpu 完全一致。原源码文件和 SHA256、独立边界验证见本篇审计证据;不声称执行了分布式或 GPU 分支。
算子策略不是“白名单里全降精度”。线性层、卷积通常进入 lower-precision;例如 CUDA 表中的 softmax、sum 和 MSE 使用 FP32,但 CPU BF16 表中未列入的 softmax 会沿输入 dtype 运行;多输入算子可能提升到最宽输入类型。显式 dtype、原地算子或 out 版本可能不参与 autocast,自定义代码要检查实际 dtype 流。
FP8 方面,NVIDIA Transformer Engine 2.13 的 delayed-scaling 文档 描述 E4M3/E5M2 recipe、amax 历史与 delayed scaling,并在支持硬件上让 Transformer 层进入 FP8 路径。它仍以 BF16/FP16 保存部分张量并用高精度累加;分布式训练还可能跨 rank 归约 amax。“开启 FP8”是引入量化运行时,不是把参数永久存成单一 8 位格式。
生产监控至少记录当前 scale、增长和回退次数、跳过的 step 数、梯度范数、参数与激活 amax、NaN 首次出现的层、关键算子 dtype。只看总 loss 会把静默下溢藏很久。
混合精度常能节省参与低精度计算的张量带宽,但原生 autocast 不一定降低参数和梯度的持久存储 dtype,但不保证总显存恰好减半。若使用独立 FP32 主权重与两个 FP32 moment,仅这三项就占 12 字节/参数;原生 FP32 参数 autocast 通常没有额外独立主权重,不能重复计账;部分算子保存 FP32 中间量;通信 buffer、cast buffer、workspace 与碎片也增加峰值。
吞吐提升也有条件。矩阵尺寸太小、CPU 或数据加载受限、频繁转换、未使用低精度加速单元,都会让 AMP 几乎不加速。小 batch 下,kernel launch 与 cast 成本甚至抵消收益。正确基准应同时报告 tokens/s、峰值显存、收敛曲线和最终指标。
以下情况尤其要谨慎:
调试时先用 FP32 建立可复现基线,再开 BF16,然后才是 FP16/FP8。每步只改一个变量,并比较前若干 step 的 loss、梯度范数和权重更新。数值问题最怕同时调整学习率、并行度、batch 与 dtype。
以 AdamW 为例,要先分清框架是否真的创建低精度参数及主副本。常见的原生 autocast 方案保持参数 FP32,.grad 通常随参数为 FP32,两个 FP32 moment:持久参数状态约为 $4+4+8=16$ 字节/参数;临时 cast 权重缓存和激活另算。另一种“低精度模型+FP32 主副本”若参数与梯度各 2 字节,主副本 4、moment 8,共 16 字节/参数;若另有 FP32 master gradient,还需再加 4。这里忽略 step 标量、workspace、通信、分片和张量生命周期,不能直接当峰值显存。这两套结构不能相加。
下面的更新式只描述第二种方案。一次更新至少涉及前向激活、反向梯度、参数、副本和两个动量。低精度 GEMM 只覆盖其中一部分。设低精度参数为 $\theta_{16}$,FP32 主参数为 $\theta_{32}$,反缩放后的梯度为 $g_{32}$,则更新链条可以写成:
$$\theta_{32}^{t+1}=\operatorname{AdamW}(\theta_{32}^{t},g_{32}^{t},m_t,v_t),\qquad \theta_{16}^{t+1}=Q_{16}(\theta_{32}^{t+1})$$
$m_t,v_t$ 是 FP32 一阶、二阶矩,$Q_{16}$ 表示舍入到前后向 dtype。若框架没有主参数副本,而直接更新 BF16 参数,许多小于当前参数 ULP 的更新会消失。是否保留主权重是优化器实现细节,不能仅从模型参数 dtype 推断。
梯度累积又多一层顺序。假设一个 optimizer step 包含 $A$ 个 microbatch,先定义 $g_a$ 已包含所需的 batch 权重:若每个 microbatch 大小相同且各自 loss 是均值,应先除以 $A$;若大小不同,应按样本数加权(token loss 按有效 token 计)。它们必须使用同一 scale $S$,先把已缩放梯度累加:
$$g_s=\sum_{a=1}^{A}Sg_a=S\sum_{a=1}^{A}g_a$$
等所有 microbatch 完成后只反缩放一次。若中途 update scale,累加 buffer 中不同 microbatch 带有不同倍数,最后无法用一个 $S$ 恢复。例如两段真实梯度为 1、3,分别乘 8、16 后统一除 16,得到 3.5 而非 4。amp_probe.py 用大小 2 与 4 的两个 microbatch,把各自平方误差的 sum 除以同一总元素数,再用 scale=8 累积;反缩放后的梯度与完整 batch FP32 基线最大差 $5.96046448\times10^{-8}$。这个实验只隔离累积与缩放,不含低精度前向误差。完整顺序见 官方累积示例。若某个 microbatch 产生 inf,这一整个 optimizer step 都应跳过,而不是只丢掉坏 microbatch,否则有效 batch 和采样权重已变化。这是保持当前 accumulation 窗口语义的策略,scaler 不会替用户恢复或重放丢失的 microbatch。
数据并行中,每个 rank(参与通信的一份进程副本)只看到本地样本。rank 3 出现 inf 而其他 rank 有限时,所有副本仍必须对“是否更新”达成一致;否则 rank 3 跳步、其余 rank 更新,参数立即分叉。普通 torch.amp.GradScaler 只在当前进程内按设备/优化器汇总 found-inf,不自动执行跨 rank all-reduce。 常规 DDP 同步的梯度若包含 inf,往往会把非有限值传到各副本;这依赖实际梯度同步路径,不能当作 scaler 的跨进程协议。存在 no_sync、分片、局部参数或自定义通信时必须另查一致性。固定版本 分片梯度缩放器源码 中的 ShardedGradScaler.unscale_ 显式调用 dist.all_reduce 同步 found-inf。这里已逐行核对两份原源码,未执行多机实验,也不建议在现有封装外盲加一次 collective(调用组和次序必须一致)。
梯度裁剪也有全局语义。ZeRO/FSDP 把梯度分片后,每卡只能算局部平方和:
$$\|g\|_2=\sqrt{\sum_{r=0}^{P-1}\sum_{i\in\mathcal{S}_r}g_i^2}$$
若这些集合是互不重叠、合起来恰好覆盖全梯度的分片,必须对局部平方和做 sum all-reduce 才得到全局范数;若每卡已有完整复制梯度,再这样相加会多乘 $P$,范数错放大为 $\sqrt P$ 倍。应调用并行框架提供的全局裁剪接口,并核对副本与分片组。正确顺序通常是:完成梯度同步,反缩放,检查非有限值,计算全局 norm,裁剪,执行 optimizer step,最后更新 scale。任一步调换都可能让“裁剪阈值 1.0”失去原含义。
混合精度还会改变 collective 的数值误差。BF16 梯度 all-reduce 比 FP32 少一半字节,但不同归约树改变加法顺序;卡数越多、梯度尺度跨度越大,末位差异越明显。若训练对归约误差敏感,可使用 FP32 梯度通信或分块高精度累加,但要接受带宽代价。排查时应分开比较“本地梯度生成精度”与“跨 rank 归约精度”。
选 FP16 还是 BF16,不应只看硬件宣传峰值。可按四步判断:
第一,确认硬件原生路径。某些设备对 BF16 与 FP16 吞吐相同,某些旧设备没有 BF16 Tensor Core;软件模拟 BF16 可能更慢。第二,检查模型来源。BF16 预训练 checkpoint 的激活范围未必适合 FP16,直接转换容易前向溢出。第三,检查数值敏感区域。softmax、归一化、概率 loss、长归约优先保留 FP32。第四,跑短程 A/B,比较吞吐、峰值、跳步率和收敛,而非只确认“能启动”。
可以把训练方案分成四档:
所谓“纯 BF16”或“纯 FP8”常是营销简写。softmax、norm statistic、optimizer state、某些 residual 累加和 master gradient 仍可能更高精度。真正有意义的配置描述,应列出 input、weight、output、accumulator 和 optimizer 五个维度。
排查顺序应尽量靠近异常源。先在每个模块前后记录有限值比例、绝对最大值、绝对非零最小值与 dtype;找到第一个从有限变非有限的边界。若 attention score 在 softmax 前已经 inf,检查 Q/K 范数、缩放因子与位置编码;若 loss 有限而 backward 首先 inf,检查导数奇点、自定义 backward 和 loss scale;若梯度有限但 step 后参数异常,检查 optimizer state、权重衰减和反缩放顺序。
静默下溢比 NaN 更难发现。建议记录零梯度比例,并按参数组看更新比率:
$$r_{\mathrm{update}}=\frac{\|\Delta\theta\|_2}{\|\theta\|_2+\varepsilon}$$
若某些层长期为 0 而 FP32 基线非零,应把低精度存储或 scale 窗口列为候选原因;还需排除冻结参数、mask、稀疏路由、断开的计算图或真实零梯度,不能只凭零比例完成归因。若所有层的比例突然增大,则更像学习率、loss normalization 或跳步恢复后的 scale 问题。
不要看到 NaN 就立即降低学习率。学习率过大确实可能导致发散,但 dtype overflow、错误 mask 产生全负无穷、空 batch 的除零、坏数据和通信错误都可能表现为同一个 NaN。先定位首次非有限张量,才能选择对应修复。
恢复训练时必须保存 GradScaler 状态。若只恢复模型和 optimizer,却把 scale 重置为很大初值,前几步可能反复溢出并被跳过;重置太小则产生额外下溢。保存点最好位于完整 optimizer step 之后,避免记录到一半累积的混合状态。
activation checkpoint 会在 backward 重跑前向。重算应保持与原前向兼容的 autocast 上下文;PyTorch v2.10.0 自带 checkpoint 会保存并重入相应状态,自定义重算仍需核实。若保存路径是 BF16、重算路径变 FP32 或 FP16,梯度对不上。torch.compile、CUDA Graph 和 fused optimizer 还可能改变 autocast 边界或引入 CPU-GPU 同步,升级版本后要重新做数值与性能回归。
自定义 autograd Function 不能假定输入永远 FP32。前向若内部要求 FP32,应显式关闭 autocast 并转换输入;反向要返回与调用约定兼容的梯度。写自定义 CUDA kernel 时,明确 accumulator 类型、饱和或 inf 行为、次正规数处理以及随机舍入。一个算子“支持 half”只代表能执行,不代表适合训练。
最后,评估数值稳定不能只跑几十步。动态 scale 的增长周期可能是数千步,某些罕见 batch 才触发极端值。至少保留一次覆盖学习率峰值、warmup 结束和验证阶段的长程对照,并把跳步数作为训练产物记录;否则断点续训后出现指标差异,很难追溯是数据还是精度状态造成。
AMP 基准应先预热到 kernel 编译、缓存和分配行为稳定,再做多次迭代。三次 warmup 只能作为起点,不能作为稳定保证。计时前后做设备同步;否则异步 kernel 会让 CPU 提交时间冒充 GPU 执行时间。显存要同时报告 allocated 与 reserved 峰值,前者是活跃张量,后者包含分配器缓存。对比方案必须使用同一 batch、相同梯度累积与相同 checkpoint 策略。
吞吐最好报告有效 token/s,而不是 batch/s。变长序列下,一个 batch 的 padding 比例不同,batch/s 会误导。质量侧至少比较训练 loss、验证指标、梯度范数和被跳过 step 数。若 AMP 每秒更快却需要更多 step 才到相同验证指标,最终 time-to-quality 未必更优。
对 FP8 还应增加量化覆盖率:多少 GEMM 真正走 FP8,多少因 shape、算子或 recipe 回退到 BF16;记录每层 amax、饱和比例和 scale 更新。仅看配置显示 FP8 无法证明加速路径被命中。kernel trace 能确认实际指令与 cast 开销。
建立门禁时,不必要求低精度与 FP32 每步完全相同。可先规定前 100 步 loss 相对误差、梯度 cosine、最终指标容差与最大跳步率,再用多个随机种子评估。数值差异是浮点并行的正常现象,持续偏向、层级爆炸或指标显著退化才是故障信号。
上线前逐项回答:硬件是否原生支持目标 dtype;矩阵尺寸是否对齐加速 tile;敏感算子是否保持 FP32;FP16 是否启用动态 scaling;裁剪是否在 unscale 后;所有 DP rank 是否共享跳步决策;梯度累积期间 scale 是否不变;checkpoint 是否保存 scaler;自定义算子是否声明 autocast 与 accumulator;监控是否能定位第一处非有限值。
然后做三个故障注入。人为把 scale 调得极大,确认系统发现 inf、跳过更新并回退;给输入加入一个幅值异常样本,确认前向监控能定位层;从 checkpoint 恢复,确认 scale、optimizer 与随机数状态连续。没有做过故障注入的告警,往往只在真正长跑失败后才发现无效。
最后保留 FP32 或 BF16 安全开关。生产训练发生异常时,能在不改数据顺序和并行布局的条件下提升精度复现,定位效率远高于临时改一堆超参。安全路径不一定长期运行,但必须定期测试,避免代码演进后早已失效。
这些流程看似比设置一个 autocast 开关繁琐,却能把“偶尔 NaN”“换卡就掉点”“断点后不收敛”变成有指标、有复现实验、有回退方案的普通工程问题。
一次训练 A 比 B 的 loss 高,并不能证明精度方案更差。数据顺序、dropout、并行归约顺序和非确定 kernel 都会制造波动。公平实验要固定数据索引与初始化,尽可能使用确定算法,并运行多个随机种子。先比较同一步同一层的输出、梯度与更新,再比较长程最终指标。
可用 FP32 输出 $y_{32}$ 作为局部参照,计算相对误差与余弦相似度:
$$e_{\mathrm{rel}}=\frac{\|y_{\mathrm{low}}-y_{32}\|_2}{\|y_{32}\|_2+\varepsilon}$$
单层误差略大未必影响训练,但若误差沿深度单调放大,往往说明 residual 累加、归一化或某个敏感算子精度不足。把统计按层绘制比只比较最终 logits 更容易定位。
还应区分可复现性与正确性。集合通信改变加法顺序后,bitwise 结果可能不同,但两条训练曲线仍落在相同统计分布。反之,两次运行逐位一致也可能稳定地实现了错误缩放。验收既要有小规模数学 oracle,也要有多种子任务指标。
混合精度上线后,持续监控跳步比例和 scale 分布。数据配方变化、序列变长、加入新 loss 或更换初始化,都可能改变数值范围;一次验证通过不意味着未来配置永久安全。把 precision 当成模型配置的一部分进行版本化,才能复现每次训练。
一个实用原则是把所有隐式转换显式化到观测层:训练启动时抽样打印关键模块的参数、输入、输出与归约 dtype,同时保存硬件、驱动、框架版本。低精度 kernel 与 autocast 策略会随版本更新,旧实验结论不能无条件外推。版本升级后的第一件事应是重跑短程数值基线与吞吐基线,而不是直接续跑昂贵训练。这样才能知道速度变化来自 kernel,精度变化来自策略,还是数据本身发生了变化。
还应把这些元数据写进 checkpoint 清单,使恢复任务能够拒绝不兼容的精度配置,而不是在数小时后以 NaN 形式暴露。可诊断性本身就是混合精度系统的一项能力。
共同主题是:硬件格式越窄,软件越需要知道张量的数值角色。格式提供可能性,尺度管理、累加方式和回退路径才决定能否稳定训练。
误解一:BF16 比 FP16 精度更高。 BF16 指数范围更大,更少 overflow;但尾数只有 7 位,1 附近分辨率更粗。应说通常更稳定,不是处处更精确。
误解二:loss scaling 能修复所有 NaN。 它主要防 FP16 小梯度下溢。前向激活溢出、除零、softmax 不稳定、学习率过大,都不会被它根治。
误解三:scale 越大越好,而且一定大于 1。 scale 太大会溢出。PyTorch 允许动态 scale 降到 1 以下;应观察 found-inf 和跳步频率。
误解四:用了 autocast 就无需关心 dtype。 自定义算子、显式 dtype、原地运算和策略表外 op 可能保持输入 dtype。关键归约与 loss 仍需审计。
误解五:AMP 会把训练显存直接砍半。 激活可能下降,FP32 优化器状态仍在。账本还包括梯度、通信 buffer、workspace 与碎片。
误解六:FP8 是 BF16 的无痛升级。 FP8 依赖尺度、amax 历史、格式选择和硬件 kernel;错误配置可能不 NaN,却悄悄降低收敛质量。
先运行文末脚本,修改 loss_scaling_sim.py 中 scale 为 1、128、1024、65536。本次对 [1e-8,100] 的实际输出:scale=1 时小梯度为 0;128 时为 9.77888703e-9 且大梯度仍为 100;1024 时小梯度约 1.00117177e-8,但大梯度已为 inf;65536 仍溢出。并非 scale 越大越接近真实训练梯度。这正是动态 scale 在 underflow 与 overflow 之间寻找窗口的原因。
在支持 BF16/FP16 的 GPU 上做四组短跑:FP32、BF16 autocast、FP16 autocast 不带 scaler、FP16 autocast 带 scaler。固定随机种子和 batch,记录 200 步吞吐、峰值显存、loss、全局梯度范数、跳步数。这四组是建议读者执行的 GPU 实验,本次未执行,也不给出速度或最终指标排名。先用脚本定位 dtype 与跳步,再比较同一任务的多 seed 长程质量;不能由本篇 CPU 结果推出 GPU 模型中哪组必然更准。
定位首个异常层时,给模块注册 hook,输出有限值比例、绝对最大值和 dtype。若前向先出现 inf,优先检查指数、归一化、attention score 与输入范围;若反向先异常,再检查 scale、梯度裁剪顺序和自定义 backward。
最后验证累加精度:构造一个大数和大量小数的向量,用 FP32、模拟 BF16 顺序累加、分块 FP32 累加分别求和。预期低精度顺序加法吞掉更多小项;这解释为什么 GEMM 输入低精度不等于 accumulator 也该低精度。
读完这篇可以继续看:
可靠的 AMP 心智模型不是“半精度开关”,而是一张数值预算表:每个张量需要多大范围、多少有效位,在何处累加、何时舍入、出现异常如何回退。把这张表画清楚,NaN 就从玄学变成可以定位的工程问题。
09 节用到的脚本全文如下(numeric_stability.py、float_formats.py、loss_scaling_sim.py、amp_probe.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""Arithmetic counterexamples, stdlib only; no hardware FTZ/GEMM simulation."""
import json
import math
import struct
from pathlib import Path
from float_formats import fp16, bf16


def q32(x):
    return struct.unpack('f', struct.pack('f', x))[0]


def sequential(values, quantize):
    total = 0.0
    for v in values:
        total = quantize(total + quantize(v))
    return total


def softmax(values):
    m = max(values)
    if not math.isfinite(m):
        raise ValueError('finite nonempty logits or an explicit masked-row policy required')
    e = [math.exp(v - m) for v in values]
    return [v / sum(e) for v in e]


def main():
    values = [256.0] + [1.0] * 256
    results = dict(bf16_sequential=sequential(values, bf16),
                   fp16_sequential=sequential(values, fp16),
                   fp32_sequential=sequential(values, q32),
                   quantize_once=bf16(math.fsum(values)), exact=math.fsum(values))
    assert results == dict(bf16_sequential=256.0, fp16_sequential=512.0,
                           fp32_sequential=512.0, quantize_once=512.0, exact=512.0)
    # Squaring rounded inputs; this models one poor algorithm, not a fused norm kernel.
    x = [9999.0, 10001.0]
    qx = [bf16(v) for v in x]
    mean = math.fsum(qx) / len(qx)
    stable_after_cast = math.fsum((v - mean)**2 for v in qx) / len(qx)
    var32_naive = q32(q32(sum(q32(v*v) for v in x) / 2) - q32(q32(sum(x)/2)**2))
    results.update(input_bf16=qx, true_variance=1.0, fp32_naive_variance=var32_naive,
                   centered_bf16_input_variance=stable_after_cast,
                   shifted_softmax=softmax([1000.0, 1001.0]),
                   raw_exp_fp16=fp16(math.exp(12)),
                   scaled_grad_clip_wrong=1/1024, scaled_grad_clip_correct=1.0,
                   mixed_scale_unscale=(8*1 + 16*3)/16, desired_sum=4.0)
    assert var32_naive == 0 and stable_after_cast == 0
    for name, v in results.items():
        print(name, v)
    (Path(__file__).with_name('numeric_results.json')).write_text(
        json.dumps(results, indent=2, allow_nan=True), encoding='utf8')


if __name__ == '__main__':
main()#!/usr/bin/env python3
"""FP16 and FP32-to-BF16 nearest-even conversion; standard library only."""
import math
import struct
def fp16(x: float) -> float:
try:
return struct.unpack('e', struct.pack('e', x))[0]
except OverflowError:
return math.copysign(math.inf, x)
def bf16(x: float) -> float:
"""Round FP64 input to FP32 first, then BF16; preserve NaN classification."""
try:
bits = struct.unpack('>I', struct.pack('>f', x))[0]
except OverflowError:
return math.copysign(math.inf, x)
if (bits & 0x7F800000) == 0x7F800000:
if bits & 0x007FFFFF:
bits = (bits & 0xFFFF0000) | 0x00400000
else:
bits += 0x7FFF + ((bits >> 16) & 1)
return struct.unpack('>f', struct.pack('>I', bits & 0xFFFF0000))[0]
FORMATS = (
('FP16', 5, 10, 2.0**-14, (2 - 2.0**-10) * 2.0**15, 2.0**-10),
('BF16', 8, 7, 2.0**-126, (2 - 2.0**-7) * 2.0**127, 2.0**-7),
('FP32', 8, 23, 2.0**-126, (2 - 2.0**-23) * 2.0**127, 2.0**-23),
)
def main():
print('format exp frac min_normal max_finite epsilon_at_1')
for name, exp, frac, low, high, eps in FORMATS:
print(f'{name:5s} {exp:3d} {frac:4d} {low:.4e} {high:.4e} {eps:.4e}')
print('\nvalue -> FP16 | BF16')
for value in (1.0001, 0.00001, 100000.0):
print(f'{value:g} -> {fp16(value):g} | {bf16(value):g}')
print('\nFP16 ties:')
for x in (2**-25, math.nextafter(2**-25, math.inf), 65519.0, 65520.0):
print(f'{x:.17g} -> {fp16(x):.17g}')
# This value lies above the exact BF16 midpoint but rounds to it in FP32.
x = 1 + 2**-8 + 2**-26
print(f'double rounding: x={x:.17g}, FP32->BF16={bf16(x)}, direct BF16 nearest={1 + 2**-7}')
if __name__ == '__main__':
main()#!/usr/bin/env python3
"""FP16 gradient quantization and scale tradeoffs; standard library only."""
import math
from float_formats import fp16
def main():
gradients = [1e-8, 3e-8, 1e-7, 1e-6, 1e-5]
scale = 1024.0
direct = [fp16(g) for g in gradients]
rescued = [fp16(g * scale) / scale for g in gradients]
print(f'shape=({len(gradients)},), loss_scale={scale:g}')
print('gradient direct_fp16 scaled_fp16/unscaled')
for g, raw, value in zip(gradients, direct, rescued):
print(f'{g:11.3e} {raw:11.3e} {value:11.3e}')
print(f'nonzero: direct={sum(x != 0 for x in direct)}/5, scaled={sum(x != 0 for x in rescued)}/5')
print('\nscale sweep: [1e-8, 100]')
for scale in (1.0, 128.0, 1024.0, 65536.0):
result = [fp16(g * scale) / scale for g in (1e-8, 100.0)]
print(f'S={scale:g}: tiny={result[0]:.9g}, large={result[1]:g}, finite={all(map(math.isfinite, result))}')
low = 2**-25 / 1e-8
high = 65504 / 1e5
print(f'no safe scalar window for [1e-8,1e5]: S>{low:.8f}, sufficient upper S<={high:.5f}')
if __name__ == '__main__':
main()"""Real CPU AMP, nonfinite injection and resume; requires PyTorch 2.10.0 CPU.
Run: python amp_probe.py. No GPU or distributed benchmark is performed.
"""
import copy
import json
from pathlib import Path
import torch
def run(scaler_class=torch.amp.GradScaler, restore_at=None):
torch.manual_seed(7)
model = torch.nn.Linear(4, 2)
opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9)
scaler = scaler_class('cpu', init_scale=8, growth_interval=2)
x = torch.randn(6, 4)
y = torch.randn(6, 2)
rows = []
for step in range(5):
opt.zero_grad(set_to_none=True)
with torch.autocast('cpu', dtype=torch.float16):
pred = model(x)
loss = torch.nn.functional.mse_loss(pred, y)
scaler.scale(loss).backward()
if step == 2:
next(model.parameters()).grad[0, 0] = float('inf')
before = [p.detach().clone() for p in model.parameters()]
scaler.unscale_(opt)
grad_dtype = str(next(model.parameters()).grad.dtype)
# Skip clipping the deliberately nonfinite step: scaler.step still checks it.
if step != 2:
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
scaler.step(opt)
scaler.update()
delta = max(float((p.detach()-b).abs().max()) for p, b in zip(model.parameters(), before))
rows.append(dict(step=step, loss=float(loss.detach()), scale=scaler.get_scale(),
max_update=delta, parameter_dtype=str(next(model.parameters()).dtype),
output_dtype=str(pred.dtype), loss_dtype=str(loss.dtype), gradient_dtype=grad_dtype))
assert (delta == 0) == (step == 2)
if restore_at == step:
checkpoint = copy.deepcopy(dict(model=model.state_dict(), optimizer=opt.state_dict(), scaler=scaler.state_dict()))
model = torch.nn.Linear(4, 2)
model.load_state_dict(checkpoint['model'])
opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9)
opt.load_state_dict(checkpoint['optimizer'])
scaler = scaler_class('cpu')
scaler.load_state_dict(checkpoint['scaler'])
assert [r['scale'] for r in rows] == [8, 16, 8, 8, 16]
return rows, torch.cat([p.detach().flatten() for p in model.parameters()])
def accumulation():
torch.manual_seed(11)
model = torch.nn.Linear(4, 2)
x = torch.randn(6, 4)
y = torch.randn(6, 2)
torch.nn.functional.mse_loss(model(x), y).backward()
reference = [p.grad.clone() for p in model.parameters()]
model.zero_grad(set_to_none=True)
scaler = torch.amp.GradScaler('cpu', init_scale=8)
opt = torch.optim.SGD(model.parameters(), lr=0.1)
# Unequal microbatches: divide each sum by the SAME total element count.
for a, b in ((0, 2), (2, 6)):
loss = torch.nn.functional.mse_loss(model(x[a:b]), y[a:b], reduction='sum') / y.numel()
scaler.scale(loss).backward()
scaler.unscale_(opt)
error = max(float((p.grad-g).abs().max()) for p, g in zip(model.parameters(), reference))
assert error < 1e-6
return error
def main():
torch.set_num_threads(1)
rows, final = run()
resumed_rows, resumed = run(restore_at=1)
assert rows == resumed_rows and torch.equal(final, resumed)
torch.manual_seed(5)
model = torch.nn.Linear(4, 2)
with torch.autocast('cpu', dtype=torch.bfloat16):
output = model(torch.randn(3, 4))
loss = torch.nn.functional.mse_loss(output, torch.zeros(3, 2))
loss.backward()
p = torch.nn.Parameter(torch.tensor(1.0))
opt = torch.optim.SGD([p], lr=0.1)
scaler = torch.amp.GradScaler('cpu', init_scale=1)
scaler.scale(p).backward()
p.grad.fill_(float('inf'))
scaler.step(opt)
scaler.update()
assert scaler.get_scale() == 0.5 and p.item() == 1
result = dict(torch_version=torch.__version__, device='cpu', threads=1,
rows=rows, resume_bitwise_equal=True,
accumulation_max_abs=accumulation(),
bf16_output_dtype=str(output.dtype), bf16_loss_dtype=str(loss.dtype),
bf16_grad_dtype=str(next(model.parameters()).grad.dtype),
backoff_below_one=scaler.get_scale(), gpu_tested=False, distributed_tested=False)
print(json.dumps(result, indent=2))
Path(__file__).with_name('amp_results.json').write_text(json.dumps(result, indent=2), encoding='utf8')
if __name__ == '__main__':
main()"""Regenerate this article's deterministic teaching figure (numpy + matplotlib)."""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
OUT=Path(__file__).resolve().parents[1]/"figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({"font.sans-serif":["DejaVu Sans"],"axes.unicode_minus":False})
from float_formats import fp16,bf16
x=np.geomspace(1e-9,1e5,1500).astype(np.float32).astype(np.float64)
y16=np.array([fp16(float(v)) for v in x]);yb=np.array([bf16(float(v)) for v in x])
fig,ax=plt.subplots(figsize=(8,4.8))
for name,y in [("FP16",y16),("BF16",yb)]:
err=np.abs(y-x)/x;err[~np.isfinite(err)]=np.nan
ax.loglog(x,np.maximum(err,1e-12),label=name,alpha=.75)
ax.axvline(65504,color="grey",ls=":",label="FP16 max finite")
ax.set(xlabel="Positive input value",ylabel="Relative rounding error",title="FP32 input to FP16 / BF16: nearest-even rounding",ylim=(1e-8,2))
ax.text(0.03,0.06,"FP16 overflow points omitted; finite relative errors only.",transform=ax.transAxes,fontsize=9)
ax.legend();ax.grid(alpha=.25);fig.tight_layout()
fig.savefig(OUT/'precision_error.png',dpi=170)
plt.close(fig)
print(OUT/'precision_error.png')

评论 (0)