

版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:分布式训练 | 难度:高阶 | 前置知识:数据并行与 ZeRO 显存切分
关键词:张量并行、流水线并行、Megatron-LM、GPipe、通信开销、并行策略
先读数据并行与 ZeRO,掌握矩阵乘法、链式求导和梯度累积即可。rank 指进程编号,process group 是参加同一次通信的一组进程;GEMM 是通用矩阵乘,all-gather 把各片拼齐到每个 rank,all-reduce 把各份逐元素求和并把结果交给每个 rank。本文按每进程使用一张设备讲解,集合通信的“求和”与 DP 中约定的“平均梯度”要分清。
ZeRO-3 能把参数、梯度和优化器状态切到数据并行 rank 上,但计算某个模块时仍需取得所需的完整参数。聚合粒度未必是整层 Transformer,可细化到子模块;如果一个实际执行的巨大 Linear 连同必需输入输出和临时空间仍放不进一张卡,单纯增加数据并行度并不把这次矩阵乘拆开,此时需要 TP、算子分块或卸载等办法;若层能放下,但整网常驻状态或激活放不下,也可考虑沿网络深度切开;能否仅靠 ZeRO-3 和重计算解决,需要先算峰值。
这对应两把不同的刀。张量并行(Tensor Parallelism,TP)在一层内部切矩阵,让多张卡共同完成同一个 GEMM;流水线并行(Pipeline Parallelism,PP)沿层切模型,让不同设备各自保存连续或交错的一段层。前者解决“这一层太宽”,后者解决“模型太深”。普通数据并行沿 batch 分样本、复制模型计算;ZeRO/FSDP 另对状态分片,三者可以组合,切的轴与状态拥有者必须分别标明。
先看一个浪费现场:4 个 pipeline stage 处理 1 个 microbatch。第 0 段前向时其余三段都空闲;数据流到第 3 段后,前几段又空闲。若把一个 global batch 切成 8 个 microbatch,让不同样本在各 stage 重叠,把总计 $4\times8=32$ 份 stage 工作分摊到 4 台设备,理想 forward sweep 用 11 个时间槽完成,但仍有填充和排空的“气泡”。本文脚本算出 4 段、8 个 microbatch 的单向 sweep 的理想利用率为 $32/(4\times11)=72.73\%$,空闲槽占 27.27%。在均衡 GPipe 训练中也会得到这一比例;其他调度不能只凭这一个公式推断实测效率。
再看 TP:若一个 MLP 的第一层权重为 $[d,4d]$,可沿输出维切成 $p$ 份,每卡算 $[d,4d/p]$;第二层 $[4d,d]$ 再沿输入维与中间激活匹配切分。这样两次 GEMM 都不需要在中间把完整 $4d$ 激活拼回每张卡,只在必要边界做集合通信。这正是 Megatron-LM 的 column-parallel 与 row-parallel 配对。
难点不在“切成几份”,而在切后保持数学等价,并让通信落在高带宽拓扑上。TP 频繁同步,通常限制在 NVLink/NVSwitch 节点内;PP 在相邻 stage 前向传激活、反向传对应梯度,更适合跨节点。这是基于通信频率的配置起点;若链路、消息量或层划分不同,需用实际 trace 比较,不能仅凭并行轴名称判定哪种拓扑一定更快。
三句话建立框架:
如果只记一句:TP 是“同一个样本的一层由多卡一起算”,PP 是“同一个样本依次经过多卡上的不同层”。它们都属于模型并行,但通信模式完全不同。
设世界规模 $W$,数据并行度为 $d_p$、张量并行度为 $t_p$、流水线段数为 $p_p$,若没有其他并行轴:
$$W=d_p\,t_p\,p_p$$
这不是越均匀越好。TP 度受矩阵维度、head 数、KV head 数和高速互联限制;PP 度受层数、切分均衡与 microbatch 数限制;最后再用 DP 提升全局吞吐。
将 batch 与 token 两维合成行数 $n=B L$。线性层输入 $X\in\mathbb{R}^{n\times d_{\mathrm{in}}}$,权重 $A\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}}$,输出为:
$$Y=XA$$
把 $A$ 沿列切为 $p$ 份:
$$A=[A_0,A_1,\ldots,A_{p-1}],\qquad A_i\in\mathbb{R}^{d_{\mathrm{in}}\times d_{\mathrm{out}}/p}$$
第 $i$ 个 rank 计算:
$$Y_i=XA_i$$
完整结果只是拼接:
$$Y=[Y_0,Y_1,\ldots,Y_{p-1}]$$
前向不必通信,只要输入 $X$ 在 TP 组内复制。若下一层能直接消费分片 $Y_i$,连 all-gather 都可省。反向时,每个 rank 产生一份输入梯度贡献 $dX_i=dY_iA_i^\top$,完整 $dX$ 要求和:
$$dX=\sum_{i=0}^{p-1}dX_i$$
因此,在输入与其梯度都要复制、未启用 sequence parallel 的约定下,column-parallel 的关键通信落在反向输入梯度 all-reduce。令标量 loss 对 $Y_i$ 的梯度为 $G_i$,则本地权重梯度为 $X^\top G_i$;若加分片偏置 $c_i$,其梯度是对所有行求和的 $\sum_{k=1}^{n}G_i[k,:]$,而非再对不同特征 shard 求和。
把输入和权重的匹配维切开:
$$X=[X_0,X_1,\ldots,X_{p-1}],\qquad A=\begin{bmatrix}A_0\\A_1\\ \vdots\\A_{p-1}\end{bmatrix}$$
每卡先算局部部分和 $Z_i=X_iA_i$,完整输出是:
$$Y=XA=\sum_{i=0}^{p-1}X_iA_i=\sum_{i=0}^{p-1}Z_i$$
所以 row-parallel 前向需要 reduce 或 all-reduce,反向则能从复制的 $dY$ 本地得到 $dX_i=dYA_i^\top$。Megatron 把 MLP 的第一层做 column parallel,激活函数逐元素地作用在本地 shard;第二层做 row parallel,最后只求和一次。attention 的 QKV 投影与输出投影也能形成类似配对。注意 row-parallel 的输出偏置应在求和后加一次:每片先加同一 $b$ 再归约会得到 $p b$。列并行的偏置则随输出特征切分,各片在自己的激活前相加。
为看清非线性和反向,写一个 MLP:第一层分片权重为 $A_i$、偏置 $c_i$,第二层分片权重为 $B_i$、完整输出偏置为 $b$,$\phi$ 是逐元素激活,如 GELU 或本文验证用的 tanh:
$$U_i=XA_i+c_i,\qquad H_i=\phi(U_i),\qquad Y=\sum_iH_iB_i+b$$
逐元素函数不会混合不同特征,所以可以留在各片计算;若换成跨隐藏维归一化等操作,这一步需要另设计通信。令 $G=\partial\mathcal{L}/\partial Y$,先由第二层反传,再乘激活导数($\odot$ 表示逐元素乘):
$$D_i=(GB_i^\top)\odot\phi^{\prime}(U_i)$$
$$\nabla_{B_i}\mathcal{L}=H_i^\top G,\quad\nabla_{A_i}\mathcal{L}=X^\top D_i,\quad\nabla_X\mathcal{L}=\sum_iD_iA_i^\top$$
$$\nabla_{c_i}\mathcal{L}=\sum_{k=1}^{n}D_i[k,:],\qquad\nabla_b\mathcal{L}=\sum_{k=1}^{n}G[k,:]$$
这些式子也解释了两个容易重复归约的地方:每片的 $A_i,B_i,c_i$ 是不同参数;复制的输出偏置 $b$ 各副本看到同一 $G$,不能再无条件相加 $p$ 次。框架还会为 DP、sequence parallel 等情况另定义梯度同步。本文权重按数学右乘写成 [in,out];PyTorch/Megatron Linear 把 weight 存成 [out,in],forward 用其转置,因此源码里“列并行”切的是存储权重的第 0 维。
这种设计的精髓不是“每个 Linear 都随便切”,而是让相邻层的分片布局衔接,从而避免在每个算子后都 all-gather。若一个自定义层偷偷需要完整 hidden,通信会突然增加。
设传输张量有 $N$ 个元素、每元素 $b$ 字节,按 ring 的 reduce-scatter 加 all-gather 计算,前一阶段有 $p-1$ 次发送、每次 $Nb/p$ 字节,后一阶段相同;故一次 all-reduce 的每 rank 发送字节为:
$$V_{\mathrm{AR}}=2\frac{p-1}{p}Nb$$
$p$ 是 TP 组大小,$b$ 是实际通信 dtype 的字节数。每 rank 接收量与发送量相等;若把发送加接收合计,数值再乘 2;集群全部 rank 的发送总量则乘 $p$,不能混着比较。对不启用 sequence parallel 的经典 Megatron Transformer block,attention 和 MLP 的 row-parallel 输出各做一次前向 all-reduce,两个 column-parallel 的输入梯度各做一次反向 all-reduce,共四次。这不含 DP 同步、embedding/loss、重算和通信元数据。
例如 $B=1,L=131072,d=8192,p=8$,假设四个边界均传输 BF16 的 $[B,L,d]$:单张量为 2 GiB,一次 all-reduce 每 rank 发 3.5 GiB,整个 block 一次 microbatch 前后向合计发 14 GiB,另收 14 GiB。这是按所列假设的逻辑字节账本,不是实测网络吞吐。FP32 通信会翻倍,$p=1$ 时该通信为零。真实实现可用 reduce-scatter、all-gather 与 sequence parallel 改写,fused kernel 和通信算法也会改变调用形态。TP 每层同步,所以延迟不能忽略:小矩阵、多层和大 TP 度会让消息切得太碎,算力利用率反而下降。
TP 对参数显存理想降为 $1/p$,但并非所有东西都跟着切。LayerNorm 参数很小,可能复制;embedding 与 LM head 有词表切分规则;激活是否分片取决于 sequence-parallel 配置;通信临时 buffer 还会增加峰值。因此应从真实 module state 和 profiler 测量,不可把全显存直接除以 TP 度。
设有 $p$ 个等耗时 stage,每个 DP 副本在一次 optimizer step 内处理 $m$ 个 microbatch,每个 stage 处理一个 microbatch 的单向计算耗时为一格。第一个 microbatch 需要 $p$ 格到达尾部,之后每格完成一个。完成一个 forward sweep 共:
$$T_{\mathrm{sweep}}=m+p-1$$
其中每个 stage 真正工作 $m$ 格,所以理想效率与气泡比例:
$$\eta_{\mathrm{pipe}}=\frac{m}{m+p-1},\qquad f_{\mathrm{bubble}}=\frac{p-1}{m+p-1}$$
当 $p=4,m=8$,效率 $8/11=72.73\%$。当 $p>1$,要达到至少 90%,由 $10m\ge9(m+p-1)$ 得 $m\ge9(p-1)$;若要严格超过 90%,则需 $m>9(p-1)$。例如 4 段、27 个 microbatch 恰好 90%,28 个才超过;$p=1$ 且 $m\ge1$ 时没有这种填充气泡。这也解释了为什么 stage 很多却只有几个 microbatch 时 PP 很差。
这个比例先由单向 sweep 推出。均衡 GPipe 训练若每段前向时间为 $t_f$、反向为 $t_b$,先全前向再全反向,总时长为 $(m+p-1)(t_f+t_b)$;每设备有效工作为 $m(t_f+t_b)$,所以比例不变,不要求前反向等长。论文中气泡相对理想有效工作时长的开销比为 $(p-1)/m$,与本文用总时长作分母的空闲比例是不同口径。这里假设各段分别等耗时、通信完全隐藏、忽略优化器和同步等其他开销。真实训练的气泡还包括 stage 不均衡、点对点传输、参数同步、数据加载与尾 batch。最后一段若有巨大词表投影,前面切得再平均也会被它卡住。
GPipe 先把所有 microbatch 前向跑完,再统一反向,调度简单但要保存更多未反向的激活。1F1B 在 warmup 后交替执行一次 forward 和一次 backward,优先释放较早完成反向的计算图;同步更新语义仍要求一次 optimizer step 所需梯度累积完再更新权重。非交错 1F1B 的 stage $s$(从 0 开始)先做 $w_s=\min(p-s-1,m)$ 个 warmup forward,然后每次做一个新 forward 与一个旧 microbatch 的 backward,最后排空剩余 backward。
tp_pp_checks.py 按 stage 资源和跨段前反向依赖做最早启动事件模拟。$p=4,m=8$、每次 F/B 都耗时 1、无通信时,GPipe 与非交错 1F1B 均为 22 个时间单位,利用率均为 72.73%;按“F 完成后持有一份图,B 完成后释放”计数,GPipe 四段峰值为 [8,8,8,8],1F1B 为 [4,3,2,1]。因此这个理想例子主要省激活驻留,并没有把气泡自动减半。它不是物理显存的测量:forward/backward 的临时存储、重算和通信 buffer 尚未计入。
将最后一段 F/B 各改成 3、其他段仍为 1,同一个 1F1B 模拟总时长变成 54,设备时间利用率为 44.44%。这是具体的失衡反例;改变调度、时长或异步资源后要重算,不能把 72.73% 当任意流水的上限或预报。
交错 1F1B 让每个物理设备承载多个 virtual stage,把一个大气泡拆细。它可改善负载与气泡,却增加更多通信边界、依赖和调度复杂度。Pipeline 并行的优化对象不只是公式里的 bubble,还包括峰值激活、通信重叠和 kernel 连续性。
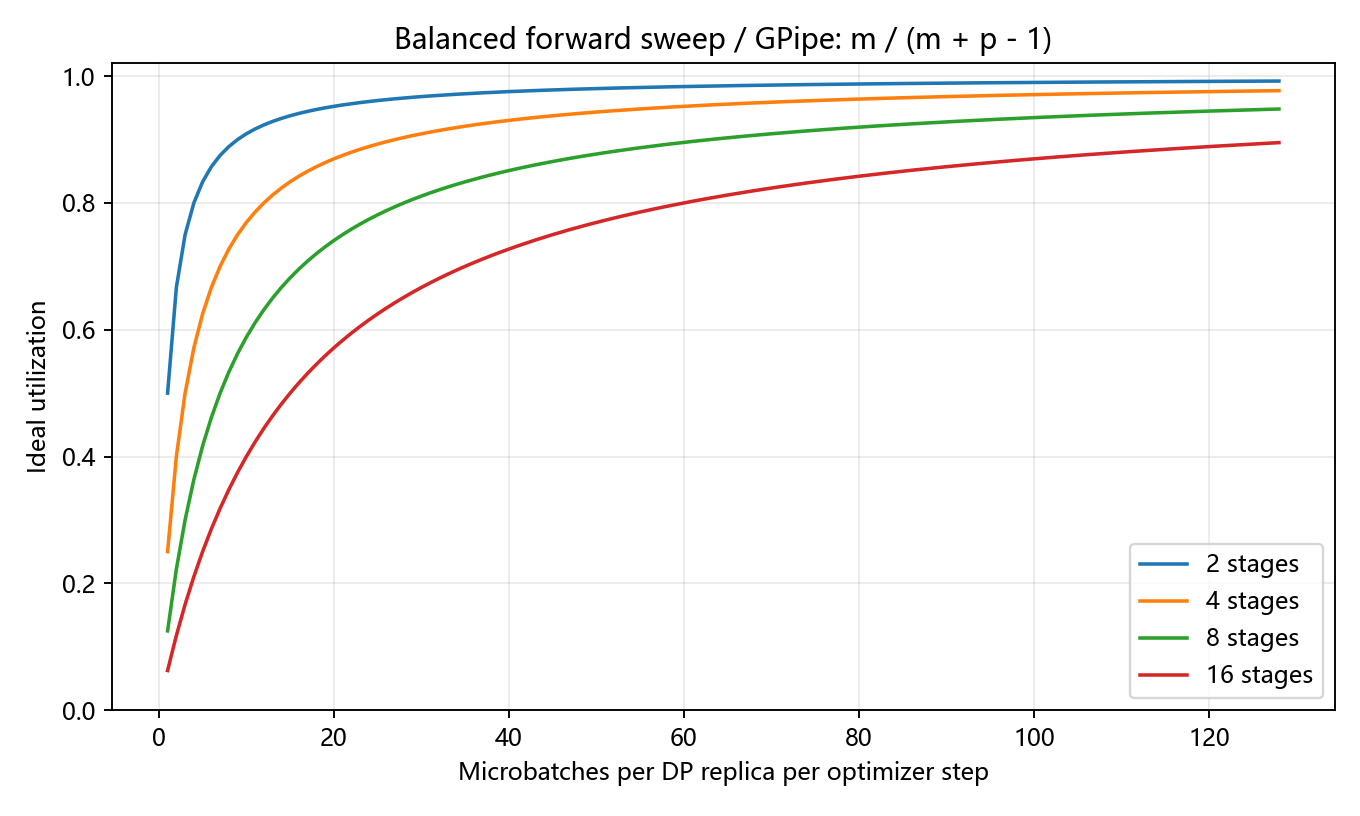
均衡同步流水线的理想利用率,按 m/(m+p−1) 计算。增加 microbatch 能摊薄填充与排空气泡;它首先描述均衡 forward sweep,也适用于上述均衡 GPipe;图中不含通信、stage 失衡与小 GEMM 效率变化,不能据此直接预测 tokens/s。
tp_linear_sim.py 只用标准库,构造 $X:[2,4]$、$W_1:[4,6]$、$W_2:[6,3]$。先完整计算,再把第一层按列、第二层按行切到两个虚拟 rank:
X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2
column shards: W1=(4, 3) each, hidden=(2, 3) each
row shards: W2=(3, 3) each, partial output=(2, 3) each
full output=[[52, 42, 72], [132, 114, 180]]
max hidden diff=0, max output diff=0
该整数例子的输出差为 0,验证无偏置、无激活时“按列拼接、按行求和”的实现;一般实数情形的代数等价性来自第 03 节推导,不能仅靠一组样本证明。脚本现在支持 --parts 1/2/3/6,非整除及错误矩阵形状会拒绝,避免 zip 静默截断。完整的非线性、偏置与梯度验证在下面的检查脚本中。真实浮点并行的归约顺序不同,通常会出现末位误差,不能要求 bitwise 一致,而应设置与 dtype 相称的容差。
pipeline_bubble.py 默认模拟 4 段、8 个 microbatch:
stages=4, microbatches=8, ideal_slots_per_sweep=11
pipeline_efficiency=72.73%, bubble_fraction=27.27%
forward schedule (slot -> active stage:microbatch)
00: S0:M0
01: S0:M1 S1:M0
02: S0:M2 S1:M1 S2:M0
03: S0:M3 S1:M2 S2:M1 S3:M0
04: S0:M4 S1:M3 S2:M2 S3:M1
05: S0:M5 S1:M4 S2:M3 S3:M2
06: S0:M6 S1:M5 S2:M4 S3:M3
07: S0:M7 S1:M6 S2:M5 S3:M4
08: S1:M7 S2:M6 S3:M5
09: S2:M7 S3:M6
10: S3:M7
前 3 格在填充、后 3 格在排空,第 3 到第 7 格这 5 格四段都忙碌;11 格总容量为 44 个设备槽,实际使用 32 个。这里打印的是前向时间表,没有实现训练反向。用参数改变 stages 与 microbatches,就能看到增加 microbatch 如何摊薄固定气泡。
额外运行 tp_pp_checks.py(需要 NumPy),固定 seed=27、FP64:TP=1/2/3/6 的 tanh+双偏置两层网络,输出与五类梯度(输入、两权重、两偏置)的最大差均不超过 $8.89\times10^{-16}$;全部 71 个输入/参数分量的中心差分最大差为 $2.44\times10^{-9}$。TP=3 时故意重复加输出偏置,最大输出差为 3.169615;倒置第二层 shard,差为 4.447151。64 组 GPipe/1F1B 事件模拟核对了依赖、任务数和均衡时长;不等 batch 的正确加权梯度为 5.533333,错把两个 microbatch 均值等权平均则为 4.3。这里没有启动多 GPU 或 NCCL。
四份脚本均在 Windows、Python 3.11.9、NumPy 2.4.3、matplotlib 3.10.7 下实际运行;前两份仅用标准库,画图另需 matplotlib,检查脚本另需 NumPy。附录含完整代码;运行当前目录的脚本即可复算 JSON 与配图。
本次核对日期为 2026-10-27,固定使用 NVIDIA Megatron-LM 的 core_v0.14.0,不把该版本称为最新。张量并行源码 提供 ColumnParallelLinear 与 RowParallelLinear。工业实现除切权重外,还管理参数初始化、bias、是否 gather 输出、异步梯度 all-reduce、梯度累积融合、sequence parallel、专家并行组和通信 buffer。前两份最小脚本只展示代数和调度账本;新增检查脚本独立核对解析梯度与事件依赖,也没有模拟真实 NCCL。
ColumnParallelLinear 的 gather_output 决定输出是否立刻汇总;RowParallelLinear 的 input_is_parallel 表示输入是否已经按最后一维切好。skip_bias_add=True 会把 bias 作为第二个返回值交给调用者,供后续融合;忽略它就漏掉偏置,重复添加则又算一遍。row-parallel 正常分支先归约无偏置的局部输出,再加完整 bias;sequence parallel 分支改为 reduce-scatter。错置布局可能触发 shape 错,也可能多做 gather 或静默算错。审计并行模型时,应给每个边界标清 global shape、local shape、分片轴、复制轴和预期 collective。
PP 代码位于同版本的流水线调度模块。非交错路径在源码中明确分 warmup、1F1B 和 cooldown;交错路径还涉及 virtual stage、microbatch 分组和通信重叠,不能只套非交错的 warmup 公式。配置中的 pipeline_model_parallel_size 切物理 stage,virtual_pipeline_model_parallel_size 启用交错。系统必须传递前向激活和反向梯度,处理 tied embedding、首尾 stage 特殊 loss、不同张量 shape、激活释放与通信重叠。
为了让对照可核验,本轮保留原始源码并逐字保留 AST 中的两类完整 forward 方法,在 PyTorch 2.10.0+cpu 上运行 48 个 rank/dtype/bias 夹具:TP=1/2/3/6、FP32/FP64、两种 bias 返回模式,以及 gather/scatter 分支,前向与本地 autograd 参考差均为 0。另执行三个原调度辅助函数:60 个非交错 rank 配置的 warmup/remaining 与公式一致,交错示例的 20 项操作序列与源码文档逐项相符。PyTorch autograd 对 NumPy 的五类解析梯度最大差为 $1.61\times10^{-15}$。
这次用 CPU 线性算子与数学集合通信回调替代 CUDA 构造、NCCL 及融合内核,验证的是原 forward 的布局/偏置分支与调度表。它没有验证多卡反向通信、完整 Megatron 模型、通信重叠、GPU 显存或吞吐;这些仍需在真实集群跑下一节的验收。
Megatron 2021 展示了 TP、PP 与 DP 的组合,并提出交错流水调度。工程上的常见布局是:同一节点内组成 TP 组,邻接节点组成 PP 链,跨副本组成 DP 组。原因是 TP 每层通信而 PP 只在 stage 边界传输;把频繁 collective 放在更快互联上更划算。
生产配置还要做 layer partition。按层数平均只在每层耗时相同才合理;MoE 层、cross-attention、视觉模块、embedding 与词表 head 的成本差异很大。应先 profile 单层前后向时间和激活尺寸,再按时间而不是按层数切 stage。
TP 的主要代价是高频 collective。TP 度增加后,每卡 GEMM 变小,计算效率下降,通信延迟占比上升;跨节点 TP 尤其敏感。维度还必须能合理整除:attention head、KV head、MLP intermediate size、词表分片与低精度 tile 对齐都会形成约束。
PP 的主要代价是气泡、激活驻留与调度复杂度。microbatch 增多能降气泡,却让每次 GEMM 的 batch 更小,可能降低算力利用率;还会增加调度次数。梯度累积数也受 global batch、DP 度与 microbatch size 约束:
$$B_{\mathrm{global}}=B_{\mathrm{micro}}\,m\,d_p$$
为了把 $m$ 调大而偷偷改变 global batch,会连学习率与收敛语义一起改变。更稳妥的做法是减小 microbatch size、保持 global batch,再检查小 GEMM 是否仍高效。
PP stage 之间有顺序依赖,在每条样本路径都经过所有 stage 的假设下,单个慢 stage 会拖住全链。设备故障、动态 shape、条件分支和 MoE 路由也比普通 DP 难处理。推理时 batch 与请求长度动态变化,训练得到的均衡切分未必仍均衡。
TP 与 ZeRO/FSDP 并非天然可任意叠加。两者可能切同一参数的不同轴,process group、参数初始化、checkpoint layout 和 optimizer state 都需协调。首先建立二维或三维 rank 映射,再启用框架明确支持的组合,避免自行套两层 wrapper。
什么时候不该用?模型单卡能放下且吞吐受数据不足或 CPU 限制时,TP/PP 只会增加同步;单层很小而层很多时,优先 PP 或 FSDP;单层巨大而层数不多时,TP 更直接;超长序列导致激活爆炸时,还要引入下一篇的序列/上下文并行。
假设 decoder hidden size 为 $d$,MLP expansion 为 $4d$,attention head 数为 $H$,每头维度为 $d_h=d/H$。采用 $t_p$ 路 TP 时,至少希望 $H/t_p$ 与 $4d/t_p$ 为整数,且本地矩阵维度满足 Tensor Core tile 对齐。GQA 还要检查 KV head 数 $H_{KV}$;若 Q head 可整除而 KV head 不可整除,框架可能复制 K/V 或根本拒绝配置。
参数容量只是下界。以 MLP 两个权重为例,忽略 bias:
$$P_{\mathrm{MLP}}=d(4d)+(4d)d=8d^2$$
理想 TP 后每卡为 $8d^2/t_p$ 个参数。然而输入 $X$、残差、LayerNorm 与某些输出仍可能复制。是否启用 sequence parallel,会决定 $[B,L,d]$ 激活是每 TP rank 一份还是沿 token 切开。评估 TP 度时要分别列参数、可分片激活、复制激活和通信 buffer,不能只用总显存除 $t_p$。
性能上,增大 $t_p$ 会改变本地 GEMM 的形状与数据复用;是否降低算术强度或耗时要看哪一维被切、缓存及 kernel。若局部矩阵太窄,GPU 的流式多处理器(SM)可能利用不足,计算缩小也未必换来相应加速。实际选型一般从“能放下的最小 TP 度”起步,再尝试少数相邻值;不是卡越多 TP 越大。
有 2 个节点、每节点 8 卡,总计 16 卡。假设 TP=8、PP=2、DP=1,合理映射是每个节点内部构成一个 TP 组,两个节点作为相邻 PP stage。这样每层 TP collective 走 NVLink/NVSwitch,只有 stage 边界激活跨节点。
若 rank 编号错误,使每个 TP 组横跨两节点,那么每个 Transformer 层的 all-reduce 都经过网络;PP 反而在节点内。数学结果完全正确,吞吐却可能大幅下降。这类问题从配置数字看不出来,必须导出每个 process group 的物理 GPU、主机名、PCIe/NVLink 路径和 NIC 亲和性。
当 DP>1 时,DP 组应从相同 TP/PP 坐标上取不同副本。例如把 rank 写成坐标 $(r_d,r_p,r_t)$,模型同一 shard 的梯度只在 $r_d$ 维同步;层内 tensor collective 只改变 $r_t$;pipeline 点对点只沿 $r_p$ 邻接。把坐标语义明确下来,checkpoint 分片和故障定位才不会依赖偶然 rank 编号。
多 NIC 节点还要关注通信并发。TP all-reduce、PP send/recv、DP reduce-scatter 可能同时争同一链路。单独 benchmark 每个 collective 很快,不代表组合后仍快;应在真实 schedule 上看每条 stream 和 NIC 的时间线。
PP 将参数按层分段,参数内存近似降为 $1/p_p$,但激活取决于 schedule。GPipe 前向完所有 $m$ 个 microbatch 才反向,每 stage 可能保留 $O(m)$ 份边界与层内激活。1F1B warmup 后尽早反向,可显著减少同时存活的 microbatch 数;不同 stage 的 warmup 长度又不同,峰值不完全一致。
activation checkpoint 将层内保存换成反向重算,但 stage 边界张量通常仍要保留或重新通信。若 PP 与 ZeRO-3 叠加,重算还可能再次触发参数 all-gather;如果 prefetch 与 release 时机不匹配,理论显存节省会被临时完整参数覆盖。
一个更实用的峰值模型是:
$$M_s^{\mathrm{peak}}=\max_t[M_{\mathrm{state},s}(t)+M_{\mathrm{act},s}(t)+M_{\mathrm{comm},s}(t)+M_{\mathrm{workspace},s}(t)]$$
$s$ 是 stage,$t$ 是时间,state 含权重、梯度与优化器状态;各项应为同一时刻互不重复计数的存储。若每份图大小接近,激活项可近似为当时存活图数乘单份大小,但不能把各项在不同时刻的最大值当成真实同时峰值。选切分点的目标应是控制 $\max_s M_s^{\mathrm{peak}}$ 并平衡每段时间,而不是让每段层数相同。首段 embedding、尾段 vocab projection 和 loss 往往需要单独计量。
同步 GPipe 或 1F1B 中,一个 global batch 的所有 microbatch 应使用同一版参数,梯度累积后再统一 optimizer step。若 loss 能按样本或有效 token 相加,所有 microbatch 使用同一版权重、对应计算相同且累积权重正确,则在精确算术下得到同一批的梯度。BatchNorm 训练态按 microbatch 计算均值/方差,改变切分会改变 forward;共享可变状态或跨样本操作同样需要单独处理,不能无条件称等价。检查脚本中 [1,2,4] 整批与按 1+2 拆分的 BatchNorm 型归一化,最大输出差为 1.069042。随机 dropout 若要严格比较,还需保证不同 schedule 消耗一致的随机数流。
异步 pipeline 为减少 flush 可能允许某些 microbatch 使用旧权重,产生 weight staleness。PipeDream 的权重暂存与调度就是为管理这个问题。吞吐更高不等于优化轨迹相同;对需要可复现或大规模预训练的任务,同步 schedule 通常更容易验收。
梯度累积的 loss normalization 也常出错。若每个 microbatch loss 已取 mean,再把 $m$ 份梯度直接相加,最终梯度比全局 mean 大 $m$ 倍;框架可能在 loss、backward 或 optimizer wrapper 某处除 $m$。迁移实现时必须确认缩放发生在哪里,特别是最后一个不完整 microbatch。若第 $j$ 片包含 $n_j$ 个有效单元(例如未被 mask 的 token),片内 mean loss 为 $\bar\ell_j$,需要先明确整批目标:
$$\mathcal{L}_{\mathrm{mean}}=\frac{\sum_jn_j\bar\ell_j}{\sum_jn_j},\qquad\nabla\mathcal{L}_{\mathrm{mean}}=\sum_j\frac{n_j}{\sum_kn_k}\nabla\bar\ell_j$$
只有所有 $n_j$ 相等时才是简单除以 $m$。还要考虑 DP 默认梯度平均的除数;不能同时在 loss 和 wrapper 各除一遍。目标若本来定义为每样本均值,应按有效样本数加权,而非擅自换成 token 均值。
第一步做容量约束:根据参数、优化器、激活和临时 buffer,排除会 OOM 的 TP/PP。第二步做整除约束:检查层数、head、KV head、MLP width、词表与 microbatch。第三步按拓扑放组:TP 留在最快域,PP 穿过节点,DP 使用余下副本。第四步才短跑候选方案。
短跑至少记录每个 stage 的 forward/backward 时间、TP collective、PP send/recv、DP collective、bubble、MFU 和峰值显存。若 stage 时间方差大,先重切层;若 collective 裸露,检查异步与 bucket;若 GEMM 利用率低,减少 TP 或增大 microbatch;若 bubble 大,增加 microbatch 或 virtual stage。
还要避免只优化稳态。训练中 checkpoint、评估、数据切换、动态 loss scale 与长短样本混合会改变节拍。视频模型的序列长度可能随分辨率和帧数变化,固定层切分在不同 batch 上会失衡。可以按长度分桶、限制每批 token 数,或使用能处理动态 shape 的 schedule,但都要重新验证 global batch 语义。
TP checkpoint 的一个权重可能沿行或列分片,PP checkpoint 又只在拥有该层的 stage 上出现。保存时应记录全局 shape、分片轴、offset、replica group 与 tied-weight 关系。仅按 rank 存文件却没有布局元数据,会显著增加从 TP=8 改成 TP=4 的恢复难度;若完整掌握原切分约定仍可转换,但必须验证。
成熟 distributed checkpoint 会把逻辑参数名与物理 shard 解耦,加载时重新规划切片。验证转换不能只看“文件读完”,应抽样 all-gather 后与原始全参数比较,并跑一个确定性 forward。optimizer state 也必须按相同参数布局重分片,特别是 Adam 的 m、v 与 FP32 主权重。
PP 的 tied embedding 是典型边界:输入 embedding 在首段,输出投影在尾段,但两者可能共享参数。系统要么在两个 stage 间同步梯度,要么采用明确的复制与更新协议。忽略它会让模型能跑、loss 也下降,却不再是原架构。
最后为每个组合保留机器可读配置:world size、各轴度数、rank 坐标映射、global/micro batch、累积数、schedule、virtual stage、precision 与 checkpoint schema。没有这份清单,性能回归时很难判断是代码变化还是并行布局变化。
假设 8 个节点、每节点 8 卡,模型单层在 4 卡上能放下,96 层在单节点放不下,目标 global batch 又允许 4 个数据副本。可先试 TP=4、PP=4、DP=4,乘积正好 64。每个节点容纳两个 TP 组,相邻两个节点组成一条四段 pipeline;相同 TP/PP 坐标跨四个副本形成 DP 组。
为什么不直接 TP=8、PP=2、DP=4?它减少 PP 气泡,但本地 GEMM 变小、每层 collective 参与卡数翻倍。为什么不 TP=2、PP=8、DP=4?单层可能放不下,而且 PP 段更多,要求更多 microbatch 才能摊薄气泡。三个方案都满足乘积约束,只有容量、profile 和拓扑能决定赢家。
设 PP=4、microbatch 数 $m=16$,理想气泡为 $3/19=15.79\%$;若为配合 DP=4,global batch 满足 $B_{\mathrm{global}}=B_{\mathrm{micro}}\times16\times4$。当目标 global batch 固定时,microbatch size 可能被压得太小。此时交错 PP 可在不继续增加 $m$ 的情况下缩小气泡,但要多传 stage 边界。
选定后再检查每卡峰值。若尾段词表 head 使 stage 3 明显更慢,可把少量 Transformer 层从尾段移到前段;若 stage 0 embedding 占显存而计算很少,切分目标应同时满足容量与时间,而不是追求参数量绝对相等。
若所有 GPU 利用率呈周期性锯齿且空白集中在迭代首尾,优先看 PP bubble;若每层 GEMM 后都有长 NCCL 条带,优先看 TP 通信或 rank 跨节点;若只有某一个 stage 长期满载、其他 stage 等待,是层切分失衡;若迭代末尾集中等待,是 DP 梯度同步没有充分 overlap。
出现 hang 时,先核对各 rank collective 调用序列。条件分支导致某些 rank 少调用一次 all-reduce,或 PP 两端 send/recv shape 不一致,都会永久等待。为通信操作记录 group、sequence number、peer、shape 与 dtype,比只看 Python stack 更有用。设置超时只能让错误更快暴露,不能修复顺序。
数值不一致时,从一个微型模型开始,关闭 dropout 和 fused kernel,分别测试 TP、PP,再测试组合。TP 常见错误是切分轴、bias 重复相加、输出误 gather;PP 常见错误是 loss 缩放、跨段激活 requires-grad、共享参数同步。一次只启用一根并行轴,能把搜索空间从三维降为一维。
OOM 若只发生在第一步,往往是 optimizer state 首次建立或通信 bucket 惰性分配;若在若干步后发生,可能是 graph retention、动态 shape 缓存或碎片;若只在某个 PP stage,先看该段真实 activation 与临时 buffer。不要看到 OOM 就统一减 microbatch,这可能掩盖泄漏却降低所有卡效率。
发布配置前确认:世界规模等于各并行轴乘积;每个 rank 坐标唯一;TP group 位于预期高速域;head、KV head、MLP 与词表可整除;各 stage 时间和峰值接近;global batch 算术正确;loss normalization 不依赖 microbatch 数;tied weight 有同步协议;checkpoint 能跨目标并行度恢复。
性能门禁同时保存 tokens/s、MFU、bubble、每类 collective 的裸露时间、峰值显存和最慢 stage。只保存总迭代时间无法解释回归。集群拓扑或通信库升级后,即使模型代码未变,也要重跑基准,因为并行策略本质上是对物理系统的映射。
最后预留降级方案:某节点高速链路异常时能否减少 TP、增加 PP;某个 checkpoint 是否可重分片;global batch 是否仍保持;恢复后数值是否连续。真正稳健的并行配置,不只是峰值最快,也要能在硬件变化和断点恢复时保持语义清楚。
同样传 1 GiB,一个大 all-reduce 与数百个小 collective 的耗时不同。常用模型 $T=\alpha n+\beta V$ 中,$n$ 是消息次数,$V$ 是字节量,$\alpha$ 表示每次启动延迟,$\beta$ 表示每字节时间。TP 在每层频繁通信,尤其受 $\alpha$ 影响;PP 消息次数少,但单次边界激活可能很大。
通信是否裸露还取决于依赖。梯度 all-reduce 可与更早层 backward 重叠,PP send 可与下一份本地计算重叠;位于关键路径上的 collective 即使字节少也会直接延长 step。性能报告应区分总 NCCL 时间与 exposed communication time。
bucket 太小会增加消息次数,太大又推迟通信启动,减少 overlap。最优 bucket 与层大小、网络延迟和反向节奏有关。框架默认值是通用折中,不一定适合视频 DiT 的大激活或 MoE 的不均匀参数。
最后还要观察尾延迟。一个 rank 因热降频、ECC、数据抖动或网络拥塞变慢,collective 会让整个组等待。平均 GPU 时间看似健康,最慢 rank 才决定训练。按 rank 记录分位数,并把异常节点与拓扑关联,是大规模并行调优的基本动作。
理论模型最终要由 trace 校准。为每次实验保存并行配置、网络拓扑、逐 stage 时间线与通信矩阵,下一次才能定位回归。若只留一行 tokens/s,既无法判断瓶颈是 GEMM、气泡还是慢 rank,也无法安全迁移到另一代 GPU。并行策略不是模型的附属启动参数,而是计算图和硬件共同组成的一部分,理应像模型结构一样接受版本管理和回归测试。
论文演进说明:单一并行轴只能解决一种容量瓶颈,规模继续增长后,真正的问题变成如何把多个轴映射到硬件拓扑并共同调度。
误解一:TP 就是把每层平均切开。 切分轴决定通信。Megatron 的 column-row 配对是为了让中间分片直接衔接,不是机械地切一半权重。
误解二:PP 段数越多,显存越省且速度越快。 参数容量会下降,但固定气泡随 $p-1$ 增长;若 microbatch 不够,更多 stage 反而更闲。
误解三:microbatch 越多越好。 它降低理想气泡,却减小 GEMM、增加调度,并可能扩大激活队列。要联动测 MFU 与显存。
误解四:1F1B 是异步优化。 常用同步 1F1B 只是改变前后向顺序,仍在一个 global batch 梯度完成后统一更新;PipeDream 式异步才涉及权重陈旧。
误解五:TP 能把所有显存除以 TP 度。 小参数、复制激活、通信 buffer 与 runtime 不会理想均分。必须看逐项账本。
误解六:三维并行度乘起来等于卡数就配置正确。 整除只是必要条件。拓扑、矩阵 tile、head 数、stage 均衡、global batch 都可能让配置不可用。
先运行 tp_linear_sim.py,使用 python tp_linear_sim.py --parts 3,把 $W_1$ 的输出与 $W_2$ 的输入切成 3 片。预期完整输出仍一致。然后故意让第二层 shard 顺序交换,结果会静默错误;这说明 distributed tensor layout 必须携带明确语义。
运行 pipeline_bubble.py,固定 stages=8,分别取 microbatches=1、8、32、72。理论效率依次为 $1/8$、$8/15$、$32/39$、$72/79$。脚本当前只实现均衡 stage 的闭式公式;扩展成事件调度模拟后,用 tp_pp_checks.py 中已实现的事件模拟比较 GPipe、非交错 1F1B 与最后一段变慢的案例,检查 makespan、每段存活图峰值和全部任务的依赖。平衡 64 组与不均衡 54 时间单位反例都能复算,观察均分层数为何不等于均分时间。
在真实集群做 TP=1/2/4/8 对照,固定 global batch 和模型,记录每层 GEMM 时间、collective 时间、MFU、峰值显存。观察容量是否解除、吞吐是否改善,以及更大 TP 是否因小 GEMM 或通信而退化;这些是待测假设,不是保证出现的曲线。用拓扑工具确认 TP rank 是否真的落在 NVLink 域内。
对 PP 做相同实验:固定 PP 度,逐步增加 microbatch 数;再固定 microbatch,增加 virtual stage。记录 bubble、激活峰值与端到端 tokens/s。不要只看 framework 打印的理论 bubble,GPU timeline 中的空白才是真实气泡。
最后做一次等价性验收:单卡、TP、PP、TP+PP 使用相同初始化和样本,关闭 dropout,比较一个 step 的 loss 和若干参数梯度。低精度与归约顺序会造成小差异,但若误差随层爆炸,优先检查 shard 顺序、bias、loss 归一化与 tied weight。
读完这篇可以继续看:
选型时先问容量瓶颈在哪里:单层太宽选 TP,层总数太深选 PP,副本吞吐选 DP,超长激活选 SP。随后才是把这些轴映射到实际互联。公式给出上限,profile 决定最终配置。
09 节用到的脚本全文如下(tp_pp_checks.py、tp_linear_sim.py、pipeline_bubble.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""CPU teaching checks: NumPy only; python tp_pp_checks.py. No GPU cluster benchmark."""
from pathlib import Path
import json
import numpy as np
from tp_linear_sim import matmul, split_columns, split_rows


def stage_order(p, m, schedule):
    if p < 1 or m < 1 or schedule not in ("gpipe", "1f1b"):
        raise ValueError("positive stages/microbatches and gpipe/1f1b required")
    orders = []
    for s in range(p):
        if schedule == "gpipe":
            ops = [("F", i) for i in range(m)] + [("B", i) for i in reversed(range(m))]
        else:
            warm = min(p - s - 1, m)
            ops = [("F", i) for i in range(warm)]
            for i in range(m - warm):
                ops.extend([("F", i + warm), ("B", i)])
            ops += [("B", i) for i in range(m - warm, m)]
        orders.append(ops)
    return orders


def schedule_events(p, m, schedule, forward=None, backward=None):
    """Earliest-start DAG simulation; one nonpreemptive compute resource per stage."""
    orders = stage_order(p, m, schedule)
    forward = [1.] * p if forward is None else list(forward)
    backward = [1.] * p if backward is None else list(backward)
    if len(forward) != p or len(backward) != p or not all(np.isfinite(x) and x > 0 for x in forward + backward):
        raise ValueError("positive finite per-stage times required")
    done, next_op, events = {}, [0] * p, []
    while sum(next_op) < 2 * p * m:
        progress = False
        for s, ops in enumerate(orders):
            if next_op[s] == len(ops):
                continue
            kind, i = ops[next_op[s]]
            deps = []
            if next_op[s]:
                last = ops[next_op[s] - 1]
                deps.append((s, *last))
            if kind == "F" and s:
                deps.append((s - 1, "F", i))
            if kind == "B":
                deps.append((s, "F", i))
                if s < p - 1:
                    deps.append((s + 1, "B", i))
            if not all(d in done for d in deps):
                continue
            start = max([done[d] for d in deps], default=0.)
            end = start + (forward[s] if kind == "F" else backward[s])
            done[(s, kind, i)] = end
            events.append(dict(stage=s, kind=kind, microbatch=i, start=start, end=end))
            next_op[s] += 1
            progress = True
        if not progress:
            raise RuntimeError("schedule dependency cycle")
    peak = []
    for s in range(p):
        # Count one graph after F completion until B completion; tie releases first.
        changes = [(e['end'], 1 if e['kind'] == 'F' else -1) for e in events if e['stage'] == s]
        live = high = 0
        for _, delta in sorted(changes):
            live += delta
            high = max(high, live)
        assert live == 0
        peak.append(high)
    total = max(done.values())
    busy = m * sum(forward + backward)
    return dict(schedule=schedule, stages=p, microbatches=m, makespan=total,
                utilization=busy / (p * total), peak_graphs=peak, events=events)


def main():
    rng = np.random.default_rng(27)
    x, a, b = rng.normal(size=(5, 4)), rng.normal(size=(4, 6)), rng.normal(size=(6, 3))
    c, d, g = rng.normal(size=6), rng.normal(size=3), rng.normal(size=(5, 3))
    h = np.tanh(x @ a + c)
    y = h @ b + d
    dz = (g @ b.T) * (1 - h * h)
    reference = [dz @ a.T, x.T @ dz, h.T @ g, dz.sum(0), g.sum(0)]
    rows = []
    for p in (1, 2, 3, 6):
        aa, bb, cc = np.split(a, p, 1), np.split(b, p, 0), np.split(c, p)
        hh = [np.tanh(x @ ai + ci) for ai, ci in zip(aa, cc)]
        partials = [hi @ bi for hi, bi in zip(hh, bb)]
        out = sum(partials) + d
        zz = [(g @ bi.T) * (1 - hi * hi) for hi, bi in zip(hh, bb)]
        actual = [sum(zi @ ai.T for zi, ai in zip(zz, aa)),
                  np.concatenate([x.T @ zi for zi in zz], axis=1),
                  np.concatenate([hi.T @ g for hi in hh]),
                  np.concatenate([zi.sum(0) for zi in zz]), g.sum(0)]
        err = max(float(np.max(abs(u-v))) for u, v in zip(reference, actual))
        assert np.max(abs(out-y)) < 1e-12 and err < 1e-12
        wrong_bias = sum(pi + d for pi in partials)
        wrong_layout = sum(hi @ bi for hi, bi in zip(hh, list(reversed(bb)))) + d
        rows.append(dict(parts=p, output_error=float(np.max(abs(out-y))), gradient_error=err,
                         repeated_bias_error=float(np.max(abs(wrong_bias-y))),
                         reversed_shard_error=float(np.max(abs(wrong_layout-y)))))
    # Independent central finite differences over all input/weight/bias elements.
    fd = 0.
    for z, grad in zip([x, a, b, c, d], reference):
        for idx in np.ndindex(z.shape):
            old = z[idx];eps = 1e-6
            z[idx] = old + eps;plus = np.sum((np.tanh(x @ a + c) @ b + d) * g)
            z[idx] = old - eps;minus = np.sum((np.tanh(x @ a + c) @ b + d) * g)
            z[idx] = old
            fd = max(fd, float(abs((plus-minus)/(2*eps)-grad[idx])))
    assert fd < 1e-7
    balanced = []
    for p in (1, 2, 4, 8):
        for m in (1, 2, 8, 27):
            for method in ('gpipe', '1f1b'):
                z = schedule_events(p, m, method)
                assert z['makespan'] == 2 * (m + p - 1), (p, m, method)
                assert abs(z['utilization'] - m/(m+p-1)) < 1e-14
                assert len(z['events']) == 2*p*m
                balanced.append({k:v for k,v in z.items() if k!='events'})
    demos = [schedule_events(4, 8, v) for v in ('gpipe', '1f1b')]
    unbalanced = schedule_events(4, 8, '1f1b', [1, 1, 1, 3], [1, 1, 1, 3])
    assert unbalanced['makespan'] > 22
    # Unequal microbatch mean example: scalar squared-error derivative 2*(w*x-y)*x.
    xx, yy, w = np.array([1., 2., 4.]), np.array([0., 1., -1.]), .3
    grad = 2*(w*xx-yy)*xx
    full = grad.mean();weighted = (grad[:1].mean()+2*grad[1:].mean())/3
    wrong = (grad[:1].mean()+grad[1:].mean())/2
    assert abs(full-weighted) < 1e-14 and abs(full-wrong) > .1
    batchnorm = lambda z:(z-z.mean())/np.sqrt(z.var()+1e-5)
    bn_error = float(np.max(abs(batchnorm(xx)-np.concatenate([batchnorm(xx[:1]),batchnorm(xx[1:])]))))
    assert bn_error > .1
    invalid = 0
    for func, args in [(split_columns, ([[1,2,3]], 2)), (split_rows, ([[1],[2],[3]], 2)),
                       (split_columns, ([[1]], 0)), (matmul, ([[1,2]], [[3]])),
                       (matmul, ([[1],[2,3]], [[4]])), (stage_order, (0, 1, 'gpipe')),
                       (schedule_events, (2, 2, 'gpipe', [1,-1]))]:
        try:func(*args)
        except ValueError:invalid += 1
        else:raise AssertionError('invalid input accepted')
    result = dict(passed=True,seed=27,numpy=np.__version__,shapes=dict(X=list(x.shape),A=list(a.shape),B=list(b.shape),c=list(c.shape),b=list(d.shape),Y=list(y.shape)),tp=rows,finite_difference_max=fd,
                  balanced_cases=balanced,demo_schedules=demos,unbalanced=unbalanced,
                  unequal_microbatch=dict(global_mean=float(full),weighted=float(weighted),wrong_equal=float(wrong)),
                  batchnorm_split_difference=bn_error,invalid_inputs_rejected=invalid,
                  limits='In-process CPU algebra and dependency simulation; no NCCL, GPU memory, latency or throughput measurements.')
    Path(__file__).with_name('validation_results.json').write_text(json.dumps(result,indent=2)+'\n',encoding='utf8')
    print(json.dumps({k:v for k,v in result.items() if k not in ('balanced_cases','demo_schedules','unbalanced')},indent=2))
    for z in demos+[unbalanced]:print(z['schedule'],z['makespan'],z['utilization'],z['peak_graphs'])


if __name__ == '__main__':main()#!/usr/bin/env python3
"""Verify column- and row-parallel linear algebra without any framework."""
def matmul(a, b):
if not a or not b or not a[0] or not b[0] or any(len(r) != len(a[0]) for r in a) or any(len(r) != len(b[0]) for r in b):
raise ValueError("nonempty rectangular matrices required")
if len(a[0]) != len(b):
raise ValueError("inner dimensions must match")
return [[sum(x * y for x, y in zip(row, col)) for col in zip(*b)] for row in a]
def split_columns(a, parts):
if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a[0]) % parts:
raise ValueError("positive parts must divide rectangular matrix width")
width = len(a[0]) // parts
return [[row[i * width:(i + 1) * width] for row in a] for i in range(parts)]
def split_rows(a, parts):
if not isinstance(parts, int) or isinstance(parts, bool) or parts < 1 or not a or not a[0] or any(len(r) != len(a[0]) for r in a) or len(a) % parts:
raise ValueError("positive parts must divide rectangular matrix height")
height = len(a) // parts
return [a[i * height:(i + 1) * height] for i in range(parts)]
def add(a, b):
if len(a) != len(b) or any(len(ra) != len(rb) for ra, rb in zip(a, b)):
raise ValueError("addition shapes must match")
return [[x + y for x, y in zip(ra, rb)] for ra, rb in zip(a, b)]
x = [[1, 2, 3, 4], [5, 6, 7, 8]] # [tokens=2, hidden=4]
w1 = [[1, 0, 2, 0, 3, 0], [0, 1, 0, 2, 0, 3],
[1, 1, 1, 1, 1, 1], [2, 1, 0, 1, 2, 1]] # [4, 6]
w2 = [[1, 0, 1], [0, 1, 1], [1, 1, 0],
[2, 0, 1], [0, 2, 1], [1, 0, 2]] # [6, 3]
full_hidden = matmul(x, w1)
full_output = matmul(full_hidden, w2)
# Column parallel W1: every rank computes a slice of output features.
w1_shards = split_columns(w1, 2)
hidden_shards = [matmul(x, shard) for shard in w1_shards]
column_joined = [left + right for left, right in zip(*hidden_shards)]
# Row parallel W2: input features and W2 rows use matching shards, then sum.
w2_shards = split_rows(w2, 2)
partials = [matmul(h, w) for h, w in zip(hidden_shards, w2_shards)]
row_reduced = [[sum(part[r][c] for part in partials) for c in range(len(partials[0][0]))] for r in range(len(x))]
max_hidden_diff = max(abs(a - b) for ra, rb in zip(full_hidden, column_joined) for a, b in zip(ra, rb))
max_output_diff = max(abs(a - b) for ra, rb in zip(full_output, row_reduced) for a, b in zip(ra, rb))
print("X shape=(2, 4), W1 shape=(4, 6), W2 shape=(6, 3), tp=2")
print("column shards: W1=(4, 3) each, hidden=(2, 3) each")
print("row shards: W2=(3, 3) each, partial output=(2, 3) each")
print(f"full output={full_output}")
print(f"max hidden diff={max_hidden_diff}, max output diff={max_output_diff}")
if __name__ == "__main__":
import argparse
parser = argparse.ArgumentParser()
parser.add_argument("--parts", type=int, default=2)
args = parser.parse_args()
try:
hs = [matmul(x, w) for w in split_columns(w1, args.parts)]
ps = [matmul(h, w) for h, w in zip(hs, split_rows(w2, args.parts))]
except ValueError as exc:
parser.error(str(exc))
reduced = [[sum(part[r][c] for part in ps) for c in range(3)] for r in range(2)]
assert reduced == full_output
print(f"requested_tp={args.parts}, shards={len(hs)}, output={reduced}")#!/usr/bin/env python3
"""Idealized GPipe bubble calculator; stdlib only."""
import argparse
parser = argparse.ArgumentParser()
parser.add_argument("--stages", type=int, default=4)
parser.add_argument("--microbatches", type=int, default=8)
args = parser.parse_args()
if args.stages < 1 or args.microbatches < 1:
parser.error("stages and microbatches must be positive")
p, m = args.stages, args.microbatches
slots = m + p - 1
efficiency = m / slots
print(f"stages={p}, microbatches={m}, ideal_slots_per_sweep={slots}")
print(f"pipeline_efficiency={efficiency:.2%}, bubble_fraction={1-efficiency:.2%}")
print("forward schedule (slot -> active stage:microbatch)")
for t in range(slots):
active = [f"S{s}:M{t-s}" for s in range(p) if 0 <= t - s < m]
print(f"{t:02d}: " + " ".join(active))"""Regenerate this article's deterministic teaching figure (numpy + matplotlib)."""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
OUT=Path(__file__).resolve().parents[1]/"figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({"font.sans-serif":["Microsoft YaHei","DejaVu Sans"],"axes.unicode_minus":False})
m=np.arange(1,129)
fig,ax=plt.subplots(figsize=(8,4.8))
for p in [2,4,8,16]:ax.plot(m,m/(m+p-1),label=f"{p} stages")
ax.set(xlabel="Microbatches per DP replica per optimizer step",ylabel="Ideal utilization",ylim=(0,1.02),title="Balanced forward sweep / GPipe: m / (m + p - 1)")
ax.legend();ax.grid(alpha=.25);fig.tight_layout()
fig.savefig(OUT/'pipeline_utilization.png',dpi=170)
plt.close(fig)
print(OUT/'pipeline_utilization.png')

评论 (0)