


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:分布式训练 | 难度:高阶 | 前置知识:张量并行与流水线并行、注意力显存账本、FlashAttention
关键词:序列并行、Ring Attention、长序列、通信与计算重叠、Ulysses
先读张量并行与流水线并行和 FlashAttention。本文会补上最小背景:rank 是进程编号,按每进程一张设备理解;all-to-all 是每个 rank 给其他 rank 各发一片;K/V 是注意力的 key/value。所有 GiB 按 1024³ 字节计算,预算假设 batch 为 1、无 TP、Q/K/V 使用相同元素字节数,另有说明时除外。
一个视频或长文被编码成 131072 个 token,hidden size 为 8192,仅一个 BF16 的 $[L,d]$ 张量就占 2 GiB。Transformer 每层不只保存一个这样的张量,还要保存归一化输入、Q/K/V、MLP 中间量、dropout 状态等;标准 attention 若显式保存 $[L,L]$ 分数矩阵,单头 BF16 就是 32 GiB,根本无法进入反向。
数据并行沿 batch 切,每个 rank 仍要处理完整序列;经典、不叠加 sequence parallel 的张量并行沿 hidden/head 切,各 head 仍处理完整长度 $L$;流水线并行沿层切,某一层的长序列峰值仍在。长上下文把瓶颈推到第四个维度:必须沿 sequence 切 token。
但“每卡拿一段 token”并不自动成立。MLP 和 LayerNorm 对每个 token 独立,本地就能算;self-attention 中,每个 query 必须看到所有 key/value。若 rank 0 只拿前 1/8 的 K/V,它算出的就成了局部 attention,数学结果已经改变。序列并行的核心问题,是怎样在不复制全部长序列、不近似 attention 的前提下交换必要信息。
目前最常见的两类答案是 Ulysses 与 Ring Attention。Ulysses 先按 sequence 分片,再用 all-to-all 把布局变成按 attention head 分片,让每个 rank 在少量 head 上看到完整 sequence;算完后再 all-to-all 变回来。Ring Attention 则让每个 rank 保留本地 query,K/V block 沿环传递,经过 $P$ 轮后本地 query 恰好见过全序列。
先补 FlashAttention 的最小背景:FlashAttention 并不近似 softmax,它把 Q/K/V 分块,并用在线 softmax 的最大值、分母和加权和递推,避免把完整 $L\times L$ 注意力矩阵写回 HBM。Ring Attention 把同一个分块思想扩展到多设备:块不只从显存搬到片上 SRAM,也沿网络搬到下一个 rank。
本文预算脚本给出:$L=131072,d=8192,P=8$ 时,一个 BF16 序列张量从每卡 2 GiB 降到 0.25 GiB,理想降低 8 倍;每层每 rank 绕环接收 K/V 的单向数据约 3.5 GiB。显存不是白省的,它被换成了通信与 $P$ 轮依赖。
三句话建立框架:
如果只记一个区别:Megatron 风格的 sequence parallel 主要切 LayerNorm/dropout 等非 TP 区域的激活;Ulysses/Ring Attention 属于长上下文的 attention 并行,真正处理完整 sequence 上的全局注意力。很多系统把后者称为 context parallel,以免名称混淆。
先把维度分清。$B$ 是 batch 大小,$L$ 是全局 token 数,$P$ 是 context 组的 rank 数;$H_q$ 是 query head 数,$H_{KV}$ 是 key/value head 数,每头宽度为 $D_h$,总 query 宽度 $d=H_qD_h$。MHA 有 $H_q=H_{KV}$,GQA 让一组 query heads 共用一个 KV head,MQA 只有一个 KV head。本文数值例是 MHA:$d=8192,H_q=64,D_h=128$。
以下推导先固定一个 batch 和一个 head,令 $Q,K,V\in\mathbb{R}^{L\times D_h}$。softmax 对每个 query 的整行 key 分数归一化。单 head 的 scaled dot-product attention 是:
$$O=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{D_h}}\right)V$$
单 head 的分数矩阵 $S=QK^\top/\sqrt{D_h}$ 有 $L^2$ 个元素,两个矩阵乘的常规计数约为 $4L^2D_h$ FLOPs(一次乘加计 2)。全部 $B H_q$ 个 heads 的算术量约为 $4BL^2d$,另有 softmax 等开销。若将序列均分到 $P$ 个 rank,单 head 本地张量是 $Q_r,K_r,V_r\in\mathbb{R}^{L/P\times D_h}$。逐 token 的 MLP 可以直接本地算,但 attention 的本地输出需要:
令 $K_{\mathrm{all}}$ 和 $V_{\mathrm{all}}$ 分别按全局顺序拼接各 rank 的 K/V;它们只是数学记号,Ring 实现无需真的聚齐这两个完整张量:
$$O_r=\operatorname{softmax}\left(\frac{Q_rK_{\mathrm{all}}^\top}{\sqrt{D_h}}\right)V_{\mathrm{all}}$$
也就是说,本地 query 仍必须与所有 rank 的 K/V 相遇。区别只在“把所有 K/V 一次聚齐”还是“逐块流过”。
对一行 query,把 key/value 分成若干块。处理前 $t$ 个块后,保存行最大值 $m_t$、指数和 $\ell_t$ 与未归一化加权和 $u_t$。新块分数为 $s$,块内最大值为 $m_b=\max(s)$,更新全局最大值:
$$m_{t+1}=\max(m_t,m_b)$$
为了把旧累计量换到新的指数基准,定义 $\alpha=\exp(m_t-m_{t+1})$,则:
$$\ell_{t+1}=\alpha\ell_t+\sum_j\exp(s_j-m_{t+1})$$
$$u_{t+1}=\alpha u_t+\sum_j\exp(s_j-m_{t+1})v_j$$
处理完所有块后:
$$o=\frac{u_T}{\ell_T}$$
为什么这套更新等价?设已处理、且 mask 允许的 key 集合为 $A_t$,始终保持:
$$m_t=\max_{j\in A_t}s_j$$
$$\ell_t=\sum_{j\in A_t}e^{s_j-m_t}$$
$$u_t=\sum_{j\in A_t}e^{s_j-m_t}v_j$$
加入新块时,对任意旧项都有 $e^{s_j-m_{t+1}}=e^{s_j-m_t}e^{m_t-m_{t+1}}$,所以旧分母和旧分子同时乘 $\alpha$,再加新块,恰好是并集上的同一个定义。最终 $u_T/\ell_T$ 里的公共缩放抵消,得到全局 softmax 加权和。这里 $T$ 是实际处理的块数,不是扩散步数。
初始尚无有效 key,取 $m_0=-\infty,\ell_0=0,u_0=0$。若新块对某行全被 mask,必须直接跳过这行,避免计算 $-\infty-(-\infty)$ 得到 NaN;第一次遇到有效块时旧累计系数设为 0。若整行没有任何有效 key,本文代码明确报错;有的框架约定输出零,不能混用两种契约。单个空块与整行全空是两回事。
算法只需保存行统计、输出累计和当前 score tile,不保存全局矩阵。在精确算术下等价;浮点数的归约顺序改变,不能承诺逐位相同。
第 $r$ 个 rank 固定本地 $Q_r$,初始持有 $K_r,V_r$。第 0 轮计算本地块,第 1 轮前把 K/V 发给下一个 rank 并接收上一个 rank 的块,如此循环。第 $t$ 轮 rank $r$ 处理来源 $(r-t)\bmod P$ 的 K/V;$P$ 轮后每个 $Q_r$ 看过所有块。
本地计算量近似:
$$C_{\mathrm{rank}}=O\left(\frac{L}{P}\cdot L\cdot d\right)=O\left(\frac{L^2d}{P}\right)$$
每 rank 需要接收 $P-1$ 次大小约 $2(L/P)d\,b$ 的 K/V,其中 $b$ 是每元素字节数:
$$V_{\mathrm{ring}}=2\frac{P-1}{P}Ldb$$
这是 $B=1$、MHA、每 rank 单独计接收的前向逻辑载荷;发送量相同,发送加接收则再乘 2,全组发送总量再乘 $P$。不计自传、不计协议和反向。$P$ 是计算轮数,网络交换只有 $P-1$ 次;$P=1$ 时前向网络载荷为零。GQA/MQA 若传输未按 query heads 展开的 K/V,通式是:
$$V_{\mathrm{ring,GQA}}=2B\frac{P-1}{P}LH_{KV}D_hb$$
例如同样 $L=131072,d=8192,H_q=64,P=8$,MHA 接收 3.5 GiB;改成 $H_{KV}=8$,只传 0.4375 GiB。若实现提前 repeat K/V,节省会消失。它们都只是注意力的前向载荷,不能当整层训练通信。
当 $L$ 与 $P$ 同比例增长、每卡本地 token 数保持不变时,单轮的 Q/KV block 大小、计算量和传输量近似不变,增长的是轮数和每卡总计算量。是否能覆盖通信取决于单轮 block 是否足够大、有效算力与链路带宽;弱扩展本身不会自动改善单轮的重叠条件。若本地 block 太小、网络慢或 kernel 没有异步双缓冲,通信会裸露出来。
训练反向不能只把前向环倒放那么简单:每个 rank 还要计算对本地 Q、流动 K/V 的梯度,并把属于原拥有者的 dK/dV 沿环累积或归还。checkpoint 与重计算还能减少保存量,但增加计算。
自回归 attention 要求 query 位置 $i$ 只能看 key 位置 $j\le i$。分块后,根据全局位置判断:
必须使用全局位置,不能把收到的每块 key 都重新从 0 编号。一个可计算的反例:分数全为 0,query 的全局位置为 1,四个 value 为 [0,1,2,3]。正确允许前两个 key,输出 $(0+1)/2=0.5$;若每个两行块的 key 索引都重置为 [0,1],四个 key 都被允许,输出为 1.5。检查脚本真实复现了这两个数。
若每个 rank 连续持有 $L/P$ 个 token,rank $r$ 有 $r$ 个完整过去块和一个三角本地块,后部 rank 工作更多。跳过未来块可省计算,但不同 rank 的有效工作量会不均。某些实现使用 zigzag 或重新排列 token,使每卡同时持有前后位置,平衡 causal attention 工作量。若只看非因果公式估算吞吐,部署到 causal LLM 时可能偏差很大。
设输入布局是 sequence-sharded:
$$[B,L/P,H,D_h]$$
$H$ 是 head 数,$D_h$ 是每头维度。Ulysses all-to-all 把它转成:
$$[B,L,H/P,D_h]$$
每卡序列完整、head 只剩 $H/P$,于是能在本地执行普通 attention;输出再 all-to-all 回 sequence shard。这里 $H=H_q$。均匀、无复制的 head 切分要求 $H_q$ 能被 $P$ 整除,GQA 还要检查 $H_{KV}$ 与 query-to-KV 分组能否保持;少 KV heads 会更早受限。框架可用不等 head 分片或复制 K/V 放宽部分约束,但必须重算布局、通信和负载,不能把均匀路径公式照搬过去。Ring 不要求按 head 数切,但要经历 $P$ 个顺序环步骤。
公平比较前向逻辑字节,还要把 Ulysses 的 Q/K/V 转换和输出逆转换全计入。均匀、无复制时,每个张量各有 $(P-1)/P$ 的本地元素发给远端;本地 Q 和输出各有 $BLH_qD_h/P$ 个元素,K、V 各有 $BLH_{KV}D_h/P$ 个元素。因此每 rank 的接收量为:
$$V_{\mathrm{Ulysses}}=\frac{P-1}{P}\frac{2BLD_hb}{P}(H_q+H_{KV})$$
在前述 8 卡例子,MHA 是 0.875 GiB,8 KV heads 的 GQA 是 0.4921875 GiB;与 Ring 的 3.5/0.4375 GiB 比较时,都是每 rank、单独计接收、前向、不计自传。GQA 例中 Ring 的 KV 量反而更小,因此不能声称某种方法的流量永远更低。固定全局长度时二者随 $P$ 的变化也不同;固定本地长度、$L\propto P$ 时,Ulysses 载荷趋于常数,Ring 载荷随轮数增长。字节少仍不等于耗时少,collective 的路由、延迟、拥塞和 kernel 效率都在公式之外。
Ulysses 的 collective 容易利用成熟 all-to-all,但跨节点 all-to-all 对网络争用敏感;Ring 只与邻居点对点通信,更贴合环形拓扑,也更容易细粒度重叠。没有一种方法在所有硬件和 head 配置上恒优。
传统 TP 的 column/row parallel 边界往往让某些激活在 TP rank 上复制。Megatron sequence parallel 把 LayerNorm、dropout 等逐 token 操作沿 sequence 切分,并用 reduce-scatter 与 all-gather 衔接 TP 区域,使这些激活内存近似降为 $1/P$。它与 TP process group 绑定,主要减少非 TP 区域的重复激活。
但 attention 若仍按 head 做 TP,每个 head 仍可能看到完整 sequence。因此配置项 sequence_parallel=true 并不等于已经支持百万 token。需要进一步的 context parallel、Ulysses 或 Ring Attention 才能沿 attention 的上下文维扩展。
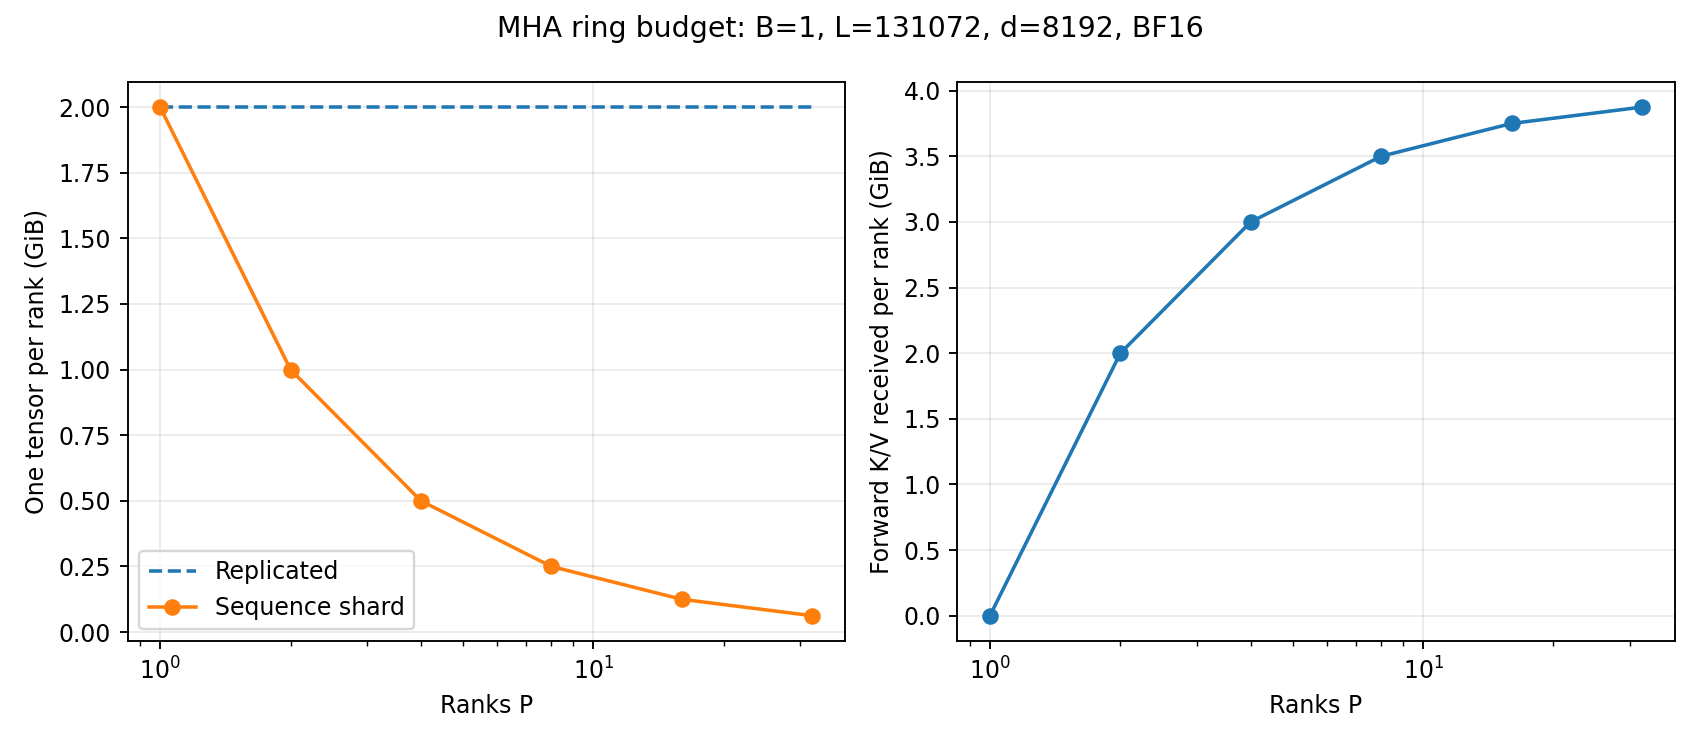
一个序列张量的每卡存储随 P 下降,而完整前向绕环接收的 K/V 字节增加并趋于上限。右图是接收量,不重复计发送量,尚未包含反向通信。
ring_attention_sim.py 只用标准库,实现完整 softmax attention 与分块在线递推。Q/K/V 均为 $[4,2]$,每个 K/V block 两行,相当于两轮 ring:
Q=K=V shape=(4, 2), kv_block=2, ring_steps=2
full[0]=[1.713718770, 1.717687378]
ring[0]=[1.713718770, 1.717687378]
max_abs_diff=0.000e+00
本组小样本在打印精度内相同;算法等价性来自第 3.2 节的不变式,浮点实现一般仍存在求和顺序引起的舍入差异。脚本没有真正启动多进程;它把 K/V block 依次喂给同一递推器,模拟每个 rank 收到环上块后的本地数学。生产实现还要异步 send/recv、双缓冲及真实分布式 backward;本文已在这个标准库脚本里补上布尔 mask、任意块次序、尾块和本地反向数学。mask[i][j] 的 True 表示允许连接,Q 的位置偏移应由调用者生成 mask,代码不会猜全局索引。
原四行样例输出保持不变,另增加 causal[0]=[1.0,2.0],并故意先访问全被屏蔽的未来块,验证空块不污染累计值。sequence_checks.py 用 NumPy 生成输入、PyTorch 2.10.0 CPU 的 FP64 autograd 作独立参考,覆盖 dense、causal、packed causal、1/2/4/大于长度的块与正反块顺序,共 216 组前后向;前向最大绝对误差 3.89e-16,全部梯度最大误差 1.80e-15。36 个坐标的中央有限差分误差为 2.44e-11;四个 rank 的实际来源次序也与全局参考一致。另验了 36 组有限轮事件模型、8 组载荷账本与 12 种非法输入。这些是本机真实 CPU 数值结果,不是多卡/NCCL/GPU 性能实验。
sp_budget.py 对 $L=131072,d=8192,H=64,P=8$ 输出:
L=131072, d=8192, heads=64, sp=8, dtype_bytes=2
one [L,d] tensor: replicated=2.00 GiB, sequence-sharded/rank=0.25 GiB
ideal memory reduction for sequence-shaped activations=8.0x
Equal-head Ulysses Q and KV divisible=True
Ring Attention rounds=8, local query tokens=16384
Ring K/V received per rank per forward=3.5000 GiB
Ulysses Q/K/V plus output received per rank per forward=0.8750 GiB
2 GiB 只是一个张量,不是整层总显存;0.25 GiB 是理想静态 shard,也没算当前通信块、输出、梯度与工作区。3.5 GiB 对应 $2(P-1)Ldb/P$,是每层、每 rank、单方向的 K/V 接收量。实际网络还包含反向与协议开销。
本轮核对固定 DeepSpeed v0.16.9 的 DeepSpeed 序列并行源码,避免上游 main 改动后失去参照。DistributedAttention.forward 对 Q、K、V 分别调用 _SeqAllToAll,执行 local_attn,再交换 scatter/gather 轴变回输出布局;可选在转换后施加 rotary embedding,提供 stream 与 overlap handle 路径。输入采用 [B,L/P,H,D_h] 时,须显式 batch_dim_idx=0、scatter_idx=2、gather_idx=1,不能直接照抄默认 gather_idx=0。
原文把整除检查写成通用规则,范围过大:该版本 _generate_layout_params 的均匀路径确有 head 整除断言,但 single_all_to_all 还会进入 uneven_heads_all2all。源码注明不等 head 分支假定 Q 与 KV head 数一致、GQA 需额外逻辑,且禁用 async。因此“这份实现有不等 head 路径”不等于“任意 GQA/异步配置都能运行”。本文 CPU 实跑固定版本未经改写的布局函数,14 个 rank/方向夹具逐元素一致;原始 wrapper 的两个夹具用显式传输适配器验证调用次序。实际通信被内存替身替代,只证明同步均匀 head、batch-first 路径的布局与委托契约,未运行不等 head、rotary、异步或真实进程组。
这个工业实现比最小公式多处理 batch 维位置、不同 Q/K/V 布局、rotary position embedding、异步 stream、autograd 的反向 all-to-all 与进程组。布局索引错一位可能 shape 仍合法但语义错误,所以系统必须统一采用明确的张量维约定。
固定 Megatron Core core_v0.14.0 的 模型并行配置源码 将 sequence_parallel 与 context_parallel_size 分开;前者对应 LayerNorm/dropout 等序列形激活,后者才是上下文组。其 Transformer 配置源码 列出 p2p、all_gather、a2a、a2a+p2p 四种通信方式。读配置时不要只看“SP”缩写,要追到具体张量在哪个轴分片以及 attention 内部采取哪种交换。
Ring Attention 的工业 kernel 通常建立两个 K/V buffer:当前块参与计算时,下一个块在独立通信 stream 接收;计算结束交换 buffer。要真正隐藏通信,必须满足:
$$T_{\mathrm{attention\ block}}\ge T_{\mathrm{send/recv}}$$
此外还要确保计算与 NCCL 没争抢同一资源到互相拖慢。仅在代码里使用 async op 不代表 timeline 上已经重叠,必须用 profiler 验证。
FlashAttention 提供单卡块级 IO 优化,Ring/Ulysses 提供多卡数据布局。两者不是竞争关系:每个 rank 的 local attention 往往正由 FlashAttention kernel 完成。前者减少 HBM 读写,后者减少单卡需要常驻的全局序列。
checkpoint 也必须保存并行元数据。若训练时改变 SP/CP 度,参数本身或许未沿 sequence 切,但 optimizer、随机数状态和位置相关缓存可能变化。恢复前应由框架的 distributed checkpoint 层重新映射,而不是直接让每个 rank 读取旧编号文件。
序列并行省的是序列形激活,不一定省参数和优化器状态;它通常要与 ZeRO/FSDP、TP、PP 组合。完整世界规模可能写成 $W=d_p t_p p_p c_p$,其中 $c_p$ 是 context parallel 度。每多一根轴,都新增 process group、拓扑映射与整除约束。
Ring Attention 保留全注意力的二次计算量。卡数增加能把每卡计算降到 $1/P$,但集群总 FLOPs 仍为 $O(L^2d)$;当上下文翻倍、卡数不变时,总计算约四倍。它突破的是单卡内存和 wall-clock 可扩展性,不是算法复杂度。
通信也不是“免费”。Ring 的每 rank 字节量随 $L$ 线性增长且有 $P$ 轮延迟链;Ulysses 有前后 all-to-all,容易受跨节点网络与并发任务干扰。若 $L$ 尚短,通信与布局转换可能比 attention 本身更贵,应比较不启用 CP 的基线;是否仍需 TP 取决于模型容量。
常见边界包括:
在低带宽以太网集群上,增加 context parallel 度可能只是把 OOM 变成通信瓶颈。应先用 activation checkpoint、FlashAttention、减小 microbatch 等单机方法,确认仍由单卡序列容量限制,再引入跨设备 SP。
一个 $[L,d]$ BF16 张量占 $2Ld$ 字节,但训练层内可能同时存在 residual、norm 输入、Q/K/V、attention output 与 MLP 中间值。设所有与序列线性相关且必须保存到反向的张量合计为 $cLd$ 个元素,序列分片后的理想每卡保存:
$$M_{\mathrm{linear/rank}}\approx\frac{cLdb}{P}$$
$c$ 由架构、融合 kernel 与 checkpoint 策略决定,不能用固定常数套所有模型。SwiGLU 会产生门控与 value 两个支路;视频 DiT 还可能有条件分支、cross-attention 与调制参数。最可靠方法是从 profiler 的 allocation timeline 识别跨 backward 存活的张量。
attention tile 与通信 buffer 是额外峰值。在常见异步实现中,Ring 为当前和下一份 K/V block 准备两套可交替使用的通信存储,当前块也可能直接使用原激活存储;FlashAttention kernel 还需要 score tile、softmax statistic 和 workspace。避免把同一块 K/V 或同一工作区在多个分类里重复计数。真实峰值是所有时刻中同时存活且不共享存储的分配之和的最大值:
$$M_{\mathrm{peak/rank}}=\max_{\tau}\sum_{a\in\mathcal{A}(\tau)}\operatorname{bytes}(a)$$
$\tau$ 是运行时刻,$\mathcal A(\tau)$ 是这一刻仍存活的独立 allocation 集合;视图不再单独加底层存储。可以再将这些分配划成线性激活、attention workspace、通信 buffer 与 runtime 等互斥类别。简单相加各类别各自的峰值只能作为上界估计,因为它们未必同时出现。
当 $P$ 继续增加时,第一项下降,但 buffer、runtime 和最小 kernel workspace 不会等比下降,显存收益逐渐偏离 $1/P$。用总 allocated 除卡数预测极限会过于乐观。
前向中,本地 Q 只需依次看过所有 K/V block。反向要得到 $dQ_r$、$dK_j$ 与 $dV_j$。当来源 $j$ 的 K/V 到达 rank $r$ 时,本地可计算它对 $dQ_r$ 的贡献,也会产生属于来源 rank $j$ 的 $dK_j,dV_j$ 部分。后两者必须跨所有 query shard 求和并归还拥有者。
可以把反向公式完整写出。令 $A$ 为 attention 概率矩阵、$G=\partial\mathcal L/\partial O$ 为上游梯度(这里的 $A$ 与前面 key 集合 $A_t$ 不同)。由 $O=AV$,先得到 $dV=A^\top G$、$dA=GV^\top$。softmax 的行雅可比给出:
$$\delta_i=\sum_j A_{ij}dA_{ij}=\langle G_i,O_i\rangle$$
$$dS_{ij}=A_{ij}(dA_{ij}-\delta_i)$$
等号成立是因为 $O_i=\sum_j A_{ij}V_j$,将 $G_i$ 点乘分配进求和即可。再由 $S=QK^\top/\sqrt{D_h}$ 的链式求导:
$$dQ=dS K/\sqrt{D_h},\qquad dK=dS^\top Q/\sqrt{D_h},\qquad dV=A^\top G$$
实现时用前向保存的 $m_i,\ell_i$,重算当前块的 $A_{ij}=\exp(S_{ij}-m_i)/\ell_i$,mask 外概率和梯度均为零。关键是 $\delta_i$ 来自全局输出,不能对每个 KV 块各做一次局部 softmax 再分别求导。块到达 rank $r$ 时,$dQ_r$ 留在本地累积;同一个 KV 块收到所有 query shards 的 $dK,dV$ 贡献,必须求和归还原拥有者。blockwise_backward 实现这套本地数学,检查脚本用独立 autograd 和有限差分验证。
因此每个块需要身份信息,环中既可能传 K/V,也可能传对应梯度累计。为了减少前向保存,backward 常重算局部 score 与概率,依赖前向保存的行最大值和归一化分母。若随机 dropout 参与 attention,重算还必须恢复相同随机 mask。
理论通信量必须同时列前向与反向。只用 $2(P-1)Ldb/P$ 报告 K/V 前向流量会低估训练网络负担;真实实现还包括 dK/dV、可能的 dQ 归约、控制同步和其他模块的 collective。性能分析应以 profiler 中每层总通信字节与裸露时间为准。
把一个本地 query block 与一个 K/V block 的 attention 计算时间记为 $T_c$,邻居传输一个 K/V block 的时间记为 $T_n=\alpha+S/\beta$,其中 $\alpha$ 是链路延迟,$\beta$ 是有效带宽,$S$ 是消息字节。在每轮计算和邻居传输可并发、块大小均匀、没有额外最后归还通信的前向模型中,首块已在本地。第 0 块计算时启动第 1 块接收,后面同样流水。有限 $P$ 轮总时间为:
$$T_{\mathrm{forward}}\approx T_c+(P-1)\max(T_c,T_n)$$
当 $P=1$,只有 $T_c$;完全串行对应 $PT_c+(P-1)T_n$。稳态轮时间才约为 $\max(T_c,T_n)$。若实际环还要把最后一块归还、各轮工作不均或传输争用计算资源,应在时间线上加入相应依赖,不能套这个有限轮式子。
只有 $T_c\ge T_n$,网络才大部分隐藏。固定本地长度只减小 kernel 内 tile,不会改变设备数决定的 $P-1$ 次整分片传输;若进一步把网络消息也切成更小块,才会增加消息数与延迟开销。两种 block 大小要区分。减小 tile 能降低临时显存,但也可能降低计算效率;增大 block 提高 GEMM 效率,却增大 buffer。block size 是计算、带宽、延迟与显存的共同旋钮。
实现还需避免隐式同步。例如在循环中把 GPU 标量取回 CPU、过早 wait 通信 handle、复用尚未完成接收的 buffer,都会把异步流水串行化。正确做法是独立 stream、event 依赖与 ping-pong buffer,并在 GPU timeline 上确认 send/recv 与 attention kernel 真正重叠。
环的物理顺序同样重要。逻辑 rank 相邻却跨交换机,会让每轮走慢链路;合理 ring 应优先沿 NVLink 域,再通过少量跨节点边连接。多维集群还可以分层:节点内用 Ulysses all-to-all,节点间用 Ring,或反过来根据硬件选择,这正是统一序列并行方法的动机。
设 context parallel 度为 $c_p$、tensor parallel 度为 $t_p$。若 TP 已把 head 切为 $H/t_p$,Ulysses 再沿 head 分 $c_p$,就需要本地可见 head 数继续可分:
$$H\ \bmod\ (t_pc_p)=0$$
具体约束取决于框架是在同一 head 轴叠加还是采用不同布局。GQA 中应将 $H_{KV}$ 单独代入;只有 8 个 KV head 的模型很难做大 head-parallel。某些系统复制 K/V 以放松整除,但通信和显存模型随之改变。
sequence length 通常也要求能被 $c_p$ 与 block size 整除。不整除时可以 padding 或不等长 shard。padding 实现简单但会浪费二次 attention 计算;不等长 shard 又使通信消息与计算不均。对长度差异大的数据,先按 token 数分桶可降低 padding 浪费;与动态不等长 ring 哪种更合适,仍取决于数据分布与调度实现。
TP 与 CP 同时使用还会出现多种 collective。attention 投影可能在 TP 组 all-reduce,context attention 在 CP 组 send/recv,层外梯度还在 DP 组 reduce-scatter。若各组在不同 rank 上以不一致顺序发起 collective,可能死锁。框架必须给跨组通信建立确定顺序或独立 stream 依赖。
视频 token 常按时间、空间高、空间宽展平。连续切 sequence 可能让每个 rank 持有若干完整帧,也可能持有同一帧的空间条带;两种布局对位置编码、局部 attention、数据增强和负载平衡影响不同。若模型有 temporal attention 与 spatial attention 分解结构,最优切分轴也可能随层变化。
全局位置必须从原始坐标生成。RoPE 若把每个 rank 的局部索引重新从 0 开始,不会报 shape 错,却让不同块位置混叠。二维或三维 RoPE 更要携带时间与空间坐标,而不是只传一个线性 offset。跨模态序列还要保持文本、图像、视频 segment 的 mask 与边界。
视频长度和分辨率经常动态变化。同一 global batch 内若 token 数差异大,padding 使最长样本决定所有 rank 工作量;packed sequence 可减少浪费,却要求 block 不跨样本做 attention。调度系统最好按总 token 数而非样本数组 batch,并把实际有效 token 纳入 loss normalization。
因果结构也不总是标准下三角。视频生成可能使用双向视觉 attention、文本到视频 cross-attention 或分块因果时间 mask。Ring 优化中“未来块可跳过”的判断必须来自真实 mask 结构,不能硬编码 LLM 假设。
第一层验收是 shape:每个边界记录 global shape、local shape、分片轴、global offset、padding 与拥有者。第二层是数学:小尺寸 FP64 单卡作为 oracle,逐项比较 forward 和 dQ/dK/dV。第三层是随机性:开启 dropout 与 checkpoint 后,在固定 seed 下比较统计和可复现范围。
输出不一致时,可按轮 dump 每个 rank 处理的 K/V 来源编号。若少一个或重复一个,是 ring 调度;若所有来源齐全但数值错,检查在线 softmax 的旧累计重标定;若仅 causal 错,检查全局位置与块分类;若 forward 对而 backward 错,检查 dK/dV 归还与跨 query shard 求和。
OOM 时不要只减 block。先区分 persistent activation、通信双 buffer、kernel workspace 与碎片。若 activation 占主导,提高 CP 或 checkpoint 有效;若 buffer 占主导,减 block 才有效;若碎片主导,可调分配器或稳定 shape。错误手段可能降低吞吐却完全不改变峰值来源。
性能验收同时做 strong scaling 与 weak scaling。strong scaling 固定全局 $L$,增加卡数,观察端到端时间能否下降;容量弱扩展固定每卡 local token,令 $L\propto P$:精确全注意力的每卡计算 $L^2/P$ 此时随 $P$ 线性增长,不能期望每卡时间不变;应比较实测时间与这一增长基线,以及通信隐藏率。Ring Attention 可随设备数扩展可处理上下文,但总计算也随之增加。
最后把精度也纳入验收。在线 softmax 很稳定,但不同 block 顺序改变浮点加法;BF16、FP8 attention 更明显。应比较最终任务指标、loss 轨迹和梯度,而不是要求多卡输出 bitwise 等同。若误差远超单纯归约顺序,再排查 scale、mask 与布局。
先看 head 约束。若本地 Q head 与 KV head 都能被目标 SP 度整除,且集群 all-to-all 带宽高,Ulysses 路径直接,local attention 可复用成熟 kernel。若 KV head 很少、SP 度很大,Ring 不沿 head 切,通常更容易扩展。再看拓扑:全连接高速交换更适合 all-to-all;邻接带宽强、跨组带宽弱时,环形点对点更自然。
再看本地块计算。较大的本地序列块可能让每轮算术量足以覆盖 K/V 传输,但增加 head dimension 会同时增加计算与载荷,不保证更容易隐藏;应代入有效算力与带宽实测。以 MHA 为例,单轮两个矩阵乘约 $4B(L/P)^2d$ FLOPs,KV 消息约 $2B(L/P)db$ 字节,两者之比约 $2(L/P)/b$ FLOPs/byte,其中 $d$ 已约掉。Ring 在这个覆盖条件满足且 kernel 效率合适时受益;较短序列或大量小 head 时,$P$ 轮延迟可能突出。Ulysses collective 次数少,但消息全局交换可能造成拥塞。决策依据应是每轮计算时间、有效链路带宽和 collective 实测,不是理论总字节一项。
混合方案把设备组织成二维网格。例如节点内 8 卡做 Ulysses,节点间若干组做 Ring;这样 head 整除只限制节点内度数,跨节点使用邻接通信。代价是布局更复杂、process group 更多,Q/K/V 需要在两个维度间保持一致顺序。只有单一方案确实受限时才值得引入。
还要把 TP 纳入考虑。如果 TP 已经切 head,Ulysses 可用 head 更少;有时降低 TP、提高 CP 更适合长序列,有时模型单层容量又要求 TP 不能降。最优并行度会随训练长度变化,短序列预训练与长序列继续训练未必使用同一布局。
prefill 处理整段 prompt,计算形态接近训练前向,序列并行能分摊长 prompt attention。decode 每步只有少量新 query,却要读取不断增长的 KV cache;此时瓶颈常是 KV 带宽与跨卡延迟,而非大块 GEMM。训练中优秀的 Ring block,在逐 token decode 里可能太细、同步轮数太多。
推理还涉及请求级并发。可以把不同请求分给数据并行副本,也可把一个超长请求沿 context 分片。前者吞吐高、单请求受单卡长度限制;后者支持超长上下文、占用多个设备。调度器应根据请求长度动态选择,而不是所有请求固定占一个 CP 组。
KV cache 的拥有关系必须稳定。若每 rank 保存一段 sequence,新增 token 的 K/V 放在哪一段、何时重平衡、beam search 如何复制,都要定义。Paged KV cache 与 context parallel 叠加时,逻辑页、物理 GPU 与全局位置形成三层映射,错误可能表现为偶发内容质量下降而非崩溃。
因此本文通信公式主要用于训练或 prefill,不能直接拿来预测 decode tokens/s。推理基准要分别报告 time-to-first-token、inter-token latency、并发吞吐、KV cache 容量和长短请求混合表现。
上线前确认:sequence、head、KV head 与 block 的整除或 padding 规则明确;每个 shard 保存全局位置;causal/packed mask 按全局索引生成;每轮 K/V 来源不重不漏;在线 softmax 保存并正确重标定最大值、分母与分子;backward 的 dK/dV 回到原拥有者;dropout 重算保持随机一致。
系统侧确认 ring 物理顺序符合拓扑,通信与计算 timeline 真重叠,buffer 生命周期无覆盖,所有 rank collective 顺序一致,checkpoint 记录分片元数据,变更 CP 度可以恢复。性能侧同时做 strong/weak scaling,并在真实长度分布而非单一最大长度上测试。
最后保留小尺寸 oracle。每次升级 attention kernel、通信库、RoPE 或 mask 实现,都自动生成随机 Q/K/V,与 FP64 单卡结果比较 forward 和全部梯度;再跑包含因果、变长、GQA、极端分数和非整除长度的边界集。长序列错误代价很高,小 oracle 是最便宜的保险。
系统能够处理百万 token,只说明容量与运行时间可接受,不保证模型会利用远距离信息。长上下文实验还要检查位置外推、训练长度分布、检索准确率与有效注意范围。并行系统解决“算得出来”,数据与模型设计决定“学得会不会”。
因此扩展长度时同时保留短上下文质量基线,按距离分桶评估信息召回,并报告有效 token 而非 padding 后长度。否则可能用大量 GPU 计算模型并未使用的上下文。
这条演进线从“单卡不保存 $L^2$ 矩阵”,走到“多卡不复制 $L$ 激活”,再走到按 head 结构和网络拓扑组合通信方式。算法、kernel 与系统三层缺一不可。
误解一:序列并行把 attention 复杂度从二次降成线性。 精确全注意力的集群总计算仍为 $O(L^2d)$;它只把工作分摊,并让内存近似随本地 token 数增长。
误解二:每卡切一段 token 后直接做本地 attention。 那只允许 token 看同一分片,会改变模型。必须让 query 见到全局 K/V,或明确接受局部/稀疏近似。
误解三:Ring Attention 是近似注意力。 在线 softmax 递推在精确算术下与完整 softmax 等价;差别来自浮点归约顺序,不是丢弃连接。
误解四:开启 Megatron sequence_parallel 就解决长上下文。 它主要减少 LayerNorm、dropout 等激活复制;长上下文 attention 通常还需 context parallel。
误解五:异步 send/recv 就等于通信被隐藏。 只有计算时间覆盖传输、stream 真能并发且无资源争抢,timeline 上才会重叠。
误解六:Ulysses 的 SP 度只受 GPU 数限制。 head 数、KV head 数与 tensor layout 必须能按所选实现合法分配;均匀无复制路径中的 GQA 比 MHA 更早受限,不等切分或复制路径另有代价。
先运行 python ring_attention_sim.py 和 python sequence_checks.py(后者需要 NumPy 与 PyTorch)。第一个只依赖标准库,第二个打印上述真实误差、反例和通过项。也可调用 blockwise_attention,把 block_size 改成 1、2、4。预期 max_abs_diff 始终接近机器精度;再把 score 全部加 1000,稳定递推仍有限,而直接 exp(score) 会溢出。这同时验证精确性与减最大值的重要性。
脚本已经支持 causal mask:用 query/key 的全局索引构造布尔矩阵,屏蔽 $j>i$;可直接运行默认示例。预期分块结果与完整下三角 attention 一致。然后故意用局部索引 mask,会发现后续 rank 错误允许关注未来或错误屏蔽过去,这是真实分布式实现中很隐蔽的 bug。
运行 sp_budget.py,固定每卡 token 为 16384,让 $L$ 与 ranks 同比例从 1、2、4、8 增长。每卡序列张量保持 0.25 GiB,而 ring K/V 流量与全局 $L$ 增长。这个弱扩展实验说明“可放下更长序列”并不等于“通信不增长”,只是计算增长可能覆盖通信。
在真实集群比较 FlashAttention 单卡、Ulysses、Ring/context parallel:固定模型与 global sequence,记录峰值显存、attention kernel 时间、collective/点对点时间、重叠率与 MFU。分别在节点内和跨节点运行;预期最佳方法随 NVLink、InfiniBand、head 数和 local block 大小变化。
最后做数值验收:关闭 dropout,用同一 Q/K/V 比较单卡与多卡输出及 dQ/dK/dV。BF16 下用合理容差,同时单独检查每个 rank 拼接后的全局顺序。输出对而梯度错,通常说明 backward 中流动 K/V 梯度没有正确归还拥有者。
读懂本文的完整前置路径是:
选 Ulysses 还是 Ring,不应从名字出发。先列出 $L,H,H_{KV},d$、网络拓扑、每卡内存与 causal 结构;再计算 local shape、通信字节、轮数和可重叠窗口;最后用 profiler 验证。长上下文系统真正的能力,是让数学等价、内存边界和物理网络三者同时对齐。
09 节用到的脚本全文如下(ring_attention_sim.py、sequence_checks.py、sp_budget.py、make_figures.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
#!/usr/bin/env python3
"""Exact blockwise attention forward/backward; Python standard library only.

This simulates local arithmetic, not distributed transport or GPU execution.
mask[i][j] is True exactly when query i may attend to key j.
"""
import math


def dot(a, b):
    if len(a) != len(b):
        raise ValueError("dot dimensions differ")
    return sum(x * y for x, y in zip(a, b))


def validate(q, k, v, mask=None):
    for x in (q, k, v):
        if not x or not x[0] or any(len(row) != len(x[0]) for row in x):
            raise ValueError("expected nonempty rectangular matrices")
        if any(not math.isfinite(a) for row in x for a in row):
            raise ValueError("inputs must be finite")
    if len(k) != len(v) or len(q[0]) != len(k[0]):
        raise ValueError("Q/K dimensions or K/V lengths differ")
    if mask is None:
        mask = [[True] * len(k) for _ in q]
    if len(mask) != len(q) or any(len(row) != len(k) for row in mask):
        raise ValueError("mask shape differs")
    if any(not isinstance(a, bool) for row in mask for a in row):
        raise ValueError("mask must contain booleans")
    if any(not any(row) for row in mask):
        raise ValueError("every query needs at least one valid key")
    return mask


def full_attention(q, k, v, mask=None, score_shift=0.0):
    mask = validate(q, k, v, mask)
    if not math.isfinite(score_shift):
        raise ValueError("score shift must be finite")
    outputs = []
    for i, query in enumerate(q):
        scores = [dot(query, key) / math.sqrt(len(query)) + score_shift for key in k]
        peak = max(s for s, allowed in zip(scores, mask[i]) if allowed)
        weights = [math.exp(s - peak) if allowed else 0.0 for s, allowed in zip(scores, mask[i])]
        outputs.append([sum(w * value[j] for w, value in zip(weights, v)) / sum(weights) for j in range(len(v[0]))])
    return outputs


def accumulate(q, k, v, block_size, mask=None, block_order=None, score_shift=0.0):
    mask = validate(q, k, v, mask)
    if not isinstance(block_size, int) or isinstance(block_size, bool) or block_size <= 0:
        raise ValueError("block_size must be a positive integer")
    if not math.isfinite(score_shift):
        raise ValueError("score shift must be finite")
    blocks = list(range((len(k) + block_size - 1) // block_size))
    order = blocks if block_order is None else list(block_order)
    if sorted(order) != blocks:
        raise ValueError("block order must visit each block exactly once")
    peak = [-math.inf] * len(q)
    denom = [0.0] * len(q)
    numer = [[0.0] * len(v[0]) for _ in q]
    for block in order:
        start = block * block_size
        end = min(start + block_size, len(k))
        for i, query in enumerate(q):
            valid = [j for j in range(start, end) if mask[i][j]]
            if not valid:
                continue
            scores = [dot(query, k[j]) / math.sqrt(len(query)) + score_shift for j in valid]
            new_peak = max(peak[i], max(scores))
            correction = math.exp(peak[i] - new_peak) if denom[i] else 0.0
            weights = [math.exp(s - new_peak) for s in scores]
            denom[i] = correction * denom[i] + sum(weights)
            numer[i] = [correction * old + sum(w * v[j][d] for w, j in zip(weights, valid)) for d, old in enumerate(numer[i])]
            peak[i] = new_peak
    outputs = [[a / denom[i] for a in row] for i, row in enumerate(numer)]
    return outputs, peak, denom


def blockwise_attention(q, k, v, block_size, mask=None, block_order=None, score_shift=0.0):
    return accumulate(q, k, v, block_size, mask, block_order, score_shift)[0]


def blockwise_backward(q, k, v, grad_out, block_size, mask=None, block_order=None):
    mask = validate(q, k, v, mask)
    out, peak, denom = accumulate(q, k, v, block_size, mask, block_order)
    if len(grad_out) != len(q) or any(len(row) != len(v[0]) for row in grad_out):
        raise ValueError("output gradient shape differs")
    if any(not math.isfinite(x) for row in grad_out for x in row):
        raise ValueError("output gradients must be finite")
    dq = [[0.0] * len(q[0]) for _ in q]
    dk = [[0.0] * len(k[0]) for _ in k]
    dv = [[0.0] * len(v[0]) for _ in v]
    scale = math.sqrt(len(q[0]))
    delta = [dot(g, o) for g, o in zip(grad_out, out)]
    for start in range(0, len(k), block_size):
        for i, query in enumerate(q):
            for j in range(start, min(start + block_size, len(k))):
                if not mask[i][j]:
                    continue
                prob = math.exp(dot(query, k[j]) / scale - peak[i]) / denom[i]
                ds = prob * (dot(grad_out[i], v[j]) - delta[i])
                for d in range(len(query)):
                    dq[i][d] += ds * k[j][d] / scale
                    dk[j][d] += ds * query[d] / scale
                for d in range(len(v[0])):
                    dv[j][d] += prob * grad_out[i][d]
    return dq, dk, dv


if __name__ == "__main__":
    q = [[1.0, 0.0], [0.0, 1.0], [1.0, 1.0], [-1.0, 1.0]]
    k = [[1.0, 0.0], [0.0, 1.0], [1.0, 1.0], [1.0, -1.0]]
    v = [[1.0, 2.0], [2.0, 0.0], [0.0, 3.0], [4.0, 1.0]]
    full = full_attention(q, k, v)
    streamed = blockwise_attention(q, k, v, block_size=2)
    max_diff = max(abs(a - b) for ra, rb in zip(full, streamed) for a, b in zip(ra, rb))
    print("Q=K=V shape=(4, 2), kv_block=2, ring_steps=2")
    print("full[0]=[" + ", ".join(f"{x:.9f}" for x in full[0]) + "]")
    print("ring[0]=[" + ", ".join(f"{x:.9f}" for x in streamed[0]) + "]")
    print(f"max_abs_diff={max_diff:.3e}")
    mask = [[j <= i for j in range(4)] for i in range(4)]
    causal = blockwise_attention(q, k, v, 2, mask, [1, 0])
print("causal[0]=", causal[0], "(future block visited first)")"""Independent CPU oracle for the tutorial; numpy and torch are required.
No distributed processes, CUDA kernels, or performance measurements are used.
"""
import json
import math
from pathlib import Path
import numpy as np
import torch
from ring_attention_sim import full_attention, blockwise_attention, blockwise_backward
from sp_budget import budget, pipeline_time
def error(a, b):
return float(np.max(np.abs(np.asarray(a) - np.asarray(b))))
def oracle(q, k, v, g, mask):
q, k, v = [torch.tensor(a, dtype=torch.float64, requires_grad=True) for a in (q, k, v)]
scores = q @ k.T / math.sqrt(q.shape[-1])
scores = scores.masked_fill(~torch.tensor(mask), -math.inf)
out = scores.softmax(-1) @ v
(out * torch.tensor(g, dtype=torch.float64)).sum().backward()
return out.detach().numpy(), [a.grad.numpy() for a in (q, k, v)]
def run():
torch.set_num_threads(1)
rng = np.random.default_rng(34)
max_forward = max_backward = 0.0
cases = 0
for nq, nk, dh, dv in [(1, 1, 1, 2), (4, 7, 3, 2), (9, 9, 4, 5)]:
for seed in range(3):
q, k, v, g = [rng.normal(size=s).tolist() for s in [(nq, dh), (nk, dh), (nk, dv), (nq, dv)]]
for kind in ['dense', 'causal', 'packed']:
mask = [[True if kind == 'dense' else j <= i and (kind != 'packed' or i // 3 == j // 3) for j in range(nk)] for i in range(nq)]
ref, grads = oracle(q, k, v, g, mask)
for block in [1, 2, 4, nk + 1]:
count = (nk + block - 1) // block
for order in [list(range(count)), list(reversed(range(count)))]:
out = blockwise_attention(q, k, v, block, mask, order)
got = blockwise_backward(q, k, v, g, block, mask, order)
max_forward = max(max_forward, error(out, ref))
max_backward = max(max_backward, *(error(a, b) for a, b in zip(got, grads)))
cases += 1
assert max_forward < 2e-12 and max_backward < 2e-12
q, k, v, g = [rng.normal(size=(4, 3)).tolist() for _ in range(4)]
mask = [[j <= i for j in range(4)] for i in range(4)]
grads = blockwise_backward(q, k, v, g, 3, mask)
finite_diff = 0.0
for a, grad in zip([q, k, v], grads):
for i in range(4):
for j in range(3):
old = a[i][j]
a[i][j] = old + 1e-5
plus = np.sum(np.asarray(full_attention(q, k, v, mask)) * np.asarray(g))
a[i][j] = old - 1e-5
minus = np.sum(np.asarray(full_attention(q, k, v, mask)) * np.asarray(g))
a[i][j] = old
finite_diff = max(finite_diff, abs((plus - minus) / 2e-5 - grad[i][j]))
assert finite_diff < 1e-9
# Every rank sees all K/V once, in the actual ring source order.
q, k, v = [rng.normal(size=(12, 3)).tolist() for _ in range(3)]
ref = full_attention(q, k, v)
ring_diff = 0.0
for rank in range(4):
rows = q[rank * 3:(rank + 1) * 3]
order = [(rank - t) % 4 for t in range(4)]
out = blockwise_attention(rows, k, v, 3, block_order=order)
ring_diff = max(ring_diff, error(out, ref[rank * 3:(rank + 1) * 3]))
assert ring_diff < 1e-12
# A local index restarts at zero and falsely allows global key 2 to query 1.
pos = [0, 1, 2, 3]
correct = [[j <= 1 for j in pos]]
wrong = [[j % 2 <= 1 for j in pos]]
toyq = [[0.0]]; toyk = [[0.0] for _ in pos]; toyv = [[float(j)] for j in pos]
global_result = blockwise_attention(toyq, toyk, toyv, 2, correct)[0][0]
local_result = blockwise_attention(toyq, toyk, toyv, 2, wrong)[0][0]
assert global_result == 0.5 and local_result == 1.5
# An all-masked first block must be skipped without exp(-inf - -inf).
future_first = blockwise_attention(toyq, toyk, toyv, 2, correct, [1, 0])
assert future_first == [[0.5]]
shifted = blockwise_attention(toyq, toyk, toyv, 2, score_shift=1000.0)
assert shifted == [[1.5]]
try:
math.exp(1000.0)
except OverflowError:
naive_overflow = True
else:
raise AssertionError('expected naive exp overflow')
# An independent two-resource event recurrence checks finite-round timing.
event_cases = 0
for rounds in [1, 2, 4, 8]:
for compute in [0.0, 1.0, 3.0]:
for network in [0.0, 0.5, 4.0]:
end = compute
for _ in range(rounds - 1):
ready = (end - compute) + network
end = max(end, ready) + compute
assert end == pipeline_time(rounds, compute, network)
event_cases += 1
ledger_cases = 0
for ranks in [1, 2, 4, 8]:
for kv in [8, 64]:
a = budget(ranks=ranks, kv_heads=kv)
local = 131072 // ranks * 8192 * 2
assert a['local_tensor_bytes'] == local
assert a['ring_received_bytes'] == (ranks - 1) * (2 * local * kv // 64)
assert a['ulysses_received_bytes'] == sum((ranks - 1) * local * h / 64 / ranks for h in [64, kv, kv, 64])
ledger_cases += 1
bad = [lambda: blockwise_attention([], [[1.]], [[1.]], 1),
lambda: blockwise_attention([[1., 2.]], [[1.]], [[1.]], 1),
lambda: blockwise_attention([[1.]], [[1.]], [[1.]], 0),
lambda: blockwise_attention([[1.]], [[1.]], [[1.]], 1, [[False]]),
lambda: blockwise_attention([[1.]], [[1.]], [[1.]], 1, block_order=[0, 0]),
lambda: blockwise_attention([[math.nan]], [[1.]], [[1.]], 1),
lambda: budget(ranks=0), lambda: budget(hidden=8191),
lambda: budget(tokens=3, ranks=2), lambda: budget(kv_heads=3),
lambda: pipeline_time(0, 1, 1), lambda: pipeline_time(2, -1, 1)]
for f in bad:
try:
f()
except ValueError:
pass
else:
raise AssertionError('invalid input was accepted')
result = dict(passed=True, forward_backward_cases=cases, max_forward_error=max_forward,
max_backward_error=max_backward, finite_difference_coordinates=36,
finite_difference_error=finite_diff, rank_order_cases=4, rank_order_error=ring_diff,
mask_counterexample=dict(global_result=global_result, local_result=local_result),
all_masked_first_block='skipped', naive_exp_overflow=naive_overflow,
stable_shifted_result=shifted, event_cases=event_cases, ledger_cases=ledger_cases,
invalid_inputs=len(bad), numpy=np.__version__, torch=torch.__version__,
scope='CPU local arithmetic only; no collective, GPU or training throughput validation')
Path(__file__).with_name('validation_results.json').write_text(json.dumps(result, indent=2), encoding='utf8')
print(json.dumps(result, indent=2))
if __name__ == '__main__':
run()#!/usr/bin/env python3
"""Ideal logical bytes, not measured network traffic. Python stdlib only."""
import argparse
def budget(tokens=131072, hidden=8192, heads=64, ranks=8, kv_heads=None, batch=1, dtype_bytes=2):
kv_heads = heads if kv_heads is None else kv_heads
values = [tokens, hidden, heads, ranks, kv_heads, batch, dtype_bytes]
if any(not isinstance(x, int) or isinstance(x, bool) or x <= 0 for x in values):
raise ValueError("all dimensions and byte size must be positive integers")
if tokens % ranks or hidden % heads or heads % kv_heads:
raise ValueError("require tokens/ranks, hidden/heads and heads/kv_heads integral")
local = batch * tokens * hidden * dtype_bytes / ranks
kv = 2 * local * kv_heads / heads
ring = (ranks - 1) * kv
ulysses = (2 * local + kv) * (ranks - 1) / ranks
return dict(local_tensor_bytes=local, kv_block_bytes=kv, ring_received_bytes=ring,
ulysses_received_bytes=ulysses, rounds=ranks,
equal_head_layout=(heads % ranks == 0 and kv_heads % ranks == 0))
def pipeline_time(rounds, compute, network):
if not isinstance(rounds, int) or isinstance(rounds, bool) or rounds < 1:
raise ValueError("rounds must be positive integer")
import math
if not all(math.isfinite(x) and x >= 0 for x in (compute, network)):
raise ValueError("times must be finite and nonnegative")
return compute + (rounds - 1) * max(compute, network)
if __name__ == "__main__":
parser = argparse.ArgumentParser()
for flag, default in [("tokens", 131072), ("hidden", 8192), ("heads", 64), ("ranks", 8), ("batch", 1), ("dtype-bytes", 2)]:
parser.add_argument("--" + flag, type=int, default=default)
parser.add_argument("--kv-heads", type=int)
args = parser.parse_args()
try:
result = budget(**vars(args))
except ValueError as error:
parser.error(str(error))
gib = 1024 ** 3
print(f"L={args.tokens}, d={args.hidden}, heads={args.heads}, sp={args.ranks}, dtype_bytes={args.dtype_bytes}")
print(f"one [L,d] tensor: replicated={result['local_tensor_bytes'] * args.ranks / gib:.2f} GiB, sequence-sharded/rank={result['local_tensor_bytes'] / gib:.2f} GiB")
print(f"ideal memory reduction for sequence-shaped activations={args.ranks:.1f}x")
print(f"Equal-head Ulysses Q and KV divisible={result['equal_head_layout']}")
print(f"Ring Attention rounds={args.ranks}, local query tokens={args.tokens // args.ranks}")
print(f"Ring K/V received per rank per forward={result['ring_received_bytes'] / gib:.4f} GiB")
print(f"Ulysses Q/K/V plus output received per rank per forward={result['ulysses_received_bytes'] / gib:.4f} GiB")"""Regenerate this article's deterministic teaching figure (numpy + matplotlib)."""
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
OUT=Path(__file__).resolve().parents[1]/"figures"
OUT.mkdir(exist_ok=True)
plt.rcParams.update({"font.sans-serif":["DejaVu Sans"],"axes.unicode_minus":False})
p=np.array([1,2,4,8,16,32]); L=131072;d=8192;b=2;g=1024**3
fig,axes=plt.subplots(1,2,figsize=(10,4.4))
axes[0].plot(p,np.full(p.shape,L*d*b/g),"--",label="Replicated")
axes[0].plot(p,L*d*b/p/g,"o-",label="Sequence shard")
axes[0].set(xscale="log",xlabel="Ranks P",ylabel="One tensor per rank (GiB)");axes[0].legend()
axes[1].plot(p,2*(p-1)/p*L*d*b/g,"o-")
axes[1].set(xscale="log",xlabel="Ranks P",ylabel="Forward K/V received per rank (GiB)")
for ax in axes:ax.grid(alpha=.25)
fig.suptitle("MHA ring budget: B=1, L=131072, d=8192, BF16");fig.tight_layout()
fig.savefig(OUT/'ring_budget.png',dpi=170)
plt.close(fig)
print(OUT/'ring_budget.png')

评论 (0)