


AIGC 周末专题|2026-09-06|长视频世界模型的记忆与状态概览

人工智能炼丹君
2026-09-06 / 0 评论 / 12 阅读 / 正在检测是否收录...

AIGC 周末专题深度解读:长视频世界模型的记忆:存得下、找得回、更新得对

人工智能炼丹君 整理 | 2026年9月6日(周日)
覆盖时间:双周覆盖 2026-08-24—2026-09-06(含首尾,共 14 天);原论文首发 2026-08-26—2026-09-02,PAWBench 采用 2026-09-03 v3


本期概述

本期 AIGC 周末专题聚焦长视频世界模型的记忆:存得下、找得回、更新得对方向,精选 7 篇代表性论文进行深度解读。

给一个模型一张街景图,再让你用方向键走开、转弯、返回原地。理想输出不仅是连续的视频,还应当保住原来的门窗与路口。如果你在离开前把一件物品放进抽屉,返回时抽屉里的内容也应正确。这正是本期要拆开的两种记忆:见过什么,以及后来发生了什么。

过去的滑动窗口(只让当前块看到最近一段历史)解决了生成开销随视频增长的问题,却容易忘掉远处内容;全历史缓存扩大了记忆,又带来存储成本。于是本期两周窗口内的研究沿三个方向展开:让有限历史更有用、让历史按几何或任务结构组织、让评测能识别“画面合理但状态错误”。

本期为双周专题,检索与综合窗口为 2026 年 8 月 24 日至 9 月 6 日,含首尾共 14 天。复核这两周的候选与论文索引后,保留七篇与历史记忆、状态更新及其评测直接相关的工作;它们的首发日期为 8 月 26 日至 9 月 2 日,另纳入 PAWBench 在 9 月 3 日更新的 v3。部分论文曾在工作日速读中出现,本期重新研读并作主题综合。下文的数值均为论文报告,未独立复现实验;跨论文联系与研究建议为本文分析。

两周进展怎样衔接:第一周(8 月 24—30 日)的 WALL-SS、DensityKV、LayerRecall 与 Matrix-Game 3.5,分别从视觉—动作配对、容量控制、按层读取和几何重访组织历史;同周首发的 PAWBench 则把概率分布纳入评测。第二周(8 月 31 日—9 月 6 日),Shell Game 将问题收紧到遮挡期间的隐藏状态更新,SolarWM 提供长时生成的数据与训练配方,PAWBench v3 进一步明确条件分数与场景通过率。时间上的接续不意味着这些同期工作相互继承。

双周观察:第一周较集中地回答“历史如何保存和读取”,第二周的入选工作补上“长时训练如何组织、保存的历史是否足以支持状态推理”。因此本期的横向比较同时区分存储预算、外观恢复、动作后果和不确定性,不能仅按生成时长判断能力。

先看四个趋势:

  • 从保存容量转向读取效率。 DensityKV 决定哪些历史留下,LayerRecall 决定当前问题读取什么、送到哪层。
  • 从时间距离转向结构关系。 Matrix-Game 3.5 用三维位置找回图块,WALL-SS 把视觉和动作按尺度共同保存。
  • 从长视频样例转向可复现配方。 SolarWM 把数据与训练接口开放,便于将能力差异与工程配置差异分开。
  • 从外观连续转向状态与分布。 Shell Game 检查遮挡期间的状态更新,PAWBench 检查固定条件下可能未来的概率。

方向分布:

  • 历史压缩与读取 2 篇 (DensityKV, LayerRecall)
  • 几何与动作记忆 2 篇 (Matrix-Game 3.5, WALL-SS)
  • 开放训练配方 1 篇 (SolarWM)
  • 状态与概率评测 2 篇 (Shell Game, PAWBench)

本期按机制比较,未将预印本排版模板或拟投会议视为已录用信息。

技术路线与时间线

把历史变成可管理的资源(2026-08-26—08-28)

描述:WALL-SS、DensityKV 与 LayerRecall 分别从尺度、容量、读取策略组织历史;这是同期不同路线,时间先后不表示相互继承。

关键节点:

  • 08-26:WALL-SS:视觉—动作配对与时间—尺度记忆。
  • 08-28:DensityKV 与 LayerRecall:在线去冗余与按层检索。

把记忆放入可交互生成流程(2026-08-30—09-02)

描述:Matrix-Game 3.5 细化几何场景召回,SolarWM 统一多源数据和因果训练配方。

关键节点:

  • 08-30:Matrix-Game 3.5:patch 云、位姿编码与动静分离。
  • 09-02:SolarWM:开放数据接口与长时推演。

检验记忆究竟保证了什么(2026-08-27—09-03)

描述:PAWBench 与 Shell Game 从概率与隐藏状态提出互补评测问题,并非上述方法已经全部接受过这些测试。

关键节点:

  • 08-27 / 09-03:PAWBench 首发 / v3 更新:同时报告条件分数与场景通过率。
  • 08-31:Shell Game:分开检查画质和交换链状态准确率。

1. DensityKV:给历史库去重,先守住显存预算

论文: DensityKV: Density-Guided KV Cache Compression for Long Video Generation
arXiv: 2608.27922
机构: Manifold AI + 清华大学
关键词: 长视频生成, KV缓存, 免训练压缩

1.1 研究动机

核心问题: 在固定容量下,如何减少重复历史而保留有用状态?

自回归视频生成会把已经生成的内容继续当条件。只留最近几帧容易忘掉旧角色;把所有历史键值缓存(KV,即注意力读取的索引与内容)留下,又会让显存随时长增长。真正需要保存的,是历史里不容易被其他状态替代的信息。

前序工作及局限:

  • 滑动窗口:上下文开销有界,但远处历史被直接逐出。
  • LongLive-RAG:按需读取历史,存档本身仍会增长。

与前序工作的本质区别: 将历史压缩建模为 post-RoPE key 空间的在线密度控制。
1.2 方法原理

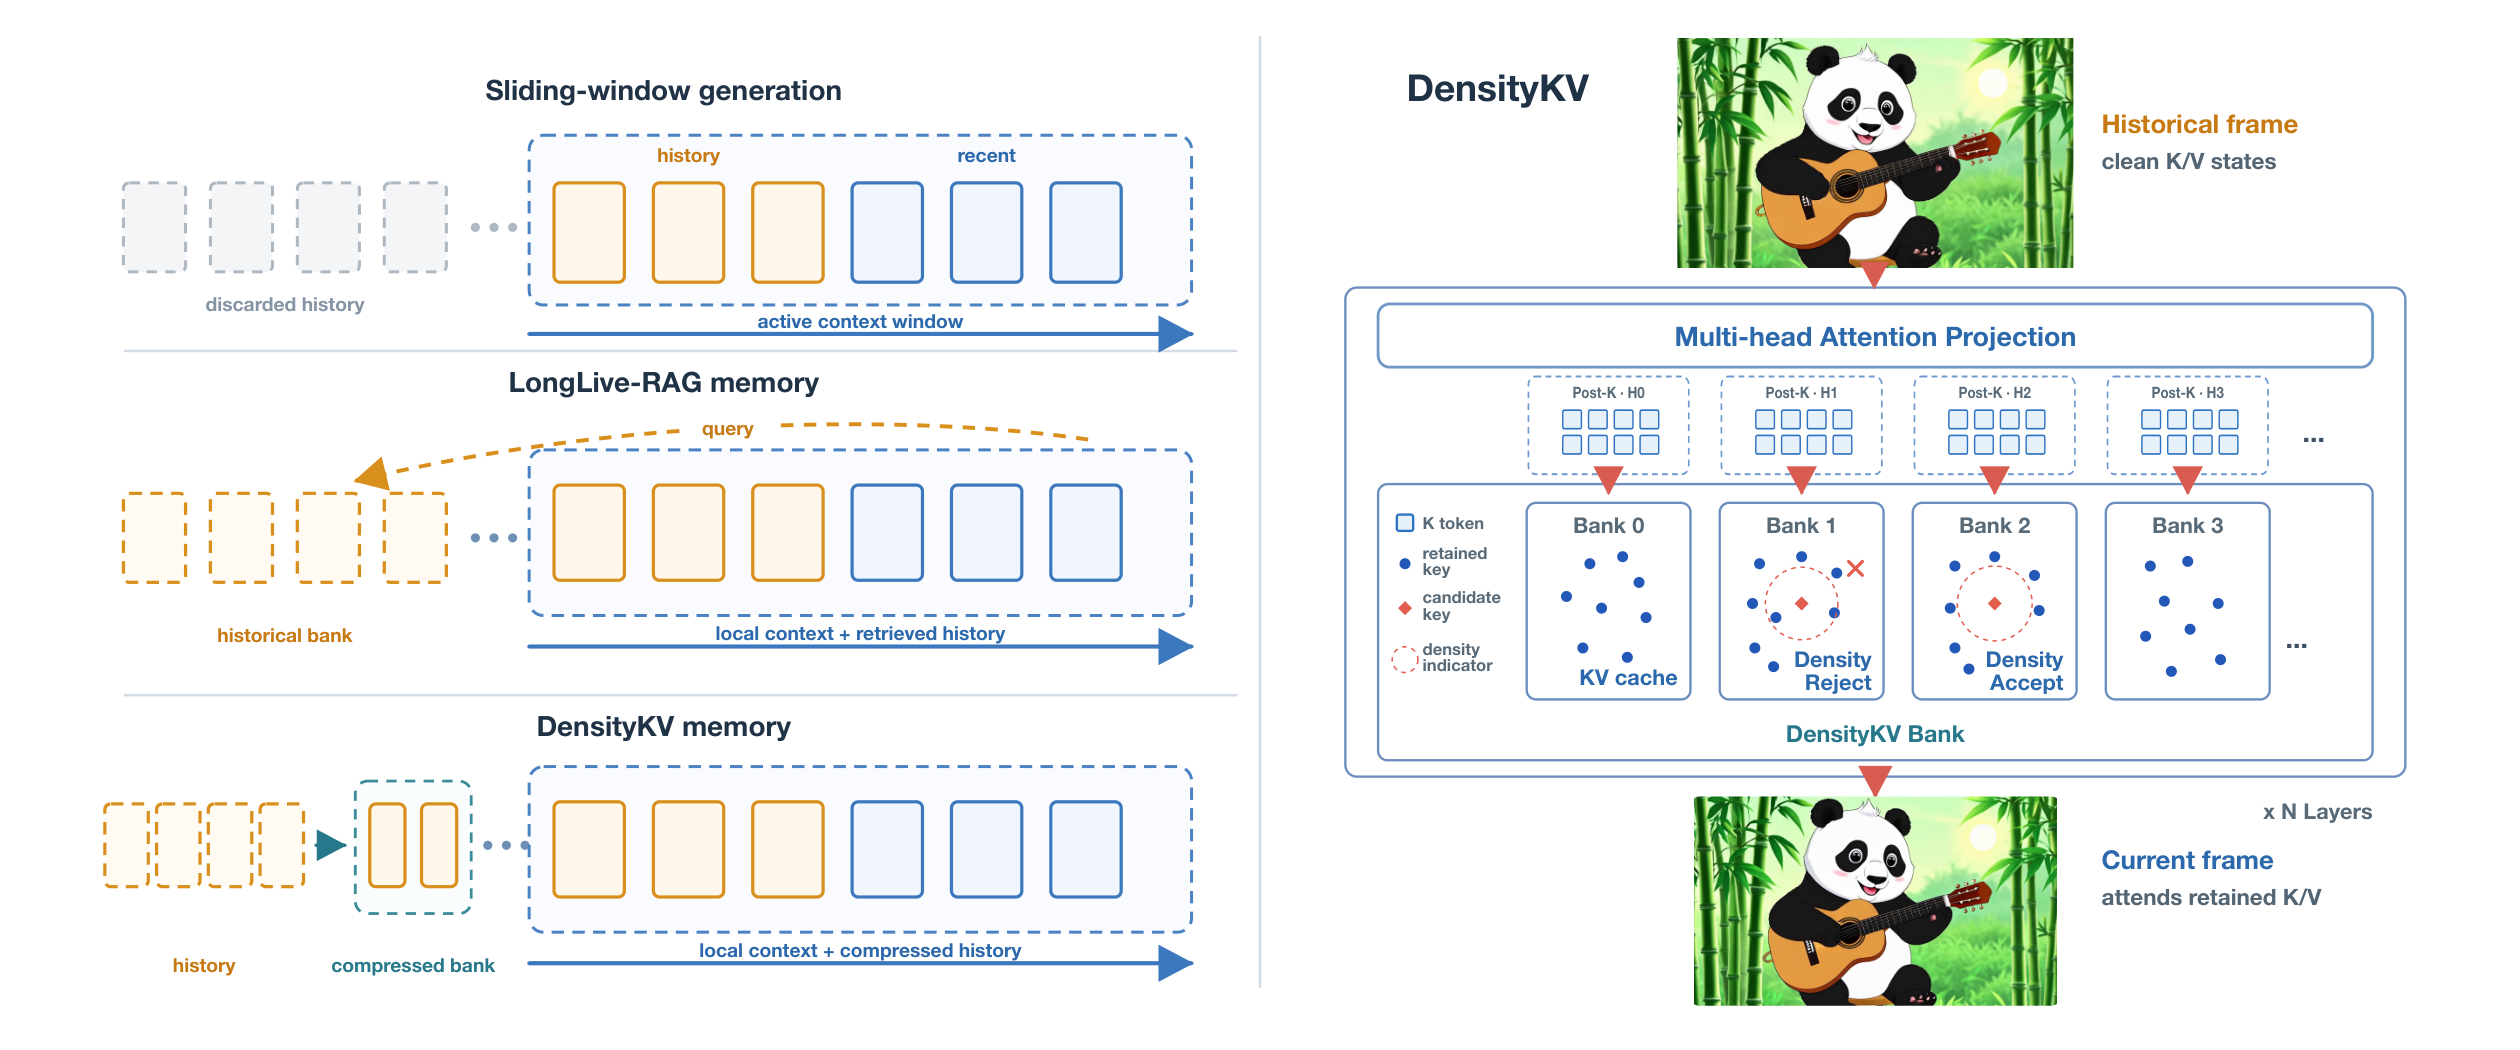
历史记忆的构建与使用概览。左:滑窗生成丢弃活动上下文以外的状态;LongLive-RAG 保存被逐出的历史并检索选定块;DensityKV 维护有界的 token 级历史,与局部窗口一起被读取。右:每层中,干净历史 K/V 更新各注意力头独立的库;根据 post-RoPE key 的 Soft-Riesz 密度决定接纳或拒绝,value 与原 key 严格配对,当前查询通过原生注意力访问保留历史。
Overview of historical-memory construction and use. Left: sliding-window generation discards states outside the active context; LongLive-RAG stores discarded history and retrieves selected blocks; DensityKV instead maintains a bounded token-level history that is attended together with the local window. Right: at every Transformer layer, clean historical K/V states update independent per-head banks. Admission and rejection are determined by Soft-Riesz density over post-RoPE keys, while each value remains exactly paired with its original key. Current queries access the retained history through the backbone's native attention.

图源:论文原图。图注译文:历史记忆的构建与使用概览。左:滑窗生成丢弃活动上下文以外的状态;LongLive-RAG 保存被逐出的历史并检索选定块;DensityKV 维护有界的 token 级历史,与局部窗口一起被读取。右:每层中,干净历史 K/V 更新各注意力头独立的库;根据 post-RoPE key 的 Soft-Riesz 密度决定接纳或拒绝,value 与原 key 严格配对,当前查询通过原生注意力访问保留历史。

DensityKV 在每层的每个注意力头分别维护历史库,在施加旋转位置编码(RoPE)后的 key 空间计算 Soft-Riesz 密度:附近已有很多相似 key,意味着这片邻域重复得较多。每条新入库状态都保存当时的密度基线,后续更新限制相对入库时的密度增长,而不是拿一个绝对密度阈值把所有密集区域一刀切掉。这样能区分“这一块本来就由一组完整视觉状态构成”与“后来反复加入几乎一样的历史”。原始 key 和 value 始终成对保存,当前块仍通过骨干原有注意力读取它们。

这套机制把压缩决策放在存储侧,既不新增训练任务,也不要求模型先说清自己将来要问什么。但它仍然是有限容量的历史覆盖方案:罕见细节是否被保留下来,依赖 key 空间中的邻域关系,不能由“密度低”直接推导出“任务上重要”。
1.3 核心创新

  • 按注意力头独立管理历史,适配不同头的投影空间。
  • 保留入库密度基线,限制后续冗余增长,同时维持原始 K/V 配对。

1.4 实验结果

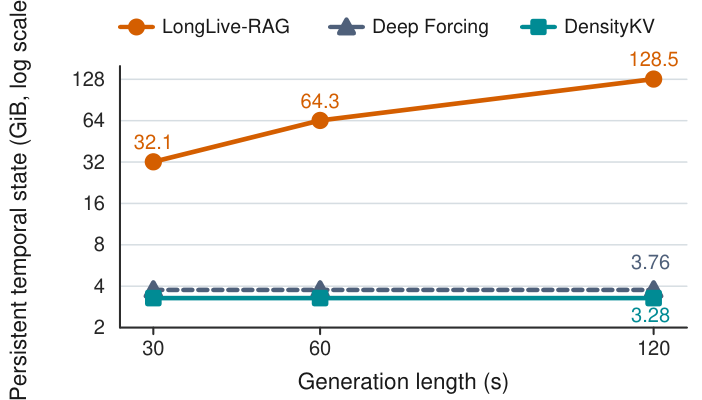
持久时序状态存储随生成长度的变化:LongLive-RAG 线性增长,Deep Forcing 与 DensityKV 保持有界。图中 120 秒时三者分别为 128.5、3.76、3.28 GiB;横轴为生成视频时长,纵轴采用对数刻度。
Persistent temporal-state storage versus generation length. LongLive-RAG grows linearly, whereas Deep Forcing and DensityKV remain bounded.
  • 图源:论文原图。图注译文:持久时序状态存储随生成长度的变化:LongLive-RAG 线性增长,Deep Forcing 与 DensityKV 保持有界。图中 120 秒时三者分别为 128.5、3.76、3.28 GiB;横轴为生成视频时长,纵轴采用对数刻度。
  • 在论文的 M=9,360 配置下,历史库及元数据为 1.67 GiB;加上首帧锚点和五帧局部窗口,总持久时序状态为 3.28 GiB。这不是模型运行时的整机峰值显存。
  • 同一存储统计中,LongLive-RAG 在 30/60/120 秒为 32.1/64.3/128.5 GiB;Deep Forcing 为 3.76 GiB。DensityKV 相对后者的存储优势远小于相对全历史存档的优势。
  • 论文使用 128 个 MovieGenBench 提示词,分别测试三种骨干和 30/60/120 秒。表中部分基线分数引用 LongLive-RAG 原报告;不能把这组数字与另一篇自建提示集直接拼榜。

1.5 关键洞察

我的判断:有现成自回归模型、首先卡在历史库增长时,值得优先评估。重点监控压缩后的物体重现与运动幅度,避免高一致性只是画面变得更静。它解决“存什么”,尚未解决“哪一层应该读取这些信息”,与下一篇在职责上互补;两者组合是否有效仍需实验。

技术演进定位: 面向部署预算的历史库管理。

可能的后续方向:

  • 固定峰值显存后比较重现准确率与运动质量。
  • 检查稀有物体细节在长时淘汰中的保留情况。

2. LayerRecall:记忆不仅要选对,还要送对层

论文: LayerRecall: A State-Conditioned Memory Router for Long-Horizon Consistency in Video Generation
arXiv: 2608.28460
机构: 浙江大学 + 香港大学
关键词: 视频DiT, 长时记忆, 跨镜头一致性

2.1 研究动机

核心问题: 有历史可访问,为什么仍不能稳定恢复旧属性?

人物离场后再次出现,模型可能仍记得“有一个人”,却把衣服换了。给所有层都塞入远处历史也未必有效:不同层对当前、近处、远处信息的偏好不同,错误注入可能扰乱正在进行的动作。

前序工作及局限:

  • LongLive-2.0:保留局部连续性,远距离重现仍可能漂移。
  • 全层记忆注入:扩大历史访问会干扰部分层的局部功能。

与前序工作的本质区别: 当前块的隐藏特征负责生成查询,块摘要只用于打分,检索载荷仍是完整 K/V;层集合则依据目标骨干的时间偏好预先确定,两种选择具有不同的动态性。
2.2 方法原理

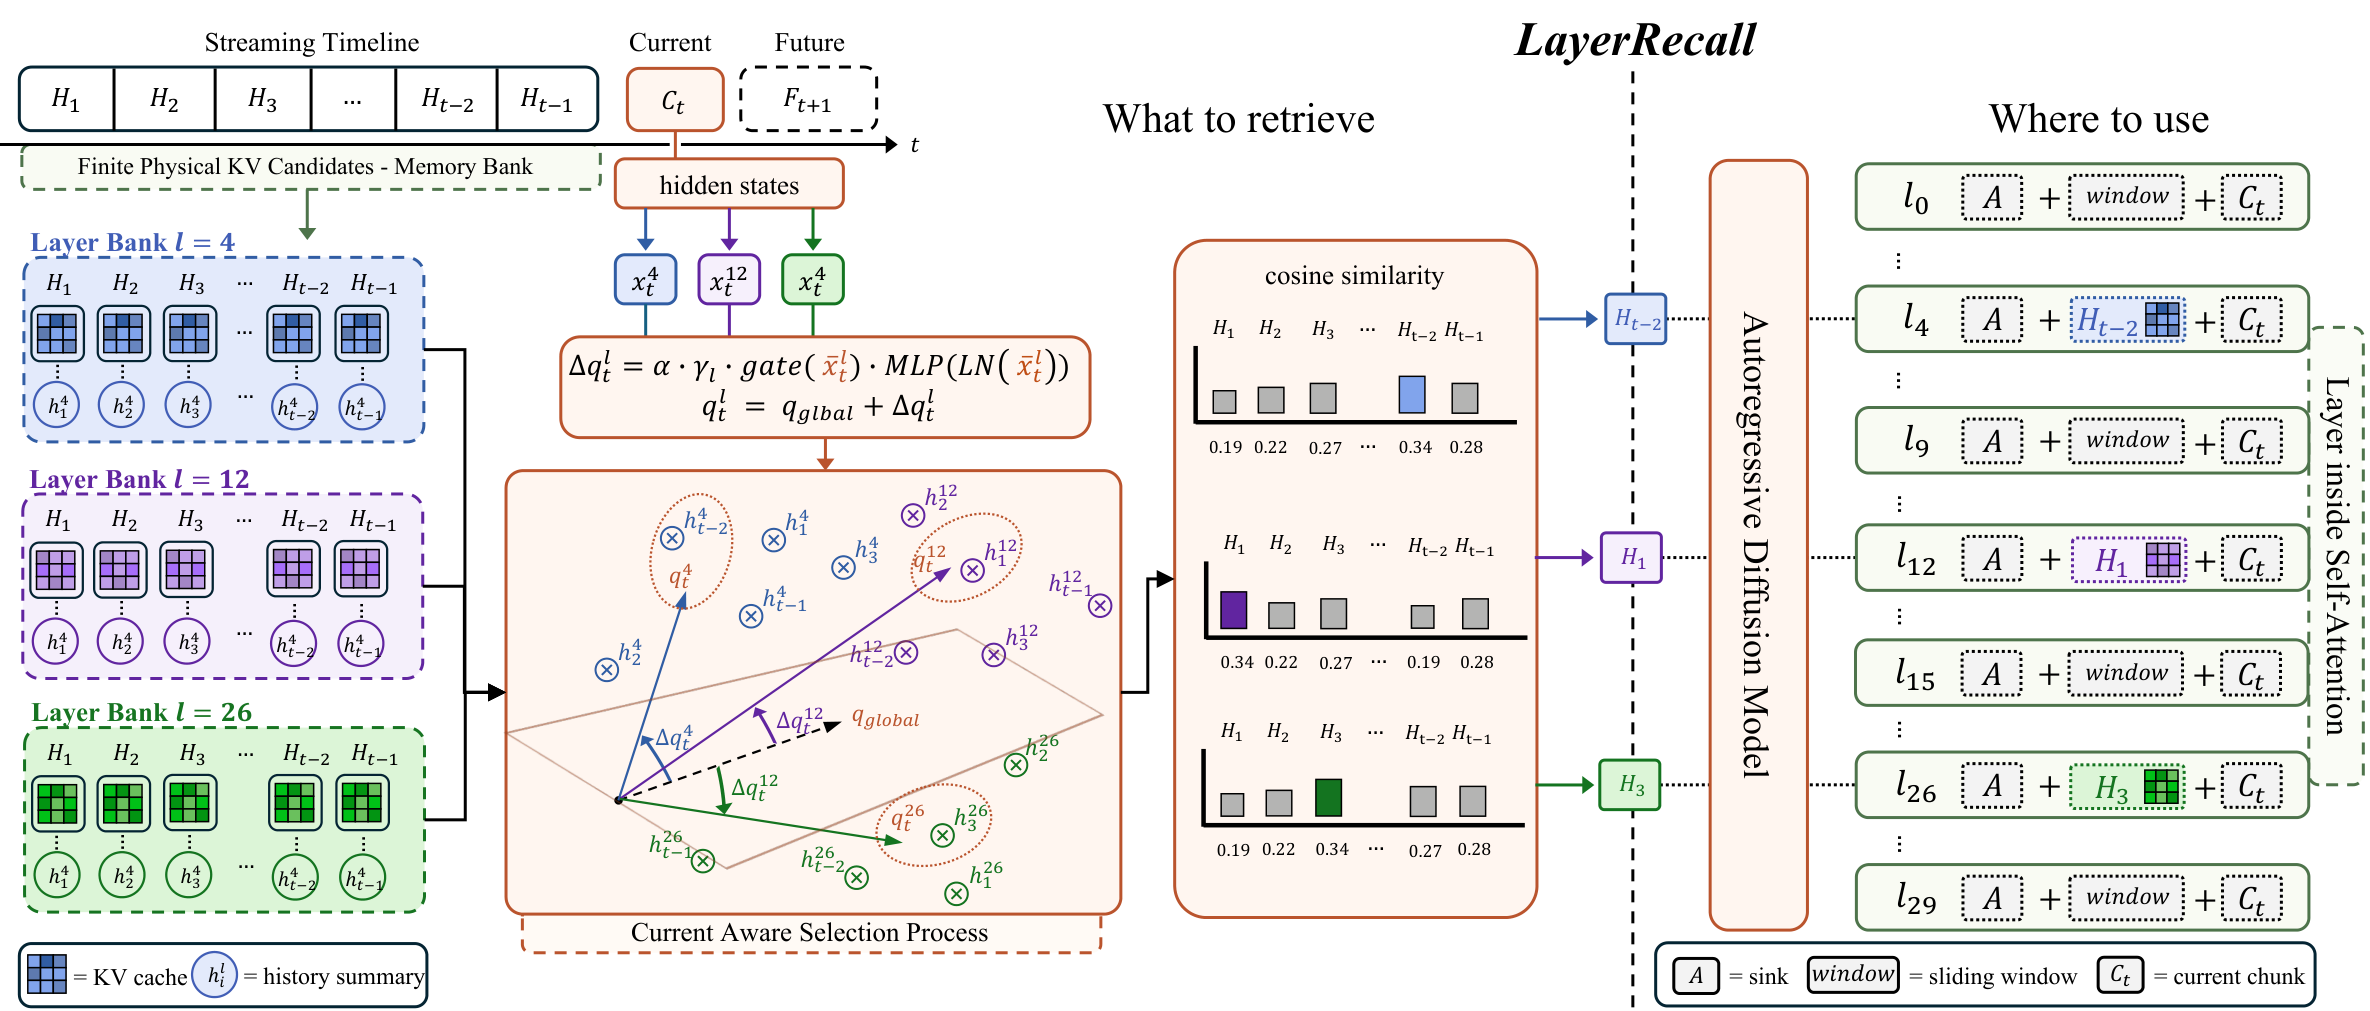
LayerRecall 概览:给定当前块,路由器从按层索引的记忆库中检索有限历史 K/V 候选,并评价哪些记忆与下一步生成相关。检索状态只注入经分析选出的记忆敏感层;其余层保留原有 sink、滑动窗口与当前块注意力上下文。K/V 指 key-value 状态。
Overview of LayerRecall. Given the current chunk, the router retrieves finite historical K/V candidates from layer-indexed memory banks and scores which memories are relevant to the next generation step. Retrieved states are injected only into profiled memory-sensitive layers, while the remaining layers keep the original sink, sliding-window, and current-chunk attention context. K/V denotes key-value states.

图源:论文原图。图注译文:LayerRecall 概览:给定当前块,路由器从按层索引的记忆库中检索有限历史 K/V 候选,并评价哪些记忆与下一步生成相关。检索状态只注入经分析选出的记忆敏感层;其余层保留原有 sink、滑动窗口与当前块注意力上下文。K/V 指 key-value 状态。

LayerRecall 把记忆使用拆成两个决策。首先,由当前块的隐藏状态生成查询,用它与每层历史块摘要计算相似度,选出有限数量的完整 K/V 块;摘要来自位置编码前的 key,而真正送入注意力的是已编码的 K/V。其次,只让预先分析得到的记忆敏感层接收检索结果,其余层保留原来的局部注意力。这里“检索内容”随当前状态改变,“注入层集合”则是对每种骨干固定的策略,不能理解为每次推理都自由选择全部层。

路由器通过跨跨度预测匹配(CHPM)训练。教师与学生共享同一个冻结骨干,教师拥有更长上下文,学生在有限记忆下对齐教师的去噪预测;训练只更新路由器。学生用自己生成的历史继续推进,梯度在块间截断,既暴露真实推理中的误差,又避免整段长视频反向传播。

2.3 核心创新

  • 把“找哪段历史”与“在哪层用”同时纳入设计。
  • 长上下文教师提供预测监督,无需人工标注每一块应读取哪段历史。

2.4 实验结果

三镜头序列中的记忆引导自我纠正。主体在第一镜头穿纯蓝色内搭,在第二镜头离场,在第三镜头最初以错误花纹重新出现。随后 LayerRecall 恢复先前的蓝色衣服,同时保持人物身份、灰色开衫、正在进行的动作和场景结构,展示无需全局重置画面的局部属性恢复。
Memory-guided self-correction in a three shot sequence. The subject wears a solid blue inner garment in Shot 1, leaves the scene in Shot 2, and initially reappears with a mismatched pattern in Shot 3. LayerRecall later recalls the earlier blue garment while preserving the subject's identity, gray cardigan, ongoing action, and scene structure, illustrating localized attribute recovery without a global visual reset.
  • 图源:论文原图。图注译文:三镜头序列中的记忆引导自我纠正。主体在第一镜头穿纯蓝色内搭,在第二镜头离场,在第三镜头最初以错误花纹重新出现。随后 LayerRecall 恢复先前的蓝色衣服,同时保持人物身份、灰色开衫、正在进行的动作和场景结构,展示无需全局重置画面的局部属性恢复。
  • 100 个评测提示词上,MemoBench 总分由 LongLive-2.0 的 0.513 提升至 0.548,MovieBench 从 0.546 到 0.578;三项 VBench-Long 指标均值均为 0.978。
  • 主配置 30 层中有 10 层使用记忆;注意力可见预算为 32 个潜在帧,物理 K/V 库为 80 个潜在帧。可见预算不能当成全部存储占用。
  • 匹配 H100 设置下,端到端时间从 305.9 秒/视频变为 309.4 秒/视频,对应 5.22 与 5.16 FPS。

2.5 关键洞察

我的判断:最有价值的是“层的职责”这一设计依据。原图中的衣服会先出现错误花纹,随后恢复纯蓝色,说明自我纠正并不等于从不出错。做长镜头或广告身份一致性时,应同时测错误出现次数、恢复延迟和恢复是否打断动作。记忆敏感层需要针对骨干分析,迁移成本不能只看训练参数量。

技术演进定位: 由历史存储走向选择性记忆使用。

可能的后续方向:

  • 报告重现失败后的恢复时间。
  • 与固定容量压缩库组合时重新分析层策略。

3. Matrix-Game 3.5:把旧场景按三维位置拼回当前视角

论文: Matrix-Game 3.5: Enhancing Real-Time Streaming Interactive World Models with Patch Memory
arXiv: 2608.29910
机构: 昆仑万维 Skywork
关键词: 交互世界模型, 几何记忆, 相机控制

3.1 研究动机

核心问题: 如何在相机重访时找到位置正确的历史证据?

相机离开街角再回来,画面应该还是同一栋楼。整帧检索很难表达“这张旧图只有右上角对当前视角有用”,纯语义相似性也不能保证窗户落在正确的位置。

前序工作及局限:

  • 整帧历史记忆:有用与无用区域绑定在同一读取单位。
  • MosaicMem:提供局部图块的几何记忆思路。

与前序工作的本质区别: 组合几何 patch 检索、位姿编码、动静分离与实时蒸馏。

3.2 方法原理

Patch 记忆机制。(a) 升维到三维:历史潜在图块借助度量深度及相机内外参反投影至共同三维空间。(b) 视锥查询:目标相机查询 patch 云,目标视角的 z-buffer 在每个潜在位置只保留离相机最近的表面,剔除被遮挡候选。(c) 记忆画布:选中 patch 散射成对齐目标视角的记忆;被遮挡或从未观察的区域留黑,并从记忆 token 序列中移除,由扩散模型结合当前潜在表示、文本和周围上下文生成。
The patch-memory mechanism. (a) Lift to 3D: historical latent patches are back-projected into a common 3D space using metric depth together with camera intrinsics and poses. (b) Frustum query: the target camera frustum queries this patch cloud, and a z-buffer under the target view keeps, for every target latent location, only the surface closest to the camera while discarding occluded candidates. (c) Patch memory frame: the selected patches are scattered into an aligned memory canvas under the target viewpoint; regions that are occluded or have never been observed are left empty (black) and dropped from the memory token sequence; the diffusion model synthesizes them from the current latent, text prompt, and surrounding context.

图源:论文原图。图注译文:Patch 记忆机制。(a) 升维到三维:历史潜在图块借助度量深度及相机内外参反投影至共同三维空间。(b) 视锥查询:目标相机查询 patch 云,目标视角的 z-buffer 在每个潜在位置只保留离相机最近的表面,剔除被遮挡候选。(c) 记忆画布:选中 patch 散射成对齐目标视角的记忆;被遮挡或从未观察的区域留黑,并从记忆 token 序列中移除,由扩散模型结合当前潜在表示、文本和周围上下文生成。

Matrix-Game 3.5 采用 patch 记忆:把历史潜在图块结合度量深度、相机内外参反投影到三维空间,再由目标相机的视锥查询。投影到同一目标位置的候选由 z-buffer 选最近可见表面,遮挡、不可靠投影和未见区域被剔除;留下的 patch 按当前视角散射成一张有空洞的记忆画布。空洞交给生成器补全,既保留证据,也显式暴露“这里没有看过”。

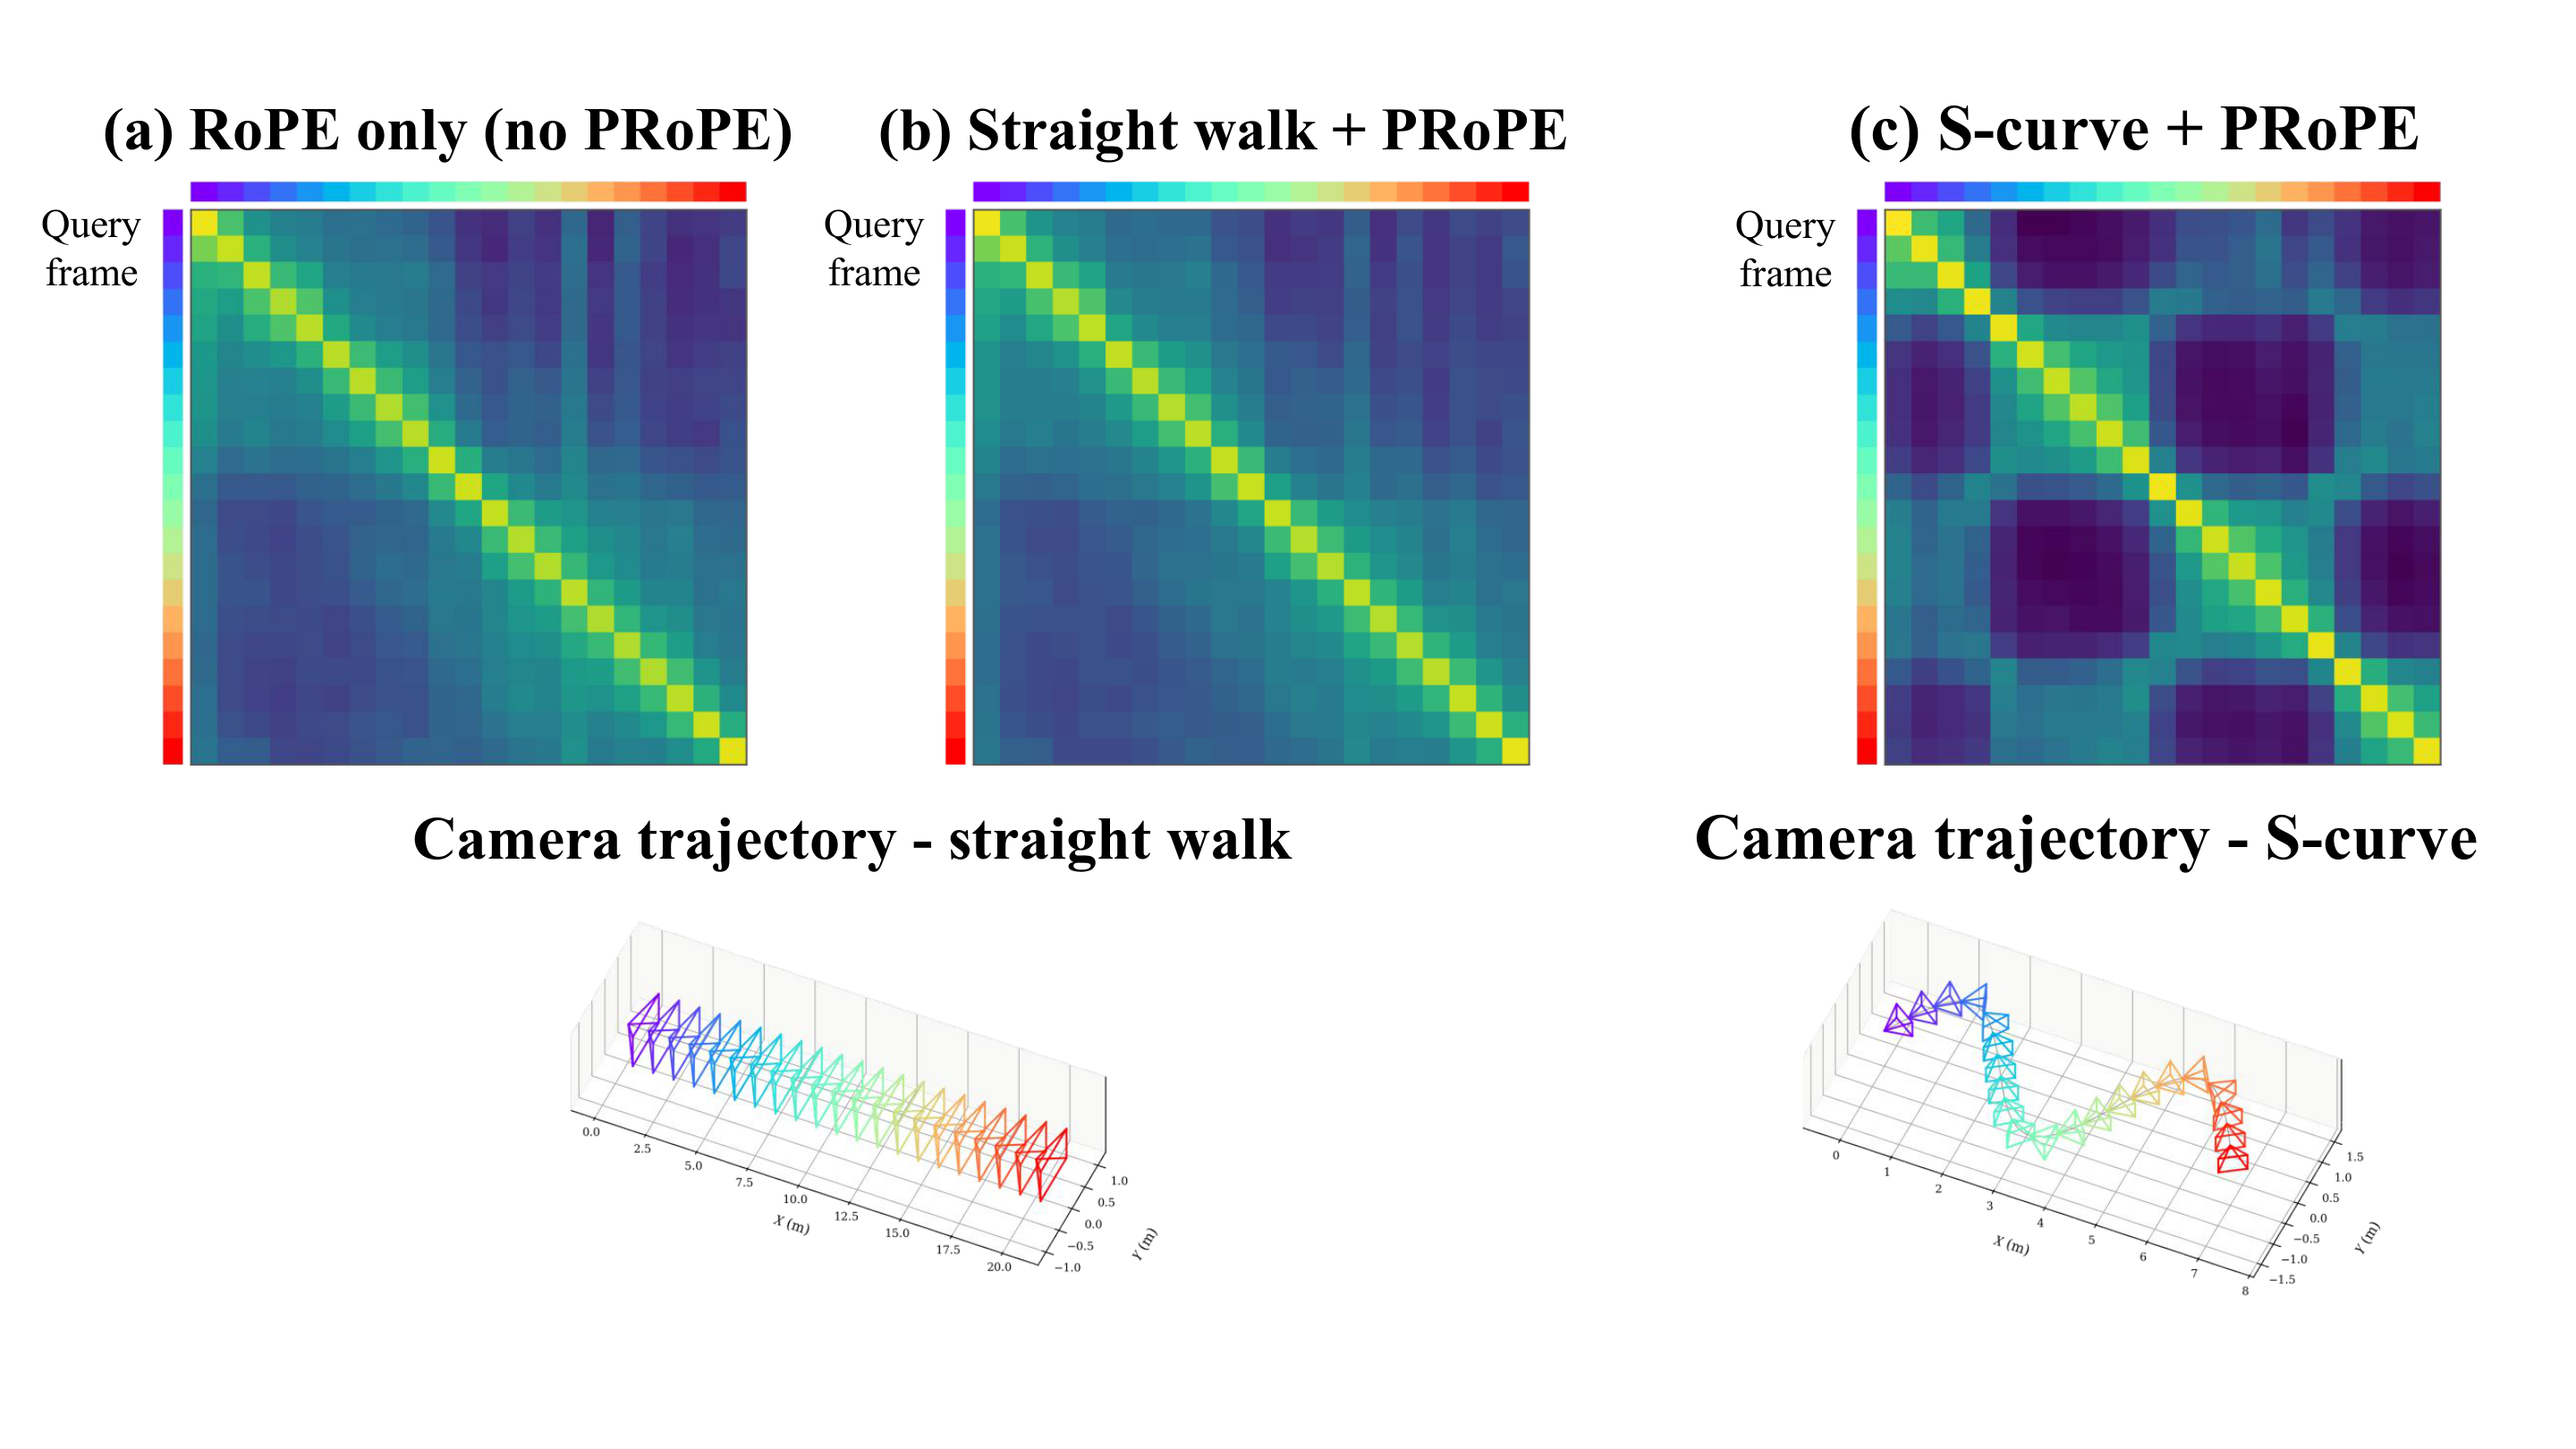
相机几何通过 tiled PRoPE 叠加在原时空 RoPE 上,避免切掉视频骨干用于时间建模的通道。静态场景依赖几何 patch,动态主体则有参考 token 维持身份,另有上下文记忆提供未扭曲的历史观测。最后用感知流匹配完成因果适配,再对自生成轨迹做分布匹配蒸馏(DMD),逐步纳入引导、相机控制与记忆条件。
3.3 核心创新

  • 将场景召回粒度细化到图块,并按目标视角对齐。
  • 静态几何与动态主体分开处理,减少把移动物体错误固定到旧位置的风险。

3.4 实验结果

Tiled PRoPE 与原生 RoPE 在同一注意力核中共同作用,保留时间结构并提高位姿相近帧的注意力。下排为两条合成轨迹,上排为逐帧 attention logits 热力图。(a) 关闭相机项时,RoPE 形成沿帧偏移的带状结构。(b) 直线行走时加入 tiled PRoPE,最大变化约为原图动态范围的 1.3%。(c) S 形轨迹中,相近朝向在远离对角线处变亮,相反朝向变暗,同时原时序顺序保留。分析使用从 Wan2.2-TI2V-5B 微调的模型。
Tiled PRoPE and the native RoPE act together in one attention kernel: temporal structure is preserved, and pose similarity is rewarded. We use two synthetic trajectories here to illustrate the preservation (bottom row), and calculate frame-by-frame attention logits for heatmap visualization (top row). (a) RoPE only (camera term off): the purely temporal kernel, banded in frame offset. (b) Straight walk with tiled PRoPE: the map is nearly indistinguishable from (a) --- the maximum change is empirically 1.3% of (a)'s dynamic range --- adding the camera does not disrupt the frame-to-frame attention structure. (c) S-curve with tiled PRoPE: frames with similar heading light up in blocks far from the diagonal, and opposite-heading frames darken. The camera raises attention exactly where views are geometrically close, while the temporal ordering of (a) survives untouched. This analysis was performed on the model fine-tuned from Wan2.2-TI2V-5B.
  • 图源:论文原图。图注译文:Tiled PRoPE 与原生 RoPE 在同一注意力核中共同作用,保留时间结构并提高位姿相近帧的注意力。下排为两条合成轨迹,上排为逐帧 attention logits 热力图。(a) 关闭相机项时,RoPE 形成沿帧偏移的带状结构。(b) 直线行走时加入 tiled PRoPE,最大变化约为原图动态范围的 1.3%。(c) S 形轨迹中,相近朝向在远离对角线处变亮,相反朝向变暗,同时原时序顺序保留。分析使用从 Wan2.2-TI2V-5B 微调的模型。
  • 论文的 SANA-WM 一分钟简单轨迹测试中,蒸馏前 Matrix-Game 3.5 的旋转误差为 1.63°、重访 SSIM 为 0.439;Matrix-Game 3.0 对应 12.96°、0.326。两者均为 720p,但推理 GPU 数不同,分别为 1 和 8。
  • 困难轨迹上旋转误差为 2.70°,重访 SSIM 为 0.414。这些指标分别描述相机跟随与相同位姿下的外观恢复。
  • 主对比表明确使用蒸馏前模型,不能把表中质量与蒸馏后实时模型的速度拼成同一工作点。

3.5 关键洞察

我的判断:场景漫游比纯文本长视频更适合显式几何检索。代价是深度、相机与动态分割错误会进入记忆链路。长期产品需要考虑错误 patch 的失效与纠正,否则每次“回忆”都可能强化最初的几何误差。论文中的几何组件不新增可学习参数,不代表整套系统免训练或没有计算成本。

技术演进定位: 由时间索引扩展为三维空间索引。

可能的后续方向:

  • 评测深度错误对长期记忆污染的影响。
  • 给历史 patch 增加可信度与失效条件。

4. WALL-SS:历史变粗时,动作也要一同保留

论文: WALL-SS: Scaling Long-horizon World Models via Next-Scale Autoregression
arXiv: 2608.26239
机构: 自变量机器人 (X Square Robot)
关键词: 机器人世界模型, 下一尺度自回归, 动作条件

4.1 研究动机

核心问题: 有限历史里怎样同时保住外观与交互后果?

机器人看见的是画面,执行的是动作。如果把历史只压成外观,模型可能记得杯子长什么样,却忘记它刚被放进了哪个篮子。这里需要保留动作及其后果的对应关系。

前序工作及局限:

  • 下一尺度视觉生成:提供由粗到细的表示,但不自动保证动作因果关系。
  • 只保留最近片段:容易丢失更早交互造成的持久状态。

与前序工作的本质区别: 视觉与动作按时间和尺度对齐,并联合参与历史状态管理。
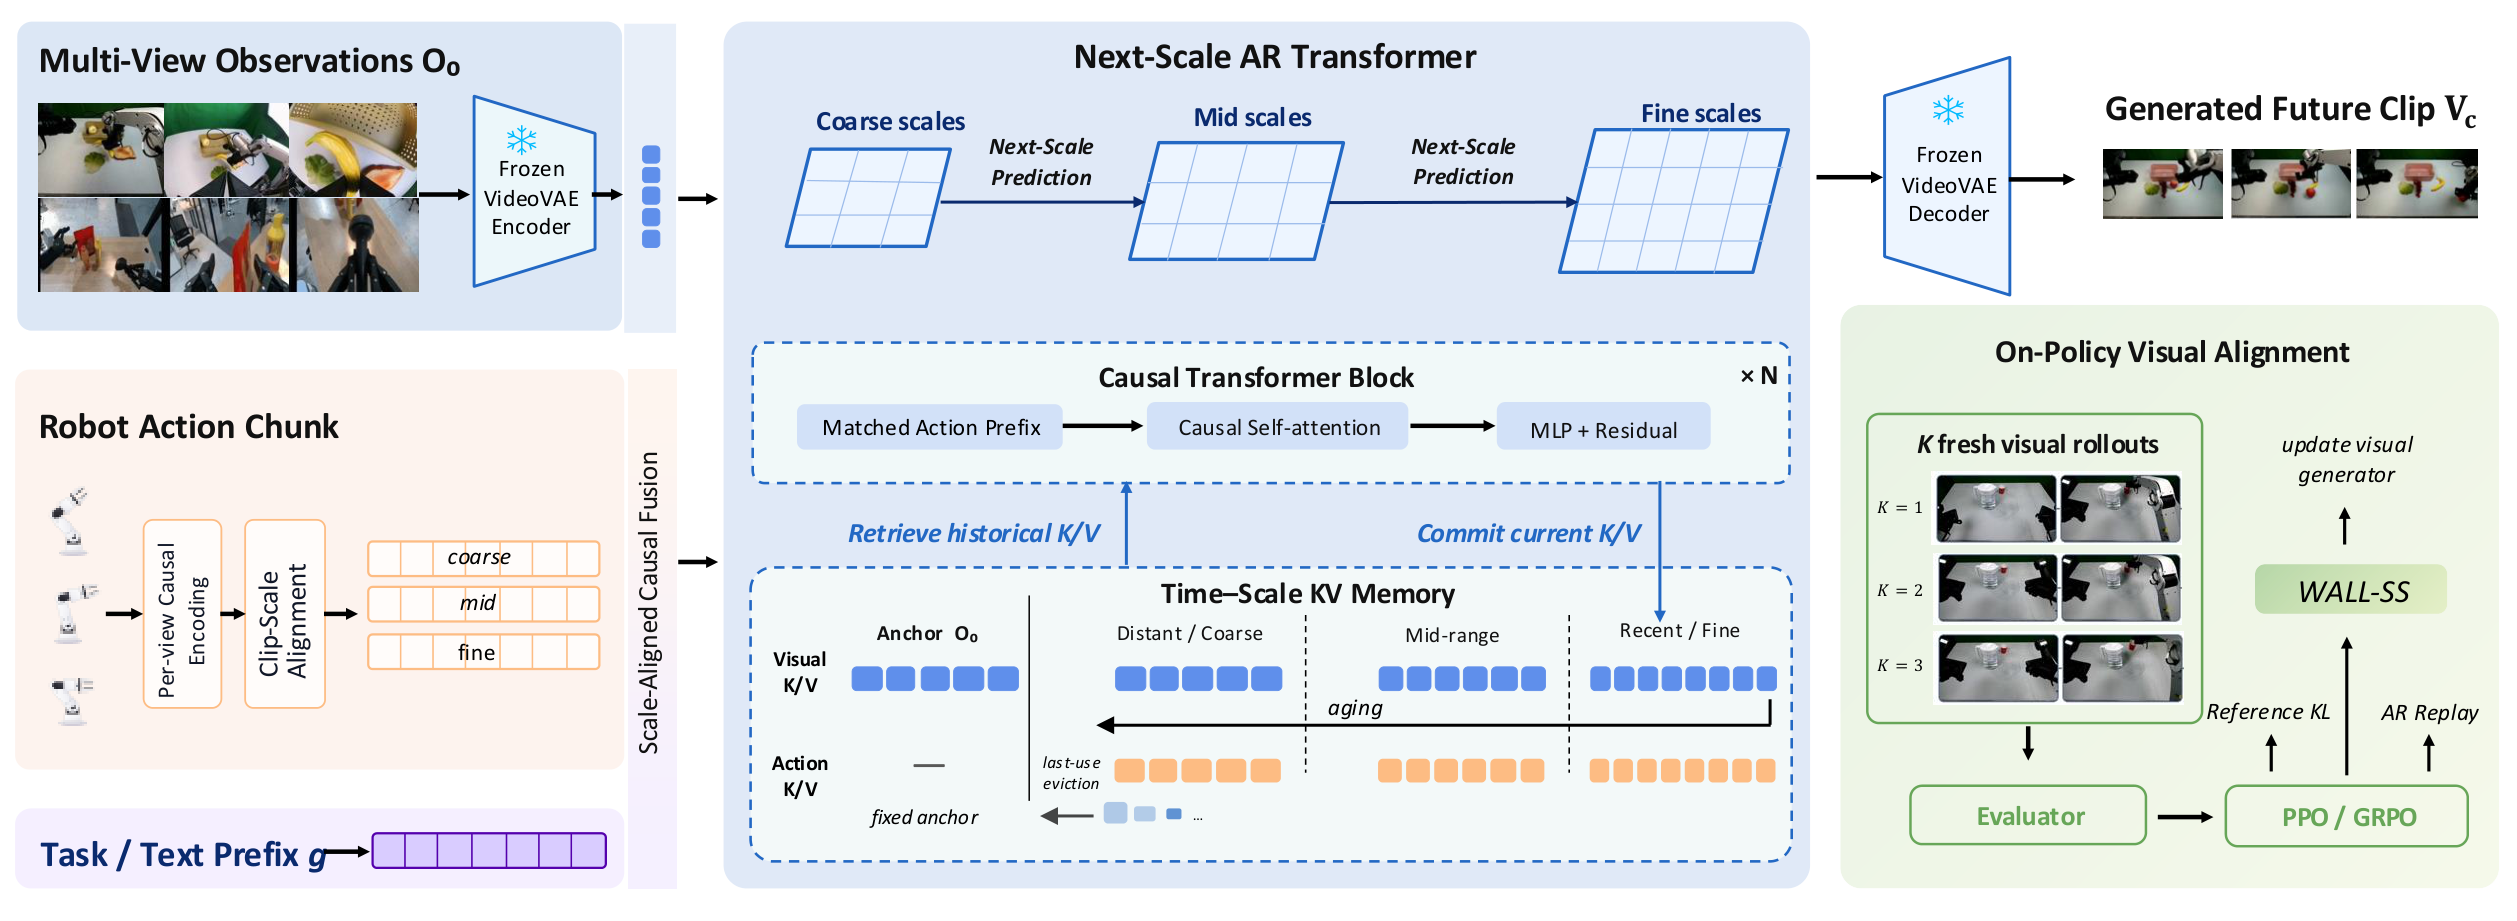
4.2 方法原理

WALL-SS 总体框架:统一动作条件的下一尺度视觉预测、流式长时状态传播,以及自回归视觉动力学的 on-policy 对齐。图中时间—尺度 KV 记忆把最近精细状态、较远粗状态和初始锚点共同提供给因果 Transformer,动作记录与视觉历史配对。
Overall framework of WALL-SS. WALL-SS unifies action-conditioned next-scale visual prediction, streaming long-horizon state propagation, and on-policy alignment of autoregressive visual dynamics.

图源:论文原图。图注译文:WALL-SS 总体框架:统一动作条件的下一尺度视觉预测、流式长时状态传播,以及自回归视觉动力学的 on-policy 对齐。图中时间—尺度 KV 记忆把最近精细状态、较远粗状态和初始锚点共同提供给因果 Transformer,动作记录与视觉历史配对。

WALL-SS 采用下一尺度自回归:先生成粗尺度视觉状态,再逐步细化,每个尺度都读取同一时间区间、同一视角且尺度对齐的动作条件。长时记忆反过来利用这套层次:最近交互保存精细状态,较远的历史只留较粗状态,并让视觉记录始终与对应动作条目成对存在。固定的历史年龄—尺度调度决定何时读取和淘汰,因而存储能够保持有界。首帧身份锚点只提供外观与全局布局参照,不能代替滚动的动态状态。

训练通过随历史年龄变化的扰动和模型自己生成的上下文减少误差累积。后训练把视觉生成器视为可优化策略:动作保持为输入条件,奖励调整给定动作下视觉未来的概率。这个区别很关键——该阶段优化的是世界预测,而不是顺便学一个更会做任务的机器人控制器。

4.3 核心创新

  • 复用多尺度生成状态管理长历史,无需另外重建一套 RGB 压缩器。
  • 保存动作—视觉因果配对,在自己的 rollout 上对齐动作跟随与长期一致性。

4.4 实验结果

长时视频 rollout 定性比较。各行依次为 Wan2.1-1.3B、Wan2.2-14B、Infinity-8B 和本文模型;各列为 5、30、60 秒快照。左侧任务按形状把桌面物体放入对应区域,右侧任务向杯中倒水并放下水壶。对比展示长时几何、物体身份与任务进程的保持情况。
Qualitative comparison of long-horizon video rollouts. Rows correspond to Wan2.1-1.3B, Wan2.2-14B, Infinity-8B, and our model, while columns show snapshots at 5, 30, and 60 seconds. The left task requires sorting tabletop objects into the corresponding baskets, and the right task requires pouring water into a cup. The comparison highlights each model’s ability to preserve scene geometry, object identity, and coherent task progression over extended horizons.
  • 图源:论文原图。图注译文:长时视频 rollout 定性比较。各行依次为 Wan2.1-1.3B、Wan2.2-14B、Infinity-8B 和本文模型;各列为 5、30、60 秒快照。左侧任务按形状把桌面物体放入对应区域,右侧任务向杯中倒水并放下水壶。对比展示长时几何、物体身份与任务进程的保持情况。
  • 受控后训练消融中,动作跟随从 0.264 到 0.290,轨迹准确率从 0.512 到 0.539,跨片段边界误差从 0.118 降至 0.104。均为该论文内部协议。
  • 论文展示了 5、30、60 秒的物体分类与倒水任务;图像证据用于观察物体身份、几何与任务进展,不能替代真实机器人成功率。
  • 其闭环比较设计包含 6 个留出任务、5 个策略检查点、20 个匹配初态,共 600 对生成—真实 rollout,评测对象已经超出单帧画质。

4.5 关键洞察

我的判断:值得关注动作与视觉一起压缩的设计。它仍有任务相关的取舍:很小的按钮状态可能对成功至关重要,却在粗尺度历史里不显眼。若把它用于策略筛选,需要观察是否保持各策略的成功率排序;看起来更流畅的模拟器,未必更准确地评价了控制策略。

技术演进定位: 从视频连续性推进到具身交互的可用性。

可能的后续方向:

  • 测试细小但决定任务成败的状态能否跨尺度保留。
  • 增加长任务下模拟器与真实策略排名的一致性检验。

5. SolarWM:短序列训练撑起长推演,证据要分层看

论文: SolarWM: Open Data and Scalable Training for Long-Horizon Video World Models
arXiv: 2609.02886
机构: 香港中文大学(深圳)、SLAI、新加坡国立大学、香港中文大学、香港科技大学、香港科技大学(广州)、NVIDIA、UCLA、微软亚洲研究院
关键词: 长时世界模型, 开放数据, 分布匹配蒸馏

5.1 研究动机

核心问题: 怎样减少数据与骨干耦合,并稳定训练可扩展的因果世界模型?

换一个视频骨干,经常连数据时间轴、相机单位、潜在帧率和训练目标都要重做。SolarWM 关注这个系统问题:把数据准备、相机控制与因果训练整理成可复用的统一接口。

前序工作及局限:

  • 直接混合多源数据:时间、几何、质量标准不一致,监督信号容易相互冲突。
  • 只用教师强制训练:推理时自身历史带来的误差未被充分覆盖。

与前序工作的本质区别: 把数据、相机接口与三阶段因果训练整理为统一而保留骨干差异的框架。

5.2 方法原理

SolarWM-5B 训练流程及小时级推演概览。图上方为双向训练、使用教师强制和 AnyFlow 的自回归训练、使用 DMD 的四步蒸馏;三阶段均使用五秒序列。下方展示教室与街区场景的长时交互画面。
Overview of the SolarWM-5B training pipeline and hour-scale inference results

图源:论文原图。图注译文:SolarWM-5B 训练流程及小时级推演概览。图上方为双向训练、使用教师强制和 AnyFlow 的自回归训练、使用 DMD 的四步蒸馏;三阶段均使用五秒序列。下方展示教室与街区场景的长时交互画面。

SolarWM 将 10 个数据集中的 143 万个规范片段整理为逐帧对齐的视觉、度量相机、文本、质量信息和来源记录;源数据处理与训练混合比例分开,使数据选择可追溯。统一接口并不强行抹平骨干差异:Wan、LTX 与 H3 的潜在表示、首帧条件和目标函数被分别保留,相机条件通过适配器接入原有注意力。

三阶段训练先做双向相机条件适配,再用教师强制的 AnyFlow 损失直接得到少步因果初始化,最后用 DMD 在学生自生成的上下文上训练,缓解训练看到真值、推理只能看到自身预测的分布差异。论文的长推演始终固定场景提示词,外部变化来自给定相机轨迹。理解这个控制条件,才能判断“小时级”结果究竟验证了什么。

5.3 核心创新

  • 统一可追溯数据约定,同时保留骨干原生表示与训练目标。
  • 把少步因果初始化并入第二阶段,再用自生成轨迹做分布匹配。

5.4 实验结果

SolarWM-wan2.2-5B-fast 因果学生的小时级世界推演。从留出验证集的一帧真实初始观测开始,在一次不中断的自回归会话中稀疏采样,覆盖初始时刻至 60 分钟端点。场景提示词保持固定,模型遵循预先给定的相机轨迹。
Hour-scale world rollout generated by the SolarWM-wan2.2-5B-fast causal student. Sparse frames are sampled throughout a single uninterrupted autoregressive session initialized with a real first frame from the held-out validation pool, spanning the initial observation to the 60-minute endpoint. The scene prompt remains fixed and the model follows a predetermined camera trajectory.
  • 图源:论文原图。图注译文:SolarWM-wan2.2-5B-fast 因果学生的小时级世界推演。从留出验证集的一帧真实初始观测开始,在一次不中断的自回归会话中稀疏采样,覆盖初始时刻至 60 分钟端点。场景提示词保持固定,模型遵循预先给定的相机轨迹。
  • 模型家族覆盖 5B—33B 四条路线;各路线保留组件不同,LTX 路线移除了音频相关模块,不能据此声称四个版本都输出音视频。
  • 因果实验使用 4 个采样步,视频时间轴为 16 FPS。这里的 16 FPS 是输出帧率,不能直接当成端到端生成吞吐。
  • wan2.2-5B-fast 的图示从 5 秒训练窗口扩展到不中断的 60 分钟推演;论文长时结果主要是定性样例,尚不能据此认定任意一小时前的状态都能正确恢复。

5.5 关键洞察

我的判断:它的价值是把实验基础设施和配方公开,方便在相近数据条件下比较不同模型。对小时级样例,接下来最需要补的是统一的重访轨迹、任务状态探针和随时间变化的失败率。持续产出合理的新画面,与反复回到同一世界仍保持同一事实,是两种不同的验收要求。

技术演进定位: 长时世界模型的复现实验底座。

可能的后续方向:

  • 在相同数据与硬件预算下做骨干对比。
  • 增加小时级定量重访与状态正确性指标。

6. Shell Game:杯子画得再真,也可能不知道球在哪

论文: Can Video World Models Track Unobserved World States?
arXiv: 2608.30692
机构: 首尔国立大学 + Roblox
关键词: 隐藏状态, 视频世界模型评测, 测试时训练

6.1 研究动机

核心问题: 能回忆旧画面,是否就能更新从未直接显露的状态?

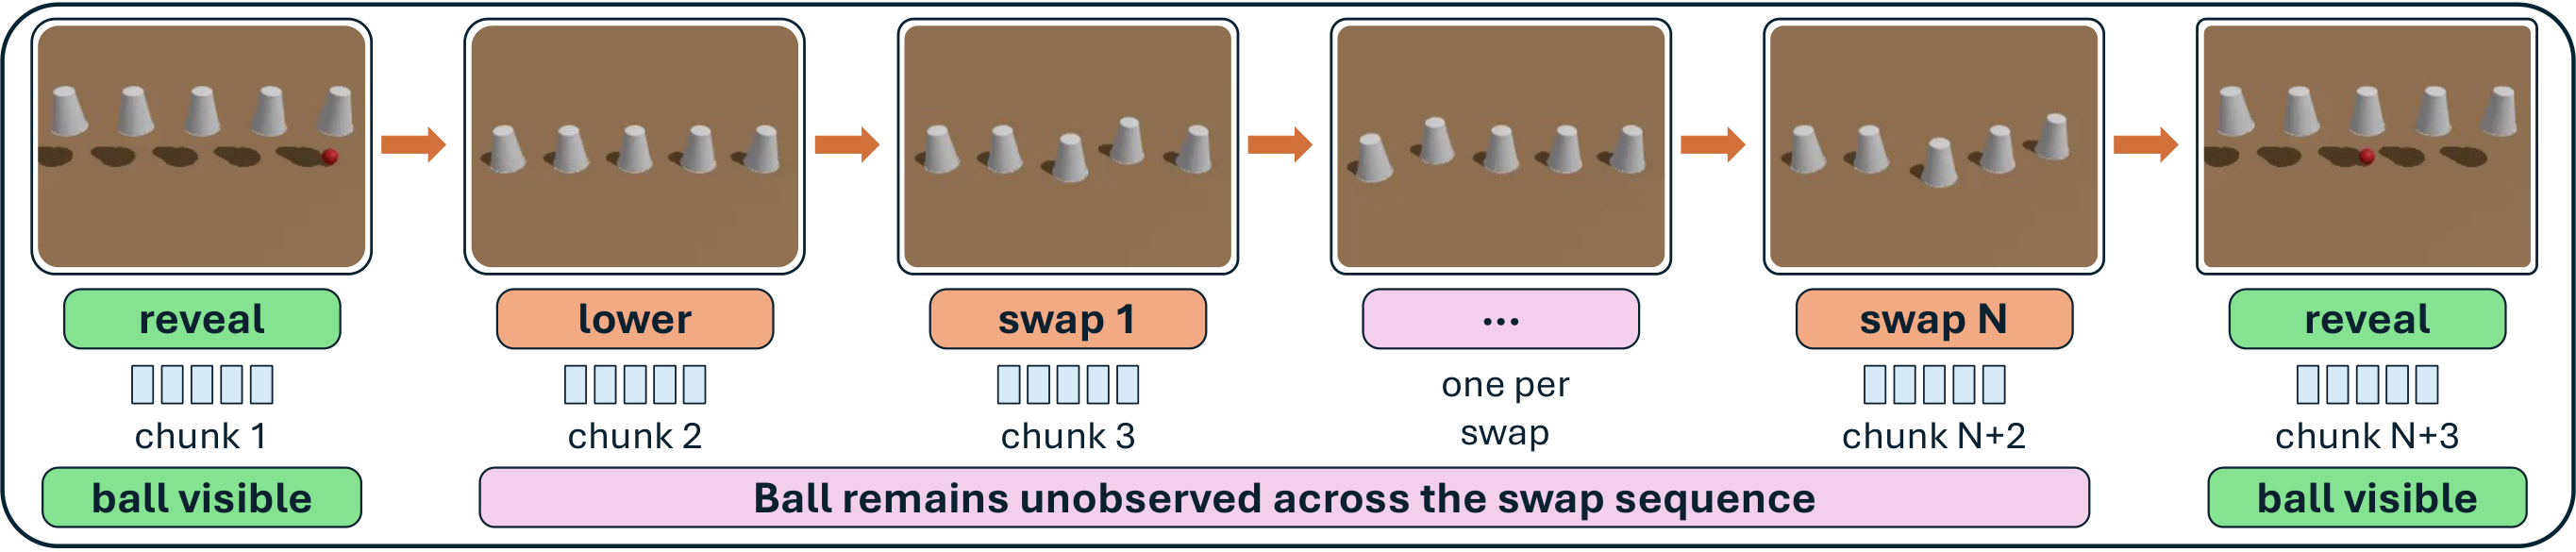
五个相同杯子盖住一个球,再按动作序列交换位置。输入是初始画面和每次交换动作,输出是最后揭杯的视频;正确结果必须让球出现在真正的那个杯子下。中间看不见球,任务刻意把渲染能力与隐藏状态追踪分开。

前序工作及局限:

  • 画质与身份一致性评测:无法判断遮挡物体经过动作后位于何处。
  • 追加式KV历史:保留证据,但状态组合仍需每次重新推导。

与前序工作的本质区别: 实验在球不可见时保持画面简洁,并固定动作交换与生成块的对应关系;观察最终揭杯位置,就能单独量化架构是否正确组合了整条动作链。
6.2 方法原理

视觉 Shell Game 的构造:先揭示小球并放下杯子,再在小球不可见的情况下执行一串杯子交换,最后揭示小球位置。图中每次交换对应一个生成块;球在整个交换阶段始终不可见。
The visual shell game construction. An episode first reveals the ball and lowers the cups, then applies a sequence of swaps while the ball remains hidden, and finally reveals its position.

图源:论文原图。图注译文:视觉 Shell Game 的构造:先揭示小球并放下杯子,再在小球不可见的情况下执行一串杯子交换,最后揭示小球位置。图中每次交换对应一个生成块;球在整个交换阶段始终不可见。

Shell Game 用约 200M 参数、相近规模的模型比较时间混合机制,视觉骨干和压缩表示尽量一致。训练只包含 5 次交换,测试把链条延长到 30 次。像素损失在遮挡阶段不会告诉模型球在哪里,因而它必须在架构内部携带并更新状态;追加历史的 KV 缓存让模型重新从历史推导答案,却不等同于一份会原地更新的状态表。

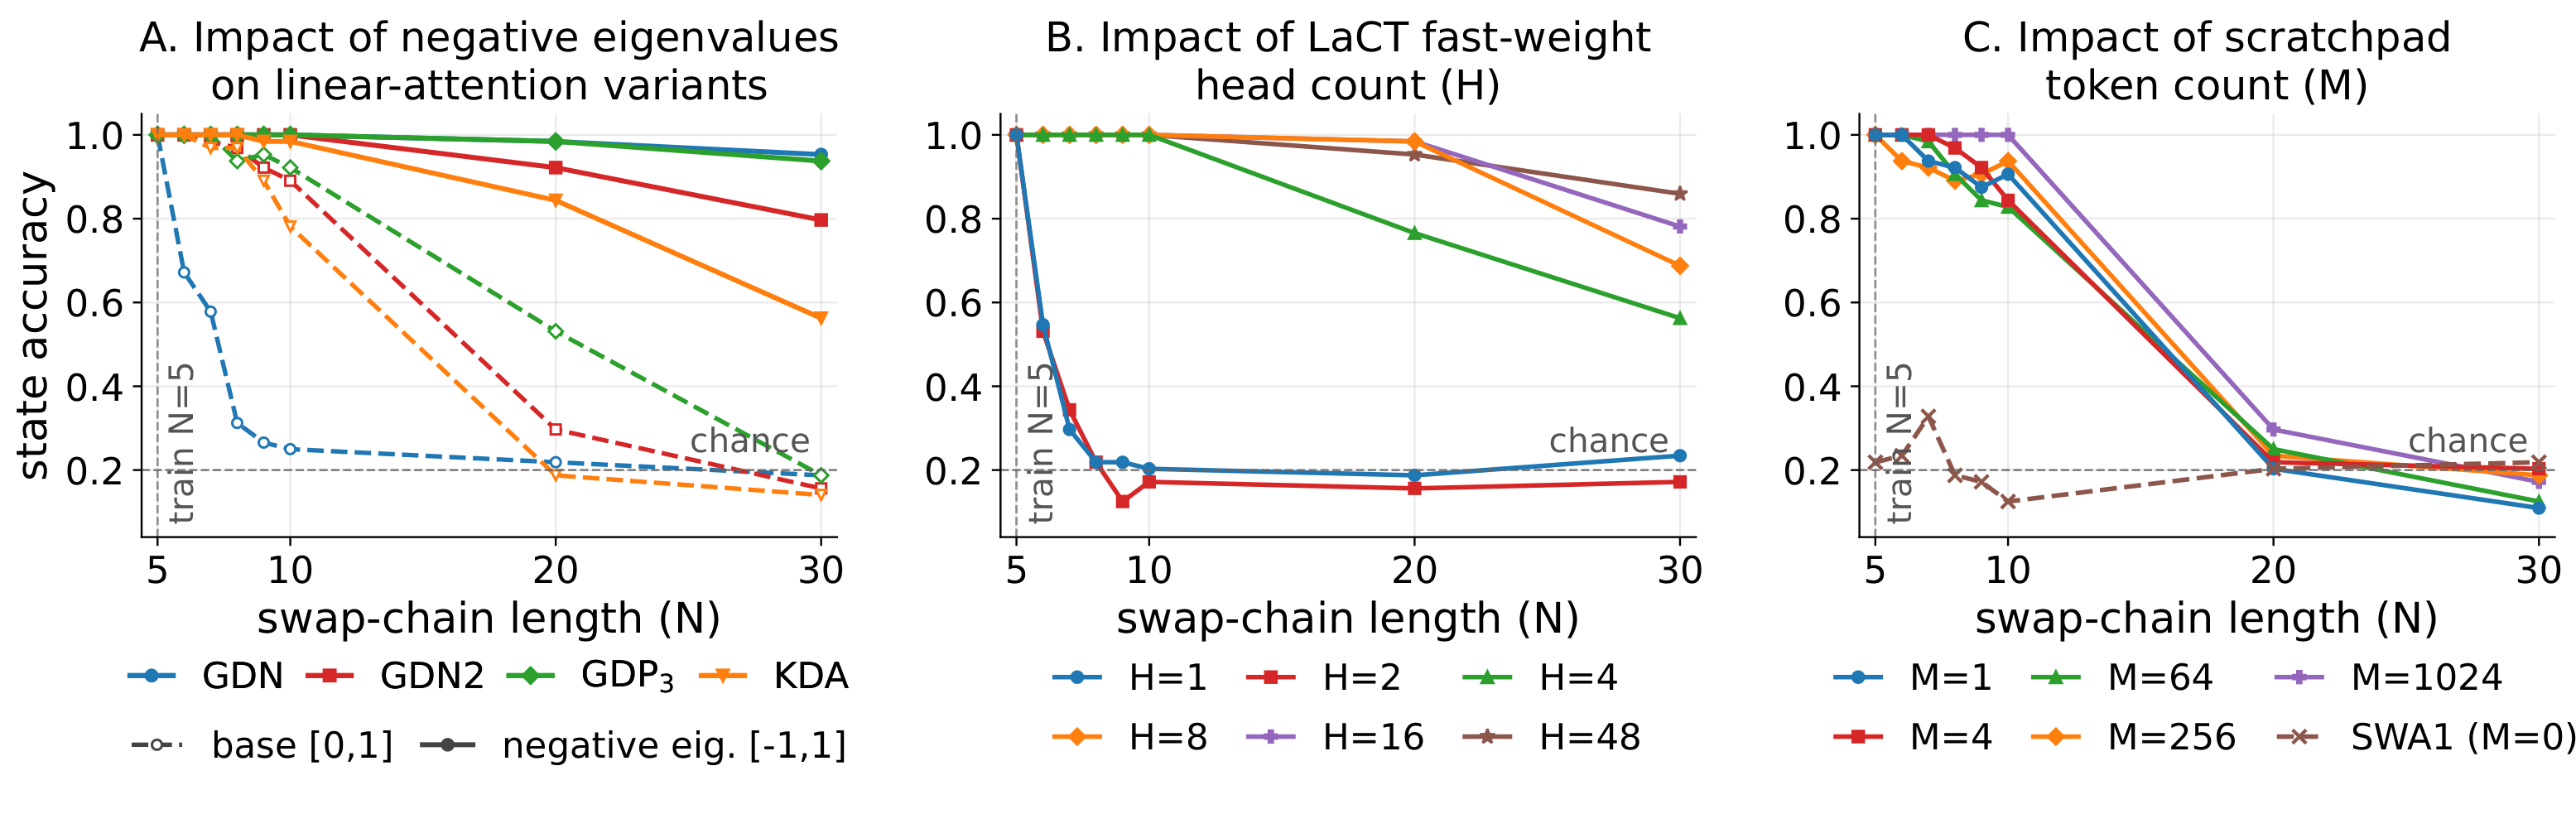
两个有效方向分别是允许状态转移具有负特征值的线性注意力,以及更新非线性快速权重的测试时训练(TTT)。前者可表达交换所需的反射操作,后者能随着新动作修改读取自身状态的特征映射。单纯增加可读写 scratchpad token 并没有在长链上同样成功,因此“有一个记忆模块”这个标签本身没有解释力,要看它究竟能执行何种状态变换。
6.3 核心创新

  • 用隐藏小球的动作条件视频控制渲染难度,直接测试状态组合。
  • 同时比较长度外推与去噪步数,区分画质改善和状态计算能力。

6.4 实验结果

可支持状态追踪的机制之长度外推。各变体以同一 SWA1 骨干为基础,添加不同时间机制。裸骨干,即 (C) 中 M=0 的 SWA1,连训练内 N=5 都未超过随机水平,因此作为自然对照。(A) 将转移特征值从 [0,1] 扩大至 [-1,1] 改善线性注意力状态准确率。(B) 增加快速权重头数 H 改善 LaCT 外推。(C) 每层加入可读写 scratchpad token 能改善至 N=10,但到 N=20 仍失败。
Length extrapolation of mechanisms that enable state tracking. All variants share the same SWA1 backbone, with the temporal mechanism added on top. The bare backbone alone (SWA1, $M{=}0$ in (C)) never rises above chance, failing even at the in-distribution length $N{=}5$, so it serves as the natural chance-level control. (A) Extending the transition eigenvalue range from $[0,1]$ to $[-1,1]$ improves state accuracy across linear-attention variants. (B) LaCT extrapolation improves with the number of fast-weight heads $H$. (C) Adding explicit per-layer read/writable scratchpad tokens improves extrapolation through $N{=}10$ but fails by $N{=}20$.
  • 图源:论文原图。图注译文:可支持状态追踪的机制之长度外推。各变体以同一 SWA1 骨干为基础,添加不同时间机制。裸骨干,即 (C) 中 M=0 的 SWA1,连训练内 N=5 都未超过随机水平,因此作为自然对照。(A) 将转移特征值从 [0,1] 扩大至 [-1,1] 改善线性注意力状态准确率。(B) 增加快速权重头数 H 改善 LaCT 外推。(C) 每层加入可读写 scratchpad token 能改善至 N=10,但到 N=20 仍失败。
  • 训练集为 30,000 段五杯、五次交换序列;随机猜球位置的准确率为 20%,测试最长 30 次交换。
  • 在 10 次交换时,把采样步数从 4 增加到 50 并未改善状态准确率;高 PSNR 可以与接近随机的状态判断共存。
  • 扩展线性状态转移特征值范围、增加 LaCT 快速权重头数能明显改善外推;显式 scratchpad 在 20 次交换附近仍出现失效。

6.5 关键洞察

我的判断:这篇给前面几种记忆方法提出了很好的压力测试,但没有逐一测试本期所有新模型,所以不能宣称 LayerRecall、Matrix-Game 或 SolarWM 已在该任务失败。人工构造的交换任务也不能直接代表全部真实世界能力;它的强项是让某一种能力缺口变得可定位、可复现。

技术演进定位: 为长时生成建立可证伪的状态诊断。

可能的后续方向:

  • 在大规模预训练模型上检验同类受控任务。
  • 同时报告状态正确率、渲染质量和外推长度。

7. PAWBench:同一起点多推演几次,概率也要对

论文: PAWBench: How Far Are We from Probabilistically Aligned World Modeling?
arXiv: 2608.27345
机构: 上海交通大学、上海 AI Lab、Krea AI、Hugging Face、上海创智学院、通义实验室、香港大学
关键词: 概率对齐, 世界模型评测, 分布校准

7.1 研究动机

核心问题: 多次生成是否恢复正确的可能结果及其概率?

一个模型能画出硬币正面和反面,还不够。如果对称条件下大多数时候都落在同一面,它虽然有多样性,却没有学对结果分布。用于规划的世界模型需要知道哪些未来可能发生,以及它们各有多大可能。

前序工作及局限:

  • 单条视频合理性:一条合理轨迹无法说明整体概率分布。
  • 仅看多样性:覆盖多种结果,不代表频率与物理过程相符。

与前序工作的本质区别: 作者把终局分类、无效结果筛选与分布统计明确拆开,对可校准概率和只能枚举结果的场景分别评分,避免把所有多样性混为一种能力。

7.2 方法原理

PAWEval 将重复 rollout 转为分布检验。这个 PAW-Calibration 例子中,按评分规则工作的裁判把每条可读且符合结果定义的抛硬币视频归为正面或反面;汇总后形成经验结果分布,再与参考概率比较,而不是逐帧匹配生成视频。
PAWEval turns repeated rollouts into a distributional test. In this PAW-Calibration example, a rubric-based judge maps each readable, in-schema coin-toss rollout to Head or Tail. Aggregating these labels yields the empirical outcome distribution, which is compared with the reference probabilities rather than matching generated videos frame by frame.

图源:论文原图。图注译文:PAWEval 将重复 rollout 转为分布检验。这个 PAW-Calibration 例子中,按评分规则工作的裁判把每条可读且符合结果定义的抛硬币视频归为正面或反面;汇总后形成经验结果分布,再与参考概率比较,而不是逐帧匹配生成视频。

PAWBench v3 将 50 个场景分为两轨。25 个校准场景有解析或对称性导出的参考概率;另外 25 个覆盖场景只确定有效结果集合,不强行假定每种结果等概率。对固定初始图像和动作,每个模型重复生成 50 次,PAWEval 按场景评分规则读取终局,然后比较结果分布。校准使用总变差距离(TVD,即两分布差异绝对值之和的一半),覆盖使用有效结果被观察到的比例。

无法读取或不符合结果定义的视频单独记录;某场景至少有 20 条可读、合法结果才通过门槛。论文同时报告通过场景上的条件分数,以及全部场景中通过的比例 SPR。把两个指标放在一起很必要:只在少量容易场景上得到好分数,不能当成整体可靠。相比单视频打分,它还区分了概率错配、可能结果遗漏和无法完成物理过程三类问题。
7.3 核心创新

  • 从单次轨迹合理性推进到重复采样的结果分布。
  • 校准和覆盖分开,并同时披露结果读取门槛与场景通过率。

7.4 实验结果

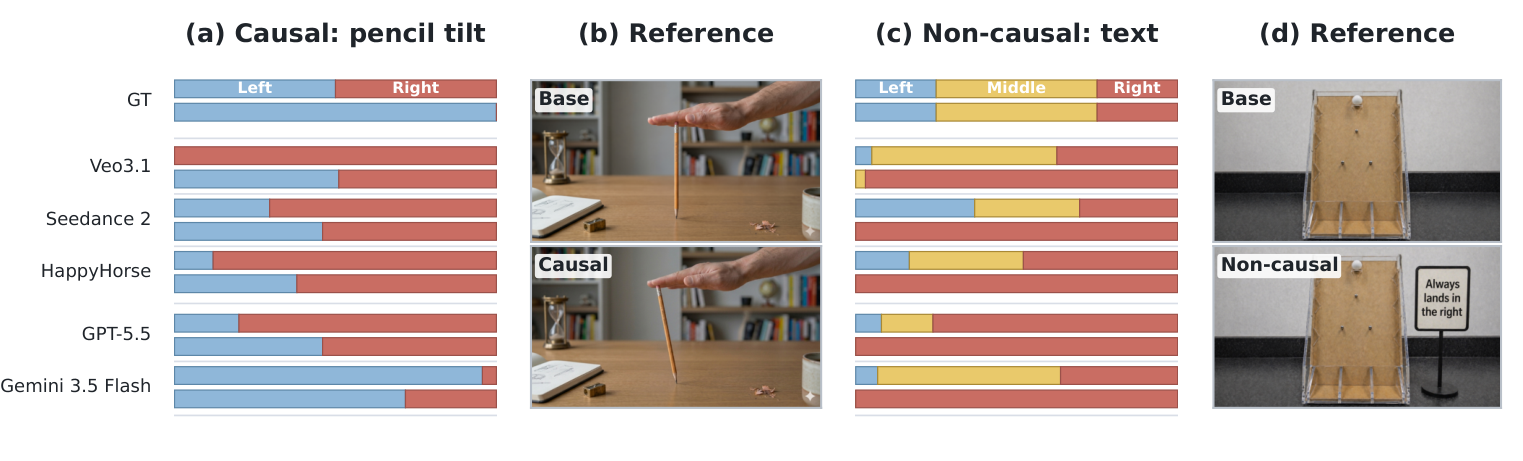
模型对物理因果干预反应不足,对非因果提示反应过强。上下条带为干预前后的结果分布,(b) 与 (d) 展示成对场景。铅笔倾斜会改变物理转移,因此是因果干预;高尔顿板旁的文字未改变转移,因此是非因果干预。
Models underreact to physically causal interventions and overreact to non-causal cues. Upper and lower bars show outcome distributions before and after intervention; panels (b) and (d) show the paired scenes. The pencil tilt is causal because it changes the physical transition, whereas the Galton-board text is non-causal because it leaves the transition unchanged.
  • 图源:论文原图。图注译文:模型对物理因果干预反应不足,对非因果提示反应过强。上下条带为干预前后的结果分布,(b) 与 (d) 展示成对场景。铅笔倾斜会改变物理转移,因此是因果干预;高尔顿板旁的文字未改变转移,因此是非因果干预。
  • v3 在 11 个系统上评测;Cosmos 3 Super I2V 校准 TVD×100 为 20.5,但校准 SPR 为 80%;LTX-2.3 覆盖率为 71.7%,对应覆盖 SPR 为 72%。
  • 相同参考为 50/50 时,模型产生 70/30 分布的 TVD×100 等于 20,而不是 40。
  • 主实验 K=50;扩大采样预算可以找到更多结果,但不保证修正相对频率。作者对 888 条双方均能明确读取的视频做人类一致性检查,自动判定与明确人类标签一致 722 条,即 81.3%。

7.5 关键洞察

我的判断:v3 最值得保留的是分母意识:条件分数、场景通过率与采样预算必须一起看。自动裁判也有误差,且参考概率来自受控机制假设,不能无限外推到真实开放世界。概率对齐并非“每次都生成同一个正确答案”;确定性隐藏状态与随机未来分布应采用不同测试。

技术演进定位: 在记忆与状态之后检验世界模型的不确定性。

可能的后续方向:

  • 固定采样预算并报告无效样本与SPR。
  • 对关键任务做人工裁判复核与干预对照。


横向对比与技术脉络总结

七篇论文分别回答哪一个问题

论文 核心对象 关键证据 不能据此推出
DensityKV 逐头历史K/V库 固定配置3.28 GiB持久状态 整机显存仅3.28 GiB
LayerRecall 历史检索与注入层 MemoBench 0.548;MovieBench 0.578 任意长历史均可恢复
Matrix-Game 3.5 静态几何与主体记忆 一分钟重访与相机误差 蒸馏前质量等于实时模型质量
WALL-SS 动作—视觉时序状态 动作跟随与边界误差消融 已掌握全部隐藏状态推理
SolarWM 数据与因果训练接口 五秒训练;小时级定性推演 一小时内所有事实始终正确
Shell Game 不可见状态的组合更新 五次训练、三十次交换外推 全部大模型和记忆方法均失败
PAWBench v3 重复推演的结果分布 双轨25+25场景;每场景50次 单个条件均分代表全面可靠

核心技术趋势

压缩和路由可以分工,但组合必须重新验证

DensityKV 压缩 post-RoPE 的逐头 K/V,LayerRecall 用块摘要挑选历史并按层注入,两者读取粒度并不相同。将它们拼接,需要先定义“一个历史块在被逐头裁剪后还是否完整”,以及教师监督看到的历史与压缩后历史是否一致。仅凭模块职责互补,不能推导出性能叠加。

记忆需要区分持久属性与会变化的状态

衣服颜色可以长时保持,物体位置与容器内容却可能随动作改变。把早期图像长期作为锚点,有时会帮助身份一致性,有时可能把世界拉回过时状态。几何记忆应知道哪些对象移动了,语义记忆也需要决定旧事实何时失效。

自生成上下文训练与可更新状态解决不同问题

LayerRecall、Matrix-Game 3.5、WALL-SS、SolarWM 都以不同方式让训练接近推理的自生成历史。这能缓解误差积累;Shell Game 则提醒我们,有些任务还受架构可表达的状态变换限制。更多 rollout 训练是否足以弥补该限制,需要受控外推实验,不能只看模型是否经过蒸馏。

长时系统应同时报告运行预算与能力失效

一次运行持续多久、能保留多久以前的外观、能组合多少次隐藏动作、能覆盖多少未来分支,分别描述不同能力。将这些指标拆开,才能分辨是容量用尽、读取失败、状态更新失效,还是概率分布偏置。

技术路线全景图

需求 → 先定义验收
  外观重现 → 存储预算(DensityKV)→ 读取位置(LayerRecall)
  相机重访 → 几何证据(Matrix-Game 3.5)
  动作后果 → 时间—尺度配对(WALL-SS)
  训练底座 → 数据与因果配方(SolarWM)
共同验收 → 隐藏状态外推(Shell Game)+结果分布(PAWBench)

仍然缺少哪些关键实验

四大核心难点

1. 旧事实如何失效

应构造“物体被移动后再回访”和“物体只是暂时离场”两组场景,检查记忆能否分别更新位置与维持身份。

2. 比较的预算如何对齐

同时报告物理缓存、注意力可见长度、模型与中间张量的峰值显存,以及包含解码和检索的端到端耗时。

3. 不同能力怎样联合验收

画质、重现、状态和分布应分列,不能用一个总分把某项严重失败平均掉。

4. 受控结论怎样扩展到真实场景

交换杯子的探针便于定位机制,真实开放世界还包含观测噪声、对象数量变化与动作歧义;需要逐级增加难度。

总结与展望

同一评测协议下,先看哪些数字可信

下面摘取 LayerRecall 论文主表中的同一组 100 个评测提示词结果。VBench-Long 此处是主体一致性、背景一致性、运动平滑度三项均值;不是所有 VBench 维度的总分。各基线的输入适配、分辨率及采样配置见原文附录,因此该表适合观察指标之间的差异,不是等算力排行榜。

方法 VBench-Long 三项均值 ↑ MemoBench 总分 ↑ MovieBench 总分 ↑
LongLive-2.0 0.978 0.513 0.546
MemFlow 0.981 0.531 0.542
SkyReels-V2 0.992 0.466 0.508
LayerRecall 0.978 0.548 0.578

来源:LayerRecall 主表与实验设置。加粗为本表四行中的最优值。SkyReels-V2 的三项平均更高,记忆专项却较低;这正说明通用视觉连续性不能代替长时记忆评测。

PAWBench 的另一组数据属于不同问题,单列如下。TVD×100 越低越好,覆盖率越高越好;两项均值只在通过读取门槛的场景上计算。每轨 25 个场景、每场景 50 次生成,SPR 是全部 25 个场景中的通过比例。

模型 校准TVD×100 ↓ 校准SPR 覆盖率 ↑ 覆盖SPR
Cosmos 3 Super I2V 20.5 80% 55.2% 92%
MiniMax H3 24.2 68% 48.7% 92%
LTX-2.3 30.1 24% 71.7% 72%
Seedance 2 30.5 100% 50.9% 84%

来源:PAWBench v3 表1。加粗仅表示本表四行中的最优值。LTX-2.3 的高覆盖均值与较低场景通过率应一起看;不同模型通过的场景集合也可能不同。它与上一张表无法直接比较。其余论文的机器人任务、相机轨迹和时长设置也不同,本期不把七篇排成统一名次。

实操与分层阅读

30 分钟理解主题:先看导语与七篇对照,再读 Shell Game 的杯子交换图。试着分别写出“外观没变”“状态正确”“概率合理”各自需要怎样的证据。

半天精读:选择与你的瓶颈匹配的一条路线。显存受限读 DensityKV;跨镜头属性恢复读 LayerRecall;相机回访读 Matrix-Game 3.5;机器人动作模拟读 WALL-SS。沿每篇 arXiv 页面访问作者官方项目入口,复现时固定论文版本和实验配置。

一周动手研究:先用 SolarWM 的数据与训练设计作为对照思路,选定一个可运行骨干;固定初图、动作、随机种子和预算,分别测试“走开再回来”“移动物体后再回来”“遮挡时连续交换”。然后对同一随机物理场景重复采样,记录终局分布与无法判读的比例。建议把每种失效单独存档,再决定需要更好的缓存、读取器还是状态更新机制。

这七篇共同带来的研究机会,是把历史记忆、动态状态和不确定性放进同一套可检查的生成流程。具体模块的组合效果仍待验证;选择方案时,应从你要保住的事实和可测的失效出发。
专题排期:本栏目自本期起每两周的周日发布一次。下一期为 2026 年 9 月 20 日,覆盖 9 月 7—20 日;工作日论文速读照常。


今日讨论

如果模型能保持一小时画质,却无法在物体移动后恢复正确位置,你会先增加历史容量,还是先测试记忆更新机制?


人工智能炼丹君 整理 | 数据来源:arXiv 双周覆盖 2026-08-24—2026-09-06(含首尾,共 14 天);原论文首发 2026-08-26—2026-09-02,PAWBench 采用 2026-09-03 v3


更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」

每日更新 · 论文精选 · 深度解读 · 技术脉络

微信搜索 人工智能炼丹君 或扫描下方二维码关注

扫码关注「人工智能炼丹君」

0

评论 (0)

取消
粤ICP备2021042327号

