今日 AIGC 论文速览
今日共 10 篇
重点论文标题列表
WeAgent-MMGenEdit (腾讯微信 AI(Weixin AI, Tencent)):3B活跃参数逼近万亿代理PriorEdit3D (北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室):7秒完成无配对3D编辑⚡ ReaDiT (伊利诺伊大学厄巴纳-香槟分校(UIUC)):一个DiT块控制图像与视频
EditVid (伊利诺伊大学厄巴纳-香槟分校(UIUC)):免训练视频编辑跃升19分FlashRender (EverEx、延世大学、高丽大学):4步完成相机轨迹重拍
今日论文速览
1. WeAgent-MMGenEdit:3B活跃参数逼近万亿代理
WeAgent-MMGenEdit: A Full-Stack Recipe for Multimodal Agentic Image Generation and Editing | 腾讯微信 AI(Weixin AI, Tencent) | arXiv:2609.05171
关键词 :代理式图像生成,多模态检索,视觉证据验证,多参考编辑,强化学习,双语基准,WeAgent
⚠️ 前序问题 :知识密集型图像生成真正难的不是把搜索接口接到模型上,而是让正确证据进入最终像素。现有代理常凭标题或元数据选图,没有逐张检查视觉内容;同一个策略又要规划、筛选并背着不断增长的上下文,容易混淆实体;即便找到了正确文字和图片,松散附件也没有明确绑定人物、属性和空间位置。结果是代理能说对事实,却仍会在信息图、多人物组合或时事更新中画错对象与版式。
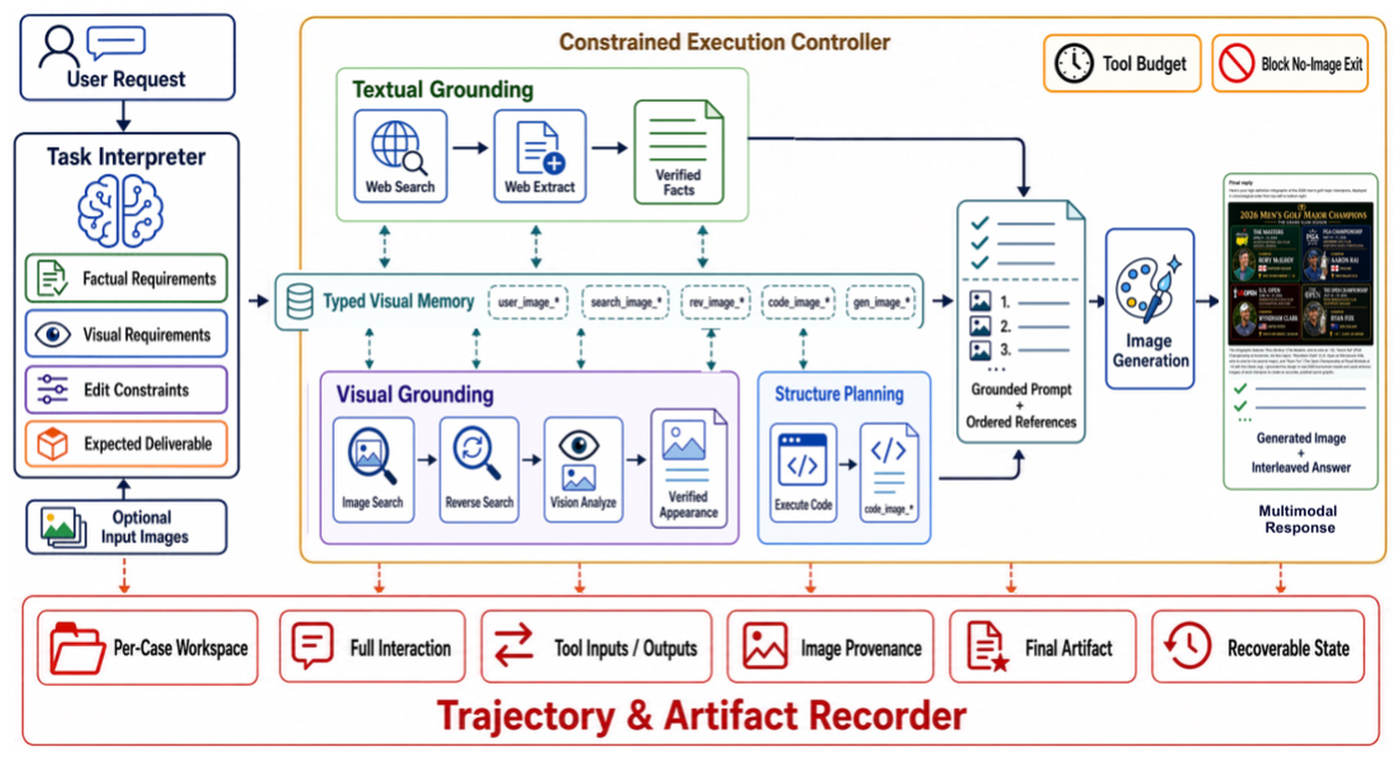
本文贡献 :WeAgent-MMGenEdit 给出一套从运行时、数据、基准到双侧后训练的完整配方。WeAgent-Harness 按“检索—验证—整合—交付”组织七类工具,把证据以稳定 ID 存入持久工作区,并用独立视觉工具显式验图;通过代码把核实后的文字、图片和布局编成稠密视觉载体,再交给生成器。数据管线构造约 2.3 万条 SFT 轨迹和 1.47 万个 RL 任务,每个任务都带代理链、生成输入和最终图像三层清单。策略侧先 SFT 再做清单约束 RL,图像侧也用多参考 SFT 和多目标 RL 训练。
实验效果 :自建 WeBench-MMGenEdit 含 300 个经人工审核的中英双语任务,生成与编辑、中文与英文各占一半,94% 的任务需要至少五跳检索,69.3% 的编辑任务含多张用户图片。在同一 Harness 和 GPT-Image-2 后端下,30B 总参数、3B 活跃参数的 WeAgent-RL 相对同规模 Qwen3-VL 基线,生成加权均分提高 12.45 分,编辑加权均分提高 16.72 分;其表现接近 1T 总参数的 Kimi-K2.6 代理。
批判点评 :这篇最有价值的设计是把证据量与策略上下文解耦:图片和网页留在持久工作区,策略只传稳定引用,需要时再验,这比把所有像素塞进上下文更适合长轨迹。三层清单也能把“搜索错了”“提示没带全”和“后端没画对”分开归因。代价是整套系统依赖搜索、视觉检查、代码渲染、图像生成和多名裁判,成本与故障面都不小;对网页时效、来源可信度和恶意内容的防护也没有被一个高分基准自动解决。
2. PriorEdit3D:7秒完成无配对3D编辑
Learning 3D Editing without Paired Supervision via Generative Prior Distillation | 北京航空航天大学、中央财经大学、VAST、北京市智能创意内容生成与沉浸体验重点实验室 | arXiv:2609.04942
关键词 :3D编辑,生成先验蒸馏,无配对监督,分布匹配,多视图一致性,前馈模型,PriorEdit3D
⚠️ 前序问题 :指令驱动 3D 编辑缺少高质量的编辑前后成对资产。测试时优化方法每个对象都要重新迭代,速度慢;用复杂管线制造伪配对数据又容易把 2D 编辑器的结构漂移和几何伪影写进监督。只在主视角追求文本对齐还会出现“正面看起来对、转到侧面就塌掉”的投影欺骗,因此需要在没有成对 3D 真值的条件下同时约束指令、身份和三维几何。
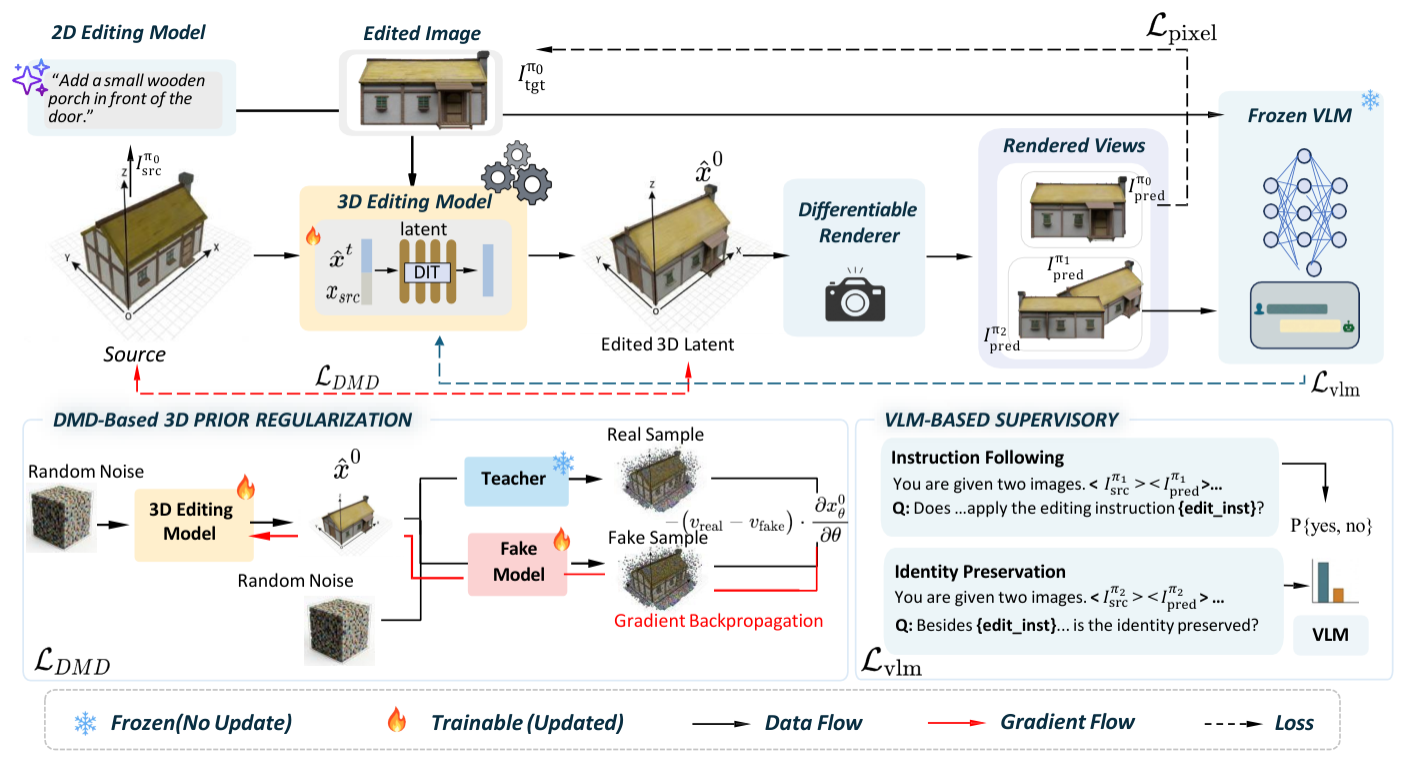
本文贡献 :PriorEdit3D 用可微渲染把三种已训练基础模型的先验直接蒸馏进前馈 3D 编辑器:主编辑视角由 2D 图像编辑模型提供像素视觉目标;新视角由视觉语言模型判断指令遵循与源对象身份;3D-aware Distribution Matching 则在图生 3D 教师的 latent 流形内约束编辑结果,阻止单视角监督导致几何坍塌。整个方法无需反演、无需局部掩码,也不依赖真实的成对 3D 编辑数据。
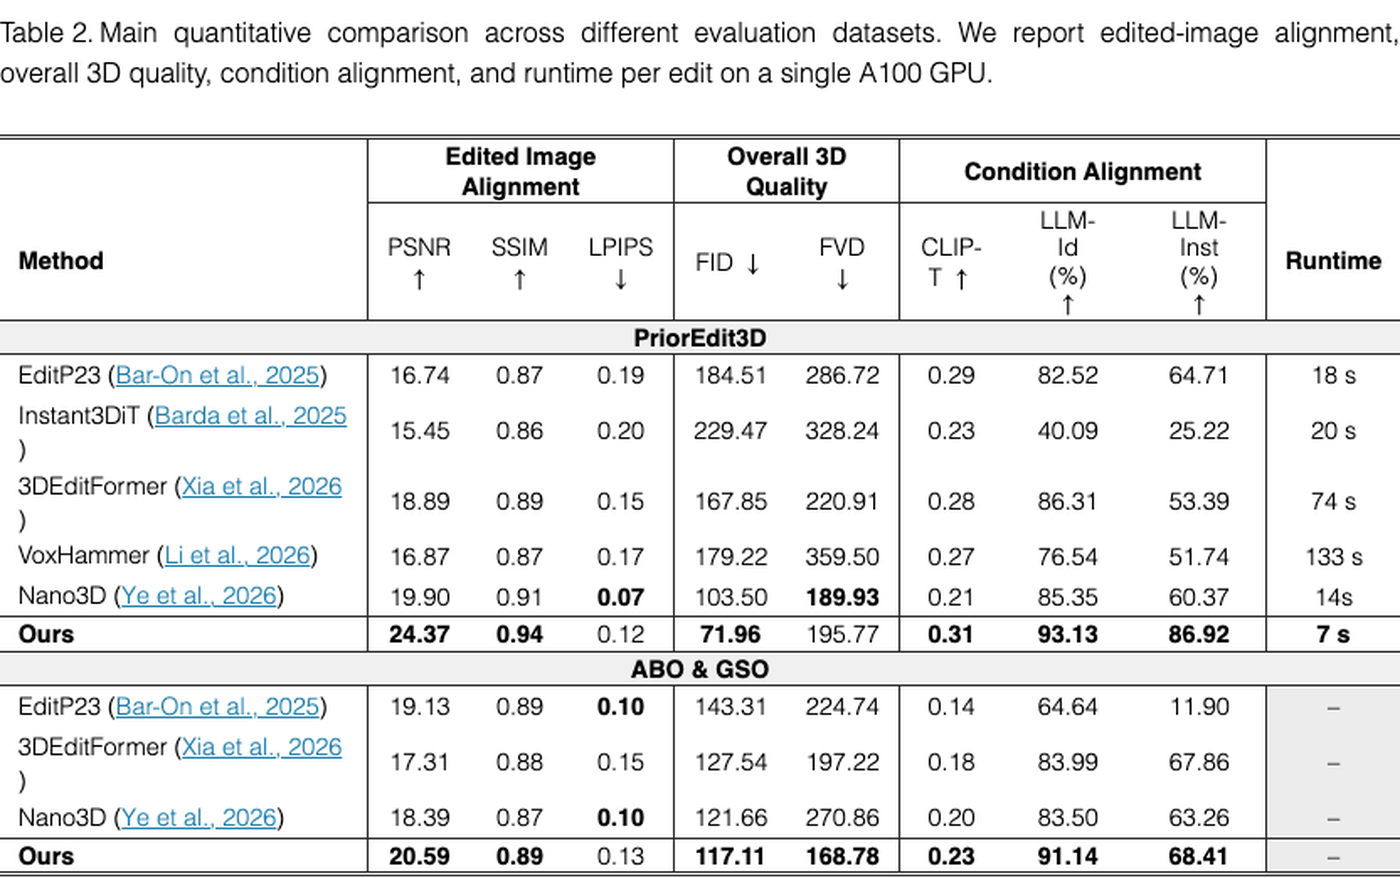
实验效果 :在作者的 PriorEdit3D 测试集上,方法达到 24.37 PSNR、0.94 SSIM、71.96 FID,LLM 身份保持率 93.13%、指令遵循率 86.92%,单个编辑在 A100 上约 7 秒;对比的 Nano3D 为 19.90 PSNR、103.50 FID、14 秒。迁移到 ABO 与 GSO 后,方法的 FVD 为 168.78、LLM 指令遵循率 68.41%,也优于表中对比项。
批判点评 :把视觉、语义和几何先验拆给三个教师是合理的,因为单一 2D 教师无法提供背面约束。消融也显示 VLM 与 3D 分布匹配各自补不同缺口。不过教师的偏差会层层传递:图像编辑器决定风格,VLM 决定语义容忍度,图生 3D 教师决定几何流形;遇到教师不熟悉的物体、透明材质或拓扑大改时,前馈速度优势可能换来保守编辑。
3. ReaDiT:一个DiT块控制图像与视频
ReaDiT Guidance: Control for Image and Video Generation using Diffusion Transformer Features | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04649
关键词 :Diffusion Transformer,空间控制,特征读出,深度控制,姿态控制,视频运动控制,ReaDiT
⚠️ 前序问题 :ControlNet 一类适配器能给扩散模型加入深度、姿态或边缘条件,但通常复制大块网络,需要大量成对数据;扩展到视频时参数和训练成本进一步放大。完全免训练的特征引导虽然轻,却可能只支持单一骨干或单一模态。问题因此变成:能否不让生成模型在前向时直接吃控制图,只从其内部表征读出空间误差,再反向调整噪声 latent。
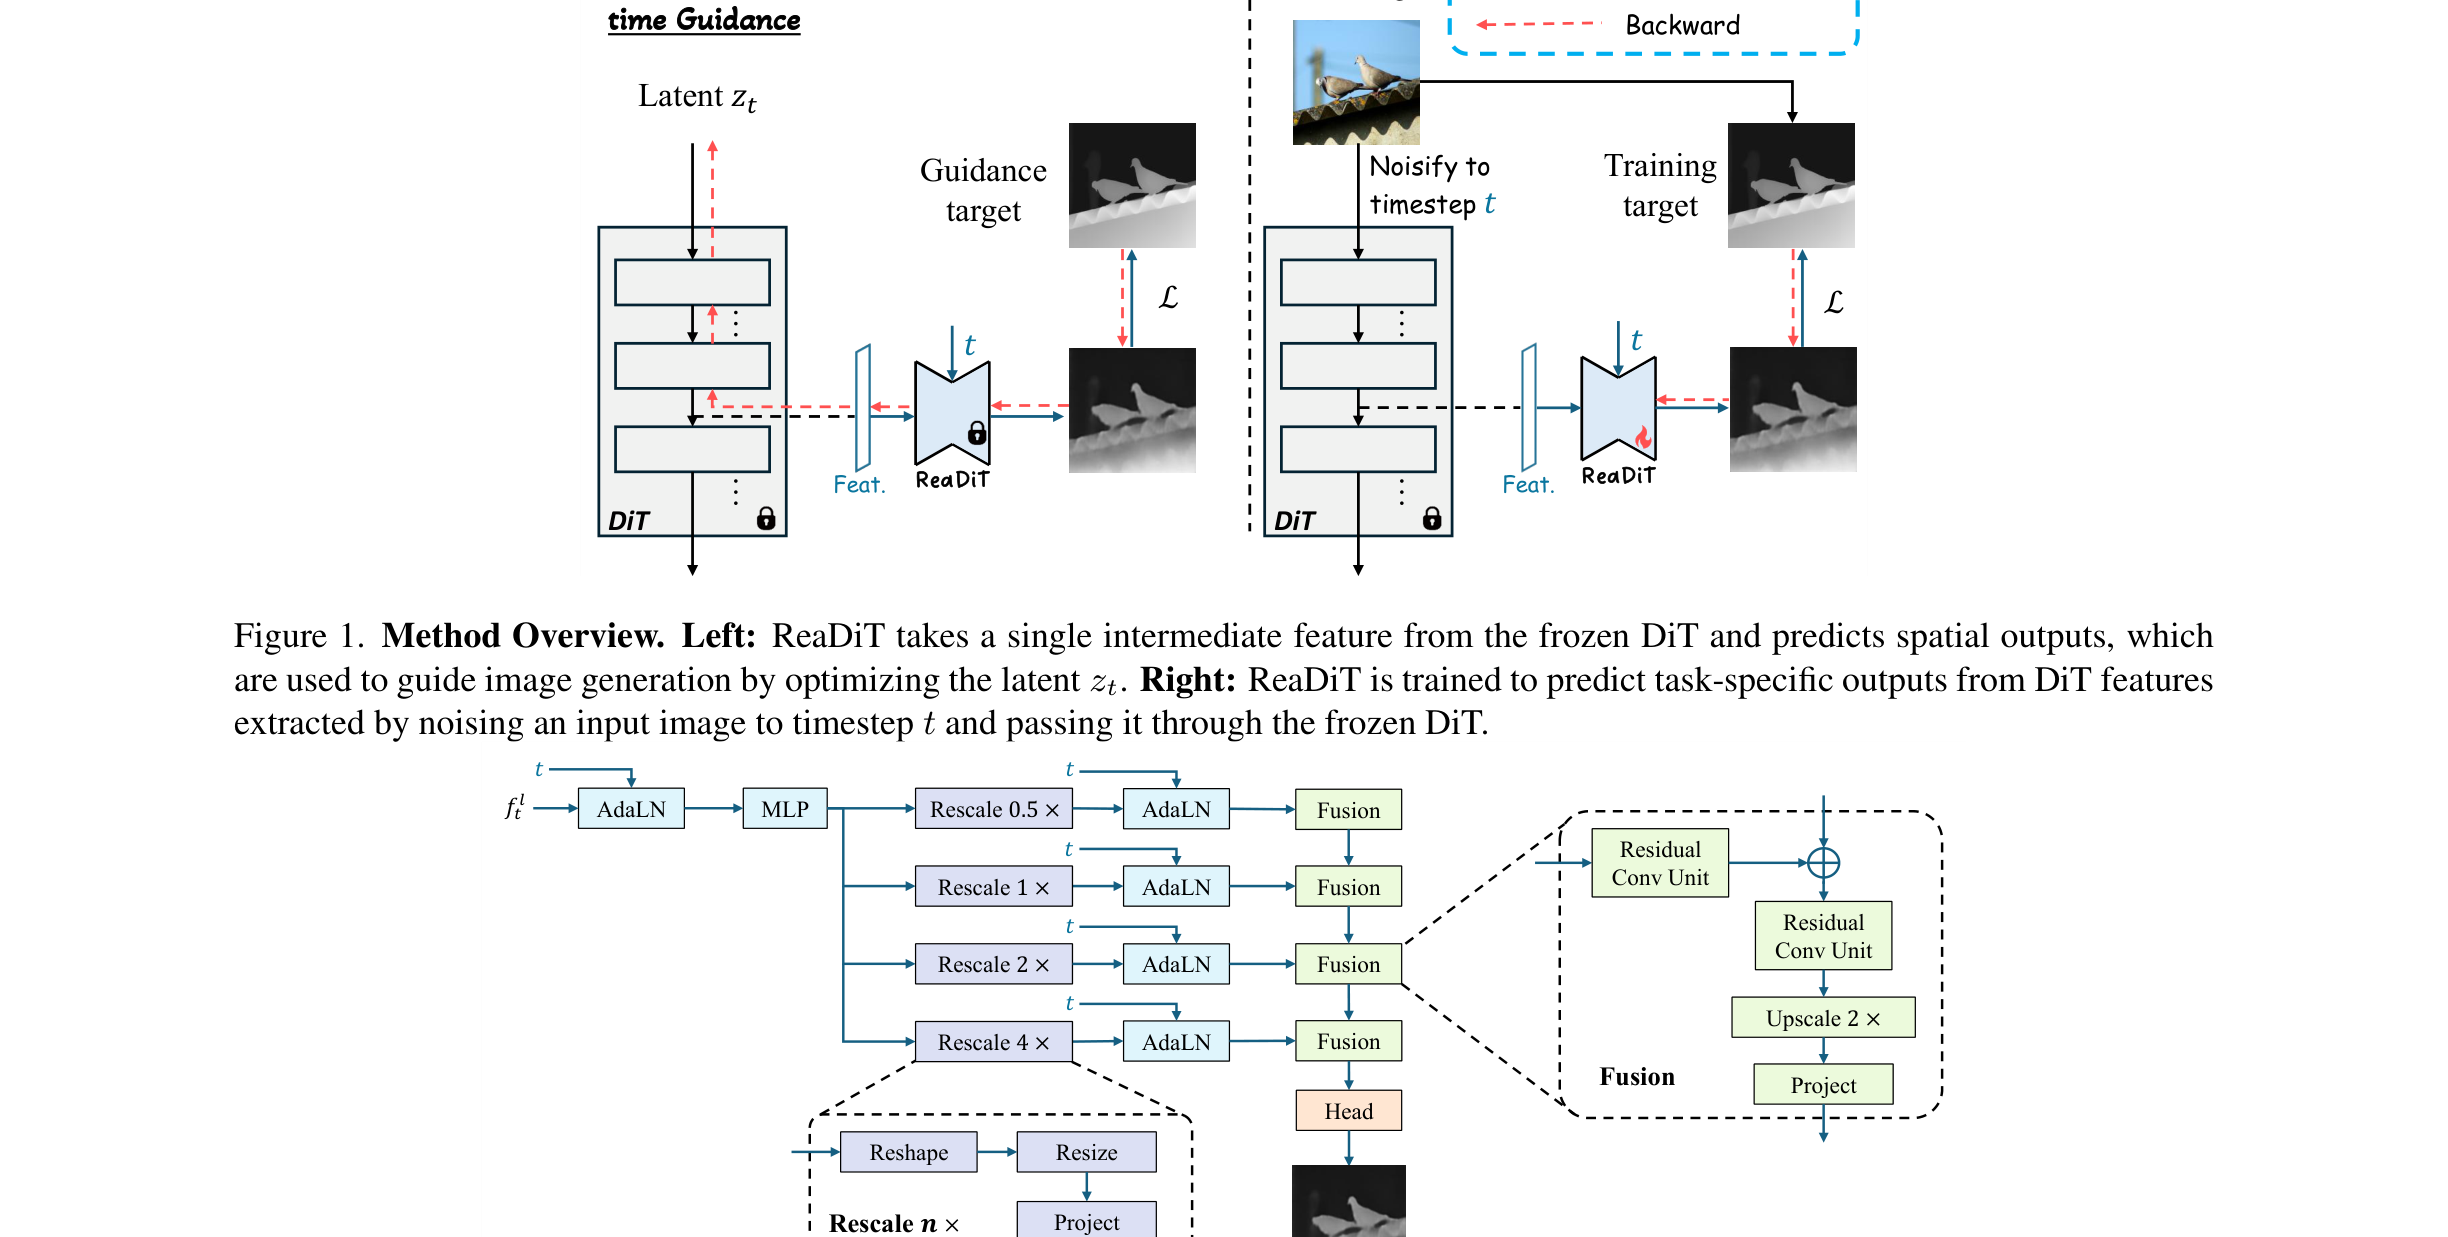
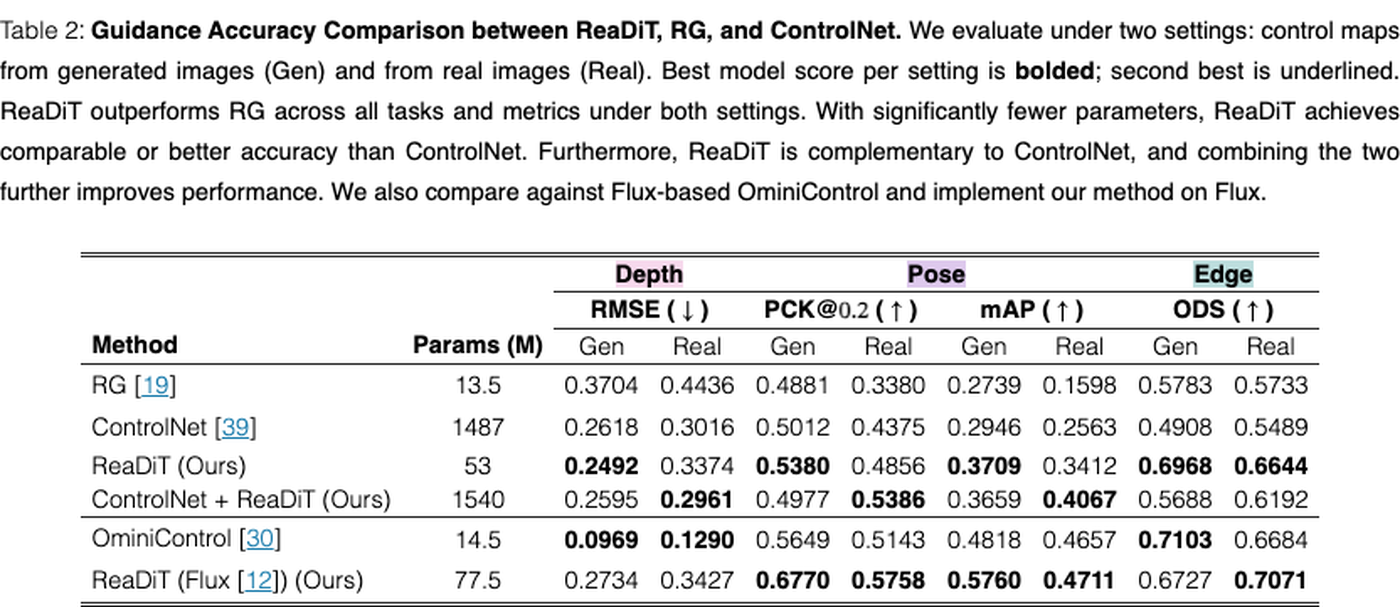
本文贡献 :ReaDiT 从冻结 DiT 的单个中间块提取特征,用一个带时间步条件的多尺度读出器预测深度、姿态或边缘,再把预测与目标控制图之间的损失梯度施加到当前 latent。生成骨干不直接接收控制条件,这种隐式条件化让同一思路可以覆盖图像和视频;在视频上还能用光流或相机轨迹目标控制运动。其图像版本约 53M 参数,远小于论文估算的 1.487B 参数 ControlNet 图像适配器。
实验效果 :图像实验中,ReaDiT 在生成图控制条件上取得深度 RMSE 0.2492、姿态 PCK@0.2 0.5380、姿态 mAP 0.3709 和边缘 ODS 0.6968,多数指标优于 1.487B 参数的 ControlNet。视频空间控制中,它把 RG 的深度 RMSE 从 0.4610 降到 0.4225,姿态 PCK 从 0.1892 提到 0.3651,边缘 ODS 从 0.5304 提到 0.6101。
批判点评 :只读一个 DiT 块就能跨图像与视频工作,说明预训练生成特征里已经包含可用空间信息;这比为每种骨干复制一套大适配器更容易维护。它的限制也来自同一点:读出器知道“当前画面离目标多远”,却不一定知道最稳定的生成路径,强梯度在遮挡、快速运动或互相冲突的控制图下可能牺牲画质。工程采用前应同时测控制误差、生成质量和额外反向传播的延迟。
4. EditVid:免训练视频编辑跃升19分
One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing | 伊利诺伊大学厄巴纳-香槟分校(UIUC) | arXiv:2609.04190
关键词 :视频编辑,免训练方法,稀疏因果记忆,身份保持,latent混合,多参考编辑,EditVid
⚠️ 前序问题 :逐帧调用图像编辑器会造成闪烁、身份漂移和背景误改;专用视频编辑模型又需要昂贵训练,并常被限定在指令编辑或主体替换中的一种。一个统一框架必须同时解决相邻帧局部连续、远距离身份一致和编辑区域边界三件事,还要保留现代图像 MM-DiT 的多种编辑能力。
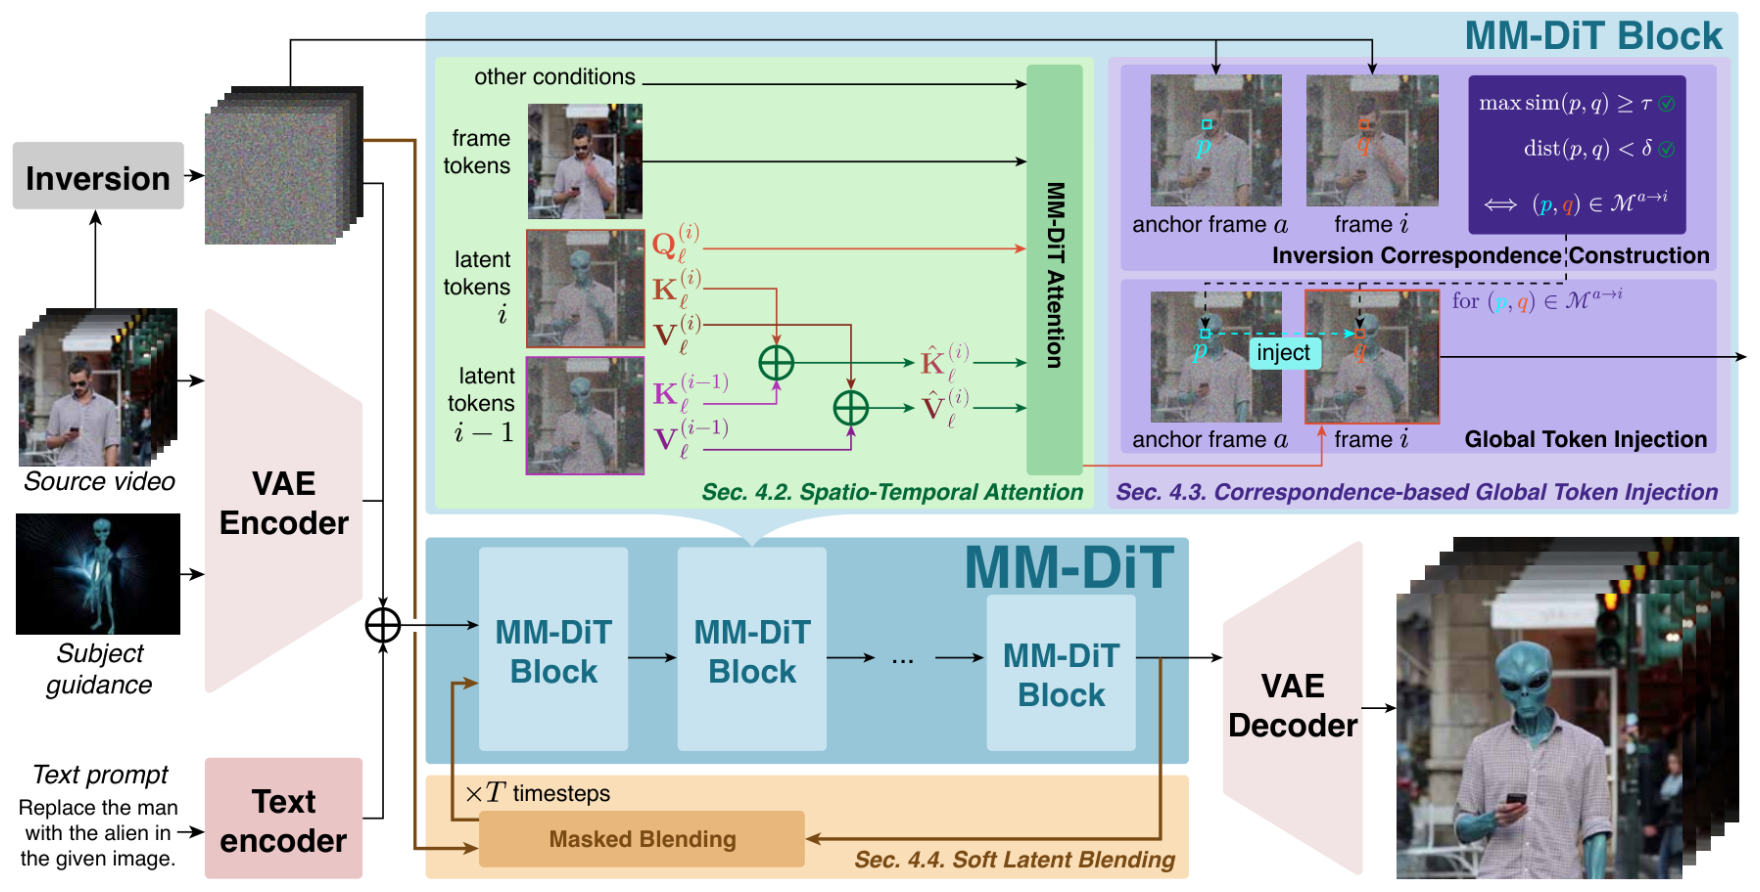
本文贡献 :EditVid 冻结图像 MM-DiT,在推理期组合三个机制:稀疏因果记忆复用上一帧选定的注意力键值,保持局部连续;基于对应关系的后注意力 token 注入把锚帧身份带到远帧;软 latent 混合让目标区域接受编辑,同时保护背景。相同框架覆盖风格迁移、属性修改、对象插入、局部编辑和主体替换,也支持指令与参考图两种条件。
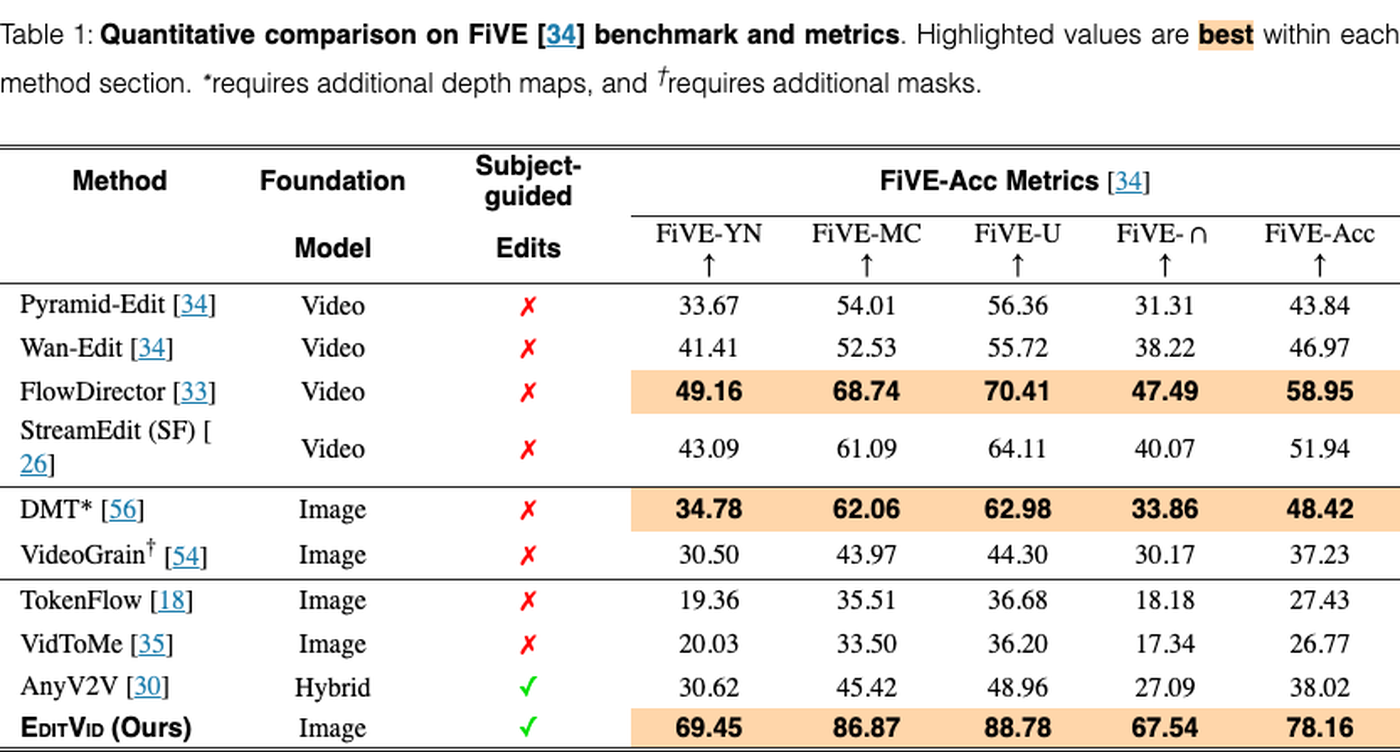
实验效果 :在 FiVE 基准上,EditVid 达到 78.16 FiVE-Acc,最强的已评估免训练基线为 58.95,提升 19.21 分;在 IVEBench 上取得有竞争力的结果。面对 7 个对比方法的用户研究中,EditVid 获得 51.8% 的总体偏好率。
批判点评 :三个机制分别对应短期、长期和空间局部性,职责划分清楚,且能复用强图像编辑器的新能力。风险在于对应关系是整个系统的支点:快速运动、长期遮挡或主体外观剧变会让锚帧 token 注入错误位置,造成“身份保持”反而覆盖合理变化。软混合也依赖编辑区域估计,细发丝、透明物体和反射场景会更难处理。
5. FlashRender:4步完成相机轨迹重拍
FlashRender: Few-Step Generative Rendering via Camera-Controlled Video MeanFlow | EverEx、延世大学、高丽大学 | arXiv:2609.03563
关键词 :生成式渲染,相机控制,MeanFlow,少步采样,视频重拍,在策略蒸馏,FlashRender
⚠️ 前序问题 :生成式渲染要把源视频沿新的相机轨迹“重拍”。传统多步扩散不仅慢,而且相机条件在不同采样步的作用不一致,这种离散化误差会弯曲去噪轨迹;直接做少步蒸馏时,学生还会在自己的 rollout 状态上积累误差,导致几何和画质同时下降。
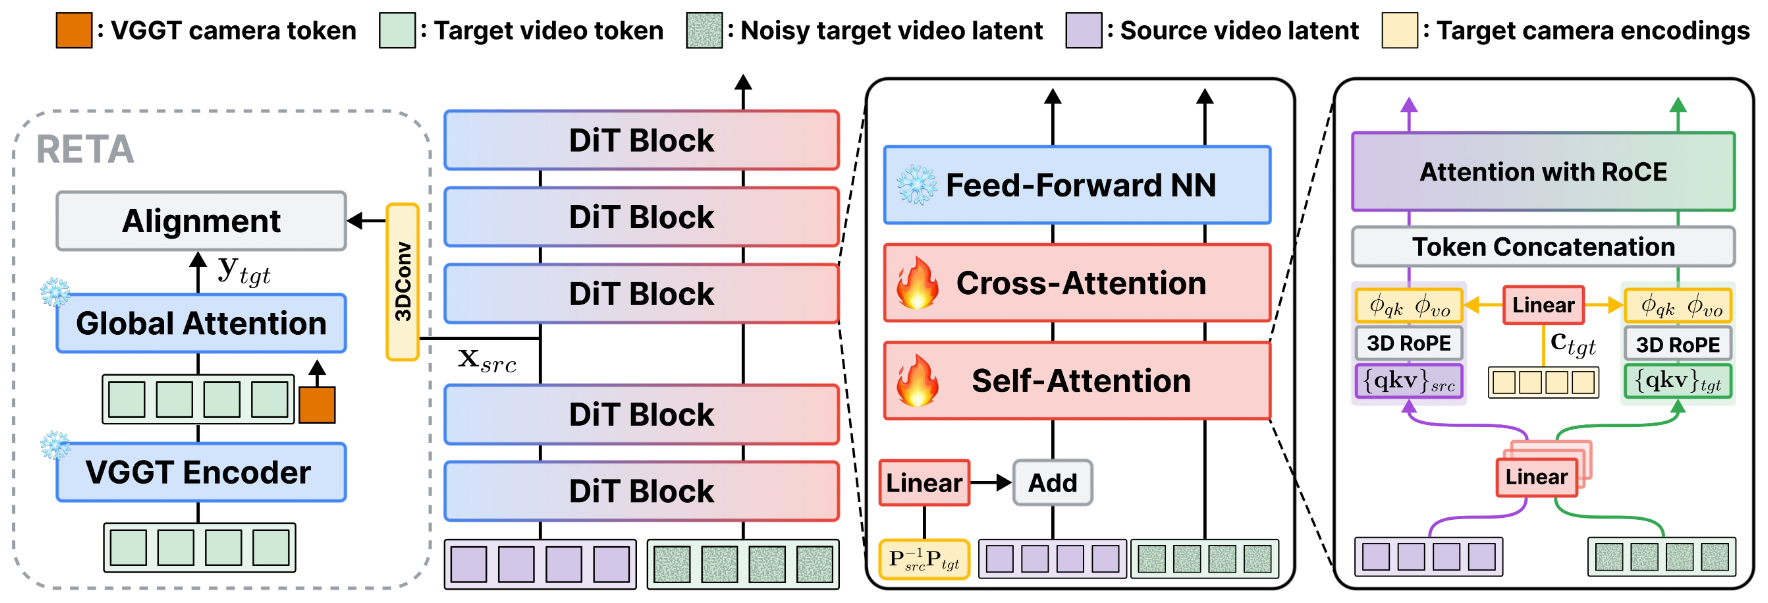
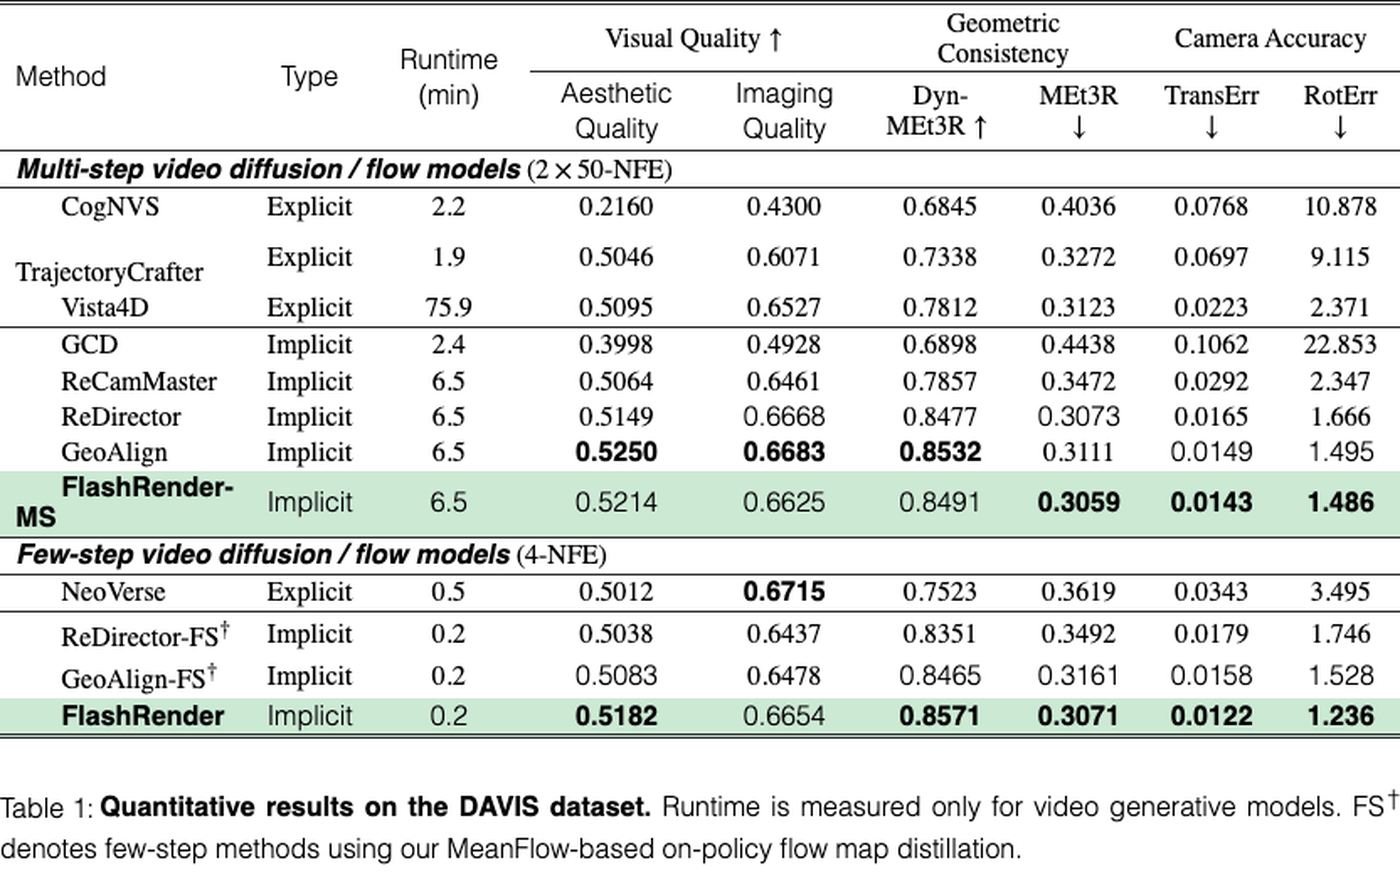
本文贡献 :FlashRender 先用 Representation Transformation and Alignment(RETA)把源视频隐藏表征对齐到冻结视觉几何模型提取的目标视角特征,把相机变换直接编码进源流,使控制在各采样步更一致。随后用 MeanFlow 目标拟合曲率更低的轨迹,最后用 on-policy flow-map distillation 针对学生自己的固定少步 rollout 修正误差。模型基于 Wan2.1-1.3B-CamCtrl,只需 4 次函数评估。
实验效果 :论文报告在视频质量和几何一致性上可匹配多步基线,同时把采样成本降低 25 倍,并在分布外目标相机轨迹上取得更好的可控性。示例以 480×832 分辨率、单张 NVIDIA B200 测速,可在数秒内完成任意长度输入视频的目标轨迹重拍。
批判点评 :方法最有启发的是先修控制不一致、降低轨迹曲率,再做少步蒸馏,而不是让学生同时吞下几何误差和时间离散误差。它仍依赖冻结几何模型提供可靠目标视角特征;反射、透明物体、动态遮挡和非刚体场景可能让几何先验失真。4 步设定很适合交互预览,但影视生产还需要评估细纹理和长镜头接缝。
6. PRISM-Bench:35项细则专门考生成音频
PRISM-Bench: An Audio-Centric Diagnostic Benchmark for Text-to-Audio-Video Generation | 上海人工智能实验室、美团 | arXiv:2609.04867
关键词 :音视频生成,评测基准,音频质量,跨模态同步,MLLM裁判,屏内声源,PRISM-Bench
⚠️ 前序问题 :文本到音视频评测通常把音频当成视频质量的附属项,或把声音单独拿出来测,无法回答模型究竟是声音本身差、声源和画面对不上,还是提示词中的音乐与对话没被执行。屏内声源需要精确同步,屏外环境声又不能被错误绑定到可见对象,两者混在总分里会掩盖失败类型。
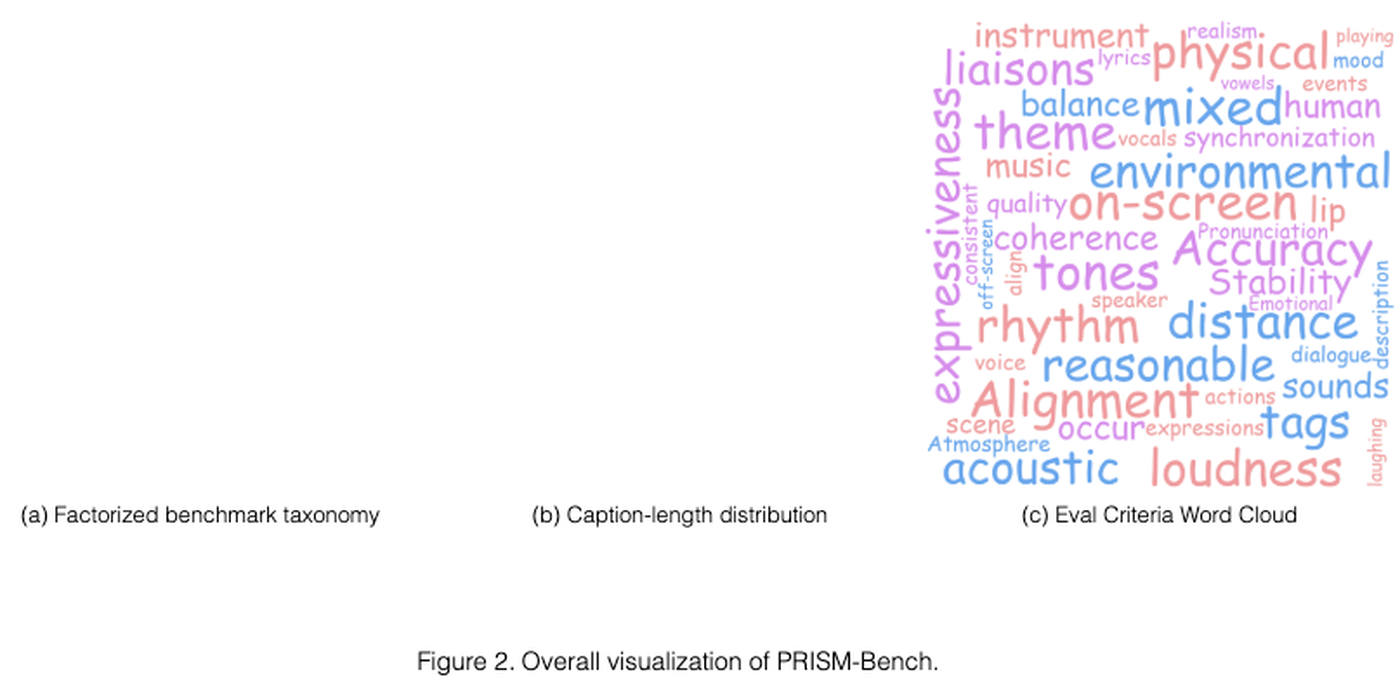
本文贡献 :PRISM-Bench 以音频为中心,把 900 个经人工核验的样本沿两条正交轴拆分:音频类型分语音、音乐和一般声音,声源可见性分屏内与屏外;再从音画一致、音频质量、表现力和提示遵循四个维度定义 35 项细粒度标准。评估采用相对真值参考的盲测并排比较,由增强的多模态大模型裁判执行,避免只给单个生成结果打绝对分。
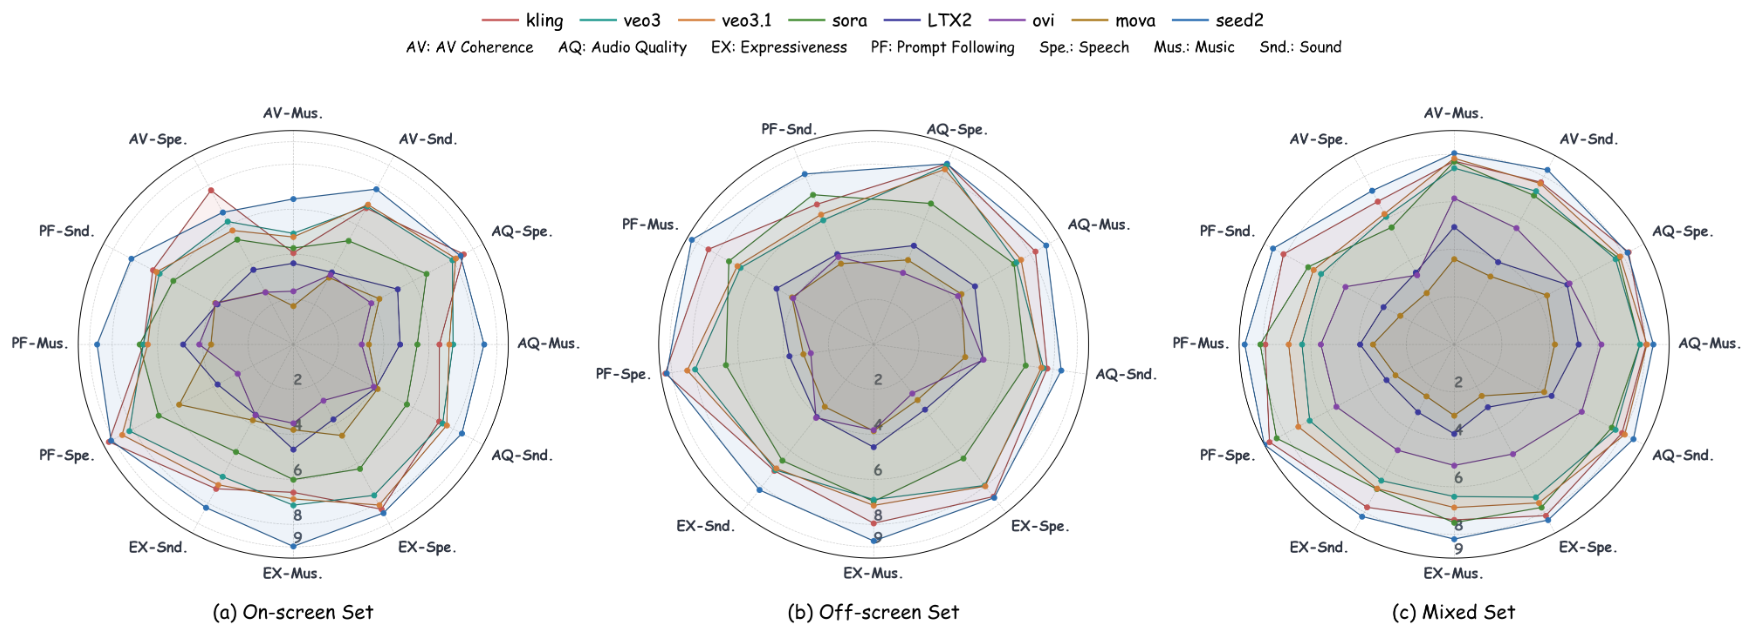
实验效果 :该裁判协议与人类评审的平均一致率超过 70%。对近期文本到音视频系统的测试显示,前沿闭源模型与开源模型之间仍有明显差距;各系统更容易优化总体感知保真度,却在复杂的音画 grounding 与控制上失分,尤其是音乐生成和需要同步的屏内声源。论文已被 ACM Multimedia 2026 接收。
批判点评 :按音频类型与声源可见性做二维切片,比继续堆一个总分更能指导模型改进,特别适合发现“画面对了但声音错了”的情况。局限是音频体验高度依赖耳机、响度校准、语言和音乐文化,35 项标准越细,标注一致性和裁判稳定性越难保证;报告结果时应保留分项雷达图,不宜只引用单一排名。
7. WorldReward:分块裁判同时看动作和画质
WorldReward: Reward Modeling for Camera-Conditioned World Models | 复旦大学、腾讯混元、上海创智学院、上海交通大学、上海人工智能实验室 | arXiv:2609.03952
关键词 :世界模型,奖励模型,相机控制,视频偏好,视觉语言模型,强化学习,WorldReward
⚠️ 前序问题 :相机条件世界模型既要执行移动和旋转指令,又要保持外观、几何和运动自然。几何奖励能估轨迹,却看不出画面是否崩坏;图像奖励能看单帧质量,却忽略动作和时序。把整段长视频与完整动作序列一次交给 VLM,又会让短暂的局部动作证据淹没在长上下文中。
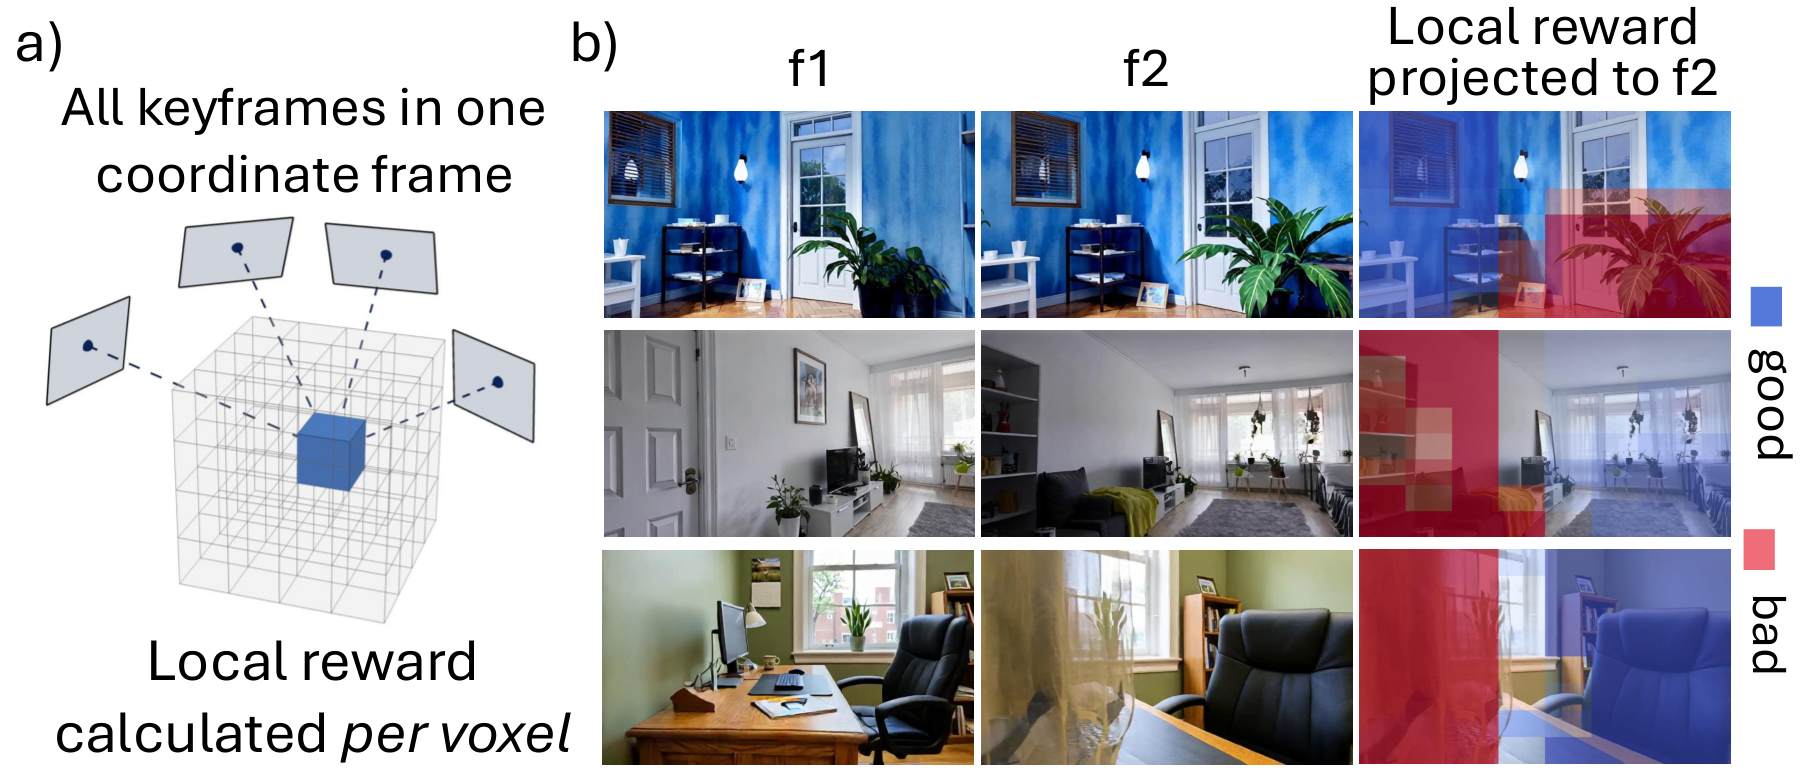
本文贡献 :WorldReward 把成对视频按动作边界切成小块,每块整理为源图、帧网格与四个动作面板组成的六图证据,让 VLM 分别判断动作一致性和视觉质量,再由投票聚合成视频级偏好。训练数据由前沿 VLM 生成结构化理由,经工具代理审计与定向人工复核;作者另建 WorldReward-Bench,覆盖平移、旋转与复合相机轨迹。
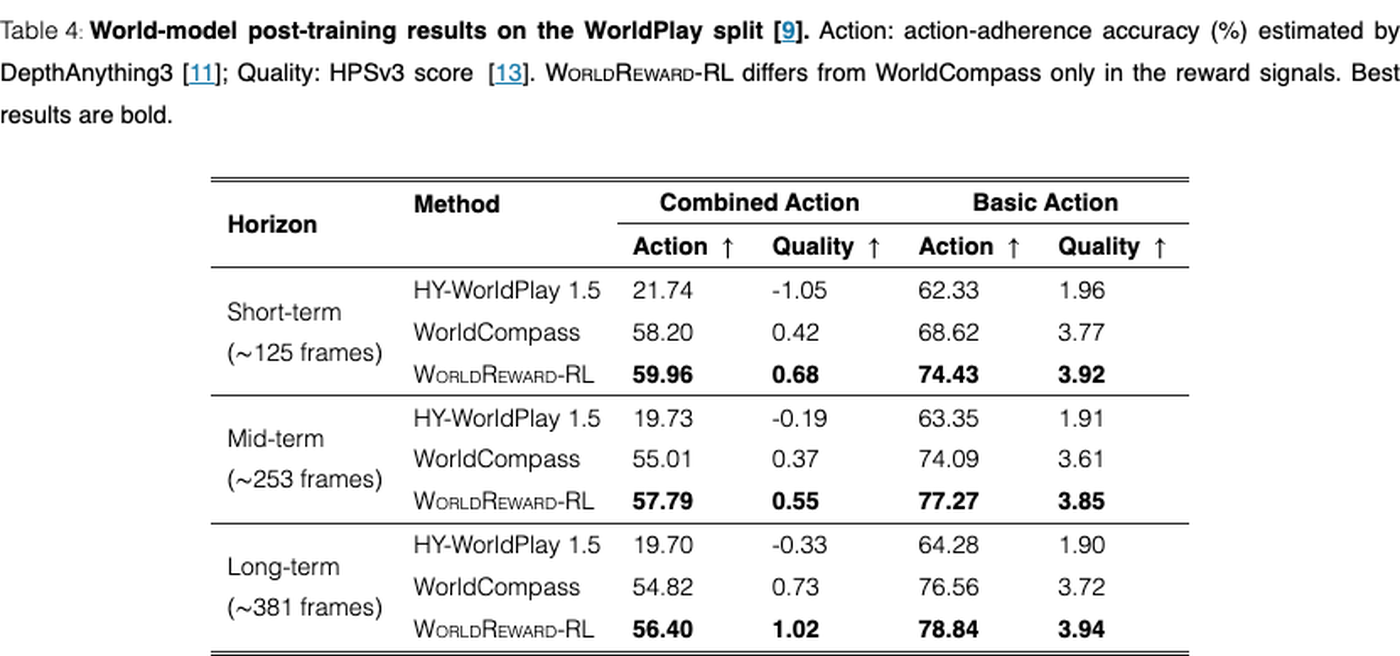
实验效果 :在人工标注的三分类偏好一致率上,WorldReward 的动作、外观和运动三项分别为 77.63%、81.32% 和 73.03%,比 GPT-5.5 高 3.42、1.45 和 3.56 个百分点。用于 HY-WorldPlay 1.5 的强化学习后,约 381 帧长时域的基础动作准确率从 WorldCompass 的 76.56% 提到 78.84%,HPSv3 质量分从 3.72 提到 3.94。
批判点评 :按动作切块是解决长上下文稀释的直接方法,而且把动作和画质分开投票,避免高画质掩盖不听指令。投票也会丢掉动作间的因果关系:单块都判断正确,不代表整条轨迹的累计位姿闭环正确。下一步更需要把局部裁判与全局状态估计结合,并验证奖励模型是否会被生成器找到视觉捷径。
8. Puffin-World:1600万样本统一原生3D状态
Puffin-World: Scaling a Unified Multimodal Model with Native 3D World States | 南洋理工大学 S-Lab、密歇根大学、北京交通大学、ACE Robotics | arXiv:2609.04196
关键词 :世界模型,3D生成,物理理解,深度重建,相机表示,多模态模型,Puffin-World
⚠️ 前序问题 :世界模型常把物理理解、相机控制、图像生成、深度估计和 3D 重建拆成多个离线模块。模块间坐标定义与误差不一致,闭环探索时会累积漂移;模型只生成外观而没有重力、尺度和几何等显式状态,也很难判断新的视图是否仍处在同一个物理世界。
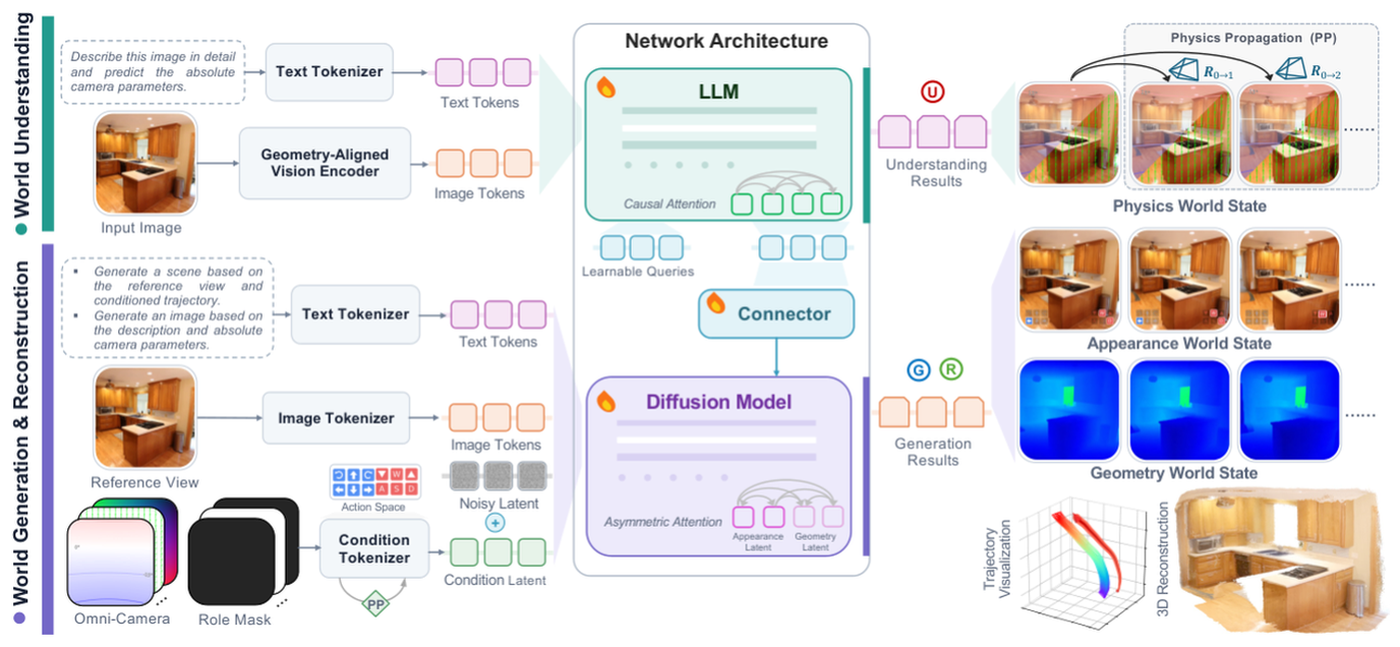
本文贡献 :Puffin-World 在一个多模态架构中联合建模三类原生世界状态:物理状态包含重力场与纬度,几何状态为深度,外观状态为图像;统一 Omni-Camera 表示支持不同自由度与相机动作。模型既把物理动力传播到未来帧,也在同一生成过程中耦合外观与几何,从而让自由视角生成同时输出可重建的底层结构。训练集 Puffin-16M 包含 1500 万视觉-语言-相机三元组和 100 万条挑战性运动轨迹。
实验效果 :论文展示统一模型可执行相机到世界的物理理解、自由视角空间模拟、3D 世界生成和重建,并支持模仿与自校准探索等交错闭环应用。作者公开了代码、模型和数据;摘要层面没有给出单一总分,而用多任务结果证明同一原生状态表示能覆盖此前分离的能力。
批判点评 :把深度和图像一起生成、把相机属性锚定到真实坐标,是走向闭环 3D 世界模型的正确方向;显式重力还能约束“看起来合理但物理方向错了”的画面。最大疑问在数据标定:重力、纬度、深度和相机真值的噪声分布不同,大规模混合后谁主导训练并不透明。模型还能生成稳定视图,不等于已经学会接触、质量和材料等完整动力学。
9. EraseSAE:单义特征做视频概念手术
EraseSAE: Surgical Concept Erasure in Text-to-Video Diffusion Models via Sparse Autoencoders | 中国科学技术大学、安徽省数字安全重点实验室、HiDream.ai | arXiv:2609.03629
关键词 :概念删除,视频扩散,稀疏自编码器,单义特征,时空掩码,生成安全,EraseSAE
⚠️ 前序问题 :视频扩散模型从松散数据学习到版权角色、不安全内容等概念。现有删除方法直接改权重或用粗粒度方向抑制,但概念在 DiT 激活中分散且与背景、动作和风格纠缠,容易出现删不干净或把无关内容一起毁掉的问题。视频还多一层时间一致性要求,逐帧独立干预会产生闪烁。
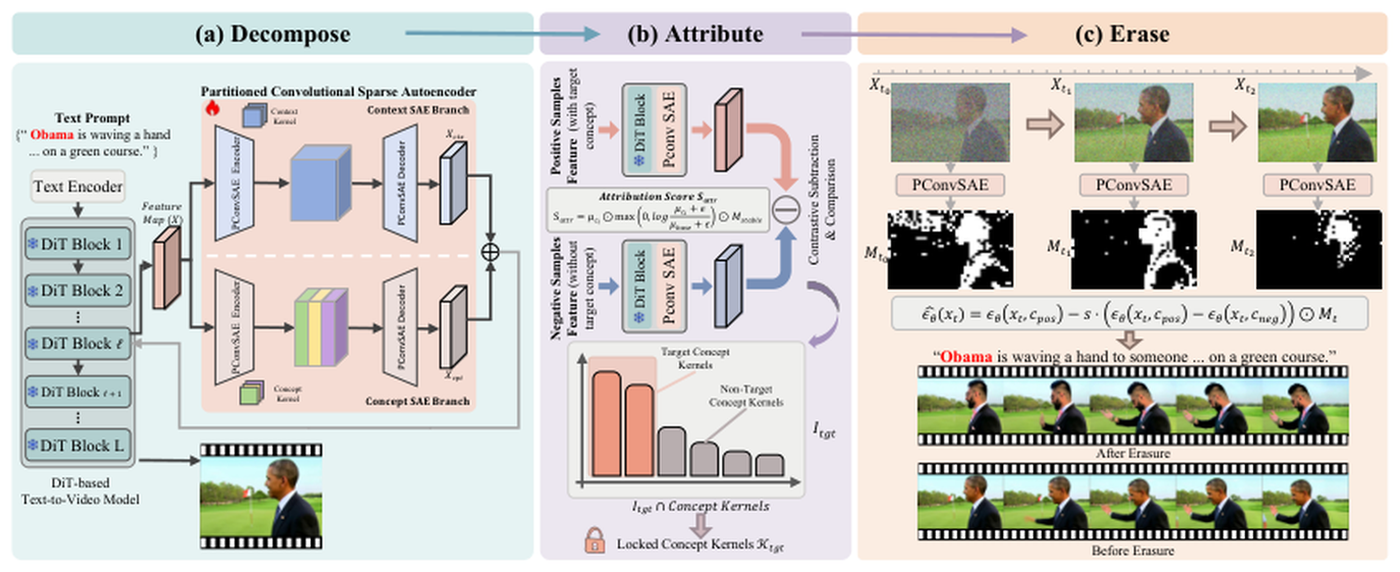
本文贡献 :EraseSAE 采用“分解—归因—删除”流程。Partitioned Convolutional Sparse Autoencoder 以分区双分支卷积把稠密时空激活拆成更可解释的稀疏单义特征;对目标提示和硬负提示做对比对数比归因,离线锁定概念核;推理时再按时间步生成时空掩码,只在概念真正激活的区域调制 classifier-free guidance,尽量保留其他对象和背景。
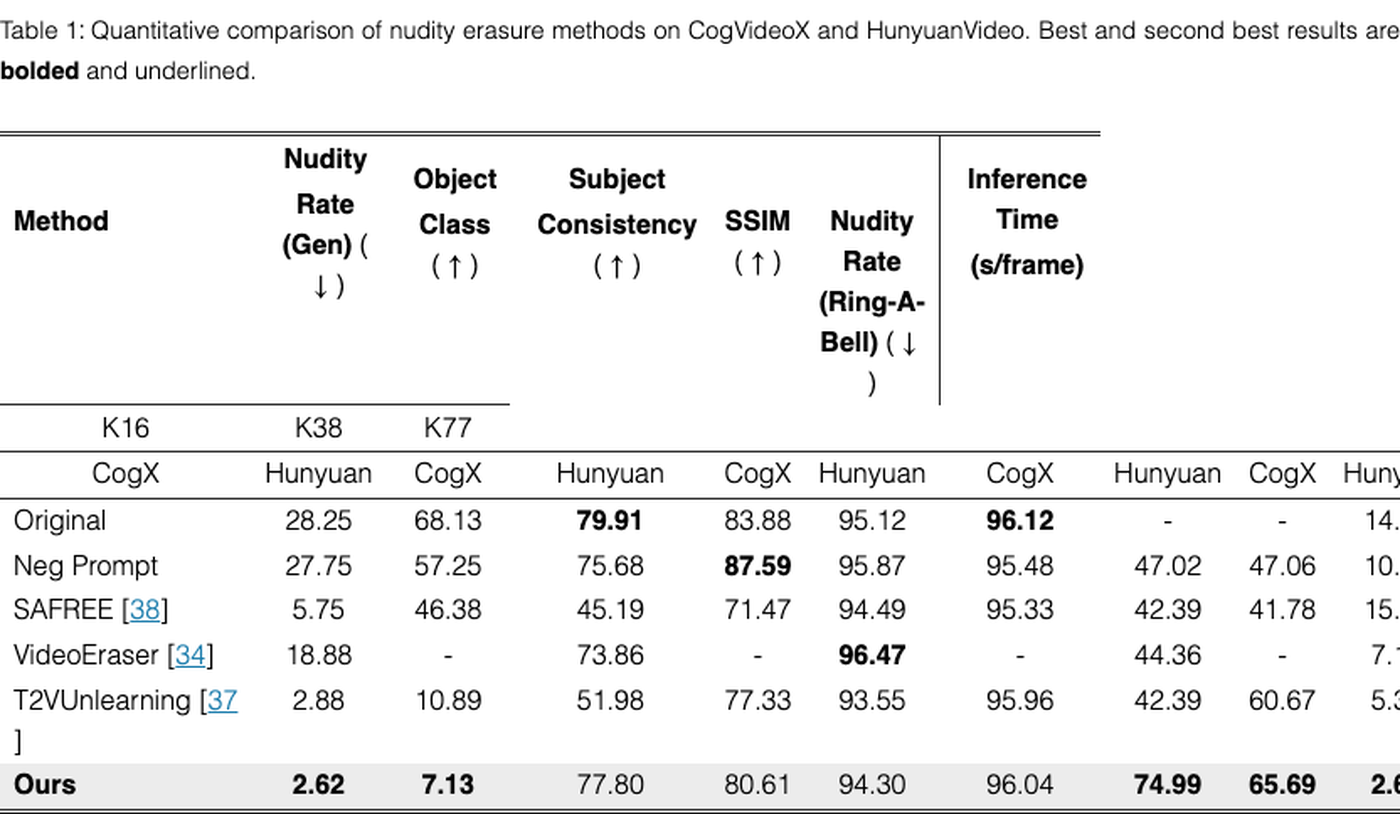
实验效果 :在 CogVideoX 的三档裸体概念测试中,EraseSAE 的生成率为 2.62%、7.13% 和 77.80%,对比 T2VUnlearning 为 2.88%、10.89% 和 51.98%;其主体一致性为 94.30%,推理约 3.66 秒/帧。在 HunyuanVideo 上 Ring-A-Bell 裸体率为 5.13%,低于 T2VUnlearning 的 9.95%,主体一致性为 96.04%。Flux.1 的 I2P 显式内容总量也从原始 605 降到 160。
批判点评 :以单义稀疏特征定位概念,比全局权重擦除更容易解释和审计,时空掩码也适合视频。不过“单义”来自稀疏自编码器的近似分解,不保证一个核只表达一个人类概念;对隐喻、组合提示或跨文化表达,硬负提示可能覆盖不足。部署时应同时报告删除率、误删率、绕过攻击和不同语言提示,不能只看平均主体一致性。
10. SVDtrunc:FLUX保留68%参数近乎无损
Importance-Aware Low-Rank Distillation of Diffusion Transformers | 海德堡大学、Zuse School ELIZA、达姆施塔特工业大学、hessian.AI | arXiv:2609.04646
关键词 :Diffusion Transformer,模型压缩,低秩分解,知识蒸馏,FLUX,参数效率,SVDtrunc
⚠️ 前序问题 :DiT 已成为高质量文生图骨干,但参数规模让显存、加载和部署成本居高不下。直接对所有投影矩阵用相同比例截断 SVD,忽略了不同块的重要性;大语言模型上的经验还让工程师担心低秩压缩会突然崩溃。需要先判断 DiT 的冗余分布,再在全局参数预算下决定哪些块可以多压。
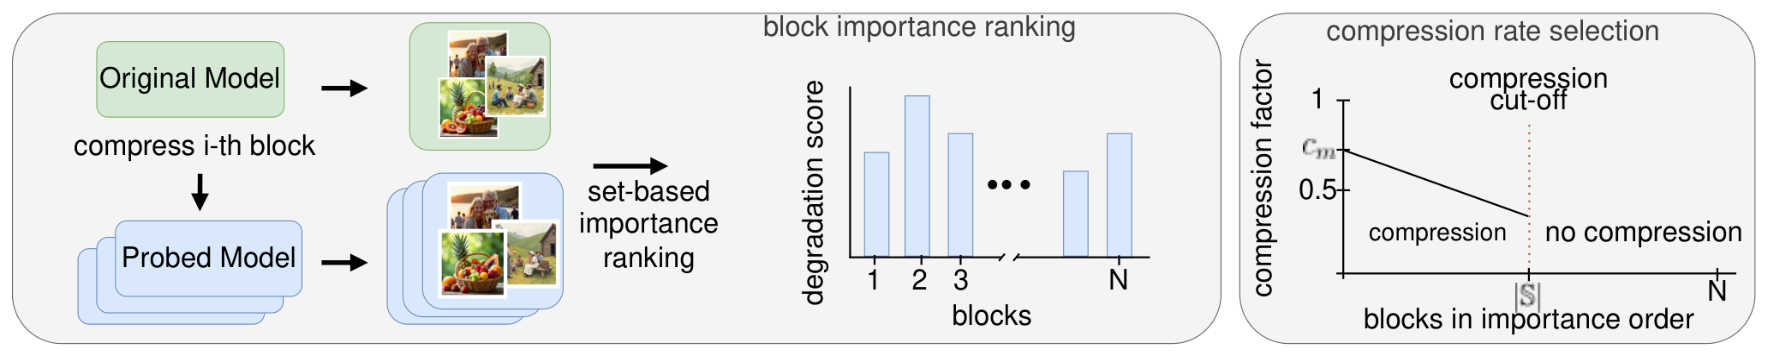
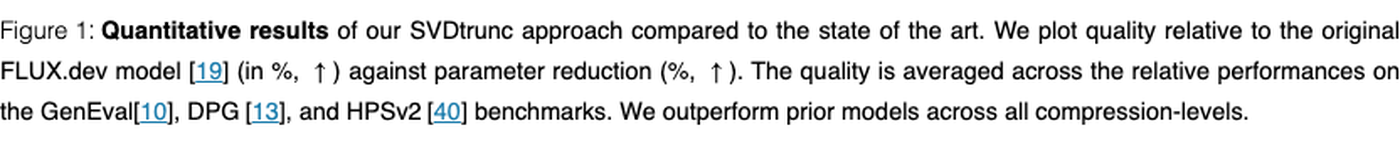
本文贡献 :作者发现 FLUX.dev 的 SVD 截断退化较平滑,冗余分散在全网络投影矩阵,而不是集中在少数 Transformer 块。SVDtrunc 先分别压缩每个块并生成探测图像,以相对原模型的质量变化给块排序;随后在全局预算下给不重要块分配更低秩,最后对全部块做模块化知识蒸馏与 rectified-flow 微调。该方法还能与减少采样步数的蒸馏叠加。
实验效果 :SVDtrunc 在 GenEval、HPSv2 和 DPG 三个基准的综合比较中,在各压缩档位都优于论文纳入的竞争方法。FLUX.dev 保留 68% 原参数时接近完整模型性能,保留 57% 时仍有竞争力;实验覆盖保留 40% 至 90% 参数的区间,且无需微调的版本也保持较强结果。
批判点评 :先用生成质量探测块重要性,比按权重范数或统一秩分配更贴近最终目标;发现 DiT 对低秩截断呈平滑退化也为工程压缩提供了有用经验。代价是每个块都要构造探测模型并生成一批图,前期搜索成本高,而且重要性依赖提示分布。若部署域与探测集差异大,原先被判定不重要的块可能正负责罕见概念。
趋势观察
代理式生成开始补上“证据进入像素”的最后一公里
WeAgent-MMGenEdit 不满足于给图像模型接一个搜索框,而是把外部证据拆成检索、逐图核验、结构化整合和最终交付四步,并让策略端与图像端分别做 SFT 和强化学习。PriorEdit3D 与 ReaDiT 也在降低监督门槛:前者从图像编辑器、视觉语言模型和图生 3D 教师蒸馏三类先验,后者只读一个 DiT 中间块,就用 53M 参数支持图像与视频的多类空间控制。
视频生成的竞争焦点转向控制稳定性与可核算效率
EditVid 用稀疏因果记忆、跨帧对应注入和软 latent 混合,把免训练视频编辑的 FiVE-Acc 从 58.95 提到 78.16。FlashRender 先修复不同采样步之间的相机控制不一致,再用 MeanFlow 和在策略蒸馏压到 4 次模型评估,采样成本降低 25 倍。SVDtrunc 则按块重要性给 FLUX 分配低秩预算,保留 68% 参数时仍接近完整模型性能。
评测与安全正在从单一总分转向可诊断的局部证据
WorldReward 按动作切分长视频并分别判断动作一致性与画质,避免局部指令证据被长上下文稀释。PRISM-Bench 把音频类型与声源是否可见交叉拆分,用 35 项细则暴露音乐和屏内同步声源的薄弱点。EraseSAE 也把概念删除落到稀疏单义特征和时空掩码上,不过最难的一档概念仍有 77.80% 生成率,说明精细归因并不等于问题已经解决。
人工智能炼丹君 整理 | 2026-09-07
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注











评论 (0)