


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

所属方向:对齐与强化学习 | 难度:核心必修 | 前置知识:无
关键词:策略梯度、REINFORCE、优势函数、GAE、PPO、裁剪、KL 约束
本文不要求先读其他树节点,但需要知道:条件概率描述给定状态时各动作的分布;期望是按概率加权平均;梯度给出参数的局部变化方向。$\pi_\theta(a\mid s)$ 对所有动作归一化为 1,$\nabla_\theta$ 表示对参数求导。后文从有限时域、离散动作推导,再说明连续动作与语言模型的接口边界。
先看一个很容易把模型训坏的场景。
设想一个调试场景,而非本文做过的模型训练实验:你有一个已经做过监督微调的语言模型,给同一个问题采样了若干回答,奖励模型认为其中一条更好。最直接的想法是:让模型提高这条回答的概率。于是你把它的对数概率乘上奖励,连续更新十轮。训练日志里的 reward 不断上升,重新采样时却发现模型开始反复输出奖励模型偏爱的句式,内容变长,语言能力下降,最后连原来会答的问题也答不好。
问题不只在奖励。至少有三笔账同时失控了:
策略梯度解决第一笔账:把“提高期望奖励”变成对可采样策略的梯度。价值函数和优势估计解决第二笔账:把状态本身的难易扣掉,只保留“这个动作比预期好多少”。PPO 的裁剪目标处理第三笔账:允许一批昂贵样本做多轮更新,减少单个样本继续把新旧概率比往有利方向推远的激励;它并不施加硬约束。
这三层关系决定了后面的算法谱系。DPO 改写优化问题,GRPO 换掉价值网络,RLOO 换基线,很多 RLHF 系统再加入参考模型 KL、奖励归一化和长度处理。名字不断变,问题仍可追溯到三个量:优势怎么估、概率比怎么算、策略走多远。
先记住四句话:
把一次语言模型生成看成一条轨迹也很直观:状态是 prompt 加已经生成的 token,动作是下一个 token,策略是词表上的概率分布,终局奖励来自奖励模型。critic 预测“从当前前缀继续生成,平均还能拿多少分”,优势则问“刚才选的这个 token,让结局比平均预期好还是差”。
PPO 的 clip 不是把梯度值裁小,也不是保证 KL 一定不超过某个阈值。它裁的是替代目标里的概率比收益。这个区别是理解所有变体的入口。
考虑一个马尔可夫决策过程。$s_t$ 是时刻 $t$ 的状态,$a_t$ 是动作,$r_t$ 是环境在这一步给出的奖励,$\gamma\in[0,1]$ 是折扣因子。策略 $\pi_\theta(a_t\mid s_t)$ 由参数 $\theta$ 控制。有限时域下,状态还应包含时刻或剩余步数,使 $V(s)$ 不会把不同时域混在一起;初始分布、环境转移与奖励在本节不显式依赖 $\theta$。一条长度为 $T$ 的轨迹记作 $\tau=(s_0,a_0,r_0,\ldots,s_T)$,折扣回报为:
$$R(\tau)=\sum_{t=0}^{T-1}\gamma^t r_t$$
训练目标是让轨迹的期望回报最大:
$$J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)]$$
轨迹概率由初始状态分布 $p(s_0)$、策略和环境转移 $p(s_{t+1}\mid s_t,a_t)$ 连乘得到:
$$p_\theta(\tau)=p(s_0)\prod_{t=0}^{T-1}\pi_\theta(a_t\mid s_t)p(s_{t+1}\mid s_t,a_t)$$
假设可以交换求导与期望、策略在被考虑动作上可微且有正概率;连续动作时把求和换成积分,并保持支持集等必要正则条件。对 $J$ 求梯度,并使用恒等式 $\nabla p=p\nabla\log p$:
$$\nabla_\theta J(\theta)=\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau)\nabla_\theta\log p_\theta(\tau)]$$
环境转移不依赖 $\theta$,因此它在对数梯度中消失,只剩策略项:
$$\nabla_\theta J(\theta)=\mathbb{E}\left[R(\tau)\sum_{t=0}^{T-1}\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$
这就是 REINFORCE 的骨架。还可以利用“未来动作不能影响过去奖励”,把整条轨迹回报换成从 $t$ 开始的 reward-to-go:
$$G_t=\sum_{l=0}^{T-t-1}\gamma^l r_{t+l}$$
于是每个动作只为它之后的结果负责:
$$\nabla_\theta J(\theta)=\mathbb{E}\left[\sum_{t=0}^{T-1}\gamma^t G_t\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]$$
这里的 $\gamma^t$ 不能漏:本文从固定初始状态、折扣总回报 $J$ 出发,$G_t$ 的折扣却从当前步重新计起。只有 $\gamma=1$,或把该权重吸收到折扣状态访问分布时,才能省略显式 $\gamma^t$。实际 PPO 常把 rollout 的时间步均匀平均,这是常用替代目标,不应与上面的精确有限时域梯度混同。
若 $G_t$ 总为正,每个样本都对其所选动作贡献正向 score 梯度,但样本共享参数,梯度可能互相抵消,不能断言所有动作概率同时提高。这样的回报加权估计在上述条件下无偏,方差却可能很大。我们需要一个不改变期望梯度的参照物。
从回报减去任何只依赖状态、不依赖本次动作的基线 $b(s_t)$,期望梯度不变。因为对固定状态 $s$:
$$\mathbb{E}_{a\sim\pi_\theta}[b(s)\nabla_\theta\log\pi_\theta(a\mid s)]=b(s)\nabla_\theta\sum_a\pi_\theta(a\mid s)=0$$
最常见的基线是状态价值函数:
$$V^\pi(s_t)=\mathbb{E}_\pi[G_t\mid s_t]$$
动作价值函数把本次动作也作为条件:
$$Q^\pi(s_t,a_t)=\mathbb{E}_\pi[G_t\mid s_t,a_t]$$
两者之差就是优势函数:
$$A^\pi(s_t,a_t)=Q^\pi(s_t,a_t)-V^\pi(s_t)$$
$A>0$ 表示这个动作比该状态下的平均动作好,$A\lt0$ 表示更差。Actor 通过优势更新策略,critic 通过回归回报学习 $V$,所以这类方法叫 actor-critic。
这里的“不依赖动作”是条件于状态的统计要求。固定的 $b_\theta(s)$ 即使共享网络参数,也必须在 actor 的乘法项中停止梯度;否则还会多出对基线求导的项。用本条动作的回报拟合后立刻当作其基线,可能引入样本依赖偏差;例如单样本直接取 $b=G$,估计恒为零。独立旧数据或适当的留一法可以避免这种直接依赖,不能只靠 detach 修复它。
价值基线也不保证在所有参数化下方差最小。令 $g=\nabla_\theta\log\pi(a\mid s)$,对 $\mathbb E[\|(G-b)g\|^2\mid s]$ 关于标量 $b$ 求导,得到:
$$b^*(s)=\frac{\mathbb E[G\|g\|^2\mid s]}{\mathbb E[\|g\|^2\mid s]}$$
分母非零时这才是该单步 score 向量的最小方差基线;它不一定等于 $V(s)$,也不直接给出整条轨迹、跨时刻协方差下的最优基线。ppo_checks.py 的 Bernoulli 例子取好动作概率 0.8、奖励 $[1,0]$:不减基线、减 $V=0.8$、减 $b^*=0.2$ 的梯度期望都为 0.16,方差分别为 0.0064、0.0576、0。这个反例不否定 critic 的实用性,而是限定“减价值一定降方差”的说法。
真实 $Q$ 和 $V$ 都不知道,只能估计。最短视的估计是一步 TD 残差:
$$\delta_t=r_t+\gamma(1-d_t)V_\phi(s_{t+1})-V_\phi(s_t)$$
$V_\phi$ 是参数为 $\phi$ 的 critic,$d_t\in\{0,1\}$ 表示这一步后轨迹是否真正终止。若 $d_t=1$,就不能再 bootstrap 到下一个状态。若 critic 等于真实价值,条件于 $(s_t,a_t)$ 的 $\delta_t$ 期望是优势,但方差仍由即时奖励和转移噪声决定;critic 有系统误差时,它也会把误差直接传给 actor。
把未来多个 TD 残差加进来,会得到不同步数的优势估计。先对不含中途 reset 的单段轨迹,GAE 用指数权重把它们合在一起:
$$\hat A_t^{\mathrm{GAE}(\gamma,\lambda)}=\sum_{l=0}^{T-t-1}(\gamma\lambda)^l\delta_{t+l}$$
实际代码不需要为每个 $t$ 再套一层求和。由上式直接得到从后向前的递推:
$$\hat A_t=\delta_t+\gamma\lambda c_t\hat A_{t+1}$$
这里有两个不同掩码:$1-d_t$ 决定 TD 的未来价值能否 bootstrap,$c_t$ 决定能否继续传播同一 episode 的后续残差。真正终止时两者都是 0;时间上限截断并 reset 时,$d_t=0,c_t=0$,TD 使用 reset 前真实下一状态 的价值,却不能接上新 episode 的残差。普通中间步两者都是 1。仅因 rollout 窗口结束时也保留末状态价值,但有限递推设 $\hat A_T=0$,不借用尚未采到的残差。
两个极端很关键。$\lambda=0$ 时,$\hat A_t=\delta_t$,只看一步,通常减少长程采样噪声,但强依赖 critic,不能无条件保证方差更小。$\lambda=1$ 且轨迹正确终止时,TD 项会望远镜式相消,得到 $G_t-V(s_t)$,对未来 critic 误差不再敏感,但仍含当前状态基线误差,且把后续所有随机奖励都带了进来。若窗口在 $H$ 步后结束而非真正终止,望远镜相消只得到:
$$\hat A_t=\sum_{l=0}^{H-1}\gamma^l r_{t+l}+\gamma^H V_\phi(s_{t+H})-V_\phi(s_t)$$
因此仍依赖尾部 bootstrap。常见的 $\gamma=0.99,\lambda=0.95$ 是经验起点,不是定律。
训练 critic 时通常使用 value target:
$$\hat V_t^{\mathrm{target}}=\hat A_t+V_\phi(s_t)$$
实现时要区分 terminated 和因时间上限触发的 truncated。真正终止的状态没有未来价值;时间截断通常仍应 bootstrap。若真实后续价值为正,把截断也清零会造成低估;若它为负则会高估。反过来,仅保留 bootstrap 却继续跨 reset 递推,会混入下一条 episode 的奖励。本文旧接口 generalized_advantage_estimate 适合单段轨迹或真正终止边界;新增 gae_transitions 显式接收每条转移的 next_values、terminated、episode_ends,处理截断。
采样成本高,所以 PPO 会冻结采样策略 $\pi_{\theta_{\mathrm{old}}}$,用同一批轨迹对当前策略 $\pi_\theta$ 做多轮小批量更新。数据来自旧策略,目标却要描述新策略,动作重要性比在固定旧策略状态上校正动作分布;它不校正整条轨迹的状态访问分布,所以以下是局部替代目标:
$$\rho_t(\theta)=\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\mathrm{old}}}(a_t\mid s_t)}=\exp(\log\pi_\theta-\log\pi_{\theta_{\mathrm{old}}})$$
未裁剪的替代目标是:
$$L^{\mathrm{PG}}(\theta)=\mathbb{E}_t[\rho_t(\theta)\hat A_t]$$
刚开始新旧策略相同,$\rho_t=1$。如果 $\hat A_t>0$,增大该动作概率会使目标变大;如果 $\hat A_t<0$,减小概率会使目标变大。但在同一批数据上更新多轮后,某些比率可能冲到 1.8、0.2,旧数据已不能可靠描述新策略附近的行为。
PPO-Clip 的核心目标只有一行:
$$L^{\mathrm{CLIP}}(\theta)=\mathbb{E}_t\left[\min\left(\rho_t\hat A_t,\mathrm{clip}(\rho_t,1-\epsilon,1+\epsilon)\hat A_t\right)\right]$$
这里的 min 取较悲观的收益。它必须与优势的符号一起看:
所以 clip 是单侧的乐观收益上限。它不会把所有比率强行夹回区间,也不会保证一次优化后每个样本都满足区间约束。一个 batch 内不同样本共享参数,更新某个样本可能把另一个样本推得更远。
PPO 通常最小化总损失,因此策略项前面带负号,再加 critic 的均方误差和熵奖励:
$$\mathcal{L}_{\mathrm{total}}=-L^{\mathrm{CLIP}}+c_v\mathbb{E}_t[(V_\phi(s_t)-\hat V_t^{\mathrm{target}})^2]-c_e\mathbb{E}_t[\mathcal{H}(\pi_\theta(\cdot\mid s_t))]$$
$c_v$ 控制价值损失权重,$c_e$ 控制探索强度,$\mathcal H$ 是策略熵。LLM 对齐还常加入相对参考模型 $\pi_{\mathrm{ref}}$ 的 KL 惩罚:
$$\tilde r_t^{\mathrm{rollout}}=r_t^{\mathrm{task}}-\beta\left(\log\pi_{\theta_{\mathrm{old}}}(a_t\mid s_t)-\log\pi_{\mathrm{ref}}(a_t\mid s_t)\right)$$
上式写的是一轮 PPO 已采样并冻结的奖励:动作来自 $\pi_{\theta_{\mathrm{old}}}$,用采样时的 actor 与 reference log-prob 算 KL 奖励,再固定 GAE 和 value target。序列任务可把任务分数放在终步,KL 项逐有效生成 token 累加。不能在 minibatch 内偷偷把 old 换成不断变化的 current,再把它当成同一份固定训练标签;若另加可微 KL loss,应单独定义其采样分布与梯度路径。
单个 token 的 log-ratio 可能为负。对固定状态、动作按 old policy 采样且 reference 在其支持集上概率为正时,其期望才是 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_{\mathrm{ref}})$。例子 $\pi_{\mathrm{old}}=[0.8,0.2]$、reference=$[0.5,0.5]$ 的两项为 0.4700 与 -0.9163,期望为 0.1927;把每个负项截成零会改变目标。沿轨迹累加还涉及 old policy 的状态访问分布与长度,不能把两个模型之间任意方向、任意归约的 KL 都叫同一约束。
注意这里有两个不同的“旧模型”。$\pi_{\theta_{\mathrm{old}}}$ 是本轮采样快照,用来计算 PPO ratio;$\pi_{\mathrm{ref}}$ 通常是固定的 SFT 参考模型,用来限制长期漂移。把两者混成一个模型,会把更新稳定性和行为保持两个问题混在一起。
一轮 PPO 可以按下面的顺序执行。顺序很重要,因为每个张量对应的策略版本不同。
第一步,冻结当前 actor 为 $\pi_{\theta_{\mathrm{old}}}$,用它与环境交互,保存每一步的状态、动作、奖励、old_logprob、critic value、终止标记。语言模型场景还要保存 completion mask,明确哪些位置真的是策略采出的动作。
第二步,在 rollout 末端决定是否 bootstrap。若轨迹真正终止,next_value=0;若只是采样窗口用完,则由 critic 估计最后状态价值。然后从后向前计算 $\delta_t$ 和 GAE。此时优势应视作固定训练标签,actor 更新不能反向穿过 GAE 进入旧 value。
第三步,用 $\hat V_t^{\mathrm{target}}=\hat A_t+V_{\mathrm{old}}(s_t)$ 构造 critic 目标。这里加的是采样时保存的旧 value。如果一边更新 critic 一边用新 value 重算 target,目标本身会追着模型移动。
第四步,打乱 rollout,切成 minibatch。当前 actor 对已经采过的动作重新计算 new_logprob,然后用对数概率之差求 ratio。直接先算概率再做除法容易在大词表和低概率动作上出现下溢。
第五步,分别计算未裁剪和裁剪后的 policy surrogate,逐样本取 min,再按有效动作 mask 求平均。同时计算 value loss、entropy bonus,以及可选的 reference KL。
第六步,反向传播并做梯度范数裁剪。一个 rollout 通常会被重复使用若干 epoch;每轮都用同一份 old_logprob,但 new_logprob 随参数更新而变化。若 approximate KL 超阈值,可以提前结束剩余更新。具体检查发生在 optimizer step 前还是后、阈值是否带倍率,要看实现;它不是投影,也不会自动回滚前一步。
第七步,丢弃这批 on-policy 数据,用更新后的 actor 重新采样。此时新策略成为下一轮的 old policy。PPO 能复用的是“一轮之内的有限次数”,并没有把数据永久变成离线训练集。
用张量形状检查这套流程也很有效。经典控制任务常见 reward/value/advantage/logprob 都是 [T, N],其中 $T$ 是 rollout 长度,$N$ 是并行环境数;语言模型常见 [B, L],其中 $B$ 是回答数,$L$ 是序列长度。若其中一个量形状不符,既可能报错,也可能在碰巧可广播时静默改变含义;例如 [B,1] 被扩到 [B,L]。后者,训练可能不会报错,却会让整条回答的每个 token 共享一个本不该共享的系数。
用一个最小数字例子把 GAE 和 clip 接起来。设两步奖励为 $[0,1]$,critic 预测为 $[0.4,0.7]$,第二步后真正终止,$\gamma=0.9$。最后一步的 TD 残差是 $\delta_1=1-0.7=0.3$;第一步是 $\delta_0=0+0.9\times0.7-0.4=0.23$。当 $\lambda=0.95$ 时:
$$\hat A_0=0.23+0.9\times0.95\times0.3=0.4865$$
对应的 value target 为 $0.4865+0.4=0.8865$,接近完整 Monte Carlo 回报 $0+0.9\times1=0.9$。若 $\lambda=0$,target 只有 $0.23+0.4=0.63$,它完全相信 critic 对下一状态的 0.7 估计。这几个数把“依赖 critic”和“纳入远期真实奖励”的差别直接展开了。
再设旧策略给第一步动作的概率是 0.25,新策略更新后变为 0.30,则 ratio 为 $0.30/0.25=1.2$。若该动作优势为 0.4865,正好到 $\epsilon=0.2$ 的上边界;继续把概率推到 0.35 时,未裁剪收益会按 ratio=1.4 计算,裁剪收益仍只按 1.2 计算,min 选择后者。若优势改为负数,1.4 一侧不会被保护,因为提高坏动作概率应该继续受到惩罚。
这个例子也说明两个超参数的作用会通过优化过程耦合。$\lambda$ 改变优势的大小和噪声,进而改变样本多久撞上 clip;$\epsilon$ 决定同一批优势可以推动概率多远。只调其中一个而不观察 ratio 分布,往往解释不了训练曲线。
code/gae_minimal.py 只依赖 NumPy。它先对一条长度为 4 的固定轨迹从后向前递推,再模拟 20000 条随机轨迹,比较不同 $\lambda$ 下 value target 对真实 $V(s_0)$ 的偏差和方差。固定轨迹的真实输出是:
rewards.shape=(4,), values.shape=(4,)
lambda=0.00  delta=[0.1445 0.143  0.597  0.2   ]  A=[0.1445 0.143  0.597  0.2   ]
lambda=0.50  delta=[0.1445 0.143  0.597  0.2   ]  A=[0.3858 0.4875 0.696  0.2   ]
lambda=0.95  delta=[0.1445 0.143  0.597  0.2   ]  A=[0.9734 0.8814 0.7851 0.2   ]
lambda=1.00  delta=[0.1445 0.143  0.597  0.2   ]  A=[1.0652 0.93   0.795  0.2   ]
同一行的 delta 不随 $\lambda$ 变化,因为它只由一步奖励和 critic 决定;$\lambda$ 改变的是未来残差往前传播的强度。最后一步已经终止,所以四组优势都等于 0.2。
随机实验故意给 critic 加入固定误差,结果是:
episodes=20000, true_V0=4.2083, critic_V0=4.5083
lambda      mean      bias       std       mse
  0.00    3.3133   -0.8950    0.7941    1.4315
  0.50    3.8265   -0.3818    0.9201    0.9924
  0.95    4.1767   -0.0316    1.8754    3.5181
  1.00    4.2130    0.0048    2.2029    4.8529
$\lambda$ 从 0 增大到 1,本次有限样本偏差从 -0.8950 降到接近 0,标准差从 0.7941 增至 2.2029。这里比较的是固定状态的 value target,不直接等于 actor 梯度估计的偏差或方差。在正文列出的四个候选中,$\lambda=0.5$ 的均方误差最低;换一个 critic 误差和奖励噪声,最优点也会移动。这展示了一个具体折中,不是任意环境下的单调定律。
这个实验的状态按时间确定,八步奖励彼此独立,均值 $\mu_k$ 从 0.2 到 0.9,标准差 $\sigma=0.8$;critic 固定,不参与拟合。设 $q=\gamma\lambda$,真正终止时尾部价值为零,展开递推可得:
$$\hat V_0^{\mathrm{target}}=\sum_{k=0}^{7}q^k r_k+\gamma(1-\lambda)\sum_{k=1}^{7}q^{k-1}V_\phi(s_k)$$
因此其期望把 $r_k$ 换成 $\mu_k$ 即可,方差为 $\sigma^2\sum_{k=0}^{7}q^{2k}$。这也解释了当前状态 $V_\phi(s_0)$ 在 target 中相消。脚本给出的解析偏差依次为 -0.8910、-0.3814、-0.0348、0,解析标准差为 0.8000、0.9207、1.8617、2.1857;20000 样本均值的标准误分别为 0.0057、0.0065、0.0132、0.0155。末行样本偏差 0.0048 小于一个标准误,不是 $\lambda=1$ 的结构性偏差。若奖励相关、状态随机或尾部截断,上面的独立噪声方差公式就需要重写。
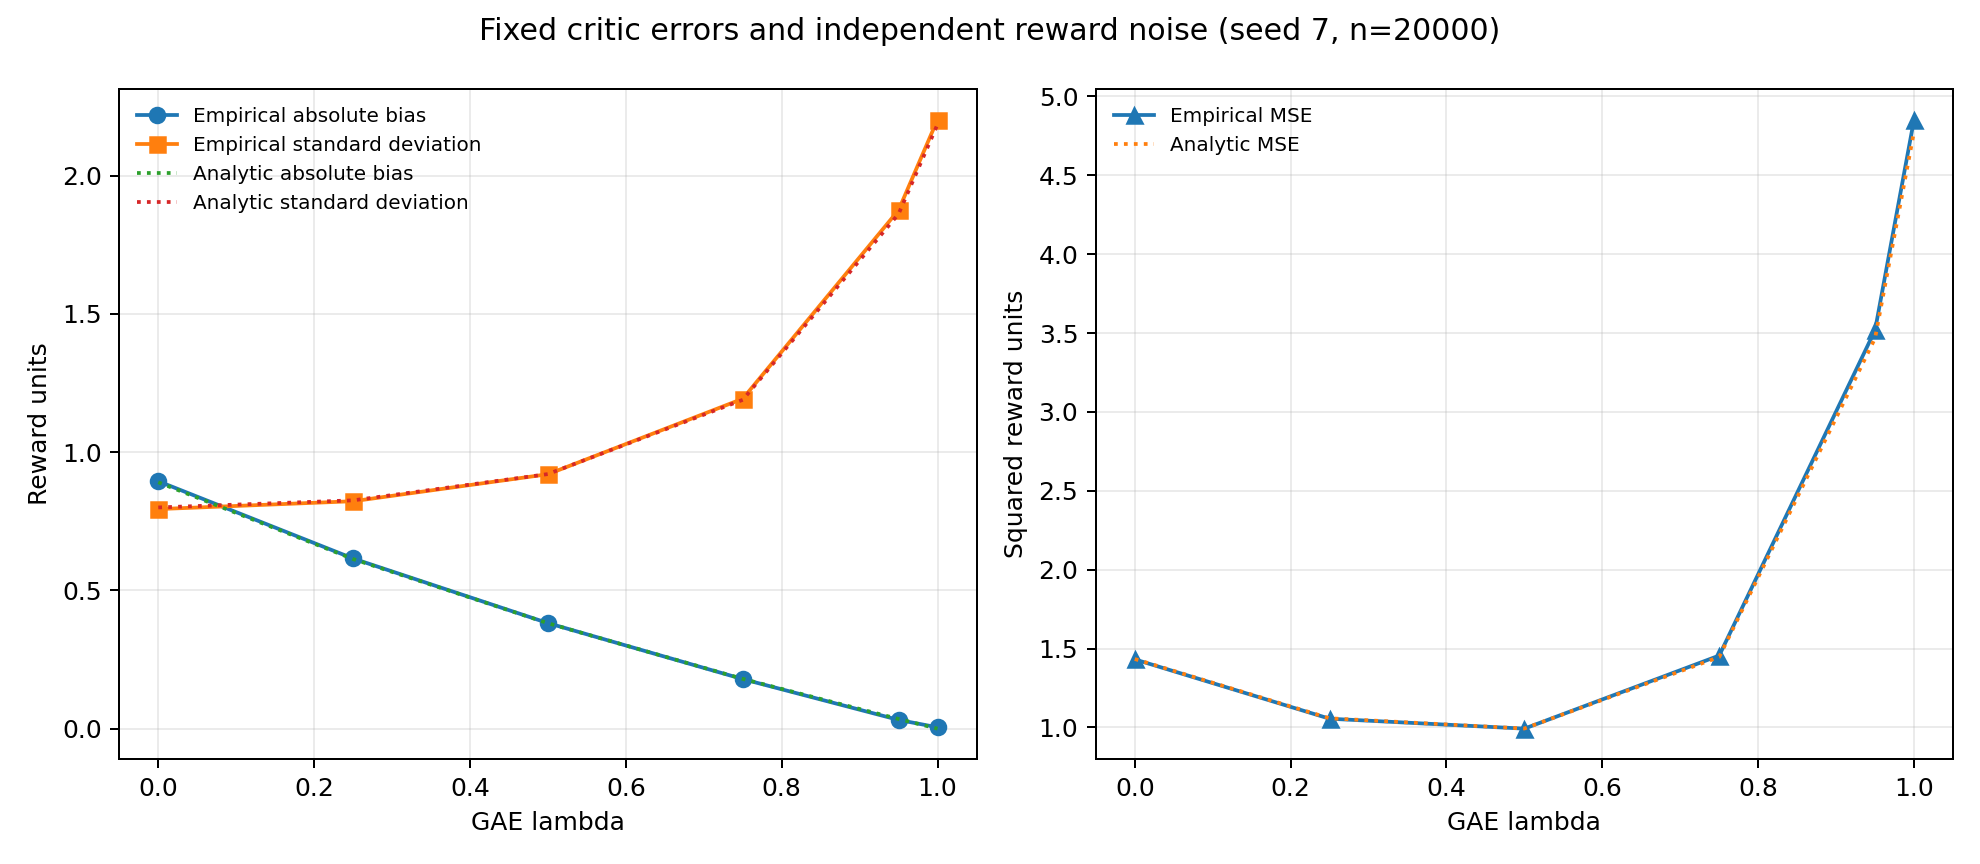
图 1:同一随机环境与 critic 误差下,$\lambda$ 改变了偏差和方差的配比。曲线由 make_figures.py 根据 seed=7、20000 条轨迹生成,并叠加解析矩;左图是奖励单位,右图 MSE 是奖励平方单位,不共用纵轴。
code/ppo_clip_minimal.py 先列出单样本裁剪表。下面四行足以解释 min:
 ratio   A    ratio*A  clip(ratio)*A  min   clipped?
 1.35   1.0     1.350        1.200    1.200    yes
 0.65   1.0     0.650        0.800    0.650    no
 1.35  -1.0    -1.350       -1.200   -1.350    no
 0.65  -1.0    -0.650       -0.800   -0.800    yes
第一行是好动作已经涨太多,因此收益停在 1.2。第二行是好动作被错误地下调,目标仍取更差的 0.65。第三行是坏动作被错误地上调,惩罚保留 -1.35。第四行才是坏动作下降过多后停止继续奖励。clip 只截断“继续沿正确方向冲得更远”的激励。
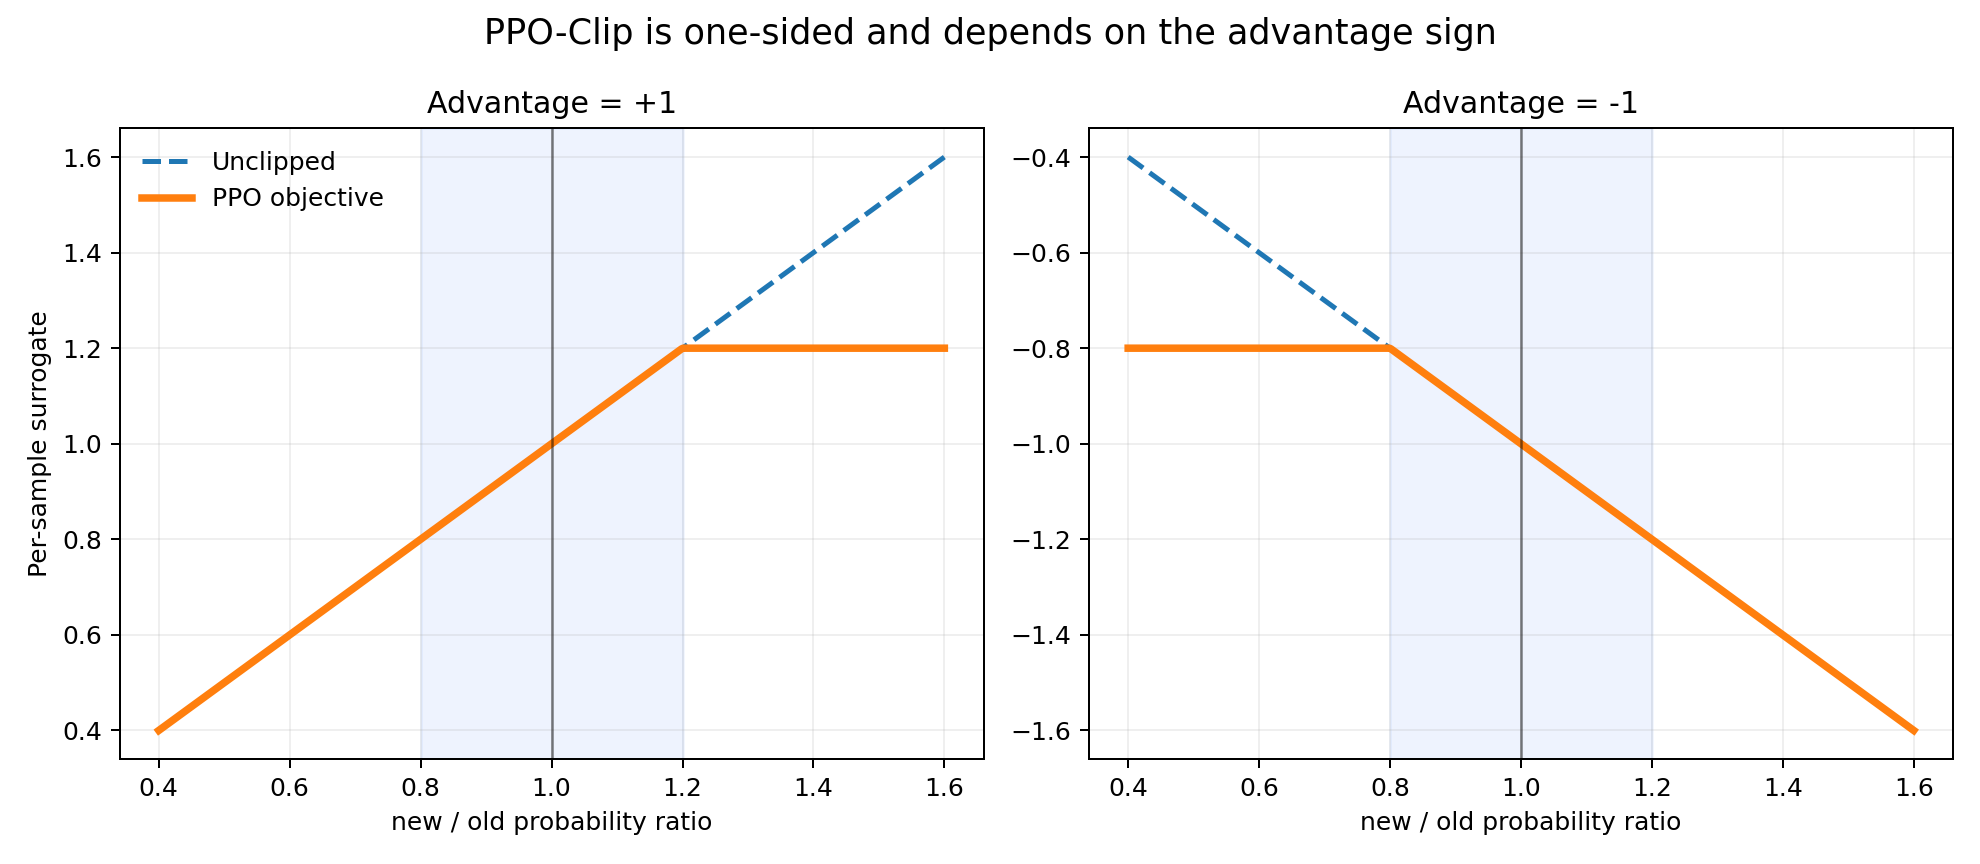
图 2:蓝色阴影是 $[1-\epsilon,1+\epsilon]$。正优势在右侧形成平台,负优势在左侧形成平台,另一侧继续保留惩罚。
脚本还构造了一个两臂老虎机:旧策略给好、坏动作各 0.5 概率,用两动作的精确旧分布期望更新 40 轮,没有实际采样一批动作。这里把优势直接固定为 $[+1,-1]$,用于隔离目标与优化的关系,不包含 critic、rollout 噪声或完整 PPO 训练。不裁剪时,好动作概率一路升到 0.9492,新旧策略 KL 达 0.8231;PPO-Clip 在第三轮越过 1.2 附近后梯度归零,停在 0.6097,KL 为 0.0246:
mode       epoch  p(good)  ratio_good   grad      KL(old||new)
unclipped      3    0.6097      1.2193   0.4890       0.0246
unclipped     40    0.9492      1.8984   0.0990       0.8231
PPO-Clip       3    0.6097      1.2193   0.4890       0.0246
PPO-Clip      40    0.6097      1.2193   0.0000       0.0246
为什么停在 1.2193 而不是精确的 1.2?因为脚本用有限学习率做离散更新,第三步从区间内跨到了区间外,跨过以后才失去梯度。真实神经网络也会出现这种越界,所以还要监控 approximate KL,并在过大时提前停止 epoch。
工业对照固定到 Stable-Baselines3 v2.7.0,不随主分支漂移。主要锚点是 PPO.train、RolloutBuffer 的 GAE 方法 和 OnPolicyAlgorithm.collect_rollouts。这是经典环境 PPO 的参考,不能直接当作 LLM trainer 的完整实现。最小脚本与工业实现的差别主要有六处:
n_epochs=10、gamma=0.99、gae_lambda=0.95、clip_range=0.2。这些是基准默认值,不应脱离任务直接复制。vf_coef 合并损失;一些实现还裁剪 value 更新。value clipping 的尺度受奖励缩放影响,不能把 policy clip 的 $\epsilon$ 无脑复用。max_grad_norm=0.5、ent_coef=0.0、target_kl=None、clip_range_vf=None。因此熵 bonus、KL early stop、value clipping 都不是默认开启;学习率可用 schedule,不能把默认常数叫作自动退火。ratio clip 本身不足以保证更新很小。本轮实际把上述三个未改写的源码方法或代码块抽出,在最小 CPU policy、buffer、logger 夹具中执行;不是安装整套 SB3 后训练环境。使用 PyTorch 2.10.0+cpu,单个 minibatch、离散两动作、SGD 学习率 0.1:未标准化优势 $[1,-1,0.5,-0.5]$ 时 logits 从 $[0,0]$ 变为 $[0.0375,-0.0375]$,value 从 0 变为 0.075;打开标准化后 logits 为 $[0.041079,-0.041079]$。另验证 value clip、截断修正和 KL 提前停止。教学 NumPy 脚本的数值梯度与解析梯度最大差 $1.69\times10^{-11}$;GAE 递推与直接有限求和最大差 $8.89\times10^{-16}$。这些是实现一致性证据,不是任务学习效果或 GPU 性能复现。
在 RLHF 里还要额外记录 reward/score、reward/non_score_reward、policy/approxkl、policy/clipfrac、loss/value、熵、响应长度和终止比例。只看总 reward 上升无法判断是任务能力提高、KL 惩罚变化,还是模型学会钻奖励与长度的空子。
clipfrac 必须先确认实现口径:常见日志统计 $|\rho_t-1|>\epsilon$,但真正进入目标平台还要满足“正优势且 ratio 过大”或“负优势且 ratio 过小”。越界比例不等于梯度被截断比例。它长期接近 0,可能说明学习率过小、epoch 太少、优势太弱,也可能只是策略已经接近局部平稳;它突然接近 1,说明新旧动作概率已大幅偏离,应结合优势符号与 KL 判断;错误方向的越界样本仍有纠正梯度。单独追求某个“漂亮”的 clipfrac 没有意义,应与 KL、entropy 和 reward 一起看。
SB3 v2.7.0 令 $\ell_t=\log\pi_\theta-\log\pi_{\mathrm{old}}$,使用 $\widehat K=\mathrm{mean}(\exp(\ell_t)-1-\ell_t)$。固定旧状态、动作按 old policy 精确平均且支持一致时,$\mathbb E_{\mathrm{old}}[\exp(\ell)-1]=0$,于是期望等于 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_\theta)$;有限 minibatch 只是估计,也不是相对 reference 的 KL。该版本在 当前 optimizer step 之前 检查是否超过 $1.5\,\texttt{target\_kl}$,触发后停止后续训练,不回滚已有更新。本轮大步长夹具中,第一步已把 logits 推到 $[1.875,-1.875]$,第二次检查才停止;这直接说明 early stop 也不是硬 KL 保证。
approximate KL 快速增大而 reward 没有改善,通常先检查学习率、更新 epoch、优势尺度和 mask。如果 KL 很小、entropy 很快下降,则可能是分布变化集中在少数关键 token,平均 KL 把局部坍缩稀释了,需要再看 token 级分位数或最大值。
critic loss 下降也不一定是好消息。若 explained_variance 仍接近 0,critic 可能只学会了回报均值;若训练 loss 很低而新 rollout 上的 value error 很高,critic 在记忆同批噪声。此时 actor 收到的优势基线并不可靠。可以检查优势均值、标准差、与 return 的相关性,并把 value 网络的学习轮数与 actor 分开调节。
语言模型还有一个常见组合信号:任务 reward 上升、KL 惩罚绝对值变大、回答长度持续增加、人工质量不升。它常意味着奖励模型偏好长度或某种格式,策略在用分布漂移换分。解决顺序应是先按长度和题型切片评估奖励,再检查 EOS 奖励与 truncation,最后才调整 $\beta$。只增大 KL 系数会把症状压住,却不能修复有偏的反馈。
正式放大训练前,可以用小 batch 做四个不依赖最终 reward 的验收。新旧模型完全一致时,所有有效位置的 ratio 应接近 1,approximate KL 应接近 0;把优势全设为 0 后,policy loss 对 actor 的梯度应为 0;交换优势正负号后,选中动作的更新方向应反转;只改变 padding 内容而保持 mask 不变时,损失应不变。这些是必要的局部检查,不能宣称抓住“大部分”错误。零优势只保证纯 policy surrogate 的梯度为零:总损失的熵、KL 或共享 critic 仍可改变 actor;翻转优势的方向测试应在 ratio=1、未 clip 的局部执行。padding 不变性测试必须让有效 token 的上下文与位置也保持不变,不能任意改动可被模型关注的上下文。
PPO 的优点是实现直接、可对 actor 和 critic 使用普通一阶优化器、同一批 rollout 可以复用多个 epoch。它的代价也很具体。
第一,PPO 仍是 on-policy 算法。ratio 能容忍有限的策略变化,却不能把很久以前的 replay data 变成可靠的当前策略数据。生成模型的 rollout 很贵,这也是许多对齐算法试图绕开在线 PPO 的原因。
第二,critic 会占显存、计算和调参预算。GAE 的质量由奖励噪声、value 误差、终止处理共同决定。critic 拟合得太慢,优势带偏;拟合得太快,又可能记住同一批高噪声回报。
第三,clip 是代理目标的启发式约束。它不等价于 TRPO 的显式 trust region,也不保证真实期望回报单调上升。大 batch、较小学习率、较少 epoch 和 target KL 能降低风险,仍需用新 rollout 验证。
第四,奖励尺度会渗透到整个系统。优势标准化能消除一部分尺度问题,critic loss、value clipping、梯度竞争和终止奖励仍受影响。LLM 的序列长度还会改变 token 级 KL 总量,导致长回答受到更大惩罚或获得更多优化机会。
以下情况不适合直接上 PPO:没有可信在线奖励或无法持续采样;若只有离线偏好对且目标适合偏好优化;离线数据远多于在线交互预算;约束必须严格满足而当前方案只有软惩罚;环境极端稀疏奖励且 critic 没有可学习信号。此时应先解决反馈、数据或约束建模,而不是把希望寄托在 clip 上。
调试时也应先分清“估计坏了”还是“优化走远了”。前者常表现为优势高噪声、critic 解释方差差、不同随机种子更新方向不稳定,应检查奖励、bootstrap 和 GAE;后者常表现为前几个 minibatch 正常,随后 ratio、KL、clipfrac 一起升高,应减少学习率、epoch 或启用 KL early stop。两类问题都会造成 reward 抖动,但修复手段完全不同。
还要保留旧策略下的原始 rollout 指标。只比较更新后的 loss 无法回答“策略是否真的更好”;每轮更新后用新策略重新采样,并按任务、长度和难度切片比较回报,才能排除同一批数据上的代理目标过拟合。至少运行多个随机种子,因为一次 rollout 的偶然高分足以让小样本实验得出相反结论。
这条演进线并不是“新论文淘汰旧论文”。REINFORCE 给出梯度来源,GAE 改善估计,TRPO/PPO 限制更新,RLHF 再把状态、动作、奖励和约束映射到序列模型。后续算法通常只替换其中一到两块。
优势是相对量。一个回答奖励为 -2,如果当前 prompt 下平均只能拿 -5,它的优势仍可能为正;一个回答奖励为 9,如果该状态平均是 9.5,它的优势反而为负。策略更新比较的是条件基线,不是绝对分数。
纯策略梯度方向不变,但真实 PPO 还有固定学习率、clip、value loss、熵和 KL 项。优势尺度改变后,各损失的相对权重、越过 clip 边界的速度都会改变。优势标准化是训练定义的一部分,不能只当日志美化。
只有“超出区间且方向有利”的样本会被截断。好动作概率下降得太多、坏动作概率上升得太多时,目标仍保留梯度去纠正。04 节的四行表比背公式更可靠。
clip 在采样动作上限制替代收益,KL 衡量固定状态下整个动作分布的变化。ppo_checks.py 取旧分布 $[0.5,0.25,0.25]$、新分布 $[0.6,0.4-10^{-10},10^{-10}]$:只观测第一动作时 ratio 为 1.2,但全分布 $D_{\mathrm{KL}}(\pi_{\mathrm{old}}\|\pi_\theta)=5.2012$。未观测动作可发生很大变化,目标平台无法给它们施加硬限制。一个低概率 token 的概率可以相对变化很多而对平均 KL 贡献有限;许多小变化也可能累积出较大 KL。工程实现常同时监控 ratio、clip fraction 和 KL。
死亡、成功等真实终止意味着后续价值为零;时间上限只是观察窗口结束,底层状态可能仍有价值。两者都清零 bootstrap 会使 rollout 尾部的 value target 偏低。LLM 的最大长度是否 bootstrap 取决于任务定义:若上限本身就是任务终局,应按有限时域终止;若只是外部采样窗口,才考虑尾部价值。EOS 也要按具体奖励任务的终局语义处理,不能只按一个 token 名称机械判断。
old policy 是一轮 PPO 的行为策略快照,几轮 minibatch 后就会更新;reference policy 是长期锚点,通常在 RL 开始时冻结。前者服务于重要性采样,后者服务于行为约束。
先在仓库根目录运行:
python3 outputs/fundamentals_files/policy_gradient/code/gae_minimal.py
python3 outputs/fundamentals_files/policy_gradient/code/ppo_clip_minimal.py
再运行:
python3 outputs/fundamentals_files/policy_gradient/code/ppo_checks.py检查双掩码、有限窗口、解析矩、基线方差、共享参数与 KL 反例。两步截断例的 reward=$[1,100]$、value=$[2,50]$;第一步 reset 前末状态 value=3,$\gamma=0.9$。正确第一步 target 是 $1+0.9\times3=3.7$,不能用 reset 后的 value=50,也不能接上第二条 episode 的 residual。
接着做三个小改动,每次只改一个变量并记录输出。
critic_scale=0.0。本实验的全部 $\lambda$ 解析偏差都变为零,样本均值仍会有误差;奖励独立且 critic 固定时,较小 $\lambda$ 的 target 方差较小。bias_variance_demo(sigma=0.1),把奖励噪声标准差从 0.8 改为 0.1。完整 Monte Carlo target 的方差会明显下降,$\lambda=1$ 的代价随之减小。ppo_clip_minimal.py 的学习率从 0.3 改为 0.03。PPO-Clip 会更接近 ratio=1.2 后才停住,说明 clip 边界不是参数投影,离散优化仍会跨界。最后给脚本加入 target_kl=0.02 的提前停止条件:每轮更新后计算 KL(old||new),超过阈值就停止。比较它与 ratio clip 的停止轮数。你会看到两种护栏观察的是不同量,也会理解工业实现为什么常把它们同时保留。
读完这篇可以继续看:
09 节用到的脚本全文如下(ppo_checks.py、gae_minimal.py、make_figures.py、ppo_clip_minimal.py)。复制到本地存成同名文件,按各脚本开头的依赖说明准备环境后即可运行。
"""Independent numerical checks for the PPO article; no environment training."""
import json
from pathlib import Path
import numpy as np
from gae_minimal import gae_transitions, generalized_advantage_estimate, analytic_target_stats
from ppo_clip_minimal import clipped_surrogate, bandit_objective, finite_difference_gradient, optimize_same_batch


def main():
    rng = np.random.default_rng(71)
    gamma, lam = .9, .95
    d, a, target = gae_transitions([1, 100], [2, 50], [3, 0], [0, 1], [1, 1], gamma, lam)
    assert np.allclose(a, [1.7, 50]) and np.allclose(target, [3.7, 100])
    d2, a2, t2 = gae_transitions([0, 1], [.4, .7], [.7, 2], [0, 0], [0, 0], .9, 1)
    assert np.allclose(t2, [2.52, 2.8])
    old = generalized_advantage_estimate([0, 0, 1, .5], [.4, .55, .7, .3], [0, 0, 0, 1], 0, .99, .95)
    general = gae_transitions([0, 0, 1, .5], [.4, .55, .7, .3], [.55, .7, .3, 0], [0, 0, 0, 1], [0, 0, 0, 1], .99, .95)
    assert all(np.array_equal(x, y) for x, y in zip(old, general))
    # Direct residual summation, independently of reverse recursion.
    error = 0.
    for _ in range(50):
        n = 7
        rew, val, nxt = rng.normal(size=(3, n))
        ends = rng.integers(0, 2, n)
        terms = ends * rng.integers(0, 2, n)
        delta, adv, _ = gae_transitions(rew, val, nxt, terms, ends, .93, .71)
        direct = np.zeros(n)
        for t in range(n):
            weight = 1.
            for k in range(t, n):
                direct[t] += weight * delta[k]
                weight *= .93 * .71 * (1 - ends[k])
        error = max(error, float(np.max(np.abs(direct - adv))))
    assert error < 2e-15
    # Exact finite-action policy gradient; environment rewards do not depend on theta.
    sigmoid = lambda x: 1 / (1 + np.exp(-x))
    theta, discount = .37, .9
    def objective(x):
        return sigmoid(x) + discount * 2 * sigmoid(2 * x)
    exact = 0.
    ps = [sigmoid(theta), sigmoid(2 * theta)]
    for x in (0, 1):
        for y in (0, 1):
            prob = (ps[0] if x else 1-ps[0]) * (ps[1] if y else 1-ps[1])
            exact += prob * ((x + discount*2*y) * (x-ps[0]) + discount * (2*y) * 2*(y-ps[1]))
    fd = (objective(theta+1e-5)-objective(theta-1e-5))/2e-5
    assert abs(exact-fd) < 1e-9
    # A value baseline is unbiased, but is not necessarily variance minimizing.
    p = np.array([.8, .2]); rewards = np.array([1., 0.]); scores = np.array([.2, -.8])
    stats = {}
    for label, base in [('zero', 0.), ('value', .8), ('optimal', .2)]:
        samples = (rewards-base)*scores
        mean = p @ samples
        stats[label] = dict(baseline=base, mean=float(mean), variance=float(p @ (samples-mean)**2))
    assert np.isclose(stats['optimal']['variance'], 0) and stats['value']['variance'] > stats['zero']['variance']
    # Two positive advantages share theta but opposing feature gradients.
    direction = (.5 - 5.) / 2
    new_p = sigmoid(.02*direction)
    assert new_p < .5
    # Clip derivative away from the nondifferentiable boundaries.
    clip_error = 0.
    for ratio in [.65, .95, 1.1, 1.35]:
        for adv in [-2., 1.]:
            step = 1e-6
            fun = lambda r: float(clipped_surrogate(r, adv)[2])
            got = (fun(ratio+step)-fun(ratio-step))/(2*step)
            expected = 0 if (adv>0 and ratio>1.2) or (adv<0 and ratio<.8) else adv
            clip_error = max(clip_error, abs(got-expected))
    assert clip_error < 1e-9
    bandit_errors = []
    for x in [-2., -.1, .1, .2, .8, 2.]:
        prob = sigmoid(x)
        for clip in [False, True]:
            expect = 0 if clip and prob > .6 else 2*prob*(1-prob)
            bandit_errors.append(abs(finite_difference_gradient(x, clip)-expect))
    assert max(bandit_errors) < 1e-9
    # Unobserved actions: observed ratio alone cannot bound full KL.
    old_probs = np.array([.5, .25, .25]); new_probs = np.array([.6, .4-1e-10, 1e-10])
    kl = float(old_probs @ np.log(old_probs/new_probs))
    ratio = new_probs/old_probs
    approx = float(old_probs @ ((ratio-1)-np.log(ratio)))
    assert abs(kl-approx) < 1e-14 and kl > 5
    ref = np.array([.5, .5]); cur = np.array([.8, .2]); terms = np.log(cur/ref)
    assert terms[1]<0 and cur@terms>0
    # Gaussian reward moments and Monte Carlo standard errors.
    means=np.linspace(.2,.9,8); true_values=np.array([sum(.99**k*means[t+k] for k in range(8-t)) for t in range(8)])
    val=true_values+np.array([.3,-.9,.35,-.25,.2,-.15,.1,-.05])
    noise=np.random.default_rng(7).normal(means,.8,size=(20000,8)); rows=[]
    for l in [0.,.5,.95,1.]:
        weights=(.99*l)**np.arange(8)
        estimates=noise@weights+.99*(1-l)*(weights[:-1]@val[1:])
        mean,bias,var=analytic_target_stats(means,val,.8,.99,l)
        se=np.sqrt(var/len(noise)); assert abs(estimates.mean()-mean)<4*se
        rows.append(dict(lam=l,mean=float(estimates.mean()),bias=float(estimates.mean()-true_values[0]),std=float(estimates.std()),mse=float(np.mean((estimates-true_values[0])**2)),theory_bias=bias,theory_std=float(np.sqrt(var)),mean_se=float(se)))
    # Exact-value critic has zero expectation bias for every lambda in this setup.
    assert max(abs(analytic_target_stats(means,true_values,.8,.99,l)[1]) for l in [0,.5,.95,1]) < 2e-15
    out=dict(passed=True,gae_direct_sum_max_error=error,truncation_advantages=a.tolist(),truncation_targets=target.tolist(),window_lambda1_targets=t2.tolist(),exact_policy_gradient=exact,finite_difference_gradient=fd,policy_gradient_error=abs(exact-fd),baseline_examples=stats,shared_positive_advantage_first_probability=float(new_p),clip_derivative_max_error=clip_error,bandit_gradient_max_error=max(bandit_errors),unobserved_action_kl=kl,exact_kl_estimator_error=abs(kl-approx),reference_sample_logratios=terms.tolist(),reference_forward_kl=float(cur@terms),moments=rows,bandit_clipped_snapshots=optimize_same_batch(True),errors=[],warnings=[])
    dest=Path(__file__).with_name('validation_results.json');dest.write_text(json.dumps(out,indent=2,ensure_ascii=False),encoding='utf8')
    print(json.dumps(out,indent=2,ensure_ascii=False))


if __name__ == '__main__':
main()#!/usr/bin/env python3
"""用 NumPy 展示 GAE 递推,以及 lambda 的偏差—方差折中。
依赖:numpy。运行:python3 gae_minimal.py
"""
import numpy as np
def gae_transitions(rewards, values, next_values, terminated, episode_ends, gamma, lam):
"""Each transition supplies its actual next-state value, before any auto-reset.
terminated stops bootstrap; episode_ends stops GAE across a reset, including
time-limit truncation. A rollout window end alone needs no terminal flag.
All inputs have shape [T]; this routine does not batch or broadcast inputs.
"""
arrays = [np.asarray(x, dtype=np.float64) for x in
(rewards, values, next_values, terminated, episode_ends)]
rewards, values, next_values, terminated, episode_ends = arrays
if rewards.ndim != 1 or not len(rewards) or any(x.shape != rewards.shape for x in arrays):
raise ValueError("Inputs must share a nonempty shape [T]")
if not (0 <= gamma <= 1 and 0 <= lam <= 1):
raise ValueError("gamma and lambda must be in [0, 1]")
if any(np.any((x != 0) & (x != 1)) for x in (terminated, episode_ends)):
raise ValueError("Flags must be binary")
if np.any(terminated > episode_ends):
raise ValueError("A termination must also end the episode")
deltas = rewards + gamma * (1 - terminated) * next_values - values
advantages = np.zeros_like(rewards)
carry = 0.0
for t in reversed(range(len(rewards))):
carry = deltas[t] + gamma * lam * (1 - episode_ends[t]) * carry
advantages[t] = carry
return deltas, advantages, advantages + values
def analytic_target_stats(reward_means, values, sigma, gamma, lam):
"""Exact moments for independent rewards, fixed values, terminal V_T=0."""
means = np.asarray(reward_means, dtype=np.float64)
weights = (gamma * lam) ** np.arange(len(means))
mean = weights @ means
mean += gamma * (1 - lam) * np.dot(weights[:-1], values[1:])
variance = sigma ** 2 * np.dot(weights, weights)
truth = gamma ** np.arange(len(means)) @ means
return float(mean), float(mean - truth), float(variance)
def generalized_advantage_estimate(rewards, values, dones, next_value, gamma, lam):
"""单段旧接口;dones 仅表示真正终止,不支持中途截断后 auto-reset。"""
rewards = np.asarray(rewards, dtype=np.float64)
values = np.asarray(values, dtype=np.float64)
dones = np.asarray(dones, dtype=np.float64)
advantages = np.zeros_like(rewards)
deltas = np.zeros_like(rewards)
gae = 0.0
for t in reversed(range(len(rewards))):
value_next = next_value if t == len(rewards) - 1 else values[t + 1]
not_done = 1.0 - dones[t]
deltas[t] = rewards[t] + gamma * not_done * value_next - values[t]
gae = deltas[t] + gamma * lam * not_done * gae
advantages[t] = gae
return deltas, advantages, advantages + values
def fixed_trajectory_demo():
rewards = np.array([0.0, 0.0, 1.0, 0.5])
values = np.array([0.40, 0.55, 0.70, 0.30])
dones = np.array([0, 0, 0, 1])
gamma = 0.99
print("=== 固定轨迹 ===")
print(f"rewards.shape={rewards.shape}, values.shape={values.shape}")
for lam in (0.0, 0.5, 0.95, 1.0):
deltas, advantages, targets = generalized_advantage_estimate(
rewards, values, dones, next_value=0.0, gamma=gamma, lam=lam
)
print(
f"lambda={lam:>4.2f} delta={np.round(deltas, 4)} "
f"A={np.round(advantages, 4)} target={np.round(targets, 4)}"
)
def bias_variance_demo(seed=7, episodes=20000, sigma=0.8, critic_scale=1.0):
"""比较 GAE value target 对真实 V(s_0) 的偏差、标准差和均方误差。"""
rng = np.random.default_rng(seed)
gamma = 0.99
reward_means = np.linspace(0.2, 0.9, 8)
horizon = len(reward_means)
dones = np.zeros(horizon)
dones[-1] = 1.0
true_values = np.zeros(horizon)
for t in reversed(range(horizon)):
future = 0.0 if t == horizon - 1 else true_values[t + 1]
true_values[t] = reward_means[t] + gamma * future
# 故意给 critic 加一组固定误差,使短视的 TD target 有偏。
critic_error = np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05])
approx_values = true_values + critic_scale * critic_error
rewards_batch = rng.normal(reward_means, sigma, size=(episodes, horizon))
print("\n=== lambda 的偏差—方差折中(估计 V(s_0))===")
print(f"episodes={episodes}, true_V0={true_values[0]:.4f}, critic_V0={approx_values[0]:.4f}")
print("lambda mean bias std mse theory_bias theory_std mean_SE")
for lam in (0.0, 0.5, 0.95, 1.0):
estimates = np.empty(episodes)
for i, rewards in enumerate(rewards_batch):
_, advantages, targets = generalized_advantage_estimate(
rewards, approx_values, dones, next_value=0.0, gamma=gamma, lam=lam
)
estimates[i] = targets[0]
bias = estimates.mean() - true_values[0]
mse = np.mean((estimates - true_values[0]) ** 2)
theory_mean, theory_bias, variance = analytic_target_stats(reward_means, approx_values, sigma, gamma, lam)
print(f"{lam:>6.2f} {estimates.mean():>8.4f} {bias:>8.4f} {estimates.std():>8.4f} {mse:>8.4f} {theory_bias:>10.4f} {np.sqrt(variance):>10.4f} {np.sqrt(variance / episodes):>7.4f}")
if __name__ == "__main__":
fixed_trajectory_demo()
bias_variance_demo()#!/usr/bin/env python3
"""生成本文的 GAE 偏差—方差图与 PPO 裁剪曲线。
依赖:numpy、matplotlib。运行:python3 make_figures.py
图片写入相邻的 figures/ 目录。
"""
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
from gae_minimal import generalized_advantage_estimate, analytic_target_stats
from ppo_clip_minimal import clipped_surrogate
OUT_DIR = Path(__file__).resolve().parent.parent / "figures"
def gae_tradeoff_figure(seed=7, episodes=20000):
rng = np.random.default_rng(seed)
gamma = 0.99
means = np.linspace(0.2, 0.9, 8)
dones = np.zeros(len(means))
dones[-1] = 1.0
true_values = np.zeros(len(means))
for t in reversed(range(len(means))):
true_values[t] = means[t] + gamma * (0.0 if t == len(means) - 1 else true_values[t + 1])
approx_values = true_values + np.array([0.30, -0.90, 0.35, -0.25, 0.20, -0.15, 0.10, -0.05])
reward_batch = rng.normal(means, 0.8, size=(episodes, len(means)))
lambdas = np.array([0.0, 0.25, 0.5, 0.75, 0.95, 1.0])
bias, std, mse = [], [], []
for lam in lambdas:
estimates = []
for rewards in reward_batch:
_, _, targets = generalized_advantage_estimate(
rewards, approx_values, dones, 0.0, gamma, lam
)
estimates.append(targets[0])
estimates = np.asarray(estimates)
bias.append(estimates.mean() - true_values[0])
std.append(estimates.std())
mse.append(np.mean((estimates - true_values[0]) ** 2))
fig, axes = plt.subplots(1, 2, figsize=(11, 4.8))
theory = [analytic_target_stats(means, approx_values, 0.8, gamma, lam) for lam in lambdas]
axes[0].plot(lambdas, np.abs(bias), "o-", label="Empirical absolute bias")
axes[0].plot(lambdas, std, "s-", label="Empirical standard deviation")
axes[0].plot(lambdas, np.abs([x[1] for x in theory]), ":", label="Analytic absolute bias")
axes[0].plot(lambdas, np.sqrt([x[2] for x in theory]), ":", label="Analytic standard deviation")
axes[0].set_ylabel("Reward units")
axes[1].plot(lambdas, mse, "^-", label="Empirical MSE")
axes[1].plot(lambdas, [x[1]**2+x[2] for x in theory], ":", label="Analytic MSE")
axes[1].set_ylabel("Squared reward units")
for ax in axes:
ax.set_xlabel("GAE lambda")
ax.grid(alpha=0.25)
ax.legend(frameon=False, fontsize=8)
fig.suptitle("Fixed critic errors and independent reward noise (seed 7, n=20000)")
fig.tight_layout()
path = OUT_DIR / "gae_bias_variance.png"
fig.savefig(path, dpi=180, facecolor="white")
plt.close(fig)
return path
def ppo_clip_figure():
ratio = np.linspace(0.4, 1.6, 500)
fig, axes = plt.subplots(1, 2, figsize=(11, 4.8), sharex=True)
for ax, advantage in zip(axes, (1.0, -1.0)):
raw, clipped, objective = clipped_surrogate(ratio, np.full_like(ratio, advantage))
ax.plot(ratio, raw, linestyle="--", linewidth=2, label="Unclipped")
ax.plot(ratio, objective, linewidth=3, label="PPO objective")
ax.axvspan(0.8, 1.2, color="#2f6df6", alpha=0.08)
ax.axvline(1.0, color="black", linewidth=1, alpha=0.5)
ax.set_title(f"Advantage = {advantage:+.0f}")
ax.set_xlabel("new / old probability ratio")
ax.grid(alpha=0.2)
axes[0].set_ylabel("Per-sample surrogate")
axes[0].legend(frameon=False)
fig.suptitle("PPO-Clip is one-sided and depends on the advantage sign", fontsize=14)
fig.tight_layout()
path = OUT_DIR / "ppo_clip_sign.png"
fig.savefig(path, dpi=180, facecolor="white")
plt.close(fig)
return path
if __name__ == "__main__":
OUT_DIR.mkdir(parents=True, exist_ok=True)
for output in (gae_tradeoff_figure(), ppo_clip_figure()):
print(f"saved: {output} ({output.stat().st_size / 1024:.1f} KiB)")#!/usr/bin/env python3
"""用 NumPy 拆解 PPO-Clip,并在两臂老虎机旧动作分布的精确求和上更新多轮。
依赖:numpy。运行:python3 ppo_clip_minimal.py
"""
import numpy as np
def clipped_surrogate(ratio, advantage, epsilon=0.2):
ratio = np.asarray(ratio, dtype=np.float64)
advantage = np.asarray(advantage, dtype=np.float64)
unclipped = ratio * advantage
clipped = np.clip(ratio, 1.0 - epsilon, 1.0 + epsilon) * advantage
objective = np.minimum(unclipped, clipped)
return unclipped, clipped, objective
def clipping_table():
ratios = np.array([1.35, 0.65, 1.35, 0.65, 1.10, 0.90])
advantages = np.array([1.0, 1.0, -1.0, -1.0, 0.5, -0.5])
raw, clipped, objective = clipped_surrogate(ratios, advantages)
print("=== 单样本裁剪表 ===")
print(" ratio A ratio*A clip(ratio)*A min clipped?")
for r, a, u, c, o in zip(ratios, advantages, raw, clipped, objective):
flag = "yes" if not np.isclose(u, o) else "no"
print(f" {r:>4.2f} {a:>4.1f} {u:>7.3f} {c:>7.3f} {o:>6.3f} {flag}")
def sigmoid(x):
return 1.0 / (1.0 + np.exp(-x))
def bandit_objective(theta, clipped):
"""旧策略两动作概率各 0.5;动作 1 优势 +1,动作 0 优势 -1。精确期望,不采样。"""
p_good = sigmoid(theta)
ratios = np.array([p_good / 0.5, (1.0 - p_good) / 0.5])
advantages = np.array([1.0, -1.0])
if clipped:
return clipped_surrogate(ratios, advantages)[2].mean()
return np.mean(ratios * advantages)
def finite_difference_gradient(theta, clipped, h=1e-5):
return (bandit_objective(theta + h, clipped) - bandit_objective(theta - h, clipped)) / (2 * h)
def bernoulli_kl(old_p, new_p):
return old_p * np.log(old_p / new_p) + (1.0 - old_p) * np.log((1.0 - old_p) / (1.0 - new_p))
def optimize_same_batch(clipped, steps=40, learning_rate=0.3):
theta = 0.0
snapshots = []
watch = {0, 1, 2, 5, 10, 20, 39}
for step in range(steps):
grad = finite_difference_gradient(theta, clipped)
theta += learning_rate * grad
if step in watch:
p_good = sigmoid(theta)
ratio_good = p_good / 0.5
snapshots.append((step + 1, p_good, ratio_good, grad, bernoulli_kl(0.5, p_good)))
return snapshots
def repeated_update_demo():
print("\n=== 在旧策略动作分布精确期望上更新 40 轮 ===")
print("mode epoch p(good) ratio_good grad KL(old||new)")
for mode, clipped in (("unclipped", False), ("PPO-Clip", True)):
for epoch, p_good, ratio, grad, kl in optimize_same_batch(clipped):
print(f"{mode:<10} {epoch:>5d} {p_good:>7.4f} {ratio:>7.4f} {grad:>7.4f} {kl:>7.4f}")
if __name__ == "__main__":
clipping_table()
repeated_update_demo()

评论 (0)