今日 AIGC 论文速览
今日共 10 篇
重点论文标题列表
LLaDA-Image (Inclusion AI AGI Research Center):从零训练开放生图模型DSAQuant (Robbyant、浙江大学、香港理工大学、香港科技大学):按去噪阶段做视频量化⚡ DM-Align (清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学):四步视频同时对齐与蒸馏
RA-GRPO (清华大学、快手科技):用反思轨迹稳定生成对齐VoRTeC (清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学):用生成流做一步视频解码
今日论文速览
1. LLaDA-Image:从零训练开放生图模型
LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes | Inclusion AI AGI Research Center | arXiv:2609.03796
关键词 :图像生成,开放模型,扩散语言模型,模型蒸馏
⚠️ 前序问题 :高质量图像生成模型常依赖不透明的数据配方、训练细节或已有模型权重,研究者难以复现从零训练过程;把理解、生成和编辑统一起来也容易牺牲其中一项能力。
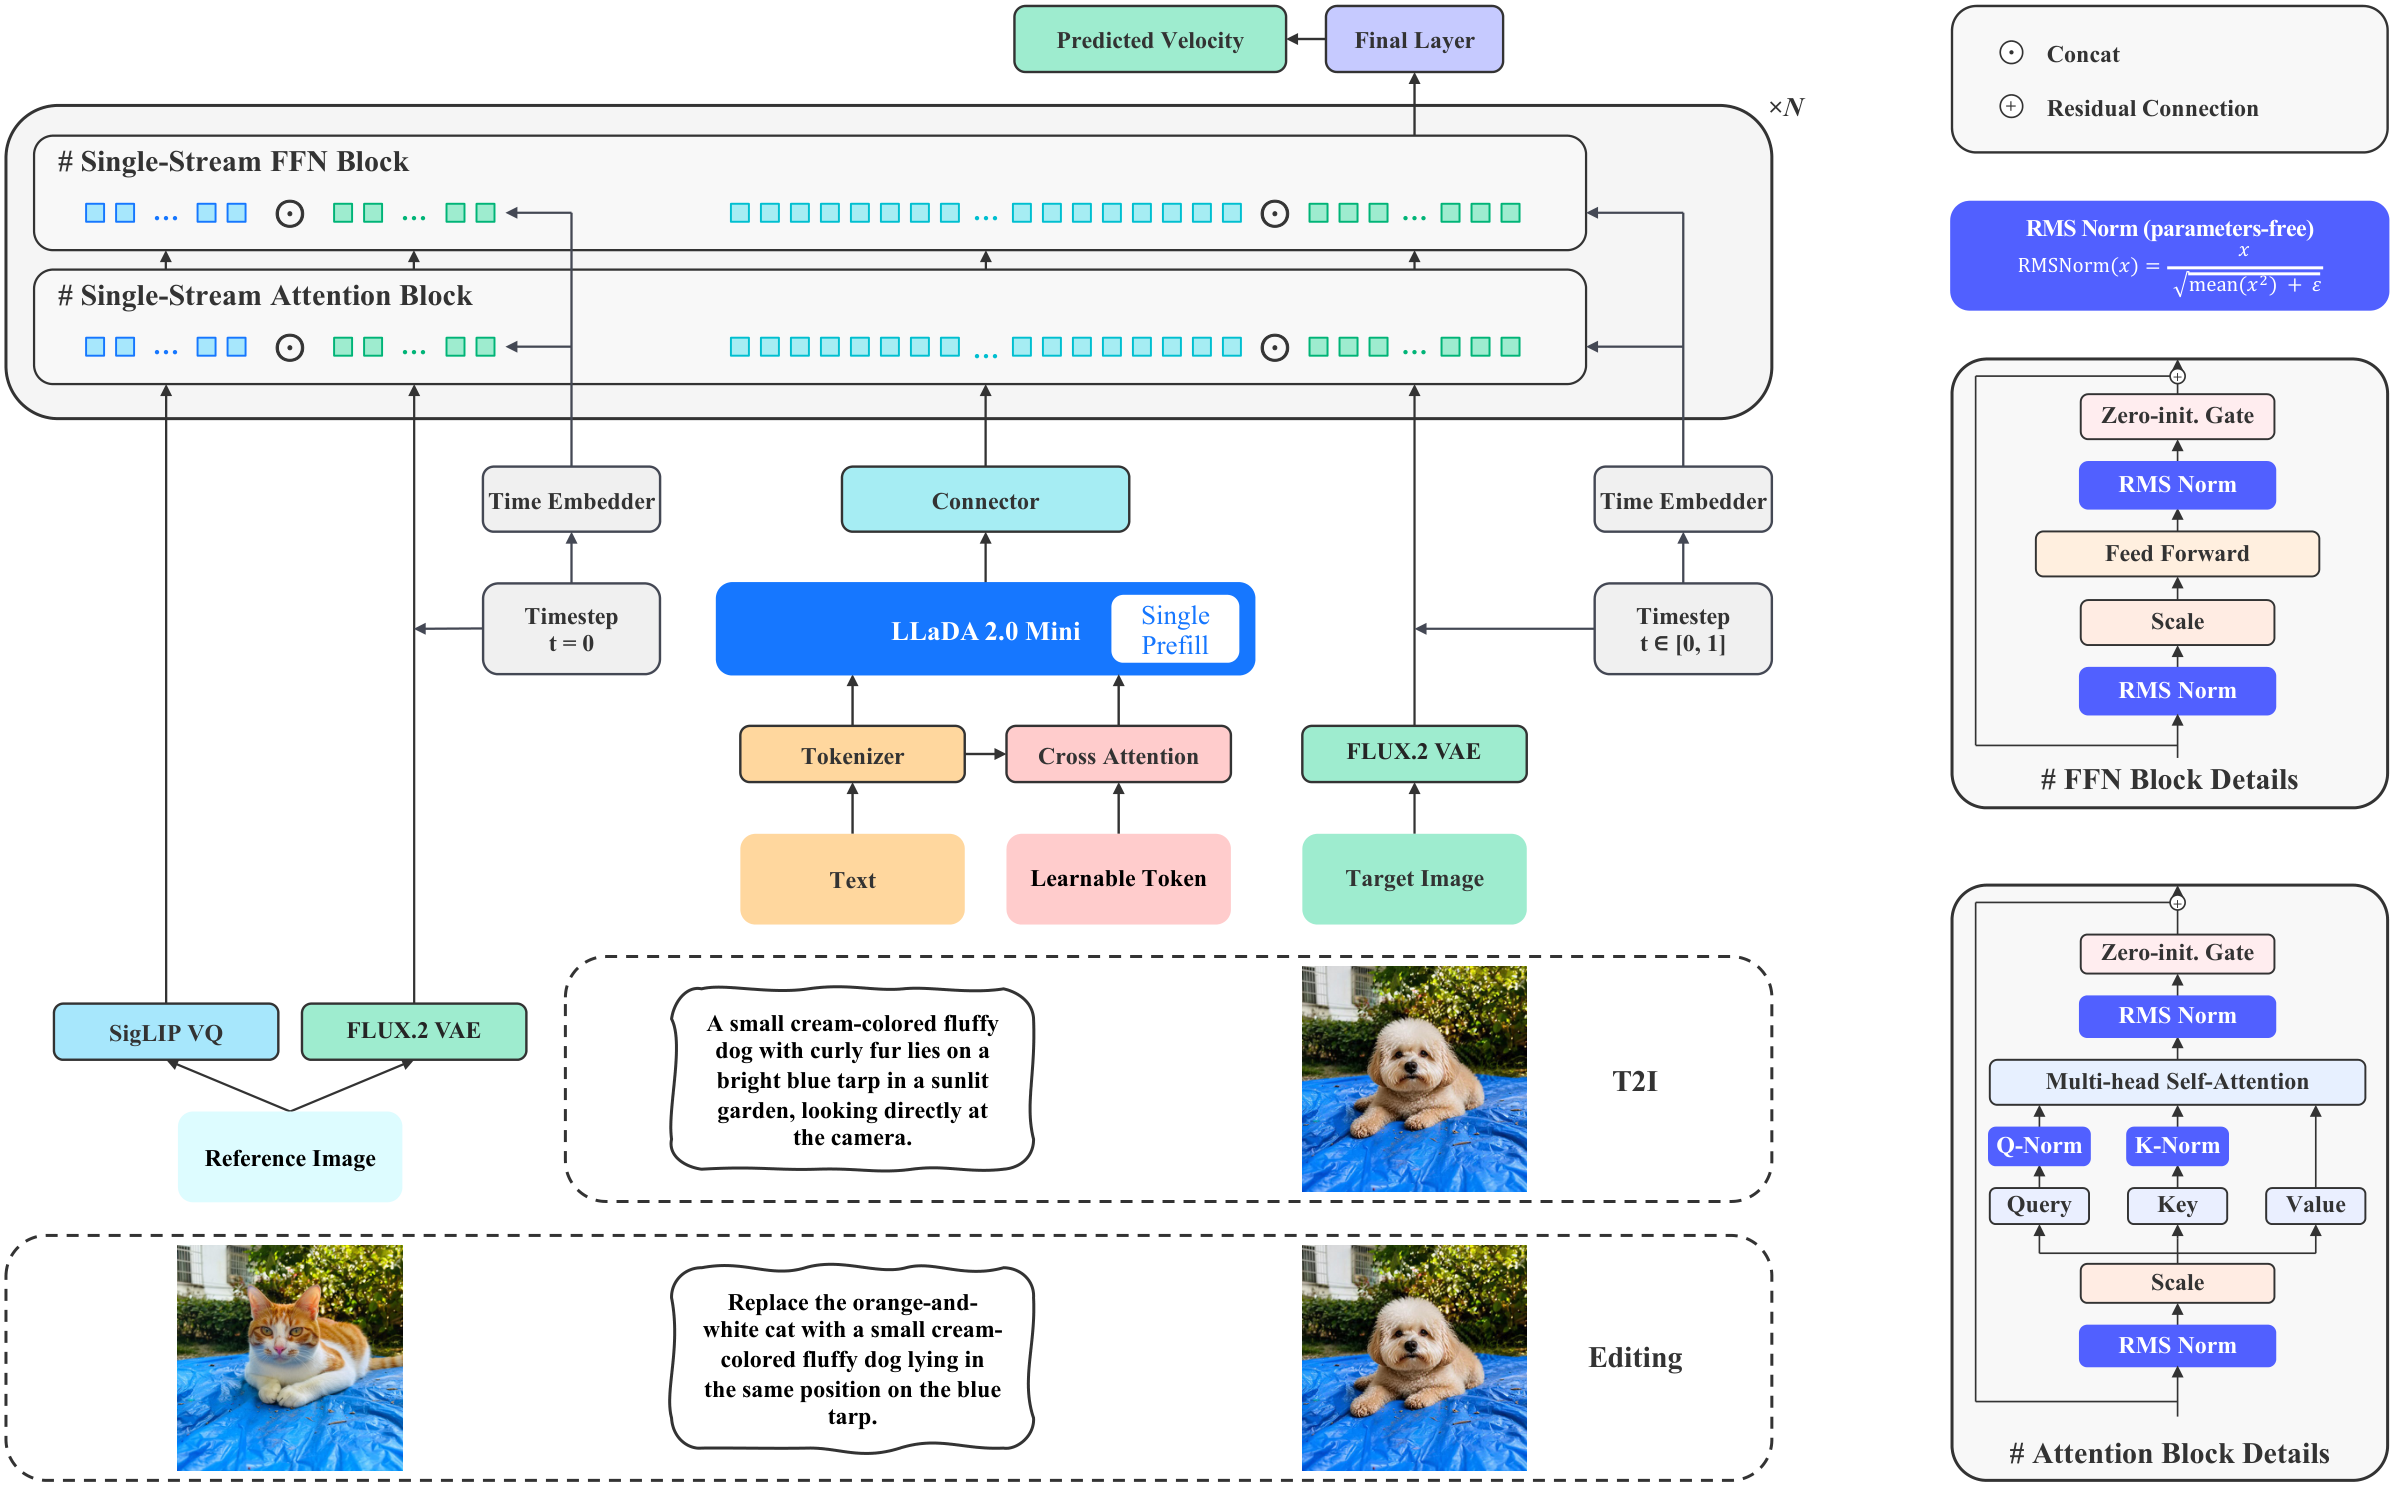
本文贡献 :作者从零训练一个 6B 参数 DiT,并接入冻结的 LLaDA2.0-Mini 视觉语言理解模块。训练先用纯图像预训练建立视觉先验,再做中期训练和图文统一训练;全流程使用 2.2 亿样本,其中 98% 为真实图像,并公开权重、代码和训练配方。团队还用 TwinFlow 将模型蒸馏为 2 至 4 步推理的 Turbo 版本。
实验效果 :LLaDA-Image 在 Qwen-Image-Bench 英文与中文轨分别得到 53.53 和 53.38,领先当时其余开源模型;LongText-Bench 英文、中文得分为 0.923 和 0.913。编辑基准 GEdit-Bench 的英文、中文总分为 7.336 和 7.294,说明统一模型已具备较强的生成、文字渲染与编辑能力。
批判点评 :2.2 亿样本的收集、清洗和训练成本仍然很高,公开配方也不会自动解决数据授权与可追溯性问题。报告覆盖模块很多,但部分组件的独立贡献和跨架构可迁移性仍需更多消融验证。
2. DSAQuant:按去噪阶段做视频量化
DSAQuant: Denoising-Stage-Aligned Quantization-Aware Training for Video Generation | Robbyant、浙江大学、香港理工大学、香港科技大学 | arXiv:2609.04031
关键词 :视频生成,量化感知训练,低比特推理,部署优化
⚠️ 前序问题 :视频扩散模型压到 W4A4 或 W3A3 后,通常还能保住提示词语义、构图与粗粒度运动,却会明显丢失纹理、锐度和局部细节。传统量化训练把所有去噪时刻一视同仁,没有利用早期规划结构、后期补细节的分工。
本文贡献 :DSAQuant 按去噪阶段切换监督目标:早期保持教师蒸馏以稳定全局结构与运动,后期逐渐转向目标驱动的细节重建;推理时在最后阶段关闭分类器自由引导,避免量化误差被 CFG 放大为高频伪影。方法同时覆盖 Wan 与 CogVideoX 系列。
实验效果 :在 Wan2.1-1.3B 的 W4A4 设置下,DSAQuant 的 VBench 平均分为 67.21,高于 BF16 模型的 66.28 和 QVGen 对称量化的 63.56;在更激进的 W3A3 下,相对当时量化训练基线最高提升 6.60 分。
批判点评 :论文重点验证生成质量,没有把端到端延迟、显存、能耗和不同硬件内核的实际收益放在同等位置;量化感知训练本身也有额外成本。后期关闭 CFG 可能改变文本对齐,需要在更广的提示与长视频任务上验证。
3. DM-Align:四步视频同时对齐与蒸馏
Joint Alignment and Distillation for Video Generation via Sample-Guided Distribution Matching | 清华大学、快手科技、哈尔滨工业大学(深圳)、北京邮电大学 | arXiv:2609.04283
关键词 :视频生成,偏好对齐,分布匹配,少步蒸馏
⚠️ 前序问题 :视频生成的偏好对齐与少步蒸馏通常分成两段:先强化学习再蒸馏计算昂贵,先蒸馏再做强化学习又容易让模型坍塌。两段流程还要重复运行多步奖励评估,并在 ODE 与 SDE 轨迹间转换。
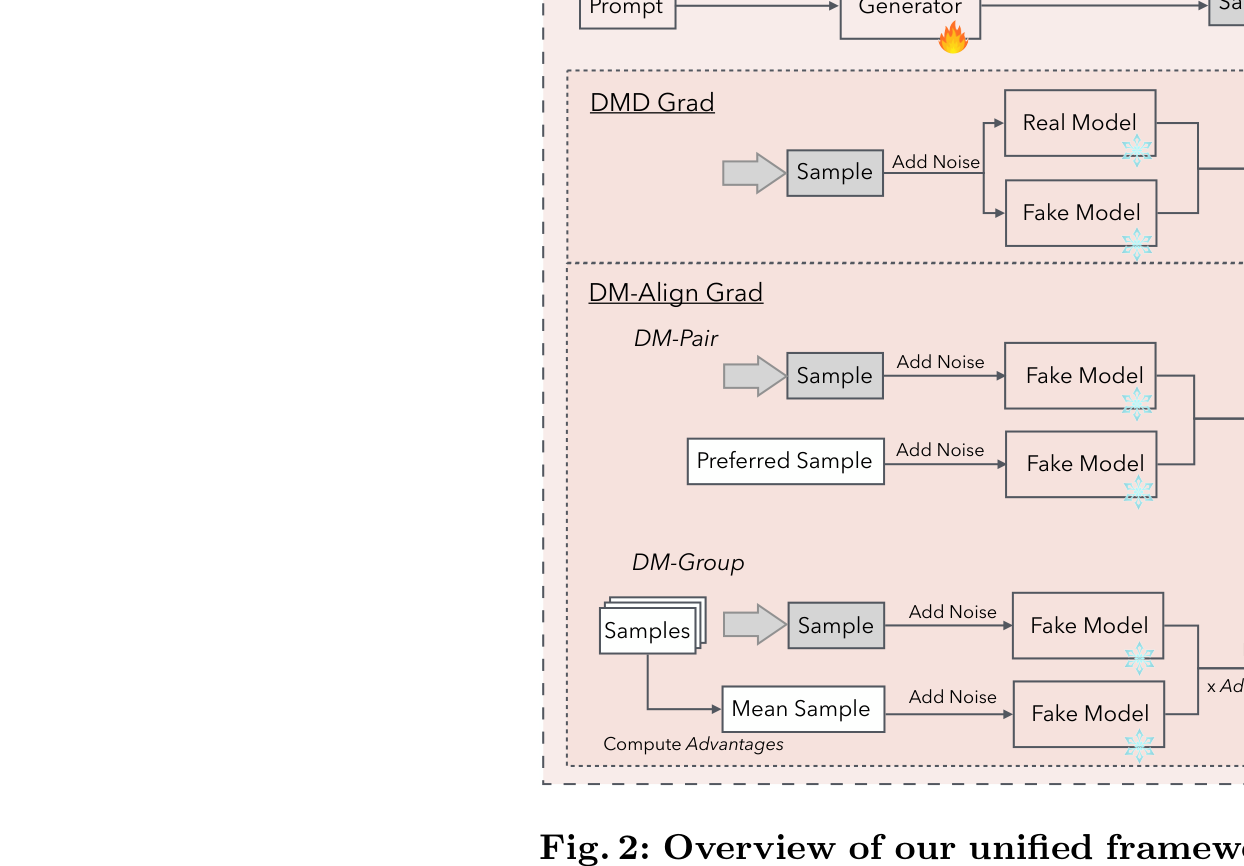
本文贡献 :DM-Align 在一次分布匹配训练中同时叠加两种梯度:DMD2 梯度缩小真实模型与学生模型的分布差距,偏好梯度则利用成对偏好或组内探索,把生成分布推向人类偏好的样本。它把类似 DPO 与 GRPO 的信号写进同一训练目标,直接产出 4 次函数评估的视频模型。
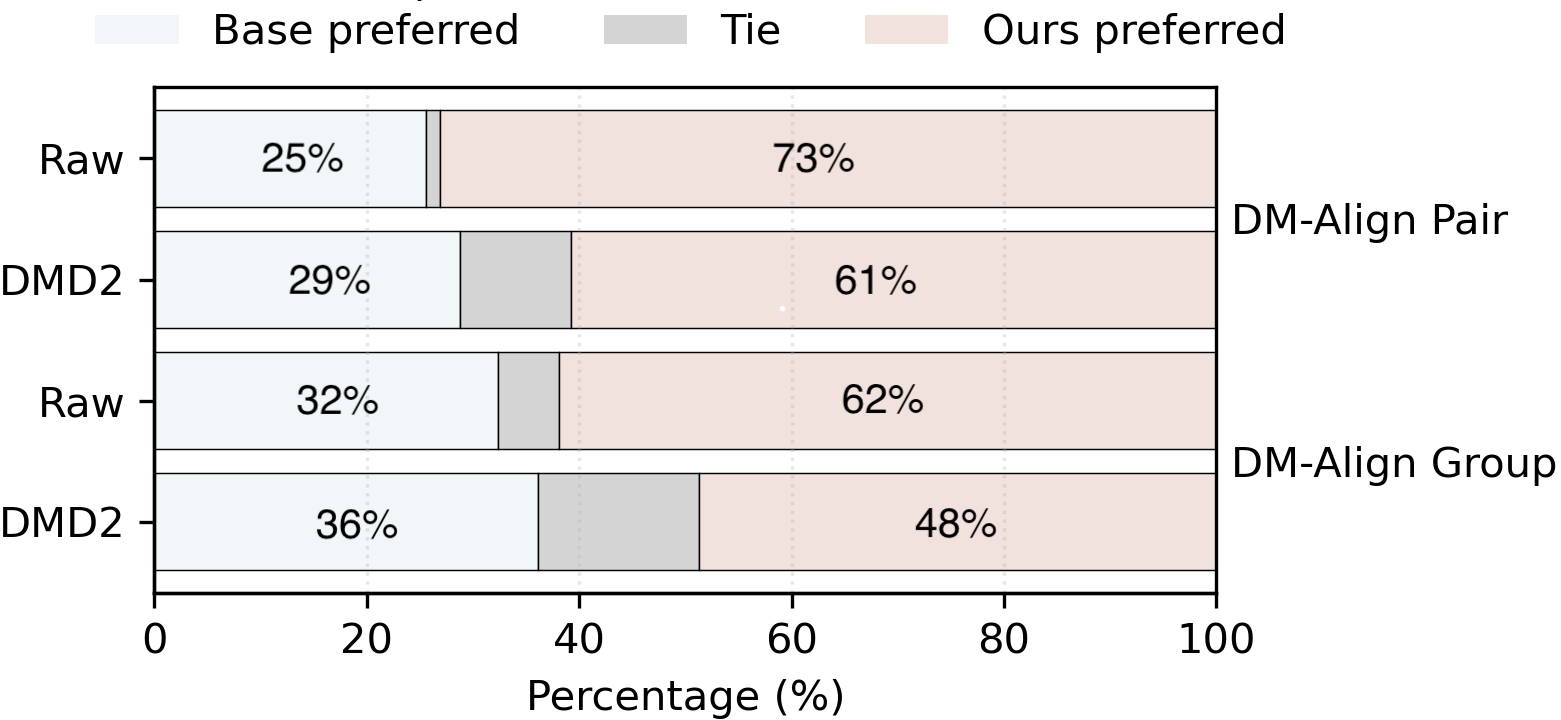
实验效果 :在 Wan2.1-T2V-1.3B、5 秒 832×480 视频上,组内模式以 4 NFE 得到 VBench 平均分 84.40、动态度 80.19;成对模式为 82.78。人工比较中,成对模式相对原模型净偏好提升 48%,相对单独 DMD2 提升 32%。
批判点评 :实验集中在 1.3B 基模、5 秒 480p 视频,尚不足以说明长视频与更大模型也能稳定受益。样本引导仍依赖奖励或偏好数据,奖励偏差与奖励投机只是减轻,不能视为消失。
4. RA-GRPO:用反思轨迹稳定生成对齐
Step Back to Move Forward: Reflection-Aware Preference Optimization for Visual Generation | 清华大学、快手科技 | arXiv:2609.04282
关键词 :偏好对齐,扩散模型,强化学习,奖励投机
⚠️ 前序问题 :生成模型用策略梯度对齐人类偏好时,探索常被局部最优牵引:奖励上升了,语义忠实度或真实感却可能下降。常规 GRPO 只从当前前向采样学习,很难主动修复已经偏离高概率数据流形的中间状态。
本文贡献 :RA-GRPO 在训练中加入“向后反思”。Diffusion Reflection 在随机中间时刻用较弱估计器反演并校正潜变量,再由 Counterfactual Path Synthesis 把校正后的路径蒸馏回策略。反思只发生在优化阶段,因此部署时没有额外采样开销。
实验效果 :在 FLUX.1-dev 与 HPSv2.1 提示集上,以 HPS 为奖励时,RA-GRPO 的 HPSv2.1、ImageReward、HPSv3 分别为 0.378、1.417、15.324,均高于论文复现的 DanceGRPO 与 MixGRPO;多目标 HPS+CLIP 训练也取得更均衡的自动指标。
批判点评 :验证主要围绕 FLUX.1-dev、HPS 提示和自动奖励模型。弱估计器、指导强度与反思时刻的选择会影响稳定性;只看自动奖励仍可能漏掉新的投机模式,需要更大规模人工偏好与跨模型复核。
5. VoRTeC:用生成流做一步视频解码
VoRTeC: Taming Foundation Flow for One-step Real time Video Compression | 清华大学深圳国际研究生院、哈尔滨工业大学(深圳)、北京大学 | arXiv:2609.02291
关键词 :视频压缩,流模型,实时解码,超低码率
⚠️ 前序问题 :传统神经视频压缩在超低码率下容易模糊,而扩散式生成压缩通常需要多步采样,难以实时运行。如何借用强视频生成模型的先验,又不复制其昂贵迭代过程,是部署瓶颈。
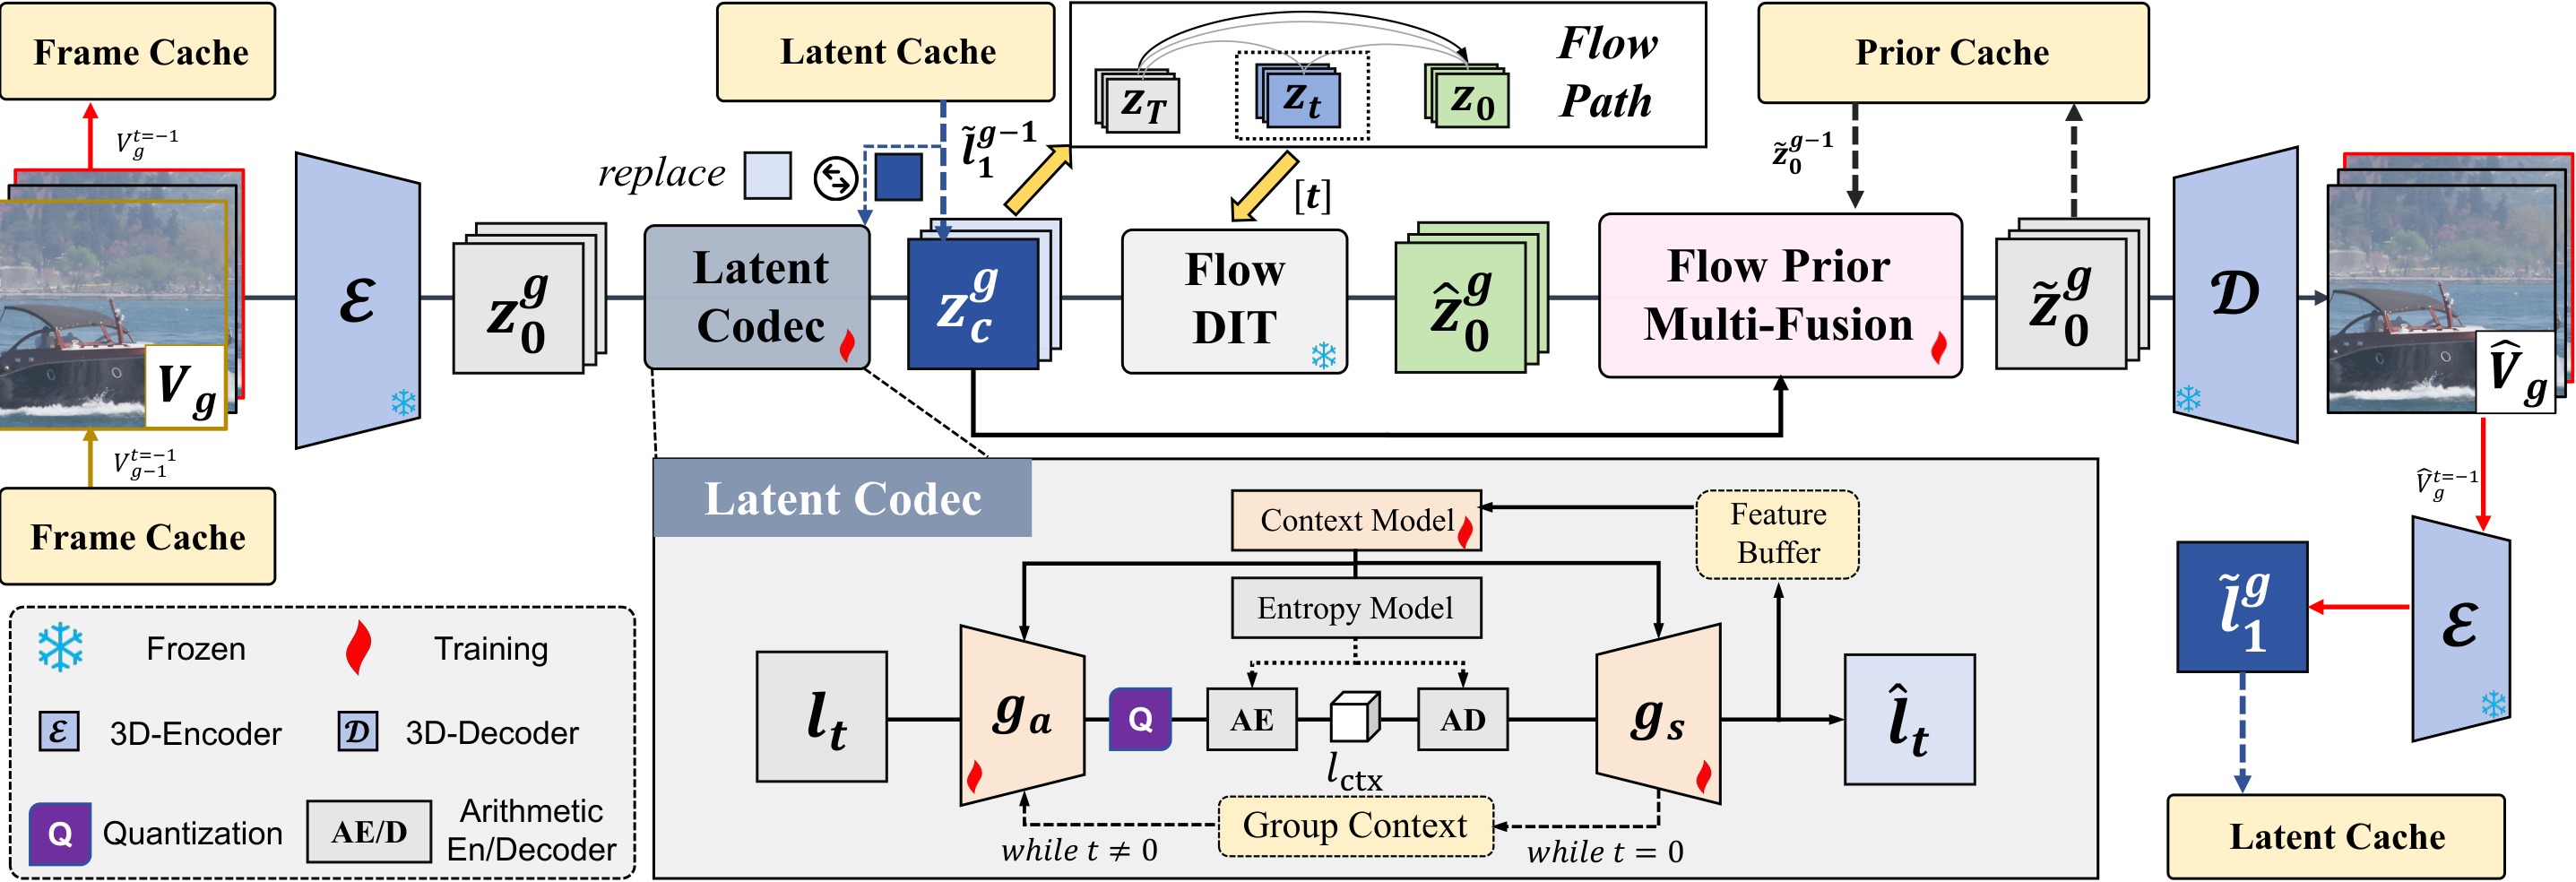
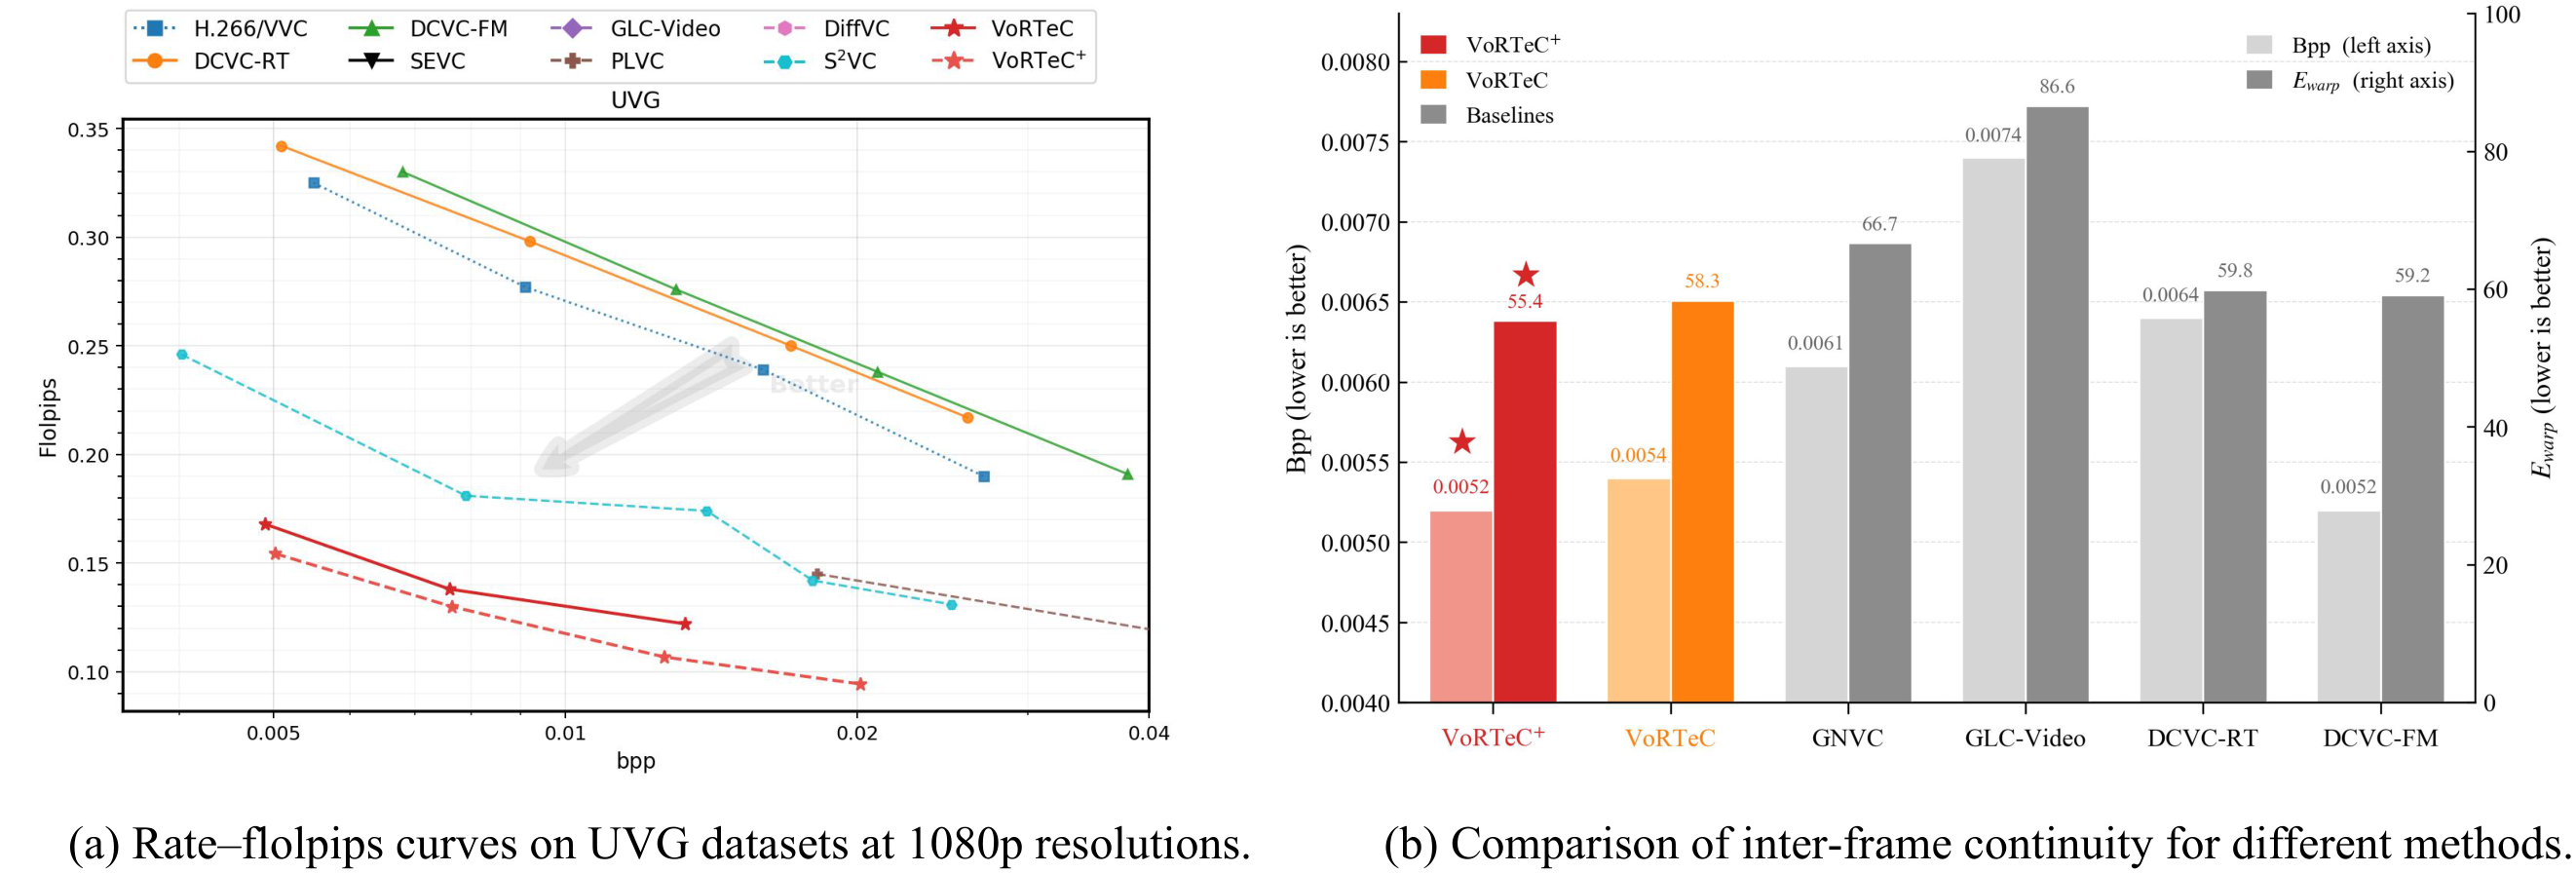
本文贡献 :VoRTeC 冻结 Wan2.1 流模型,只训练紧凑潜码与轨迹位置预测器,用多尺度先验把一次解码对齐到生成流。跨帧组复用尾帧,并缓存生成先验,以降低连续视频的重复计算;训练不需要访问基础流模型的参数或梯度,可在单张 A6000 上完成。
实验效果 :论文报告在相近感知质量下可节省 58.12% 至 73.25% 码率,并达到低于 0.01 bpp;推理相对多步生成压缩加速 3 至 197 倍,720p 达 13 fps、480p 达 32 fps。
批判点评 :速度依赖具体显卡、分辨率与缓存条件,不能直接外推到移动设备。对取证、医疗、遥感等要求像素真实性的场景,生成先验可能引入不可接受的幻觉,需要独立的保真约束与错误标记。
6. Editable Visual Design:让视觉设计真正可编辑
Editable Visual Design | 腾讯混元、中山大学、清华大学、香港中文大学、上海交通大学 | arXiv:2609.04034
关键词 :视觉设计,智能体,图像生成,HTML CSS
⚠️ 前序问题 :文生图可以快速给出海报或信息图,但输出通常是一张扁平位图,文字、图标和布局无法继续精确编辑;纯代码生成又容易缺少视觉想象与审美反馈。
本文贡献 :该系统让视觉语言模型充当创意大脑、图像生成器充当视觉世界模拟器,先想象整体效果,再把素材隔离为独立资产并用原生 HTML/CSS 重建文字、层级与布局。Agent Design Replay 学习专业设计轨迹,智能体通过截图反馈持续比较和修改。
实验效果 :论文用海报、信息图、营销物料和长文本版式等案例展示:输出中的文字保留为真实文本,元素可以用鼠标拖动,图层与样式可继续修改。论文当前以定性案例证明可编辑工作流,没有给出可横向比较的统一量化分数。
批判点评 :缺少大规模用户研究、任务完成时间和跨基线量化评测,使“更专业”仍难精确判断。流程依赖图像生成和代码智能体的能力,素材版权、网页代码安全与复杂版式的兼容性也需要产品级约束。
7. Temporal Context Routing:把脚本精确路由到时间轴
The Missing Temporal Link: Temporal Context Routing for Script-Driven Audio-Video Generation | 北京大学、Qwen Applications、香港科技大学、香港中文大学、上海交通大学 | arXiv:2609.02367
关键词 :音视频生成,时间控制,脚本驱动,多模态生成
⚠️ 前序问题 :脚本驱动的音视频生成会同时处理镜头、对白、动作和音效,但全局文本条件不知道某条指令应该在哪一秒生效,常出现切镜过早、对白错位或动作与声音不同步。
本文贡献 :Temporal Context Routing 先把脚本事件映射到音频与视频共享的时间轴,再将每段提示的引导信号只路由到匹配的时空位置。它给现有联合音视频模型补上显式时间链接,而不用让所有帧共同接受整段脚本。
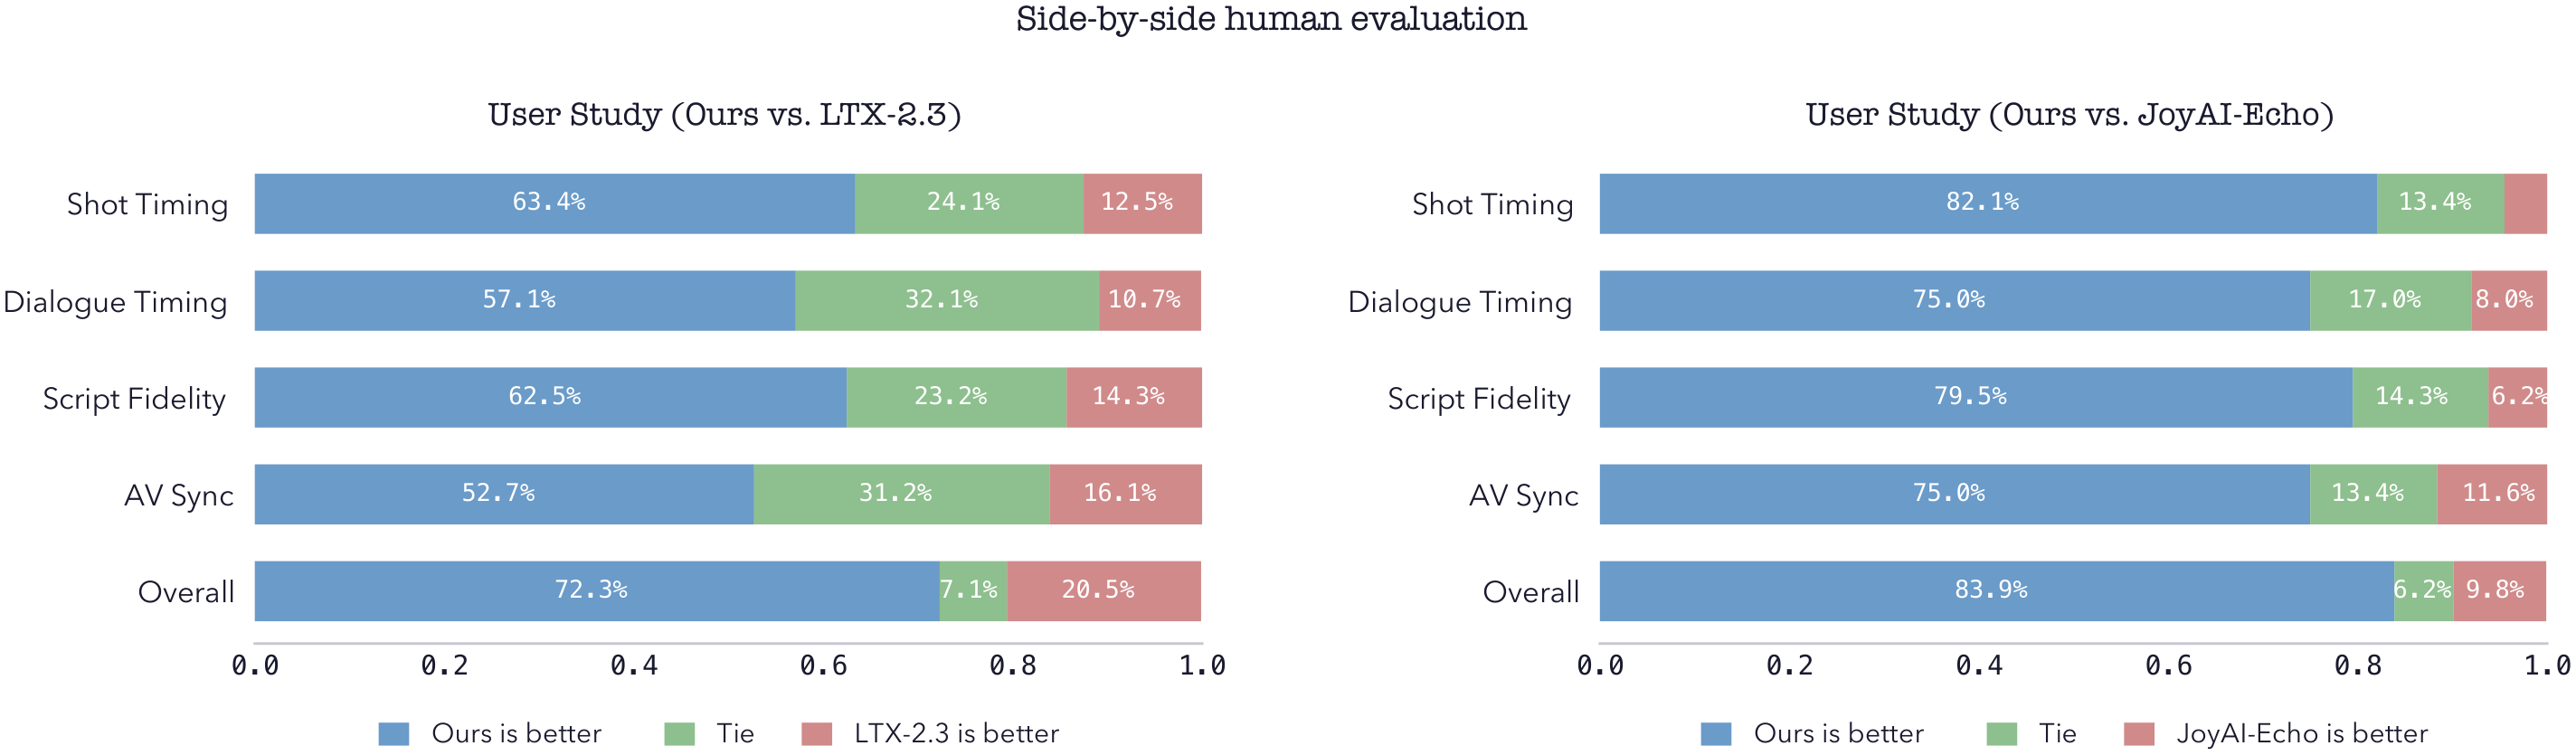
实验效果 :在 200 条测试脚本上,镜头边界平均绝对误差从 1.11 秒降到 0.042 秒,下降约 96%;对白在 0.5 秒容差内的准确率从 28.3% 提升到 84.1%,同时视觉质量与音画同步指标保持相近。
批判点评 :实验规模仍有限,长叙事、重叠对白、快速多事件和镜头外音源会让路由更复杂。用户研究偏好不能替代对叙事连贯性与错误恢复的长期评估。
8. Unreal Engine World Data:用虚幻引擎规模化造数据
Building Pretraining Data for World Models: An Unreal Engine-Based Pipeline for Action-Conditioned Video Generation | Joy Future Academy、京东、清华大学、香港科技大学 | arXiv:2609.03557
关键词 :世界模型,合成数据,虚幻引擎,动作条件视频
⚠️ 前序问题 :动作条件世界模型需要既有可控动作轨迹、又有高质量画面的长视频数据。直接在游戏引擎中边运行物理、边实时渲染,容易因帧率波动破坏动作与画面对齐,也难在数百 GPU 上稳定扩展。
本文贡献 :作者把流程拆成两段:PIE 先按真实物理运行并记录角色、控制和相机状态,MRQ 再离线重放轨迹并高质量渲染。系统加入缓存感知的任务分片、节点槽位、场景筛选、亮度与审美过滤,以及失败恢复、上传和健康检查。
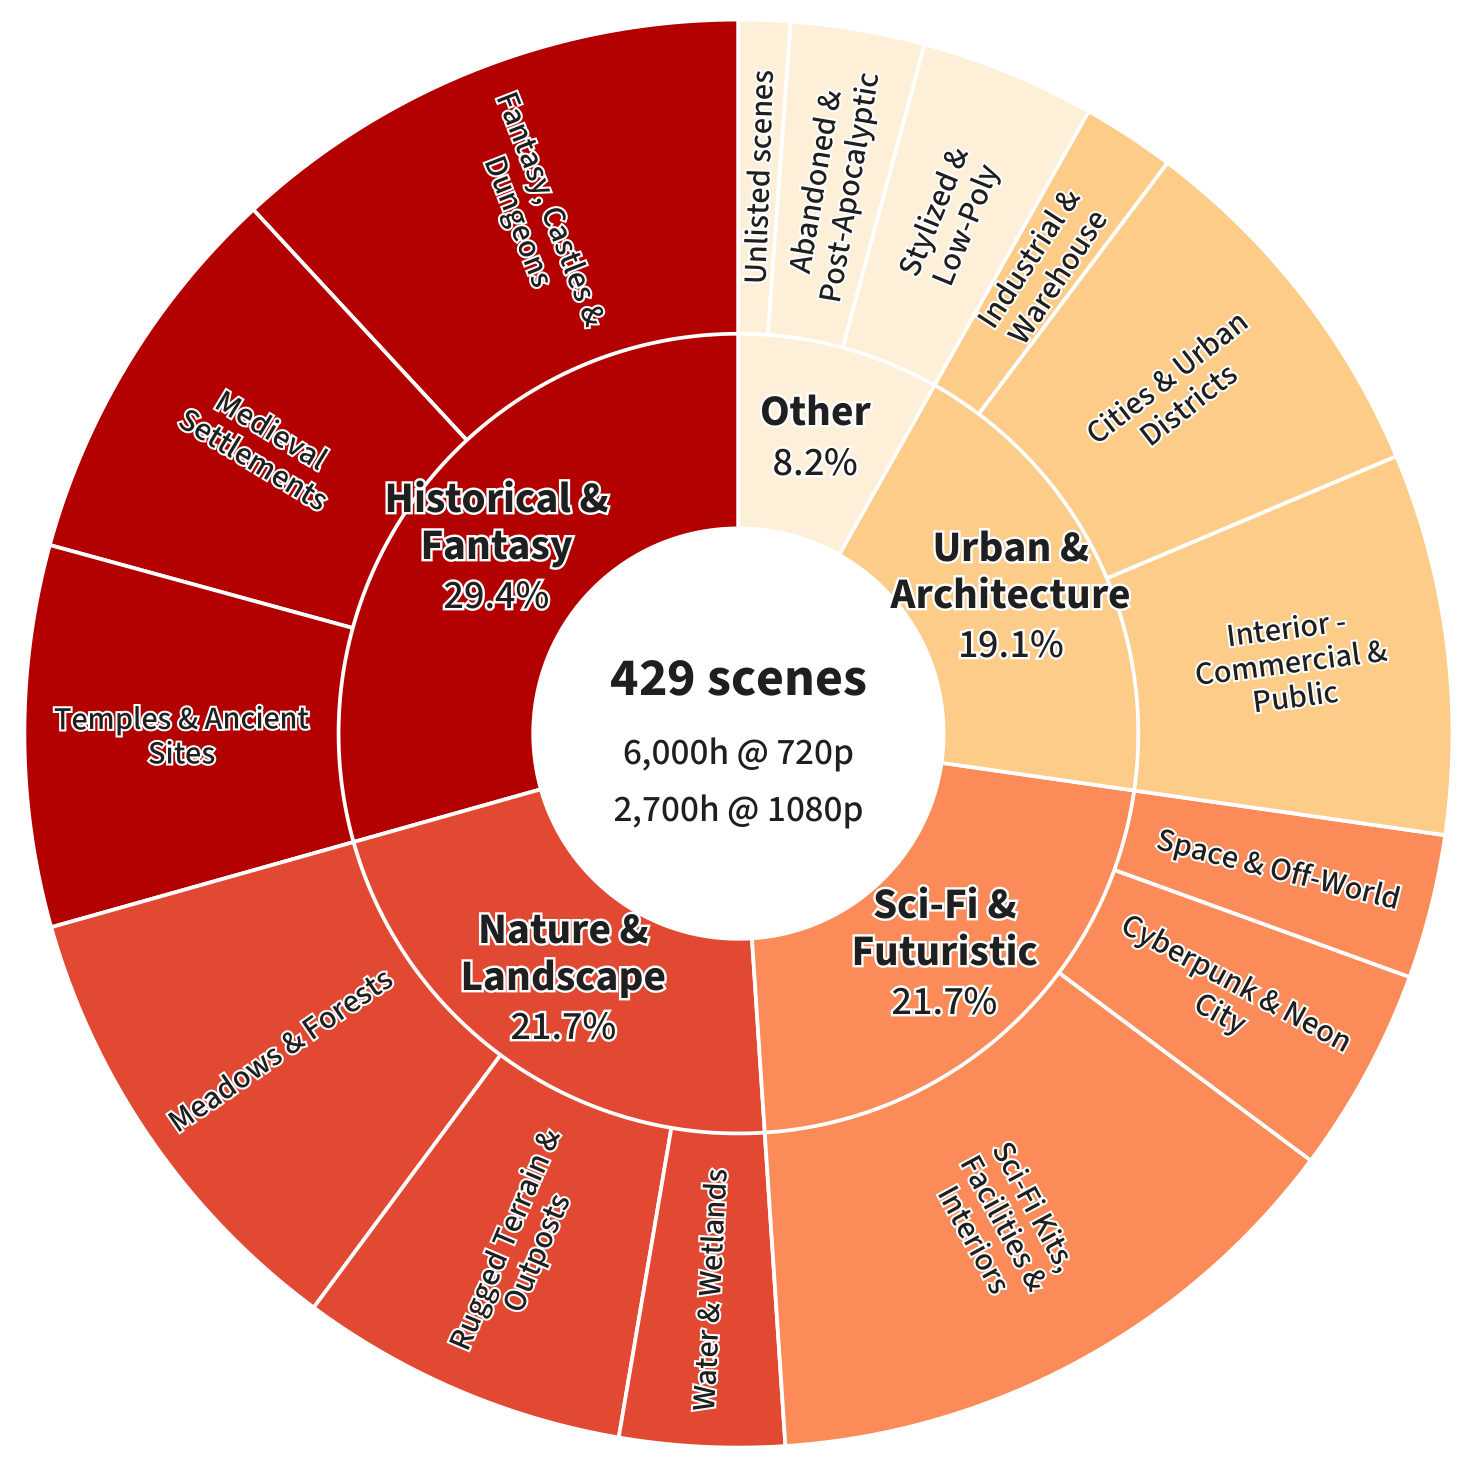
实验效果 :在 25 台服务器、共 200 张 RTX 5090 上,系统从 2384 个资产包整理出 429 个关卡与 40 个类人角色,生成 2691 小时 1080p 和 6076 小时 720p 动作条件视频,并用于 EchoWM 数据建设。
批判点评 :合成场景仍有引擎域偏差,审美和亮度过滤可能进一步删掉困难样本;资产许可、人物动作覆盖和 200 GPU 的成本也决定了复现门槛。数据规模不能替代真实世界验证。
9. Structured-Prior Inpainting:给交通标志注入物理先验
Structured-Prior-Guided Diffusion Inpainting with Physical Consistency for Traffic Sign Augmentation | 高德地图、阿里巴巴集团 | arXiv:2609.02348
关键词 :图像修复,合成数据,交通标志,物理一致性
⚠️ 前序问题 :稀有交通标志样本不足,但普通文生图或修复模型容易生成错误文字、色彩和边缘。视觉上“像标志”还不够,训练检测器需要类别语义、模板几何与法规颜色都准确。
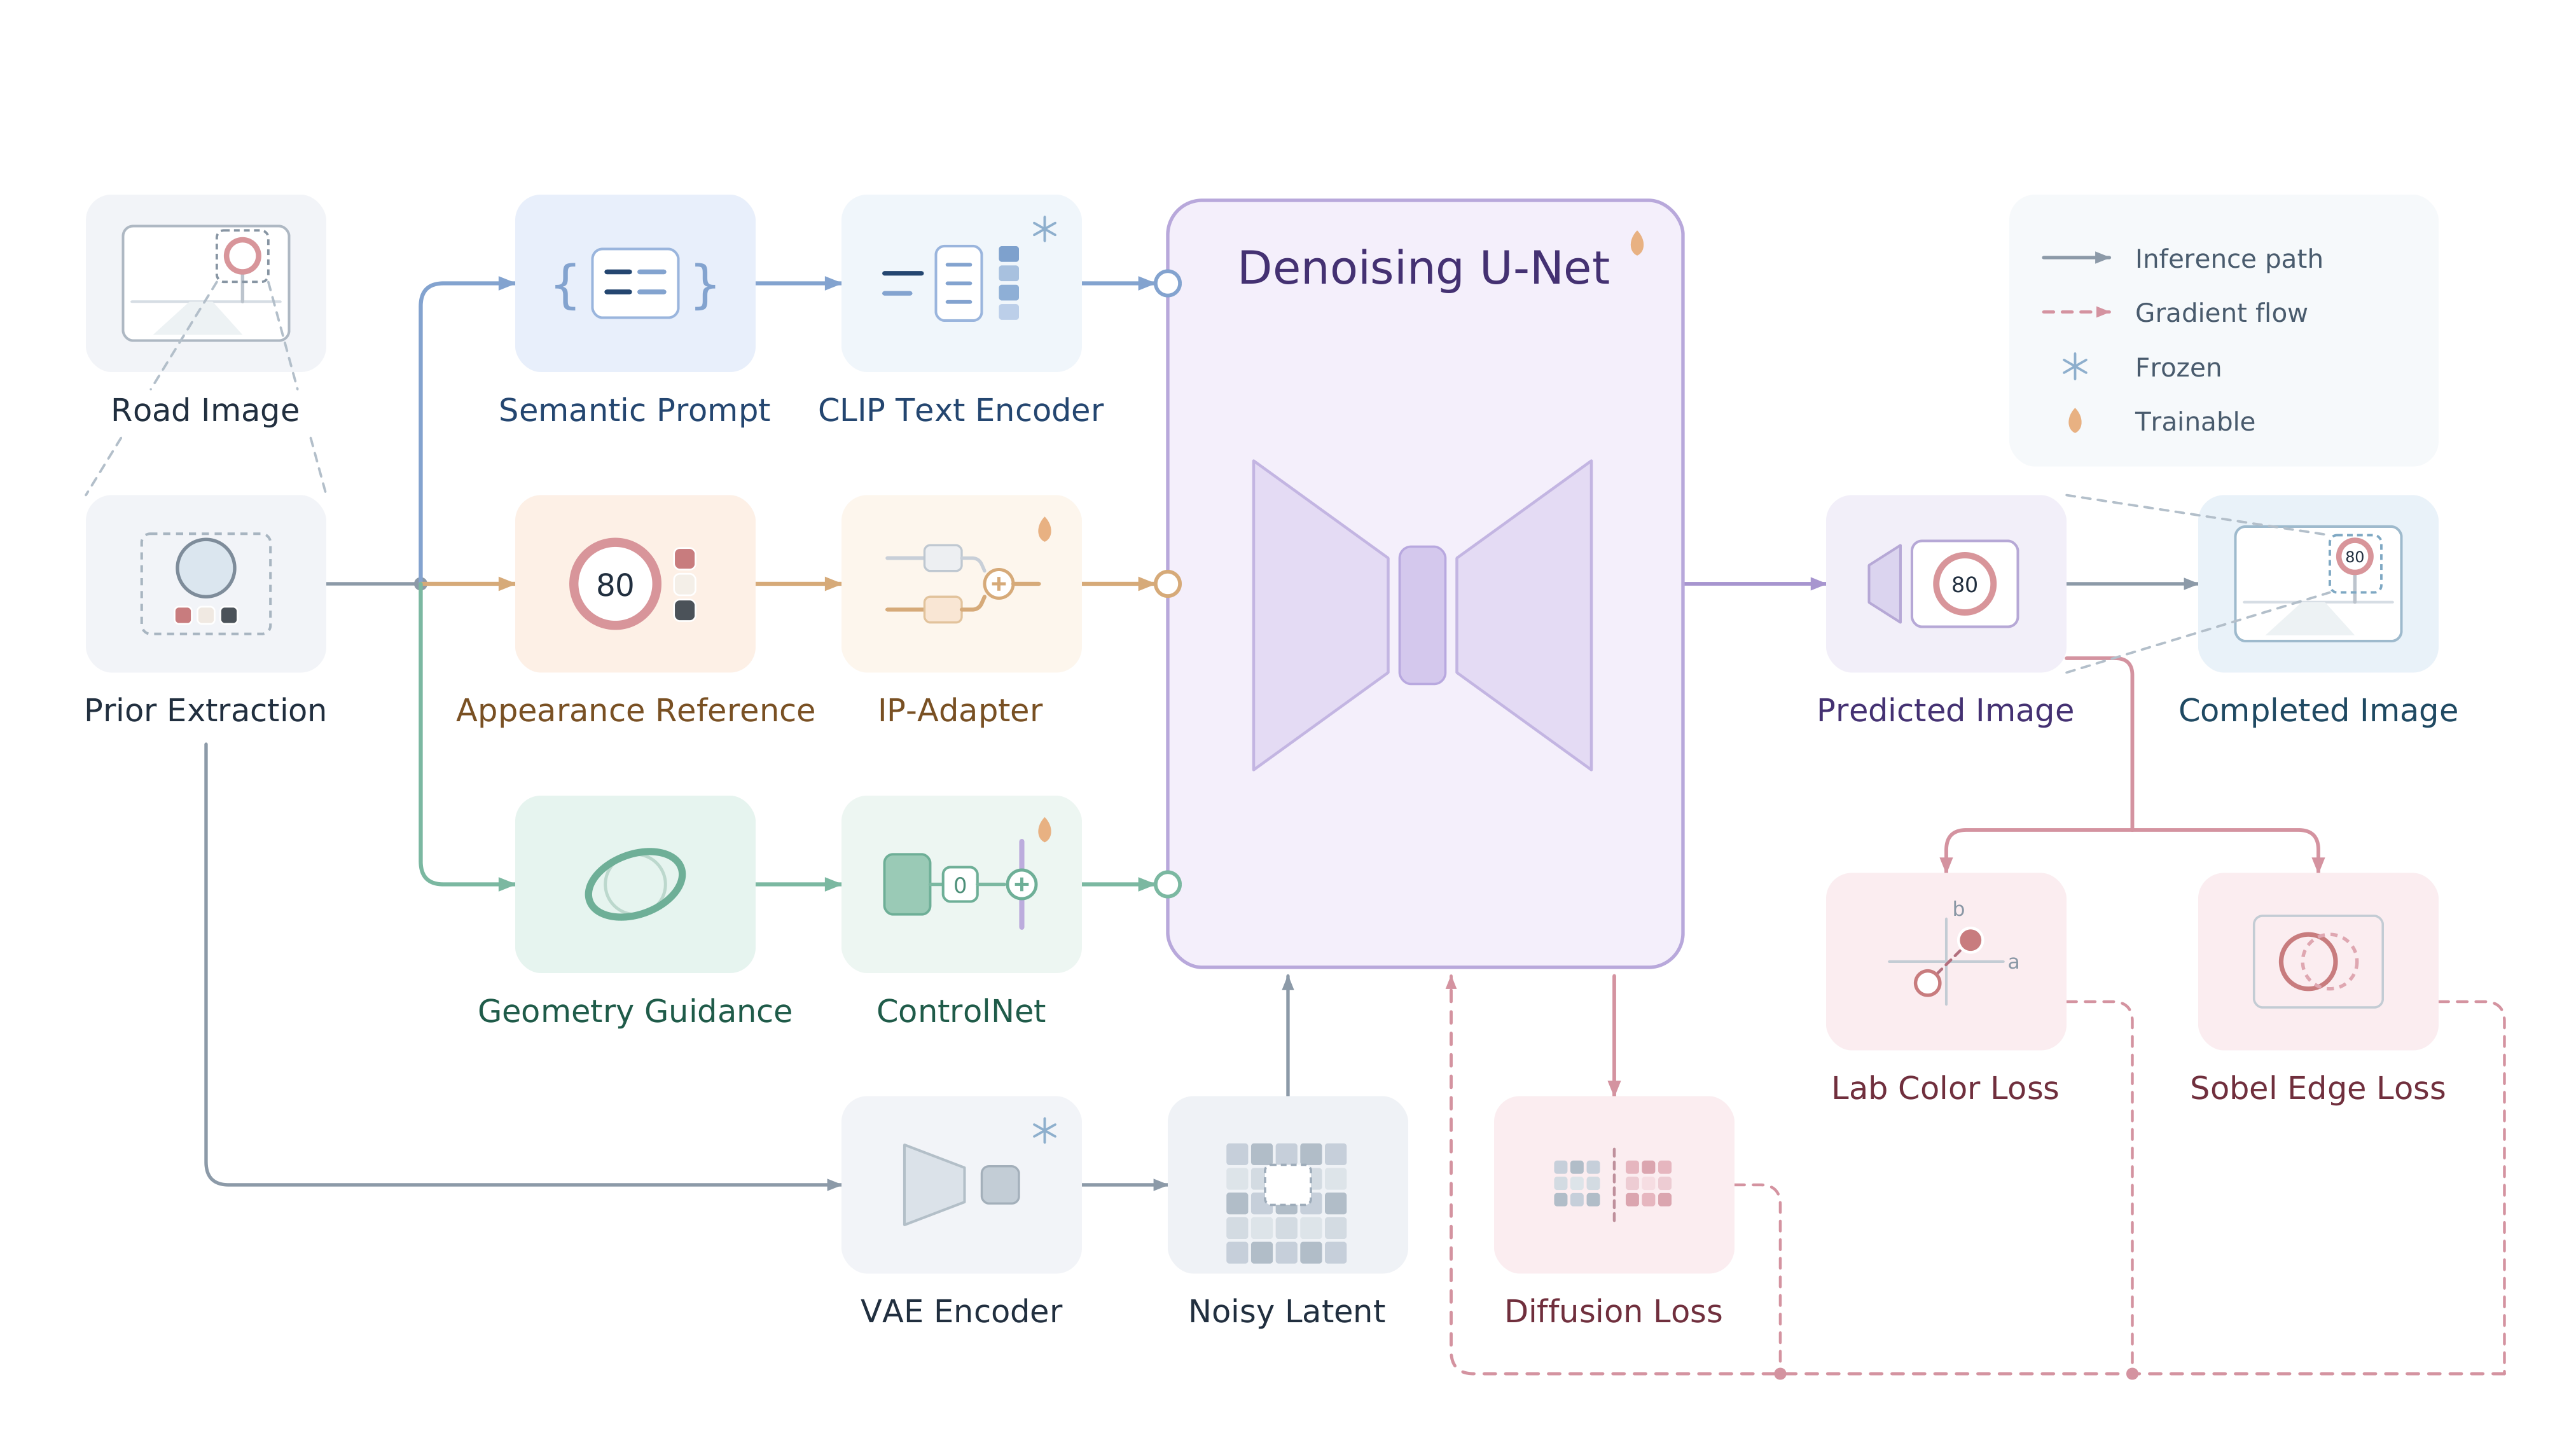
本文贡献 :方法把三类结构先验送入扩散修复:JSON 语义提示描述类别,正视矢量图通过 IP-Adapter 提供测量颜色,仿射对齐的矢量模板通过 ControlNet 约束几何;训练再加入 CIELAB 颜色 L1 损失和 Sobel 边缘损失,强化物理一致性。
实验效果 :在 TT100K2021 零样本测试中,OCR 完全匹配率为 91.1%,而 12B 参数 FLUX.1 Fill 为 44.2%;基于 SD1.5 的方案推理时间约为其十四分之一。把合成图加入训练后,稀有类别 AP50 提升到原来的 1.23 至 7.40 倍。
批判点评 :公开验证集中在一种交通标志数据源,检测增益会受合成比例、地区法规、拍摄距离和天气影响。用于道路安全前,还需跨国家模板、夜间、遮挡和极端退化测试,并保留可审计的生成记录。
10. Pitch-class Steering:用潜空间探针控制旋律
Pitch-class Steering for Diffusion-based Music Generation via Latent-space Probes | 卡内基梅隆大学、独立研究者 | arXiv:2609.04516
关键词 :音乐生成,扩散模型,旋律控制,潜空间探针
⚠️ 前序问题 :文本能描述音乐风格,却很难要求扩散音乐模型严格跟随指定旋律。重新训练完整模型或改架构成本高,而 MIDI 条件又不一定能直接接入现有生成器。
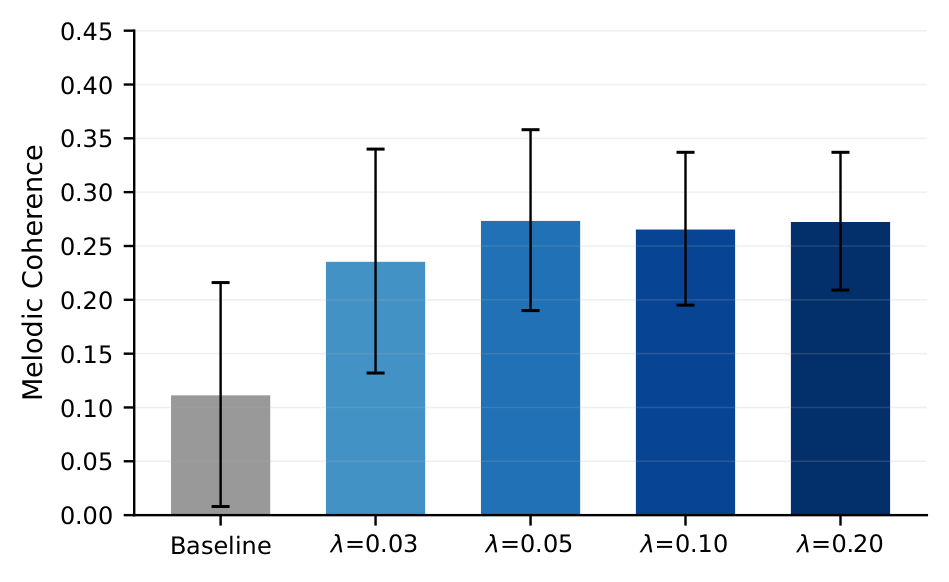
本文贡献 :作者用配对音频与 MIDI 训练一个 12.5 万参数卷积探针,从 Stable Audio Open 的 VAE 潜变量逐帧解码音高类别。生成时冻结基础模型,把探针的可微损失作为引导信号,在每步去噪中推动潜变量靠近目标旋律,不修改生成模型结构。
实验效果 :在 9 个提示词与 3 条旋律组成的 27 次试验中,引导生成的旋律一致性相对无引导基线提升 2.4 倍;Wilcoxon 检验给出 p<1e-5。论文已被 IEEE MLSP 2026 接收。批判点评 :27 次试验规模很小,统计显著不等于覆盖多样音乐风格。每步反向传播引导会增加推理开销,配对 MIDI 数据的偏差也可能限制泛化;还需听感盲测和更长曲目验证。
趋势观察
生成训练开始公开到数据与优化器层级
LLaDA-Image不仅开放权重,还披露2.2亿样本、纯图像预训练、Muon与少步蒸馏配方,竞争焦点正从模型接口转向可复现的完整训练系统。
视频部署优化必须贴合去噪阶段
DSAQuant按阶段分配量化监督,DM-Align把偏好对齐和少步蒸馏并成一次训练,VoRTeC则预测生成流位置完成一步解码;三者都在利用生成轨迹的内部结构减少成本。
显式控制信号重新进入生成链路
时间路由、交通标志模板与音高探针分别把时间、物理几何和旋律注入生成过程,显示开放式文本提示正在与可验证、可定位的结构条件结合。
人工智能炼丹君 整理 | 2026-09-08
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注

















评论 (0)