今日 AIGC 论文速览
今日共 10 篇
重点论文标题列表
TBDub (阿里巴巴淘天集团 TaoLive AIGC):两步口型配音跑到7.13FPSAlignGraft (新南威尔士大学):弱模型一次对齐全家复用⚡ SeRV (俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校):375小时数据生成3D手语
PAI-Actor (Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab):1080P多角色电影替换MVWeaver (中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学):1861支MV教会歌曲转镜头
今日论文速览
1. TBDub:两步口型配音跑到7.13FPS
TBDub: Production-Oriented Visual Dubbing | 阿里巴巴淘天集团 TaoLive AIGC | arXiv:2609.06144
关键词 :视频编辑,视觉配音,少步蒸馏,口型同步
⚠️ 前序问题 :把原视频语音替换为新音频时,嘴形必须同步,同时还要保住身份、牙齿、光照、遮挡与背景。X-Dub 在干净数据上有效,但面对直播压缩、绿幕素材和上游生成视频时,容易出现嘴部粘连、身份漂移、边界闪烁,并且 30 步采样难以投入生产。
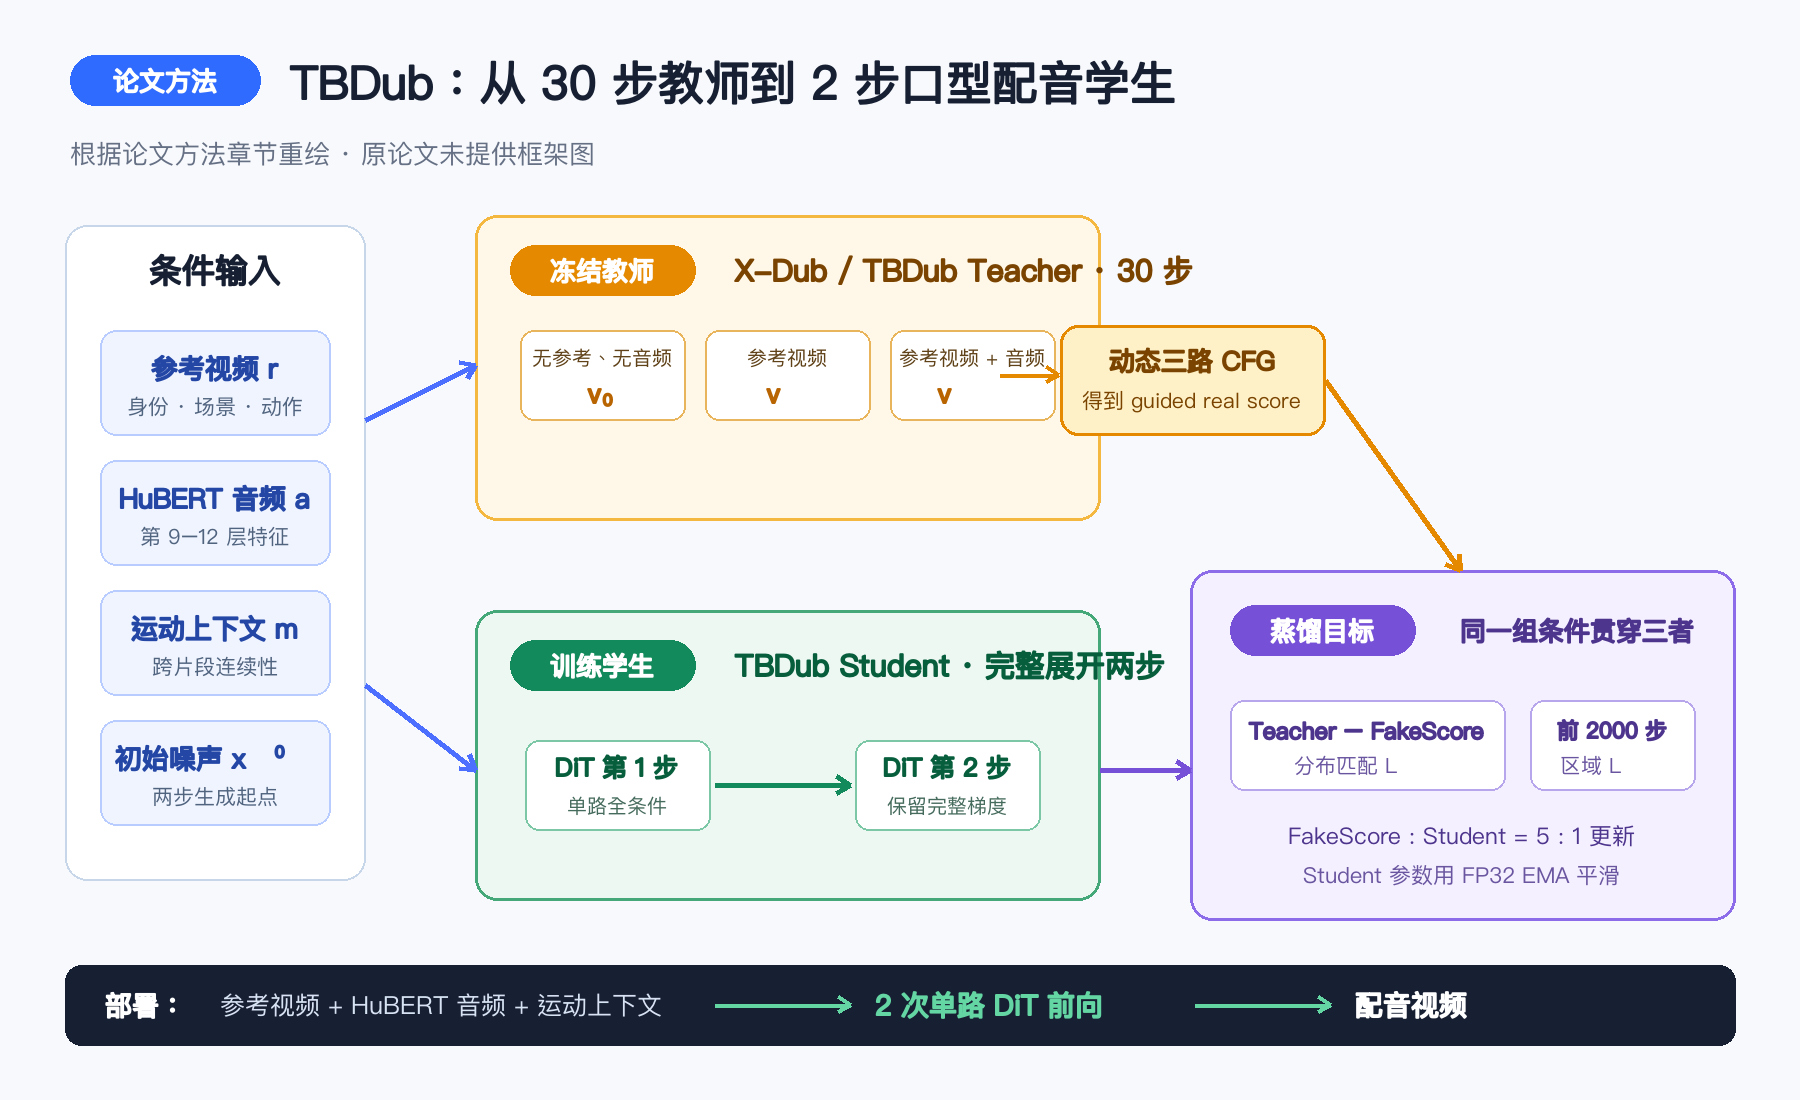
本文贡献 :TBDub 先用生产域数据、失败规则、非对称条件退化、干净口腔先验和多层 HuBERT 音频特征,对完整视频 DiT 做任务自适应后训练,得到 30 步教师;再把 DMD/DMD2 改造为条件视频编辑蒸馏,对完整两步轨迹反向传播,并用分区重建监督稳定身份和口腔细节,得到两步学生。
编辑依据论文方法章节重绘;原论文未提供方法框架图。
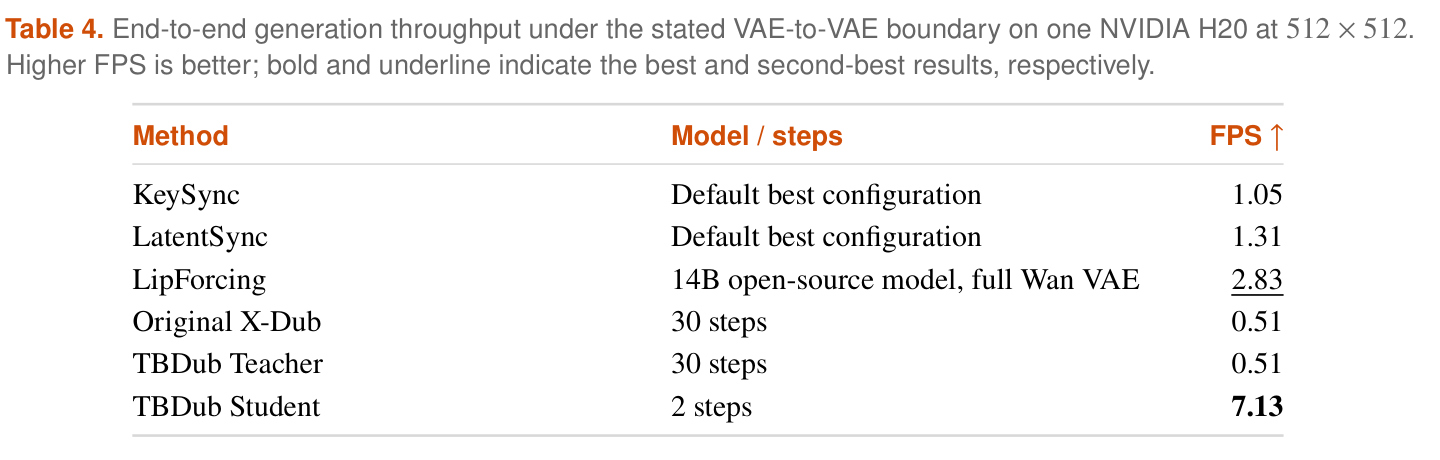
实验效果 :在 38 段 TalkVid 视频上,教师相对 X-Dub 的口型同步、身份一致性和视觉质量 MOS 分别提高 0.14、0.95 和 0.90 分。两步学生在单张 NVIDIA H20、512×512 的端到端计时中达到 7.13 FPS,总延迟降低 13.93 倍,DiT 阶段加速 42.49 倍,同时大体保留教师的画质与音画同步。
论文 Table 4:单张 NVIDIA H20、512×512、VAE-to-VAE 计时边界下的端到端生成吞吐量。
批判点评 :38 段视频与单一 H20 配置仍不足以覆盖真实直播中的语言、脸型、遮挡和码率变化;音频前端使用英语 HuBERT,也需要跨语言检验。方法继承 Wan 与 X-Dub 的大部分能力,训练数据和生产过滤规则对结果贡献很大,不能只归因于两步蒸馏。
2. AlignGraft:弱模型一次对齐全家复用
Test-Time Weak-to-Strong Alignment: Transferring Implicit Rewards from Weak to Strong Flow Models | 新南威尔士大学 | arXiv:2609.05968
关键词 :测试时对齐,流模型,弱到强迁移,偏好优化
⚠️ 前序问题 :每个新生成模型、检查点和奖励目标都重新做强化学习或偏好优化,成本高且把奖励强度永久写死。现有测试时对齐又常要求奖励函数梯度或另训价值模型,部署仍需保留奖励基础设施。
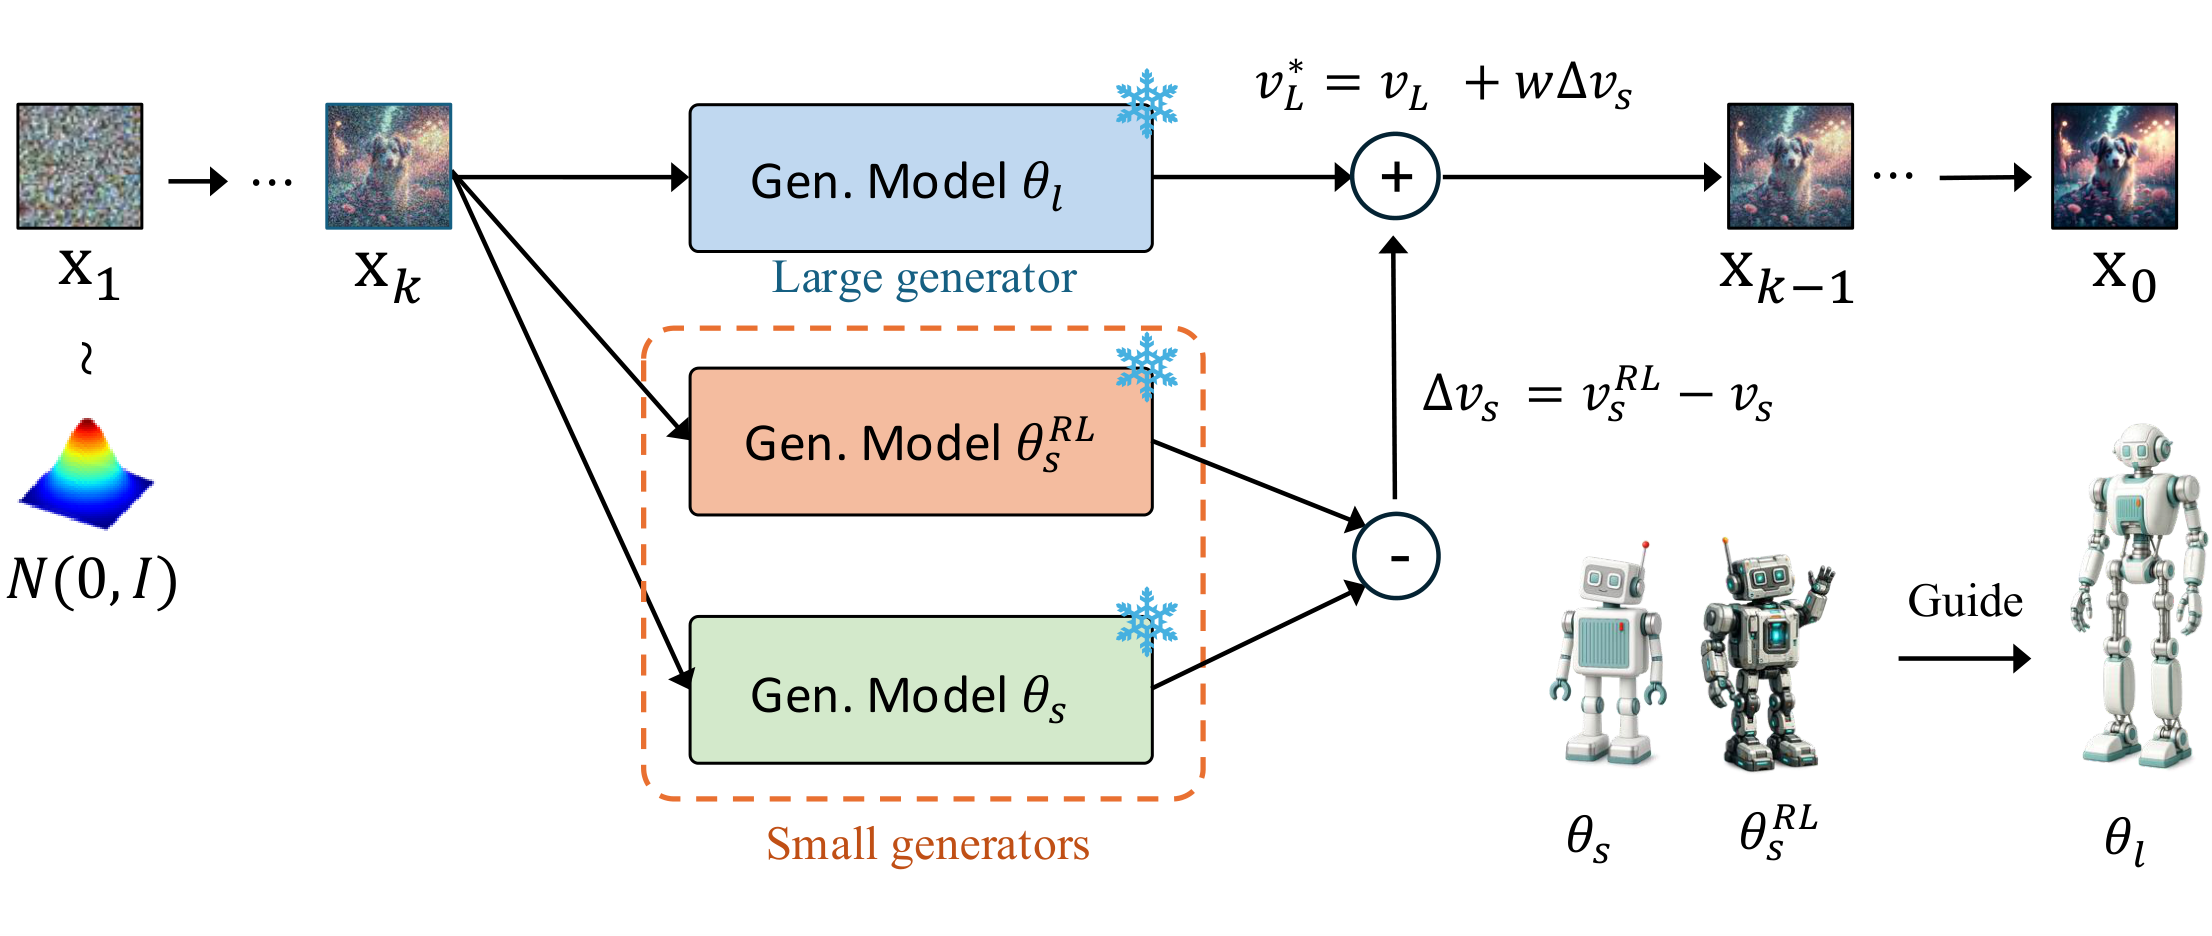
本文贡献 :AlignGraft 保存一个弱模型的“基础版与已对齐版”模型对,把两者在每个采样步的速度差视为隐式奖励方向,再将这段差值加到同潜空间、同前向加噪核的强模型速度上。强模型保持冻结,测试时只用一个标量调节对齐强度,不需要奖励评估、反向传播或新的微调。
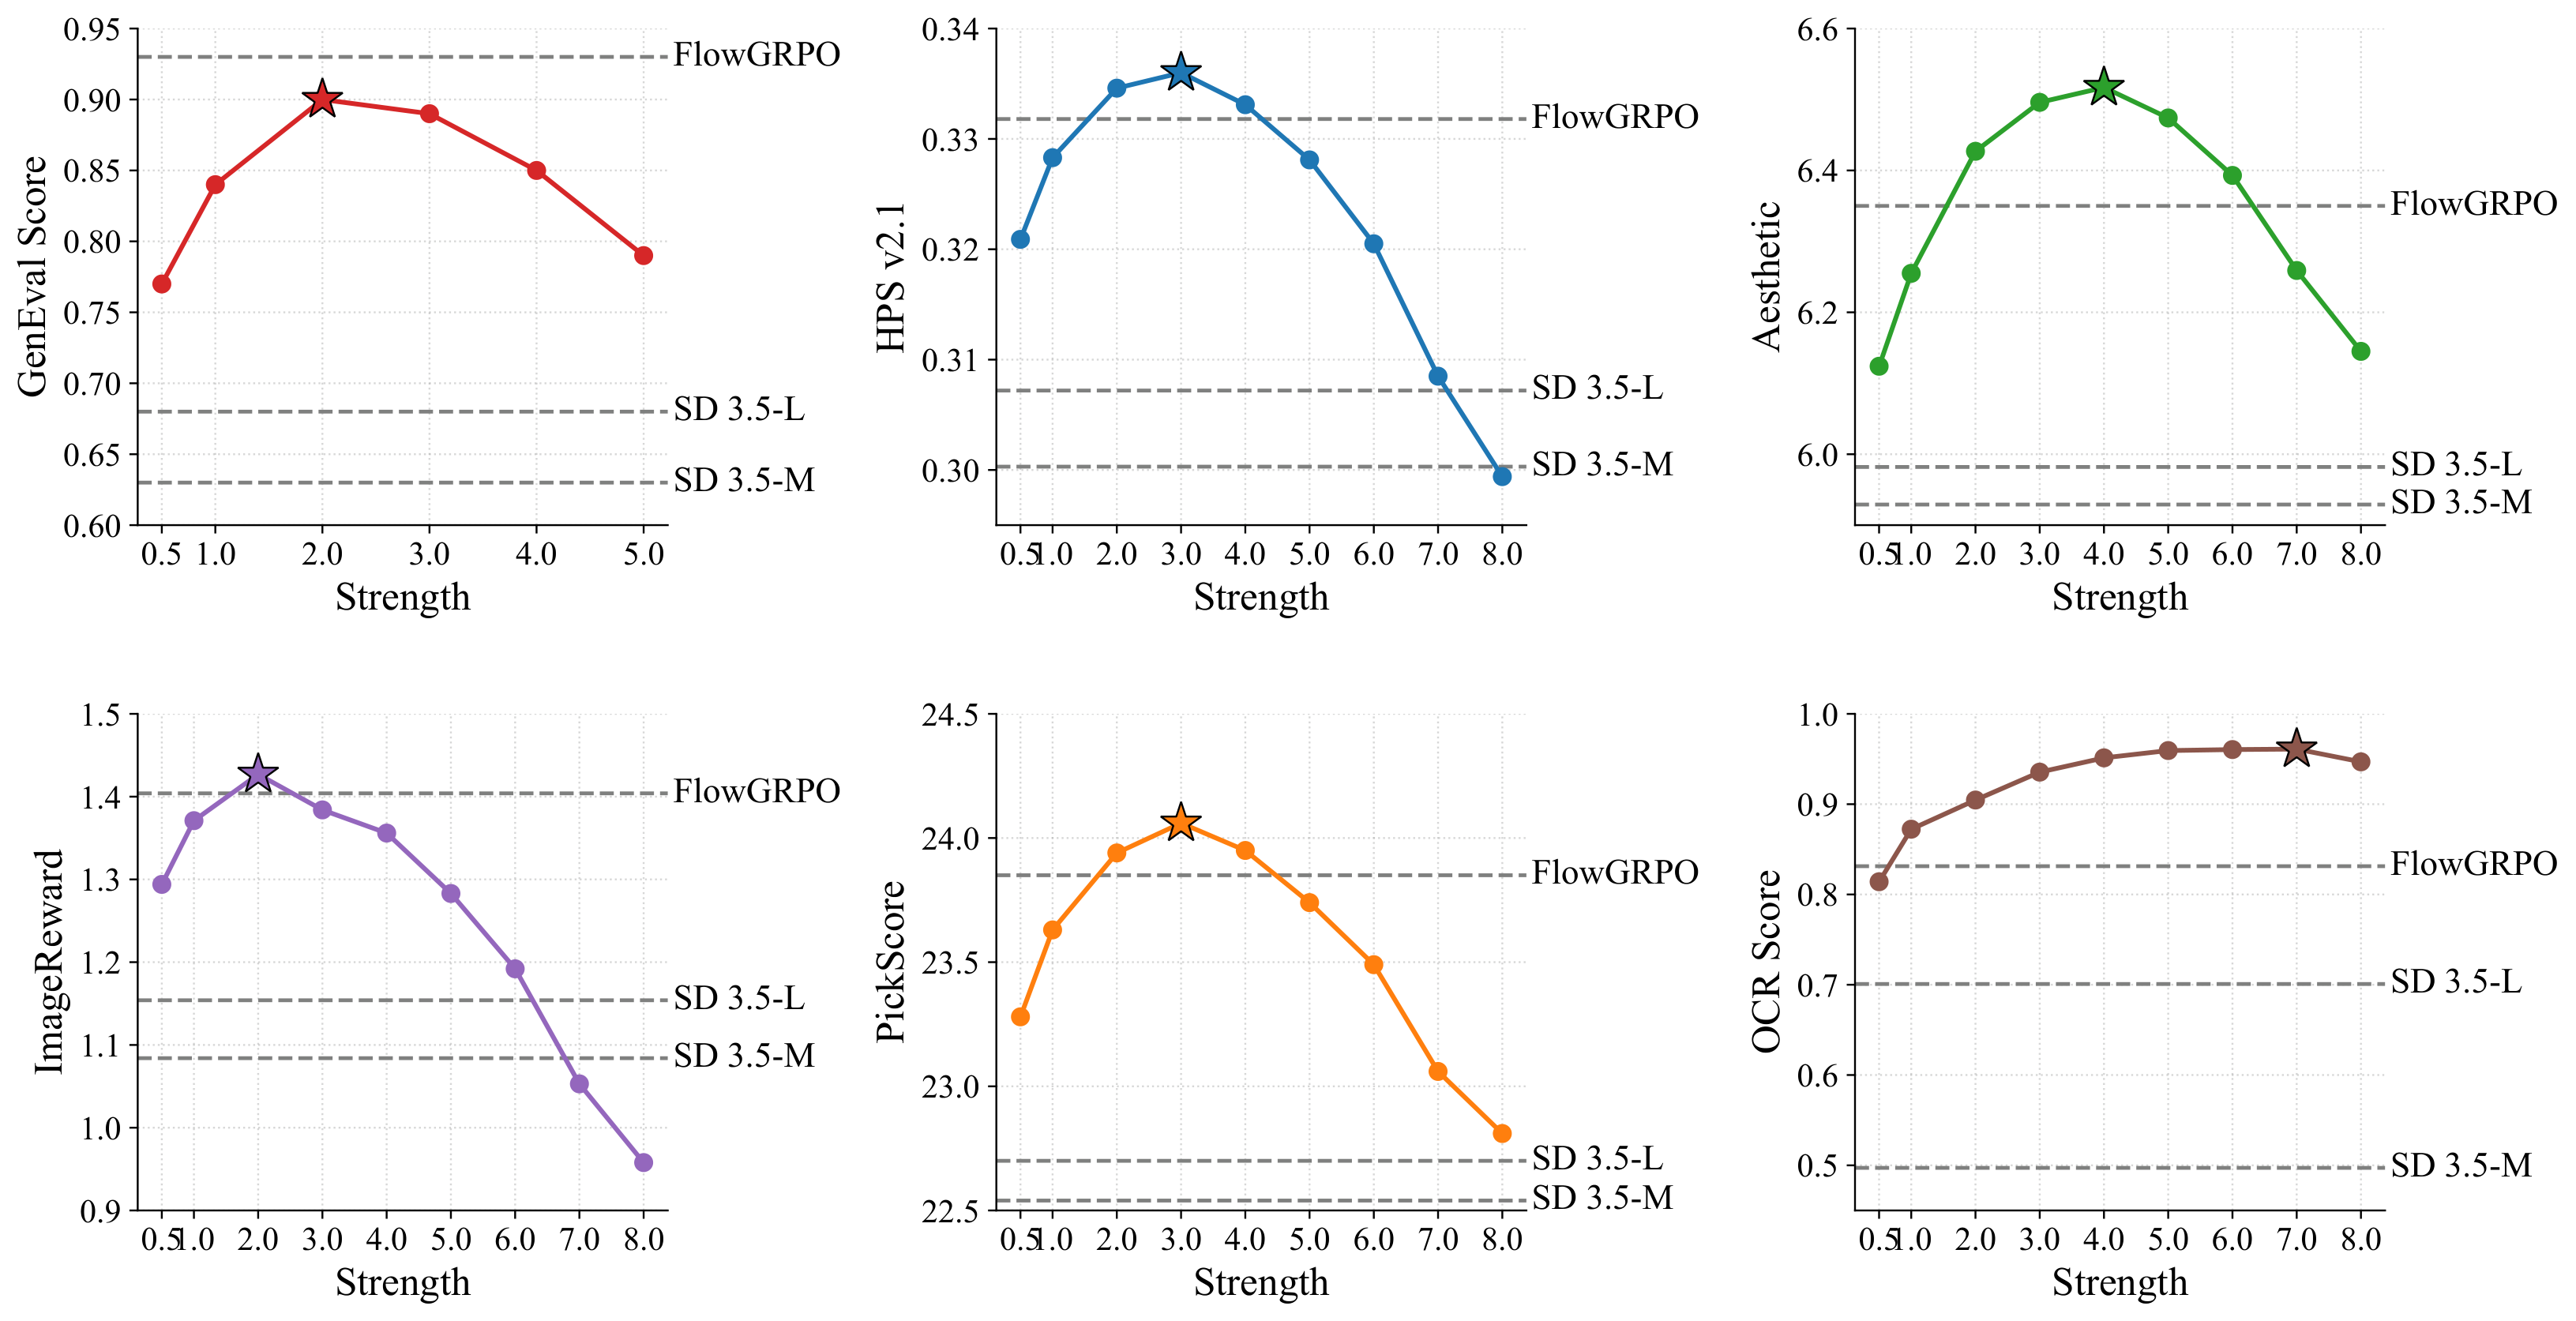
实验效果 :把 SD3.5-Medium 的 GenEval 对齐迁移到 SD3.5-Large 后,强模型总分从 0.68 升到 0.90,接近源对齐模型的 0.93;位置关系从 0.28 升到 0.91,计数从 0.67 升到 0.84。相同思路也在 FLUX 同族模型和 Wan 1.3B 到 14B 视频模型间提升了多项偏好与对齐指标。
批判点评 :迁移要求源模型对能在强模型状态上给出分布内信号,并共享潜空间和噪声过程;跨完全不同架构并非自动成立。弱模型学到的奖励偏差也会被一起移植,强度外推过大可能损害保真度。
3. SeRV:375小时数据生成3D手语
SeRV: Semantic-Aligned Residual Vector Quantization for American Sign Language Generation | 俄克拉荷马大学、佐治亚大学、马萨诸塞大学阿默斯特分校 | arXiv:2609.05742
关键词 :手语生成,残差向量量化,动作生成,语义对齐
⚠️ 前序问题 :手语动作令牌器通常只追求姿态重建,未必把文本语义组织进离散空间;后续生成器即使能复原大动作,也可能把承载词义的手形和细粒度关节做错。配对的文本与三维手语动作数据又很稀缺。
本文贡献 :SeRV 在残差向量量化器中同时加入句子级动作文本对齐和令牌级文本条件监督,让粗到细的多层码本既可重建动作又可预测语义;随后用分层 GPT 逐级生成身体和手部令牌。团队还从 YouTube-ASL 视频恢复三维动作,构建 375 小时的动作文本基准。
实验效果 :在 YouTube-ASL 上,身体与手部 DTW-JPE 分别为 4.98 和 6.70,优于 SOKE 的 5.42 和 7.44;SiBLEU-4 从 2.18 提升到 3.13。在 How2Sign 上身体与手部误差也最低,不过 MaDiS 的 SiBLEU-4 为 4.47,仍高于 SeRV 的 4.12。
批判点评 :训练数据来自二维视频重建的三维动作,手指遮挡与视角误差可能被写进码本。DTW-JPE 与 SiBLEU 不能完全代表手语可理解性,仍需由聋人和专业手语者做语义、自然度与文化适切性评测;结论目前也只覆盖美国手语。
4. PAI-Actor:1080P多角色电影替换
PAI-Actor: Cinematic Multi-Character Replacement in Dynamic Scenes | Utopai Studios、加州大学尔湾分校、南洋理工大学、新加坡国立大学 Show Lab | arXiv:2609.05918
关键词 :角色动画,视频编辑,多角色生成,自回归蒸馏
⚠️ 前序问题 :角色替换系统多围绕单张人物或单主体展开,面对电影中的多人互动、遮挡、手持物、相机运动和动态光影时,容易改坏背景或让身份漂移;双向视频模型画质高,却难扩展到长片段。
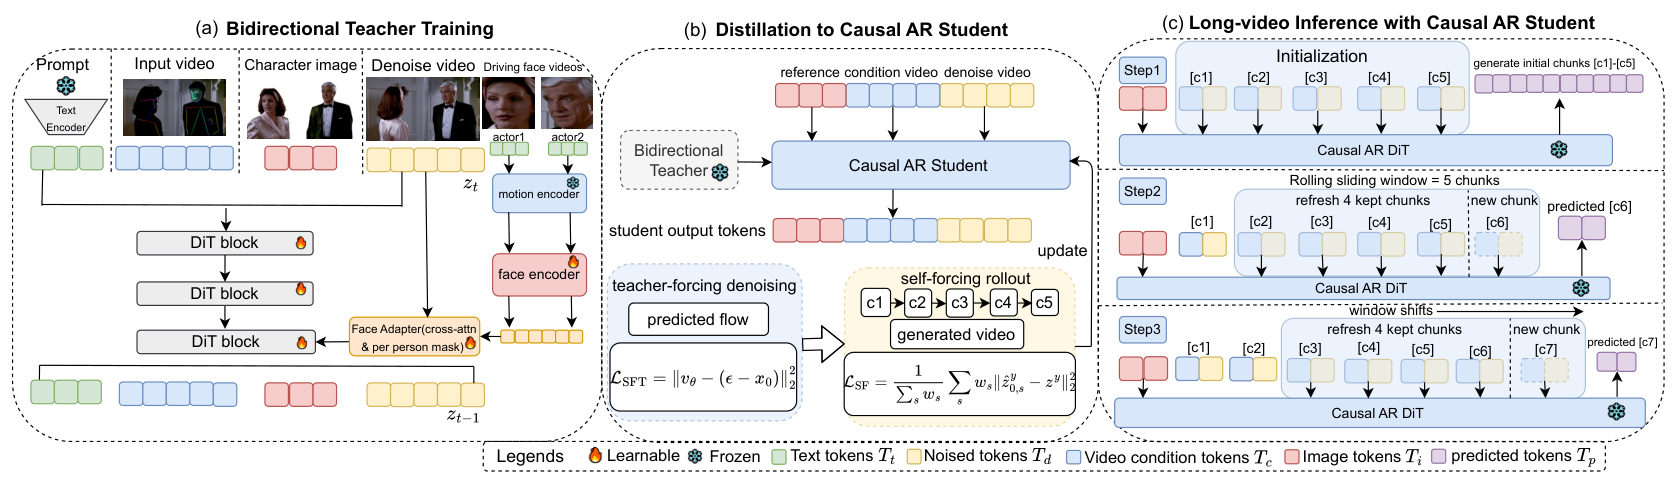
本文贡献 :PAI-Actor 把多角色替换改写为结构引导的人体恢复:从电影中抹去原演员,以身体与人脸关联后的骨架和每个角色参考图作为条件,在约 3 万段电影片段上训练 1080P 双向 DiT。随后通过因果适配与 on-policy self-forcing,把双向教师蒸馏为可使用 KV 缓存的自回归视频到视频模型。
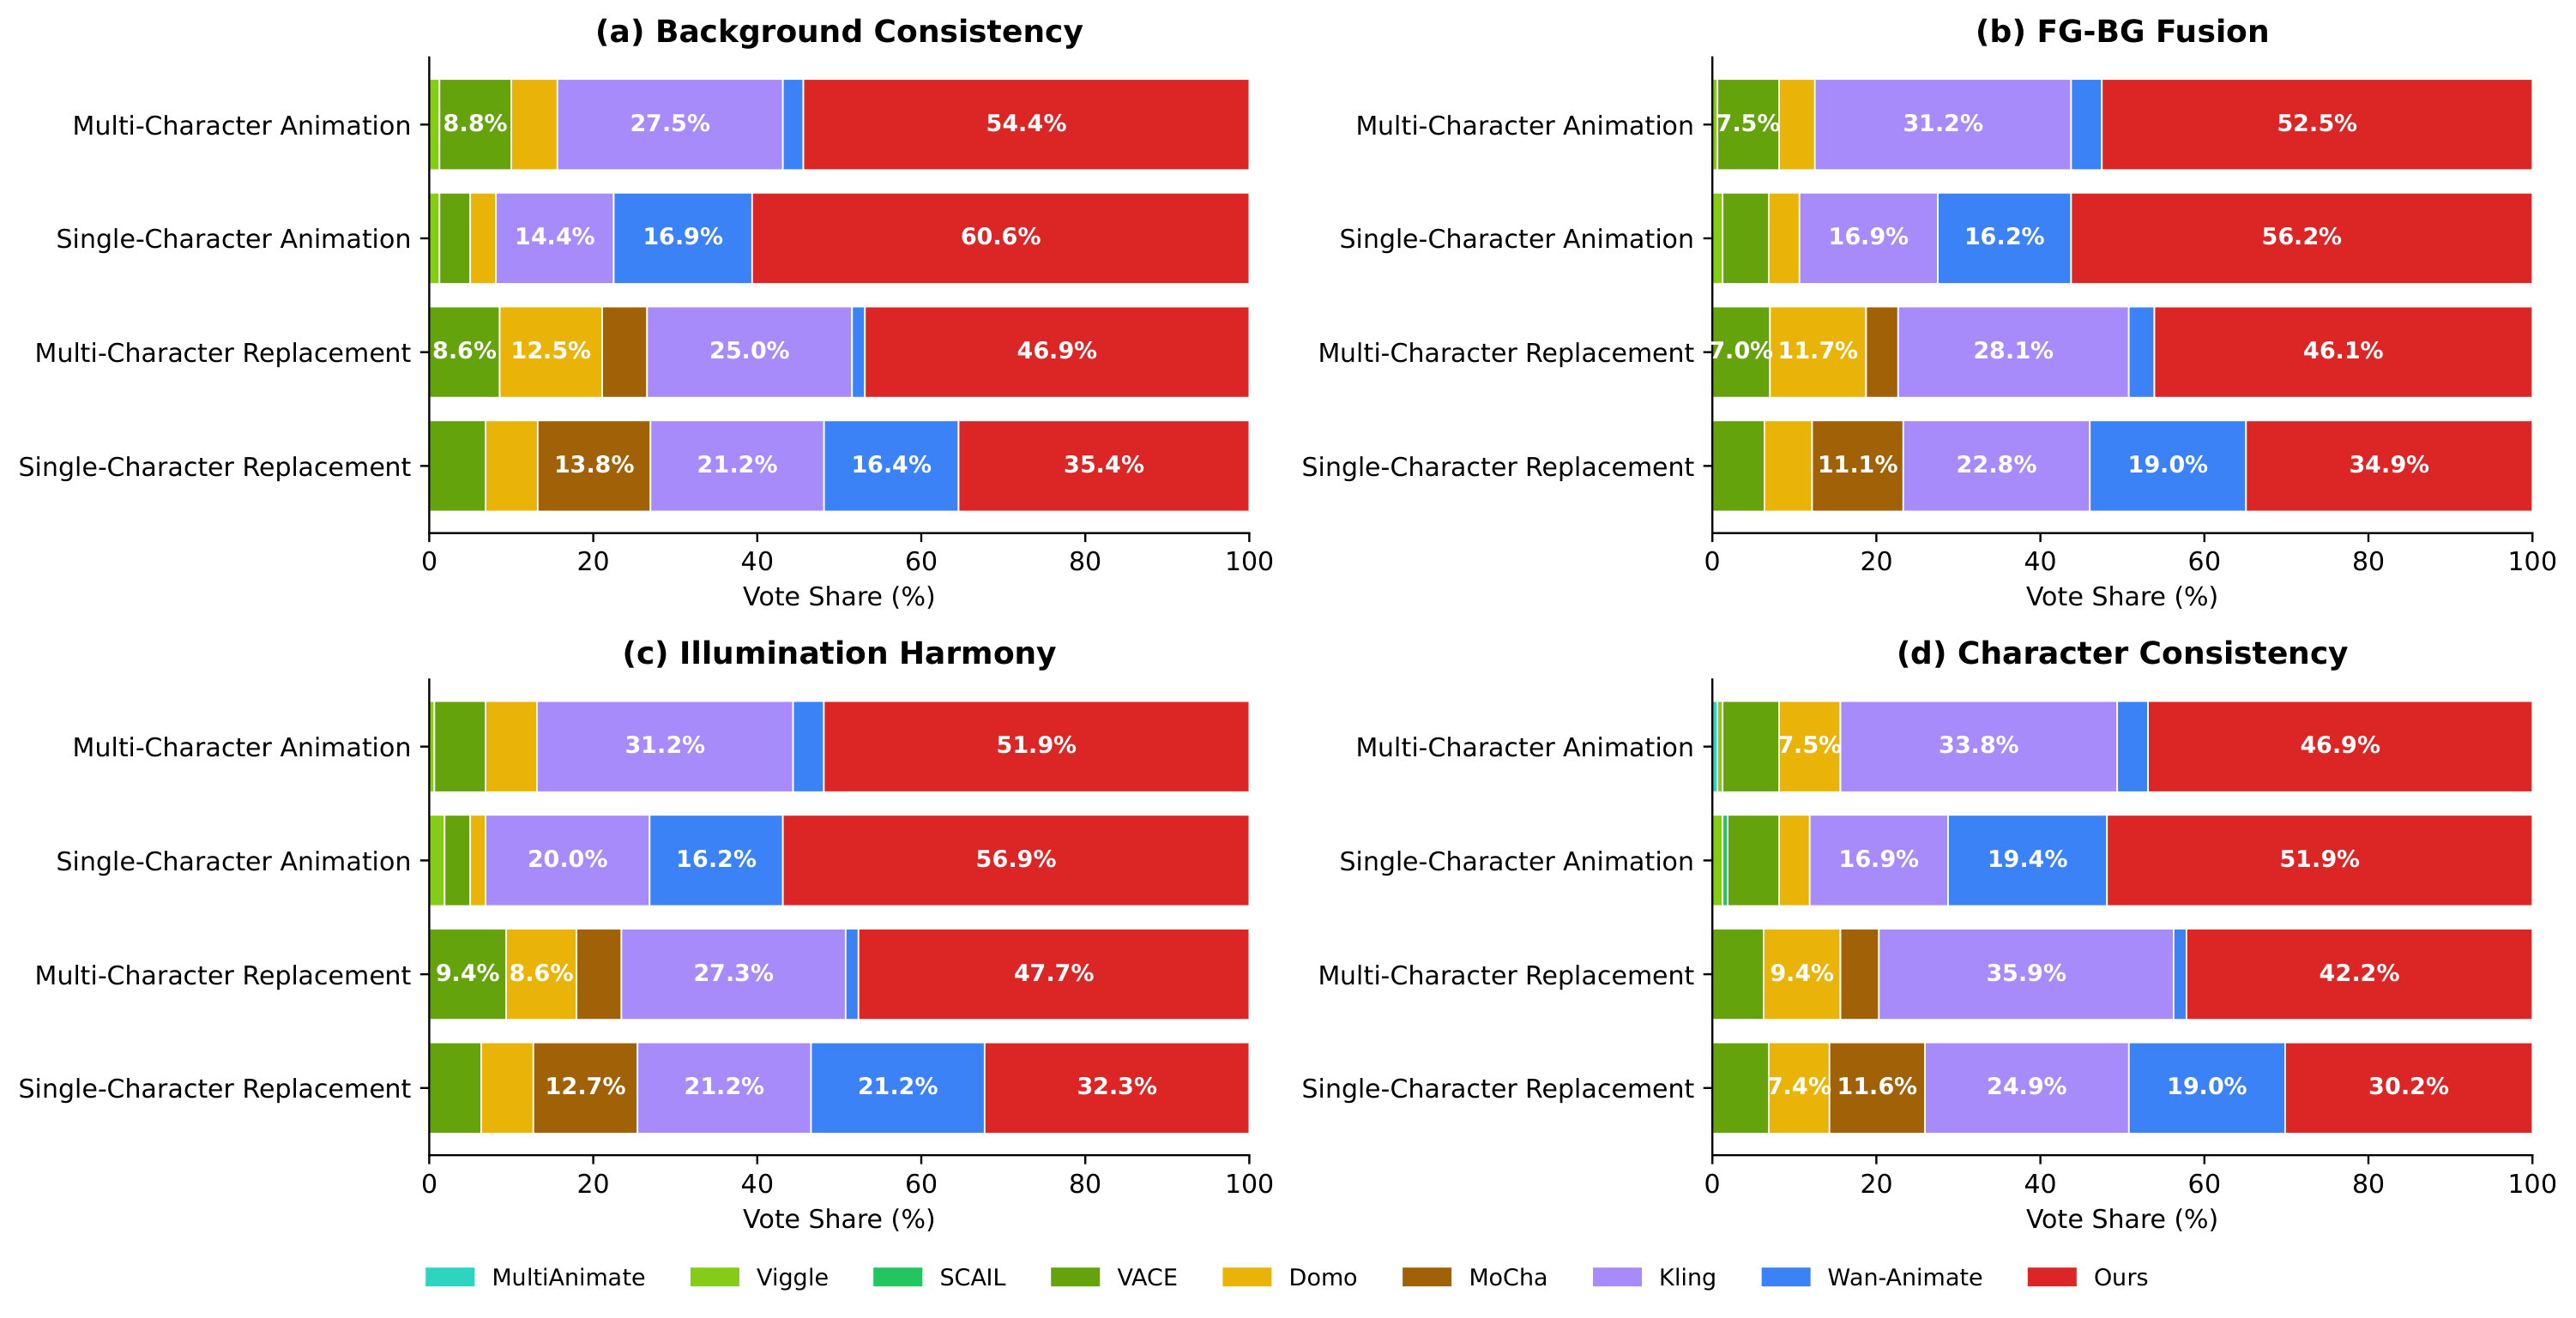
实验效果 :论文在角色动画子集的大多数指标上优于对比方法,并展示多人身份、背景与姿态一致性。自回归学生可生成约 417 帧、17 秒的 1920×1056 视频,而双向教师因全局注意力不能扩展到该长度。
批判点评 :训练三个阶段合计数百 GPU 小时,峰值显存约 114 至 136 GB,生产门槛很高。电影数据还涉及演员肖像、版权与合成滥用风险;失败案例中极端像素位移、复杂遮挡和长时身份漂移仍未解决。
5. MVWeaver:1861支MV教会歌曲转镜头
MVWeaver: A Hierarchical Music Video Generation Agent with a Learned Song-to-Visual Bridge | 中国科学院自动化研究所、快手可灵 KlingAI、上海戏剧学院、北京电影学院、康斯坦茨大学 | arXiv:2609.06478
关键词 :音乐视频,生成智能体,分层规划,音画生成
⚠️ 前序问题 :自动音乐视频系统可以拼出漂亮镜头,却常停留在歌词字面联想:整首歌的情绪、人物动机和反复意象没有发展,镜头之间也缺少可追踪的概念与状态。
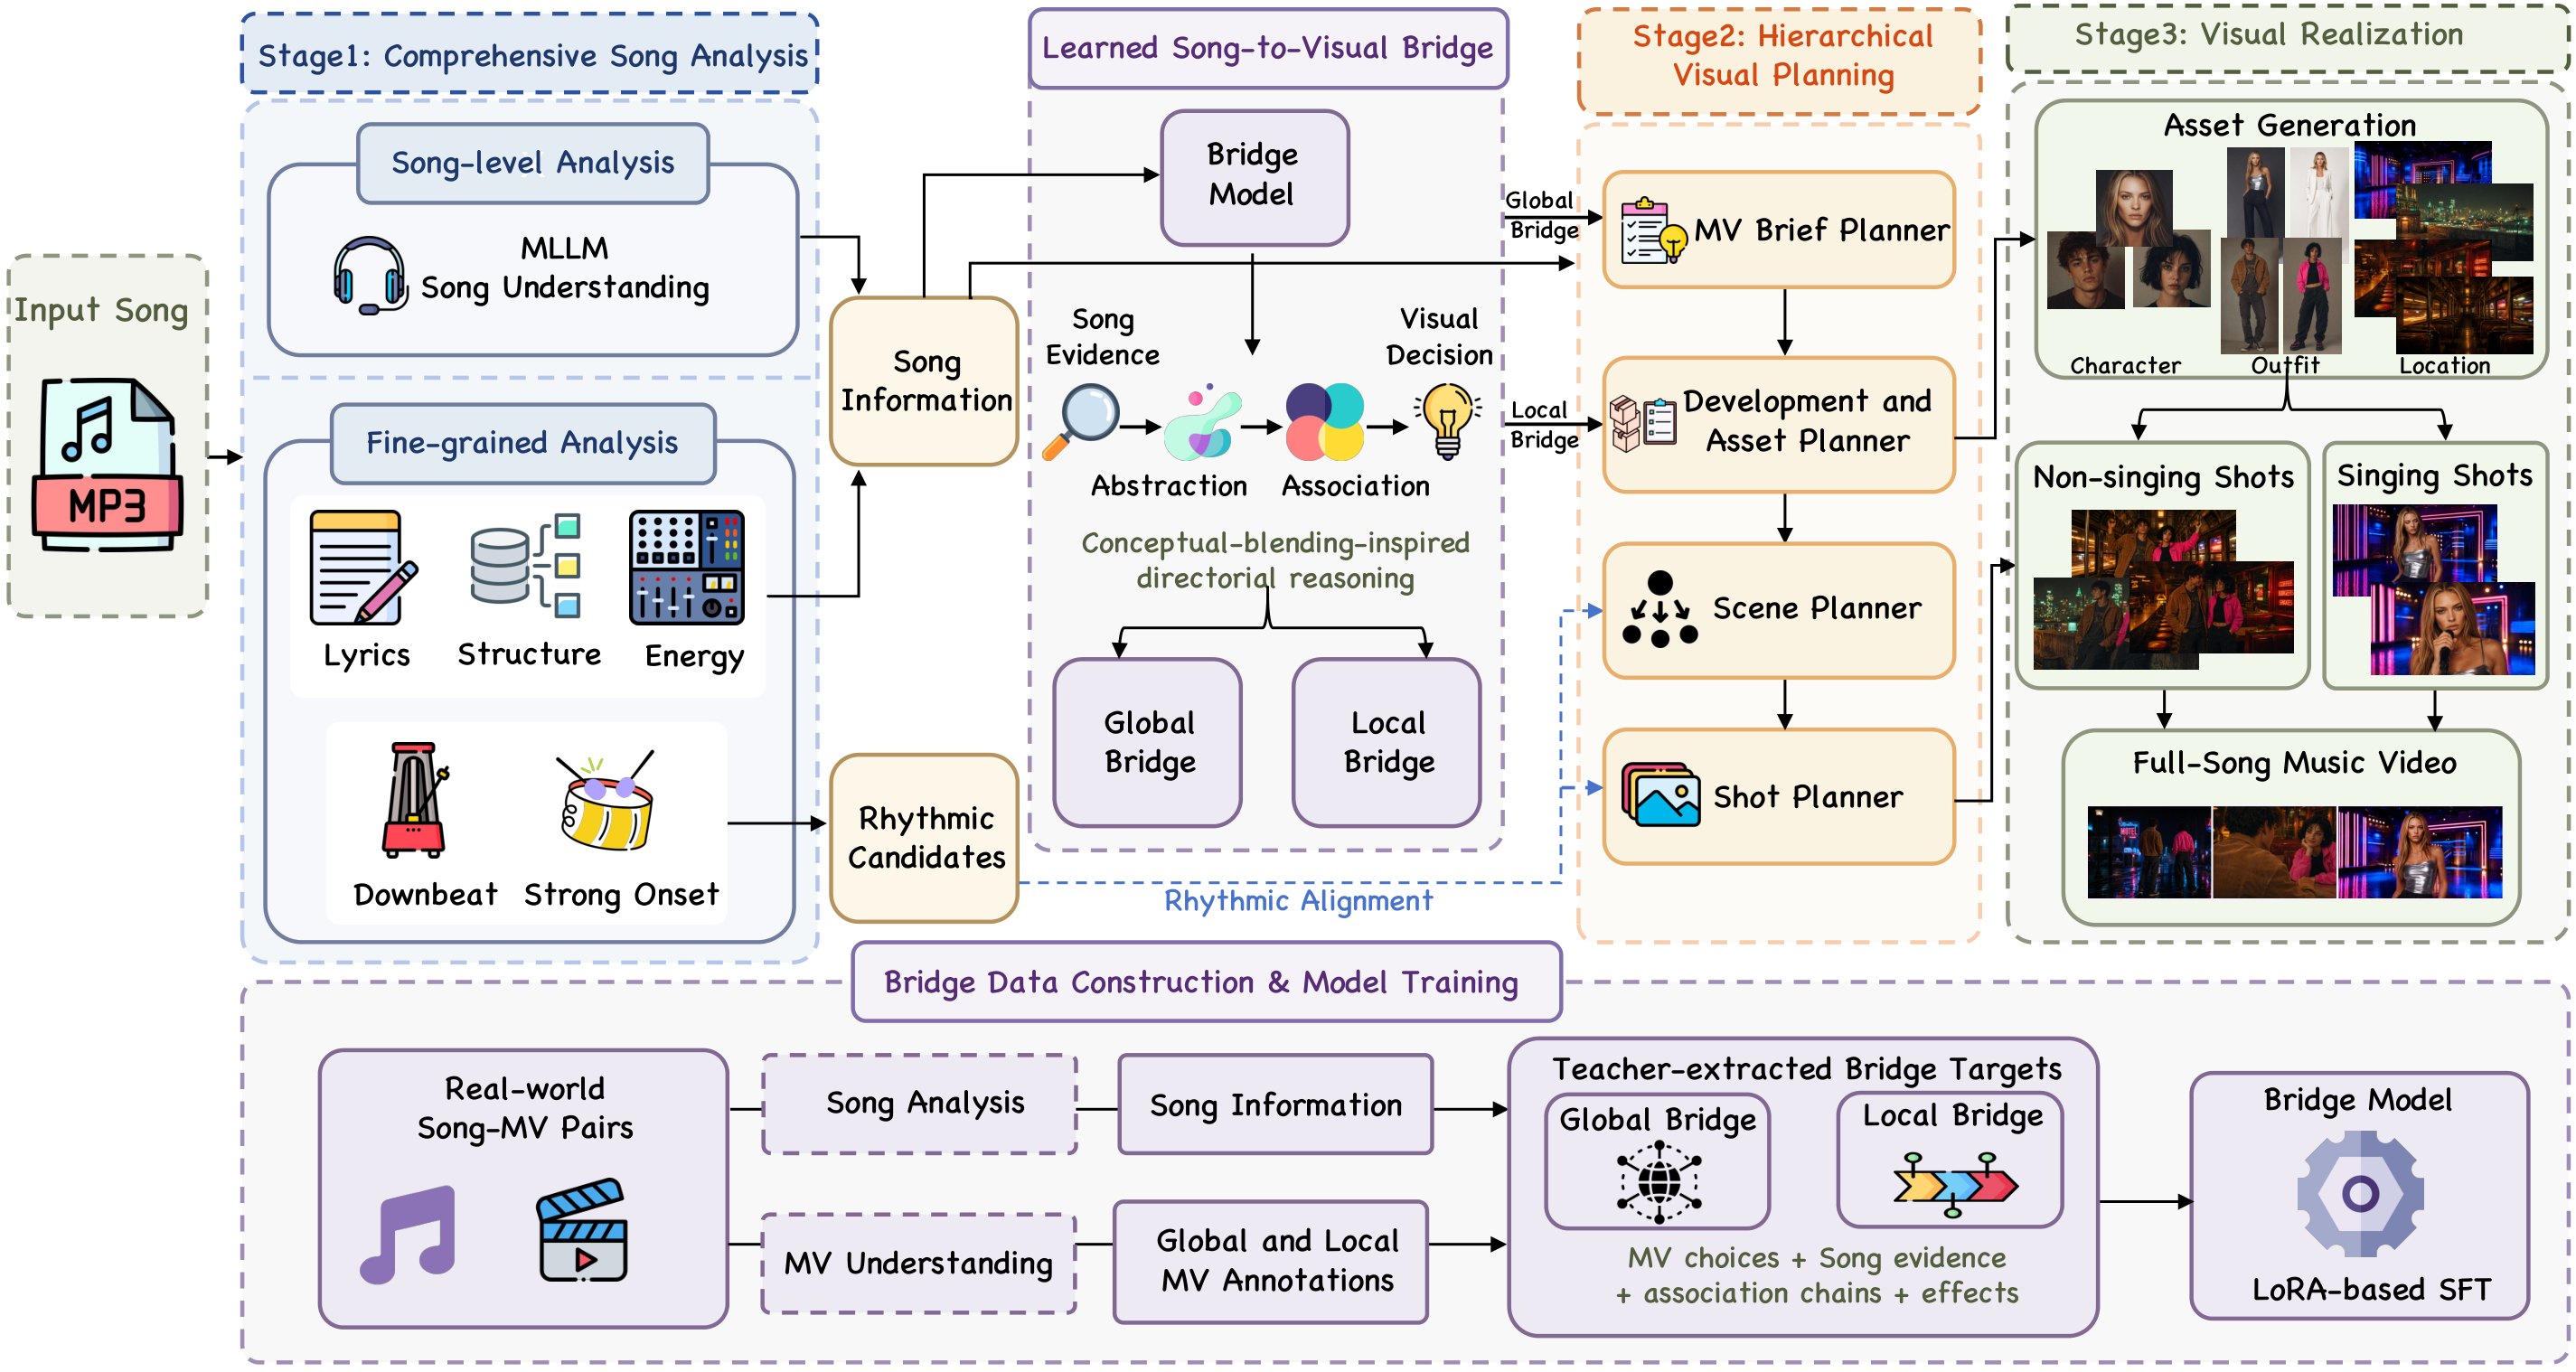
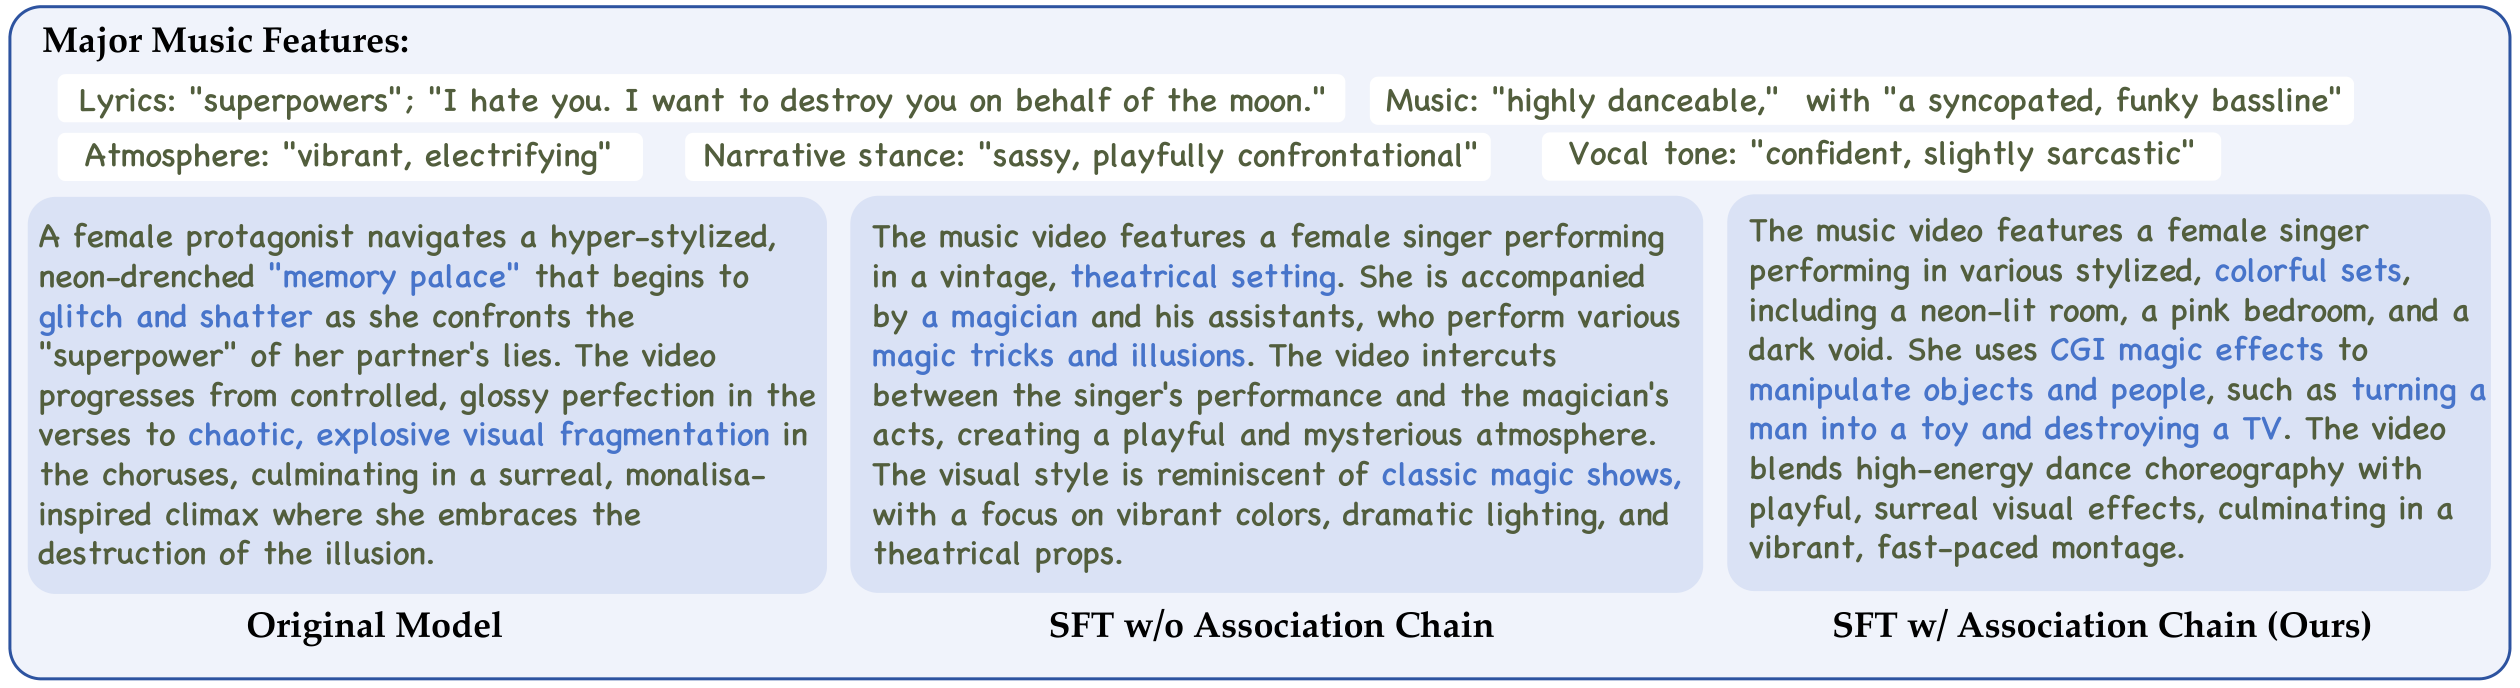
本文贡献 :MVWeaver 先做结构化歌曲分析,再由视觉规划器生成全局概念、段落计划和可执行镜头,最后调用图像与视频模型渲染。关键的 song-to-visual bridge 来自 1861 组真实歌曲与 MV,包含歌曲侧、MV 侧以及教师推导的转译理由,并用 LoRA 微调大语言模型学习从听歌理解到视觉设计的中间桥。
实验效果 :在 1 至 5 分评测中,MVWeaver 的歌曲解释、视觉发展、概念连贯和镜头连续得分分别为 4.08、3.63、4.30、4.10,均高于 AutoMV 和去掉桥接模块的版本;与所有对比方法成对比较后的总体用户偏好率为 67.06%,AutoMV 为 30.59%。
批判点评 :1861 组真实 MV 的规模、文化分布和版权来源会影响桥接模型学到的视觉惯例。长视频一致性评分仍难覆盖完整观影体验;若歌曲分析出错,层级规划会把错误系统性传播到所有镜头。
6. ToPO:把整图偏好路由到词和像素
ToPO: Token-Conditioned Preference Routing for Attention-Based Latent Diffusion Models | 清华大学、电子科技大学、斯坦福大学 | arXiv:2609.03688
关键词 :偏好优化,扩散模型,注意力,空间时间路由
⚠️ 前序问题 :一条成对偏好只说明整张图谁更好,却没有指出哪个提示词、空间位置和去噪时刻该更新。Diffusion-DPO 把全局信号铺到大量局部坐标,容易浪费梯度或修错区域。
本文贡献 :ToPO 用冻结参考去噪器比较优选与劣选分支的局部平方残差,构造与小批次相关、停止梯度的可分空间时间路由;再用优选分支交叉注意力把内容词映射回空间,并加入像素中点排序项。整个过程不需要局部标签或另训奖励模型。
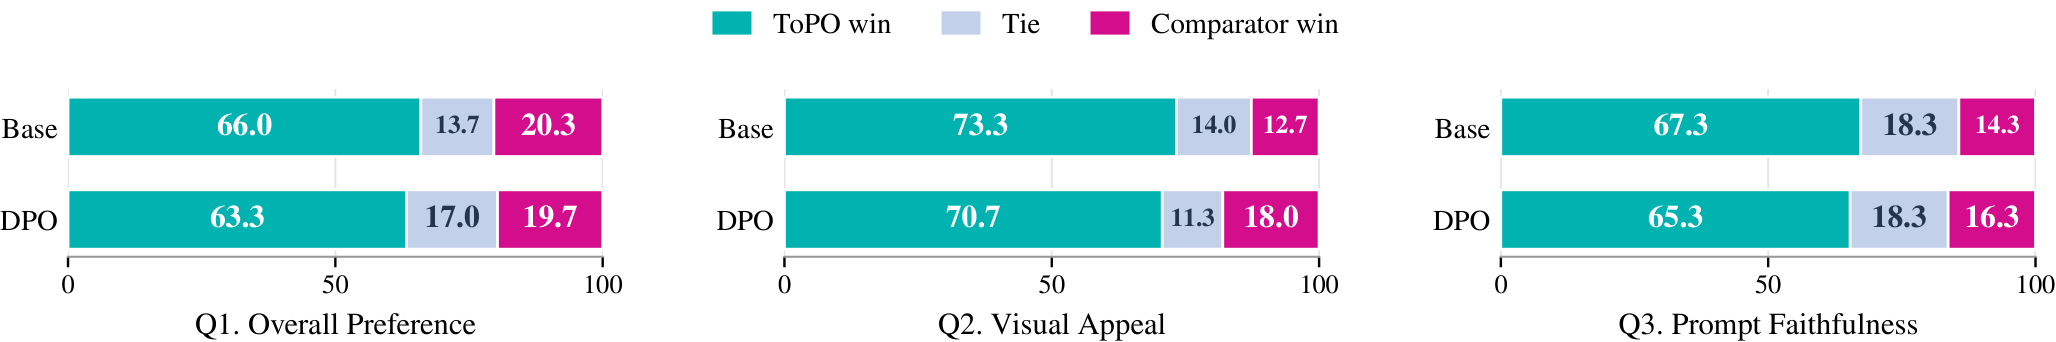
实验效果 :在 SD-1.5 上,ToPO 的 GenEval 与 T2I-CompBench 平均分为 0.5092 和 0.4123,高于 Diffusion-DPO 的 0.4591 和 0.3521;在 SDXL 上 GenEval 为 0.6168,T2I-CompBench 为 0.4975,与 Diffusion-DPO 的 0.4974 近似持平。300 提示盲测的六组问题中,ToPO 均获得更多原始选择。
批判点评 :路由依赖参考模型残差和交叉注意力的可解释性,未证明可直接迁移到所有 DiT 或无交叉注意力架构。盲测只公开聚合计数,不能进行参与者层面的显著性推断;部分 SDXL 自动指标也没有全面领先。
7. Diffuse2Seg:扩散模型零训练造分割标签
Diffuse2Seg: Diffusion Models Can Segment Anything Without Supervision | 柏林工业大学、CARIAD SE(大众汽车集团) | arXiv:2609.06491
关键词 :开放世界分割,扩散特征,伪标签,无监督学习
⚠️ 前序问题 :SAM 的开放世界分割能力依赖 1100 万图像和超过 10 亿人工掩码,继续扩大标注极其昂贵。自监督视觉特征生成的伪标签又常偏向前景物体,难覆盖天空、道路等无定形区域。
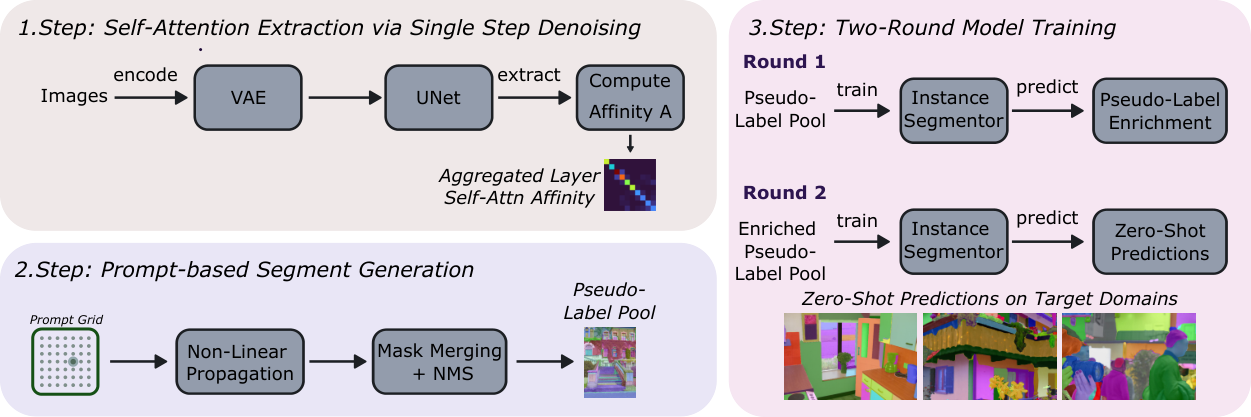
本文贡献 :Diffuse2Seg 不训练扩散模型,而是从文生图模型的自注意力中提取对象结构,将密集点网格通过保边的非线性 p-Laplacian 传播为软掩码,再合并为从部件到完整物体的多粒度实例图,去重后用于训练开放世界分割器。
实验效果 :生成伪标签在五个领域的 AR1000 比此前最佳标签生成器高 4.3 至 7.1 个百分点。用这些标签训练的无检测器分割模型在 things 与 stuff+things 上分别提升 7.4 和 7.7 个百分点,并在后者超过检测器式 UnSAM 2.1 个百分点。
批判点评 :伪标签会继承文生图训练数据的类别偏差,对小目标、透明物、医学或机器人极端域未必可靠。评测以平均召回为主,边界精度和错误标签对下游安全任务的影响仍需单独检查。
8. OAVC:只改目标不带跑背景
Object-Aware Background-Controlled Editing via Weighted Velocity Guidance | 卡内基梅隆大学、中国科学院计算技术研究所、中国科学院大学 | arXiv:2609.06288
关键词 :图像编辑,视频编辑,免训练控制,整流流
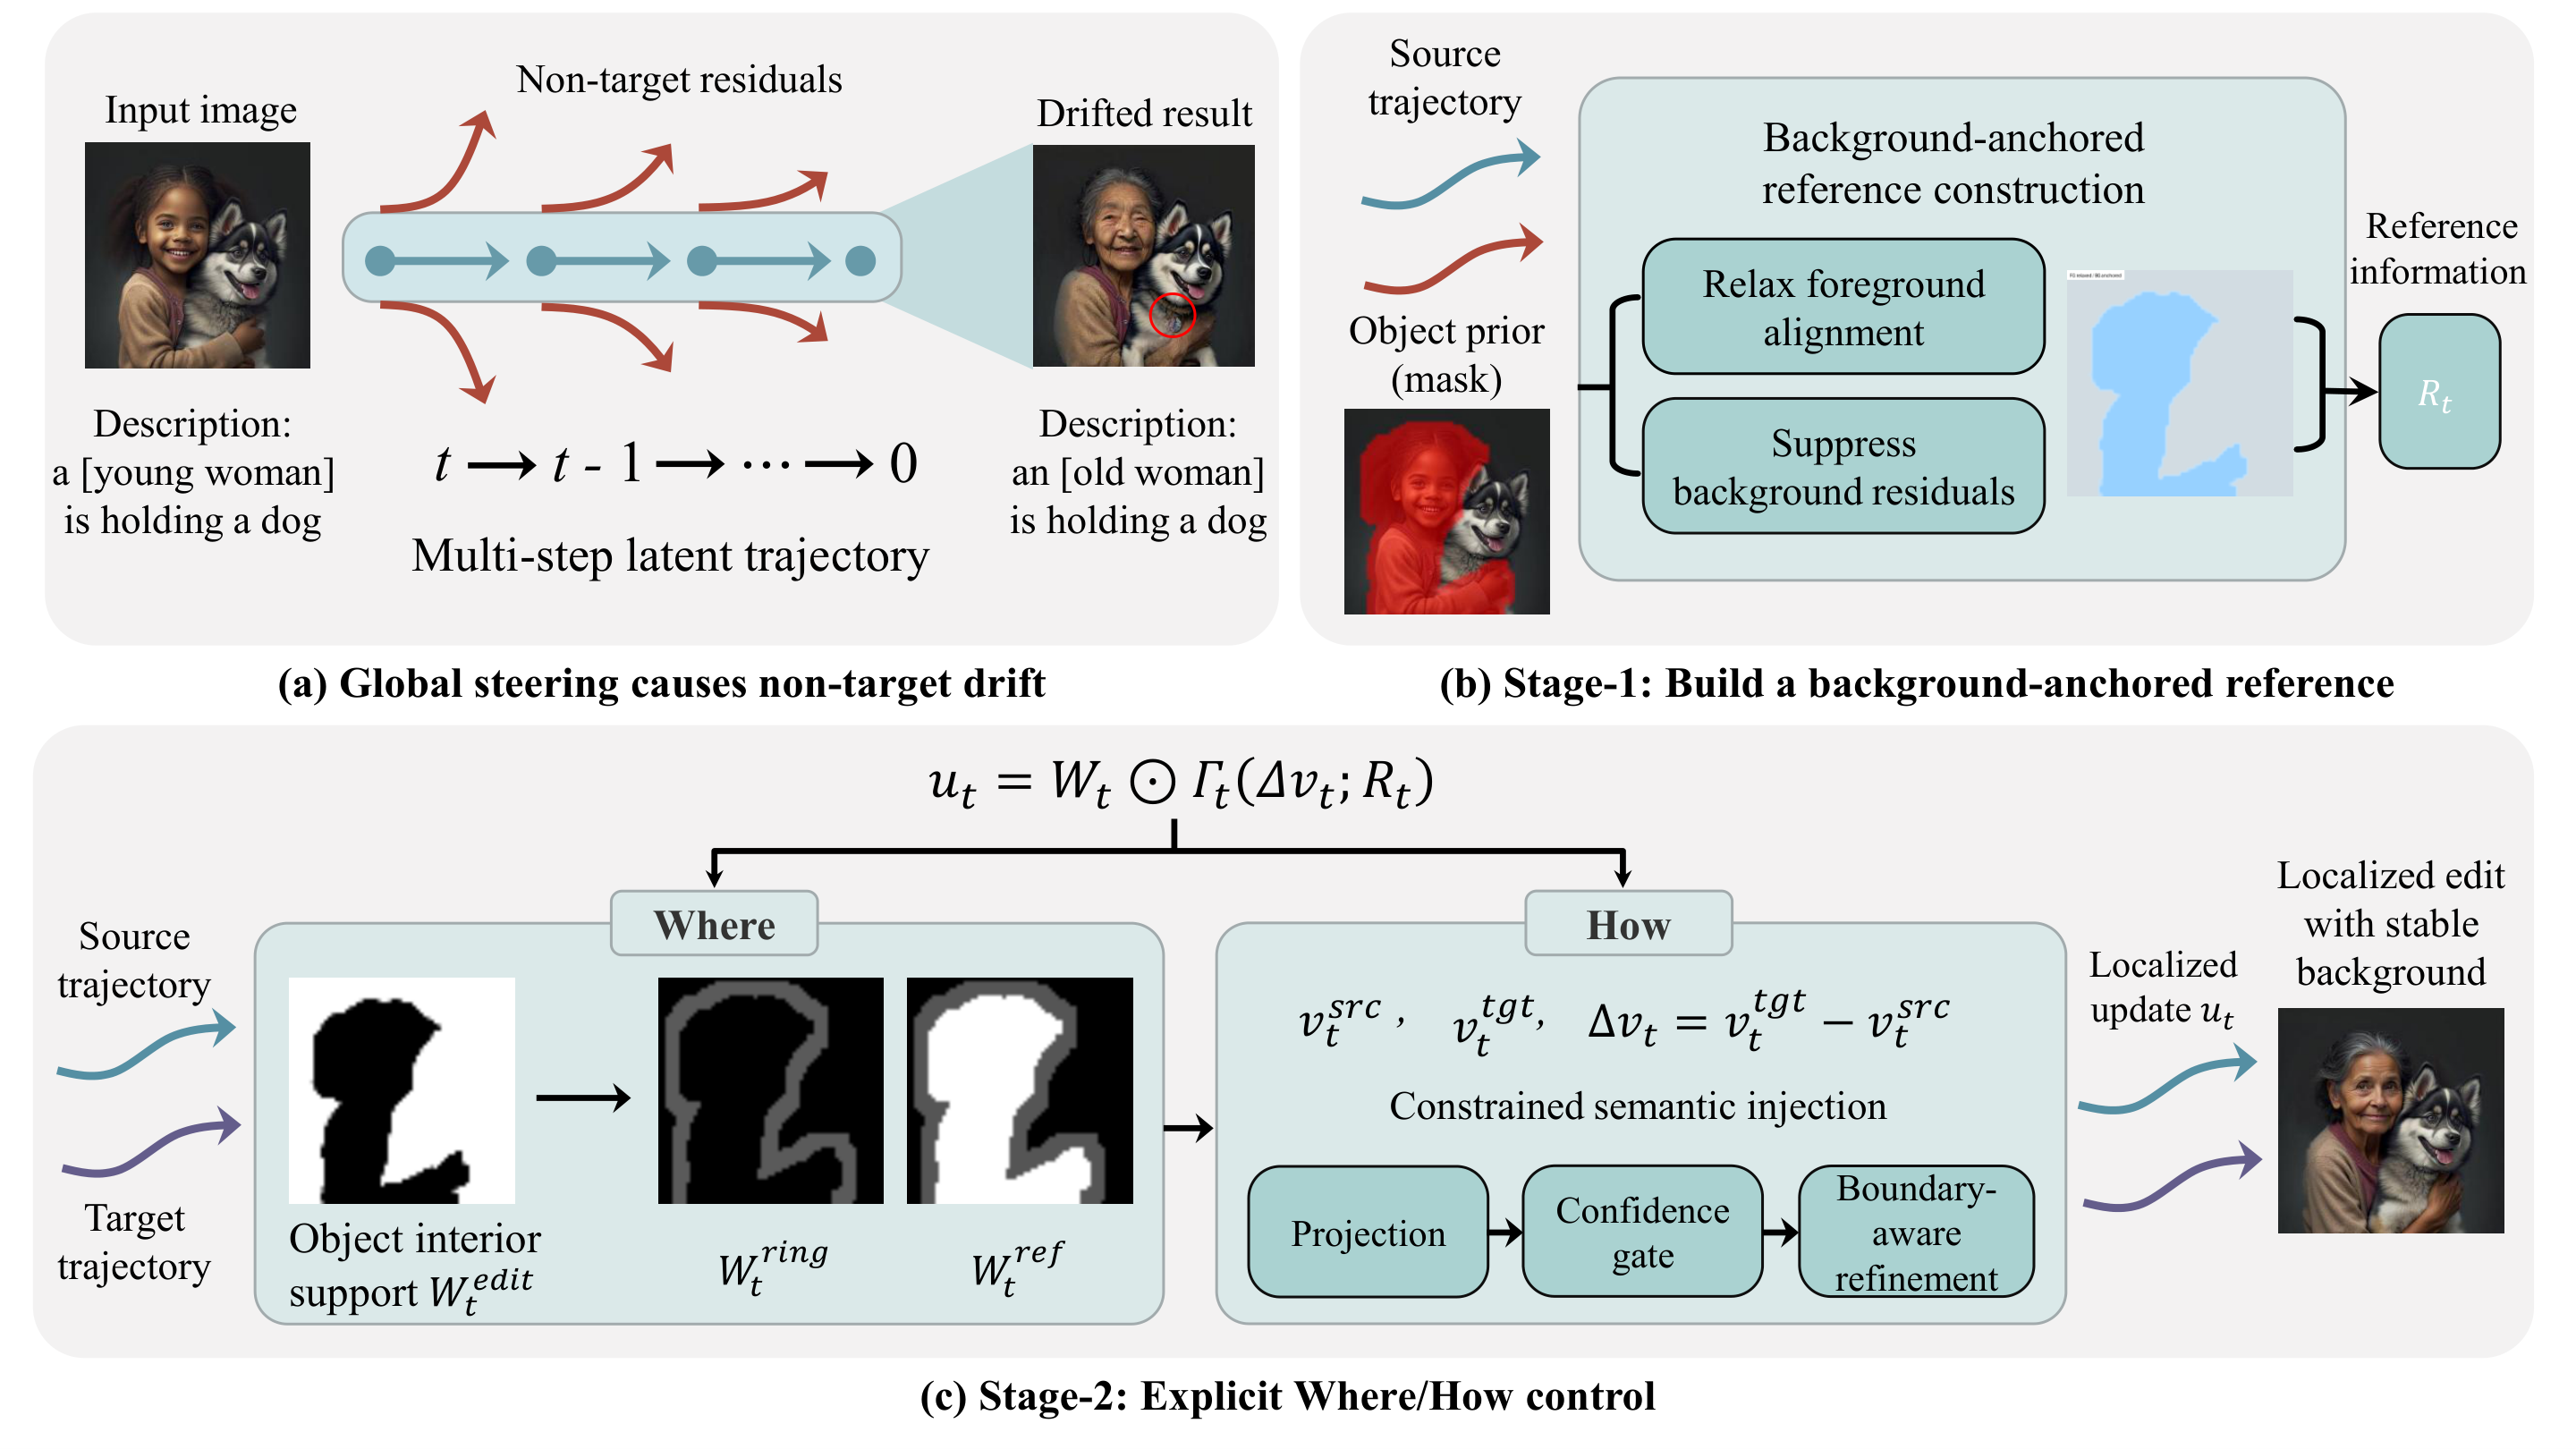
⚠️ 前序问题 :免训练编辑通常把源提示与目标提示的速度差全局加到潜空间。目标之外的小残差虽然单步很弱,却会在多步积分中累积,最终带跑背景纹理、反射和物体边界。
本文贡献 :OAVC 把“语义残差能在哪里生效”和“如何注入动力学”拆开:先在源提示下建立背景锚点和对象支持区,再用受约束的投影抑制会引发漂移的速度分量,并按时间和边界置信度加权注入目标语义。它不训练或修改预训练模型参数,可接到 SD3.5、FLUX 和视频流编辑器上。
实验效果 :在 PIE-Bench 上,FLUX 版本相对 DNAEdit 将结构距离从 18.87 降至 4.07,背景 PSNR 从 24.99 dB 提升到 33.30 dB;SD3.5 版本也从 14.19 降至 4.11、从 26.66 dB 升到 32.64 dB。100 例盲测中,OAVC 赢下 94 个有明确结果的背景保持比较中的 74 个,占 78.7%。
批判点评 :默认依赖 SAM3 提供对象支持区,分割遗漏或膨胀会直接限制编辑。它在背景保持上更强,但 CLIP 编辑性分数较低;人工评测也显示编辑实现偏好差异未达 0.05 显著水平,存在保真与改动强度的权衡。
9. AngelFingerprint:水印直接藏进编辑模型权重
AngelFingerprint: A Traceable, Explainable, and White-Box Stealthy Watermark for Text-Guided Image Editing | 台湾大学、日本国立信息学研究所 | arXiv:2609.04709
关键词 :生成水印,图像溯源,文本引导编辑,白盒安全
⚠️ 前序问题 :常见生成水印只携带固定 ID,能说明图像来自哪个模型,却无法解释改了什么;水印若由独立编码器或后处理模块写入,在开源白盒场景中又容易被定位和移除。
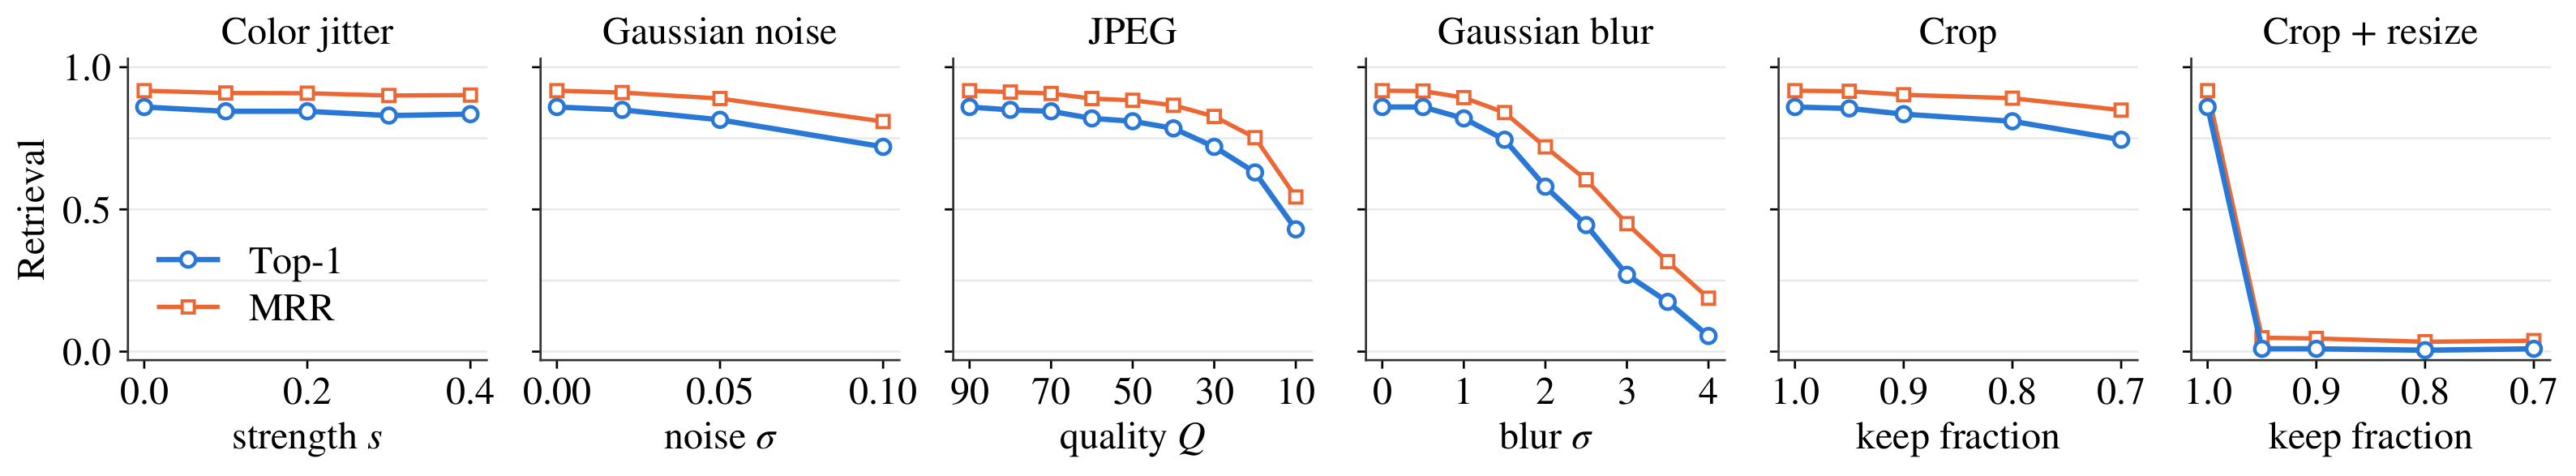
本文贡献 :AngelFingerprint 用 LoRA 把编辑提示的 CLIP 文本嵌入写进扩散模型权重,专用提取器再从像素恢复语义载荷。速度对齐锚点限制水印对编辑结果的扰动,仿照 JPEG 的 DCT 中频掩码避开显眼低频和脆弱高频,让架构、推理代码与计算图保持不变。
实验效果 :在 MagicBrush 的 200 候选提示检索中,SD3-Medium 版本 Top-1 为 86.0%、MRR 为 0.917,而提示反演 Top-1 为 20%;UltraEdit 版本 Top-1 为 65.5%。中频滤波版本在水印开关之间得到 PSNR 22.91 dB、SSIM 0.704。
批判点评 :把 LoRA 融入权重提高了隐蔽性,却没有证明能抵抗模型再训练、合并、剪枝或蒸馏等强白盒攻击。200 路封闭检索和单一编辑数据集规模有限;语义载荷也会带来隐私与滥用提示暴露问题。
10. Srijika:生成66套可安装印度字体
Srijika: OpenType-Layout-Reusing Font Restyling for Nine Indic Scripts | Loopdesk Technologies LLP | arXiv:2609.05661
关键词 :字体生成,扩散模型,OpenType,印度文字
⚠️ 前序问题 :印度婆罗米系文字包含大量合字、半形和元音附标。只生成漂亮字形位图并不能得到可用字体,因为 cmap、GSUB 替换闭包、GPOS 定位和锚点关系必须共同满足排版引擎契约。
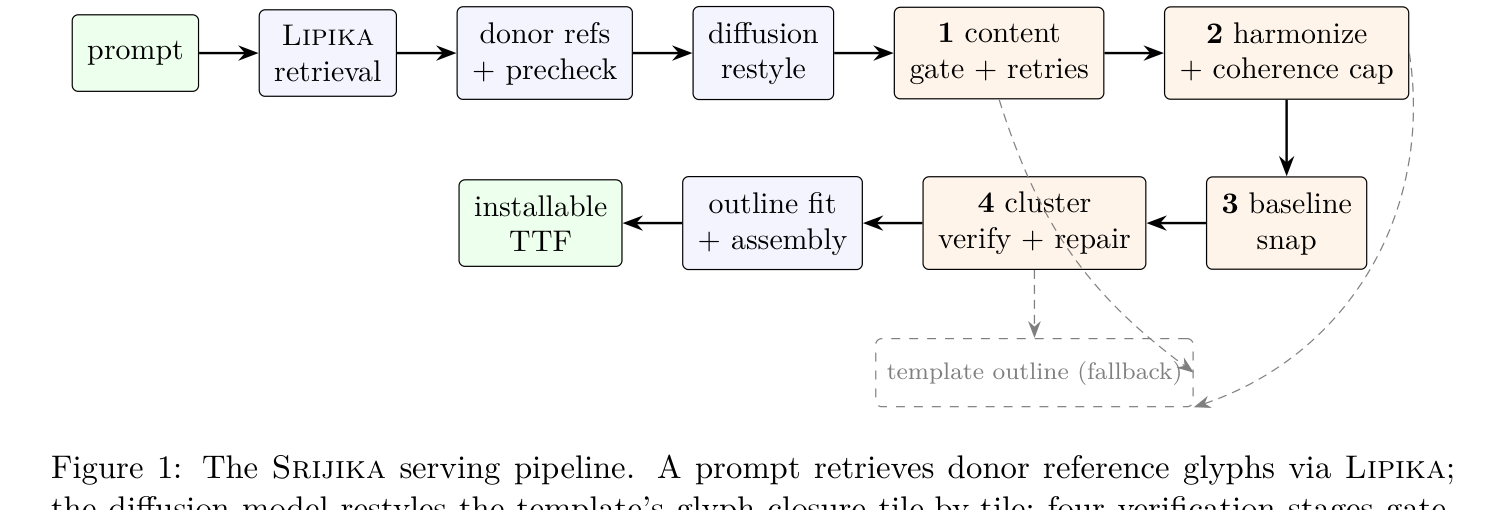
本文贡献 :Srijika 不从零生成字体,而是保留完整模板字体的字符映射与替换闭包,用约 650 个开放许可字体族的检索系统 Lipika 将自然语言风格落到参考字体,再由参考条件潜扩散逐字重绘轮廓。内容门控、风格协调和排版簇验证会自动回退失败字形,最终重建为 TTF。
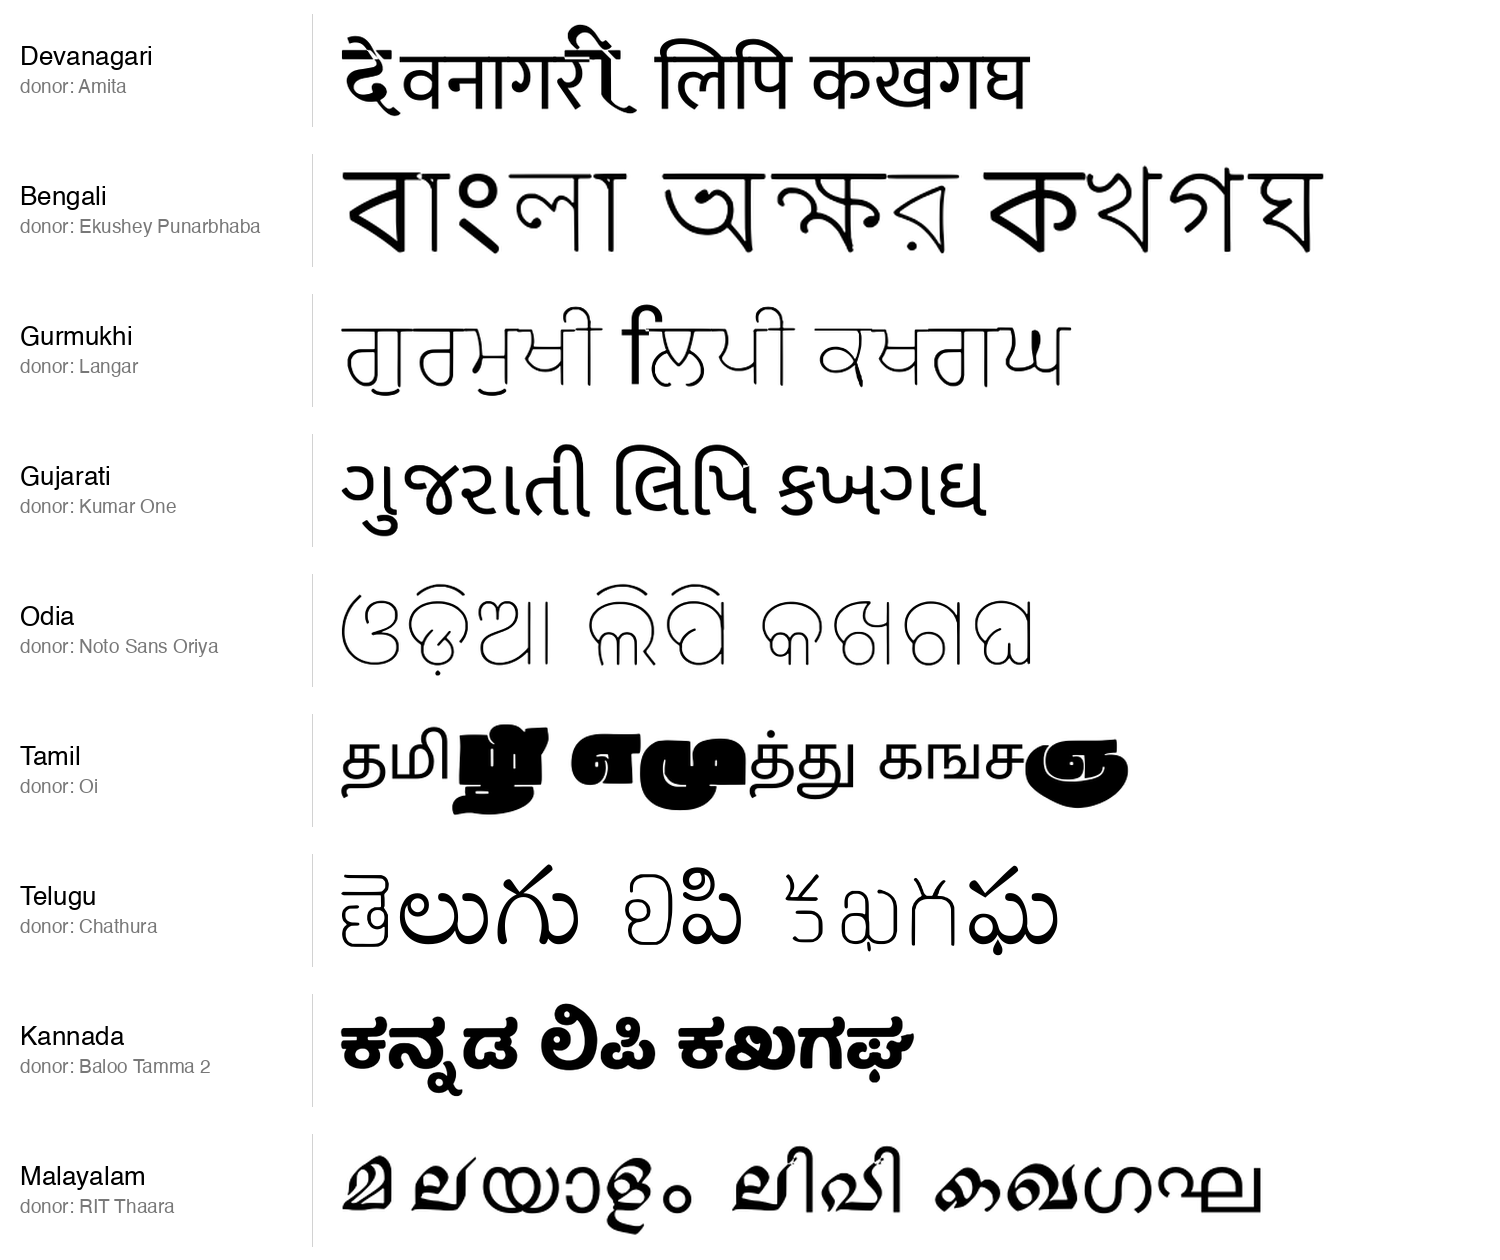
实验效果 :系统产出 66 个 TTF,包含 57 个预设和 9 个开放词汇示例;全部通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在高难合字探针上复现模板字形 ID 序列,并审计 80,915 个字形与 54,812 个锚点。
批判点评 :论文只与无学习基线比较,缺少独立风格指标、人类研究和完整 GPOS 视觉质量审计。检索编码器与评测嵌入的数据并非完全独立,风格提升可能被高估;工程上的回退机制保证可安装,却可能留下大量未真正重绘的字形。
趋势观察
少步与长视频开始接受完整系统计时
TBDub把视觉配音压到两步并报告VAE到VAE的端到端速度,PAI-Actor则诚实披露17秒视频仍需95分钟;生产可用性正在从采样步数口号转向全链路成本。
对齐信号从整图分数走向可迁移局部场
AlignGraft把弱模型对的速度差跨规模移植,ToPO把整图偏好分配到词元、空间和时间,说明生成对齐正从重复微调转向复用和精确分配。
生成系统更重视可验证的结构契约
SeRV用语义码本约束手语,OAVC显式限定对象区域,AngelFingerprint嵌入可恢复提示,Srijika复用OpenType闭包;输出是否可编辑、可追溯、可执行,正与视觉质量同样重要。
人工智能炼丹君 整理 | 2026-09-09
更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」
每日更新 · 论文精选 · 深度解读 · 技术脉络
微信搜索 人工智能炼丹君 或扫描下方二维码关注















评论 (0)