
搜索到
12
篇与
3D生成
的结果
-
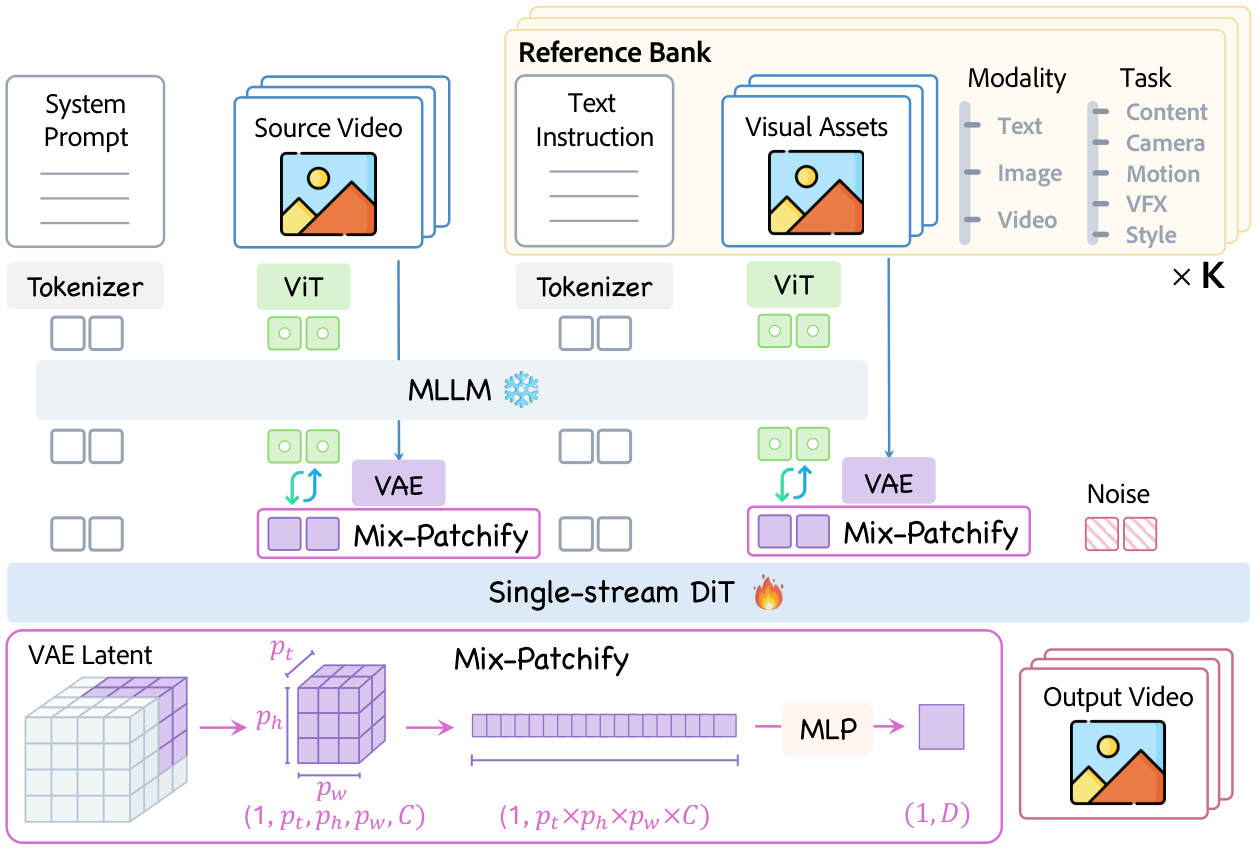
 AIGC 每日速读|2026-10-20|Adobe多参考视频编辑OmniXRef 今日 AIGC 论文速览 今日共 10 篇 · 多参考视频编辑 1 篇 · 多轮图像编辑 1 篇 · 视频几何纠错与视频配音 2 篇 · 像素生成与推理效率 2 篇 · 语音与个性化生成 2 篇 · 可控3D头像与世界模型 2 篇 重点论文标题列表 OmniXRef(Adobe):多段参考各取所需再改视频 MTEdit(商汤):先拼好编辑轨迹再拆训练对 VGC(加州默塞德):生成完再修镜头下的几何 MFlow(Adobe):按数据方向学该预测什么 Sink-Sparse(西安交大):保留重要注意力再补全局 选读入口:要用多段参考改视频,先读 OmniXRef;连续修图越改越脏读 MTEdit,生成视频已有几何变形读 VGC。训练像素生成器读 MFlow,长序列注意力慢读 Sink-Sparse;动作细节配错音读 SCR-V2A,语音首响预算紧读 DriftTTS。两图合成准备慢读 Kingfisher;表情带偏镜头读 VDAs,镜头回访忘场景读 PPMem。 今日论文速览 1. OmniXRef:多段参考各取所需再改视频 OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing | Adobe Research;布朗大学 | arXiv:2610.22744 关键词:视频编辑, 多模态参考, 属性迁移, 位置编码 前序问题:想让原视频沿参考片的镜头运动,再套另一段的灯光,模型却把参考人物也搬了进来。多个参考不仅要“都看到”,还要分清每段只允许借什么。 方法直觉:把每个参考做成一个带任务和编辑说明的小包,再给这些包预留固定位置。网络可同时比较全部输入,而不把参考数量改变误当成位置含义改变。 本文贡献:冻结 Qwen3-VL-8B 多模态语言模型提取交错文本/视觉上下文,视觉位置换成视频编码潜变量,单流扩散 Transformer 联合去噪。Mix-Patchify按任务压缩参考的空间 token,源/目标保持细粒度、参考时间轴不压缩。R²-RoPE 是预留参考槽的旋转位置编码:为参考预留8槽,训练随机分配不重复位置,避免增加参考时越出训练坐标范围。约1000万训练样本经272P单参考、272P双参考、480P精调逐级学习;主要文字编辑数据约700万为内部数据。 图2|OmniXRef-Model整体结构。参考包统一承载文本、图像和视频参考。多模态语言模型从交错输入提取语义上下文;单流扩散Transformer通过完整自注意力联合处理上下文文本、视觉token及噪声,使多个参考包同时约束编辑结果。下方Mix-Patchify将视频潜变量按所需粒度切块,再映射为扩散token。 实验效果:OmniXRef-Bench 共125例,覆盖镜头、动作、内容、风格、视觉特效五类,用 Gemini 3.8 Flash 裁判。RA参考遵循、VQ画质、SP源内容保留各按0至5分评估;综合分另惩罚参考泄漏,非简单均值。总体综合分OmniXRef/Seedance 2.5为3.78/2.73,SP为4.68/3.71;但VQ为3.68/3.70,画质并未胜过该商用对照。支持三参考的展示来自双参考训练后的组合泛化,不能据8槽宣称8参考质量已充分评测。 表2|OmniXRef-Bench视频参考属性迁移的逐类别语言模型裁判评估,含内容、风格、特效、镜头、动作及五类总体均值。RA为参考遵循,VQ为视觉质量,SP为源内容保留,三者均为0至5分且越高越好;Score按原协议综合并惩罚参考泄漏,不能按三分算术平均解释。商用模型为参考,粗体只标其余方法最优;横线表示缺少结果。 批判点评:训练与推理要付多参考 token 及全注意力开销;局部压缩并不消除随参考数增加的计算。有限125例及语言模型裁判适合看属性迁移趋势,非普遍产品排名。主表和消融表的完整模型数值略异,正文统一用主表;项目页 仍标Code Soon,没有已开源证据。 2. MTEdit:先拼好编辑轨迹再拆训练对 MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing | 商汤研究院;香港科技大学;斯坦福大学;清华大学AIR | arXiv:2610.23751 关键词:多轮编辑, 轨迹数据, 上下文学习, 质量漂移 前序问题:连续改八次图,第八次可能已经脏了;若训练数据本身也靠逐轮改图获得,模型会学到这种累积退化。怎样得到既遵循连续指令、又不越改越坏的训练链? 方法直觉:先在同一画布里共同生成多个编辑状态,再把画布拆成轨迹。共享视觉上下文让各状态互相约束,比每轮只承接上一次的误差更稳。 本文贡献:PTC(packed trajectory canvas,打包轨迹画布)流程先筛高分辨率美学种子图,再用视觉语言模型规划画布提示,让闭源图像模型一次生成多个状态。随后做坏例过滤、拆格、局部特征匹配与几何对齐,并补逐轮指令,得到50万条轨迹、269万次编辑,最多8轮、平均5.38轮。既包含只执行当前指令,也包含需记住历史的约束、指代和简短指令。用块因果注意力及交错位置编码联合训练多轮,微调 Qwen-Image-Edit-Causal。 图2|MTEdit数据构造。(a)筛选高分辨率与高美学质量种子图。(b)视觉语言模型依据种子图规划PTC画布提示,指导闭源图像模型在共享视觉上下文中共同生成多个编辑状态。(c)过滤坏例、生成逐轮提示,拆分画布并做局部特征匹配和几何对齐,将状态转换为含指令与目标图的多轮编辑轨迹。 实验效果:MTEdit-Bench 含100条8轮逐步编辑链,另有三类各50条4轮上下文任务。受控消融用相同图像/提示、相同教师,各造1万条8轮链,再让同一主干训练5000步:第8轮 PTC/逐轮生成的 IF 指令遵循分为5.06/4.26,CC 内容一致性分为4.44/3.84,DRS 抗画质漂移分为4.22/3.96。IF/CC 是视觉语言裁判0至10分,低于6的首次失败后后续轮置零;DRS是两种画质评分平均、0至5分,不随失败清零。 表3|逐步编辑子基准上的受控消融。Method表示训练数据用PTC共同生成还是逐轮生成;每种构造各1万条八轮轨迹、同主干同超参数训练5000步。逐轮报告IF指令遵循、CC内容一致性与DRS抗画质漂移,均越高越好,粗体标最优。IF/CC为0至10分且首个失败之后后续归零;DRS为0至5分并保留实际分数。 批判点评:结果支持数据构造方式,不代表闭源教师可被低成本替代;画布生成、筛选与对齐成本仍须支付。完整模型第8轮DRS为4.33,但指令遵循仍落后最强闭源模型,不能把画质稳定等同编辑正确。低分置零会放大早期失败影响,比较时应沿用同协议;未核实MTEdit专属代码或数据下载入口,也无会议接收证据。 3. VGC:生成完再修镜头下的几何 Learning to Correct Geometry in Generated Videos | 加州大学默塞德分校;南洋理工大学;北京大学;卡内基梅隆大学 | arXiv:2610.23856 关键词:视频修正, 几何一致性, 配对监督, 光流 前序问题:镜头移动时,灯杆变成两根、门框扭曲;换一个视频生成器又要重新解决。能否在成片后统一修正,而不修改原生成模型? 方法直觉:拿真实视频当正确答案,让现有补帧生成器制造“同场景但几何出错”的版本,再训练一个专门纠错的视频模型。难点是错片仍要走原镜头路线。 本文贡献:VG-Pairs按相机旋转和平移量决定分段数,在运动方向转折处选关键帧,分段用 Wan 2.1-Fun-InP 补中间帧并拼接,避免只给首尾时走捷径。VGC以 Wan 2.1-1.3B 做视频到视频去噪,输入错片、文本和从错片计算的光流;光流是相邻帧运动场,用于区分全局相机移动与局部物体运动,推理时同样可得。训练使用约8000条DL3DV及6.3万条SpatialVID视频,81帧、832×480,32张H100训练1万步。 图3|VGC流程。从真实视频中按相机运动选自适应关键帧,图生视频补全器合成有几何扭曲的片段作训练输入;纠错器学习还原几何一致的目标视频。光流由错片计算并作辅助条件,帮助区分镜头移动与场景动态。中央三维重建仅用于示意,实际流程不使用该重建。 实验效果:在200条保留DL3DV提示、CogVideoX-5B文生视频上,用独立三维重建再投影衡量一致性:PSNR由15.6668到16.6940,像素均方误差MSE由0.0333到0.0264,均改善;LPIPS感知距离却由0.5285升至0.5733,反而变差。图生视频的3DCS三维一致性误差亦由0.7944到0.8121,越低越好,不能宣称所有几何指标均提高。大模型14B扩展到动态场景和720P,属于另一配置。 表2|DL3DV中三种CogVideoX来源生成器的文生/图生视频几何修正。通过独立三维重建与再投影计算PSNR、结构相似度SSIM、感知距离LPIPS、均方误差MSE和三维一致性误差3DCS;前两者越高越好,后三者越低越好。括号是加VGC后的变化,亦展示与VideoGPA叠加。PSNR和MSE多改善,但LPIPS均变差,图生视频的部分SSIM、3DCS也退化,不能据原表概括所有指标改善。 批判点评:改进主要来自配对监督;加光流的增益有限,额外纠错生成、视频编码及光流计算均增加延迟,论文未给完整部署耗时。重投影自洽也不保证忠于真实场景。已核实NeurIPS 2026接收;代码 现释放14B无光流版,不能直接等同上述1.3B含光流实验。项目页作者与arXiv有一名作者差异,本稿保留arXiv原始名单与机构。 4. MFlow:按数据方向学该预测什么 Rethinking the design space of Vanilla Pixel Diffusion Transformers | Adobe Research;马里兰大学帕克分校 | arXiv:2610.23854 关键词:像素生成, 流匹配, 参数化, 高频细节 前序问题:直接在像素上生成时,预测干净图像有时比预测变化速度容易,但换大模型、换视频就未必。固定一种目标,还可能让整套训练都在迁就不合适的表示。 方法直觉:不同数据方向的难度不同:轮廓和细纹不必用同一种预测目标。让模型为每个方向学习“更像图像还是更像速度”,再统一还原成采样需要的速度。 本文贡献:先用 PCA 主成分分析计算固定的图像块或视频块正交方向,再学习各方向的系数 m_i,范围0至1。目标为 x₀−Mε:x₀是干净信号,ε是噪声,M按这些系数重加权噪声;m_i=0对应干净预测,1对应速度预测。将输出解析恢复为速度后计算流匹配损失,避免系数靠缩小目标投机。另加 ConvRefiner:冻结主干,用轻量卷积残差和对抗损失补细节,专门处理 JiT 类大图像块模型的高频缺失。 图3|MFlow预测参数化。按PCA数据主方向比较固定干净预测、固定速度预测、低秩二值分配的AsymFlow,以及连续可学习的MFlow。左侧曲线展示各方向的系数m_i,0偏向干净图像、1偏向速度;右侧用干净图像减去重加权噪声展示不同目标。黑色表示干净预测,白色表示速度预测。 实验效果:UCF-101 类别条件视频为16帧、128×128;各模型独立调采样参数,B级 MFlow/JiT/AsymFlow 的 FVD(视频特征分布距离,越低越好)为122/152/126。ImageNet 256×256、H级加相同感知损失时,FID(图像分布距离,越低越好)为1.81/1.82/1.79,并非全面最优。卷积细化器在冻结训练600轮的主干上另练30轮,恢复每像素0.5至0.7周期的径向高频能量,FID基本保持;文生图另有5000步细化训练。 表4|UCF-101类别条件视频生成B级模型比较。作者分别训练并独立调优每个模型的采样超参数,视频为16帧、128×128;FVD以1万生成视频估计分布距离,越低越好。潜空间基线为Wan视频编码器加latent-DiT;像素JiT、AsymFlow、MFlow分别为152、126、122。表内编码器名中的1.3B不是所比较生成器的参数规模。 批判点评:价值是减少人工选择预测子空间,不是推理必然更快。小模型、是否加入感知损失会改变排名;高频统计改善也不等同细节真实。大规模文生图用了内部预训练与微调数据,复现门槛需单算;额外卷积、训练和显存没有完整端到端量化。作者项目页 未提供方法代码入口,不能把网页模板仓库当代码;论文仍在审稿。 5. Sink-Sparse:保留重要注意力再补全局 Sink-Sparse Hybrid Attention for Efficient Inference in T2I/T2V Diffusion Transformers | 西安交通大学;厦门大学;上海交通大学 | arXiv:2610.22975 关键词:生成加速, 稀疏注意力, 离线校准, 全局补偿 前序问题:视频token越多,反复计算全连接注意力越慢;每一步再搜索该留哪些关联,也可能吃掉稀疏化收益。能否一次找好,以后重复利用? 方法直觉:同一层同一注意力头常反复关注相似位置。保留这个稳定骨架,再用低分辨率全局摘要补上弱关联,兼顾省算与上下文。 本文贡献:离线在每个主干分别跑4提示×2噪声种子的完整轨迹,汇总精确块级注意力概率质量;每行选能覆盖阈值τ的最少块,固定掩码跨步复用。在线稀疏分支保留重要块,补偿分支只将key/value(供查询读取的键和值)按30个token均值池化,query仍保持原长;依据两支归一化常数自适应融合。模型权重、采样步数不变,免训练不等于免校准。 图4|Sink-Sparse Hybrid Attention两阶段流程。离线对少量提示、种子及去噪步采集稠密注意力,精确汇总块级概率质量并按行覆盖阈值τ选出每层每头固定掩码。在线各步复用掩码,稀疏分支保留稳定高质量关联;全长query读取均值池化的key/value以补全局信息,最后按归一化常数融合两分支。 实验效果:单A800 80GB,Wan2.1-1.3B、832×480、81帧、50步:τ=0.85时由164.80降到106.73秒、1.54倍;VBench八维均分0.656到0.659,越高越好,非官方完整总分。τ=0.70可到94.57秒、1.74倍,但均分降为0.647。Z-Image-Turbo 2048×2048、8步由23.39到14.88秒、1.57倍;GenEval2中各属性问答软分的几何均值Soft-TIFA GM由16.38降至15.21,越高越好。计时排除初始化和写文件;默认离线校准约22分钟为按稠密耗时估算。 表1|Wan2.1-1.3B文生视频主比较,832×480、81帧、50步、单A800 80GB。Dense为同一优化算子栈的稠密基准164.80秒,加速倍数以它为分母;计时不含模型初始化和视频写入。τ=0.70/0.85为速度/质量档。八列分别评主体、运动平滑、动态幅度、背景、场景、美学、成像及总体一致性,均越高越好;八维均分由未四舍五入值计算,非完整VBench总分。 批判点评:这是已测两主干上的质量与速度取舍,图像设置并非无损。固定掩码可能遗漏罕见或分布变化下的关系,不应跨主干直接复用;稀疏率只统计主分支,不包含补偿分支。尚未核实作者代码入口,也未报告完整峰值显存,不把免训练写成零部署成本。 6. SCR-V2A:盯住真正发声的局部来配音 Semantic-Critical Regions for Video-to-Audio Generation | 悉尼大学 | arXiv:2610.23021 关键词:视频配音, 局部语义, 适配控制, 音画对齐 前序问题:画面里人和乐器都很大,真正发声的却是手与琴弦接触处。只用整帧语义,配音可能听着像那个场景,却错过细小动作和节奏。 方法直觉:先找“哪里最能解释声音”,把局部热图与原视频同时送入生成器:局部提示事件,全局保住场景,标签补声音类别。 本文贡献:SCR指语义关键区域。用MotionFormer视频编码器预测声音标签,只微调最后块与分类头;保留概率高于0.65、最多5个标签,通过类别梯度加权的激活图定位区域,跨标签取最大,再与原帧各占50%叠加。热图适配器弥合热图和自然视频的差别,二者由共享视觉编码器编码后拼接,经控制适配器注入预训练音频扩散U-Net(带跨层跳接的去噪网络),标签作辅助语义条件,最后解码频谱与波形。 图2|SCR-V2A整体结构。声音相关视觉定位预测标签并提取语义关键区域热图;原始视频与经热图适配器处理的热图由共享编码器编码,融合后经控制适配器注入冻结音频扩散U-Net,并联合声音标签的文本特征生成频谱与波形。彩色箭头区分视频、定位、融合、音频及文本路径,火焰/锁表示可训练/冻结组件。 实验效果:在VGGSound约20万条10秒片、310类上训练,并用CountixAV测跨域。域内SCR-V2A/MMAudio 的FAD(VGGish特征上的音频分布距离,越低越好)为1.07/1.84,DeSync音画时间不同步分为0.680/0.440、越低越好,后者更强。跨域FAD为2.16/2.22。30人对20视频的5秒音频作五分评价,本法总体音质3.93±0.94、语义对齐4.10±0.88、时间对齐3.50±0.97;MMAudio时间对齐3.87±0.94。195M指可训练参数,非整模型参数或推理内存。 表1|VGGSound域内和CountixAV域外客观比较。FD、FAD为不同音频特征空间的分布距离,KLD为类别概率分布差异,DeSync为时间不同步分,均越低越好;IS为音频质量/多样性分,IB为ImageBind音画语义相似度%,均越高越好。Seeing&Hearing直接在测试时优化IB,比较需注意该条件。#Params按文中说明计可训练参数,非总推理参数;粗体/下划线标最优/次优。 批判点评:局部区域有助分布质量和语义,不保证时序最佳。梯度热图、双路视觉编码和扩散本身均需计算,缺端到端时延与峰值显存证据,不能只凭可训练参数宣称部署轻。标签误判也会把注意力引向错处;这些差异不由小规模听评自动证明显著。arXiv明确写ACM Multimedia Asia 2026已接收,未核实专属代码入口。 7. DriftTTS:把迭代搬到训练来一步发声 DriftTTS: One-stage Single Step Text-to-Speech via Generative Drifting | 首尔市立大学人工智能系 | arXiv:2610.22960 关键词:语音生成, 生成漂移, 单步采样, 片段监督 前序问题:语音生成器要反复调用解码器,交互响应变慢;蒸馏虽能减步,却通常先付一遍多步教师训练。能否从头训练一个只调用一次的模型? 方法直觉:让生成结果在训练中靠近真实语音片段、远离当前错误分布,推理时就直接落到目标附近;片段一起比较还能避免单帧“对了、拼起来却不顺”。 本文贡献:沿用Matcha-TTS文本编码器和时长预测器,用MAS单调对齐搜索把每个文字token的表示按持续时间展开,形成接近目标梅尔频谱(声学能量随时间与频带变化)的先验。解码器接先验与随机噪声,一次预测频谱,无时间步嵌入。训练随机裁80帧约0.93秒片段,以掩码自编码器MAE提取特征;真实批次作吸引样本、生成批次作排斥样本且排除自身,三个温度共同计算漂移损失。 图1|DriftTTS训练流程。文本编码器与MAS单调对齐搜索依据每个token持续时间重复其表示,构造先验ε=μ;解码器单次把先验映为生成片段。片段漂移在MAE掩码自编码器的特征空间中比较生成与真实目标片段,将训练中的生成分布推向目标;推理无需重复该漂移优化。 实验效果:LJSpeech单说话人训练2000轮、4张A10,每GPU批量64;另训练MAE,波形仍由HiFi-GAN声码器合成。500条评测、单A10、批量1:NFE即解码器调用次数,DriftTTS为1;WER单词错误率1.80%,MOS五分听感均分4.43±0.08,对照Matcha-TTS十次调用为1.93%、4.38±0.08。RTF为模型推理秒数/音频秒数,排除声码器:0.00441对0.0187,约4.2倍;单步RapFlow为0.00419,仍略快。MOS来自153人290份响应。 表1|LJSpeech评测。NFE为推理解码器调用次数;WER为单词错误率%、越低越好;MOS为五分主观听感均值及所报区间、越高越好,来自153名听者的290份响应。单A10测RTF即推理秒数除音频秒数,表中单位10⁻³且不含声码器,越低越好。Ground truth为真实语音,Vocoded GT为声码器重建。 批判点评:“从头单阶段”限定TTS模型,不代表没有预训练声码器或额外特征网络。去MAE后WER升至20.03%,片段与特征空间是必要条件;训练大批量和2000轮的成本不能隐去。多说话人、零样本与长语音尚待验证,MOS区间重叠也不能声称听感显著胜过多步。作者音频页 可访问,尚无代码入口;机构是首尔市立大学,非首尔大学。 8. Kingfisher:重组前四级图码来换风格 Kingfisher: Fast Personalized Visual Autoregressive Generation via Scale-Aware Prompt-Conditioned Scale Decomposition | 越南胡志明市科学大学;越南国家大学胡志明市分校;日本国立情报学研究所 | arXiv:2610.23238 关键词:个性化生成, 视觉自回归, 风格迁移, 尺度分解 前序问题:想保留一张实拍的主体、借另一张的画风,逐对训练LoRA适配器太慢;直接混合图像表示又容易把主体和风格一起换掉。 方法直觉:视觉自回归生成先画粗结构再补细节。抓住最早几级里决定主体与外观的部分,拆开后重新组合,再让冻结的生成器补完后续。 本文贡献:在冻结的 Infinity 多尺度生成器上,只处理前四级残差码。用中性外观提示和物体提示查询生成器,SVD奇异值分解提取“中性外观仿射空间”与“物体内容子空间”,据此投影并联合优化内容、风格及残差。重组时前两级换外观、第三级保留内容语义锚、第四级补内容方向;其余级由原生成器按位自校正生成。无需更新模型权重,但每对图片仍有图码优化。 图3|Kingfisher整体流程。将内容图A和风格图B用冻结编码器变为多尺度残差码,通过中性与物体提示分别构造外观仿射空间、物体内容子空间;在选定早期尺度将图码拆为内容、风格和残差并优化约束,再重组成语义前缀。冻结Infinity生成器按位自校正补剩余尺度,保留A结构并引入B外观。 实验效果:CSD-100的100张图各配5张不同类别风格图,共500个有序组合,每法一图,固定种子2026。Kingfisher/UnZipLoRA 的内容相似度CSD-C为0.5519/0.5782,后者更好;风格相似度CSD-S为0.5222/0.3673,本法更好,二者均为特征余弦相似度。单A100每对准备23.54±1.86秒,对照CSD-VAR为171.65±11.82秒;准备后每图1.61±0.15秒,对照1.39±0.12秒。20人600次强制选择中获254票、42.3%,是相对偏好。 表2|单A100效率与人工偏好。Prep./pair是每对内容/风格图的准备优化秒数;Infer./image是准备完成后单张生成秒数,两者不可混用。数值为均值与所报告离散度。人工偏好来自20参与者共600次强制选择:Votes为票数、Pref.为占比;这不是开放用户群的绝对满意率。 批判点评:加速集中在准备阶段,并非每图推理最快。171.65除23.54约7.29倍,与摘要7.5倍和正文“超过10倍”不一致,本稿保留原秒数;也不沿用未明确分母的54倍宣传。仅单张内容/风格、固定种子协议,不足证明开放场景通用解耦;项目页 标代码即将开放。 9. VDAs:表情与镜头分开驱动头像 Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars | 慕尼黑工业大学;Woven by Toyota;Toyota Motor Europe | arXiv:2610.23772 关键词:可控头像, 视频扩散, 表情解耦, 多视角 前序问题:拿一段正脸表情去驱动侧面头像,表情编码里夹带的原镜头会把新视角拉回去;仅靠传统三维脸模又难表达舌头与嘴内细节。 方法直觉:把“做什么表情”和“从哪儿看”分开,再用不同相机的参考、驱动和目标三元组训练,迫使模型不能偷用驱动镜头。 本文贡献:在 WAN-Animate-14B 上使用 X-NeMo 学习式表情码,经解耦器分成表情与相机部分,再翻译回原模型可接受的条件格式,相机部分取中性值。代理网格将头部/躯干局部坐标方向与明暗编码成图像,联合控制镜头、颈部及上身,三维骨架补姿态。冻结去噪主干,只微调条件相关组件;公开多视角数据上的相机三元组进一步去掉视角捷径。 图2|Video Diffusion Avatar结构。镜头、上身姿态与表情作为独立控制信号进入WAN-Animate-14B。解耦的X-NeMo表情码翻译成原生条件格式,并配视角中性相机码;代理网格渲染编码镜头和姿态。多视角数据的参考、驱动、目标相机三元组训练多视角一致性,主扩散块冻结而条件相关组件微调。 实验效果:单张A100训练34小时,推理20步。BecomingLit 的25条同人驱动测试中,VDAs/MVP4D 的脸部LPIPS感知距离为0.202/0.282,越低越好;JOD感知质量预测分为3.99,对照中最高CAP4D为2.40,越高越好。另测22条Multiface同人和13条BecomingLit跨人驱动。完整模型在单A100生成77帧、576×1024约12分钟;四步蒸馏原型改为288×512可达论文所报4.8帧/秒,但降低画质。 表2|定量结果:每格左/右依次为BecomingLit和Multiface;同人驱动各25和22例,跨人驱动仅BecomingLit的13例。MMDM为CAP4D的扩散组件。PSNR、JOD感知质量、ID身份相似度、Expr表情一致性越高越好;LPIPS和AKD平均关键点距离越低越好。跨人无逐像素真值,故仅评身份、表情及关键点;颜色在各数据集内部排序。 批判点评:完整模型适合离线制作,不能把34小时训练或低分辨率原型速度当作高清实时渲染能力。作者当前仓库对快速版写约3.5帧/秒,与论文4.8的原型口径分开;长序列仍可能漂移,光照烘在参考中。静态三维高斯重建只是多视角一致性探针,视频输出不等于直接交付可实时渲染的三维资产。代码 已有推理脚本与权重说明。 10. PPMem:把场景记成平面再转镜头 Persistent Planar Memory for Video World Models | 清华大学;蚂蚁集团;香港科技大学 | arXiv:2610.23795 关键词:视频生成, 世界模型, 平面记忆, 相机控制 前序问题:镜头绕回刚才的房间,墙和门却换了位置;只看最近几帧不够,逐像素累积三维点又让场景记忆膨胀。怎样在连续生成中保存可再投影的空间结构? 方法直觉:墙、地板和立面大多接近平面。把这些面记住,再从下一段的目标相机渲染深度,相当于让生成器沿着同一份场景草图继续画。 本文贡献:在 Wan 2.2 TI2V 5B 扩散 Transformer(用注意力网络逐步去噪的视频生成器)上,每段生成约25帧,并预测平面。每面用7个参数表示:中心深度、两个矩形尺度、四元数(四维旋转表示)。旧面通过遮挡投票删除,近邻按观测质量去重,再与新面合并。深度既作为输入通道,也经 DTF(把深度切成网络处理的特征单元token再融合)补入几何特征;先训练视频主干,再冻结主干训练几何头及 LoRA 低秩适配器。推理去噪后另做一次启用几何适配器的前向来提取平面。 图2|PPMem整体结构。带噪视频潜变量与源视图投影RGB、可见掩码、平面池渲染的部分深度按通道拼接,前序上下文帧在时间上前置。Wan扩散主干的两路token分别由视频解码器恢复RGB,或经几何LoRA及ViT深度token融合后解码成逐帧平面。平面合并进持久池,再按下一段目标相机渲染并回馈条件。 实验效果:主实验训练使用 DL3DV 与 RealEstate10K 超过8万片段,576×1024;两测试集各100场景。DL3DV 的121帧完整系统对照中,PPMem/Gen3C 的 PSNR(像素保真信噪比,越高越好)为13.98/13.59,LPIPS(感知距离,越低越好)为0.464/0.565。各模型按自身原生分辨率评测,不能把差异全部归给记忆。同主干、低分辨率消融中,预测深度/真值及其倒数均小于1.25的比例由无持久记忆64.0%升至70.3%。约400帧后10万个平面约5MB,仅为几何记忆;额外深度编码器约8700万参数,非零推理成本。 表2|DL3DV和RealEstate10K上的短程完整系统比较。两种帧预算N=49与N=121;N指输出帧数,VMem短档用48帧。49帧时多数基线只生成一段,121帧时Voyager、VMem、SPMem需自回归衔接。PSNR、CLIP语义及DINOv2结构相似度越高越好,LPIPS感知距离越低越好。每种方法按自身原生分辨率与画幅评测,输入及真值相应裁剪缩放。 批判点评:适合静态、平面丰富且相机路径已知的环境;作者亦承认动态内容与非平面细节受限。5MB不能当整机显存,作者仓库默认设置约需19GiB GPU内存。主榜是跨系统比较,消融才控制主干;深度 token 融合的阈值准确率也未优于仅通道拼接。已核实 NeurIPS 2026 接收;项目与代码 可访问,未运行模型。 趋势观察 控制先分清信息该进哪里 MTEdit共享画布防止训练轨迹漂移,OmniXRef按参考包限定属性,VDAs把表情与镜头分开;保持内容不能靠泛泛加大条件强度。 记忆与纠错处理不同时间点 PPMem把几何记忆带入下一段生成,VGC在视频生成后修正;前者不能代替后者的成片检查,后者也没有持久世界状态。 省算需要保留成本账 Sink-Sparse要离线校准并付全局补偿,Kingfisher要逐对优化图码,DriftTTS把多步推理的工作搬到训练;同叫免训练或一步,账本并不相同。 主指标无法代替全部验收 MFlow补高频而FID变化小,VGC重投影改善却有感知退化,SCR-V2A音频分布质量与时间对齐也有取舍。 今日讨论 OmniXRef 在125例多参考编辑测试中的综合分为3.78,Seedance 2.5为2.73;源内容保留分为4.68/3.71,但画质分为3.68/3.70,并未领先。如果要给真实剪辑流程选模型,你会用哪些指标同时检查参考属性迁移、源内容保留、参考泄漏、画质和参考数增加后的计算成本,而不只看综合分? 人工智能炼丹君 整理 | 2026-10-20
-
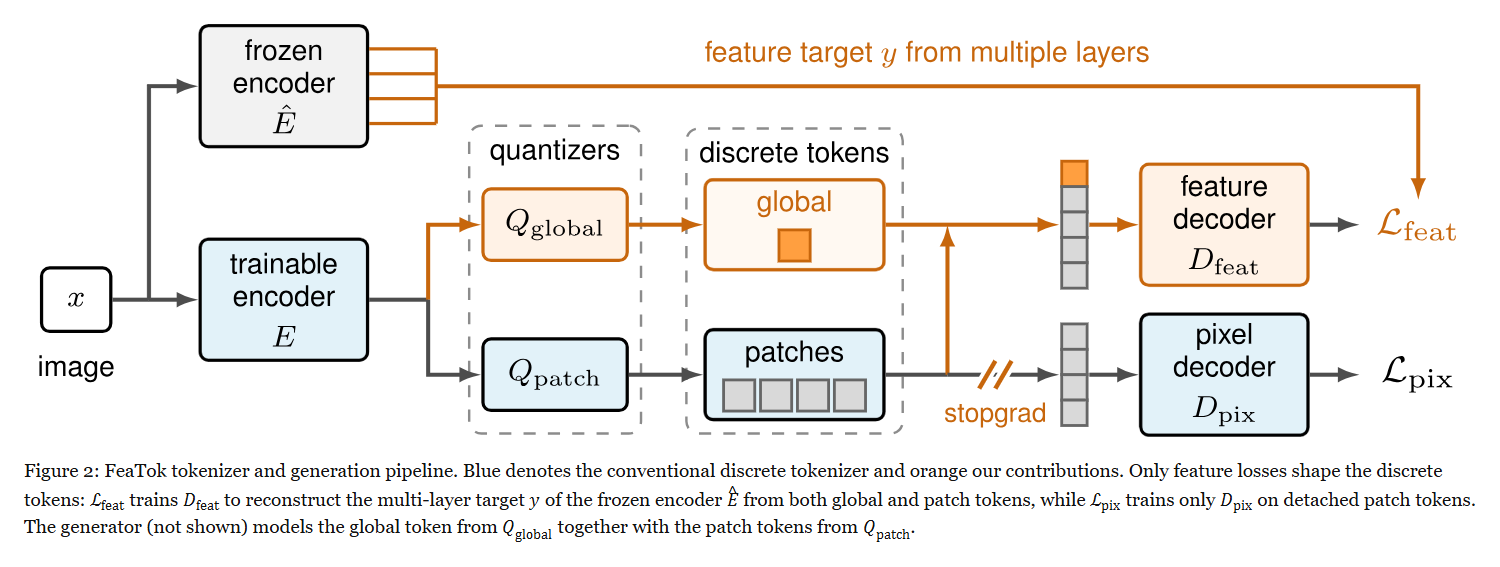
AIGC 每日速读|2026-10-19|Meta让图像token先学特征FeaTok 今日 AIGC 论文速览 今日共 10 篇 · 图像表征与统一生成 2 篇 · 图像编辑与蒸馏 2 篇 · 视频计算与采样加速 2 篇 · 视频时序控制 1 篇 · 三维材质生成 1 篇 · 音乐与长语音生成 2 篇 重点论文标题列表 FeaTok(Meta):图像token先学特征再画图 Intern Lumina U2(上海AI Lab):一个视觉位置装八本码表 ACEdit(特拉维夫大学):连续改十次也守住原图细节 FocusOPD(中科大):只在早期深层补蒸馏监督 Speculative Forcing(KAIST):画好的视频token提前交卷 选读入口:想重新训练图像表示,先读 FeaTok,关心统一图像理解与生成再接 Intern Lumina U2;连续改图会漂移,直接看 ACEdit,要合并多个教师看 FocusOPD。视频算得慢,按位置早停读 Speculative Forcing,按时间缓存读 SoftCache;事件先后不对读 TSG。商品三维小字丢失看 SUPRA-Tex,低预算文生音乐看 MIDI-REPA,语音超过50秒开始跳读或变声看 VoXtend。 今日论文速览 1. FeaTok:图像token先学特征再画图 FeaTok: Feature-Loss Tokenization for Image Generation | Meta FAIR;Mila;蒙特利尔大学;哥伦比亚大学;牛津大学;麦吉尔大学 | arXiv:2610.22060 关键词:图像生成, 特征重建, 离散编码, 全局条件 前序问题:把图片压成离散token后,重建得像,不代表后面的生成器容易学。逐像素还原会迫使编码器保留许多局部细节,却未必组织好物体与场景的关系;token就是供模型预测的离散视觉单元。 方法直觉:先教编码器抓住视觉特征中的结构,再单独教解码器把这些单元画回像素。生成器先决定全局内容,再补局部,减少每一步从零猜整幅画的负担。 本文贡献:FeaTok用冻结视觉编码器四个等间隔层的归一化特征均值作目标,通过特征重建训练编码器、量化器与特征解码器;像素解码器仍训练,但在输入处截断梯度,像素损失不能反过来塑造token。全局特征和局部图块各用一个量化器,生成时先预测全局token,再以其为条件预测图块。SigLIP、SigLIP2、DINOv2、DINOv3均做受控实验;只换特征目标时SigLIP2并不获益,加入全局token才超过像素版。 图2|FeaTok的编码及生成流程。蓝色为传统离散编码器,橙色为本方法:特征损失L_feat只训练特征解码器D_feat,从全局及局部图块token重建冻结编码器的多层目标y;像素损失L_pix仅训练像素解码器D_pix,输入的图块token已截断梯度。图中未画出的生成器联合建模全局量化器Q_global与图块量化器Q_patch的token。 实验效果:ImageNet-1k、256×256、五万张生成样本,无引导FeaTok-L-DINOv3的gFDr6为3.13,离散基线VFMTok2为4.38;它平均六种特征空间中以固定参考距离归一化的Fréchet距离比,越低越好。对连续RAEv2为3.13对3.95,采样运算量1.27对47.72 TFLOPs,TFLOPs指每图万亿次浮点运算,约38倍是算量比。单L40S、批量256、含像素解码的实测吞吐14.36对1.09图/秒,峰值22.0对13.4 GiB。 表2|ImageNet-1k 256×256上的连续特征基线对比。无引导时FeaTok以更低采样运算量取得所列模型最低gFDr6;Size为生成器参数量,TFLOPs为无引导每图采样浮点运算量。各指标列以粗体和下划线表示最优、次优。有引导连续基线转录自Singh等人2026论文;有引导RAEv2仍优于FeaTok,不能把无引导结论扩到整表。gFDr6为六特征空间归一化Fréchet距离比均值,越低越好。 批判点评:有引导RAEv2仍以2.17优于FeaTok的3.08,不能称全面超越连续模型。DINOv3特征监督使重建PSNR从20.61降至17.45,PSNR是逐像素重建信噪比、越高越好,说明细节存在代价。文生图还需预训练75000次后微调500次,不是从零500次。项目页明确代码与权重待开源审批。 2. Intern Lumina U2:一个视觉位置装八本码表 Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation | 上海AI Lab;华为;上海交大;大连理工;清华;上海创智学院;悉尼大学;港科大(广州);中科院深圳先进院;中科大;港中文 | arXiv:2610.20818 关键词:统一生成理解, 多码本, 掩码扩散, 稳定性感知采样 前序问题:统一模型既要读懂图片,又要生成纹理。一处画面只用一个离散编号,容量受限;直接把连续图像特征接入文本模型,又要协调不同表示和训练目标。 方法直觉:每个视觉位置用八个互补编号描述,主干同时推理所有位置,小预测头在每个位置内依次补齐八个编号,把空间并行与局部依赖分工。 本文贡献:冻结AToken编码器将图像、视频、三维输入转成统一离散表示,每处有8个码本、每码本4096项。各码本独立嵌入后在同一位置拼接、投影成一个主干token;掩码扩散主干预测缺失位置,多码本自回归头依次预测该位置的8个码。文本按块扩散生成,图像全画布迭代;MoE即混合专家,只激活部分参数。整机约16.9B参数、每token激活约1.4B,B为十亿。 图3|Intern Lumina U2整体结构:视觉输入由AToken编码成视觉token,文本编码为文本token;MoE混合专家扩散语言主干通过文本头恢复掩码文本、以块扩散生成回答,通过多码本自回归头恢复掩码视觉位置。每个视觉token的K个码按顺序预测;本模型K=8,不同位置由主干并行处理。 实验效果:主模型在1024张昇腾910B上训练,另有训练token预算不同的NVIDIA参考线。同一检查点、1024×1024、553条GenEval提示、每提示1图、引导强度4.0的加速实验,默认96个外层扩散步需159.9秒;PHV即Plateau-Halton sampling with V-verify,以置信度平台决定解掩码、Halton顺序选位置,再由验证器按隐状态漂移刷新缓存,合用后平均60.4步、35.9秒,4.45倍。主干前向次数由192降至121,含有条件和无条件两支;相应GenEval物体属性组合分86.6至89.3;原文该计时表未清楚注明卡型,不把35.9秒视作指定910B的单卡性能。 表4|同一检查点1024×1024文生图推理加速:553条GenEval提示,每条一图,引导4.0、温度0.9、随机种子42。Steps为实际外层扩散步数,平台自适应行随提示变化;BB fwd同时计有条件及无条件主干前向,括号为缓存命中率。时间为去掉首次内核预热后的每图墙钟时间,含缓存预热。选定PHV使用δ_p=0.18、f_p=0.005,其余缓存和验证参数固定。单图GenEval不能与表7四种子协议直接对比,所列配置均未低于production path。 批判点评:该加速表是单种子协议,不能与四种子主榜的89分混算;60.4步也不是60.4次主干前向。多码本头本身仍有解码开销。当前生成能力限图像生成和编辑,视频与三维是理解输入,尚未验证视频或三维生成。代码可访问,本次未运行模型。 3. ACEdit:连续改十次也守住原图细节 ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning | 特拉维夫大学 | arXiv:2610.22328 关键词:多轮图像编辑, 自生成轨迹, 非对称条件, 分数蒸馏 前序问题:先换衣服,再加道具,改到后面人脸和背景一起漂移。训练时看干净原图,使用时却不断编辑自己的输出;误差逐轮累积,用固定配对目标硬教也会错位。 方法直觉:学生照常在自己的上一轮结果上编辑,老师始终看干净原图与累计指令。学生走一条可能出错的长路,老师从源头判断现在该变成什么,避免把旧错误当成要保留的细节。 本文贡献:学生为四步FLUX.2-klein-9B,冻结教师与可训练辅助编辑器为同系列base版。教师和辅助器都看原图及合并指令,二者预测差形成分数蒸馏梯度,辅助器拟合学生当前输出分布。训练以10轮自生成编辑轨迹暴露真实输入,仅对抽中的当前轮当前去噪步回传梯度,轮间直接传潜变量,省去反复像素编解码。学生只训练rank16的LoRA低秩适配权重,共27.8M参数,M为百万。 图2|ACEdit方法。左:学生沿自身生成轨迹逐轮编辑,上一轮图像I_(e-1)和当前指令产生当前去噪步的干净估计。右:估计加噪至τ,同时送入冻结教师及可训练辅助编辑器;两者都以干净原图I_0和截至第e轮的累计指令为条件。教师表示期望的干净条件分布,辅助器拟合学生实际生成分布,二者预测差给出蒸馏梯度,把多轮输出推向不退化的目标分布。 实验效果:96张合成图、每图10条局部指令,共960条;单B200约4.4 GPU小时,505次迭代中只有100次学生更新,推理仍为4步。EdiVal-10测试252条真实照片编辑链,十轮末KRIS视觉语言裁判质量分2.73至3.19、一致性3.03至3.85,均为1至5分;指令遵循3.31至3.38未标显著差异。未编辑背景LPIPS感知距离由0.351降至0.254,越低越好;未编辑锚点DINOv2距离只在148条有效链统计。 表1|EdiVal-10定量对比。除锚点距离外,均在252条编辑链累计十轮后计算;锚点距离只统计148条锚对象大部分位于编辑区外的链。质量为KRIS视觉语言裁判的1至5分和第1至10轮HPSv3变化;保留性为同裁判一致性、未编辑锚点DINOv2距离及背景LPIPS距离;编辑性用第10轮指令遵循分检查是否偷懒不编辑。模型按主干分组,粗体及下划线为列最优和次优,星号表示与本方法配对差异超过两个标准误。 批判点评:稳定性改善不等于永不忘记旧编辑,论文仍出现“让登山者微笑”时抹掉先前墨镜的失败。Emu Edit的HPSv3质量变化-0.15还略优于本方法-0.17,不应每列都称第一。与30步MT-OPSD的主干和分辨率不同。作者项目代码仍标Coming soon。 4. FocusOPD:只在早期深层补蒸馏监督 FocusOPD: Structure-Guided On-Policy Distillation for Diffusion Models | 中科大;港科大(广州);华为诺亚方舟实验室 | arXiv:2610.21250 关键词:图像生成, 多教师蒸馏, 方向对齐, 监督预算 前序问题:把构图、画字和审美三个教师合进一个生成器,只匹配最后输出,学生内部特征仍可能接不住教师能力。全层全时刻强行对齐,又增加训练开销。 方法直觉:先定位差距集中在哪些层、哪些去噪阶段,再把额外监督花在那里。高噪声早期负责搭结构,深层负责落实语义,方向一致可能比把所有特征数值抄齐更有用。 本文贡献:在学生自己的10步轨迹上抽取并截断梯度的状态,让学生和同架构教师读取同一输入。保留原OPD即在策略分布上的输出蒸馏,再对选定深层和早期步骤的逐token特征归一化,最小化余弦方向差;只更新学生的LoRA适配权重。SD3.5-M受控配置选最后12层、前40%去噪段,推理只保留学生,不增加教师。 图4|FocusOPD流程:教师与学生读取来自学生轨迹的相同状态,输出监督遵循原有OPD协议,额外特征方向监督集中在早期去噪与深层。推理只使用训练后的学生,没有额外教师调用。 实验效果:512×512、训练至检查点1000,SD3.5-M加在DiffusionOPD上,GenEval组合正确率0.953至0.967,PickScore偏好奖励23.797至23.944,LAION审美分6.052至6.199,均越高越好。独立监督预算消融中,选择12层及早期40%的更新耗时18.99秒,全24层全轨迹21.77秒,纯输出监督16.54秒;每个并行进程的CPU教师缓存分别432、2160和0 MiB,不能说是GPU显存。 表3|SD3.5-M和DiffusionOPD上的特征监督消融。单次更新耗时统计第11至1000步;教师缓存是每个并行进程存于CPU的张量负载,不是GPU显存。特征变量都用余弦距离、权重λ=0.3;所有方法训练完整24层Transformer,Last-12只限制监督位置而非只训练12层。Time列标监督覆盖范围,Time/up为秒,缓存为MiB。 批判点评:主表与开发集消融数字不同,不能把消融的0.960当主榜0.967的同一运行。各指标并非单调:DanceOPD加监督后的文字识别准确率0.952降至0.945,STEP-OPD的PickScore也稍降。论文对两个主干选窗是否完全一致有文字出入;本期12层/40%只指明示的SD3.5-M配置。额外监督比纯输出训练更贵,未确认独立公开实现。 5. Speculative Forcing:画好的视频token提前交卷 Speculative Forcing for Efficient Autoregressive Video Generation | 韩国科学技术院(KAIST AI);NAVER AI Lab | arXiv:2610.22347 关键词:视频生成加速, token早停, 收敛验证, 上下文缓存 前序问题:少步视频模型仍让每个视觉token完整跑四步,即使静态背景早已接近最终结果,也要陪着运动区域继续算。把整块一起早停又会把未修好的细节带入后续视频。 方法直觉:逐个检查中途的干净估计,足够接近四步结果的token先定稿;后续只更新还没完成的部分。已交卷的内容仍能作为上下文被其他位置读取。 本文贡献:提供两种验证器:免训练版使用与干净历史内容的相似性及跨步稳定性;学习版读取冻结生成器的中间特征,用三层三维卷积预测每token相对完整结果的剩余误差,再做局部时空平滑。接受后冻结该token,只保留key/value供注意力匹配和取回内容。学习头分别用1000条提示或1000个初始场景的完整轨迹训练,阈值控制提前接受程度。 图3|Speculative Forcing:基线让每个token走完整去噪表;本方法把中间干净估计当草稿,验证器预测其相对完整结果的剩余差距rel_k(i)。预测已收敛者接受定稿,后续只作为注意力的key和value参与上下文,因此下一次去噪仅更新尚未接受的token。 实验效果:单H100、LongLive 1.3B、5秒VBench视频,学习版平均每token去噪1.68次,吞吐26.40至41.74帧/秒,总分83.08至83.21;这不是整机只调用1.68次。30秒VBench-Long为1.72次、24.5至37.8帧/秒。Lingbot-World 2.0相机运动测试200场景、每段253帧,平均2.55次、18.1至24.5帧/秒;质量随时间波动的Drift由3.094降至2.839,越低越好。 表1|LongLive生成5秒视频。Mean Steps是每个token平均实际去噪次数,不是完整网络调用次数;标准VBench的16个维度汇总为总分、质量与语义分,均越高越好,吞吐在单张H100上测量。TF为免训练验证器,H为学习头验证器;与1至4步统一采样分别对照。 批判点评:阈值放松并非免费:世界生成阈值从0.24提至0.32,虽到28.3帧/秒,Drift却升至3.398。定稿是不可撤回的,错误接受会影响后续上下文;训练版还要先采完整轨迹。它研究token去噪早停,与上期交付缓存的Speculative Sampling是不同机制。代码仓库当前仅说明内部审查后发布,尚未确认实现可用。 6. SoftCache:缓存还够用就往前多走一步 SoftCache: Adaptive Step Size Caching for Diffusion Transformers | 特拉维夫大学;莱赫曼大学 | arXiv:2610.22369 关键词:扩散加速, 自适应步长, 特征缓存, 网格重排 前序问题:缓存加速通常只决定“重算还是复用”,但一次刚刷新的缓存与即将过期的缓存,仍按相同步长前进,没把剩余精度余量用于减少采样节点。 方法直觉:缓存越新、估计误差越小,就允许走得远些;快到刷新阈值时收回原步长。跳到原网格之间后,还要同步调整后面的节点,否则会浪费一次计算走极短的路。 本文贡献:用输入廉价探针累计的陈旧信号与阈值之间的归一化余量设置复用步长;轨迹开始及探针突变时禁跳。为支持离网格时刻,用最近两次新算残差沿时间线性外推,并在大加速时阻尼;跳后将剩余节点重新均匀分布到终点。无需训练,但多保存一个历史残差张量,刷新阈值仍需按速度目标选择。 图2|刷新信号包含的不只是二值决定。(a)无缓存FLUX轨迹上,复用残差相对误差E_i的分箱中位数与四分位带随累计刷新信号A_i上升。(b)硬缓存只将A_i与阈值τ比较,并在缓存节点使用原步长Δ_i;SoftCache还读取距阈值的余量,A_i越低步长越长,上限JΔ_i。星号表示两面板同一A_i:低误差允许长跳,高误差只短跳,越过τ则重算刷新。 实验效果:FLUX.1-dev、1024×1024、DrawBench 200提示、原50步Euler、单H100 NVL,与同提示同随机种子的无缓存结果比较。最快档去噪环节15.49至2.24秒、6.91倍,PSNR18.58对SeaCache17.46,LPIPS0.327对0.409;PSNR信噪比越高、LPIPS感知距离越低表示更接近原采样。峰值分配内存均33.8 GB。混元视频65帧640×480、946提示最快档6.05倍;Wan2.1另在RTX A5000,不能跨设备比较绝对耗时。 表1|FLUX、DrawBench 200提示,每个分块对应一个速度档,逐行报告实际加速比。DrmSim为DreamSim感知距离;PSNR信噪比、SSIM结构相似度越高越好,LPIPS和DreamSim距离越低越好,四者均衡量与同提示同种子无缓存采样的保真度,不能读成绝对生成质量或人类偏好。 批判点评:6.91倍计同步后的去噪循环,不是含全部编解码的端到端服务时间。四个保真指标衡量接近无缓存结果,不能等同人类更喜欢;随预算收紧它自身也会变差,FLUX慢档PSNR23.20、快档18.58。需验证新主干的刷新信号是否仍可靠。代码入口可访问。 7. TSG:把视频先后顺序写成可执行约束 Temporal Specification Guidance for Text-to-Video Generation | 宾夕法尼亚大学;丰田北美研发 | arXiv:2610.20822 关键词:可控视频生成, 时序逻辑, 注意力引导, 生成验收 前序问题:要求红灯变绿,模型可能两种颜色都画到了,却顺序错了;要求一个物体先进入、另一个持续存在,文字出现不代表时序要求真的满足。 方法直觉:把“先发生、持续到、在某段时间出现”写成机器可检查的时间规则,再沿着增加规则满足度的方向调整生成过程。 本文贡献:TSG即Temporal Specification Guidance,用带时间区间的时序逻辑表达事件约束,从视频对文本的注意力提取每个概念随时间的证据。LogSTOP在对数空间计算可微满足分,将其对注意力的梯度改写为注意力偏置,额外条件前向得到引导方向,叠加CFG无分类器引导;CFG通过有条件和无条件预测差加强提示。无需外部概念分类器,也不对视频Transformer权重反向传播;默认前15采样步启用。 图2|时序规格引导TSG。额外条件前向中,逐注意力头对时序证据按规格评分,并应用由梯度得到的logit偏置,再以得到的预测扩充无分类器引导CFG。Transformer权重不接收梯度。示例视频由Wan2.2 5B生成。 实验效果:220提示、11类约束、5至6秒视频、五种主干,规则满足准确率提高9.5至20个百分点。单B200、Wan2.1-1.3B为15.9%至31.4%,时间1.39至2.35分钟,峰值30.48至30.52 GiB;画质分69.25降至67.39。A14B另用H200,满足率35.9%至46.8%,耗时24.28至35.18分钟。评测均匀抽21帧,Qwen2.5-VL-7B判概念是否存在后才按规则计分。 表1|220提示基准上的时序约束满足率、画质、时间和峰值内存。除Wan2.2 A14B在H200测量外,其余时间与内存均在B200测量;时间单位分钟,内存GiB。Base为仅CFG,TSG为加入规格引导;满足率变化应读为百分点,附带倍数为各自基线时间比,跨设备绝对时间不能直接排序。 批判点评:免训练也付出额外前向时延,低显存增量不能写成低计算代价。最强配置仍只有46.8%满足率,注意力只是概念代理,视觉语言裁判和21帧抽样也可能漏掉短事件。其优势是可检查的约束接口,还不能宣称视频已严格满足形式化保证;原文未确认可用独立代码入口。 8. SUPRA-Tex:三维表面也能保住小字纹理 SUPRA-TEX: 3D Generation with Super-Aligned Texture | 华为;上海交大;华中科大 | arXiv:2610.22352 关键词:三维纹理生成, 物理材质, 可见锚定, 不可见面补全 前序问题:给商品照片生成三维资产,正面标签变糊、背面纹理接不上;光照烘进颜色后,换个灯源就显得不真实。可见面细节与不可见面补全需要分开处理。 方法直觉:先把照片中可信的颜色和材质投到三维表面,当作固定参考;生成器集中补看不到的区域,再协调全表面,减少反复改写已经观察到的小字和图案。 本文贡献:二维编辑模型估计去光照的反照率、金属度、粗糙度,即物理渲染PBR材质;有效观测投到可见表面体素,未观察处不以虚构填充值冒充证据。冻结材质编码器将观测编码到目标生成潜空间,另附覆盖范围与边界距离;交错流Transformer把观测作为只读key/value,交替更新未观察单元与全表面。60层生成器在64张GPU训练,推理25步Euler、不用CFG。 图1|SUPRA-Tex。左:二维转换器从单参考图估计去光照的反照率、金属度、粗糙度。中:利用网格M与相机投影π将有效估计投到可见体素,部分PBR输入省略不可见体素;冻结材质编码器E_mat将其映到目标潜空间,连同覆盖与边界元数据组成观测C_o。右:以几何潜变量G为条件,交错流Transformer从噪声Z_1生成完整材质Z_0。插图中固定只读流O提供key/value,生成流X交替更新未观察单元U与全表面S;冻结解码器D_mat输出表面PBR材质,分别从左右打光展示。 实验效果:给定真实网格与单张参考图,在DTC-Tex的100个商品及Complex-Tex的110个网格,以同光照同相机渲染参考视角和15个新视角。新视角前景PSNR为22.134对Pixal3D的20.377、20.488对19.402,PSNR越高越接近真实像素。另在两者共享预测几何的端到端实验,DTC-Tex四视角PSNR28.65对26.88;几何生成与贴纹理协议必须分开看。 表2|在表1各方法各指标的有效对象上,分开报告一个参考视角及15个新视角的保真度;PSNR_fg使用真实前景掩码,PSNR越高、LPIPS感知距离越低越好。Shaded为带光照渲染,Albedo为反照率。新视角先对每个对象平均、再跨对象平均,包含已观察和未观察表面;缺少PBR输出的方法对应反照率为横线。 批判点评:新视角同时包含已见和未见表面,不能把它称为纯背面准确率。几何是固定条件,形状或相机错位无法靠纹理修复;二维金属度估错也会被保留下来。商业系统对比另用两视图,不能与此处单图实验混算。代码与权重入口已读,未实跑。 9. MIDI-REPA:用音符结构教小模型作曲 MIDI-REPA: Improving Text-to-Music Generation with Symbolic Representation Alignment | 台湾大学;加州大学圣迭戈分校 | arXiv:2610.20967 关键词:文生音乐, 符号监督, 表征对齐, 低成本训练 前序问题:音乐生成器直接从密集波形学旋律与节奏,有限预算下容易学到音色却抓不住音符结构。扩大参数并非唯一办法,训练目标本身也可以更明确。 方法直觉:先让现成转谱器把训练音频写成简化音符表,训练时要求生成器的中间特征也能读出这张表;推理时撤掉老师,仍按文本生成声音。 本文贡献:在122M参数FluxAudio-S上,用自动音乐转录AMT提取与音频潜变量时间对齐的MIDI音符目标,轻量时间卷积头以余弦相似度辅助流匹配训练。MuScriptor音符卷帘表是108时间帧×88音高的二值矩阵;与分7乐器族的立方目标、Basic Pitch目标对比。最稳配置对齐第L2层、覆盖完整去噪轨迹,冻结SAME-L音频编码器处理10秒44.1kHz立体声。 图1|MIDI-REPA框架:自动音乐转录AMT提取的符号目标通过轻量投影头与余弦相似度对齐损失监督中间音频表征,同时保留去噪目标。设计研究分别检查(a)对齐哪一种符号目标、(b)在主干哪一层对齐、(c)在流匹配轨迹的哪一段启用对齐。 实验效果:筛选后的JamendoMIDI有51077曲,排除验证及重叠参考后训练49034曲、约3161小时,30万次更新,单RTX3090约31.3 GPU小时;该时间未单独覆盖全量离线转谱成本。Song Describer Dataset(SDD)受控实验,Fréchet音频距离FAD从0.5275降至0.4947,越低越好;CLAP音频与文本嵌入相似度从0.2220至0.2686,越高越好。ATTM另80条提示为FAD0.497、CLAP0.315;推理25步Euler和4.5引导,不增加转谱器或对齐头。 表4|80条域内提示上的ATTM客观比较。Borda排名在17个官方系统加本方法的集合上重算,表中仅展示六个官方决赛系统和FluxAudio-S基线。训练成本按ATTM峰值FP16吞吐换算,A100-eq为等效GPU小时,不是实际设备时间;FAD音频分布距离越低、CLAP音频文本相似度和CCS字幕一致性分越高越好。重算Rank并非新增官方比赛名次。 批判点评:14.2 A100等效GPU小时是按峰值半精度吞吐换算,不是实际在A100训练;ATTM重算综合排名也不是比赛官方新名次。MIDI监督取决于转谱质量,Basic Pitch在同一测试FAD0.5363还差于基线。这里只验证短片段,未证明完整歌曲结构。arXiv明确Submitted to ICASSP 2027,不能写已接收。代码入口已核验。 10. VoXtend:短语音模型连续读到四分钟 Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech | 首尔市立大学 | arXiv:2610.19553 关键词:长语音合成, 窗口限制, 说话人保持, 免训练外推 前序问题:只见过50秒语音的流式模型,读长文时会跳音、越读越不像同一个人。持续保留开头的参考声音并清理旧缓存,也没有消除这种退化。 方法直觉:先让模型反复工作在熟悉的位置区间,再持续提醒它“声音像开头这个人”。缩短窗口解决发音位置偏差,给参考声音加注意力偏置解决身份漂移。 本文贡献:在VoXtream2上定位:把缓存重置推迟到900帧,发音加速仍在训练边界625帧附近出现,说明不是简单丢历史。于是把时间Transformer的缓存窗口W从625缩为375帧,帧率12.5Hz,相当50秒与30秒窗口;重置仍保留声学提示和近期帧并重算key/value。再向参考音频对应的注意力logit即归一化前分数加常量b=1.5,强化声纹条件,无需追加训练。 图2|音频生成的局部位置与每帧预期推进音素数,分别取窗口W=400、625、900帧。阴影为随机8段语句的标准误。把缓存重置推迟到900帧仍在625附近异常推进,用来区分位置范围问题与重置丢失历史;这是方法诊断图,非生成系统结构图。 实验效果:LibriSpeech-Long dev-clean的281段、15.89小时、最长约4分钟,平均7.88秒开头作声学提示。整体单词错误率WER8.63%至3.58%,越低越好;说话人嵌入余弦相似度SPK-SIM0.659至0.759,越高越好。158名听众评自然度,每模型325次评分,五分制MOS均4.03。仅缩窗口至375的RTX3090实时因子RTF由0.415至0.433,RTF是计算时长除音频播放时长、小于1表示快于播放;不是完整双改动的计时。 表1|长语音整体及分段表现。WER为单词错误率(%)、越低越好,SPK-SIM为说话人特征余弦相似度、MOS为五分主观评分,均越高越好。MOS按均值与95%置信区间报告;GT为真实语音,GT+Mimi为编解码重建。按0至210秒分段与整体分别比较,不能把单段变化当整段平均。 批判点评:Qwen3-TTS与MOSS-TTS错误率仍更低,不能称长语音整体最强。窗口太小至250帧,WER反升6.51%;声学提示占用和重置重算也构成成本。证据来自特定主干与英语朗读,未验证多人对话或跨语言;VoXtend是本期沿用作者项目域名的短标签。作者音频样例可访问,尚未确认公开代码。 趋势观察 先决定表示要服务谁 FeaTok限制像素梯度,Intern Lumina U2给每处八个码;重建、生成和理解的表示目标需要明确分工。 把监督花在实际输入上 ACEdit让学生面对自己的编辑输出,FocusOPD沿学生轨迹补早期深层监督,MIDI-REPA则在音乐中间特征补音符结构。 加速要区分计算粒度 Speculative Forcing按token早停,SoftCache按缓存余量跳时间节点;前者平均token次数、后者去噪循环加速都不能替代服务端到端计时。 保持与改变要有具体条件 TSG约束事件时间,SUPRA-Tex固定可信观测,VoXtend调整位置窗口并保留声纹条件;它们各有额外计算与失效场景。 今日讨论 FeaTok无引导采样为1.27 TFLOPs,对照RAEv2为47.72,但批量256的端到端吞吐是14.36对1.09图/秒,显存则22.0对13.4 GiB。若你要选择线上图像表示,哪种证据能够支持你在同显存预算、同质量目标且含像素解码的条件下采用FeaTok,并验证算量优势能兑现多少请求吞吐? 人工智能炼丹君 整理 | 2026-10-19
-
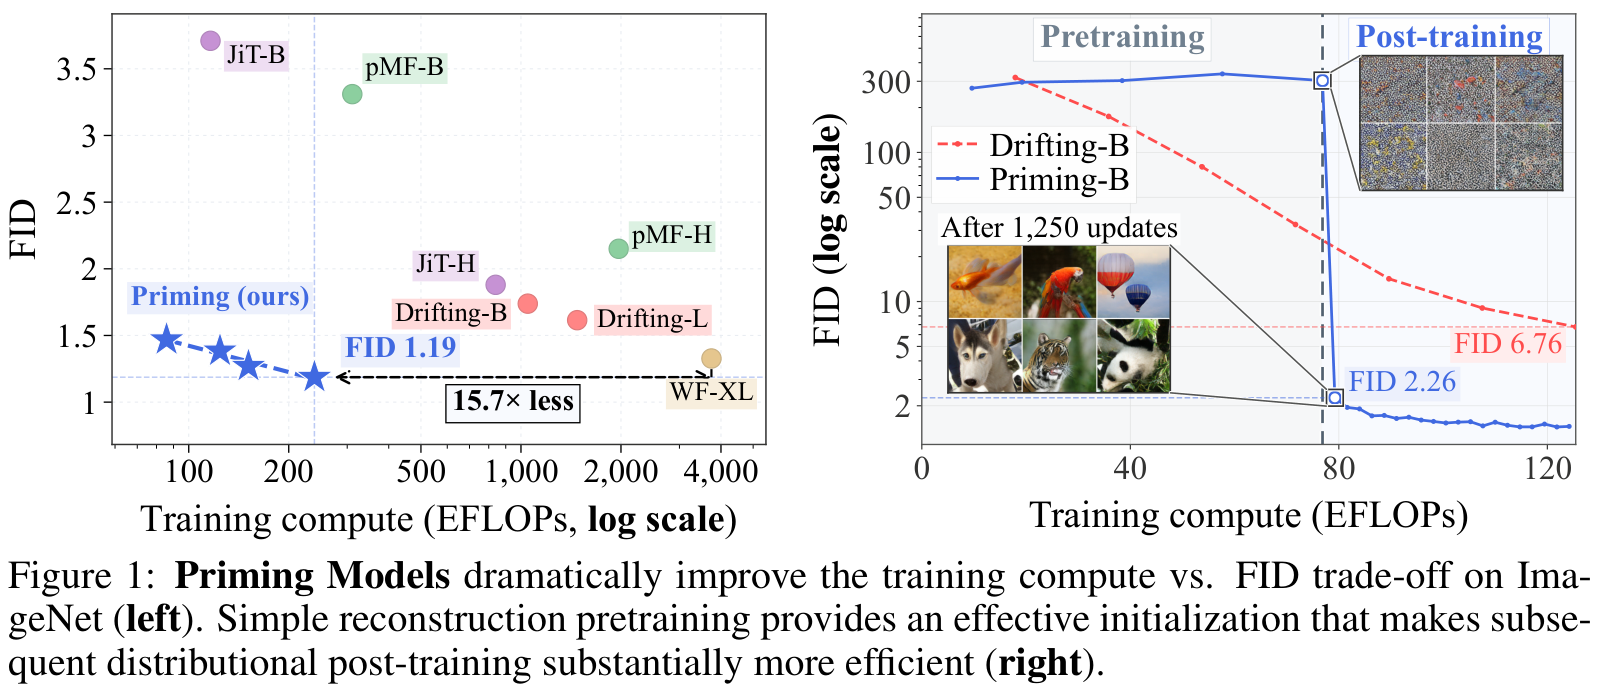
AIGC 每日速读|2026-10-16|首尔大学先修图再一步生成Priming 今日 AIGC 论文速览 今日共 10 篇 · 一步生成与表征训练 2 篇 · 视频蒸馏与交互服务 2 篇 · 视频缓存压缩 1 篇 · 原生高分辨率编辑 1 篇 · 三维场景生成 1 篇 · 语音驱动与语音合成 2 篇 · 生成视频物理评测 1 篇 重点论文标题列表 Priming(首尔大学):先学修复再学一步作画 RECON(澳国立):把语义送进生成器后半段 Glance Forcing(武汉大学):一条轨迹只负责初始化 Speculative Sampling(中科大):先画未来但别急着提交 TempoKV(上交):缓存只存难预测的残差 选读入口:训练一步图像模型先读 Priming,再读 RECON 理解语义如何传到后层;做少步视频看 Glance Forcing,搭交互产品再看 Speculative Sampling 的到显示时延,长视频显存紧张看 TempoKV。需要4K改图看 BluePixel 的背景保留,换相机重访同一场景看 SceneAE。语音驱动人像看 Kandinsky S2V,要研究解码能否改错看 Revise-TTS;最后用 PhyMetric 检查视频到底违反了什么物理现象。 今日论文速览 1. Priming:先学修复再学一步作画 Are We Overthinking One-Step Generation? | 首尔大学;哈佛大学 | arXiv:2610.20331 关键词:一步生成, 重建预训练, 分布后训练, 最优传输 前序问题:想把噪声一次变成图像,直接从零匹配整批生成图与真实图的分布,训练常很昂贵。模型还没学会物体结构,就要同时解决像什么、覆盖哪些样本的问题。 方法直觉:先练修复被噪声破坏的图像,再练从纯噪声作画。修复阶段有一一对应的正确答案,先教会网络图像长什么样;后训练再要求一批作品的整体分布接近真实数据。 本文贡献:Priming Models 两阶段使用同一生成网络。第一阶段在固定噪声水平 s=0.8 做像素重建,并加感知特征损失;s 表示混入噪声的水平,不是采样步数。第二阶段从高斯噪声一步生成,利用冻结图像编码器的特征做熵正则最优传输:在两批特征间分配匹配关系,并加入停止梯度的生成样本项,即该分支只作数值参照、不反向更新,以优化分布而非逐图照抄。默认不用额外可学习风格向量,也不需要多步扩散教师蒸馏。 图1|Priming 的训练投入与生成质量:左侧在ImageNet比较训练浮点运算量与FID,展示质量和训练成本的权衡;右侧说明简单重建预训练提供有效初始化,使后续分布后训练更高效。FID是生成与真实特征分布的距离,越低越好。 实验效果:ImageNet 的256×256类别条件生成中,约4.051亿参数的 Priming-L 先训练160遍数据,再后训练25000次更新,FID为1.19,总训练量238.95 EFLOPs;1 EFLOP代表10的18次方浮点运算。FID衡量生成与真实图像特征分布差异,越低越好。原表 W-Flow 为1.33、3744.43 EFLOPs,属于不同方法的训练账本比较。文生图的一步版本 GenEval 从一步 MeanFlow 的0.548提高到0.818;GenEval测物体、属性与空间组合正确率,但仍低于100步流模型的0.873。 表2|文生图对比:Priming优于一步MeanFlow,使用logit-normal噪声分布预训练的变体以较少训练运算接近四步MeanFlow;扩展到两步也具有竞争力。†标记的对照数值来自Wang等人2026a论文。GenEval衡量物体属性组合正确率,DPG-Bench衡量密集文本指令遵循,均越高越好;EFLOPs是训练浮点运算总量,不是秒数。 批判点评:摘要“约十分之一训练量”不能解释为同硬件快十倍;预训练、特征编码与批间传输计算仍要支付。训练特征选择也会改变排名:更换编码器可改善另一分布指标却恶化FID,说明单分数不足以验收。RT-1视频预测中,其FVD(视频特征分布距离,越低越好)为30.96,仍差于32步流模型的27.24,不能照搬表注称所有质量指标均胜。本文代码提供训练入口,本次未实跑模型。作者代码。 2. RECON:把语义送进生成器后半段 Representation Conditioning for Generation | 澳大利亚国立大学 | arXiv:2610.20608 关键词:表征条件, 语义注入, 训练加速, 扩散Transformer 前序问题:用视觉编码器监督生成器的前几层,前半段学到了物体语义,后半段却未必能用好。以往 REPA 表征对齐训练结束后,还会丢掉连接两种特征的投影头。 方法直觉:把已经学会的语义做成一张便签,直接交给后面的绘图层。训练时用真实图像提取的可靠便签;生成时没有真实图,就让保留下来的投影头估计这张便签。 本文贡献:Representation Conditioning(RECON,表征条件)将视觉编码器特征池化成默认1个语义 token,即供网络注意力读取的特征单元,与图像块特征拼接送入后续层。推理复用 REPA 的多层感知机投影头,因此不再调用真实图像编码器。为缓解训练用真特征、推理用预测特征的落差,只在归一化噪声时间 t<0.5 时注入;高噪声阶段不提供便签。默认大模型用零填充对齐维度,无新增参数;小模型若特征维度不足,仍可能增加线性映射。 图1|RECON把原先丢弃的表征用于后层条件:(a)REPA以冻结视觉编码器监督投影头gϕ,推理时丢弃该头;(b)RECON训练时将视觉编码器的token送往后层;(c)推理保留gϕ作为编码器代理,执行同样条件注入;(d)ImageNet 256×256、无引导的五万样本生成FID随训练步数变化,RECON更早达到SiT-XL/2与REPA最终质量。 实验效果:ImageNet 256×256、SiT-XL/2、批量256、无引导设置下,训练40万次更新后,RECON的生成FID为3.25,REPA为7.90;延长到240万次为2.21。该指标用5万生成样本估计,越低越好。摘要63倍对SiT、25倍对REPA指达到相近质量所需的训练收敛进度,不是推理速度。MS-COCO文生图在MMDiT、15万次训练、50次网络评估、引导强度1下,FID从9.85降到8.26,图文特征相似度CLIP从0.2273升到0.2313。 表3|MS-COCO文生图:MMDiT主干,常微分方程采样,50 NFE(网络函数评估次数),训练150000次;w是引导强度。FID越低越好,CLIP图文相似度越高越好;在展示的两种引导强度下RECON优于REPA。 批判点评:保留投影头、拼接语义token都需要运行,参数不增不代表零推理开销。ImageNet主协议仍用250步随机微分方程采样,文生图用50步常微分方程采样,不能称一步生成。不同引导方式会改变最终排名;有引导的系统对比还包含Autoguidance(以较弱生成模型作参照的引导),必须与无引导收敛图分开读。作者代码。 3. Glance Forcing:一条轨迹只负责初始化 Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance | 武汉大学;电子科技大学;中山大学;华盛顿大学;新加坡国立大学;中南大学 | arXiv:2610.20220 关键词:视频蒸馏, 慢快专家, 轨迹初始化, 分布匹配 前序问题:把能同时看前后帧的视频模型变成实时逐块生成器,通常先收集大量教师去噪轨迹。若只留一条轨迹,单个学生同时拟合布局和纹理,质量会明显崩塌。 方法直觉:先搭骨架和最后描细节,本来就不该由同一种步伐完成。把高噪声阶段的语义布局与低噪声阶段的细节交给不同适配器,减少它们争用同一表示的冲突。 本文贡献:Glance Forcing 使用慢、快两组 LoRA,即少量低秩可训练权重;预训练教师保持冻结。慢专家处理早期结构,快专家处理后期纹理,各自接受阶段目标。概率流常微分方程轨迹用于把少步路径拉直,之后的分布匹配蒸馏仍负责生成质量。单样本设置压缩的是轨迹监督,不是从零只看一个视频就学会所有内容;后续分布匹配仍使用25000规模的数据。 图3|慢快专家流程:逐块自回归扩散模型使用分阶段LoRA适配器完成去噪,Slow-LoRA在早期产生粗结构,Fast-LoRA在后期细化细节;专家各自的目标进一步改善时间连贯性与空间保真度。LoRA是以少量低秩权重适配原网络。 实验效果:Wan2.1-1.3B(13亿参数)、480×832、81帧,使用8张A100训练。逐块四步设置的完整模型 VBench 综合分84.33,Causal Forcing为84.04;VBench汇总视频质量与语义等维度,越高越好。单轨迹版本后训练后为84.22,但语义分79.11低于对照81.84。轨迹采集约1个A100 GPU小时,是初始化数据准备成本;不能把图示11600倍扩展成完整训练或推理收益。完整模型相对Causal Forcing人评胜率63.3%,来自50条提示、3名标注者、150票,不能套给所有单样本变体。 表1|与既有模型对比,生成质量与此前方法相当或更好。Data为训练数据规模,Dyn.为动态程度,Vision.为VisionReward视觉奖励分,Instruct.为指令遵循;*表示跨阶段沿用同组模型。吞吐与首段时延在H100上分别用每秒帧数与秒报告,不含VAE解码时间;轨迹初始化行与分布匹配后训练行应分开比较,单轨迹版语义分并非最优。 批判点评:单条轨迹的内容很敏感:低运动样本后训练总分79.81,而默认男孩样本84.22,差异远大于对照间的零点几分。两个专家也要按阶段切换,单轨迹并未消除冻结大教师、后训练和适配器成本。应先检查自己的运动分布和语义需求。作者项目页。 4. Speculative Sampling:先画未来但别急着提交 Speculative Sampling in Interactive Video Generation | 中国科学技术大学;香港中文大学;独立研究者 | arXiv:2610.20556 关键词:交互视频, 预测缓存, 可撤换未来, 端到端时延 前序问题:用户改变动作指令后,即使模型采样很快,也可能要等到整段视频播完才生效。缩小生成块能减少等待,却损失联合建模质量和GPU并行效率。 方法直觉:可以一次画出较长的未来,但每次只交付一小段;没交付的部分先放缓存。指令不变就继续用,指令变了就替换尚未承诺的未来,已经交付的前缀保持不动。 本文贡献:每次将接下来要交付的1个潜帧与额外噪声潜帧拼成较大的双向窗口,共同采样并缓存预测。潜帧是视频压缩空间中的时间单元,通常对应多个像素帧。有限状态机协调生成和缓存消费;新条件触发可行位置重规划,不强行打断正在执行的生成。作者把到显示的时延拆成生成前等待、首个可交付输出计算(含视频解码)、播放排队,避免只报Transformer单次前向时间。 图3|投机采样服务控制:(a)联合生成填充预测缓存,供细粒度交付及播放,按播放进度补充;(b)有限状态机在Produce生成与Consume复用之间协调,此例每次交付q=1个潜帧。新条件在可行位置重规划,不中断正在执行的生成,两种状态下播放均继续。 实验效果:每组服务臂使用30条配对的60秒交互轨迹。Wan1.3B的480p长块在低频更新下,响应时延中位数从3.23秒降到1.32秒,95百分位从4.64秒降到1.91秒;高频更新中位数从3.11秒降到1.35秒。长块设置用8张B300运行扩散主干,另有视频解码GPU;短块用4张,两种资源配置不能直接当同成本比较。LTX长块低频中位数4.82→2.39秒,但播放欠载比例0.069%→0.204%。 表3|Wan1.3B、LTX-2.3及Sol-H3的480p级在线服务实验。Baseline为整块承诺,投机采样为本方法;LTX括号内配置对扩散Transformer应用CUDA Graph录制与重放。普通执行下长短块隔离块大小,括号内外的短块隔离执行方式。L50、L95分别是响应时延中位数与95百分位,单位秒;GPU内核活跃度与播放欠载为百分比,GPU活跃度是所监测设备按时间加权的平均值,设备覆盖范围按各模型正文定义。 批判点评:缓存的未来可能被新指令废弃,因此要额外支付生成、存储及重规划成本。它移除了固定块边界的部分等待,却不保证所有模型和执行模式更好:LTX短块采用CUDA Graph时,低频中位时延反而从1.81升到2.01秒,欠载也增加。CUDA Graph是预录制并重放GPU工作以减少调度开销,不能与普通执行混成一个对照。作者项目页。 5. TempoKV:缓存只存难预测的残差 TempoKV: Predictive KV Cache Quantization for Autoregressive Video Generation | 上海交通大学;华南理工大学;阿里巴巴 | arXiv:2610.15324 关键词:视频缓存量化, 时序预测, 非对称KV, 低比特残差 前序问题:长视频逐段生成时,注意力要保存以往帧的key/value缓存,显存不断增长。直接套语言模型的量化方案,会忽略视频相邻帧的冗余,也可能使误差随时间放大。 方法直觉:能从历史猜到的部分不用完整抄一遍,只存猜错多少。key负责注意力匹配,value是按匹配结果取回的内容;先猜key,再用重建key帮助猜value,比两者各猜各的更准确。 本文贡献:TempoKV 用8条BF16校准提示离线收集缓存,线性回归拟合固定预测器。BF16是16位脑浮点格式。推理先从同位置历史key预测当前key,再从已重建当前key和短value历史预测value,只对预测残差做低位量化。默认key看前2帧、value看前1帧,并可让key获得更多比特;不更新生成模型权重,但并非无需校准或额外算子。 图2|TempoKV:(a)离线从8条校准提示采集干净BF16缓存轨迹,以线性回归拟合预测器;(b)在线由重建key历史预测当前key,再由对齐的重建key与value历史预测value,只存低位残差R。key用于注意力匹配,value用于内容聚合,BF16是16位脑浮点格式。 实验效果:MovieGen前128条提示、832×480、717帧的Causal Forcing实验中,key/value各2比特的k2v2达到6.71倍缓存压缩,六项VBench视觉分均值77.04,BF16为76.95;改用k4v2,压缩4.73倍、均值77.11。k4v2表示key4比特、value2比特。Self-Forcing同协议k2v2为73.32,仍低于BF16的74.23,说明高压缩在不同主干上代价不同。 表1|MovieGen上的Causal Forcing,832×480、717帧。每个精度组内最优与次优分别用粗体与下划线标记。压缩比仅针对缓存;k4v2表示key4比特、value2比特。PSNR/SSIM越高越接近BF16,LPIPS/FID越低越接近;Visual Quality是六种视频视觉维度均值,不能当作整机加速。 批判点评:6.71倍是缓存体积的压缩比,包含量化元数据等开销,不能换算整机显存减少6.71倍或推理快6.71倍。预测器、反量化和保留历史都有成本;必须与自己的注意力实现一起计时。论文称代码将发布,未给可核实的作者仓库,本期不补造代码链接。 6. BluePixel:原生4K编辑还要守住背景 BluePixel: Toward Native 4K Agentic Image Editing | vivo;南京大学;上海交通大学 | arXiv:2610.19882 关键词:原生4K编辑, 渐进VAE适配, 背景保持, 专家协作 前序问题:把图片中的字或衣服改对,背景也可能悄悄变化;到4K分辨率,微小漂移尤其明显。只提高分辨率,也不能让通用编辑器自动具备调色、虚拟试穿等专长。 方法直觉:先让模型承载大画布,再按任务学专长,最后提速。编辑处跟教师走,不编辑处锚定原图;精确调色等操作交给专用工具,系统再逐次检查。 本文贡献:BluePixel 把1K预训练编辑器通过渐进式VAE适配升到原生4K;VAE是将像素压缩到潜空间并重建的自编码器。后续以监督微调、持续学习和奖励优化兼顾能力与细节。少步蒸馏的SATP(源图锚定目标投影)按教师预测相对源图的编辑强度区分保留区域与变化区域,构造教师结果和原图潜变量的混合目标,补偿非编辑区漂移。配套系统分解指令、路由专家,以同一奖励模型验收并有限重试。 图2|第一阶段与最终模型对比:第一阶段检查点能够编辑但能力有限;经历第二阶段的渐进监督微调、按基准定向微调、持续学习与强化学习后,最终模型的编辑质量及细节保真度明显提高。此图是阶段结果对照,不是SATP模块架构。 实验效果:50步教师压到4步后,单张昆仑芯P800 XPU、BF16精度、无其他优化下完成一次4K编辑为8.7秒,正文称约4倍加速;这是编辑器,未包含任意多轮工具调用。VINS-4KEval++共3305例,七模型共同覆盖2513例的表8中,BluePixel综合8.62/10、成功率63.2%,GPT Image 2为9.15、74.8%;非编辑区一致性9.06,对照9.34。 表8|VINS-4KEval++七模型共同覆盖2513例,BluePixel综合排名第二,仅次GPT Image 2,非编辑区一致性也第二。采用BluePixReward裁判,BluePixel做提示改写并报告8个种子的均值,外部模型每例一个输出;每种子明细在原论文表4。分数0至10、越高越好,Success为同一裁判认定成功的比例;IF为指令遵循,NC为非编辑区一致性,VQ为视觉质量。 批判点评:本模型报8个随机种子的平均值并做提示改写,外部模型每例1个输出;同一自家奖励模型又用于训练与评测,排名应配合独立人评。完整系统会增加规划、验收和重试时延;8.7秒不能代表整套系统。SATP完整推导与训练配方另待配套论文,当前论文并非所有环节都可独立复现。作者代码。 7. SceneAE:存一个场景再换相机看 SceneAE: Scene Generation and Reconstruction in Queryable 3D-Anchored Latent Space | 北京邮电大学;加州大学伯克利分校;鉴智机器人;SynapX | arXiv:2610.19708 关键词:三维锚点潜空间, 场景生成, 几何内容解耦, 相机控制 前序问题:按视频帧存场景,同一个房间换一条相机路线就可能又生成一遍,还会把物体外观与观察角度绑在一起。记住了之前的画面,不等于有可重复查询的场景。 方法直觉:把场景记成稀疏的空间笔记:每条笔记有三维坐标和局部内容。相机移动时只查询这些笔记并渲染;生成时先安排几何,再给几何填外观。 本文贡献:SceneAE 以3000个显式三维锚点及其隐式内容特征表示场景。编码器借冻结的Depth Anything 3估深度并提特征,反投影成点云后选择锚点,聚合可见视角信息;解码器按目标相机输出RGB和深度。生成Transformer先按相机控制未来几何布局,再以几何为条件生成内容,避免每换轨迹都重新合成整段视频。 图3|几何与内容解耦的扩散Transformer:先以相机条件控制未来几何布局,再用几何布局控制纹理内容,因而更准确跟随相机。场景潜空间直接锚定三维位置,解码时可重复查询。 实验效果:DL3DV、RealEstate10K和ScanNet训练样本用9视角,分辨率518×376,8张A800训练10万次。RealEstate10K双视角条件下,像素重建信噪比PSNR为19.8、结构相似度SSIM为0.68,对照GLD为19.4、0.67,均越高越好;DL3DV同设置PSNR17.9却低于GLD的18.1。表1每步145毫秒,对照285毫秒,不能称完整视频仅145毫秒。往返轨迹记忆实验PSNR30.7,对照GEN3C29.8。 表1|外观生成定量对照:报告像素重建信噪比PSNR、结构相似度SSIM,以及VBench的主体、背景和多视角一致性,均越高越好;另报GFLOPs(十亿次浮点运算)与每步毫秒数衡量效率。单视角、双视角及两个数据集应分别看,不能把每步时间当整段端到端时间。 批判点评:重复查看同一表示很有吸引力,但几何质量依赖深度基础模型、相机位姿和可见性估计。几何对比中Gen3R采用VGGT生成评估参考,本方法与GLD采用DA3,参考源不同,不能简单当同一真实三维标尺。它主要展示相机驱动场景生成与重建,尚不能据此声称任意动态世界均稳定;未确认作者代码入口。 8. Kandinsky S2V:语音驱动人物且记住前情 Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation | Kandinsky 实验室(Kandinsky Lab) | arXiv:2610.19290 关键词:语音驱动视频, 多尺度记忆, 口型同步, 策略蒸馏 前序问题:单张照片配音生成长人物视频,既要嘴型跟得上声音,又要跨段保持身份、姿态和动作;只盯嘴部,容易丢掉整个人物的连贯表演。 方法直觉:声音与文字负责当下怎么说,参考图负责是谁,压缩记忆负责刚才怎么动。旧帧记粗略轮廓,最近帧保留细节,把记忆预算花在时间上更近的地方。 本文贡献:Kandinsky S2V 1.0 用冻结Qwen2.5-Omni的文本和音频特征,参考图经视频VAE编码,三尺度FramePack将过去30个潜帧按远到近分为24、4、2帧并逐级减小压缩;当前视频帧只注意对应时间段的音频。训练117万单说话人片段,结合参考记忆混合和按脸面积调整的损失。π-Flow蒸馏把每段策略的5个干净潜变量估计一次预测出来,再通过无需额外网络调用的子步积分,最终16个策略段、不用有无条件双分支引导。 图2|Kandinsky S2V架构:冻结Qwen2.5-Omni的Thinker文本特征及音频塔特征,分别进入扩散Transformer内Nt个文本块与Na个音频块。参考图经冻结Hunyuan三维VAE编码,其潜变量与带噪目标zt及多尺度FramePack历史记忆拼接,C表示拼接。每个块执行视觉自注意力V2V、文本交叉注意力V2T、按周期插入的音频交叉注意力V2A及前馈层;最后由冻结VAE解码回像素。交叉注意力使当前视觉特征读取相应条件。 实验效果:Lite与Pro是系列简称,实际参数约23亿和214亿。每段生成125帧、25 FPS,对应5秒播放时长。H100、512×768、单GPU上,Pro基础版每段914秒,蒸馏版173秒;8GPU时162秒与57秒。1280×768单GPU为3854秒与675秒,体现设备、分辨率不同不能只报一个速度。作者摘要给5.4倍端到端收益;80条俄语HD人评中,多数项目74%至100%打平,牙齿嘴部蒸馏版获38%偏好、基础版3%。 表5|发布推理代码在H100上对Lite与Pro逐块计时。每行GPU数量与耗时按位置一一对应;SD为512×768,HD为1280×768,时间单位秒。每块125帧、25 FPS,故播放时长5秒;单卡Pro蒸馏版SD为173秒、基础914秒,不能将输出帧率当生成速度。 批判点评:25 FPS是输出帧率,不是实时生成吞吐。Pro蒸馏后EMTD口型相关分8.03略低于基础8.05,Lite也出现同步下降,不能写蒸馏后所有指标都升。自回归长链还会累积误差,数据以单说话人为主,多人互动并非已验证能力。作者项目页。论文所列代码仓库及权重集合本次回读均为404,暂未确认可下载状态。 9. Revise-TTS:说错的声音token还能再改 Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech | 谢菲尔德大学;HojoAI | arXiv:2610.19499 关键词:语音合成, 非掩码修正, 层级二值量化, 迭代自纠错 前序问题:掩码扩散语音模型像填空,一旦高置信度预测被提交,后续步骤通常不再改它。早期发错的声音单元会留在上下文里,继续影响后面。 方法直觉:允许已经写上的答案被擦掉重做。声音先编码成可从粗到细细化的二进制单元,模型既练补全缺失内容,也练从掺杂错误的整段内容里恢复正确声音。 本文贡献:HBQ是层级二值量化,每次把当前量化区间对半分,形成有粗细次序的位串,可打包成整数或逐位预测。GRN是生成式修正网络,训练输入混合真实和随机token;token是离散声音单元。模型预测完整序列,推理按余弦进度保留部分预测、把剩余位置换成随机token再修正,而非用专门掩码符号永久填空。一次重建训练目标不等于一次推理,主实验仍迭代32步。 图1|层级二值量化HBQ:每轮将选定量化区间对半分。连续值z=-0.113经过三轮产生位序列011,对应离散索引3;按正文重建值为-0.125。二值位可按整数或逐位提供给语音模型。 实验效果:主模型使用Emilia英语46800小时、中文49900小时,16张A100训练25万次;小规模消融另用4卡,不能混成主训练成本。LS-PC英语测试中,Revise-TTS单词错误率2.00%,OmniVoice为1.57%,说话人相似度0.519对0.697;Seed中文测试错误率1.19%对0.89%,中文这里按字符计错。32步修正保留了可用自然度,但没有全面超越基线。Higgs编码器的受控实验中,修正模式同样弱于掩码模式的说话人相似度。 表4|固定Higgs声音编码器,用8张GPU在Emilia英语/中文微调后,比较掩码与生成修正解码。Steps列100k指100000次训练更新,不是100000次推理;主推理协议是32次修正。SIM是说话人相似度、越高越好,英语WER为单词错误率、中文同列按字符计错,越低越好。修正并未在所有数据集和指标占优。 批判点评:这篇的价值是展示可撤回的解码机制及量化接口的限制。词错率越低越好,说话人相似度越高越好;二者要一起验收。换到HBQ的编码器重建本身就较差,不能把主系统的差距全归因于修正策略。作者明确Under review,不写会议接收;没有核实到作者代码和真实端到端计时,32步也不等于实时。 10. PhyMetric:别只问视频看起来合理吗 PhyMetric: Diagnosing Physical Plausibility in Text-to-Video Generation via Scene-Level QA | 内华达大学里诺分校 | arXiv:2610.19823 关键词:视频生成评测, 物理合理性, 场景诊断, 问答裁判 前序问题:生成的玻璃杯碰撞后没有正确反应,画面却很逼真;泛泛问“符合物理吗”,视觉语言模型可能高置信度说是。整体分数无法告诉开发者究竟哪一步坏了。 方法直觉:把验收改成观察清单:针对这个场景本应出现的现象逐项问是非题,再挑能回答问题的时间帧。问的是可见后果,而非让裁判凭印象打一个总分。 本文贡献:PhyMetric覆盖6类物理领域、50个细分类别、1115个场景,每场景8个平衡是非问题,共8920题,带12种诊断维度。为每个场景提供物理规律、预期时序、可见征象与常见失败的结构化先验,再按问题选择视频帧交给视觉语言模型作答,逐场景、维度与类别聚合;它评估生成结果,不是给生成器装物理仿真引擎。 图3|PhyMetric评估:给定物理场景s,文生视频模型按描述cs生成视频Vs。对每个场景是非问题,按问题抽取帧,并提供描述规律、预期后果和常见失败的结构化物理先验Ks;视觉语言模型结合帧与先验回答。问题正确率先聚成场景分S(s,Vs),再对全部场景平均成模型分,使整体印象转成可诊断的物理检查。 实验效果:完整1115场景、两种开源裁判的平均总体分,Wan2.2-14B为72.78,Cosmos-7B为72.59;数值接近,且会随裁判变化。受控消融中,Qwen3.5-9B裁判使用场景问题及先验为74.91,无先验72.75;换成泛化的整体问题时48.88,接近均衡是非题的50%机会水平。该受控结果不是完整榜单分数,也不是人类标注准确率。 表2|完整1115场景的开源视觉语言裁判结果。Average是两种裁判的平均分;Overall为总体聚合,Weighted按题目难度和诊断维度权重聚合,分数越高越好,不能与100场景受控实验混用。Wan2.2-14B平均Overall为72.78,Cosmos-7B为72.59,两个裁判下细微顺序会变化。 批判点评:先验并非越多越好:GPT-5.4裁判加入默认先验后受控分数从73.94降到72.25,尽管与人的相关性可能改善。问题构造、抽帧和裁判偏差仍影响结论;每场景8次问题判断还增加评估调用成本。接近0.2分的模型差距不应写成已证明的绝对物理优势。作者项目页。 趋势观察 先学什么影响后训练成本 Priming先做重建,RECON把语义送给后层,Glance按噪声区间分工;同样少步,不同初始化承担的责任不同。 交付与计算要分开计账 投机采样延后未来帧的承诺,TempoKV只压缓存,Kandinsky输出25 FPS但仍慢生成;吞吐、响应、存储和播放时长是四件事。 保留接口比追求单分数更难 BluePixel锚定未编辑背景,SceneAE解耦几何与内容,Revise-TTS暴露声音编码器质量瓶颈;模块相接处决定最终效果。 诊断问题需要足够具体 PhyMetric把整体合理性拆成场景问题;其不同裁判并非一致受益,BluePixel也用自家奖励判定成功,验收来源应明确。 今日讨论 Priming-L在ImageNet 256×256达到FID 1.19,但RT-1视频的FVD为30.96,仍高于32步流模型的27.24。若要判断“先重建再一步生成”能否替代你的少步模型,哪种实验能固定总训练算量,并同时检查图像分布、长时序一致性和特征编码器带来的评价偏差? 人工智能炼丹君 整理 | 2026-10-16
-
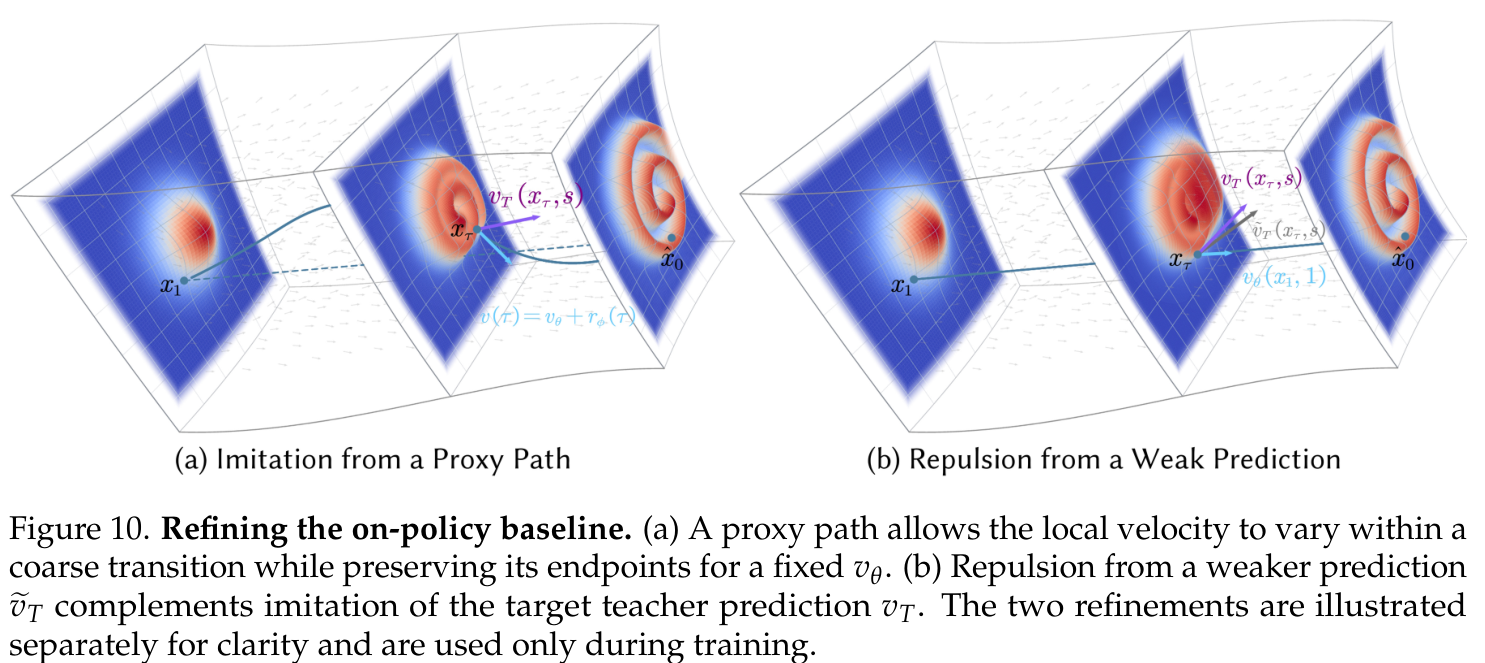
AIGC 每日速读|2026-10-15|微软把生成压到4次评估SMD 今日 AIGC 论文速览 今日共 10 篇 · 少步生成与高分辨率 2 篇 · 理解与编辑控制 2 篇 · 视频超分与运镜 2 篇 · 原生三维生成 1 篇 · 语音与歌声编辑 2 篇 · 音画同步评测与奖励 1 篇 重点论文标题列表 SMD(微软):把局部弯路留给训练 AReA(多伦多大学):大画布先看全局再看细节 DuplexBridge(中科大):先分清没听懂还是没画对 QK-Edit(字节):只换查询与键保住原结构 FlashVSR+(上海AI Lab):单张4090做完整4K超分 选读入口:如果你要缩短生成等待,先读 SMD,接着用 AReA 看大分辨率下如何省注意力;做视频修复再读 FlashVSR+ 的4090卸载条件。复杂编辑失败先读 DuplexBridge 的责任划分,需要保留原视频结构再读 QK-Edit,运镜控制看 GTL。三维贴图异常看 Channel Match;有现场噪声的改词看 AnyEdit,改变语气看 Prime-EVC,音画验收最后读 SyncReward。 今日论文速览 1. SMD:把局部弯路留给训练 Simplifying and Improving On-Policy Distillation for Few-Step Diffusion | 微软研究院;纽约大学;香港科技大学 | arXiv:2610.18472 关键词:少步蒸馏, 同策略回归, 代理路径, 教师排斥 前序问题:把几十次去噪直接缩成几次,常会遇到同一大步内教师方向不断变化:学生只预测一个方向,局部监督互相打架,视频训练还可能先变好再退化。 方法直觉:像用一条直线代替弯路:学生学习这一大段的平均方向,训练时另找一个能弯曲、但不改变起终点的辅助路径,接住局部变化。部署时只走学生的大步。 本文贡献:Simplified Matching Distillation(SMD,简化匹配蒸馏)沿学生当前生成路径查询冻结教师,回归速度。Pivot 辅助网络输出积分为零的残差,使区间内方向可变而终点不变;再用同一教师的弱引导或跳层预测作负参照,拉开与较差方向的距离。只在训练使用 Pivot 和教师,不依赖在线分数估计或对抗训练,也不改部署模型结构。 图10|对同策略回归的两项改进:(a)代理路径允许一个粗步长内的局部速度变化,但固定学生速度时保持起终点不变;(b)排斥同一教师较弱的预测,与模仿目标教师预测互补。两项改进为便于解释分别展示,均只用于训练。 实验效果:原论文 Qwen-Image 实验统一为 4 NFE;NFE 是生成网络前向调用次数,教师 50 步含有条件与无条件两分支,共 100 次。SMD 的 GenEval(物体及属性组合正确率)0.873,高于 Lightning 的 0.852,略低于教师 0.874;密集指令遵循分 DPG 为 88.7,教师 88.3。OneIG 综合分同为 0.540,但多样性 0.144 低于教师 0.195。 表2|Qwen-Image 文生图:NFE 计算网络前向评估次数,教师的 50×2 包括有条件与无条件两个 CFG 引导分支;粗体和下划线为少步方法中的第一、第二,不含教师。†是 PDD 原文表3及6–8的欧拉版本,未有公开 checkpoint。各项越高越好;综合分不等于每项都领先。 批判点评:少调用网络不能直接换算墙钟加速;训练仍要教师查询和 Pivot。Wan2.1-14B 视频的语义分 80.52 低于 AnyFlow 的 82.10,330亿参数(33B)的音画联合模型分别测 4/8 次调用,不能统称全任务四次且全面领先。作者代码含推理与训练入口,本次未执行模型复现。 2. AReA:大画布先看全局再看细节 AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers | 多伦多大学;Vector研究所 | arXiv:2610.17227 关键词:高分辨率生成, 自适应感受野, 跨尺度注意力, 局部窗口 前序问题:把原生约千像素的图像模型直接拉到四千像素,注意力计算猛增,还容易复制主体、扭曲布局。只改位置编码,不能同时处理关注对象数量暴涨的问题。 方法直觉:构图时看整幅画的缩略版,修细节时只看邻近区域。缩的是被查询的上下文,输出画布始终保持目标分辨率,因此不需要先生成小图再放大。 本文贡献:AReA 即自适应感受野注意力,无需训练。早期保留全分辨率 query(查询),对 key/value(供匹配与聚合的信息)按块取中心代表,统一到较粗坐标;后期改用逐渐收缩的窗口。稀疏全局信息桥维持远处联系,重叠边界缓解接缝,离散小波变换识别平滑区并进一步拆窗。切换按噪声水平设定,FLUX.1 前 8 步、Qwen-Image 前 20 步采用全局粗阶段。 图4|AReA 流程:在噪声水平阈值 σ⋆处从阶段一切换到阶段二。阶段一全分辨率查询访问每个 f×f 块选出的一个 key/value,f 随步数调整,坐标映射到接近训练分辨率的网格;阶段二逐渐缩小局部窗口,并进一步拆分离散小波变换图中平滑区域的窗口以降低计算。 实验效果:H100 上的 Aesthetic-4K 含 195 条提示。在 4096×4096 的 FLUX.1 设置,单图时间从全注意力 314 秒降至 151 秒;另用 1000 条复杂提示组成 HRGen-1K,图文对齐 CLIP 分从 23.36 到 29.89,偏好预测 PickScore 从 19.04 到 21.44,均越高越好。6144×6144 的最高加速 3.2 倍属于另一分辨率设置。 表1|Aesthetic-4K 上 FLUX.1 与 Qwen-Image 在不同分辨率和宽高比的对照,粗体为最佳、下划线为第二;时延单位秒、越低越好,奖励、美学、图文匹配和偏好分越高越好,整体与局部裁剪的 Fréchet 距离越低越好。收益随主干与分辨率变化。 批判点评:不增参数仍需实现窗口、信息桥与拆窗调度;切换阈值按主干经验选择。固定窗口消融虽有不错的美学或 CLIP 分,却出现布局破碎,因此这些分数不能替代主体数量和接缝检查。作者项目页提供演示及代码入口,未实跑其模型。 3. DuplexBridge:先分清没听懂还是没画对 DuplexBridge: Coordinating Understanding and Generation for Unified Image Editing | 中国科学技术大学;阿里巴巴Wan团队 | arXiv:2610.18819 关键词:统一图像编辑, 角色分工, 双向信任门控, 完整遵循评测 前序问题:让统一模型先理解指令再编辑,最终改错时却不知道该罚谁:可能理解阶段认错对象,也可能条件没错、生成阶段执行失误。共享一个奖励会把责任混在一起。 方法直觉:先把任务写成可验收的交接单:改哪个对象、最终变成什么、哪些内容必须保留。理解者对交接单是否忠实负责,绘图者对是否照交接单完成负责。 本文贡献:同一模型分别承担理解与生成角色,不另接外部理解模块。源图约束的结构化 bridge 传递目标、变化和不变量;理解的局部监督不看生成图,生成的局部监督检查实际收到的条件。只有伙伴可信时才接收相应全局任务反馈,同时保留有效局部反馈,交替训练两角色。 图3|伙伴互信门控:执行可信度控制理解者能否接收全局反馈,提示可信度控制生成者能否接收全局反馈;局部反馈仍各有独立有效性掩码。图将两角色的全局资格及局部奖励符号简写;路由矩阵假定判断可用,Yr 是基准编辑结果,与任务提供的参考图不同。 实验效果:CE-Bench 有 1200 个任务;CCR 指所有变化与保留要求同时通过的任务比例,区别于平均要求通过率。Wan-Image-7B 直接编辑的 CCR 为 53.83%,完整系统 77.08%,包括提示增强、监督微调及强化学习。共同监督初始化后,仅比较门控:无门控 70.92%,双门控 77.08%,不能把全系统增益都归给门控。 表10|Wan-Image 全局奖励门控消融:前四行只变化两项语义信任决策,保留局部监督与奖励有效性条件。oracle 使用额外标注;等数量随机门控与保留分组结构的随机门控是不同对照。CCR 为全部变化与保留要求同时通过的任务百分比,双门控为77.08,无门控为70.92。 批判点评:推理增加了原生理解及条件生成环节,训练还需奖励判断;文中奖励模型的相对时延不等于整套编辑端到端时延。自动裁判与人评仍有误差,公开任务类别构成也随要求数量变化,不能把要求越多分越低解读为单变量因果。未确认作者完整训练实现的公开入口。 4. QK-Edit:只换查询与键保住原结构 QK-Edit: Revisiting Attention-based Injection in MM-DiT for Image and Video Editing | 加州大学默塞德分校;字节跳动Seed;字节跳动智能创作;香港中文大学 | arXiv:2610.17829 关键词:图像视频编辑, 查询键替换, 多模态注意力, 无需训练 前序问题:给真实视频换主体时,直接套用旧图像编辑的注意力注入,可能保住原结构却不听新指令,或跟上指令却把动作与背景弄坏。 方法直觉:注意力里,query 像每个位置提出的问题,key 用于匹配位置,value 才是取回的内容。借用原视频的查询与键来固定布局,同时让新文本和当前内容负责改变外观。 本文贡献:在把文本与视觉合并处理的多模态扩散 Transformer 中,只替换视觉 query/key,保留目标文本特征与目标 value。生成素材可在原采样时缓存,真实素材先反演回噪声并记录特征;图像仅在前 30% 去噪步注入,视频为前 20%。不训练参数,但需要源特征缓存及真实素材的反演计算。 图6|查询与键操纵策略:替换注意力 Q 与 K 的视觉部分,在目标提示遵循和源结构保持之间取得平衡;Q 是查询特征,K 是用于匹配的键,文本部分及用于聚合内容的 value 保留目标分支。 实验效果:A100 上以 FLUX.1-dev 编辑图像、HunyuanVideo 编辑视频。真实 TGVE+ 视频中,帧间 CLIP 余弦一致性 0.921、偏好预测 PickScore 20.52,Flatten 为 0.887、19.91;但描述修改方向的 ViCLIP 分为 0.196,低于 Flatten 0.204。论文覆盖 65 至 129 帧、320×320 至 1280×720 的视频设置。 表3|TGVE+ 真实视频编辑:比较修改方向及输出整体的 ViCLIP 语义对齐、帧间 CLIP 一致性和 PickScore 偏好预测,箭头均向上。QK-Edit 的方向分0.196低于 Flatten 的0.204,其他展示列较高,不能解读为所有指标第一。 批判点评:结构保持不等于所有语义指标最佳,且不是每条基准样本都使用最大分辨率和帧数。缓存与反演使“免训练”仍有时间和显存成本,原文未给统一端到端开销数字。真实反演在复杂运动中易有误差,未改区域仍可能被轻微改动;文字渲染与体操等复杂运动也受主干限制。未确认作者方法仓库可用。 5. FlashVSR+:单张4090做完整4K超分 FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching | 上海人工智能实验室;香港中文大学;清华大学;CPII(InnoHK) | arXiv:2610.17552 关键词:生成式视频超分, 混合注意力, 奖励蒸馏, 缓存卸载 前序问题:视频超分即从低分辨率恢复高分辨率;即使把扩散压成一步,4K 时空注意力仍可能撑爆显存,切成小块又容易产生边缘瑕疵,普通蒸馏也未必保住文字。 方法直觉:大部分层只管附近像素和前面的帧,少数层负责远处联系;训练时多学习奖励高的教师轨迹,奖励模型只负责打分,无需把梯度穿过它。 本文贡献:每五个扩散 Transformer 块保留一个全局块,其余采用局部时空注意力,适配训练后再蒸馏。Ry-DMD(奖励收益分布匹配蒸馏)用奖励加权的教师轨迹修改目标分布估计,支持不可微的黑盒奖励。4090 上另用适配注意力算子,并把保留全局层的 key/value 缓存卸到 CPU 固定内存,异步预取回显卡。 图2|FlashVSR+ 三阶段训练:第一阶段用图像视频数据训练140亿参数的全注意力多步教师;第二阶段适配混合注意力学生获得强初始化;第三阶段用 Ry-DMD 蒸馏成一步生成器,奖励反馈修改教师项估计,无需奖励梯度。 实验效果:效率测 89 帧视频,含 1080p、2K、4K。最高约 2 倍是去噪主干加速,峰值显存约降 45%;单张 24GB RTX 4090 的 4K 运行还包含上述卸载优化。文字识别奖励实验中,识别准确指标从基线 0.624 到 0.776;像素保真 PSNR 从 23.94 到 24.86,感知差异 LPIPS 从 0.246 到 0.240,后者越低越好。 图6|89帧视频的效率对照:(a)H200同级 GPU 上的 GPU 计算时间与峰值显存;(b)RTX4090 的端到端墙钟推理时间,包含 CPU key/value 缓存卸载与异步预取开销。SeedVR2整帧运行显存不足,改用切块;H200同级设备上的Ours-Base与旧FlashVSR结构及流程相同,旧算子不支持4090。两个面板口径不同,主干加速不能直接当完整路径加速。 批判点评:一步不等于实时;CPU 传输、预取、编码解码仍占时间。真实 VideoLQ 上无参考质量 MUSIQ 为 47.64,低于旧 FlashVSR 的 49.70,不能宣称所有质量分都更好。项目与代码入口已核验,训练适配和高分辨率设备条件需要一起复现。 6. GTL:把运镜主体和焦点分开控 Gen Through the Lens: Camera-Controllable Video Generation via Cross-Coordinate Conditioning Fusion | 腾讯视频太阳系 | arXiv:2610.15900 关键词:可控视频生成, 三坐标条件, 三维框控制, 景深与变焦 前序问题:输入一张照片再让相机环绕人物,常分不清是相机动、人物动还是焦距变;只给相机轨迹,人物位置与景深也未必按要求走。 方法直觉:分别给摄影机设置、世界里的运动轨迹、主体的三维占位框,再让它们在同一几何空间中对齐,避免把所有摄影要求挤进一句模糊提示。 本文贡献:Gen Through the Lens(GTL)融合相机、世界、物体三个坐标空间:恢复有统一实际尺度的相机参数,以彩色世界网格编码运镜,以带深度的三维框编码主体位姿,并加入分层景深与变焦条件。Wan2.1-14B(140亿参数)的编码器、解码器与生成主干冻结,只训练上下文适配器,分运镜、主体及变焦、景深三阶段加入控制。 图3|GTL 总体架构:在相机、世界与物体坐标空间联合输入相机运动、物体运动及景深控制信号,引导视频生成,源图像和几何条件共同约束生成主干。 实验效果:训练基础集约 11 万段,另构建 8000 段变焦与 15000 段景深数据,统一 81 帧、480p;原文报告约 288 GPU 小时。1000 段独立测试中,GTL 的视频分布距离 FVD 为 86.54,RealCam-I2V 为 98.76,越低越好;相机平移误差 8.59 对 9.86,但旋转误差 4.89°高于对照 4.63°。 表2|与现有方法的定量比较:误差及分布距离越低越好,重叠及语义指标越高越好;屏幕空间误差按图像对角线的百分比报告。*列需谨慎,RealCam-I2V 与 GEN3C 不支持显式物体运动或目标定位,可能使它们的物体指标较差。GTL旋转误差并非最优。 批判点评:主体框训练以人为主,非人物泛化主要来自定性展示;部分对照不支持显式物体控制,物体指标并非同等功能比较。几何来自自动估计,误差会传到条件和评测,训练成本也不是单次生成时延;未提供可直接对照的推理显存或时间,未确认完整开源实现。 7. Channel Match:形状没坏也要校准纹理接口 Channel Match: Calibrating Shape Latents for Few-Step 3D Generation | 威廉玛丽学院;SparcAI公司 | arXiv:2610.15321 关键词:原生三维生成, 少步蒸馏, 通道统计校准, 几何纹理接口 前序问题:三维模型两步就生成了正确形状,贴上材质却出现黑斑,问题可能不是网格坏了,而是几何隐变量的统计分布偏离纹理模型训练时的输入。 方法直觉:几何与纹理像两道串联工序:前一道加速后输出格式没变,数值分布却变了。先把接口上每个通道的均值与波动尺度校准,再交给原来的纹理生成器。 本文贡献:在 TRELLIS.2 的 1024³ 分辨率设置,用连续自一致性与解析速度回归联合蒸馏几何模型,自适应平衡两种损失。自定义 JVP 注意力核计算沿教师方向的速度变化;JVP 是雅可比矩阵与向量之积,无需显式存整张雅可比矩阵。Channel Match 无需再训练,按通道标准差亏损检测分布塌缩,触发尺度或均值加尺度校准,保持生成器不变。 图1|少步分布偏移及 Channel Match 校准:从左到右是输入、未校准两步学生的无纹理网格与物理材质渲染,以及校准后网格与渲染。偏移的形状潜变量会让冻结纹理模型产生黑斑;校准后几何保持不变。示例选择几何简单、两步教师和学生都接近多步参考的样本,以隔离潜变量统计偏移而非几何重建错误,并非全部复杂物体的保证。 实验效果:单张 A800-80GB 上,几何采样从 5.29 秒到 1.18 秒,约 4.5 倍;图像到形状完整路径 11.51 秒到 7.55 秒,约 1.5 倍。72 个容易出材质伪影的演示资产,统一四视角、对照十二步教师渲染,完整校准将感知差异 LPIPS 从 0.0802 降到 0.0747;这是更接近教师,不是接近真实照片的直接测量。 表3|TRELLIS.2 的72个演示资产与十二步教师渲染作四视角比较。仅标准差和均值加标准差两种校准都使学生更接近教师,完整校准在这批材质伪影较多的资产上收益更大。下半部分为各指标改善的资产比例;它不代表完整 Toys4K 或真实纹理误差。 批判点评:3216 个较简单 Toys4K 资产中,单独校准标准差更稳,完整均值校准反而可能稍差。JVP 增加的是训练开销,纹理阶段保持不变限制总加速。原文的结构相似度 SSIM、像素保真 PSNR 在正文与表格有个别数值不一致,因此本文只采用一致的 LPIPS 与计时数据;尚未确认作者完整公开实现。 8. AnyEdit:改人声时留下现场的声音 AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency | 香港中文大学(深圳);华为媒体技术与体验设计研究所;澳门城市大学;Amphion公司 | arXiv:2610.15665 关键词:语音歌声编辑, 环境一致性, 抗噪韵律, 分阶段声学渲染 前序问题:在有伴奏、回声或街噪的录音里换一句话,常把环境声一并擦掉,或让没修改的词也变了音调。先做人声分离还会引入分离伪影。 方法直觉:先在干净的语义空间里决定说什么、怎么唱,再借周围原始声音还原现场感。这样编辑能力和噪声混响的处理不必在同一个步骤里互相干扰。 本文贡献:不显式分离人声:自回归模型生成韵律与内容风格 token(离散片段编码);教师学生训练从受损录音恢复干净韵律,50Hz 特征压成 6.25Hz token。流匹配声学模型再依据原音色及上下文渲染频谱。未修改区域加权监督稳定原有语气,并用歌曲重复段对齐挖出的真实配对做直接偏好优化;这仍依赖合适的重复结构。 图1|AnyEdit 总体架构:先在干净语义空间预测韵律与内容风格,再结合原声学上下文生成频谱并还原波形;NFE 为流匹配推理时的函数评估次数,图中按常微分方程积分步骤计,不包含全部前后处理。 实验效果:AnyEditBench 同时覆盖中英语音和歌声、干净/模拟/真实环境。真实英语语音中,单词错误率 WER 为 0.0616,Vevo2 为 0.0778;真实英语歌声 WER 为 0.1749,对照 0.2809,背景嵌入相似度为 0.7384,对照 0.5671,后者越高越好。但英语语音背景相似度 0.7705 低于 SSR-Speech 的 0.8729。 表2|AnyEditBench 真实环境子集,分语音与歌声两域。英语用单词错误率 WER、中文用字符错误率 CER,基频相关仅测歌声;粗体为各域最优,下划线指优于统一基线 Vevo2。另列说话人及背景相似度、混响时间误差与信噪比误差,不能仅以识别率概括环境保持。 批判点评:极端语音信噪比 0dB,即信号与噪声功率相当时,WER 为 0.386,差于 Vevo2 的 0.196,不能把平均收益当全条件保证。两阶段处理与多步声学解码仍有成本,未给统一时延。arXiv 备注明确称 NeurIPS 2026 接收;作者演示与公开评测集可访问,未确认完整训练代码。 9. Prime-EVC:情绪先配好再一步变声 Prime-EVC: One-Step Expressive Emotional Voice Conversion via Emotion-Primed Flow Matching | 九州大学;东华大学;腾讯混元;日本国立情报学研究所;东京大学;独立研究者 | arXiv:2610.16036 关键词:情绪语音转换, 一步流匹配, 韵律条件, 说话人保持 前序问题:想把同一句话由平静改成兴奋,直接把多步情绪转换模型砍成一步,往往只剩平滑的平均音色,目标情绪没真正进入音高和能量。 方法直觉:与其让一步采样临时猜出情绪,不如先预测“这个人表达这种情绪时”的逐帧音高与强弱,把难题移到条件端,再让解码器完成剩下的声学细节。 本文贡献:Prime-EVC 是情绪语音转换而非从文本直接生成。冻结 HuBERT 提取内容,通过 FiLM(按特征缩放和偏移)融合说话人与五类情绪;情绪方差适配器预测逐帧音高与能量,再施加情绪分类及频谱时间变化监督。扩散 Transformer 的条件流匹配解码器一步欧拉更新生成梅尔频谱,BigVGAN 将其转成波形。 图1|Prime-EVC 的编码、条件、渲染流程:从原语音取得内容,以说话人与情绪融合风格及逐帧韵律构造条件,再由一步条件流匹配解码器和声码器生成转换语音。一步指流解码更新,不是整条路径只有一次计算。 实验效果:ESD 英语十位说话人、五类情绪、16kHz,6000 次转换;16 位听者评每系统 100 条样本。自然度主观均分 3.77±0.03、情绪均分 3.90±0.04(±表示95%置信区间半宽),高于四步 DurFlex 的 3.63、3.79。A6000、批量 1,含声学模型及声码器的 RTF 为 0.038(耗时/音频时长),对照四步 0.132、百步 1.917。 表1|ESD 上整体比较,粗体仅在转换系统中排名;GT 为真实语音,vocoded 为声码器重建。自然度与情绪主观评分给均值及95%置信区间,自动质量、情绪与说话人相似度越高越好,字符及单词错误率、RTF越低越好;RTF包含声学模型及共享声码器,主干参数量并不相同。 批判点评:一步只计流解码器的网络评估,内容编码与声码器仍执行;模型约 9800 万参数,对照约 1.59 亿,也影响速度。说话人是训练过的十个嵌入,不是任意新音色克隆;去掉部分监督时 WER 还略好,情绪与可懂度需一起看。arXiv 标注在研预印本;作者样例可听,未确认训练代码。 10. SyncReward:声音对得上也得让人认同 SyncReward: Human-Aligned Synchronization Reward for Audio-Visual Generation | 中国人民大学;腾讯微信 | arXiv:2610.16338 关键词:音画同步奖励, 人类评分对齐, 时间对比学习, 生成后训练 前序问题:视频里的声音语义相关,却未在可见动作发生时响起;只奖励某个同步指标,模型可能把指标刷高,观众仍觉得嘴型或撞击声对不上。 方法直觉:先学习同一片段中哪个声音对应哪个时刻,再学人类如何判定“完全不同步、部分同步、同步”。内容匹配与时间对齐分别训练,避免只靠主题相似过关。 本文贡献:基于音画感知编码器,先用同片段错时负样本及跨片段语义负样本做对比学习,再冻结编码器,以人类 0/1/2 级评分训练交互 Transformer 与打分头,结合回归和成对排序。输出 0–2 的同步分。SyncReward-Data-80K 是约 8 万条评分;作者仓库说明为 80001 条评分覆盖 57099 个片段,不能把评分数直接写成独立片段数。 图3|SyncReward 两阶段训练:第一阶段以匹配音画片段、同视频错时负样本和同批跨视频语义负样本做对比学习;第二阶段冻结两种编码器,只训练跨模态 Transformer 与评分头,结合人类同步评分的回归和成对排序损失,输出0–2分。火焰与雪花分别表示训练和冻结。 实验效果:整体人评排序相关 Spearman ρ×100 为 78.2、成对排序准确率 83.6%,只做第一阶段为 60.5、74.6%。LTX-2.3 每提示生成 16 条再择优,人类偏好分为 63.67%,基模为 32.31%;用 DiffusionNFT 后训练为 65.78%。这些偏好分是基于基模比较的暂定估计,原文说明尚待完整两两评估,不能当全对全胜率。 表2|以同步分作奖励,分别比较十六选一与 DiffusionNFT 后训练;人类和 Gemini 偏好使用相同留出提示,自动指标也在同一批生成视频计算。当前偏好分为相对基模比较的暂定估计,作者说明将以完整两两评估替换;不同自动指标不构成统一胜率。 批判点评:十六选一要支付 16 次生成与打分成本;后训练有额外训练预算,未提供完整部署时延。模型可能提高嘴型同步却遗漏提示要求的乐器,同步奖励不能单独保证内容遵循。作者仓库提供打分、训练及基准入口,本次未复现;四类声音覆盖也不等于所有长视频场景。 趋势观察 把额外工作放到合适阶段 SMD的Pivot只留训练,AReA随去噪进度改感受野,Prime-EVC先把情绪放进条件。一步或少步的含义,要结合其余模块和前后处理判断。 编辑失败需要明确责任 DuplexBridge区分理解与执行,QK-Edit区分结构与内容。局部机制有效不保证所有语义指标都赢,验收要同时覆盖改变与保留。 接口分布同样影响最终质量 Channel Match的形状没坏但材质变差,AnyEdit把干净编辑与现场渲染分开。模块单独达标仍可能在连接处出错。 奖励与设备条件决定兑现方式 FlashVSR+依赖混合训练及4090缓存卸载,SyncReward十六选一需要额外生成。偏好分、去噪速度和完整产品耗时是不同账本。 今日讨论 SMD把Qwen-Image从教师100次网络评估压到4次,GenEval为0.873对0.874,但多样性从0.195降到0.144。训练仍要教师查询与Pivot,部署也有前后处理;你会用哪些指标和固定预算实验,验证减少网络调用后是否仍保住服务需要的变体覆盖? 人工智能炼丹君 整理 | 2026-10-15
-
AIGC 每日速读|2026-10-14|斯坦福让图像少误导文本SFG 今日 AIGC 论文速览 今日共 10 篇 · 图像生成机制 2 篇 · 视频缓存、压缩与纠错 3 篇 · 原生三维编辑 1 篇 · 流式动作与长动作评测 2 篇 · 情绪语音生成 1 篇 · 视频文字评测 1 篇 重点论文标题列表 SFG(斯坦福):减少图像对文本的错误反馈 T2I Sinks(复旦):高注意力位置不能随手删 CORAL-KV(AMD):跨层预测压小视频缓存 UniGVC(中科大):同一码流选直播或高清回看 PreCoG(港大):先看预览再修缓存轨迹 今日论文速览 1. SFG:减少图像对文本的错误反馈 Images Talk Back: Guiding MMDiTs by Suppressing Image-to-Text Feedback | 斯坦福大学;清华大学;纽约大学 | arXiv:2610.13941 关键词:多模态扩散, 语义反馈引导, 双向注意力, 推理期控制 前序问题:MMDiT 用联合注意力让当前图像更新内部文本表征;图像少画一个物体时,这条反馈可能把错误写回文本,并继续影响后续图像。 本文贡献:Semantic Feedback Guidance(SFG,语义反馈引导)在冻结模型中增加辅助分支:加强图像到文本反馈、减弱文本到图像条件,再让采样方向远离该分支。iSFG 则在正常条件前向内直接抑制前者、加强后者。修改位置在 softmax 与 value 聚合后,保留注意力归一化和模态内项;图像 SFG 只在前 20% 采样步启用额外分支。 图2|图像对文本反馈路径:输入prompt保持不变,当前图像通过图像到文本消息写入内部文本状态,随后文本再指导图像更新。缺失橙子的中间图像可能被纠正,也可能把缺失状态延续;文本标签和AI生成水果仅示意可能状态。 实验效果:表 2:1024×1024 图像、相同 prompt 与 seed,FLUX 的 CFG→CFG+SFG,GenEval 0.6661→0.7479,HPSv2.1 30.96→31.66;SD3.5M 的 GenEval 0.6890→0.7110。表 3:SD3.5M 的 iSFG 为 0.7047、HPS 32.98,比 CFG 高 1.33,增益与 SFG 不相同。 表2|有CFG的文生图比较:SD3.5M与FLUX上,各额外引导均叠加CFG。Count、Pos、C.-Attr分别为计数、位置、颜色属性,Overall为六类平均;HPSv2.1为四风格平均,ImageReward用同图像。各方法prompt与seed相同,FLUX的GenEval从0.6661至0.7479。 批判点评:SFG 无 CFG 时约用 1.2K 次模型评估,有 CFG 时约 2.2K;iSFG 零额外评估不等于零时延,也不能套用 SFG 的较大 GenEval 收益。干预支持反馈方向解释,尚不证明所有模型、场景都有效。官方仓库可见图像与视频推理源代码及配置,未运行复现。 2. T2I Sinks:高注意力位置不能随手删 Exploring Attention Sinks in Text-to-Image Transformers from Diffusion and Autoregressive Models | 复旦大学;上海创智学院;上海科学智能研究院 | arXiv:2610.13337 关键词:生成注意力分析, attention sink, 结构性位置, register探针 前序问题:某些 token 获得异常多的注意力,并不说明它们可有可无;把语言模型中对 attention sink 的直觉直接套给图像生成,可能损坏结构。 本文贡献:本文以 T2I Sinks 作阅读简称。对 FLUX.1、Z-Image 和 Infinity-2B 逐层逐头分析注意力,再以 logit 惩罚、value 清零、头剪枝及阶段性 token 移除作干预。扩散模型的 sink 常在模态边界、文本区和空间角落;自回归模型集中于首个全局 token。额外 register token 只作小范围探针。 图1|图像生成attention sink研究总览:(a)双向扩散与因果自回归架构;(b)FLUX.1与Infinity-2B的代表性sink;(c)logit惩罚、value替换和头剪枝;(d)干预及分阶段全局token移除结果。扩散sink聚集在模态边界和空间角落,Infinity首个全局token明显集中。 实验效果:表 5:Infinity-2B 从首尺度起移除全局 token,GenEval 64.56→11.37;从第 4 尺度开始为 62.90。FLUX 全程移除结构位置则为 67.14→64.81。表 7:FLUX 加 register,GenEval 67.14→68.85、DPG 83.67→84.01,register 的 top-1 sink 比例仅 0.53%。 表7|FLUX的register token探针:加入register后GenEval和DPG改善,原生sink位置的top-1比例略降;register自身比例0.53%,说明部分重新分配,不能称完全取代结构性sink。 批判点评:结构角色依赖生成范式和阶段,不能把 sink 都称为坏注意力。register 的结果是单主干探针;部分位置干预影响小,但剪掉高 sink 头更伤,关注位置不能替代关注头。本文未提供可确认的作者方法代码入口,也未证明通用推理加速。 3. CORAL-KV:跨层预测压小视频缓存 CORAL-KV: Compact Cross-Layer Prediction and Residual Coding for Autoregressive Video KV Caches | AMD;威斯康星大学麦迪逊分校 | arXiv:2610.12514 关键词:视频KV压缩, 跨层预测, 低秩加分块, 残差量化 前序问题:长视频的历史 key/value 缓存不断增长;只在单层内聚类量化,残差误差会随生成累积,边界处还可能突然失真。 本文贡献:CORAL-KV 先用上一层重建缓存预测当前 key,再用当前重建 key 和上一层 value 预测当前 value,只量化预测残差。block-DPLR 用块对角项建模头内通道、低秩项建模跨头联系;可跨视频复用离线预测器,也可固定低秩项、为当前视频重拟合块对角项,以更大缓存换保真。 图3|CORAL-KV重建:第ℓ层由前一层重建缓存预测key,加量化key残差;再用当前重建key与上一层value预测value,加量化value残差。两预测器都由块对角与rank-r低秩部分组成,解码不取原始key/value。 实验效果:表 1:单视频 HY-WorldPlay 285 帧,QVG-4→复用 CORAL-KV,缓存 13.36→6.90 GB、相对 BF16 输出的 PSNR 16.66→16.98 dB;MAGI-1 192 帧为 1.58→0.99 GB、26.14→31.09 dB。视频适配版本 MAGI-1 为 1.15 GB、32.47 dB,相对 BF16 的生成时延增加 10.0%。 表1|匹配比较中的保真与总缓存:HY-WorldPlay含285帧的已完成缓存块,保真评估保留最近48个latent帧;16视频列把共享预测器只计一次。PSNR/SSIM/LPIPS相对BF16生成,时延列为相对BF16开销,协议见附录F.3,不是全进程峰值显存或并发吞吐。 批判点评:内存数字只涵盖存储缓存,不是整个进程峰值显存;16 视频数是共享参数核算,不是16路并发实测。时延在 MI355X 测量,HY-WorldPlay 适配版本开销达29.1%。保真对照是同 seed 的 BF16 输出,不能当真实视频准确率。只验证两个主干,本文未确认作者代码入口。 4. UniGVC:同一码流选直播或高清回看 Unified Generative Video Compression with Autoregressive and Bidirectional Video Diffusion | 中国科学技术大学;快手 | arXiv:2610.13023 关键词:生成式视频压缩, 共享码流, 双模式解码, 单步蒸馏 前序问题:双向扩散解码画质更好却需要整段视频;自回归解码适合流式播放,但上下文受限。同一视频直播和回看不应被迫存两份码流。 本文贡献:层次潜变量 codec 生成同一压缩码流和递归条件,分别驱动双向 BI-DiT 与窗口自回归 AR-DiT。先联合适配 codec 和两套 LoRA,再用双向模型作教师把 AR 蒸馏到一步,最后在像素空间微调并训练条件 tiny decoder。共享的是传输表示,解码端仍保留两套参数。 图1|UniGVC训练与推理:(a)共同适配共享latent codec和双向/窗口因果DiT的LoRA;(b)合并LoRA,在相同codec条件下用双向DiT的真实score、伪score及对抗监督将AR蒸馏为一步;(c)像素空间改进AR及条件tiny decoder;(d)同一codec条件选择回看或流式解码。 实验效果:表 2:HEVC-B 1080p、0.0005–0.004 bpp,50步双向+原VAE为0.14 FPS,一步AR+tiny decoder为36.85 FPS。每帧 codec、DiT、解码器分别7.42、16.10、3.62 ms;最终训练组合相对双向基线的 BD-LPIPS +0.001、BD-DISTS +0.017,仍有感知差距。 表2|解码加速和增强消融:BI-50为50步双向,AR-1为一步自回归,Orig为原Wan VAE,Tiny为轻量解码器;Adv.DMD、Pixel FT、Cond.VAE-D为不同训练组件。在HEVC-B 1080p与0.0005–0.004 bpp四码率测试,最终AR为36.85 FPS,BD-LPIPS和BD-DISTS仍高于双向基线。 批判点评:250倍左右是对该50步双向方案的解码速度比较,不能称比通用视频编码器快250倍。极低码率可能补出合理但非原视频的细节;高FPS依赖一步AR与tiny decoder,不能套给双向质量档。原文声明代码和模型以后发布,未确认已开放。 5. PreCoG:先看预览再修缓存轨迹 PreCoG: Preview-Edit for Efficient Video Correction in Generation-Time | 香港大学NICE Lab;北京邮电大学 | arXiv:2610.13174 关键词:视频生成纠错, 低成本预览, 缓存轨迹编辑, 反事实软投影 前序问题:每次查出漏物体、动作绑定或时序错误就重新完整生成,既重复计算,又可能把已正确的内容改坏。 本文贡献:PreQA 用规划、评估、修正三个步骤,将原 prompt 拆成固定要求并从低步数预览诊断失败;PreEdit 以目标与反事实条件的预测差编辑缓存轨迹,用分块软投影减弱无关方向变化。每次选要求覆盖率最高的预览继续改,只对最终选中候选完整渲染;无需额外训练视频主干。 图1|共用轨迹的预览与完整渲染:成对视频具有相同prompt与seed,预览用少步完成。图中百分比是采样步数比例,不是实测耗时比例;主体与阶段大体对应,细节和姿态仍可能不同。 实验效果:表 1:Wan2.2-T2V-A14B、81帧、832×480、原40步,预览14+2+2步、最多4轮。直接生成→PreCoG,VBench 82.06→83.49、T2V-Comp 55.27→62.28、VS2 3.708→3.854;耗时895.0→2022.9秒,为2.26倍。相对VSR的3620.3秒更快,但VSR的VS2为3.973。 表1|视频纠错比较:列出VBench、T2V-CompBench、VS2及推理耗时,Δ为相对直接生成。PreCoG提高质量和对齐,耗时2022.9秒仍是直接生成的2.26倍;VS2 3.854低于VSR的3.973,不代表各项最高。 批判点评:这里的VBench是六维均值,不与其他论文全维总分直接比。98.24%预览一致性来自固定seed的初始候选诊断,不能保证任意纠错后续。规划和反馈依赖Qwen3.8-27B,多轮纠错仍有额外成本;人工评估仅4人。未确认作者完整框架代码入口。 6. 3DRAG:在原生三维潜空间拖动物体 3DRAG: 3D-Native Object Drag Editing with Generative Models | 上海科技大学 | arXiv:2610.13216 关键词:原生3D拖拽, 稀疏体素, 占用感知位移, logits级融合 前序问题:用2D扩散监督拖3D常有视角不一致,纯几何变形又容易破坏拓扑、纹理或未编辑区域。 本文贡献:在TRELLIS的稀疏3D潜空间构建弹性位移场,用占用感知winner-takes-all避免映射冲突;对结构和SLAT两阶段反演,缓存潜变量及Q/K/V。生成时搬移潜状态,在logits层融合目标与缓存源token,未编辑区域用缓存保留。无需训练或每次编辑优化,仍需反演与去噪。 图2|3DRAG流程:输入物体编码到稀疏体素潜空间,同时由拖拽指令建立位移场。TRELLIS结构ST与SLAT阶段反演获取缓存潜变量和Q/K/V;采样时用缓存与位移场保持细节、产生自然变形并保留未编辑区域。 实验效果:表 1:100个3D物体、单H20、64³体素,反演及去噪各25步。3DRAG未编辑区域PSNR 31.50、拖拽MD 15.89、FID 21.99、耗时227.74秒;APAP为22.52、18.01、63.31、275.13秒。纯几何ARAP仅3.32秒,不能称全表最快或交互实时。 表1|3D拖拽比较:评估未编辑区域保留、拖拽准确、整体3D质量和运行时间,向上/下箭头标明优劣。3DRAG的PSNR为31.50、MD为15.89、耗时227.74秒;ARAP仅3.32秒,生成方法的质量收益不能当全表最快。 批判点评:64³限制细薄结构精度,TRELLIS的VAE仍带色偏;GPTEval3D由模型裁判给分,不能当独立人工真值。原文列MM ’26会议信息与DOI,未把其他稿件模板当接收。官方仓库可见编辑UI、推理及依赖配置,需另备TRELLIS权重,未运行复现。 7. Sonic-AMG:声音边来角色边做反应 Sonic-AMG: Streaming Human Motion Generation from Spatial Audio | 布朗大学;麻省理工学院;耶鲁大学;香港大学 | arXiv:2610.13300 关键词:空间音频动作生成, 因果flow, 自身rollout训练, 空间反馈 前序问题:离线模型先知道整段声音及真实身体位置,在线角色却要边听边动;生成姿态的误差又会改变声源相对位置,形成训练推理差异。 本文贡献:将声学内容与身体相对声源位置分成token,用因果Transformer和flow head生成动作潜变量,再以因果解码器还原四帧片段。rehearsal训练结合整段teacher forcing与短自身rollout;空间反馈根据生成root姿态重新计算声源相对位置,使训练和在线条件一致。 图2|Sonic-AMG架构:交错声学what、空间where与动作token,经因果Transformer与flow head生成动作latent;空间反馈从解码root姿态更新身体相对声源位置SSL。Xk、zk、mk分别为四帧动作块、latent及投影token。 实验效果:表 2:SAM,在真实身体位置GT条件下,MOSPA→Sonic-AMG,FID 8.242→6.505、R@1 0.942→0.957;实际Online条件下Sonic为FID 8.066、R@1 0.943。作者项目报告RTX A6000首帧184 ms,对照MOSPA为10846 ms;首帧时延不是长期稳定吞吐。 表2|SAM定量比较:Causal表示支持因果生成,†表示引用Xu等2025报告;GT使用真实身体的声源相对位置,Online由生成root姿态更新。Sonic-AMG GT的FID为6.505,Online为8.066;R-precision与Diversity含95%置信区间,不应混用协议。 批判点评:主实验仍假设已知世界声源位置,且给4帧真实初始动作;不能把GT最优数字当完全自主在线表现。长时连贯与多事件切换主要是定性证据,机器人演示是离线物理仿真。作者项目页已核验;原文称代码与模型将在接收后发布,未确认接收。 8. Emo-BPO:同时学目标情绪和反向情绪 Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS | 威廉玛丽学院;埃默里大学;乔治梅森大学 | arXiv:2610.12958 关键词:情绪语音生成, 双向偏好优化, 对比扩散引导, 后期引导调度 前序问题:只奖励目标情绪,没有学习如何远离竞争情绪,CFG的正反预测容易缺少区分,细粒度语气控制不稳。 本文贡献:把同文本、不同情绪的音频对调换次序,训练情绪对齐与情绪对比两条score分支;推理用对比CFG强化目标、压低其他情绪,并把引导强度留给后期去噪。基于Grad-TTS,只微调扩散解码器,冻结文本编码器及时长预测器,波形用HiFi-GAN生成;仍依赖已有情绪标注。 图1|Emo-BPO总览:训练调换同文本情绪对,部分微调预训练主干,同时学习情绪对齐EA与情绪对比EC扩散分支。推理在CFG内组合两路预测,强化目标情绪并抑制竞争情绪;训练仍利用已有情绪标注。 实验效果:表 1:英语ESD与EmoVoiceDB、三次运行均值,Emo-BPO的Emo SIM 99.23、UTMOS 4.52、平均情绪识别0.87;CosyVoice2为98.47、4.43、0.82。WER为3.84,略高于CosyVoice2的3.77,不能说可懂度也最佳。表 2的30人主观MOS为3.93、情绪MOS 4.25。 表1|客观情绪TTS评估:比较Emo SIM、韵律相似、可懂度、UTMOS及五类情绪识别,三次独立运行取平均。Emo-BPO的UTMOS为4.52、情绪识别均值0.87;可懂度列实为WER、越低越好,3.84不优于CosyVoice2的3.77。 批判点评:只有英语五类情绪,同文本配对与情绪标签是数据条件,免新增标注不等于无监督。自动MOS和情绪分类器可能有域偏差,没有给出完整部署时延。arXiv备注明确称Interspeech 2026接收;作者项目页可听样例,未确认完整训练代码开放。 9. ELMA:长动作要记住上一段约束 ELMA: Benchmarking Anaphoric Compositions for Long-Term Text-to-Motion Generation | 庆应义塾大学;庆应AI中心;索尼集团 | arXiv:2610.13549 关键词:长动作生成, 跨段指代, 连续数据集, 状态保持评测 前序问题:“继续敬礼并走路”要求保留上一段手势,只给各段独立字幕会让生成角色换动作时忘记约束。 本文贡献:从真实连续视频筛出30秒全身动作,以自动跟踪、姿态恢复和两阶段质量过滤构建ELMA,再生成带前文的六段字幕并标注指代依赖。数据含13.2k片段、110小时;ELMABench取测试集1k片段,每段5秒,只在指代目标段计分。A2M训练把当前与此前CLIP文本嵌入加权融合。 图3|ELMA数据构建:上部为动作收集,下部为字幕标注。SAM2人物跟踪与两阶段后处理筛出高质量动作,先生成连贯episode的分段字幕,再识别指代目标和跨段依赖;全部自动生成,仍有恢复和标注误差。 实验效果:表 2:FlowMDM在T2M训练→A2M推理时FID 1.9363、R-P@3 0.4211;A2M训练→A2M推理为1.5287、0.4662。但Matching Score 7.6015→8.1161变差;UniMotion的FID 18.3490→19.0050也未改善。不能把数据微调收益称跨模型普遍有效。 表2|不同训练推理设置:T2M为独立指令,A2M为带前文依赖指令;FID、Matching Score越低越好,R-P@3越高越好,Diversity应接近GT。FlowMDM的A2M训练改善FID与检索,但Matching Score变差,UniMotion也非统一改善。 批判点评:由视频恢复的动作和自动字幕有噪声,30秒及六段不能代表任意长流。依赖保持仍用分布与文本动作嵌入度量,需检查具体状态。arXiv备注与项目页称NeurIPS 2026 Evaluations & Datasets接收;作者项目页仍为Coming Soon,数据和代码未确认可下载。 10. TextVBench:分开测视频文字正确和稳定 TextVBench: Evaluating Text Rendering and Preservation in Video Generation | 中国科学技术大学 | arXiv:2610.13412 关键词:视频文字生成评测, OCR目标匹配, 时间一致性, 多参考文字保留 前序问题:视频里的字可能一直错但十分稳定,也可能每帧变;只看清晰度或OCR识别率,会混淆字符正确、跨帧保持与额外乱码。 本文贡献:分别构建300个中英T2V prompt和200个Ref2V参考,先把OCR候选关联到指定文字目标,再算空间字符保真S、同目标相邻观测的时间保真T,以长度加权聚合成TextVScore。多参考只在活跃视角匹配并处理重现;额外可读文字单列Extra,不混进主分。 图2|TextVBench统一评估:目标来自T2V指定文本或Ref2V参考区,编号框为OCR观测;同目标可跨框拼接而不改写。空间保真对目标,时间保真对同目标前后观测;漏掉EVERY DAY是24个归一字符中的8个。多参考跳过不活跃视角并在重现时比较;长度加权得到S/T,额外文字独立报告。场景和数值是示意。 实验效果:表 1:八个T2V模型、六个Ref2V模型,共2400+1200视频,3FPS抽样、最多30帧、OCR置信阈值0.80。T2V中MiniMax-H3的TextVScore 68.320,Wan2.2-A14B为43.853;Ref2V头三名仅56.506、56.465、56.388,相差0.119分,不足以宣称可靠总排名。 表1|总体结果:T2V测指定文字生成,Ref2V测参考文字保留;Spatial和Temporal范围0–1,TextVScore为0–100,Extra越低越好,粗体仅为各轨道列内最优。Ref2V前三名只差0.119分,不能将小差距看作可靠总排序。 批判点评:模型按各自推荐设置测试,不是算力对齐。未决OCR候选路由依赖Qwen3.8-27B;难度同时改变文字量、布局等属性,切片下降不证明单一原因。3FPS也会漏短暂闪烁,中文字形等OCR误差仍影响得分。本文未确认作者评测实现或数据下载入口。 趋势观察 信息流要看因果作用 SFG抑制错误回写,T2I Sinks显示高注意力token可能有结构作用。注意力数值、语义直觉和干预结果应分开看。 共享表示不消除部署成本 CORAL-KV共享预测器,UniGVC共享码流,PreCoG共享缓存轨迹;分别节省缓存、传输或重复渲染,仍有拟合、解码模型和反馈计算。 在线与长时条件各有门槛 Sonic-AMG在线重算空间位置,但主实验仍需声源坐标;ELMA测跨段依赖,部分指标和模型未改善。真实状态保持还要逐段验收。 可控性需要具体失败指标 3DRAG分别测未编辑区域与拖拽,Emo-BPO同时看情绪和WER,TextVBench分开正确文字与稳定文字。单一总分不能代替产品目标。 今日讨论 SFG把FLUX的GenEval从0.6661提高到0.7479,iSFG零额外模型评估但增益较小;如果你的图像任务更在意物体计数、偏好分或时延,会用哪些实测证据选择这两种控制? 人工智能炼丹君 整理 | 2026-10-14
-
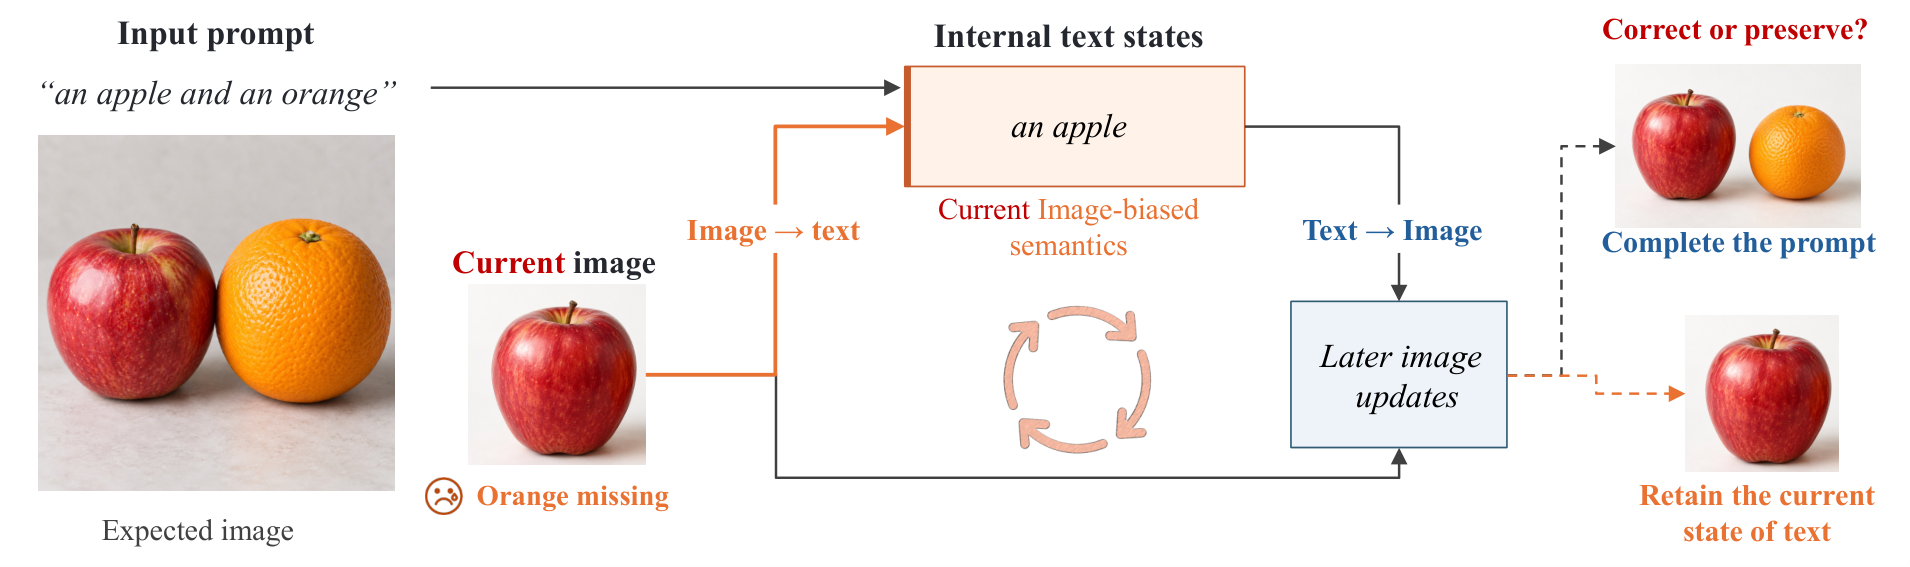
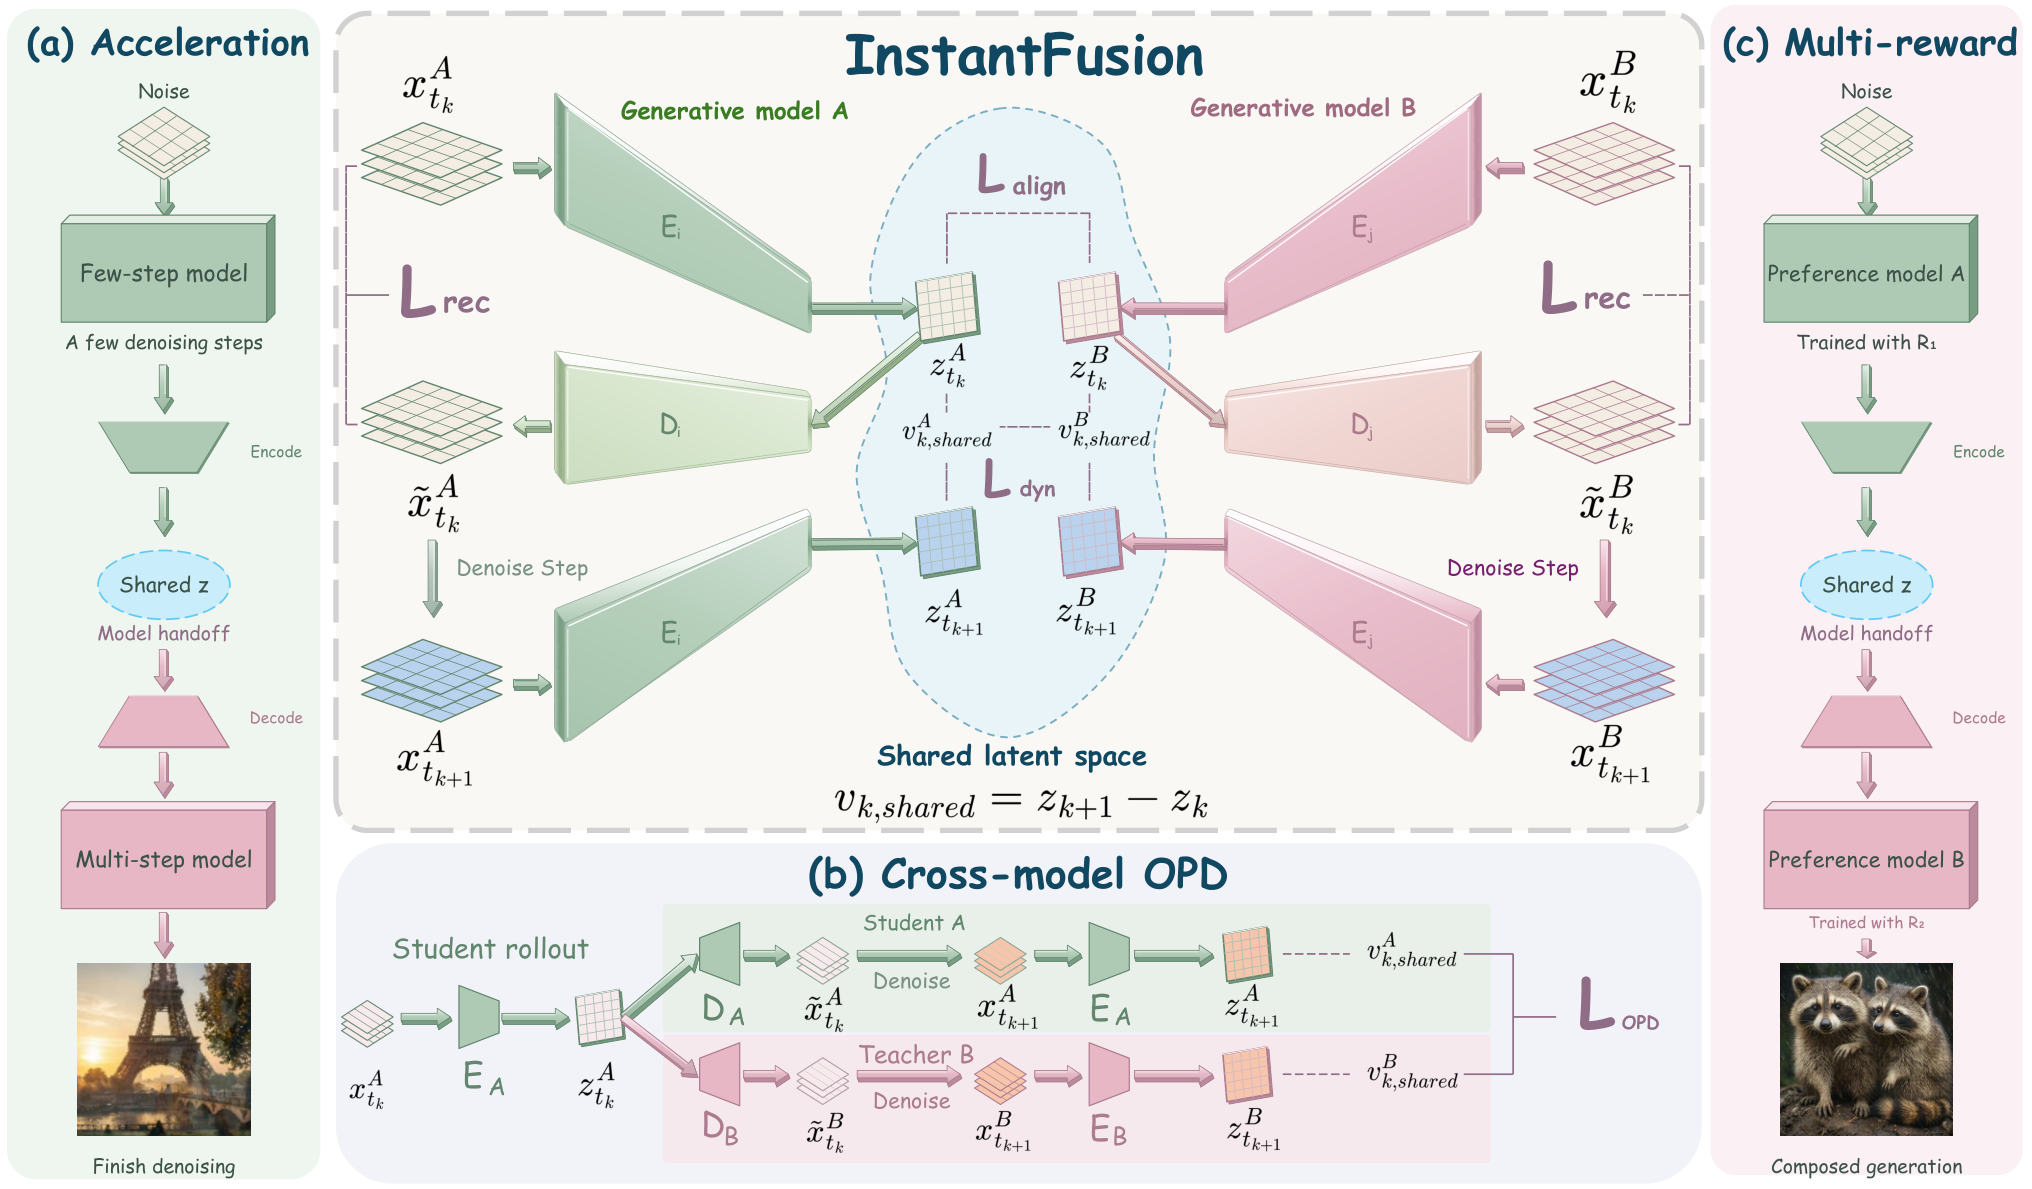
AIGC 每日速读|2026-10-13|上海AI Lab接力画图InstantFusion 今日 AIGC 论文速览 今日共 10 篇 · 图像生成接口与表征 3 篇 · 流式视频与效率 4 篇 · 语义图像编辑 1 篇 · 语音量化 1 篇 · 音乐生成评测 1 篇 重点论文标题列表 InstantFusion(上海AI Lab):让不同图像模型接力去噪 RG(阿里):让内部表征真正带动画图 CoVA(南开):把VAE特征分阶段用好 Memory Forcing(快手):固定缓存也保留中程历史 ForcingBooster(港科大):简单区域提前停复杂区域多算 今日论文速览 1. InstantFusion:让不同图像模型接力去噪 InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators | 上海人工智能实验室;复旦大学;上海交通大学;香港中文大学 | arXiv:2610.13944 关键词:跨模型图像生成, 共享潜空间, 动态对齐, 接力去噪 前序问题:不同生成器各有所长,但中间状态直接交给另一模型会出现伪影;为每对模型训练桥接器,又难随着模型数量扩展。 本文贡献:为每个冻结生成器训练轻量 Latent AutoEncoder,把中间状态编码到共享空间,再由目标模型解码。训练同时约束重建、同噪声状态对齐与局部去噪速度对齐;推理根据预测干净潜变量的变化选择交接点。同一接口支持模型组合、接力加速及跨架构蒸馏,不必为每对模型单独建映射。 论文 Figure 1:InstantFusion 概览。训练时,每个冻结生成器的专用 LAE 把中间状态映射到共享表示空间,同时对齐潜状态与去噪动态。推理时,发送模型的状态经共享空间翻译到接收模型的潜空间,自适应准则决定接收模型何时接管去噪。图中接口、接力加速、偏好组合与蒸馏是不同用途。 实验效果:表 2:接入 Qwen-Image 后,SD3 的 GenEval-v2 从 22.14→35.06,FLUX.1 从 22.86→36.54,分别增加 12.92、13.68 分;OneIG-Bench 平均分为 0.4776、0.5007。SD3 组合的 CLIP 分 28.65→26.98、推理分 0.2770→0.2730,不能说所有指标同时提升。 论文 Table 2:基础生成器与跨模型组合比较,展示少量高质量生成器如何帮助较弱模型。列含 GenEval-v2、CVTG-2K、CLIP 及 OneIG-Bench 的对齐、文字、多样性、风格、推理与平均分。Qwen-Image+SD3 的 GenEval-v2 为 35.06,+FLUX.1 为 36.54;各自增量为 12.92、13.68 分。部分 CLIP 与推理数值下降,原表增量箭头不能替代实际数值判断。 批判点评:当前方法要求共享 VAE 和兼容时间参数,不能任意拼接不同编解码器;同时装载多个主干增加显存与存储。冻结主干仍需训练接口,重复往返也会损伤保真度。表 3 不同接力对象有速度与质量取舍,不能把摘要加速范围外推所有组合。官方仓库可见 LAE/OPD 训练及 SD3/Qwen 推理实现,HuggingFace 可见接口权重;其他演示组合未逐一确认实现,未运行复现。 2. RG:让内部表征真正带动画图 Learning Representations to Guide Pixel Diffusion Transformers | 中山大学;阿里巴巴;香港大学;上海交通大学 | arXiv:2610.12978 关键词:像素空间生成, 表征引导, 低维瓶颈, 训练目标修正 前序问题:中间层对齐视觉教师后,语义可能被后续像素合成覆盖;更强表征或更复杂像素解码器,不一定换来更好的生成。 本文贡献:Representation Guidance 用低维瓶颈连接普通 Transformer 编码器与解码器;比较解码器有无内部表征时的预测速度差,把停止梯度后的差值加进 flow matching 训练目标,迫使生成使用表征。默认由 EMA 网络形成引导,训练仍叠加 DINOv2 的 REPA 对齐;内部引导不能说成完全不用外部表征监督。 论文 Figure 6:Representation Guidance 训练。编码器把带噪输入 z_t 经瓶颈映射为 r;共享解码器在有 r 和无 r 两种条件下预测干净图像,再转成 v_with_rep 和 v_without_rep,其差为 Δv_rep。无表征分支由原 flow matching 目标 v=x−ε 监督,有表征分支由沿停止梯度偏移外推的 v_RG 监督。 实验效果:表 2:ImageNet 256×256,RG-XL/16 为 725M 参数、600 epochs,FID 1.55;RG-L/16 为 459M、同训练轮数,FID 1.79。表中的 PixelDiT-XL 为 797M、320 epochs、FID 1.61,JiT-G/16 为 2B、600 epochs、FID 1.82;训练预算与外部模型并不完全相同。 论文 Table 2:ImageNet 256×256 类别条件结果,比较潜空间与像素空间模型。预训练列列出额外使用的外部模型,粗体标示列内最佳。RG-XL/16 在 600 epochs 达 FID 1.55,725M 参数,外部表征列为 DINOv2;同时列出 IS、Precision、Recall。不同模型训练轮数及预训练组件不同,FID 排名不等于同成本比较。 批判点评:RG 增加两次无梯度 EMA 前向,推理无需这两次教师调用,但训练成本仍存在;低噪声区间、warm-up 和引导强度均属方法条件。现有实验聚焦图像,视频、3D、音频迁移尚未证实。官方仓库目前仅有 README 与展示素材,作者把代码和权重列为待发布,不能称已开源实现。 3. CoVA:把VAE特征分阶段用好 CoVA: Composing VAE Representations for Generative Learning | 极豪科技;南开大学 | arXiv:2610.13322 关键词:生成表征学习, VAE特征组合, 分阶段监督, 软标签幅值 前序问题:VAE 特征擅长重建,却不一定带来生成需要的语义结构;直接平均类别嵌入又会改变幅值,让 FID 改善与语义作用混在一起。 本文贡献:在线训练小型 latent composer,通过类别监督、掩码重建和水平翻转一致性整理 VAE 特征。前期用其密集特征对齐 SiT,中后期停止对齐,最后阶段使用停止梯度的类别后验软条件,并恢复硬标签嵌入的幅值,隔离方向语义与条件强度效应。辅助模块只在训练使用。 论文 Figure 3:SRA2 与 CoVA 比较。(a)SRA2 通过轻量投影与辅助对齐损失,把 SiT 中间特征对齐到 VAE 特征。(b)CoVA 在线组合干净 VAE 潜变量,语义及空间目标训练 composer,早期用密集特征作对齐,后期用停止梯度的类别后验作软条件。(c)分阶段从对齐转为软条件,使训练收敛更快、生成质量更好。 实验效果:表 1:ImageNet 256×256、batch 256、不开 CFG,同为 400K 次训练,SiT-XL/2 的 FID 从 17.2→7.4,REPA 为 7.9。表 3:增加 8.5M 辅助参数,训练吞吐从 8.1→7.0 iter/s,计算量 114.46→122.69 GFLOPs;改善收敛不等于单次训练更快。 论文 Table 1:不同训练迭代数的 FID。全部在 ImageNet 256×256、batch 256、不开 CFG;列出 SiT-B/2、L/2、XL/2 的参数数目及 REPA、SRA2、CoVA。XL/2 同为 400K 时原 SiT 17.2、REPA 7.9、CoVA 7.4;CoVA 1M 为 4.4、2M 为 3.6,不能把不同迭代数当同预算结果。 批判点评:主实验是类别条件 ImageNet,不能外推开放域文生图。表 5 显示只缩小条件幅值就能降 FID,却损失 Recall,评估应一起看覆盖度。原文未给出可确认的 CoVA 官方方法代码入口。 4. Memory Forcing:固定缓存也保留中程历史 Memory Forcing: Attendable Mid-Horizon History for Streaming Video Generation | 南京大学;清华大学;快手可灵团队;上海人工智能实验室 | arXiv:2610.11756 关键词:流式视频生成, 固定KV缓存, 中程记忆, 分库RoPE 前序问题:只保留开头与最近帧的 KV 缓存,会忘掉已离开窗口的事件;人物离场再回来,身份和场景容易漂移。 本文贡献:把原有固定大小缓存分成 sink、archive、working 三区。近期区满时,将与新片段最不相似的旧片段移入档案区,档案满后按 FIFO 淘汰;所有 key 保持原始形式,在注意力时用 Bank-aware RoPE 重赋时间位置,使旧事件可被检索。继续沿用 Rolling Forcing 的滚动去噪和 DMD 训练。 论文 Figure 2:Archive & Working Banks,每行缓存大小相同。(a)只有当前窗口被填满。(b)首个 chunk 进入 sink 并固定保留。(c)有空位时后续 chunk 写入 working。(d)working 满后,根据与新片段的相似度选历史写入 archive。(e)archive 满时由 FIFO 丢弃最旧 chunk。原 caption 分五步叙述,原图(d)合并相似写入与 FIFO 淘汰;颜色区分三类记忆,未增加独立历史存储。 实验效果:表 1:1.3B 模型,官方 VBench 总分 5 秒 83.88、60 秒 83.20,下降 0.68 分;LongLive 为 83.23→82.21,下降 1.02 分。表 2 的 30 秒消融中,working-only 总分 82.41,archive+working 为 83.58;60 秒 similarity 写入为 83.20,FIFO 为 82.96。 论文 Table 2:Wan2.1-T2V-1.3B 在官方 VBench 的 30秒及60秒消融,全部为16 FPS、832×480,报告总分、质量、语义。(a)记忆库;(b)Bank-aware RoPE 的连续、阶梯、折叠、插值分配;(c)相似度写入与 FIFO。30秒 archive+working 为83.58,working-only为82.41;60秒相似度写入为83.20、FIFO为82.96。 批判点评:缓存不增大不等于保存全部过去,档案仍会淘汰,最不相似也不必然等于最重要;分库和 RoPE 需要适配训练。论文对 Gen-Complex、MovieGen 等集合的结果不同,不能只用一个总分替代记忆验收。原文明确代码与权重拟在接收后发布,未确认会议接收或现已开源。 5. ForcingBooster:简单区域提前停复杂区域多算 ForcingBooster: Adaptive Patch-wise Denoising for Fast Autoregressive Video Diffusion | 香港科技大学;VAST;澳门科技大学 | arXiv:2610.12625 关键词:自回归视频加速, patch动态路由, 提前退出, on-policy训练 前序问题:每个 patch 都执行相同去噪步数,静态背景浪费计算;统一减步又让新区域与复杂细节得不到足够修正。 本文贡献:轻量 router 在每步预测各 patch 的停止概率,提前停止的干净预测及其 KV 作为仍在去噪区域的上下文。通过无梯度自身 rollout 记录退出并回放,以重建损失和计算成本训练路由概率;主干和时间表固定,首个 chunk 仍用四步。这里需要路由器训练,并非免训练加速。 论文 Figure 2:自适应 patch 推理与 on-policy router 训练。(a)router 选择继续去噪的 patch,已停止 patch 的预测提供可复用 KV 上下文。(b)无梯度 rollout 记录退出位置用于回放,重建和计算成本通过停止概率训练 router。主干固定,路由模块仍需训练。 实验效果:表 1:Causal Forcing 1.3B、81 帧、480×832、16 FPS,单 A800、BF16、batch 1。含文本编码、router、KV 与 VAE 的平均端到端时间 11.15→8.56 秒,1.30 倍;patch-NFE 减少 50.19%,VBench 总分 82.08→81.55。减少一半 patch 更新不能叫两倍端到端加速。 论文 Table 1:Causal Forcing checkpoint 上的比较,时间包括生成直至 VAE 解码。加速和 denoising patch-NFE 减少均相对该模型四步基线;列含质量、语义、总分、时间、加速及 NFE 减少。ForcingBooster 时间8.56秒、1.30倍、减少50.19%,总分81.55;四步11.15秒、总分82.08。首段统一四步,不能将 NFE 减少等同整体加速。 批判点评:保留质量是接近基线而非完全相同;路由误判会让尚未完成的细节早退,不同主干加速幅度也不同。文中路由器训练 500 steps,动态稀疏执行有开销。作者项目页及官方仓库可见 Wan 方法实现和权重入口,未运行复现。 6. CacheScope:把完整计算留给高风险步骤 CacheScope: Exact-Compute Allocation for Training-Free Diffusion Acceleration | 中山大学 | arXiv:2610.12530 关键词:扩散缓存加速, 轨迹归一化, 浅层探针, 完整计算调度 前序问题:浅层特征变化同时受到输入轨迹位移和网络响应影响;直接用变化量决定缓存更新,可能把计算花在错误步骤。 本文贡献:每步运行第一个 Transformer block,分别量出输入位移 Δx 与输出变化 Δy,用 s=Δy/(Δx+ε) 衡量沿当前轨迹的灵敏度。累计达到阈值才运行余下 blocks 并更新缓存,否则沿用同一有界一阶重建器;CFG 两分支分别累计。无需训练、梯度或辅助网络,改变的是完整计算落点。 论文 Figure 2:CacheScope 概览。每步先运行第一个 Transformer block 为浅层探针,量出输入轨迹相对位移 Δx_t 和探针响应 Δy_t,累计 s_t=Δy_t/(Δx_t+ε)。超过阈值 τ 才精确计算其余 blocks 并刷新缓存,否则沿用不变的有界一阶重建器。这是相对原探针调度的唯一改动;CFG 的两分支维护独立累计量与缓存。 实验效果:表 2:32 个留出 prompt、各指标取中位数。Wan2.1 Moderate 的原始探针调度 D 与 CacheScope S 约为 2.492、2.493 倍加速,LPIPS 0.0772→0.0414;但 SSIM 0.8961→0.9220。FLUX Fast 下 S 为 3.566 倍、LPIPS 0.1246;数值需按同主干、速度区间和同一重建器解释。 论文 Table 2:32个留出 prompt 的受控调度比较,指标为 prompt 中位数。D、M、S 信号共享同一个 DiCache 有界一阶 Γ 重建器、探针深度和 warm-up,只改变累积信号;统计检验使用附录F.2严格匹配跳步的子集。列含加速、LPIPS、PSNR、SSIM,粗体/下划线为主干和速度档内最佳/次佳。Wan Moderate 的D/S LPIPS为0.0772/0.0414,FLUX Fast 的S为3.566倍、0.1246。 批判点评:LPIPS、PSNR、SSIM 是相对密集生成输出的保真,不是真实图像真值。浅层探针不是完整误差证明,阈值与 warm-up 仍需选;快档可能出现细节偏差,不能称无损。原文未给出可确认的作者方法代码入口,部署价值需在自己的 prompt 与采样器上验证。 7. HD-VSR:消费卡靠关键帧与插帧做超分 High-Throughput Generative Video Super-Resolution on a Single Consumer GPU | Ethical AI Novelties;塞浦路斯理工大学 | arXiv:2610.13179 关键词:生成式视频超分, 稀疏关键帧, RIFE插帧, 邻域注意力 前序问题:逐帧运行扩散超分成本高;全局时空耦合虽能稳视频,却难在单张消费卡上兼顾吞吐和显存。 本文贡献:本文以 HD-VSR 作阅读简称。用预训练一步 AdcSR 增强稀疏关键帧,用 RIFE 从相邻高分辨率关键帧插出中间帧,再以运动门控决定是否回退生成;把部分高分辨率全局注意力替换为邻域注意力,语义关键低分辨率层保留全局。zero-shot 指推理时组合,不是组件从未训练。 论文 Figure 2:所提流程。复用两个预训练组件:AdcSR 对稀疏关键帧做超分,RIFE 作时间插帧。新贡献在组合方式:运动感知交错关键帧策略决定何时调用生成主干,免微调的混合注意力加速空间生成器高分辨率层,时间装配把超分关键帧和插帧合并为完整序列。 实验效果:表 1:RTX 4090、1280×720、关键帧间隔 K=3、batch B=8,吞吐 32.66 FPS、峰值显存 8.99 GB;同 K、B=1 为 8.28 FPS、2.33 GB。表 4 的 4K、B=1,邻域注意力相对原实现 0.76→1.10 FPS,44.7% 提升,基线和口径不同。 论文 Table 1:1280×720下不同关键帧间隔K和batch B的吞吐与显存。K=1、B=1为3.04 FPS、2.03 GB,K=3、B=1为8.28 FPS、2.33 GB;K=3、B=8为32.66 FPS、8.99 GB。K增大时更多帧来自插帧,B增大是吞吐批量,表格不能证明单流32.66 FPS的低延迟。 批判点评:32.66 FPS 是批量交错吞吐,不能当单段低延迟实时生成;插帧需要后一关键帧,高运动和遮挡会受影响。表 3 有感知分下降,作者明确以重建保真换效率,不能称超分质量全面领先。本文未提供可确认的整套框架官方代码入口,AdcSR 与 RIFE 本身也不是本文新模型。 8. ThinkDrag:先理解拖拽意图再改变图像 ThinkDrag: Semantic Drag-Based Image Editing with Visual Reasoning | 南洋理工大学S-Lab | arXiv:2610.13316 关键词:拖拽图像编辑, 视觉推理, 端点标记, 语义编辑评测 前序问题:把拖拽当几何位移,容易移动了像素却没有形成合理的姿态或物体变化;大结构改动也让特征点跟踪失准。 本文贡献:基于 BAGEL 训练统一理解与生成模型,用合成语义编辑对、拖拽点和推理轨迹监督 LoRA。Drag Endpoint Markers 为起终点建立图像空间对应,可直接生成,也可先输出显式推理。构建 145 例 DragBench++,以参考编辑与语义点跟踪补充原有几何距离评测。 论文 Figure 4:ThinkDrag 统一多模态模型流程。源图像、文本化拖拽约束及 Drag Endpoint Markers 为图像生成提供空间对应;模型可直接编辑,或先产生解释拖拽意图的推理轨迹再编辑。图中两种模式共享理解与生成模型,端点标记区别于仅用于展示的箭头。 实验效果:表 1:DragBench++,ThinkDrag 参考图保真 IF* 为 0.905、MD_MLLM 为 34.24;LightningDrag 为 0.836、57.28。原 DragBench 上 ThinkDrag FID 30.05、MD 28.84,GeoDrag MD 22.77 更低。附录推理模式相对直接模式只赢 75/145,即 51.7%,不是稳定全面胜出。 论文 Table 1:DragBench++与DragBench结果,TTO/OS/FT分别为测试时优化、一步方法、微调。IF对输入图像,IF*对参考编辑,MD为DIFT跟踪距离,MD_MLLM为语义跟踪距离,FID衡量分布差异;↑/↓标指标方向,缺测为横线。ThinkDrag主表为直接模式:++上IF*0.905、MD_MLLM34.24;原DragBench的MD28.84,GeoDrag22.77更低。 批判点评:数据和新评测含合成图像及模型裁判,参考编辑也不是唯一正确解。主表采用直接模式,不能把全部提升归给显式推理;推理增加串行生成时间,点跟随精度未处处最好。作者项目页与仓库已核验;当前仅 README/LICENSE/assets,数据、权重和推理代码均列 TODO,尚不能据此复现。 9. TTS-Q:把量化精度留给后期音色 TTS-Q: Perception-Guided Post-Training Quantization of Text-to-Speech Diffusion Transformers | Wyze;纽约市立大学城市学院;中科院计算所;台湾大学;清华大学 | arXiv:2610.12474 关键词:语音扩散量化, 音色保真, 任务匹配校准, 后期FFN精度 前序问题:低字词错误率不代表声音仍像目标说话人;四位语音扩散量化的音色损失集中在特定层与去噪阶段。 本文贡献:在任务匹配候选中选初始重建误差高的语音,取特定采样状态校准 FlatQuant;权重保持 W4,把末期 FFN 激活升为 A9,其余用 A3,匹配约四位的名义激活预算。该预算按参数加权,并不保证同样的实测时延;没有重新训练 TTS 主干,仍有离线校准优化。 论文 Figure 1:TTS-Q。上方文本和说话人参考条件化TTS DiT,采样状态用于离线校准,阴影FFN为推理精度分配;CER/SIM为字符错误率/说话人相似度。左下按初始损失排序任务匹配候选,取语音-步数快照拟合均匀W4A4。右下权重W4,晚期FFN激活升精度、其他位置降精度;早晚示意在相同名义预算比较,名义预算不等于实测时延。 实验效果:表 1:Seed-TTS-eval 留出集,3.5B 英文,均匀 W4A4 参考 SIM 0.7796→TTS-Q 0.7829,全精度为 0.7834;WER 1.813%→1.918%,全精度 1.919%。各方案 32 条校准、steps {13,14}。附录 S11 的 15.83→4.44 GB 来自均匀 W4A4 部署,未测试混合 TTS-Q 路径。 论文 Table 1:Seed-TTS-eval留出集,zh/hard/en为1720/300/888项;中文CER和英文WER均为百分数,另报SIM。校准均为32项、steps{13,14}、64快照;三个均匀W4A4行仅选择数据不同,lossmax为均匀参考。TTS-Q权重W4,A9/A3均衡预算在1B/3.5B为4.000/3.947位;粗体只在量化结果中按列比较,全精度不参与。3.5B英文SIM为0.7829、WER为1.918%。 批判点评:名义四位不等于全程 W4A4,更不能把均匀量化的显存和速度归给混合方案;1B 部署量化路径还可能更慢。原摘要与 PDF 均记首发 8月11日,本期是首次纳入,不能称10月新发。原文未给出可确认的方法官方仓库或权重入口。 10. MusicEval Probes:音乐裁判是否真的听了音频 What Do Audio-Language Judges of Generated Music Listen For? Four Probes with Controls from Expert Ratings | 华沙理工大学计算机科学研究所 | arXiv:2610.13247 关键词:音乐生成评测, 音频语言裁判, 位置偏差, 专家对照 前序问题:裁判评分与专家相关,不等于它真正听懂音乐质量;文本提示、候选位置和问法都可能改变生成模型排名。 本文贡献:以 MusicEval Probes 作阅读简称,审计五个开放音频语言裁判:去掉音频、同 prompt 换另一模型音乐、交换成对顺序、重写指令,并用专家评分计算相应对照。MusicEval 覆盖 2748 段音乐,后两项也测 SongEval,直接检验生成音乐评价是否可靠,而非提出音乐生成器。 论文 Figure 1:五个裁判的四种探针中两种,附95% bootstrap区间。左侧同prompt换音乐,实心/空心为裁判分对实际播放片段/被替换片段专家分的标准化系数,分别看质量与对齐;真正听音频应追随播放片段。右侧在相同300段音乐上换三种指令问法,比较与专家质量分的相关。 实验效果:表 1:Qwen3-Omni 音乐质量 Spearman 相关为 0.31;去掉音频后为 0.04,专家构造的 prompt-only 对照为 0.08。表 2:600 对样本交换顺序,Music Flamingo 99% 仍选同一位置,Qwen3-Omni 为 25%;随机参照是 50%,同位置意味着优选音乐随交换改变。 论文 Table 2:同prompt交换的列报告裁判分对实际播放与被替换片段专家分的标准化回归系数,共2327次交换。顺序交换列报告600对样本两种顺序下选同位置的比例、其中选第二位置的比例、顺序平均偏好与专家一致的比例;随机参照为0.50/0.25/0.50,区间见表13和12。Music Flamingo同位置0.99,Qwen3-Omni为0.25,不能把同位置率当音质准确率。 批判点评:相关系数不是准确率,位置偏差也不是总体音质差。问法实验使用固定 300 段片段,结论受裁判版本、prompt 和数据集约束。模型级相关与片段级相关不能混用,选音乐生成器时应同时做专家验证。原论文未提供可确认的本研究官方实现入口。 趋势观察 表征既要对齐也要服务生成 InstantFusion对齐中间状态与速度,RG直接改变内部表征对预测的影响,CoVA分阶段使用VAE特征。表征图看着更有语义,不等于最终生成收益。 预算应该落在最需要的位置 Memory Forcing决定缓存留下谁,ForcingBooster决定哪些patch继续去噪,CacheScope决定哪些步骤完整计算,TTS-Q把名义精度留给晚期FFN。预算口径不同,收益须配条件。 吞吐与训练收敛各有代价 HD-VSR高FPS依靠批量和插帧;CoVA单步训练更慢但同迭代FID更低。不能把batch吞吐叫单流低延迟,也不能把少训练轮数直接等同省时比例。 评测要拆开目标和对照 ThinkDrag的几何点距与语义合理性未必一致,MusicEval Probes检验音频、位置和问法的干扰。生成部署需要原始任务与人工验收共同决定。 今日讨论 InstantFusion把SD3的GenEval-v2从22.14提高到35.06,但仍要求共享VAE、兼容时间参数并装载多个主干;你需要哪些指标和显存证据,如何判断接力生成是否值得用在自己的图像工作流中? 人工智能炼丹君 整理 | 2026-10-13
-
AIGC 每日速读|2026-10-12|Google把token留给细节BudgetPix 今日 AIGC 论文速览 今日共 10 篇 · 图像计算与自训练 3 篇 · 视频编辑与加速 3 篇 · 局部三维生成 1 篇 · 音视频与语音控制 2 篇 · 生成编辑评测 1 篇 重点论文标题列表 BudgetPix(Google):按细节分配可变token预算 Data-space DMD(字节):不用时间表直接反复修图 Rubric-CEPR(MBZUAI):只把核验通过的编辑教回模型 VINCIE-NExT(字节):先编辑关键帧再把变化传给视频 PTD(NVIDIA):让四步学生沿自己的曲线学 今日论文速览 1. BudgetPix:按细节分配可变token预算 BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion | 伊利诺伊大学厄巴纳-香槟分校;Google | arXiv:2610.12307 关键词:像素空间扩散, 四叉树, 可变token预算, 多尺度解码 前序问题:固定网格给平滑背景和复杂纹理相同的计算预算;直接减少 token 又容易破坏细节,难用一个模型适配不同推理预算。 本文贡献:BudgetPix 按图像强度直方图熵构造四叉树,复杂区域保留细 patch,平滑区域合并为粗 token;多尺度 Patch Aggregator 编码粗格,Refiner 恢复固定分辨率。训练时扰动布局与预算,推理按当前去噪预测重估布局。新增编解码路径需要训练,Transformer 从已有像素空间扩散模型初始化。 论文 Figure 3:BudgetPix 总览。编码器把固定大小图像变成不同尺度、可变数量的 token,解码器恢复固定分辨率,训练和推理都支持不同 token 数。紫色编码器与解码器从头训练,蓝色 Transformer 从已有主干初始化;图中三部分共同构成预算自适应像素空间扩散。 实验效果:表 1:1024² PixelDiT-T2I,BudgetPix 在 25% token 预算下 GenEval 为 0.725、DPG-Bench 为 83.7;原模型全预算分别为 0.721、84.8。原模型同为 25% 预算时降至 0.323、55.1。不同指标说明保留指令遵循的程度,不能把 25% token 预算直接当四倍端到端加速。 论文 Table 1:1024² PixelDiT 文生图在 100%、90%、80%、70%、60%、50%、25% token 预算下的 GenEval 与 DPG-Bench。BudgetPix 各预算指标高于对应原模型;25% 时 GenEval 0.725、DPG 83.7,原模型全预算为 0.721、84.8。这里是预算与指标比较,未给出四倍端到端时延。 批判点评:布局依据中间预测,尚未出现的小细节可能分不到 token;PixelDiT 的全分辨率像素阶段还形成计算下限。需先微调,不能视为免训练插件,也不能把一个指标接近说成画质无损。作者项目页目前未提供可确认的方法代码或权重入口。 2. Data-space DMD:不用时间表直接反复修图 Few-Step Generation via Data-Space Iteration | 字节 Seed | arXiv:2610.12102 关键词:少步图像生成, 数据空间迭代, DMD蒸馏, 自rollout 前序问题:少步采样通常仍沿概率流选定几个时间点;难例和不同空间区域需要的修正次数不同,手工时间表未必适合。 本文贡献:共享生成器从噪声开始,直接把上一轮数据预测、原始噪声和迭代编号作为条件,反复修正干净样本,不再在每轮输出后按指定时间点重新加噪。通过分布匹配蒸馏 DMD 训练每一轮输出,并用自身 rollout 形成训练输入。它取消流时间离散化,仍需选择迭代次数与训练噪声采样。 论文 Figure 1:(a)现有少步生成沿概率流空间迭代,需要预定时间离散化,可能并不最优;图中从初始噪声经多个带噪状态到数据端点。(b)数据空间迭代直接修正每轮数据预测,以原始噪声和轮次作条件,取消流时间离散化瓶颈。两排小图用于示意各自迭代过程。 实验效果:表 3:类别条件 ImageNet 256×256,四次网络评估、启用 CFG 时,Data-space DMD 的 FID 为 2.29,均匀时间表 DMD 为 2.61,搜索三种时间表后的 Phased DMD 为 2.37。250 次评估的流模型 FID 为 2.06,少步方案尚未达到该教师水平。 论文 Table 3:ImageNet 256×256 的主结果,FID 越低越好。上半不开 CFG,下半启用 CFG;比较 250 NFE 流模型、1–4 NFE DMD、4 NFE Phased DMD 与数据空间 DMD。oracle 仅取三种搜索时间表中的最佳结果;数据空间方法无需时间表,启用 CFG 的四步 FID 为 2.29,教师 250 NFE 为 2.06。 批判点评:主结果是类别条件小图,文生图与其他模态仍属未来工作;自 rollout 有训练成本,不是把任何现有采样器换个循环就有效。不同训练权重与 CFG 需同时核对。作者在附录给出实现细节,未从论文入口确认独立代码仓库或权重。 3. Rubric-CEPR:只把核验通过的编辑教回模型 Rubric-CEPR: Self-Evolving Image Editing via Reward-Verified Self-Distillation | 穆罕默德·本·扎耶德人工智能大学;阿尔托大学 | arXiv:2610.12469 关键词:图像编辑, 内部奖励, 可行性门控, 自蒸馏 前序问题:模型自己生成的编辑样本可能真实却没按指令改;单一奖励还可能让“保留得好”补偿“根本没编辑”,把失败教回模型。 本文贡献:Planner 从未标注图像提出结构化编辑要求,Editor 采样多个候选,冻结 Critic 利用原编辑器的视觉语言特征和 VAE 潜变量检查新状态、旧状态消除及局部保留。任何适用检查不通过就拒绝,再把最佳可行样本用于 LoRA 加权去噪训练;主要循环不查询外部奖励模型。 论文 Figure 2:Rubric-CEPR 的提出、编辑、核验与蒸馏循环。冻结 Qwen-Image-Edit 提供 Qwen2.5-VL 理解分支、MMDiT 与 VAE;Planner 的 LoRA 给出指令 c 和结构化要求 s,Editor 的 LoRA 采样 K 个编辑。冻结 Critic 以语义支持与增益、VAE 保留检查构成 R=Gate·√(Edit×Preserve),新状态、旧状态消除、正确操作、无关内容保留与局部性任一适用项失败即拒绝;最佳通过样本训练 Editor,难度带内提案轨迹训练 Planner,进入下一轮。主要循环不查询外部奖励模型。 实验效果:表 1:Qwen-Image-Edit-2509 在 ImgEdit 的 0–5 分制总分 4.36→4.60,相对提升 5.5%;物体分离 3.41→4.26,相对提升 24.9%。总分差为 0.24±0.02,报告的是三次训练种子的标准差。表 2 的 GEdit-Bench 总分 7.39→8.31。 论文 Table 1:ImgEdit 各编辑类别及总分,0–5 分制。内部奖励自蒸馏使 Qwen-Image-Edit-2509 总分 4.36→4.60,相对提升 5.5%,差值 0.24±0.02 为三种子标准差;物体分离 3.41→4.26,相对提升 24.9%。Δ 按 100×(适配分−原分)/原分计算;† UniWorld 使用外部奖励,其原模型与裁判协议不同,不能直接横向归因。 批判点评:内部可检查的编辑更受益:若原模型完全采不到正确样本,多采样也找不到训练目标;调整类内部信号最多追回 30% 的 oracle 空间。主要结果是一次适配,不能称为持续多轮自进化。跨论文裁判协议不同。作者仓库可访问,未运行复现。 4. VINCIE-NExT:先编辑关键帧再把变化传给视频 VINCIE-NExT: Unlocking Video Editing from Images via In-Context Modeling | 新加坡国立大学;字节 Seed;中国科学技术大学 | arXiv:2610.12104 关键词:视频编辑, 图像示范, 共享空间位置, 编辑链 前序问题:视频编辑三元组昂贵;成熟图像编辑数据很多,但改对一帧不代表变化能稳定传到所有视频帧。 本文贡献:把任务拆成视频→图像→编辑图像→视频,以源与目标图像对作为上下文示范;TDF3D-RoPE 将示范和视频帧放在共享空间坐标中,统一扩散主干联合学习各子链。Chain-of-Editing 在推理时先得到编辑图像,再生成编辑视频,也允许更强图像编辑器提供示范。 论文 Figure 2:VINCIE-NExT 总体架构。把视频编辑分成视频→图像→图像→视频子任务链,源图 Iˢ 与编辑图 Iᵗ 作为上下文视觉示范。统一扩散主干据此把成熟图像编辑先验迁移到视频帧;图中各段代表可组合子链,而非完全无需视频编辑训练数据。 实验效果:表 1:431 段 OpenVE-Bench,Gemini 2.5 Pro 按 1–5 分评分,VINCIE-NExT 总分 3.08,高于 OpenVE-Edit 的 2.49,但低于 Runway Aleph 的 3.65;输出分辨率分别为 640×480、1280×704、1280×720。表 2 的第一阶段 256×256 模型,全数据加 CoE 为 2.65,不是同条件的 3.08。 论文 Table 1:OpenVE-Bench 八类编辑比较,Gemini 2.5 Pro 按 1–5 分自动评分。#Reso. 为输出分辨率,灰行是闭源商业模型。VINCIE-NExT 在 640×480 总分 3.08,OpenVE-Edit 在 1280×704 为 2.49,Runway Aleph 在 1280×720 为 3.65;各类包括全局风格、背景、局部改删增、字幕、创意与相机编辑。 批判点评:训练仍用了 OpenVE 视频编辑配对,不能叫完全不用配对视频;关键帧编辑错误会被传播,长视频与大相机运动仍待验证。CoE 增加串行扩散阶段。arXiv 注释明确已接收 NeurIPS 2026。作者项目页有仓库入口,但当前仓库只有 LICENSE 和 README,方法实现与权重尚未公开。 5. PTD:让四步学生沿自己的曲线学 Parametric Trajectory Distillation for Few-Step Video Generation | 洛桑联邦理工学院;NVIDIA;斯坦福大学 | arXiv:2610.11498 关键词:视频少步蒸馏, 参数化轨迹, 教师速度监督, 多样性 前序问题:把高度弯曲的教师轨迹压成几次学生评估,学生容量可能学不动,导致细节变软或不同种子生成近似视频。 本文贡献:Parametric Trajectory Distillation 让学生预测片段的平均速度与多项式曲率,在学生当前曲线上查询教师速度,以最小二乘损失同时学位移和形状;部署时去掉曲率头,只用平均速度更新端点。MiniMax-H3 的最后一个较平滑片段采用教师积分目标,并非所有片段都同一种监督。 论文 Figure 2:参数化轨迹蒸馏。一次学生评估输出平均速度 h 与曲率系数 c,参数化潜变量去噪片段;在学生曲线上查询教师速度,以同一个最小二乘损失监督两者。推理只使用 h 更新片段端点,移除曲率头。小视频图示意片段终止于数据端点,同样构造适用于中间噪声层;箭头为步长缩放速度,默认每片段查询两次教师。 实验效果:表 1:Wan2.1-14B 四次网络评估,匹配训练设置的 PDD 复现 VBench 总分 83.67→PTD 84.57,语义分 77.40→81.10。盲测人类偏好份额相对 PDD 为 55.1%,相对 MiniMax-H3 上的 LightX2V Turbo 为 63.4%。这是两项独立比较,不是所有基线的平均胜率。 论文 Table 1:Wan2.1-14B 的 VBench 与多样性。粗体只对比相同训练设置下 PDD 第96次更新与 PTD 第64次更新;灰色行是已发表参考,训练预算及协议不同。NFE 含引导评估,教师为 50×2;多样性是 V-JEPA 2 与 VideoMAE V2 特征余弦距离。PTD 总分和语义分提升,但这两项多样性不高于该 PDD 复现;rCM 用专有 prompt 且未报告多样性。 批判点评:表 1 的 VideoMAE 多样性 0.0254→0.0180,改善并非所有指标同时成立;发表的参考行训练预算和协议不同。去掉训练曲率头不等于不用蒸馏,四次评估也不等于视频生成时延。作者项目页有演示,未确认 PTD 方法权重公开。 6. iCATS:按交互与噪声动态稀疏注意力 iCATS: Fast Video Generation via Interaction-Aware Sparse Attention and Timestep-Adaptive Sparsity | 杭州师范大学;平头哥半导体;阿里巴巴 | arXiv:2610.11302 关键词:视频DiT加速, 交互聚类, SNR稀疏调度, 尾部合并 前序问题:独立按特征距离聚类 query 与 key,未必保留实际注意力交互;固定稀疏度和不规则簇填充又会损伤画质与 GPU 利用率。 本文贡献:iCATS 用 query-key 点积交互定义聚类目标,并改写成低成本二次型;以信噪比 SNR 调整各去噪时间步的 top-p 稀疏掩码。执行时将不满计算块的尾部 token 重新分配,减少 padding。无需微调生成主干,但聚类、调度与稀疏 kernel 都有实际开销。 论文 Figure 3:iCATS 的稀疏注意力流程。①按 query-key 交互聚类,用簇中心估计簇级 softmax;②以 SNR 引导每个去噪步的 top-p 值并选注意力计算区域;③在稀疏 kernel 前重分配未对齐计算块的 query 簇尾部 token,减少不规则簇的 padding。图中 interaction clustering 为交互聚类,Euclidean clustering 仅用于首个稀疏步初始化 query 簇。 实验效果:表 1:5 秒 720p、八张 H100,HunyuanVideo-T2V-13B 的 iCATS-Base 从 1730 秒降至 854 秒,2.03 倍,PSNR 31.017 dB;Wan2.1-T2V-14B 从 1889→1222 秒,1.55 倍,PSNR 29.301 dB。相应 VBench 为 0.844 与 0.838。 论文 Table 1:三种视频主干的密集、SVG、SVG2、iCATS-Base 与 Turbo 比较。PSNR、SSIM、LPIPS 衡量相对原模型输出的保真度,VBench 衡量视频质量,Time 是实测秒数,Sparsity 是理论注意力计算削减比例。5秒720p、八H100下,Hunyuan Base 为854秒、2.03倍、31.017dB,Wan文生视频 Base 为1222秒、1.55倍、29.301dB;不可把稀疏率当整体加速率。 批判点评:PSNR 比的是相同配置的原密集模型输出,不是真实视频真值;理论稀疏率不能当实际整体加速率。八卡结果不能外推单卡,且聚类多卡并行和 token 级 kernel 仍待优化。未从论文作者入口确认代码或权重公开。 7. SpaceFlow:不同3D部位分配不同控制强度 SpaceFlow: Locally Controllable 3D Generation | 苏黎世联邦理工学院;斯坦福大学;Microsoft | arXiv:2610.12399 关键词:3D生成, 局部几何控制, 部件条件路由, 自相似引导 前序问题:对整个物体统一控制强度,难同时保住指定结构并让其他部位自由生成;局部材质 prompt 还可能串到别的部件。 本文贡献:SpaceFlow 在 TRELLIS 推理中给每个几何 primitive 指定强弱控制,在受控时间段注入高控制区域;生成结构后用 PartField 划分部件,将局部文本或图像外观条件路由到对应区域,再用自相似引导细化外观。几何约束与外观条件分别作用,支持同一物体各部位不同自由度。 论文 Figure 2:SpaceFlow 流程。输入可编辑几何及局部控制强度 τᵢ,在受控时间段把高控制区域注入稀疏结构 flow;PartField 分割生成结构后,将每个部件的文字或图像条件只路由到该部件,再经外观 flow 与自相似引导得到局部几何和外观可控的3D资产。 实验效果:表 1:83 个资产,局部 τ=3/10 对比统一 τ=3,prompt 与几何保真胜率 78.3%、总体胜率 75.9%,但真实感胜率仅 43.4%;对比统一 τ=10,总体胜率为 68.7%。表 4 的外观总体评分 6.78,但纹理细节 6.49 低于 TRELLIS 的 6.87。 论文 Table 1:83个资产上局部几何控制胜率。SpaceFlow 低/高 τ 为3/10,与统一全局 τ=3及τ=10的 SpaceControl 比较 prompt与几何保真、真实感和总体偏好;括号为95% Wilson区间。对τ=3,总体75.9%但真实感43.4%;对τ=10,总体68.7%,说明保真与真实感存在条件相关取舍。 批判点评:胜率来自指定视觉语言裁判与资产集,表中附 95% Wilson 区间,不能当任意3D对象的成功率。语义与强几何约束冲突时会变形;更多局部控制也未必提升纹理细节。原文给出推理设置,未确认作者已发布 SpaceFlow 实现。 8. SepGen:同次生成视频混音和两路分轨 SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model | 特拉维夫大学;Google | arXiv:2610.11361 关键词:音视频生成, 分轨生成, 文本寻址, 混音噪声调度 前序问题:音视频模型通常只给一条混音;想换视角做空间音频,或单独编辑某个声源,就缺少可寻址的独立波形。 本文贡献:SepGen 在预训练音视频双流模型中增加分轨 adapter,每路由独立描述指定声源,在同次采样中生成视频、混音与分轨。分离模式保持输入混音干净;生成模式在高噪声读取带噪混音,低于阈值 σ_g 后读取其干净预测,减少分轨与混音错位。原混音主干保持不变。 论文 Figure 2:σ空间中的三种推理调度,从左到右:(a)分离模式保持混音 m 干净;(b)朴素共享噪声生成让分轨和混音处于同一噪声层;(c)SepGen 的分轨在 σ_g 以上读带噪混音,以下读其干净估计 ẑ₀,m,以改善生成时各声源与混音的对应。 实验效果:表 1:134 个声音案例和 60 个语音案例,联合生成的声音裁判分为 3.82,FlowSep 串行分离为 3.35;语音 WER 为 0.07,即 7%,FlowSep 为 1.03,即 103%。额外自分离声音分为 4.21,却使 WER 变为 0.10;这需要再运行一次,不能算同次采样。 论文 Table 1:生成评测,134个声音与60个语音案例;所有串行基线对同一生成混音和相同描述做分离,两行 SepGen 都使用生成 checkpoint。Judge/J-swap 为声音裁判及描述交换分,CLAP/C-swap为声音文本对齐及交换分,越高越好;语音WER与跨轨Cosine越低越好。联合采样WER0.07是7%,额外自分离WER0.10是10%;粗体与下划线是最好与次好,不代表额外自分离也是一次采样。 批判点评:当前训练和评估固定两个声源,不能声称任意数量分轨;声源仍带原场景混响与距离线索,完整新视角空间渲染属于后续工作。codec 重合成相位还影响 SI-SDR 的解释。作者项目页列出代码、模型和数据入口,未运行复现。 9. EDICT:全局改音色局部切换说话方式 Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS | 新加坡国立大学;LIGHTSPEED;南洋理工大学;独立研究者 | arXiv:2610.11437 关键词:语音生成, 音色编辑, 局部指令, KV缓存重建 前序问题:参考语音克隆保留旧音色,文字设计又难在同一参考上微改;整句表达指令无法准确控制每个文本片段的语气。 本文贡献:EDICT 先把参考语音和结构化属性编辑送入可训练音色编辑器,生成 codec token 参考,作为各段共享的身份锚。冻结 TTS 主干按分段指令连续生成,在每个边界重建 KV 缓存:换入新指令和文本,同时保留首段与最近一段选定声学上下文,让表达变化但声音身份连续。 论文 Figure 1:EDICT 联合全局音色编辑与局部表达控制。可训练编辑器读取源参考和全局编辑指令,输出共享codec参考;每段冻结TTS均使用它。在指令边界重建KV缓存,以选定历史声学上下文保持衔接,多个片段组成一条连续话语。 实验效果:表 4:Qwen3-TTS-VD 联合控制,EDICT 的片段指令准确率 81.62%、过渡质量 83.45%;原 Joint 为 60.19%、70.07%。段间说话人相似度为 0.917、与原 0.918 接近;英文 WER 3.6%→5.1%,中文 CER 1.2%→1.9%,内容正确性付出代价。 论文 Table 4:Qwen3-TTS-VD上的联合音色及表达控制,请求结合TimbreEdit-Bench的音色编辑与IntraTTS-Bench的分段指令。SIM-T是整条语音与目标声线相似度,SIM-I是段间相似度;WER/CER分别为英文/中文百分数,粗体/下划线为最好/次好且分语种排名。EDICT的SegAcc81.62%、Trans83.45%、SIM-I0.917;错误率5.1%/1.9%,须与控制分共同看。 批判点评:音色编辑器仍要训练,冻结 TTS 主干不等于全系统免训练;训练、指令构造和评测含合成数据与模型裁判。指令遵循更高不能代替低错误率,推广到更多声线还待验证。作者演示页,未确认官方方法代码与权重入口。 10. RISEBench++:检查图像编辑是否真的推理对 Reasoning-Informed Visual Editing | 上海交通大学;东南大学;华南理工大学;微软亚洲研究院;复旦大学;华东师范大学 | arXiv:2610.12343 关键词:生成编辑评测, 隐式规则, 多轮一致性, 多图条件 前序问题:画得自然或保住外观,不代表模型从图中推断了正确状态;因果、空间规则和多轮条件经常在编辑图像中失效。 本文贡献:RISEBench++ 用六类推理、12 个子类和 65 种任务组织 1000 个英中文人工标注案例,覆盖单图、多图与多轮编辑。裁判分别评指令推理、外观一致性和视觉合理性,以任务条件检查生成图像;论文另研究带规划与核验的编辑执行流程,本期关注生成能力评测。 论文 Figure 3:RISEBench++的三维评测与流程。指令推理与外观一致性由Gemini-3-Flash按类别专用prompt评判,视觉合理性由Gemini-3.1-Flash-Lite评判;分别检查是否推理并执行正确、保留应保内容及画面是否合理,不能以自然外观替代推理正确性。 实验效果:表 1、2:共评估 58 个视觉编辑方案。英文集 GPT-Image-2.5 Sunburst 总任务准确率 56.6%,逻辑类 27.0%、混合类 39.0%;Nano Banana Pro 总分 54.6%,逻辑类 36.0%。领先总分也可能有明显类别短板,不能从一个榜单分推断所有编辑能力。 论文 Figure 6:英文RISEBench++细粒度任务准确率雷达图,展示七个模型在12个子类的65种任务上的表现。各轴对应不同任务,局部短板与总分排名并不一致;数值是此评测协议的任务判定,不是所有真实编辑的通用成功率。 批判点评:准确率是本数据集、指定模型版本和裁判协议下的任务判定;混合多轮错误会累积,英中文结果须分别看。不是纯视觉理解测验,产出要求确实编辑图像。官方仓库提供评测说明与样例,完整千例数据链接已单独核查。 趋势观察 先定义计算预算再谈加速 BudgetPix分配token,Data-space DMD调整迭代位置,PTD匹配学生能学的曲线,iCATS兼顾注意力保真和kernel开销。token比例、网络评估次数和端到端时延是不同口径。 内部监督也要验证失败条件 Rubric-CEPR用不可互相补偿的门控筛目标;RISEBench++把推理执行与外观合理性分开。画面真实或自评高分都不够,仍要检查未编辑内容和真实任务约束。 把控制绑定到正确对象与时间 VINCIE-NExT绑定关键帧示范,SpaceFlow路由到局部部件,SepGen分配声源描述,EDICT在分段边界重建上下文。局部控制有效,还要验证全局一致性与连续性。 更高总分仍可能付出代价 EDICT内容错误率、SpaceFlow纹理细节、PTD部分多样性都揭示不同目标间的取舍。部署时应使用自己的分辨率、声源数、视频长度与硬件复核。 今日讨论 BudgetPix用四叉树按熵分配token,在25%预算下GenEval为0.725,但全分辨率像素阶段形成计算下限;你会用哪些细节证据与端到端时延测量,判断这种预算在自己的图像生成场景中是否值得采用? 人工智能炼丹君 整理 | 2026-10-12
-
AIGC 每日速读|2026-10-09|KAIST视频生成快11.1倍GRACE 今日 AIGC 论文速览 今日共 10 篇 · 视频表示与自回归生成 3 篇 · 图像token与跨模态编辑 2 篇 · 几何与物理场景生成 2 篇 · 连续语音与情绪控制 2 篇 · 生成图像文字评测 1 篇 重点论文标题列表 GRACE(KAIST):压缩潜空间让视频快11.1倍 QuadTok(UCSD):用四叉树把token留给细节 SGF+(清华):让记忆写入与去噪各练各的 CrossEdit(Adobe):从复杂音频编辑迁移到音视频 Tetris3D(KAIST):生成能互相支撑的3D物体 今日论文速览 1. GRACE:压缩潜空间让视频快11.1倍 GRACE: Generation-aware latent compression for efficient video generation | 韩国科学技术院;Kakao | arXiv:2610.10524 关键词:视频潜空间, 双潜变量, 生成对齐, 非对称去噪 前序问题:更强的 VAE 压缩能减少视频 token,却会改变预训练生成模型熟悉的分布。重建更清楚的潜空间,也未必更容易生成。 本文贡献:GRACE 保留冻结编码器从降采样视频得到的基础潜变量,另学残差潜变量补回丢失信息;在冻结 DiT(用 Transformer 做扩散生成)的特征空间对齐压缩前后表示。第二阶段用 LoRA 适配 DiT,让基础部分比残差更早去噪,后者依托已稳定的结构补细节。 论文 Figure 2:GRACE 总览。第一阶段冻结编码器从降采样视频提取基础潜变量,残差编码器从完整视频补信息,联合解码;对齐损失在冻结 DiT 内匹配压缩前后表示,右侧虚线框示意新增模块。第二阶段用 LoRA 适配 DiT,每步让基础部分处于更低噪声,先于残差稳定。 实验效果:表 1、2:Wan2.1-I2V-14B 的 token 约 32.8k→4.3k,VBench-I2V 总分 87.92→87.90;480×832、81 帧、50 步、单 A100 下加速 11.1 倍。表 3 的 736×1280、81 帧配置为 15.5 倍。计时含条件图编码、去噪和视频解码,不含加载、文本编码及 MP4 写盘。 论文 Table 1:视频自编码器在 256×256×81 重建与 480×832×81 生成条件下的对比。GRACE 将潜变量 token 从 32.8k 减至 4.3k,适配同一 Wan2.1-I2V-14B 后总分 87.92→87.90;但重建 PSNR 35.15→32.63 dB。灰色行是本文方法,粗体仅比较后三种同为 4.3k token 的压缩表示。 批判点评:接近的总分不保证逐项或逐帧无损;表 1 重建 PSNR 35.15→32.63 dB,说明优化生成不等于改善重建。仍需训练 VAE 与适配主干,不能即插即用,更不能把特定 GPU 与视频长度的倍数外推所有配置。作者项目页提供演示与方法入口。 2. QuadTok:用四叉树把token留给细节 QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation | 加州大学圣迭戈分校 | arXiv:2610.10497 关键词:自回归图像, 四叉树token, 空间对应, 复杂度引导 前序问题:固定二维网格把平滑背景和复杂纹理分到相同预算;一维压缩序列虽灵活,却容易丢掉 token 与空间区域的明确对应。 本文贡献:QuadTok 用四叉树逐级细分区域,并按广度优先顺序串成序列。tokenizer 的亲缘注意力限制粗细层与兄弟节点交互;互补探测树的重建收益决定哪些区域多分 token。生成器在预先给定的树拓扑上,用普通因果注意力逐项预测视觉码,保留零样本布局控制。 论文 Figure 2:(a)四叉树按广度优先遍历串成一维序列,ViT 特征聚合成树节点,再量化与解码;(b)层级解码,粗节点恢复整体结构,细节点补局部;(c)互补探测树估计各区域的重建收益,用于形成内容自适应树。 实验效果:表 1:256×256 ImageNet 上平均 230 个 token,相比 LlamaGen 的 256 个少约 10%,rFID 2.19→1.46,但 PSNR 20.79→20.37;零样本 COCO 为 232 个 token、rFID 7.88。表 2 的 947M 类别条件生成模型 gFID 为 2.08。 论文 Table 1:256×256 ImageNet 与 COCO 重建比较。QuadTok 的 token 数是各数据集平均序列长度,ImageNet 训练的 tokenizer 直接迁移 COCO;f 为 LlamaGen 降采样倍率。表中更低 rFID 与更低 PSNR 可同时出现;三层树预算更多,不能只按树深度归因。 批判点评:重建时的内容自适应树不等于生成器自行预测树:采样前须指定拓扑。文生图仍是未来工作,类别条件与布局控制不能直接叫通用文生图。表 2 各系统训练与采样设置不同,不能只凭 gFID 归因于树结构。官方仓库已提供 tokenizer 训练、重建与预编码,生成模型不在该发布范围。 3. SGF+:让记忆写入与去噪各练各的 SGF+: Decoupling Gradient Flows for Autoregressive Video Generation | 清华大学;京东探索研究院;香港中文大学 | arXiv:2610.10429 关键词:自回归视频, 上下文梯度, 参数分离, 长时生成 前序问题:当前帧去噪和给未来写入 KV 记忆若共享参数,两种梯度可能冲突;只截断记忆梯度,又让后续生成无法监督记忆怎么写。 本文贡献:SGF+ 先无梯度自生成并记录干净上下文与采样出口,再并行重算可微 KV,让未来预测的原生成损失监督记忆写入。把写入与去噪参数分开,以因果注意力连接两者,不增加辅助损失。论文实测采用两套完整参数,而非只训练两个小 adapter。 论文 Figure 4:SGF 与 SGF+ 的两遍训练。第一遍无梯度自回归生成,记录停止梯度的干净上下文 X 和采样出口的带噪目标 Z*;第二遍从记录重构计算,让未来生成损失通过可微 KV 监督上下文。SGF 共享 θ,SGF+ 分别使用写入 θ_c 与去噪 θ_d。 实验效果:表 1 的 240 秒、分块生成,主体一致性由 SGF 的 97.72→98.21,审美 62.54→64.74,动态程度 56.97→56.92。训练窗口为 5 秒;作者另展示最长 24 小时连续生成,定量主表评测的是 60 秒与 240 秒。 论文 Table 1:60 秒和 240 秒的逐帧、分块生成比较,分别使用 VBench-Long 和 MovieGen-128 prompt。每组各方法的初始化、prompt 与随机种子一致;质量与一致性指标越高越好。动态程度可能因跳景或形变变高,不能单项决定质量;此表不是 24 小时量化评测。 批判点评:24 小时是演示能力,不是完整时长的定量质量或剧情评测。动态程度及部分图像质量并非全面更好;复制参数还增加存储成本。长期画面稳定不保证事件逻辑成立。作者项目页包含长视频材料。 4. CrossEdit:从复杂音频编辑迁移到音视频 CrossEdit: Cross-Modal Training Enables Rich Audio-Visual Editing | Adobe Research;卡内基梅隆大学 | arXiv:2610.10264 关键词:音视频编辑, 跨模态迁移, 合成编辑对, 指令遵循 前序问题:修改电影场景时既要理解组合指令,又要只动指定内容并保持声音与画面一致;这样的真实音视频编辑配对很难大规模收集。 本文贡献:CrossEdit 利用声音可相加的特点合成复杂音频编辑对,结合音视频掩码重建、唇同步编辑及精选跨模态任务做微调。统一 MoE DiT 通过 flow matching 编辑图像、音频与视频,将已学的复杂指令能力迁移到未见过的音视频场景编辑组合,并提出 CrossEditBench 与 AV-FES。 论文 Figure 2:CrossEdit 编码音视频输入的架构。图中省略图像,因为图像按单帧视频处理;音频与视觉经各自 VAE 进入统一生成模型,条件侧还使用干净语义表示。跨模态迁移仍依赖音视频重建等训练任务。 实验效果:表 2 的 CrossEditBench:相对 CrossEdit-Base,AV-FES 0.26→0.30,视觉子分 0.20→0.26,音频子分 0.31→0.33。模型总参数 12B、每次激活 3B;这些编辑分是论文协议下的综合评分,不是 30% 任务成功率。 论文 Table 2:CrossEditBench 的零样本音视频场景编辑。灰色列为单模态 FES 子分,带下划线为所提技术带来的改善;表中另列指令、内容一致性与 ImageBind 音画对齐。综合 AV-FES 0.30 是协议评分,不是任务成功率。 批判点评:零样本指特定未训练任务与指令组合,不是没用过音视频数据;唇同步编辑和掩码重建都参与训练。表中 ImageBind 对齐分 16.29 仍低于输入的 19.79,某些未编辑内容可能漂移。演示不等于模型权重已公开。作者演示页。 5. Tetris3D:生成能互相支撑的3D物体 Tetris3D: 3D Scene Generation With Objects That Fit Together | 韩国科学技术院 | arXiv:2610.10539 关键词:3D场景生成, 物理关系, 遮挡补全, 自回归物体 前序问题:单张图恢复多个物体时,各自漂亮的形状摆到一起仍可能相交、悬空或不稳;遮挡又让真正接触的区域不可见。 本文贡献:Tetris3D 按视觉语言模型推断的物理依赖顺序生成物体,显式读取邻居几何和支撑、容纳等关系。深度与反投影图像特征把形状直接放到场景坐标中,可见到不可见的交叉注意力帮助补全遮挡部分;ComOb 提供 120 万个带物体网格与关系标注的模拟场景。 论文 Figure 2:Tetris3D 按视觉语言模型推断的物理依赖拓扑顺序自回归生成场景。每个物体经过稀疏结构及结构化潜变量两阶段;各 DiT 将深度、反投影图像与交互条件注入对应网格 token,可见到不可见交叉注意力补全遮挡区域。 实验效果:表 1 的 Toys4K 组合场景中,相对 ShapeR,场景 F1 0.6480→0.8407,平均位移 D_mean 115.1→38.91,穿透深度 PD 0.8862→0.0036,均按原表量纲。真实 MessyKitchens 表 2 的场景 F1 为 0.9620,PD 为 0.0011。 论文 Table 1:Toys4K 组合场景的重建、分布生成和物理稳定比较。带 † 方法用 FoundationPose 将生成物体对齐场景;所有方法使用真值深度。CD、MMD 与覆盖率的缩放及位移单位遵循原文,物理稳定是指定模拟协议下的结果。 批判点评:Toys4K 主表给所有方法真值深度;真实数据才用估计深度与推断关系,两种条件不能混成统一收益。物理稳定是引擎与对象假设内的评估,不是任意现实接触的保证。没有从论文项目入口确认方法代码已发布。 6. PositionForcing:用预测位置引导单阶段3D Position Forcing: Self-Conditioning 3D Generation | 南开大学;腾讯混元;香港中文大学;复旦大学;上海创智学院;香港大学 | arXiv:2610.10342 关键词:单阶段3D生成, 位置自条件, 逐级量化, 位置VAE 前序问题:无序形状 token 在单阶段生成中仍需隐式找位置;先单独生成位置虽然能提供结构,却又多出一条生成阶段。 本文贡献:Position VAE 联合学习形状解码与 token 位置恢复。每个去噪步从预测的干净潜变量恢复位置,按当前噪声程度由粗到细量化,再通过 RoPE 反馈给 DiT;训练阶段用真值 query 位置。这种自条件提供空间引导,无需独立位置生成阶段。 论文 Figure 2:(a)Position VAE 学习形状与 token 位置的对应,可同时解码几何与位置;(b)去噪中从预测干净潜变量恢复位置,通过 RoPE 注入后续步骤;(c)位置随去噪逐级量化,由粗到细提供引导。 实验效果:表 3 的图像条件 3D 生成,相比 Hunyuan3D 2.1,ULIP-I 0.125→0.130,Uni3D-I 0.320→0.321,ULIP-T 为 0.077、与 TRELLIS 2 持平。表 1 的 20% 噪声位置恢复准确率,联合微调 92.5%,冻结 VAE 为 23.0%。 论文 Table 3:图像条件 3D 生成比较。列出是否单阶段,以及 ULIP-T/I、Uni3D-T/I 的文本与图像语义相似度;粗体为该列最佳。Position Forcing 的 ULIP-T 与 TRELLIS 2 持平,其他小幅增益也不构成所有网格质量的保证。 批判点评:小幅语义相似度改善不等于每个网格拓扑都正确;位置恢复准确率是在指定 128³ 网格与噪声下测得,不能当生成成功率。需要位置解码器和联合训练,新增位置恢复的时延不能视为免费。作者项目页提供结果入口。 7. MORCA:按最终视频误差决定缓存复用 MORCA: Offline-to-Online Reinforcement Learning for Adaptive Cache Reuse in Video Diffusion Acceleration | 上海交通大学;阿里云;阿里巴巴 | arXiv:2610.10457 关键词:视频扩散缓存, 终点误差, 潜变量状态, 离线在线强化学习 前序问题:当前步的缓存误差不必对应最终视频损伤;固定阈值也难准确满足用户指定的加速预算。 本文贡献:MORCA 保留 SeaCache 的残差缓存粒度,用学习到的调度器替代阈值。状态同时包含潜变量特征、误差代理与剩余复用预算;以相对无缓存视频的终点保真度训练策略,先做离线 IQL,再在线补充轨迹,决定本步重算还是复用。 论文 Figure 2:MORCA 总览。下部调度器逐步选择缓存复用或重算;左上将目标加速映射为复用总预算,与误差代理、步统计、潜变量特征及当前复用数共同组成状态;右上以 IQL 做离线到在线强化学习。 实验效果:表 2:50 步 Wan2.2-A14B、RTX A6000,在约 3 倍加速时,SeaCache 为 320.41 秒、PSNR 14.99,MORCA 为 326.93 秒、PSNR 16.77、LPIPS 0.3435。Wan2.1-1.3B、RTX 4090 的 MORCA 为 84.98 秒、实际 3.01 倍,PSNR 20.95。 论文 Table 2:Wan2.2 与 Wan2.1 在不同目标加速下的时延及相对无缓存输出保真度,粗体为最佳、下划线为次佳。PSNR、SSIM、LPIPS 用相同 prompt 与种子的无缓存视频作参考,不是现实视频真值;目标与实际加速略有差异。 批判点评:PSNR、SSIM、LPIPS 比的是同 prompt 与种子的无缓存输出,不是现实视频真值或人工偏好。不是免训练缓存法,离线数据与在线 rollout 都有成本;预算离散会留下加速误差。在约 2.4 倍的 Wan2.1 配置,LPIPS 未胜过全部基线。作者仓库当前只标 Coming soon,方法实现尚未公开。 8. JoyAI-Voice2.0:连续潜空间同时规划语义声学 JoyAI-Voice 2.0: A Full-Continuous Autoregressive Speech Generation Model with Semantic-Acoustic Joint Representation | 京东探索研究院 | arXiv:2610.08834 关键词:连续语音生成, 语义声学双编码, 局部扩散, 语音克隆 前序问题:连续语音生成避免量化损失,却可能把声学噪声传回自回归规划,长期输出不稳定;只保语义又会丢掉音色与微小韵律。 本文贡献:JoyAI-Voice 2.0 将 AudioVAE 连续潜变量分成 patch,双编码器分别抽取纯化语义与完整声学信息,融合后交给 1.5B 因果 Transformer 规划下一块。局部 DiT 以历史块为条件生成下一块,再解码为 48 kHz 波形;训练结合 flow matching、停止预测、SFT 与 DiffusionNFT。 论文 Figure 3:JoyAI-Voice 2.0 架构。原始波形由 AudioVAE 压缩为连续潜变量并分块,双编码器抽取纯化语义和声学表示,融合后由因果自回归 Transformer 规划;局部 DiT 生成下一块完整潜变量,最终解码为 48 kHz 波形。 实验效果:表 2 的 Seed-TTS,中文 CER 0.74%、英文 WER 1.27%、困难集 CER 5.53%;三个子集的平均识别错误率为 2.51%,相对 dots.tts 的 2.95% 降低 14.9%。说话人相似度平均 74.8,低于 dots.tts 的 79.2,内容正确不等于声线最像。 论文 Table 2:Seed-TTS 零样本语音克隆。中文及困难集用 CER,英文用 WER,SIM 为说话人相似度;错误率越低越好、SIM 越高越好。平均识别错误率混合不同子集口径,2.51% 不能当所有语言的统一 WER;粗体标注各列最佳。 批判点评:平均 2.51% 混合中文 CER 与英文 WER,不能统称所有语种 WER。MDVD-Eval 是作者的中文多属性集,并用模型裁判评分;不能外推任意语言与真实交互延迟。原文首发 9 月 29 日,本期从候选池补充这篇未读报告,未确认官方代码或权重公开。 9. SteerSpeech:用小向量调节说话情绪强度 Steerspeech: Activation Steering For Emotion Control In Generated Speech | 弗吉尼亚大学;Netflix | arXiv:2610.10415 关键词:语音情绪控制, 激活steering, 低秩变换, 多专家监督 前序问题:情绪 prompt 或参考语音难细调强度;直接加激活差向量又可能改掉说话人身份与文本内容。 本文贡献:SteerSpeech 冻结 Qwen3-TTS 主干,为每种情绪训练 33,793 参数的低秩变换。将情绪与中性激活差修正为 steering 向量,用情绪、身份和转录专家共同监督;生成后再 replay,并用直通估计器跨过离散语音 token 训练,推理时以强度 α 注入隐藏层。 论文 Figure 1:SteerSpeech 总览。冻结语音主干,只学习情绪 steering 的低秩变换;训练经生成与 replay,用情绪、身份和转录专家监督修正向量,推理以 α 调节注入强度。免主干微调不等于完全免训练。 实验效果:表 1 汇总:愤怒目标情绪分从朴素 steering 的 0.651→0.835,WER 6.0%→5.1%;快乐情绪分 0.487→0.524,但 WER 7.1%→9.7%。表 2 的代表性情绪 A/B 主观比较中,相对朴素 steering,情绪强度偏好为 78.1%。 论文 Table 2:代表性情绪的主观 A/B 偏好,三组比较分别列情绪强度、身份保留与自然度。SteerSpeech 相对朴素 steering 的情绪偏好 78.1%,但身份与自然度偏好为 41.2%、47.7%;相对情绪参考语音也并非全项占优。 批判点评:更强情绪并非所有属性都更好;表 2 相对参考语音,身份偏好仅 12.6%、自然度偏好 16.2%。因此不能把强度偏好称为整体音质胜率。需训练低秩变换,且仅在指定主干与情绪上验证;arXiv 注释明确 ICASSP 2027 在审,未接收,也未确认官方代码。 10. UltraText:检查整幅图里的长文本是否对 UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation | 西湖大学;蚂蚁集团;浙江大学;上海创智学院;香港科技大学;中科院自动化所;微信AI;MBZUAI;香港城市大学;北京大学 | arXiv:2610.09823 关键词:生成文字评测, 双语密集文本, 整图裁判, 保真度与清晰度 前序问题:一个招牌写对,不代表海报、菜单或网页里的所有区域都对。文字看起来清楚,也可能遗漏或改写指定内容。 本文贡献:UltraText Bench 提供 432 个英中文 prompt,覆盖 24 类场景、三个难度和每图 4–12 个文本区域;生成器只接收 prompt。完整结构化参考交给 Q-Judger,对整图六项评分映射为文字保真、清晰、空间与场景四维,并把失败覆盖率与有效图质量均值分开报告。 论文 Figure 4:任务与评分协议。生成器只接收 prompt,Q-Judger 读取完整参考与生成图,输出六项整图评分,再合成为四维与综合分;参考字段并非与分数逐项对应,网格只给粗位置,可共享格子。无效响应不评分并降低覆盖率;面包店示意简化自指定四区域记录。 实验效果:表 5 的 24 个模型配置:Z-Image-Turbo 相比 Base,清晰度 70.60→74.41,保真度 55.51→40.75;Qwen-Image-2512 的英文综合分由 L1 的 86.50 降到 L3 的 42.86。综合分权重为 60/30/5/5,分数在 0–100 范围。 论文 Table 5:24 个模型配置排行榜。VLM 评分 0–100,英中文 prompt 宏平均等权汇总;综合权重为保真、清晰、空间、场景 60/30/5/5。L1/L2/L3 为不同负载,Low/High 为 API 品质;失败影响覆盖率而不直接记零分,排名不等于字符正确率。 批判点评:这些是视觉语言模型评分,不是正确字符百分比;默认采样、分辨率和 API 设置不同,不能把 Base/Turbo 差异单独归因于加速。语言集独立编写且字符负载不同;报告没有置信区间,近分排名须谨慎。官方数据与评测仓库。 趋势观察 表示要为生成目标服务 GRACE 用 DiT 特征指导潜空间压缩,QuadTok 给复杂区域更多 token,JoyAI 把语义与声学分开再融合。重建指标、token 数和生成质量需要分别核对。 不同计算职责可以明确拆分 SGF+ 分开上下文写入与去噪,Position Forcing 从预测干净形状恢复位置,MORCA 按终点误差调度缓存。相似模块的职责不同,训练与部署成本也不同。 控制需要保留未编辑属性 CrossEdit 在组合指令中兼顾音画与内容,Tetris3D 条件化邻居关系,SteerSpeech 约束声线与转录漂移。控制强度或几何稳定单项更好,都不能代替整体质量。 把指标拆开才看得见代价 JoyAI 的低识别错误不代表最高说话人相似度;UltraText 的文字清晰不代表内容正确。总分与偏好都有边界,评估时要同时看分项、失败覆盖率和实验设置。 今日讨论 GRACE 用双潜变量在指定 A100 设置实现 11.1 倍提速,但重建 PSNR 下降;你会用哪些指标与逐帧证据,验证残差潜变量补回的信息足以满足上线画质要求? 人工智能炼丹君 整理 | 2026-10-09
-
AIGC 每日速读|2026-10-08|Stanford视频生成快3.53倍LoT 今日 AIGC 论文速览 今日共 10 篇 · 生成架构与后训练 3 篇 · 图像视频算力与量化 3 篇 · 多参考图与长视频记忆 2 篇 · 数字人与生成语音增强 2 篇 重点论文标题列表 LoT(Stanford):按细节分配视频生成算力 LiFT(阿姆斯特丹):共享主干多循环细化图像 MEND(得州奥斯汀):奖励收益够大才移动样本 RefRoute(达特茅斯):十六张参考图也能轻量合成 Keepsake(中佛罗里达):长视频只留难替代的历史帧 今日论文速览 1. LoT:按细节分配视频生成算力 Level-of-Token Diffusion | 斯坦福大学;Google | arXiv:2610.05816 关键词:多分辨率token, 图像视频生成, 算力分配, 不对称flow 前序问题:天空、虚化背景和人脸被分配同样密度的 token,生成时算力花在很多低细节区域。直接压缩 token 又会让预训练 DiT 只能输出低分辨率流场,难兼顾省计算与完整画面。 本文贡献:Level-of-Token 把框、语义掩码、纹理方差或景深转成大小和形状不同的矩形 token 布局。重要区域用细 token,其余区域合并;经分块不对称 flow、形状嵌入、与原网格对齐的 RoPE 及按形状区分的输出头,DiT 处理较短序列,但每步仍恢复完整分辨率速度场。需要微调预训练模型。 论文 Figure 3:LoT 流程。完整分辨率 token 网格 x_t 按 LoT 布局映射成较短序列,DiT 以 token 形状 s、时间步 t 与文本 c 为条件处理;按形状区分的输出头 h_e_i 恢复不对称速度 u,再转为完整秩速度用于 flow-matching 训练。 实验效果:表 2 的 Wan2.1 14B、三倍 token 压缩预算下,论文报告平均视频生成加速 3.530 倍;Aesthetic 为 0.5104、Imaging 为 0.5650,完整基座为 0.5518、0.6465。表 1 的 FLUX2 4B 对应预算最高加速 2.040 倍。数字代表不同预算下的速度与质量取舍。 论文 Table 2:视频生成量化比较。相同 token 预算下,与压缩基线相比,LoT 的 Aesthetic、Imaging 分数及加速更好;表内同时列出完整分辨率 Wan2.1 14B,压缩后这些质量分仍低于完整模型,不能把基线间优势读成全面无损。 批判点评:标题的 3.53 倍限于上述视频配置,不代表任意布局或所有模型。全画面都需要细纹理时,可减少的 token 很少;压缩过强仍损害细节。它不是只靠换采样器的免训练技巧。可从作者项目页核对布局及演示,本期未确认可下载的方法代码。 2. LiFT:共享主干多循环细化图像 LiFT: Loop Flow Transformers | 阿姆斯特丹大学;TNO | arXiv:2610.05538 关键词:循环DiT, flow matching, 推理深度, 参数共享 前序问题:生成质量通常随参数增长,模型存储预算有限时很难扩容。让同一主干循环多次,又常要求每次直接猜最终目标,训练深度之外未必继续改善。 本文贡献:LiFT 反复调用共享 DiT 核心,给每次循环连续深度坐标,并把各步预测监督到初始速度估计与 flow-matching 目标之间直线路径的对应位置。训练随机采样内部坐标,推理使用均匀网格;一个固定 checkpoint 可在不增加参数、不重新训练的情况下改变循环次数,并和外层积分步数共同分配计算。 论文 Figure 2:深度循环与时间 flow。(a)采样器沿生成时间推进,每步调用一次网络;(b)每次调用把共享核心运行 K 次,每次有自己的深度坐标 s_k,共享读出头给出预测 u_k;(c)训练把每个预测回归到从停止梯度的初始估计 b=sg(u_0) 到 u* 的路径对应点;(d)训练随机采样内部坐标,推理用均匀网格。各面板颜色标出同一循环,为清晰省略归一化及首次 h_0 重注入。 实验效果:表 2 的 ImageNet 256×256、50 个积分步设置:L/2 R10 在训练的两次循环时 FID 为 20.30,推理八次循环为 10.95。图 7 对应 dense L/2 的 250 步为 15.74,八次循环 LiFT 计算约少 30%。所有点均按五万张生成图评价。 论文 Figure 7:增加循环细化相同噪声的图像。展示 LiFT L/2 R10 在 50 个积分步与 dense L/2 在不同步数的选定配对样本,各行共享类别及初始噪声,列标题给每图 TFLOPs。第二列八次循环与末列 dense 的 250 步相比,计算少约 30%、FID 10.95 对 15.74;这些选定图不替代五万张量化评测。 批判点评:更深并非始终更好,八次后也有回退;B/2 小模型在所测预算下仍落后 dense 基线。实验为无 CFG 的类别条件图像生成,不能直接推广视频或文生图。FLOPs 是解析估计,未验证设备延迟、能耗或峰值显存;作者页中的代码入口仍标为 Coming Soon。 3. MEND:奖励收益够大才移动样本 MEND: RL For Flow Models via Proximal Velocity Matching | 得州大学奥斯汀分校;Google;科罗拉多大学博尔德分校 | arXiv:2610.05954 关键词:生成后训练, 可微奖励, 近端速度匹配, 多样性 前序问题:奖励重加权需要大量更新,直接沿奖励梯度推动所有样本又可能牺牲多样性。一个高分样本是否还该移动、移动多远,常由统一更新幅度决定。 本文贡献:MEND 在同一 prompt 组内给奖励设上限,已达上限的样本保持不动;其余样本沿奖励梯度提出三个不同长度的候选,只有截断后的奖励收益超过二次位移代价才接受。再把接受的位移转成存储状态处的速度回归目标。行为 adapter 随训练做 EMA,方法不使用冻结参考、KL 项或 advantage 权重。 论文 Figure 4:MEND 总览。(1)同一 prompt c 的组中,达到奖励上限 κ 的样本保持;(2)低于上限的样本沿奖励梯度得到三个提议,判据从截断奖励扣除位移代价并选最佳候选,示例选最短 y_1;(3)训练 adapter 在存储状态回归到行为预测加接受位移 d 的目标,即公式 5 的速度目标,行为模型随后用 EMA 跟随。 实验效果:表 2 的 DrawBench 200 个提示、每个五个种子:训练 PickScore 的 MEND 100 次更新得到 23.70,Flow-GRPO 约四千次为 23.52,两者到基座的距离同为 0.313;MEND 六个评价指标中五个更高。另一个等预算协议的表 7:PickScore 为 24.03,ReFL 23.92、DiffusionNFT 23.43,不能混成同一实验。 论文 Figure 3:SD3.5-M、Flow-GRPO、DiffusionNFT 与 MEND 的图像比较。每行共享同一提示与种子,各图标注 PickScore;这是配对示例而非整体成功率。 批判点评:更新次数差距不等于训练时间快四十倍,候选需解码和奖励评价。必须有可微奖励;目标选择的收益保证不等于模型每次更新保证,更无法识别错误奖励。长训练仍可能奖励投机;表 2 美学分数还低于 Flow-GRPO。作者项目页提供复现入口,实际代码状态按页面核验。 4. RefRoute:十六张参考图也能轻量合成 RefRoute: Decoupling Conditioning Cost from References via Compact Residual Conditioning and Spatial Routing | 达特茅斯学院 | arXiv:2610.07720 关键词:多参考图生成, 紧凑残差条件, 空间路由, 注意力加速 前序问题:多张参考图都编码成密集网格再全局注意力,计算随数量和分辨率上涨;不同参考的外观还会串到错误人物或物体上。 本文贡献:RefRoute 把每张参考图先降采样再 VAE 编码,用全分辨率像素残差编码器补回细节。条件路由与注意力路由把参考分配到目标区域,限制跨参考交互,同时允许区域外的选择性访问以处理反射、接触等场景关系。单张 1024×1024 参考的 token 从 4096 减为 256,仍需训练及多参考微调。 论文 Figure 2:RefRoute 总览。每张参考图先降采样并由 VAE 编码成紧凑 token,残差编码器从完整分辨率提取互补特征,在 DiT 输入投影后加到对应参考嵌入;增强嵌入与文本、带噪目标通过条件专用 adapter 和注意力路由联合处理。 实验效果:图 4 独立计算成本实验中,16 张参考图、50 步和四步配置分别比对应 FLUX 基线快 18.3、14.2 倍。表 2 的 ManyRef100 包含 10–17 张参考,多参考微调后的 Weighted-Ref-VIEScore 为 36.06,FLUX.2-Klein-9B 为 8.88;该分数不是成功率。 论文 Figure 4:参考数量与推理成本。与 FLUX.2-Klein 基线及相同主干上的 OminiControl2 参考分支实现相比,RefRoute 在所测配置中时延增长更慢、峰值分配显存接近恒定;分支实现比较不代表完整 OminiControl2 训练系统。 批判点评:加速实验和微调质量实验需分别理解。少参考 MICo-Bench 的 52.81 仍低于对应基座 55.67,不能宣传所有参考数量都更好。评分依赖多模态模型,自建数据有合成及筛选偏差。原文仅承诺发表后释放代码、配置和相关数据,不能写成当前已开源。 5. Keepsake:长视频只留难替代的历史帧 Keepsake: Selective Spatial Memory for Long-Horizon Video Generation | 中佛罗里达大学 | arXiv:2610.06588 关键词:长视频生成, 空间记忆, 固定容量, 免训练控制 前序问题:生成越久就保存越多历史帧,检索和存储持续增长;只保留最新帧又会忘掉刚离开的场景。历史帧价值随新视角出现而改变,一次性决定保留不够。 本文贡献:Keepsake 在每个视频块生成后,把已有和新增观察建成位姿—外观图,以相机距离及视觉相似度衡量替代关系。保留优先级同时看强替代帧数量与最近替代者相似度,优先留下难替代观察,逐步删除冗余直到满足固定容量。只修改持久记忆更新规则,宿主生成器、采样及检索规则保持原样,无需再训练。 论文 Figure 2:Keepsake 总览。上部将它插入长视频循环作为记忆更新模块,每个生成块后更新持久记忆,保持生成器及检索规则;下部把旧记忆和新观察汇集成位姿—外观图,边权结合相机邻近与视觉相似度。节点统计强替代者数量和最近替代者相似度,共同决定保留优先级;删除低优先级观察直到满足容量 B。缩略图与展示分数为说明示意。 实验效果:附录表 5 的十五条匹配 180 秒 MemCam 轨迹:完整记忆 5397 帧、FVD 734.2;Keepsake 留 32 帧、FVD 476.6,降低 35.1%,LPIPS 0.5980→0.5876。表 1 的另一组 60 秒 WorldMem:FVD 3077.6→1116.9,每次检索 77.92→4.54 ms。 论文 Table 5:长时 MemCam 结果。十五条匹配的 180 秒轨迹,有限记忆策略容量 B=32;比较完整保留、FIFO 与 Keepsake 的存储条目、LPIPS 和 FVD。Keepsake 的 32 帧相对完整 5397 帧仍改善质量,不能由检索收益推出完整生成时延。 批判点评:检索毫秒不是整段生成耗时,32 帧是记忆库容量而非视频长度。样本仅十五条匹配轨迹,几何与视觉相似度也未必代表未来所有重要事件;最优预算随任务变化。原文称策略代码在补充材料,本期未确认独立公开仓库,不能泛称无限长记忆已解决。 6. CentriQ:先去均值再做低比特量化 CentriQ: Calibration-Free Quantization of Diffusion Transformers via Exact Mean Centering | Tenstorrent;洛桑联邦理工学院 | arXiv:2610.06260 关键词:DiT量化, 无校准, 均值补偿, 四比特激活 前序问题:DiT 的条件归一化会重新引入逐 token 均值。Hadamard 旋转不一定能把这部分能量均匀摊开,单个大坐标会撑大量化范围;照搬语言模型的免校准量化会损伤图像。 本文贡献:CentriQ 先减去每个 token 的通道均值,再旋转与量化;减去的成分通过完整精度的 rank-1 分支精确补回线性层输出,因此不是丢掉均值。激活尺度由无数据规则得到,权重拟合使用抑制重尾影响的稳健目标。同一路径覆盖 PixArt-Σ、FLUX.1-schnell 和 SANA 的 adaLN 条件设计。 论文 Figure 3:CentriQ 的一个量化线性层。上部为在线逐 token 路径,下部为离线权重路径;每个 token 的均值 x̄_t 与权重行和向量 w_1 构成全精度 rank-1 分支,绕过权重与激活量化并补回均值分量。 实验效果:表 1 的 MJHQ、W4A4:FLUX.1-schnell 的 FID 为 18.8,带校准 SVDQuant 为 18.3,BF16 为 19.5;SANA-1.6B 为 16.2、19.3、16.0。表 2 的 FLUX W4A2 消融中,完整方法 FID 35.59,只有旋转为 455.30,二比特结果仍有明显质量差距。 论文 Figure 4:FLUX.1-schnell 在 W4A4、W4A2 与 W2A4 下的 GenEval 提示结果,同一行共享提示和种子;标记是 GenEval 检测器的判断,而非人工成功率。 批判点评:rank-1 补偿精确不代表整个量化模型无损。二比特激活采用模拟量化,没有支持它的融合 kernel;A100 整数张量核结果不能等同新 GPU 的 NVFP4。FID 单项改善也不是逐张更好。arXiv 注释明确代码及项目页将稍后发布,本期不放尚未确认的方法仓库。 7. BASA:标准注意力后端也能高效稀疏 Backend-Agnostic Sparse Attention for Fast High-Resolution Visual Generation | 上海交通大学;复旦大学;香港大学 | arXiv:2610.08772 关键词:稀疏注意力, 平移窗口, 全局KV池化, 高分辨率生成 前序问题:固定窗口算得快但边界易出方格伪影,细粒度滑窗质量较好却依赖复杂专用 kernel。理论注意力稀疏度并不保证实际加速。 本文贡献:BASA 在不同 DiT 层与去噪步交错平移空间窗口,让邻域跨边界交换信息;池化的全局 K/V 补长程上下文,标准 SDPA 完成本地与全局计算。视频窗口保留完整时间跨度,仅做空间稀疏。实验还用密集教师蒸馏注意力层,不应把全部结果写成免训练替换。 论文 Figure 3:BASA 总览。(a)稀疏注意力结合多个组件,在减少注意力成本时恢复局部及全局视觉交互;(b)作为 DiT 块视觉自注意力模块的替换,其余生成流水线保留。实验中的注意力蒸馏仍需训练。 实验效果:表 3 的单 A100、Wan2.1-T2V-1.3B,从 832×480 外推到 1664×960:窗口 10×10、池化 4×4 时,预热后注意力前向延迟 509.66→112.84 ms,加速 4.52 倍、稀疏度 90%。表 4 的一百段视频中,Imaging Quality 65.22%→67.02%,Aesthetic 57.53%→56.87%。 论文 Table 3:Wan2.1-T2V-1.3B 从 832×480 到 1664×960 的视频分辨率外推注意力效率。配置在 latent 网格上定义;时延为预热后的注意力前向耗时,加速相对 dense Wan,列出实现、稀疏度、TFLOPs、MFU 与 kernel 效率,不是端到端采样速度。 批判点评:4.52 倍限注意力前向,不能当端到端视频生成加速。各质量维度有升有降,表 1 的相似度还是与密集模型输出比较。窗口过小可能损伤保真度,标准后端兼容也不等于所有硬件都实测;未确认该方法独立代码链接。 8. TalkLikeYou:一步生成个人说话习惯 Talk Like You: Imitating How You Speak in Real-Time Talking Head Generation | 中国科学院自动化研究所;中国科学院大学;中科院香港创新研究院;澳门科技大学 | arXiv:2610.06658 关键词:数字人生成, 说话习惯, 一步flow, 运动空间 前序问题:同一发音,不同人露齿、张嘴和嘴角运动习惯不同。只保证音画同步与清晰度容易生成千人一面的表情,单人微调又增加部署成本。 本文贡献:TalkLikeYou 在隐式关键点运动空间建模说话习惯,用音频、源运动与可选习惯条件生成旋转和表情变化,再以冻结渲染模块合成视频。flow 模型预测干净运动,一步采样;两阶段学习先用预设 one-hot 习惯,再学习参考视频到统一习惯空间,并用 PLAD 评价相似性和多样性。 论文 Figure 2:TalkLikeYou 框架。flow 运动生成器从可选习惯来源一步采样习惯感知运动,再渲染视频;两阶段习惯学习增强泛化与稳定性。统一习惯空间中星号表示 one-hot 习惯编码、圆点为参考视频样本;第一阶段用对齐损失关联视频特征及对应习惯编码。 实验效果:表 1 的 HDTF:FID 7.71、FVD 112.94、身份相似度 CSIM 0.94,对应 Ditto 为 21.61、319.03、0.87。Sync-C 为 8.73,但 Sync-D 6.82 仍高于 Sonic 的 6.70,唇同步并非所有指标最优。推理运动采样为一步,训练两阶段在 RTX 3090 上分别 48、72 小时。 论文 Figure 3:三种选定说话习惯下与先进基线的视觉与唇同步比较。需放大观察细节,动态视频见作者补充材料;静态帧不单独证明完整时序质量。 批判点评:一步运动采样不代表整条视频流水线只做一次前向,静态图也无法证明时序同步或个人习惯完整复现。定制需参考视频或预设习惯,跨人物、姿态与口型应另测。作者项目页和官方仓库提供方法入口。 9. AuraSE:降噪时尽量不改词与声线 AuraSE: Low-Hallucination Generative Speech Enhancement via Multimodal Flow Matching and Inference Policy Optimization | 香港中文大学深圳;Microsoft Research | arXiv:2610.06632 关键词:生成语音增强, 多模态flow, 推理策略优化, 内容保真 前序问题:生成式降噪能让音频更干净,却可能改词或改说话人。即便输入转录文本,不同句子的最佳 guidance、温度和步数也不同。 本文贡献:AuraSE 用文本与声学双流再转单流的 MMDiT,保留退化音频的专门通路。IPO 从当前模型在多组解码配置下生成候选,按感知质量、词错误率、说话人相似度和语义保真组合奖励形成偏好对,周期刷新数据并优化。部署最终固定十步 ODE,不做逐句搜索,不使用 CFG。 论文 Figure 1:AuraSE 总览。左侧双流再转单流 MMDiT 以转录为条件增强退化 mel 并预测 flow 速度;中央双流块让 mel 与文本共同注意力但保持独立投影;右侧 IPO 用多样推理策略解码、评分、在缓冲中组成自生成偏好对,再闭环更新模型。 实验效果:表 3 每个合成测试集 824 句:有混响 WER 从 AuraSE 基础版 9.65% 降至 IPO 8.22%,无混响从 8.43% 降至 6.98%。表 4 的真实 DNS 盲测 OVRL 3.144→3.365,人类盲听综合分 3.60±0.13→3.74±0.13,区间为 95% 置信区间半宽。 论文 Table 3:合成主测试,有混响与无混响各 824 句;除 WER 外越高越好,粗体及下划线为增强系统中最佳与次佳,排除原始噪声音频参考。SIG、BAK、OVRL 是感知质量,SIM 是说话人相似度,SBS 是语义保真,不能只选一个维度宣称零幻觉。 批判点评:低 WER 不等于零幻觉,说话人相似度也并非所有系统最高。输入转录及评测依赖外部识别器,后训练还要多次声码器及奖励计算。结果限于论文的英语增强条件,不可直接外推所有语言、麦克风和音乐修复;本期未确认官方代码入口。 10. CoAl:对齐上下文token提升生成 Learning to Read the Contextual Tokens in Diffusion Transformers | 特拉维夫大学;康奈尔大学 | arXiv:2610.06844 关键词:多模态DiT, 上下文对齐, 全局语义, 生成表征 前序问题:多模态 DiT 会不断更新文本 token,但其内容与生成质量的关系不清楚。只对齐图像 token 的局部特征,可能忽略上下文中逐步形成的全局场景信息。 本文贡献:作者先用轻量瓶颈把多层上下文 token 映射给冻结语言模型,从隐表示询问生成图语义;再提出 Contextual Alignment(CoAl),把单个早期层的上下文表示通过小型 Q-Former 对齐到干净图的冻结 SigLIP 全局语义嵌入。空提示条件加权减少照抄 prompt 的捷径,额外对齐网络只在训练使用。 论文 Figure 6:Contextual Alignment。轻量 Aligner 把多模态 DiT 的上下文 token 映射成嵌入,以负余弦相似度损失对齐到冻结语义编码器从干净输入图得到的教师嵌入。 实验效果:表 1 的从零训练实验:REPA 加 CoAl 后 FID 4.95→4.29,Recall 0.338→0.407;另一个 SD3 在 Fine-T2I 上微调实验,基础 FID 19.30、常规 flow 微调 17.18、CoAl 16.75。两种协议数据与指标范围不同,不能直接排名。 论文 Table 1:与表征对齐基线的量化比较。(a)完整模型从零训练:给 REPA、HASTE、SRA 加 CoAl,分别列 FID、CLIP、HPS、Precision 与 Recall;(b)预训练模型微调:比较基础、常规 flow、视觉对齐及 CoAl 的 FID 和分布覆盖。两种实验使用不同协议,数字不能横向混排。 批判点评:读到语义及与偏好分相关,不等于模型能逐步逻辑推理或保证最终画面。Reader 训练集中于单个人物和十五类问题,标签来自 VLM;全局语义对齐也不能保证局部细节正确。这篇入选依据是实际改进生成的 CoAl,而非一般视觉问答;未确认方法代码已公开。 趋势观察 预算应跟随内容与条件 LoT 根据画面细节改变 token 布局,RefRoute 压缩参考条件并路由到指定区域,Keepsake 留下难替代视角。减少重复信息比统一压缩所有输入更值得先测。 计算位置和更新目标都能调整 LiFT 把计算放在共享主干循环,MEND 先检查样本移动是否值得,AuraSE 把多配置偏好训练进固定解码器。它们减少的是不同成本,不能用同一加速口径相互比较。 低比特与稀疏仍需保留关键通路 CentriQ 用精度较高的分支补回均值,BASA 用全局池化恢复长程信息。压缩不是简单删去内容,关键是被省略的部分如何表达及补偿。 可解释表征要落到生成验证 TalkLikeYou 用运动空间表示习惯,CoAl 对齐上下文全局语义。表征可读不等于可靠控制,仍须核对质量变化、数据范围与失败例。 今日讨论 你的生成内容中,哪些区域可以降低细节预算,哪些区域必须保持完整? 人工智能炼丹君 整理 | 2026-10-08
-
AIGC 每日速读|2026-10-07|腾讯原生2K音画训练快2.5倍Prism 今日 AIGC 论文速览 今日共 10 篇 · 音画与流式声音生成 2 篇 · 规则一致性与四维世界 2 篇 · 图像生成与连续编辑 2 篇 · 视频编辑与推理加速 3 篇 · 结构可控声音变形 1 篇 重点论文标题列表 Prism(腾讯):原生二千像素音画训练提速 S2PD(剑桥):先串行推演再并行修画面 PVD(港理工):两个半身专家接力生成图像 WorldSonus(港科大):世界画面逐段配上立体声音 ALIVE(罗切斯特):插入的物体跟着人物互动 今日论文速览 1. Prism:原生二千像素音画训练提速 Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training | 腾讯混元;复旦大学;浙江大学 | arXiv:2610.05416 关键词:联合音画生成, 原生2K训练, 动态稀疏注意力, 跨模态引导 前序问题:2K 视频的 token 数量让全注意力训练昂贵,先生成低分辨率再超分又难补回原生细节。固定稀疏块还可能把不同运动方向或关键发声区域混在一起,省了计算却损伤动作与声音对应。 本文贡献:Prism 在 MOVA 双分支 DiT 中替换视频自注意力,保留音频与跨模态注意力。先划分 8×8×8 时空宏区,结合视频特征通道方差和音频到视频交叉注意力范数,为各区选择 64、128 或 256 token 的块形状;再用 Top-k/Top-p 混合策略分配注意力预算。稀疏布局适应空间结构和音画耦合,而非统一删去固定区域。 论文 Figure 2:Prism 架构。把 token 序列划分为时空宏区,动态给各宏区指定适配的块形状,再以 Top-k/Top-p 混合块稀疏注意力把计算集中到信息量高的交互。 实验效果:作者在十万条 2K 视频上训练,报告原生 2K 联合音画训练加速 2.5 倍。表 2 的 95% 稀疏配置相对全注意力训练:cpCER 从 0.374 降到 0.187,DeSync 从 1.05 降到 0.63,MotionQ 从 0.53 升到 0.89。2K-Bench 为 300 条未见的十秒视频;训练吞吐与这些质量指标是两类证据。 论文 Figure 3:与此前开源方法的定性比较。音频必须参看项目演示视频,更多结果见附录 A.7;此静态图展示视频画面,不单独证明音频质量。 批判点评:2.5 倍不能移写成端到端生成速度,95% 稀疏也不等于整个模型少算 95%。静态截图无法核对音频,须结合项目音画演示。自建测试集和自动评价不代表所有镜头、说话人与低分辨率任务都同样获益。项目页与官方代码给出复现入口。 2. S2PD:先串行推演再并行修画面 S2PD: Serial-to-Parallel Diffusion for Physically and Logically Consistent Video Generation | 剑桥大学;丰田欧洲 | arXiv:2610.06847 关键词:视频扩散, 串并行采样, 物理一致性, 游戏规则 前序问题:即使不断采样程序生成的训练数据,并行视频扩散仍会生成违规棋步、错误碰撞或不连贯物体。问题可能在于模型缺少逐段协调事件的串行计算,而不只是数据不够。 本文贡献:Serial-to-Parallel Diffusion 在高噪声阶段按时间块自回归去噪,先协调相互依赖的事件;到较低噪声再切换为整段并行细化,减少纯串行采样的闪烁。训练使用多种块大小;实验在从零训练的 DiT-B 与 Wan-5B-LoRA 上,按匹配训练预算比较双向并行、因果 Diffusion Forcing 和 Block Causal。 论文 Figure 2:各方法的注意力模式与本文采样策略。(a–c)分别为双向、因果 Diffusion Forcing(cDF)与 Block Causal(BC)的注意力掩码及噪声水平;(d)先串行去噪再并行细化;(e)时间切片内部的 token 顺序;(f)训练使用多种块大小。 实验效果:表 2:DiT-B 的 2048 每次 rollout 非法转移从并行基线 47.9 降到 0.9,双摆动力学误差从 73.4 降到 1.1;Wan 的 Kubric MOVi-A CD-FVD 从 252.8 降到 137.0。国际象棋则为 51.0→12.3,仍逊于另两种串行方法的 4.6 和 6.8,不能写成全任务最优。 论文 Figure 6:Wan-5B-LoRA 架构的定性比较。在 MPMWorlds 与真实魔方数据集上,串行方法表现相近,相比双向基线生成更连贯的视频。 批判点评:程序世界中的规则错误减少,不是开放世界物理定律的保证。串行块越小通常越慢,表 4 显示质量和采样成本需一起调;混合方法相对纯并行也有额外串行开销。建议先检查自己的事件依赖是否需要串行推演。项目页可核验,本文不使用未经确认的会议接收背书。 3. PVD:两个半身专家接力生成图像 Two Halves are More than One: Phase-wise Velocity Distillation for Fast and High-Quality Image Generation | 香港理工大学;OPPO研究院 | arXiv:2610.08070 关键词:图像生成, 分阶段蒸馏, 平均速度, 显存压缩 前序问题:粗结构与细节生成发生在不同噪声区间,却常由同一个完整学生网络承担。压到一次完整主干计算预算时,统一学生容易兼顾不好两个阶段;少步模型也未必减少活跃参数或显存。 本文贡献:Phase-wise Velocity Distillation 从教师抽取约半深度主干,先用 flow matching 对齐初始化,再学习粗到细两个区间的平均速度;文生图采用共享冻结主干与阶段 LoRA,并加阶段判别器做对抗细化。两个半身专家依次执行,累计 FLOPs 约等于一次完整教师主干前向,但实际仍是两次专家调用。 论文 Figure 3:PVD 总览。(a)从教师抽取半身主干,经 flow matching 微调初始化局部学生;(b)分阶段 LoRA 专家在划分的时间区间上学习平均速度;(c)文生图任务使用分阶段判别器进行对抗细化。 实验效果:表 1 的 ImageNet 256×256、归一化计算预算 1.00 下,PVD FID-50K 为 1.48,iMF 为 1.72,多步 LightningDiT 为 1.35。表 3 的 Qwen-Image 蒸馏:活跃参数 20.43B→10.40B,峰值显存 38.42→19.84 GiB,减少 48.36%;GenEval 为 0.8720→0.8846。 论文 Figure 1:文生图结果。上排为教师:Stable Diffusion 3.5-Medium、FLUX.1-dev、Qwen-Image,分别使用 50×2、50、50×2 步;下排以两个半身分阶段专家顺序生成,累计计算约等于一次完整教师主干前向。这是计算预算比较,不能读成只调用一个专家。 批判点评:活跃参数不是所有权重总量,等 FLOPs 也不是已实测的一倍调用延迟。Qwen 的 DPG 从 89.10 降到 86.54,WISE 从 0.64 降到 0.59,质量没有全面超过教师;密集计数和罕见布局仍困难。可从官方仓库核对权重与实现,再按具体 GPU 测显存及延迟。 4. WorldSonus:世界画面逐段配上立体声音 WorldSonus: Bringing Sound to Worlds | 香港科技大学;Noiz AI;沐曦;上海交通大学 | arXiv:2610.08760 关键词:视频到音频, 因果流式生成, 立体声, 交互提示 前序问题:交互视频的未来画面尚未产生,双向配音不能等待整段视频再工作。声音还要随左右位置与用户文字控制变化,同时维持跨块连续性。 本文贡献:WorldSonus 用因果自回归 Transformer 与 rectified-flow 头,逐块输出 48 kHz 立体声。两种时间尺度的视觉 token 同时提供场景计划与帧级线索,环形 KV 缓存限制历史长度;提示词在块边界更新。训练用冻结 Synchformer 的 ShiftNCE 做时间对齐,结合真实立体声筛选和全景一阶 Ambisonics 的视角解码学习方向,教师只在训练使用。 论文 Figure 1:WorldSonus 总览。(a)因果流式流程:视频映射为两种时间尺度的视觉 token,条件化自回归 Transformer 和 rectified-flow 头;(b)训练专用 ShiftNCE:冻结 Synchformer 教师以对比窗口匹配指导时间对齐;(c)立体声空间监督:真实立体声筛选与全景一阶 Ambisonics 视角解码提供方向依据;(d)交互文字控制:在块边界动态更新提示,保留会话状态和声学连续性。 实验效果:表 1 的单 H100 设置中,100 ms 音频块计算为 41.2 ms,实时因子约 0.41。VGG 五秒测试 FAD 为 1.73,PrismAudio 为 2.09;交互五秒为 2.68 对 6.22。五秒与十秒拆分各 4096 条,三十秒拆分为 1024 条,跨时长结果分别统计。 论文 Figure 2:两个交互片段中,与双向基线比较立体声布局。红框标出声源;能量平衡曲线中负值表示左声道占优,正值表示右声道占优。 批判点评:41.2 ms 是模型块计算,不是含采集、传输、播放缓冲的完整交互延迟。时间同步并非全优:VGG 五秒 DeSync 为 0.686,PrismAudio 为 0.539,后者更低。因果音频表示和有限立体声数据仍构成限制,三十秒评测不足以保证无限长会话稳定。项目页可听原始演示。 5. ALIVE:插入的物体跟着人物互动 ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing | 罗切斯特大学;Adobe Research | arXiv:2610.08779 关键词:视频编辑, 首帧引导, 物体插入, 时间局部条件 前序问题:给视频首帧加一本书很容易,随后让人拿起、翻开它却难:插入物体常留在原地或穿过手。只写物体名称,也缺少每个阶段该发生什么交互的描述。 本文贡献:ALIVE 把干净源视频 latent 与带噪目标 latent 沿通道拼接,编辑后的首帧保持干净,以 LoRA 训练 LTX-2.5 22B 编辑器。35,800 对数据混合渲染、真实、模型生成与通用编辑来源,并标注多级提示。可选 VLM 从原视频、编辑首帧和物体名称预测分段交互描述与帧区间,再通过时间局部交叉注意力路由到对应片段。 论文 Figure 3:ALIVE 总览。(a)源视频与带噪目标 latent 沿通道拼接(C),编辑首帧 latent 保持干净(金色);火焰表示编辑器及 VLM 的 LoRA 微调。(b)监督 VLM 从同样的视觉输入与物体名提示 P1 预测 P4 描述及帧区间,P4 文本独立编码;注意力图比较共享的 P0–P3 条件与时间局部 P4 条件。 实验效果:表 1 的 128 例交互插入测试中,0–100 的 VLM Overall:只给物体名的 ALIVE 为 86.71,Señorita 为 60.24;预测分段提示后为 87.66。103 例通用插入中,ALIVE 为 92.28,加入 VLM 后为 91.71,增强并非对所有任务有益。 论文 Figure 4:交互物体插入定性结果。(a)拿书,(b)提篮,分别展示首帧、视频 40% 和 90% 位置。AnyV2V 的方形帧以较窄宽度展示;† 表示按照各方法官方提示格式额外提供交互指导。 批判点评:这些是自动 VLM 判断与抽帧协议下的分数,不能当作接触力或真实物理正确率。区间预测错误、布料和物体旋转仍会造成伪影;编辑器也不是在线流式生成器。论文明确实现和实验在罗切斯特完成,署名 Adobe 合作不应改写为单一机构成果。项目页可查演示,未确认可下载的方法代码。 6. MC-Sparse:缓存稀疏布局再补注意力尾项 MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers | 腾讯混元;复旦大学;上海创智学院;香港中文大学;南开大学;北京大学;上海交通大学 | arXiv:2610.06801 关键词:视频生成加速, 稀疏注意力, 元数据缓存, 残差补偿 前序问题:稀疏注意力与完整注意力之间的差距不只来自删掉低权重连接,还来自块结构绑定和近似选择错误。每步重新精确筛选又可能吞掉节省的计算。 本文贡献:MC-Sparse 在锚点步骤精确选择 KV 索引,并用相似查询重排与 token 级选择减少结构误差;跨去噪步缓存查询分组、选择索引及完整减稀疏的残差,近似补回被丢弃尾项。Q、K、V 特征仍在当前步重新计算,因此不是复用旧视频 token。预热、锚点刷新和 CUDA 实现成本都需计入。 论文 Figure 6:MC-Sparse 流程总览,展示查询分组、精确选择及元数据复用、token 稀疏注意力和尾项补偿之间的连接;具体预算与刷新策略以正文为准。 实验效果:表 1 的 Minimax-H3-Base 768p 视频分支:15% 注意力密度下,DiT 去噪加速 1.80 倍,相对完整注意力输出 PSNR 为 27.30 dB;25% 密度为 1.61 倍、28.44 dB。15% 时 VBench ImgQual 从 69.20 变为 68.94,接近基线仍有质量差异。 论文 Figure 1:Minimax-H3-Base 768p 的质量和效率。左侧为质量指标及 DiT 去噪延迟:15%、25% 注意力密度分别相对 FA3 全注意力加速 1.80、1.61 倍;右侧为 15% 密度生成帧与完整注意力参考的逐段比较。接近参考不代表无损。 批判点评:这里的 PSNR 对齐完整模型输出,不是真实视频;1.80 倍也不包含 VAE 与条件编码。各任务约五十个评测样本、硬件并行设置和内部三维数据限制泛化与复现判断,不能宣传无损或全系统同幅提速。项目页已给出,未把未知代码状态写成开源完成。 7. CtrlCache:转向与动作变化决定是否复算 CtrlCache: Accelerating Interactive Video World Models with Control-Aware Caching | 奥克兰大学;新南威尔士大学 | arXiv:2610.08777 关键词:交互世界视频, 免训练加速, 控制感知, 残差缓存 前序问题:少步交互世界模型还要多次运行昂贵 DiT。只按内部特征相似度决定缓存,容易忽视用户突然转向或改变动作时需要及时刷新。 本文贡献:CtrlCache 先把输入控制分成初始、变化、持续转向与稳定状态:初始及动作变化块完整计算,转向和稳定块才在选定内部去噪步复用本块最近完整步的残差,首尾步骤始终完整。稳定交互时,再把上一块最后一帧的低频历史先验混入首步干净 latent 估计;无需重新训练,也不把所有历史特征无条件沿用。 论文 Figure 3:CtrlCache 总览。(a)按块自回归去噪,首尾步骤保持完整计算;(b)动作感知策略在转向与稳定块的选定内部步复用残差,在初始及动作变化块保留完整计算;(c)稳定交互中,频率混合历史先验把前一块最后干净帧的结构用于指导首步干净 latent 估计。 实验效果:表 1 的 WBench 导航、单 A100 设置:Matrix-Game 2.0 去噪时间 14.99→10.67 秒,加速 1.41 倍,Overall 0.6543→0.6786;LingBot-World v1 为 1.26 倍、0.7816→0.8127,v2 为 1.21 倍、0.8042→0.8201。使用相同提示、控制和初始帧比较。 论文 Figure 4:CtrlCache 与基线的定性比较。各方法使用相同初始条件和控制序列;蓝色虚线框用于比较布局、物体位置及运动细节,红框标出外观或结构失真,绿框标出本文保留较好的细节。控制字符串沿用 WBench:W/S/A/D 为平移,left/right/up/down 为视角变化。 批判点评:计时排除 KV 提交与更新,不能直接当完整交互延迟;TeaCache 与 EasyCache 在此表还更快,CtrlCache 选择了不同质量取舍。v2 的画质与交互分项略降,不能写成每项提升。复用步位置和控制规则依赖具体模型,移植时需要重新验证。项目页提供方法说明。 8. UniSlider:滑杆刻度对应感知变化 UniSlider: Perceptually Uniform Sliders for Continuous Image Editing | 巴塞罗那自治大学计算机视觉中心;Adobe Research | arXiv:2610.06831 关键词:连续图像编辑, 感知均匀性, LoRA, 自适应采样 前序问题:把编辑强度从 0.2 拉到 0.3,有时完全没变化,有时突然跳到另一种样子。现有强度参数并不对应均匀的可感知变化,界面有刻度却缺少稳定控制。 本文贡献:UniSlider 在冻结的 FLUX.2-klein-4B 上训练按强度缩放的 LoRA,完整运行少步采样,用 DreamSim 距离把中间图推向输入与满强度输出之间的相应感知位置。满强度目标只需缓存基座的默认编辑,不需人工中间图。推理再测量样本的感知曲线,自适应重映射滑杆参数,补偿残余不均匀。 论文 Figure 3:UniSlider 训练。采样强度 s,按公式 3 缩放可训练 LoRA 与冻结主干组合,完整运行 T 步得到 x_s;满强度 x_edit 在 s=1 时仅缓存一次。公式 4 的损失把 x_s 推向输入 x_src 与 x_edit 之间由 s 指定的感知位置。 实验效果:表 1 的 300 例基准:感知距离变异系数 CV-DSim 为 0.652,SliderEdit 为 1.199;LPIPS 单调性违例率为 0.016 对 0.251。表 3 中,只用均匀采样的 UniSlider 为 0.871,自适应采样后为 0.652,表明训练和参数重映射均有作用。 论文 Figure 2:训练缩小滑杆不均匀差距,自适应采样继续补偿。三行对同一图像执行同一指令:左侧为等滑杆刻度的 SliderEdit、仅用训练损失的 Vanilla、带强度重参数化的完整 UniSlider;右侧为每张图相对输入的 DreamSim 感知距离,以输入到完整编辑的总距离归一化。对角线表示理想均匀变化。 批判点评:DreamSim 上的匀速不等于每种语义属性都线性变化,原文失败例中颜色变化会掩盖球尚未膨胀的问题。编辑身份保持与 VQA 单调性也并非逐项最佳,基座本身的错误会沿滑杆传播。不同基座的比较需看附录同基座对照。作者项目站本次 TLS 验证失败,未降级访问,也不声称演示或代码已核验;本卡依据可访问的原论文全文。 9. ChronoWorld:用四维记忆回看修正世界 ChronoWorld: Camera-Controlled Consistent 4D World Generation via Spatiotemporal Cues and Geometric Reflections | 北京大学王选计算机研究所;加州大学默塞德分校 | arXiv:2610.06687 关键词:相机可控生成, 四维世界, 几何记忆, 反思修正 前序问题:按新相机轨迹生成视频时,动态物体在不同视角可能对不上,局部漂亮也不能保证整个时空场景一致。需要把生成结果放回可重建的几何状态,再检查历史视角。 本文贡献:ChronoWorld 的 Observation–State–Reflection 框架以相机条件 STC-DiT 生成视频,通过时空极线因果注意力联结视角约束和时间顺序;多头重建 decoder 预测颜色、几何与运动等四维属性。统一 4D 记忆用于检索和重渲染,几何反思再据不一致结果做校正,把视频观察转成可检查的世界状态。 论文 Figure 2:ChronoWorld 框架。相机轨迹条件化的时空线索 Diffusion Transformer(STC-DiT)去噪目标视频,多头重建 decoder 预测四维属性。 实验效果:表 1 的相同输入视频与目标相机轨迹设置:ChronoWorld 的 FVD-4D 为 177.41,Free4D 为 216.67;相对位姿旋转、平移误差为 0.95、2.34,对方为 1.73、3.28。表 2 的重建一致性 PSNR 为 18.87、SSIM 为 0.73。本次也核对 v2,相应主表数字一致。 论文 Figure 4:不同相机轨迹下 ChronoWorld 与基线的定性结果。作者提示放大查看局部细节;量化效果须结合 FVD-4D、相机误差和重建一致性表格。 批判点评:4D 同步、相机误差与重建一致性是不同指标,不宜合并为现实世界正确率。几何由生成和估计共同建立,回看改进仍可能继承错误;原文未给出足以验证无限场景或完整实时延迟的证据。训练使用八张 A100 80GB,推理单 A100;未确认官方项目或代码入口,不宣称已开源。 10. Smorph:换音色时保留节奏与音高 Smorph: Playable Sound Morphing with Diffusion Models | 美国西北大学;Adobe Research;Wizdom Music | arXiv:2610.06478 关键词:声音生成, 音色变形, 结构引导, 音乐交互 前序问题:从铜管变成弦乐、从鼓声变成气泡声时,音色与节奏结构常一起变化。音乐设计希望保持音高轮廓或响度包络,让声音身份沿连续路径变化。 本文贡献:Smorph 在扩散采样中组合文本或音频端点引导,并让所有中间状态共享固定的 RMS 或音高结构条件;支持提示到提示、音频到提示和音频到音频变形。SoundCanvas 预生成 5×5、共 25 个声音组成二维网格,鼠标在邻近样本间双线性交叉混音,MIDI 键盘触发当前音色。当前引导无需额外训练,但所用基座与音频条件模块已有预训练或适配。 论文 Figure 2:结构引导的组合指导,详见第 3.1 节。变形参数 α∈[0,1] 插值音频或文本端点条件 c_1…c_N;共享结构参考 c_S 为所有中间状态锚定时间包络或音高轮廓,并在全部 T 个去噪步保持固定。 实验效果:表 2 的 Clotho→Clotho、RMS 音频到提示设置:相对 SDEdit,结构控制分数 S_ctrl 从 0.356 升到 0.646,mel-L1 从 1.518 降到 1.027;目标音色相似度从 0.695 降到 0.646,KAD 从 4.420 升到 4.902。结构保留增强伴随目标变形及分布质量取舍。 论文 Figure 3:有显式结构控制(上排)与无显式控制(下排)的变形路径。每格为 mel 频谱,灰线为输入 RMS、橙线为生成 RMS;显式控制在展示的路径中更好保留预期时间包络。 批判点评:实时的是预生成样本间的演奏与混音,不是鼠标每次移动都实时运行扩散。感知路径也不保证处处线性;音乐人案例属于探索性反馈。机构由作者项目页核实,arXiv 注释和项目页标示 ISMIR 2026,但本期不把这一标示扩大为独立查证的接收结论;没有确认方法代码下载。 趋势观察 计算应随阶段与控制变化 S2PD 把高噪声串行推演和低噪声并行细化分开,PVD 把粗细生成交给不同专家,CtrlCache 在动作变化时刷新。减少计算之前,需要先识别哪些阶段或控制状态承载关键依赖。 缓存内容比缓存数量更关键 MC-Sparse 缓存布局与误差补偿,WorldSonus 限制流式历史,ChronoWorld 保存可重建的四维状态。缓存有不同语义,不能把索引、旧特征与几何记忆混为同一种技巧。 连续控制需要可测的约束 UniSlider 用感知距离修正滑杆,Smorph 用音高或响度结构锚定音色变化,ALIVE 用时间区间对齐交互。控制的意义要落到具体条件与失败例,而非只展示连续参数。 速度与质量必须分别核对 训练吞吐、DiT 去噪、单音频块计算和端到端响应是不同预算。自动质量分数的改善也常伴随其他维度退步,本期逐项写清测试条件,不拼成统一性能榜。 今日讨论 你的生成工作流更需要降低训练成本,还是让交互控制更稳定? 人工智能炼丹君 整理 | 2026-10-07
-
AIGC 每日速读|2026-10-06|加州理工稳住镜头外场景LoGo 今日 AIGC 论文速览 今日共 10 篇 · 长视频一致性与定制 2 篇 · 一步图像生成与后训练 2 篇 · 视频蒸馏与加速 3 篇 · 配对动作生成 1 篇 · 语音与音乐生成 2 篇 重点论文标题列表 LoGo(加州理工):镜头绕一圈场景少变形 Depth as Time(普林斯顿):一步生成把去噪搬进深度 DuoMatching(港中文):图像老师帮视频补回细节 VDOT++(悉尼大学):四步蒸馏别硬配每个token Reward Composition(UCLA):审美加分先过提示词约束 今日论文速览 1. LoGo:镜头绕一圈场景少变形 LoGo: Local-Global Rewards for Consistent Long-Horizon Video Generation | 加州理工学院 | arXiv:2610.03636 关键词:长视频生成, 相机控制, 三维一致性, 局部奖励 前序问题:镜头绕过墙面再回来,门可能移位、墙上数字可能变形。给整段视频一个三维一致性分数,会让局部错误被大面积正确区域稀释;只强化局部几何,又可能鼓励模型把画面变灰、变糊来降低误差。 本文贡献:LoGo 将关键帧经 VGGT 重建到共享三维空间,以 voxel 聚合 RGB 和深度重投影误差,把奖励分配到出错区域。训练混合归一化后的局部与全局奖励,并交替使用美学和相机跟随奖励。它改善的是相机可控视频的后训练信号,而非新增一个持久世界记忆模块。 论文 Figure 4:(a)说明 voxel 奖励如何聚合:把关键帧重建到共享三维空间,按体素汇总局部误差。(b)把局部奖励投影回视频帧进行可视化,突出需要修正的区域。 实验效果:表 1 的 TrajectoryBench 上,Lingbot2 的 PSNR-D 从 16.0 提高到 18.2 dB,极线误差从 1.507 降至 1.111,约下降 26%。表 2 的 DL3DV 上,同一基座极线误差由 2.161 降至 1.365。三个基座均有三维一致性收益,但相机指标并非逐项变好;例如 UniWorld 在表 1 的旋转误差由 13.8 变为 14.0。 论文 Figure 3:LoGo 的动机。(a)只用全局奖励难改善三维一致性;局部奖励改善以 PSNR 衡量的一致性,却降低以 HPSv3 衡量的画质,因此要组合二者。(b)绿色 LoGo 曲线扩展一致性与质量的 Pareto 前沿。(c)训练中的奖励曲线及质量评估显示,局部奖励随训练损害画质,LoGo 在改善一致性的同时维持质量。 批判点评:作者明确限定静态场景,超过 400 帧仍困难;因此不能写成动态世界无限稳定。奖励依赖重建模型估计的几何,改善重投影指标也不等于恢复真实物理。建议优先看局部奖励与画质的消融,再判断自己的相机轨迹是否在测试范围内。代码与 benchmark 已给出官方仓库。 2. Depth as Time:一步生成把去噪搬进深度 Depth as Time in One-Step Generative Models | 普林斯顿大学 | arXiv:2610.03626 关键词:一步生成, 深度探针, 共享权重, 模型压缩 前序问题:一步生成只调用一次网络,但网络内部仍有许多层。多步扩散的逐步去噪到底消失了,还是被重排到网络深度里?仅看最终图像,无法区分一次直达和层内反复细化。 本文贡献:作者用模型自身输出头解码中间层,并用独立训练及随机探针做对照:时间条件 flow-map 模型呈现随深度去噪的规律,部分 MeanFlow 任务甚至先去噪再加噪。进一步用带内部时间区间条件的共享 block 拟合教师隐藏层,把层数与独立参数组数拆开。 论文 Figure 2:大规模一步图像生成器也呈现沿深度逐渐去噪的现象。FLUX-schnell 和 MeanFlow 的逐层终点预测逐渐显露清晰图像结构;不依赖 τ 的 Drifting 模型作为对照。对 FLUX-schnell,模型输出头与独立训练探针得到相似的归一化终点距离下降规律,随机探针不能复现。 实验效果:附录表 1 的 ImageNet 256×256 实验:MeanFlow SiT-L/2 从 459M 参数压到 27.6M,压缩 16.6 倍;经 FD-loss 后训练,FID-50k 为 4.87,教师为 4.01。两组独立 block 的学生用 46.5M 参数达到 4.04。附录表 2 中,另行训练的两组 block 学生将执行次数减半后 FID 为 5.25。 论文 Table 1:ImageNet 256×256 的参数压缩结果。在教师原始深度、固定 K 执行次数下,分别报告 FD-loss 后训练前后的 FID-50k,各行采用最优 CFG 强度 ω。压缩倍数相对教师参数量;高亮行使用单个共享 block,灰色行为教师。增加独立 block 数量可用更多参数换取质量。 批判点评:16.6 倍是参数压缩,单组 block 仍可执行 24 次,不能换算成 16.6 倍延迟加速。相似的深度轨迹也不等于逐点复现教师的采样轨迹;缺少时间索引任务的 Drifting 模型未呈现同样规律。公开代码适合研究内部计算,结论尚不是所有一步模型的普遍定理。 3. DuoMatching:图像老师帮视频补回细节 DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation | 香港中文大学;字节跳动;香港科技大学;香港交互感知研究中心 | arXiv:2610.03543 关键词:视频蒸馏, 联合边缘分布, 图像教师, 潜空间桥接 前序问题:视频教师能教会时间连贯,但少步学生仍可能丢掉 prompt 中的羽毛、毛发等细节。整段视频的联合分布匹配会受到周围帧制约,需要额外的单帧监督补足视觉与语义先验。 本文贡献:DuoMatching 在视频联合 DMD 上增加来自图像教师的边缘 DMD。LatentBridge 将视频 latent、前一片段与局部帧编号映射到图像 latent,避免直接套用不同 VAE 空间;Latent Variation Sampling 用相邻 latent 的差异切分时间区间,每段抽样一片,提高有限监督预算的覆盖。 论文 Figure 3:DuoMatching 总览。(a)用图像教师参考分布 P_i 补充联合分布匹配;每组表示一个视频,节点表示帧级分布。(b)LatentBridge 根据视频 latent z^l、前一片 z^(l−1) 和局部帧编号 i,通过 ℓ₁ 重建损失映射到对应图像 latent。(c)Latent Variation Sampling 用相邻 latent 的差异分段,并在段内随机抽样。 实验效果:表 1 按生成单位和 NFE 分组:两步逐帧设置的 VBench Total 从 Causal Forcing++ 的 80.67 到 83.53;四步 chunk 设置从 82.79 到 83.51。表 2 在同一 Wan2.1 教师下,对四个基线的整体偏好为 80.87%–94.35%;对 Causal Forcing++ 的时间与运动偏好为 49.57%,说明主要收益来自画质与语义。 论文 Figure 1:DuoMatching 的动机与结果。自回归模型的后续帧常退化,图中 Q-Align 曲线展示这一现象。联合 DMD 缓解漂移,但学生与视频教师仍有画质差距,示例中缺少 prompt 要求的羽毛。联合与边缘匹配的组合改善画质、补回羽毛,同时保留时间连贯性;这张示例不代替完整统计评估。 批判点评:Full、Frame、Chunk 的函数评估单位不同,不能跨组把 NFE 当作相同成本排序。图像教师与桥接模块也带来训练成本;更清晰的单帧不是所有运动指标都提高的保证。项目页提供代码,值得在相同生成模式与预算内复现。 4. VDOT++:四步蒸馏别硬配每个token VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation | 悉尼大学;上海人工智能实验室;香港科技大学;香港中文大学 | arXiv:2610.03221 关键词:少步视频生成, 非平衡最优传输, 跨规模蒸馏, 条件生成 前序问题:同一个文字或图像条件允许多种正确视频。把学生与教师每帧的空间 token 强制全量配对,可能把本来合理但位置不同的内容当作错误,并在分布重叠不足时给出不稳定指导。 本文贡献:VDOT++ 在 DMD 上加入非对称非平衡最优传输:放松学生侧质量约束,下调不可靠 token 的质量,同时保持教师侧覆盖。ℓ₁ 距离使聚合更接近加权中位数,减少远处匹配的影响;DMD 与对抗项分两次反传。相同训练配方分别训练三类任务的生成器,还研究大 score 网络指导小生成器。 论文 Figure 3:VDOT++ 总览。上方:给定条件,少步生成器同时使用 DMD score 差异、逐帧最优传输匹配和对抗损失,经两次顺序反传及一次优化更新。下方图示一对时间帧,为清楚省略扩散时间与帧索引 (t,q)。DMD 在对应时空坐标提供 score 差异;平衡 OTD 显式耦合空间 token,却强制全量匹配;对称 UOT 放松两侧。非对称 UOT 放松学生侧、保持教师侧约束,压低不可靠学生 token 质量并维持教师覆盖。 实验效果:表 III 的文生视频 VBench 中,Wan-14B 四次评估学生的归一化均分为 81.59,50×2 次评估教师为 77.70;表 IV 的图生视频对应为 78.38 和 77.92。表 II 的 flow 条件任务却是 80.29,对应教师 80.35,因此不是每个任务、每项指标都超过教师。 论文 Figure 4:可控视频生成的定性对比。比较 100 次函数评估的 VACE 教师与 4 次评估的 VDOT、VDOT++,任务为(a)flow 条件的视频到视频,(b)视频向外扩展,(c)多参考图像到视频。顶行给出输入条件,每种方法展示 0、2.5、5 秒的帧。 批判点评:“统一”指训练配方跨任务复用,并非一个 checkpoint 同时完成全部任务。NFE 降低也不能直接等同端到端加速倍数。正文提到 CVPR 2026 的是前作 VDOT,这个扩展版本未核实接收证据,不能借前作会议作本篇背书;本文未发现可核验的新代码仓库。 5. Reward Composition:审美加分先过提示词约束 Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards | 加州大学洛杉矶分校;Arena Intelligence | arXiv:2610.02967 关键词:图像后训练, 人类偏好, rubric奖励, 奖励投机 前序问题:优化审美奖励,模型可能擅自添加装饰、乱码或写实风格;只优化提示词完成度,又可能牺牲细节。把不同量纲的分数简单平均,无法处理“这个要求只对某类 prompt 生效”的情况。 本文贡献:这项图像后训练研究组合人类偏好、内容满足度和禁止内容 checklist。各奖励轴独立归一化;只有意图严格的 prompt 激活额外约束;适用的反投机检测发现问题后否决正向偏好加分。不同奖励配置得到的权重再做融合,使审美优化受到意图约束。Reward Composition 是本文的编辑短名。 论文 Figure 2:两类反复出现的奖励投机失败。左侧:prompt 要求不含文字,RL 策略却在餐巾上添加乱码。右侧:prompt 要求 Elsa Beskow 的故事书插画风格,基座保持该风格,而 RL 策略偏向照片写实。这些案例解释为何需要按 prompt 启用约束和否决。 实验效果:表 1 的 2026-09-04 Arena 快照中,FLUX.2-dev 从 1132.8±14 到 1202±13,约增加 69 Elo。表 2 在 1k 验证 prompt、五个候选 checkpoint 中选择最佳值,Stage 3 在 Gemini 评估配 Arena RM 的对比胜率为 0.660,单偏好为 0.507;这些自动评估与线上 Elo 不是同一个指标。 论文 Figure 1:奖励设计可视化。只用偏好训练会偏向通用装饰并忽略要求;只用满足度会洗掉细节并丢失风格和景物;Arena-T2I-Hard 能恢复要求元素但保留多余装饰;不加意图门控的禁止内容奖励,即使 prompt 允许细节也会将其压平。Stage 1 仅在意图严格时施加约束,示例中能满足要求而未明显损伤质量。 批判点评:只测试两个基座、单个随机种子,内容分解问题未经人工逐条审计。排行榜数字属于 9 月 4 日快照,不是今天的排名;多个 checkpoint 择优也需与固定预算评估区分。作者说释放 1k 训练子集,但本次项目页未提供可核验下载入口,因此不声称数据或代码已可下载。 6. PMD:冻结视频模型顺手生出动作 Parasitic Co-Denoising: Unlocking 3D Human Motion Generation in a Frozen Video Diffusion Model | 新加坡南洋理工大学 | arXiv:2610.03047 关键词:三维动作生成, 视频扩散, 共去噪, 多层特征融合 前序问题:视频模型学会了人怎么动,却没有显式输出可用于动画的三维动作。先生成视频再估计动作需要多阶段处理;从零训练动作生成器又受动作数据覆盖限制。 本文贡献:Parasitic Motion Decoder(PMD)附着在冻结的 Wan2.1 上。先对齐动作与视频 latent,再用轻量 flow-matching decoder 读取视频 DiT 多层特征,按噪声水平 σ 自适应融合,并与视频共享去噪日程。视频与动作的噪声独立,耦合来自同一日程和特征条件;一次联合采样流程得到配对输出。 论文 Figure 2:Parasitic Motion Decoder(PMD)的结构。先将动作与视频 latent 对齐,再让动作 decoder 与冻结视频宿主同步去噪;σ 自适应多层融合把宿主的中间特征送入动作流。 实验效果:表 1 的 MBench Protocol B:19M 可训练参数的 PMD,动作条件一致性 0.58、泛化 0.72;2B 可训练参数的 MotionVLA 对应 0.55、0.66。表 2 的 HumanML3D 上,PMD 的 R-Precision Top-1 为 0.537,FID 为 0.098;DisCoRD 的 FID 为 0.032,说明语义对齐优势没有覆盖全部分布质量指标。 论文 Figure 3:MBench prompt 上的定性比较,展示各动作生成方法对文字动作要求的可视化结果。图展示动作语义与轨迹外观;抖动、足部接触等质量仍应结合实验表分别判断。 批判点评:19M 是附加可训练模块,不包含冻结视频宿主,因此不是整个系统只有 19M 参数。冻结宿主没有接受本工作三维动作监督,但附加模块训练仍用配对动作数据。动作抖动、接触和 FID 也并非全面最佳;没有找到作者可核验代码链接,不把模板或会议样式当作接收证据。 7. Custom Forcing:两分钟视频保持同一个主体 Custom Forcing: Training-Free Subject Customization for Autoregressive Video Generation | 韩国庆熙大学;得克萨斯大学奥斯汀分校 | arXiv:2610.02914 关键词:视频个性化, 自回归生成, KV缓存, 免训练定制 前序问题:自回归视频能不断续写,却容易把用户给定的某只宠物或物品变成同类通用实例。固定参考帧只能提供初始锚点;文本的类别先验与后续漂移会逐步削弱主体身份。 本文贡献:Custom Forcing 将五张参考图和一张场景定制 anchor 一次写入持久 KV cache。DVA 根据当前主体相似度相对初始水平的下降增强参考 value;ACG 比较读取与不读取 anchor 的注意力输出,沿远离通用类别先验的方向引导。冻结基座,无需逐主体训练。 论文 Figure 3:Custom Forcing 总览。上方:参考图与 FLUX.2 [klein] 生成的定制 anchor 副本一次写入 KV cache。中间:冻结基座每层 self-attention 在 DVA 以 g(t) 放大参考 value 后,分别读取含及不含 anchor 的缓存,得到 z_+、z_-。左下:DVA 根据当前已完成 chunk 的相似度 s(t) 相对初始 μ_base 的下降设置 g(t)。右下:ACG 以 κ 沿远离 z_- 的方向外推,再与 z_+ 混合。 实验效果:表 1 的两分钟测试:固定 K/V 的首段与末段 DINO-I 为 0.583、0.415,Custom Forcing 为 0.622、0.578。表 2 在单 H100、30 秒、100 个案例上,相对 FramePack-F1、SkyReels-V2 DF、SkyReels-V3 的逐帧生成时间优势为 9.5、11.5、28.5 倍;这些基线架构和规模不同。 论文 Figure 4:两分钟生成示例。只使用定制 K/V 时,主体在第一分钟内发生漂移;Custom Forcing 在展示的两种主体案例中维持到两分钟。两种案例分别生成,并非证明一个视频同时控制两个主体。 批判点评:相对固定 anchor,DVA 与 ACG 增加 11%–13% 生成时间。测试为动物和物品、每段一个主体、最长两分钟,局部细节漂移和多个主体仍未解决。实际能力受冻结基座限制。作者项目页可访问,但没有找到该方法的可核验代码仓库。 8. SpectralCache:复用奇异子空间少算主干 SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching | 史蒂文斯理工学院;美国东北大学;达姆施塔特工业大学 | arXiv:2610.02660 关键词:扩散加速, 世界视频生成, 频谱缓存, 特征近似 前序问题:世界视频模型每个去噪步都运行昂贵主干。直接复用完整特征没有利用结构:相邻步骤的主导奇异子空间相对稳定,变化更多体现在低维奇异值上。 本文贡献:SpectralCache 在完整步分解最终层特征,缓存最近两次的奇异子空间、奇异值和残差。近似步固定子空间,只线性外推奇异值;误差累积或间隔到阈值后,交替刷新主干和缩放奇异值,以进一步少算完整步骤。它是免训练近似,不是精确复用。 论文 Figure 4:SpectralCache 总览,区分完整主干计算与近似缓存步骤;稳定奇异子空间和残差被复用,奇异值通过外推或缩放更新,触发条件控制刷新。 实验效果:表 1 的 HunyuanVoyager-13B,512×768、49 帧设置下加速 5.22 倍;静态 WorldScore 从基线 66.28 变为 65.90,动态从 46.40 变为 46.13。Aether-5B 的 480×720、41 帧生成加速为 2.20 倍。不同模型与任务的收益应分别读,不能都写成 5.22 倍。 论文 Figure 1:SpectralCache 与基线在 HunyuanWorld-Voyager-13B 上的比较。(a)视觉效果,(b)延迟,(c)质量。在所测条件下加速约 5.22 倍,同时保持较高视频保真;接近原模型仍不代表逐像素无误差。 批判点评:频谱稳定和固定缩放系数来自所测模型的经验,强动态或采样日程改变时需重新验证。质量接近基线仍存在误差,不能写“无损”;PSNR 对齐基线生成也不是对齐真实视频的证明。当前原文没有可核验代码链接,工程复现还需要补足实现和预算测量。 9. DriftTTS:不用生成老师四步合成语音 DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift | 马萨诸塞大学阿默斯特分校;伍斯特理工学院 | arXiv:2610.03390 关键词:语音合成, drifting模型, 分布匹配, 少步生成 前序问题:少步 TTS 往往依赖多步生成教师或预设噪声到数据轨迹。能否直接让真实和生成 mel 特征的分布接近,并让生成器学习自己实际会访问的中间状态? 本文贡献:DriftTTS 在原始 mel 与冻结 MelMAE 特征空间构造真实样本吸引、生成样本排斥的 drift 目标,训练文本条件 decoder。on-policy rollout 用模型自身中间状态学习少步更新;MelMAE 只用于训练。推理从高斯噪声逐步替换 mel 状态,再由 HiFi-GAN 转为波形,无生成教师蒸馏。 论文 Figure 1:DriftTTS 总览。文本条件高斯噪声经少步 drift decoder 迭代细化为 mel 频谱,再用 HiFi-GAN 转为波形。训练时在 mel 域特征空间使用真实与生成样本计算 on-policy 分布匹配 drift 目标,优化 decoder。 实验效果:表 1 在 LJSpeech、相同 HiFi-GAN 和 Whisper-medium 评估下,四步 DriftTTS 的 MCD 为 3.87 dB、WER 3.7%,Matcha-TTS 为 3.85 dB、3.4%。表 2 的 MOS 为 4.18±0.16,对方 3.96±0.18;配对检验按受试者聚合 p=0.31,按语句 p=0.044。 论文 Table 1:LJSpeech 评估。所有合成系统使用同一个 HiFi-GAN 声码器,WER 由 Whisper-medium 计算,听测统计另见 Table 2。四步 DriftTTS 的 WER 为 0.037、MCD 为 3.87、UTMOS 为 4.25、MOS 为 4.18;四步 Matcha-TTS 对应 0.034、3.85、4.36、3.96。NFE 是声学生成器的函数评估次数。 批判点评:更高 MOS 均分不能写成所有统计口径显著胜出,两个客观指标还略逊基线。无生成教师不等于没有预训练组件,仍用 MelMAE 与声码器;只报告单说话人数据。推理次数应不超过训练深度 K,训练两步的模型直接跑四步会退化。官方代码可访问。 10. Music Rubric:音乐奖励别只盯一个分数 Rubric-Based Optimization for Text-to-Music Generation | 华盛顿大学;艾伦人工智能研究所 | arXiv:2610.03589 关键词:文本到音乐, rubric奖励, 音频语言模型, 后训练 前序问题:提高某一个音乐自动评分,可能牺牲提示词符合度或其他听觉质量。让音频语言模型按多个维度打分是否更稳,也要区分“音乐听起来好”与“速度、调性、乐器确实正确”。 本文贡献:作者用七维自然语言 rubric 评价 prompt 对齐、风格乐器、旋律、节奏、结构、制作和音乐性。MusicGen-small 与 ACE-Step v1 将候选排名转为 DPO 偏好对;ACE-Step 另用 DiffusionNFT 在线优化标量奖励,并比较一次联合评分和逐维评分。Music Rubric 是本文编辑短名。 论文 Figure 1:MusicCaps 上 DPO 后各评估器分数相对未训练模型的百分比变化,正值为好。上排为 MusicGen-small,下排为 ACE-Step v1。每面板对应一个偏好来源:左三列斜线柱按单一自动指标排序,右三列实心柱按音频语言模型 rubric 排序。面板内三柱对应三个评估器,三柱皆正表示无这三项的取舍。各排尺度不同,上排最大柱使用断轴以保持小柱可读;绝对变化见附录表 1、2,基线分数见表 4。 实验效果:附录表 3:ACE-Step 用 Qwen3-Omni 逐维奖励训练 125 次更新后,相对原模型 CLAP、SongEval、Audiobox 分别增加 0.0180、0.1057、0.3385。第 5.4 节的小听测有 7 人、40 条 caption、52 次判断,36 次偏好训练后模型,即 69%,95% 区间 48%–89%;这些是不同口径的证据。 论文 Figure 2:ACE-Step v1 的 DPO 与 DiffusionNFT 比较,每个评分器一面板。面板内三组为 rubric 偏好 DPO(斜线)、一次请求评价全部维度的联合提示 DiffusionNFT、每维度独立请求的逐维提示 DiffusionNFT。每组三柱为与 Figure 1 同色的三个评估器,以相对未训练模型的分数变化百分比表示。所有面板同尺度,对 Qwen2-Audio 最大柱使用断轴;绝对变化见附录表 2、3,基线分数见表 4。 批判点评:评分器和提问方式决定信号是否有效:Music Flamingo 联合评分可出现奖励上涨而外部指标下降,rubric 也没有改善所测调性准确率。短音乐、少量听测与宽置信区间不足以承诺长曲或专家质量;直接属性测量与 rubric 更适合互补使用。本次未找到可核验的作者代码入口。 趋势观察 奖励要定位错误并尊重条件 LoGo 将几何错误定位到三维区域;图像奖励组合按 prompt 意图启用约束,音乐 rubric 则暴露评分器和提示方式的影响。更细的奖励有机会改善生成,但也需要防止对评分代理的过度优化。 一步调用仍包含内部迭代 Depth as Time 把压缩目标推进到网络深度,SpectralCache 从稳定子空间中减少重复计算。参数、执行次数与端到端延迟是三种预算,本文分别给出对应测试条件。 跨模态先验需要明确桥接 DuoMatching 把图像教师接到视频 latent,PMD 把视频宿主知识接到动作流。对齐接口是关键,但附加参数或少步采样不能抹去宿主与训练的成本。 质量应按维度报告 主观偏好、文字符合度、三维一致性和接触质量不一定同步上升。不同论文的 benchmark、生成单位与采样预算不同,这份日报不把分数拼成统一排行榜。 今日讨论 你会优先改善长视频的一致性,还是压缩少步生成的内部计算? 人工智能炼丹君 整理 | 2026-10-06
-
AIGC 每日速读|2026-10-05|NeurIPS省七成token保孔洞SILSA 今日 AIGC 论文速览 今日共 10 篇 · 3D生成 1 篇 · 持久世界建模 2 篇 · 视频表征与3D控制 3 篇 · 个性化图像生成 1 篇 · 音频生成 2 篇 · 视频生成评测 1 篇 重点论文标题列表 SILSA(伊利诺伊大学):省七成token保住孔洞 Oneira(莫纳什大学):新物体能互动且留下后果 World Observer(KAIST):镜头外的物体也继续演化 SemanTok(Stability AI):小模型先学会视频语义 Tacit-TTS(杜比实验室):免转写克隆语音快十倍 今日论文速览 1. SILSA:省七成token保住孔洞 SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation | 伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02201 关键词:图像生成3D, 切片潜空间, Rectified Flow, 拓扑约束 前序问题:高分辨率 3D 生成常先预测活跃体素,再补局部几何;连续曲面被拆成大量局部 token,细杆、孔洞和远距离连接容易断裂。增加体素数能补细节,却同时推高序列长度与训练显存。问题不只是模型画得像不像,还包括生成的网格是否保留原有结构。 本文贡献:SILSA 沿 x、y、z 三轴使用重叠的滑动窗口切片,每个 token 概括一段局部深度窗口。Slice VAE 将带朝向的表面采样编码成切片潜变量,再通过稀疏体积解码器重建网格;Volumetric Anchor Lattice 给三组切片共享的 3D 工作空间。切片级持久同调与相邻切片 Betti 转变损失约束连通分量和孔洞,图像条件 Rectified Flow 则一次生成整组潜变量。 论文 Figure 2:SILSA 总览。沿 x、y、z 轴以重叠切片 latent 表示形状。拓扑感知 SliceVAE 将表面编码为固定的多轴切片 latent,再通过稀疏体积上采样解码为高分辨率网格。图像条件 Rectified Flow Transformer 生成 latent,并以 Volumetric Anchor Lattice 作为共享 3D 记忆协调不同轴。VAE 训练中的切片级持久同调与 Betti 转变损失监督连通分量、孔洞和拓扑一致性。 实验效果:表 3 中固定 384 个 token,对比最紧凑基线 Dora 的 1280 个减少 70.0%;batch size 4、单张 A100 下训练显存 8.7GB,对比 Dora 的 14.6GB 减少 40.4%,端到端推理 0.34 秒/形状,对比 0.82 秒减少约 58.5%。表 1 的 PSNR 为 32.74,SparseFlex 为 30.12;表 2 的 Betti-Err 为 1.582,对比 1.743。arXiv comments 明确标注 Accepted at NeurIPS 2026。 论文 Figure 3:自然场景输入图像的 image-to-3D 生成结果。图中展示 SILSA 从不同输入得到的 3D 形状;这是定性展示,不能仅凭样例推出分布外形状可靠性。 批判点评:这些数字来自不同对照:70% token、显存和延迟以 Dora 为参照,PSNR 与 Betti-Err 的强基线是 SparseFlex,不能拼成对同一模型的全面领先。切片拓扑监督改善结构,并不提供任意形状的拓扑保证;作者也承认分布外结构及信息不足的输入视角会降低保真。值得关注的是表示方式,而不是把单物体结果直接外推到完整场景。 2. Oneira:新物体能互动且留下后果 Oneira: From Open-Ended Generation to Open-World Interaction in Video World Models | 莫纳什大学;大连理工大学;香港中文大学(深圳);牛津大学;布里斯托大学 | arXiv:2610.01614 关键词:交互式视频生成, 显式世界状态, 状态持久性, 条件视频 前序问题:能生成新房间,不代表能持续与新房间里的东西互动。镜头发现一个新苹果,模型要把它变成可操作对象;把苹果拿走之后,再回头也应看到空桌面。纯视频续写往往把交互当作局部视觉效果,缺少记录事件后果并供后续片段查询的状态载体。 本文贡献:Oneira 用显式世界状态表把视频生成与交互闭环连接。coding agent 读取当前观察和目标,定位实体、规划动作并把结果写回表;探索中发现的新物体也会注册。渲染引擎沿相机轨迹把更新后的表转成粗条件视频,视频生成器结合首帧、可选记忆帧和分块 caption 补齐外观与动作;末帧和更新后的状态进入下一段。它的贡献落在生成可互动且状态连续的视频环境。 论文 Figure 2:Oneira 单片段流程。给定输入图像与目标,coding agent A 读取世界状态表并规划动作 P_k。引擎 E 将每个动作写入表,把更新结果 T_k 沿相机路径 C_k 渲染成粗条件视频 V_k(第 3.2 节)。交互表现为物体框的删除或重新着色;被移动物体的框暂时移除,静止后从生成帧重新注册,新露出的物体也如此。视频模型 G 结合首帧、可选记忆帧、V_k 与分块 caption c_k 生成片段(第 3.3 节),末帧与更新后的表启动下一段。球体仅为示意,条件与生成帧来自同一个 Oneira 片段。 实验效果:表 1 的 InteractionBench 包含 100 个交互案例和 50 条记忆链。Oneira 的交互成功率为 0.78、目标正确率 0.82,LingBot-World-V2 分别为 0.49、0.39;记忆部分 State 通过率 0.80,MiniMax-H3 Ref2VA 为 0.68。图 3 展示三个片段组成的 30 秒链,比较执行交互后转回原处的状态。 论文 Figure 3:三个片段组成的 30 秒链的定性比较。各列上方标出当时的动作,橙色单元格表示 caption 携带交互的 chunk,插图显示 Oneira 的条件视频。红色标签标注 baseline 帧中的失败。Oneira 在指定 chunk 控制两次交互,并在相机转回时维持改变后的状态。 批判点评:状态表使“后果被记住”更明确,却没有让底层视频模型成为物理仿真器。作者列出的动作空间仍是离散的,连续控制和精细接触并未解决;长时域视觉一致性仍受生成器能力限制。100 个交互案例与 50 条记忆链是作者的专用评测,不能等同于开放世界任意操作均可靠。 3. World Observer:镜头外的物体也继续演化 World Observer: Joint Actor-Observer Generation for Persistent World Modeling | 韩国科学技术院(KAIST)人工智能学院 | arXiv:2610.02162 关键词:视频世界模型, 全景观察者, 多视角生成, 镜头外动态 前序问题:视频世界模型通常只生成行动者当前看见的画面。汽车驶出视野之后,没有可见证据约束它继续前进;再次入镜时可能丢失、停住或变成别的车。仅保存旧图像能帮助记住外观,却不一定能维护镜头外持续发生的动态。 本文贡献:World Observer 把“行动”和“观察”拆成两个同步生成流:透视 actor 负责当前视角,全景 observer 持续观察选定区域,二者由共享 DiT 联合生成。共同全景源的 warping 建立几何对应;Observer Sink 从高分辨率初始全景取四个透视参考,帮助物体重返视野时恢复细节。观察者还能放在不同位置,或接收单独条件来控制画面外的事件。 论文 Figure 4:模型总览。(a)World Observer 使用共享 DiT 联合生成 actor 与全景 observer 两条流。(b)Observer Sink 将高分辨率初始全景转换为四个透视参考,以保留精细外观信息。 实验效果:表 1 的真实/合成 OOV 测试中,单观察者 2B 模型的 FVD 为 291.7/196.2,LingBot-World 为 420.0/333.3;OOV-D_gt 为 0.426/0.531,对方为 0.337/0.340。多观察者仅在合成集测试,FVD 为 147.0,但 OOV-D_gt 为 0.528,略低于单观察者 0.531。因此视角增加改善部分指标,并非所有动态指标同步上涨。 论文 Figure 7:与其他模型的定性比较。红框标出目标离开视野前与重新进入视野后的物体。已有模型常丢失物体、冻结其状态或不一致地重建它;World Observer 在视野外间隔后更好地保持物体身份与状态演化。 批判点评:方法目前需要全景条件,作者将从普通透视图补全全景列为后续方向;真实世界多观察者条件稀缺,多观察者优势只在合成集有证据。有限的观察者预算也无法覆盖整个世界。它更像把算力分配到感兴趣区域,而不是获得无限范围的世界记忆。 4. SemanTok:小模型先学会视频语义 SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation | Stability AI;卡尔斯鲁厄理工学院 | arXiv:2610.00686 关键词:视频tokenizer, 自回归生成, DINO语义监督, 可变长度token 前序问题:自回归视频生成需要先确定场景是什么,再补纹理细节。可变长度 tokenizer 虽能从粗到细输出,已有 decoder-REPA 对齐却可能利用带噪输入满足损失,未必迫使短 token 前缀本身承载语义;小 AR 模型因此仍可能生成类别不对或随时间漂移的画面。 本文贡献:SemanTok 保留 VideoFlexTok 的可变长度训练和 nested dropout,在编码端加入冻结 DINO 特征,并用轻量 Dense DINO 与 Class DINO 读出头,要求每个保留下来的 token 前缀单独预测教师语义。冻结 tokenizer 后,AR 模型按时间优先、由粗到细的顺序预测 token,再由扩散 decoder 还原视频。语义监督直接落在短前缀,而不只落在 decoder 的中间状态。 论文 Figure 2:方法总览。(1)tokenizer 训练:encoder、FSQ 与扩散 decoder 联合训练,nested dropout 使 decoder 能从任意 token 前缀重建视频。SemanTok 保留 VideoFlexTok 的训练方案(橙色),再加入冻结教师的语义监督:教师特征输入 encoder,每个保留的前缀都学习预测这些特征(紫色;细节见图 3)。(2)AR 训练与生成:冻结 tokenizer,AR 模型按时间优先、粗到细的顺序预测 token,步骤(1)的 decoder 将任意生成前缀渲染为视频。 实验效果:摘要与实验分析报告:201M 的 SemanTok AR 模型可匹配或超过约 3.4 倍规模的 VideoFlexTok AR 模型;附录表 4 中相应规模阶梯为 201M 和 679M。正文还报告在相同 AR 模型下,k=16 时每 token 预测约少用 32% 的 bits。图 7 比较同一 Kinetics-600 弹吉他类别的 rollout,201M 的 SemanTok 随时间退化更慢。 论文 Figure 7:SemanTok 在两种 AR 模型规模下保持优势。图中是同一 Kinetics-600 弹吉他类别的 class-to-video rollout。在 201M 模型下,SemanTok 随时间缓慢退化,而 VideoFlexTok 只在 t=1 时清晰。项目页提供视频。 批判点评:“小模型追上大模型”限定在作者的数据、token 预算与指标配置;参数量减少不等于端到端生成耗时同比减少。正文专门指出每帧仅 1 个 token 时不能兼顾全部目标,附录重建表也显示部分 PSNR/SSIM 逊于基线。语义更准和逐像素重建更准是两种目标,部署时仍需按预算权衡。 5. Tacit-TTS:免转写克隆语音快十倍 Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning | 杜比实验室 | arXiv:2609.38658 关键词:语音克隆, Masked LM, 非自回归生成, ReFlow蒸馏 前序问题:自回归 TTS 逐个预测语义 token,零样本音色克隆效果好但延迟高。非自回归系统更快,却常要求参考音频的转写;参考是陌生语言、婴儿咿呀或无意义发音时,ASR 生成的错误文本反而污染条件。目标是在不要求参考转写的同时降低生成耗时。 本文贡献:Tacit-TTS 从 IndexTTS2 蒸馏,将 text-to-semantic 阶段替换为 masked 非自回归生成,同时保留预训练的说话人和情绪条件。免训练长度估计结合参考音频语速与目标文本音节数,确定输出长度;连续潜表示和 ReFlow 蒸馏则加速下游 semantic-to-mel 的 flow-matching 渲染器,最后由 vocoder 合成波形。 论文 Figure 2:Tacit-TTS 流程总览。输入为参考音频与目标文本,encoder 提取条件表征;text-to-semantic 模型通过 masked-LM 生成语义 token,semantic-to-mel 模型将其转成 mel 频谱,最后由 vocoder 合成波形。 实验效果:单张 NVIDIA A100 上,作者对超过 5 秒的语音报告相对 IndexTTS2 超过 10 倍加速。图 3 的端到端测试包含参考条件计算:4 秒输出约 9.0 倍、31 秒附近最高约 14.9 倍、125 秒为 11.8 倍。表 1 中 LibriSpeech speaker similarity 为 0.875,教师为 0.870;但 WER 为 5.54,教师为 3.115。参考语言另测试了 8 种语言及非词汇声音。 论文 Figure 3:IndexTTS2 与 Tacit-TTS 的端到端生成时间(包含参考条件计算)随输出时长的变化。使用同一参考片段,以固定段落重复延长输出。虚线表示实时速度;Tacit-TTS 曲线上方数字是相对教师的加速比,插图放大 Tacit-TTS 曲线。4 秒、31 秒附近和 125 秒的示例加速比约为 9.0、14.9 和 11.8 倍,不能当作全数据平均。 批判点评:更快没有消除质量损失:普通中文测试上的音色相似度和内容准确度仍落后于教师。图 3 使用固定段落重复拉长输出,最高 14.9 倍不能写成所有语音平均加速;长序列的全注意力成本也开始侵蚀收益。四个常规数据集的其他基线质量数字来自教师论文,而跨语言与非词汇测试由作者重跑,比较范围应分开理解。 6. 4Director:完整网格让物体转身不丢脸 4Director: Controlling Video World Models with Rigid 3D Geometry | Stability AI;伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02160 关键词:可控视频生成, 4D场景, 刚体网格, Motion Adapter 前序问题:2D 框只能指定物体在屏幕上的位置,不能完整表达深度和转向;3D 点或 blob 也缺少完整表面。镜头与物体同时移动时,模型容易每帧重新猜未观测几何,导致物体转了一半、遮挡出错或身份变化。专业创作需要把相机和物体轨迹放进统一的 3D 坐标系。 本文贡献:4Director 从输入图为每个物体一次重建 canonical mesh,每帧只施加一个指定刚体变换。网格、背景点云与相机共享坐标系,用户编排轨迹后渲染成深度视频;可训练 Motion Adapter 将几何条件注入预训练视频模型,后者补充外观、光照与非刚体动态。团队构建含 20,774 个片段的 RealCOD-Rigid,并以身份判断门控 mask IoU,形成 IG-IoU 指标。 论文 Figure 3:4Director 总览。左侧:每个物体只重建一次为完整 canonical mesh,每帧用一次刚体变换移动;网格、背景点云与相机共享坐标系,用户在该坐标系指定物体与相机轨迹,并将场景渲染成深度视频(第 3.1 节)。右侧:可训练的 Motion Adapter 分支将刚体渲染注入预训练视频生成器,由后者补充外观、光照与非刚体动态(第 3.2 节);训练使用 RealCOD-Rigid(第 4 节)。 实验效果:表 1 中 4Director 的 FVD 为 370.4,SymphoMotion 为 405.4、VerseCrafter 为 484.7;IG-IoU 为 60.4,对应 52.9 和 54.8,camera RotErr 为 3.65°。图 5 对比共同相机与物体控制,显示其更完整地跟随指定转向;图 6 另展示物体离开视野后重返的定性案例。 论文 Figure 5:相机与物体共同控制的定性比较。每个片段顶行展示输入图像和规定的轨迹,其下为四个 baseline、4Director 以及源视频按时间对齐的帧。箭头表示物体朝向,源视频中为绿色、生成视频中为红色。该组案例里只有 4Director 完成源视频的转向;baseline 保留原朝向、只转了一部分、模糊或丢失主体。 批判点评:完整网格减少逐帧几何猜测,却会把错误重建固定进控制条件。论文失败案例中,倒立舞者被当作一个刚体平移,生成结果一直保持初始姿态而没有跳舞,说明刚体轮廓可能压制应有的非刚体动作。IG-IoU 还依赖视觉语言裁判判断身份;作者的 VBench 优势多数在 2 个点以内,应避免把图中单例写成稳定保证。 7. GenCine:相机与物体在3D里一起编排 Generative Cinematographer: Composing Camera and Object Motion in 3D | 约翰斯霍普金斯大学 | arXiv:2610.02180 关键词:视频运动控制, 3D运动handle, XYZ引导图, LoRA 前序问题:同一条 2D 拖拽轨迹可能对应完全不同的 3D 运动;相机和物体一起动时,屏幕坐标更难区分“物体真的转身”和“镜头绕过去”。另一方面,整物体刚体控制过硬,人体、动物或机械臂的不同部分需要分别编排,而不必为每类对象建立物理模型。 本文贡献:GenCine 把单张图提升为可编辑的 3D 场景 scaffold,艺术家在共同世界坐标系里设置相机路径,并以局部 3D handle 控制前景不同部分。背景 XYZ、前景 XYZ 和恒定前景身份颜色图分别表达静态位置、动态位置和跨帧对应;有效性 mask 标记缺失条件。轻量 guidance branch 与 Wan 模型的 LoRA 学习这些控制,从真实视频恢复轨迹并结合合成数据训练。 论文 Figure 3:GenCine 的 3D 控制流程。首先从 RGB 图估计深度与动态 mask,再提升为供动作编排的 3D 场景。艺术家通过 Blender 等 3D 界面,在共同世界坐标系指定相机和物体运动。控制转为背景 XYZ、前景 XYZ 和前景身份图,分别指示静态场景位置、移动 handle 的位置及身份。有效性 mask 区分可用条件与缺失值,动态 mask 标出初始前景。冻结的 Wan VAE 将图编码给视频模型;训练配对从视频运动恢复的条件,推理时同样的图表达艺术家编排的控制。 实验效果:表 1 的 Camera Shooting 上,GenCine 的 TransErr 为 1.00,Wan-Move 为 1.02;受控前景 R-LPIPS 为 0.18,对方为 0.19。Object Interactions 上整体 LPIPS 为 0.35,Wan-Move 为 0.37,但整体 PSNR 为 16.54,略低于 Go-w-Track 的 16.59。图 5 给出艺术家编排运动的定性对比,体现 3D 意图与 2D 投影控制的区别。 论文 Figure 5:艺术家编排运动的定性比较。自上而下为 Living room、Bus 和 Robotic arm;每组按行展示 Wan-Move、VerseCrafter、Go-with-the-Track 和 GenCine。第一列为 3D 控制(GenCine)或共享的 2D 投影(baseline),随后四帧采样各控制区间。实线与虚线分别表示已执行和剩余目标路径,圆点表示当前目标,半透明 mask 表示投影目标区域。 批判点评:主要价值是可表达的控制接口,数值优势相当局部,不支持“全指标碾压”的结论。多个 handle 只是分段刚体近似,不能可靠表示复杂形变;单图深度估计出错、遮挡和超出归一化范围的运动都会影响控制。它与 4Director 各有取舍:局部操作更灵活,但没有完整网格带来的全表面约束。 8. PEARL:从用户历史推理个性化画面 Personalized Image Generation with Reasoning and Reflection | 范德堡大学;Adobe;马里兰大学帕克分校;佐治亚大学 | arXiv:2610.00737 关键词:个性化图像生成, 用户历史, 推理反思, DPO 前序问题:个性化图像生成通常依赖挑选好的参考图片,而真实用户偏好分散在评论、帖子、图片和 metadata 中。把某件商品放到什么环境、某个主题应采用什么风格,需要综合历史线索;检索一张最像的图片并不能完整表达生活方式与审美。 本文贡献:PEARL 将多模态 planner、reflector 与冻结图像生成器串成 reason-reflect 循环:先从历史形成场景计划并渲染,再根据实际图像与历史的不匹配修订计划。训练先蒸馏 silver personalization trajectory,再采用交替策略 DPO,用与用户历史相关的检索奖励优化两种策略。配套 benchmark 区分电商商品的 Personalized Scene Generation 和社交媒体的 Personalized Creative Generation。 论文 Figure 2:Pearl 的训练流程。先用 Silver Personalization Trajectory 做 warm start,再通过 Render-in-the-Loop 优化两种策略。图左的教师产生推理与计划供 planner 和 reflector 蒸馏;图右把两种策略与冻结渲染器串接,按奖励给候选排序、构建偏好对并做交替 DPO 更新。 实验效果:表 1 的 Amazon 场景生成中,H@5 为 0.2297,PMG 为 0.2143;MLLM Overall 为 3.92,对方为 3.48。表 2 的 Instagram 创作生成中,跨类别 R@1 为 0.876,Pigeon 为 0.748,MLLM Overall 为 3.541,对方为 3.334。图 4 将两种任务的指标归一化后汇总,比较完整 PEARL 与移除 reflection 的版本。 论文 Figure 4:消融:Pearl 与 Pearl -Reflection 的比较。该可视化对两种任务的指标进行归一化和汇总,展示保留 reflection 前后的差异;坐标是汇总后的相对值,不是原始 benchmark 分数。 批判点评:用户“喜欢”不等于模型能识别出用户:检索与 MLLM 分数只是偏好对齐的代理指标。作者明确指出电商场景没有每个用户—商品组合的自然真实目标图,只能间接评估;策略训练也只做了一轮交替 DPO。Instagram 的 LPIPS 和 MS-SSIM 并非最优,因此不能把摘要中的平均个性化提升写成所有画质指标普遍提升。 9. PLACE:让双耳声像跟随多模态条件 PLACE: Positional Latent Adaptation via Conditioned Embeddings for Binaural Audio Generation | 杜比实验室;佐治亚理工学院 | arXiv:2610.00630 关键词:双耳音频生成, 空间条件, 低秩latent适配, ILD与ITD 前序问题:音频与画面语义一致,还不一定听得出声音来自左边还是右边。现有空间声音生成器的条件接口常较固定,难以同时接收文本、视频和可选音频。想让耳机中的声像随场景变化,需要条件中的空间信息真正改变生成 latent,而不是只描述声源类别。 本文贡献:PLACE 基于 AudioX,增加 Perception Encoder Core 视频特征,将文本与视频表征对齐以提取空间线索,再用依赖条件的低秩变换调整生成 latent。适配器通过解码音频上的耳间声级差 ILD 和时间差 ITD 损失训练;五个预训练 encoder 与 SAO decoder 冻结,AudioX 通过 LoRA 微调。系统支持不同模态条件组合,而非只处理视频输入。 论文 Figure 1:PLACE 框架总览,蓝色突出视频特征路径,橙色突出文本路径。(a)AudioX 生成 latent,空间条件在冻结 SAO decoder 之前驱动其变换;五个预训练 encoder 与 decoder 全部冻结,AudioX 用 LoRA 微调。(b)投影后的 PE Core 特征在 MAF 模块之前补充 CLIP 与 Synchformer 特征。(c)文本—视频 cross-attention 与联合 self-attention 产生空间特征 H_c-sp。 实验效果:表 1 的 FAIR-Play split 1 上,ITD 误差 0.1077ms、ILD 误差 2.0495dB,ViSAGe 分别为 0.1136ms、2.1306dB;split 2 的 ITD 却较差。表 3 的分布外 T2A 听测平均分为 55.5,SpatialSonic 为 44.8;域内 V2A 为 65.3,对方 ViSAGe 为 44.9。原文只写 Submitted to ICASSP 2027,不能称为会议接收。 论文 Table 3:主观听测表。评分范围为 1–100,越高越好;SC 为语义一致性,SI 为空间感,SP 为空间一致性,Sy 为同步性(T2A 不评此项),AR 为音频真实感,Avg 为所评维度的均值。GT 是真实音频参考,不参与最佳模型加粗;粗体表示每种条件各列最优模型。表中区分域内与分布外 T2A、域内与 Gemini 视频条件 V2A;n 统计评分数。PLACE 在域内 T2A 均分 40.5,分布外 T2A 为 55.5,域内 V2A 为 65.3,Gemini V2A 为 58.4。 批判点评:收益取决于模态与分布。域内 T2A 听测均分仅 40.5,低于 SpatialSonic 的 44.4 和 AudioX 的 41.1;BEWO-1M SS-set 上 FSAD、ITD、ILD 也逊于 SpatialSonic,优势集中在原文定义的 SpatialCLAP 差值指标。听测表中的 n 是评分数,不能当作独立听众人数。空间一致性进步不等于全面音质领先。 10. VTR-Bench:视频逼真了字却还常写错 VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation | 香港城市大学;香港科技大学(广州);香港科技大学;西湖大学;电子科技大学 | arXiv:2610.01499 关键词:视频生成评测, 视觉文字渲染, WER, 关键帧引导 前序问题:广告、科学演示和界面视频里的文字常承担核心信息。模型能把灯光与动作做得漂亮,招牌仍可能拼错、缺字或小字不可读;只评审美与物理合理性无法发现这些问题。需要把文本正确性与画面任务完成度分开衡量。 本文贡献:VTR-Bench 用 300 个 prompt 覆盖五类场景,对具体文字载体分别转写并计算 WER,同时用每条 prompt 的 20 问 checklist 检查场景与运动要求。作者另外提出关键帧引导生成流程,由 Director agent 根据视觉反馈反复调整图像、首帧及运动计划,再生成视频。主贡献是生成模型评测与改进,符合 AIGC 范围,而不是通用视频理解。 论文 Figure 2:VTR-Bench 总览。左侧:专家设计五种场景类别,引导场景 seed 生成与人工过滤;保留的 seed 用于构造 prompt,再通过参考图生成和 VLM 审查迭代完善,最后人工复核。右侧:生成视频在两个维度分别评估,Video Score 以 20 问 checklist 衡量场景与视频要求完成度,WER 比较针对具体文字载体的 VLM 转写与参考文字,衡量视觉文字保真。 实验效果:主表 1 比较 11 个视频模型,Wan3.0 的整体 WER 最低,为 0.250,Video Score 为 0.849;MiniMax H3 为 0.447/0.756,Seedance2.5 为 0.641/0.791。表 2 中 Qwen3.8-27B 对文字块 WER 的 Pearson 为 0.9541,视频级为 0.9842,支持其与人工转写的相关性。官方代码:VTR-Bench。 论文 Figure 1:即使视频视觉上可信,现有视频模型仍难正确渲染文字。上方是 Seedance2.5 生成的视频;Video Score 是 20 问 checklist 中满足要求的比例,WER 是相对参考文字的词错误率。左下展示视频中的四种文字渲染问题,右下展示 11 个模型在 VTR-Bench 上的整体 WER。 批判点评:WER 是词级编辑距离,0.250 不等于“25% 的视频失败”,也不能推出每个视频都错四分之一。不同模型的分辨率与生成管线不同,排行榜还受评审模型影响;相关性高不意味着每条转写都正确。关键帧 agent 的迭代成本也应单独核算,不能把更高预算的改进当作单次生成能力。 趋势观察 从像素记忆走向状态载体 Oneira 显式记录交互后果,World Observer 持续生成选定区域的视角;两条路线都让镜头外状态获得约束,但尚未证明无限时域或全面物理可靠性。 控制接口先解决几何歧义 4Director 用完整刚体网格,GenCine 用局部运动 handle;它们共同把相机和物体放进世界坐标系,分别在完整几何与形变灵活性之间取舍。 短序列必须携带可用信息 SILSA 的切片潜变量与 SemanTok 的短语义前缀都减少局部 token 负担;这是不同任务中的表示设计趋势,不能把各论文加速数字横向相乘。 评测拆开能力与代价 视频里的字、音频的空间感、用户历史匹配和端到端耗时都需要独立指标。各论文测试集、评分口径和硬件不同,本期不做跨论文统一排行榜。 今日讨论 SILSA 用切片拓扑监督改善单物体孔洞与连通性;面对输入视角不充分或分布外形状,你会优先增加多视角条件,还是设计可验证的拓扑约束? 人工智能炼丹君 整理 | 2026-10-05