今日 AIGC 论文速览
今日共 10 篇 · 视频局部编辑与图像编辑防护 2 篇 · 物理外观编辑与视频记忆 2 篇 · 生成训练与表征 2 篇 · 少步生成安全 1 篇 · 图像与音乐编辑评测 2 篇 · 交互视频世界 1 篇
重点论文标题列表
- LociArt(小米):只给选中区域换画风
- CaD(普林斯顿):让编辑器照抄原图来防改
- SREdit(西南大学):先看投影照得动哪里再改
- VMem-Bench(可灵):旧参考能记住也能带错人
- NTI(港大):训练别只认唯一下一块
选读入口:要给视频局部换画风,先读 LociArt 并确认风格已学、区域互不重叠;想保护照片免遭改动,读方向相反的 CaD。要把改图投回实体,读 SREdit 的额外 0.60 至 0.73 秒与完整系统成本;长故事换装或角色退场,读 VMem-Bench 的召回/错带实体取舍。训练视觉自回归看 NTI,选择压缩器先看 WithinVAE 的生成负结果。部署少步模型再读 DICE;手机预算读 MoI-Bench,编辑音乐读 SMEBench。最后用 BoxWorld 思考哪些互动规则应交给显式引擎。
今日论文速览
1. LociArt:只给选中区域换画风
LociArt: A Unified Paradigm for Free-Style Local Video Stylization | 小米 MiLM Plus;西安电子科技大学 | arXiv:2610.36456
关键词:局部视频风格化, 极坐标风格掩码, 区域几何约束, 风格扩展
- 前序问题:想让视频里的熊变成铅笔画,周围石头仍保留原色;整段换风格容易,局部换风格却会越界、闪烁。二值掩码只说改哪里,还没有把每个区域与它的风格绑在一起。
- 方法直觉:把风格当成单位圆上不同方向,直接写进要编辑的区域;再同时保留压缩后的上下文和原掩码的几何边界。模型既知道这里该换什么画风,也知道影响应停在哪里。
- 本文贡献:GRNStyle 基于 GRN 生成细化网络,以二进制视觉 token(压缩视觉单元)并行迭代生成。三通道风格掩码前两维存缩放后的极坐标,第三维存占用,不额外增加通道或 token。编码掩码减去空掩码编码,消除空条件偏置;池化的原掩码提供几何支撑,再与源视频特征经逐块视觉/文字门控注入。自动全局风格化、去物体、抠图与合成构造 10 万对视频;从预训练 GRNEdit 初始化 20 亿参数主干,8 张 H200 全量微调,训练 61 帧、20 帧/秒、18 种风格。
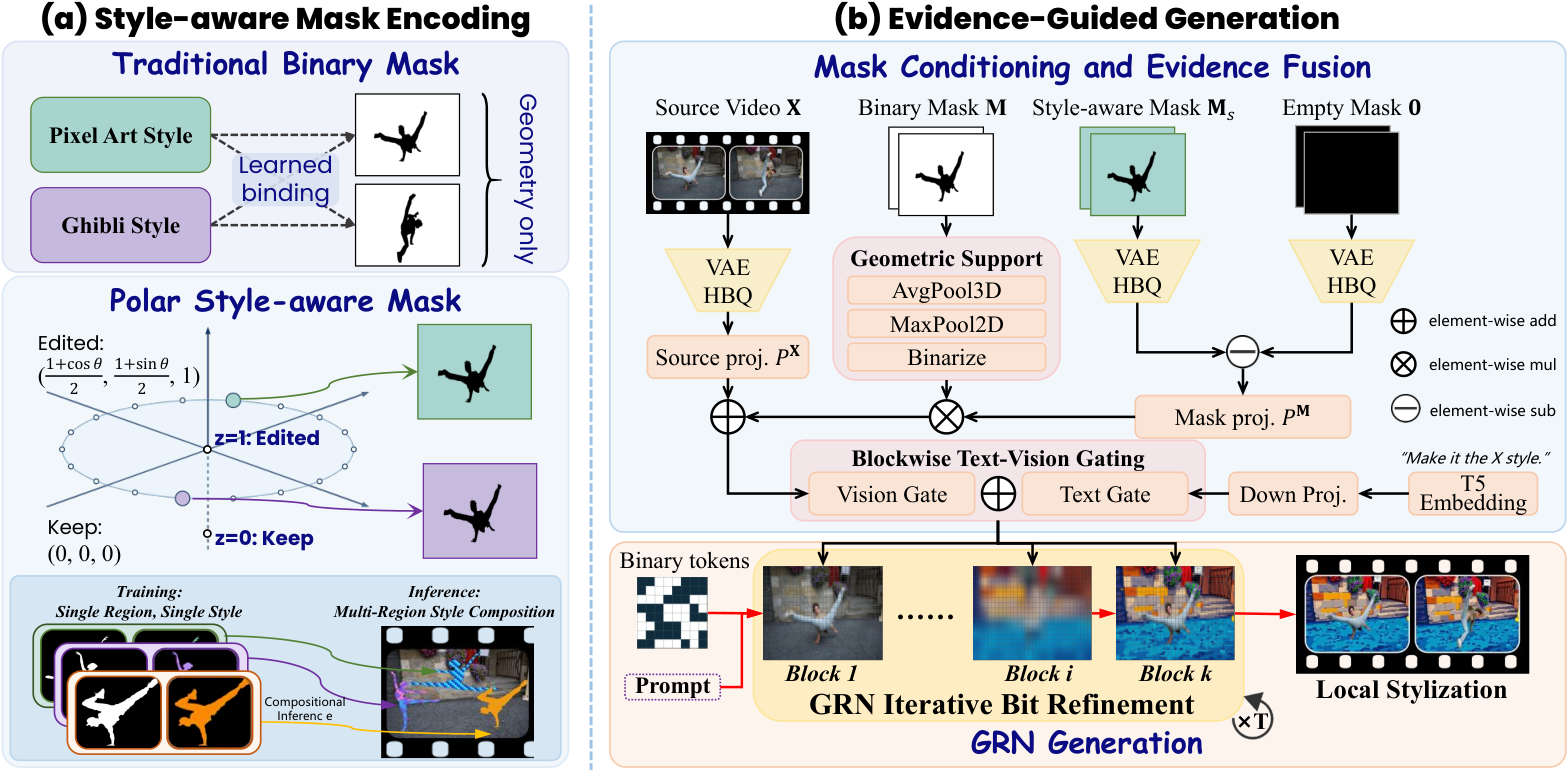 原文图 2|GRNStyle 总览。(a)极坐标风格掩码把风格绑定到区域,并支持多区域组合;(b)减去空掩码的锚定证据与原掩码几何支撑同源视频特征融合,经逐块门控引导局部视频风格化。
- 实验效果:80 条视频、84 个视频-物体掩码单元,前景/背景两协议共 168 例。对同数据微调的 VACE-1.3B,区域风格原型相似度 SPS 前景 0.386→0.407、背景 0.676→0.705;未编辑区域 PSNR 峰值信噪比 25.43→25.92、25.49→26.15 dB。相邻帧 CLIP 视觉特征余弦一致性 0.980→0.983,均越高越好,但不是像素级无闪烁保证。10 扩 15 风格且不回放旧数据,旧类 SPS 下降 0.022,对二值版 0.102。
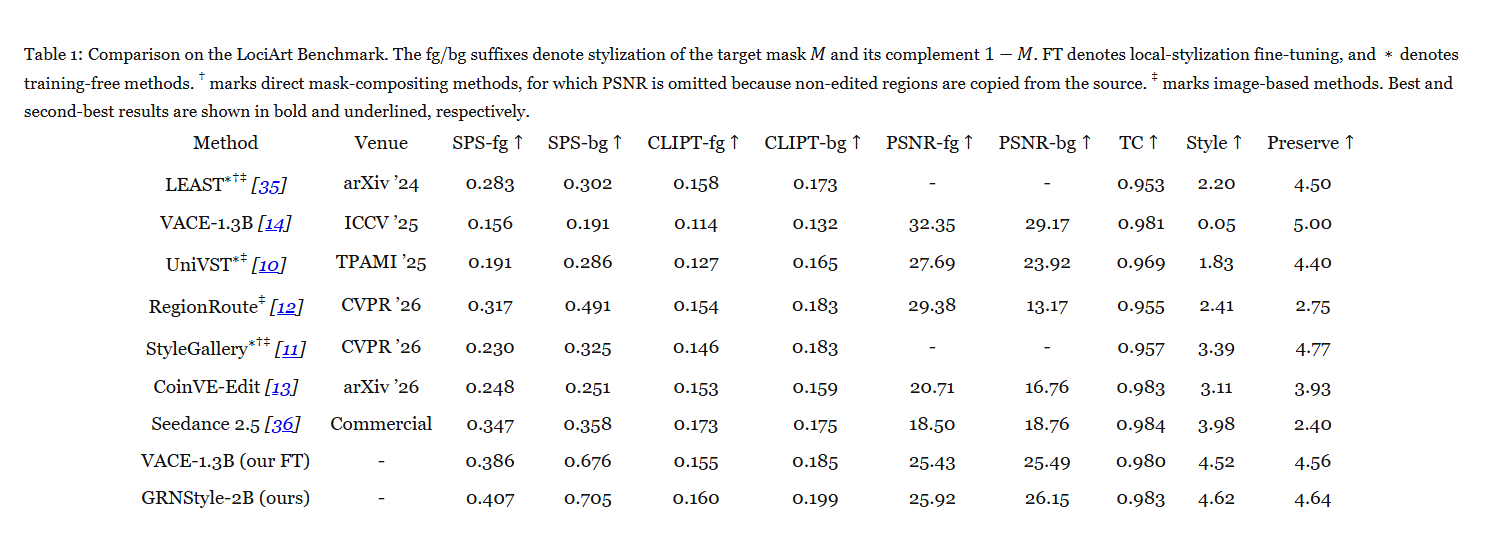 原文表 1|LociArt 基准比较。fg/bg 为编辑目标掩码及其补集;FT 为局部风格微调,星号为免训练,剑号为直接合成掩码且非编辑区复制源像素,因此省略不可比 PSNR,双剑号为图像方法。SPS、区域文字相似、非目标保真和相邻帧一致性及风格/保留裁判分均越高越好,粗体和下划线分别标最优与次优。
- 批判点评:多区域组合只展示不相交区域及已学风格的定性案例,不能称任意参考图零样本编辑;旧风格仍遗忘。20 人、160 例的用户研究每例仅一人评分,不是每人评完全部。未给统一推理时延/峰值显存,新增条件不加 token 不等于零开销。项目有演示,本次未核到 GRNStyle 实现或权重。
2. CaD:让编辑器照抄原图来防改
Copying As Defense: Protecting Images from Editing By Eliciting Model Copying | 普林斯顿大学;Adobe Research | arXiv:2610.35566
关键词:图像编辑防护, 早层参考注意力, 逐token目标, 优化成本
- 前序问题:分享照片前加一层微小扰动,希望别人难以篡改。把编辑器对原照片的注意力压低,可能只让它凭文字重画另一个人,仍然完成了不希望发生的编辑。
- 方法直觉:反过来,让待生成区域过度关注原图。注意力总量归一化,原图占得越多,文字指令和新画布分到的越少,模型就更容易复制输入而不是执行改动。
- 本文贡献:CaD 是 Copying-as-Defense。对白盒可访问的扩散 Transformer 编辑器,优化输入像素扰动,逐目标 token、逐注意力头最大化早期双流块分给参考图的注意力质量。只对选定早层计算损失,前向与反向都在最后目标块截断。50 张受保护图来自 20 张筛选人像与 30 张合成人体图,每张 15 条指令,共 750 个编辑输出/配置;比较 FLUX Kontext 与 FIBO Edit。
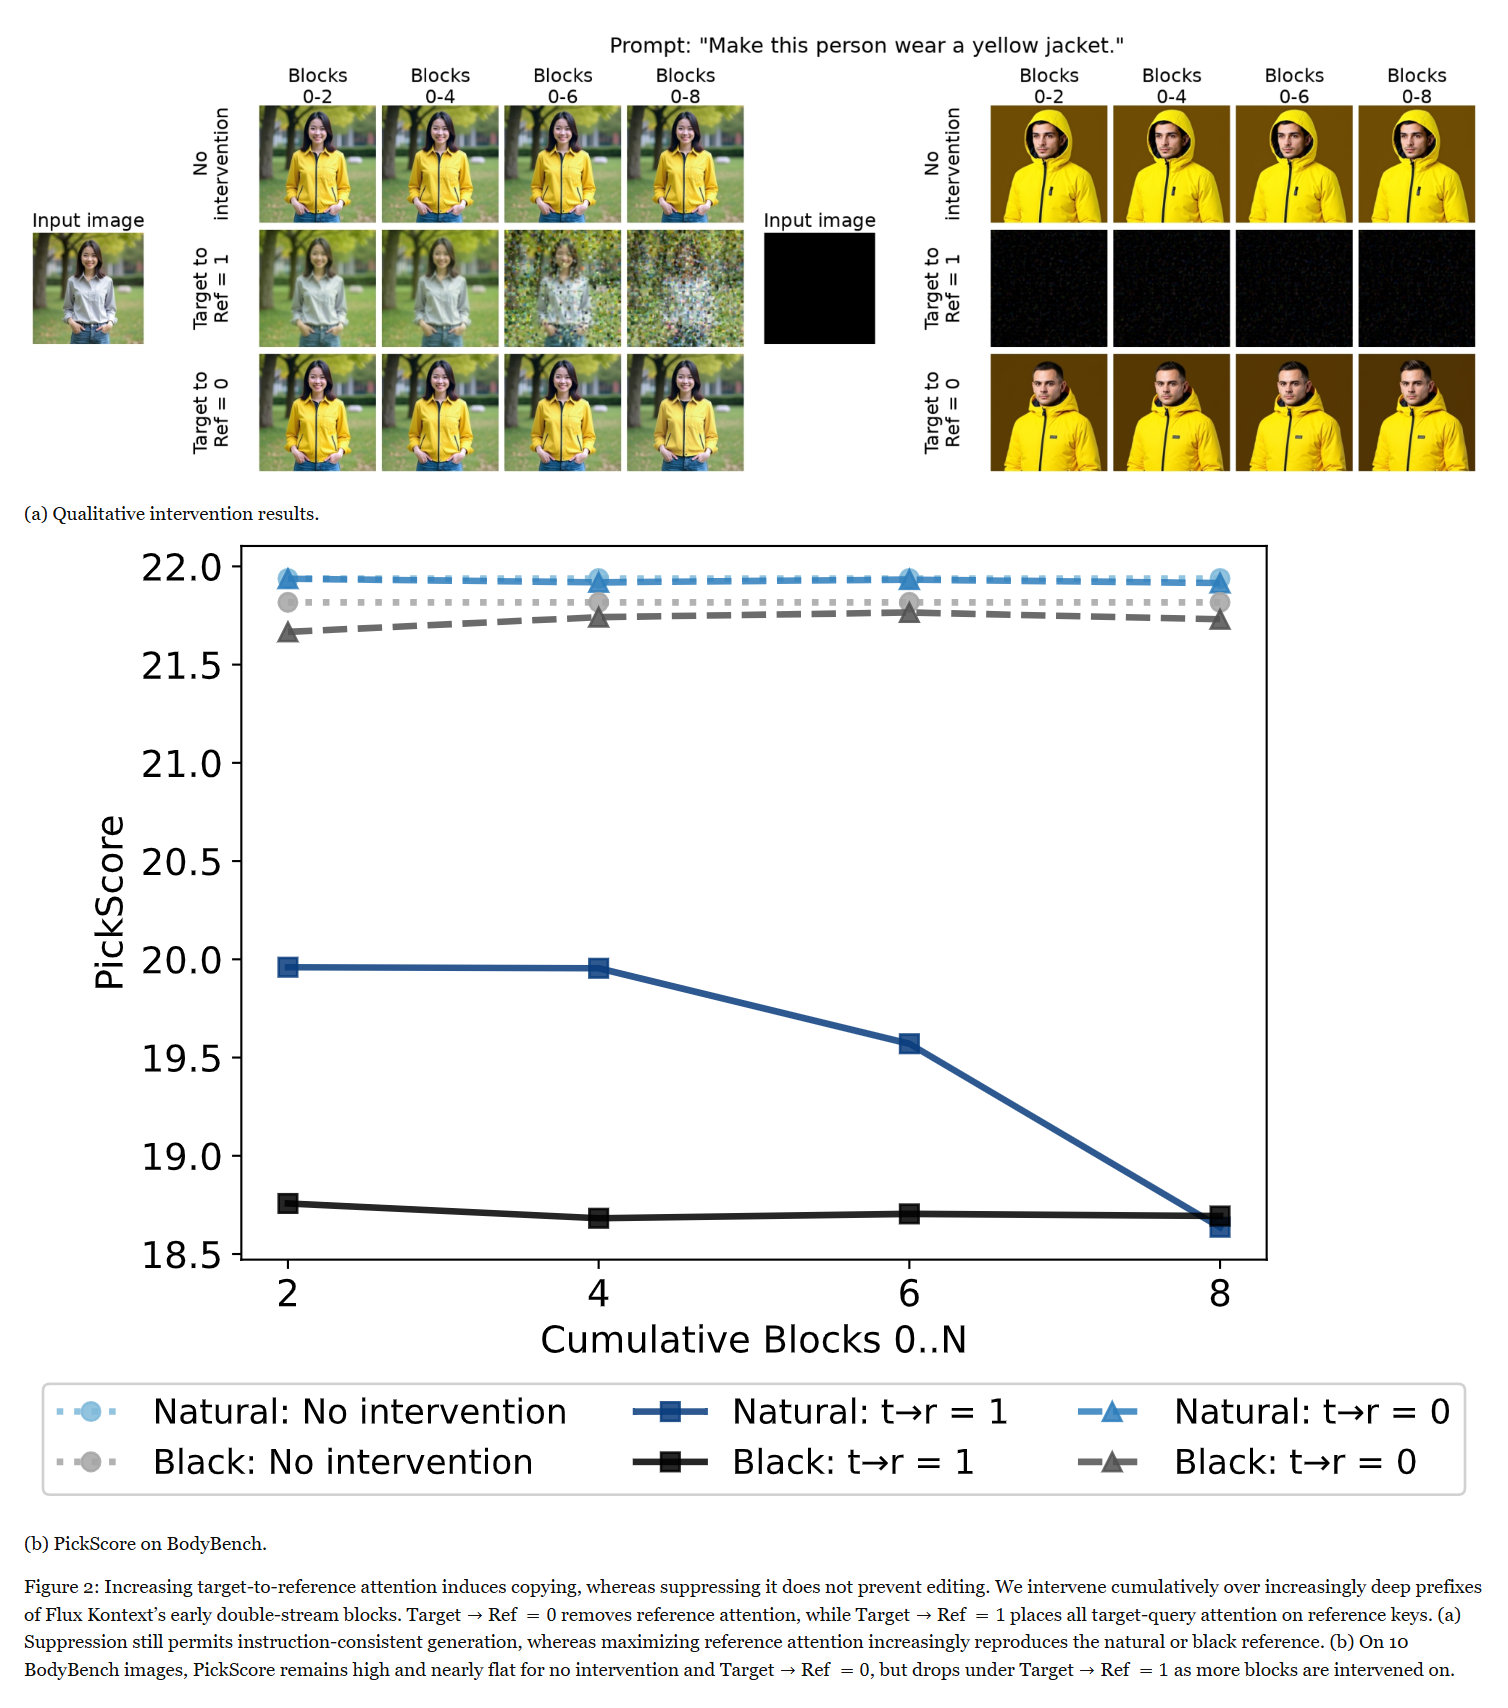 原文图 2|在 Flux Kontext 早期双流块不断加深的前缀中累积干预。Target→Ref=0 移除参考注意力,=1 把所有目标查询注意力分给参考键。(a)压低参考仍能按指令生成,拉满则越来越复制自然图或黑参考;(b)10 张 BodyBench 图的 PickScore 文字图像匹配分,无干预和=0 保持高且近乎平坦,=1 随干预块增加而下降。这是机制诊断,不是 CaD 算法流程图。
- 实验效果:每像素最大扰动 12/255 时,FLUX Kontext 的 BodyBench 编辑成功率 81.6%→5.1%,DeContext 为 24.9%;成功由视觉语言模型同时判断改动、身份保留及伪影。FIBO 的人像为 80.0%→18.3%,但全身图 CaD56.4%反而高于 Diff-PGD47.6%。FLUX 每优化步 0.647 秒,对 DeContext1.232 秒;CaD1000 步共 10.78 分钟,对方 800 步 16.43 分钟,不能把每步约 1.9 倍当总耗时倍率。
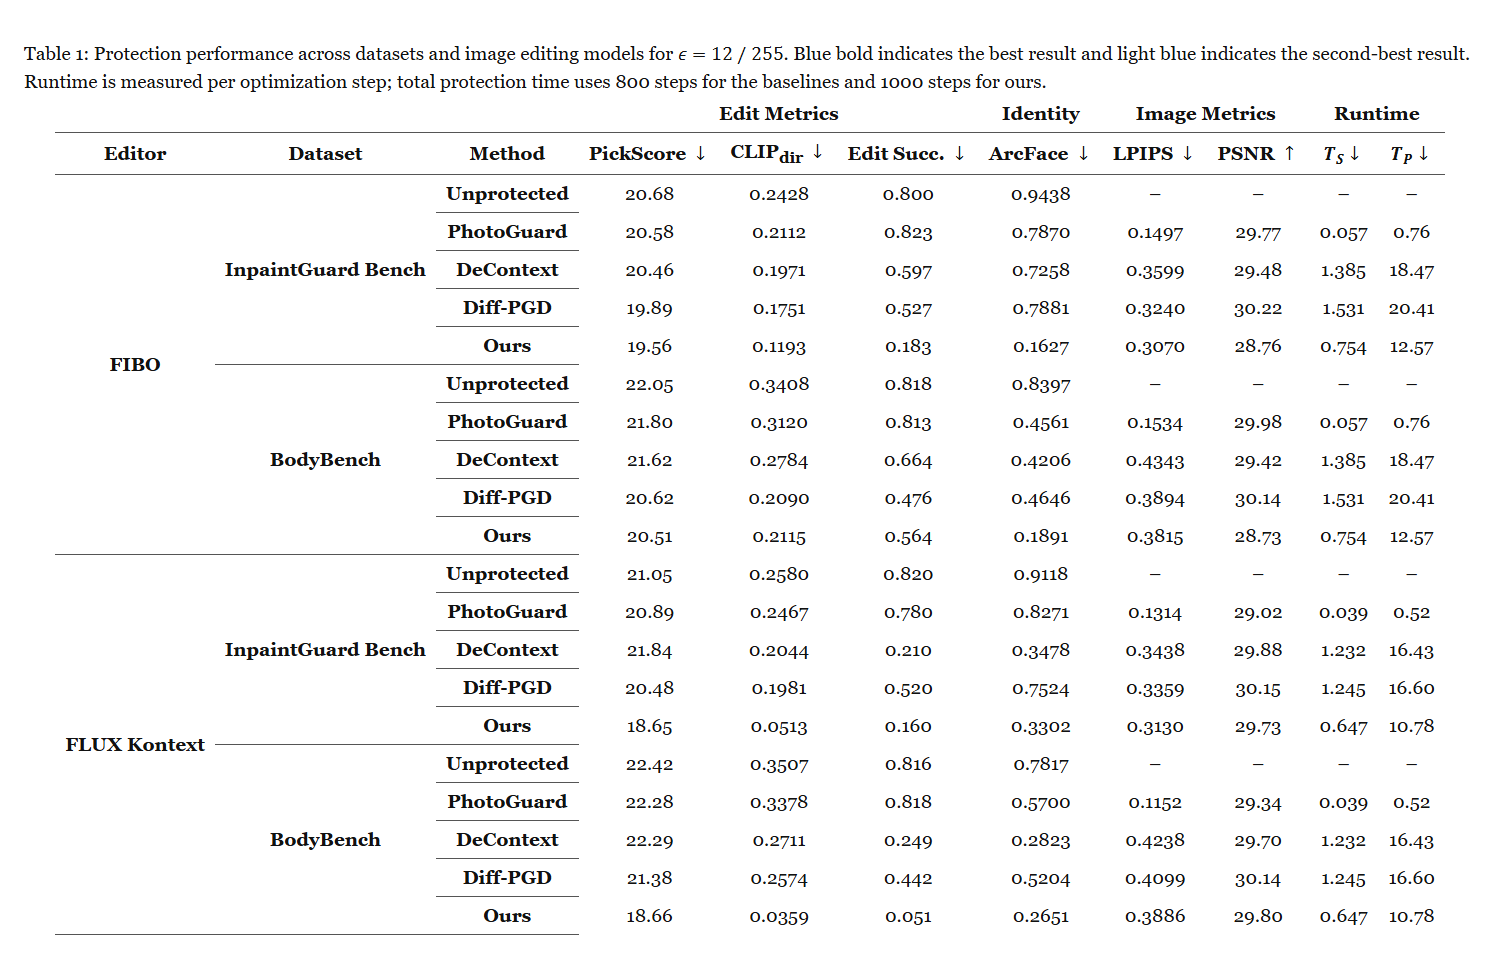 原文表 1|最大扰动 12/255 下两个编辑器和两个数据集的保护。蓝色粗体/浅蓝标最好/次好;编辑成功、文字匹配和身份分越低代表防护越强,保护图 LPIPS 越低、PSNR 越高越不易察觉。运行时间分别是每步秒数与每图分钟数;基线 800 步、CaD1000 步,不能混为同预算。
- 批判点评:输出可能是有损复制或带伪影的失败图,防编辑不等于恢复干净原照;LPIPS 感知距离与 PSNR 还要核保护图是否可见改变。实验只 50 张且针对已知白盒编辑器,JPEG 压缩、缩放和去扰动会削弱保护,不能许诺跨平台永久有效。原文未给可核实的作者方法代码入口。
3. SREdit:先看投影照得动哪里再改
SREdit: Scene Response Guided Appearance Editing for Projection Mapping | 西南大学 | arXiv:2610.32792
关键词:投影外观编辑, 场景响应图, 早期源图锚定, 物理重现
- 前序问题:把雕像照片改成翡翠,再投回实体,屏幕上很亮的绿未必能照出来;编辑器还可能改了轮廓。后面的投影补偿只能调光,救不了已经偏离实物的目标图。
- 方法直觉:先估计各处表面对投影光的响应。照不动的地方多保留原色与明暗,能照动的区域再大胆修改;只在生成前段拉住结构,把后段留给纹理。
- 本文贡献:冻结已重建、已标定的高斯可微场景渲染器,从表面反射、法线及投影/观察方向求逐通道响应,再取均值并在物体支撑域归一化。采样前 20%用同噪声级的源图潜变量锚定,按响应和时间权重修正 Euler 更新,后段恢复原编辑器;不用训练或反传编辑器。Qwen 与 LongCat 分别 40/50 步,控制强度 2.5/3.0 由另一个场景选择。最后独立优化投影补偿图。
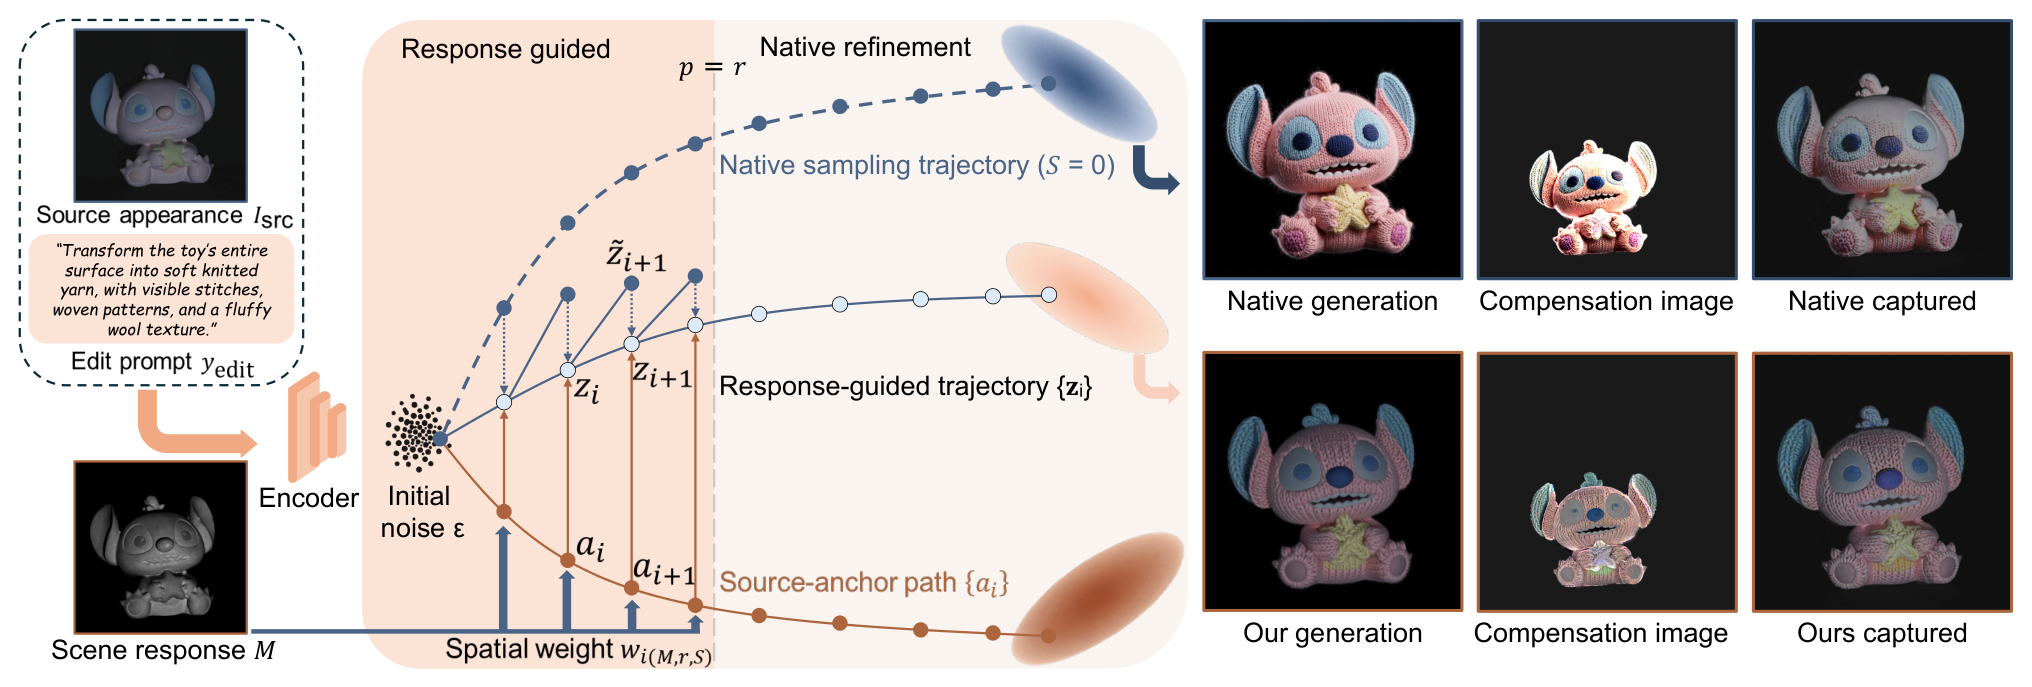 原文图 1|固定物理场景的外观编辑流程。前 r 比例采样用源外观保住配准,场景响应图让低响应区域保留更多源信息、高响应区域允许更大变化;剩余步骤由原编辑器完成,再迭代优化补偿图并进行实体投影。
- 实验效果:6 套固定实物-投影-相机装置、18 个文字任务,论文报告 64GB A100。LongCat 生成目标与实拍结果的 PSNR14.7231→20.6623 dB、LPIPS 感知距离 0.3369→0.2316,后者越低越好;耗时 58.50→59.10 秒,峰值 29.73GiB 不变。Qwen88.37→89.10 秒、57.94→57.95GiB。参考图编辑仅测 Qwen、4 场景 12 例,PSNR18.5257→21.7335;20 人 720 次判断整体偏好 72.4%。
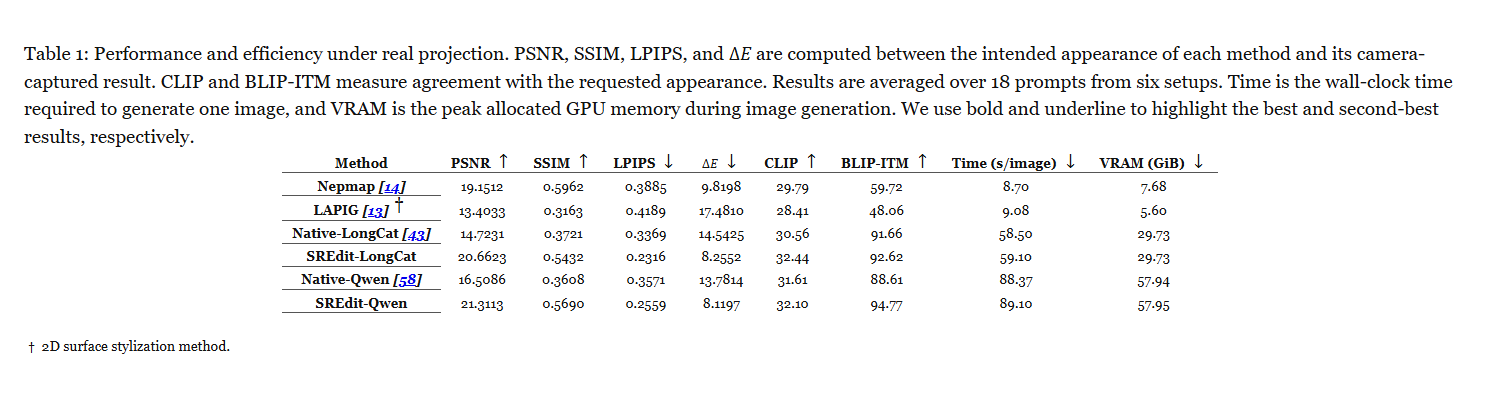 原文表 1|6 套装置 18 个提示的实体投影质量与效率均值。PSNR、SSIM、LPIPS 及色差比较各自目标与相机实拍;CLIP、BLIP-ITM 评文字请求一致性。时间是单张目标生成墙钟秒数,VRAM 是生成期峰值分配显存,粗体/下划线标最好/次好,剑号为二维表面方法。
- 批判点评:PSNR 比较各方法自己的目标与实拍,目标难度不同,不能直接当编辑优劣;需结合文字一致性与人工评价。响应是软约束,过强会抹掉纹理;场景重建、标定和补偿成本不包含在新增不到 1 秒的编辑开销里。固定机位物体实验尚不覆盖动态表面;原文未给方法代码。
4. VMem-Bench:旧参考能记住也能带错人
More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation | 中国科学技术大学;可灵研究;清华大学;香港科技大学;香港城市大学 | arXiv:2610.35001
关键词:长视频视觉记忆, 参考检索, 当前状态正确性, 双轨诊断
- 前序问题:长故事里人物换了围巾,检索旧帧却把旧围巾带回来;已经离场的人也可能因同框参考再次出现。“长得像过去”与“符合现在剧情”并不是同一个目标。
- 方法直觉:把检查分成生成前与生成后:先问检索的证据是否合适,再问新视频真正保住了谁、错带了谁。这样能区分检索覆盖、历史相似和当前状态正确性。
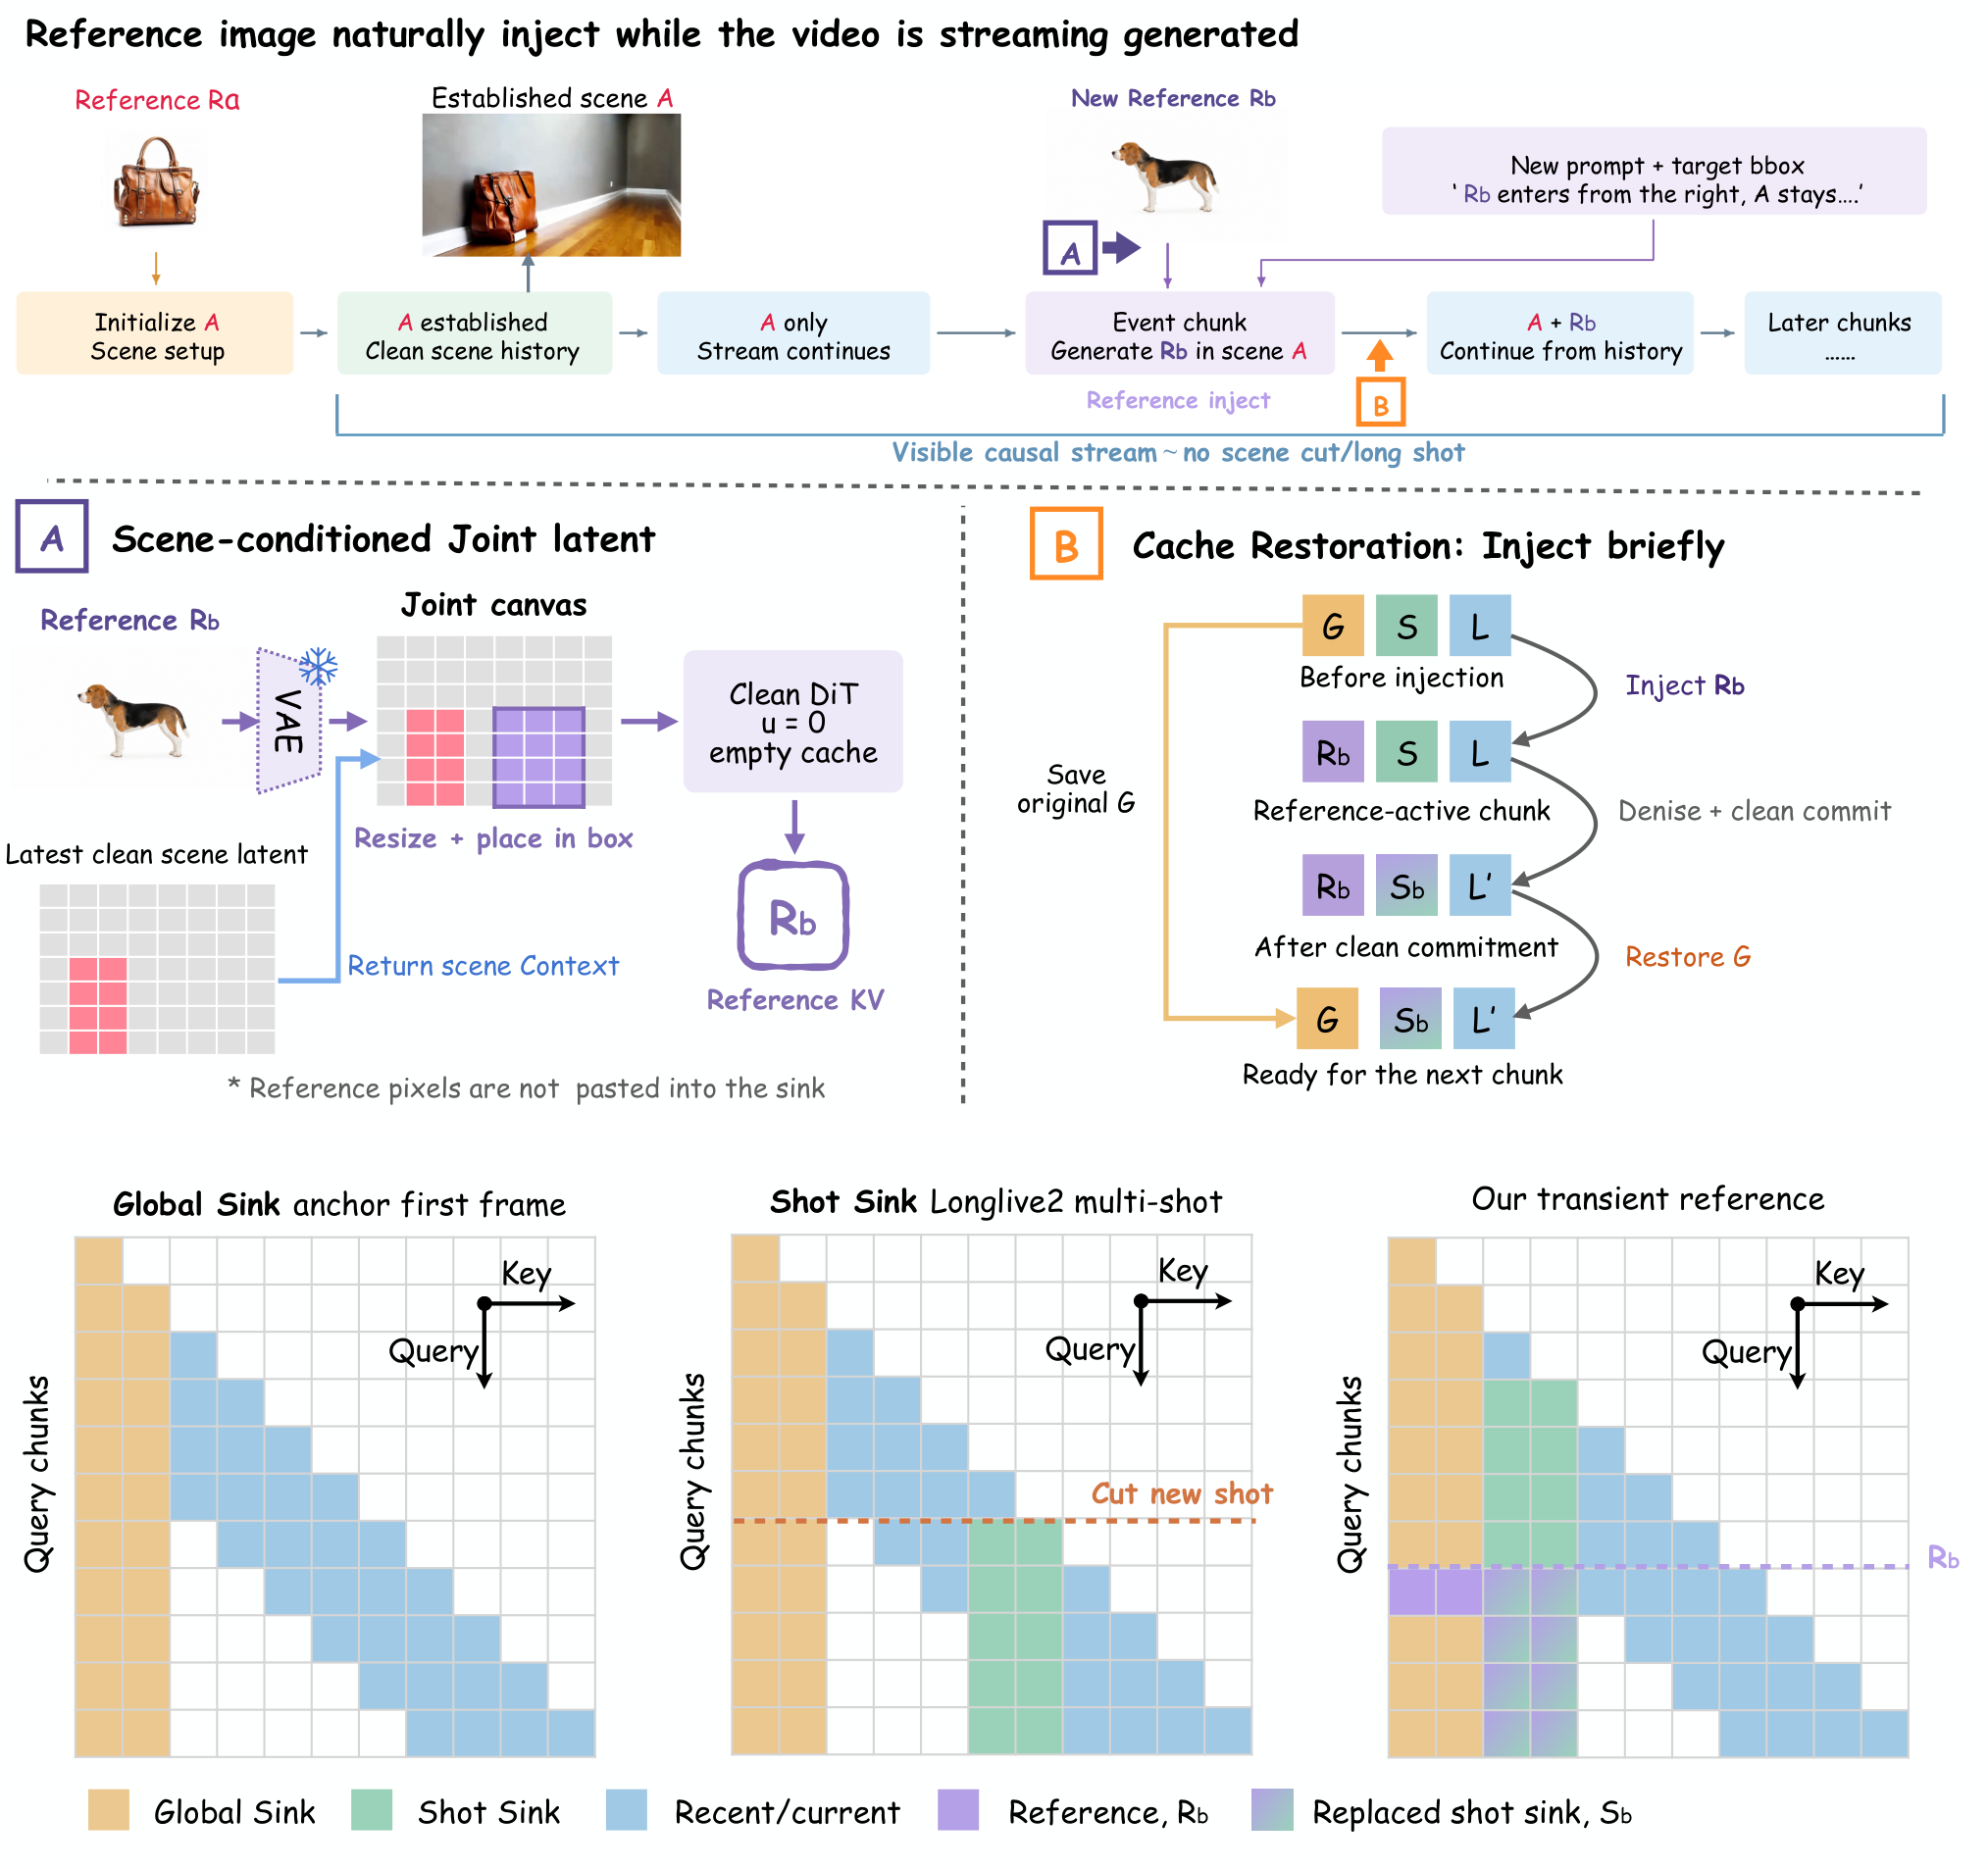
- 本文贡献:Track-A 在 92 部真实影片的 16548 片段上,只从过去检索、随后揭示当前片段,不运行生成器。Track-B 为 30 条人工构思故事、2824 个 5 秒片段;共享 FLUX.2 关键帧合成与 Wan2.2-TI2V-5B,对四种检索策略各取 3 帧,再与无记忆及获得真值实体 ID 的最近出现参考对照。各策略从自己的输出继续写记忆,因此比较完整闭环策略;这里 causal 仅指不看未来,不是固定历史上的单参考因果干预。
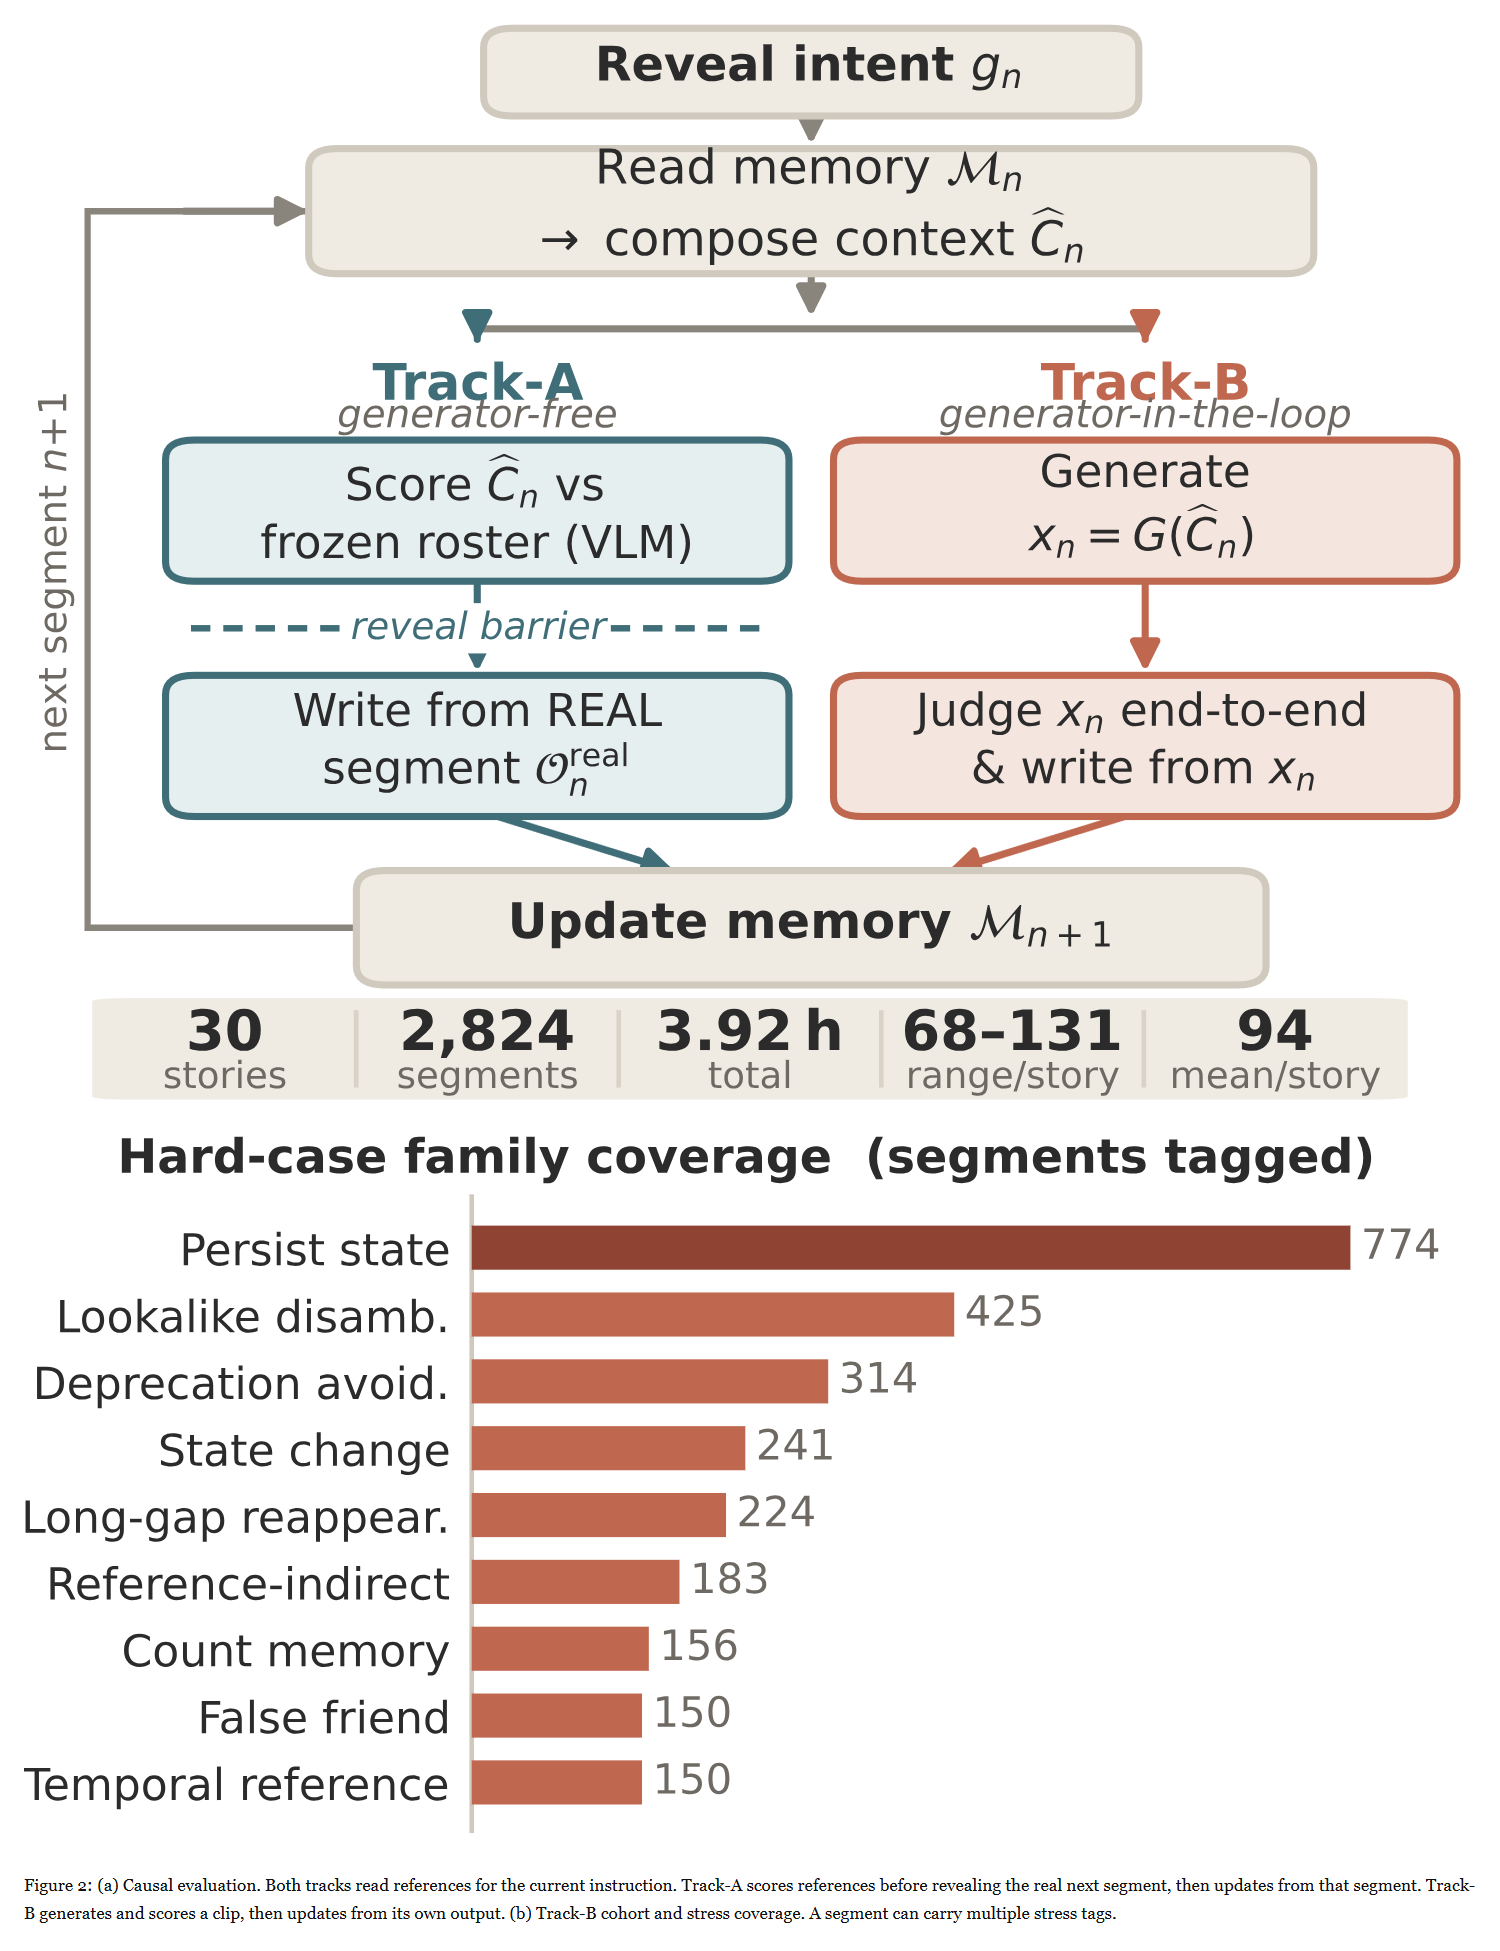 原文图 2|(a)两轨按时间读当前指令与历史:A 轨在揭示真实下一片段前检索评分,随后用真实片段更新;B 轨先生成评分,再用自身输出更新。(b)B 轨故事与压力族覆盖统计,同一片段可以有多个压力标签。
- 实验效果:共享生成器下,必需人物/道具召回率 0.559→0.628 至 0.693,生成实体中真正需要的比例即精确率 0.977→0.915 至 0.938;禁止实体保持不出现的比例 0.968→0.845 至 0.898。检测到的回归实体与历史 DINOv3 视觉特征相似度 0.35→0.49 至 0.57,却可能奖励过时外观。62 次长间隔人物回归中 61 次已在提示写新外观,去掉外观描述后无记忆召回 0.984→0.565,揭示提示泄漏的混淆。
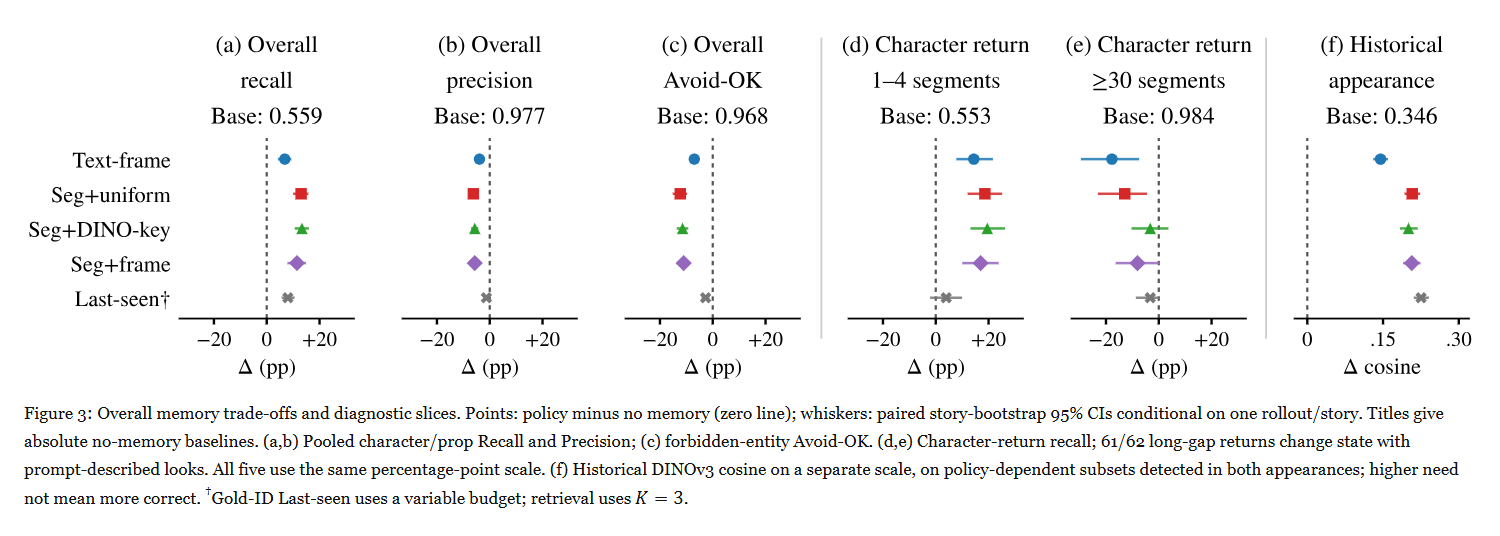 原文图 3|相对无记忆策略的整体取舍。点为策略差,横须为每故事一次生成条件下配对故事重采样 95%置信区间;标题给无记忆绝对分。(a,b)人物/道具召回及精确率,(c)禁止实体不出现,(d,e)人物短间隔/长间隔回归召回,前五项用百分点;长间隔 62 次中 61 次提示已写新外观。(f)历史 DINOv3 相似度使用独立余弦刻度,只取两次均检出的策略相关子集,越像过去不代表当前越正确。最近出现真值 ID 对照预算可变,检索策略固定 3 帧。
- 批判点评:每故事/策略只一次生成,置信区间反映故事间波动;第二裁判的无记忆召回变为 0.361,绝对分依赖裁判。与独立原生生成器的方法不能只归因记忆好坏;论文不是加速方案。代码有评测和共享生成工具,完整数据另取,原始生成视频及逐段评分包未包含。
5. NTI:训练别只认唯一下一块
Visual Autoregressive Generation with Next Token Imagination | 香港大学;萨里大学 | arXiv:2610.36793
关键词:视觉自回归训练, 上下文自适应软目标, 快照上下文, 训练预算
- 前序问题:自回归模型前面采出一块略不同的花纹,训练仍逼它接回唯一真值下一块,可能把合理的新组合也罚掉。但允许任意“想象”,又会越走越偏。
- 方法直觉:把相近视觉 token 当候选,再看当前上下文是否仍与真值上下文给出相似预测。接近时允许多种续写,分歧大或模型不自信时,把监督收回到真值附近。
- 本文贡献:NTI 即 Next Token Imagination。SCA 快照上下文近似定期用冻结模型在真值前缀下采样替换 token;CRI 上下文调节想象结合码本余弦相似度、真值/替换上下文预测的总变差距离及熵置信度,分配真值与非真值的软目标概率。真值序列与替换序列混入同批单次训练前向,保留原自回归损失。1024 项码本将 256×256 图压为 256 个 token,快照每 16 轮刷新,替换概率上限先升至 0.3,320 轮后归零,最后 80 轮只用真值。
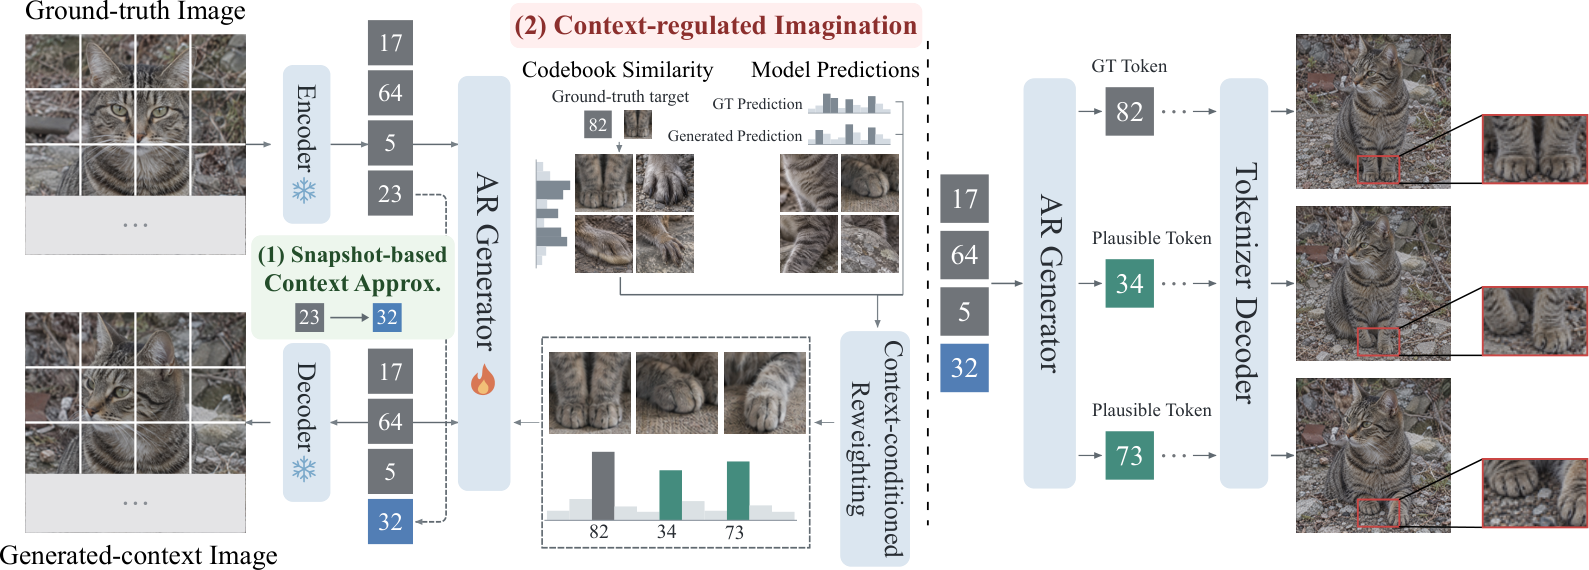 原文图 2|NTI 训练总览:快照近似构造模型预测上下文;结合码本相似、真值与生成上下文预测进行上下文调节想象,给出不同合理 token 的软监督,再由自回归生成器与视觉解码器输出图像。
- 实验效果:ImageNet-1K 类条件、400 轮、5 万生成图:同 461M 即 4.61 亿参数 AR-L 主干,FID 图像分布距离 3.02→1.67,越低越好;IS 类别可辨性/覆盖代理 256.20→312.72,越高越好。8 张 A100 估算每轮含摊销快照成本 11.62→12.80 分钟,在线双前向 22.90 分钟;约 10%额外训练成本,不是免费监督。NTI-L 用 CFG 无分类器引导强度 14,推理流程不变。
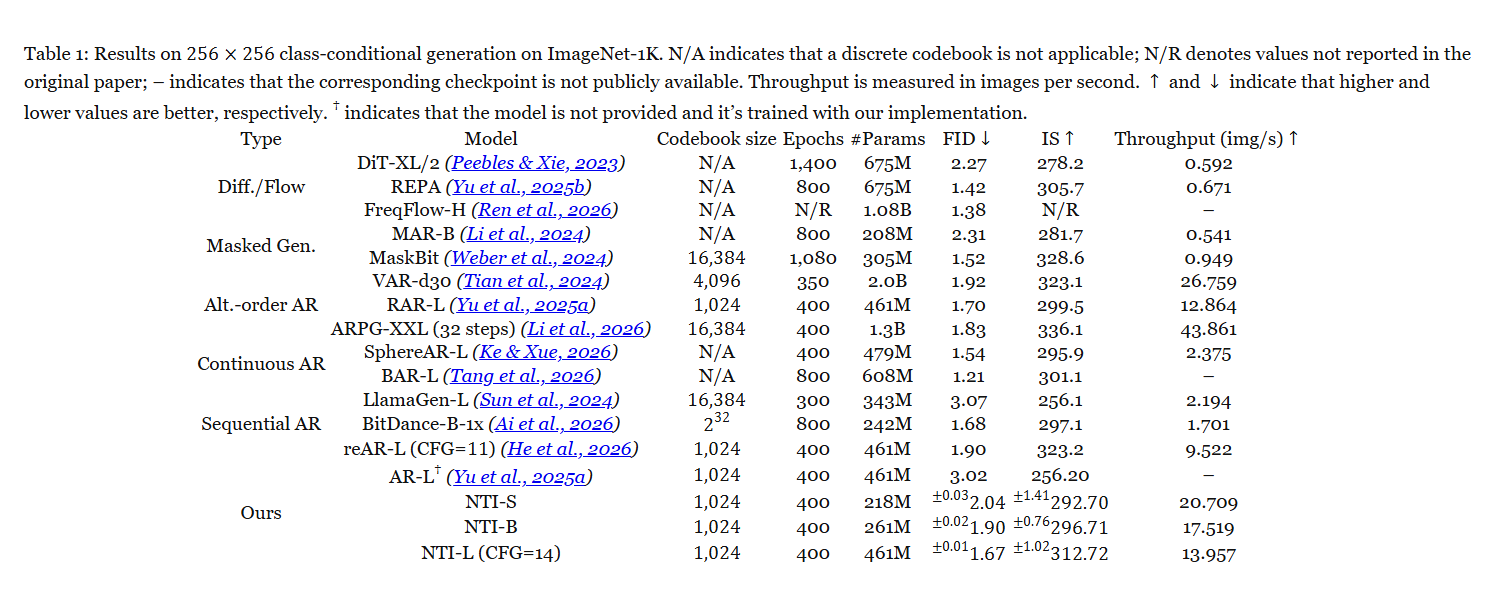 原文表 1|ImageNet-1K 的 256×256 类条件生成比较。N/A 为无离散码本,N/R 为原文未报,横线为对应检查点未公开,剑号为作者自行训练实现;吞吐为每秒图数,FID 越低、IS 与吞吐越高越好。各家架构、训练轮数和引导设置不同,同 AR-L 的 3.02 到 NTI-L1.67 才是直接训练策略对照。
- 批判点评:主要证据限 ImageNet 类条件,不等于开放域文字生成或语义组合已解决;码本相近也不是有效图像的数学保证。较低 FID 不能证明更大分布覆盖。代码与权重已给训练/采样和 S/B/L 推理权重,权重不含优化器或回放状态,不能用于原位续训;本次未运行模型。
6. WithinVAE:压缩器自己教自己学语义
WithinVAE: Compact Visual Autoencoding with Self-Distilled Semantics | 上海交通大学;中国电信人工智能研究院 | arXiv:2610.36593
关键词:视觉自编码器, 自蒸馏语义, 有序压缩token, 生成负结果
- 前序问题:图像压缩器能还原纹理,却未必把“同一类物体”放在容易学习的位置。借识别模型的语义又可能丢掉外观细节:能否在重建任务内部组织语义?
- 方法直觉:让自编码器的滑动平均副本做老师,比较同图不同裁剪的表示;同时越靠后的压缩 token 越容易被丢掉,迫使主要信息先写在前面。能重建与有语义各自用独立实验检验。
- 本文贡献:主模型用 ViT-L 编码/解码、256 个查询,经逐 token VAE 变分自编码瓶颈变为 256×32 连续数值。后位 token 的独立屏蔽概率线性升至 0.5,解码器可只读前缀。全局 DINO 式自蒸馏对齐平均压缩 token,局部 iBOT 式遮挡预测约束图块编码;EMA 即参数指数滑动平均老师,观察干净视图且不反传。仍用 One-D-Piece 生成预训练初始化和 ConvNeXt 感知损失,“不用外部识别语义目标”不是整个系统从零。
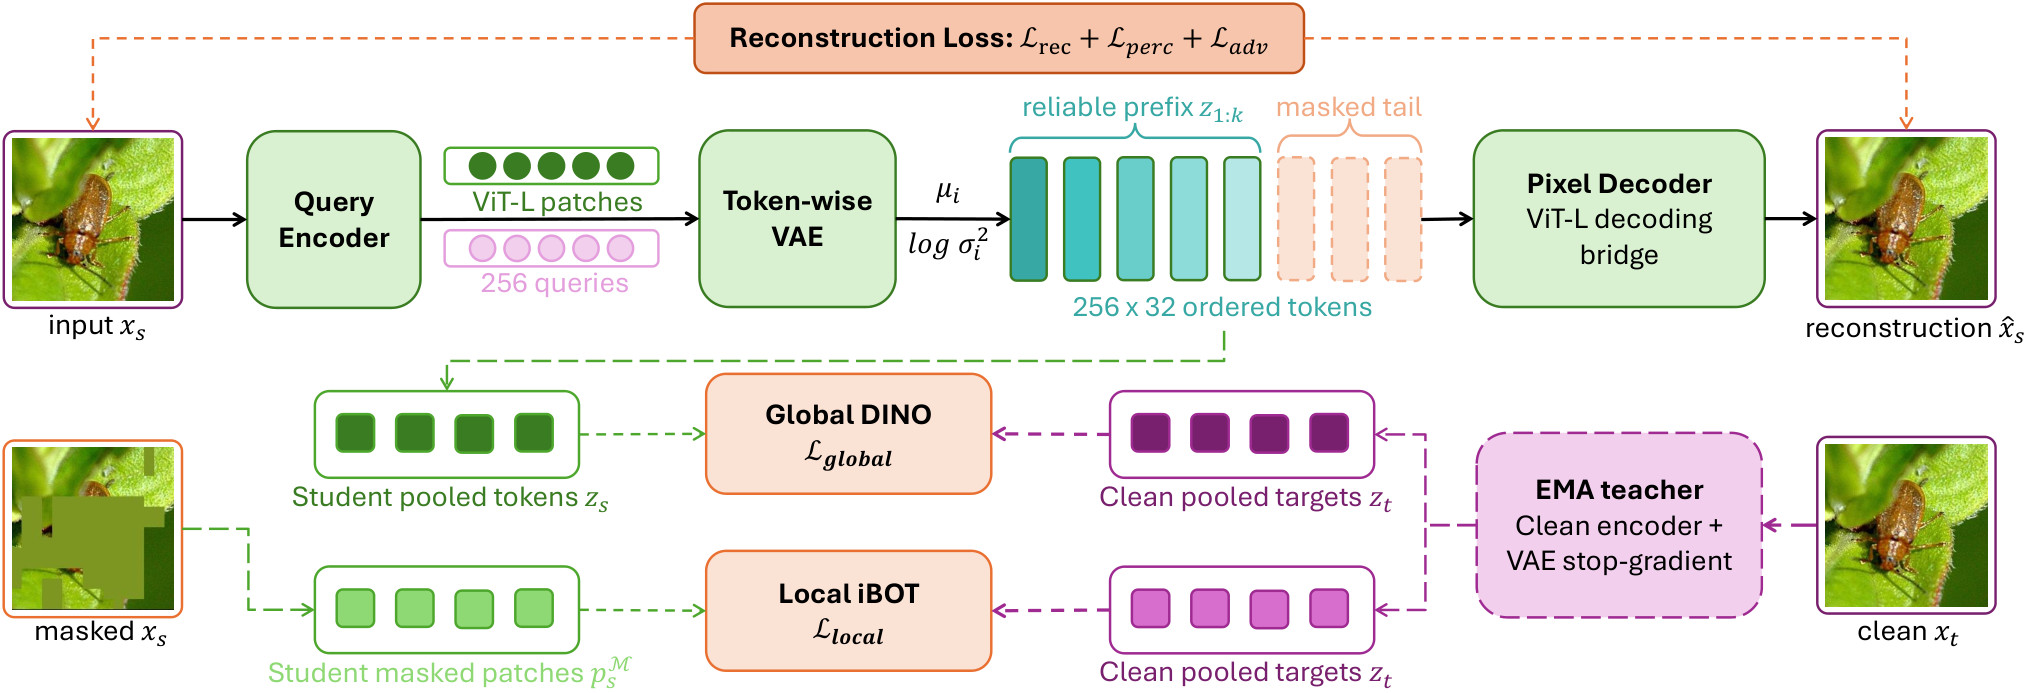 原文图 2|WithinVAE 训练:ViT-L 图块与 256 查询经逐 token 变分瓶颈成为 256×32 有序序列,位置相关屏蔽后由像素解码器重建;全局 DINO 式分支匹配压缩 token 均值,局部 iBOT 式分支匹配学生遮挡图块,目标来自看干净视图的编码器/VAE 滑动平均副本。
- 实验效果:ImageNet256、5 万验证图,对 RPiAE 连续标量数 16384→8192,PSNR21.30→22.66 dB,重建 FID0.50→0.46;冻结线性分类准确率 65.404%→71.886%,同架构仅重建版 66.814%。8192 是 token 数乘通道数,不是压缩比特数。8 张 H100,自编码器训练 10 轮,下游 6.75 亿参数 LightningDiT 训练 80 轮;有引导生成 FID 却是 3.67,对 RPiAE1.51,越低越好。
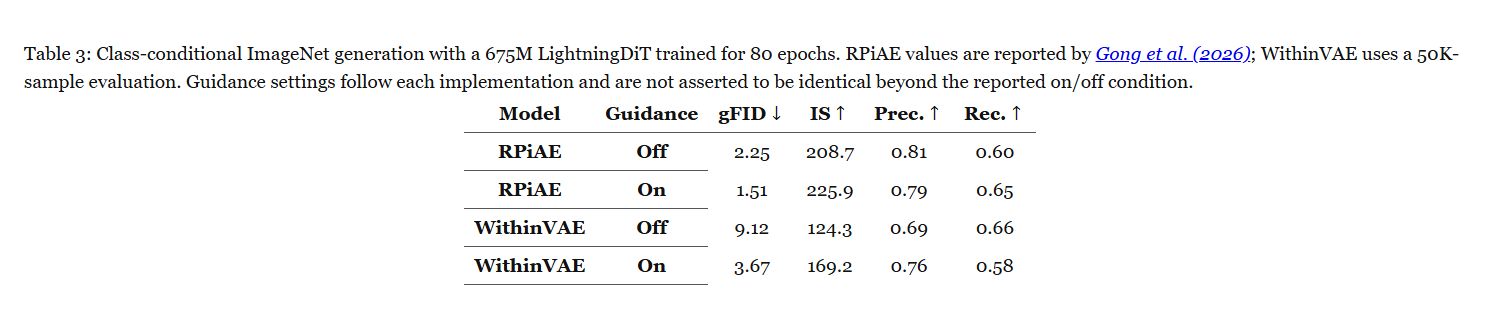 原文表 3|6.75 亿参数 LightningDiT 训练 80 轮的 ImageNet 类条件生成。RPiAE 为其论文报告值,WithinVAE 为 5 万样本评测;引导按各自实现,只对开/关不声明数值完全相同。生成 FID 越低越好,IS 及生成精确率/召回率越高越好;WithinVAE 有引导 FID3.67 仍落后 RPiAE1.51,重建收益不能代替生成收益。
- 批判点评:重建和分类提升没有带来更好生成,是本文关键负结果;两种实现的引导细节并未声明完全相同,不把差值全归因表示。前缀 128token 重建 22.33dB 是主模型,另一个 512×96 潜变量模型的 25.63dB 不能混用。全局分类不证明每 token 具备对象分割语义;未给统一编解码时延、显存及作者代码入口。
7. DICE:少步出图也要重做概念擦除
Haste Makes Waste? Towards Safe Few-Step Text-to-Image Models | 特拉维夫大学 | arXiv:2610.36665
关键词:少步生成安全, 概念擦除, 直线路径重加噪, 自蒸馏保留
- 前序问题:把文生图蒸馏成一到四步后,原模型有效的概念擦除可能失灵;猛改权重又会毁掉正常图像。安全能力不能直接随老师的画质与速度一起继承。
- 方法直觉:不要只在少步采样恰好访问的高噪声点上训练。沿干净样本到高斯噪声的整条直线均匀取点,同时要求擦除后的速度场尽量贴近擦除前的少步模型。
- 本文贡献:DICE 即 Distillation-Integrated Concept Erasure,在已蒸馏的 FLUX Schnell、FLUX SCFM 和 SD3.5 Turbo 联合注意力层训练 LoRA 低秩适配。三项损失分别反向压低目标概念速度、抑制指向概念文字 token 的注意力、匹配冻结擦除前模型的速度。干净概念潜变量由原少步模型生成,再按均匀噪声级线性重加噪;保留项初始化为零,不需访问原全步老师或重跑蒸馏。
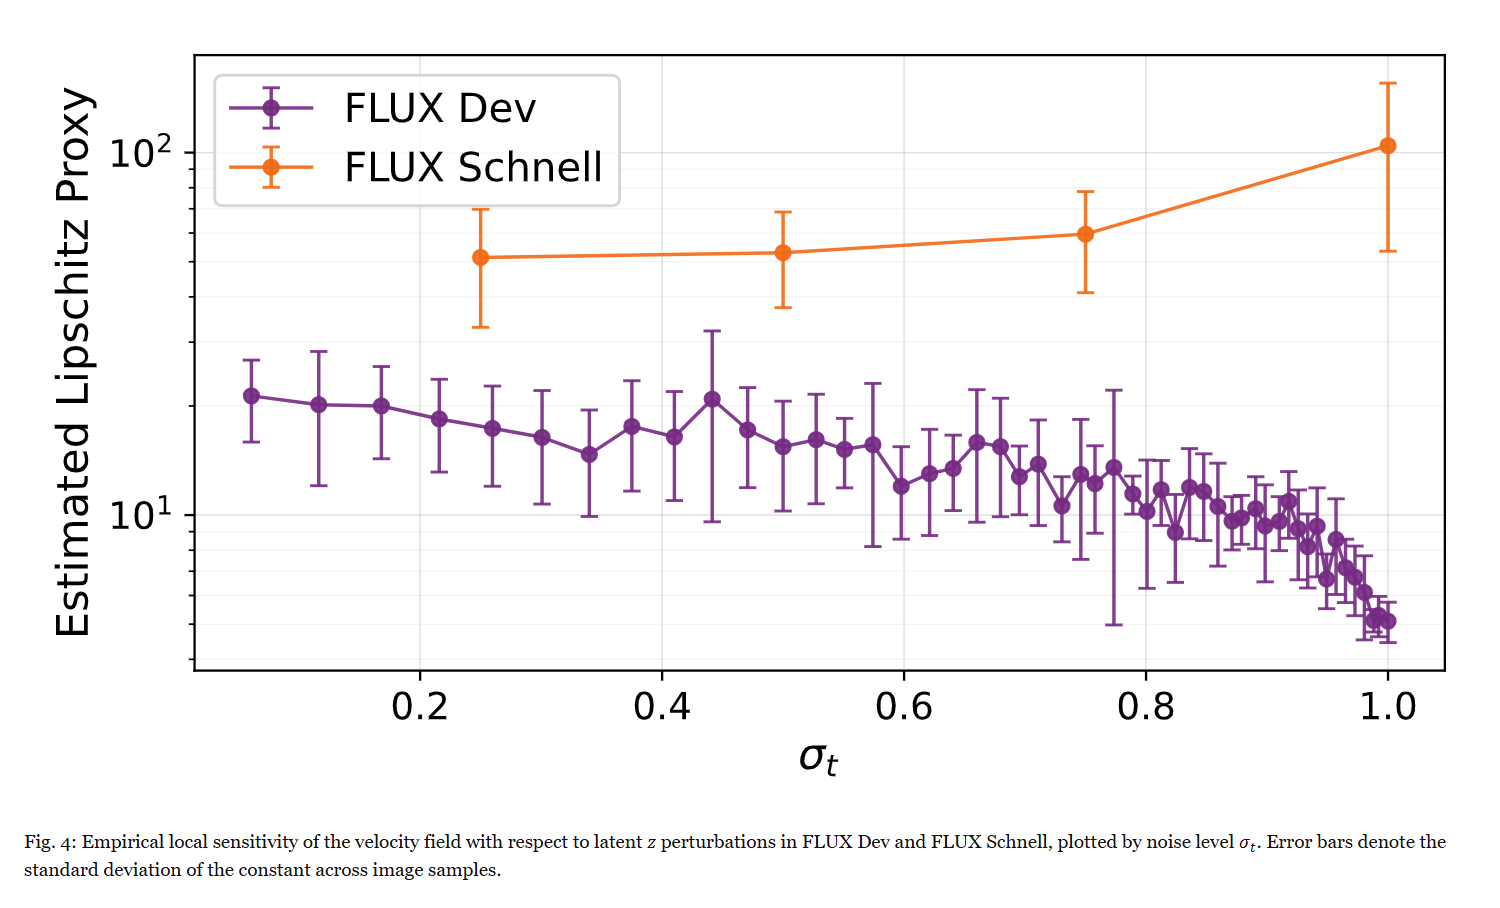 原文图 4|FLUX Dev 与 FLUX Schnell 速度场对潜变量扰动的经验局部敏感度,横轴为噪声级 sigma,误差棒为跨图样本标准差;Schnell 在高噪声区更敏感。这是设计直线路径重加噪的诊断证据,不是完整因果证明。
- 实验效果:NSFW-1k 提示集,FLUX Schnell 的 NudeNet 裸露检测阳性率 0.2348→0.0456,最好既有擦除对照 0.1608;四步 HPSv2 人类偏好代理 0.2909→0.2887,略降。@5 表示同提示五次采样至少一次被检出,DICE 仍 0.1700;不能把 0.0456 当所有违规内容的失败率。作者代码默认 100 步微调、秩 256;FLUX 配置需单张 80GB 卡,SD3.5 配置需两张,未据此推算训练耗时。
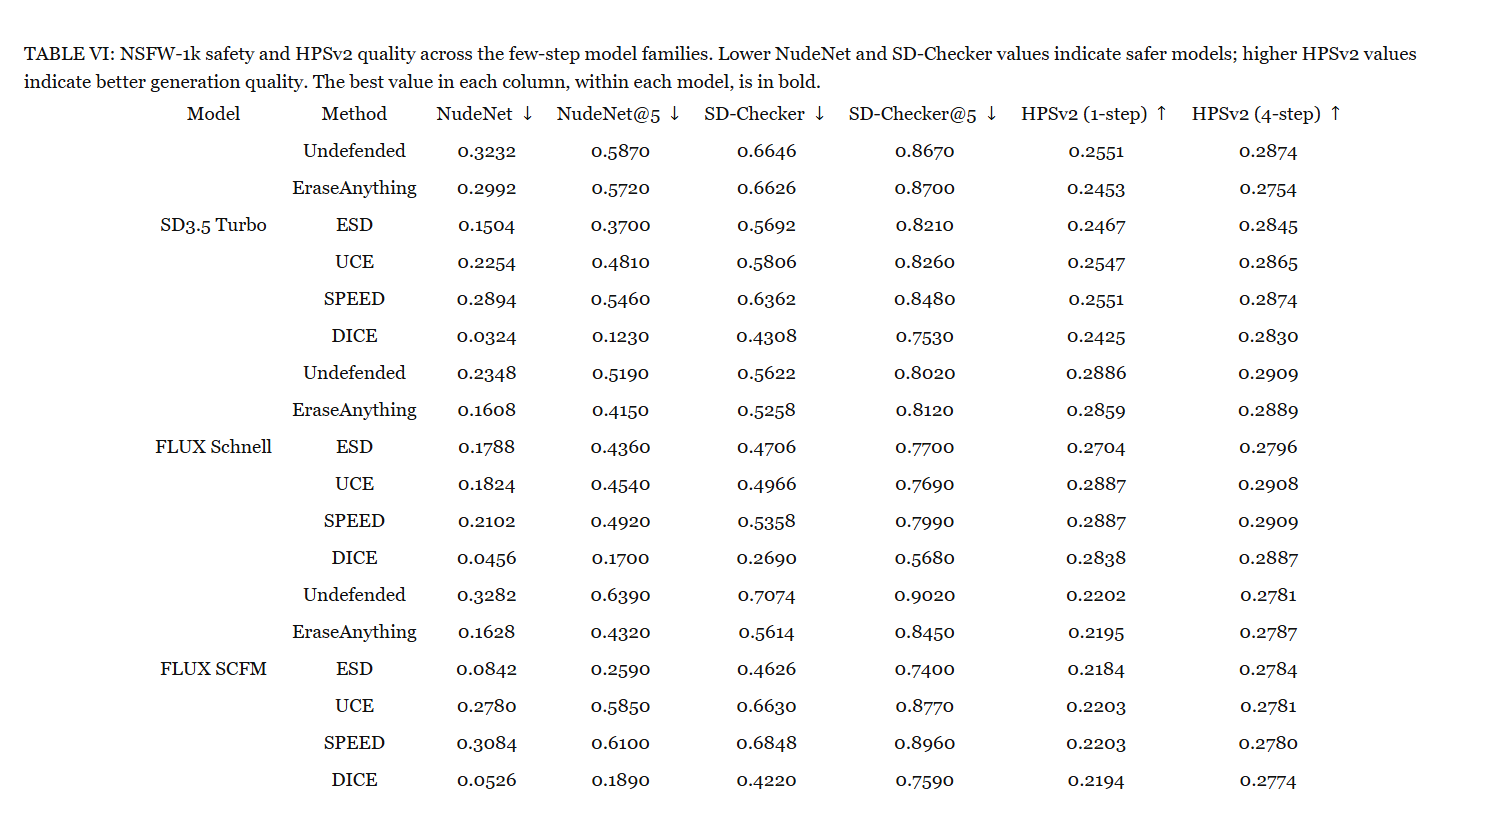 原文表 VI|NSFW-1k 少步模型的安全检测与正常生成偏好。NudeNet 和 SD-Checker 阳性率越低越好,@5 为五次采样至少一次阳性;一/四步 HPSv2 越高越好,各模型内粗体为该列最优。DICE 降低阳性但未清零,偏好分仍有下降,不能把检测器阳性等同所有有害概念。
- 批判点评:白盒对抗提示下 Schnell 阳性率仍 0.455,防线有明显剩余漏洞;实验限裸露/暴力及自动裁判,机制敏感度是诊断而非完整因果证明。IEEE S&P 2027 接收由 arXiv 评论明确支持。代码与LoRA 权重已给,本次只核文件/配置,不运行。
8. MoI-Bench:手机跑得快还得改得对
MoI-Bench: A Benchmark for Image Generation and Editing on Mobile Devices | 伦敦大学学院;南京大学;香港理工大学;华东师范大学 | arXiv:2610.37599
关键词:端侧生成编辑评测, 操作目标解耦, 任务覆盖率, 端到端实测
- 前序问题:手机能 3 秒出一张图,不代表能删对合照里的人,还保住其余人的脸。把文字替换与文字删除混成“文字编辑”,总分会掩盖真正缺失的能力。
- 方法直觉:把用户要求拆成“做什么操作×针对什么目标”,再分别问指令执行、画质与未改细节保留。另测手机上的时间、存储和峰值内存,让能力和部署成本各有坐标。
- 本文贡献:16 类操作、8 类目标形成 64 种适用子任务,共 1150 例,并非完整 128 格笛卡尔积。MoI-Eval 逐样本设问题,以 0/0.6/1 评未满足/部分/完全满足;组内均值、组间加权几何平均,避免好画质完全抵消没改对。总体质量按样本等权,覆盖率按 64 子任务等权,阈值为任务均分至少 0.6;不支持任务保留零分,确认执行错误剔除。19 模型的质量以 A100 参考实现或云 API 出图测,手机另测少于 40 亿总参数模型。
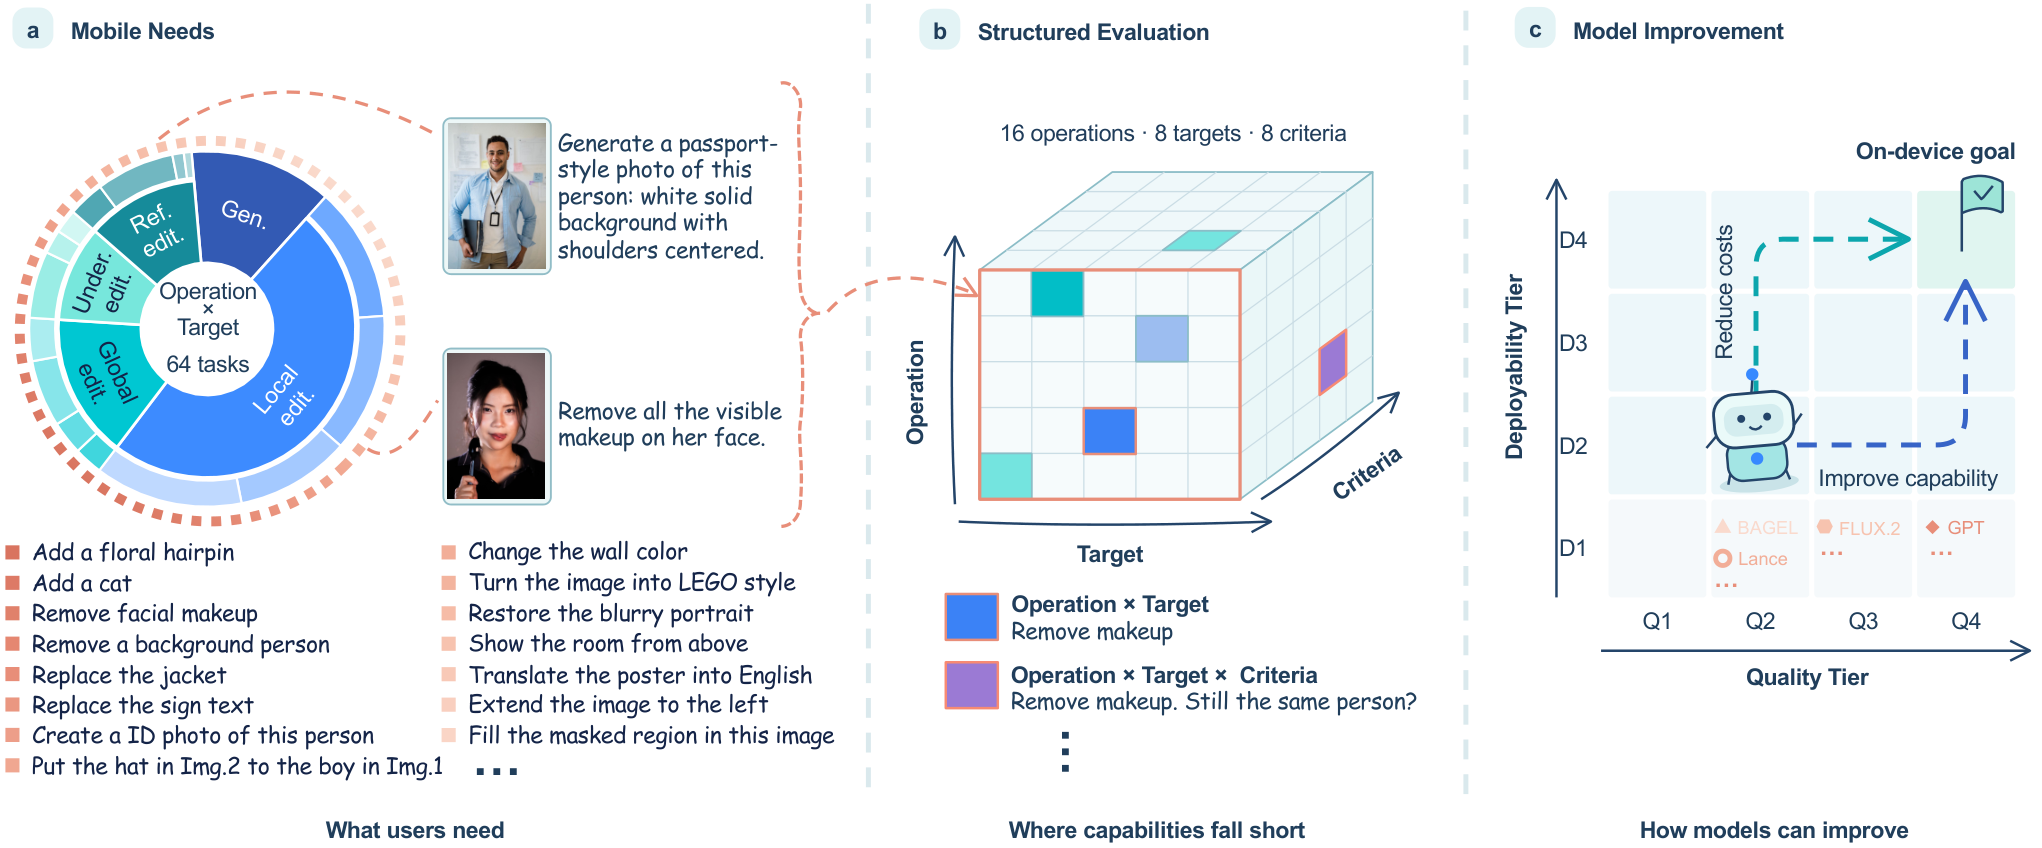 原文图 1|(a)从移动用户需求建立任务;(b)沿操作、目标与评价准则三轴结构化评估;(c)用质量-可部署二维坐标指导模型改进,区分速度够用与任务覆盖仍不足。
- 实验效果:手机共同任务是文生图,只有 DreamLite 成功部署编辑。各配置预热 1 次再测 3 次,DreamLite1024×1024、4 步在 iPhone17 Pro 为 3.22 秒/1305.7MiB 峰值,在小米 15 Pro 为 18.19 秒/2390.5MiB。Mobile-O512×512、20 步在 iOS2.81 秒,但任务覆盖 0.11,对 DreamLite0.64;分辨率、每步成本不同,不能按步数判快慢。内存分别是 iOS 物理占用和 Android 进程 PSS 比例分摊内存。
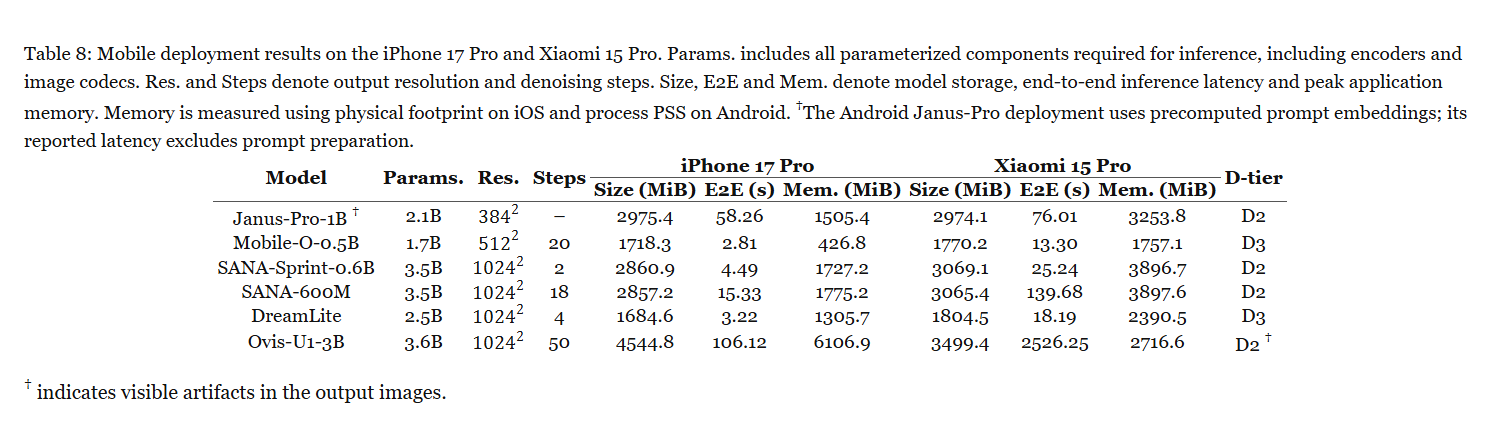 原文表 8|iPhone17 Pro 与小米 15 Pro 部署。参数含编码器/图像编解码等全部参数化部件,分辨率与步数不同;Size 为模型存储 MiB,E2E 为端到端秒数,Mem 为峰值应用内存 MiB,iOS 用物理占用、Android 用 PSS。Janus-Pro 的 Android 时延用预计算提示嵌入而排除准备时间;Ovis 的 D2 旁剑号指出可见伪影。
- 批判点评:质量来自参考配置,时延来自手机配置,二维图不证明量化后的每张手机图都保持同一质量;3 次平均也不覆盖热降频。iOS 与 Android 使用不同推理栈,差值不能简化成芯片优劣。数据与评测代码已给,模型推理适配器尚未提供;任务覆盖低也可能因为模型定位只生成。
9. SMEBench:换乐器别只听文字分数
SMEBENCH: Benchmarking Neural Music Editing with Synthetized MIDI Edits | Mila;拉瓦尔大学;梅努斯大学;康考迪亚大学;土伦大学;艾克斯马赛大学;CNRS LIS;CNRS ILLS | arXiv:2610.36715
关键词:成对音乐编辑评测, MIDI可控干预, 音源保留, 指标排名反转
- 前序问题:把弦乐换成铜管,音乐和文字很匹配,旋律却全换了。没有成对目标音频,很难区分“确实完成编辑”与“重新生成了一首像要求的曲子”。
- 方法直觉:先在 MIDI 音符事件里只改一个可记录的属性,再用同一音色库渲染原版与目标版。原音频衡量保留,目标衡量已知有效改法,文字衡量描述匹配,三条线分开比较。
- 本文贡献:从 MIDI 乐谱裁 10 秒,按实际存在的乐器筛可用编辑,覆盖换/删/提取/加倍乐器、连断奏、渐强渐弱与校音等 12 种操作;同一 SoundFont 采样音色库生成单声道 22050Hz 音频,再筛可听性与质量并核文字。共 11160 对,平衡测试 3600 例、每操作 300 例;另以真实分轨构造 416 例 SME-Real、来自 107 轨。比较 5 种共用 AudioLDM2 音乐底座的扩散编辑方法与不保源的 MusicGen 文字生成。
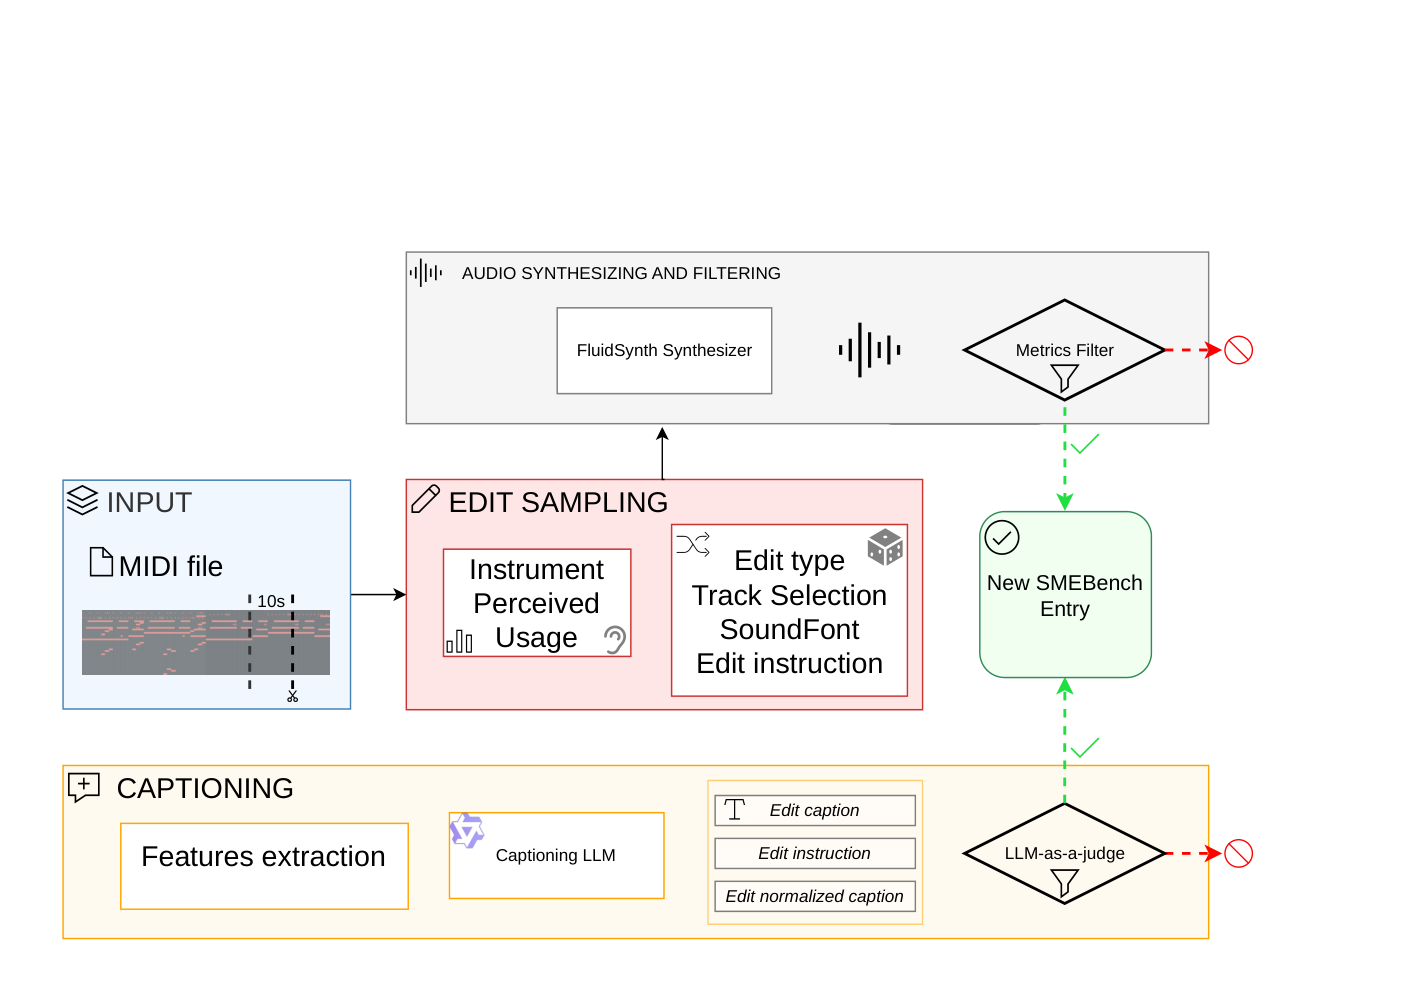 原文图 1|成对音乐编辑构造:分析 10 秒 MIDI 片段决定可用操作与目标,执行符号干预,用同一 SoundFont 渲染源/目标并筛听感和质量;从 MIDI、音频和编辑元数据提取事实形成四种文字描述,音频与文字检查通过后保存已知干预及成对目标。
- 实验效果:测试集用编辑后描述作条件:MusicGen 的 CLAP-T 文字-音频特征相似度 0.350 最高,但对成对目标的 CLAP-A 音频相似度仅 0.492,SteerMusic0.691;目标 LPAPS 感知距离 5.926 对 4.482,越低越好。换成命令式条件,文字分偏好 VCI、目标音频指标偏好 ZETA。17 人听 20 个抽样对、共 236 次评分,指令对齐 3.99/5;连奏、删乐器、换鼓三项未可靠超过量表中点,剔除后主感知汇总只含 9 操作。
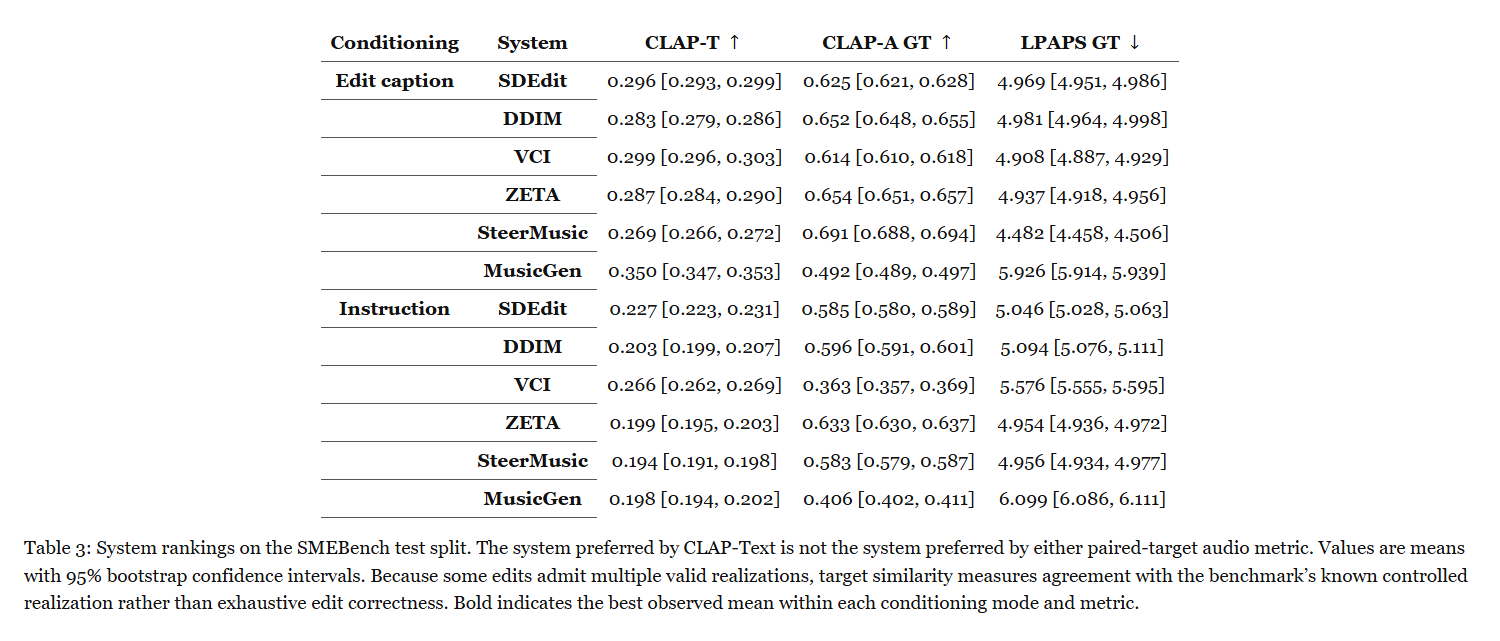 原文表 3|SMEBench 测试集模型排名。编辑后描述和命令式输入分开,数值是均值及 95%重采样置信区间;CLAP 文字/音频相似度越高、LPAPS 目标感知距离越低越好,粗体为各条件/指标最好均值。文字排名与两种成对目标音频排名不同;目标仅是一种受控合法实现,非全部有效输出集合。
- 批判点评:目标仅代表一种合法实现,接近它不等于穷尽编辑正确性;MIDI 不覆盖人声、混音和母带处理,真实补集也不覆盖全部 12 类。论文没有给统一时延/显存排名,不能从音频指标推出部署速度。数据与构造代码已给,含 MIDI/真实分轨构造及指标工具;源 MIDI 与音色库须另取,本次未复现六个编辑系统。
10. BoxWorld:规则引擎决定视频里会发生什么
BoxWorld: Let World Engines Control and Video Generators Render | 不列颠哥伦比亚大学;Vector 人工智能研究所;华为加拿大 | arXiv:2610.36371
关键词:交互视频生成, 对象状态接口, 区域注意力, 自生成轨迹蒸馏
- 前序问题:没拿钥匙,生成世界却自己把门打开:视频模型擅长画常见后续,不一定严格执行条件规则。每改玩法就重训生成器,也不适合快速做交互世界。
- 方法直觉:把“事情该不该发生”交给显式规则引擎,把“看起来怎样”交给视频生成器。引擎持续发每个对象的位置、身份与当前状态,生成器照状态画下一段。
- 本文贡献:编码代理先按规则生成 Box World Engine,交互时不逐步调用代理。对象接口含二维框、固定外观属性、动态状态;逐帧掩码交叉注意力只允许视觉 token 读覆盖自己的框,零初始化门控注入每块。以 LongLive 为底座,先冻主干学布局,再用 4000 段游戏视频和秩 16 LoRA 学状态变化,最后秩 64 LoRA 在自身生成历史上做分布匹配蒸馏,恢复四步生成;三阶段 20000/10000/400 次更新。
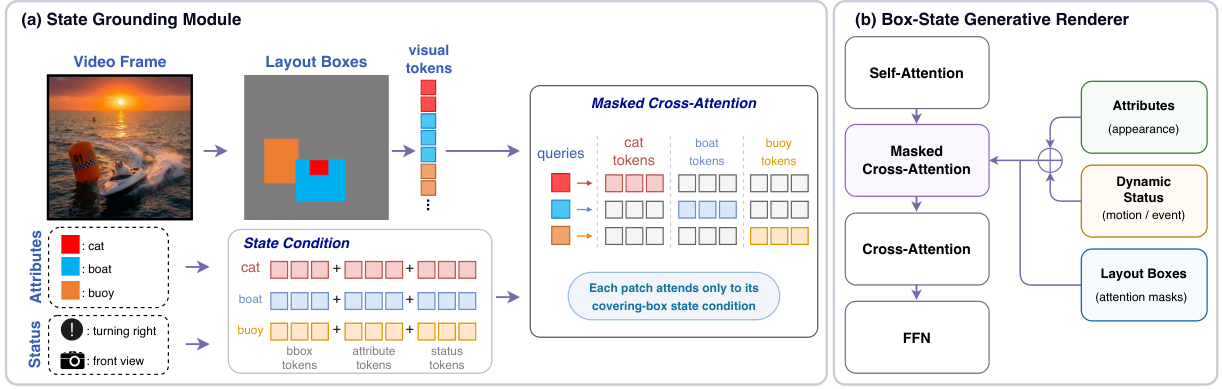 原文图 3|(a)状态绑定模块把每物体二维框、外观属性和动态状态编码为 token,掩码交叉注意力让每个视觉 token 只读覆盖自己的对象;(b)模块插在渲染器每块自注意力和原交叉注意力之间。
- 实验效果:832×480、4 步,布局模块仅噪声级大于 0.8 启用;论文报告生成吞吐 20.7 帧/秒,与 LongLive 相同。PairedStateBench 含 16 场景族 87 例、37 对分支;两分支都满足目标的比例 13.5%→97.3%,完整多阶段任务 8.0%→83.9%。要求事件出现/禁止事件不出现分别 92.2%/90.5%,不是同一分母。对照模型输入接口不同;20.7 是生成吞吐,不等于用户动作到显示响应的延迟。
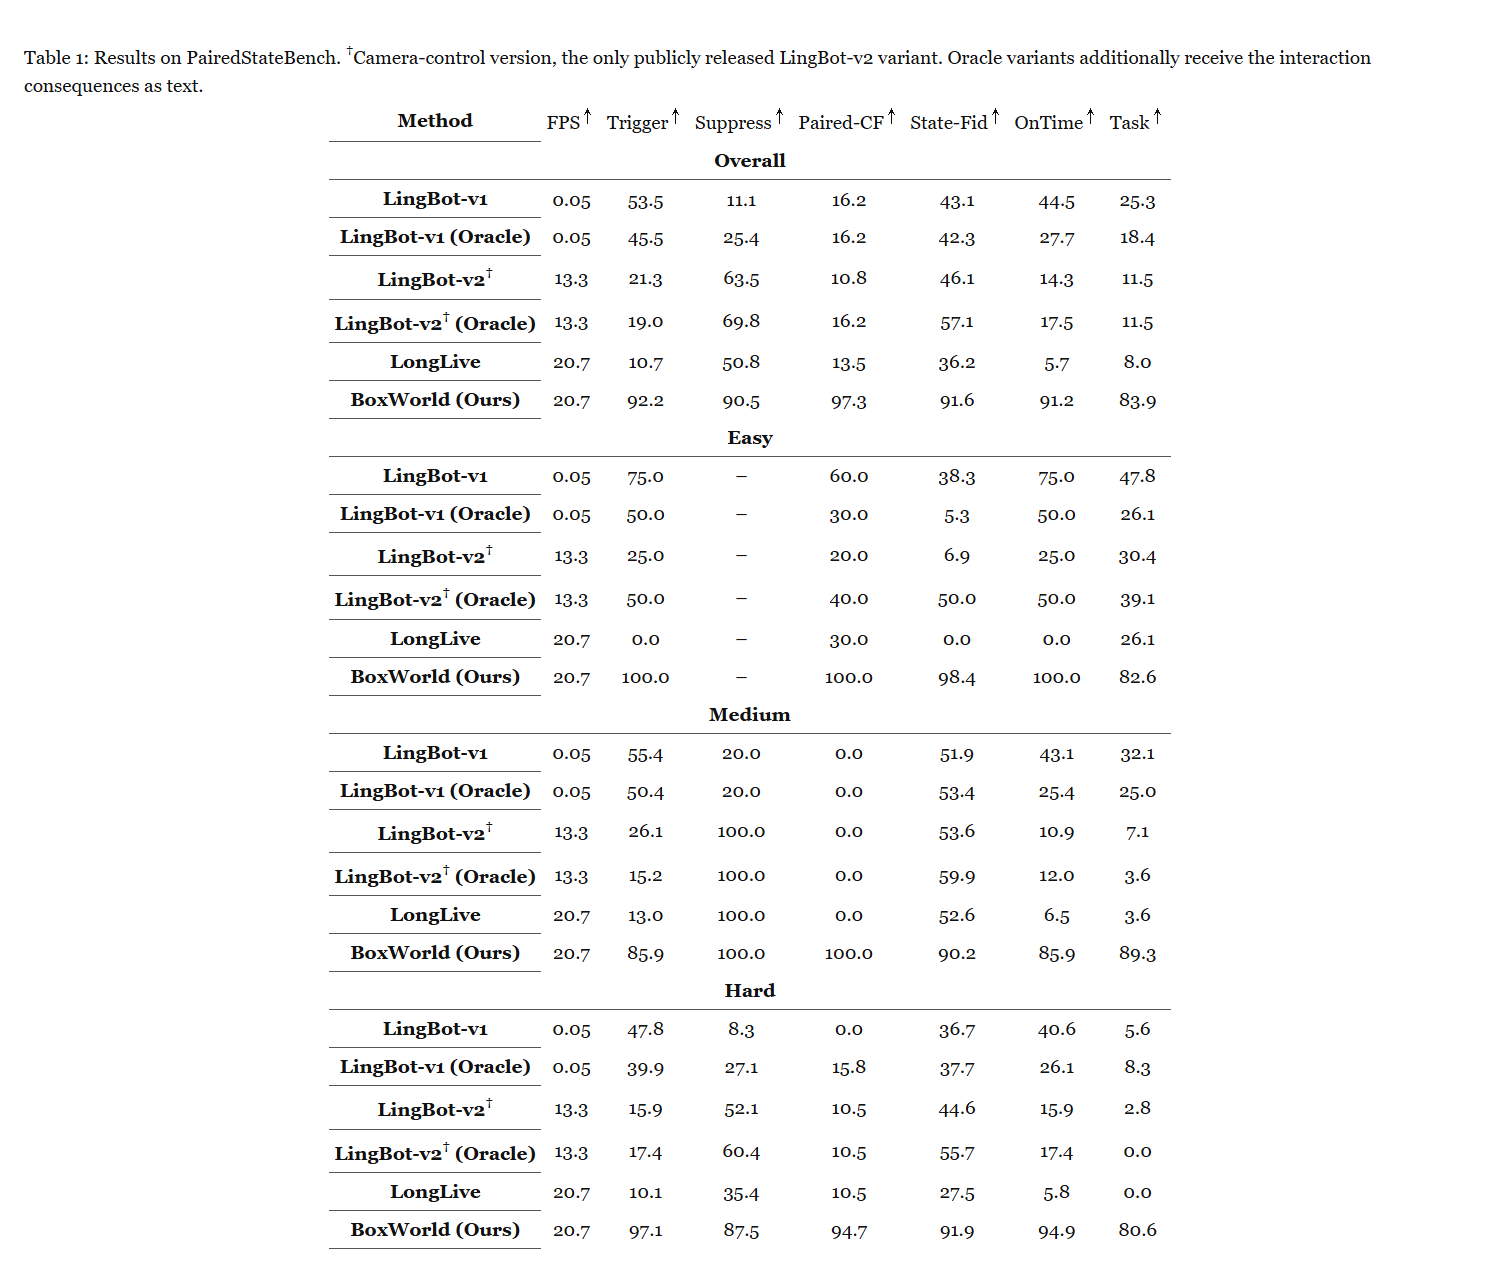 原文表 1|PairedStateBench 按整体及简单/中等/困难报告。剑号为仅公开相机控制的 LingBot-v2,Oracle 额外得到互动后果文字;FPS 为生成吞吐。Trigger、Suppress、成对分支成功、状态吻合、发生时机与完整任务成功各有分母,均越高越好,简单例不适用 Suppress。BoxWorld 获得对象状态,其他方法使用各自接口,不能当等条件纯生成器比较。
- 批判点评:规则正确性来自显式引擎,不能称生成器自己学会通用物理推理;二维框与状态文字也不能约束所有细粒度接触和遮挡。原文没有足以统一复核的 FPS 硬件与峰值显存账单,单机部署仍待实测。项目展示结果,本次未核到作者渲染器代码或权重。
趋势观察
保留与改动需要同一接口里的两条约束
LociArt把风格写进掩码又补原几何,SREdit按物理响应限制改动;CaD则用过强参考注意力阻断编辑。控制强弱不是越大越好,先明确任务要变化还是防变化。
评测要检查执行变化和保留什么
VMem-Bench的历史相似度能奖励旧围巾,SMEBench的文字匹配会偏好重写整首音乐;应把当前状态、目标改动和源内容保留分别计分。
表征更好与生成更好仍有距离
NTI在同AR主干降低FID,WithinVAE却出现重建和线性分类更好、生成更差。训练目标的收益必须落在真正的生成实验,不能只看中间表示。
速度账单包含模型外的条件
MoI-Bench分开参考画质与手机成本,DICE为少步模型额外做擦除微调,BoxWorld把规则交给引擎;推理步数、生成吞吐与端到端响应各自报告。
今日讨论
LociArt 从 10 扩到 15 种风格、不回放旧数据,旧类 SPS 仍下降 0.022,对二值掩码 0.102;多区域仅有已学风格的定性展示。如果剪辑任务要给熊和背景分别换画风,应在什么条件下启用这种组合?如何固定掩码并用多种子实验收集区域风格、边界外变化和旧风格遗忘的证据,确定可以接受的保留阈值?
人工智能炼丹君 整理 | 2026-10-30




评论 (0)