今日 AIGC 论文速览
今日共 10 篇 · 编辑目标与多轮修复 2 篇 · 长视频生成与推理加速 2 篇 · 图像生成接口与多样性 2 篇 · 像素生成架构 1 篇 · 语音与音乐生成 2 篇 · 4D视听场景 1 篇
重点论文标题列表
Partial (首尔大):末帧只锁该改的区域EditAgent (Adobe):多轮改图带着证据选结果WanAR+FixAR (CMU):隔几段回看长视频修漂移AB-Attention (InfRec):少算注意力还补回漏算份额AnyOrder-AR (石溪大学):旧自回归模型补出任意区域
选读入口:做图生视频转变,先看 Partial 的背景反向运动 0.599 降至 0.387,并检查编辑区域未来是否仍有效;多轮改图读 EditAgent,同时核算约十余倍基准总 GPU 小时。做长镜头相机控制读 WanAR+FixAR 的静态场景边界,部署视频主干再看 AB-Attention 的 H20 内核与代码待开放。复用旧图像模型补图读 AnyOrder-AR;需要同提示多方案看 TokenRepel 的多样性/指令正确率取舍;训练像素模型读 SpecSlot 的调用计数。克隆声音先挑参考读 AudioSelector,手头有鼓谱再读 MiDiff,最后用 SonoWorld4D 核对新听音位置与完整全景的实验条件。
今日论文速览
1. Partial:末帧只锁该改的区域
Edited Endpoints as Partial Goals for Image-to-Video Generation | 首尔大学;OGQ | arXiv:2610.39179
关键词 :图生视频, 编辑终点, 局部约束, 时序伪影
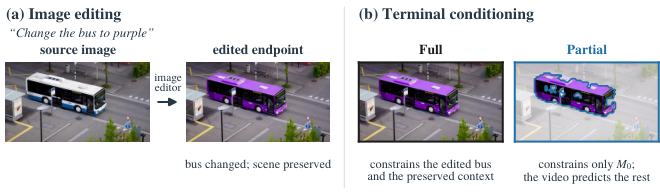
前序问题 :想把视频中的公交车逐渐变紫,先改出一张终点图能说清目标。但编辑器同时保留了起点的路牌和道路布局;把整张图强压成末帧,移动过的背景可能突然倒回原位。方法直觉 :终点图只负责告诉模型车该变成什么样,没被要求改动的背景交给视频模型继续预测。编辑相关区域与未来仍然有效的区域是两件事,前者只能提供一个可用的近似。本文贡献 :从 FLUX.2-klein-base-9B 编辑器中提取预选物体/编辑短语的文字—图像注意力,平均归一化后,用双分量高斯混合与 Ising 空间相邻先验估计二值掩码 M0。在每轮去噪中,末帧潜变量只在 M0 内投向编辑终点,外部保留模型预测;掩码固定在终点坐标,不跟随运动。适配 Wan2.2-Turbo、SANA-Video 和 HunyuanVideo-1.5,不微调视频模型;这研究图生视频转变,不是对已有整段视频逐帧编辑。
Figure 1|编辑终点保留下来的背景未必适合未来:整帧约束把新外观和旧布局一起锁住;Partial 只锁编辑器注意力估计的 M0 蓝框内,淡化位置保留视频预测。源帧来自 DAVIS 公交车,经 FiVE-Bench 提供。
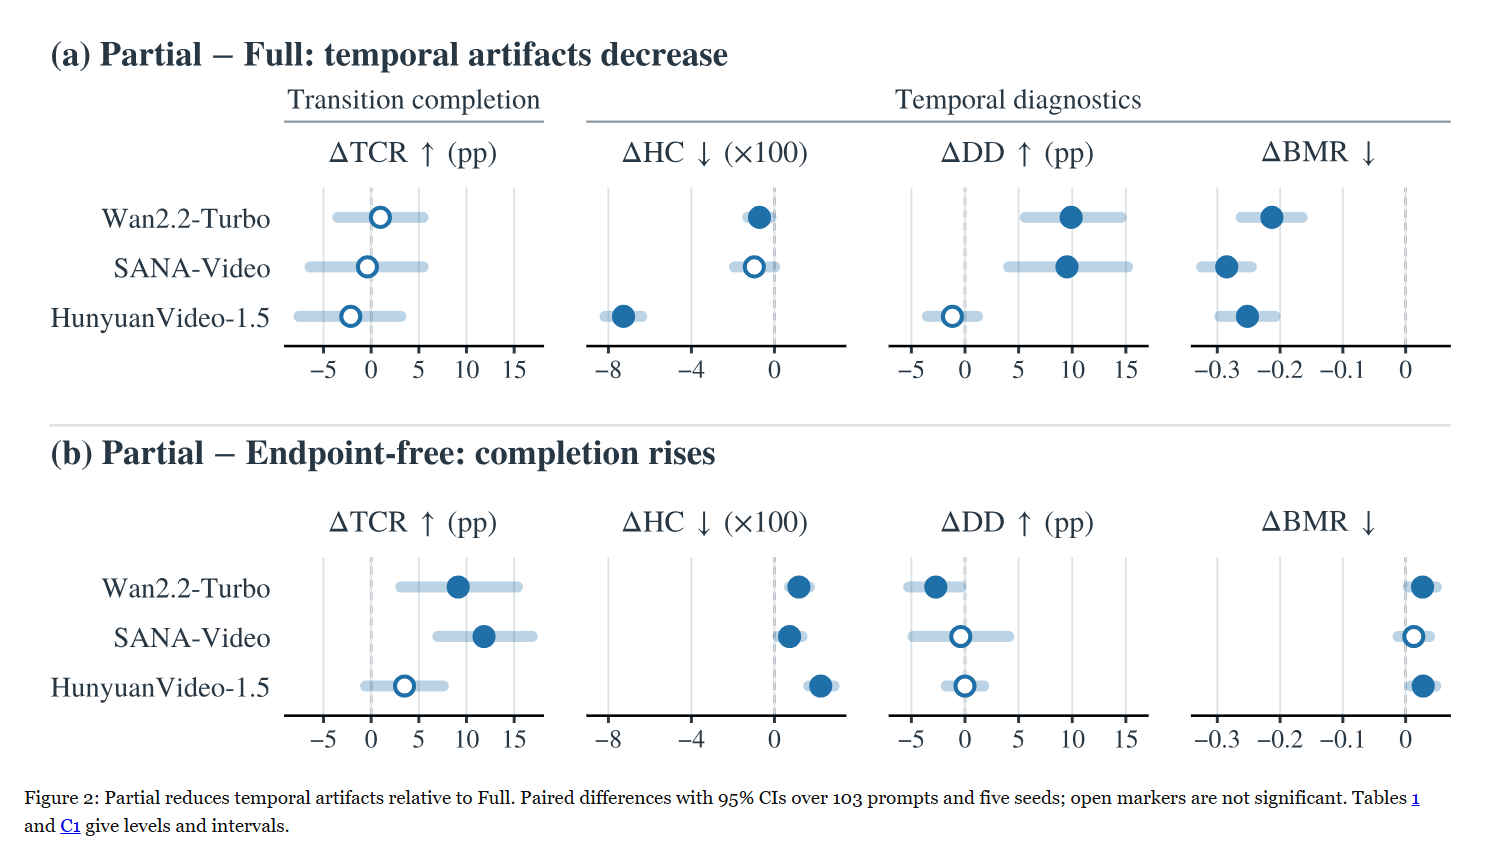
实验效果 :TC-Bench-I2V 的 120 条提示中 103 条源视频仍可用,每条件配对 5 种子,共 515 段。Wan2.2 上 Full→Partial:转变完成率 TCR 41.94%→42.91%,差异不显著;背景晚期反向运动占比 BMR 0.599→0.387,显著下降。Hunyuan 的硬切诊断 HC 从 12.96→5.69,HC 是相邻帧 CLIP 特征相似度相对中位数的最大跌幅、表中乘 100,越低越好。供体背景对照额外生成一段 Partial 视频,在仍约束整帧时也减伪影,说明不只是约束面积起作用。
Figure 2|Partial 相对 Full 的时序诊断配对差。103 提示、5 种子,误差条为 95%置信区间;空心标记表示不显著,原文表 1 与 C1 另列绝对水平和区间。改善伪影与 TCR 差异不显著需分别解读。
批判点评 :无显著差异不等于已证明完成率等价;相关区域里仍可能有不该在未来重现的路牌。动态程度 DD 只检测运动,不能断言运动正确。选择掩码还需图像编辑与注意力提取,供体实验多一次生成,不能把视频阶段 FPS 当完整系统延迟。原文给出项目 与代码预告;指定代码仓当前 404,未核到可用实现或数据。
2. EditAgent:多轮改图带着证据选结果
EditAgent: Rethinking Agentic Image Editing | Adobe Research;加州大学圣迭戈分校 | arXiv:2610.39664
关键词 :多轮图像编辑, 专用工具路由, 候选对比, 历史修复
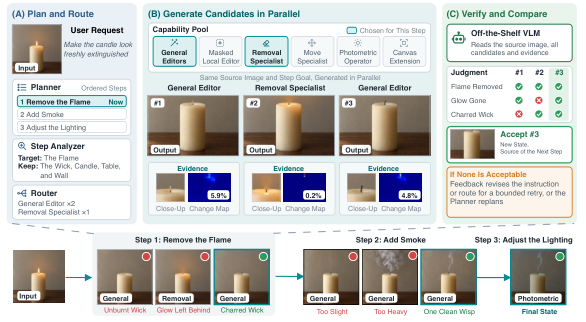
前序问题 :先磨砂玻璃,再让房间更亮,第二轮可能把第一轮磨砂擦掉。一直让同一个编辑器反复改自己的结果,会累积错误;只给裁判看缩略图,也容易漏掉局部瑕疵。方法直觉 :同一原图交给通用编辑器和适用的专用工具并行尝试,再给裁判局部放大、改动图和可计算的量,而不是只问哪张好看。每轮结束再检查旧要求是否仍成立。本文贡献 :规划器拆依赖步骤,分析器与路由器选方法;SAM 2.1 分割模型把定位框转成掩码。能力池含局部编辑、去物体、移动、缩放合成、光度算子、旋转和扩图。每次最多 3 候选,裁判一次横向比较及读取核验记录;每步最多 2 次重试,每轮最多 2 次重规划。后续轮次若破坏历史要求,做一次修复并仅在通过检查时采纳。这里核心输出是编辑图像,不把通用工具调用本身当 AIGC 贡献。
Figure 3|下方请求拆成有依赖的步骤,每次接受结果成为下一步源图;上方放大第一步:A 规划器排序,分析器/路由器选择适用方法;B 各方法从同源并行生成并附核验记录;C 现成视觉语言裁判比较候选和记录,接受或反馈重试。
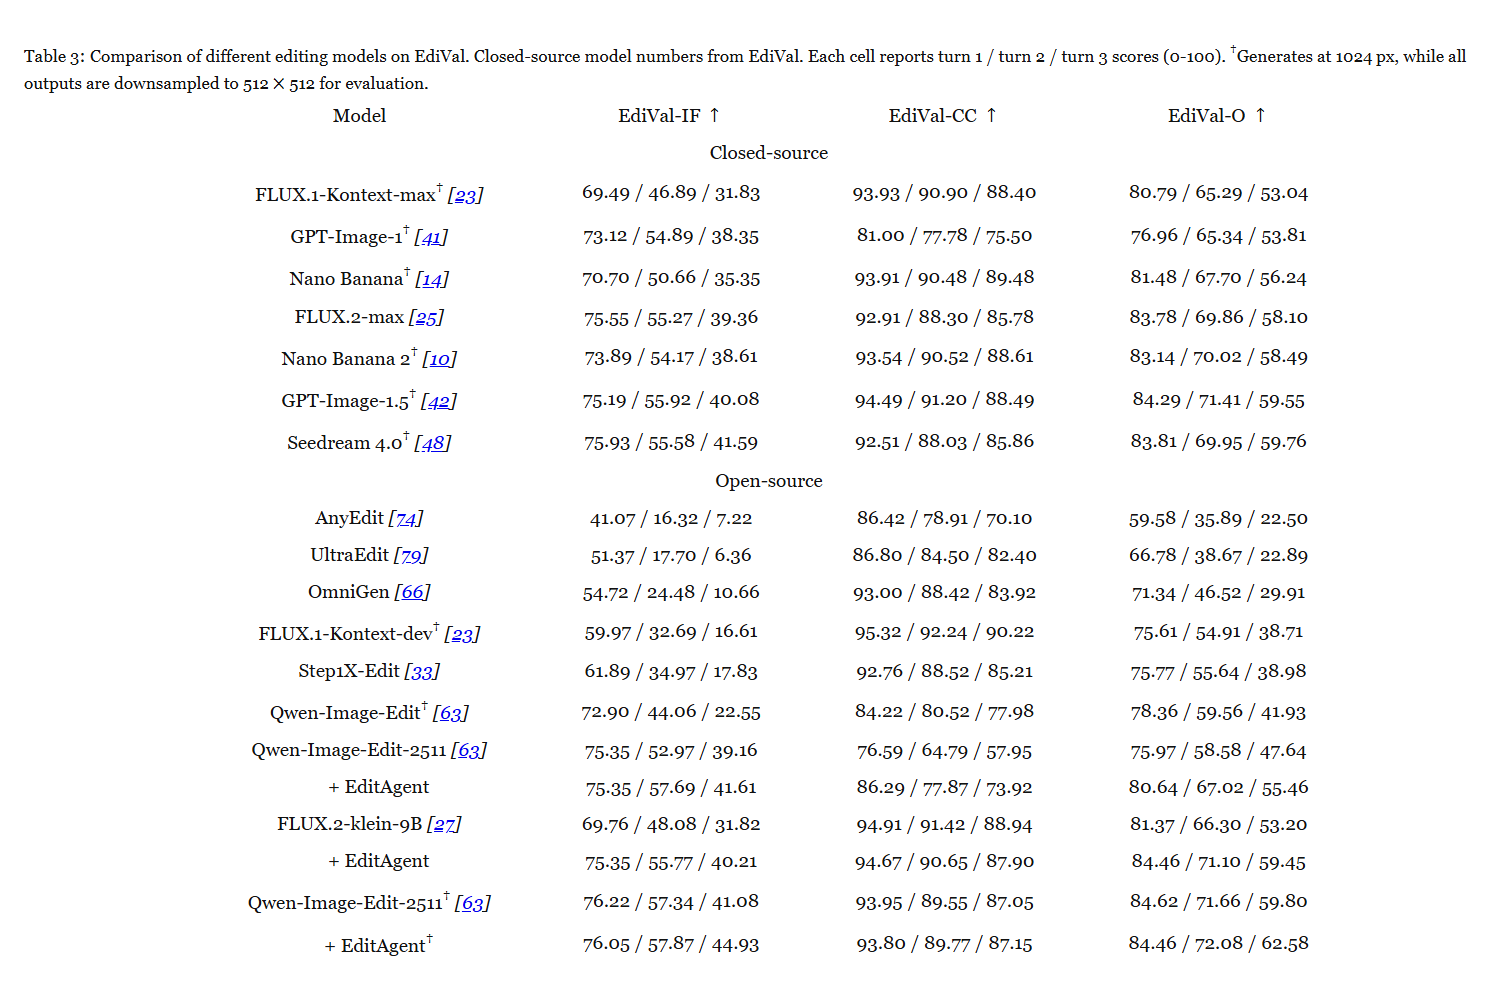
实验效果 :诊断集 600 组、30 类编辑,5 名专业修图师共同标注。144 例、4 次生成预算的并行/串行盲比中,并行赢 102、串行赢 28、平 14;78.5%以 130 个非平局为分母,裁判调用最多 2 次对 4 次。EdiVal 含 572 个三轮会话,512 像素下 Qwen 编辑器第 3 轮综合分 47.64→55.46,FLUX 为 53.20→59.45;同基准 H100 总推理 GPU 小时却从 1.1→12.9、0.5→6.3,不是每图延迟。
Table 3|EdiVal 各模型比较,每格为第 1/2/3 轮的 0 至 100 分,分别衡量指令遵循、内容一致和综合质量;闭源数字取自 EdiVal。带剑号方法按 1024 像素生成,所有输出下采样到 512×512 评价。不能把分辨率不同的行视作完全同算力对照。
批判点评 :能力池收益依赖定位、专用模型与裁判;同一 Qwen 兼任内部和部分外部评分器,作者另换 Gemma 复核。诊断集专业人士协商标注,不是 5 份独立投票;方法提到 515 组可用候选,但前述 600 减 81 为 519,原文口径存在 4 组差异,不能擅自补齐。未核到本方法官方实现,论文列出的底座和工具开源不等于整套 EditAgent 已开源。
3. WanAR+FixAR:隔几段回看长视频修漂移
Hierarchical Diffusion for Camera-controlled Autoregressive Video Generation | 卡内基梅隆大学;牛津大学 | arXiv:2610.37983
关键词 :相机控制, 长视频生成, 层级纠错, 静态场景
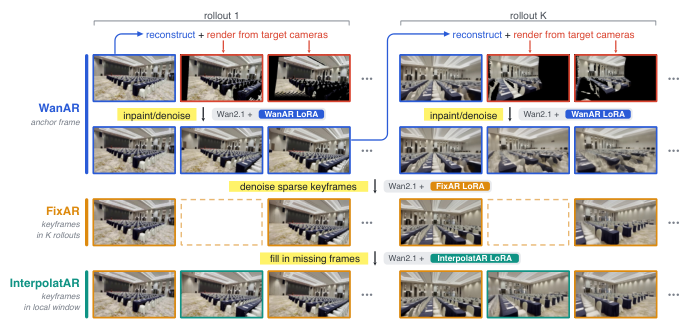
前序问题 :拿一张室内照片让相机绕着走,越走越远容易歪墙、丢家具。只把相机姿态编码交给模型,坐标尺度也可能对不上;每段都看上一段最后一帧又会把错误传下去。方法直觉 :先按深度把旧画面搬到新机位,模型补看不见的空洞;积累几段后抽稀关键帧,一次回看更长历史来修正,再把中间帧补齐。本文贡献 :WanAR 用 MoGe-2 估深度,按目标相机姿态变换上一帧,作为视频补全条件。FixAR 跨多次生成抽取稀疏关键帧去噪纠错,InterpolatAR 插回相邻关键帧之间的画面。三阶段共享 Wan2.1-I2V-14B 底座,各加载秩 32 的 LoRA 低秩微调参数;每个模型、每个数据集用 8 张 H100 训练 1 万步,约一天。训练分辨率 256×256;评价统一裁剪缩放和时间采样,不把原生分辨率直接混比。
Figure 2|WanAR、FixAR、InterpolatAR 共用 Wan2.1 主干、各装阶段专用 LoRA。上:MoGe-2 估输入或上一段末帧深度,变换到未来机位作为 WanAR 条件;中:跨段抽稀关键帧由 FixAR 回看较长历史纠漂移;下:InterpolatAR 补相邻修正帧之间的画面。三阶段整体仍可自回归延长。
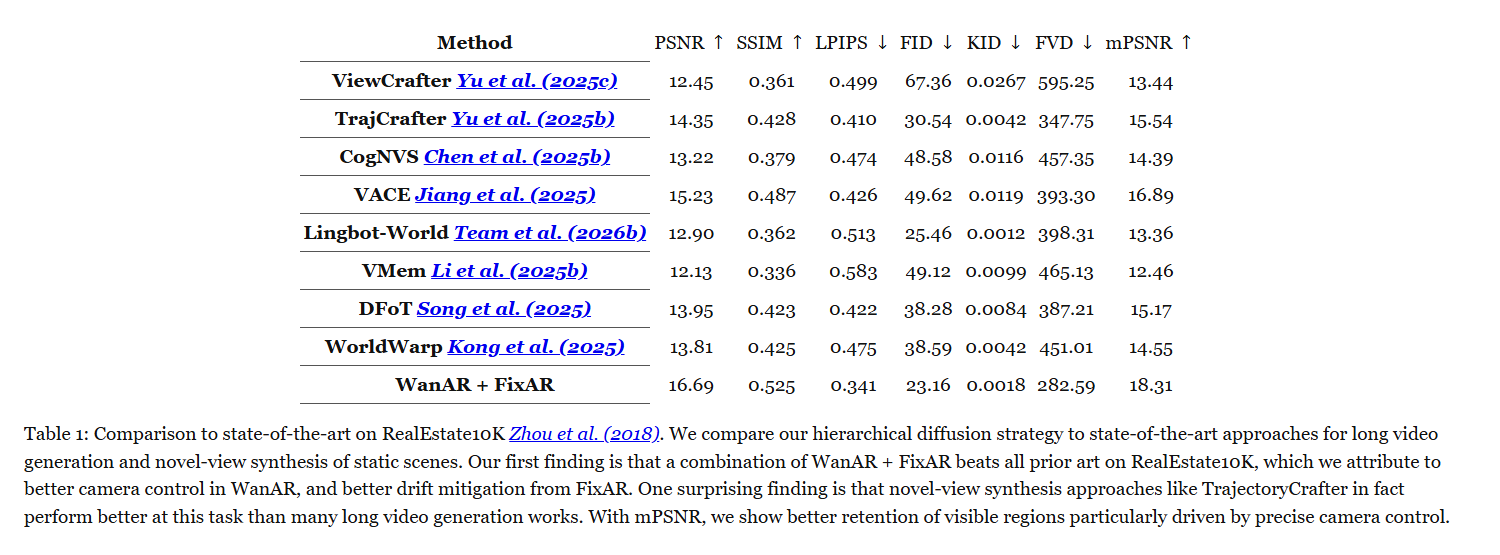
实验效果 :RealEstate10K 中,相比 TrajCrafter,峰值信噪比 PSNR 14.35→16.69 dB、感知差异 LPIPS 0.410→0.341、视频分布距离 FVD 347.75→282.59;前者高、后两者低更好。DL3DV 的 FVD 703.82→640.64,但 FID 图像分布距离 47.75 差于 Lingbot 的 40.26。单张 80GB H100 生成 280 帧,本文 336×592 耗 12 分钟/峰值 41GB;480×832 耗 17 分钟/48GB,两档都要 10 次扩散模型调用。
Table 1|RealEstate10K 静态场景长视频与新视图合成比较。WanAR+FixAR 结合精确机位控制和层级纠错,主要指标优于表列基线;TrajCrafter 这类短新视图方法也强于多种长视频方法。mPSNR 只计与首帧共同可见区域,用于观察机位一致性,不代表所有未知区域有唯一真值。
批判点评 :只适合静态场景,不能据此宣称人物动态或通用世界模型。尺度分布差很多时跨数据集失效;没有内置长久记忆,绕回原处仍可能不一致。FixAR 本身有限历史,仍不消除漂移。原文的项目 明确代码待开放;不同基线主干、原生分辨率与调用数不同,17 分钟不是纯架构同算力胜出。
4. AB-Attention:少算注意力还补回漏算份额
AB-Attention: Accurate Block Attention for Accelerating Video Diffusion Transformers | InfRec;香港中文大学(深圳);山东大学;东京大学;复旦大学;加州大学伯克利分校;香港科技大学;新加坡国立大学 | arXiv:2610.39663
关键词 :视频扩散加速, 块内聚类, 概率加权采样, GPU内核
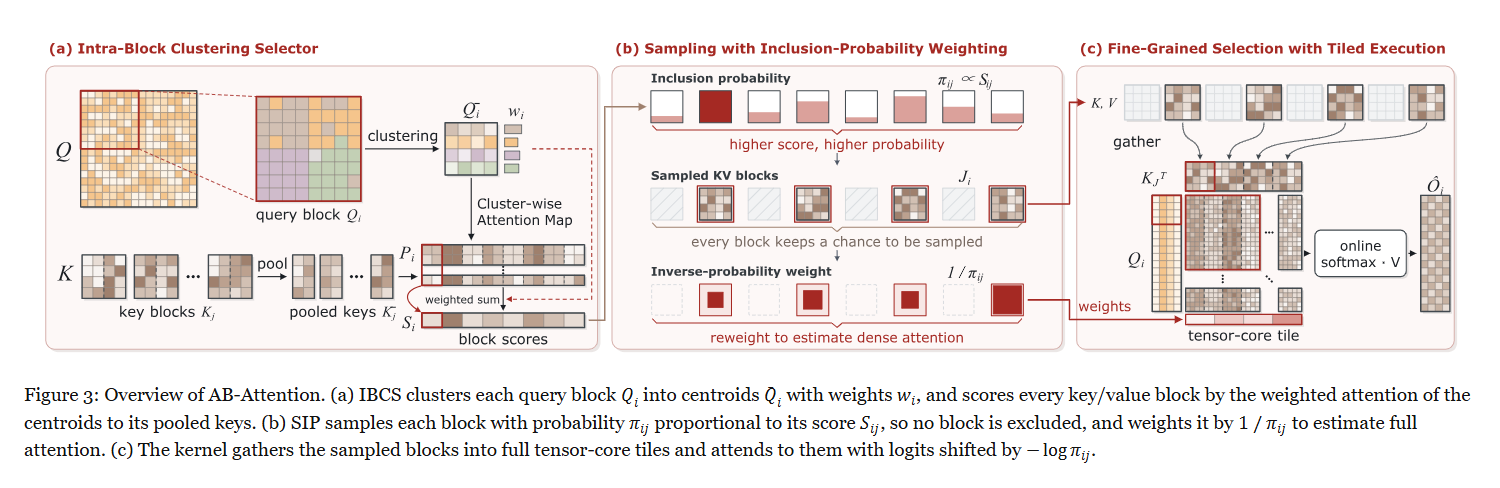
前序问题 :长视频的所有视觉 token 相互看一遍很贵。只保留重要块虽省算力,丢掉的块也从注意力归一化里消失,容易让结果偏离完整注意力。方法直觉 :把算力多分给可能重要的小块,但不让任何块的入选概率变成零;抽到后按入选概率倒数补权重,像抽样调查校正抽样偏差。本文贡献 :块内查询聚类选择器 IBCS 在每个 128 查询块里聚 8 个中心,估计各键值块重要性,不全局重排 token。SIP 即按入选概率加权采样,无放回抽取 4-token 键值块,在注意力 logit 上减去入选概率的对数;内核再把小块拼入完整 tensor-core 计算瓦片。分子和归一化因子的估计分别无偏,其比值并非因此严格无偏。无需训练,只支持前向推理。
Figure 3|A:IBCS 在每查询块内聚类,中心加权注意力为键值块评分;B:SIP 按评分设入选概率π,不排除任何块,抽中后按 1/π补权重;C:内核收集小块装入 tensor-core 瓦片,并在 logit 上减 logπ。概率校正不意味着归一化后的比值严格无偏。
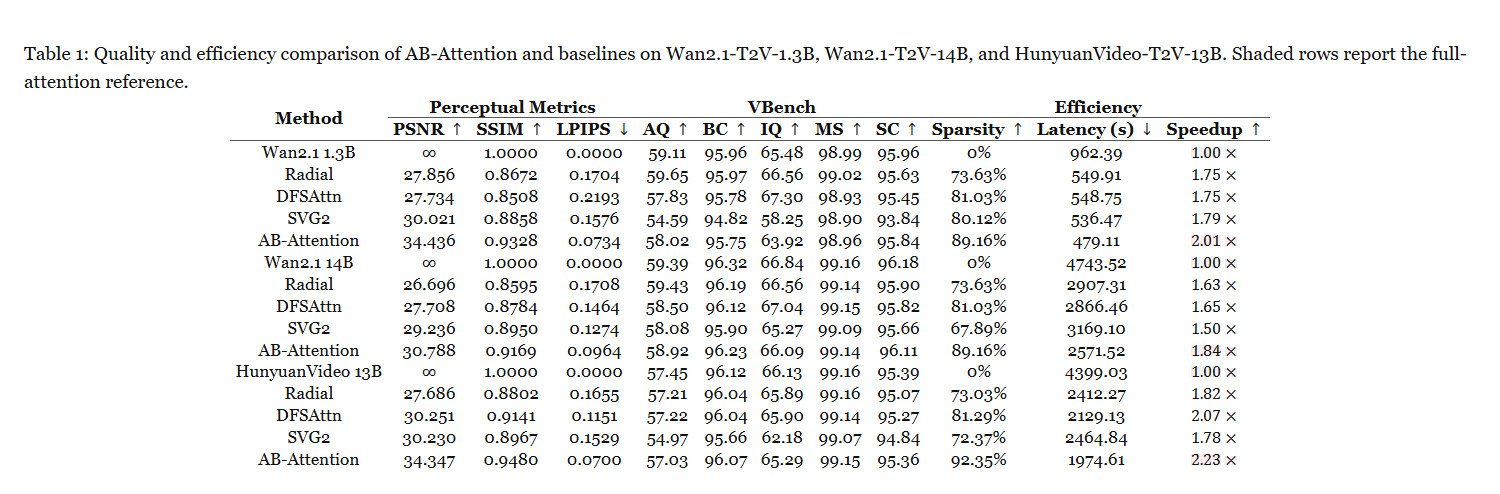
实验效果 :600 条 Penguin 提示、720p,Wan2.1 为 81 帧、HunyuanVideo 为 129 帧;同提示和种子对照完整注意力。H20、BF16、50 步中前 10 步及首个 Transformer 块仍密集计算,稀疏计划每 4 步更新。Wan14B 跳过稀疏阶段 89.16%注意力、PSNR 相对密集输出 30.788 dB、总耗时 4743.52→2571.52 秒,1.84 倍;Hunyuan 为 92.35%、34.347 dB、4399.03→1974.61 秒,2.23 倍。
Table 1|Wan2.1 文生视频 1.3B/14B 与 HunyuanVideo13B 的画质和效率。阴影行为完整注意力参考;PSNR/SSIM/LPIPS 比较同种子密集输出,VBench 列衡量美观、背景一致、成像、运动平滑、主体一致。稀疏度是稀疏阶段跳过的注意力比例,时延和加速是整段生成测量;H20 设置下最高 2.23 倍。
批判点评 :89%至 92%不是整个生成流程节省同等比例;PSNR 高表示更像密集参考,不代表人类画质绝对更好。VBench 部分维度仍略低于密集版。内核针对 H20、只测 3 个文生视频主干,其他硬件与训练反向尚无验证。官方仓库 当前只有说明与演示,明确写代码待放出,不能称已可复现。
5. AnyOrder-AR:旧自回归模型补出任意区域
Unlocking Any-Order Generation in Pretrained Autoregressive Image Models | 纽约州立大学石溪分校;ILLS;蒙特利尔高等技术学院 | arXiv:2610.39293
关键词 :任意顺序生成, 自回归适配, 位置条件, 区域补全
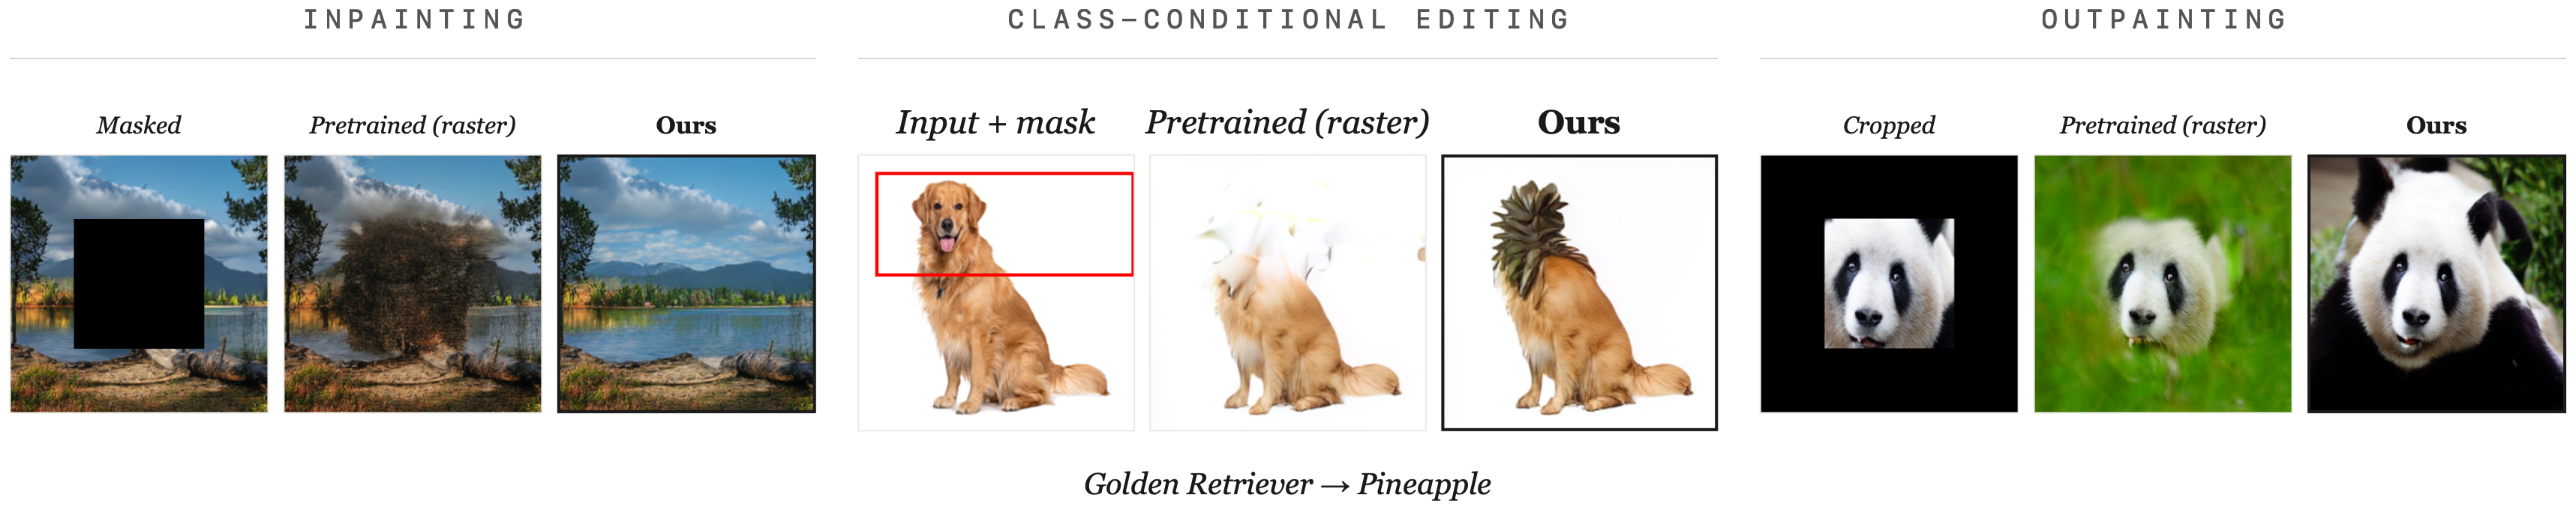
前序问题 :模型按从左上到右下的固定次序画图,补中间一块时却需要同时看它四周;会画整张图,不代表预训练接口能表达这种条件。方法直觉 :保留已经学会的图像知识,明确告诉模型下一个要预测哪个空间位置,再从熟悉的逐行顺序逐步过渡到随机顺序,避免直接打乱训练把旧知识冲掉。本文贡献 :未来感知位置嵌入在输入层加入下一个目标位置的向量;LlamaGen 旋转位置编码、RAR 绝对位置编码都按真实空间位置而非解码步索引。顺序课程从逐行到均匀随机排列,继续训练 LlamaGen-L/XL 和 RAR-L/XL 四个底座,不改离散视觉 tokenizer 或加补图专用网络。保留键值缓存 KV cache 与并行解码;vLLM 服务仍需仓库自定义模型适配。AnyOrder-AR 是本期便于阅读的短名。
Figure 1|同一逐行自回归 LlamaGen-L 适配后,通过改变已知 token 位置完成左侧补图、中间区域条件重画、右侧扩图,不需任务专用训练、采样器改造或辅助网络。原逐行列失败源于不能消费非连续上下文,不是同任务共享接口下的弱基线;这是能力概览而非架构图。
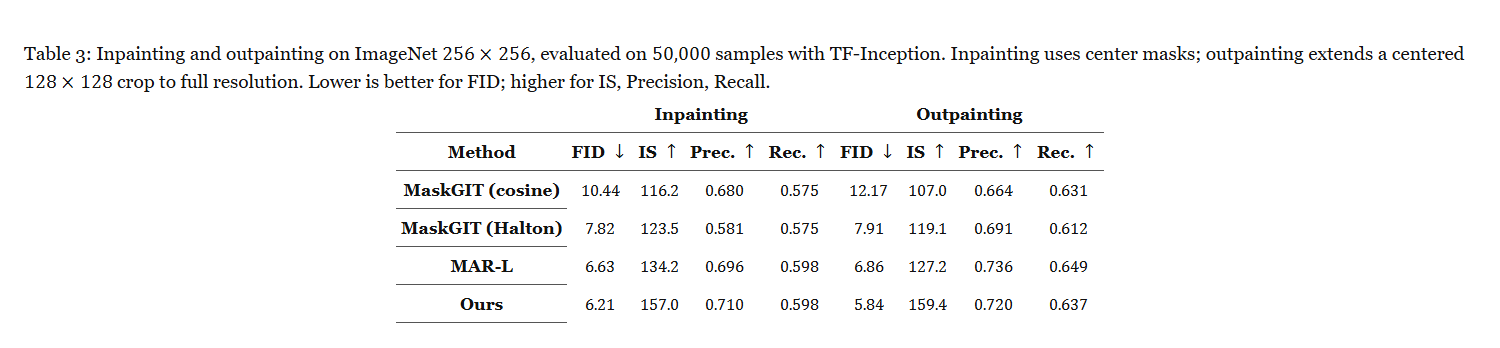
实验效果 :ImageNet 256×256、5 万样本,中心补图 FID 6.21,对 MaskGIT 余弦日程 10.44、Halton 日程 7.82、MAR-L 6.63;FID 越低越好。扩图从 128×128 中心裁剪补到全图,FID 5.84 对 MAR-L 6.86,但精确率/召回率 0.720/0.637 低于 MAR-L 的 0.736/0.649。代价是四底座类别条件生成 FID 增加 1.17 至 1.93;适配约多 13%至 33%训练计算,LlamaGen-XL 总预算约原预训练 1.25 倍。
Table 3|ImageNet256×256 补图/扩图,以 TF-Inception 评价 5 万样本。补图用中心掩码;扩图把 128×128 中心裁剪补到全图。FID 越低越好,IS、精确率、召回率越高越好;MaskGIT 包含余弦和 Halton 两日程,MAR-L 在扩图精确/召回仍较高。
批判点评 :这里只验证 ImageNet 类别条件和区域补全,不能当文字指令编辑、身份保留或高分辨率已解决。比从头训练的对照匹配总计算,但训练日程不相同;对 MAR-L 也没有运行级不确定性估计。代码 含训练、补图、扩图与 vLLM 入口;arXiv 评论明确 NeurIPS 2026 poster,不从论文排版猜接收。
6. TokenRepel:同一句提示别总画得一样
TokenRepel: Generating Diverse Image Sets Without Compromising Quality | 澳大利亚国立大学;Homenet Research;CarryAI | arXiv:2610.39913
关键词 :图像集多样性, token排斥, 密度保护, 推理引导
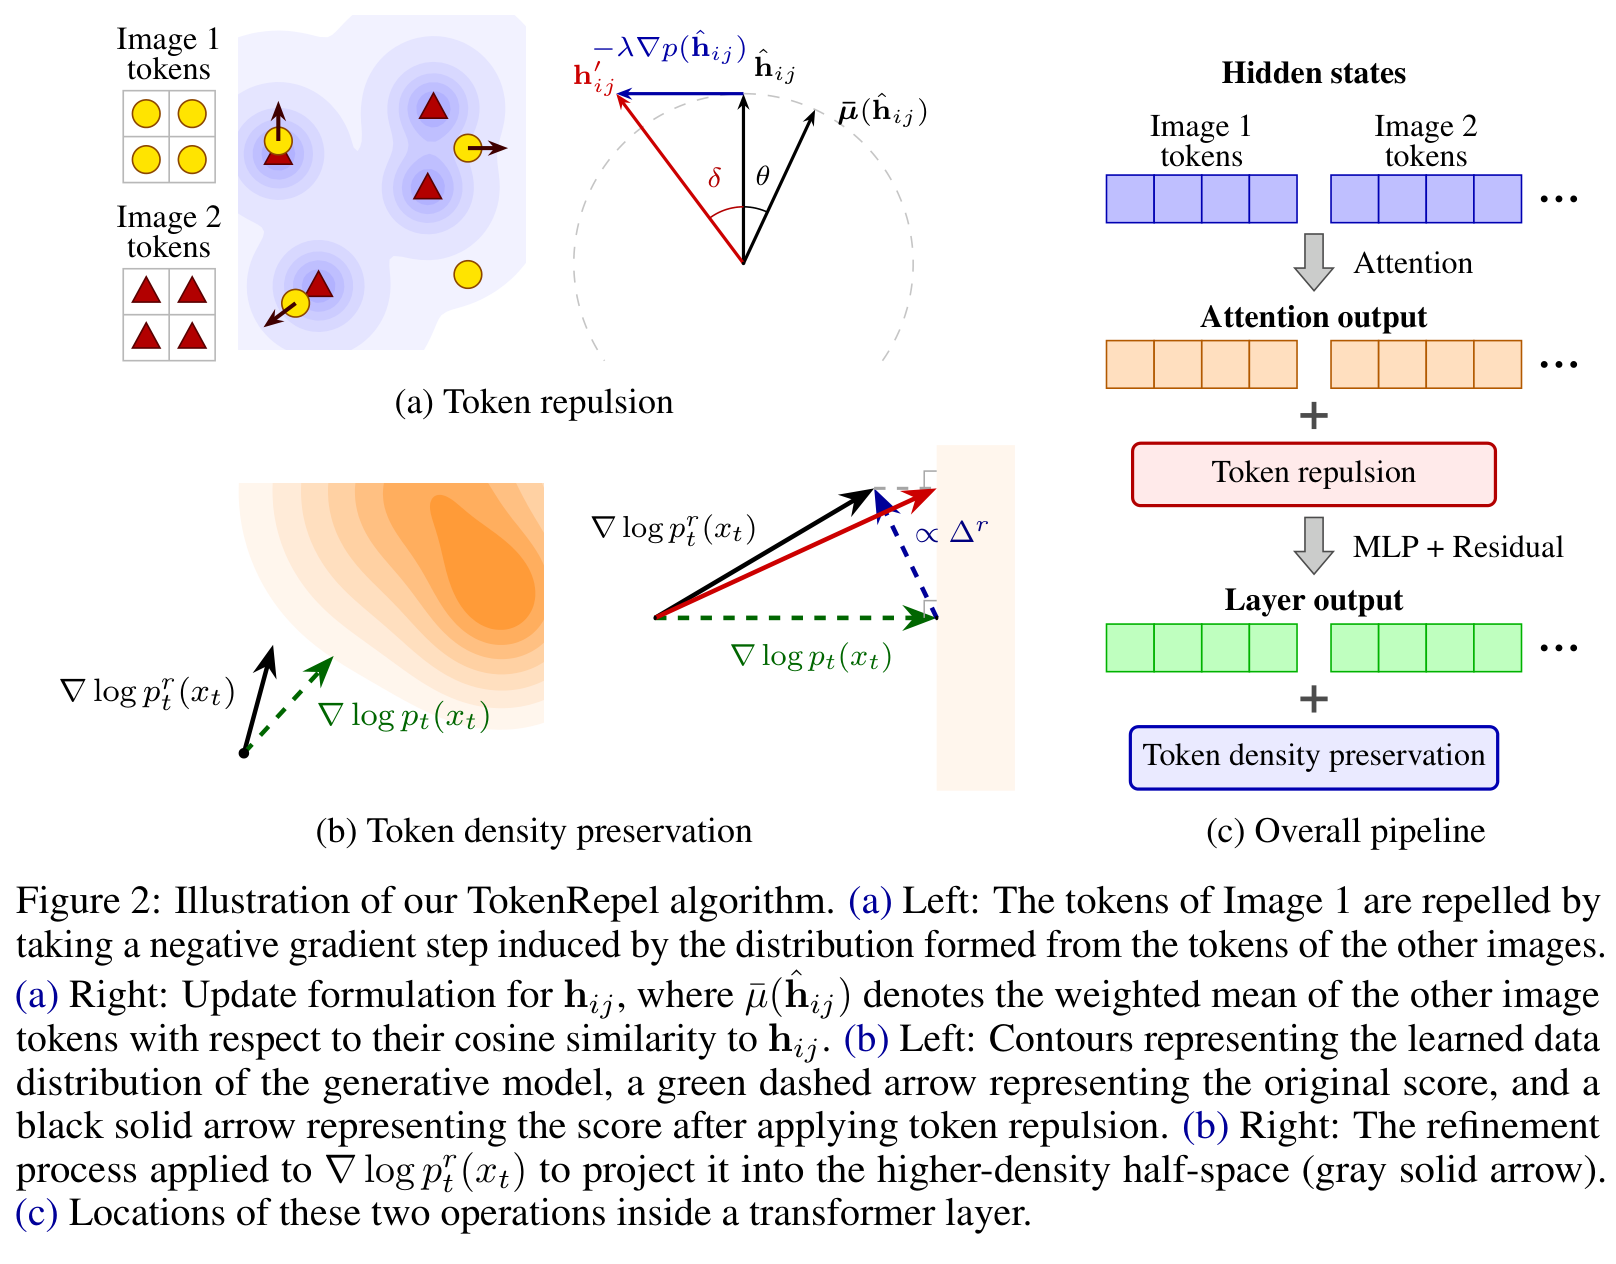
前序问题 :同一句提示生成四张图,换了随机种子却常常只有同一构图的细微变体。强行拉开样本又可能把人物结构和文字要求一起拉坏。方法直觉 :先让不同图的内部视觉特征拉开夹角,再把会偏离模型高密度方向的更新削掉。目标是整组图有更多变化,同时尽量留在模型熟悉的图像范围内。本文贡献 :把隐藏 token 归一化到单位球面,用 von Mises-Fisher 混合分布的负黎曼梯度推动跨图 token 分散;密度保护把排斥引起的预测变化投到与模型 score 方向相容的半空间,并扩到中间层。score 是引导样本向更高概率区域移动的方向估计。测试 FLUX.1-dev、4 步 FLUX.2-Klein-9B、SDXL;分别只在前 3/1/5 步施加排斥,早层做密度保护,不需训练。
Figure 2|TokenRepel 方法示意。a 左:图 1 的 token 受其他图 token 构成分布的负梯度排斥;a 右:按余弦相似度加权的其他图 token 均值决定梯度方向。b 左:等高线为学得分布,绿虚箭头为原 score,黑实箭头为排斥后 score;b 右:密度保护把排斥更新投到高密度半空间,灰色实箭头表示投影结果。c:排斥放在注意力输出后、密度保护放在层输出后,说明两种操作在 Transformer 层内的位置。
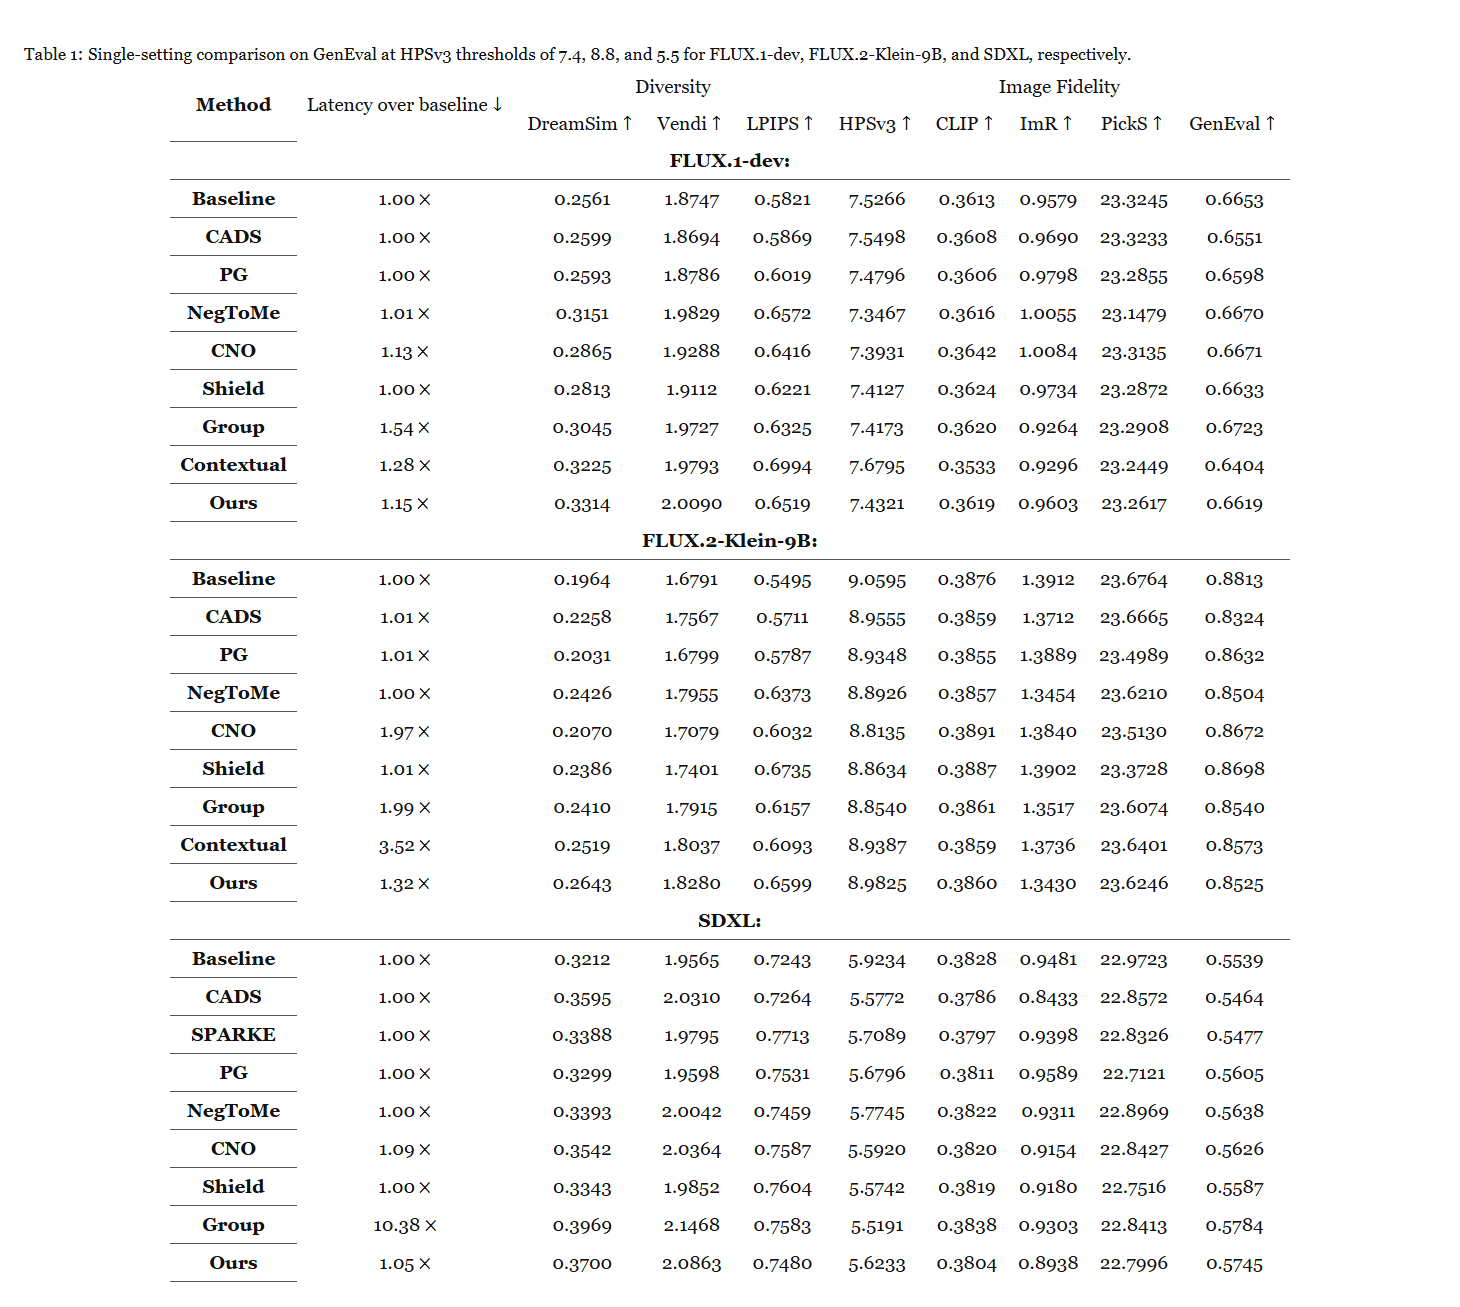
实验效果 :GenEval 每提示 4 图、512 分辨率、各法同初始噪声。FLUX.2 单设置下,成对 DreamSim 视觉距离 0.1964→0.2643、Vendi 特征谱熵对应的有效样本数 1.6791→1.8280;两者越高越多样。HPSv3 偏好分 9.0595→8.9825,GenEval 指令组合正确率 0.8813→0.8525,时延为底座 1.32 倍。FLUX.1 为 1.15 倍、SDXL 为 1.05 倍,不能把三主干的成本合成一个数字。
Table 1|GenEval 固定设置比较,FLUX.1、FLUX.2 与 SDXL 分别采用 HPSv3 阈值 7.4、8.8、5.5。多样性列为成对 DreamSim、Vendi 与 LPIPS;质量列含偏好、图文和组合指令分,时延为各自底座倍数。提高多样性仍可能降低部分质量指标,阈值设置不等于质量完全无损。
批判点评 :“不损质量”是受阈值约束的取舍,表里 GenEval、PickScore 与部分偏好分仍下降;批大小变大使 Vendi 升高,也受计数口径影响,不直接证明总体分布更丰富。保护机制不直接适用于输出概率的自回归模型。arXiv 评论为 NeurIPS 2026,正文另有 camera-ready 差异说明;未在原文直接核到本方法代码仓,不以引用的 FLUX 链接冒充。
7. SpecSlot:细节多一份全局通信不翻倍
Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers | 北京大学;南洋理工大学;商汤 | arXiv:2610.40647
关键词 :像素空间生成, 频带分工, 全局局部注意力, 计算口径
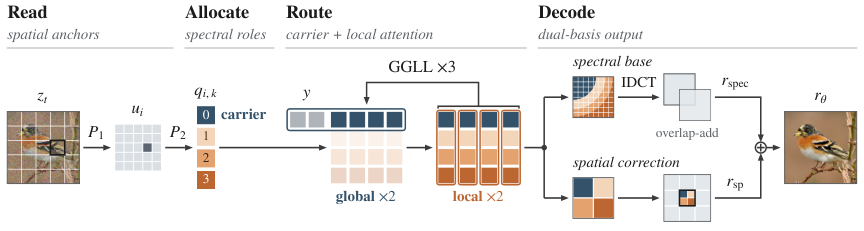
前序问题 :直接在像素上生成图像,切更小图块能保细节,但 token 数和全局注意力一起膨胀。局部纹理也被迫参与所有区域的通信,算力未必花得合算。方法直觉 :同一空间锚点分给多个 slot,各管一段频率;只有最低频 slot 跨区域沟通,细节先在锚点内部交流。slot 是具有指定输出职责的特征单元,不是额外图像。本文贡献 :W 为空间锚点数,K 为每锚点频带 slot 数,总图像状态数 N=W×K;DCT 离散余弦变换把平滑结构与细节分到互不重叠系数带。全球注意力只处理 W 个低频载体及上下文状态,局部注意力混合各锚点的 K 个 slot。重叠窗口频谱解码与空间修正相加,生成状态、速度目标和损失仍在像素空间,不是外训压缩器。整流流模型以连续速度把噪声搬到图像。
Figure 2|每个空间锚点展开 K 个 slot;G 块只让最低径向频率 slot0 载体跨锚点并与上下文交换,L 块在单锚点内部混合全部 slot。最终解码重叠 DCT 频谱基底与锚点对齐空间修正,在像素空间相加。
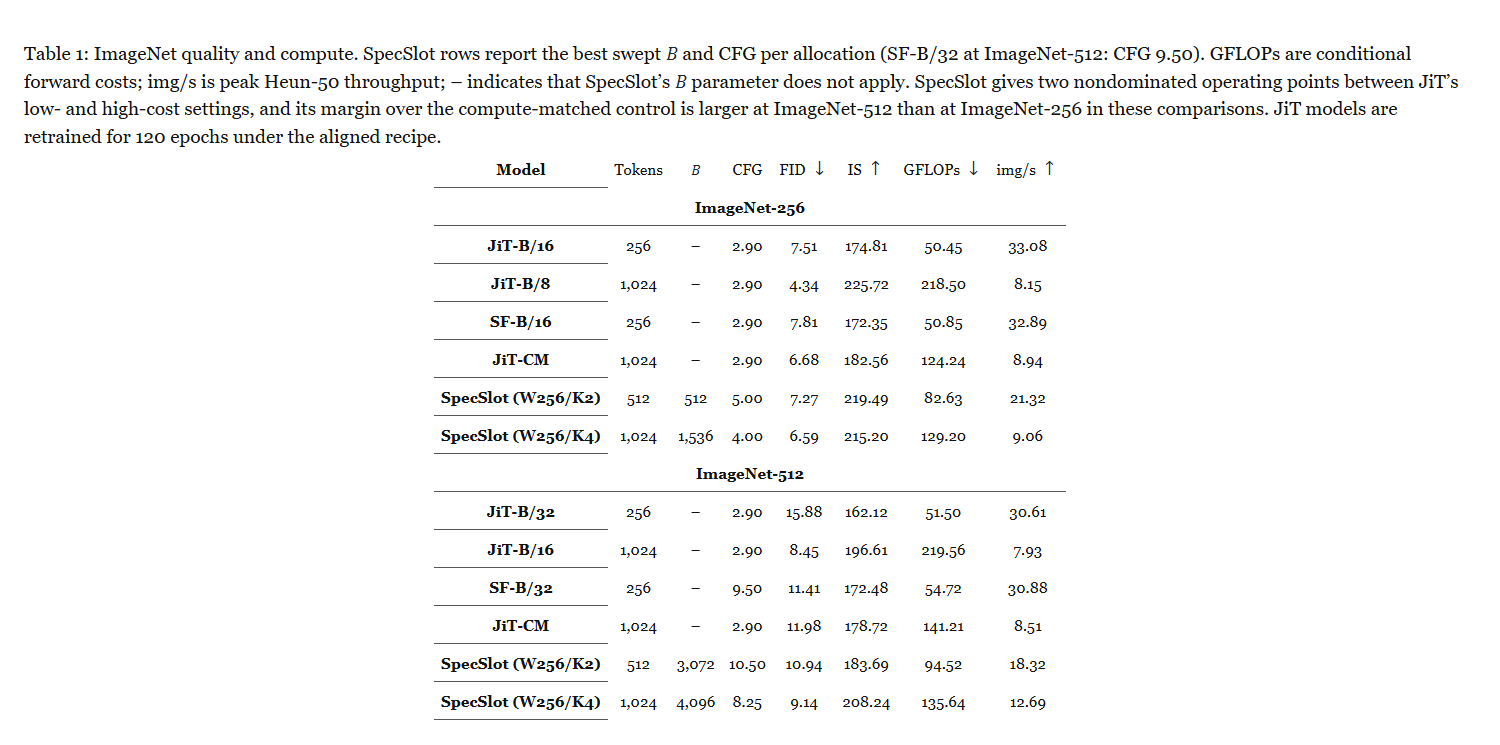
实验效果 :同配方重训 120 轮,ImageNet-512 的 W256/K4:FID 9.14 对计算匹配 JiT-CM 的 11.98,单次条件前向 135.64 对 141.21 十亿浮点运算。相对 JiT-B/16 的 219.56 少 38.2%计算,但 FID 仍差 0.69。256 像素文生图、400 轮,DPG-Bench 复杂指令分 62.21 对 61.15,GenEval 却 26.99 对 29.78。单 H800、批 128 的 512 训练峰值 17.39GB/卡;Heun-50 是区间数,另表固定批量实测含无分类器引导的网络调用为 187 次/图,不能理解成只调用 50 次。
Table 1|ImageNet 画质与计算。各 SpecSlot 分配报告扫参后最佳证据宽度 B 与引导 CFG,SF-B/32 在 512 分辨率 CFG9.50;十亿浮点运算为单次条件前向,图/秒为 Heun-50 峰值吞吐,横线是 B 不适用。JiT 均按统一配方重训 120 轮;512 分辨率计算匹配差距更大,但高计算 JiT-B/16 的 FID 仍更低。
批判点评 :减少前向浮点运算不等于按同比例降低端到端时间;引导强度 CFG 在模型间不同,两个文生图指标也不一致,不能概括为全面胜出。更密锚点或更多 slot 仍增加局部计算。arXiv 标注 ICLR 2027 在审,绝非已接收。代码 含模型与训练入口,权重仓链接已核验但本次未运行模型。
8. AudioSelector:克隆声音先挑好参考片段
What Makes a Good Audio Prompt for Zero-Shot TTS? Learning Prompt Selection from Synthesis Outcomes | 耶路撒冷希伯来大学 | arXiv:2610.40372
关键词 :零样本语音合成, 参考选择, 输出监督, 词错误率
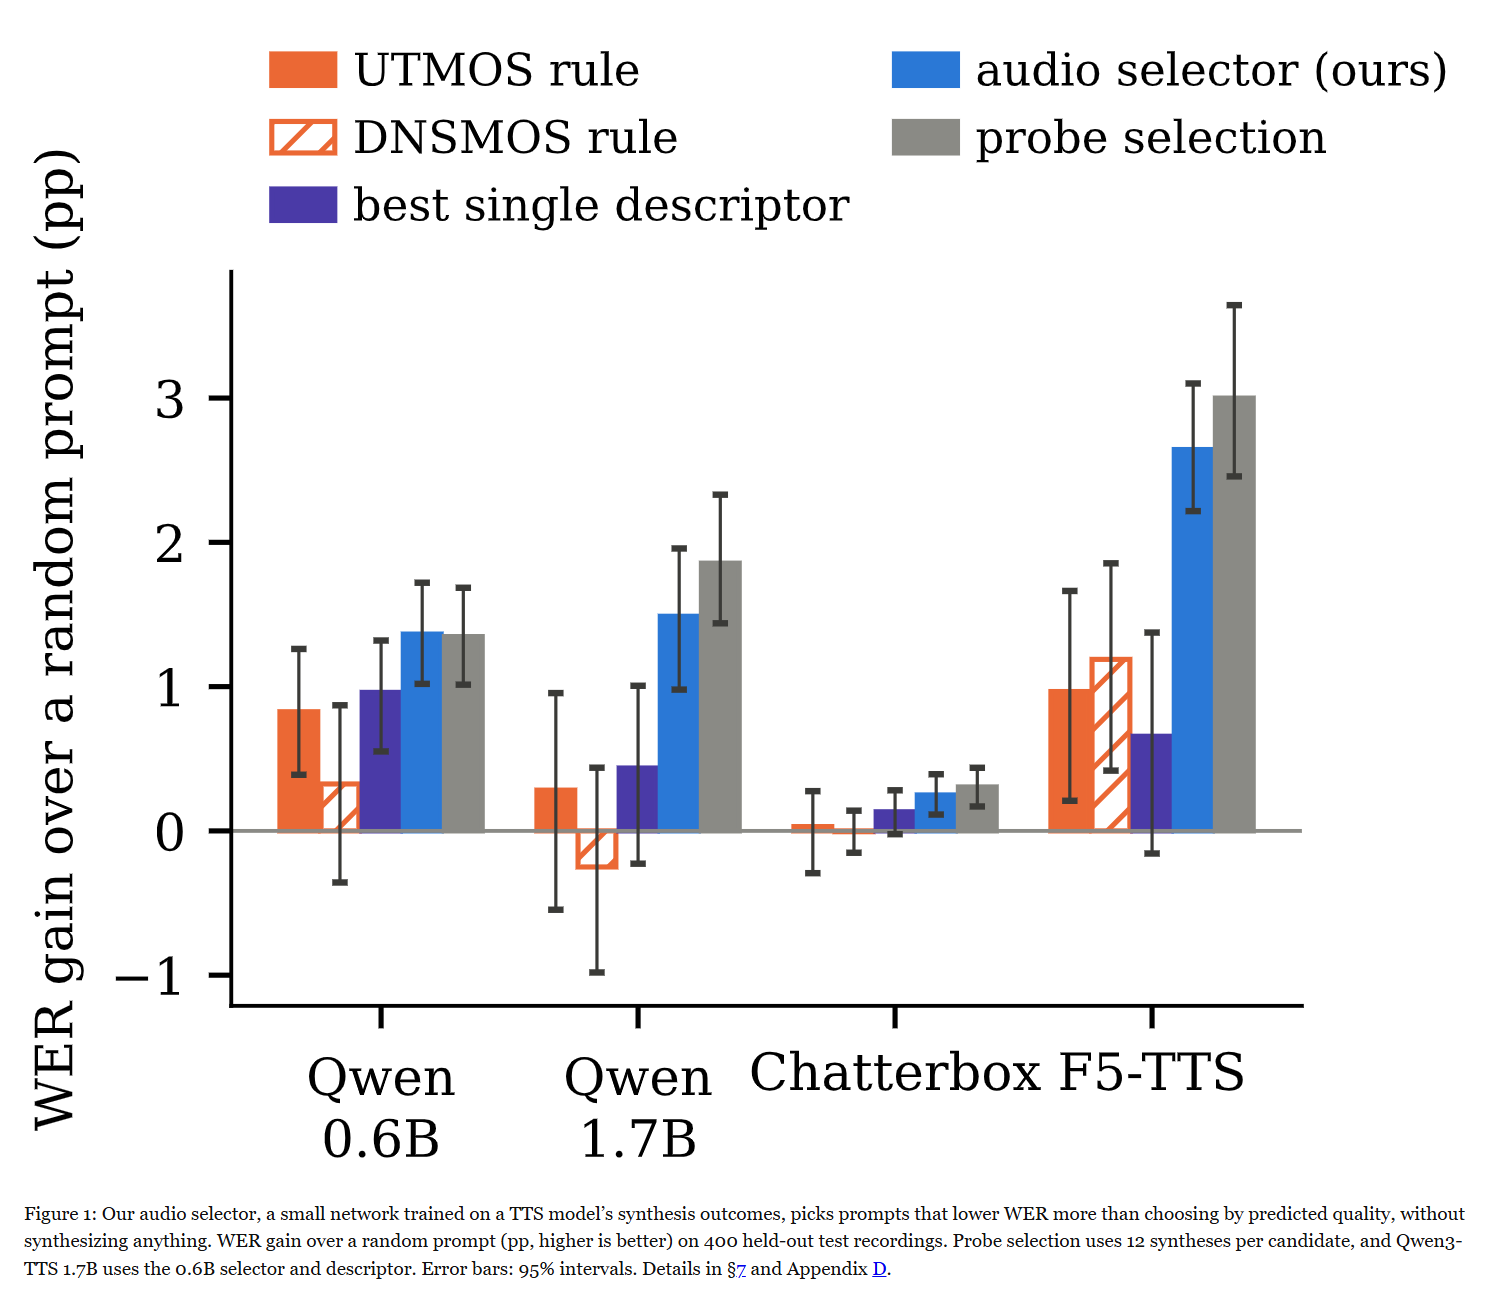
前序问题 :从一段播客里剪几秒来克隆声音,最干净的一段不一定让合成器少念错字。挑参考的音质与用它生成后的可懂度,是两种目标。方法直觉 :先离线观察同一合成器使用不同片段后会念错多少,再让小网络直接从参考音频预测哪段更适合。部署时只挑片段,不必为每个候选预合成许多句。本文贡献 :冻结 2100 万参数 Whisper-base 编码器,训练两层 Transformer 及注意力池化的 140 万参数网络;按每条录音内部候选的词错误率排序监督,5 个随机初始化模型分数取均值。每条主说话人的 30 秒区间剪出 3/5/10 秒候选 10/6/3 个,共 19 个;每候选用 5 句×3 种子生成 15 个输出。训练/开发/测试隔离录音,并移除训练中与测试声音匹配者。AudioSelector 为本期对论文 audio selector 的短称,不是新模型品牌。
Figure 1|由合成结果训练的小音频选择网络,选出的参考带来比预测音质更大的词错误率收益,选择时无需合成。400 条独立测试录音、随机参考为基准,WER 收益按百分点且越高越好;探测法每候选合成 12 次,Qwen1.7B 复用 0.6B 的选择器/描述器,误差条为 95%区间。这是方法效果概览,原文没有独立网络结构图。
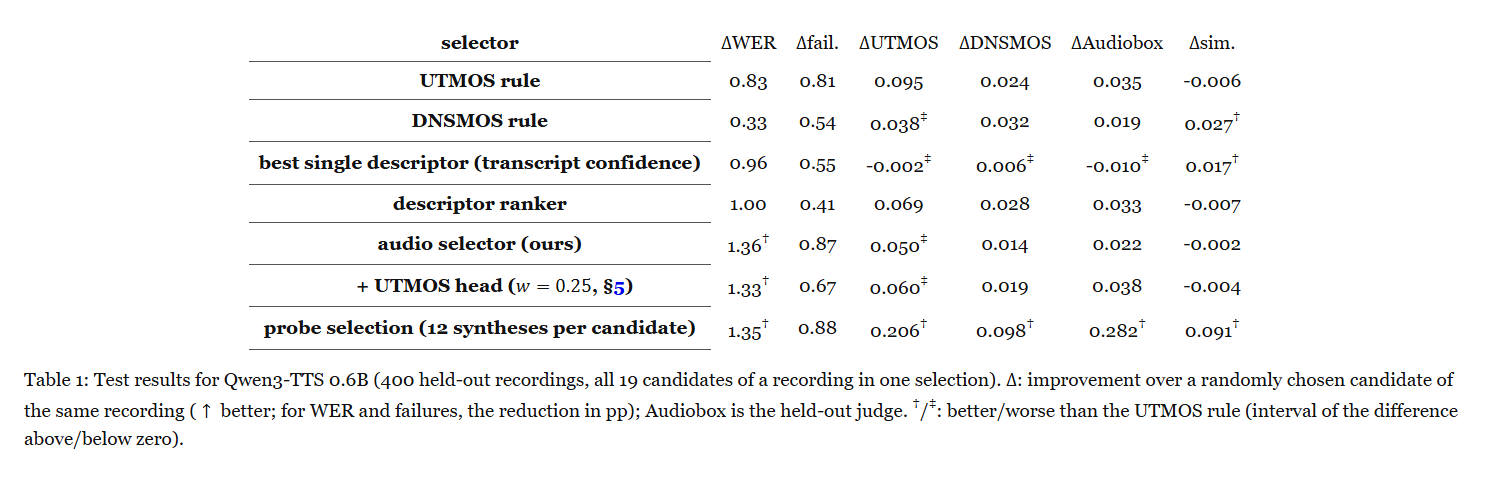
实验效果 :400 条英语测试录音,Qwen3-TTS 0.6B 相对随机参考的 WER 词错误率降 1.36 个百分点、约相对 32%;UTMOS 预测自然度选取降 0.83 个百分点。1.36 与 0.83 来自四舍五入表值,配对原始差报告 0.54 个百分点。效果接近每候选试合成 12 句、每录音 228 次合成的方案。选择时不合成不等于无计算,仍需编码 19 段、5 网络打分;离线标注每底座约 100 至 270 个 L40S GPU 小时。
Table 1|Qwen3-TTS0.6B 的 400 条测试录音,每条 19 候选共同选取。Δ为相对同录音随机候选的改进,WER 与失败为下降百分点,其余为指标单位;Audiobox 为未参与选择的保留裁判。剑号/双剑号表示与 UTMOS 规则配对差区间显著更好/更差,不能按表中舍入值替代原始配对差。
批判点评 :只测 4 个模型、3 家族及英语录音/加噪语音,最好选择器依赖本底座的生成标签。7 人、72 条录音听测未发现自然度代价,却不足以验证可懂度优势;也未覆盖重音和表现力。WER 主要用自动识别器,不能代表所有人类听感。未核到作者在原文给出的独立实现链接,公开底座不能代替选择器代码。
9. MiDiff:用鼓谱指导坏鼓声再生成
MiDiff: MIDI-Conditioned Diffusion Models for Drum Audio Enhancement | 巴伊兰大学 | arXiv:2610.38619
关键词 :鼓声音频修复, MIDI条件, 在线转谱, 测试集选参
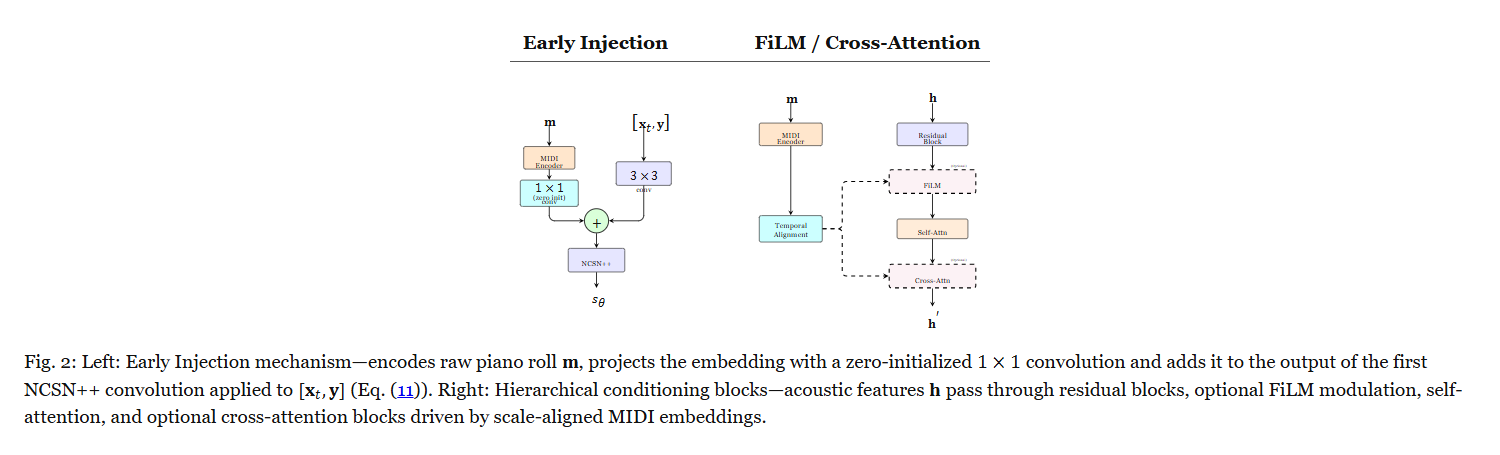
前序问题 :现场鼓声被混响、削波和噪声弄糊,仅靠音频不易知道某一下究竟是什么鼓、打了多重。即使敲击时刻找对,音色仍可能恢复错。方法直觉 :MIDI 钢琴卷帘像一份时间对齐的鼓谱:每行一种鼓、格子亮度是击打力度。把鼓种和力度直接交给去噪网络,比只在输出端催它敲准时间更有效。本文贡献 :在 SGMSE 语音增强扩散的复数短时傅里叶变换 STFT 域里建模;STFT 把波形变成带幅相的时间—频率表示。冻结预训练 9 鼓类、128 维 MIDI 编码器,各 U-Net 层用可学习时间对齐,再结合入口注入、FiLM 特征缩放/平移和交叉注意力。没有真值 MIDI 时,先用音频网络去噪,噪声降低后让带扩散时间条件的自动鼓转谱器在线估计,再切 MiDiff。两张 A100 训练 60 轮;采样 30 个预测步,每步另 1 个 Langevin 校正,不是 30 次网络计算。
Figure 2|左:入口注入把原始 MIDI 卷帘编码,经零初始化 1×1 卷积投影,加到 NCSN++处理带噪音频与退化观测的首层输出。右:层级音频特征依次经过残差块、可选 FiLM 特征调制、自注意力和可选交叉注意力,各层读入时间尺度对齐的 MIDI 嵌入。
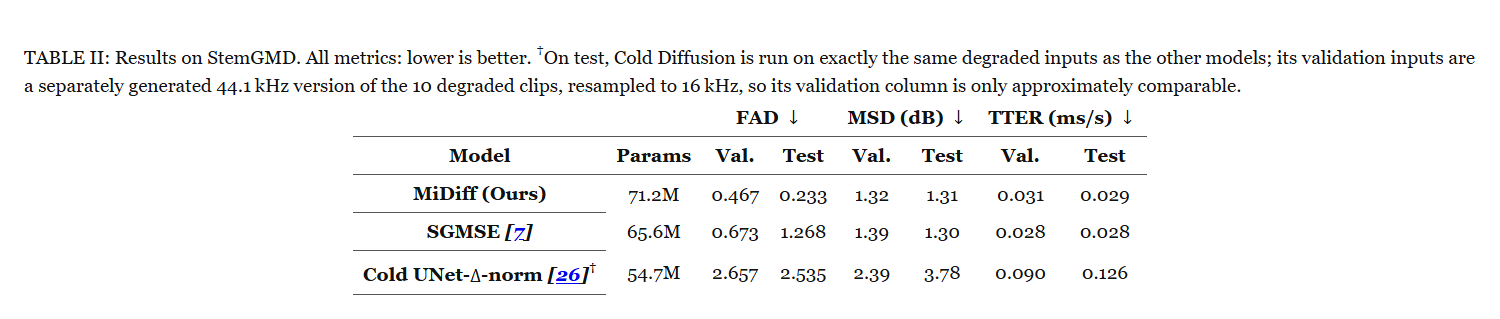
实验效果 :StemGMD 同一鼓手不同会话,训练 16.08 小时、测试 1.16 小时 100 段,16kHz 单声道。真值鼓谱下 FAD 音频特征分布距离 1.268→0.233,越低越好;参数 65.6→71.2 百万,多 5.6 百万。时序误差却 0.028→0.029 毫秒/秒,说明主收益不在敲击定时。无外部鼓谱时 FAD 0.676、较音频基线约降 47%,但切换时间 0.75 从测试集 9 点扫描选出,属于事后最佳值。
Table II|StemGMD 结果全部指标越低越好。FAD 衡量音频特征分布距离,MSD 为 dB 谱距离,TTER 为每秒瞬态时序误差。带剑号 Cold Diffusion 测试与其他模型用相同退化输入;验证输入却来自单独 44.1kHz 退化再下采样 16kHz,只能近似比较验证列。MiDiff 较 SGMSE 主要改善 FAD,而测试 MSD 及 TTER 略差。
批判点评 :合成鼓库与模拟退化,训练/测试共享鼓手和音色库,未验证真实录音、独立鼓手或独立鼓组。16kHz 最高可恢复 8kHz 以下频段;无正式听测,单次随机采样也分不清小差异。真值 MIDI 是强条件,无谱结果不能等同独立验证泛化;时延和峰值显存未给统一测量。项目 保留旧版 0.29/0.56 数字与编码压缩描述,和当前原文不同;代码按钮无有效实现链接,本稿以原文为准。投稿 IEEE/ACM TASLP 不等于接收。
10. SonoWorld4D:换个听音位置声源也跟着走
SonoWorld4D: From One Video to a 4D Audio-Visual Scene via Diffusion Synchronization | 马里兰大学帕克分校 | arXiv:2610.40640
关键词 :4D视听生成, 动态声源, 双空间扩散, 新视点声场
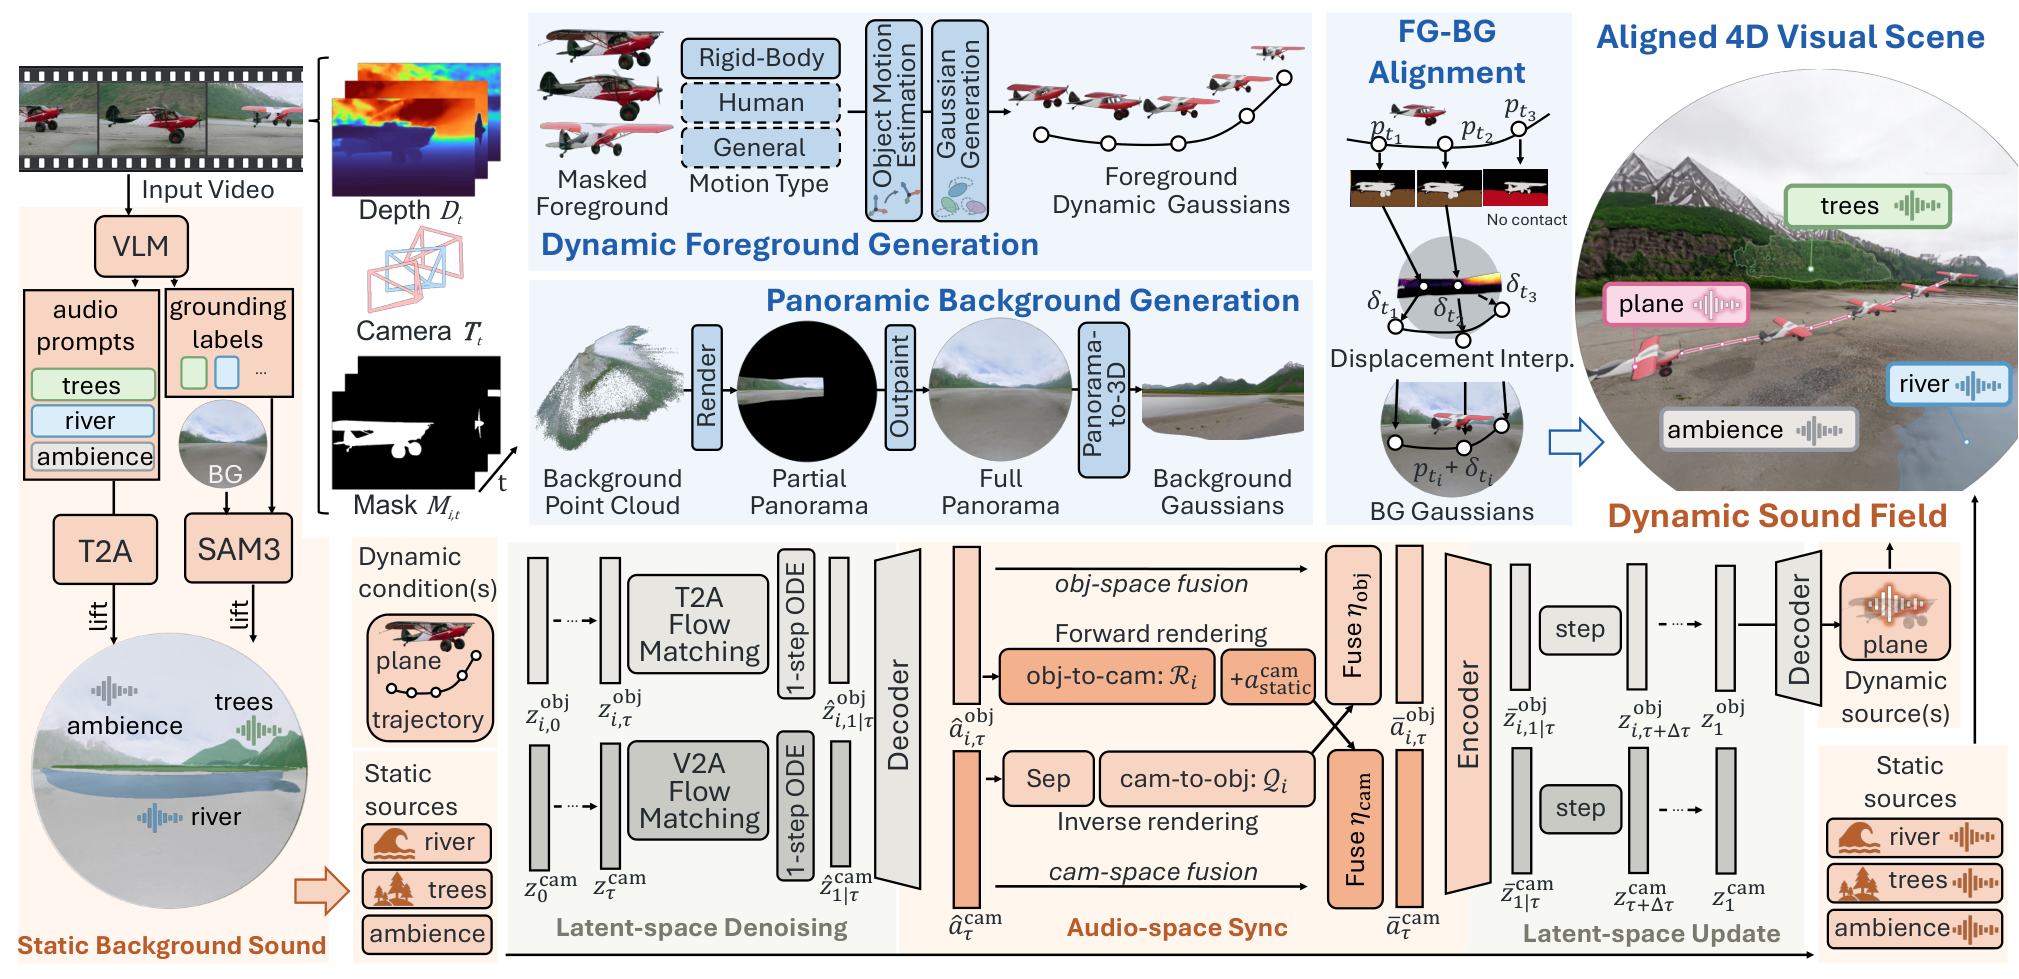
前序问题 :看一辆车从镜头前经过,换到街对面的虚拟听众,声音峰值和频率变化应随新距离改变。把原机位合成的单声道录音直接搬过去,常把旧机位的响度与多普勒变化也搬过去。方法直觉 :先给每个会动的物体一条轨迹和一份贴身声音,再让物体坐标与相机坐标的生成结果互相校正。这样换听众时可以重新计算传播,而不是只平移一段录音。本文贡献 :深度、相机和前景分割分解场景,动态物体与 360 度背景用可快速渲染的 3D 高斯表示,做尺度和局部位移对齐。静态声源用文字生成;动态声源在每步扩散中从物体空间渲染到相机混音,又经声源分离与逆渲染映回各物体,双空间同步。新听众的距离衰减、遮挡、传播时延和多普勒效应参与声学渲染,再编码 ambisonics 球谐方向声场、解码为双耳声音。
Figure 2|单目视频先估深度、机位、前景掩码及视觉语言模型的音频提示。视觉分支重建动态物体高斯,将扩出的 360 度全景变为背景高斯,以尺度和局部位移对齐世界坐标。音频分支静态源用文字生成;动态源每步由前向渲染 Ri 把物体预测映到相机混音,再由分离和逆渲染 Qi 映回各源。最后支持新视点视觉/空间声音渲染。
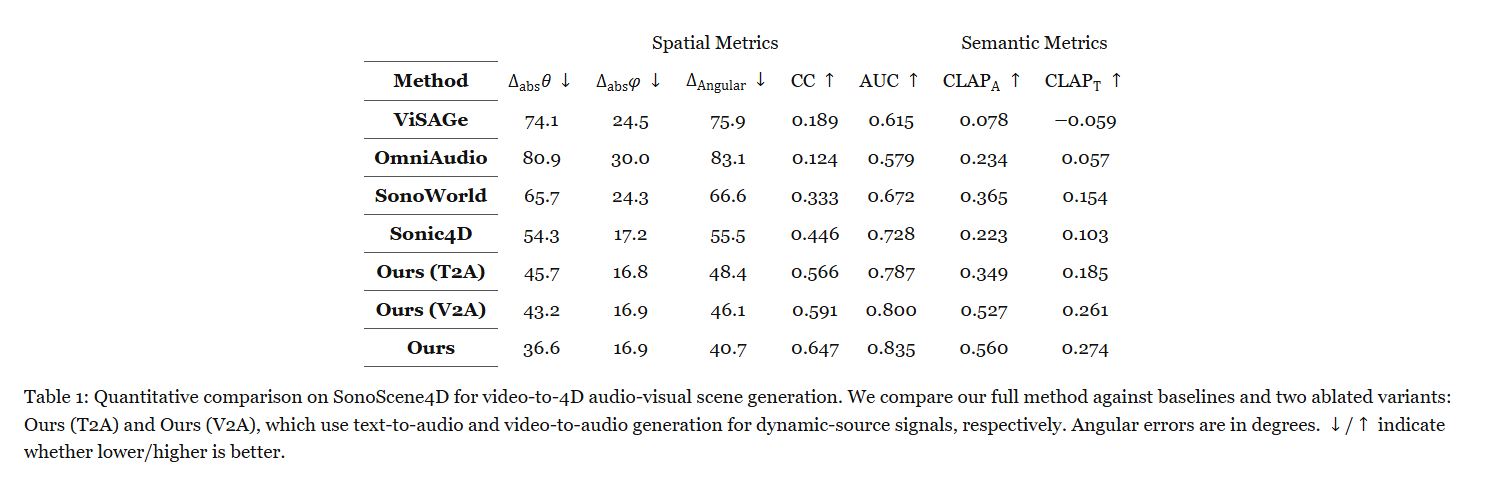
实验效果 :SonoScene4D 共 54 段、每段 8 秒,30 帧/秒 360 度视频配 48kHz 一阶 ambisonics 麦克风,麦克风与相机不在同位置。相对最接近的 Sonic4D,方向角误差 55.5→40.7 度、声场相关系数 0.446→0.647;越低/越高分别更好。50 人、9 场景听测中音频偏好 66.4%,是成对选择率。重要条件:该定量实验用采集的完整背景全景和跟踪裁出的前景视频,不能把分数都归于任意单目视频输入。
Table 1|SonoScene4D 视频转 4D 视听场景比较,含完整方法与动态声音分别用文字生成 T2A、视频生成 V2A 的消融。方位/俯仰与整体角误差以度计、越低越好;相关系数 CC、方向检出 AUC、音频及文字 CLAP 语义相似度越高越好。基线任务输入不同,完整方法优势需连同完整背景全景的评测条件理解。
批判点评 :基线有单声源、全景输入或不支持新视点等差异,作者为它们适配输入/渲染,需按任务解释。实时的是已构建场景的视听渲染,不是整个场景生成;未报告统一端到端耗时/峰值显存。真实场景的几何、分割和源分离错误会沿流程传递。项目 明确实现待开放;54 段与 9 场景听测也不足证明复杂场景全覆盖。
趋势观察
编辑条件要区分现在与未来
Partial把旧布局从终点要求中释放,EditAgent又在多轮中主动保住历史要求。该放开的背景与该保留的编辑依赖不同任务,不能统一用越像源图越好打分。
省计算与省时间分别核算
AB-Attention只在部分步稀疏化,SpecSlot将全局与局部角色拆开,AudioSelector把反复试合成搬到离线训练。三者省的计算阶段不同,完整时间账单必须单独看。
生成灵活性要报告代价和反向指标
AnyOrder-AR补图更灵活但类别生成FID变差,TokenRepel更分散但组合指令分下滑,SpecSlot的DPG与GenEval方向不同。一个亮点数字不应遮住任务间取舍。
强条件实验要和真实部署分开
MiDiff真值鼓谱与测试集选切换点,SonoWorld4D的完整全景背景,都给模型更有利条件。收益可以读,但下一步应固定参数、限制输入并做独立测试。
今日讨论
Partial 把 Wan2.2 的 BMR 从 0.599 降至 0.387,TCR 差异却不显著。如果公交车要变紫并驶出画面,应在什么条件下启用“掩码固定在终点坐标,不跟随运动”的约束?如何固定提示和种子,测量完成率、背景反转和物体离场,决定何时撤掉终点约束?
人工智能炼丹君 整理 | 2026-11-02


评论 (0)