AIGC 每日速读|2026-11-18|中山大学视频编辑注意力提速-QASK-Edit

人工智能炼丹君
2026-11-18 / 0 评论 / 0 阅读 / 正在检测是否收录...

今日 AIGC 论文速览

今日共 10 篇 · 视频编辑与重拍 2 篇 · 长视频参考与交互 4 篇 · 图像编辑 2 篇 · 生成提速与声动 2 篇

重点论文标题列表

  • QASK-Edit(中山大学):视频编辑按来源分配注意力
  • LiveView(浙大):直播视频按新机位实时重拍
  • Reference Forcing(罗切斯特大学):初始画面拉住长视频外观
  • DecoEdit(浙大):图像编辑同时控三维姿态
  • RAGE(西安交通大学):不画蒙版也能守住未改区

选读入口:做视频编辑推理加速且要保住未改区,先看 QASK-Edit;直播素材需要在线换机位,看 LiveView;长视频人物衣服与背景变样,看 Reference Forcing。要旋转物体又保留纹理,看 DecoEdit;无蒙版改图时背景漂移,看 RAGE。做跨镜对白与静默控制看 Découpage;做游戏事件驱动视频看 GameWM;人体动作变形看 ReMoVe;自回归视频降噪与缓存一起提速看 ScoutCache;台词、声线和肢体动作一起生成看 DuoFlow。


今日论文速览

1. QASK-Edit:视频编辑按来源分配注意力

QASK-Edit: Adaptive Sparse Attention Across Queries and Key Sources for Efficient Video Editing | 中山大学 | arXiv:2611.20704

关键词:视频编辑, 稀疏注意力, 扩散 Transformer, 参考视频, 推理加速, 区域保真

  • 前序问题:视频编辑模型同时读源视频、参考图、音频和文字,长 token 序列拖慢推理。统一的稀疏比例会漏掉某些查询真正需要的条件,甚至改坏原本无需编辑的区域。
  • 方法直觉:不同来源的条件、同一来源的不同查询,所需注意力预算并不相同;应按近似误差风险逐块决定精算还是近似。
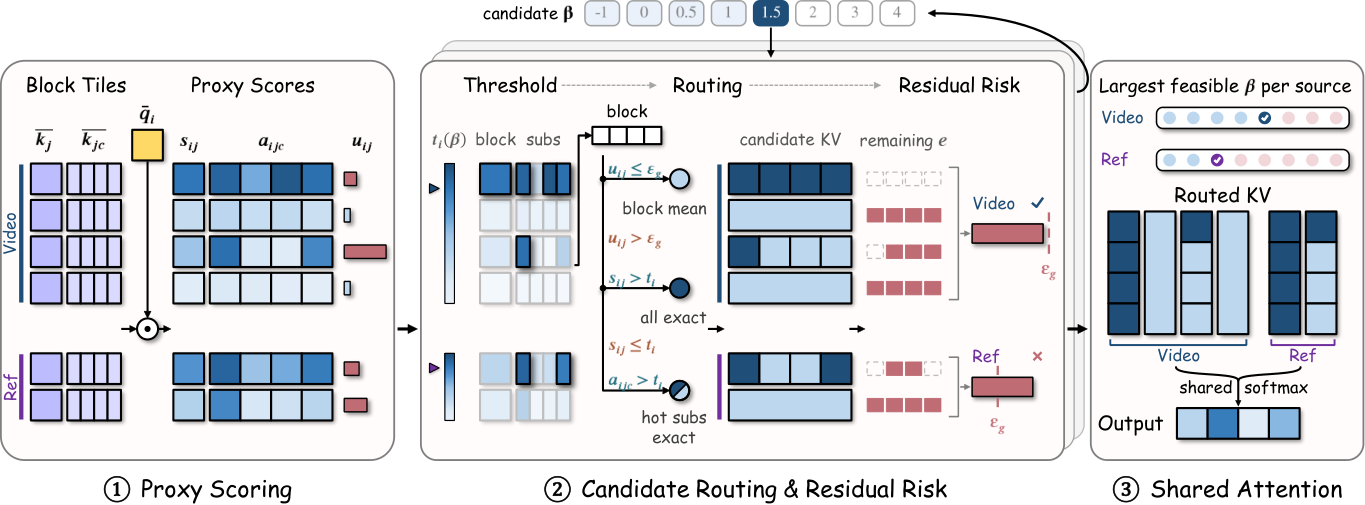
  • 本文贡献:QASK-Edit(Query-Adaptive Sparsity over Key Sources for Video Editing)是无需再训练的稀疏注意力路由:先汇总块与子块,再对每个查询 tile(计算分块)、每类 key 来源分别计算注意力质量和近似风险,在各自风险预算内选阈值,最后把来源合入同一次 softmax。
图 2:QASK-Edit 总览。先为块、子块和第二级子块生成摘要。对每个查询 tile,在各 key 来源的风险预算内,按近似计算的剩余风险分别选路由阈值;阈值决定该块精算还是近似。最后将所有来源的贡献合入一个 softmax,输出注意力结果。
Figure 2 : Overview of QASK-Edit. The process begins with the generation of summaries for blocks, sub-blocks, and second-level sub-blocks. For each query tile, we independently select a routing threshold for each key source within the risk budget, based on the residual risk introduced by approximate calculations. This routing threshold then determines whether to perform exact or approximate calculations. Finally, we aggregate the contributions of all key sources into a single softmax and output the final result.
  • 实验效果:作者在 StreamEdit、UniEdit-Flow 和 MiniMax-H3 三个视频编辑器上测试。StreamEdit 相对密集注意力端到端最高 1.46×,FiVE-Acc 为 0.5819 对 0.5826,背景 PSNR 为 23.20 对 23.42;参考条件视频生成另达最高 1.36×。FiVE-Acc 是 FiVE-Bench 的视觉语言模型编辑成功评分,越高越好;背景 PSNR 越高表示未改区越接近原视频。速度与质量均限于指定模型和任务条件。
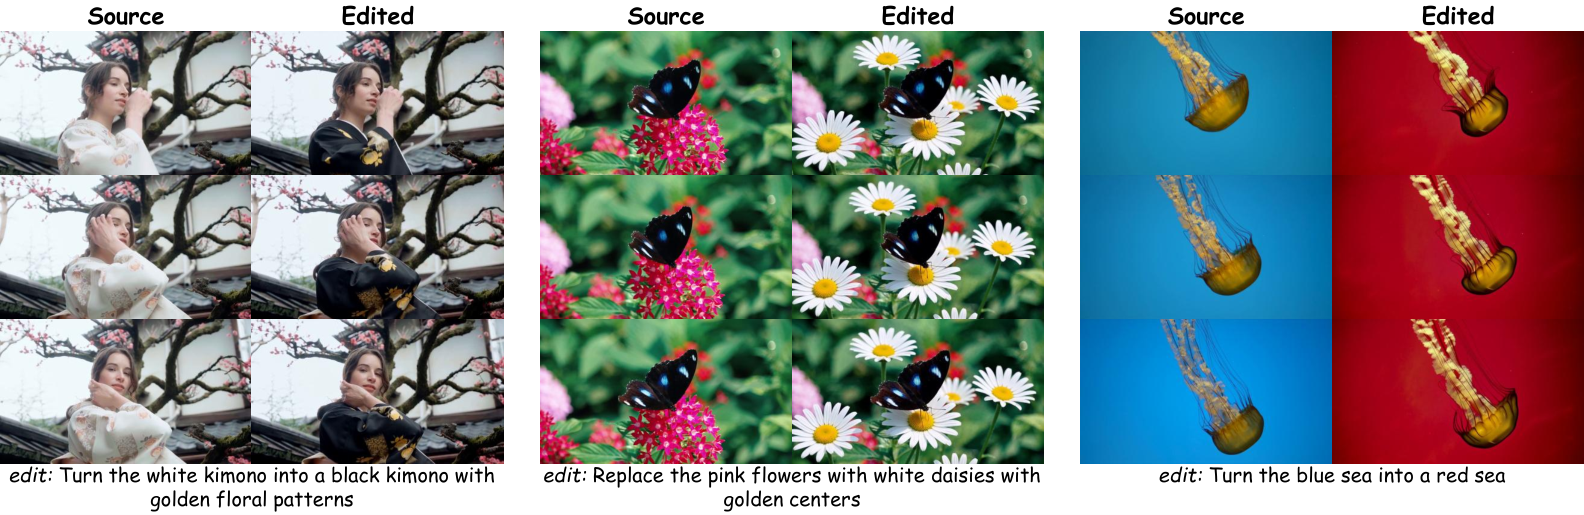
图 1:QASK-Edit 在 MiniMax-H3 上的视频编辑定性结果。每对源视频与编辑视频各展示三帧,覆盖换衣、替换物体、场景改色等任务;图示编辑结果与时间一致性。
Figure 1 : Qualitative video editing results of QASK-Edit on MiniMax-H3. Three sampled frames are shown for each source–edited video pair, covering diverse editing tasks such as clothing modification, object replacement, and scene recoloring. The results demonstrate high-quality edits with preserved temporal consistency.
  • 批判点评:“保持质量”并非所有指标持平:MiniMax-H3 的 FiVE-Acc 从密集版 0.4879 降到 0.4572。路由需要块摘要与风险预算,部署前应在自己的编辑任务上核对未改区和指令遵循。

2. LiveView:直播视频按新机位实时重拍

LiveView: Real-Time Camera-Controlled Re-filming of Streaming Videos | 浙江大学;Xmax.AI;香港科技大学(广州);香港科技大学 | arXiv:2611.20461

关键词:视频重拍, 实时生成, 相机控制, 流式视频, 师生蒸馏, 跨帧注入

  • 前序问题:直播视频想临时换机位,离线方法通常要看到整段视频,或者先做昂贵的深度几何预处理;输入流与目标视角还容易不同步。
  • 方法直觉:把刚到的源帧与对应目标潜变量交错放进同一时序,再把双向教师压成只能看过去的学生,才能在流式约束下保持跨视角对应。
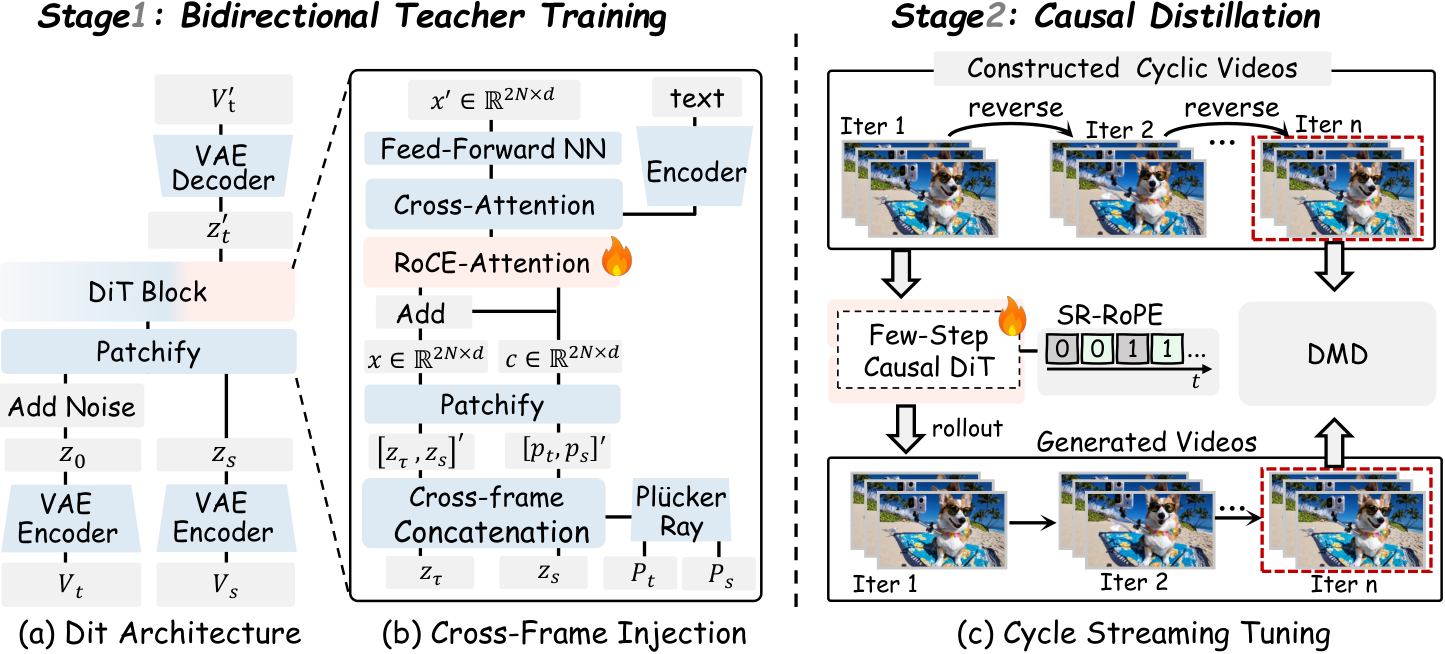
  • 本文贡献:LiveView 先训练双向相机控制视频到视频教师,再以分布匹配蒸馏成少步因果学生。Cross-Frame Injection 对齐源帧与目标帧;Shared Relative RoPE 将位置索引限制在预训练范围,Cycle Streaming Tuning 用循环相机轨迹训练长时间稳定性。RoPE 是 Transformer 表示相对位置的旋转编码。
图 2:LiveView 两阶段训练。第一阶段训练双向相机控制视频到视频教师,跨帧注入把同步的源与目标潜变量、相机射线嵌入交错输入。第二阶段用分布匹配蒸馏把教师压成少步因果 DiT,并加入循环流式训练和共享相对 RoPE,以稳定长时流式生成。
Figure 2 : Overview of the two-stage training pipeline of LiveView. Stage 1: We train a bidirectional camera-controlled V2V teacher, where Cross-Frame Injection interleaves synchronized source–target latents and camera ray embeddings. Stage 2: We distill the teacher into a few-step causal DiT via distribution matching distillation (DMD), enhanced with Cycle Streaming Tuning and Shared Relative RoPE (SR-RoPE) for stable long-horizon streaming generation.
  • 实验效果:论文短片与 177 帧长片实验表中,LiveView 都报告 10 FPS;短片相机平移误差 0.0178,对照 NeoVerse 为 0.0217。原文另展示 1053 帧流式样例。FPS 是每秒生成帧数,数值越高越快;平移误差越低越好。
图 4:LiveView 与已有方法的定性比较。上半部分为短片段,下半部分为长片段。
Figure 4 : Qualitative comparison with state-of-the-art methods. The top is the short clip and the bottom is long clip.
  • 批判点评:长片相机旋转误差为 1.603,高于 NeoVerse 的 0.998;所称实时速度应按论文的硬件、分辨率和计时范围解读。1053 帧是定性展示,不能等同任意时长的稳定保证。

3. Reference Forcing:初始画面拉住长视频外观

Reference Forcing: Long Video Generation with Region-Guided Drift Correction | 罗切斯特大学;Adobe | arXiv:2611.21559

关键词:长视频生成, 参考帧, 主体一致性, 背景一致性, KV 缓存, 漂移纠正

  • 前序问题:长视频按片段自回归生成时,人物衣服和背景会逐段漂移;仅保存或检索最近的 KV 缓存也可能反复引用已经变样的历史。
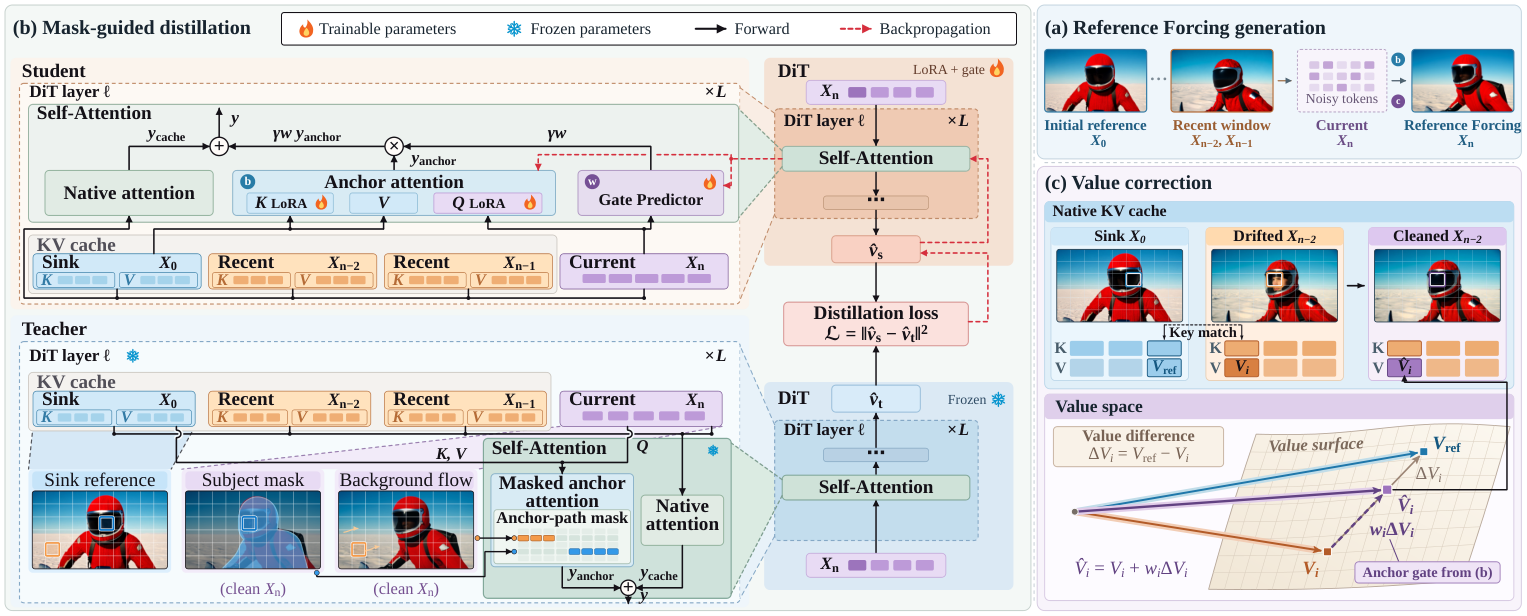
  • 方法直觉:最初几帧是尚未漂移的外观锚点。让后续区域专门对齐对应的初始区域,再把缓存中漂移的 value 拉回初始外观,可减少误差累积。
  • 本文贡献:Reference Forcing 先用现成分割器给教师建立主体与背景区域的锚定注意力,再将行为蒸馏进学生的独立注意力支路;推理时无需外部分割器。第二步 value correction 按 key 匹配,把已漂移片段的 KV 缓存 value 向初始片段校正。KV 是注意力缓存的键和值。
图 2:Reference Forcing 总览。(a) 新片段 X_n 以初始片段 X_0、最近窗口和噪声 token 为条件,并使用 (b) 锚定支路与 (c) value 校正。(b) 每层学生在冻结的原生注意力旁增加对 query/key 的 LoRA 及锚定门 w,学习匹配教师由主体掩码和背景光流约束的锚定预测。(c) 将漂移片段 X_{n−2} 的 value 向 X_0 中按 key 匹配的 value 校正,强度由 (b) 学到的门控制。
Figure 2: Overview of Reference Forcing. (a) Each chunk X n X_{n} is generated from the first chunk X 0 X_{0} , the recent window, and noisy tokens, with the anchor path of (b) and the value correction of (c). (b) In every layer, the student adds an anchor path (LoRA on the query and keys, and the anchor gate w w ) to the frozen native attention and learns to match the prediction of a teacher whose anchor path is masked by the subject mask and the background flow. (c) Value correction moves the values of the drifted chunk X n − 2 X_{n-2} toward their key-matched values in X 0 X_{0} , with the anchor gate w w learned in (b) as strength.
  • 实验效果:在 MovieGenBench、LongLive 主干的 120 秒视频中,同容量 12 潜帧缓存、同初始噪声下,主体一致性从 97.06 到 97.27,背景一致性从 96.30 到 96.56;两项均为 VBench-Long 得分,越高越好。原文还展示两小时视频样例,但表格定量比较只到 120 秒。
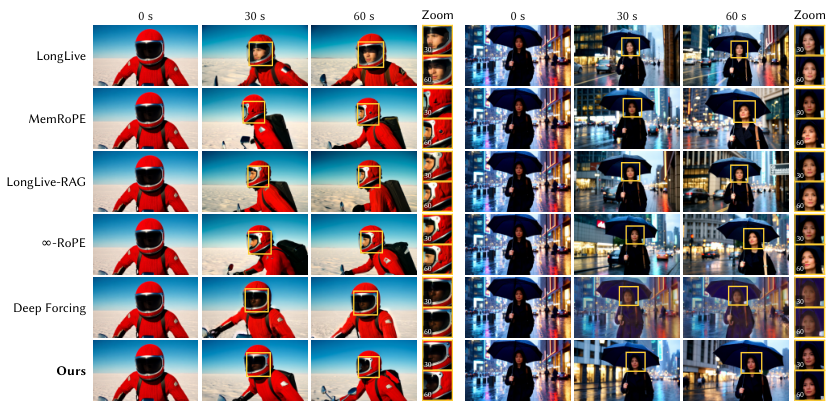
图 3:所有方法使用同一提示词和初始片段的定性比较;方框标出主体变化,并在放大列显示。左例中基线把宇航员的黑色面罩变透明,Reference Forcing 保持黑色;右例中基线使女性面部变浅、左肩带变宽变亮,Reference Forcing 保持两处外观。
Figure 3: Qualitative comparison. All methods share the prompt and first chunk; boxes mark subject changes, magnified in the zoom column. Left: the dark visor of the astronaut turns transparent in baselines but stays dark in Reference Forcing. Right: in baselines, the face of the woman becomes lighter and the strap on her left shoulder wider and brighter, whereas Reference Forcing keeps both.
  • 批判点评:同一 120 秒表中动态性从 46.45 降到 44.69,保外观可能压住变化;另需训练锚定支路并增加缓存校正。两小时示例不能外推为两小时统计优势。

4. DecoEdit:图像编辑同时控三维姿态

DecoEdit: Beyond Flat Control for 3D-Aware Unified Image Editing | 浙江大学;阿里巴巴集团;伊利诺伊大学厄巴纳-香槟分校 | arXiv:2611.19121

关键词:图像编辑, 三维姿态, 身份保真, 多条件控制, 数据集, 评测

  • 前序问题:文字、框和蒙版能指定二维位置,却难让物体旋转到目标三维姿态、同时保住商标与纹理;单纯套用几何渲染又容易抹掉外观。
  • 方法直觉:目标几何与原物体细节应走两条条件路径:一条负责朝向、尺度和位置,另一条记住原图的高频身份线索。
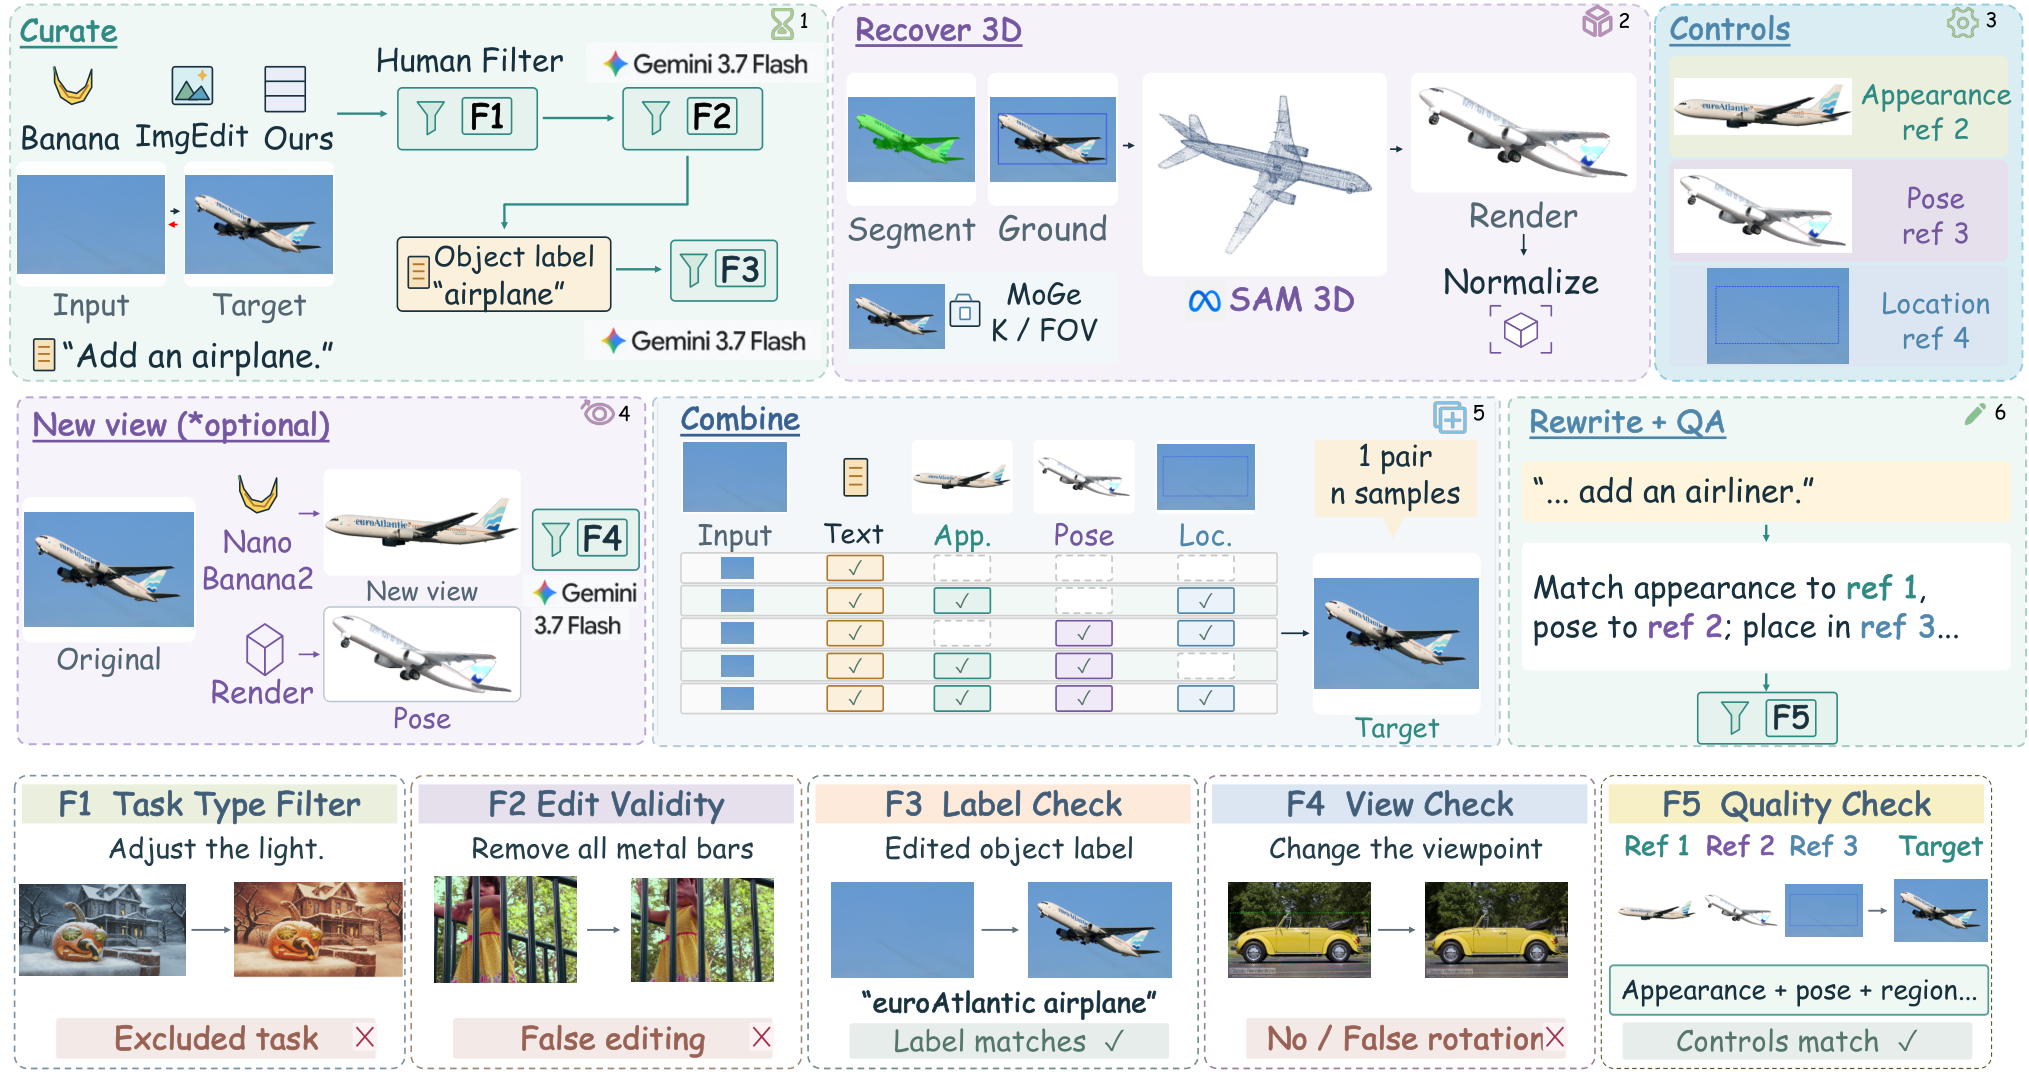
  • 本文贡献:DecoEdit 把一维文字、二维空间与三维控制统一输入双流 Mixture-of-Transformers;用 SAM-3D 的标准化结构渲染锚定目标姿态,另将未损坏的源物体图送入保细节路径。作者还构建 160 万样本的 DecoDataset 和多任务 DecoBench,其中约 65 万为三维训练样本。
图 1:DecoEdit 的数据构建流程,经过五道筛选取得高质量样本。
Figure 1: Data construction pipeline. It involves five filters to select high-quality samples.
  • 实验效果:DecoBench 的 50 个随机案例由 4 名评审排序,归一化人工均分 DecoEdit 为 70.25、Seedream 5.0 为 66.31;该分数越高表示相对排序越好。论文称三维方向控制和实例纹理保留同时改善。
图 3:DecoEdit 与已有先进方法在三维感知编辑任务上的定性比较。
Figure 3: Qualitative comparison with existing state-of-the-art method on 3D-aware tasks.
  • 批判点评:人工排序仅 50 个案例且来自作者基准;SAM-3D 结构、数据构建和双条件训练都有额外成本。归一化排名不能当作编辑成功率,也不能直接外推到所有开放域图片。

5. RAGE:不画蒙版也能守住未改区

RAGE: Residual-Adaptive Gating for Flow-Based Image Editing | 西安交通大学 | arXiv:2611.21177

关键词:图像编辑, FlowEdit, 背景保持, 残差门控, 无蒙版, 免训练

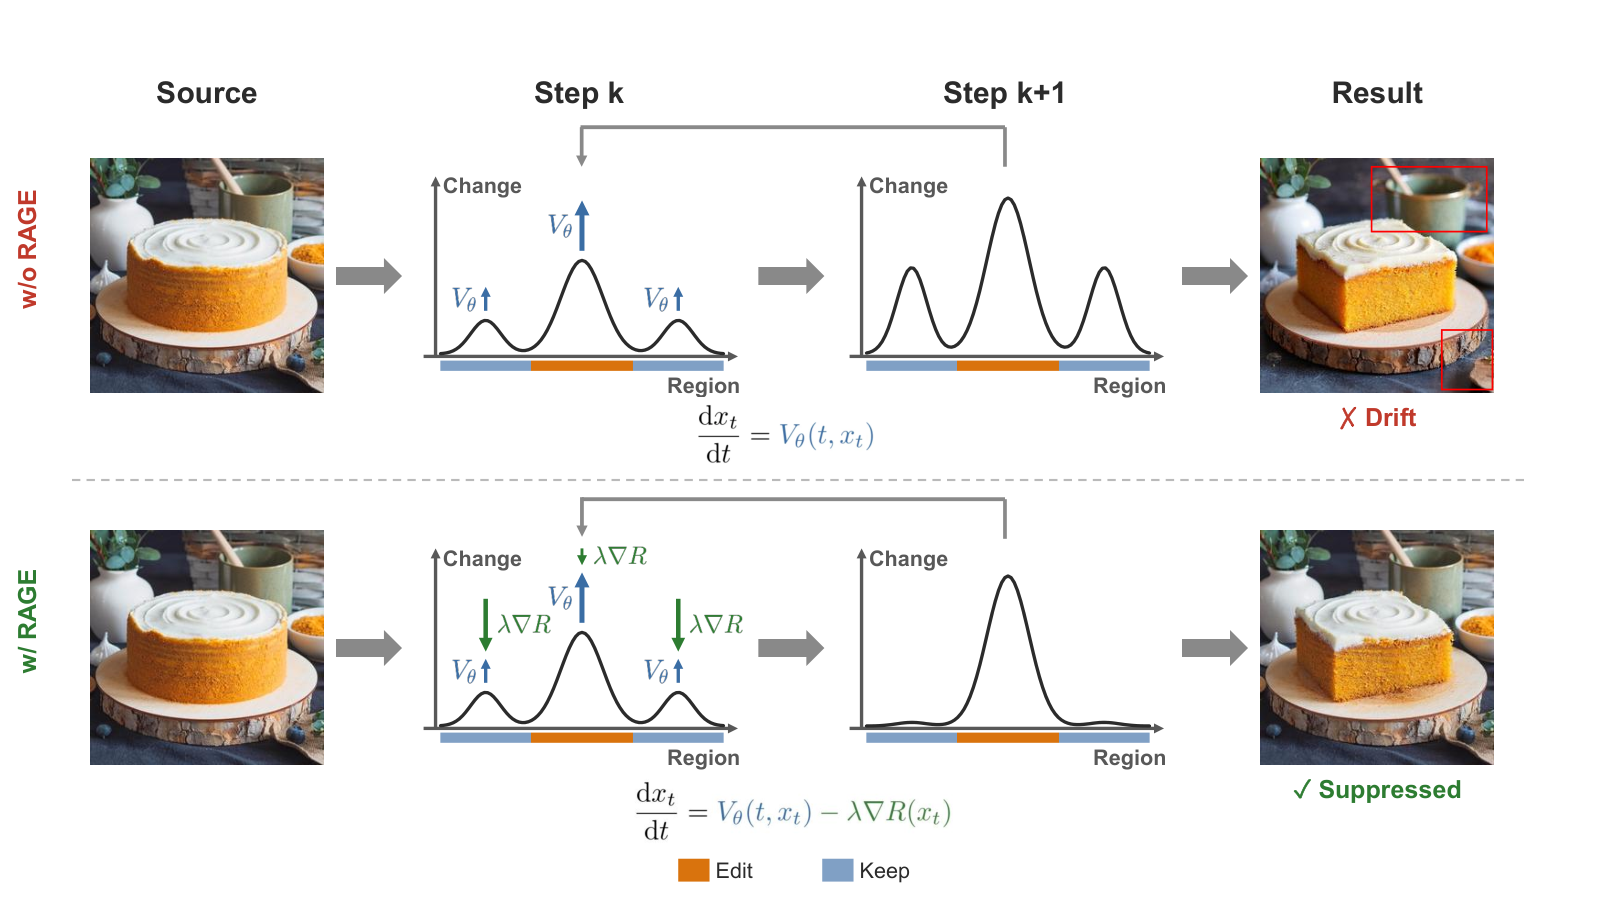
  • 前序问题:基于流的图像编辑把源图推向目标指令,但速度场不区分应改与应留区域,细小误差会在每步积累成背景漂移。
  • 方法直觉:局部改动残差小的地方更可能应该保留,大改动处则应让编辑通过;门控的回拉强度随残差增大而指数下降。
  • 本文贡献:RAGE(Residual-Adaptive Gating for Flow-Based Image Editing)在每次采样后做一次轻量门控插值,把小残差潜变量拉回源图,同时放行大的语义编辑。它叠加在 FlowEdit 类编辑器上,不需估计蒙版、重训模型或改架构。
图 1:上方无 RAGE 时,基础编辑速度 Vθ 在未编辑区域造成意外漂移,并随采样步累积。下方加入 RAGE 后,源图感知的校正 λ∇R 有选择地抑制小偏移,同时放行大幅且有意义的编辑。
Figure 1: Without RAGE (top), the base editing velocity V θ V_{\theta} causes unintended drift in non-editing regions that accumulates over timesteps. With RAGE (bottom), the source-aware correction λ ∇ R \lambda\nabla R selectively suppresses small deviations while leaving large, meaningful edits unimpeded.
  • 实验效果:PIE-Bench 上,Stable Diffusion 3 主干的背景 PSNR 从 FlowEdit 的 22.18 提至 29.84;PSNR 衡量未编辑区与原图相似程度,越高越接近。作者按七项指标等权平均排名,在 17 种方法中 RAGE-SD3 排名 2.14、FlowEdit-SD3 为 8.57。
图 2:PIE-Bench 上基于 FLUX.1-dev 的定性比较。从左到右依次为源图、DNAEdit-FLUX、FireFlow-FLUX、FlowEdit-FLUX 与本文 FLUX 版本;各例下方给出源与目标提示词并标出改动概念,红框标出编辑区以外的意外变化。各行覆盖形状修改、物体替换、颜色编辑、物体增加和表情编辑。
Figure 2: Qualitative comparison on PIE-Bench with FLUX.1-dev. From left to right: Source, DNAEdit-FLUX, FireFlow-FLUX, FlowEdit-FLUX, and Ours (FLUX). Source and target prompts appear below each example, with the changed concepts highlighted. Red boxes mark unintended changes outside the edited region. The selected rows cover shape modification, object replacement, color editing, object addition, and expression editing.
  • 批判点评:排名混合不同主干与指标,不能解释成所有编辑更好。该规则默认大残差代表合理修改;若大幅错误恰落在背景,门控可能放行。采样每步仍要多一次插值。

6. Découpage:对白跨镜头声音不串戏

Découpage: Directorial Audio-Visual Control for Long Multi-Shot Video Generation | 香港科技大学;蚂蚁集团;浙江大学 | arXiv:2611.18866

关键词:音视频生成, 多镜头, 剧本控制, 对白时序, 口型同步, J-cut

  • 前序问题:多镜头生成中,画面切到听者时说话可以继续,留白时也应安静;现有联合生成容易把声音和切镜绑死,让听者张嘴或在静默段凭空说话。
  • 方法直觉:视觉镜头和声学对白要有独立的时间表;人物是否出镜、是否正在说话,再决定嘴部运动是否受语音驱动。
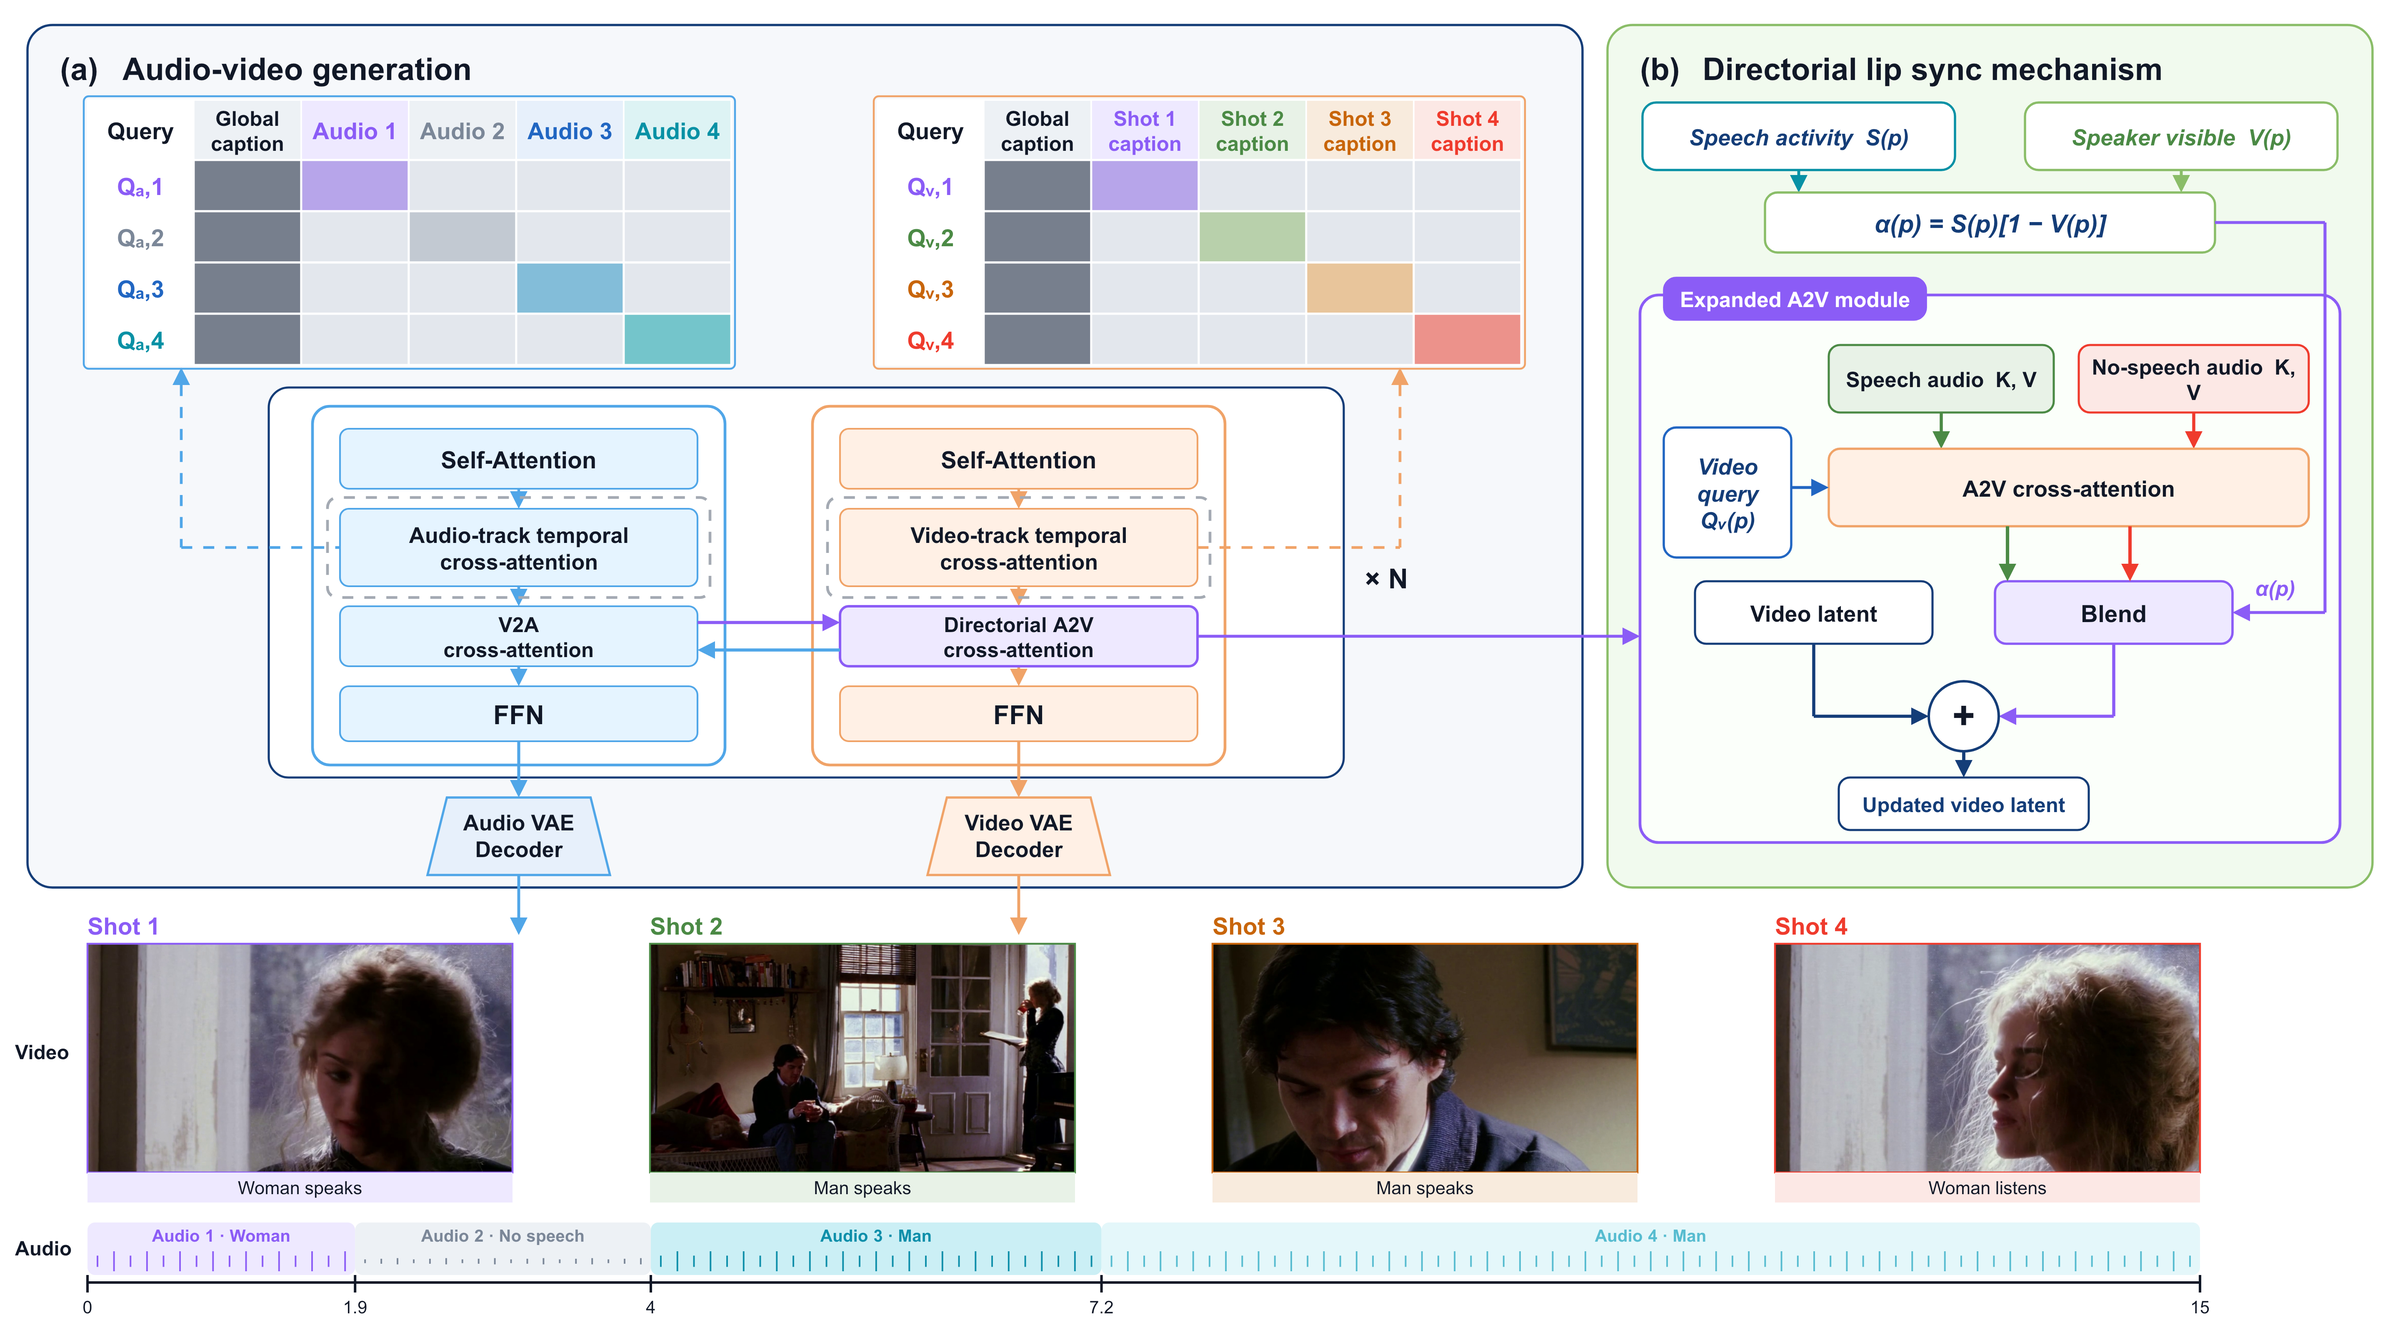
  • 本文贡献:Découpage 基于 LTX-2.3 联合音视频扩散模型,让视觉轨与声学轨采用双时间表交叉注意力;导演式唇同步根据说话者可见性混合说话与无声的残差。J-cut 指声音先于新画面进入,L-cut 指切镜后上一场声音继续。
图 3:Découpage 总览。(a) 双轨时间交叉注意力沿独立视觉和声音时间表引导联合音视频生成,让对白跨过镜头切点继续。(b) 导演式唇同步机制按说话者可见性混合有声与无声的音频驱动视频残差,以压制听者不该出现的嘴部动作。
Figure 3: Overview of Découpage . (a) Dual-track temporal cross-attention guides joint audio-video generation along independent visual and acoustic schedules, allowing dialogue to continue across shot boundaries. (b) The directorial lip-sync mechanism blends speech and no-speech A2V residuals based on speaker visibility to suppress unintended listener articulation.
  • 实验效果:论文用各 200 条、分别长 15 秒和 60 秒的多角色剧本评测,并在五镜头案例中展示跨镜对白、听者静默和指定留白。对照包括 LTX-2.3、MiniMax-H3 与 MOVA;结论限定为剧本给定的镜头与对白时间控制。
图 4:五镜头剧本的定性比较。列为镜头提示和目标对白时间表,行为各模型的关键帧及合成音频波形;蓝色与橙色标出两名角色说话时窗,灰色表示静默。Découpage 遵循跨镜头结构与转场、让第 4 镜的听者保持静默,并正确合成第 5 镜的静默和打火机闪光,使音画时序更贴近剧本。
Figure 4: Qualitative comparison on a five-shot screenplay. Columns present shot prompts and the target dialogue schedule; rows show keyframes and synthesized audio waveforms across models. Blue/orange highlights mark each character’s speech windows, and gray denotes silence. Découpage adheres to the multi-shot structure across transitions, respects the Shot-4 listener, and correctly synthesizes the Shot-5 slience and lighter flick, achieving superior audio-visual alignment.
  • 批判点评:需约 3 万条清洗对齐音视频序列进行模型适配,原文使用 32 张 H20 做 LoRA 训练;自动语音识别与镜头检测评分有阈值误差。指定时序成功不等于任意剧本的叙事质量都好。

7. GameWM:让游戏引擎定输赢模型画过程

GameWM: Toward Next-Generation Video Games with Interaction-Centric World Models | 腾讯光子工作室群 | arXiv:2611.19247

关键词:交互视频生成, 游戏世界模型, 引擎状态, 角色参考, 实时因果生成, 技能表现

  • 前序问题:把生成视频模型当成给游戏引擎粗画面换皮的渲染器,会浪费它生成不同交互细节的能力;若把规则也交给视频模型,又难保证胜负和事件时序准确。
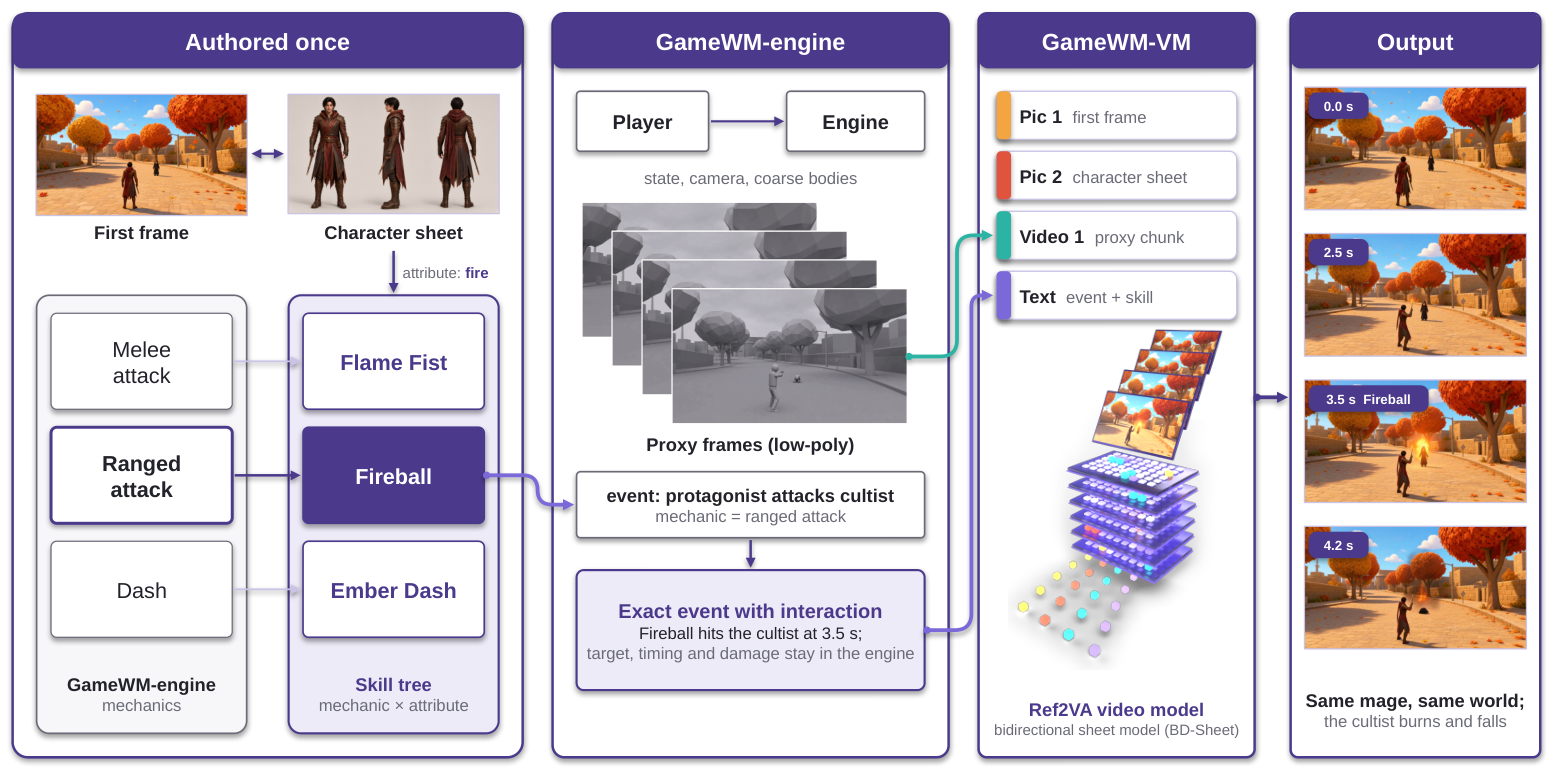
  • 方法直觉:游戏引擎锁定规则、状态、镜头与事件结果;视频模型接收低模代理画面、首帧、角色图和技能描述,负责生成外观与动作细节。
  • 本文贡献:GameWM 把代理视频和角色设定通过参考接口送入视频模型,设计以交互事件为中心的数据引擎,并给 5B、14B、33B 主干训练四步因果学生。同一射击或近战规则可呈现为不同角色技能,但命中与倒地时点仍由引擎约束。
图 3:从创作资产到游玩。左侧一次性制作首帧、角色图和将角色属性“火”与游戏机制结合的技能树;中间运行时 GameWM 引擎渲染低多边形代理帧并计算事件结果,这里远程攻击成为火球;右侧四种输入填入 GameWM 视频模型的参考接口,输出列展示 BD-Sheet 生成的画面。
Figure 3: From authored assets to play. Left: authored once, a first frame and a character sheet, and a skill tree that fuses an attribute of the sheet (fire) with each mechanic. Middle: at run time the GameWM-engine renders low-poly proxy frames and resolves the event, here a ranged attack that becomes Fireball. Right: the four inputs fill the slots of the GameWM-VM’s reference interface (H3’s Ref2VA, Section 6 ); the output column shows frames of a BD-Sheet sample generated from them.
  • 实验效果:作者展示 33B 双向模型与四步因果版本的定性案例:同一代理事件对应不同角色与技能表现,样本为 124 帧、24 FPS、1280×704。论文明确因接口和输入不可对齐,没有给跨系统性能排名。
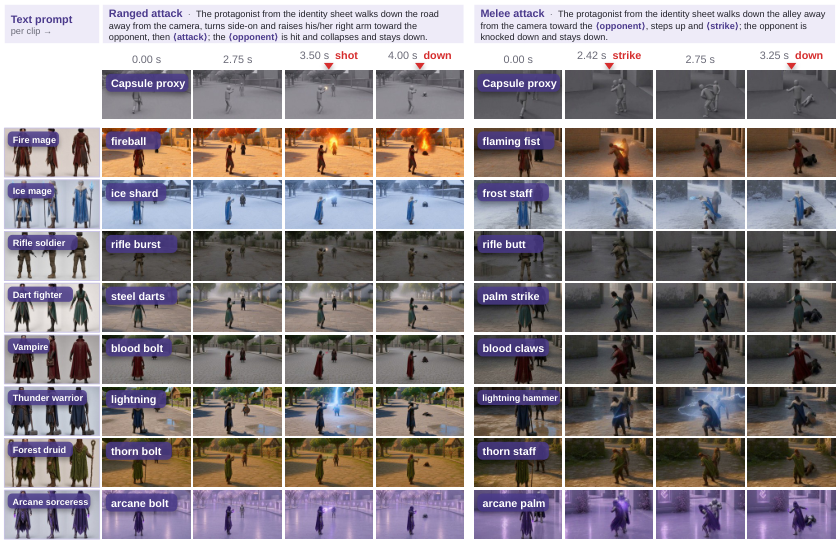
图 8:同一机制的多种表现,左四列为射击,右四列为近战;每段视频保持同一胶囊代理和同一文字模板,列上方方框标注。每行是一名角色,最左为角色图及名称,随后是各场景首帧及相应机制的技能标签。样例使用 BD-Sheet、30 步;红色刻度标出从代理读出的开火、打击和倒地时点;远程攻击的 DMD-Sheet 版本见原文图 13。
Figure 8: One mechanic, many realizations: ranged and melee. The left four columns are the shooting clip and the right four a melee clip; each clip keeps one capsule proxy and one caption template (the box above its columns). Each row is one character: its sheet and name (far left), a first frame of that character in each scene, and its skill for each mechanic (the tag on the first frame of each clip). BD-Sheet, 30 steps; red ticks mark the shot, the strike, and the fall as read off the proxies. The DMD-Sheet version of the ranged clip is in Figure 13 .
  • 批判点评:“实时”是系统设计目标,不能把示例的 24 FPS 源片规格当作实际推理吞吐。案例依赖游戏引擎代理、角色图和事件日志,本文并未证明通用开放世界规则能由模型自行维持。

8. ReMoVe:把粗视频动作修回人体结构

ReMoVe: Refining a Video Model's Own Motion for Coherent Human Video Generation | 上海交通大学;北京科技大学;蒙纳士大学;马来亚大学;昆士兰大学;香港城市大学 | arXiv:2611.18666

关键词:人体视频生成, 动作修复, 三维网格, 深度条件, 身份一致, 相机控制

  • 前序问题:人像视频越长、动作越大,四肢结构和面部身份越容易漂;强行套外部动作模板又会抹去基础模型原本可用的动作。
  • 方法直觉:把粗生成视频当动作草案,先恢复并细化人体运动,再用网格和深度两种几何条件重新生成,可同时守住人体和场景。
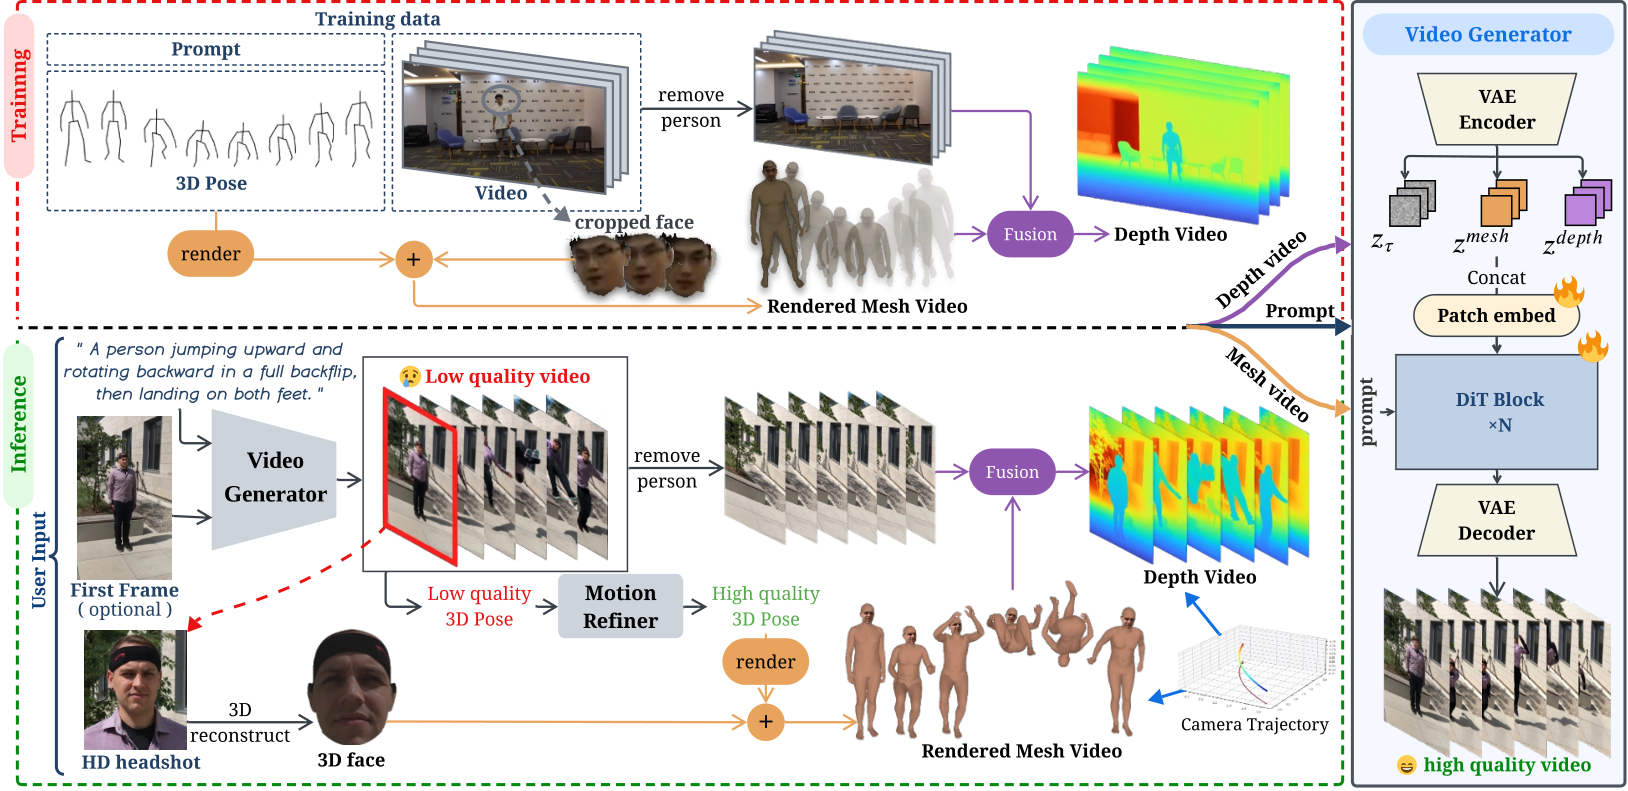
  • 本文贡献:ReMoVe 从基础视频及首帧头像恢复动作并修正,渲染三维人体网格、迁移脸部外观,并由相机轨迹推导深度;将网格与深度视频编码后连同文字输入 DiT 重生成。DiT 是以 Transformer 为骨干的扩散生成器。
图 2:ReMoVe 总览。左侧为训练时(上)与推理时(下)的网格和深度条件构建;右侧为生成链路,将网格与深度视频经 VAE 编码,和带噪视频潜变量拼接,连同文字提示送入 DiT,生成最终高质量视频。
Figure 2: Overview of ReMoVe. On the left is the construction of mesh and depth conditions during training (top) and inference (bottom). On the right is the generation pipeline, where the mesh and depth videos are encoded by the VAE, concatenated with the noisy video latent, and fed into the DiT together with the text prompt to produce the final high-quality video.
  • 实验效果:在 Wan-TI2V-5B 人体视频设置中,网格加深度版的人体解剖指标 HA 为 92.66,对基础 Wan 的 90.88;视频分布距离 FVD-16 为 69.87,对基础 Wan 的 91.41。HA 越高越好,FVD-16 越低表示生成分布更接近参考。
图 4:人体视频生成的定性比较。ReMoVe 保留 Wan 原有的动作先验,同时提升人体结构稳定性、外观一致性和时间连贯性;图中展示在复杂人体动作上与已有方法的比较。
Figure 4: Qualitative comparison of human video generation. ReMoVe preserves the original motion prior of Wan while substantially improving human structural stability, appearance consistency, and temporal coherence, outperforming prior methods on challenging human motions.
  • 批判点评:优势依赖动作恢复、三维渲染和二次视频生成,计算链较长;文中也列出 GT-motion(真实动作输入)条件组,不能与从粗视频自动恢复动作的组混作同一条件。

9. ScoutCache:视频降噪与缓存一起提速

ScoutCache: Efficient Few-Step Autoregressive Video Diffusion via Conditional Readout and Selective Caching | 香港科技大学(广州);广东工业大学;香港科技大学 | arXiv:2611.21038

关键词:长视频生成, 少步扩散, KV 缓存, 条件读出, 稀疏缓存, 推理加速

  • 前序问题:少步自回归视频扩散仍要反复降噪、读取历史 KV,并给新片段构建缓存;只省其中一步,其他步骤会成为瓶颈。
  • 方法直觉:浅层特征变化可估计部分降噪更新;历史依赖按层和注意力头分配,缓存位置则兼顾内容与空间覆盖。三处一起省算才可能缩短整段视频。
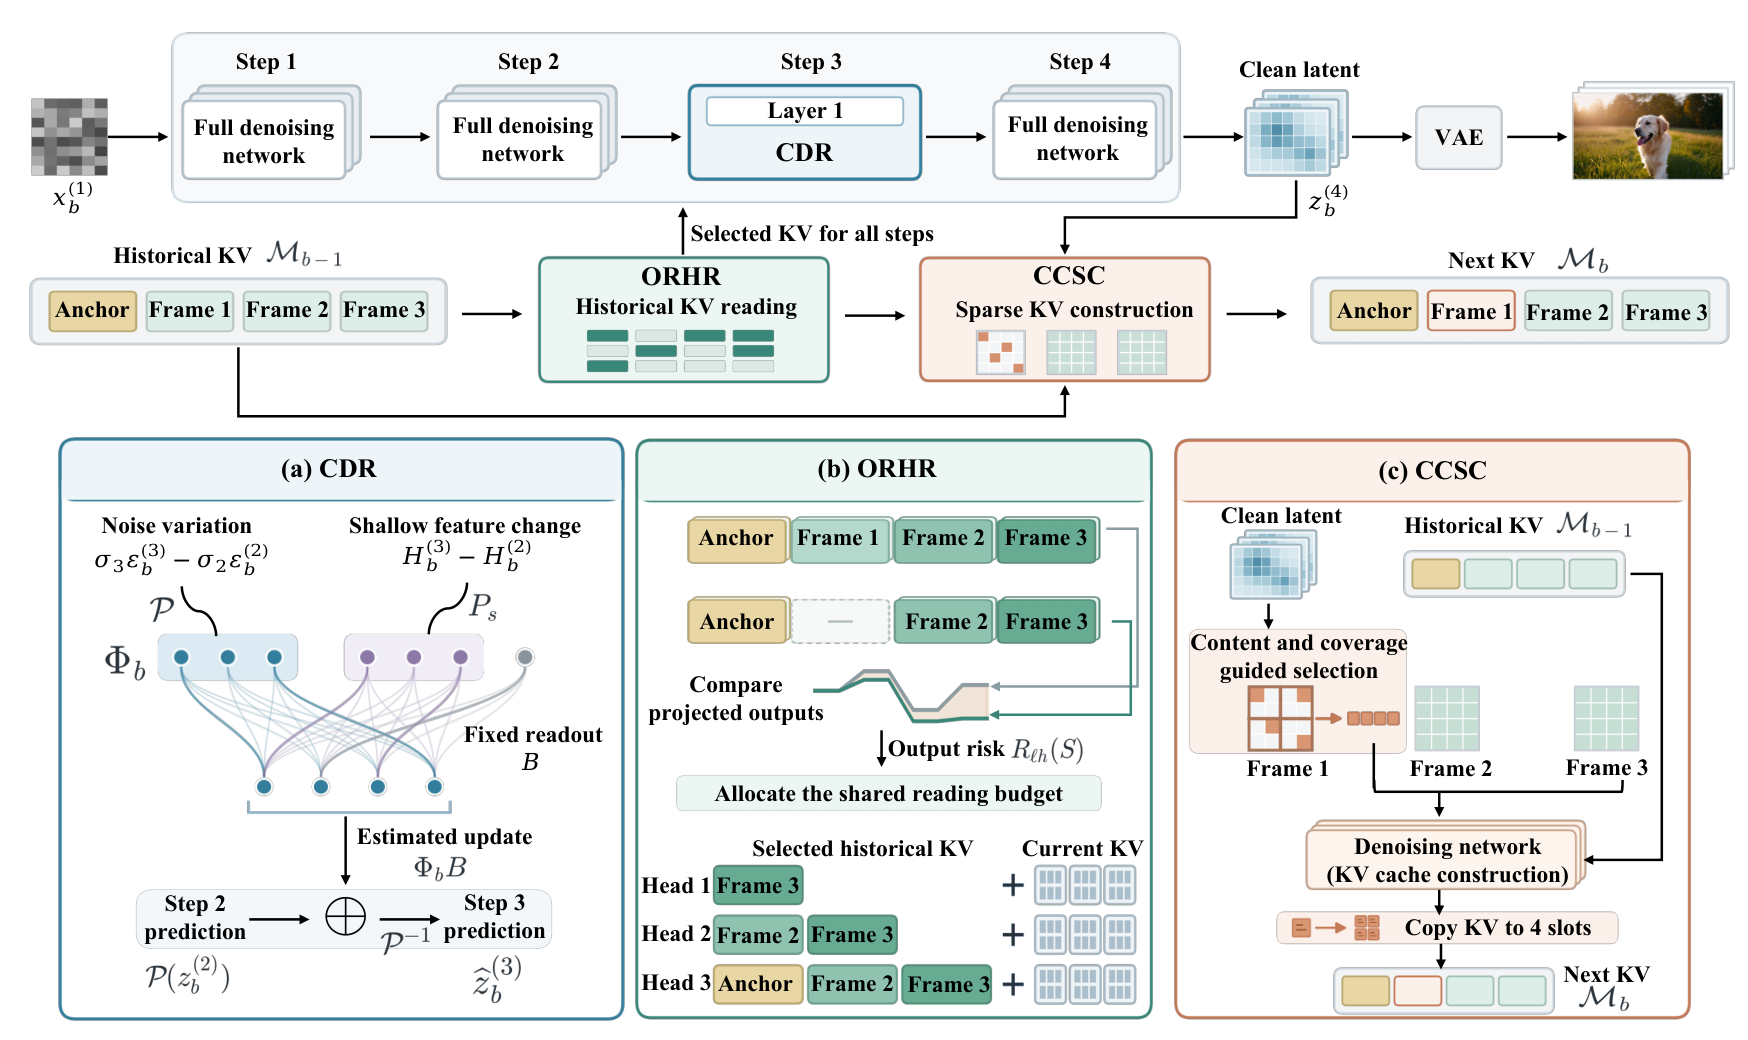
  • 本文贡献:ScoutCache 无需修改预训练权重,组合 CDR 条件降噪读出、ORHR 按注意力输出扰动风险分配历史读取、CCSC 按内容和空间覆盖选择缓存 token;三者分别减少降噪、读缓存与建缓存成本。
图 2:上方是集成降噪加速与 KV 缓存优化的整体推理链路;下方是三个模块。(a) CDR 根据噪声变化和浅层特征变化估计干净潜变量的更新。(b) ORHR 按注意力输出扰动分配历史 KV 读取预算。(c) CCSC 根据内容与空间覆盖选择 token,以降低缓存构建成本。
Figure 2 : The top shows the overall inference pipeline, integrating denoising acceleration and KV cache optimization. The bottom illustrates three components. (a) CDR estimates clean latent updates from noise variations and shallow feature changes. (b) ORHR allocates historical KV reading budgets based on attention output perturbations. (c) CCSC reduces cache construction costs through content and coverage guided spatial token selection.
  • 实验效果:在作者的 Self-Forcing 与 LongLive 设置、VBench 和 MovieGen 评估下,报告最高分别 2.28× 与 1.86× 的加速,同时生成质量指标总体改善。这是各自主干与测试时长上的最高值,不是两个模型的统一平均速度。
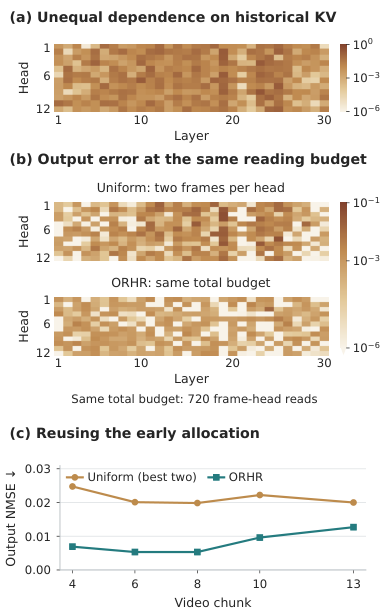
图 7:ORHR 机制分析。(a) Transformer 不同层与注意力头对历史 KV 的依赖不均匀。(b) 在相同 720 次历史帧访问预算下,比较均匀读取与 ORHR 的注意力输出误差。(c) 用早期片段校准的分配继续处理后续视频片段,输出归一化均方误差 NMSE 持续更低,且无需重新校准。
Figure 7 : Mechanism analysis of ORHR. (a) Unequal historical KV dependence across Transformer layers and heads. (b) Attention output errors under uniform reading and ORHR with the same budget of 720 frame accesses. (c) Output NMSE across subsequent video chunks using the early calibrated allocation, demonstrating consistently lower errors without recalibration.
  • 批判点评:三处都有预算与选择规则,收益取决于主干的层间历史依赖、视频长度和缓存布局;应按端到端时间、画质与显存同时核对,不把单模块加速当整条流水线收益。

10. DuoFlow:说话声音和肢体动作同步生成

DuoFlow: Towards Synchronized Speech and Motion Generation with Fine-Grained Control | 清华大学;腾讯 | arXiv:2611.21530

关键词:语音生成, 人体动作生成, 多模态同步, 声线控制, 分层动作, 流匹配

  • 前序问题:只靠台词推断说话风格和肢体动作,难指定挥手顺序、身体部位与声线;串联两个模型又可能出现口播和动作错位。
  • 方法直觉:语音和动作在同一秒级时间坐标、同一噪声级别下联合去噪,并分别接入声线与动作条件,才能保持可控且同步。
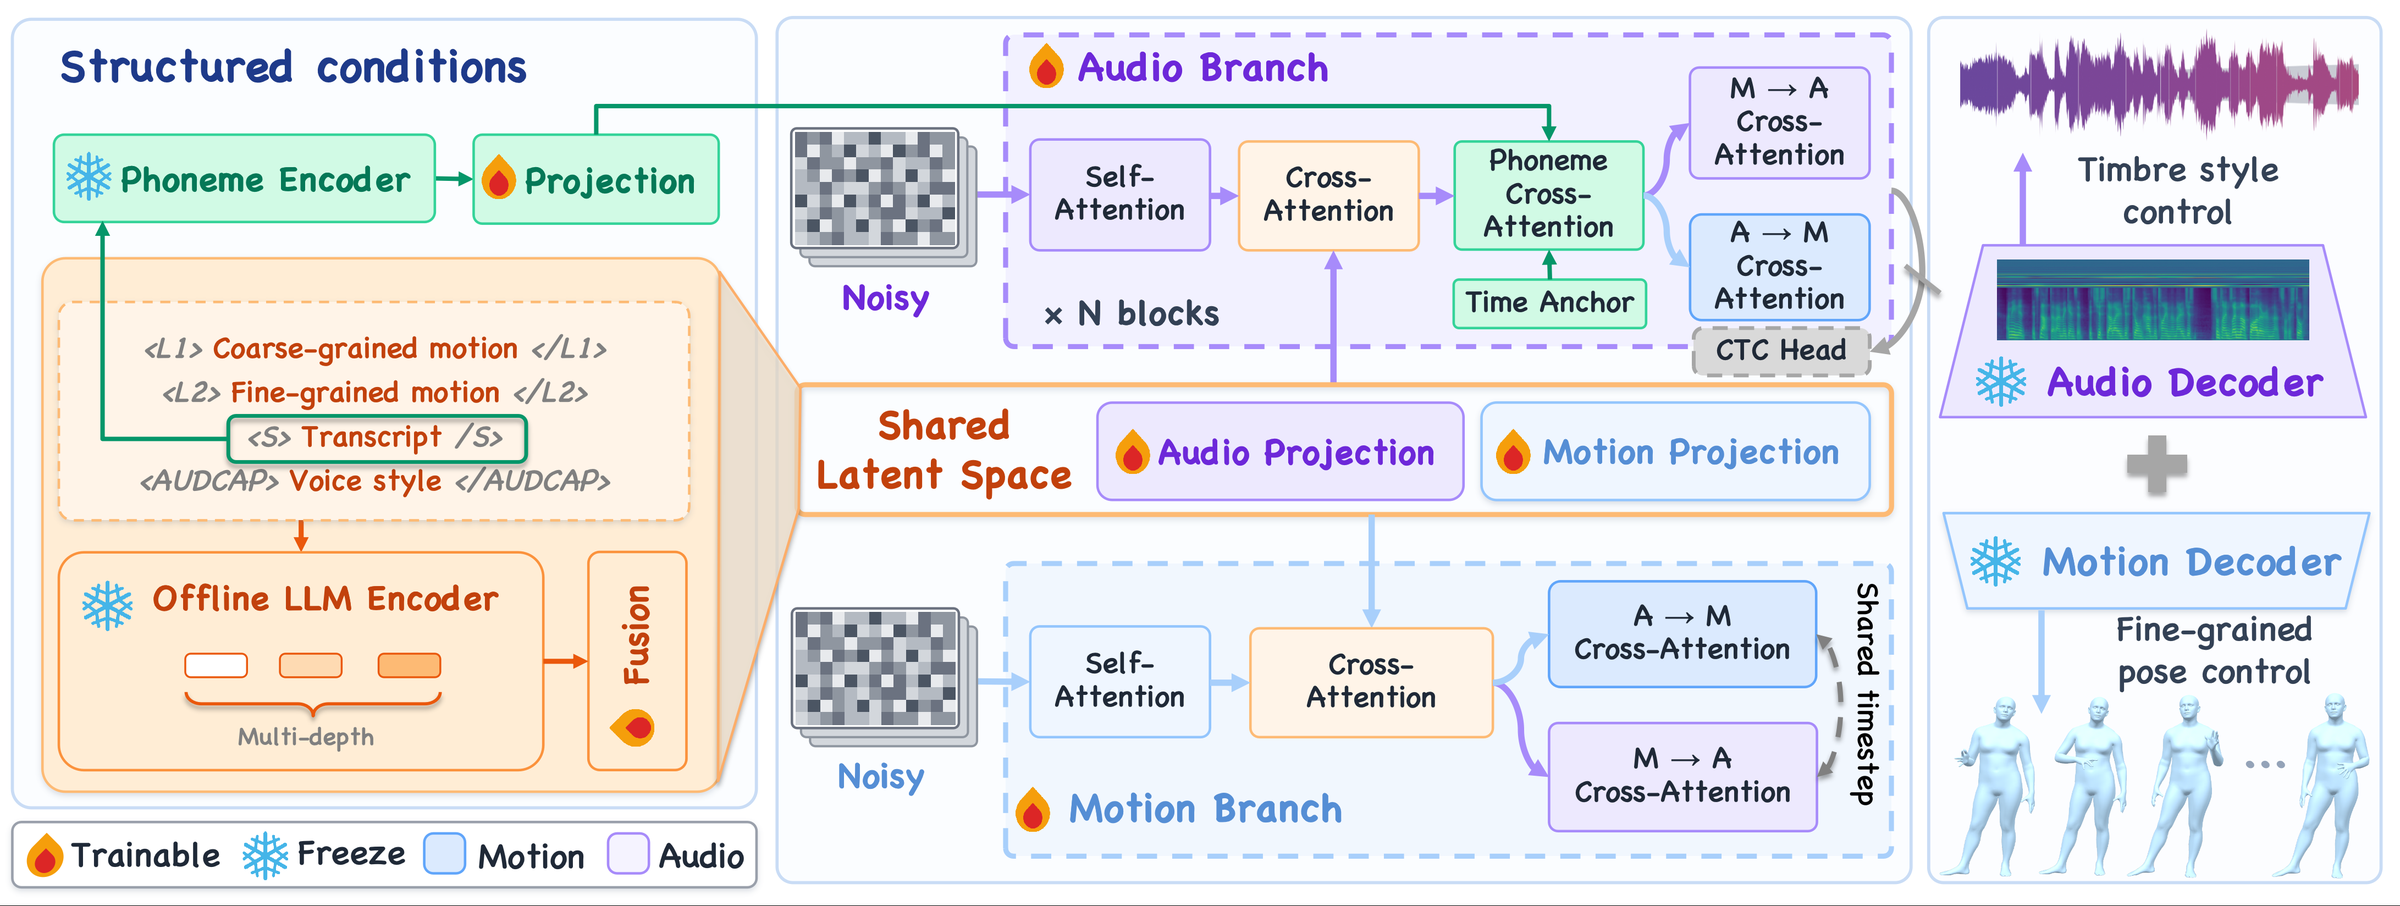
  • 本文贡献:DuoFlow 以双流潜空间 flow Transformer 同时生成语音和 SMPL-X(含手、脸的参数化人体)动作;跨流注意力交换信息,独立连接器注入声音与两级动作指令,音素顺序锚点和 CTC(连接时序分类)训练约束语音时间。MotionSpeech 基准含台词、声线描述与分层动作条件。
图 3:DuoFlow 总览。选定的动作指令、台词和声音描述组成双潜流共享的语义条件;冻结的音素编码器提供独立语音条件。归一化音素进度锚点维持 token 顺序,多层音素 CTC 头仅在训练时监督音频状态。每个双流块结合自注意力、条件交叉注意力、音素交叉注意力和双向声动信息交换;冻结解码器将去噪潜变量还原成波形与动作序列。
Figure 3 : Overview of DuoFlow. The selected motion instruction, transcript, and voice description form a shared semantic condition for two coupled latent streams. A frozen phoneme encoder supplies a separate audio condition. Its normalized phoneme-progress anchor preserves token order, and phoneme-CTC heads supervise the audio states at multiple depths during training only. Each dual-stream block combines self-attention, condition cross-attention, phoneme cross-attention, and bidirectional speech–motion exchange. Frozen decoders reconstruct the denoised latents as a waveform and a motion sequence.
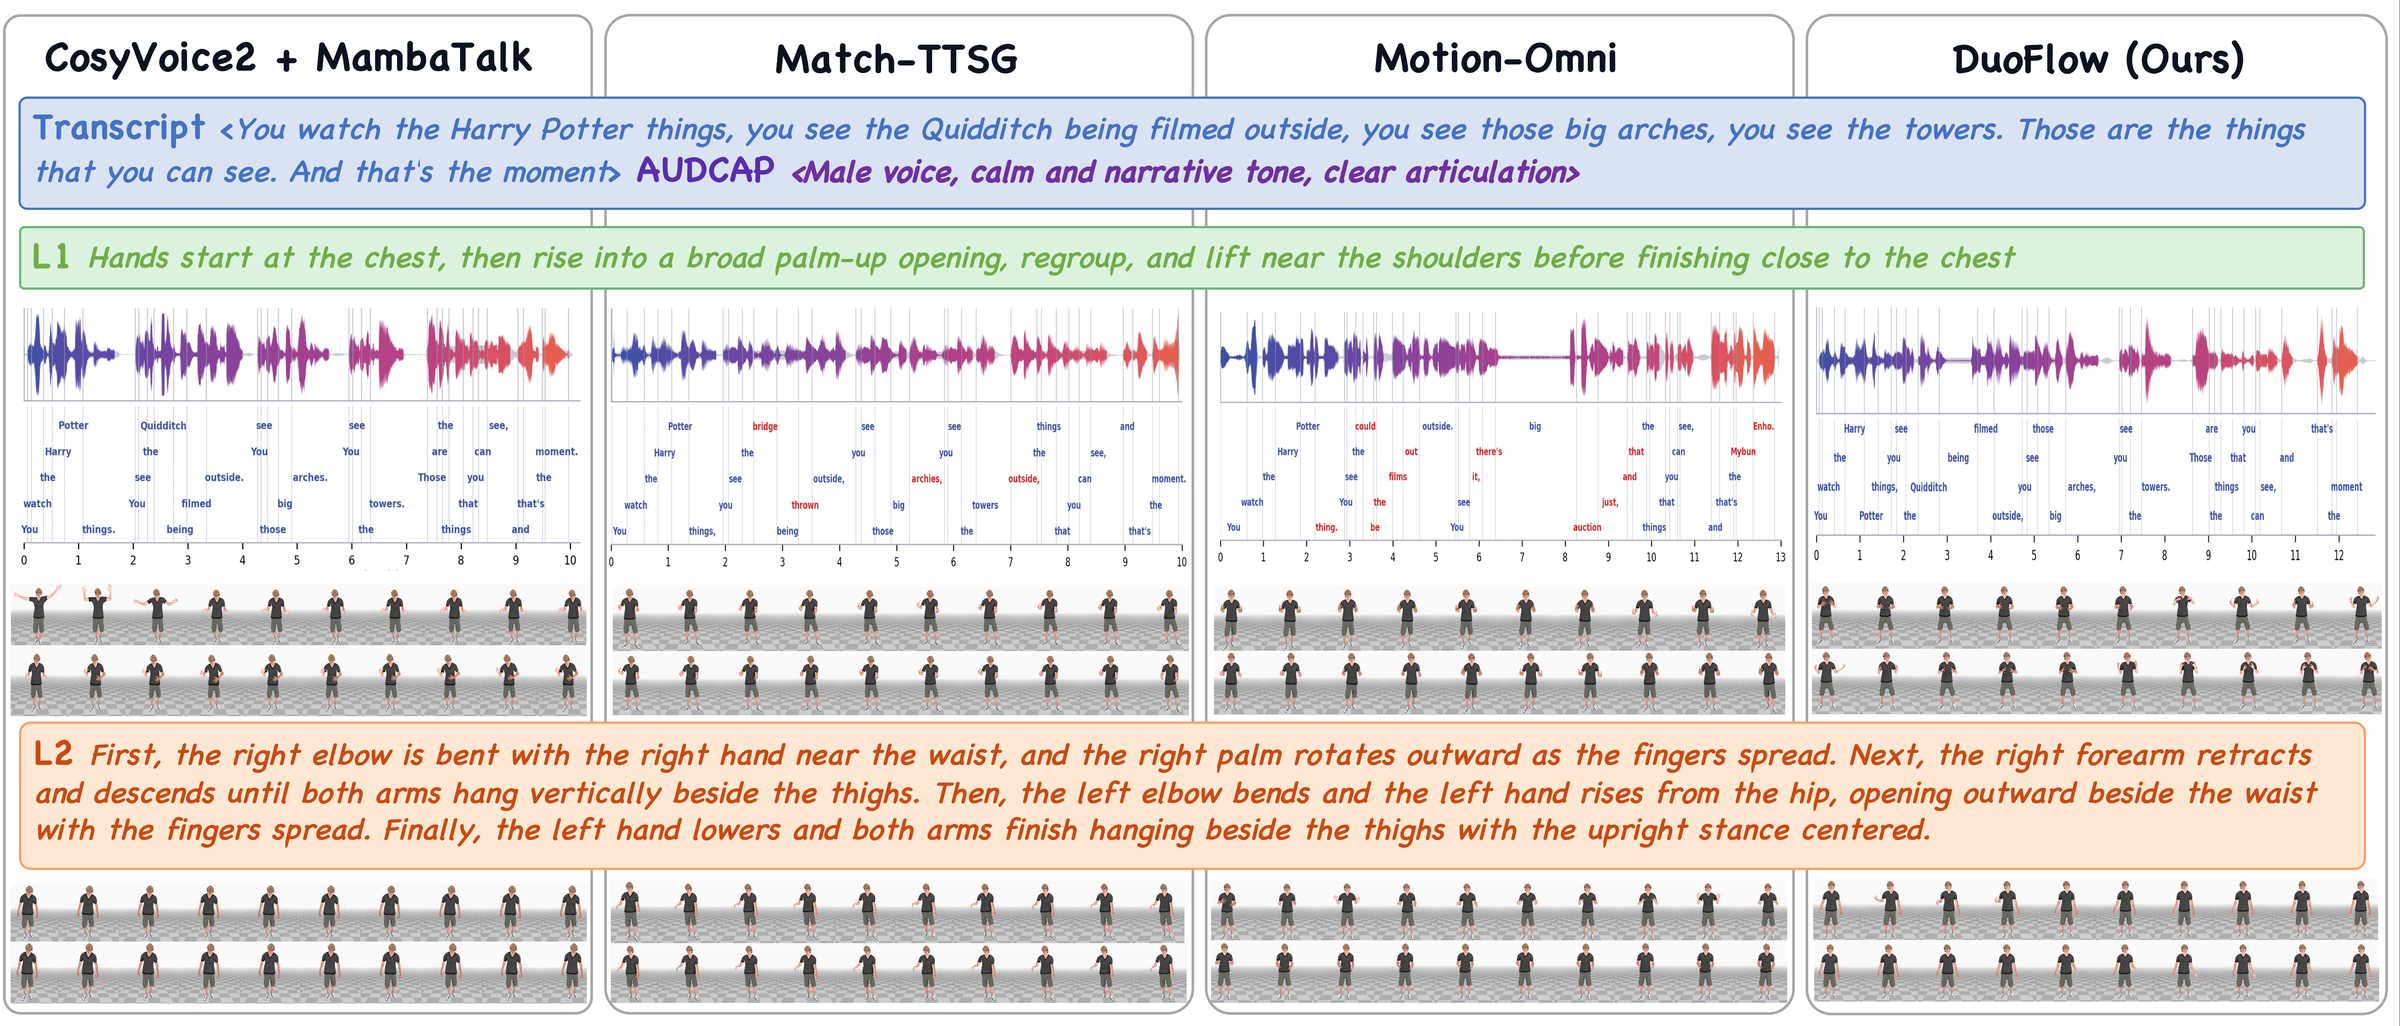
  • 实验效果:在 MotionSpeech 表 2 中,DuoFlow 的词错误率 WER 为 4.71%,CosyVoice2+MambaTalk 为 6.12%;细粒度动作配对准确率 L2 PairAcc 为 90.40%,对照为 53.63%。WER 越低越好;PairAcc 是冻结的文本—动作评估器给出的描述匹配率,越高越匹配。
图 4:分层动作控制的定性比较。上半部分在相同粗粒度 L1 动作指令下展示生成波形、时间对齐的台词文字和采样动作帧;下半部分改为细粒度、按时间排序的 L2 指令后的结果。时间对齐台词中的红字标出与输入文字不匹配之处。
Figure 4 : Qualitative comparison under hierarchical motion control. The upper block shows generated waveforms, time-aligned transcript words, and sampled motion frames under the same coarse L1 motion instruction. The lower block shows the results after changing the motion description to a fine-grained, temporally ordered L2 instruction. Red words in the time-aligned transcripts mark mismatches with the input text.

  • 批判点评:作者报告生成 12.9 秒片段平均需 1.33 秒,快于部分对照但慢于 Match-TTSG 的 0.35 秒;联合训练还需先做语音预训练。CosyVoice2+MambaTalk 不接收 L2 指令,53.63% 是描述兼容性而非等价控制测试;配对准确率也不代表任意角色动作的真实感。

趋势观察

参考条件不该被一视同仁

QASK-Edit 给不同 key 来源分风险预算,Reference Forcing 则把初始帧作为不漂移的外观锚点;两者都在指定任务中验证,不能把参考条件视作免费。

生成加速要看整条链路

LiveView 把双向教师蒸馏为流式学生,ScoutCache 同时缩减降噪、历史读取和建缓存;实际收益需连同画质、硬件和视频长度报告。

精细控制依赖可核对的中间约束

DecoEdit 分开几何与纹理,Découpage 拆开镜头和声音时间表,GameWM 让引擎负责事件结果;新增条件与训练数据也是代价。


今日讨论

QASK-Edit 在 StreamEdit 上最高提速 1.46×,FiVE-Acc 由 0.5826 到 0.5819;但在 MiniMax-H3 上该指标由 0.4879 降到 0.4572。若要把稀疏注意力接进视频编辑产品,如何验证每类参考条件的风险预算确实守住未改区,何时应退回密集注意力?


人工智能炼丹君 整理 | 2026-11-18


更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」

每日更新 · 论文精选 · 深度解读 · 技术脉络

微信搜索 人工智能炼丹君 或扫描下方二维码关注

扫码关注「人工智能炼丹君」

0

评论 (0)

取消
粤ICP备2021042327号