AIGC 每日速读|2026-11-17|KlingAI场景文字自然改-HarmonyText

人工智能炼丹君
2026-11-17 / 0 评论 / 2 阅读 / 正在检测是否收录...

今日 AIGC 论文速览

今日共 10 篇 · 场景与音乐编辑 2 篇 · 视频生成与加速 3 篇 · 图像构图与对齐 3 篇 · 语音生成与音频评测 2 篇

重点论文标题列表

  • HarmonyText(KlingAI):无蒙版改字仍保住画面质感
  • MusicFlux(巴黎高等电信学院):一套模型兼做音乐生成与编辑
  • ReDiverse(UIUC):四步视频蒸馏找回随机性
  • JVT(浙江大学):像素空间直接生成视频与深度
  • Token2Tile(NVIDIA):视频注意力按token挑、按tile算

选读入口:要改照片里的文字且保住背景质感,先看 HarmonyText;要在原曲上补片段或修音效,看 MusicFlux;四步图像/视频生成缺变化看 ReDiverse。想直接在像素上生成视频和几何看 JVT,想给视频 DiT 降注意力成本看 Token2Tile;复杂提示漏物体看 SST。声音克隆的参考编码看 RSE-TTS,文生图奖励是否真的看懂关系看 CrossPairs,自回归出图的多要求幻觉看 InfiHall-Bench,文生音频评测和理由看 CoTTAGE。


今日论文速览

1. HarmonyText:无蒙版改字仍保住画面质感

HarmonyText: Harmonious Scene Text Editing via Reverse-to-Refined Pair Synthesis and Region-Decoupled Frequency Learning | 华南理工大学;Kolors Team, KlingAI Research | arXiv:2611.17733

关键词:场景文字编辑, 无蒙版编辑, RePair, 频率约束, 图文一致性

  • 前序问题:只给自然语言、不画区域蒙版地修改照片里的字,常会出现字对了但背景颜色、笔画边缘和材质不协调。以生成结果当伪真值训练,还会把这些瑕疵教给模型。
  • 方法直觉:编辑区需要学习“字该是什么”,未编辑区需要记住“原图是什么”;再专门约束高频细节,才能让新字像原本就印在场景里。
  • 本文贡献:SIGGRAPH Asia 2026 已接收的 HarmonyText 先用 RePair 反向精修有瑕疵的编辑样本,经文字验证、区域匹配与质量过滤组成 2.5 万对 STE25K。训练时,区域解耦优化 RDO 让未改区对齐原图、改字区对齐伪目标;两级小波高频约束 CHFTG 保留笔画和纹理。
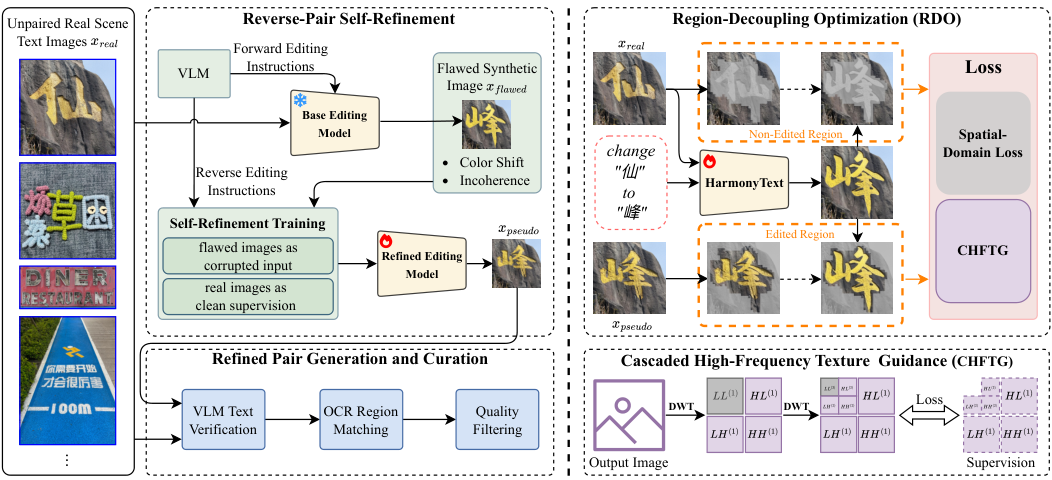
图 2:HarmonyText 框架总览。左侧 RePair 从无配对的真实场景文字图出发:基础编辑器先生成带色偏与不协调问题的编辑图,再反转编辑方向,将瑕疵图作受损输入、原始真实图作干净监督,训练重建无瑕疵文字;所得配对经过文字验证、区域匹配和质量过滤,组成 STE25K。右侧 RDO 对改字区和未改区使用不同目标:未改区锚定原图以保背景,改字区受伪目标监督以准确生成文字;CHFTG 在两个频率层级施加分区域小波约束,保留细纹理和清晰笔画。图左还展示了反向自精修、正向生成、验证及过滤的完整步骤。
Figure 2. Overview of the proposed HarmonyText framework. (Left) RePair constructs high-quality paired data from unpaired real scene text images. A base editing model first produces flawed edits with color shifts and incoherence. The editing direction is then reversed, treating flawed outputs as corrupted inputs and original real images as clean supervision targets, training the model to reconstruct artifact-free scene text. The resulting pairs are further curated via text verification, region matching, and quality filtering to form STE25K. (Right) Region-Decoupled Optimization (RDO) assigns distinct objectives to edited and non-edited regions: non-edited regions are anchored to the source image for background preservation, while edited regions are supervised against the pseudo-target for accurate text generation. Cascaded High-Frequency Texture Guidance (CHFTG) further applies region-decoupled wavelet constraints across two frequency levels, preserving fine-grained textures and enforcing crisp text strokes. Overview of HarmonyText. The left side shows the RePair data synthesis pipeline from real scene-text images through flawed edits, reverse self-refinement, forward generation, verification, region matching, and filtering. The right side shows Region-Decoupling Optimization and Cascaded High-Frequency Texture Guidance for edited and preserved regions.
  • 实验效果:在作者自建的 155 图 HarmonyText-Bench 盲测中,8 名评审对每组方法各给出 1240 次判断;相对 GPT Image 2.0,HarmonyText 获选 61.7%,对方 37.5%,其余为平局。这个偏好同时考虑文字指令、自然融合和背景保持;对 Nano Banana Pro 的获选率仅 53.2%。
图 3:HarmonyText 与其他先进方法的场景文字编辑定性对比。箭头指出编辑结果相对原图在颜色、纹理或整体协调性上偏离的位置;作者认为 HarmonyText 的纹理保留、颜色一致性和字与背景衔接较好,细节建议放大看。每行展示一条中文或英文改字指令的原图及多种基线和本文输出,箭头标出瑕疵;图例只说明这些被选中的样例,不能代表所有场景。
Figure 3. Qualitative comparisons of scene text editing between our HarmonyText and other SOTA methods. Arrows indicate regions where the edited result deviates from the original appearance in color, texture, or coherence. Our HarmonyText achieves the best visual harmony, with superior texture preservation, color consistency, and text-background coherence. Best viewed with zoom-in. Qualitative comparison grid for several Chinese and English scene-text editing prompts. Each row shows the source image and outputs from multiple baselines and HarmonyText; arrows mark color, texture, or coherence artifacts. HarmonyText more closely preserves the source appearance while producing the requested text.
  • 批判点评:偏好来自作者构建的场景文字基准与指定短指令,不能外推到任意图像编辑。RePair 的数据筛选和双区域训练增加准备成本;与最强对照的优势也远小于对早期文字编辑器的优势。

2. MusicFlux:一套模型兼做音乐生成与编辑

MusicFlux: Flexible Conditioning for Text-Guided Music Generation and Editing | 巴黎高等电信学院;巴黎综合理工学院(LTCI 实验室) | arXiv:2611.13834

关键词:音乐生成, 音乐编辑, 补全, 音效修复, 流匹配

  • 前序问题:音乐局部补全和修复既要服从文字,也要保持原录音的节奏与音色。把源音频与目标序列直接拼接可保留上下文,但长音频令序列翻倍,推理与显存开销高。
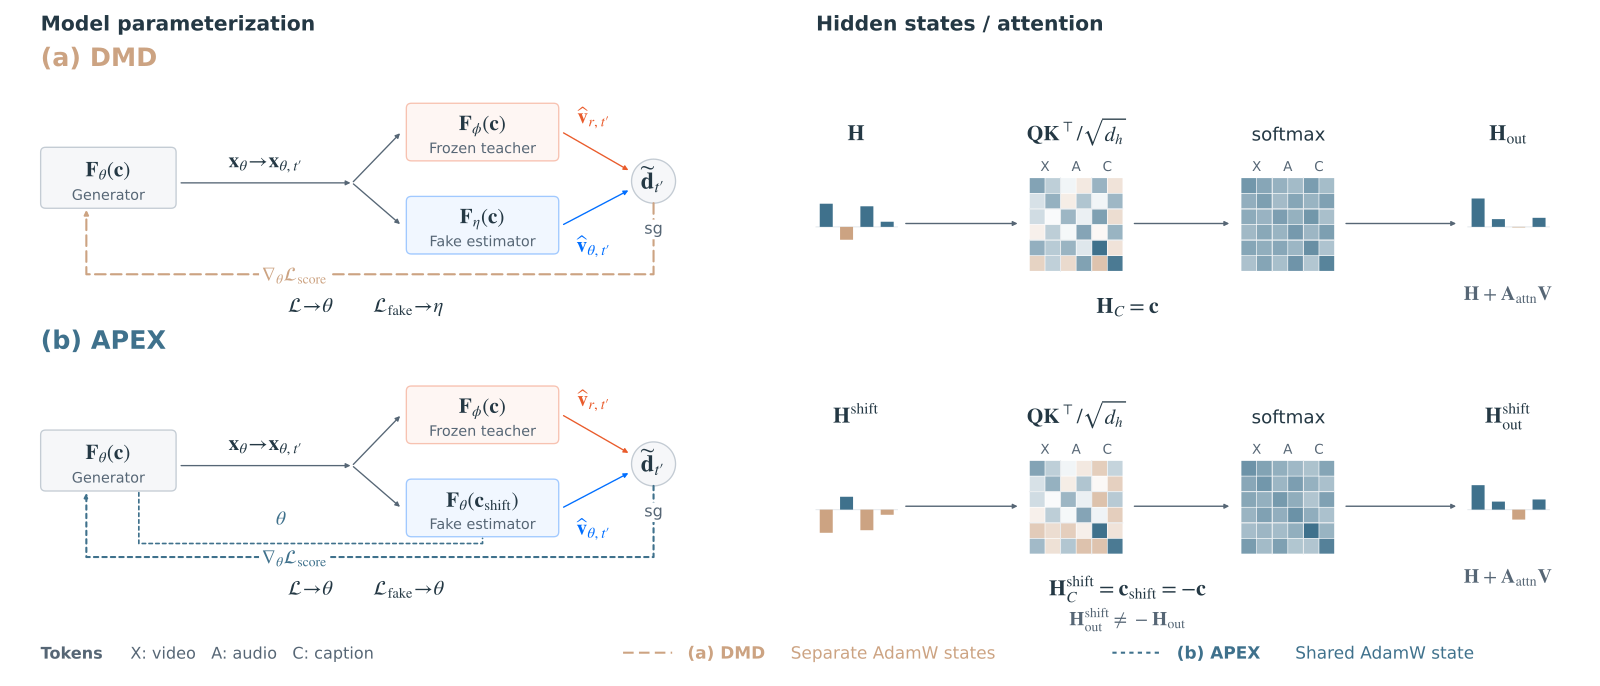
  • 方法直觉:让同一个流匹配生成器处理生成、局部补全和修复;源音频可直接并排进入注意力,也可变成对生成轨迹的轻量位移,换取速度。
  • 本文贡献:MusicFlux 基于 TangoFlux 训练两种约 8.6 亿参数的条件方式:Concat 将源与待生成潜变量沿时间拼接,CAR 用轻量 shift 网络在原长度序列上重参数化流轨迹;两者共享文字、源音频和编辑蒙版条件,覆盖文生音乐、inpainting/outpainting 与音效修复。
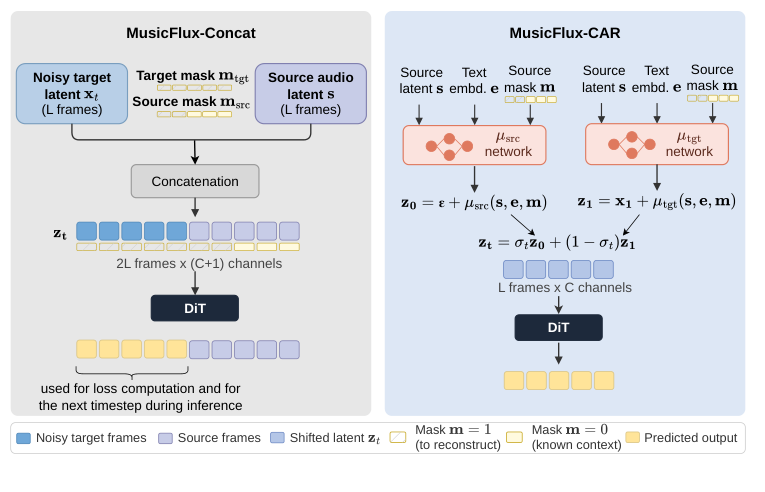
图 2:左侧 MusicFlux-Concat 将带噪目标潜变量与源音频潜变量沿序列维拼接,得到两倍帧长,并将二元蒙版沿通道拼接。右侧 MusicFlux-CAR 用轻量辅助网络按源音频、文字和蒙版移动流的噪声起点及目标终点,使扩散仍直接在原来长度的帧空间运行,从而减少复杂度;两种条件方式的流程在同图比较。
Fig. 2. (Left) MusicFlux-Concat: The target latent x_t and source audio latent s are concatenated along the sequence dimension (2L frames), while the binary mask m is concatenated along the channel dimension. (Right) MusicFlux-CAR: Condition-Aware Reparameterization uses lightweight auxiliary networks to shift the noise start-point z_0 and target endpoint z_1. Diffusion operates directly in the shifted space over L frames, reducing complexity.
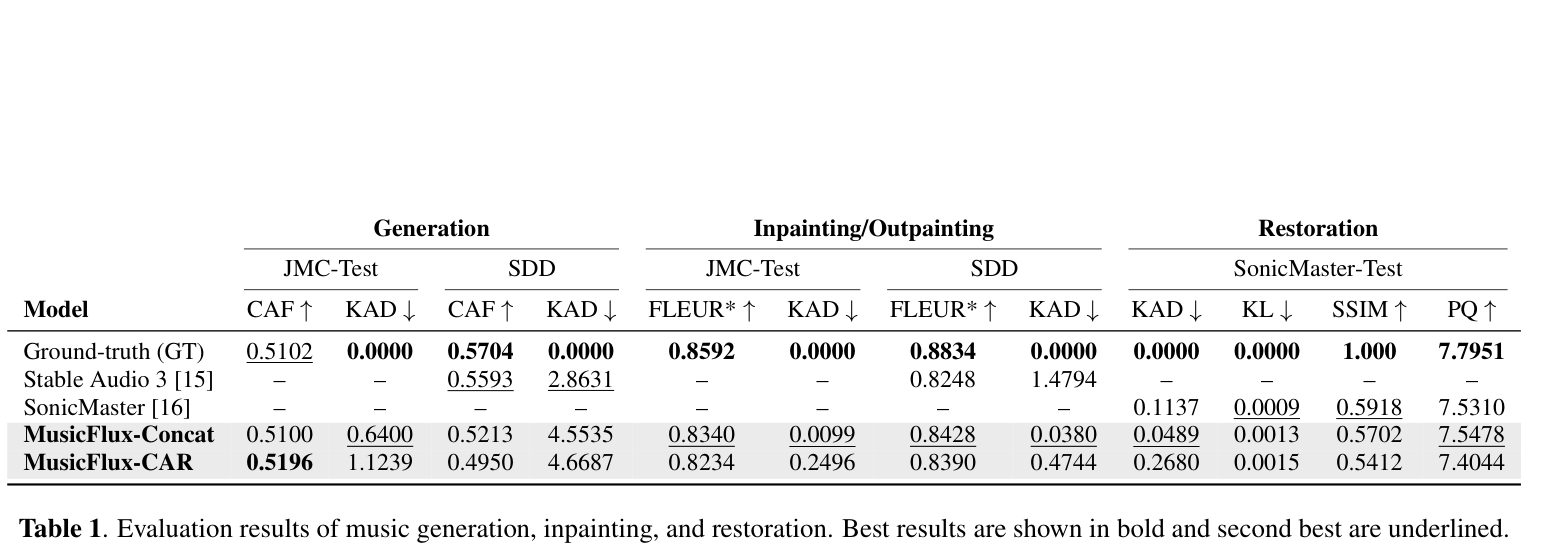
  • 实验效果:在 JMC-Test 的补全任务中,Concat 的 FLEUR 为 0.8340,CAR 为 0.8234;FLEUR 由音频大模型评价新片段与上下文的衔接,越高越好。单样本、645 潜变量、FP32 条件下,CAR 推理实时因子 RTF 0.1188、动态内存 75.71 MiB,Concat 为 0.2203、150.11 MiB;RTF 越低越快。
表 1:音乐生成、inpainting/outpainting(局部补全/扩展)和音效修复的评测结果;粗体表示最好,划线表示次好。表内对比真值、Stable Audio 3、SonicMaster 与 MusicFlux-Concat/CAR;JMC-Test 和 SDD 是生成/补全数据,SonicMaster-Test 是修复数据,列出 CAF、KAD、FLEUR*、KL、SSIM 与 PQ 等任务指标。
Table 1. Evaluation results of music generation, inpainting, and restoration. Best results are shown in bold and second best are underlined.
  • 批判点评:CAR 省时省内存但局部编辑略弱;域外 Song Describer 的文生音乐,Stable Audio 3.0 的 CAF 与 KAD 均更好。两版与基线的训练数据和参数规模不同,不能把表中差距全归因于条件方式。

3. ReDiverse:四步视频蒸馏找回随机性

Restoring Diversity in Distilled Image and Video Generators by Probing Activations | 伊利诺伊大学厄巴纳-香槟分校;fal;约翰斯·霍普金斯大学 | arXiv:2611.18550

关键词:视频生成, 图像生成, 扩散蒸馏, 多样性, 激活干预

  • 前序问题:扩散模型蒸馏到四步后,同一提示换随机种子仍可能出现几乎相同的构图。减少去噪步数缩短了采样时间,却削弱了创作时需要的变化。
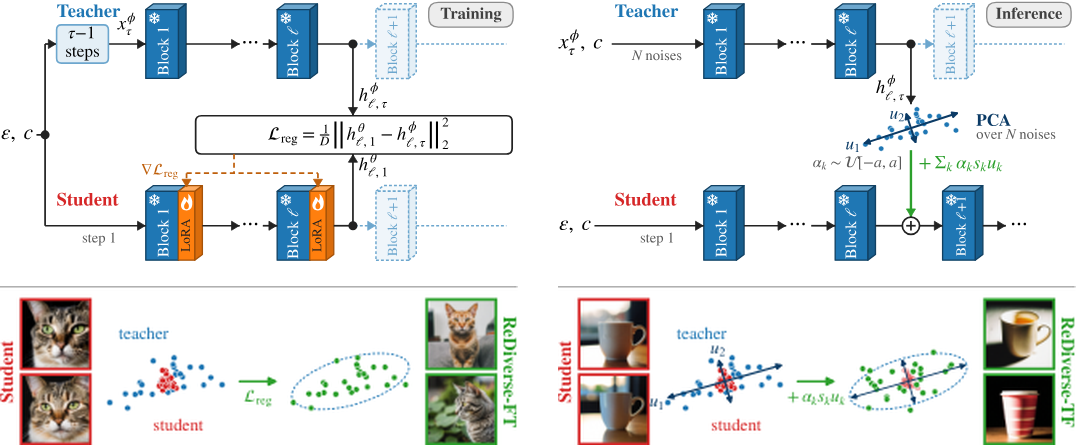
  • 方法直觉:学生的激活总波动并未消失,而是挤进少数方向;在第一次去噪的中间 block 把教师缺失的变化方向补回来,可恢复不同种子的差异。
  • 本文贡献:ReDiverse 定位蒸馏学生首次去噪中的“方向塌缩”层。FT 路线训练小型 LoRA 适配器,使学生在同一噪声下的激活回归教师;TF 路线预先用主成分分析 PCA 找教师的主要变化方向,推理时直接调整学生激活。
图 5:ReDiverse 总览。蒸馏学生在第一次去噪的中间塌缩层 ℓ 失去教师在不同噪声下的变化方向,后续层仍有渲染能力;本文在该层通过训练路线 (a) 或推理路线 (b) 恢复变化。每个图的下方展示教师蓝色、学生红色、ReDiverse 绿色激活分布以及干预前后样本。(a) FT 对同一噪声回归教师激活,只更新 LoRA 适配器,示例提示是“一只猫的照片”;(b) TF 用 PCA 找教师变化方向,再让学生沿这些方向移动,示例是“一只杯子的照片”。
Figure 5: ReDiverse overview. The student loses the teacher’s variation across noises at the collapsed block ℓ \ell , while the later blocks can still render it; ReDiverse restores it there, by training (a) or at inference (b). Below each diagram, the activations (blue: teacher, red: student, green: ReDiverse) and samples, before and after. (a) ReDiverse-FT regresses the student’s activation onto the teacher’s for the same noise, updating only LoRA adapters. (b) ReDiverse-TF finds the teacher’s directions of variation by PCA and moves the student along them.
  • 实验效果:在 Wan 2.1 四步视频学生、VBench 300 条提示且每条 10 个种子的设定里,DINO 特征多样性由 31.6 升到 52.2,教师为 51.6;该分数越高表示同提示不同种子的视觉差异越大。VBench 主体一致性由学生的 96.7 降到 95.0,说明多样性和稳定性仍有取舍。
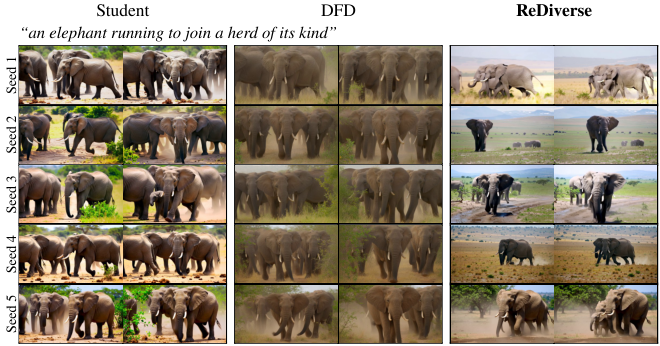
图 8:Wan 2.1 的定性结果。每行是一个随机种子,每段视频展示首帧和末帧;三列使用同一噪声,以便比较原四步学生、对照方法和 ReDiverse 的变化。原文提示最佳观看方式是补充材料中的视频,静态图仅显示首尾帧。
Figure 8: Qualitative results on Wan 2.1. Rows are seeds, each clip shown by its first and last frame, same noise for all three columns. Best viewed as videos available in supplementary material.
  • 批判点评:FT 需要教师激活与额外适配训练,TF 也要预先估计教师主方向;作者的质量指标并非全部不变。更大的种子间差异不自动等于每条视频更好,应同时检查主体、文本对齐和运动。

4. JVT:像素空间直接生成视频与深度

JVT: Just Video Transformer makes pixel-space video diffusion simple | 浙江大学;上海创新研究院;上海人工智能实验室 | arXiv:2611.18549

关键词:像素空间视频生成, DiT, RGB视差联合生成, 相机控制, 3D几何

  • 前序问题:视频生成通常先压到潜空间再解码;直接处理原像素维度很高,常需额外自动编码器、细节头或分阶段结构。像素与深度等逐帧信号也不易共同对齐。
  • 方法直觉:把原始视频切成足够大的时空 patch,保留简洁的扩散 Transformer;让 RGB 与视差一起生成,几何信息可在每帧直接对应。
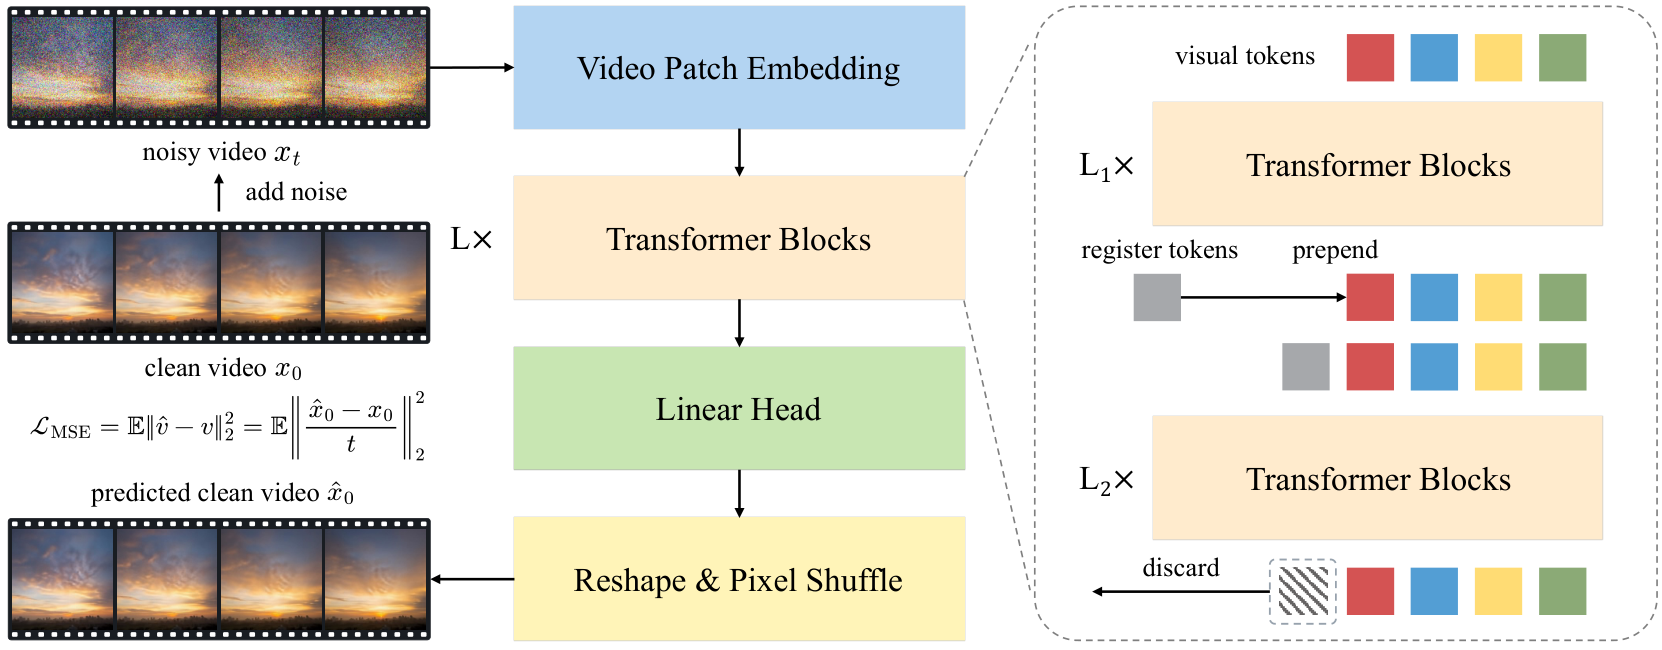
  • 本文贡献:Just Video Transformer(JVT)用大 patch 的 DiT 直接预测干净像素视频,不依赖预训练 VAE、辅助细节头或级联。研究比较 patch embedding、register token 与自适应层归一化;在相机条件任务中联合输出 RGB 与视差,视差可按相机参数反投影成点云。
图 2:JVT 架构与 register token 设计。网络从带噪输入 x_t 预测干净视频 x̂_0;视觉 token 先通过前 L₁ 个块,再加入 register token,经过后 L₂ 个块后丢弃 register,其中总块数 L=L₁+L₂。
Figure 2: JVT architecture and register token design . The network predicts a clean video x ^ 0 \hat_{0} from a noisy input x t x_{t} . Register tokens are prepended to visual tokens after the first L 1 L_{1} blocks, and then discarded after the remaining L 2 L_{2} blocks, where L = L 1 + L 2 L=L_{1}+L_{2} .
  • 实验效果:RealEstate10K 相机条件任务中,JVT 的 RGB+视差版本相对自身 RGB 版本,在平移方向误差低于 5° 的相对平移准确率 RTA@5 上从 72.4 提到 79.5;视频 FVD 从 27.0 到 27.5,FVD 越低越好。它提升相机平移跟随但 RGB 分布质量略退;结果图展示 RGB、视差和点云。
图 5:RealEstate10K 上的 RGB 与视差联合生成及点云重建。图中并排展示生成 RGB 帧与逐帧对齐的视差图;利用相机参数把视差恢复的深度反投影得到彩色点云,推理时不另用重建模型。
Figure 5: Joint RGB-disparity generation and point-cloud reconstruction on RealEstate10K . We show generated RGB frames alongside aligned disparity maps. Colored point clouds are obtained by unprojecting depth recovered from disparity using the camera parameters, without an additional reconstruction model at inference.
  • 批判点评:相机旋转准确率普遍接近满分,平移仍是难点。联合输出增加目标维度,FVD 也略升;不同论文的 FVD 采样数、训练数据和算力并不统一,不能把表中所有行当作严格同条件比较。

5. Token2Tile:视频注意力按token挑、按tile算

Token2Tile: Token-Wise Sparse Attention with Tile Execution through a Low-Rank Space for Video DiTs | 北京理工大学;NVIDIA | arXiv:2611.17930

关键词:视频扩散加速, 稀疏注意力, token选择, GPU tile, 免训练

  • 前序问题:视频 DiT 的时空注意力很贵。每个 query token 最重要的 key 各不相同,但 GPU 核更擅长按成块的 tile 执行;只按块筛选会浪费计算或丢掉关键连接。
  • 方法直觉:先在低维空间为每个 query 选重要 key 群,再把多个 query 的选择合并成 GPU 可执行的 tile;遗漏群仍用残差近似,兼顾精度与硬件效率。
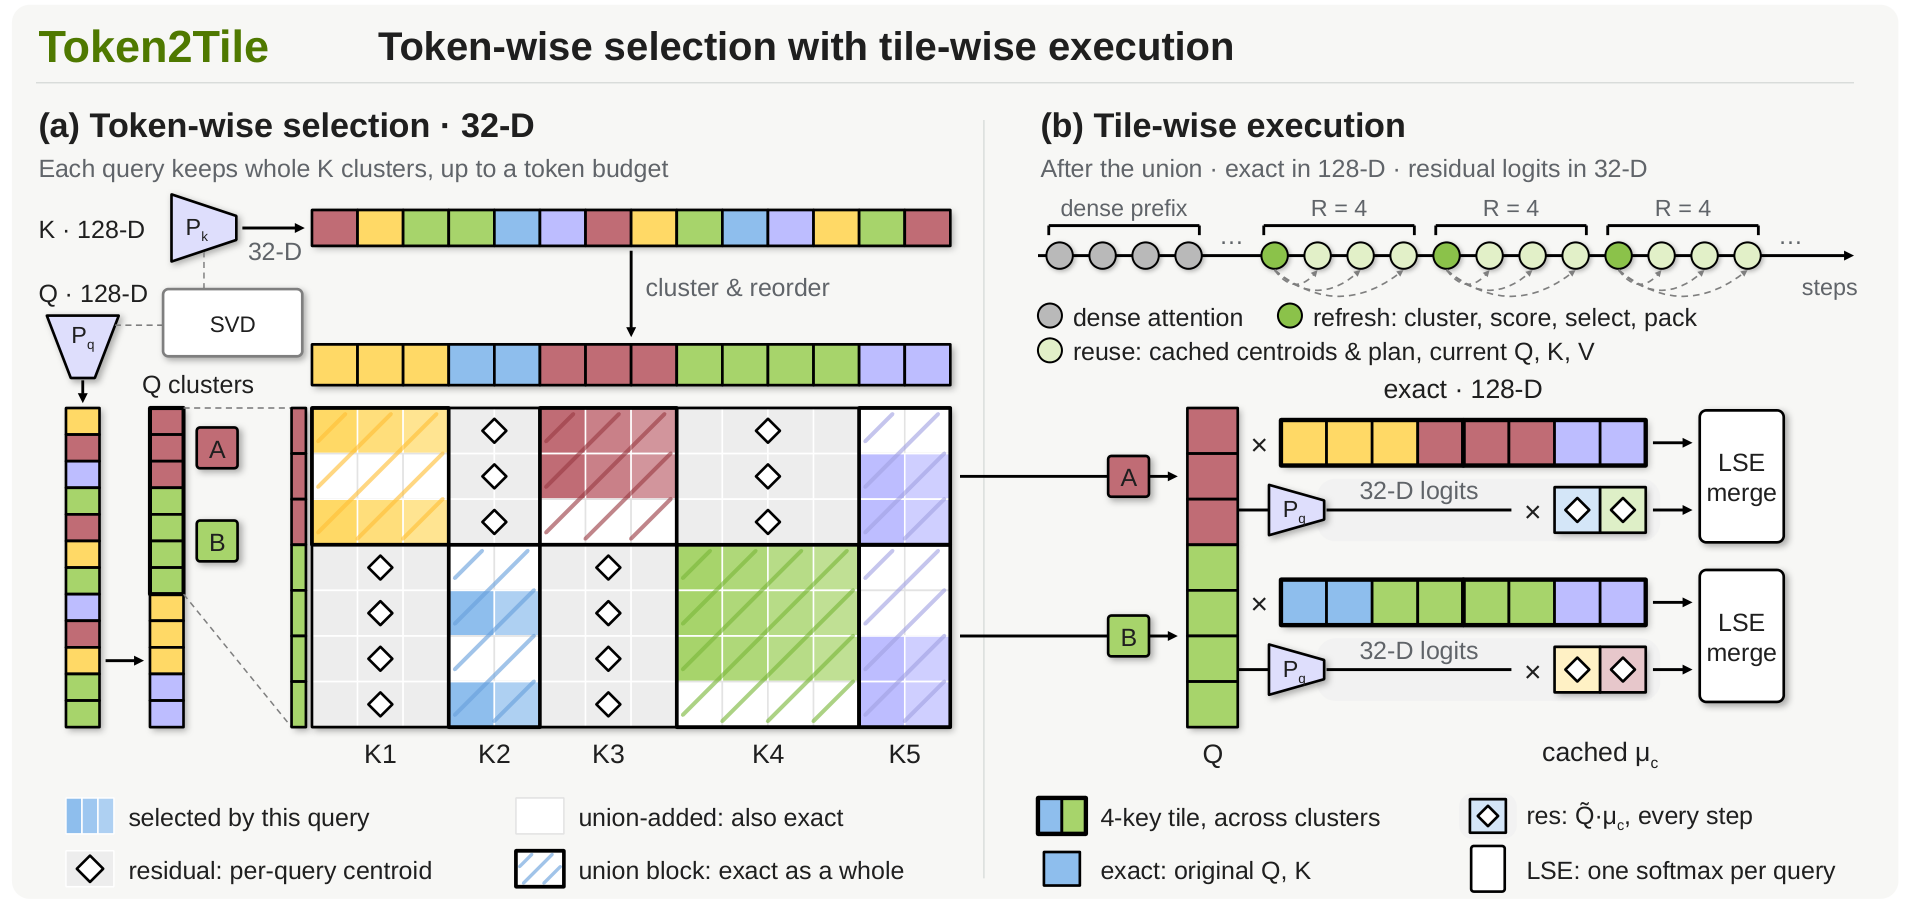
  • 本文贡献:Token2Tile 是免训练稀疏注意力算子:在线把 Q/K 从 128 维投到保留 logit 结构的 32 维,按 token 聚类和打分;每个 query 选够预算的 key 群,同群 query 合并执行集合,剩余群用质心残差并通过 LSE 合并 softmax。计划每 4 次调用刷新,避免物化 N×N 注意力矩阵。
图 3:按 token 选择、按 tile 执行。(a) 对二阶矩平方根乘积做 SVD,得到匹配的 Pq、Pk 投影,将 Q/K 从 128 维降到 32 维并逐 token 聚类;每个 query 取满足预算的最短 key 群前缀(着色),同一 query 群执行成员选择的并集(外框),其余群每群以一个质心残差项近似(灰色菱形)。(b) 原始 Q 与跨群边界打包为 tile 的被选 key 相乘,低维 QPq 与未选群质心相乘;LSE 合并成每个 query 的 softmax。聚类、选择和计划每 R=4 次调用刷新,复用时使用当前 Q/K/V;不物化 N×N 张量。
Figure 3: Token-wise selection with tile-wise execution. (a) An SVD of the second-moment square-root product gives matched projections P q , P k P_{q},P_{k} from 128 to 32 dimensions, in which queries and keys are clustered per token. Each query keeps the shortest prefix of whole key clusters that meets its token budget (colored); a query cluster executes the union of its members’ selections (outlined), and each remaining cluster contributes one centroid term per query (grey, ⋄ \diamond ). (b) The original Q Q multiplies the union keys, packed into tiles across cluster boundaries; Q ​ P q QP_{q} multiplies the centroids of the unselected clusters, and an LSE merge yields one softmax per query. Clusters, selections and plans are refreshed every R = 4 R=4 calls; reuse calls use the current Q Q , K K , V V . No N × N N\times N tensor is materialized.
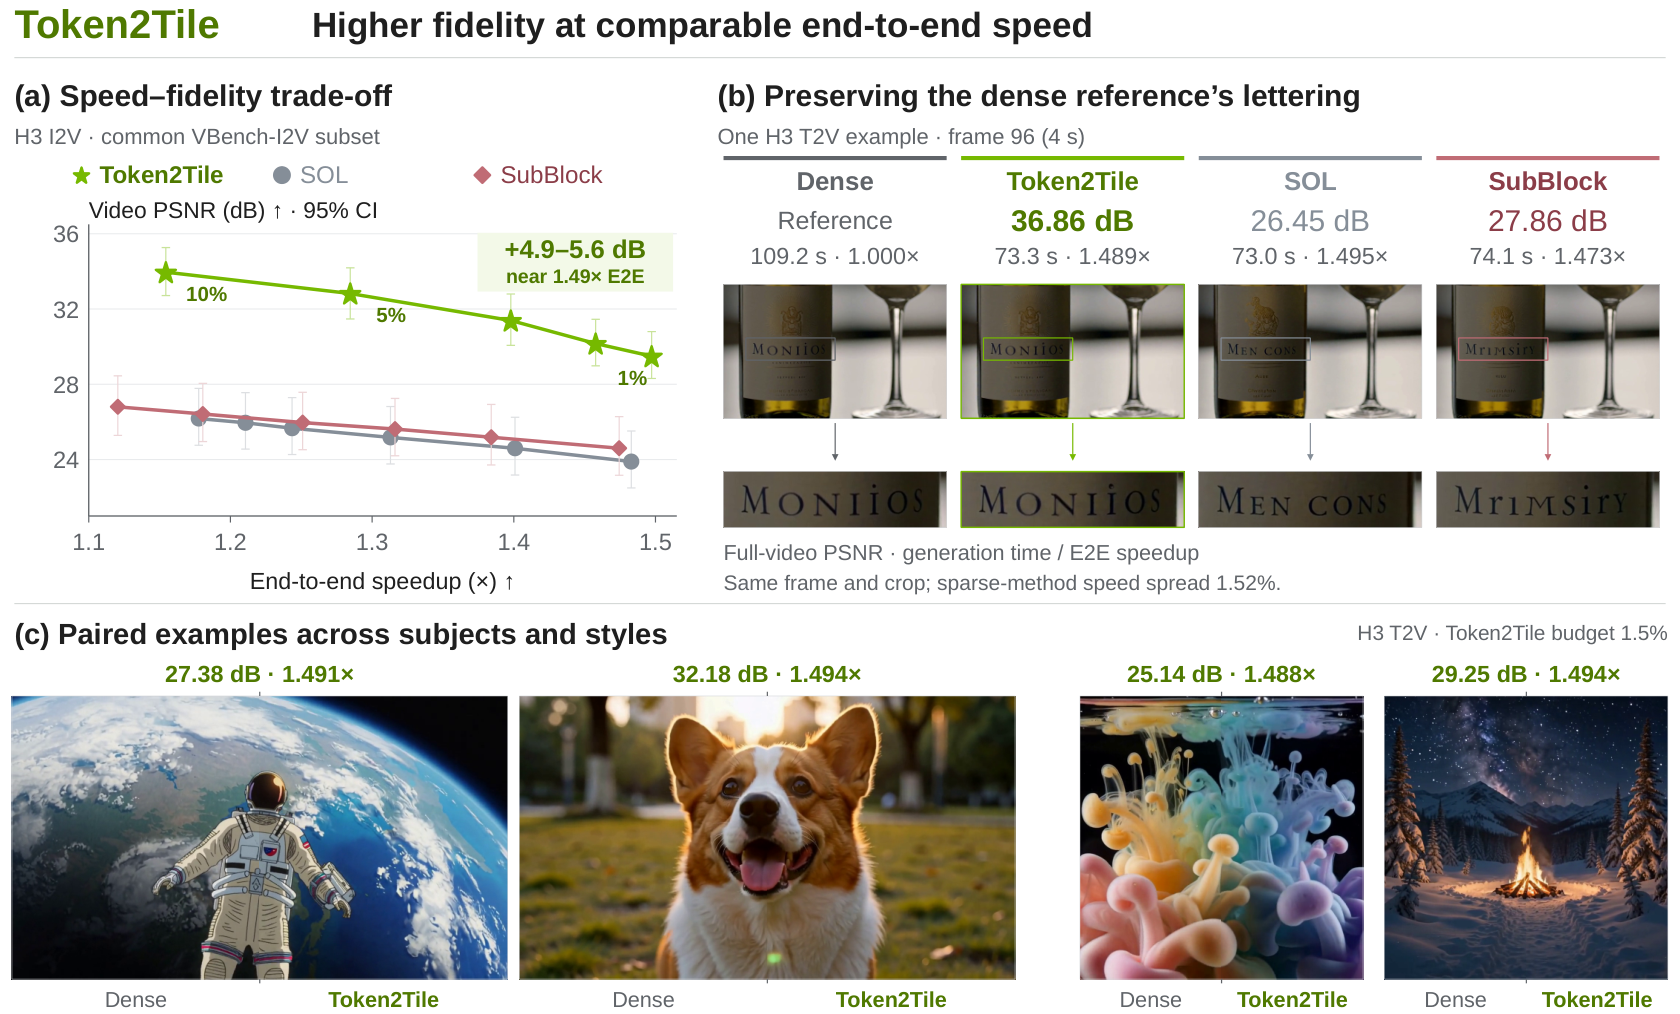
  • 实验效果:在 MiniMax-H3 与 Wan2.1-14B 的作者配置上,相对稠密 FlashAttention-3,8 张 H200 的端到端生成加速为 1.48~1.54 倍,VBench 各项分数距稠密版本不超过 0.5 点。在相近速度下,H3 的视频对稠密输出 PSNR 比 SOL/SubBlock 高 5.5~6.8 dB;PSNR 越高越接近稠密参考。
图 1:相近生成速度下与稠密参考的保真度。(a) H3 图生视频在共同 VBench-I2V 子集上的扫描,PSNR 误差线为 95% bootstrap 区间,绿色标签是名义预算;在约 1.49 倍加速附近,Token2Tile 的 PSNR 提高 4.9~5.6 dB。(b) 三种稀疏方法在 1.47~1.50 倍速度区间的文字区域裁切,标示全视频 PSNR 和请求时间。(c) 四个文生视频样例在 1.5% 预算下,左半是稠密结果、右半是 Token2Tile。
Figure 1: Higher dense-reference fidelity at comparable generation speed. (a) H3 I2V sweep on a common VBench-I2V subset with 95% bootstrap PSNR intervals; green labels are nominal budgets. Near 1.49 × 1.49\times on this subset, Token2Tile improves PSNR by 4.9–5.6 dB. (b) Crops of lettering from the dense video and three sparse methods at 1.47 1.47 – 1.50 × 1.50\times (whole-video PSNR, request time). (c) Dense-left/Token2Tile-right splits of four T2V examples at 1.5%.
  • 批判点评:低维投影、聚类和 tile 打包本身有开销;八步蒸馏 H3 在四卡设定中的端到端收益仅 1.03~1.11 倍。PSNR 是对稠密视频的相似度,不等同于人类偏好或绝对画质。

6. SST:让理解分支教会图像构图

Structural Self-Teaching for Compositional Generation in Unified Multimodal Models | 三星电子;首尔国立大学 | arXiv:2611.18261

关键词:组合式图像生成, 统一多模态模型, 短语定位, 结构监督, LoRA

  • 前序问题:统一多模态模型能在给定图中找到“哪只牛是花纹的”,生成复杂提示时却常漏物体、绑错属性或摆错位置。单纯 LoRA 微调未必利用已有的定位能力。
  • 方法直觉:理解分支已知道词组对应的图像区域;把这个区域当训练时的隐式结构老师,约束生成分支,推理时仍只需文字。
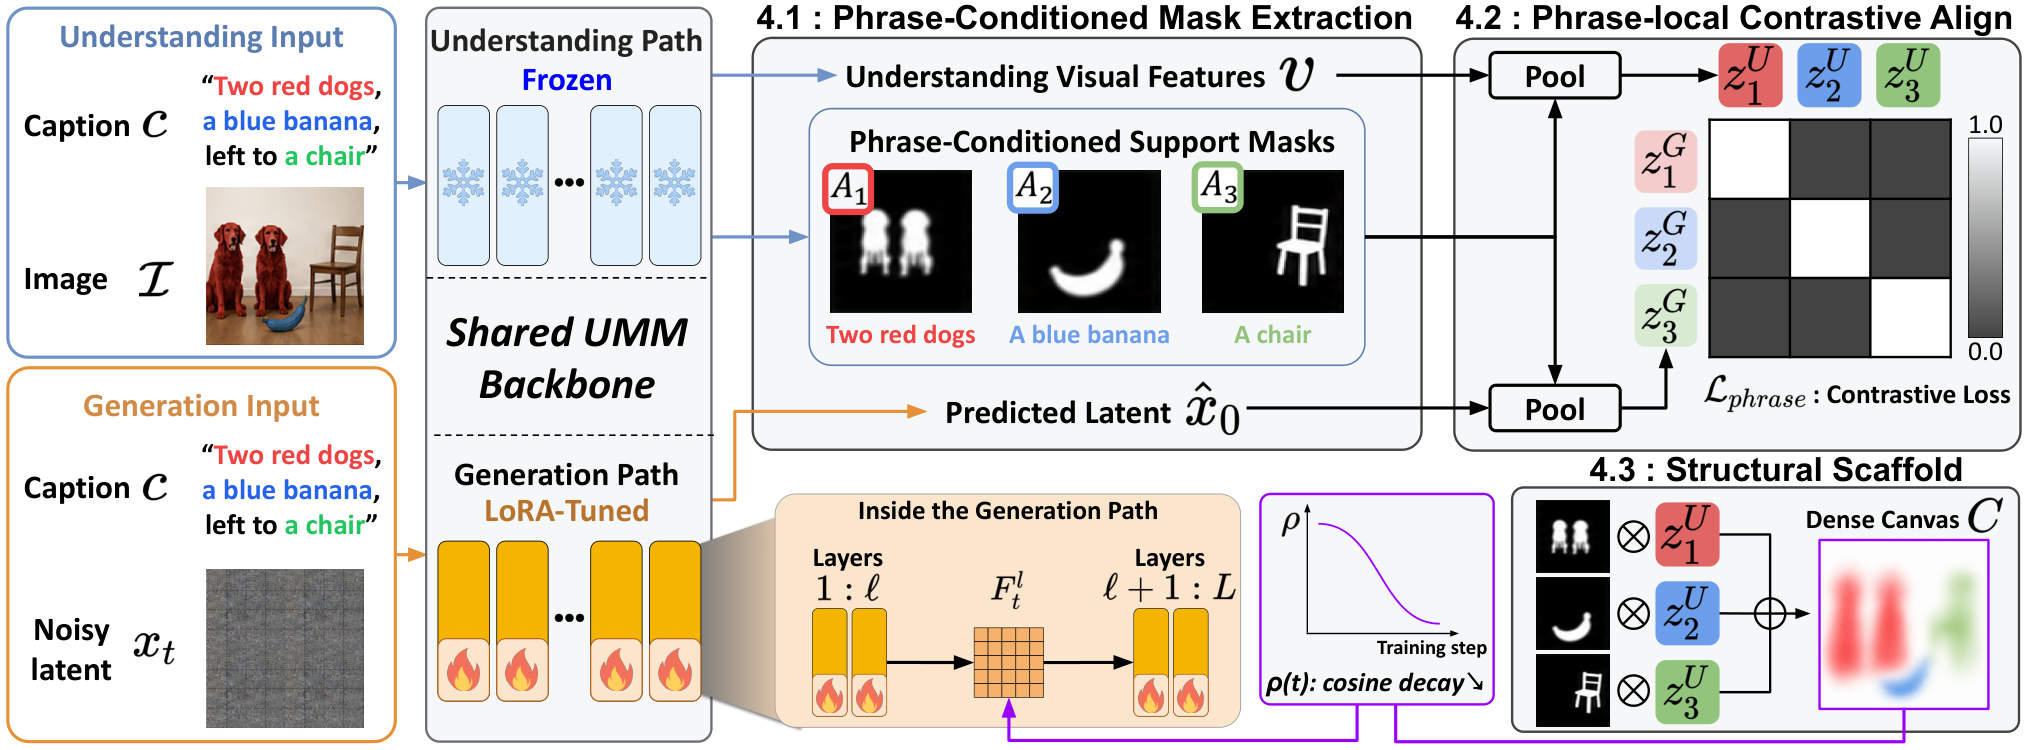
  • 本文贡献:Structural Self-Teaching(SST)从冻结的理解路径注意力提取短语支持蒙版:一项损失对齐生成图与目标图对应短语区域的表征;另一项结构 scaffold 调制生成路径中间空间特征,并在训练中逐步 dropout,推理时移除。不需要外部框或分割标注。
图 3:结构自教学总览。冻结理解路径提取的短语条件支持蒙版 {A_p},为 LoRA 微调的生成路径提供两种训练信号:一是参考图与生成图相应短语区域表征的局部对比对齐;二是结构 scaffold,用于调制中间空间特征 F_t^ℓ。scaffold 采用按样本余弦衰减的 dropout,推理时移除。
Figure 3 : Overview of structural self-teaching. Phrase-conditioned support masks { A p } \{A_{p}\} extracted from the frozen understanding path provide two training-time signals for the LoRA-tuned generation path: phrase-local contrastive alignment between reference and generated phrase representations, and a structural scaffold that modulates an intermediate spatial feature F t ℓ F_{t}^{\ell} . The scaffold is applied with sample-wise cosine-decayed dropout and removed at inference.
  • 实验效果:在 GenEval2 的 BLIP-3o 4B 上,使用同一训练数据、三次运行平均,算术均分 AM 从 LoRA 的 54.70±0.18 升到 SST 的 58.29±0.15;几何均分 GM 从 13.00±0.35 到 16.13±0.28,均为越高越好。BAGEL 等其余三种主干的 AM、GM 也高于同数据 LoRA。
图 1:统一多模态模型能定位自己未能生成的短语。给定符合组合提示的图文对,理解路径给出逐短语注意力图并定位概念;同一提示下,基础生成器却可能漏物体或纠缠属性。结构自教学在训练中转移这种内部区域支持,提高短语覆盖和组合忠实度。
Figure 1 : Unified multimodal models can localize phrases they fail to generate. Given an image-text pair that satisfies a compositional prompt, the understanding path produces phrase-wise attention maps that localize the requested concepts. However, generation from the same prompt can omit objects or entangle attributes, as shown by the base UMM. Structural self-teaching transfers these internal supports during training, improving phrase coverage and compositional fidelity.
  • 批判点评:短语蒙版主要覆盖名词,因此动词关系收益不稳定:BLIP-3o 8B 的 Verb 分数从 LoRA 的 21.22 降到 SST 的 17.14。训练需额外跑理解路径,虽无推理附加模块,不能称为零训练成本。

7. RSE-TTS:八个向量压缩参考声音

RSE-TTS: Compact Text-to-Speech through Shared Text-Aware Reference Encoding and Generation | VoxNexus 团队 | arXiv:2611.15464

关键词:语音合成, 零样本声音克隆, 参考编码, 参数共享, 文本音频对齐

  • 前序问题:参考音频编码器和语音生成器各用一套骨干,会重复占参数;压得太狠又可能丢说话人特征,导致克隆声音不稳。
  • 方法直觉:语音生成骨干本身学过文字与声音的关系,也可反过来编码参考语音;把参考转写和音频一起读进来,再压成固定八个向量。
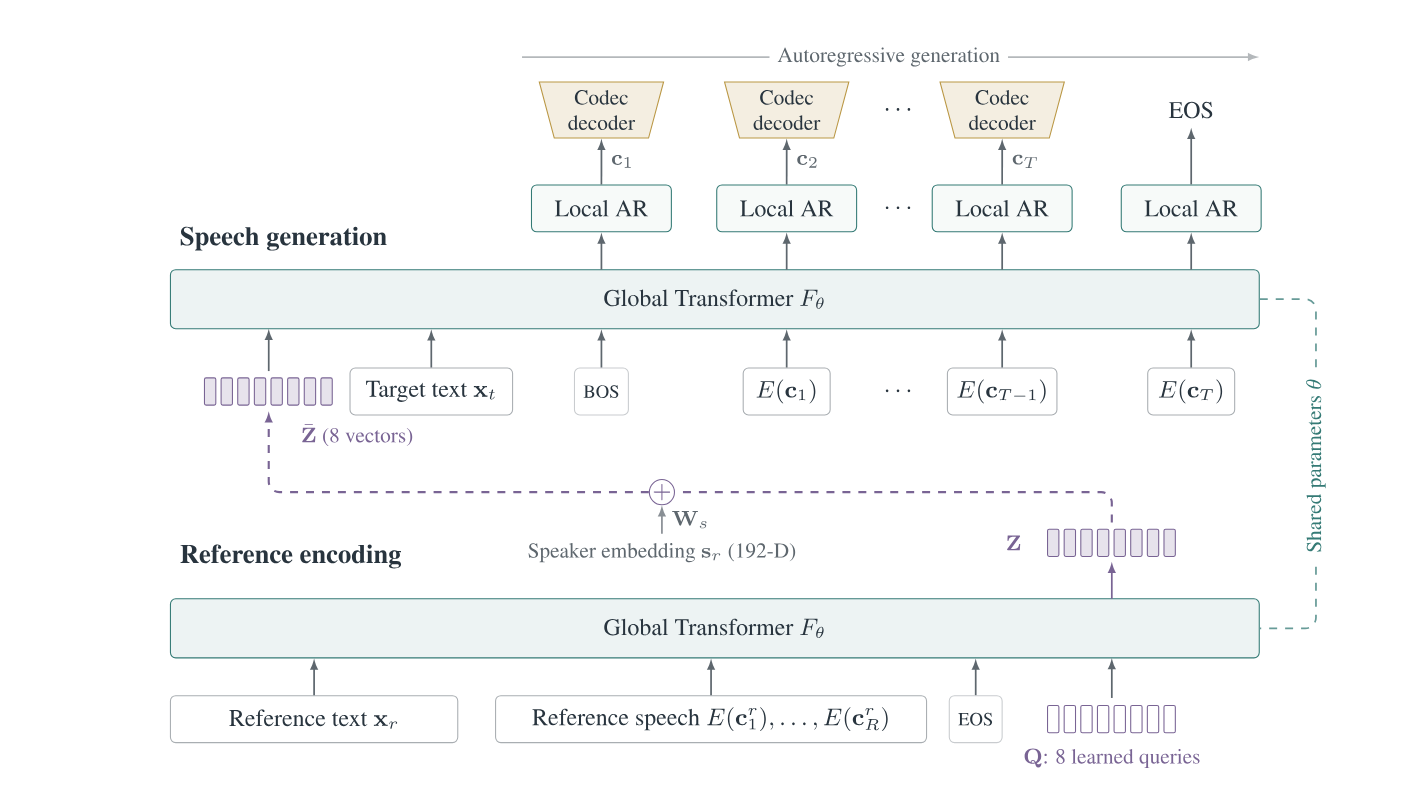
  • 本文贡献:RSE-TTS 的 Reconstructive Speaker Encoder 与生成端共享 Global Transformer;八个学习查询把参考文字和音频压成连续向量,再结合说话人嵌入条件生成。Local 模块逐帧生成离散 codec,避免为参考编码另训一套同规模骨干。
图 1:RSE-TTS 复用同一个 Global Transformer 编码参考文字与语音,并生成新话语。八个学习查询产生 Z,与投影后的说话人嵌入结合形成 Z̄;生成时 Global 接收帧嵌入 E(c_i),Local 产生离散 codec 帧 c_i。图中重复绘制的 Local 和解码器块代表连续生成步骤,不是不同参数组。
Figure 1: RSE-TTS uses the same Global transformer to encode reference text and speech and to generate a new utterance. Eight learned queries produce \mathbf{Z} , which is combined with a projected speaker embedding to form ¯ \bar{\mathbf{Z}} . During generation, Global consumes frame embeddings E ⁡ ( i ) E(\mathbf{c}_{i}) , while Local produces discrete codec frames i \mathbf{c}_{i} . Repeated Local and decoder blocks illustrate successive generation steps, not separate parameters.
  • 实验效果:相同 2 万小时英文训练子集的消融中,共享文本+音频编码与独立文本+音频编码的唯一训练参数分别为 118.2M 与 228.5M,减少约 48%;Seed-TTS 的 WER 为 1.33% 对 1.41%,说话人相似度 SIM 为 0.552 对 0.564。WER 越低越易听懂,SIM 越高越像参考声,压缩仍有轻微音色代价。
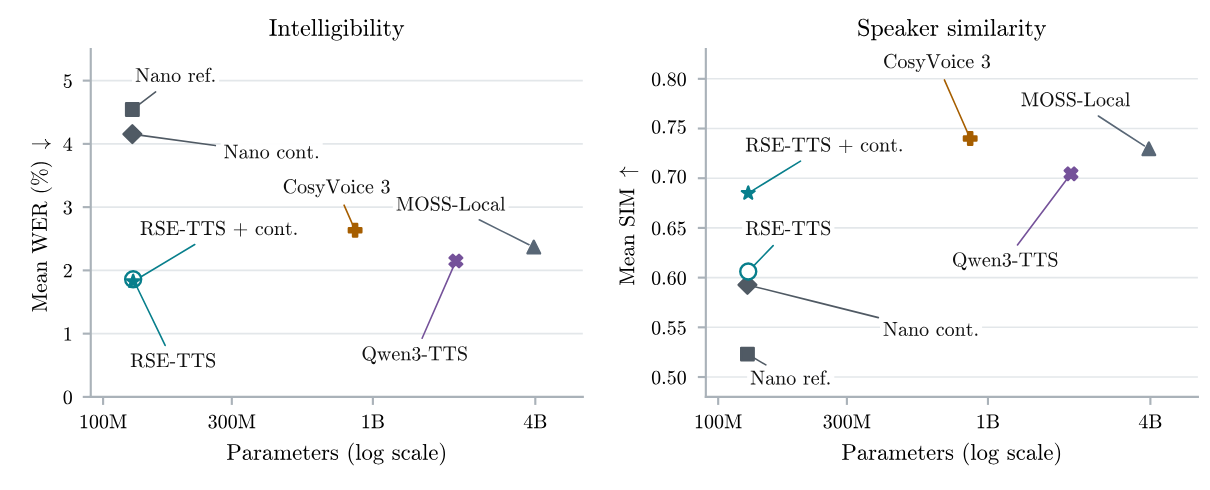
图 3:模型大小与可懂度、说话人相似度的关系。WER 和 SIM 分别在 Seed-TTS、CV3-eval 与 MiniMax 上等权宏平均;参数数包含生成器和实际运行的波形解码器。WER 越低、SIM 越高越好;横轴采用对数刻度。Ref. 表示参考条件,cont. 表示声学续写。
Figure 3: Model size versus intelligibility and speaker similarity. WER and SIM are macro-averaged with equal weight across Seed-TTS, CV3-eval, and MiniMax. Parameter counts include the generator and active waveform decoder. Lower WER and higher SIM are better; the horizontal axis uses a logarithmic scale. “Ref.” denotes reference conditioning and “cont.” denotes acoustic continuation.
  • 批判点评:输入需有参考语音及正确转写;原文把转写顺序颠倒后 SIM 从 0.538 降至 0.497。实验证据集中在英文基准,且声学续写路线的 SIM 可以更高,不能把“更省参数”写成所有音色指标最优。

8. CrossPairs:奖励模型也要看懂图文关系

Rethinking Visual Reasoning in Text-to-Image Reward Modeling | 斯坦福大学 | arXiv:2611.17585

关键词:文生图对齐, 奖励模型, 组合提示, 视觉推理, 偏好学习

  • 前序问题:文生图奖励模型可能偏好好看的图,却没看出提示里的数量、颜色或空间关系错了;普通偏好微调甚至会损害原视觉语言骨干的理解能力。
  • 方法直觉:固定同一张图,只把正确提示换成错误提示,让偏好学习专注“图与文字是否对应”,再与普通同提示双图偏好样本混训。
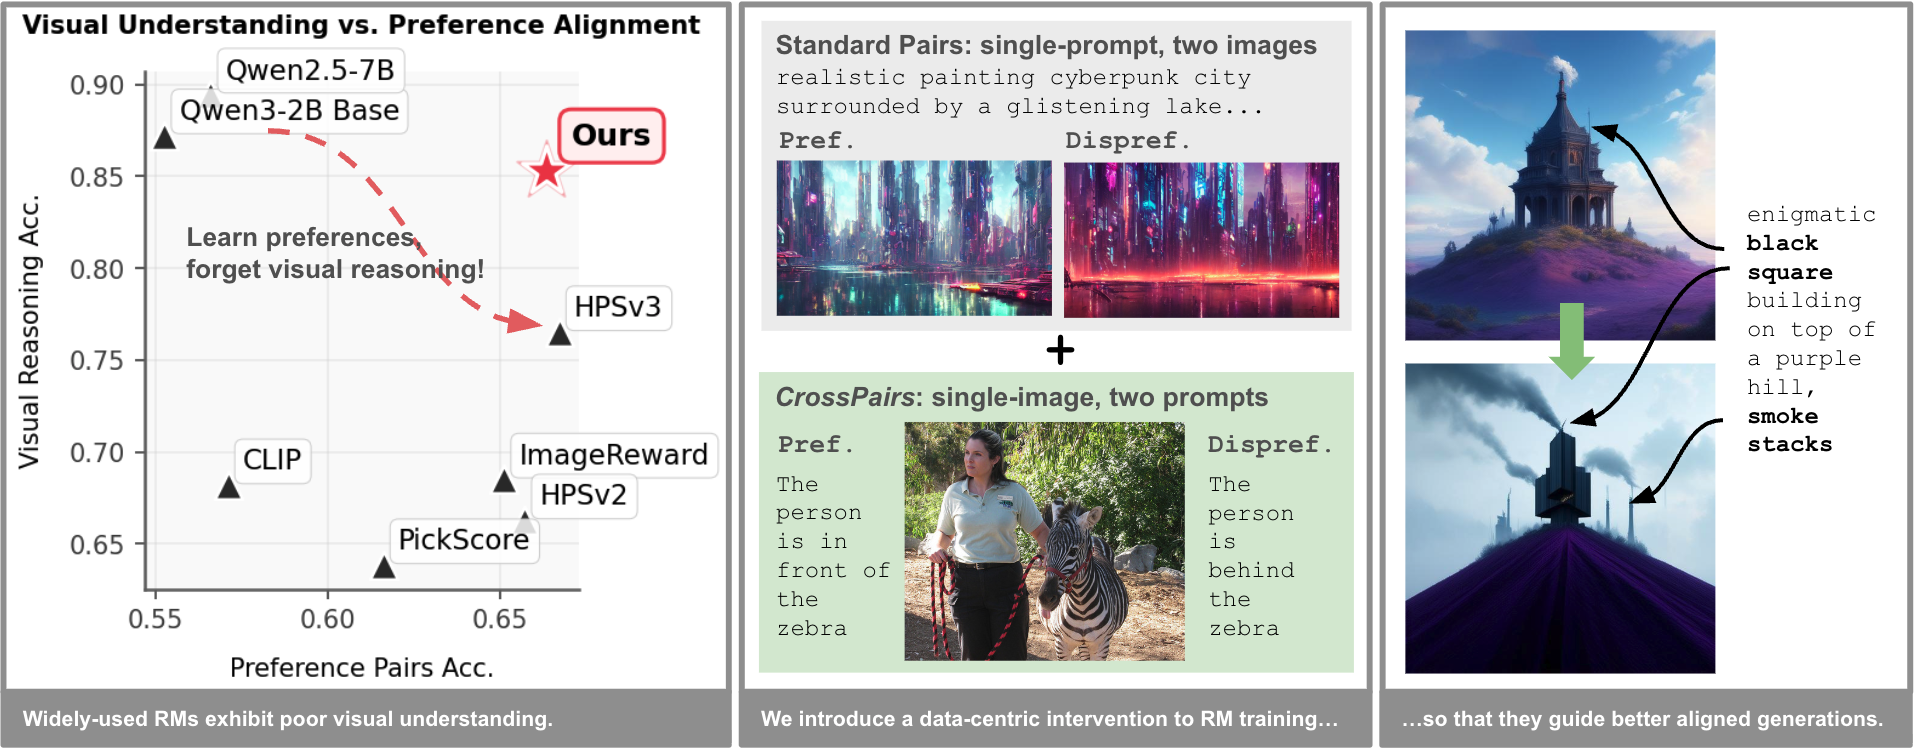
  • 本文贡献:CrossPairs 将现有视觉推理数据转成“同图、不同提示”的偏好对,和常规“同提示、不同图”的人类偏好一起训练奖励模型,减少审美差异对构图判断的干扰。奖励分数再用于 best-of-n 候选筛选或 DiffusionNFT 强化学习后训练;best-of-n 是生成 n 张后挑分数最高的一张。
图 1:左侧说明现有奖励模型的视觉理解较差:视觉语言骨干本来有较强推理能力,偏好微调甚至在稳健微调下也会侵蚀它。中间展示 CrossPairs:同一张图配不同提示,隔离图文对齐信号,避免审美差异混入;与标准偏好对混训使理解和偏好预测同时改善。右侧展示该奖励模型引导后,生成的组合准确性提高。
Figure 1 : (Left) Existing reward models exhibit poor visual understanding. VLM backbones possess strong visual reasoning, but this is eroded during preference fine-tuning, even with robust fine-tuning techniques. (Center) We introduce CrossPairs – preference pairs sharing a common image but differing in prompt – to isolate text-image alignment signal by eliminating aesthetic confounds. Mixed with standard pairs during training, our method achieves a Pareto improvement. (Right) The resulting reward model guides generations with superior compositional accuracy.
  • 实验效果:原文在 GenEval 组合提示实验中报告,用该奖励模型做 best-of-n 选择和 RL 后训练,相对比较奖励模型的平均生成提升分别为 4.0% 与 5.5%,并优于使用约 6 倍偏好对训练的 HPSv3。这里是特定生成器、采样与 GenEval 口径,非所有图像任务的胜率。
图 6:使用不同奖励模型做后训练后的生成样本。前三列的提示来自 Pick-a-Pic,后三列来自 GenEval;图展示指定样例的差异,不能替代完整基准分数。
Figure 6 : Generated samples after post-training with different reward models. The first three columns are prompts from Pick-a-Pic; the last three columns are prompts from GenEval.
  • 批判点评:训练数据混合 119765 对 ImageRewardDB 与约 3.7 万对转化的视觉问答偏好;同图换提示的负例质量会影响学到的关系。奖励模型改善生成只是经作者的筛选和 RL 流程观察,不能脱离这些流程泛化。

9. InfiHall-Bench:拆解自回归出图的幻觉

InfiHall-Bench: A Benchmark for Hallucination Evaluation in Autoregressive Text-to-Image Generation | 哈尔滨工业大学(深圳) | arXiv:2611.18053

关键词:文生图评测, 视觉自回归, 组合提示, 幻觉, 置信度加权

  • 前序问题:许多文生图评测提示太简单,或只测试单一属性关系,难定位视觉自回归模型在多要求同图时究竟漏了哪一项。粗到细生成中,早期语义错误也未必会被后续尺度修复。
  • 方法直觉:把可核查的属性、空间、动作、部件和场景要求组合起来逐项评测;微调时减少已能准确预测的 token 权重,让训练聚焦不确定内容。
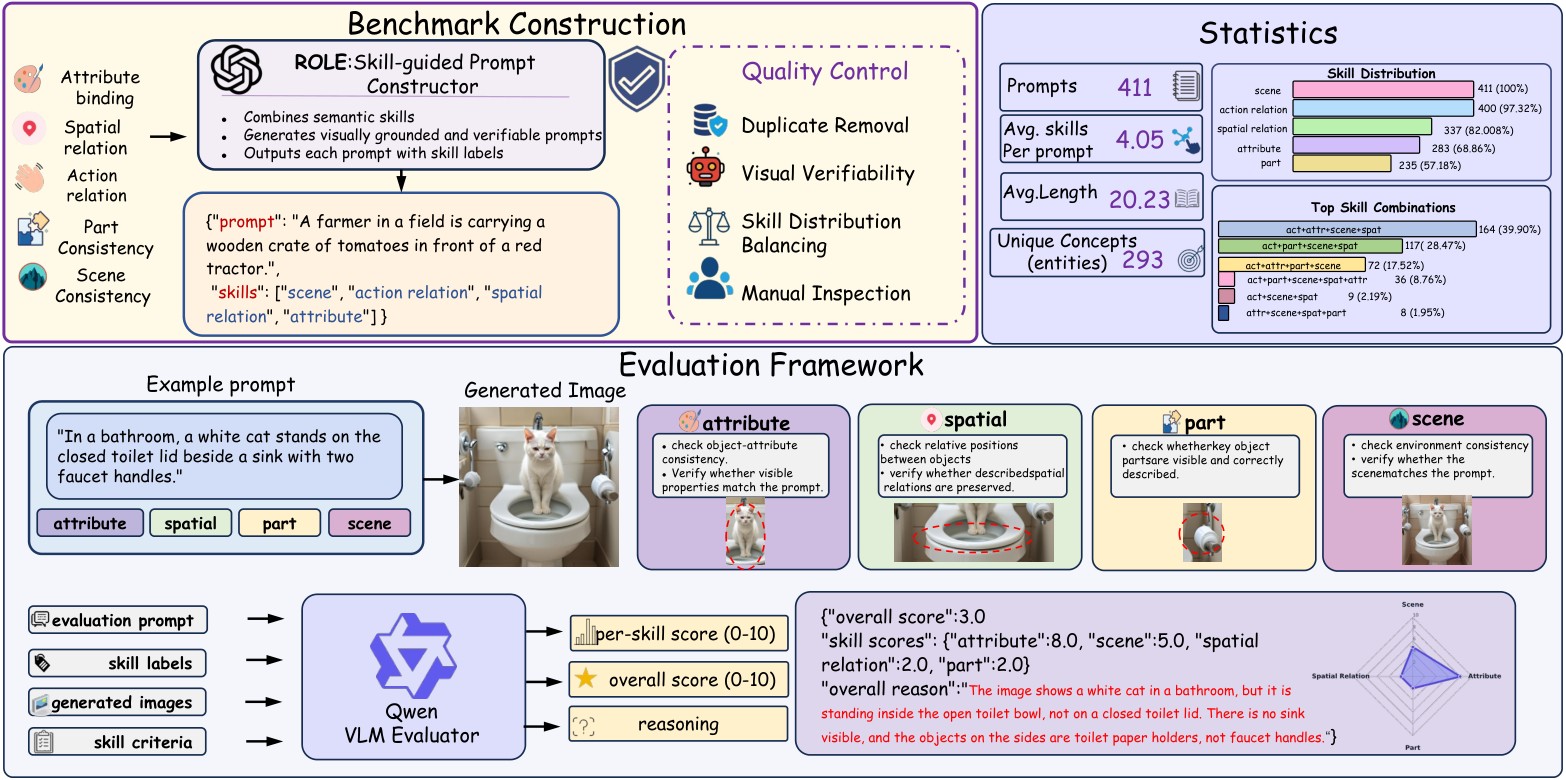
  • 本文贡献:InfiHall-Bench 由 411 条提示构成,每条平均标注 4.05 个技能;结果可追溯到具体未满足的要求。论文再提出 CMHM,在视觉自回归每个尺度的 teacher-forced 微调中按目标 token 置信度加权,降低易预测 token 权重,同时以干净样本回放约束模型漂移;推理结构不变。
图 2:InfiHall-Bench 的构造和评估。上半部分用五项可见技能引导提示构造并做质量控制;下半部分展示评审协议,输出总体分、逐技能分数和解释原因。
Figure 2: Benchmark construction and evaluation. The upper panel shows skill-guided prompt construction, followed by quality control. The lower panel illustrates the evaluation protocol to produce an overall score, per-skill scores, and reasons.
  • 实验效果:在作者用 Qwen3.7-Plus 打分的 InfiHall-Bench 上,Infinity-2B 用同数据均匀加权微调后的 Overall 为 57.30,CMHM 为 58.13;8B-512 为 63.80 对 64.77。分数越高表示同图满足更多明确要求;提升有但幅度有限。
图 4:Infinity-2B 的结果示例。由左至右分别是原始基线、均匀加权的 LoRA 微调、置信度蒙版幻觉缓解 CMHM,图注指出分数逐步提高;这是示例图,整体趋势需结合主表理解。
Figure 4: Result of Infinity-2b. The images from left to right belong to baseline,lora,CMHM,which show that the scores are getting higher.
  • 批判点评:主表是自动评审分数,不等同于人工判断;基准聚焦五类可见技能,未覆盖所有审美或知识需求。CMHM 需要额外计算逐尺度置信度,不能把无推理模块理解为无训练开销。

10. CoTTAGE:给音频生成打分还说清原因

CoTTAGE: An Explainable Judge for Text-to-Audio Generation | 台湾大学;Amazon AGI;NTU AI-CoRE | arXiv:2611.17644

关键词:文生音频评测, 音频质量, 文本相关性, 可解释评分, 人类偏好

  • 前序问题:文生音频只给一个相似度分数,难知道是漏了声音事件、顺序错了还是本身音质差;通用音频模型写的理由也可能脱离实际听到的声音。
  • 方法直觉:先让模型依据声音说明扣分原因,再预测文字相关性和整体音质;用人类成对偏好校准分数与理由,而不是只回归单个标签。
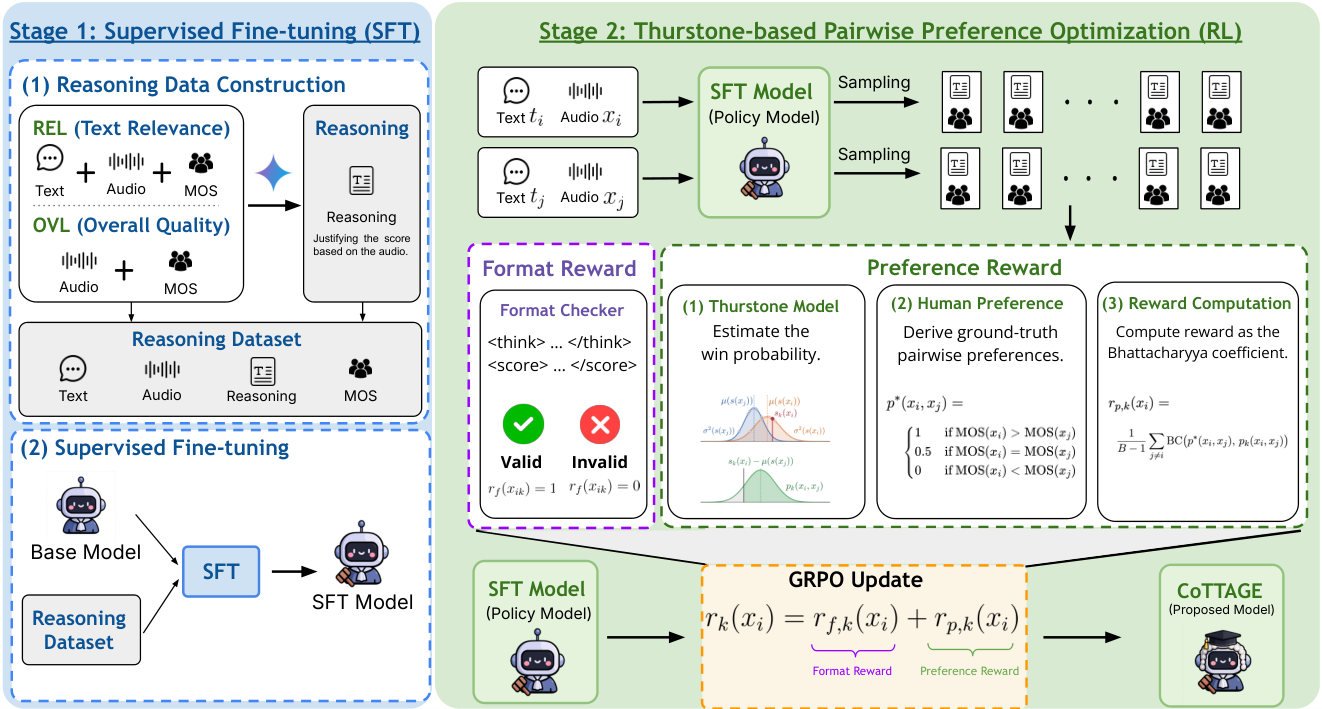
  • 本文贡献:CoTTAGE 基于 Qwen2.5-Omni-7B,先监督微调生成有音频根据的理由,再用 Thurstone 式偏好目标做强化学习;另外收集逾 1 万条整体音质 OVL 人工标注。分别评估文字相关性 REL 与整体音质 OVL;REL 看声音是否符合文字,OVL 看听感质量。
图 3:CoTTAGE 的完整训练流程,先以有音频依据的理由和分数做监督微调,再按人类偏好排序进行强化学习;图注原文仅称“整体训练流程”,其余步骤据图中标注说明。
Figure 3: The overall training pipeline of C o ttage .
  • 实验效果:在域外 Clotho 的文字相关性评测,CoTTAGE 对人工分数的 Pearson 线性相关 LCC 为 0.607,Gemini-3.1 Pro 为 0.548;LCC 越高越接近人工判断。其 OVL 在 Clotho 的 LCC 为 0.559,专用 PAM 为 0.445。结果依赖原文数据集和标注口径。
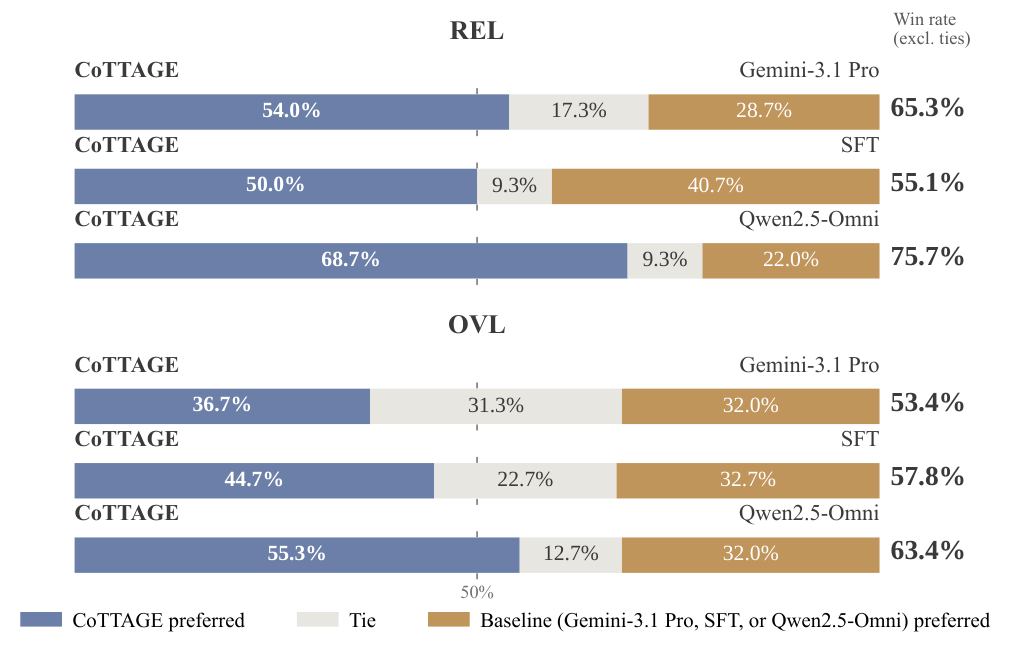
图 4:生成评分理由的人工成对评价结果;CoTTAGE 的解释分别与 Qwen2.5-Omni-7B、只做监督微调的版本,以及专有模型 Gemini-3.1 Pro 比较。
Figure 4: Results of human pairwise evaluation of generated scoring rationales. C o ttage is compared against Qwen2.5-Omni-7B, the SFT-only variant, and the proprietary model Gemini-3.1 Pro.

  • 批判点评:先生成解释再打分增加评估时延,解释即使在人类偏好测试中胜出,也不保证每句都是真实声学证据;模型对未知音频类型和新标注群体仍需单独测。

趋势观察

编辑的关键是保留该保留的内容

HarmonyText 用原图锚定未改区域,MusicFlux-Concat 让模型直接接触源音乐;两者面向不同模态,却都要同时满足新指令和旧内容的约束。

视频降本要把生成质量一起算

ReDiverse 修复少步蒸馏后的种子多样性,Token2Tile 缩短注意力计算,JVT 则探索像素空间的简洁主干;多样性、速度、几何一致性分别有不同代价。

生成的反馈信号越来越细

SST 用短语区域教生成分支,CrossPairs 用同图异提示训练奖励,InfiHall-Bench 和 CoTTAGE 分别定位图像要求和音频质量;自动分数仍需与人工判断校对。


今日讨论

HarmonyText 在作者的场景文字盲测里对 GPT Image 2.0 获选 61.7%,但对 Nano Banana Pro 仅 53.2%。若产品同时追求改字准确与背景不受损,如何验证未编辑区是否保留原貌,哪些指标和人工样例能揭示字体或材质失败?


人工智能炼丹君 整理 | 2026-11-17


更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」

每日更新 · 论文精选 · 深度解读 · 技术脉络

微信搜索 人工智能炼丹君 或扫描下方二维码关注

扫码关注「人工智能炼丹君」

0

评论 (0)

取消
粤ICP备2021042327号