今日 AIGC 论文速览
今日共 10 篇 · 参考引导修复与图像编辑 4 篇 · 视频生成与物理诊断 2 篇 · 图像训练加速 1 篇 · 声音与动作生成 2 篇 · 三维记忆世界生成 1 篇
重点论文标题列表
- AlbumVSR(普渡):拿相册修视频别修成另一人
- RADI3N(布法罗):挪动部件让纹理跟着走
- PicturePerfect(高通):同一个人换表情保住背景
- WeGenEditBench(腾讯):高分改图也要逐项查漏
- Any Forcing(西电):先把首帧做好再一步续拍
选读入口:修模糊人脸视频先读 AlbumVSR,重点看 0.586→0.670 的身份收益和未计入 0.07 秒的预处理;需要摆物体部件读 RADI3N,同一人照片换表情读 PicturePerfect,评测编辑是否漏要求读 WeGenEditBench。部署长视频再读 Any Forcing 的首帧 4 步与后续 1 步;训练扩散模型看 RadialObj,不把 FID 收益当墙钟倍数。交互音频读 MFlowAudio 的首块和解码代价;数字人读 TalkFlow 的单说话人协议。做世界模型前先用 GeoFlip 拆开事件与结构,最后对照 L3G-World 完整/快版及空间记忆增长。
今日论文速览
1. AlbumVSR:拿相册修视频别修成另一人
AlbumVSR: Identity-Preserving Face Video Super-Resolution from a Personal Photo Album | 普渡大学 | arXiv:2610.39001
关键词:参考引导视频修复, 身份保持, 流式扩散, 相册纹理
- 前序问题:模糊视频里,鼻眼细节已经丢失。单靠模型补清晰,可能补出一张好看却不像本人的脸;同一个人的其他照片能提供线索,但拍摄角度不同,不能直接贴上去。
- 方法直觉:把相册分成两份证据:一份回答是谁,另一份把皮肤等纹理转到当前脸朝向。前者整个人共用,后者逐视频窗口更新,让生成器参考身份与姿态对齐的细节。
- 本文贡献:以冻结的 FlashVSR-tiny 单步视频扩散 Transformer 为底座。MagFace 身份编码器与 CLIP 外观编码器将相册聚合成 4 个 token(模型读入的特征单元);先按质量加权中心筛除余弦相似度低于 0.5 的参考,若全被筛掉则保留最高质量一张。FLAME 人脸网格的 UV 纹理坐标融合出 512×512 图集,再按低清视频的 DECA 人脸拟合结果渲染 256×256 五通道视图,分 8×8 块得到 64 个纹理 token。每层交叉注意力追加这 68 个 token 的键/值,原文字缓存不变;仅训练相册头与秩 16 的 LoRA 低秩适配,共约 2300 万参数,约占 17.5 亿冻结参数的 1.3%。首窗 21 帧、此后每次推进 8 帧。
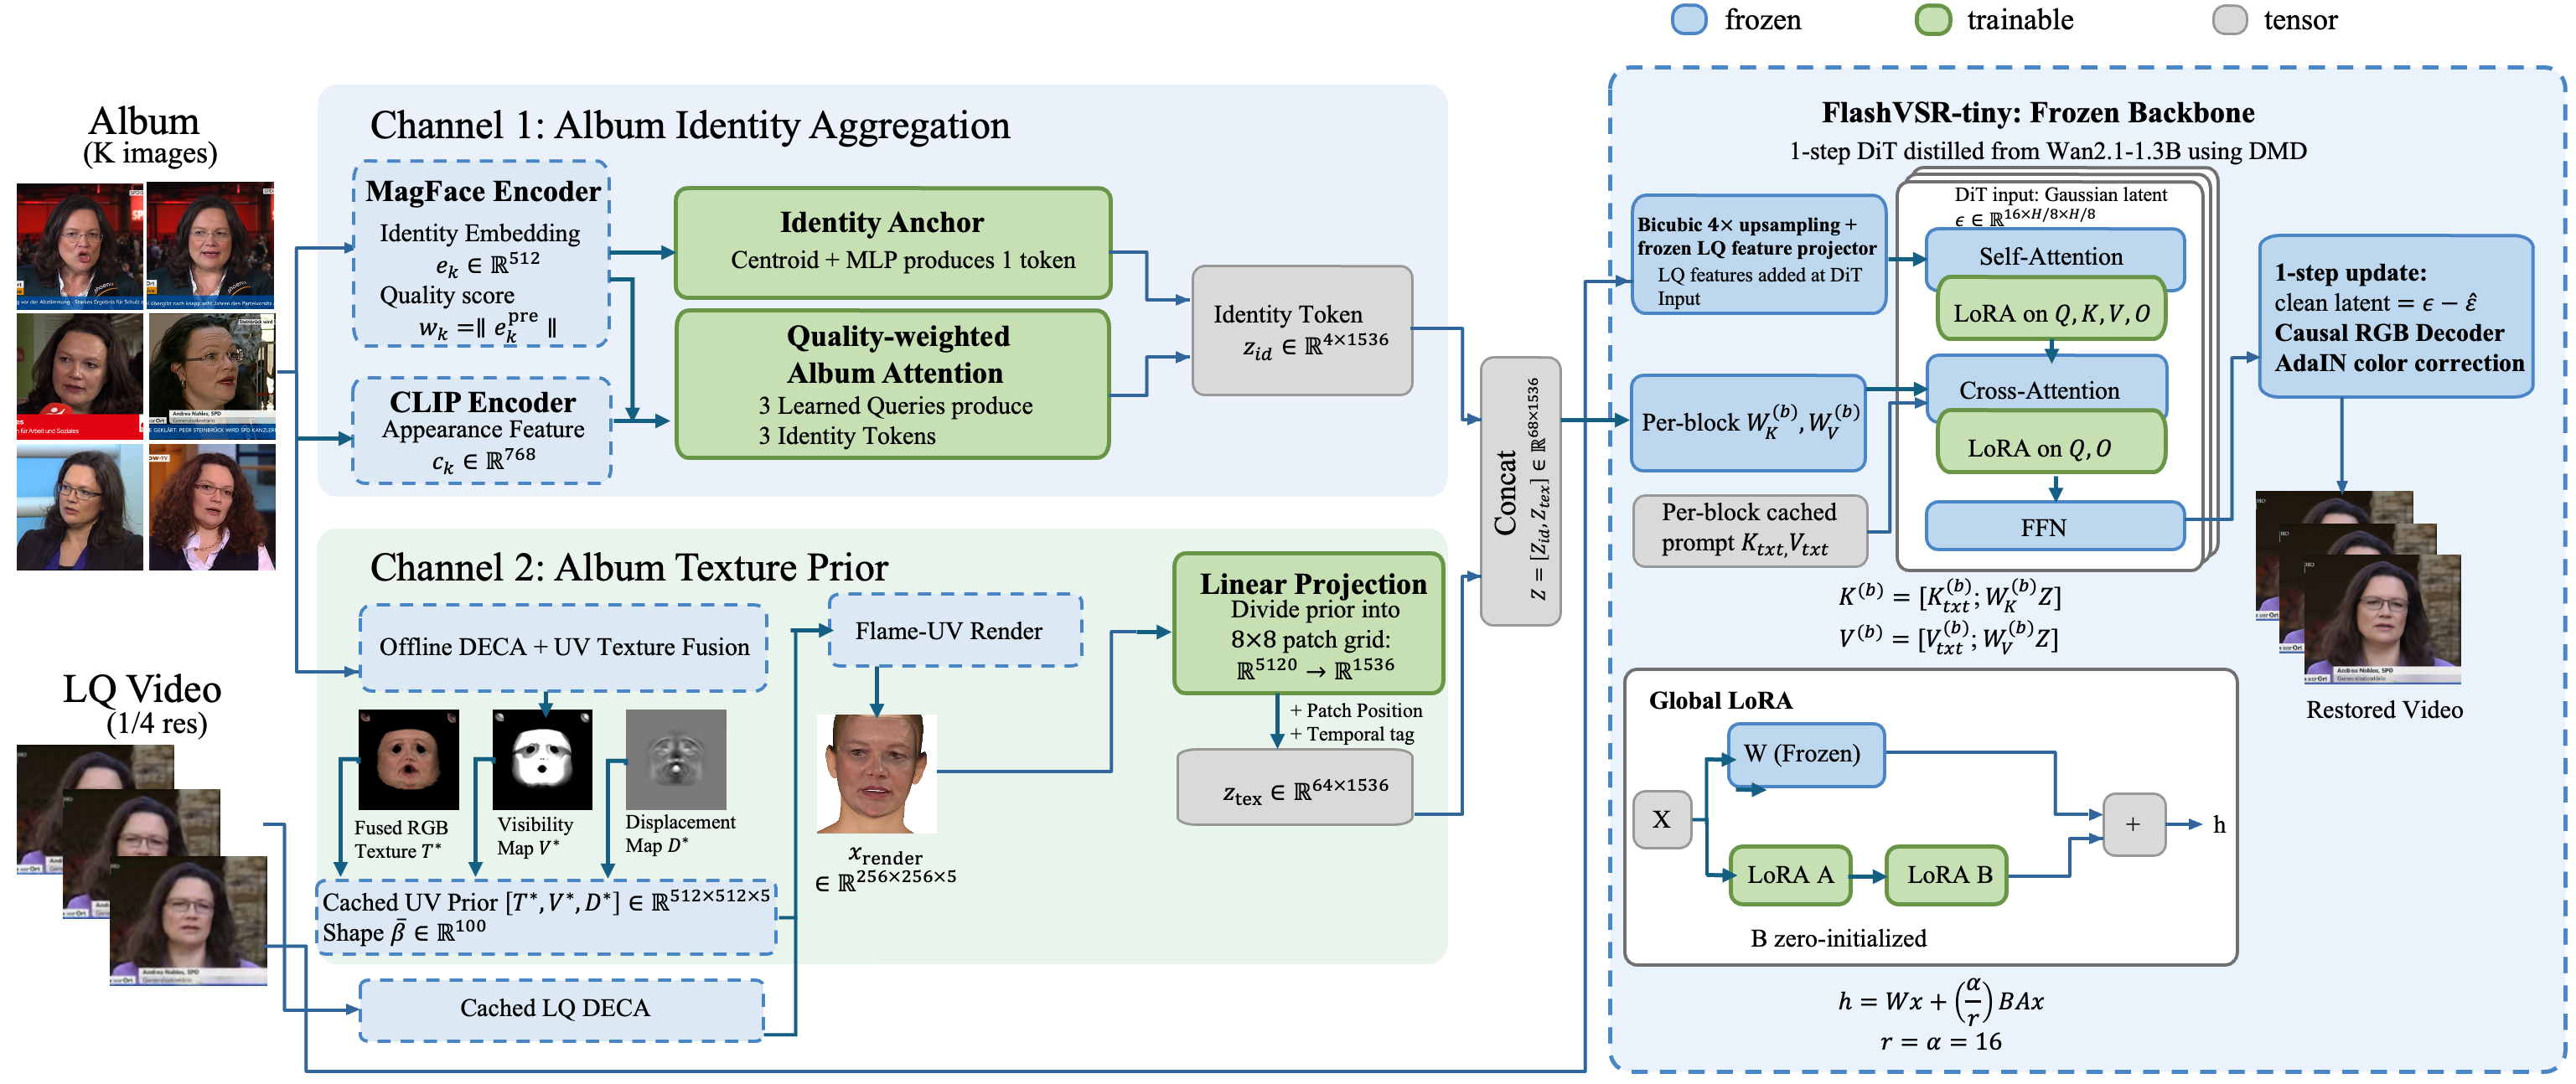 Figure 1|每个身份的相册只编码一次。4 个集合 token 承载身份;融合纹理、可见性、位移图逐流式窗口渲染并编码为 64 个 token。冻结 DiT 每层把相册键/值追加到文字缓存,训练只更新相册头与 LoRA。
- 实验效果:VoxCeleb2 的 488 个身份分 355 训练、42 验证、91 测试,测试相册来自不同拍摄会话,含 3–21 张、中位数 9 张。重退化含两轮模糊噪声、4 倍降采样和视频压缩;各视频只评分前 85 帧,输入另补 4 帧末帧副本,先身份内平均再等权平均。相对冻结底座,ArcFace 身份余弦 ID-GT 为 0.586→0.670,脸部峰值信噪比 PSNR-F 为 24.98→26.71 dB;按未舍入配对差计算的身份增益为 0.083,95%区间[0.072,0.095]。RTX4070Ti 修复调用 0.07 秒/帧,A100 为 0.04 秒/帧,含窗口 UV 渲染但不含离线相册编码与低清视频拟合。
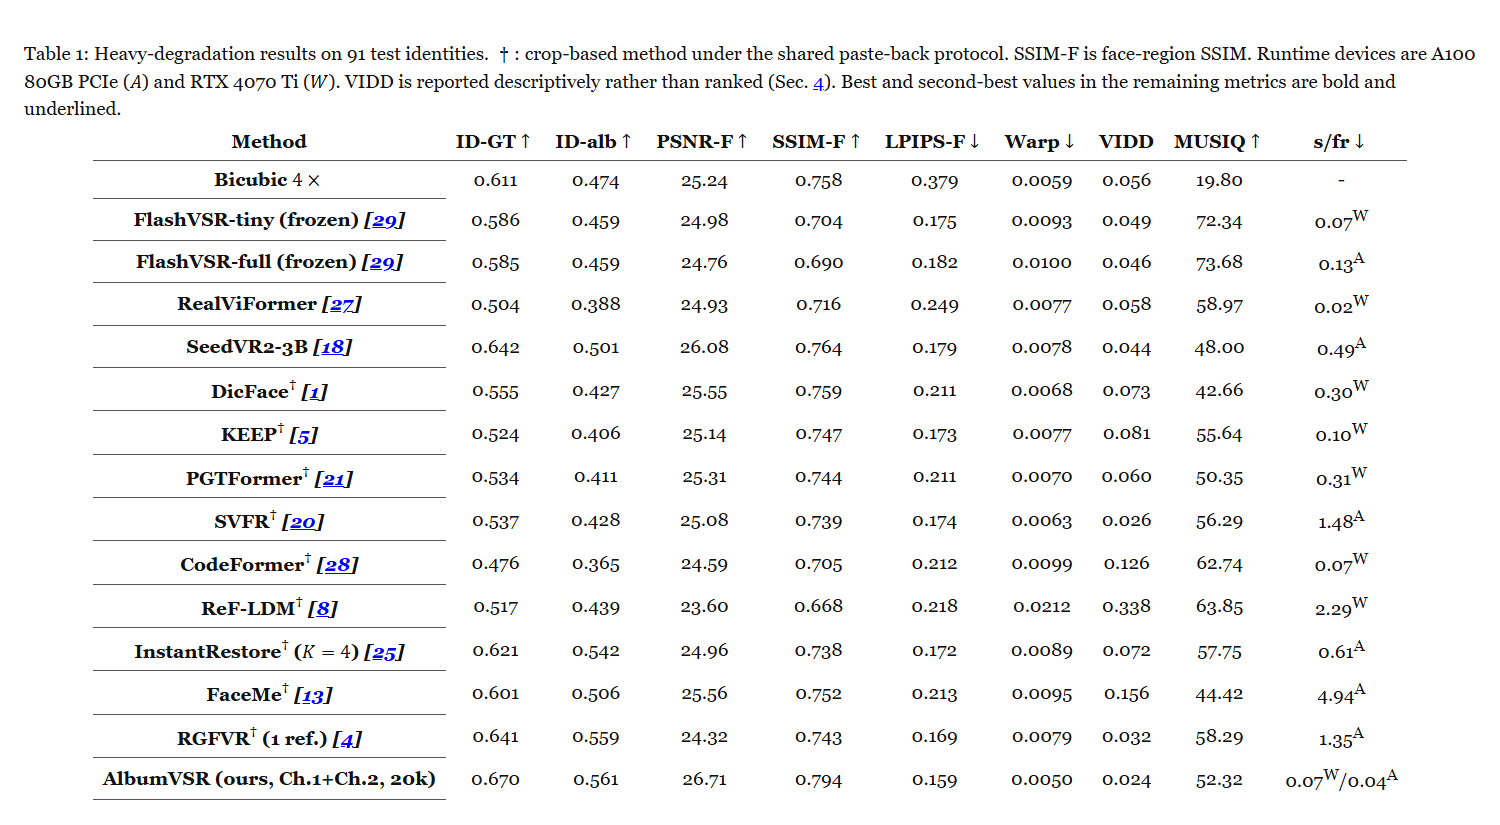 Table 1|91 个测试身份的重退化结果;剑号方法统一用裁脸后贴回协议。SSIM-F 为脸部结构相似,时延设备 A 为 80GB A100 PCIe、W 为 RTX4070Ti。VIDD 仅描述、不排名,其余指标粗体/下划线为最佳/次佳。ID-GT、ID-alb、PSNR-F、SSIM-F、MUSIQ 越高越好;LPIPS-F、Warp 和秒/帧越低越好,时延排除预处理。
- 批判点评:更像本人不等于所有画质指标都更好:无参考画质 MUSIQ 从 72.34 降到 52.32,轻退化下身份分也低于 SeedVR2。第 2 路纹理在最终 2 万步消融中身份只增 0.001、区间跨零,主要收益是 MUSIQ 增加 0.69。相邻帧身份变化 VIDD 低于真值不自动代表更自然。只测单数据集的合成退化与整理过的相册,尚未证明真实监控或受污染相册有效;0.07 秒不是完整直播时延。原文未给本方法官方代码链接。
2. RADI3N:挪动部件让纹理跟着走
RADI3N: GeometRic ImAge EDiting via ParametrIc 3D CoNtrol | 纽约州立大学布法罗分校;萨里大学;西蒙菲莎大学 | arXiv:2610.40973
关键词:几何图像编辑, 部件控制, 协方差平滑, 跨图注意力
- 前序问题:想只转动照片中鹦鹉的头,拖二维点可能把脖子拉断;即使三维形状摆对,生成器又可能把旧位置的纹理抄回来。形状控制和外观跟随要一起解决。
- 方法直觉:先在三维里摆好部件,再借原图恢复外观。部件边界的转动要平滑;借纹理时,弱化注意力对旧坐标的执着,让它找语义上对应的部位。
- 本文贡献:视觉语言模型定位物体与部件,SAM3D 把单图升为网格;多视角分割投到 UV 纹理坐标后投票,抽取稀疏控制点,接受三平移加三旋转的 6 自由度命令。CS-ARAP 在尽量保持局部刚性的变形求解中,先平滑邻域协方差再做奇异值分解求旋转,并加入双拉普拉斯项抑制边界曲率突变。随后用 IP-Adapter 图像条件与 SDS(借扩散模型给渲染图的梯度)细调网格。最终跨图注意力只调源图键的旋转位置编码 RoPE:去高频、放大低频,让纹理随新几何移动,无需把原图反演回噪声。
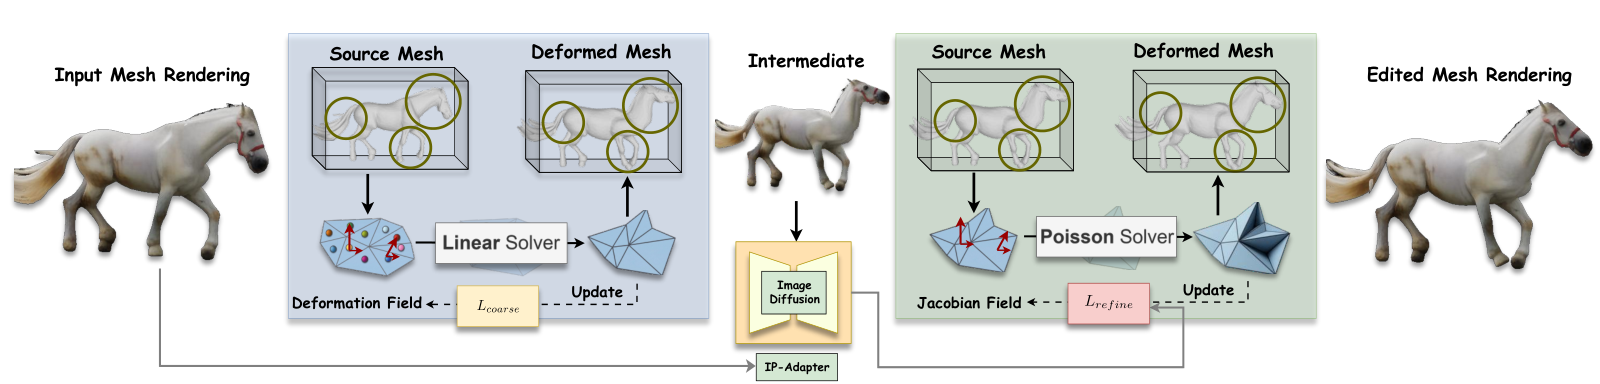 Figure 2|几何编辑流程。阶段 1:输入图升成 3D 网格,CS-ARAP 通过协方差平滑和双拉普拉斯求解得到平滑形变;中间渲染和源视图经 IP-Adapter 保持身份。阶段 2:将阶段 1 的雅可比场用控制点约束与扩散模型 SDS 梯度联合细调,生成语义合理的最终网格再渲染。
- 实验效果:GeoBench 含 811 源图、5988 条移动/旋转/缩放指令。相对 Nano Banana2,三轴平均绝对角误差 MAAE 从 12.04°降至 7.07°,误差不超过 5°的比例从 37.4%升到 78.9%;换独立 Hunyuan3D 重建器测角度后,本方法为 8.41°与 74.6%,说明收益不只来自复用 SAM3D 评分。端到端每编辑 95–100 秒,FlowDrag 为 120–135 秒,FreeFine 为 40–45 秒;CS-ARAP 单独求解 1.79 秒、69 次迭代,不等于完整编辑时间。
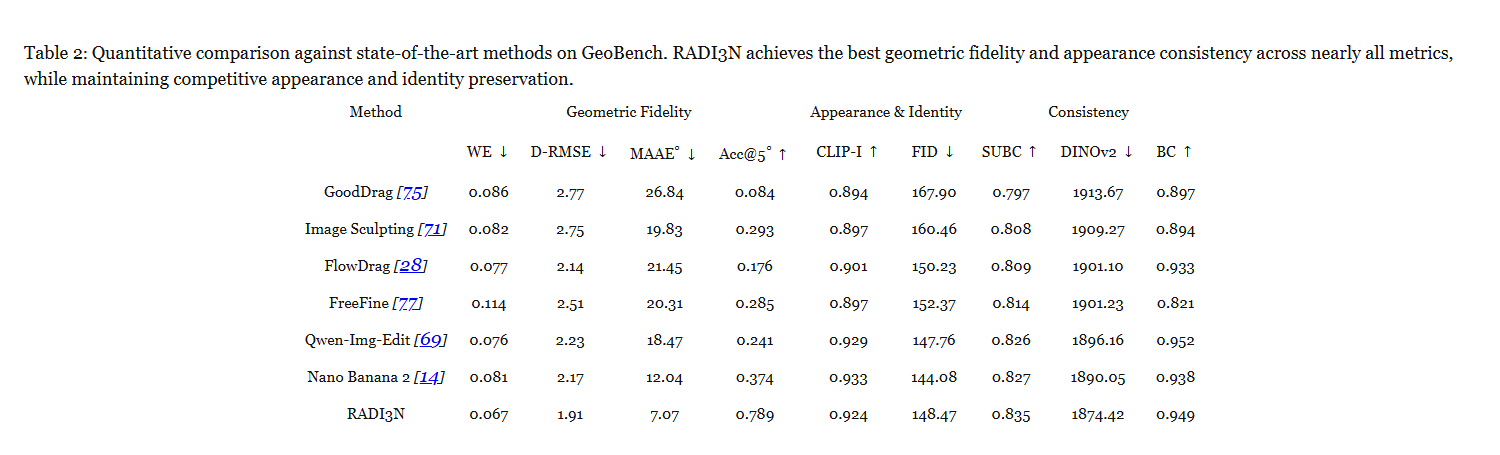 Table 2|GeoBench 几何与外观比较。WE 是变形误差、D-RMSE 是深度均方根差、MAAE 是三轴平均绝对角误差,均越低越好;Acc@5°为角误差 5°内比例。外观用 CLIP-I、FID、主体一致 SUBC、DINOv2 距离、背景一致 BC 评价;RADI3N 几何更准,CLIP-I、FID 与 BC 并非全部第一。
- 批判点评:几何更准有外观取舍:CLIP 图像相似度 0.924、图像分布距离 FID148.47,均不及 Nano Banana2 的 0.933 与 144.08。角度仍依赖自动重建,极端遮挡或初始网格错误可能传给后续优化;视频只是下游应用展示,不能写成已有视频参考编辑基准全面胜出。代码地址当前为空仓,尚无可核实实现;95–100 秒的硬件口径未在主文同处给出。
3. PicturePerfect:同一个人换表情保住背景
PicturePerfect: Diffusion-based Same-identity Facial Replacement | 高通 AI Research | arXiv:2610.39344
关键词:同身份面部替换, 表情编辑, SDXL, 光照增强
- 前序问题:合影中某人闭眼,另一张同一个人的照片表情正好。只传关键点会丢脸部细节,直接把参考脸贴过来又会带入错误光照、角度和背景。
- 方法直觉:训练时给模型看同一个人的参考脸,但故意打乱颜色、位置和照明,迫使它借表情与身份,再适应原合影,而非原样复制参考照片。
- 本文贡献:从目标图分割内脸,施加仿射、颜色、翻转及 NeuralGaffer 重打光增强,得到驱动脸。SDXL 的变分自编码器 VAE 先压缩图像,再把原图、增强驱动脸、带噪目标潜变量沿宽度拼接,训练扩散模型恢复目标。内部数据抽 25000 张中性脸,每张用 LivePortrait 生成 20 种表情,约 50 万图、6724 身份;每组 21 图可抽 420 个有序异图配对,总计可采样超过 1000 万对,并非 1000 万独立实拍。8 张 A100、有效批 64,微调 25000 步,图像训练尺寸 576×576。
 Figure 2|PicturePerfect 网络:从同身份源图 s 与目标 tg 中,将目标内脸分割为驱动 d;缩放、旋转、平移和重打光模拟现实变化。三图通过 SDXL 的 VAE 编码,源图、增强驱动和带噪目标沿空间宽度拼接,由文字条件扩散模型学习去噪。
- 实验效果:同分布测试从 FFHQ 与 VoxCeleb2 各合成 5000 样本:身份余弦 CSIM 为 0.818,LivePortrait 为 0.558;FID 图像分布距离 7.81,DAM 为 24.86,越低越好。跨拍摄条件测试中,真实 PicturePerfect 的 CSIM0.631、FID28.08,但表情距离 2.50 差于 HyperReenact 的 2.25,姿态距离也未领先。10 人对每人 252 个同分布、175 个跨分布输出作真假判断,本方法被判真的比例 59%和 44%,这是感知比例而非任务成功率。
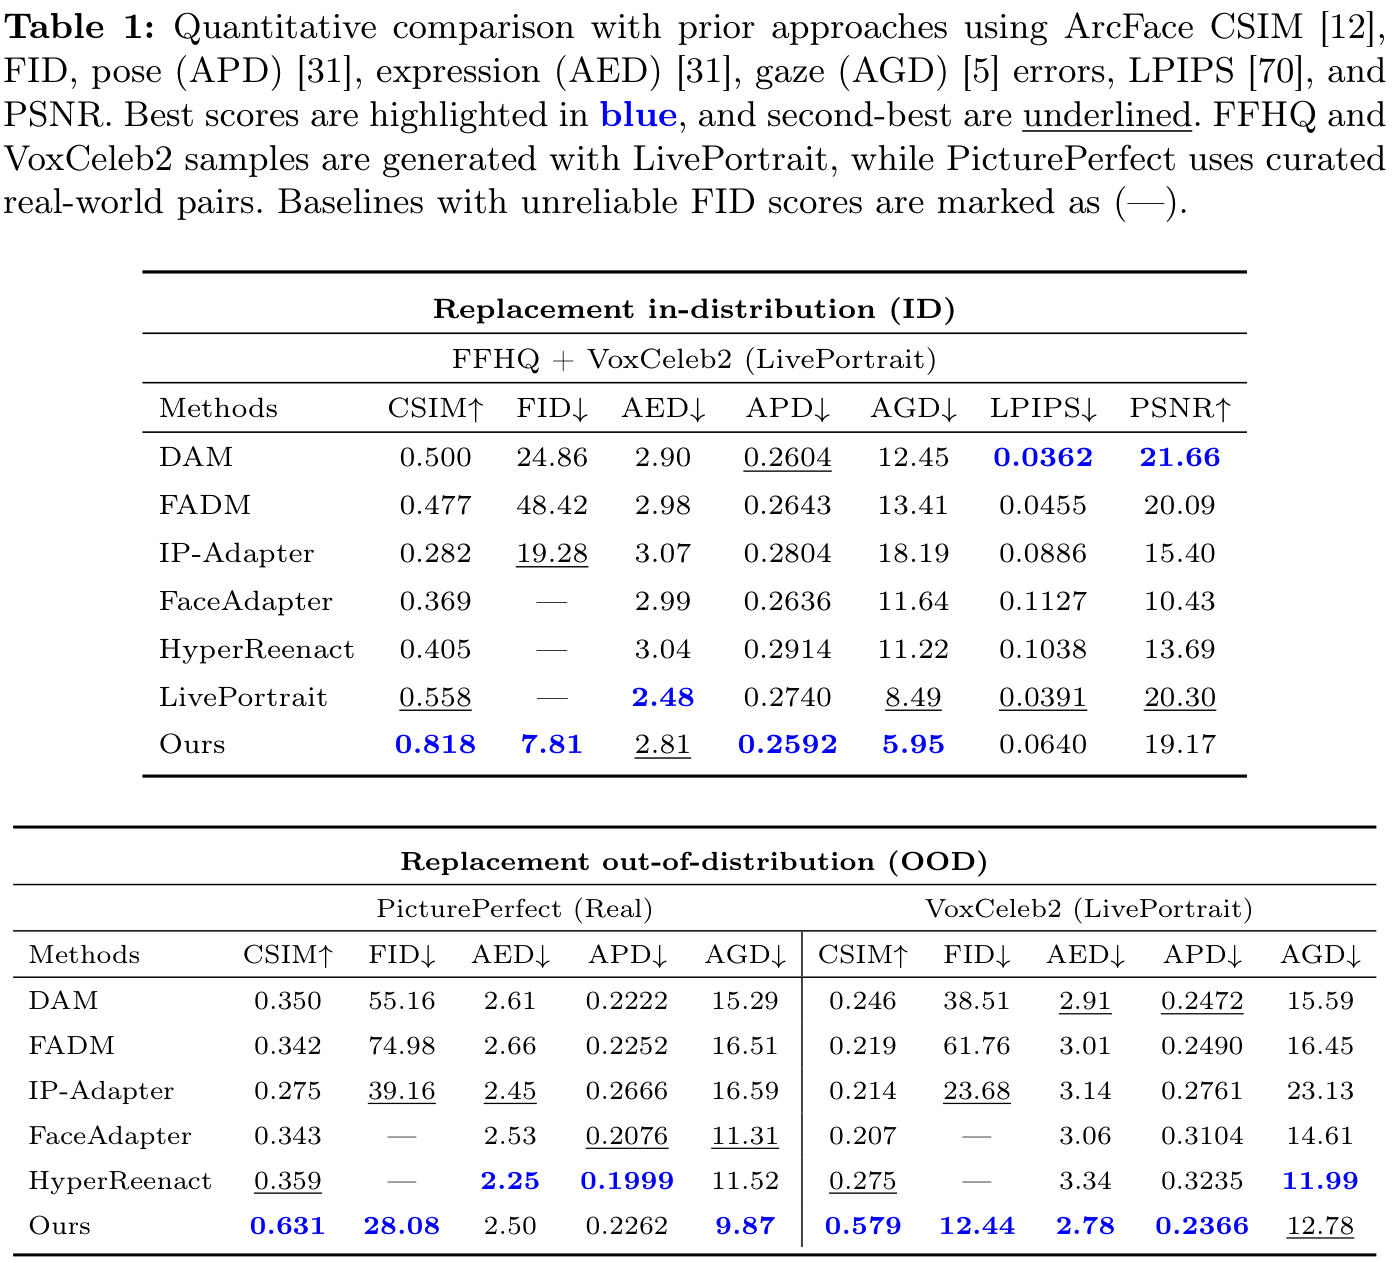 Table 1|与已有方法比较 ArcFace 身份余弦 CSIM、图像分布 FID、姿态 APD、表情 AED、视线 AGD、感知 LPIPS 和像素 PSNR。蓝色/下划线为最佳/次佳。FFHQ 与 VoxCeleb2 样本由 LivePortrait 合成,PicturePerfect 采用筛选的真实跨会话配对。不可靠 FID 记横线;上半同分布与下半跨分布分开评价,不能因身份胜出宣称姿态表情全胜。
- 批判点评:它专为同身份照片替换设计,不是跨身份换脸或视频时序模型。训练主要依赖 LivePortrait 合成,眼部、头发及极端脸尺寸仍会出错;PSNR 像素还原和 LPIPS 感知距离也并未全胜。没有增强时部分数字反而更高,作者将其解释为复制捷径,补充表中保留了这些反向结果。原文是 ECCV2026 生物识别生成模型 Workshop 终稿,不写成 ECCV 主会;数据是将来开放声明,未核到本方法代码,主文也未报告每图推理时间。
4. WeGenEditBench:高分改图也要逐项查漏
From Evaluation to Evolution: Benchmarking Image Editing and Evolving Image Models | 中山大学;腾讯 WeChat Vision;西安电子科技大学;复旦大学;清华大学深圳国际研究生院 | arXiv:2610.41210
关键词:图像编辑评测, 原子检查单, 定向数据, 低秩适配
- 前序问题:让模型把鞋子和摆件都变成银色,鞋子改得漂亮就可能拿高分,漏改的摆件被总分盖住。这样的反馈很难告诉下一轮训练到底缺什么。
- 方法直觉:评分前把需求拆成小检查单,先留下哪一项没做到的证据,再汇总;训练时只把失败类别与抽象条件传给新数据构造,避免照着测试图重新造题。
- 本文贡献:基准有 2740 实例、19 任务族、148 任务类型,覆盖单图、文字密集及多参考编辑。统一视觉语言裁判逐项记录扣分与理由,再给执行、保留、画质、专门要求四维 0–5 分;每子集 10%实例由 3 位专家抽审,修订后所有模型重评相关样本。WeGenEvoStudio 用失败诊断、检索新素材、合成监督、秩 16 的 LoRA 适配再重评。每个底座—基准单独训练 25000 例,分给 5 个弱类别各 5000 例;32 张 MLU590、每设备批 1,额外还有检索、生成与裁判调用成本。
 Figure 4|WeGenEvoStudio 把评价证据转为定向训练数据。诊断 Agent 挑弱项、形成数据处方,构造 Agent 检索概念或新的源图,合成生成与编辑任务;监督更新后重新评价闭环。图中的曝光编辑和分数条只用于示意流程,不代表独立量化实验。
- 实验效果:15 种模型配置中,GPT-Image-2 单图总分 4.076,Seedream5.0Pro 文字编辑 4.291;不同场景总分公式不同,不能横向直接当同一能力。GPT 单图中总分≥4 的 644 输出仍有 315 个含严重失败项,即 48.9%,不是全部输出的失败率。在报告选定的 Top-5 单图弱类别上,FLUX.2 总分 1.083→3.517;Qwen 编辑器 2.834→3.208,按未舍入值增 0.373、13.2%。目标类别因底座而异,前后只比较共同有效实例。
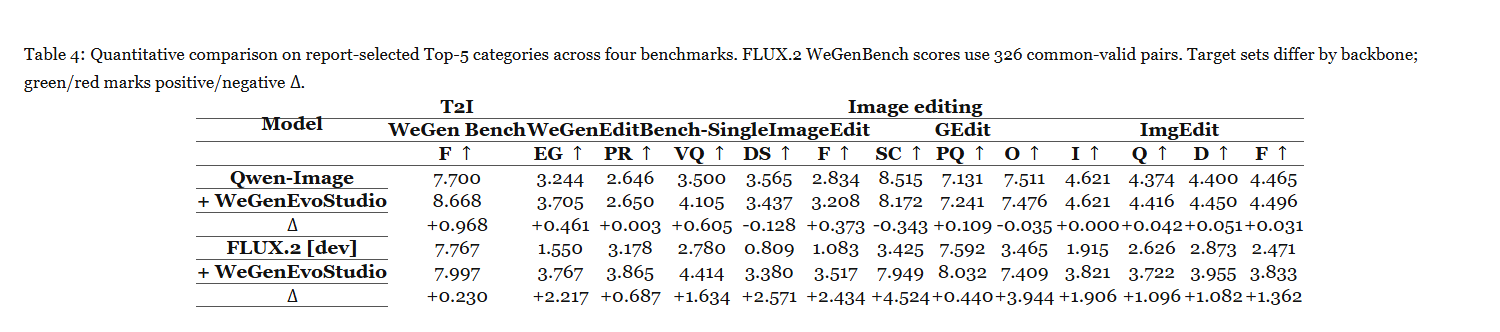 Table 4|四基准中报告选择的 Top-5 类别比较。FLUX.2 在 WeGenBench 使用 326 个共同有效配对;不同底座目标集不同,绿/红为正/负变化。T2I 列是文生图,其他为编辑;EG/PR/VQ/DS 分别执行、保留、画质、专门要求,F/O 为相应总分。数值展示专化收益及负向维度,不等于全基准或多轮进化成绩。
- 批判点评:Top-5 定向收益不能冒充全基准进步,更不能证明已完成多轮自主进化。Qwen 在 GEdit 完整基准总分反降 0.190,单图目标上专门要求分降 0.128;更会执行显眼操作仍可能破坏其他规则。裁判版本与少量无效响应影响有效样本,微小名次差未必稳健;检索消融也有动物类别退步。未核到本框架官方实现地址,不能把各底座开放当作系统已开源。
5. Any Forcing:先把首帧做好再一步续拍
Any Forcing: Any-Step Generality and One-Step Stability for Autoregressive Video Generation | 西安电子科技大学;华为计算技术研究所;华为诺亚方舟实验室 | arXiv:2610.42031
关键词:自回归视频, 一步采样, 对抗蒸馏, 长期记忆选择
- 前序问题:把扩散视频压成一步后,第一张潜在帧一旦模糊,后续就一路带偏;只留下最近画面,又容易忘记最初的主体。换采样预算时也常要重训模型。
- 方法直觉:训练时同时检查整段是否真实、少一步能否接近多一步、首帧是否够好。推理时保留开头和最近画面,再从旧画面里挑真正还有用的少量记忆。
- 本文贡献:以 Causal Forcing 的 ODE 蒸馏因果模型初始化 Wan2.1-1.3B 学生。共享判别器做真实分布对齐、相同步噪声的相邻步一致性及首帧增强,前 200 训练步另对齐教师常微分方程 ODE 采样终点;16 张 A100 训练 1000 次迭代,每次生成器更新配 5 次假分布评分模型更新。长视频保留 3 个全局锚点、2 个长期记忆及 1 个近期上下文;候选须同时比最弱记忆更贴近全局锚点和近期内容才替换。将历史位置按顺序映回训练 RoPE 位置编码范围,选择只用干净历史查询,不用当前纯噪声查询。
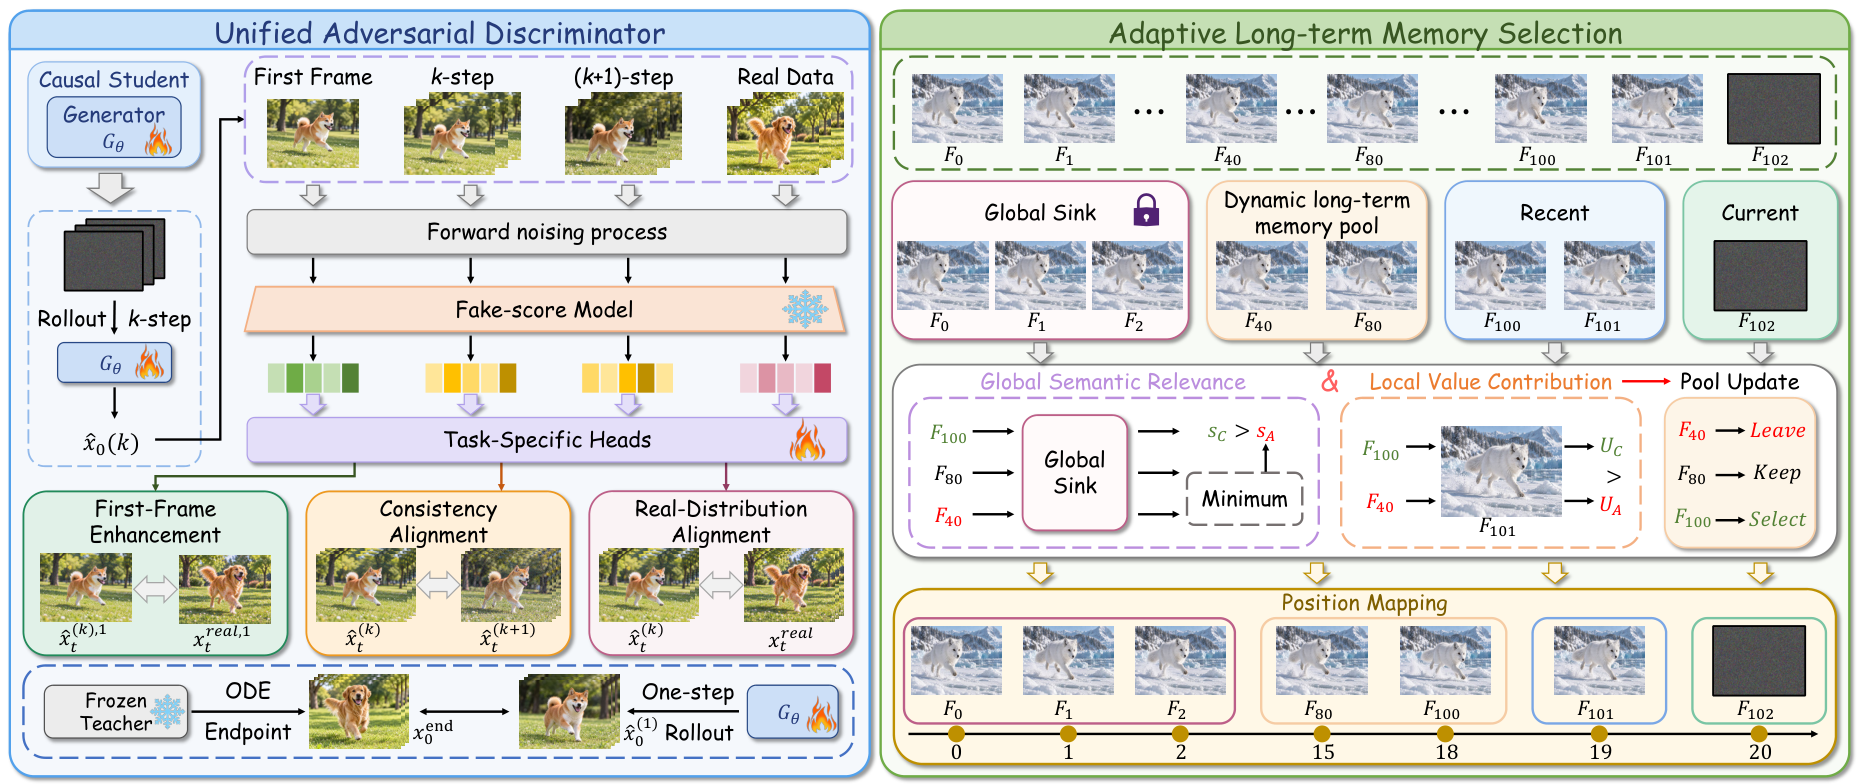 Figure 3|Any Forcing 整体。左:共享判别器联合真实分布对齐、跨步一致性和首帧增强,早期加教师 ODE 终点监督。右:全局锚点、动态记忆池、近期上下文组成记忆;按全局语义相关及局部价值判断新候选,随后将位置映入训练 RoPE 范围。图中 Fj 仅以视频帧示意第 j 帧。
- 实验效果:480p、946 提示各采 5 次,VBench 的 5 秒总分:4 步 85.09;首个潜在帧 4 步、以后 1 步为 85.06;首帧 2 步、以后 1 步为 84.79。这里 NFE 是每潜在帧的模型函数调用数,“一步”不代表全视频只调一次,也不代表首帧一步。30/60 秒在前一种计划下为 84.56/84.46。单 H100 短/长视频吞吐 20.9/24.7 帧每秒;长视频无训练选择机制,与生成器的蒸馏训练分开计。
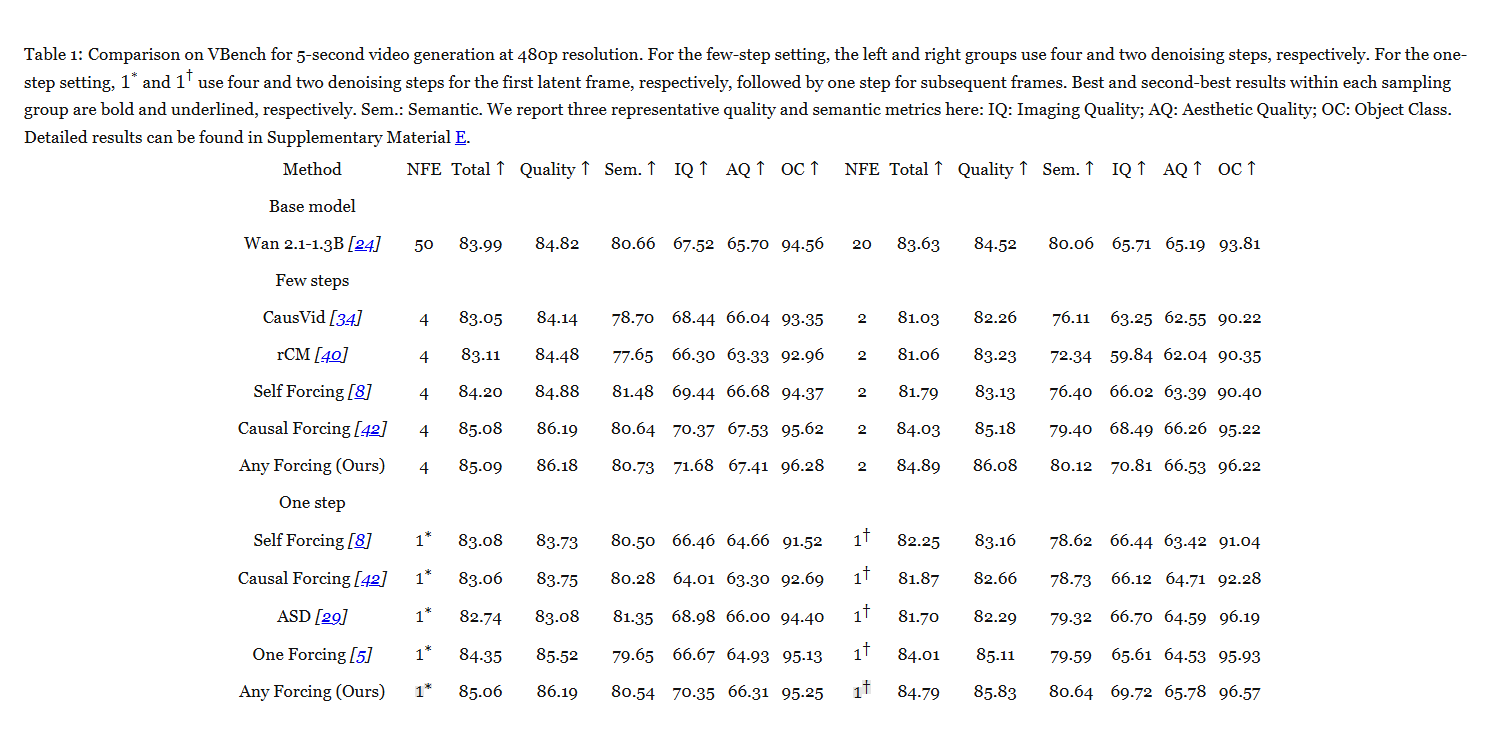 Table 1|480p 的 5 秒 VBench 比较,少步左右组分别 4 步、2 步;一步组 1*和 1†首个潜在帧分别 4 步、2 步,此后均 1 步。各采样组内最佳/次佳粗体/下划线;Sem 为语义,IQ 成像质量、AQ 美学、OC 物体类别,越高越好。完整维度另在补充材料,一步不能解释成全片一次调用。
- 批判点评:长视频对照把 Infinity RoPE 等记忆策略接到同一本文生成器上,主要隔离记忆策略差别,不能当成各原始系统直接排名。128 提示的消融不能说覆盖全部 946 提示;综合分接近也不证明每一维都不退步。固定容量会丢历史,60 秒稳定不等于无限记忆。官方项目有展示与评测,目前未提供可核实的代码仓链接;FPS 未给完整交互首帧响应时间。
6. RadialObj:让扩散更新别只挤少数通道
No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates | 延世大学;NAVER AI Lab | arXiv:2610.40914
关键词:扩散训练加速, 残差门, 通道参与度, 无教师正则
- 前序问题:给扩散模型加特征对齐,训练变快了,究竟是教师传来空间结构,还是模型内部更新方式也变了?只盯最终图像,很难分清原因。
- 方法直觉:Transformer 每个残差分支前有逐通道旋钮,控制该通道更新放进去多少。作者观察到,加速训练往往让更多通道共同承担更新,于是尝试只约束特征长度来改变这种分配。
- 本文贡献:AdaLN-Zero 用门向量α逐通道缩放残差输出,且同一门跨图像 token 位置共用。归一化参与比 nPR 为各门幅度平方之和的平方,除以四次方和再除通道数 D;若只有 m 个等幅非零通道,它为 m/D,衡量分配是否集中,不衡量更新总大小。Radial 目标在速度预测损失外,惩罚每张图全部 token 与通道拼平后的特征范数偏离目标 c,无教师、无样本两两距离。扫描 5 个目标后选 c=10√(ND),N 是 token 数,D 是通道数;前 5 次迭代校准辅助梯度约为主损失的 10%。
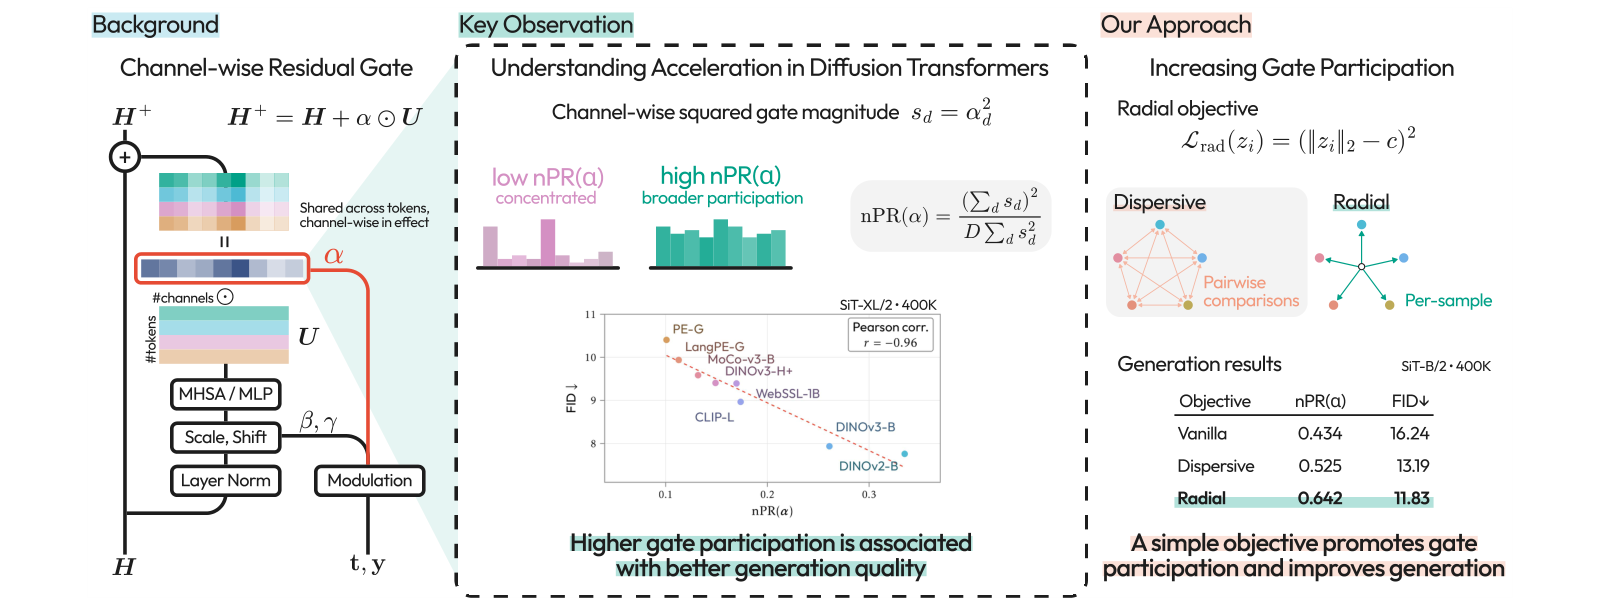 Figure 1|从残差门观察到训练改进。左:AdaLN-Zero 逐通道缩放残差输出,同门跨 token 位置共享。中:nPR 衡量门幅度平方在通道上分配的均匀程度,跨 REPA 教师更高的平均参与度与更低 FID 相关。右:Radial 只惩罚每样本特征范数,不需预训练教师或样本两两比较。
- 实验效果:ImageNet256×256、SiT-B/2 训练 40 万步:FID 图像分布距离从普通训练 16.24、Dispersive13.19 降到 11.83,越低越好;末层门平均 nPR 从 0.434、0.525 升到 0.642。这里在 101 个扩散时间点×1000 类别上计算后平均。带教师的 REPA 仍更好,FID7.71;Radial 的空间 FID 为 5.27,略差于 Dispersive5.25。它是在同训练步数改善质量,不能直接换算同等质量墙钟加速倍数。
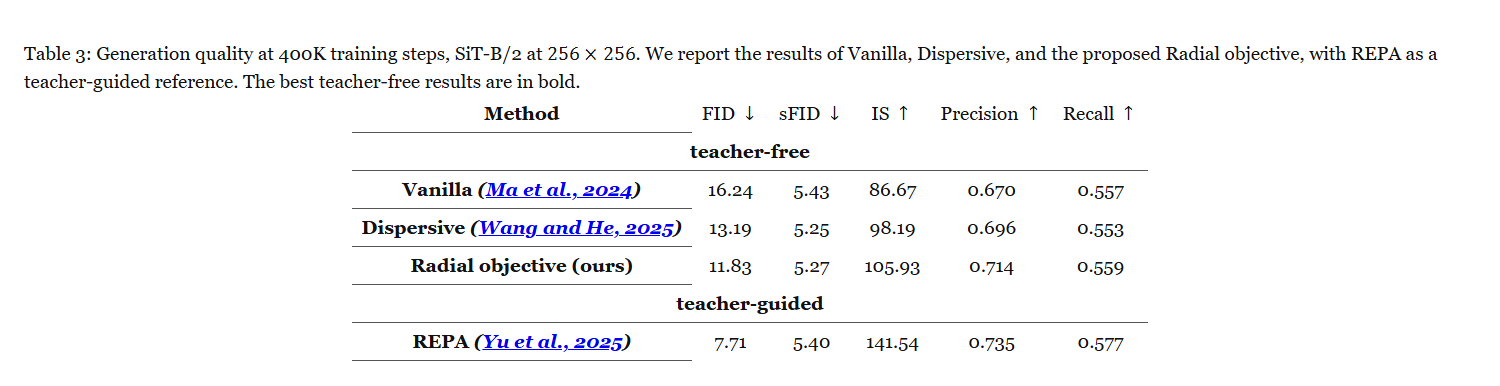 Table 3|ImageNet256×256、SiT-B/2 训练 40 万步,比较普通训练、Dispersive 和 Radial,REPA 是带教师参考;最佳无教师结果加粗。FID 和空间 FID 越低越好,IS、精确率和召回率越高越好;Radial 的 FID11.83 优于 13.19,但空间 FID5.27 略差于 5.25,REPA 的 FID7.71 仍更优。
- 批判点评:相关性不是完整因果证明:训练后把门强行拉均匀并不总能改善质量。理论只在忽略跳连交叉项、通道对称等条件下讨论局部门空间小步,不能保证实际优化器每步都提高参与度。目标范数经 FID 选优,这份搜索也有成本;研究以 ImageNet 类别条件模型为主,尚未验证任意文生视频。论文给的代码链接当前 404,不宣称可复现。
7. MFlowAudio:边出声音边接新的提示
MFlowAudio: Efficient Text-to-Audio Synthesis via Mamba-based Stateful Flow Matching | 伦敦大学学院;伦敦国王学院 | arXiv:2610.41852
关键词:文生音频, 有状态流匹配, 双轴Mamba, 动态提示
- 前序问题:想先听人群再听马鸣,整段生成必须等完,分段生成又可能在提示切换处咔哒一下。普通注意力还会随时长积攒越来越多历史缓存。
- 方法直觉:像逐行读谱一样沿时间保留固定状态,再横着看潜在通道间的联系;每块接上上一块状态,换提示时削弱与旧状态重复的驱动力,让新声音接进来。
- 本文贡献:TCMamba 把时间扫描与通道扫描结合,用流匹配学习从高斯噪声到声音潜变量的连续速度场;VAE 负责波形压缩/解码,文字用 T5 编码。有状态流匹配 SFM 按块缓存每次前向的终态,在固定块长、通道数和文字长度下,状态缓存不随总时长增大。SDCG 即状态解耦条件引导,在切换边界额外做一次带历史但无文字的前向,区分新文字与旧声音贡献;不是完全免费控制。44.1kHz 数据训练,581M 约 5.81 亿参数,8 张 H100、每卡批 64 训练 100 轮。
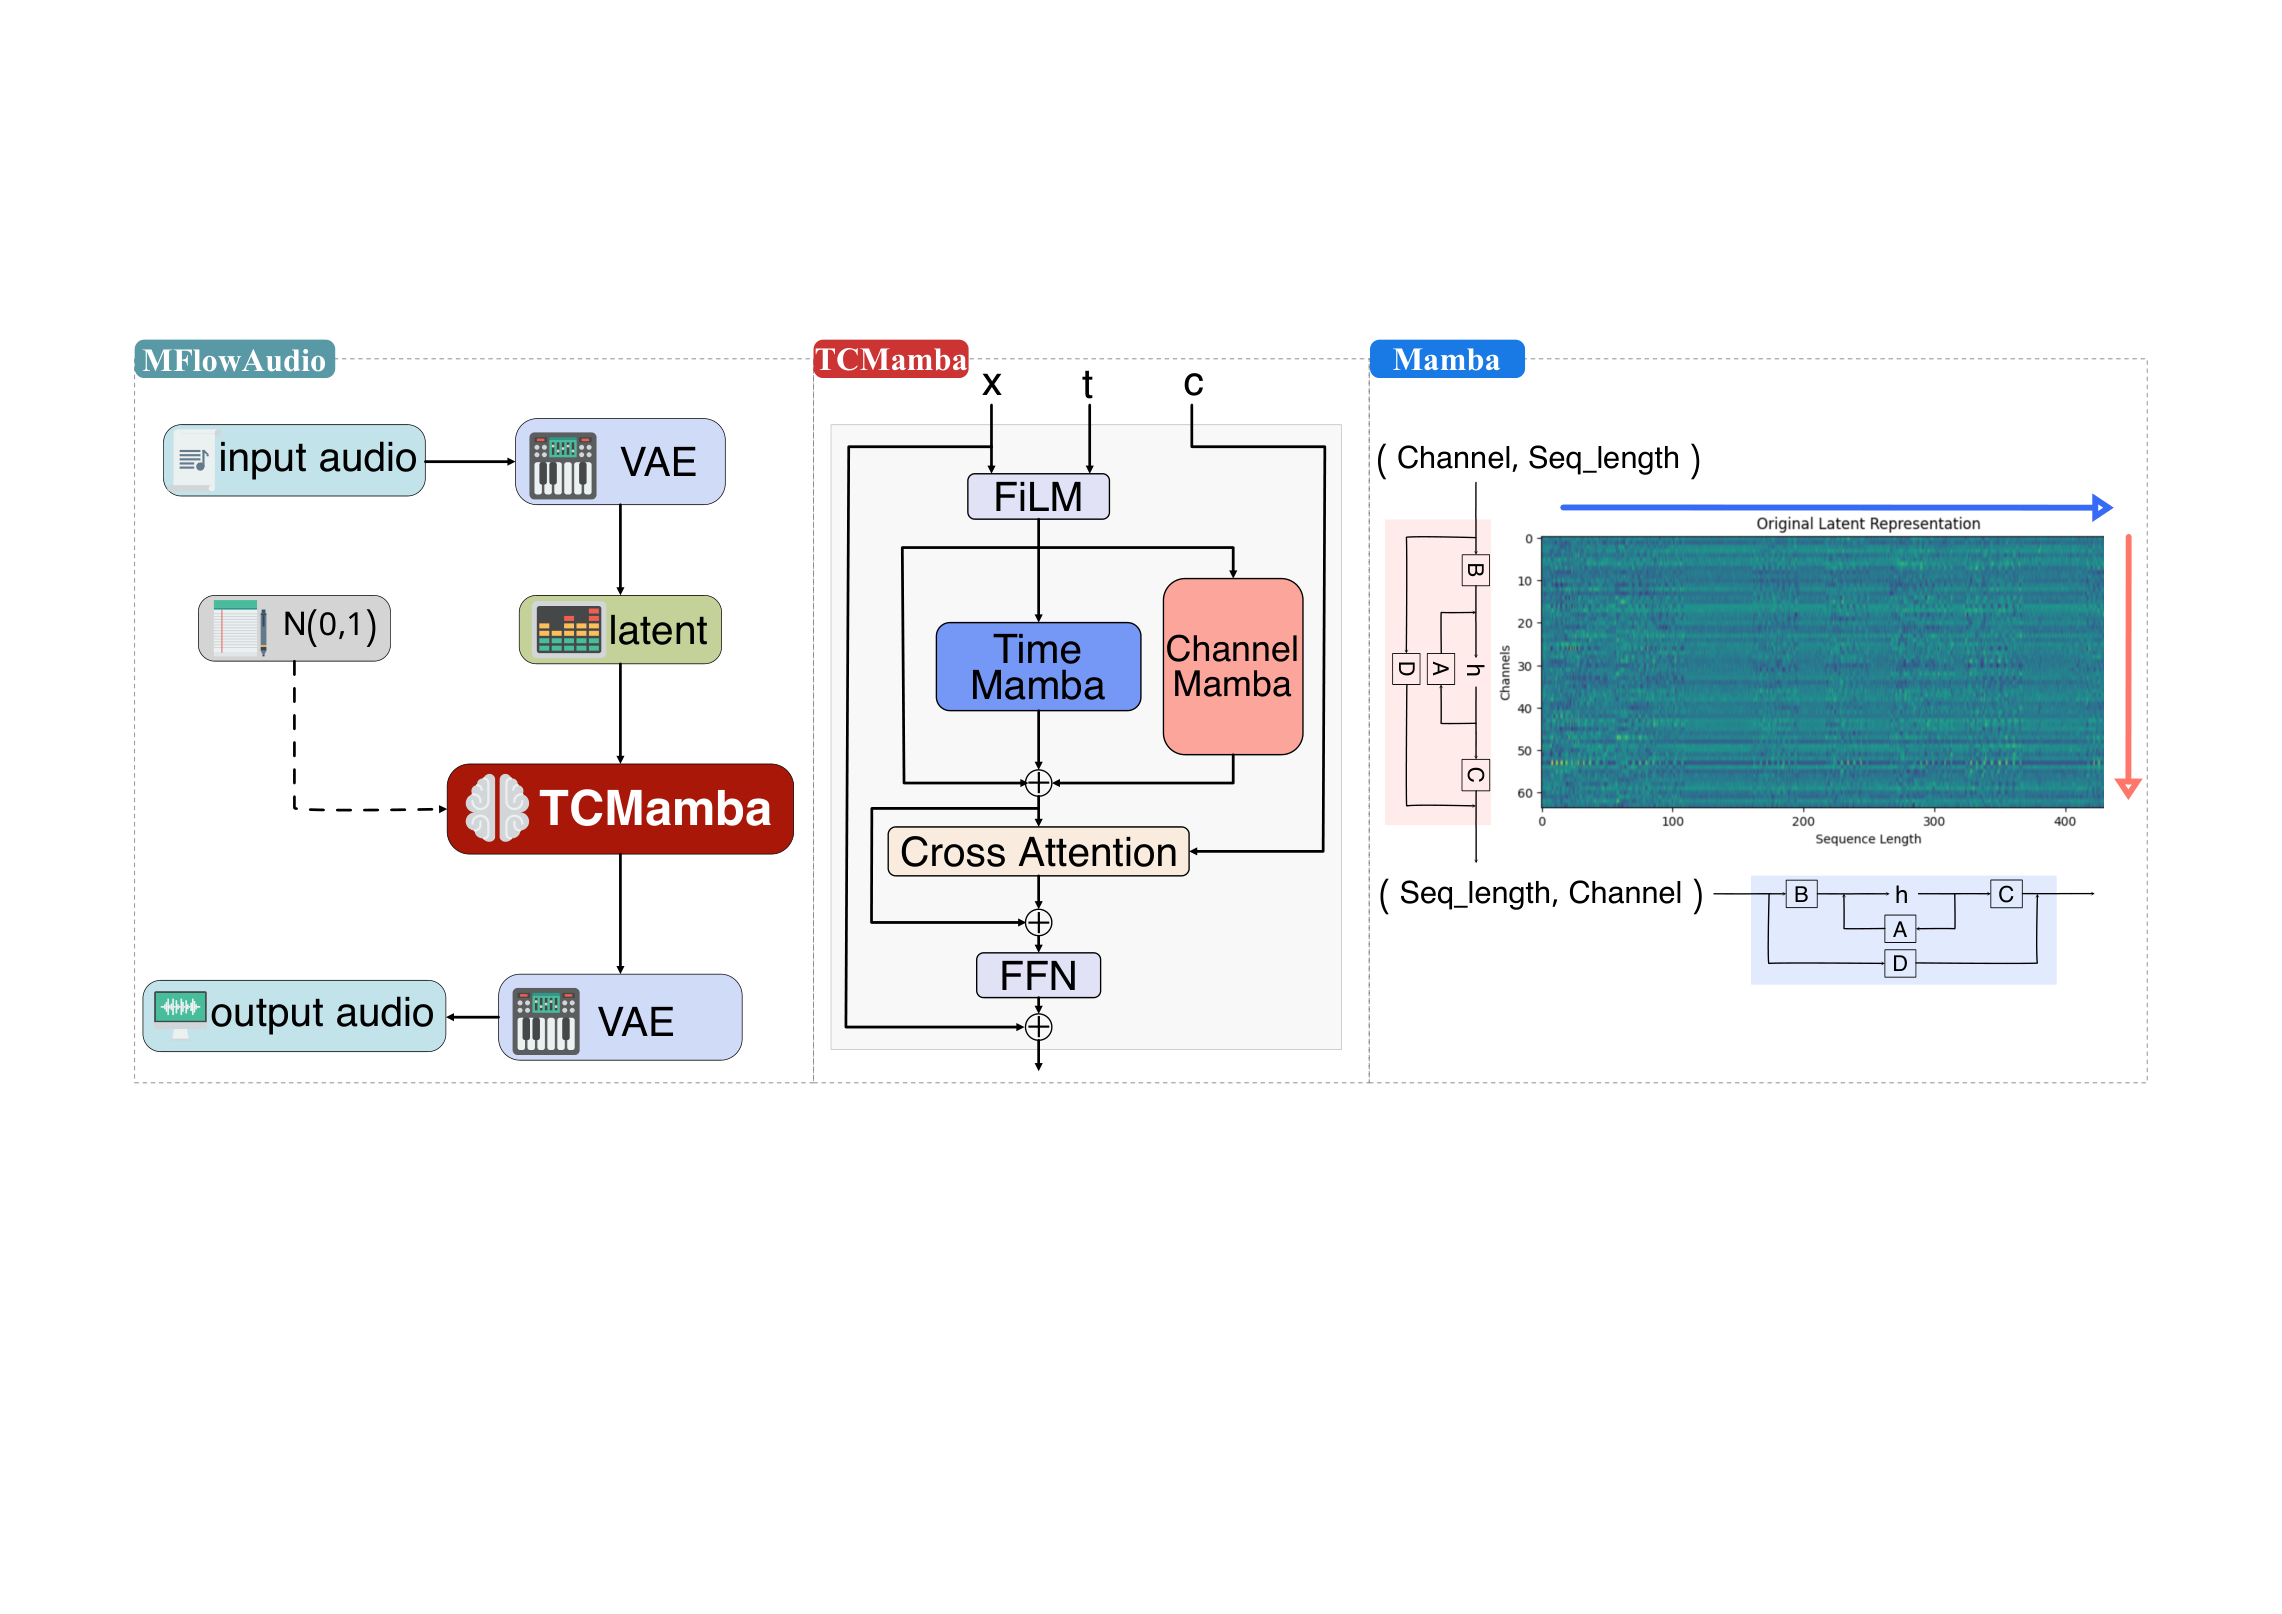 Figure 1|MFlowAudio 关键组件。左:VAE 及声码器在声音和潜变量间编码/解码,噪声经 TCMamba 变成声音。中:TCMamba 块含文字与时间调制、时间 Mamba、通道 Mamba、交叉注意力及前馈层。右:沿时间和潜通道的双扫描机制分别捕获时间依赖与跨通道关系。
- 实验效果:单 RTX5080/16GB、20 次平均,10 秒音频耗 1.93 秒,TangoFlux3.51 秒;30 秒耗 3.10 对 3.55 秒,后者延迟降低约 12.7%,不是 14.5%少耗时(14.5%对应速度比提升)。64 个潜在位置约 3 秒一块,首块约 1.8 秒。AudioCaps4352 测试样本的 10 秒结果:FD 音频特征分布距离 11.8569 优于 15.8429,但 VGGish 特征 FAD 距离 2.5248 差于 2.1963;文字声音对齐 CLAP0.4957 也略低于 0.4990。动态提示边界谱变化比 BBR 为 4.3287,TangoFlux 为 11.6443,越低表示切换点相对背景变化更平滑。
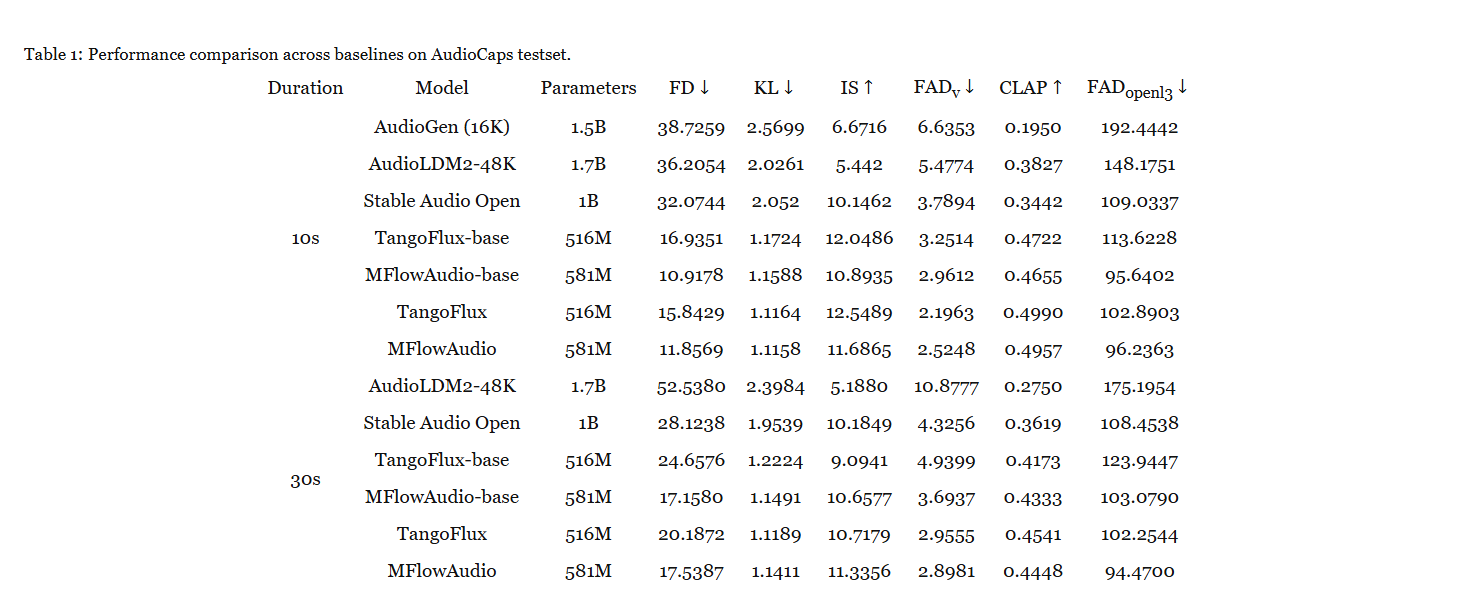 Table 1|AudioCaps 测试集的 10 秒/30 秒结果,参数列 B 为十亿、M 为百万。FD、KL 及 VGGish/OpenL3 特征 FAD 越低越好,IS 及 CLAP 对齐越高越好;base 与后续微调配置分列,不应跨列混搭。MFlowAudio10 秒 FD 占优,但微调后 VGGish-FAD 与 CLAP 仍不及 TangoFlux。
- 批判点评:不能把固定 18MB 的状态缓存当成整个系统显存恒定:它按一次前向计,采样步数及解码器仍有开销。非因果 VAE 要重叠和前瞻,边界控制还额外前向;完整播放时延需连解码一起算。消融中引导的 BBR4.3287 反差于未经调整的 4.2633,控制服从与平滑有取舍;BBR 也不等于听感无瑕。arXiv 评论标注 NeurIPS2026,但正文不扩写奖项;演示页存在,未核到本方法完整训练代码。
8. TalkFlow:嘴脸和身体分开生成再协调
TalkFlow: Structured Latent Flow Matching for Speech Driven Holistic Motion Generation | 纽约州立大学石溪分校;Futurewei Technologies | arXiv:2610.40972
关键词:语音驱动动作, 三流潜空间, 流匹配, 面身协调
- 前序问题:数字人嘴型跟上了,手势却慢半拍;把脸与全身都压进同一表示,又可能丢表情细节。它们节奏不同,但必须演同一段话。
- 方法直觉:先让整套骨架记住身体连接关系,再把上身、下身、表情分三路压缩与生成,用少量可控的信息交换协调,而非各自生成后硬拼。
- 本文贡献:SMPL-X 参数化人体含 55 关节旋转与 100 表情系数。先用整身图卷积保留拓扑,再形成上身/下身/表情三路连续潜变量;自编码器与生成器都用 FiLM 按特征缩放偏移并加门,连接上身—下身及上身—表情,无直接下身—表情边。HuBERT 语音、Librosa 声学、FastText 词向量和 SBERT 句向量组成分路条件,不能省略转录文字。冻结解码器后以流匹配从随机噪声生成动作,并加积分后解码的重建损失。训练窗 240 帧即 8 秒,时间压缩 4 倍;长序列推理只重叠 8 原始帧、线性混合与平滑,区别于训练分段重叠 60 帧。
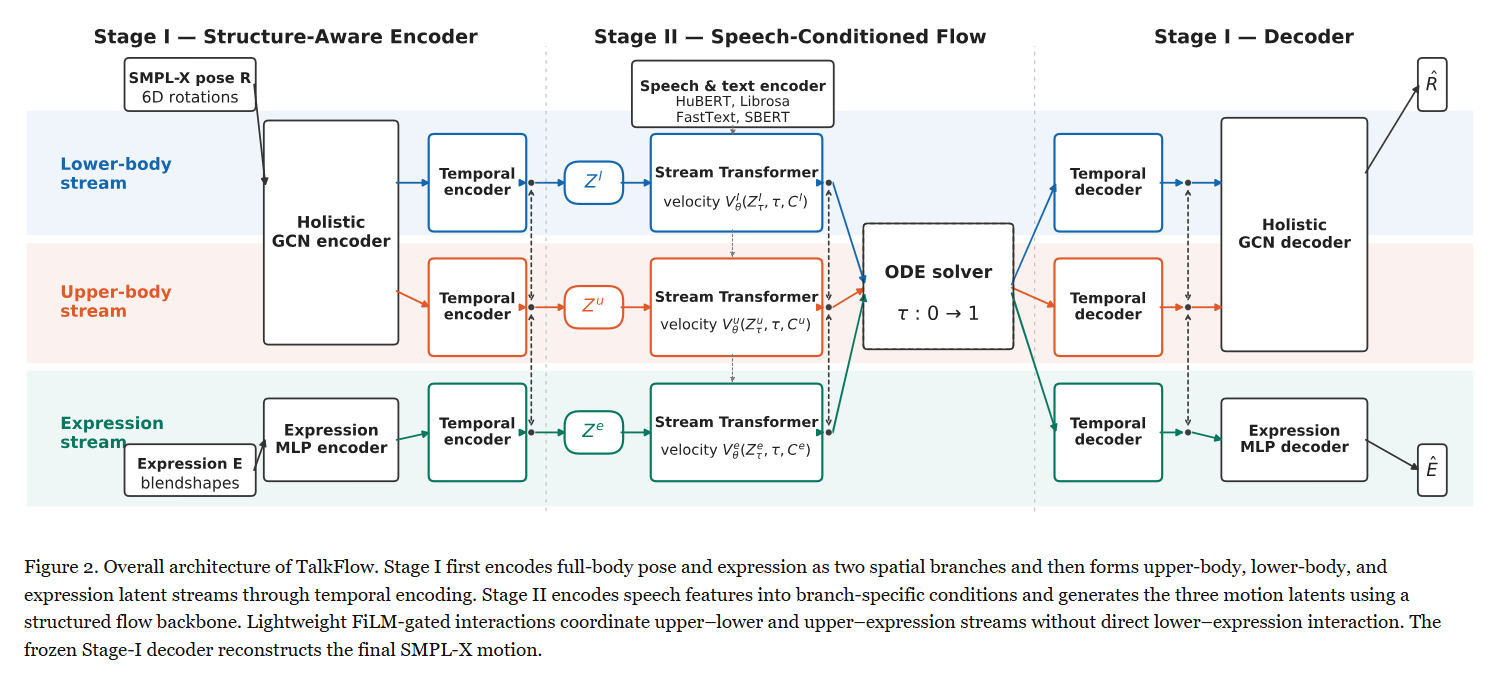 Figure 2|TalkFlow 整体架构。阶段 1 先按整身姿态和表情两条空间支路编码,再经时间编码形成上身、下身、表情三路潜变量。阶段 2 把语音特征分路条件化并用结构化流生成。FiLM 门交互协调上身—下身与上身—表情,无直接下身—表情交互;冻结阶段 1 解码器还原 SMPL-X 人体动作。
- 实验效果:BEAT2 沿用 Speaker-2 单说话人、85%/7.5%/7.5%划分。50 次 Euler 函数求值(逐步积分速度场),预提取语音条件后单 RTX4070TiSUPER 为 0.006 秒/帧,不含特征准备。表中面部顶点均方误差 MSE5.77,单位 10⁻⁸;顶点 L1 差 LVD6.65,单位 10⁻⁵,均优于 MambaTalk6.29/6.90。动作特征分布距离 FGD5.24,单位 10⁻¹,差于 EchoMask4.62;节拍一致 BCS7.84、单位 10⁻¹,也低于 ProbTalk8.10。37 人排名中,真实感、语义和整体同步获最低平均名次,越低越好。
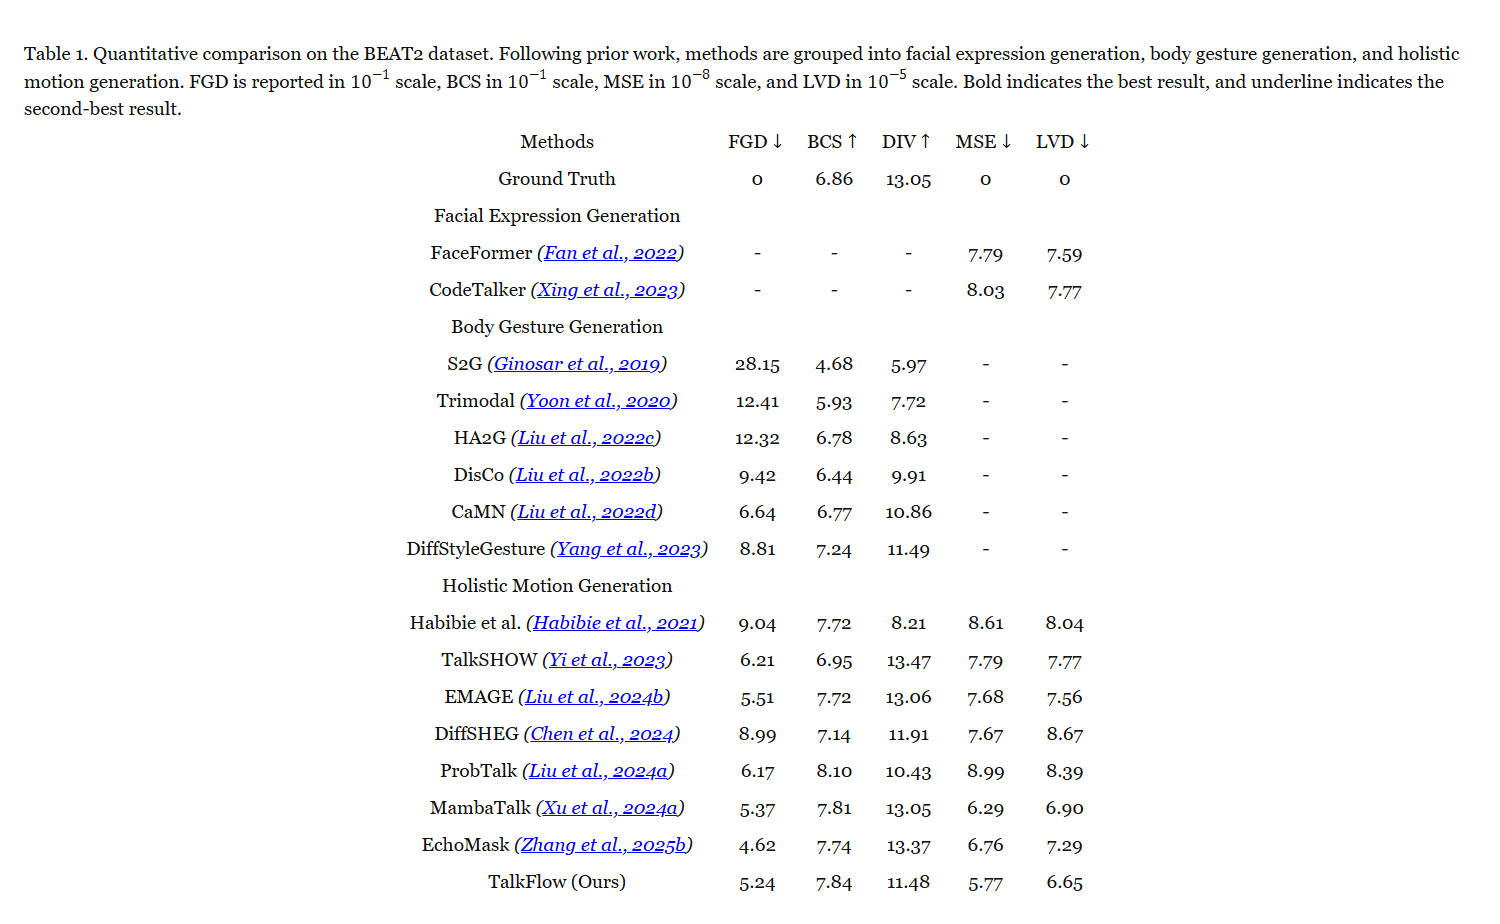 Table 1|BEAT2 比较,按表情、身体手势和全身动作生成分组。FGD 与 BCS 以 10⁻¹显示,MSE 以 10⁻⁸、LVD 以 10⁻⁵显示,DIV 是坐标变化量;粗体/下划线为最佳/次佳。FGD、MSE、LVD 低更好,BCS、DIV 高不自动等于更自然;TalkFlow 面部误差较好但动作分布及多样性非全面领先。
- 批判点评:节拍分接近最佳不代表更自然:真值 BCS6.86 还低于多种生成器,强行追节拍不能代表自然。DIV 是坐标差异量,不是高层风格多样性,TalkFlow 为 11.48 而 EchoMask13.37。单说话人不能证明跨人泛化,也无显式风格或全局位移,偶有滑脚。项目与代码已有训练/推理源码;完整基准评分仍依赖外部 EMAGE 工具,本次未运行模型。
9. GeoFlip:挪一点支撑结果会翻转吗
GeoFlip: Benchmarking Geometry-Sensitive Physics in Video Generation | 纽约市立大学;墨尔本大学;中山大学;香港中文大学;卡内基梅隆大学 | arXiv:2610.42002
关键词:视频生成评测, 几何干预, 物理结果翻转, 结构完整性
- 前序问题:同一块木板,伸出桌边少一点能稳住,多一点就会掉下去。两个视频都很清晰、动作也流畅,却可能无视这点几何差别而给出同样结果。
- 方法直觉:固定文字、质量和摩擦等物理条件,只改支撑范围或物体位置,先用仿真验证结果应该翻转,再分别看生成器有没有改对事件,以及有没有顺手把硬物掰弯。
- 本文贡献:基准含 482 对、964 段参考,覆盖支撑、力矩、重力、接触、弹性、滑轮六类;程序建场、物理模拟与数值误差检查后用 Blender 渲染。模型只看各自首帧和共享提示,独立生成。事件正确率先在每任务内按事件类别平衡召回,再对任务等权宏平均;不确定算错。结构完整性只把明确无变形/增件等的条件算清楚,不与事件正确合并成一个成功标签。像素 PSNR 和结构 SSIM 另评参考相似度。
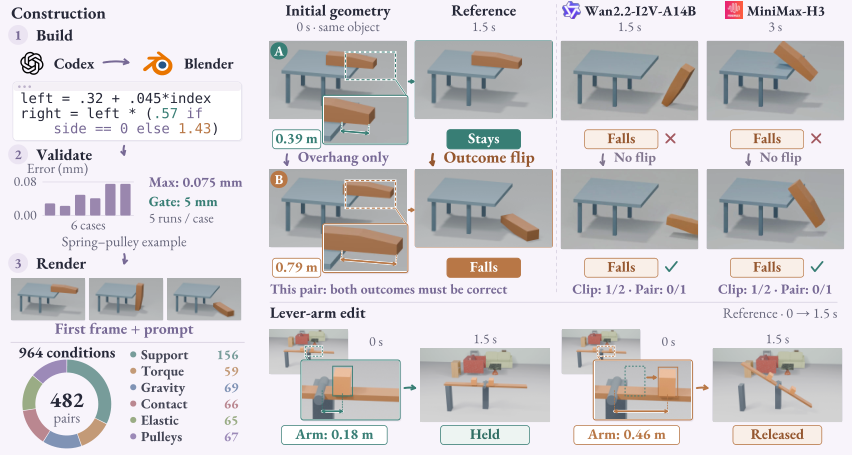 Figure 2|几何诱发物理结果翻转的构造与配对评测。先程序建场、数值验证再渲染,482 对共 964 条件;保持提示和其他物理设置不变,只改几何。示例增加桌边悬出范围使稳住变跌落,但模型可能两种初始条件都跌落;整对两项都正确才算配对成功,不能用单条件正确率替代。
- 实验效果:16 模型主比较用共同 442 个条件、34 任务,不是全部 964 段;GPT-6-Astra 每视频看 8 抽帧。Wan2.2 事件正确率最高 27.98%,结构完整仅 34.38%;LingBot 分别 26.69%与 60.81%。LTX 的 PSNR29.87dB 最高,事件率却 18.41%,可见像不像参考与物理事件不同。跨裁判另用 346 条件,事件/结构排名 Spearman 相关 0.906/0.929;结构分绝对差平均 15.14 个百分点,即便排序一致,宽严仍差很大。
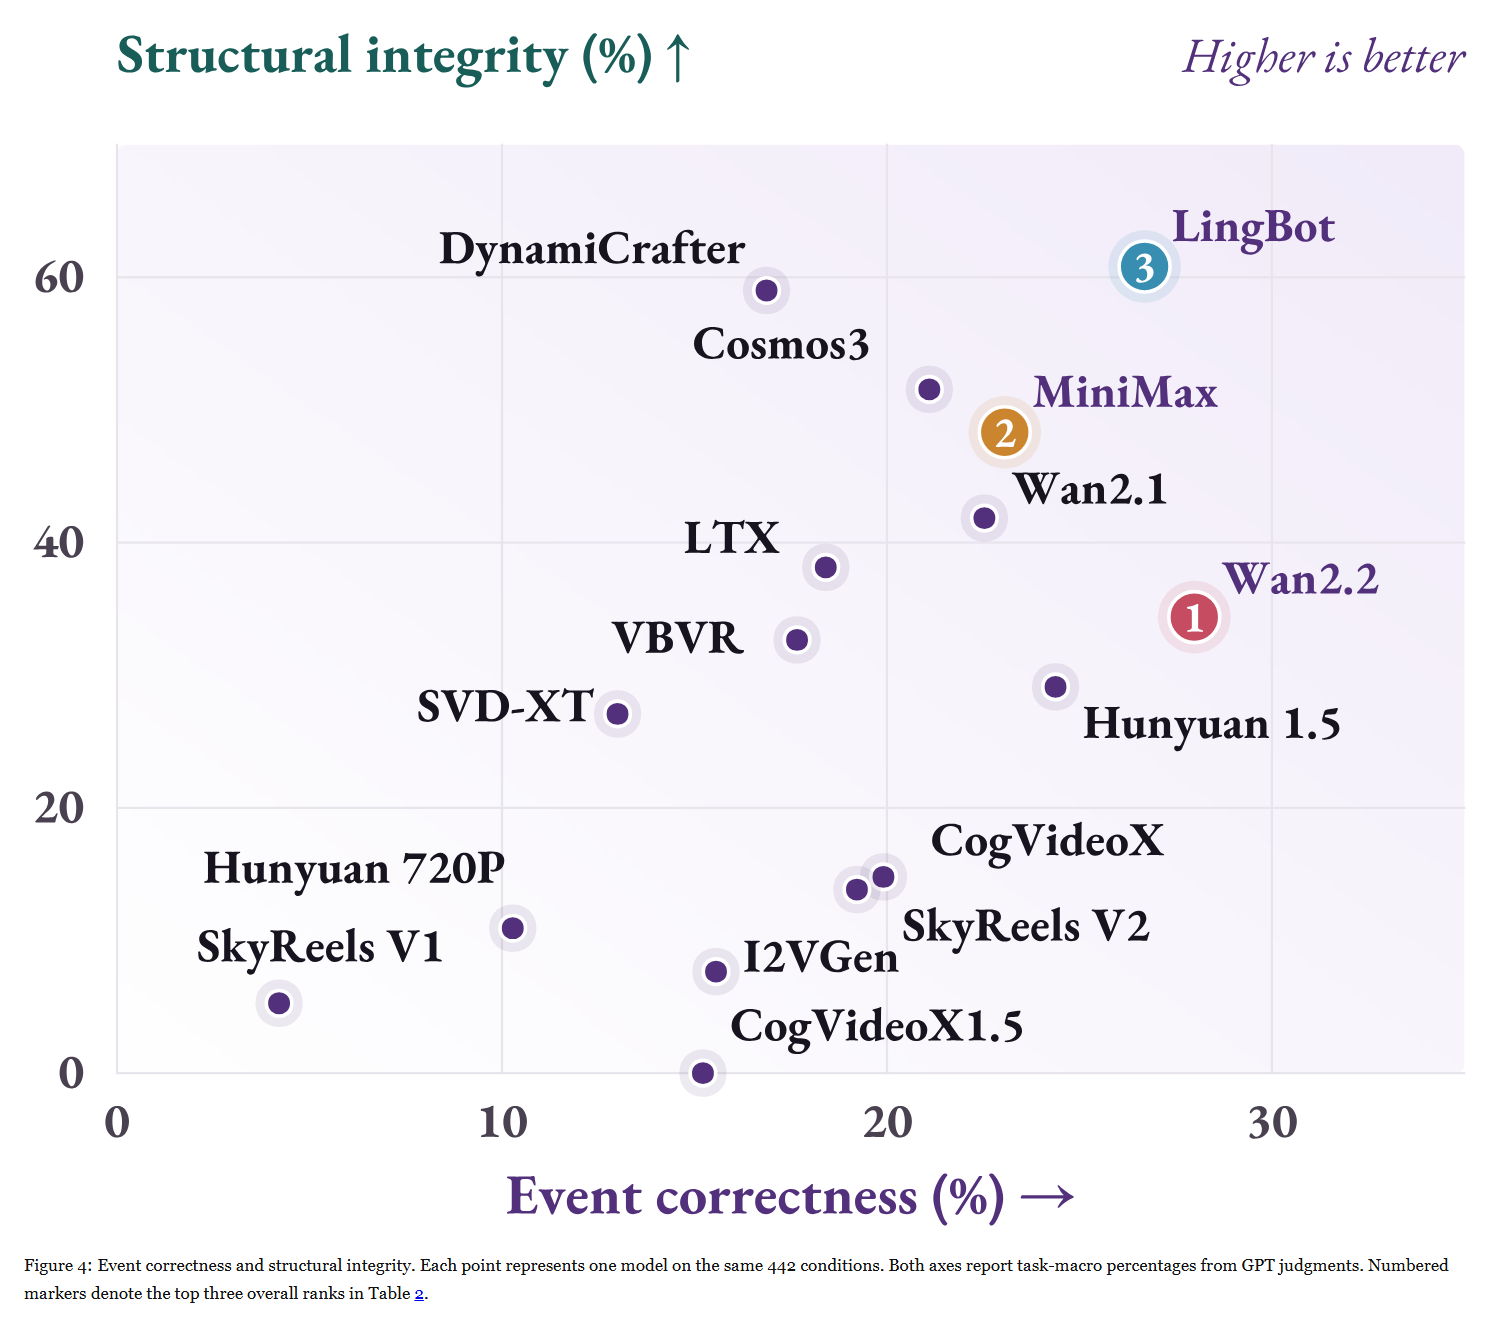 Figure 4|同 442 条件下 16 种视频模型的事件正确率与结构完整性散点,每点一个模型;两轴均为 GPT 裁判按任务宏平均的百分比,编号对应原论文表 2 前三总体名次。事件高不代表结构完整,Wan2.2 事件 27.98%而结构 34.38%,LingBot 结构 60.81%但事件 26.69%。
- 批判点评:27.98%是任务宏平均事件率,不是几何配对同时成功率,也不是现实物理能力上限。参考相似度只用 40 段,与 442 条件的事件/结构分分母不同;模型采用各自分辨率、帧数与采样计划,不能当同算力竞赛。八抽帧可能漏过程错误,结构标签裁判分歧明显。研究提供受控诊断而非视频纠错算法,执行完整 16 模型及双裁判需另付生成/评测成本;原文未给官方基准代码链接。
10. L3G-World:把三维记忆直接喂给视频模型
L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory | KAIST AI;梨花女子大学;KAIST Urban AI Institute | arXiv:2610.40614
关键词:世界生成, 潜在三维记忆, 高斯更新, 少步蒸馏
- 前序问题:相机绕房间一圈回来,家具位置变了。保存每帧历史会越来越占内存;保存三维场景后每次渲染彩色图再编码,又拖慢新画面生成。
- 方法直觉:记忆按场景的地盘分配,不按走了多久重复堆;把视频模型本来读的压缩特征也放进三维点里,换视点时直接渲染给它。
- 本文贡献:L3G-Mem 用彩色重建误差和不透明度找记忆缺口,只在那里聚类创建高斯元(带位置、尺度及特征的可渲染单元),并取当前可见旧高斯做残差修正。新旧 token 共同注意力交互;每高斯另存变分自编码器 VAE 潜特征。L3G-Gen 以 Cosmos-Predict2.5 为底座,拼接目标视点渲染的潜特征、不透明度和噪声生成下一块,再回写记忆。LoRA 低秩微调、AnyFlow 少步蒸馏得到 Fast 版;各模块用 4 张 A100 训练。内存随已探索空间增大,重复走相同区域才趋稳,不是无限地图零增长。
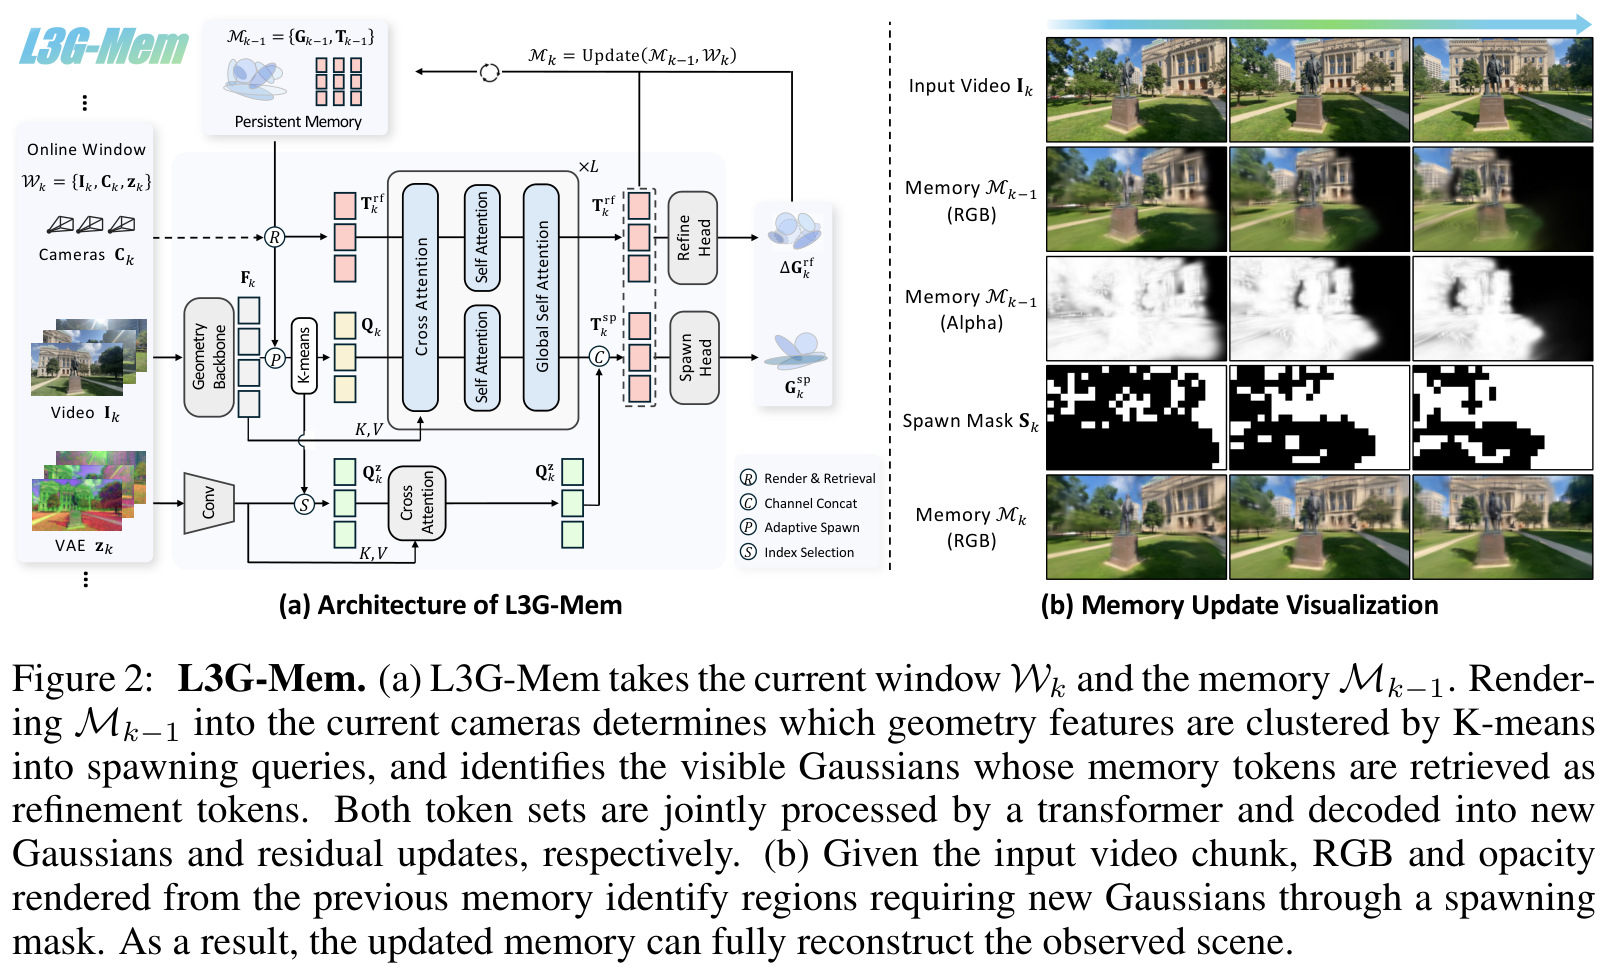 Figure 2|L3G-Mem。a:将当前窗口与前一记忆输入,先按当前相机渲染旧记忆,确定哪些几何特征要聚类成新建查询,哪些可见高斯的 token 应取出精修;两组共同经 Transformer,分别解码为新高斯与残差更新。b:旧记忆的 RGB 和不透明度用新建掩码找待补区域,更新后记忆能重建当前已观测场景。
- 实验效果:481 帧往返同相机路径测试中,完整模型 DL3DV 返回视点的 PSNR16.00dB、LPIPS 感知差异 0.366,NeoVerse 为 13.53/0.652;这是前后同位姿自洽,不是未知世界真值。原文表 1 另用单 H100、400 帧成本测试:480×832、峰值 7.4GiB、总吞吐 9.02 帧/秒;实时流程采用少步版,不能把完整模型画质与 Fast 速度当同一配置。表 2 的 VAE 渲染 1086.58 帧/秒只计记忆条件形成,也不是整段视频速度。
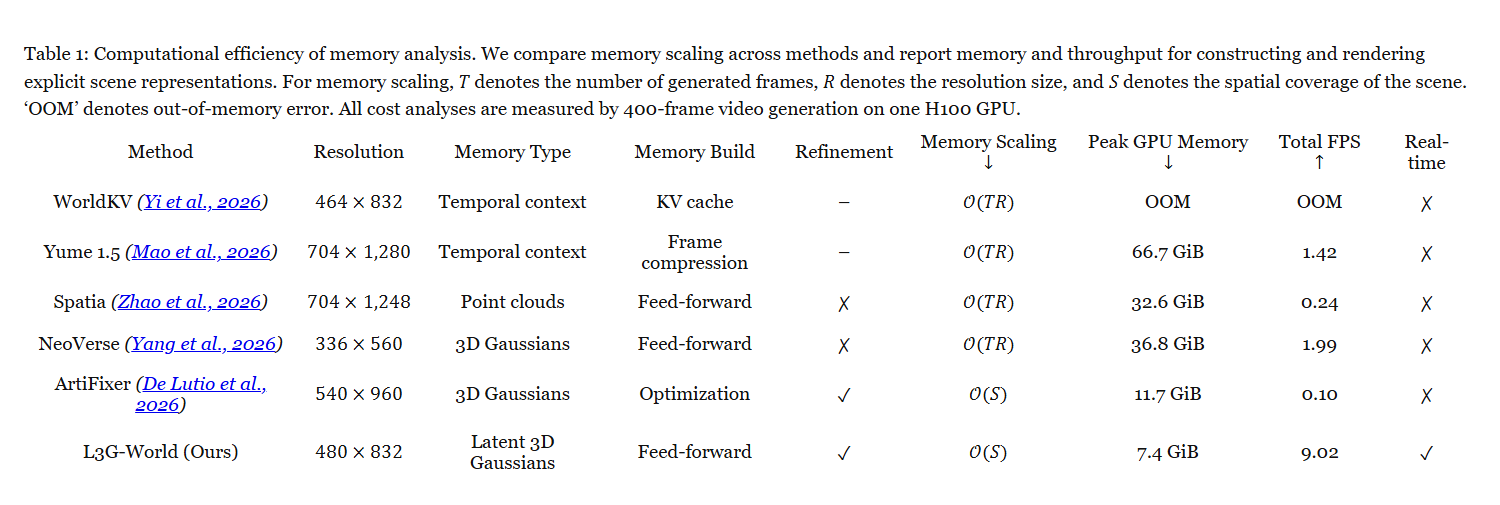 Table 1|记忆计算效率。T 为生成帧数,R 为分辨率大小,S 为场景空间覆盖;OOM 表示显存不足。所有成本按单 H100 生成 400 帧测量,各方法原生分辨率不同。比较记忆类型、构建、精修、空间增长、峰值显存、全流程 FPS 与是否实时;L3G-World 行 480×832、7.4GiB、9.02FPS,不能混同独立记忆渲染吞吐。
- 批判点评:快版在 DL3DV 的 FID43.05 差于完整版 40.57,RealEstate10K 的自洽与位姿也非全项领先;未知区域仍是生成,不证明物理正确。主文实验设置写单 A100 效率,而表 1 明确 H100,应按表分开引用。摘要的原语减少 38.6 倍与正文对 NeoVerse 的 266–417 倍基线不同,不能混作同一加速倍数。项目与仓库当前发布计划仍未勾选模型/推理代码,仅有说明和展示;尚不能声称可直接复现。
趋势观察
先确定参考究竟提供什么
AlbumVSR 把身份与朝向对齐纹理拆开,RADI3N 分开几何与纹理,PicturePerfect 破坏驱动光照以免复制。参考不是越完整越好,需阻断会随条件变化的错误线索。
单一总分会藏住真实取舍
WeGenEditBench 高分输出仍可能漏项,GeoFlip 把事件与结构分开,TalkFlow 的节拍分甚至高过真值也不保证自然。按任务失败逐项复核,比只看榜首更有用。
缓存越小越要写清计数口径
Any Forcing 只保少量历史,MFlowAudio 每前向状态缓存不随时长增长,L3G 记忆按空间覆盖增长。三者都不是无限上下文无成本;首帧、额外前向和解码仍要单算。
诊断有价值但别跨越因果边界
RadialObj 给出门参与度相关性及局部条件分析,WeGenEvoStudio 做一轮定向适配。前者不是完整因果定理,后者不是已验证无限自我进化。
今日讨论
AlbumVSR 的 ID-GT 从 0.586 到 0.670,MUSIQ 却从 72.34 降到 52.32;第 2 路纹理只把身份增 0.001。若相册里混入错人,应怎样用“相似度低于 0.5”的筛选与错人相册对照,确定何时拒绝参考、退回普通视频修复?
人工智能炼丹君 整理 | 2026-11-03


评论 (0)