今日 AIGC 论文速览
今日共 10 篇 · 跨镜头与复杂视频编辑 2 篇 · 口型修复与换音编辑 2 篇 · 人物个性化动画 1 篇 · 联合音视频生成 2 篇 · 图像生成与扩散效率 2 篇 · 关系可控空间音频 1 篇
重点论文标题列表
MoviEdit (Adobe):先打全片草稿再跨镜头修改VideoEditor-MoE (腾讯):一条指令让多个修改一起发生TaoMate-FVSR (阿里):修清嘴唇也要听对声音VidDub (港科大):换了台词别再逼嘴形照旧One Image (Mila):一张照片先自造姿态样本
选读入口:要把已改好的一帧传遍多镜头,先读 MoviEdit,注意首帧/任意帧参考分数和 8 张 H100 计时;一条指令改多处读 VideoEditor-MoE,先看有利案例筛选限制。修生成视频小脸读 TaoMate-FVSR,换台词配音读 VidDub,两者的真值首帧与嘴区监督不同。单图驱动跳舞读 One Image Is Enough 的 9.3 分钟每人物准备;连续数字人读 TaoMate-HD 的文本窗口,联合训练读 OmniOPD 的分组教师成本。部署前对照 Z-Cache 的 FLOPs 和墙钟,训练一步图像模型读 EASD,做空间声音最后读 Rel2Traj 的真值结构与听测边界。
今日论文速览
1. MoviEdit:先打全片草稿再跨镜头修改
MoviEdit: Long-form Multi-Shot Video Editing Made Easy | Adobe;韩国科学技术院 | arXiv:2611.02737
关键词 :跨镜头视频编辑, 任意帧参考, 全局草稿, 自回归传播
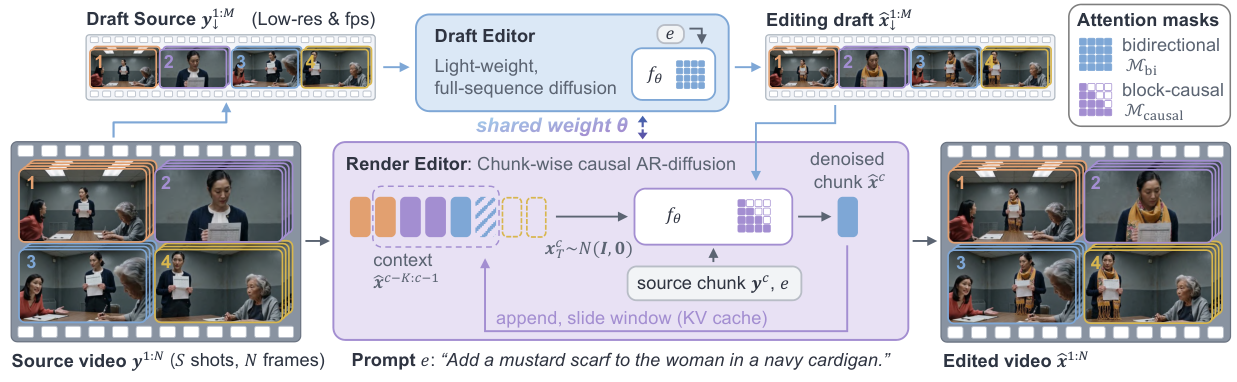
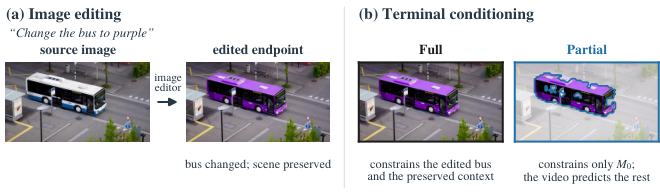
前序问题 :把一段短片里同一人的外套换掉,镜头一切,衣服可能换色,甚至改到另一个人。只在每个镜头单独改,难以保证全片认的是同一个主体、沿用的是同一个改法。方法直觉 :先看完整段视频,在稀疏小画面上定下全片修改草稿,再逐块补清楚。草稿管跨镜头一致,最近片段管动作连续,源视频管未编辑区域;参考可以是任意镜头中已改好的一帧。本文贡献 :三条自动制数路线分别做像素对齐修改、跨镜头主体定位、半像素对齐生成,从 205228 对筛到 86619 对,约 8.7 万对,另混入私有短单镜头编辑数据。扩散 Transformer 的 Draft/Render 两阶段共享权重:前者在时空压缩、时间帧数减半的全序列上双向注意;后者读取草稿、原片及最近块,因果自回归细化。用速度矩匹配蒸馏为草稿 12 步、渲染 4 步,并缓存文字、草稿、源片和生成历史的键/值特征。64 张 H200 上先训文字编辑 17000 步,再训参考帧传播 8000 步。
Figure 5|长视频编辑的级联建模。MoviEdit 共享同一去噪器 fθ,先在下采样全序列上用 Draft Editor 生成全局一致的轻量修改草稿,再由 Render Editor 逐块传播到全分辨率视频,同时抑制长时间外观漂移。
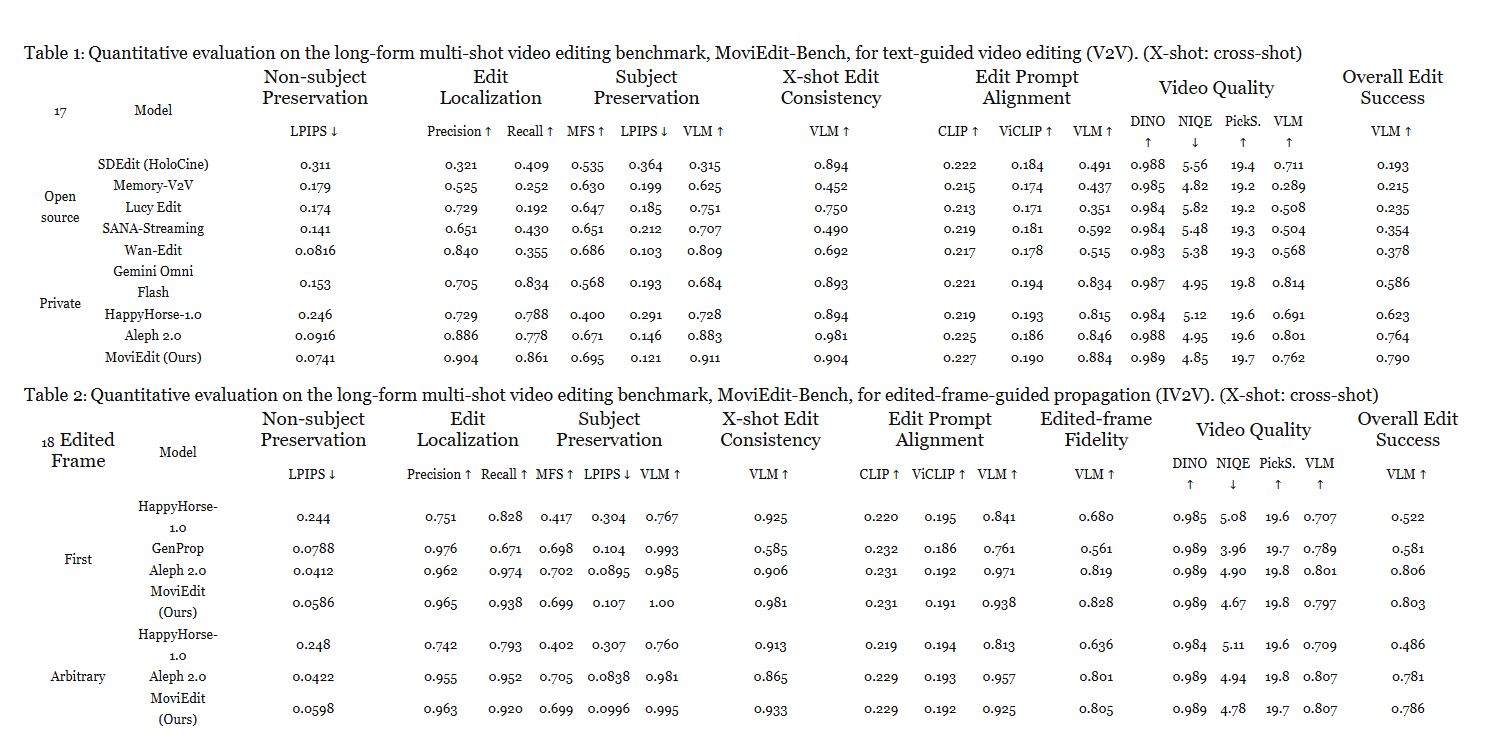
实验效果 :MoviEdit-Bench 含 64 条生成源视频、128 个编辑场景,15 秒多镜头且不提供物体掩码。文字编辑的 overall edit success 为 0.790,Aleph 2.0 为 0.764;它是抽样帧同时满足所有适用视觉语言裁判条件的比例,非完整视频零错误率。任意帧参考传播为 0.786 对 0.781,首帧子集为 0.803 对 0.806。540p、361 帧、8 张 H100 上,去噪耗时 364.1→11.8 秒,30.9 倍;包含 3.6 秒草稿与 8.2 秒渲染,不冒充含读写与编解码的端到端响应。
Table 1 与 Table 2|MoviEdit-Bench 的长多镜头定量评测,分别对应文字指导 V2V 及已编辑参考帧指导 IV2V 传播;X-shot 表示跨镜头。参考评测又分首帧与任意帧。文字总分 0.790 对 Aleph 的 0.764,首帧参考 0.803 对 0.806、任意帧 0.786 对 0.781,各指标与子集不能混成全面领先。
批判点评 :任意帧已编辑参考确有证据,但全片草稿需要先看到未来源帧,不能据此称实时在线编辑。相似人物和局部遮挡仍会选错目标;25 秒 17 镜头是训练 15 秒以外的展示,非无限长验证。首帧参考并非全面超过 Aleph;训练数据与模型也未完整公开。项目页 目前提供展示和独立基准仓库,不等于编辑器权重已开源。
2. VideoEditor-MoE:一条指令让多个修改一起发生
VideoEditor-MoE: Scaling Complex Video Editing with Mixture of Experts | 腾讯;新加坡国立大学;厦门大学 | arXiv:2611.03043
关键词 :复杂视频编辑, 混合专家, 键值路由, 稀疏激活
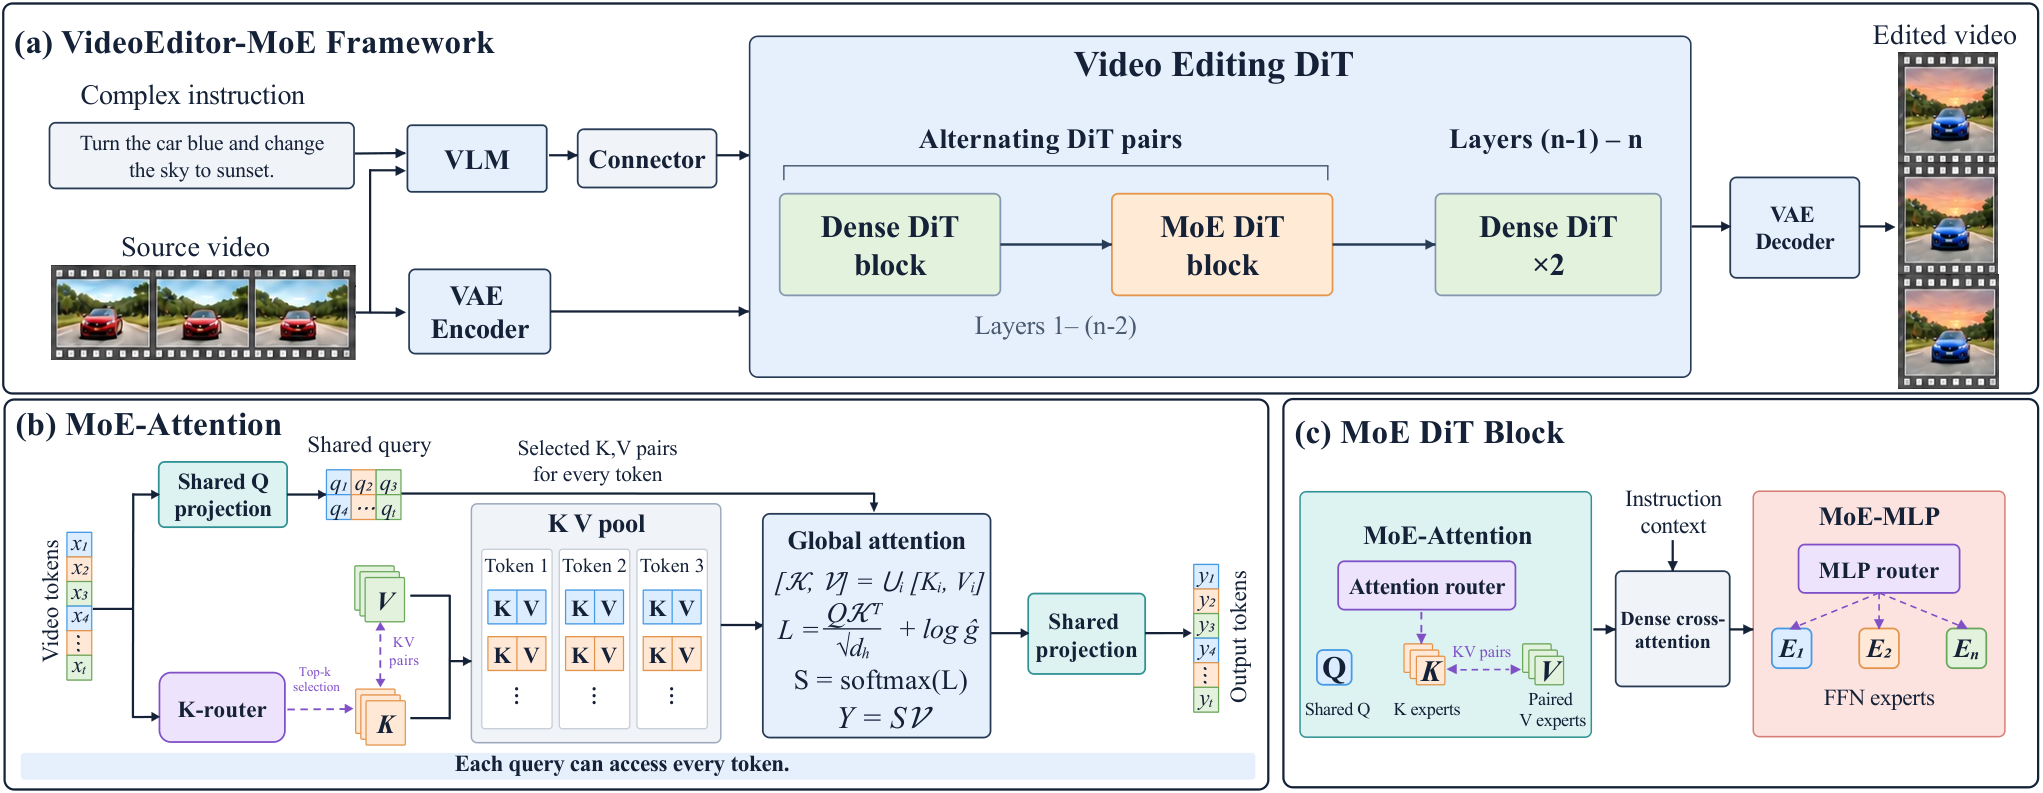
前序问题 :让车变蓝、天空变日落,视频可能只改对一件事。把模型整体做大很贵,按“加物体、换背景”手工分专家,又可能忽略同一对象的多项修改彼此相关。方法直觉 :让每个视觉 token(模型处理的特征单元)自行选专家,还让注意力读取不同专家提供的键/值。专家不必对应人起的任务类别,而可随内容和噪声状态分工。本文贡献 :从 Kiwi-Edit 的 50 亿参数、30 层视频底座扩展。在前 28 层交替插入混合专家 MoE 模块,最后两层保持稠密;注意力与前馈网络各自路由。查询和输出投影共享,全部 token 经选中的成对键/值专家形成候选,路由权重的对数加进注意力分数,仍保留全局跨帧交互。140 亿版用 7 专家选 3,560 亿版扩为 35 专家而仍选 3,每 token 约激活 80 亿;140/560 亿仅计 DiT,含其他模块约 185/605 亿。训练有流匹配、相邻帧速度差和负载均衡;扩大模型时用 AdamW 解耦权重衰减,避免专家输出被压小。
Figure 2|VideoEditor-MoE。(a)前 28 层交替稠密与 MoE 扩散 Transformer 块,之后保留两个稠密块。(b)共享查询读取所有视频 token 经路由得到的键/值对。(c)每个 MoE 块由专家自注意力、稠密指令交叉注意力和专家前馈网络组成。
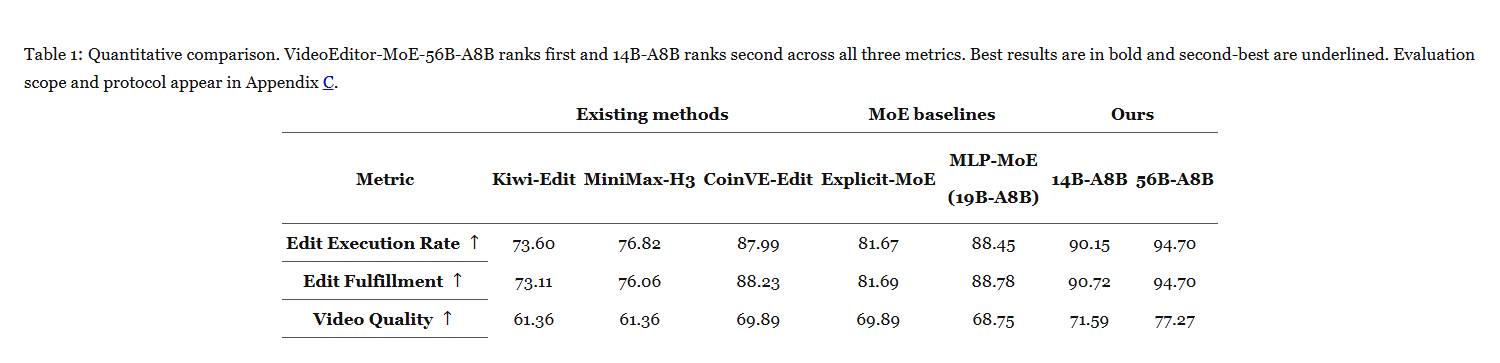
实验效果 :49 帧、832×480、16 帧每秒输出,50 步 Euler 采样。主表中 140 亿/560 亿版的编辑执行分 90.15/94.70,前馈 MoE 对照 88.45;执行指每条原子修改在首、中、末三帧至少两帧可见,再按案例平均乘 100。但附录 C 明确案例是依赖结果筛选、偏向 560 亿版的有利样例,因此这些数字只说明该样例集,不能当总体基准成功率。140 亿版用 24 张 80GB H100 训练 18630 步,视觉编码器和视频自编码器冻结。
Table 1|定量比较:560 亿总参数、每 token 激活 80 亿的版本在三个指标第一,140 亿版第二,粗体与下划线分别标最佳/次佳。按附录 C 范围,这些是依赖结果筛选的有利案例而非总体基准;执行、完成度与画质也不是同一量。
批判点评 :同样激活 80 亿不代表同显存、同延迟:560 亿权重仍须保存,注意力还读取多份键/值,主文未给同硬件完整推理成本。三帧裁判也漏掉中间动态;路由内容敏感来自 20 训练样本的探测,不能证明专家就是稳定语义类别。代码仓库 有训练推理实现,权重页需申请访问;不能把有利样例上的领先扩大成无条件结论。
3. TaoMate-FVSR:修清嘴唇也要听对声音
TaoMate-FVSR:Audio-Guided Facial Video Restoration | 阿里巴巴集团 | arXiv:2611.03393
关键词 :音频引导人脸修复, 参考注入, 源噪声混合, 口型纠正
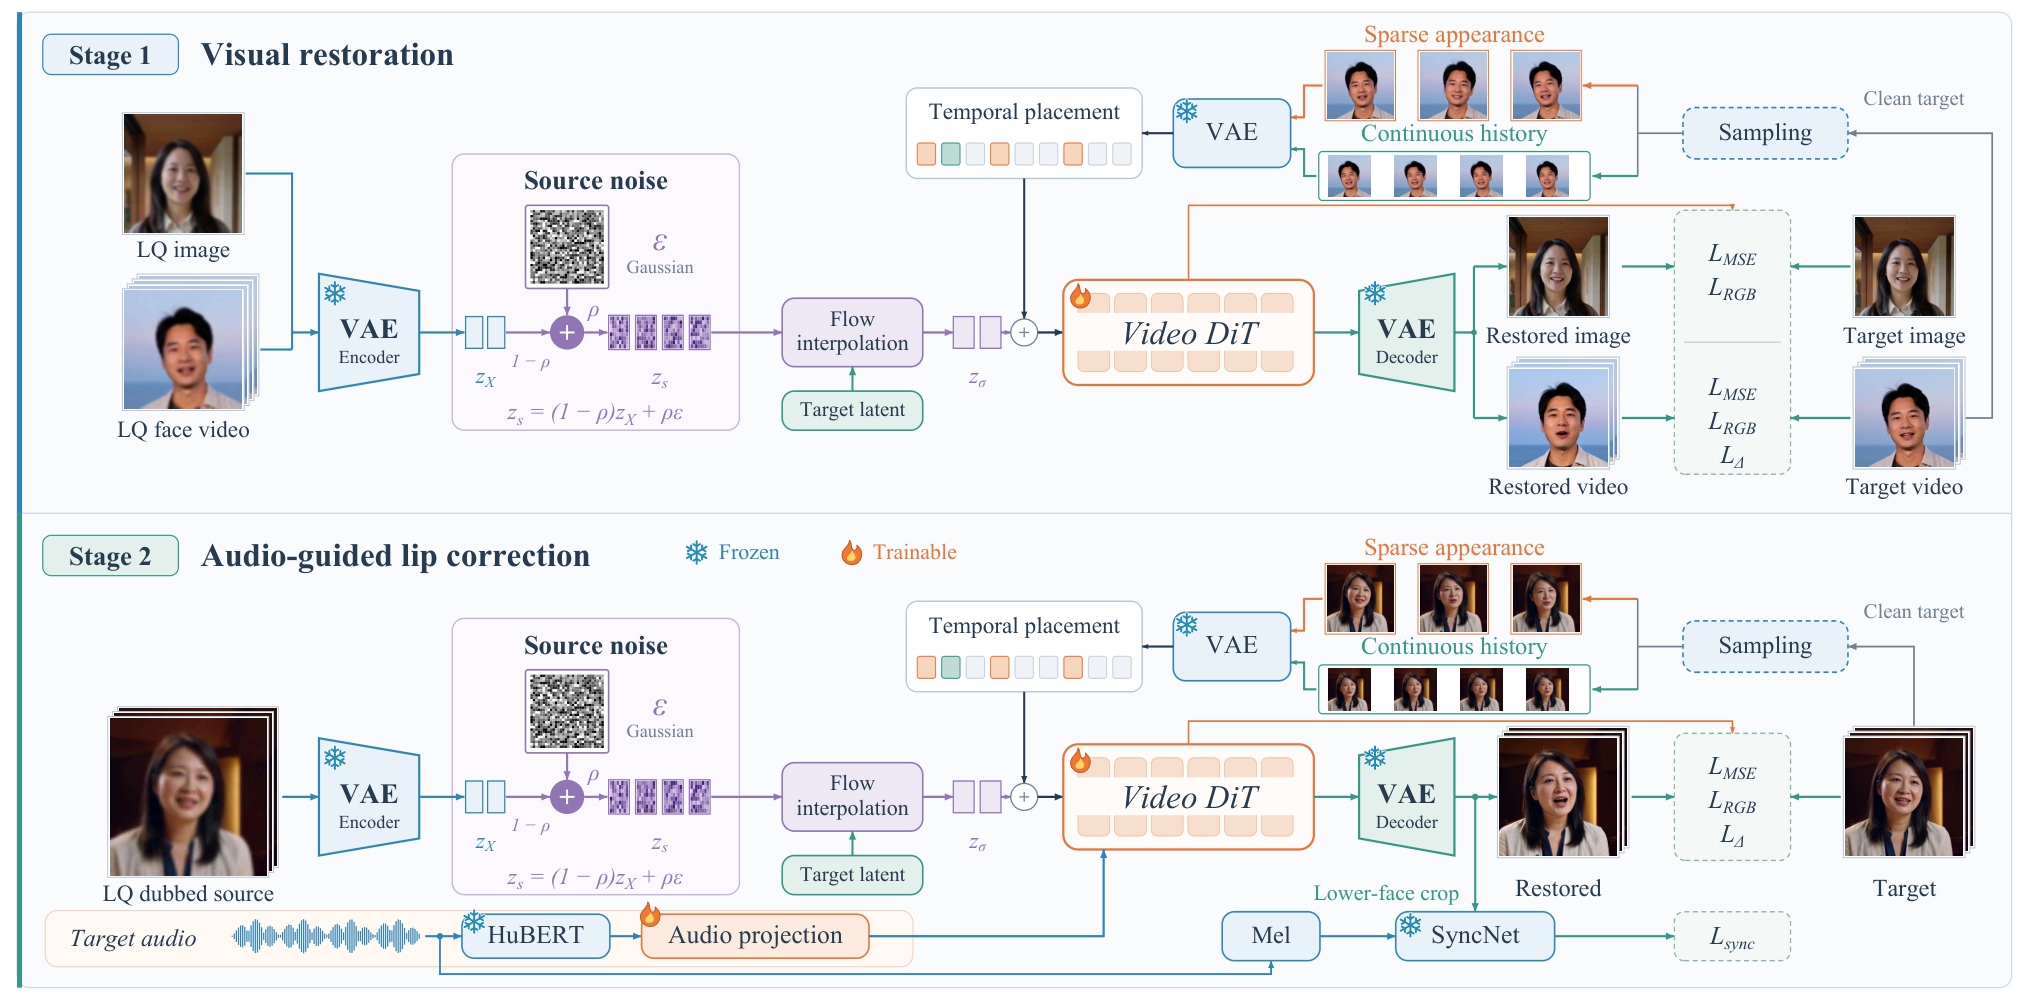
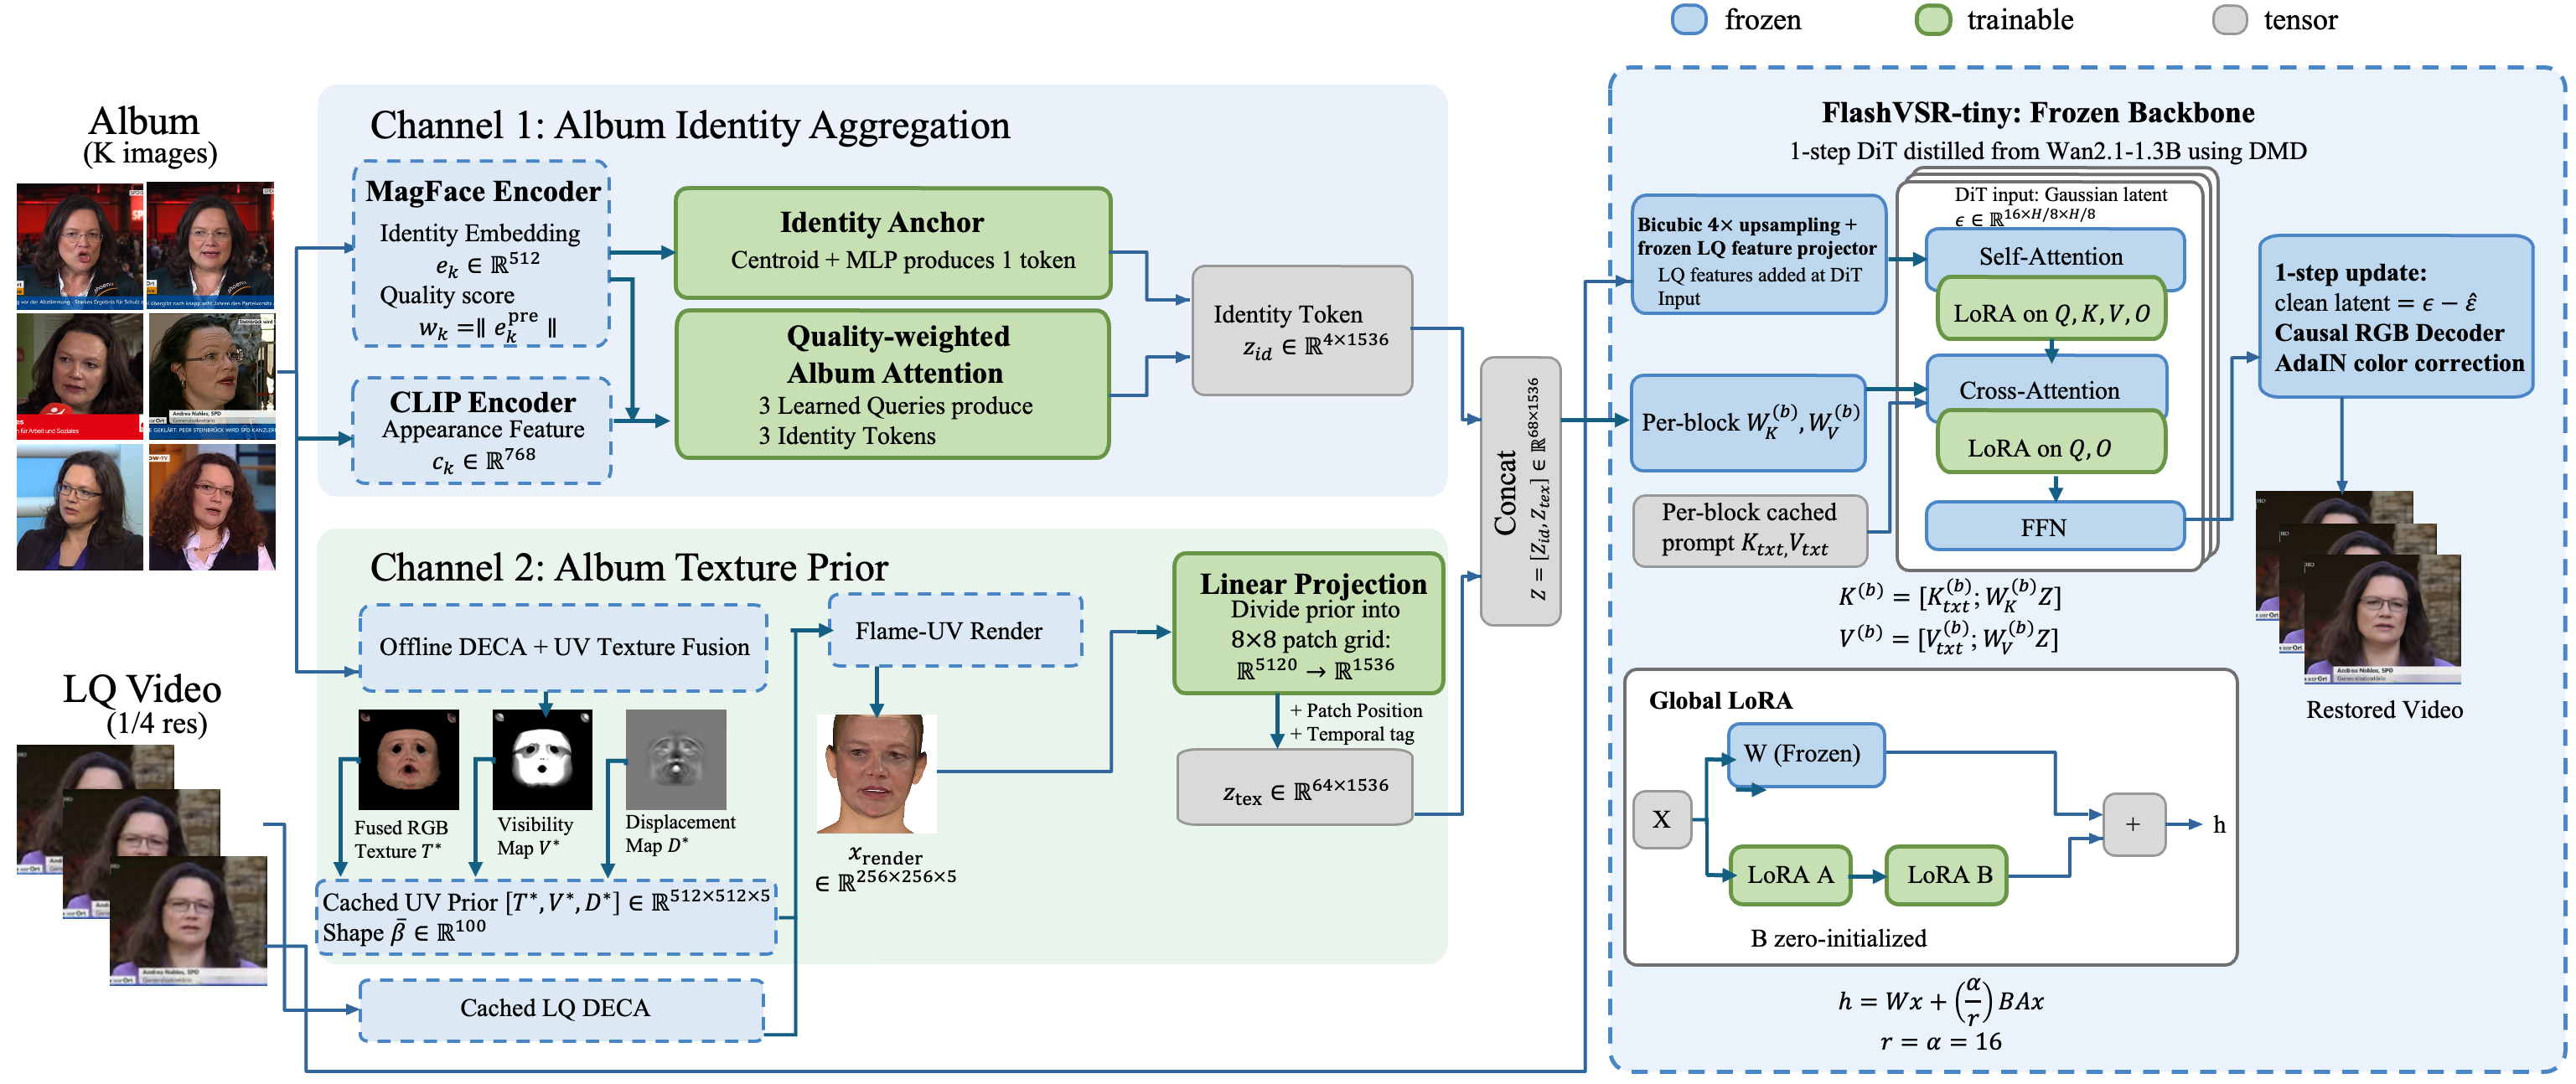
前序问题 :生成视频里的脸太小,普通超分辨率可能把牙齿补清楚,却补出与声音不符的嘴形。若替换了音轨,继续复制原嘴唇运动反而会把错误保留下来。方法直觉 :把低清源脸当结构线索,允许嘴部重新生成;把清晰参考只当外观锚,把最近几帧只当运动线索,再让目标声音约束发音动作。本文贡献 :冻结因果视频 VAE(把像素压缩到潜空间的自编码器)、HuBERT 语音编码器及 SyncNet 音画同步判别器,训练 Wan 视频 Transformer 和条件投影。源潜变量混入 0.80–0.95 强度噪声,再做流匹配,混合强度与流时间是不同量。稀疏参考独立编码、连续 4 帧历史序列编码,放入互不重叠的时间位置后投影相加,不替换去噪状态。第一阶段用退化图像/视频学习还原;第二阶段用口型被改变的退化视频配目标声音纠正发音,加入同步监督。窗口 5 条件帧加 72 有效帧,步幅 56,复用 16 帧重叠潜轨迹及有状态解码。
Figure 2|音频引导人脸视频修复。第一阶段用退化图像/视频与对应目标联合训练;静态图只使用流匹配均方误差ℒMSE 及 RGB 损失,视频另加时序监督。第二阶段用退化配音源与目标音轨修口型。稀疏外观参考和连续历史放在不同条件位置。视频自编码器 VAE、HuBERT 及 SyncNet 冻结,视频 Transformer 与条件投影可训练;生成视频小图用于示意输入和目标角色。
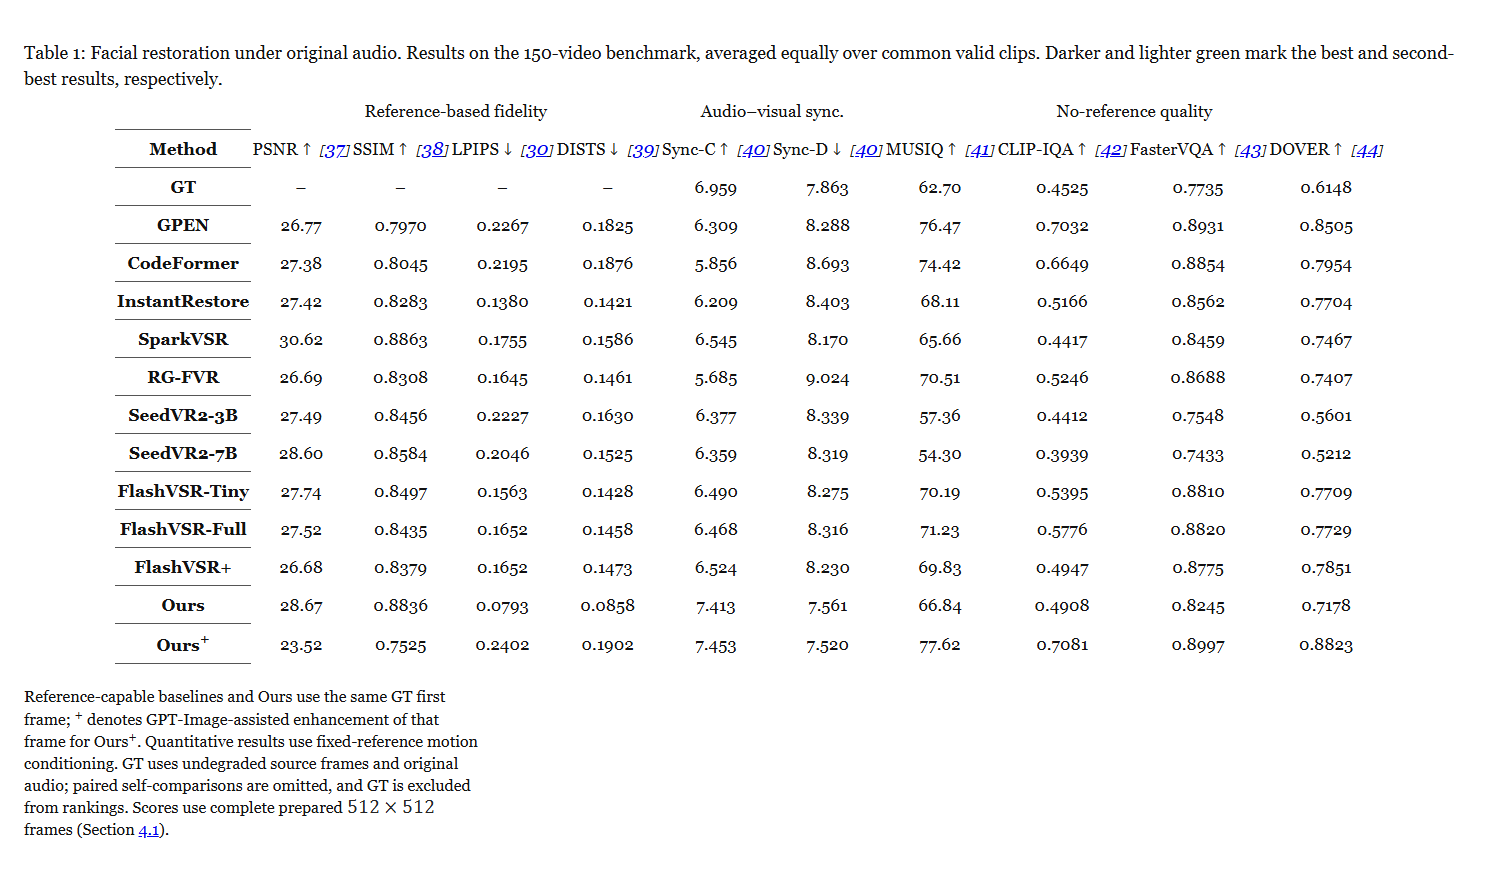
实验效果 :150 条 MEAD/HDTF/TalkVid 及内部说话人视频,4 倍降采样后回到 512×512,同一有效视频等权平均;可接参考的对照与 Ours 都用未退化真值首帧。Ours 的 LPIPS 感知误差 0.0793、DISTS 结构纹理感知距离 0.0858,低于 InstantRestore 的 0.1380/0.1421;同步置信 Sync-C 为 7.413、距离 Sync-D 为 7.561,前者高后者低更好。SparkVSR 的 PSNR 像素还原 30.62dB 仍高于本方法 28.67dB。30 视频去掉音频后 Sync-C 为 4.283,完整为 7.621。
Table 1|原音轨人脸修复:150 条视频基准,对共同有效片段等权平均,深绿/浅绿标最佳/次佳。支持参考的方法与 Ours 同用真值首帧,Ours+额外用 GPT-Image 增强该帧;完整 512×512 帧评分。Ours 感知误差与同步更好,SparkVSR 像素还原更好,增强参考又改变忠实度与锐利度的取舍。
批判点评 :把参考交给 GPT-Image 增强的 Ours+,无参考画质 MUSIQ 达 77.62,但 PSNR 降到 23.52dB、LPIPS 升至 0.2402,说明更锐利不等于忠实。原生生成视频没有真值,首帧参考来自输入,与 150 条定量协议不能混说。修复与换音 30 条评测分开;未给统一墙钟与峰值显存,不能称实时。官方项目已指向实现仓库,但本次只核资源,不运行模型。
4. VidDub:换了台词别再逼嘴形照旧
VidDub: Replacement-Aware Distillation for Two-Step Video Dubbing | 香港科技大学;腾讯;浙江大学;独立研究者;清华大学;阿卜杜拉国王科技大学 | arXiv:2611.03404
关键词 :视频配音编辑, 换音监督, 两步蒸馏, 全上下文
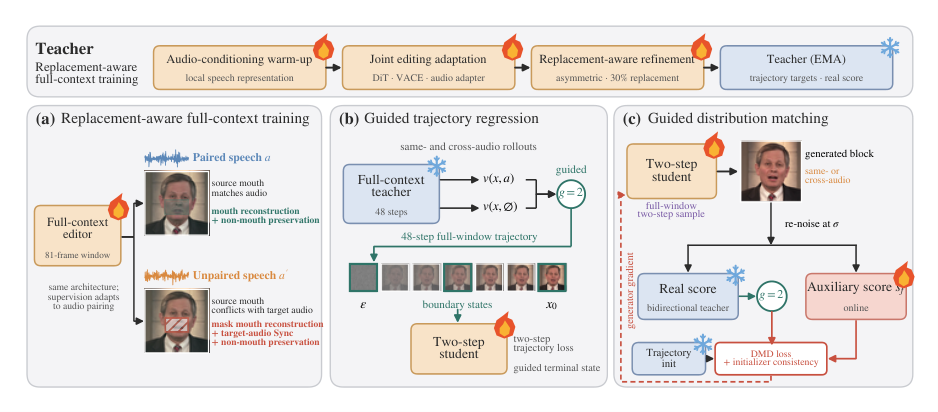
前序问题 :给同一段表演换台词时,脸和背景应该保留,嘴形却必须改变。若训练仍要求重建原视频嘴部,音频在催它变,像素损失又在逼它不变。方法直觉 :按声音是否被替换决定哪些源像素可信:原音轨可重建全脸,换音轨只保留嘴外区域,嘴内交给音画同步信号。先解决监督冲突,再把采样压到两步。本文贡献 :Wan-1.3B 配 VACE 视频条件与 2.87 亿参数音频适配器,冻结 Whisper-small 语音特征。每窗 81 帧对应 21 个视频潜帧,窗口内双向注意。教师训练混 70%原音、30%替换音:替换音时屏蔽嘴区的流速度、像素与感知重建,只保嘴外和同步损失;同步训练器冻结但梯度穿过它和解码器。随后把 48 步带 CFG(有条件与无条件预测组合的引导)教师轨迹回归到两步学生,再用分布匹配蒸馏补画质;推理每步仅一条音频条件分支。长片每次推进 64 帧,融合 17 帧重叠。
Figure 3|三阶段训练蒸馏。顶部是教师的音频预热、联合编辑适配和换音感知精修。(a)不成对替换语音时屏蔽源嘴部重建。(b)用带引导轨迹回归,把 48 步 CFG 教师蒸馏成两步学生。(c)分布匹配蒸馏恢复最终两步模型的视觉真实感;CFG 即组合条件与无条件预测的引导。
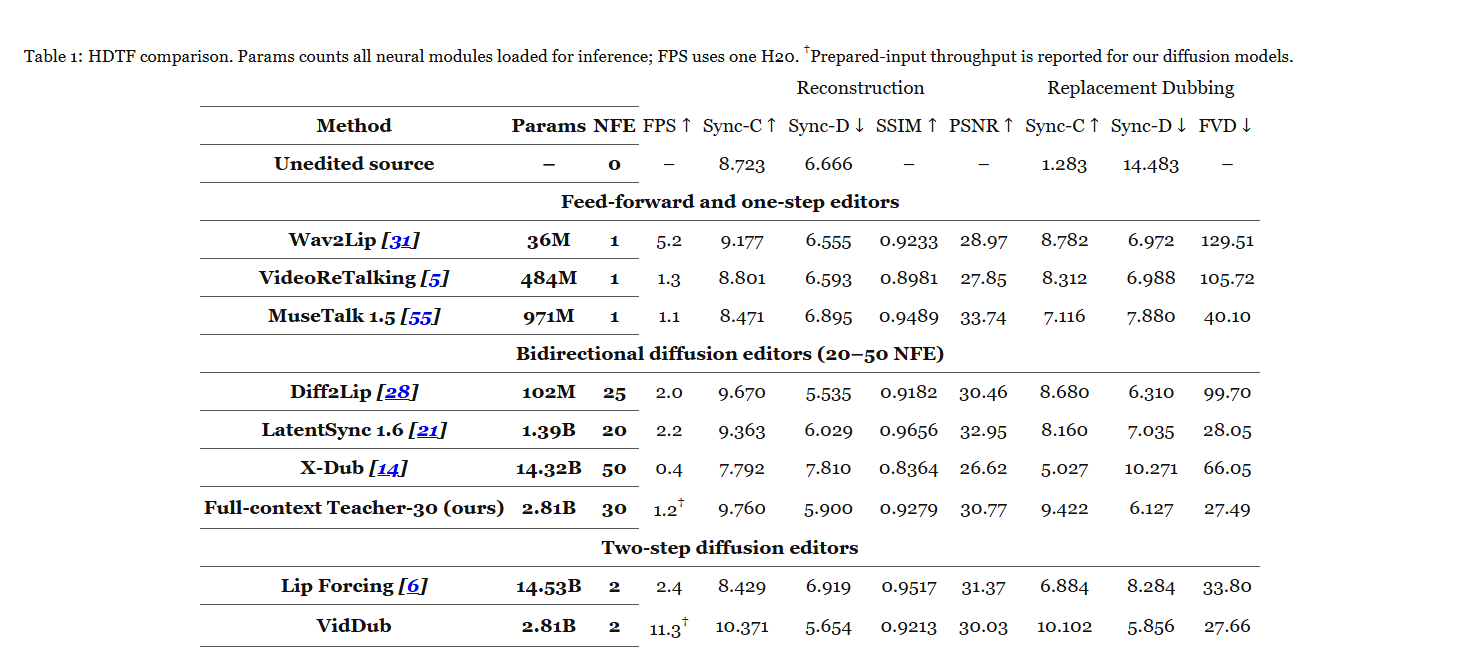
实验效果 :HDTF-30 换音:两步 VidDub 的 Sync-C 同步置信 10.102、Sync-D 距离 5.856,Lip Forcing 为 6.884/8.284;FVD 视频分布距离 27.66,教师 27.49,低更好,两步并非画质无损。单 H20 预处理输入上的吞吐 11.3 帧每秒,不包括完整数据准备。独立三种训练种子的嘴区屏蔽消融,换音 Sync-C 平均增 0.833。TalkVid 请求 500 条,跨方法排名另用共同有效 308 条;VidDub-Bench 共同有效 245 条,不能把各方法有效分母混成统一 500/256 条。
Table 1|HDTF 比较。Params 包含推理时加载的所有神经网络模块,FPS 在单 H20 上测量;†表示本文扩散模型只报告预处理完成输入上的吞吐。分同音重建与换音配音,两步 VidDub 换音 Sync-C/D 为 10.102/5.856、FVD27.66,教师 FVD27.49,不将预处理吞吐当全流程速度。
批判点评 :它是离线整窗编辑,不是两步就能实时直播。身份并非全胜:HDTF 换音身份余弦 0.902,LatentSync 为 0.970;同音像素还原也有退步。补充材料的持久缓存流式尝试在 60 秒出现下脸塌陷,不能当最终稳定实现。最终长片用源片重新锚定的重叠窗口。代码仓库 已有训练推理与发布校验,未在本机复现,媒体数据权限与依赖仍要逐项核查。
5. One Image:一张照片先自造姿态样本
One Image Is Enough: Self-Generated Supervision for Personalizing Human Video Diffusion at Test Time | 康考迪亚大学;魁北克人工智能研究所 Mila | arXiv:2611.02964
关键词 :单图人物动画, 自生成监督, 静态片段适配, 测试时个性化
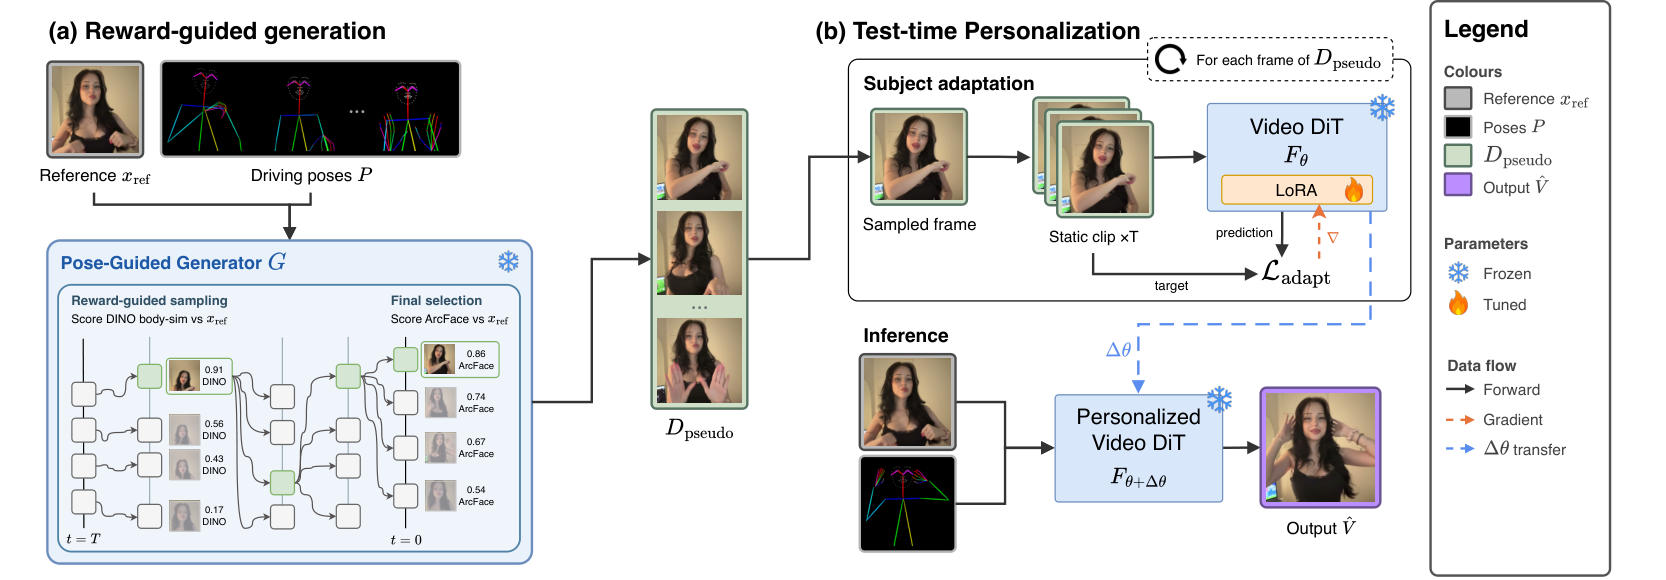
前序问题 :拿一张人物照驱动跳舞,转身后容易脸不像、衣服变样。微调能记住人,却通常要这人的多姿态视频,还可能把原视频里的运动方式一起学进去。方法直觉 :先用图像模型把同一人“摆”成几个关键姿态,再把每张图重复成静止短片来微调。训练信号只带外观,不带错误运动,让视频模型原有动作能力继续工作。本文贡献 :基于 FLUX.1 Kontext 加姿态 ControlNet,用域内视频二帧配对先训练生成器 LoRA(低秩参数适配器);这部分并非完全无需训练。测试时从驱动姿态做最远点采样,默认取 5 个关键姿态,各用 8 个相互作用候选。去噪后半段按 DINOv2 身体外观相似与清晰度重采样并加噪保持多样,末尾用 ArcFace 人脸身份相似选一帧。把选出的每张图和固定姿态重复成静态片段,对冻结的 UniAnimate-DiT/Wan2.1-I2V-14B 仅更新每人物低秩适配器。推理合并适配权重,不新增模型参数。
Figure 2|单图人物个性化流程。输入单一参考 xref 与驱动姿态序列 P,用姿态条件图像生成器 G 合成目标姿态的伪真值帧。(a)每姿态多个候选组成相互作用粒子系统,按相对参考的 DINO 身体外观奖励在去噪中重采样,最后用 ArcFace 人脸身份选一帧;所有奖励只读参考。(b)每人物低秩更新Δθ在所选帧的静态重复片段上适配冻结动画模型 Fθ,再由适配模型生成视频。没有用该人物视频、目标真值或人类反馈;仍需要驱动姿态及预先域内训练。
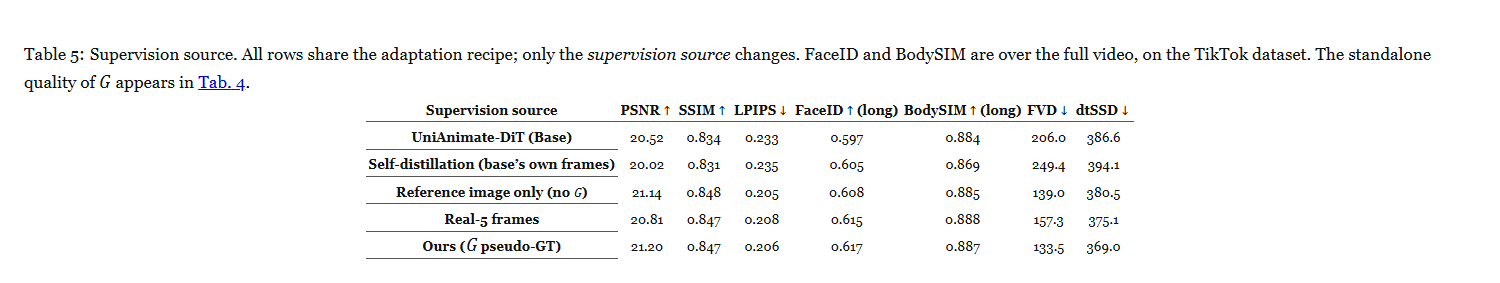
实验效果 :在 TikTok 同配方、只换监督来源的对照中,FVD 视频分布距离从底座 206.0 降到 133.5,5 张真实帧适配为 157.3;FaceID 全视频人脸身份相似从 0.597 到 0.617,真实帧为 0.615。与主比较表的另一底座 402.14 分开,不跨表混算。跨人动作驱动在 Unseen100-Val 上身份 0.431→0.571,姿态准确率 0.817→0.822。单 H100、81 帧,每人物造伪帧 9.2 分钟、适配 5 步 5.8 秒,总约 9.3 分钟,峰值 62.1GiB;每视频推理另 1.8 分钟、21.6GiB。
Table 5|监督来源对照。所有行使用同一适配配方,仅改变监督来源;FaceID 人脸身份、BodySIM 身体外观相似在 TikTok 完整视频上计算,生成器 G 单独图像质量另在原表 4 报告。伪帧 FVD133.5 低于真实 5 帧 157.3,但身体相似 0.887 略低于 0.888,不宣称全指标最好。
批判点评 :无目标人物视频,不等于无驱动姿态、无域内训练或无需每人物成本。真实 5 帧的身体相似 0.888 略高于伪帧 0.887;选帧奖励消融中另一组合 FVD429 低于默认 496,不能照图注称默认所有指标最好。摘要称代码权重可用,但官方仓库目前只有说明、许可证和展示,标注 2026 年 12 月计划开放;依仓库实况写待开放。arXiv 明确 WACV2027 已接收。
6. TaoMate-HD:边续说话边把视频补高清
TaoMate-HD: Progressive-Resolution Autoregressive Audio-Video Generation | 阿里巴巴集团;南京大学 | arXiv:2611.03394
关键词 :流式音视频生成, 渐进分辨率, 分阶段缓存, 文本续读
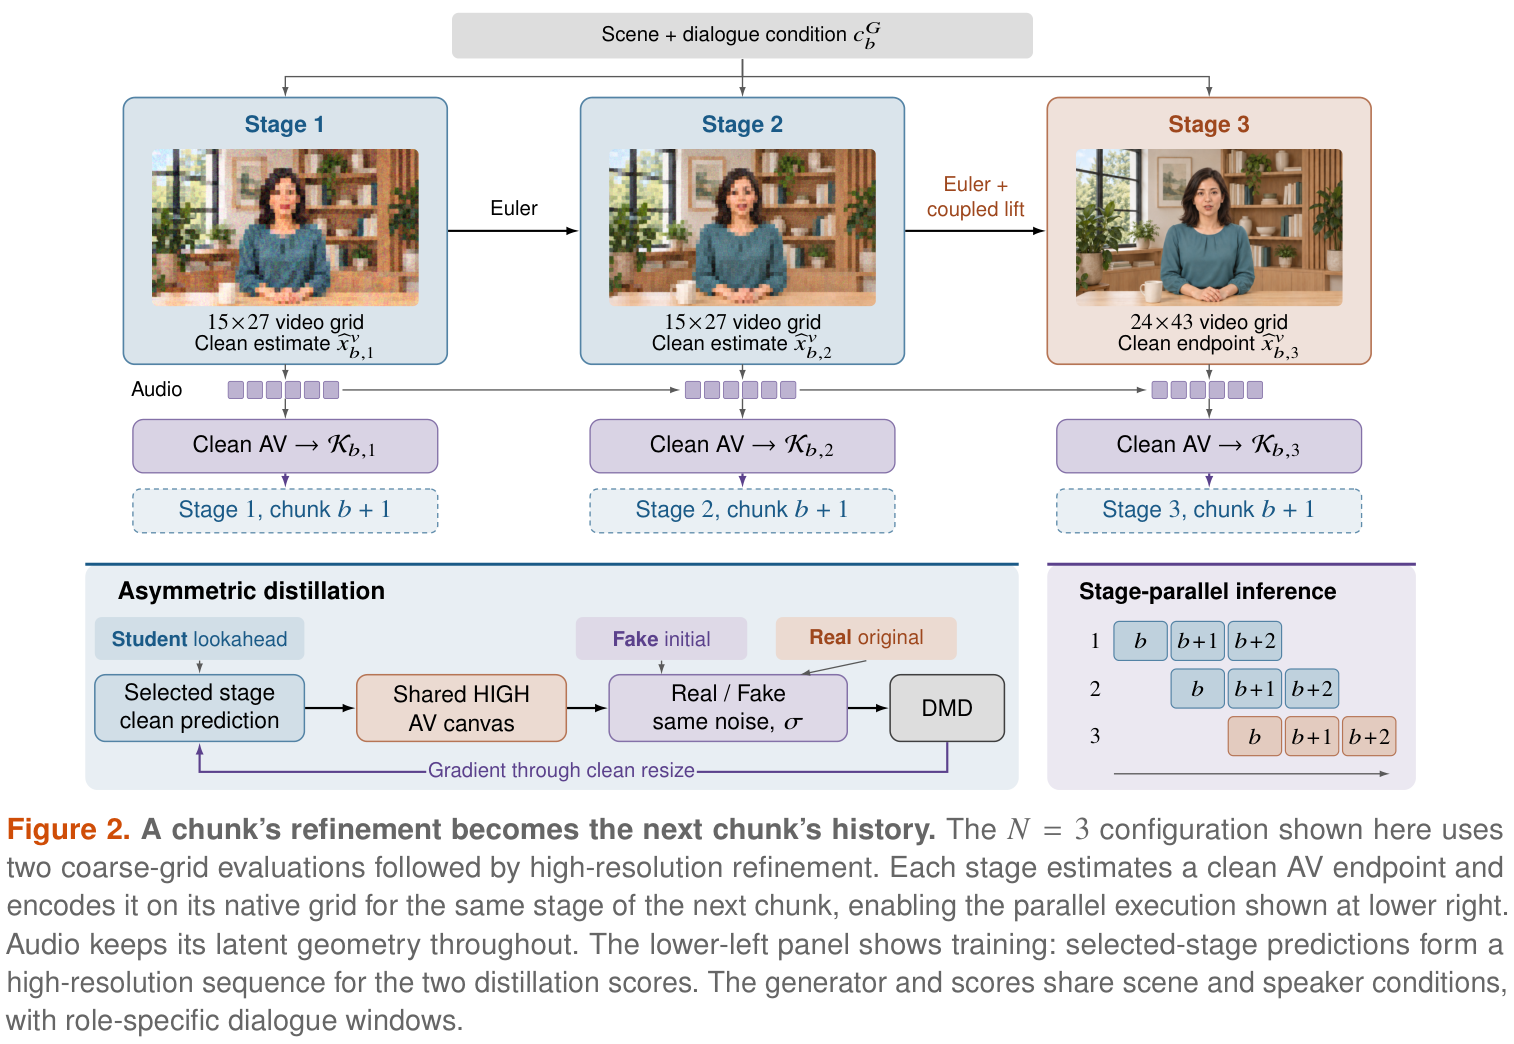
前序问题 :数字人边收新文字边说话,高清每步都算太慢;文字窗口前移,又可能重复说重叠句子或把句尾接错。视觉变清楚和台词接得上要同时解决。方法直觉 :每块先在小画面想清结构,最后一步才补高清;每一阶段把自己的音画预测交给下一块同一阶段。保留已经说出的音频历史,新文字中的重叠内容就能充当上下文。本文贡献 :从 MiniMax-H3 训练秩 128 低秩适配,10000 对自构造蒸馏数据。每块 3 次去噪:前 2 次 480×864,末次 768×1376,声音潜空间尺寸不变;升分辨率时用耦合高低网格噪声修正,避免直接插值改变噪声分布。各阶段独立缓存键/值,留初始视频锚与最近 2 块音画;换文字只刷新文字投影,不重编码旧历史。学生读重叠的新窗口,学生分布评分器保留初始窗口,教师读原始转录前缀,形成非对称分布匹配蒸馏;每块还需 3 次干净历史编码。
Figure 2|每块的细化成为下一块历史。N=3 指两次粗视频网格评估后一次高清细化;各阶段估计干净音画终点,在自身原网格编码,交给下一块同阶段,支持右下的阶段并行。声音潜变量几何全程保持。左下训练部分从所选阶段的干净预测组成高清序列,供真假两个蒸馏评分器使用;生成器与评分器共享场景、说话人条件,但各角色文字窗口不同。
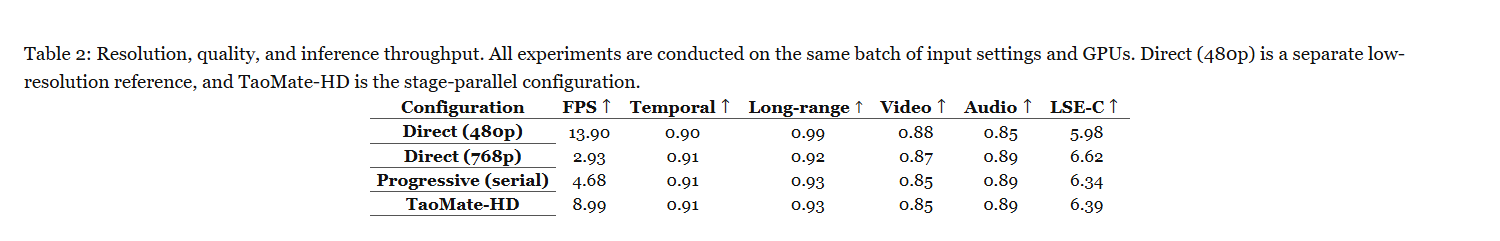
实验效果 :100 个 1–10 分钟序列,768×1376、24 帧每秒、32kHz 立体声。8 张 H20 同设置比较,直接高清平均 491 秒、渐进串行 307 秒,1.60 倍;加入阶段重叠、量化、注意力和编解码调度后 160 秒,额外 1.92 倍,最终 8.99 帧每秒,尚低于 24 帧播放率。时间包含预编码文字后的生成与音画解码。续读配置的 CER(转录字符错误率)30.751%→19.570%,降 11.181 个百分点;首尾声学特征余弦 0.97064→0.97905。
Table 2|分辨率、质量与推理吞吐,全部用相同批次输入和 GPU。直接 480p 是独立低分辨率参照,TaoMate-HD 指阶段并行部署。直接 768p、渐进串行、并行分别 2.93、4.68、8.99 帧每秒;最后一项还合并量化与编解码调度,不能只归为分辨率或并行的单项收益。
批判点评 :1.92 倍是整套部署优化收益,不能只归因阶段并行;跨其他论文 22.4 倍比较有计时区间和分辨率差异,不拿来当同条件加速。续读两配置还改变历史、增广和辅助监督,11.181 点不是单因素因果效果;插入错误反增 2.74 点,同步距离也略退步。小时级有展示,主量化是 1–10 分钟;长程色亮度分低于旧 TaoMate。项目已开放推理与预览权重,未验证完整训练重现。
7. OmniOPD:教会画面也别把声音教坏
OmniOPD: Stable On-Policy Distillation for Joint Audio-Video Generation | 中国科学技术大学 | arXiv:2611.02803
关键词 :音视频联合生成, 在策略蒸馏, 特权视觉, 可靠性加权
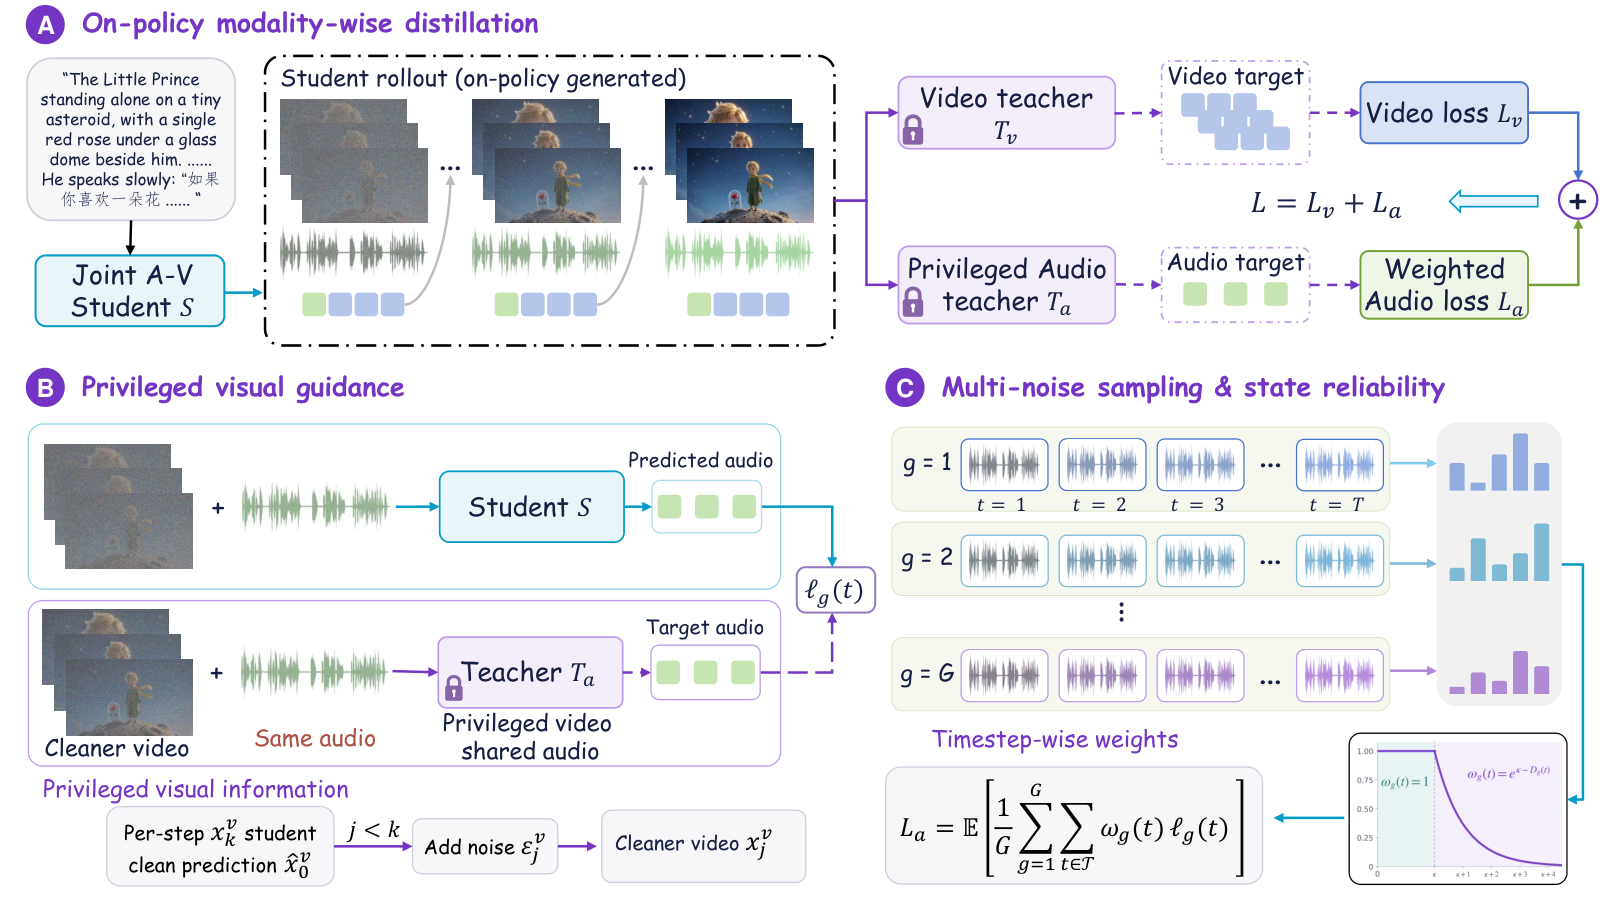
前序问题 :同一模型同时优化画面和声音,声音 token 远少于视频 token,训练信号容易不稳;只把声音奖励乘大,画面和声音可能一起退步。方法直觉 :请专长不同的音频、视频教师分别教学生。音频教师额外看到更干净的画面,更容易判断该发什么声音;多采几条轨迹,再降低不可靠步骤的影响。本文贡献 :用 LTX-2 的 220 亿参数双流模型初始化,分别按视觉或音频及同步奖励做低秩强化学习教师,蒸馏时冻结。学生自己生成去噪轨迹,即在策略 OPD,不只看教师分布样本。音频教师与学生共用同一音频状态,但教师视频时间 q=t/[t+exp(s)(1−t)]小于学生 t,t 越小噪声越低,s 为正移位量;由学生干净预测重新加噪构造条件。每提示采 G 条联合音画轨迹增加声音监督,按教师学生的转移 KL 差异(概率分布偏离度)给越界步骤指数降权;视频蒸馏同时保留。G 增加也会增加轨迹生成和教师调用。
Figure 3|OmniOPD。(A)学生按自身轨迹采样,冻结视频教师与音频教师分别蒸馏各模态。(B)音频教师与学生看同一音频状态,却额外看更干净视频上下文,产生更有信息的音频目标。(C)多噪声采样覆盖不同噪声与去噪步骤,状态可靠性加权减轻不可靠信号。
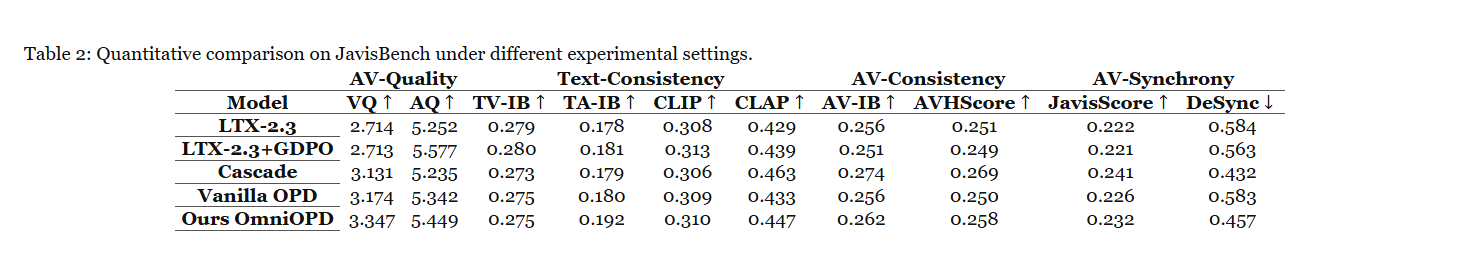
实验效果 :JavisBench 相同设置对比普通 OPD:VQ 视觉质量 3.174→3.347、AQ 音频质量 5.342→5.449,DeSync 音画失同步 0.583→0.457,低更好。对 LTX-2.3 基线为 2.714/5.252/0.584。它没有同时追平每个教师:音频教师 AQ5.576,顺序训练 Cascade 的 DeSync0.432 都更好。组数从 1 到 2 时 AQ 反降 5.342→5.223,3 组才到 5.393,不能宣称更多分支必然提升。主文没有统一训练墙钟或峰值显存。
Table 2|JavisBench 不同训练设置的定量比较,覆盖音画质量、文本一致、音画语义一致及同步。普通 OPD 的视觉/音频质量 3.174/5.342,OmniOPD 为 3.347/5.449;失同步 DeSync 从 0.583 降到 0.457,但 Cascade 的 0.432 更低,不能称每项领先。
批判点评 :不对称教师输入更干净,其“KL”依赖共同转移参数和协方差的假设,宜看作训练可靠性准则,不当成自动可证的真实音频误差。正文写 LTX-2,表写 LTX-2.3,复现须核具体 checkpoint。公开代码仓库 有推理、合并与评测脚本,评分还依赖多个模型服务;可核到这些接口,不代表完整教师强化训练都已重现。
8. Z-Cache:缓存猜错后回头修一段
Z-Cache: Accelerating Diffusion Transformers via Self-Reflection | 上海交通大学;南方科技大学;阿里云;华中科技大学 | arXiv:2611.01846
关键词 :扩散缓存, 双锚点回溯, 质量恢复, 墙钟开销
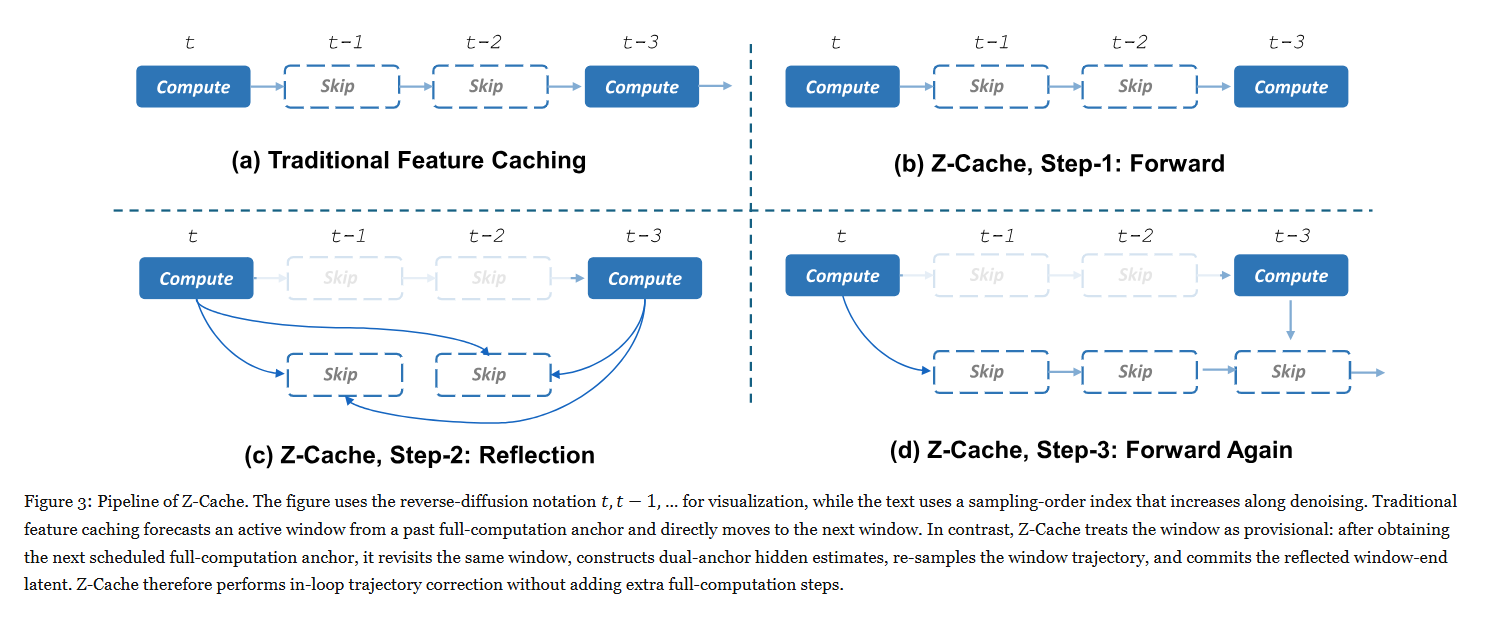
前序问题 :扩散模型跳过中间完整计算、直接复用特征,能省计算,但猜错的特征会把后面图像一路带偏。等下次完整计算得到更准特征时,错误已经传播了。方法直觉 :先把一段缓存采样当临时草稿;拿到下一次本来就要算的完整特征后,用前后两个锚点重估中间特征,再重跑这段潜变量更新,确认后才继续。本文贡献 :这是免训练包装器,可接 TaylorSeer、SpeCa、MagCache 等预测器。采样顺序 a 到 b 之间先按旧锚预测,b 处做原计划的完整前向;再用两端预测的凸组合修正,权重(i−a)/(b−a)随窗口位置前移。丢掉临时窗口潜状态,重采样同一段,并用保留的 b 处特征提交修正后的末端。这里不新增完整前向,但有缓存读取、预测、潜更新及特征存储,绝非零额外工作;局部误差界依赖更新的 Lipschitz 连续及双锚确能降低特征误差。
Figure 3|Z-Cache 流程。图按反向扩散 t、t−1 等标注,正文则按随采样推进递增的序号。传统缓存只从旧完整计算锚点预测当前窗口,随后前进;Z-Cache 把窗口视为临时状态,拿到下一次原定完整计算锚点后,构建前后双锚特征,重新采样该窗口并提交修正末端,在循环内纠正轨迹而不增加完整前向次数。
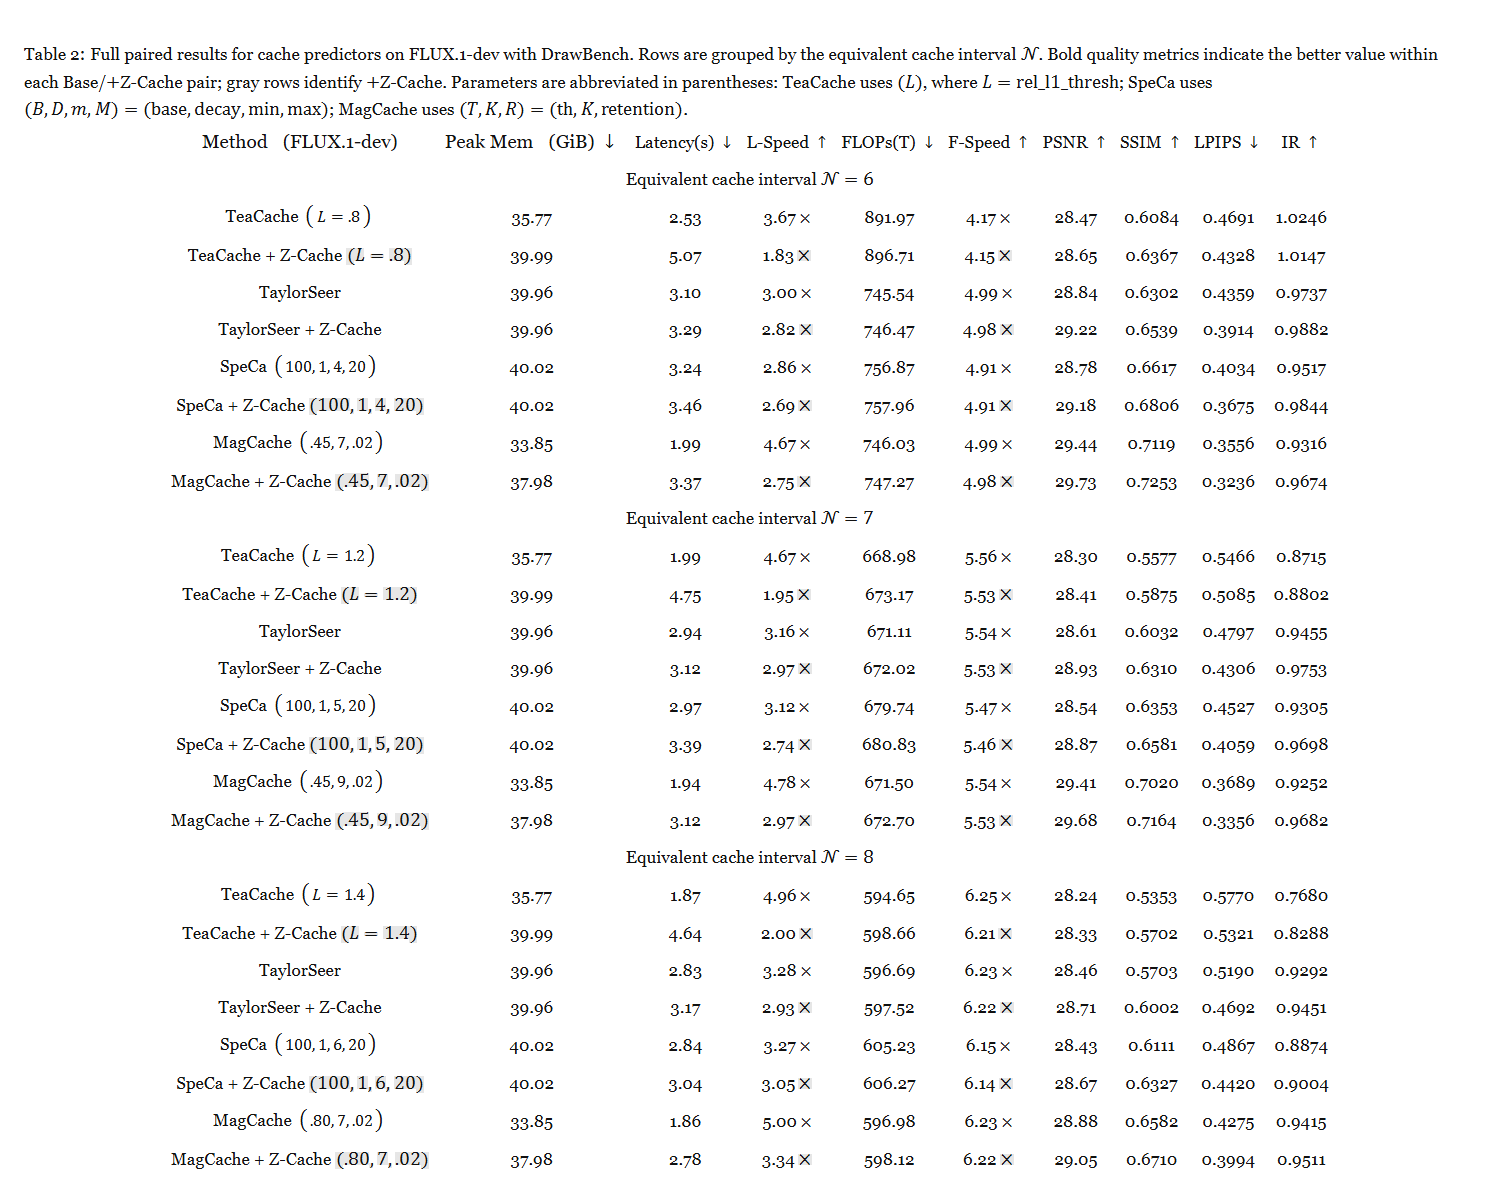
实验效果 :FLUX.1-dev/DrawBench 等效缓存间隔 8,TaylorSeer 加 Z-Cache 后,相对原 50 步的 FLOPs(浮点运算数)缩减 6.22 倍,墙钟加速却是 2.93 倍;相对 TaylorSeer 本身延迟 2.83→3.17 秒,LPIPS 感知差异 0.5190→0.4692、PSNR 像素一致 28.46→28.71,峰值同 39.96GiB。MagCache 同间隔加包装后延迟 1.86→2.78 秒、峰值 33.85→37.98GiB。HunyuanVideo/VBench 间隔 7,得分 79.09→79.60,耗时 21.01→23.08 秒;原 50 步为 80.66、145 秒。
Table 2|FLUX.1-dev 在 DrawBench 的完整成对结果,按等效缓存间隔 N 分组;每组基础/加 Z-Cache 成对中较好质量加粗,灰行是 Z-Cache。括号参数:TeaCache 的 L 是 rel_l1_thresh,SpeCa 的 B/D/m/M 分别 base/decay/min/max,MagCache 的 T/K/R 分别 th/K/retention。L-Speed 是墙钟加速、F-Speed 是计算量缩减,均相对原采样。间隔 8 的 TaylorSeer 包装后 F-Speed6.22 倍而 L-Speed2.93 倍;延迟和显存有额外代价。
批判点评 :它恢复激进缓存质量,不是让已有缓存再更快;比较无加速模型可快,比较同预测器通常更慢。摘要“6.22 倍”须按主表区分计算量与墙钟。以原采样输出作参考的 PSNR 或 LPIPS 衡量轨迹接近,不等于人类偏好无损;TeaCache 某设置 ImageReward 还退步。arXiv 评论明确 NeurIPS2026 poster,未找到可核实的本方法官方仓库地址,不把引用的 FLUX 仓库当其源码。
9. EASD:给不同蒸馏目标分配噪声区
Efficient Hybrid Distillation: Synergizing Score and Adversarial Objectives for One-Step Diffusion | 清华大学;鹏城实验室;美团 | arXiv:2611.03017
关键词 :一步图像生成, 混合蒸馏, 噪声区间, 冻结教师判别器
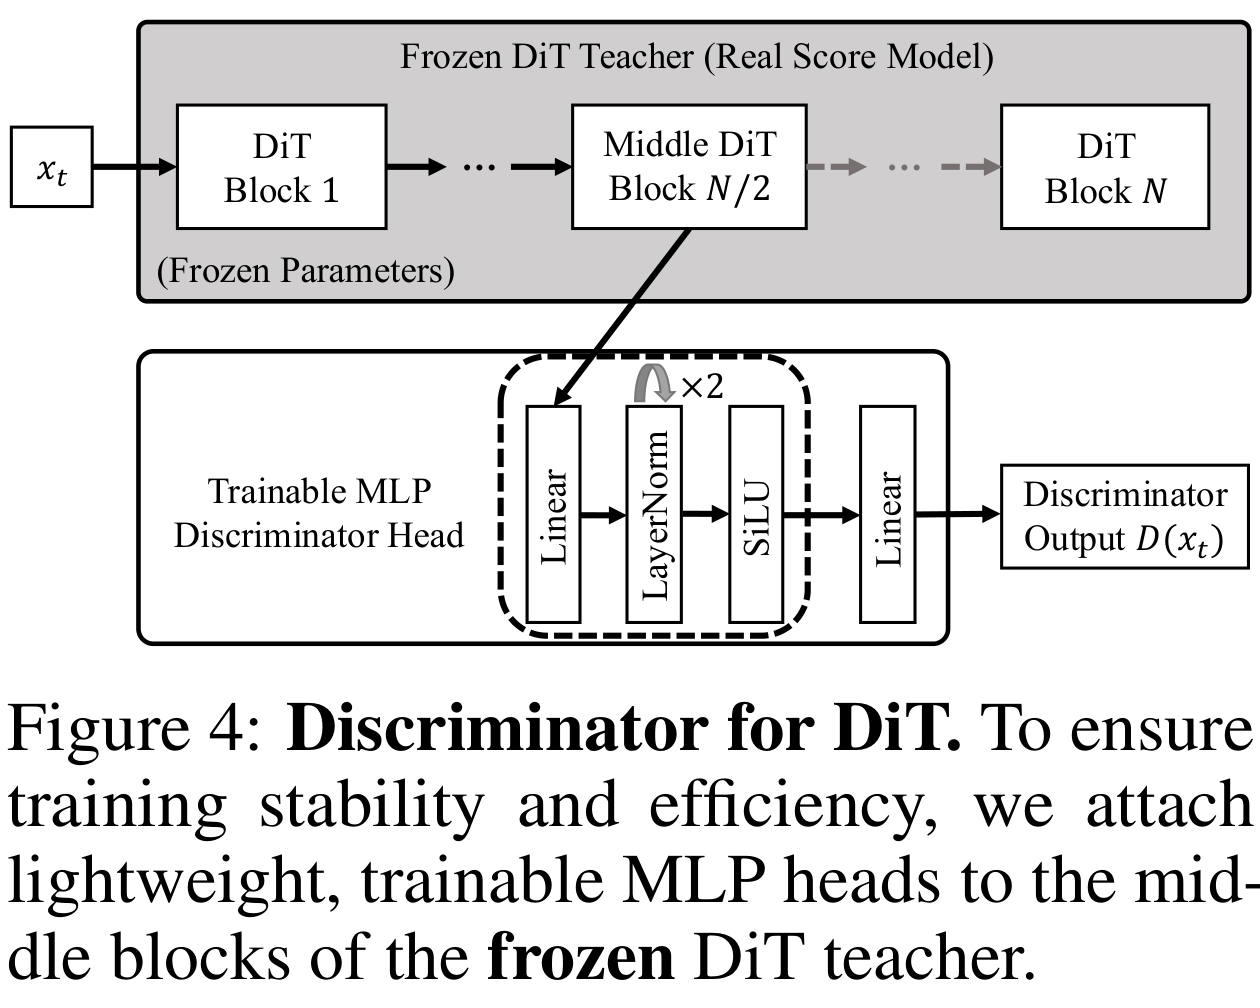
前序问题 :把扩散模型蒸馏成一步,分数蒸馏和对抗蒸馏简单相加,并不保证互补:前者低噪声时信号弱,后者高噪声时又分不清真假,白花训练算力。方法直觉 :让擅长全局分布的分数目标多看高噪声,让判别细节的对抗目标多看较低噪声;仍留两者少量重叠,避免极低噪声判别器过拟合和模式坍塌。本文贡献 :Efficient Adversarial Score Distillation 用 Logit-Normal 采样:先从均值μ、标准差 s 的正态取值,再经 sigmoid 映射到 0–1 噪声时间。分数目标μ=0.8、对抗目标μ=−0.8,二者 s=1.6,软偏置而非硬切半区。流匹配直接在速度预测空间蒸馏;冻结教师中间层接轻量前馈判别头,只训练头以保持特征稳定。学生分布评分网络用指数滑动平均 EMA 或周期预热稳定;ImageNet 默认不叠加 CFG,并用潜空间模式分离损失保持类内多样性。
Figure 4|用于扩散 Transformer 的判别器。为保证训练稳定与效率,在冻结的教师 Transformer 中间块连接轻量可训练前馈网络头;教师特征保持不变,判别头学习真假分布区别。
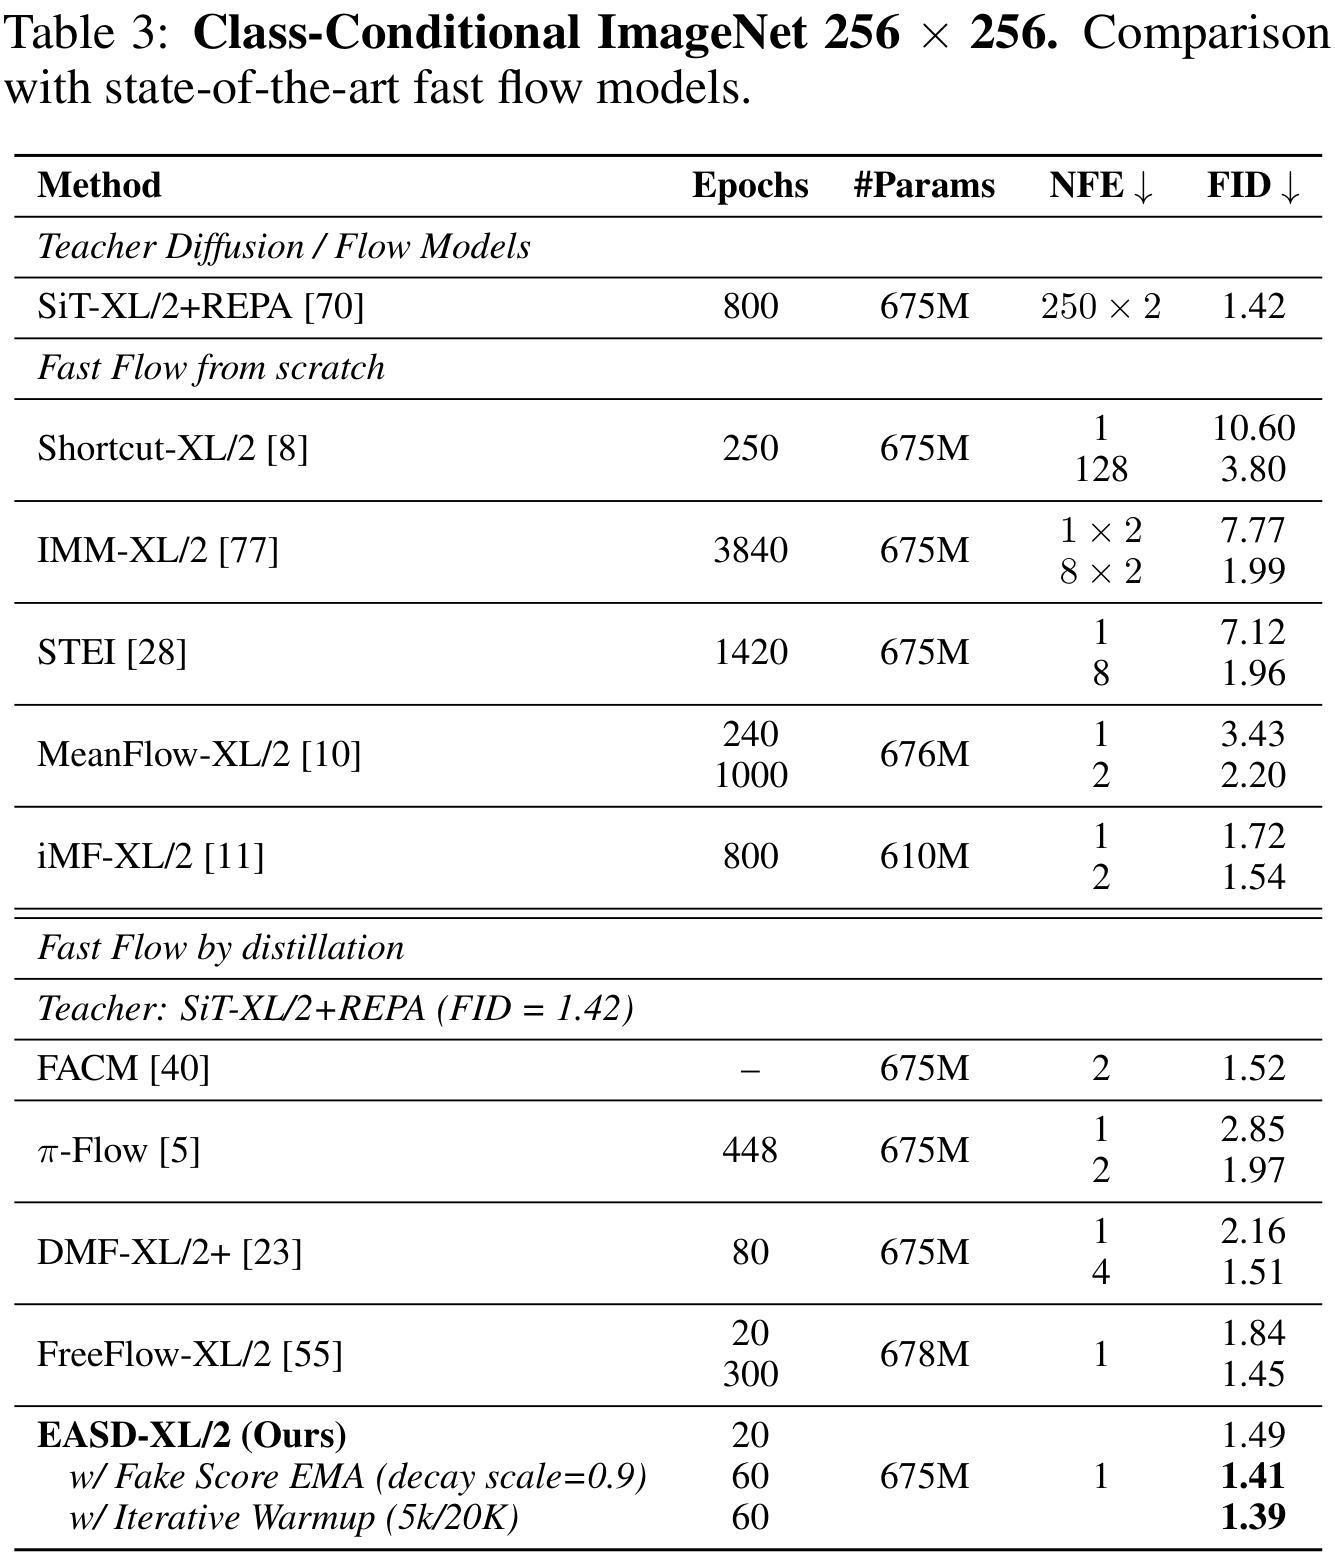
实验效果 :ImageNet256×256、1000 类,以 50000 生成图计算 FID 分布距离,越低越好。6.75 亿参数 SiT-XL/2+REPA 教师 FID1.42;一步 EASD 训 20 轮为 1.49、60 轮加评分 EMA 为 1.41,周期预热版本 1.39;60 轮与 20 轮须分开。ImageNet64 严格同混合范式对照,5:1 更新比、批 280 下,DMD2 到 10 万/20 万步 FID1.72/1.52,加噪声自适应为 1.50/1.35,完整 EASD 为 1.46/1.26;相应报告时间 28 小时与 23 小时,不能把训练步数比当墙钟倍数。
Table 3|类条件 ImageNet256×256 上与快速流模型比较,列出轮数、参数、NFE 模型函数调用数及 FID。教师 SiT-XL/2+REPA 为 6.75 亿参数、FID1.42;EASD 一步 20 轮 1.49,60 轮评分 EMA 版 1.41、迭代预热版 1.39。训练轮数和引导调用口径不同,不能当成相同训练成本或开放文本任务排名。
批判点评 :1.39 是类条件 ImageNet,不是开放文本生图或高清视频指标;不同模型训练轮数、教师预训练成本也不相同。所谓两目标统一依赖理想判别器等近似,实际对抗仍可能坍塌,不能写为不会冲突。原文明确 NeurIPS2026 接收;摘要称代码模型可用,但官方 EASD 仓库目前只有 Coming soon 说明,按待开放报告。推理一步不包含教师、评分器与判别器的训练代价。
10. Rel2Traj:让狗的声音一直跟着汽车
Rel2Traj: Inter-Source Relation-Aware Trajectory Generation for Text-To-Spatial-Audio | 早稻田大学;休斯敦大学 | arXiv:2611.01147
关键词 :空间音频生成, 多声源轨迹, 关系条件扩散, 双耳渲染
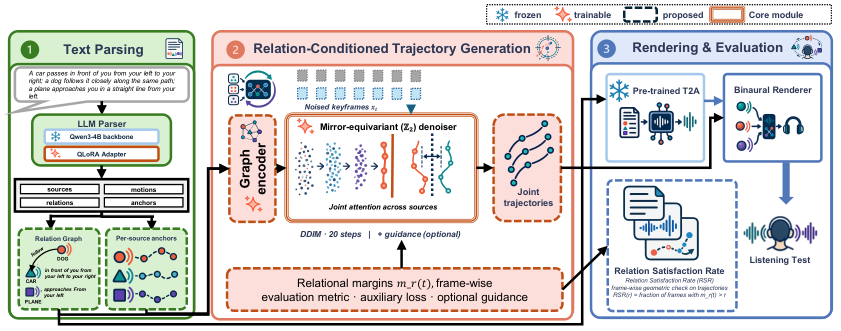
前序问题 :“汽车从左到右开,狗跟在后面”,两个声音各自移动合理,也可能中途交叉、不再跟随。只逐声源生成,难让整段的相对关系一直成立。方法直觉 :先把描述拆成谁跟谁、每个声源大概在哪里,再一起生成所有轨迹;把已有声效沿轨迹做双耳渲染,让几何可核对,也让人用耳机检验听觉关系。本文贡献 :用 Qwen3-4B 的量化低秩 QLoRA 适配解析运动、关系和每源 10 项锚点;两轮关系图消息传递后,宽 192、4 层 8 头的镜像等变 Transformer 联合去噪每源 16 个三维关键帧,以 20 步 DDIM 采样、插值到 30 帧每秒。轨迹生成器共 152 万参数,其中去噪 92 万。固定渲染器处理多普勒、头相关传递函数 HRTF 及房间反射,声音来自 ESC-50 和预训练文生音频模型离线材料。5091 训练、242 验证、1020 组合测试场景,时长 8–14 秒;冻结 5 组运动—关系组合只在测试出现。
Figure 1|Rel2Traj 三阶段:(1)文本解析成声源关系图与每源锚点;(2)关系条件关键帧扩散联合生成全部轨迹;(3)双耳渲染与评测。底部逐帧关系边界同时定义 RSR 满足率、辅助训练损失及可选采样引导;所有报告结果关闭该引导。
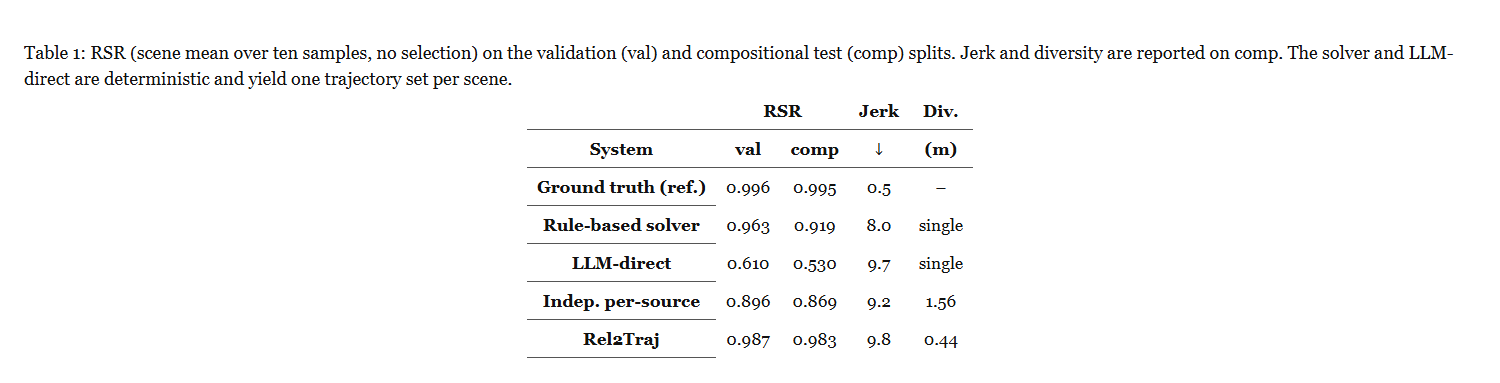
实验效果 :RSR 关系满足率是规定时间内、超过死区阈值的合格帧占比,每场景 10 次生成、不择优,再按场景平均。组合测试 0.983,独立逐源 0.869、规则求解 0.919;几何主表除 LLM 直接输出外都使用真值解析结构,因此不是完整文本端到端成功率。24 名有效听者、28 道覆盖 6 类关系的二选一,识别率 86.0%,与真值差−3.3 个百分点;等效检验只支持预设±10 点范围。
Table 1|验证 val 与组合留出 comp 的 RSR,每场景 10 次采样平均、不择优,再按场景平均;位置三阶导 jerk 及轨迹多样性在组合集报告。规则求解器与 LLM 直接输出是确定性的,每场景只有一组轨迹。Rel2Traj 组合 RSR0.983、独立逐源 0.869,但 jerk9.8 高于 9.2;除 LLM 直接输出外主表使用真值结构条件,非完整文本端到端成绩。
批判点评 :联合模型的 jerk(位置三阶导数幅度、越低越平顺)9.8 高于独立模型 9.2,关系更准不代表轨迹更平滑;去掉显式关系损失 RSR 反为 0.987,不能把收益全归辅助几何损失。受控语言、每场最多 1 条声源间关系、不含纯竖直运动限制开放描述。没有报告完整解析、音频生成和渲染总时延;仅投稿 ICASSP2027,尚非接收。项目页 有音频与轨迹浏览器,未核到官方实现仓库。
趋势观察
参考要分清外观与目标动作
MoviEdit用已改帧指导跨镜头,TaoMate-FVSR把外观参考与运动历史分槽,VidDub在换音时停用原嘴部重建。共同方向是只保留参考中仍可信的部分,而不是照抄全部像素。
算力数字先拆清计数范围
MoviEdit的11.8秒来自8张H100去噪,Z-Cache的6.22倍是FLOPs缩减,TaoMate-HD的8.99帧每秒来自整套部署。采样步数、单token激活参数和完整响应时间各自回答不同问题。
自动评分要先看选择和分母
VideoEditor-MoE明确筛出自身有利案例;VidDub另报共同有效集合;Rel2Traj几何表使用真值解析。先看样本怎么来,再决定数值能推到多广。
论文与代码开放各查一次
One Image Is Enough和EASD摘要称资源可用,仓库却仍待开放;VideoEditor-MoE有实现但权重需申请。能读论文、能看展示和能复现实验是三个阶段。
今日讨论
MoviEdit 把 540p、361 帧在 8 张 H100 上的去噪从 364.1 秒降到 11.8 秒,任意帧参考总分 0.786 略高于 Aleph 的 0.781,首帧子集 0.803 却低于 0.806。若目标人物在切镜后被遮挡,应按参考帧位置、相似人物和遮挡程度分组,如何验证全局草稿到底是在保身份,还是把首个错误传播到整片?
人工智能炼丹君 整理 | 2026-11-04


评论 (0)