今日 AIGC 论文速览
今日共 10 篇 · 参考视频编辑 1 篇 · 高分辨率与图内文字编辑 2 篇 · 视频续写与像素生成 2 篇 · 图像蒸馏与推理搜索 2 篇 · 可控语音与空间音频 2 篇 · 数值属性控制 1 篇
重点论文标题列表
- ReXMo(吉林大学):换了主角也要留下原表情
- FLASH(复旦大学):小图定编辑大图接着补细节
- FlowTranslator(复旦大学):把招牌换成译文还留下街景
- ReCR(斯坦福大学):长视频该记住哪些旧画面
- U-JiT(Meta):不先压视频也能补回高频
选读入口:需要参考照片换视频演员,先读 ReXMo,特别区分真实换角和往返重建;要改 4K 海报接着读 FLASH 的 309.69/215.31 秒取舍,改街景招牌读 FlowTranslator 的固定译文协议。续写越长越跑偏看 ReCR 的历史选择与显存增长,研究基础架构看 U-JiT 的 128/256 分辨率条件。做四步生图训练读 StepX-OPD;语音服务读 TTSonic 的内容/音色拆分,空间音频编辑读 Spatial Transfusion。愿多花推理算力再看 PATTS;需要明确属性刻度最后看 ScoreDial 的独立审计,避免把代理分数当物理事实。
今日论文速览
1. ReXMo:换了主角也要留下原表情
ReXMo: End-to-End Video Character Replacement with Expression and Motion Preservation | 吉林大学 | arXiv:2611.04633
关键词:参考视频编辑, 角色替换, 成对三元组, 表情适配器
- 前序问题:把双人表演的一位演员换成参考照片中的人,动作骨架相同,嘴角和眼神却可能变了;两人靠近时,表情还会串给另一人。只给姿态或挖空人物区域,难以保住这些细节。
- 方法直觉:先造出“动作与场景一样、身份不同”的视频对,再倒过来训练:让模型从换过人的视频恢复原演员。全身替换学好后冻结它,另给每位演员接一条表情信息通道。
- 本文贡献:底座为 Wan2.2-TI2V-5B。训练三元组是合成驱动视频、原视频和原身份参考帧;驱动潜变量与带噪目标按通道拼接,参考图另编码为上下文 token(特征单元)。冻结预训练主干、自编码器和文字编码器,只更新秩 80 的 Motion LoRA 低秩适配器及扩展输入层。第二阶段用约 3 万段 512×512 对齐脸部片段,冻结运动提取器,每 5 个扩散 Transformer 块插入一次表情交叉注意力;仅训 Face Encoder 和 Face Adapter,按演员对应关系注入。两阶段均用 97 帧、24 帧每秒片段,各训 1 万步;Wan2.2-Animate 只用于造训练数据,不参与最终推理。
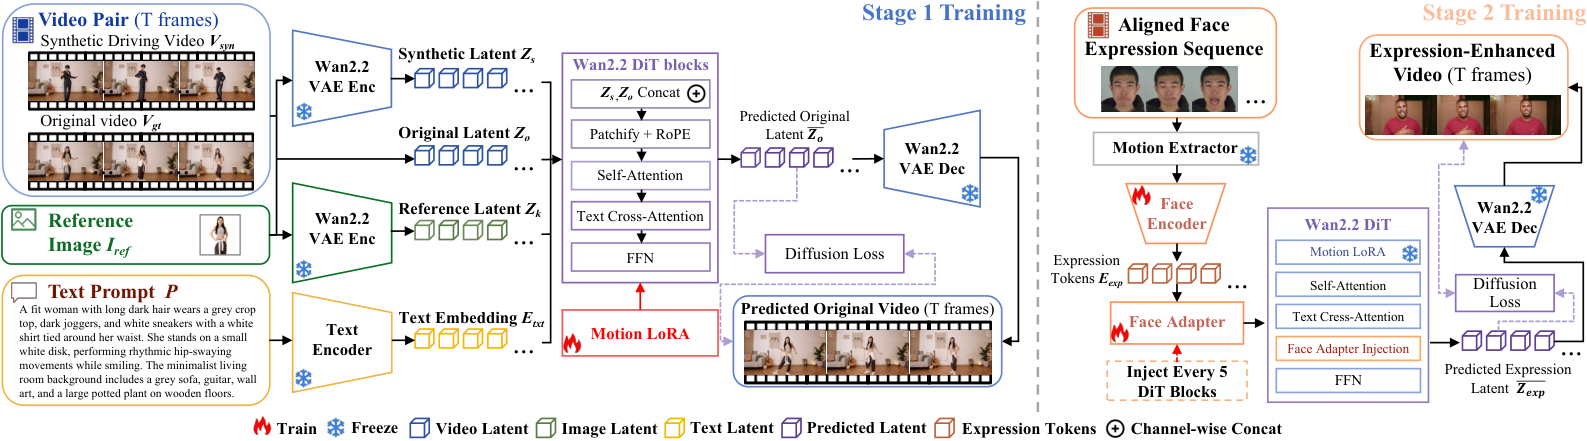 Figure 2|ReXMo 两阶段:第一阶段用合成跨身份配对三元组学习参考引导角色替换;第二阶段冻结替换模型,用对齐脸部序列训练表情增强适配器,保留细微表情。
- 实验效果:合成跨身份基准先由原演员 A 生成新身份 B,再恢复 A,与原 A 比较,属于往返重建协议。单人 Pose-DTW(姿态动态时间对齐距离,低更好)由 SCAIL-2 的 0.0263 降到 0.0258,PCK@0.2(容差内关键点比例)0.9879→0.9890;多人距离 0.0314→0.0312。表情适配消融的 Expr-LMD(表情关键点误差)0.3415→0.2905、LVD(关键点速度差)0.0389→0.0288。人物替换感知评分中画质 4.32、时序 4.12、外观 4.39,但运动平滑 3.90 低于 SCAIL 的 3.92。
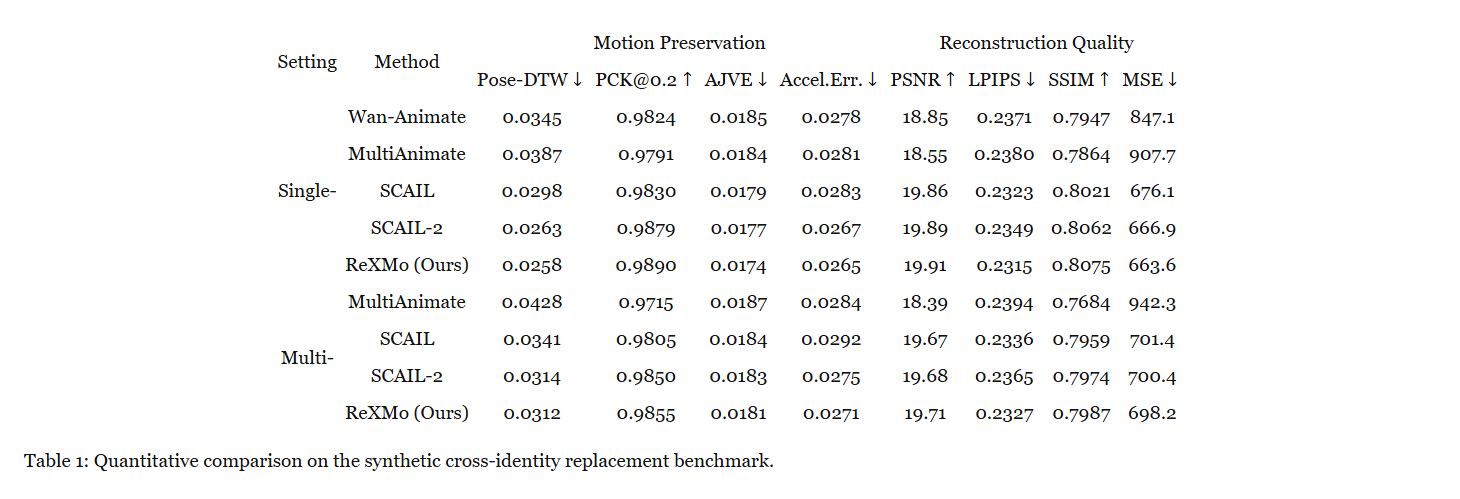 Table 1|合成跨身份替换基准的定量比较,分单人和多人。原视频 A 先改为 B,再恢复 A,用姿态动态时间距离、关键点正确率、关节速度及加速度误差衡量动作,用 PSNR、LPIPS、SSIM、均方误差衡量重建。各列箭头给出方向;这是往返重建而非任意换角的成功率。
- 批判点评:提升包含很小的重建差值,往返协议也不能等同任意真实视频换角的成功率。多人对应路由不是无条件解决遮挡;论文没有交代足够清楚的测试规模、统一推理墙钟与峰值显存,不能称实时或零额外成本。50 人偏好实验是配对选择,不当成 50 条视频。原文承诺后续公开数据与代码,未给可核验实现地址;标题机构来自作者地址脚注。
2. FLASH:小图定编辑大图接着补细节
Efficient and Faithful High-Resolution Image Editing with Sparse Cross-Resolution Denoising | 上海创智学院;复旦大学;阶跃星辰;香港中文大学 | arXiv:2611.04416
关键词:高清图像编辑, 跨分辨率去噪, 局部注意力, 渐进推理
- 前序问题:把海报改到 4K,直接放大模型网格会让注意力计算暴涨;先在 1K 修改再交给超分模型,又可能修清了纹理却偏离原来的编辑目标。
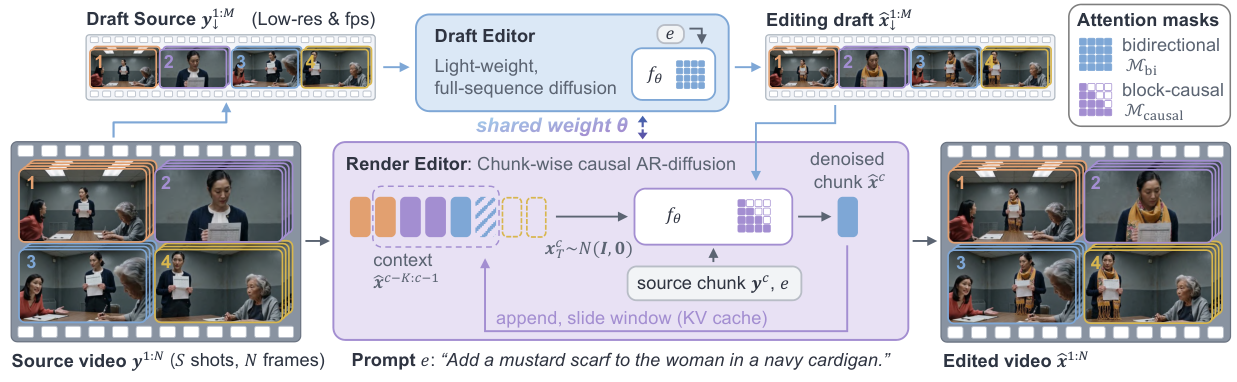
- 方法直觉:保留一条看完整张小图的编辑轨迹,高分辨率分支沿着它补细节。大图只读附近的源图和目标区域,先保证修改方向一致,再花计算恢复局部纹理。
- 本文贡献:以 FLUX.2 Klein Base 4B 为底座,在 VINS-120K 实际 131010 个样本上训练。冻结 1K 分支,只给高分支加秩 32 的 LoRA。信息单向从小图流向大图;大图查询读取对齐的小图带噪目标邻域,以及本尺度源图/目标的 Halo 扩展窗口。主配置小图半径 R=3,线性放大 n=2/4 对应 Halo 宽 h=Rn=6/12 个潜空间 token。按分辨率调整噪声时间,YaRN 扩展旋转位置编码。渐进版前 12 步只走 1K,再将干净估计解码、缩放、重新编码和加噪,余下 16 步由同一编辑器完成,非外接超分。
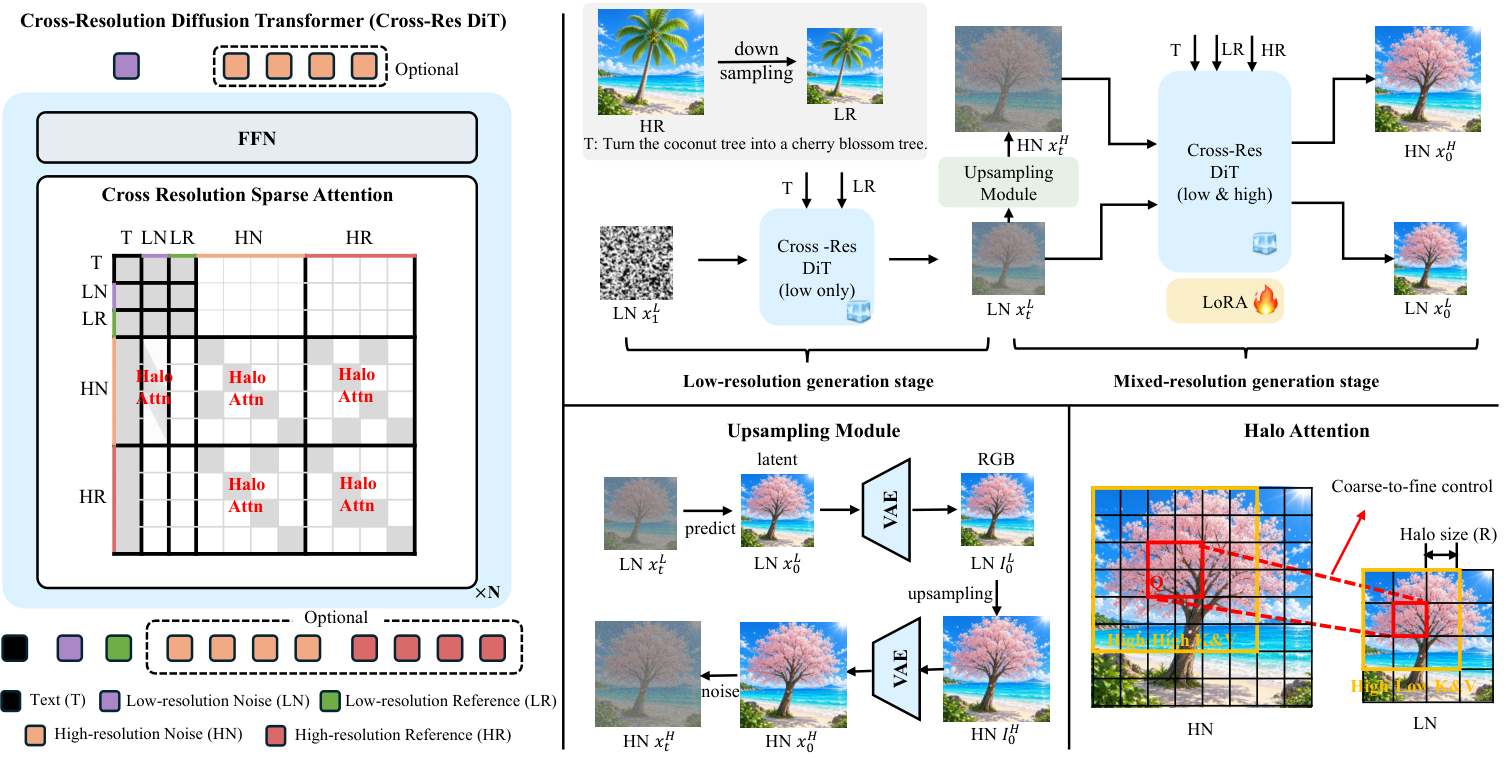 Figure 3|FLASH 总览:冻结 1K 分支锚定全局编辑,局部高分辨率注意力恢复细节,渐进推理以 1K 去噪前缀替代早期高分辨率步骤。
- 实验效果:1K/2K/4K 在此分别为 1024×1024、2048×2048、4096×4096 像素。509 条、12 类指令的 VINS-4KEval,质量按编辑类型宏平均。4K 主配置 28 步、单图,直接/渐进耗时 309.69/215.31 秒,含分辨率过渡但不含模型加载,减少 30.5%;HaarPSI 全图感知相似 0.4067→0.3775,保留区结构相似 mSSIM 为 0.7621→0.7369。独立 R=1 前向诊断 17.33→4.13 秒,注意力 15.2→0.60 秒,分别 4.2 倍和 25.3 倍;这不是主配置 R=3 的端到端加速。
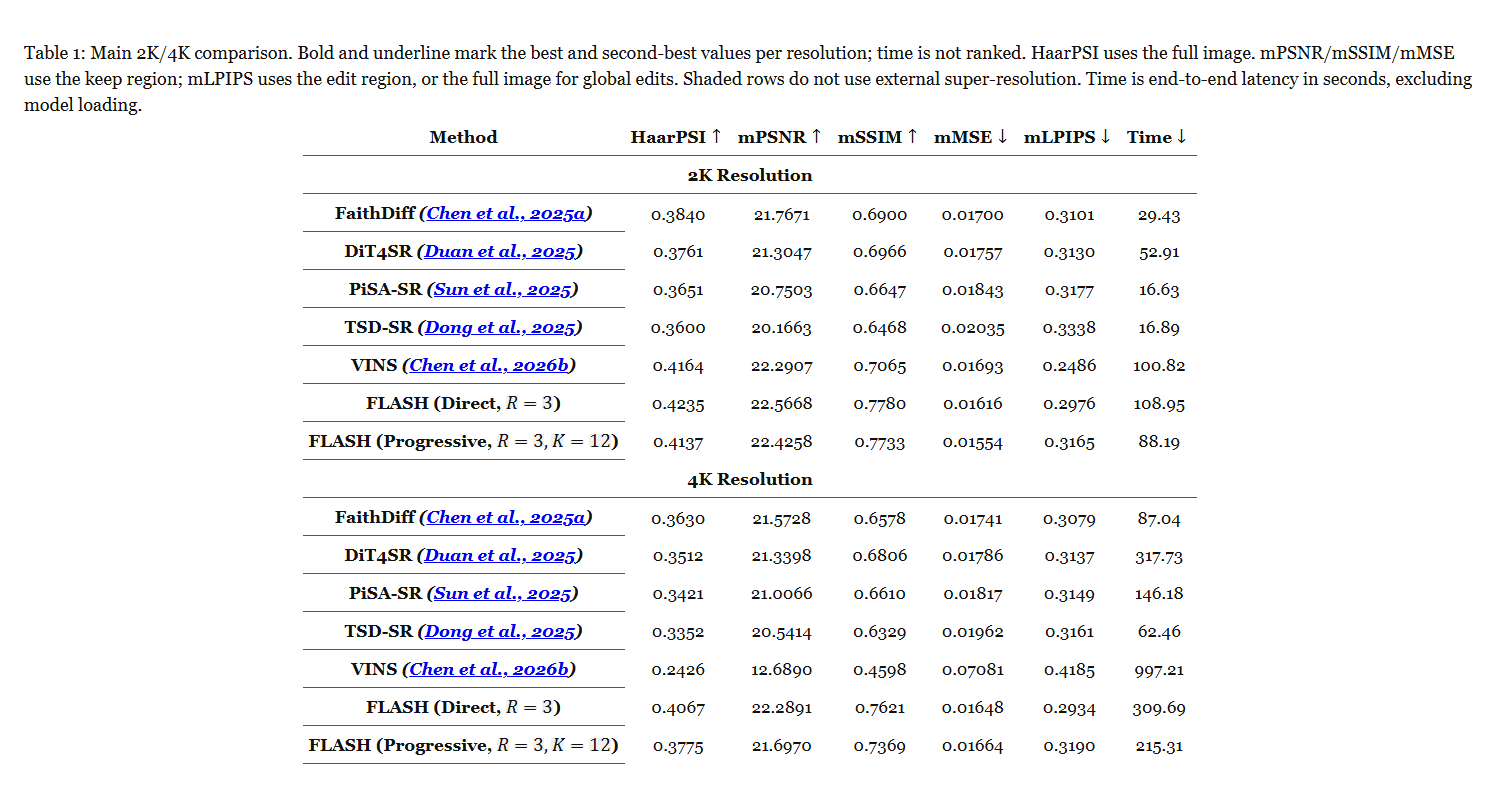 Table 1|2K/4K 主比较,粗体/下划线为最好/次好,时间不排名。HaarPSI 用全图,mPSNR/mSSIM/mMSE 用保留区,mLPIPS 用编辑区,整体编辑时用全图。阴影行不接外部超分;时间是含完整生成、不含加载的秒数。直接/渐进 4K 为 309.69/215.31 秒,质量存在取舍。
- 批判点评:源图相似不等于编辑完成:这些指标主要衡量未改区域和源输出差异,不能证明每条指令都执行正确。扩大邻域并非各指标单调变好,渐进也有可见质量代价;未报告可统一比较的峰值显存。原文指向的 FLASH 仓库在本次 GitHub 读取返回 404,按暂不可获取报告,不宣称代码已开放。
3. FlowTranslator:把招牌换成译文还留下街景
FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing | 复旦大学;上海市多模态具身智能重点实验室 | arXiv:2611.04303
关键词:图内翻译, 免训练编辑, 噪声解耦, 位移反馈
- 前序问题:翻译照片里的招牌,文字翻对还不够:字要写进原位置,街景不能重画。源图与目标只差几个小字时,两条去噪路径太像,模型又容易原样输出。
- 方法直觉:先在文字区域稍微松开两条路径共用的噪声,让修改启动;等译文字形开始出现,再把已经形成的修改位移放大一点,末段停止放大以修稳笔画。
- 本文贡献:冻结 60 亿参数 Z-Image-Turbo。PP-OCRv5 识别文字和框,每图调用一次 Doubao-Seed-2.0-lite,生成原文/译文描述。每步用同一扩散 Transformer(DiT)分别预测源与目标速度,只在扩展 15%的文字掩码内累积速度差。RCR 即 Region Coupling Release,早期部分解除噪声相关,强度 0.5,从噪声时间 0.6 到 0.3 关闭;CE 即 Coupling Expansion,中段按 sin²时间门放大已有位移,强度 0.4。共 50 个求解步、前 45 步编辑,速度差增益 1.3;每步需源/目标分支,免训练不等于一次前向。
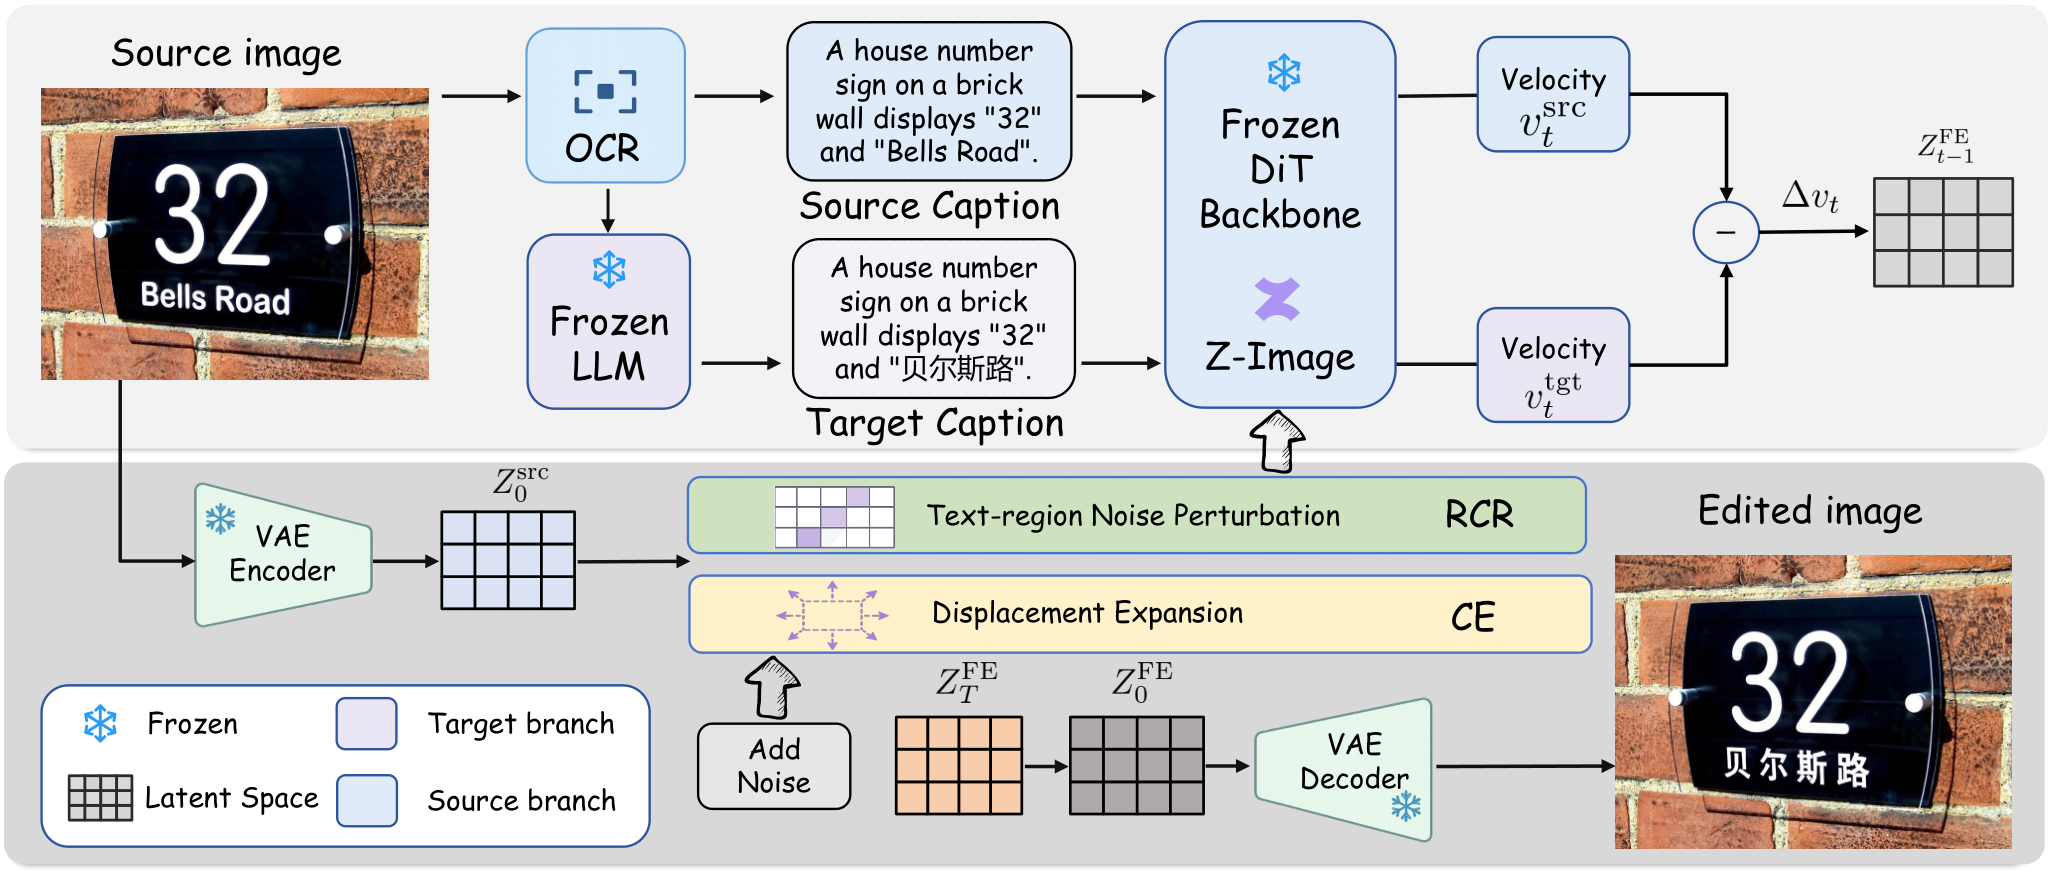 Figure 2|FlowTranslator:OCR 抽源文字,冻结语言模型生成目标译文描述;冻结 VAE 把源图编码成潜变量。每步同一冻结 DiT 预测源/目标条件速度,速度差更新编辑状态;RCR 在文字区扰动目标噪声,CE 将已累积位移放大再反馈。最终编辑潜变量解码为译文图片。
- 实验效果:PRIM 每方向 340 条真实文字条、5 种英译语言,EasyOCR 回读,BLEU 衡量译文词组匹配、COMET 估计翻译质量,均越高越好。对相同设置的 Masked FlowEdit,平均 BLEU16.9→20.6、COMET53.3→57.2;CE 单独 BLEU20.21,完整 20.57,主要收益来自位移反馈。1280 张 ScenePair 英译中,固定各方法文字框与目标译文,准确率 33.44%→40.08%,结构相似 SSIM0.9533→0.9509;这隔离的是指定译文渲染阶段,不是整条识别翻译链路。
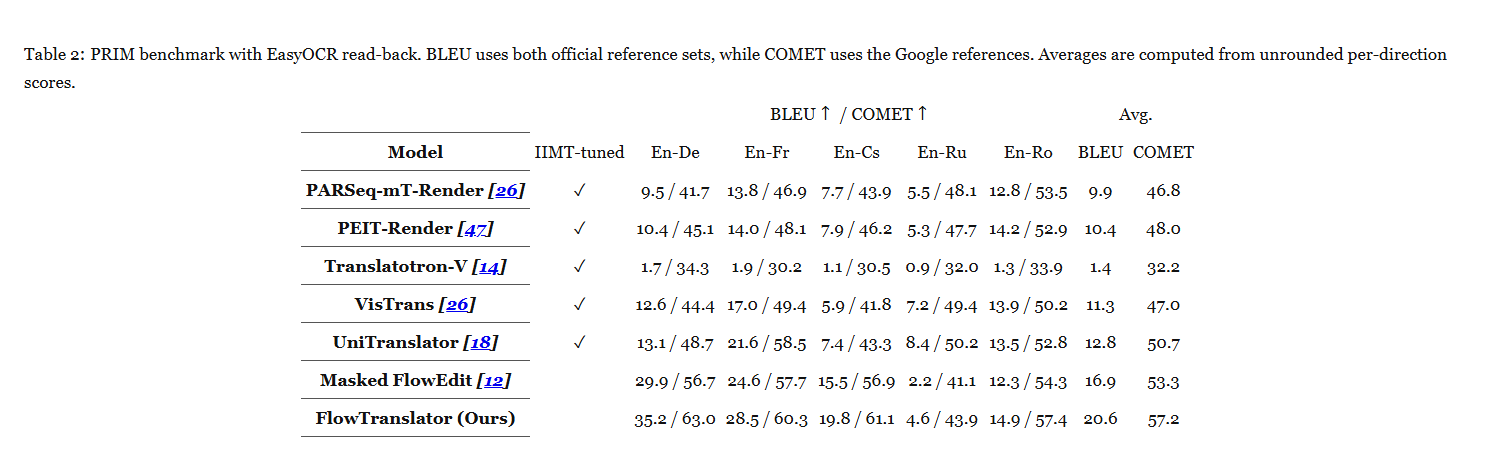 Table 2|PRIM 的 EasyOCR 回读评测。BLEU 使用两套官方参考译文,COMET 使用 Google 参考译文,平均值由未四舍五入的各方向数值计算。五种英译方向每种 340 条,完整方法平均 BLEU20.6、COMET57.2;英译俄仍是明显弱项。
- 批判点评:俄文字形仍弱,英译俄 BLEU 仅 4.6;TTV 合成文字图基准的大字上的增益很小,且源图 SSIM 低于专门训练方法。掩码外潜变量不变也不保证解码后每像素不变。实验用单 RTX4090,但未给完整时延或峰值显存;外部 OCR 与商业语言模型同样有成本。未核到本方法官方实现,不将其引用的 FLUX 仓库当成源码。
4. ReCR:长视频该记住哪些旧画面
What Remains in Sight? Autoregressive Video Decoding as Representation-Guided Context Rewriting | 斯坦福大学 | arXiv:2611.04164
关键词:自回归视频生成, 历史选择, 位置重编号, 全历史缓存
- 前序问题:视频不断往后续,最近几帧看得清,开头的人和场景却忘了。盲目拉长注意力窗口很贵,而同一长度的窗口里,也可能塞满重复的近景。
- 方法直觉:每次续写前从过去挑一小组画面:既像整段故事、又能补充近期没出现的信息,还要保住早期与末端线索。挑完按时间顺序重新排成紧凑序列供模型读取。
- 本文贡献:不训练主干,每块生成 3 个潜帧。取第 20 层(从 0 计)的干净历史前向特征,逐帧平均并归一化,只计算一次。全局与近期摘要分别作早期/近期加权;贪心选择同时考虑全局相似、近期冗余、首尾覆盖和已选帧之间的重复。再最多交换一帧以扩展空间布局范围。全部层保存未加位置编码的键/值,每块选好历史后,在紧凑时间位置重新施加 RoPE 旋转编码。可见历史预算不超过原生窗口,不增加解码器前向,但保留所有过去键/值以便重选。
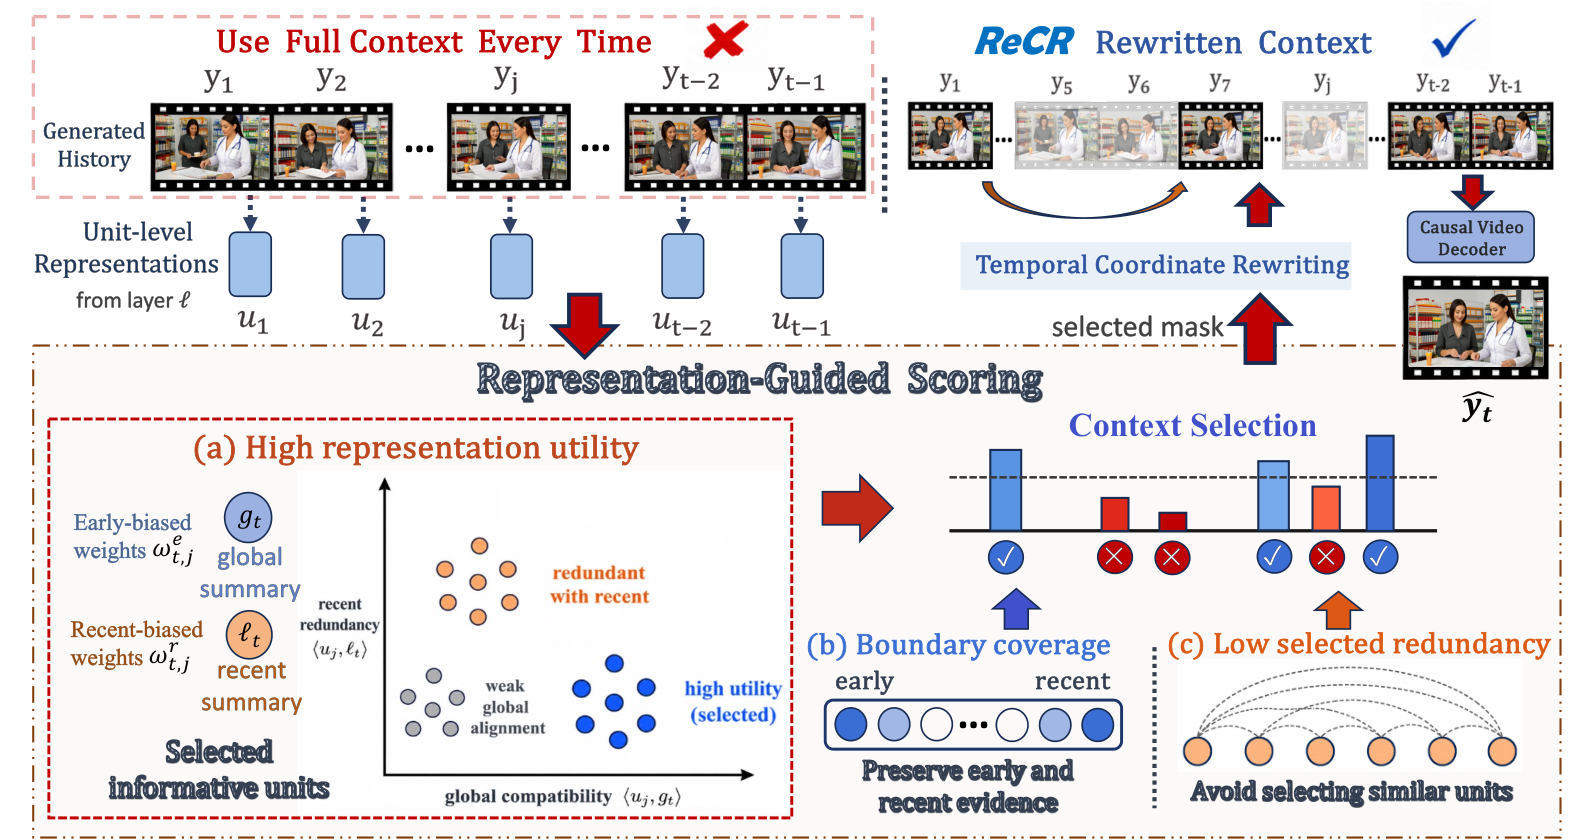 Figure 2|ReCR 不暴露全部历史或固定近期窗口,而用单元表示给历史打分,选择紧凑可见上下文。选择偏好表示效用、首尾覆盖,并减少重复;图中未画出的空间范围交换每步最多一次。之后按紧凑因果轴重编时间位置,再送给因果视频解码器。
- 实验效果:128 条 MovieGen 提示、四步因果主干,在 30/60 秒 VBench-Long 上报告。Self-Forcing 的综合质量 60 秒 78.19→81.60,Causal-Forcing77.41→82.08;该分数由七个质量维度汇总,不是完整 VBench 总分。并非单项全胜:Self-Forcing 主体一致 96.67→96.43。单 H200、批 1 的 60 秒续写,Self-Forcing 每块 728→712 毫秒,Infinity-RoPE 却 667→710 毫秒。300 秒是超长展示,主要系统量化是 60 秒。
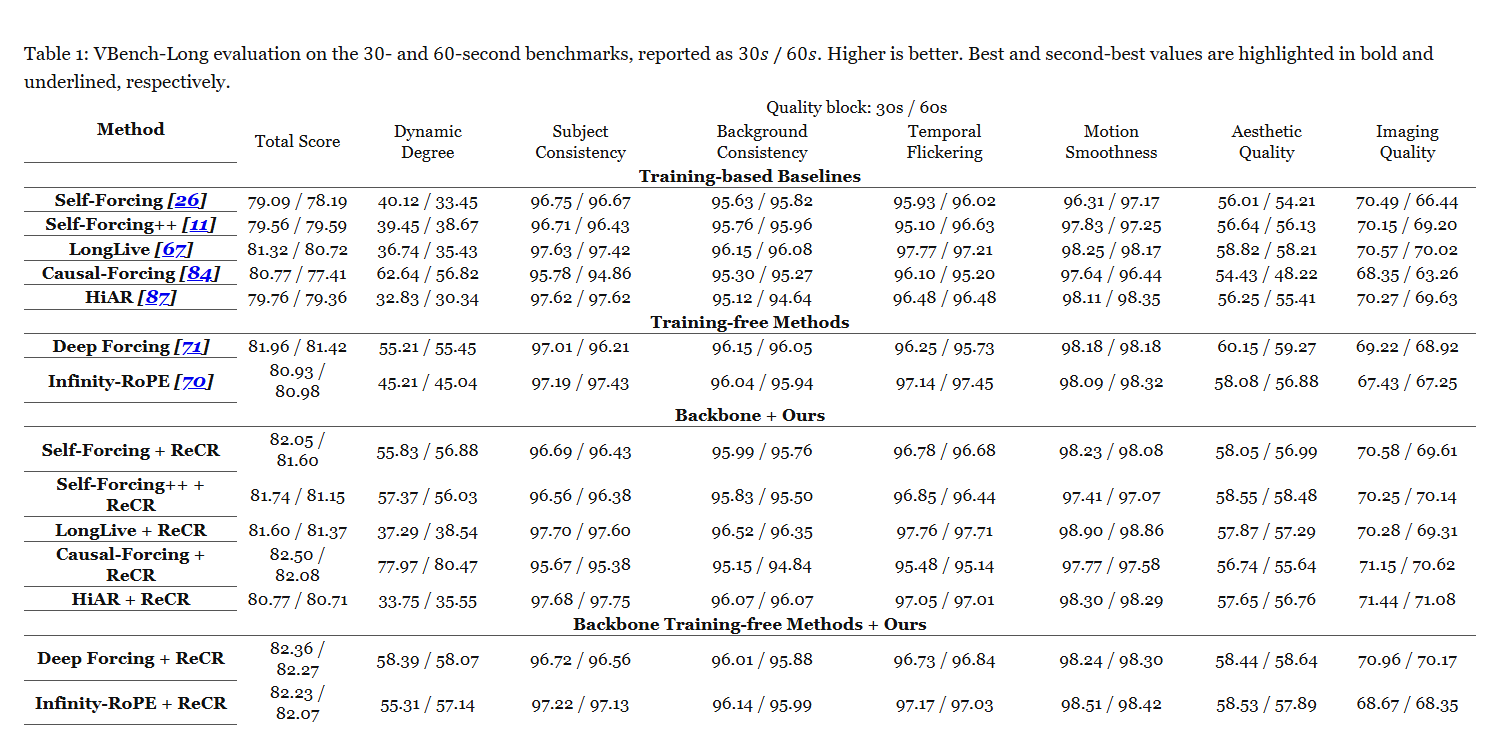 Table 1|VBench-Long 的 30 秒/60 秒评测,每格按两时长列出,分数越高越好;粗体和下划线为最好与次好。综合质量来自所列七个质量维度;动态程度、主体/背景一致、闪烁、运动平滑、美学与成像质量分别保留,不将总体增益说成每项全胜。
- 批判点评:固定可见 token 不等于固定显存:全历史 GPU 缓存随时长线性增长;官方例子 240 潜帧、30 层、每帧 1560 个 token、12 头、头宽 128、16 位数需约 69GB,仅是缓存估算。取特征、选择与重排也有计算。官方代码仓库含选择器、缓存与合成解码器示例,实际接入视频主干仍需自己改注意力接口,不冒称已提供完整基准一键复现。
5. U-JiT:不先压视频也能补回高频
Pixel-space video generation with U-JiT | Meta FAIR;索邦大学;Valeo.ai | arXiv:2611.04764
关键词:像素视频生成, 多尺度Transformer, 高频细节, 采样配方
- 前序问题:视频先压到潜空间,会损失细节;直接在像素上生成,又常把大块时空 patch(图像分块)投影成太窄的特征,细纹理像被切掉了一截。
- 方法直觉:沿模型深度先细后粗再细:外层的小 patch 看清局部,内层的大 patch 和宽通道处理语义,再通过跳连还原。让同一个生成模型承担原先自编码器负责的细节工作。
- 本文贡献:U 形 Transformer 在不同层改变时空 patch 大小,用线性投影和时空重排下采样/上采样,每尺度一条残差连接。外层注意力按 8×8×4 窗口分块,像素层再将 token 压缩后计算注意力以控制浮点运算。预测干净视频、用速度误差训练,另加 LPIPS 学习型图像特征距离作为感知损失。采样调整时间分配,把更多步骤留给低频结构;使用 CFG(组合有条件/无条件预测的引导),仅在 0.1–1 时间区间启用。潜空间基线也调引导和时间偏移,避免把配方收益全算成架构收益。
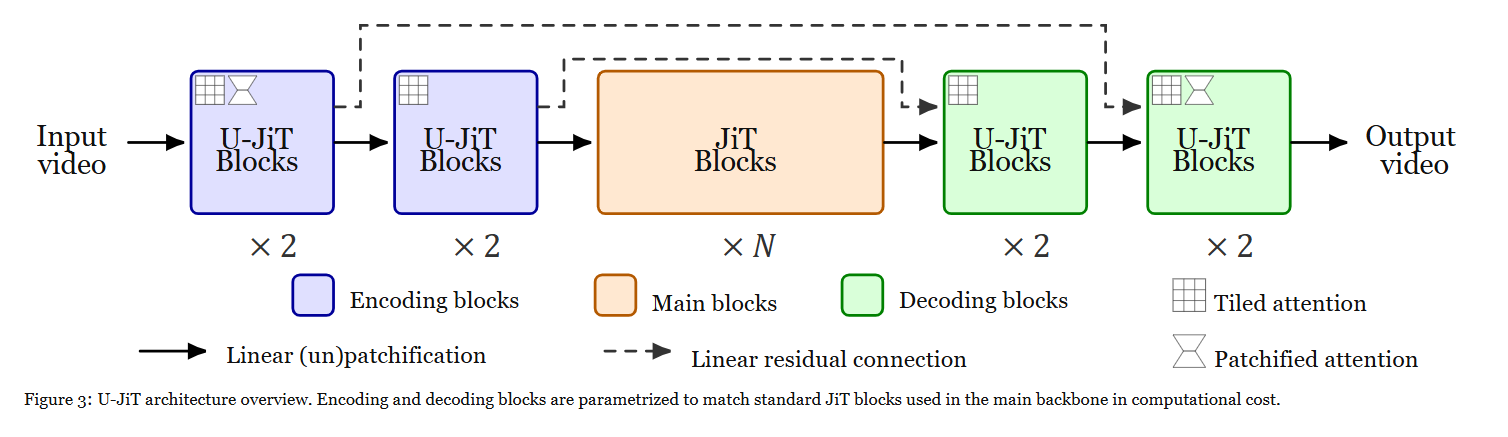 Figure 3|U-JiT 架构总览。编码与解码块按计算量匹配主干中的标准 JiT 块;外层小 patch、内层大 patch,通过下/上采样与跳连同时保留细节和语义。
- 实验效果:Kinetics-600、128×128,5 帧条件、生成 12 帧但评估接续 11 帧。XL 版 5.87 亿参数,单前向约 1.3 万亿次浮点运算,FVD(视频分布距离,低更好)0.61,JiT 为 0.71、此前 WaiT 为 0.84;相对后者降低约 27%,最强同训潜空间对照 0.62。逐帧 FID 图像分布距离 3.15,Wan2.1 潜空间版 11.05。256×256 类别生视频生成 65 帧,FVD3.00 对最佳潜空间 3.31;每条切 4 段 16 帧,5 万视频合计 20 万段用于评分。
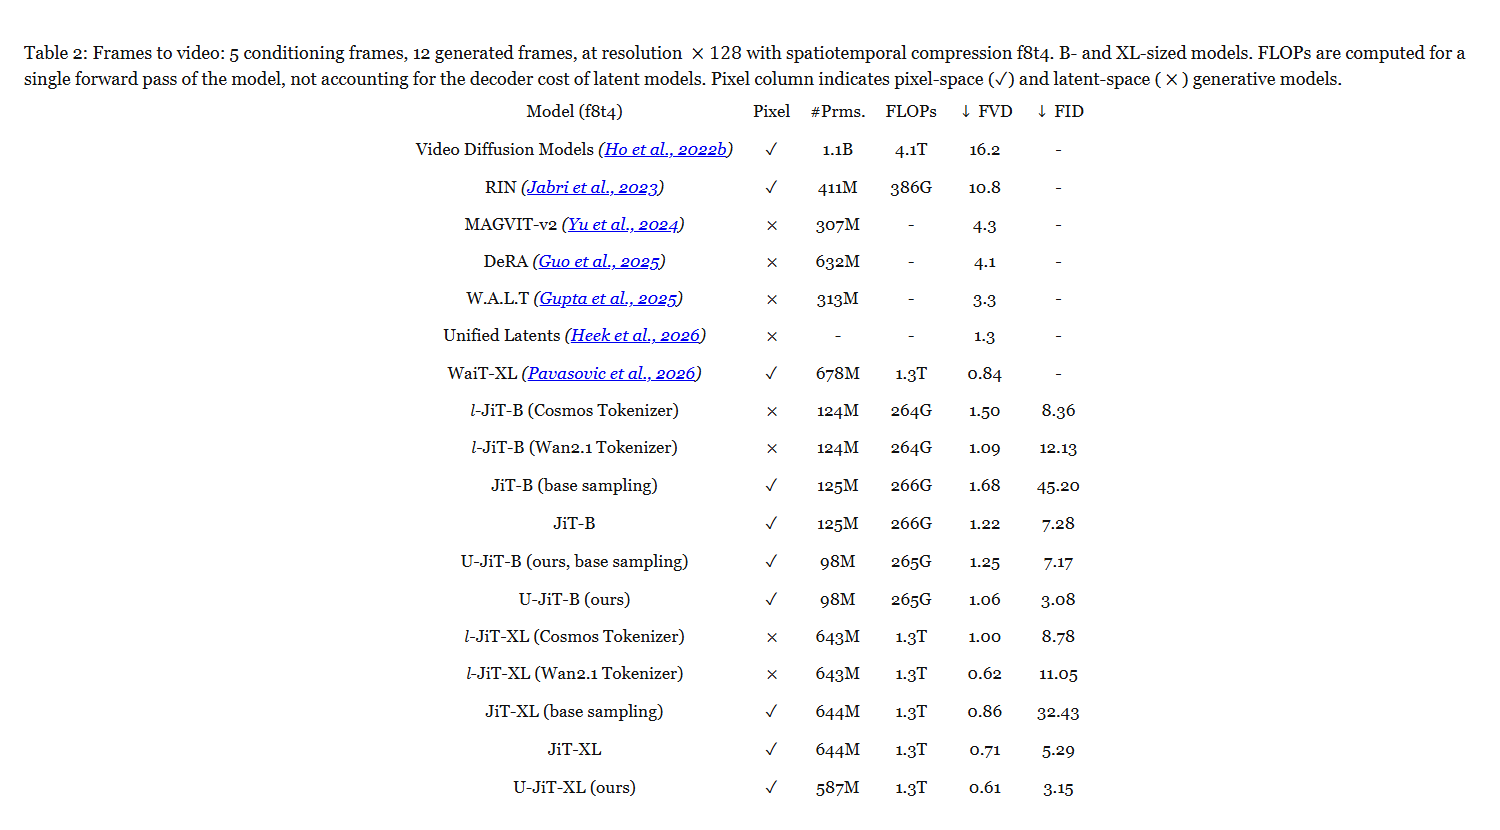 Table 2|5 条件帧续 12 帧,128×128、空间 8×8 时间 4 的内部压缩,比较 B 与 XL 规模。FLOPs 为单前向且不含潜模型解码器,Pixel 勾叉区分像素/潜空间;实际续写评估 11 帧,生成多一帧用于 patch 对齐。U-JiT-XL 的 FVD0.61、FID3.15,对照口径不能外推为高清文字生成。
- 批判点评:这里的 f32t8 表示内层 patch 空间 32×32、时间 8 帧,不是另训视频自编码器;也不是已经验证 4K 开放文字视频。FLOPs 只计单次前向,潜模型解码开销没计入,不能据此推断完整墙钟或显存更省。高分辨率主实验需 400/600 轮训练,成本不能忽略;未核到本方法公开实现,原文引用的 JiT 代码属于基线。
6. StepX-OPD:四步学生直接向多个老师学
StepX-OPD: Rethinking Multi-Teacher On-Policy Distillation in Diffusion Models | 阶跃星辰;西湖大学 | arXiv:2611.04386
关键词:多教师蒸馏, 四步生图, 在策略状态, 低噪声回归
- 前序问题:先把画图、写字、听指令几位老师合成全步模型,再压成四步,第二阶段可能把第一阶段刚学到的能力丢回去,训练也得排队等。
- 方法直觉:让学生从一开始就按四步走,每次在自己真正会经过的状态上请相应老师纠错;靠近干净图像时,再直接对齐速度方向,少绕一段长轨迹。
- 本文贡献:在策略 OPD 指用学生自己产生的状态教学。每个训练批只来自一种能力数据,静态路由到对应冻结教师,不混平均教师输出。四段轨迹每轮随机内部时间点,在相邻状态间插值,再按精确前向加噪分布构造监督点;用轨迹分布匹配 TDM 和低噪声速度回归共同训练,回归权重 0.5。前 200 步由初始学生自蒸馏预热,之后接 3 位教师。SD3.5-Medium 与 FLUX.1-dev 分别实验,秩 32 低秩学生,8 张 H800、全局批 256。
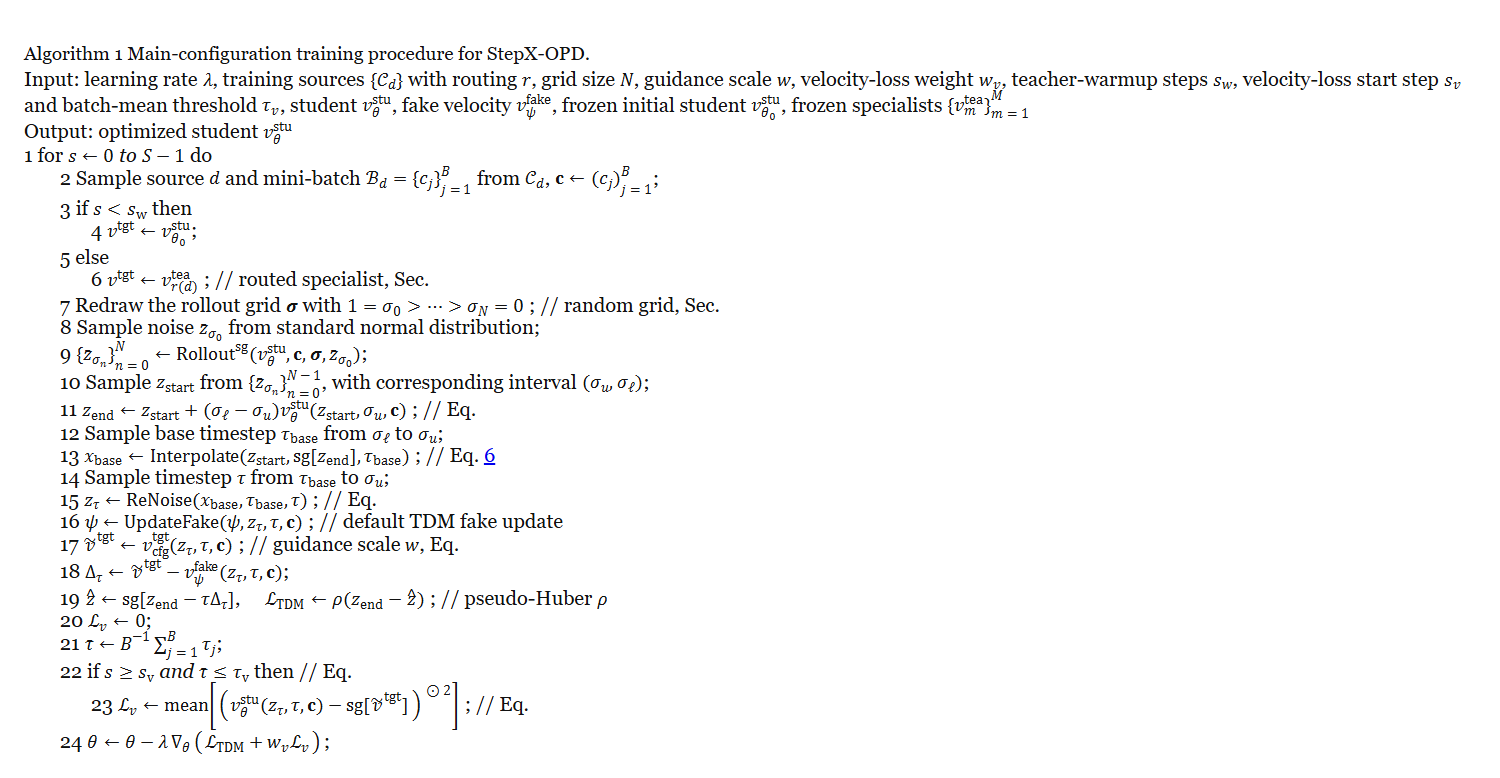 Algorithm 1|StepX-OPD 主配置训练流程:按数据源选批,预热后路由冻结专长教师,学生四步轨迹随机内部时间点;在相邻状态间插值并重新加噪,同一教师提供分布匹配和低噪声速度回归目标;学生与分布评分器分别更新。保留原算法的输入、循环和回归开关。
- 实验效果:512×512 下,四步模型的四指标标准化 Average 在 SD3.5 为 0.8901,顺序 DiffusionOPD+TDM 为 0.8403;FLUX 为 0.8902 对 0.8761。SD3.5 的 GenEval 组合准确 0.944、OCR 文字识别准确 0.899,40 步 Flow-OPD 为 0.905/0.885;PickScore 人类偏好代理 22.98 低于顺序蒸馏 23.41。SD3.5 报告优化阶段 GPU 小时少约 37%,不包含从零训练全部教师。四步是学生 4 次前向;SD3.5 全步 CFG 要两分支,40 步对应 80 次前向,不能混为相同计数。
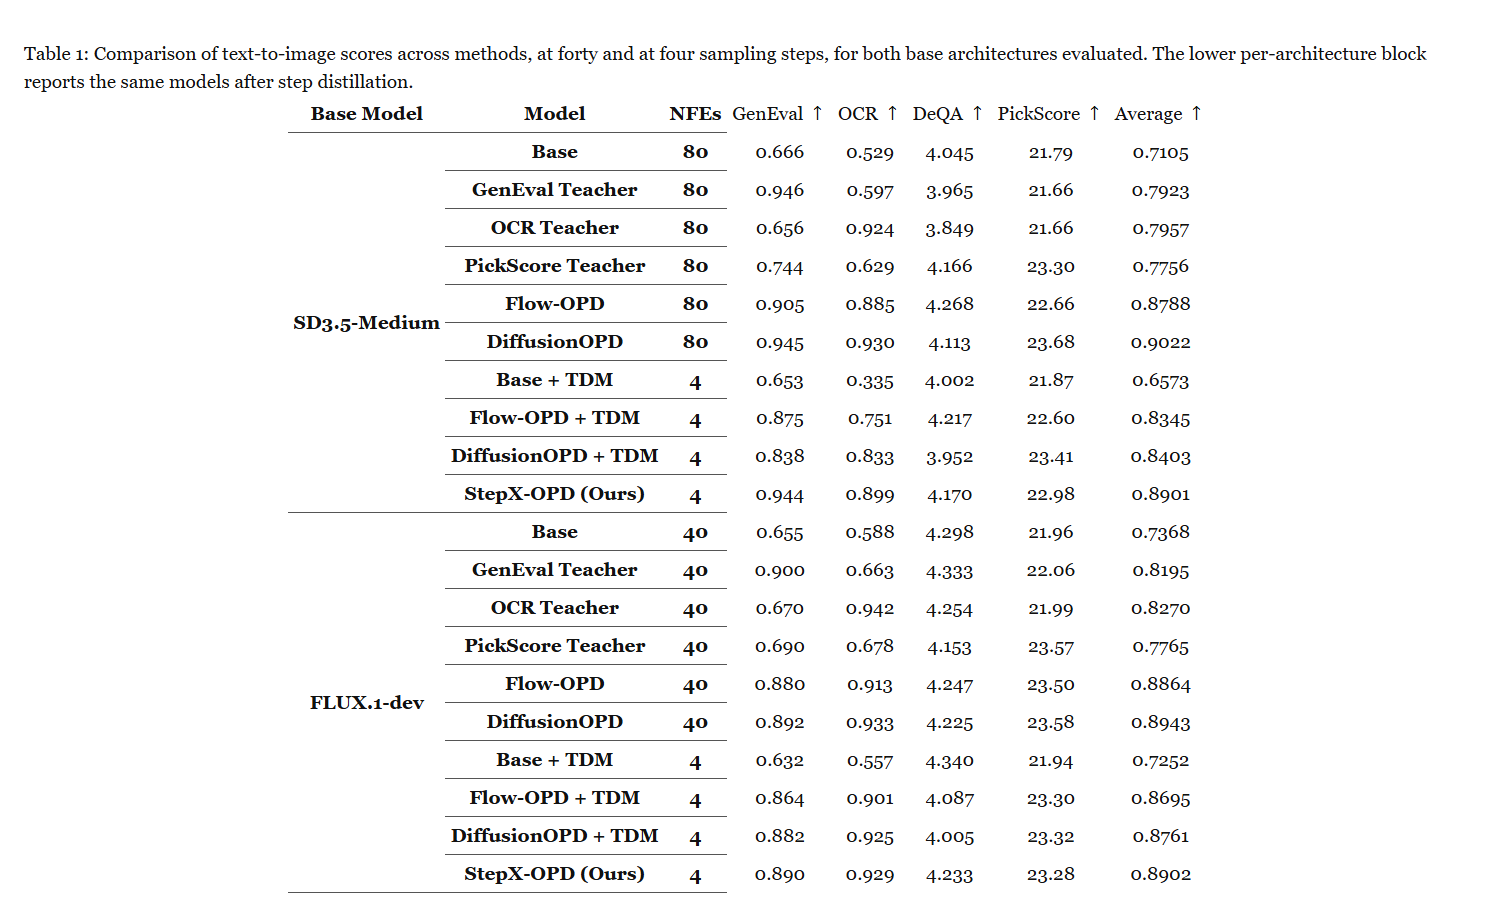 Table 1|两个基础架构的 40 步与 4 步图像生成,后半块为压缩后模型。NFE 为前向次数:SD3.5 的 40 步有引导为 80 次,四步学生为 4 次;FLUX 分别 40 与 4。Average 只用组合、文字、画质和偏好四指标的固定归一化,非九项原分平均。
- 批判点评:Average 只汇总 GenEval、OCR、DeQA 画质代理、PickScore,经固定区间归一化,不是四项原分直接平均,也不是全部九项雷达图。未要求文字时仍会把提示词写进图:计数从底座 21 升到 DiffusionOPD218,StepX 降到 94,却未回到 21。官方代码仓库有训练推理,但 README 描述按 KL 分布差异加权的回归变体,主文主配置为无该权重的代理损失,复现需核配置,不能笼统称完全一致。
7. TTSonic:内容语气和音色分开控制
TTSonic: A Unified Framework for Composable and Controllable Speech Generation | 字节跳动抖音内容团队 | arXiv:2611.04282
关键词:可控语音生成, 语义声学分离, 音色设计, 噪声参考克隆
- 前序问题:换个说话人不该改台词,照着“压低声音、稍显迟疑”读又不能把身份一起换掉。把语义、语气和音色全塞进同一表示,往往顾此失彼。
- 方法直觉:先规划说什么、怎么说,再用另一条音色条件把它唱成声音。换声时直接复用源语音的内容 token,设计新嗓音时只替换音色向量。
- 本文贡献:16kHz 输入经 19 层 E-Branchformer 和有限标量量化 FSQ,每秒 25 个离散语音 token、码本 16384 项;先用自动语音识别监督语义,再冻结编码器,只调量化映射,兼顾重建与理解。Qwen3.5 初始化的语言模型自回归生成语义/韵律序列,可先输出简短风格规划。因果流匹配声学模型将每 token 重复到 2 个梅尔频谱帧,接参考音色或 Text2Timbre 文字生成的 192 维说话人向量,声码器输出 24kHz 波形。换声与增强绕过语言模型,使用源语音 token;声学训练仅见同一句语音的 token 与音色,不用成对换声目标。
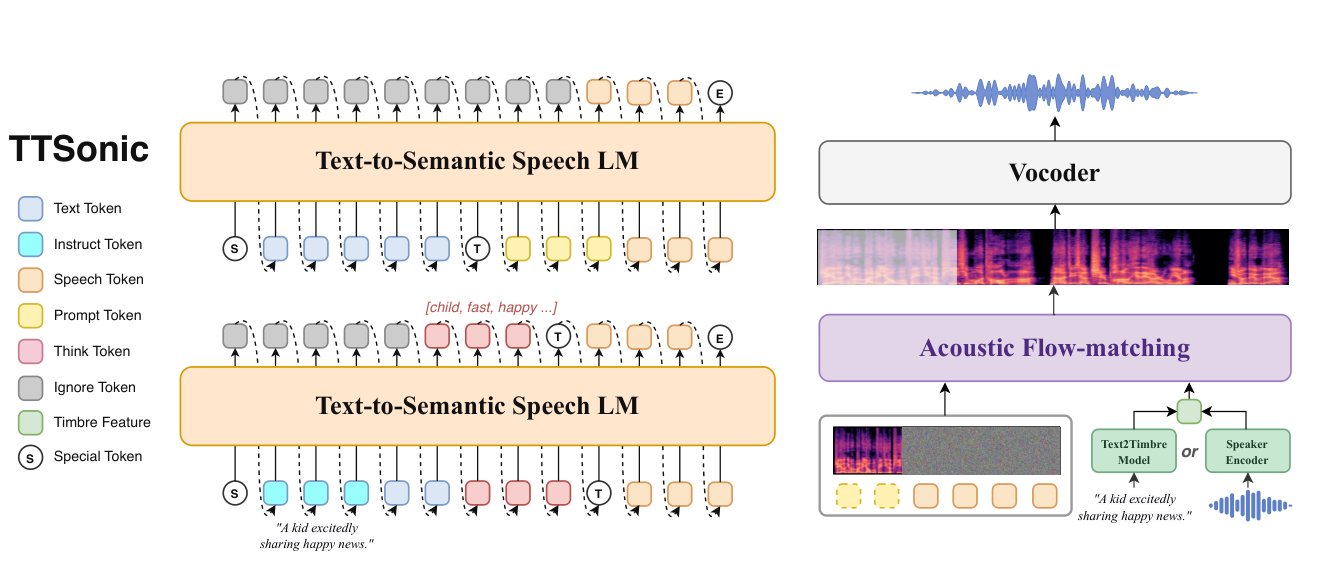 Figure 2|TTSonic 由语音 tokenizer、文字到语义语言模型、声学流匹配模型组成。语言模型支持标准克隆和带风格规划的指令控制;流匹配既可接参考语音提取的说话人特征,也可接 Text2Timbre 生成的音色嵌入。
- 实验效果:20 亿参数,Seed-TTS 中文 CER 字符错误率 0.78%、SIM 说话人余弦相似 0.784,CosyVoice3 为 1.12%/0.781;英文 WER 词错误率 1.66%却落后 Auk 的 1.02%。中文指令 APS(声学参数控制准确率)88.8%,英文 77.6%,FireRedTTS3 英文 80.7%。VoiceBank 含噪参考克隆,WER1.90%→1.45%、WavLM 相似 0.299→0.369。受控编码器对照中,第二阶段使换声自然度 NMOS3.64→3.91,但英文客观 WER2.67%→3.13%。
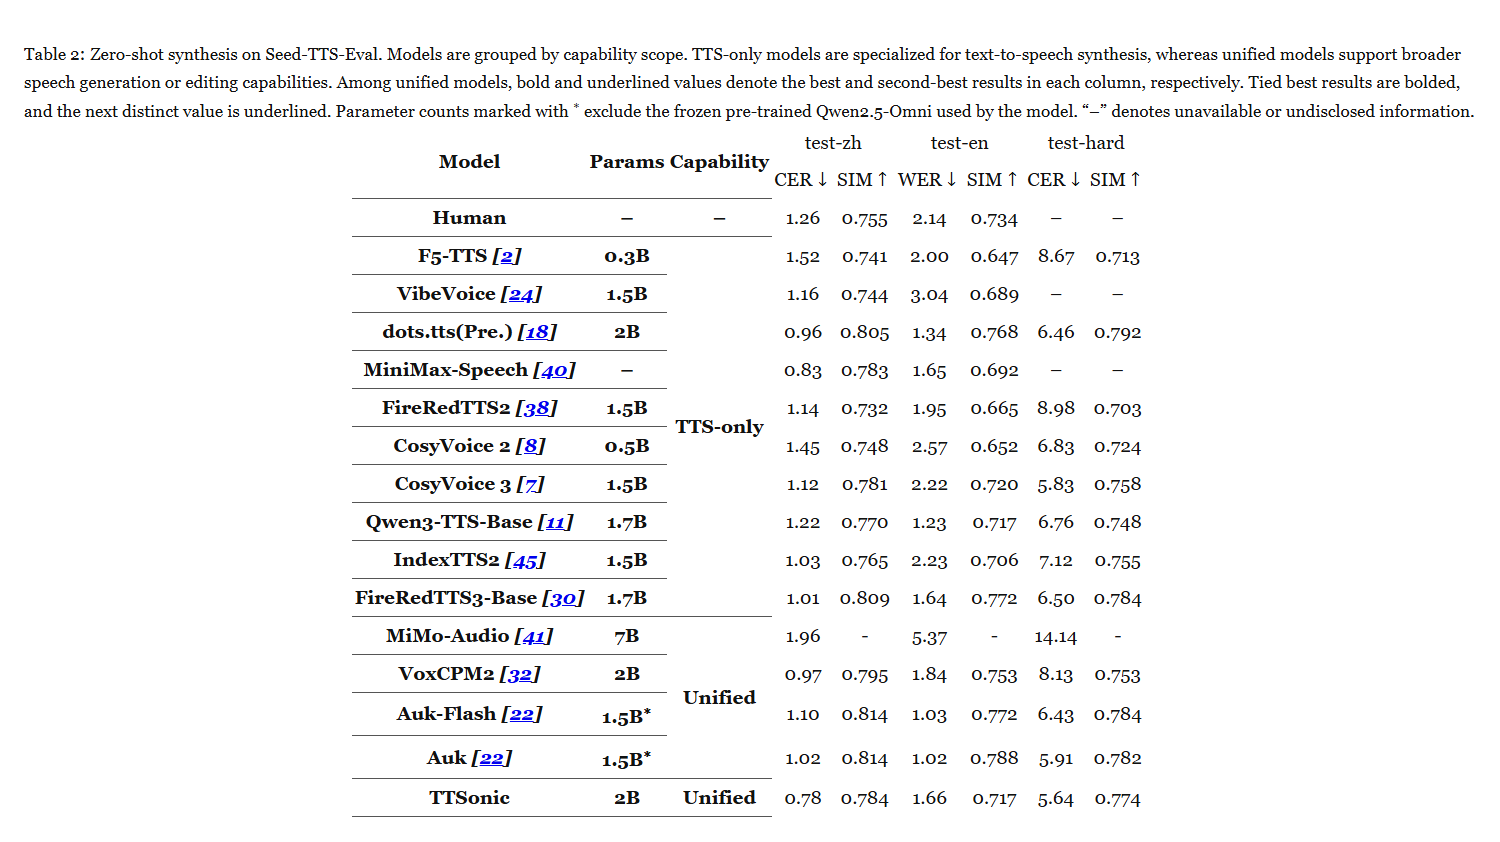 Table 2|Seed-TTS-Eval 零样本合成,按 TTS 专用与统一多任务模型分组;统一模型列内粗体/下划线为最好/次好,相同最优同时加粗。星号参数不包含该方法冻结的 Qwen2.5-Omni,横杠表示未公开。中文及困难中文看 CER 字符错误率,英文看 WER 词错误率,SIM 为说话人相似;低错误和高相似分别更好。
- 批判点评:自然度收益伴随内容准确与换声相似的取舍,不能写成第二阶段各指标全升。SIM、APS 和自然度回答不同问题;同评测表含引用公开结果与本方复测,非全部统一重训。因果模块也不自动保证低延迟,论文未给完整首包、实时因子或峰值显存。官方演示页可听样例,本次未核到公开权重与训练代码。
8. Spatial Transfusion:只移动钟声别把整个房间重录
Spatial Transfusion: From Structured Spatial Scene Understanding to Generation and Editing | 微软;卡内基梅隆大学 | arXiv:2611.02330
关键词:空间音频生成, 原子编辑, 模态路由, 一阶全景声
- 前序问题:让钟声从左移到右,背景风声和房间混响应该延续;按新描述重生整段,钟声动了,其他声源也可能全换掉。
- 方法直觉:让理解和生成共用骨干,但给声音和文字各自的适配器。编辑时把原音频直接交给去噪分支,教它每次只改一个场景因素,而不把旧场景仅压成文字。
- 本文贡献:采用四通道一阶全景声 FOA,保留全方位方向线索;16kHz 音频由 FOA-VAE 压到每秒 7.8 个、512 维潜变量。冻结 Sci-Phi 的 Phi-4 多模态骨干,新增文字秩 16、音频秩 640 低秩路径及输入/时间/输出模块,共 9.43 亿可训参数,对比全量 38.5 亿。文字因果预测,音频双向流匹配;编辑源潜变量还与带噪目标按通道拼接。12 种原子操作涵盖增删换源、移动、音量、音高与时间;四阶段从单源到至多 5 源,再接自然语言,共 460 万理解/生成场景、240 万编辑场景。
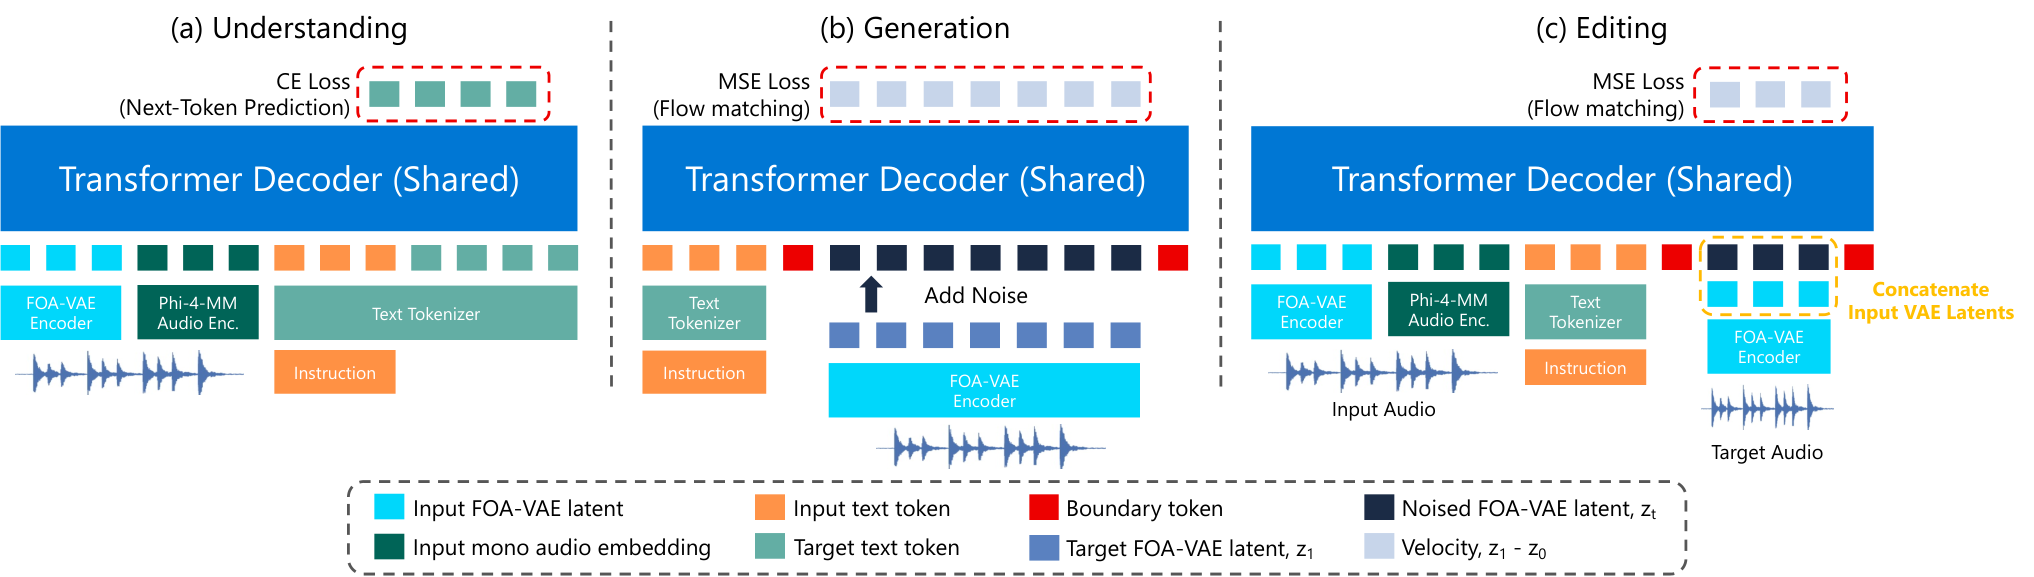 Figure 1|共享 Transformer 骨干:(a)理解用文字交叉熵,(b)生成和(c)编辑用目标 FOA-VAE 潜变量的流匹配。编辑额外把干净源潜变量与带噪目标按通道拼接。FOA 是一阶四通道全景声,非普通单声道。
- 实验效果:主表是第三阶段结构化 JSON 条件、FOA-MEIR 留出集,生成/编辑 50 步,引导系数 3.5/4.0。生成 FAD-PSELD(兼顾声学事件与方向的分布距离)3.82→0.964,编辑 0.596→0.323,均相对同骨干全量微调且低更好。编辑 CLAP-AA 源输出语义相似 0.795→0.841,EditFLAM 语义修改响应 15.5→17.8;仅语义操作算后者。完全复制输入的距离 0.005 却修改分 0,说明保真不能代替改对。
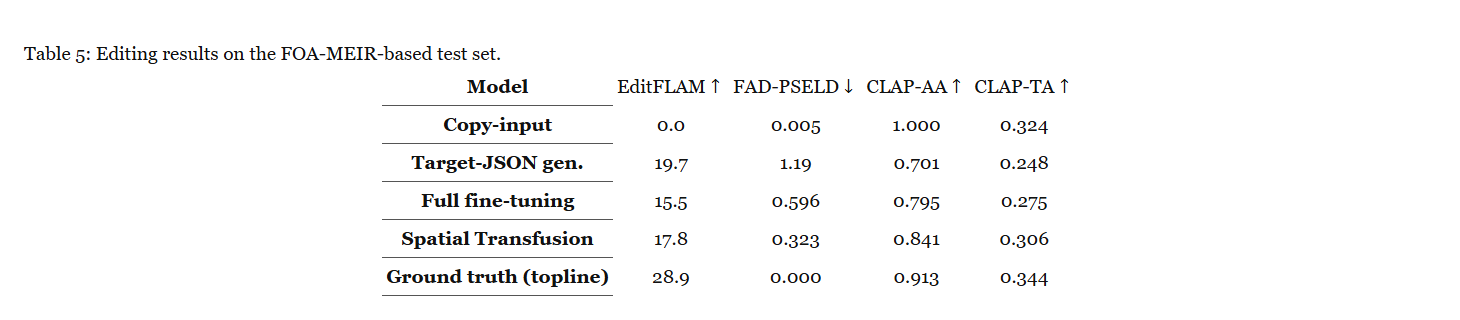 Table 5|FOA-MEIR 留出集编辑结果。复制输入可保留声音但 EditFLAM 为 0;仅真值目标 JSON 重新生成的修改分 19.7 高于 17.8,却更损源音频相似与空间分布。完整方法比全量微调的修改响应、源输出相似、文本相似和空间分布距离更好;主表对应阶段 3 的结构化输入。
- 批判点评:阶段 4 自然语言接口的编辑距离 0.772,不能拿阶段 3 的 0.323 宣传自由文字编辑。理解方向误差 13.6°→14.3°、声源数准确 0.674→0.635,整体保留能力不代表每项不退步。模型仍依赖模拟场景与固定操作体系,未报告统一墙钟/峰值显存,9.43 亿可训也不等于总模型只有这么大。细节可读原论文 PDF;所列项目页本次重定向到 GitHub 登录页,未核实公开音频样例或完整实现。
9. PATTS:等想法和画面可靠了再打分
PATTS: Parallel-Aware Test-Time Scaling for Thought-Image Generation in Multimodal Discrete Diffusion LLMs | 澳大利亚国立大学;CSIRO Data61;亚马逊 | arXiv:2611.04948
关键词:并行思考生图, 轨迹搜索, 可靠性门控, 测试时计算
- 前序问题:同时“想”和“画”的扩散模型,不一定越想越对。中间草图还没稳定就请视觉裁判评分,会淘汰本来能画对的轨迹;只挑最终图又浪费了前面的纠错机会。
- 方法直觉:同时养几条思考与画图轨迹,先看模型自己的不确定性和前后稳定度;等文字与画面足够一致,再增加外部裁判权重,提前淘汰较差路线。
- 本文贡献:MMaDA-Parallel 在同一离散去噪轨迹并行生成推理和图像 token。截点用最高概率填补未解码位置得到预览,取熵、前两名概率差、剩余遮挡比例、相邻预览重合、跨模态相似与排名稳定等 6 类特征。逻辑门混合标准化内部可靠性分与 Qwen2.5-VL-7B 的外部是/否概率;低可靠性时复用缓存裁判分,并按递减存活预算搜索。门参数在独立开发集固定,所谓信任是代理权重,不是已校准的正确概率。
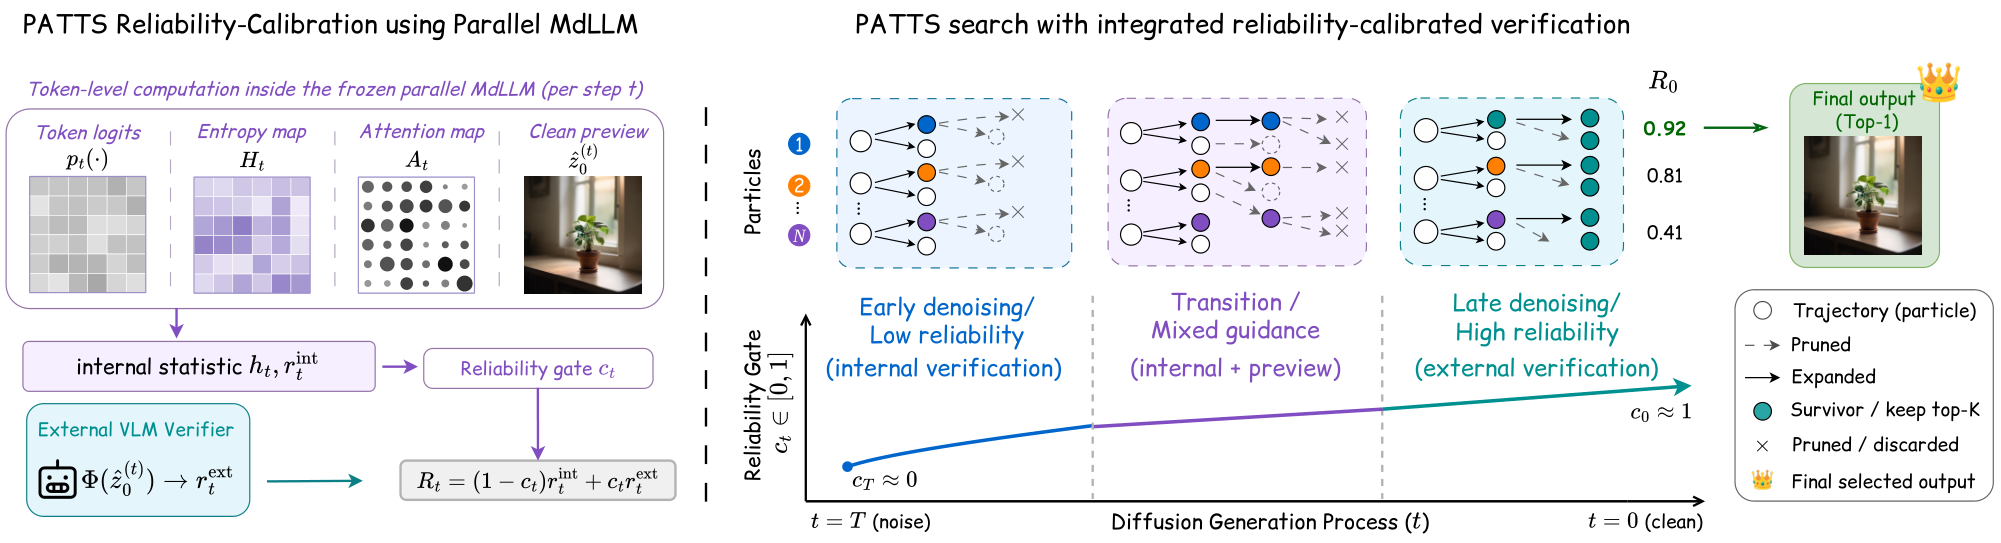 Figure 1|PATTS 方法。左侧每个截点读模型 token 概率、熵、注意力与干净思考/图像预览,生成内部可靠性特征。右侧信任门在内部轨迹可靠性与外部视觉语言验证间分配奖励权重,据分数剪枝并传播,最后从存活轨迹选结果。
- 实验效果:GenEval 含 553 提示、6 类任务,整体是类别准确率等权平均。512×512、32 次图像/128 次文字去噪、引导 4.0,N=32 指初始搜索轨迹数。4 次重复下,GenEval 无搜索 0.628、最终 32 选 1 为 0.787、FKD0.810、PATTS0.844±0.014。按论文生成模型前向计数 NFE,PATTS1796 次、平均验证 38.2 个预览、端到端 55.1 秒;FKD5280 次/160 个/154.9 秒,无搜索 161 次/9.9 秒。次数不是采样步数,也不包含独立裁判的全部计算。
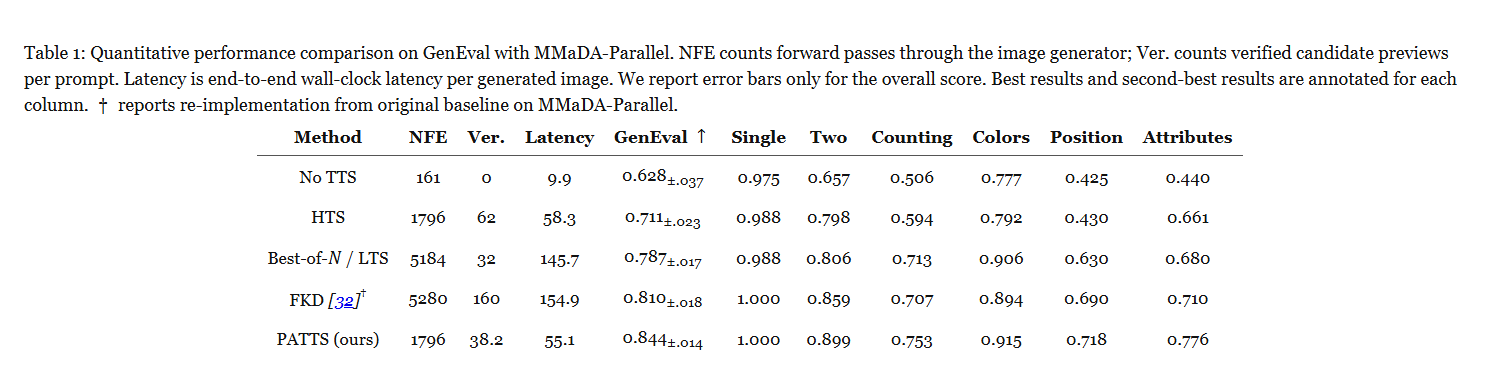 Table 1|MMaDA-Parallel 上的 GenEval。NFE 计生成器前向,Ver 计每提示验证的候选预览,时延为生成一张选中图片的端到端墙钟;只整体分数报告误差条,粗体/下划线为最好/次好,†为在同主干重实现基线。N=32 是搜索轨迹,非 32 步采样;PATTS 平均 38.2 次验证是重复运行平均数。
- 批判点评:相对搜索方法更省,但比一次直出仍贵约 5.6 倍墙钟。全部完整方法实验只用一个主干,跨三基准不等于跨模型已验证;信任特征在 N=16 计数子集的排名一致仅 0.19 对时间门 0.17。arXiv 评论确认 WACV2027 接收,但所给 PATTS 仓库本次 GitHub 读取 404,按代码暂不可获取报告,未宣称可立即复现。
10. ScoreDial:把喜欢的程度变成可调刻度
ScoreDial: Precise Control of Visual Attributes in Image Generation via Regressor Guidance from Limited Human Ratings | 庆应义塾大学;普利司通 | arXiv:2611.05004
关键词:数值可控生图, 人评回归, 误差自适应, 独立审计
- 前序问题:“让房间更复杂”只指定方向,“复杂度 0.7”还要求落到指定刻度。若拿同一个评分器既指导生成又验收,模型可能只学会讨好分数。
- 方法直觉:先用少量人评学一把尺,数值条件把图推到大致位置,再按当前误差逐步修正;最后另请没参与生成的评分器和人看,确认画面属性真的变了。
- 本文贡献:每属性 100–479 张人评图训练冻结视觉特征上的岭回归 R;轮胎实际 118 张、室内 100、食物 479、肥皂 150。SD3.5-Medium 分别做域 LoRA,并把目标 c 的嵌入注入全部 Transformer 块。30 步采样前 20%不开梯度引导,其后对解码的干净估计计算(R(x)−c)²梯度,归一化方向,用当前误差与噪声确定幅度,每活动步共两次引导/重新加噪;不反传穿过整个去噪器。域训练池 984/100/479/800 张,不把有人评数与全部训练图数混说。
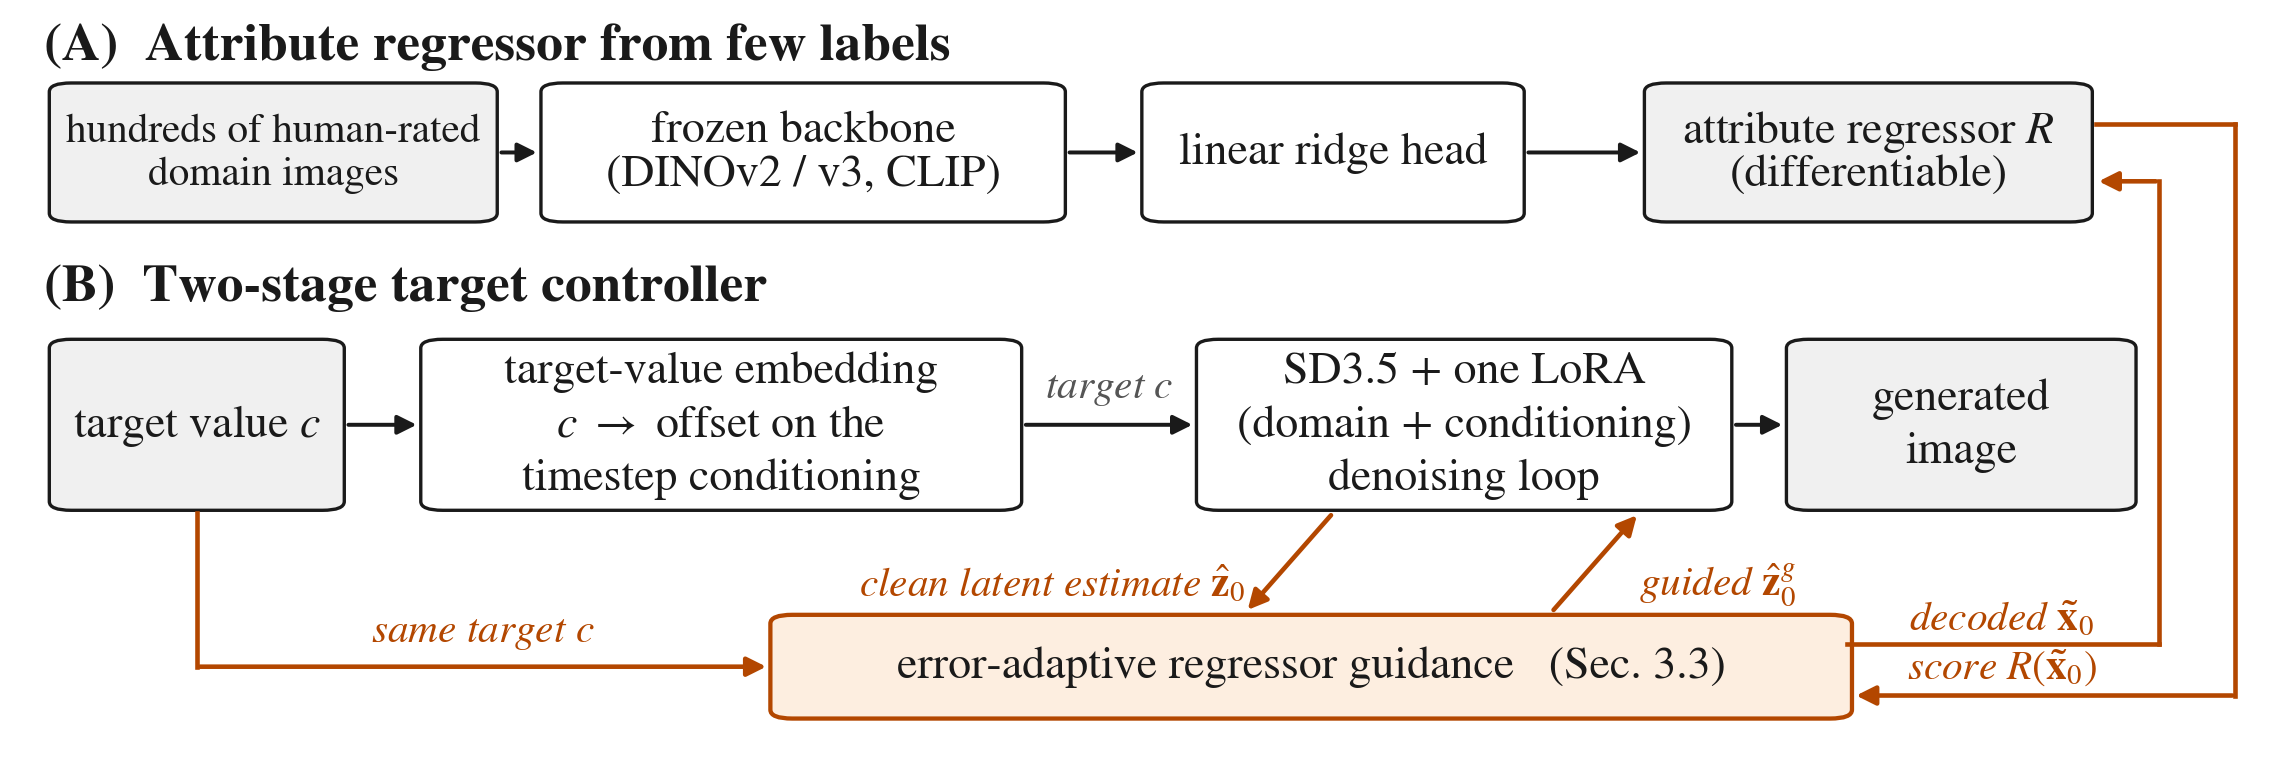 Figure 2|ScoreDial 分开目标定位与剩余误差修正。(A)冻结预训练视觉骨干和岭回归头组成可微属性评分器 R。(B)目标 c 的可学习嵌入进入每个 Transformer 块,并与域 LoRA 共同训练;活动引导步在干净解码图上计算误差,归一化平方误差梯度,再按误差和噪声调步长修正潜变量。
- 实验效果:1024×1024,目标 0.1/0.3/0.5/0.7/0.9 各 10 个种子,每属性 50 图。四属性 R 平均绝对误差 0.0069–0.0129;排序相关ρ=0.980 是五档并列目标下可达到的上限,非完美预测人类。独立 SigLIP 审计器仍用同批人评,但未参与训练生成器或引导;其轮胎端点位移 0.285,MPGD-flow 为−0.021。单 RTX5090、批 1,平均 29.5 秒/11.9GB,对纯数值提示 5.5 秒/7.7GB、MPGD-flow16.6 秒/11.9GB。
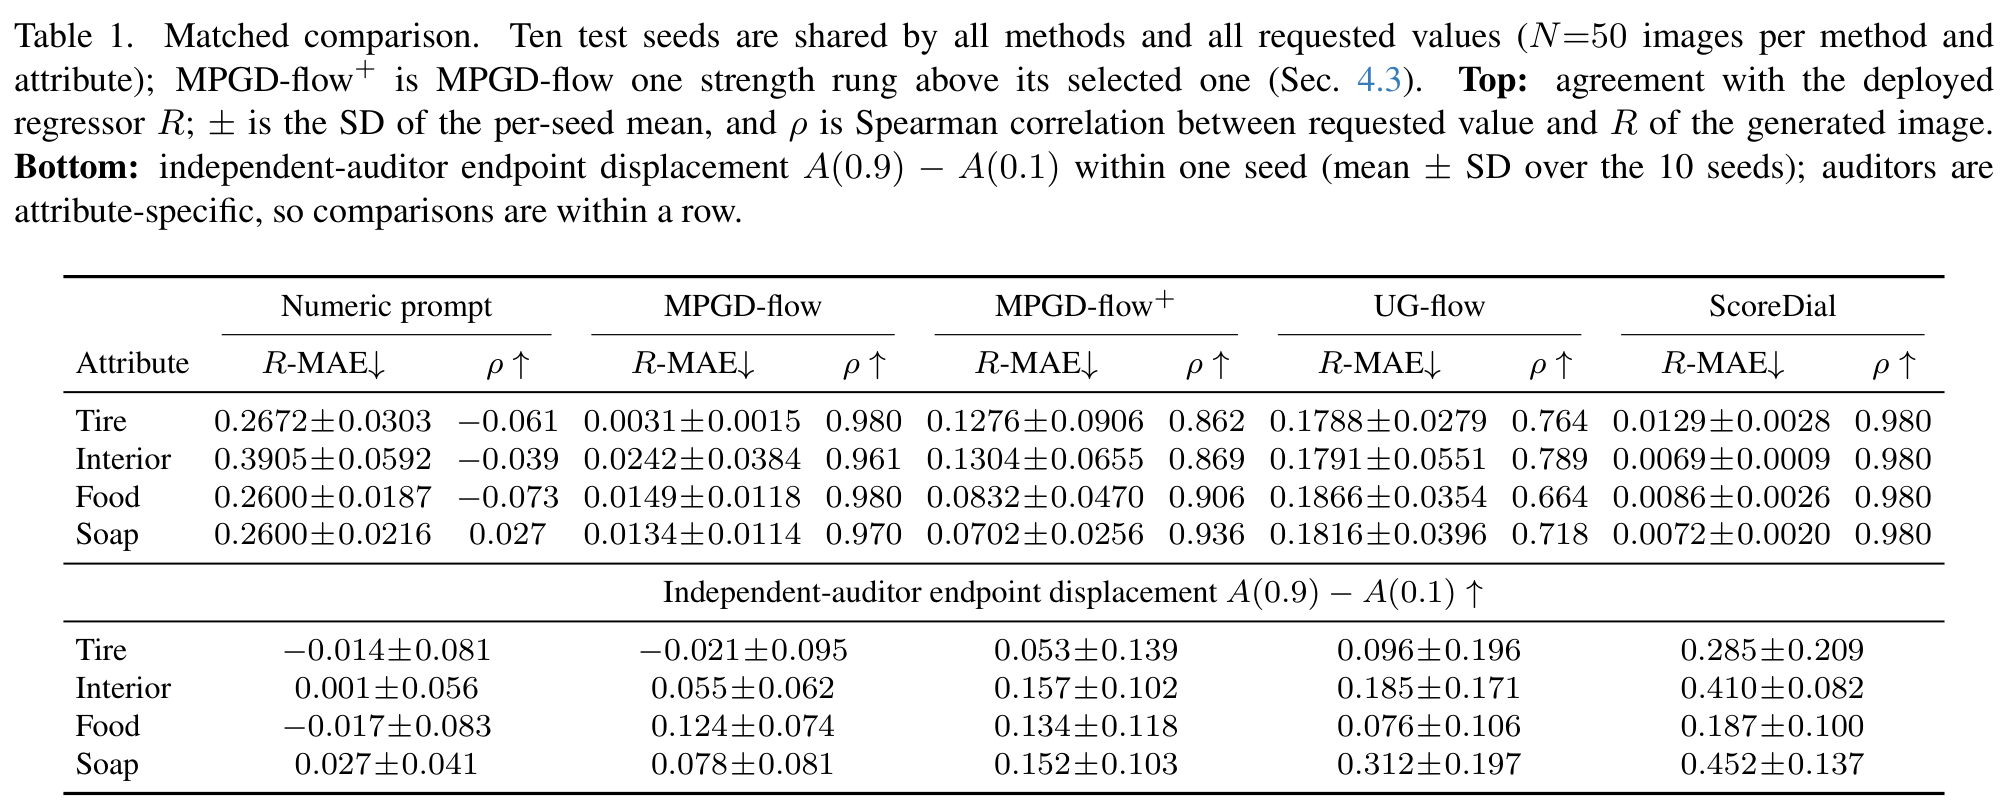 Table 1|同种子匹配比较:每方法每属性 5 档目标×10 种子=50 图,MPGD-flow+把强度提高一档。上半部分是部署 R 的误差及目标/输出 Spearman 相关,±为每种子均值的标准差;下半是独立审计器的同种子 0.9/0.1 端点位移均值与标准差。审计器按属性训练,只同行比较;R 精确不自动等于真实属性变化。
- 批判点评:轮胎与肥皂各 15 人盲评,平均人评分随目标变化的线性 R²为 0.665/0.786;不推广为四属性都做了同样人评。轮胎“防滑”是视觉印象,不是实测摩擦性能。独立骨干共用标签仍非完全独立人群,四窄域结果也不是万能语义旋钮。WACV2027 接收由 arXiv 评论确认;官方代码仓库含拟合、训练和生成脚本,说明插值梯度非确定性,不能保证同种子逐位复现;本次未运行模型。
趋势观察
要保留的是有用证据
ReXMo让身份与表情分路,FLASH让小图管布局,ReCR挑选历史。条件并非越多越好,关键是它是否仍支持目标修改。
速度必须带上计时口径
FLASH的25.3倍只指独立注意力诊断,主配置渐进端到端省30.5%;PATTS比搜索基线更快,却比一次直出更慢。
高相似与高分都需要反例
复制空间音频有极低分布距离却没做修改;ScoreDial的评分误差小,还要看独立审计与人评。源保真、执行完成和实际偏好分别核验。
参数不等于全部部署成本
ReCR不增加解码前向却保留全历史缓存;StepX少算训练阶段不含预训教师;TTSonic分离模块也仍缺端到端延迟证据。
今日讨论
ReXMo 的表情误差从 0.3415 降到 0.2905,但单人往返姿态距离只从 0.0263 到 0.0258,感知运动平滑 3.90 还低于 SCAIL 的 3.92。若双人表演中有人转头遮住半张脸,应如何验证新增表情通道保住了原来的情绪,而不是只在容易跟踪的合成脸上提高了关键点分数?
人工智能炼丹君 整理 | 2026-11-05


评论 (0)