今日 AIGC 论文速览
今日共 10 篇 · 多轮图像编辑与参考视频生成 2 篇 · 实时视频音效 1 篇 · 长视频缓存压缩 2 篇 · 少步图像与视频训练 3 篇 · 情绪视频对齐 1 篇 · 复杂多参考生成评测 1 篇
重点论文标题列表
- TailSteer(港中文):连续改图别把旧细节磨掉
- DualCast(浙江大学):商品和主播两张参考各司其职
- LiveFoley(莫纳什大学):看着视频现场补音效
- NanoKV(浙江大学):视频历史压小但不承诺同比提速
- NextGAN(西湖大学):先教判别器指对生成方向
选读入口:反复改图总磨掉背景,先读 TailSteer 的保留与成功率取舍;想用商品图加主播图新生成视频看 DualCast,不要把它当原视频动作编辑。游戏或交互配音读 LiveFoley 的 156 毫秒口径;显存不够读 NanoKV 与 VAR-Q,前者需拟合、后者免校准。做少步生成训练,按梯度信号 NextGAN、文字监督 NitroFusion2、轨迹分布 VA-TDM 依次选;需要情绪表演对齐看 EmoReward,复杂多参考验收看 LongBanana 的逐项清单与通过率。
今日论文速览
1. TailSteer:连续改图别把旧细节磨掉
TailSteer: Trajectory-Tail Steering for Drift-Resistant Multi-turn Image Editing | 香港中文大学;商汤;上海人工智能实验室 | arXiv:2611.06741
关键词:多轮图像编辑, 轨迹尾部训练, 在策略监督, 内容保留
- 前序问题:给人物连续换衣服、改发型,十几轮后连没有要求改变的脸和背景也变了。单次编辑分高,不能保证把输出反复作为输入时仍保住旧细节。
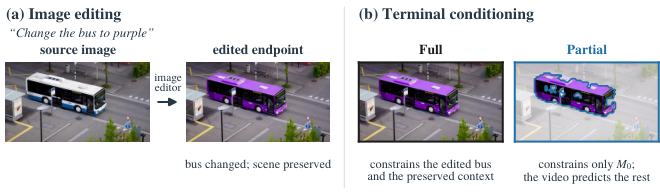
- 方法直觉:去噪早期负责大结构,末尾仍能修正细小漂移。让早期像原模型一样走,只在轨迹尾部逐渐拉回本应不变的区域,避免为保真牺牲整段生成能力。
- 本文贡献:冻结原编辑器,用无改动和局部编辑指令生成轨迹,经检查得到保留掩码。目标端点在保留区复制源图,其余区域沿用模型自己选定的编辑结果,不需要人工配对目标图。训练副本在前段拟合原模型速度,后段混合原速度与指向保留端点的速度;监督点来自副本自己实际到达的状态,即在策略训练。缓存早期锚点缩短回放,尾部从固定起点连续走;只反传采样点,不穿过整段回放。推理只用一个训练后的模型,不切模型或附加保真模块。
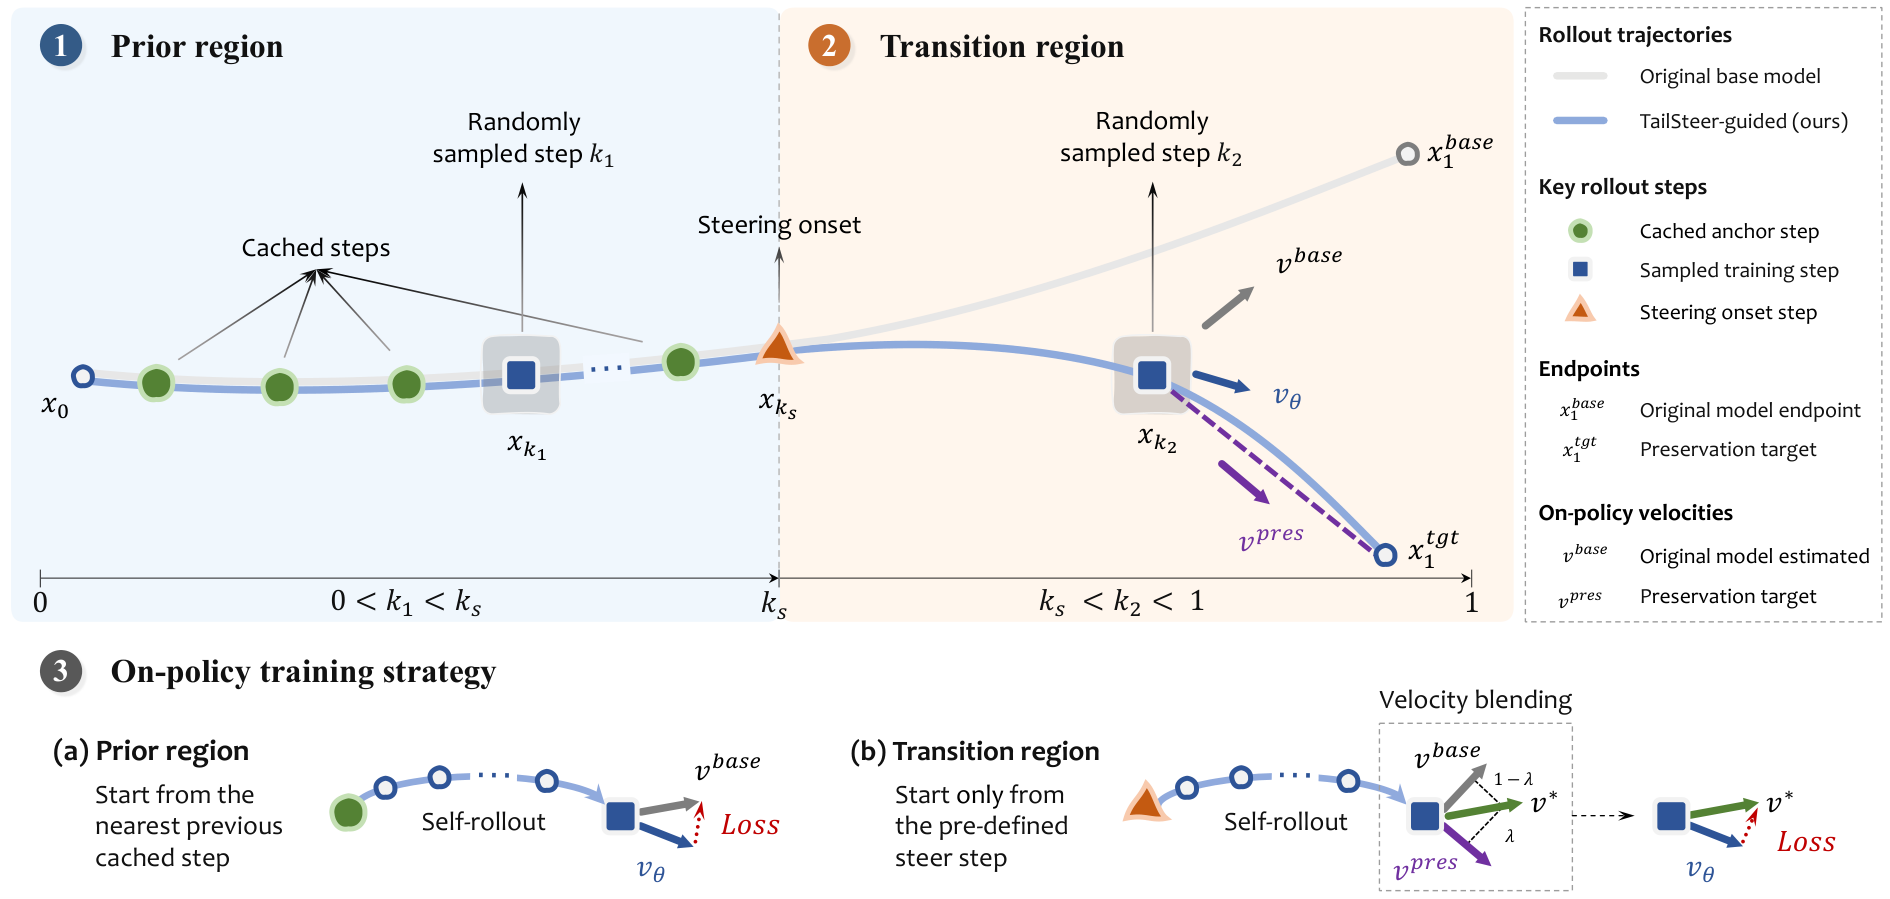 Figure 5|TailSteer 在策略训练:分别随机取早期状态和尾部状态;早期监督原模型速度,转向区逐渐混合原速度与指向保留端点的速度。早期从最近的前置缓存锚点回放,尾部固定从转向起点回放;在训练副本实际到达的状态重算目标,仅对所取一步的预测反传。
- 实验效果:四个底座覆盖 FLUX、SenseNova 和 Qwen,训练各 2000 次更新、有效批 16、8 张 H100。FLUX.2 Klein 9B 每次编辑 50 步、训练从第 46 步开始转向保留目标:Add & Preserve 十轮非编辑区 PSNR 峰值信噪比 13.85→19.96dB,SSIM 结构相似 0.289→0.621,感知距离 LPIPS0.524→0.290。累计对象准确率 31.02%→31.84%,但 MSE-Bench 第五轮成功率 40%→33%;单轮 GEdit 英文 7.47→7.52,中文 7.42→7.39。15–20 轮示例只是可视化,不是平均成功率。
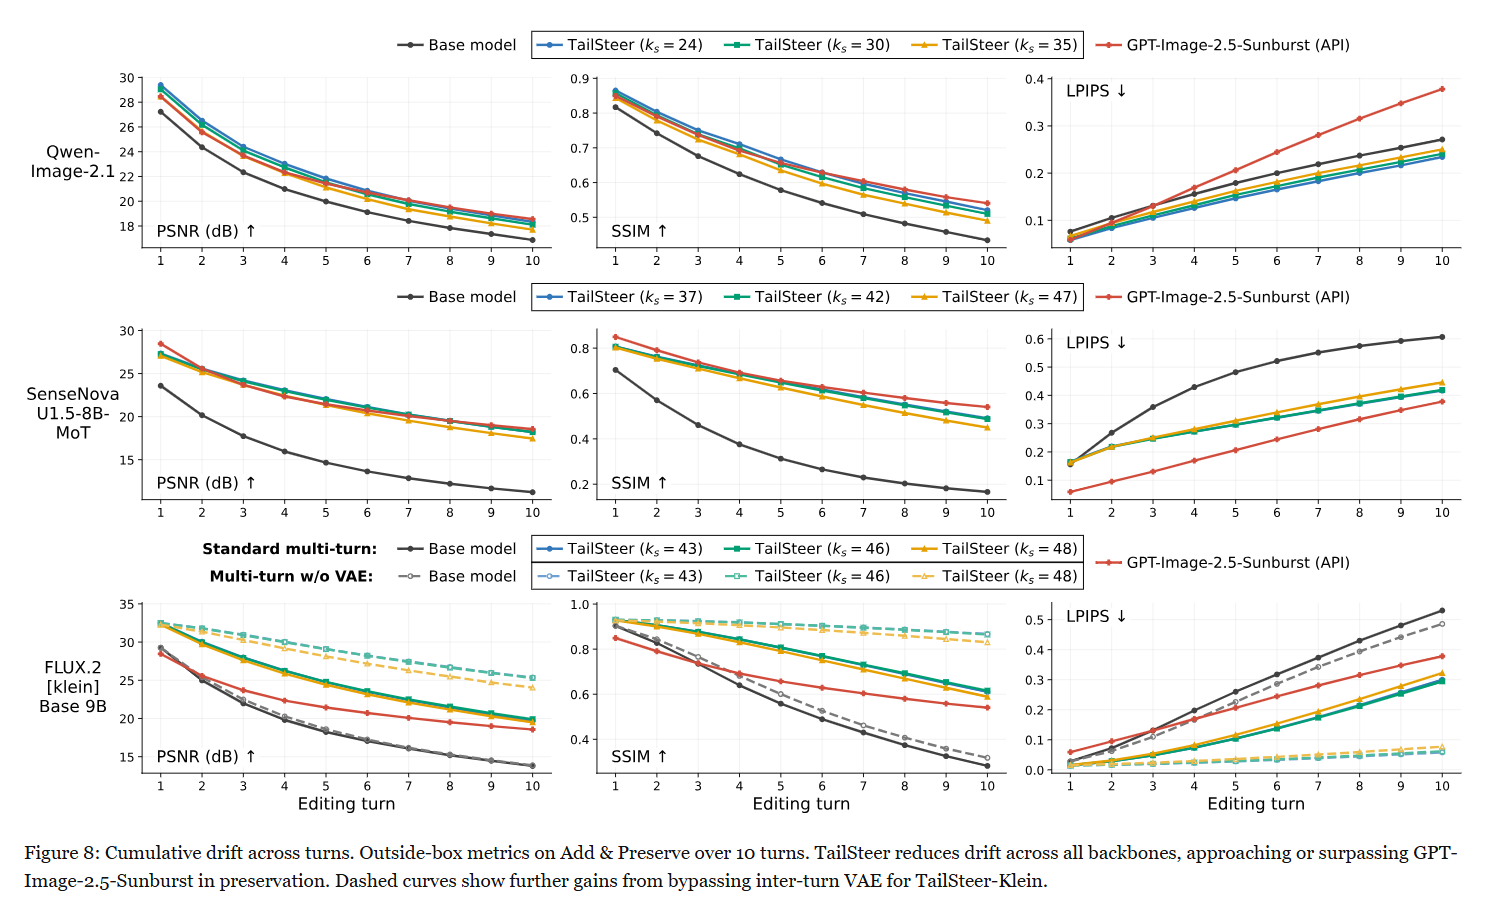 Figure 8|Add & Preserve 十轮编辑的框外漂移指标。TailSteer 在全部底座降低漂移,保留能力接近或超过 GPT-Image-2.5-Sunburst;虚线表示 TailSteer-Klein 绕开轮间 VAE 重新编码后的进一步收益。该图评价保留,不代表所有编辑成功指标都提升。
- 批判点评:保留背景与执行新指令是两个目标,起始步越早未必越好,不能称所有指标全面提升。“无需配对数据”仍需 11947 张候选源图、轨迹生成和筛选;并非零数据训练。推理沿用原步数,但未给统一新增墙钟或显存测量。原文给出的项目页本次返回 404,未确认可用代码或权重;本次未运行训练。
2. DualCast:商品和主播两张参考各司其职
DualCast: Dual-Image Conditioned Diffusion Transformers for Digital Human E-Commerce Video Generation | 浙江大学;蚂蚁集团 | arXiv:2611.05825
关键词:参考视频生成, 双图角色分离, 区域加权, 电商数字人
- 前序问题:拿商品图和主播照片生成展示视频,模型可能只认商品,把人物挤出画面;也可能人物很像,包装文字却变了。两张参考承担的职责不同,直接混在一起会互相争抢条件。
- 方法直觉:给“卖什么”和“谁来卖”固定入口:商品放序列前端,人物放后端,中间才生成视频;训练时对商品和脸部错误多扣分。
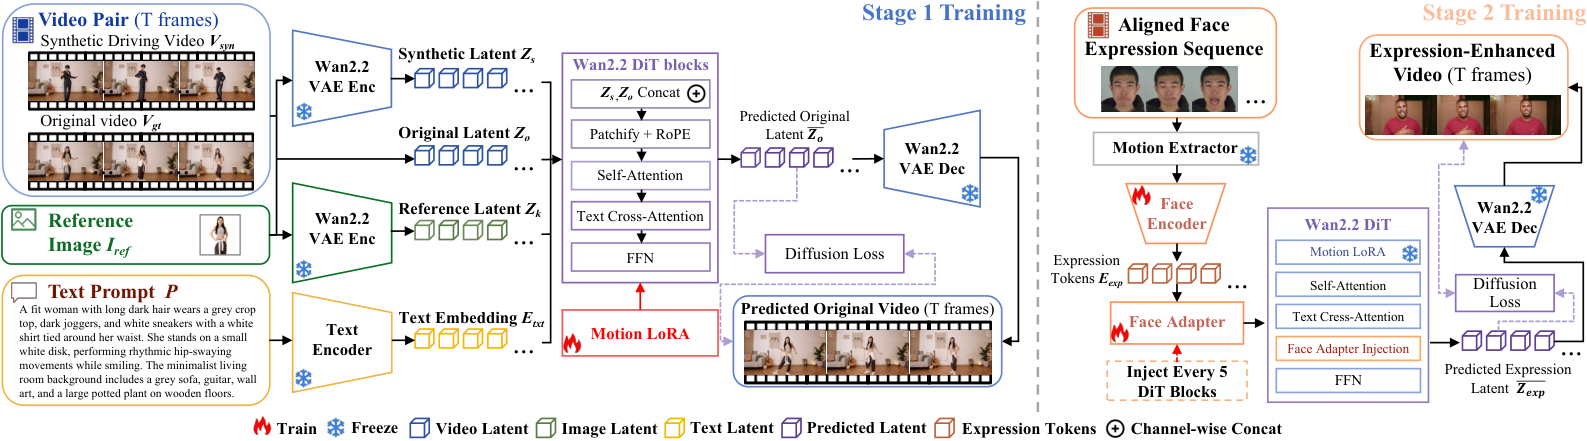
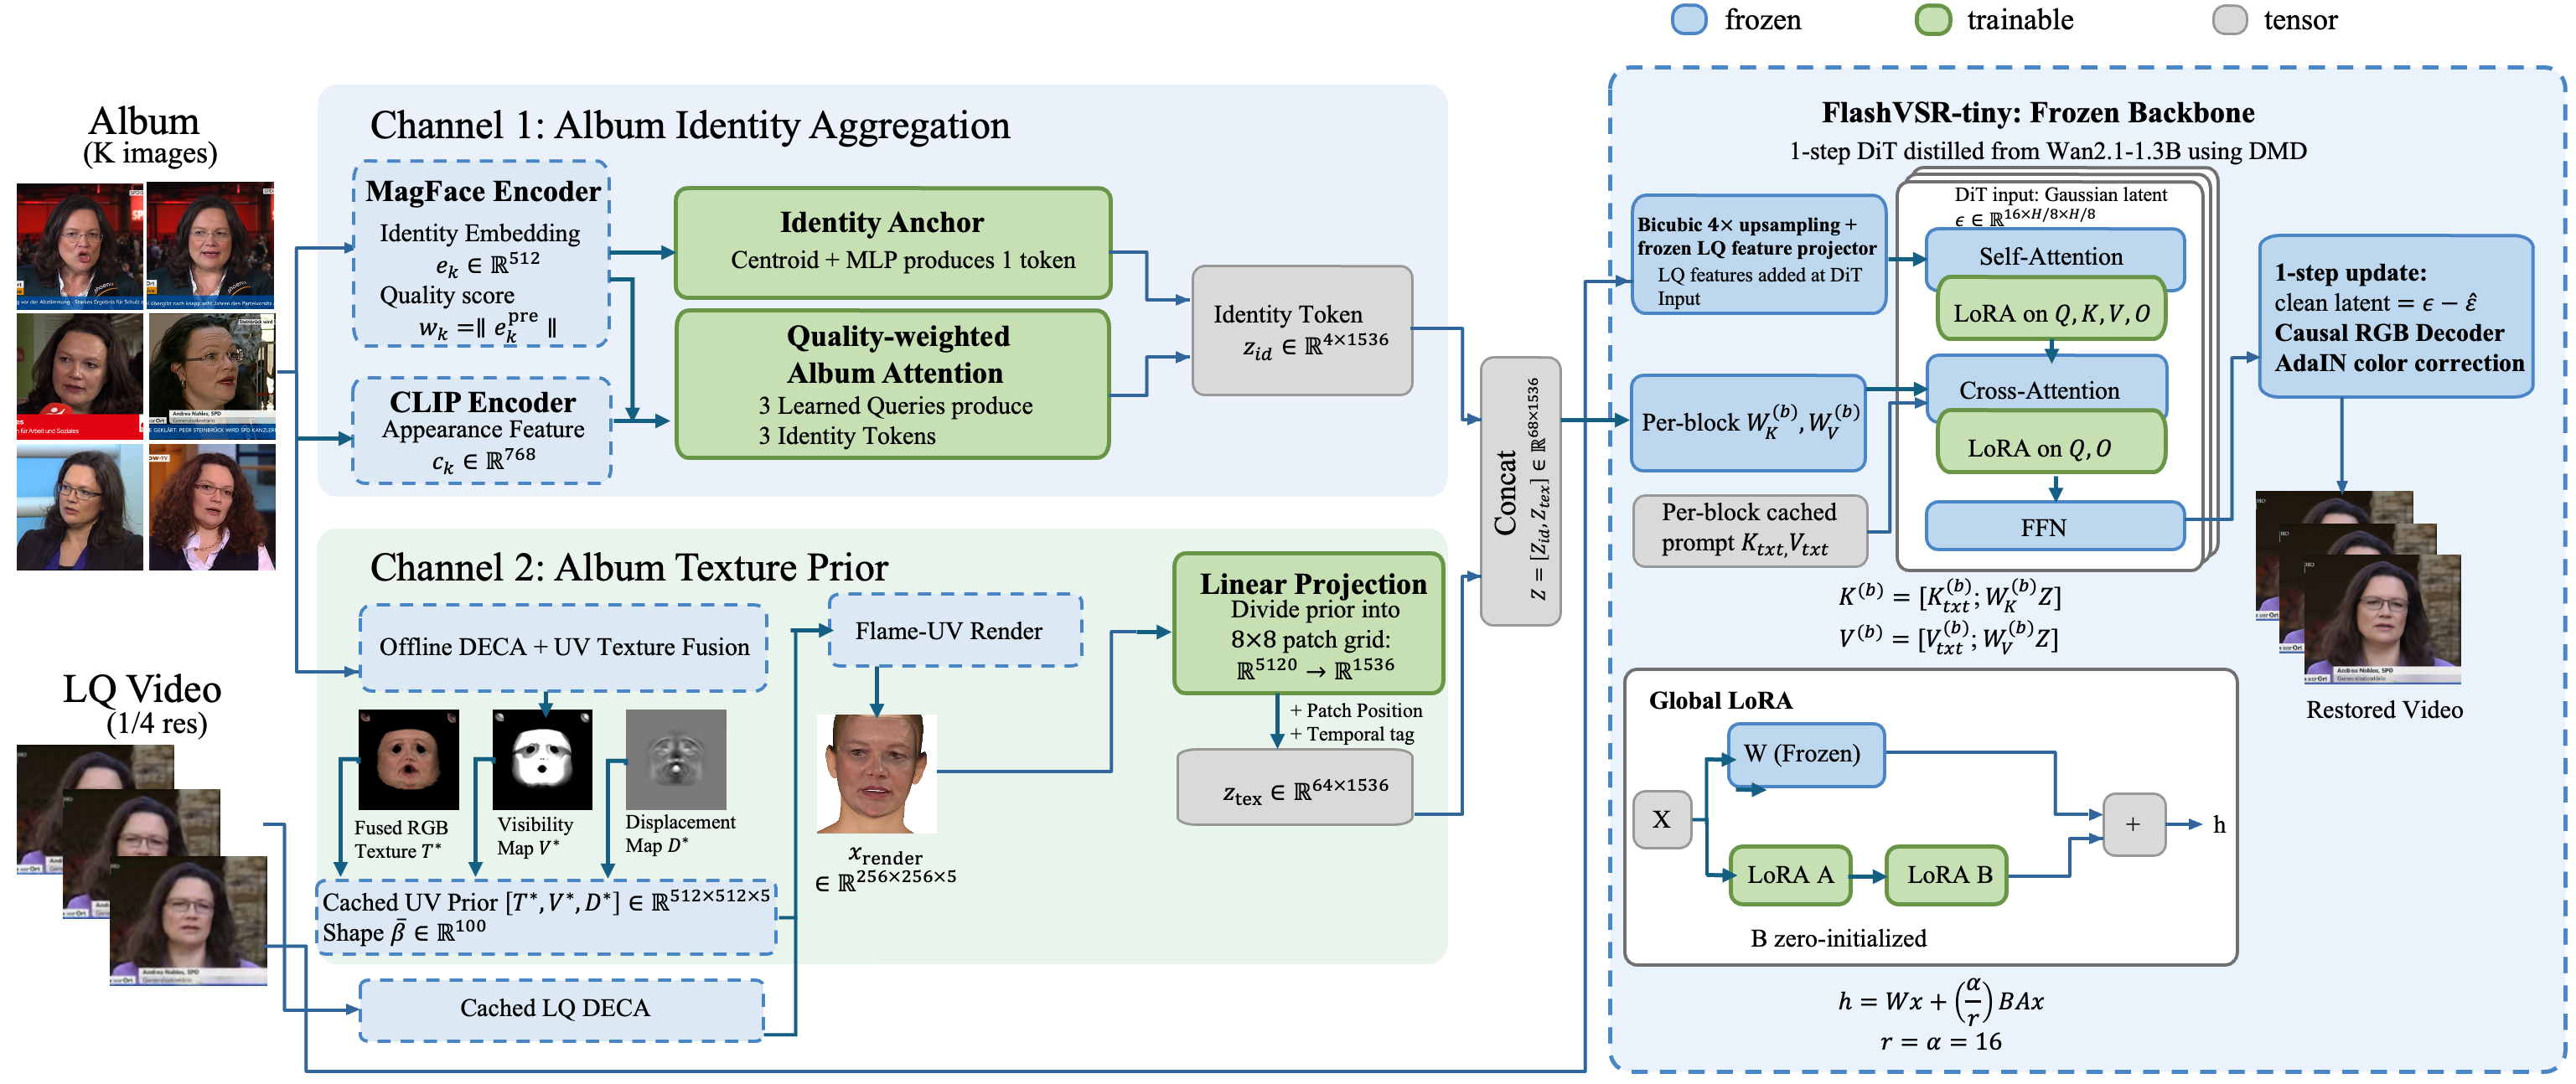
- 本文贡献:以 Wan2.2-I2V-14B 扩散 Transformer 为底座。VAE 变分自编码器分别把两张图压为潜变量,固定在时间序列两端;只去噪、监督、解码中间视频,不输出参考帧。CLIP 图像语义编码各 257 个 token(特征单元),与文字一起做交叉注意力。背景、商品、脸和交叠区损失权重 0.5/2/2/3;按 2:1:1 概率训练双参考、仅商品、仅人物。保留底座高低噪声双专家分工,在各自噪声区间微调。训练集 1 万段含合成视频,非 1 万段真实拍摄。
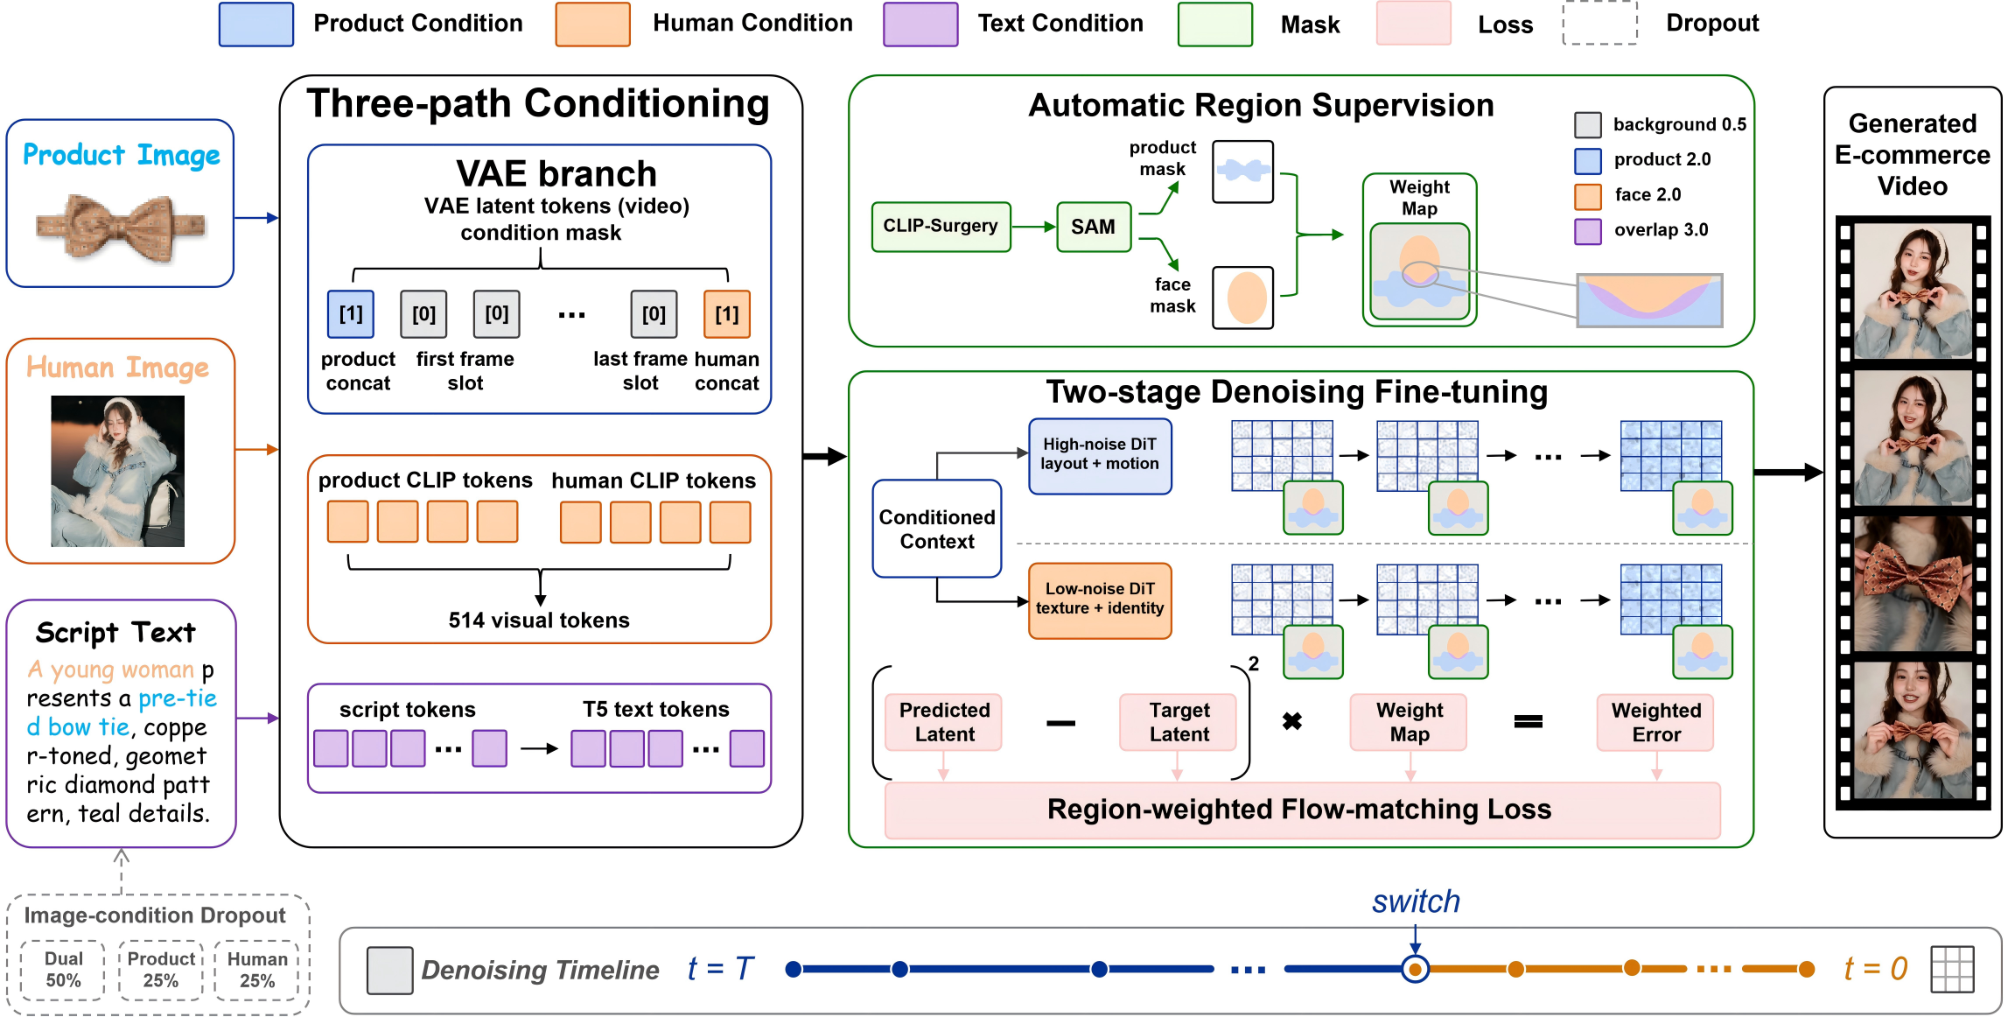 Figure 2|DualCast 总览。商品和人物分别 VAE 编码,固定于扩展潜序列前后边界;仅中间视频潜变量去噪、监督及解码。两参考的 CLIP 嵌入与文字一起作交叉注意力上下文。商品与脸掩码决定区域加权,条件丢弃让同一模型支持双图、仅商品、仅人物三种输入。
- 实验效果:独立 150 组留出商品/人物,生成 720×560、81 帧;不兼容方法用最接近比例。五维感知分由多模态模型按 0–5 打分再除 5,平均 0.9848,对 VACE0.9224;脸身份指标 ID-Adj0.8517,对底座 0.8206、Wan2.7 的 0.8498。11 个单指标平均名次 1.73,非 11 项全胜。两阶段各在 128 张 A100 训练 8 小时。附录推理统计混合六个方法,不能把双参考均值 867 秒直接归给 DualCast。
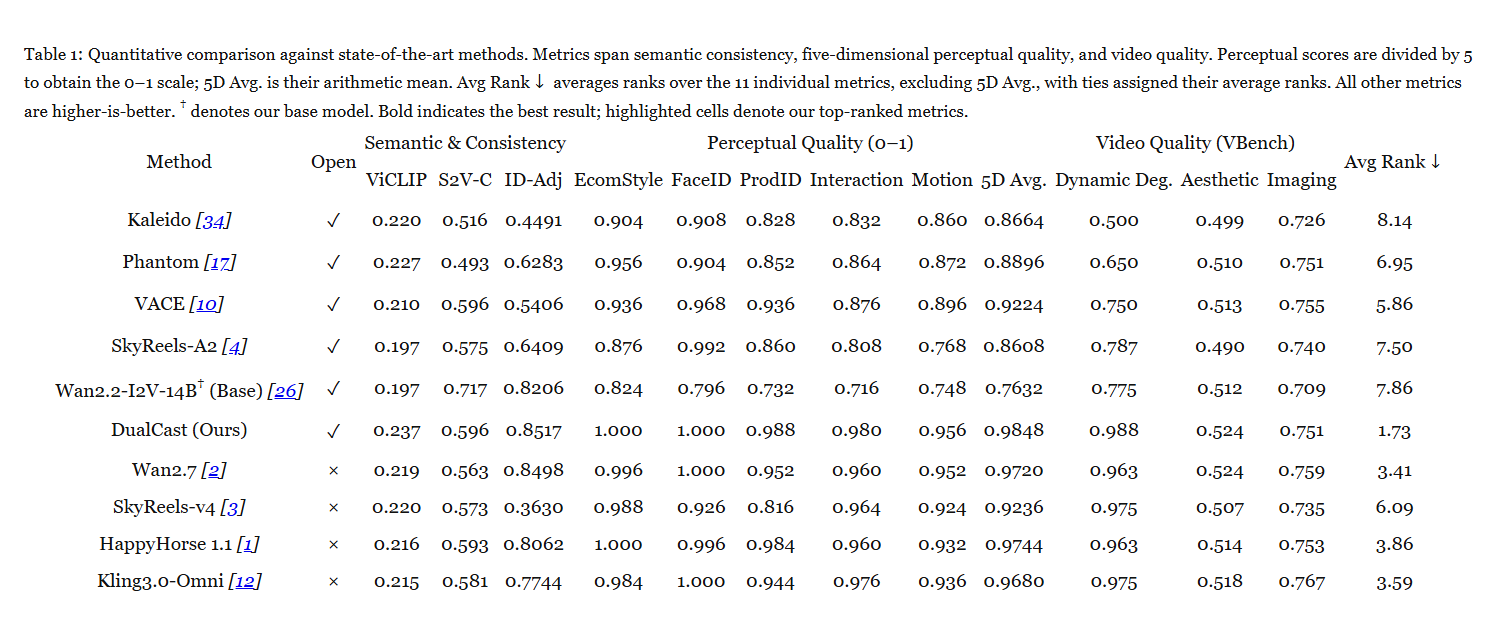 Table 1|语义一致、五维感知质量和视频质量的定量比较。感知原分除 5 归一到 0–1,5D Avg 是其算术平均;平均名次计算 11 个独立指标并排除 5D 平均,并列用平均名次。只有平均名次越低越好,其他越高越好;†为本方法底座,粗体为最优、高亮为本方法名列第一的指标。
- 批判点评:这是双图条件下新生成展示视频,并非保持任意原视频动作的参考编辑。自动时序诊断仍标出 14/150 商品变形、13/150 重影,属于模型疑似标记而非人工确诊;零身份漂移标记不等于绝不换脸。主表高分依赖固定模型裁判,跨域广告和真实直播仍需核验;原文未给可确认独立代码地址。
3. LiveFoley:看着视频现场补音效
LiveFoley: Dynamic Real-Time Video-to-Audio Generation for Immersive Interactive Worlds | 莫纳什大学;南京大学;生数科技;坦佩雷大学;阿里巴巴;清华大学 | arXiv:2611.05988
关键词:流式视频生音频, 滑动窗口, 因果扩散, 延迟预算
- 前序问题:画面里敲了一下门,声音迟半拍就出戏。等整段视频再配音能看全动作,但无法边玩边听;把视觉窗口缩短又容易看不清动作。
- 方法直觉:保留一整窗历史,让窗口尾端贴住最新帧,只输出新到帧的特征。音频去噪再看看已经生成的声音,既不断上下文,也不用等未来。
- 本文贡献:冻结 Synchformer 视觉编码器,每个窗口 16 帧,25 帧每秒下覆盖 0.64 秒;步幅 1/2/4 个 token 分别只需等待 0.08/0.16/0.32 秒。两层 Synchronizer 把不同步幅特征对齐,音频后端统一每秒 12.5 次生成、每段 80 毫秒。History LocDiT 局部流匹配头读前两段干净声音;可选 Future-Warmup 同时预热下一段,用当前隐状态加未来视觉近似条件,下一段丢弃并在下一轮重生,额外等 80 毫秒。因果声学 VAE 支持 16kHz 单声道和 48kHz 立体声。
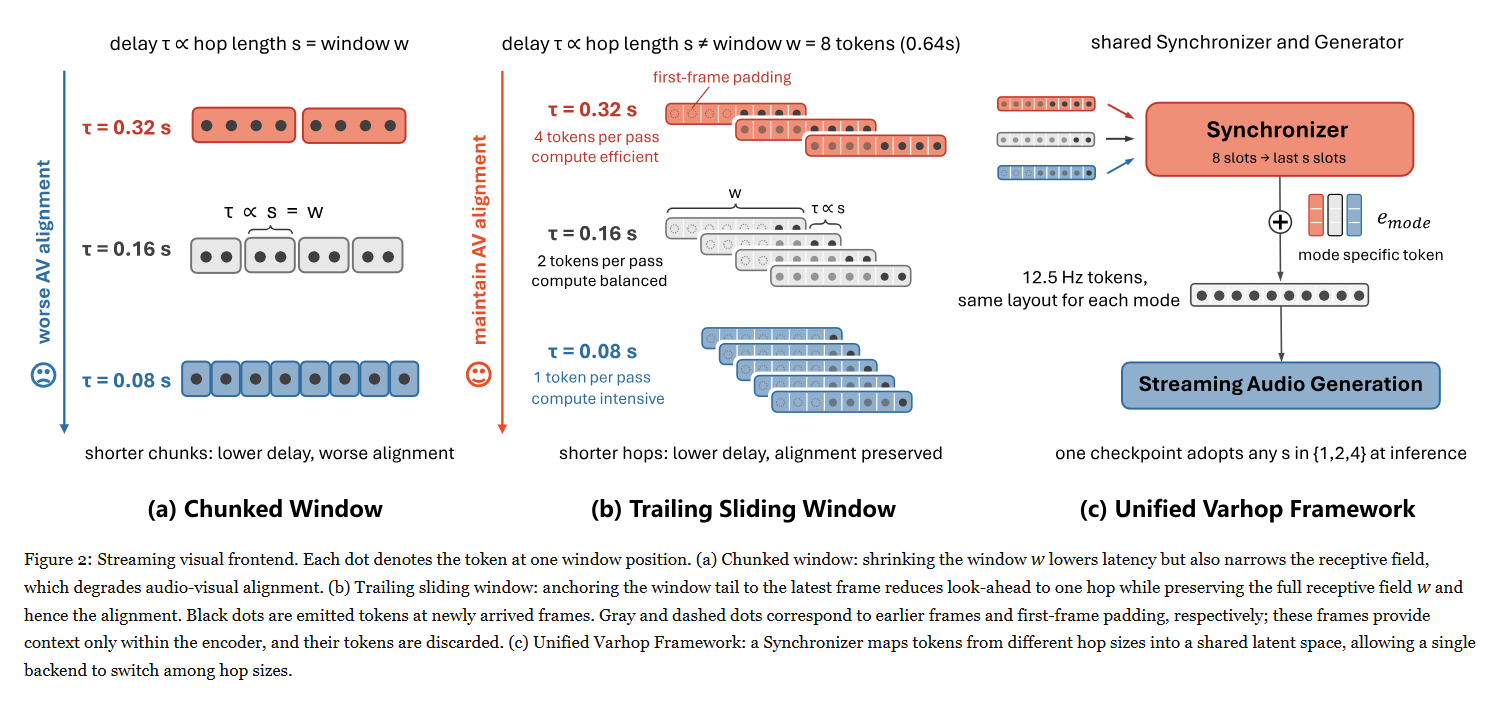 Figure 2|流式视觉前端。每点表示一个位置的 token。(a)缩小分块窗口会减延迟也缩感受野。(b)窗口尾贴最新帧,保持完整历史感受野,只等一次步幅;黑点为新输出,灰点为历史、虚点为首帧填充,只供编码上下文、不输出。(c)Synchronizer 把不同步幅的 token 映射到共享空间,一个后端切换步幅。
- 实验效果:约 2000 小时、74.5 万段训练;VGGSound 完整测试中,48k 版 DeSync 声画错位代理 0.48,离线 MMAudio-L0.47,低更好。16k 版 PANNs 特征分布距离 9.56,对离线 8.48,仍有质量差距。人听平均意见分:音质 MOS-Q3.23、同步 MOS-A3.58,离线同步 3.79。单 A800、步幅 1 默认 History 首段可播放音频 156 毫秒,包含 80 毫秒前端等待;236 毫秒为在该测量上加 80 毫秒未来等待的估算。步幅 4 让前端调用频率减为四分之一,不等于全系统快四倍。
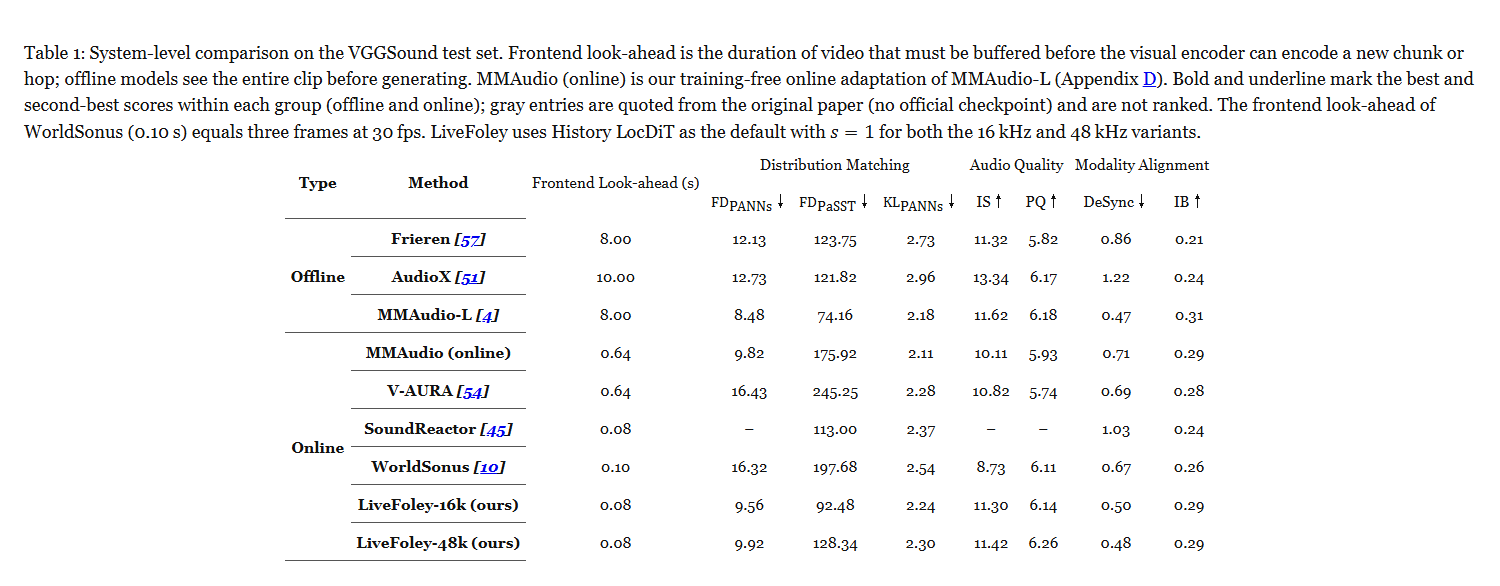 Table 1|VGGSound 系统比较。前端等待为编码新分块或步幅前必须缓冲的视频时间;离线模型先看完整段。在线 MMAudio 是作者免训练改造。粗体/下划线为各在线或离线组最好/次好;灰色为无官方权重的引用结果、不排名。WorldSonus 的 0.10 秒是 30 帧每秒下 3 帧;LiveFoley 的 16/48kHz 均默认 History LocDiT、步幅 1。
- 批判点评:模型必须对已听见的声音立即承诺,突发事件与长程声学延续仍受因果约束;不能把在线领先写成整体胜过离线。感知延迟阈值来自特定用户实验,不保证节奏游戏所有人都无感。官方项目页提供演示,官方代码仓库目前只写 Code coming soon;本次未运行模型测时。
4. NanoKV:视频历史压小但不承诺同比提速
NanoKV: High-Ratio KV Cache Compression for Autoregressive Video Generation | 浙江大学;英伟达 | arXiv:2611.06377
关键词:视频缓存压缩, 键值分工, 低比特残差, 混合维度注意力
- 前序问题:长视频越续写,历史键值缓存越占显存;一刀切压缩会忘掉场景。即使存小了,注意力前再解回全尺寸,也可能更慢。
- 方法直觉:把相似历史共有的内容存一次,剩余差异才压缩;负责“查哪段”的键要保住注意力输出,负责“取什么”的值要保住低比特内容,两者分开训练。
- 本文贡献:冻结视频主干,在线聚类中心共享内容,把多头与通道合并后的残差投影为 INT4 四比特系数,同时存中心索引和尺度。键解码器按连续网络块输出对齐;值编码/解码器在实际量化路径上拟合。基础版还原全维键值后计算注意力,Fast 版另拟合低维读取器,敏感层、头或历史保留全维,按统一 softmax 归一合并。48 条轨迹拟合,每种设置用 100 张图×4 相机动作即 400 段视频评估;拟合不包含测试图。
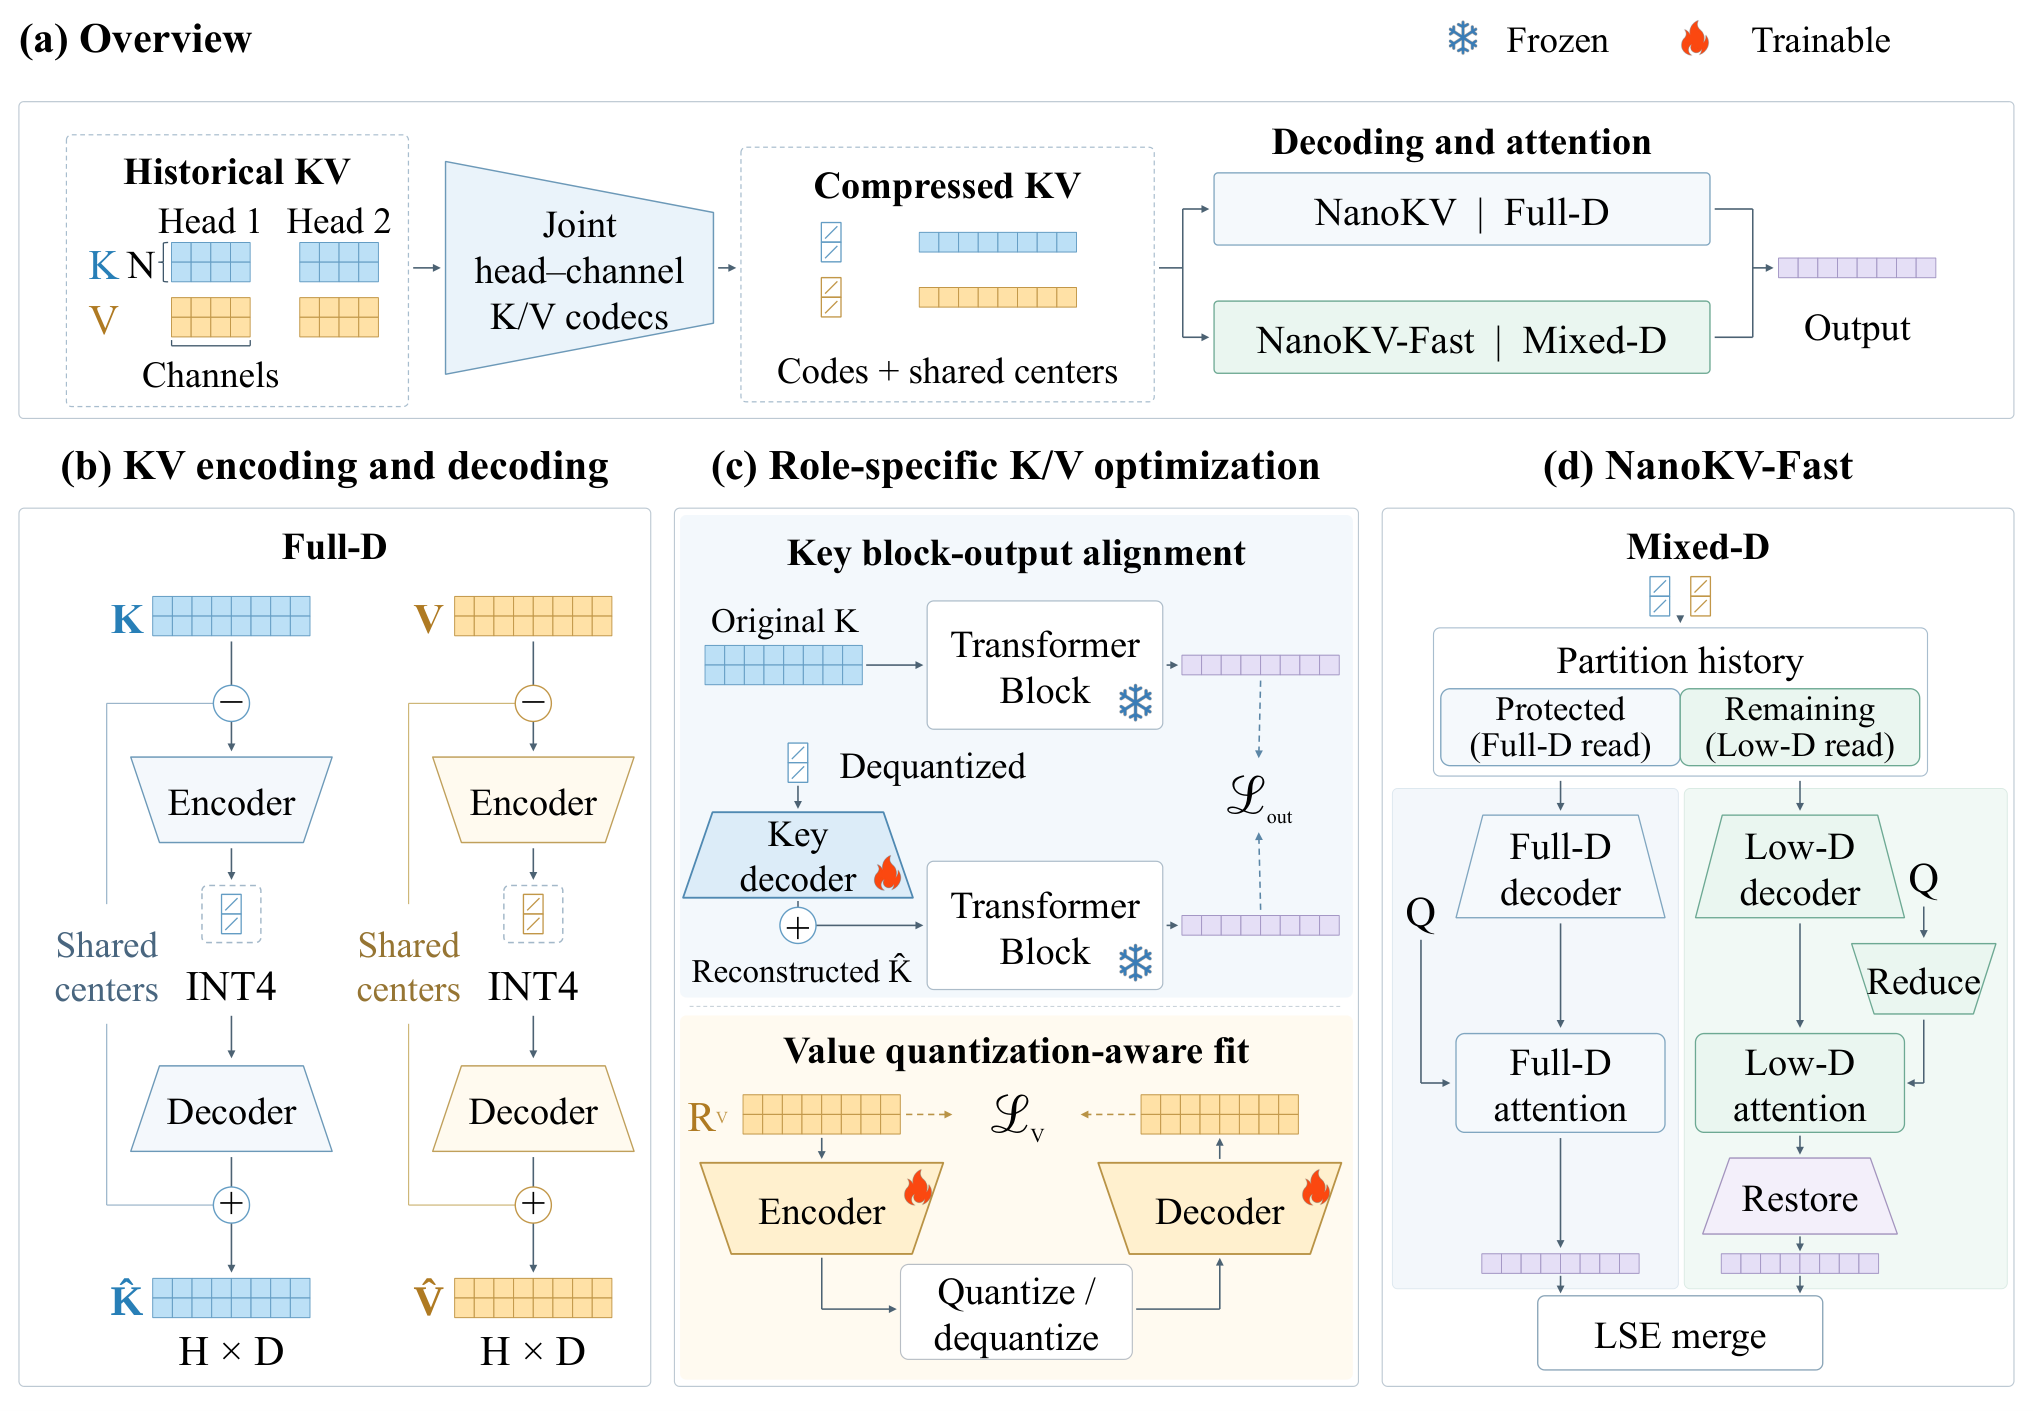 Figure 4|NanoKV 总览。(a)多头通道联合编码,把历史存为系数和共享中心,基础版全维读取,Fast 版混合维度读取。(b)残差编码为 INT4,解码后加回中心。(c)键解码器用块输出对齐,值编码解码器用量化感知拟合。(d)固定策略把历史分到全维/低维注意力;低维分支先降低查询维度,恢复输出维度后用 LSE 即对数求和指数统计合并。
- 实验效果:单 A100 的 HY-WorldPlay:计入附加存储的 KV 由 20.96GiB 到 0.80GiB,有效 26.09 倍,名义系数 32 倍。对同输入未压缩输出的 PSNR19.56dB,比 KVTC18.56 高 1dB;它不是对真实视频的保真。端到端加速比基础版 0.96、Fast1.06,1 以下更慢;Fast 的 PSNR 降为 19.04。进程峰值 NVML 显存 58.70→38.56GiB,并未压成原来的 1/26。另一 LingBot 主干 Fast 加速比仍仅 0.98。
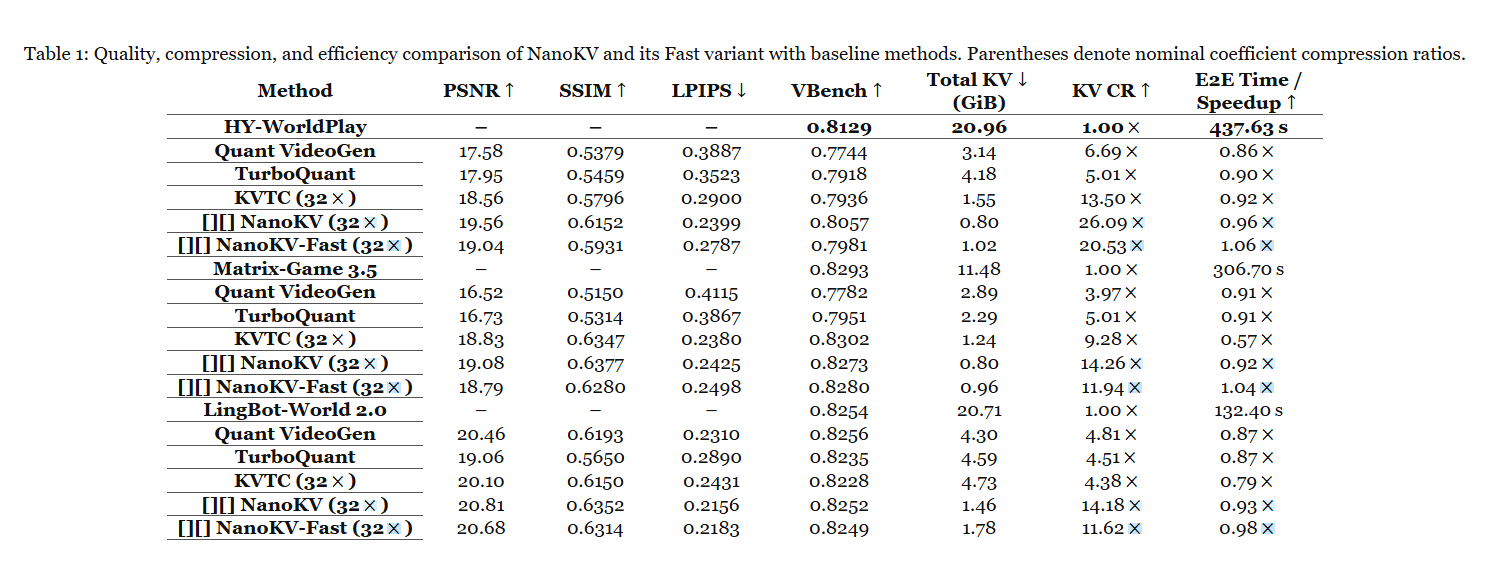 Table 1|质量、压缩与效率比较。括号内是名义系数压缩率,有效 KV 压缩含附加存储;总 KV 单位 GiB。PSNR/SSIM/LPIPS 对同输入未压缩生成比较,非真实视频;VBench 评整体质量。原模型列绝对端到端秒数,其余列原耗时除方法耗时的加速比,低于 1 表示更慢。
- 批判点评:场景一致性、缓存大小、总显存与墙钟必须分别看。Fast 省的是历史注意力计算,后期近似误差还会累积;编码拟合也不是免训练量化。官方代码可见三底座集成、拟合和推理说明,未在本机复现其 GPU 结果。
5. NextGAN:先教判别器指对生成方向
NextGAN: Towards Simple and Scalable GAN Training for Image and Video Generation | 西湖大学;剑桥大学;浙江大学;独立研究者 | arXiv:2611.06270
关键词:少步生成, 梯度回归, 冻结表征, 对抗训练
- 前序问题:判别器只告诉生成器“像不像”,没有明确教它往哪改。一步生图没有后续纠错机会,训练给出的梯度方向尤其关键。
- 方法直觉:在真实与生成特征之间选中间点,直接教判别器的输入梯度指向真实特征。生成器仍沿这个标量势函数上升,不把整套采样流程换成新的求解器。
- 本文贡献:同条件下独立配对参考/生成特征,在线段插值点回归两端位移。标量 critic 是可训练打分势函数,输入梯度才是被监督的方向;固定生成器时,这等价于带梯度能量惩罚的对抗目标。图像用冻结视觉编码器,视频用关掉 LoRA 低秩适配器的原 Wan 主干作表征,再加势函数头;训练时交替更新判别器与生成器。视频随机回放长度,只反传最后一次去噪,不需要在线教师速度或预存教师轨迹。
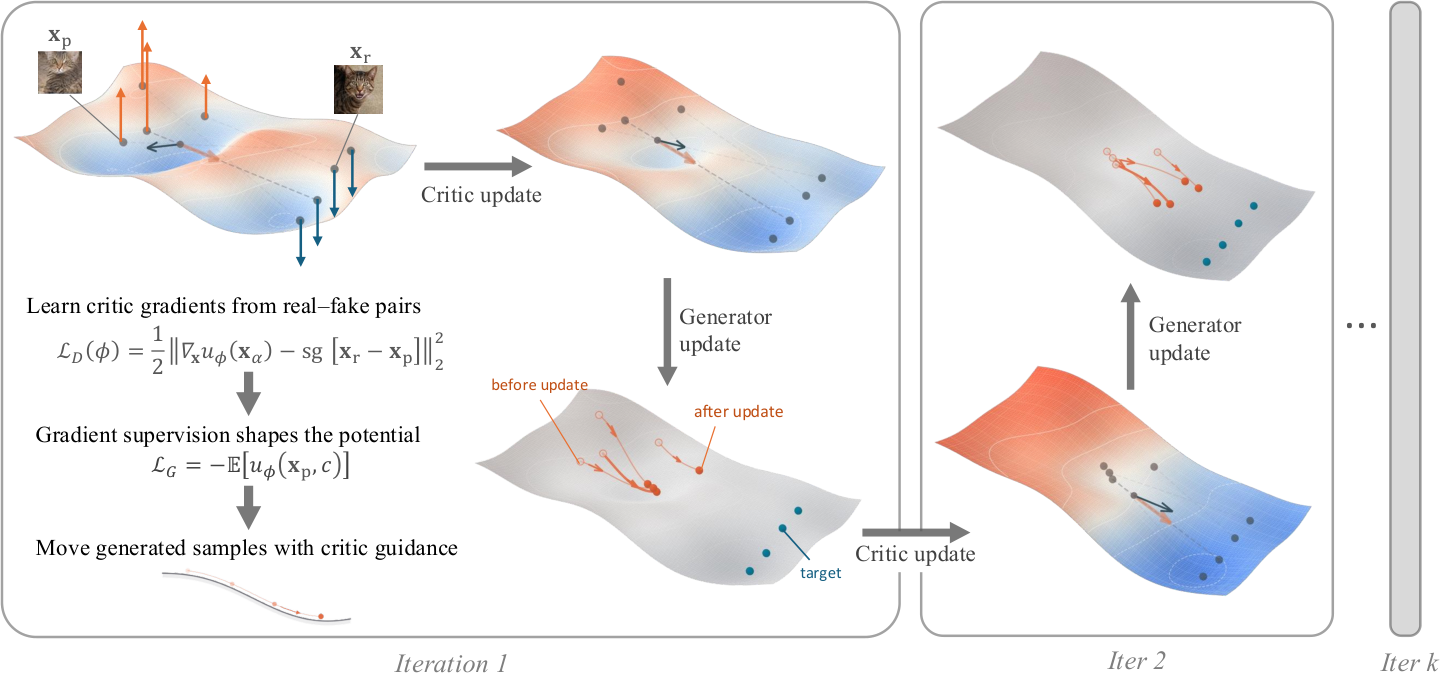 Figure 2|NextGAN 如何教生成器。生成和真实特征的插值点上,先把标量 critic 的输入梯度训练为两端位移,端点停止梯度;再固定 critic,让生成特征沿势函数上升。曲面画的是负势函数,所以上升看起来向下。两次更新在训练中交替。
- 实验效果:ImageNet256×256 潜空间 DiT-XL/1 一次网络计算 FID 分布距离 1.54,对抗形式 1.36;像素 JiT-B 为 2.87,低更好且设置不同。832×480×81 帧,Wan2.1-1.3B 一次/两次/四次网络前向的 VBench 总分 80.80/83.13/82.72;两次比 rCM 高 1.25 分、AnyFlow 高 0.47 分。14B 两次为 82.73,同规模 AnyFlow 仍领先。步数/前向不是实测墙钟,未据此宣称同比倍速。
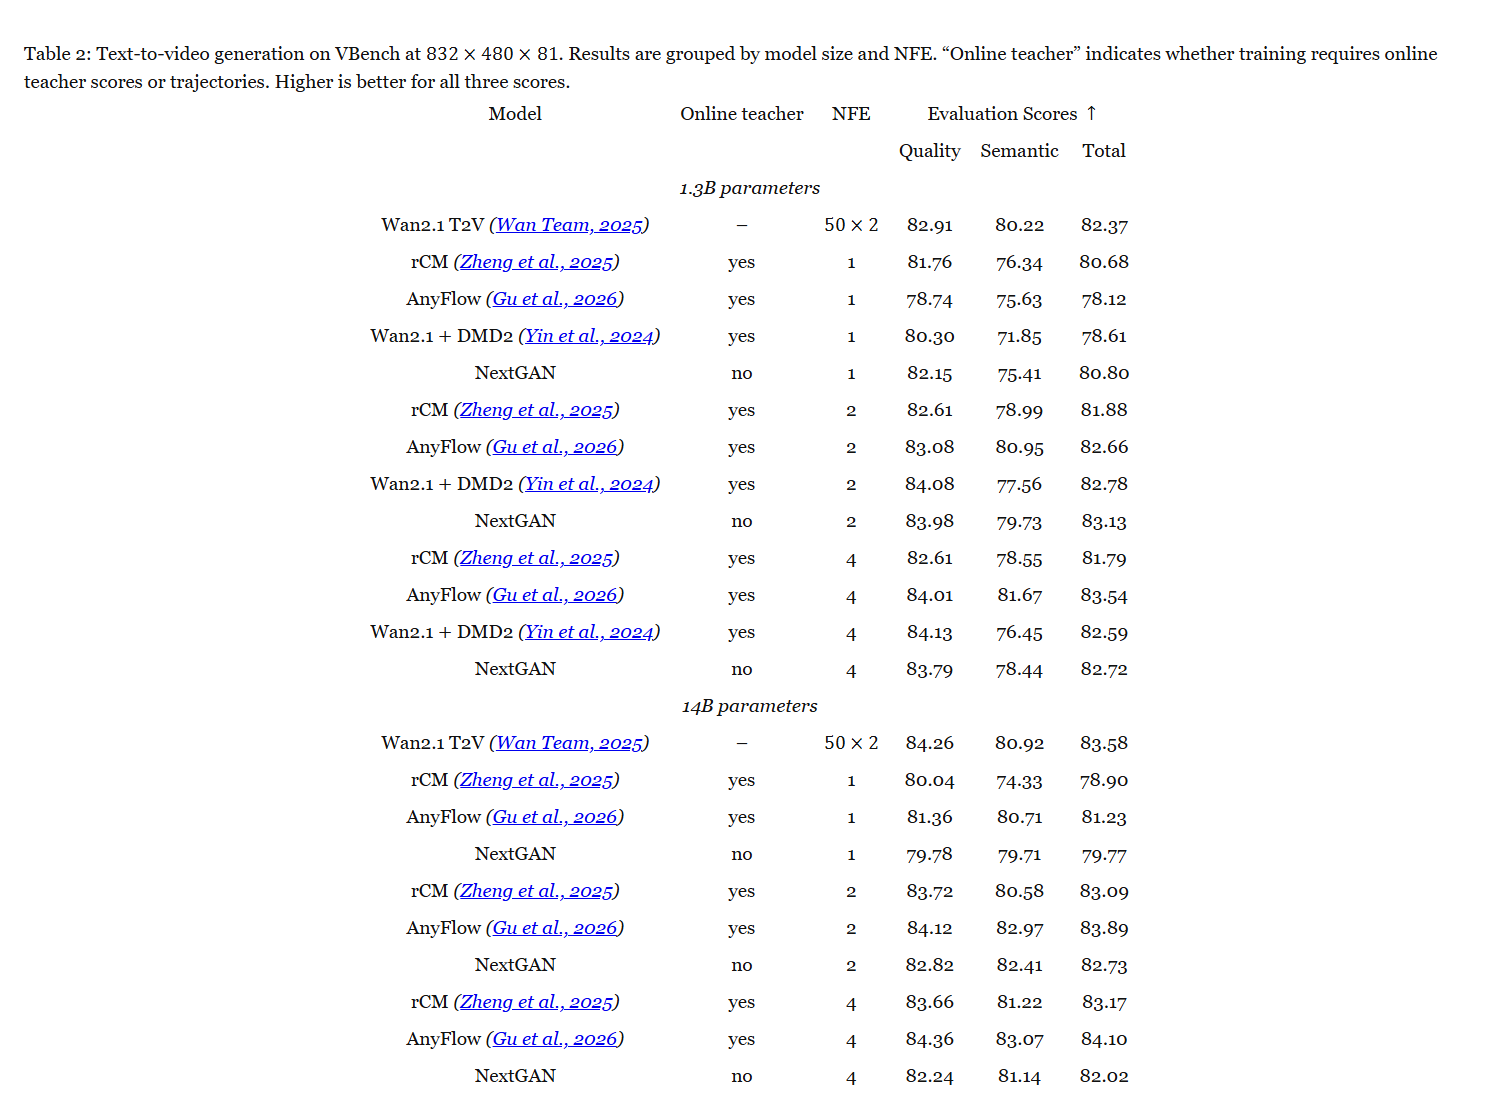 Table 2|832×480×81 帧的文字生成视频 VBench 结果,按参数规模和 NFE 网络计算次数分组。是否需要在线教师评分单独标注;同一步数和规模下比较,不把 1.3B 排名外推到 14B。NextGAN1.3B 两次总分 83.13,14B 两次 82.73,14B 仍有更强对照。
- 批判点评:更多步数没有保证更高总分;不依赖在线教师也仍需预训练主干、冻结特征反传与交替对抗优化。理想粒子动力学收敛条件不能当有限神经网络必然收敛。原文所列 LINs-lab/NextGAN 仓库,本次 GitHub 读取返回 404,代码可获取性未确认,不宣传能立刻复现。
6. NitroFusion2:一步生图也得把字写对
NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers | 萨里大学;Turing Elite Research Labs | arXiv:2611.05648
关键词:对抗蒸馏, 文字流监督, 按属性判别, 少步图像生成
- 前序问题:一步画海报容易让字母糊成纹理。只用图像特征区分真假,会奖励画面锐利,却不一定检查文字是否真的拼对。
- 方法直觉:联合注意力里的文字 token 已经读过图像,让它来当判别器的观察口;每次只问字体、物体或布局等一个方面,监督就能对准对应错误。
- 本文贡献:学生和冻结判别主干都从 Z-Image-Turbo 初始化。TSAD 即 Text-Stream Adversarial Distillation,在文字流中间注意力输出接轻量判别头,保留图像流头;独立文字编码器没有读图,不能直接提供这种图像梯度。ACD 即 Aspect-Cued Discrimination,按图像标注文字、物体、风格、背景、动作、布局六方面,加完整描述共七类提示,每步均匀抽有效项。学生仍读原提示,裁判读抽到的提示并路由专门头,共用一次主干计算。参考训练图 10 万张,由 12 步底座生成,中英各半。
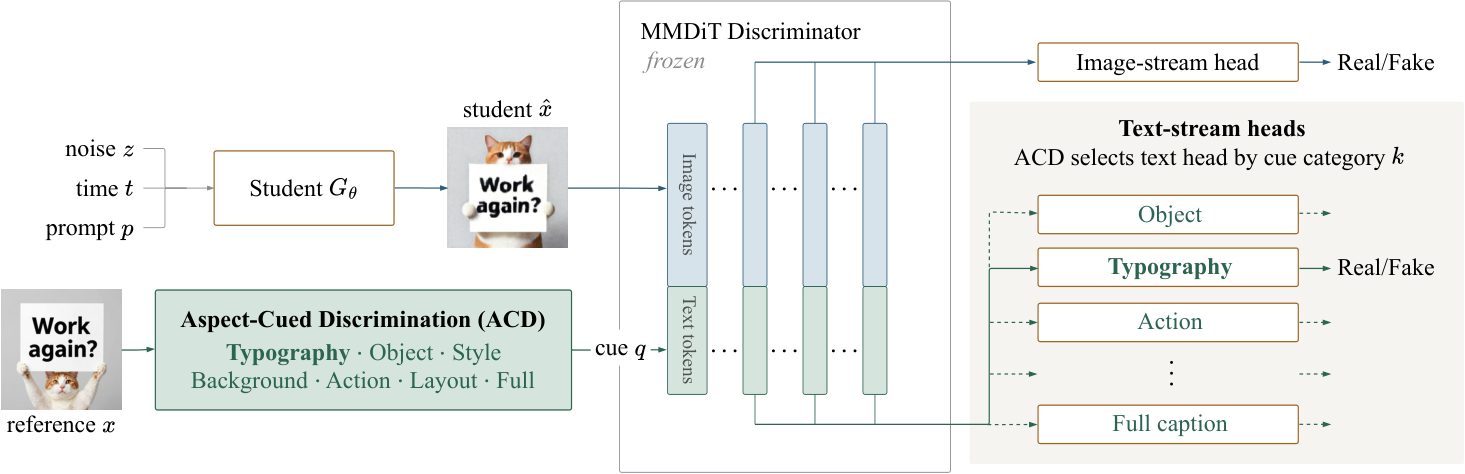 Figure 2|TSAD 与 ACD 架构。TSAD 在文字 token 中间状态接判别头,并保留常规图像流头。ACD 从图像构造有证据支持的属性字段,每训练步抽一项作为裁判条件并选择对应文字头,让判别聚焦该属性。
- 实验效果:6B 即 60 亿参数,一个模型支持不同步数。一次前向 NFE=1 时,LongText 英文 43.34、中文 47.78,对 TwinFlow29.18/36.85;GenEval 组合正确 75.86、DPG 复杂指令 86.48。两次文字分 76.03/81.95,但 GenEval74.46 低于底座两次 76.53。八次底座文字分 91.74/92.56 仍明显更高;不能把一个指标超过八步理解成整体等质八倍快。
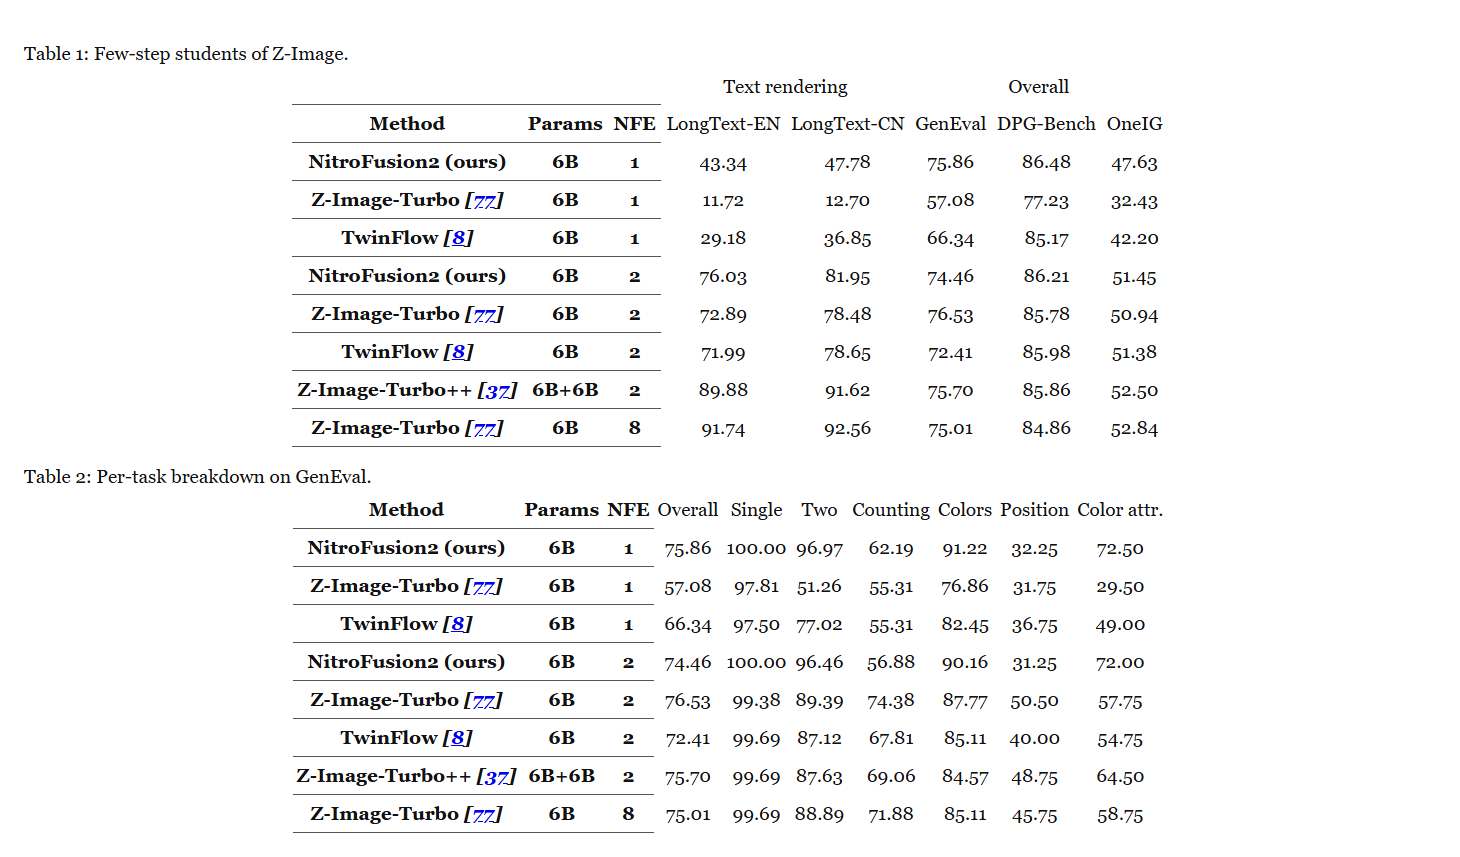 Table 1 和 Table 2|Z-Image 少步学生与 GenEval 细分,原 HTML 把两表放在同一复合图。参数、NFE、中英文文字渲染、组合、复杂提示和整体质量分别比较;两步 Turbo++为 6B+6B 两套权重。GenEval 保留单物体、双物体、计数、颜色、位置和颜色属性六类,不能把总分替代所有任务都胜出。
- 批判点评:它把训练信号从局部纹理扩展到提示描述的属性,但极复杂布局仍难;所有消融共 1000 训练步,不等于最终模型总训练预算。两步 Turbo++用两套 6B 权重,不能当成同一 6B 模型对比。尚缺同硬件完整墙钟与峰值显存测量。官方项目页列出官方推理代码、权重和 ComfyUI 流程;推荐两步流程第一步额外用 0.5 强度去蒸馏 LoRA,第二步关掉,复现须区分与主表的采样配置。本次未跑模型。
7. VA-TDM:四步学生要学自己真会走的路
VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation | 香港科技大学;香港中文大学深圳 | arXiv:2611.06796
关键词:速度对抗蒸馏, 轨迹分布匹配, 双形式监督, 四步生成
- 前序问题:把 50 步教师压成 4 步,学生的中间图仍带噪,直接拿最终干净图再加噪训练裁判,可能学的是另一种分布,给学生错误方向。
- 方法直觉:沿学生自己走过的每段轨迹监督速度,既用稳定但只约束平均内容的信号,也用更完整但方差高的分布信号,让两者共同教同一个学生。
- 本文贡献:VAD 即 Velocity Adversarial Distillation,用可学习 critic 估计教师与学生速度差。A 形式从学生干净预测构造低方差速度,匹配条件均值;B 形式跟随中间状态再加噪,连接真实学生分布的 score(对数密度梯度)。两套在线场共用骨干、分输出头,显式输入当前转移终点;混合两种生成器更新并对 critic 输出停止梯度,避免不稳定。教师速度正则需相应修正 critic 比例。先沿学生轨迹做教师常微分方程回归预热,再做各段分布匹配,不只是对最终图训。
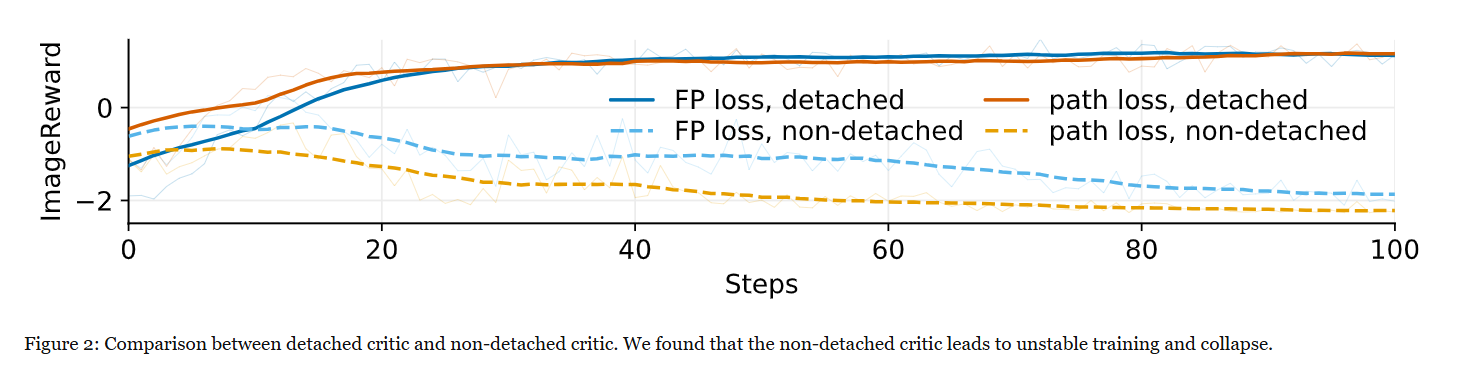 Figure 2|critic 输出是否停止梯度的比较。让梯度穿过未停止的 critic 输出会导致不稳定并崩溃;实际 VA-TDM 采用停止 critic 输出的更新。此图是训练机制证据,不是模型架构图。
- 实验效果:每次学生生成 4 次网络前向,记 4 NFE。SD3.5-Medium 的 GenEval0.67,对四步 TDM0.61;文字识别 OCR0.59 对 0.57。FLUX.2 Klein4B 的组合 0.80 对官方四步 0.78,同提示图像间 LPIPS 多样距离 0.56 对 0.47,但 PickScore 偏好代理 0.8694 低于 0.8746。教师 50 步的无分类器引导每步有条件/无条件两分支,计 50×2=100 次前向。还扩到 33B 音视频 H3,不能把 100/4 当实测 25 倍端到端加速。
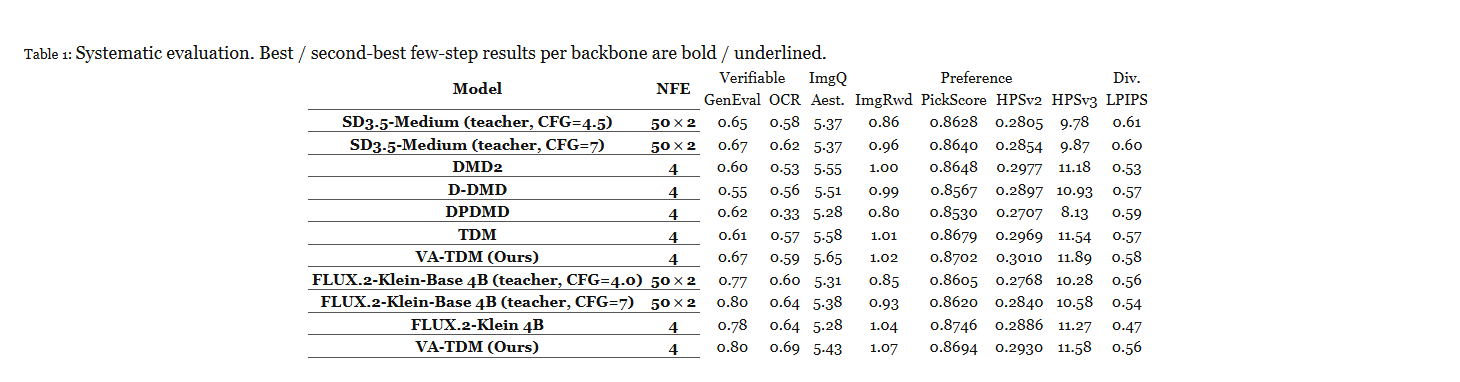 Table 1|分底座的四步系统评估。每底座少步配置最好/次好用粗体/下划线标注;保留可核验组合与 OCR、画质、美学及偏好、多样性各列。教师 50 步有条件与无条件两分支计 100 次 NFE,学生四步计 4 次。FLUX 的 PickScore 并非最优,不称全指标领先。
- 批判点评:共享辅助骨干节省的是两套在线场训练成本,蒸馏本身仍要教师与预热;正文未给统一部署墙钟和峰值显存。A/B 理论匹配依赖精确场等假设,实践停止梯度也有意改变梯度,不能直接套完美收敛结论。官方代码给出 SD3.5 四步学生参考训练;不等于 33B 模型全套训练资产已公开。
8. EmoReward:别让假笑骗过视频奖励
EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL | 香港科技大学;腾讯混元;复旦大学;滑铁卢大学 | arXiv:2611.06518
关键词:情绪视频生成, 奖励校准, 证据有效性, 跨训练记忆
- 前序问题:“克制的悲伤”不一定需要夸张表情。固定奖励若总偏爱大幅动作,生成器可能挤出假笑和过量肢体运动,把评分抬高却演错情绪。
- 方法直觉:先把情绪拆成可观察线索,再问每条线索在当前画面是否可信;从一次已完成训练中归纳哪个裁判可靠,用固定权重表指导下一次训练。
- 本文贡献:Plan 生成情绪脚本,含愉悦度、唤醒度、面部动作单元 AU、身体线索和表达时间窗;Act 只评分已经生成的视频。七个奖励提供器参与融合,色彩和运动强度另作辅助观测,共九通道,不能说九个全进记忆校准。Reflect 按训练阶段、脸置信度、冲突和微妙表达门控,剔除无效证据后归一权重;RewardMemory 从完成的参考轮次估相关性,导出有界乘数,下一轮固定不变。只有生成器接受强化学习梯度,裁判和记忆不在线更新。
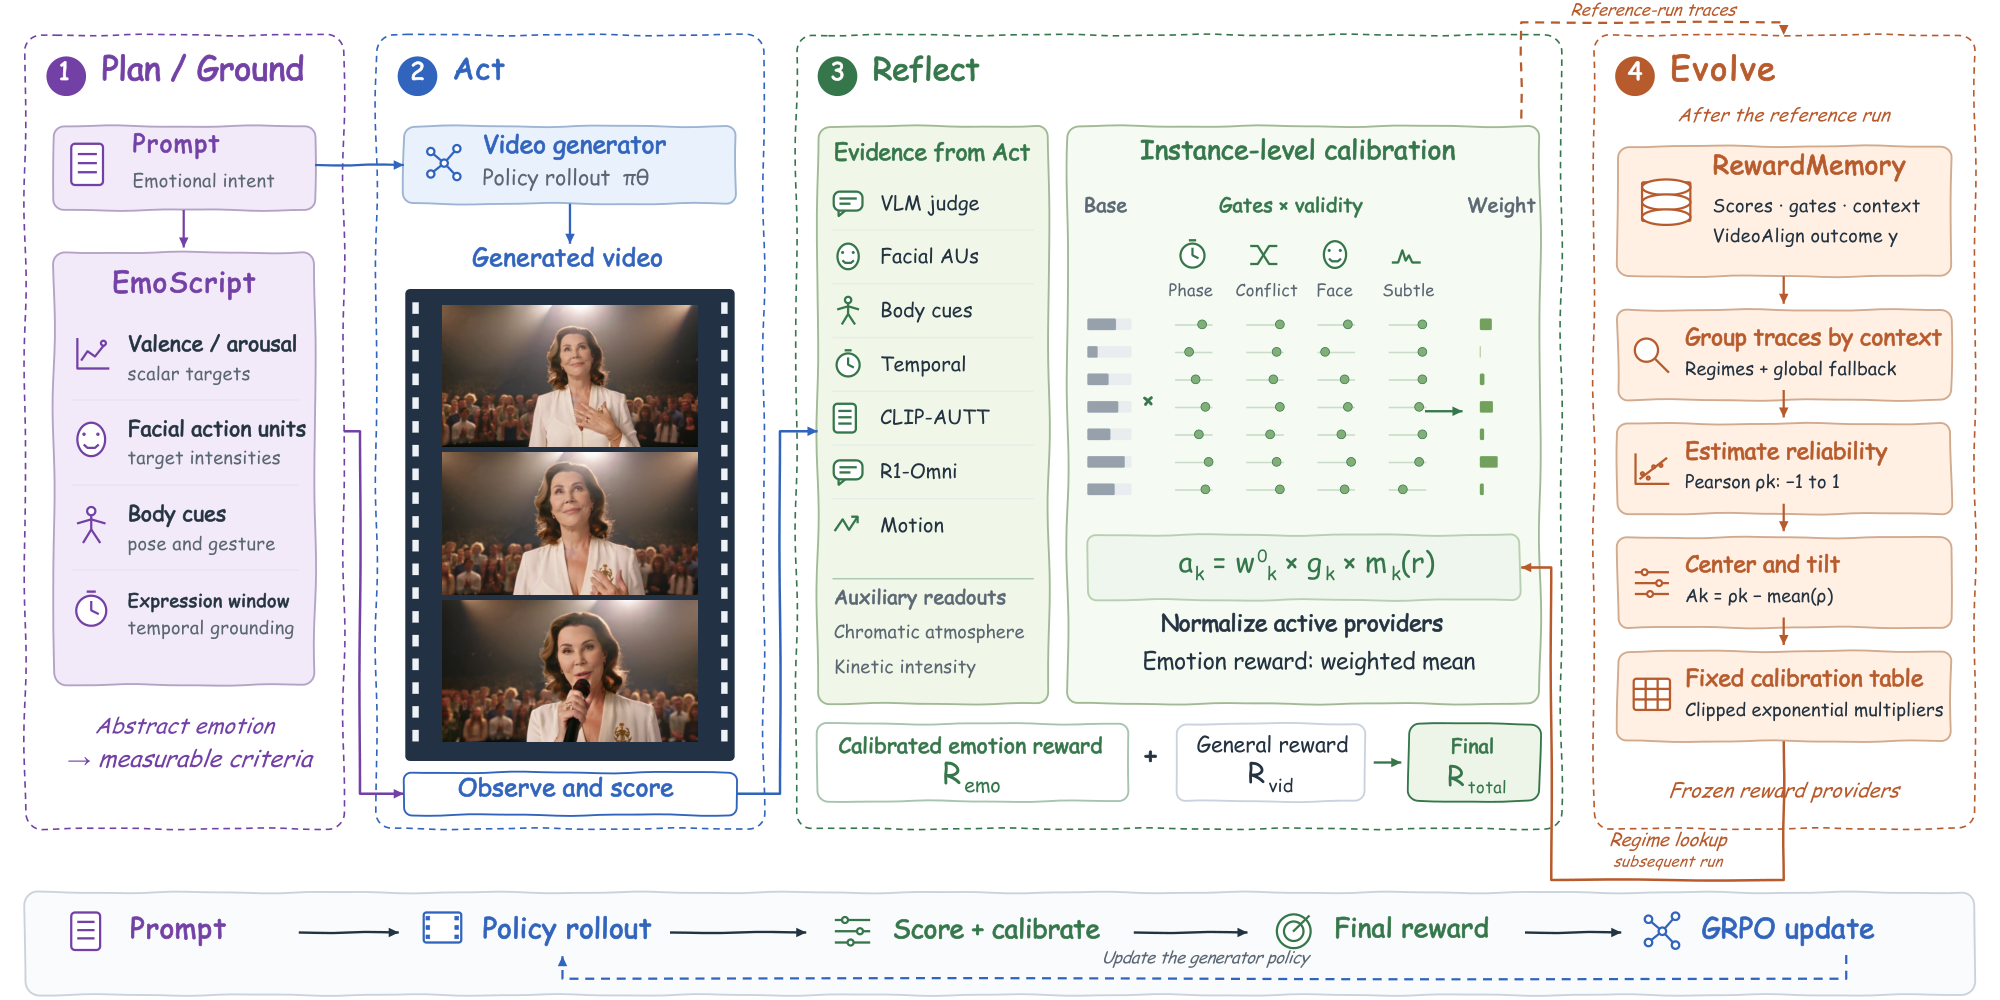 Figure 2|EmoReward 在当前视频和跨训练轮次校准情绪证据。Plan 把意图变为评价准则,Act 返回分数和证据有效性;Reflect 把当前门与记忆乘数结合,对活跃提供器归一。Evolve 从已完成参考训练估计情境可靠性,构造下一轮固定乘数。情绪奖励补充原视频奖励;GRPO 更新生成器,提供器与记忆表保持冻结。
- 实验效果:HunyuanVideo1.5、批 2、每提示 4 个候选,独立 302 个情绪提示;在 SAGE-GRPO 上 VideoAlign 总体加 0.5645。VideoAlign 也参与优化,因此该增益不是独立情绪真实性证明。18 人对 30 提示三档评价,每方法每维 540 个判断:情绪“好”60.0%对 SAGE53.0%,时序 54.3%对 51.5%,画质 57.2%对 45.0%。它们是好评比例,不是配对胜率;自动偏好与文本对齐变化不全为正。
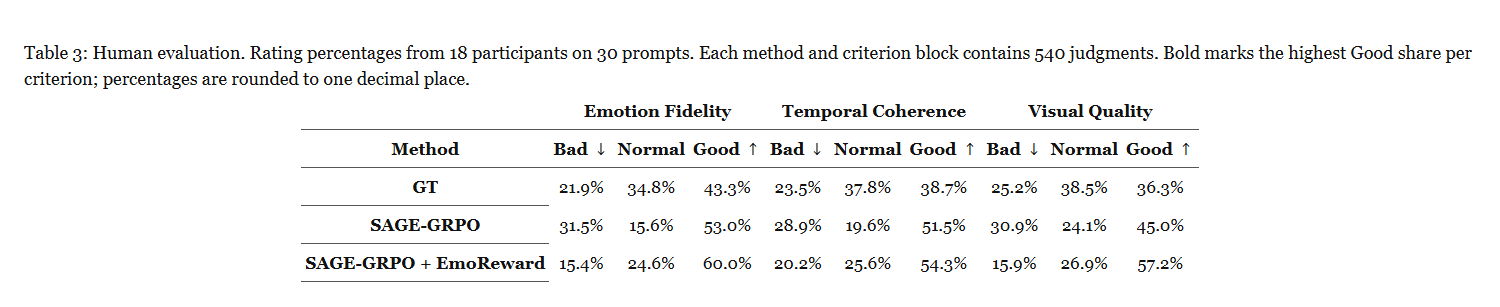 Table 3|18 位参与者对 30 个提示进行情绪保真、时序连贯和画质三档评价;每方法每维 540 次判断。粗体表示每维最高 Good 比例,百分比保留一位小数。保留 Bad/Normal/Good 完整分布,好评比例不当成配对偏好胜率或独立样本人数。
- 批判点评:记忆可靠性与原评价器有信息重叠,仍缺匹配全局记忆对照来单独证明按情境校准的收益。人评需按参与者和提示处理重复判断,不能把 540 次当 540 个独立人;跨图像底座部分预算也不等。七路评分增加后训练成本,未报告统一开销。官方仓库已可读,未运行其中训练流程;名称“自演化”不代表运行中自己重训奖励模型。
9. VAR-Q:按视频生成块保护缓存大数
VAR-Q: Tuning-free KV Cache Quantization for Visual Autoregressive Image and Video Generation | 加州大学圣巴巴拉分校;明尼苏达大学 | arXiv:2611.05380
关键词:视觉自回归, 免校准量化, 块通道分组, 比特打包
- 前序问题:把语言模型的缓存量化搬到视频上,一样的四比特可能忽然让画面崩掉。视觉模型一次生成一帧或一尺度,数值结构不等于逐字生成的连续 token 流。
- 方法直觉:少数大数承载关键功能,量化一组时不能把大数与小数混在同一标尺里。沿特征通道和生成块同时切分,直接借用采样循环已有边界。
- 本文贡献:分析发现键的大数受投影权重、归一化通道增益和 RoPE 旋转位置编码共同影响,值更依赖输入。对每个“通道×生成块”单独设对称量化尺度,默认子块比例 r=1;减小 r 在块内再细分,增加尺度存储但不需检测或校准。键和值共用分组规则。Triton 内核把低于 8 比特的整数实际打包到字节、读取时解包,避免只把数值量化却仍按 16 比特存。覆盖逐尺度图像/视频和逐帧视频九模型,无需微调主干。
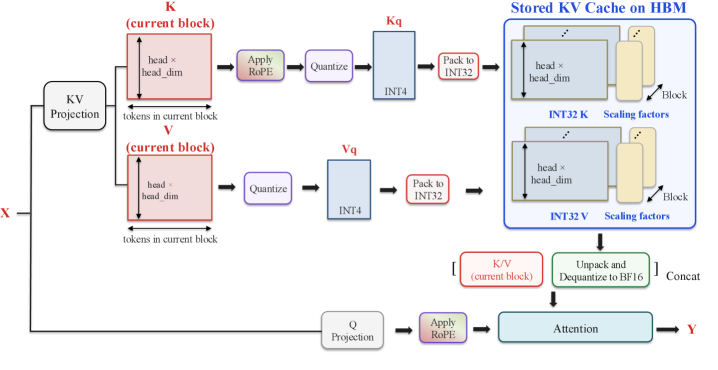 Figure 8|VAR-Q 流程。缓存按通道与生成块两个轴分组,各组量化并由位打包内核压缩存储;生成块边界来自模型的逐尺度或逐帧循环,不另检测大数。
- 实验效果:A10080GB 上,Self-Forcing1.3B 的 5 秒视频、批 12,INT4 缓存 67.49→16.95GB,省 74.88%;VBench 总分 82.94→80.99,低 1.95 分。LongLive1.3B 的 30 秒、批 20,INT4 总分 80.92→79.60;INT6 为 80.94,但缓存省 59.25%。Infinity-8B 在 INT3 的组合准确 83.28,距 BF16 的 83.54 低 0.26 分。GB 是十进制容量,别与 NanoKV 的 GiB 混算;各主干位宽和序列不同。
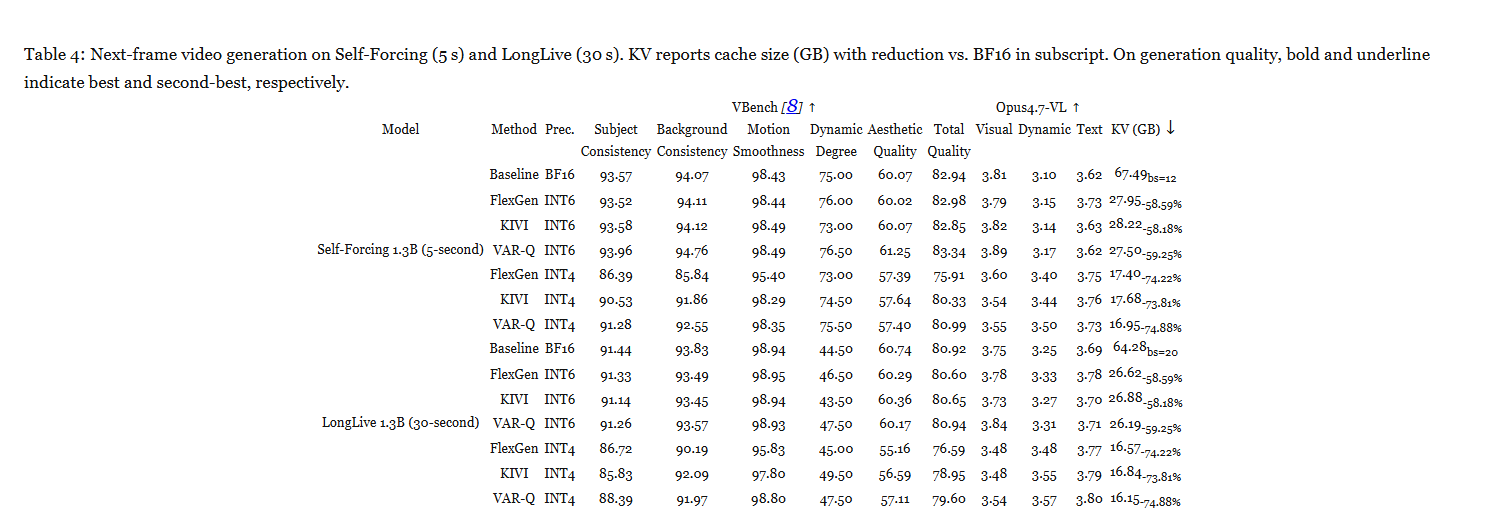 Table 4|逐帧 Self-Forcing5 秒与 LongLive30 秒生成,列键值缓存 GB 及相对 BF16 降幅。质量粗体/下划线为最好/次好;分别保留 VBench 主体、背景、平滑、动态、美学和总质量,以及视觉模型的画质、动态与文字评分。Self-Forcing 批 12、LongLive 批 20,不能横跨两个模型直接比容量;INT4 质量存在退步。
- 批判点评:不能把“最高 78.5%省缓存”与“几乎不掉质量”当所有四比特配置都成立;视频低位宽仍有明显取舍。最大 6 倍批量是容量受限下的批大小,不是每条视频六倍提速;此处不据摘要上限外推吞吐。原文只说早期版本曾在 ICCV2025 工作坊展示,不标主会接收,尚未核到可用官方实现链接。
10. LongBanana:三十多张参考能否真正用对
LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis | 华南师范大学;不列颠哥伦比亚大学;Vector Institute;加拿大 CIFAR AI 讲席;卡内基梅隆大学;滑铁卢大学;可灵研究;马里兰大学;清华大学;香港科技大学;香港大学 | arXiv:2611.06856
关键词:多参考图像生成, 关系约束, 原子清单, 生成评测
- 前序问题:把 32 张人物和物品参考交给生图系统,画面好看却可能漏人、串身份或站错位置。一个整体美学分数看不出究竟漏了哪项要求。
- 方法直觉:把“谁、什么属性、和谁有什么关系”拆成图结构,再变成可核查清单。评估器逐条找证据;生成工作流则能检查中间图,决定补查参考或修图。
- 本文贡献:90 任务按 3×3 分类,每例约 32 张参考、20 条约束,总计 4670 个原子检查。检查按内容、关系绑定和全局约束分工,评分 0/1/2 表示未满足/部分或不确定/满足;负项要求“不出现”时,正确缺席给 2。RPR 工作流依次取证推理、计划执行、反思修图;图像仍由生成模型输出,非纯语言推理榜。人评覆盖 90 任务×10 配置=900 图、46700 次检查,其中 15%即 7005 项双标,一致率 89.4%、加权κ0.83。
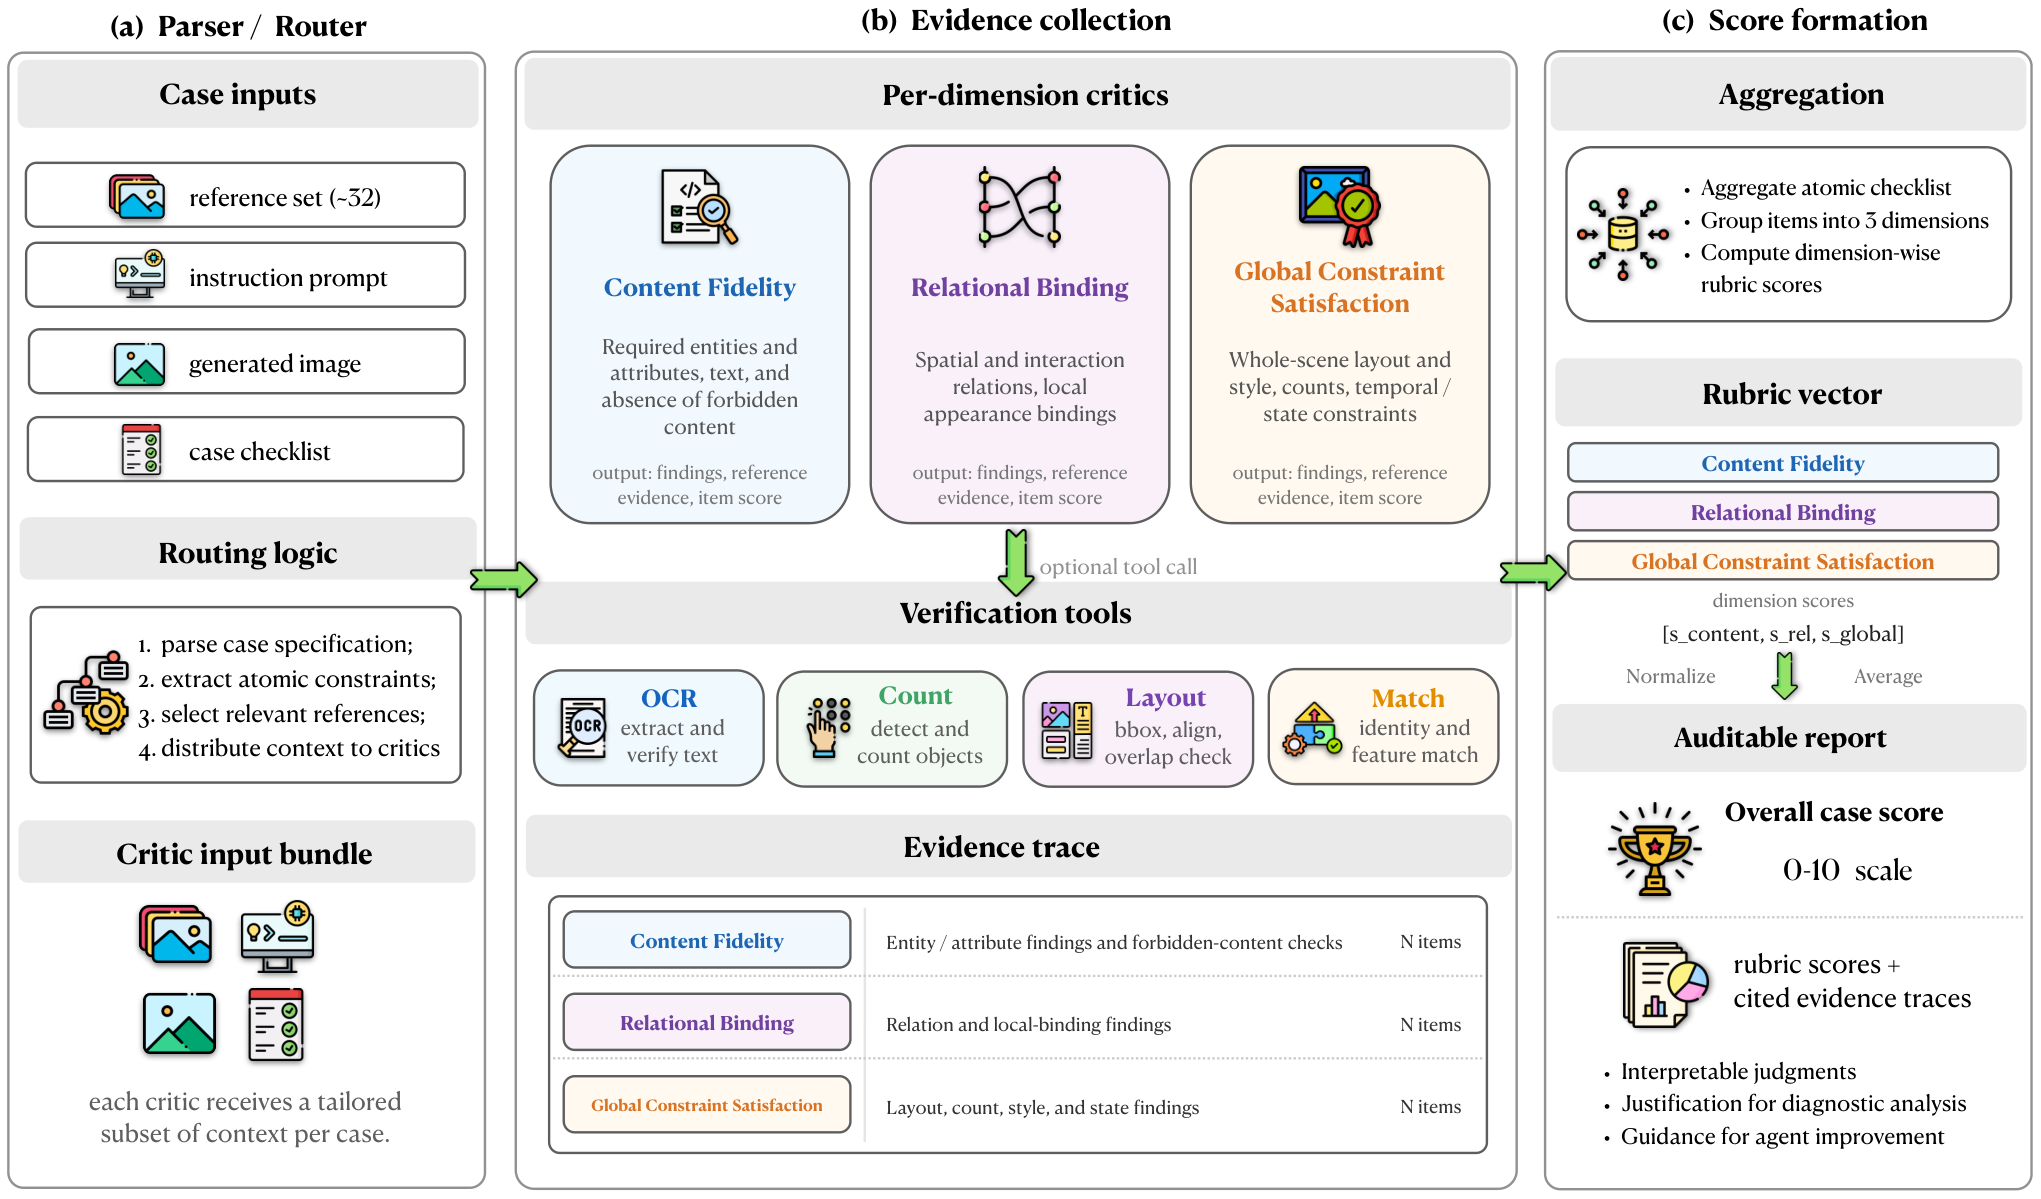 Figure 4|LongBanana-Eval 流程。解析器为每项拼装相关参考证据,路由给内容保真、关系绑定、全局约束三类裁判;裁判检查证据、按需调用核验工具,返回标签及支持轨迹。逐项平均得到各维及整体分。
- 实验效果:固定 Nano Banana2,OpenClaw 加 RPR 使非加权清单均分 76.1→78.4;P@70%即难度加权得分至少 70 的任务比例 40.0%→47.8%,与 OpenCode 最简配置并列,非唯一最好。OpenCode 加 RPR 均分 77.3→77.8 但通过率 47.8%→43.3%。自动清单裁判与人类三档精确一致率 66.81%,普通单次视觉模型 50.99%,仍有 24.81%完全相反的 0/2 错误。
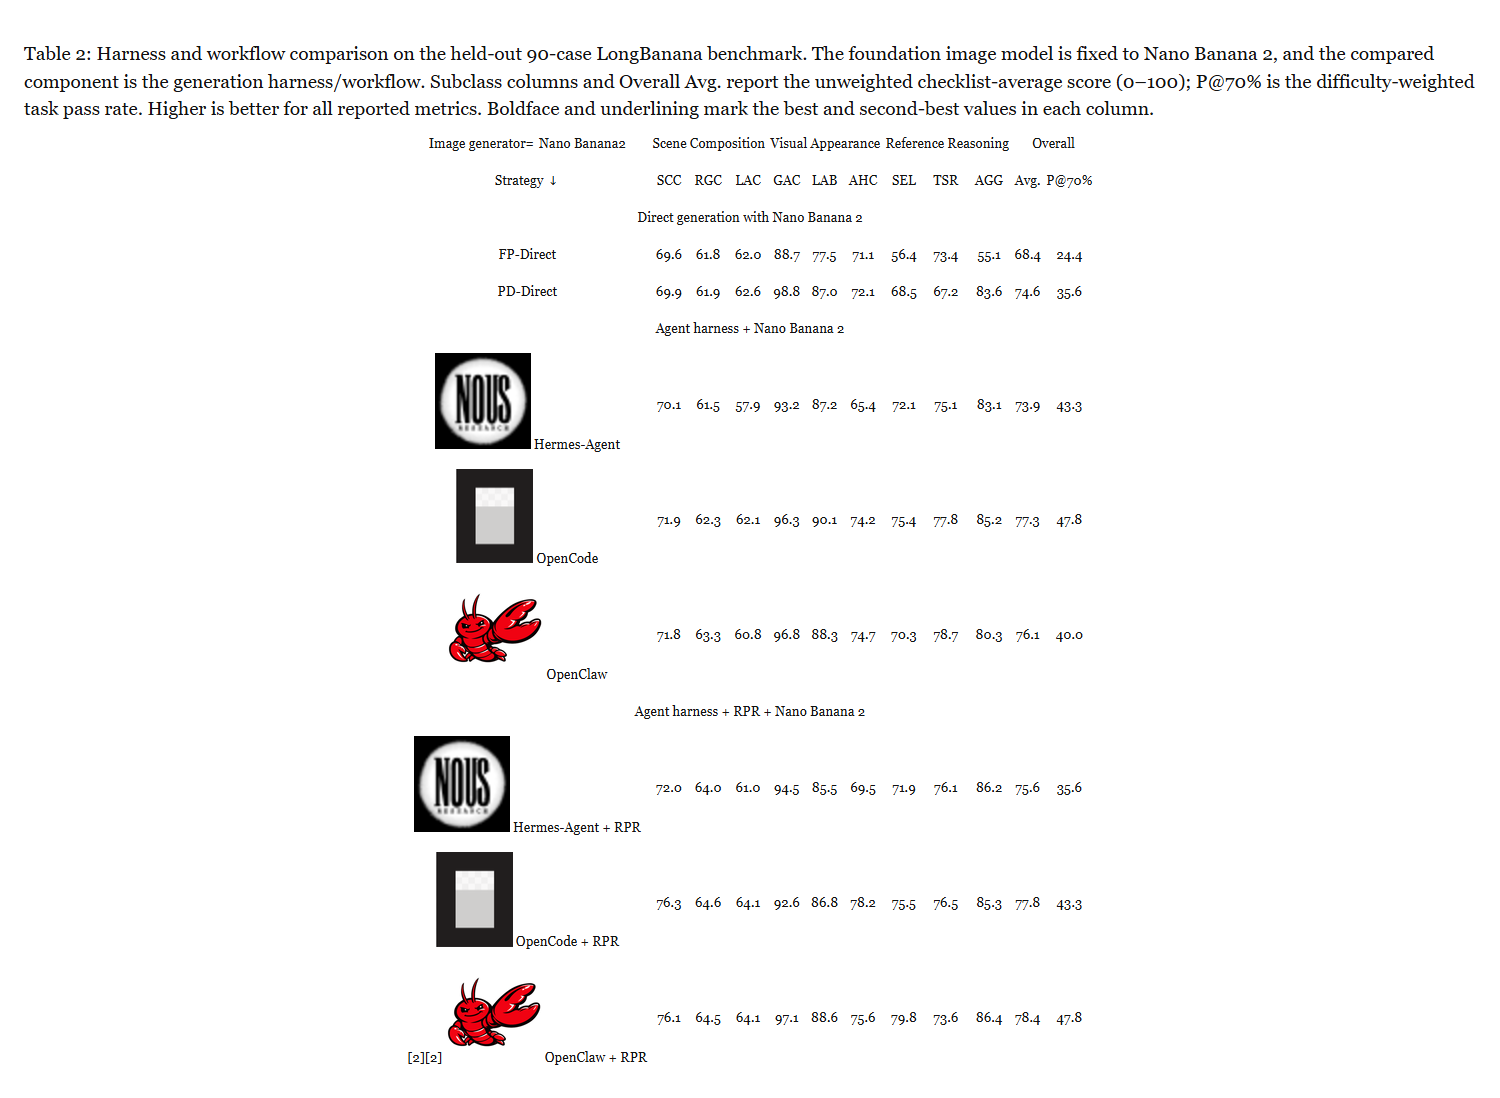 Table 2|留出 90 任务,固定图像底座 Nano Banana2,只比较生成外壳与工作流。九子类和 Overall Avg 是 0–100 非加权清单平均,P@70%是难度加权得分至少 70 的任务比例;均越高越好,粗体/下划线最优/次优。比较直接、分解、最简代理和加 RPR,不把均分与通过率混同。
- 批判点评:这是复杂条件图像合成评测,不能因有智能体就外推通用代理能力。直接分解基线能看到构造关系图,代理看不到,比较需保留该不对称。RPR 多次生成、检查和调用工具,未给同成本结论;均分涨也可能通过率跌。官方项目页及仓库明确声明已被 NeurIPS2026 接收,arXiv 评论标评测数据轨道。公开仓库另有新接口,与论文固定实验配置并非逐项相同,不能直接当原表复现。
趋势观察
保留与编辑要同时验收
TailSteer把十轮背景PSNR推至19.96dB,却在所选起点让第五轮成功率40%降至33%;不动的地方更像,不等于该改的都改对。
压缩比不是整机倍速
NanoKV有效KV压26.09倍,基础版墙钟反而稍慢;VAR-Q省的是低比特缓存。容量、峰值显存、吞吐与每段延迟分别计量。
少步学习的监督口在移动
NextGAN教判别梯度方向,NitroFusion2读取看过图像的文字状态,VA-TDM监督学生真实中间分布;少步不是只删采样循环。
评分要回答具体问题
EmoReward的人评好评与优化器分数不同;LongBanana均分78.4也只有47.8%任务跨过加权70分门槛。报告分布、协议与成本,才知道能否用。
今日讨论
TailSteer 在 FLUX.2 Klein 从第 46 步加强保留,十轮非编辑区 PSNR 由 13.85 升到 19.96dB,但 MSE-Bench 第五轮成功率 40%降到 33%。若用于连续换装,应如何验证保留背景与执行新指令同时成立,避免把没改对但更像原图的结果误当成功?
人工智能炼丹君 整理 | 2026-11-06


评论 (0)