今日 AIGC 论文速览
今日共 10 篇 · 视频重照明与运动控制 4 篇 · 图像编辑与少步生成 2 篇 · 视频质量与联合生成评测 2 篇 · 语音编辑与蒸馏 2 篇
重点论文标题列表
FlashRelight (浙江大学):借一段视频给人像换光WeLM-Image (腾讯):一套模型读图也能改图Chronos (中科大):先排动作再锁人物身份HME (澳国立):让扩散噪声记住参考动作Disen-Forcing (澳国立):把记场景和管动作分开
选读入口:给拍好的肖像视频换灯光,先读 FlashRelight 的去光和迁光。要处理多张静态参考图,读 WeLM-Image。要从参考图造新视频,按身份与动作顺序选 Chronos,按运动轨迹选 HME。续写 30 秒后总跑偏,读 Disen-Forcing 怎样给注意力头分工。生成片返工读 ArtiVidRM 的缺陷清单,做语音改词、加笑声读 VoxCanvas-41M,关心语音推理成本读 Route-DMD。少步生图看 FisherDistill 的教师统计,跨镜头音画验收读 CAST-Bench 的声源与说话人指标。
今日论文速览
1. FlashRelight:借一段视频给人像换光
FlashRelight: Portrait Video Relighting with Dynamic Lighting | 浙江大学;vivo 影像实验室 | arXiv:2611.06355
关键词 :视频参考编辑, 肖像重照明, 动态光照, 两阶段扩散
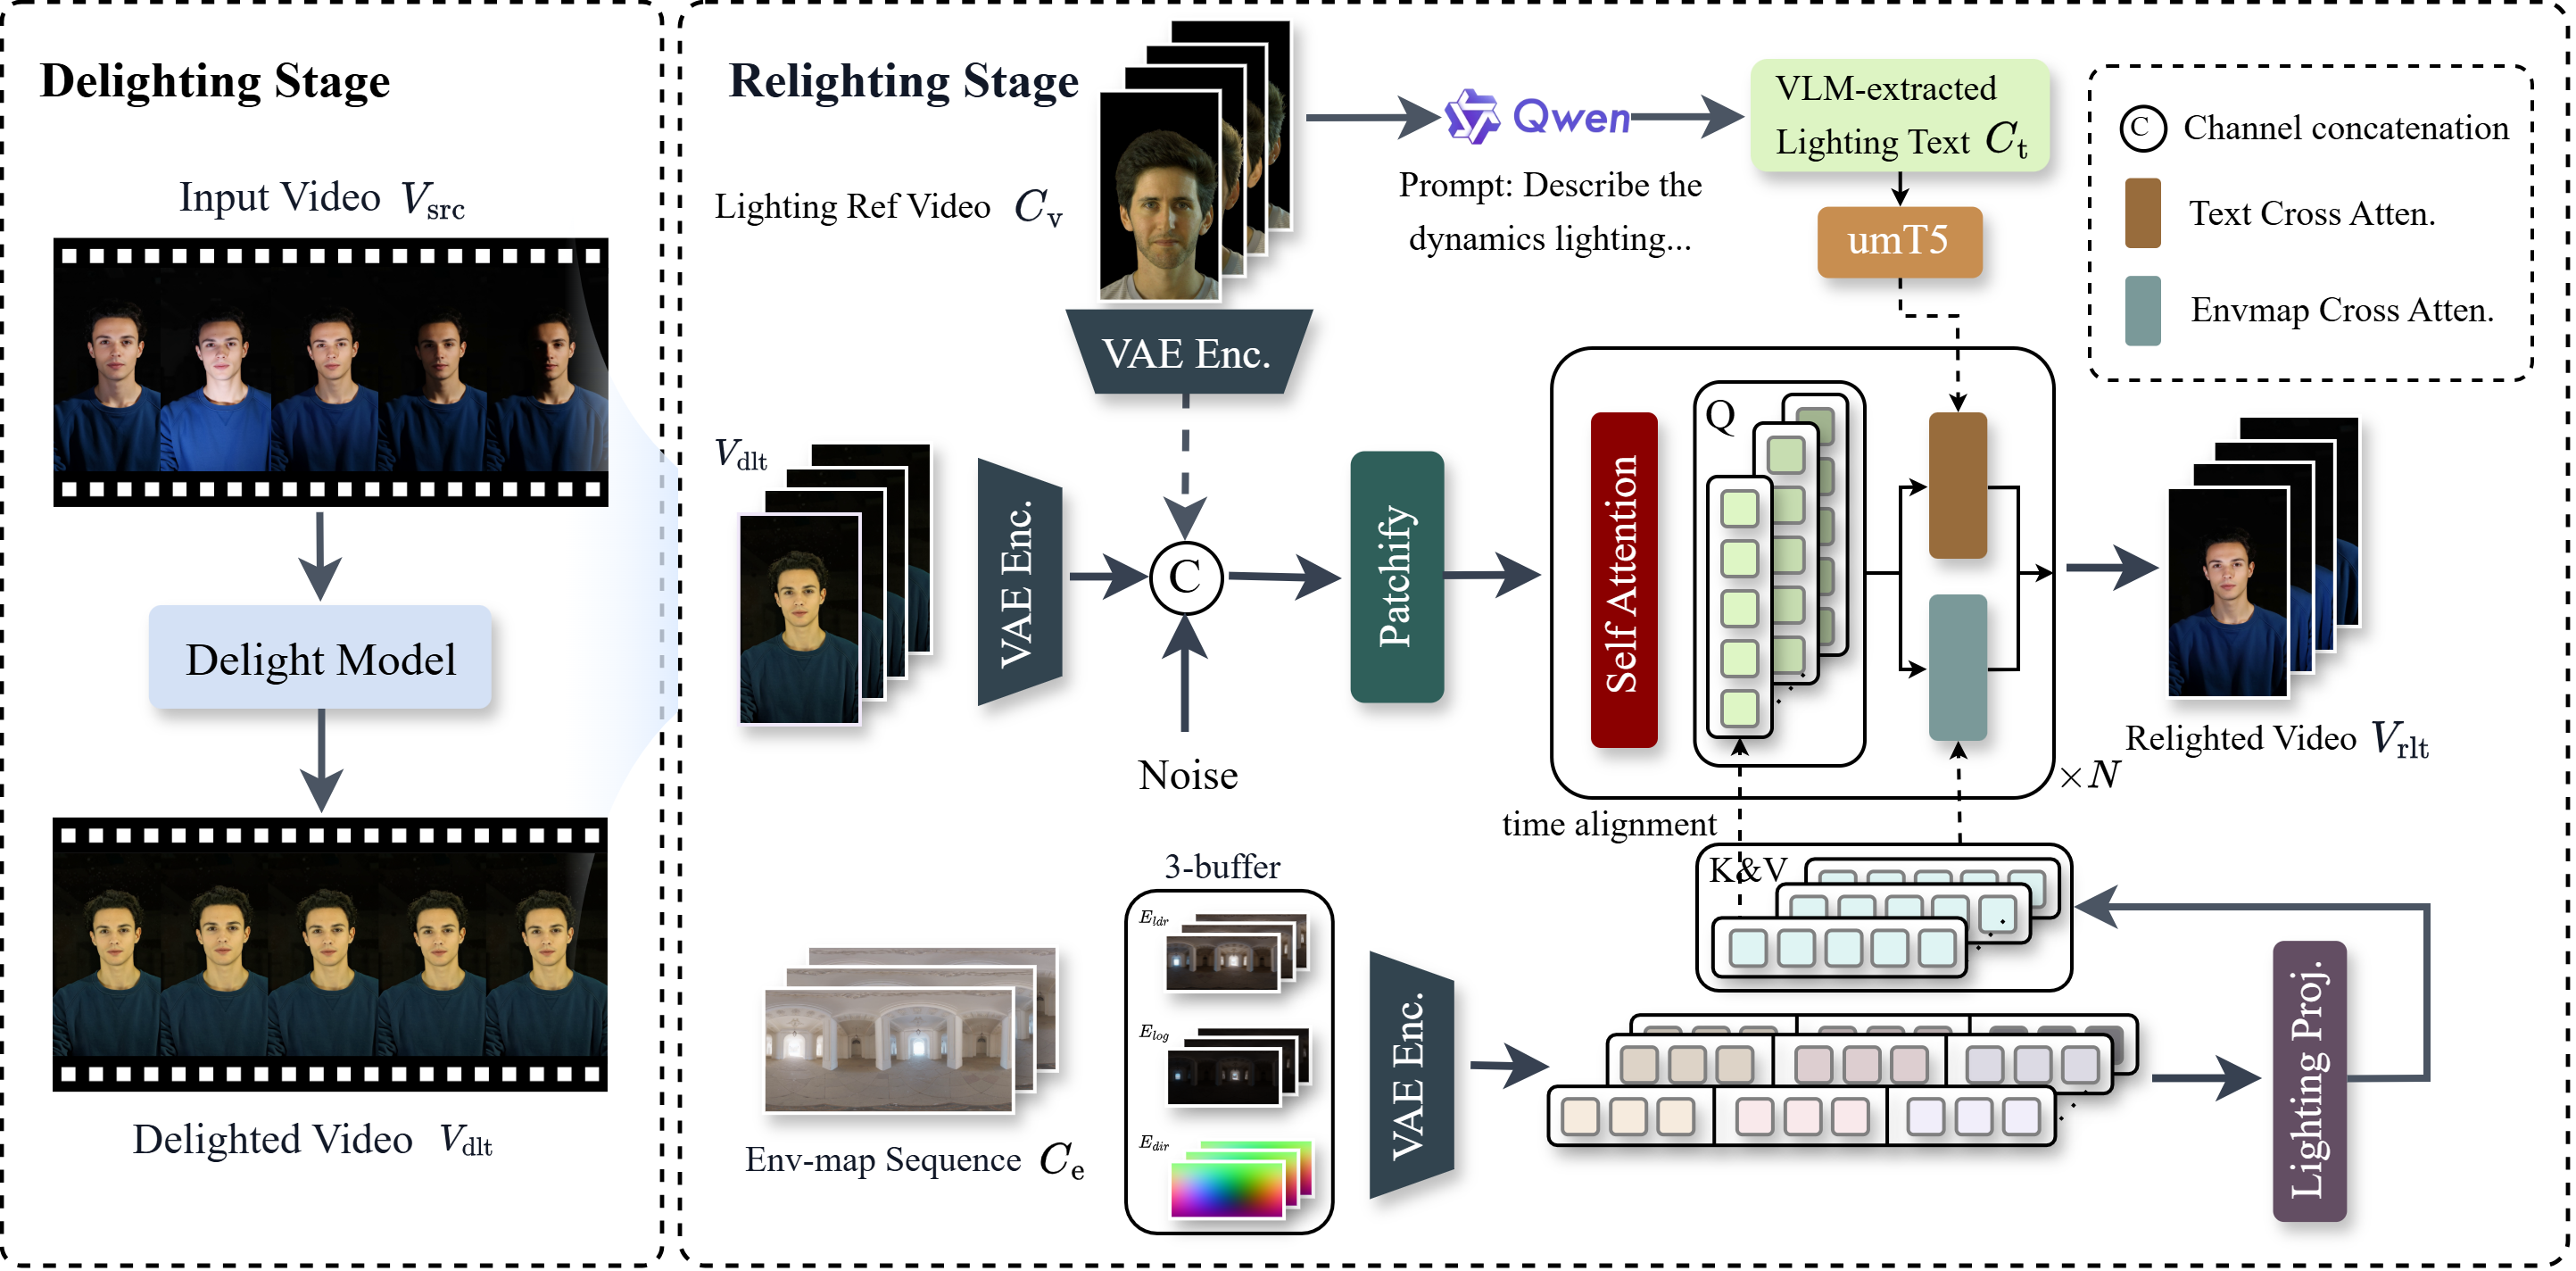
前序问题 :一段自拍已经拍完,脸上还是原来的顶光。你想借另一段视频里的彩灯变化,却要保住原来的人、动作和衣服。直接加一层滤镜会把旧阴影和新高光叠在一起,转头时尤其明显。方法直觉 :先把旧光压成接近中性的底片,再按目标打新光。给第二阶段一段参考视频时,尽量只拿光的颜色、方向和变化节奏,让第一段视频继续决定人物长相与动作。本文贡献 :两个阶段都从 Wan2.1-1.3B 视频扩散模型初始化。去光模型压制源光和阴影,输出携带原外观的近中性视频。重照明模型每次启用一种条件:环境光贴图序列通过时序对齐的交叉注意力逐帧控制,文字经 umT5 编码控制语义,参考视频的潜变量与去光视频、噪声按通道拼接,并辅助提取灯光描述。训练时把参考视频强模糊、平移和缩放亮度,降低人物特征泄漏。数据混合 OLAT(逐次只开一盏灯的采集)合成序列和动态合成视频,兼顾可控照明与肖像运动。两阶段分别训练 3 万和 4 万次更新,使用 LoRA 低秩权重更新。
Figure 3|FlashRelight 分两步。左侧去光模型压制输入视频原有照明与阴影,输出近中性的肖像视频。右侧将它与一种有效的动态光照条件送入重照明模型,生成最终视频。参考视频提供潜变量和光照描述,环境贴图通过时序对齐的交叉注意力进入去噪。
实验效果 :未参与训练的 10 位受试者、16 条环境光序列上,对 DiffusionRenderer,前景 LPIPS(感知距离,低更好)由 0.3781 到 0.1635,PSNR(像素保真度,单位 dB)由 17.3683 到 23.1099,身份特征相似度由 0.6143 到 0.8097。文字条件下 FID(生成与目标图像的特征分布距离)31.16,对 Light-A-Video 的 51.78,但相邻帧感知变化 tLPIPS 为 0.1417,对方 0.1395。单张 H20 上,832×480、49 帧、两阶段各 50 步合计 185.9 秒,PyTorch 峰值预留显存 15.23 GiB,对照为 503.3 秒和 44.22 GiB。计时不含外部预处理与保存。
Figure 7|参考视频引导的动态换光。每列上方给出参考视频的灯光变化,每行左侧是源肖像。对应输出把参考的明暗、高光、颜色变化带到源肖像,同时尽量保留源人物身份与动作。这里展示定性样例。
批判点评 :参考视频迁光没有配对真值,论文用定性样例验证,环境光与文字实验的分数不能代替这一任务的定量结果。去光视频也只是实用中间态,强遮挡和残余阴影可能影响第二阶段。官方仓库 已建,核验时 README 仍预告发布。
2. WeLM-Image:一套模型读图也能改图
WeLM-Image: A Unified Image Generation Model towards Visual Intelligence | 腾讯微信视觉团队 | arXiv:2611.07392
关键词 :多参考图像编辑, 共享注意力, 稀疏专家, 少步蒸馏
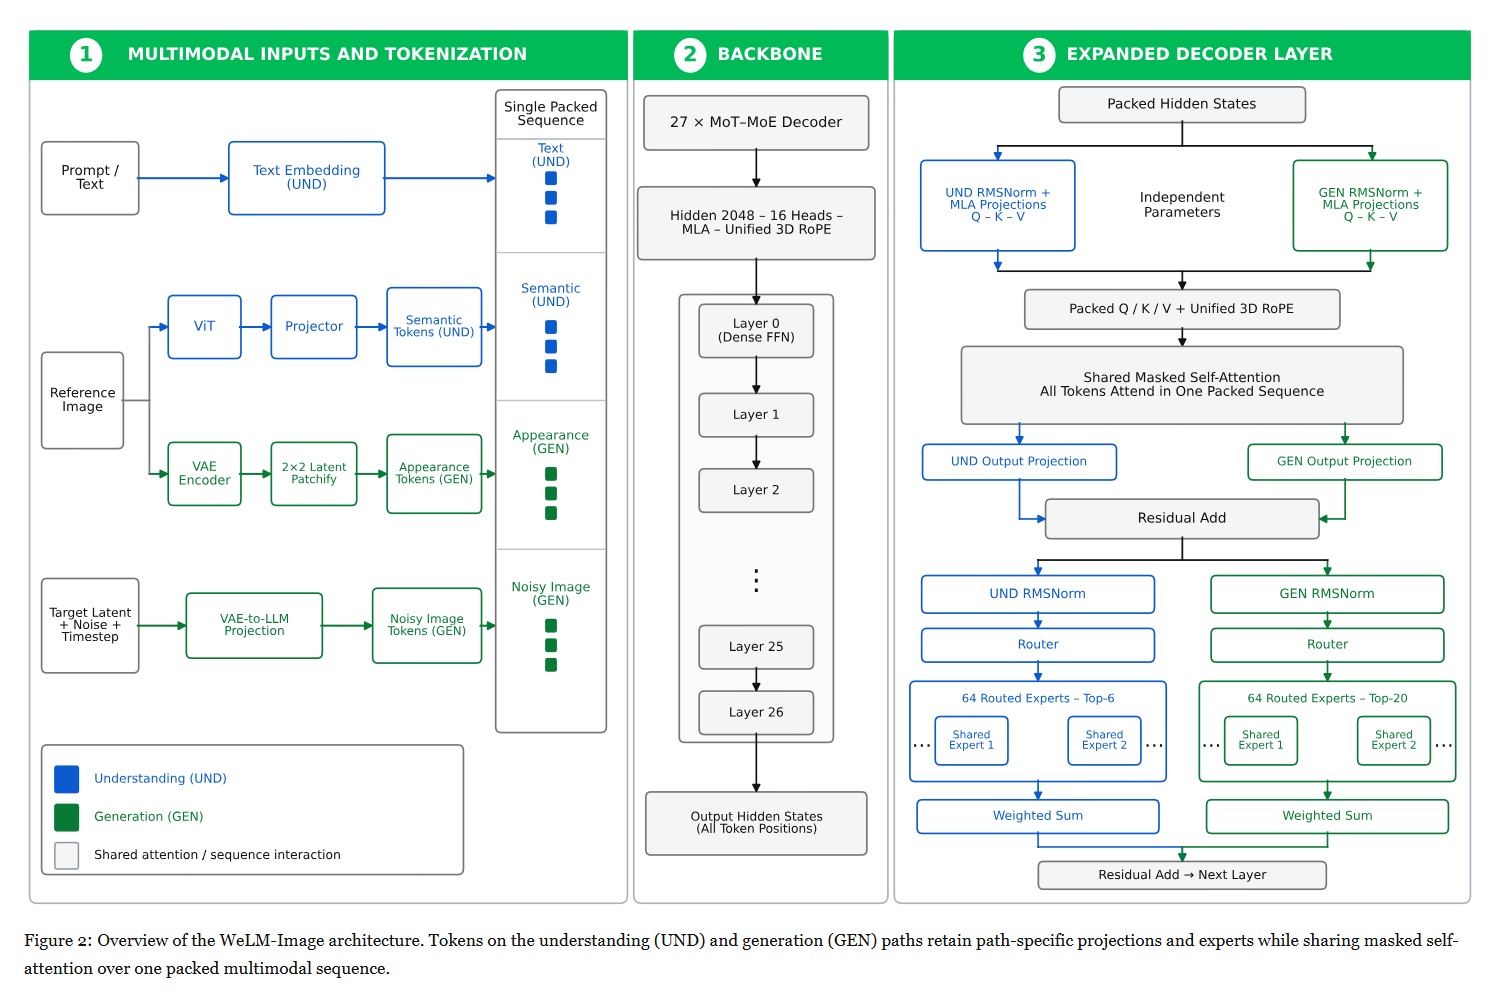
前序问题 :把两张商品图和一张布景图交给模型做海报,模型得分清哪张负责什么,还要保住商品字样。多张参考一多,理解、合成和推理成本会一起上升。方法直觉 :让读图和画图走两条分工明确的路径,仍能在同一序列互相看见。画图时按当前图块调用少数专家,给编辑保留足够容量。本文贡献 :文本、参考图语义、图像潜变量和加噪目标交错打包。MoT(Mixture-of-Transformers)让理解与生成分用投影和前馈权重,共用带遮罩的自注意力。MoE(混合专家)为每个 token(特征单元)挑选部分前馈网络,主干含视觉编码器、排除图像压缩模型,存 317 亿参数,每个目标潜空间 token 激活约 54 亿生成参数。统一三轴旋转位置编码同时保留文本顺序和图块行列。先分别按规则表优化文生图、编辑策略,再让学生在自己到达的不同噪声状态学习对应老师。Turbo 用 MeanFlow 学噪声区间的平均变化,压缩到 8 步。
Figure 2|从左到右为多模态输入与分词、27 层主干,以及单层展开。理解路径和生成路径各保留专用投影与稀疏专家。打包后共享带遮罩的自注意力,归一化、位置编码、输出投影与残差连接维持各自的数据流。
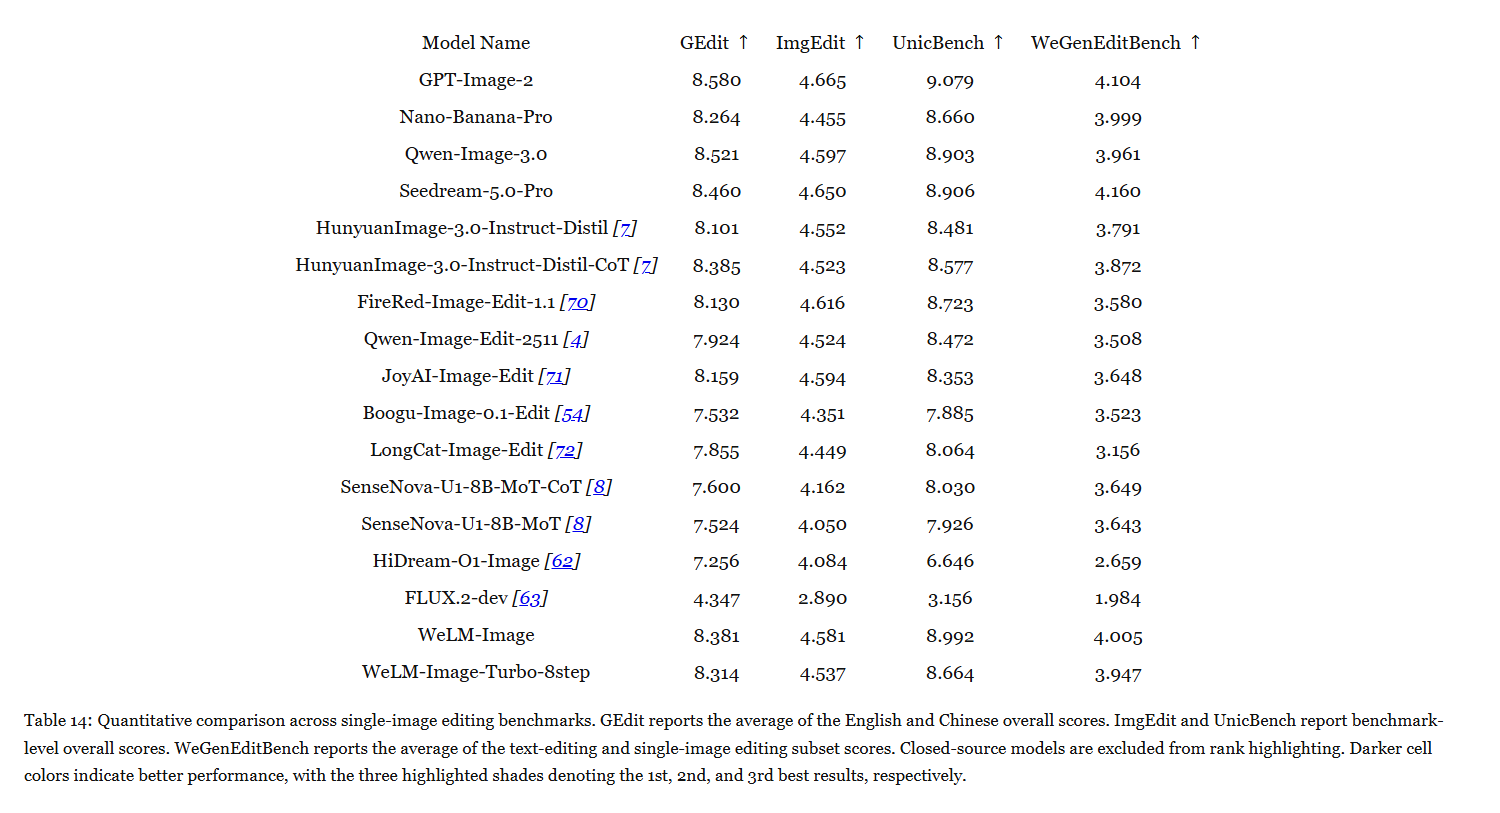
实验效果 :论文 1536 分辨率模型在单图编辑 UnicBench 总分 8.992,Turbo 为 8.664,GPT-Image-2 为 9.079。GEdit 中英总分均值为 8.381,同组 HunyuanImage-3.0-Instruct-Distil-CoT 为 8.385。单张 H20 输出 1024×1024,一次预热后的 3 次平均墙钟(不计加载):纯文字生图 50 步基版 56.99 秒,8 步 Turbo 4.98 秒。Turbo 输入 1 至 4 张图的编辑为 6.78 至 13.17 秒。
Table 14|单图编辑四套基准。GEdit 取英语与中文总分平均,ImgEdit 和 UnicBench 用各自总分,WeGenEditBench 取文字编辑和单图编辑子集平均。闭源模型作为参照,排除在前三着色之外。
批判点评 :参数激活数按目标 token 计,设备仍得容纳全套权重与运行缓存。质量分数和测速分别对应论文的评测配置,不能用 4.98 秒替代多参考编辑耗时。技术报告公开,原文未给可确认的本模型权重或代码入口。
3. Chronos:先排动作再锁人物身份
Chronos: Sequential Identity-Preserving Video Generation by Temporal Anchoring | 中国科学技术大学;华南理工大学;华为;独立研究者 | arXiv:2611.05893
关键词 :参考视频生成, 人物身份保留, 关键帧锚定, 候选路由
前序问题 :给人物照片,让他在视频里先拿起蛋糕再咬一口。脸抓得太紧,模型可能只会轻微转头,反过来做大动作时又容易换脸或打乱次序。方法直觉 :把长指令拆成有先后的镜头关键帧,让生成器有具体画面可追。不同模型各生成候选,再同时看动作、脸和画面选片。本文贡献 :语义提示锚定用 GPT 模型提取参考图的身份线索,按遮挡与视角风险补足描述。视觉帧锚定把描述变成按时间排列的参考关键帧,单段用首锚,多段可加分段锚。Wan2.2 I2V-14B(140 亿参数的图生视频模型)两轨共用,单段还用 Seedance,多段还用 Wan FLF2V(首尾帧条件生成)。生成后按文本、身份、视频质量和语言模型复核加权排序,对异常片段额外复审。
Figure 2|输入参考图、原提示和可选时间段说明。语义锚定先提身份线索,按低、中、高风险调整提示。视觉帧锚定给第一轨一个锚帧,第二轨可再加分段锚帧。各轨生成器分别出片,经文字、主体、质量与语言模型评分,再复审异常候选并选出最终视频。
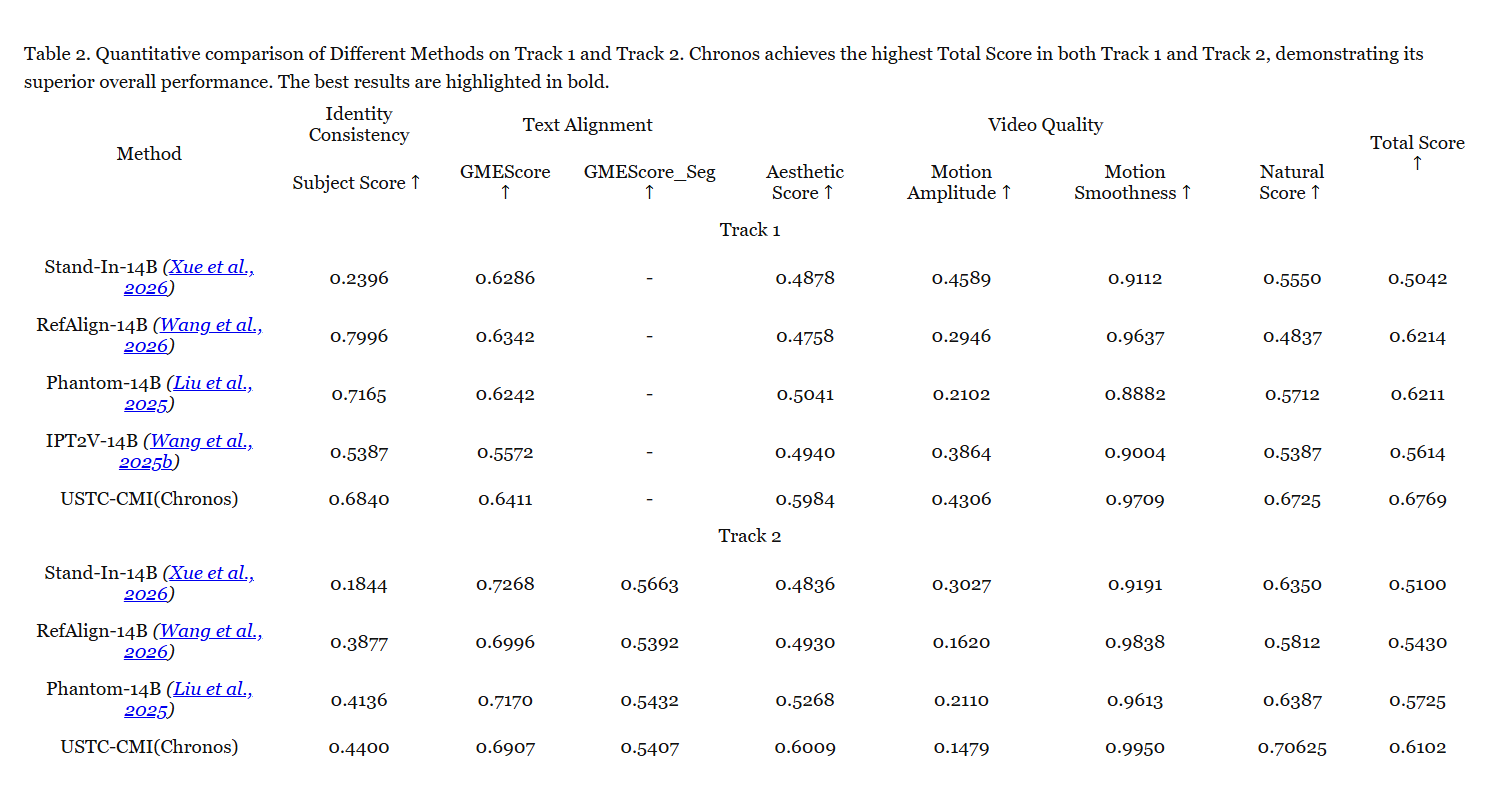
实验效果 :ACM MM 2026 身份保持视频生成挑战官方榜单按名次汇总,低分更好:人脸轨 2.5 并列第一,顺序动作轨 1.25 独列第一。论文的对照评测是另一套高分更好的总分,单段 0.6769 对 RefAlign 的 0.6214,多段 0.6102 对 Phantom 的 0.5725。单段主体分 0.6840 低于 RefAlign 的 0.7996,多段动作幅度分 0.1479 也低于对照组。
Table 2|两轨分别报告身份、文本对齐、画面和运动相关分数,以及高者更好的总分。Chronos 在两轨总分均领先,单项仍有取舍。表内粗体为该项最优。
批判点评 :这是参考图生新视频,输入并不要求保留某段源视频。多模型采样与额外裁判是成本,论文未给统一的每条延迟和显存。成绩属于本次挑战及给定参评系统。赛事榜单 核实两个名次,原文未列 Chronos 独立实现。
4. HME:让扩散噪声记住参考动作
Householder Motion Embedding: Noise Modulation for Motion-Controllable Video Generation | 澳大利亚国立大学;Vertex Lab;亚马逊 | arXiv:2611.07294
关键词 :参考运动迁移, 光流控制, Householder 反射, 噪声调制
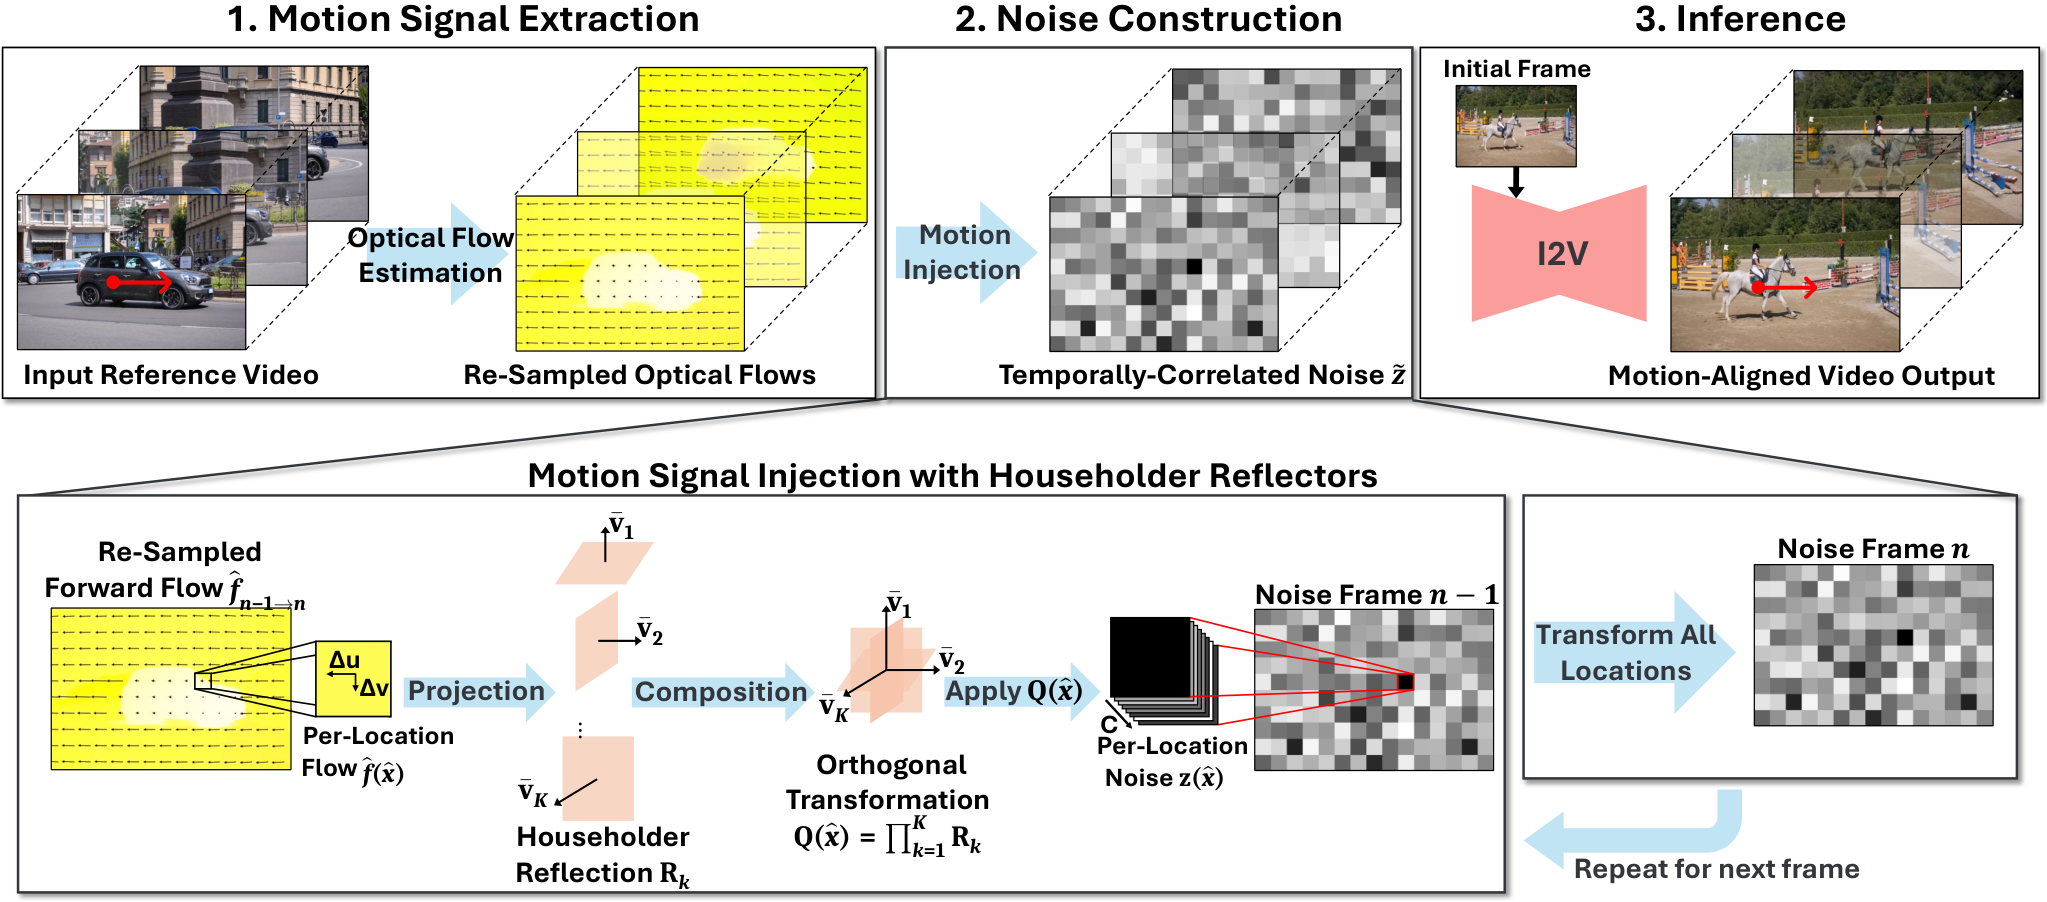
前序问题 :想让新画面里的车走参考视频中的路线。把噪声像素跟着光流搬动,插值可能把原本独立的噪声混在一起,还得补一遍分布修正。方法直觉 :固定空间位置,只旋转该位置的一组噪声通道。旋转不改变标准高斯云团的形状,却能用上帧的噪声和当前光流在帧间留下一致的运动线索。本文贡献 :HME(Householder Motion Embedding)先估计光流,也就是相邻帧的像素位移,并重采样到模型压缩后的图块网格。每个位置用流的横向、纵向分量生成反射方向,将前一帧的通道向量经 K 次 Householder 反射(沿超平面镜像)映射到下一帧。复合变换保持正交,因此在固定运动条件下保留帧内标准高斯结构。γ 是混入独立噪声的退化程度,调低能让生成更贴参考运动。以 CogVideoX-5B-I2V 为底座微调,输出由首帧、文本和运动条件共同决定。
Figure 2|三阶段依次估计与重采样光流、用 Householder 反射构造跨帧相关的噪声,以及微调扩散模型并推理。右上用首帧和运动条件生成新视频,底部展开了光流到反射方向、通道正交变换、逐帧递推的过程。
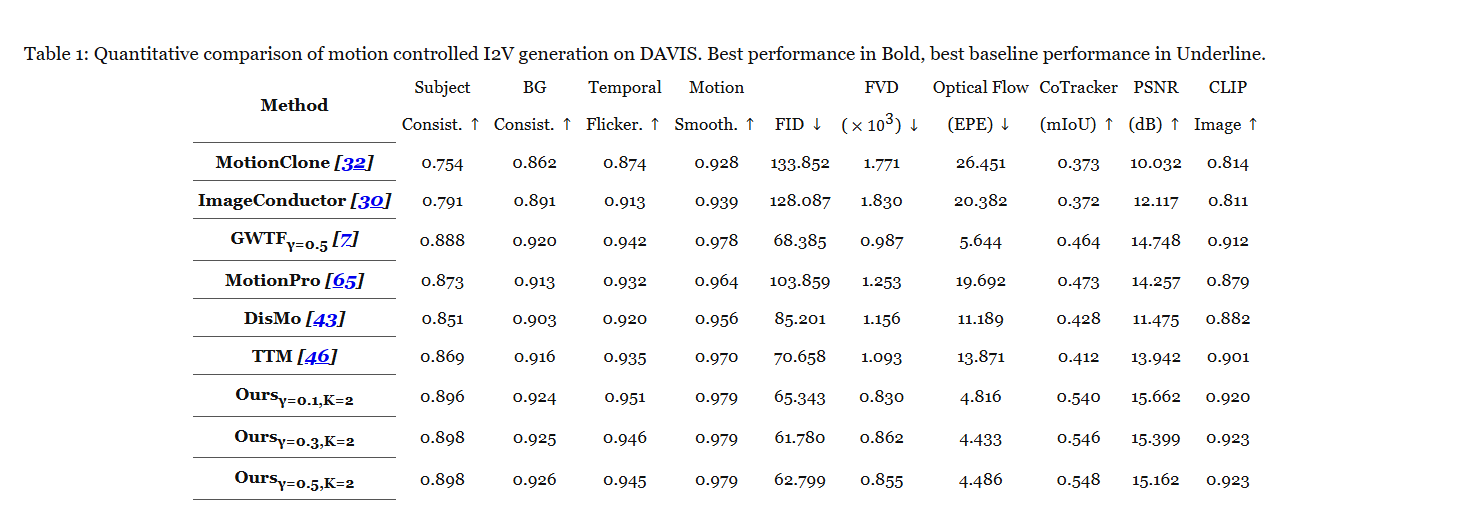
实验效果 :DAVIS 运动迁移上,γ=0.3、K=2 相较 GWTF 的 γ=0.5,光流端点误差 EPE 从 5.644 降到 4.433,CoTracker 轨迹重叠 mIoU 从 0.464 到 0.546。默认两次反射在 RTX PRO 6000 Blackwell 上构造一份 1024×1024、16 通道噪声潜变量用 2.80 毫秒,是 GWTF 约 2.7 倍速度。论文另外在 480×720、49 帧条件下,用 10 万段视频微调 3 万次,4 张 A100 共 40 GPU·天。
Table 1|DAVIS 的运动控制图生视频对比。分别衡量主体和背景一致性、闪烁和平滑性、特征分布距离、光流误差、轨迹重叠与图像相似度。粗体为最优,下划线为最强对照。
批判点评 :2.7 倍是噪声构造的对照,完整生成仍要先估光流再做扩散采样。低 γ 容易把光流里的错误一并传给生成。论文试的是图生新视频的运动控制,无法据此保证保留任意源视频的像素。原文未列独立实现入口。
5. Disen-Forcing:把记场景和管动作分开
Disen-Forcing: Disentangling Semantic Anchoring from Motion for Autoregressive Video Diffusion | 澳大利亚国立大学;Sony AI;CSIRO;索尼集团 | arXiv:2611.02822
关键词 :长视频扩散, 首帧锚定, 注意力头分工, 分布匹配蒸馏
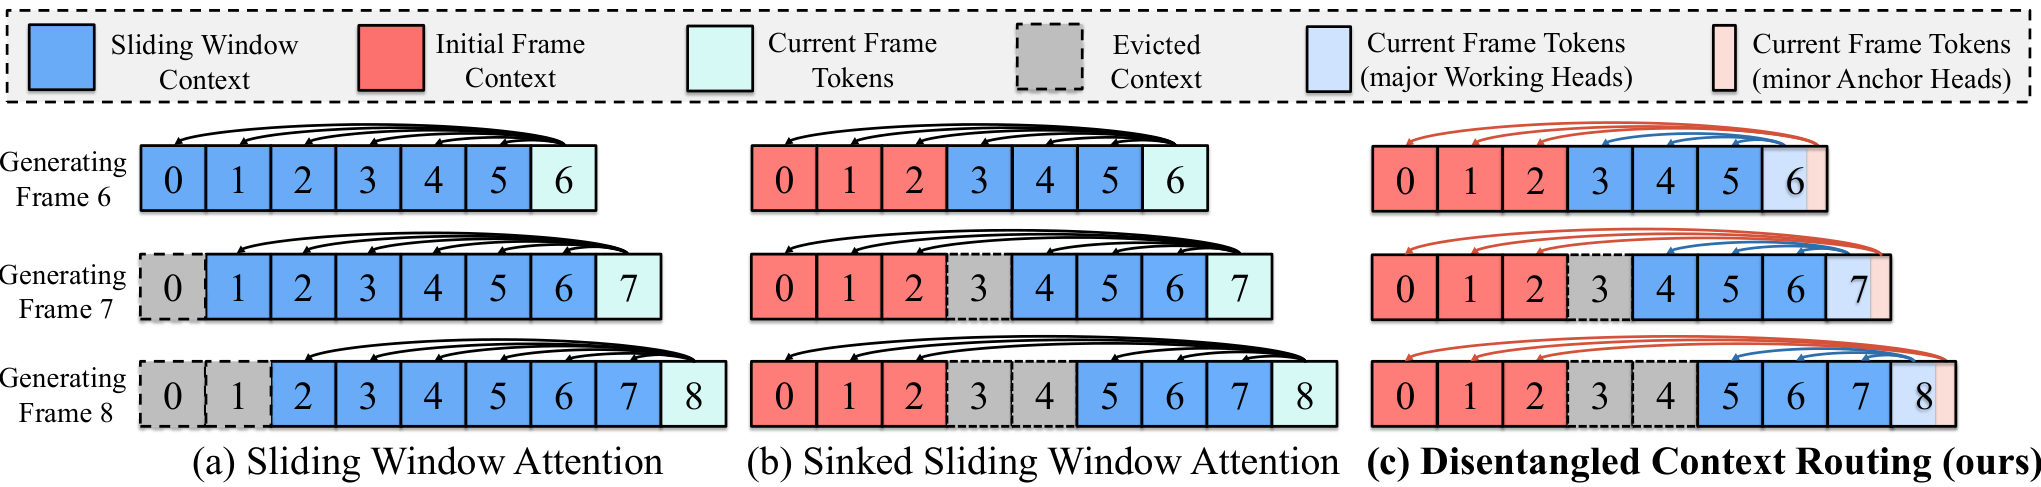
前序问题 :逐段续写时,首帧从缓存滚出去,场景和人物容易漂移。强行让每个注意力头都看首帧又可能把动作冻住,变成一段稳定却不怎么动的视频。方法直觉 :有些注意力头擅长认开场,有些负责看最近的动作。前者保留全局参照,后者专注局部,用同样的缓存预算做两种工作。本文贡献 :从蒸馏前的初始模型测各头分给首帧的平均注意力,按百分位固定少数 Anchor Heads。分布匹配蒸馏时,锚定头只读开场和当前帧,工作头只读滑窗与当前帧。额外做一次反事实前向,把锚定头的开场缓存替换为经图像解码再编码的局部上下文,用其相邻帧注意力作为固定目标,以 KL 散度(概率分布差异)约束常规前向。额外前向只发生在训练。以 Self-Forcing 和 Causal-Forcing 两个底座验证。
Figure 5|三种上下文路由。左图滑窗前进后丢弃早期帧。中图在滑窗外保留首帧上下文,但所有头看到同样内容。右图在蒸馏时仅让少量锚定头访问开场,工作头只看局部滑窗,保留原有分工。
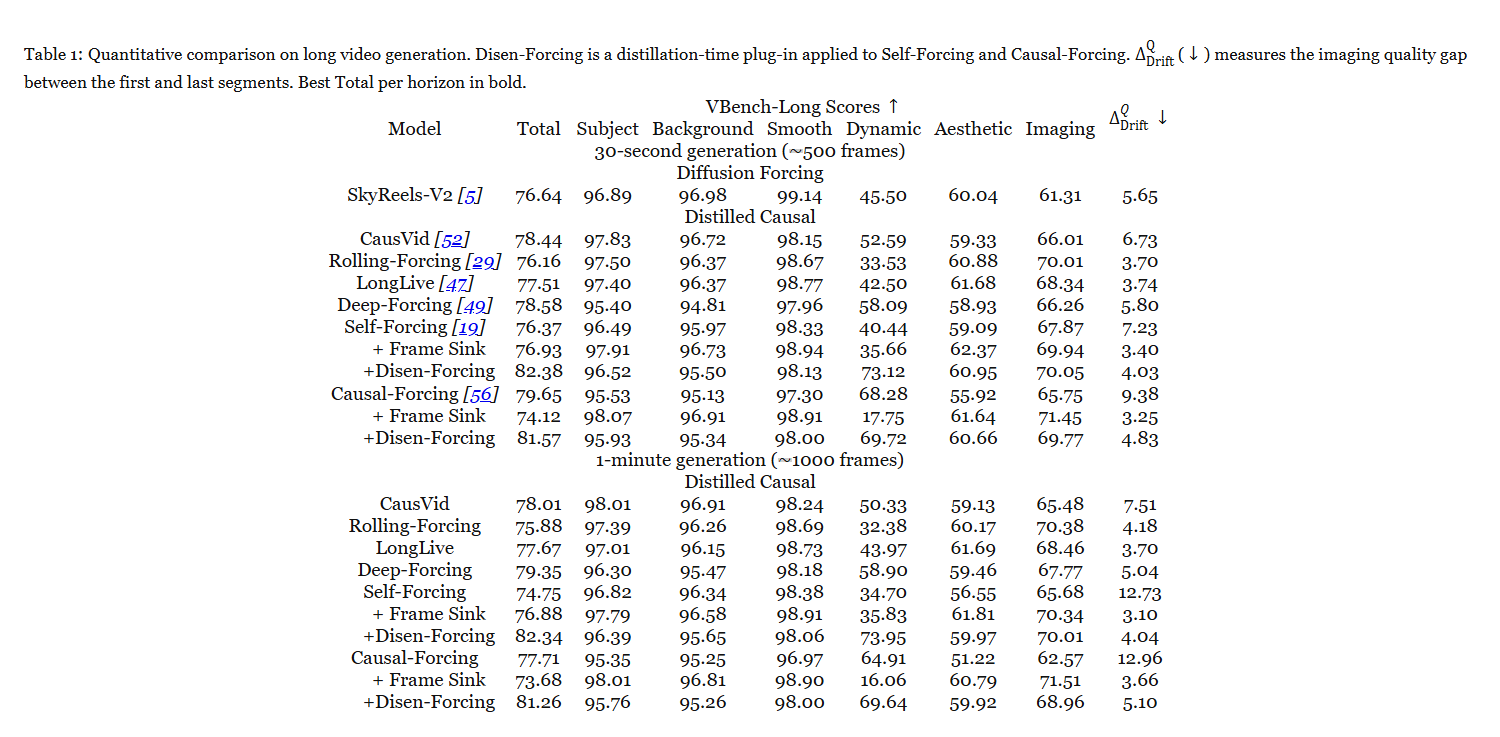
实验效果 :30 秒约 500 帧的 VBench-Long,Self-Forcing 加全头首帧缓存时动态分 35.66、首尾成像质量差 3.40,改用分工后为 73.12 和 4.03,原底座为 40.44 和 7.23。动态分高者更活跃,首尾差低者漂移更小。60 秒约 1000 帧的 VBench-Long 六项均分由原底座 74.75 到 82.34。训练 600 次有效更新用 8 张 H100 约 14 小时,附录所测摊销单步耗时 10.2 到 10.8 秒,论文记约 5%。
Table 1|30 秒约 500 帧与 1 分钟约 1000 帧的长视频对照。分工可用于 Self-Forcing 和 Causal-Forcing 蒸馏。首尾成像质量差越低越好,VBench-Long 六项均分越高越好,粗体标出各时长最高总分。
批判点评 :全头首帧缓存仍有更小的首尾成像差和更高的个别一致性分。分头方案改善的是动作与外观的平衡,也会继承教师的错误。不同大小模型能观察到头的分工,迁移后的生成收益仍待验证。项目页 有长视频演示,代码标注即将发布。
6. ArtiVidRM:先列视频瑕疵再打分
ArtiVidRM: Verifiable Artifact-as-Rubric Reward Modeling for Explicit Quality Articulation in Video Generation | 东南大学;Opus AI Research;中国科学院自动化研究所;伊利诺伊大学厄巴纳-香槟分校;加州大学洛杉矶分校 | arXiv:2611.07301
关键词 :视频纠错, 缺陷清单, 奖励模型, 偏好预测
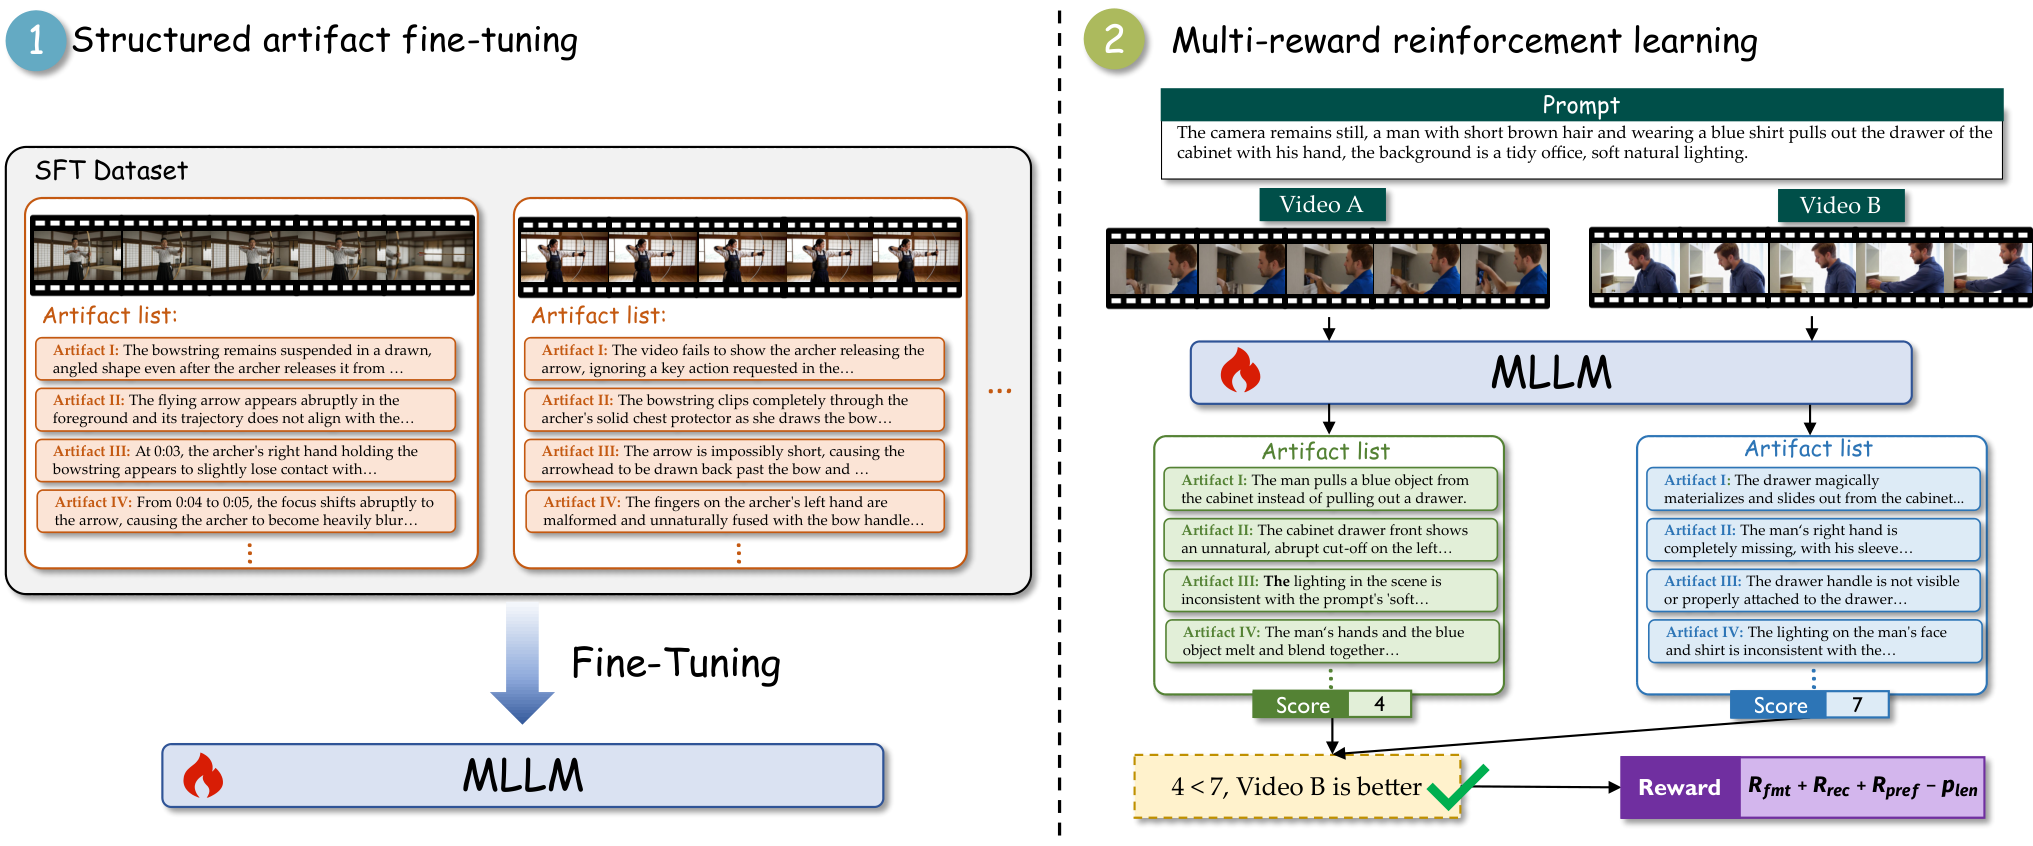
前序问题 :生成片里的手穿过抽屉,奖励模型给了低分,却没说哪里坏、怎么改。一句听起来像解释的评语,也可能和最终评分无关。方法直觉 :先指出能在画面中核对的瑕疵,再用清单打分。生成器需要第二次出片时,可以把瑕疵转成更具体的提示。本文贡献 :多个检查器先给候选瑕疵,合并后按视频证据核验,过滤后保留 22640 对视频。用 Qwen3-VL-8B-Instruct 多模态模型先监督学习结构化清单,再用强化学习同时奖励格式、语义覆盖和偏好排序。覆盖奖励鼓励找到人类关心的瑕疵,不对列得越长给越多分。长度惩罚对多报全罚、少报半罚,因为漏报还会扣召回分。配对奖励用两条视频的分差学习人类排序。
Figure 3|两阶段训练。左侧用有瑕疵清单的视频监督微调多模态模型,右侧对同一提示的 A、B 视频分别列瑕疵和给分,再联合格式、语义覆盖、配对偏好和长度惩罚训练。
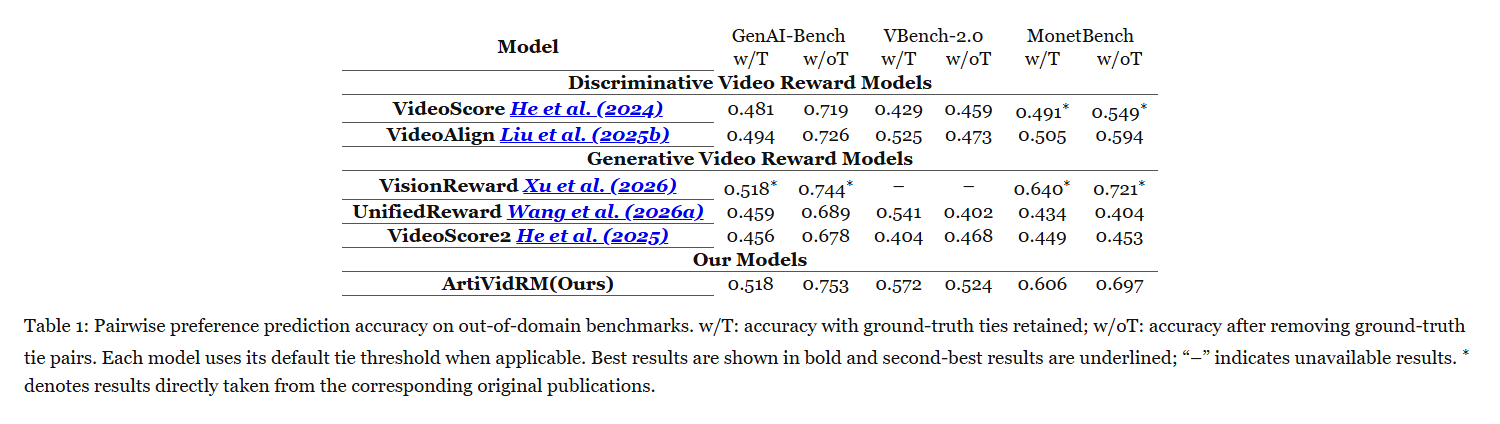
实验效果 :GenAI-Bench 去掉人工平局后,成对偏好准确率 0.753,VisionReward 为 0.744。保留平局时两者同为 0.518。VBench-2.0 保留平局 0.572,对 UnifiedReward 的 0.541,MonetBench 两种口径都落后 VisionReward。用清单改写提示让 Veo 3.1 再生成,VBench 美学、成像两维分别提高 1.85 和 1.30 分,主体与场景一致性几乎不变。
Table 1|域外基准上的成对偏好准确率。w/T 保留真实平局,w/oT 剔除真实平局。各模型使用默认的平局阈值(适用时)。粗体是最好结果,下划线是第二,星号为原论文报告值,短横线为无可用数据。
批判点评 :闭源实验是改提示重生成,不能在原片上只修一处。额外的视频模型评估和二次生成消耗算力,论文未报告统一额外时延。自动清单偏向显眼的渲染、光照和纹理问题,罕见错误仍值得人工查验。原文未给独立代码入口。
7. VoxCanvas-41M:一句话指挥录音改词加笑声
VoxCanvas-41M: A Large-Scale Bilingual Dataset for Instruction-Based Speech Editing and Its Learning Dynamics | 上海交通大学;上海创智学院;北京通用人工智能研究院;天津大学 | arXiv:2611.08251
关键词 :指令语音编辑, 双语训练数据, 非语言声音, 学习动力学
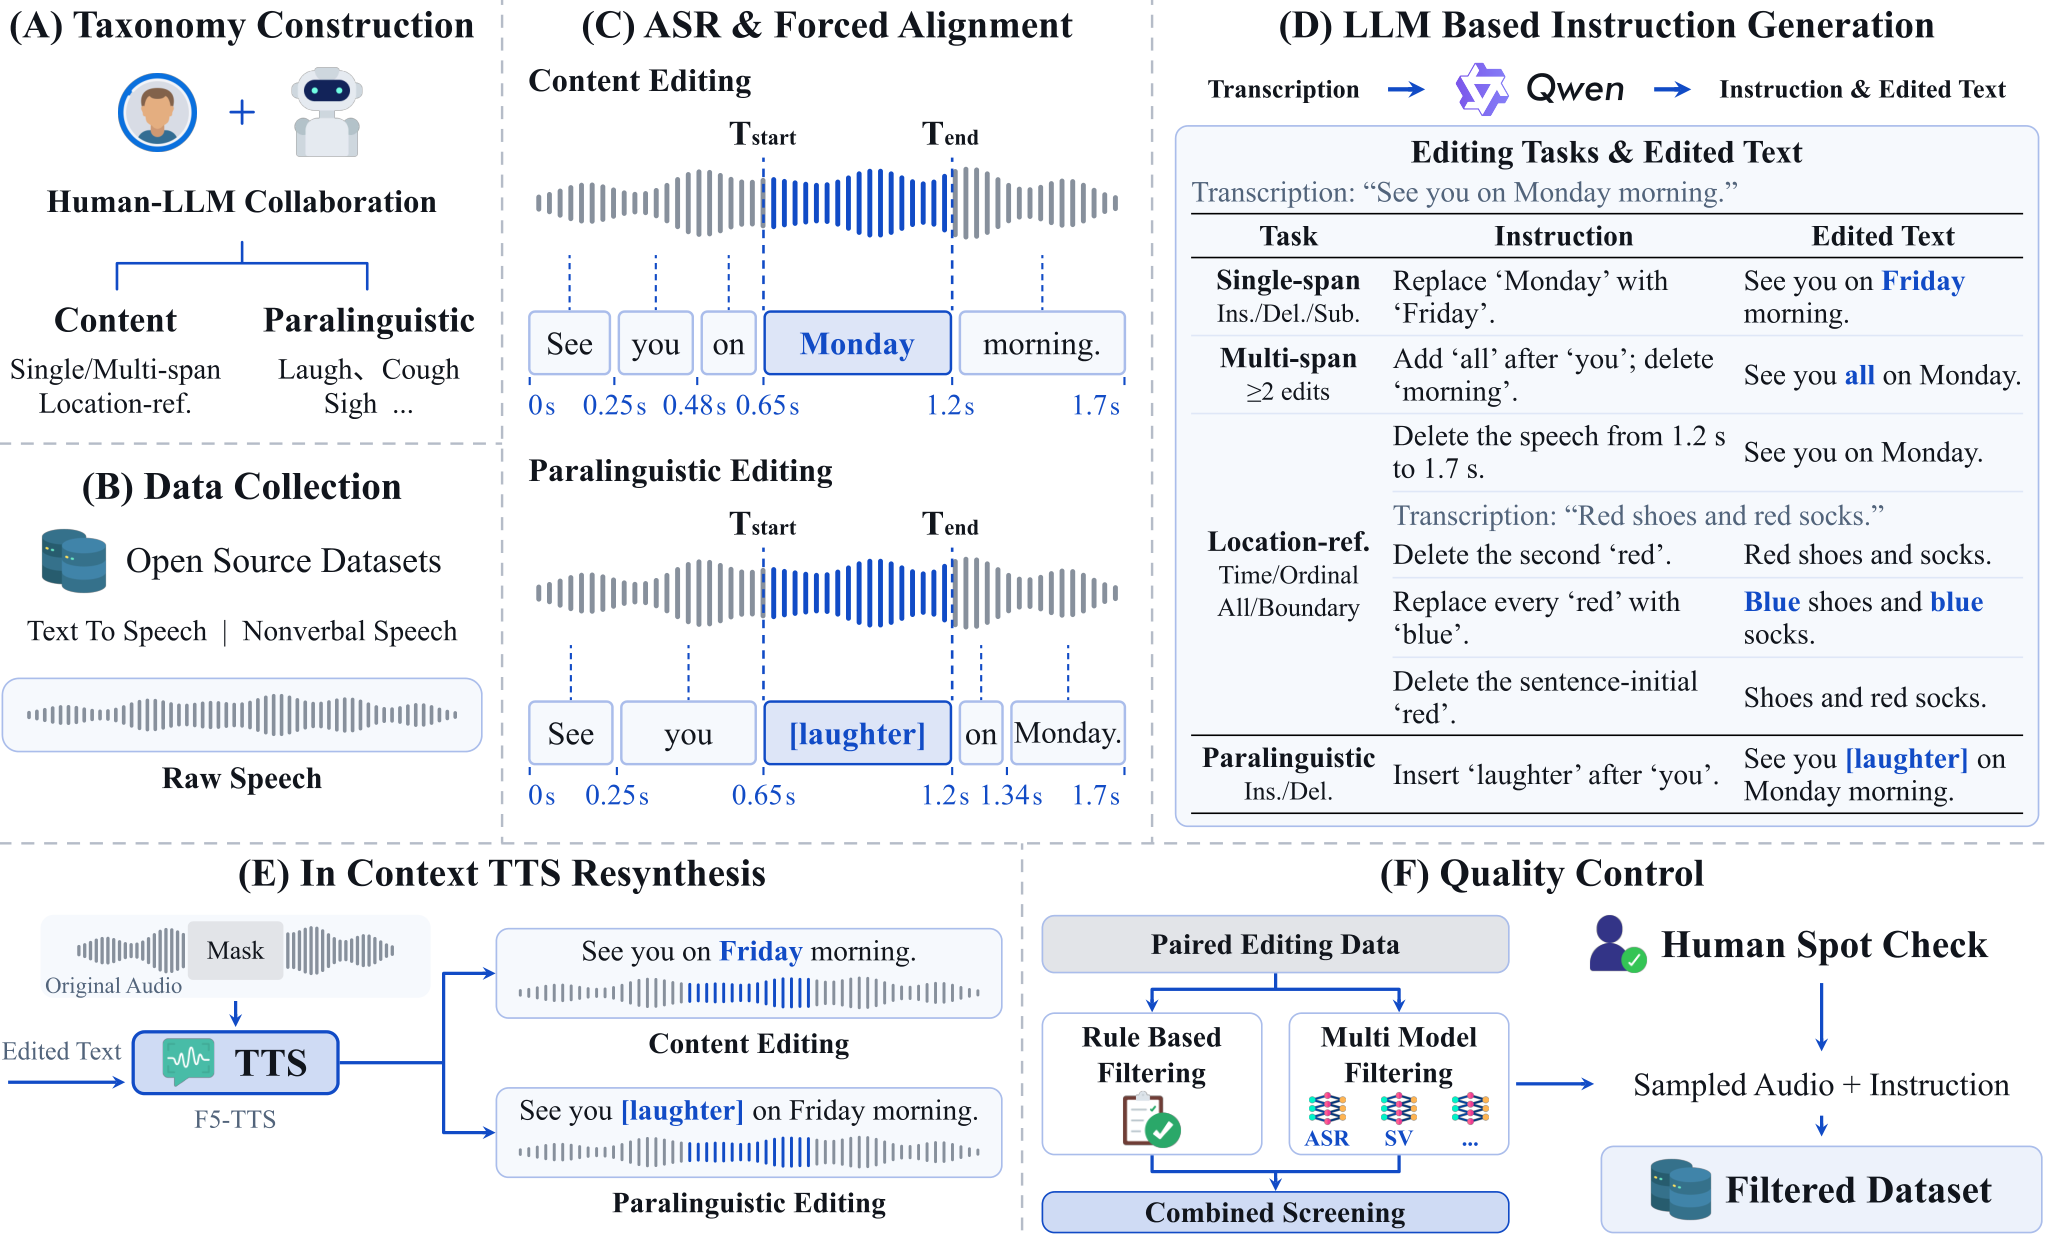
前序问题 :录好的一句“周一早上见”改成周五,最好只替换那两个字,声音和前后停顿都保住。让模型在指定位置加笑声又需要另一类样本,而真实成对录音难以大规模收集。方法直觉 :先定位字词与声音发生的时间,再只让合成器补上编辑区段。能自动制造一对前后录音,就能系统比较插入、删除和替换是怎么学会的。本文贡献 :从公开语音收集音频,Qwen3-ASR 重转写,再用强制对齐把词或字映射到时间。语言模型生成操作说明和编辑后文本,F5-TTS 文本转语音在原音频上下文里补段。规则、多模型和人工抽查筛选,英语筛零词错误,中文筛零拼音错误,避免同音字误罚。约 4100 万对是编辑样本对数,覆盖单段、多段、按位置定位,以及 39 类笑声、叹气等非词语声音的增删。用低秩适配微调 AuK,仅约 1.3% 的原模型参数量参与训练。
Figure 1|语音编辑数据生产。A 建任务分类,B 从开源语音集取原录音,C 自动转写和强制对齐,D 大语言模型写编辑指令与目标文本,E 用文本转语音结合原上下文重合成局部,F 规则和多模型筛选后做人类抽查。
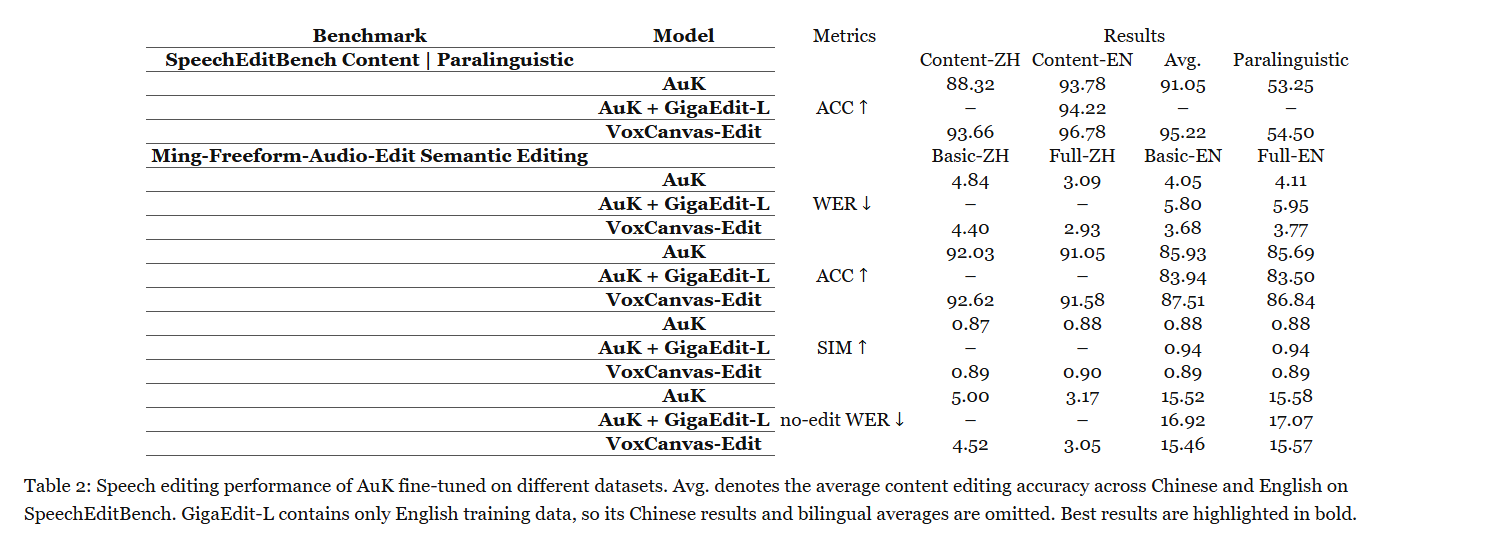
实验效果 :SpeechEditBench 上中英内容编辑准确率平均由 AuK 的 91.05 到 95.22,非词语编辑由 53.25 到 54.50。英语内容准确率 96.78,对同设置用 GigaEdit-L 微调的 94.22。另一套 Ming 自由编辑测试的英语完整项,词错误率 4.11 到 3.77,音色相似度 0.88 到 0.89,GigaEdit-L 同项音色相似为 0.94。学习曲线显示把插入与删除混训会拖慢插入,删除本身变化较小。
Table 2|在不同数据上微调 AuK 的语音编辑结果。SpeechEditBench 的 Avg. 是中英内容编辑准确率平均。GigaEdit-L 只含英语,故略去中文与双语平均。另一组分中英文的基础与完整项,分别报词错率、准确率、音色相似和未编辑内容的词错率。粗体是最好成绩。
批判点评 :数据主要由合成编辑与识别筛选得到,零拼音错可能放过同音词。任务覆盖中英内容和非词语声音,尚无情绪、风格或依赖历史的多轮编辑。1.3% 是微调参数口径,不能换算为推理速度。数据管线 、数据页 与演示 均可访问,数据页有具体发布范围。
8. Route-DMD:四步语音蒸馏分任务走
Route-DMD: Distribution Matching Distillation with Task-Routed Mechanism for Speech Foundation Models | 上海交通大学;北京通用人工智能研究院;上海创智学院;南洋理工大学;腾讯混元 | arXiv:2611.08011
关键词 :语音基础模型, 少步蒸馏, 任务路由, 说话人分离
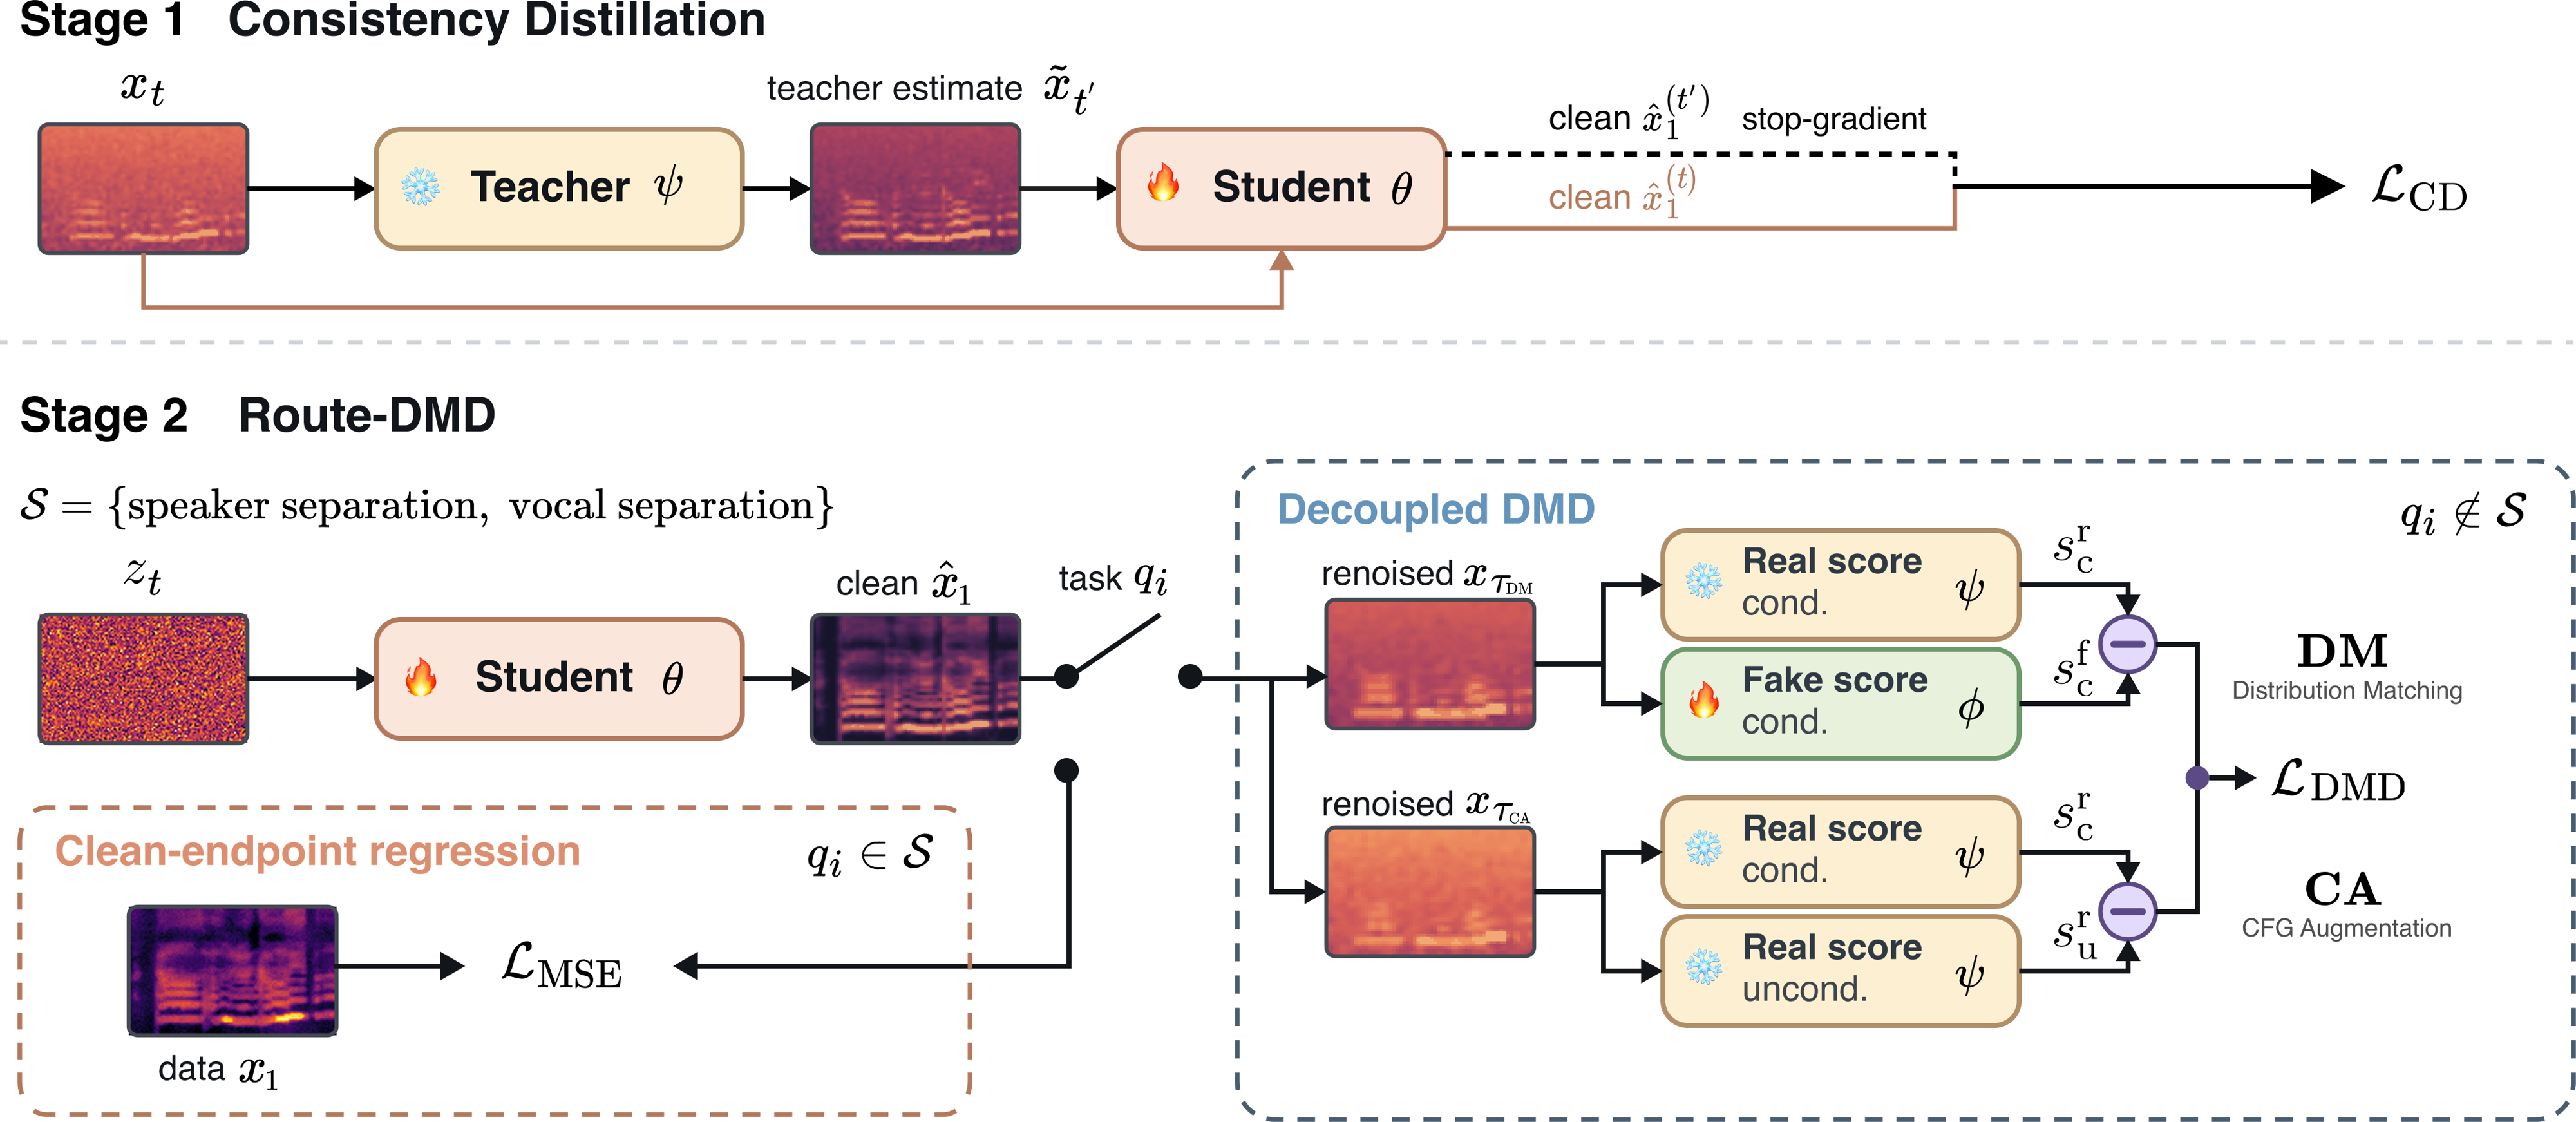
前序问题 :同一个语音模型既要念文本、改录音,也要从混合音轨里分离说话人。把生成任务的少步蒸馏直接搬到分离,学生失误后,老师可能在没见过的混合状态上给错方向。方法直觉 :先让学生学会从不同噪声水平走向同一个答案,再按任务选监督。分离有对应的干净音轨可直接比,生成或开放式编辑则更适合学输出分布。本文贡献 :第一阶段从 AuK 教师初始化,做 500 次一致性蒸馏更新。第二阶段按任务路由,目标说话人或人声分离直接对干净目标做均方误差回归。其他任务用解耦 DMD(分布匹配蒸馏),将分布差和条件引导分开计算,保留学习学生分布的辅助评分网络。教师生成回放用 APG(自适应投影引导)减轻语音削波,四步学生推理省掉 CFG(分别计算有条件与无条件预测再组合的无分类器引导)。
Figure 1|先做一致性蒸馏,让学生从相邻噪声状态预测同一干净端点。随后按任务分流,分离任务用干净音轨的均方误差,其他任务用解耦 DMD。右侧分别从真实与生成分布评分差、真实条件与无条件评分差取训练信号。
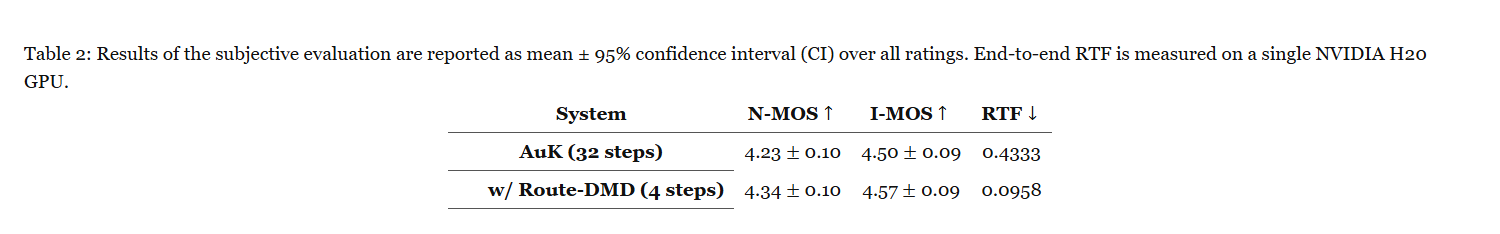
实验效果 :单张 H20 上,端到端 RTF(耗时除以生成音频时长)从 32 步 AuK 的 0.4333 降到 4 步的 0.0958,约快 4.5 倍。主观自然度均值 4.23 到 4.34、指令跟随均值 4.50 到 4.57,两者各自的 95% 置信区间都重叠。SeedTTS-Eval 平均词错误率 2.65 到 2.85,Libri2Mix 由 9.12 到 10.07,后者虽有主观质量代理指标提升,字词识别仍回退。
Table 2|主观自然度和指令跟随报告全体评分均值及 95% 置信区间。端到端实时因子在单张 NVIDIA H20 上测量,越低越快,比较 32 步 AuK 与四步 Route-DMD。
批判点评 :分离退回有配对真值的监督,迁移到缺干净目标的任务要重新选路。四步加速是单卡与测试协议下的端到端结果,未展示相同倍数的显存下降。AuK 仓库 提供四步 AuK-Flash 权重指引、推理与蒸馏训练入口,项目页 可听任务样例。
9. FisherDistill:少步生图用统计信号补课
FisherDistill: Diffusion Distribution Distillation via Closed-Form Fisher Critics | 纽约州立大学布法罗分校;加州大学伯克利分校;Meta 署名作者以个人身份参与 | arXiv:2611.07604
关键词 :少步图像生成, Fisher 线性判别, 分布匹配, 冻结教师特征
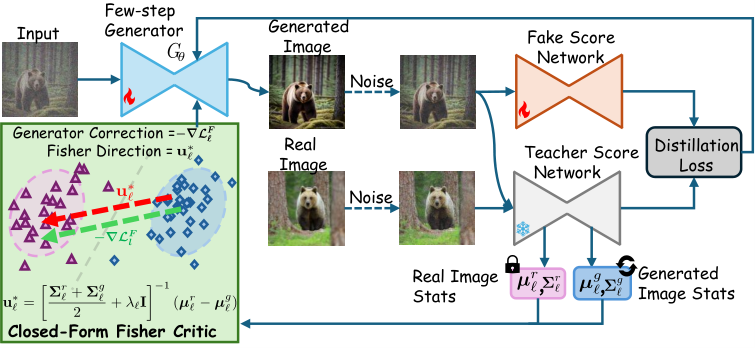
前序问题 :学生模型只用一步生图,即使学了老师的去噪能力,生成图的整体分布仍可能偏。再加一个需交替训练的对抗判别器,会引入一套新的优化。方法直觉 :把真假图像投到同一个老师的特征空间,找出均值分得最开、组内波动相对最小的方向。学生朝真实的一侧修正。本文贡献 :冻结教师的中间层先离线统计真实图的均值与协方差(特征之间共同变化的程度),在线用滑动平均追踪生成图。将两类均值差用带正则的组内协方差重新加权,线性方程直接给 Fisher 方向。用上一更新留下的统计量固定本步方向,避免同一批既拟合又打分,梯度仍通过当前教师特征回学生。Fisher 修正叠在原蒸馏目标上,保留原方法需要的生成分布评分网络。
Figure 3|Fisher 修正叠加于原蒸馏。真实图经冻结教师离线提特征,生成图在线估计统计,两者各有均值和协方差。所选层用正则化协方差求从生成均值指向真实均值的 Fisher 方向,并将它转成学生的梯度信号。原蒸馏与生成分布评分器仍在。
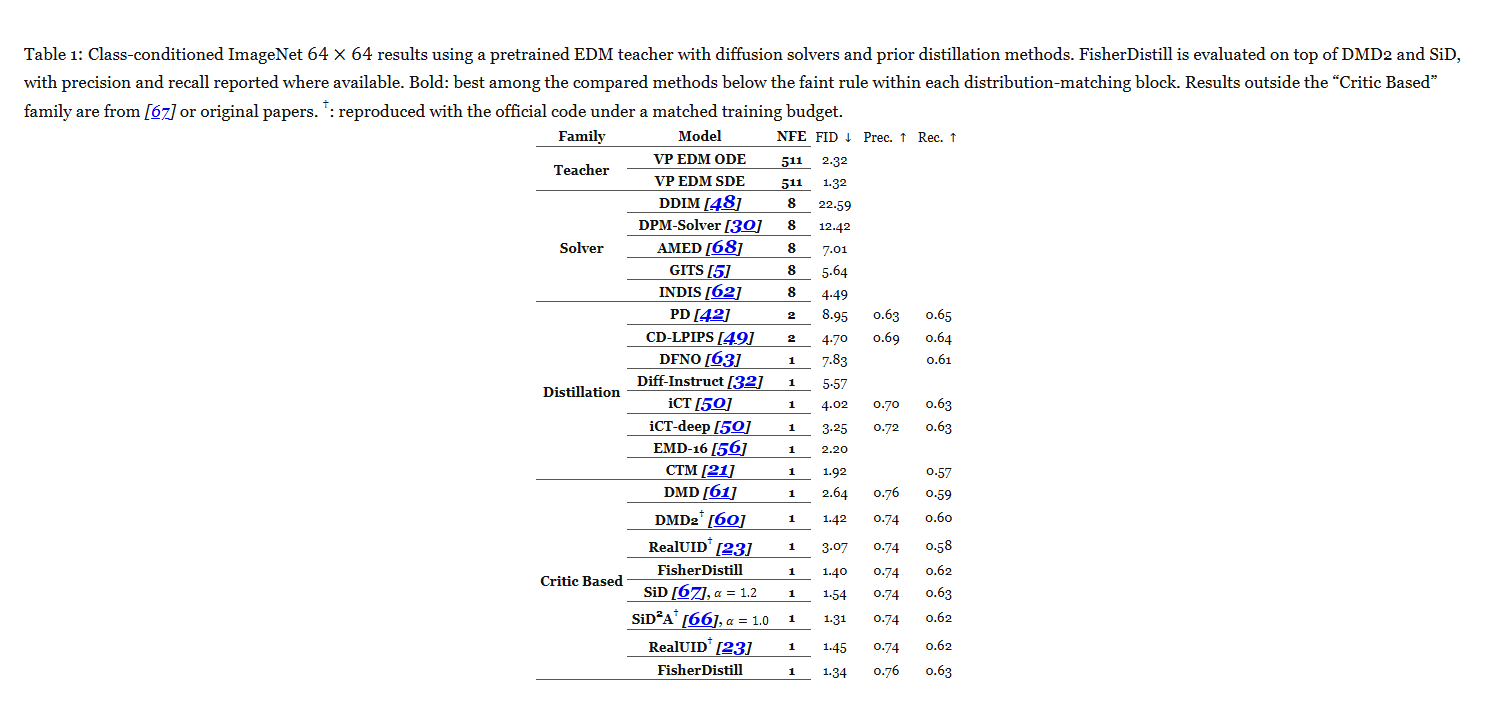
实验效果 :ImageNet 64×64 类别条件生图,一次 NFE(网络前向次数)的 DMD 设置下 FID 从 2.64 降到 1.40,同预算对抗精修 DMD2 为 1.42。换用 SiD 起点,1.54 到 1.34,对抗 SiD²A 仍为 1.31。SD v1.5 的消融中,初始 FID 9.28,仅用均值差变 9.85,完整协方差降到 8.46。几组 FID 都是特征分布距离,低更好,不能等同单张观感。
Table 1|预训练 EDM 教师下的 ImageNet 64×64 类条件生成。比较求解器、蒸馏、对抗精修和 Fisher 精修,有数据时报告前向次数、FID、精确率和召回率。每个分布匹配组内最优加粗,带匕首号者用官方代码按匹配预算复现,其他组结果来自原文或引用工作。
批判点评 :真实图统计、挑选能区分真假的教师层和求解协方差都发生在训练端,论文未给统一的端到端训练节时量。推理前向数没增加。低分辨率类条件结果也不能替代高分辨率文字渲染验证。项目页 与论文所链仓库 可访问,本次仅确认说明与演示,未确认可跑的训练入口。
10. CAST-Bench:听清每个镜头是谁在发声
CAST-Bench: Tracing Every Sound to Its Source in Multi-Shot Audio-Video Generation | 西北工业大学;复旦大学;浙江大学;北京大学 | arXiv:2611.05422
关键词 :音视频联合生成, 多镜头评测, 声源绑定, 说话人一致性
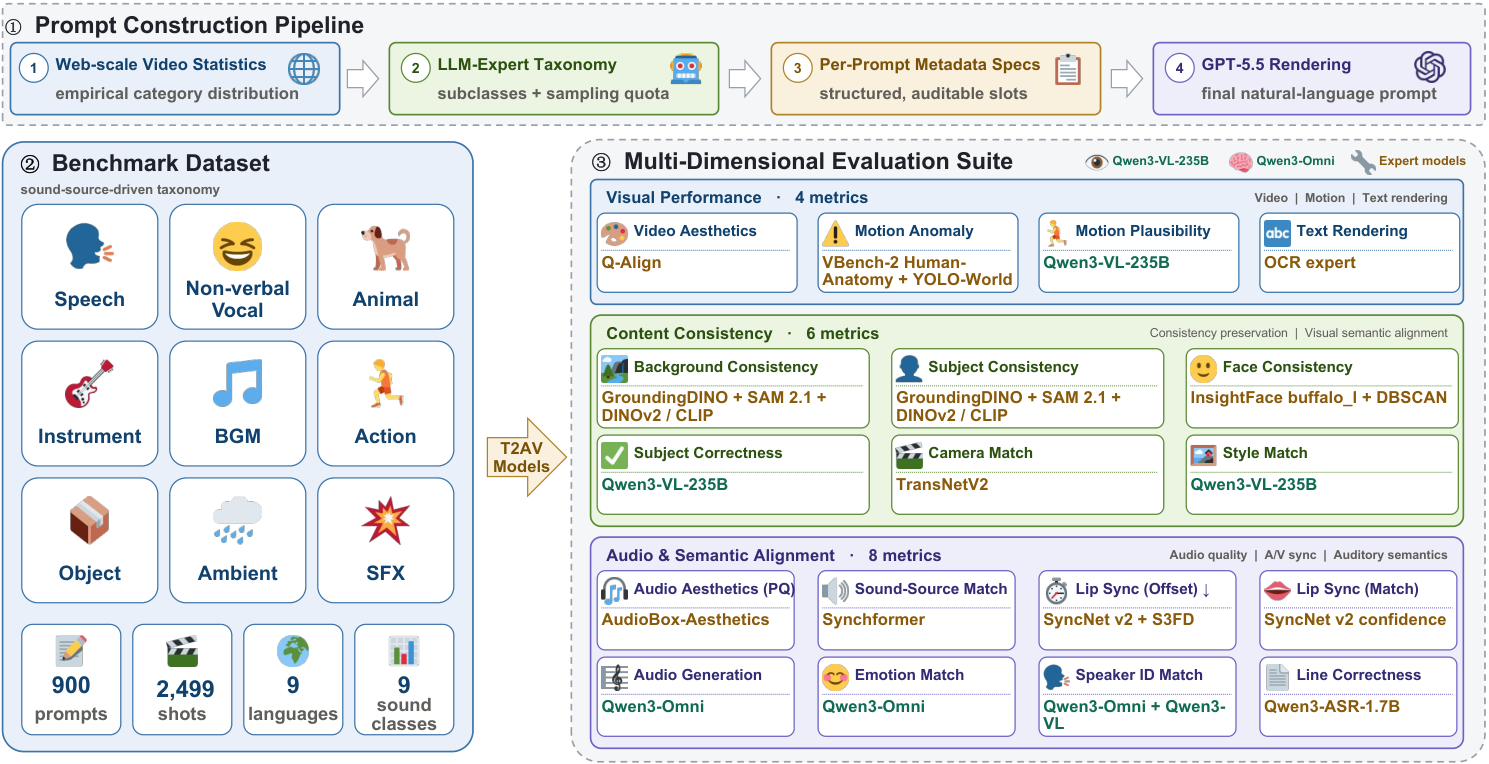
前序问题 :两个人跨镜头对话,画面和声音各自都像真的,但第二镜头的人可能说了第一人的台词,背景敲门声也可能消失。只看一个总分,发现不了是串音还是漏事件。方法直觉 :先给每条要求填一张卡,写清谁发声、什么时候响、声画各要满足什么。生成后按同一份结构化清单逐项核对。本文贡献 :CAST-Bench 先从网络视频统计声源,再由专家与语言模型划分九类声源,每类 100 条。为每条指定主体、声源、事件和镜头,再用 GPT-5.5 渲染成自然语言,经专家校验。900 条中 439 条单镜头、461 条多镜头,合计 2499 个镜头,覆盖九种语言。18 个指标按画面表现、内容一致性、音频与语义对齐分组,组合专用模型与多模态裁判,检查声源匹配、嘴型、说话人身份和台词。
Figure 2|左上从网络视频统计到专家和语言模型分类、结构化元数据、GPT-5.5 渲染提示,再由专家核验补齐覆盖。左下是 900 提示、2499 镜头、九种语言和九类声源。右侧展示画面、内容及声音语义共 18 项指标,单、多镜头分别报告。
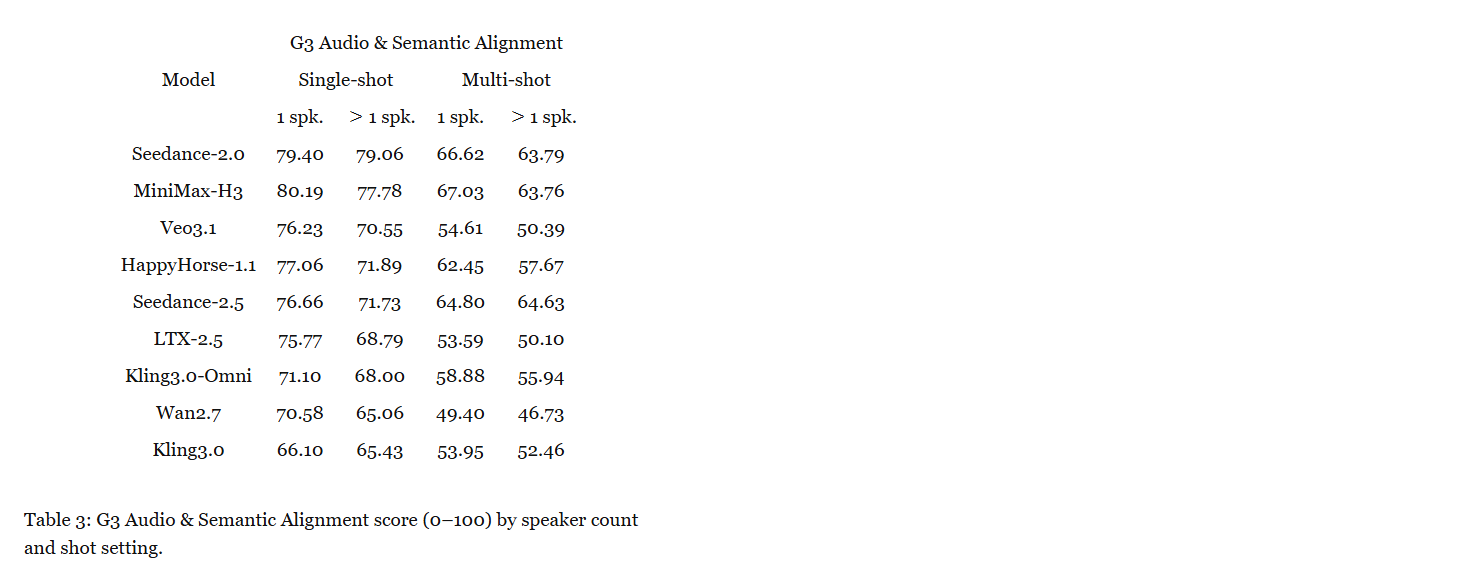
实验效果 :单镜头评 12 个系统,九个共同系统另评多镜头。只看其中音频与语义对齐的 0–100 分,Veo 3.1 单镜头单人 76.23、多人 70.55,多镜头单人 54.61、多人 50.39。Kling 3.0-Omni 对应 71.10、68.00、58.88、55.94,单人单镜头两者顺序与多人多镜头相反。论文按子集分别评分,并报告每模型抽 50 条、每条三名标注者的对照。
Table 3|音频与语义对齐分为 0–100。先区分单镜头与多镜头,每组再区分恰好一位说话人与多于一位说话人,比较九种系统。
批判点评 :多镜头协议增加跨镜头任务,分数差反映不同难度和打分规则,不能当作完全同条件的因果降幅。常见接口生成约 10 秒,Veo 为 8 秒,模型条件也影响排名。多路裁判与生成都有成本,原文未给统一单条延迟。官方仓库 提供提示与评测入口。
趋势观察
参考信号要分清职责
FlashRelight 用源视频定身份动作、用参考片定灯光。Chronos 用参考照和时序锚帧造新片,HME 让参考片只提供光流。测试需要分别验收内容保留和实际控制。
稳定还要留出动作空间
Disen-Forcing 在 30 秒 Self-Forcing 对照中,把全头缓存的动态分 35.66 提到 73.12,同时首尾成像差由 3.40 变为 4.03。两项都报,才看得清取舍。
少步蒸馏按任务和分布选信号
Route-DMD 给分离单独走干净目标回归。FisherDistill 在 DMD 生图上把 FID 从 2.64 降到 1.40,靠冻结教师特征的协方差描述生成分布偏差。
返工清单与验收分母各有用处
ArtiVidRM 用瑕疵清单给 Veo 3.1 重写提示,成像分改善而主体一致性几乎不变。CAST-Bench 按镜头数和说话人数拆分,揭示跨镜头说话人归属的薄弱环节。
今日讨论
FlashRelight 在 10 位未见受试者、16 条环境光序列上把身份相似度从 DiffusionRenderer 的 0.6143 提到 0.8097,借参考视频换光却只有定性样例。如果手里有同一个人打两种动态光的成对视频,如何验证迁光后的灯光变化和身份保留各自达标,并让只复制原视频的对照无法通过?
人工智能炼丹君 整理 | 2026-11-09






评论 (0)