今日 AIGC 论文速览
今日共 10 篇 · 流式视频编辑与视频生成 4 篇 · 图像编辑、生成与评测 3 篇 · 音效与音乐编辑 2 篇 · 视频生成加速 1 篇
重点论文标题列表
- AR-Edit(巴黎萨克雷):边播边改且保住原片
- StitchEdit(港科大):换视角也留住空间关系
- UniRGBA(字节):烟雾泡泡直接带透明通道
- TraF(华为):续长视频时记住去噪过程
- Video-Coder(中佛罗里达大学):让三维草稿指导成片
选读入口:直播输入还在到来,先看 AR-Edit 怎样保住未改部分,核对首帧延迟和稳态帧率。手里只有静态图又要改遮挡或视角,转到 StitchEdit。做烟雾叠层看 UniRGBA,做 30 秒续写看 TraF。要在成片前约束碰撞和轨迹,读 Video-Coder。改一段音效选 FoleyForge,改多轨音乐选 ProCraft。关心图文细节、视频注意力预算和否定词失效,分别读 UniMore、InstaGen 和 T2I-NSI。
今日论文速览
1. AR-Edit:边播边改且保住原片
AR-Edit: Training-Free Autoregressive Video Editing without Inversion | 巴黎萨克雷大学、巴黎综合理工、Télécom Paris、法国国家科学研究中心 | arXiv:2611.09795
关键词:视频编辑, 流式推理, 注意力注入, 少步扩散
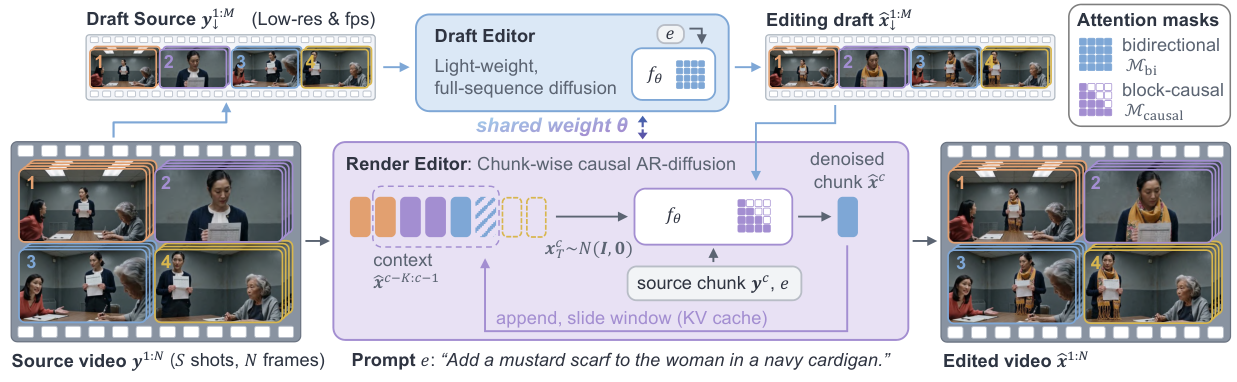
- 前序问题:直播画面里想把外套换色,下一段视频还没到,背景和人脸却得尽可能保持原样。离线反演会先用模型把原视频还原成可重新生成的噪声,再改着生成。它需要看完整片段,也增加每段开销。
- 方法直觉:把注意力想成两步:查询 Q 和键 K 决定往哪里找,值 V 是读出来的内容。作者在少步视频模型里发现,高噪声阶段的 Q、K 跨时间步较稳定,V 随内容改变。于是每段原片只抽一次 V,改后的文字仍然掌握信息流向。
- 本文贡献:AR-Edit 在干净端对当前源视频块前向计算一次,缓存深层自注意力的 V。输出从高斯噪声起步,用目标提示去噪。默认在 Reward Forcing 的前两步替换指定深层的全部 V,随后从源、目标提示的差异词提取交叉注意力软掩码,只在编辑区外继续借用源 V。每段结束刷新历史缓存,下段只读已经到来的帧。这条路线依赖 DMD(分布匹配蒸馏,把教师输出分布迁给少步学生)训练好的因果主干。
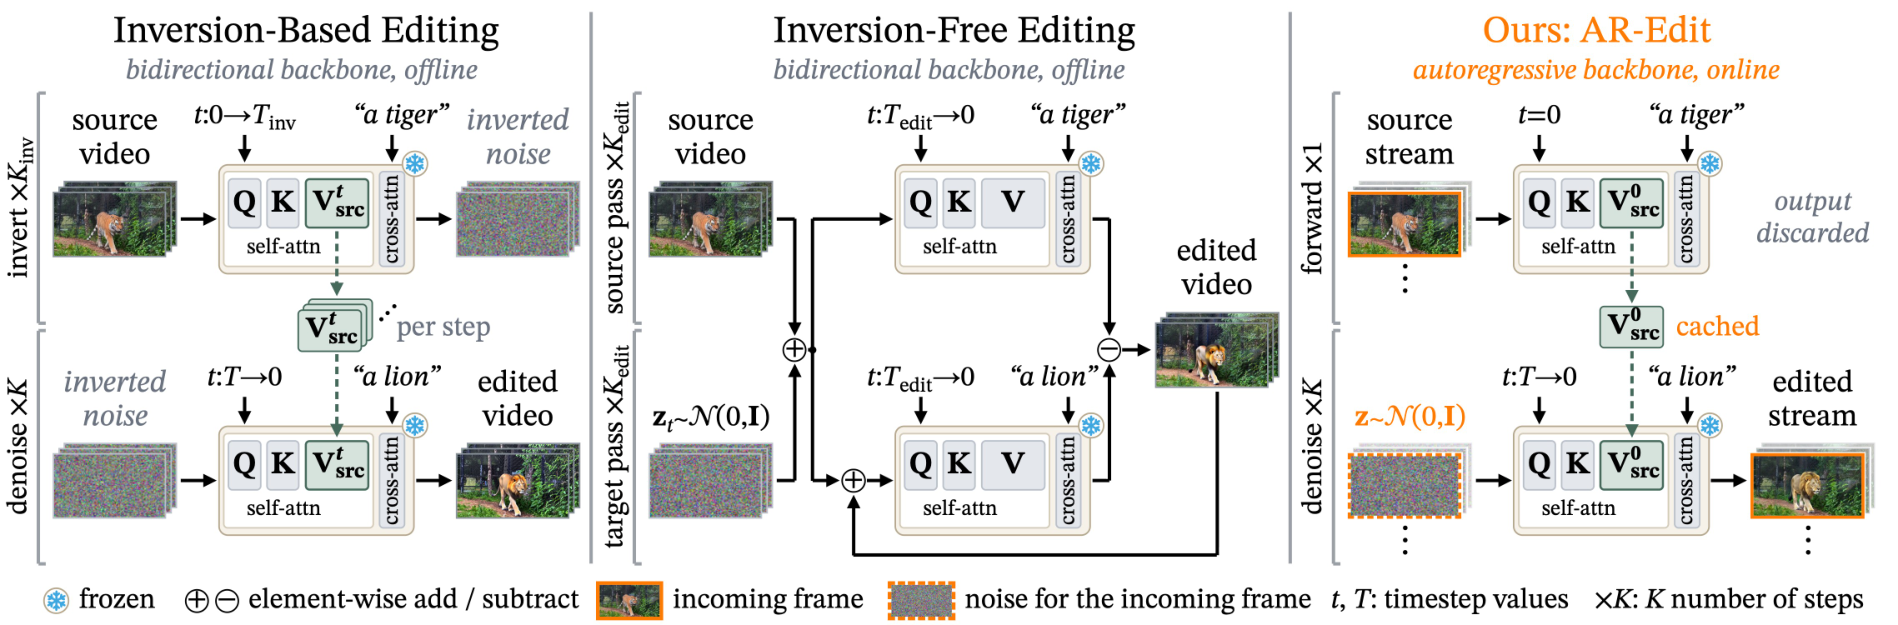 视频编辑路线对比|左侧先将源视频反演为噪声,再按目标提示去噪。中间直接把源视频传输成编辑结果。两条离线路径都需多次运行双向主干。右侧 AR-Edit 在自回归主干中按到达顺序处理,单次提取源 V,在目标提示引导的纯噪声去噪过程中注入。
- 实验效果:作者用 120 条 Pexels 片段,覆盖 10 类编辑。单张 H100 上,同用 Self Forcing 的四步设置,AR-Edit 相对 StreamEdit 由 6.12 升至 10.25 帧/秒,首帧延迟由 1.38 降到 0.85 秒,已分配显存峰值由 41.3 降至 31.8 GB。每块前向次数 NFE 从 10 到 6,6 次包括四次去噪、一次源 V 提取和一次刷新。Reward Forcing 上相对 DynaEdit 的保留分 7.17→7.28、文本分 5.96→6.11。保留与文本由 Qwen2.5-VL 按 1–10 评分。高光强度直方图相似度 TF 从 0.39 到 0.47。
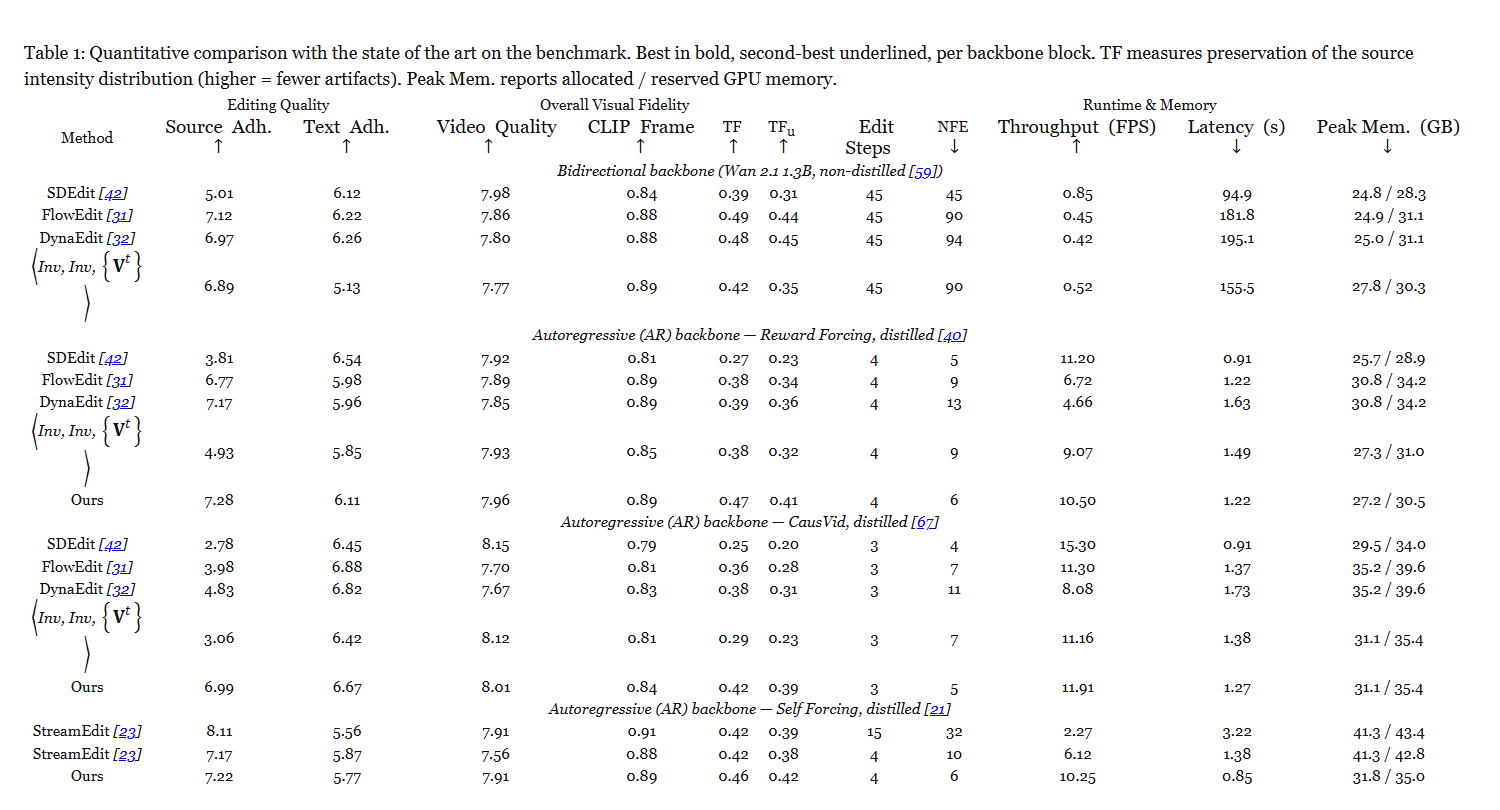 编辑质量与成本|按主干分块,粗体最佳、下划线次佳。TF 衡量源强度分布的保持程度,越高越少过曝类瑕疵。峰值显存同时列出实际分配量与框架预留量。
- 批判点评:四步 Self Forcing 对照的文本遵循分仍从 5.87 略降至 5.77,较强的源信号会压住编辑。论文测的是显卡侧首帧和吞吐,10.25 帧/秒不能直接折算为 25 或 30 帧/秒直播能力。差异词掩码适合局部变化,改整场光线或要求重排空间关系时要另验。 来源补充:项目或实现、代码或模型、基准或数据。
2. StitchEdit:换视角也留住空间关系
StitchEdit: Stitching Depth Priors into Image Editors via Per-Layer Gradient Probing | 香港科技大学 | arXiv:2611.07922
关键词:图像编辑, 深度先验, 梯度探测, LoRA
- 前序问题:把杯子移到书后面时,模型可能把杯子画在书面上,或把原本挡住的东西也重画。位置、遮挡和换视角要求编辑器先弄清近远关系。
- 方法直觉:同一图像主干已学过一些几何规律。先让模型学会预测深度,再用少量样本检查每层的深度训练方向与编辑训练方向是否冲突,就能决定哪些层值得继续调。
- 本文贡献:冻结多模态扩散 Transformer,在注意力的查询、键、值投影插入 LoRA(低秩参数更新),用源图条件学习去噪出深度图。再用两个任务的梯度余弦相似度衡量更新方向:接近 1 同向,负值说明一阶近似下会互相损害。保留浅层的适配器并用较高学习率,中层按余弦逐步减弱,深层冲突区移除适配器。实际编辑只输入原图与指令,部署无需额外深度网络。
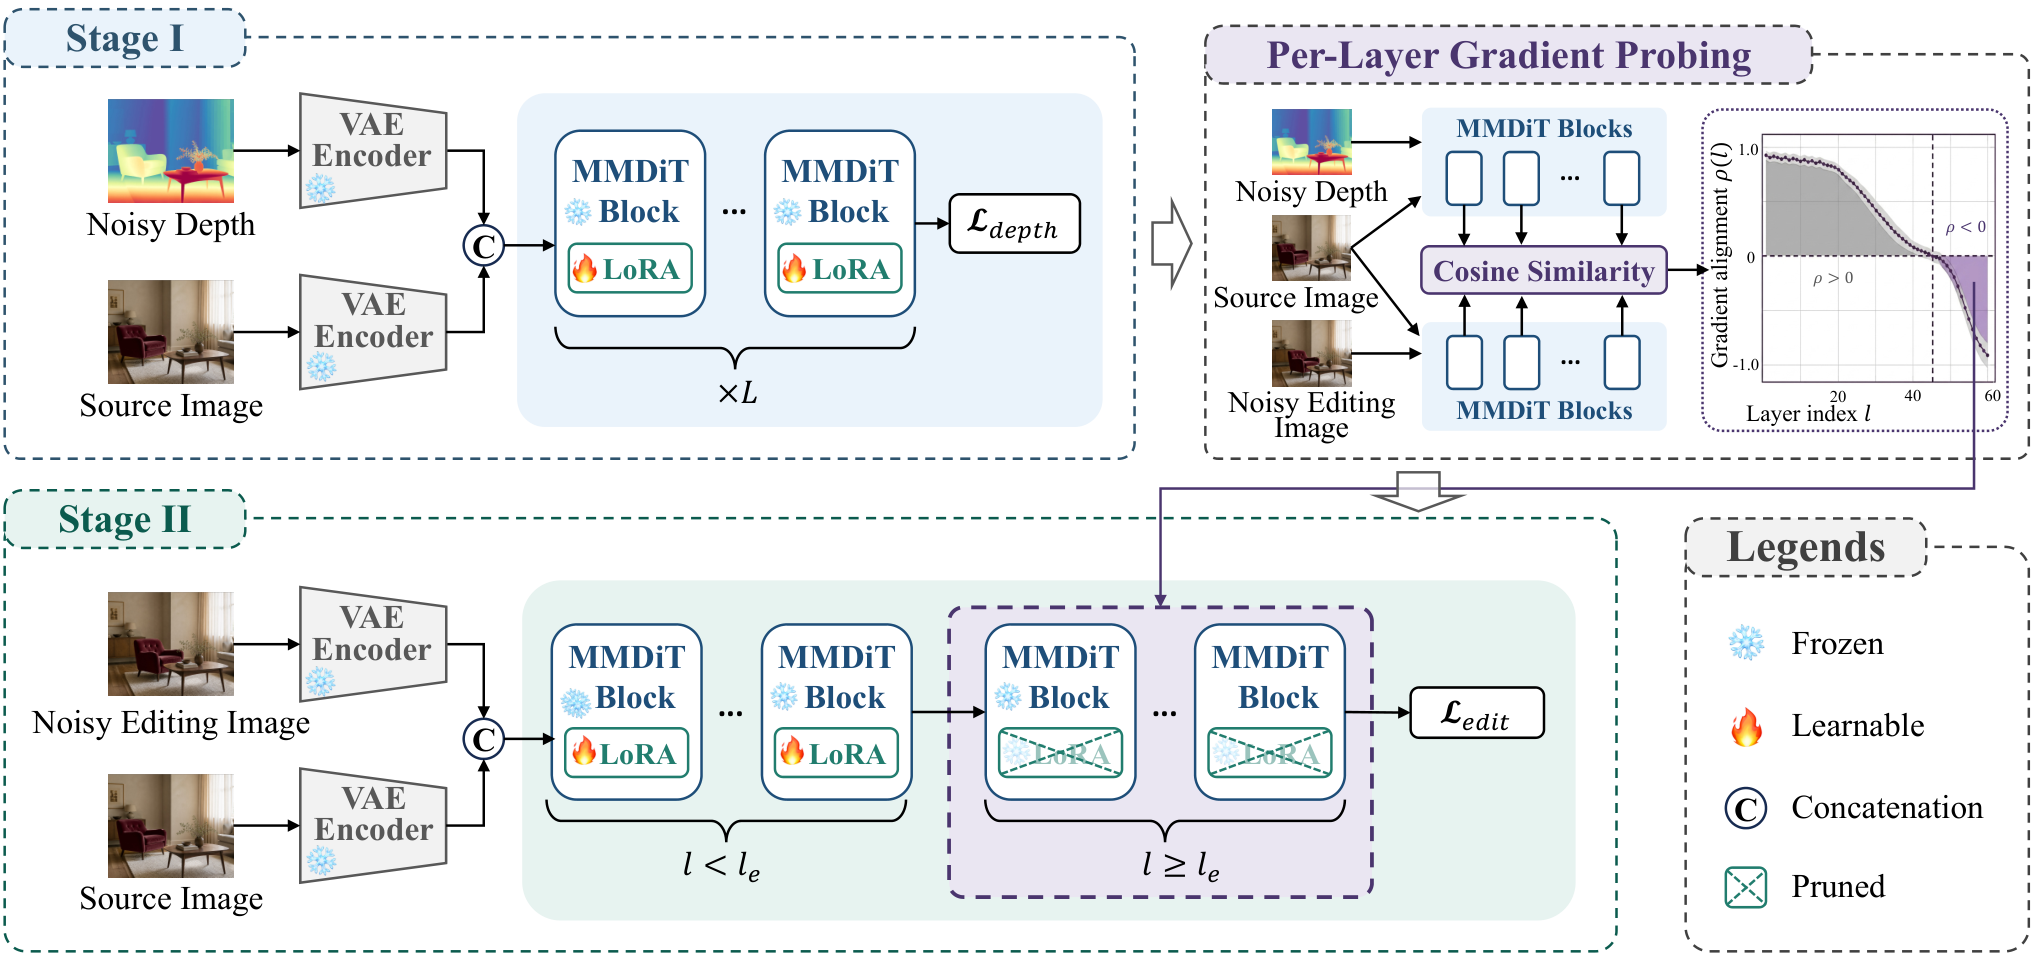 两阶段训练|第一阶段冻结主干并用 LoRA 激活深度能力。逐层探测衡量深度和编辑目标是否兼容。第二阶段按探测曲线决定适配器裁剪边界及每层编辑学习率。
- 实验效果:150 个 StitchEditBench 样例覆盖空间变换、遮挡和视角。相对同一深度初始化后各层统一微调,感知距离 LPIPS 由 0.14 降到 0.10,深度一致分 DCS 从 0.80 升至 0.92,基于 CLIP 图文表征的编辑方向相似度由 0.76 到 0.81。四个方案中获 58% 偏好票,Nano-Banana 为 16%。作者报告校准探测约需单张 H100 30 分钟,编辑推理不增加新分支。
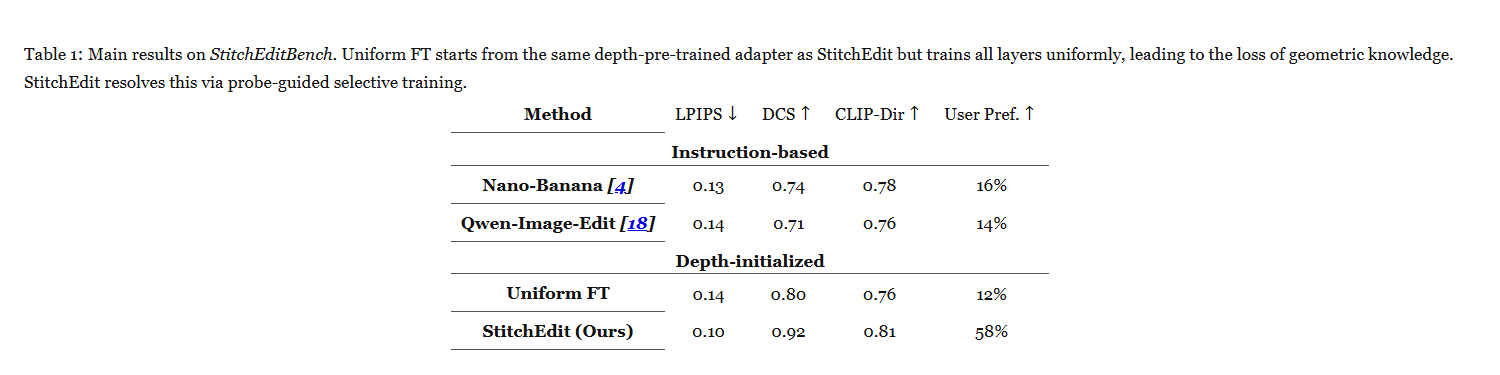 StitchEditBench 主结果|统一微调从同一个深度适配器起步,但统一更新各层会丢失几何知识。StitchEdit 依据探测结果选择性训练,比较感知距离、深度一致性、编辑方向和用户偏好。
- 批判点评:文字难以表达精确的位移和旋转角。浅层到深层的冲突曲线来自这套主干与校准样本,换模型应重做探测。论文写明代码和基准拟待接收后放出,项目页可读。 来源补充:项目或实现。
3. UniRGBA:烟雾泡泡直接带透明通道
UniRGBA: Unifying RGB and Alpha in Pretrained Video Diffusion Models | 字节跳动 | arXiv:2611.09069
关键词:视频生成, 透明通道, 视频编码, DoRA
- 前序问题:想把烟雾、玻璃泡泡叠进已有画面,仅生成彩色视频还得再抠图。半透明区域会透出背景,简单的前景轮廓很难表达这些细节。
- 方法直觉:给原视频编码器加一条透明度输入,尽量保留原模型已经学会的颜色和动作。RGB 是红绿蓝三通道,alpha 是每个像素的覆盖程度,合起来是 RGBA。
- 本文贡献:作者扩展 Wan2.1 的视频 VAE(把像素压缩为可去噪的潜变量并解码回来),在首尾卷积把新输入和输出通道以零初始化,保留原 RGB 权重,选择性解冻约 5% 参数。训练用颜色、透明度、合成后的外观、硬透明区域、感知与分布约束。KL 散度惩罚潜变量分布偏离冻结的 RGB 编码器。后期加轻量对抗训练,再用 DoRA(把权重大小和方向分开适配)微调原扩散 Transformer,让同一套潜变量走原有生成主干。
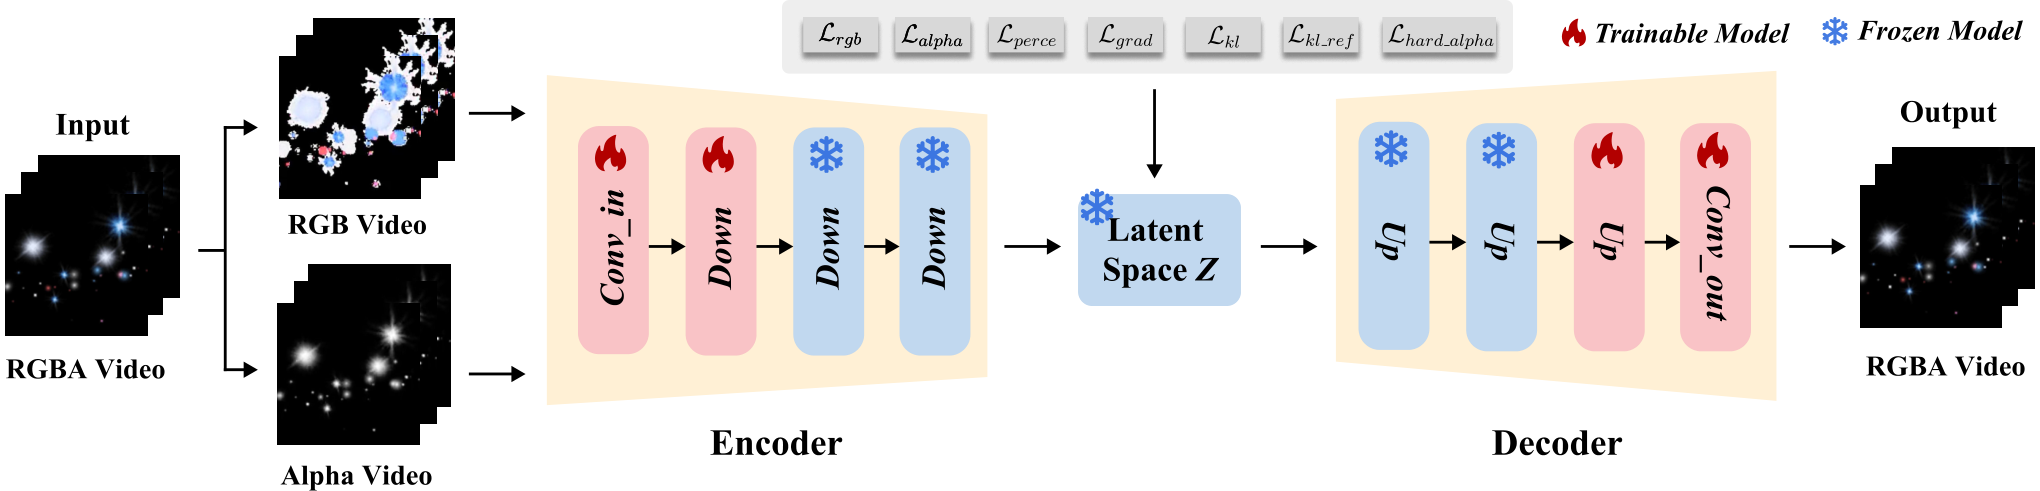 RGBA 视频编码器|在 Wan2.1 VAE 的输入和输出卷积加零初始化通道。橙色参与训练,蓝色冻结。目标包括 RGB、alpha、合成效果及硬透明区域的像素损失,以及感知、KL 和参考 KL 约束。
- 实验效果:作者的特效数据上,第二阶段重建相对 Wan-Alpha 的整体峰值信噪比 PSNR 由 25.00 升至 29.16 dB,alpha 由 30.50 到 34.45 dB。透明视频文本匹配分为 4.2600 对 3.9794,美学分则为 0.4694 对 0.5232。RGB WebVid 重建对原 Wan2.1 从 36.73 降至 33.41 dB。最终重建训练用 1.7 万条高质量数据,VAE 实验用 32 张 GPU;正文未给出生成端的统一时延对照。
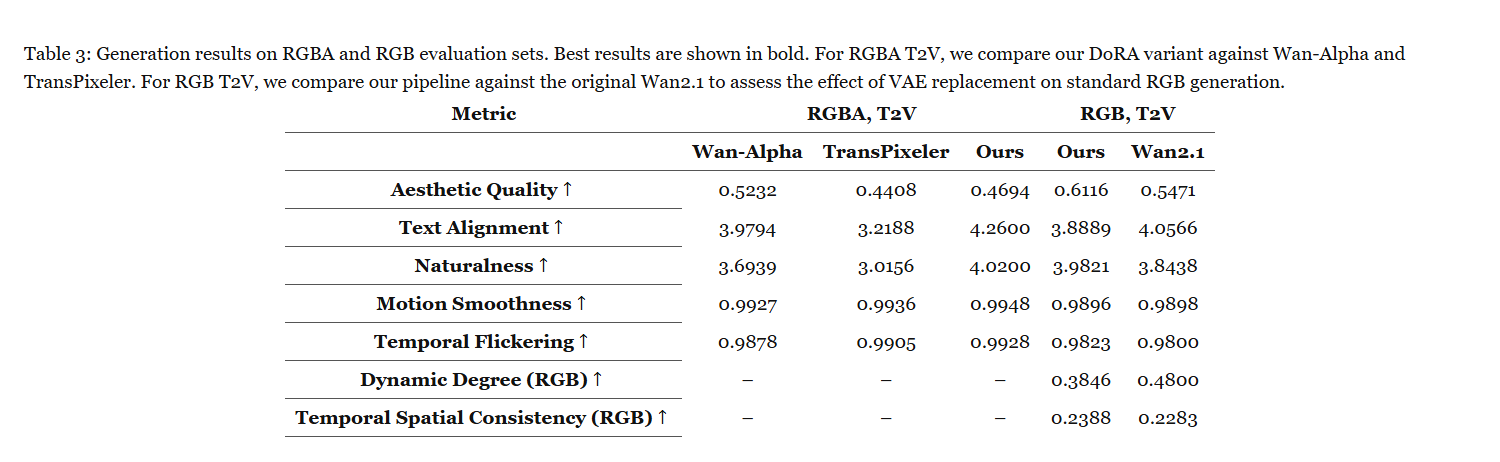 生成评估|透明文生视频比较 DoRA 变体、Wan-Alpha 和 TransPixeler。普通 RGB 文生视频与原 Wan2.1 比较,检验替换编码器的影响。各行粗体为最佳。
- 批判点评:局部半透明区域尤其值得单验。其 alpha 掩码内 PSNR 为 22.02 dB,Wan-Alpha 为 22.54 dB,与整体透明度指标走向不同。用在实拍抠像或要适配不同合成背景时,应测最终合成边缘和颜色。原文未给出本方法公开代码。
4. TraF:续长视频时记住去噪过程
Trajectory Forcing: Exploiting Diffusion Trajectories for Autoregressive Long Video Generation | 华为诺亚方舟实验室 | arXiv:2611.09096
关键词:长视频生成, 自回归扩散, 去噪轨迹, 分布匹配蒸馏
- 前序问题:长视频按块生成时,上一块的最终帧看起来正常,后面却可能突然静止、变糊或换了主体。只给下一块看最后成片,会丢掉此前生成过程中的线索。
- 方法直觉:把去噪比作反复从草稿改到成片。上一块的不同版本分别留下粗结构和细节,下一块的不同去噪阶段可以借用合适的草稿。
- 本文贡献:Trajectory Forcing 训练分两段。先把真实视频和高斯噪声插值,用模型重预测造出近似去噪轨迹,做监督学习。再让学生模型逐块生成,把自己真正走过的去噪轨迹作为上下文,用 DMD(分布匹配蒸馏)对齐教师的输出分布。轨迹位置由 γ 控制,极大值退回只取终点,默认四步设置取 γ=2。推理保留滑窗以及首块注意力缓存锚点。
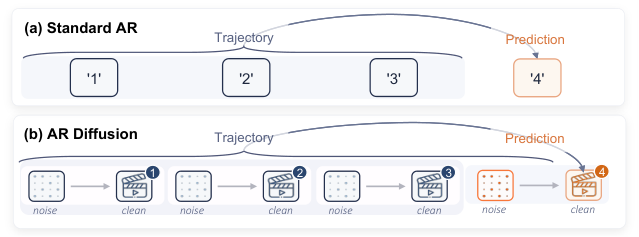 自回归与自回归扩散|(a) 普通自回归的 token 是单个已完成单元,下一 token 直接看此前 token。(b) 扩散视频块经过 T 次去噪形成轨迹,理想因子分解中每次去噪都可看前序块的完整轨迹。
- 实验效果:以 Wan2.1 13 亿参数学生评测,5 秒 VBench 946 条提示,总分 85.15,对 Self Forcing 84.31,吞吐从 17 降至 15 帧/秒、首段延迟从 0.69 到 0.78 秒。128 条提示的 30 秒评估把时序、单帧、文本三个分数等权平均,TraF 73.98 对 Self Forcing 71.06。默认第二阶段维护轨迹缓存,作者估计训练时间多约 6%,没有增加去噪器求值次数。
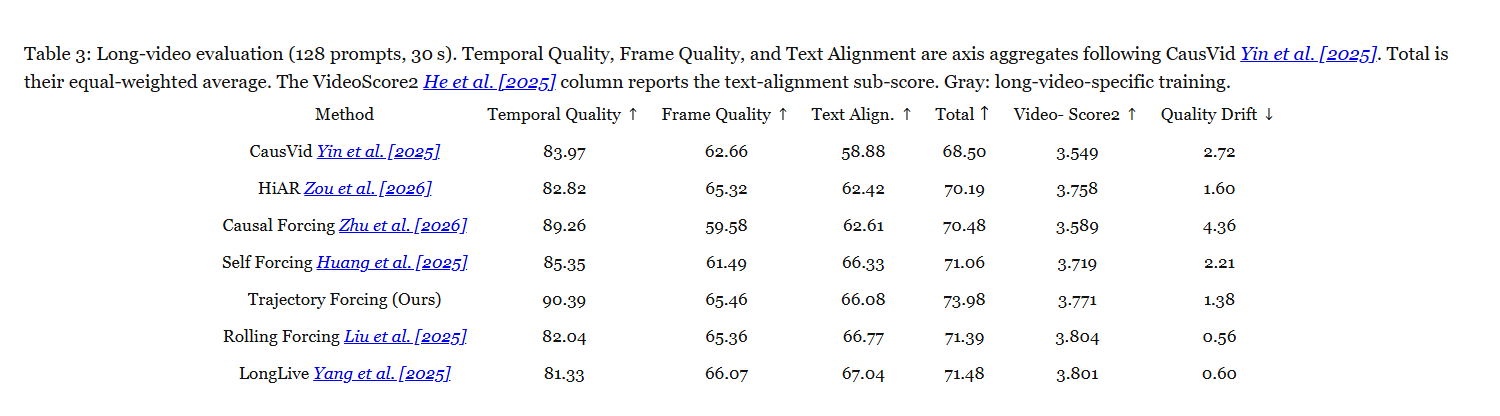 30 秒视频评估|128 条提示。时序质量、单帧质量和文本对齐按 CausVid 协议聚合,三轴等权得到总分。VideoScore2 一列是文本对齐子分。灰色标出经过长视频专项训练的方法。
- 批判点评:30 秒综合分最高与首尾最稳是两件事。首尾各 5 秒的成像分绝对差为 1.38,Rolling Forcing 是 0.56,后者另做了长视频训练。30 秒是论文验证窗口,超出该长度的漂移还需单独测。NeurIPS 2026 接收见 arXiv 评论。 来源补充:项目或实现。
5. Video-Coder:让三维草稿指导成片
Video-Coder: Reinforcing Agentic Coding for Video Generation | 中佛罗里达大学、维尔茨堡大学、Microsoft Research、清华大学、北卡罗来纳大学教堂山分校、威斯康星大学麦迪逊分校 | arXiv:2611.09894
关键词:视频生成, 三维预演, 强化学习, 物理一致性
- 前序问题:拍一个球碰倒杯子,直接文生视频可能让球穿杯而过。给生成器一段结构正确的预演,能把构图、碰撞时机和物体轨迹明确下来。
- 方法直觉:先用可运行代码搭出粗略三维舞台,让镜头和物体按规则走,再由视频生成器完成外观。代码是中间工件,实验检验的是最终视频的表现。
- 本文贡献:在能执行代码、渲染并返还错误或视觉反馈的环境中训练 Qwen3.5-9B。先用约 6000 个监督示范教它生成三维草稿,再用约 2000 条强化学习样例联合优化执行结果和下游生成视频。训练后期逐渐降低执行奖励,让代理更重视最终成片。渲染出的草稿作为结构与运动条件传给下游模型。
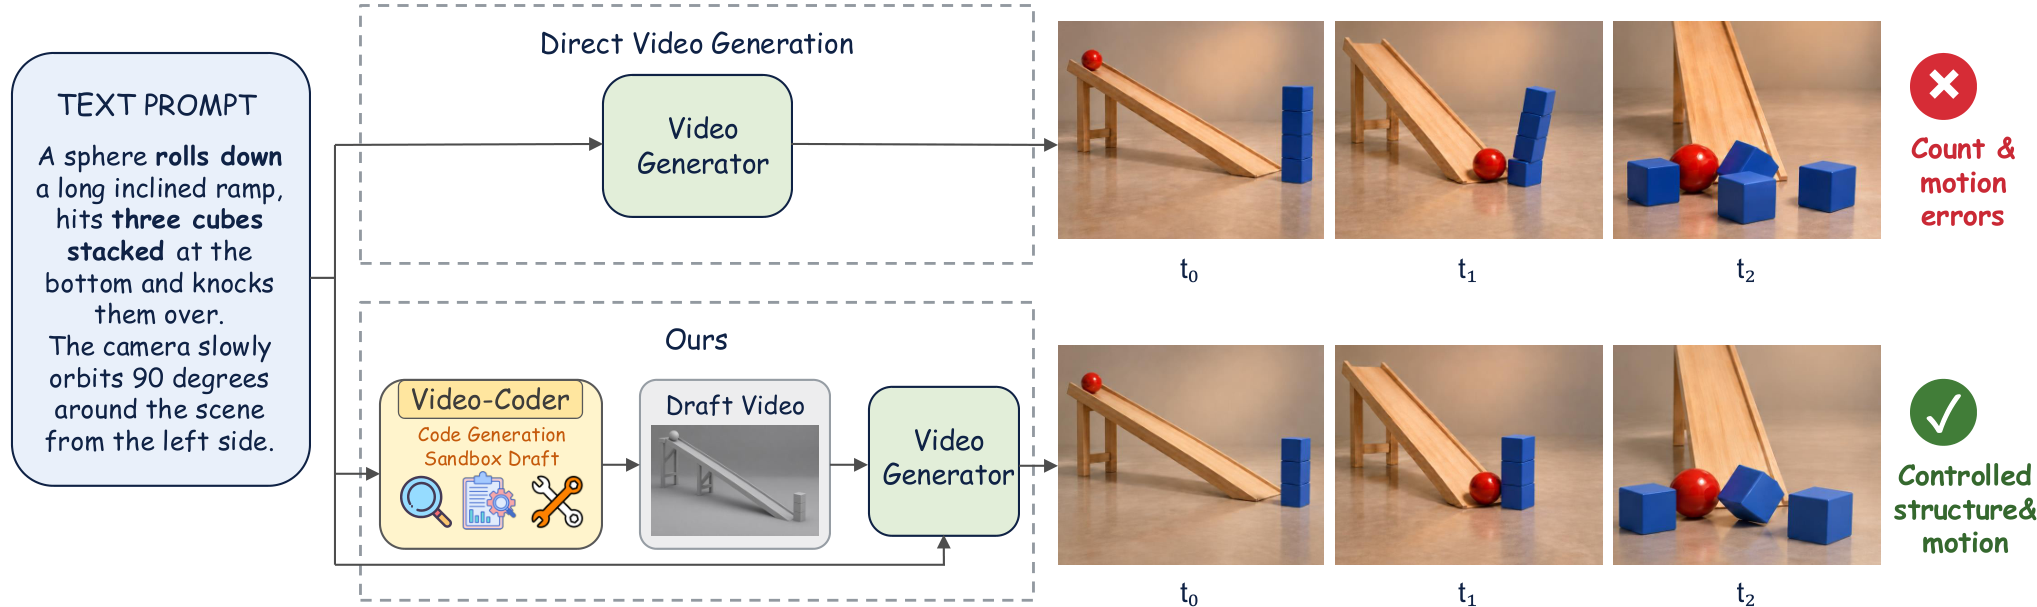 从代码到视频|Video-Coder 编写并执行代码搭建三维场景,渲染草稿视频,为下游视频生成器提供显式结构和运动信号。
- 实验效果:PhyGenBench 的力学、光学、热学、材料四项聚合分,MiniMax-H3 加 90 亿参数 Video-Coder 从 0.61 到 0.67,光学由 0.73 到 0.79。VBench-2.0 对应物理均分 54.58%→78.19%,其中材料项 75.02% 低于 CogVideoX-1.5 的 83.19%。训练代理用 8 张 H100,强化学习阶段另用 16 张 H100 部署下游模型生成训练反馈。
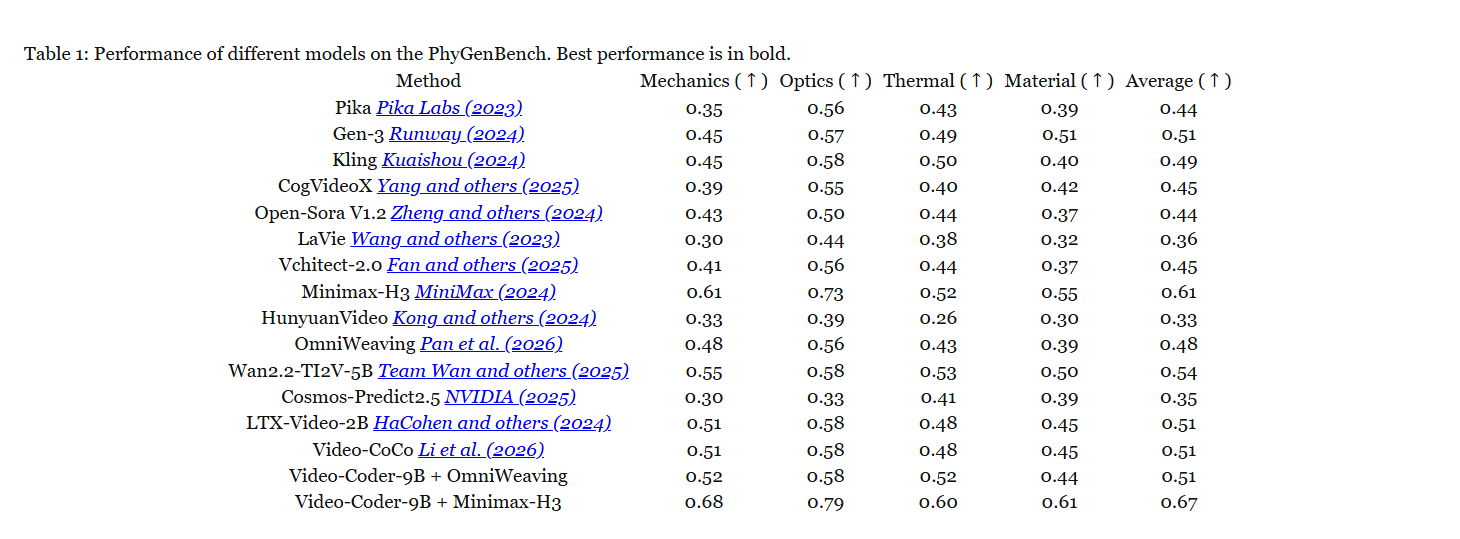 PhyGenBench 物理评估|比较各模型在力学、光学、热学和材料四项及平均分上的表现。粗体表示最佳。
- 批判点评:推理多了写代码、执行和渲染,论文没给统一端到端延迟。简单刚体碰撞适合显式预演,难描述的材质和复杂流体不能凭有草稿就保证准确。作者仓库提供训练和推理入口,结果仍依赖下游生成器。 来源补充:项目或实现、代码或模型。
6. FoleyForge:一句话修改现成音效
FoleyForge: Free-form, Controllable, Rectified-flow Editing of Sound Effects | Adobe、纽约大学 | arXiv:2611.08695
关键词:音效编辑, 整流流, 声音保真, 响度控制
- 前序问题:有一段雨声音效,想让它像打在铁皮屋顶上,同时保留原来的节奏。纯文字重新生成容易换掉声音身份,传统音效工具则要求操作者知道要动哪种参数。
- 方法直觉:让模型同时听原声和读改法,再给响度、改动强度和能量轮廓各自的旋钮。能量轮廓指声音能量随时间的起伏,保住它通常更像原音,但也会限制有意改动。
- 本文贡献:以 Sketch2Sound 为基础微调整流流 Transformer。整流流学习把噪声沿速度场搬运到音频表征。用音频语言模型生成编辑指令,配对数字信号处理或保持相似的生成式改动,共 46.4 万组三元样本(源音、指令、目标音)。冻结文字与音频编码器,仅训生成主干。无分类器引导比较保留和省略条件时的模型预测,分别控制响度、改动强度与能量轮廓。
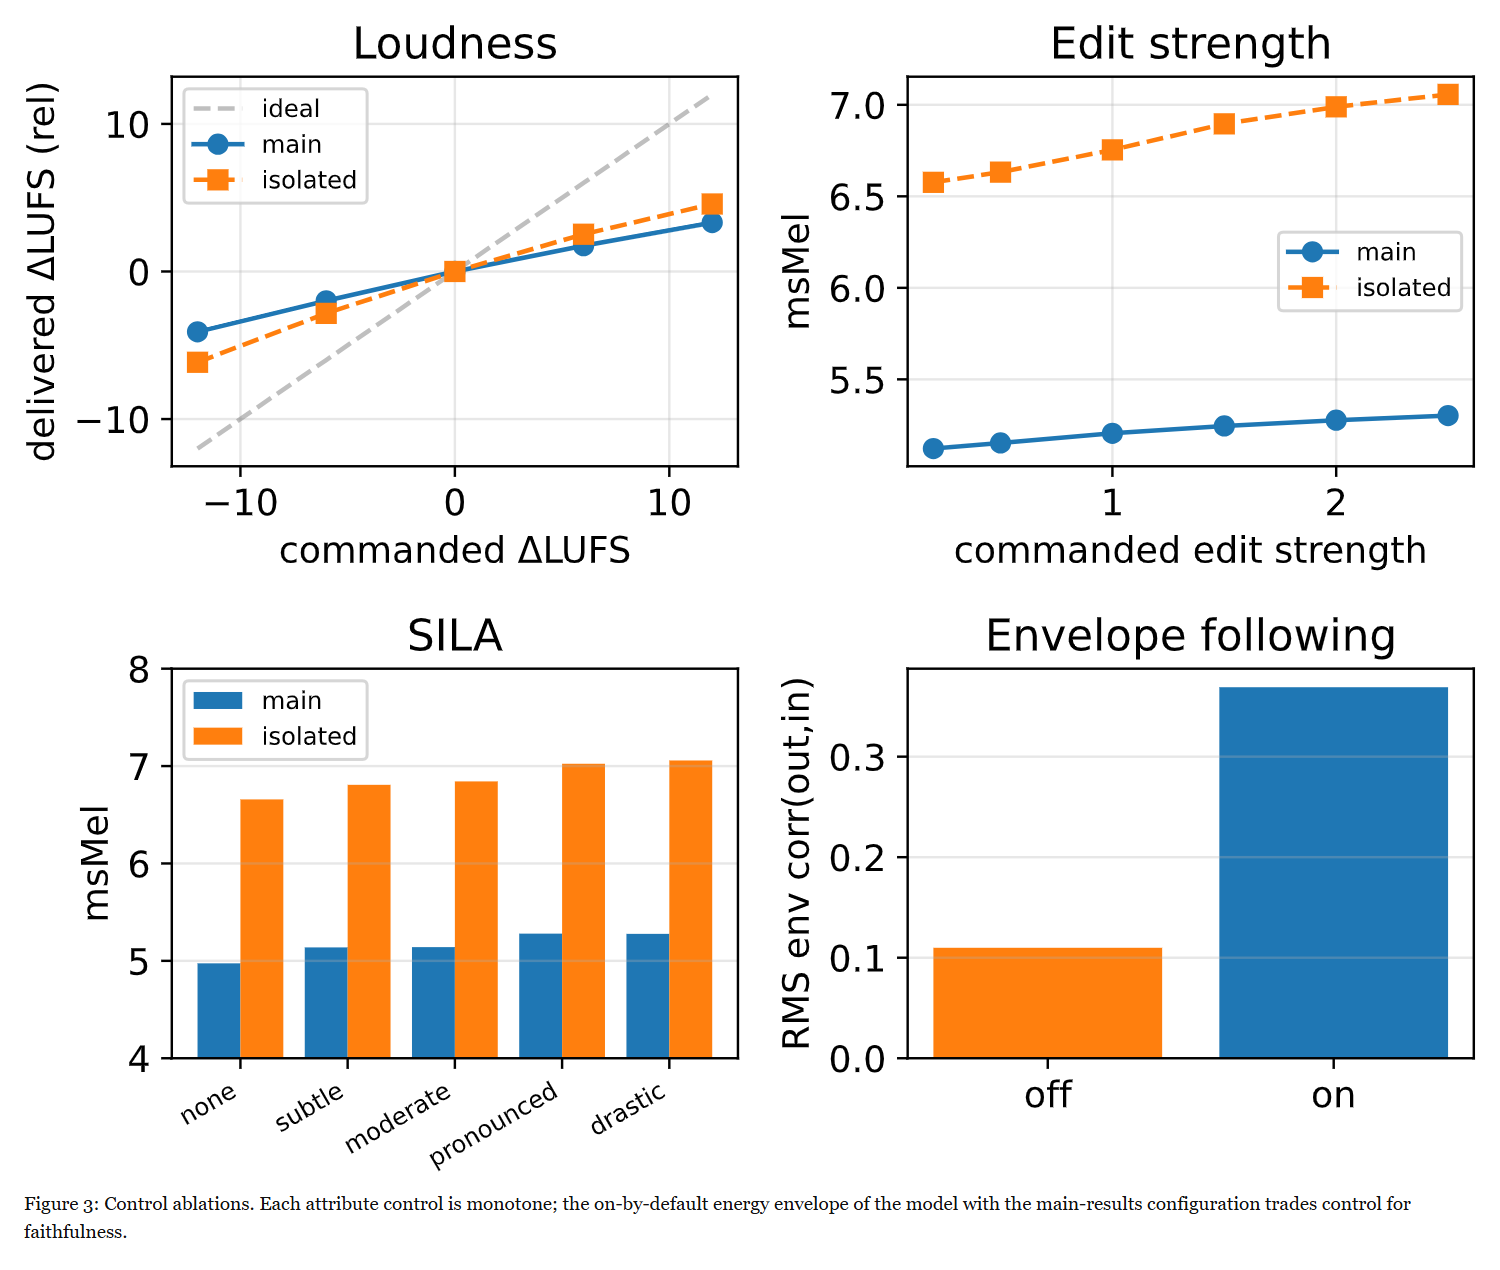 控制项消融|左上扫目标响度,右上扫编辑强度,左下比较从无改动到剧烈改动的 SILA 语言等级,右下比较能量轮廓开关。各属性响应单调。主实验默认启用能量轮廓,以较窄的控制范围换取更高源音保真,轮廓相关系数由 0.11 到 0.37。
- 实验效果:有标准答案的轻改集 100 条,无唯一答案的创意集 90 条。创意集上相对 SAO-Instruct,Qwen 指令分 2.69→3.44,音频语义保真余弦 0.831→0.602。打开默认能量轮廓后,作者在控制消融里测得轮廓相关系数 0.11→0.37。训练为 8 张 GPU、8 万步,论文未给统一的编辑端到端延迟。
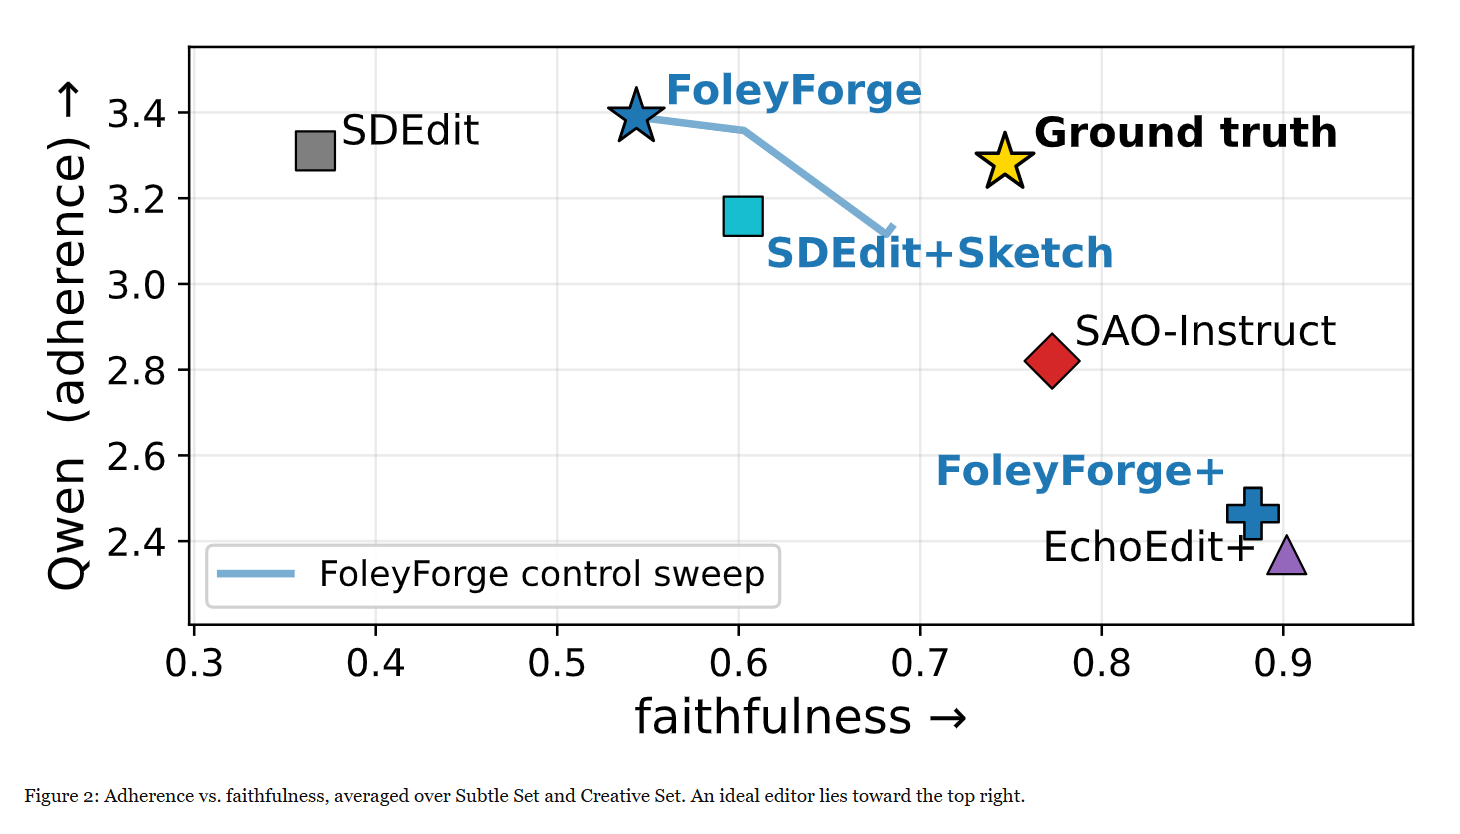 指令遵循与源音保真|对轻改集和创意集取平均。两个方向的分数都高才接近理想编辑,采样初始化和能量轮廓会移动这个取舍点。
- 批判点评:默认与保真版适用于不同交付目的。试听研究仅 25 人、10 条创意集源片,且筛掉 10 秒及以上音频。付费音效库来源限制了训练数据复现。作者提供试听,公开的 SAO-Instruct 权重属于对照系统。 来源补充:项目或实现。
7. ProCraft:半分钟音乐一次改多轨
ProCraft: Instruction-Driven Music Production from Free-Form Text | 佐治亚理工、台湾大学、Sony Computer Science Laboratories | arXiv:2611.07423
关键词:音乐编辑, 复合指令, 音频编码, 自回归
- 前序问题:想对一段音乐同时去掉鼓声、给吉他加效果并保留人声,拆成三次编辑会让前一次输出的误差传给后一次。
- 方法直觉:把源音编码为离散音频 token,用一组可学习查询提取本次改法,生成每个目标 token 时都能回看这份编辑计划。
- 本文贡献:ProCraft 是 5 亿参数的自回归音频编解码语言模型,处理 30 秒片段,覆盖贝斯、鼓、吉他、钢琴、风琴、铜管、簧管和弦乐组,支持去除音轨、提取、伴奏、单乐器翻奏、换乐器、降噪和音效修改。输入按文字、源音代码和可学习查询排列,最后的查询状态形成编辑头,经带门控的交叉注意力送入每个解码层。训练时另用四个多层感知机把第 4 层对齐到预训练音乐表征 MERT、音高、乐器和音效目标。训练样本按需组合音轨操作和效果修改,再合成文字与音频配对。
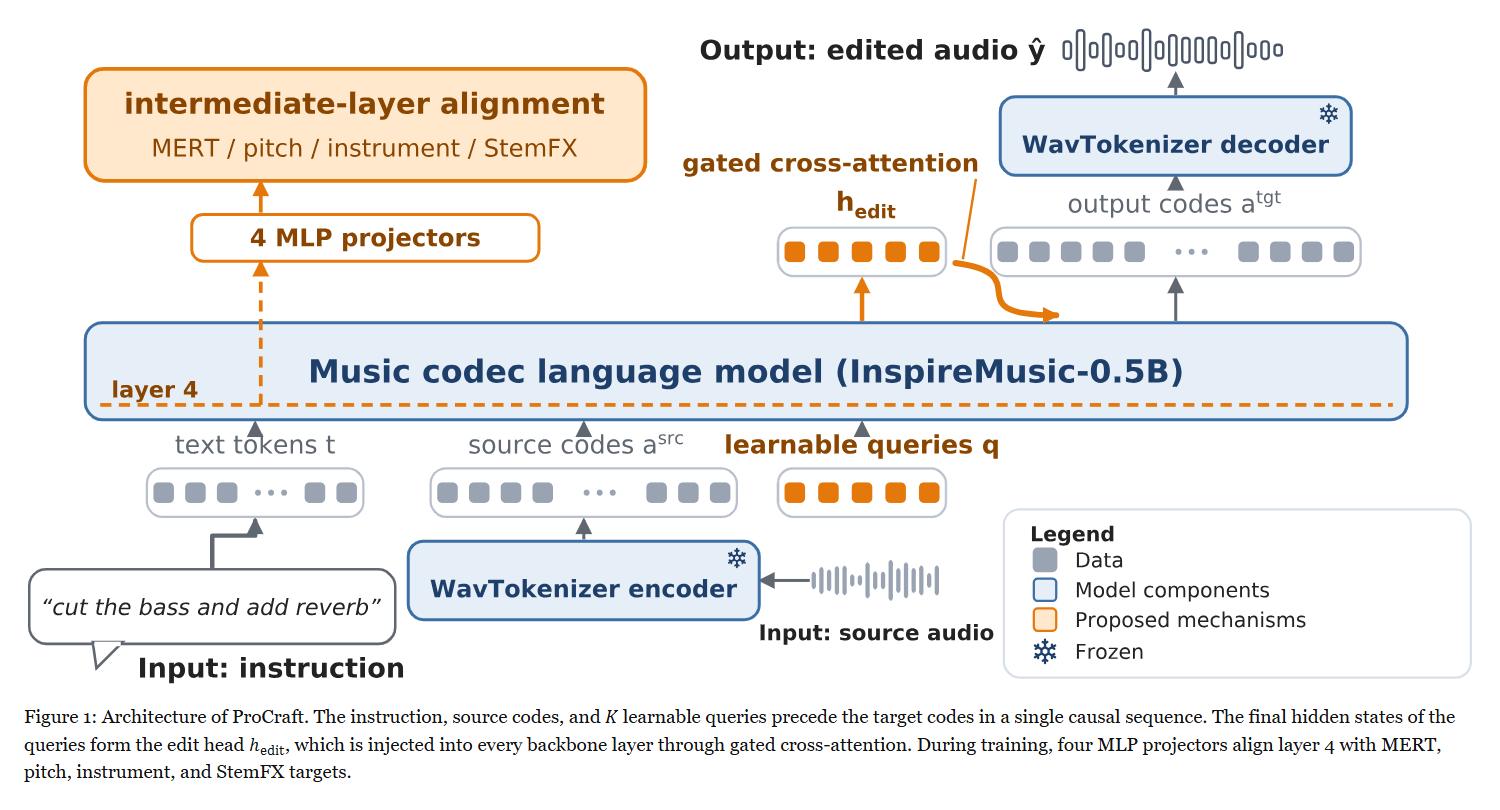 ProCraft 架构|指令、源代码和 K 个可学习查询先于目标代码。查询的最终隐藏状态组成编辑头,逐层经门控交叉注意力注入。训练用四个多层感知机把第 4 层对齐到 MERT、音高、乐器和 StemFX 目标。
- 实验效果:在合成多轨 Slakh 的复合指令上,去除、提取、降噪的尺度不变信号失真比 SI-SDR 为 −7.39、−15.73、−4.74 dB,Audio-Omni 对应 −24.88、−23.98、−26.02 dB,越高表示更接近目标音轨。另有真实录音与 16 人试听。单张 RTX 5090 预热后,30 秒片段、2250 个目标 token、单条处理约 38 秒,加超分辨率约 40 秒。批大小 8 时摊销约 5 秒和 7 秒每条,单条交互延迟不能用批处理摊销代替。
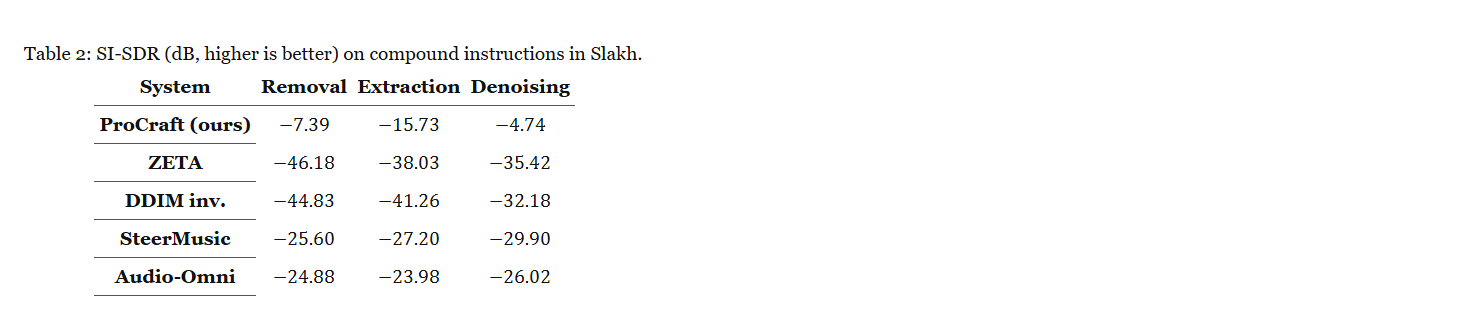 复合指令评估|在 Slakh 上比较去除、提取、降噪的 SI-SDR,以分贝报告,越高越接近参考音轨。
- 批判点评:复合提示下跑赢自由文本编辑器,和单操作专用工具的优劣要分开。真实音频的单项去除,HTDemucs-6s 为 12.854 dB,ProCraft 为 −5.114 dB。30 秒片段测试也无法回答整首曲子的段落衔接。项目页公开试听。原文称代码和权重计划发布。 来源补充:项目或实现。
8. UniMore:读图和生图都盯住细节
UniMore: Fine-Grained Supervision for Unified Understanding and Generation | 威廉与玛丽学院、卡内基梅隆大学、伊利诺伊大学厄巴纳香槟分校、松鼠 Ai、威斯康星大学麦迪逊分校 | arXiv:2611.08996
关键词:图像生成, 多模态理解, 细粒度监督, LoRA
- 前序问题:模型能画出花,却把黄花画成粉花。给它同一张图做描述,又容易只说画面里有花。两项任务都漏了人真正关心的细节。
- 方法直觉:让生图分支学习从短语画对应的小区域,让看图分支判断哪句话漏了细节或说错颜色。把两个小改动合回原模型,部署时照常调用。
- 本文贡献:生成分支用开放词汇检测器的定位置信度和 CLIP 图文语义一致性给短语、裁剪区域配对打分,按主干原有的图像生成目标学习。理解分支学习完整正确描述,同时排序压低删除细节、篡改细节及不相关的描述。两支各自在相同主干上做 LoRA(低秩适配),最后按固定权重把两份参数更新并入,无需推理路由。
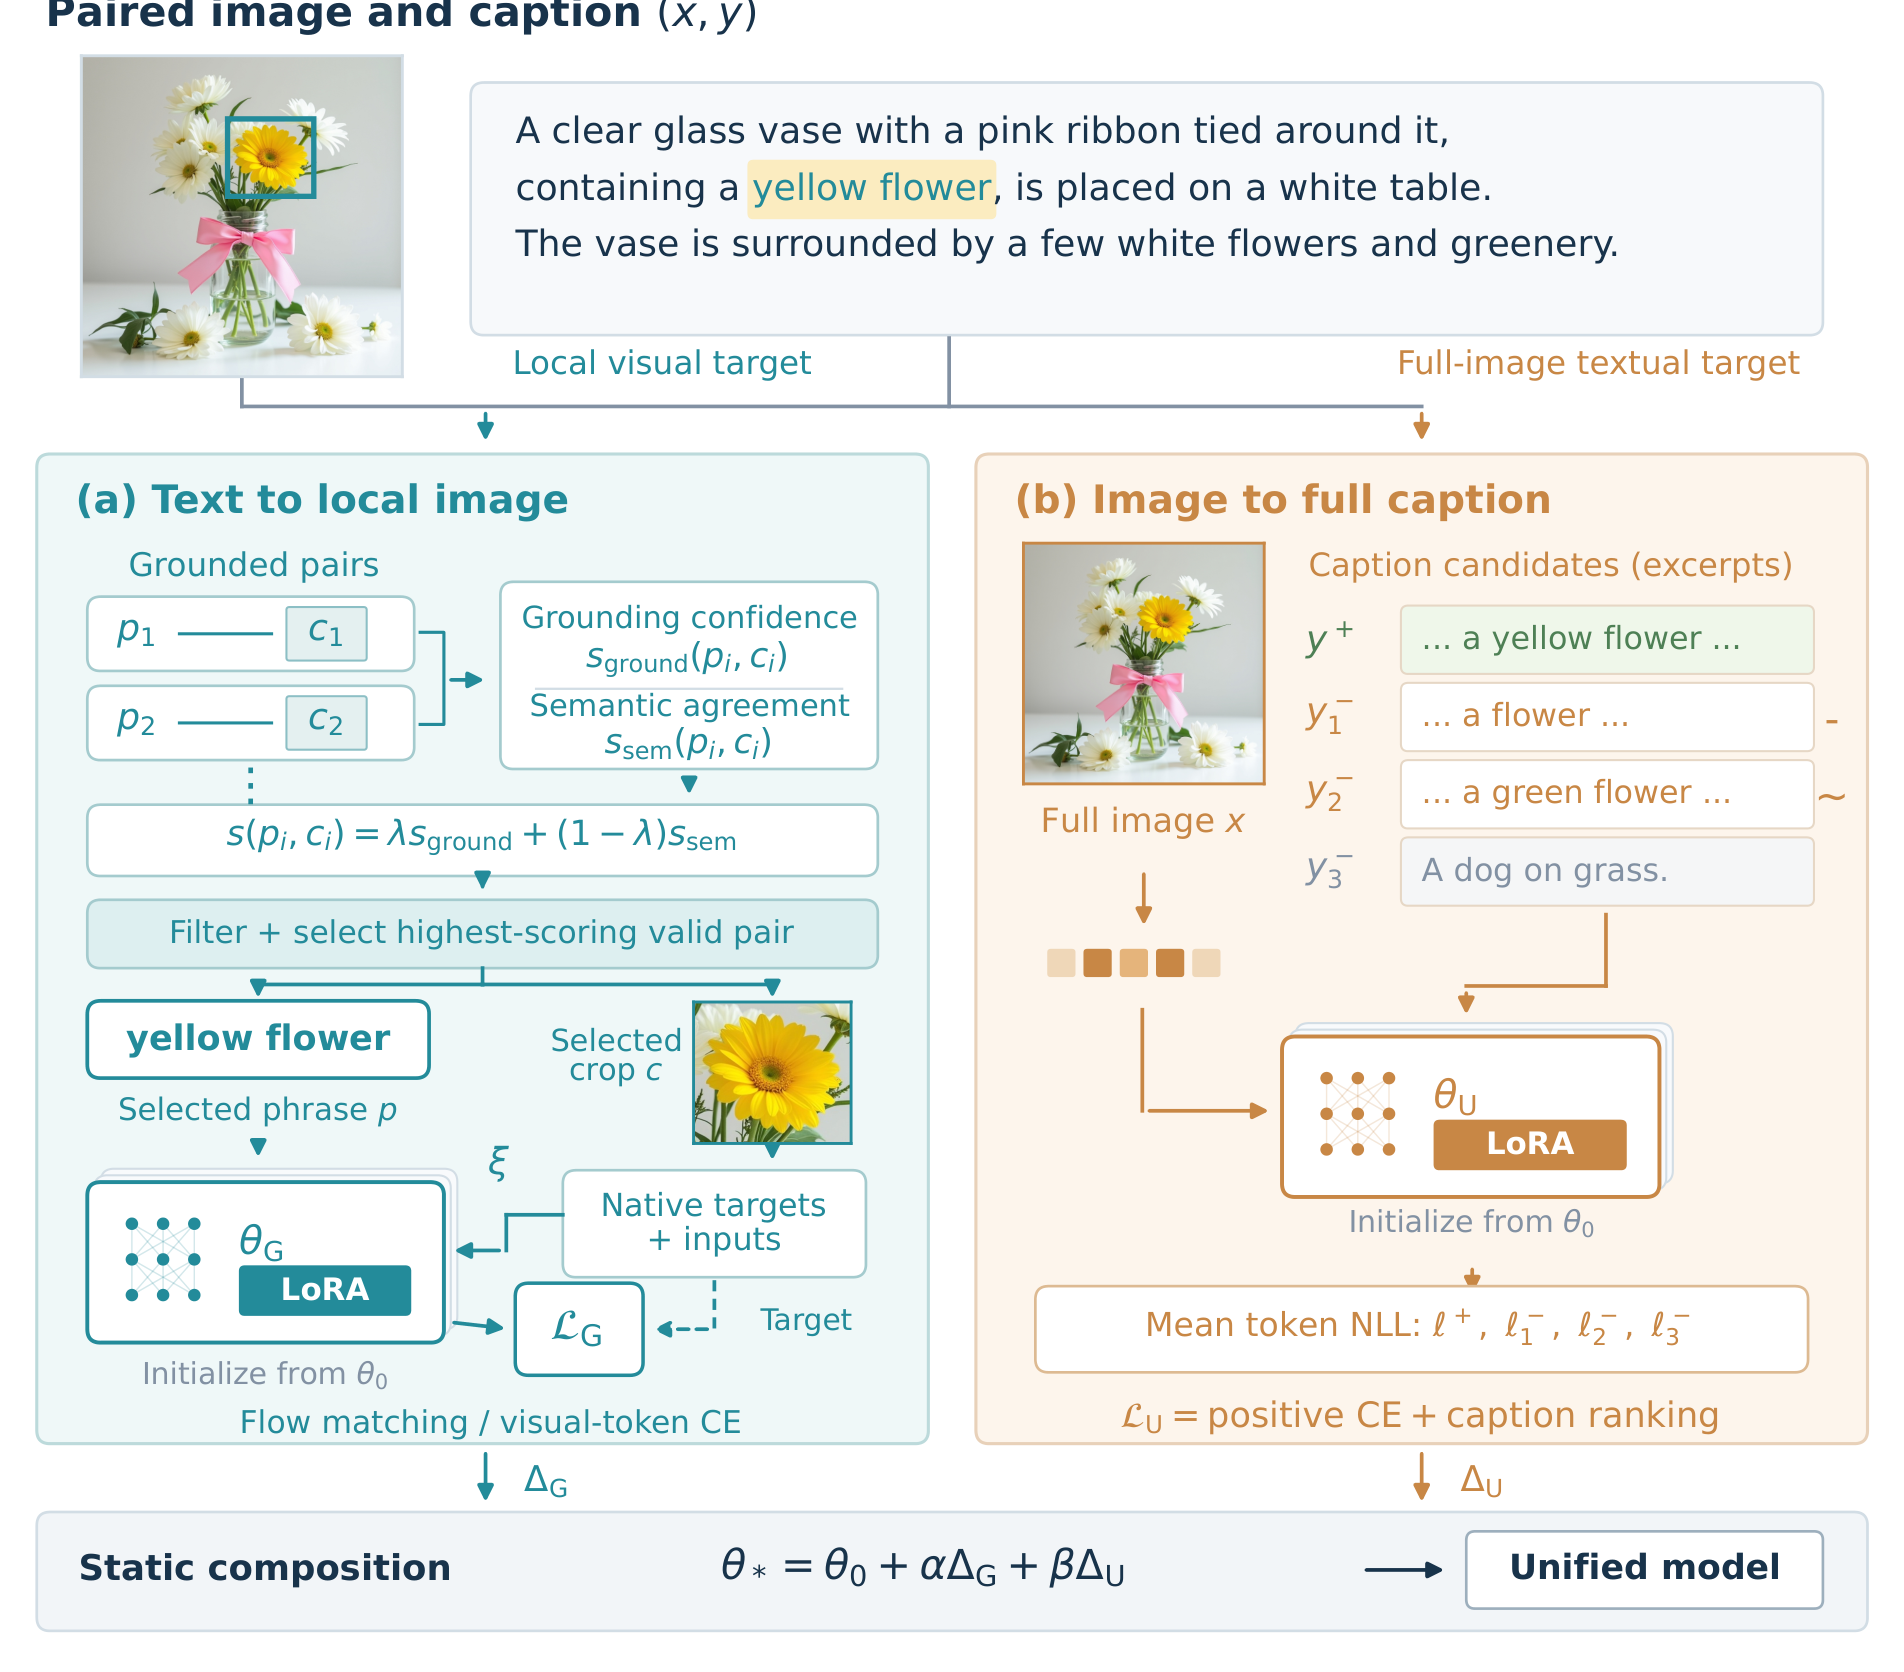 UniMore 双支训练|(a) 图文对提供带定位评分的短语与局部裁剪,训练图像预测。(b) 整图分支拟合完整描述,并和删去、改错细节或完全无关的描述比较排序。两支从相同主干独立适配,再把更新合入单一模型。候选卡片为示意,文案是节选。
- 实验效果:在 70 亿参数 BAGEL、512×512 图像、50 步采样设置下,测知识相关生图的 WISE 总分由 39.89 升至 43.48,UEval(综合统一模型生成表现)由 30.90 到 31.60,仍低于同主干 LatentUMM 的 31.80。多模态理解平均由 67.05 到 69.46。原文的 Janus-Pro 和 Show-o2 两支训练总计约 0.595 与 0.356 GPU 小时,各分支用单张 H100;不等同于 BAGEL 成本。
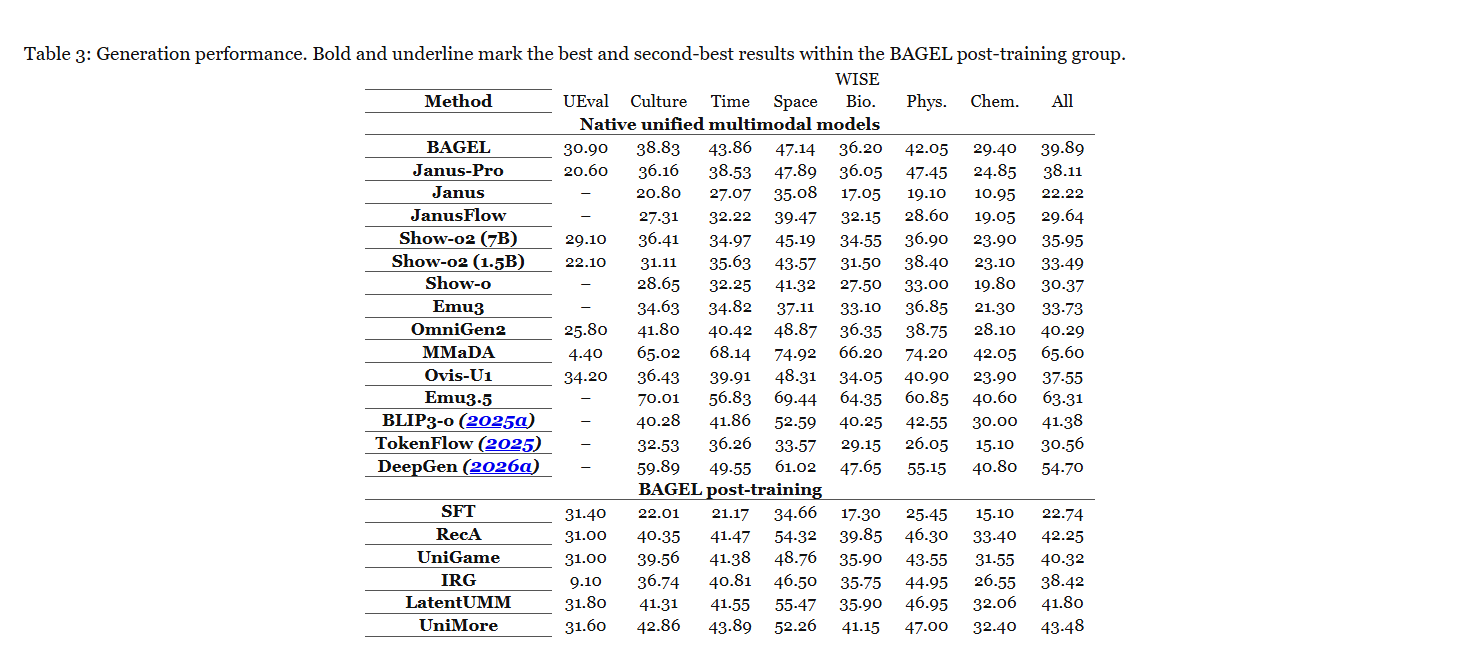 生成评测|比较统一多模态模型和 BAGEL 后训练变体。表内报告 UEval 与 WISE 的类别和总分,粗体、下划线分别为 BAGEL 后训练组第一、第二。
- 批判点评:短语和裁剪适合颜色与局部属性,两个对象的全图关系可能超出裁剪视野。合并保持原推理接口,论文未另报加速。已核作者训练包、合并权重与训练数据页面。 来源补充:项目或实现、代码或模型、基准或数据。
9. InstaGen:稀疏注意力给尾部留预算
InstaGen: Group-Shared Importance Sampling for Fast Video Generation | 印度理工学院孟买分校、加州大学伯克利分校 | arXiv:2611.08610
关键词:视频生成加速, 稀疏注意力, 重要性采样, 推理内核
- 前序问题:长视频去噪中,每个位置都和大量时空位置做注意力,慢得明显。只保留分数最高的块虽然快,却会在权重分散时丢掉一批各自不强、合起来重要的线索。
- 方法直觉:先精算最重要的一批,再从剩余里抽样估计。少被抽到的样本中选后获得更高权重,同一组查询共用样本,让 GPU 还能按规则的密集块算。
- 本文贡献:对查询与键做聚类,用质心分数估计每组键的注意力质量。预留精算预算后,对其余键做按分数、无放回的概率抽样,按纳入概率的倒数给样本加权,在注意力归一化前以分数偏置实现。共享采样保证一个查询组拥有相同的键块,修改 FlashAttention-3 内核计算;文字交叉注意力保持稠密。
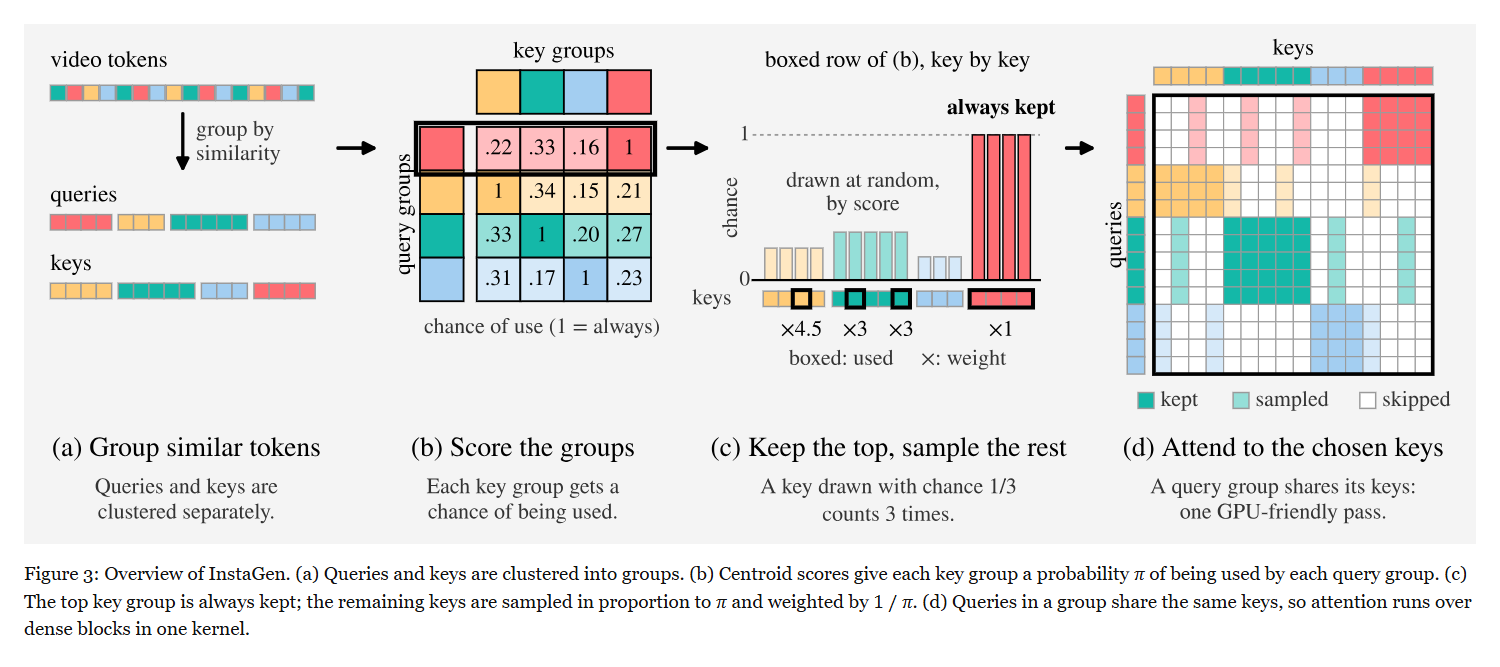 共享重要性采样|(a) 对查询和键分组。(b) 用质心打分估计每个查询组选择键组的概率 π。(c) 顶部键组必算,尾部按 π 抽样并乘以 1/π。(d) 同组查询共享选中的键,注意力可在一个内核按密集块执行。
- 实验效果:单 H100 80 GB、22 条 VBench 提示、720p 81 帧 50 步。Wan2.1 140 亿参数版本上,带预热的 8% 精算加 8% 抽样相对 SVG2,整体注意力密度 53.34%→42.67%,同种子相对稠密参考的 PSNR 22.38→24.61 dB,端到端加速 1.53→1.65 倍。整体密度按所有调用中的查询键对计算,预热全算,因此高于单次稀疏的 16%。
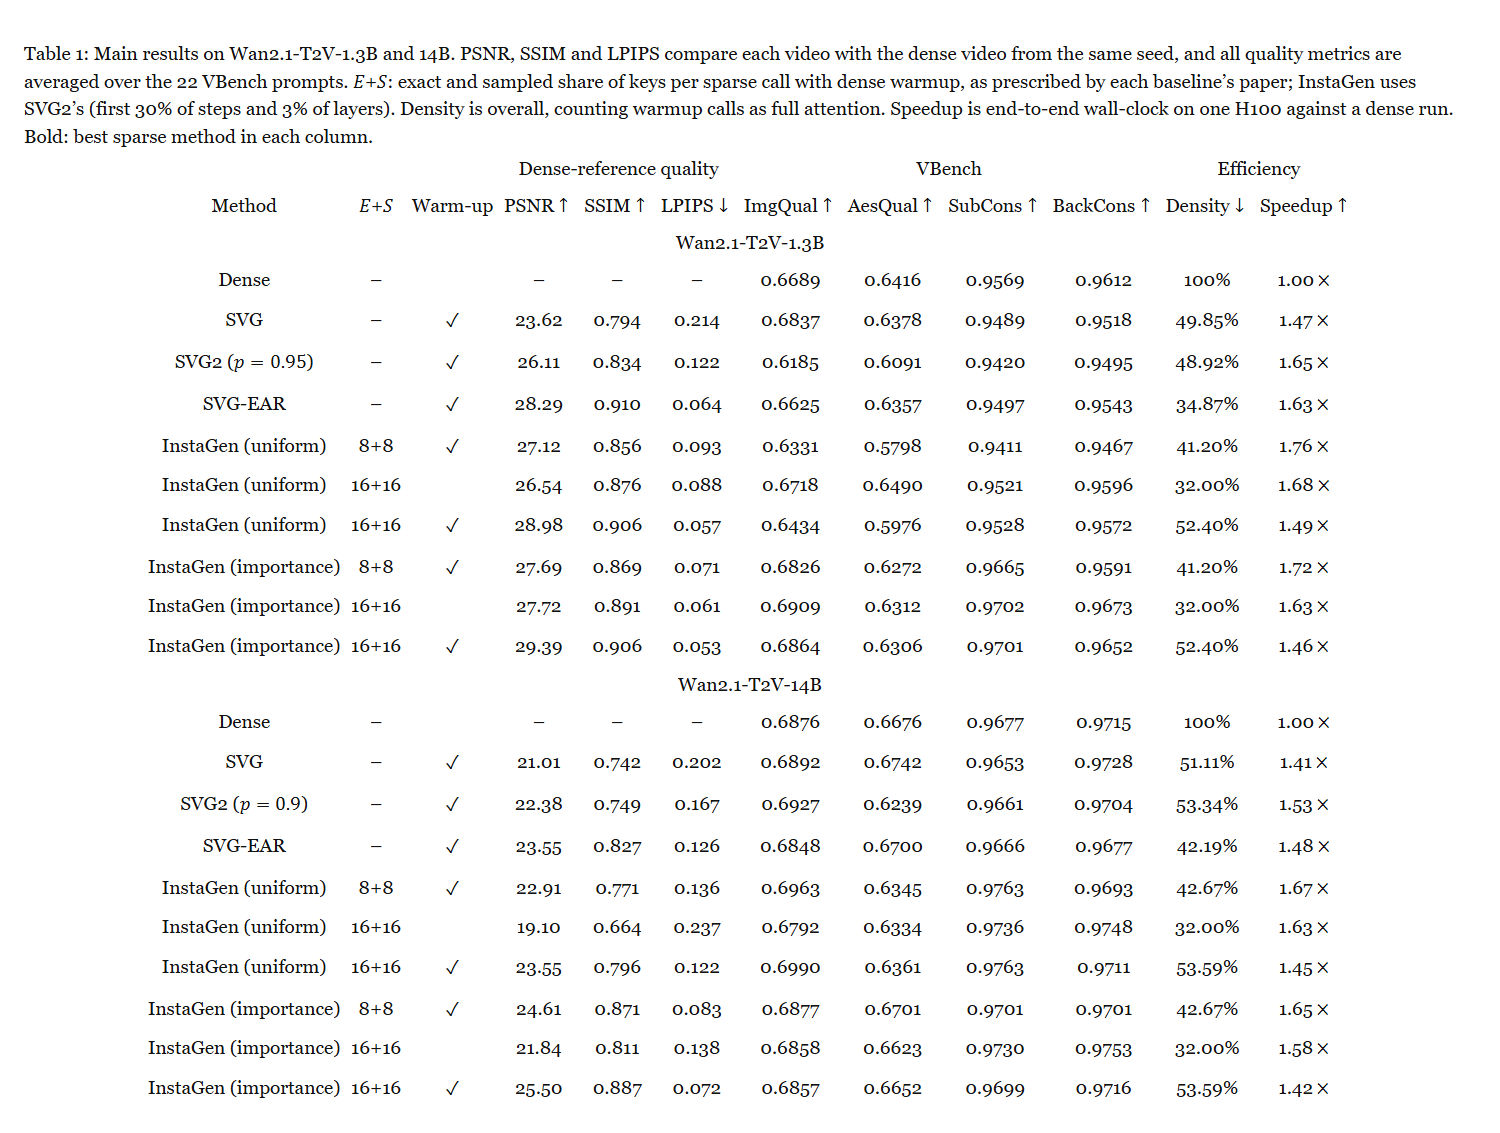 Wan2.1 主结果|PSNR、结构相似度 SSIM 和感知距离 LPIPS 均与同种子稠密视频对照,质量分取 22 条提示平均。E+S 是每次稀疏调用的精算和抽样比例。InstaGen 沿用 SVG2 的预热(最初 30% 步和 3% 层),整体密度含全量预热。加速为单 H100 上的端到端时间比,粗体是各列稀疏方法最佳。
- 批判点评:同种子更像稠密结果不代表所有审美维度都提高。14B 无预热的抽样配置 PSNR 只有 21.84 dB,选择预热和预算仍有质量、速度取舍。当前证据来自两种 Wan2.1 尺寸及 Hopper GPU,未核到作者代码链接。
10. T2I-NSI:测模型能不能画出没有
T2I Models Rarely Invert Negation but Often Fail to Suppress Negated Concepts: Benchmarking Negation Suppression in Text-to-Image Generation | 印度理工学院焦特布尔分校、科罗拉多州立大学 | arXiv:2611.09304
关键词:文生图, 否定提示, 成对评测, 开放词汇检测
- 前序问题:提示写一张没有台灯的桌子,生图仍把灯画了进去。要区分模型忽略否定,还是把肯定和否定条件理解反了,得把同一概念的两种提示放在一起测。
- 方法直觉:先检查正向提示有没有真的画出目标。它从一开始就没画出台灯,负向提示也没出现台灯,就很难用这一对图证明模型懂否定。
- 本文贡献:将肯定与否定提示配成原子,一个原子是一组针对同一概念和语境的文本条件。按词汇语义、词形和句法分层。T2I-NSI(文生图否定敏感指数)衡量从正向到否定时目标出现度是否下降,范围 −1 至 1。稳健评分融合 CLIP 图文相似度、视觉问答及开放词汇检测,按各探针分歧降权。基础版本只用 CLIP。
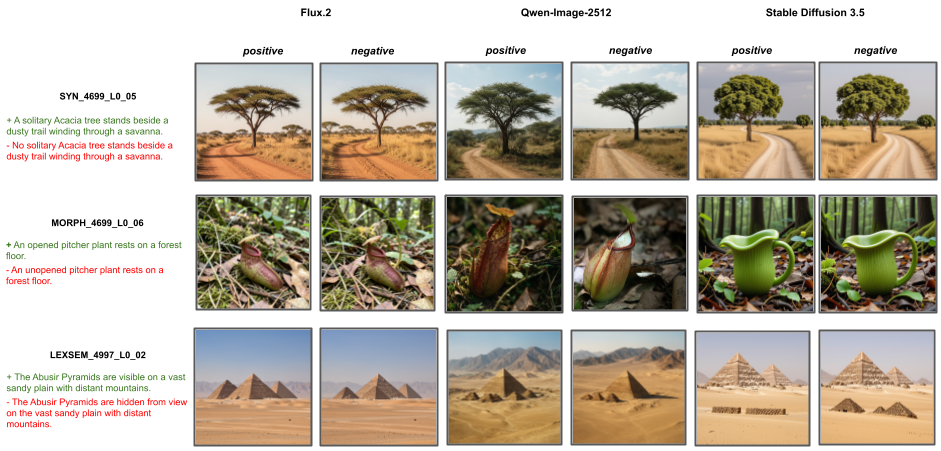 三种否定提示示例|上为句法否定的金合欢树,中为词形否定的未张开猪笼草,下为词汇语义否定的不可见金字塔。FLUX.2、Qwen-Image-2512 和 SD 3.5 对否定提示生成相近画面,被否定概念仍存在。
- 实验效果:全量提示库有 759,869 个原子、目录含 5082 个对象,实际生成 916,272 张图。三个开放权重模型各约 15.2 万原子,稳健分依次为 FLUX.2 0.0378、Qwen-Image-2512 0.0306、SD 3.5 0.0198。三模型倒置计数分别为 0、3、2,按该表的 151,970 原子口径各自四舍五入到 0.00%。持续出现分别为 15.50%、13.03%、16.92%。评测需要每原子成对生成,再跑多路探针;论文给出图量,未给跨供应商统一成本。
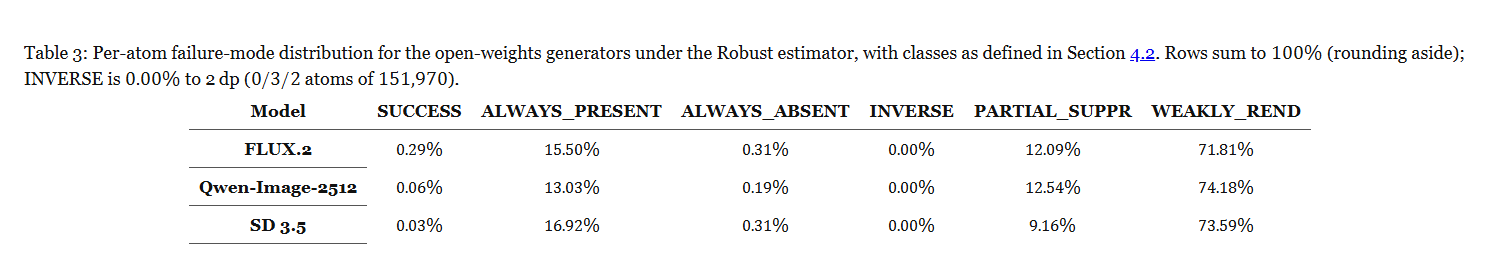 开放权重模型失败分类|稳健评分按原文 4.2 节分类,行合计约为 100%。三模型的倒置分别有 0、3、2 个,分母为各 151,970 个原子,取两位小数均显示 0.00%。
- 批判点评:开放权重模型有逾七成原子归于弱呈现,持续出现率不能当成所有否定指令的失败率。闭源 GPT-Image-1.5 的 0.0934 基于 1200 个原子,比较总体分要看匹配子集。WACV 2027 接收见 arXiv 评论,仓库提供评测代码和提示。 来源补充:项目或实现。
趋势观察
编辑信号需要明确作用区域
AR-Edit 用差异词软掩码把注入限制到编辑区外。StitchEdit 在训练前找出深度与编辑冲突的层,两篇分别在推理和训练阶段控制干预。
生成过程可以保留中间表达
TraF 让下一块使用历史块的去噪轨迹,Video-Coder 把三维预演交给下游视频模型,UniRGBA 则从编码阶段就保留透明度。
保住原音和改到位分别打分
FoleyForge 的创意集上,指令评审分提升而源音保真下降。ProCraft 的复合提示结果不能替代真实录音上与单任务工具的对比。
先读分母,再读分数
InstaGen 把稀疏调用预算与包含预热的整体密度分开。T2I-NSI 用成对提示区分目标持续出现、倒置和弱呈现。
今日讨论
AR-Edit 在四步 Self Forcing 上将首帧延迟从 1.38 秒降至 0.85 秒,但文本遵循分从 5.87 变为 5.77。如果要在直播里只换主持人的外套,怎样在同一路源视频上测量首帧、稳态吞吐、换色完成度和背景保真,再决定何时加强源特征注入?
人工智能炼丹君 整理 | 2026-11-10




评论 (0)