今日 AIGC 论文速览
今日共 10 篇 · 流式视频参考注入与视频修复 2 篇 · 图像身份与统一编辑 2 篇 · 参考加速与多样性修复 2 篇 · 图像生成训练 2 篇 · 可控音乐合成 1 篇 · 原生三维生成 1 篇
重点论文标题列表
ReferStream (新国大):新角色入场保住原场景TINDER (南洋理工):从坏帧反推噪声再去退化ALADDIN (Sumsub):一步换身份保留表情姿态FrameForge (中科大):用虚拟时间学不同图像改法ToDoPro (港大):先小图探路再省参考计算
选读入口:视频正在生成、希望临时加入参考角色,先读 ReferStream;已有视频模糊或低清,接着读 TINDER 并比较 4 倍超分的保真与感知冲突。改人脸身份选 ALADDIN,兼顾主体/边缘/指令三类改图读 FrameForge。多参考服务卡显存读 ToDoPro,四步模型总重复构图读 ReSeed。训练预算分配读 KnowThenDraw,联合训练损失低却出图崩读 SpeeDiff。想编辑弯音和力度读 GuitarLFM;最后再用 GenSfM 理解四张未标机位照片如何联合生成三维。
今日论文速览
1. ReferStream:新角色入场保住原场景
ReferStream: Interactive Subject Injection for Streaming Video Generation | 伯恩茅斯大学;新加坡国立大学;浙江大学;香港科技大学;之江实验室 | arXiv:2610.37566
关键词 :流式参考注入, 场景上下文, 临时缓存, 主体保留
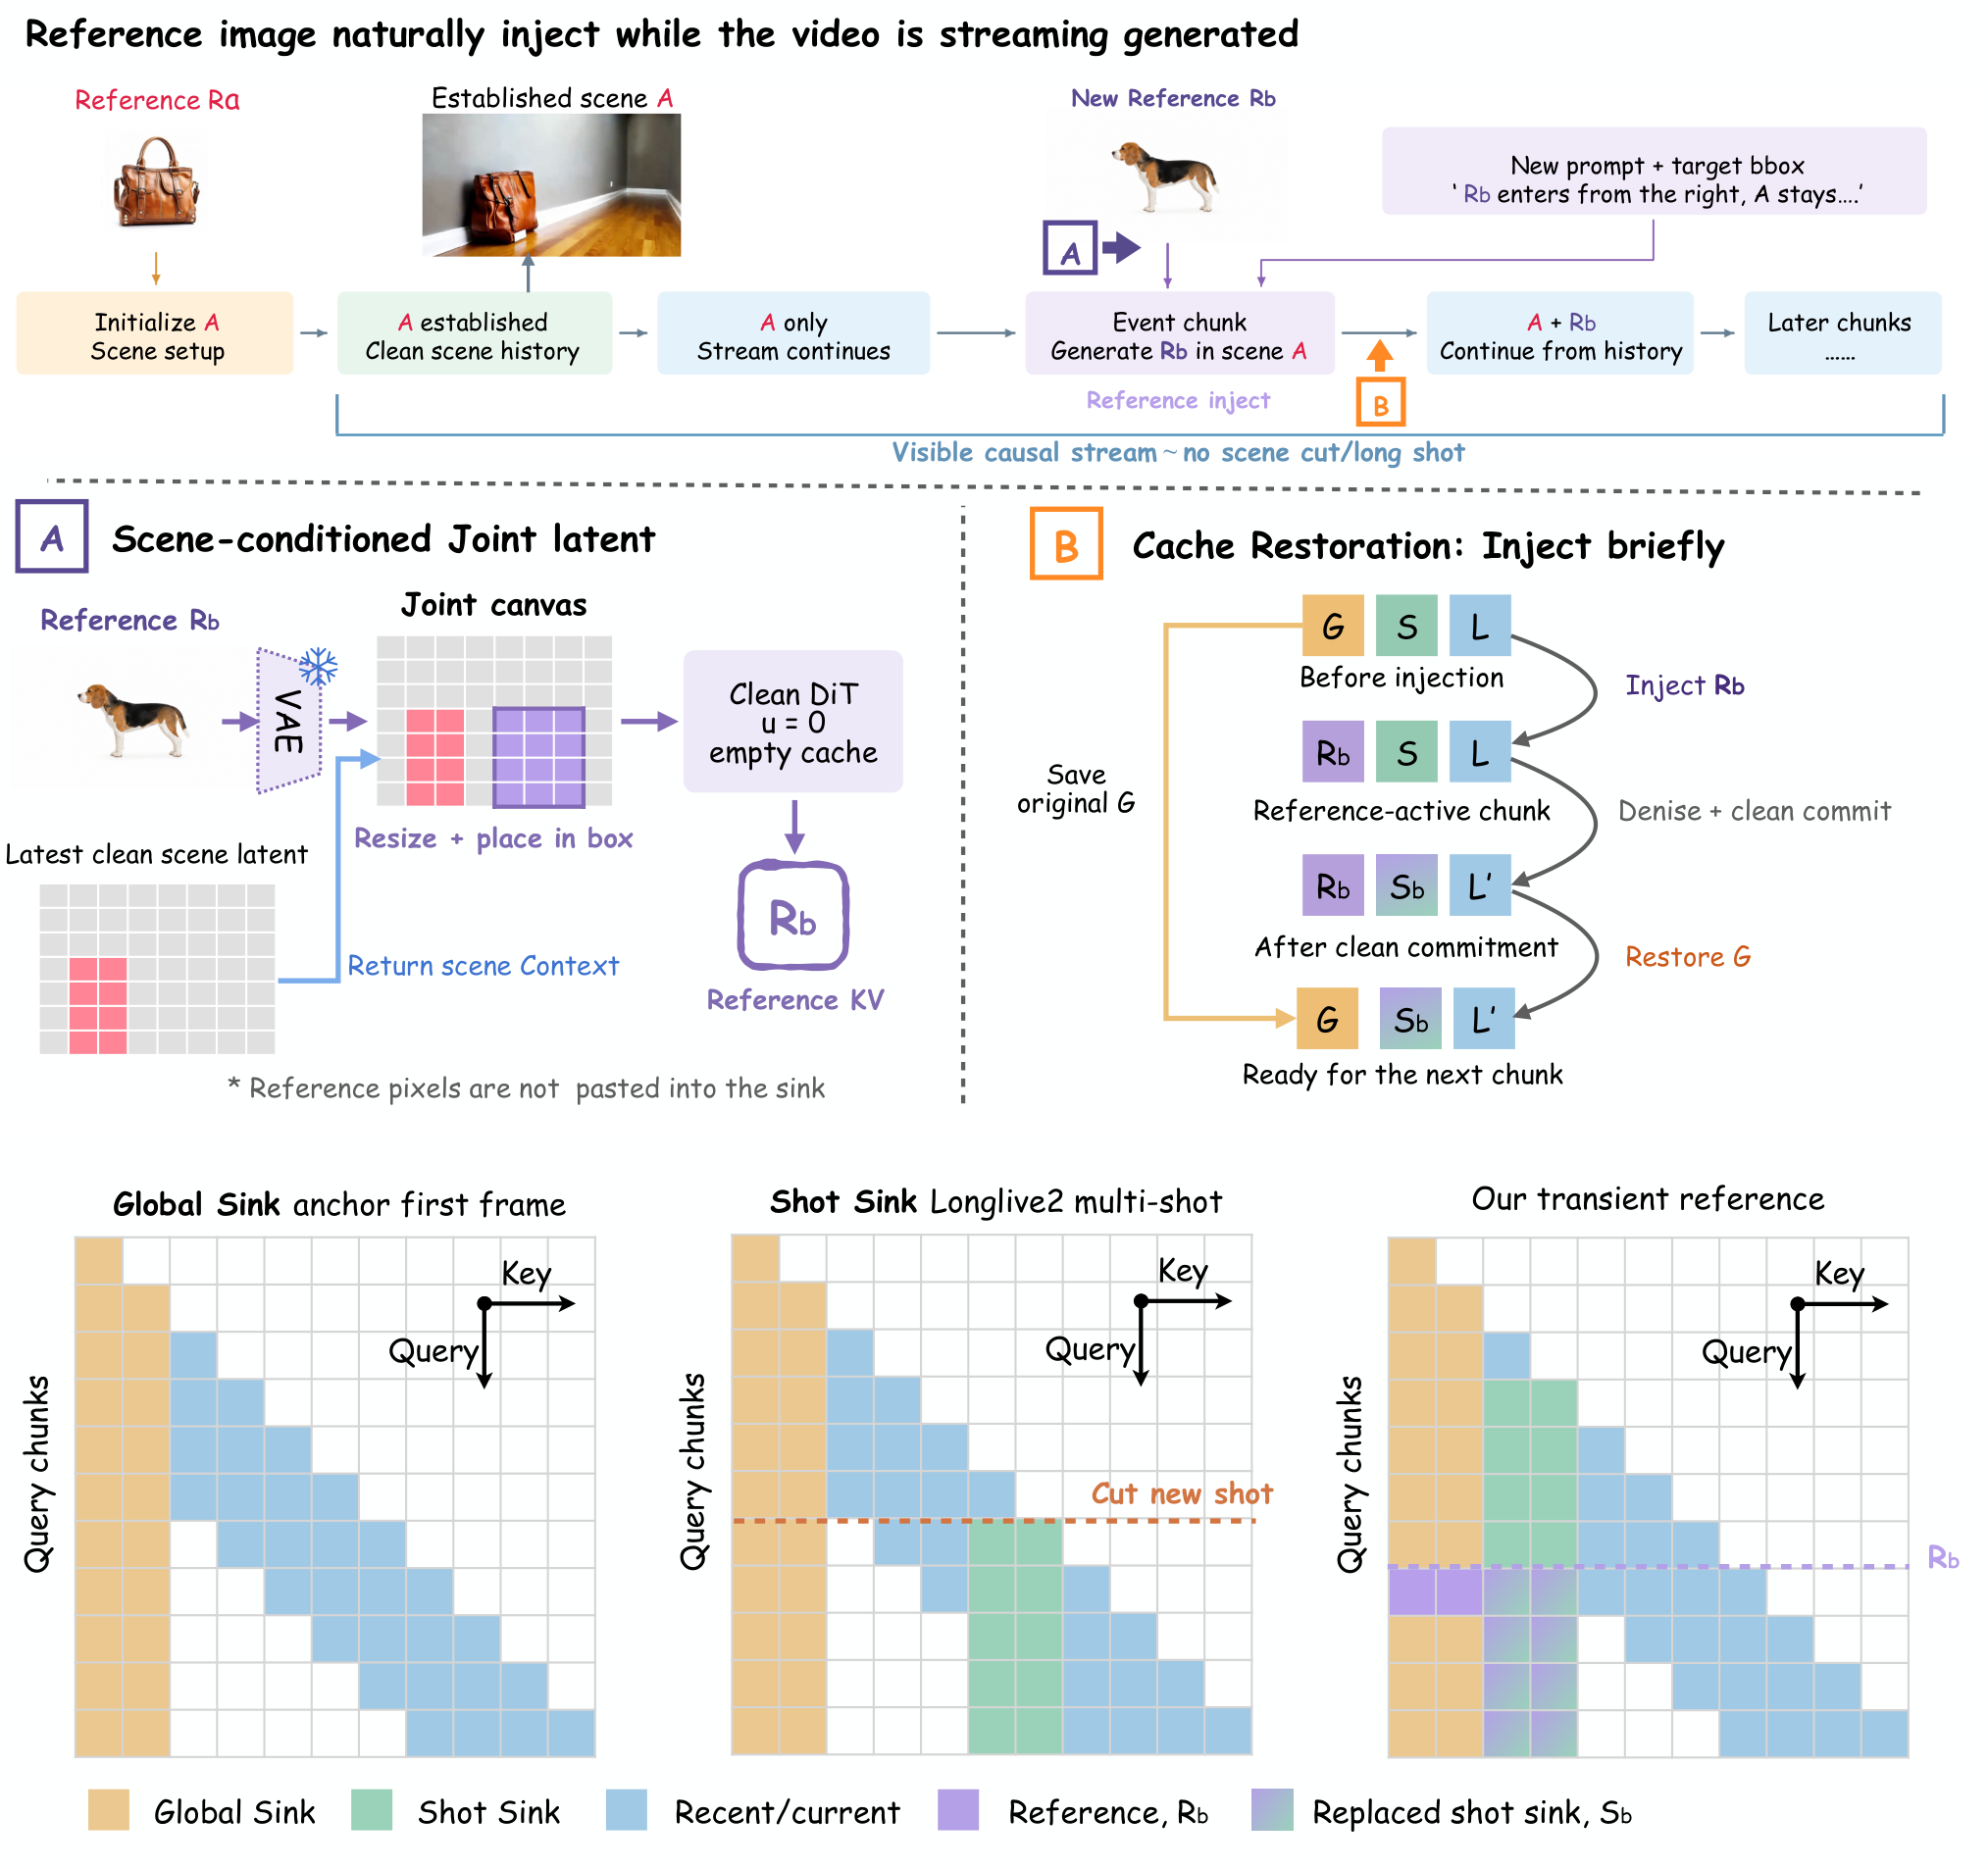
前序问题 :视频已经生成到雨伞镜头,这时才给一张黑猫照片,希望猫接着入场,伞还在。把照片长期塞进生成记忆,可能连伞和背景也改掉;已输出画面又不能重来。方法直觉 :先把参考放进当前场景的压缩画布,让模型在原场景里理解新角色;只在入场这一小段借用参考记忆,随后恢复原记忆。新角色继续依靠刚生成的视频历史留下来。本文贡献 :冻结 LongLive2-5B,无需额外训练。Joint Latent 将参考的 VAE(变分自编码器,将图像压缩并重建)的特征缩放到最新干净场景帧的指定矩形,再做一次干净前向,抽取注意力键/值 K/V。Cache Restoration 先备份全局缓存条目,注入参考,生成并提交当前 chunk(连续潜变量片段)后,仅恢复备份条目,保留新生成历史及推进的位置。默认每 chunk 8 个潜帧、4 个采样步;参考矩形不是前景分割,重叠处后写覆盖,位置只作软引导。
原文图 2|连续镜头入场示意。上:主体 A 已建立,参考 B 到达并约束下一片段。中 A:将参考与最新场景潜变量合成,干净 DiT 前向提取参考键值 R_j;中 B:备份全局 K/V、注入 R_j、去噪并提交后恢复备份,保留新局部历史 L′。S′为更新后的镜头锚点,无刷新时等于 S。下部是缓存访问示意,不是实测注意力;照片来自基准,后续生成是示意。
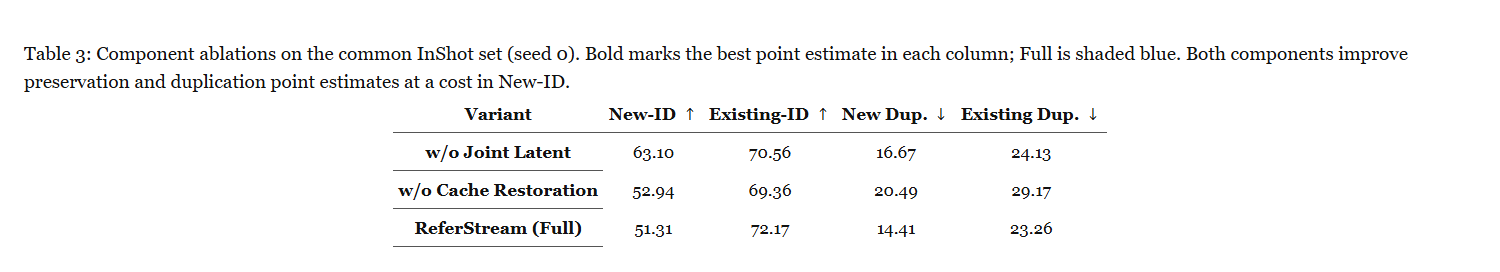
实验效果 :自建基准 68 条脚本,48 条连续镜头、20 条可切镜头;有不一致参考的条目统一排除,按有效案例等权。整体对无视觉参考的 LongLive2,新主体相似度 39.99→52.86、旧主体相似度 42.29→73.18,目标类别计数准确率 73.90%→82.33%。相似度是原值乘 100,不是身份识别准确率。共同单种子消融中,去掉场景合成/完整方法的新主体相似度 63.10/51.31、旧主体相似度 70.56/72.17,保留与引入有取舍。
原文表 3|共同连续镜头集合、种子 0 的组件消融。粗体为各列最好点估计,完整方法为蓝行。新/旧主体相似度越高越好,新/旧重复率越低越好;场景合成和缓存恢复都改善原主体保留与重复指标,但代价是新主体相似度下降。
批判点评 :这是生成中的参考注入,不能回改已输出帧。离线基线提前得到全部参考,输出分辨率和帧率也不同,不能据分数声称更快;额外干净前向和 K/V 备份尚无统一时延/显存账单。基准是开发型精选集合,检测漏检、自动时间对齐和单种子影响结论。项目 的仓库目前为网页与演示素材,未核到生成实现。
2. TINDER:从坏帧反推噪声再去退化
Taming Noise Initialization for Zero-shot Video Restoration with Image Diffusion Priors | 南洋理工大学;河北工业大学;瑞典皇家理工学院;深圳北理莫斯科大学 | arXiv:2610.37290
关键词 :零样本视频修复, 噪声初始化, 自适应频域混合, 轨迹注意力
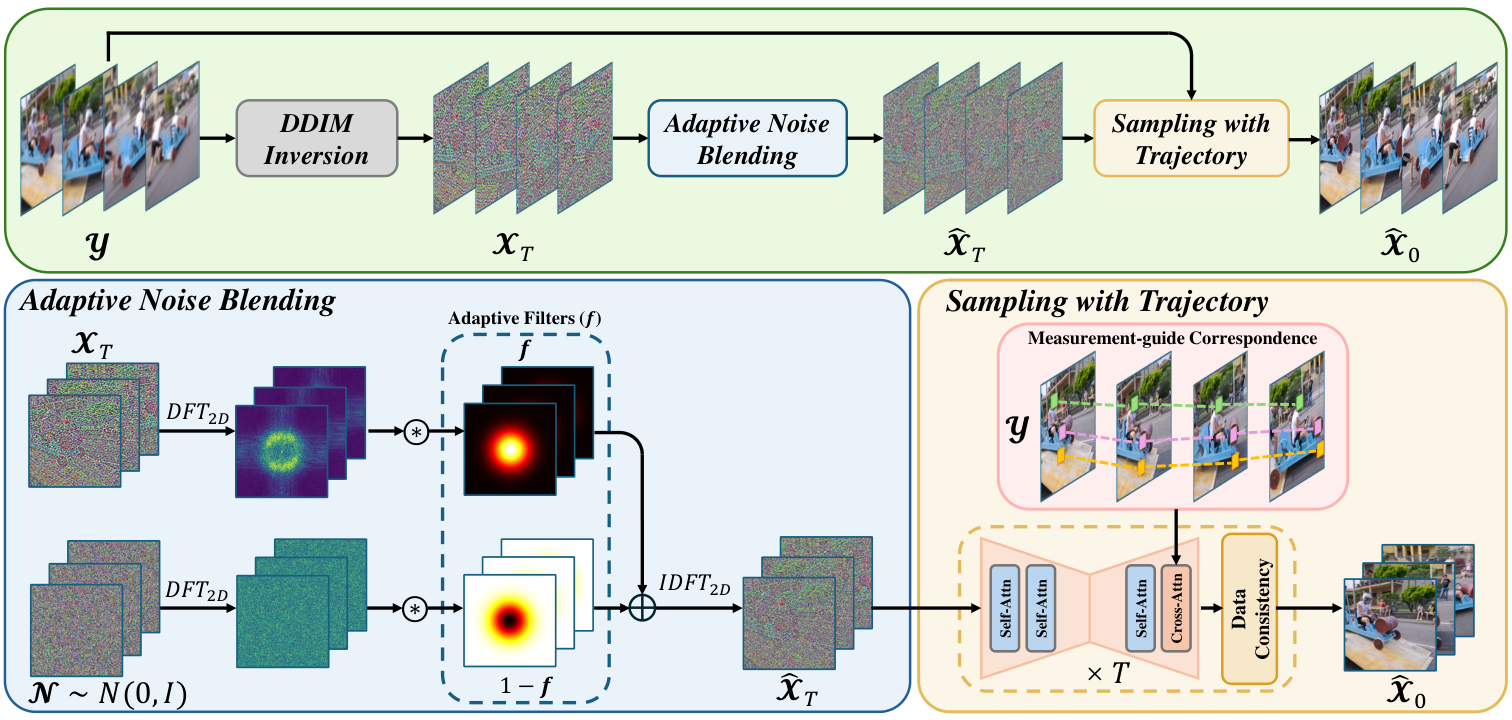
前序问题 :用图像扩散器逐帧修模糊视频,单帧好看却会闪。独立噪声丢掉帧间关联,同一噪声又不反映物体运动;从坏帧反推噪声,还可能把模糊纹理一起带回去。方法直觉 :让初始化先记住原视频怎样连续变化,再保留较可靠的低频结构、用随机噪声替换受污染频率。恢复时让相邻帧中对应区域互相参照,同时约束结果符合已知退化测量。本文贡献 :原文称 TINDER:先做 20 步 DDIM 确定性扩散反演,将退化帧映射回相关初始噪声;按各帧频域能量选择高斯低通截止频率,以 η 表示保留能量比例,再混入高频高斯噪声。MGTA(测量引导轨迹注意力)从坏帧的邻帧 patch(局部图块)匹配建立对应,只在采样的 UNet(U 形多尺度去噪网络)解码层沿轨迹聚合特征;在反演时加入该注意力反而强化退化。DDS 或 DiffPIR 负责每步的数据一致性,无需再训练视频底座。
原文图 2|TINDER 总览:从退化视频做 DDIM 反演生成具有原时序关联的噪声,再用自适应噪声混合抑制反演中保留的退化、使噪声趋向高斯;采样过程中再以测量引导轨迹注意力利用帧间关联。
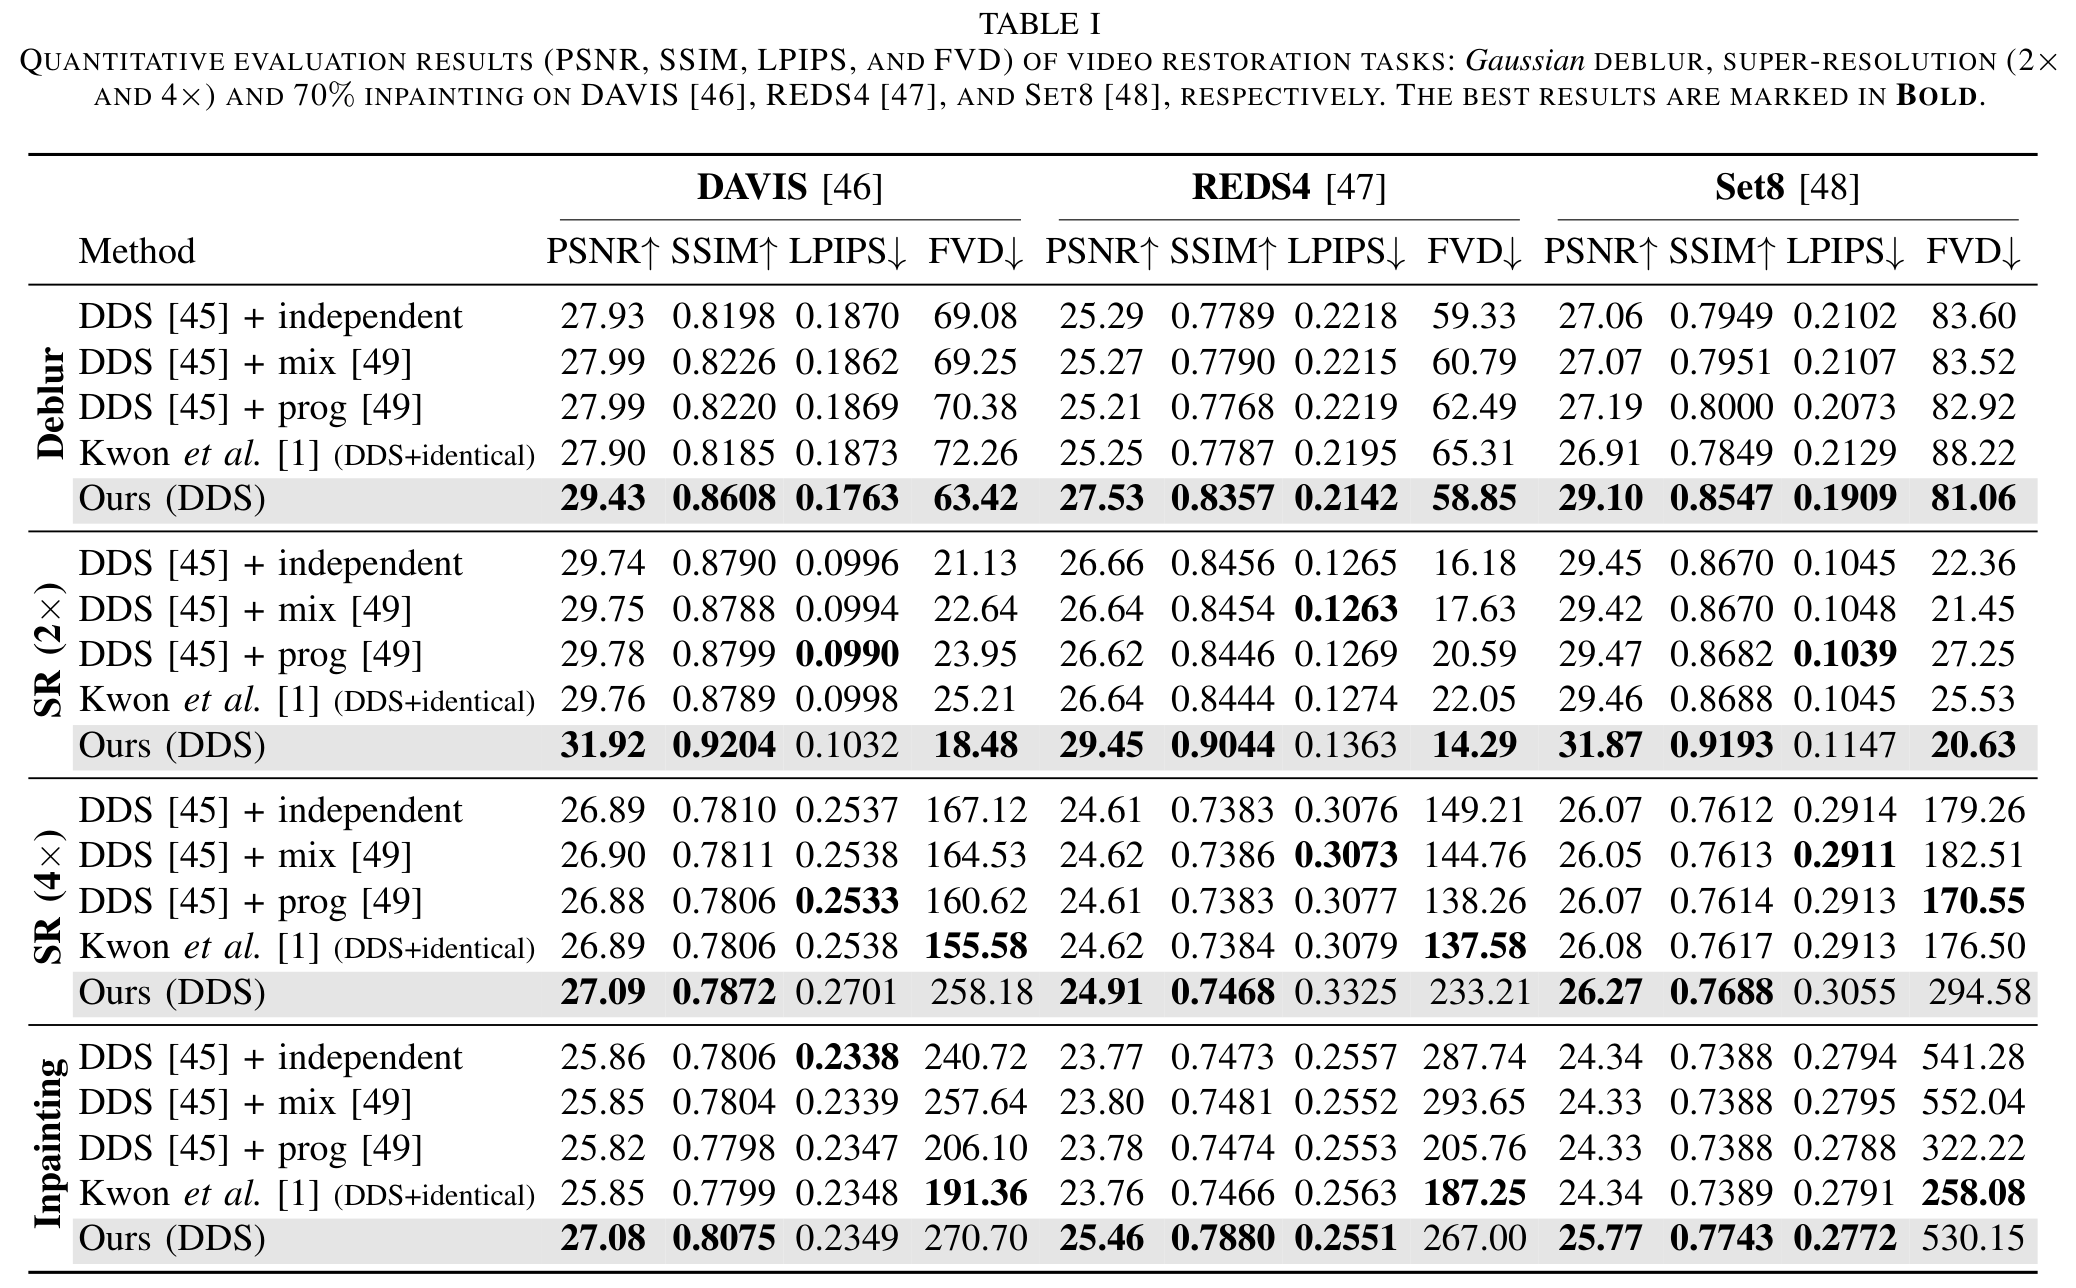
实验效果 :DAVIS、REDS4、Set8 各取 100 段、每段 16 帧;测 13×13、标准差 2.0 高斯模糊、2/4 倍超分及随机 70%像素缺失。同 DDS 下 DAVIS 去模糊对同噪声基线,PSNR 峰值信噪比保真分 27.90→29.43 dB,LPIPS 感知距离 0.1873→0.1763,FVD 视频分布距离 72.26→63.42,后两者越低越好。RTX A5000 上整流程 9.67→20.18 秒/视频;MGTA 约多 1.94 秒和 500MB,采样另需 20 或 50 步。
原文表 I|DAVIS、REDS4、Set8 的视频去模糊、2 倍/4 倍超分与 70%随机缺失修补定量比较;PSNR 和 SSIM 越高越保真,LPIPS 感知距离和 FVD 视频分布距离越低越好,粗体为最优。4 倍超分保真略升而感知/视频距离变差;修补也非所有指标领先。
批判点评 :4 倍超分的 DAVIS PSNR 26.89→27.09,却伴随 LPIPS 0.2538→0.2701、FVD 155.58→258.18 变差,不能写成全面修复领先。任务依赖已知退化和可靠对应,未证明真实未知混合退化同样有效。正文说 70%缺失,超参数表却标 10%,本稿沿主设置并披露冲突;arXiv 评论只列期刊名,不据此宣称已接收。原文未给可核实代码入口。
3. ALADDIN:一步换身份保留表情姿态
ALADDIN: Adversarial Latent Diffusion Distillation for One-Step Identity Swapping | Constructor 大学;Sumsub | arXiv:2610.37503
关键词 :一步身份编辑, 对抗训练, 伪标签三元组, 独立身份评测
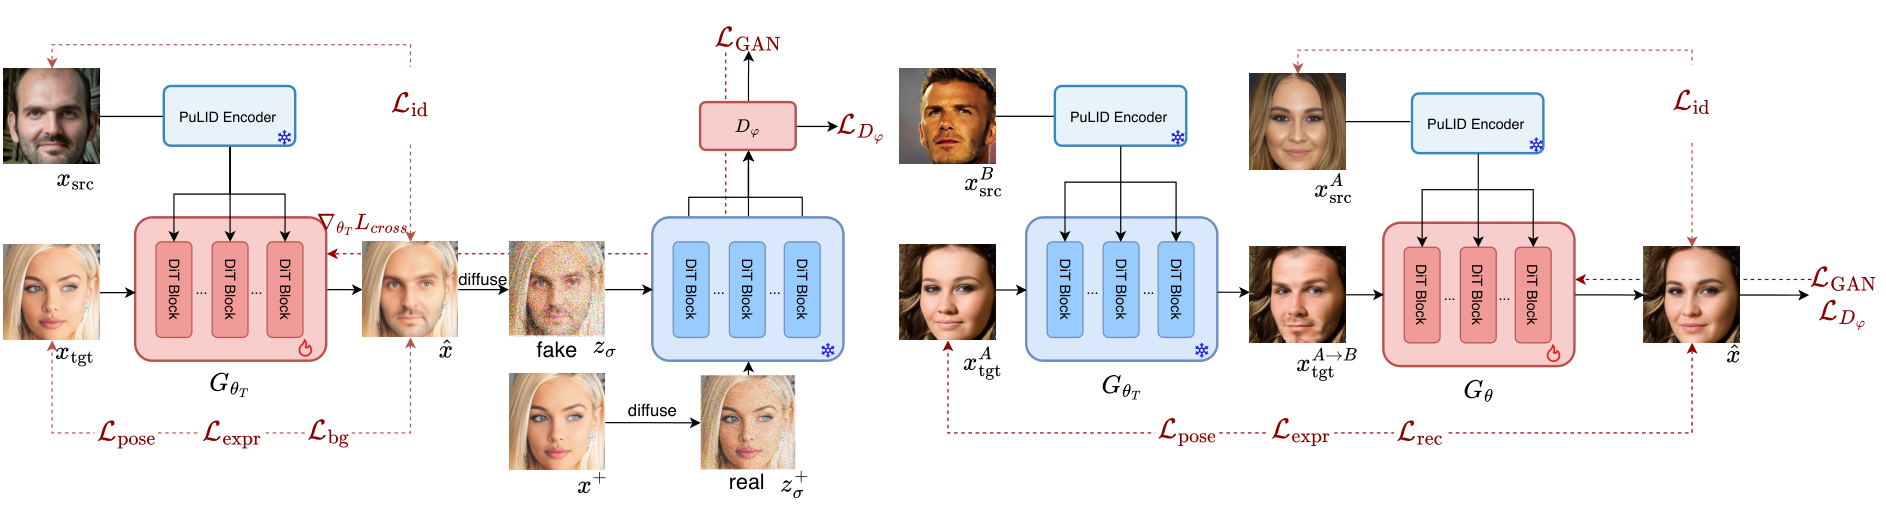
前序问题 :换上参考人物的身份,还要保留目标照片的表情、头发和眼镜。多步扩散耗调用次数,纯对抗生成又容易损失真实感;如果训练与打分用同一个人脸编码器,指标还会偏向熟悉它的方法。方法直觉 :借预训练流模型的生成能力直接做一步修改,再借同一冻结模型的中间特征判断真假。先换成别人,再让学生换回本人,用原照片监督,获得真实感与身份强度之间可调的折中。本文贡献 :以 FLUX.1-Krea-dev 初始化,冻结 VAE 和底座,训练秩 64 LoRA 低秩适配及 PuLID 身份交叉注意力;目标潜变量按固定噪声级 0.2 做一次速度更新。判别器读取冻结扩散器四层特征,身份、姿态、50 维几何表情及脸外掩码损失约束输出。老师混合跨身份/同身份对训练,学生用老师在线生成的三元组伪目标与感知重建训练;这不是每步模仿老师轨迹的常规蒸馏。
原文图 2|ALADDIN 训练。左:老师接目标和冻结 PuLID 源身份,单步生成,由身份、姿态、表情和背景损失约束;生成/真实图的潜变量加相同噪声级后经冻结扩散器,中间特征供判别器判断真假。右:冻结老师将身份 B 移到 A 的目标图;学生从老师初始化,把 A 换回伪目标,用真实 A 目标图作重建监督。
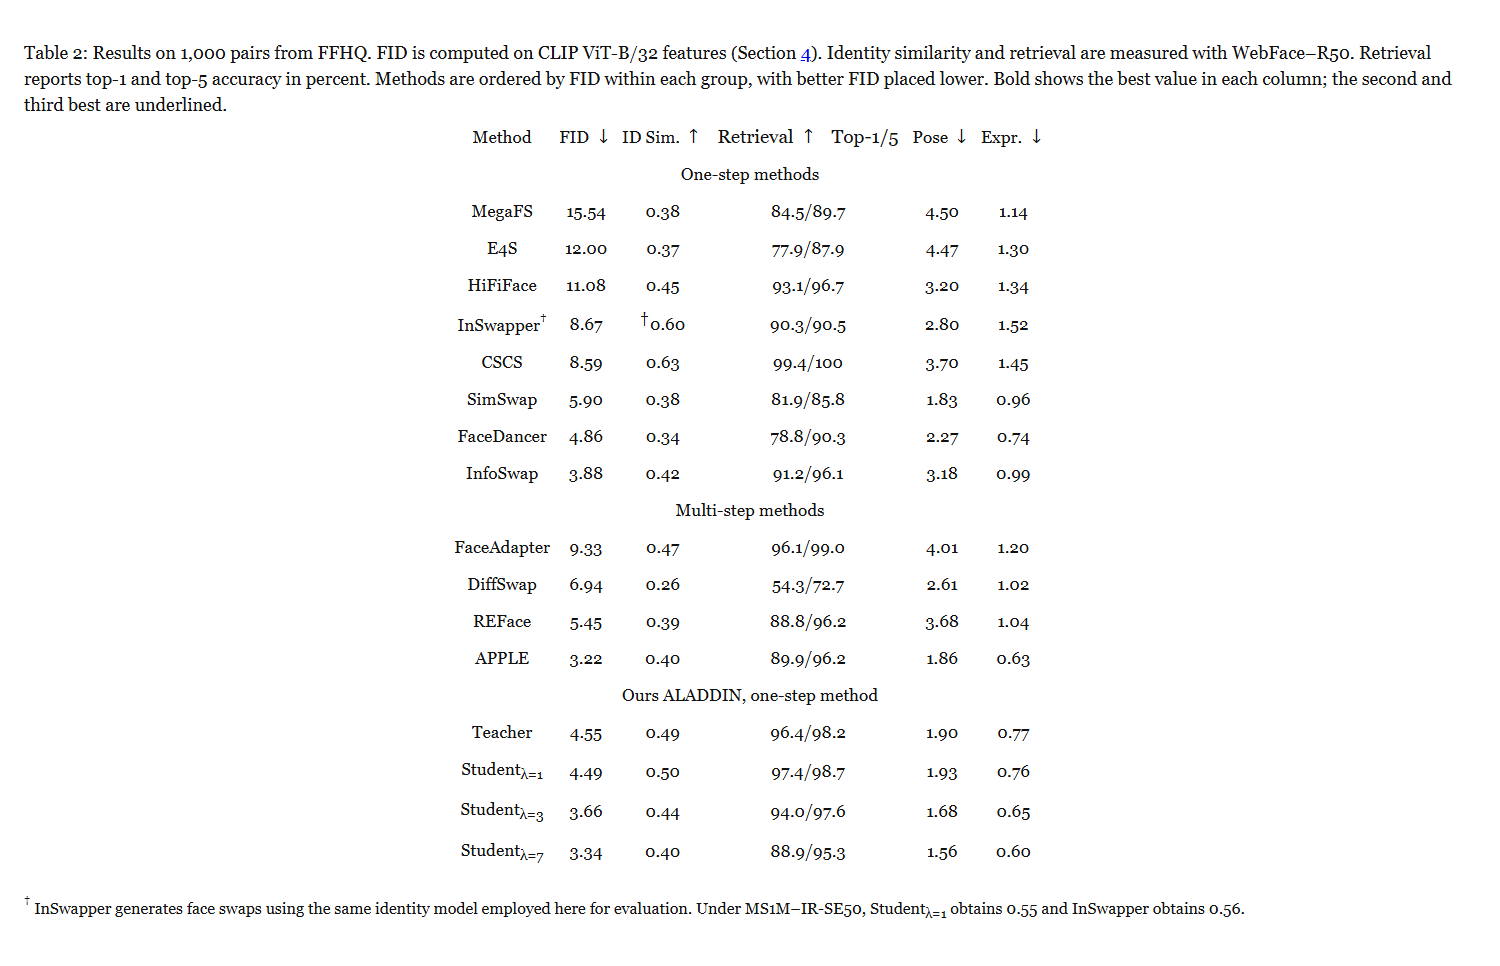
实验效果 :512×512、固定 1000 组 FFHQ,独立 WebFace-R50 评身份。学生重建权重 7 对 APPLE,身份相似度同为 0.40,CLIP 特征分布距离(文中称 FID)3.34/3.22,姿态误差 1.56/1.86、表情误差 0.60/0.63,误差越低越好。生成器 1 次网络评估对 28 次,不等于整流程快 28 倍。4 张 H100 上,老师 10 万图对约 4.5 小时,学生 1.5 万图对约 50 分钟;训练集本身有 410 万图像,不能写成只需 10 万张原始数据。
原文表 2|FFHQ 固定 1000 图对比较,FID 使用 CLIP ViT-B/32 特征;身份相似度与 Top-1/Top-5 检索率由 WebFace-R50 计算,检索率以百分数报告。组内按 FID 从差到好排列;粗体/下划线标领先值。InSwapper 用同一评分身份模型作条件;换独立 MS1M 编码器,学生权重 1 为 0.55,对 InSwapper0.56。姿态和表情误差越低越好。
批判点评 :增大重建权重会削弱身份迁移:权重 1/7 相似度 0.50/0.40。大年龄差、少见身份和纹身保留仍失败;分布距离采用 CLIP 而非标准 Inception 特征,不能横比通用 FID。InSwapper 用评分编码器作条件,仍有例外。arXiv 明确写 Accepted to WACV 2027;未找到作者方法代码,不把引用的 FLUX 仓库当实现。
4. FrameForge:用虚拟时间学不同图像改法
FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation | 中国科学技术大学;FrameX.AI | arXiv:2610.36545
关键词 :视频先验迁移, 虚拟时间路由, 中间潜变量, 统一图像编辑
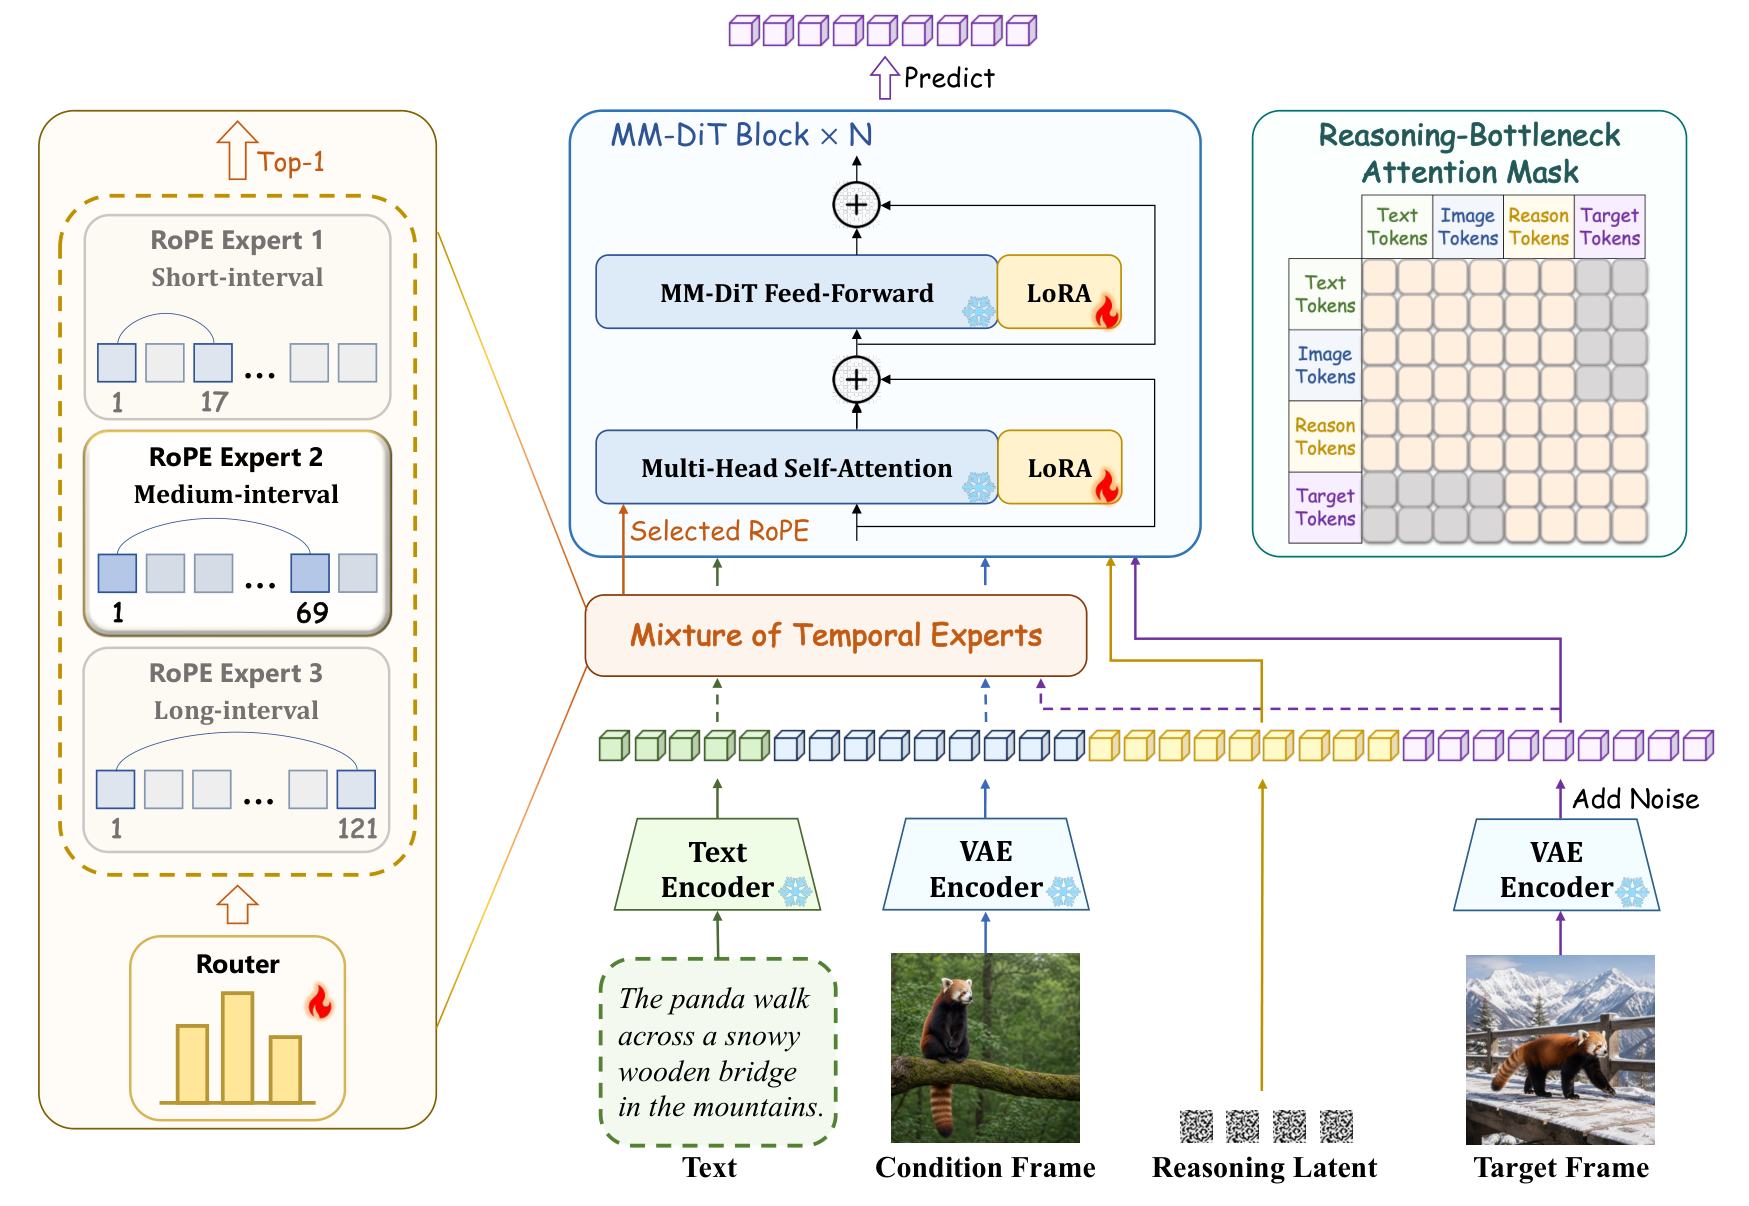
前序问题 :保留人物换背景、把边缘图画成照片、让猫换姿势,对输入的保留程度不同。把所有任务都当相同间隔的“前帧→后帧”,会让一个共享编辑器互相拖累。方法直觉 :借视频模型对不同幅度变化的经验,按输入与去噪阶段选择虚拟时间距离;再加一个中间特征状态,帮助传递“怎么变”。它输出的是图片,虚拟时间不是实际生成长视频。本文贡献 :冻结 HunyuanVideo1.5-T2V-720P 与 VAE,统一秩 32 LoRA。MoTE(时间专家混合)每步路由选择一套 RoPE 旋转位置编码,等效视频跨度 17/69/121 帧,实际只保留条件、目标与一个中间位置。CoTR(时间推理链)加无像素监督的噪声中间潜变量;训练中期以 0.5 概率屏蔽目标与文字/条件的直接注意力,迫使信息经中间状态,末期和推理恢复全注意力。三任务各 17 万样本,合计 51 万,512×512。
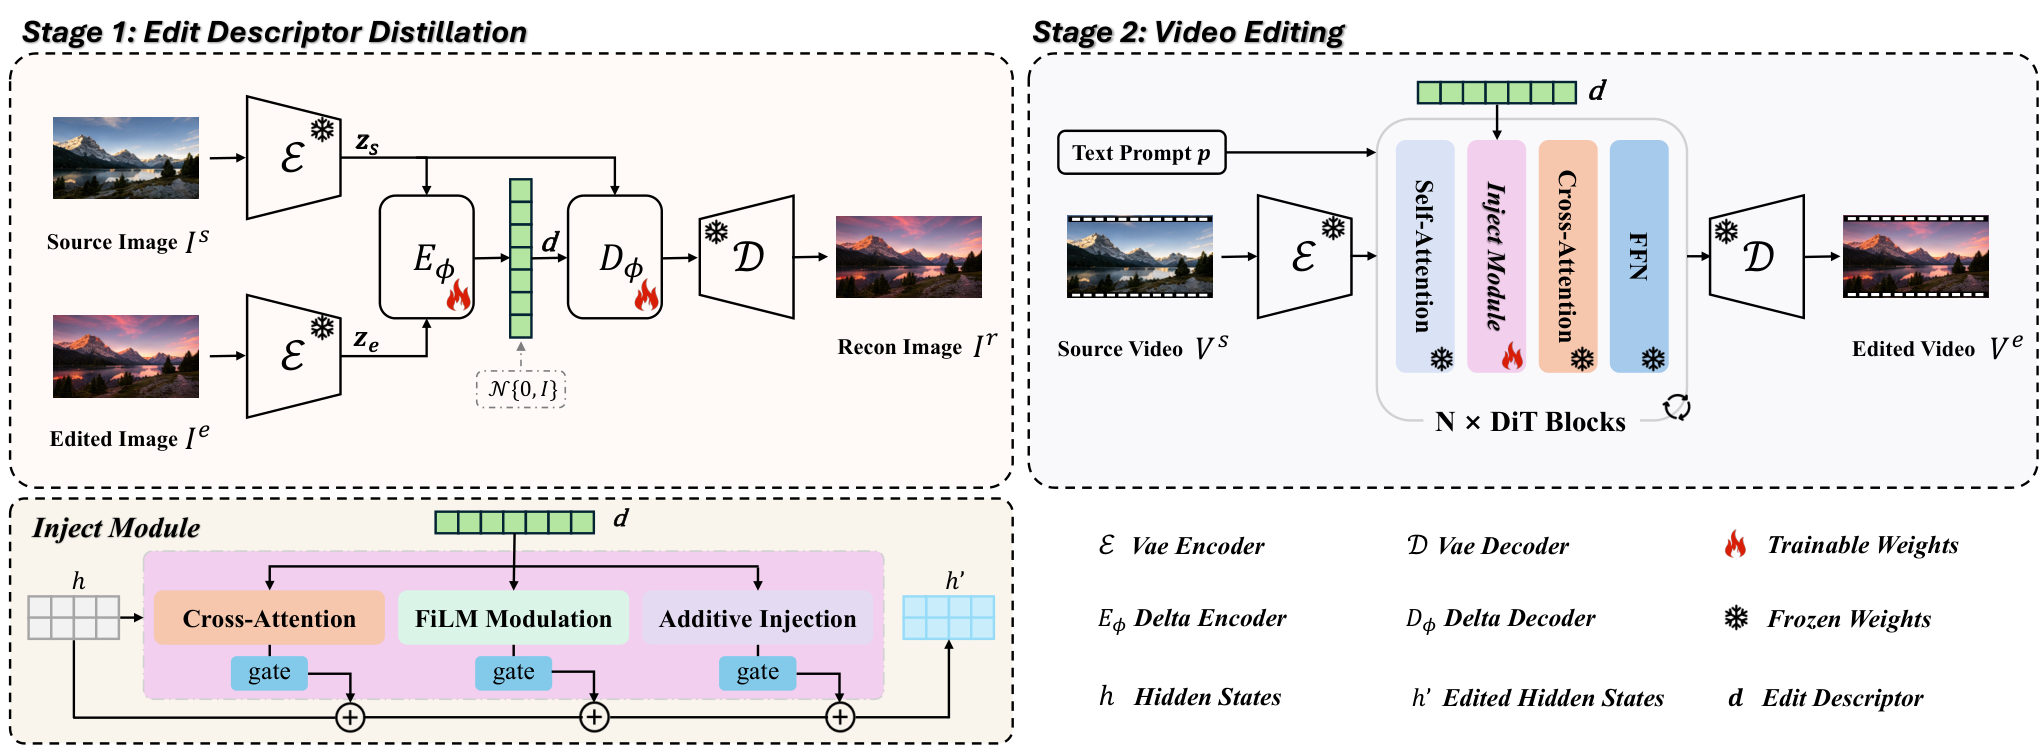
原文图 2|FrameForge 将不同条件图像任务建模成视频底座的目标帧预测。多模态扩散 Transformer 共同处理文字、条件、中间推理和带噪目标 token 并预测速度;MoTE 每步选虚拟间隔的 RoPE;CoTR 加入从噪声开始、经注意力更新的中间隐层状态。训练中期随机屏蔽条件/文字到目标的直接注意力,鼓励中间路径。
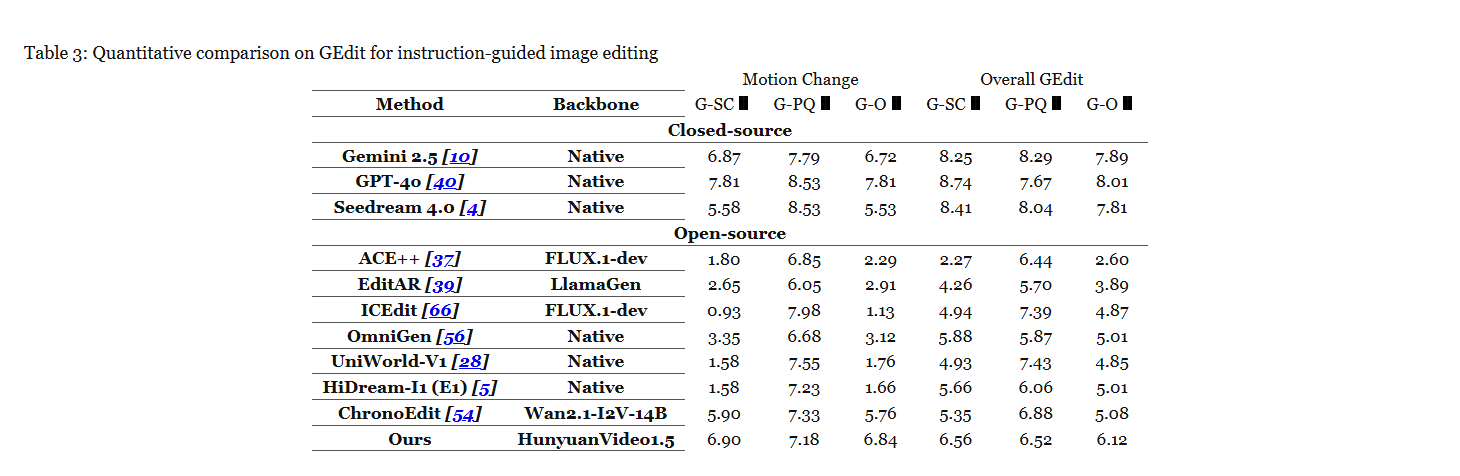
实验效果 :GEdit 英文 606 例、11 类,GPT-4.1 评语义/画质/综合:动作修改综合 ChronoEdit 5.76→6.84,全类 5.08→6.12;但画质 6.88→6.52。DreamBench 30 主体×25 提示综合 0.739,对 ChronoEdit 0.729,主体一致性 0.739 低于 0.757。2 张 A800 训练 1.2 万更新约 6 天,1.82 亿可训练参数;推理 50 步及额外中间状态,未给统一单图延迟/显存。
原文表 3|GEdit 指令图像编辑,分别列动作修改及全类总体的语义一致、感知质量和综合分,均越高越好。闭源与开源分组,主干列不同。FrameForge 动作综合 6.84、全类 6.12 优于 ChronoEdit,但全类画质 6.52 低于 6.88,闭源总体仍更强。
批判点评 :“推理链”是隐层通信设计,没有可读的逐步推理或中间图真值;全类综合仍低于闭源对照。主干、数据和任务接口与其他方法不同,不能把跨系统差距全归因路由。作者项目 、推理代码 及LoRA 权重 均已核到;仓库含三专家/一个中间潜变量配置与三任务入口,权重未下载验证。会议接收未确认。
5. ToDoPro:先小图探路再省参考计算
ToDoPro: Faster and Better Reference-Based Generation: Early Token Reduction via Downsampled Self-Probing | 香港大学;南洋理工大学 | arXiv:2610.34782
关键词 :参考生成加速, 低分辨率探测, 分层token裁剪, 激活显存
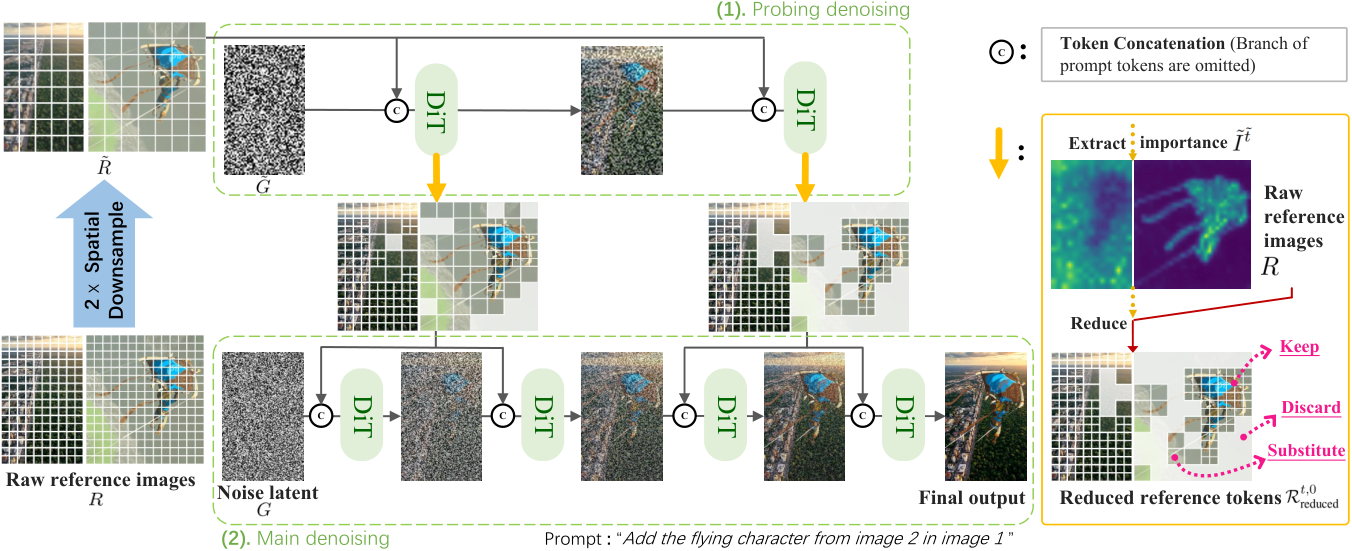
前序问题 :同时给多张参考,模型把背景、无关小物和主体一起反复读,越加参考越慢、显存越高。直接缩小所有图又会丢主体纹理;外接重要性模型还会增加部署负担。方法直觉 :先让原模型在小图上走一趟便宜的探路,判断文字和待生成画面真正会读取哪里。重要区域保留细节,中等区域保留缩略全局,低价值区域再丢掉。本文贡献 :参考图长宽各缩 2 倍;FLUX.2-Klein-4B 先探 2 步再做原 4 步主采样,Qwen-Image-Edit/HiDream 分别探 10 步、主 40/50 步。用生成及文字查询对参考的注意力,在全部层平均为利用分数;Triton 内核兼容不显式保存注意力矩阵的 FlashAttention。每个原 2×2 token 块(模型特征单元)按高/中/低重要度做 4→4、4→1、4→0,中档坐标放在原块中心,无需训练或新参数。
原文图 5|空间与时间下采样的自探测裁剪。先用长宽各 2 倍下采样图及稀疏时间表做去噪,抽取参考利用分数;主采样前据此保留高重要度、丢弃低重要度、用低分辨率 token 替换中等重要度。例图用 4 步 FLUX.2-Klein-4B;探测和主采样是两个阶段。
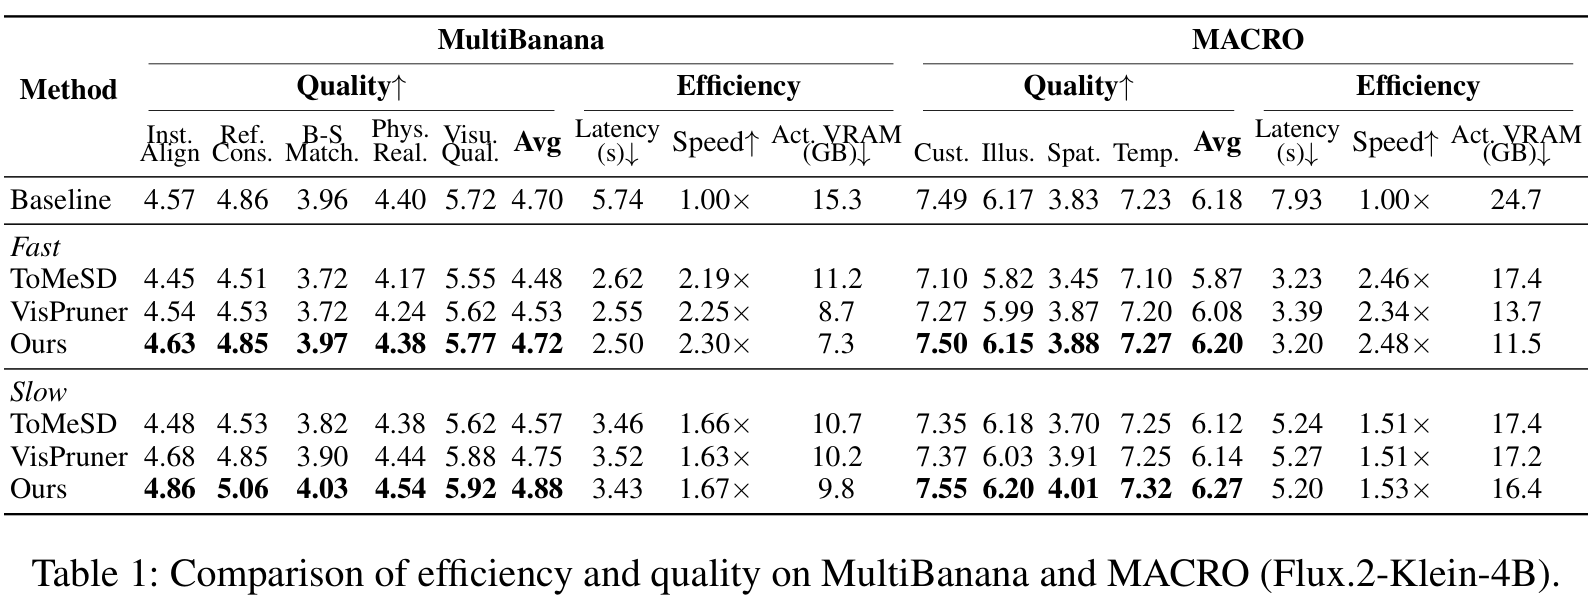
实验效果 :单 80GB H800、种子 42,FLUX.2-Klein-4B 在 MultiBanana 快速档,端到端 5.74→2.50 秒,2.30 倍;峰值激活显存 15.3→7.3GB,五维质量均值 4.70→4.72。MACRO 7.93→3.20 秒、24.7→11.5GB,四任务均分 6.18→6.20。慢档 MultiBanana 3.43 秒、9.8GB、均分 4.88。质量改善与速度是不同档位,不能拼成同一最优点。
原文表 1|FLUX.2-Klein-4B 在 MultiBanana 和 MACRO 的质量/效率。MultiBanana 五维为指令、参考、背景主体匹配、物理真实、视觉质量,MACRO 四任务为定制、插图、空间、时间;平均分越高越好。时延为端到端秒数,Speed 为对原模型倍率,Act.VRAM 为激活显存 GB,时延/显存越低越好。快慢档分开,不能拼成同一工作点。
批判点评 :激活显存不含全部模型常驻权重,不能承诺 7.3GB 卡可运行。极高裁剪率会失去必要细节,小字/稀疏部件可能在探测时漏掉;新目标 token 占多数时收益缩小。参考一致性快速档 4.85 略低于原 4.86。作者仓库 目前为空,“将开源”不等于代码已可用。
6. ReSeed:只补首步找回不同种子差异
A First-Step Bias Restores Lost Diversity in Diffusion Model Distillation | 格拉茨技术大学;奥地利复杂性科学中心;瑞士数据科学中心 | arXiv:2610.37110
关键词 :少步蒸馏修复, 种子响应, 首步偏置, 多样性取舍
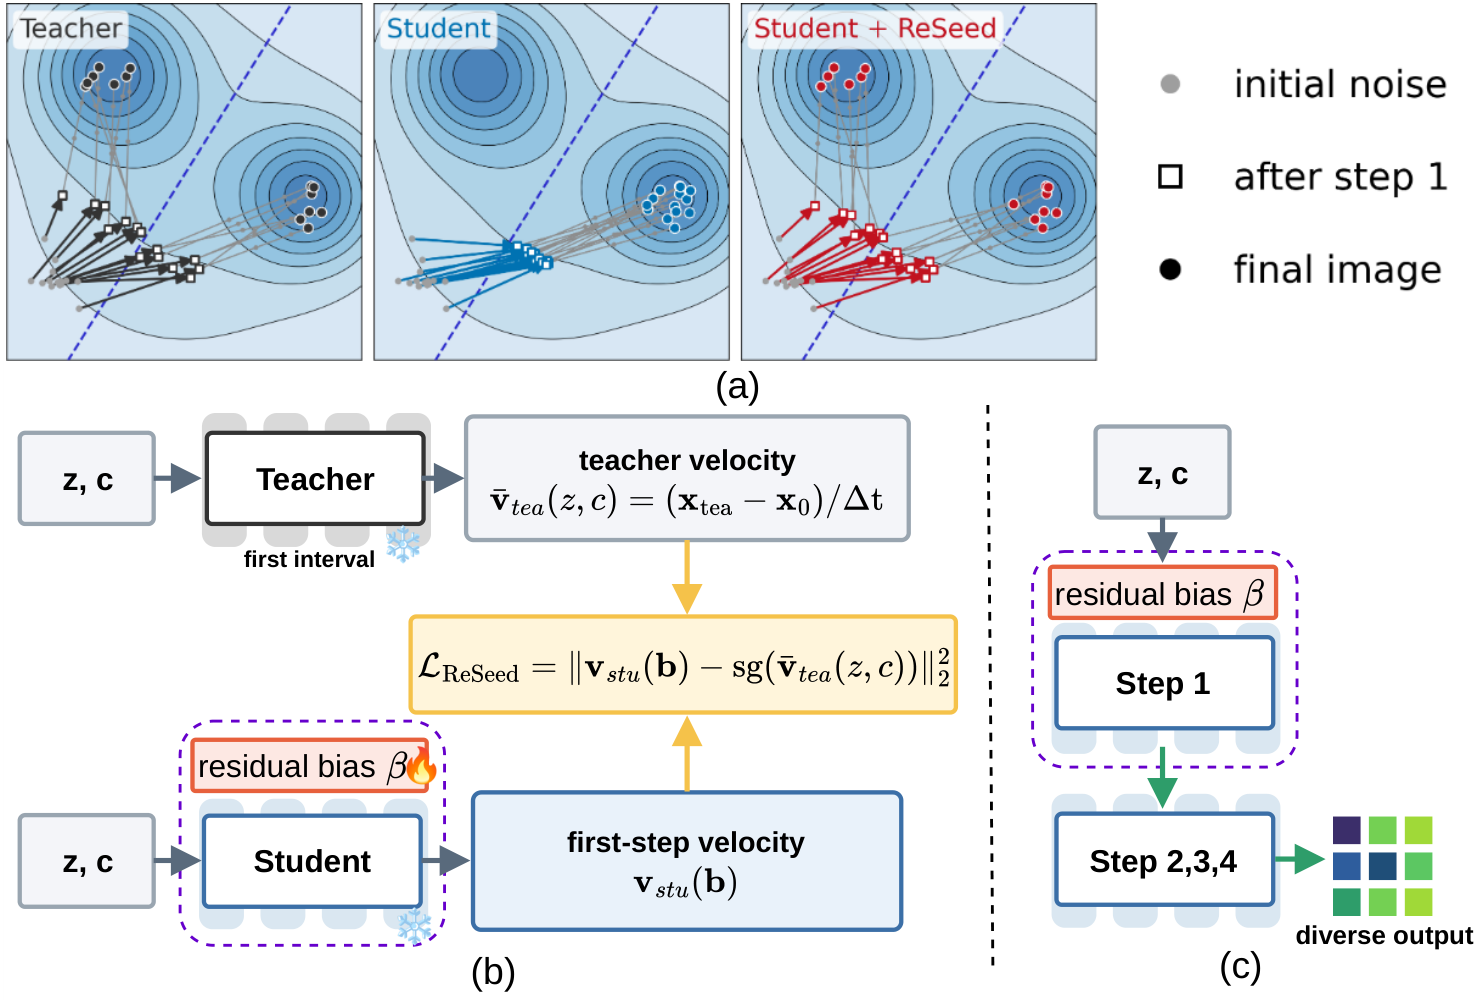
前序问题 :四步模型出图很快,同一句提示换随机种子却总画出相似构图。究竟要重训整模型,还是某一个去噪区间把随机差异压掉了?方法直觉 :先替换老师的第一段轨迹定位瓶颈,再只给学生首步加小偏置,学老师在这段时间走了多远。偏置本身不携带种子,差异来自它改变了冻结网络对不同输入的响应。本文贡献 :冻结蒸馏学生,在每个 Transformer 块输出增加零初始化逐通道残差偏置,仅首步启用。监督目标是老师从相同噪声/提示出发、跨首个学生区间的平均速度,非终点瞬时速度;后 3 步仍用原学生。FLUX 学生增加 233472 参数,占去噪器 0.00196%,约 8000 提示-噪声对训练,不需目标图、解码或对抗网络。理论界只约束首步端点响应误差,不保证最终图像多样性。
原文图 3|ReSeed 概览。(a)首步收缩可能合并不同种子轨迹,老师和 ReSeed 保留替代路径;(b)冻结底座,把首步块输出偏置拟合到老师区间平均速度;(c)偏置在第 2 至 4 步关闭。示意说明干预位置,不是最终多样性的理论保证。
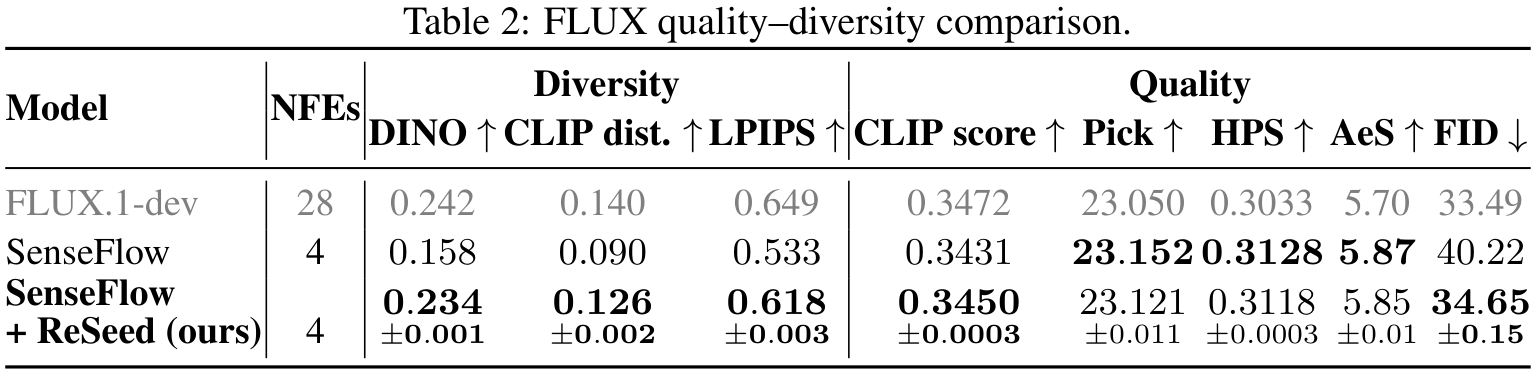
实验效果 :FLUX 四步 SenseFlow,100 提示各 10 种子,DINOv3 视觉特征两两余弦距离 0.1575→0.2336,提升 48.3%;另 5000 张 COCO 图的 FID 为 40.22→34.65。Wan 四步 DMD2 在 320 条 VBench 提示每条 8 视频,DINOv2 视频多样性 0.3374→0.4290,但动态程度 0.531→0.329、文字匹配 0.2419→0.2365。采样网络评估次数不增;各模型实测时延多 0.14%至 0.41%,激活峰值至多多 1MiB。
原文表 2|FLUX 质量与多样性比较。NFE 为去噪器网络评估次数,DINO/CLIP 特征距离和 LPIPS 跨种子距离越高越多样;CLIP 文字匹配、PickScore/HPS 偏好代理、美学越高越好,FID 分布距离越低越好。ReSeed 保留 4 次评估并提高多样性、降低 FID,但偏好及美学略降;误差为跨适配训练种子波动。
批判点评 :更分散的特征不等于更丰富且符合提示的内容;FLUX 人类偏好代理分与美学也略降。视频只一次适配训练,跨提示 bootstrap 不能代表跨训练波动;仅验证流匹配 Transformer。作者代码 包含训练、生成和评测入口,但权重及完整提示库不在仓库,老师/学生另备。
7. KnowThenDraw:先学语义再让扩散画细节
Know, then Draw: A New Learning Paradigm for Visual Generation | 加州大学圣迭戈分校;Adobe Research | arXiv:2610.37626
关键词 :自回归预训练, 语义token, 像素扩散渲染, 计算分配
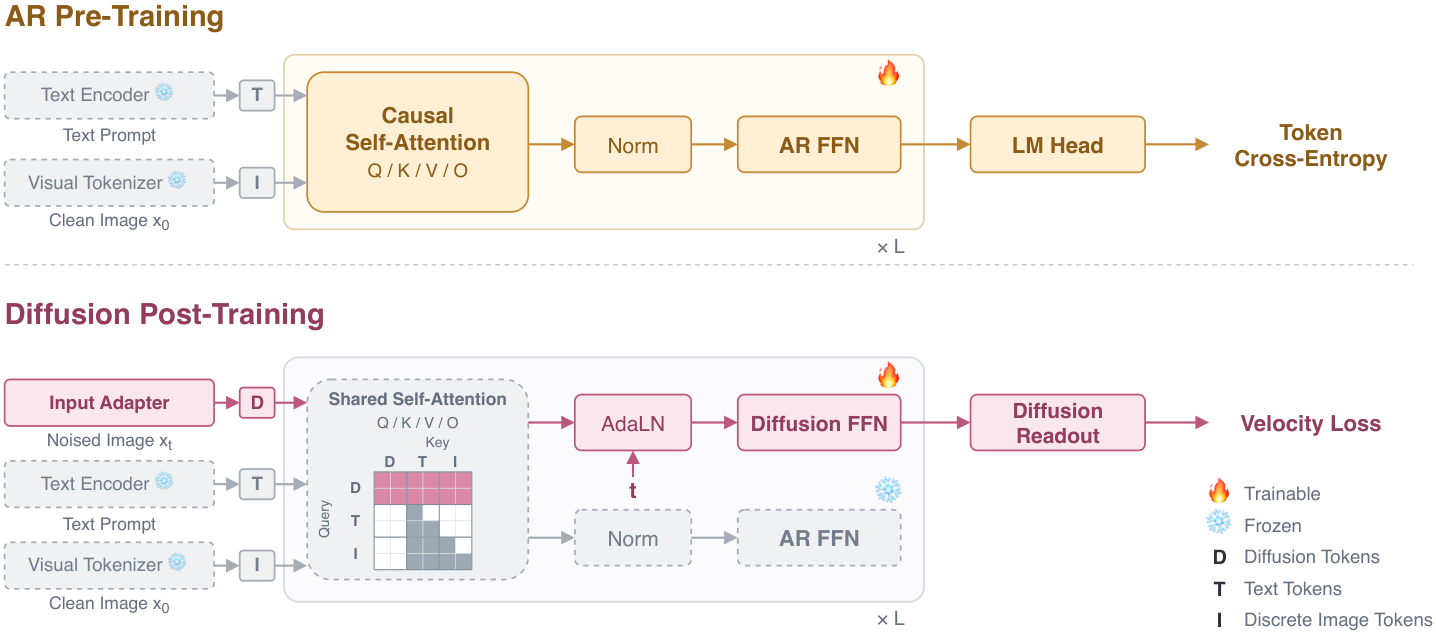
前序问题 :画得像不代表理解“两个物体、颜色和位置”。如果自回归阶段花大量精力还原像素纹理,能否反而挤占学习场景语义的预算?方法直觉 :把“知道该画什么”与“画得细腻”交给不同学习目标。先预测语义编码,随后冻结该骨干,让扩散模块把其表示渲染成像素;前一阶段的编码不必单独解码成好图。本文贡献 :AR 自回归按位置指令、随机顺序预测离散视觉 token。比较重建型、语义加重建型及 Semantic-LM 纯语言监督码本;后者量化冻结 Qwen2.5-VL 视觉特征,无图像解码器或重建损失。后训练复用冻结 AR 注意力投影,仅训练输入、时间和扩散专用前馈/归一化及像素输出模块。训练渲染用真图 token,推理改用 AR 生成 token,存在条件分布差异;分别拟合两阶段规模规律,主口径预算约 3:2。
原文图 2|学习分工:自回归预训练用离散 token 预测获取视觉知识;随后冻结预训练骨干,增加复用其注意力与表示的扩散模块,将知识渲染为高保真图片。自回归专注知识,扩散专注渲染。
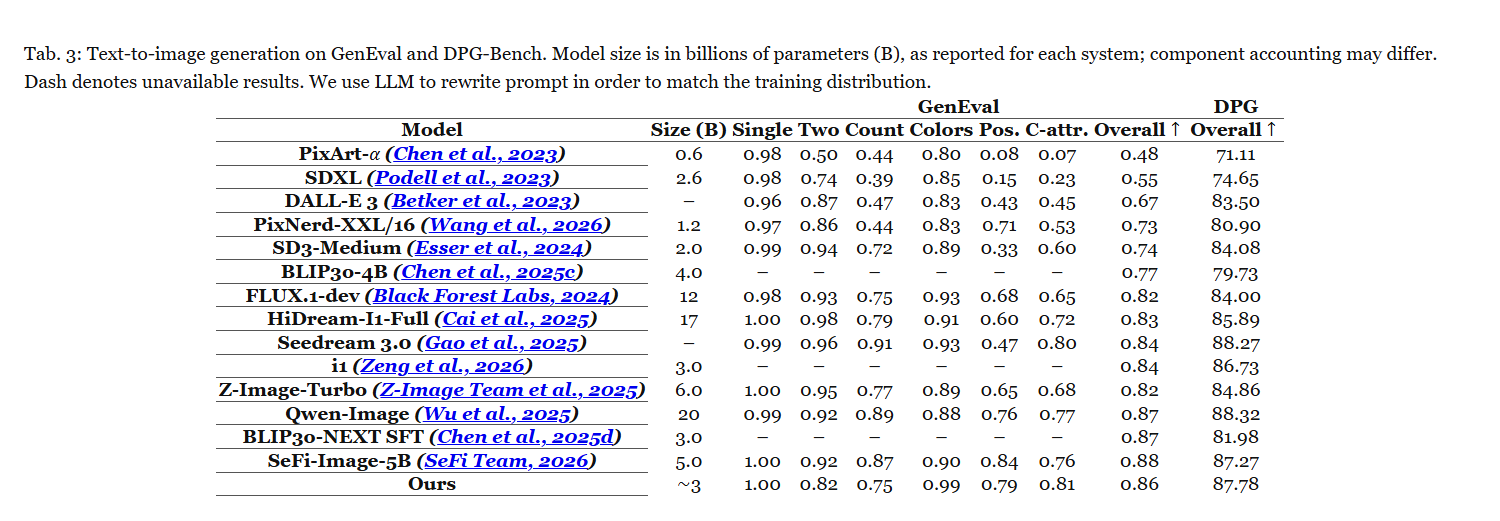
实验效果 :约 400M 最终参数、同累计图像曝光的控制实验:AR→像素扩散 GenEval 组合指令分 65.51、DPG 细粒度提示分 71.11;纯像素扩散 61.16/62.56。约 3B 最终版训练 6600 H100 GPU 小时,GenEval0.86、DPG87.78;前者 553 提示每条 1 图,后者 1065 提示每条 4 图。推理 AR 采样后再 50 步 Euler 像素渲染,带语义/文字双引导,未给统一整图延迟。
原文表 3|GenEval 与 DPG 文生图评测。模型大小以十亿参数计,各系统组件计数可能不同,横线为缺失结果。作者用大语言模型改写提示匹配训练分布。GenEval 分单物体、双物体、计数、颜色、位置与颜色属性,综合为六类均值;本方法约 3B,综合 0.86,DPG87.78。
批判点评 :评测用大语言模型改写提示,并按固定种子评分选提示变体,不能当完全未触碰的测试协议。6600 小时没有计入所有外部预训练资产;3960/2640 是阶段预算分配,非各阶段独立计时。拟合损失下限是外推且混合真图条件影响,不能证明 AR 普遍胜扩散。原文未给作者方法代码入口。
8. SpeeDiff:像素回路拦住潜空间坍缩
SpeeDiff: Scalable Pixel-Anchored End-to-End Latent Diffusion Model | 字节跳动 Seed;加州理工学院;Meta | arXiv:2610.36419
关键词 :端到端潜空间训练, 像素重建锚定, 双表示对齐, 训练成本
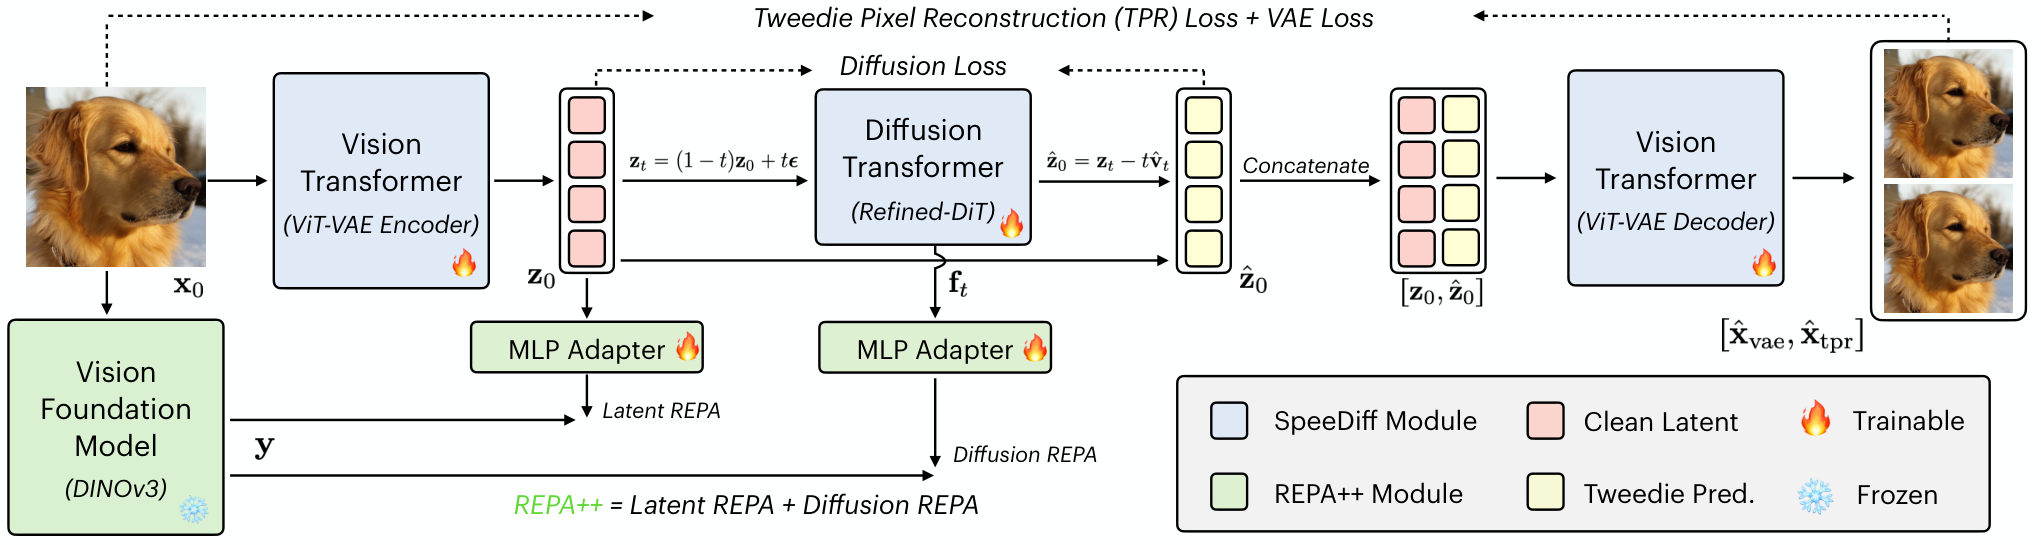
前序问题 :同时训练图像压缩器和扩散器,损失下降却画不出东西:编码器可能把不同图压到几个狭窄峰,扩散预测常数就能拿低损失,像素语义却丢了。方法直觉 :不能只在压缩空间里自我打分,还要把去噪估计解码成图片,核对真的保留原图。让像素误差沿完整路径反传,堵住“把表示做简单就过关”的捷径。本文贡献 :TPR(Tweedie 像素重建)从中间噪声状态估计干净潜变量,送 VAE 解码器并与真图计算均方/感知误差,同时保留 VAE 重建和流匹配损失,不切断到编码器的梯度。全 Transformer VAE 与改进 DiT 联合缩放,REPA++同时将干净潜变量和早层扩散特征对齐到冻结 DINOv3 视觉表示。每训练步 1 次编码、1 次扩散和 2 次解码;256 图用空间 16 倍压缩、32 通道,512 图改 32 倍压缩。
原文图 2|SpeeDiff 四条训练分支:VAE 编码/解码重建;标准随机插值和速度预测的扩散损失;Tweedie 干净潜变量估计解码后与真图比较的 TPR 分支;潜变量和中间扩散特征同时对齐视觉底座的 REPA++分支。VAE 与扩散从零联合训练,梯度不截断;视觉特征底座冻结。
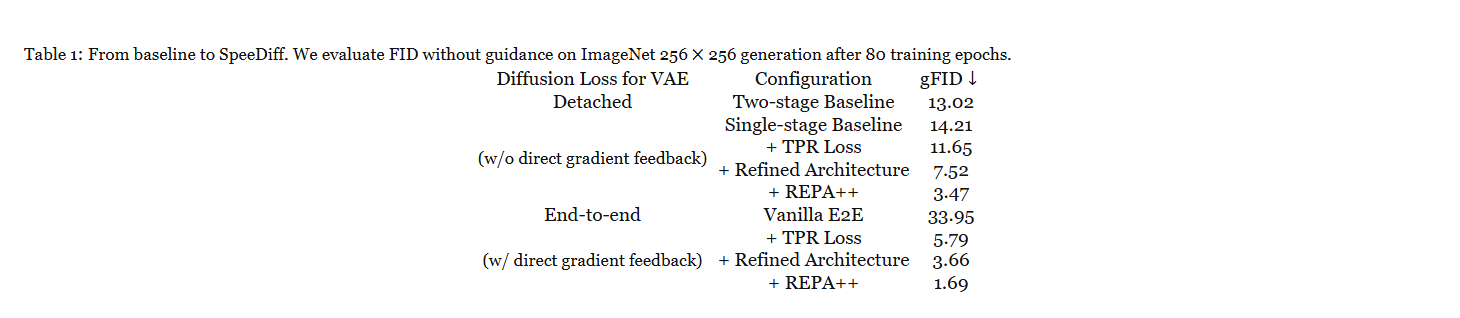
实验效果 :ImageNet 类条件、无引导、5 万生成图评 gFID 生成图与真图视觉特征的分布距离。80 轮原始联合训练 33.95,加 TPR 为 5.79,加架构为 3.66,再加 REPA++为 1.69;XL200 轮在 256/512 分别 1.50/1.53。更实用的同 7.93FID 对照,16 张 H100、批 256,训练步 23.52 倍减少,计每步 0.16→0.31 秒后耗时加速 12.14 倍;峰值 57.34GB 对 26.97GB。默认采样 250 次网络评估。
原文表 1|80 轮 ImageNet256 生成、无引导 FID。上半部分扩散到 VAE 梯度截断,下半为真正端到端;原联合训练 33.95,加入 TPR 降 5.79,再加架构 3.66 和 REPA++1.69。两个组依次加组件,FID 越低越好,表示像素锚定使联合梯度有效。
批判点评 :摘要 140/61 倍是特定收敛比较口径,不是逐步训练或出图速度;完整联合训练更费显存。最佳版依赖预训练 DINOv3,不能称整个系统从零;尚未证明开放域文字生成同样有效。arXiv 明确接收 CVPR 2026,本月上传不等于本月才完成研究;未给可核实方法代码。
9. GuitarLFM:先改每根弦的演奏再合成
Expressive Guitar Synthesis via Controllable Latent Flow Matching | 台湾大学 | arXiv:2610.36786
关键词 :可控吉他合成, 逐弦音高包络, 跨弦注意力, 潜空间流匹配
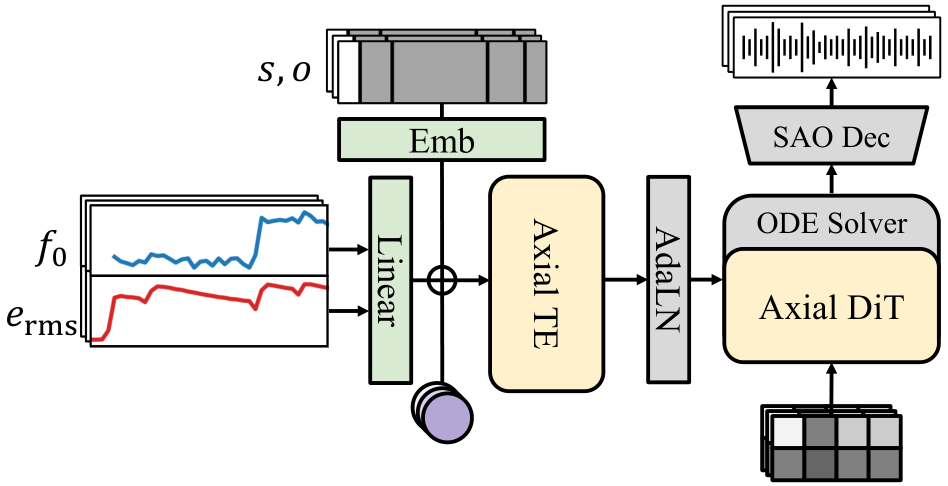
前序问题 :MIDI 乐谱写了哪个音、何时弹,却没写弯音和余音怎样变化。直接把乐谱变音频,即使音符正确,演奏细节也难以单独修改。方法直觉 :先预测每根弦的连续音高和响度曲线,把“怎么演奏”变成能编辑的中间控制;再让声音生成器负责音色和波形,不必同时猜演奏与合成。本文贡献 :六弦输入含音高、发声状态、音内相对位置、起音及力度。轴向 Transformer 分开沿时间/弦建模,跨弦门从零初始化;先出 f0 基频和 RMS 均方根振幅包络,再由条件编码器经 AdaLN 自适应归一化调制扩散 Transformer,流匹配生成 Stable Audio Open 压缩音频。逐弦解码,经各弦学习的脉冲响应滤波后混合;可再用仅 MIDI 的力度预测器替代音频提取力度。
原文图 2|逐弦声音合成器架构:音高 f0 及 RMS 振幅包络经条件编码,发声状态 s 和起音 o 提供额外提示;紫色圆是学习的弦身份嵌入。轴向 Transformer 特征经自适应归一化调制轴向扩散 Transformer,由常微分方程求解器生成压缩音频,Stable Audio Open 解码;每弦输出再用学习的各弦脉冲响应混合。
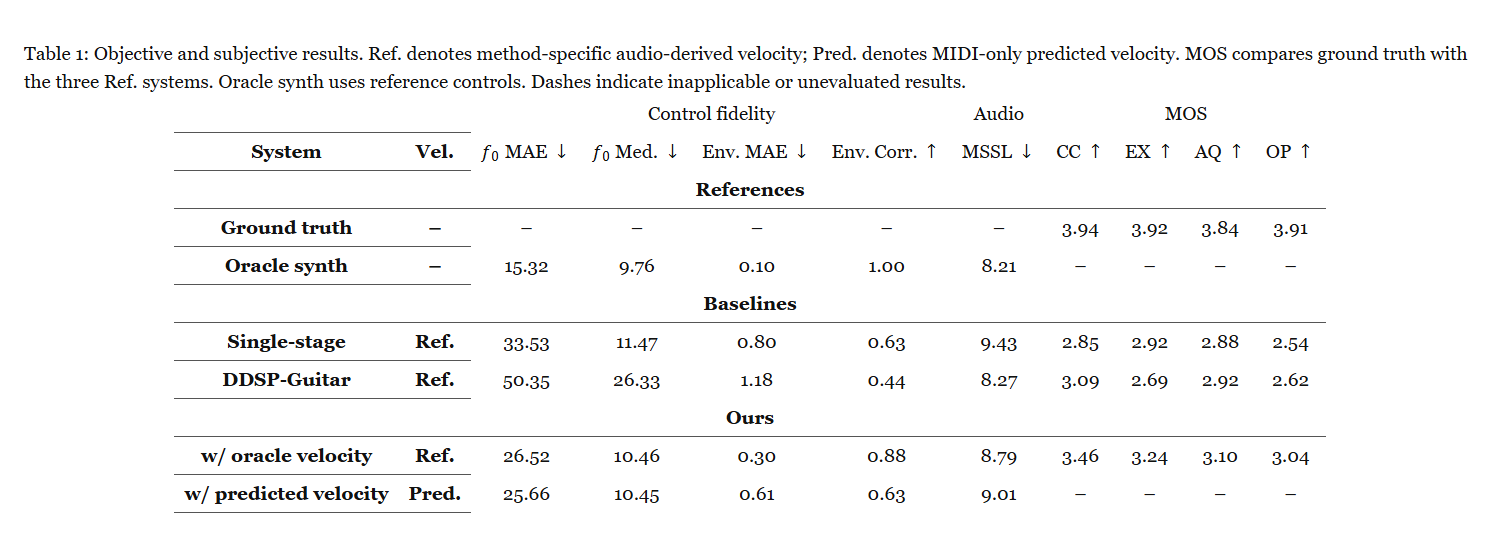
实验效果 :GuitarSet 按录音 306/18/36 划训练/验证/测试,44.1kHz,训练裁 5.9 至 11.9 秒。真实音频力度条件下,对同结构单阶段,f0 平均绝对误差 33.53→26.52 音分(100 音分为半音),包络相关 0.63→0.88。32 人听 18 段 8 秒,1 至 5 分总体偏好 2.54→3.04;但多尺度频谱损失 8.79 高于 DDSP-Guitar8.27,越低越好。推理 50 个 Euler 步、引导强度 2,条件/无条件预测额外耗计算,未报统一实时率。
原文表 1|客观与主观结果。Ref 为各方法从音频提取的力度,Pred 为仅 MIDI 预测力度;MOS 听感仅比较真音频和三个 Ref 系统。Oracle synth 用真实控制作合成上界,横线表示不适用/未评。音高误差用音分、包络误差和 MSSL 越低越好,包络相关及内容正确/表现力/音质/偏好评分越高越好。
批判点评 :听感分只评音频提取力度版本,不能移植给纯 MIDI 版;后者包络误差 0.61 对 0.30,听感未评。单数据集和逐弦专门录音限制泛化,项目长音频样例无对照。代码 与模型页由项目给出,本次不运行音频模型。ICASSP 2027 只是投稿,非接收。
10. GenSfM:四张照片一起猜形状和机位
Generative Structure from Motion with Native 3D Diffusion | 香港大学;Transengram;腾讯 | arXiv:2610.35522
关键词 :原生三维生成, 联合形状位姿, 紧凑机位编码, 逐体素图像条件
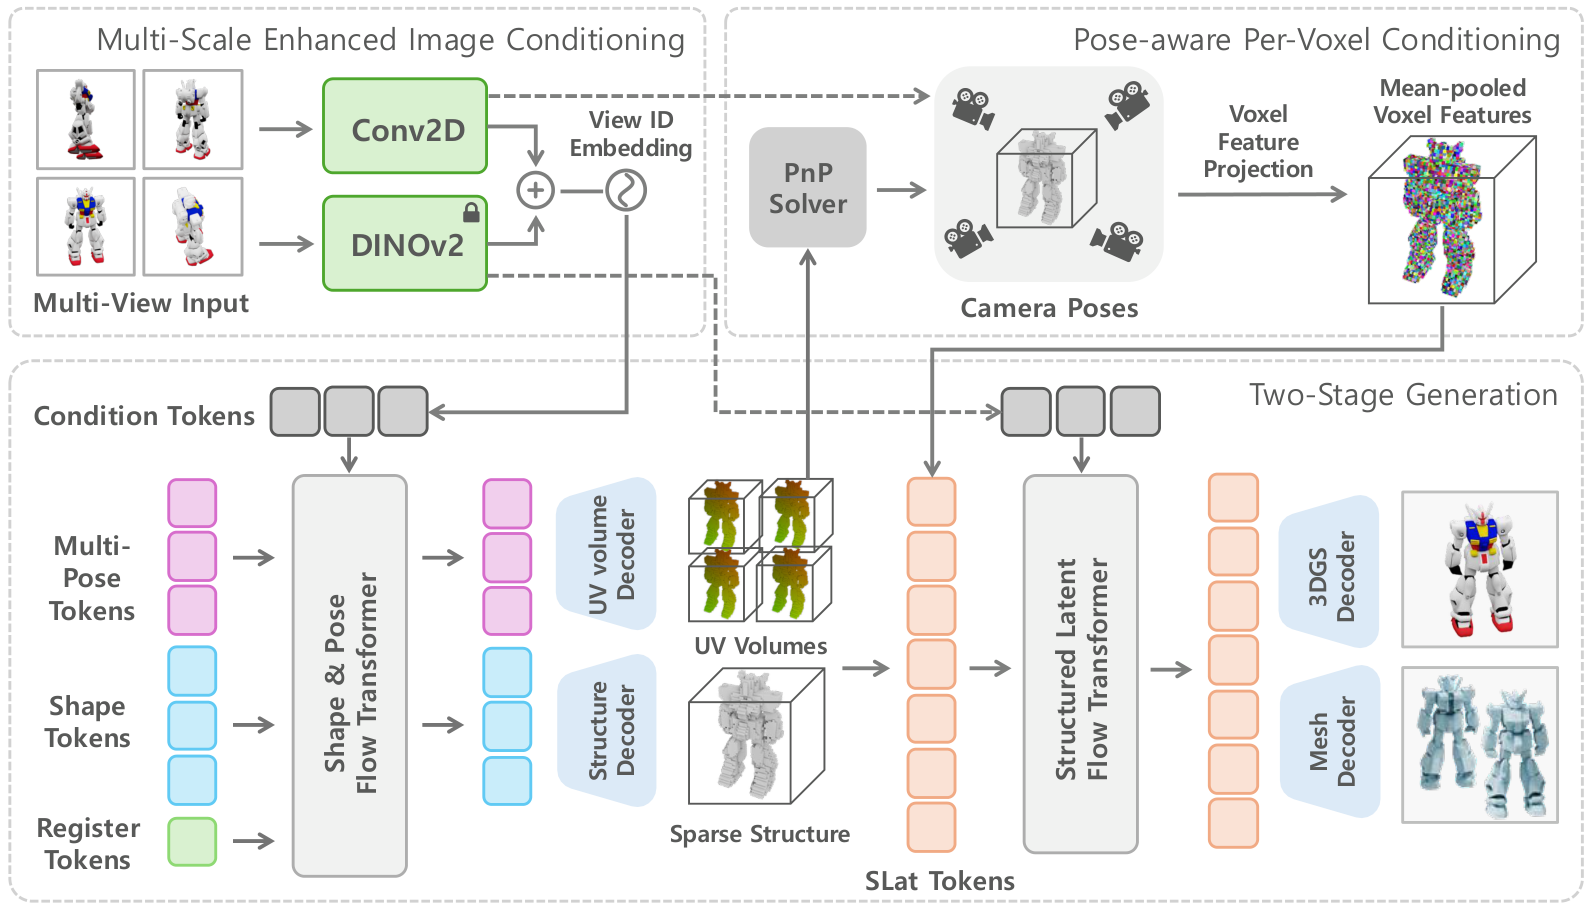
前序问题 :四张没标相机的物体照片,既要补出没看到的背面,也要找准各照片从哪里拍。先估机位再生成,第一步错了,细节就会贴到错误表面。方法直觉 :把形状和每个机位一起放进同一去噪过程,相互校正;粗形状与机位对齐后,再按真实投影位置读取图像纹理,而不只靠整图语义猜细节。本文贡献 :基于 TRELLIS,粗阶段联合处理 4096 形状 token、四视图共 256 机位 token 及 128 共享 register 全局信息 token。UV 体积把每体素投到图像的二维坐标编码成 4×4×4 机位潜网格,较 16 立方网格少 64 倍 token,非全模型快 64 倍。DINOv2 语义加多尺度卷积特征作条件;细阶段按估计机位逐体素采样并跨视图平均。约 43 万资产、每资产 24 渲染视图,训练每次取 4 张。
原文图 2|GenSfM 粗到细总览:把未知位姿的多视图三维恢复化为联合生成;粗阶段用多模态形状-位姿扩散 Transformer 同时去噪稀疏结构与逐视图三维机位 token,恢复形状与相机;细阶段按恢复的机位为每体素采样图像条件,细化几何与外观并输出结构化潜变量。
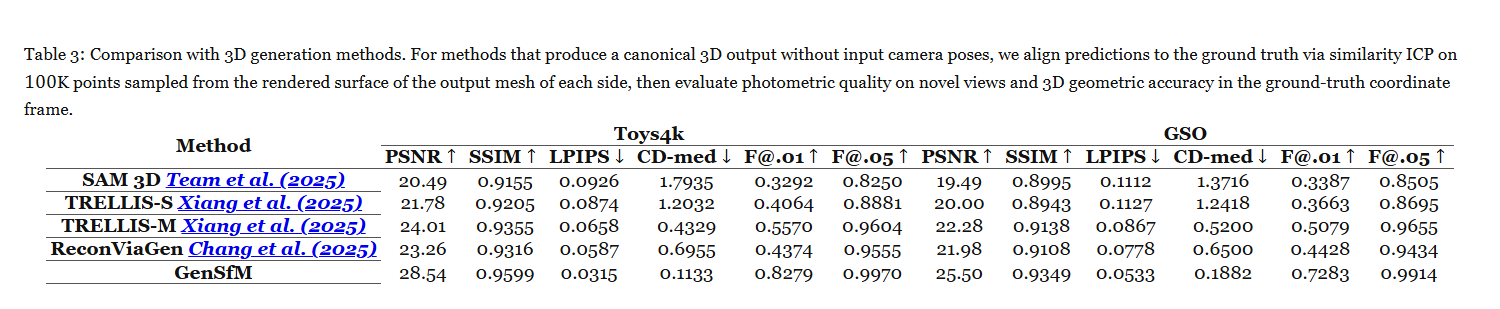
实验效果 :Toys4k/GSO 各前 400 物体、每物体两组互斥四视图,共各 800 物体-视图组。相似变换 ICP(迭代匹配点云)对齐后,对 TRELLIS-M,未见视图 PSNR24.01→28.54、22.28→25.50 dB;双向平方 Chamfer 点云距离的跨物体中位数 0.4329→0.1133、0.5200→0.1882,表中单位×0.001。原始相对旋转误差低于 5 度比例 97.23%/98.21%。粗/细各 25 步,机位/粗阶段各 8 张 H200、细阶段 4 张,均训练 100 万更新。
原文表 3|与三维生成方法比较:对无输入机位的标准化三维输出,两侧输出网格各采 10 万表面点,以相似变换 ICP 迭代对齐到真值坐标,再评价未见视图光度和几何。PSNR/SSIM/F 分越高越好,LPIPS 及双向平方 Chamfer 跨物体中位数越低越好;Toys4k 和 GSO 分开,不能混同另一表的点图最小二乘对齐。
批判点评 :各能力族用不同对齐协议,不能跨表混用数字;未知侧仍是生成推断,非测量真值。只验证物体中心、四视图,场景和更多视图待证;细阶段训练用真值机位,推理误差会错贴特征。NeurIPS 2026 接收有 arXiv 评论证据;项目 可查,尚未核到方法代码和统一推理时延/显存。
趋势观察
控制介入的位置决定保留边界
ReferStream临时替换全局缓存,TINDER改初始噪声与采样注意力;两者都处理视频连续性,但一个引入新主体,一个恢复已知退化。
借视频先验仍须先看实际输出
FrameForge借虚拟时间生成单张图,ReferStream才是流式视频。不能因为底座叫视频模型,就把任务和收益写成视频编辑。
首步与表征是两类不同修复
ReSeed在冻结学生首步补种子响应,SpeeDiff在训练期让像素误差约束潜空间;前者维持四步采样,后者默认250次网络评估。
可编辑中间表示需要协议兜底
GuitarLFM把每弦演奏曲线暴露出来,GenSfM把形状和机位一起生成;前者听感只评音频力度版,后者限四视图物体,控制接口不能代替泛化证据。
今日讨论
ReferStream 加入场景合成后,旧主体相似度 70.56→72.17,新主体 63.10→51.31。已输出画面不能重来时,如何固定参考到达时刻与目标框,用多种子实验分别收集主体还原、旧场景保留和重复率证据,决定何时启用场景合成或减弱注入?
人工智能炼丹君 整理 | 2026-10-29




评论 (0)