今日 AIGC 论文速览
今日共 10 篇 · 参考视频编辑 1 篇 · 参考图效果与变换迁移 2 篇 · 多视角视频生成 2 篇 · 视频蒸馏与推理加速 2 篇 · 语音与空间音频生成编辑 2 篇 · 三维场景编辑 1 篇
重点论文标题列表
- EditDistill(浙大):首帧怎么改整段跟着走
- KINESYS(工业光魔):借参考特效但少动原镜头
- CrossPair(蚂蚁):示范一对图迁移同一种改法
- WorldCast(小米):大幅绕拍时记住人物背面
- OmniShowcase(KAIST):四面参考加法线转台稳绕拍
选读入口:已有视频想改衣服、照明或局部物体,先读 EditDistill,重点看首帧代表性和 CLIP-E 没有领先的边界。图像上借烟火等参考特效选 KINESYS,已有改前改后示范想迁移同一操作选 CrossPair。需要数字相机轨迹及人物多面锚点看 WorldCast;以四面照片做主体展示看 OmniShowcase。训练四步视频模型读 SF2,已有 Blackwell 推理服务读 Triage。研究图像先验能否跨到声音读 ImageTTS;要移动某个声音且保住其他音轨读 AMBIT。最后,需要把单视图修改落回可渲染三维资产时看 VidEdit3D,并核对逐场景拟合成本。
今日论文速览
1. EditDistill:首帧怎么改整段跟着走
EditDistill: Is It Possible to Guide Video Editing with Image Editing? | 浙江大学;浙江理工大学;清华大学;北京航空航天大学 | arXiv:2610.34303
关键词:首帧示范编辑, 编辑描述, 时序保留, 轻量条件注入
- 前序问题:把首帧里的人换上红围巾不难,难的是走动、转身后围巾还在,背景和动作也没被重画。逐帧调用图像编辑器会闪烁,单给修改后的首帧又可能把整个场景带偏。
- 方法直觉:从修改前后两张图里提炼“改了什么”,把它与图里原本的内容分开;让视频底座负责把这个变化安放到各帧。描述的是变化规则,而不是把某一帧像素贴满整段。
- 本文贡献:第一阶段在冻结 VAE(图像与压缩潜变量间的编解码器)空间,读取原图、改图及差分,以残差重建和 KL 相对熵分布约束学出 1024 维编辑描述;推理取分布均值。第二阶段冻结 Wan2.1-I2V-14B,隔三块插入融合器:交叉注意力定位局部,FiLM 特征缩放/平移调全局外观,加法分支补编辑偏置,零初始化门控制注入。训练除流匹配外,约束输出变化描述与示范一致,并用冻结 DINO 视觉特征保留源帧结构。两阶段用约 200 万图对、10 万筛选合成视频对及 OpenVid 重建样本;分别 20 万与 3 万次更新,16 张 80GB H800。
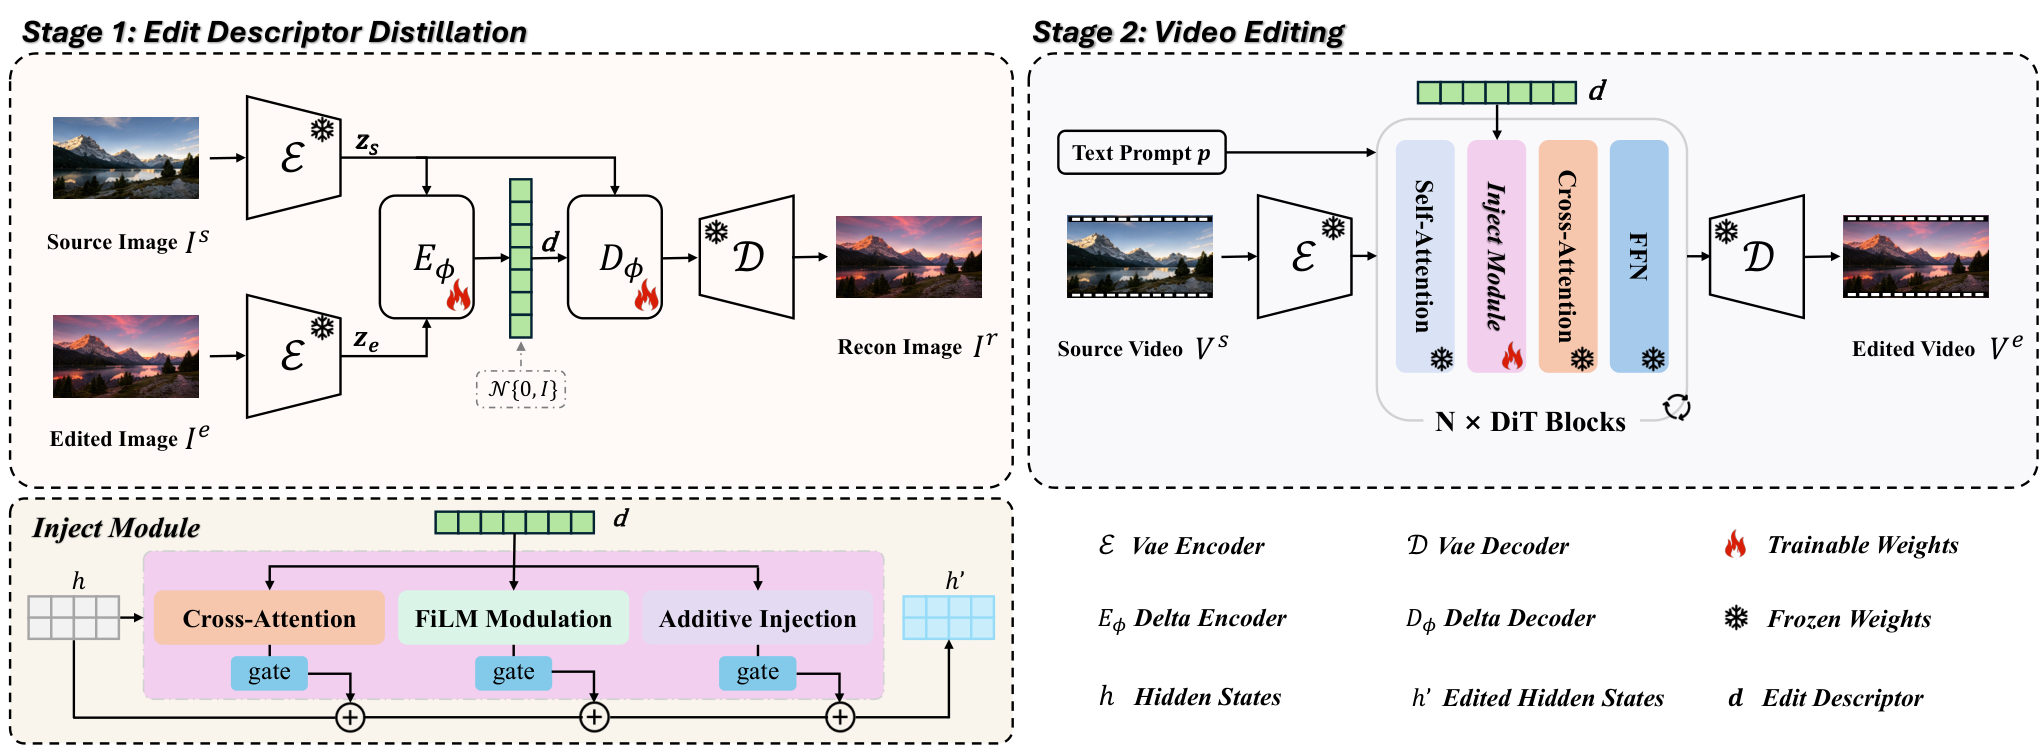 原文图 3|EditDistill 总览:第一阶段将修改前后图像对编码为编辑描述 d;第二阶段冻结 Wan2.1-I2V-14B,仅训练轻量融合注入模块,在选定 Transformer 块注入 d,引导源视频去噪成时间连贯的编辑视频。
- 实验效果:VACE-benchmark 统一 480×832、81 帧,推理 50 步;与 VACE 比,未编辑区域 DINO 相似度 0.701→0.738,光流对齐误差 Warp(越低越稳)3.42→2.97,FVD 视频特征分布距离 914.6→852.1。CLIP-E 编辑方向相似度 0.245,略低于 VACE 的 0.247;CLIP-T 文字匹配 0.282 也低于 0.302。注入模块约 480MB,原文称不足底座参数 4%;这是模块大小,不能当实际峰值显存或整片时延。
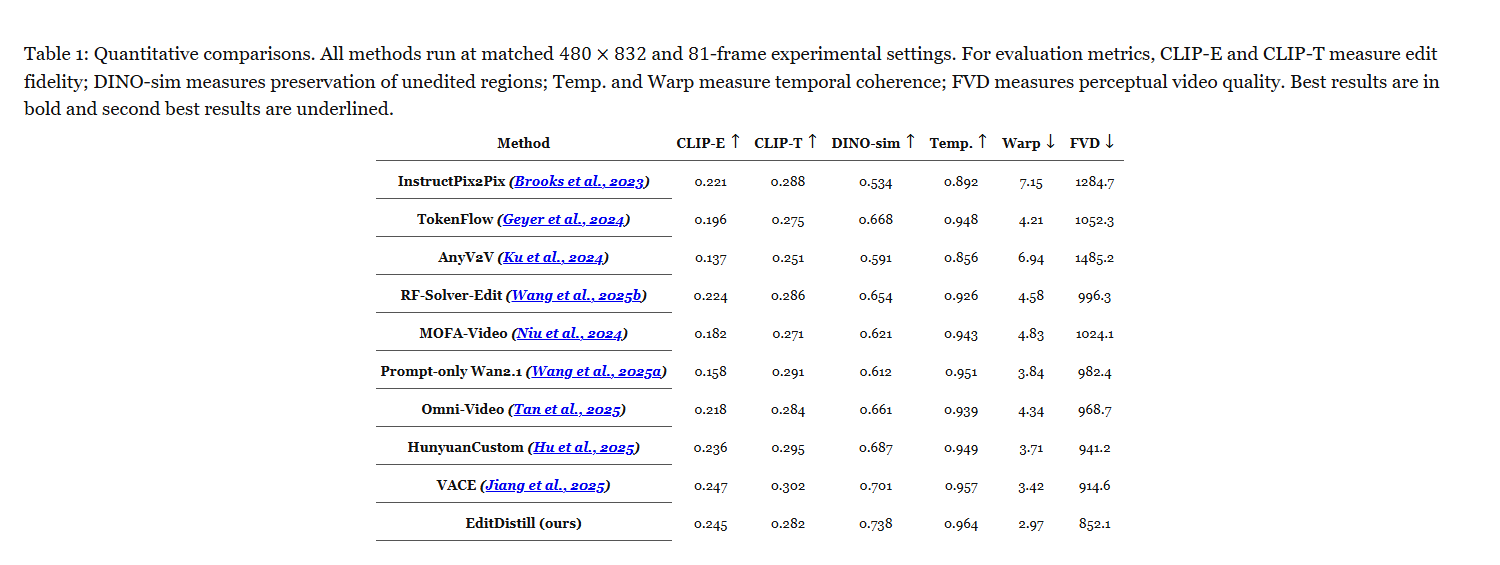 原文表 1|统一 480×832、81 帧比较。CLIP-E 和 CLIP-T 分别测编辑方向和文字匹配,DINO-sim 测非编辑区域保留,Temp.与 Warp 测时序相似和光流对齐误差,FVD 测视频分布距离;前四项越高越好,Warp/FVD 越低越好,粗体和下划线分别为最优和次优。EditDistill 在保留、时序和 FVD 领先,编辑匹配并非全部最优。
- 批判点评:主体一致性 0.942 低于 Omni-Video 的 0.964,首帧无法代表的大动作、遮挡和转场仍是弱点;局部注意力也可能溢到邻区。编辑描述可重复使用不等于已验证任意视频底座迁移。代码 已有推理入口及模块,权重可用性本次未下载验证。
2. KINESYS:借参考特效但少动原镜头
KINESYS: Test-Time Adaptation for Reference-Based Effect Editing in Images | 北卡罗来纳大学教堂山分校;工业光魔;费耶特维尔州立大学 | arXiv:2610.33292
关键词:参考特效编辑, 测试时适配, 双路反馈, 多候选搜索
- 前序问题:想给赛车加上参考照片里那种烟雾,编辑器却连车身和机位都改了。只问“烟像不像”会漏掉源图被破坏,只追求相似又可能什么都没改;作者研究的是图像特效编辑。
- 方法直觉:请两位分工不同的检查员指导调参:一位对照特效参考问形态和位置,另一位看原图、指令与结果,检查是否乱改。对几个随机起点分别优化,挑能在新噪声上也稳定工作的版本。
- 本文贡献:FLUX.2 Klein 4B 冻结底座,逐请求调秩 16 的 LoRA 低秩适配。Gemma 4 E4B-it 做参考问答,EditReward 给指令与质量反馈;每轮 3 个固定噪声候选共用一套适配权重,奖励加权抑制坏样本,早期排斥项维持多样性。五次独立搜索在第 16/31 次更新后保留 3/2 路,每路最多 100 次更新;用同一留出噪声评估中间权重,选择后再采样新变体。底座每次出图 4 步,参考长边上限 384 像素;用户还需指令、三条类别问题和可选掩码。
 原文图 2|KINESYS 总览:参考问答 VQA 与看源图的 EditReward 提供互补反馈。K 次独立搜索各有自己的 LoRA 参数φ_k 和 N 个固定噪声候选;α_i 为候选目标权重,随时间衰减的λ_div(t)D 防止早期模式坍缩。横轴 0 到 T 为优化更新,弱搜索在剪枝点停止,留下的继续到后续权重检查点。
- 实验效果:81 请求、两随机种子中,各方法共同完成 156 例;八类包括烟雾、火焰、积雪、船尾浪。相对 Nano Banana 2,LPIPS 源图感知距离 0.429→0.377(越低越接近),TPIPS 文本条件感知相似度 0.696→0.731(越高越接近)。16 编辑的人评中,保留原图偏好 45%对 25%,特效转移 48%对 42%,其余为平局;前者 41 份答卷,多数非特效专家。多路反复出图并反传是每请求额外成本,论文未给统一耗时和峰值显存。
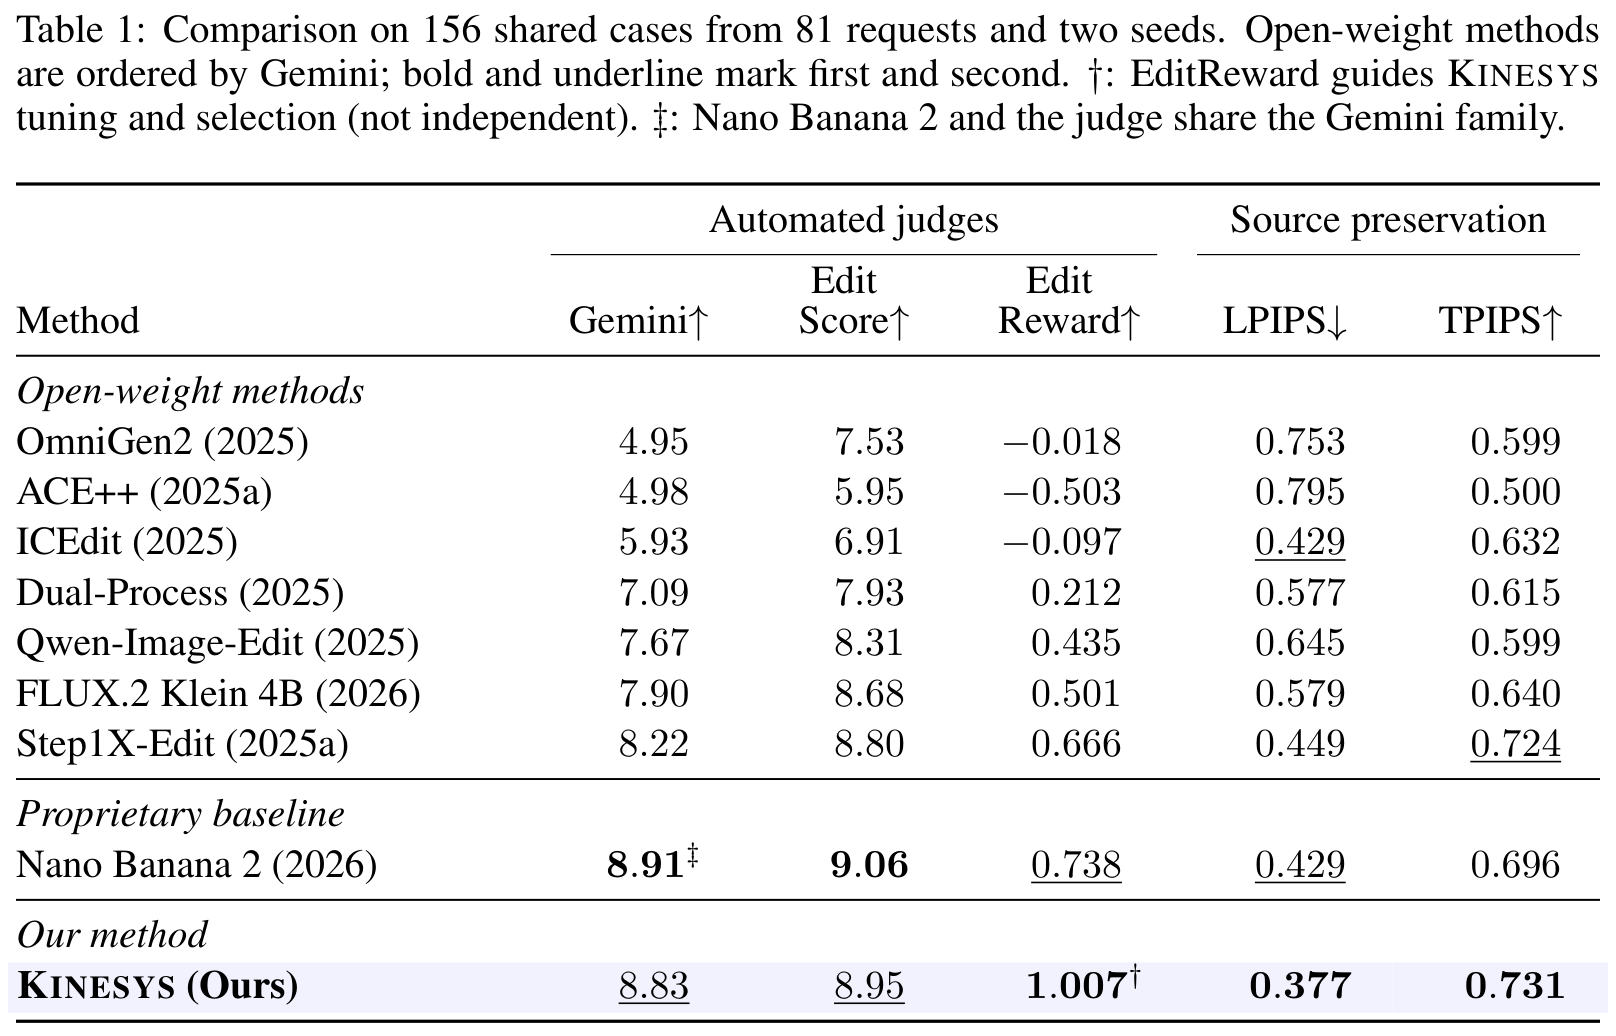 原文表 1|81 个请求、两种子中各方法共同完成的 156 例比较;开源权重方法按 Gemini 分排列,粗体/下划线为一/二名。匕首表示 EditReward 用于本方法优化和选择,并非独立裁判;双匕首表示 Nano Banana 2 与 Gemini 裁判同属一模型家族。LPIPS 距离越低、TPIPS 相似度越高越保留源图,其余为编辑质量模型评分。
- 批判点评:源图相似不等于特效成功;EditReward 既参与优化又选最终权重,不能把该分数当独立验证。人评样本小,156 例还排除了各服务未共同完成的 6 例;与闭源特效转移接近不能写成全面超越。项目 可查,本次未找到作者可确认的方法代码链接。
3. CrossPair:示范一对图迁移同一种改法
CrossPair: Unlocking Generalist Visual Transformation Learning in Image Editors | 浙江大学;蚂蚁集团 | arXiv:2610.34333
关键词:示例驱动编辑, 双路径条件, 关系方向对齐, 跨内容迁移
- 前序问题:给“这张改前→这张改后”的示范,再让模型处理另一张图,它可能复制示范人物而没学会改法。修复、换装、风格化看似不同,都需要把变换从示范内容中剥出来。
- 方法直觉:让一条路径理解操作含义,另一条保留颜色与纹理,再要求两组不同场景的“变化方向”一致。比较的是各场景内部怎样变,不是假设两张不相关照片的同位置就是同一个物体。
- 本文贡献:以 Qwen-Image-Edit-2511 为底座,把示范前、示范后、待改图按固定角色顺序送入 VLM 视觉语言编码和 VAE 外观编码。冻结 DINOv3 在训练时找每组图的变化区域,聚合特征差分并对齐方向;目标图只提供停止梯度的变化权重,预测分支保留梯度,低噪声时才加强该约束。只训练秩 128 LoRA,DINO 分支推理移除。Transform-360K 实际有 91010 条四图记录,360K 指记录级图像出现次数,非 36 万独立样本;含 8000 多细粒度关系。
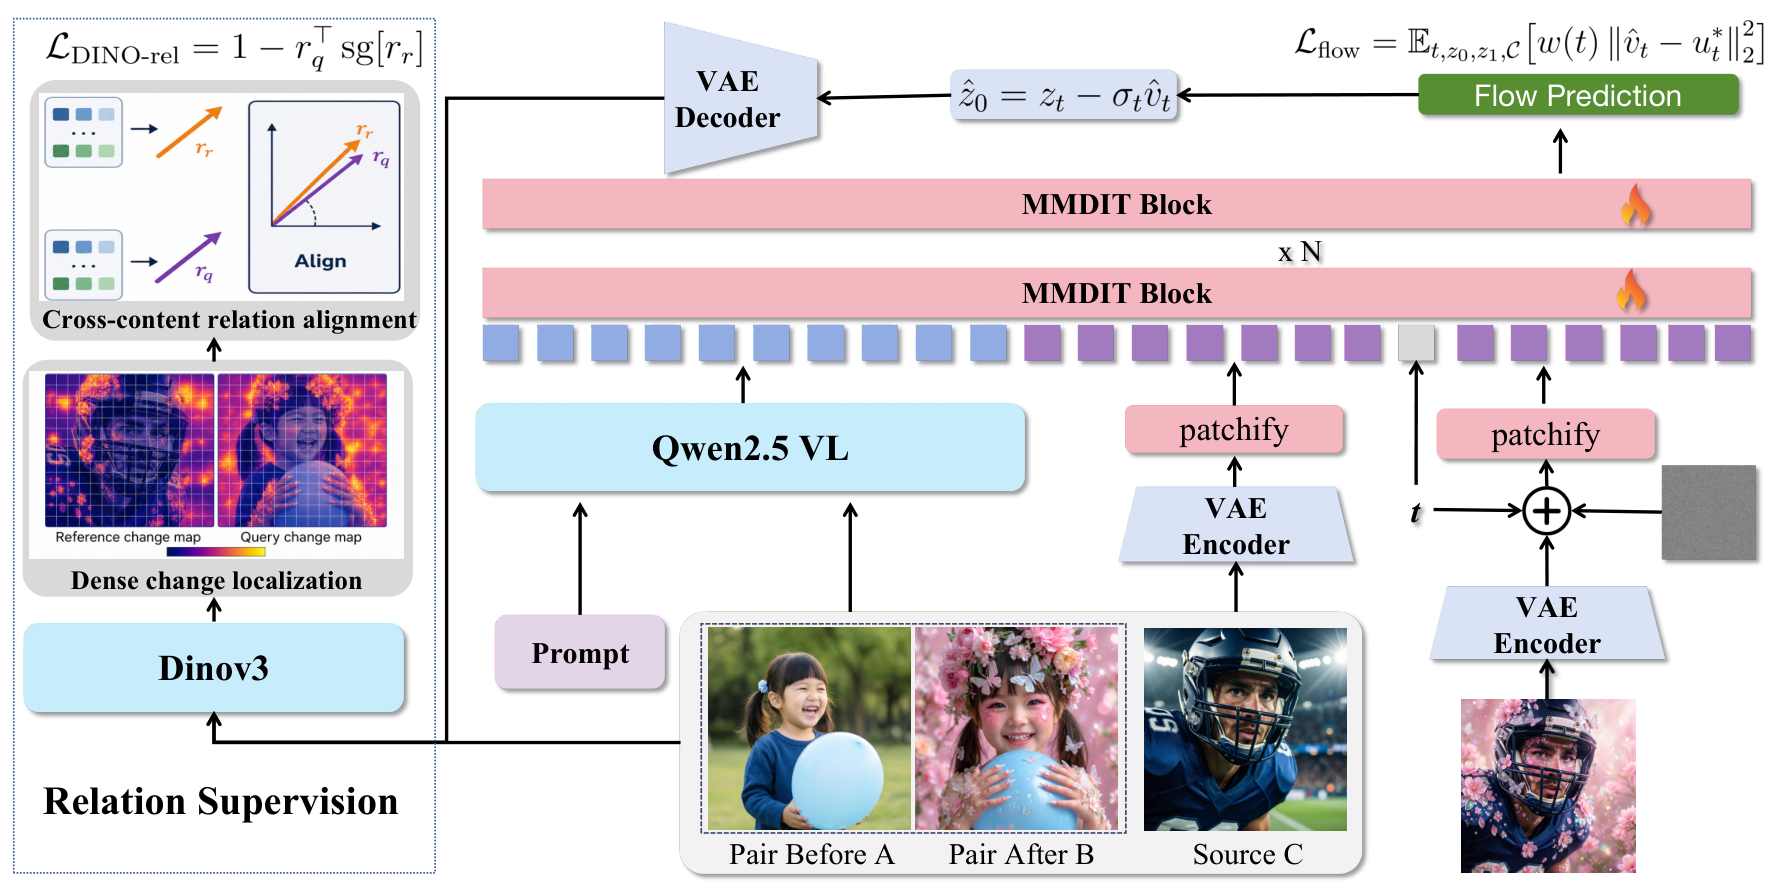 原文图 2|CrossPair 总览:示范图对和待改图一起进入底座原有 VLM 语义及 VAE 外观路径,引导流预测。仅在训练时,正确目标提供停止梯度的变化定位权重,冻结 DINOv3 比较示范及预测查询的变化方向;VAE/VLM 编码器冻结,只训练生成器 LoRA。
- 实验效果:1095 个已见操作留出查询上,Relation252K 衍生训练版的 CLIP 目标图相似度 0.871、方向相似度 0.438,对照 RelationAdapter 为 0.777/0.355。450 个未见操作查询上,扩展数据版目标相似度 0.783、LPIPS 距离 0.402;原数据版为 0.744/0.440。GPT-5.5 一次匿名排序的未见操作首选率 43.5%,但保留源内容首选率仅 11.2%。训练图面积上限 262144 像素;额外 DINO 只增训练成本,论文未给统一部署时延/显存对照。
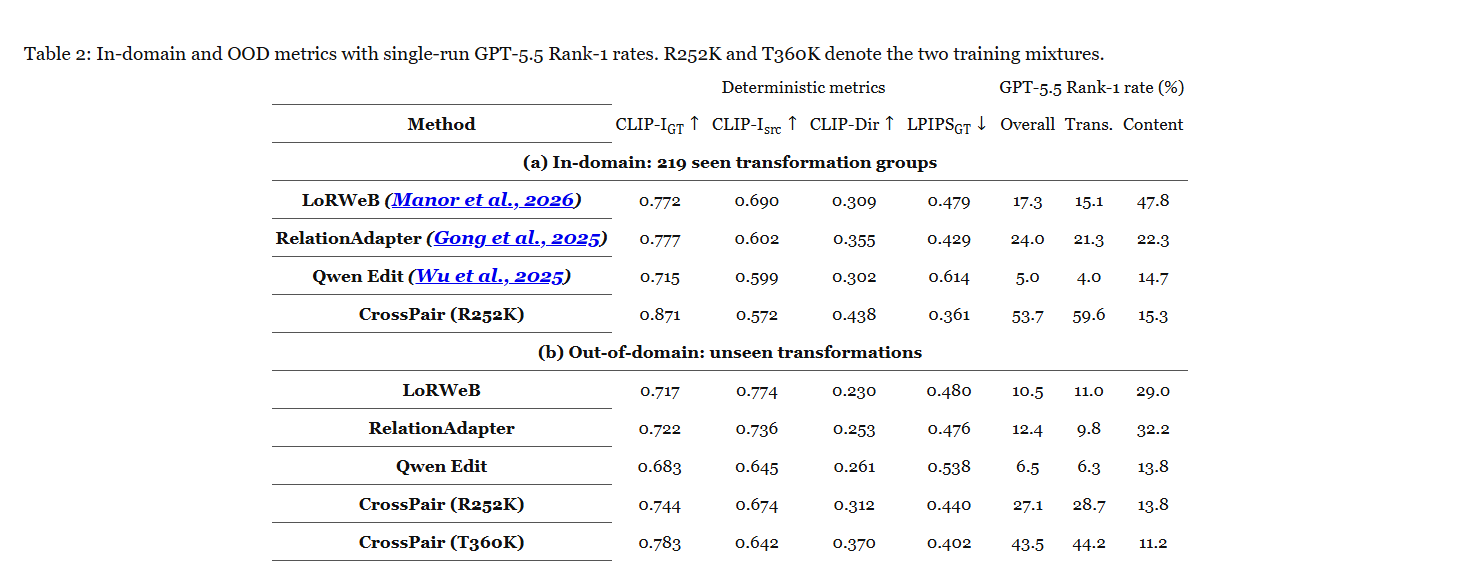 原文表 2|已见操作和未见操作的确定性指标及 GPT-5.5 单次排序首选率。R252K/T360K 表示不同训练混合。CLIP-I 对目标/源图相似度、CLIP-Dir 方向相似度越高越好,LPIPS 对目标距离越低越好;首选率分整体、操作与源内容保留三类,不能把整体首选率当编辑成功率。
- 批判点评:推理只给一对示范不等于训练只靠一对:训练另有待改图的正确结果,也有可指明操作的文字。新数据版同时改变数量和组成,不能把全部收益归因单一损失;系统对照保留各自原生采样器。源图保留弱于 LoRWeB,任务需权衡迁移力度;原文未提供可核实的项目或代码入口。
4. WorldCast:大幅绕拍时记住人物背面
WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control | 武汉大学;小米 | arXiv:2610.33135
关键词:相机轨迹控制, 多视角人物记忆, 几何对齐, 大角度视频
- 前序问题:镜头绕人物转半圈,正脸像本人,背面却换了发型和衣服。第一帧里根本没有这些信息;镜头走对路径,与人物每一面保持同一身份,是两个耦合问题。
- 方法直觉:把源图投影成沿相机轨迹的粗参考,明确哪里看不到;再把人物正背侧参考放进共同三维坐标,目标机位从对得上的参考里取细节,而不从所有照片无差别拼信息。
- 本文贡献:Wan2.1-I2V-14B 接收初始图、文字、目标内外参及补充人物视图。深度反投影后沿轨迹渲染 RGB 和覆盖掩码,Plücker 射线编码相机位置与方向;GAMA(几何对齐记忆注意力)先用前景掩码和多视图几何估计对齐参考,再在 20 处插入记忆块。第一阶段用 76698 条 SpatialVID 和 5 万 UE5 序列训练相机控制,第二阶段用 3 万 Blender 多视角样本训练记忆分支;81 帧、832×480,两个阶段分别 5/8 轮。
 原文图 2|WorldCast 总览:把沿目标轨迹对齐的几何指导,与先在共同坐标系对齐的多视角人物记忆结合,使相机路径和人物补充外观共同指导视频生成。
- 实验效果:CLACT 评测含 42 场景(17 合成、25 真实)各六条轨迹。相对 Uni3C,ATE 绝对轨迹误差 0.098→0.065,相对旋转误差 1.069→0.896,跨视角几何差异 MEt3R(越低越一致)0.324→0.228,ArcFace 身份相似度 0.374→0.555。画质分 0.719,低于 Lyra 2.0 的 0.725;不是所有指标领先。增加多参考和 20 个记忆块需要计算与存储,原文没有统一实测时延账单。
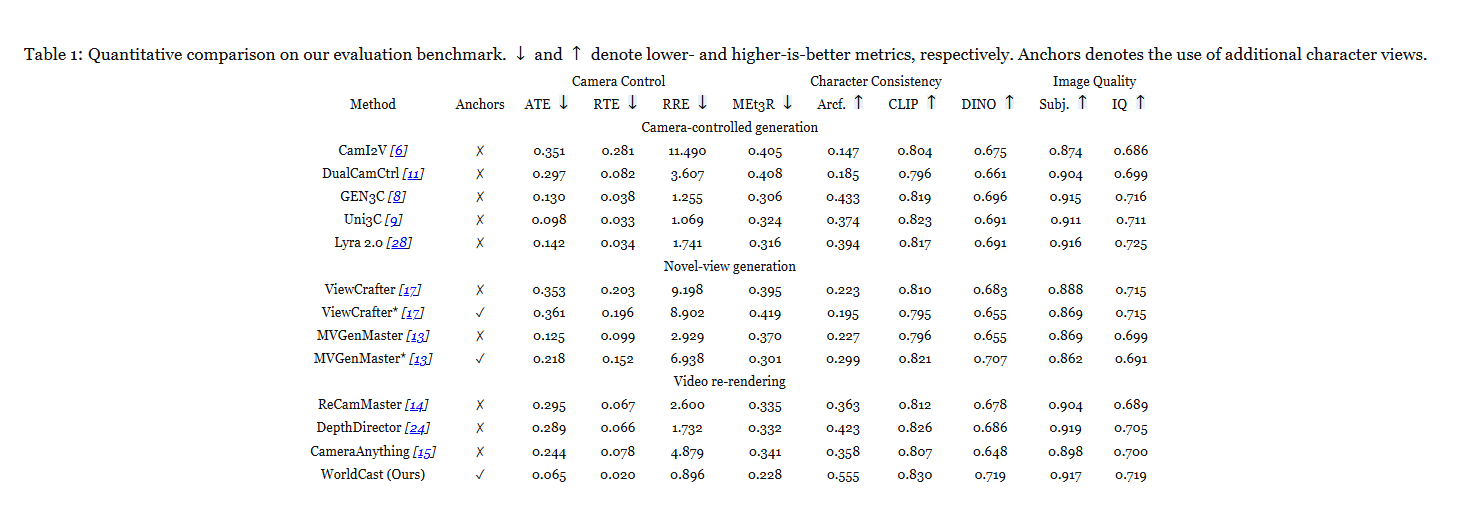 原文表 1|CLACT 主比较,箭头表示越小/越大越好,Anchors 表示是否增加人物视图。ATE/RTE/RRE 为绝对轨迹、相对平移/旋转误差;MEt3R 为跨视角几何差异;Arcf./CLIP/DINO 为身份或视觉特征相似度,Subj./IQ 为主体稳定和画质。WorldCast 使用额外人物视图,画质和主体稳定未在所有对照中领先。
- 批判点评:方法用了额外人物参考,而大多数相机基线只给初始图;不能把信息增量全当架构收益。遮挡、前景分割和相机对齐失准仍会污染记忆。代码 有推理入口,README 明确专用权重仍待发布,不能据演示命令声称现在能完整复现;其推荐显存也不是论文峰值测量。
5. OmniShowcase:四面参考加法线转台稳绕拍
OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images | KAIST;仁荷大学;FLIPTION | arXiv:2610.35684
关键词:多视角主体生成, 法线转台, 三维一致性, 合成视频数据
- 前序问题:给了茶壶四面照片,视频绕拍时仍可能长出第二个壶嘴。照片分别告诉模型各面像什么,却没明确告诉它这些面属于怎样的同一件立体物体。
- 方法直觉:先由同样四张参考重建粗几何,转一圈记录表面朝向,作为独立的结构说明书;照片提供外观,法线提供形状。说明书不必逐帧对齐最终视频,镜头动作仍由文字指定。
- 本文贡献:构建 4000 条 Showcase-4K 视频,12 种相机运动、88 种轨迹配置。主体由真实三维资产渲染,视频修补只生成背景;条件也从四张参考重建,避免训练偷用真值网格。25 帧法线转台编码为 7 帧潜变量,80 帧目标编码为 20 帧,再加四张独立参考,共 31 个时间位置;token 即模型处理的特征单元。条件保持干净,仅目标加噪。Wan2.1-I2V-14B 只调秩 128 LoRA,四张 B200 训练 33000 次更新约 50 小时。
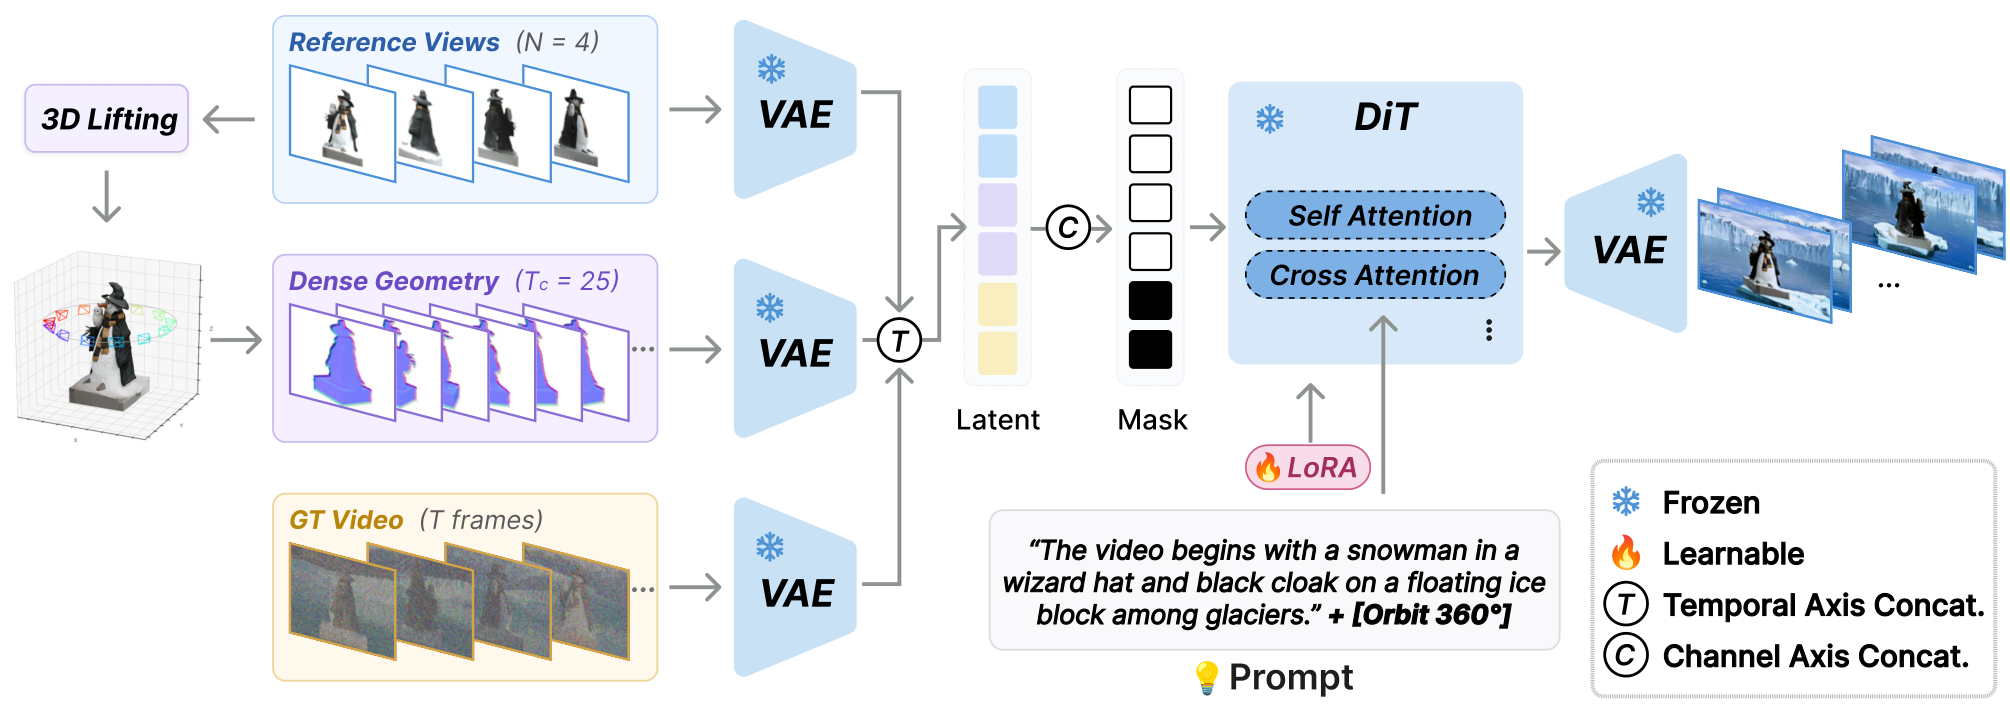 原文图 4|OmniShowcase 总览:从 N=4 张参考图重建几何并渲染法线转台。参考图及法线条件送入经 LoRA 调优的图生视频扩散 Transformer 参考路径;模型用照片外观与法线结构生成视频,无需针对每个新主体再优化。
- 实验效果:ShowcaseBench 的 50 主体、四条 360 度轨迹与训练资产隔离,另测 NAVI 的 35 主体,各方法均给同样四张图。相对 3DreamBooth,留出集 DINO 主体相似度 0.707→0.799,归一化并刚性对齐后的 GT-CD 双向点云距离 0.1717→0.0824;NAVI 相对 MV-S2V 为 0.1816→0.0975。留出集美学分 0.574 低于 MAGREF-MV 的 0.614。推理虽无需逐主体调优,仍要先重建与渲染转台,不能当作零预处理。
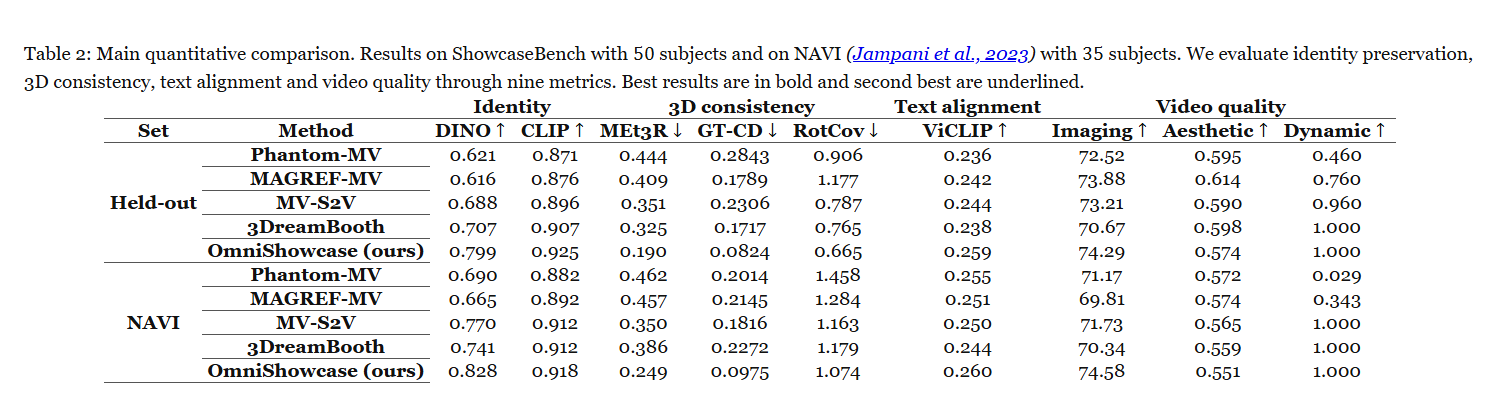 原文表 2|ShowcaseBench 的 50 主体与 NAVI 的 35 主体主比较,共九指标。DINO/CLIP 测身份,MEt3R、GT-CD 及 RotCov 测跨视图结构、对齐后点云距离及视点覆盖,ViCLIP 测文字匹配,Imaging/Aesthetic/Dynamic 测画质、美学与运动。相似度和画质类越高越好,三个结构/覆盖距离越低越好;粗体/下划线为最优/次优。美学指标未领先。
- 批判点评:它是多视图主体生成,不是对原视频逐帧重拍,也不是数字相机路径的严格控制。不同参考间主体非刚性变化处理不了,背景有合成感,几何分还依赖重建和对齐器。仓库 当前只有说明及素材,数据、推理、权重和训练代码均列为待发布。
6. SF2:少步视频还要学中间表征
Beyond Distribution Matching: Self-Supervised Representation Forcing for Few-Step Video Generation | 上海交通大学;腾讯混元;南洋理工大学 | arXiv:2610.35594
关键词:少步视频蒸馏, 表征自监督, 非对称噪声, 时空一致性
- 前序问题:把几十步视频压成四步,最终画面分布看着接近,人物关节仍会跳,倒掉的墙还会长回来。只约束出图结果,没有直接要求学生学会稳定的内部时空表示。
- 方法直觉:让学生看更破碎的噪声拼图,老师看同一生成轨迹上较干净的一刻;学生既要出好视频,也要预测老师中间层怎样理解它。老师来自学生参数的慢速平均,无需另请视觉大模型。
- 本文贡献:Self Flow Forcing(SF2)保留 DMD 分布匹配蒸馏目标,复用已有四步生成轨迹,取高/低噪声状态。学生混合两者,EMA 指数移动平均老师只看较干净状态;用投影器把学生 30%深度特征对齐老师 70%深度,余弦损失只更新学生。默认同一空间掩码跨帧复用,避免从相邻帧照抄;双向/因果最大比例设 0.4/0.2。EMA 动量 0.99,先 100 次仅训练投影器,再加入权重 0.5 的表征目标。
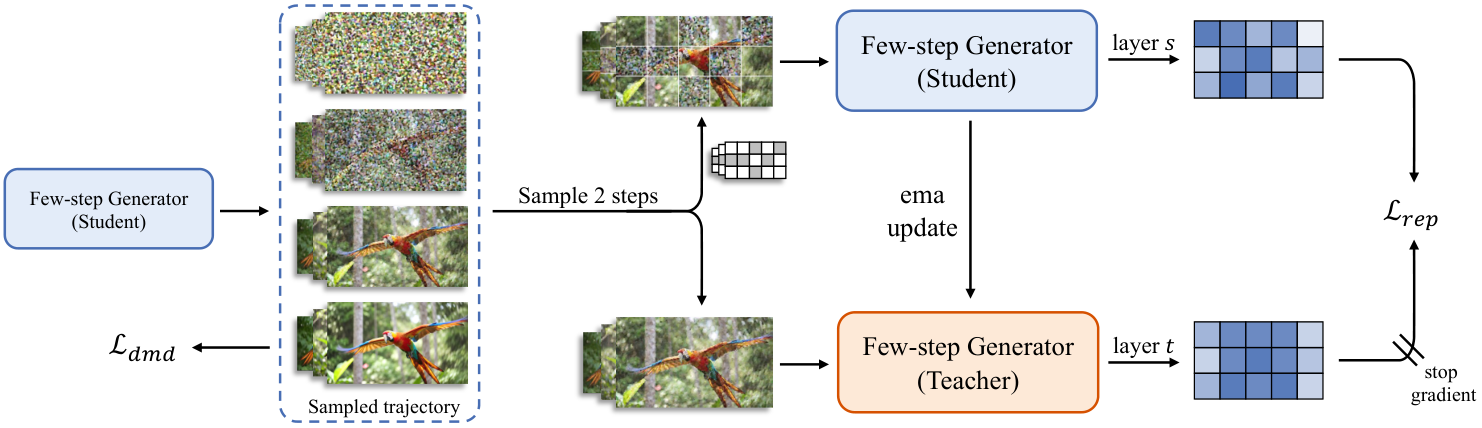 原文图 1|SF2 总览:学生去噪轨迹最干净预测继续承担标准 DMD 输出损失;两个中间状态 x_t/x_s(t>s)用空间掩码混成学生的高污染输入,EMA 老师只看较干净 x_s。通过可学习投影器和停止梯度的余弦损失对齐不同深度隐层,老师以指数平均更新,不引入外部预训练特征。
- 实验效果:Wan2.1-T2V-1.3B、四步、848×480,单 H100 同组比较:双向版 VBench 视频质量及语义评测总分 83.19→84.15,报告速度 16.2 FPS(帧/秒)、时延 4.22 秒不变;因果版相对 Causal-Forcing 总分 84.04→84.15,VisionReward 偏好模型均分 6.326→7.523,报告 17 FPS。一个训练周期定义为 1 次生成器和 5 次判别 score 模型更新,新增分支占周期 6.2%,不是训练总成本免费;推理不保留 EMA 或投影器。吞吐按表注为帧/秒,正文另写样本/秒有冲突,不能据此换算完整视频时延。
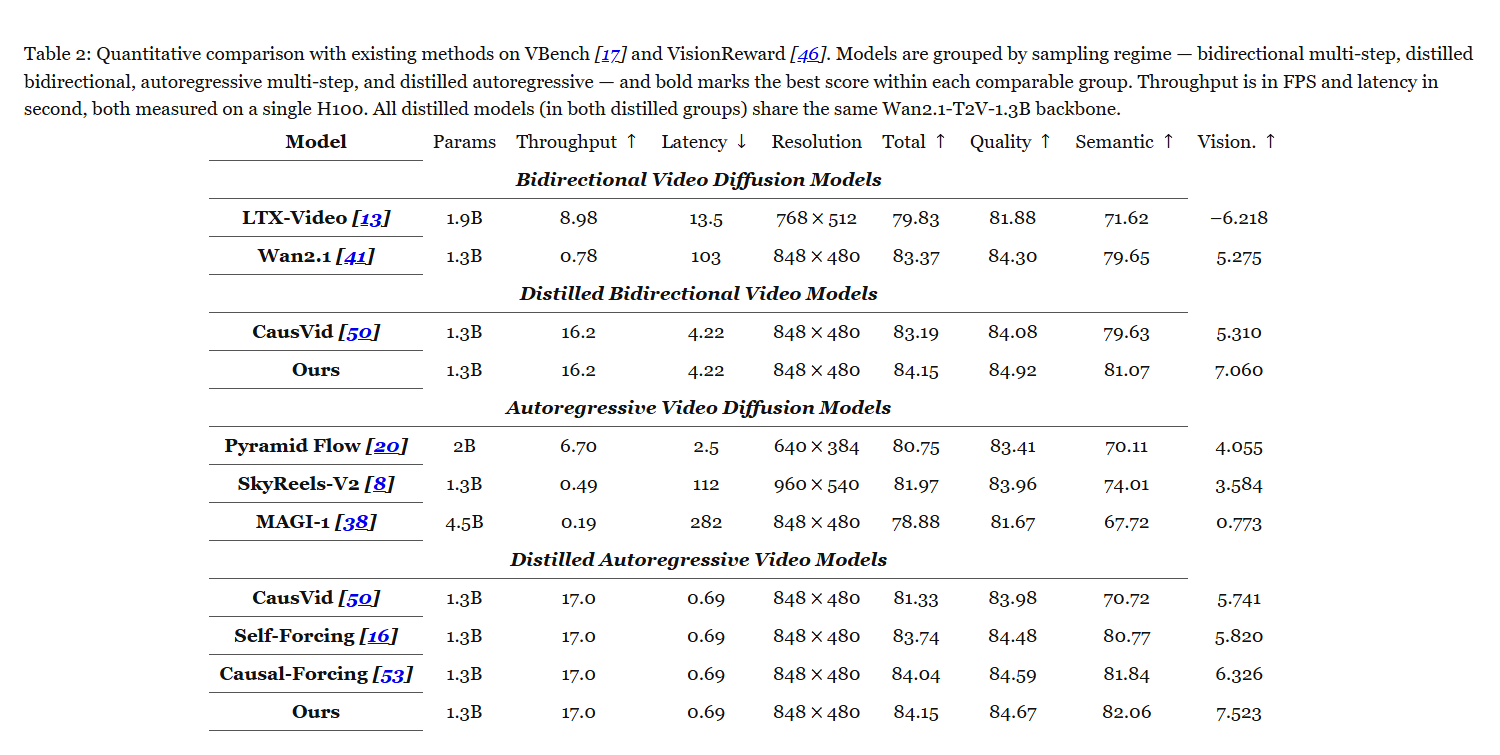 原文表 2|VBench 及 VisionReward 比较,分双向多步、蒸馏双向、自回归多步、蒸馏自回归四组,粗体只标各可比组最优;蒸馏组共享 Wan2.1-T2V-1.3B。吞吐量按表注为 FPS,时延为秒,单 H100;正文另一处写 samples/s,存在单位表述不一致,本稿沿表注且不跨组解释整片时延。Total/Quality/Semantic 和 VisionReward 均越高越好。
- 批判点评:不把内部特征对齐等同物理正确证明;三维重渲染探针也用了外部重建器,因果/双向速度及延迟口径不能混作整片首帧体验。arXiv 评论明确已接收 NeurIPS 2026。仓库 当前只有 README 并写代码将发布,不能称已可复现。
7. Triage:注意力每块分三档算
Triage: Skip, Skim, or Refine Attention Tiles in Video Diffusion Transformers | 首尔大学 | arXiv:2610.35706
关键词:视频推理加速, 注意力分块, 四位计算, 误差路由
- 前序问题:视频几万个 token 彼此做注意力,计算量随长度平方增长。统一砍掉一部分块会漏掉重要细节,保留块全用同一种低精度,又把算力花在了误差本就很小的地方。
- 方法直觉:像读长文:无关段落看摘要,普通段落略读,关键段落精读。根据每块近似造成的输出误差,把多花一次计算能换来多少精度算清楚,再按同一个预算价格选择。
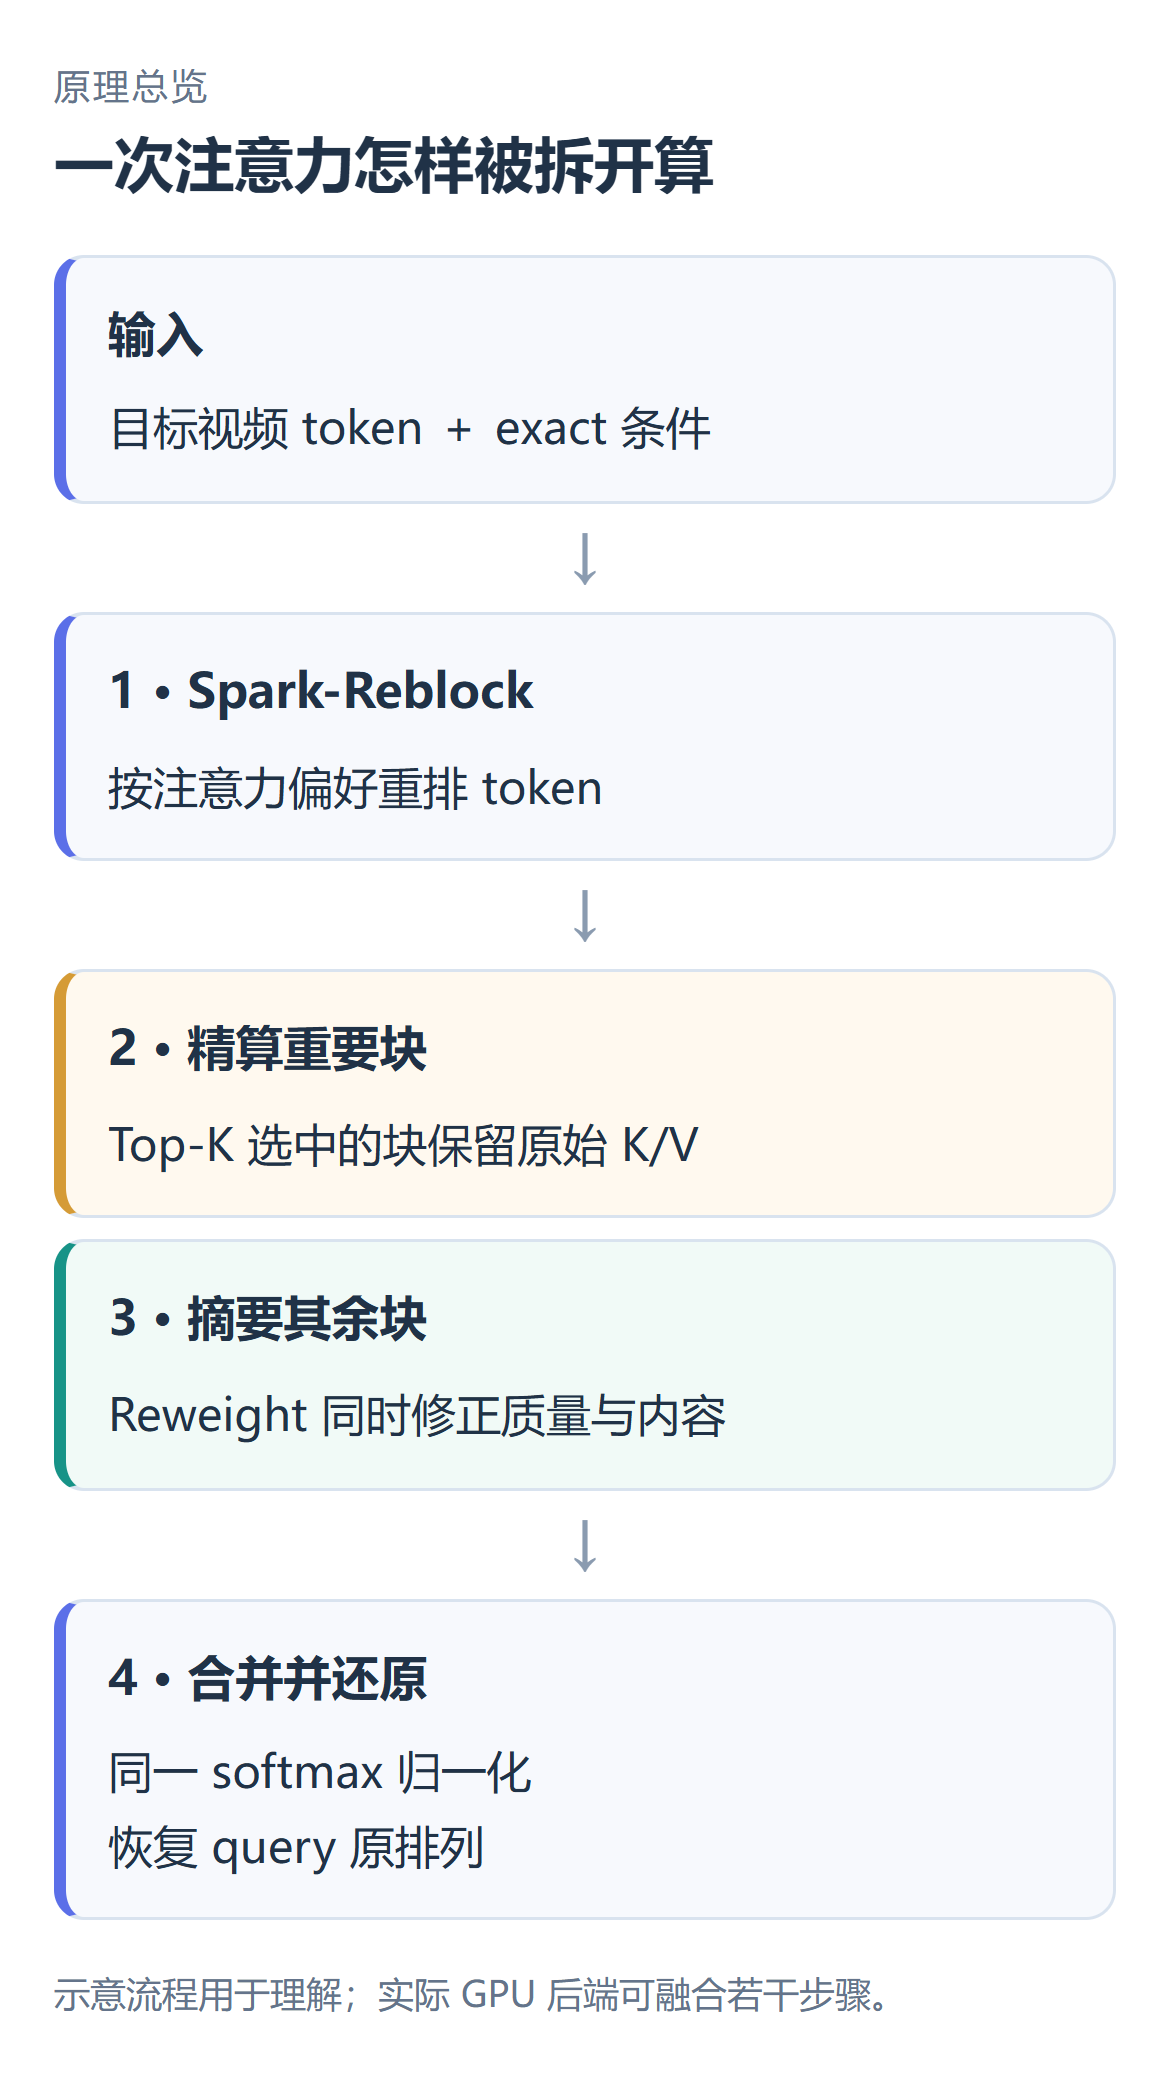
- 本文贡献:先用聚类树把相似查询和键组成 tile 注意力块,统计均值、方差和键值协方差,预测三档误差。skip 以块均值贡献替代,非直接清零;skim 用 NVFP4 四位乘法;refine 再加量化残差乘法。价格π越大越节省,路由按误差下降与新增成本决定升级。单个融合内核在同一次 softmax 归一化中合并三档,利用 RTX Blackwell 的 FP4 计算单元,无需再训练生成器。
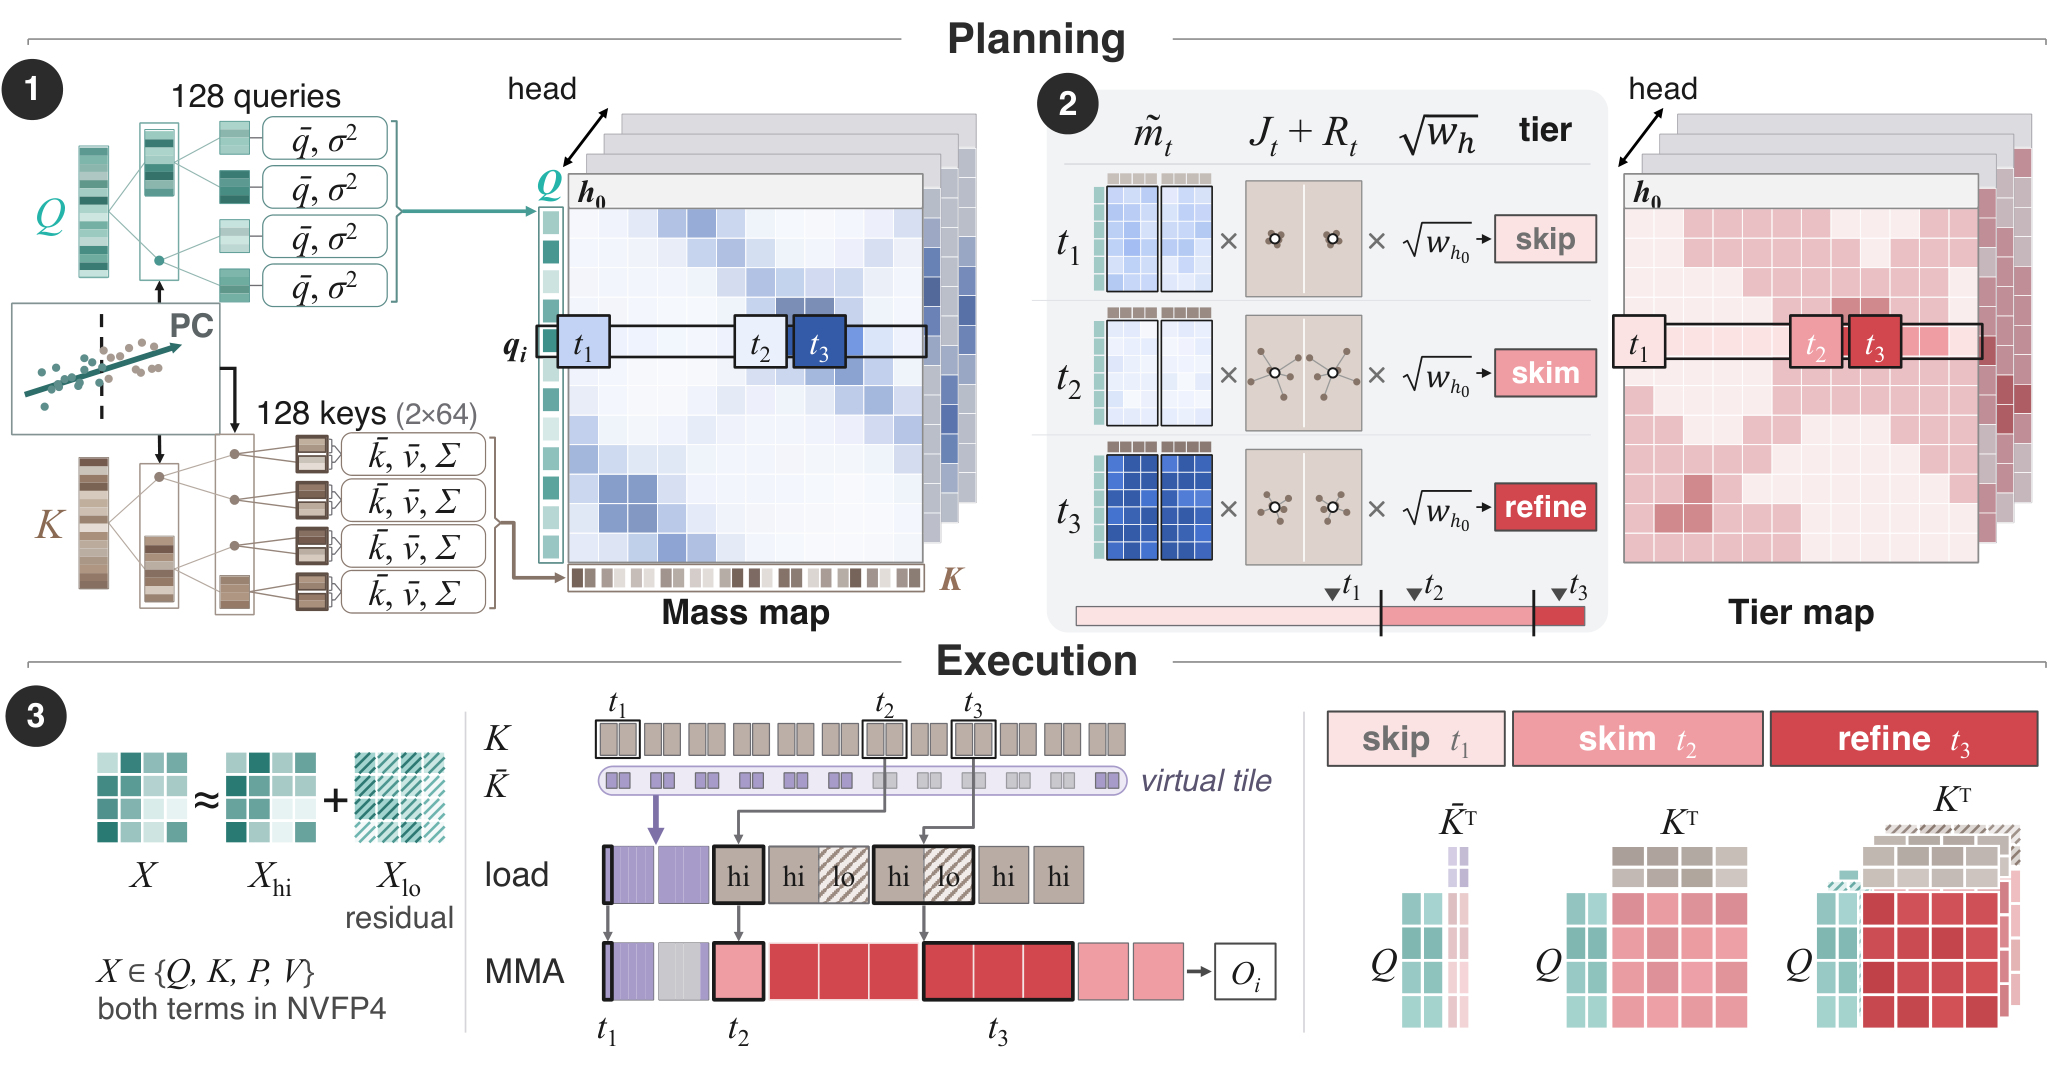 原文图 5|Triage 总览:规划阶段①聚类树将相似查询与键分块,②路由按预测误差分值 Ẽ_t=m̃_t(J_t+R_t)√w_h 选择略过、低精度或残差精修;m̃_t 为估计注意力质量,J/R 为近似误差项,w_h 为头输出权重。执行阶段③同一遍计算中,略过块用均值,普通块用一次 NVFP4 乘法,精修块用三次乘法计入残差。块图案仅作示意。
- 实验效果:五设置各 50 提示/图文对,只换视觉自注意力,首 20%步和第一块仍密集计算。RTX 5090、HunyuanVideo 540p/129 帧在π=0.3 时整段加速 2.32 倍、对密集视频 PSNR 像素信噪比 34.46 分贝;π=0.15 是 2.21 倍、36.37 分贝。同卡 Wan2.2 720p 只加速 1.38 倍;96GB RTX PRO 6000 的 LTX-2.5 为 1.84 倍。含预处理的单次注意力 4.1–8.6 倍,与不含预处理的内核最高 13.5 倍不同。
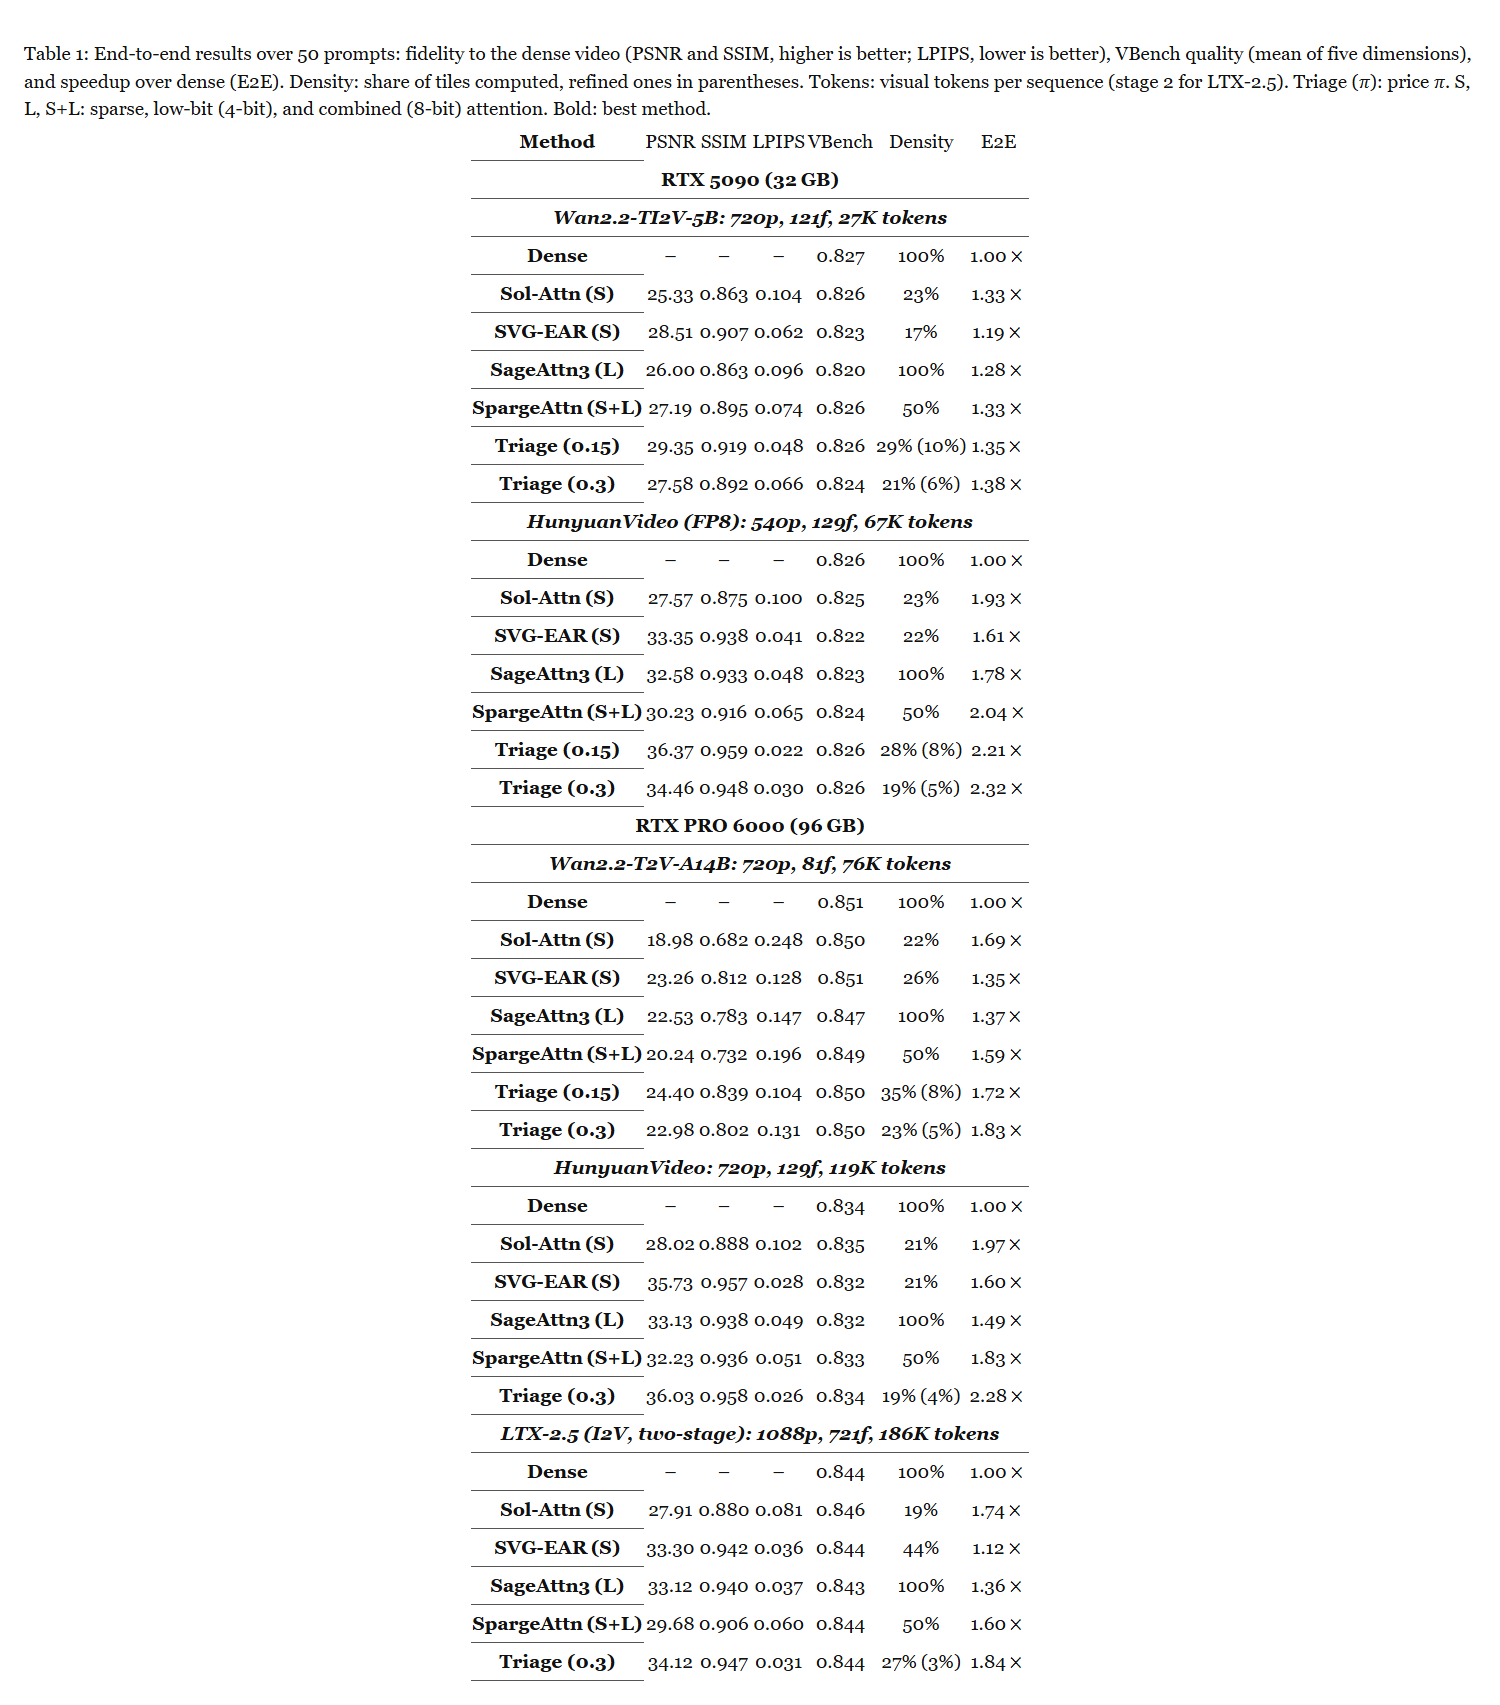 原文表 1|五设置各 50 提示的端到端结果:PSNR/SSIM 相对密集输出越高越好、LPIPS 距离越低越好;VBench 为五维平均质量,E2E 为整片相对密集版速度比。Density 是计算块占比,括号是全部块中的精修占比;Tokens 是每序列视觉 token,LTX 仅指阶段 2。π为误差与计算的价格。S/L/S+L 分别稀疏、四位及八位组合;粗体标最好方法,硬件分 32GB RTX 5090 和 96GB RTX PRO 6000。
- 批判点评:PSNR 衡量贴近密集输出,不是现实世界真值;VBench 画质也并非每组都超过密集版。收益依赖 Blackwell 硬件、序列长度与密集暖启,不能泛化为所有 GPU 或整套服务提速。原文没有作者方法仓库;其 CUTLASS 引用只是底层库,ICML 模板也不当接收证据。
8. ImageTTS:画图底座读频谱学说话
ImageTTS: Repurposing Pretrained Image Diffusion Transformers for Speech Synthesis | 武汉大学;微软;香港中文大学 | arXiv:2610.34807
关键词:跨模态生成迁移, 图像潜空间, 零样本语音, 风格指令
- 前序问题:图像生成器学到的东西能否帮助语音,而不只是借用同款网络?语音还要求字念对、短参考里是谁在说话,两类能力必须分开检验。
- 方法直觉:把频率随时间变化的声谱图当灰度图片复制成三通道,让图像编码器压缩;再比较同一结构从画图权重和随机权重起步,分清“表示能装下声音”和“生成先验真有帮助”。
- 本文贡献:100 频带的 log-mel 声谱插值到 512 高,时间补齐 16 倍数并归一化成伪 RGB;冻结 FLUX.2 VAE 和 Qwen3 文字编码器,微调 4B 图像 DiT 扩散 Transformer,做条件流匹配。零样本用参考语音前缀,指令版把文本内容与说话风格一起编码;生成声谱再经 BigVGAN-v2 声码器还原波形。规模版用 10 万小时 Emilia、64 张 40GB A100 训练 18 万次更新,指令版再用 9000 小时和零样本等量混合训 5 万次。
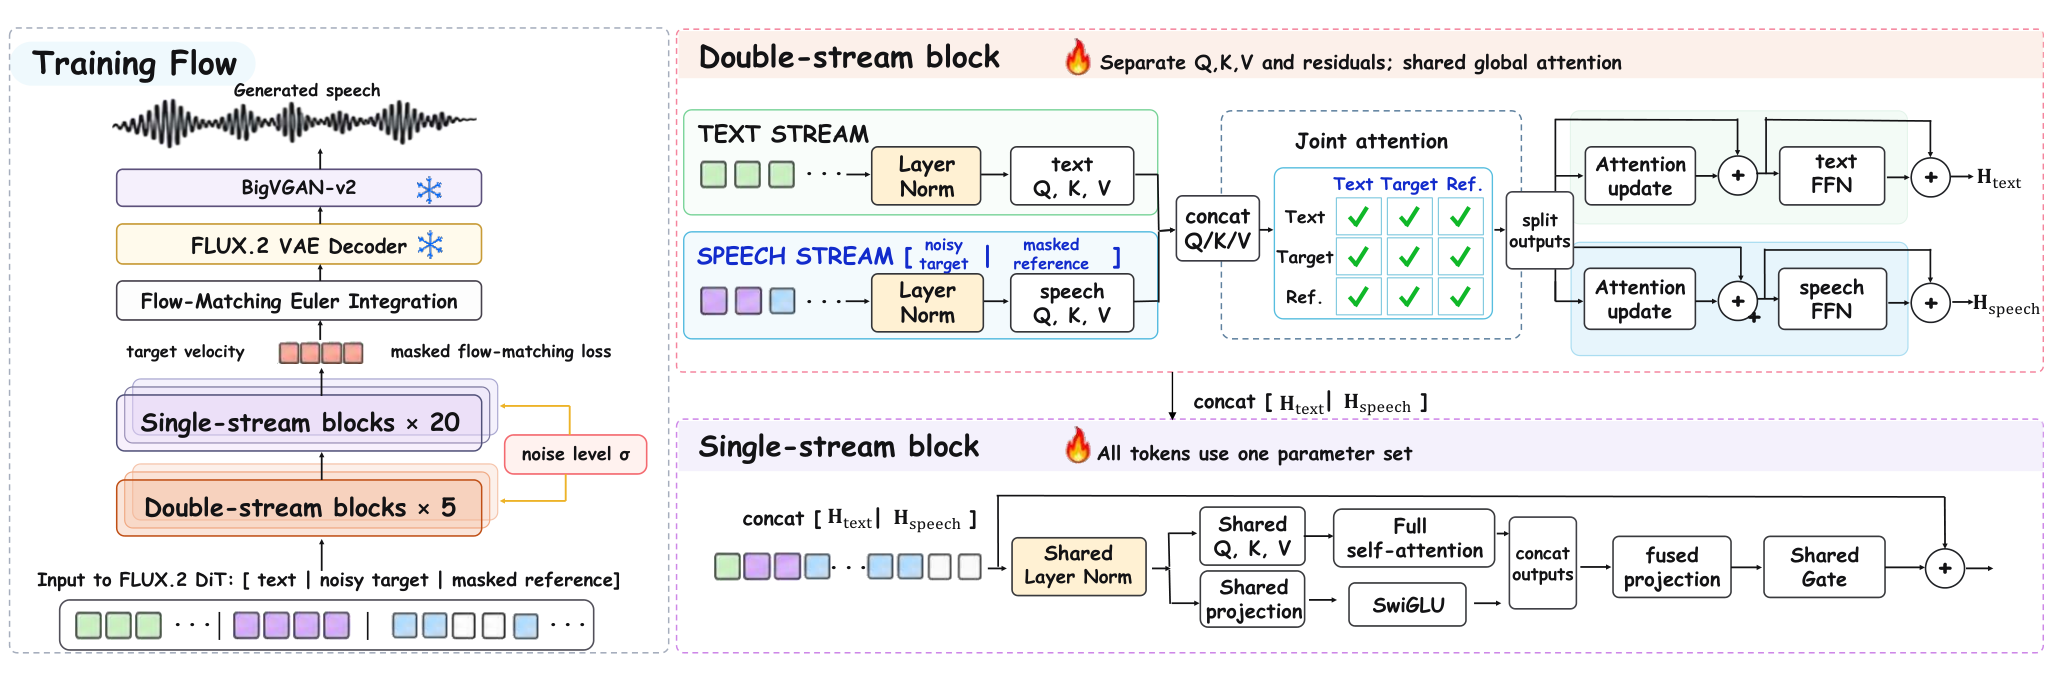 原文图 2|ImageTTS-base 架构:以流匹配 DiT 为主干,由双流块和单流块组成,并接受时间步σ条件。用 Euler 积分求解潜变量,经冻结 FLUX.2 VAE 解码器与 BigVGAN-v2 声码器合成语音。
- 实验效果:585 小时 LibriTTS 初始化实验,同为 10 万次更新,图像预训练/随机的 WER 词错误率 2.7%/4.2%;随机训 15 万次仍 3.8%。冻结 VAE 在 LibriTTS 重建 STOI 可懂度 0.99、说话人相似度 0.95,这是重建而非生成分。规模版 Seed-TTS 英文 WER1.12%、中文 CER 字错误率 1.68%,中文说话人相似度 0.72 低于 F5-TTS 的 0.76;CapSpeech 风格属性平均准确率 0.66。推理 50 个 Euler 求解步,文字/语音双引导需额外前向,非只调用网络 50 次。
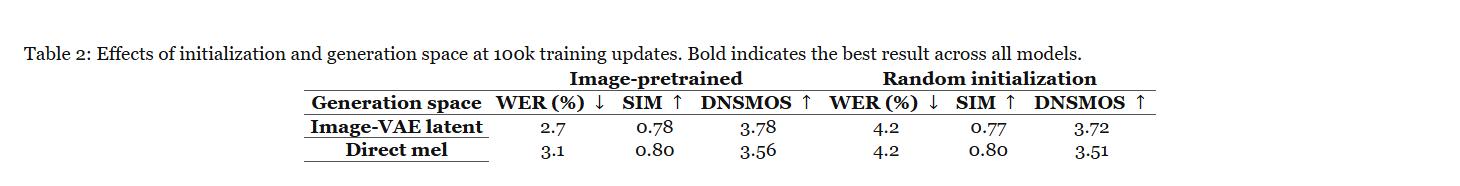 原文表 2|同为 10 万次训练更新,交叉比较图像预训练/随机初始化及图像 VAE 潜空间/直接 mel 建模,粗体为各指标最优。WER 词错误率按百分数越低越好,SIM 说话人相似度、DNSMOS 预测感知质量越高越好;潜空间预训练 WER2.7%,随机 4.2%,直接 mel 保留说话人略强,表示选择存在取舍。
- 批判点评:正确发音与身份保持有取舍,不能把重建分数套给生成。更大私有数据系统不是同数据公平对照;只在约 10 万小时 Emilia 组比较优势。未给统一实时率或峰值显存,演示 自称 ICLR 2027 匿名投稿,不构成接收;本次未发现可确认的代码。
9. AMBIT:挪一个声源其他声音少受扰
Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion | 香港科技大学;Noiz AI;华盛顿大学 | arXiv:2610.34415
关键词:空间音频编辑, 可执行场景计划, 四通道表示, 在策略自蒸馏
- 前序问题:把狗叫从左边移到右边,背景音乐却变声或偏了方向。空间音频编辑既要执行哪条声源怎么动,也要保留其余声音的音色、响度与位置,只写一段目标描述不够。
- 方法直觉:先列完整目标场景:改谁、保留谁、何时响、沿哪里移动,再渲染声音。计划负责可说清的控制,原音频负责计划写不全的细节;两者共同约束,减少保留部分被重新想象。
- 本文贡献:FOA 一阶 Ambisonics 以 W 全向及三方向分量表达声场,非四个独立扬声器。共享 Transfusion Transformer 在自回归模式逐 token 产 ScenePlan,在流匹配模式生成音频潜变量;可执行计划含声源类型、文字、时间和三维直线路径。编辑同时用原始潜变量及 CLAP 对比音文特征;VAE 以共享解码器全向重建、分组 KL 和空间协方差保留通道关系。OPSD 在策略自蒸馏让老师纠正学生自己产生的计划前缀与采样状态,联合更新两模式。主干及接口 3.326 亿可训练参数,训练 160 万 FOA 例及 100 万编辑对。
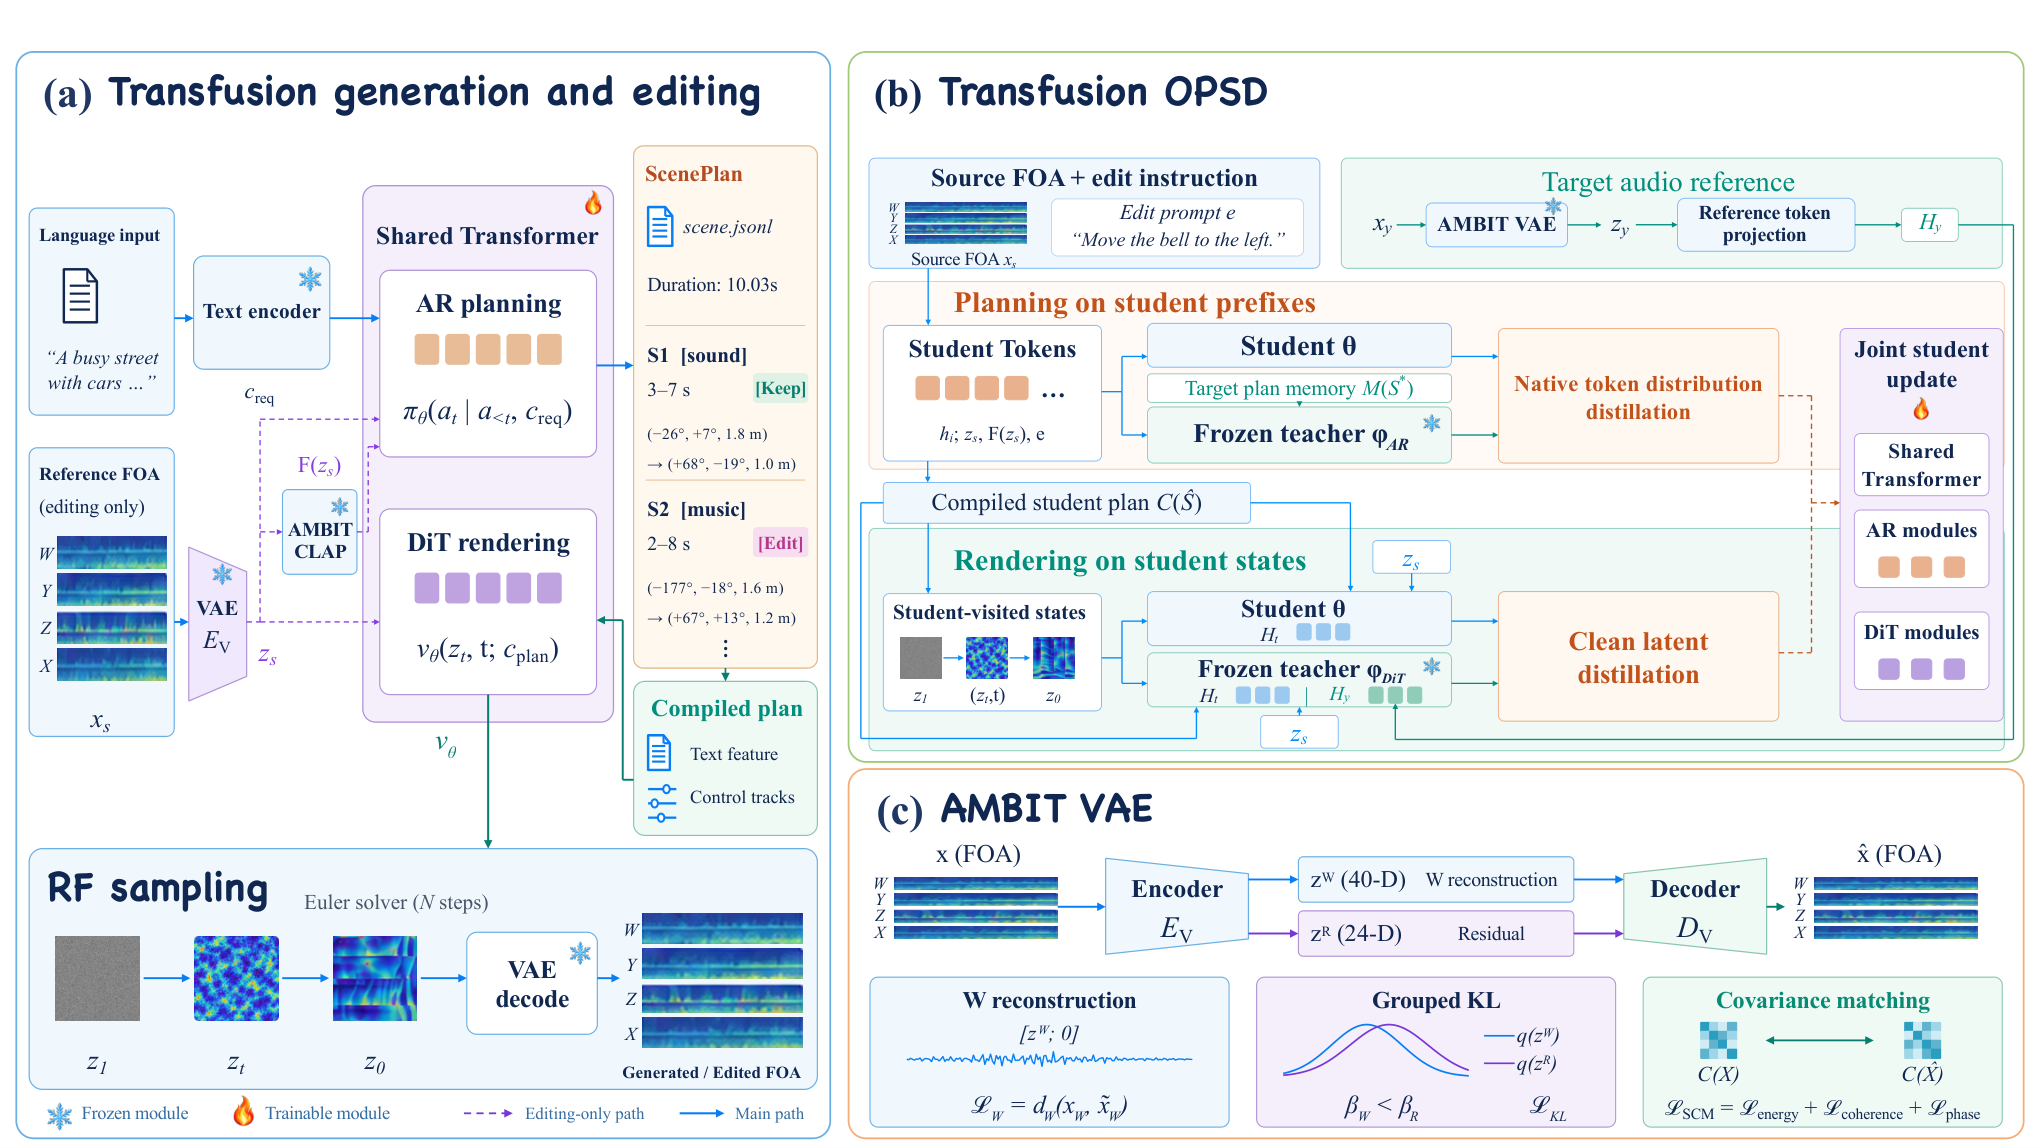 原文图 2|AMBIT 总览:(a)共享 Transformer 预测可执行 ScenePlan 并以编译计划指导原生 FOA 潜空间流渲染;编辑在两模式使用源潜变量,在规划时加入 Ambit CLAP 特征。(b)OPSD 在学生前缀和实际访问状态上蒸馏 token 及干净潜变量预测,联合更新共享块及自回归/DiT 模块。(c)VAE 结合共享解码器的全向 W 辅助恢复、分组 KL 和空间协方差监督。
- 实验效果:8000 生成请求、5000 编辑对;相对 SwanWeave,基础版编辑配对 CLAP 音文相似度 0.68→0.84,FAD 音频特征分布距离 0.57→0.24;未编辑声源方向平均绝对误差 0.90→0.17 弧度,绝对响度变化 8.40→1.65 分贝。单声源指标只在带标注的孤立活动区间计算,不能覆盖所有重叠混音。联合 OPSD 的 FAD0.211,对继续监督训练为 0.232。计划最长约 15 秒,规划与连续渲染均耗计算,未提供统一端到端时延。
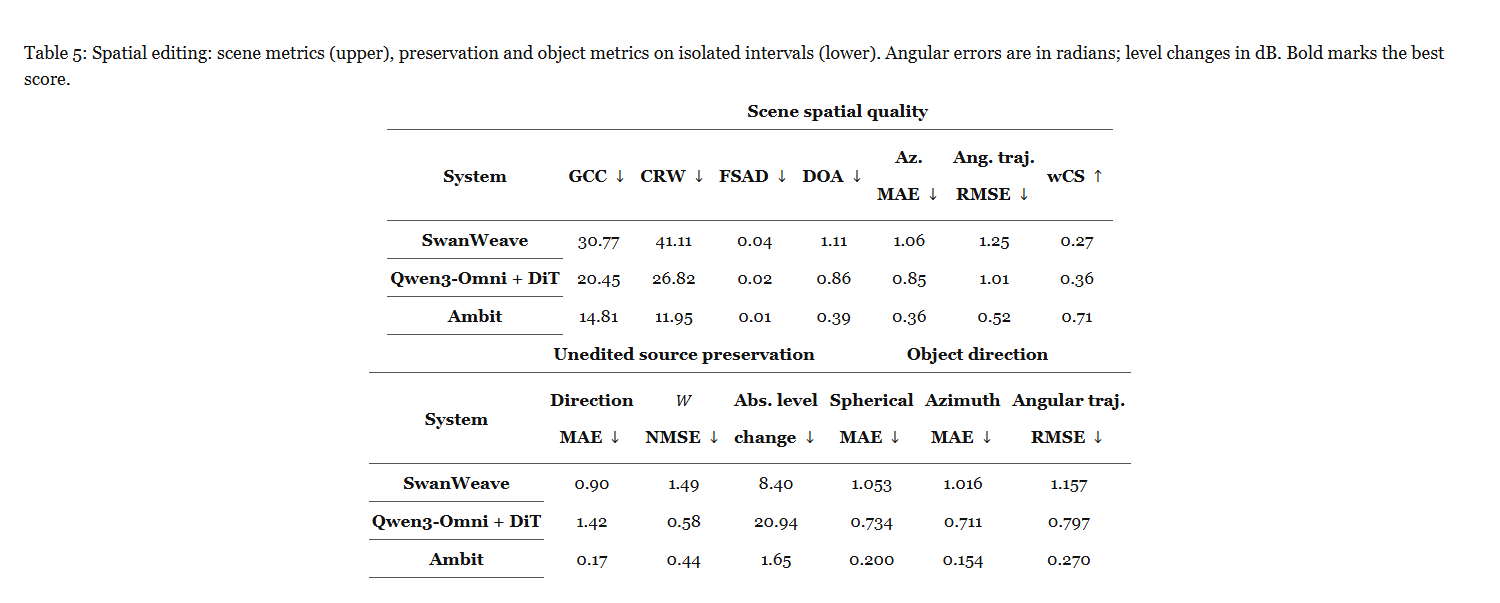 原文表 5|空间音频编辑:上部为混合声场指标,下部为孤立区间上的非编辑声源保留与目标声源方向。角度误差单位为弧度,响度变化为分贝;Direction MAE 为方向平均绝对误差,W NMSE 为全向通道归一化均方误差,Angular traj.RMSE 为角轨迹均方根误差,越低越好,wCS 方向加权余弦相似度越高越好。粗体为各列最好。保留原声需单独检查,不能用目标方向正确替代。
- 批判点评:长声景和连续多轮编辑的一致性仍待验证;语音自然度 UTMOS3.52 低于 Qwen3-TTS 的 4.18,不是音质全胜。方向误差弧度不能误写成角度。代码 有生成和编辑实现,但 README 明确预训练模型尚待发布,现有命令需要本地模型包。
10. VidEdit3D:先沿镜头改视频再改三维
VidEdit3D: Flexible 3D Gaussian Editing with Video Diffusion | 西湖大学;利兹大学;南洋理工大学;加州大学默塞德分校 | arXiv:2610.35756
关键词:三维高斯编辑, 轨迹组织, 视频先验, 区域选择优化
- 前序问题:给三维场景里的人戴上耳机,一张视图改好了,换角度耳机却不见了;逐视图编辑还可能动到邻近家具。目标既是跨角度一致,又允许局部形状真的改变。
- 方法直觉:把静态三维场景的绕拍渲染排成平滑视频,借视频模型的时序能力传播首视图编辑,再只把该改的区域拟合回三维。镜头移动造成的画面变化不应变成人物自己乱动。
- 本文贡献:输入已重建 3DGS(三维高斯点及颜色、透明度组成的可渲染场景)、标定视图、改过的锚点图及前后提示。TGR 选 4 或 7 关键视图,最远点覆盖后排成短闭环,样条插值成 61 帧片段,双向从同一锚点传播。FAVE 共享源/改状态噪声,用源结构校正限制漂移;ECG 在同一改后状态对比源/目标图条件,早期放大源条件拉开编辑信号。注意力差分给区域掩码;RS-GS 用跨视图掩码和深度剔除遮挡后背景,只更新选中高斯。
 原文图 2|VidEdit3D 总览:将三维编辑转成沿轨迹的视频编辑。第一步 TGR 组织选中视图为平滑片段;第二步 FAVE 从用户修改锚点传播,借 ECG 增强语义对齐、注意力掩码保留背景;第三步 RS-GS 以逆渲染将二维结果抬升回三维,仅允许目标高斯更新。
- 实验效果:50 编辑案例、同场景同提示,参考条件方法还给同一锚点。相对 EditSplat,CLIP-D 图像变化与文字变化方向相似度 0.0813→0.1275;相对 GaussCtrl,跨视图几何差异 MEt3R0.1137→0.1126,改进幅度较小。底座 Wan2.1-I2V-14B-480P,50 步日程强度 0.9,即 45 个有效去噪步;每个接受片段都需传播,再做 3000 次高斯优化。免网络微调并不免三维拟合,论文未给统一整流程时延/显存。
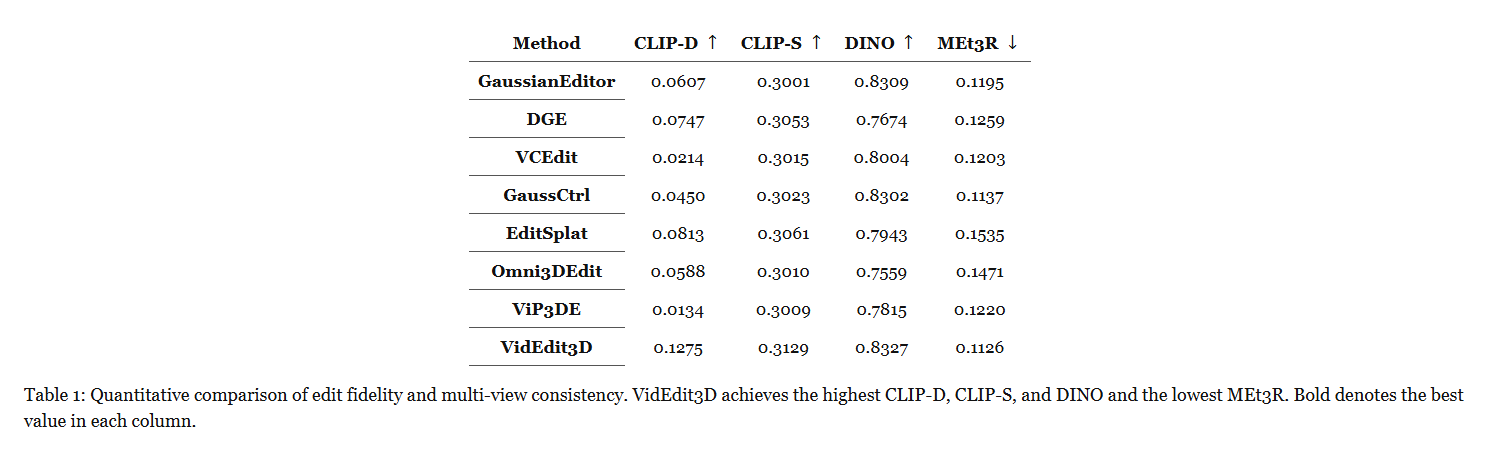 原文表 1|编辑忠实度与多视图一致性比较:CLIP-D 为编辑方向对齐,CLIP-S 为目标语义匹配,DINO 为跨视图特征相似,前三项越高越好;MEt3R 为重叠相邻视角几何差异,越低越好。VidEdit3D 四项领先,粗体标最优,但 MEt3R 相对 GaussCtrl 的优势只有 0.0011,不夸大为几何完全正确。
- 批判点评:视图相似度过滤在首个不合格片段就停止该分支,覆盖不足或重遮挡仍可能留下未改区域;新对象还受选中高斯及增密范围限制。跨角度一致不能证明几何真值正确。仓库 当前仅说明和素材,方法代码标为即将发布。
趋势观察
示范变化比完整目标更适合传递编辑意图
EditDistill把图对提炼为变化描述,CrossPair把跨场景特征变化对齐;两者都在区分内容和操作,但前者用于视频时序,后者用于不同图像。
几何条件的对齐方式决定控制边界
WorldCast按相机几何读取人物锚点,OmniShowcase用独立法线转台给形状而不逐帧锁相机;不能将两种多视图方法当成同一种控制。
速度优化要标明省的是哪一步
SF2以额外训练换四步质量,Triage改注意力精度,KINESYS反而按请求多路调优;收益需要回到训练、推理和服务成本分别看。
保留能力需要单独测
KINESYS的源图保留、AMBIT的未编辑声源方向与响度、VidEdit3D的非目标高斯冻结,各自给出更具体的保持对象。
今日讨论
EditDistill 对比 VACE,未编辑区域 DINO 相似度 0.701→0.738、Warp 误差 3.42→2.97,但编辑方向 CLIP-E 为 0.245,仍低于 0.247。面对首帧无法代表的大动作,固定修改与生成预算后,如何用转身、遮挡的分级实验,收集证据区分“更稳地传播改动”和“编辑力度更弱”,分别衡量目标变化与非目标保留?
人工智能炼丹君 整理 | 2026-10-28





评论 (0)